吴恩达机器学习(新版):第一门课 · 监督机器学习——回归与分类
本电子书由视频课程重构而成(个人学习用)。 课程视频、字幕与讲义版权归 DeepLearning.AI / Stanford 所有。本电子书仅为个人学习所做的中文书面重构,未获授权、不得用于任何商业用途或公开传播。 书中截图均取自对应分P视频画面;引用处标注了「分P号 @ 时间」,方便回源核对。
| 原课程 | Machine Learning Specialization(DeepLearning.AI / Stanford Online,2022 新版),讲师 Andrew Ng(吴恩达) |
| 视频来源 | Bilibili 搬运合集 BV16jyuBBEom(共 142 个分P,本册为第一门课,p1–p41) |
| 官方配套 | DeepLearning.AI 课程主页 |
| 参考笔记(2014 版课程,用于术语与章节校准) | fengdu78/Coursera-ML-AndrewNg-Notes |
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
本册导读
本册对应新版专项的第一门课《Supervised Machine Learning: Regression and Classification》,共 10 个模块、41 个视频,覆盖:
- 欢迎与机器学习的应用(模块 1)
- 什么是机器学习:监督学习、无监督学习(模块 2)
- 线性回归与代价函数(模块 3)
- 梯度下降(模块 4)
- 多元线性回归与向量化(模块 5)
- 特征缩放、学习率与特征工程(模块 6)
- 逻辑回归与决策边界(模块 7)
- 逻辑回归的代价函数(模块 8)
- 逻辑回归的梯度下降实现(模块 9)
- 过拟合与正则化(模块 10)
易错点索引(M1–M14,整理自个人学习记录):本册正文已在对应位置用
> 易错点 M#标出。
编号 易错点 一句话纠正 位置 M1 把 clustering 当 classification 范式 / 任务 / 算法要分层 §2.4 M2 因「数值通常不同」才区分 $y,\hat y$ 二者角色本就不同 §3.2 M3 认为 cost 小 = 符合真实需求 cost 只对应 optimization objective §3.4 M4 把等高线上的 $(w,b)$ 当成 cost 点=参数位置,$J$=函数值 §3.6 M5 以为 gradient 是最速下降方向 gradient 最速上升,取负才下降 §4.3 M6 以为不能越过 minimum 可振荡跨越,振幅递减即可收敛 §4.4 M7 以为凸 ⇒ 唯一解 凸只保证局部=全局;唯一要满秩/正定 §4.5 M8 以为不缩放不影响 GD 缩放改善 conditioning §6.1 M9 以为 test 自己重算 $\mu,\sigma$ 更准 只在 train 上 fit,之后统一 transform §6.1 M10 把 $p_i$ 当「真实 $y_i$ 的概率」 $p_i$ 恒为 class 1 概率 §7.2 M11 以为 batch 越大越 noisy 平均会降方差,batch 大更稳 §4.6 M13 把 Ridge「降 variance」当直接偏好 直接偏好是 small $\lVert w\rVert_2$ §10.3 M14 以为 $\lambda$ 小更易欠拟合 $\lambda$ 大→欠拟合,$\lambda$ 小→过拟合 §10.3
第一章 欢迎来到机器学习
(对应模块 1,视频 p1–p2)
1.1 机器学习就在你身边
(p1)
你大概每天都在用好几次机器学习,却未必意识到。比如:
- 想做寿司卷、想知道某件事,你在 Google、Bing 或百度上做网络搜索,能搜到好结果,是因为机器学习软件学会了如何给网页排序;
- 把照片传到 Instagram 或 Snapchat、想让朋友看到自己,应用能自动识别并标注照片里的朋友;
- 看完一部《星球大战》,视频平台能推荐你可能喜欢的类似电影;
- 用手机上的语音转文字写短信、对 Siri 说"放一首蕾哈娜的歌"、对 Google Assistant 说"给我显示附近的印度餐馆"——这背后是语音识别;
- 收到标题为"恭喜,你赢了一百万美元"的邮件,邮箱服务会把它标为垃圾邮件。
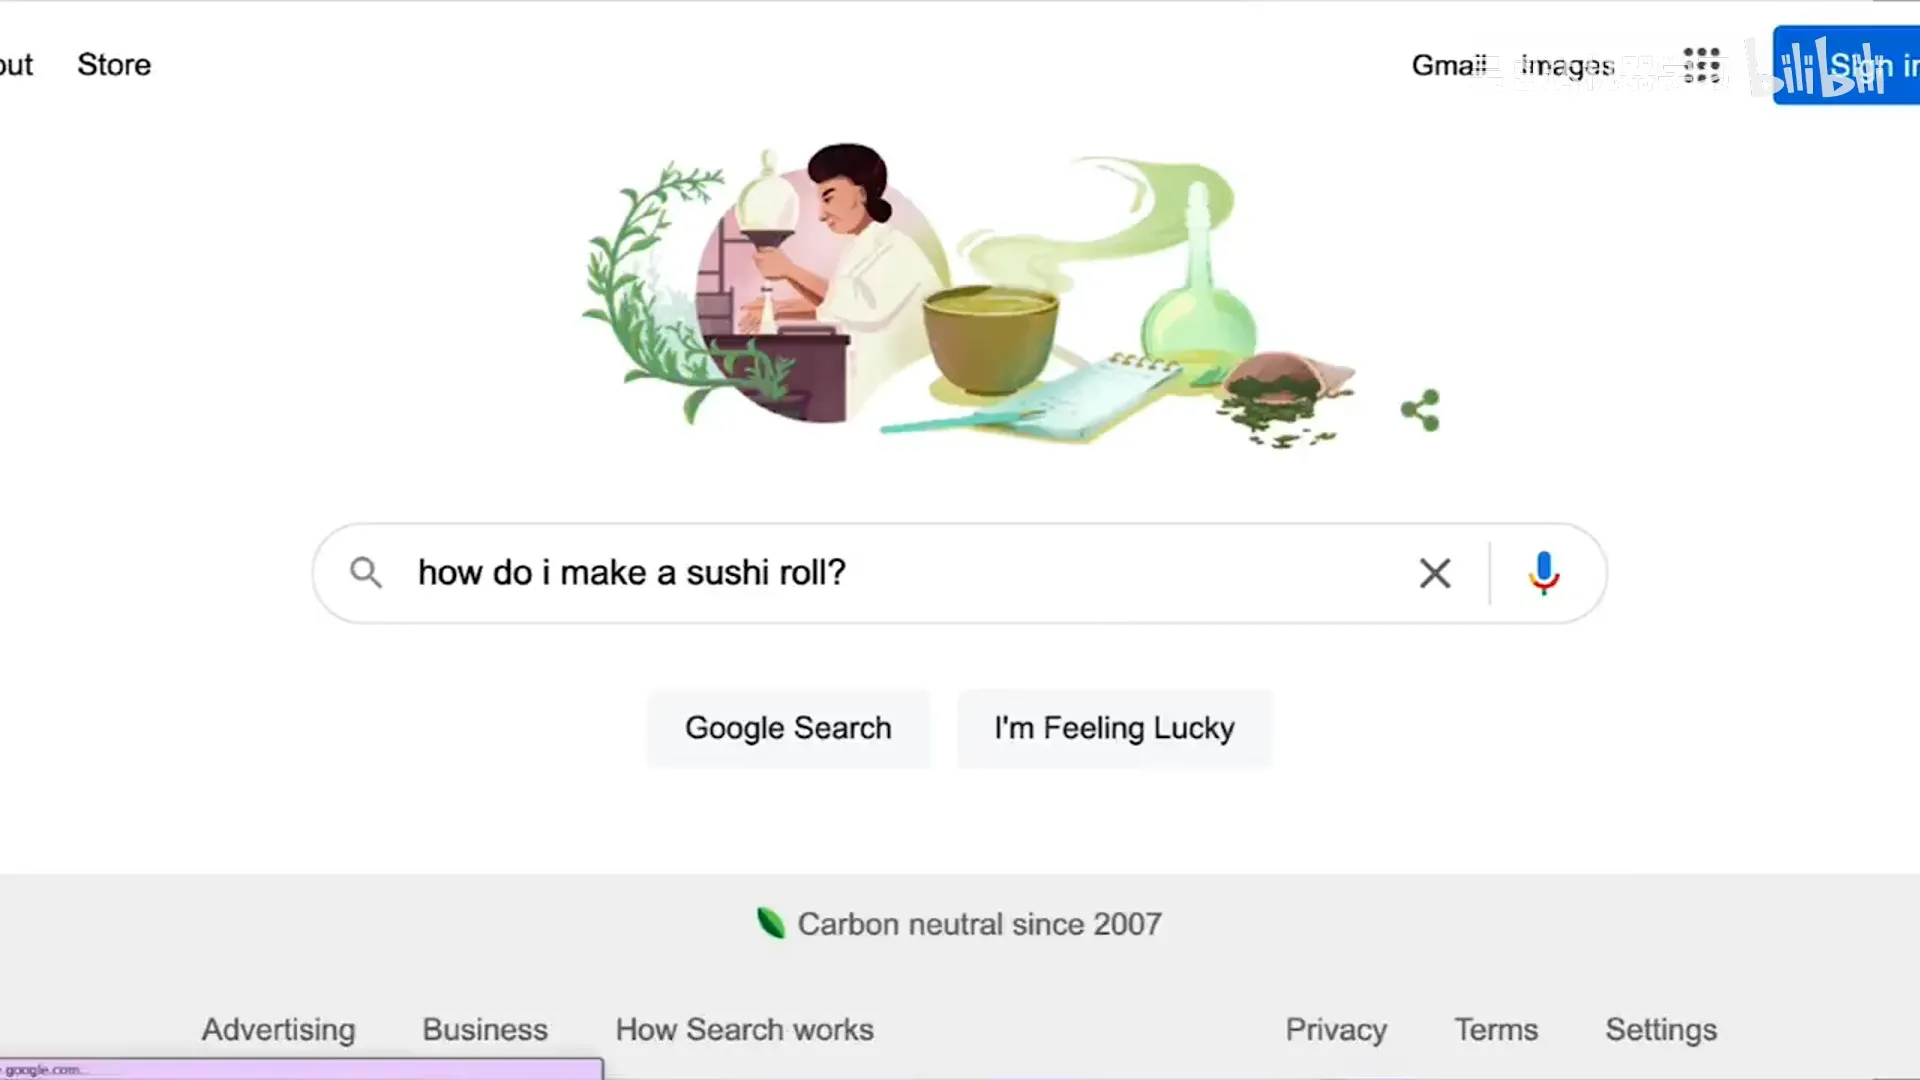
📷 机器学习就在身边:搜索排序、照片打标、语音助手等
回到原视频 (00:00:20)
1.2 什么是机器学习
(p1)
课程给出的通俗定义是:
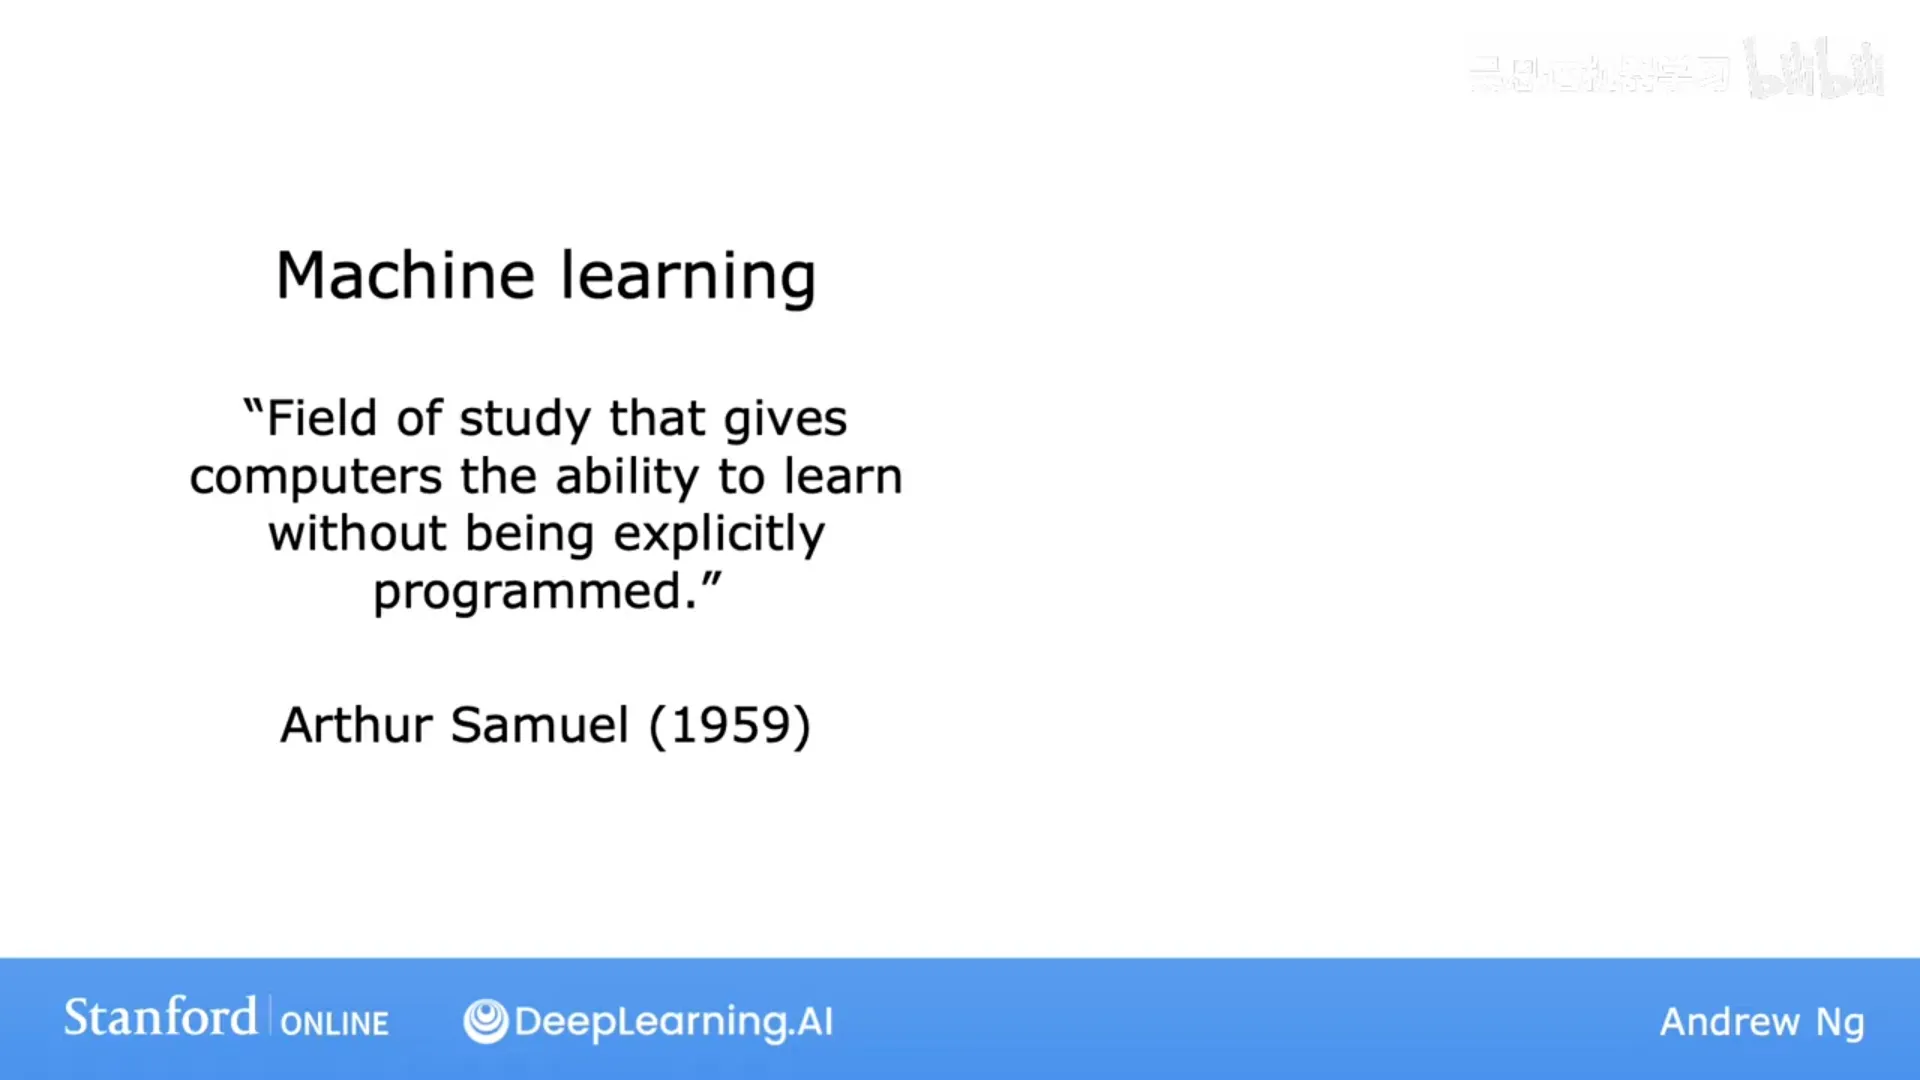
机器学习是一门"让计算机无需被显式编程就能学习"的科学。
📷 机器学习的定义:让计算机无需显式编程就能学习
回到原视频 (00:02:11)
在消费级应用之外,机器学习也迅速进入大公司与工业场景:例如优化风力发电机的发电量以应对气候变化、进入医院帮助医生做出准确诊断、以及在工厂里做计算机视觉质检——检查流水线上刚下线的产品是否有缺陷。吴恩达本人在 Landing AI 就做过大量制造业质检的工作。
1.3 为什么现在学机器学习
(p2)
机器学习是人工智能(AI)的一个子领域。人们想造出智能机器,而其中一些基本任务(比如 GPS 里"从 A 到 B 的最短路径")可以用明确的程序写出来;但更多真正有趣的任务——网络搜索、识别人类语音、从 X 光片诊断疾病、造自动驾驶汽车——我们根本不知道如何手写显式程序。唯一可行的办法,就是让机器自己从数据中学习。
由于各个行业都存在大量尚未开发的机会,今天对这项技能的需求巨大且远未被满足。麦肯锡的一项研究估计,AI 与机器学习到 2030 年每年将额外创造约 13 万亿美元的价值。
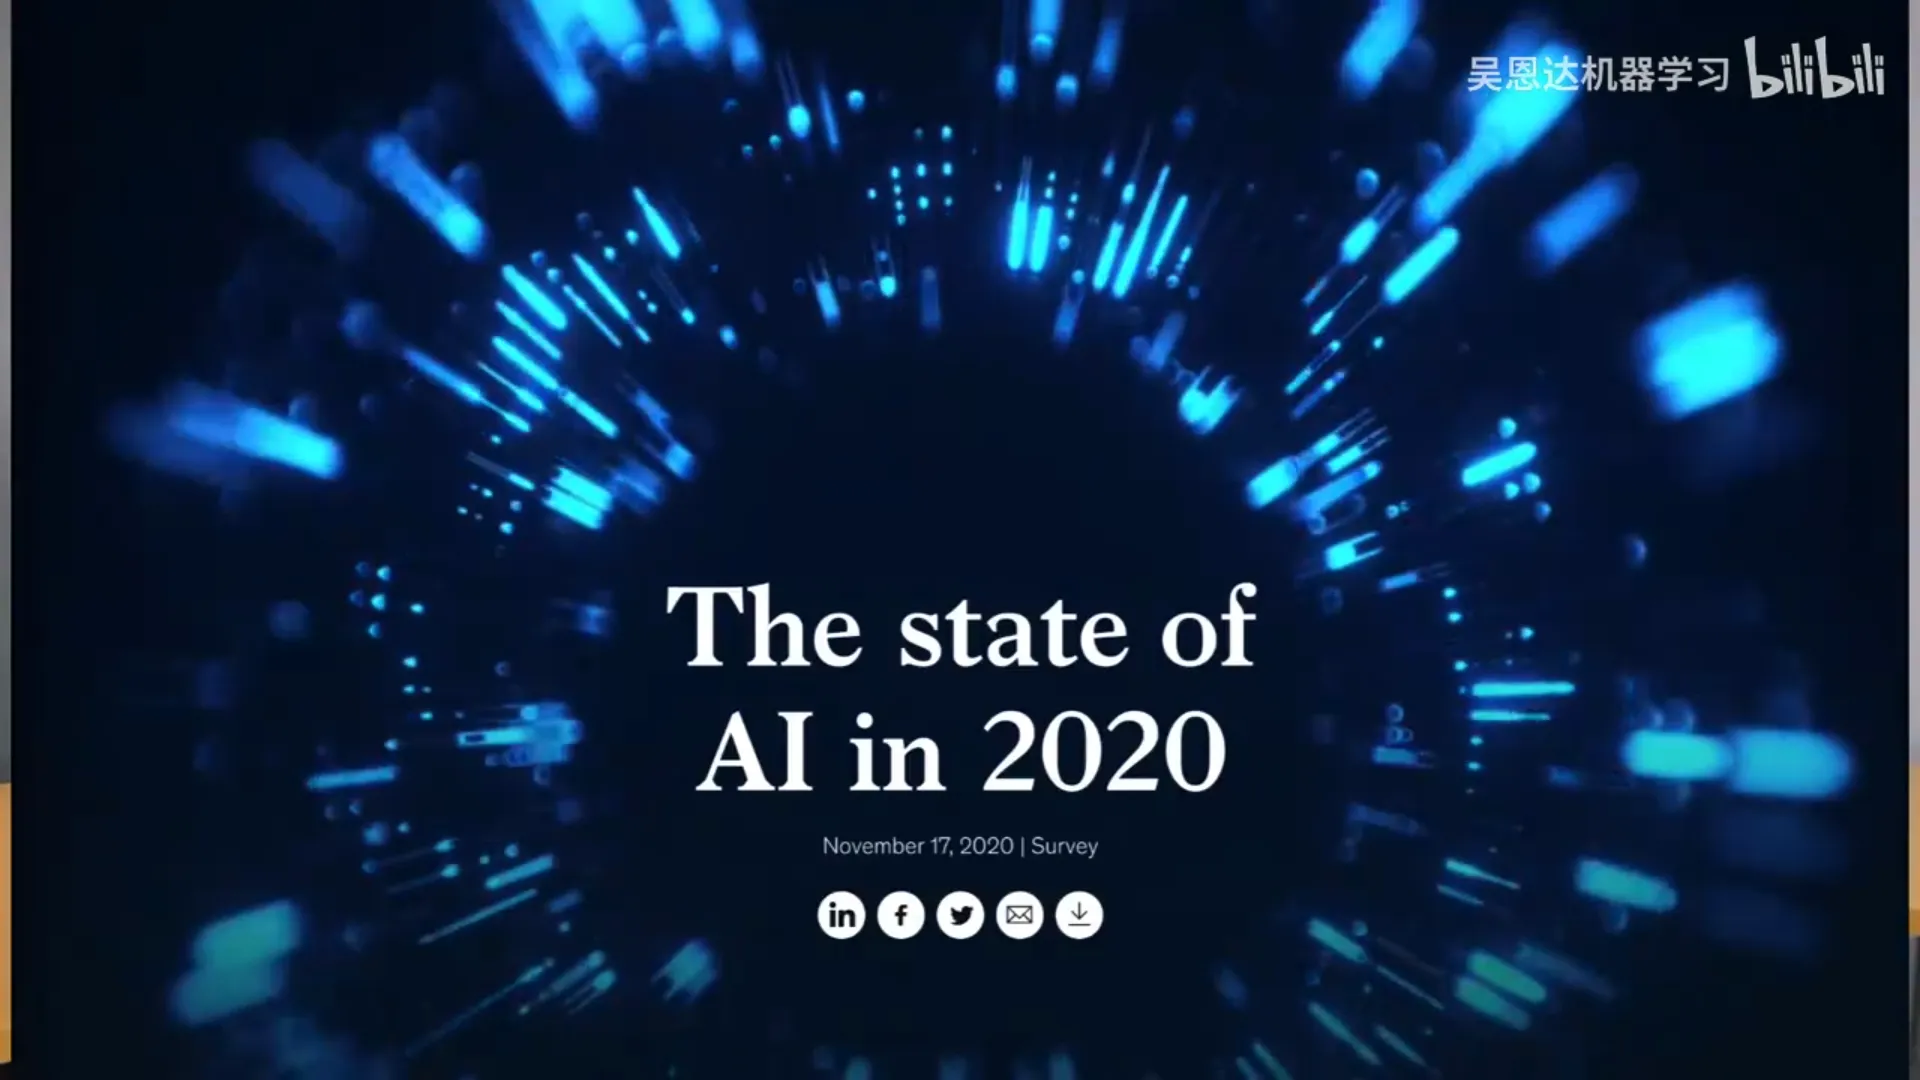
📷 AI 与机器学习的经济价值:到 2030 年每年约 13 万亿美元
回到原视频 (00:03:04)
关于长远的"通用人工智能(AGI)",课程态度是清醒的:AGI 目前被过度炒作了,我们离那个目标还很远——不知道是 50 年、500 年还是更久;但多数 AI 研究者相信,用学习算法(也许从人脑的工作原理中汲取一些灵感)是接近这一目标的最好路径。
这门课的目标有两层:既要学最重要的机器学习算法(其中一些正是当今大公司正在使用的),也要学让它们真正跑起来的实用技巧——因为"给你一套最先进的工具"和"让你能用这套工具造出一栋三层楼",是完全不同的两件事。
第二章 机器学习的两种主要类型
(对应模块 2,视频 p3–p8)
2.1 塞缪尔的跳棋程序
(p3)
机器学习最经典的定义出自 Arthur Samuel:
机器学习是"让计算机在不被明确编程的前提下获得学习能力"的研究领域。
塞缪尔在 20 世纪 50 年代写过一个跳棋程序。有意思的是,塞缪尔本人并不是一个很好的跳棋手。他做的是让计算机跟自己对弈成千上万局,通过观察"哪些棋盘局面倾向于赢、哪些倾向于输",程序逐渐学会了什么是好局面、什么是坏局面,并通过追求好局面、避开坏局面,越下越好。因为计算机有耐心陪自己对弈数万局,它积累的经验最终让这个程序比塞缪尔本人还要强。
📷 Arthur Samuel 的跳棋程序:通过自我对弈学会下棋
回到原视频 (00:00:24)
由此得到一条朴素而重要的规律:你给一个学习算法越多的学习机会,它的表现通常就越好。
2.2 监督学习 vs 无监督学习
机器学习有两大类:
- 监督学习(supervised learning):用带"正确答案"的数据学习 x→y 的映射,实际应用中用得最多、进步也最快;
- 无监督学习(unsupervised learning):数据里没有标签,让算法自己去找结构与模式。
此外还有强化学习(reinforcement learning),本课程会简要提及。本专项共三门课:第一、二门讲监督学习,第三门讲无监督学习。
2.3 监督学习:从 x 到 y 的映射
(p4)
监督学习的定义:学习从输入 x 到输出 y 的映射。关键特征是给算法提供带"正确答案"(标签 y)的例子;算法通过观察"输入 x 与正确标签 y"的配对,最终学会只凭输入 x 就给出相当准确的预测。
可以说,今天机器学习创造的经济价值中约 99% 来自监督学习。典型例子:
| 输入 x | 输出 y | 应用 |
|---|---|---|
| 一封邮件 | 是否垃圾邮件 | 垃圾邮件过滤 |
| 一段音频 | 文本转录 | 语音识别 |
| 英语文本 | 目标语言文本 | 机器翻译 |
| 广告信息 + 你的信息 | 你是否会点击 | 在线广告(最赚钱) |
| 图像 + 雷达等传感数据 | 其他车辆的位置 | 自动驾驶 |
| 产品照片 | 是否有划痕/凹痕 | 制造质检(视觉检测) |
📷 监督学习的标准例子:垃圾邮件过滤、语音识别等
回到原视频 (00:01:05)
例:房价预测——回归问题
设想用房屋面积(平方英尺)预测房价(千美元)。数据画出来后是一条条小叉。一位朋友想知道 750 平方英尺的房子能卖多少:
- 若拟合一条直线,读出来大约是 15 万美元;
- 若拟合一条曲线,可能更接近 20 万美元。
这里之所以是监督学习,是因为每一栋房子都给了"正确答案 y"(真实售价),算法的任务是对新房子给出更多这样的正确答案。课程后面会讲如何让算法系统地选出最合适的直线/曲线,而不是凭手感挑一个"让朋友卖得最高"的。
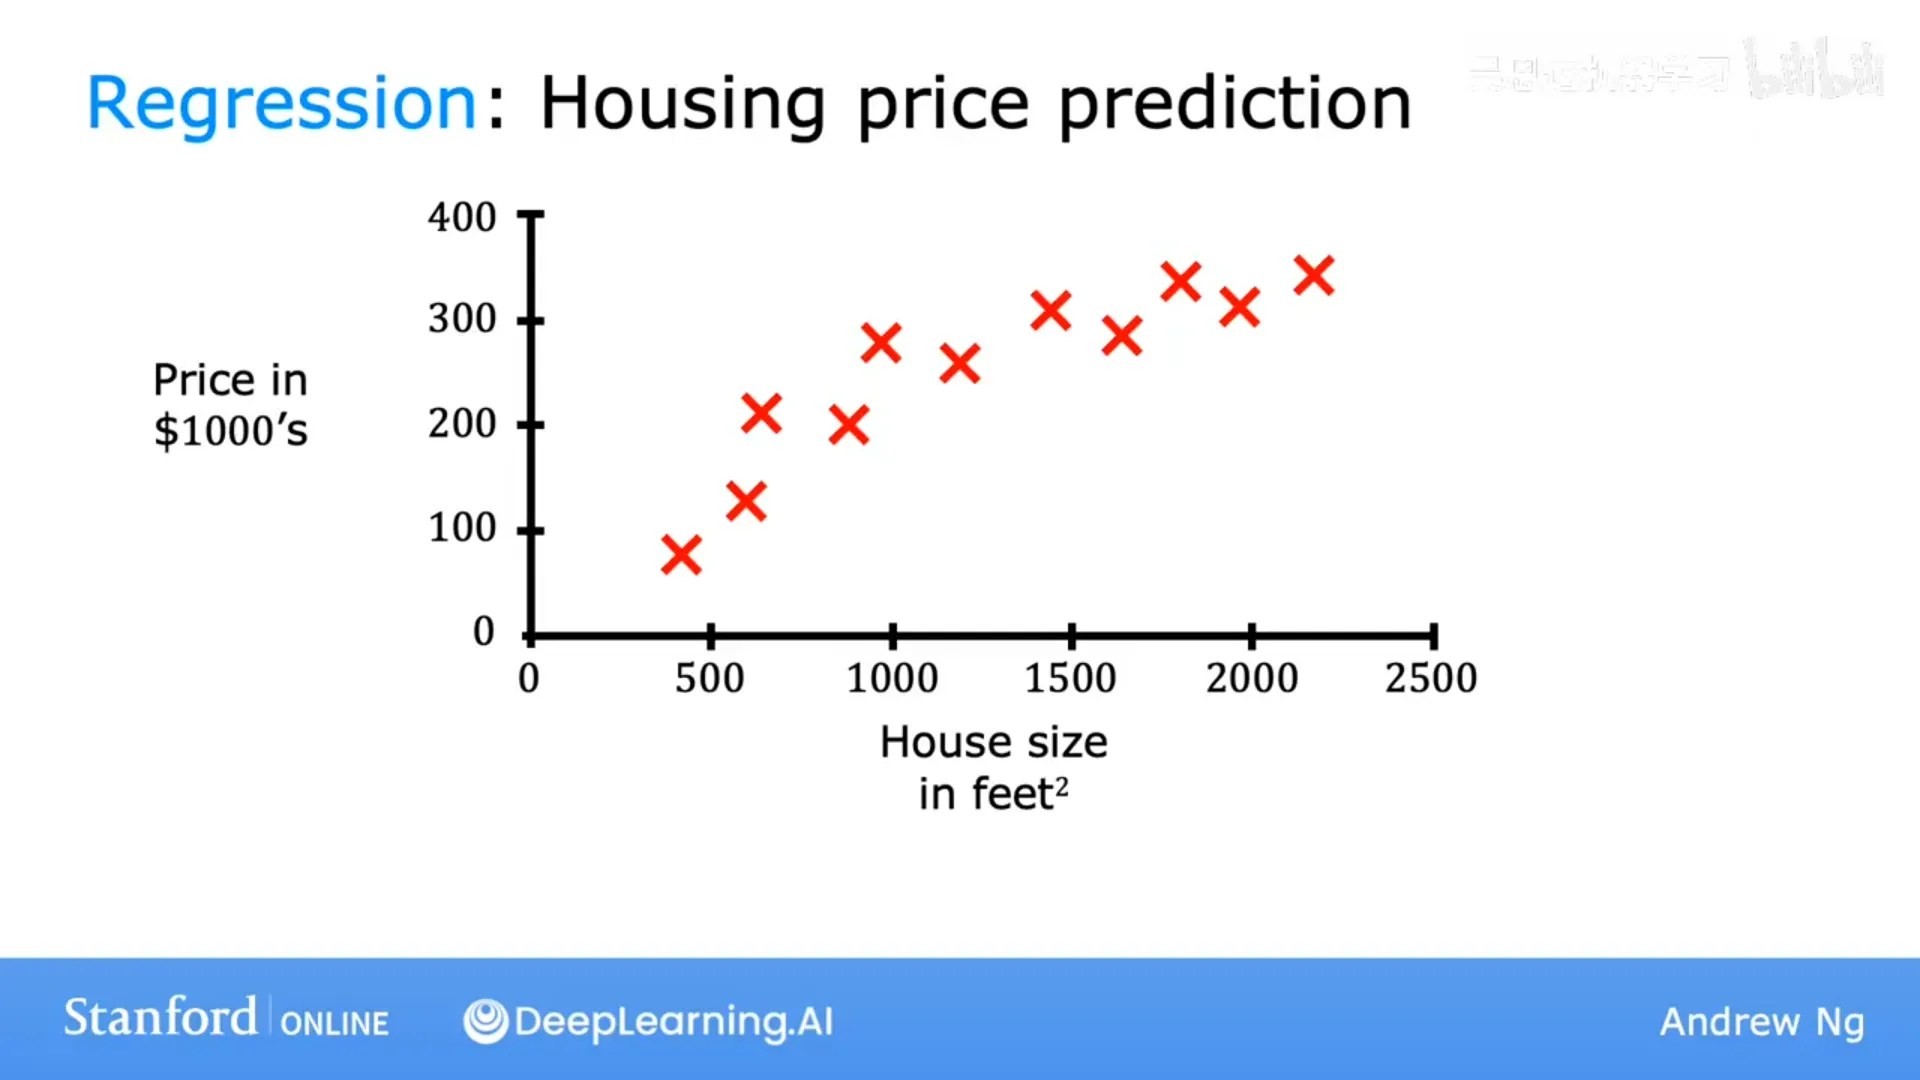
📷 用房屋面积预测房价:拟合直线或曲线
回到原视频 (00:03:44)
这种"从无限多个可能数字中预测一个数字"的监督学习,称为回归(regression)——房价可以是 15 万、7 万、18.3 万,或其间任何数。
例:乳腺癌检测——分类问题
(p5)
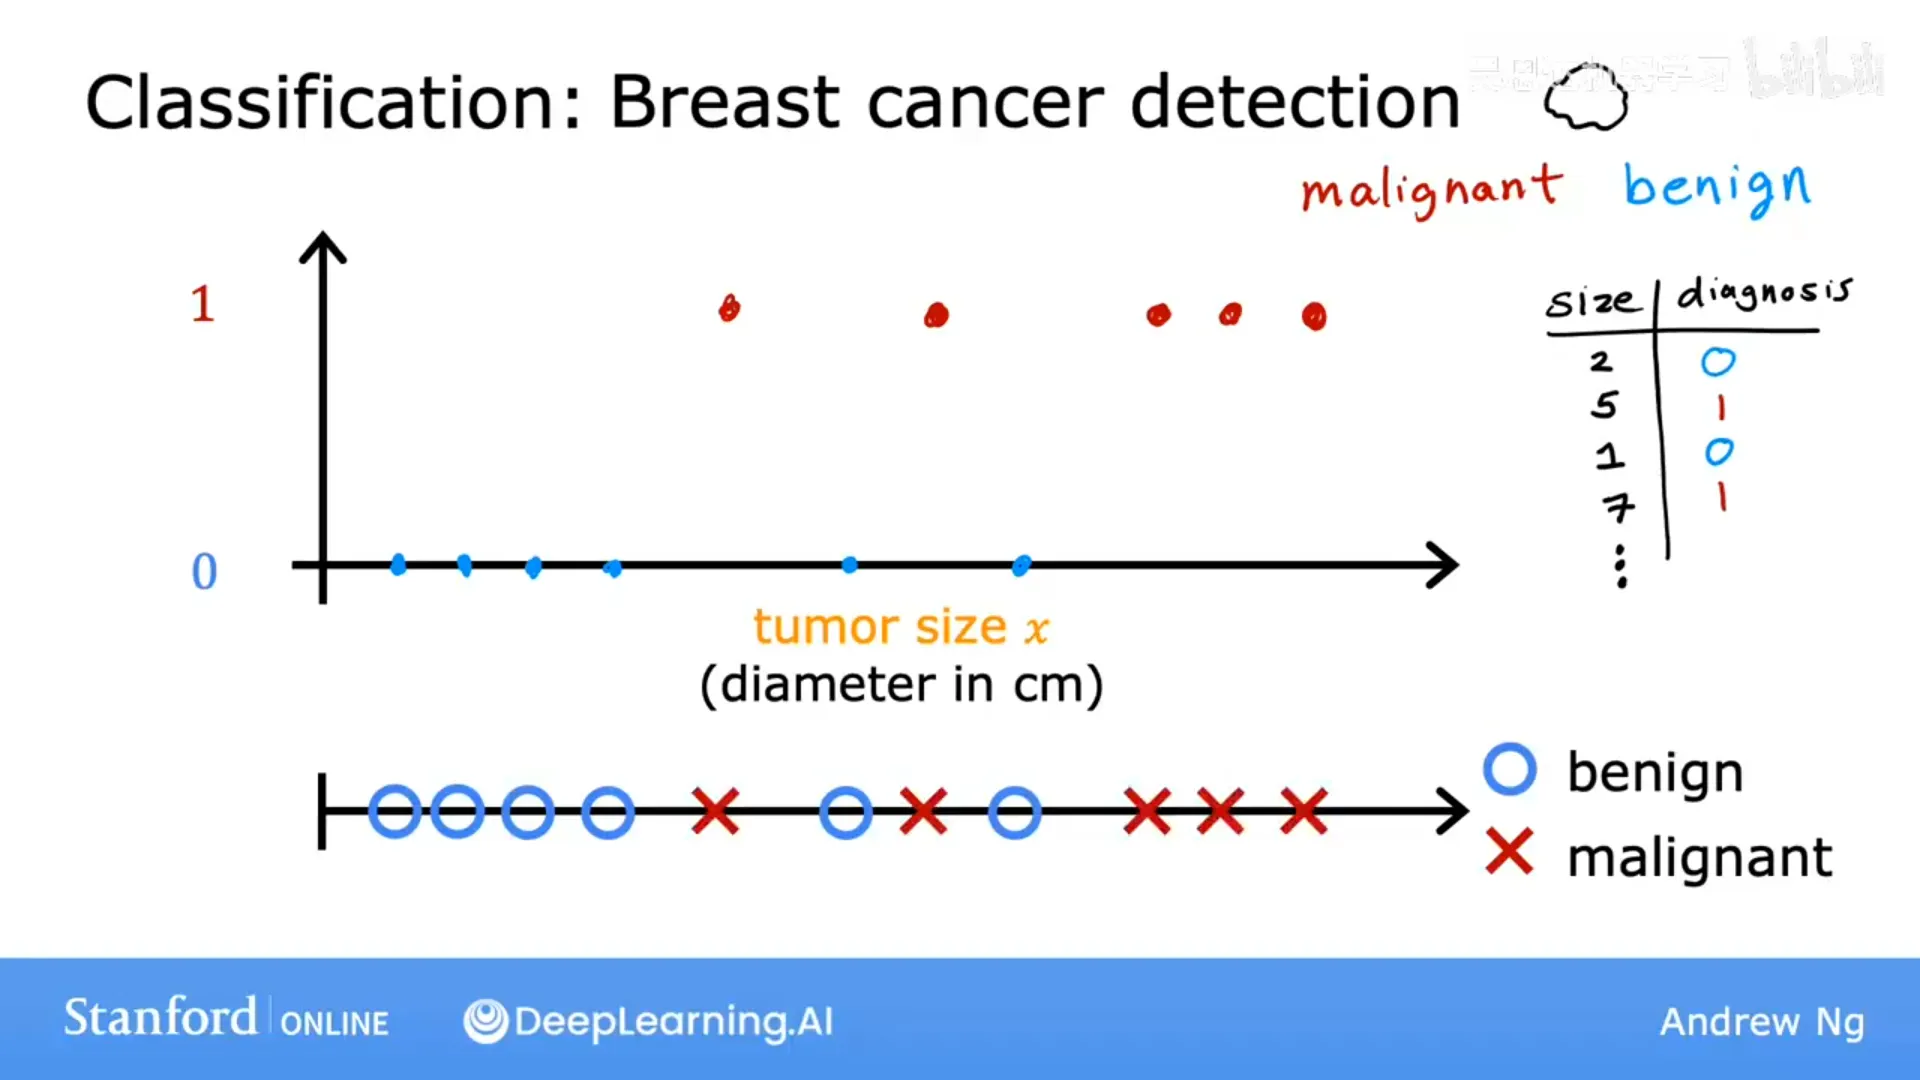
用患者的医疗记录判断一个肿瘤(肿块)是恶性(癌性、危险)还是良性。把良性记为 0、恶性记为 1,画在图上(横轴肿瘤大小,纵轴只有 0/1 两个值)。
与回归不同:这里可能的输出只有很少几个(类别)。只有两个可能输出,就构成一个分类(classification)问题。也可以用两个不同符号画在同一条数轴上:圆圈 O 表示良性,叉号 × 表示恶性。
📷 乳腺癌检测:良性/恶性二分类
回到原视频 (00:00:28)
分类也可以有多于两个类别:若肿瘤是恶性,还可以预测是类型 1 还是类型 2 的癌症——于是有三种可能的输出类别。注意术语:输出"类(class)"与"类别(category)"可以互换使用。
分类与回归的分界:分类预测的是一个小的、有限的可能输出集合(如 0、1、2),而不是其间所有可能数字(如 0.5、1.7);类别不一定非得是数字(例如判断图片是猫还是狗)。
用多个输入做分类
(p5)
除了肿瘤大小,若还知道患者年龄,数据集就有了两个输入。医生测量肿瘤大小、记录年龄后,学习算法要找出一条边界,把恶性肿瘤和良性肿瘤分开,从而帮助诊断。
在更真实的乳腺癌检测中,朋友们的模型其实用了很多额外输入:肿瘤团块厚度、细胞大小一致性、细胞形状一致性等等。
📷 用肿瘤大小与患者年龄两个输入,学习一条分类边界
回到原视频 (00:02:47)
小结
- 监督学习把输入 x 映射到输出 y,算法从"正确答案"中学习;
- 两大类型:回归(预测数字)与分类(预测有限类别)。
2.4 无监督学习:让算法自己找结构
易错点 M1(层级混淆):不要把它归到 classification。分层要清楚——学习范式(监督 / 无监督 / 强化)、任务(分类 / 回归 / 聚类)、算法(K-means 是聚类算法,逻辑回归是分类模型)。「自动把数据分成若干组」是 clustering(聚类,任务),属于无监督范式。
(p6)
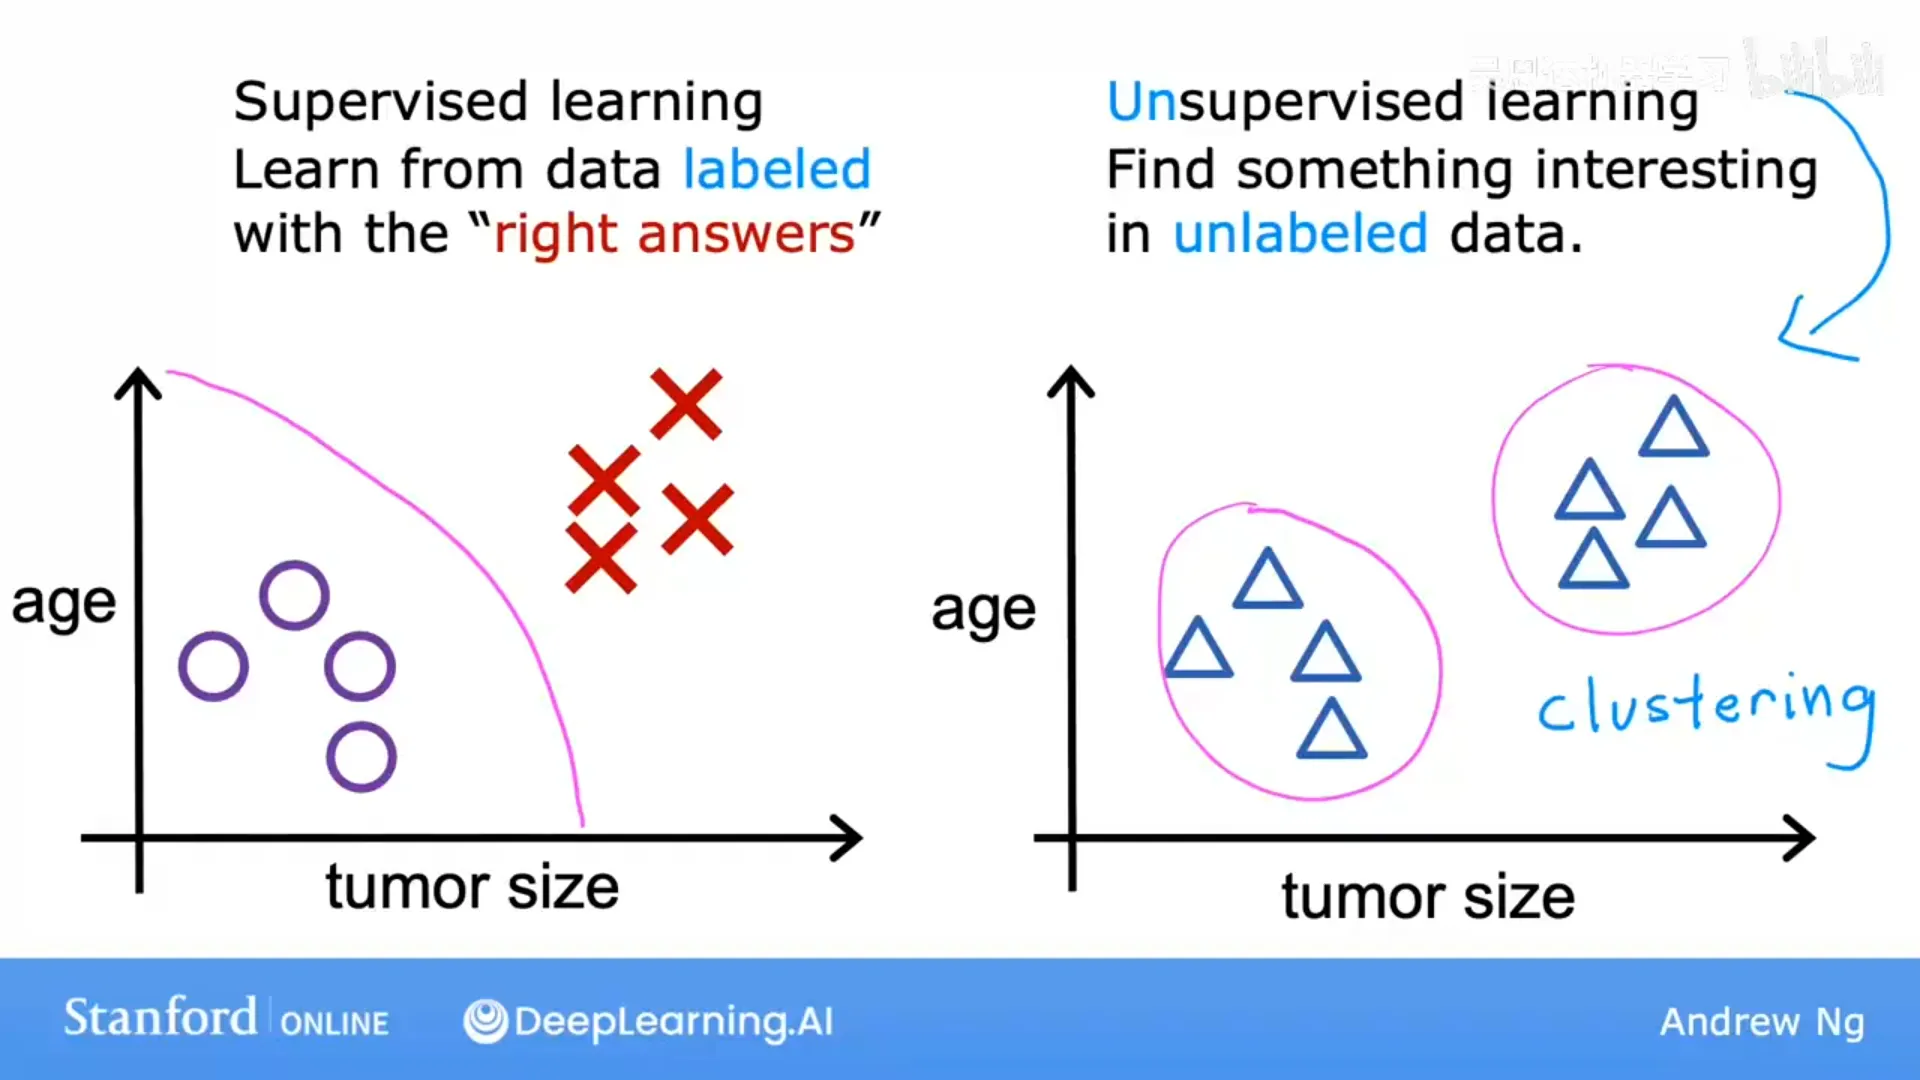
在监督学习里,每个样本都带有输出标签 Y(如良性/恶性);而在无监督学习里,数据不与任何标签 Y 关联。例如只给你"肿瘤大小 + 患者年龄",却不告诉肿瘤是良性还是恶性。
这时任务不是"诊断",而是找出数据中的某种结构或模式。之所以叫"无监督",是因为我们不试图监督算法为每个输入给出所谓的正确答案,而是让算法自己发现数据中有什么有趣的模式或结构。
对这个数据集,无监督算法可能把数据分成两个簇(cluster)——这就是聚类算法(clustering algorithm)。
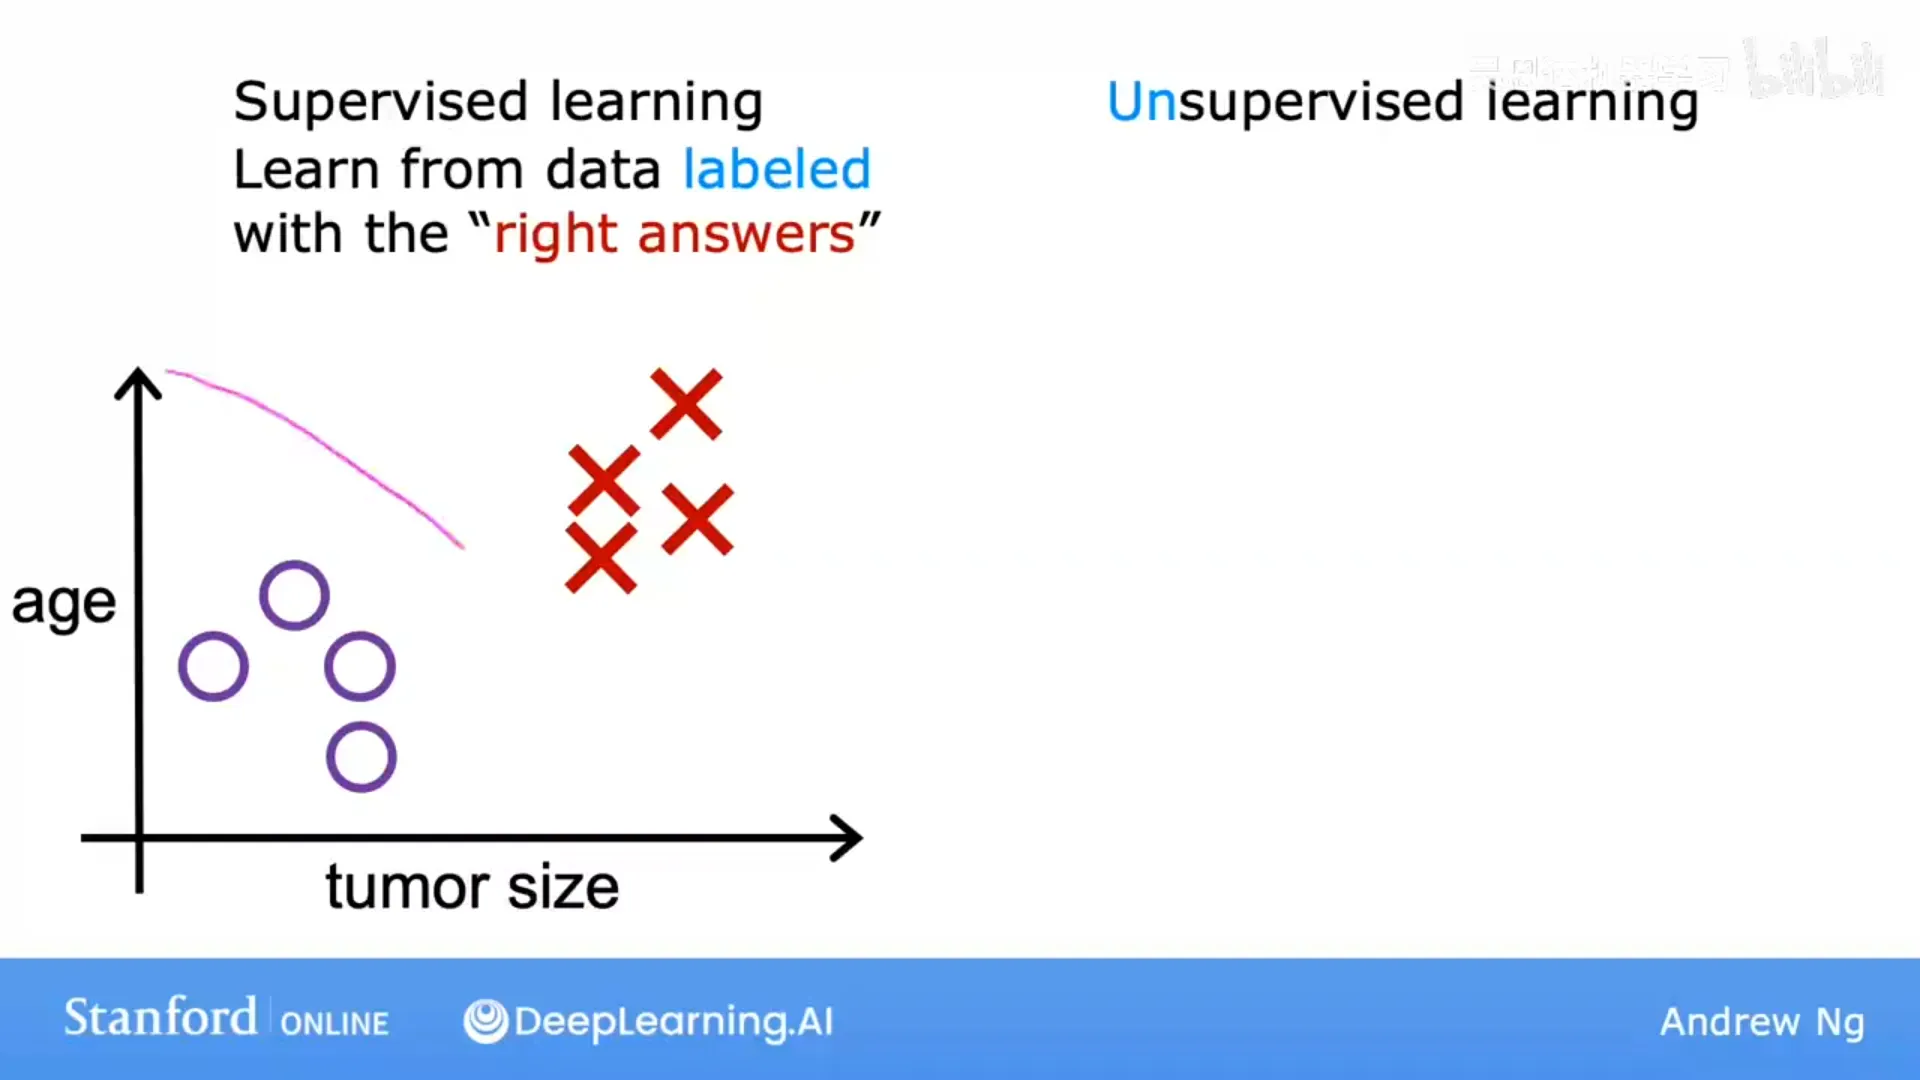
📷 无监督学习:把未标注数据聚成簇
回到原视频 (00:00:41)
例:Google News 的新闻聚类
Google News 每天扫描互联网上成千上万篇新闻,把相关报道分组。以"大熊猫在日本最古老的动物园产下罕见双胞胎幼崽"为例,下方相关的文章里反复出现 panda(熊猫)、twin(双胞胎)、zoo(动物园)。
关键在于:没有编辑在指挥算法"去找含熊猫/双胞胎/动物园的文章"——新闻话题每天都在变、数量巨大,不可能靠人力。算法必须自己判断当天新闻里有哪些聚类。这正是它是无监督学习的原因。
📷 Google News:聚类算法自动把相关新闻分到一组
回到原视频 (00:02:17)
例:DNA 微阵列与市场细分
- DNA 微阵列:每个小格代表某个人某个基因的表达量(红/绿/灰)。运行聚类,可以把个体分成不同类型的人群(类型 1/2/3)。因为我们没有事先告诉算法"类型 1 有哪些特征",这正是无监督学习。
- 市场细分:企业用聚类把客户自动分成不同细分群体。DeepLearning.AI 团队就做过这样的分析,发现学习者的主要动机大致有三类:提升技能、寻求职业发展、了解 AI 如何影响自己的领域。
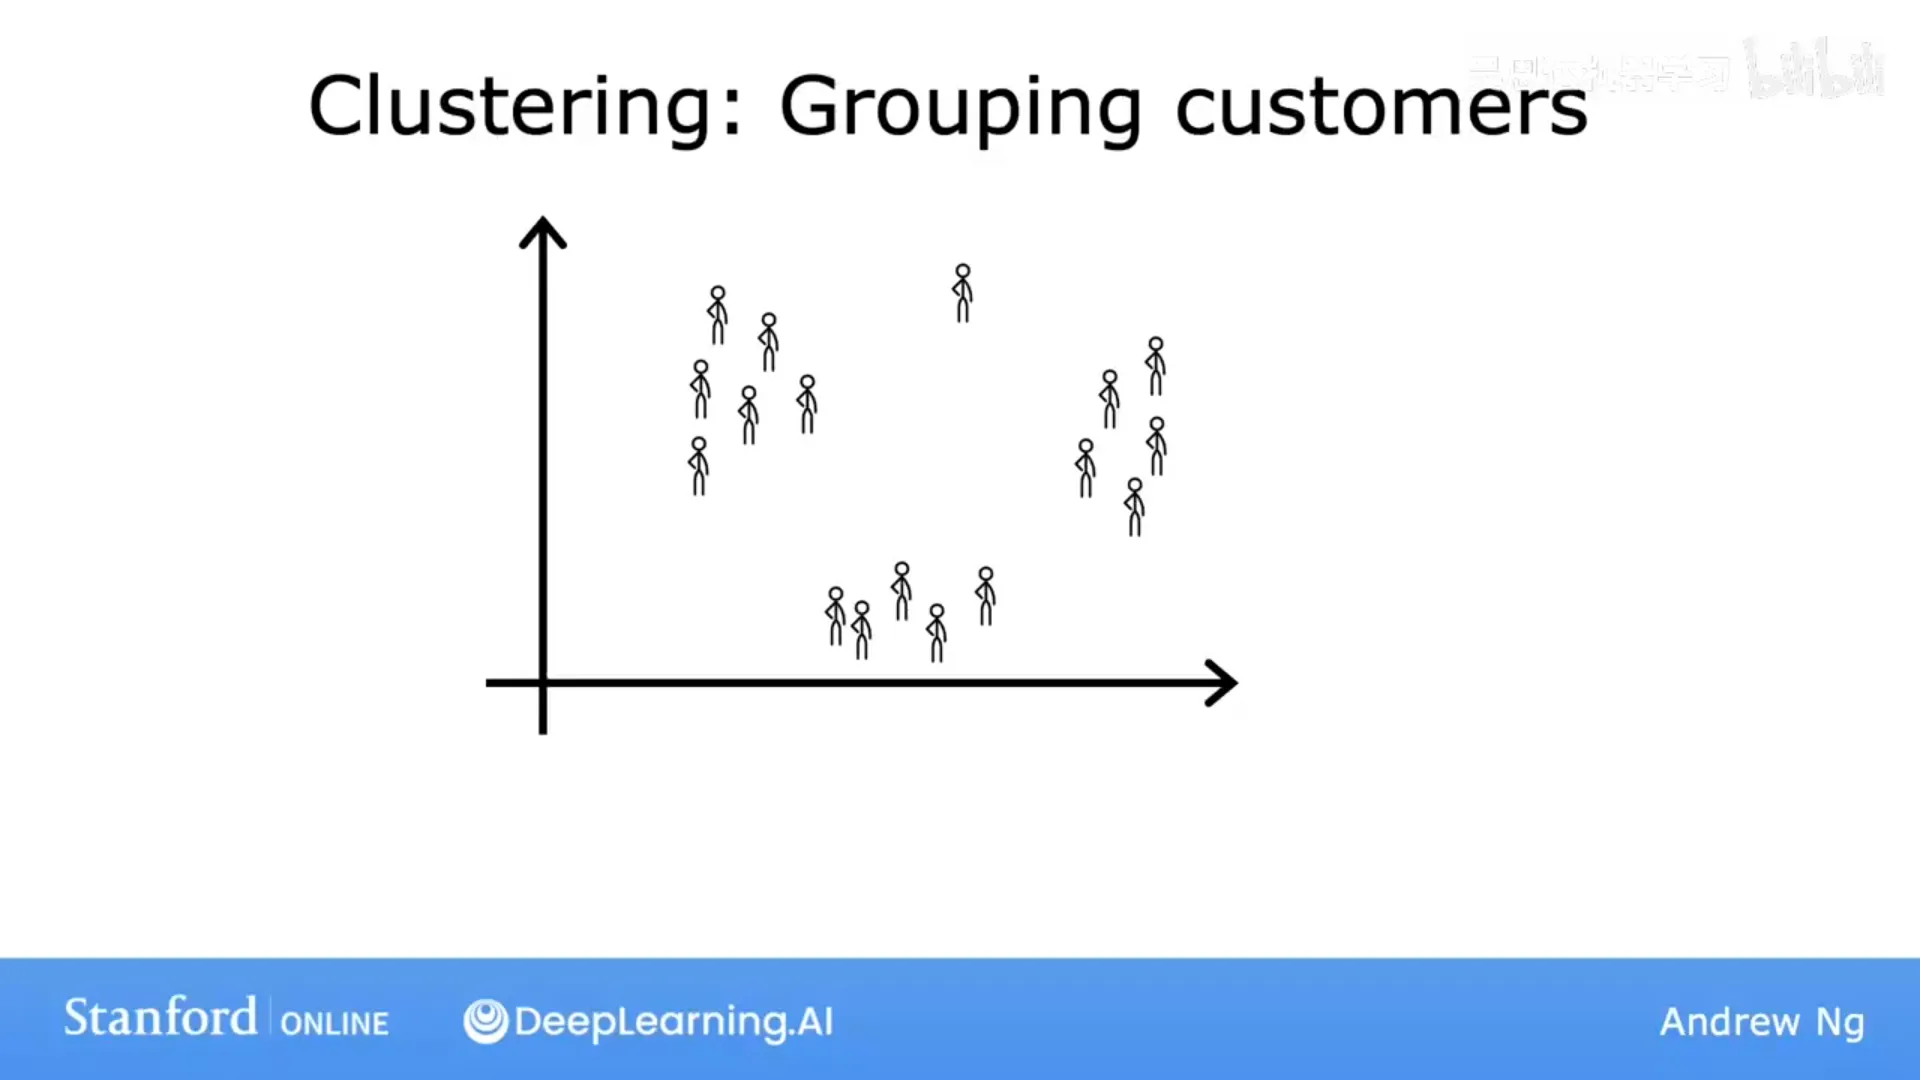
📷 根据客户数据自动发现市场细分
回到原视频 (00:06:41)
无监督学习的其他类型
(p7)
在监督学习中,数据同时包含输入 x 和输出标签 y;在无监督学习中,数据只有输入 x,算法要在其中找出结构、模式或有意思的东西。
聚类之外,本专项还会讲两种无监督学习:
- 异常检测(anomaly detection):检测异常事件,在金融欺诈检测中尤其重要(异常交易可能是欺诈信号);
- 降维(dimensionality reduction):把一个大数据集"几乎神奇地"压缩成更小的数据集,同时尽量少丢信息。
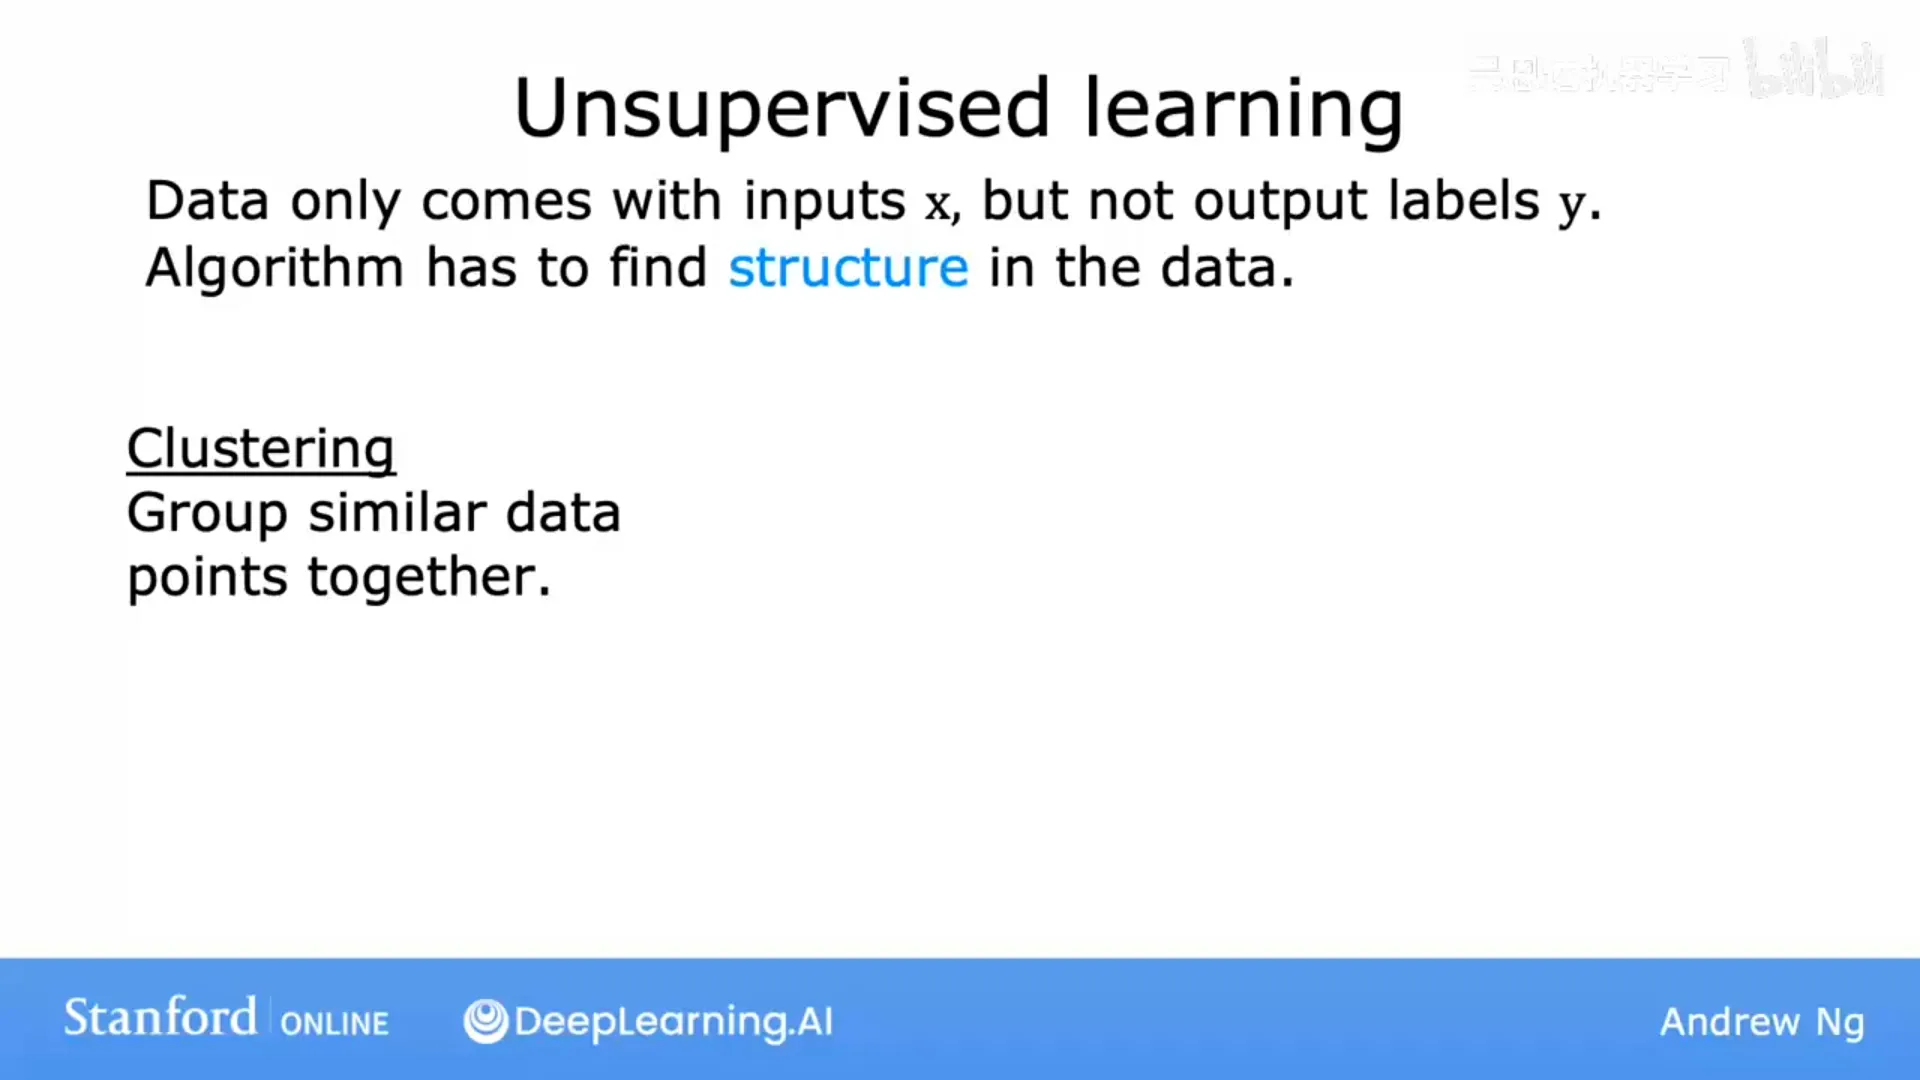
📷 无监督学习的另外两类:异常检测与降维
回到原视频 (00:00:53)
2.5 工具:Jupyter Notebook
(p8)
课程会大量使用 Jupyter Notebook——这是当今机器学习与数据科学从业者最广泛使用的环境,很多人把它当作写代码、做实验的默认工具。它也是许多大公司开发者正在用的同一套工具。你可以直接在浏览器里运行代码,亲手验证课程里的想法。
Notebook 里主要有两类"单元格(cell)":
- Markdown 单元格:写文本/说明(点一下会显示格式,按
Shift+Enter再渲染回好看的文本); - 代码单元格:里面是代码,按
Shift+Enter运行。
课程有两种实验:可选实验(optional lab)——基本不用自己写代码,打开、逐行运行即可;以及练习实验(practice lab)——让你亲手写代码。建议你在可选实验里先预测代码会做什么,再运行对照,甚至改改代码看会发生什么。熟悉 Jupyter 会对你之后的学习很有帮助。
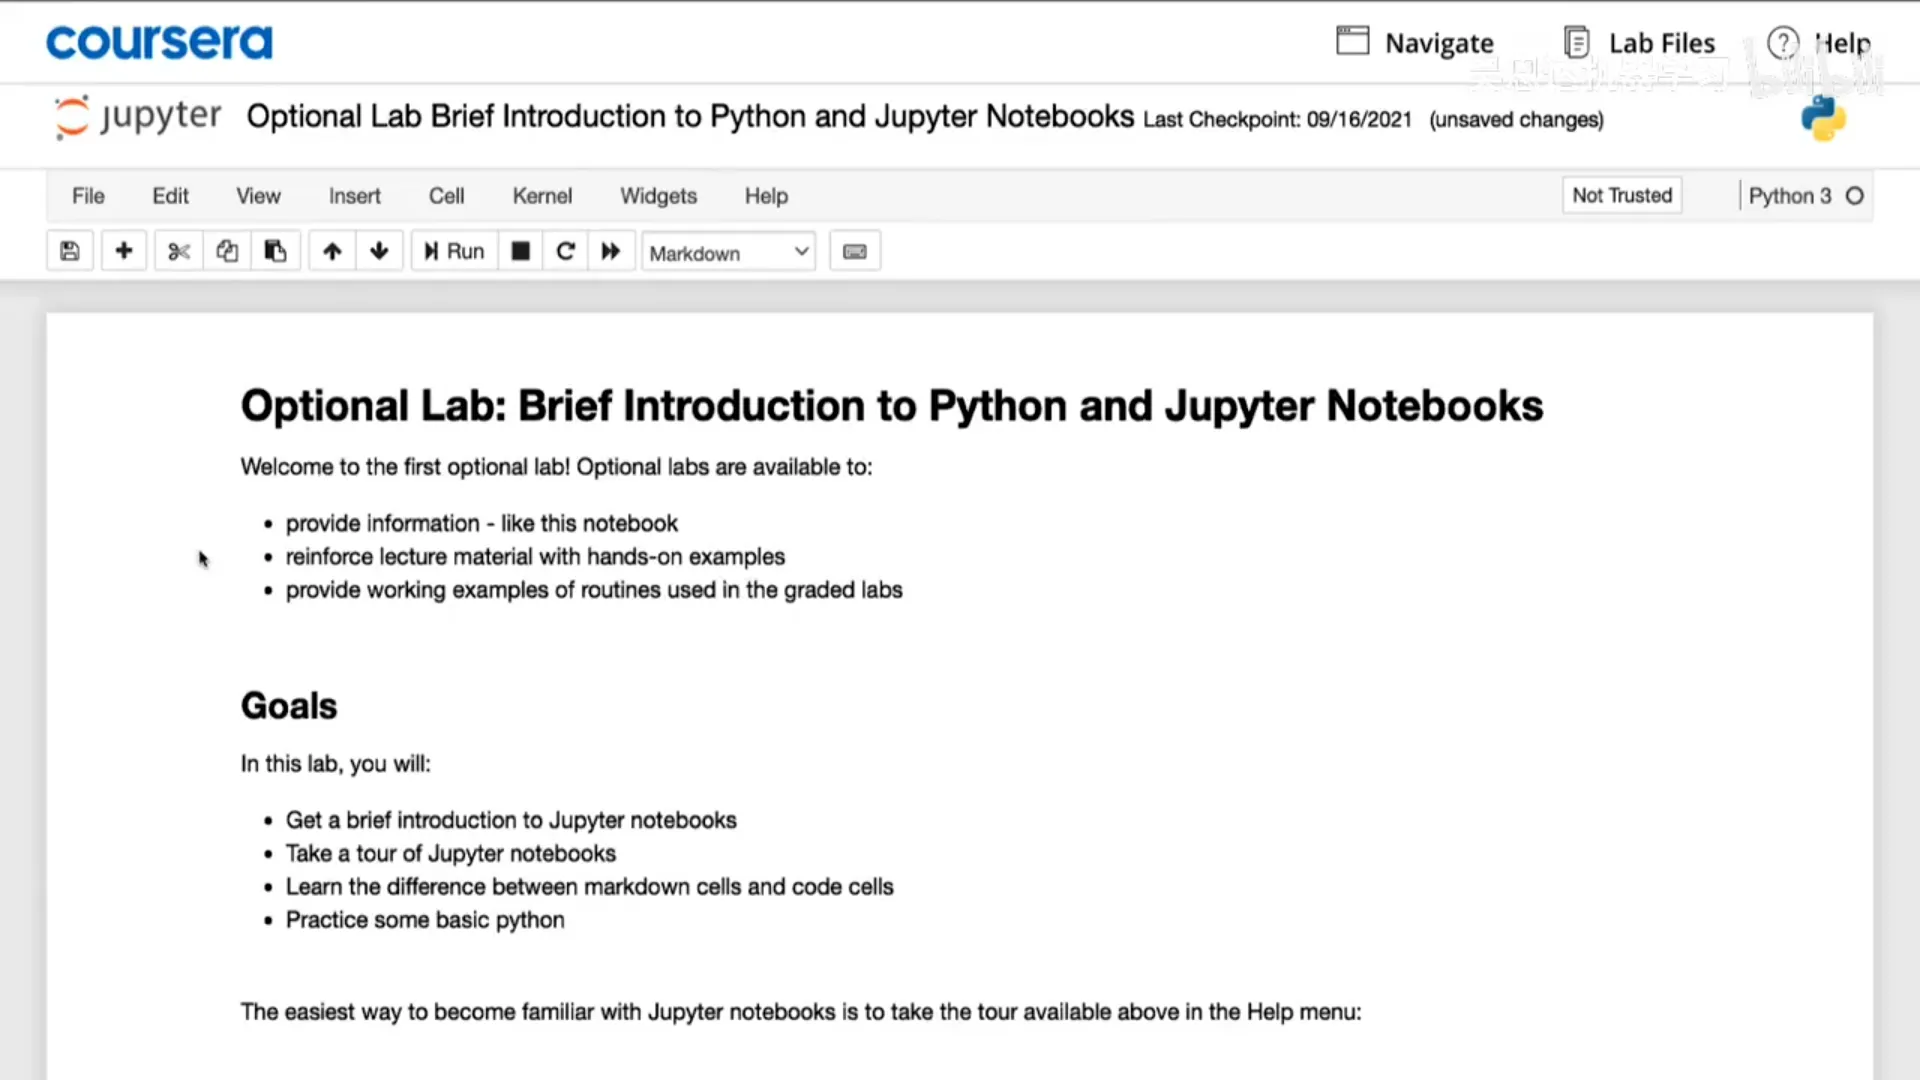
📷 课程使用的 Jupyter Notebook 环境
回到原视频 (00:02:21)
第三章 线性回归与代价函数
(对应模块 3,视频 p9–p14)
3.1 从房价预测认识线性回归
(p9)
线性回归(linear regression)就是把一条直线拟合到数据上,它可能是今天世界上使用最广泛的学习算法。先看一个具体问题:根据房屋面积预测房价。
用波特兰的房价数据集,横轴是房屋面积(平方英尺),纵轴是价格(千美元),每个小叉是一栋已售出的房子。假设你是房产经纪人,客户要卖一套 1250 平方英尺的房子,你能估多少钱?
做法是从数据建立一个线性回归模型,拟合出一条直线;在 1250 处与直线相交,向上/向左读数,得到大约 22 万美元。
这是监督学习:因为训练时给出了每套房子的正确答案(价格 y);模型输出是数字,所以它是回归模型。作为对照,分类模型预测的是"类别或离散类别"(如猫/狗、有无某种疾病)——分类的输出是有限几个,回归的输出可以是无限多个数。
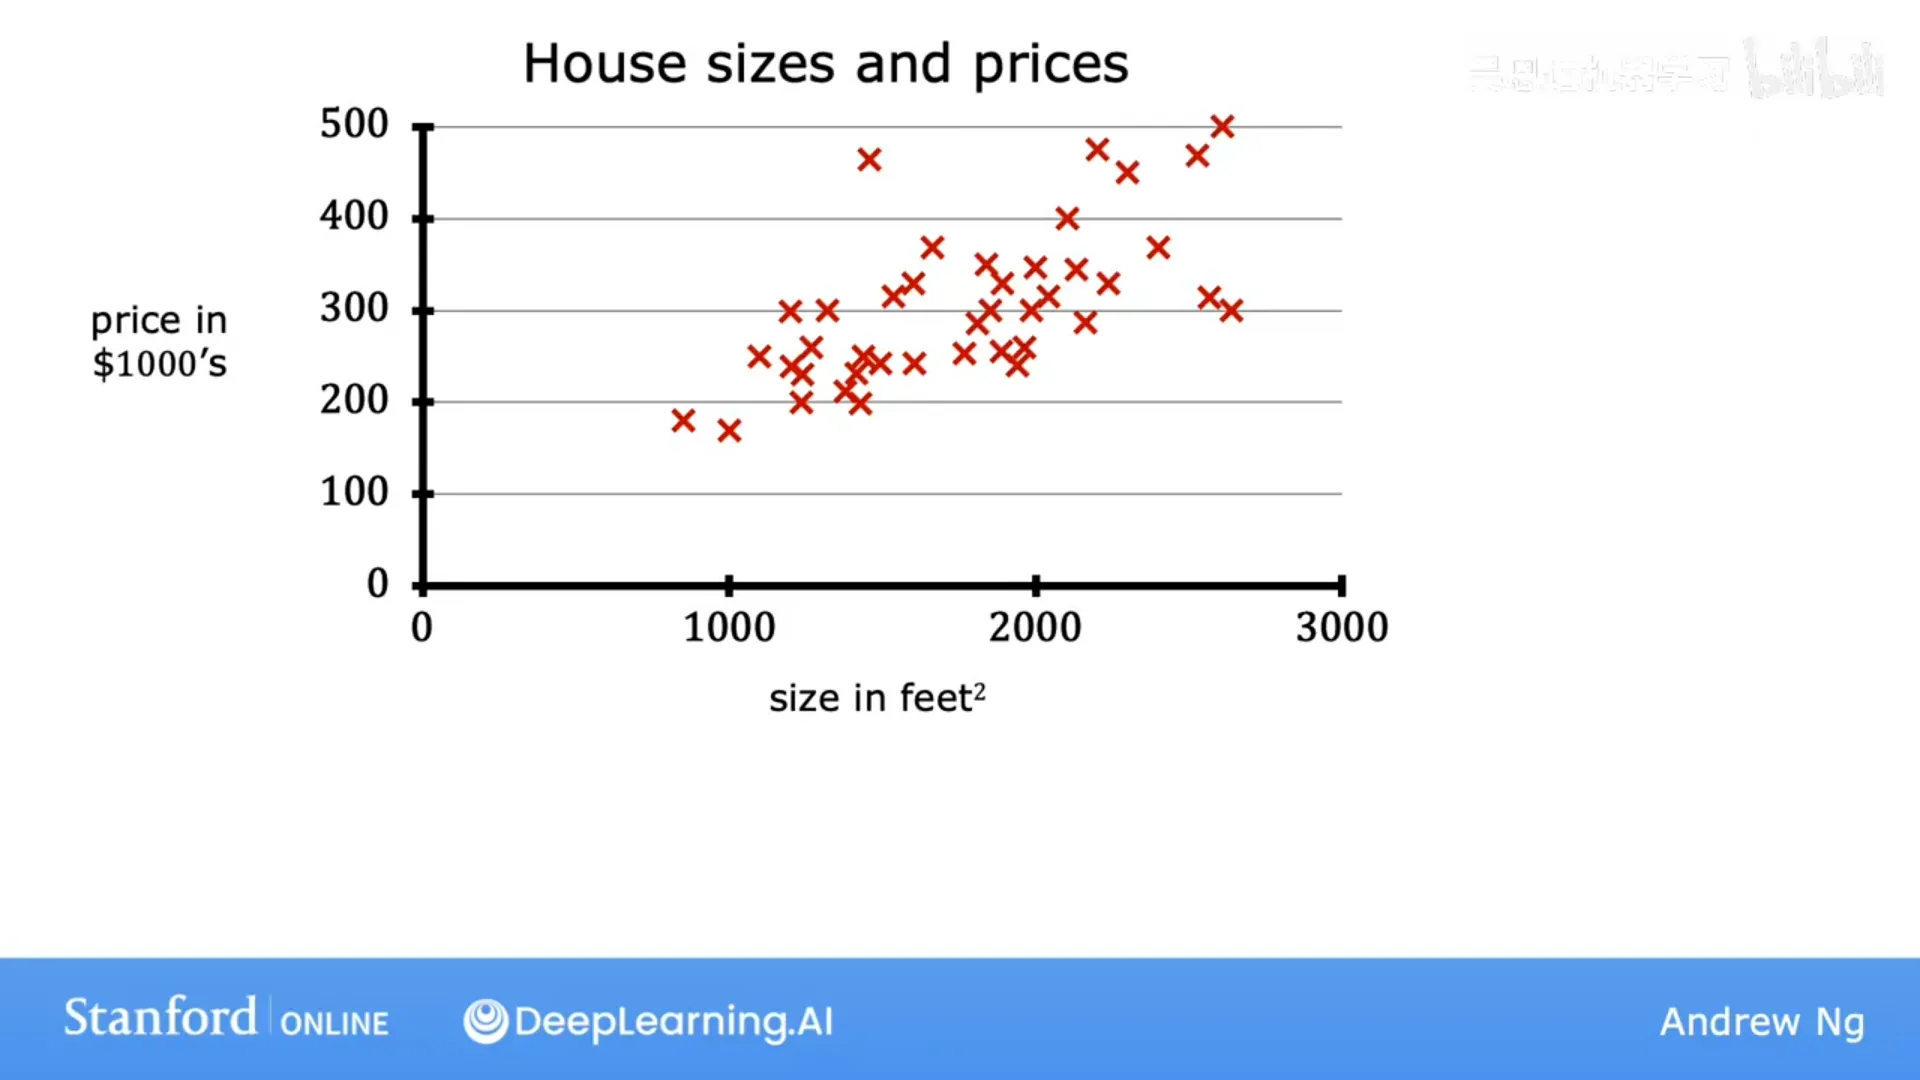
📷 用房屋面积预测房价:线性回归拟合一条直线
回到原视频 (00:01:32)
用数据表看同一件事
同样的数据也可以看成一张表:输入列是房子面积,输出列是价格。图上的横纵轴就对应这两列;表里 47 行就有图上 47 个点。例如第一行:2104 平方英尺、售价 40 万美元。
3.2 机器学习的标准符号
易错点 M2:区分 $y$ 与 $\hat y$ 不是因为它们通常数值不同,而是角色不同:$y$ 是真实标签(ground truth),$\hat y$ 是模型预测。哪怕某次 $\hat y=y$,角色依然不同。
(p9)
这是本专项会反复用到的符号体系(现在记不住也没关系,用多了自然熟悉):
| 符号 | 含义 |
|---|---|
| x(输入变量,也叫特征) | 特征;房价例子里 x = 房子面积 |
| y(输出变量,也叫目标变量) | 要预测的量;例子里 y = 房价 |
| m | 训练样本总数(此例 m = 47) |
| (x, y) | 单个训练样本 |
| (x⁽ⁱ⁾, y⁽ⁱ⁾) | 第 i 个训练样本(上标 i 是索引,不是幂!) |
用来训练模型的数据集叫训练集(training set);客户那套还没卖的房子不在训练集里——没人知道它的价格,模型就是要预测它。
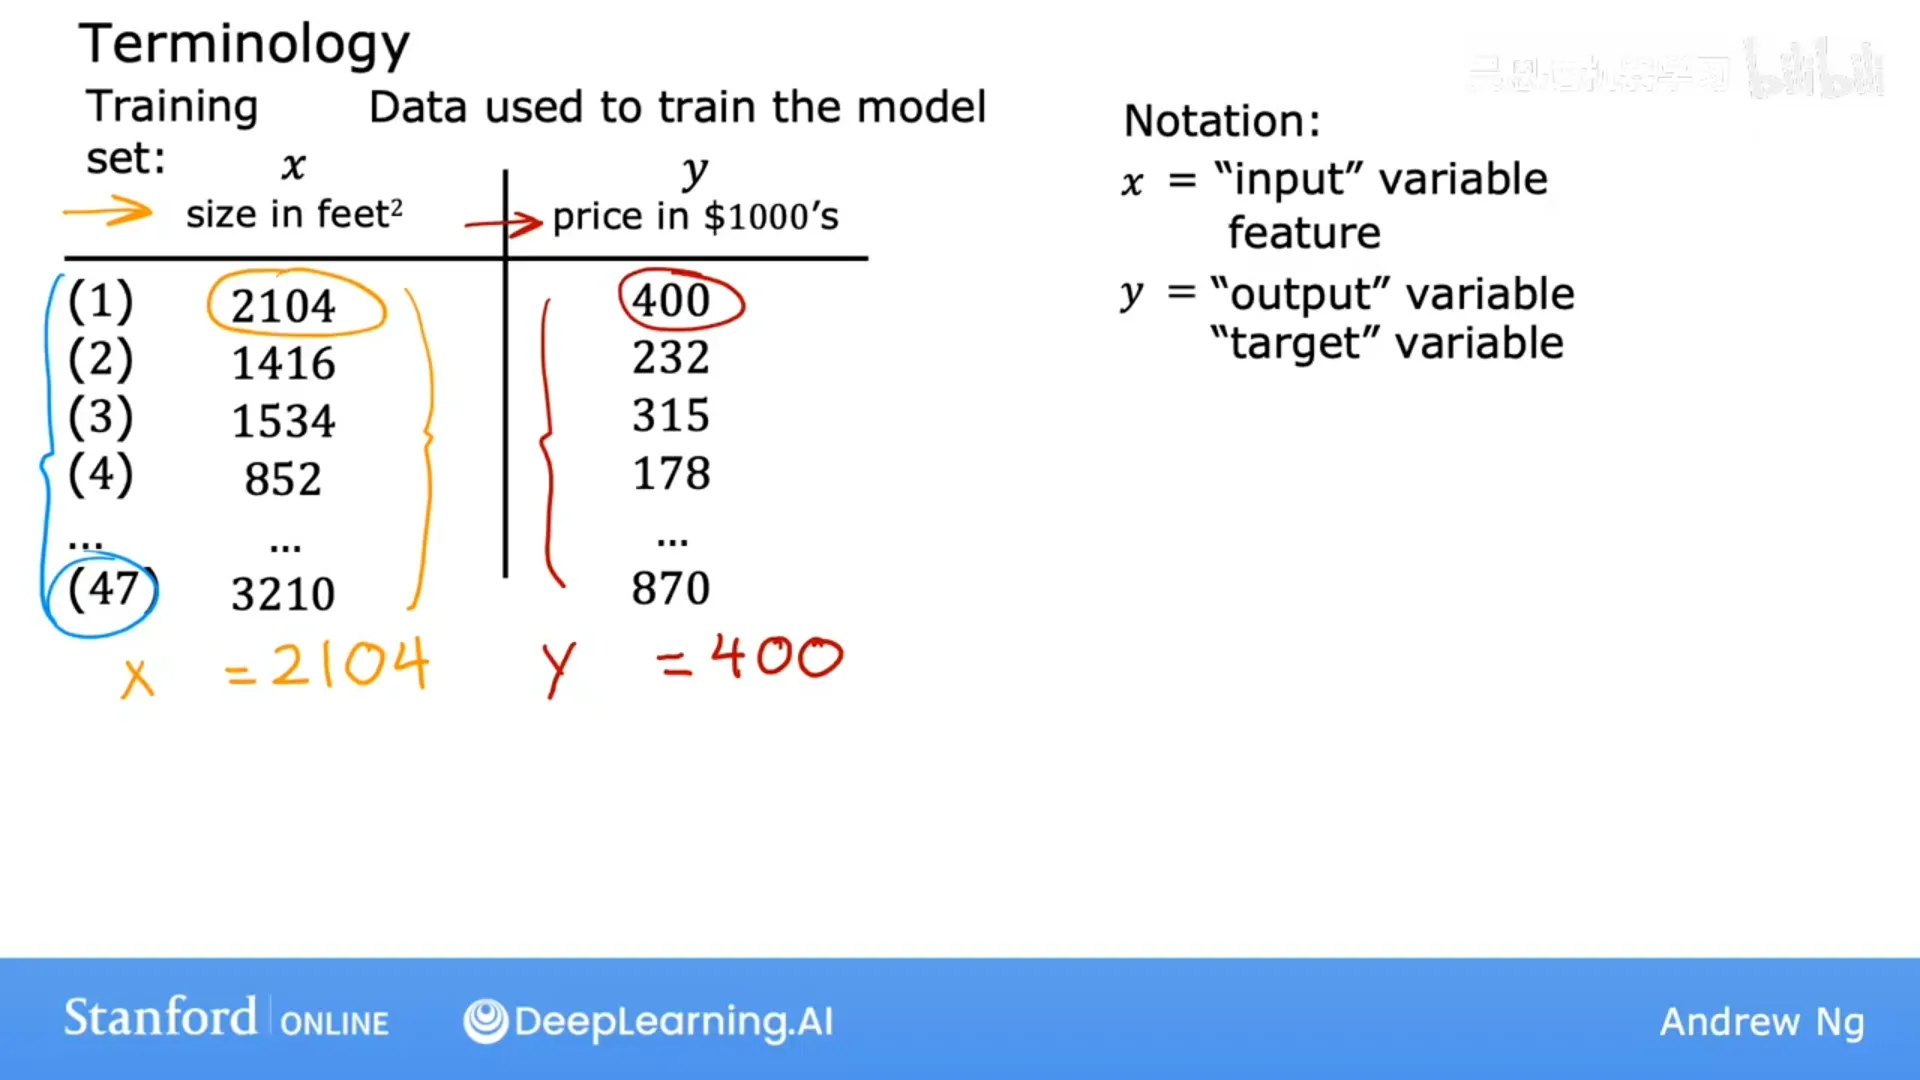
📷 训练集与标准符号:输入 x、目标 y、样本数 m、第 i 个样本
回到原视频 (00:08:03)
3.3 监督学习的工作流程与模型 f
(p10)
监督学习的流程是:把训练集(含输入特征与输出目标)交给学习算法,算法产出一个函数 f(历史上叫"假设 hypothesis",本课就叫函数 f)。f 接收新的输入 x,输出估计/预测 ŷ(读作"y-hat")。
约定:y 是训练集里的真实目标值;ŷ 是模型的估计值,它可能不等于真实值。
怎么表示 f?先假设它是直线
$$f_{w,b}(x) = w\,x + b \qquad f(x) = w\,x + b$$
其中 w、b 是数字(参数)。选择不同的 w、b 会得到不同的直线。因为只有一个输入特征 x,这称为单变量线性回归(univariate linear regression)(uni = 一,variate = 变量)。
为什么先用直线?因为它简单、好处理,而且能作为基础,最终帮你实现更复杂的非线性模型(如拟合曲线)。
把预测写清楚
对第 i 个训练样本,模型预测为 ŷ⁽ⁱ⁾ = f(x⁽ⁱ⁾);我们希望 ŷ⁽ⁱ⁾ 尽量接近真实目标 y⁽ⁱ⁾。要衡量"一条线拟合得好不好",就得构造代价函数。
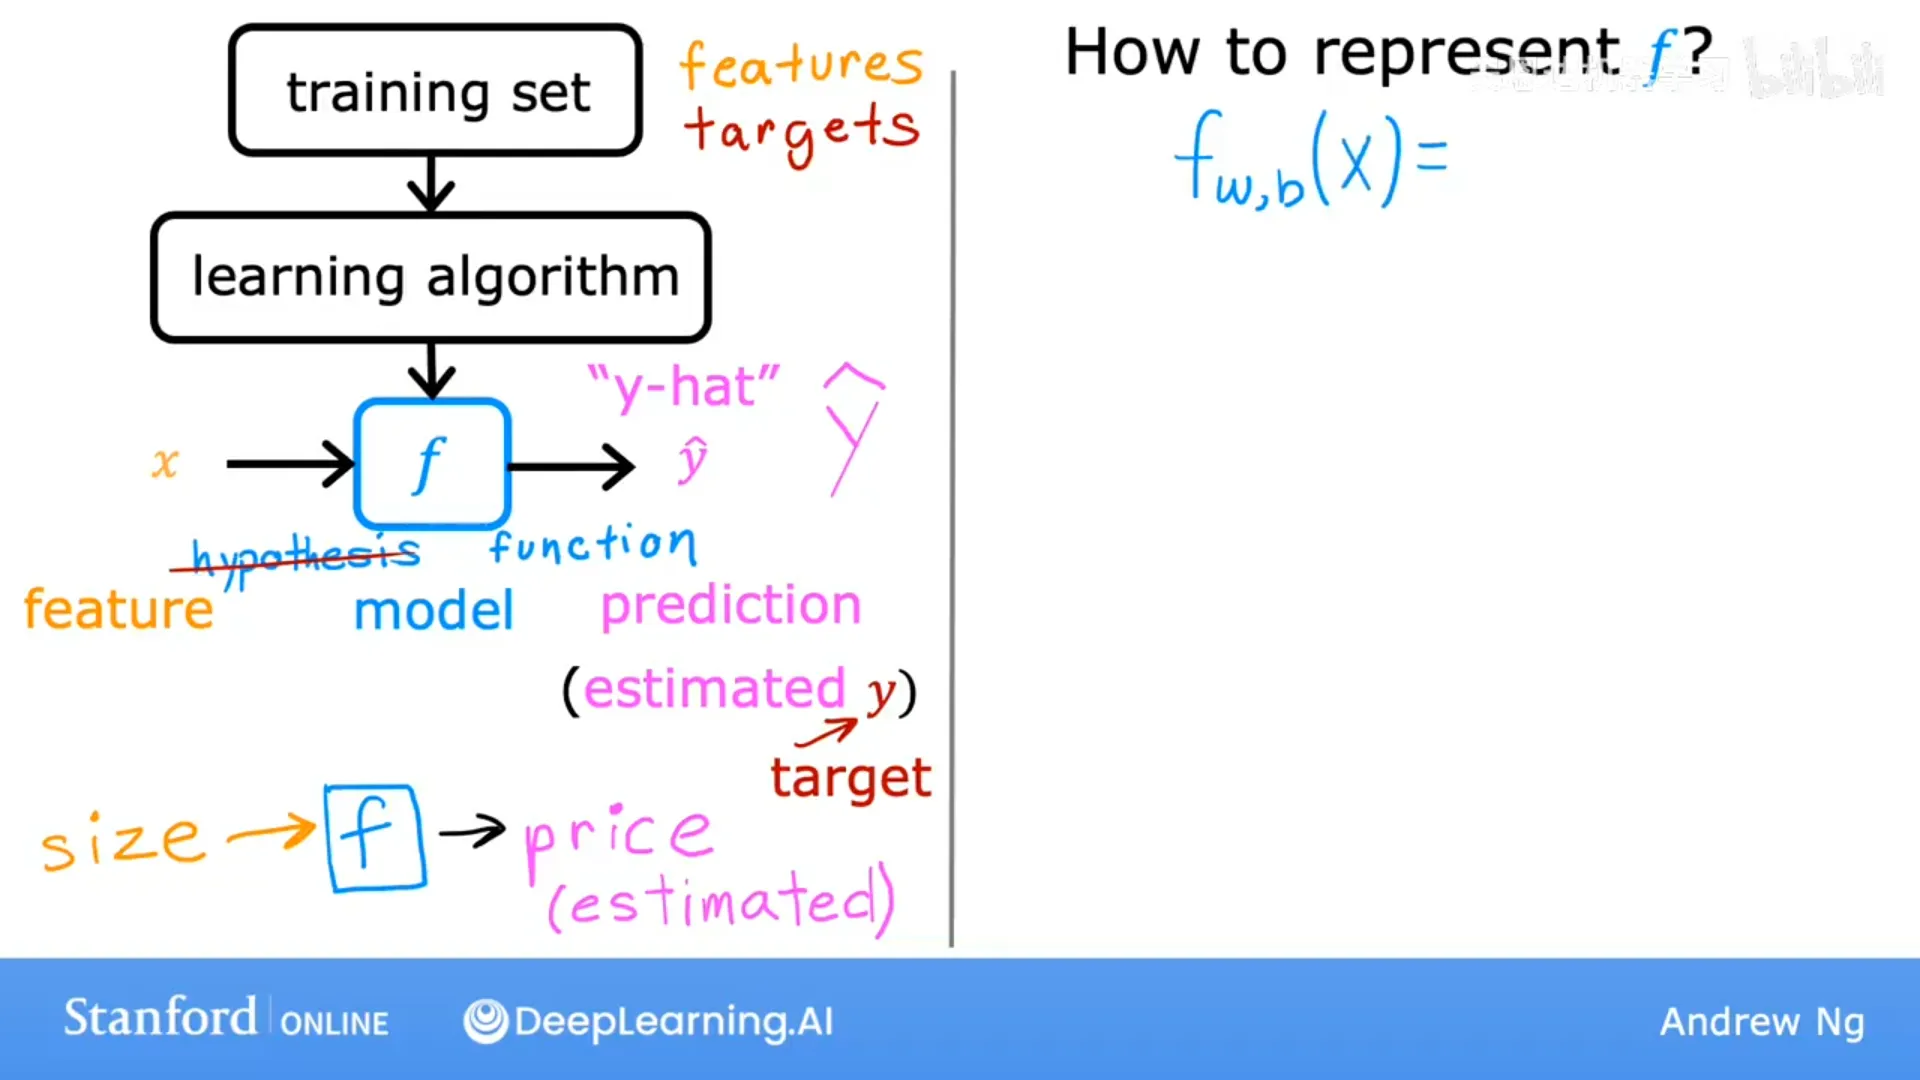
📷 监督学习流程与模型 f_{w,b}(x)=wx+b、预测值 ŷ
回到原视频 (00:02:47)
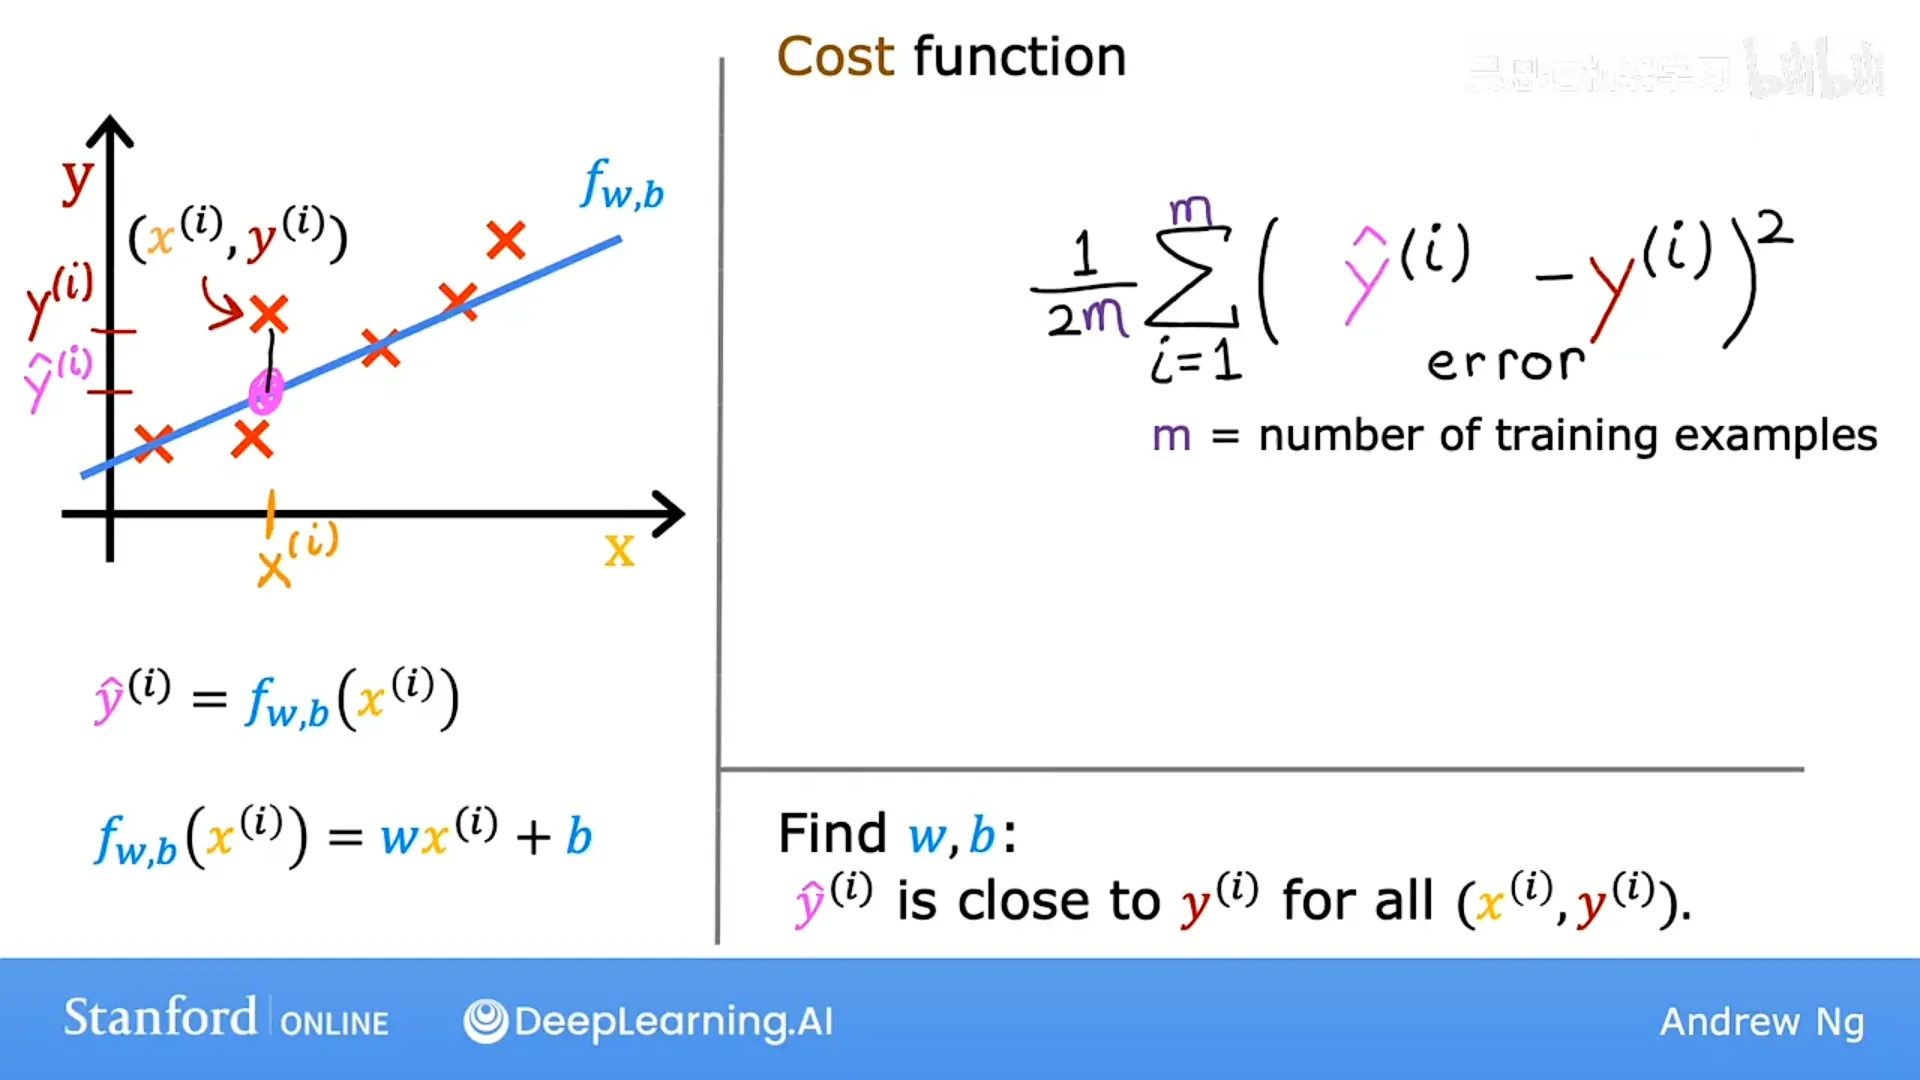
3.4 代价函数:衡量"线拟合得好不好"
易错点 M3:$J$ 变小只说明模型更符合当前定义的训练目标与训练数据,不自动意味着泛化更好、或更符合真实业务目标。请记住两条线:
optimization objective ≠ real-world objective。
(p11)
为了引入术语:w 和 b 是模型的参数(parameters)——训练中可以调整、用来改进模型的变量;它们有时也被叫做系数、权重。
不同的 w、b 会得到不同的直线。为了衡量某组 (w, b) 与训练数据契合得多好,我们定义代价函数 J。做法是:
- 对每个训练样本,取预测值与真实值之差
ŷ − y(叫误差); - 把误差平方;
- 对所有 m 个样本求和;
- 求平均(除以 m),得到"平均平方误差";
- 按惯例再除以 2,即 1/(2m)——这一步只是让后面的公式更整洁。
于是:
$$\begin{aligned}
J(w,b) &= \frac{1}{2m}\sum_{i=1}^{m}\big(\hat{y}^{(i)} - y^{(i)}\big)^2 \ &= \frac{1}{2m}\sum_{i=1}^{m}\big(f_{w,b}(x^{(i)}) - y^{(i)}\big)^2
\end{aligned}$$
这就是平方误差代价函数(squared error cost function)——它是线性回归(以及各类回归问题)中最常用的代价函数。线性回归的目标,就是找到让 J(w, b) 最小的 w 和 b。
📷 平方误差代价函数 J(w,b) 的定义
回到原视频 (00:07:20)
3.5 代价函数的直观理解
(p12)
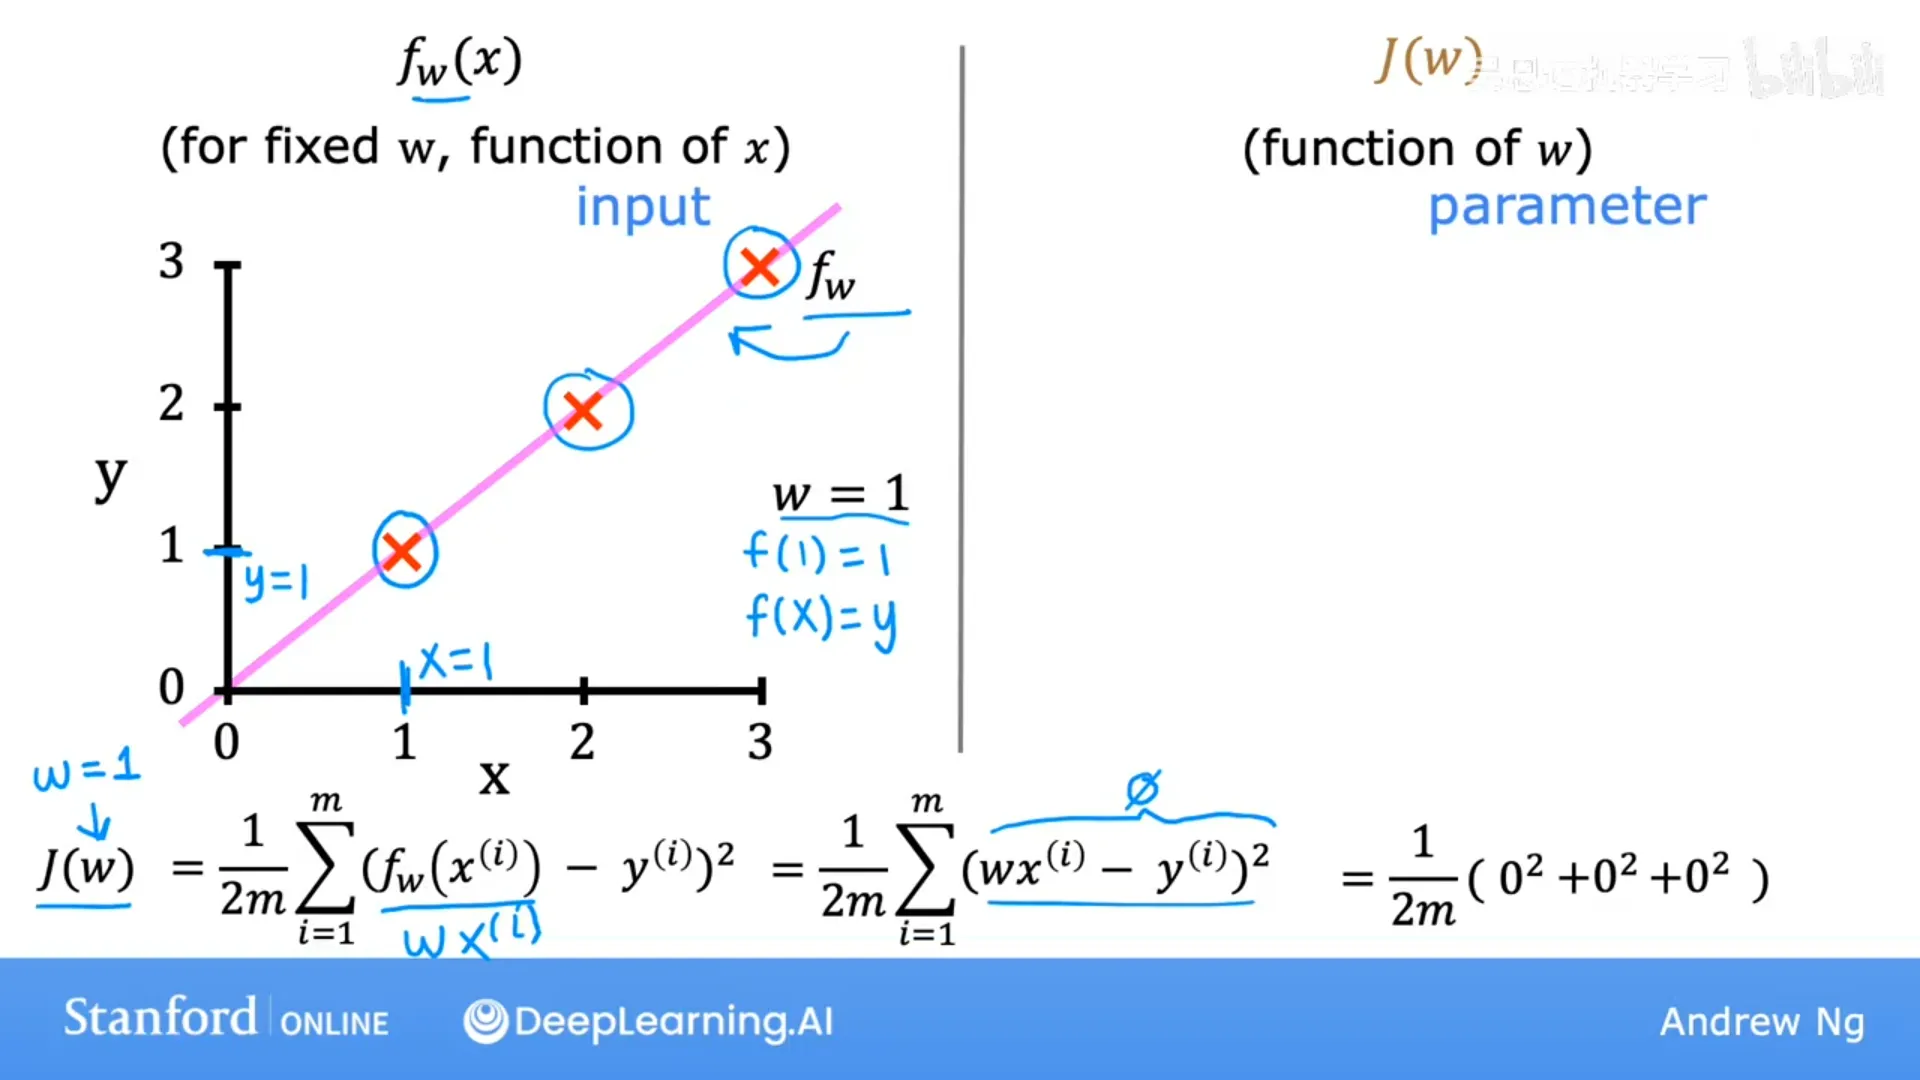
为了看清楚代价函数在做什么,先简化模型:令 b = 0,于是 f_w(x) = w·x,代价函数只剩一个参数 w。
设训练集是三个点 (1,1)、(2,2)、(3,3)。把左图(f 的图)和右图(J 的图)并排看:
- 左图横轴是 x、纵轴是 y;右图横轴是 w、纵轴是 J。因为 J 是 w 的函数——w 控制拟合直线的斜率。
试几个 w:
- w = 1:直线 y = x 正好穿过三个点,每个样本误差都是 0,于是 J(1) = 0;
- w = 0.5:误差项分别是 (0.5−1)²、(1−2)²、(1.5−3)²……求和得 3.5;再乘 1/(2·3),得 J ≈ 0.58;
- w = 0:得到水平线 y = 0,J = (1/6)·(1+4+9) = 14/6 ≈ 2.33;
- w = −0.5:成本更高,约 5.25。
把这些点描出来,就得到 J(w) 的曲线(开口向上的 U 形/碗形)。每个 w 对应左边一条拟合直线,也对应右边 J 图上的一个点;让 J(w) 最小的 w,就是最佳拟合——在这个例子里选 w = 1。
📷 w 不同取值对应的拟合直线与代价 J:w=1 时 J=0 最优
回到原视频 (00:06:37)
3.6 可视化代价函数:3D 碗形与等高线
易错点 M4:等高线图上,一个点 $(w,b)$ 是一组参数(一个模型)的位置,不是 cost;该点对应的 $J(w,b)$ 才是 cost。记法:在参数空间里移动 $(w,b)$,用函数值 $J$ 判好坏。
(p13)
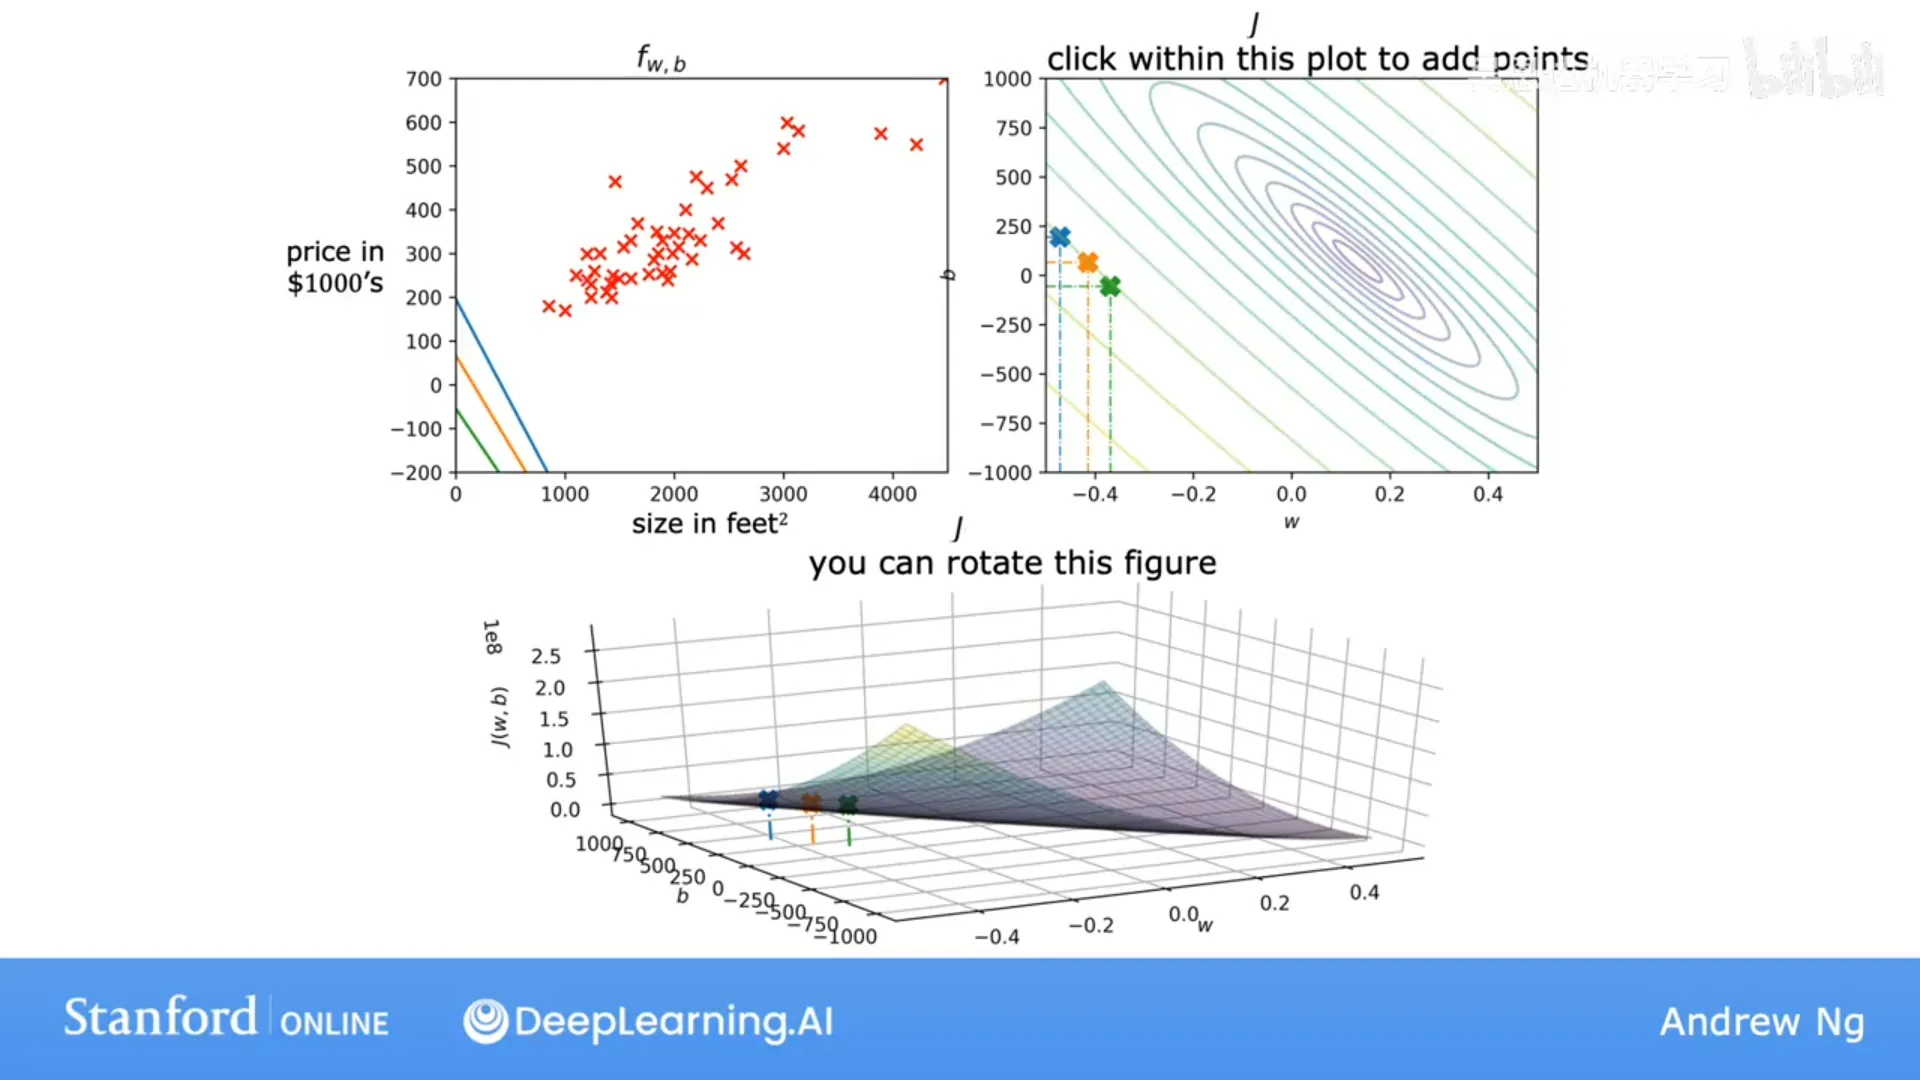
回到完整模型(同时有 w 和 b)。若选 w = 0.06、b = 50,直线 f(x) = 0.06x + 50 明显低估房价,是个很差的模型。
只有 w 时,代价函数是一条 U 形曲线(像"汤碗");而有两个参数 w、b 时,代价函数是一个三维的碗形/吊床形曲面。曲面上的任意一点,都对应一组 (w, b) 的选择,其高度就是 J(w, b)。
另一种非常有用的画法是等高线图(contour plot)——就像地形图上的等高线是"同一高度的水平切片"。它把三维曲面压到二维:横轴是 w、纵轴是 b,每个椭圆代表代价 J 相同的一组 (w, b)。越靠近最小椭圆中心的点,代价越小(中心处 J 取最小值)。
📷 代价函数的三维碗形曲面与等高线图(同一函数两种画法)
回到原视频 (00:05:24)
3.7 把参数选择"画"出来
(p14)
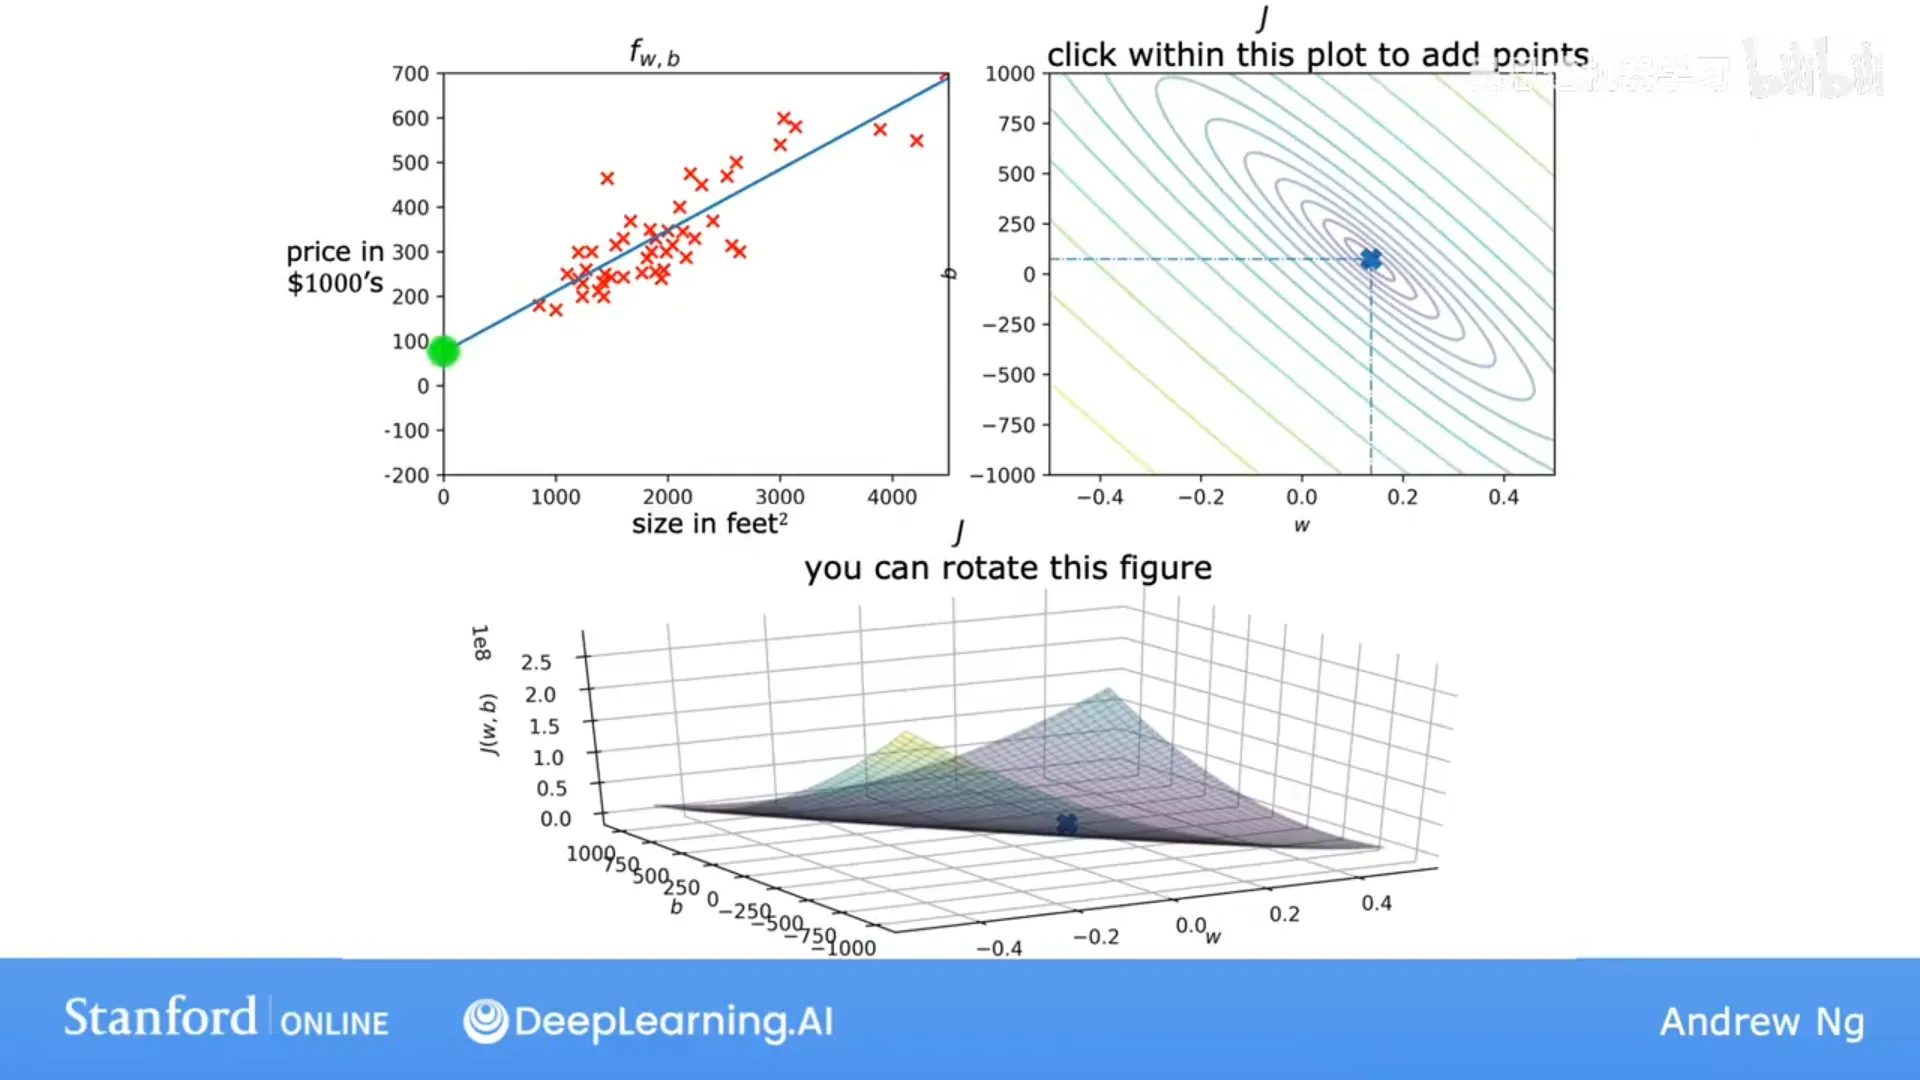
看四个例子,把等高线图上的点与左边的拟合直线对应起来:
| (w, b) 大致取值 | 拟合效果 | 在等高线图上的位置 |
|---|---|---|
| w ≈ −0.15, b ≈ 800 | 很差(斜率是负的) | 离中心很远,代价高 |
| w = 0, b ≈ 360 | 一般(水平线) | 稍近一些 |
| 另一组 | 更差 | 更远 |
| 较好的一组 | 很好地拟合数据 | 非常接近最小椭圆的中心 |
要点:拟合越好的直线,对应 J 图上越接近最小值的点。 但"手动读等高线图找最优 (w, b)"不是好办法,而且在更复杂的模型上根本行不通——我们需要一个用代码自动找最优参数的高效算法,这就是下一章的梯度下降。
📷 四组 (w,b) 的拟合直线与其在代价函数上的位置
回到原视频 (00:02:43)
第四章 梯度下降
(对应模块 4,视频 p15–p20)
4.1 下山:梯度下降的直觉
(p15)
梯度下降(gradient descent)是机器学习中最重要的算法之一:它不仅能训练线性回归,还能训练当今最大、最复杂的 AI 模型(包括第二门课要讲的深度学习模型)。而且它可以用来最小化任意函数,不限于线性回归的代价函数。
算法流程:先给参数一个初始猜测(线性回归里常令 w = 0, b = 0),然后反复地、每次稍微调整 w 和 b,努力减小 J,直到 J 收敛到一个最小值。
用"下山"来理解:俯视代价曲面就像看一片有高低起伏的公园,你的目标是尽快走到某个山谷底部。每一步你环顾 360°,问自己"朝哪个方向迈一小步下坡最快?"——数学上这是最陡下降的方向。迈一步,站定,再环顾,再迈……直到到达谷底。
一个有趣的性质:从不同起点出发,可能到达不同的局部最小值(local minimum)。比如从左边出发停在第一个谷底,从稍右边出发会停在另一个谷底。
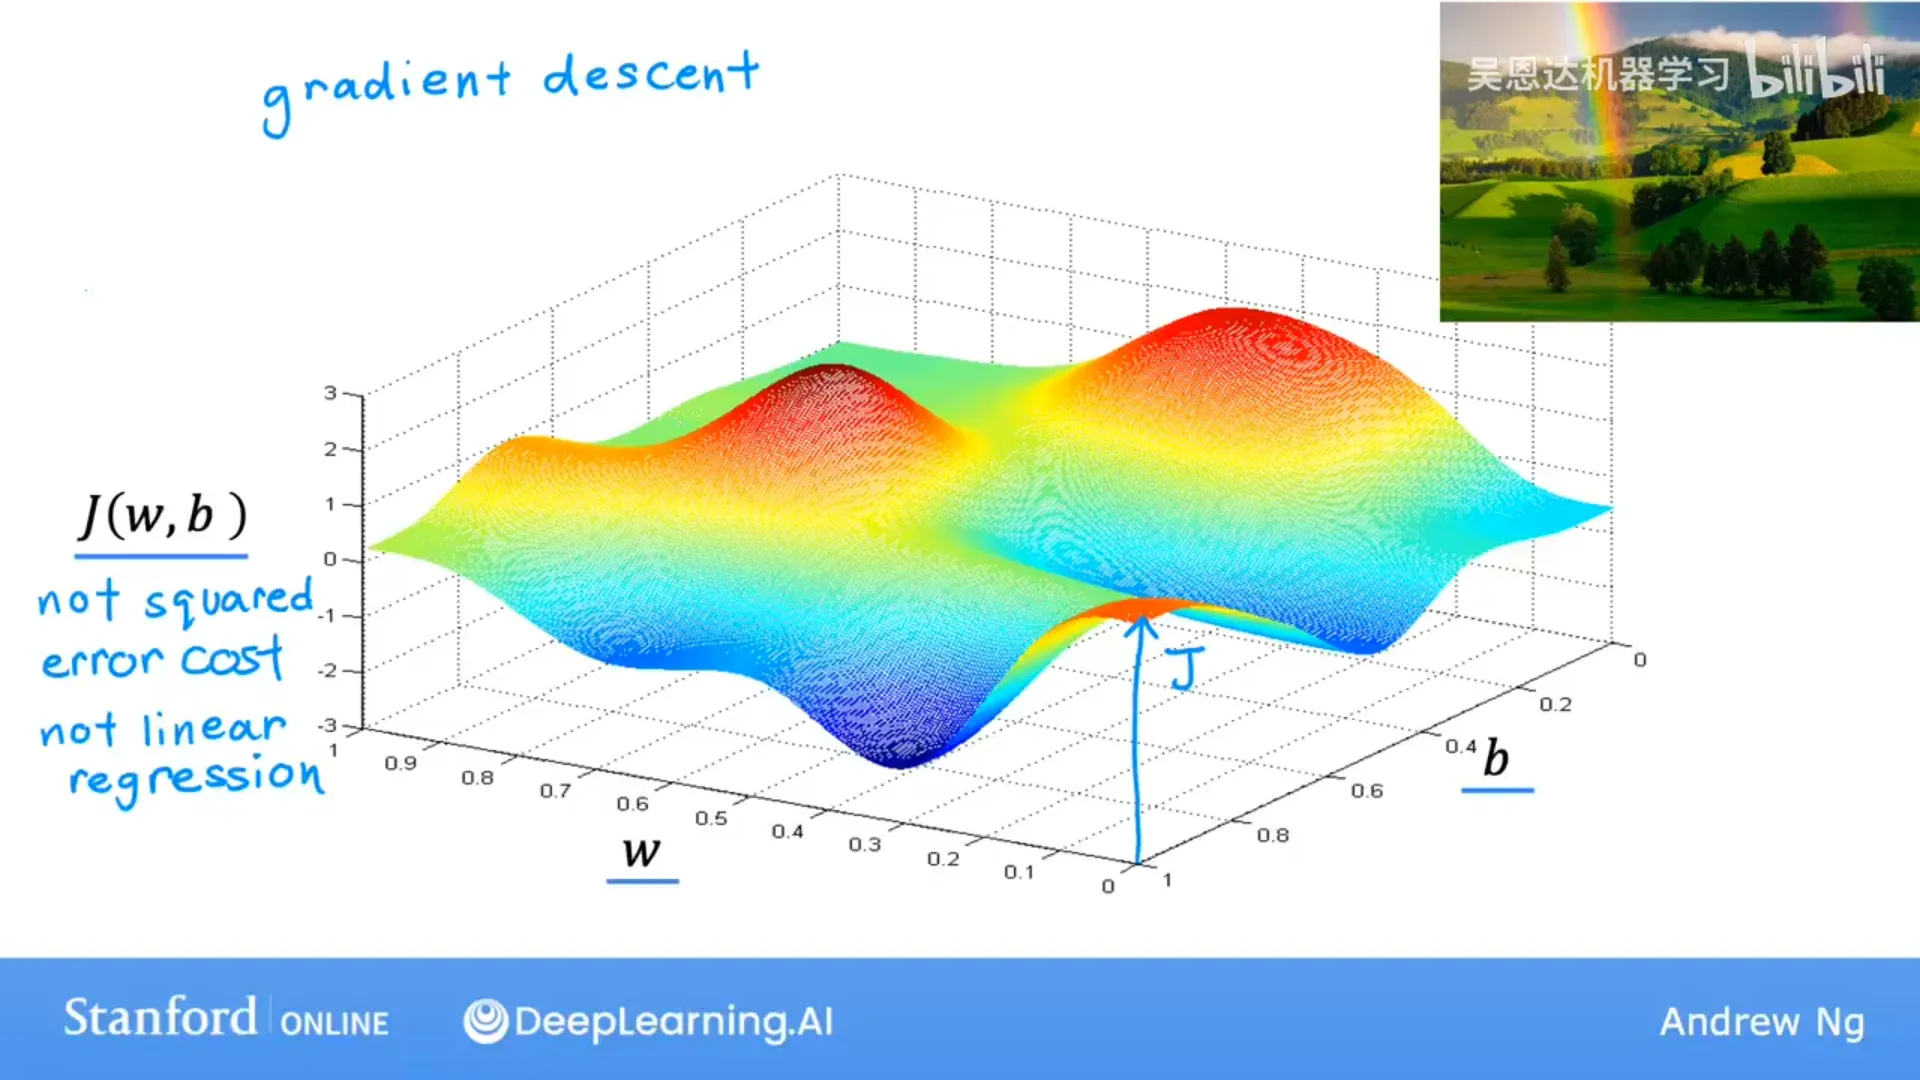
📷 梯度下降的"下山"直观:每一步朝最陡下降方向迈一小步
回到原视频 (00:04:00)
4.2 算法与"同时更新"
(p16)
梯度下降的更新规则是:
$$\begin{aligned}
w &:= w - \alpha\,\frac{\partial}{\partial w}\, J(w,b) \ b &:= b - \alpha\,\frac{\partial}{\partial b}\, J(w,b)
\end{aligned}$$
要点:
:=是赋值(assignment),不是数学上的"相等断言"(后者在代码里写作==)。a := a + 1在编程中是合法且常见的。- α 是学习率(learning rate),一个小的正数(如 0.01),控制每一步迈多大:α 大则步子大、更激进;α 小则步子小。
- 导数项告诉你该往哪个方向走;它和学习率一起决定步子大小。(严格说是偏导数,但为讲解方便统称导数。)
关键细节:要同时更新 w 和 b。 正确做法是先把两边的右侧都算好,存进临时变量,再一起赋值:
tmp_w = w - alpha * dJ_dw
tmp_b = b - alpha * dJ_db
w = tmp_w
b = tmp_b
而错误做法是"更新完 w 再算 b",此时 b 的表达式里已经用到了新的 w,得到的是另一种算法。它不是同一个梯度下降,虽然有时也能"差不多工作",但不应采用。
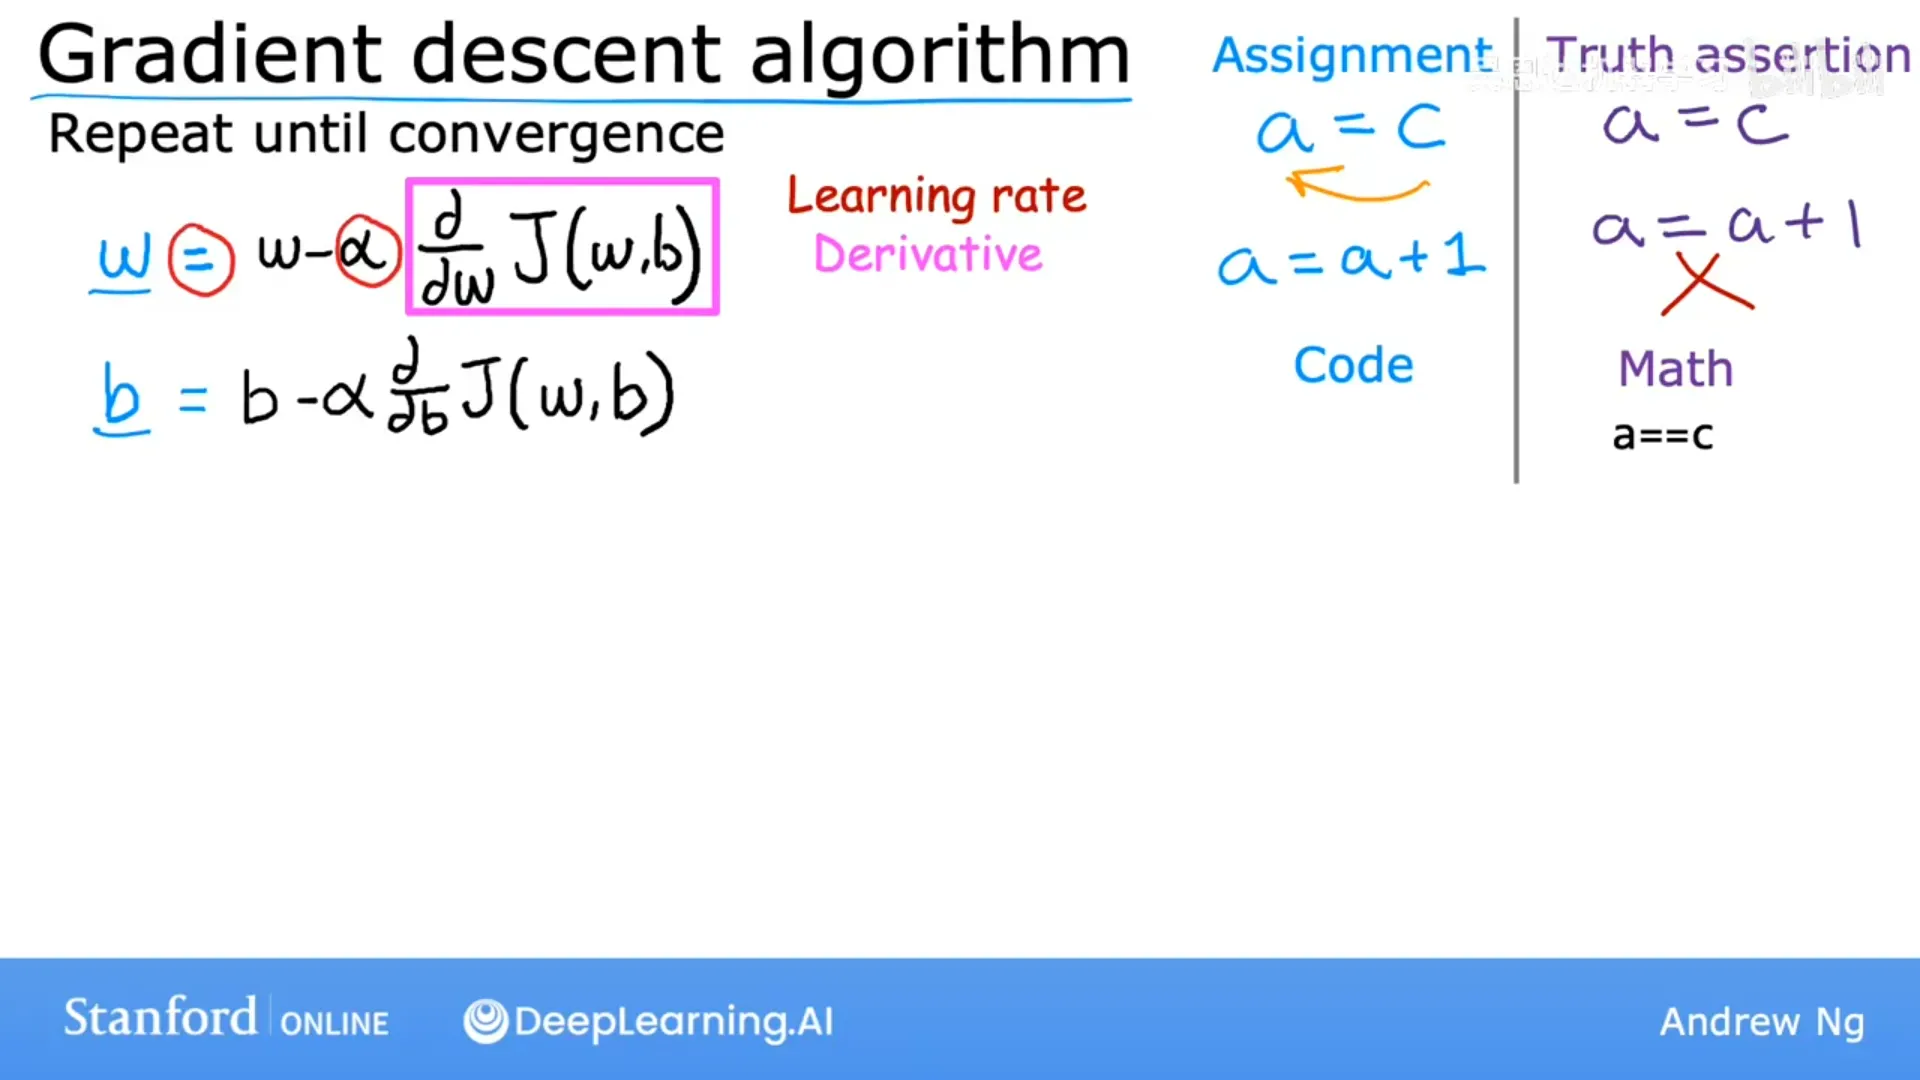
📷 梯度下降的更新公式与"同时更新"的正确/错误实现
回到原视频 (00:05:26)
4.3 导数项为什么合理
易错点 M5:$\nabla J$ 是最速上升方向;梯度下降走的是 $-\nabla J$(最速下降)。求导项的符号决定 $w$ 往哪边挪。
(p17)
先把问题简化到只有一个参数 w,看二维图(横轴 w、纵轴 J(w)):
- 在某点画切线,切线的斜率就是该点的导数(例如斜率 = 2/1 = 2,是正数)。若该点切线向右上倾斜 → 导数为正 →
w := w − α·(正数),w 变小 → 在图上向左移动,J 减小,靠近最小值; - 若在某点切线向右下倾斜 → 导数为负 →
w := w − α·(负数) = w + 正数,w 变大 → 向右移动,J 同样减小。
两种情况下梯度下降都在朝最小值走。
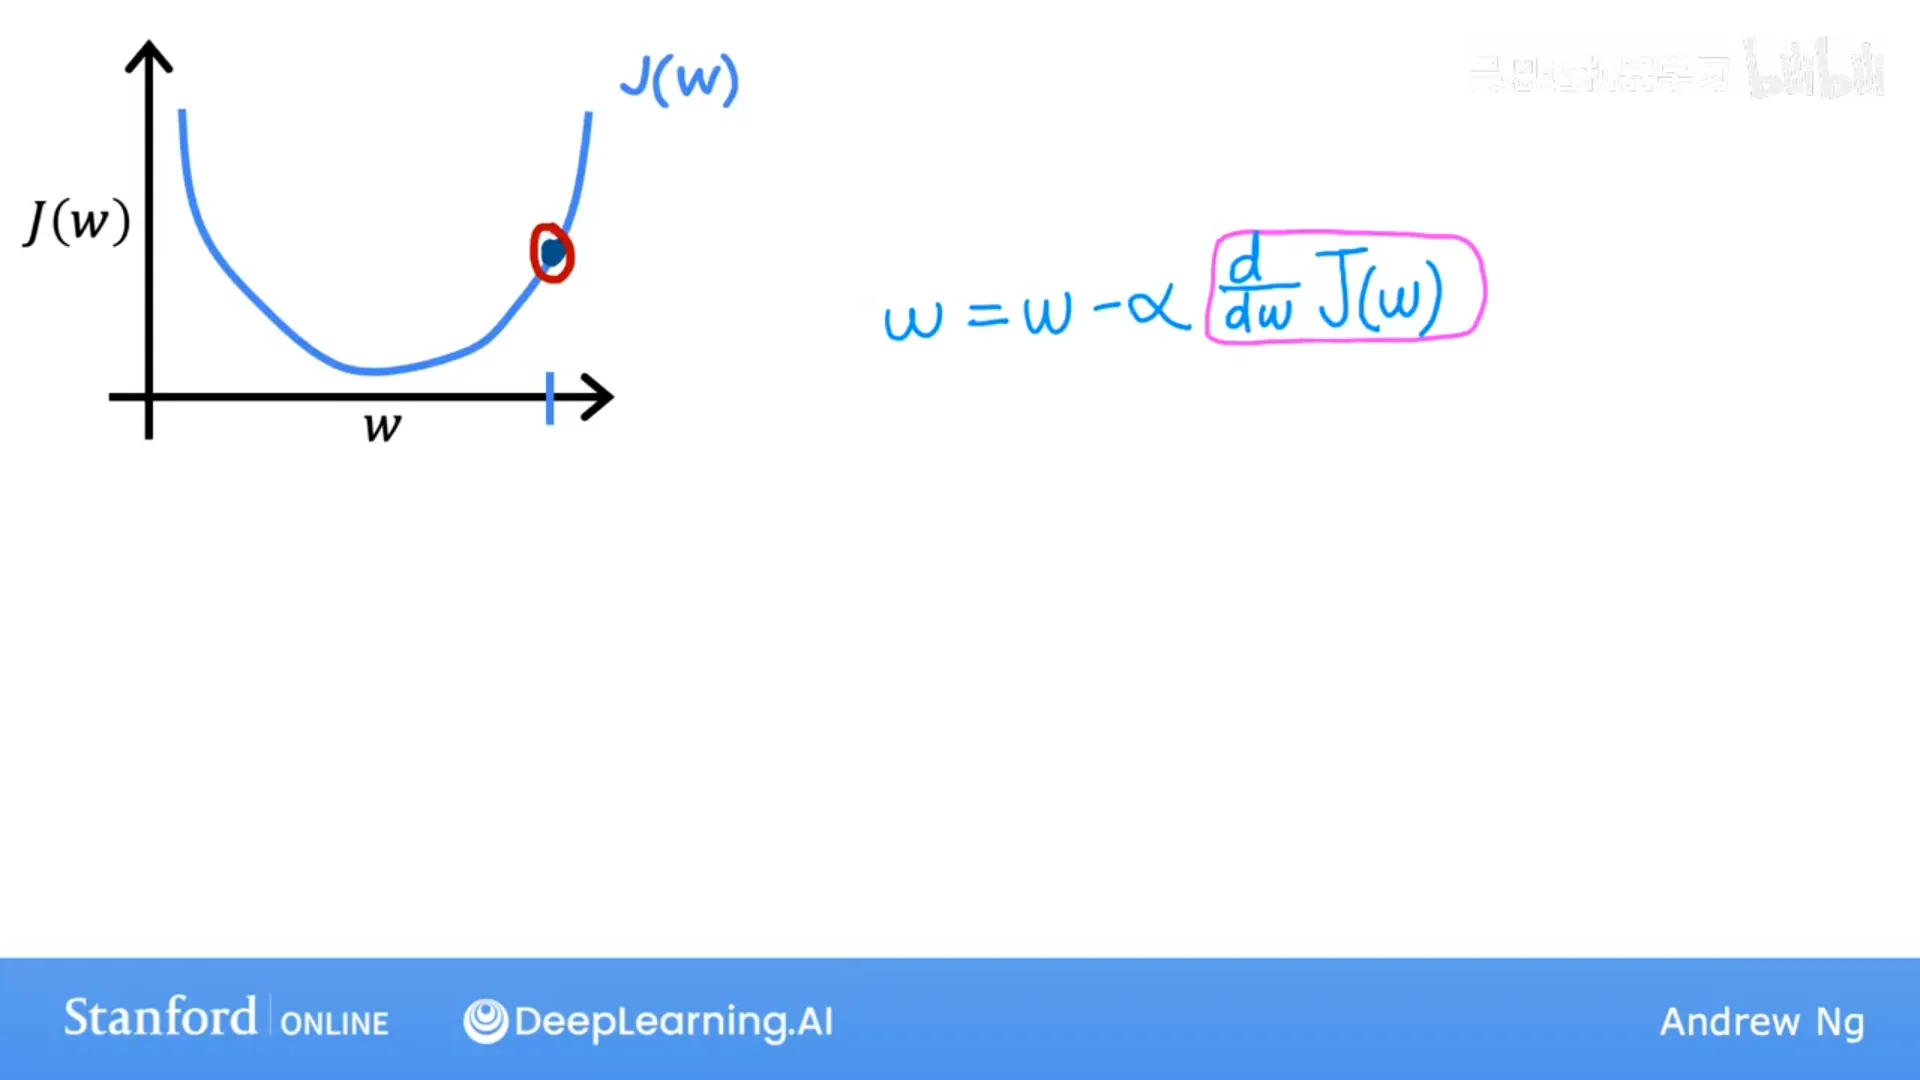
📷 切线斜率即导数:导数为正时 w 左移、为负时 w 右移,都在减小 J
回到原视频 (00:02:51)
4.4 学习率 α 的选择
易错点 M6:梯度下降可以越过最低点并来回振荡,只要振幅越来越小,仍会收敛(例如 $4\to-2\to1\to-0.5\to\cdots$)。$\alpha$ 太小 → 太慢;$\alpha$ 太大 → 振荡甚至发散。
(p18)
- α 太小:每步都极小,梯度下降能工作但非常慢,需要很多步才接近最小值;
- α 太大:步子太大会越过最小值,甚至每一步越走越远,可能发散、无法收敛;
- 已在局部最小值:该点切线斜率为 0 → 导数项为 0 →
w := w − α·0 = w,参数不再变化。这正是我们想要的:它把解留在局部最小值。
另一个漂亮的性质:即使 α 固定,随着接近局部最小值,导数会自动变小,因而每一步也自动变小——所以梯度下降会自然"缓步收敛",不需要手动调小学习率。
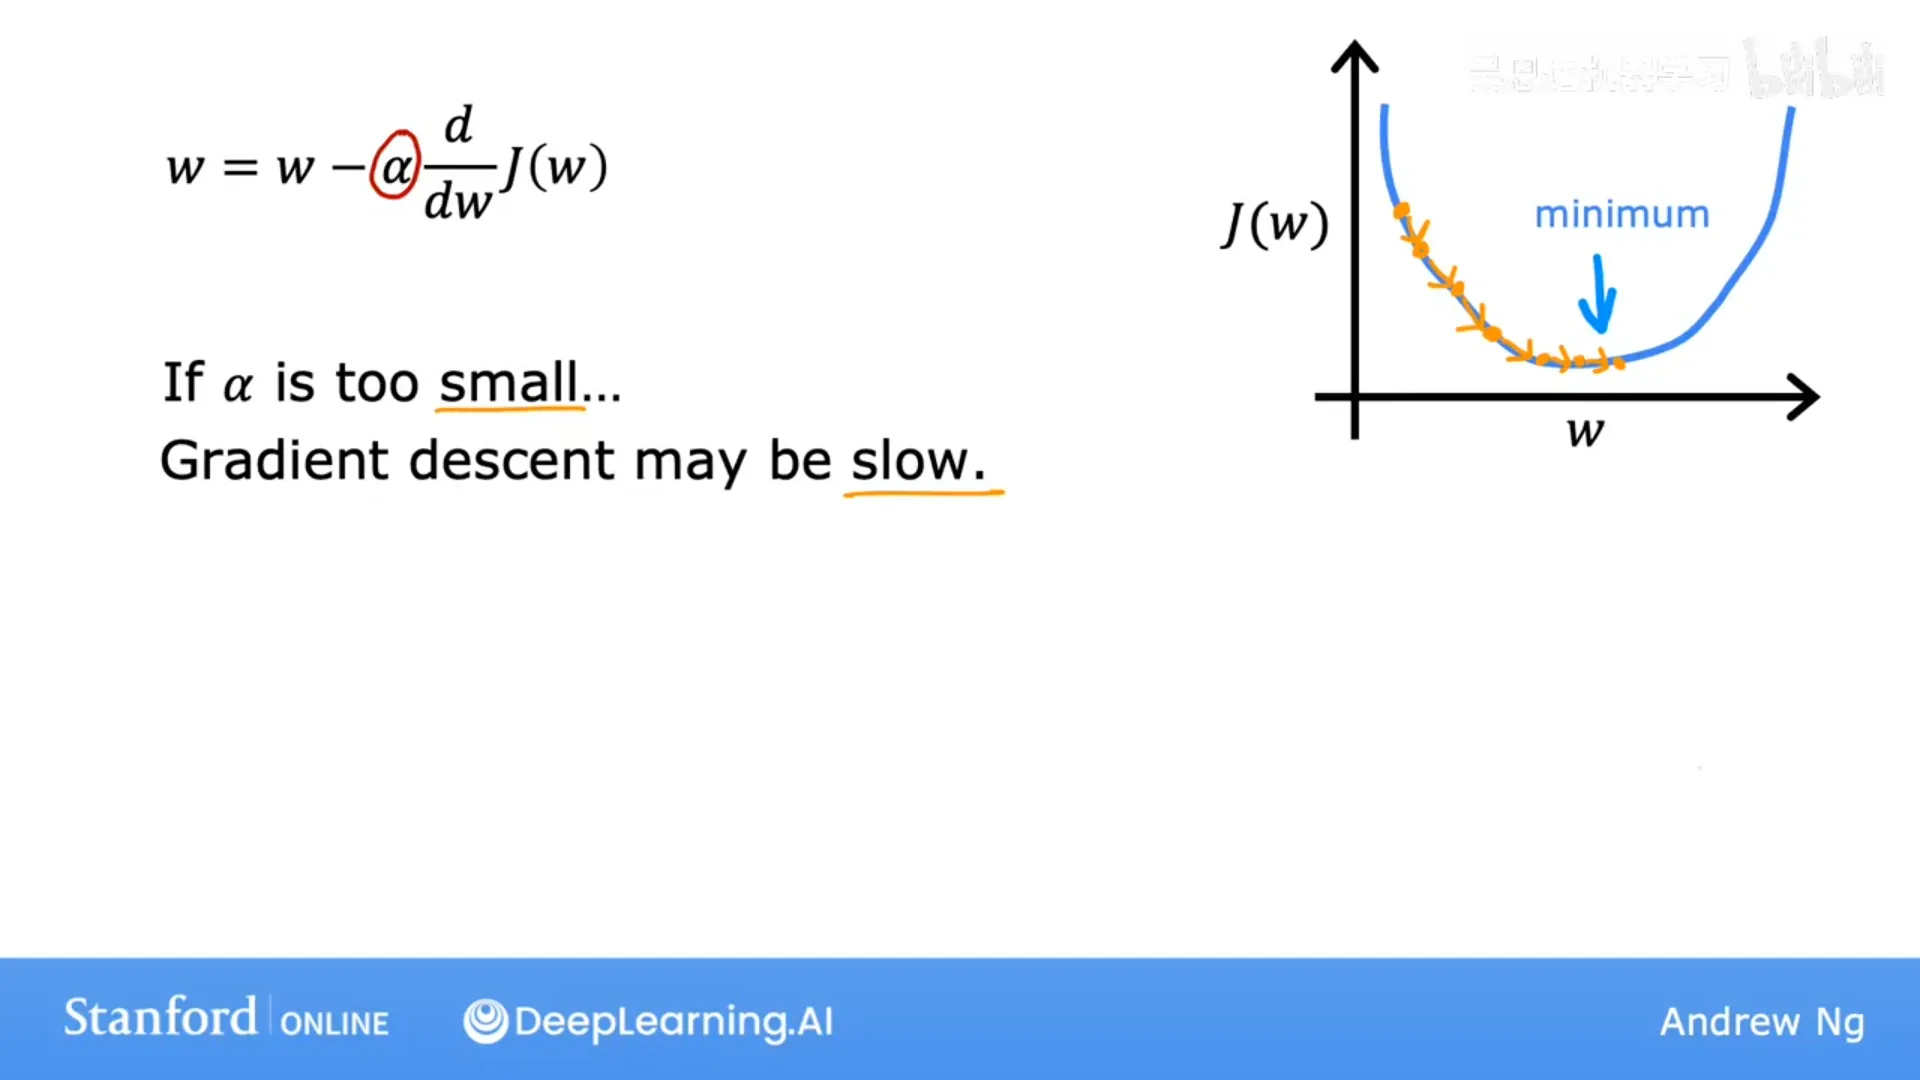
📷 学习率太大导致越过最小值甚至发散
回到原视频 (00:02:20)
4.5 线性回归的梯度下降
(p19)
把线性回归模型、平方误差代价函数、梯度下降三者合起来,可以推导出两个偏导数:
$$\begin{aligned}
\frac{\partial J}{\partial w} &= \frac{1}{m}\sum_{i=1}^{m}\big(f(x^{(i)}) - y^{(i)}\big)\, x^{(i)} \ \frac{\partial J}{\partial b} &= \frac{1}{m}\sum_{i=1}^{m}\big(f(x^{(i)}) - y^{(i)}\big)
\end{aligned}$$
(推导用到一点微积分;不熟悉微积分完全可以跳过,直接使用这两个公式即可。之所以之前代价函数要除以 2,正是为了让这里的导数更简洁——它把求导时产生的 2 抵消掉了。)
于是线性回归的梯度下降就是反复同时更新:
$$\begin{aligned}
w &:= w - \alpha\,\frac{1}{m}\sum_{i=1}^{m}\big(f(x^{(i)}) - y^{(i)}\big)\, x^{(i)} \ b &:= b - \alpha\,\frac{1}{m}\sum_{i=1}^{m}\big(f(x^{(i)}) - y^{(i)}\big)
\end{aligned}$$
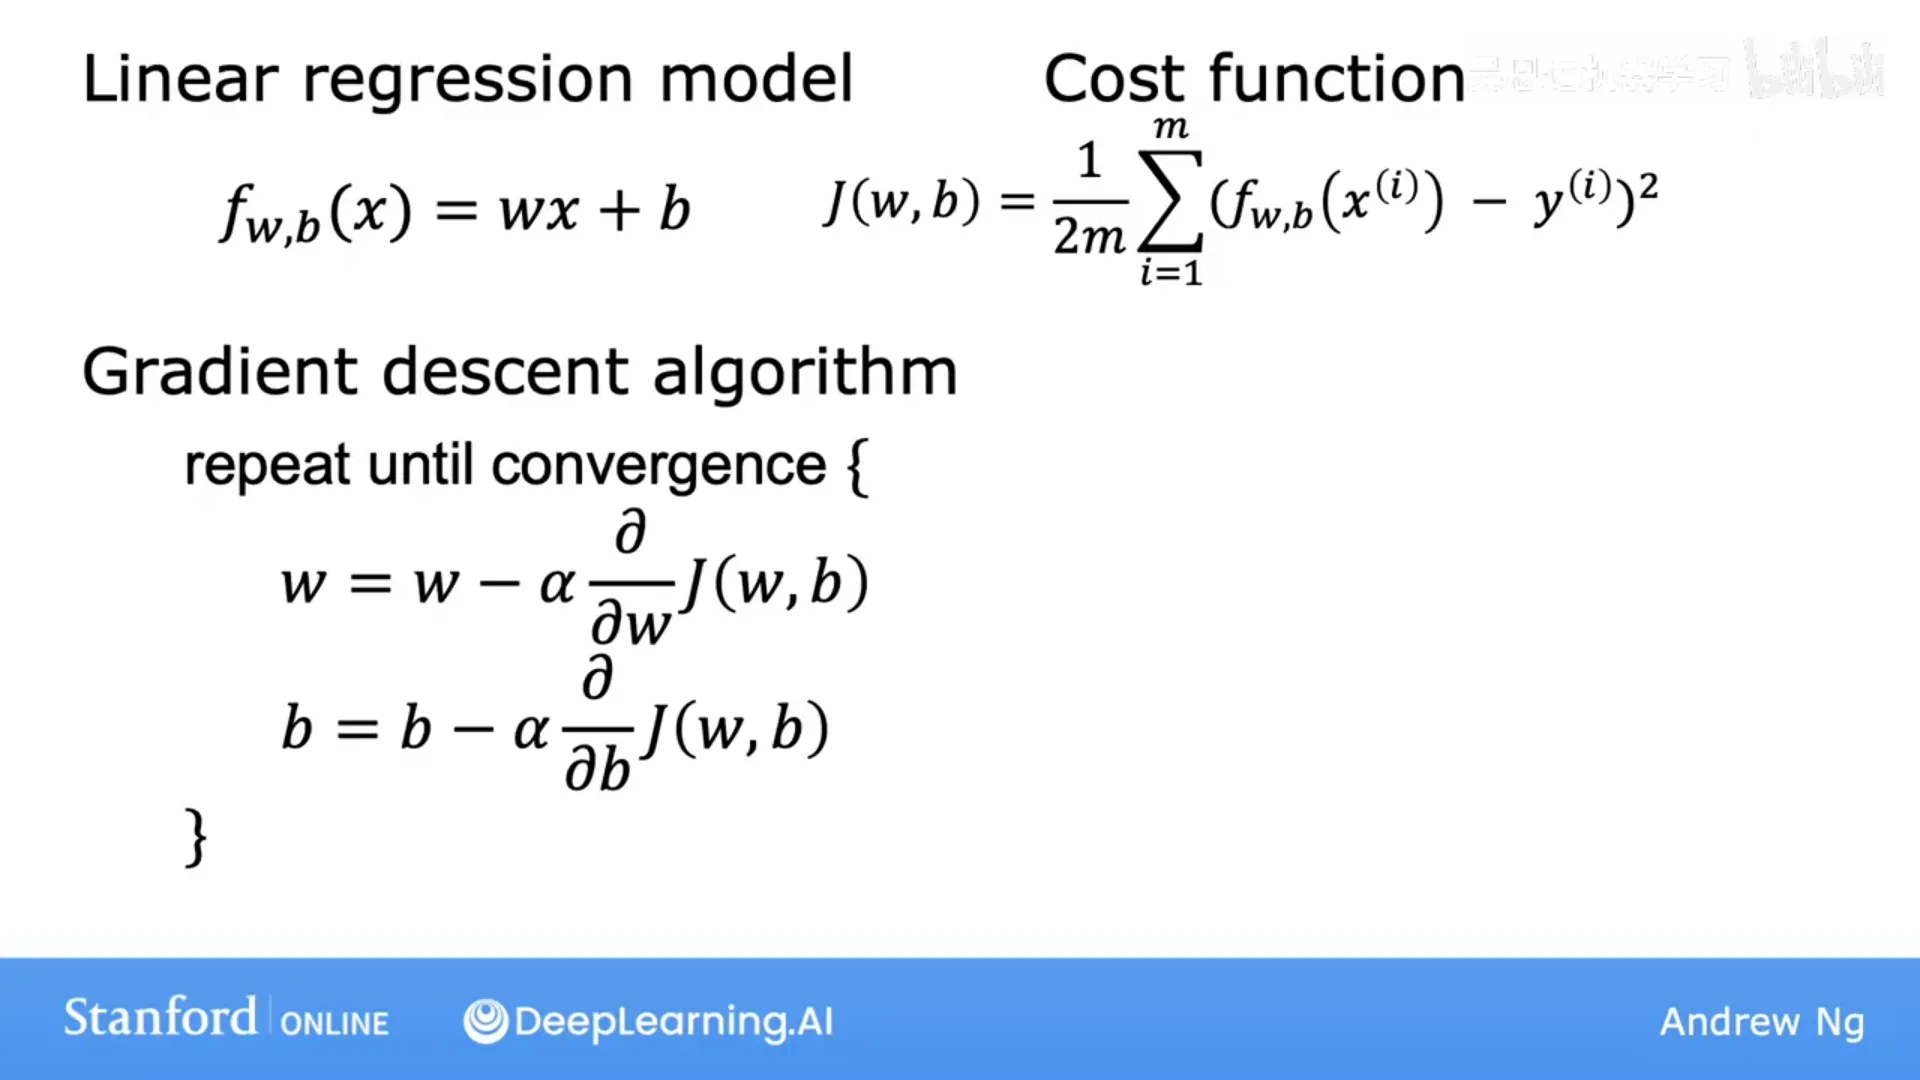
📷 线性回归梯度下降的导数公式与更新规则
回到原视频 (00:00:42)
好消息:代价函数是凸的
易错点 M7:凸 ≠ 唯一解。凸保证「局部最小 = 全局最小」;唯一性还要看 $X^\top X$ 是否满秩 / 正定(特征是否相关)。一维判据是 $f''(x)\ge0$;
数学角落:线性回归的 $J(w)=\frac{1}{2m}\lVert Xw-y\rVert^2$ 有二阶导 $\nabla^2 J=\frac1m X^\top X$。因为对任意 $v$ 有 $\lVert Xv\rVert^2\ge0$,所以 $X^\top X\succeq0$(半正定)⇒ $J$ 是凸的。当 $X$ 满列秩时 $X^\top X\succ0$(正定),此时严格凸,最优解唯一。
之前担心"梯度下降可能停在局部最小值",但对线性回归 + 平方误差代价函数来说,代价函数是一个凸函数(convex function)——只有一个全局最小值,不可能有别的局部最小值。因此在凸函数上用梯度下降,只要学习率合适,总会收敛到全局最小值。
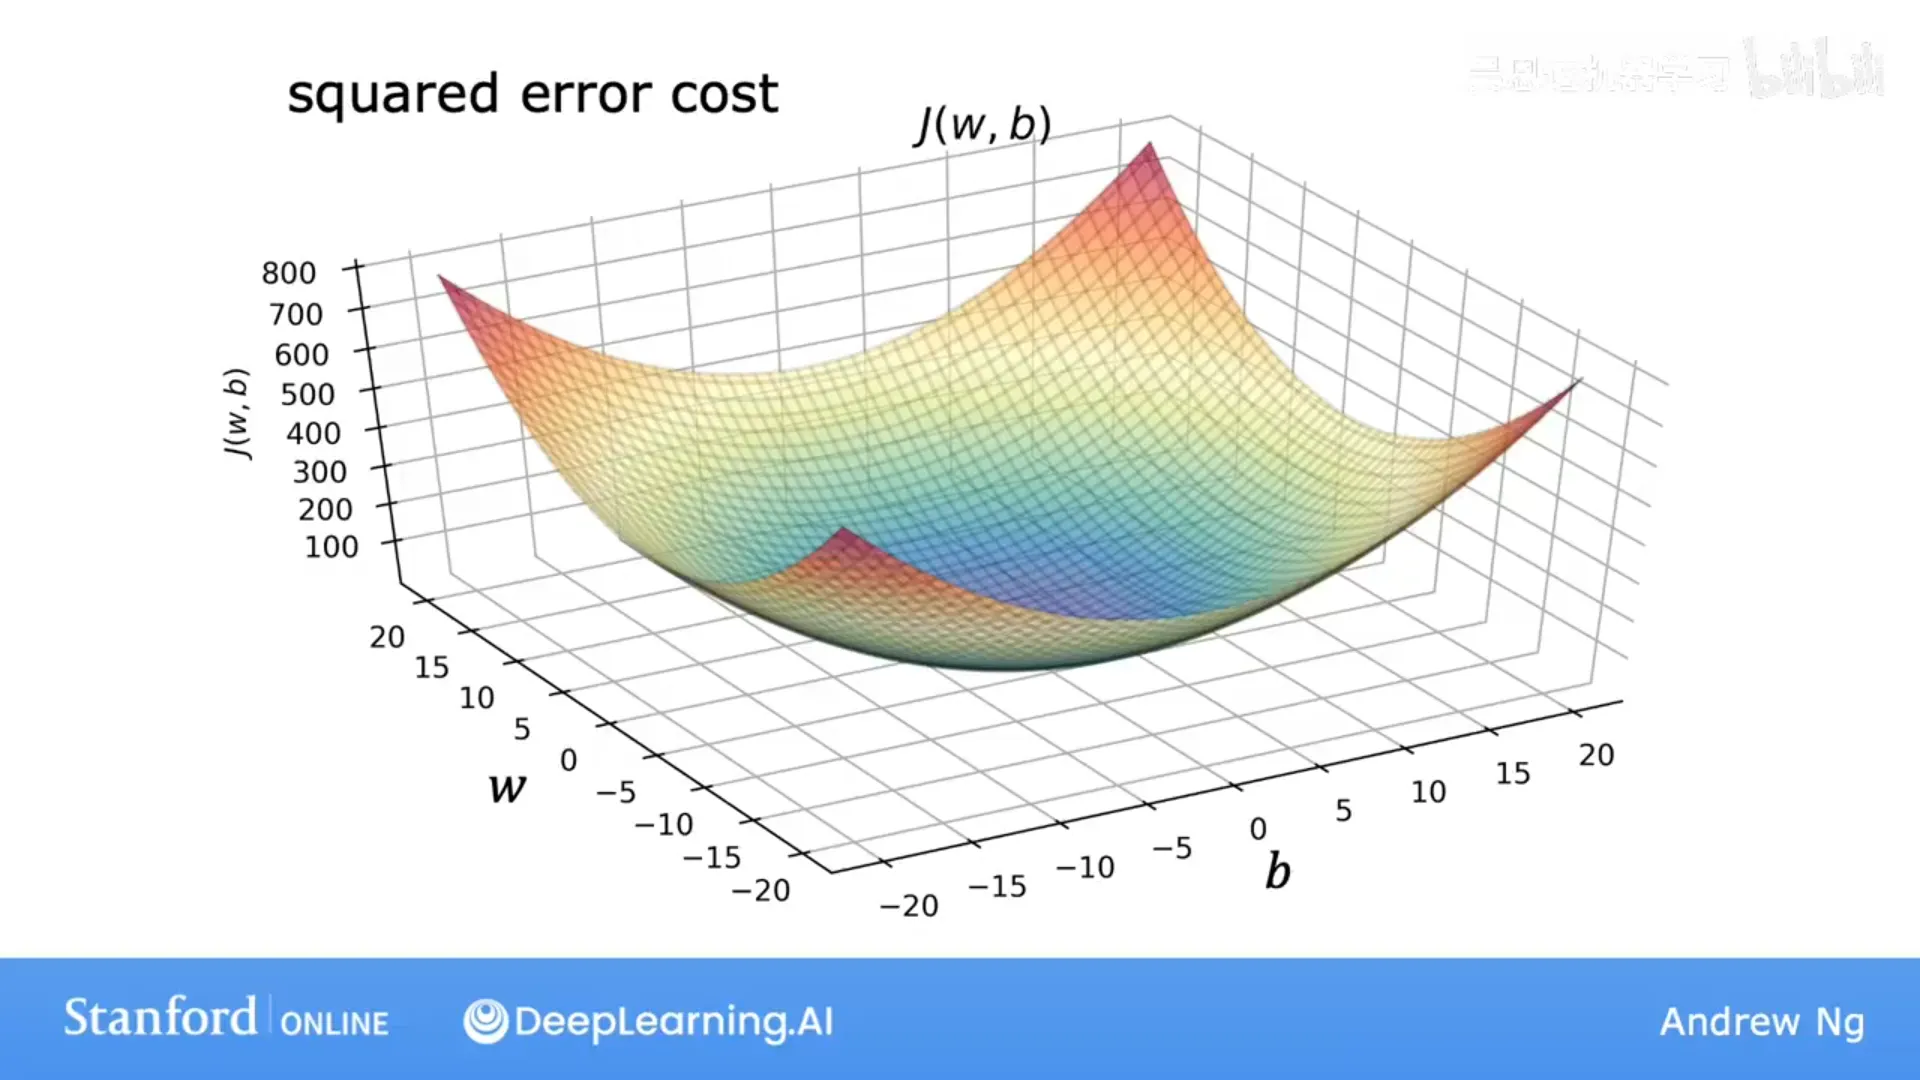
📷 平方误差代价函数是凸函数:只有唯一全局最小值
回到原视频 (00:05:42)
4.6 运行梯度下降(批量梯度下降)
易错点 M11:mini-batch 梯度是样本梯度的平均,batch 越大,随机扰动越容易相互抵消($\mathrm{Var}(\hat g)\propto 1/B$),梯度通常更不 noisy;batch 太小才更抖。
(p20)
以 w = −0.1、b = 900 为起点运行:每更新一步,代价就下降一点,参数 (w, b) 沿一条轨迹前进;左边对应的拟合直线越来越好,直到到达全局最小值——那条拟合相当不错的直线。之后就可以用它预测客户房价(例如 1250 平方英尺 → 约 25 万美元)。
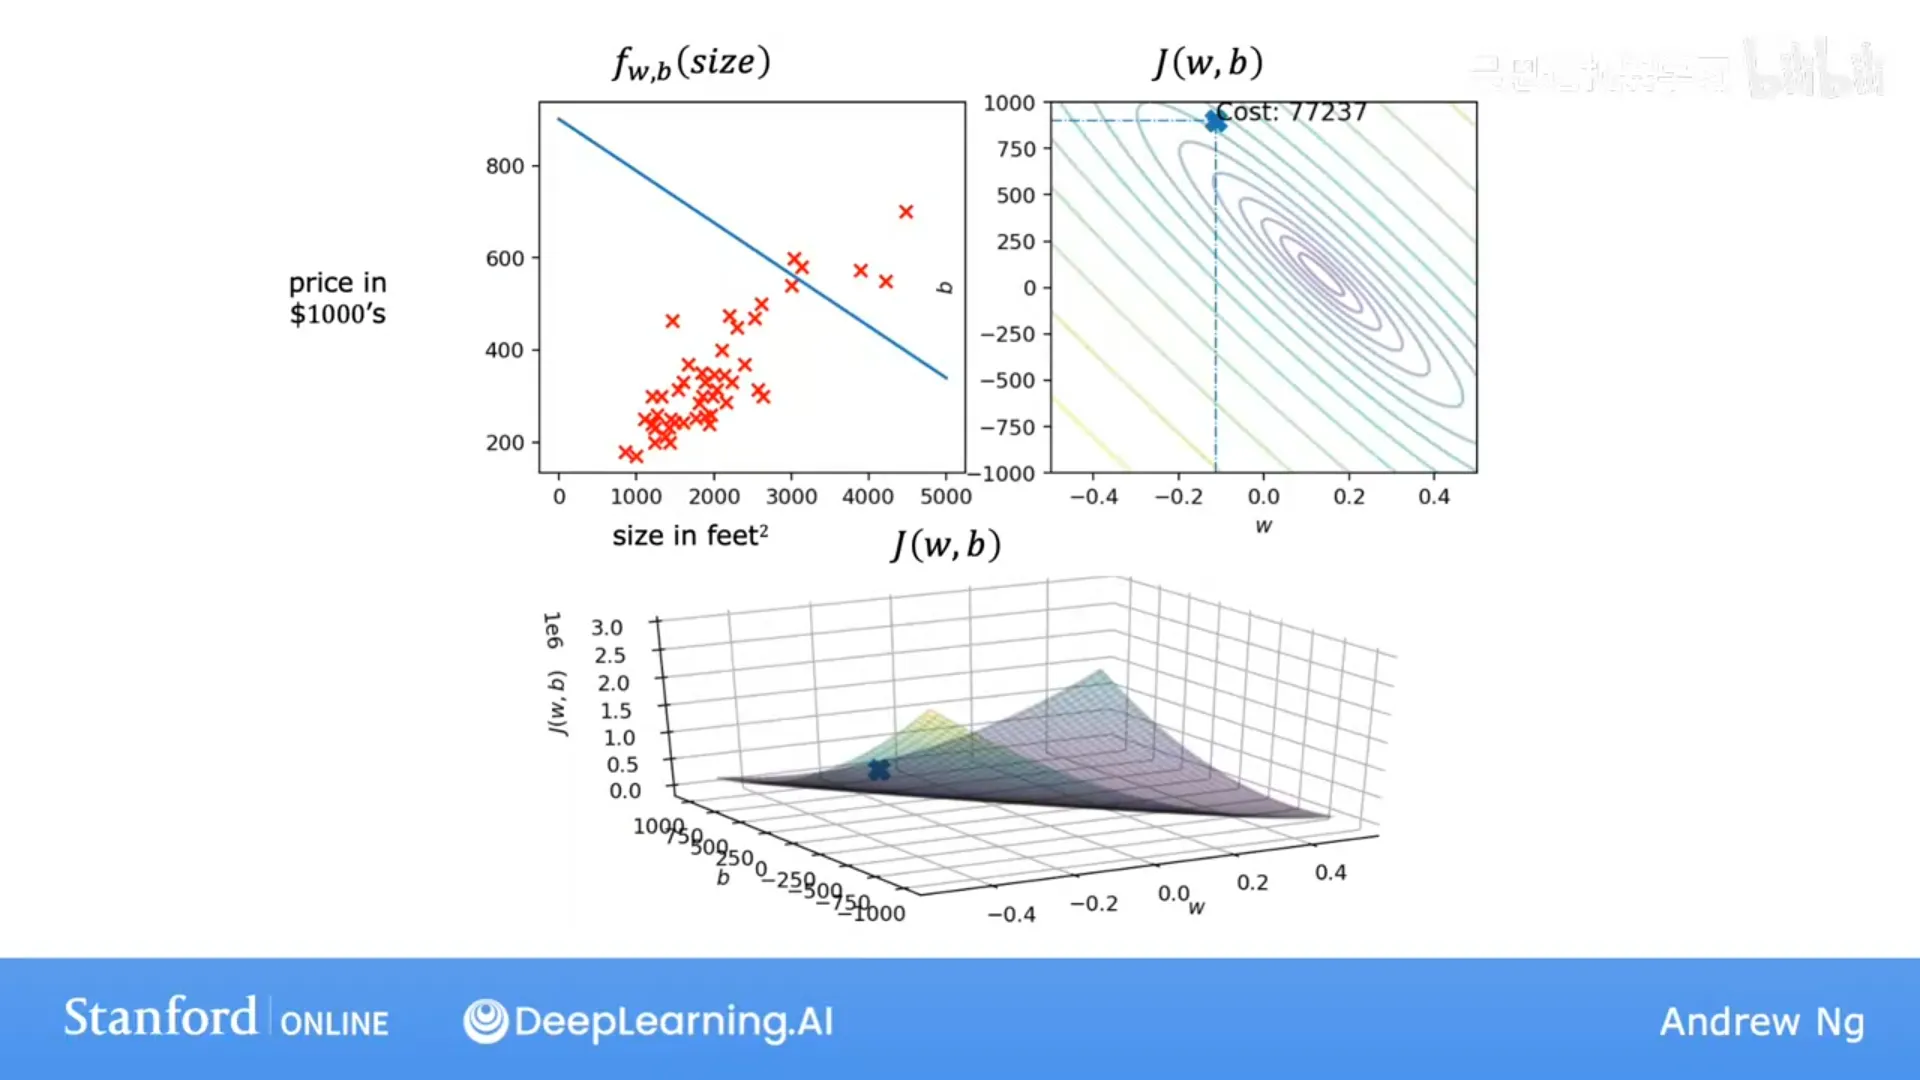
📷 梯度下降的运行轨迹:每次更新代价下降,拟合直线越来越好
回到原视频 (00:00:08)
这个过程叫批量梯度下降(batch gradient descent):"批量"指的是每一步都用到全部训练样本(在算导数时对 i = 1..m 求和),而不是只用其中一个子集。名字不算直观,但这就是机器学习界的叫法。
至此,你已经完成了第一个机器学习模型——单变量线性回归。
第五章 多元线性回归与向量化
(对应模块 5,视频 p21–p24)
5.1 从单特征到多特征
(p21)
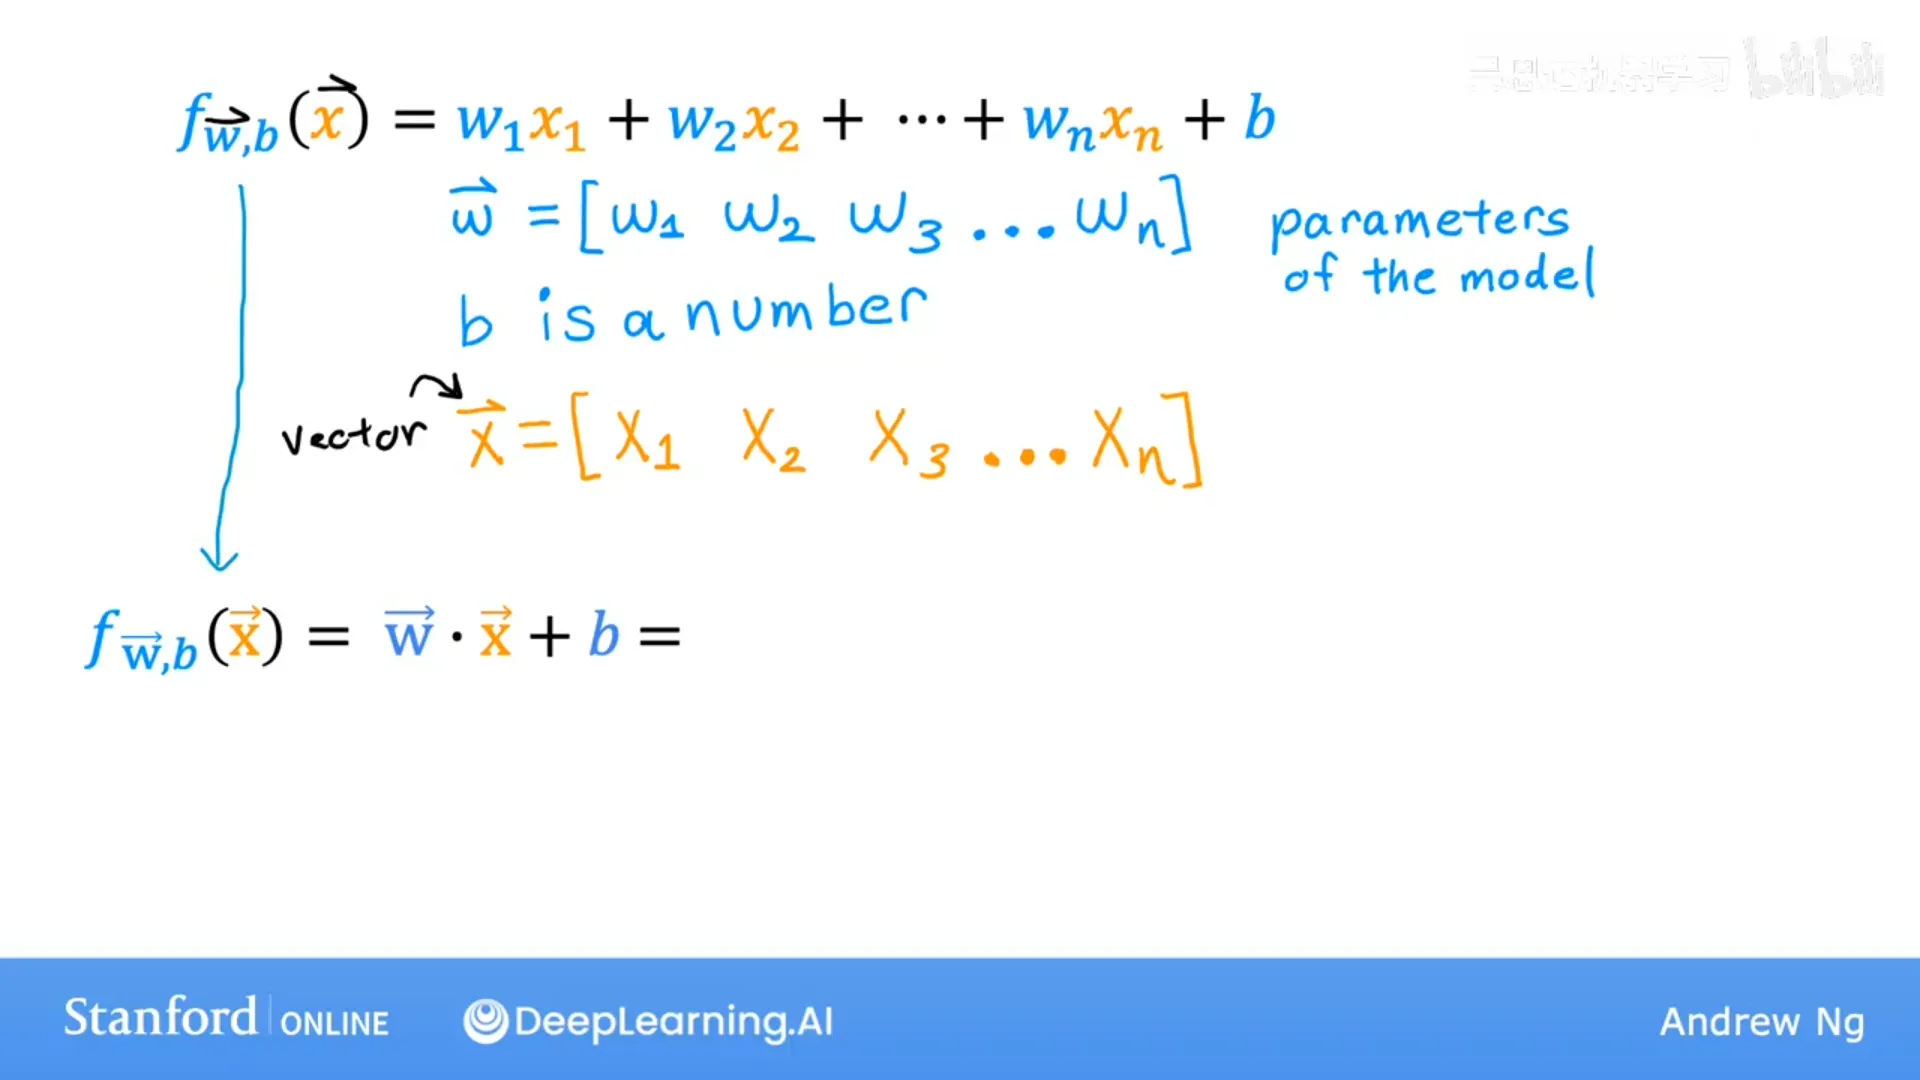
原版线性回归只有一个特征(房子面积)。但若同时知道卧室数量、楼层数、房龄,显然能得到更好的预测。
引入新符号:用 x₁, x₂, …, xₙ 表示 n 个特征,n 是特征总数(此例 n = 4)。第 i 个训练样本记为 x⁽ⁱ⁾,它是一个包含 n 个数字的向量(也叫行向量);其中第 j 个特征记为 x⁽ⁱ⁾_j(例如 x⁽²⁾₃ 表示第 2 个样本的第 3 个特征,即楼层数 = 2)。
模型则从 wx + b 扩展为:
$$f_{w,b}(x) = w_1 x_1 + w_2 x_2 + w_3 x_3 + w_4 x_4 + b$$
以一个房价模型为例:0.1·x₁ + 4·x₂ + 10·x₃ − 2·x₄ + 80(价格单位千美元)。可以这样解读参数:b = 80 是"没有面积、没有卧室/楼层/房龄"时的基础价 8 万美元;w₁ = 0.1 表示每多 1 平方英尺加 $100;每多一个浴室加 $4,000;每多一层加 $10,000;房龄每多一年减 $2,000。
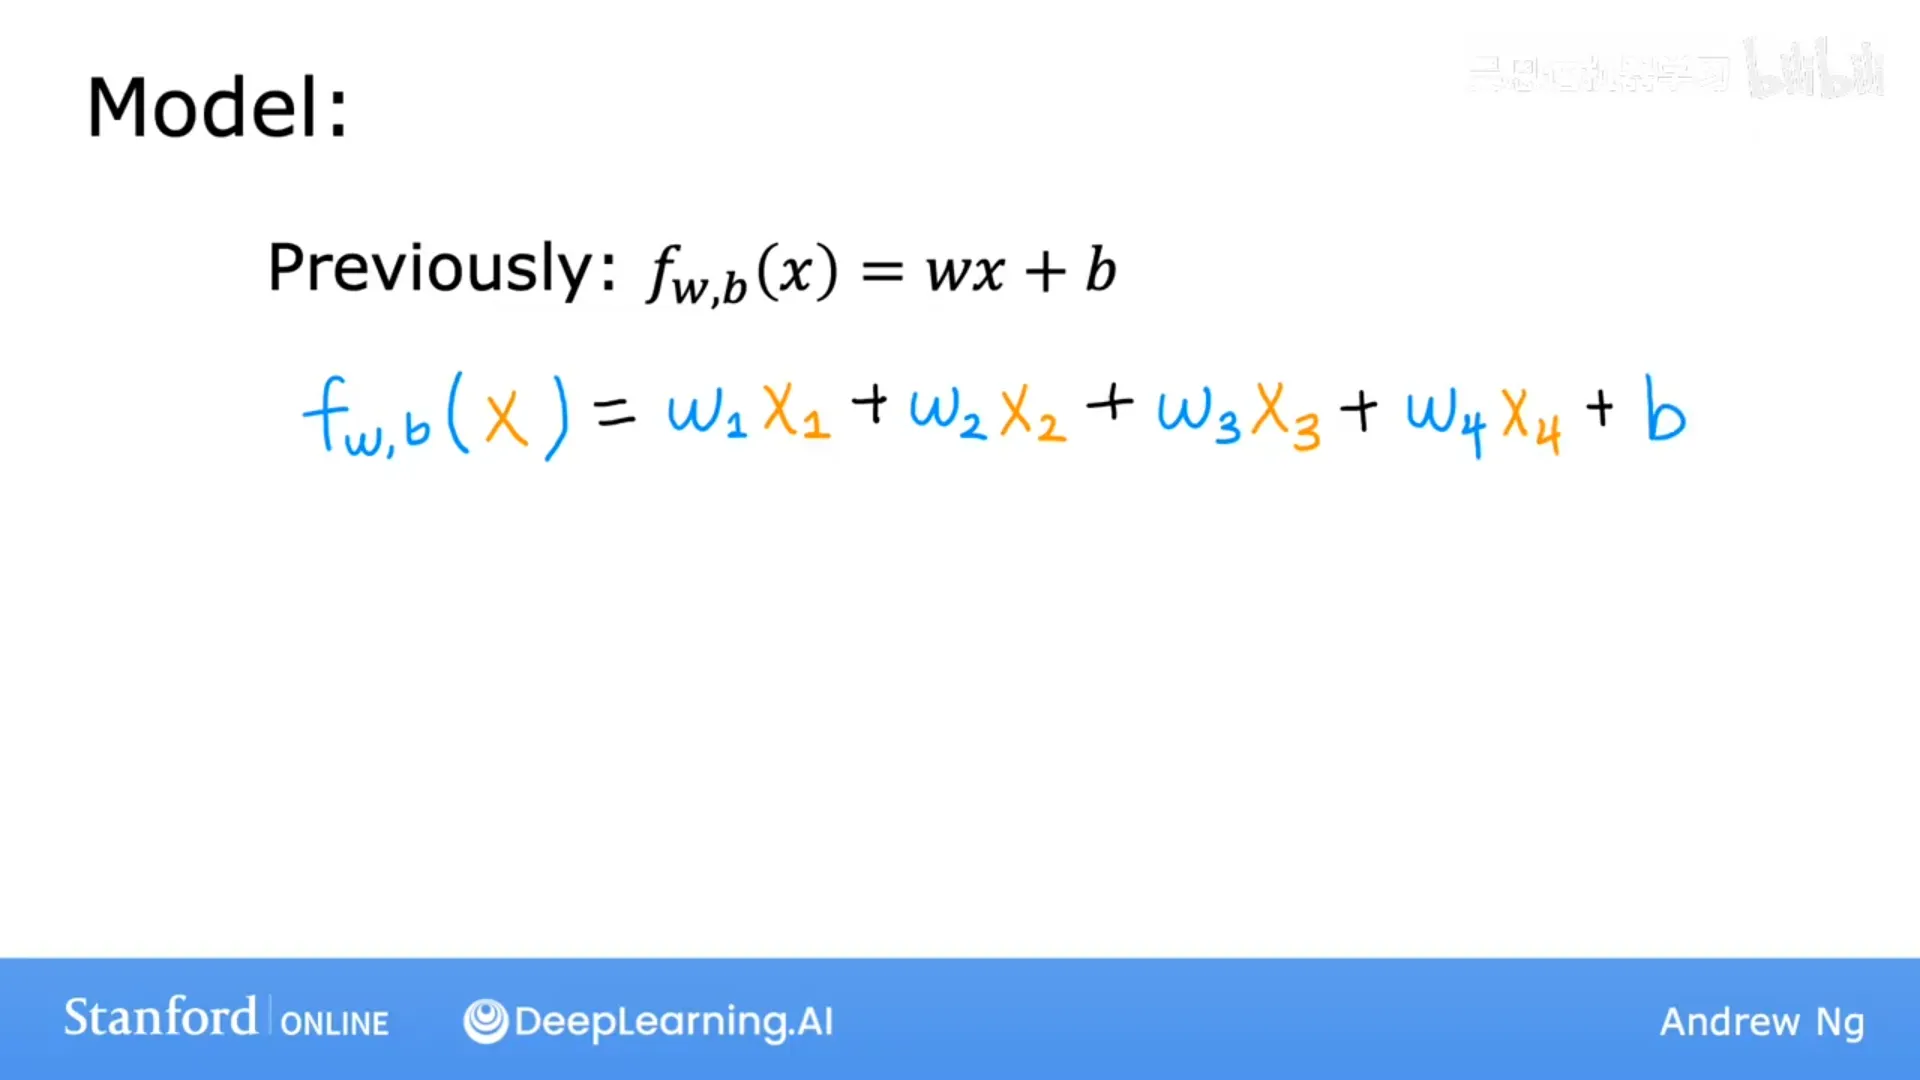
📷 多元线性回归:用多个特征预测房价
回到原视频 (00:04:02)
用向量写得更简洁
把所有 w 收进一个向量 w = [w₁, w₂, …, wₙ],把 x 也写成向量,则模型就是:
$$f_{w,b}(x) = w \cdot x + b \qquad \big(w \cdot x = w_1 x_1 + w_2 x_2 + \cdots + w_n x_n\big)$$
这种"多个输入特征"的线性回归称为多元线性回归(multiple linear regression),以区别于单变量回归。(注意别叫它"多变量回归",那个词在别处另有所指。)
📷 用向量点积简洁地写出多元线性回归模型
回到原视频 (00:07:42)
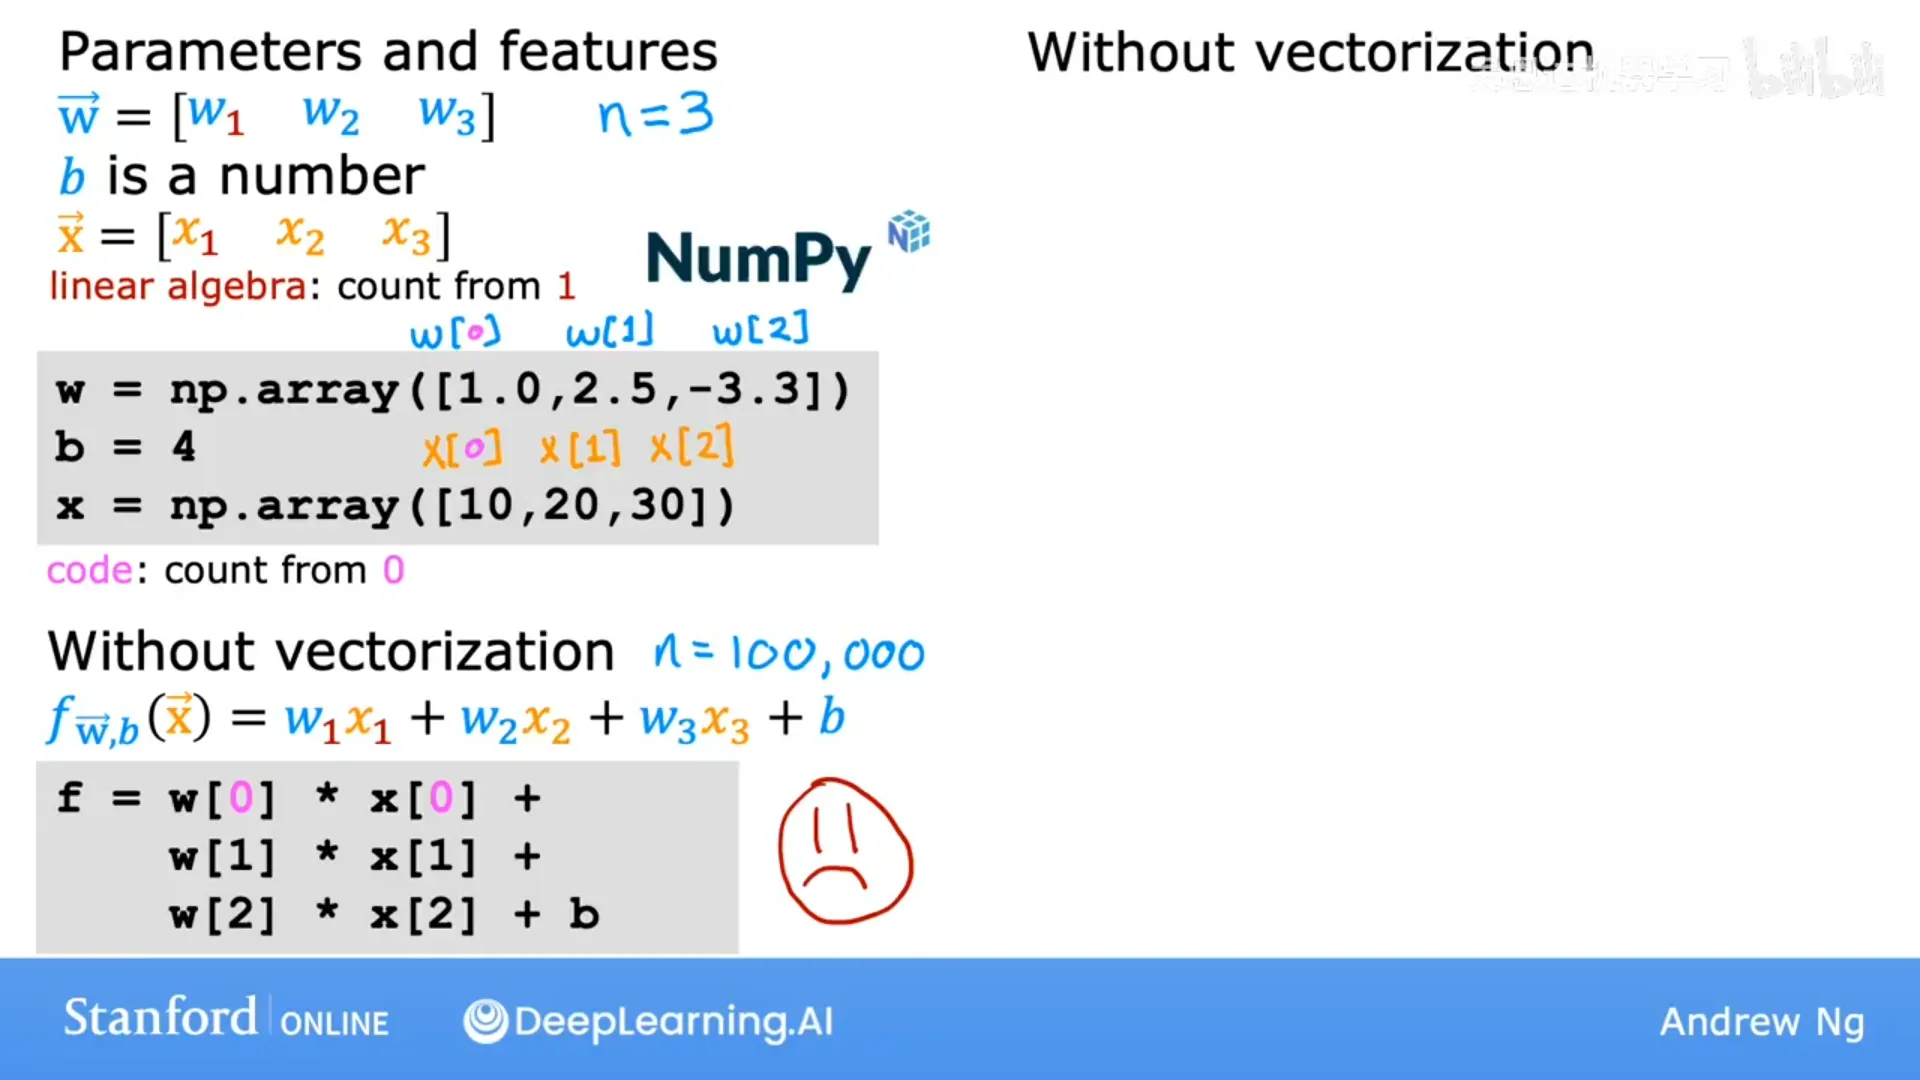
5.2 向量化:让代码更短、更快
(p22)
向量化(vectorization)在实现学习算法时既让代码更简洁,也让运行更高效,还能让你用上现代数值线性代数库甚至 GPU。
设 n = 3,w = [w₁,w₂,w₃]、x = [x₁,x₂,x₃]。三种写法对比:
# 1) 逐项硬写(n 大时不可用)
f = w[0]*x[0] + w[1]*x[1] + w[2]*x[2] + b

# 2) for 循环(比 1 好,但仍未向量化)
f = 0
for j in range(n):
    f += w[j] * x[j]
f += b

# 3) 向量化(一行)
f = np.dot(w, x) + b
(注意 Python/NumPy 索引从 0 开始,而数学记号从 1 开始。)向量化有两个好处:代码更简洁;运行快得多——因为 np.dot 在底层能利用并行硬件(CPU 或 GPU),而不是一个接一个地做加乘。
📷 向量化:np.dot 一行代替 for 循环
回到原视频 (00:02:45)
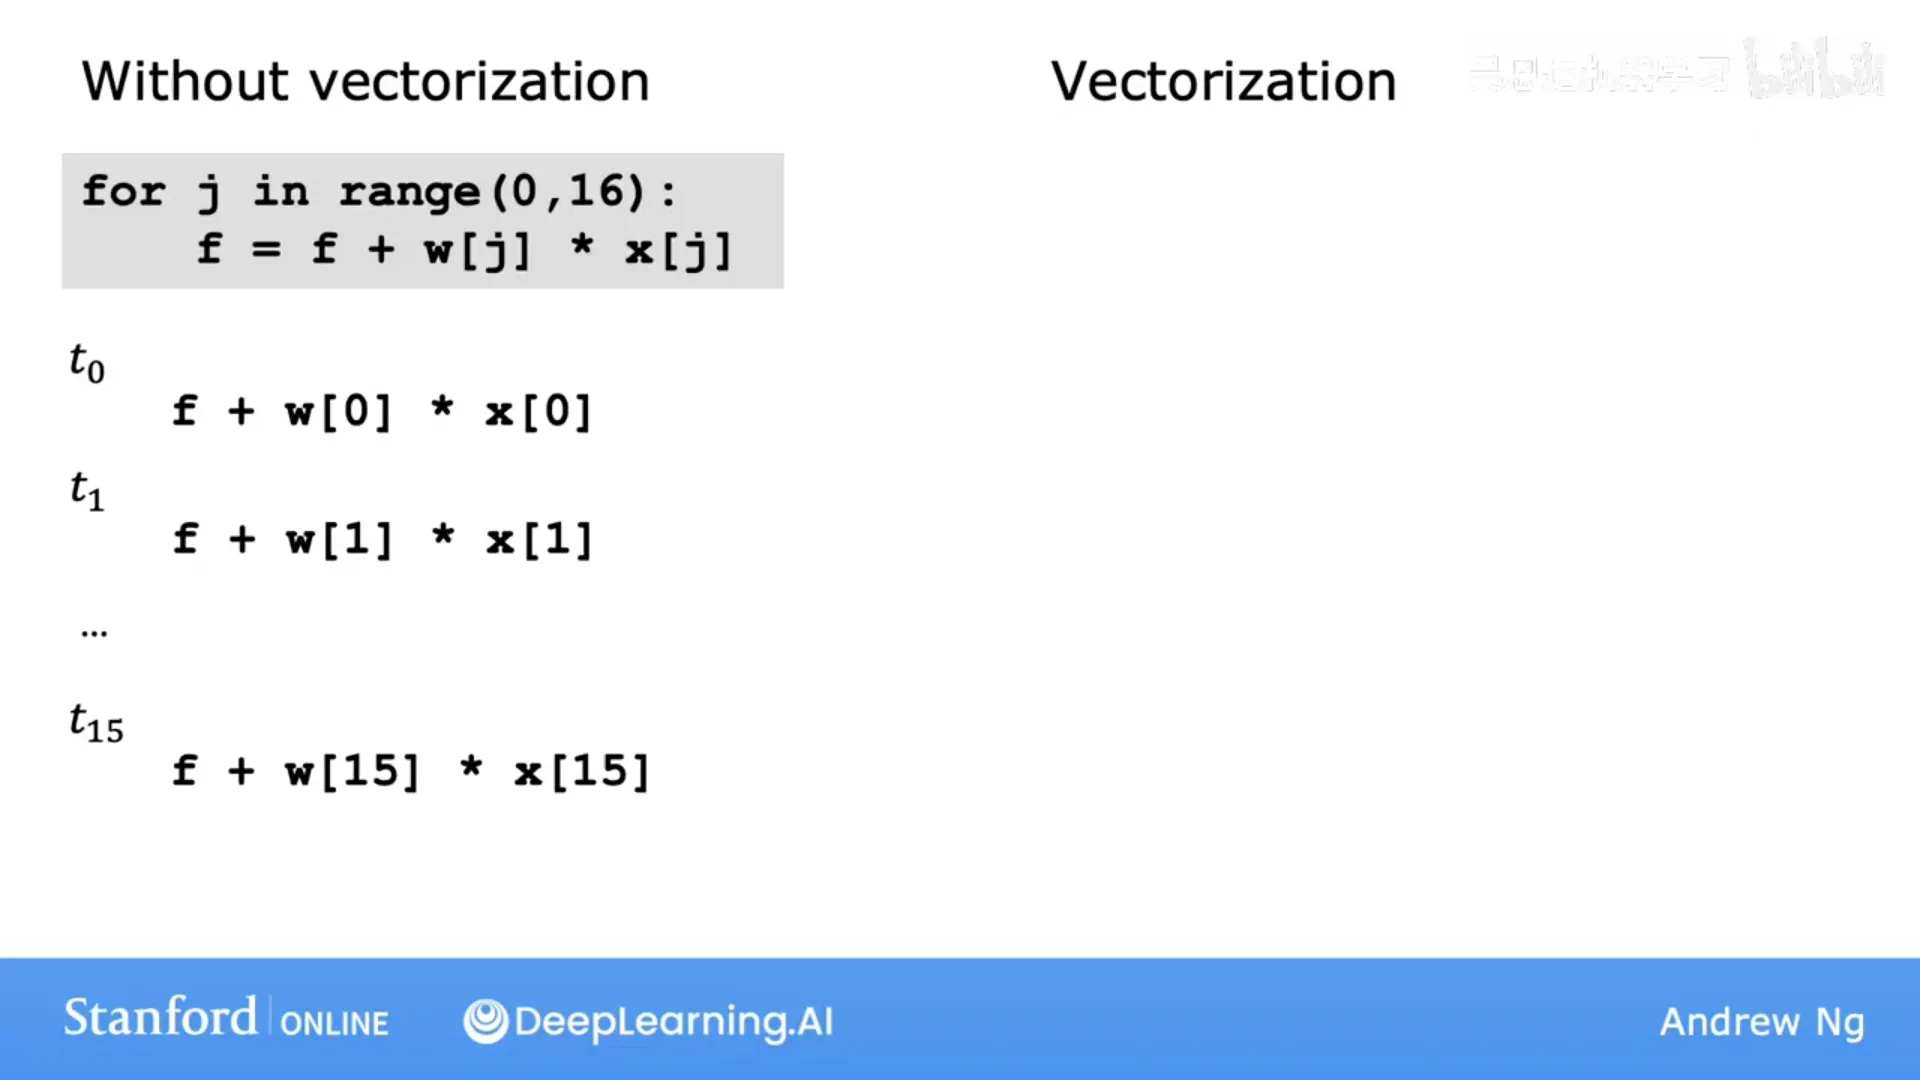
5.3 向量化为什么快
(p23)
看一个 for j in range(15) 的循环:它一个时间步算一个——t0 算索引 0,下一步算索引 1……串行执行。
而 NumPy 的向量化函数依靠硬件并行:计算机可以一步取出 w 与 x 的全部值,并行地把每对相乘,再用专用硬件把这 16 个数快速求和,而不是一个接一个地加起来。所以向量化代码在更短时间内完成同样的计算。
当数据很大、模型很大(机器学习里很常见)时,这个区别可能是"一两分钟"对"很多很多小时"。
📷 for 循环逐步串行 vs 向量化一步并行
回到原视频 (00:01:20)
同样的技巧也用在参数更新上:若要把 w₁…w₁₆ 都按 w_j := w_j − 0.1·d_j 更新,向量化写法就是一行 w = w − 0.1 * d,底层并行完成 16 次计算。
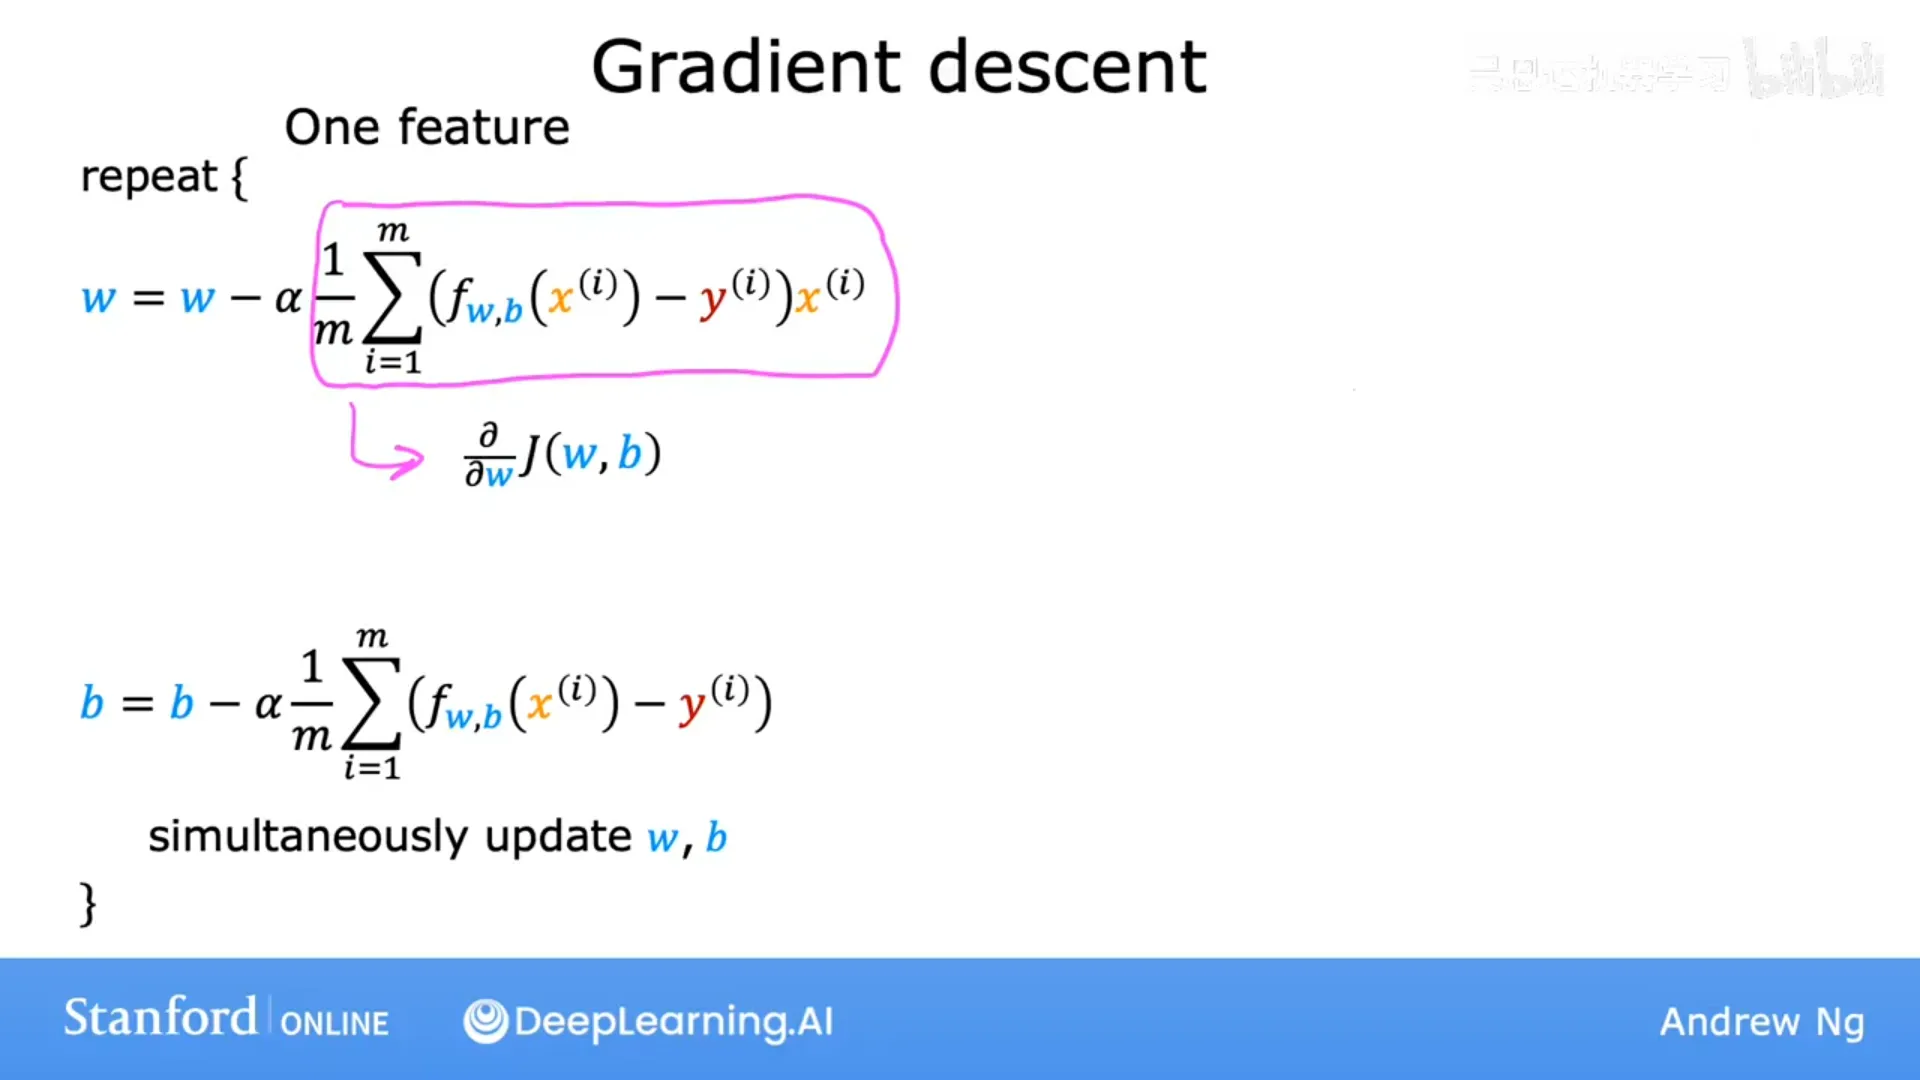
5.4 多元线性回归的梯度下降
(p24)
把 w₁…wₙ 收进向量 w 后,模型为 f_w,b(x) = w·x + b,代价函数为 J(w, b)。梯度下降对每个 w_j 更新:
$$\begin{aligned}
w_j &:= w_j - \alpha\,\frac{\partial J}{\partial w_j} \qquad (j = 1,\dots,n) \ b &:= b - \alpha\,\frac{\partial J}{\partial b}
\end{aligned}$$
其中(与单特征情形形式相同,只是把标量换成了向量分量):
$$\begin{aligned}
\frac{\partial J}{\partial w_j} &= \frac{1}{m}\sum_{i=1}^{m}\big(f(x^{(i)}) - y^{(i)}\big)\, x^{(i)}j \ \frac{\partial J}{\partial b} &= \frac{1}{m}\sum{i=1}^{m}\big(f(x^{(i)}) - y^{(i)}\big)
\end{aligned}$$
📷 多元线性回归的梯度下降更新规则
回到原视频 (00:02:53)
旁注:正规方程(normal equation) 线性回归还有另一种解法——正规方程:用高级线性代数库一次性解出 w 和 b,不需要迭代。它的缺点是可不推广到逻辑回归、神经网络等其他算法,且当特征数 n 很大时很慢。几乎没有从业者会自己实现它;但如果你调用成熟的库做线性回归,底层可能就是在用正规方程。对本课而言,梯度下降通常是更好的选择。
第六章 让梯度下降更有效
(对应模块 6,视频 p25–p30)
6.1 特征缩放:让取值范围可比
易错点 M8:不缩放通常不改变模型的表达能力,但会影响优化——量纲差异大时,等高线被拉成狭长的「峡谷」,梯度下降 zig-zag、收敛慢、对 $\alpha$ 更敏感。缩放改善的是 conditioning(条件数),不是模型本身。
易错点 M9:预处理($\mu,\sigma$)只在训练集上 fit,然后用同一组训练统计量 transform 验证集 / 测试集 / 线上新数据。让测试集自己重算 $\mu,\sigma$ 数值上也许看着「更准」,但会破坏特征坐标系的一致性,并造成 data leakage。
(p25)
先看特征大小与参数大小的关系。用两个特征预测房价:x₁ = 面积(300–2000 平方英尺),x₂ = 卧室数(0–5)。对一套 2000 平方英尺、5 卧室、售价 50 万美元的房子:
- 若取 w₁ = 50、w₂ = 0.1、b = 50:预测 ≈ 1 亿多美元,离谱;
- 若取 w₁ = 0.1、w₂ = 50、b = 50:预测 = 200k + 250k + 50k = 50 万美元,正好。
规律是:特征取值范围大 → 合理的参数值小;取值范围小 → 合理的参数值大。
再看散点图:x₁ 的尺度远大于 x₂。这会让代价函数的等高线变成又高又瘦的椭圆(横轴范围窄、纵轴范围大)。若直接在这个数据上跑梯度下降,它会来回反弹很久才到达全局最小值。
特征缩放就是把各特征变换到相近的范围(例如都落在 0–1 附近)。缩放后等高线更接近圆形,梯度下降能走一条更直接的路径到全局最小值,快得多。
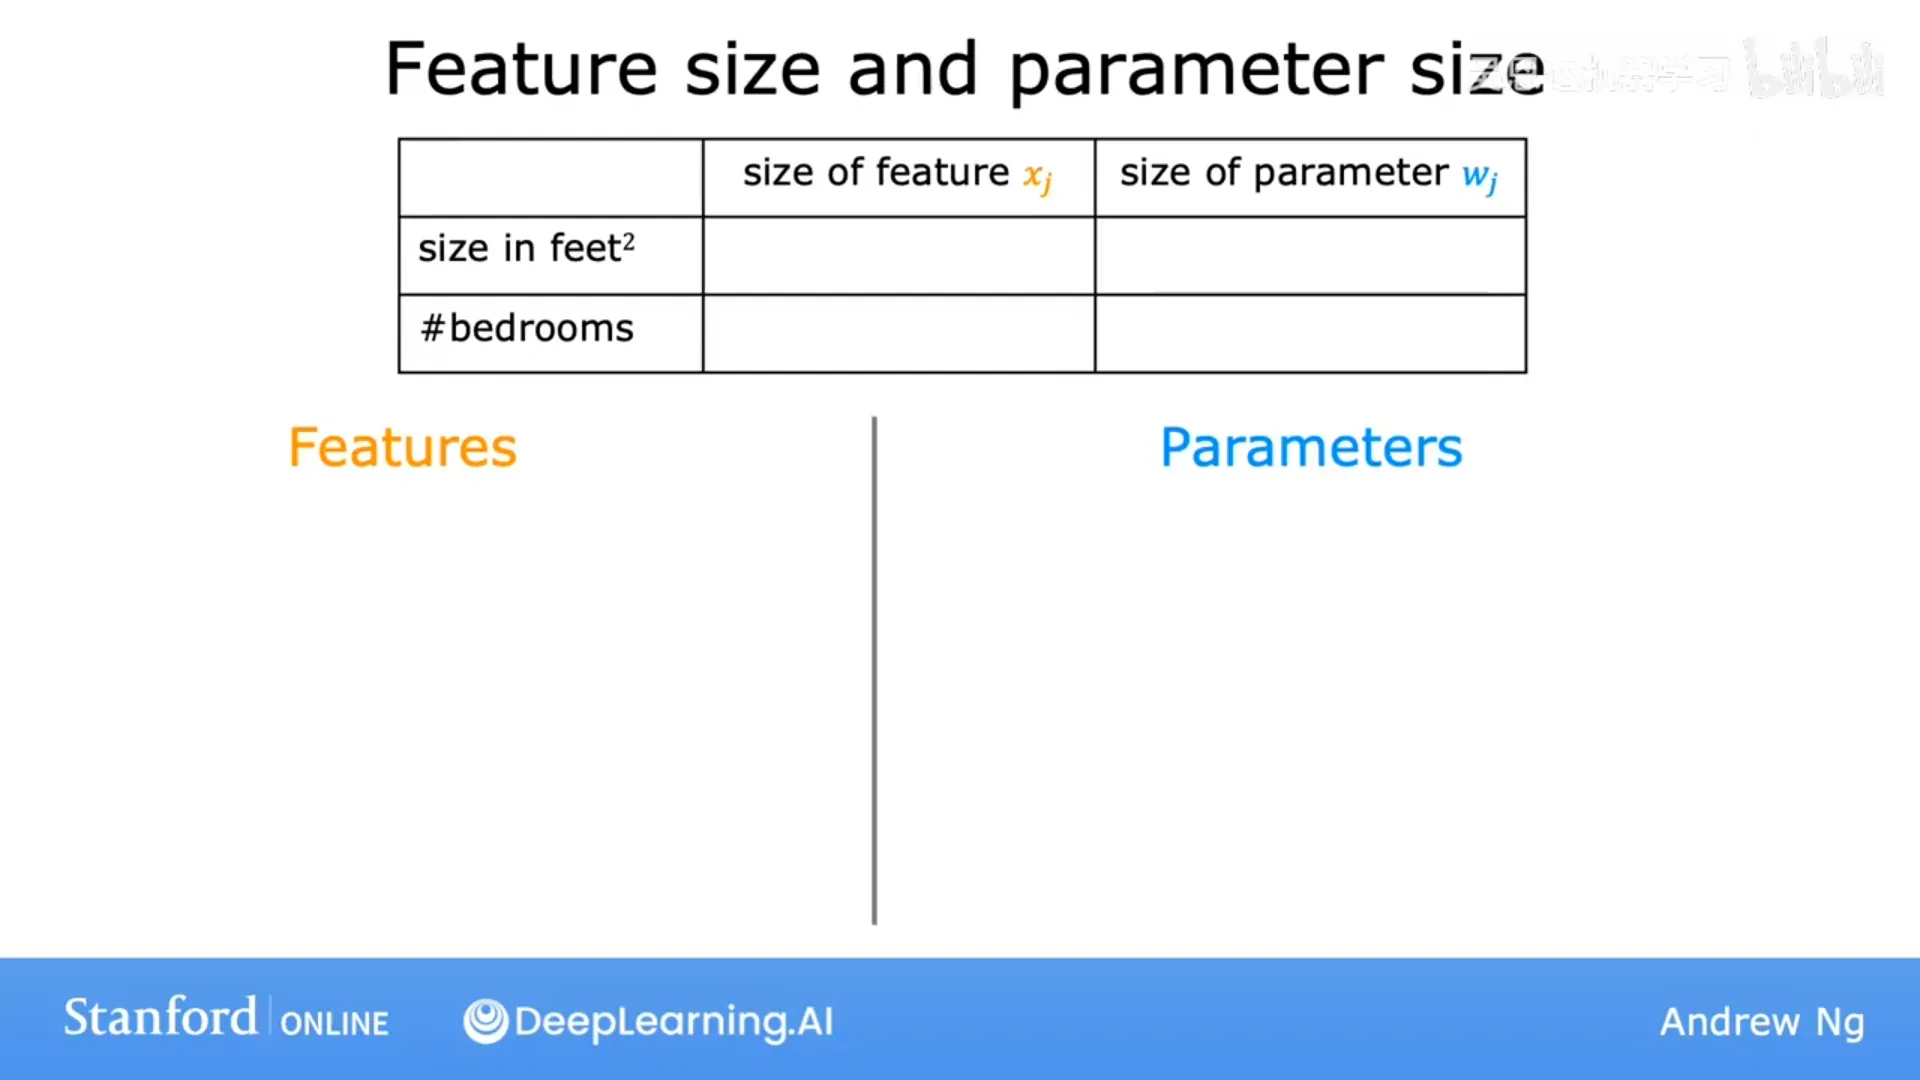
📷 特征范围差异导致瘦长的等高线,梯度下降来回震荡
回到原视频 (00:03:30)
6.2 三种常见的缩放方法
(p26)
- 除以最大值:如 x₁ 除以 2000 → 落在 0.15–1;x₂ 除以 5 → 落在 0–1。
- 均值归一化:
x := (x − μ) / (最大值 − 最小值),使数据以 0 为中心(如 x₁ → −0.18~0.82,x₂ → −0.46~0.54)。 - Z 分数归一化(z-score):
x := (x − μ) / σ,μ 是均值、σ 是标准差(例如 x₁ → −0.67~3.1,x₂ → −1.6~1.9)。
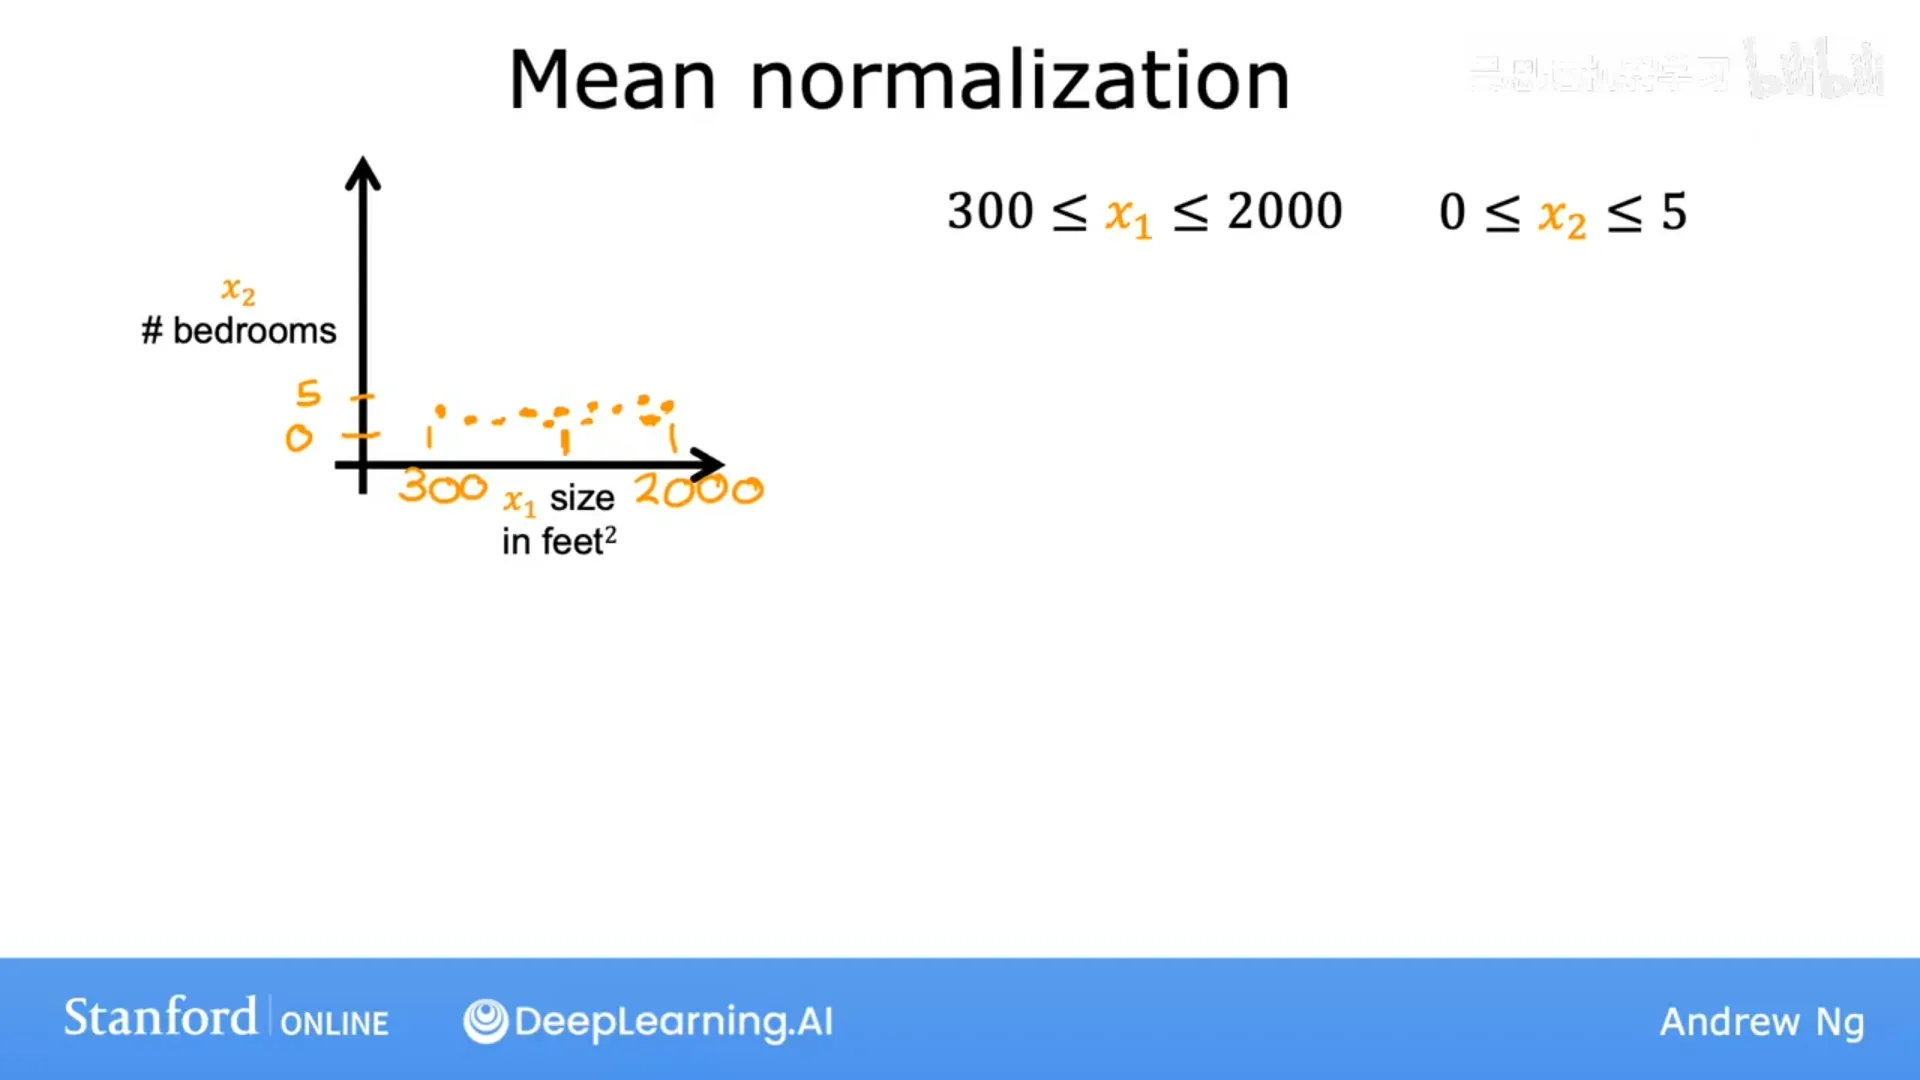
📷 均值归一化:先减均值,再除以范围
回到原视频 (00:01:01)
经验法则:让每个特征大致落在 −1 到 +1 附近即可,不必严格。范围在 −3~3 或 −0.3~0.3 都可以接受;但若是 −100~100,或 −0.001~0.001,或像"体温 98.6~105"这种整体偏大的量,就该缩放。做特征缩放几乎没有坏处——拿不准就做。
6.3 判断梯度下降是否收敛
(p27)
实用做法:画学习曲线——横轴是迭代次数,纵轴是每次迭代后在训练集上算出的代价 J。
- 正常:J 每次迭代都应下降;若 J 在某次迭代后上升,通常意味着 α 太大或代码有 bug;
- 收敛:J 趋于平缓(例如此例约 300 次迭代后变平、400 次基本收敛)即判定收敛。不同问题的收敛所需迭代次数差异巨大(可能 30 次,也可能十万次),所以很难预先知道,要靠观察曲线。
也有自动收敛测试:若某次迭代 J 的下降量小于阈值 ε(如 0.001)就宣布收敛。但选 ε 很困难,吴恩达更倾向直接看图。
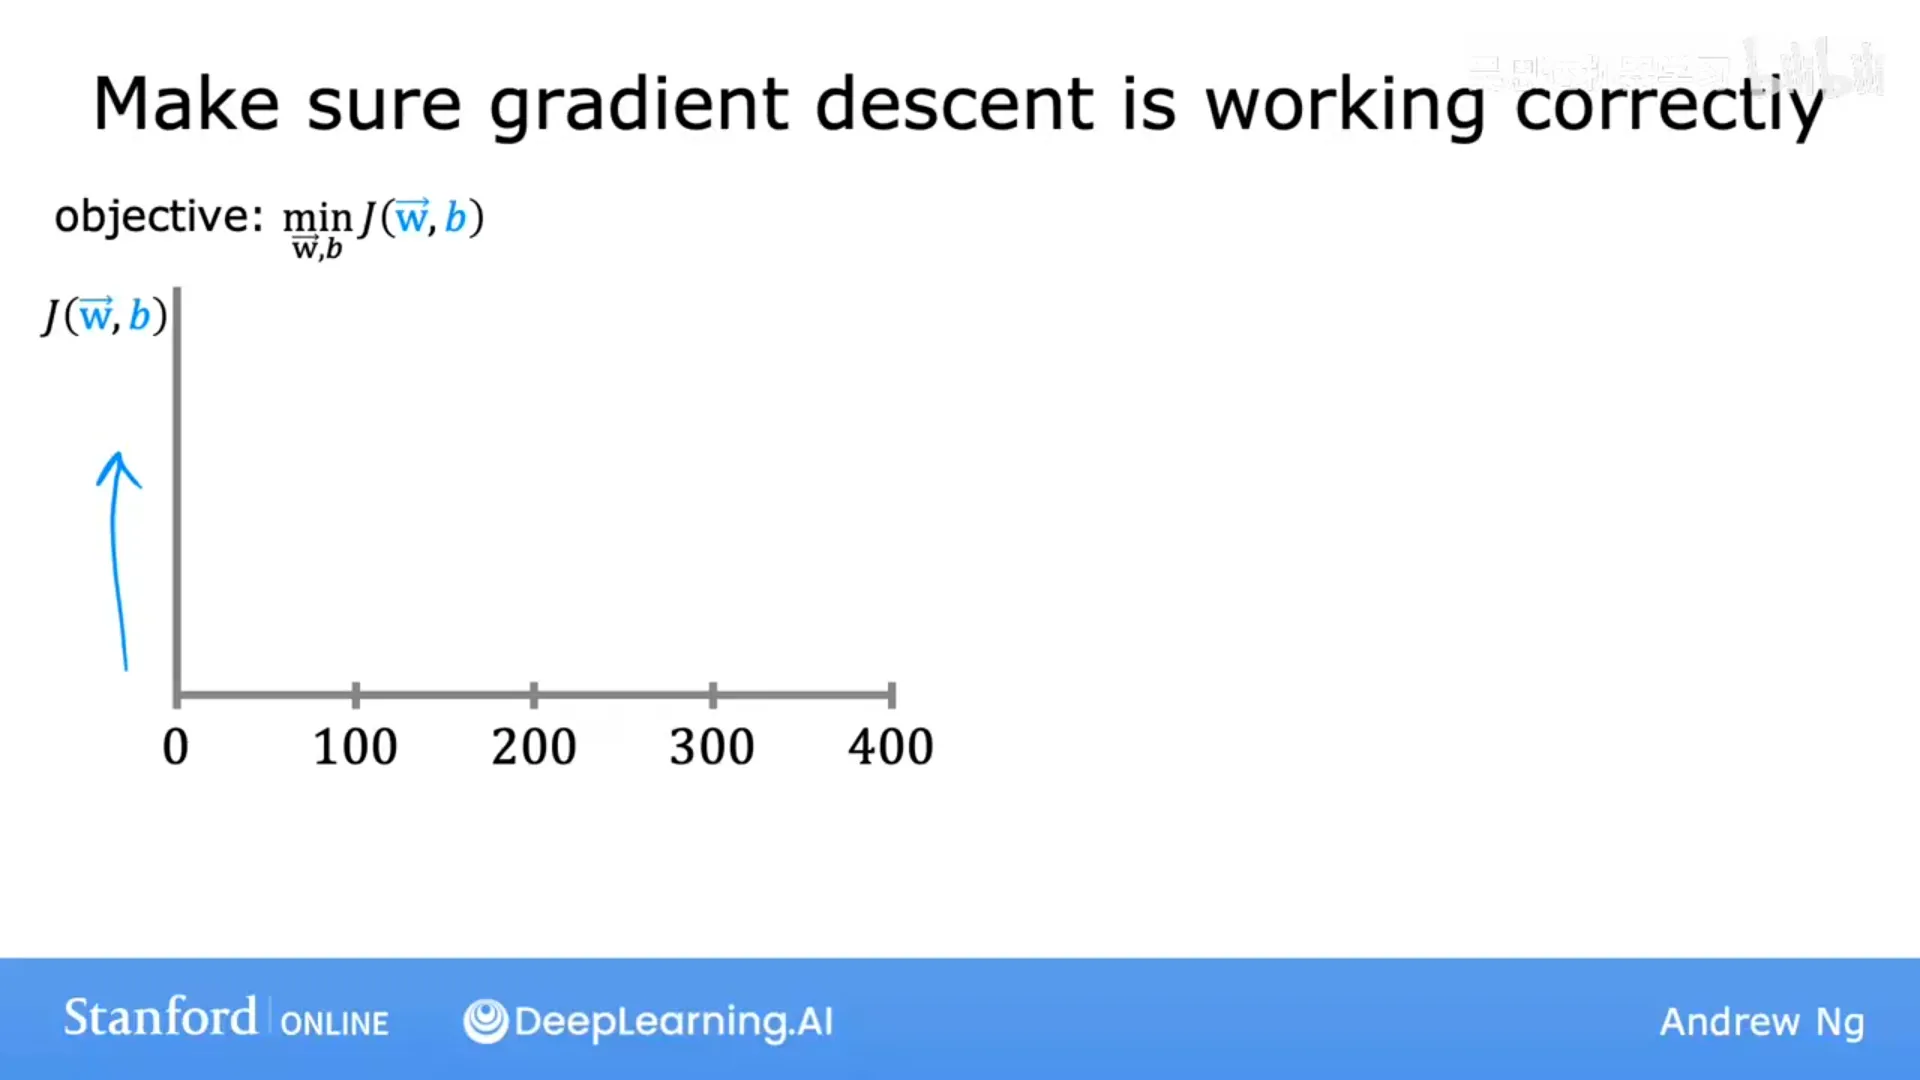
📷 学习曲线:横轴迭代次数、纵轴代价 J
回到原视频 (00:01:07)
6.4 选择学习率 α
(p28)
- α 太小:收敛极慢(能工作,但要很多步);
- α 太大:可能越过最小值、震荡,甚至每步都在上升、发散。
- 若代价有时上升有时下降或持续上升,这是"梯度下降没在正常工作"的明确信号——可能是 α 太大,也可能是代码写错(例如把
w := w − α·导数写成了w := w + α·导数)。
调试技巧:把 α 设成非常小,看 J 是否每次迭代都下降。如果连很小的 α 都不能让 J 稳定下降,那多半是代码有 bug。
实用策略:试一系列 α(如 0.001 → 0.003 → 0.01 → 0.03 → 0.1,每次约 3 倍),画出各自的 J-迭代曲线;先找到一个太小、再找到一个太大,然后取略小于最大合理值的那个。
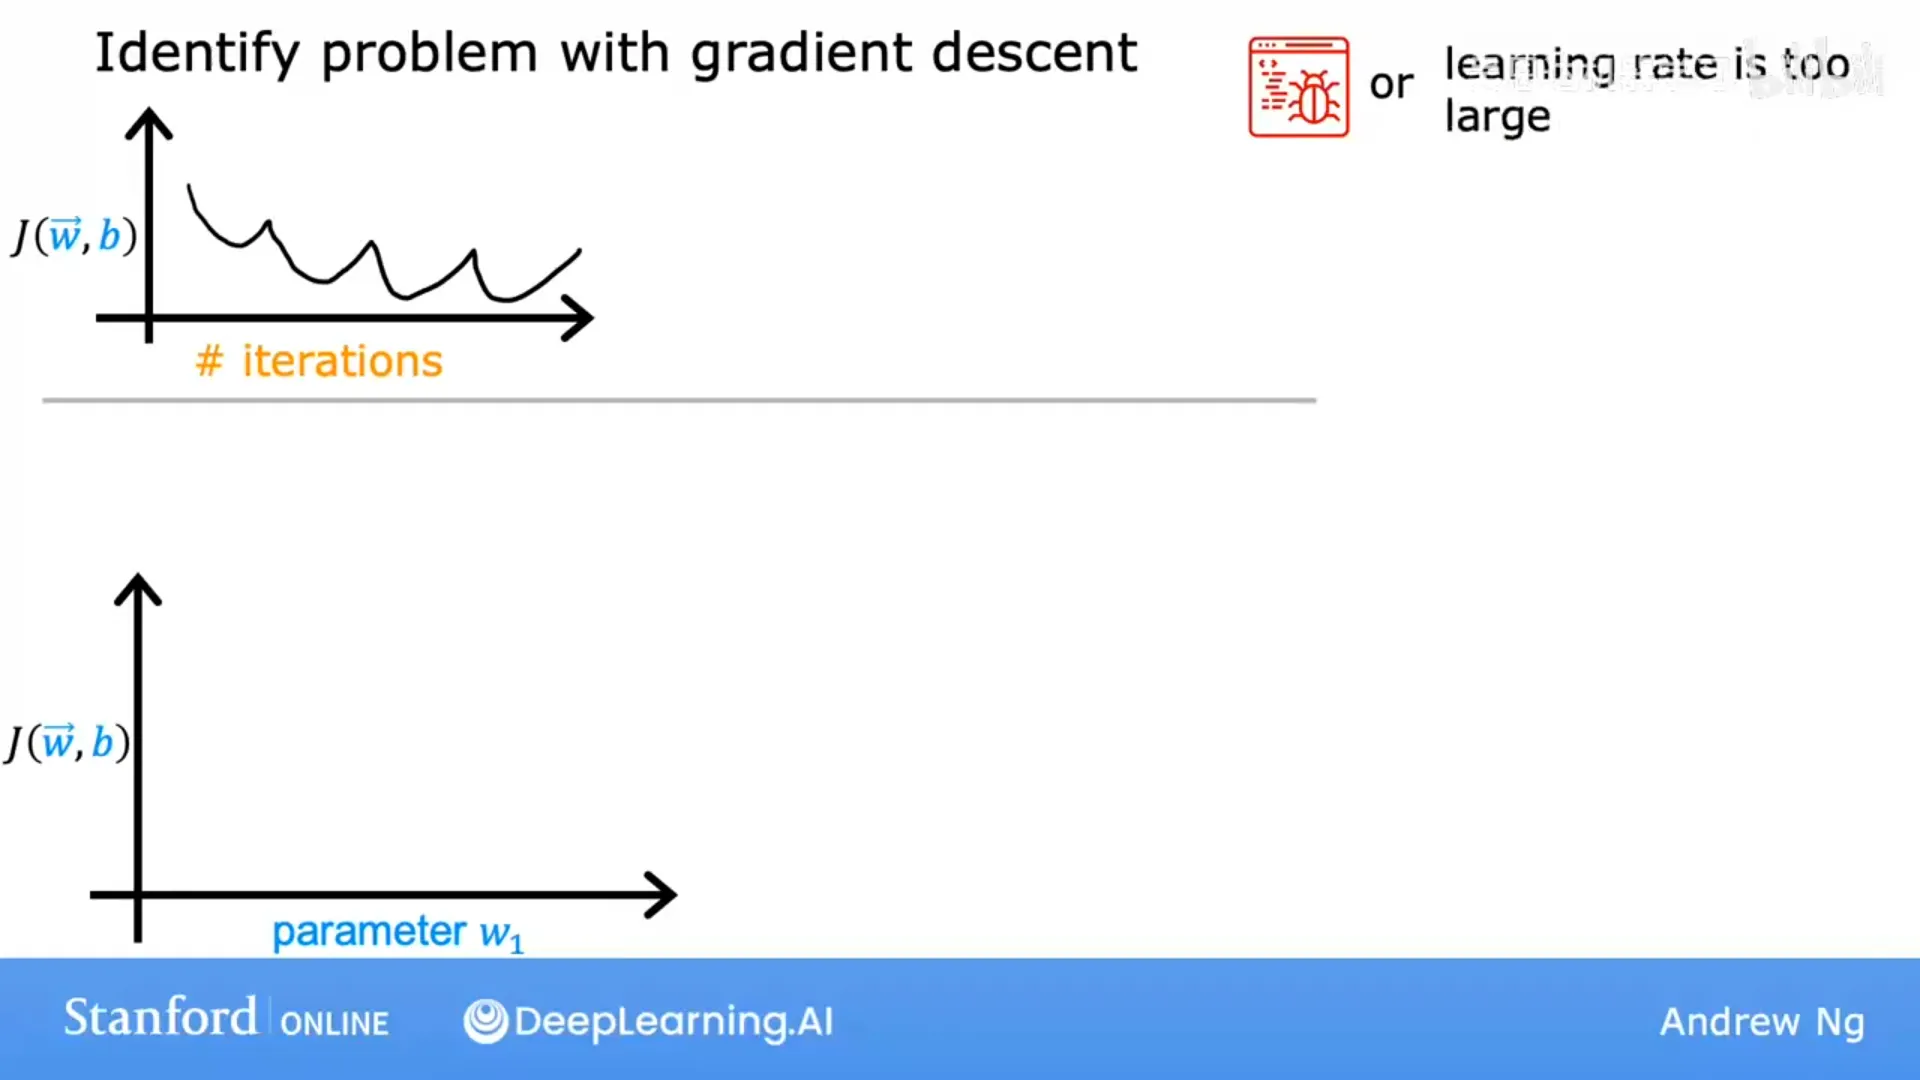
📷 α 太大导致代价上升/震荡
回到原视频 (00:00:38)
6.5 特征工程
(p29)
特征选择/设计对算法性能影响巨大,在很多实际应用里,选对特征是让算法跑好的关键。
例子:预测房价,只有两个特征——地块临街宽度 x₁、地块深度 x₂。你可能会意识到土地面积 = 宽度 × 深度更能预测价格,于是定义新特征 x₃ = x₁ × x₂。这时模型 w₁x₁ + w₂x₂ + w₃x₃ + b 可以让数据自己决定究竟"宽度、深度、还是面积"最重要。
这种"用对问题的理解/直觉,通过变换或组合原始特征来设计新特征、让算法更容易做准确预测"的做法,就叫特征工程(feature engineering)。
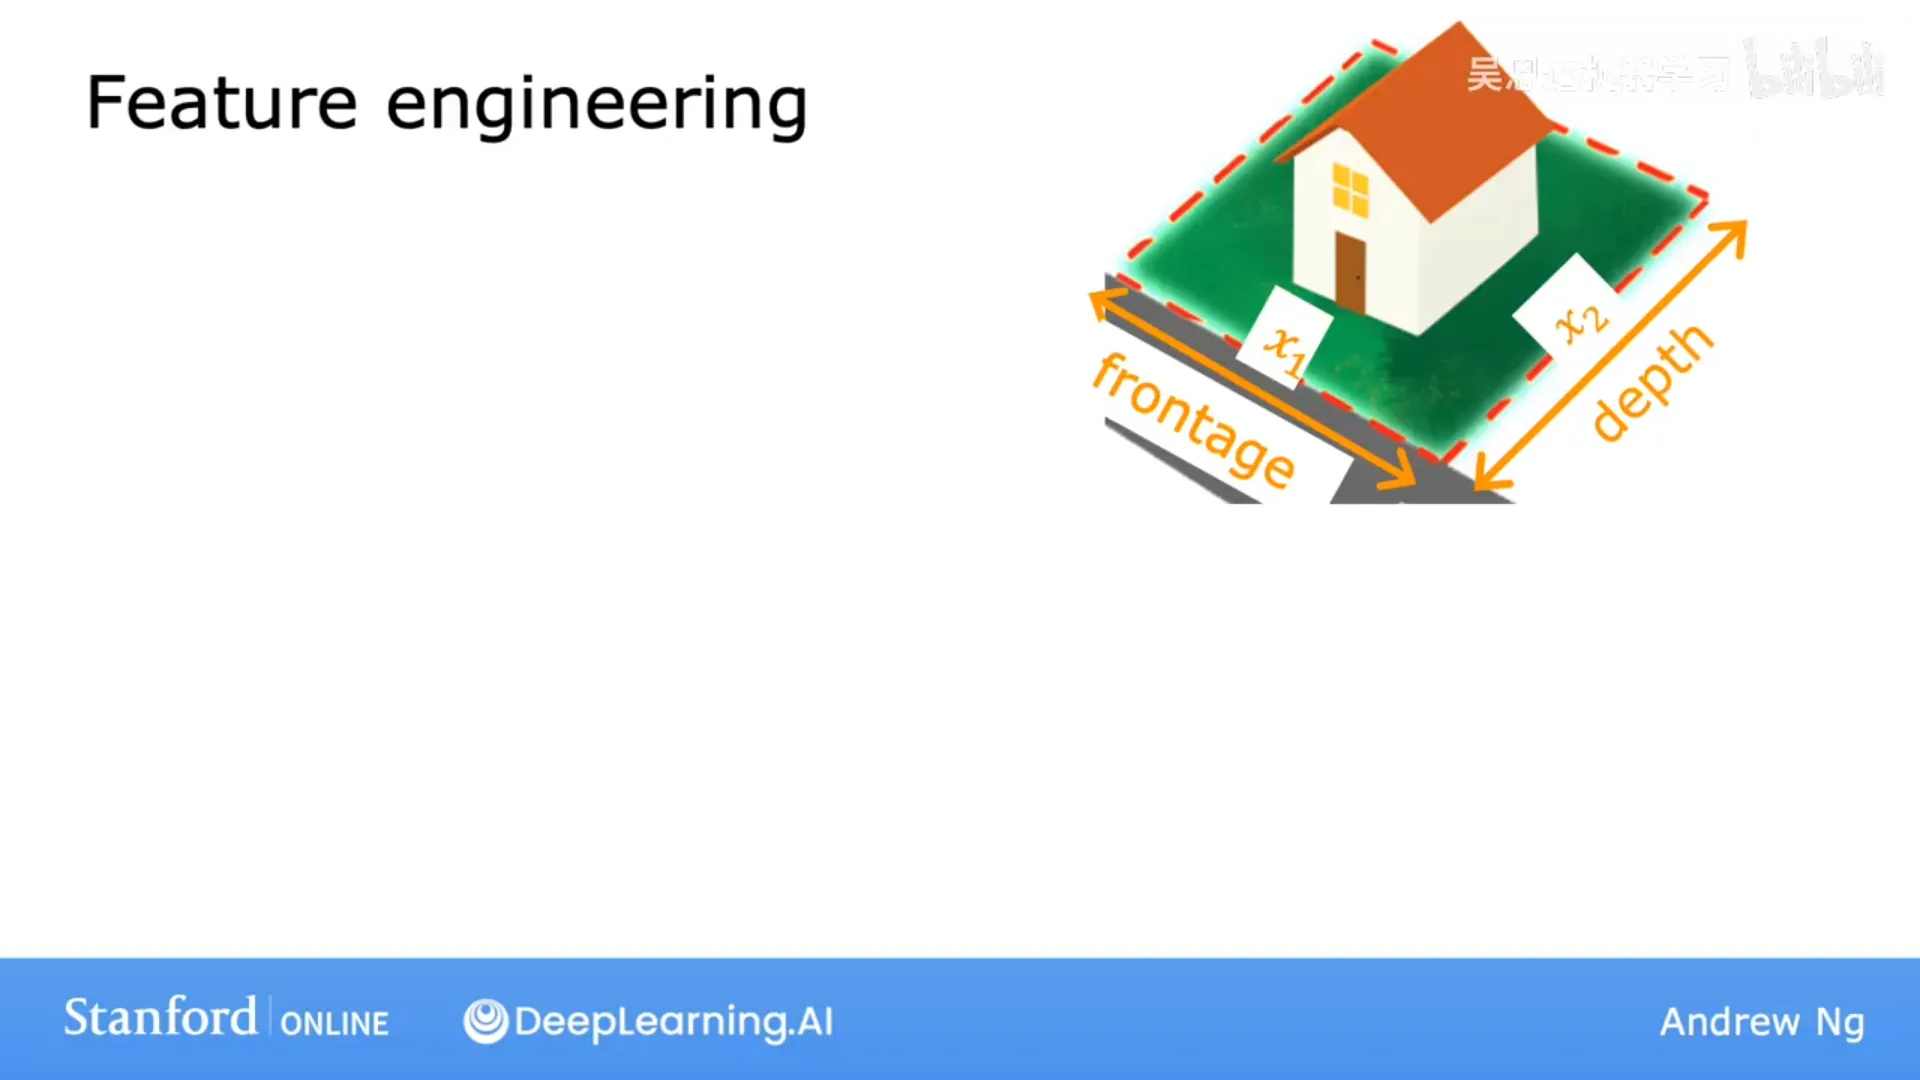
📷 特征工程:用"宽度×深度"造出更有预测力的"面积"特征
回到原视频 (00:00:56)
6.6 多项式回归:拟合曲线
(p30)
把多元线性回归与特征工程结合,就能拟合曲线——多项式回归(polynomial regression)。
对"面积 vs 房价"的数据,直线拟合并不好。可以尝试:
- 二次函数:特征取 x 和 x² ——但二次曲线最终会下弯,不符合"房子越大越贵"的直觉;
- 三次函数:特征取 x、x²、x³ ——曲线最终会回升,拟合更好;
- 也可用 平方根:
w₁x + w₂√x + b——它随 x 增长而变缓,但永不下降。
重要提醒:一旦构造出高次幂特征,特征缩放变得更重要——若面积 1–1000,则 x² 是 1–10⁶、x³ 是 1–10⁹,取值范围天差地别,必须缩放。
至于"到底该选哪些特征/哪种模型",第二门课会给出系统的方法与评估流程。
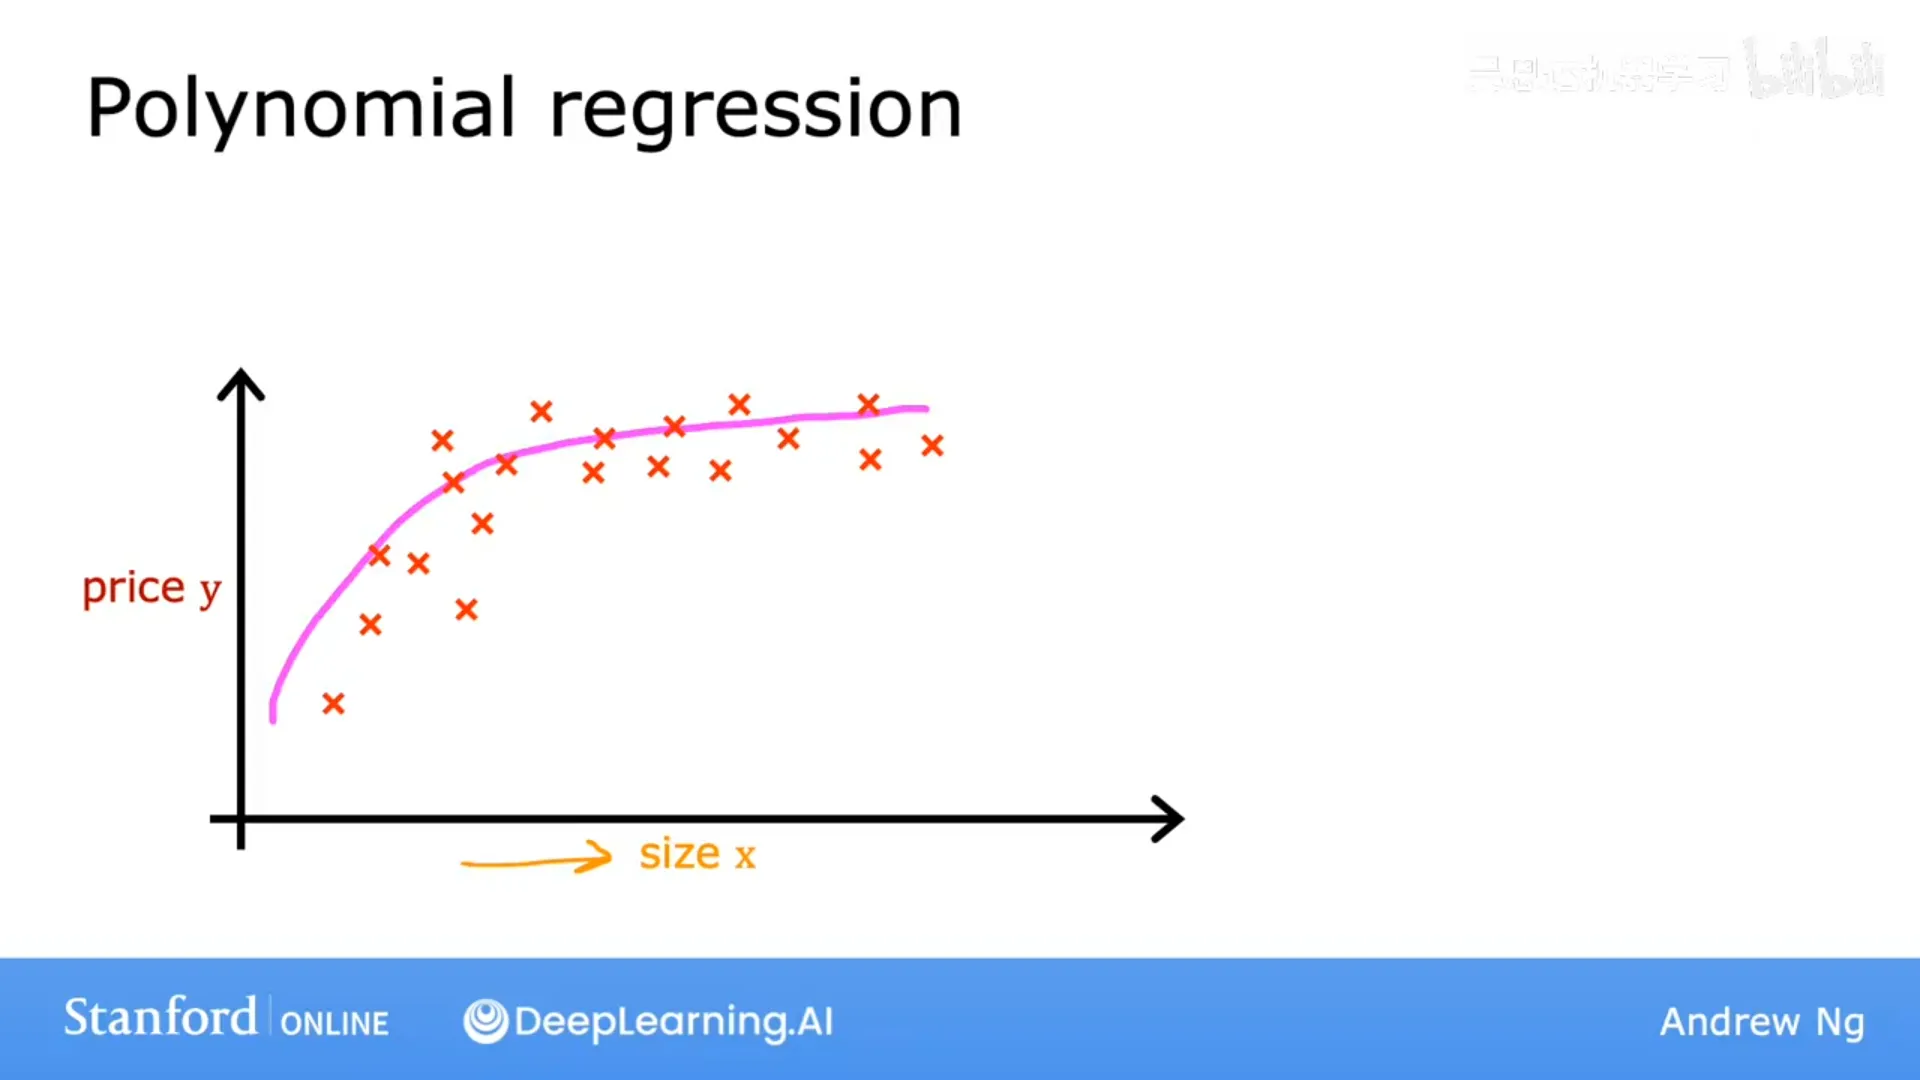
📷 多项式回归:用 x、x²、x³ 拟合曲线
回到原视频 (00:00:34)
工具旁注:Scikit-learn 是极其广泛使用的开源机器学习库。虽然本课强调"自己实现"才能扎实理解,但在真实工作中,你很可能用 Scikit-learn 等库几行代码就训练出模型。
第七章 逻辑回归与决策边界
(对应模块 7,视频 p31–p33)
7.1 为什么线性回归不适合分类
(p31)
分类(classification)问题中,输出 y 只取少数几个可能值(而非任意数值)。常见例子:
- 邮件是否垃圾邮件(是/否);
- 在线金融交易是否欺诈;
- 肿瘤恶性/良性。
只有两个可能输出的分类叫二元分类(binary classification)。约定用 0/1 表示两个类别(0 = 假/否,1 = 真/是),也常叫 负类(negative) 与 正类(positive)——注意"正/负"只表示"存在/不存在"(如"是否垃圾"的"是/否"),不含好坏褒贬,两个方向怎么指派是任意的。
先试试用线性回归做分类(画肿瘤大小 vs y∈{0,1},再取阈值 0.5):看起来还凑合。但只要在最右边加一个训练样本,最佳拟合线就被拉过去,0.5 对应的决策边界(decision boundary)向右移动,分类结果就变差了——而那个新样本本不该改变我们的结论。
所以线性回归不是分类的好算法:它的输出可以 <0 或 >1,还会被极端样本带偏。我们需要一个新算法 逻辑回归(logistic regression)——尽管名字里有"回归",它其实是分类算法(历史命名),输出总在 0 和 1 之间。
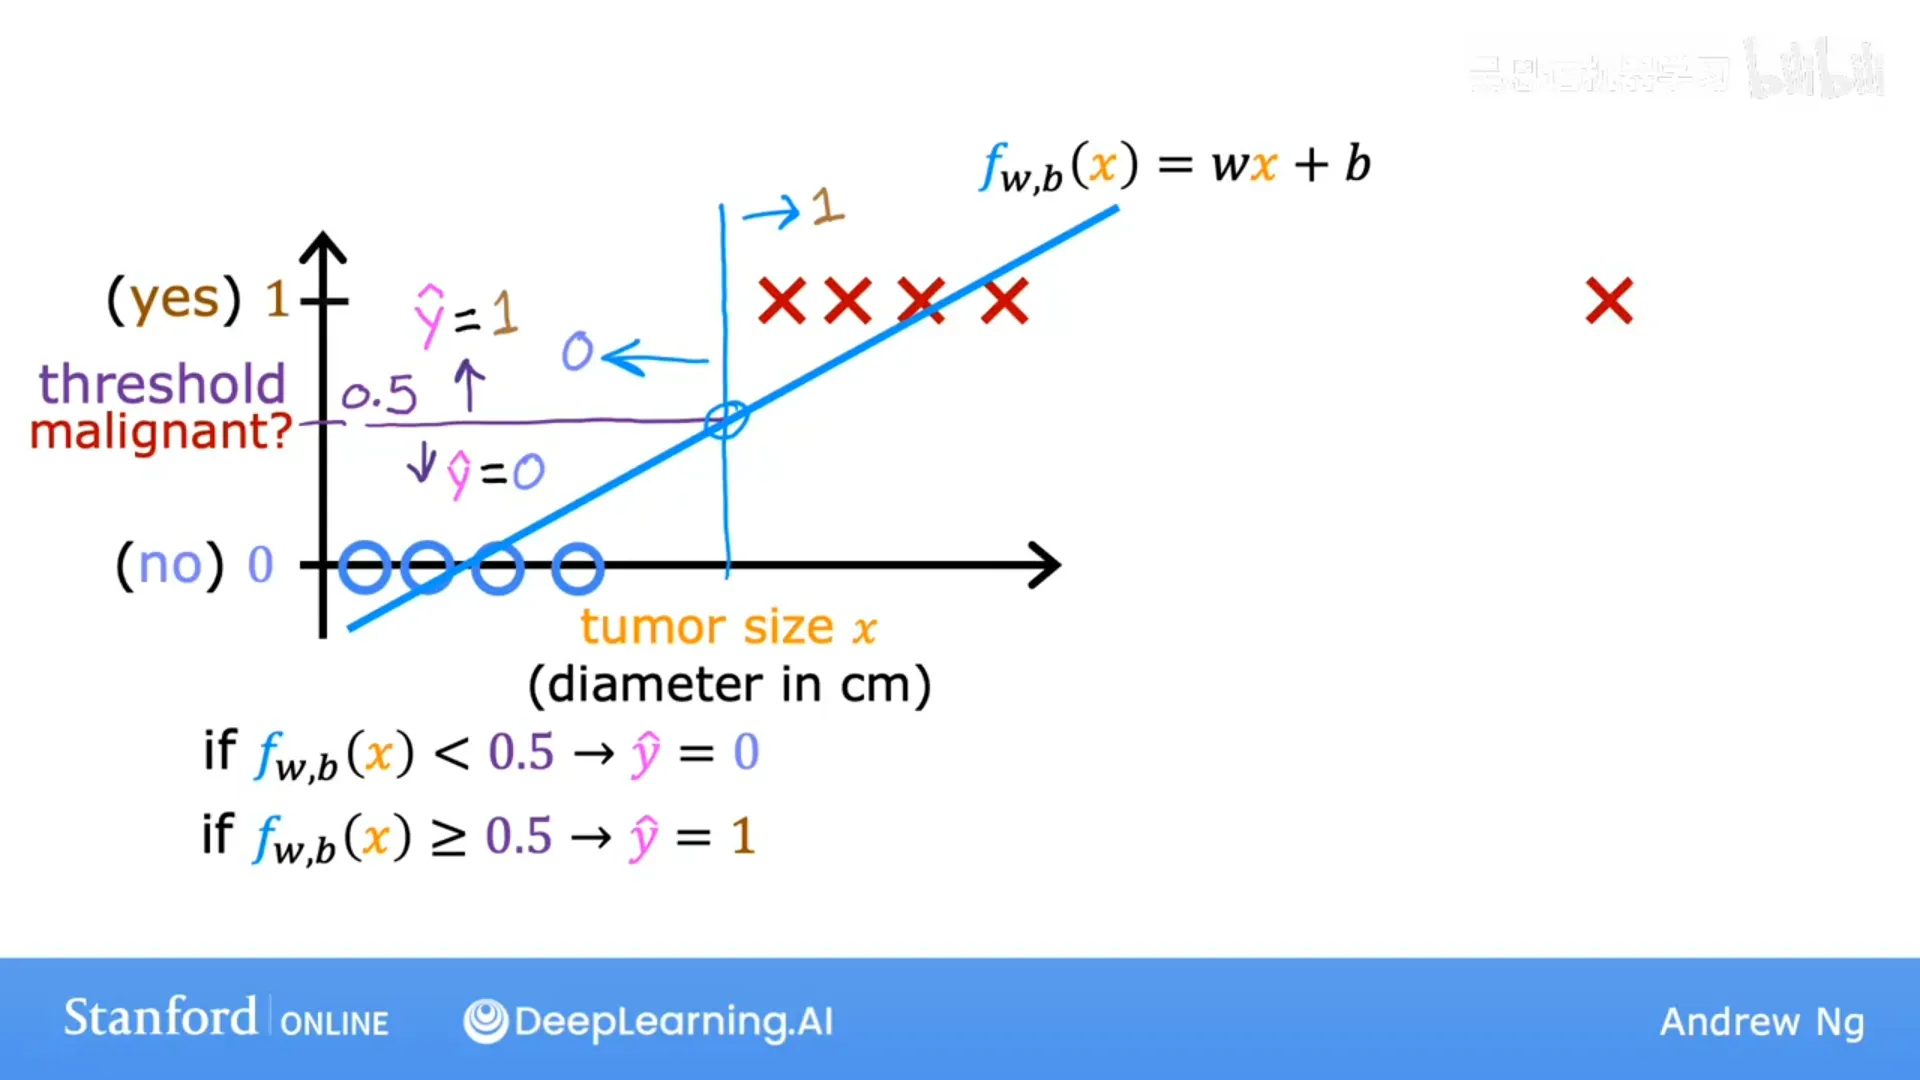
📷 线性回归做分类:加一个极端样本就会把决策边界带偏
回到原视频 (00:06:42)
7.2 Sigmoid 函数与逻辑回归模型
易错点 M10:$p_i=\sigma(w^\top x_i+b)$ 永远表示「类别 1 的概率」 $P(y_i=1\mid x_i)$,不是「真实标签发生的概率」。因此 $y_i=1$ 时,真实类别概率 = $p_i$;$y_i=0$ 时,真实类别概率 = $1-p_i$。
(p32)
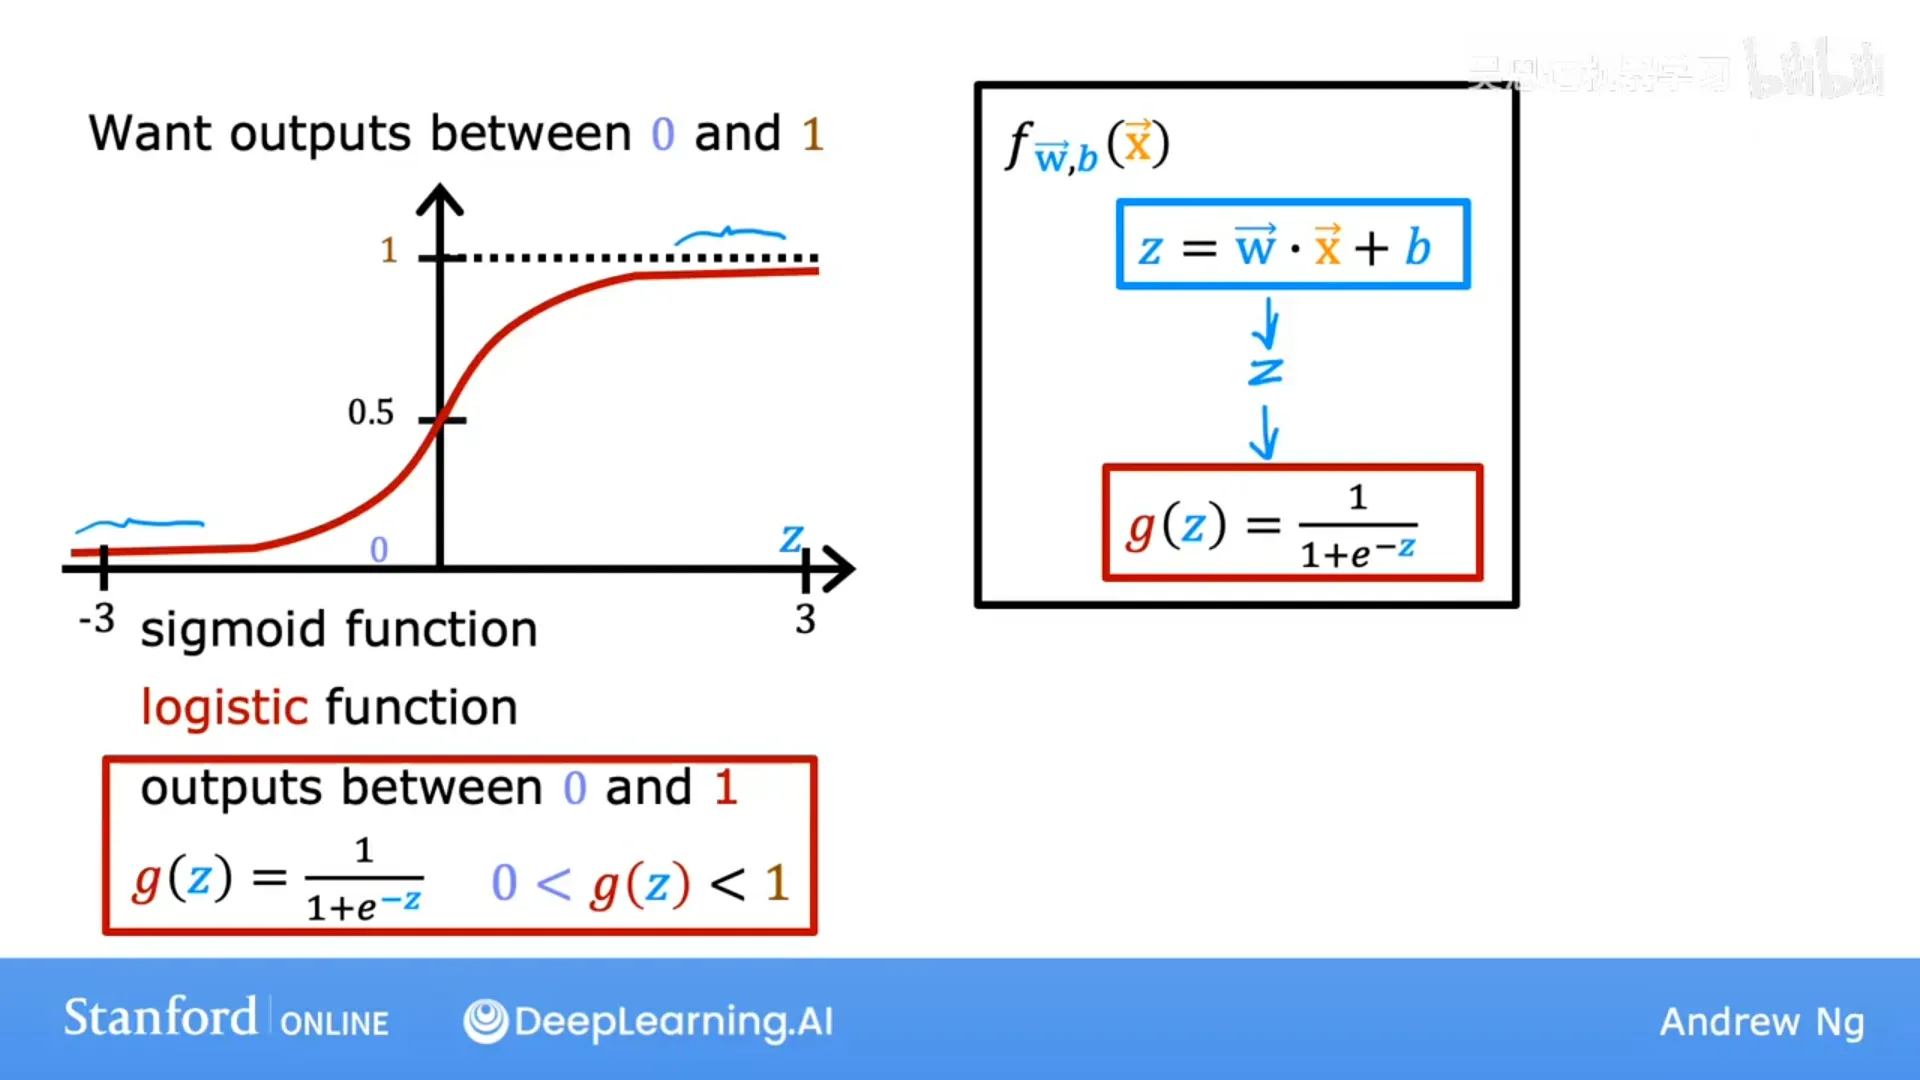
逻辑回归用到 Sigmoid 函数(也叫逻辑函数)g(z):
$$g(z) = \frac{1}{1 + e^{-z}}$$
性质:z 很大时 g(z) ≈ 1;z 很小时 g(z) ≈ 0;z = 0 时 g(z) = 0.5。因此它就是一条把实数映射到 (0,1) 的 S 形曲线。
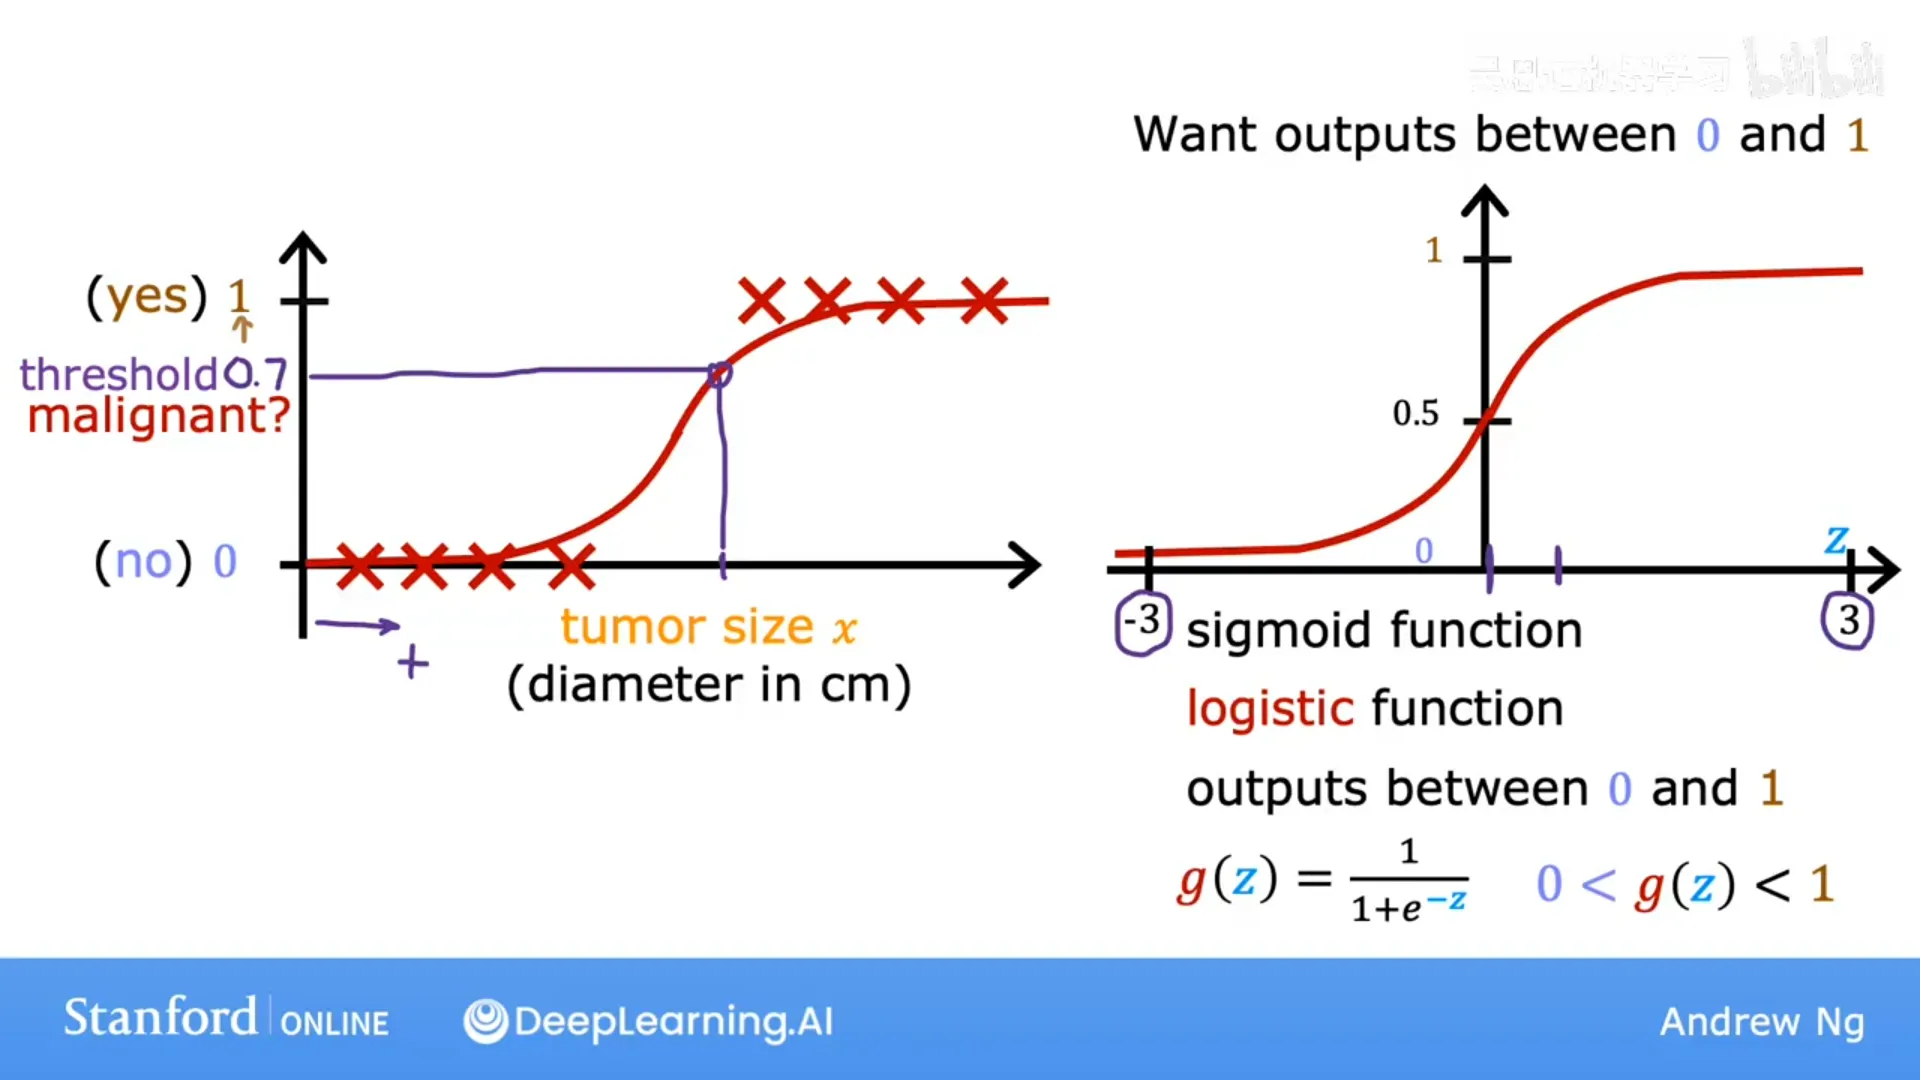
📷 Sigmoid 函数:输出总在 0 与 1 之间,z=0 时取 0.5
回到原视频 (00:02:26)
逻辑回归模型分两步:
$$\begin{aligned}
z &= w \cdot x + b \ f(x) &= g(z) = \frac{1}{1 + e^{-(w \cdot x + b)}}
\end{aligned}$$
📷 逻辑回归模型 = Sigmoid(w·x + b)
回到原视频 (00:05:12)
如何解释输出
把 f(x) 解释为:在给定输入 x 时,y = 1 的概率。例如模型输出 0.7,表示"这个肿瘤有 70% 的概率是恶性的"。由于 y 只能是 0 或 1,两个概率之和为 1:若 P(y=1) = 0.7,则 P(y=0) = 0.3。
(论文里可能写成 f(x) = P(y=1 | x; w, b),分号表示 w、b 是影响该计算的参数;本课不需要记这些记号。)
有趣的历史:很长一段时间里,很多互联网广告其实是由略微变形的逻辑回归驱动的——它决定了在大型网站上给你看哪些广告,价值巨大。
7.3 决策边界
(p33)
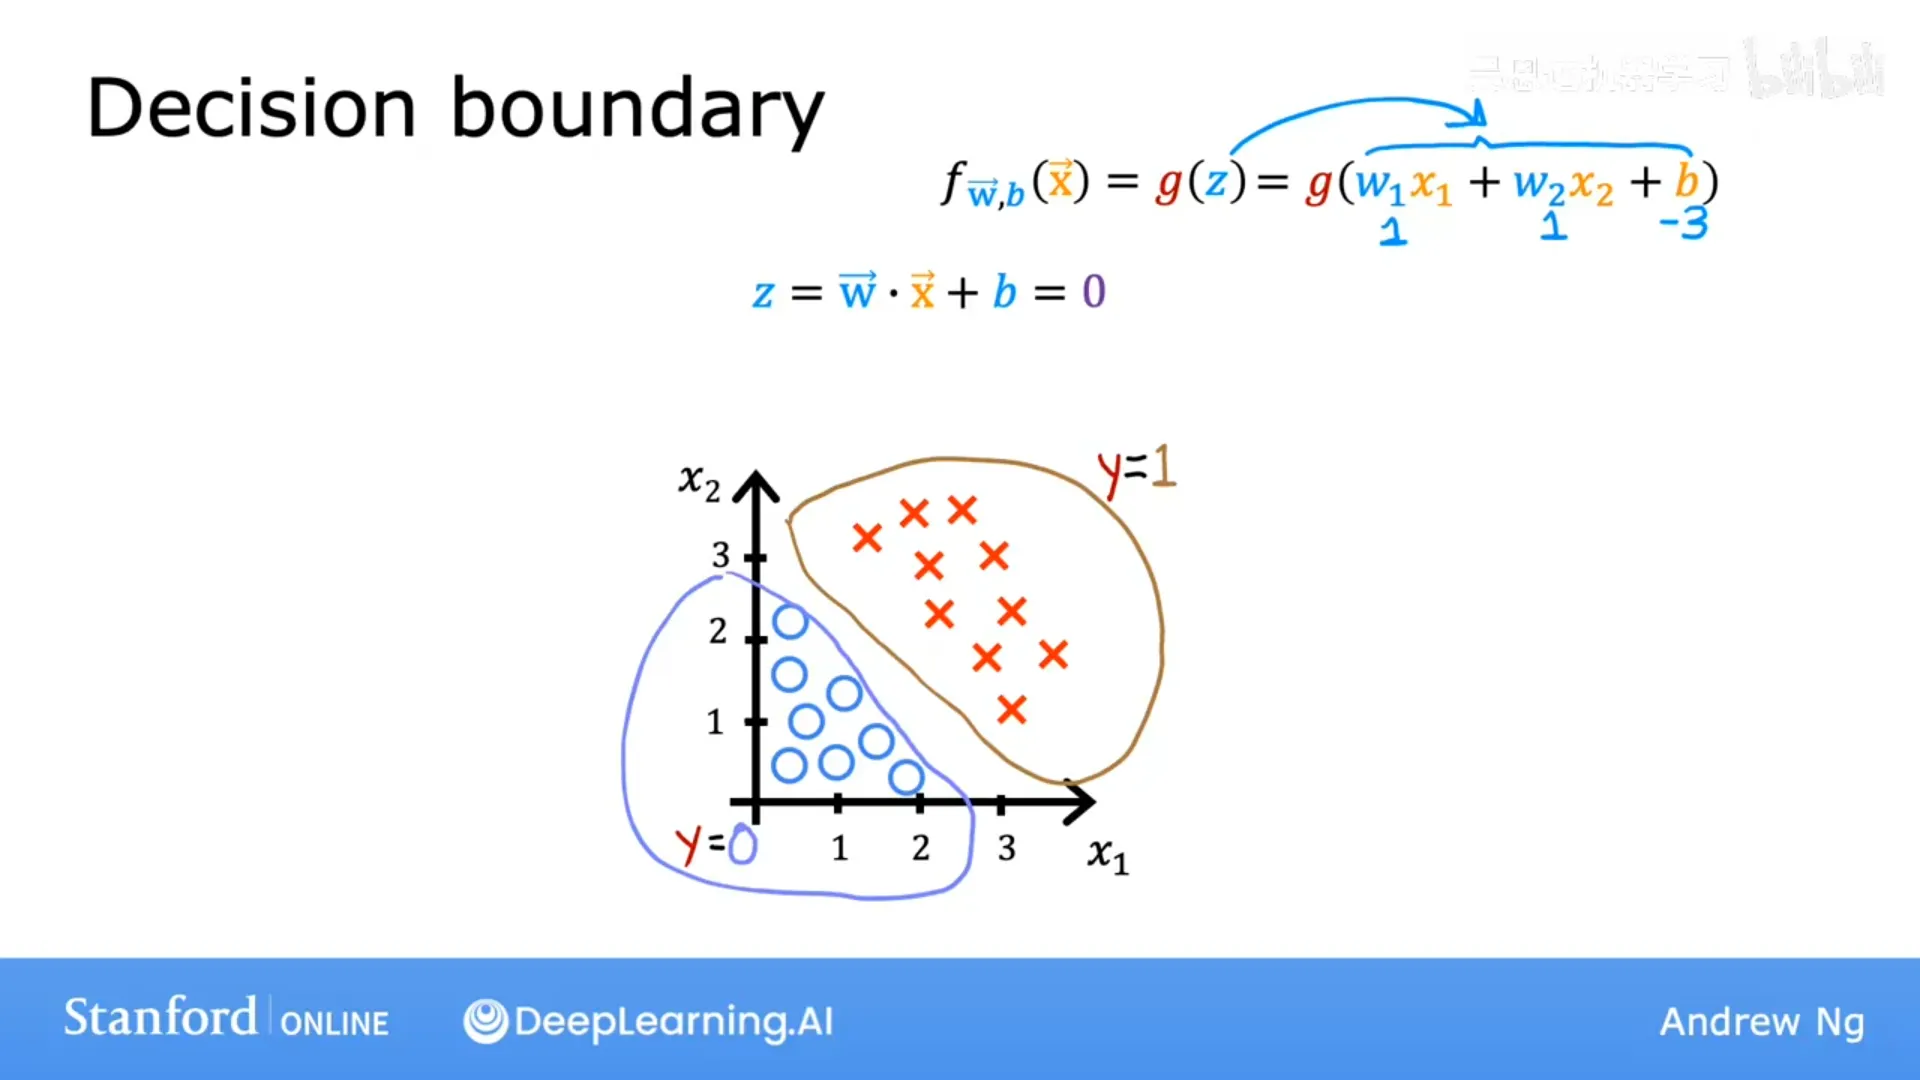
要从概率变成 0/1 预测,通常取阈值 0.5:f(x) ≥ 0.5 → ŷ = 1,否则 ŷ = 0。
由 Sigmoid 的性质可推出:f(x) ≥ 0.5 当且仅当 z = w·x + b ≥ 0。因此:
w·x + b ≥ 0→ 预测 1;w·x + b < 0→ 预测 0。
使 w·x + b = 0 的那条线,就叫决策边界(decision boundary)——它是你对"y=0 还是 y=1"恰好中立的地方。
例(线性边界):两个特征 x₁、x₂,取 w₁ = w₂ = 1、b = −3,则决策边界是 x₁ + x₂ = 3(一条直线);在它右侧预测 1,左侧预测 0。参数不同,边界就是另一条线。
📷 决策边界:x₁ + x₂ = 3 把平面分成预测 1 / 预测 0 两半
回到原视频 (00:05:13)
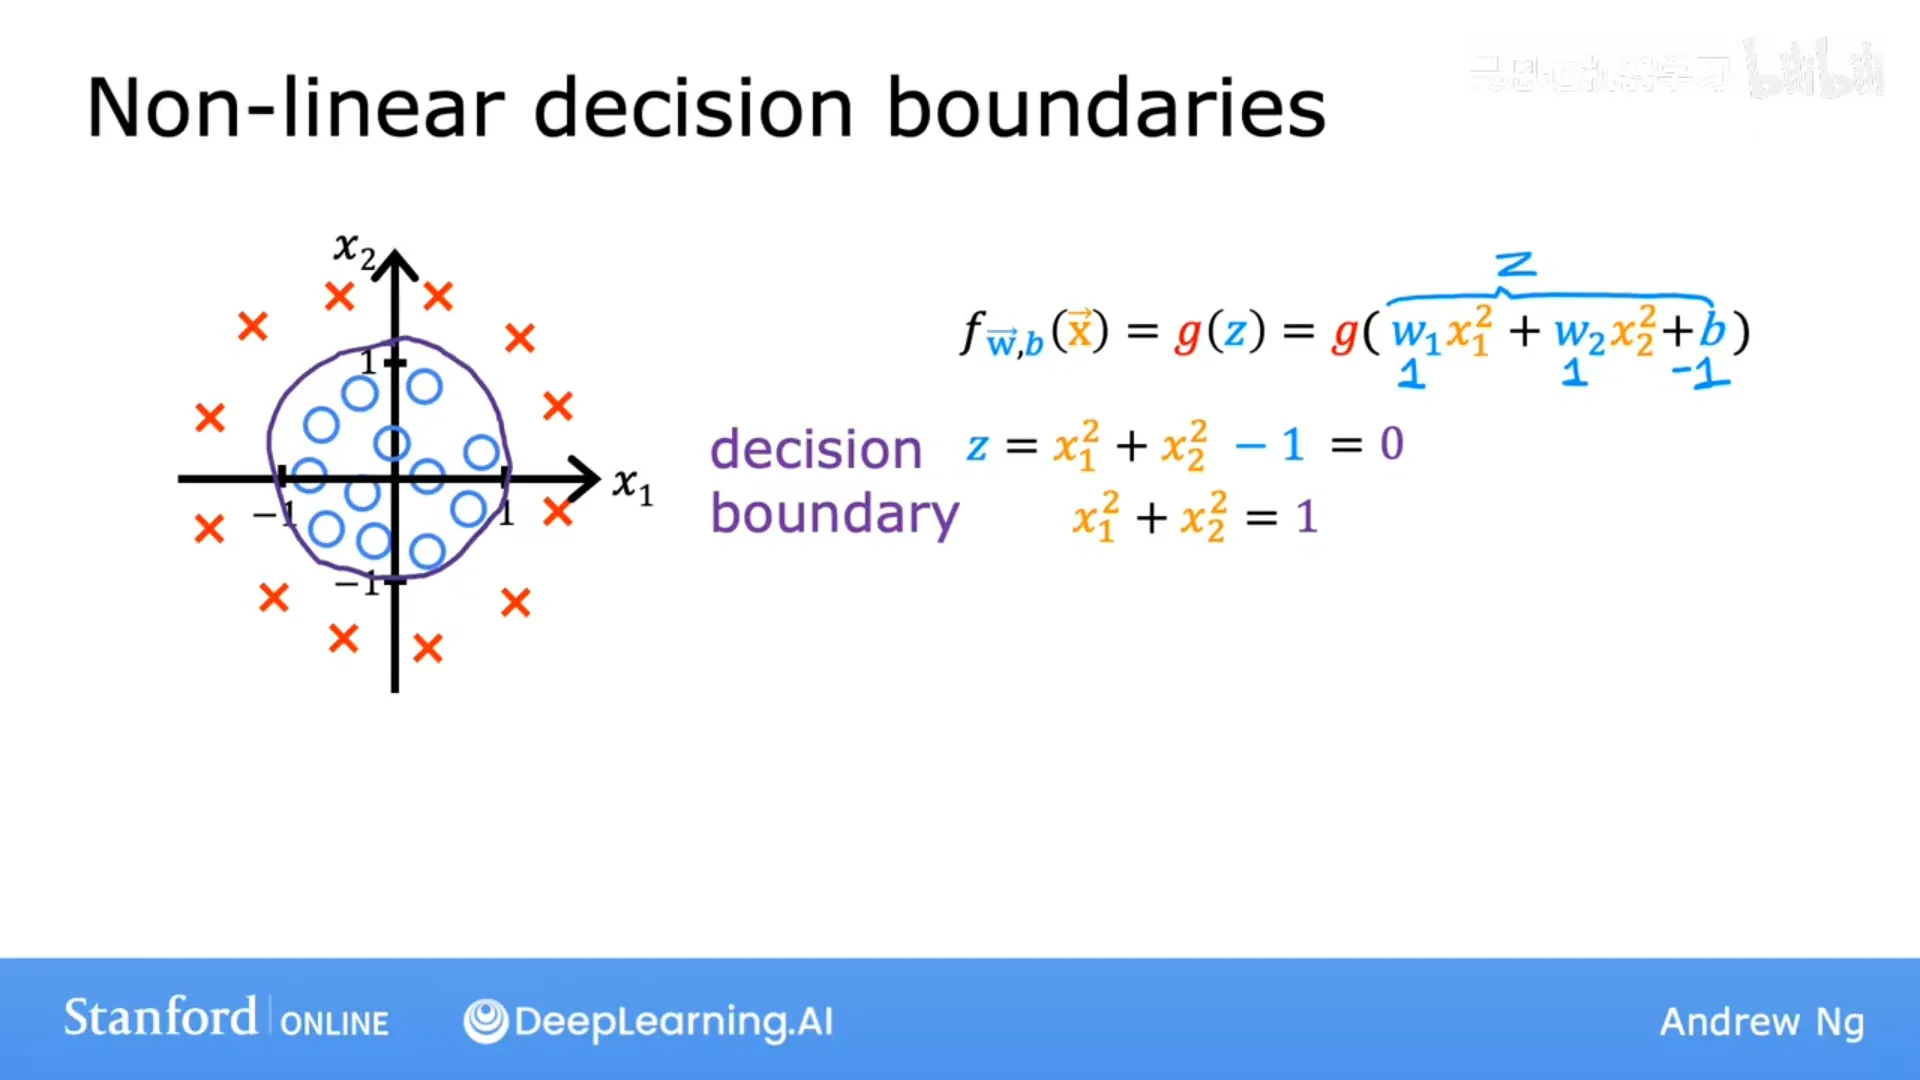
例(非线性边界):加入多项式特征,令 z = w₁x₁² + w₂x₂² + b。取 w₁ = w₂ = 1、b = −1,则决策边界是 x₁² + x₂² = 1(一个圆):圆外预测 1,圆内预测 0。用更高阶的多项式项还能得到椭圆乃至更复杂的形状。
📷 用多项式特征得到圆形等非线性决策边界
回到原视频 (00:08:00)
要点:如果只用 x₁、x₂ 等原始特征(不含高阶多项式),逻辑回归的决策边界永远是线性的;加入多项式特征才能得到复杂边界。
第八章 逻辑回归的代价函数
(对应模块 8,视频 p34–p35)
8.1 为什么平方误差不好用
(p34)
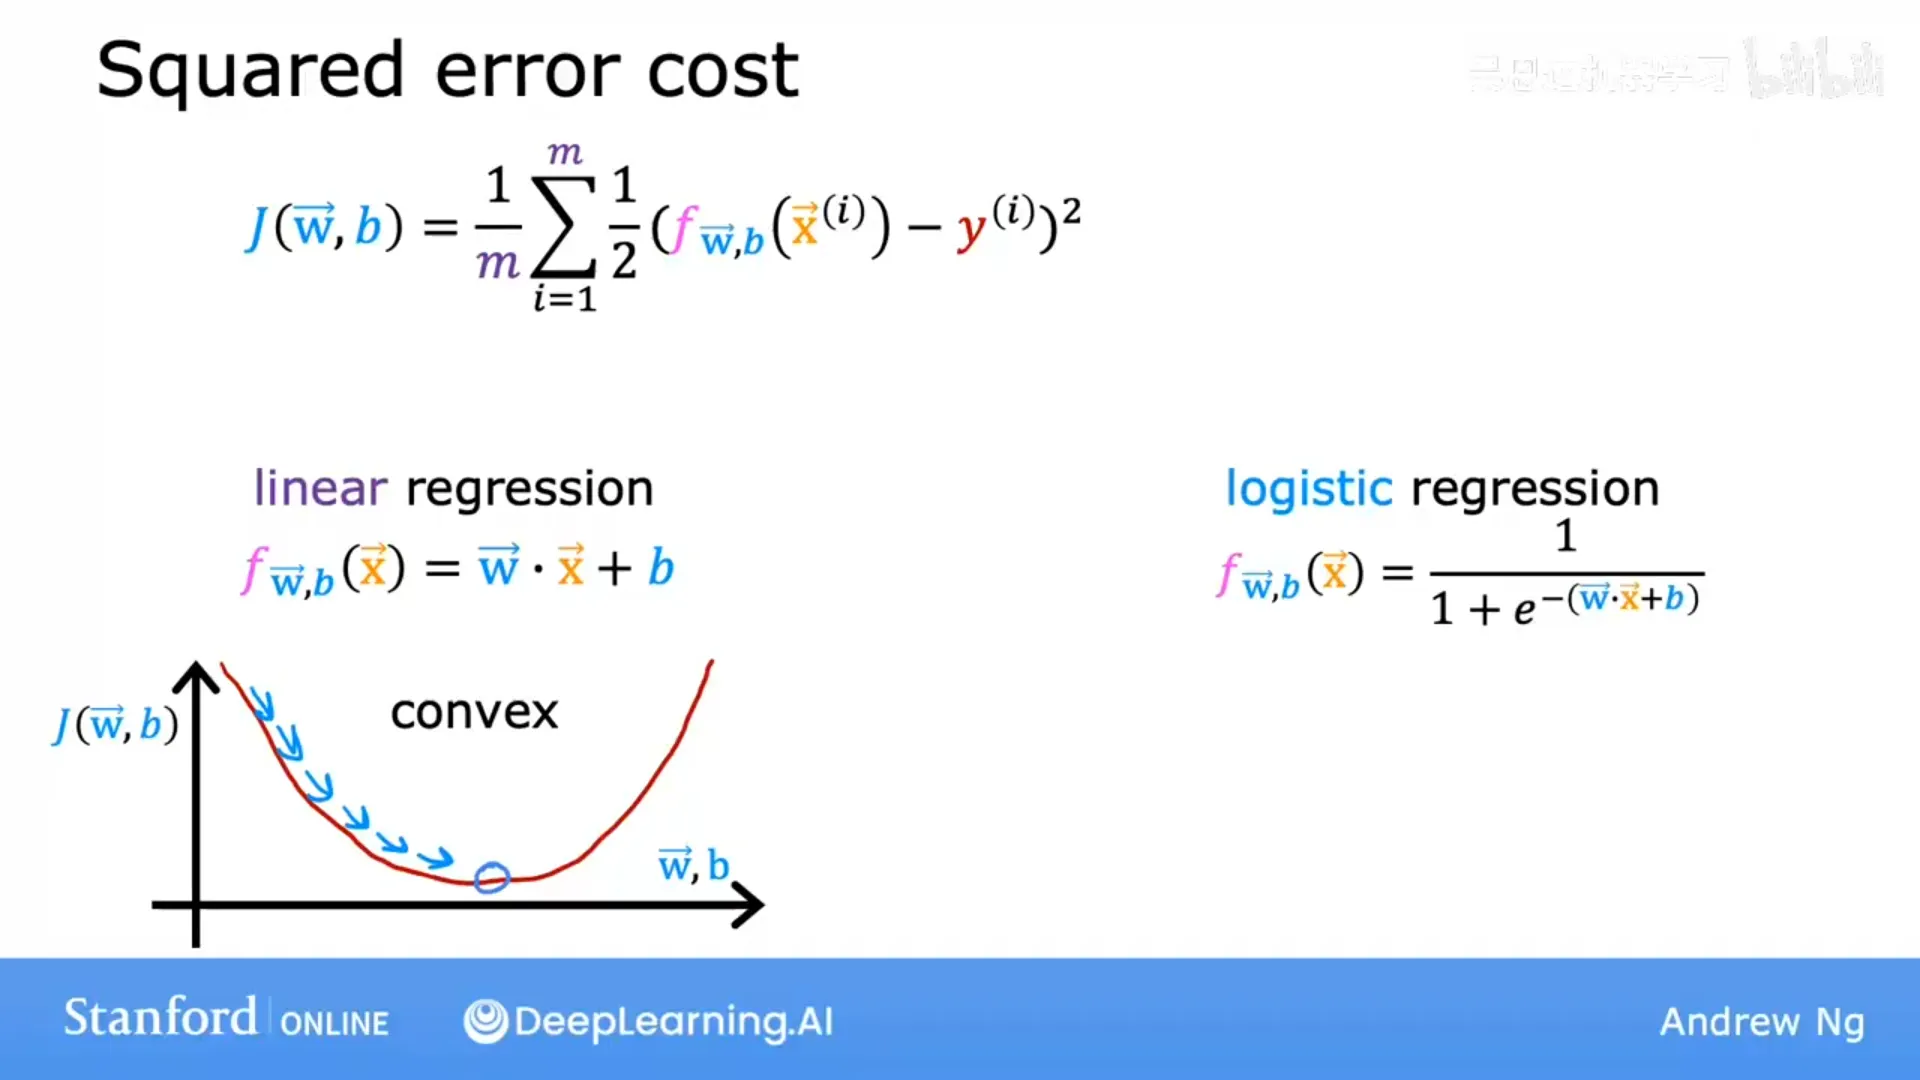
训练逻辑回归同样要选 w、b。若沿用线性回归的平方误差代价函数,把 f(x) = 1/(1+e^{−(wx+b)}) 代进去——得到的代价函数会非凸(non-convex),形状崎岖、有很多局部最小值,梯度下降容易陷进去。
所以逻辑回归需要一个新的、能保证凸性的代价函数。
📷 把 Sigmoid 代入平方误差会得到非凸、崎岖的代价曲面
回到原视频 (00:02:18)
8.2 逻辑损失函数
数学角落(Likelihood → NLL → BCE):把每个样本的 Bernoulli 似然乘起来,取对数($\log$ 严格递增,保住 argmax),再取负号($\max f\iff\min(-f)$),就得到负对数似然 NLL,展开正是 二元交叉熵 BCE:$-\big[y\log p+(1-y)\log(1-p)\big]$。语义上:NLL 在惩罚模型「不相信真实发生的那个标签」。
(p34)
把代价定义里的每一项叫单个样本的损失 L(f(x), y)。逻辑回归用对数损失:
$$L\big(f(x), y\big) = \begin{cases} -\log\big(f(x)\big), & y = 1 \\[2pt] -\log\big(1 - f(x)\big), & y = 0 \end{cases}$$
为什么合理? 分两种情况看(注意 f 始终在 (0,1)):
- y = 1 时(真的是恶性),损失 = −log(f):f 越接近 1,损失越接近 0;f 越接近 0,损失越大(趋于 +∞)。激励模型把概率尽量预测得高。
- y = 0 时,损失 = −log(1−f):f 越接近 0,损失越小;f 越接近 1,损失趋于 +∞。所以在"实际是良性"时预测"几乎肯定是恶性",会受到极大的惩罚。
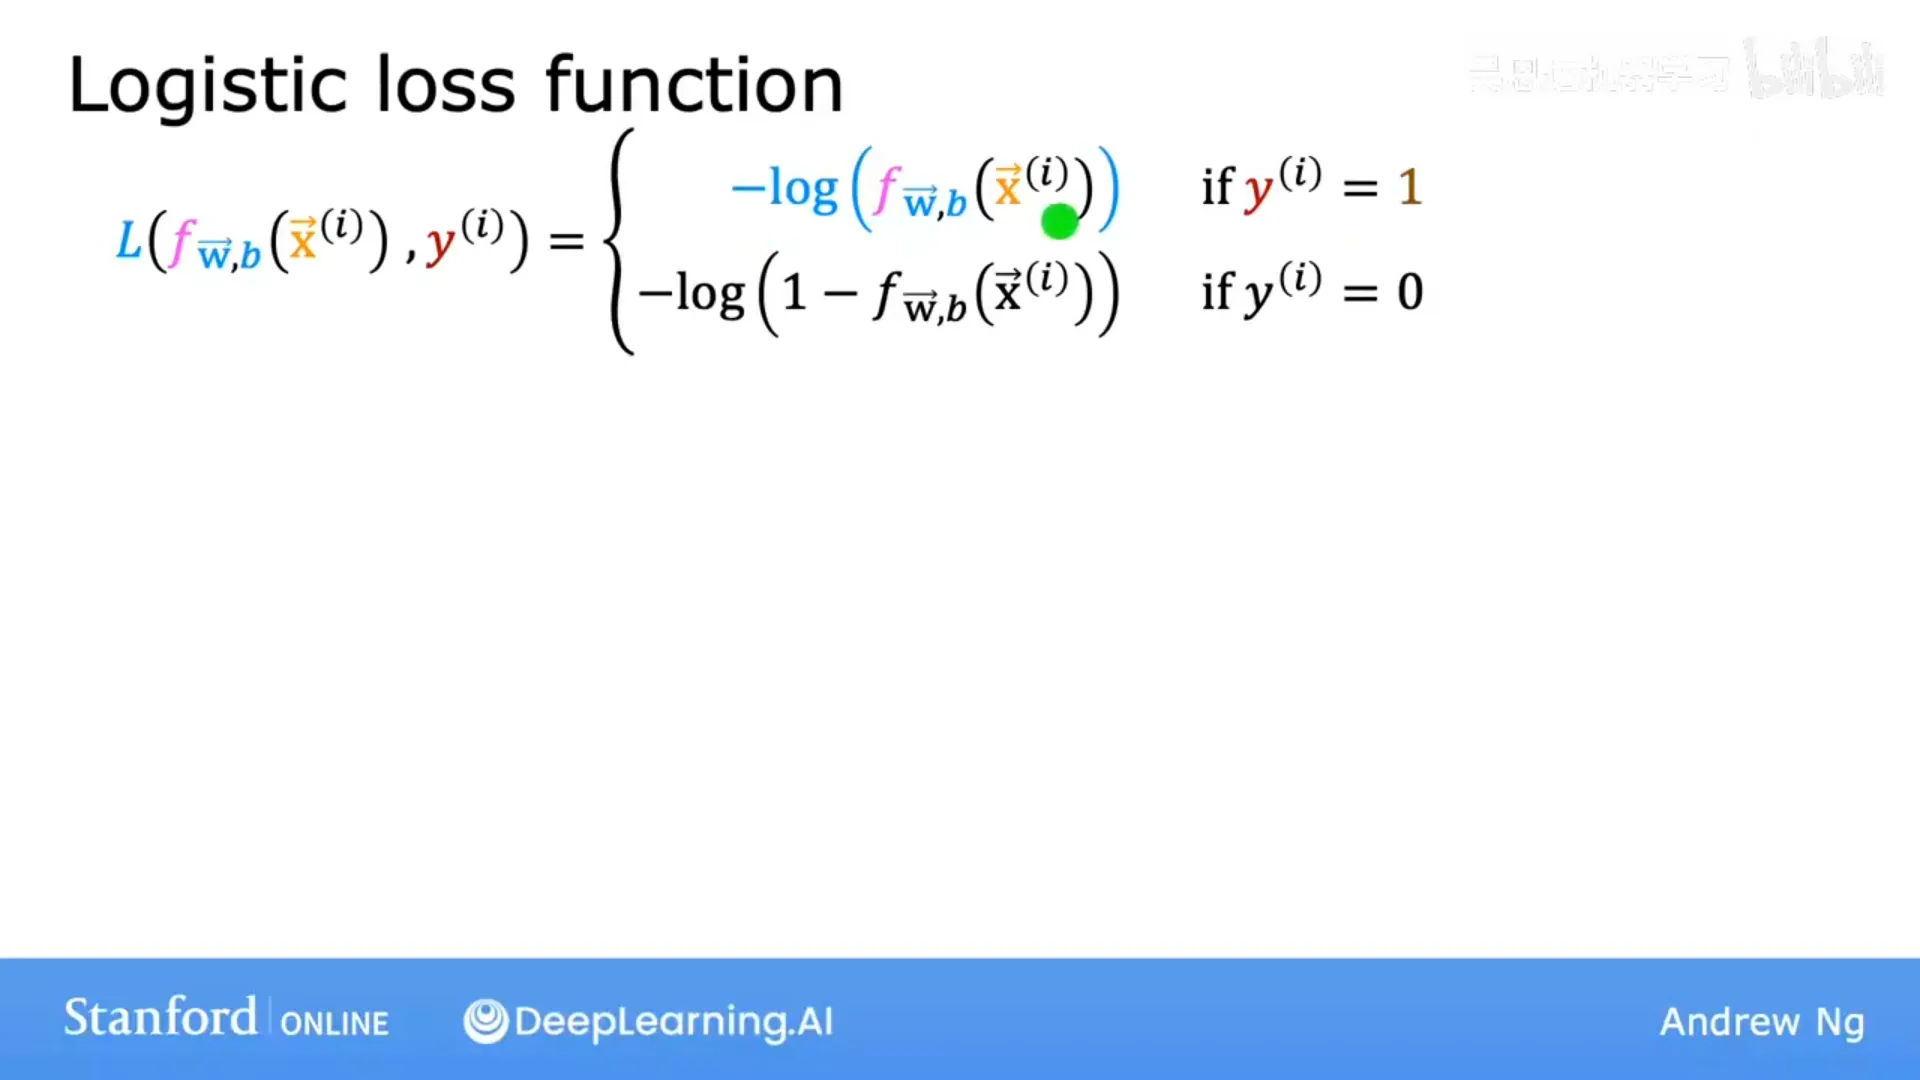
📷 y=1 时的损失 −log(f):预测越接近 1 损失越小
回到原视频 (00:04:39)
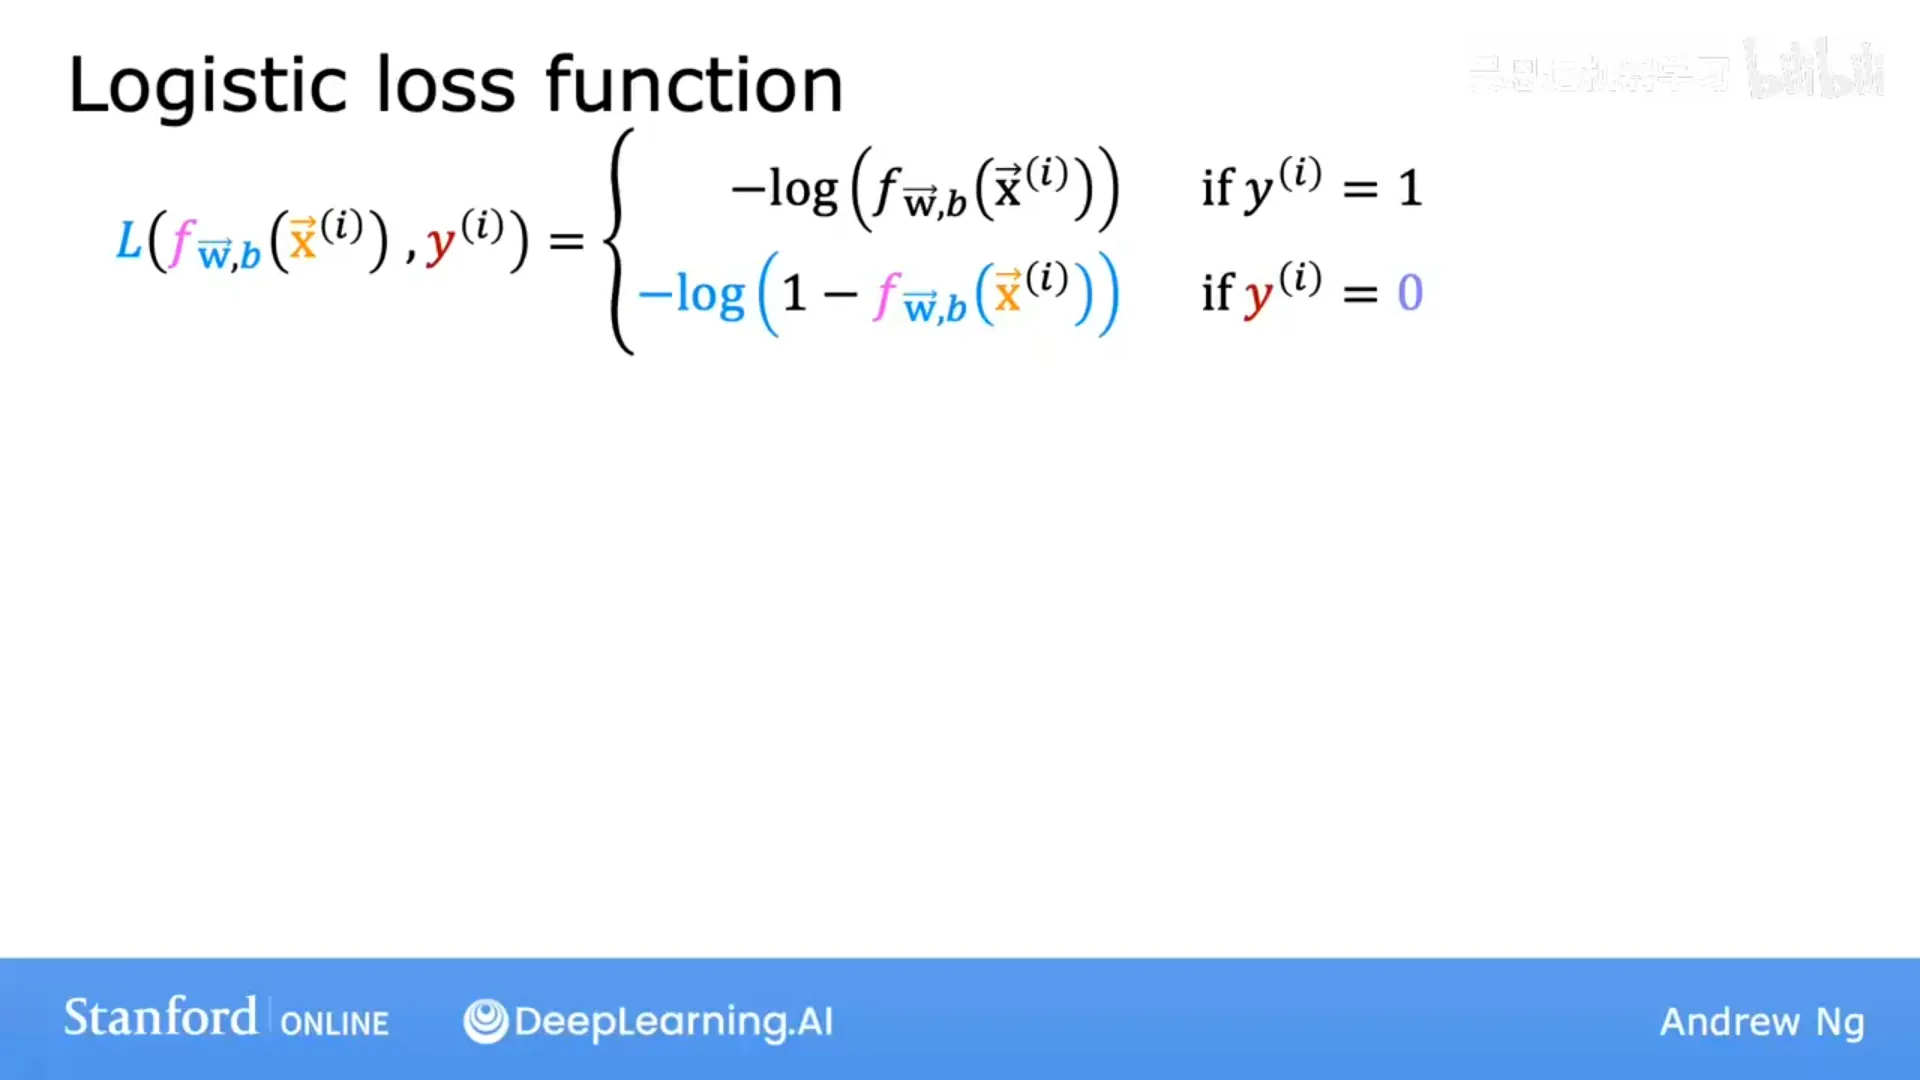
📷 y=0 时的损失 −log(1−f):预测越接近 0 损失越小
回到原视频 (00:07:43)
这个损失函数是从统计学的最大似然估计(maximum likelihood estimation)推导出来的,并且保证整体代价函数是凸的——因此梯度下降能可靠地找到全局最小值。(凸性的证明超出本课范围。)
8.3 简化写法
(p35)
因为二元分类里 y 只能是 0 或 1,两段式损失可以合并成一行:
$$L\big(f(x), y\big) = -\,y\log\big(f(x)\big) - (1 - y)\log\big(1 - f(x)\big)$$
验证:y = 1 时第二项为 0,只剩 −log(f);y = 0 时第一项为 0,只剩 −log(1−f)。
于是逻辑回归的代价函数(对全体样本取平均):
$$J(w,b) = -\frac{1}{m}\sum_{i=1}^{m}\Big[\, y^{(i)}\log\big(f(x^{(i)})\big) + \big(1 - y^{(i)}\big)\log\big(1 - f(x^{(i)})\big) \Big]$$
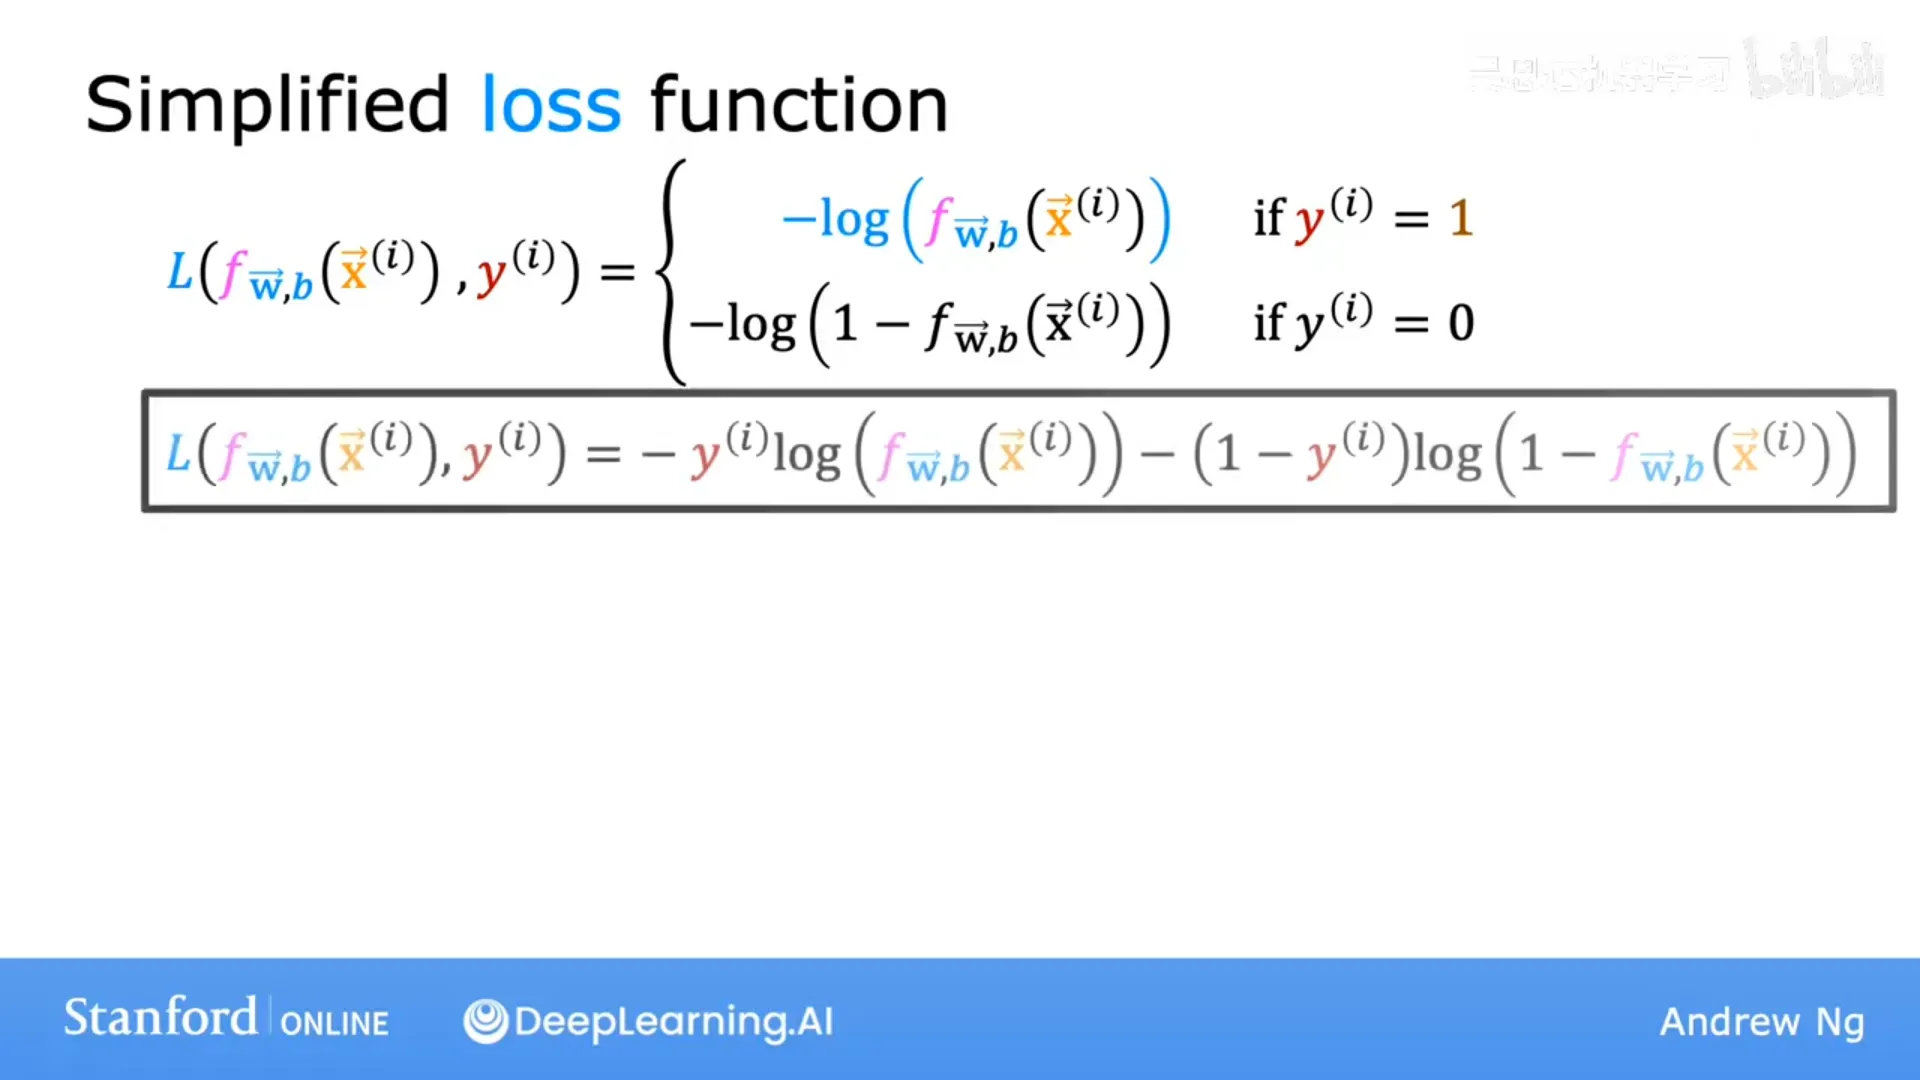
📷 逻辑回归损失的简化写法与整体代价函数
回到原视频 (00:00:53)
第九章 逻辑回归的梯度下降实现
(对应模块 9,视频 p36)
(p36)
用梯度下降最小化逻辑回归的代价函数 J(w, b),更新规则是:
$$\begin{aligned}
w_j &:= w_j - \alpha\,\frac{1}{m}\sum_{i=1}^{m}\big(f(x^{(i)}) - y^{(i)}\big)\, x^{(i)}j \ b &:= b - \alpha\,\frac{1}{m}\sum{i=1}^{m}\big(f(x^{(i)}) - y^{(i)}\big)
\end{aligned}$$
一个容易让人困惑的点:这两个公式在形式上和线性回归的梯度下降一模一样!但它们是两个完全不同的算法——因为 f(x) 的定义变了:线性回归里 f(x) = w·x + b,而逻辑回归里 f(x) = g(w·x + b)(Sigmoid)。
其余要点:
- 同时更新所有参数(和之前一样);
- 监控收敛的方法(学习曲线)同样适用于逻辑回归;
- 特征缩放同样能加速逻辑回归的梯度下降;
- 也可以用向量化实现得更快。
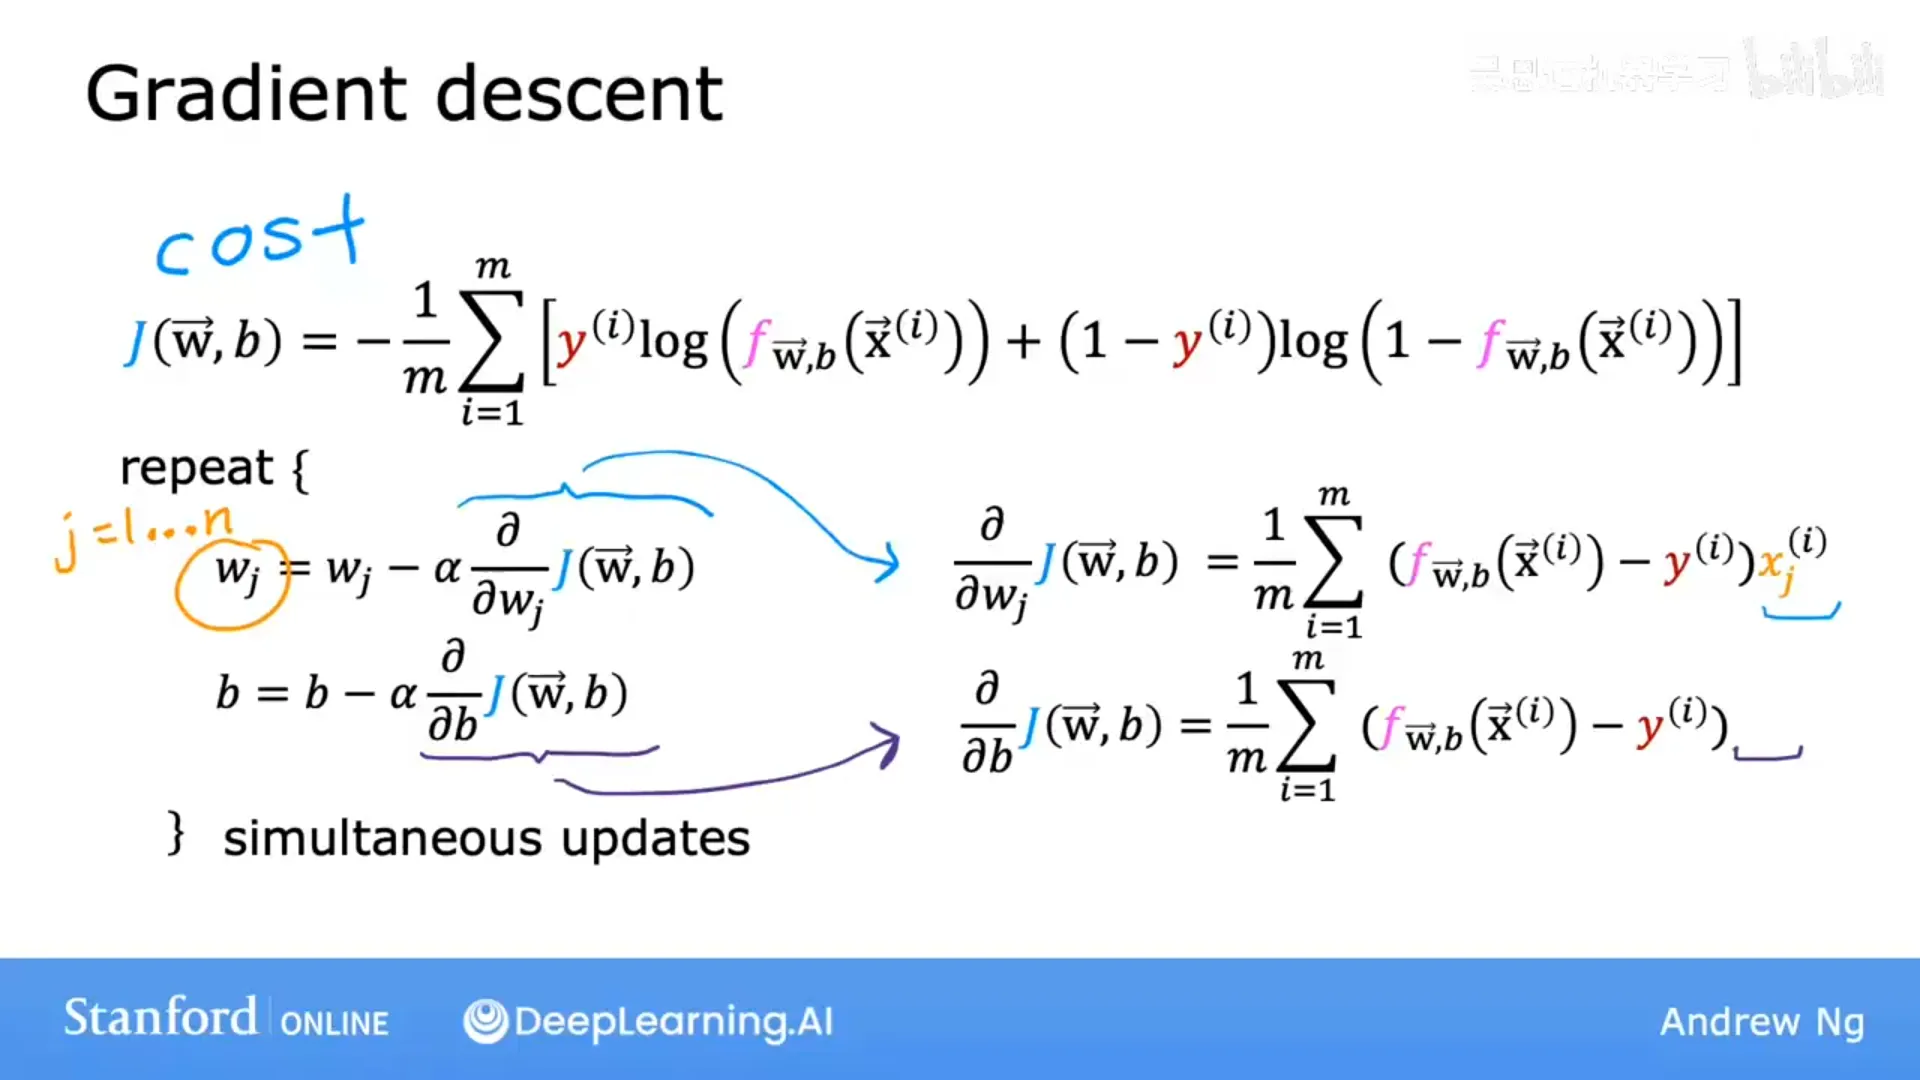
📷 逻辑回归的梯度下降:形式与线性回归相同,但 f(x) 不同
回到原视频 (00:02:42)
工具旁注:也可以用 Scikit-learn 几行代码训练逻辑回归分类器——这是产业界很多从业者的日常。
第十章 过拟合与正则化
(对应模块 10,视频 p37–p41)
10.1 欠拟合与过拟合
(p37)
用"房价 vs 面积"的三组拟合来说明:
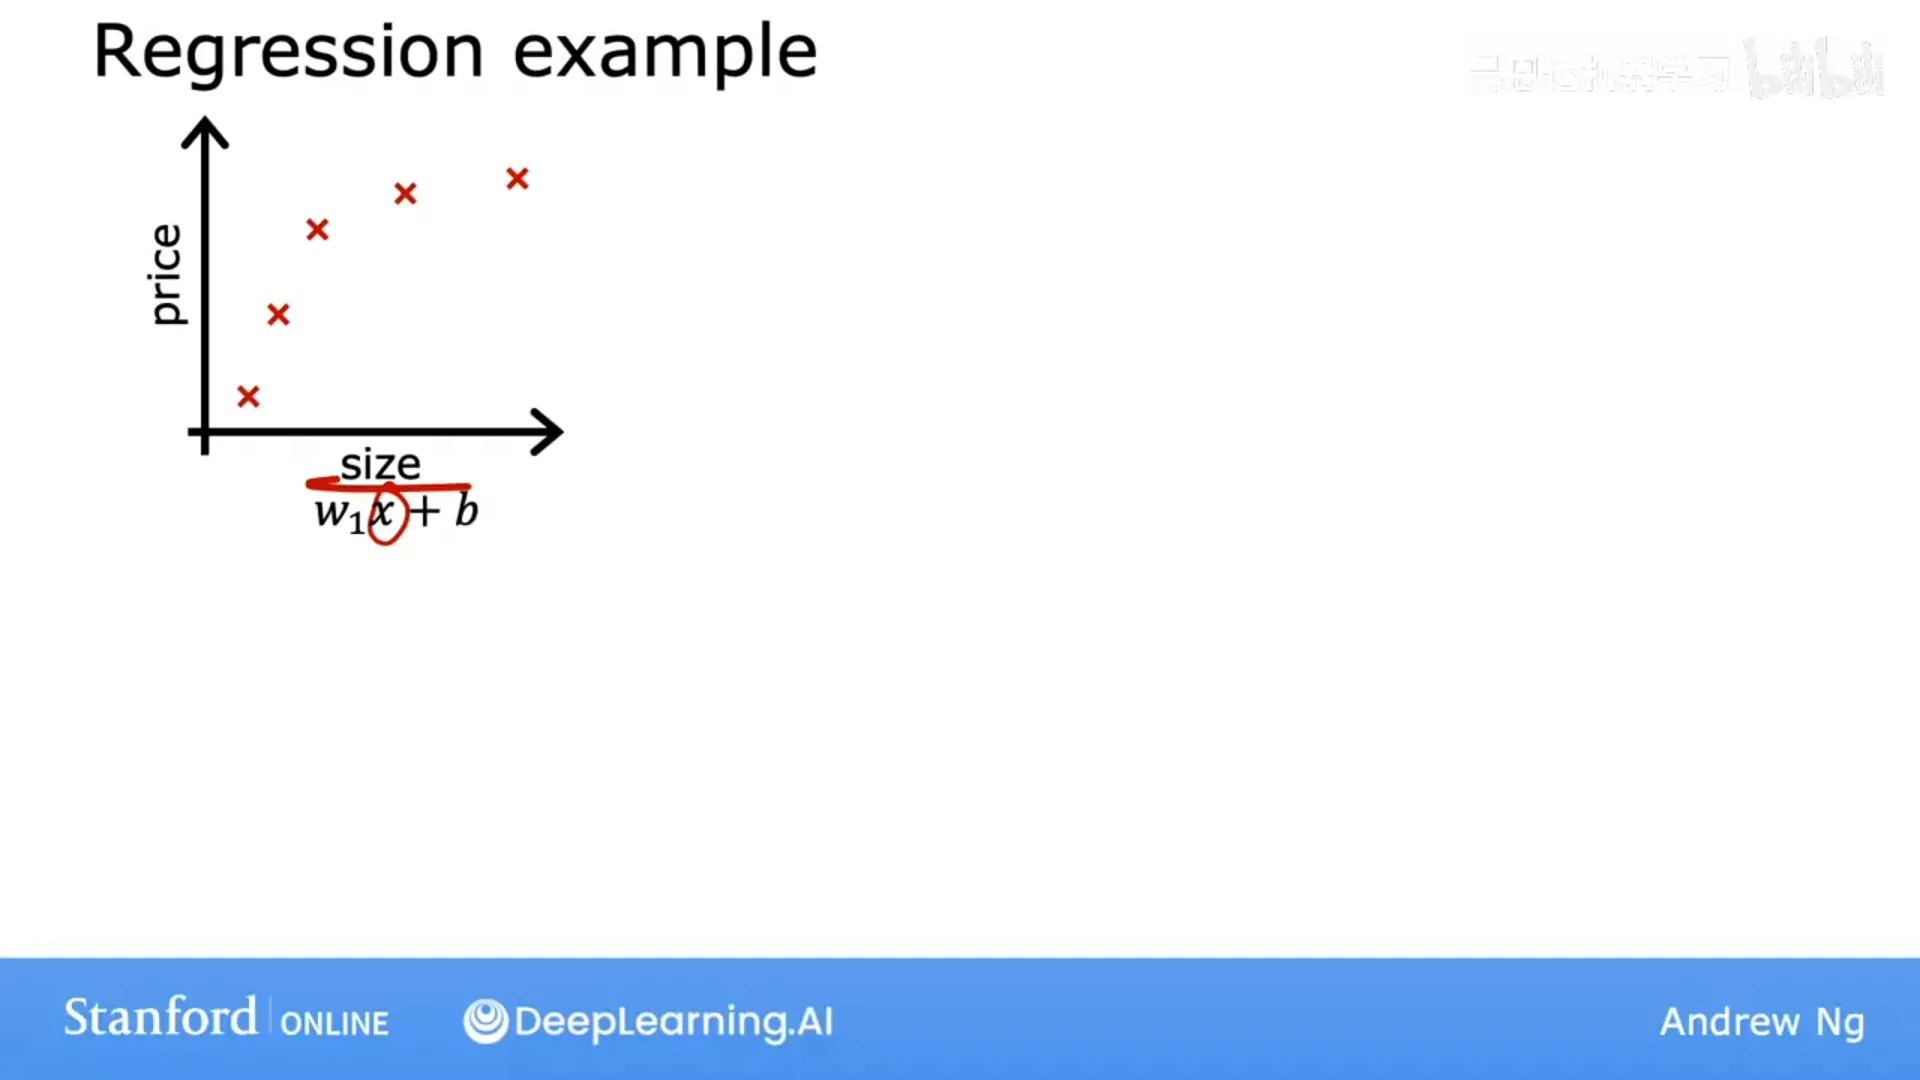
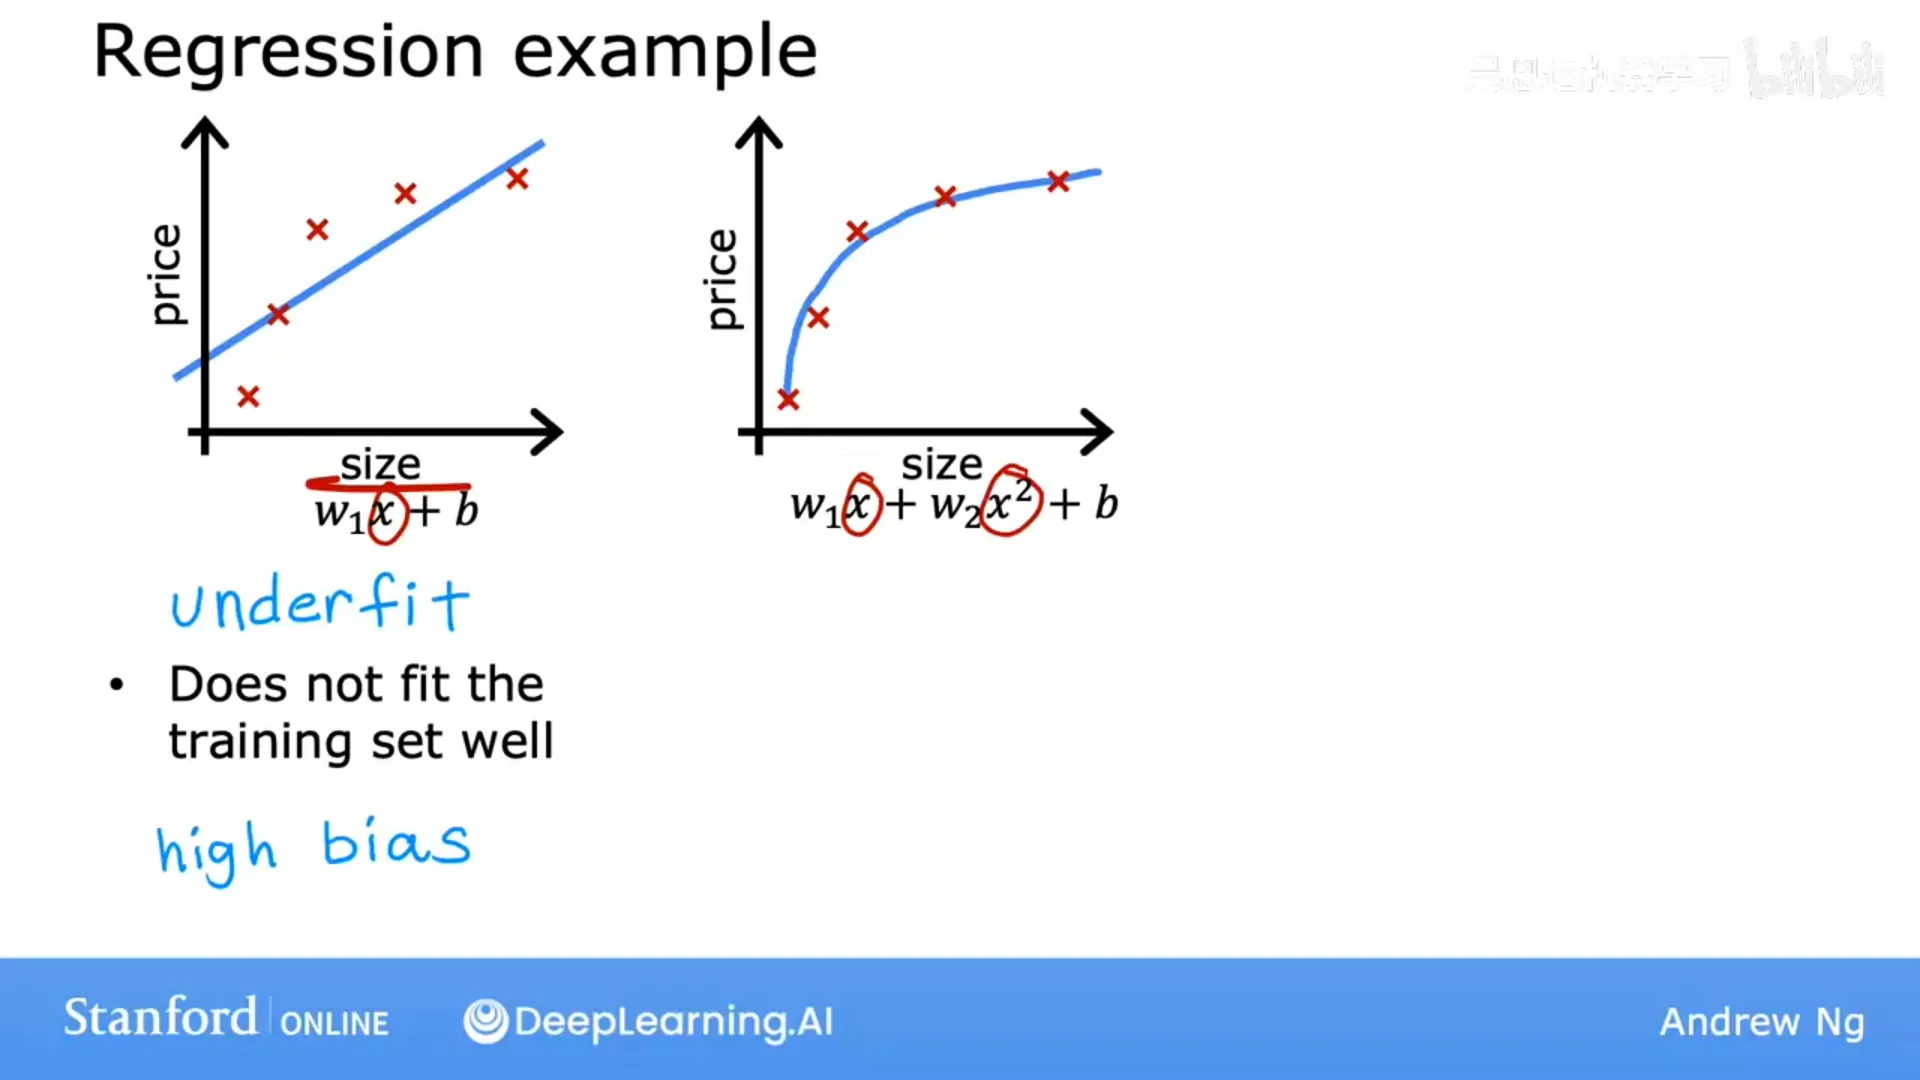
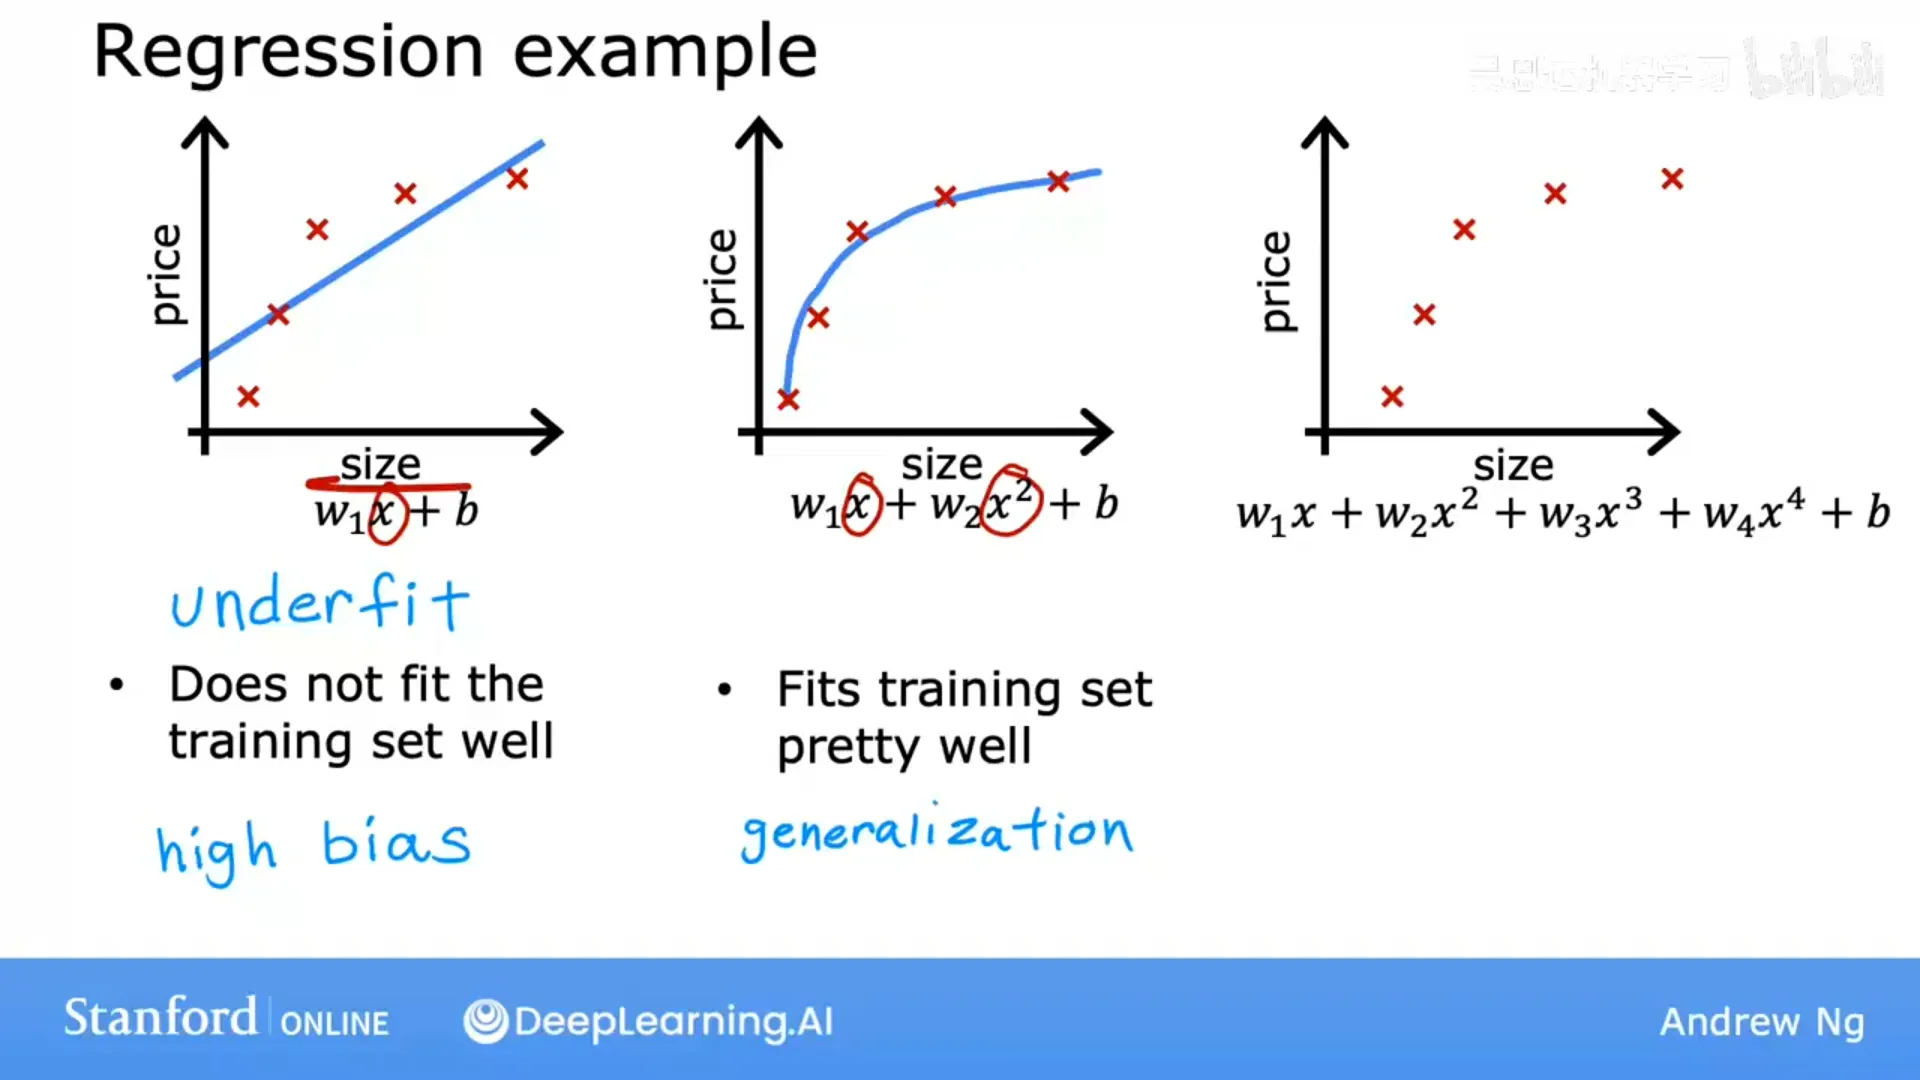
- 欠拟合(underfit)/ 高偏差(high bias):用直线拟合明显弯曲的数据。模型连训练集都拟合不好,无法捕捉数据中明显的模式。称"高偏差",是因为算法带着一个很强的预设("价格就是面积的线性函数"),即使数据显示并非如此。
- 恰到好处(just right):用二次函数拟合,贴合数据且能泛化——即使对训练集之外的新房子也能给出合理预测。
- 过拟合(overfit)/ 高方差(high variance):用四阶多项式,曲线精确穿过全部 5 个训练样本(代价甚至为 0),但剧烈波动——会出现"更大的房子反而更便宜"这种荒谬预测。称"高方差",是因为训练集稍有不同,拟合出的函数就可能完全不同。
📷 欠拟合(高偏差):直线拟合弯曲数据
回到原视频 (00:01:41)
📷 恰到好处:二次拟合既贴合又泛化
回到原视频 (00:03:52)
📷 过拟合(高方差):四阶多项式穿过所有点但剧烈波动
回到原视频 (00:04:45)
术语提醒:机器学习里"过拟合 = 高方差"、"欠拟合 = 高偏差"常被当作同义词使用。另外,"偏差"在机器学习中还有社会公平层面的含义(对某性别/种族的偏见)——这个同样至关重要,但和这里的"高偏差"是两回事。
分类问题同样会欠拟合/过拟合:用简单线性边界 → 欠拟合;用合适的多项式(如椭圆边界)→ 恰好;用非常高的阶数去完美分割每个训练点 → 过拟合。
金发姑娘(Goldilocks)比喻:粥太冷不行、太热也不行,不冷不热刚刚好。机器学习的目标,就是找到一个既不过拟合、也不欠拟合的模型——既没有高偏差、也没有高方差。
10.2 三种对付过拟合的方法
(p38)
- 收集更多训练数据:数据越多,算法越不容易去拟合噪声,即使仍用高阶多项式也能表现不错。很有效,但往往不可行(比如当地只有那么多房子)。
- 减少特征(特征选择 feature selection):只保留最相关的特征子集。缺点是会丢掉信息——被丢掉的特征可能本来有用。(第二门课会讲自动选特征的算法。)
- 正则化(regularization):保留所有特征,但缩小参数值。这是本课重点,也是吴恩达最常用的技术。
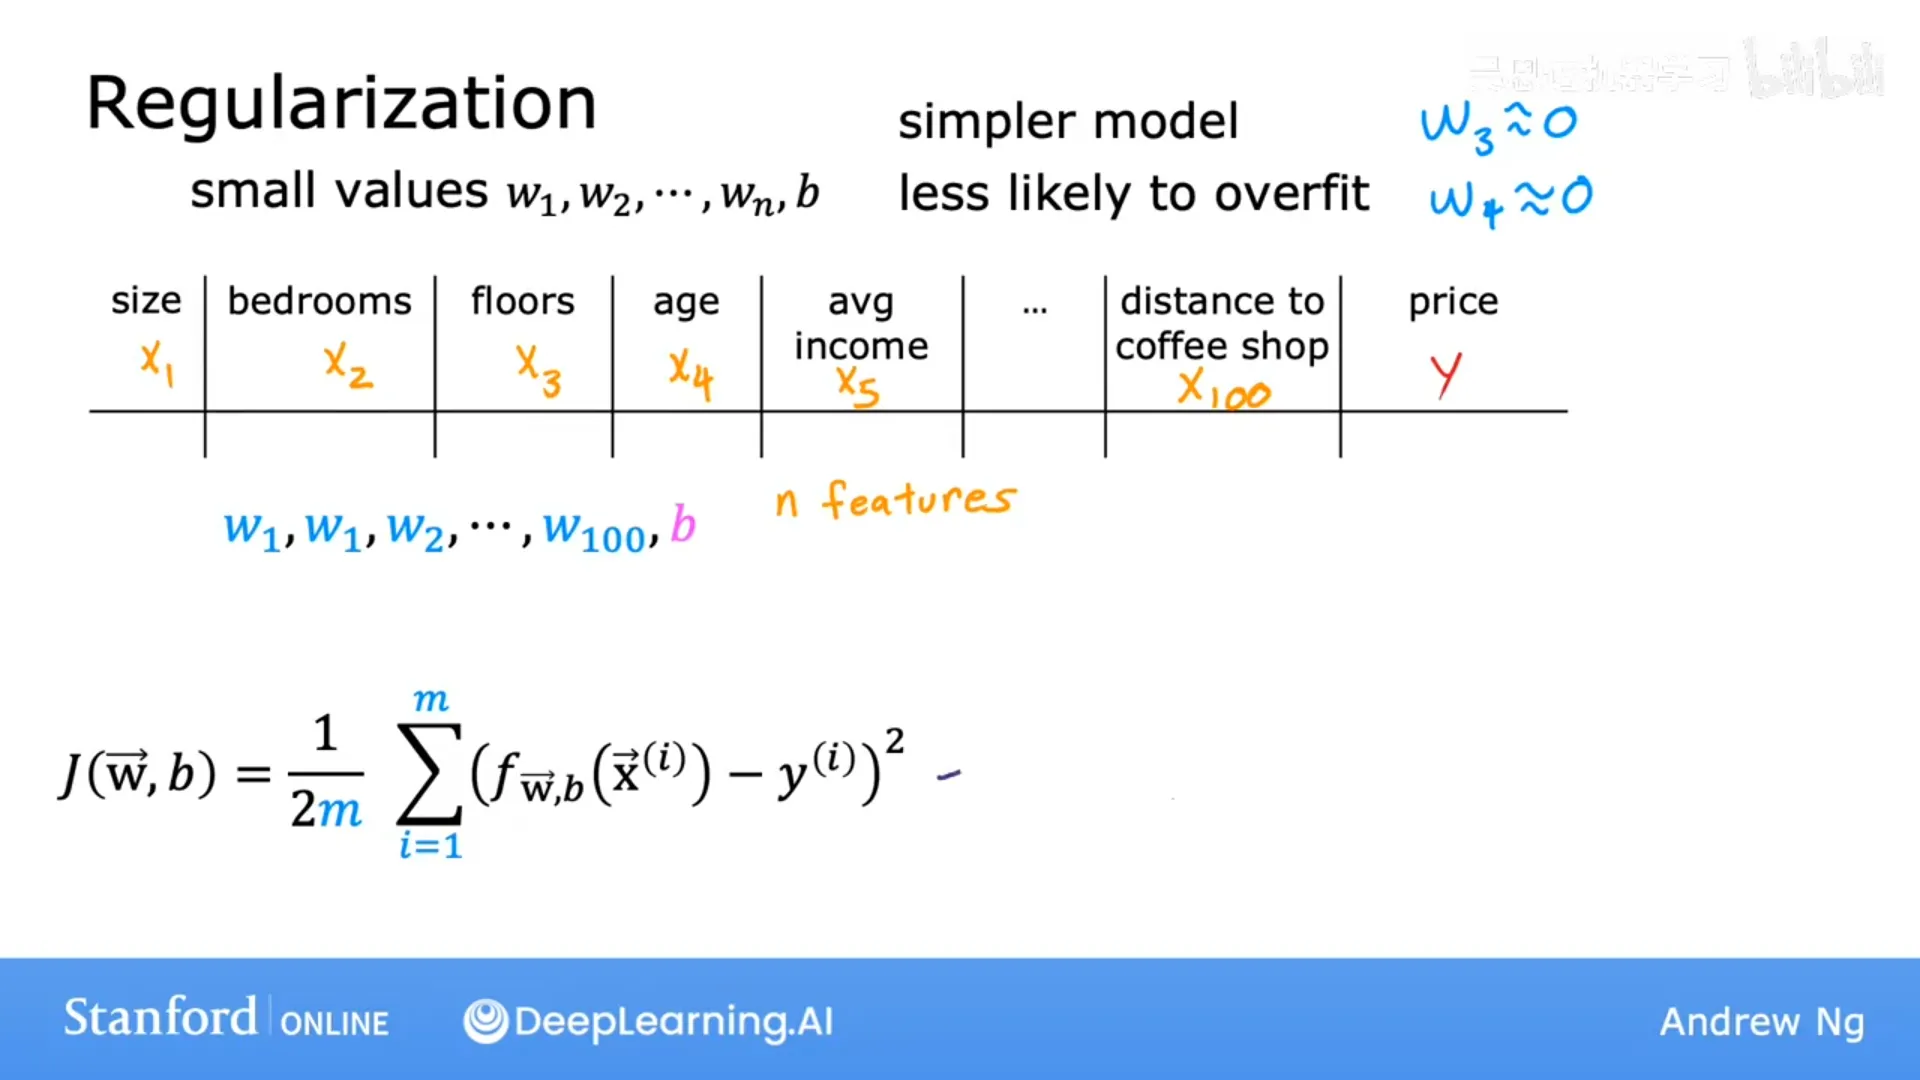
正则化的直觉:过拟合模型的参数往往很大;把某个特征对应的参数设为 0,等价于删掉该特征。而正则化是一种更温和的做法——不删特征,只是"压制"它们的影响,让参数都变小。经验上,只要能让高阶多项式模型用较小的参数,就能得到更平滑、更好泛化、不易过拟合的曲线。
(按惯例,通常只正则化 w₁…wₙ,不正则化 b——是否正则化 b 差别很小。)
📷 正则化:把参数"压制"得更小,而不是直接删特征
回到原视频 (00:03:46)
10.3 正则化的代价函数
易错点 M13:Ridge 的直接 inductive bias 是「偏好小的 $\lVert w\rVert_2$」;「方差下降、稳定性上升、偏差上升」是它的统计后果——不要把「降低 variance」当成正则化本身的偏好。
易错点 M14:$\lambda$ 大 → 约束强 → 高 bias → 欠拟合;$\lambda$ 小 → 约束弱 → 高 variance → 过拟合。别记反。
(p39)
若已知该惩罚哪些特征,可以在代价里给它们加大权重(如 1000·w₃² + 1000·w₄²),迫使 w₃、w₄ 趋近于 0。但实际中特征很多、往往不知道该惩罚谁,于是对所有 w_j 一起惩罚:
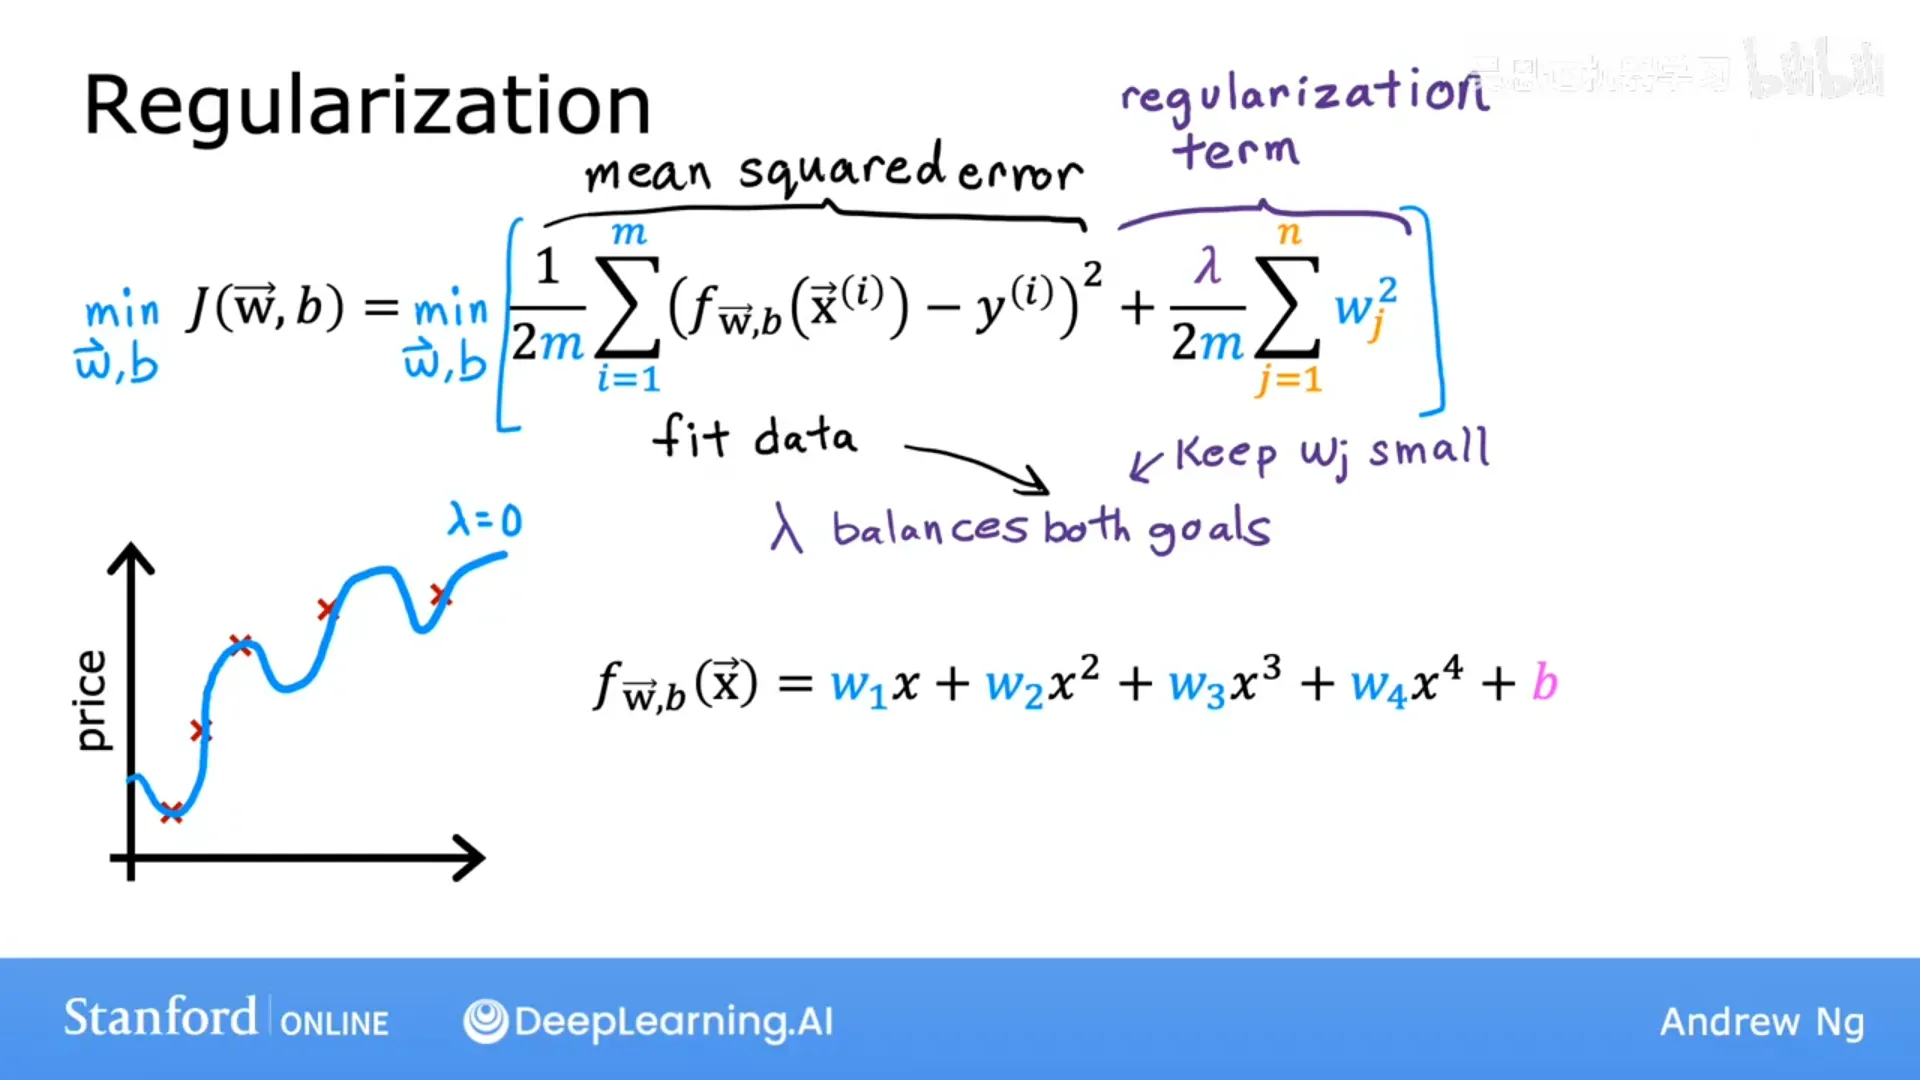
$$J(w,b) = \underbrace{\frac{1}{2m}\sum_{i=1}^{m}\big(f(x^{(i)}) - y^{(i)}\big)^2}_{\text{平方误差项}} + \underbrace{\frac{\lambda}{2m}\sum_{j=1}^{n} w_j^2}_{\text{正则化项}}$$
- λ 是正则化参数,控制两项的相对权重;
- 惯例上把正则项也写成除以 2m,这样两项按同样方式缩放,选 λ 更容易,且训练集规模 m 变化时原先的 λ 更可能仍适用;
- b 不参与正则化。
λ 的两种极端:
- λ = 0:完全没正则化 → 高阶多项式过拟合;
- λ 非常大(如 10¹⁰):为让代价变小,所有 w_j 被迫趋近 0 →
f(x) ≈ b,一条水平线 → 欠拟合。
所以要选一个介于两者之间的 λ,平衡"拟合数据"与"保持参数小"。(模型选择那一部分会讲如何选 λ。)
📷 正则化代价函数:平方误差项 + λ·参数平方项
回到原视频 (00:03:58)
📷 λ 过大导致所有参数被压到接近 0,模型欠拟合
回到原视频 (00:07:11)
10.4 正则化线性回归
数学角落:Ridge 的闭式解 $(X^\top X+\lambda I)^{-1}X^\top y$ 相当于把 $X^\top X$ 的特征值整体上移:$\mu_i\to\mu_i+\lambda$。于是原本很小的方向不再被求逆时疯狂放大——这就是 Ridge 改善共线性 / ill-conditioning(小特征值放大噪声)的机制。
(p40)
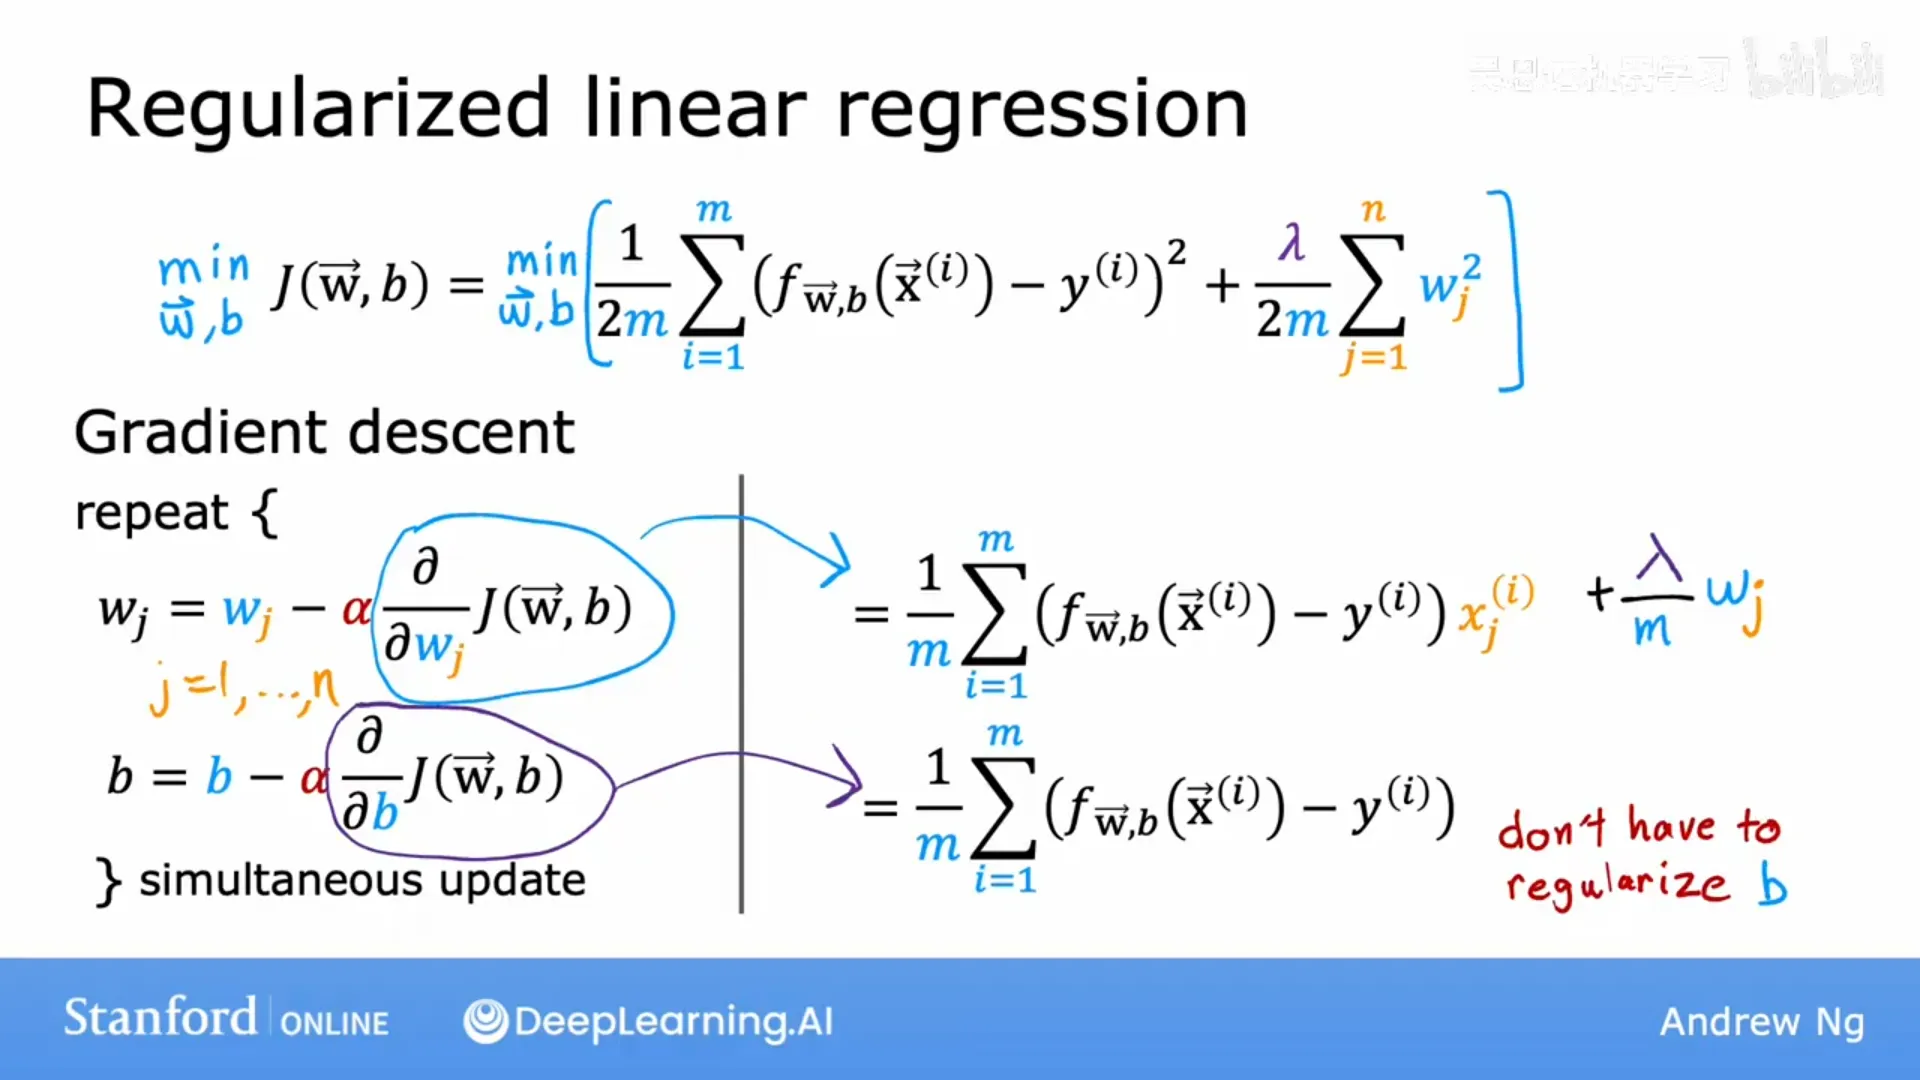
对正则化后的代价函数求导,唯一的变化是 w_j 的导数多了一项 (λ/m)·w_j(b 的导数不变,因为不正则化 b)。于是更新规则为:
$$\begin{aligned}
w_j &:= w_j - \alpha\left[\, \frac{1}{m}\sum_{i=1}^{m}\big(f(x^{(i)}) - y^{(i)}\big)\, x^{(i)}j + \frac{\lambda}{m} w_j \right] \ b &:= b - \alpha\,\frac{1}{m}\sum{i=1}^{m}\big(f(x^{(i)}) - y^{(i)}\big)
\end{aligned}$$
把 w_j 的更新式整理一下,可以更清楚地看到正则化的作用:
$$w_j := \underbrace{w_j\Big(1 - \alpha\frac{\lambda}{m}\Big)}_{\text{略小于 }1} - \alpha\,\frac{1}{m}\sum_{i=1}^{m}\big(f(x^{(i)}) - y^{(i)}\big)\, x^{(i)}_j$$
即:每次迭代先把 w_j 乘以一个略小于 1 的数(把它"缩小一点点"),再做常规的梯度更新。这就是"正则化在每一步都稍微收缩参数"的含义。
📷 正则化线性回归的梯度下降更新规则
回到原视频 (00:02:24)
10.5 正则化逻辑回归
(p41)
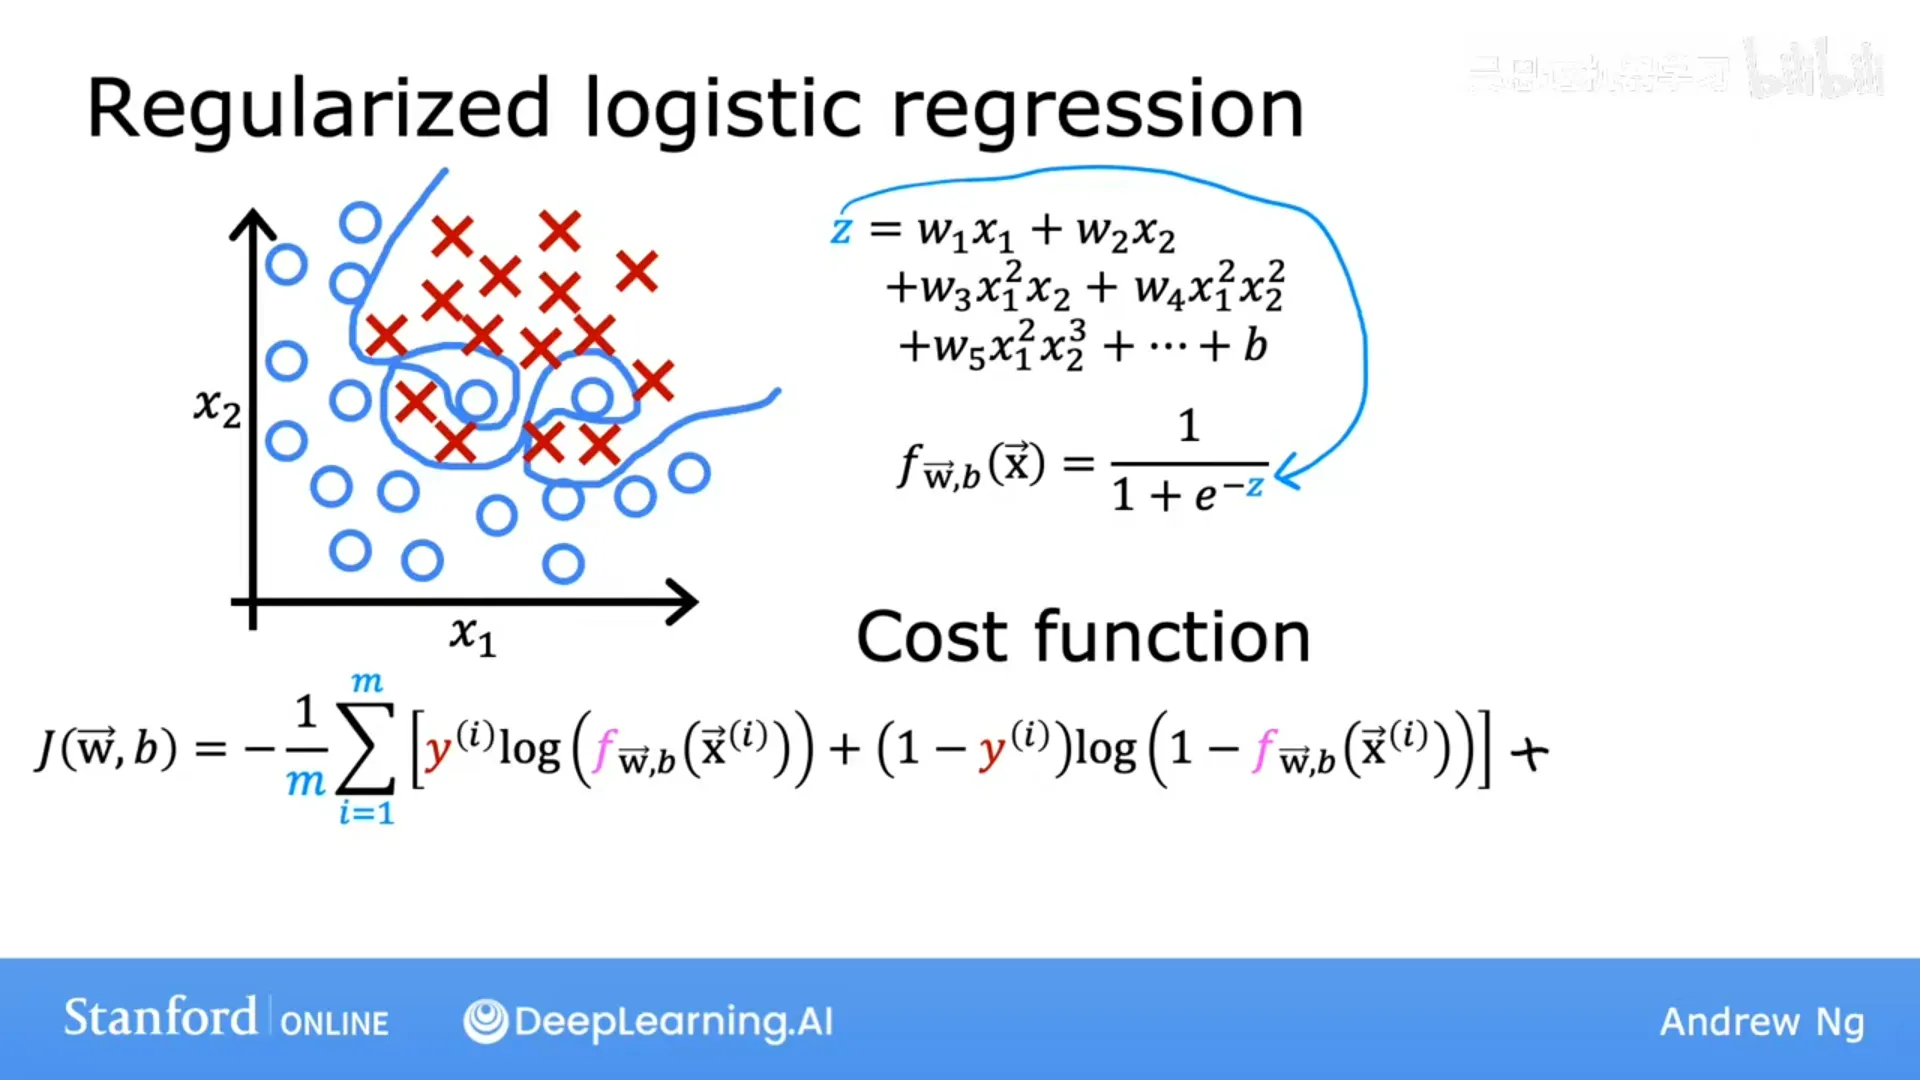
思路完全相同:在逻辑回归的代价函数后加上同样的正则项
$$\frac{\lambda}{2m}\sum_{j=1}^{n} w_j^2$$
于是梯度下降的更新式与正则化线性回归形式上一致——唯一区别仍是 f(x) 的定义不同(逻辑回归用的是 Sigmoid):
$$\begin{aligned}
w_j &:= w_j - \alpha\left[\, \frac{1}{m}\sum_{i=1}^{m}\big(f(x^{(i)}) - y^{(i)}\big)\, x^{(i)}j + \frac{\lambda}{m} w_j \right] \ b &:= b - \alpha\,\frac{1}{m}\sum{i=1}^{m}\big(f(x^{(i)}) - y^{(i)}\big)
\end{aligned}$$
效果是:即使使用了大量的高阶多项式特征,也能得到更合理、能泛化的决策边界,而不是去完美地穿过每个训练点。
📷 正则化逻辑回归:即使特征很多也能得到合理的决策边界
回到原视频 (00:01:13)
自测与思考题(进阶)
按你的反馈,这里刻意不做「二选一 / 定义复述」题,而是反例、推导、错误诊断、参数变化、迁移类型。
- 诊断收敛:A 的 $J$ 从 2.3 单调降到 0.5 后几乎不动;B 的 $J$ 在 $0.9\leftrightarrow1.3$ 之间来回跳。分别更像 $\alpha$ 太小、合适、还是太大?
- 构造反例:给一组线性回归数据,使最优参数不唯一;并说明此时 $X^\top X$ 有什么性质。
- 推导:说明 $\nabla^2 J=\frac1m X^\top X\succeq0$,并指出何时是正定(严格凸)。
- 迁移 / 参数变化:把特征单位从「米」换成「厘米」($\times100$)。最优 $\hat y$ 会变吗?$J$ 的等高线形状会变吗?梯度下降更难还是更容易?为什么?
- 纠错:有人说「测试集自己重算 $\mu,\sigma$ 更准,所以 train/test 应各算各的」。指出其中的两个错误。
- 参数变化:Ridge 中令 $\lambda\to\infty$,$\hat y$ 会变成什么?偏差 / 方差各如何变化?
- 对比:逻辑回归里 $(y=0,p=0.9)$ 与 $(y=1,p=0.9)$,哪个 NLL 更大?为什么?
- 几何连接:为什么 feature scaling 后等高线从狭长椭圆趋向圆?把它和 condition number 联系起来。
参考答案要点
- A 更像 $\alpha$ 合适但收敛后趋平(或偏小、很慢);B 在最小值两侧振荡,更像 $\alpha$ 偏大(接近 $2/\lambda_{\max}$ 的上限)。关键是看是否发散与振幅是否递减。
- 例如 $x_2=x_1$、$y=4x_1$:任意 $w_1+w_2=4$ 都给出完全相同的预测,数据无法分辨 $w_1,w_2$。此时 $X$ 列相关,$X^\top X$ 奇异(有零特征值),不是正定。
- $J$ 的梯度是 $\frac1m X^\top(Xw-y)$,再求导得 $\frac1m X^\top X$;$v^\top X^\top Xv=\lVert Xv\rVert^2\ge0$ ⇒ 半正定。当 $X$ 满列秩时 $Xv=0\Rightarrow v=0$,故正定、严格凸、解唯一。
- $\hat y$(预测)不变(只是参数坐标缩放:$w_1$ 变为原来的 $1/100$)。但等高线形状会变:未缩放时该方向被拉伸,等高线更狭长、condition number 更差、GD 更慢、对 $\alpha$ 更敏感;缩放让各方向尺度可比,$\kappa$ 下降,GD 更容易。
- 错误一:破坏了训练时假设的特征坐标系(模型学到的是 train 的 $\mu,\sigma$);错误二:用了测试集信息 → data leakage,测试结果不再可信。
- $w\to0$,$\hat y\to b$(近似常数预测器,$b\approx\bar y$);偏差 ↑、方差 ↓,最终欠拟合。
- $(y=0,p=0.9)$ 的 NLL 更大:$-\log(1-0.9)=-\log0.1\approx2.30$,而 $(y=1,p=0.9)$ 为 $-\log0.9\approx0.105$。模型「越不相信真实标签」,惩罚越大。
- 缩放把各特征方向的尺度拉齐,$X^\top X$ 的特征值比值 $\lambda_{\max}/\lambda_{\min}$ 变小(condition number 下降),等高线椭圆的长短轴之比随之变小、趋向圆;GD 在圆上各方向步长一致,收敛更快。
结语
恭喜你完成了本册——《吴恩达机器学习(新版)》第一门课的全部内容。你已经掌握:
- 监督学习的基本框架,以及回归与分类两大问题;
- 线性回归、代价函数与梯度下降(含特征缩放、学习率选择、特征工程、多项式回归);
- 逻辑回归、Sigmoid、决策边界与对数损失;
- 过拟合/欠拟合与正则化。
吴恩达在结尾鼓励道:理解并能应用线性回归与逻辑回归,已经足以做出一些非常有价值的产品——而在实战中知道何时、如何减少过拟合,同样是一项宝贵的能力。
下一门课预告:本专项第二门课将进入神经网络(深度学习)。它的构建会大量复用你已经学到的东西——代价函数、梯度下降、Sigmoid 函数。
附:来源与参考
- 课程:Machine Learning Specialization(DeepLearning.AI / Stanford Online,2022 新版),讲师 Andrew Ng
- 课程主页:https://www.deeplearning.ai/specializations/machine-learning
- 视频来源:Bilibili 搬运合集
BV16jyuBBEom(本册对应分P p1–p41) - 参考笔记(2014 版课程):https://github.com/fengdu78/Coursera-ML-AndrewNg-Notes
- 相关工具/库:NumPy、Jupyter Notebook、Scikit-learn
版权说明:课程视频、字幕与讲义版权归 DeepLearning.AI / Stanford 所有。本电子书为个人学习所做的中文书面重构,未获授权,不得用于任何商业用途或公开传播。书中截图取自对应分P视频画面,并在图旁标注了「分P号 @ 时间」以便回源核对。