吴恩达机器学习(新版):第二门课(上) · 神经网络与深度学习
本电子书由视频课程重构而成(个人学习用)。 课程视频、字幕与讲义版权归 DeepLearning.AI / Stanford 所有。本电子书仅为个人学习所做的中文书面重构,不得用于任何商业用途或公开传播。书中截图取自对应分P视频画面,并标注「分P @ 时间」以便回源核对。
| 原课程 | Machine Learning Specialization(DeepLearning.AI / Stanford Online,2022 新版),讲师 Andrew Ng(吴恩达) |
| 视频来源 | Bilibili 搬运合集 BV16jyuBBEom(本册为第二门课的神经网络部分,分P p42–p70) |
| 官方配套 | https://www.deeplearning.ai/specializations/machine-learning |
| 参考笔记(2014 版课程) | https://github.com/fengdu78/Coursera-ML-AndrewNg-Notes |
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
本册导读
第二门课《Advanced Learning Algorithms》内容其实横跨两个相当不同的主题,因此拆成两册。本册专注神经网络(深度学习),覆盖:
- 神经网络直觉:从生物神经元到需求预测(p42–p45)
- 神经网络中的层与前向传播(p46–p48)
- TensorFlow 实现(p49–p51)
- 用 Python 从头实现前向传播(p52–p53)
- 通往 AGI 之路?(p54,可选话题)
- 矩阵乘法与神经网络的向量化实现(p55–p58,可选的线性代数铺垫)
- TensorFlow 训练细节:损失、反向传播、fit(p59–p60)
- 激活函数的选择(p61–p63)
- 多类分类与 Softmax(p64–p68)
- Adam 优化与其他层类型(p69–p70)
配套的另一册《机器学习实践与决策树》覆盖机器学习诊断、偏差/方差、误差分析、项目周期、倾斜数据集,以及决策树与集成学习。
第一章 神经网络直觉:从生物神经元到需求预测
(对应模块 1,视频 p42–p45)
1.1 为什么要学神经网络
(p42)
第一门课我们学了线性回归和逻辑回归——它们很强,但当特征很多、关系很复杂时就不够用了。神经网络(也叫深度学习)是当今最强大、最广泛使用的学习算法之一,也是这几年 AI 突破的主要推手。
本门课的独特之处,除了算法本身,还有如何构建一个实用的机器学习系统。吴恩达指出:现实中大量团队做 ML 项目时会卡在"下一步做什么"——比如"该花更多时间收集数据,还是买一块更大的 GPU 训练更大的网络?"他常看到团队做了半年才发现方向不对。掌握系统化的方法,能帮你避免浪费那半年。
术语小注:推理(inference)指"用训练好的参数做预测"。例如你从网上下载别人训练好的神经网络参数,用它来对新数据做预测,这就是推理。训练(training)则是用数据学出参数的过程。
1.2 生物神经元与"为什么是现在"
(p43)
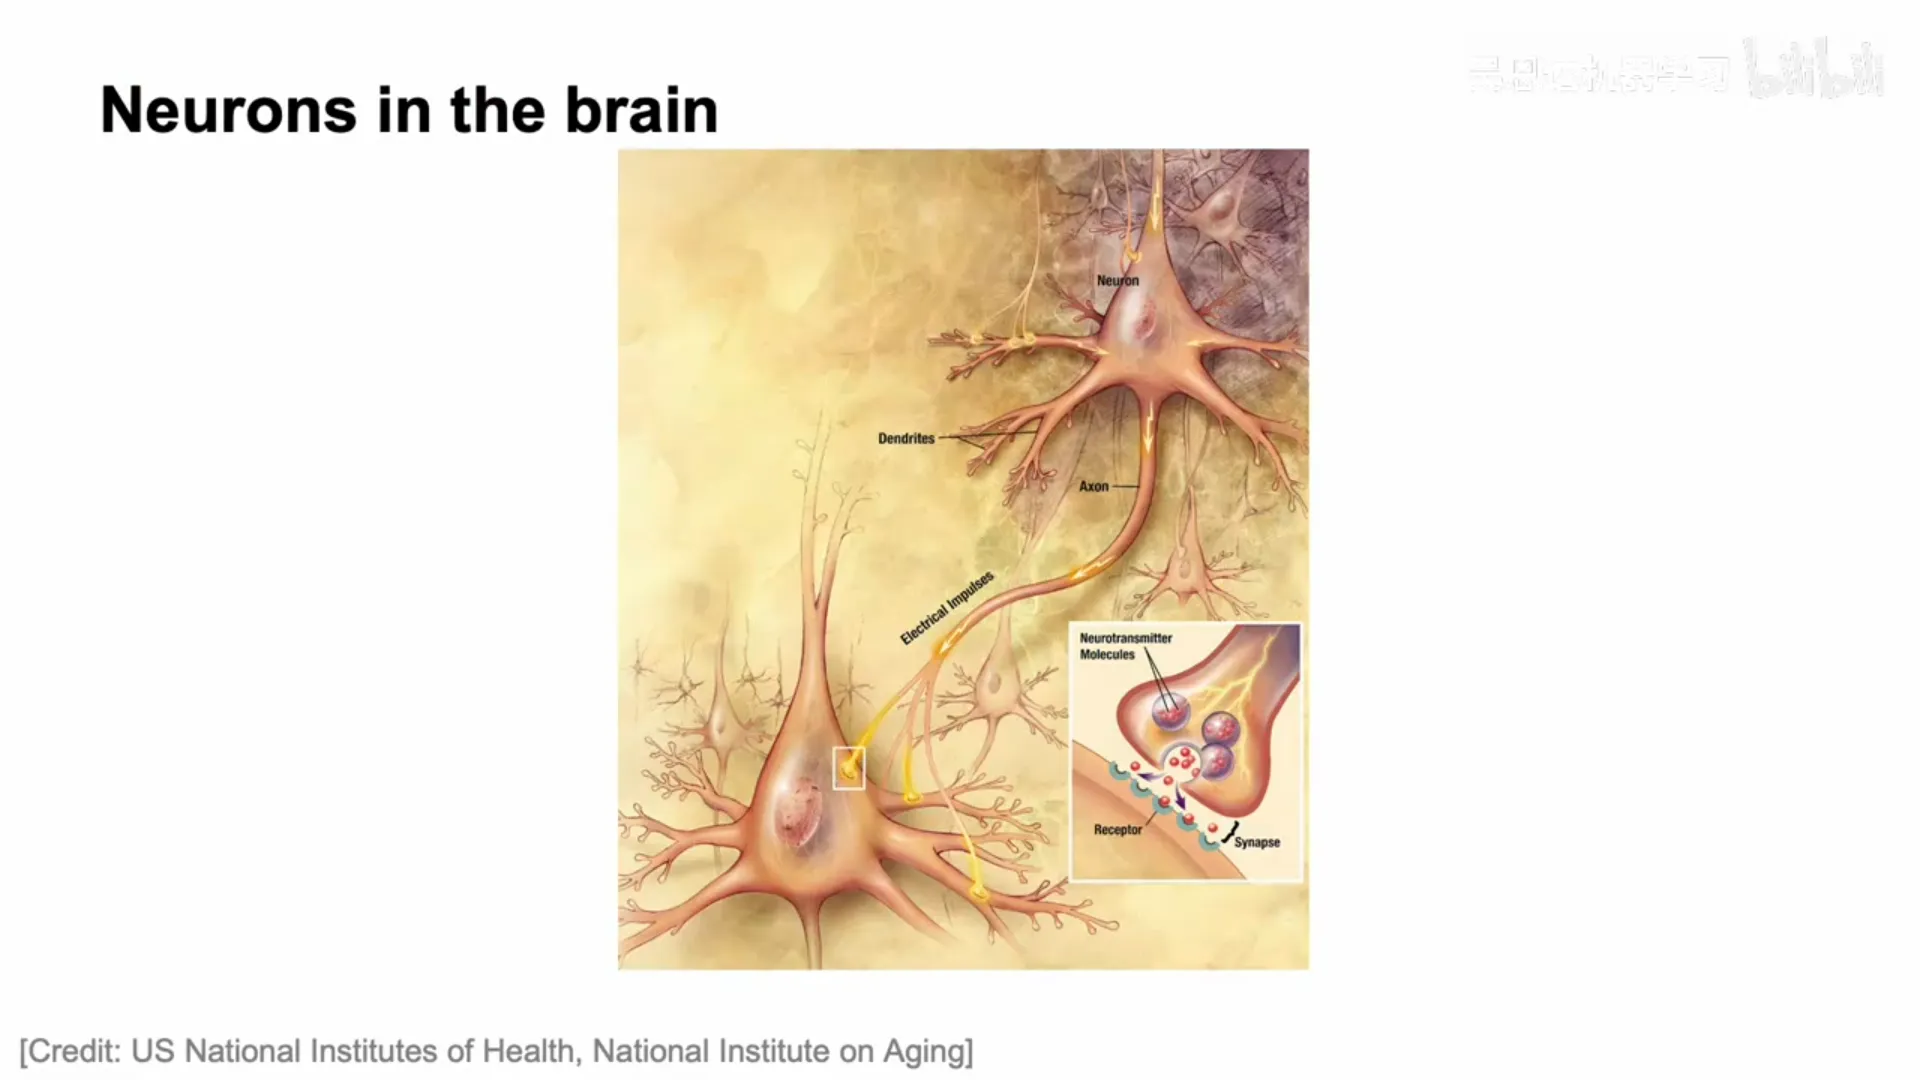
神经网络最早的动机是模仿大脑。生物神经元的结构是:
- 有许多输入端(生物学上叫树突 dendrites),从其他神经元接收电脉冲;
- 神经元本体(细胞体,含细胞核)对输入做某种计算;
- 通过输出端(轴突 axon)把电脉冲发给下游神经元;
- 下游神经元再把多个输入汇总、继续传递。
你我的思维,就建立在这些神经元相互传递电脉冲、并不断形成新连接之上。
编者拓展|神经网络的三起两落(一段很值得知道的历史):用大脑启发计算的想法很早就有——1943 年 McCulloch 与 Pitts 提出人工神经元模型;1958 年 Rosenblatt 造出感知机(Perceptron),一时轰动;1969 年 Minsky 与 Papert 指出单层感知机连 XOR 都学不了,加上算力不足,把研究带入第一次「AI 寒冬」;1986 年反向传播被重新普及,多层网络重获可行;2012 年 AlexNet 在 ImageNet 上夺冠,深度学习才真正引爆。今天你用的每一个模型,都站在这条时间线上。
人工神经网络用一个极度简化的数学模型来近似它:
一个神经元接收一个或多个数字作为输入 → 做计算 → 输出一个数字 → 这个数字又成为下一个神经元的输入。
构建时不是"一次一个神经元",而是同时模拟很多个;把它们连接成群,就形成了网络。
📷 人工神经元对生物神经元的极度简化:多个输入→计算→一个输出
回到原视频 (00:03:16)
重要提醒:尽管有生物学类比,但我们至今几乎不知道大脑究竟如何工作——神经科学每隔几年就会有基础性突破,说明还有很多未知。因此盲目模仿现有的大脑知识不会让我们走得太远;做深度学习的人已不再依赖生物动机,而是用工程原则设计更有效的算法。生物类比很有趣,但别太当真。
为什么神经网络"现在"才兴起?
数据和算力在几十年里发生了巨变:
- 数据爆炸:互联网、手机普及、社会数字化、纸质记录电子化(订单、健康记录等都变成了电子数据);
- 传统算法次线性:把更多数据喂给线性回归、逻辑回归,性能很快趋于饱和,无法有效利用海量数据;
- 神经网络能持续受益:实验发现——小型网络性能一般,中型网络更好,非常大的网络在数据充足时性能还能继续提升。
两件事叠加,造就了深度学习:大数据 + 更快的算力(尤其 GPU)。GPU 原本为生成精美图形而设计,却恰好非常适合深度学习的矩阵运算。
📷 数据量 vs 性能:传统算法很快饱和,大神经网络还能持续受益
回到原视频 (00:07:49)
1.3 需求预测:从一个神经元到一层
(p44)
引例:预测某款 T 恤是否会成为畅销品。
版本一(单特征):只有输入特征 价格 x。用逻辑回归拟合,输出 1/(1+e^{−(wx+b)})。为了过渡到神经网络,把输出改记作 a——
a 代表"激活(activation)"。这是神经科学术语,指"神经元向下游发送信号的强度"。
这个逻辑回归单元就可以看成大脑中一个神经元的极简模型:它把价格作为输入,计算那个公式,输出"这件 T 恤成为畅销品的概率"。换句话说,神经元就像一台小计算机,唯一的工作是输入一个(或几个)数字,输出一个(或几个)数字。
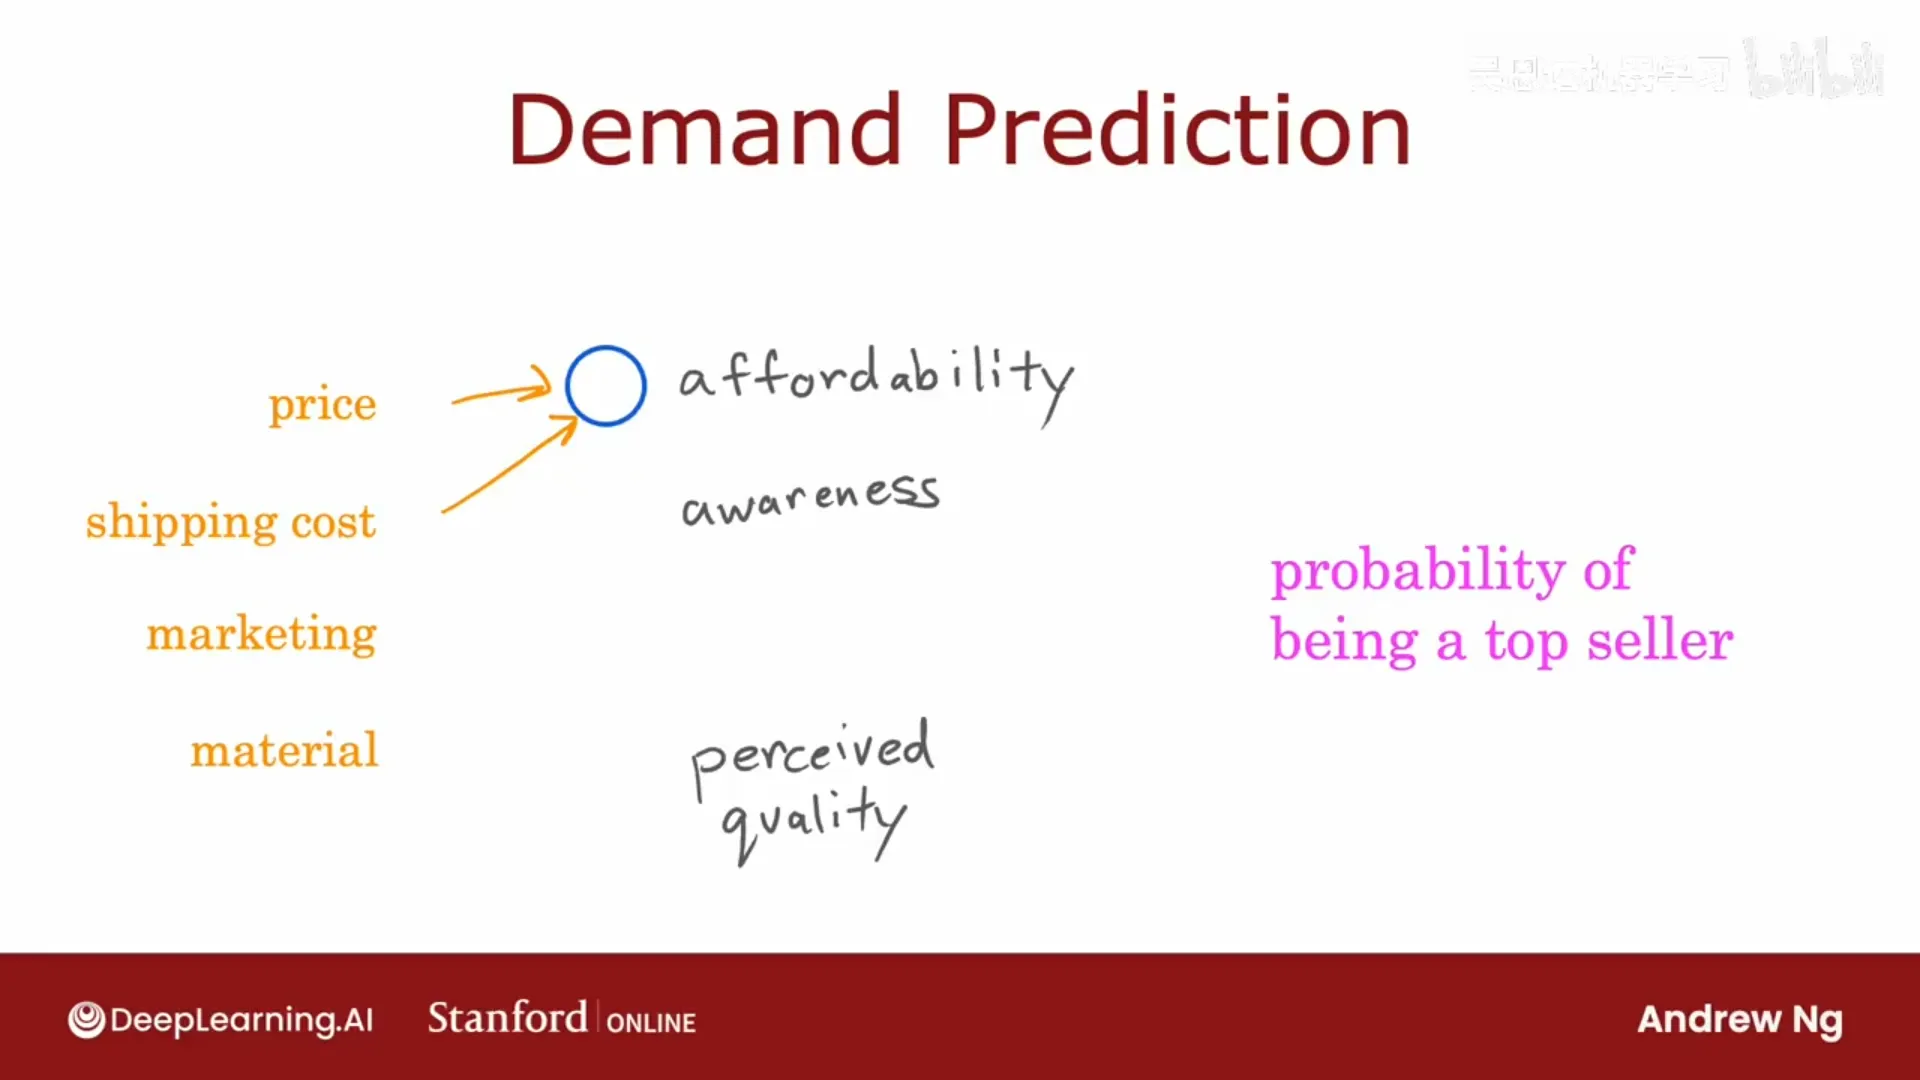
版本二(多特征,一个隐藏层):现在有四个特征——价格、运费、营销量、材料质量。直觉上,"是否畅销"取决于三个中间因素:
- 是否实惠:主要看 价格 + 运费(你要付的总金额是两者之和);
- 知名度:主要看 营销;
- 感知质量:主要看 价格 和 材料质量(有趣的是,贵有时会被当成好)。
于是可以:
- 用神经元 A(逻辑回归单元)输入「价格、运费」,估计"是否实惠";
- 用神经元 B 输入「营销」,估计"知名度";
- 用神经元 C 输入「价格、材料质量」,估计"感知质量";
- 把 A、B、C 的输出接入神经元 D,输出"畅销概率"。
按神经网络术语:
- 把一组神经元放在一起称为一层(layer)——它们接收相同/相似的输入、一起输出一组数字;左边三个神经元组成一层;
- 右边的单个神经元也是一层,叫输出层(output layer),因为它的输出就是整个网络的预测;
- 中间量(实惠、知名度、感知质量)叫激活值(activations);
- 四个数字的输入列表叫输入层(input layer)。
📷 需求预测的神经网络:输入层 → 隐藏层(实惠/知名度/感知质量)→ 输出层
回到原视频 (00:04:26)
两个关键简化
简化一:全连接。 手动决定"哪个神经元接收哪些特征"太麻烦。实际实现中,某一层的每个神经元都能访问上一层的每一个值(这就是"全连接 dense")。你可以想象:在预测"实惠"时,它知道价格、运费、营销、材料,但可以通过把相应参数设得很小来学会忽略不相关的特征。
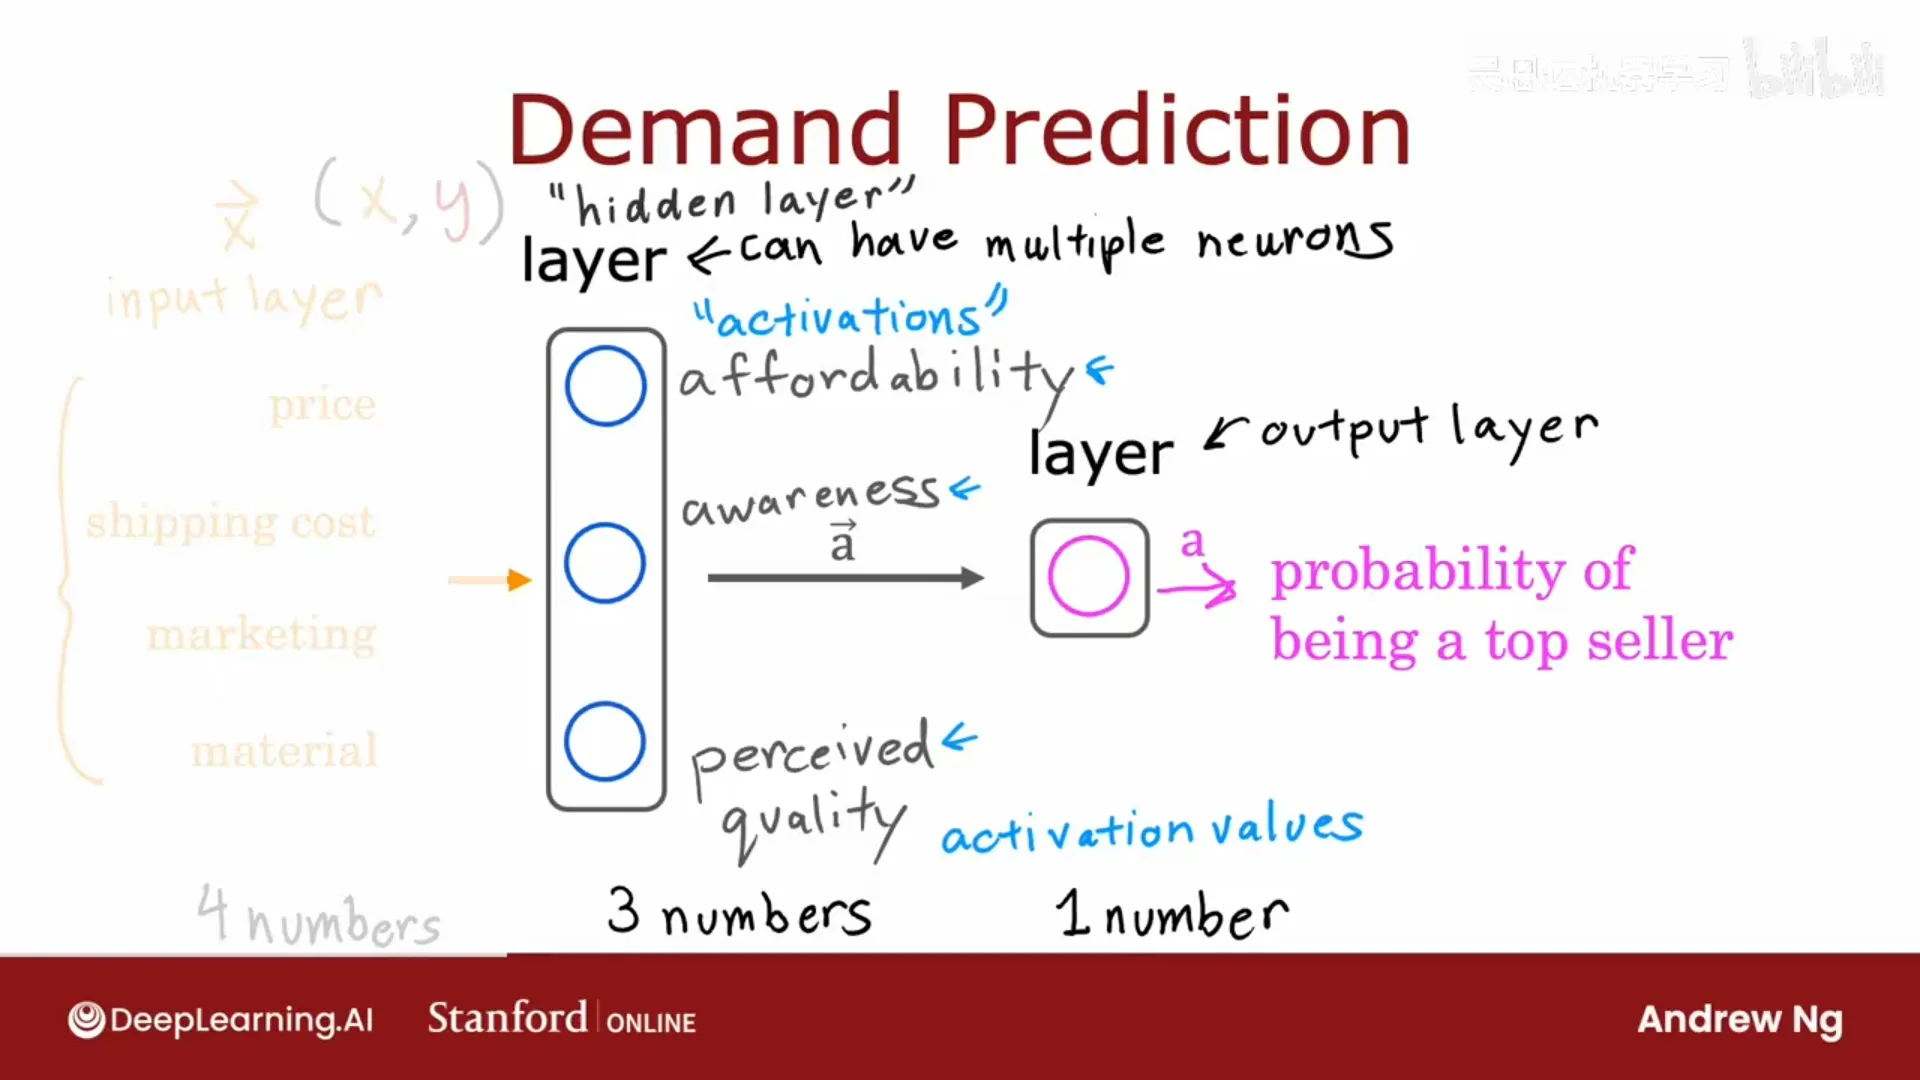
简化二:让网络自己学特征。 把网络的左半部分遮住再看——剩下的就是一个逻辑回归!只不过它用的不是原始特征(价格、运费…),而是自己学出来的新特征(实惠、知名度、感知质量)。
回想第一门课:要预测房价,你得手动做特征工程(用"地块宽度 × 深度"造出"面积")。而神经网络可以自己学出这些特征——这正是它成为当今最强学习算法之一的原因。
📷 遮住输入层:这只是一个"能自己学特征"的逻辑回归
回到原视频 (00:11:05)
更多隐藏层
网络也可以有多个隐藏层:x → 隐藏层1(3 个神经元)→ 隐藏层2(2 个神经元)→ 输出层;甚至可以更多层。要几个隐藏层、每层几个神经元,这就是神经网络架构(architecture)的问题——选得合适与否会明显影响性能,后面的课程会讲怎么选。(有些文献把这种多层网络叫多层感知机 MLP。)
1.4 例子:人脸识别与"逐层抽象"
(p45)
一张 1000×1000 像素的图片,在计算机里其实是一个 1000×1000 的像素亮度矩阵(亮度 0~255)。把它展平成一维,就是一百万个输入特征。任务:输入这张图,输出"照片中的人是谁"。
网络结构:一百万个输入 → 隐藏层1 → 隐藏层2 → 隐藏层3 → 输出层(估计"是某个人的概率")。
一个非常有趣的现象:在大量人脸图片上训练后,去可视化各隐藏层到底在算什么,会看到一种清晰的逐层抽象:
- 第 1 层:神经元在检测短小的边缘/线段(一小段垂直边、某个方向的斜线……);
- 第 2 层:把小线段组合起来,检测面部的部位(如"某一位置有没有眼睛"、"鼻子的一个角"、"鼻子底部"……);
- 第 3 层:把部位聚合,检测更大、更完整的面部形状;
- 输出层:依据这组丰富的特征判断身份。
关键在于:没有人告诉它"第 1 层找边缘、第 2 层找眼睛鼻子"。神经网络自己从数据里学出了这些特征检测器;而且各层看到的窗口越来越大(第 1 层看小窗口,第 2、3 层看的区域越来越大)。
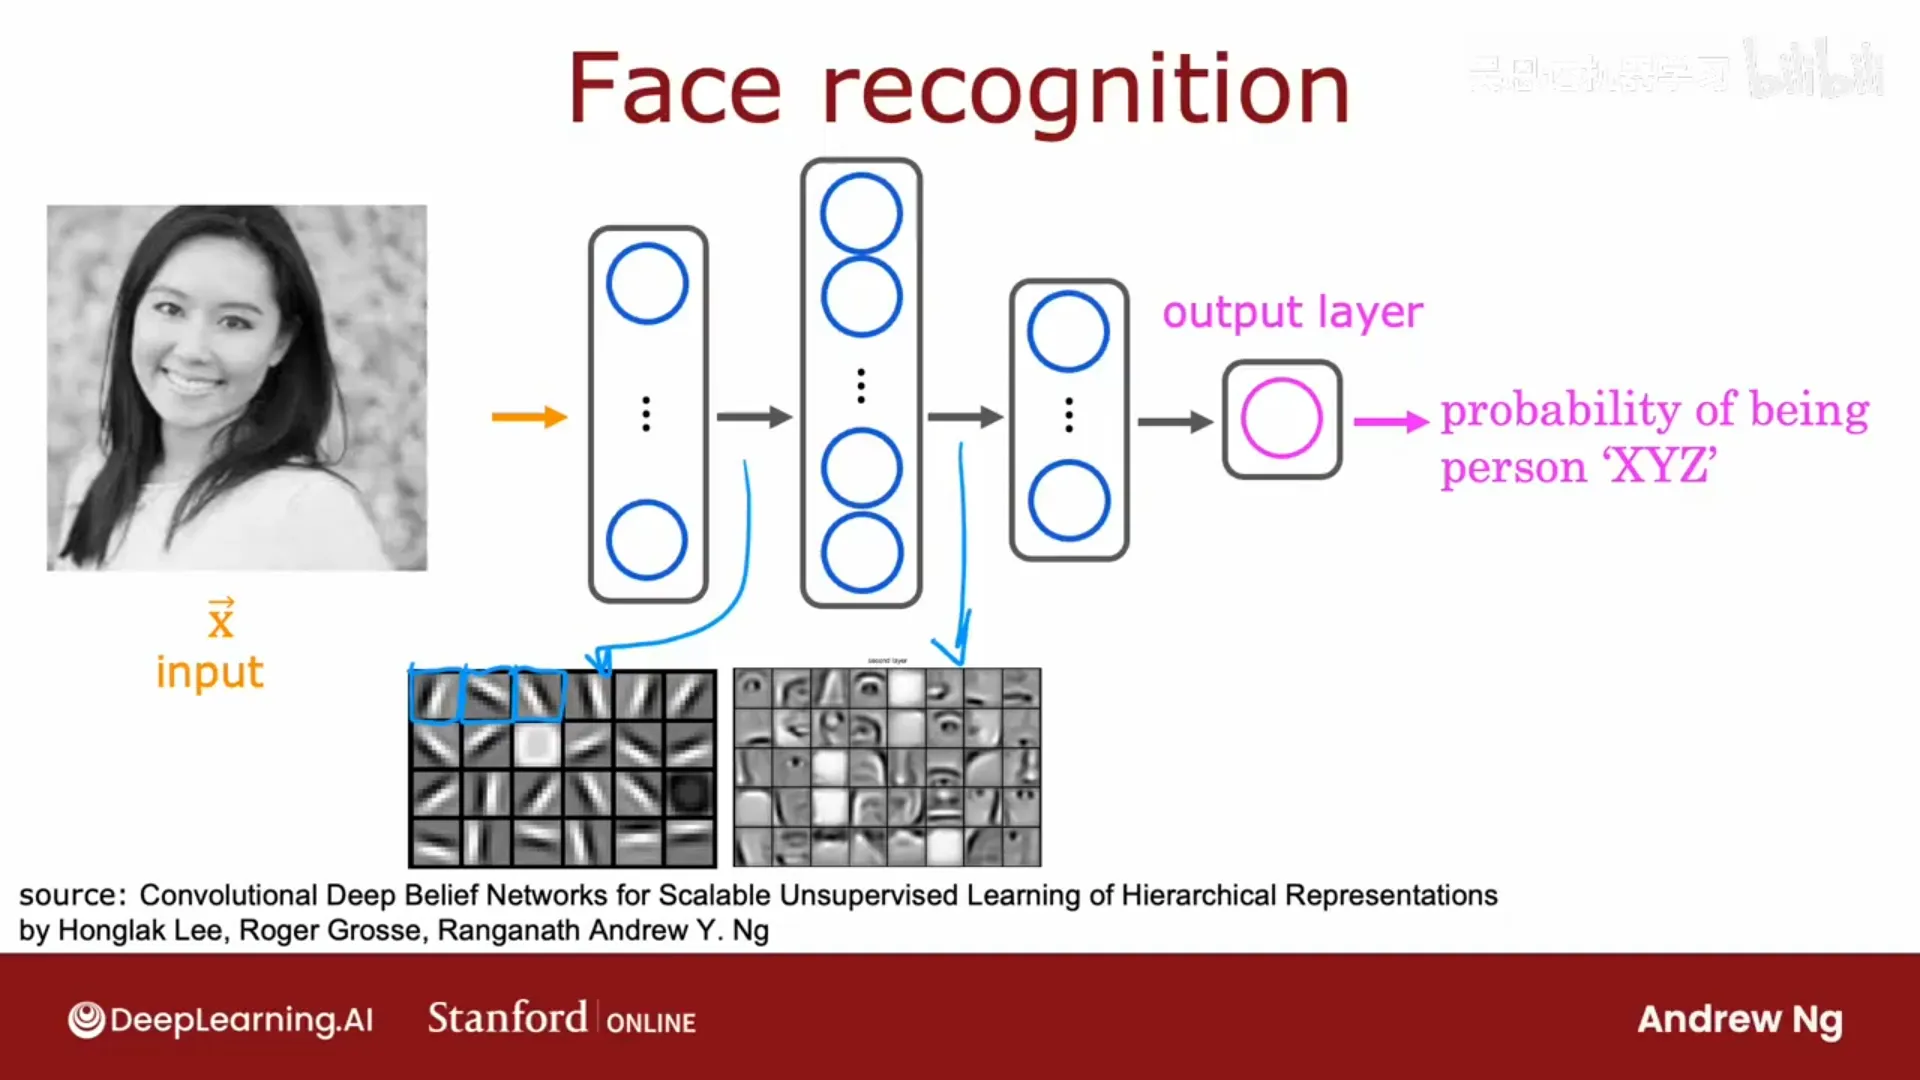
📷 隐藏层的逐层抽象:第1层找边缘、第2层找眼睛鼻子、第3层找整张脸
回到原视频 (00:03:30)
换个数据集试试:用侧面拍摄的汽车照片训练同一个算法——第 1 层仍学边缘,但第 2 层学会检测汽车部件,第 3 层学会检测完整的汽车形状。只要换数据,网络就自动学出完全不同的特征。
第二章 神经网络中的层与前向传播
(对应模块 2,视频 p46–p48)
2.1 一个层在算什么
(p46)
现代神经网络的基本模块是神经元层。放大需求预测的隐藏层:它输入 4 个数字,3 个神经元各自做一个逻辑回归:
$$\begin{aligned}
a_1 &= g(w_1\cdot x + b_1) &&\text{例如 }0.3\ a_2 &= g(w_2\cdot x + b_2) &&\text{例如 }0.7\ a_3 &= g(w_3\cdot x + b_3) &&\text{例如 }0.2
\end{aligned}$$
其中 g(z) = 1/(1+e^{−z}) 是 Sigmoid,z = w·x + b 是你在线性/逻辑回归里熟悉的内积加偏置。三个结果构成激活向量 a = [0.3, 0.7, 0.2],送进输出层。
输出层只有一个神经元:
$$a_1^{[2]} = g\big(w_1^{[2]}\cdot a^{[1]} + b_1^{[2]}\big) \qquad \text{例如 }0.84$$
这 0.84 就是网络的最终输出。
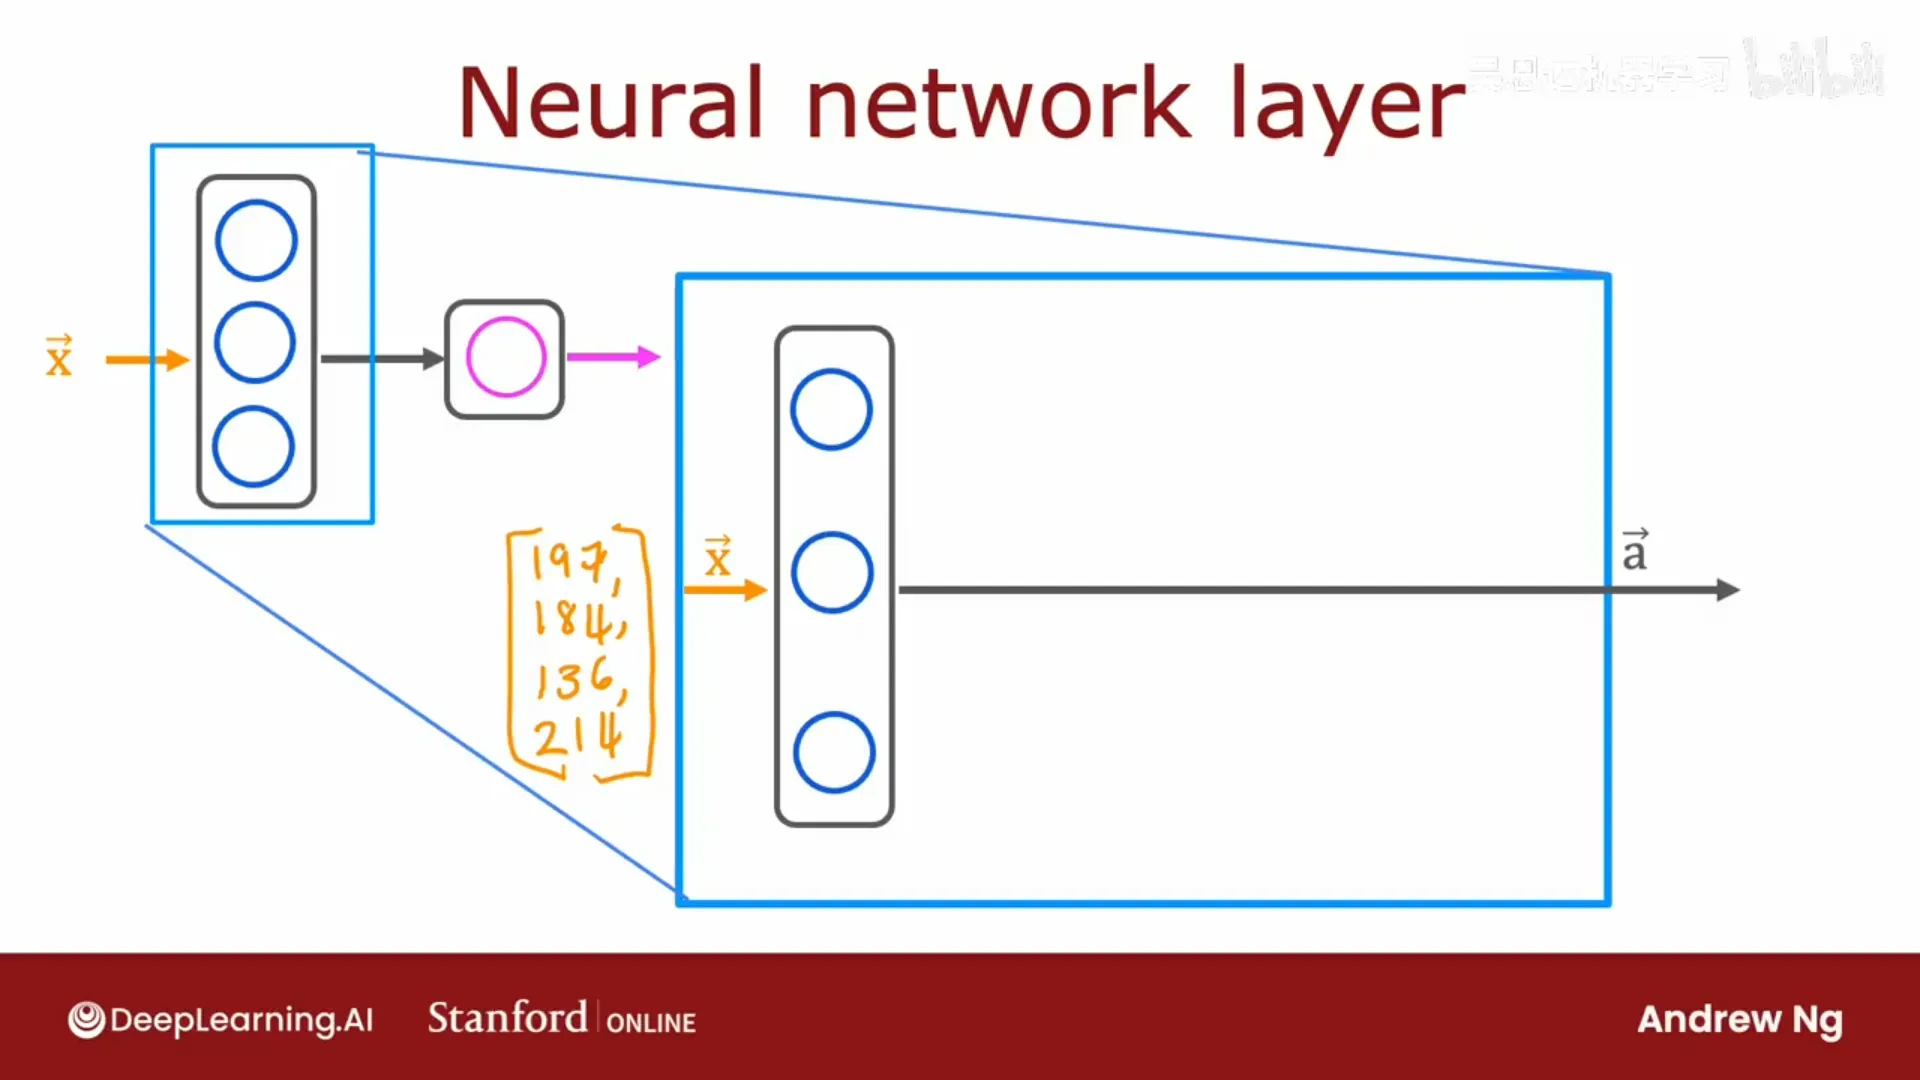
📷 隐藏层里每个神经元就是一个小的逻辑回归单元
回到原视频 (00:01:03)
2.2 层的编号与符号约定
(p46)
- 输入层 = 第 0 层;隐藏层依次是第 1、2…层;输出层是最后一层。
- 方括号上标标注层:
a^[1]是第 1 层的输出,w^[1]、b^[1]是第 1 层的参数。看到^[1]就表示"与第 1 层有关的量"。 - 如今有些网络有几十甚至上百层。
两个上标要分清:
x⁽ⁱ⁾的圆括号上标表示第 i 个训练样本;a^[l]的方括号上标表示第 l 层。
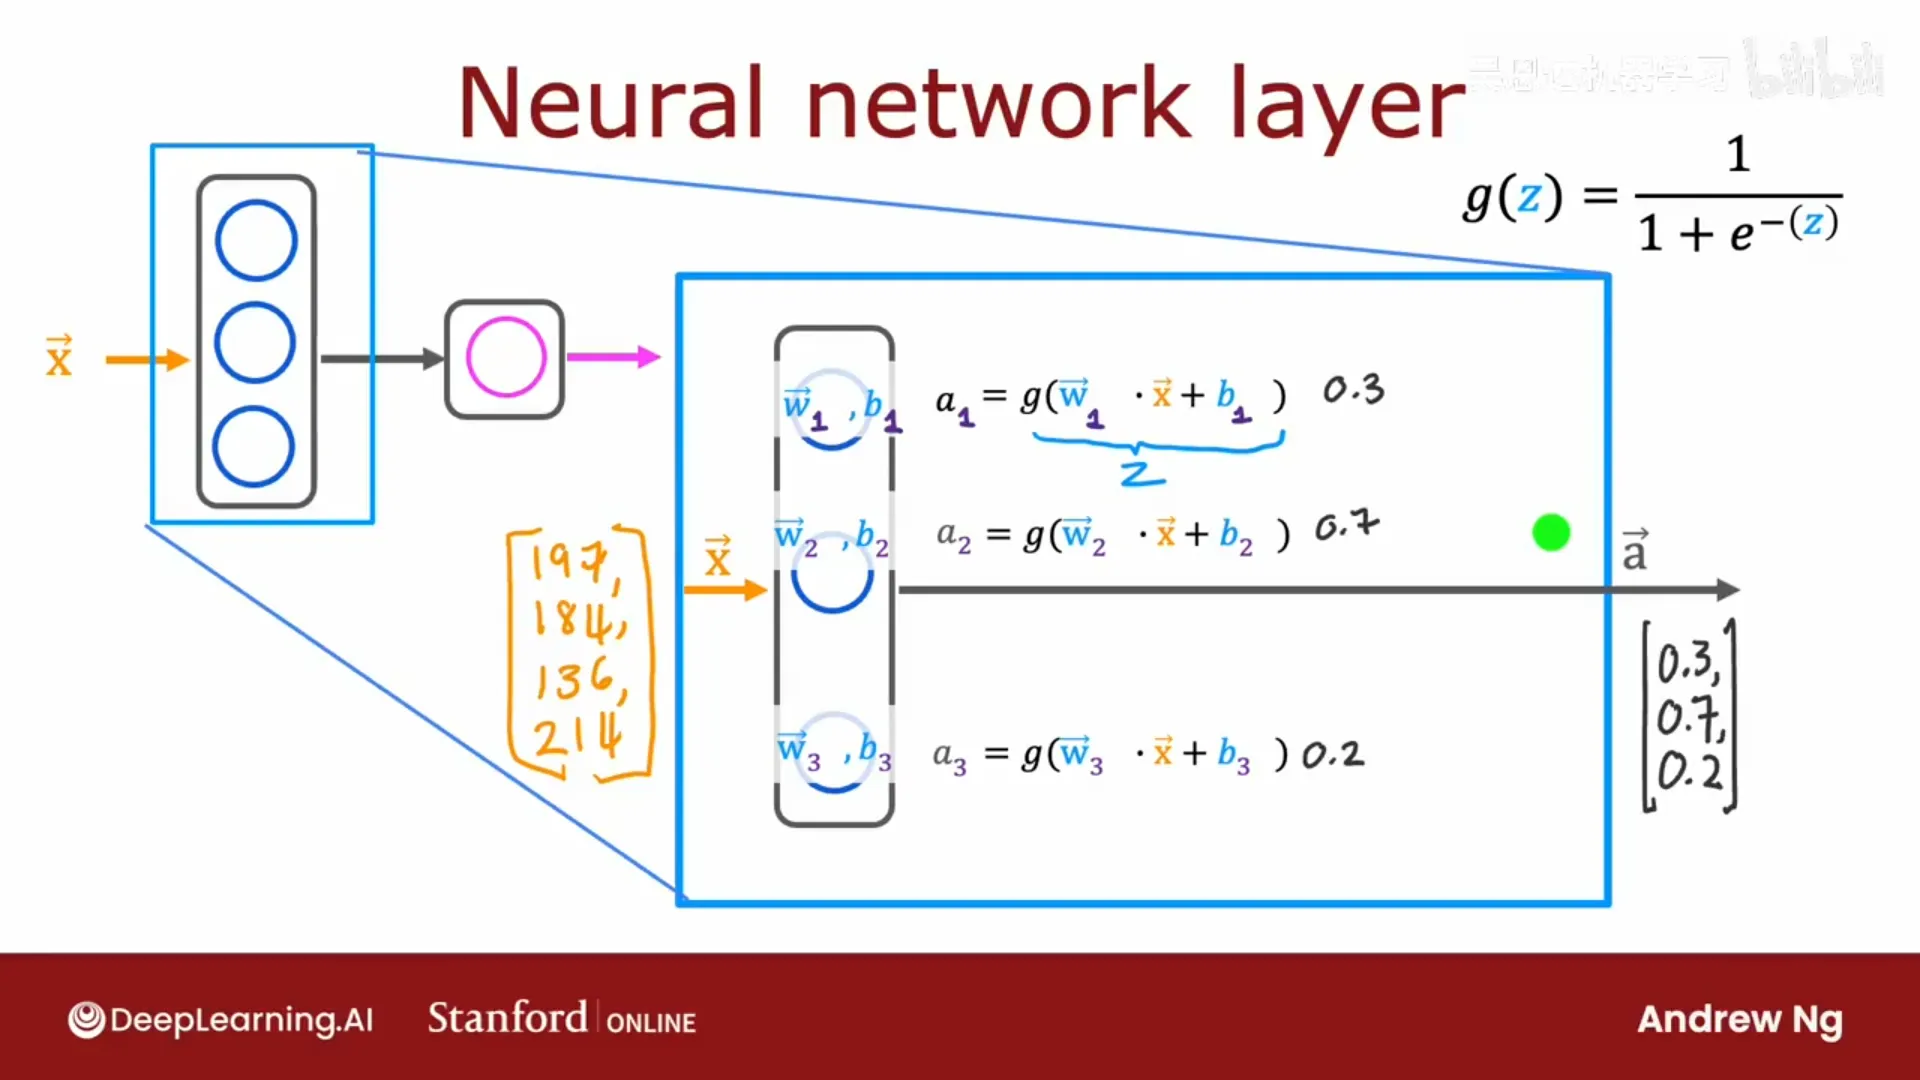
📷 层编号:输入层=第0层,方括号上标表示层号
回到原视频 (00:03:35)
2.3 任意层的通用公式
理解要点:一个「神经元」本质上就是一个逻辑回归单元——先做内积 $w_j^{[l]}\cdot a^{[l-1]}+b_j^{[l]}$,再过激活函数。一层 = 一组并行的逻辑回归;整个网络就是「逻辑回归的输出喂给下一层逻辑回归」。
(p47)
一个四层网络(不算输入层)中,第 3 层第 j 个单元的激活是:
$$a_j^{[l]} = g\big(w_j^{[l]}\cdot a^{[l-1]} + b_j^{[l]}\big)$$
逐项解读:
w_j^[l]是第 l 层第 j 个单元的权重向量;- 点积的对象是前一层的输出
a^[l−1](注意是 l−1,不是 l!); b_j^[l]是同一层同一单元的偏置;- 上标
[l]表示层,下标j表示该层的第 j 个单元(神经元); g在神经网络语境里叫激活函数(activation function)——因为它输出"激活值"。
为统一,把输入向量 x 记作 a^[0],这样上式对第 1 层也成立(a^[1] = g(w^[1]a^[0] + b^[1]))。
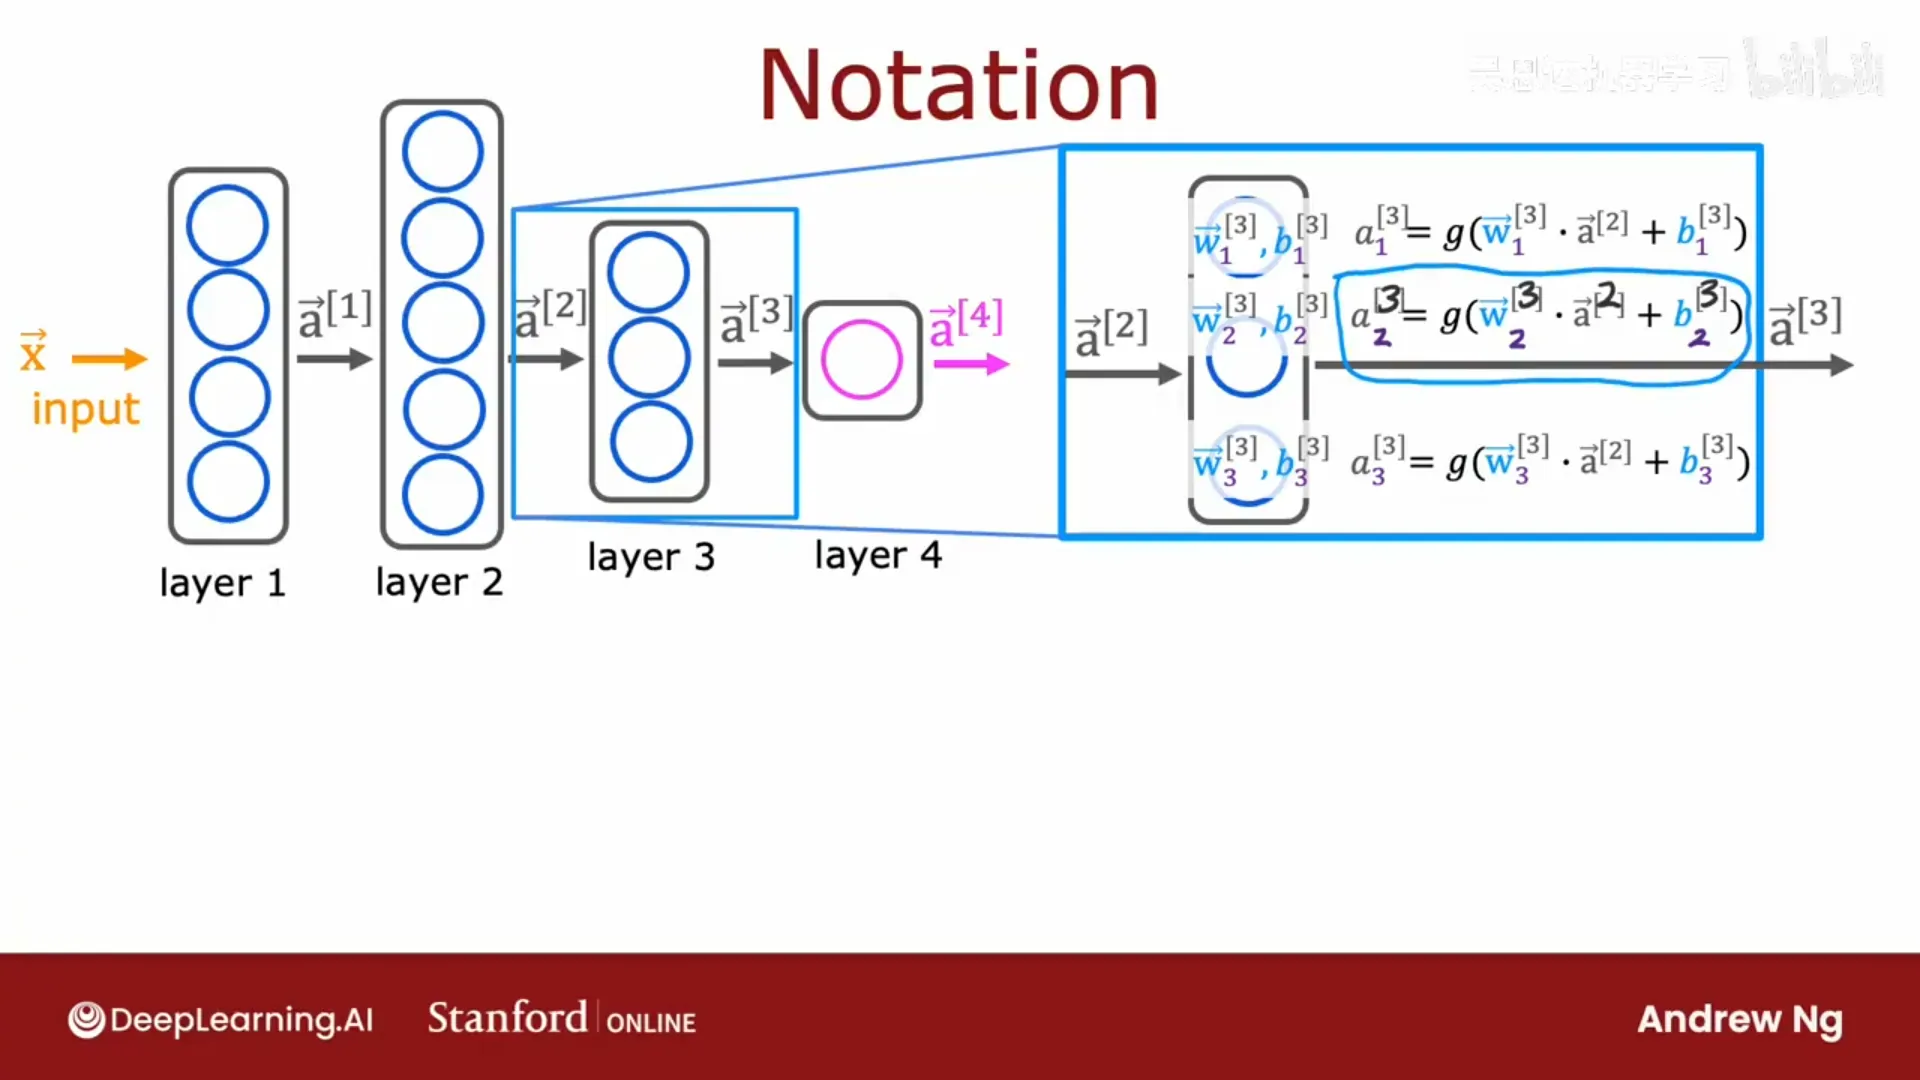
📷 任意层激活的通用公式(层 l、单元 j)
回到原视频 (00:04:29)
2.4 前向传播:做出预测
(p48)
以手写数字 0/1 识别为例:8×8 图像展开成 64 个像素特征(255 = 白、0 = 黑、中间是灰)。网络架构:隐藏层1(25 单元)→ 隐藏层2(15 单元)→ 输出层(1 单元)。
推理过程就是从左到右依次计算:
$$\begin{aligned}
a^{[1]} &= g\big(w^{[1]}\cdot x + b^{[1]}\big) &&\text{25 个数字}\ a^{[2]} &= g\big(w^{[2]}\cdot a^{[1]} + b^{[2]}\big) &&\text{15 个数字}\ a^{[3]} &= g\big(w^{[3]}\cdot a^{[2]} + b^{[3]}\big) &&\text{1 个数字 = 网络输出}
\end{aligned}$$
可选的最后一步:按 0.5 阈值得到 0/1 标签(a^[3] ≥ 0.5 → 1,否则 0)。
因为计算沿着"从左到右"的前向方向传播激活值,这个算法叫前向传播(forward propagation)。与之相对,用于学习参数的算法叫反向传播(backward propagation)(下一章讲)。
这种"隐藏单元数一开始较多、然后逐层减少"的架构(64 → 25 → 15 → 1)是很典型的一种选择。
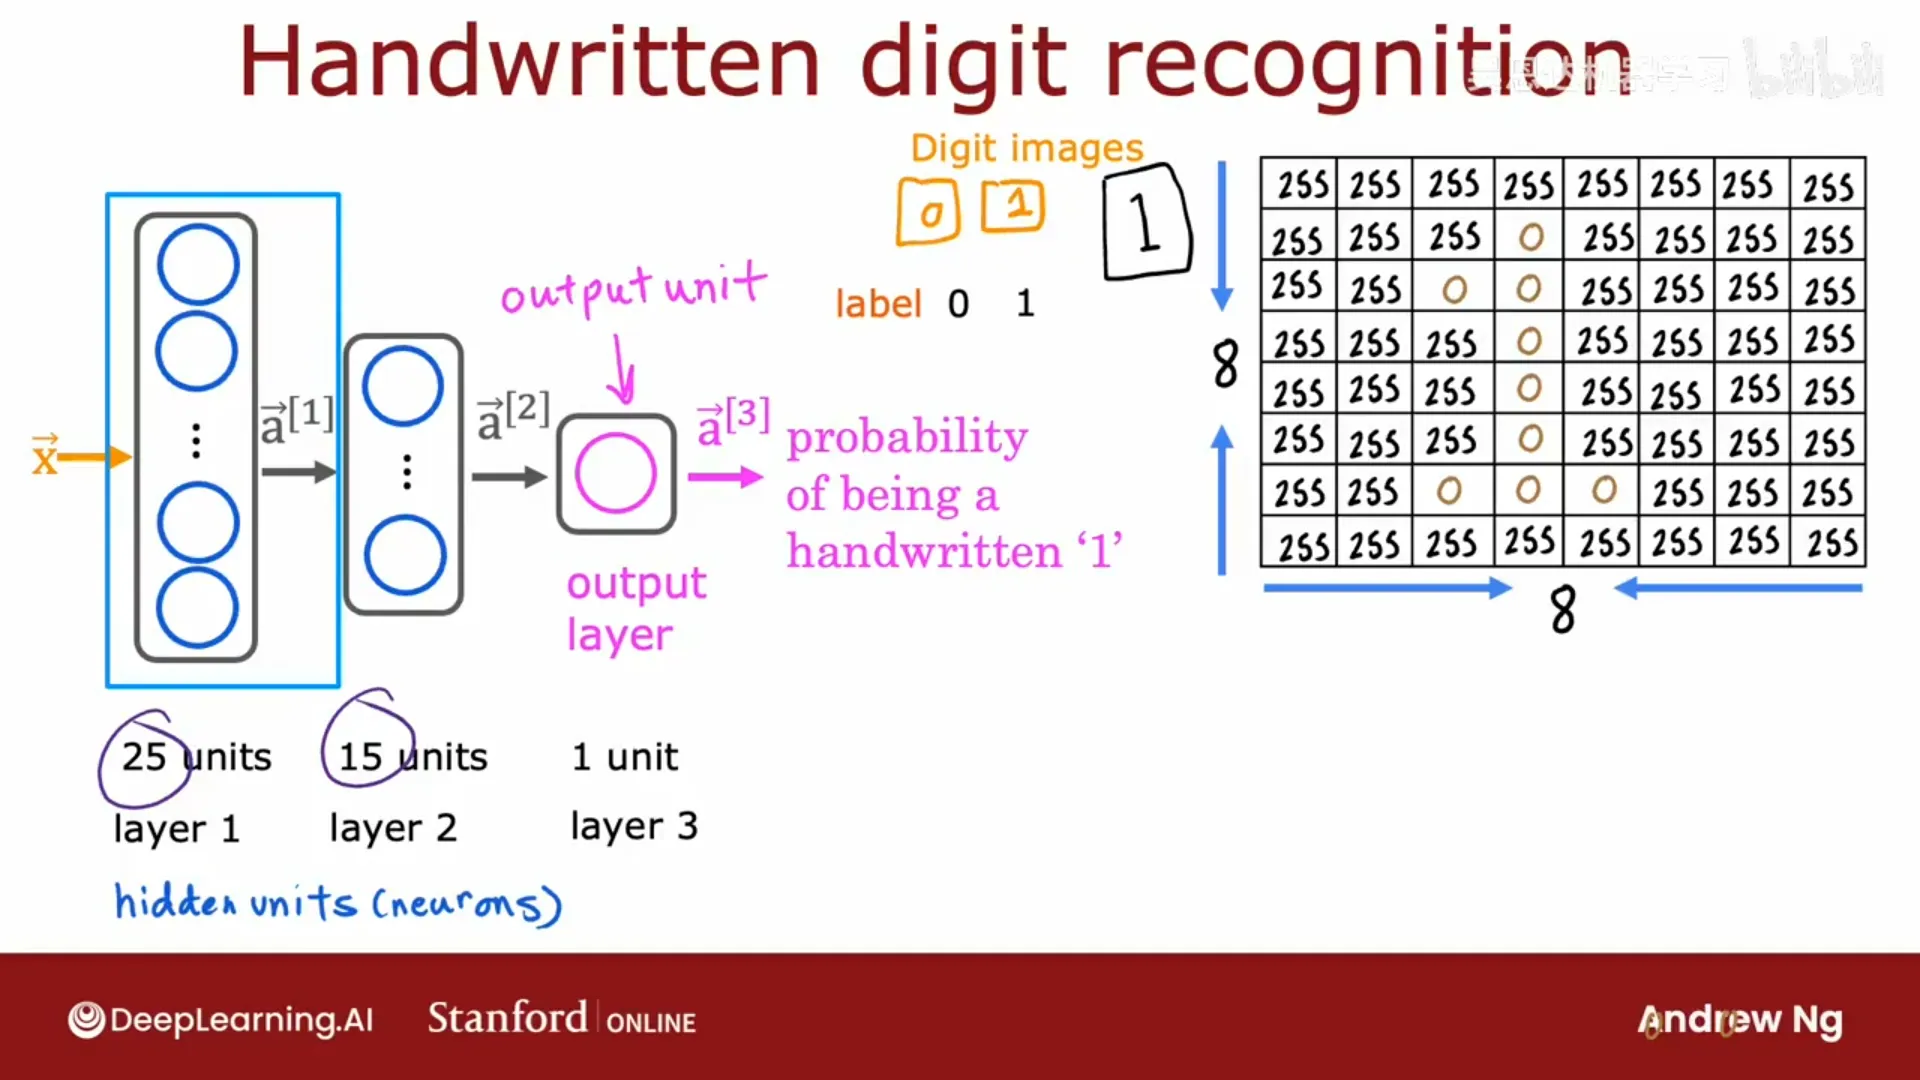
📷 手写数字识别的前向传播:x → a^1 → a^2 → a^3
回到原视频 (00:01:34)
第三章 TensorFlow 实现
(对应模块 3,视频 p49–p51)
3.1 用 TensorFlow 做推理
(p49)
TensorFlow 是深度学习的主流框架之一(另一个流行的是 PyTorch),也是吴恩达自己最常用的工具。
编者拓展|TensorFlow 与 PyTorch:两者都是主流深度学习框架。TensorFlow 由 Google 推出,工业部署生态成熟(本课用它,因为
Sequential/compile/fit这种「代码即配置」的写法很好懂);PyTorch 由 Meta 推出,更接近「写 NumPy」的直觉,在研究界更受欢迎。二者思想高度相通——学会一个,迁移到另一个主要是查 API。
换一个更生活化的例子:咖啡烘焙。你控制两个参数——温度和时间;数据集标记了结果是否为"好咖啡"(叉号 = 好、圆圈 = 坏)。直觉上:
- 温度太低 → 没烘熟(生豆);
- 时间太短 → 也不行;
- 时间太长或温度太高 → 烘过头、焦了;
- 只有中间那块小三角区域才是好咖啡。
(现实中确实有项目用 ML 优化咖啡烘焙。)给定特征 x = [200, 17](200℃、17 分钟),用 TensorFlow 做前向传播:
x = np.array([[200.0, 17.0]])                    # 注意是 1×2 的二维数组
layer_1 = tf.keras.layers.Dense(units=3, activation="sigmoid")   # 3 个单元的隐藏层
a1 = layer_1(x)                                  # a1 是 1×3
layer_2 = tf.keras.layers.Dense(units=1, activation="sigmoid")
a2 = layer_2(a1)                                 # a2 是 1×1(一个数)
# 可选阈值
a2 = a2.numpy()          # 转成 NumPy
yhat = 1 if a2 >= 0.5 else 0
要点:
Dense就是前面学的全连接层(dense layer);- 层是一个函数:把它作用在输入上就得到激活值;
layer_1输出 3 个数,layer_2接收这 3 个数、输出 1 个数。
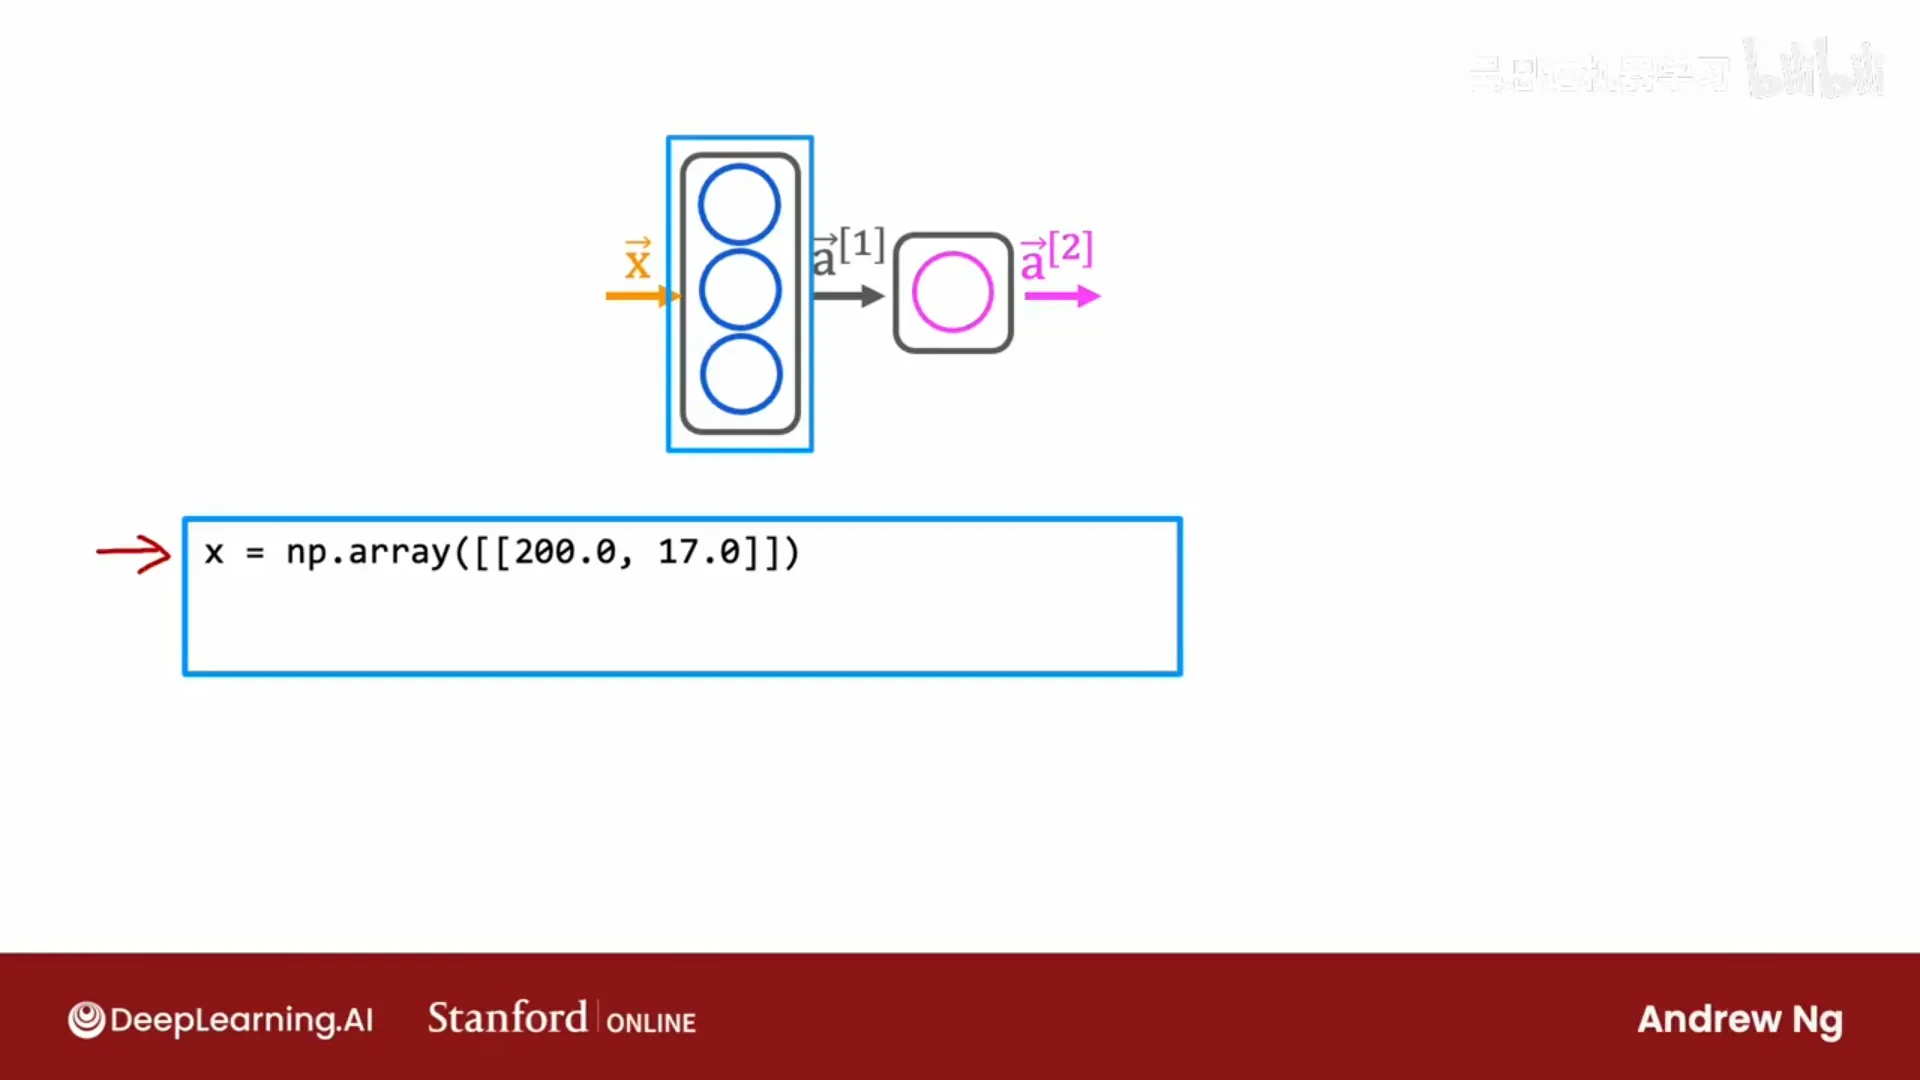
📷 TensorFlow 推理:把特征向量喂给全连接的 Dense 层
回到原视频 (00:03:12)
3.2 TensorFlow 中的数据表示:张量
(p50)
有一个历史遗留的坑:NumPy 很早成为 Python 线性代数的标准库,很久之后 Google Brain(吴恩达曾创建并领导)才做出 TensorFlow,于是两者的数据约定不完全一致。了解这些约定能让你写出正确、能跑通、且高效的代码。
矩阵 = 二维数组:
x = np.array([[1, 2, 3],
              [4, 5, 6]])     # 2 行 3 列 → 2×3 矩阵
维度用"行数 × 列数"表示。[[1,2,3],[4,5,6]] 是 2×3;[[0,1],[2,3],[4,5],[6,7]] 是 4×2。
行向量、列向量、一维数组的区别(很容易混淆,务必看清方括号数量):
| 写法 | 结果 | 含义 |
|---|---|---|
np.array([[200, 17]]) |
1×2 的二维数组 | 行向量 |
np.array([[200], [17]]) |
2×1 的二维数组 | 列向量 |
np.array([200, 17]) |
一维数组 | 既不是行向量也不是列向量,就是一个数字列表 |
TensorFlow 更习惯用矩阵(二维数组)表示数据:因为它要处理超大数据集,用矩阵在内部计算上更高效。所以第一门课里我们用一维数组表示特征 x;到了 TensorFlow 里,就写成 [[200, 17]] 这样的二维数组。
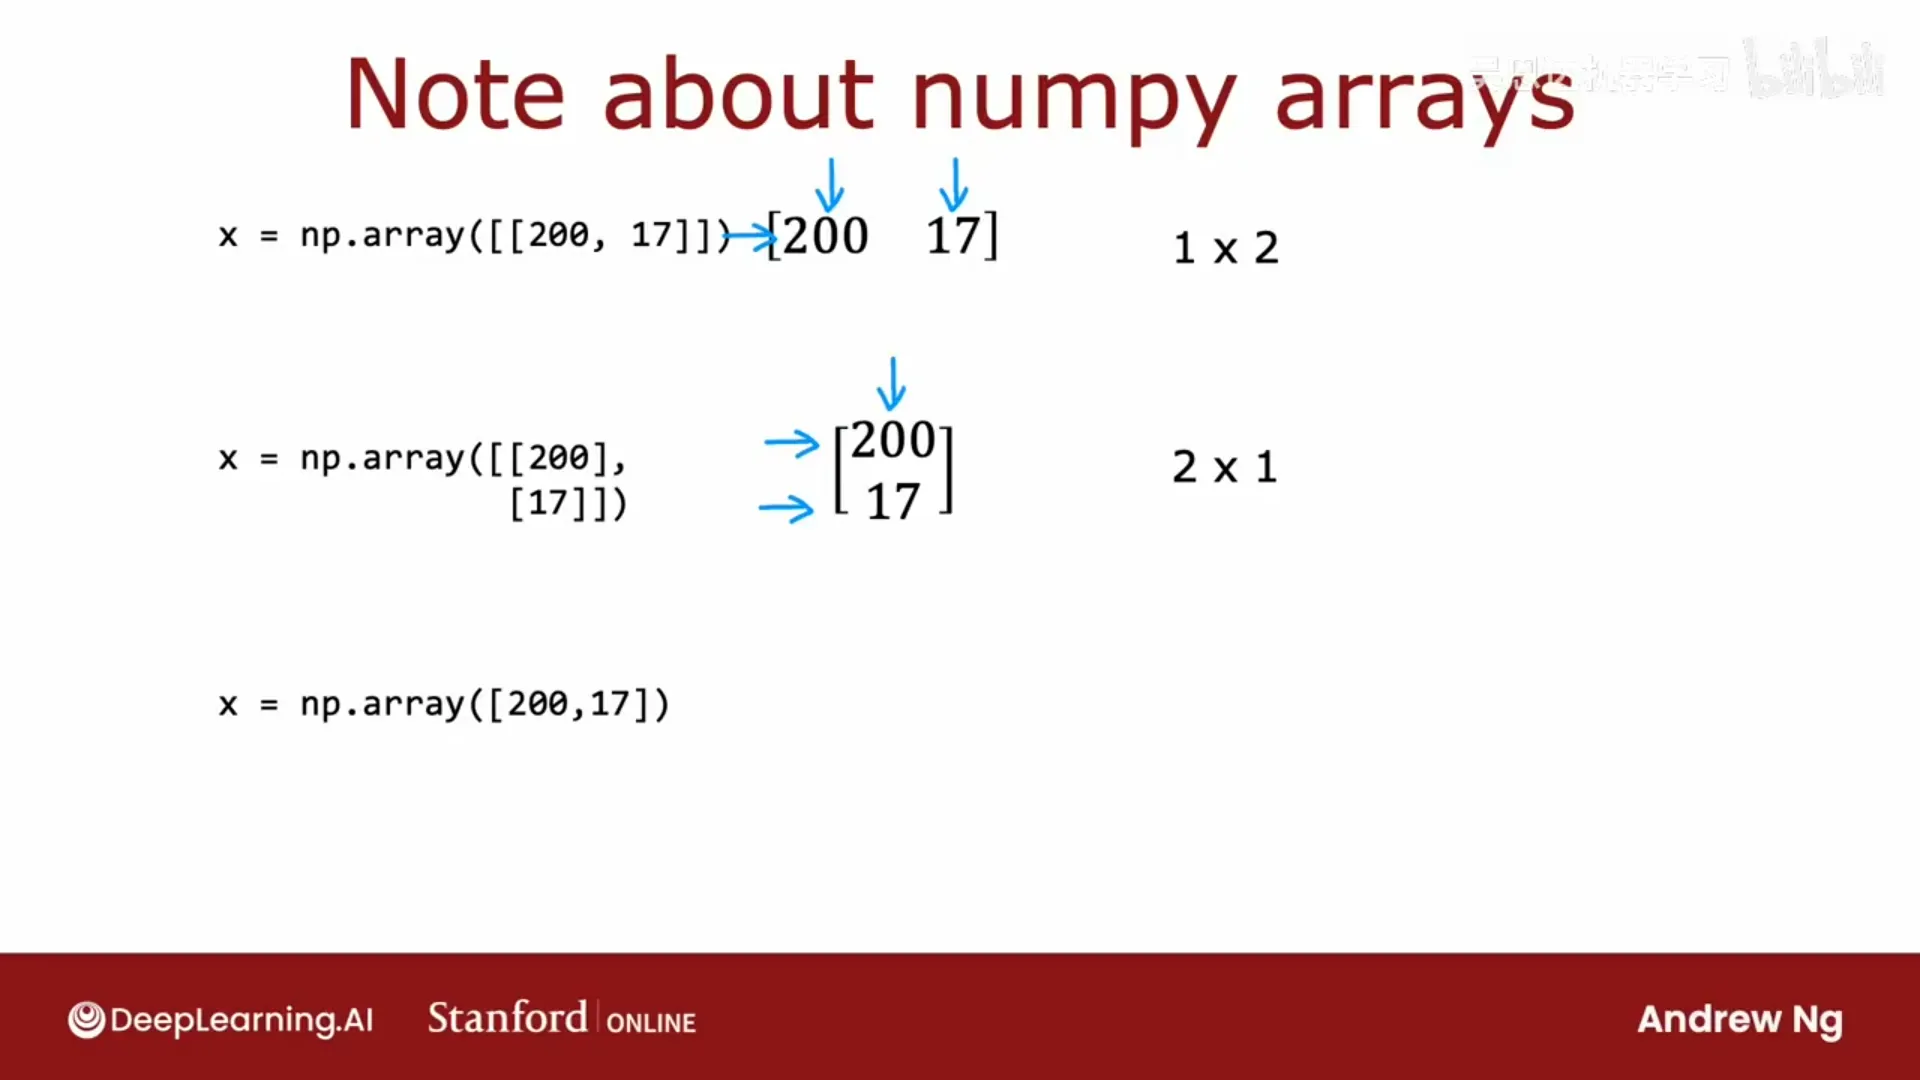
📷 矩阵/行向量/列向量/一维数组的区别(注意方括号数量)
回到原视频 (00:04:59)
张量(tensor) 是 TensorFlow 用来存储与高效计算矩阵的数据类型——本课可以把它当成矩阵。张量通常有 shape 和 dtype,例如 a1 会是 1×3 的矩阵,a2 会是 1×1 的矩阵(虽然只有一个元素)。a1.dtype 是 float32(32 位浮点)。想把张量转回 NumPy 数组:a1.numpy()。
实践建议:用 NumPy 加载/操作数据,把它传给 TensorFlow 时会自动转成内部张量格式。
3.3 构建神经网络:Sequential + compile + fit + predict
(p51)
除了"手动逐层调用",TensorFlow 还提供更简洁的 Sequential 写法:
model = tf.keras.Sequential([
    tf.keras.layers.Dense(units=3, activation="sigmoid"),
    tf.keras.layers.Dense(units=1, activation="sigmoid"),
])

model.compile(loss=..., optimizer=...)   # 指定损失函数等(下一章细讲)
model.fit(X, Y, epochs=100)              # 用数据 X、Y 训练
yhat = model.predict(x_new)              # 做推理(前向传播)
Sequential:把若干层顺序串联成一个模型;compile:配置损失函数等;fit:在数据上训练;predict:对新样本做前向传播。
惯例:实际写代码时不会真的把每层赋给 layer_1 / layer_2 两个变量,而是直接在 Sequential([...]) 里把层顺序列出来,代码更紧凑。
提醒:别满足于"五行代码搞定一个复杂网络"。本课特意回过头讲从头实现前向传播——因为当模型变慢、结果诡异、疑似 bug 时,对底层机制的理解能让你更有效地调试。现实中大多数工程师确实直接用 TensorFlow/PyTorch,但理解原理仍然值得。
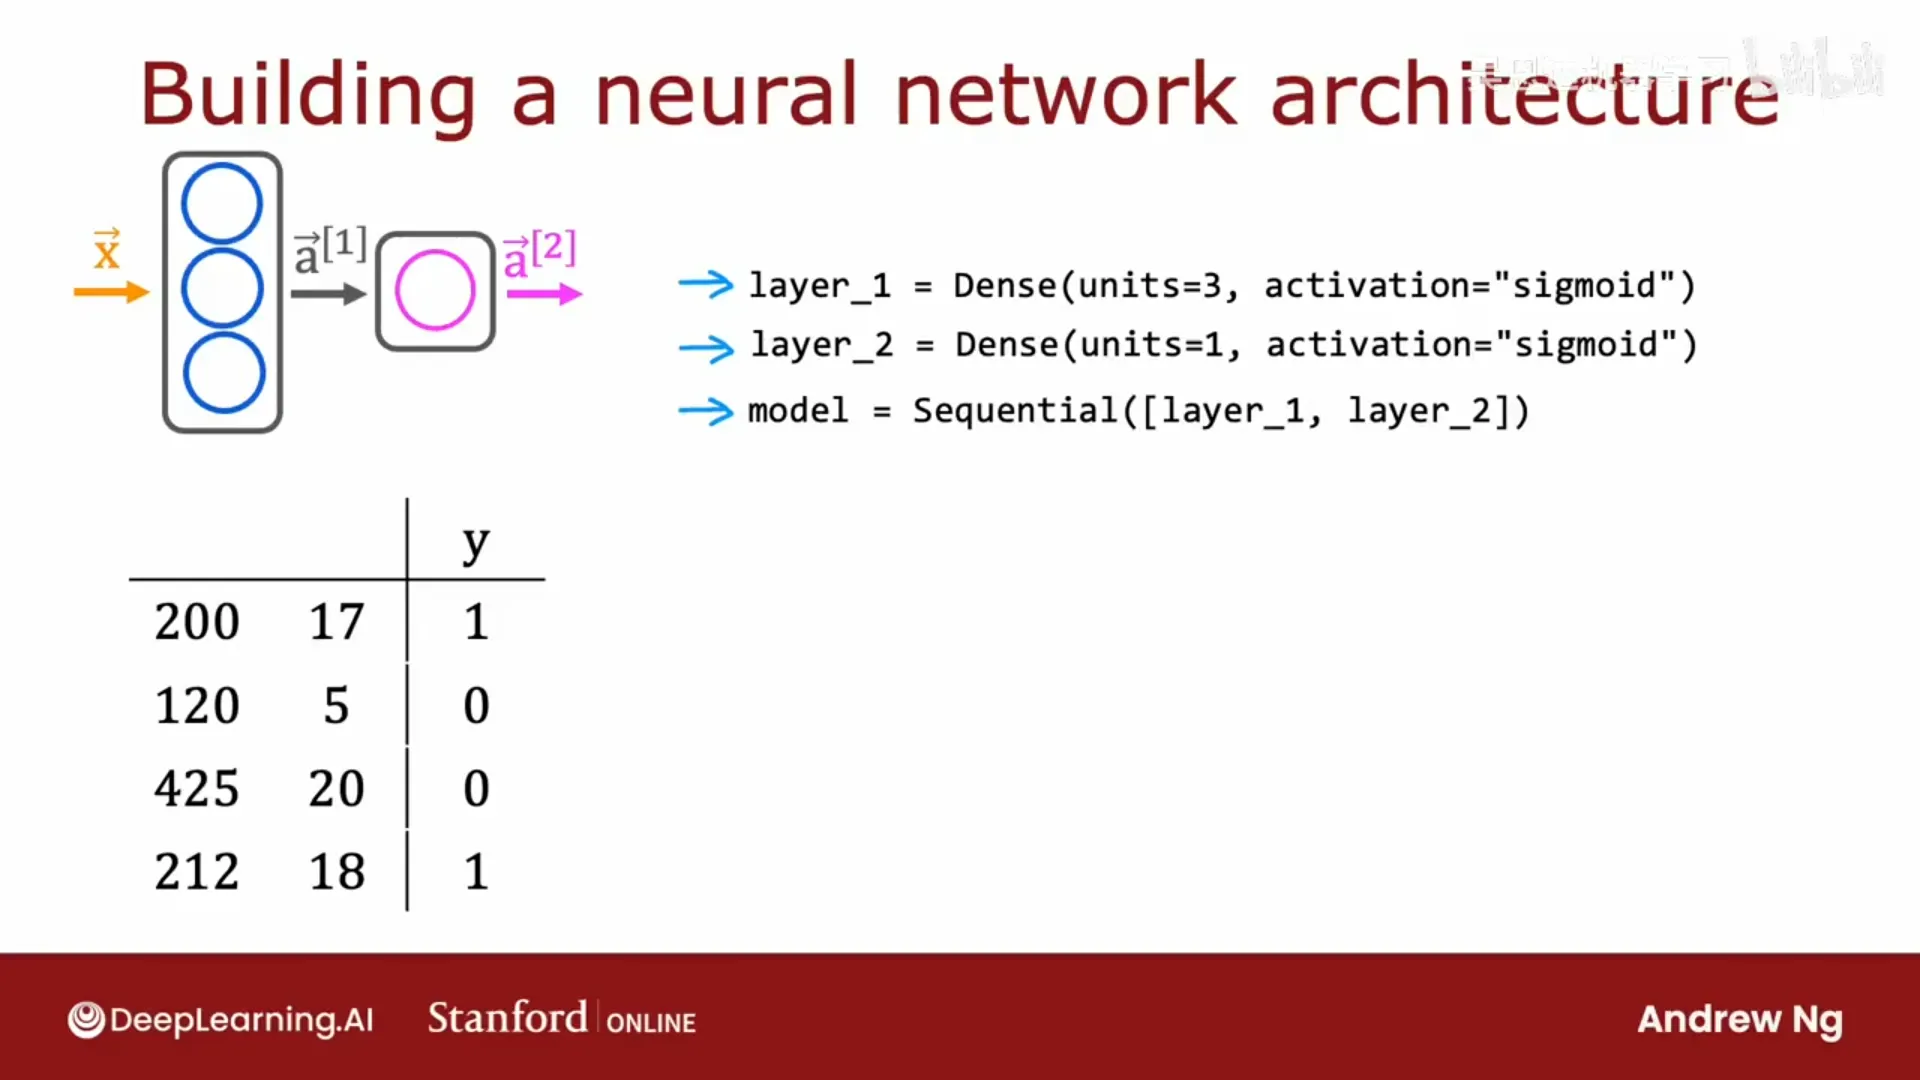
📷 TensorFlow 三件套:用 Sequential 建网、compile+fit 训练、predict 推理
回到原视频 (00:01:35)
第四章 用 Python 从头实现前向传播
(对应模块 4,视频 p52–p53)
4.1 硬编码版(一个单层)
(p52)
用一维 NumPy 数组表示向量和参数(约定 w2_1 读作 w^[2]₁):
x = np.array([200, 17])

# 第 1 层(3 个单元)
w1_1 = np.array([1, 2]);  b1_1 = np.array([-1])
z1_1 = np.dot(w1_1, x) + b1_1
a1_1 = sigmoid(z1_1)

w1_2 = np.array([-3, 4]); b1_2 = np.array([1])
a1_2 = sigmoid(np.dot(w1_2, x) + b1_2)

w1_3 = np.array([5, -6]); b1_3 = np.array([2])
a1_3 = sigmoid(np.dot(w1_3, x) + b1_3)

a1 = np.array([a1_1, a1_2, a1_3])   # 第 1 层输出(3 个数)

# 第 2 层(1 个单元)
w2_1 = np.array([-7, 8]); b2_1 = np.array([3])
z2_1 = np.dot(w2_1, a1) + b2_1
a2_1 = sigmoid(z2_1)                 # 网络最终输出
这能工作,但为每个神经元硬编码显然不可扩展(若第 1 层有 100 个神经元呢?)。
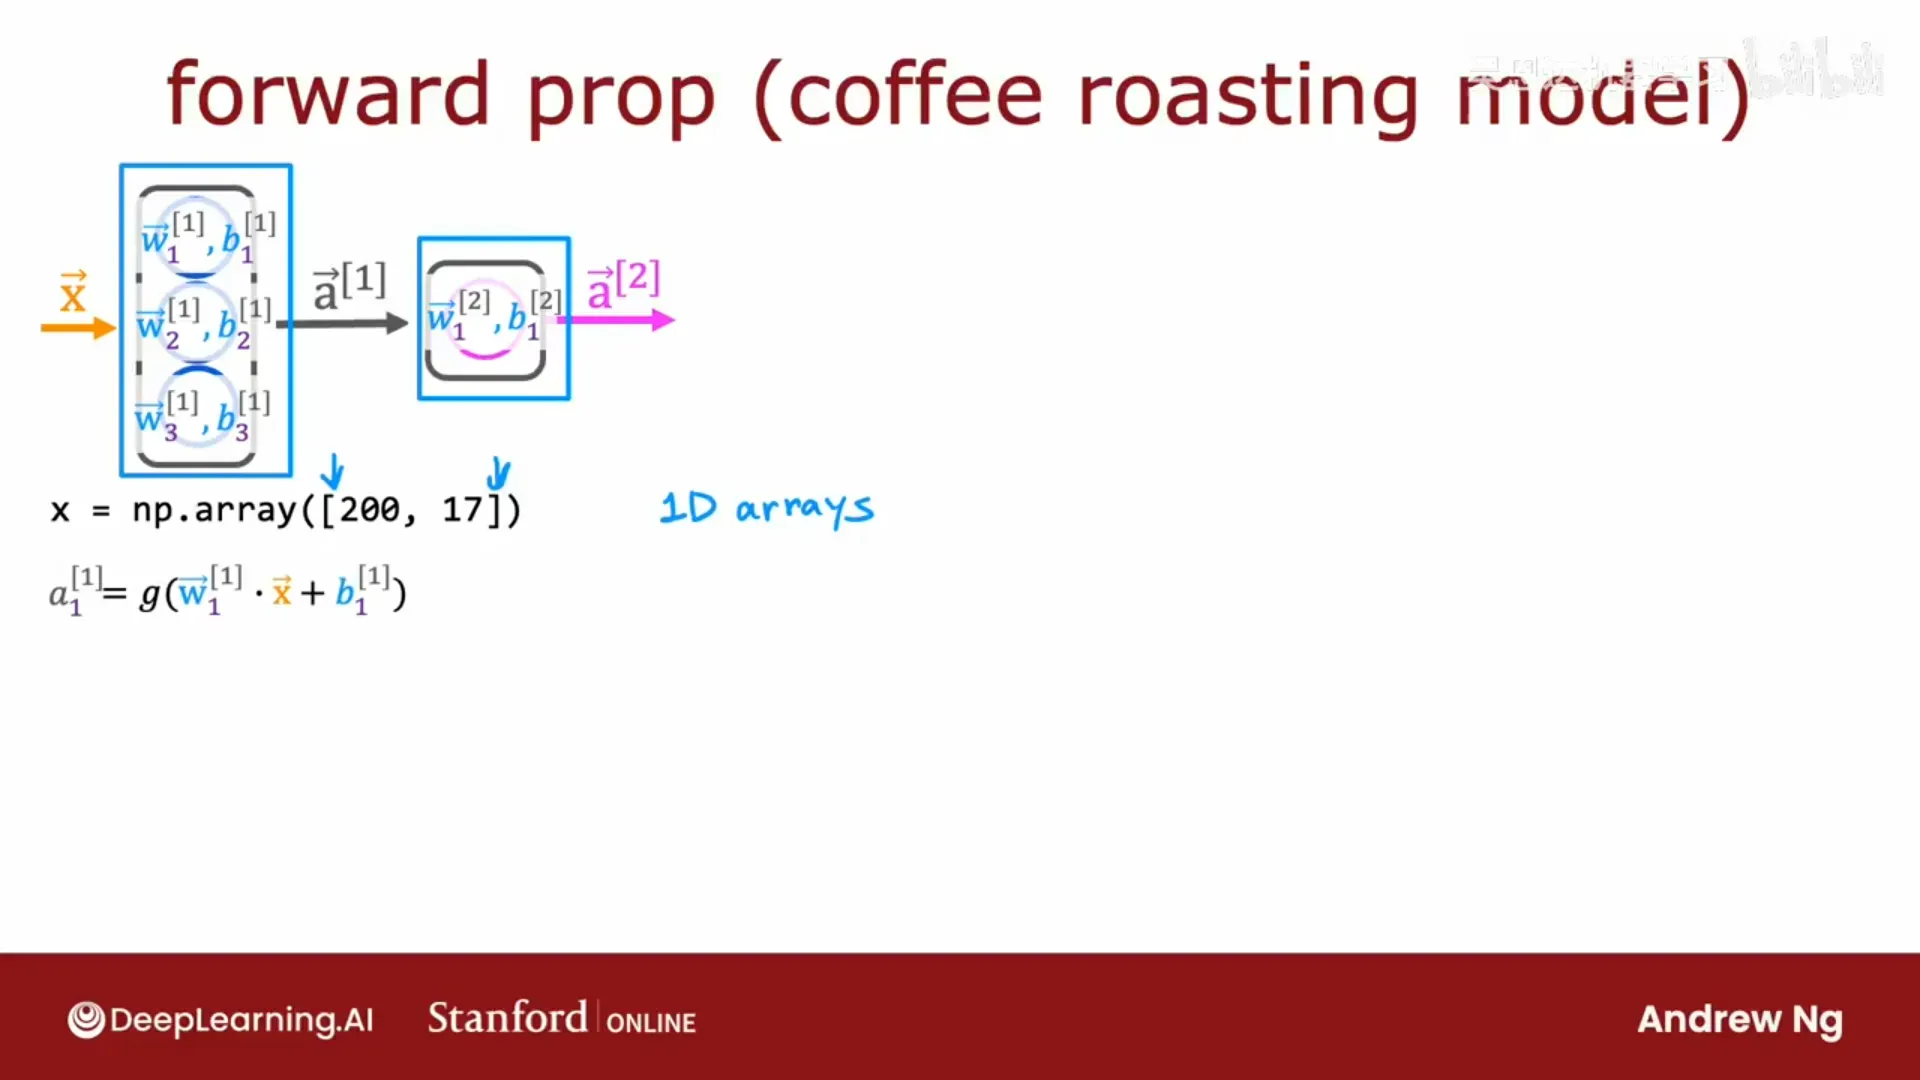
📷 用 Python/NumPy 硬编码一层的前向传播
回到原视频 (00:02:05)
4.2 通用版:写一个 dense 层函数
(p53)
关键是把一层的所有参数堆成矩阵/数组:
W:把各神经元的权重向量按列堆叠成矩阵。若上一层有 2 个输出、本层有 3 个神经元,则W是 2×3——第 1 列是第 1 个神经元的权重向量 w₁₁…;b:把各神经元的偏置堆成一维数组,若本层 3 个神经元则b = [b₁, b₂, b₃]。
def dense(a_in, W, b):
    units = W.shape[1]          # 本层单元数 = W 的列数
    a_out = np.zeros(units)     # 先初始化为 0
    for j in range(units):
        w = W[:, j]             # 取第 j 列 = 第 j 个神经元的权重向量
        z = np.dot(w, a_in) + b[j]
        a_out[j] = sigmoid(z)
    return a_out
W.shape[1]取矩阵的列数,也就是"本层有多少个隐藏单元";W[:, j]是 Python/NumPy 中"取矩阵第 j 列"的写法;- 循环 j 从 0 到 units−1(Python 索引从 0 开始);
- 最后返回本层的激活向量
a_out。
于是整个网络就是顺序串联若干 dense 层:
def sequential(x):
    a1 = dense(x,  W1, b1)
    a2 = dense(a1, W2, b2)
    a3 = dense(a2, W3, b3)
    a4 = dense(a3, W4, b4)
    return a4                   # f(x)
- 给定输入 x,先算 a1,再算 a2…最后 a4 就是 f(x);
- 约定:矩阵用大写
W,向量/标量用小写(线性代数的常见约定)。
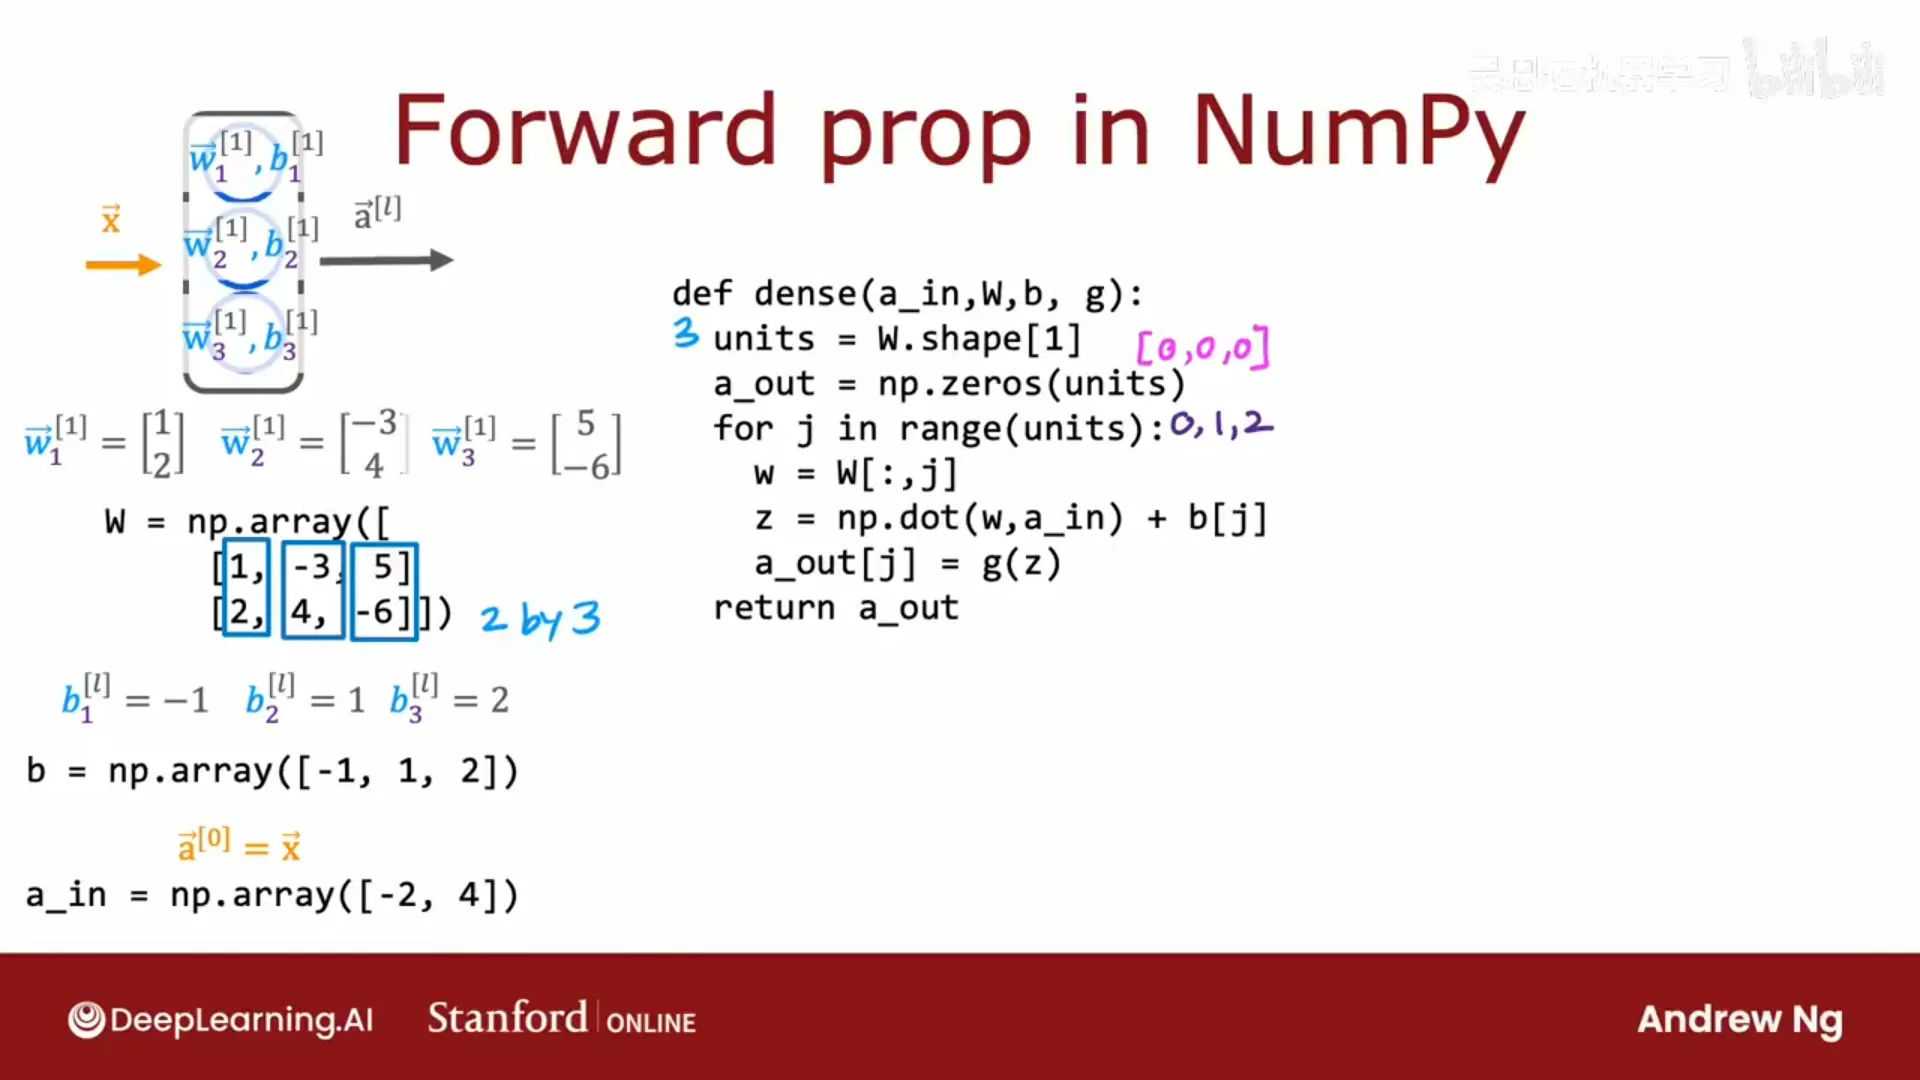
📷 用 dense 函数实现通用的一层,再顺序串联成整个网络
回到原视频 (00:04:52)
为什么值得自己实现:一是更懂 TensorFlow/PyTorch 里在发生什么;二是调试能力——吴恩达坦言自己跑 ML 算法"第一次几乎从来都不成功",能读懂底层会让调试高效得多。他还提了一个有趣的动机:万一有一天你想做一个比 TensorFlow/PyTorch 更好的框架,那你就得亲手实现这些东西(他不建议大多数人这么做,但总得有人做)。
第五章 通往 AGI 之路?(可选话题)
(对应模块 5,视频 p54)
5.1 别把 ANI 的进步误当成 AGI 的进步
(p54)
ANI(Artificial Narrow Intelligence,人工狭窄智能) 指"只会做一件事、但常常做得非常好"的 AI:智能音箱、自动驾驶、网络搜索、农业/工厂专用 AI。ANI 近年进步巨大,创造了巨大价值。
AGI(Artificial General Intelligence,通用人工智能) 指"能做人类能做的任何事"的 AI。问题是:
ANI 的巨大进步,会让人正确地得出"AI 进步很大",但也让一些人错误地外推成"我们在 AGI 上也有大量进展"。其实未必。
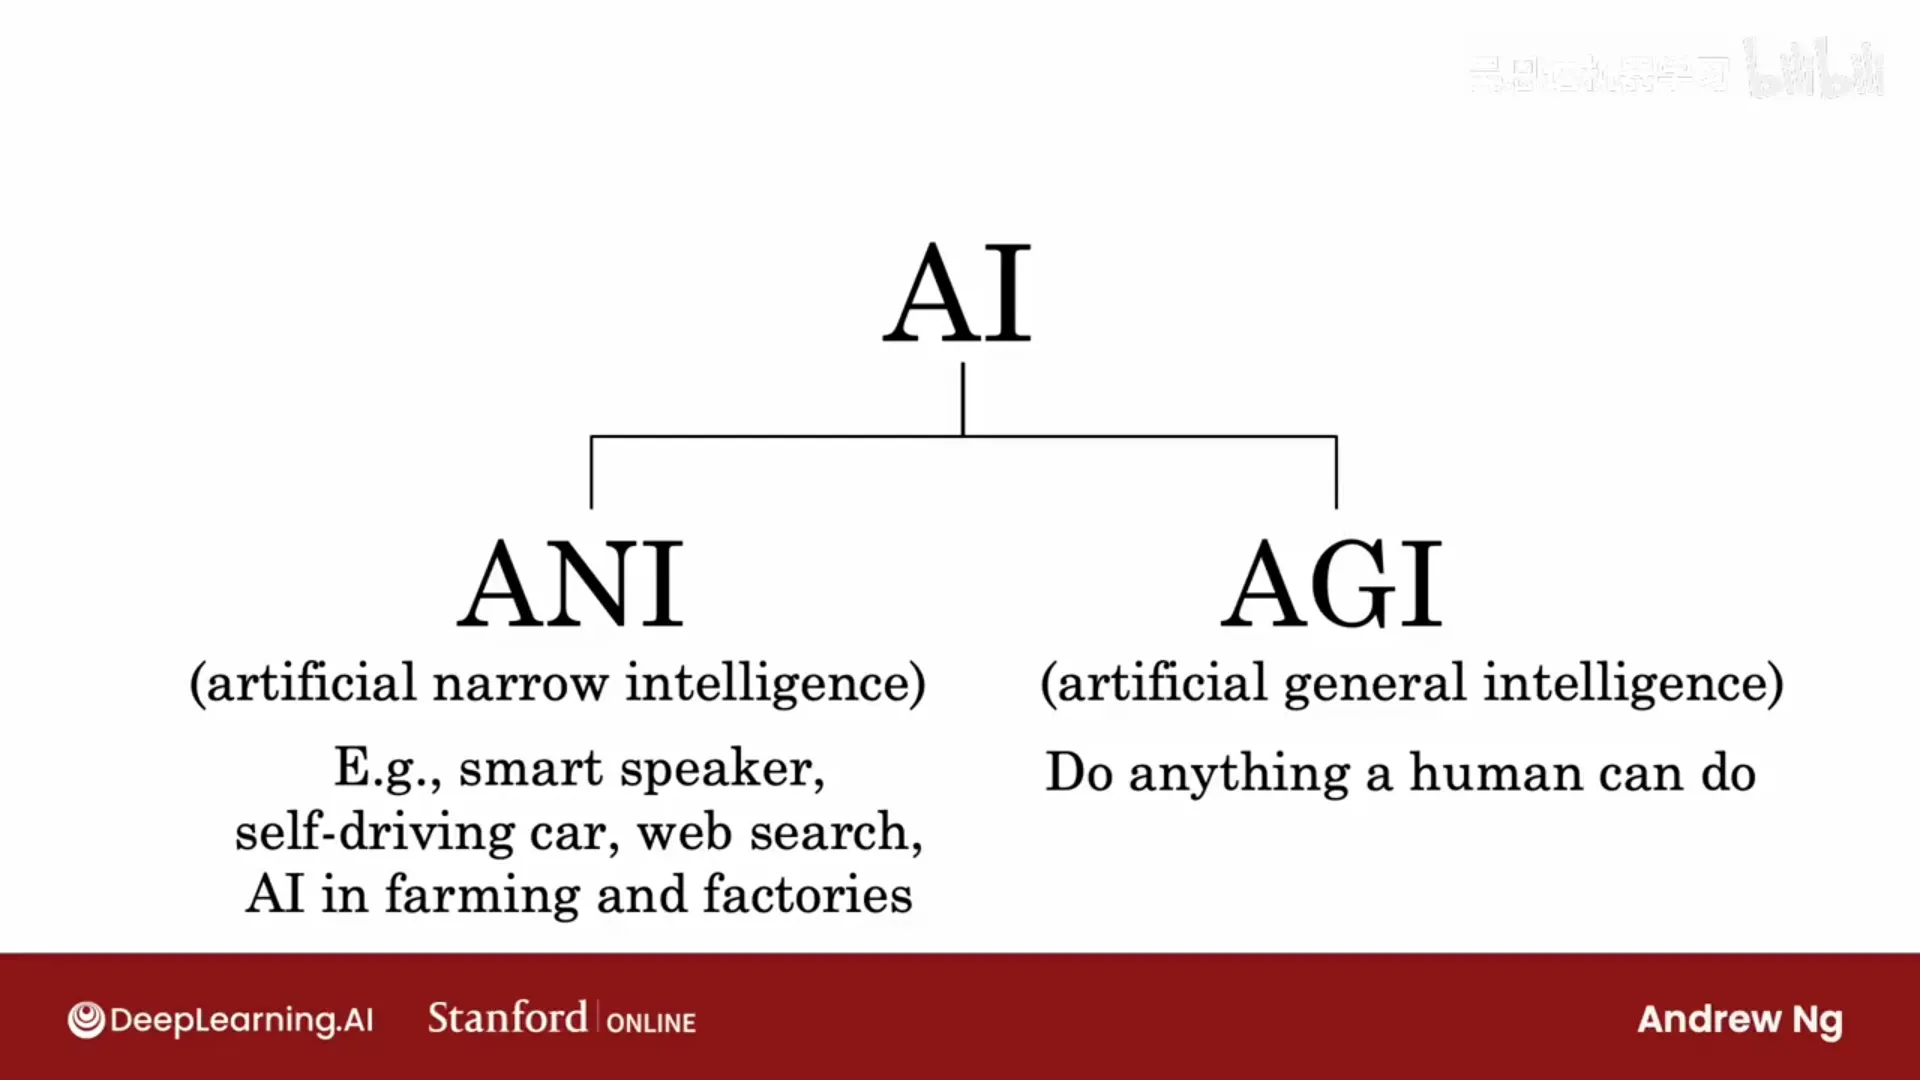
📷 ANI 与 AGI:ANI 的巨大进展不等于 AGI 的进展
回到原视频 (00:02:36)
早期有一种模糊的期待:模拟足够多的神经元 → 就能模拟大脑 → 得到真正的智能。但这条路有两个大问题:
- 我们的人工神经元(一个逻辑回归单元)远比生物神经元简单;
- 我们至今几乎不知道大脑如何工作——关于"神经元如何从输入映射到输出"仍有基本问题未解。
所以单纯靠模拟大脑来达到 AGI,会极其困难。
5.2 但仍有希望:大脑的惊人可塑性
有一类动物实验给人希望——它们强烈暗示:同一块脑组织可以完成出人意料的多种任务:
- 听觉皮层本用于听声音。若切断耳朵与它的连接、改把图像输入进去,它会学会看;
- 躯体感觉皮层(本处理触觉)被重接上图像输入后,也会学会看;
- 有系统把摄像头装在额头、把灰度图像映射到舌头上的一排电压网格,帮助盲人用舌头"看";
- 人类可以练出一定程度的回声定位(人声纳);
- 带磁罗盘的触觉腰带能让人获得"方向感"——不是"腰在震动",而是"我知道北方在哪";
- 把第三只眼移植到青蛙身上,大脑会自己学会处理这个新输入。
神经科学家称之为惊人的可塑性。于是有一个学习算法假设:
也许大量的智能都来自一个(或少数几个)学习算法;只要搞清楚这个算法,就能在计算机里实现它。
吴恩达的态度是乐观但避免炒作:这是历史上最迷人的科学与工程问题之一;也许(也许不是)大脑真的由一两个算法驱动,而且没人知道那是什么算法,但通过大量努力,也许有一天我们会找到它的近似。而在短期内,即便不追求 AGI,神经网络本身就已经是非常强大、非常实用的工具集。
📷 大脑可塑性的实验证据:听觉皮层学会"看"等
回到原视频 (00:05:04)
第六章 矩阵乘法与神经网络的向量化实现
(对应模块 6,视频 p55–p58;这几集是可选内容,但它是理解"为什么神经网络能做大"的关键)
6.1 向量化:把循环变成矩阵乘法
数学角落(内积的 ML 语义):$w^\top x=\sum_i w_i x_i$ 就是加权求和——每个 $w_i$ 表示「特征 $i$ 对预测的重要程度」。而矩阵 $Wx$ 是对 $W$ 的列做线性组合(系数由 $x$ 给出);于是 $A^{[l]}=g\big(W^{[l]}A^{[l-1]}+b^{[l]}\big)$ 可读作「对上一层的特征做加权组合,再逐元素过激活」。用这层语义去理解符号,比一上来硬套投影/夹角更稳。
(p55)
神经网络能在过去十年被规模化,一个关键原因是它可以被向量化——用矩阵乘法高效实现。并行硬件(GPU,以及部分 CPU 能力)尤其擅长做大矩阵乘法。没有这些想法,深度学习不会有今天的规模与成功。
回顾那个 for 循环版的 dense:循环里的所有运算,可以用几行替代:
# 输入与参数都写成二维数组(矩阵)
Z = np.matmul(A_in, W) + B      # 矩阵乘法 + 广播加偏置
A_out = g(Z)                    # 对 Z 逐元素应用激活函数 g
return A_out
要点:
np.matmul(或@)是 NumPy 的矩阵乘法;这里 A_in 与 W 都是矩阵,直接相乘再加 B;- 在向量化版本里,
A_in、W、B、Z、A_out全都是二维数组(矩阵); - 一行顶一个循环,而且快得多——这正是密集层前向传播的高效实现。
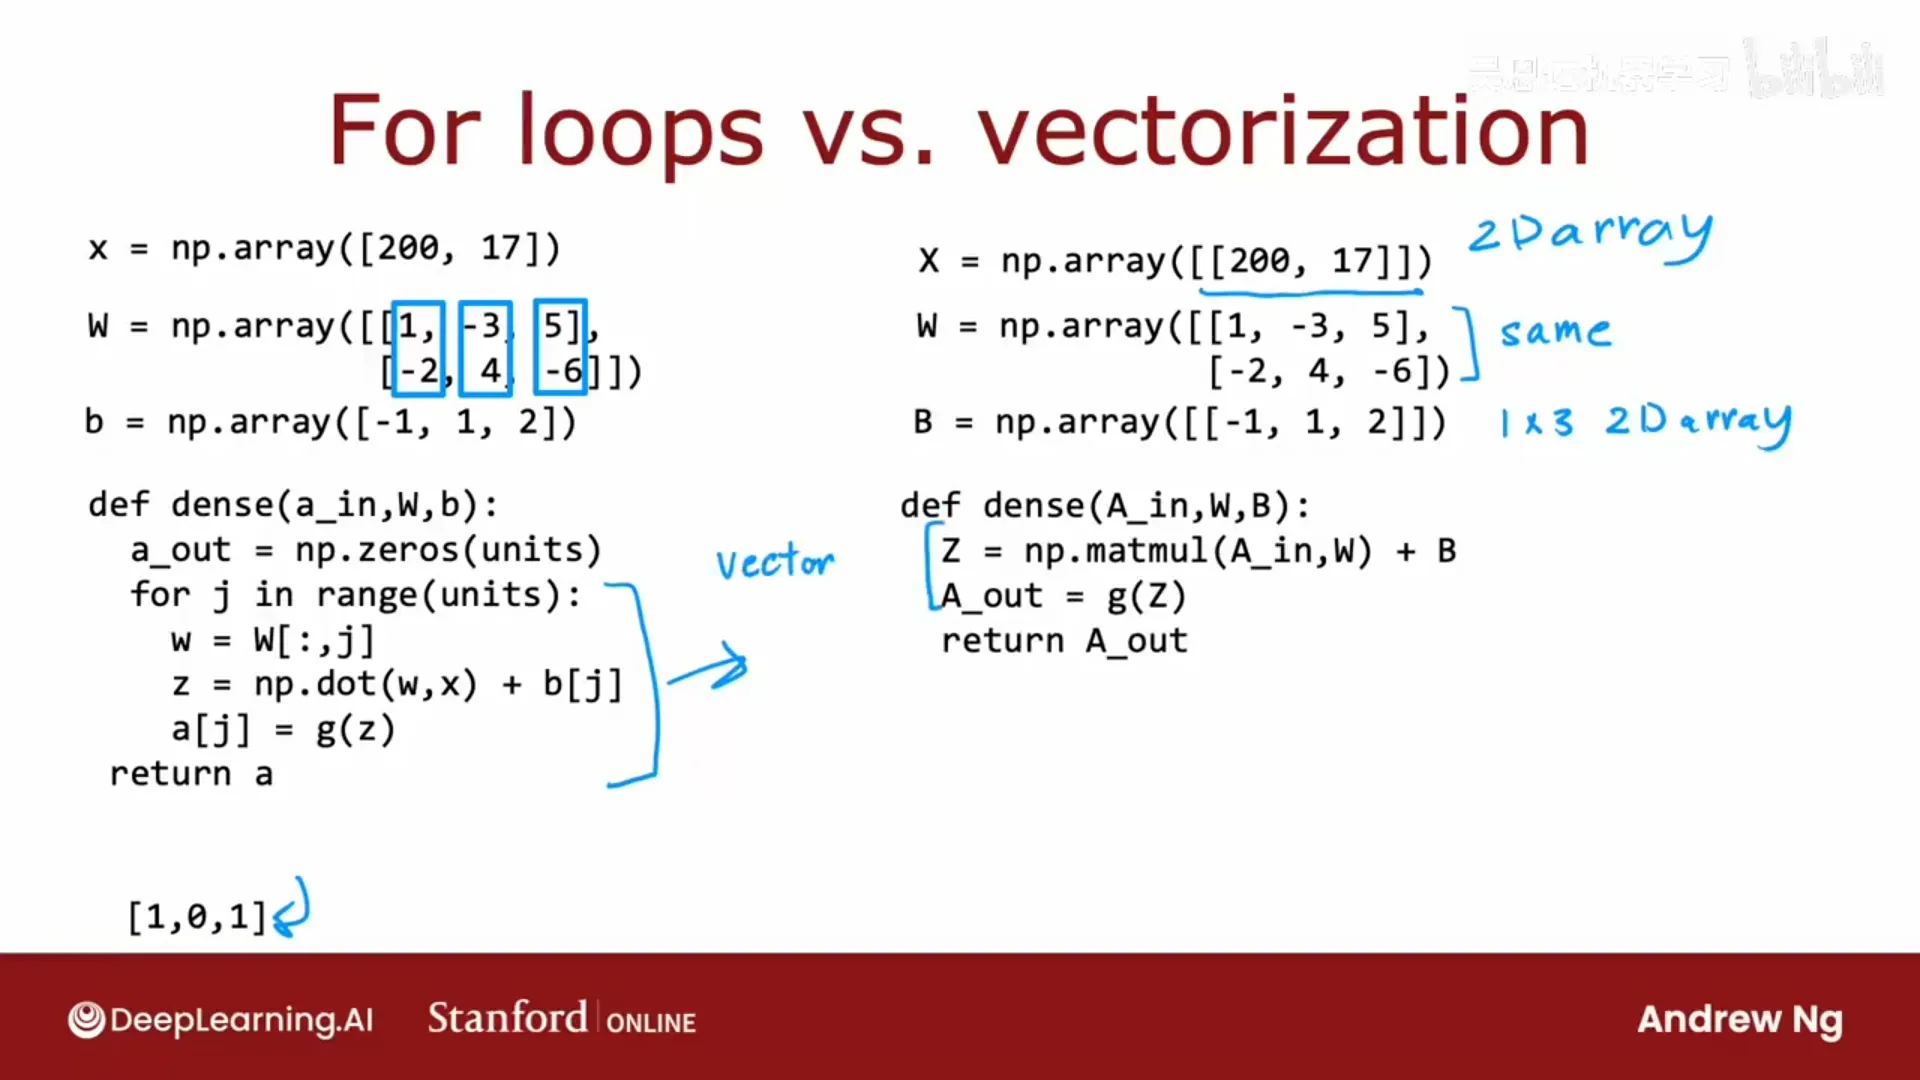
📷 向量化 dense:Z = matmul(A, W) + B,再逐元素激活
回到原视频 (00:01:57)
6.2 矩阵乘法回顾(可选,给不熟线性代数的人)
(p56–p57)
向量点积与"转置"
两个向量 a=[1,2]、w=[3,4] 的点积:
$$a\cdot w = 1\times 3 + 2\times 4 = 3 + 8 = 11$$
另一种等价写法:把 a 竖起来(列向量)再转置成行向量 aᵀ = [1, 2](1×2 矩阵),然后
$$z = a^{\top} w \qquad (1\times 2)\times(2\times 1) = 1\times 1$$
结果同样是 11。"向量点积"与"aᵀ 乘 w"是同一件事——这一点有助于理解矩阵乘法。
向量 × 矩阵
设 aᵀ = [1, 2](1×2),矩阵
$$W = \begin{bmatrix} 3 & 4 \\ 5 & 6 \end{bmatrix} \qquad (2\times 2)$$
则 z = aᵀ W 是 1×2 矩阵:
- 第 1 个元素 =
aᵀ与 W 第 1 列 [3,4] 的点积 = 1×3+2×4 = 11; - 第 2 个元素 =
aᵀ与 W 第 2 列 [5,6] 的点积 = 1×5+2×6 = 17。
所以 z = [11, 17]。
矩阵 × 矩阵的一般规则
设 Aᵀ 是 3×2(3 行 2 列),W 是 2×4。则 Z = Aᵀ W 是 3×4。
计算规则:
Z的第 i 行第 j 列元素 =Aᵀ的第 i 行 与W的第 j 列做点积。
一个有用的心智图像:看一个矩阵时,重点是它的列;看它的转置时,重点是它的行。例如把 A 的每一列想象成一个向量;转置后这些列变成了 Aᵀ 的行。
维度要求:Aᵀ 的列数必须等于 W 的行数(这里都是 2)——因为只有同长度的向量才能做点积。而输出 Z 的维度是"Aᵀ 的行数 × W 的列数"。
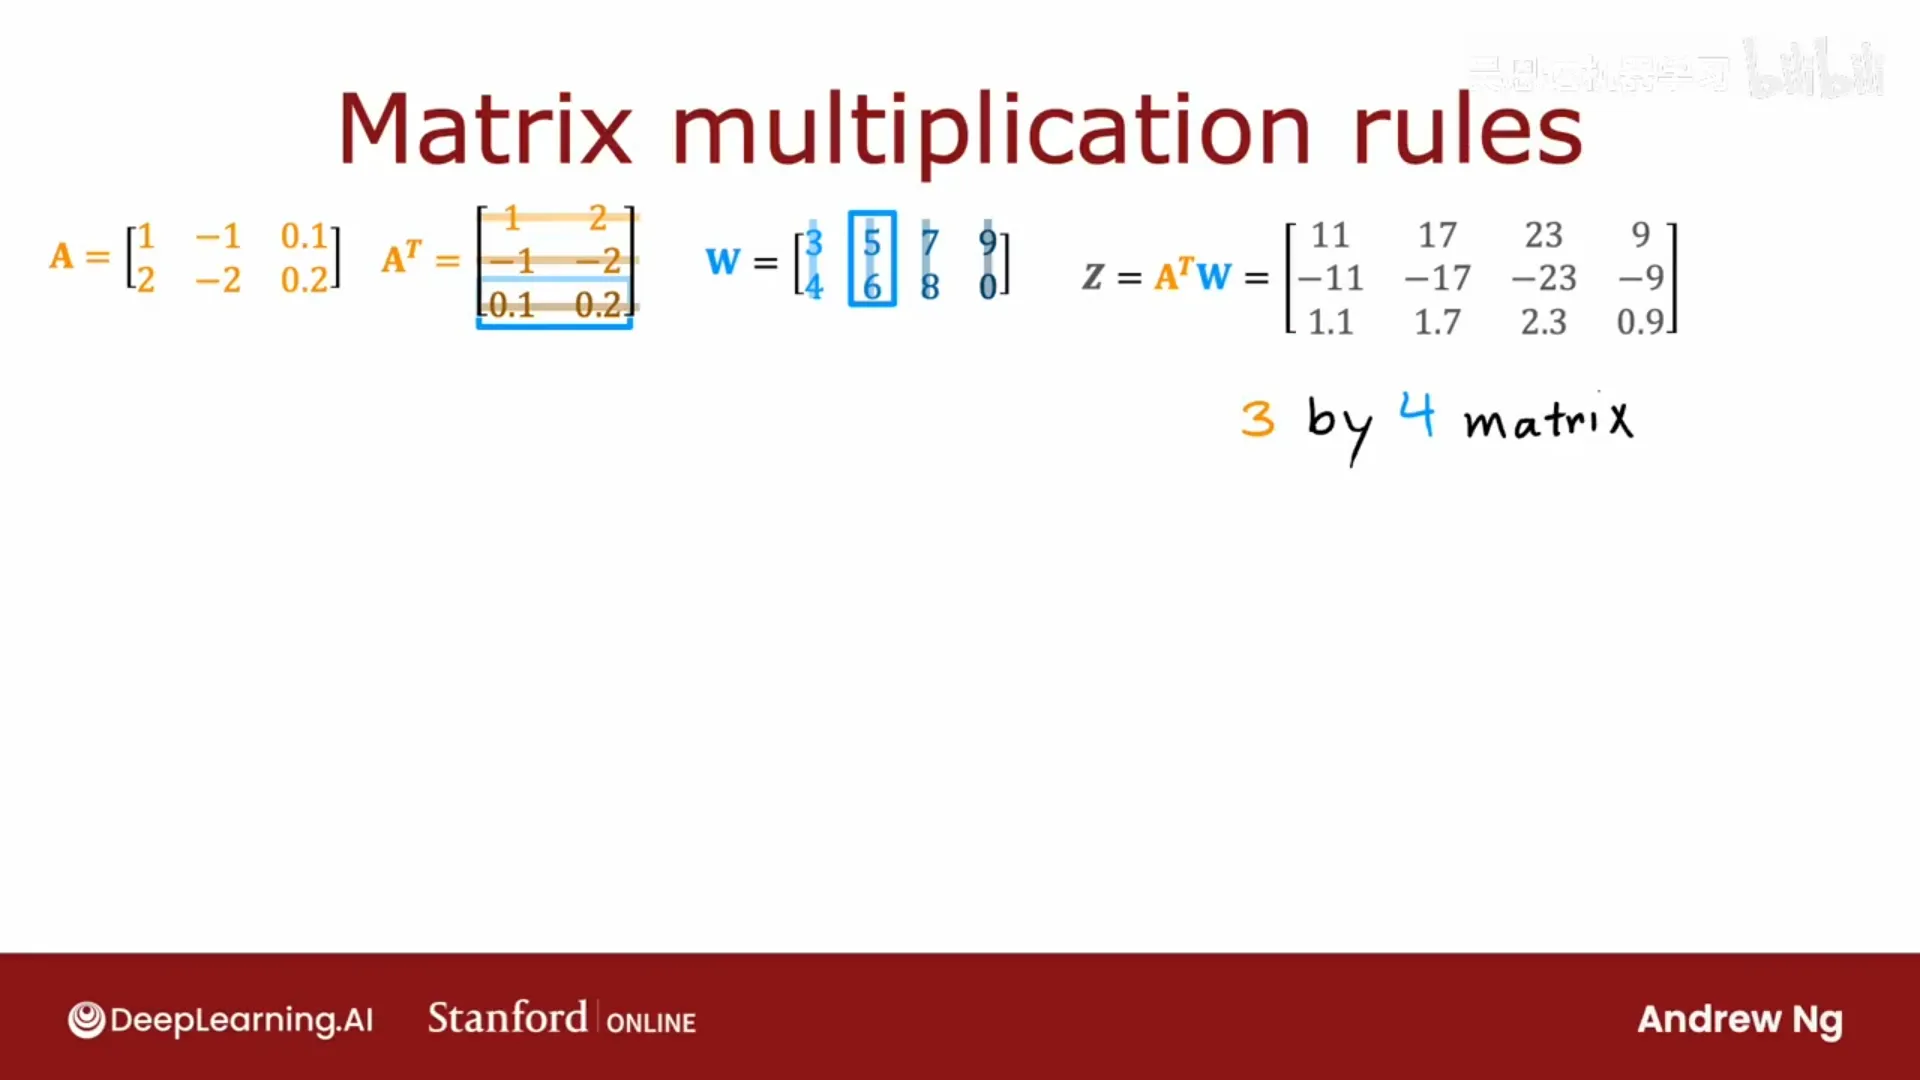
📷 矩阵乘法:Z 的第 i 行第 j 列 = Aᵀ 第 i 行 · W 第 j 列;要求中间维度匹配
回到原视频 (00:06:48)
6.3 把它套回前向传播
(p58)
咖啡例子:输入 A_in = [[200, 17]](1×2),W 是把 w₁,w₂,w₃ 按列堆叠成的 2×3 矩阵,B = [[b₁, b₂, b₃]](1×3)。则:
Z = np.matmul(A_in, W) + B     # 得到 [[165, -531, 900]]
A_out = sigmoid(Z)             # 逐元素激活 → [[1, 0, 1]](约)
逐个验证:把 [200, 17] 与 W 的第 1 列点积 + b₁ = 165;与第 2 列点积 + b₂ = −531;与第 3 列点积 + b₃ = 900。Sigmoid 之后:165 的 Sigmoid 几乎为 1、−531 的几乎为 0、900 的几乎为 1。
TensorFlow 的一个小差别:它约定每个样本放在矩阵 X 的"行"里(而不是列里),所以代码里变量叫 A_in 而不是 Aᵀ。正是这个约定,让"几行代码就能实现前向传播并获得巨大加速"成为可能——因为矩阵乘法有专用硬件可以极快地完成。
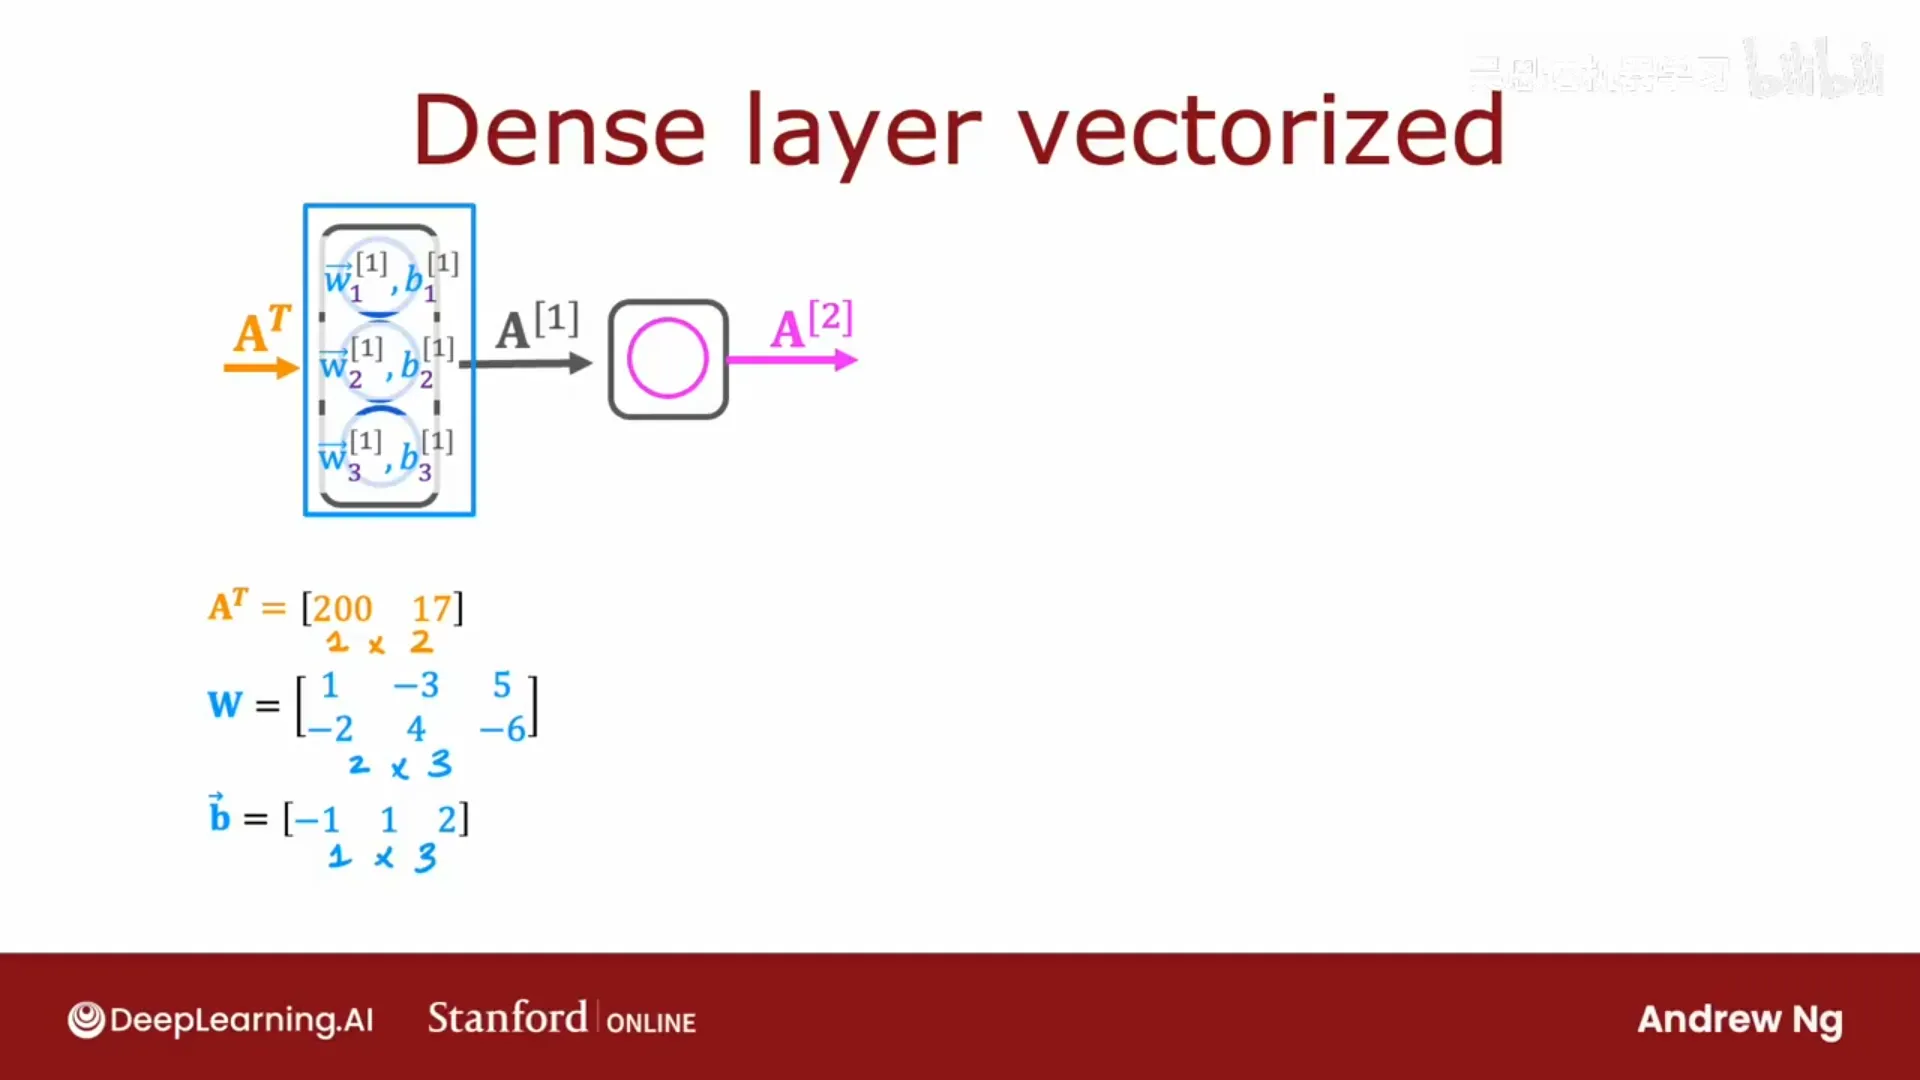
📷 把输入、权重按矩阵组织,一行 matmul 就完成整层前向传播
回到原视频 (00:02:43)
第七章 TensorFlow 训练细节
(对应模块 7,视频 p59–p60)
7.1 训练一个神经网络的三步
(p59)
回顾第一门课训练逻辑回归的三步:
- 指定如何从输入 x 和参数 w、b 计算输出(即
f(x) = g(w·x+b)); - 指定损失函数与代价函数(损失是单个样本的,代价是全体平均);
- 用梯度下降最小化代价函数。
神经网络完全一样,只是用 TensorFlow 表达。以手写数字识别(25/15/1 三层)为例:
# 1) 指定模型架构(同时也就指定了前向传播与所有参数)
model = tf.keras.Sequential([
    tf.keras.layers.Dense(25, activation="sigmoid"),
    tf.keras.layers.Dense(15, activation="sigmoid"),
    tf.keras.layers.Dense(1,  activation="sigmoid"),
])

# 2) 编译:指定损失函数
model.compile(loss=tf.keras.losses.BinaryCrossentropy())

# 3) 训练:把"所有层的所有参数 W、B"作为代价函数的自变量去最小化
model.fit(X, Y, epochs=100)
- 第 1 步的代码片段同时就指定了所有层、所有参数(w^[1],b^[1],w^[2],b^[2],w^[3],b^[3]),因此完整定义了"f(x; W, B)";
epoch:跑多少轮学习算法(如梯度下降步数);- 第 3 步里,代价函数 J(W, B) 是关于"神经网络中所有 W、B 参数"的函数——最小化它,就是优化整个网络。
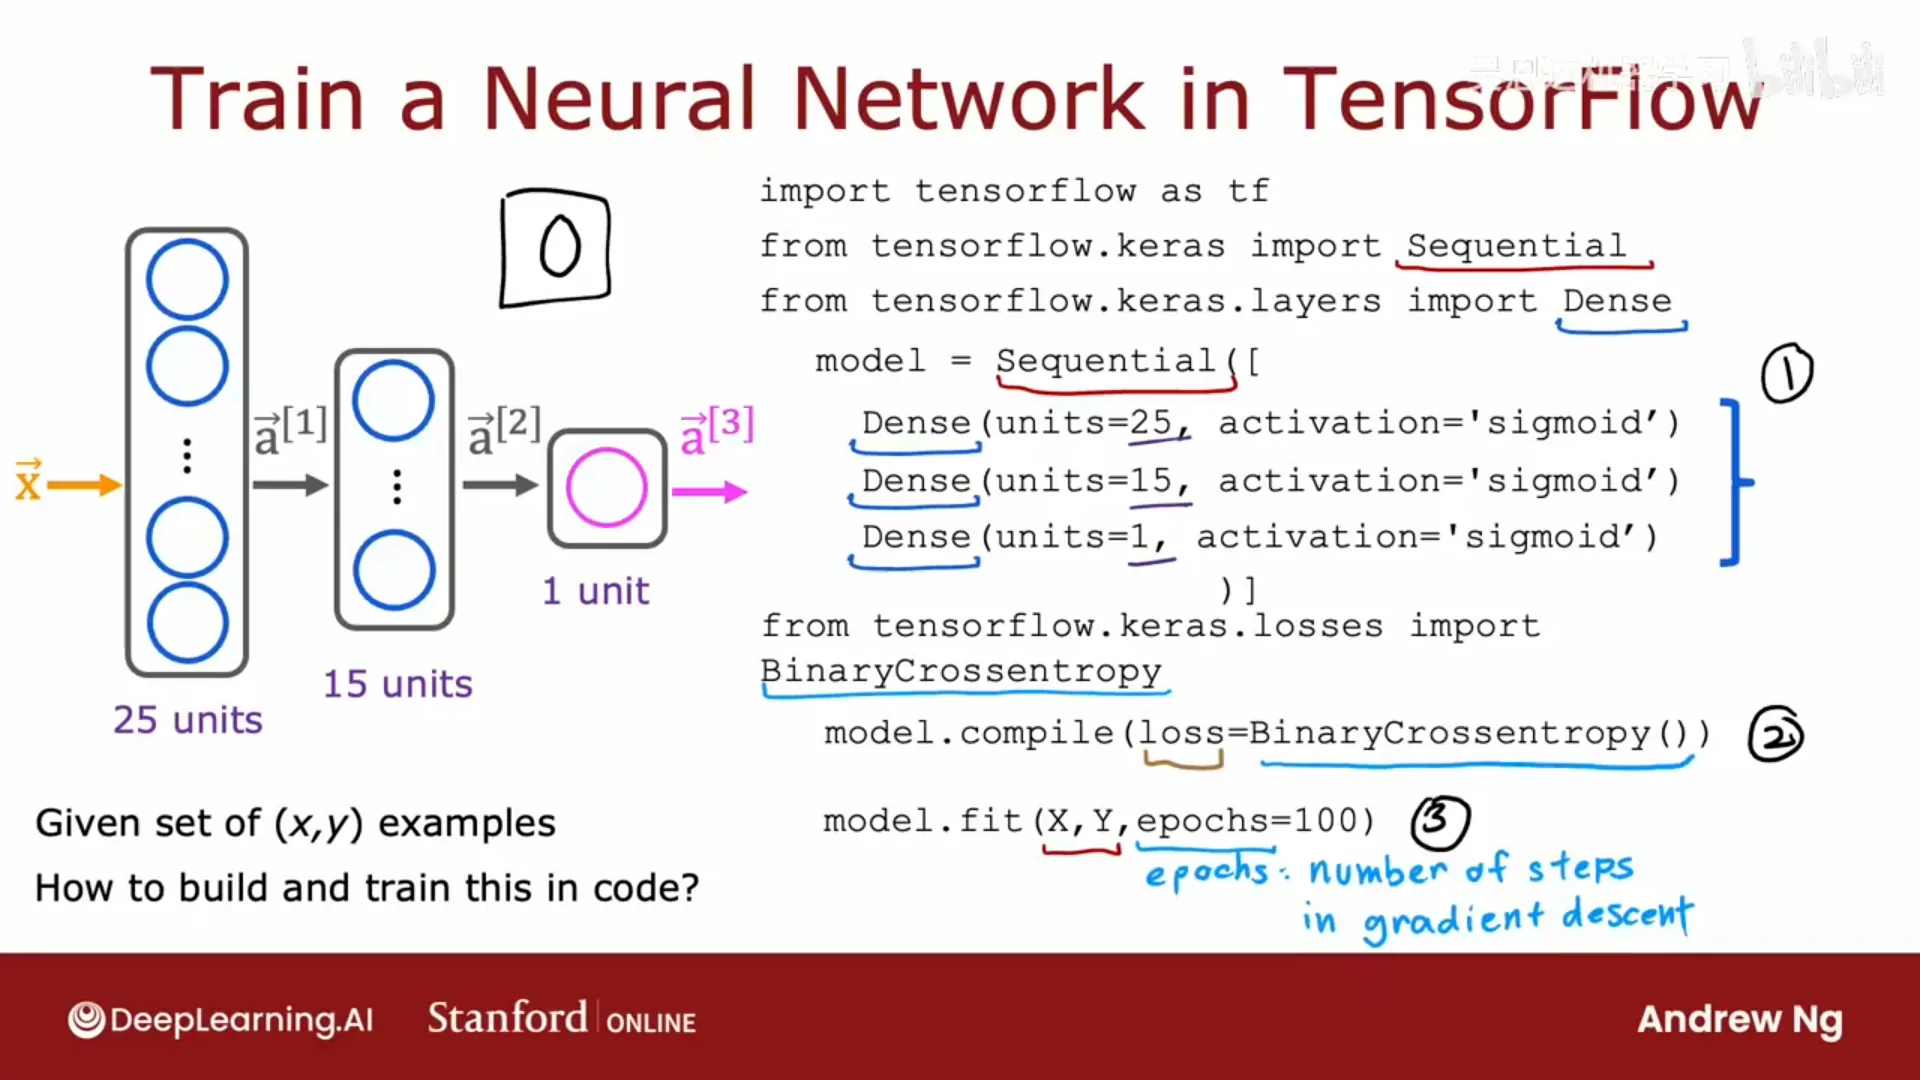
📷 训练神经网络三步:用 Sequential 指定模型 → compile 指定损失 → fit 训练
回到原视频 (00:02:50)
7.2 损失函数与代价函数
(p60)
二分类(如 0/1 数字):损失用与逻辑回归完全相同的二元交叉熵:
$$L\big(f(x),y\big) = -y\log\big(f(x)\big) - (1-y)\log\big(1-f(x)\big)$$
TensorFlow 里就是 tf.keras.losses.BinaryCrossentropy()。
名字来历:统计学里这个函数叫交叉熵损失;"二元"只是强调这是二分类。(Keras 原本是独立于 TensorFlow 的库,后来并入 TensorFlow,所以有
tf.keras.losses....这样的路径。吴恩达坦言他记不住所有损失函数的名字,现查文档即可。)
回归问题:可以用均方误差:
model.compile(loss=tf.keras.losses.MeanSquaredError())
它的单样本损失是 ½(f(x) − y)²。
代价函数:指定单个样本的损失后,TensorFlow 知道"你要最小化的代价 = 所有 m 个样本损失的平均"。而 J(W, B) 的 W、B 是网络中所有层的所有 W、B 参数——优化它就是在优化整个网络。
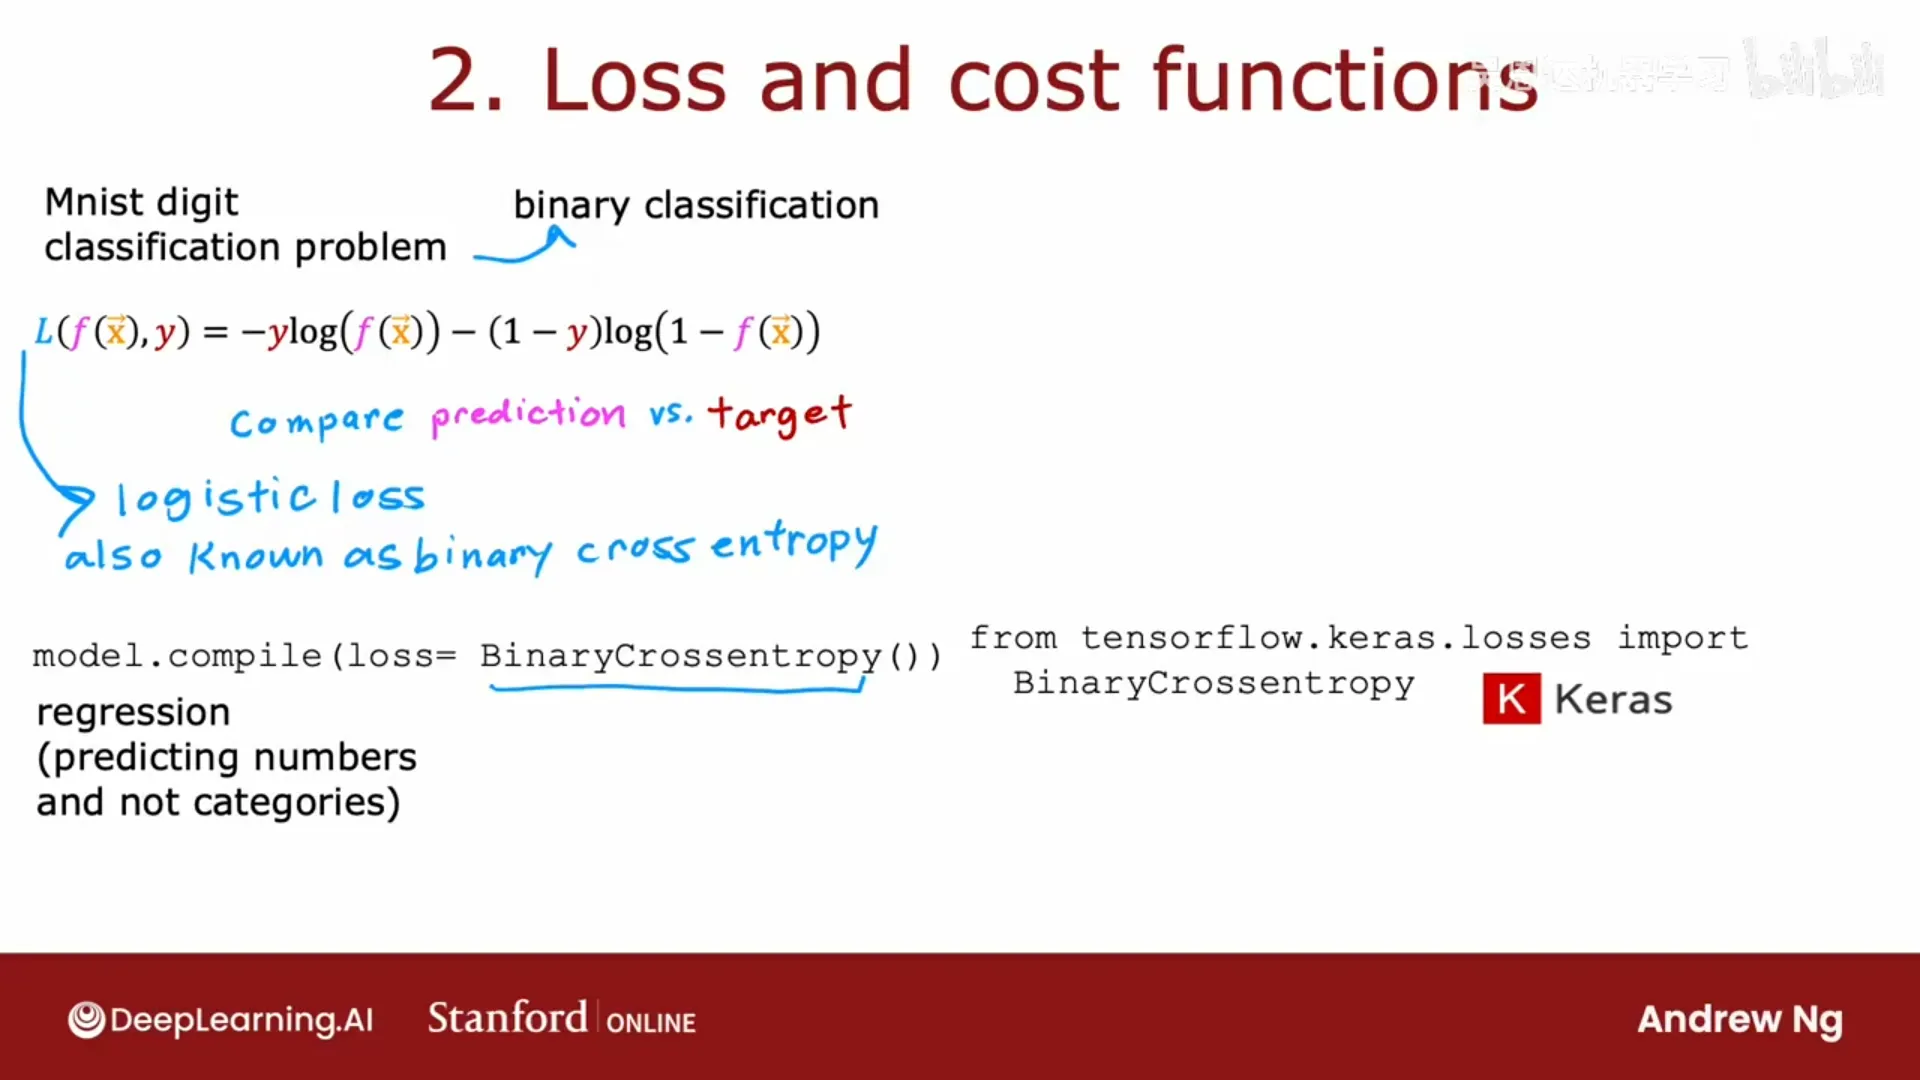
📷 二元交叉熵(分类)与均方误差(回归)两种损失
回到原视频 (00:07:59)
7.3 fit 背后发生了什么:反向传播
(p60)
要用梯度下降,关键是要算出那些偏导数 ∂J/∂w。TensorFlow(以及几乎所有现代框架)用反向传播(backpropagation)自动计算这些偏导数——所有这些都在 fit 里实现。
编者拓展|反向传播的数学本质:链式法则:神经网络是一层套一层的复合函数,要求「损失对最靠前那层参数的偏导」,只需从后往前反复用链式法则把局部导数相乘即可:
$$\frac{\partial L}{\partial w^{[1]}}=\frac{\partial L}{\partial a^{[3]}}\cdot\frac{\partial a^{[3]}}{\partial a^{[2]}}\cdot\frac{\partial a^{[2]}}{\partial a^{[1]}}\cdot\frac{\partial a^{[1]}}{\partial w^{[1]}}$$
「反向」的意思是梯度的传播方向与计算方向相反——前向传播算激活,反向传播算梯度。它本身不神秘,就是「复合函数求导」;难的是工程实现(高效、数值稳定、自动微分)。你只需:
model.fit(X, Y, epochs=100)
(TensorFlow 实际上还会用一种比梯度下降更快的优化算法——后面会讲 Adam。)
关于"用库 vs 自己写":技术成熟后,库会接管底层——今天的排序、开平方、矩阵乘法,几乎没人再自己写;深度学习也已成熟到大多数商业实现直接用 TensorFlow / PyTorch。但理解底层仍有价值:即使成熟库也会出意外,理解原理才更容易解决问题。(吴恩达回忆:深度学习早期,很多开发者包括他自己都用 Python/C++ 从零实现;今天这样做已经很少见了。)
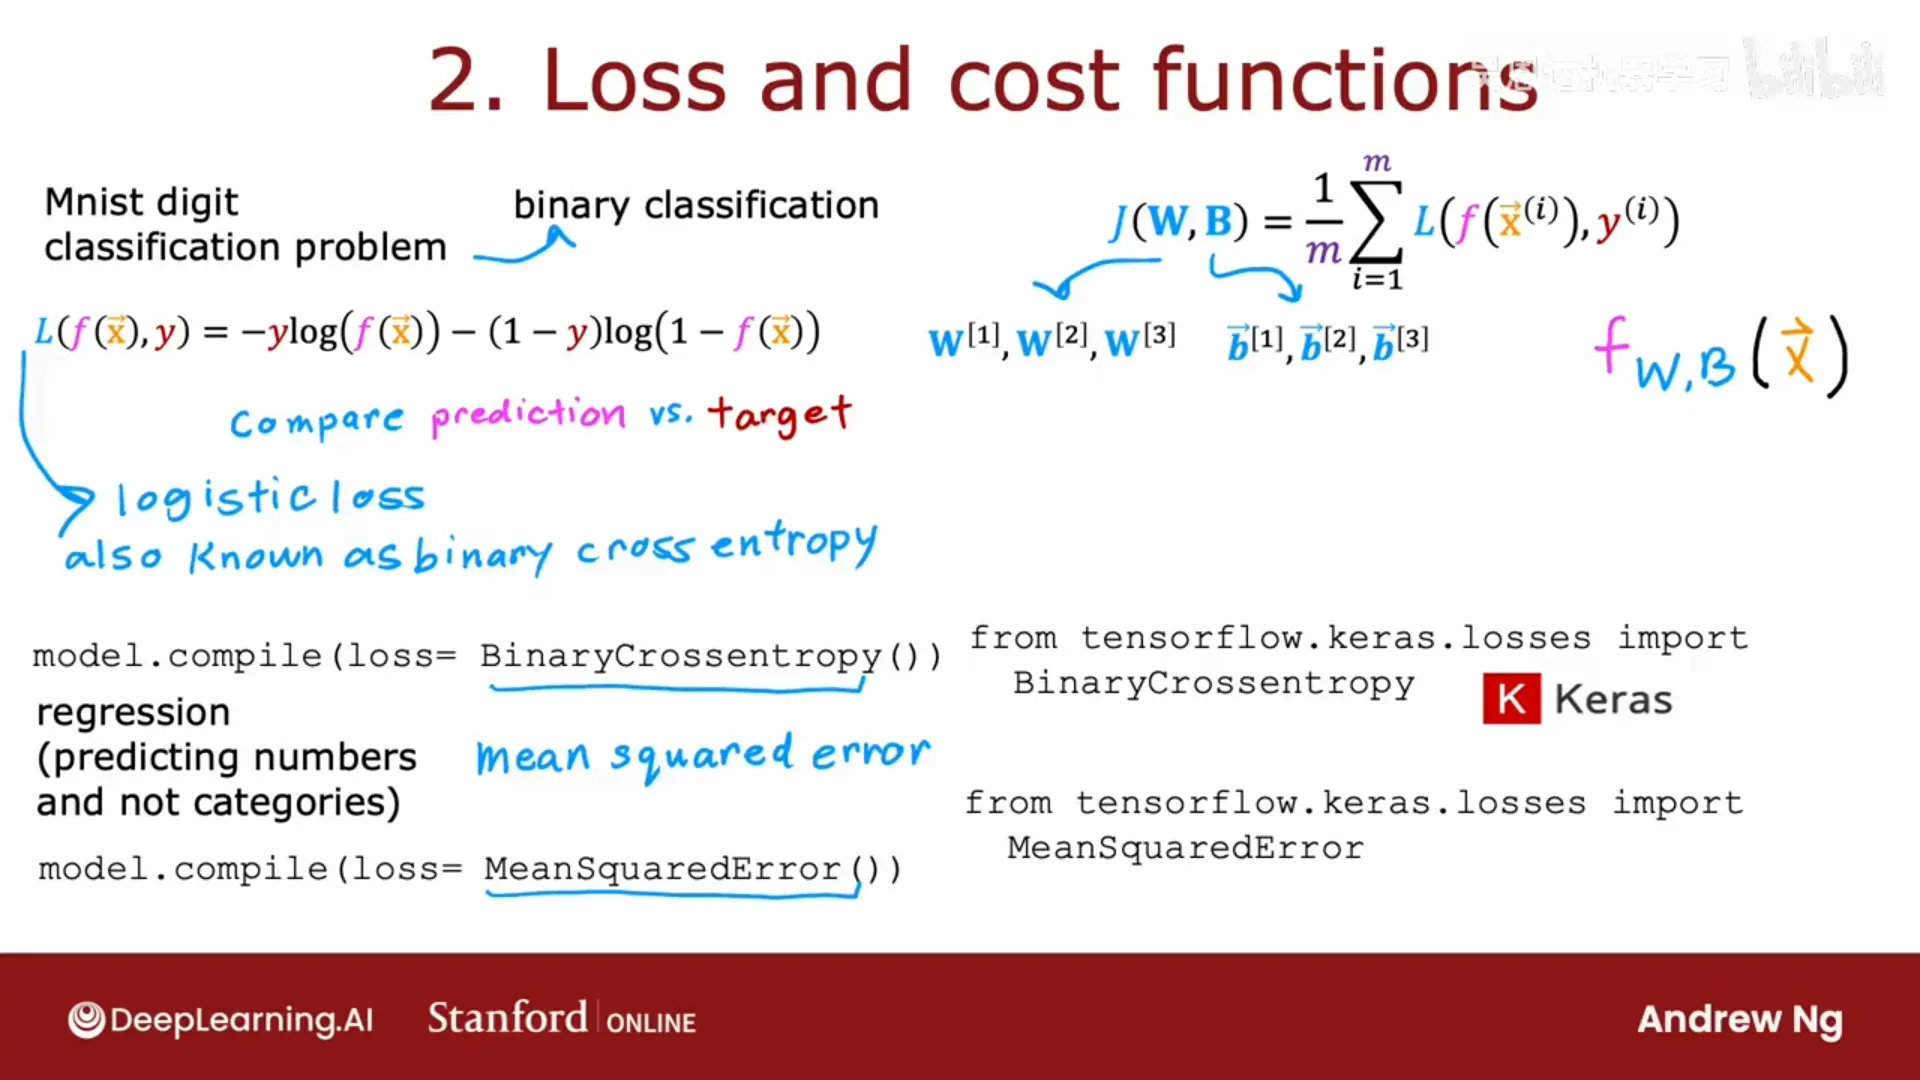
📷 fit 内部用反向传播自动求导;代价是全体样本损失的平均
回到原视频 (00:09:28)
第八章 激活函数的选择
(对应模块 8,视频 p61–p63)
8.1 Sigmoid 之外的激活函数
(p61)
之前所有神经元都用 Sigmoid——因为我们是从"把很多逻辑回归单元串起来"引入神经网络的。但换用其他激活函数,网络会强大得多。
以需求预测里的"知名度"为例:它其实不该是 0/1 二元的——人们可能"有点了解、比较了解、非常了解、彻底火出圈"。所以输出应该是任意非负数,而不是被压在 (0,1) 之间。这时可以换用:
ReLU(Rectified Linear Unit,修正线性单元):
$$g(z) = \max(0, z)$$
- z < 0 时 g(z) = 0;z ≥ 0 时 g(z) = z(一条从原点向右上 45° 的直线);
- 于是激活值 a 可以取0 或任意非负数。
线性激活函数:
$$g(z) = z$$
- 有人会说"这等于没用激活函数"(确实如此,相当于直接输出
w·x + b)。本课还是叫"线性激活函数"。
最常用的三个激活函数:Sigmoid、ReLU、线性。(后面还会讲第四个 Softmax。)
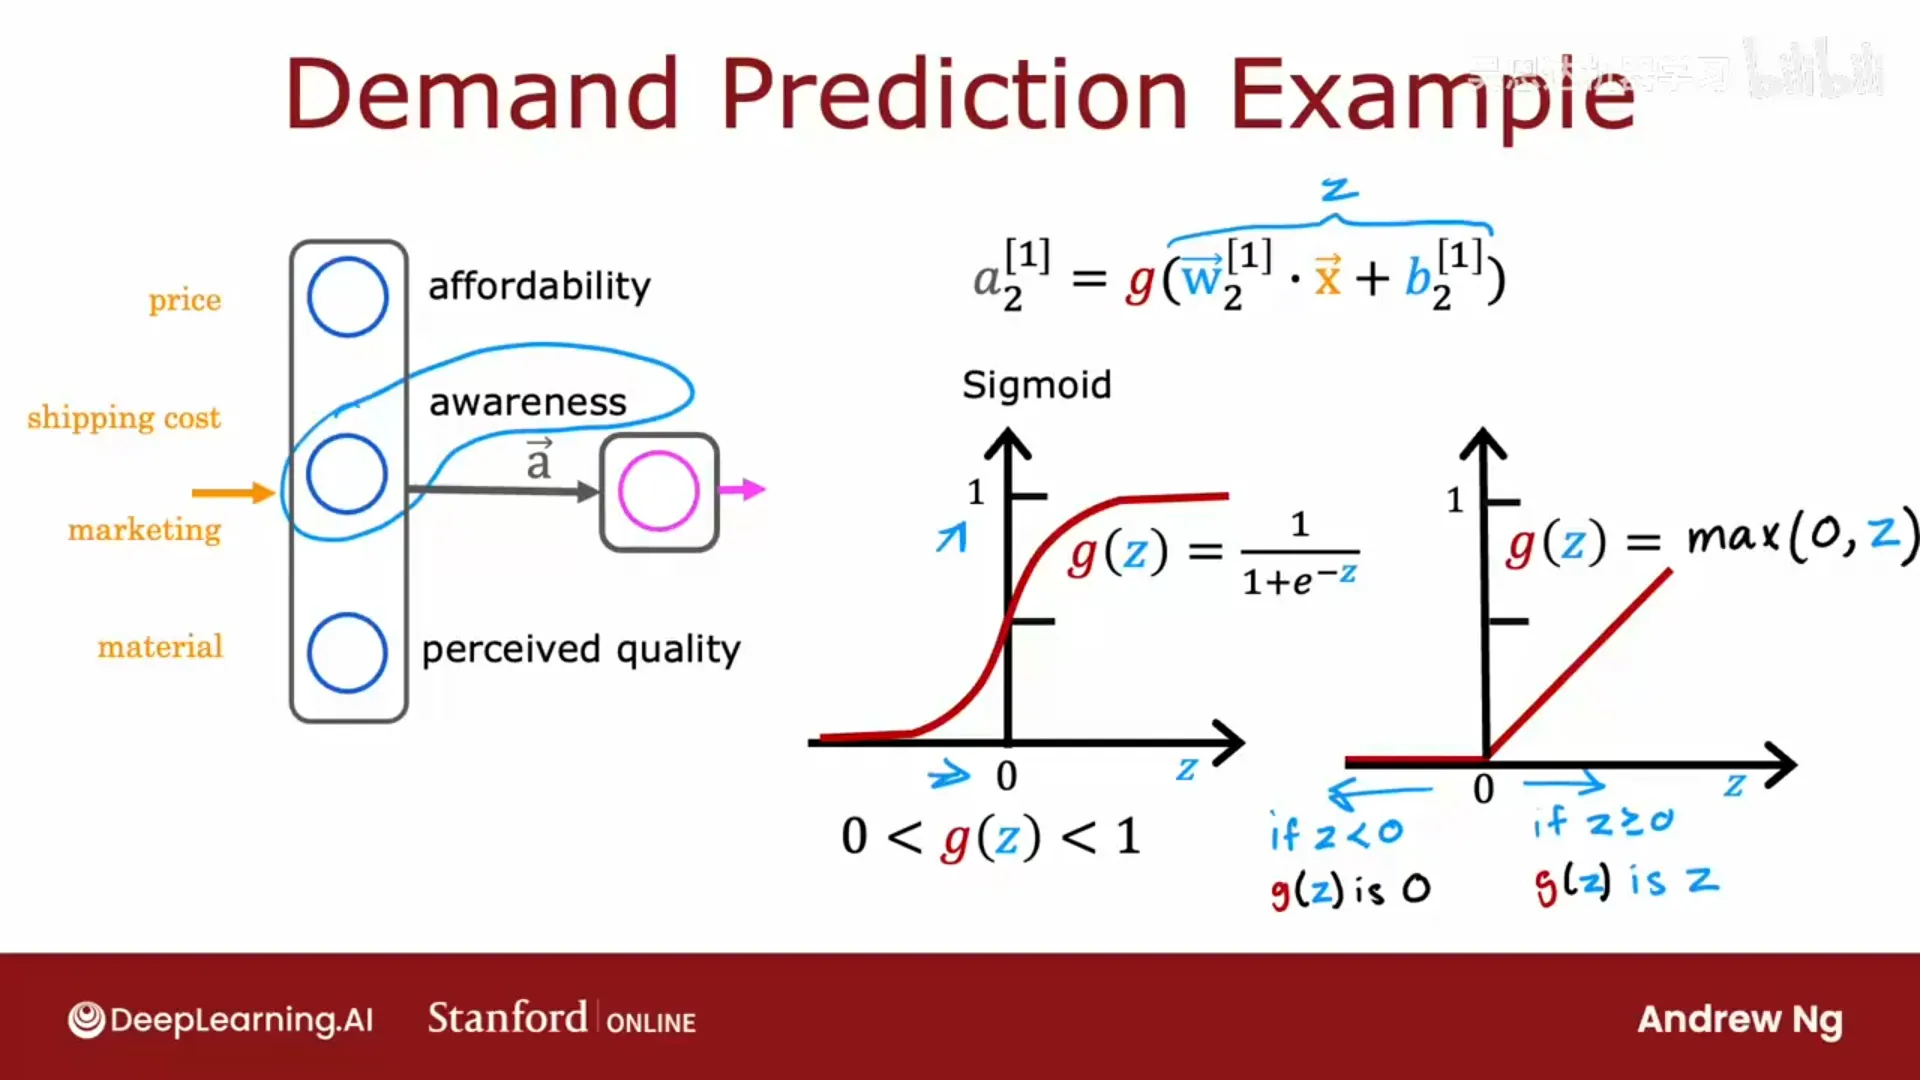
📷 ReLU:g(z) = max(0, z),可以取任意非负值
回到原视频 (00:02:38)
8.2 怎么选激活函数
(p62)
输出层:由"y 是什么"决定(这是吴恩达几乎总是使用的准则):
| y 的样子 | 输出层激活函数 |
|---|---|
| 0/1(二分类) | Sigmoid(网络要预测 P(y=1)) |
| 可正可负的实数(如"股价相对今天涨/跌多少") | 线性 |
| 非负实数(如房价) | ReLU |
隐藏层:默认用 ReLU。 如今绝大多数实践者隐藏层都默认 ReLU(早期大家用 Sigmoid,如今几乎不再在隐藏层用 Sigmoid)。两个原因:
- 计算更快:ReLU 只要算
max(0, z);Sigmoid 要算指数、再做除法,效率略低; - 更重要:ReLU 只有一侧变平(左侧),而 Sigmoid 两侧都变平。梯度下降在"平坦"的地方会非常慢;激活函数是成本函数的一部分,Sigmoid 会让成本函数出现大片平坦区、梯度很小,拖慢学习。经验上,用 ReLU 能让网络学得更快。
编者拓展|为什么「平坦」会拖慢学习:设激活函数在某处的导数是 $g'$,那么梯度里就会乘上这个 $g'$。Sigmoid 在两侧的导数都趋近于 0——一旦神经元的输入落入「饱和区」,梯度就几乎消失(这叫梯度消失),学习几乎停滞。ReLU 在 $z>0$ 处导数恒为 1,不会把它「压小」,所以深层网络用 ReLU 学得更快。这也是 2011 年前后 ReLU 被重新发现、并迅速取代 Sigmoid 的原因。
tf.keras.layers.Dense(25, activation="relu")     # 隐藏层
tf.keras.layers.Dense(1,  activation="sigmoid")  # 二分类输出层
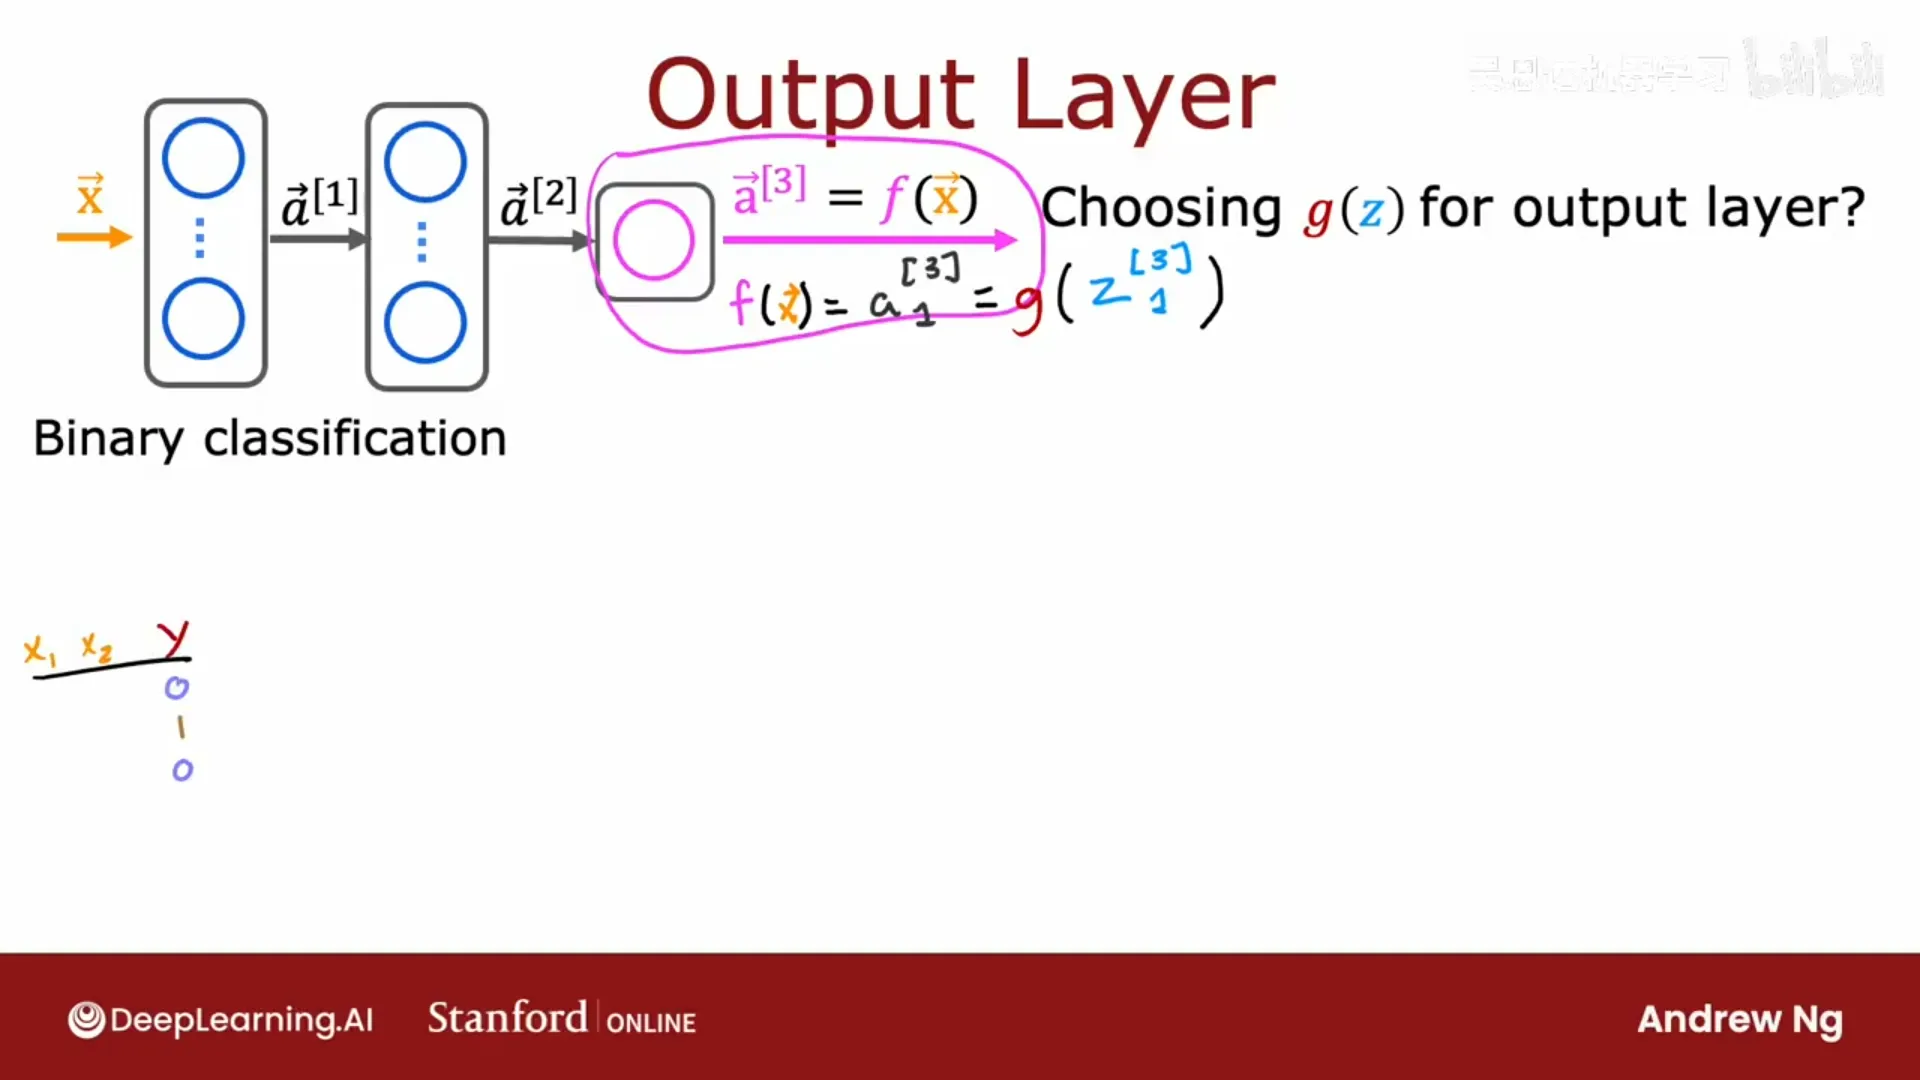
📷 输出层激活函数的选择:二分类→Sigmoid,任意实数→线性,非负→ReLU
回到原视频 (00:01:01)
文献里还有 tanh(双曲正切)、leaky ReLU、swish 等;每隔几年就有人提出新的激活函数。偶尔 leaky ReLU 会更好(吴恩达的工作里偶尔用到),但对绝大多数应用,Sigmoid / ReLU / 线性已经足够。
8.3 为什么必须有"非线性"激活函数
(p63)
如果所有神经元都用线性激活,会发生什么?
看一个小网络:a₁ = g(w₁x + b₁)、a₂ = g(w₂a₁ + b₂)。若 g(z) = z,则
$$a_2 = w_2(w_1 x + b_1) + b_2 = (w_2 w_1)\,x + (w_2 b_1 + b_2)$$
令 w = w₂w₁、b = w₂b₁ + b₂,就得到 a₂ = w·x + b。
结论:一个线性函数的线性函数还是线性的。 所以无论多少层:
- 所有层都用线性激活 → 整个网络完全等价于线性回归;
- 隐藏层全线性、只有输出层用 Sigmoid → 整个网络完全等价于逻辑回归。
也就是说,在隐藏层用线性激活,等于白加了那些层——网络无法表达比线性函数更复杂的东西。
经验法则:不要在神经网络的隐藏层里用线性激活函数;隐藏层默认用 ReLU 就好。
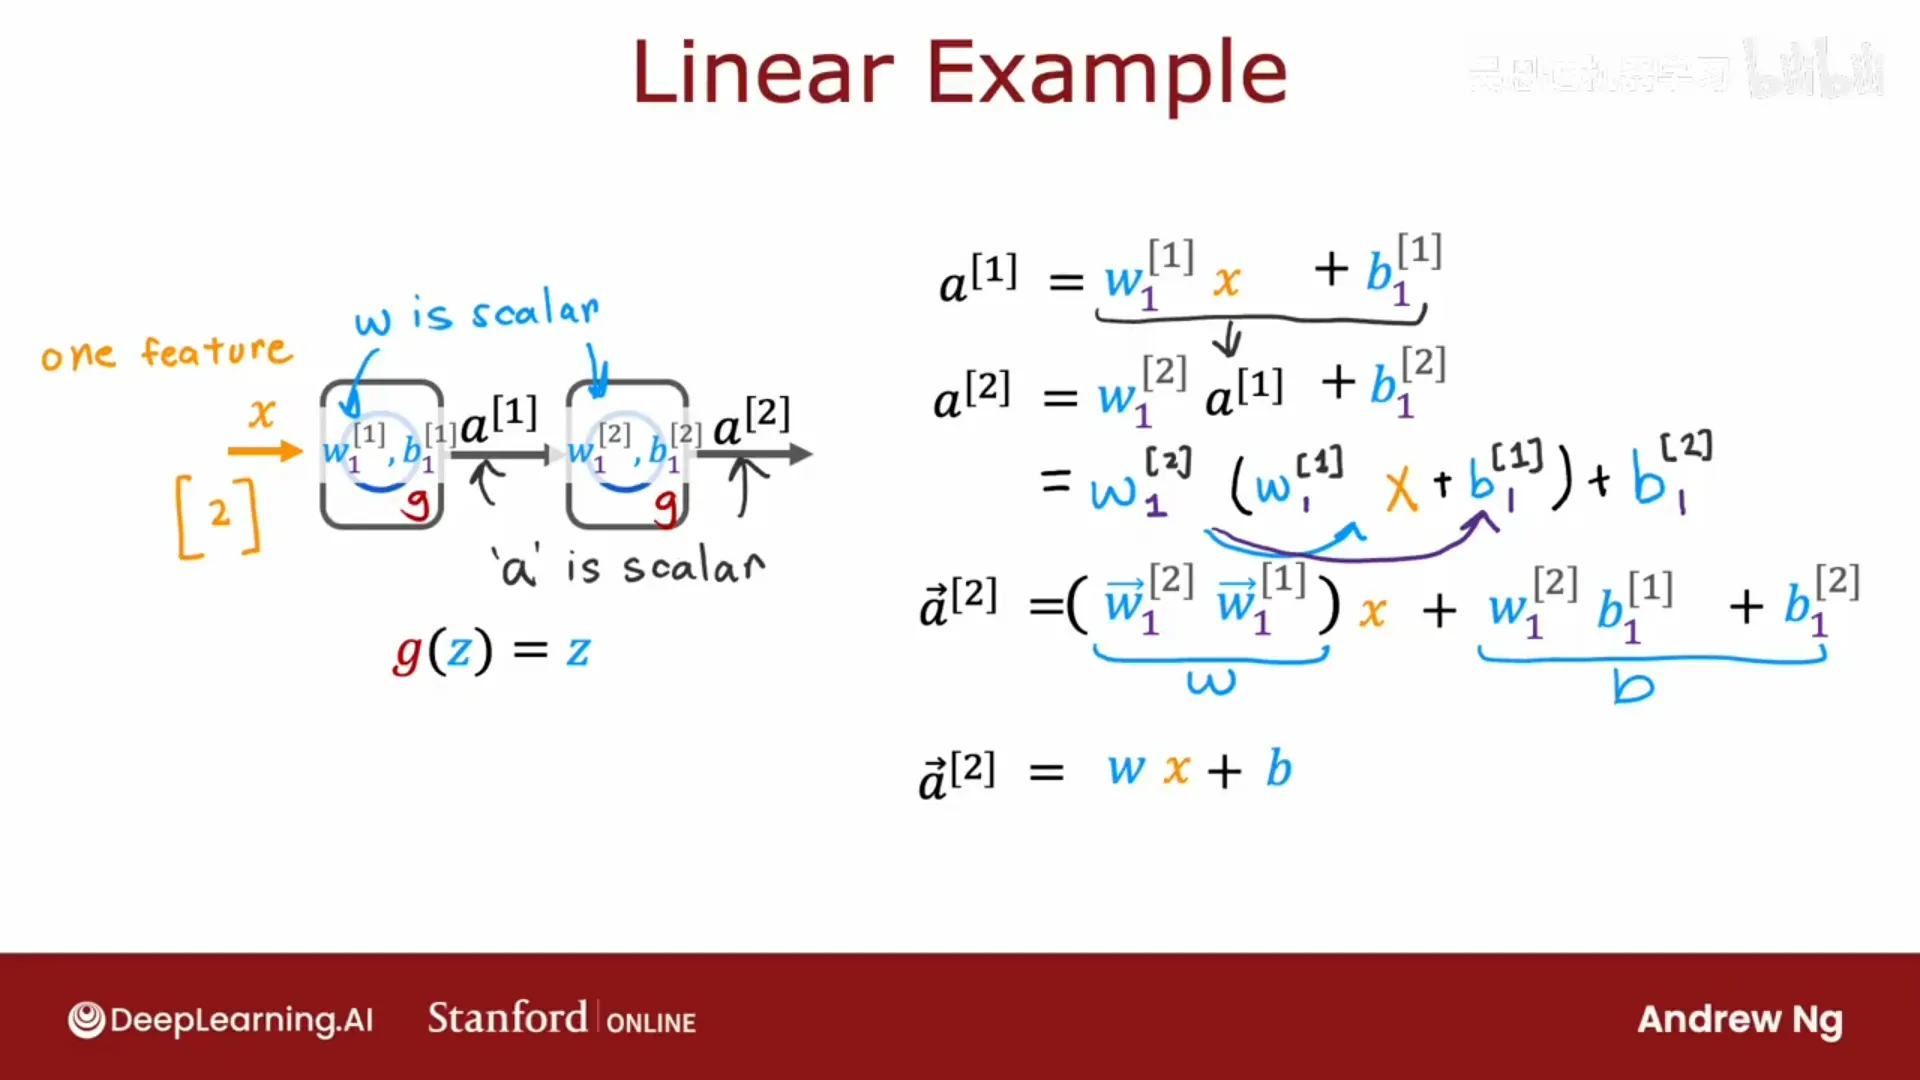
📷 若全用线性激活,多层网络会塌缩成线性回归
回到原视频 (00:02:48)
第九章 多类分类与 Softmax
(对应模块 9,视频 p64–p68)
9.1 多类分类
(p64)
多类分类(multiclass classification) 指 y 可以取多于两个离散类别,例如:
- 识别邮政编码里的 10 个数字(0–9);
- 判断患者属于 3~5 种疾病之一;
- 检测药丸的缺陷类型(划痕 / 变色 / 缺角)。
它仍然是分类问题——y 只取少量离散值,只是从 2 个变成了 3、4、10…个。此时不再只估计 P(y=1|x),而要同时估计 P(y=1|x)、P(y=2|x)、P(y=3|x)、P(y=4|x) 等。
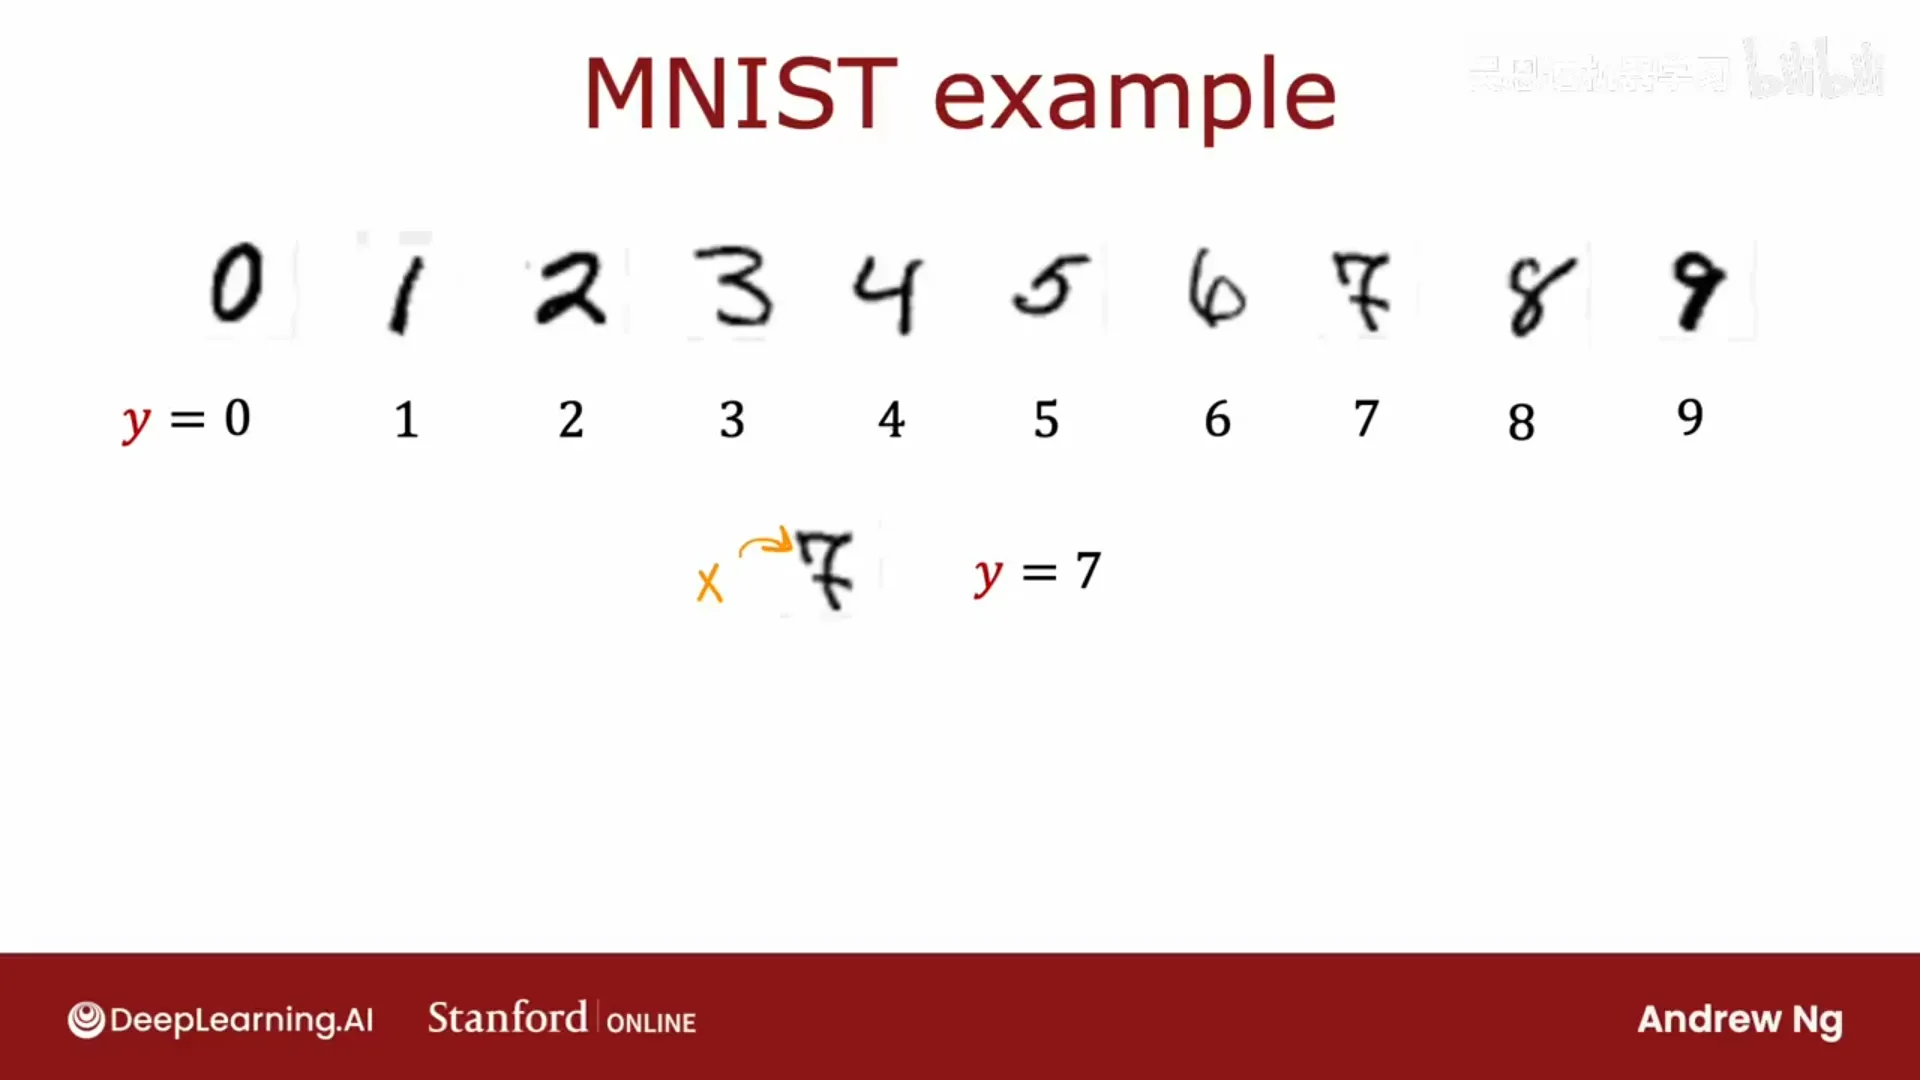
📷 多类分类:y 可以取多于两个离散类别
回到原视频 (00:01:04)
9.2 Softmax 回归:逻辑回归的推广
易错点(Softmax ≠ 多标签):Softmax 用于互斥的多分类(各类概率之和 = 1);若一个样本可同时属于多个类别(多标签,如一张图既有「人」又有「车」),应改用每个类别各自的 Sigmoid + 二元交叉熵,而不是 Softmax。
(p65)
先给逻辑回归"化个妆",方便推广。逻辑回归其实可以看成计算两个数:
$$\begin{aligned}
a_1 &= P(y=1\mid x) = g(z) &&\text{Sigmoid}\ a_2 &= P(y=0\mid x) = 1 - a_1
\end{aligned}$$
(a₁ + a₂ = 1。)
Softmax 回归把它推广到 n 个类别。以 4 类为例:
$$\begin{aligned}
z_1 &= w_1\cdot x + b_1,\quad z_2 = w_2\cdot x + b_2,\quad z_3 = w_3\cdot x + b_3,\quad z_4 = w_4\cdot x + b_4\ a_1 &= \frac{e^{z_1}}{e^{z_1}+e^{z_2}+e^{z_3}+e^{z_4}} = P(y=1\mid x)\ a_2 &= \frac{e^{z_2}}{e^{z_1}+e^{z_2}+e^{z_3}+e^{z_4}} = P(y=2\mid x)\ a_3 &= \cdots,\quad a_4 = \cdots
\end{aligned}$$
一般地(n 个类别):
$$\begin{aligned}
z_j &= w_j\cdot x + b_j\ a_j &= \frac{e^{z_j}}{\sum_{k=1}^{n} e^{z_k}} = P(y=j\mid x)
\end{aligned}$$
关键性质:由于分母相同,a₁ + a₂ + … + aₙ 恒等于 1。
编者拓展|Softmax 与「交叉熵」的名字:Softmax 名字里的 soft 是对 max 的「软化」——真正的 max 会输出 one-hot(如
[0,0,1,0]),Softmax 则在放大最大项的同时保留其它类别的微小概率,于是可导、可用梯度下降。而 交叉熵(cross-entropy) 来自信息论:$-\log p(\text{正确类})$ 正是「用你的预测分布去编码真实答案所需的惊讶程度」——你把正确类的概率压得越低,代价越高。所以「Softmax + 交叉熵」成为分类任务的标准组合。小测验:若 a₁=0.30、a₂=0.20、a₃=0.15,则 a₄ 必为 0.35(因为概率之和为 1)。
而当 n = 2 时,Softmax 退化成逻辑回归(参数形式略有不同,但等价)——所以它是逻辑回归的推广。
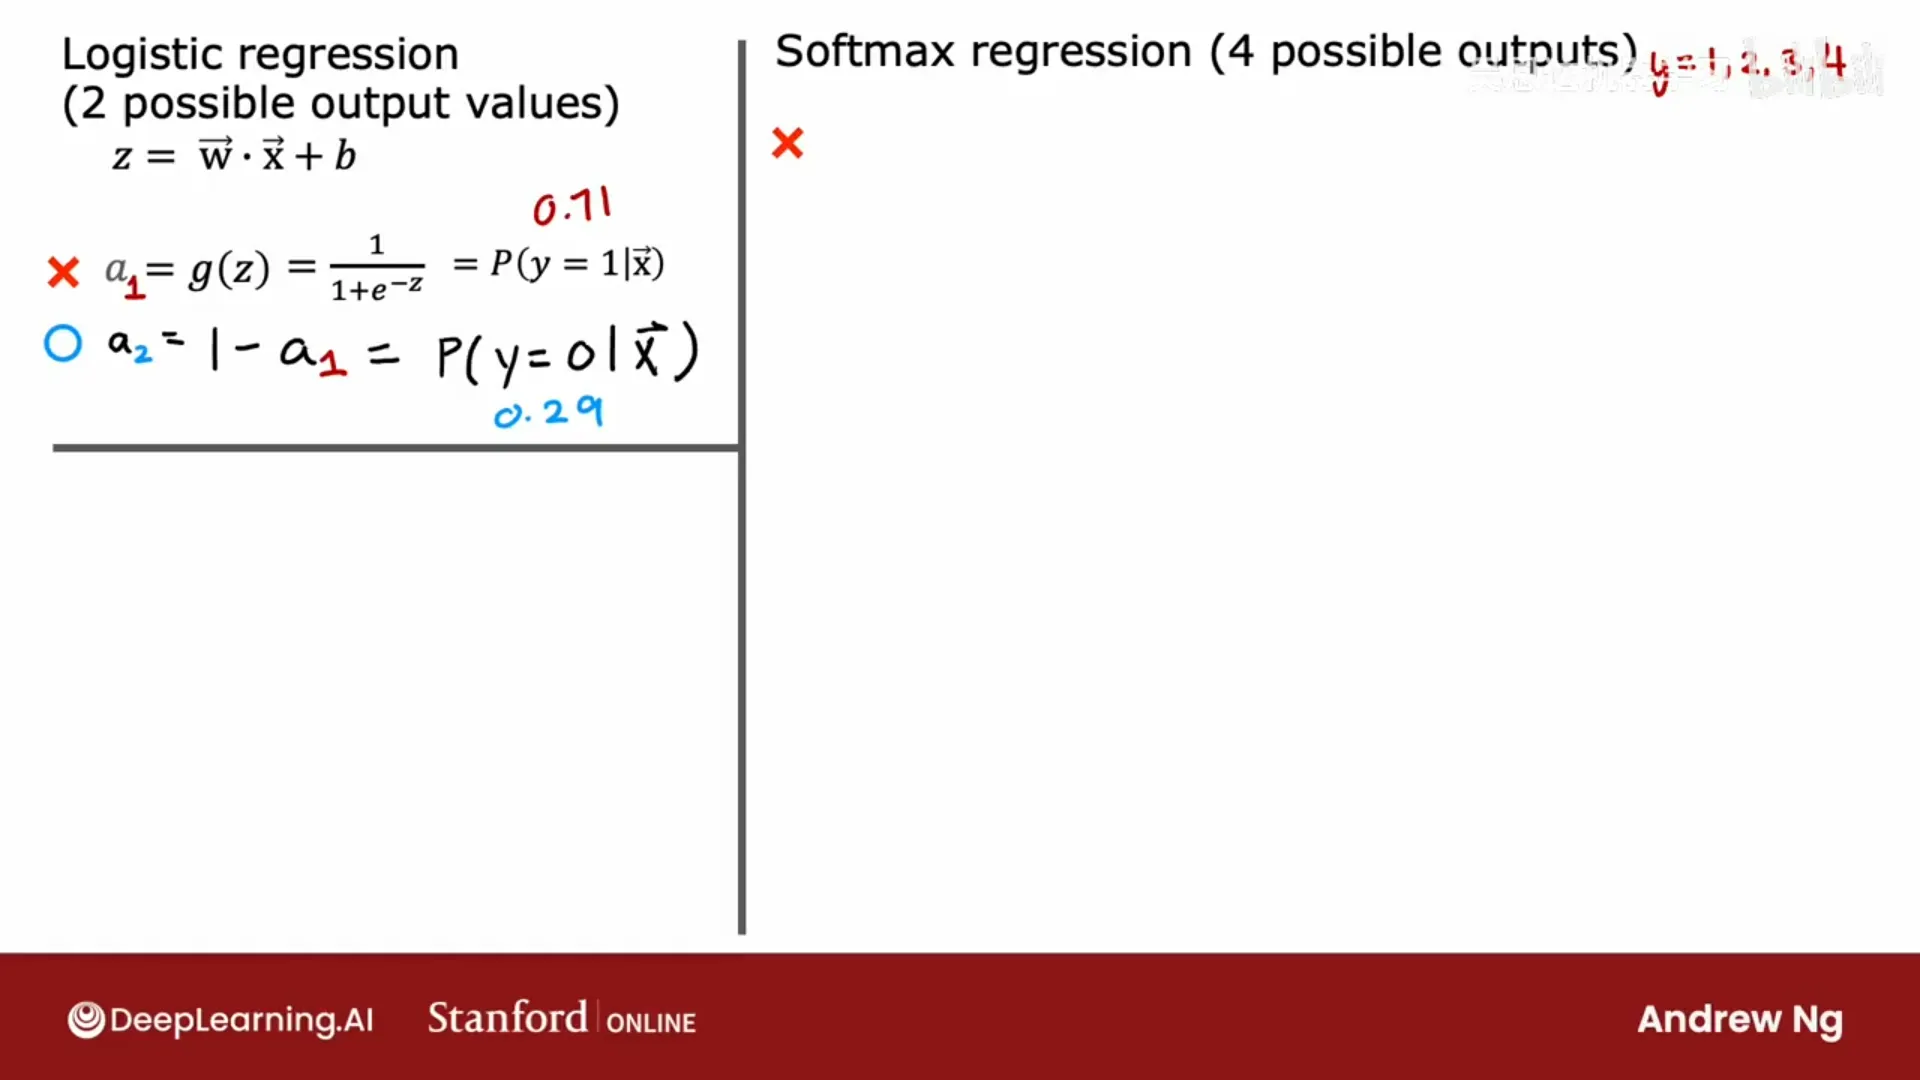
📷 Softmax 回归:把 z 指数化后归一化,得到各类别的概率
回到原视频 (00:02:25)
Softmax 的代价函数
损失取决于真实标签 y=j:
$$L = -\log(a_j) \qquad \text{(模型认为 } y=j \text{ 的概率的负对数)}$$
- 若 y=1 → 损失 = −log(a₁);若 y=2 → −log(a₂);… 若 y=n → −log(aₙ);
- 这与逻辑回归的损失完全是同一个思想(y=1 时 −log(a₁)、y=0 时 −log(a₂)),只是推广到 n 类;
−log(a_j)函数:a_j 越接近 1,损失越接近 0;a_j 越小,损失越大——激励算法把"正确类别"的概率尽量推向 1。
9.3 带 Softmax 输出层的神经网络
(p66)
把 Softmax 放进神经网络的输出层:10 类数字识别就把输出层改成 10 个单元,这一层用 Softmax 激活函数。
前向传播不变(a^[1]、a^[2] 照旧),最后由输出层计算 z₁…z₁₀,再经 Softmax 得到 a₁…a₁₀——分别是 y=1…10 的概率估计。
Softmax 与其他激活函数的关键区别:
- Sigmoid / ReLU / 线性都是逐元素的(a₁ 只依赖 z₁,a₂ 只依赖 z₂);
- Softmax 的每个 a_j 都依赖全部 z——
a₁是z₁…z₁₀的共同函数。这是 Softmax 独特的性质。
TensorFlow:
model = tf.keras.Sequential([
    tf.keras.layers.Dense(25, activation="relu"),
    tf.keras.layers.Dense(15, activation="relu"),
    tf.keras.layers.Dense(10, activation="softmax"),   # 10 类
])
model.compile(loss=tf.keras.losses.SparseCategoricalCrossentropy())
model.fit(X, Y, epochs=100)
- 损失函数叫 稀疏类别交叉熵(SparseCategoricalCrossentropy);
- "类别(Categorical)":y 被分成一个个类别(1~10);
- "稀疏(Sparse)":每个样本只属于其中一个类别(一张图不可能既是 2 又是 7)。
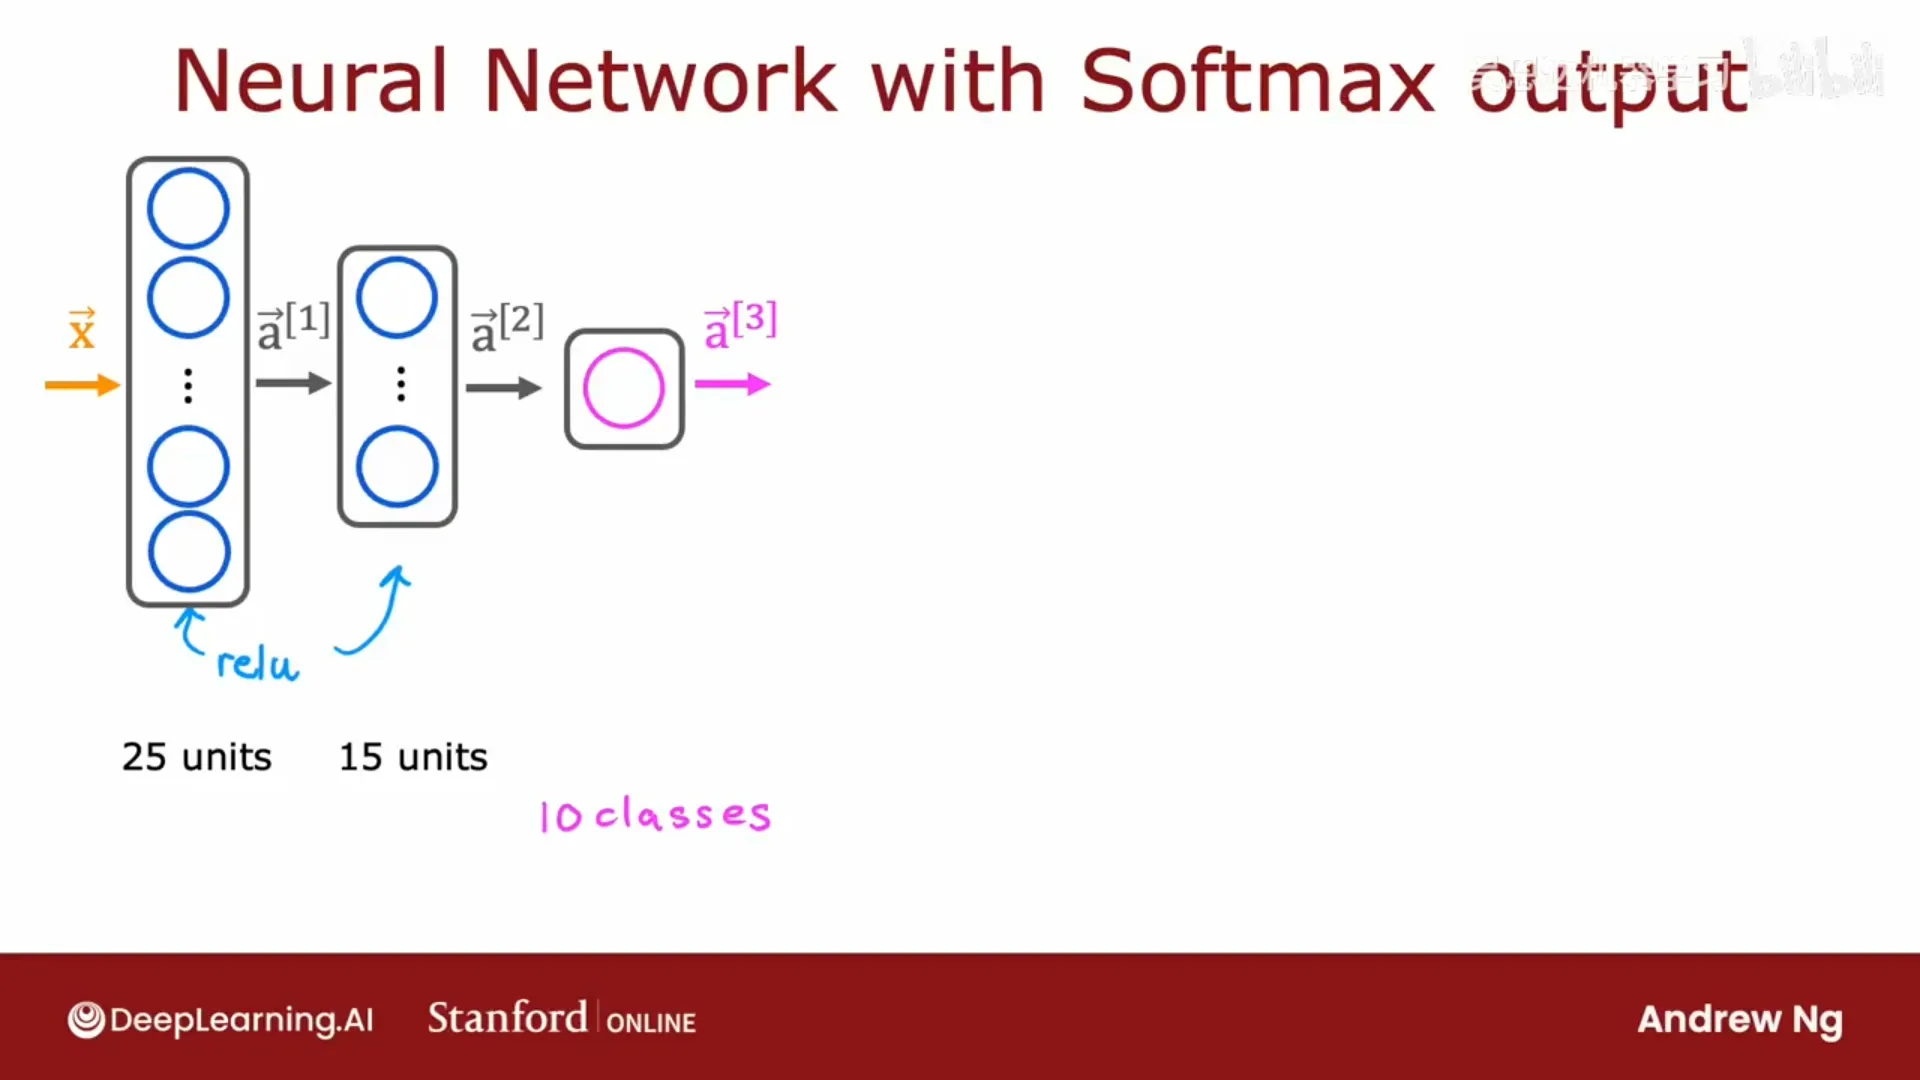
📷 带 10 个输出单元的 Softmax 输出层
回到原视频 (00:00:35)
9.4 数值稳定性:推荐的写法(from_logits=True)
(p67)
先看一个演示:
选项一:$x = \dfrac{2}{10000}$
选项二:$x = \left(1+\dfrac{1}{10000}\right) - \left(1-\dfrac{1}{10000}\right)$
数学上两者相等,但用计算机(浮点数、内存有限)计算时,选项二会有明显的舍入误差。这说明:计算方法不同,数值精度不同。
逻辑回归里这个问题不大,但 Softmax 会更严重。解决办法是:不要让 TensorFlow 显式计算中间的 a,而是把损失写成含 z 的表达式,让 TensorFlow 自己重新排列项、用更精确的方式计算。
具体做法(推荐写法):
# 输出层只用"线性"激活(只算 z,即 logits)
model = tf.keras.Sequential([
    ...,
    tf.keras.layers.Dense(10, activation="linear"),
])
# 把 softmax 与交叉熵"合并"进损失,让 TensorFlow 数值更稳
model.compile(loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True))
要点:
- logits 就是这里的 z(网络的原始输出);
from_logits=True让 TensorFlow "把 z 作为中间值、重新排列各项以更数值准确地计算损失";- 代价是代码可读性稍差(这也是为什么"两段代码概念上等价、但推荐这个"),但数值上更准确——官方推荐用它;
- 这时网络的最后一层不再输出概率 a₁…a₁₀,而是输出 z₁…z₁₀;若最后真需要概率,再做一次 Softmax 映射(逻辑回归同理,需要时用逻辑函数把输出映射成概率)。
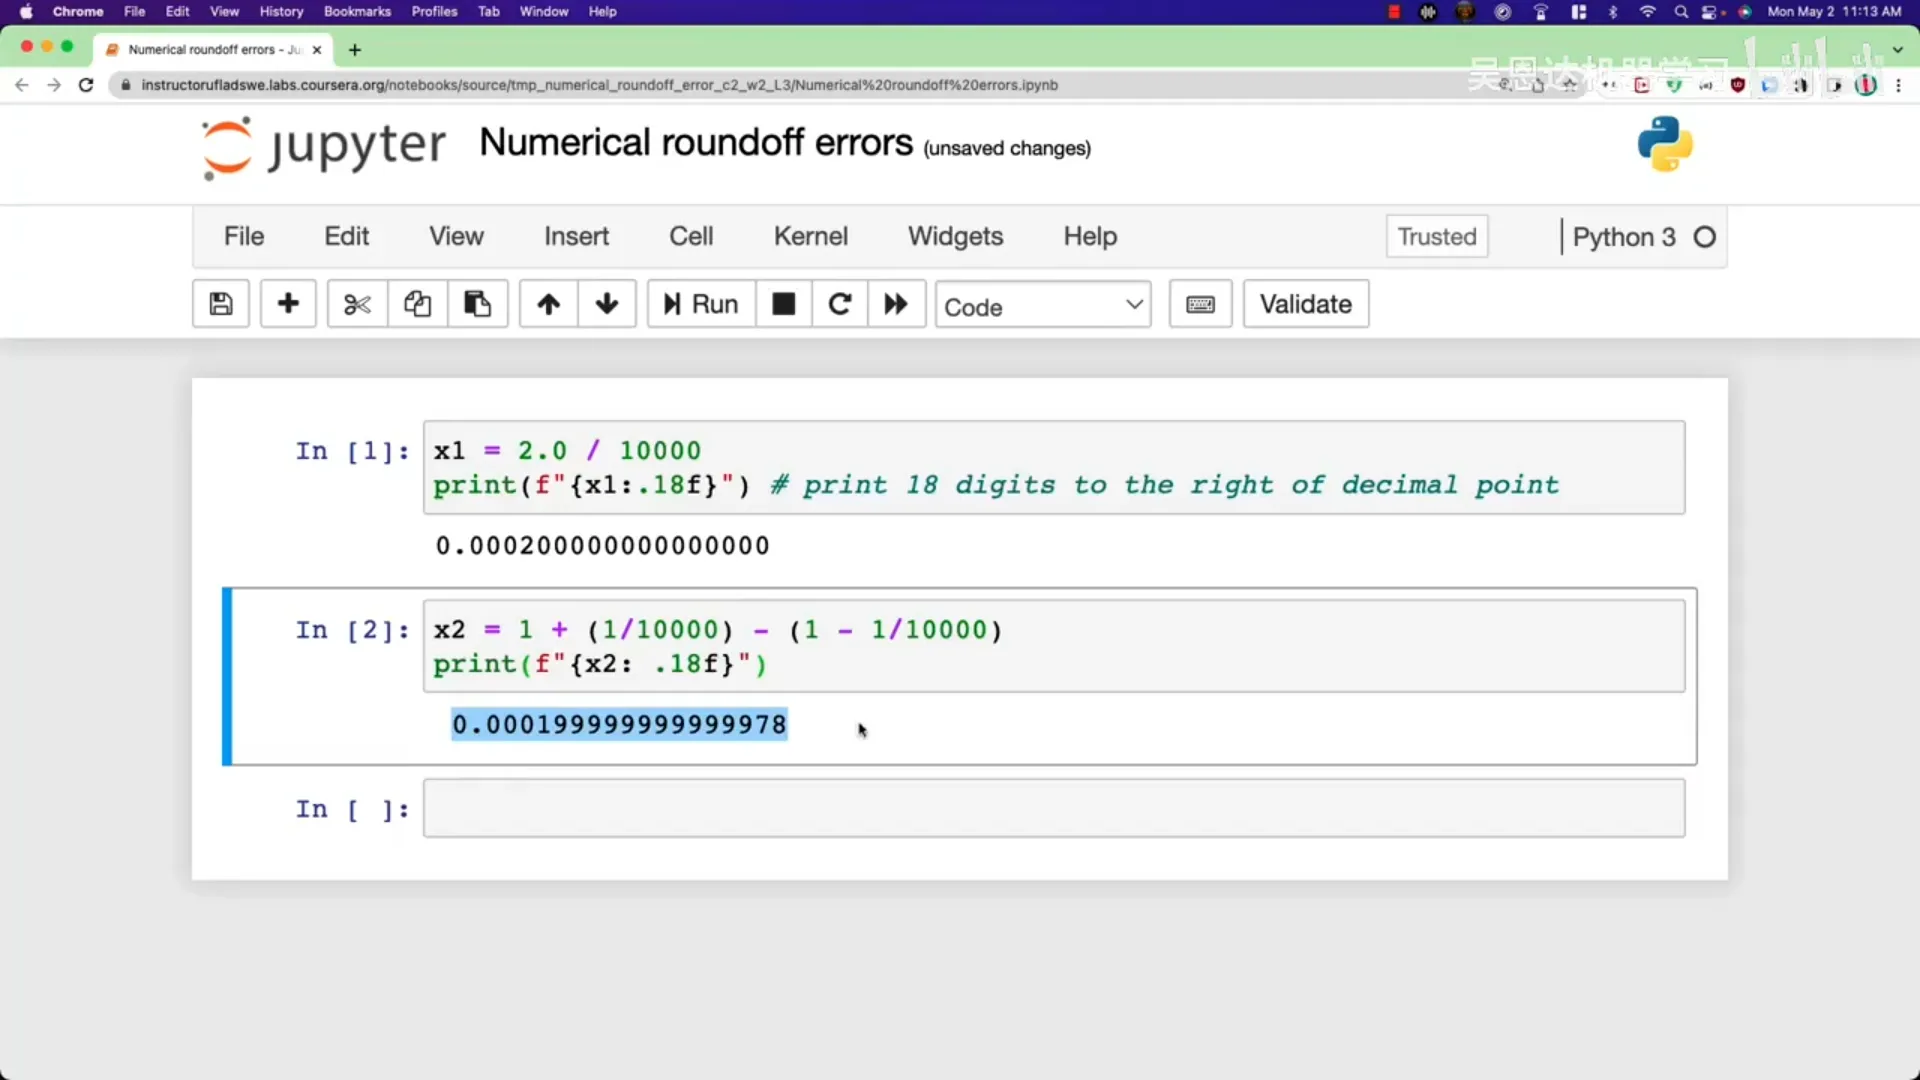
📷 from_logits=True:把 Softmax 与交叉熵合并,减少数值舍入误差
回到原视频 (00:01:47)
9.5 多标签分类(多类 vs 多标签)
(p68)
有个容易混淆的概念:多标签分类(multi-label classification)——同一个输入 x 可以同时带有多个标签。
例:自动驾驶/辅助驾驶中,给一张车前图像要同时判断:有车吗?有公交车吗?有行人吗? 一张图可以同时"有车 + 有行人,无公交车"。所以目标 y 是一个含 3 个数字的向量,而不是单个数字。
两种做法:
- 当成三个独立的二分类问题,训练三个神经网络(这也不失为合理方法);
- 训练一个网络同时预测三个:输出层放 3 个单元,每个都用 Sigmoid,分别输出"有车/有公交/有行人"的概率。
区分清楚:
- 多类(multiclass):y 只取一个值,但有多个可能取值(如 0~9 中的一个);
- 多标签(multi-label):y 是一个向量,可以同时有多个标签。
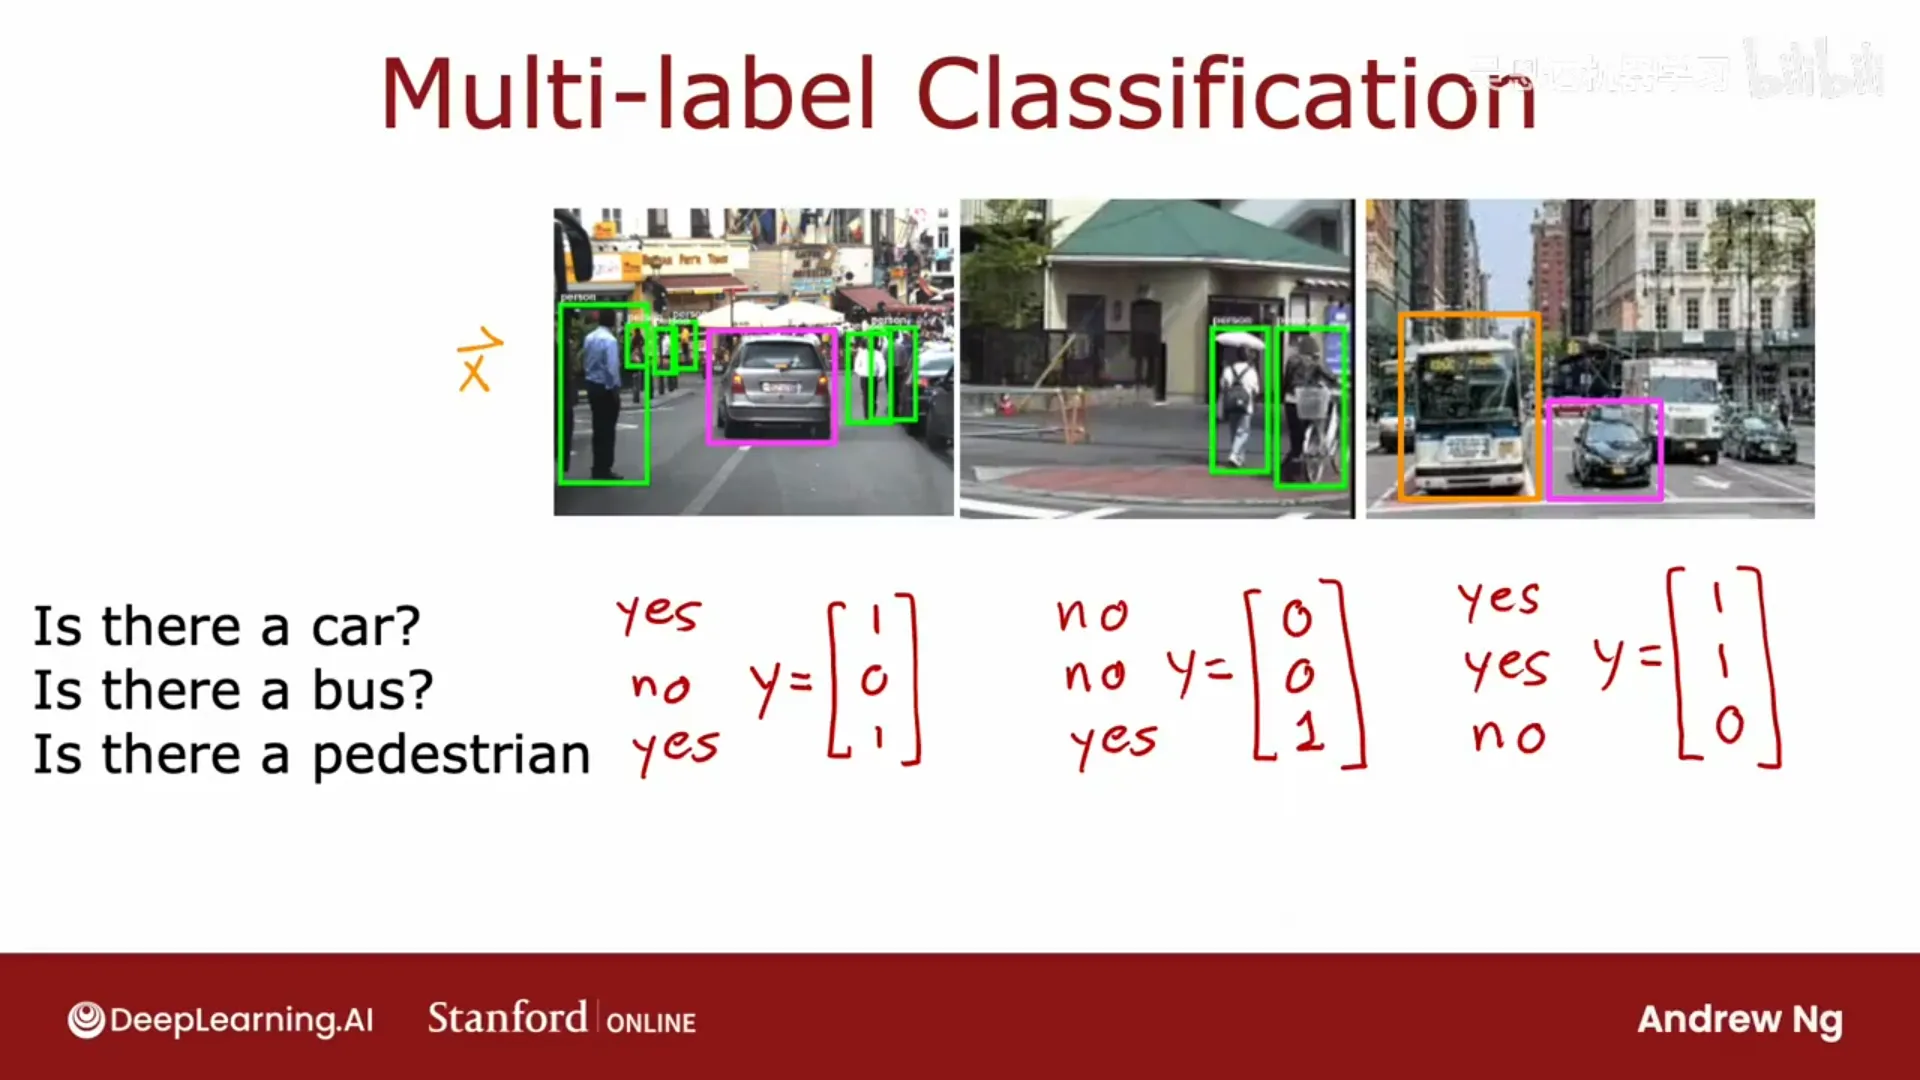
📷 多标签分类:一张图同时判断"有车/有公交/有行人"
回到原视频 (00:01:31)
第十章 Adam 优化与其他层类型
(对应模块 10,视频 p69–p70)
10.1 Adam 优化算法
(p69)
梯度下降有个常见困境:
- 若学习率 α 太小,它会在同一方向上反复走很小的步子(很慢,几乎一直在朝同一个方向前进);
- 若 α 太大,它会在最小值附近来回振荡。
理想情况下,我们希望 α 能自动调整:发现"一直同向、步子太小"就调大 α;发现"来回振荡"就调小 α。
Adam(Adaptive Moment Estimation) 正是这样做的:
编者拓展|Adam 的名字与「两个动量」:Adam 全称 Adaptive Moment Estimation(自适应矩估计)。「矩」指梯度的统计量:一阶矩是梯度的均值(相当于动量,用来判断方向、加速同向移动),二阶矩是梯度的平方均值(相当于 RMSProp,用来自适应地缩放每个参数的学习率)。Adam 把这两种思想合在一起,并对初期的估计做偏差修正——所以它既能「加速」又能「防止振荡」,成为事实标准。原论文:Kingma & Ba, 2014。
- 若某参数一直朝大致相同的方向移动 → 增大该参数的学习率,在那个方向上更快前进;
- 若某参数不断来回振荡 → 减小该参数的学习率,更平滑地走向最小值。
关键点:Adam 不是用一个全局 α,而是为每个参数各用一个学习率。若模型有 w₁…w₁₀ 和 b 共 11 个参数,Adam 实际上就有 11 个学习率(α₁…α₁₁)。
model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=1e-3),
    loss=...)
- Adam 仍需一个初始学习率(例子里用 10⁻³),值得试几个值;
- 但由于它会自动调整,对初值比原始梯度下降鲁棒得多;
- Adam 通常比梯度下降更快,已成为训练神经网络的事实标准——不知道用什么优化器时,选 Adam 是安全的选择。
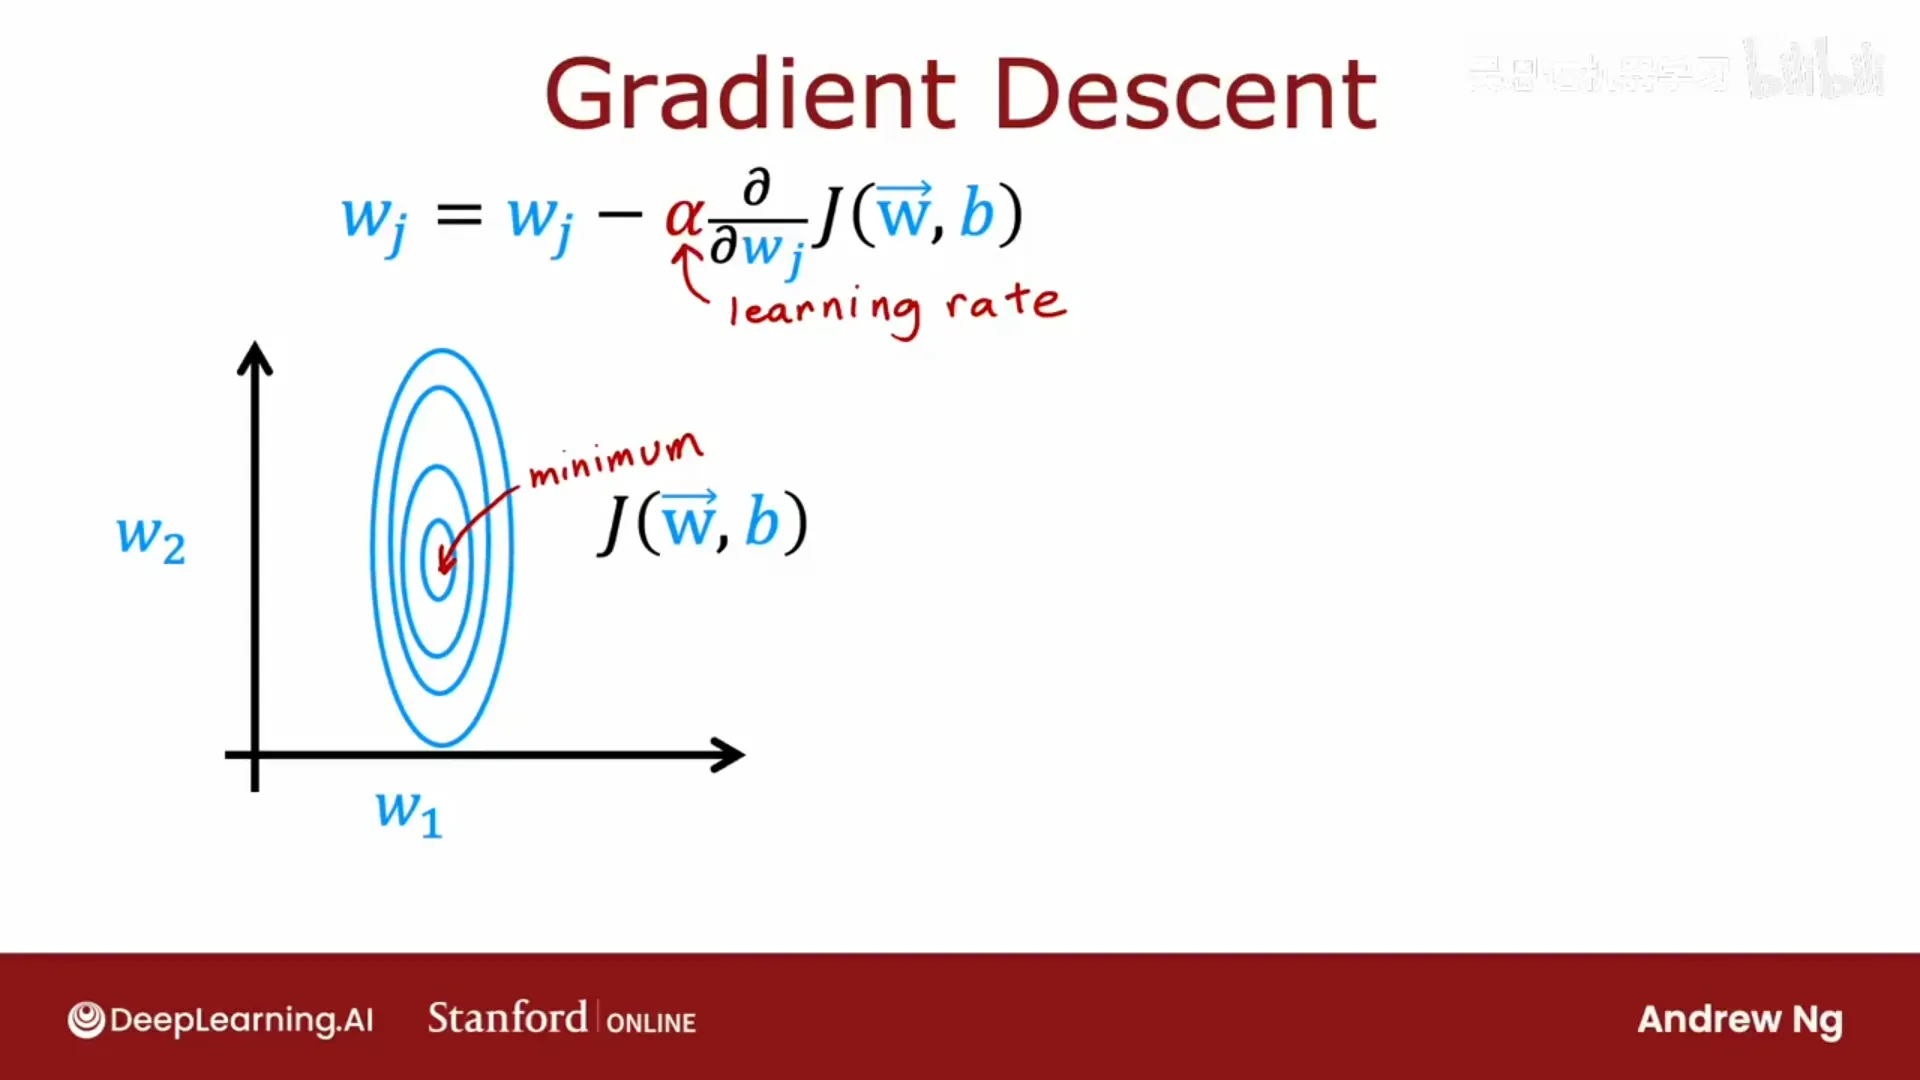
📷 Adam:根据梯度是否持续同向/振荡,自动调整每个参数的学习率
回到原视频 (00:01:04)
10.2 其他层类型:卷积层
(p70)
到现在我们用的都是稠密层(Dense)——每个神经元都接收上一层的全部激活。另一种常见层是卷积层(convolutional layer):每个神经元只查看输入的一个局部窗口。
用图像分类为例:稠密层里每个神经元看整张图;而卷积层的:
- 第 1 个神经元只看蓝色框内一小块像素;
- 第 2 个神经元只看另一小块;
- 第 3 个、第 4 个……直到最后一个,各看不同的小区域。
两个好处:
- 加快计算;
- 这种网络可能需要更少的训练数据,也更不容易过拟合。
(卷积层由 Yann LeCun 等人弄清了大量细节并推广使用。)
编者拓展|卷积网络的小历史:「只让神经元看局部窗口」的思想来自对视觉皮层的研究,Yann LeCun 在 1989–1998 年把它做成了 LeNet(识别手写数字,曾被用于读支票);2012 年的 AlexNet 用更深的卷积网络在 ImageNet 上大幅夺冠,开启了深度学习时代。「局部连接 + 权重共享」也正是它能用更少参数、更少数据、更不容易过拟合的原因。
用一维例子更清楚——心电图(ECG/EKG)分类:
- 输入是 100 个时间点上的电压值 x₁…x₁₀₀(心电信号),要判断患者是否有心脏问题;
- 卷积层第 1 个隐藏单元只看
x₁…x₂₀(信号的一小段窗口); - 第 2 个看
x₁₁…x₃₀;第 3 个看x₂₁…x₄₀;… 第 9 个看x₈₁…x₁₀₀; - 下一层也可以还是卷积层(每个单元只看上一层的一个小窗口);
- 最后用一个 Sigmoid 单元汇总、做二分类。
关于卷积层有很多架构参数(窗口多大、每层多少神经元)。本课不深入,但值得建立一个直觉:神经网络可以有各种不同的层类型;如今很多前沿架构(Transformer、LSTM、注意力模型)的研究,本质上就是在发明新的层类型、再像积木一样组合成更复杂、更强大的网络。
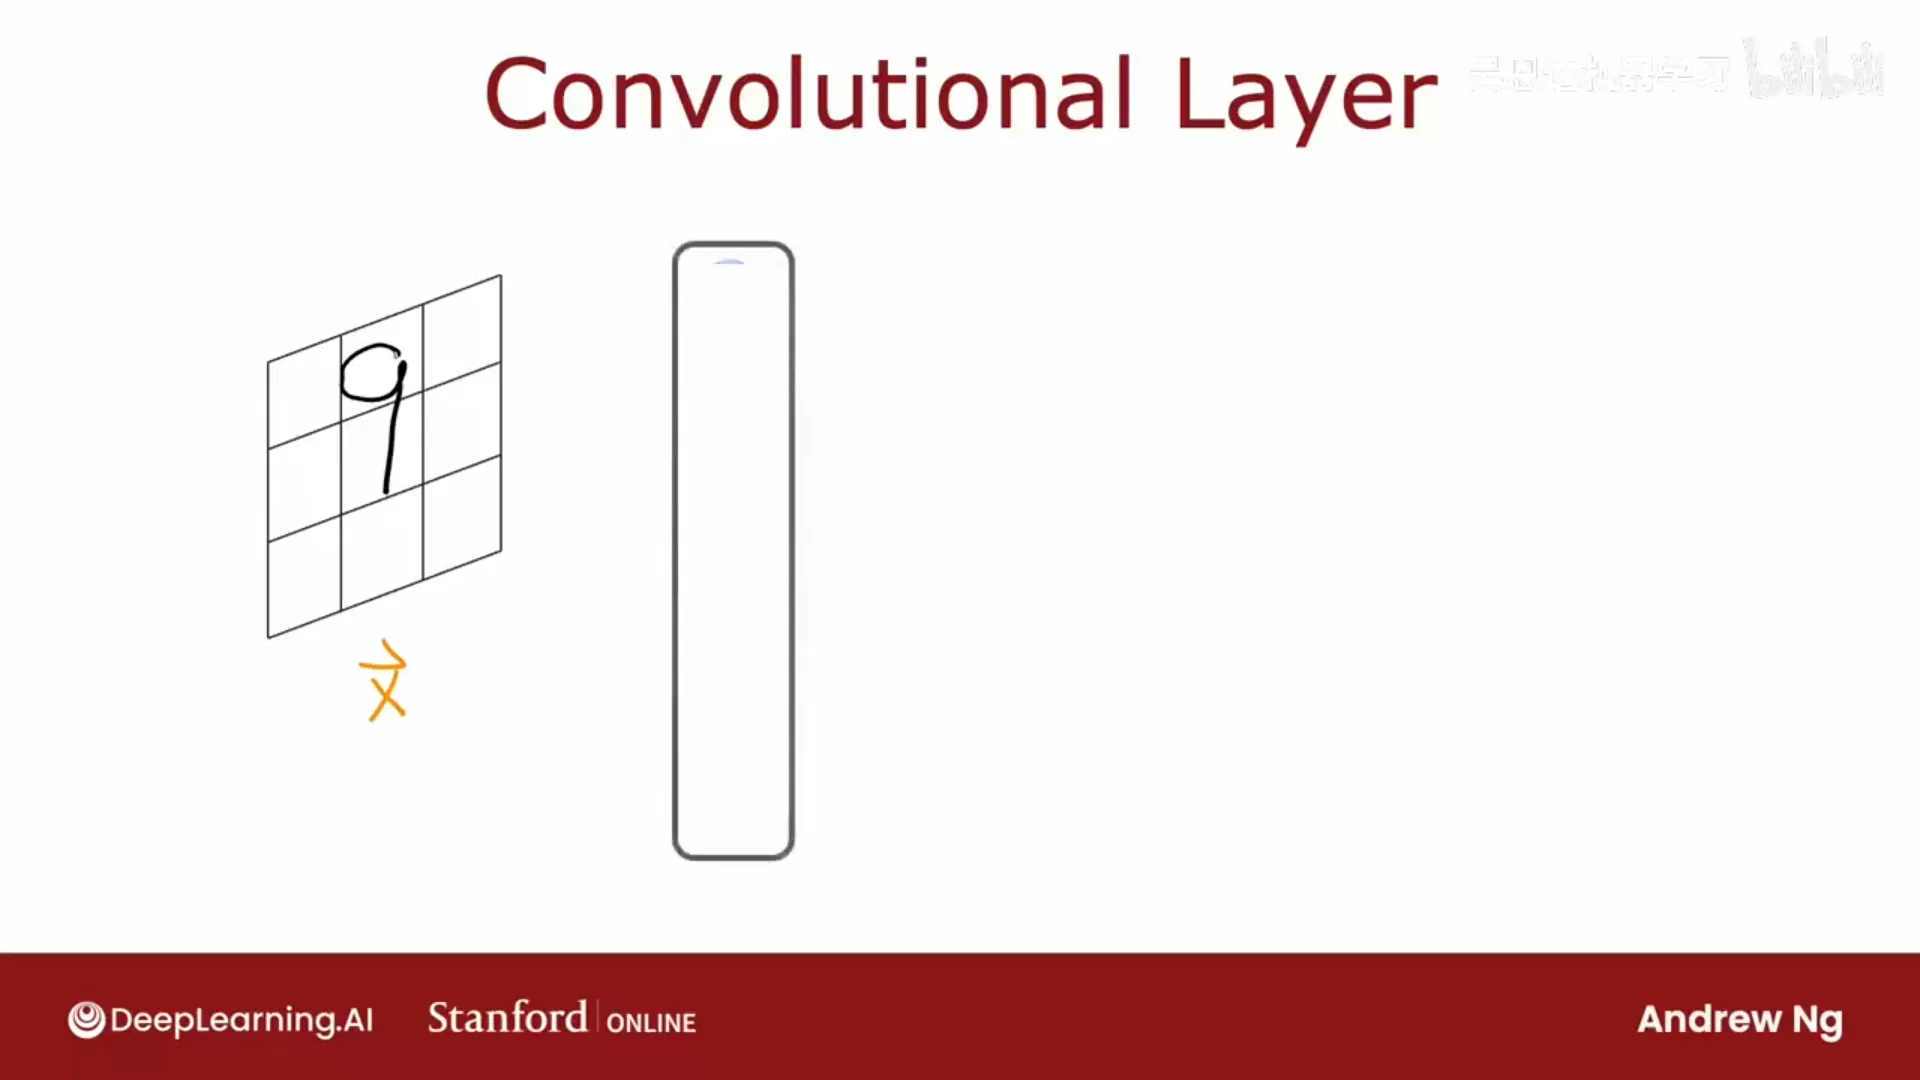
📷 卷积层:每个神经元只看输入的局部窗口(图像 / 心电信号)
回到原视频 (00:01:33)
自测与思考题(进阶)
- 计数:一个 $64\to25\to15\to1$ 的全连接网络,不带偏置与带偏置各有多少参数?
- 推导:证明「多层线性网络仍等于单层线性网络」(用矩阵乘法把两层合起来)。
- 反例:为什么必须有非线性激活?给出一个没有激活就学不会的简单函数。
- 对比:
Softmax + 交叉熵与多标签 Sigmoid + BCE各适合什么场景?互相换用会怎样? - 迁移:向量化(矩阵乘法)为什么比 Python
for循环快?至少说出两个原因。
参考答案要点
- 不带偏置:$64\times25+25\times15+15\times1=1990$;带偏置再加 $25+15+1=41$,共 $2031$。
- 若 $A^{[1]}=W^{[1]}x$、$A^{[2]}=W^{[2]}A^{[1]}$,则 $A^{[2]}=(W^{[2]}W^{[1]})x$——仍是一个线性映射 $W' x$。任意多层同理。
- XOR:单个线性模型的最优是「对所有输入输出 0.5」(忽略输入);没有非线性,深层也只是线性,学不会 XOR。
- Softmax 用于互斥多分类;多标签用逐类 Sigmoid + BCE。混用会导致概率被强行归一化(丢失「可同时为真」),或无法给出互斥概率。
- ① 减少 Python 解释器的循环开销;② 底层调用优化过的 BLAS / SIMD(向量指令),并可利用多核/缓存。(并不保证每个小向量都真的并行。)
结语
恭喜你完成神经网络这一册!你掌握了从直觉到实现的完整链路:
- 前向传播(从单个神经元 → 层 → 多层网络);
- TensorFlow 实现(Dense、Sequential、张量与数据约定);
- 从零用 NumPy 实现(
dense函数、参数堆叠成矩阵); - 矩阵乘法与向量化(为什么神经网络能被规模化);
- 训练(三步:指定模型 / 编译损失 / fit;反向传播自动求导);
- 激活函数(Sigmoid / ReLU / 线性,以及"隐藏层不能用线性"的原因);
- 多类分类与 Softmax、数值稳定性(logits)、多标签分类;
- Adam 优化与卷积层。
下一册预告:《机器学习实践与决策树》——评估与模型选择、偏差与方差、学习曲线、误差分析、数据增强/合成/迁移学习、完整项目周期与伦理、倾斜数据集与精确率/召回率,以及决策树与集成学习(随机森林、XGBoost)。这些内容与神经网络相对独立,是"把模型真正用好"的方法论。
附:来源与参考
- 课程:Machine Learning Specialization(DeepLearning.AI / Stanford Online,2022 新版),讲师 Andrew Ng
- 课程主页:https://www.deeplearning.ai/specializations/machine-learning
- 视频来源:Bilibili 搬运合集
BV16jyuBBEom(本册对应分P p42–p70) - 参考笔记(2014 版课程):https://github.com/fengdu78/Coursera-ML-AndrewNg-Notes
- 相关框架/库:TensorFlow(Keras)、NumPy、PyTorch
- 经典工作:反向传播(backpropagation)、Adam(Kingma & Ba, 2014)、ReLU、Softmax / 交叉熵、卷积网络(LeCun 等)、Transformer(Vaswani 等, 2017)
版权说明:课程视频、字幕与讲义版权归 DeepLearning.AI / Stanford 所有。本电子书为个人学习所做的中文书面重构,未获授权,不得用于任何商业用途或公开传播。书中截图取自对应分P视频画面,并标注「分P @ 时间」以便回源核对。