吴恩达机器学习(新版):第二门课(下) · 机器学习实践与决策树
本电子书由视频课程重构而成(个人学习用)。 课程视频、字幕与讲义版权归 DeepLearning.AI / Stanford 所有。本电子书仅为个人学习所做的中文书面重构,不得用于任何商业用途或公开传播。书中截图取自对应分P视频画面,并标注「分P @ 时间」以便回源核对。
| 原课程 | Machine Learning Specialization(DeepLearning.AI / Stanford Online,2022 新版),讲师 Andrew Ng(吴恩达) |
| 视频来源 | Bilibili 搬运合集 BV16jyuBBEom(本册为第二门课的实践方法 + 决策树部分,分P p71–p100) |
| 官方配套 | https://www.deeplearning.ai/specializations/machine-learning |
| 参考笔记(2014 版课程) | https://github.com/fengdu78/Coursera-ML-AndrewNg-Notes |
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
本册导读
第二门课的内容横跨两个相当不同的主题。本册专注"把机器学习真正用好"的方法论,以及决策树,覆盖:
- 机器学习诊断:下一步做什么(p71–p73)
- 偏差与方差(p74–p79)
- 机器学习项目的迭代开发:误差分析、数据、迁移学习、完整周期、伦理(p80–p85)
- 倾斜数据集与精确率/召回率(p86–p87)
- 决策树(p88–p89)
- 决策树学习算法:熵、信息增益、独热编码、连续特征、回归树(p90–p95)
- 集成学习:随机森林与 XGBoost(p96–p100)
配套的另一册《神经网络与深度学习》覆盖神经网络的前向传播、TensorFlow 实现、训练、激活函数、Softmax、Adam 等。
第一章 机器学习诊断:下一步做什么
(对应模块 11,视频 p71–p73)
1.1 核心问题:下一步做什么
(p71)
现实中:训练好的模型几乎从来不会第一次就表现得好。构建 ML 系统的关键,是决定下一步做什么来提升性能。
吴恩达见过一些团队花 6 个月做出来的东西,更有经验的团队几周就能完成——差别就在于能否高效地反复做对"下一步"的决定。
以"已实现正则化线性回归来预测房价,但预测误差大得无法接受"为例,你至少有 6 个方向可试:
- 获取更多训练样本;
- 减少特征(用小一点的特征集);
- 增加特征(找房屋的其他属性);
- 增加多项式特征(x₁², x₂², x₁x₂…);
- 减小 λ;
- 增大 λ。
问题在于:其中一些有用,一些纯属浪费时间。有人花好几周收集数据,结果毫无提升;有时确实有帮助,有时没有。
所以我们需要诊断(diagnostics)——某些测试能深入揭示算法的问题、指导该往哪投入时间。学习如何做诊断、如何运行它们,是本门课的核心之一。跑诊断要花时间,但常常能省下几个月。
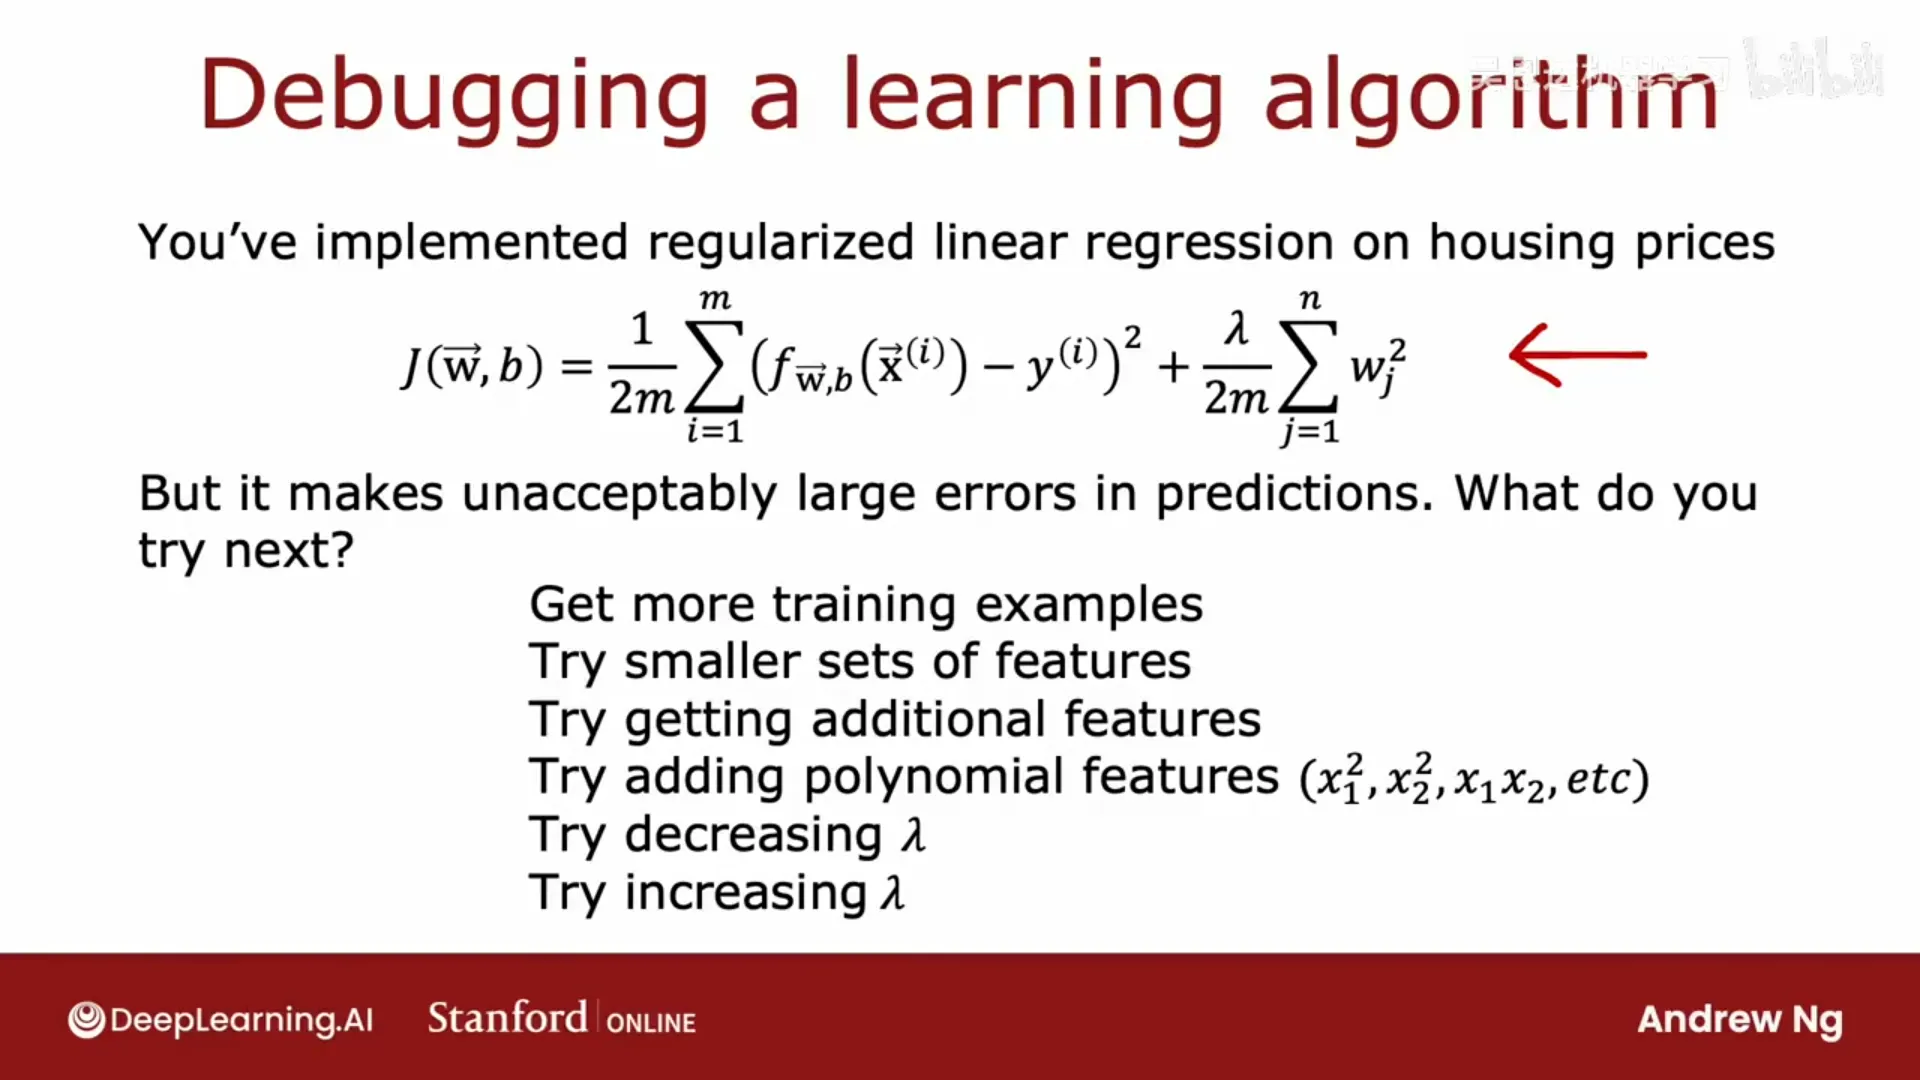
📷 面对误差,你有 6 个可能方向,但需要用"诊断"来确定哪个有用
回到原视频 (00:01:19)
1.2 用训练集/测试集评估模型
(p72)
当特征多于一两个时,画不出 f(x)(四维函数怎么画?),所以需要更系统的评估方法。
做法:把数据分成训练集和测试集(如 70% / 30% 或 80% / 20%)。
- 在训练集上拟合参数 w、b;
- 在测试集上评估性能。
符号:
- 训练集:
(x⁽¹⁾, y⁽¹⁾), …, (x^(m_train), y^(m_train)),样本数 m_train; - 测试集:
(x_test⁽¹⁾, y_test⁽¹⁾), …, (x_test^(m_test), y_test^(m_test)),样本数 m_test。
回归用到的两个量(都不含正则化项,正则项只属于训练目标):
$$\begin{aligned}
J_{\text{train}}(w,b) &= \frac{1}{2m_{\text{train}}}\sum_{\text{训练集}}\big(f(x^{(i)}) - y^{(i)}\big)^2\ J_{\text{test}}(w,b) &= \frac{1}{2m_{\text{test}}}\sum_{\text{测试集}}\big(f(x^{(i)}) - y^{(i)}\big)^2
\end{aligned}$$
例(四阶多项式、5 个点的训练集):它能完美拟合训练集,所以 J_train ≈ 0;但曲线剧烈波动、泛化差,遇到训练集之外的样本预测与真实值差距很大,所以 J_test 很高。这告诉你:训练误差低不代表泛化好。
分类问题:常用另一套定义——用误分类比例(预测 ŷ≠y 的样本占比)作为 J_train、J_test。例如 0/1 数字分类,J_test = "测试集中把 0 判成 1 或把 1 判成 0 的比例"。
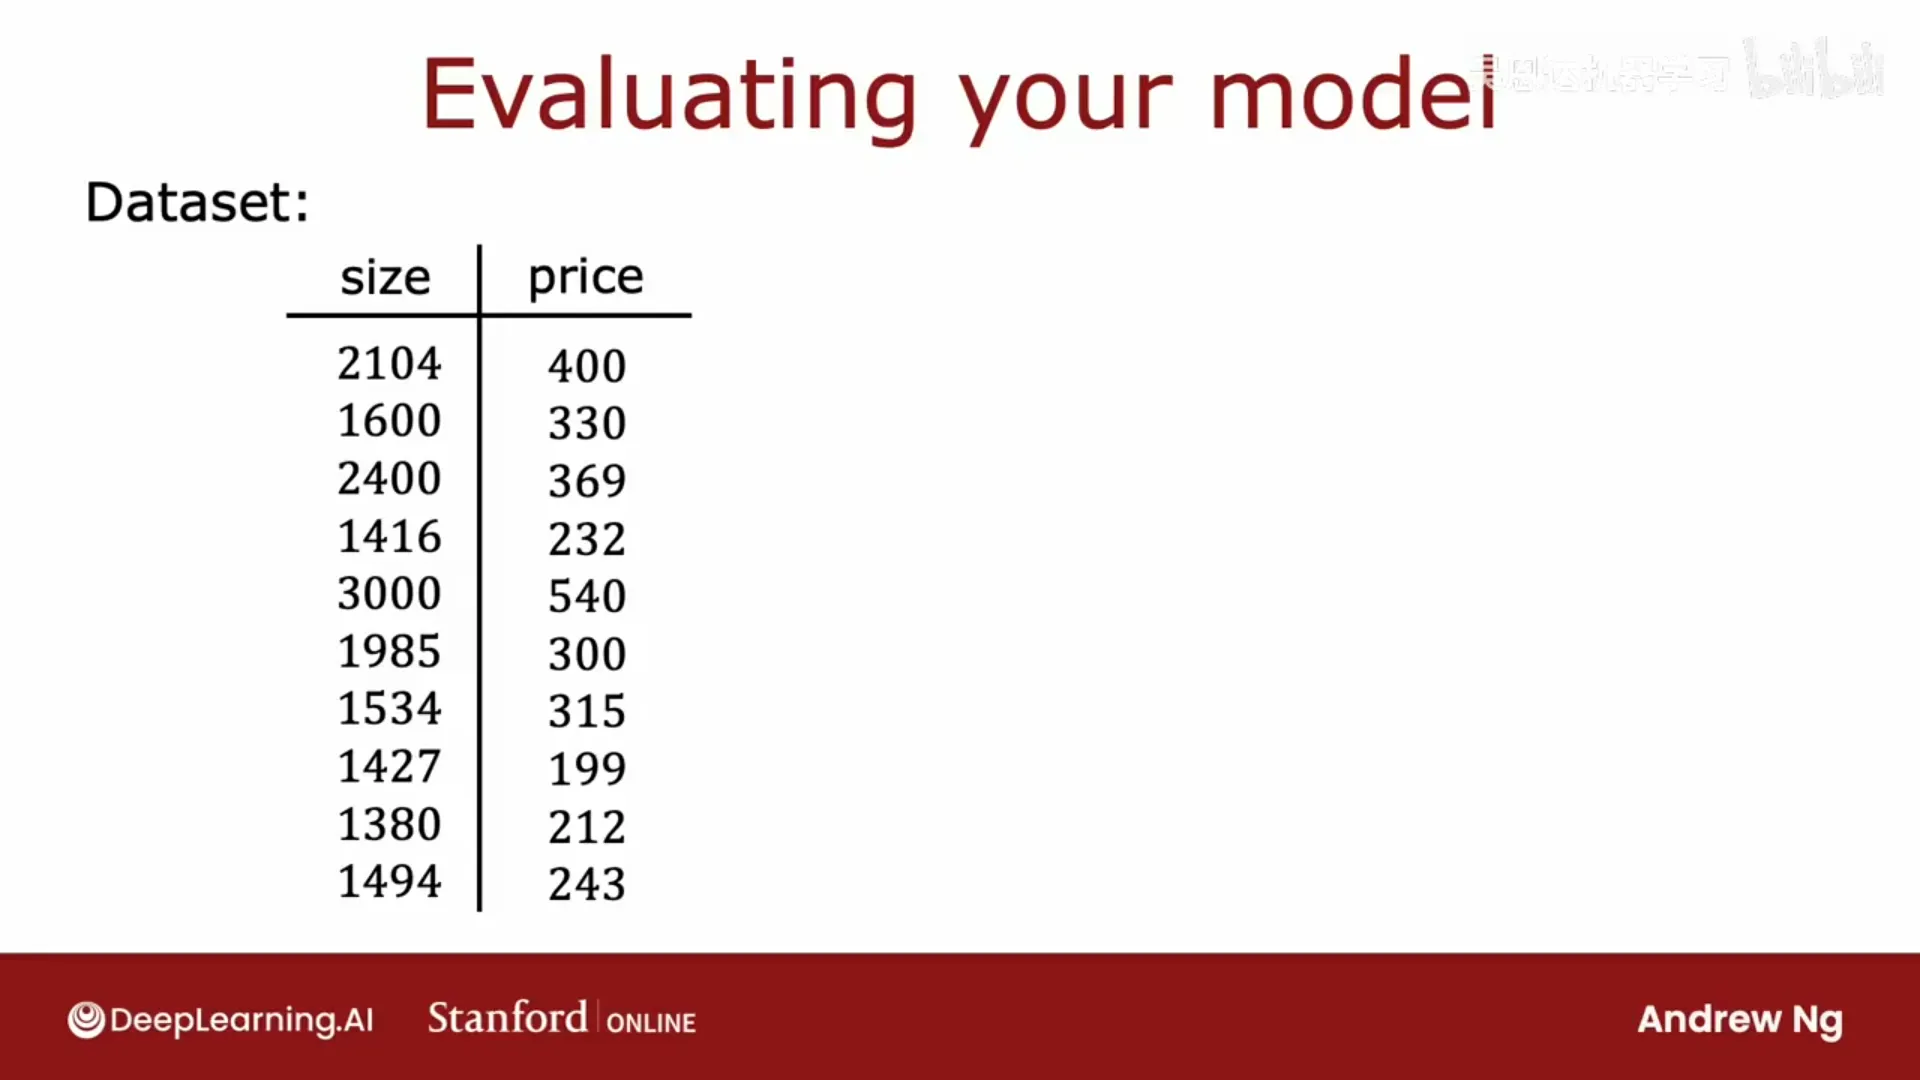
📷 把数据分成训练集/测试集,用 J_train 与 J_test 评估
回到原视频 (00:02:01)
1.3 模型选择与交叉验证集
(p73)
要选"多项式阶数 d"(或其他模型/超参数)时,直接用测试集去挑是有缺陷的。
为什么?因为你把 d 也"拟合"到了测试集上:你挑了让 J_test 最小的 d,于是这个 J_test 会过于乐观(低于真实泛化误差)。这和"用训练集估计泛化误差会过于乐观"是同一个道理。
正确做法:把数据分成三份:
| 子集 | 用途 | 常见比例 |
|---|---|---|
| 训练集(train) | 拟合参数 w、b | 60% |
| 交叉验证集(cross-validation / 验证集 validation / 开发集 dev) | 选择模型与超参数(d、λ、网络结构…) | 20% |
| 测试集(test) | 最后评估泛化误差 | 20% |
交叉验证集有几个名字:验证集(validation set)、开发集(dev set)——意思相同。吴恩达个人最常用"开发集",因为念起来最短。
三个误差:
- $J_{\text{train}}$ —— 训练误差
- $J_{\text{cv}}$ —— 交叉验证误差(也叫验证误差 / 开发误差)
- $J_{\text{test}}$ —— 测试误差
模型选择流程:
- 对每个候选模型(d=1,2,…,10),在训练集上拟合参数;
- 在交叉验证集上算 J_cv;
- 选 J_cv 最低的模型;
- 最后在测试集上评估一次,报告 J_test 作为泛化误差的估计。
黄金法则:
所有关于模型/算法的决定(选参数、选多项式阶数、选网络架构)都只用训练集和交叉验证集;测试集在做完所有决定之后才用,且只用一次。
这样才能保证测试集给出不偏乐观的泛化误差估计。
编者拓展|一个极其常见的坑:数据泄漏(data leakage):上面这条「黄金法则」之所以重要,是因为一旦你在做任何决定之前就看过测试集(哪怕只是「试了几次觉得哪版更好」),测试集就被间接拟合了,它给出的性能会偏乐观——等真上线,效果会明显变差。更隐蔽的一种是特征泄漏:某个特征在训练时「偷看」了标签。记住:测试集只用一次,且只用于最终报告。这个流程同样适用于选择神经网络架构(小/中/大网络,或不同的层数/单元数)——用 J_cv 选,最后用测试集报告。
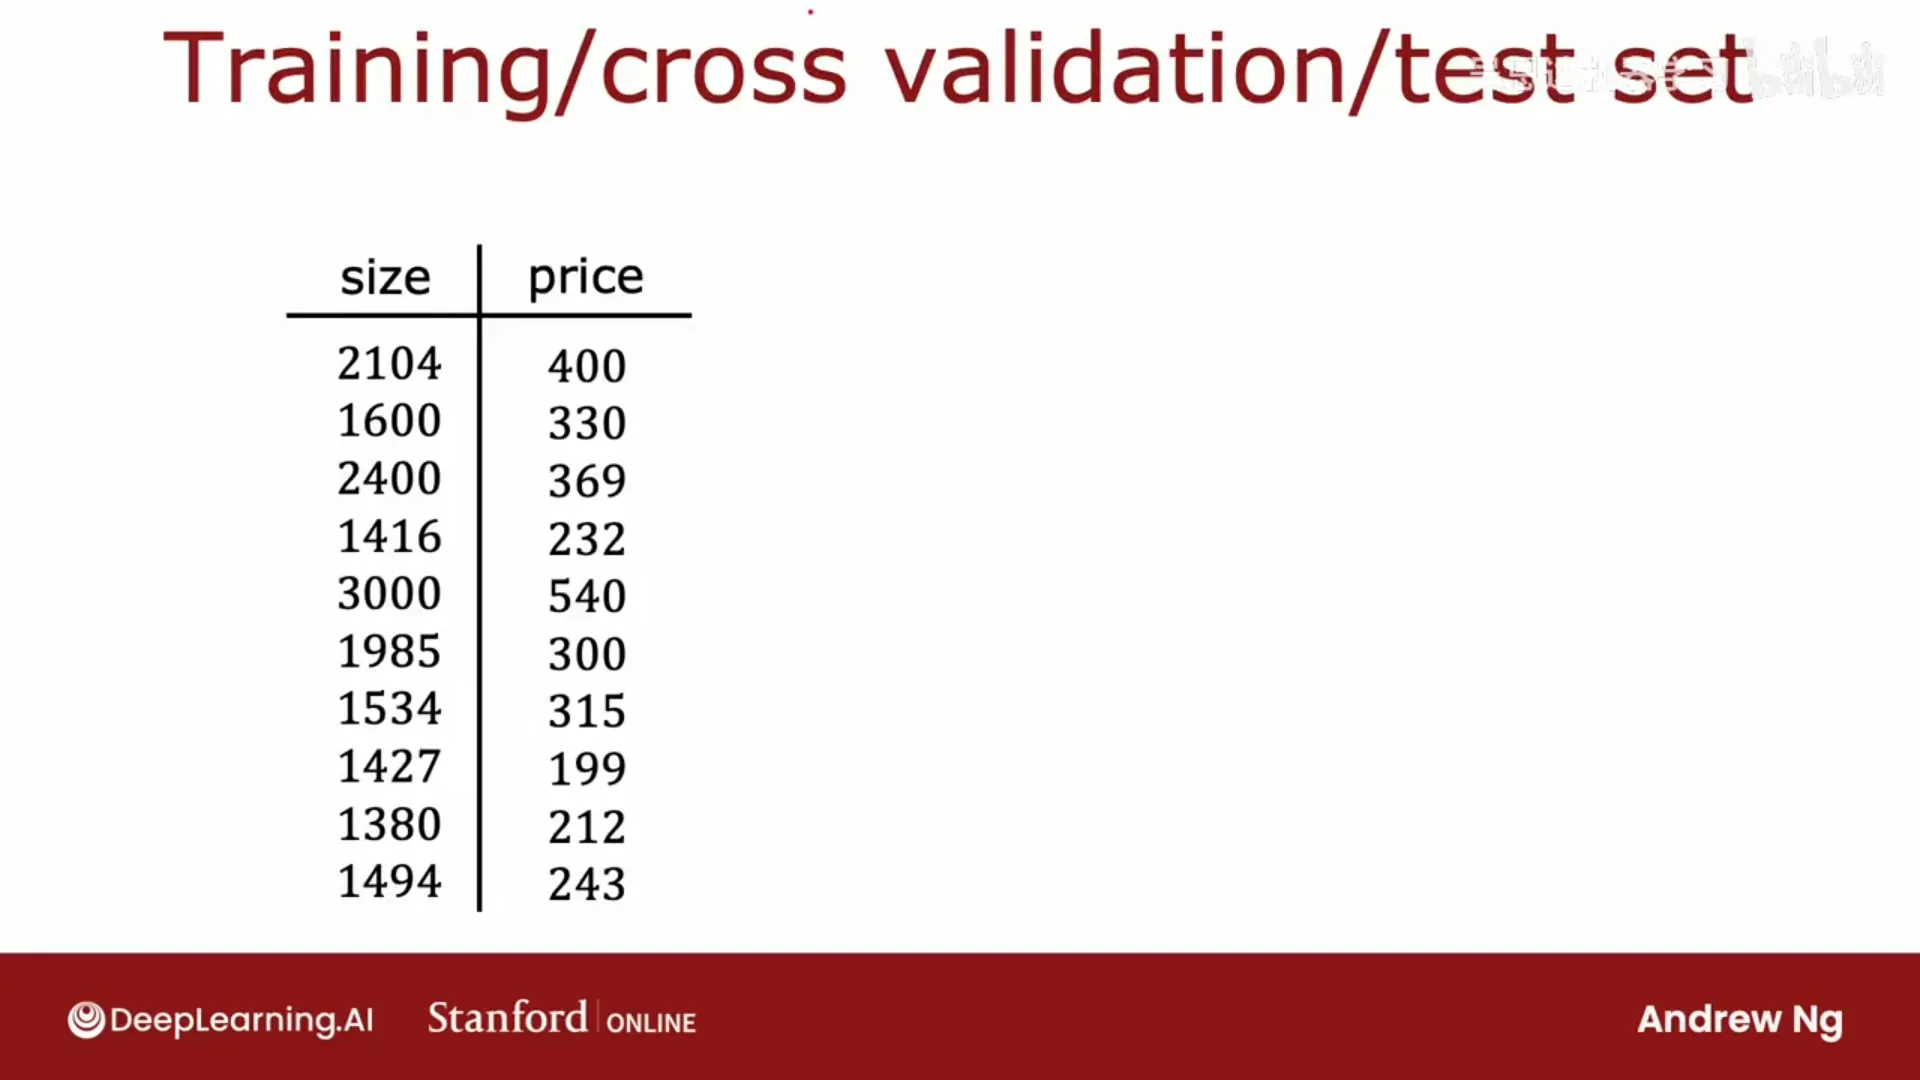
📷 模型选择:训练集拟合、交叉验证集选模型、测试集最终评估
回到原视频 (00:05:13)
第二章 偏差与方差
(对应模块 12,视频 p74–p79)
2.1 用 J_train 与 J_cv 诊断
(p74)
先回顾两个概念:
- 高偏差(high bias)= 欠拟合:模型太简单,连训练集都拟合不好;
- 高方差(high variance)= 过拟合:模型太复杂,训练集拟合得很好,但泛化差。
当特征很多、画不出 f(x) 时,用 J_train 与 J_cv 来诊断:
| 情况 | 判据 |
|---|---|
| 高偏差(欠拟合) | J_train 很高(J_cv 也高,两者接近) |
| 高方差(过拟合) | J_cv 远大于 J_train(J_train 通常很低) |
| 恰到好处 | J_train 低,且 J_cv 与 J_train 接近(都不比对方差太多) |
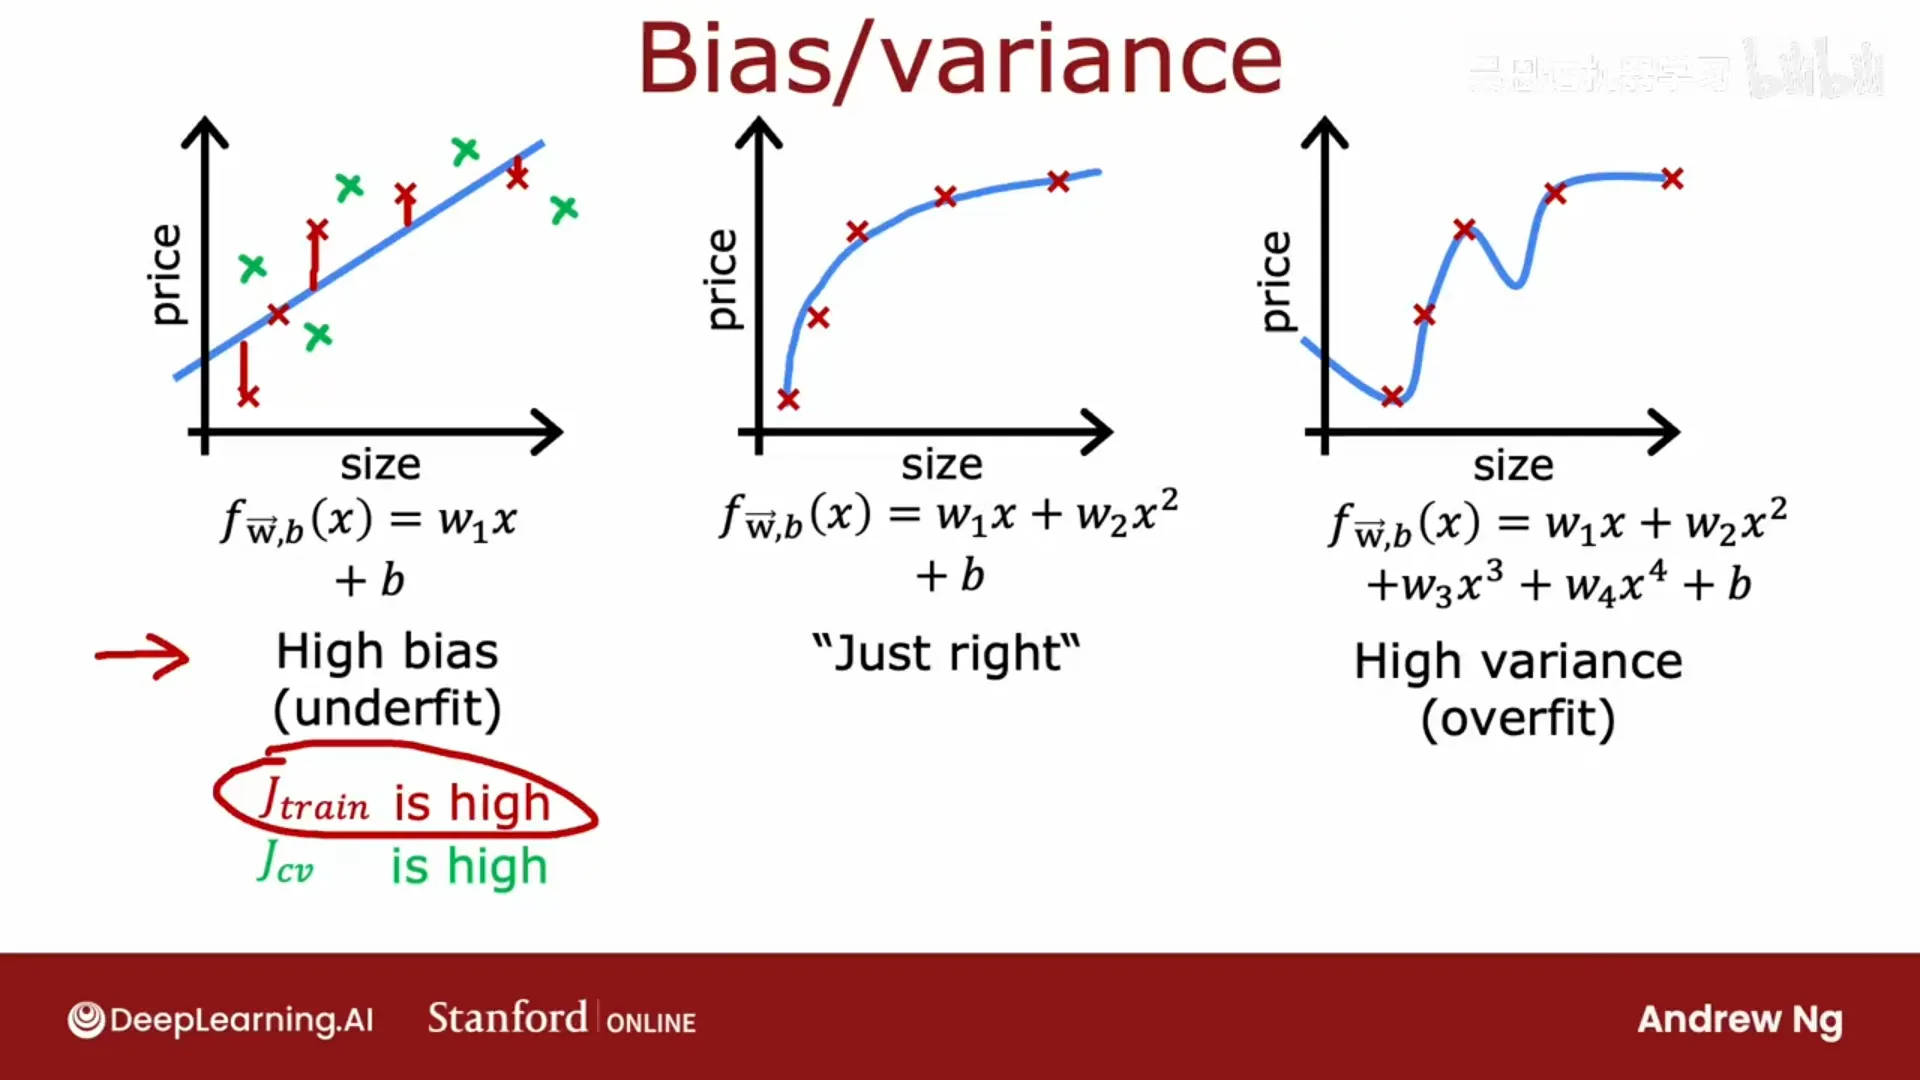
📷 高偏差:J_train 很高(连训练集都拟合不好)
回到原视频 (00:02:40)
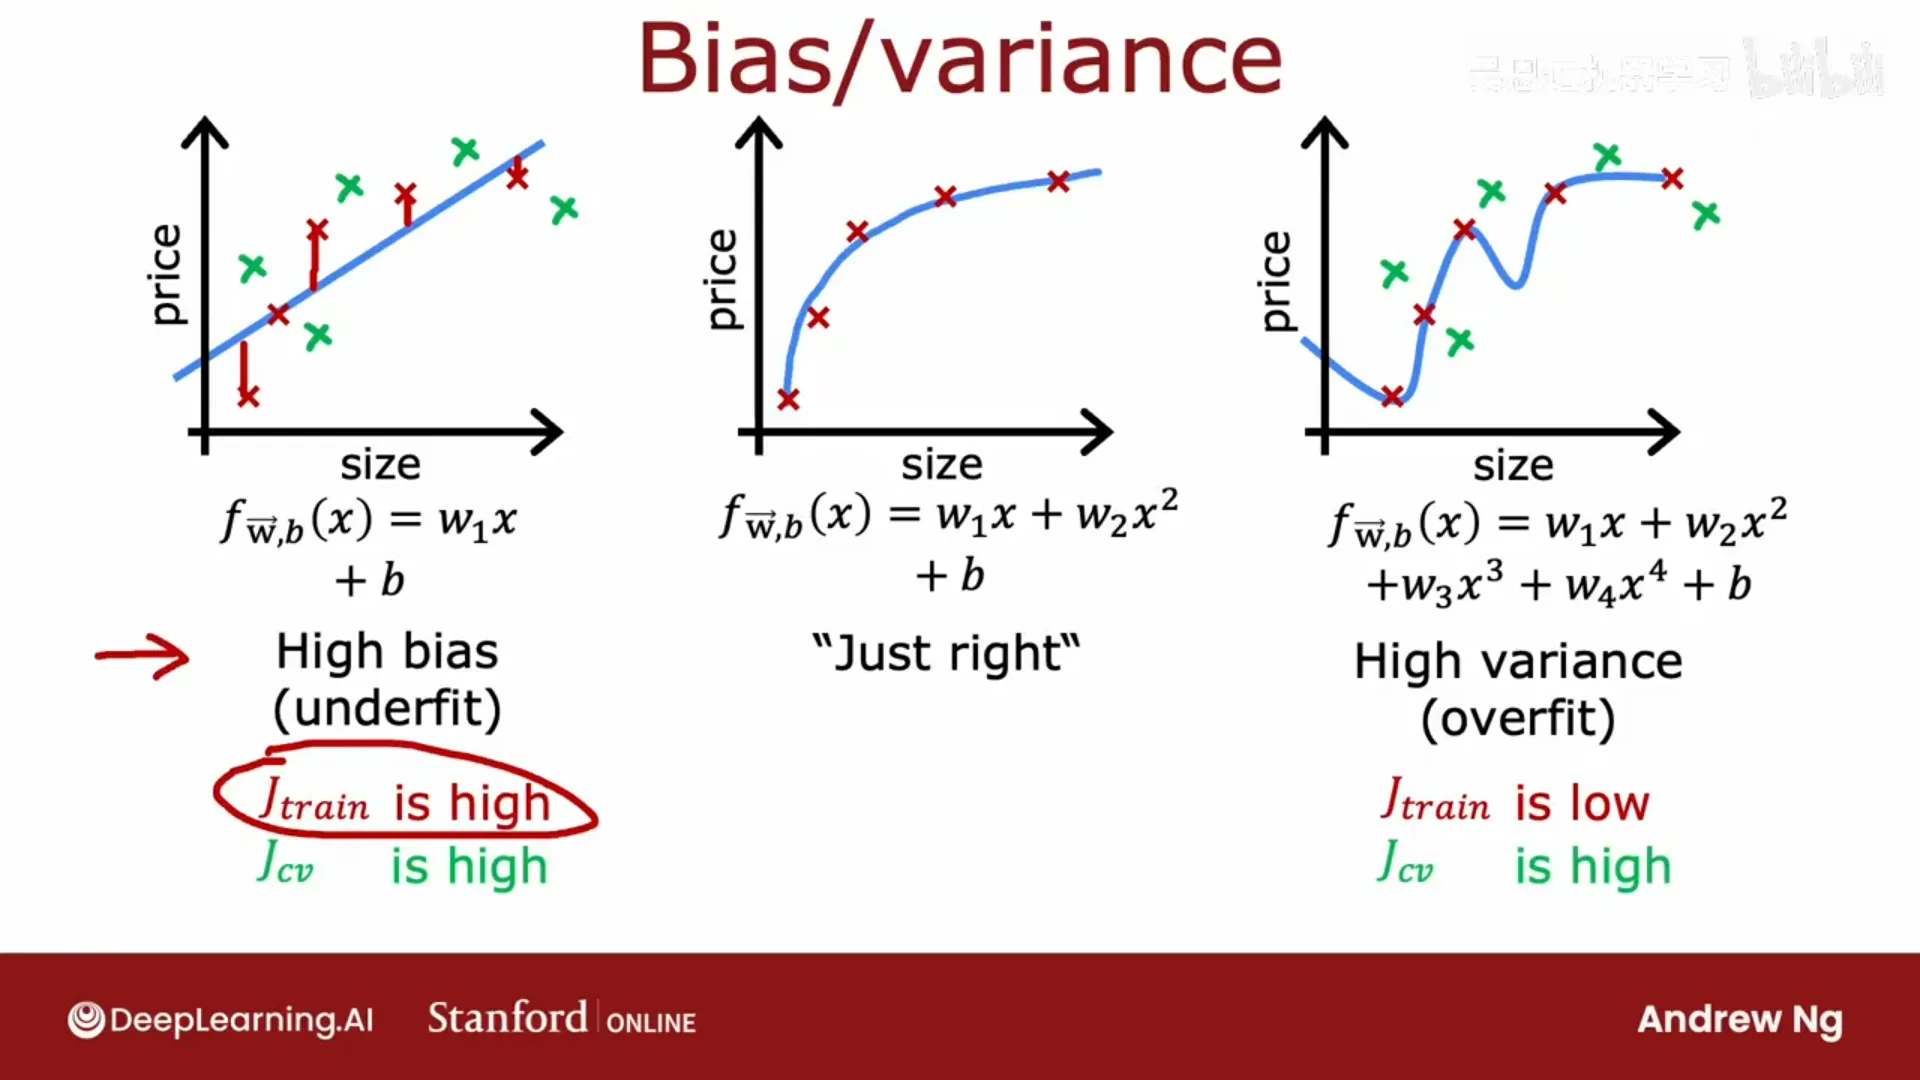
📷 高方差:J_cv 远大于 J_train
回到原视频 (00:03:07)
2.2 偏差/方差随模型复杂度的变化
数学角落(偏差-方差分解):对重复采样的数据集,预期测试误差可分解为
$$\mathbb{E}\big[(t-\hat y)^2\big]=\underbrace{\sigma^2}_{\text{不可约噪声}}+\underbrace{\big(\mathbb{E}[\hat y]-f^*\big)^2}_{\text{偏差}^2}+\underbrace{\mathbb{E}\big[(\hat y-\mathbb{E}[\hat y])^2\big]}_{\text{方差}}$$
画成「随模型复杂度变化」的曲线,就是经典的 U 形:左边偏差主导(欠拟合),右边方差主导(过拟合)。
(p74)
若把 J_train、J_cv 画成多项式阶数 d 的函数(不使用正则化时):
- J_train 随 d 增大而单调下降(模型越复杂,越能拟合训练集);
- J_cv 先降后升:d 太小 → 欠拟合(J_cv 高);d 太大 → 过拟合(J_cv 也高);中间的 d 最好。
所以 J_cv 曲线的最低点对应"既没有高偏差也没有高方差"的模型。
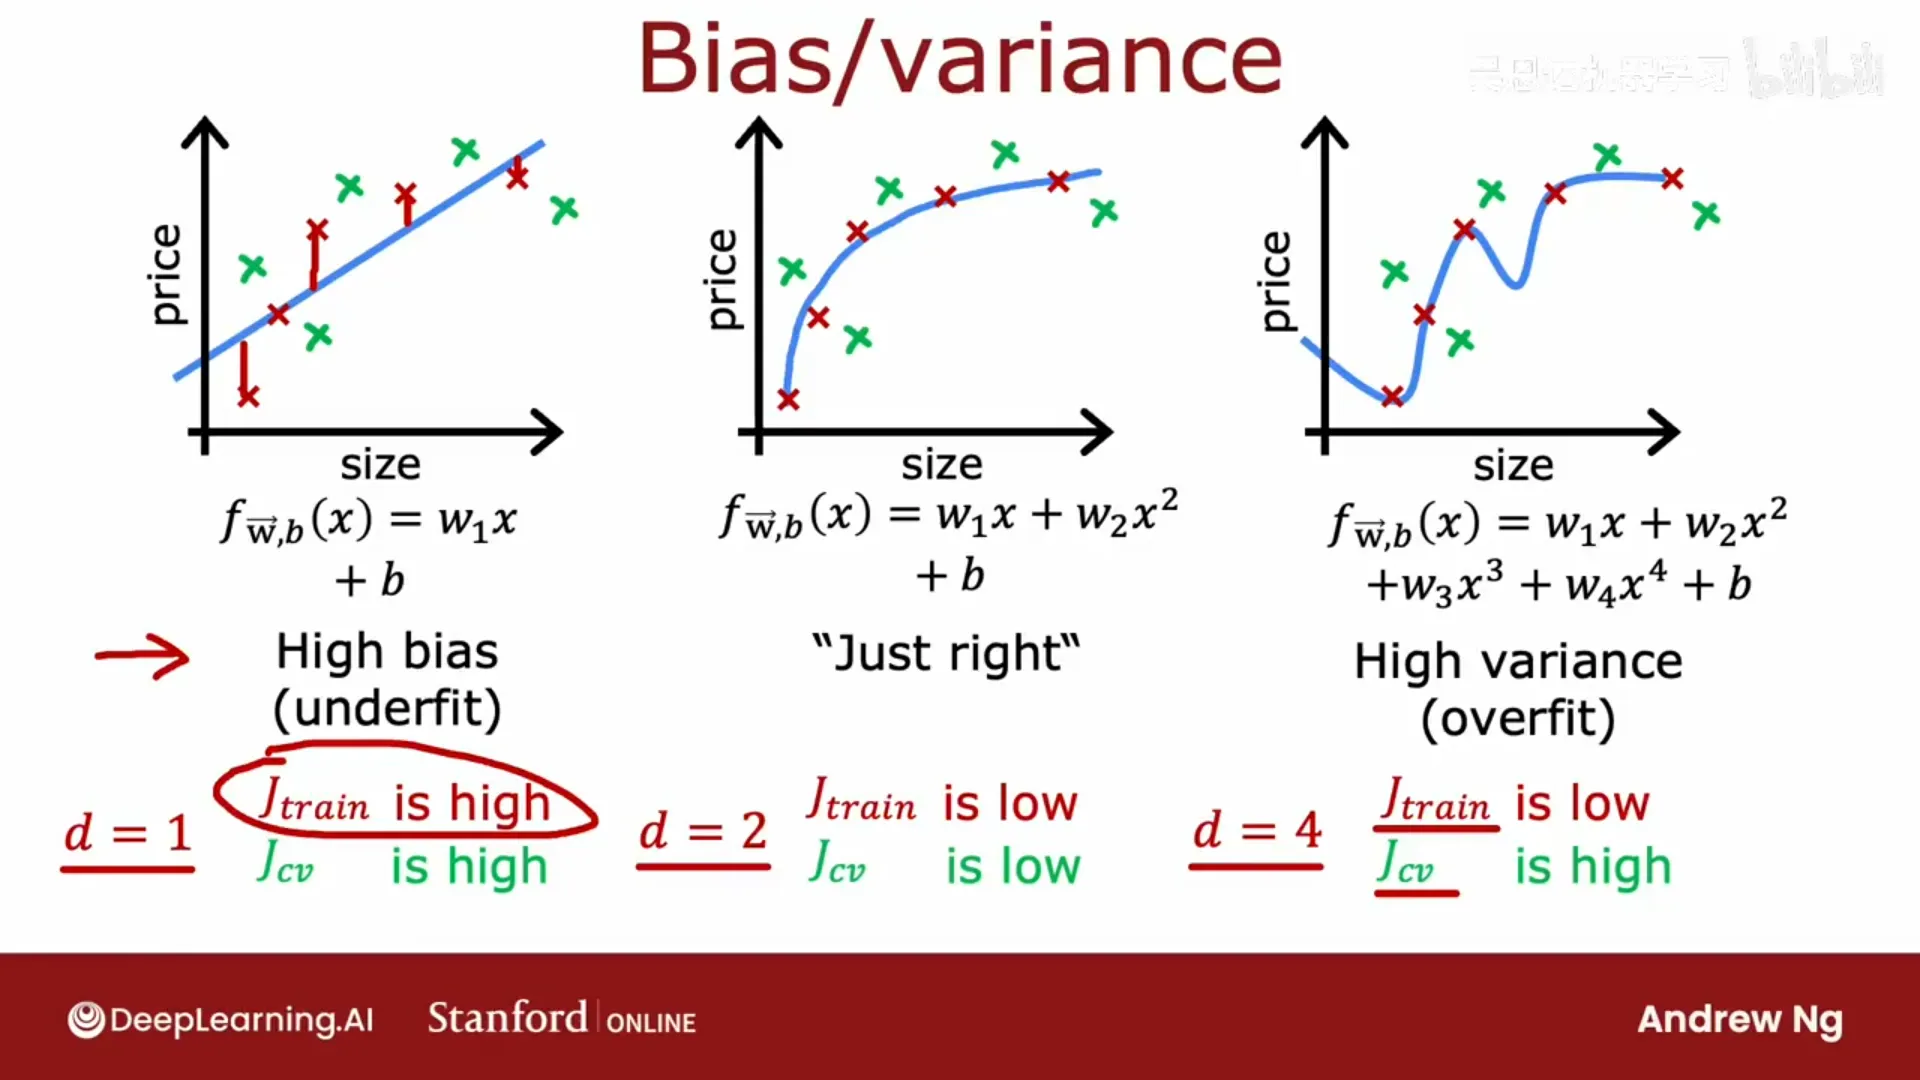
📷 J_train 与 J_cv 随多项式阶数 d 的变化:J_cv 先降后升
回到原视频 (00:05:06)
2.3 正则化与偏差/方差
易错点 M13:正则化的直接 mechanism 是「参数收缩(prefer small $\lVert w\rVert$)」;「方差 ↓、稳定性 ↑、偏差 ↑」是它的统计后果——不要把「降低 variance」当成正则化本身的偏好。
易错点 M14:$\lambda$ 大 → 约束强 → 高 bias → 欠拟合;$\lambda$ 小 → 约束弱 → 高 variance → 过拟合。别记反。
(p75)
λ 的选择决定了偏差与方差的平衡:
- λ 太小(含 λ=0)→ 几乎没有正则化 → 高方差(过拟合);
- λ 太大 → 参数被强行压到接近 0 →
f(x) ≈ b(近似水平线)→ 高偏差(欠拟合)。
把 J_train、J_cv 画成 λ 的函数:
- J_train 随 λ 增大而上升(越强调参数小,越难拟合训练集);
- J_cv 先降后升(左边过拟合、右边欠拟合),存在一个 λ 最优点。
用交叉验证选 λ:试一系列 λ(如 0, 0.01, 0.02, 0.04, …, 10,每次翻倍),对每个 λ 拟合参数并算 J_cv,选 J_cv 最小的 λ,最后用测试集报告 J_test。
有趣的对照:λ 的曲线与 d 的曲线大致互为镜像——d 图里高方差在右、高偏差在左;λ 图里高方差在左、高偏差在右。但两者的解决办法一样:用交叉验证评估一系列取值,选最好的那个。
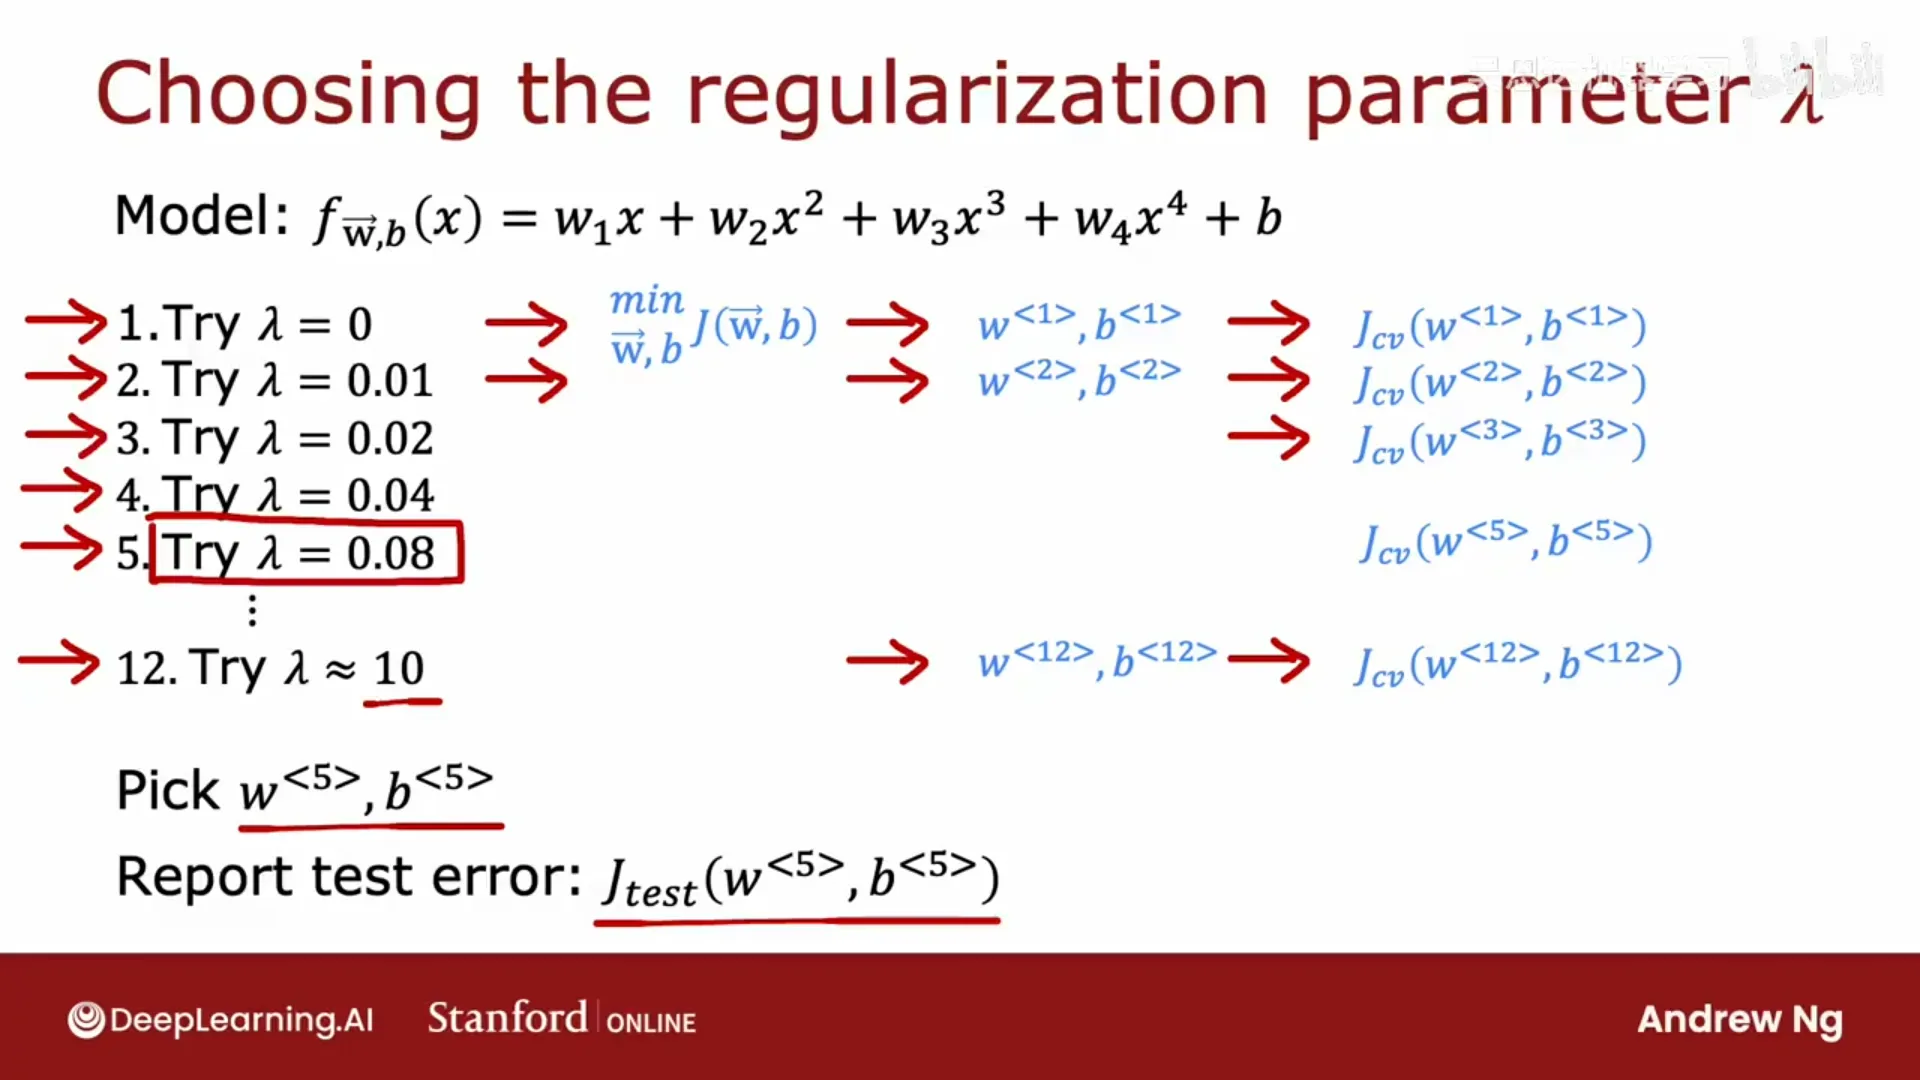
📷 J_train 与 J_cv 随 λ 的变化:λ 太小过拟合、太大欠拟合
回到原视频 (00:05:46)
2.4 建立"基准表现"再判断高低
(p76)
仅看"J_train 高不高"是不够的——"高"是相对什么而言? 需要一个参照。
以语音识别为例(目标:把音频转成文字;误差 = 转录不完全正确的比例):
- 训练误差 J_train = 10.8%,交叉验证误差 J_cv = 14.8%。
单看 10.8% 好像"很高、像是高偏差"。但如果人类在这份音频上的错误率就有 10.6%(很多音频本身嘈杂、真的没人能准确转录),那么 10.8% 其实已经非常好。
所以引入"基准表现(baseline performance)"——你合理期望算法能达到的误差水平,例如:
- 人类水平(在音频、图像、文本这类非结构化数据上,人类通常是很强的基准);
- 某些竞争算法的表现(别人实现过的早期版本,甚至竞争对手的算法);
- 或凭经验估计。
判据变成:
- J_train 与基准之间的差距很大 → 高偏差(模型还有很大提升空间);
- J_train 与 J_cv 之间的差距很大 → 高方差;
- 两者都大 → 高偏差 + 高方差同时存在(神经网络里偶尔如此)。
在上面的例子里:J_train 只比人类差 0.2%(不算高偏差),但 J_cv 比 J_train 高 4% → 主要是高方差。
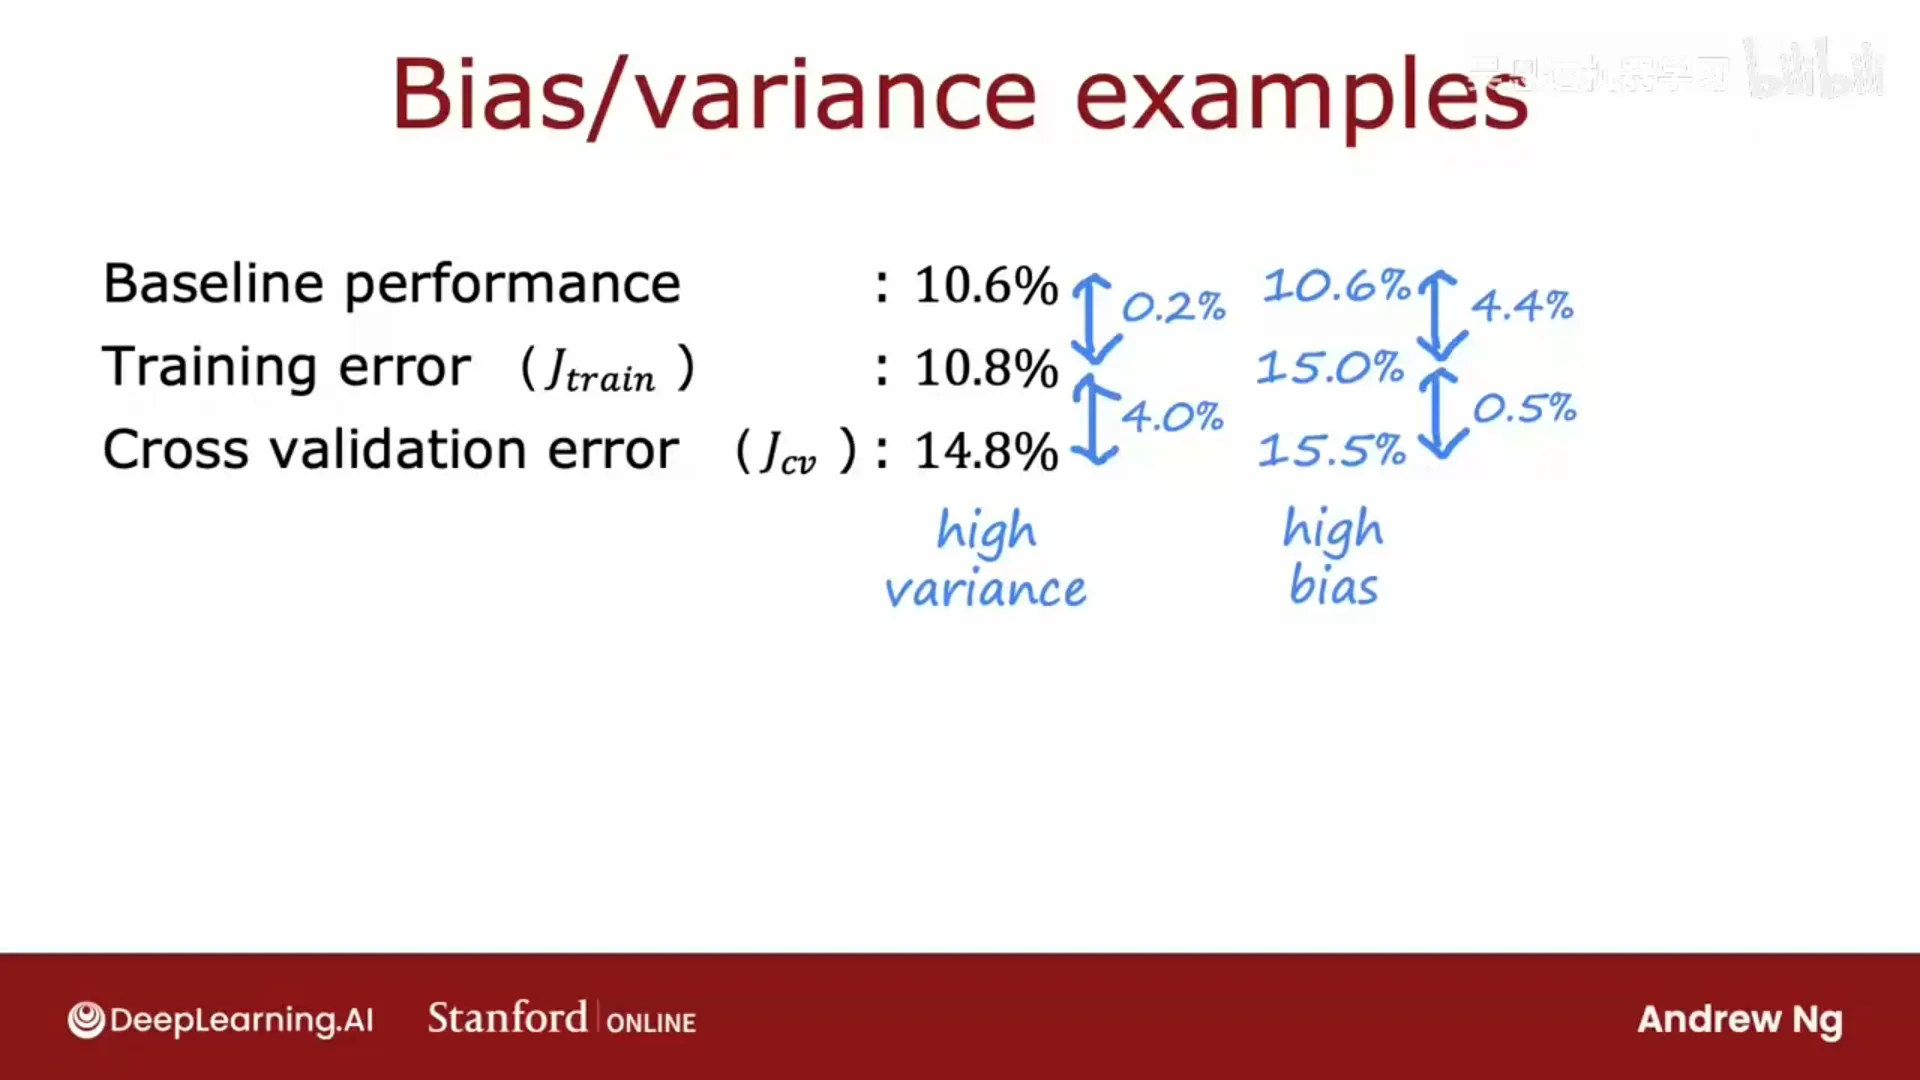
📷 用基准表现判断:J_train−基准 看偏差,J_cv−J_train 看方差
回到原视频 (00:06:59)
2.5 学习曲线
(p77)
学习曲线:横轴是训练集大小 m,纵轴是误差;两条曲线是 J_train 与 J_cv。
基本形状:
- J_train 随 m 增大而上升(样本越多,完美拟合训练集越难;m 很小时 J_train 可以接近 0——用一两个点几乎总能完美拟合);
- J_cv 随 m 增大而下降(数据越多,模型泛化越好);且 J_cv 通常高于 J_train(毕竟参数是拟合训练集的)。
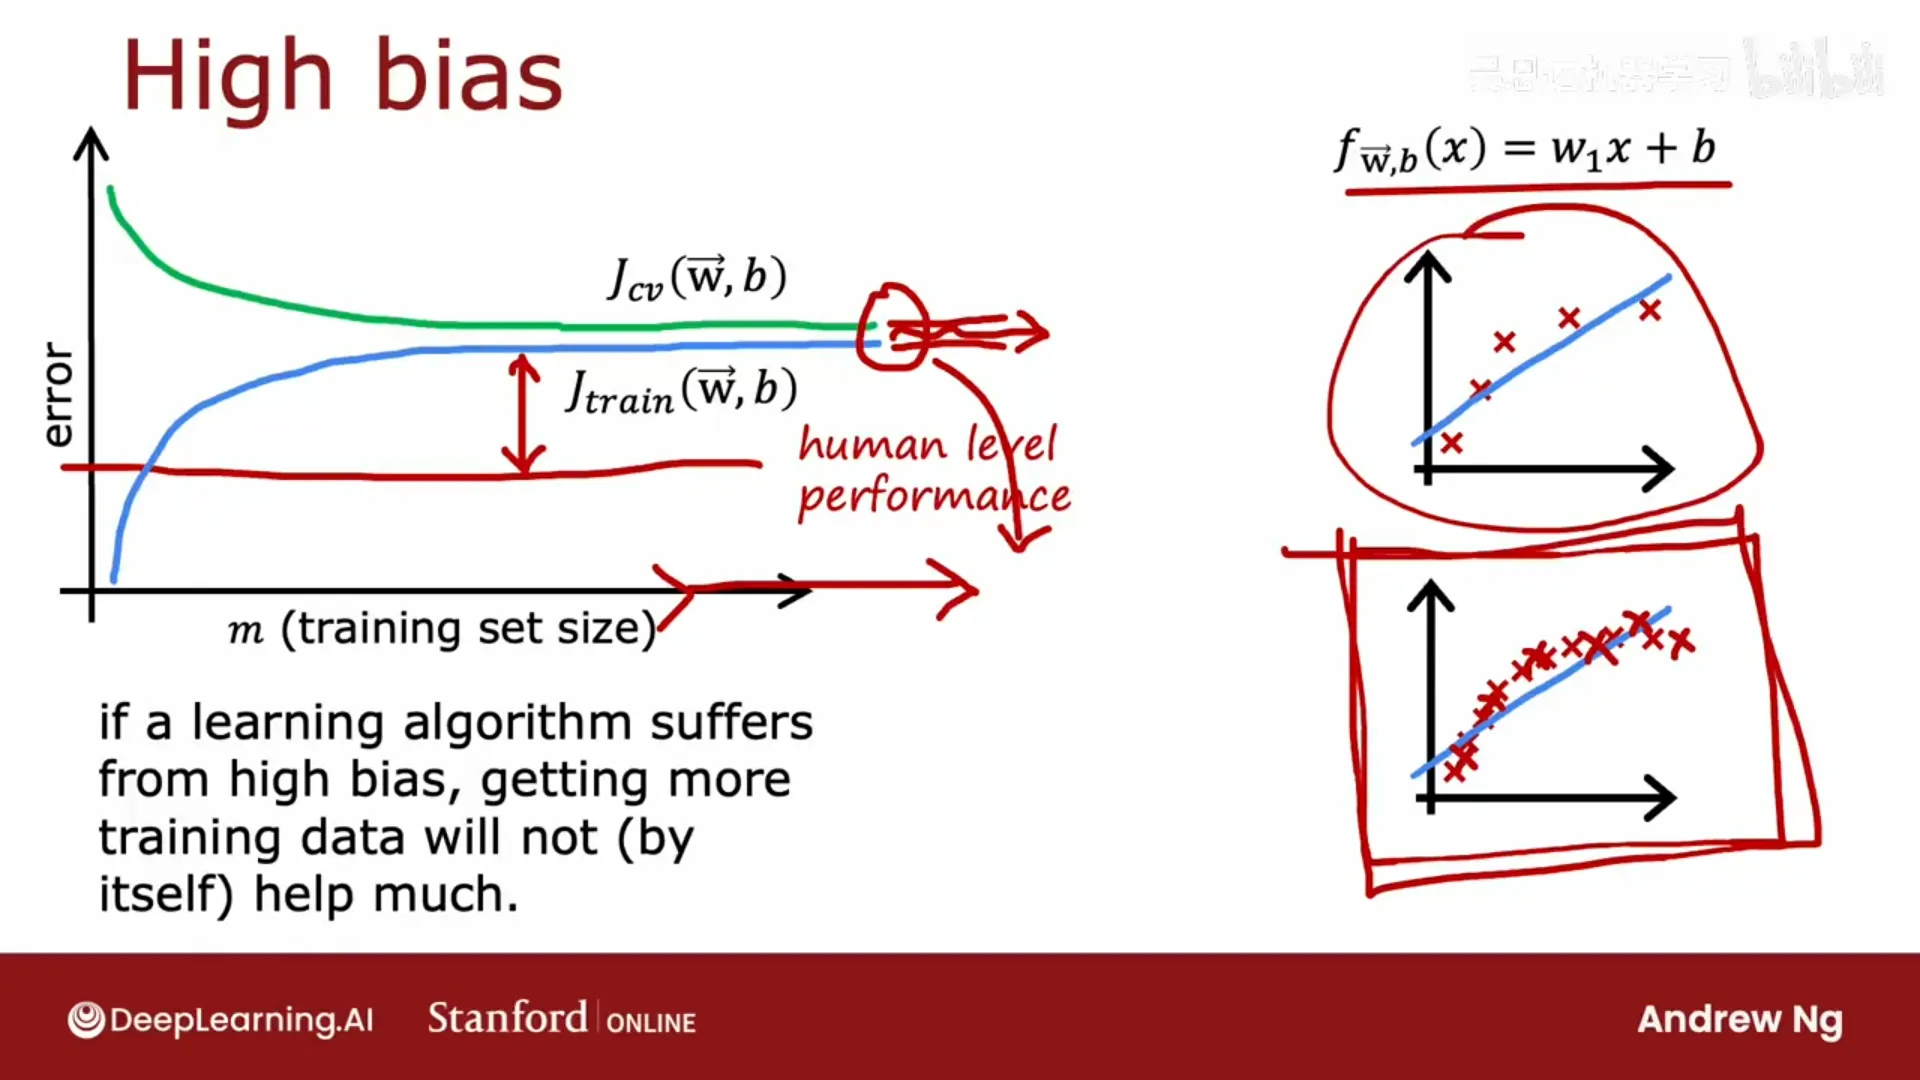
高偏差(欠拟合)时的学习曲线:
- J_train 上升后变平并保持较高;J_cv 下降后也变平,两者接近但都很高;
- 关键结论:若算法高偏差,单纯增加训练数据帮助不大——外推到右边,两条曲线仍会保持平坦、永远不会下沉到基准(如人类水平)。
所以在投入大量精力收集数据前,先检查是不是高偏差。
高方差(过拟合)时的学习曲线:
- J_train 低、J_cv 远高于 J_train,两者之间差距很大;
- 关键结论:若算法高方差,增加训练数据很可能有效——外推到右边,J_cv 会继续下降、接近 J_train。
绘制学习曲线:取训练集的不同子集(100、200、300…个样本)分别训练,记录 J_train、J_cv。缺点是计算代价高(要训练很多个模型),所以实践中不常画,但脑子里有这张图对判断很有帮助。
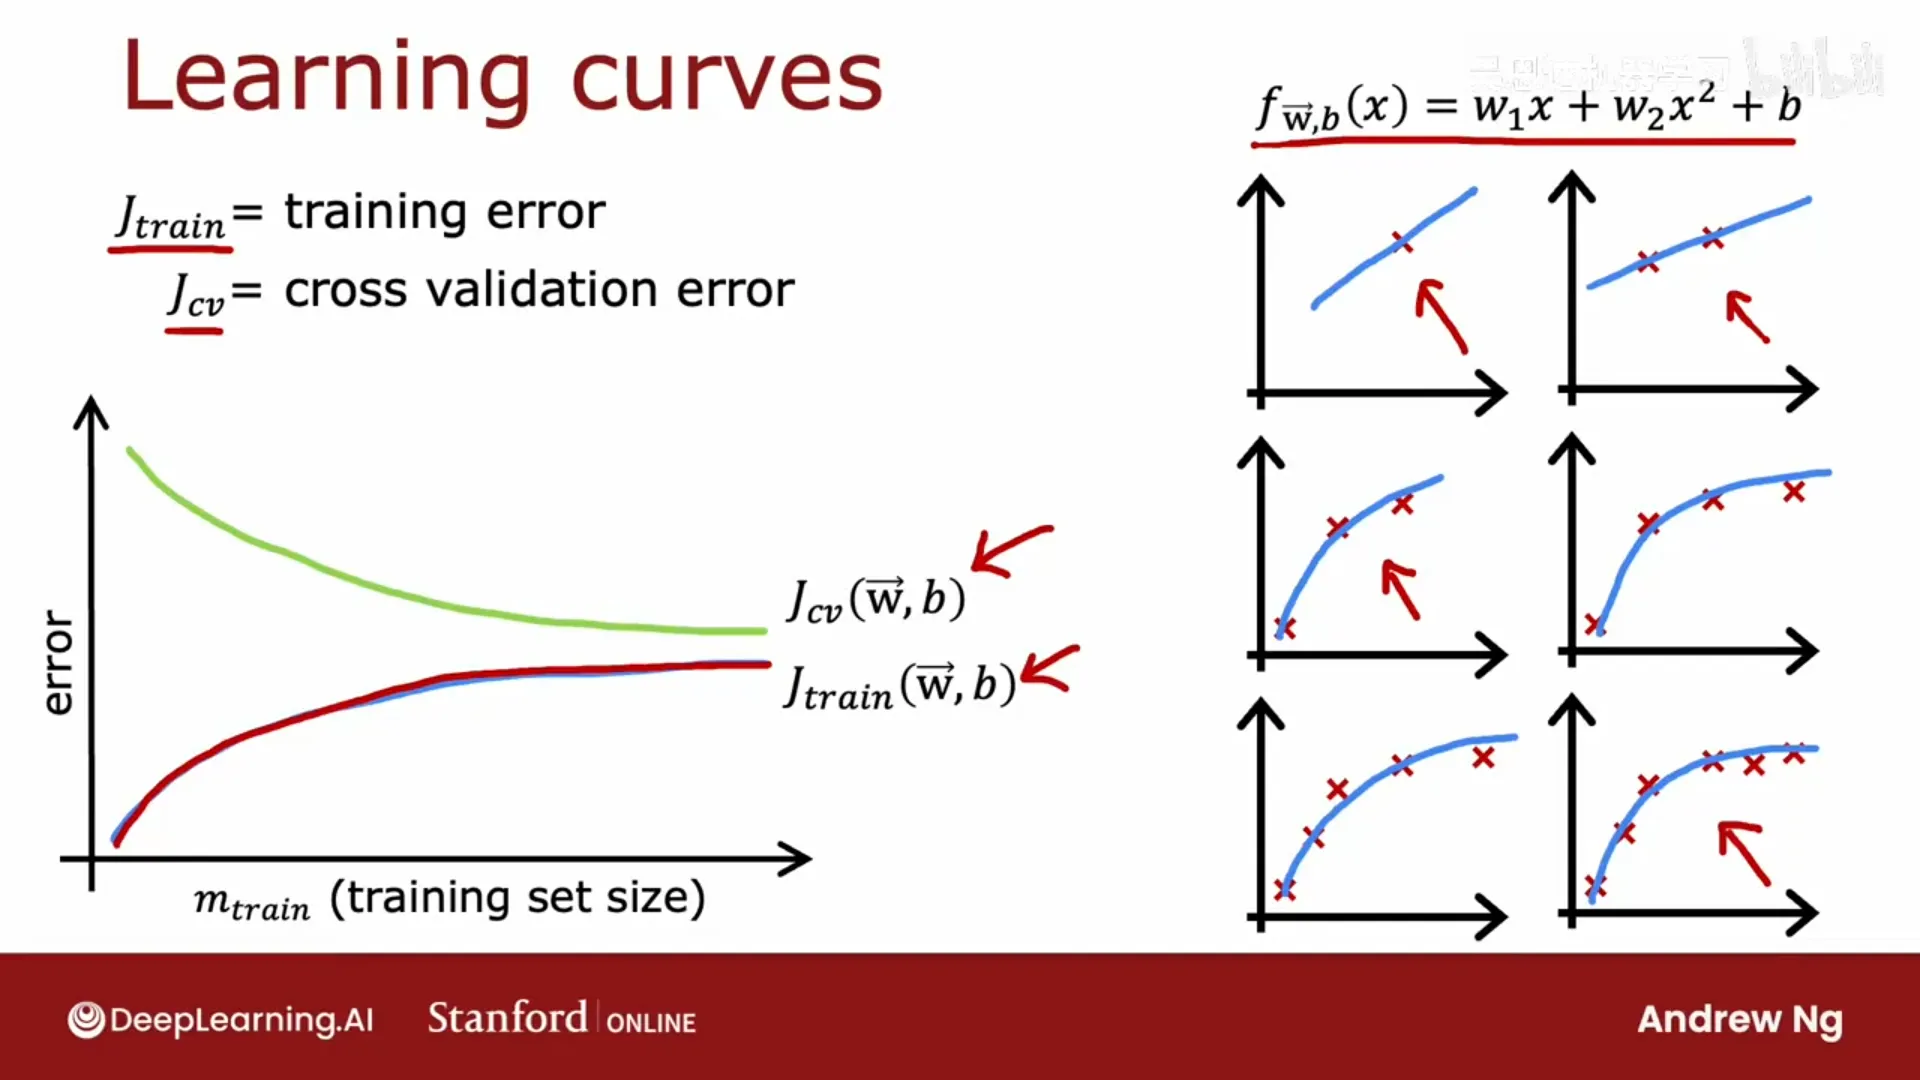
📷 高偏差的学习曲线:两条曲线都趋平且都很高,加数据帮助不大
回到原视频 (00:03:39)
📷 高方差的学习曲线:J_cv 远高于 J_train,加数据有帮助
回到原视频 (00:07:17)
2.6 回到"下一步做什么"
(p78)
现在可以把开头的 6 个方向按偏差/方差归类:
| 方向 | 主要解决 |
|---|---|
| 获取更多训练样本 | 高方差 |
| 尝试更小的特征集 | 高方差 |
| 增加(额外)特征 | 高偏差 |
| 增加多项式特征 | 高偏差 |
| 减小 λ | 高偏差 |
| 增大 λ | 高方差 |
概括成两条:
- 高方差(过拟合) → 解决思路是"要更多数据"或"简化模型";
- 高偏差(欠拟合) → 解决思路是"让模型更强、更灵活"。
两个常见误区: * 不要为了修正高偏差而减少训练集——那只会让交叉验证误差更差; * 不要把"高方差"误当成"高偏差"。诊断对了,方向才对。
吴恩达引用一位博士生的说法:
"偏差-方差权衡是那种很快就能学会、却要用一生去掌握的概念。"
编者拓展|「权衡」二字的来历:经典统计学习理论里,模型复杂度与泛化误差的关系是一条 U 形曲线:复杂度太低 → 偏差主导(欠拟合);太高 → 方差主导(过拟合)。因为「降低偏差往往抬高方差、反之亦然」,所以叫偏差-方差权衡(bias-variance tradeoff)。本章后面的「神经网络 + 大数据」部分,正是要说明如何绕开这种痛苦权衡。
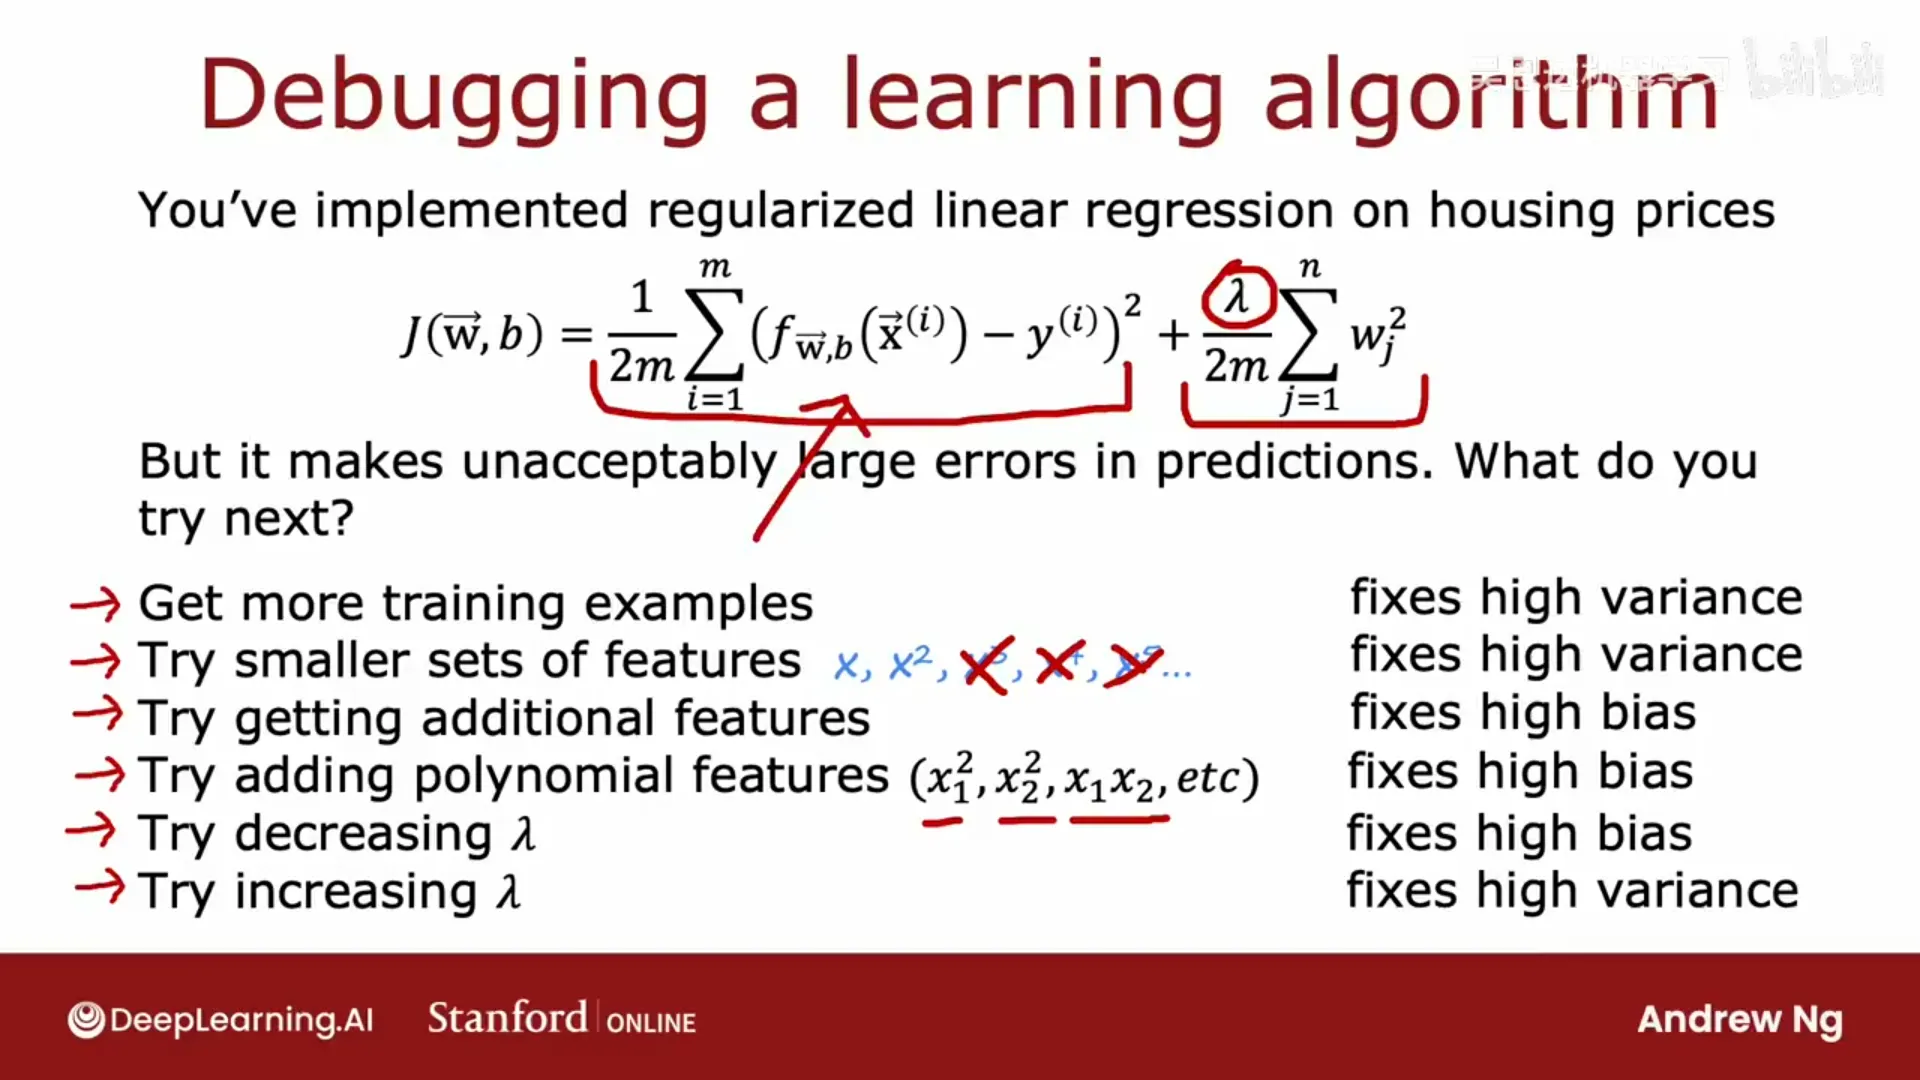
📷 6 个方向按"解决高偏差 / 高方差"分类
回到原视频 (00:05:39)
2.7 神经网络与偏差/方差
(p79)
传统上人们讲"偏差-方差权衡":模型越简单偏差越高、越复杂方差越高,得在中间取平衡。但神经网络 + 大数据提供了一条新的路:
大型神经网络在小到中等规模数据上训练时,是"低偏差机器"——只要网络足够大(更多层 / 每层更多单元),几乎总能很好地拟合训练集。
一个很有效(但不总适用)的流程:
- 训练一个网络,问:它在训练集上表现好吗?(把 J_train 与基准比较)
- 不好(高偏差)→ 把网络变大(更多层/单元),重复,直到 J_train 与基准相当(约等于"拟合了训练集");
- 达标后,问:它在交叉验证集上表现好吗?
- 不好(J_cv 远高于 J_train,高方差)→ 获取更多数据,然后重复;
- 循环直到同时满足两者,就得到不错的模型。
核心洞察:用更大的网络几乎总能降偏差;用更多数据来降方差——不必像传统那样在两者间痛苦权衡。
注意:
- 正则化得当时,更大的网络几乎没有坏处(唯一代价是更慢:训练与推理都更慢),往往还能显著提升性能;
- 但训练更大的网络计算上会变得昂贵——这也是深度学习兴起真正依赖快速硬件(GPU)的原因;
- 更多数据也有上限(有时你只能获取一定量的数据);
- 在开发生命周期中,高偏差/高方差是会变化的:你一开始可能是高偏差,增大网络后又变成高方差,再收集数据后又变回来——每个阶段都重新测一次,据此决定下一步。
📷 大网络降偏差、更多数据降方差:摆脱"偏差-方差权衡"的新路径
回到原视频 (00:02:28)
第三章 机器学习项目的迭代开发
(对应模块 13,视频 p80–p85)
3.1 迭代循环
(p80)
开发 ML 系统是一个反复迭代的过程:
- 决定系统架构:选模型、决定用什么数据、可能还要选超参数;
- 实现并训练模型——几乎从来不会第一次就达到预期;
- 跑诊断:看偏差/方差(上一章)、做误差分析(下一节),也检查是否有代码 bug;
- 根据诊断决定下一步:增大网络?改 λ?加数据?加特征?减特征?
- 带着新的架构选择再循环——通常要迭代多次才能达到想要的性能。
"决定循环里下一步做什么"的效率,直接决定整个项目的速度。
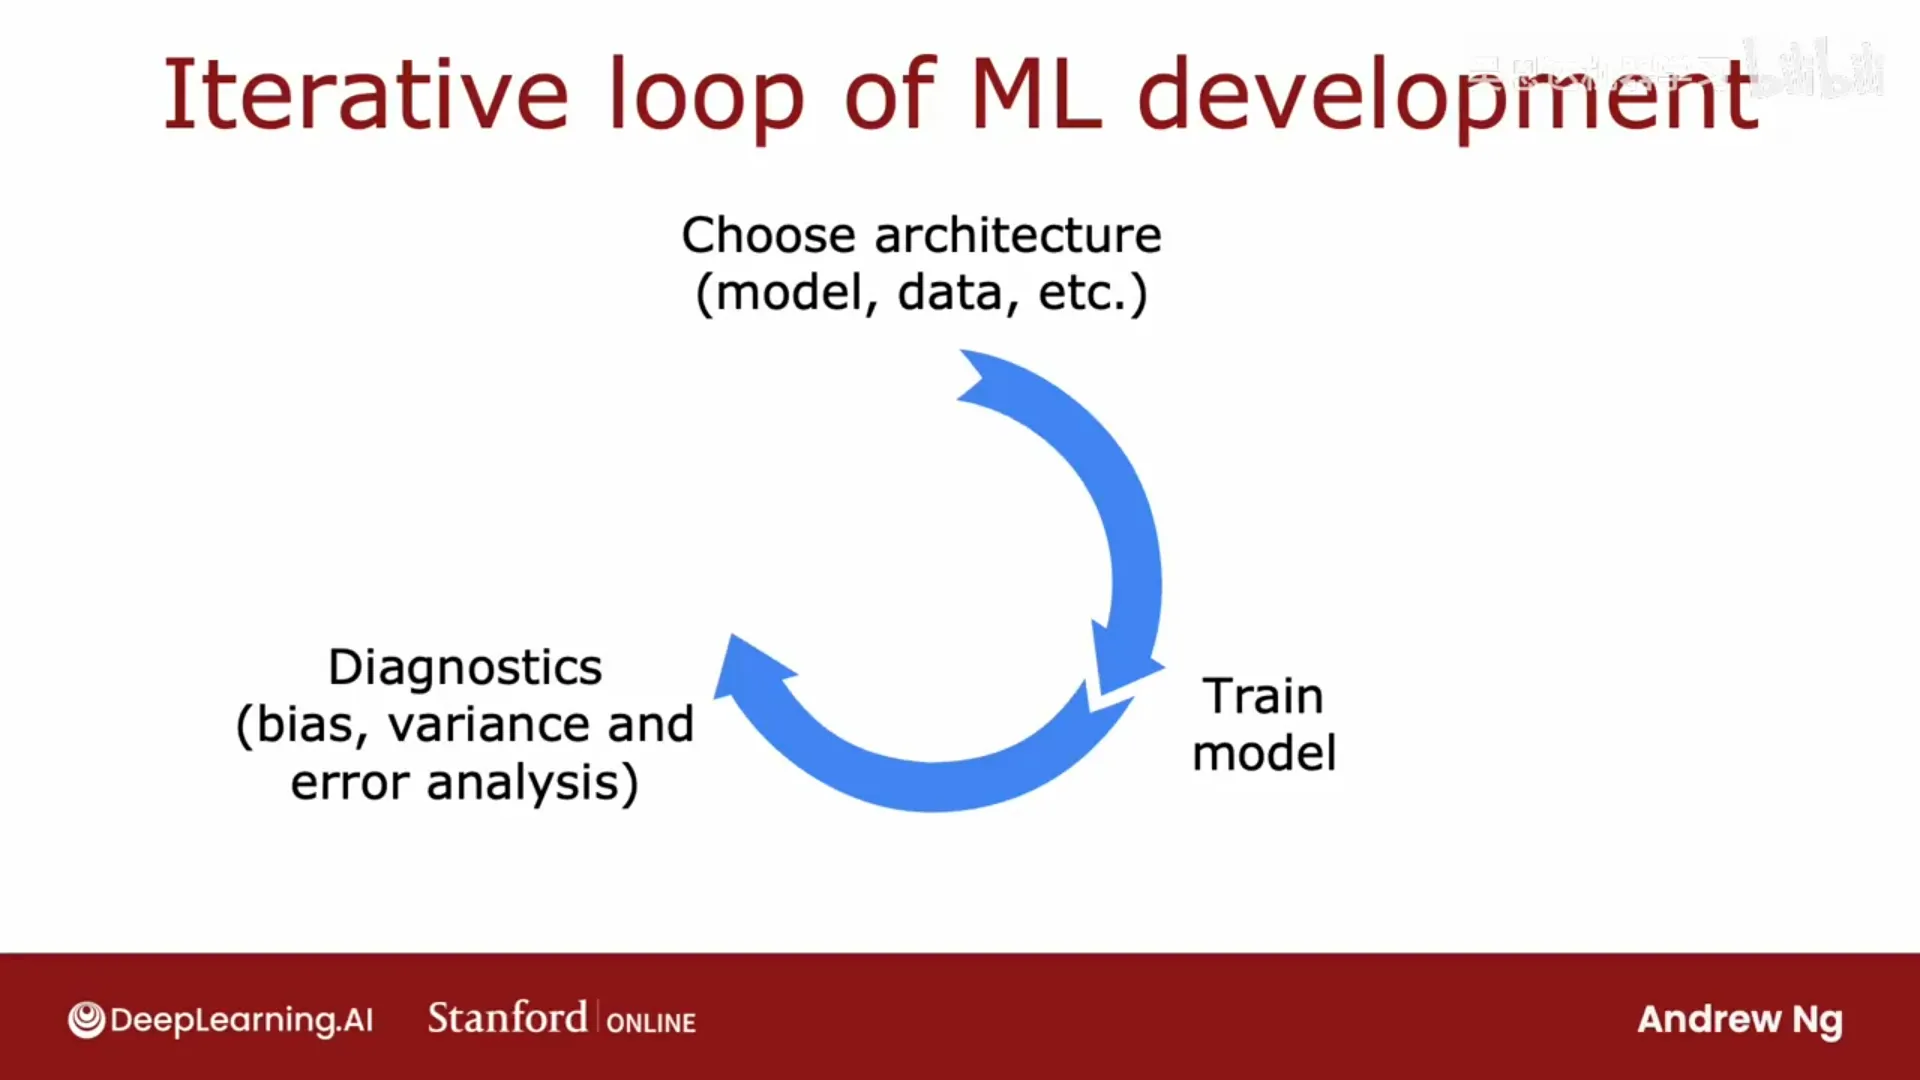
📷 ML 开发的迭代循环:设计 → 训练 → 诊断 → 决定下一步 → 再循环
回到原视频 (00:01:12)
以垃圾邮件分类器为例:把邮件文本转成特征(如取最常见的 10,000 个英文单词,每个词对应一个 0/1 特征表示"是否出现";也可以记录出现次数,但 0/1 也能工作得不错)。用逻辑回归或神经网络训练后,若效果不佳,你有很多想法:
- 收集更多数据(有些团队用蜜罐项目:创建大量假邮箱地址、故意让垃圾邮件发送者获知,从而大量收集垃圾邮件数据);
- 分析邮件路由(email routing):邮件从发件人到你会经过一系列服务器,邮件头部信息记录了它如何传输——路径有时能帮助判断是否是垃圾邮件;
- 从正文里提取更复杂特征:比如把"折扣/discount"和"打折/deal"视为同一个词;或检测故意拼错的单词(垃圾邮件常把 watches/medicine/mortgage 拼错来绕过过滤器)。
问题仍是:这么多想法,哪个更有希望? 选对方向能让项目快 10 倍;选错可能浪费数月。偏差/方差分析与误差分析,正是帮你筛选的工具。
3.2 误差分析
(p81)
误差分析(error analysis) 是仅次于偏差/方差的重要诊断手段:手动检查算法分错的样本,把它们归类到共同的主题/特征上,并统计数量。
例:500 个交叉验证样本中算法分错 100 个。逐个查看这 100 个并计数:
| 错误类型 | 数量 |
|---|---|
| 医药类垃圾邮件 | 21 |
| 钓鱼/窃取密码邮件 | 18 |
| 异常邮件路由 | 7 |
| 故意拼写错误 | 3 |
| 含图片的垃圾邮件 | … |
结论很直接:医药垃圾邮件和钓鱼邮件是大问题(应优先投入),而"故意拼写错误"虽然也是问题,但只占 3/100——即使你造出极其复杂的检测拼写错误的算法,也只能解决 3 个错误,净收益很小,不值得优先做。
(吴恩达坦言:他当年就花了很多时间做拼写错误检测,后来才意识到净影响很小——如果早做误差分析,就能省下那些时间。)
注意事项:
- 类别可以重叠(不是互斥):一封邮件可能既是医药垃圾、又有异常路由;
- 若交叉验证集很大(如 5000 个、分错 1000 个),随机抽约 100~几百个来看就够了,不必全看("合理时间内能看完的数量");
- 误差分析对"人类擅长"的任务更容易做(判断"这邮件是不是垃圾"人类很在行);如果连人类都做不好(如"预测用户会点哪个广告"),误差分析会更难。
误差分析的价值:把"下一步做什么"从猜测变成有数据支撑的优先排序——例如决定"专门去收集更多医药垃圾邮件的数据",或"专门写检测钓鱼 URL 的特征"。
📷 误差分析:手动统计每类错误的数量,据此排优先级
回到原视频 (00:00:19)
3.3 添加数据
(p82)
更聚焦地补数据:与其"收集所有类型的数据"(慢且贵),不如根据误差分析只补有问题的那类。例如发现"医药垃圾邮件是主要错误"→ 专门去找更多医药垃圾邮件样本。若你有大量未标注数据,可让标注员专门挑出某类样本。
数据增强(data augmentation)——从已有样本变出新样本(对图像、音频尤其有用):
- 图像:把现有图旋转、放大/缩小、改变对比度;甚至把字母放在网格上做随机畸变(distortion)。这些变形不改变标签(A 还是 A,但注意镜像只对某些字母成立);
- 音频:把原始音频与背景噪音相加——例如人群嘈杂声、车内噪音,或模拟手机信号不好的效果。一个音频片段就能变成三个训练样本。这在语音识别里非常关键(可以人工扩大训练量、构建更准确的系统)。
关键原则:
你施加的变形/噪声,必须能代表测试集里真实存在的类型才有效。
- 把 A 轻微旋转/缩放、或给音频加背景噪音/坏信号——如果这些代表测试集里会遇到的情况,就是好的增强;
- 加纯随机噪声(如给每个像素加随机噪声)通常没用——因为测试集里几乎不会出现那种图像。
数据合成(data synthesis)——从零造全新样本:
- 例:照片 OCR。真实样本是街拍照片里的小字母图块;你可以用电脑里的各种字体、颜色、对比度渲染文字再截图,造出大量逼真的合成训练数据(左边是真实照片,右边是合成图,看起来确实很逼真)。
- 数据合成主要用于计算机视觉,音频/其他任务用得较少;为特定应用生成逼真合成数据可能需要不少编码工作,但往往能大幅提升平均表现。
从"模型中心"到"数据中心":过去几十年研究者习惯固定数据集、改进模型,于是我们有了一流的算法(线性回归、逻辑回归、神经网络、决策树)。但有时把精力放在数据上(收集特定类型的数据、数据增强、数据合成)反而更有效——这是一种数据驱动(data-centric)的方法。
📷 数据增强:旋转/缩放图像,或给音频叠加背景噪音
回到原视频 (00:03:30)
3.4 迁移学习
(p83)
迁移学习(transfer learning) 让你用其他任务的数据来帮你的任务——当你的应用数据很少时非常有用。
流程(以"手写数字 0–9 识别,但数据很少"为例):
- 先在一个大数据集(如 100 万张图、1000 个类别:猫/狗/车/人…)上训练一个神经网络;
- 保留前几层的参数(w^[1],b^[1],…,w^[4],b^[4]),换掉输出层(从 1000 个输出改为 10 个输出),只随机初始化新输出层的参数(w^[5],b^[5] 维度变了,必须重训);
-
在你的小数据集上继续训练:
-
选项一:冻结前面所有层(保持参数不变),只训练新的输出层——训练集非常小时更合适;
- 选项二:所有参数都继续训练,但用上一步的值初始化——训练集稍大时更好。
两步叫法:
- 监督预训练(supervised pre-training):在大数据集上训练;
- 微调(fine-tuning):用预训练的参数初始化,再在你自己的数据上继续训练。
为什么有效? 检测"猫/狗/车/人"时,网络前几层学到的是边缘、角点、基本曲线/形状——这些是通用的低级图像特征,对识别手写数字同样有用。
两个要点:
- 输入类型 x 必须相同:图像任务的预训练必须在图像上做;音频任务要在音频上预训练;文本任务在文本上预训练;
- 你通常不必自己预训练——很多人已经把预训练好的模型免费发布在网上(如 BERT、GPT、ImageNet 预训练模型),你可以直接下载、换输出层、微调。有了好的预训练模型,有时只用 50 张图微调就能得到不错的效果。
这也是机器学习社区共享成果的方式:别人花几周训练的模型,你直接下载微调即可。吴恩达希望你也回馈社区。
编者拓展|迁移学习为什么「讲得通」:深度学习的一个核心发现是:网络浅层学到的特征往往是通用的(边缘、角点、纹理),深层才逐步特化到具体任务。所以你可以把在大数据上预训练好的「通用特征提取器」搬过来,只重新训练「特化」的顶层(或做少量微调)。今天几乎所有大模型(BERT、GPT、CLIP……)的用法都建立在这个基础上——预训练 + 微调已经成了标准范式。
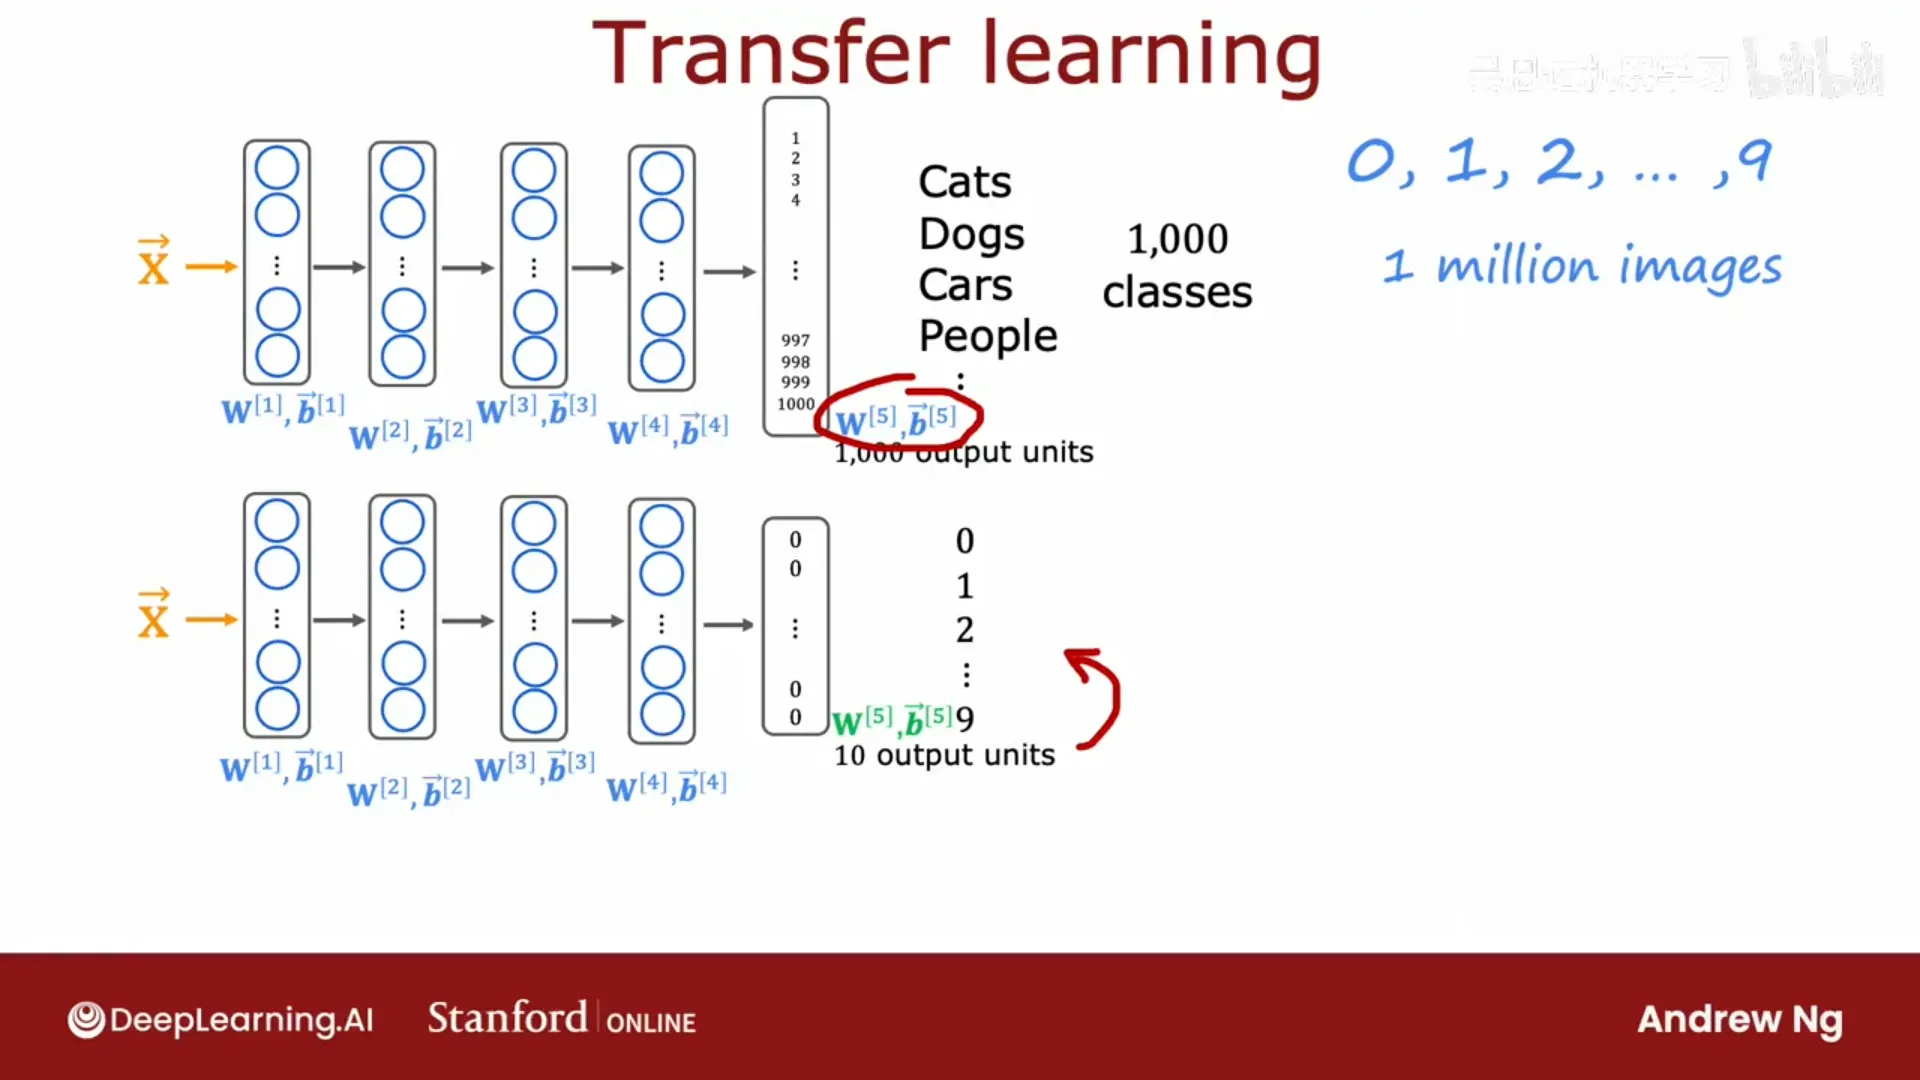
📷 迁移学习:在大型数据集上监督预训练,再在自己的小数据上微调
回到原视频 (00:02:14)
3.5 机器学习项目的完整周期
(p84)
一个完整的 ML 项目包含这些阶段:
- 确定项目范围(scoping):决定做什么(如"语音搜索:用说话而不是打字做网页搜索");
- 收集数据:决定需要什么数据并去获取(音频 + 转录标签);
- 训练模型:训练 → 偏差/方差分析 → 误差分析 → 迭代改进;
- (根据分析)回去收集更多数据——可以是所有数据,也可以是特定类型的数据;
- 部署到生产:让用户能用;
- 监控与维护:持续监控性能,性能下降时回炉重训。
例(语音识别):吴恩达发现模型在背景有车噪时表现特别差,于是用数据增强获取更多"像在车里说话"的语音数据来提升性能——这就是"分析 → 补数据 → 再训练"的循环。
部署的常见形态:
- 把训练好的模型跑在一个推理服务器(inference server)上;
- 移动应用通过 API 调用把输入 x(如录音)传给它,服务器调用模型返回预测 ŷ(转录文本);
- 服务少量用户 vs 数百万用户,所需的软件工程量差别巨大(从"笔记本上跑跑"到"大量数据中心资源");
- 常需要记录输入 x 与预测 ŷ(在隐私与授权允许的前提下)——这对监控很有用。
为什么要监控? 因为数据会漂移。例如:
- 新出现的名人、新当选的政治家——人们搜索这些训练集里没有的新名字,系统就会表现不佳;
- 监控让我们发现数据何时变化、模型何时变不准,从而重新训练、更新模型。
MLOps(机器学习运维) 指系统化地构建、部署、维护 ML 系统的实践:保证模型可靠、可扩展、有良好的日志与监控,并能适时更新。对服务数百万用户的系统,还常需高度优化的实现以控制计算成本。
📷 部署:移动应用通过 API 调用推理服务器,并记录数据用于监控
回到原视频 (00:03:55)
3.6 公平、偏见与伦理
(p85)
ML 算法正在影响数十亿人,所以构建影响人的系统时,必须认真考虑公平性、偏见与伦理。历史上已有多起完全不可接受的案例:
- 一个招聘工具在歧视女性(该公司已停用,但人们希望它一开始就没被推出);
- 部分人脸识别系统更频繁地把深肤色个体误匹配为嫌疑人;
- 一些贷款审批系统歧视特定子群体;
- 算法可能强化负面刻板印象(例如让某些人搜不到"像自己"的职业榜样,可能阻止他们从事某些职业)。
不当/有害的用途:
- 未经同意用 deepfake 造假视频(BuzzFeed 曾公开透明地做过一例奥巴马 deepfake 作演示,但未经同意、不公开地生成虚假视频是不道德的);
- 社交媒体为优化用户互动而放大阴谋论、仇恨与有害内容;
- 用机器人刷虚假评论(商业或政治目的);
- 有人用 ML 从事欺诈、构建有害产品。
原则:技术本身是中性的,但使用技术的人要负责。构建影响人的系统时,务必让系统相对公平、尽量少偏见、符合伦理,只做你真正相信能让社会变得更好的事。
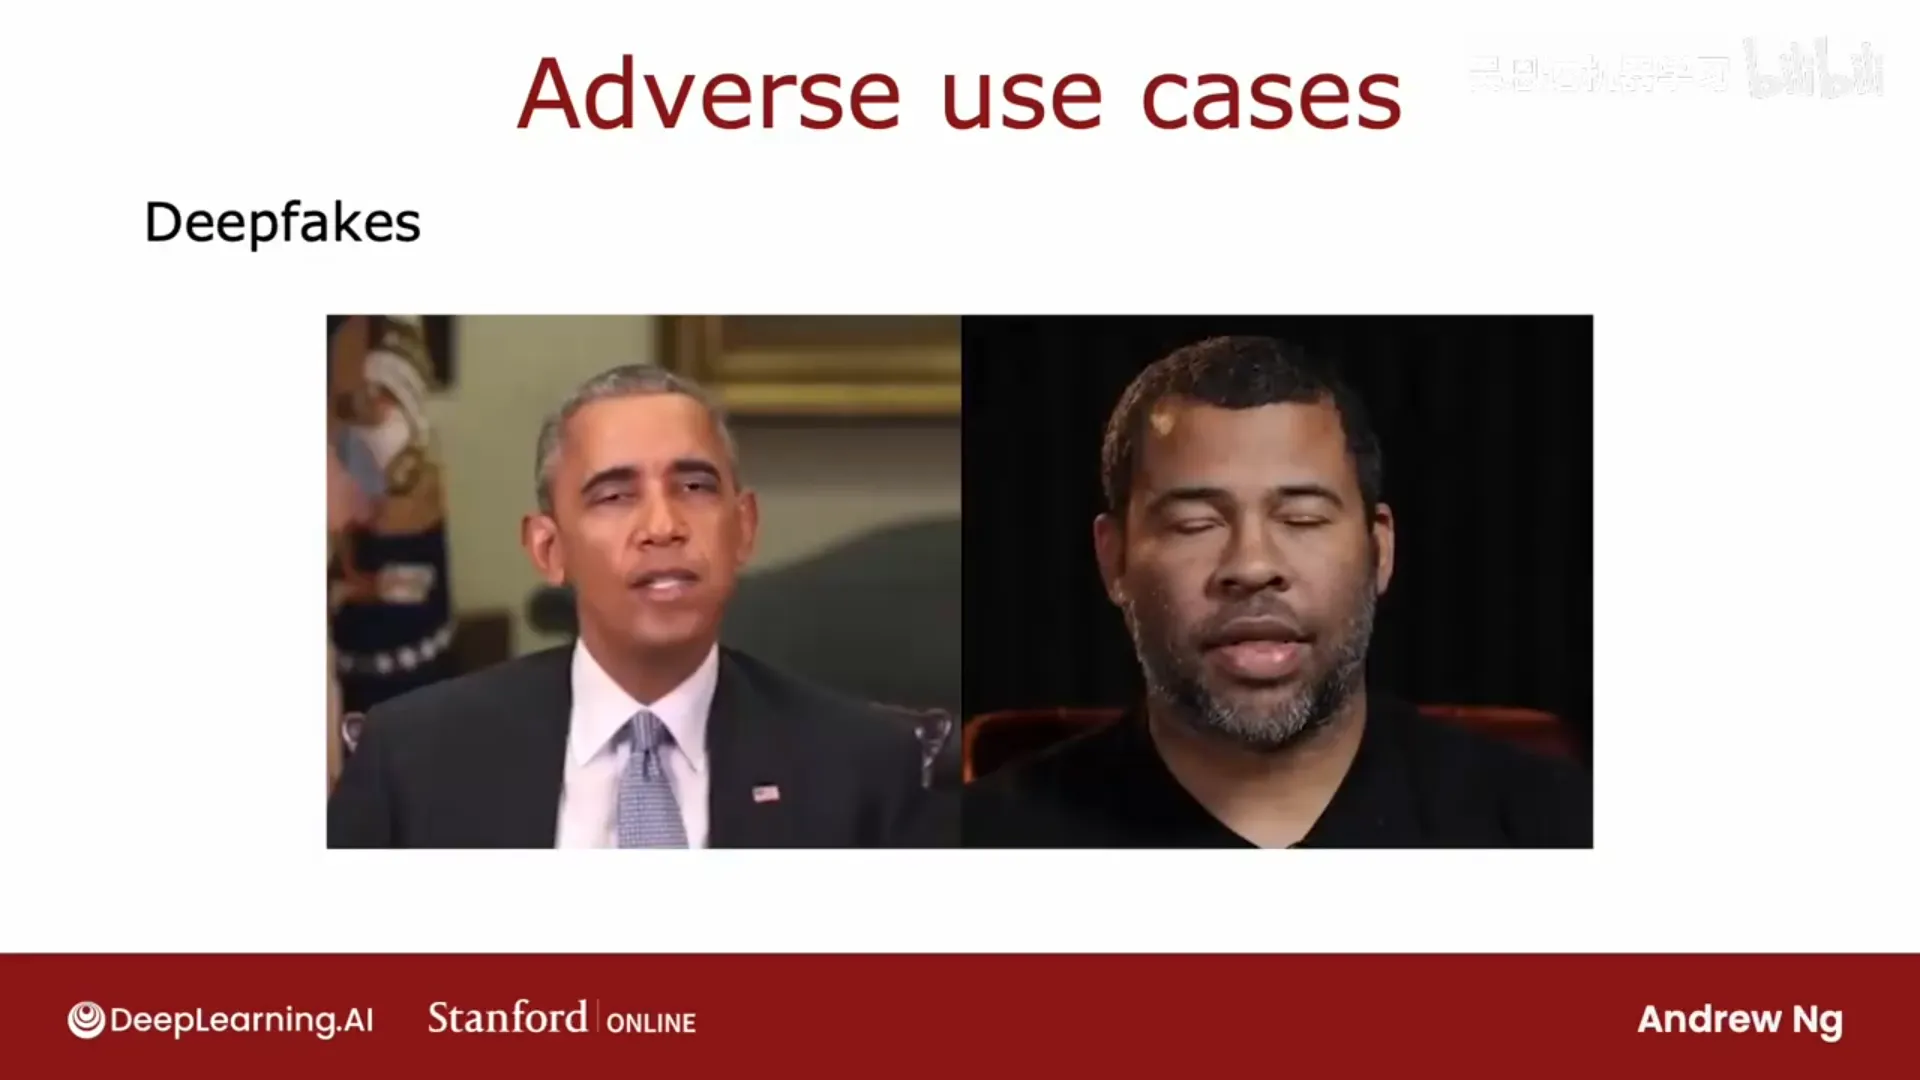
📷 公平与伦理:ML 影响数十亿人,偏见与不当使用是真实风险
回到原视频 (00:02:12)
第四章 倾斜数据集与精确率/召回率
(对应模块 14,视频 p86–p87)
4.1 倾斜数据集:准确率会骗人
(p86)
当正负样本比例严重失衡(远非 50:50)时,准确率/错误率不再是好指标。
例:用实验室数据检测一种罕见病(y=1 表示患病)。若只有 0.5% 的人患病,那么一个永远输出 y=0 的"笨算法"就有 99.5% 的准确率(0.5% 错误率)——它甚至"优于"你那个 1% 错误率的学习算法,但它一个病人都诊断不出来,毫无用处。
所以:如果错误率 1%、另一个 0.5%、另一个 1.2%,你很难判断哪个算法最好——因为错误率最低的那个可能完全没用。
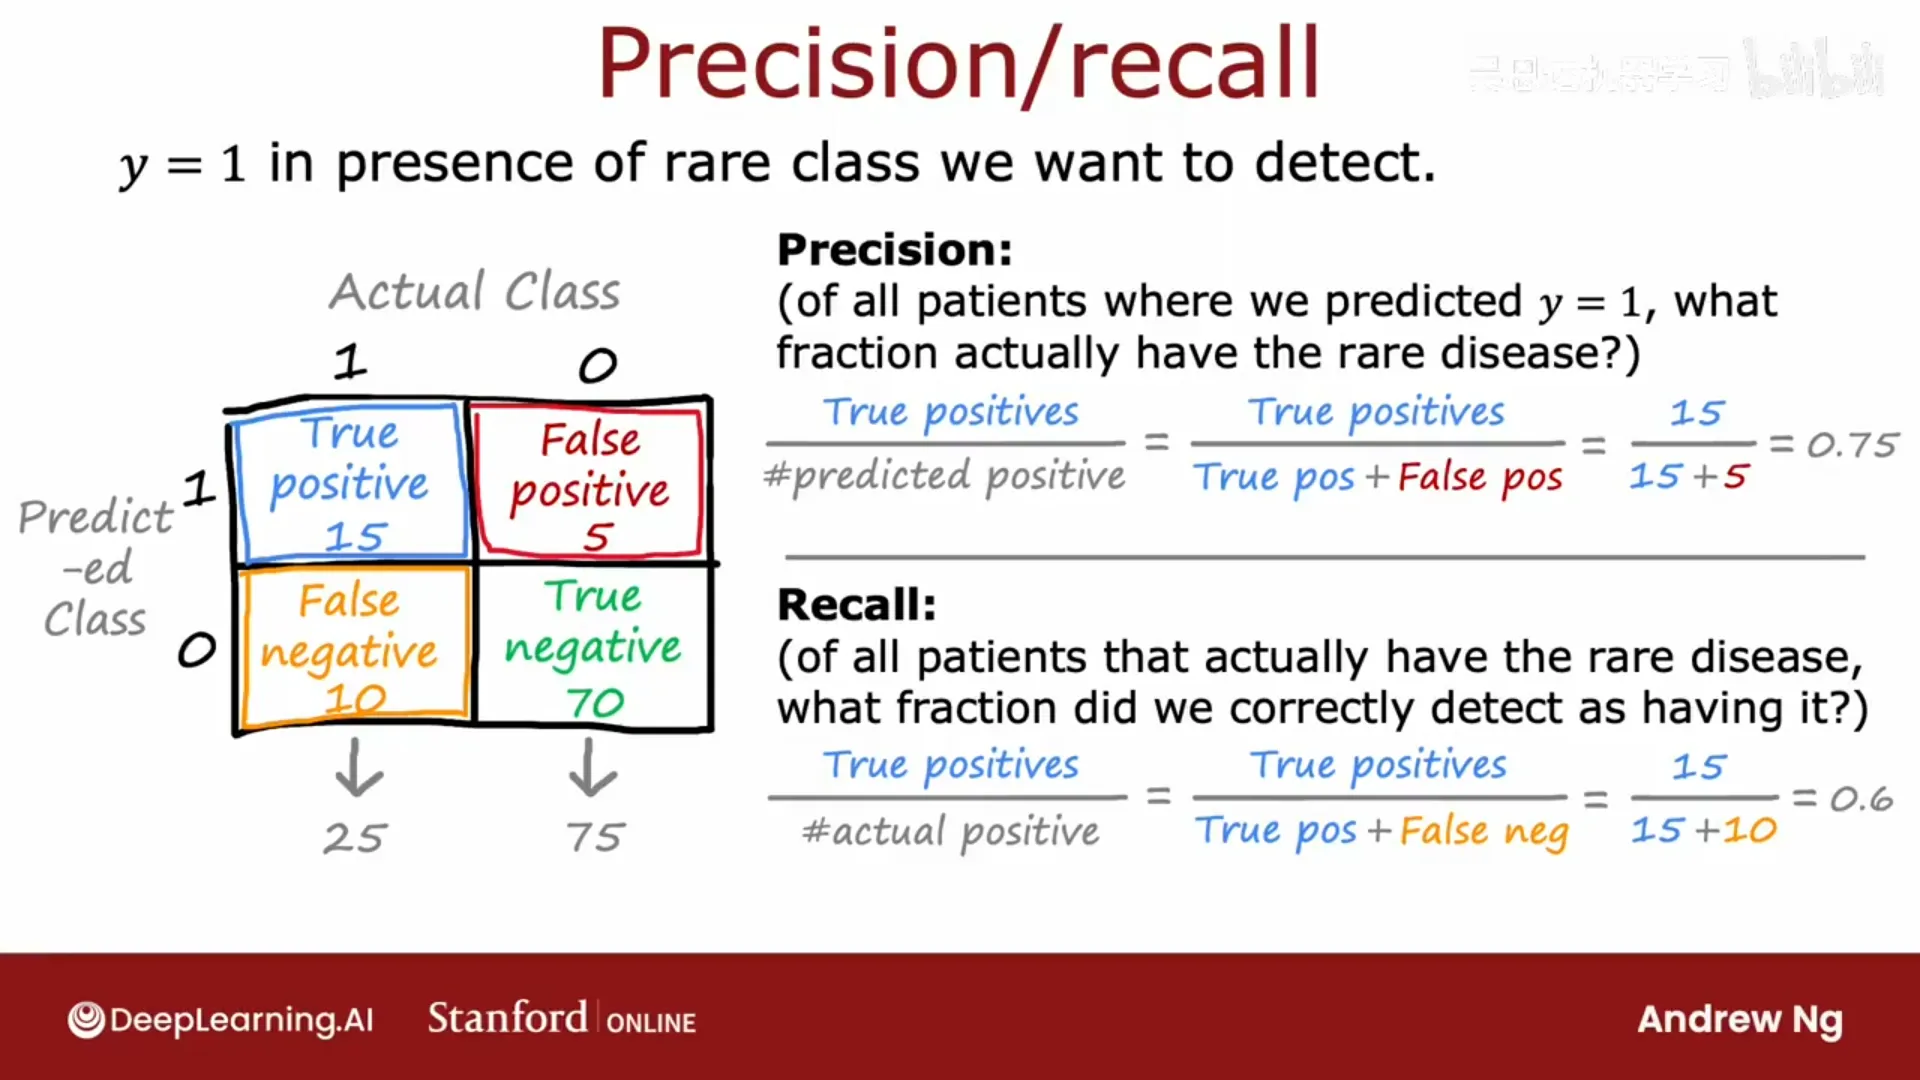
改用精确率(precision)和召回率(recall)。为此先构建混淆矩阵(confusion matrix)(以实际类别为列、预测类别为行):
| 实际 1 | 实际 0 | |
|---|---|---|
| 预测 1 | 真正例 TP | 假正例 FP |
| 预测 0 | 假负例 FN | 真负例 TN |
例(交叉验证集 100 个样本:25 个实际为正、75 个实际为负):
- TP = 15(实际 1、预测 1);FP = 5(实际 0、预测 1);
- FN = 10(实际 1、预测 0);TN = 70(实际 0、预测 0)。
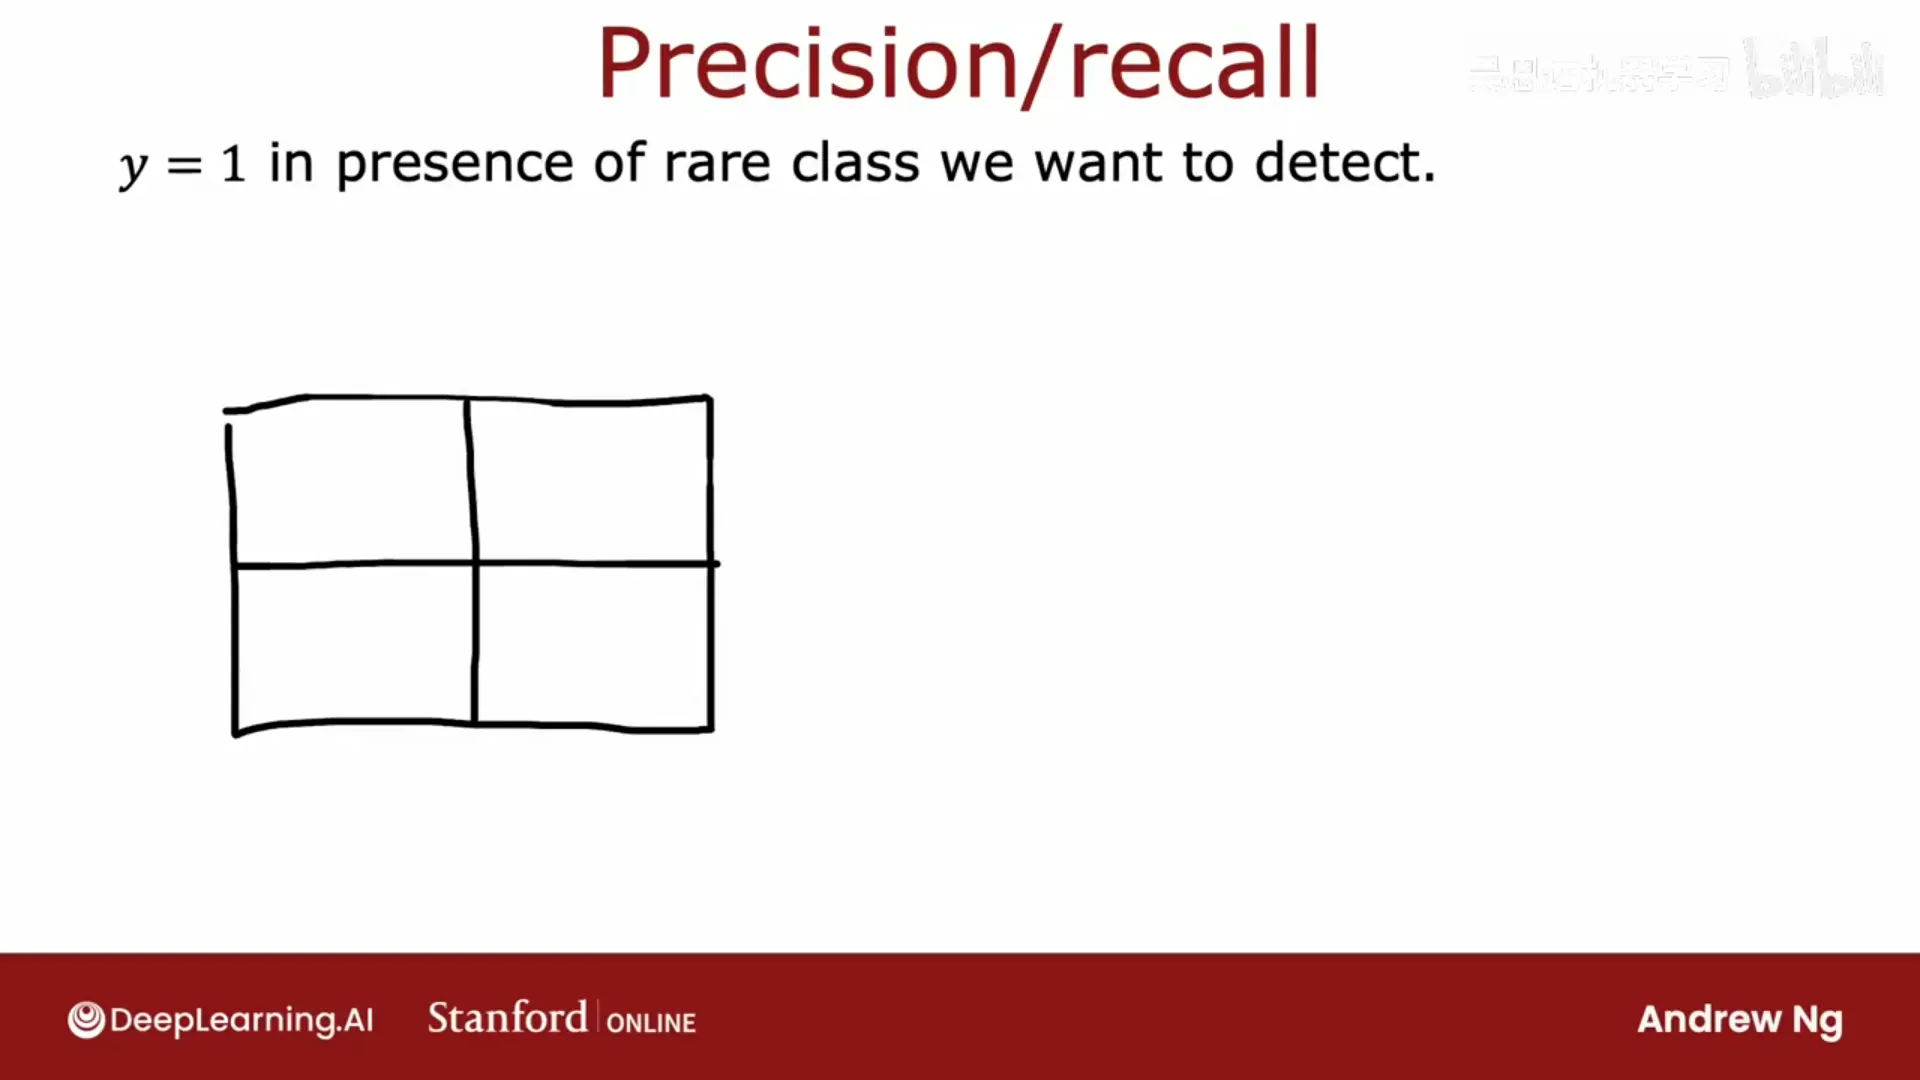
📷 混淆矩阵:真正例/假正例/假负例/真负例
回到原视频 (00:03:33)
4.2 精确率与召回率
(p86)
$$\text{Precision} = \frac{TP}{TP + FP}, \qquad \text{Recall} = \frac{TP}{TP + FN}$$
精确率=所有"预测为正"的样本中实际为正的比例;召回率=所有"实际为正"的样本中被正确检出的比例。
代入例子:
- 精确率 = 15 / (15 + 5) = 15/20 = 0.75(75%);
- 召回率 = 15 / (15 + 10) = 15/25 = 0.60(60%)。
为什么这两个指标好:
- 如果一个算法总是预测 0,则 TP = 0 → 召回率 = 0(立刻暴露它没用);精确率则未定义(0/0),实践中也按 0 处理;
- 精确率 0 或召回率 0 的算法都是不可用的;
- 这对指标帮你同时确认:它判正时是否可信(精确率)、它有没有找出该找的人(召回率)。
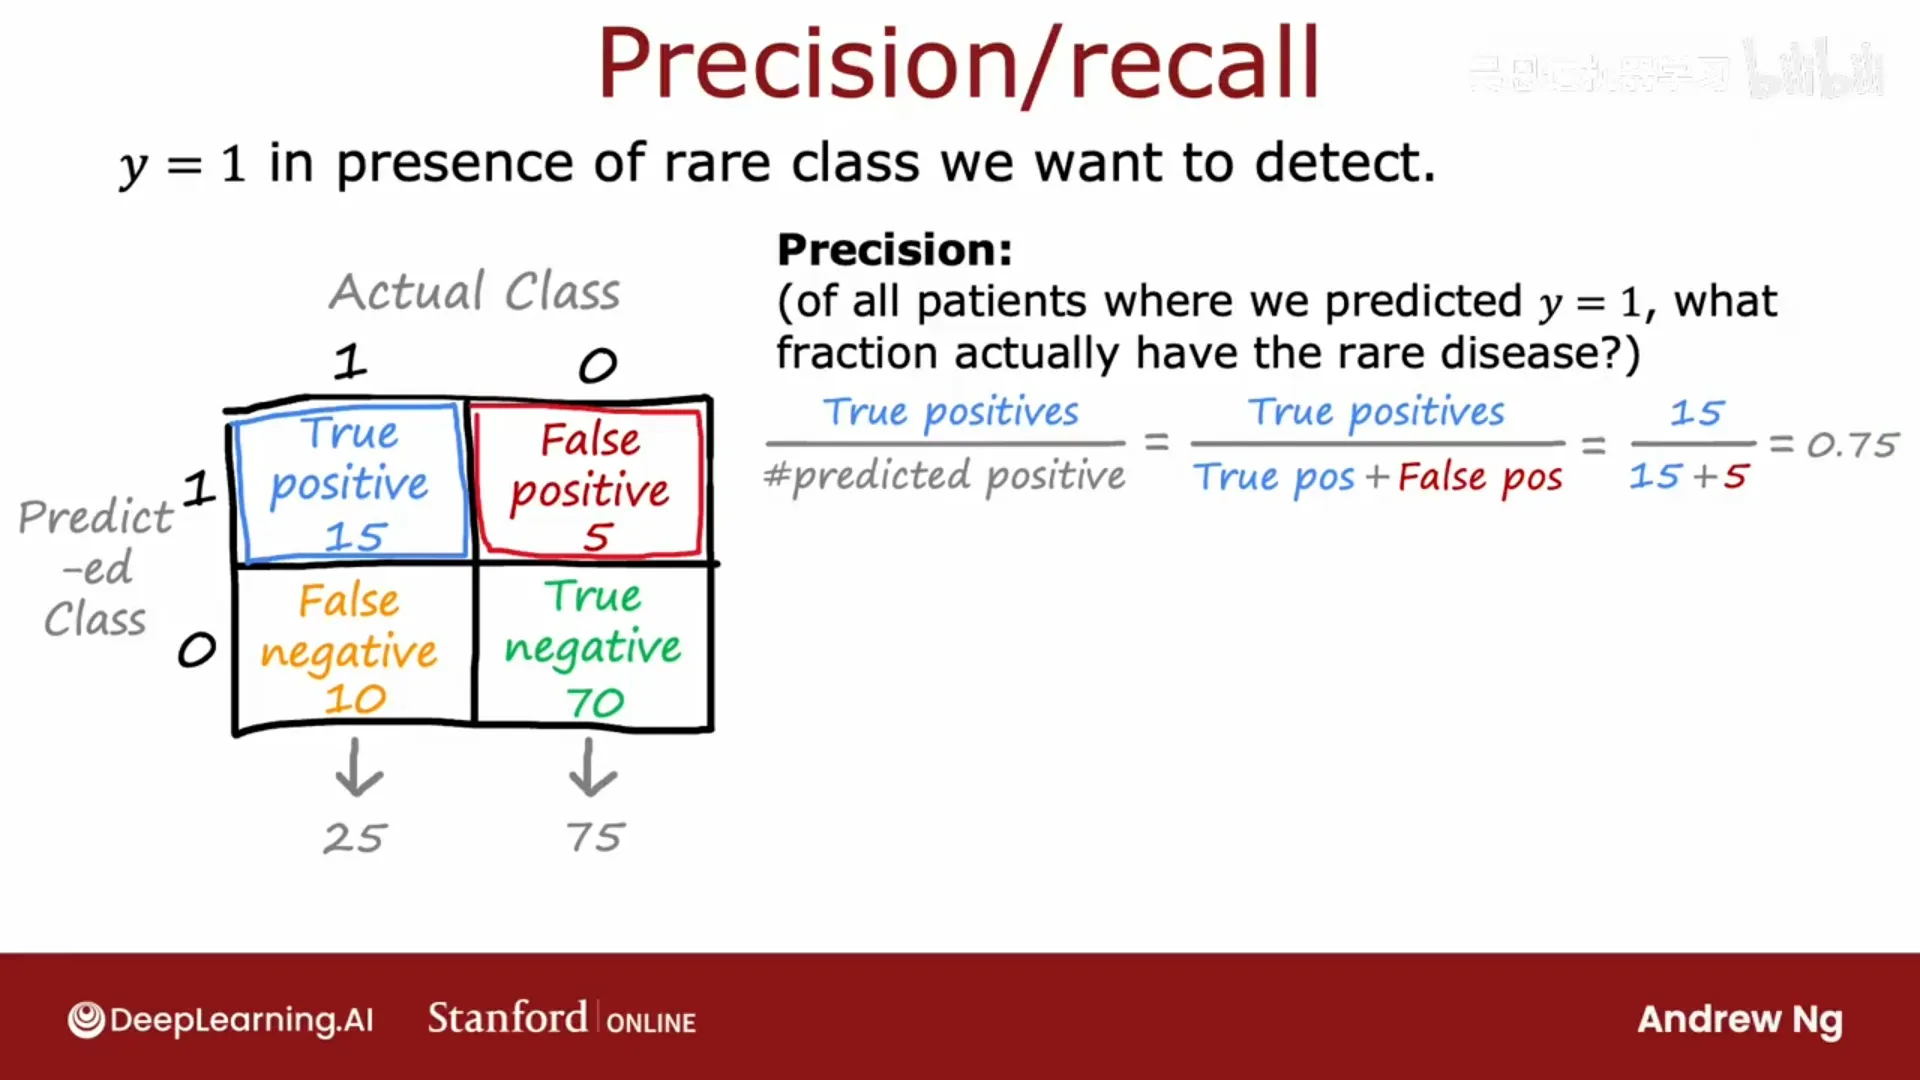
📷 精确率:预测为正的样本里有多少真的为正
回到原视频 (00:07:28)
📷 召回率:实际为正的样本里被找出了多少
回到原视频 (00:08:43)
4.3 精确率与召回率的权衡
(p87)
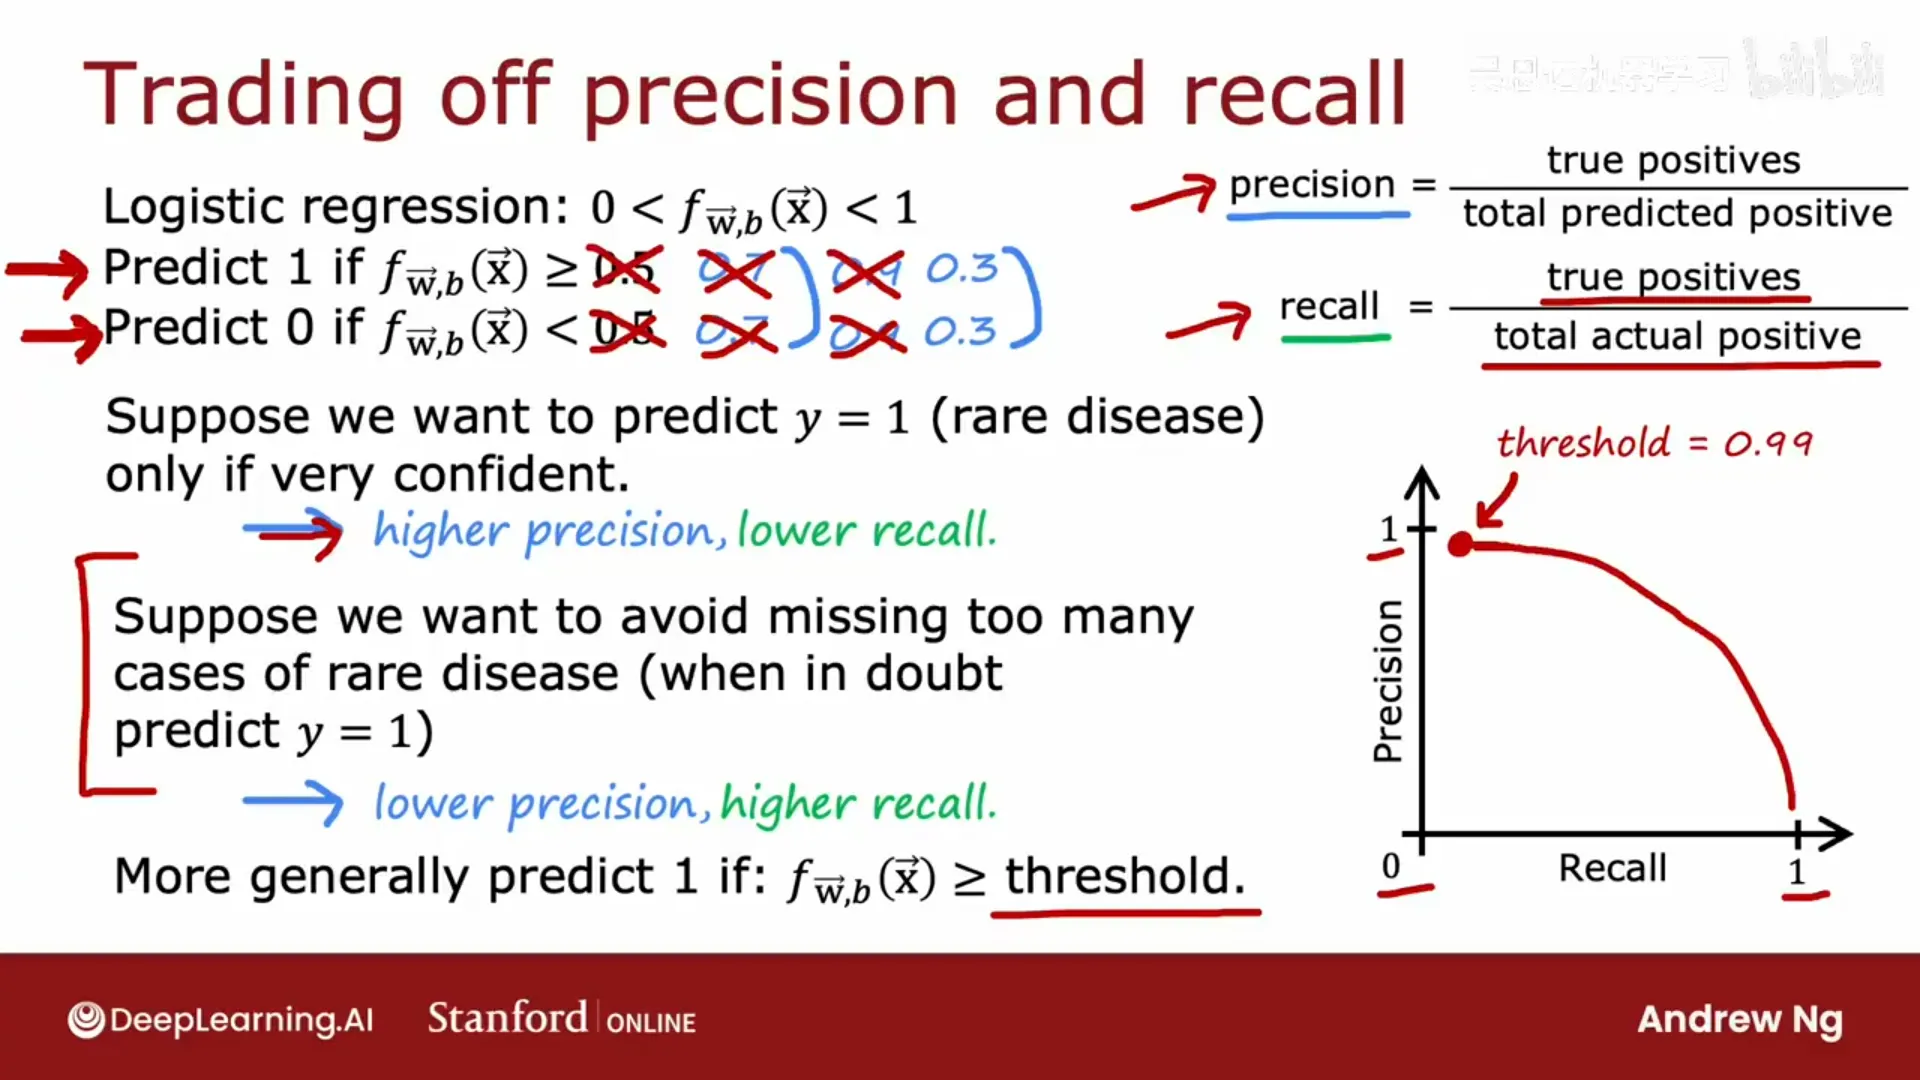
逻辑回归输出概率,我们通常按 0.5 阈值判正负。改变阈值就在两者间权衡:
提高阈值(如 0.7、0.9,"非常有信心才判正"):
- 精确率上升(判正时更可能是对的);
- 召回率下降(更少判正,漏掉更多真病例)。
- 适用场景:预测为阳性的代价很高(例如后续要做的治疗有侵入性、昂贵),而漏诊后果不严重。
降低阈值(如 0.3,"不确定就判正,安全第一"):
- 精确率下降;
- 召回率上升。
- 适用场景:治疗不太痛苦/昂贵,而不治疗的后果很糟——宁可多报也不要漏。
更一般地:把不同阈值下的精确率/召回率画成曲线,你就能手动挑一个点——平衡"假正例的代价"与"假负例的代价"。
注意:这个"选最佳点"通常没法用交叉验证自动完成——因为"哪个权衡更好"取决于你的业务判断,需要你来指定。
📷 提高/降低阈值在精确率与召回率之间的权衡曲线
回到原视频 (00:05:47)
4.4 用 F1 分数自动折中
(p87)
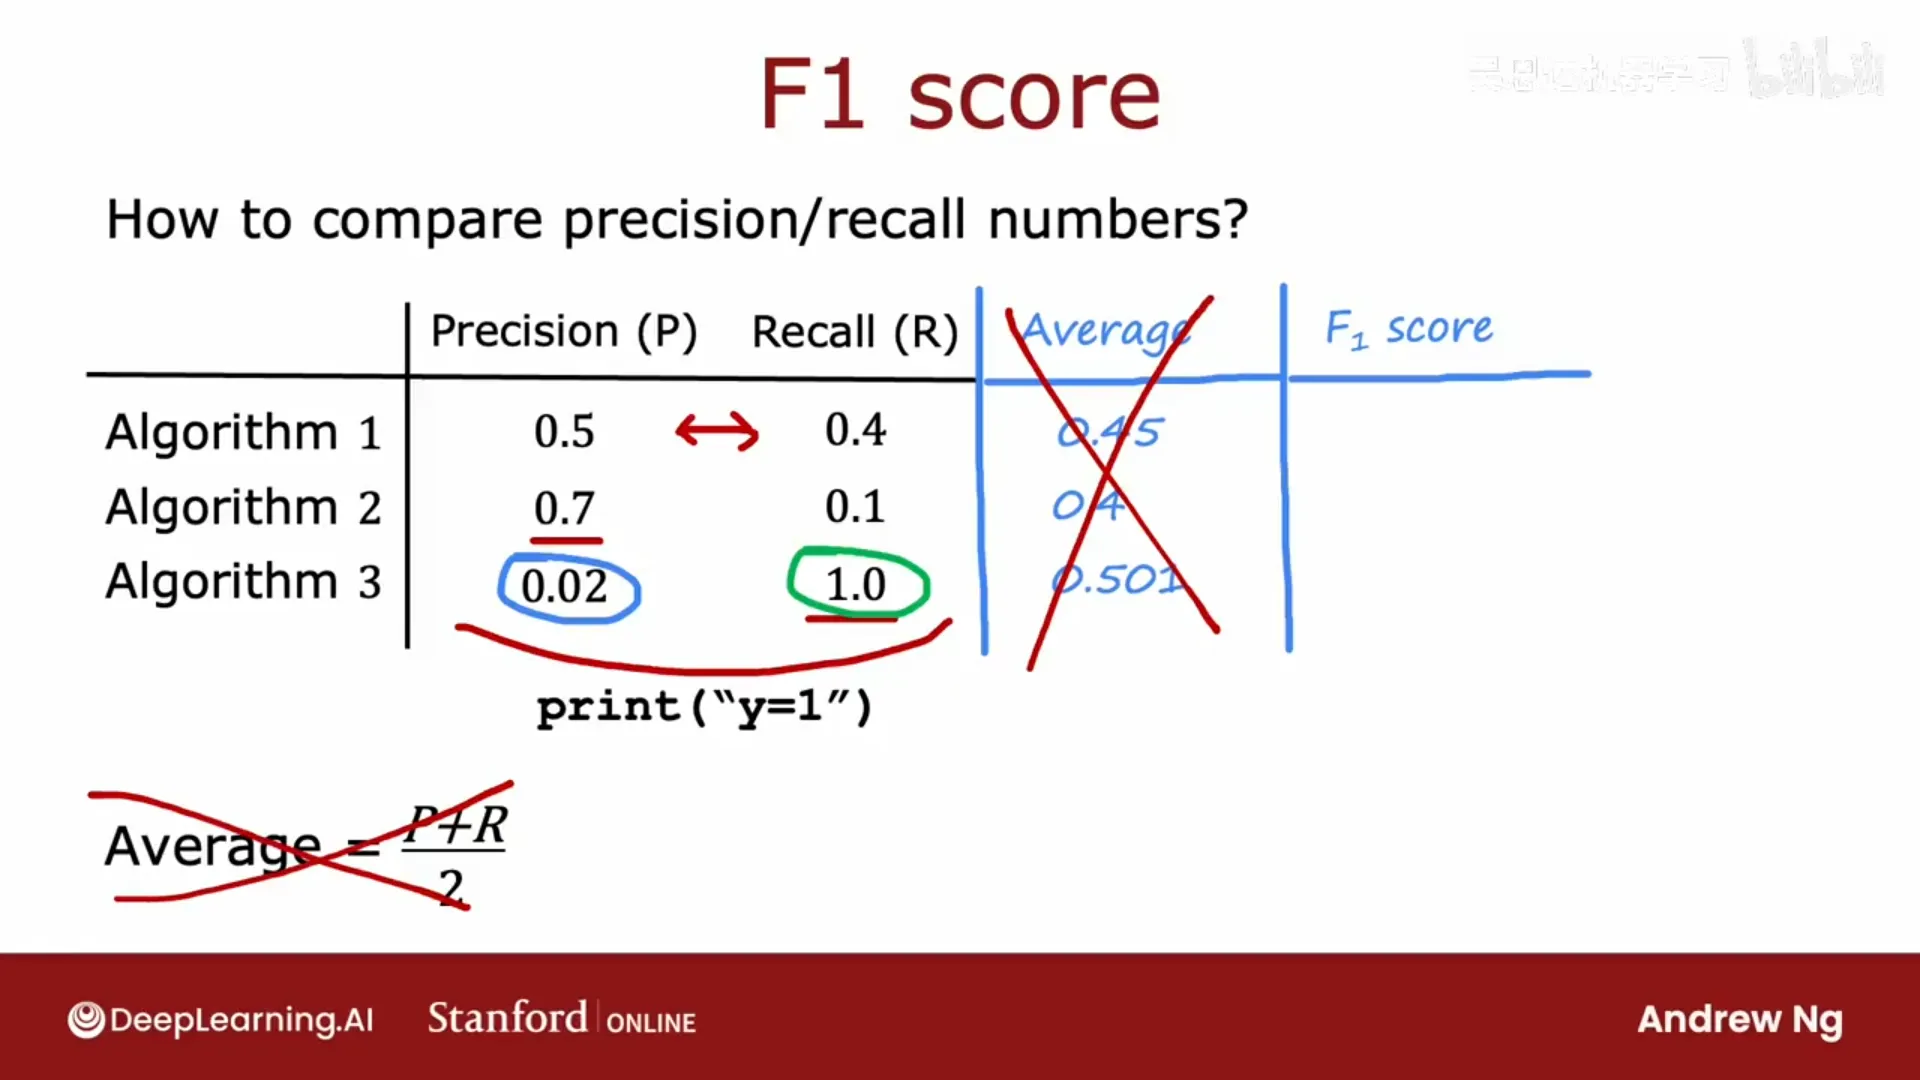
若要在多个算法间自动选一个,就需要把 P、R 合成一个数字。
不要用算术平均! 例如"总是判正"的算法召回率完美(1.0)、精确率极低,算术平均却可能不低,看起来"不错"——但它其实是个没用的算法。
正确做法是 F1 分数:
$$F_1 = \frac{2}{\frac{1}{P} + \frac{1}{R}} = \frac{2PR}{P + R}$$
- 它是 P 与 R 的调和平均(harmonic mean);
- 调和平均更看重较小的那个值:只要 P 或 R 很低,F1 就会被拉低,不会被另一个高值"掩盖"。
例(三个算法):
| 算法 | 精确率 P | 召回率 R | 算术平均 | F1 |
|---|---|---|---|---|
| 1 | 0.5 | 0.4 | 0.45 | 0.444 |
| 2 | 0.1 | 1.0 | 0.55 | 0.175 |
| 3 | 0.02 | 1.0 | 0.51 | 0.039 |
算法 3 的召回率完美(因为它几乎对所有人都判正),但精确率极低 → F1 只有 0.039。F1 告诉我们:算法 1 最好。
📷 F1 分数 = P 与 R 的调和平均,更看重较小的值
回到原视频 (00:09:00)
第五章 决策树
(对应模块 15,视频 p88–p89)
5.1 决策树模型:以"猫分类器"为例
(p88)
决策树(decision tree) 是非常强大、被广泛使用的学习算法,也是很多机器学习竞赛的夺冠利器。虽然学术界对它的关注不如神经网络,但它非常值得放进你的工具箱。
例子:开一家猫咪收养中心,想根据三个特征快速判断一只动物是不是猫:
- 耳朵形状:尖耳 / 垂耳;
- 脸形:圆 / 不圆;
- 胡须:有 / 无。
10 个训练样本(5 只猫 5 只狗),特征都是离散/分类值(只取几个离散值),标签 y 是 1/0(二元分类)。
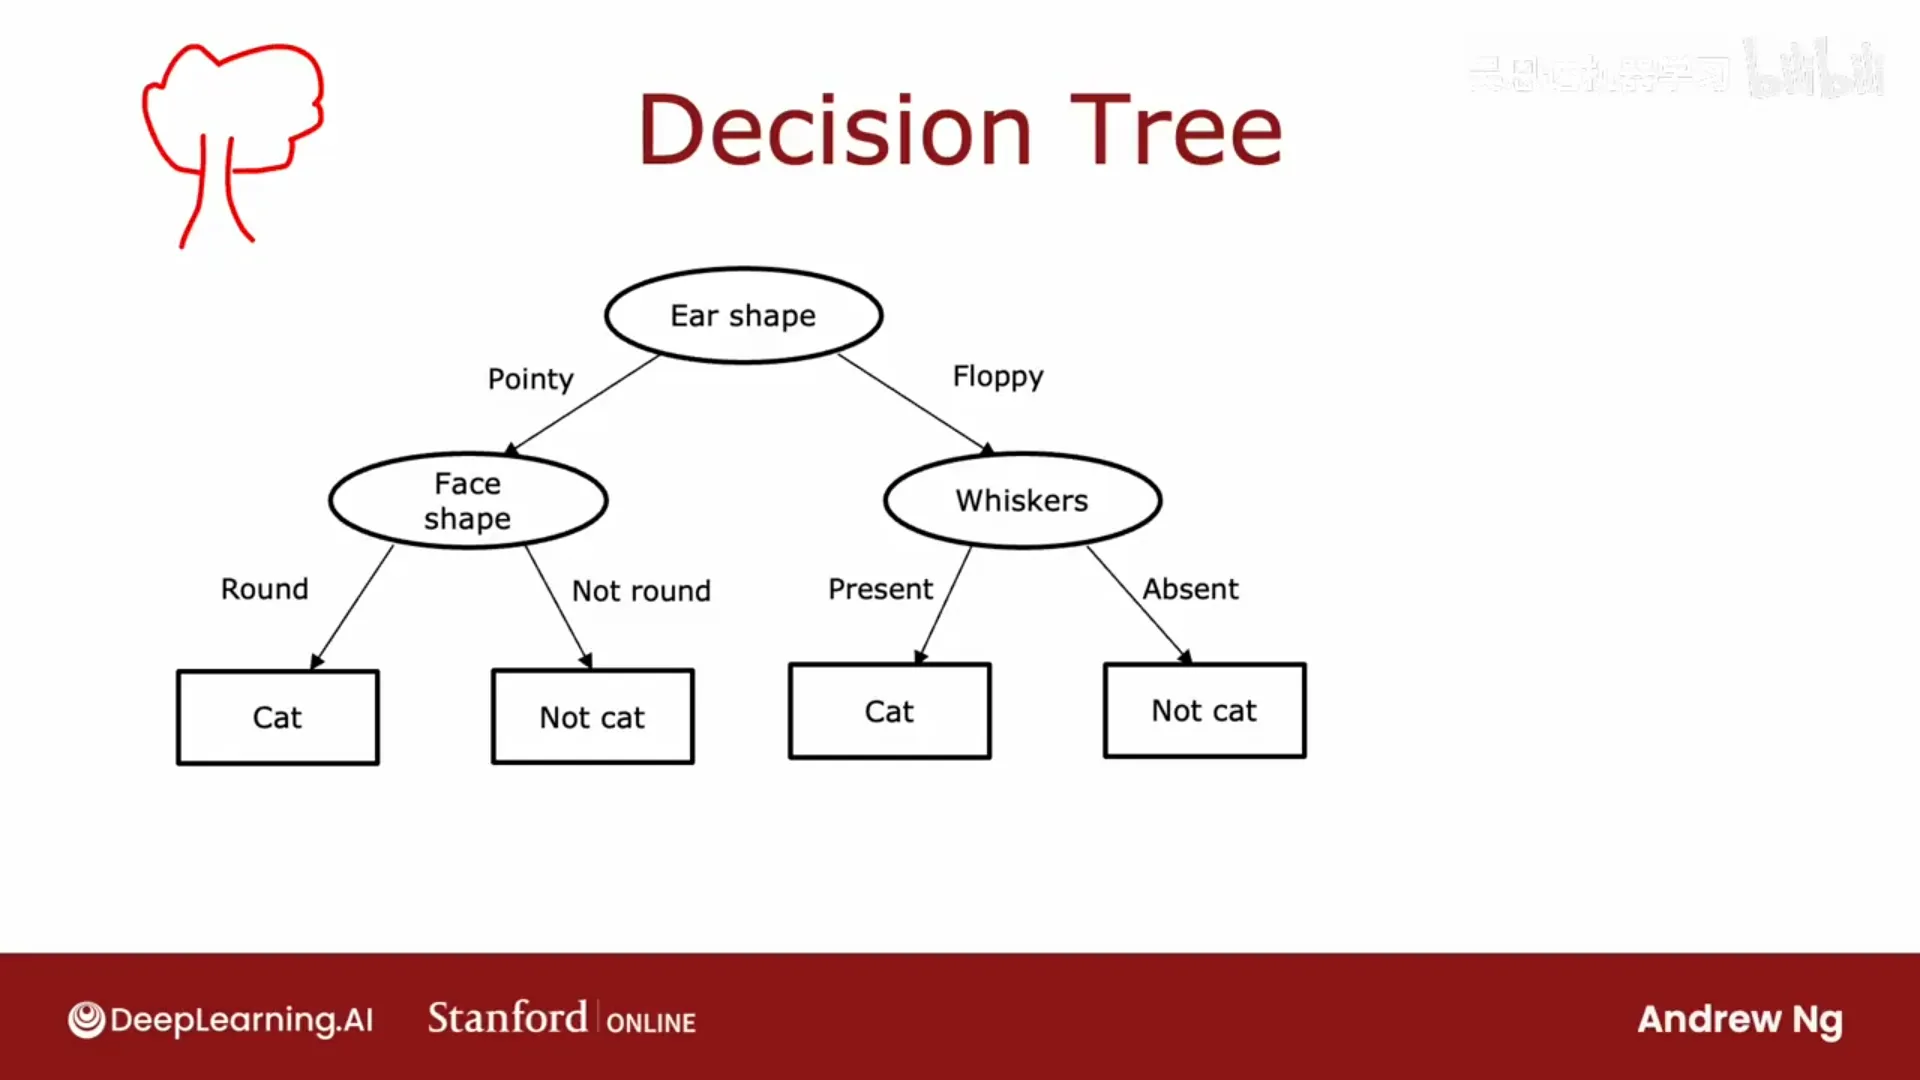
决策树模型长成一棵树(计算机科学里的树是"根在顶部、叶子在底部"——可以类比成室内悬挂植物):
- 从根节点(root node)开始,看它写的特征(如"耳朵形状"),根据样本该特征的值向左或向右走;
- 到达中间的决策节点(decision node)继续判断(每个决策节点看某个特征,据此决定往哪走);
- 最后到达底部的方框——叶节点(leaf node),那里给出预测。
一个具体例子:一只尖耳、圆脸、有胡须的猫 → 从根节点看耳朵(尖)→ 向左走 → 看脸形(圆)→ 向下走 → 到达叶节点,预测"是猫"。
也可以用一句玩笑话记住:机器学习工程师在哪露营?——在"随机森林"里。
📷 决策树:从根节点按特征一路判断,到叶节点得到预测
回到原视频 (00:03:07)
同一个问题可以构造出很多不同的决策树(换特征、换分裂顺序),有些更好、有些更差。例如:
- 有的树根节点用"耳朵形状";
- 有的树根节点也用耳朵形状、但下面用"胡须";
- ……还有各种组合。
决策树学习算法的任务就是:从所有可能的树中,选出一棵在训练集上表现好、并能很好泛化到新数据(交叉验证集/测试集)的树。
5.2 学习过程
(p89)
构建决策树的核心是递归地选择"在哪个特征上分裂"。以 10 个样本为例:
- 选根节点的特征:用某个算法(下章讲)算出各特征的"信息增益",假设选耳朵形状——按它把 10 个样本分成左右两组(5 个尖耳 → 左,5 个垂耳 → 右);
- 只看左分支(5 个样本):再用算法选一个特征,假设选脸形——分成"圆脸 4 个"和"非圆脸 1 个";
- 左边这 4 个全是猫 → 创建叶节点、预测"是猫";那个非圆脸的不是猫 → 叶节点预测"非猫";
- 再看右分支(5 个样本,1 猫 4 狗):选特征(假设胡须)继续分。分出的左边 1 个是猫、右边 4 个不是猫——每个节点都"纯净"了,于是创建叶节点。
过程中有两个关键决策:
(1) 每个节点选哪个特征分裂? 目标是最大化纯度(purity)——让分出的子集尽可能"全是猫"或"全不是猫"。
如果有"该动物是否有猫的 DNA"这种特征,分出来左右都 100% 纯,就完美;但现实中只能用现有特征。
(2) 什么时候停止分裂? 几种标准:
- 节点已经 100% 单一类别(纯度最高);
- 达到最大深度(max depth)——深度定义为从根节点到该节点所需的跳数(根节点深度 0,它下面一层深度 1…)。若设最大深度为 2,就不再分裂更深处的节点;
- 一次分裂带来的纯度提升(信息增益)小于阈值;
- 节点里的样本数低于阈值(例如"若一个节点只剩 3 个样本,就不再分")。
为什么要限制树的生长? 因为树太大会过拟合——就像高阶多项式或超大神经网络一样。限制深度、最小增益、最小样本数,都能保持树较小、降低过拟合风险。理论上最大深度可用交叉验证选,但实践中开源库往往有更好的默认选择。
吴恩达也承认:决策树算法"看起来有点复杂和杂乱",因为它由很多研究者逐年改进叠加而成(有人提出基本版、有人加新的分裂标准、有人加停止标准……)。但这不影响它效果非常好——本课重点是如何用好它(后面会给出用开源库的实用建议)。
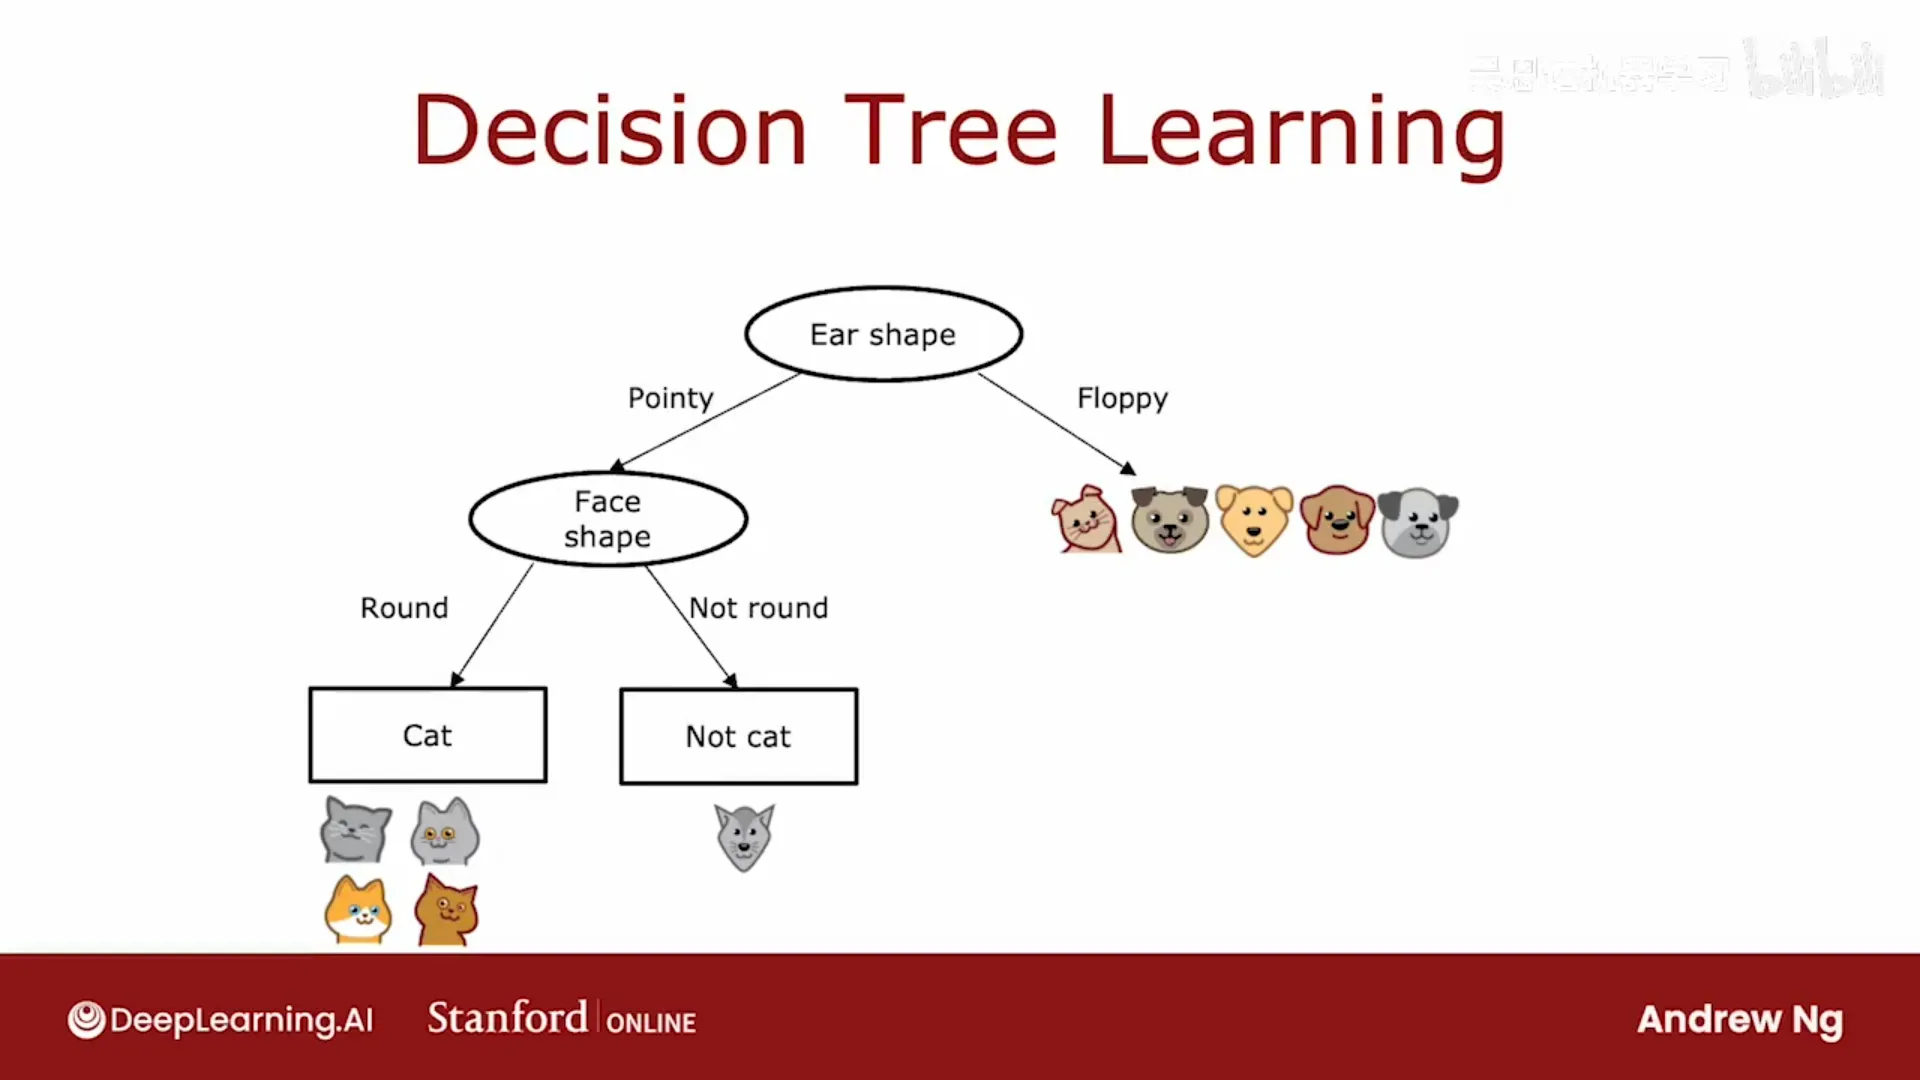
📷 决策树递归构建:每个节点先看是否满足停止条件,否则选最优特征分裂
回到原视频 (00:02:33)
第六章 决策树学习算法
(对应模块 16,视频 p90–p95)
6.1 测量纯度:熵
(p90)
如何量化一组样本的"纯度"?用熵(entropy)——它衡量不纯度。
设 p₁ 是"是猫(y=1)"样本的比例,p₀ = 1 − p₁ 是"不是猫"的比例。熵函数:
$$H(p_1) = -p_1\log_2(p_1) - p_0\log_2(p_0)$$
(取以 2 为底的对数,是为了让曲线峰值恰好为 1。)
性质:
- 当样本 50-50(p₁ = 0.5)时,熵最大 = 1(最不纯);
- 当样本全是猫(p₁=1)或全不是猫(p₁=0)时,熵 = 0(完全纯粹)。
几个例子(6 个样本):
| 样本构成 | p₁ | 熵 H(p₁) | 含义 |
|---|---|---|---|
| 3 猫 3 狗 | 0.5 | 1.00 | 最不纯 |
| 5 猫 1 狗 | 5/6 ≈ 0.83 | ≈ 0.65 | 较纯 |
| 6 猫 0 狗 | 1.0 | 0 | 完全纯 |
| 2 猫 4 狗 | 1/3 ≈ 0.33 | ≈ 0.92 | 很不纯(更接近 50-50) |
| 0 猫 6 狗 | 0 | 0 | 完全纯 |
计算约定:0·log(0) 在技术上未定义,但为计算熵,约定 0·log(0) = 0——这样在 p₁=0 或 1 处熵正好为 0。
编者拓展|「熵」从哪来:熵的概念来自 Shannon 1948 年的信息论。$H(X)=-\sum p_i\log_2 p_i$ 度量的是一个随机变量的平均不确定性(单位是 bit):取值越均匀、越难猜,熵越大;越确定,熵越小。决策树用「信息增益 = 分裂前后熵的减少」来挑特征,本质就是用一次提问换取尽可能多的信息——这也解释了为什么它和「20 个问题」游戏是同一个直觉。
你也可以用 Gini 准则(Gini index)——形状与熵类似、同样适合构建决策树。本课用熵。
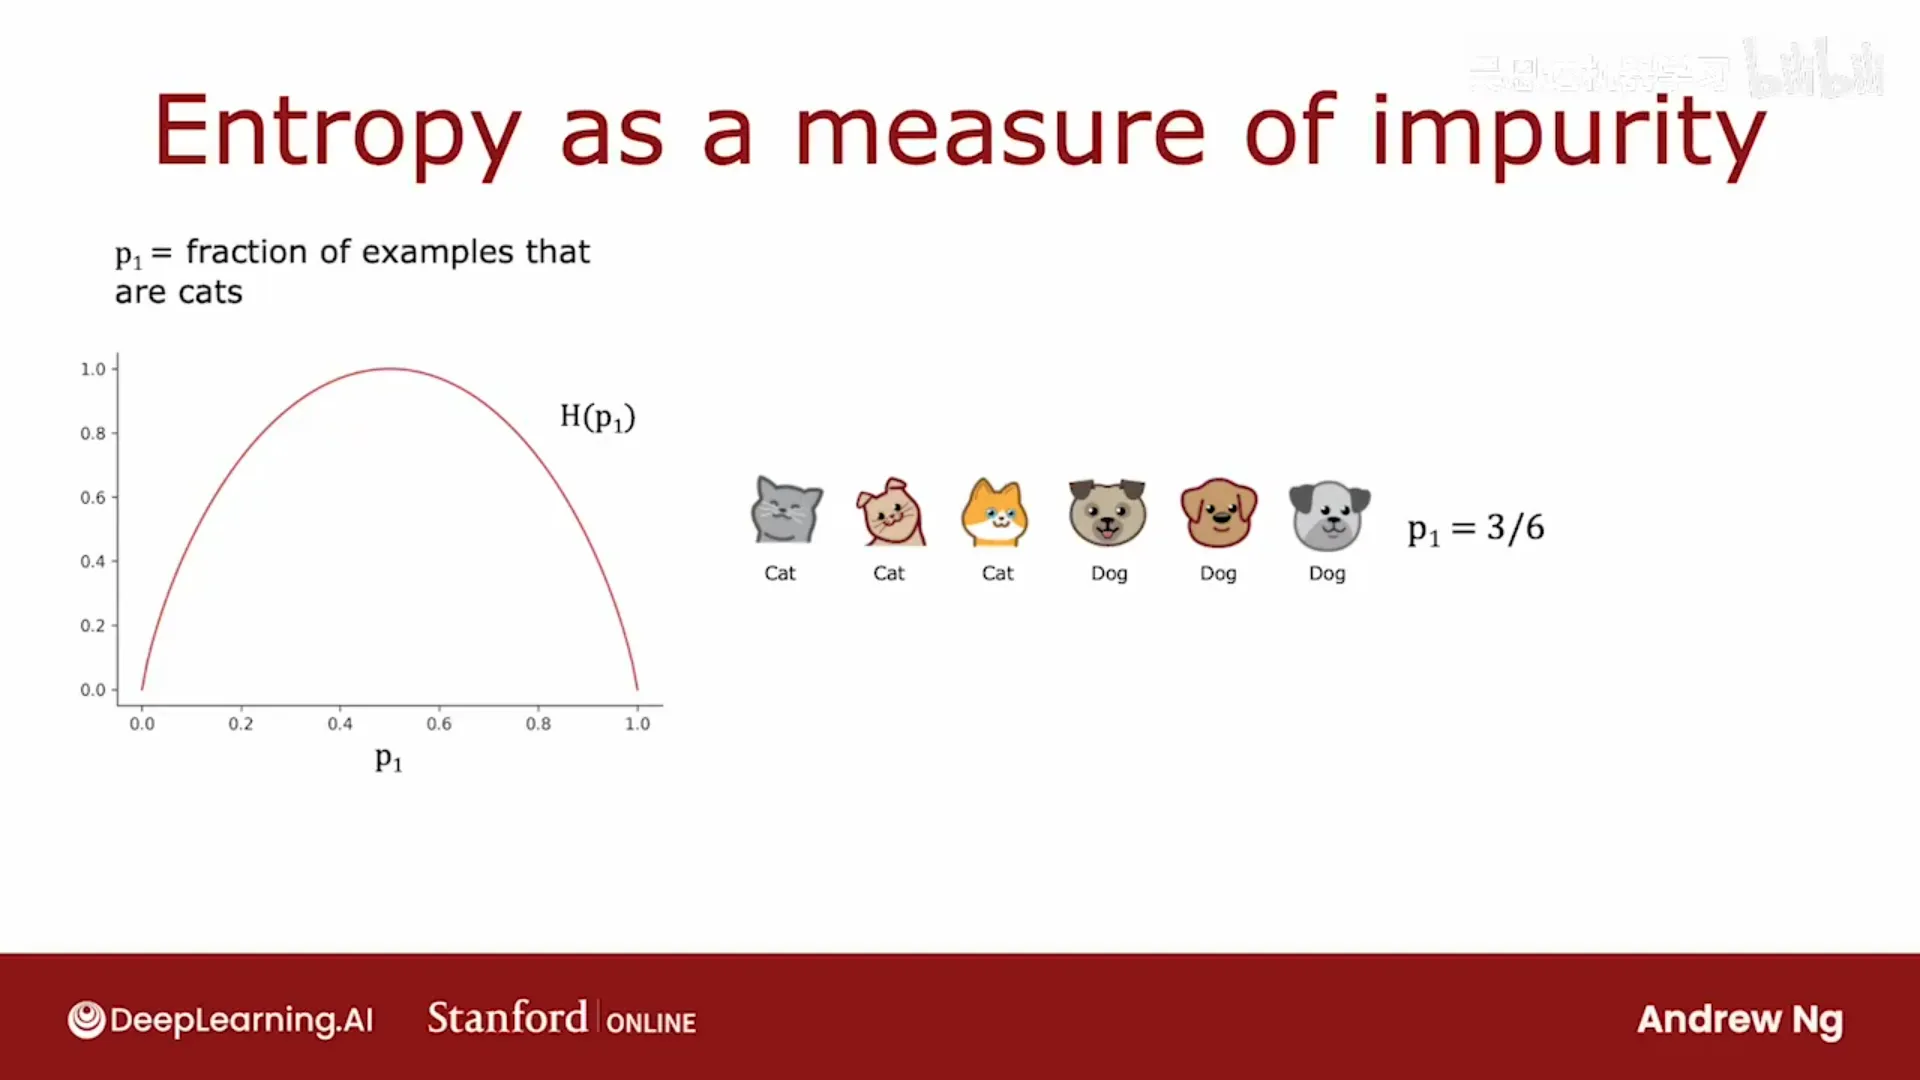
📷 熵函数:p₁=0.5 时最大(1),全纯时为 0
回到原视频 (00:01:11)
6.2 选择分裂特征:信息增益
(p91)
信息增益(information gain)= 熵的减少量。
以根节点为例(10 个样本,5 猫 5 狗,根节点熵 H(0.5) = 1)。对每个候选特征,计算分裂后的加权平均熵:
$$\text{加权平均熵} = w_{\text{左}}\,H(p_{1,\text{左}}) + w_{\text{右}}\,H(p_{1,\text{右}})$$
其中 w_左、w_右 是分到左/右分支的样本比例。
为什么要加权(而不是简单平均)? 因为节点里样本越多,它的熵是否低就越重要——"一个有很多样本、且很不纯的节点"比"一个只有少量样本、很不纯的节点"更糟。
三个候选特征的计算(根节点,10 个样本):
| 特征 | 左分支 | 右分支 | 加权平均熵 |
|---|---|---|---|
| 耳朵形状 | 5 个,p₁=0.8 | 5 个,p₁=0.2 | 0.5·H(0.8)+0.5·H(0.2) ≈ 0.72 |
| 脸形 | 7 个,p₁=4/7 | 3 个,p₁=1/3 | 0.7·H(4/7)+0.3·H(1/3) ≈ 0.97 |
| 胡须 | 4 个,p₁=0.75 | 6 个,p₁=2/6 | 0.4·H(0.75)+0.6·H(2/6) ≈ 0.88 |
信息增益定义为:
$$\text{信息增益} = H(p_{1,\text{根}}) - \big[w_{\text{左}}H(p_{1,\text{左}}) + w_{\text{右}}H(p_{1,\text{右}})\big]$$
于是:
- 耳朵形状:1 − 0.72 = 0.28 ← 最大
- 脸形:1 − 0.97 = 0.03
- 胡须:1 − 0.88 = 0.12
选信息增益最大的特征(耳朵形状)。
为什么用"信息增益"而不是直接比较加权熵? 因为"信息增益太小就停止分裂"是一个现成的停止标准——gain 低于阈值时不再分裂,避免树无谓变大、过拟合。这是一个额外的实用功能。
通用公式(以"耳朵形状"为例):设
- p₁_根 = 根节点中正例比例;p₁_左、p₁_右 = 左右子树中正例比例;
- w_左、w_右 = 指向左/右分支的样本比例。
则
$$\text{Information Gain} = H(p_{1,\text{根}}) - \big[w_{\text{左}}H(p_{1,\text{左}}) + w_{\text{右}}H(p_{1,\text{右}})\big]$$
从所有候选分裂里,选信息增益最高的特征。
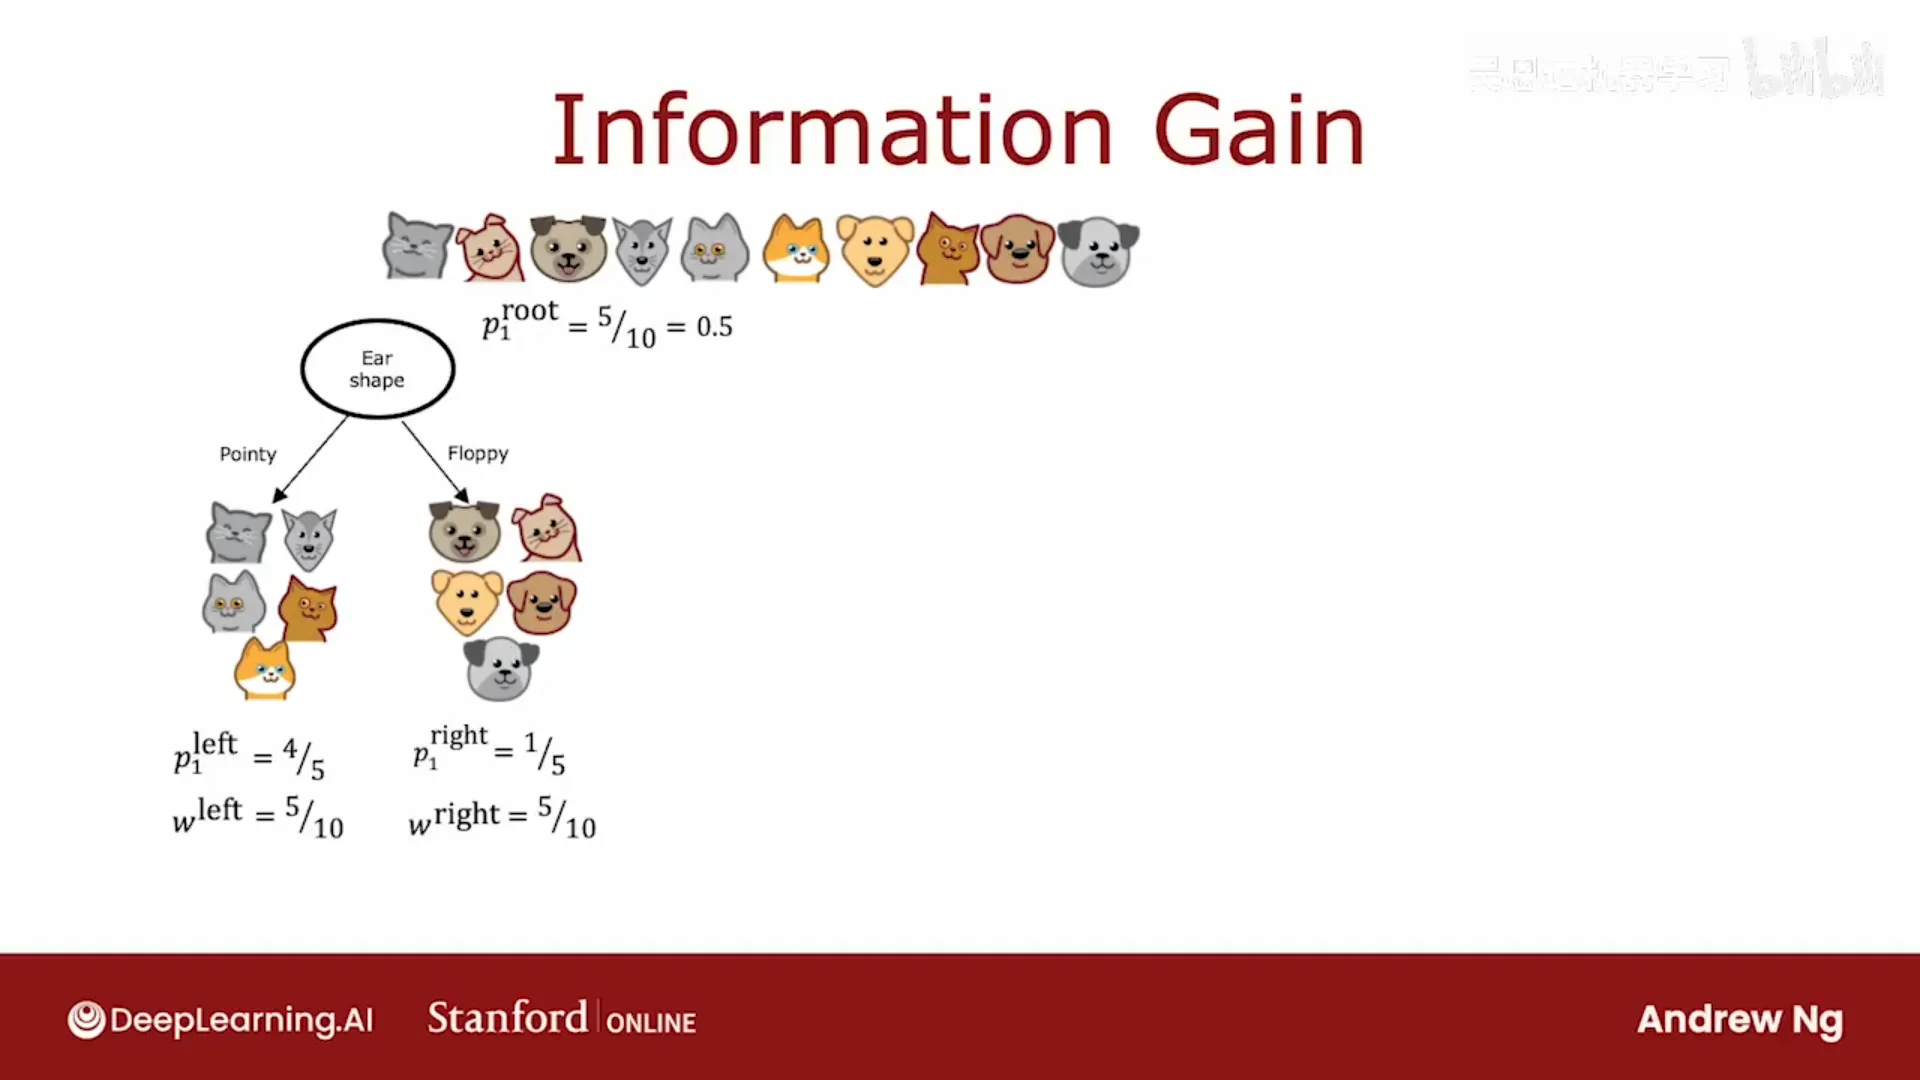
📷 信息增益:根节点熵 减去 左右分支加权熵,选增益最大的特征
回到原视频 (00:10:18)
6.3 整合成完整算法
(p92)
决策树构建过程:
- 从根节点开始(含全部训练样本),计算所有特征的信息增益,选增益最大的特征分裂;
- 按该特征把数据分成左右两个子集,建立左/右分支;
- 对左、右分支递归地重复;
- 直到满足停止标准(节点纯、达到最大深度、增益小于阈值、样本数小于阈值)。
关键洞察:构建根节点之后,构建左子树 = 用左手边那批样本"重新训练一棵(更小的)决策树",右子树同理。这就是一个递归算法——"用更小的子树拼出整棵树"。看决策树的软件实现时,常会看到"递归算法"的说法。(不亲自实现的话,不理解递归也完全能完成作业。)
可视化过程:遮住根节点和右分支,只看左分支那 5 个样本——把它当成一个小数据集,重新算各特征的信息增益(注意此时"耳朵形状"的增益为 0,因为这 5 个都是尖耳),选最优特征继续分,直到满足停止标准;再回过头构建右子树。
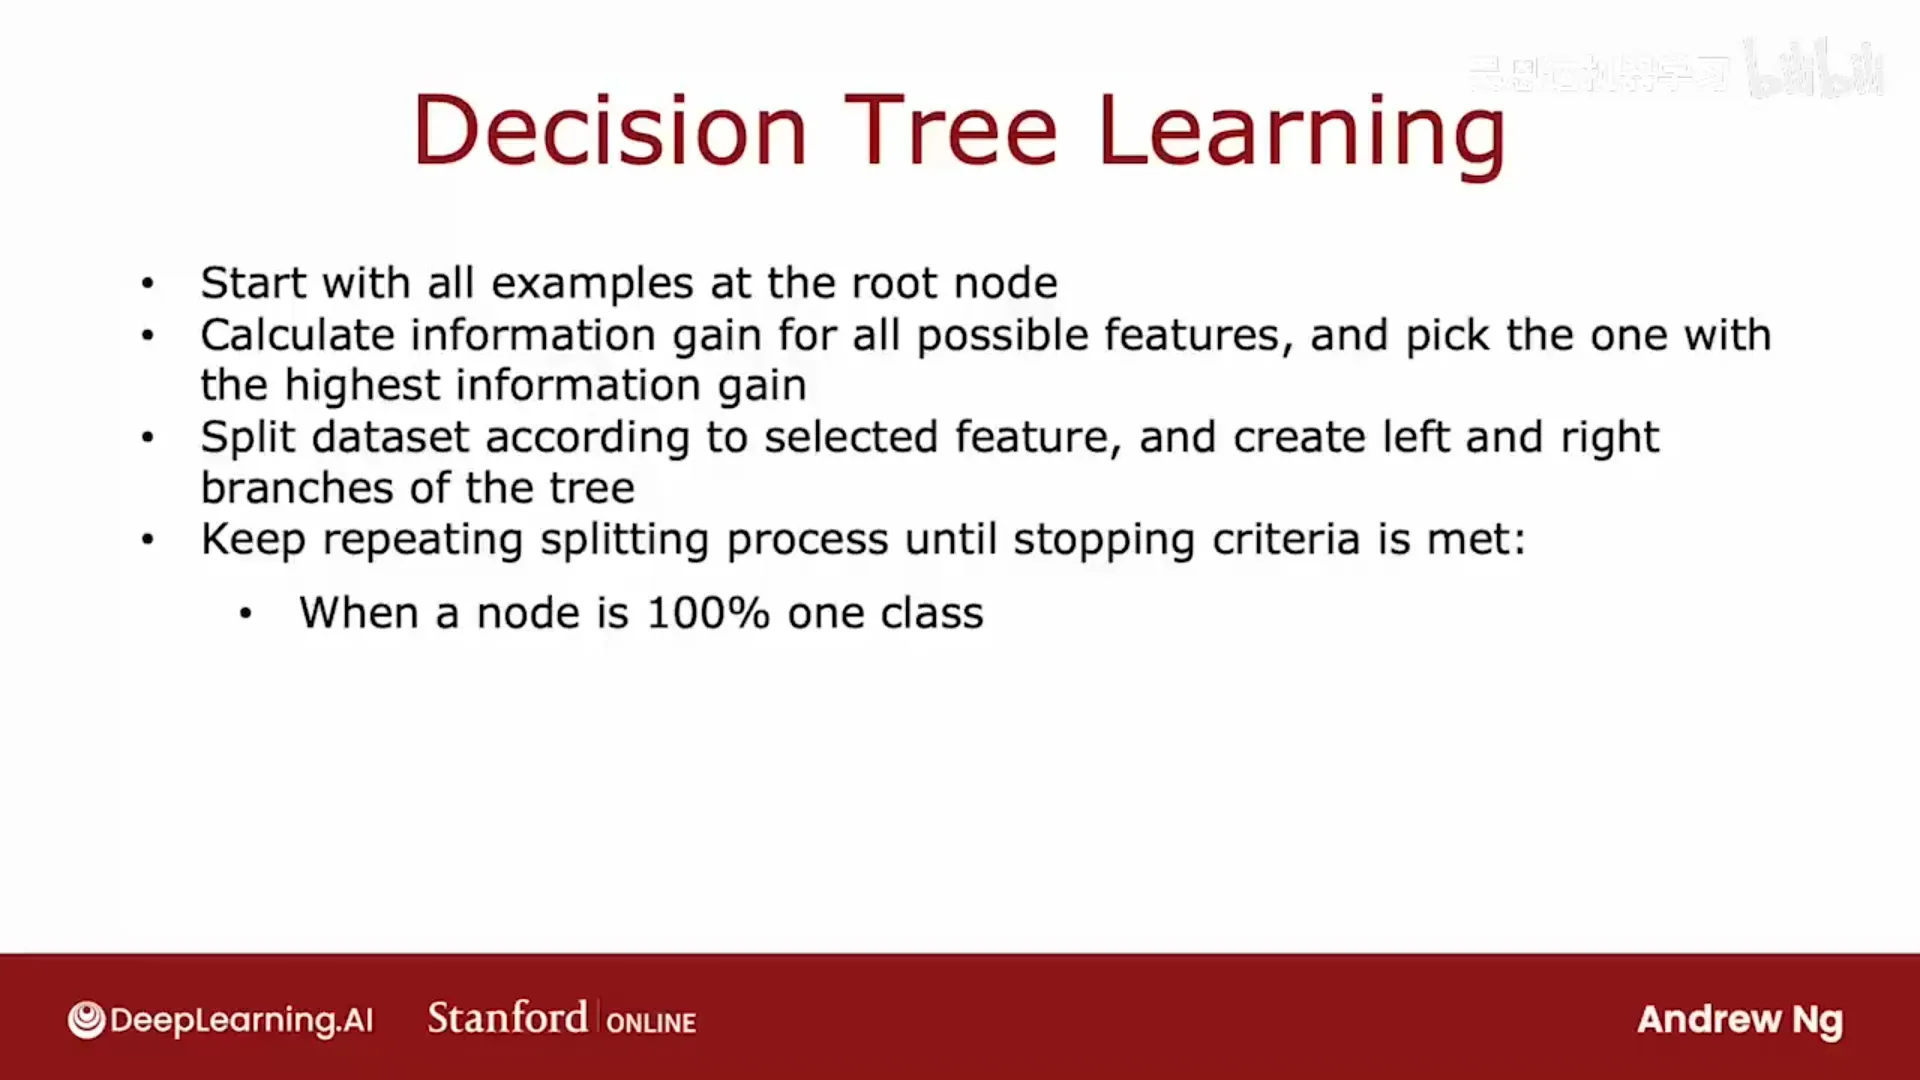
📷 递归构建:先定根节点分裂,再对左右子集分别"再建一棵树"
回到原视频 (00:01:16)
6.4 处理多值特征:独热编码
(p93)
之前每个特征只有两个取值。若"耳朵形状"有三种取值(尖耳 / 垂耳 / 椭圆耳),可以有两种处理:
- 直接按它分裂成三个子分支;或
- 独热编码(one-hot encoding):把它拆成三个二元特征——"是否尖耳?"、"是否垂耳?"、"是否椭圆耳?"。每行数据里恰好一个为 1(这就是"one-hot / 独热"名字的来历——总有一个特征是"热"的(=1))。
一般地,一个 k 值的分类特征可以拆成 k 个 0/1 特征。这样又回到"每个特征只取两个值"的设定,之前的学习算法无需修改即可使用。
独热编码不只用于决策树:神经网络、逻辑回归、线性回归都要求输入是数字,所以也可以用独热编码把分类特征编码成 0/1 输入。例如把"脸形:圆/非圆"、胡须"有/无"、耳朵"尖/垂/椭圆"编码成一组 0/1 特征,送入神经网络训练猫分类器。
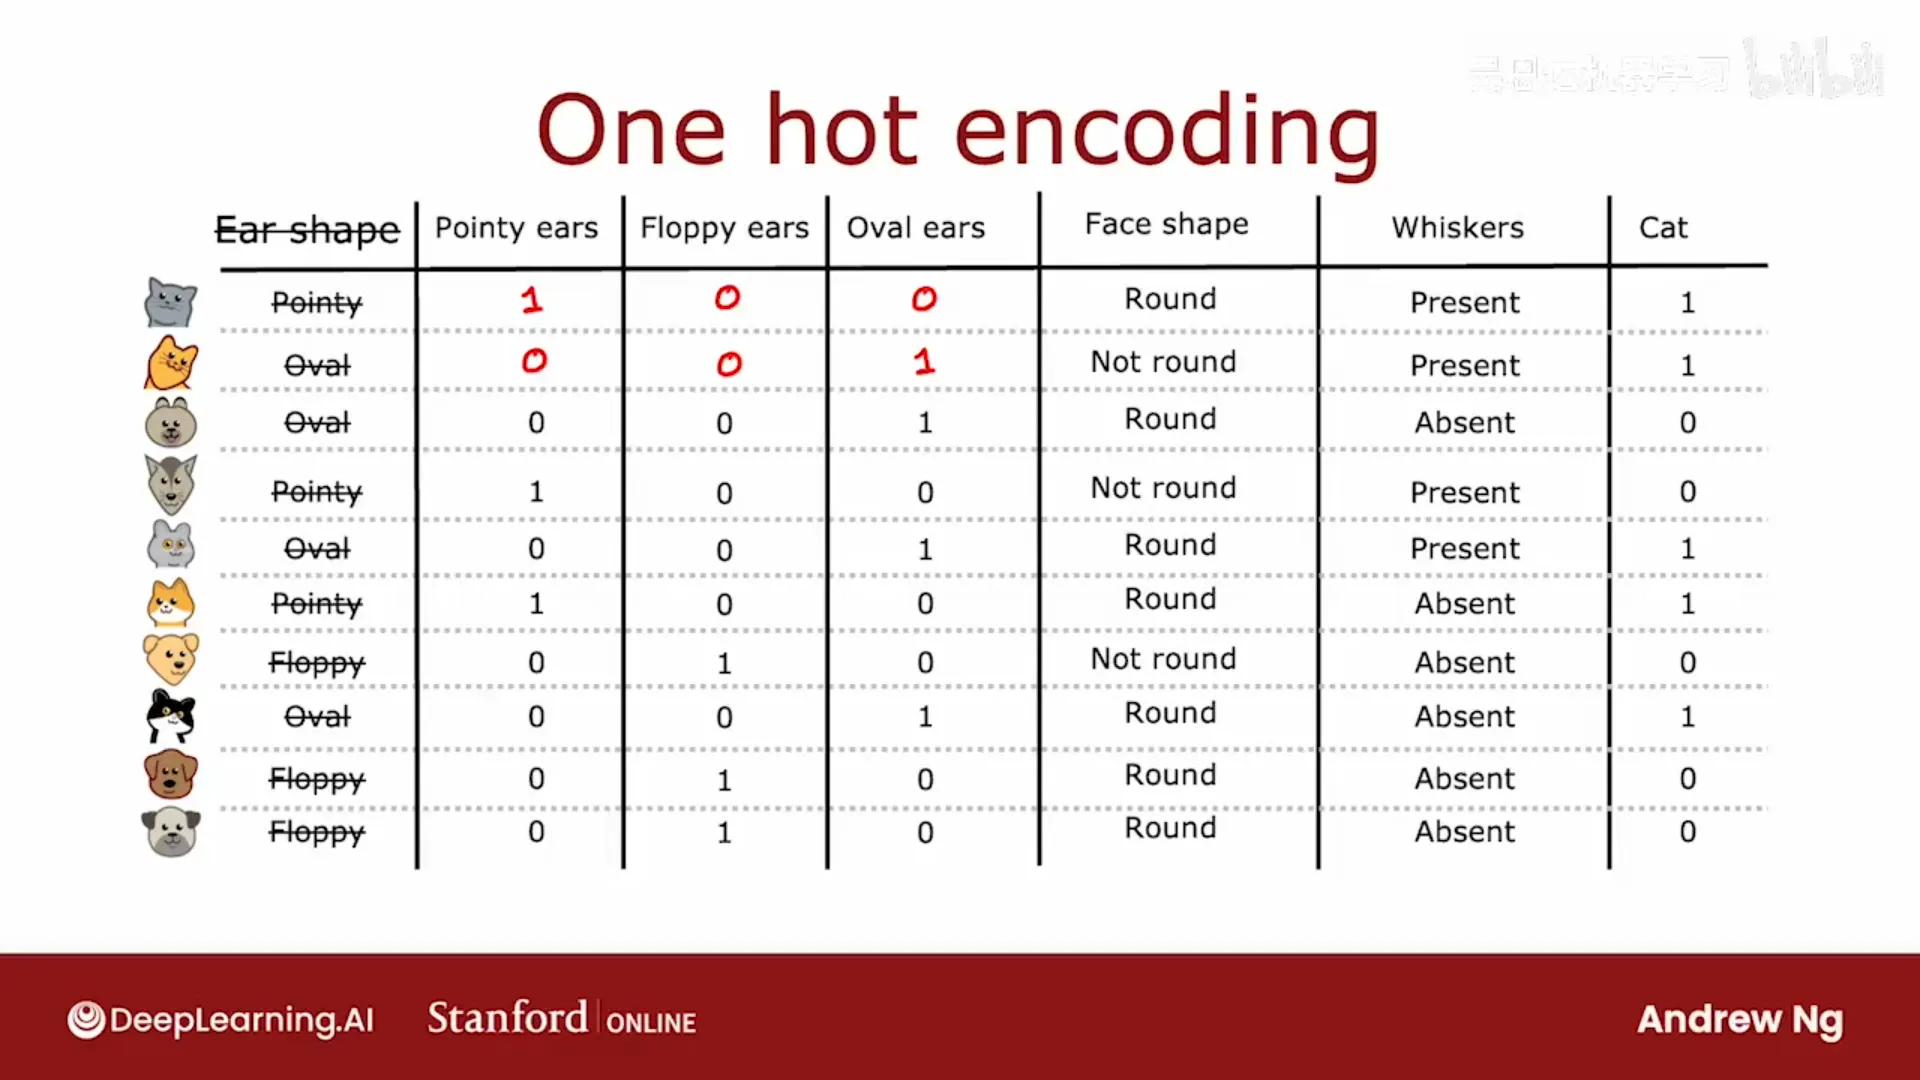
📷 独热编码:把 3 值的"耳朵形状"拆成 3 个 0/1 特征
回到原视频 (00:02:32)
6.5 处理连续值特征
(p94)
若特征取任意数值(如动物体重),决策树的做法是:按"是否 ≤ 某个阈值"来分裂。
学习算法要选择最优阈值。做法:
- 把样本按该特征值排序;
- 取相邻值的中点作为候选阈值(m 个样本 → m−1 个候选);
- 对每个候选做常规的信息增益计算;
- 若该连续特征的最大信息增益优于所有其他特征(含其他连续特征的各阈值),就在该特征的这个阈值上分裂。
例(体重特征):尝试"≤8"→ 增益 0.24;"≤9"→ 增益 0.61;"≤13"→ 增益 0.40。0.61 最高且高于其他特征,于是按"体重 ≤ 9"分裂。
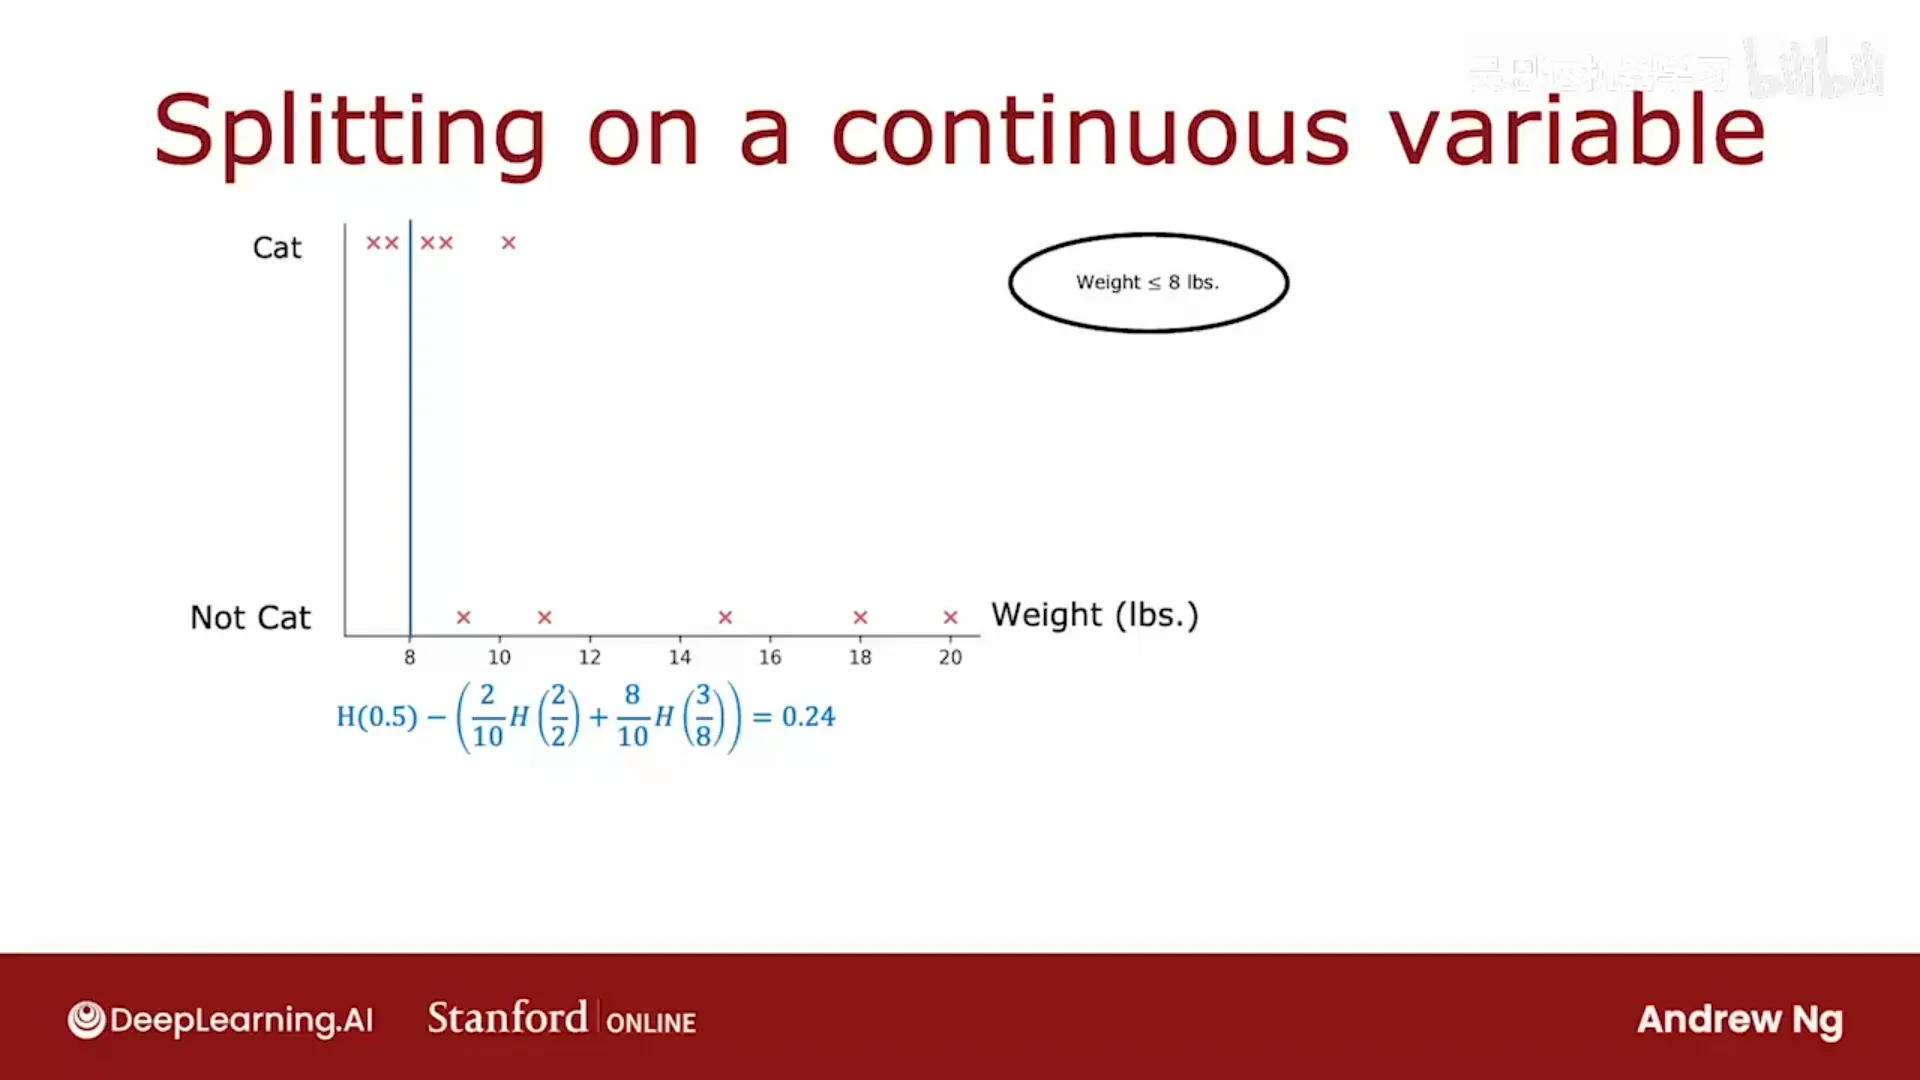
📷 连续特征:按"体重 ≤ 阈值"分裂,选信息增益最大的阈值
回到原视频 (00:03:12)
6.6 回归树(可选)
(p95)
决策树也能做回归(预测数值,如预测动物体重):回归树(regression tree)。
- 叶节点的预测值 = 该节点内训练样本 y 的平均值(例如落到某叶节点的动物体重是 7.2、8.4、7.6、10.2,就预测其均值 8.35);
- 选择分裂特征的标准:从"最小化熵"变成"最小化方差"。用加权平均方差衡量(w_左·Var_左 + w_右·Var_右),或等价地看方差的减少量:
$$\text{方差减少量} = \operatorname{Var}(\text{全部样本}) - \big[w_{\text{左}}\operatorname{Var}_{\text{左}} + w_{\text{右}}\operatorname{Var}_{\text{右}}\big]$$
- 选方差减少最多的特征分裂;
- 其余(递归、停止标准、叶节点预测取均值)与分类树相同。
例(γ 无关,纯方差):全部 10 个样本方差 20.51;按耳朵形状分裂后方差减少 8.84、按脸形 0.64、按胡须 6.22 → 选耳朵形状。
结果:同一个决策树框架,既能做分类,也能做回归。
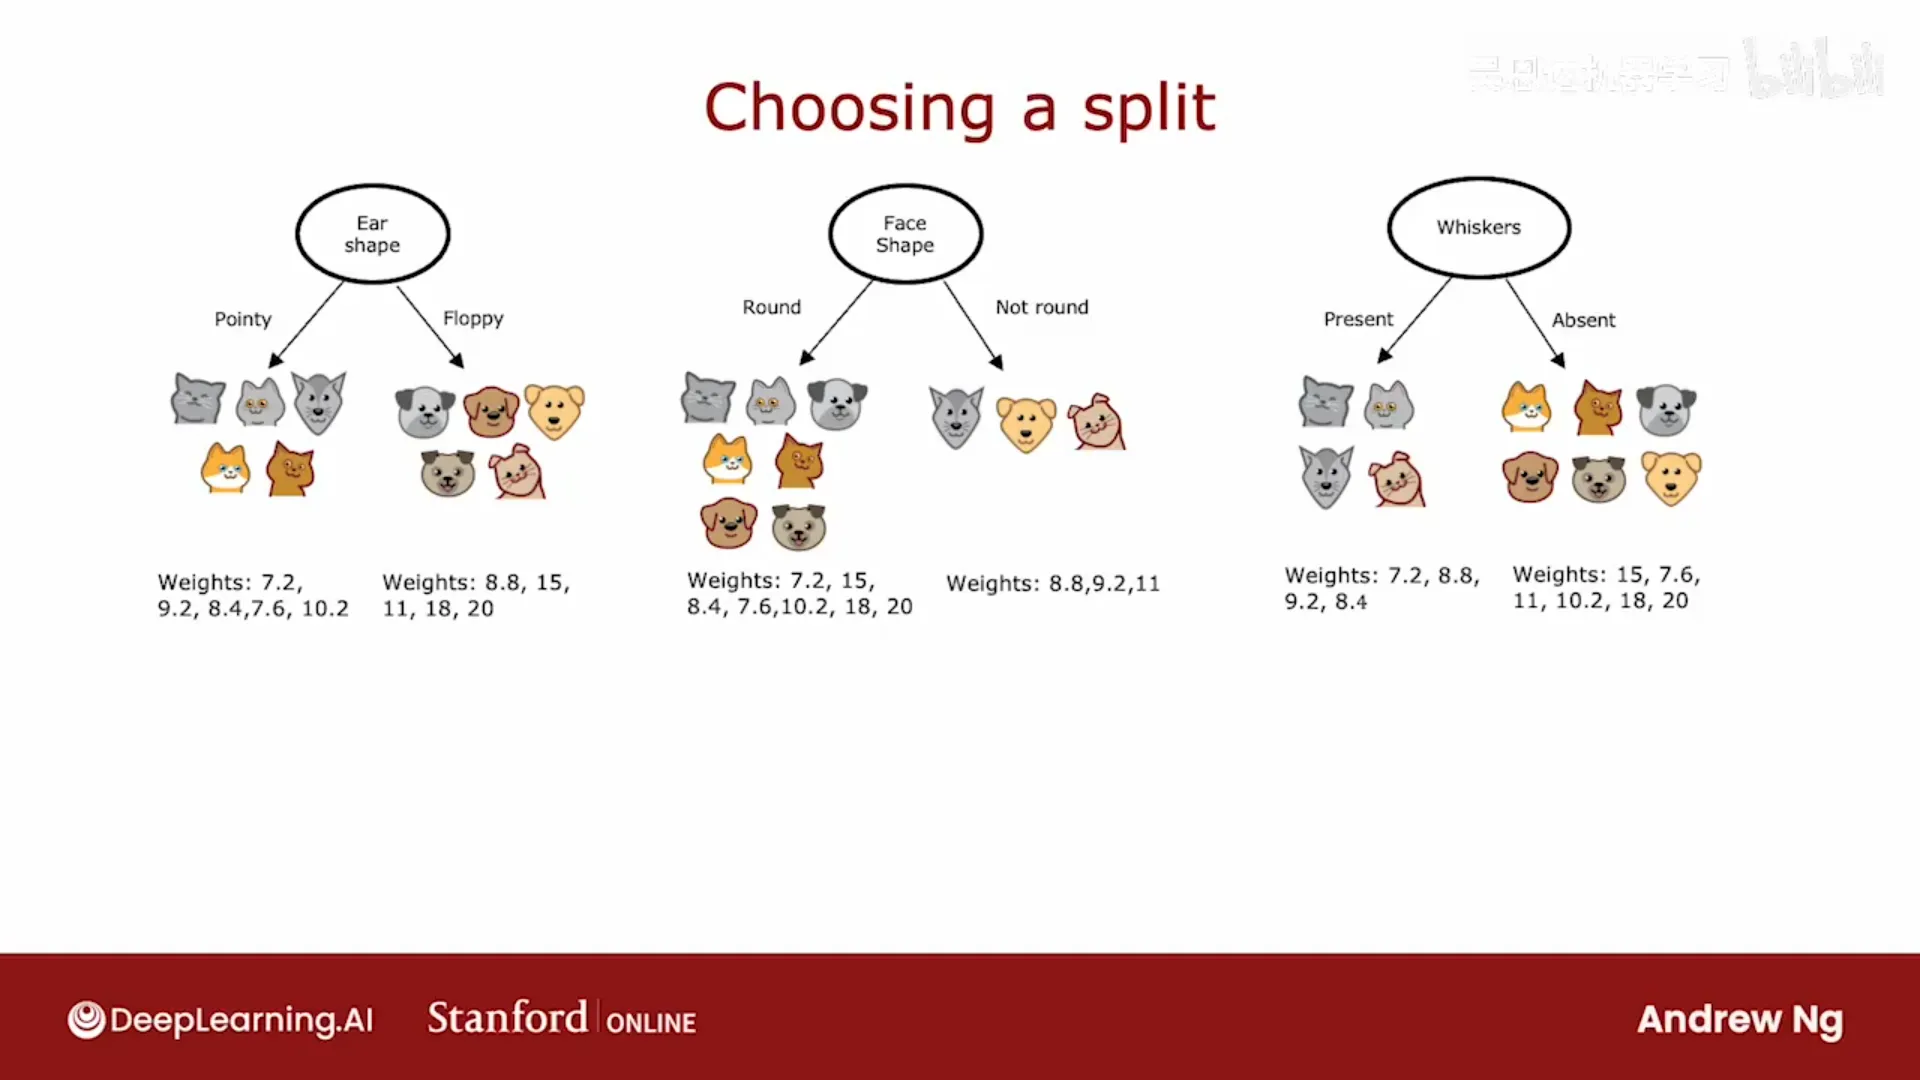
📷 回归树:叶节点预测 y 的均值,按"方差减少最多"选分裂特征
回到原视频 (00:04:31)
第七章 集成学习:随机森林与 XGBoost
(对应模块 17,视频 p96–p100)
7.1 单棵树的问题:太敏感
(p96)
单个决策树对数据的微小变化高度敏感。 例:只把 10 个训练样本中的一个换成另一只猫(原为"尖耳、圆脸、无胡须",新为"垂耳、圆脸、有胡须"),根节点选的最佳特征就可能从"耳朵形状"变成"胡须"——于是左右子树的数据子集完全不同,整棵树也完全不同。
解决办法:不建一棵树,而是建一大"堆"树——树集成(tree ensemble)。
预测时让所有树投票:例如三棵树里两棵说"是猫",最终就预测"是猫"。这样任何单棵树的影响都被稀释(三票里只占一票),整体算法更稳健。
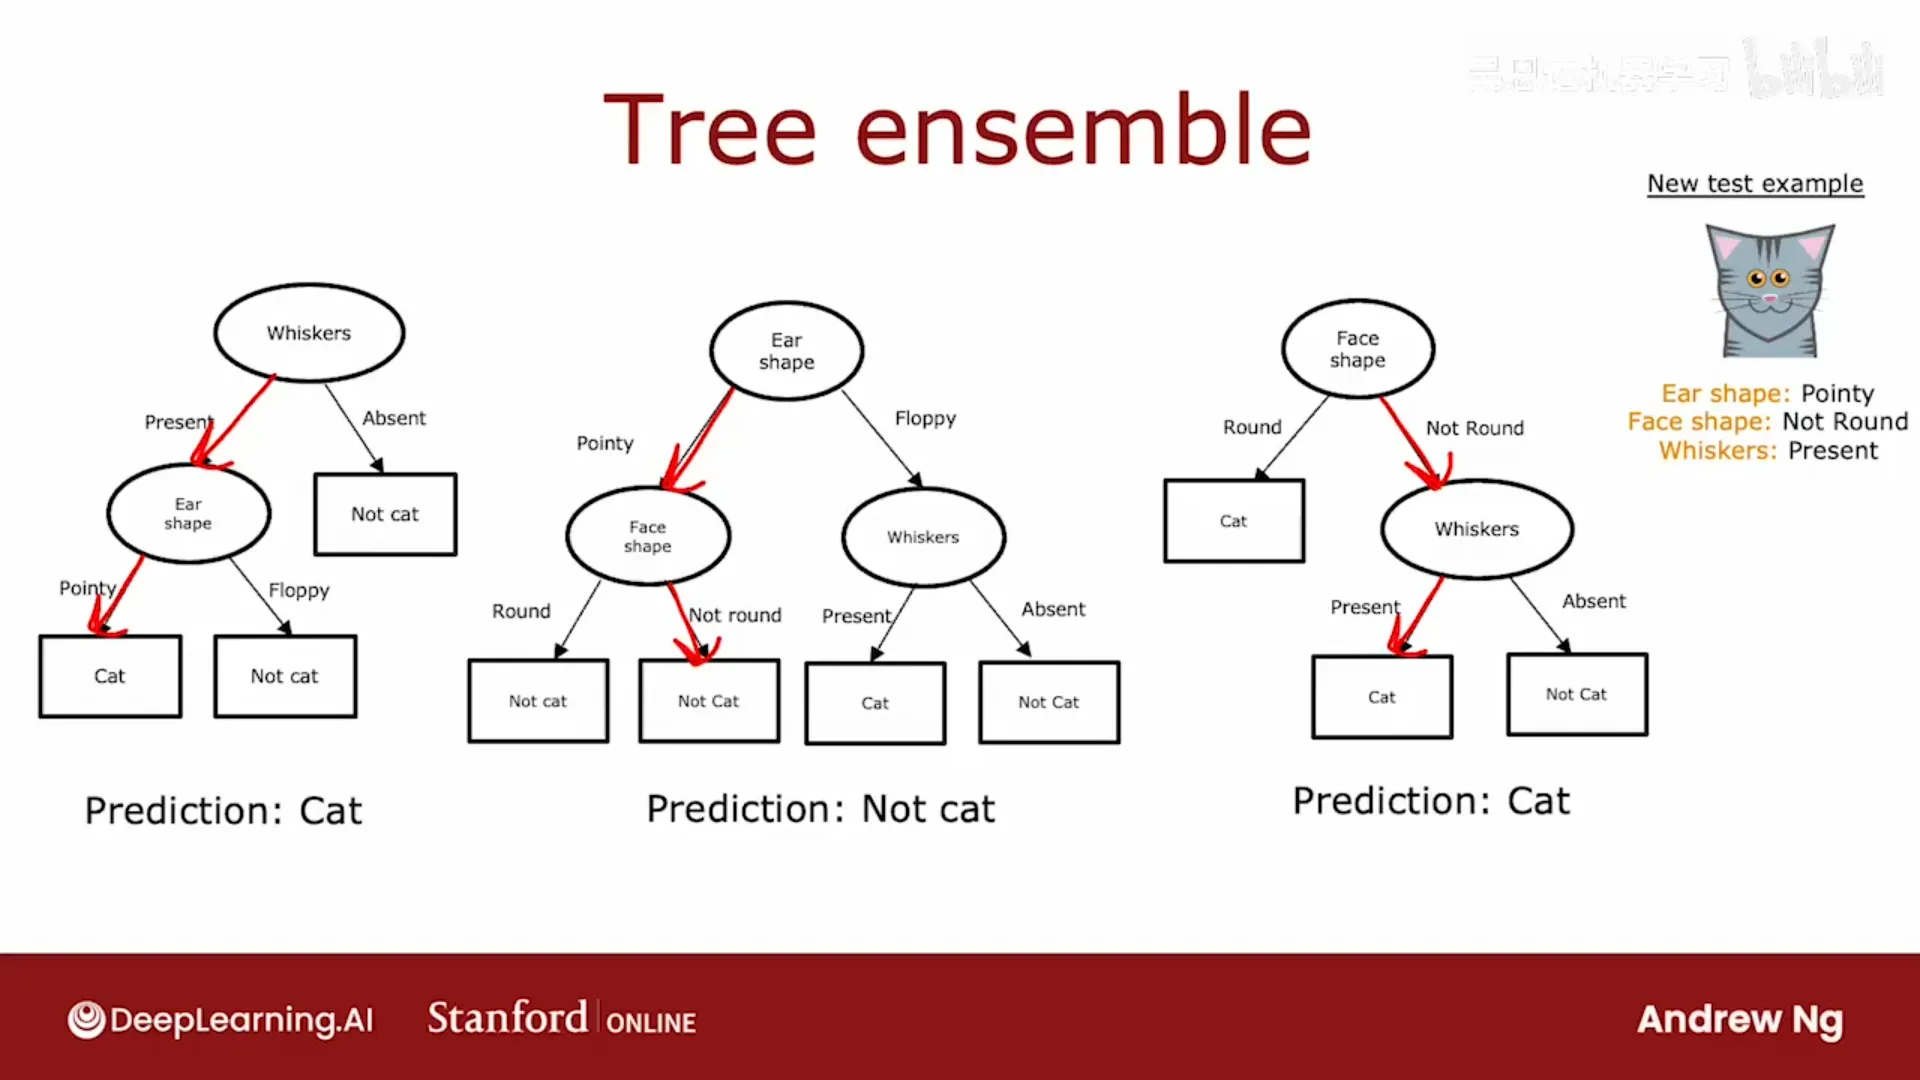
📷 树集成:多棵树各投票,整体对单棵树的变化不敏感
回到原视频 (00:02:50)
7.2 有放回抽样
(p97)
构建树集成需要有放回抽样(sampling with replacement):
- 把 10 个训练样本放进(假想的)袋子;
- 每次随机摸一个、记下、放回("放回"是关键——不放回的话,摸 4 次就总是那 4 个);
- 重复 m 次,得到一个新的、大小为 m 的训练集。
这个新集合有些样本重复、有些样本没被抽到——因此与原始集相似但有差异。(举例:从 4 个彩色标记里摸 4 次,可能得到"绿、黄、蓝、蓝"——重复了蓝色、没抽到红色。)这种"相似但不同"的新训练集,正是构建树集成的关键积木。
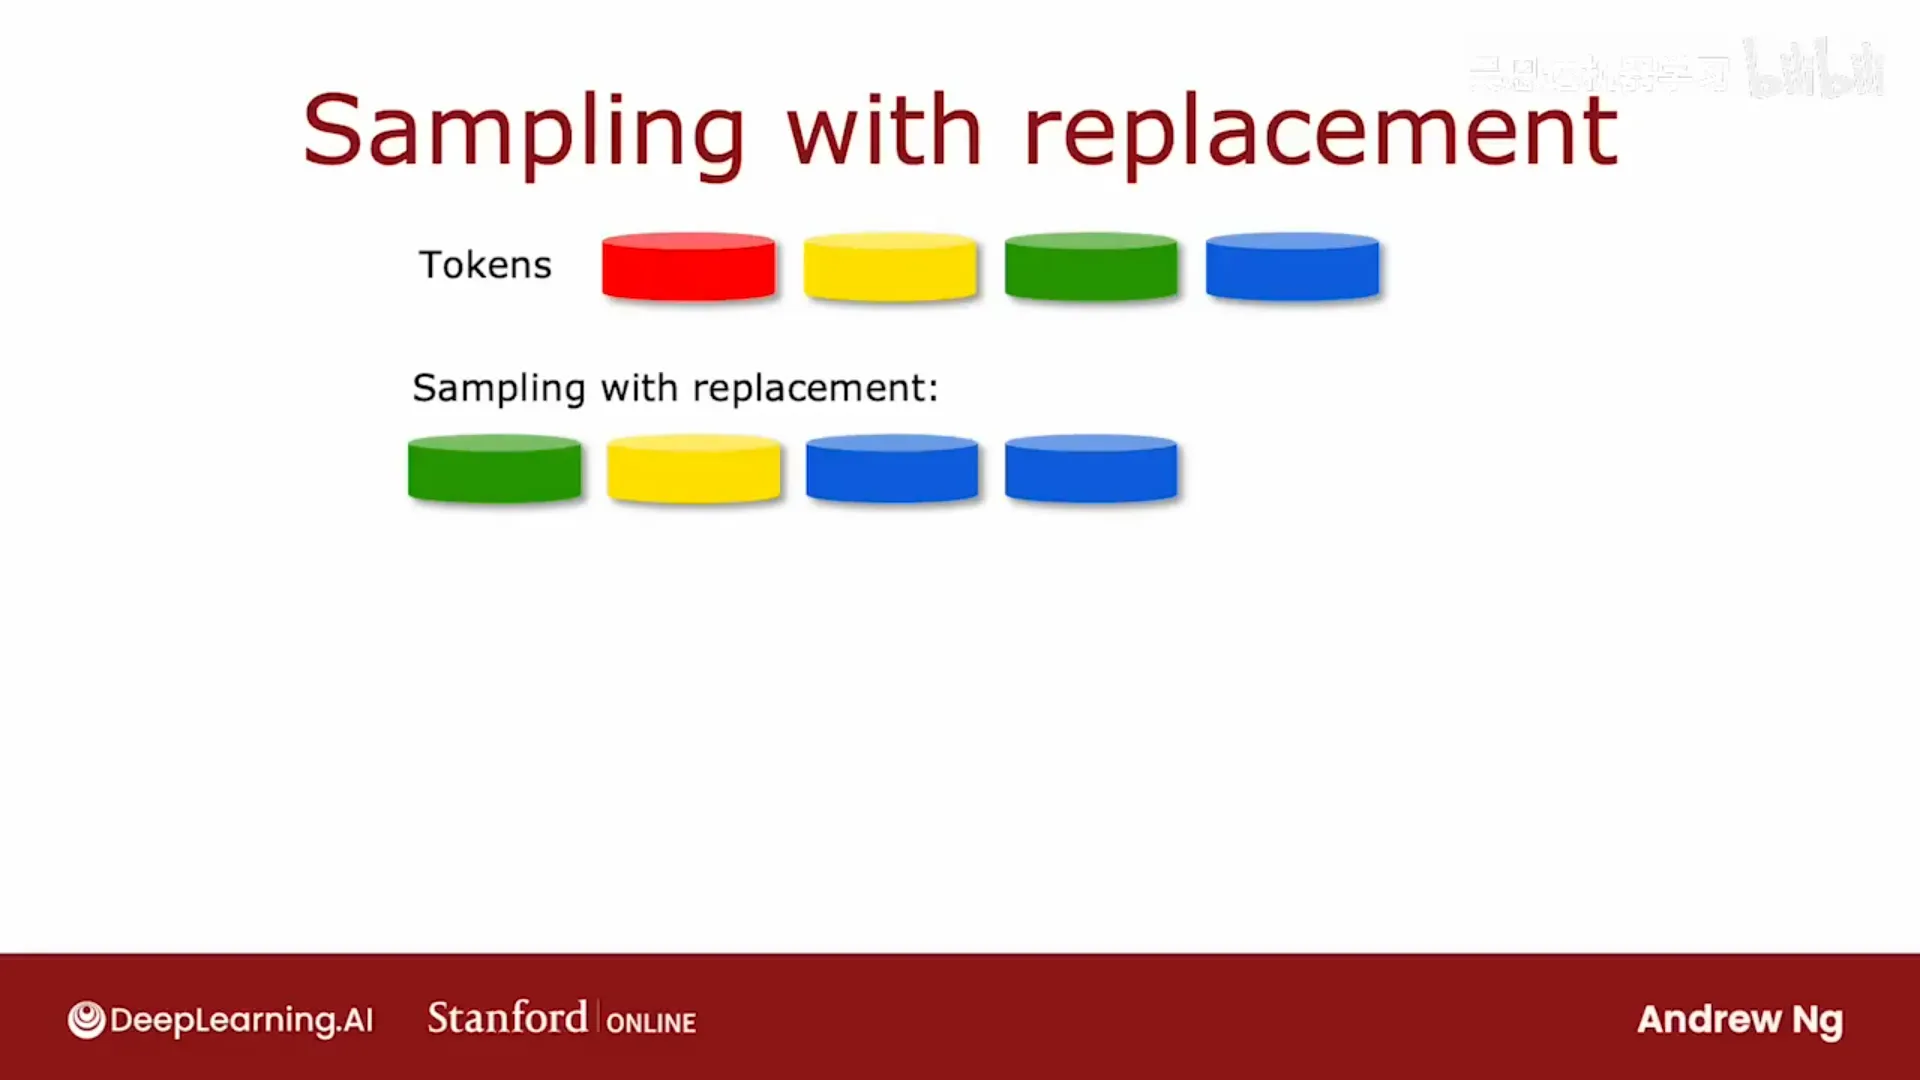
📷 有放回抽样:抽一个、放回、再抽,得到相似但有差异的新训练集
回到原视频 (00:01:25)
7.3 随机森林
(p98)
袋装决策树(bagged decision tree):
for b = 1 to B:
    用有放回抽样生成一个大小为 m 的新训练集
    在新训练集上训练一棵决策树
预测时:让 B 棵树投票决定最终预测
- B(树的数量) 典型取 约 100(推荐范围 64~128);再大只是变慢、收益递减(不做 1000 棵——那只会显著变慢、性能提升不明显);
- 因为用了"袋子(bag)",所以叫"袋装"(这也是用小写 b、大写 B 的原因)。
随机森林(random forest)是对袋装决策树的改进:
问题:即使有放回抽样,很多数据集里各棵树的根节点附近仍然选择相同的特征,导致树太相似。
做法:在每个节点分裂时,只从随机抽取的 k 个特征中选最优(而不是用全部 n 个特征):
if n 个特征可用:
    随机选 k 个特征作为"允许的特征"(k < n)
    只从这 k 个特征里选信息增益最高的来分裂
- 当 n 很大(几十、上百)时,k 的典型选择是 √n(本课只有 3 个特征时,这种随机化用处不大);
- 这让你学到的树集合更加不同,投票时预测更准确。
为什么更稳健? 有放回抽样让算法探索了数据的多种小变化,并把它们平均起来;因此训练集的任何进一步小改动都不太可能对整体输出造成大影响。
编者拓展|随机森林与 Leo Breiman:随机森林由统计学家 Leo Breiman 于 2001 年提出,它把两件事结合起来——Bagging(bootstrap aggregating,有放回抽样 + 投票,Breiman 1996)与随机特征子集(Amit & Geman 1997 的思想)。直觉是:把许多「高方差、低偏差」的树平均起来,方差被抵消,得到一个又稳又准的模型。它至今仍是表格数据上最强的基线之一。
(再次记住那句玩笑:机器学习工程师在哪露营?——在随机森林里。)
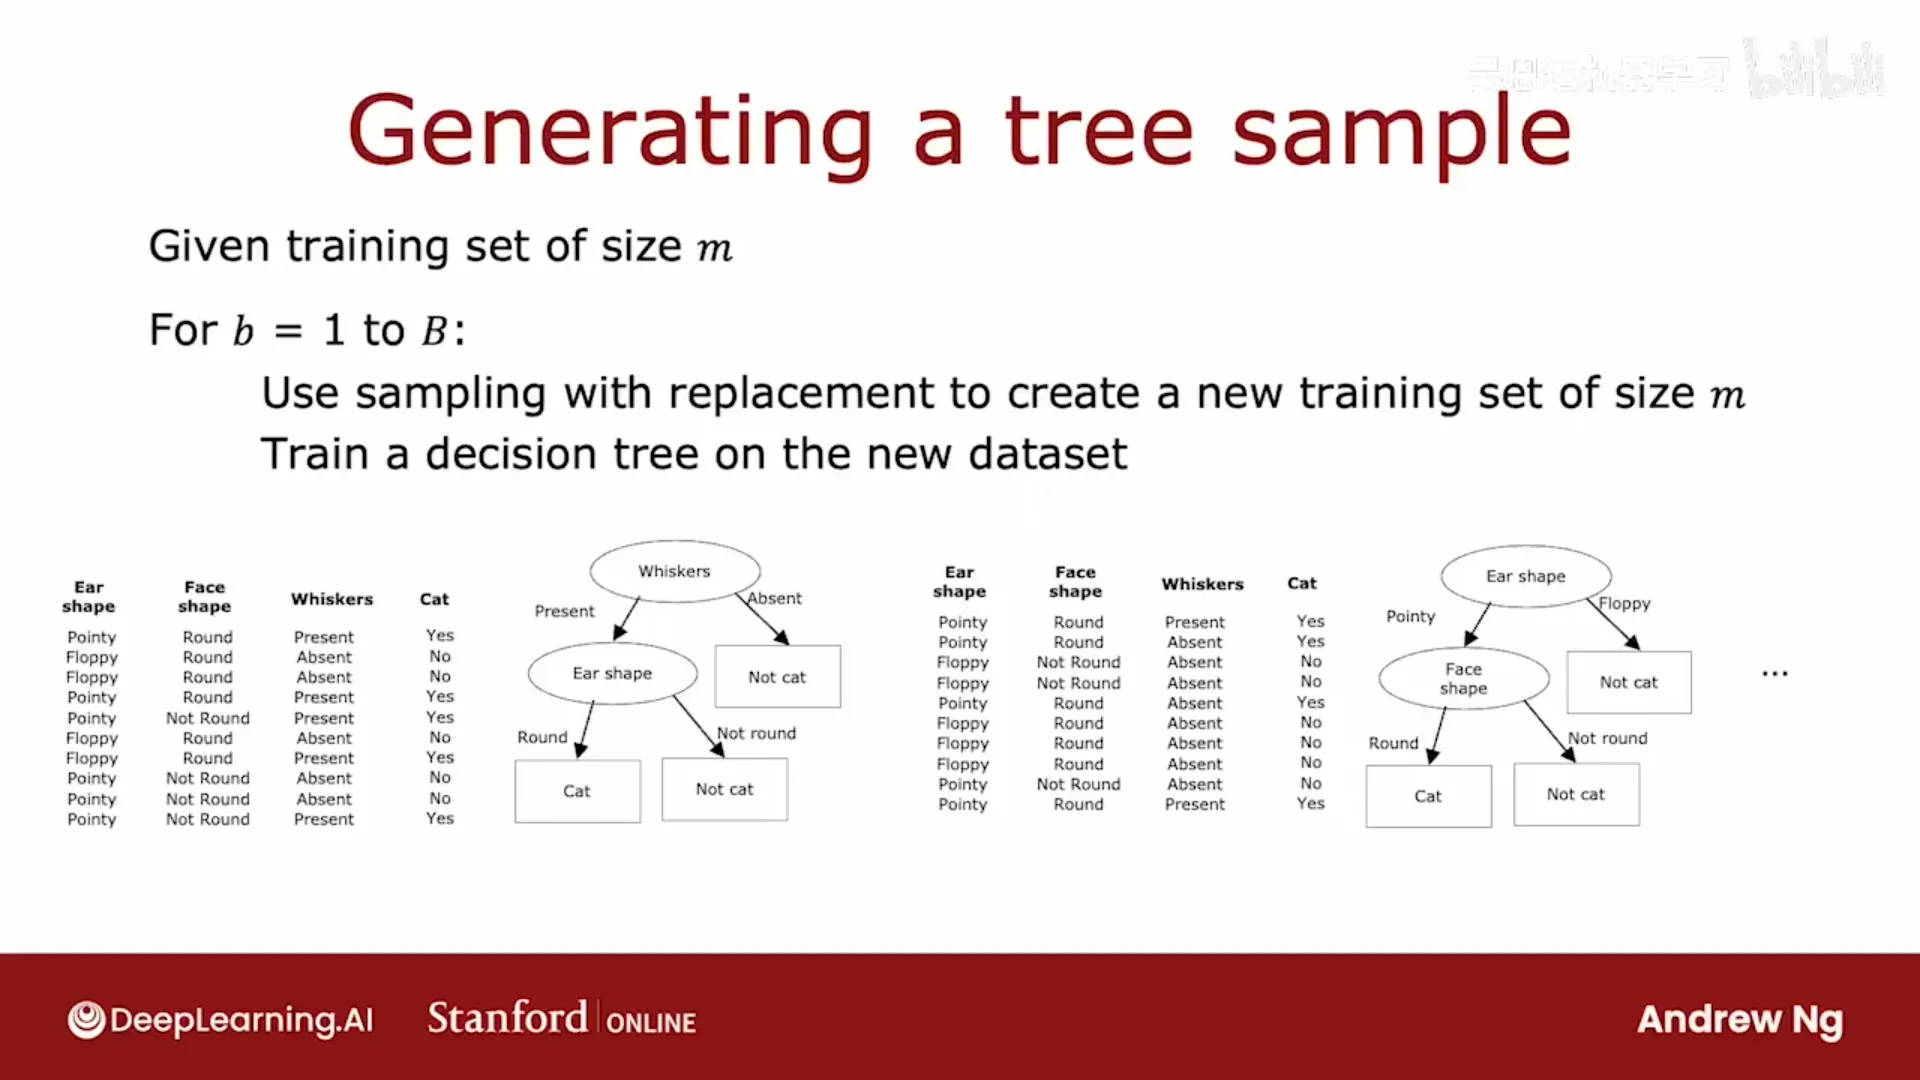
📷 随机森林:有放回抽样造多份数据;每个节点再从随机特征子集中选分裂特征
回到原视频 (00:01:46)
7.4 XGBoost:提升决策树
(p99)
提升(boosting)的思想:每一轮更关注"上一轮仍分错的样本"。
类比——刻意练习:练钢琴不是每次从头弹整首曲子(很耗时),而是专攻还没掌握的那几小节——这才是更高效的练习方式。提升就是让每一棵新树专注在当前集成仍处理不好的样本上。
流程:
- 训练第一棵树后,回到原始训练集,看它对每个样本的预测,标记哪些错了;
- 第二次有放回抽样时,给"仍然分错"的样本更高的被选中概率("关注"这些样本);
- 如此迭代 B 次,第 b 轮时更可能抽到"前 b−1 棵树集成仍分错"的样本;
- 最终让这些树的集成协同处理难题。
("给样本加权"的数学细节较复杂,但用实现时不需要关心。)
XGBoost(Extreme Gradient Boosting) 是目前最常用的提升树实现:
编者拓展|「提升」与「梯度提升」的关系:Boosting 的思想是「串行地、每一步修正前一步的错误」——和 Bagging(并行训练、投票)正好相反。把「每一步都沿损失函数的负梯度方向」这一思想形式化,就得到 梯度提升(Gradient Boosting, Friedman 2001);XGBoost 是它的高效工程实现(正则化目标、二阶信息、列采样、稀疏感知、系统级优化)。它的作者 陈天奇 是华人研究者,这也让 XGBoost 成为在 Kaggle 上最常被引用的算法之一。
- 快、高效且开源易用;
- 内置默认的分裂与停止标准;
- 一项创新是内置正则化防止过拟合;
- 在 Kaggle 等竞赛中竞争力极强——XGBoost 与深度学习是两大夺冠算法;
- 技术细节:它用给样本加权代替真的做有放回抽样,因此比抽样更高效(但"更关注难样本"的直觉不变)。
import xgboost as xgb
model = xgb.XGBClassifier()          # 分类;回归用 xgb.XGBRegressor()
model.fit(X, Y)
yhat = model.predict(X_new)
📷 XGBoost:每次新树都更关注"当前集成仍分错"的样本
回到原视频 (00:04:57)
7.5 决策树 vs 神经网络:怎么选
(p100)
两者都是非常强大、非常有效的算法。选择时可参考:
| 决策树 / 树集成 | 神经网络 | |
|---|---|---|
| 表格/结构化数据 | ✅ 很擅长 | ✅ 也很有竞争力 |
| 非结构化数据(图像/视频/音频/文本) | ❌ 不推荐 | ✅ 首选 |
| 混合数据(结构化 + 非结构化) | —— | ✅ 也表现良好 |
| 训练速度 | ✅ 非常快(利于快速迭代) | ❌ 可能很慢 |
| 可解释性 | 小树可解释(几十个节点可打印出来看);但集成后很难(100 棵树 × 数百节点) | 较差 |
| 迁移学习 | ❌ 不支持 | ✅ 支持(小数据集时很关键) |
| 串联多个模型 | 只能一次训一棵 | ✅ 输出是可微的平滑函数,可用梯度下降同时训练多个串联网络 |
实用建议:
- 表格/结构化数据:决策树与神经网络都可。多数应用会用 XGBoost(集成树通常比单棵树更好;单棵树只在算力极紧时才考虑);
- 非结构化数据(图像、视频、音频、文本):用神经网络,决策树/集成树不推荐;
- 需要迁移学习、或要把多个模型串联成更大的系统(如多个模型协同工作):用神经网络——因为神经网络把输出 y 计算为输入的平滑/连续函数,因此可微,即使串联多个也能用梯度下降同时训练;而决策树只能一次训练一棵。
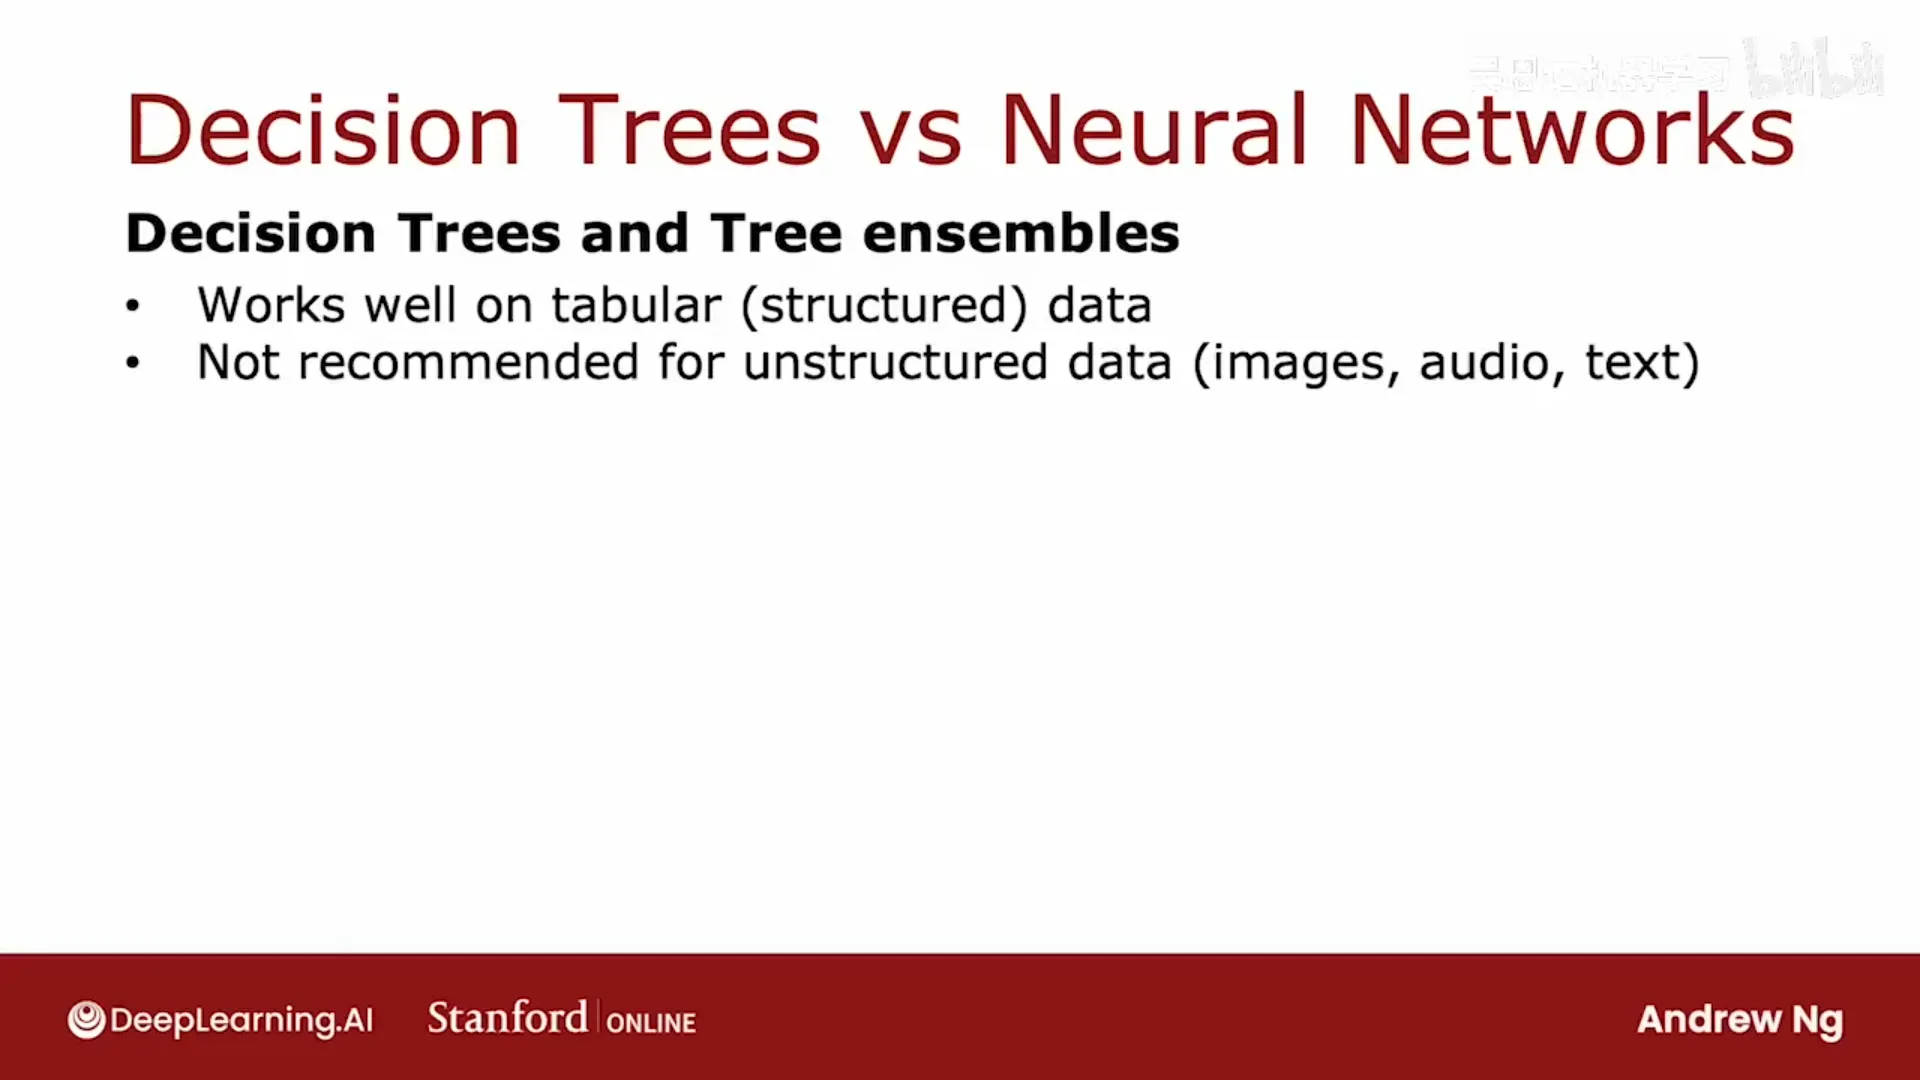
📷 决策树/集成 vs 神经网络:按数据类型、训练速度、可解释性、迁移学习来选
回到原视频 (00:01:15)
自测与思考题(进阶)
- 诊断:$J_{train}=1\%$、$J_{cv}=11\%$,更像高偏差还是高方差?下一步优先做什么?反过来 $J_{train}=15\%$、$J_{cv}=16\%$ 呢?
- 参数变化:增大正则化 $\lambda$ 时,$\lVert w\rVert$、偏差、方差各如何变化?为什么?
- 取舍:精确率与召回率在什么业务下应更看重召回率?(举一个例子。)
- 理解:随机森林为什么比单棵决策树更稳?用「有放回抽样」解释。
- 反例:判断对错并说明理由——「$J_{train}$ 很低就说明模型很好」。
参考答案要点
- 前者更像高方差(过拟合):优先加数据 / 加正则 / 简化模型;后者更像高偏差(欠拟合):优先改用更强的模型(更多特征/更多层)。
- $\lambda\uparrow\Rightarrow\lVert w\rVert\downarrow$;偏差 ↑;方差 ↓。原因是参数被收缩(约束变强),模型更不灵活、对噪声不敏感。
- 漏检代价高的场景,如疾病筛查 / 垃圾邮件倾向——宁可误报也要尽量不漏(召回率高)。
- 每棵树在不同 bootstrap 子集上训练、并随机选特征分裂,各自的方差被平均,因此整体更稳、泛化更好。
- 错。低 $J_{train}$ 只说明拟合了训练集;可能是过拟合,要看 $J_{cv}$ 与泛化差距。
结语
恭喜你完成机器学习实践与决策树这一册!本册讲的不是"某个新模型",而是如何把模型真正用好,以及另一类强大的算法:
- 诊断(训练/验证/测试集、模型选择);
- 偏差与方差(诊断方法、学习曲线、基准表现、神经网络的新路径);
- 误差分析与数据驱动(增强、合成、迁移学习);
- 完整项目周期与 MLOps、伦理与公平;
- 倾斜数据集与精确率/召回率/F1;
- 决策树(熵、信息增益、独热编码、连续特征、回归树);
- 集成学习(随机森林、XGBoost),以及决策树与神经网络的取舍。
有了"神经网络"与"实践方法 + 决策树"这两块,你已经具备构建多种机器学习应用的能力。
附:来源与参考
- 课程:Machine Learning Specialization(DeepLearning.AI / Stanford Online,2022 新版),讲师 Andrew Ng
- 课程主页:https://www.deeplearning.ai/specializations/machine-learning
- 视频来源:Bilibili 搬运合集
BV16jyuBBEom(本册对应分P p71–p100) - 参考笔记(2014 版课程):https://github.com/fengdu78/Coursera-ML-AndrewNg-Notes
- 相关工具/库:Scikit-learn、XGBoost、Pandas/NumPy
- 经典工作:决策树(ID3/C4.5/CART)、随机森林(Breiman)、XGBoost(Chen & Guestrin)、迁移学习、MLOps 实践
版权说明:课程视频、字幕与讲义版权归 DeepLearning.AI / Stanford 所有。本电子书为个人学习所做的中文书面重构,未获授权,不得用于任何商业用途或公开传播。书中截图取自对应分P视频画面,并标注「分P @ 时间」以便回源核对。