吴恩达机器学习(新版):第三门课 · 无监督学习、推荐系统与强化学习
本电子书由视频课程重构而成(个人学习用)。 课程视频、字幕与讲义版权归 DeepLearning.AI / Stanford 所有。本电子书仅为个人学习所做的中文书面重构,不得用于任何商业用途或公开传播。书中截图取自对应分P视频画面,并标注「分P @ 时间」以便回源核对。
| 原课程 | Machine Learning Specialization(DeepLearning.AI / Stanford Online,2022 新版),讲师 Andrew Ng(吴恩达) |
| 视频来源 | Bilibili 搬运合集 BV16jyuBBEom(共 142 个分P,本册为第三门课,p101–p142) |
| 官方配套 | https://www.deeplearning.ai/specializations/machine-learning |
| 参考笔记(2014 版课程) | https://github.com/fengdu78/Coursera-ML-AndrewNg-Notes |
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
本册导读
本册对应新版专项的第三门课《Unsupervised Learning, Recommenders, Reinforcement Learning》,共 10 个模块、42 个视频:
- 欢迎(模块 1)
- 聚类与 K-means(模块 2)
- 异常检测(模块 3)
- 推荐系统入门与协同过滤(模块 4)
- 均值归一化与 TensorFlow 实现(模块 5)
- 基于内容的过滤与大规模推荐(模块 6)
- 强化学习基本概念(模块 7)
- 状态-动作值函数与 Bellman 方程(模块 8)
- 连续状态、深度强化学习与优化(模块 9)
- 总结(模块 10)
第一章 欢迎
(对应模块 1,视频 p101)
前两门课花大量时间讲监督学习;这最后一门课讲一系列超越监督学习的新技术:
- 第 1 周·无监督学习:聚类(把数据分组)、异常检测——许多公司的重要商业应用都在用;
- 第 2 周·推荐系统:访问购物/视频网站时,它如何为你推荐商品或电影。这是商业价值最高的 ML 技术之一(推动数十亿美元的商品流通),但学术界关注相对较少;理解了它,你也能大致理解大型在线广告公司如何决定给你看哪些广告;
- 第 3 周·强化学习:你可能在新闻里看到它在玩视频游戏上超越人类;吴恩达也多次用它控制机器人。RL 是一项新兴技术——商业应用数量远不如其他技术——但它很令人兴奋,开辟了学习算法的新前沿。你将亲手实现一个 RL 算法,把模拟月球着陆器安全降落。
第二章 聚类与 K-means
(对应模块 2,视频 p102–p107)
2.1 什么是聚类
易错点(层级):聚类是无监督范式下的任务,K-means 是聚类算法——别和分类(classification)混:分类需要标签,属监督学习。分层记住:范式(监督/无监督/强化)→ 任务(分类/回归/聚类)→ 算法(K-means、逻辑回归…)。
(p102)
聚类算法查看一堆数据点,自动找出彼此相似的点并分组。
对比监督学习:监督学习的数据集有输入 x 和标签 y,可以拟合决策边界;无监督学习的数据只有 x、没有标签 y——图上只有点,没有标成两类。我们请算法自己去发现数据中有趣的结构。聚类要发现的特定结构就是"簇(cluster)"——彼此相似的点组,例如把数据分成两组。
聚类的应用:新闻聚类(把相关报道分组)、市场细分(deeplearning.ai 用它分析学习者的动机:提升技能 / 发展职业 / 了解 AI 对本领域的影响)、DNA 数据分析(按基因表达把人群分组)、天文数据分析(把天体分组,判断哪些构成星系)。
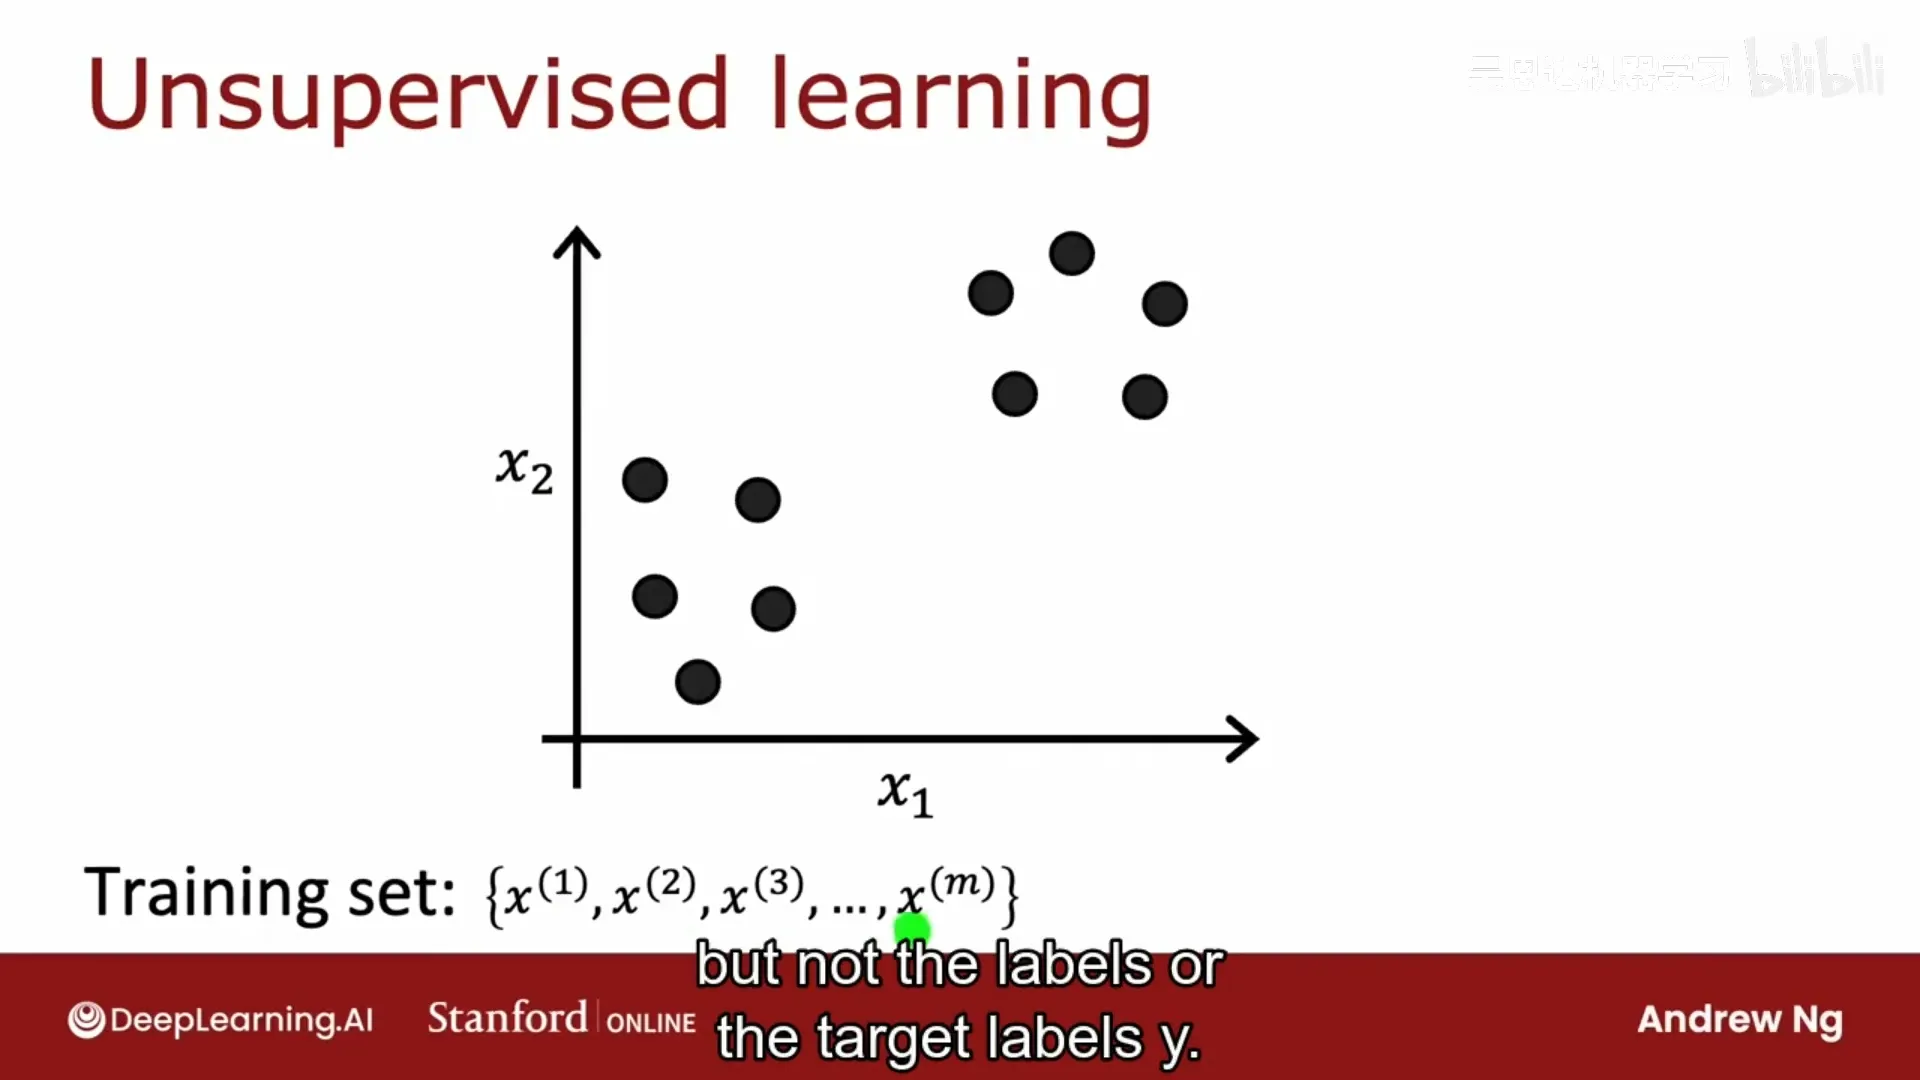
📷 聚类是无监督学习:只有数据点、没有标签,算法自己找簇
回到原视频 (00:01:08)
2.2 K-means 的直观理解
(p103)
最常用的聚类算法是 K-means。它反复做两件事:① 把点分配给簇质心;② 移动簇质心。
流程:
- 随机猜测 k 个簇中心的位置(称簇质心 centroid);
- 分配点:遍历每个样本,看它离哪个质心最近,就"染成"那个颜色(分配给它);
- 移动质心:对每个簇,把所有同色点的平均位置作为该质心的新位置;
- 重复 2、3,直到点的颜色和质心位置都不再变化——此时 K-means 收敛("不断重复这两步也不会有进一步变化")。
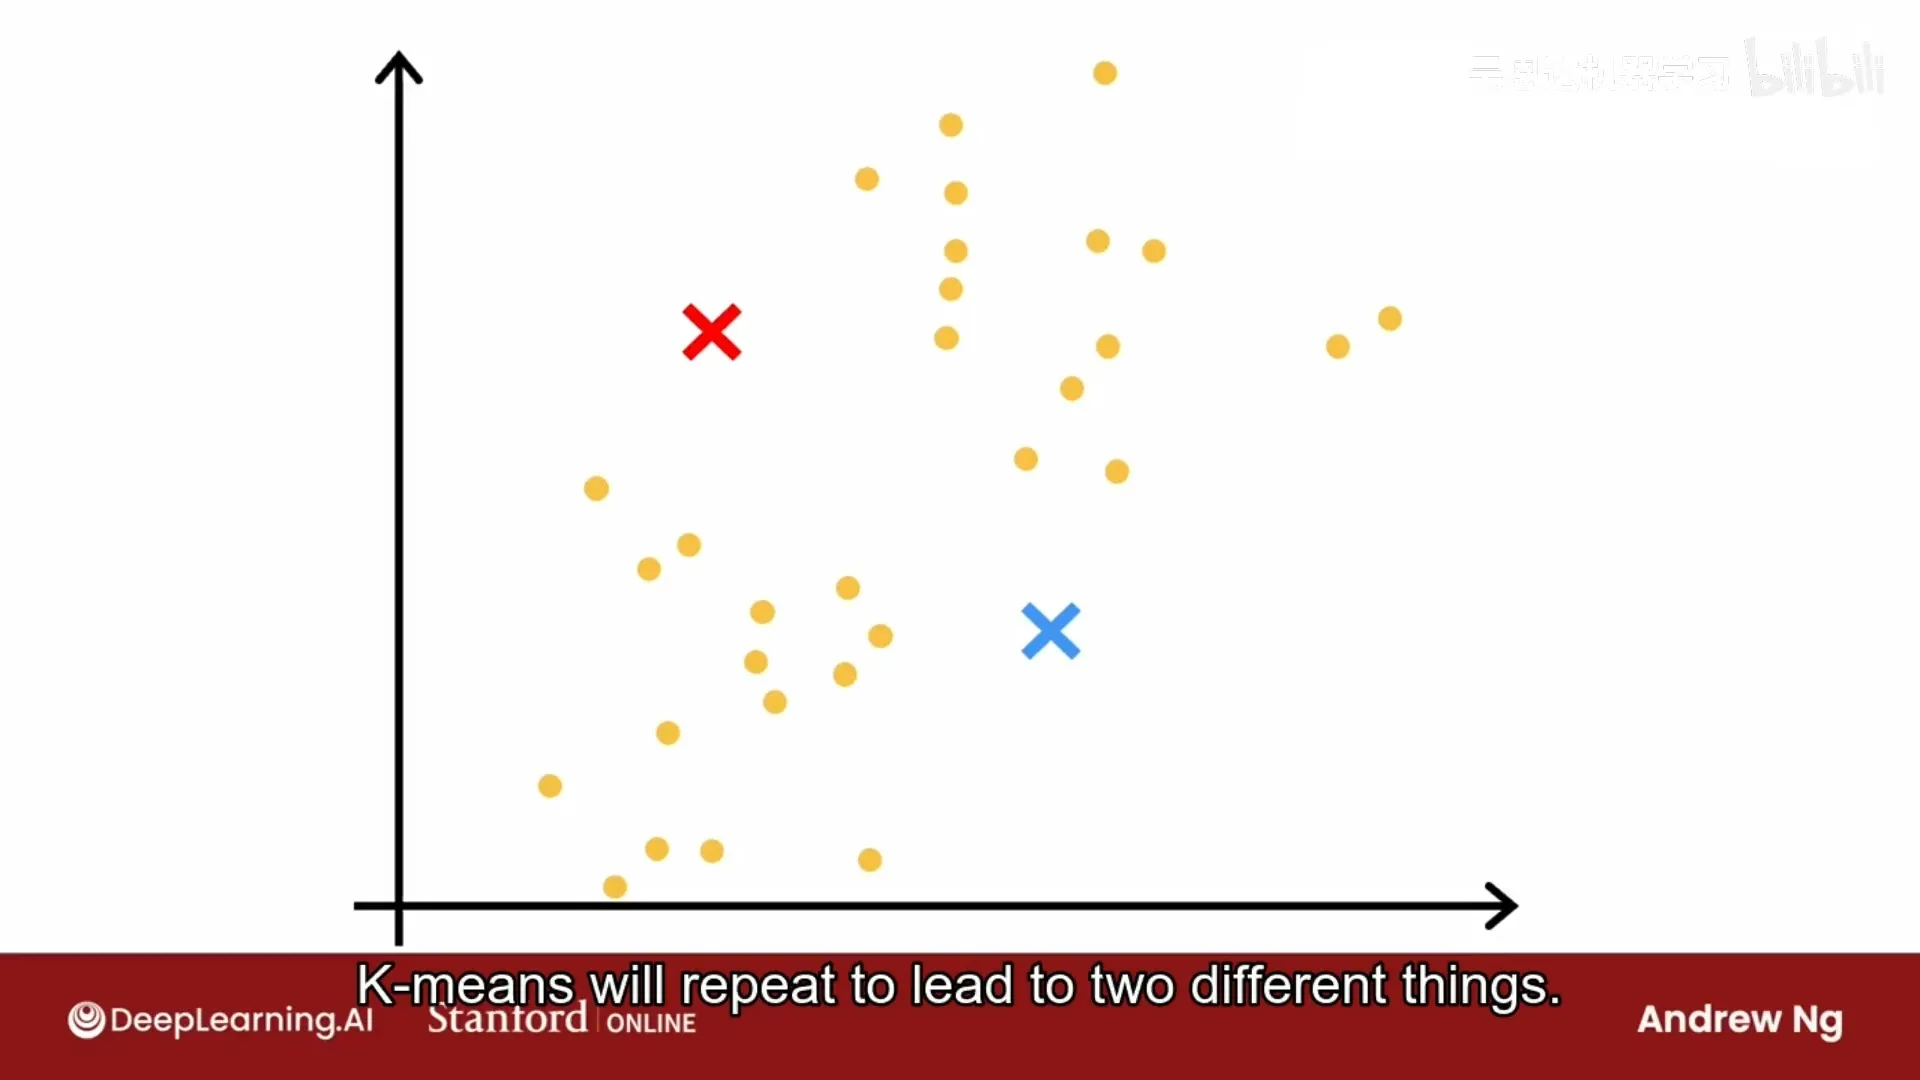
📷 K-means 反复做两件事:分配点到最近质心、把质心移到同色点均值处
回到原视频 (00:01:08)
2.3 K-means 算法
(p104)
第一步:随机初始化 k 个簇质心 μ₁, …, μ_k(μ 与训练样本 x 同维)。
第二步(分配):对 i = 1…m,令 c⁽ⁱ⁾ = 离 x⁽ⁱ⁾ 最近的质心的下标:
$$c^{(i)} = \arg\min_k \big\| x^{(i)} - \mu_k \big\|^2$$
(用平方距离更便于实现,且最小平方距离与最小距离等价。)
第三步(移动):对 k = 1…K,令 μ_k = 分配给簇 k 的所有点的均值:
$$\mu_k = \frac{1}{\big|\{\,i : c^{(i)} = k\,\}\big|}\sum_{i:\,c^{(i)}=k} x^{(i)}$$
特例:若某个簇没有分到任何点,最常见做法是直接删掉该簇(得到 k−1 个簇);若确实需要 k 个簇,也可以随机重新初始化该质心。
K-means 也常用于簇并不清晰分离的数据。例如设计 T 恤尺码(S/M/L):身高体重是连续变化的、没有明确分界,但用 K-means 找出 3 个质心,就能据此定义三种尺码。
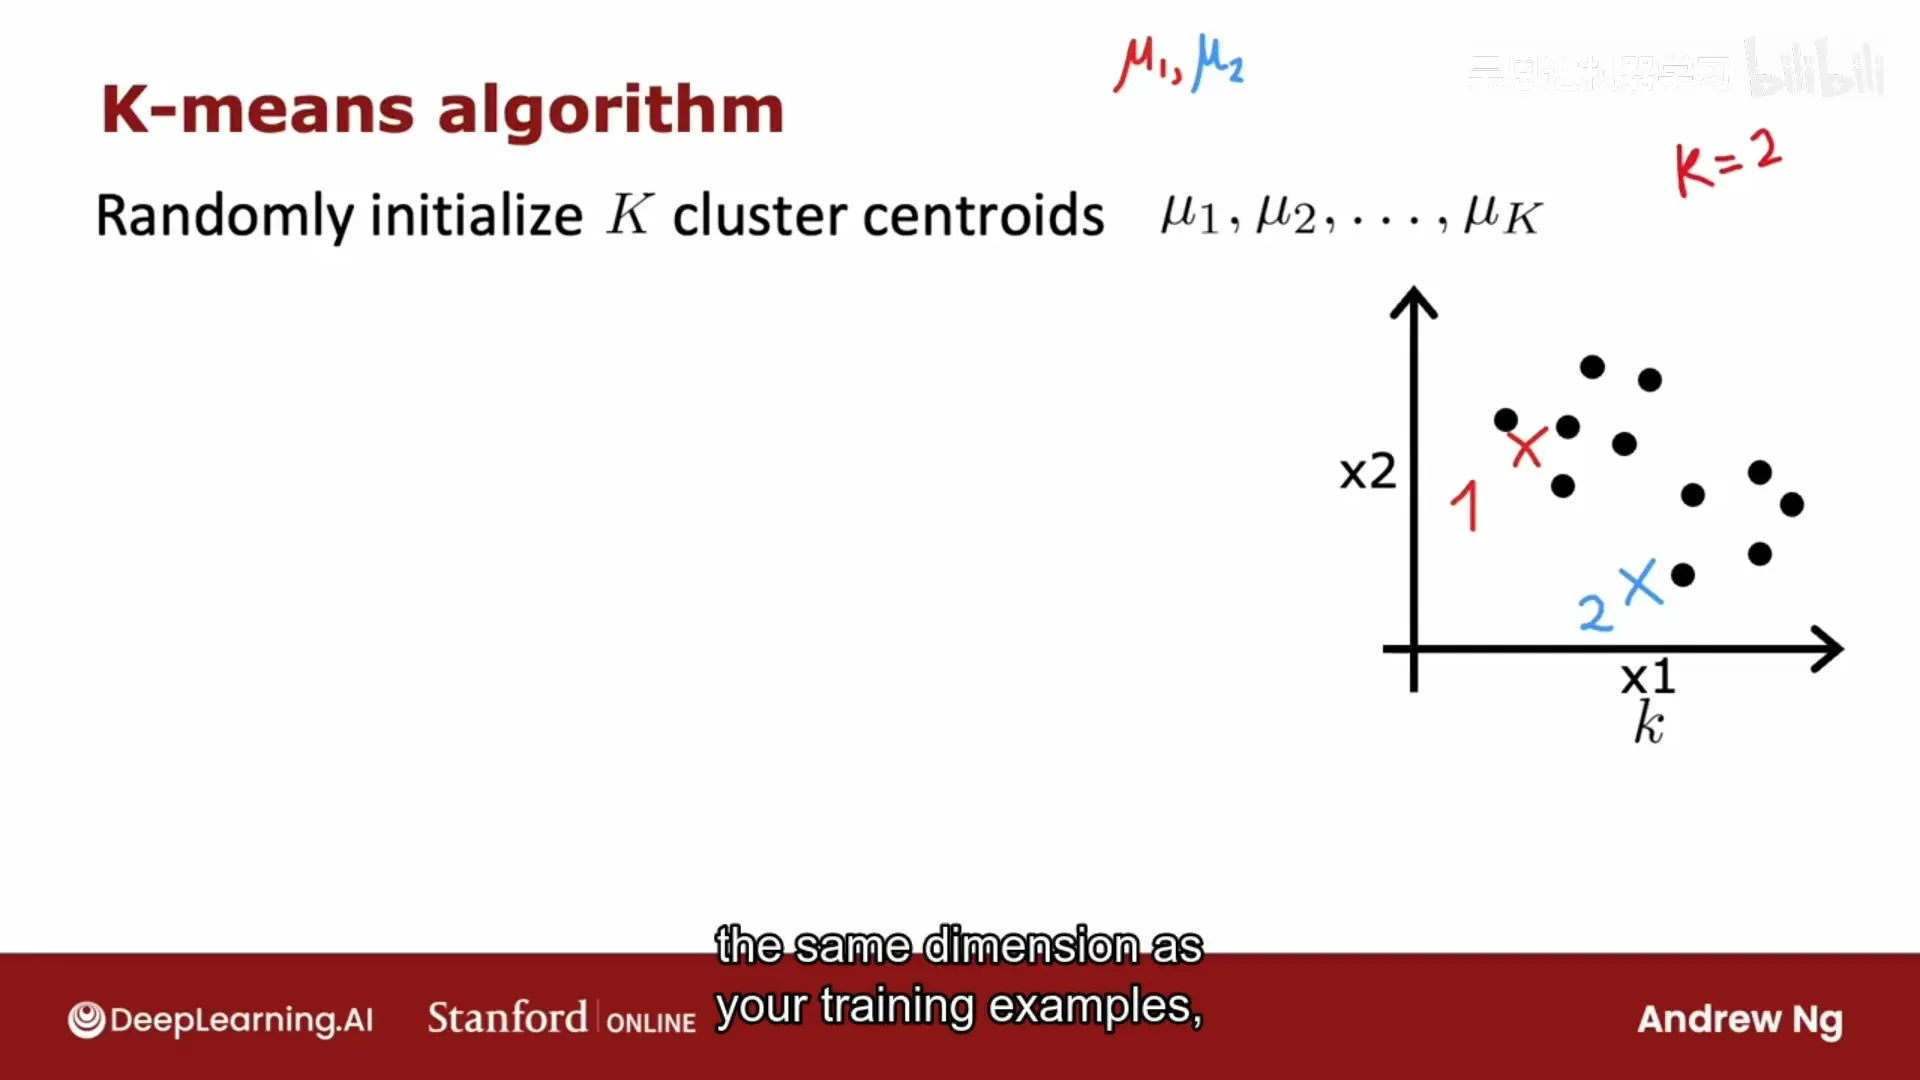
📷 K-means 算法:初始化 k 个质心,反复"分配 + 移动"
回到原视频 (00:01:12)
2.4 优化目标:失真函数
(p105)
K-means 其实在优化一个特定的代价函数(只是不用梯度下降):
$$J\big(c^{(1)},\dots,c^{(m)},\mu_1,\dots,\mu_K\big) = \frac{1}{m}\sum_{i=1}^{m}\big\| x^{(i)} - \mu_{c^{(i)}} \big\|^2$$
即"每个训练样本到它所属簇质心的平均平方距离"。这个代价函数也叫失真函数(distortion function)。
两步分别在最小化 J:
- 分配点(固定 μ):把 x⁽ⁱ⁾ 分给最近的质心,正是让该项最小;
- 移动质心(固定 c):把 μ_k 设为分配点的均值,正是让该项最小(可自己举例验证:把质心放在点之间比放在一侧的平均平方距离更小)。
因此 K-means 保证收敛:每次迭代失真只会下降或不变(若上升,说明代码有 bug)。当代价不再下降,就该停止。
编者拓展|K-means 其实是「EM 算法」的一个特例:K-means 的「分配 → 移动」两步,正是 EM(Expectation–Maximization)算法的骨架——E 步根据当前参数推断隐藏变量(每个点属于哪个簇),M 步再据此更新参数(质心)。K-means 被称为「硬 EM」(一个点只属于一个簇),而高斯混合模型(GMM)是它的「软版本」(给出属于每个簇的概率)——你在 EECS 189 里会见到 GMM。这个方法由 Lloyd 于 1957 年提出,所以又叫 Lloyd 算法。
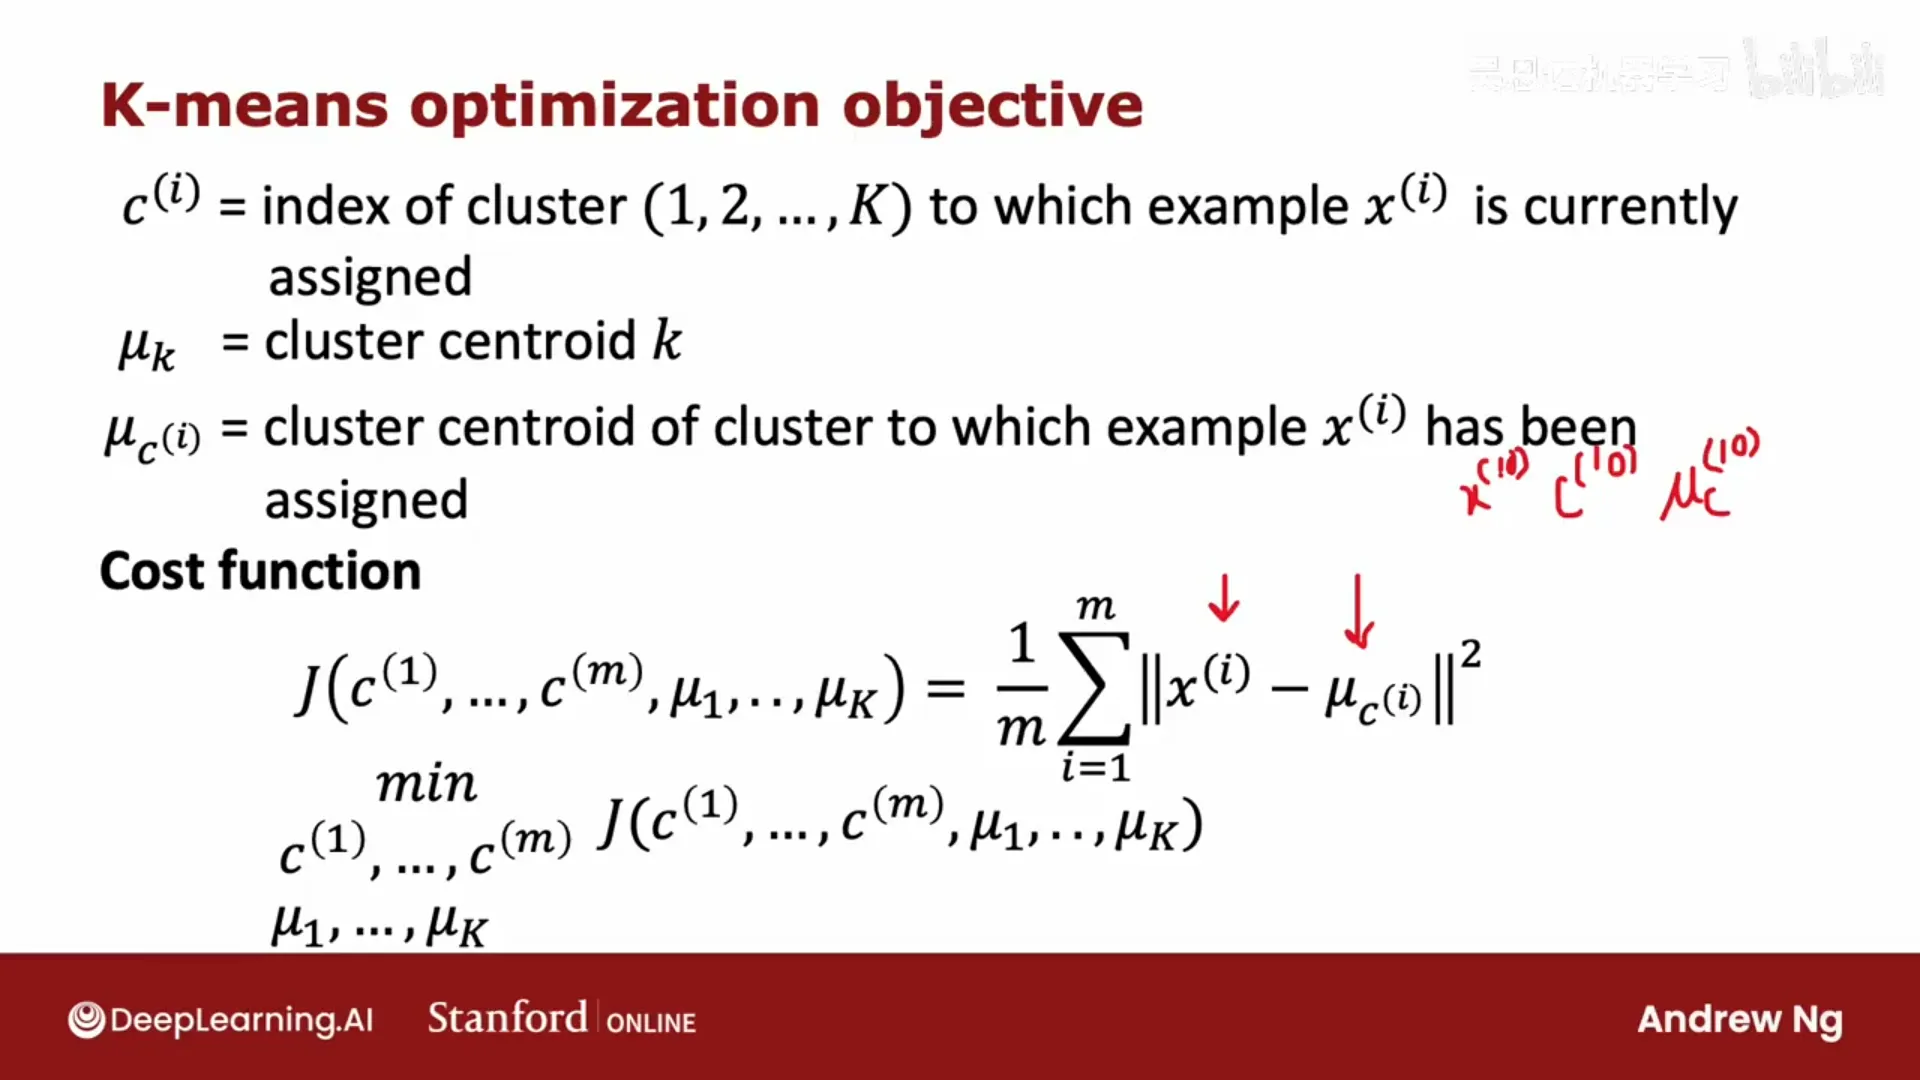
📷 K-means 的失真函数:样本到所属质心的平均平方距离
回到原视频 (00:03:00)
2.5 初始化与多次运行
(p106)
要让 K-means 效果好,初始化很关键。
- 应选 k < m(簇数小于样本数);否则连"每个簇至少一个样本"都保证不了。
- 常用初始化:随机选 k 个训练样本,把它们的位置作为初始质心。
- 不同的初始化可能掉进不同的局部最优:例如 k=3 时,若不幸在同一团点里初始化了两个质心、另一团里一个,就会得到很差的聚类。
解决办法:多次随机初始化,各跑一次,取失真最小的一次。常见做法是跑 50~1000 次(超过就会收益递减、计算代价高)。吴恩达说他用 K-means 时几乎总是用多次随机初始化。
📷 不同的随机初始化可能导致不同的局部最优
回到原视频 (00:01:08)
2.6 如何选择簇数 k
(p107)
k 的正确值往往本来就是模糊的——同一份数据,有人说看到 2 个簇、有人说看到 4 个,都可能是对的(无监督学习没有"正确答案"可对照)。
- 肘部法(elbow method):把失真 J 画成 k 的函数。k 增大时 J 总在下降(所以"选 J 最小的 k"没用,那几乎总会选最大的 k)。若曲线有个明显的"拐点(肘部)",就选那个 k。但很多曲线是平滑下降的,没有清晰肘部——吴恩达说自己几乎不用肘部法。
- 实用做法:看你用这些聚类做什么(下游用途),用它表现的好坏来选 k。
编者拓展|无监督学习为什么「没有标准答案」:监督学习有标签 y,可以直接算误差;而无监督学习没有标签,你无法说「聚类 A 比聚类 B 更对」。这带来两个后果:① 评价指标(如失真、轮廓系数)只能当参考,最终要看下游任务效果;② 「选几个簇」「这算不算异常」这类问题,往往由业务目标决定。这也是为什么本册反复强调「看你拿它做什么」。例如 T 恤尺码:3 种尺码 vs 5 种尺码,是"合身度"与"生产/运输成本"的权衡——取决于你的业务。
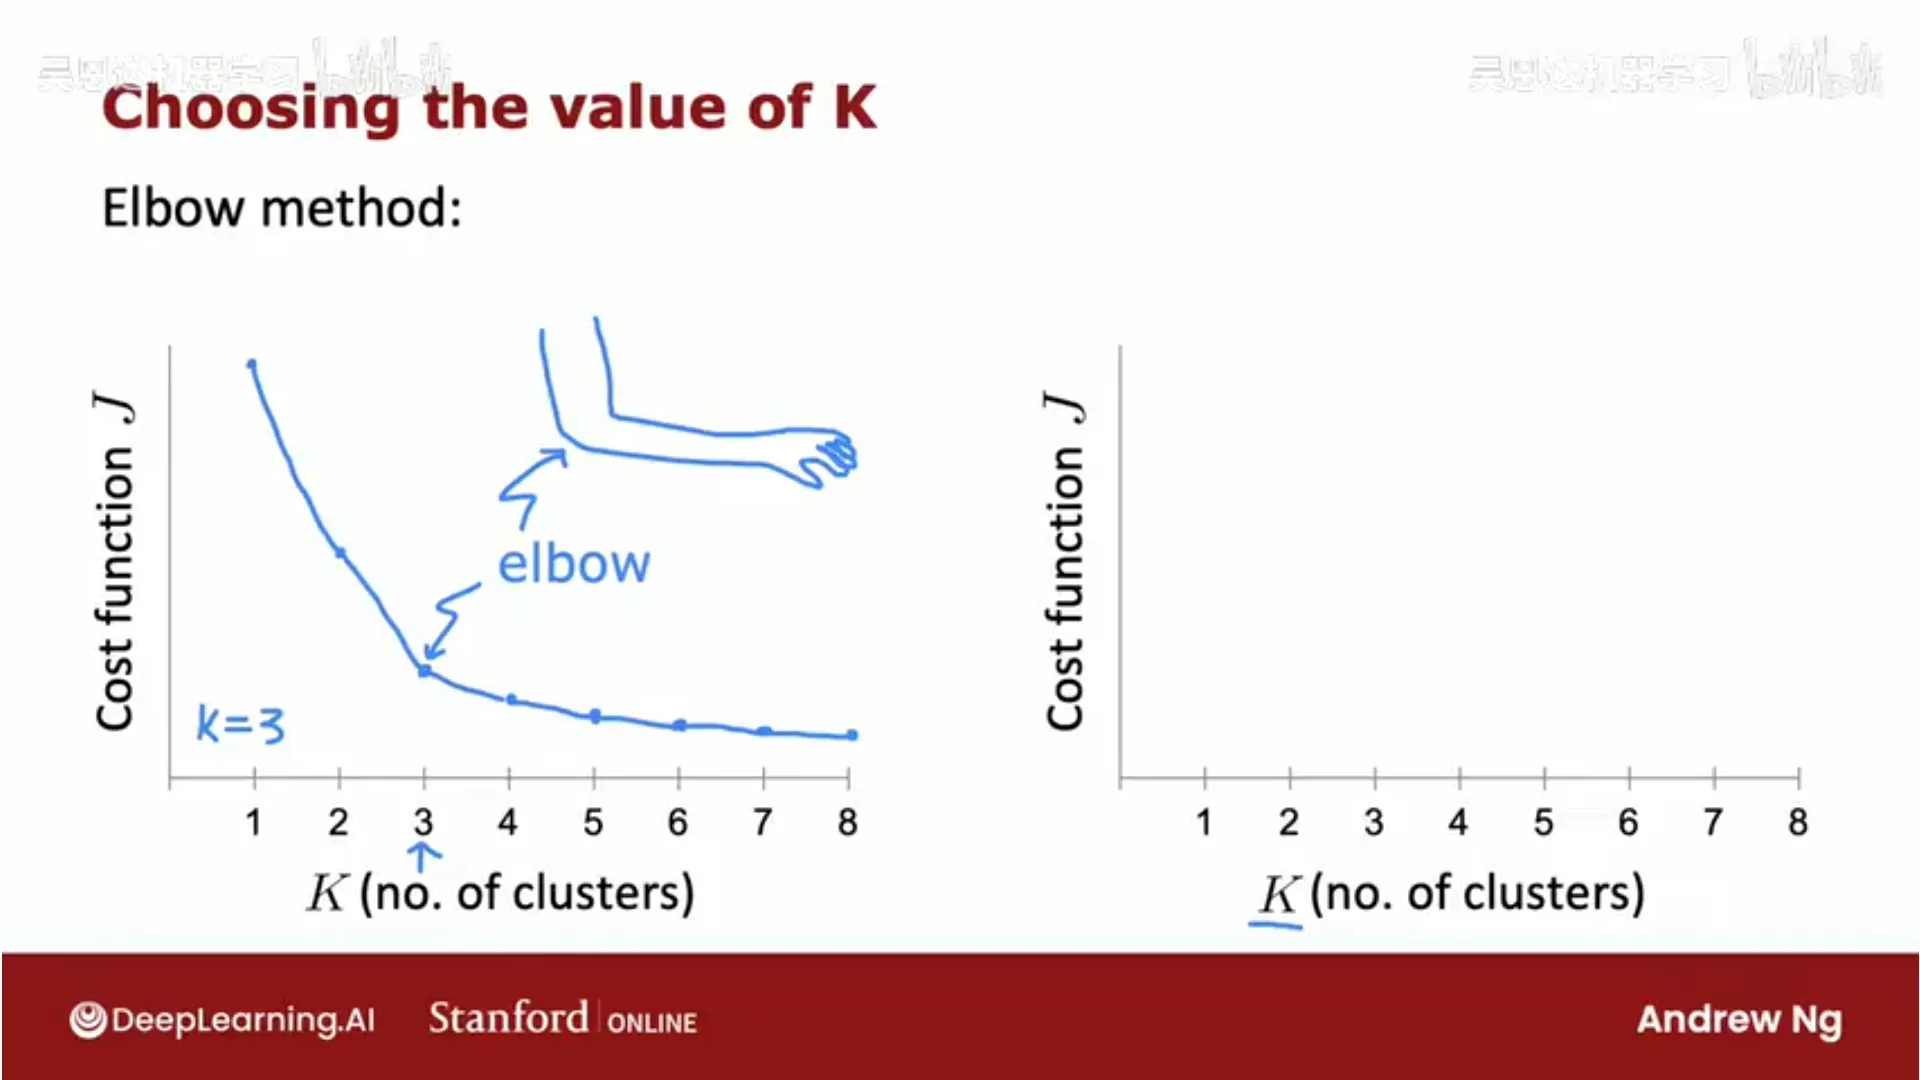
📷 肘部法:若 J 随 k 的曲线有明显拐点,可选该 k
回到原视频 (00:03:14)
第三章 异常检测
(对应模块 3,视频 p108–p113)
3.1 发现异常事件
(p108)
异常检测:从正常事件的无标签数据集中学习,当出现异常/不寻常事件时发出警报。
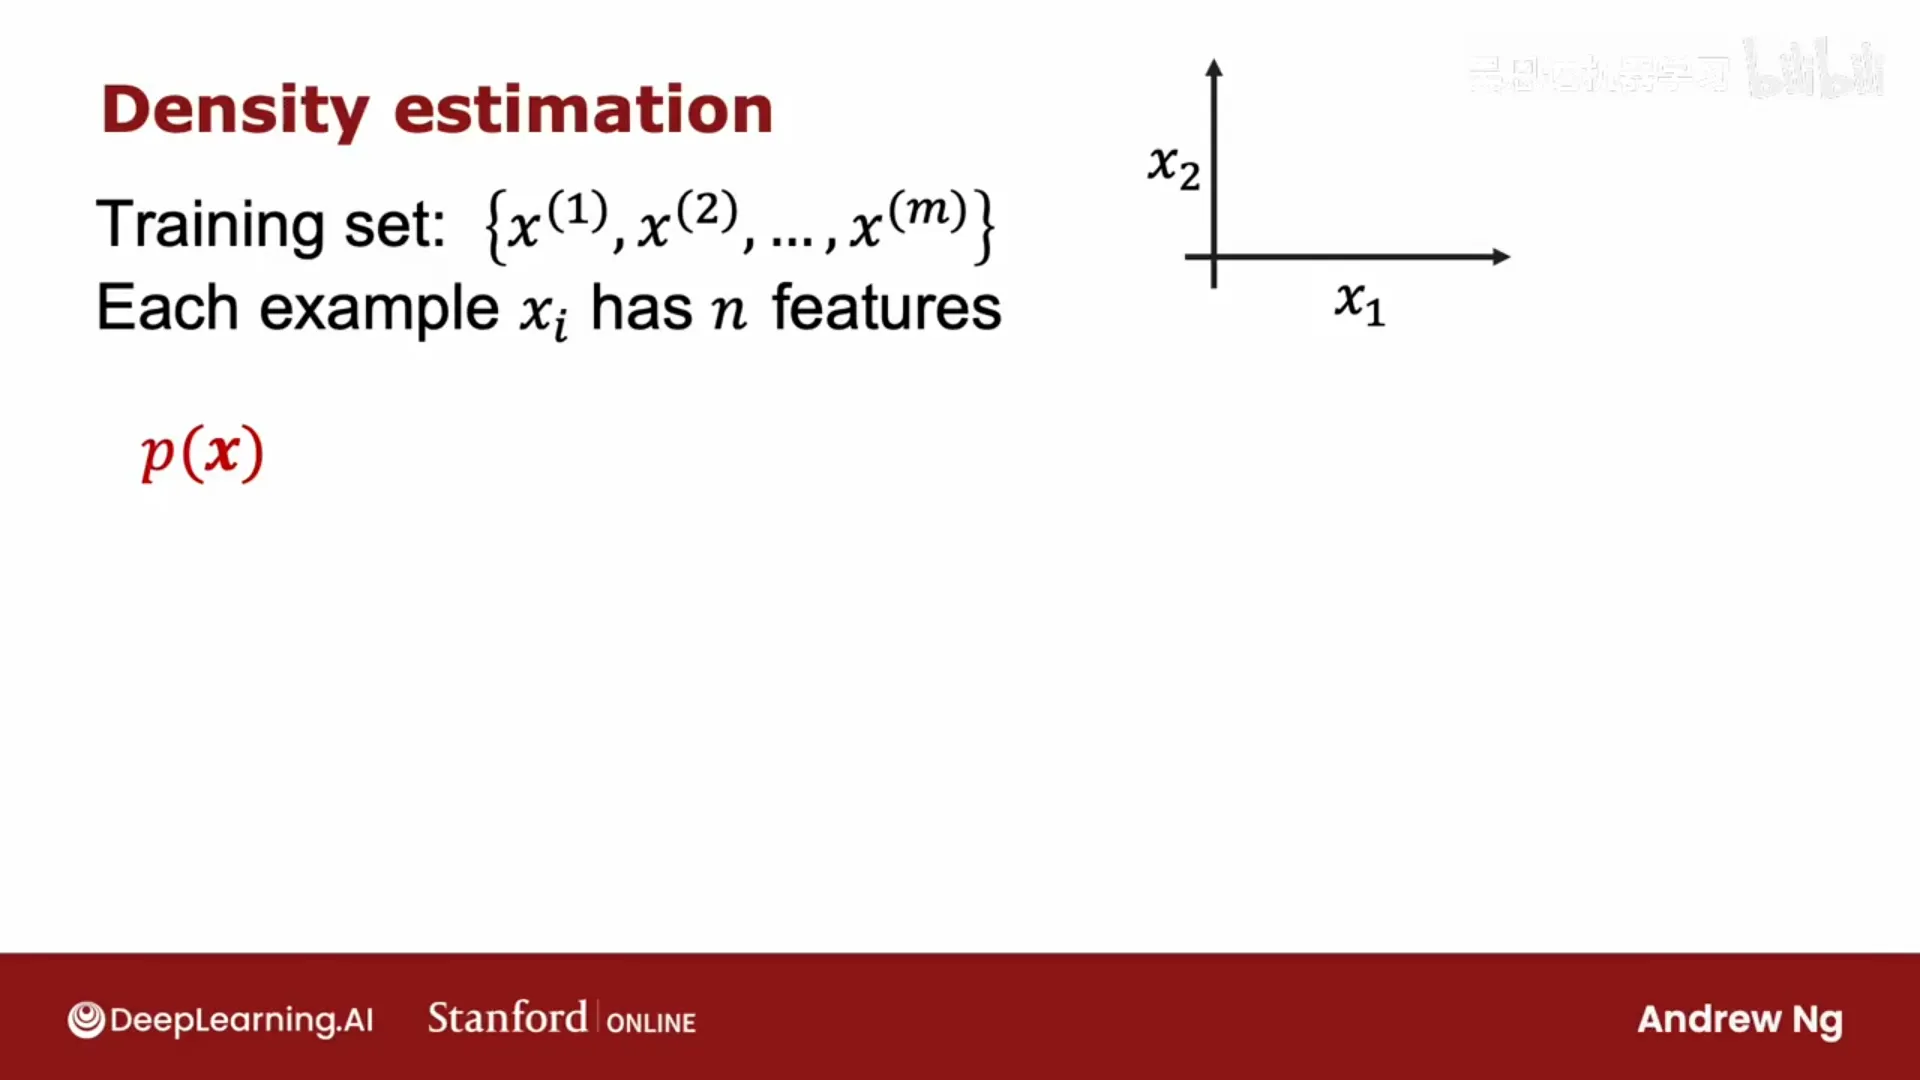
例(飞机发动机制造):给每台下线发动机测量特征(x₁ = 产热、x₂ = 振动…)。因为坏发动机很少,容易收集到的是大量正常发动机的数据。问题是:新下线一台发动机,它的特征 x 看起来和以前造的相似(正常),还是有非常奇怪的地方(值得更仔细检查再装机)?
做法:密度估计——建立"特征 x 的概率模型 p(x)",学出哪些区域概率高、哪些区域概率低(中间高、往外逐渐低)。
判定:给定新样本 x_test,计算 p(x_test):
- 若 p(x_test) < ε(一个很小的阈值)→ 标记为异常;
- 否则 → 正常。
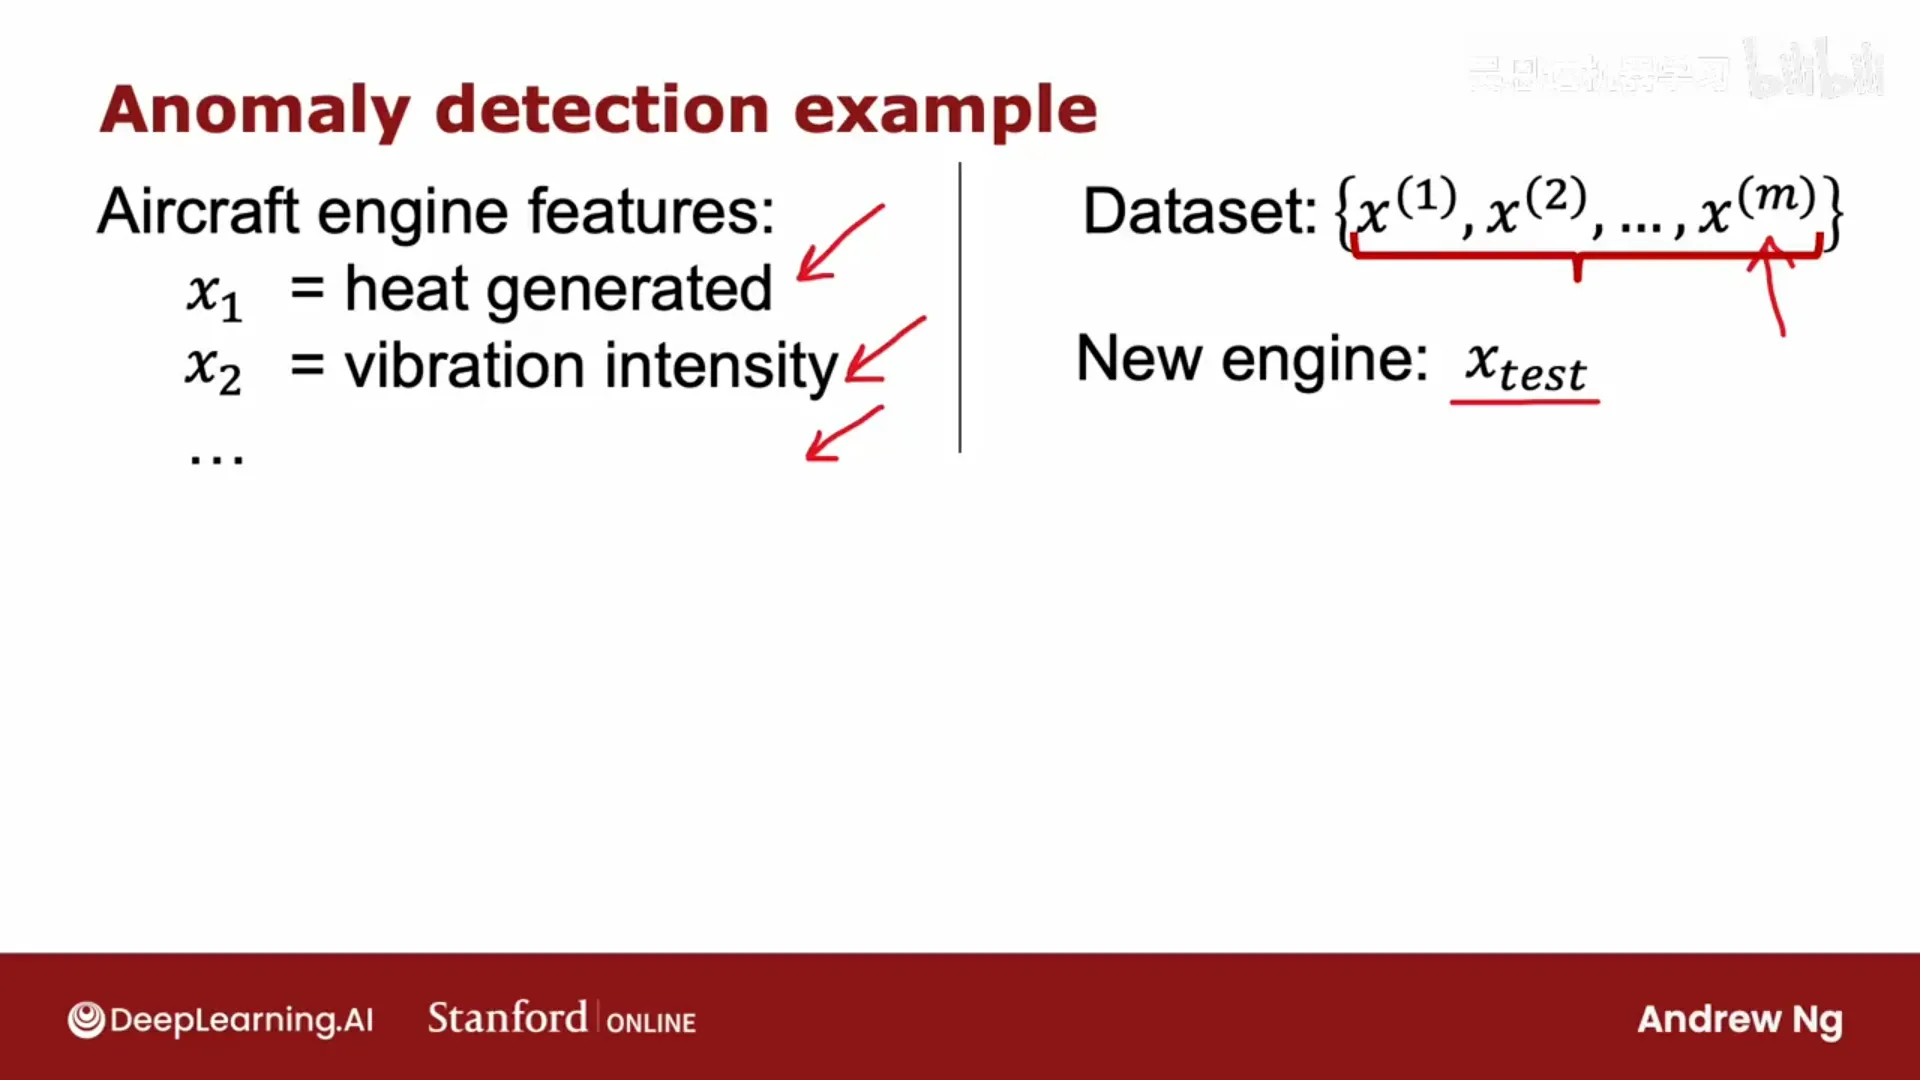
📷 异常检测:用密度估计建模 p(x),p(x) 很小就标记为异常
回到原视频 (00:02:54)
应用:欺诈检测(为每个用户的活动建模 p(x):登录频率、访问页面数、交易次数、发帖数、打字速度……异常账号交给安全团队进一步核查,如要求手机验证/验证码;也用于识别金融欺诈)、制造业质检(发动机、印刷电路板、手机、电机…检查刚造出的单元是否异常)、数据中心服务器监控(内存使用、磁盘访问、CPU 负载、网络流量;某台机器行为与众不同,可能硬盘/网卡故障,或被黑客入侵)。
3.2 高斯(正态)分布
(p109)
高斯分布(正态分布、钟形曲线):若随机变量 x 的概率由均值 μ 和方差 σ² 的高斯分布给出,则 p(x) 是一条以 μ 为中心、宽度由 σ(标准差) 决定的钟形曲线。
$$p(x;\mu,\sigma^2) = \frac{1}{\sqrt{2\pi}\,\sigma}\exp\!\left(-\frac{(x-\mu)^2}{2\sigma^2}\right)$$
- μ 变大 → 曲线整体右移;
- σ 变小 → 曲线更窄更高;σ 变大 → 更宽更矮(曲线下面积恒为 1)。
用数据估计参数(对 m 个样本):
$$\mu = \frac{1}{m}\sum_i x^{(i)}, \qquad \sigma^2 = \frac{1}{m}\sum_i \big(x^{(i)} - \mu\big)^2$$
(这在统计上叫最大似然估计;有些统计课用 1/(m−1),但差别很小,吴恩达总用 1/m。)
编者拓展|「最大似然估计(MLE)」是什么:给定一批数据,MLE 问的是:哪组参数最可能生成出这批数据? 对高斯分布,答案就是「用样本均值估计 $\mu$、样本方差估计 $\sigma^2$」。这就是为什么用 $1/m$ 而不是 $1/(m-1)$——后者是「无偏估计」,而 MLE 追求的是「最可能」。MLE 是本册前半部分(高斯、异常检测)乃至整个统计机器学习的核心工具,EECS 189 会用好几讲专门讲它。
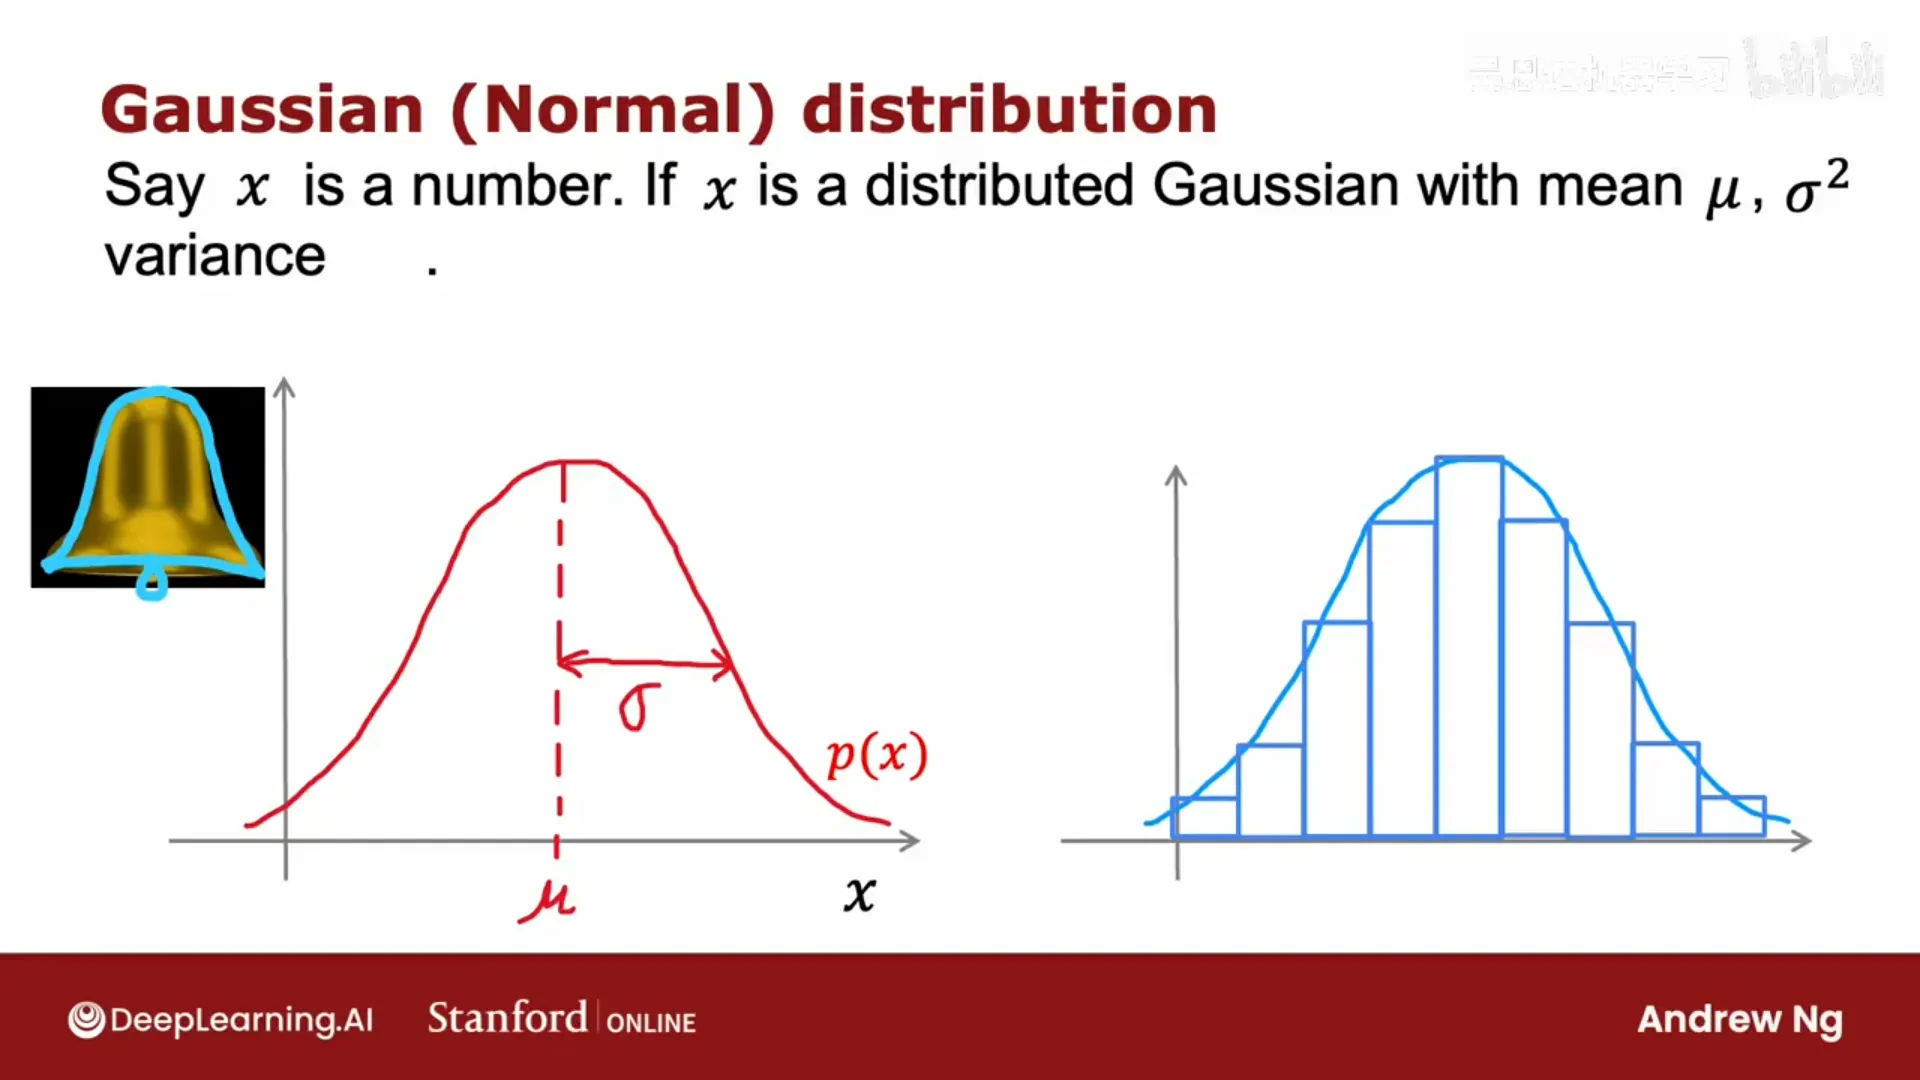
📷 高斯分布:以 μ 为中心、宽度由 σ 决定的钟形曲线
回到原视频 (00:03:06)
3.3 异常检测算法(多特征)
(p110)
当有 n 个特征时,把每个特征的"概率"相乘:
$$p(x) = \prod_{j=1}^{n} p\big(x_j;\mu_j,\sigma_j^2\big)$$
(这对应"假设各特征统计独立";即使实际不完全独立,该算法通常也能正常工作。)
为什么相乘? 直觉:若"非常热的概率是 1/10"、"剧烈振动的概率是 1/20",则"又热又振"的概率是 1/10 × 1/20 = 1/200——同时出现两个异常特征会非常罕见。相乘让任何一个特征异常都能把整体概率拉低。
完整流程:
- 选择可能指示异常的特征 xᵢ;
- 拟合参数:对每个特征 j,
μ_j = 均值、σ_j² = 方差(向量化:μ = x 的均值); - 给定新样本 x,计算 p(x);若 p(x) < ε → 标记异常。
📷 多特征异常检测:把各特征的概率相乘得到 p(x)
回到原视频 (00:01:05)
3.4 开发与评估异常检测系统
(p111)
即使是"无监督"任务,如果能拿到少量已标注的异常样本,就能评估系统、更快地决策(改特征、调 ε)。
数据划分(以飞机发动机为例:10,000 台正常、20 台异常):
| 子集 | 内容 |
|---|---|
| 训练集 | 大量正常样本(无标签,或假设全为 y=0) |
| 交叉验证集 | 一些正常 + 少量已知异常(y=1) |
| 测试集 | 一些正常 + 少量异常 |
- 在训练集上拟合 p(x);
- 在交叉验证集上评估(能检出多少异常、误报多少正常),用来调 ε、增删特征;
- 最后在测试集上评估。
- 异常极少时(如只有 2 个),也可以不设测试集,把异常全放交叉验证集——缺点是没有公平的最终评估、对 ε/特征的选择有过拟合风险。
注意分布高度倾斜:异常(正例)远少于正常(负例),所以应像第二门课那样用真正例/假正例/假负例/真负例、精确率/召回率/F1 来评估,而不是准确率。
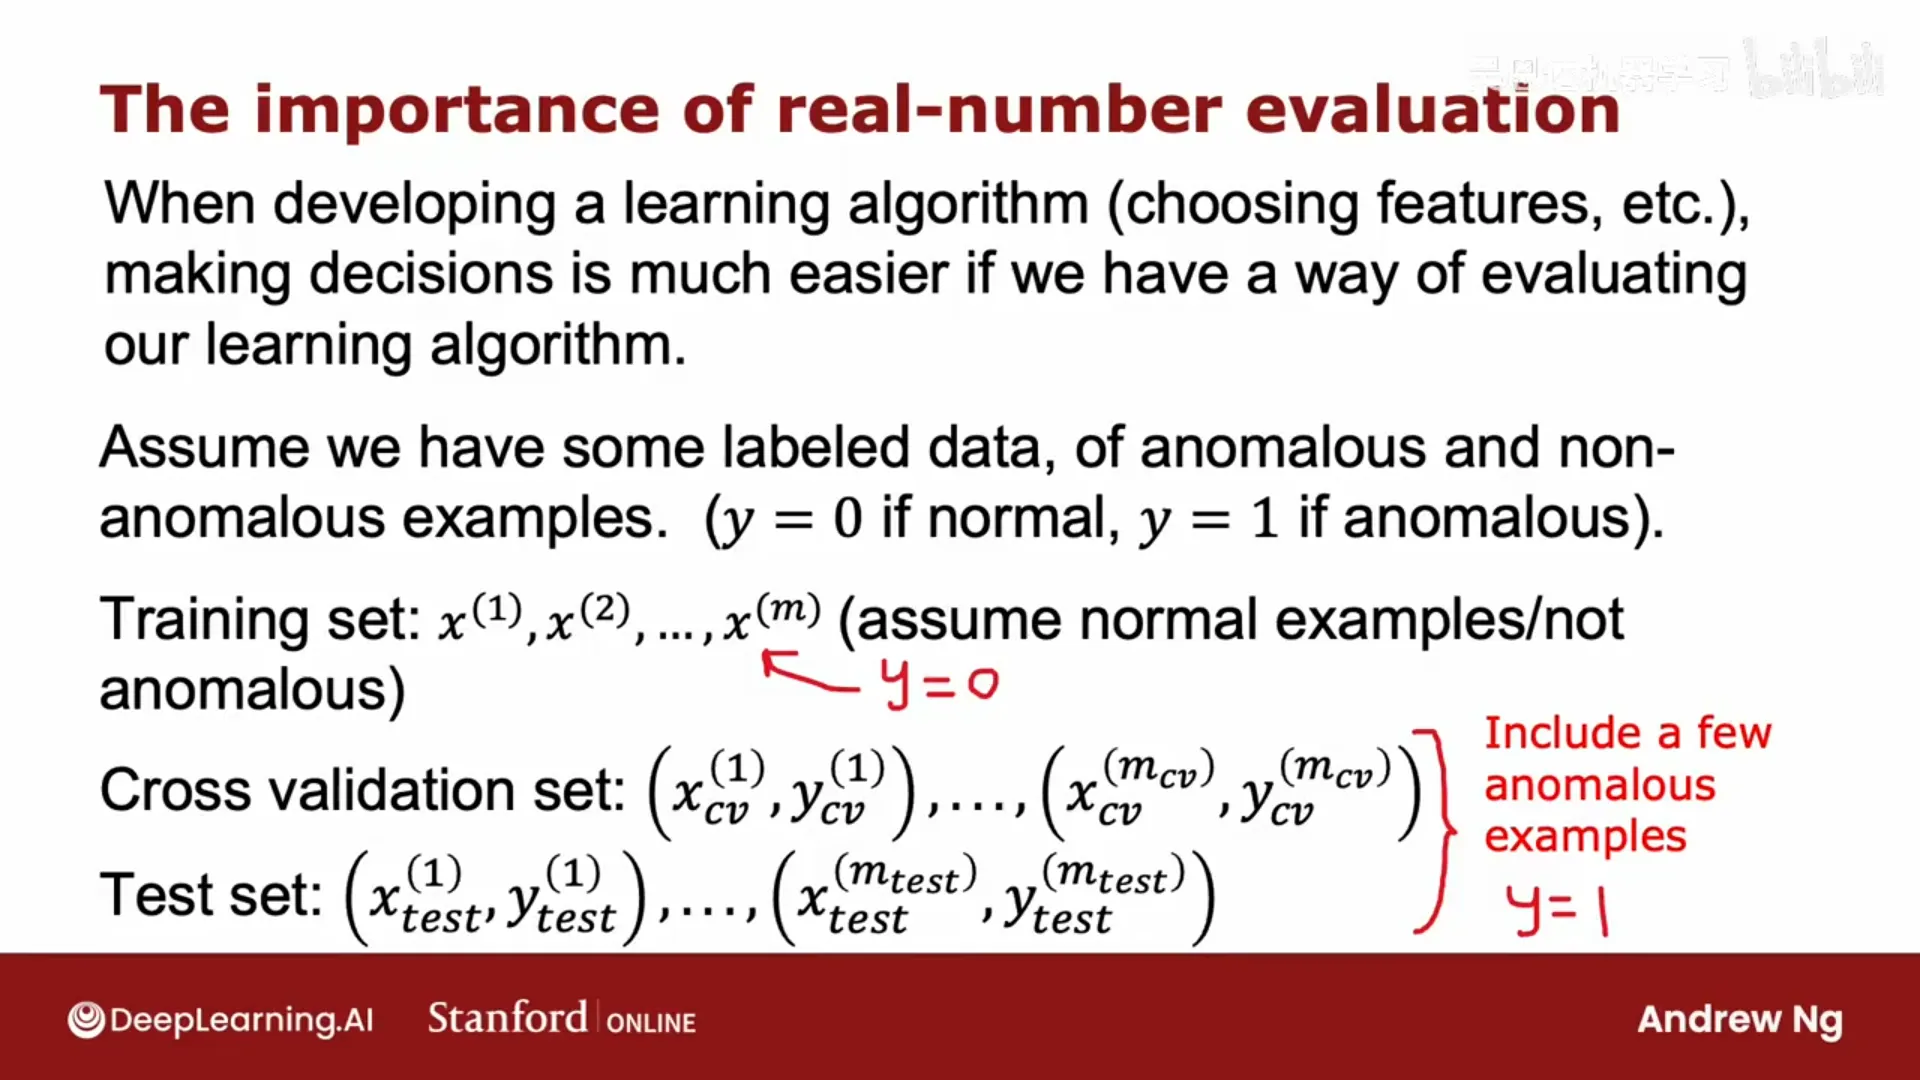
📷 异常检测的评估:训练集拟合 p(x),交叉验证集调 ε,测试集最终评估
回到原视频 (00:03:38)
3.5 异常检测 vs 监督学习
(p112)
既然有少量标注异常,为什么不用监督学习? 关键区别在于对问题的假设:
| 异常检测 | 监督学习 | |
|---|---|---|
| 正样本数量 | 非常少(0~20 个并不罕见) | 较多 |
| 如何建模 | 只用负样本学 p(x);正样本仅用于 CV/测试评估 | 直接学"正样本长什么样" |
| 异常类型 | 认为有很多种异常、未来可能全新 | 假设未来的正样本与训练集相似 |
| 适用场景 | 欺诈检测(新骗术层出不穷)、制造业找新缺陷、安全(黑客总有新手法) | 垃圾邮件过滤(垃圾邮件多年都相似)、天气预测、已知疾病的诊断 |
一句话:异常检测试图找出"可能与以前所见完全不同的新异常";监督学习则假设"未来的正样本与见过的相似"。
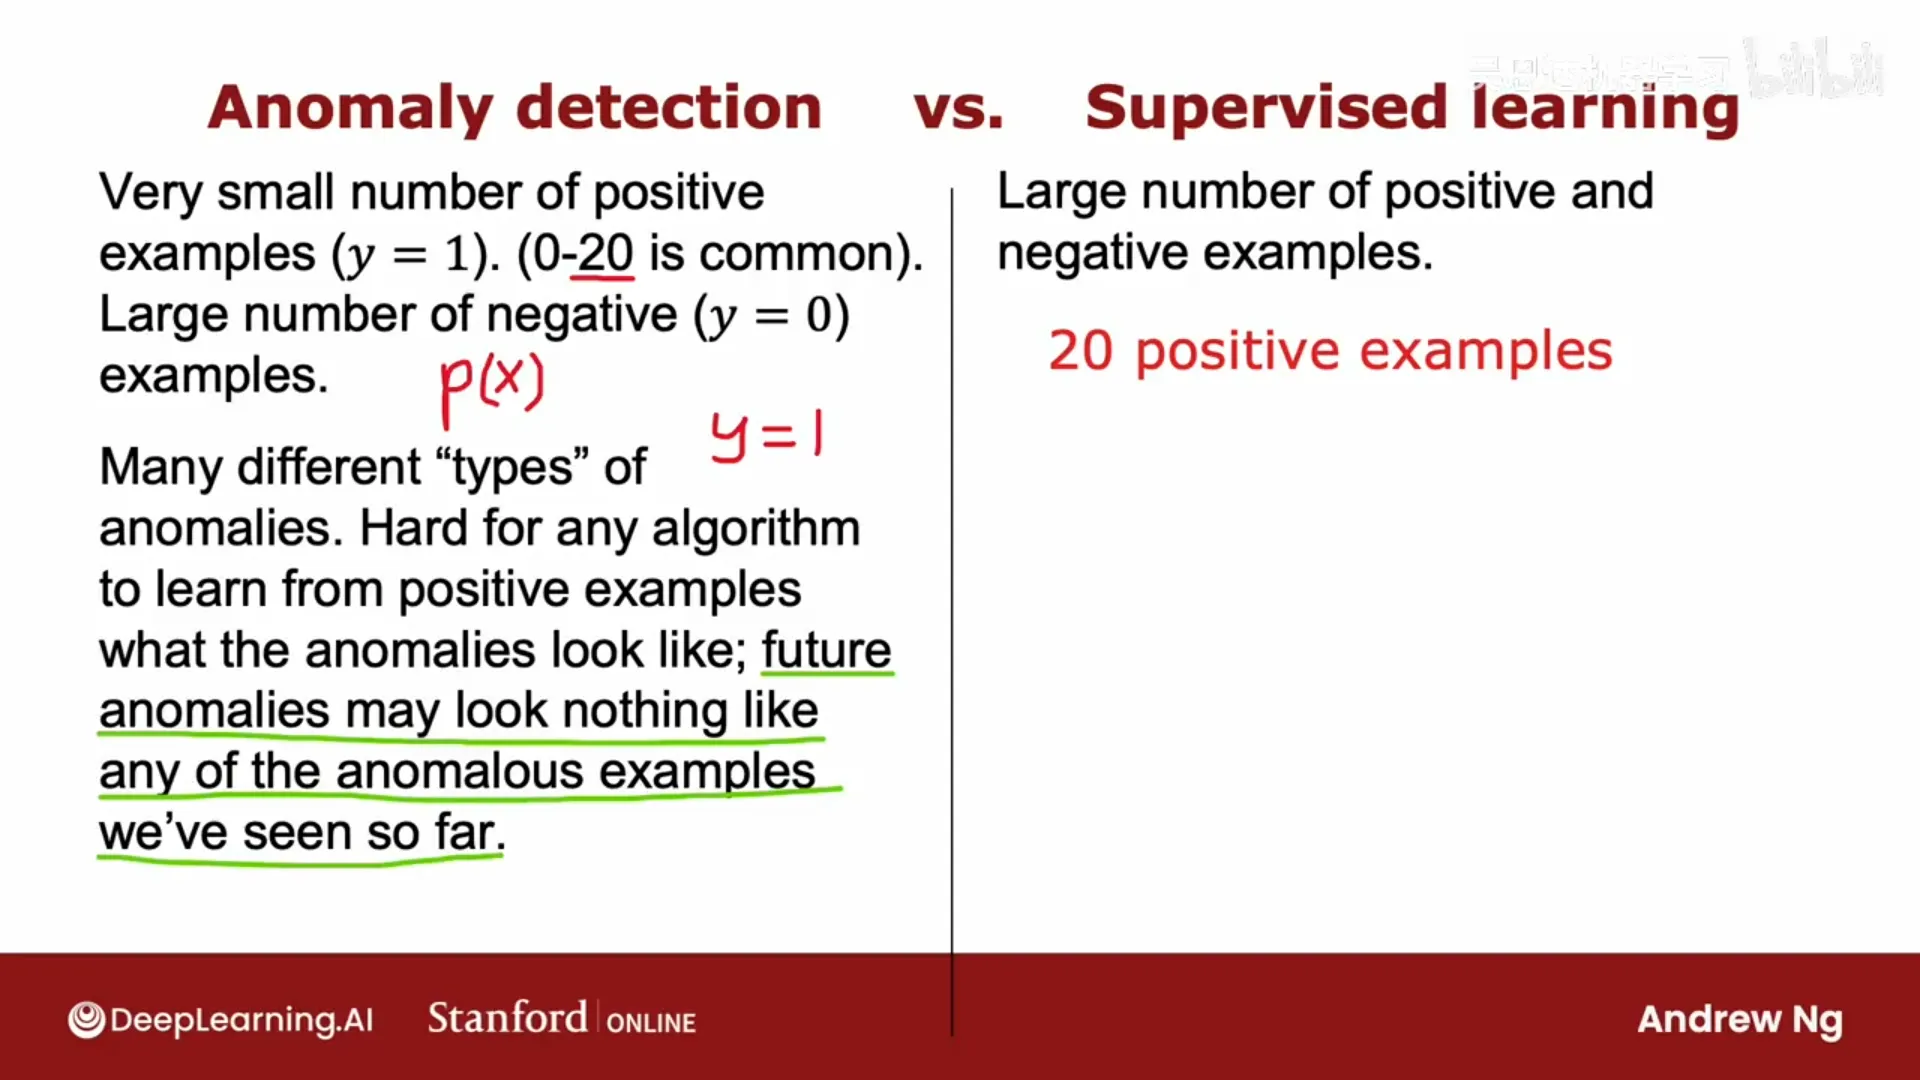
📷 异常检测 vs 监督学习:取决于异常是否有多种类型、是否会全新出现
回到原视频 (00:02:28)
3.6 特征选择与变换
(p113)
特征选择对异常检测比监督学习更重要:监督学习有标签,能学会忽略无关特征;而异常检测只靠无标签数据,更难判断该忽略哪些特征。
(1) 让特征尽量接近高斯分布:画直方图(plt.hist)检查。若某个特征明显不是钟形,就做变换让它更像高斯:
log(x)、log(x + c)、√x、x^(1/3)等;- 实践做法:试一批变换,挑一个看起来最像高斯的;别忘了对交叉验证集/测试集做同样的变换。
(2) 误差分析:训练后看交叉验证集上算法漏检的异常。常见问题是"正常和异常的 p(x) 都很大"——即某个异常样本的特征看起来和其他样本相似。此时尝试造一个新特征来把它区分开。例如检测服务器异常:
- 单看 CPU 负载高、网络流量大,都不算异常;
- 真正奇怪的是 CPU 负载很高但网络流量很低 → 造新特征
x₅ = CPU 负载 / 网络流量。
另一个例子:某用户交易次数看起来和别人一样,但打字速度极快——加这个新特征就能把它识别为异常。
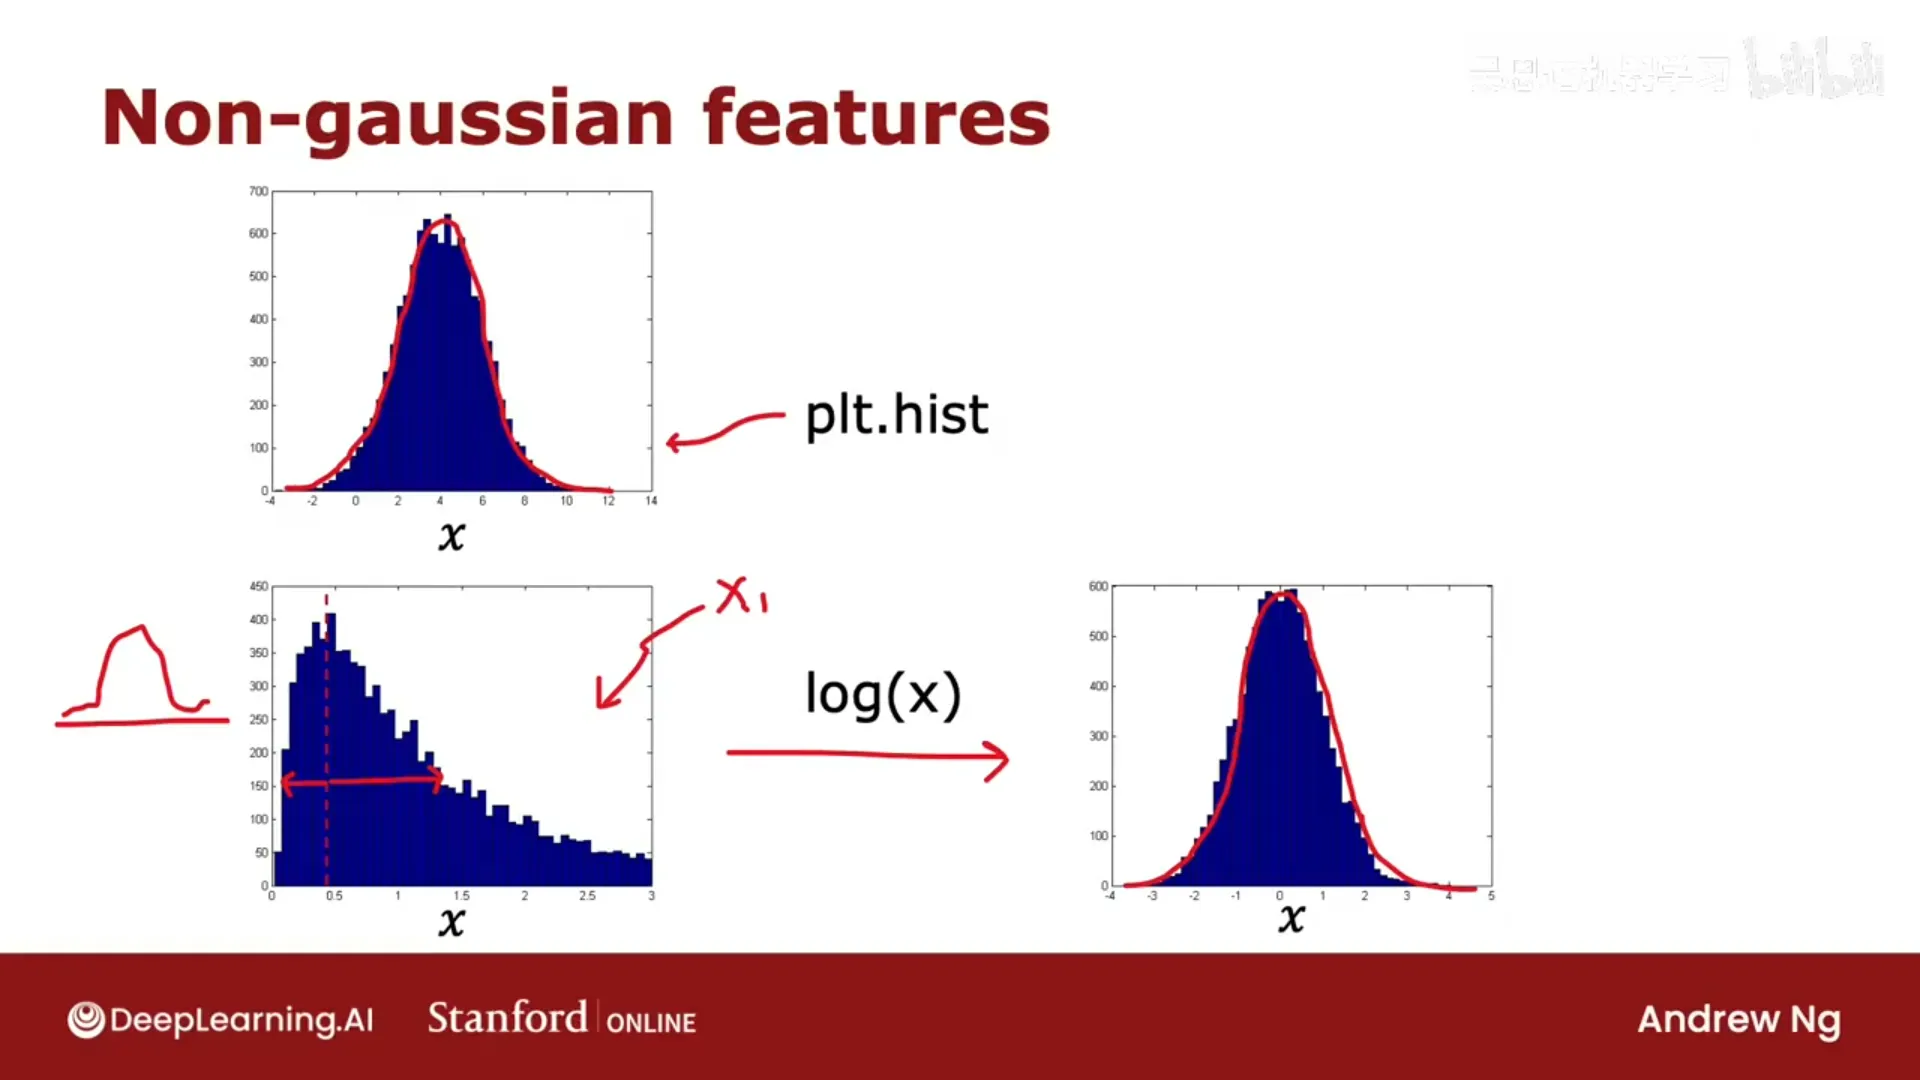
📷 特征变换:让特征更接近高斯分布(可用 log、平方根、幂次等)
回到原视频 (00:02:40)
第四章 推荐系统:协同过滤
(对应模块 4,视频 p114–p117)
4.1 提出建议
(p114)
推荐系统的商业影响力远超学术关注度:亚马逊、Netflix、外卖应用……很多公司很大一部分销售额由推荐系统驱动。
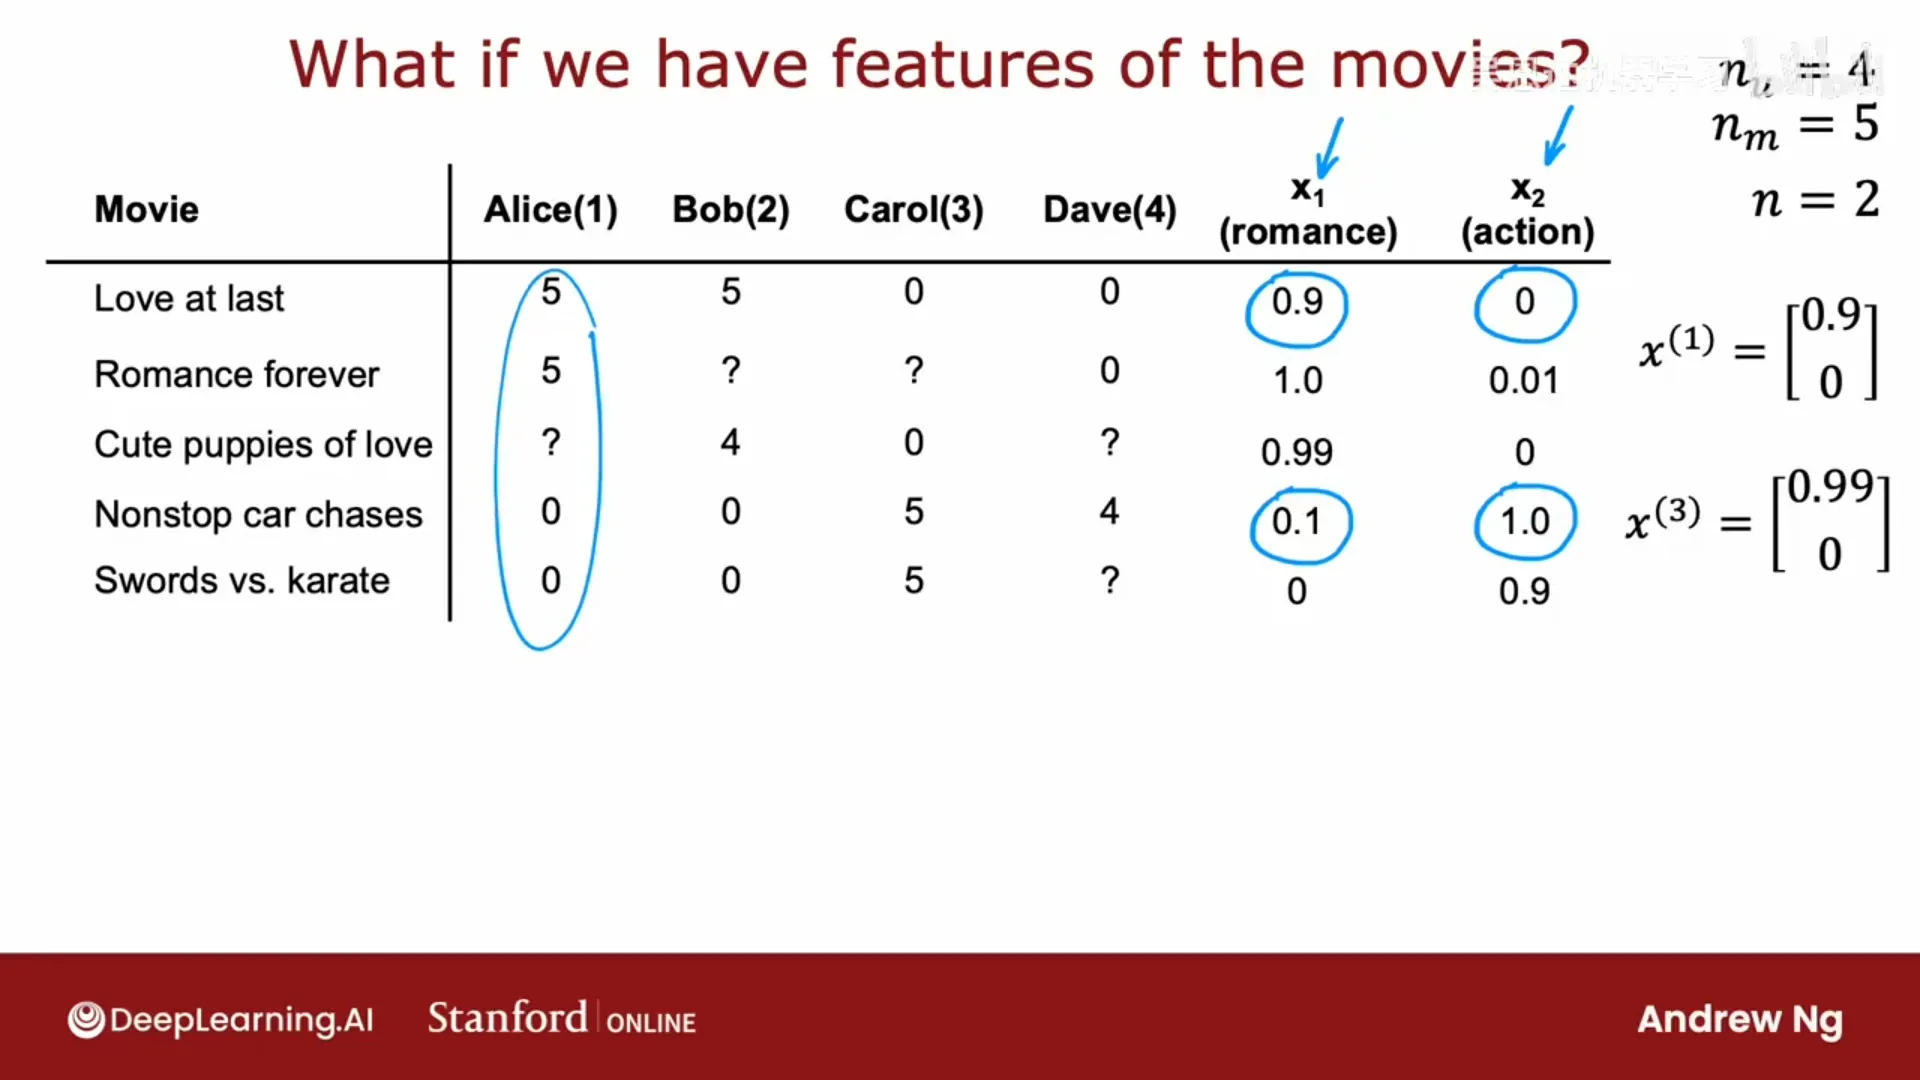
以电影评分预测为例:4 个用户(Alice/Bob/Carol/Dave)、5 部电影,用户给电影打 0~5 星,但不是每个人都看过每部电影(未看过的评分记为 ?)。
符号:
- n_u = 用户数(此例 4);n_m = 电影/项目数(此例 5);
- r(i,j) = 1 表示"用户 j 给电影 i 评过分",否则 0;
- y(i,j) = 用户 j 给电影 i 的评分(当 r(i,j)=1 时存在)。
目标:对用户尚未评分的电影预测他会打多少分,从而推荐他更可能打高分的电影。
📷 推荐系统:评分矩阵,问号表示用户还没看过的电影
回到原视频 (00:01:14)
4.2 若有每部电影的特征:像"每个用户一个线性回归"
(p115)
先做一个特殊假设:我们已知每部电影的特征,例如
- x₁ = "有多浪漫"、x₂ = "有多动作"。
于是可以为每个用户拟合一个线性回归:
$$\text{用户 } j \text{ 对电影 } i \text{ 的评分预测} = w^{(j)}\cdot x^{(i)} + b^{(j)}$$
例:Alice(用户 1)喜欢浪漫片、讨厌动作片。若 w⁽¹⁾ = [5, 0]、b⁽¹⁾ = 0,则对《可爱的小狗之恋》(特征 [0.99, 0])预测评分为 4.95——很合理。
成本函数(对用户 j),只对他评过分的电影求和:
$$J\big(w^{(j)}, b^{(j)}\big) = \frac{1}{2}\sum_{i:\,r(i,j)=1}\big(w^{(j)}\cdot x^{(i)} + b^{(j)} - y^{(i,j)}\big)^2 + \frac{\lambda}{2}\sum_{k=1}^{n}\big(w^{(j)}_k\big)^2$$
(惯例上把 1/m⁽ʲ⁾ 去掉,因为它是常数、不影响最优解。)
对所有用户:把每个用户的成本加起来:
$$J(w,b) = \sum_{j=1}^{n_u}\Bigg[\frac{1}{2}\sum_{i:\,r(i,j)=1}\big(w^{(j)}\cdot x^{(i)} + b^{(j)} - y^{(i,j)}\big)^2 + \frac{\lambda}{2}\sum_k \big(w^{(j)}_k\big)^2\Bigg]$$
最小化它(梯度下降等)就得到所有用户的参数——本质上就是"为每个用户训练一个线性回归"。
📷 若已知电影特征,就为每个用户拟合一个线性回归
回到原视频 (00:01:50)
4.3 若没有特征:协同过滤
(p116)
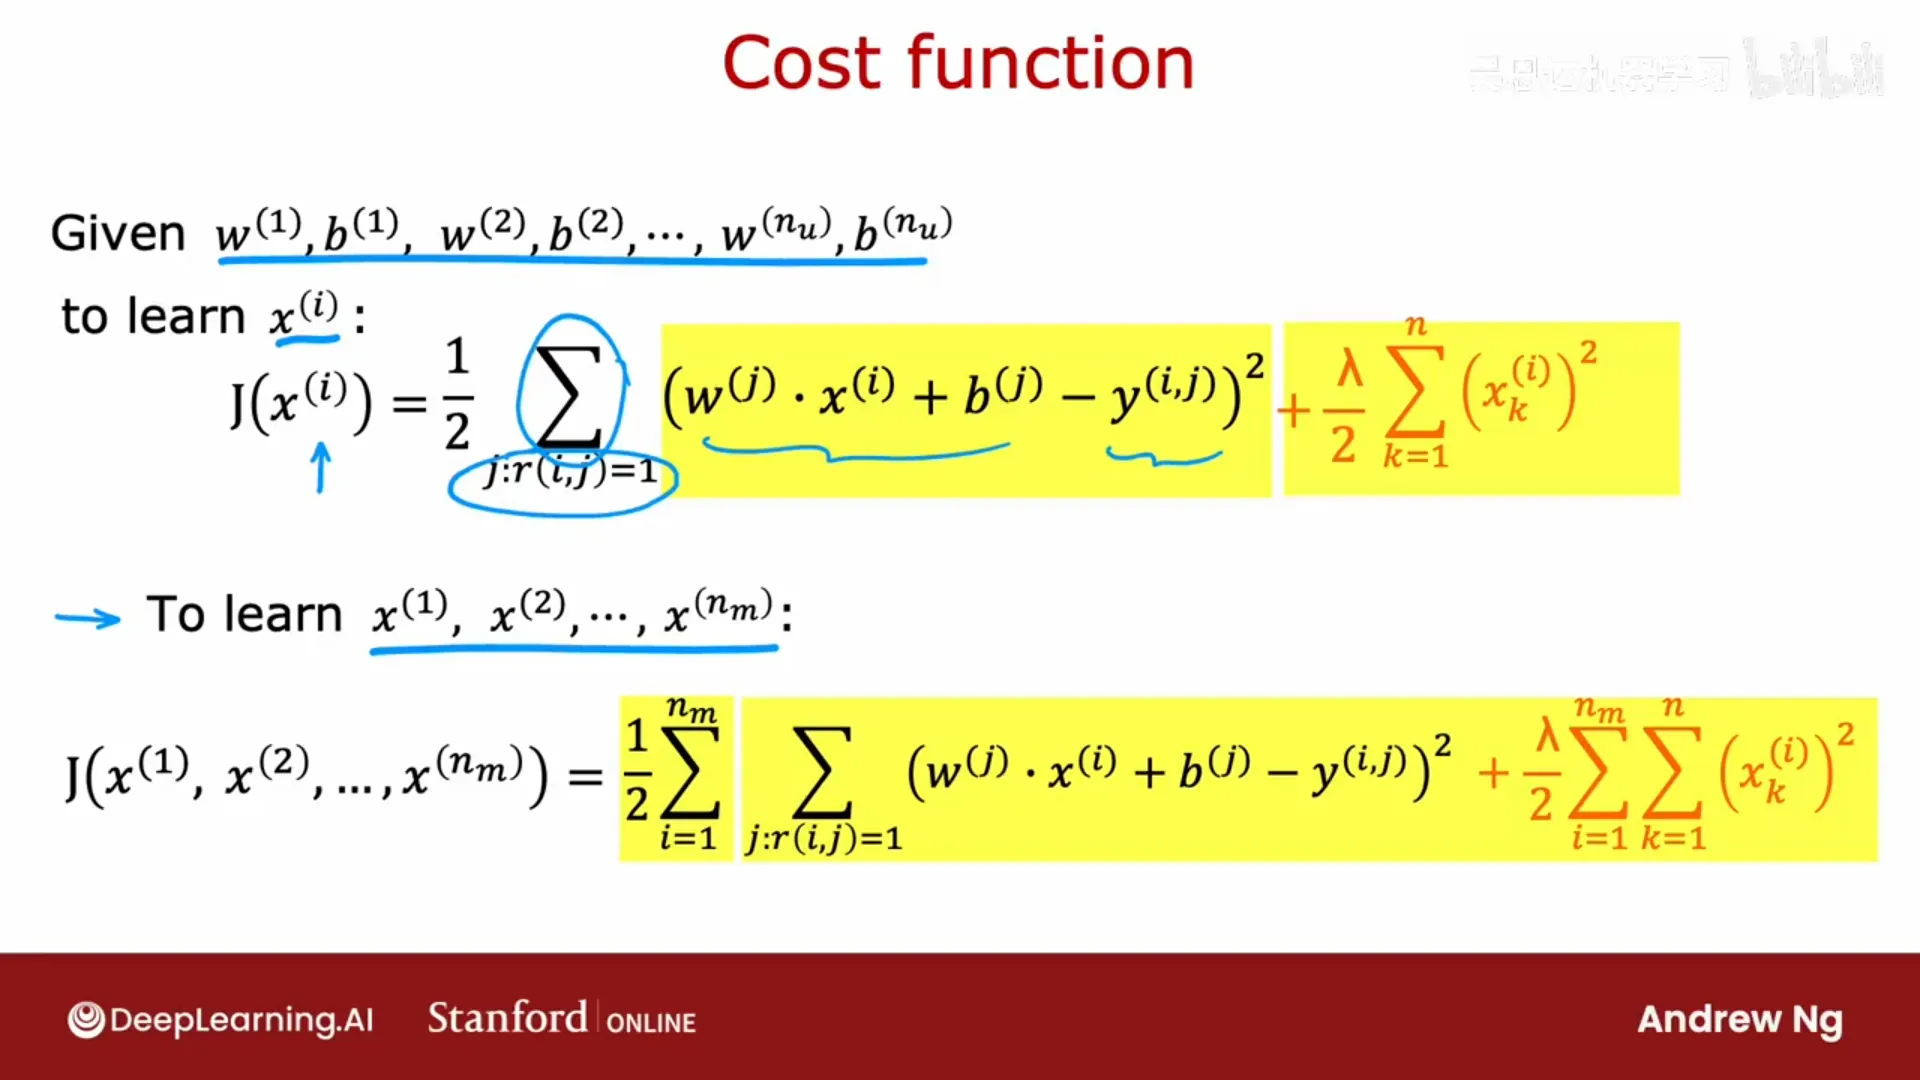
但特征从哪来? 反向思考:如果已知用户的参数 w、b,能不能反推出电影的特征 x?
例:已知 4 个用户的参数,且知道他们对电影 1 的评分,我们希望 w⁽ʲ⁾·x⁽¹⁾ ≈ 评分。比如 Alice、Bob 给电影 1 打 5,Carol、Dave 打 0;结合 w⁽¹⁾=[5,0]、w⁽²⁾=[5,0]、w⁽³⁾=[0,5]、w⁽⁴⁾=[0,5],可以推得 x⁽¹⁾ = [1, 0](浪漫片)。
对每部电影 i 学其特征 x⁽ⁱ⁾ 的成本函数(对评过电影 i 的所有用户 j 求和):
$$J\big(x^{(i)}\big) = \frac{1}{2}\sum_{j:\,r(i,j)=1}\big(w^{(j)}\cdot x^{(i)} + b^{(j)} - y^{(i,j)}\big)^2 + \frac{\lambda}{2}\sum_k \big(x^{(i)}_k\big)^2$$
对所有电影求和,就是"在已知用户参数时学习所有电影特征"的代价函数。
这就是协同过滤的妙处:特征不必外部提供,算法可以自己学出来。
协同过滤:同时学 w、b 和 x
把上面两个代价函数合起来(注意两个求和其实都是"对所有 (i,j) 有评分的配对求和"):
$$\begin{aligned}
J(w,b,x) = \sum_{(i,j):\,r(i,j)=1}\big(w^{(j)}\cdot x^{(i)} + b^{(j)} - y^{(i,j)}\big)^2 &+ \frac{\lambda}{2}\sum_j\sum_k \big(w^{(j)}_k\big)^2 \ &+ \frac{\lambda}{2}\sum_i\sum_k \big(x^{(i)}_k\big)^2
\end{aligned}$$
算法:用梯度下降同时优化 w、b、x:
$$\begin{aligned}
w^{(j)} &:= w^{(j)} - \alpha\,\frac{\partial J}{\partial w^{(j)}}\ b^{(j)} &:= b^{(j)} - \alpha\,\frac{\partial J}{\partial b^{(j)}}\ x^{(i)} &:= x^{(i)} - \alpha\,\frac{\partial J}{\partial x^{(i)}}
\end{aligned}$$
这就是协同过滤算法。
编者拓展|协同过滤的另一个名字:矩阵分解:把评分矩阵 $Y$(用户 × 电影,很多格是问号)近似写成 $Y \approx W X^\top$($W$ 是用户参数、$X$ 是电影特征),这正是矩阵分解(matrix factorization)。所以协同过滤「同时学 $w,b,x$」的本质,就是用低秩矩阵去填补评分矩阵里的空缺。这个视角也解释了它为什么能泛化:相似的用户会得到相似的 $w$,于是他们能互相「推荐」特征。"协同"的含义:多个用户对同一部电影的评分"协同"起来,让算法推断出电影的特征,进而预测其他用户的评分。
📷 协同过滤:同时学习用户参数 w、b 和电影特征 x
回到原视频 (00:07:52)
4.4 二元标签:收藏/点赞/点击
(p117)
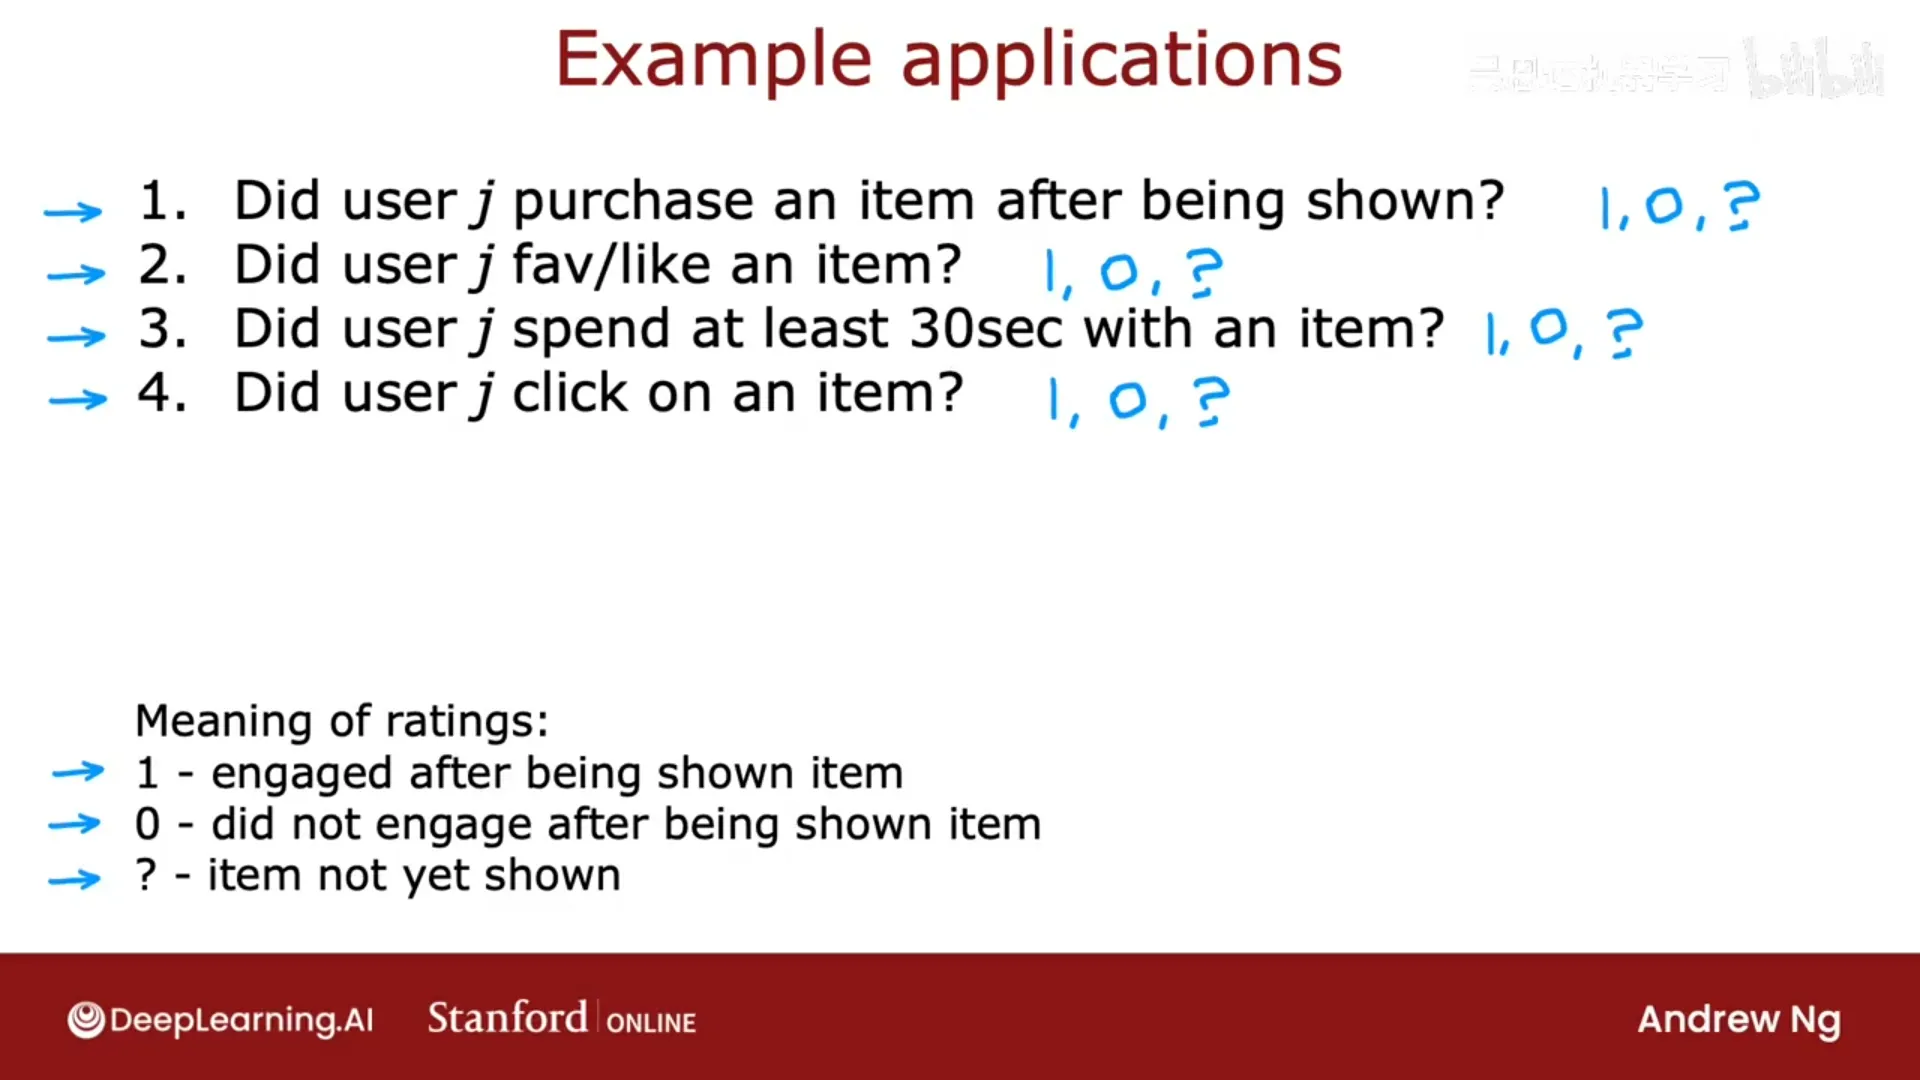
很多推荐系统只有二元标签(喜欢/不喜欢、点击/未点击、购买/未购买),而非 0~5 星评分。把算法推广到这种情况,就像从线性回归推广到逻辑回归:
- 把
w⁽ʲ⁾·x⁽ⁱ⁾ + b⁽ʲ⁾送入 Sigmoid,预测 P(y=1):f = g( w⁽ʲ⁾·x⁽ⁱ⁾ + b⁽ʲ⁾ ), g(z) = 1/(1+e^{−z}) - 损失改用二元交叉熵:
L(f, y) = −y·log(f) − (1−y)·log(1−f) - 代价函数 = 对所有 r(i,j)=1 的配对求损失的平均(+ 正则项)。
二元标签的常见含义(往往隐式地从用户行为推断):
| 标签 | 含义 |
|---|---|
| 1 | 用户看过该项目后发生了互动(点击、停留 30 秒以上、明确喜欢、购买) |
| 0 | 用户看过但没有互动 |
| ? | 该项目还没展示给用户 |
(例:在线广告中,"点击=1、看过未点击=0、没看过=?";视频网站用"是否看了至少 30 秒"来推断是否喜欢。)
📷 二元标签的协同过滤:用 Sigmoid + 二元交叉熵(类似逻辑回归)
回到原视频 (00:04:03)
第五章 均值归一化与 TensorFlow 实现
(对应模块 5,视频 p118–p120)
5.1 均值归一化:让"新用户"也有合理预测
(p118)
加一个第五位用户 Eve,她什么都没评分。若直接训练协同过滤,由于正则项会让参数变小,得到 w⁽⁵⁾ = 0、b⁽⁵⁾ = 0,于是预测 Eve 给所有电影都打 0 星——这显然不合理。
均值归一化:对每部电影先算它的平均评分 μ,然后把每个评分减去该电影的平均值,用这些新值作为 y 去训练。
预测时再加回 μ:
$$\text{用户 } j \text{ 对电影 } i \text{ 的预测} = w^{(j)}\cdot x^{(i)} + b^{(j)} + \mu_i$$
效果:对像 Eve 这样的新用户,w⁽⁵⁾ = b⁽⁵⁾ = 0,于是预测 = μ_i——即"默认她会给这部电影打其他用户的平均分"。这比"全打 0 分"合理得多,也顺便让优化算法跑得更快一点。
(也可以按列归一化,帮助"没人评过的新电影";但按行归一化帮助"没怎么评分的新用户"更重要——新电影一开始本来就不该推荐给太多人。)
📷 均值归一化:把每部电影的评分减去其均分,预测时再加回,改善新用户体验
回到原视频 (00:03:10)
5.2 用 TensorFlow 实现协同过滤
(p119)
TensorFlow 不只用于神经网络——它很适合实现协同过滤,因为它的自动微分(autodiff)能自动求导:你只需实现代价函数 J,不必自己算导数。
用梯度带(GradientTape)实现:
optimizer = tf.keras.optimizers.Adam(learning_rate=0.01)

for iter in range(200):
    with tf.GradientTape() as tape:
        # 你自己写:用 X、W、b、Ynorm、R 计算代价 J
        cost_value = cofi_cost_func(X, W, b, Ynorm, R, num_users, num_movies, lambda_)
    grads = tape.gradient(cost_value, [X, W, b])   # 自动求导
    optimizer.apply_gradients(zip(grads, [X, W, b]))
要点:
- 代价函数的参数是 X、W、b(三者都是参数);
tf.GradientTape记录计算代价的操作序列,tape.gradient就得到对 X、W、b 的导数;- 有了自动微分,不限于梯度下降——可以用更强大的 Adam;
- 为什么不用
model.compile/fit?因为协同过滤的代价函数不能很好地嵌入标准 Dense 层,所以要自己写代价函数,再借 TensorFlow 的 autodiff 与 Adam 优化。
实践实验用的是真实数据集 MovieLens。
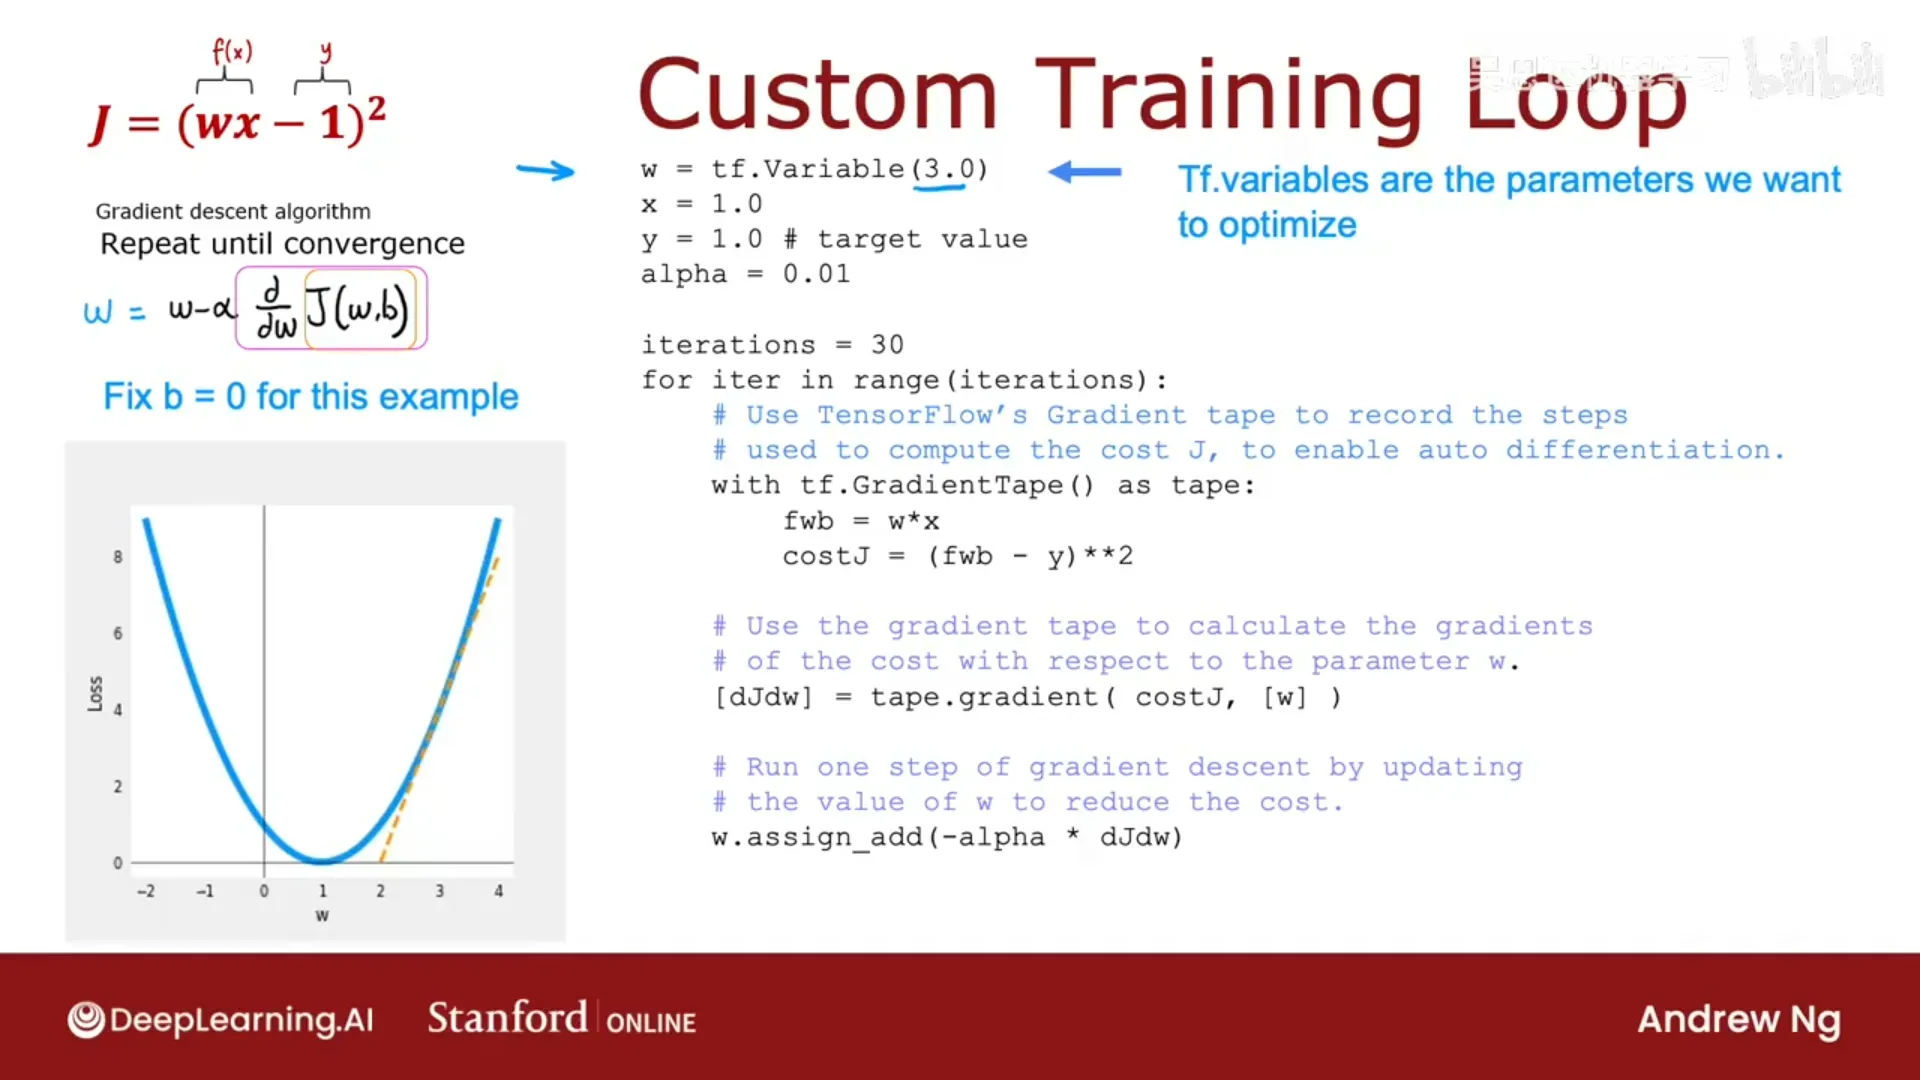
📷 用 TensorFlow GradientTape 实现协同过滤:写代价函数,autodiff 自动求导
回到原视频 (00:03:46)
5.3 查找相关项目
(p120)
协同过滤学出的特征 x⁽ⁱ⁾ 单个看起来难以解释(不像"浪漫/动作"那么直观),但合起来确实描述了这部电影。由此可以找相似项目:
$$\text{电影 } i,k \text{ 的相似度} \;\to\; \sum_{l=1}^{n}\big(x_{k,l} - x_{i,l}\big)^2 \quad(\text{越小越相似})$$
找距离最小的 5~10 部电影,就是"与你看的这部电影相似"的推荐。这个"找相似项目"的小积木,后面还会用来实现更强的推荐系统。
协同过滤的两个局限
- 冷启动问题:新项目(几乎没人评过的新电影)怎么排名?新用户(只评过很少项目)怎么保证给他合理推荐?(均值归一化能缓解,但还有更好的方法。)
- 无法利用"侧面信息(side information)":例如电影的类型、明星、出品方、预算;用户的人口统计(年龄、性别、位置)、明确表达的偏好、IP 地址、用的是 Chrome / Firefox / Safari / Edge(浏览器与用户行为有惊人相关性)等。
基于内容的过滤正是为解决这些局限而生,它是当今许多商业应用采用的最先进技术。
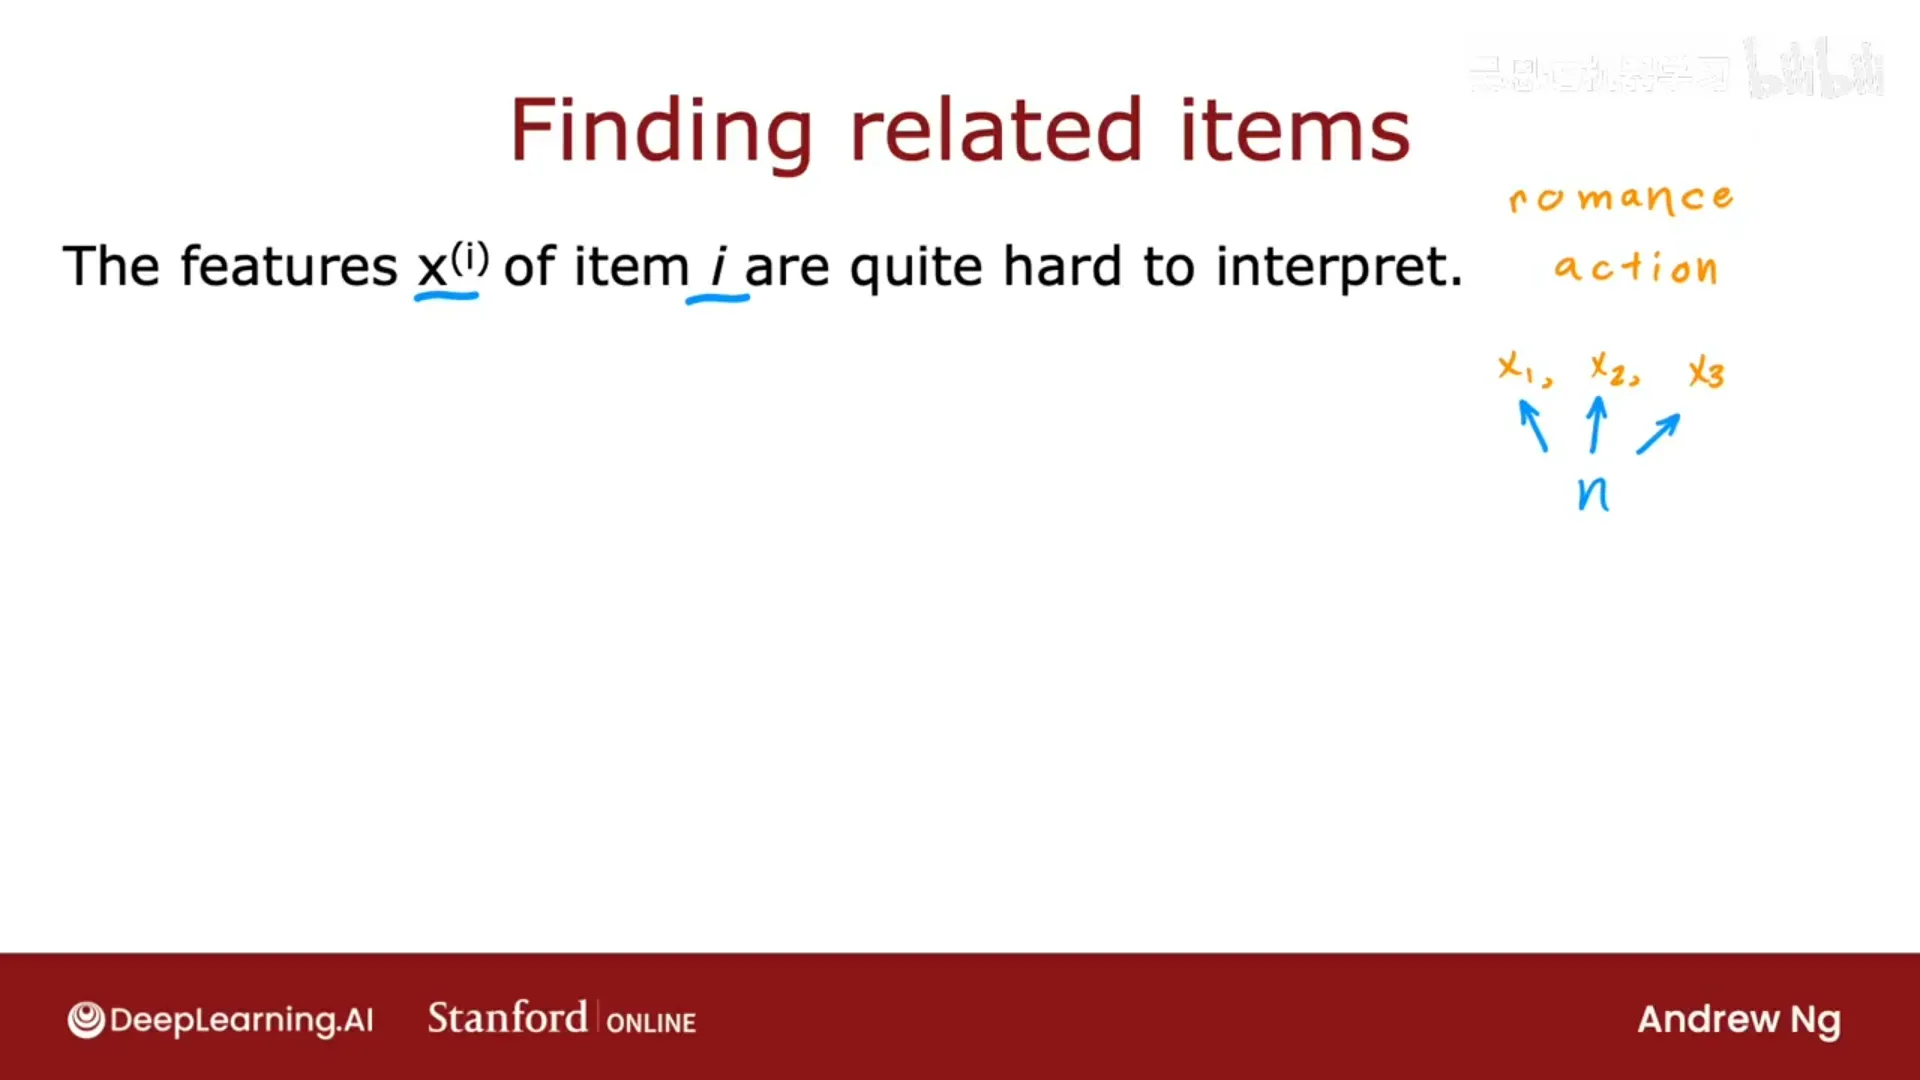
📷 查找相关项目:用学到的特征向量之间的平方距离衡量相似度
回到原视频 (00:01:36)
第六章 基于内容的过滤与大规模推荐
(对应模块 6,视频 p121–p125)
6.1 协同过滤 vs 基于内容的过滤
(p121)
| 协同过滤 | 基于内容的过滤 | |
|---|---|---|
| 思路 | 基于"与你评分相似的用户"的评分推荐 | 基于"用户特征与项目特征的匹配"推荐 |
| 输入 | 用户对项目的评分 | 用户特征 + 项目特征(也可继续用评分) |
用户特征示例:年龄、性别(独热)、国家(独热,约 200 个值)、过去行为(如看过目录中前 1000 部电影中的哪些)、用户对各类型电影的平均评分(这个特征依赖评分,但完全合理)。
项目特征示例:上映年份、类型、影评人评价、电影的平均评分(同样可依赖评分,也可按国家/用户群体统计)。
核心思路:用户特征向量 x_u 和项目特征向量 x_m 的长度可以不同,但我们要为二者各算出一个长度相同的向量:
$$\begin{aligned}
v_u^{(j)} &= \text{描述用户 } j \text{ 的向量(如 32 维)}\ v_m^{(i)} &= \text{描述电影 } i \text{ 的向量(如 32 维)}\ \hat{y} &= v_u^{(j)}\cdot v_m^{(i)}
\end{aligned}$$
(去掉了 b⁽ʲ⁾,它对性能没有影响。)v_u 可理解为"用户对各题材的偏好",v_m 是"电影各题材的分量",点积反映"这个用户有多喜欢这部电影"。
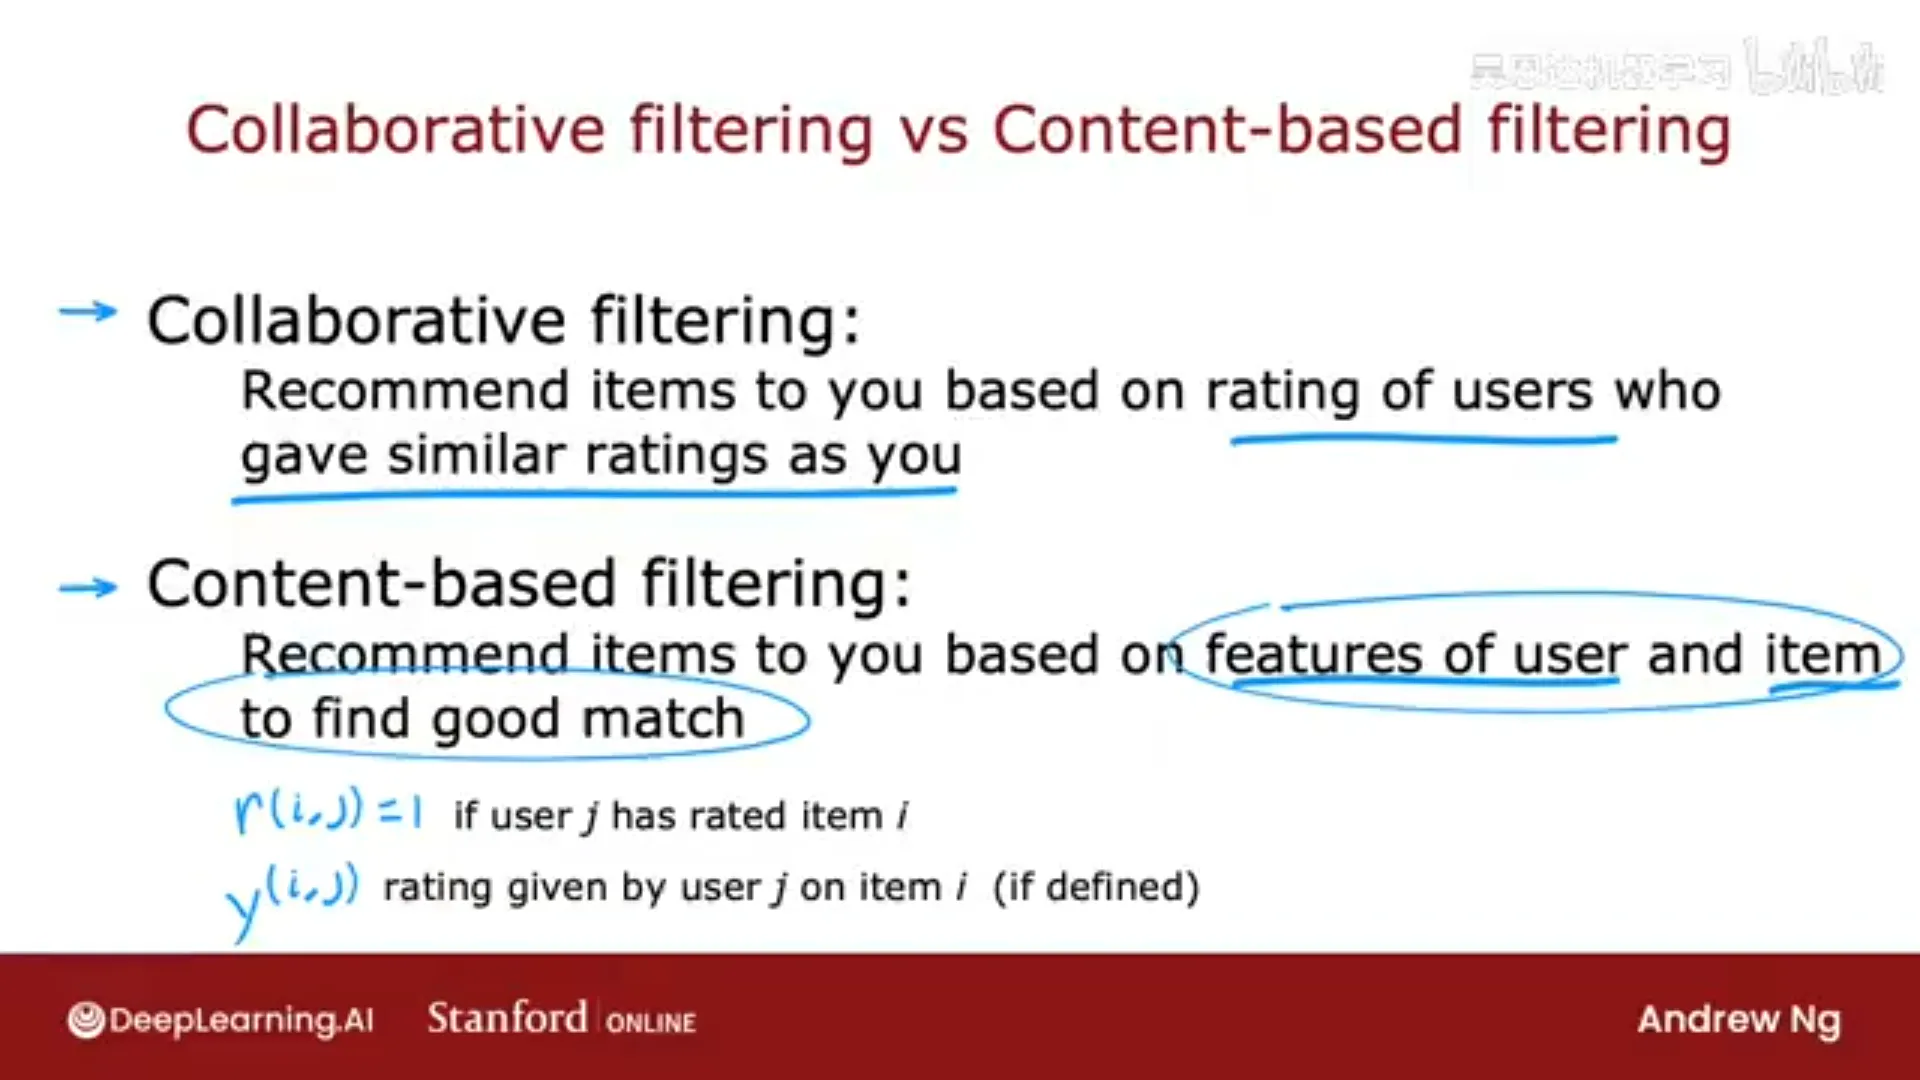
📷 基于内容的过滤:从用户特征与项目特征各算出等长向量 v_u、v_m,取点积
回到原视频 (00:01:55)
6.2 用深度学习实现
(p122)
用两个神经网络:
- 用户网络:输入用户特征 x_u,经若干全连接层,输出 32 维的 v_u;
- 电影网络:输入电影特征 x_m,经若干全连接层,输出 32 维的 v_m;
- 预测:两者点积
v_u · v_m。
(用户网络与电影网络层数、每层单元数都可以不同,但输出维度必须相同。)
编者拓展|「双塔(two-tower)」模型:用户网络与项目网络各自独立编码、只在最后做点积——这种结构今天叫 双塔模型(two-tower / dual encoder)。它的巨大优势是:两座塔可以分开预计算——所有电影向量 $v_m$ 离线算好、建好索引;用户来访问时只跑用户塔一次,就能和几百万部电影的向量比相似度(配合向量数据库做最近邻)。这正是第 27 讲讲过的「向量数据库」的用武之地。
代价函数(对所有有评分的 (i,j) 求均方误差,+ 正则项):
$$J = \sum_{(i,j):\,r(i,j)=1}\big(v_u^{(j)}\cdot v_m^{(i)} - y^{(i,j)}\big)^2 + \text{(正则项)}$$
训练:用梯度下降同时优化两个网络的所有参数。若有二元标签,也可对点积加 Sigmoid、用二元交叉熵。
为什么能用深度学习:这体现了"把多个神经网络组合起来"的威力——用户网络 + 电影网络 + 点积共同构成一个更大的系统。
找相似项目:给定电影 i,找其他电影 k 使 ‖v_m⁽ᵏ⁾ − v_m⁽ⁱ⁾‖² 最小。而且这些可以预先算好(离线算出每部电影最相似的 10~20 部),用户访问时直接查表。
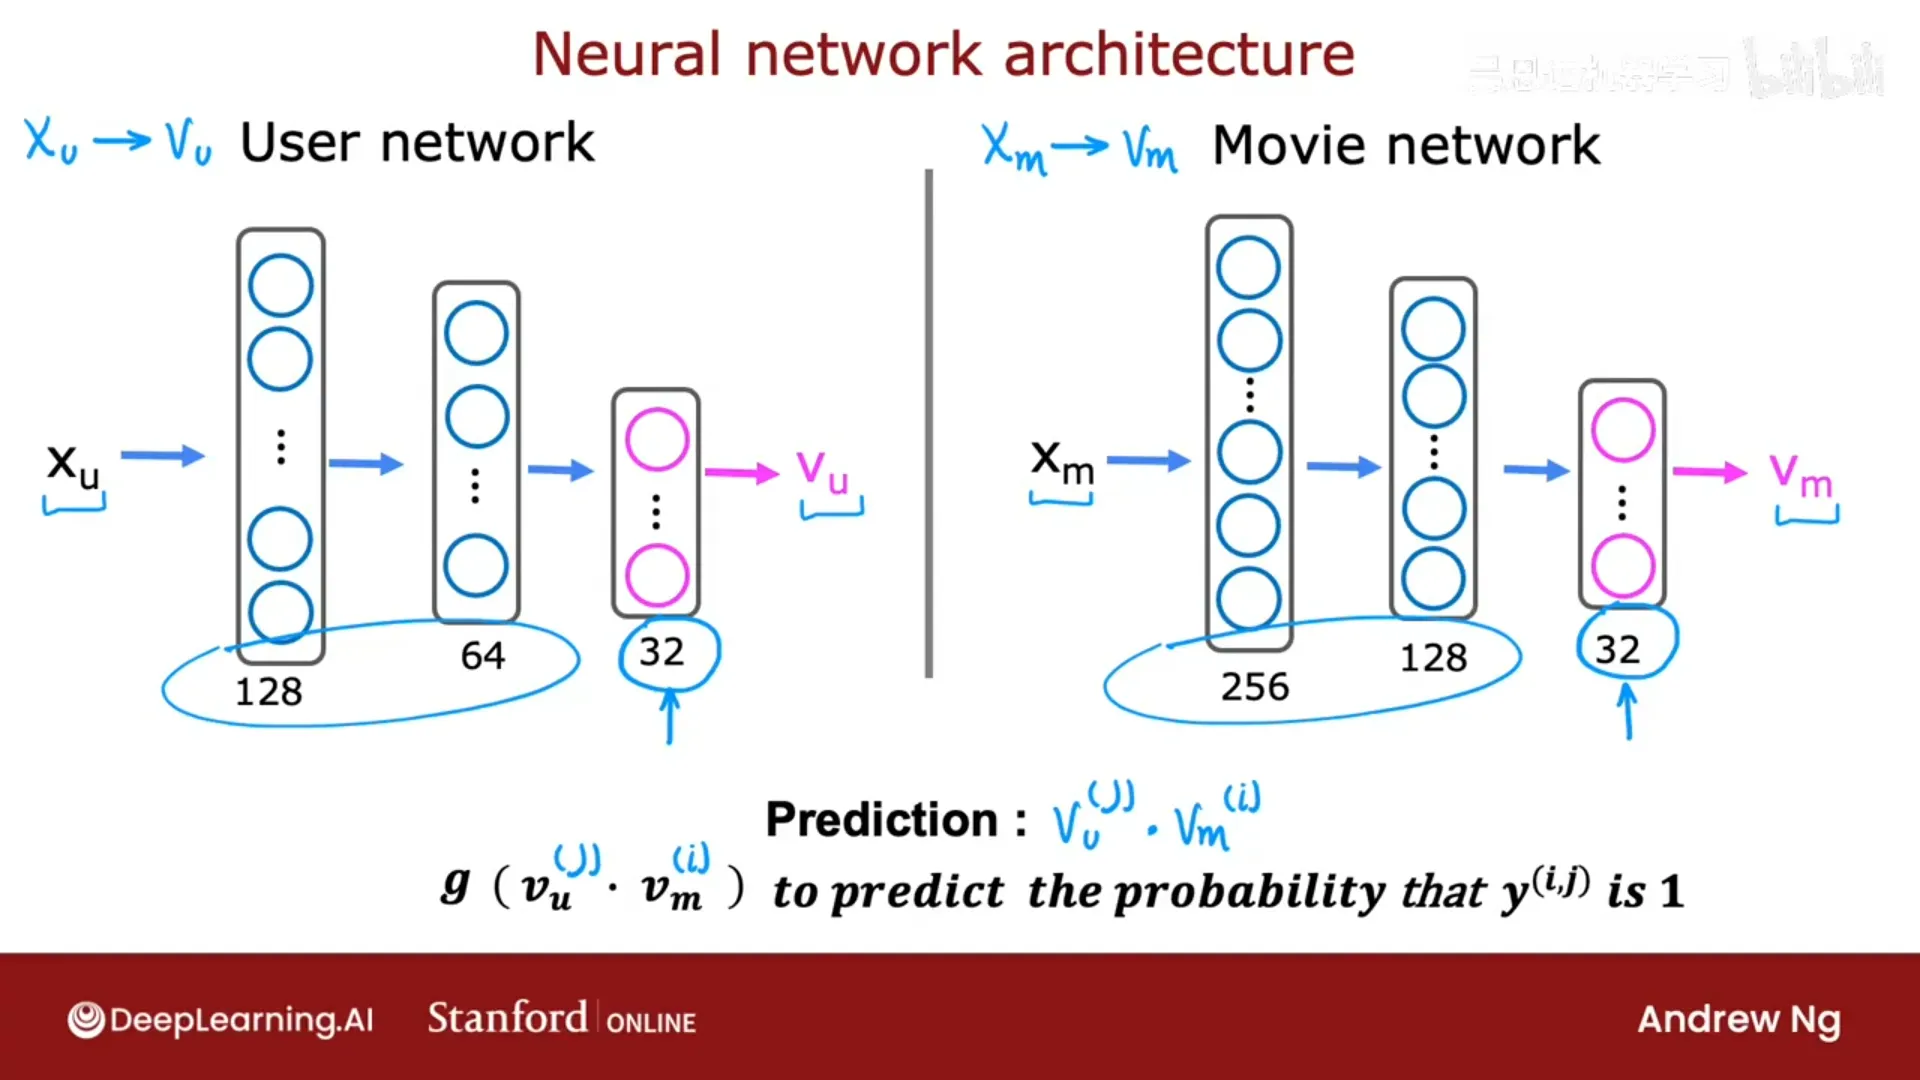
📷 基于内容的过滤:用户网络输出 v_u、电影网络输出 v_m,点积得到预测
回到原视频 (00:03:13)
6.3 从大目录中推荐:检索 + 排序
(p123)
大平台的目录可能有数千到数千万个项目(电影/广告/歌曲/商品)。每次用户访问都对每个项目跑一遍网络推理,计算上不可行。
所以许多大型推荐系统分两步:
- 检索(retrieval):生成一个候选列表(几百个),力求覆盖面广。做法举例:
- 对用户最近看过的 10 部电影,各找最相似的 10 部(预先算好,查表即可);
- 加上用户看得最多的 3 个类型里最热的 10 部;
- 加上用户所在国家最热的 20 部;
- 合并、去重、去掉已看过/已购买的。
- 排序(ranking):用训练好的模型对这几百个候选精确打分(算 v_u·v_m),按预测评分展示最高的那些。
优化:若所有 v_m 已预先算好,排序时只需对用户网络跑一次推理得到 v_u,再与候选的 v_m 做点积——非常快。
权衡:检索项目越多,效果通常越好但越慢。建议做离线实验,看"把检索量从 100 提到 500"能提升多少相关性,再决定。
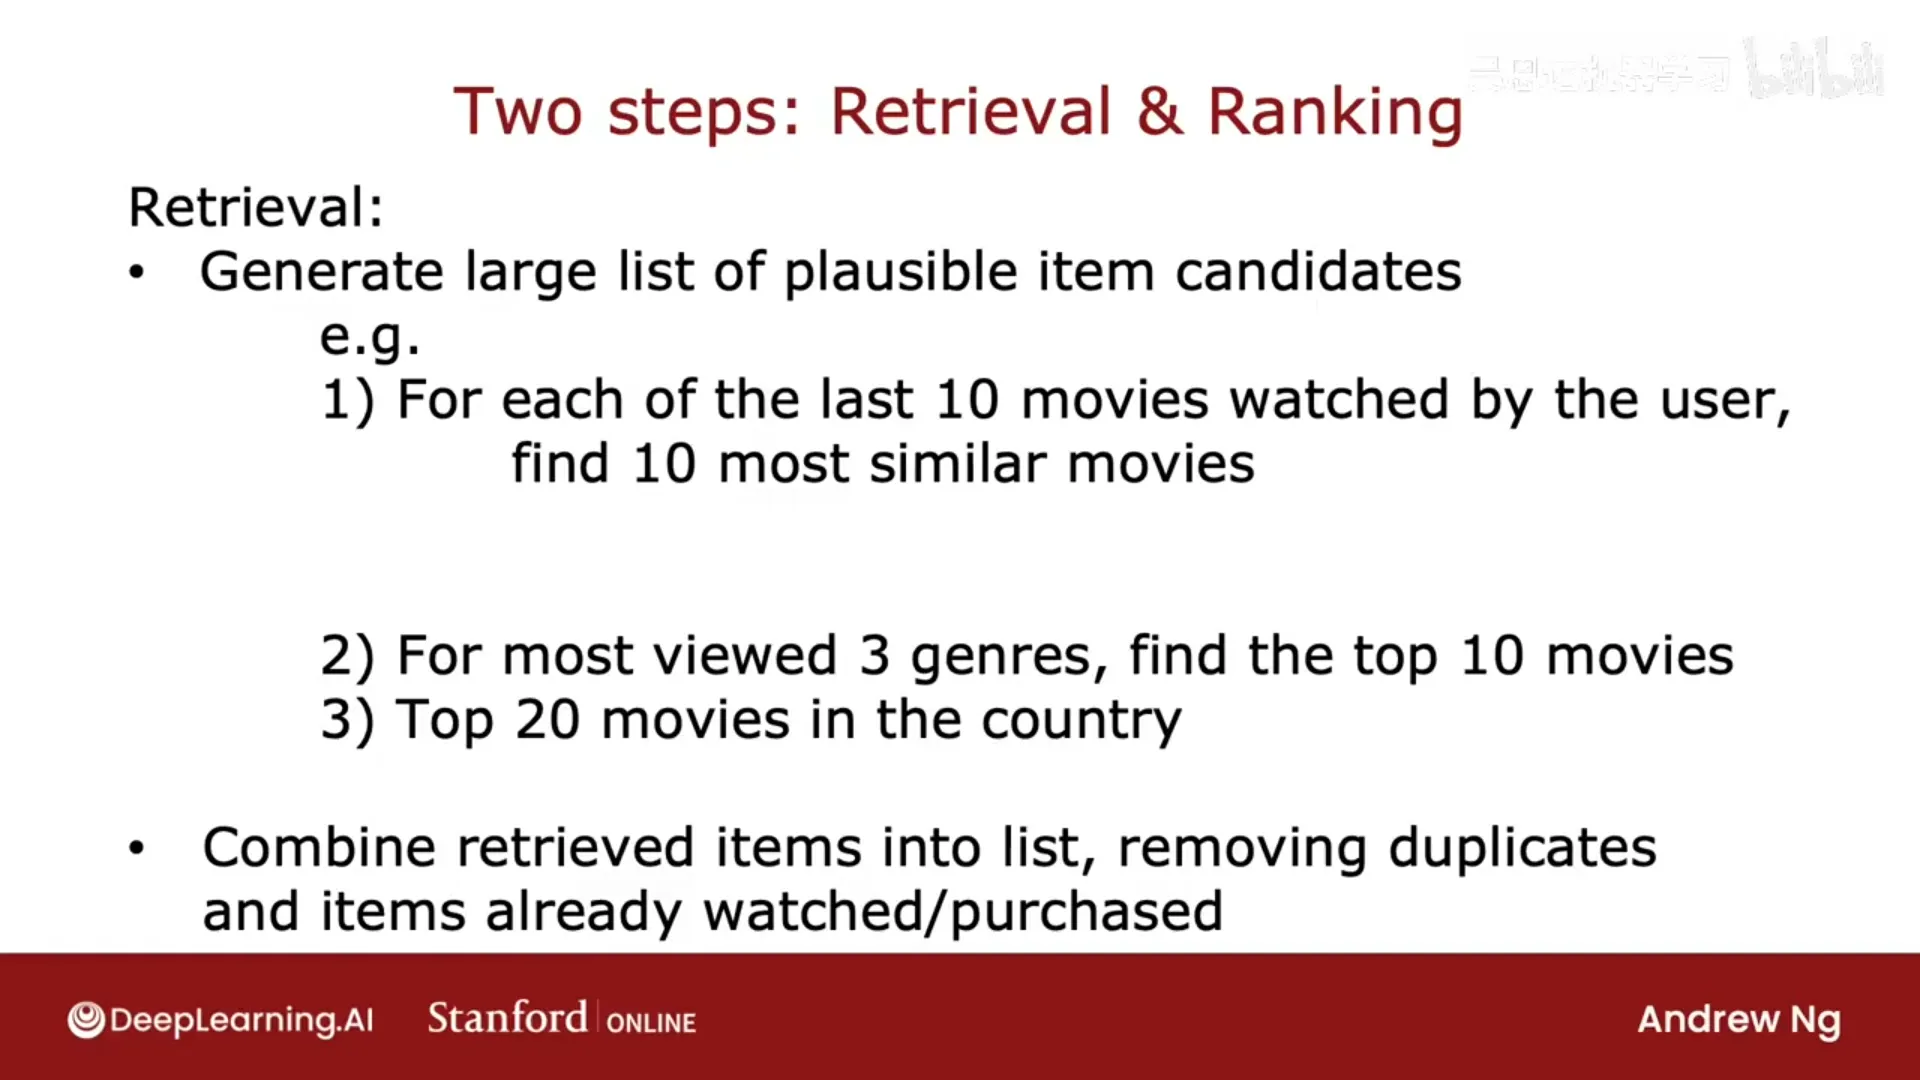
📷 大规模推荐:先"检索"出几百候选、再"排序"精选——兼顾速度与准确
回到原视频 (00:01:24)
6.4 推荐系统的道德使用
(p124)
推荐系统很赚钱,但一些问题用法会让个人和社会变糟。设计时有大量选择(用什么样的标签、优化什么目标、推荐什么)。
目标的选择:
- 推荐"用户最可能打 5 星的电影"——看起来没问题;
- 推荐"用户最可能购买的产品"——也合理;
- 推荐"最可能被点击且广告主出价高的广告"——这是利润最大化,但可能有负面影响。
问题案例:
- 广告会放大最有害的生意。旅游公司:越能给用户好体验 → 越赚钱 → 能出更高广告价 → 获得更多流量 → 良性循环。发薪日贷款:越擅长压榨客户 → 越赚钱 → 出价更高 → 获得更多流量 → 恶性循环,最剥削的公司获得最多流量。改善措施之一是拒绝剥削性企业的广告——但"如何定义剥削性"本身极难。
- 最大化用户参与度会导致大型社交/视频网站放大阴谋论、仇恨与有害内容——因为它们太吸引注意力,能让人停留更久。改善措施(不完美)是过滤问题内容(仇恨言论、欺诈、骗局、某些暴力内容),但"该过滤什么"出奇地棘手。
- 不透明:用户以为网站在推荐"你会喜欢的东西",其实很多网站是在最大化自己的利润。尽可能向用户公开你的推荐标准,能增加信任。
原则:构建影响人的系统时,既考虑收益,也考虑可能的危害,邀请多样化的观点参与讨论与辩论,只做你真正相信能让社会变得更好的东西。
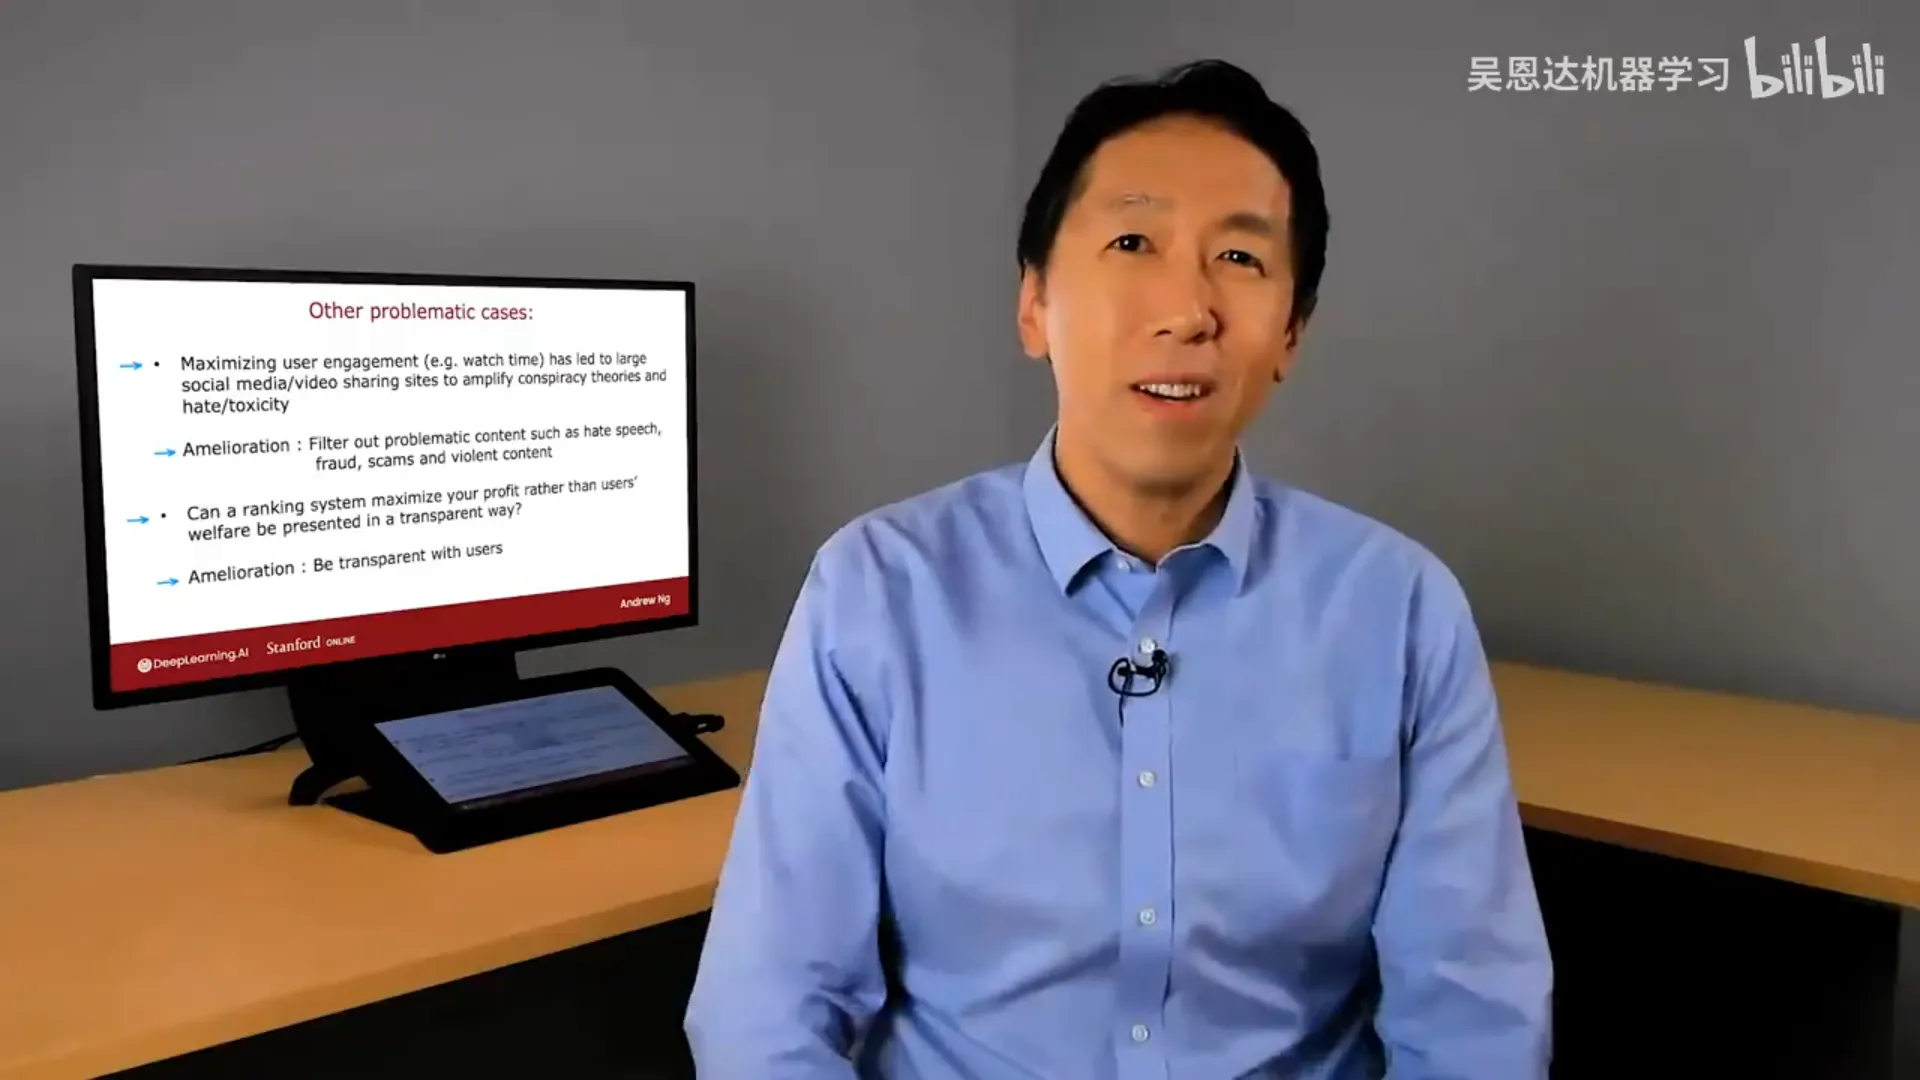
📷 推荐系统的道德问题:目标选择、广告放大、参与度最大化带来的危害
回到原视频 (00:10:31)
6.5 基于内容过滤的 TensorFlow 实现
(p125)
在 TensorFlow/Keras 中把基于内容的过滤搭成神经网络:
user_NN = tf.keras.models.Sequential([
    tf.keras.layers.Dense(256, activation="relu"),
    tf.keras.layers.Dense(128, activation="relu"),
    tf.keras.layers.Dense(32),                    # 输出 32 维 v_u
])
item_NN = tf.keras.models.Sequential([
    tf.keras.layers.Dense(256, activation="relu"),
    tf.keras.layers.Dense(128, activation="relu"),
    tf.keras.layers.Dense(32),                    # 输出 32 维 v_m
])

user_input = tf.keras.layers.Input(shape=(num_user_features,))
vu = user_NN(user_input)
vu = tf.linalg.l2_normalize(vu, axis=1)           # 归一化为单位向量(有用的小技巧)

item_input = tf.keras.layers.Input(shape=(num_item_features,))
vm = item_NN(item_input)
vm = tf.linalg.l2_normalize(vm, axis=1)

# Keras 专门的"点积层"
output = tf.keras.layers.Dot(axes=1)([vu, vm])

model = tf.keras.Model([user_input, item_input], output)
model.compile(loss=tf.keras.losses.MeanSquaredError())
要点:
- 用户网络 / 项目网络都是
Sequential的 Dense 堆叠,隐藏层默认用 ReLU,输出层 32 维; tf.linalg.l2_normalize把向量归一化为单位长度——这个额外步骤能让算法效果更好(名称来自"归一化 L2 范数");tf.keras.layers.Dot是 Keras 专门的"两个向量点积"层;- 损失用均方误差。
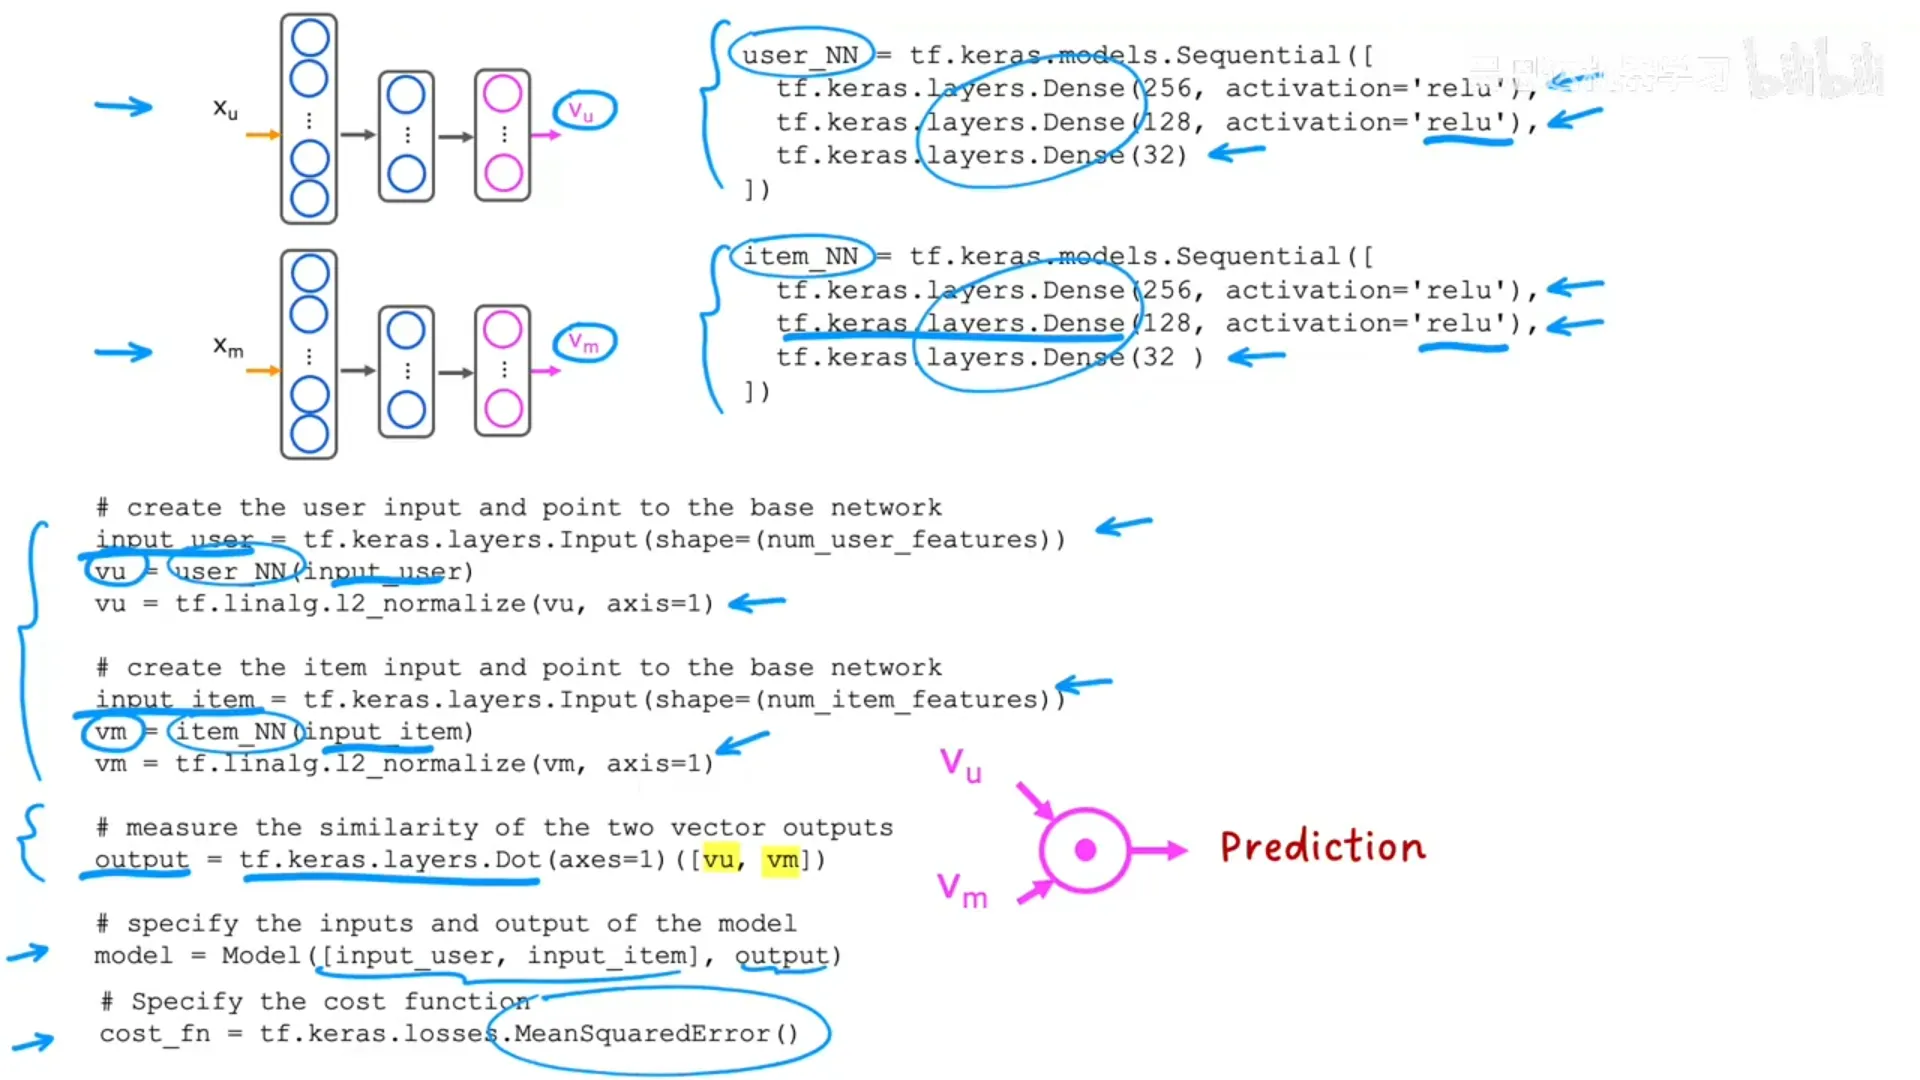
📷 Keras 实现基于内容的过滤:用户网络 + 项目网络 + L2 归一化 + Dot 层
回到原视频 (00:03:43)
第七章 强化学习基本概念
(对应模块 7,视频 p126–p130)
7.1 什么是强化学习
(p126)
强化学习在今天的商业应用中还不算广泛,但它是机器学习的支柱之一,有大量令人兴奋的研究推动它进步。
引例:斯坦福自主直升机(重 32 磅,带机载计算机、GPS、加速度计、陀螺仪、磁罗盘,能较准确知道自己的位置/方向/速度)。若让你写程序让它飞起来:每秒 10 次,你要根据直升机的位置、方向、速度,决定如何移动操纵杆以保持平衡。吴恩达用强化学习让这架直升机学会了倒飞和各种特技动作。
为什么不用监督学习? 理论上可以"让专家飞行员告诉你每个状态的最佳动作",但在空中移动时"确切正确动作"非常模糊(稍稍左倾还是大幅左倾?加一点还是很多油门?),很难得到 (x, 理想动作 y) 数据集。
强化学习的关键输入是奖励函数(reward function)——它告诉系统"何时飞得好、何时飞得差"。吴恩达用训练狗来类比:
你没法直接"展示"给小狗该怎么做。你让它自己行动:做对了就说"好狗",做错了就说"坏狗"。它自己学会多做"好狗"的事、少做"坏狗"的事。
直升机也一样:飞得好给正奖励,坠毁给很大的负奖励(如 −1000)。强化学习的强大之处在于:你只需要告诉它"做什么"(奖励),不需要告诉它"怎么做"(最优动作)——这给系统设计带来极大的灵活性。(他也真的用这套"好狗/坏狗"方法训练过机器狗跨越障碍。)
应用:控制机器人(本课实验:让模拟月球着陆器着陆)、工厂优化、股票交易(例如如何在几天内最优地卖出 100 万股,避免一次性抛售压低价格)、游戏(跳棋、国际象棋、桥牌、围棋、很多电子游戏)。
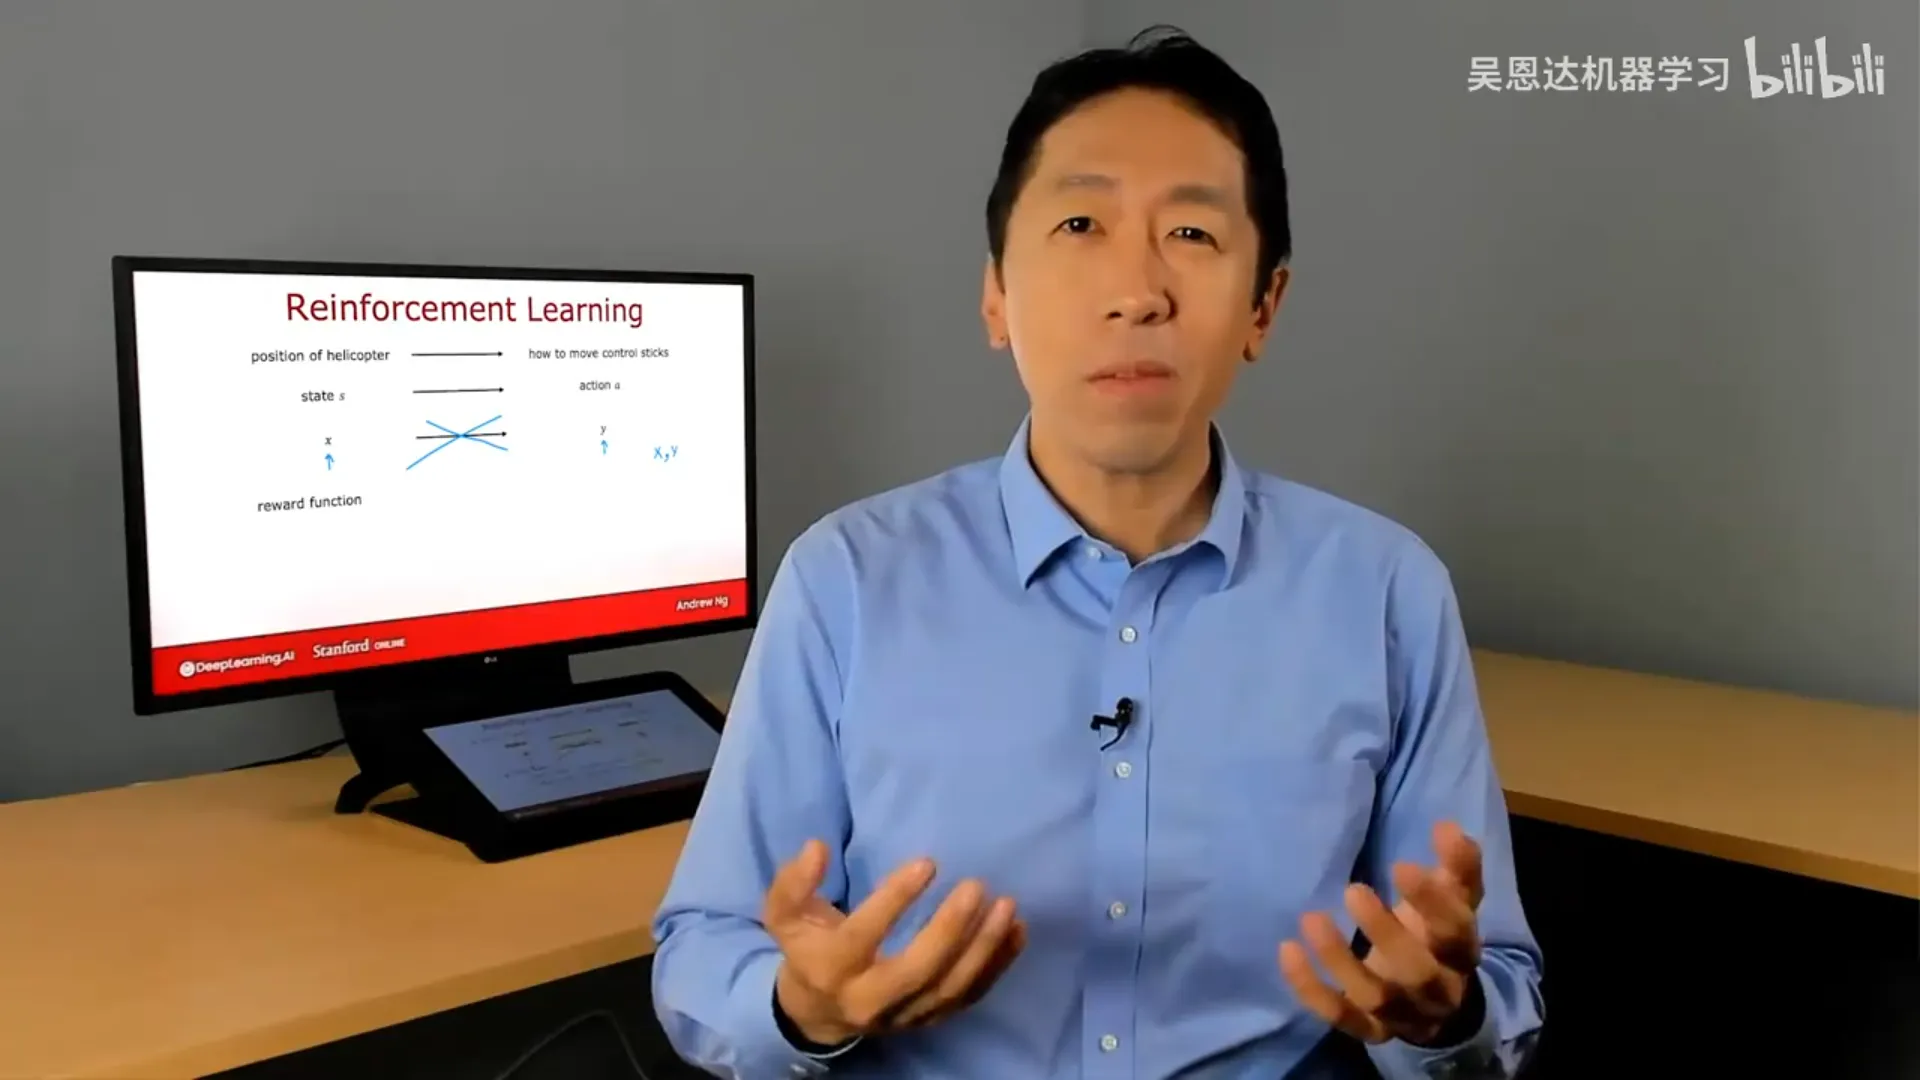
📷 强化学习:像"好狗/坏狗"那样只给奖励,让系统自己学会怎么做
回到原视频 (00:04:56)
7.2 火星探测器示例:把问题形式化
(p127)
用简化的火星探测器例子(受 Emma Brunskill 与 Jack Retté-Agarwal 的工作启发)。
- 探测器可在 6 个位置之一(6 个状态 s₁…s₆),初始在状态 4;
- 每步可选两个动作:向左或向右;
- 奖励:状态 1 奖励 100(最有趣的采样点,但更远)、状态 6 奖励 40(也很有趣但不如状态 1)、中间状态奖励 0;
- 状态 1 和 6 是终止状态(terminal state):到达后获得该状态奖励,这一天就结束了,不能再获得更多奖励。
例子:从状态 4 一直向左 → 奖励序列 0,0,0,100;一直向右 → 0,0,40;也可以"先向右再向左"(浪费了时间)。
每次采取动作时,四个核心要素:
$$S \;\xrightarrow{\;A\;}\; R(S) + S'$$
(注意 R(S) 是当前状态的奖励,不是新状态的。)
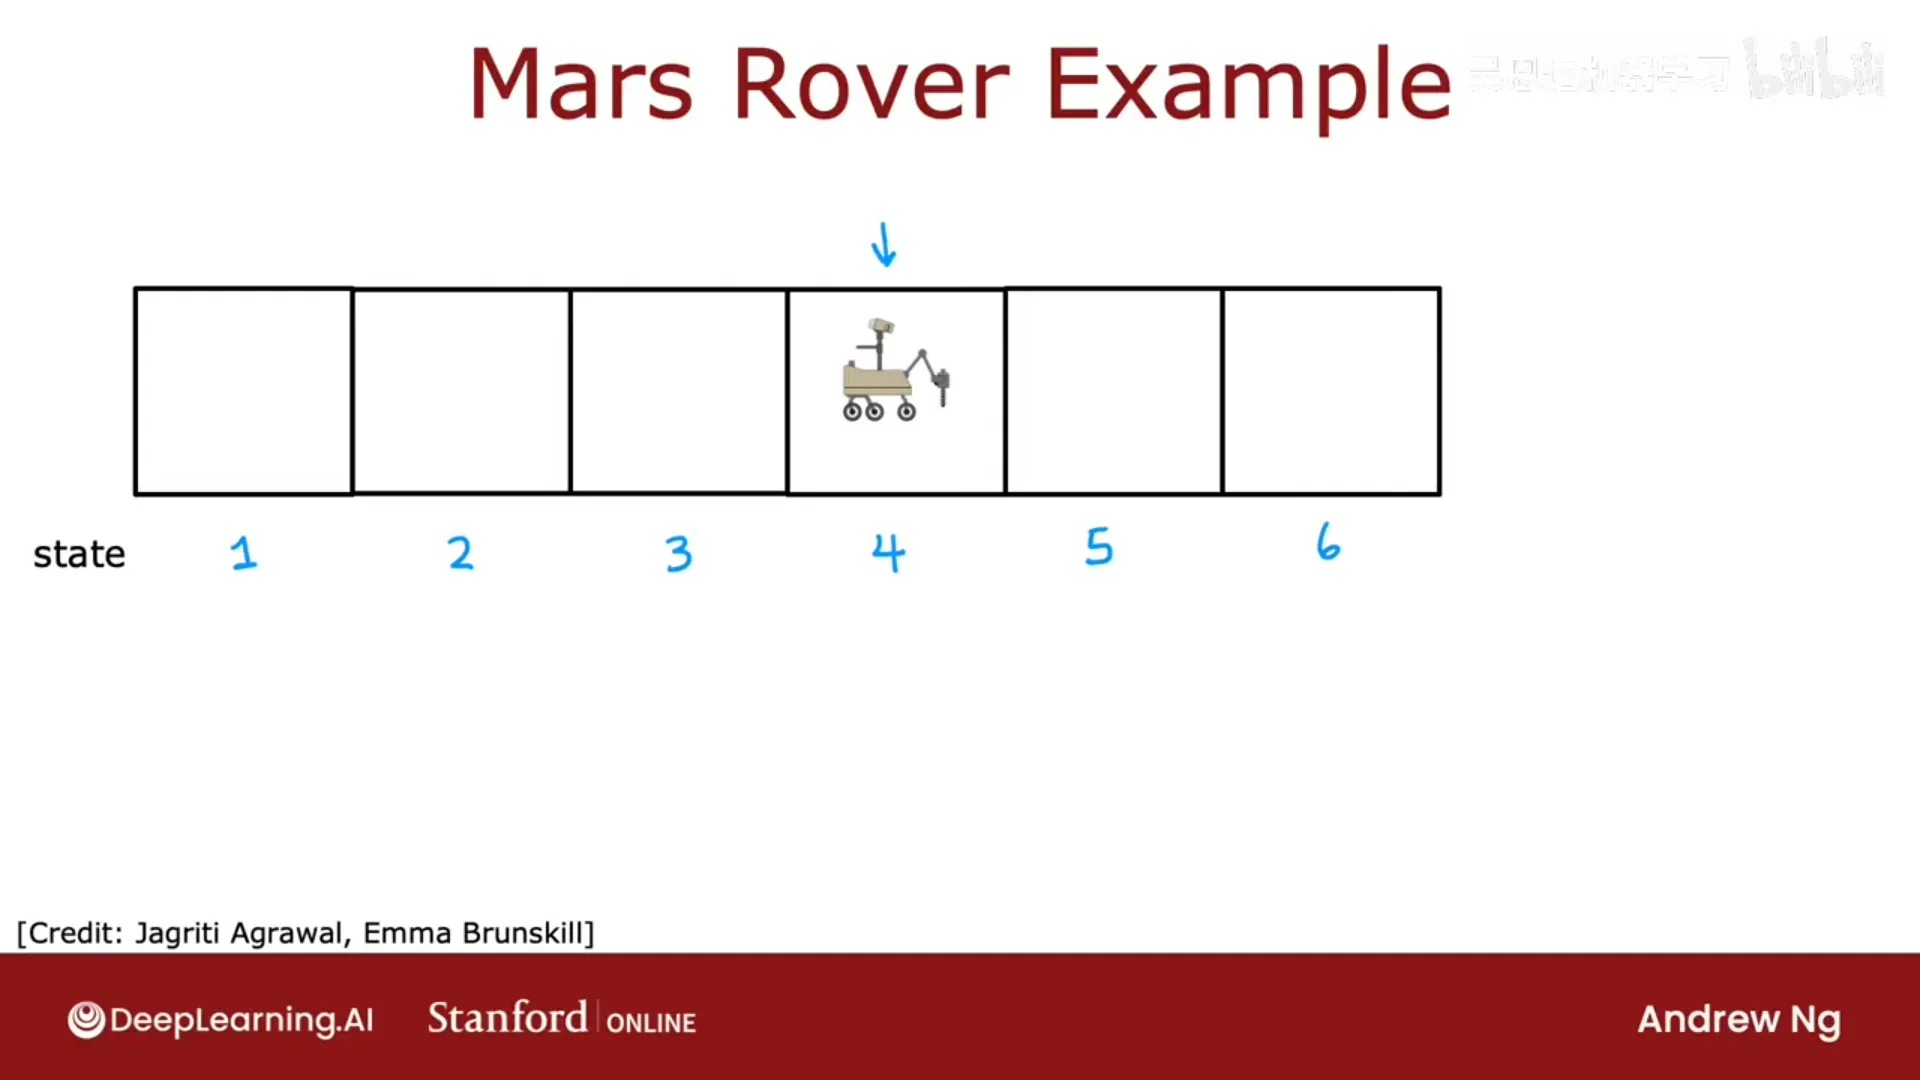
📷 火星探测器 MDP:6 个状态、向左/向右两个动作、终点奖励 100/40
回到原视频 (00:01:32)
7.3 回报与折扣因子
(p128)
怎么判断"哪一组奖励更好"?引入回报(return)。
类比:脚边有 5 美元可以直接捡,或者走半小时捡 10 美元。10 美元更多,但要走半小时——能更快拿到的奖励更有吸引力。
回报 = 折扣后的奖励总和:
$$\text{Return} = r_1 + \gamma r_2 + \gamma^2 r_3 + \gamma^3 r_4 + \cdots$$
其中 γ(折扣因子,discount factor) 是略小于 1 的数(常用 0.9、0.99、0.999)。
作用:让算法有点"急功近利"——第一步奖励全额计入,第 t 步的奖励要乘 γ^(t−1)。越早得到的奖励,总回报越高。
例(γ=0.5,一直向左、从状态 4 出发):0 + 0.5·0 + 0.5²·0 + 0.5³·100 = 12.5;从状态 3 出发则为 25,状态 2 为 50,状态 1 为 100。
金融解释:γ 就是利率 / 资金时间价值——今天的一美元比将来的一美元更值钱。
负奖励的效果:若有负奖励,折扣因子会激励系统尽量把负奖励推到未来(就像"能晚几年还债就更划算")——这在很多应用里正是应该做的。
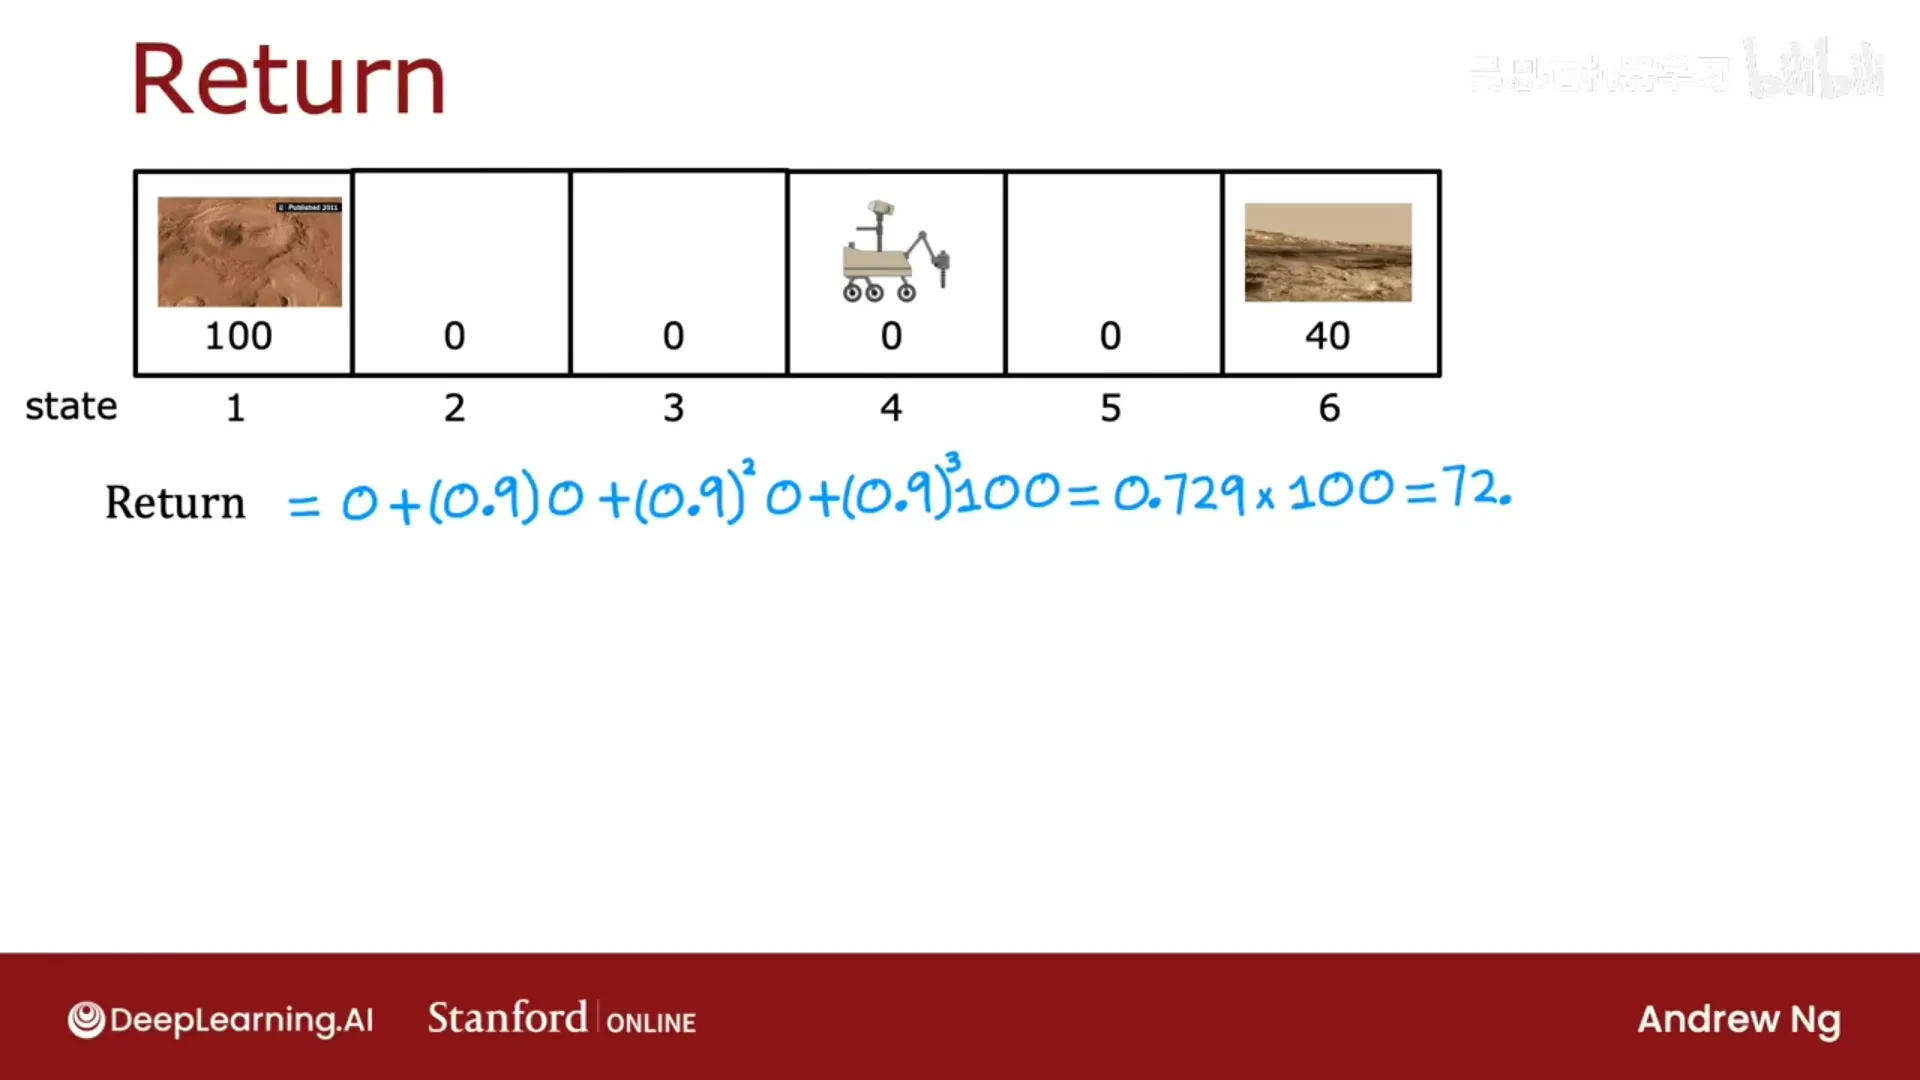
📷 回报 = 折扣后的奖励总和;越早的奖励权重越高
回到原视频 (00:02:08)
7.4 策略 π
(p129)
策略(policy)π 是一个函数:输入状态 s,输出要采取的动作 a:
$$a = \pi(s)$$
例如一个策略:状态 2、3、4 向左走,状态 5 向右走。
强化学习的目标:找到一个策略 π,使回报最大化。
(吴恩达说"策略"这个名字不太亲切,也许叫"控制器"更自然,但 RL 界已通用"策略"。)
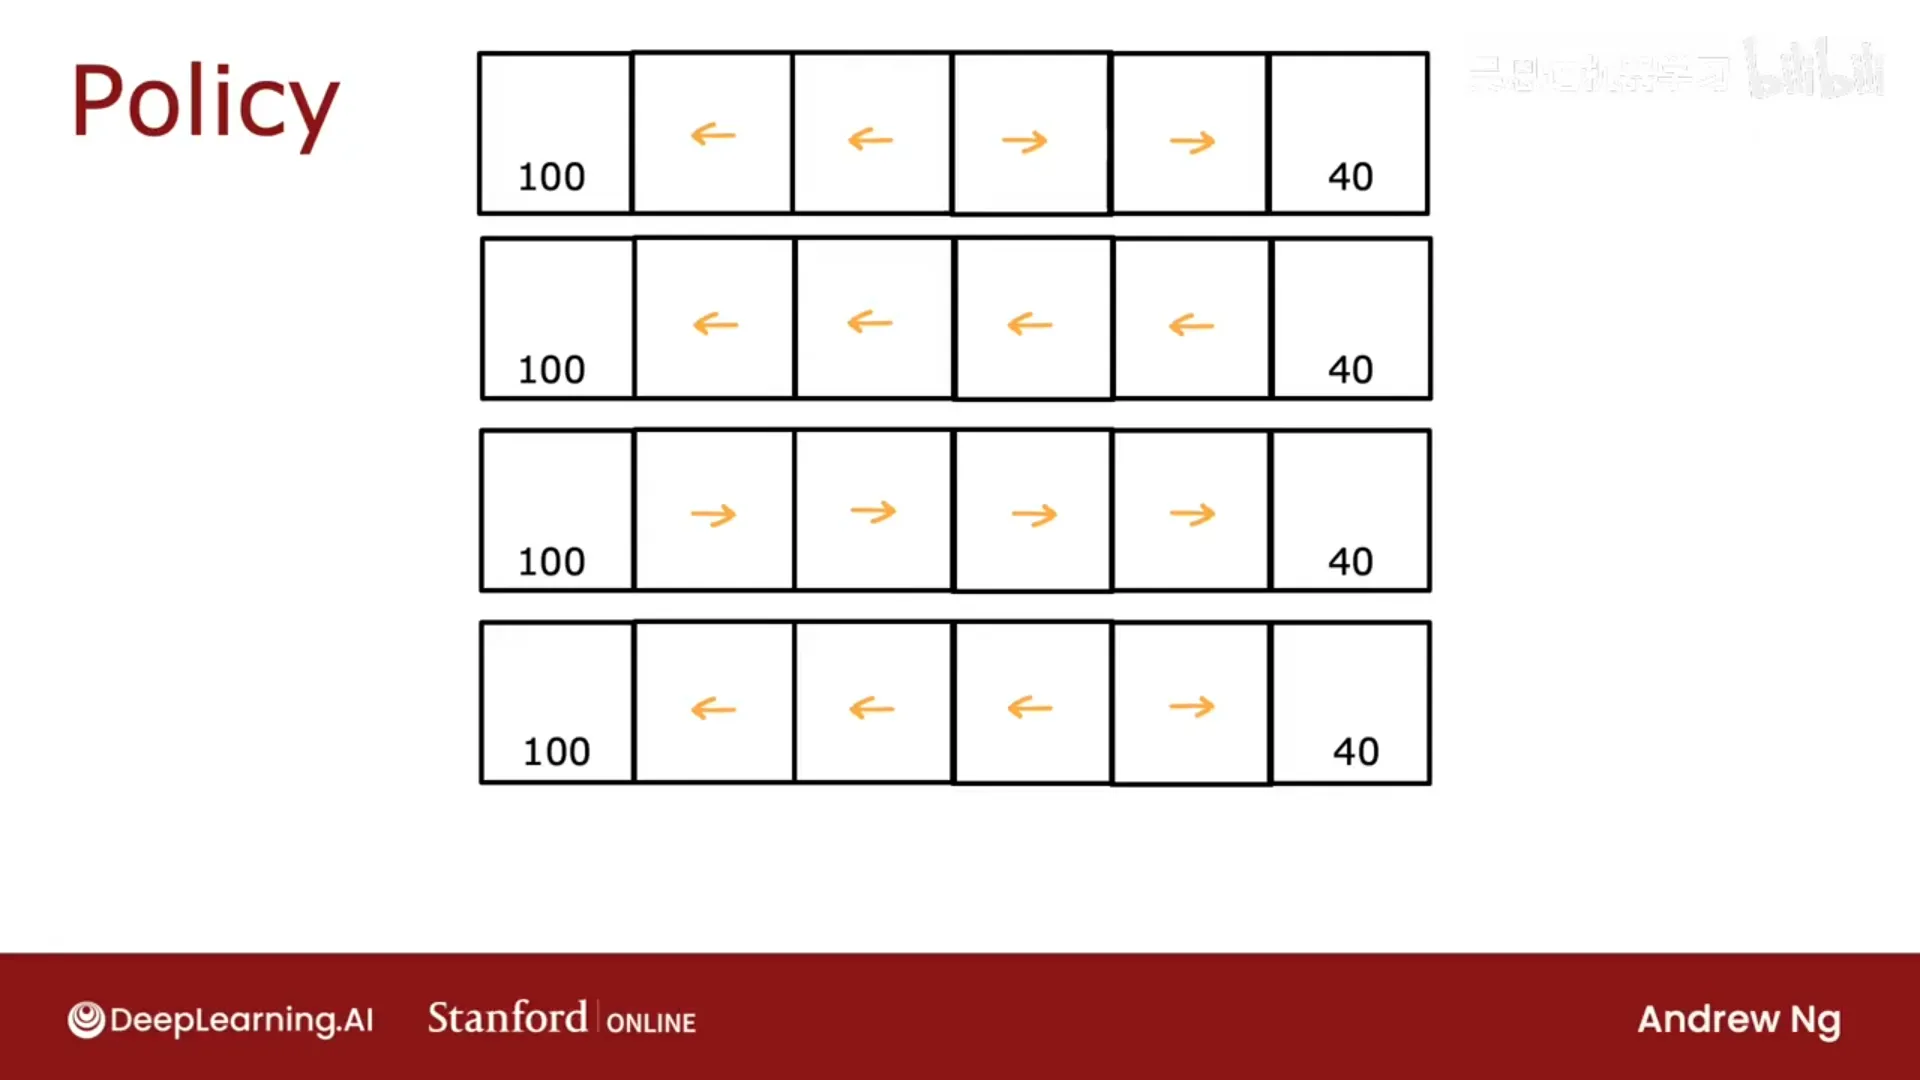
📷 策略 π:把任意状态映射到要采取的动作
回到原视频 (00:00:57)
7.5 关键概念回顾与 MDP
(p130)
把关键概念串起来:状态、动作、奖励、折扣因子 → 回报 → 策略(选动作以最大化回报)。
同一套形式可套用到各种应用:
| 应用 | 状态 | 动作 | 奖励 |
|---|---|---|---|
| 火星探测器 | 6 个位置 | 左/右 | 100/40/0 |
| 自主直升机 | 位置/方向/速度 | 各种操纵杆动作 | 飞好 +1、坠毁 −1000 |
| 下棋(简化) | 所有棋子位置 | 所有合法着法 | 赢 +1、输 −1、平 0 |
这套形式有个正式名字:马尔可夫决策过程(Markov Decision Process,MDP)。
编者拓展|什么是「马尔可夫性」:「未来只取决于当前状态,而与「怎么走到这里」无关」——这个假设叫马尔可夫性(Markov property)。它极大简化了问题:你不需要记住整段历史,只要知道当前状态 $s$,就能决定下一步。很多看似复杂的问题,一旦写成 MDP,就变成了「在每个状态选一个动作」的干净问题。
"马尔可夫"的含义:未来只取决于当前状态,而不取决于你是如何到达当前状态的。
另一种看法:有一个我们要控制的智能体(agent),它根据策略 π 选择动作 A,环境因此发生变化,然后我们观察到新状态并获得奖励。
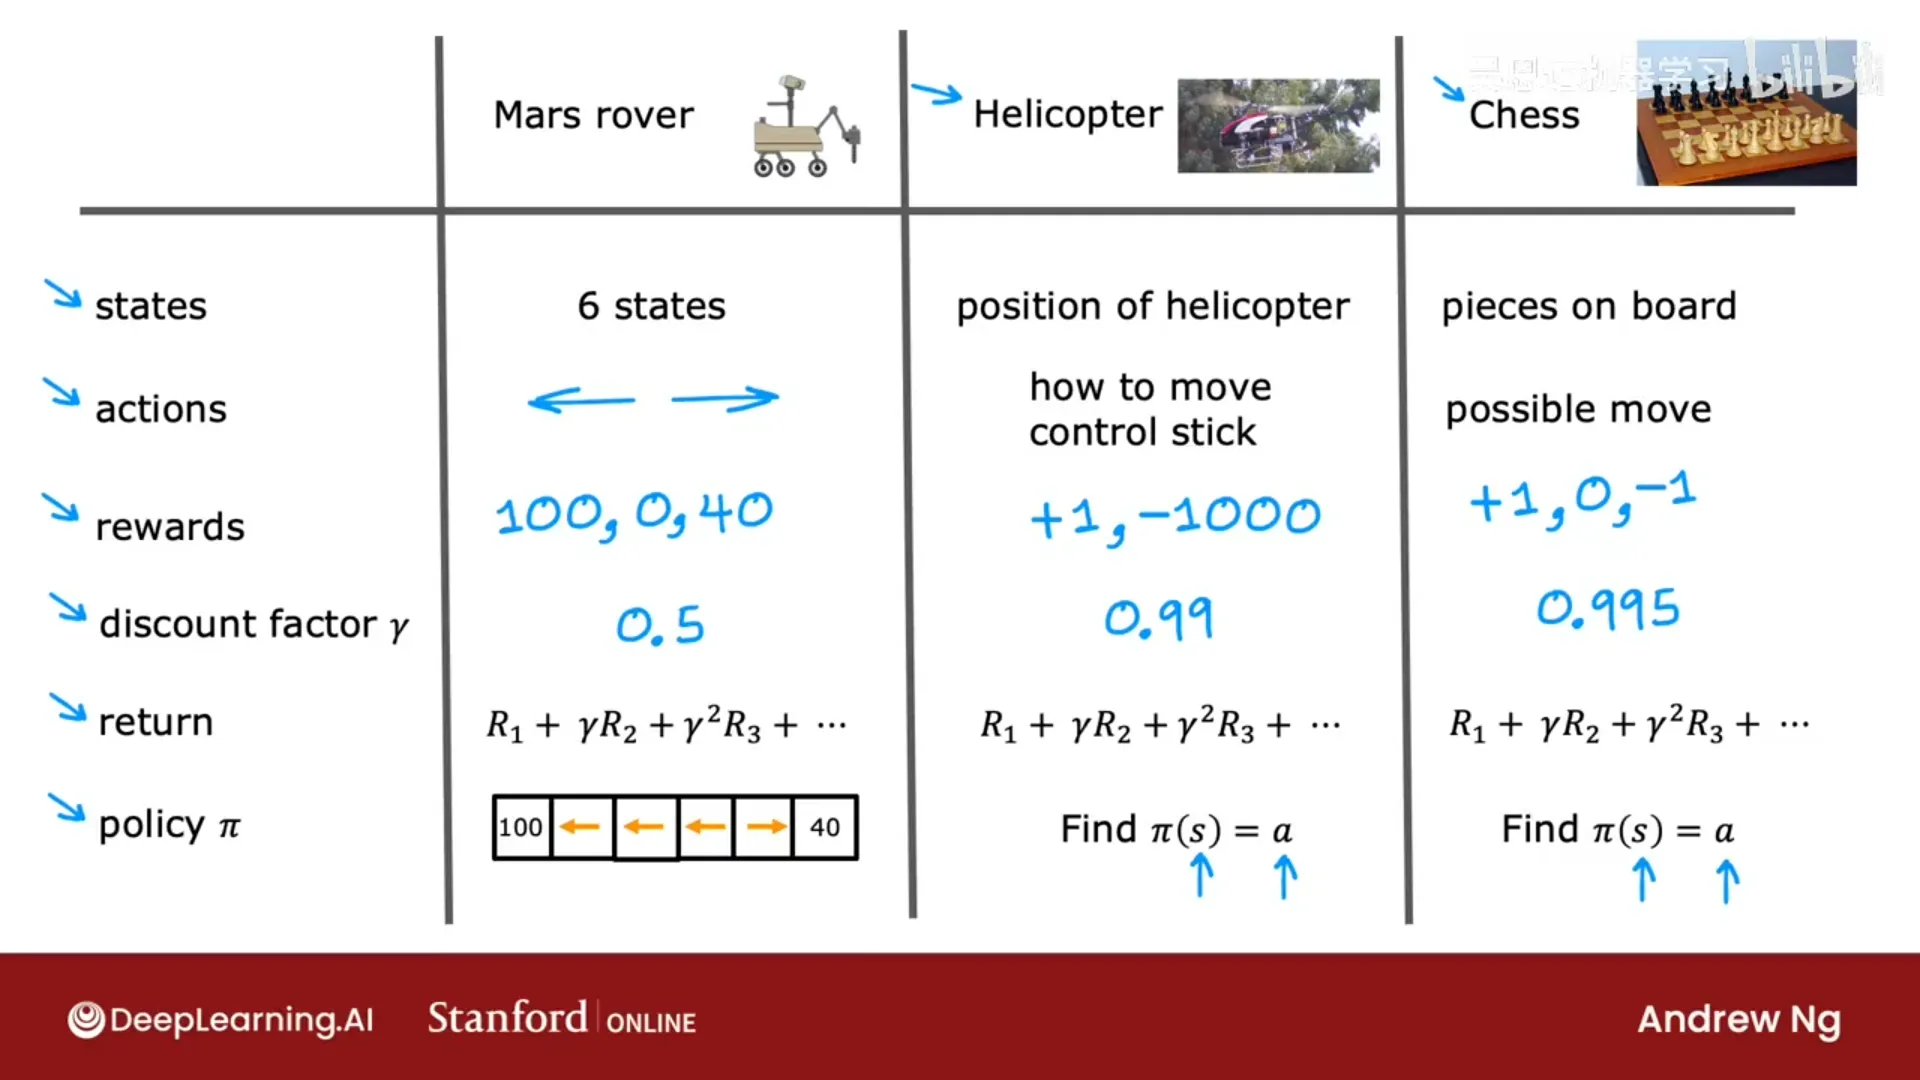
📷 MDP:策略选动作、环境变化、观察状态与奖励
回到原视频 (00:03:18)
第八章 状态-动作值函数与 Bellman 方程
(对应模块 8,视频 p131–p134)
8.1 状态-动作值函数的定义
(p131)
强化学习算法需要计算的关键量是 状态-动作值函数(state-action value function),通常记作大写 Q:
$$Q(s,a) = \text{从状态 } s \text{ 出发、先采取一次动作 } a \text{、之后都采取最优动作时的回报}$$
Q 函数(Q function) 与"状态-动作值函数"是同一个东西。
这个定义有点循环:要算 Q 好像得先知道"最优动作"。别担心——后面会给出在还不知道最优策略时计算 Q 的方法。
例(γ=0.5,最优策略:状态 2/3/4 向左、状态 5 向右):
Q(2, →):从状态 2 向右到状态 3,之后最优(向左)→ 回报0 + 0.5·(0 + 0.5·(0 + 0.5·100))… = 12.5;Q(2, ←):0 + 0.5·100= 50;Q(4, ←)= 12.5;等等。
关键用途:一旦能算出 Q,就能选动作——在状态 s,选择使 Q(s,a) 最大的动作 a:
$$\pi(s) = \arg\max_a Q(s,a)$$
这就是最优策略。直觉:Q(s,a) 是"先做 a、之后最优"的回报,所以为了回报最大,就该选让 Q 最大的那个 a。
(文献里有时把 Q 写成 Q* 或"最优 Q 函数"——指的是同一个东西。)
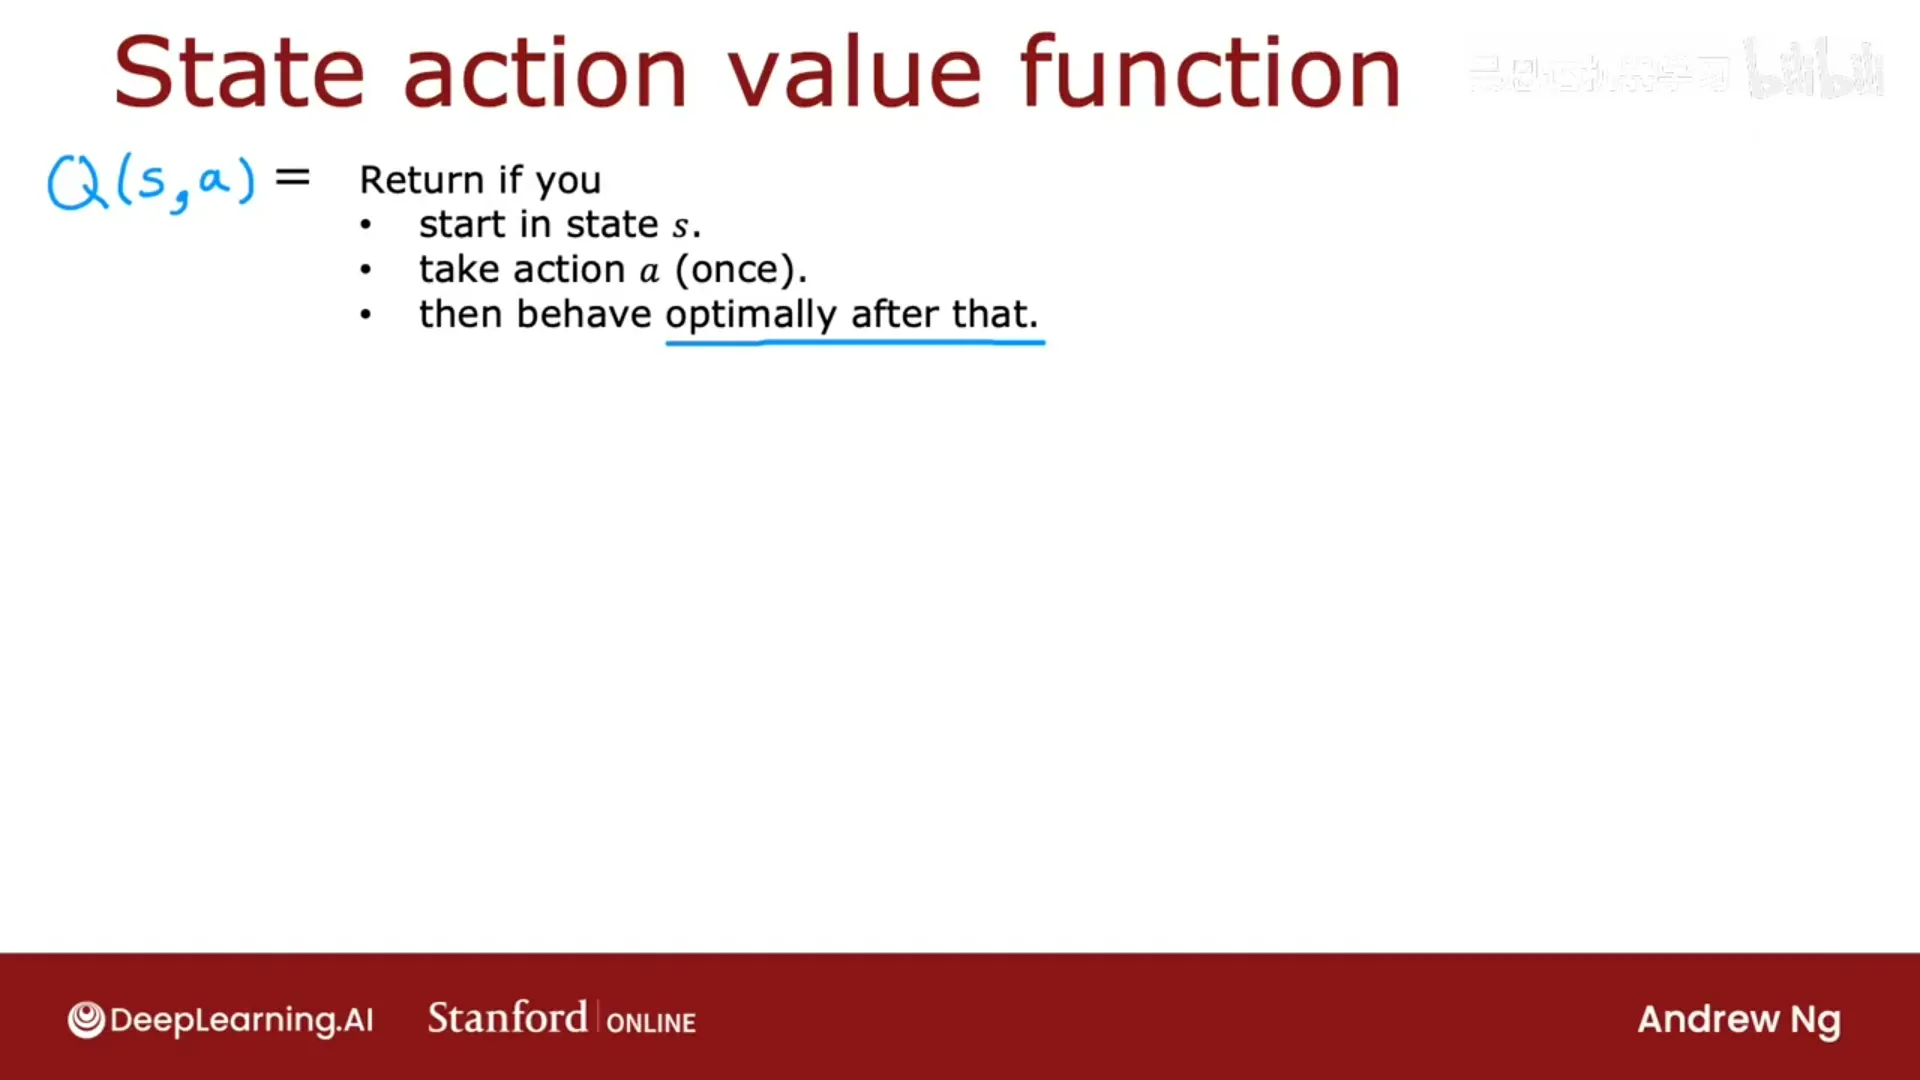
📷 Q(s,a):先采取 a、之后最优时的回报;选 argmax 就是最优动作
回到原视频 (00:01:37)
8.2 交互式理解 Q
(p132)
课程提供了一个可选实验(Jupyter),可以改奖励、折扣因子 γ,实时看 Q 与最优策略如何变化:
- 把右侧终点奖励改小(如 40 → 10):本来到状态 5 会向右走(近),现在即使很近也宁可一路向左(左侧 100 更值);
- 把 γ 改大(0.5 → 0.9):火星车更有耐心,愿意"长途跋涉"等更大的远期奖励(状态 5 向左的 Q 变高);
- 把 γ 改小(→ 0.3):火星车非常没耐心,在状态 4 就宁愿去够近的 40 而不是远的 100。
这直观展示了奖励与 γ 如何影响 Q 值与最优策略。
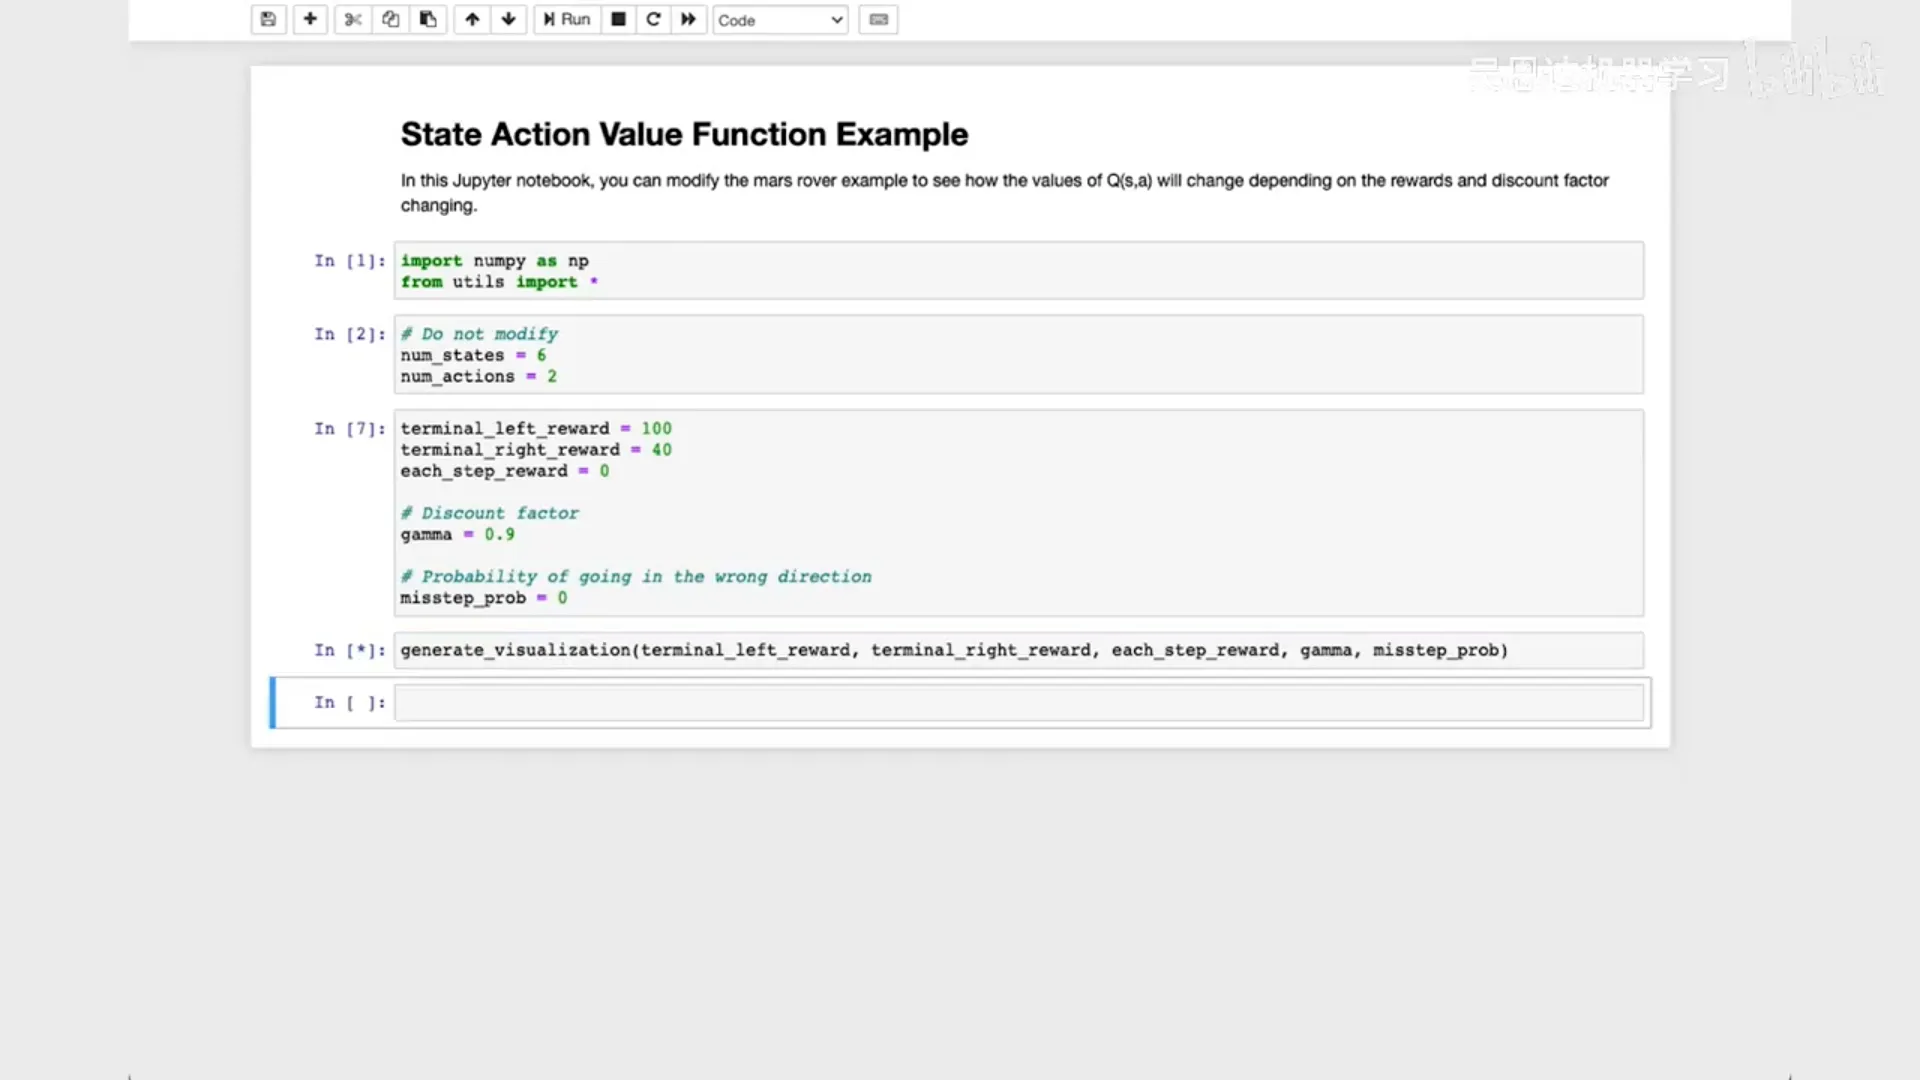
📷 改 γ 与奖励,Q 值与最优策略随之改变
回到原视频 (00:03:02)
8.3 Bellman 方程
(p133)
如何计算 Q? 用 Bellman 方程:
$$Q(s,a) = R(s) + \gamma \max_{a'} Q(s',a')$$
- R(s):在状态 s 立即得到的奖励(即时奖励);
- s':从 s 采取 a 后到达的新状态;
- max_{a'} Q(s', a'):从 s' 出发、之后最优所能获得的最佳回报;
- 总回报 = 即时奖励 + γ × 从下一状态开始的最佳回报。
验证(γ=0.5):Q(2, →),s'=3,max(Q(3,·)) = max(25, 6.25) = 25,所以 Q(2,→) = 0 + 0.5·25 = 12.5 ✓;Q(4,←) 同样 0 + 0.5·25 = 12.5 ✓。(终止状态没有 s',方程简化为 Q(s,a) = R(s),所以那里 Q=100 或 40。)
直觉:总回报可以拆成两部分:
$$\begin{aligned}
\text{总回报} &= R(s) + \gamma\cdot(\text{从下一状态 } s' \text{ 开始的最优回报})\ &= \text{立即奖励} + \text{折扣后的未来回报}
\end{aligned}$$
这正是 Bellman 方程的本质。
编者拓展|Bellman 与动态规划:Bellman 方程把「长期回报」拆成「现在 + 折现的未来」,其思想是 Richard Bellman 在 1950 年代提出的动态规划(Dynamic Programming)。它的关键洞察是:最优解具有「最优子结构」——要算「从 $s$ 出发最优」,只需知道「从下一状态 $s'$ 出发最优」。Q-learning / DQN 本质上就是在用采样与函数近似去解这个 Bellman 方程。
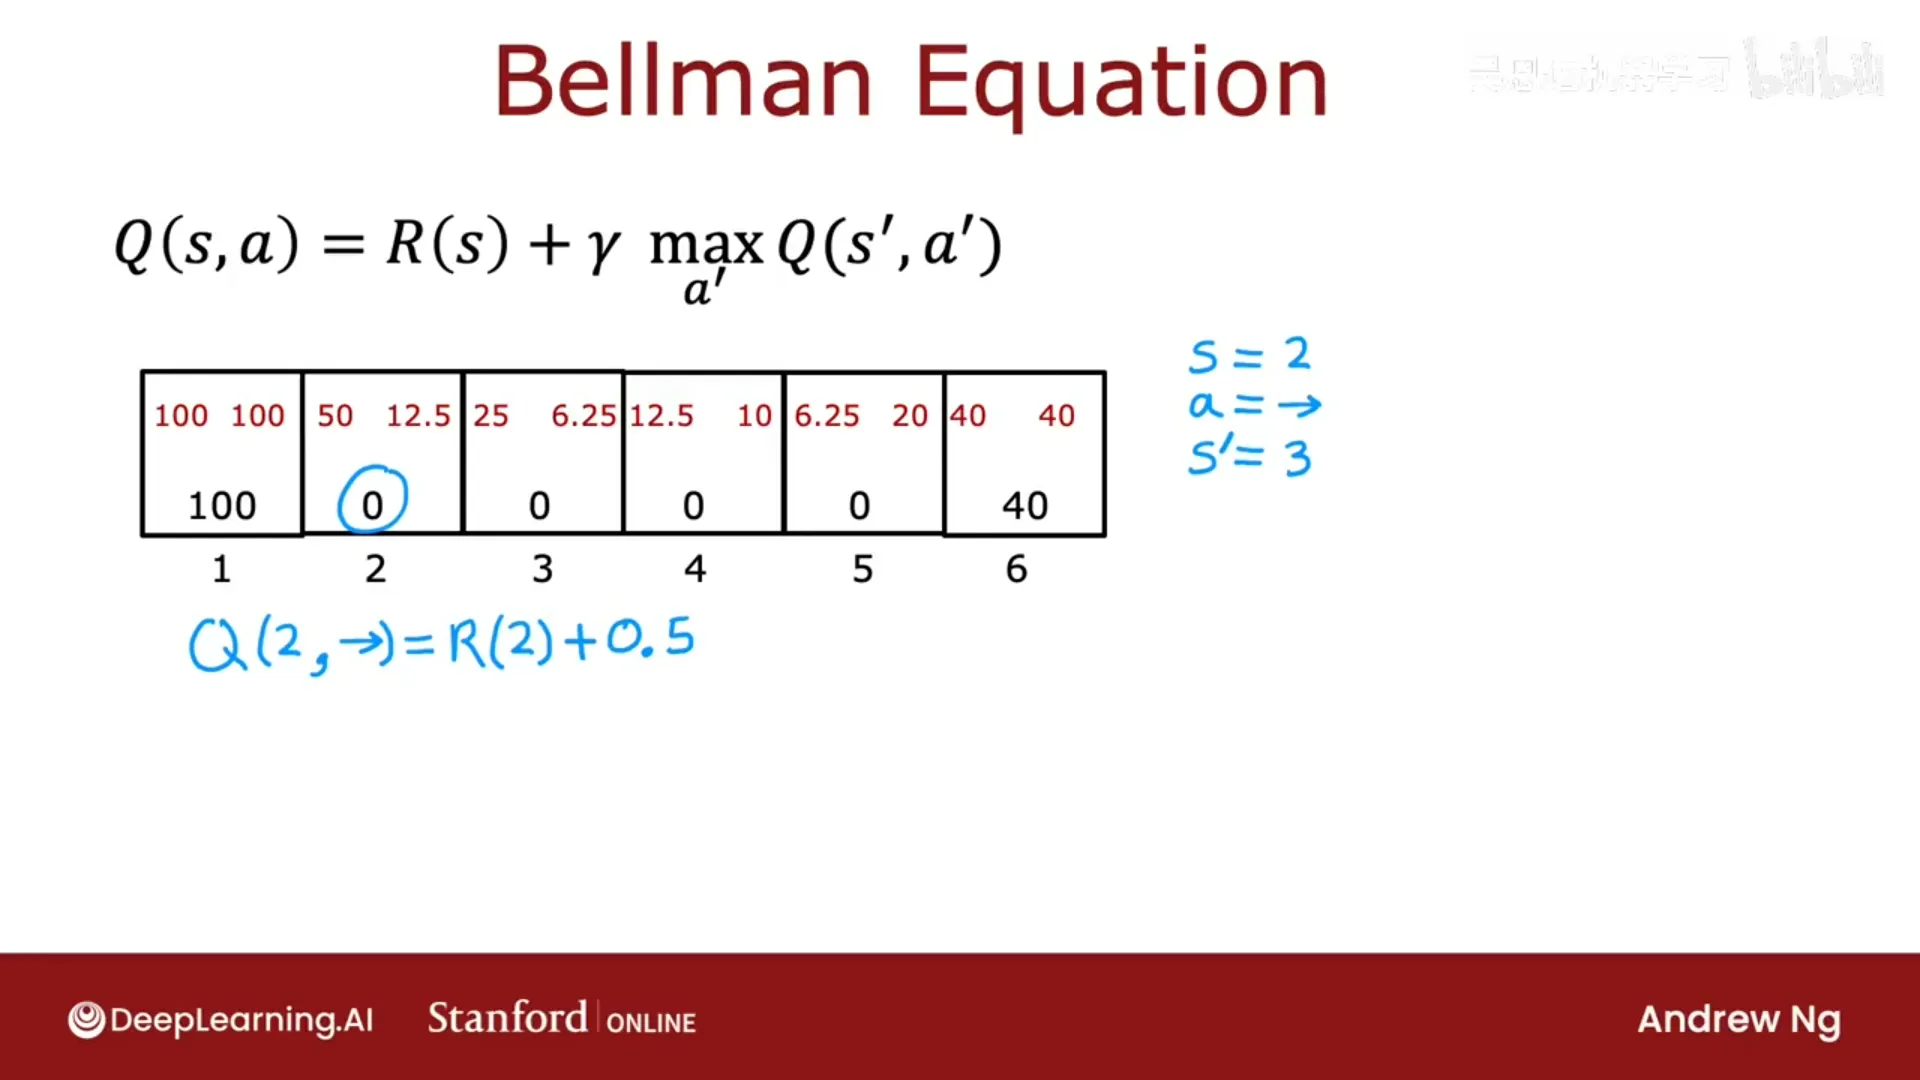
📷 Bellman 方程:Q(s,a) = 即时奖励 + γ · max_{a'} Q(s',a')
回到原视频 (00:03:26)
8.4 随机环境(可选)
(p134)
现实中动作结果常常不可靠:命令火星车向左走,它可能打滑往右走。设 90% 按指令、10% 走反。
于是从同一状态出发、执行同一策略,每次得到的状态序列和奖励序列都不同(是随机的)。
此时我们不再"最大化回报"(那是个随机数),而是最大化期望回报(expected return)——即"把策略尝试上万次,对所有折扣奖励总和取平均"(统计里"期望"就是平均)。
Bellman 方程相应加一个期望:
$$Q(s,a) = R(s) + \gamma\,\mathbb{E}\big[\max_{a'} Q(s',a')\big]$$
(因为 s' 是随机的,要对它取期望。)
可选实验:把"误差概率"(走错方向的概率)从 0.1 调到 0.4,会看到 Q 值与最优回报都下降——因为你对机器人的控制力变弱了。
这种框架的正式名称是随机 Markov 决策过程(随机 MDP)。
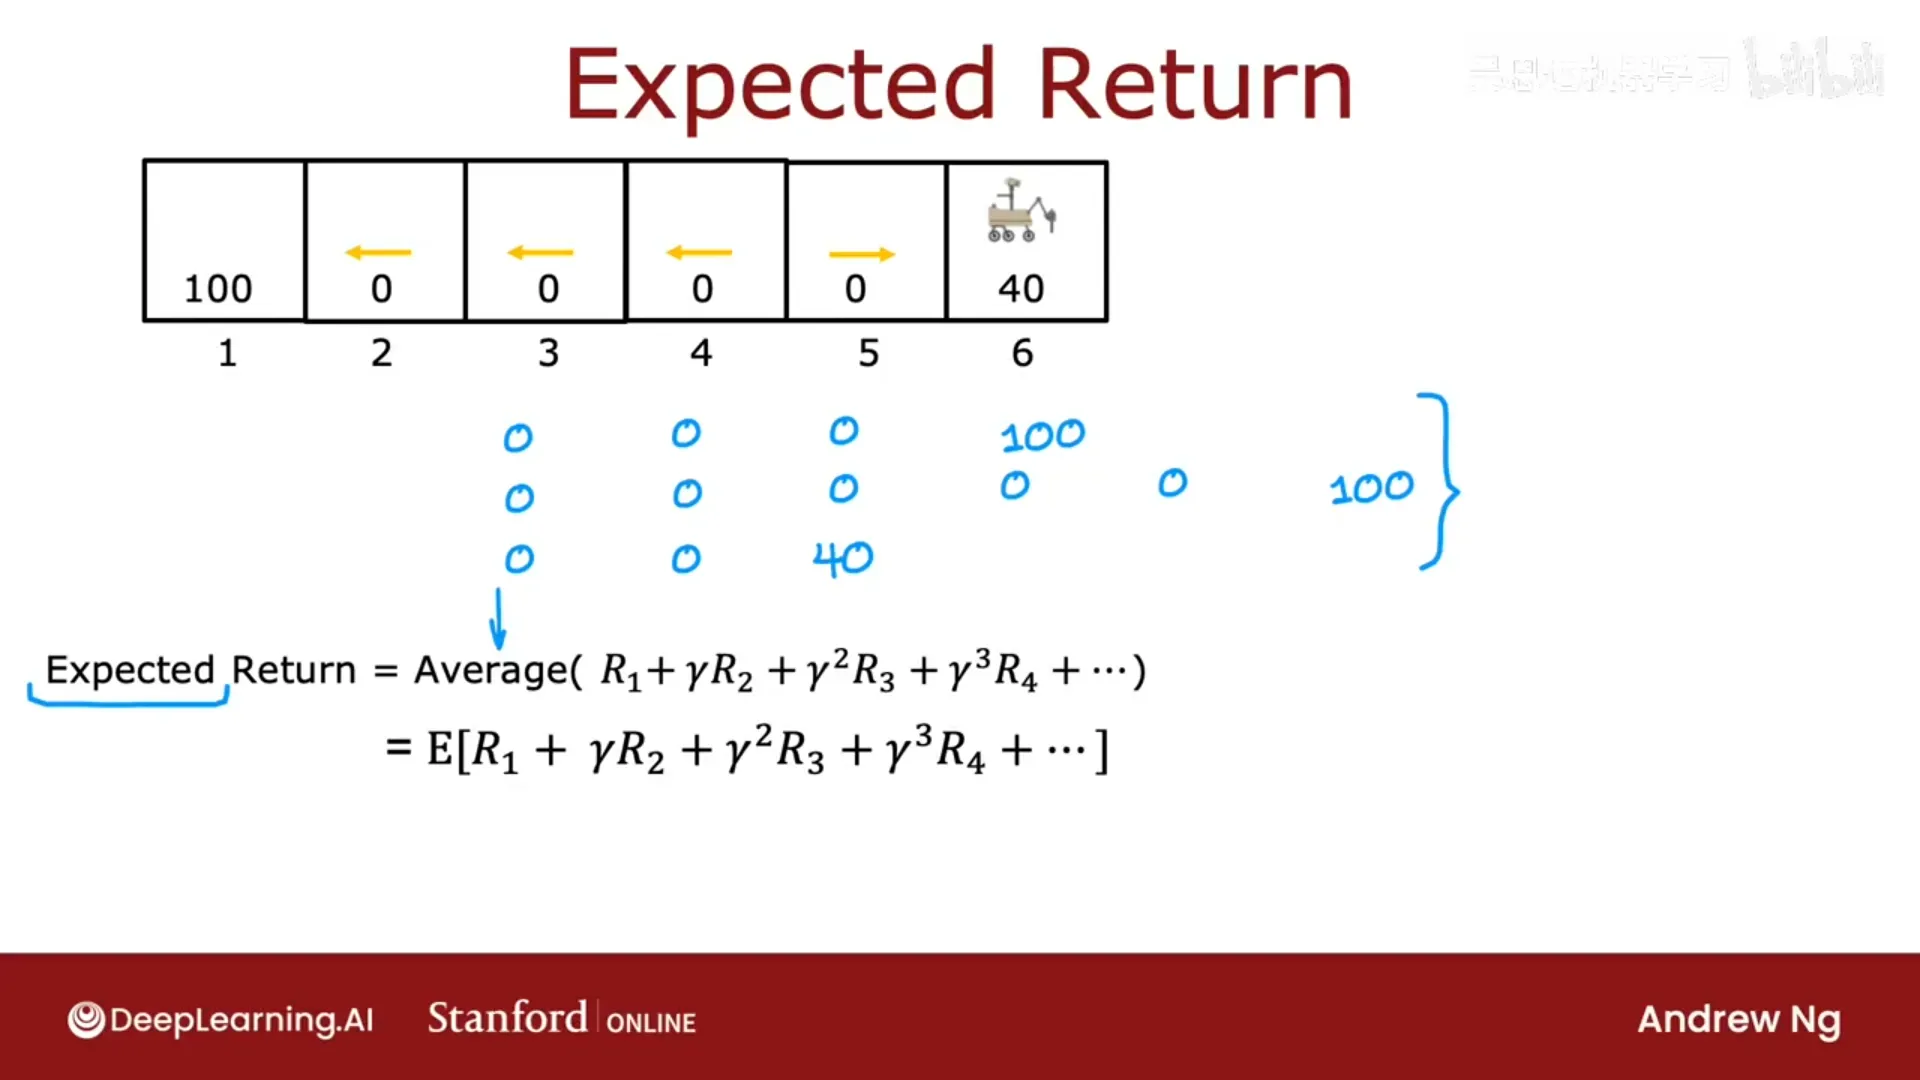
📷 随机 MDP:动作有失败概率,目标变成最大化"期望回报"
回到原视频 (00:05:07)
第九章 连续状态与深度强化学习
(对应模块 9,视频 p135–p141)
9.1 连续状态空间
(p135)
很多机器人控制应用(包括本课的月球着陆器)有连续状态空间,而非"6 个离散位置"。
- 火星车在一条线上:位置可以是 0~6 公里之间的任意数字(2.7、4.8…);
- 控制汽车/卡车:状态可能包括 x、y、朝向 θ、x 方向速度 ẋ、y 方向速度 ẏ、角速度 θ̇——一个6 个数字的向量,每个都可取连续值;
- 自主直升机:状态包括位置 (x,y,z)、滚转 φ、俯仰 θ、偏航 ψ、以及三个方向的速度和各角速度——一个12 个数字的向量。
区别:状态不再是"1~6 之一",而是一个数字向量,其中每个数字都可取大量可能值。
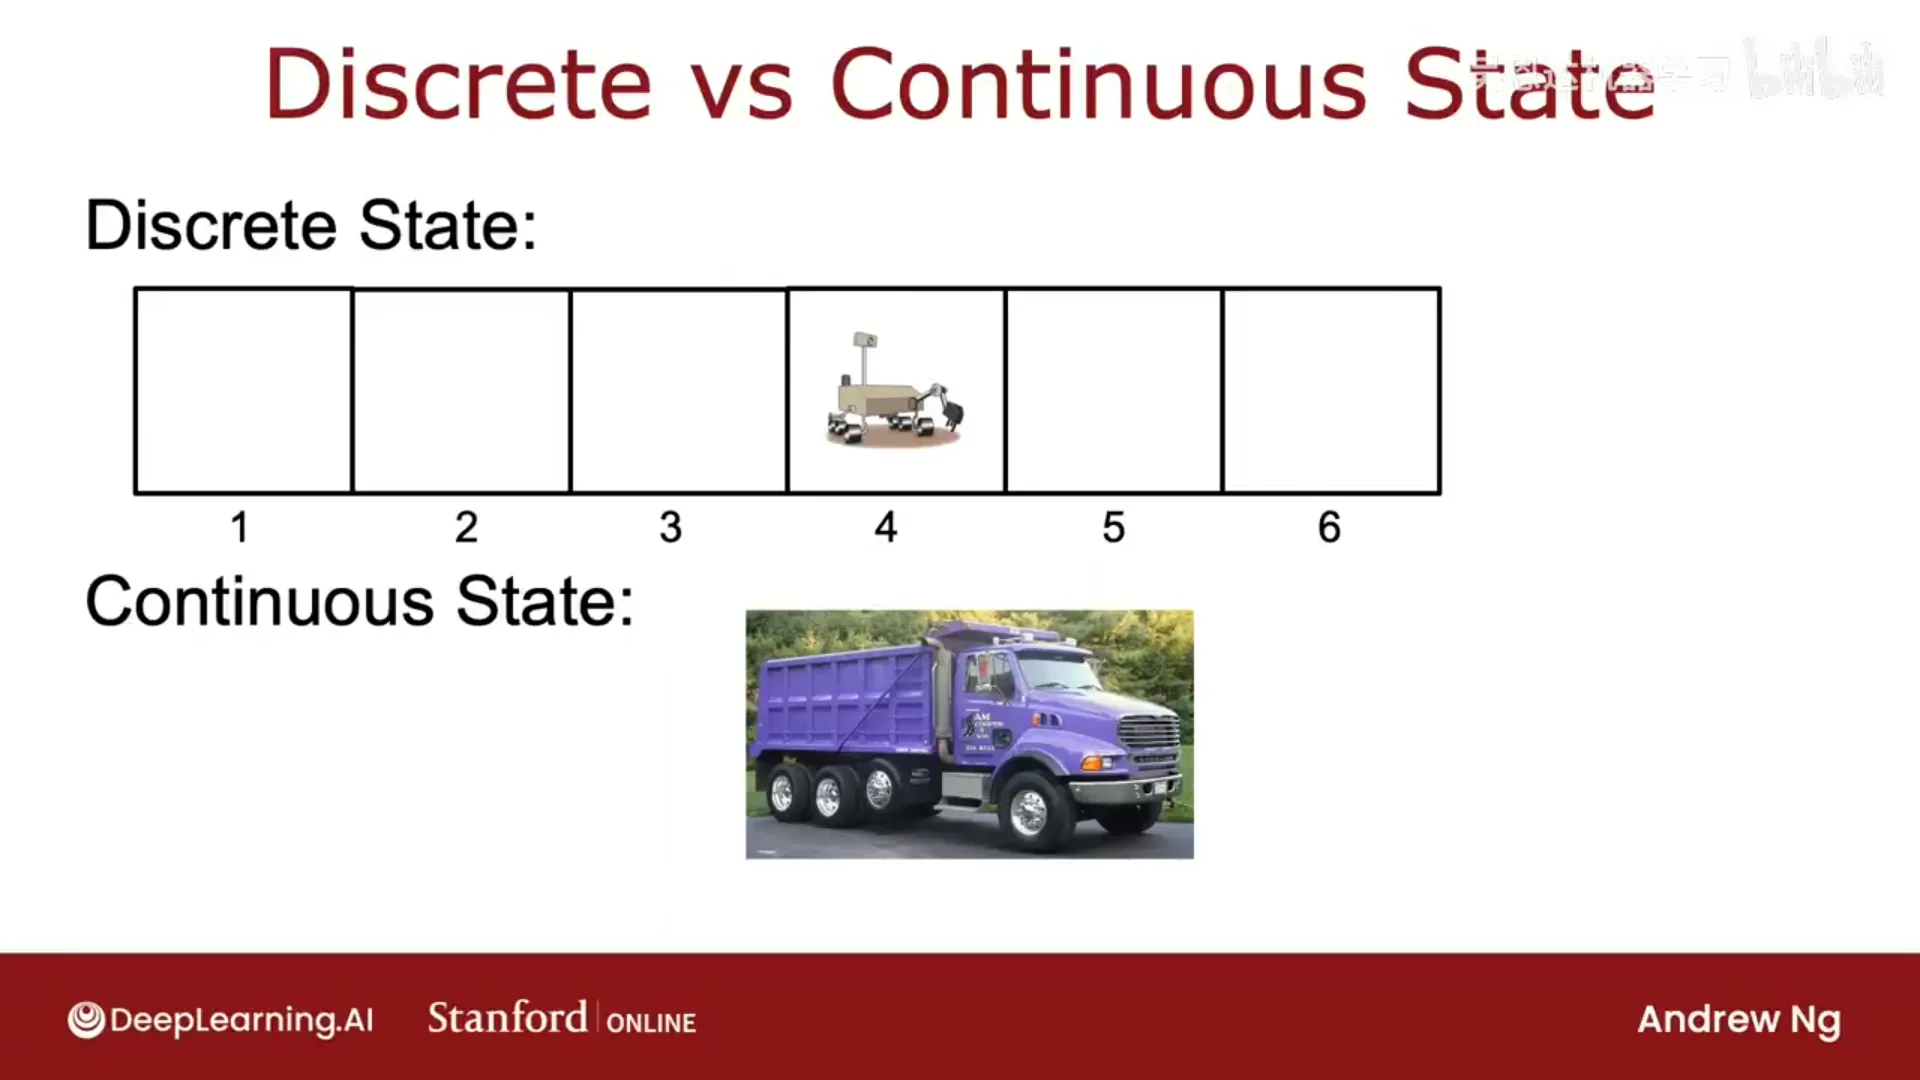
📷 连续状态空间:汽车的状态是 x、y、θ、ẋ、ẏ、θ̇ 的连续向量
回到原视频 (00:02:14)
9.2 月球着陆器
(p136)
月球着陆器(Lunar Lander)是 RL 研究中经典的应用:
- 动作(4 个):不做(nothing)(受重力/惯性下落)、左(点火左侧推进器,推向右)、主(点火主引擎,向上推)、右(点火右侧推进器,推向左);
- 状态(8 维):位置 x、y(高度)、速度 ẋ、ẏ、角度 θ、角速度 θ̇、以及 l、r(左腿/右腿是否着地,二值);
- 奖励:成功到达着陆台得 100~140(越靠近中心越高);靠近平台给正奖励、远离给负奖励;坠毁 −100;软着陆 +100;每条腿着地 +10;点火主引擎 −0.3、点火侧推器 −0.03(鼓励不浪费燃料)。
这个奖励函数相当复杂——设计者仔细思考想要什么、不想要什么并编码进去。设计奖励函数通常仍比"为每个状态指定准确动作"容易得多。
目标:学一个策略 π,使折扣回报最大(月球着陆器常用 γ = 0.985)。
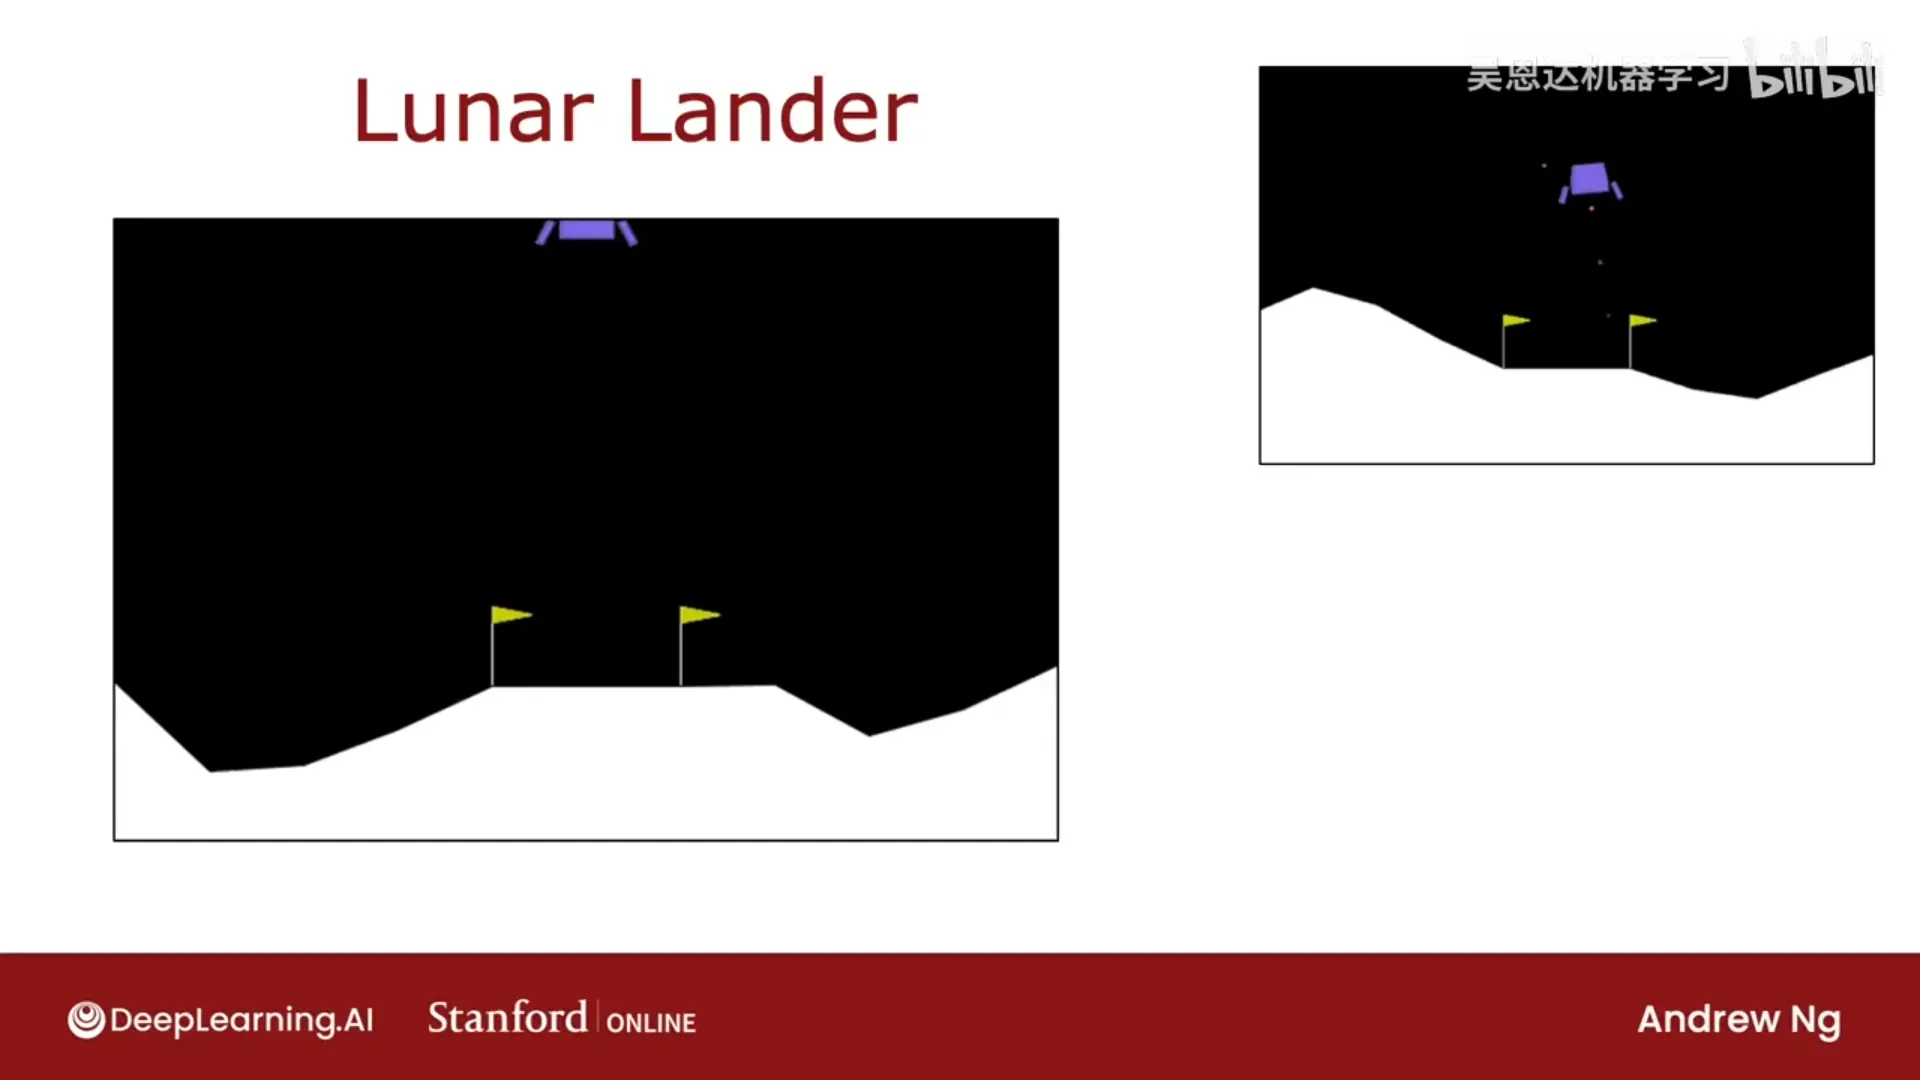
📷 月球着陆器:4 个动作(不做/左/主/右)、8 维状态、复杂奖励函数
回到原视频 (00:00:56)
9.3 学习 Q 函数:深度 Q 网络(DQN)
(p137–p138)
核心思路:训练一个神经网络来近似 Q(s,a),再用它选动作。
输入:状态 s + 动作 a。对月球着陆器,s 是 8 个数字;a 用独热编码成 4 个数字;合起来 12 个数字。经两层(各 64 单元)隐藏层,输出一个数 = Q(s,a)。
到了某个状态 s,对四个动作各算一次 Q(s,a),选 Q 最大的动作。
如何得到训练集 (x, y)? 用 Bellman 方程:
$$\begin{aligned}
x &= (s, a)\ y &= R(s) + \gamma \max_{a'} Q(s',a')
\end{aligned}$$
收集经验:在模拟器里随机采取动作(有些好、有些坏),记录大量元组 (s, a, R(s), s')——每个元组都能造一个训练样本:
$$\begin{aligned}
x &= (s,a) &&\text{12 个数字}\ y &= R(s) + \gamma \max_{a'} Q(s',a')
\end{aligned}$$
(一开始不知道 Q,就用神经网络的当前猜测代入——虽然不准,但会一轮轮变好。)然后用监督学习(均方误差)训练网络去预测 y。
完整 DQN 算法:
- 随机初始化神经网络参数 Q;
- 反复:
- 在模拟器中采取动作(先随机飞,好动作坏动作都做),收集元组,只保留最近 10,000 个——这叫重放缓冲区(replay buffer);
- 偶尔训练:从缓冲区取样本构造 (x, y) 训练集,训练一个新的网络 Q_new 使其
Q_new(s,a) ≈ y; - 更新 Q ← Q_new。
- 每轮迭代,
max_{a'} Q(s', a')的估计都更准一点,最终收敛到接近真实 Q → 用它选好动作。
这套算法叫 DQN(Deep Q-Network,深度 Q 网络)——因为用深度学习/神经网络来学 Q。想法部分来自 Mnih 等人。
编者拓展|DQN 与强化学习的三次高光:DeepMind 2013–2015 年的 DQN 用「深度网络 + 重放缓冲区 + 目标网络」让机器直接从像素学会了玩 49 款 Atari 游戏,登上 Nature 封面;2016 年同一团队用 AlphaGo 击败李世石(策略网络 + 价值网络 + 蒙特卡洛树搜索);而今天大家最熟悉的 RLHF(用人类反馈的强化学习训练 ChatGPT 的那一步),也是强化学习——它正以「对齐」的形式,成为大模型时代的关键技术。
架构优化:与其输入 (s,a) 输出一个 Q,不如输入 s、一次输出 4 个 Q 值(Q(s,左), Q(s,主), Q(s,右), Q(s,不做)):
- 一次推理就能比较 4 个动作(原来要 4 次);
- 计算 Bellman 方程里的
max_{a'} Q(s',a')也更方便。
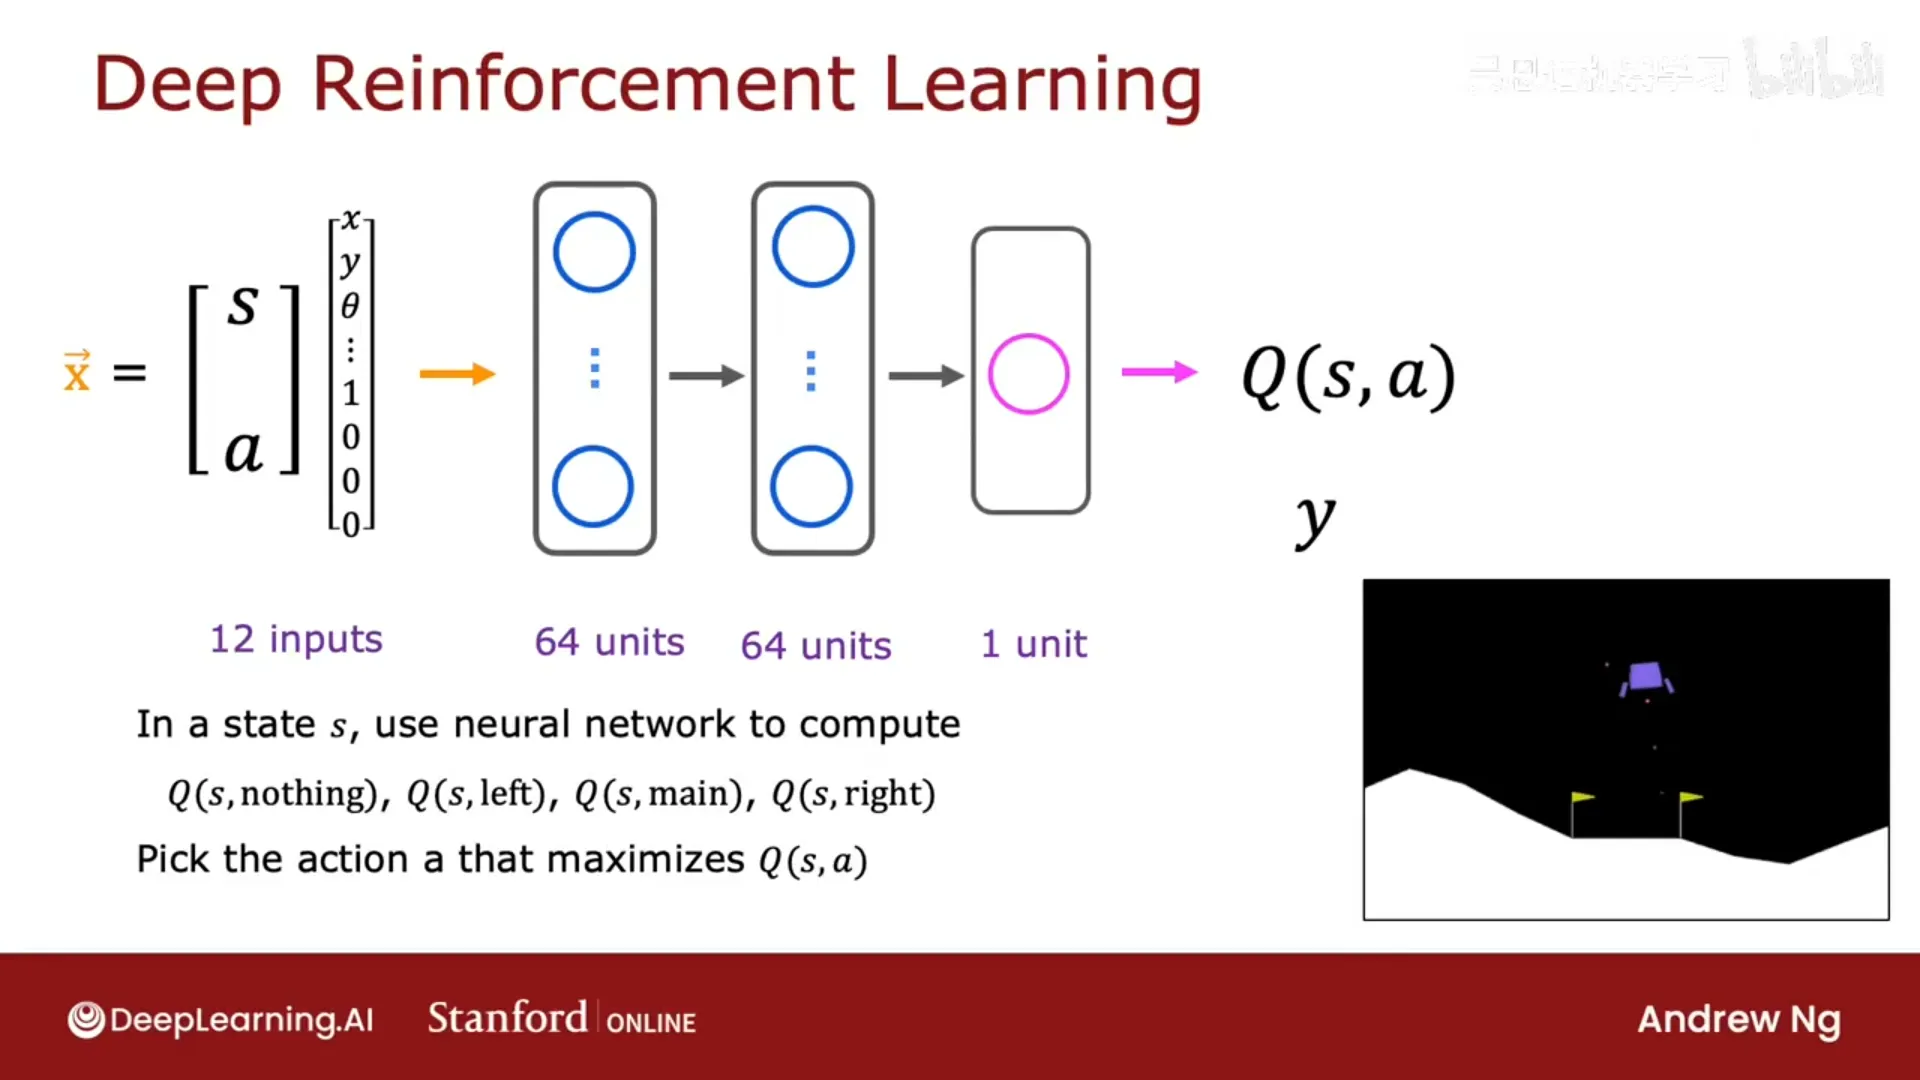
📷 用一个神经网络输入状态(8维)+动作(独热4维),输出 Q(s,a)
回到原视频 (00:02:16)
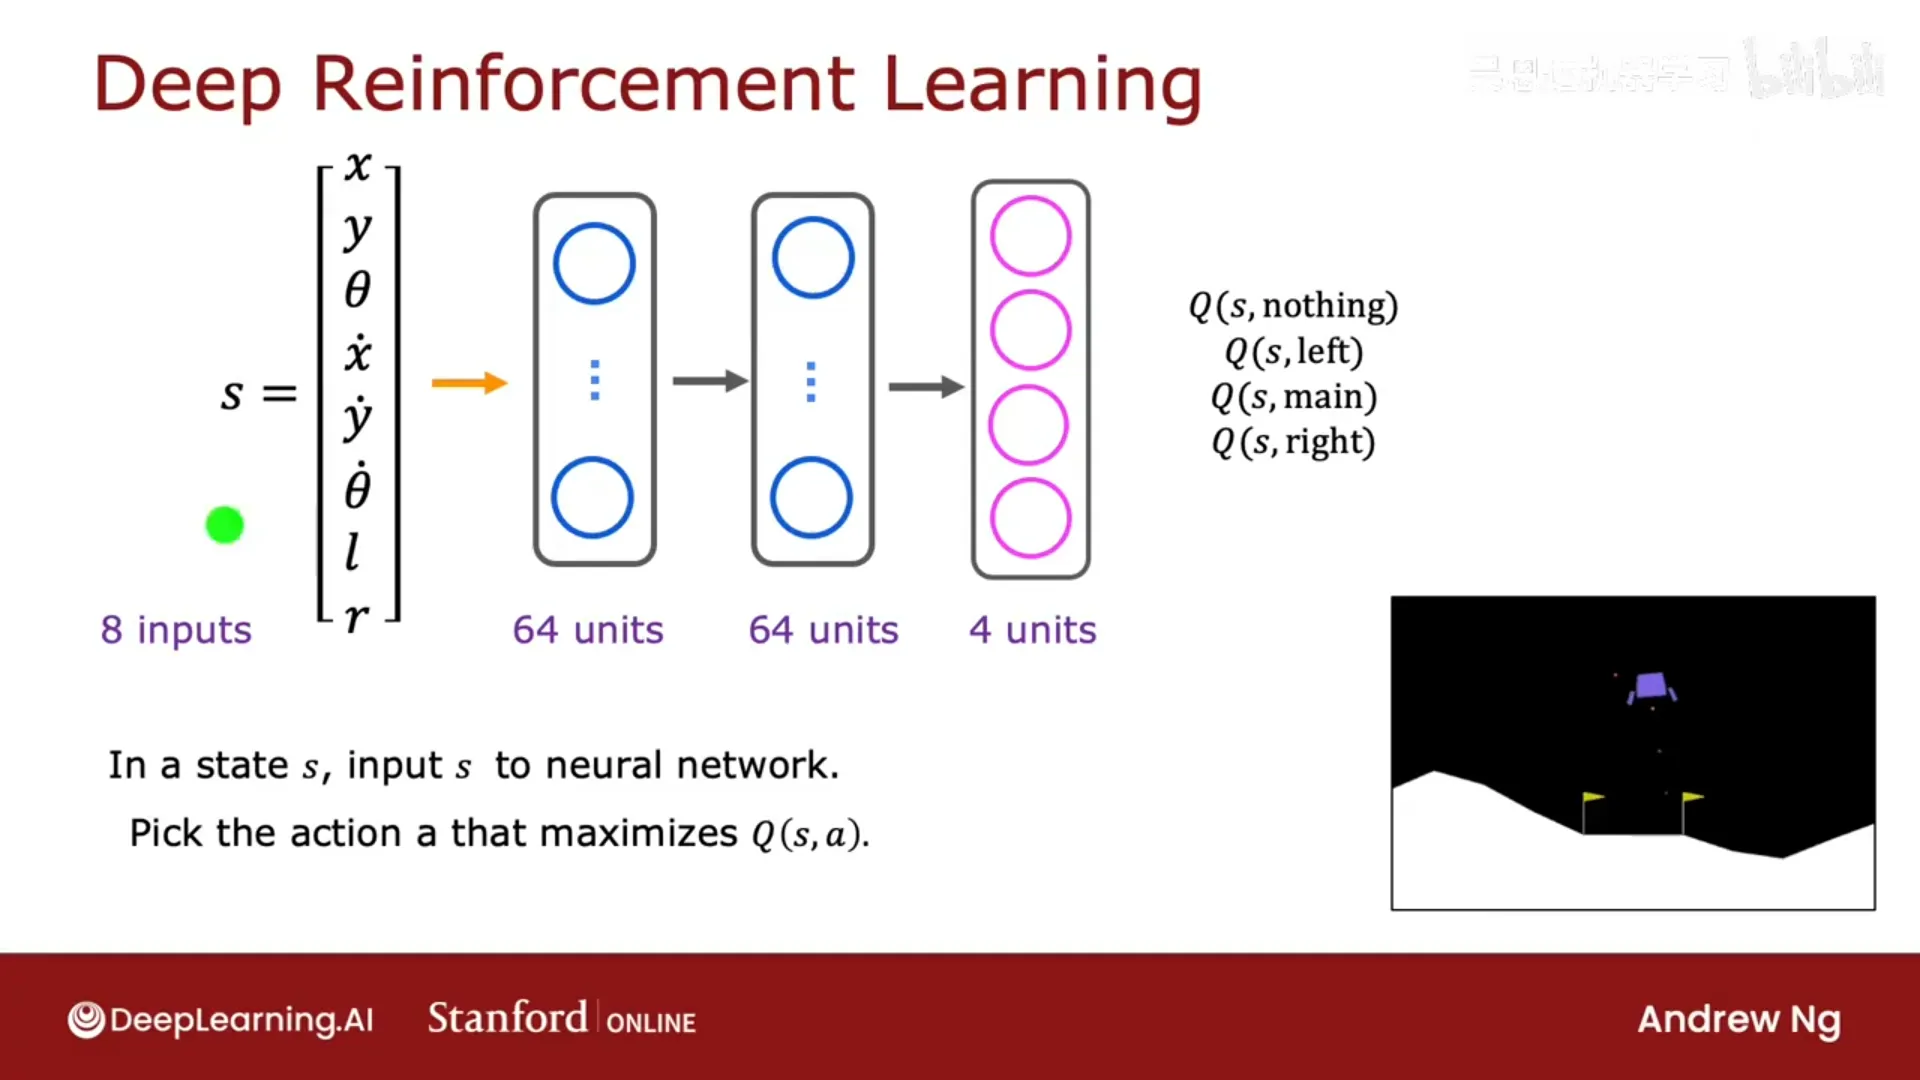
📷 更高效的架构:输入状态,一次输出全部动作的 Q 值
回到原视频 (00:01:20)
9.4 ε-贪婪策略(探索与利用)
(p139)
学习过程中,即使 Q 还不准,也得在模拟器里采取动作。怎么做?
- 若完全随机:通常很差;
- 若总是选 max Q:可能有问题——因为 Q 是随机初始化的,若它一开始就"碰巧"认为"点火主引擎从来不好",那么算法永远不会尝试主引擎,也就永远不会发现它有时其实很好。
ε-贪婪策略(ε-greedy):
- 大多数时候(如 95%)选最大化 Q(s,a) 的动作——这叫贪婪/利用(exploitation);
- 小部分时候(如 ε=5%)随机选一个动作——这叫探索(exploration),用于"尝试可能不好的想法"、了解更多。
实用技巧:开始时把 ε 设得很高(甚至 1.0,完全随机),再逐渐减小到 0.01——前期多探索、后期多利用。
名字有点反直觉:它其实是"95% 时间贪婪",所以也许该叫"1−ε 贪婪"。但历史上这个名字沿用下来了。
注意:RL 比监督学习对超参数更挑剔——监督学习中学习率小一点,顶多训练慢 3 倍;而 RL 中 ε 或其他参数设得不好,学习时间可能变成 10 倍甚至 100 倍。所以调 RL 参数常比调监督学习更让人头疼。
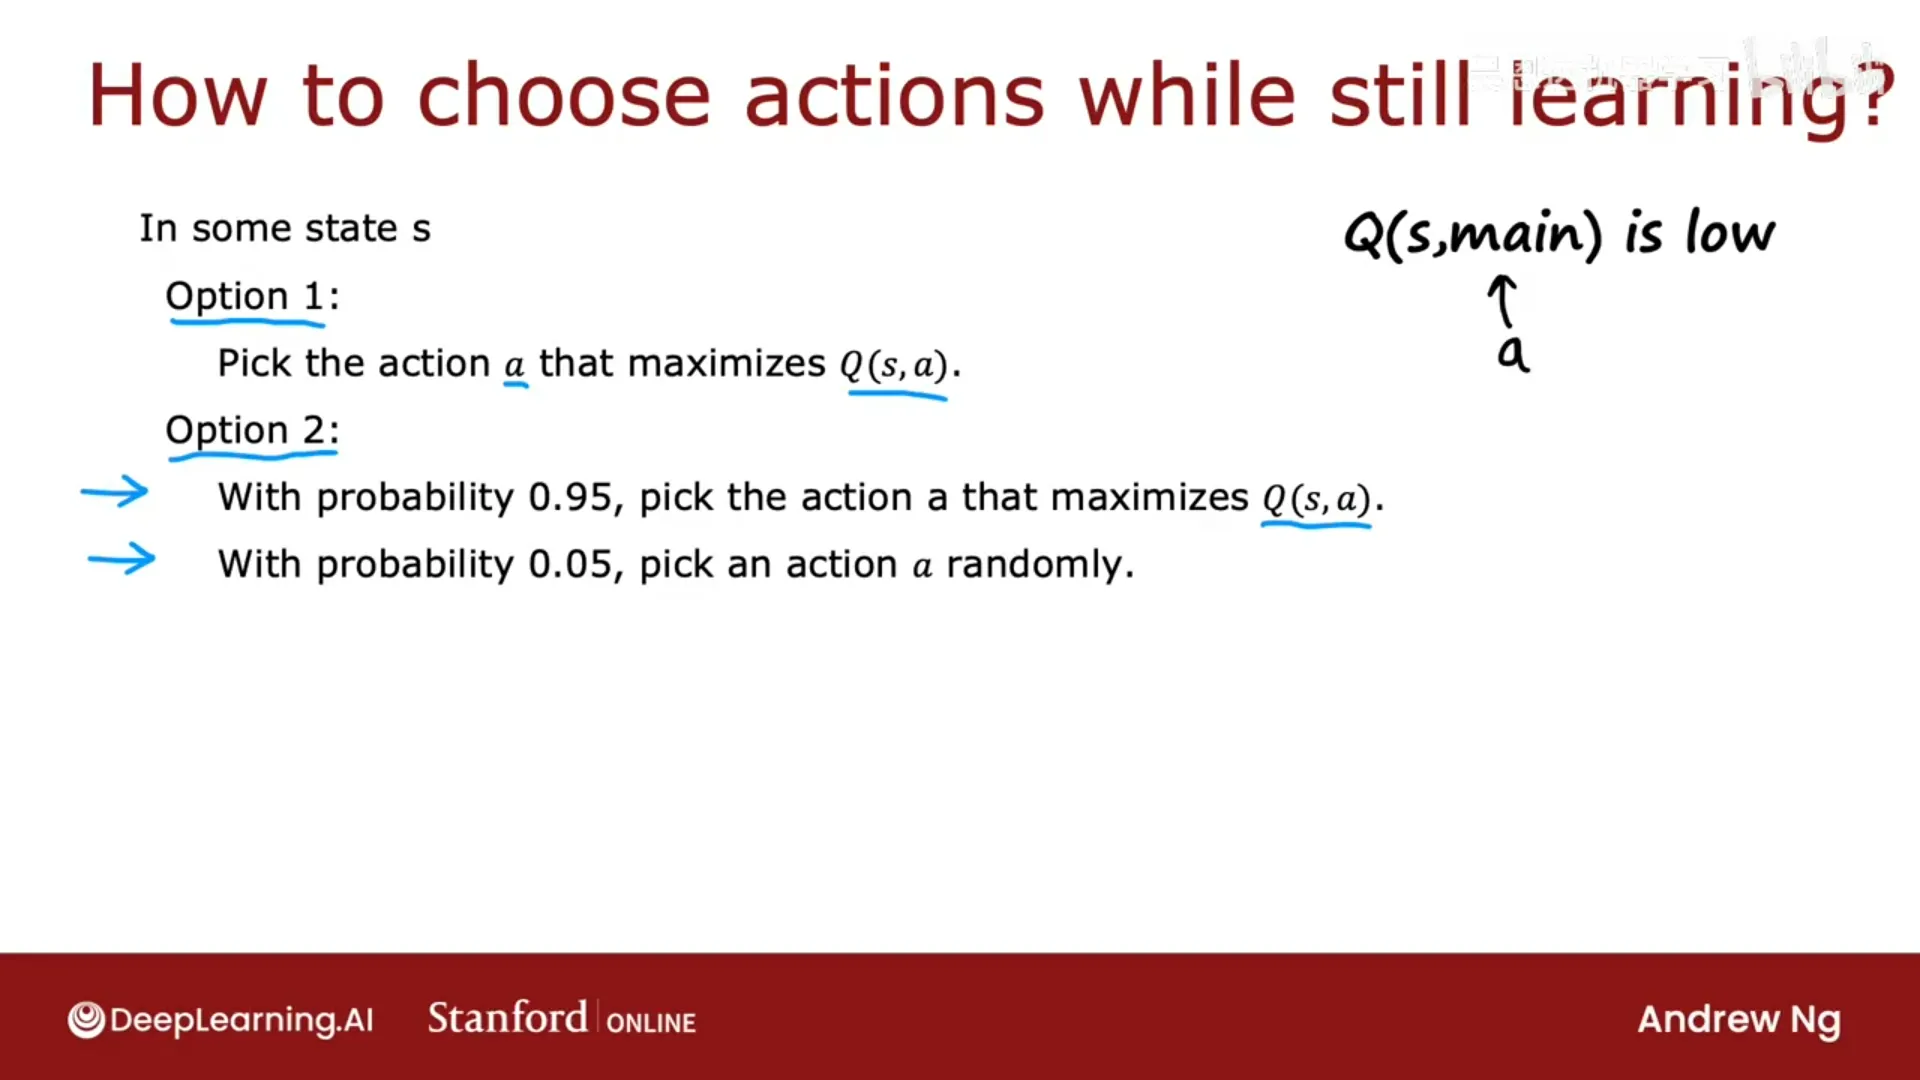
📷 ε-贪婪:大多数时候贪心地选 max Q,小部分时间随机探索
回到原视频 (00:02:43)
9.5 优化:小批量与软更新(可选)
易错点 M11:mini-batch 梯度是样本梯度的平均,batch 越大,随机扰动越容易相互抵消($\mathrm{Var}(\hat g)\propto 1/B$),梯度通常更不 noisy;batch 太小才更抖。(这与「样本多→噪声大」的直觉相反:平均会压低方差。)
(p140)
小批量(mini-batch):当训练集极大(如一亿样本)时,批量梯度下降每步都要遍历全量,非常慢。小批量每次只用一小部分(如 1000 个)样本估梯度:
- 每步更快,但方向更噪声,可能偶尔"走错方向";
- 平均而言仍趋向全局最小值。当训练集很大时,小批量通常比批量梯度下降更快——这同样适用于监督学习(用它训练线性/逻辑回归、神经网络都更快)。
在 DQN 里:即使重放缓冲区存了 10,000 个元组,训练时也可以只取 1000 个——更快。
软更新(soft update):在"Q ← Q_new"这一步,如果新网络碰巧更差,直接覆盖会让 Q 变坏。软更新用加权平均:
$$\begin{aligned}
W &:= 0.01\,W_{\text{new}} + 0.99\,W\ B &:= 0.01\,B_{\text{new}} + 0.99\,B
\end{aligned}$$
- 即"99% 保留旧值、1% 接受新值",让 Q 的变化更渐进、稳定;
- 两个系数之和应为 1(若用
1·W_new + 0·W,就退回到原来的"直接覆盖"); - 软更新能让 RL 算法收敛更快、更稳定,减少震荡与发散。
有了小批量与软更新,月球着陆器(相当复杂、有挑战的应用)应该能表现得很好。亲自写代码看着着陆器安全降落,是很酷的体验。
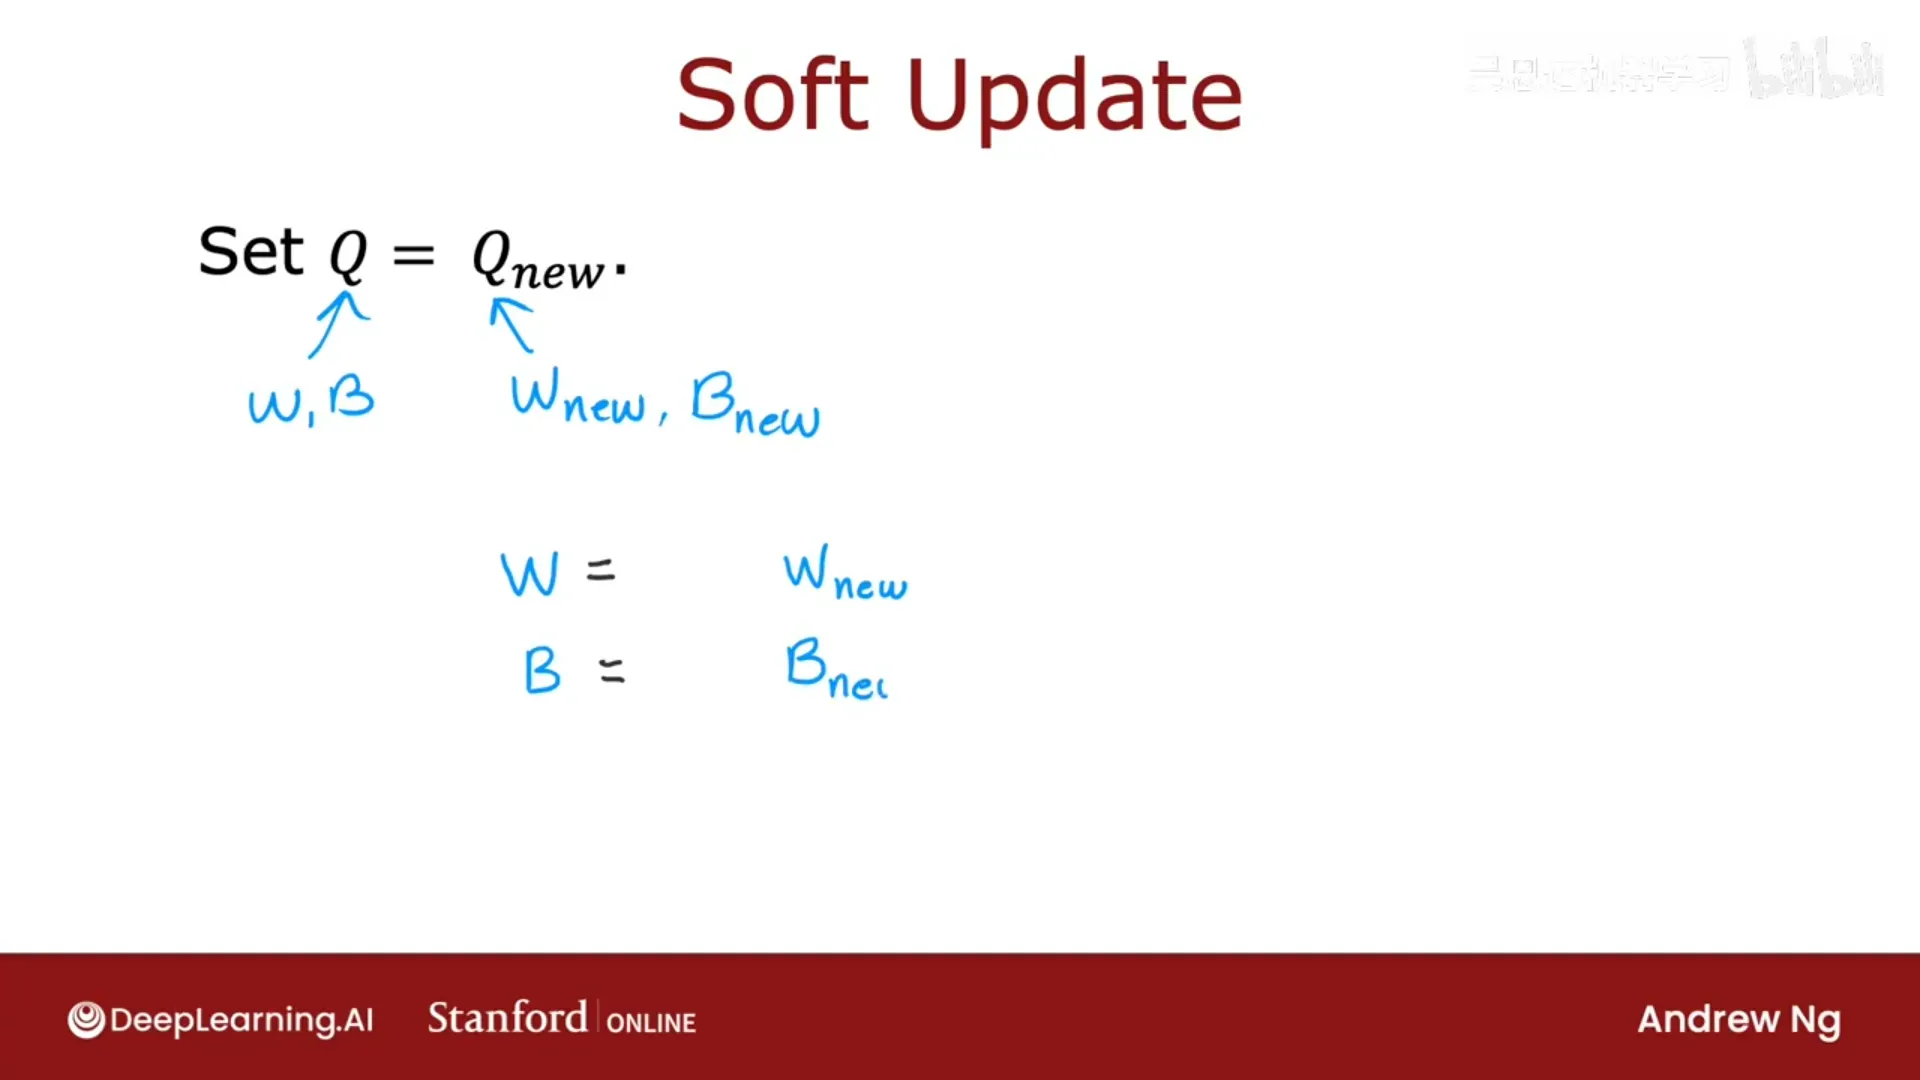
📷 软更新:W ← 0.01·W_new + 0.99·W,让 Q 的参数渐进变化、更稳定
回到原视频 (00:09:10)
9.6 强化学习的现状
(p141)
吴恩达对 RL 的冷静评估:
- 模拟 vs 现实差距:许多论文基于模拟环境(游戏)。在模拟/游戏里跑通,比在真实机器人上跑通容易得多——即使模拟成功,落地到现实也极具挑战;
- 实际应用远少于监督/无监督学习:媒体对 RL 报道很多,但今天 RL 的应用远少于监督与无监督学习。做实际应用时,你更可能最终用监督/无监督学习;
- 吴恩达自己用过几次 RL(尤其机器人控制),但日常工作里用监督与无监督学习的频率高得多;
- 但 RL 仍是机器学习的主要支柱之一,研究势头强劲、未来潜力很大——把它作为框架,能帮你更有效地构建实用的 ML 系统。
📷 强化学习的现状:研究热、模拟易、现实难、实际应用少于监督/无监督学习
回到原视频 (00:00:45)
第十章 总结
(对应模块 10,视频 p142)
至此,整个专项三门课走完:
- 第一门课 · 监督机器学习(回归与分类):线性回归、逻辑回归、成本函数、梯度下降;
- 第二门课 · 高级学习算法:神经网络、决策树、树集成,以及机器学习实践建议(偏差/方差、训练/验证/测试集、如何有效改进算法);
- 第三门课 · 无监督学习、推荐系统与强化学习:聚类、异常检测、协同过滤、基于内容的过滤、强化学习。
有了这一整套工具,你已经能够构建许多类型的机器学习应用。吴恩达说:机器学习已经对社会产生巨大影响(每天有数十亿人通过网页搜索、产品推荐、语音识别等使用它),也帮助了科学发现、创造了巨额价值;但最好的机器学习应用还没有被发明出来——那就要靠你了。他希望你把技能用于改善他人的生活。
最后,他对学习者表达了感谢:他知道学习这些很耗时、大家都很忙,因此非常感谢你投入时间观看视频、完成测验与实验。
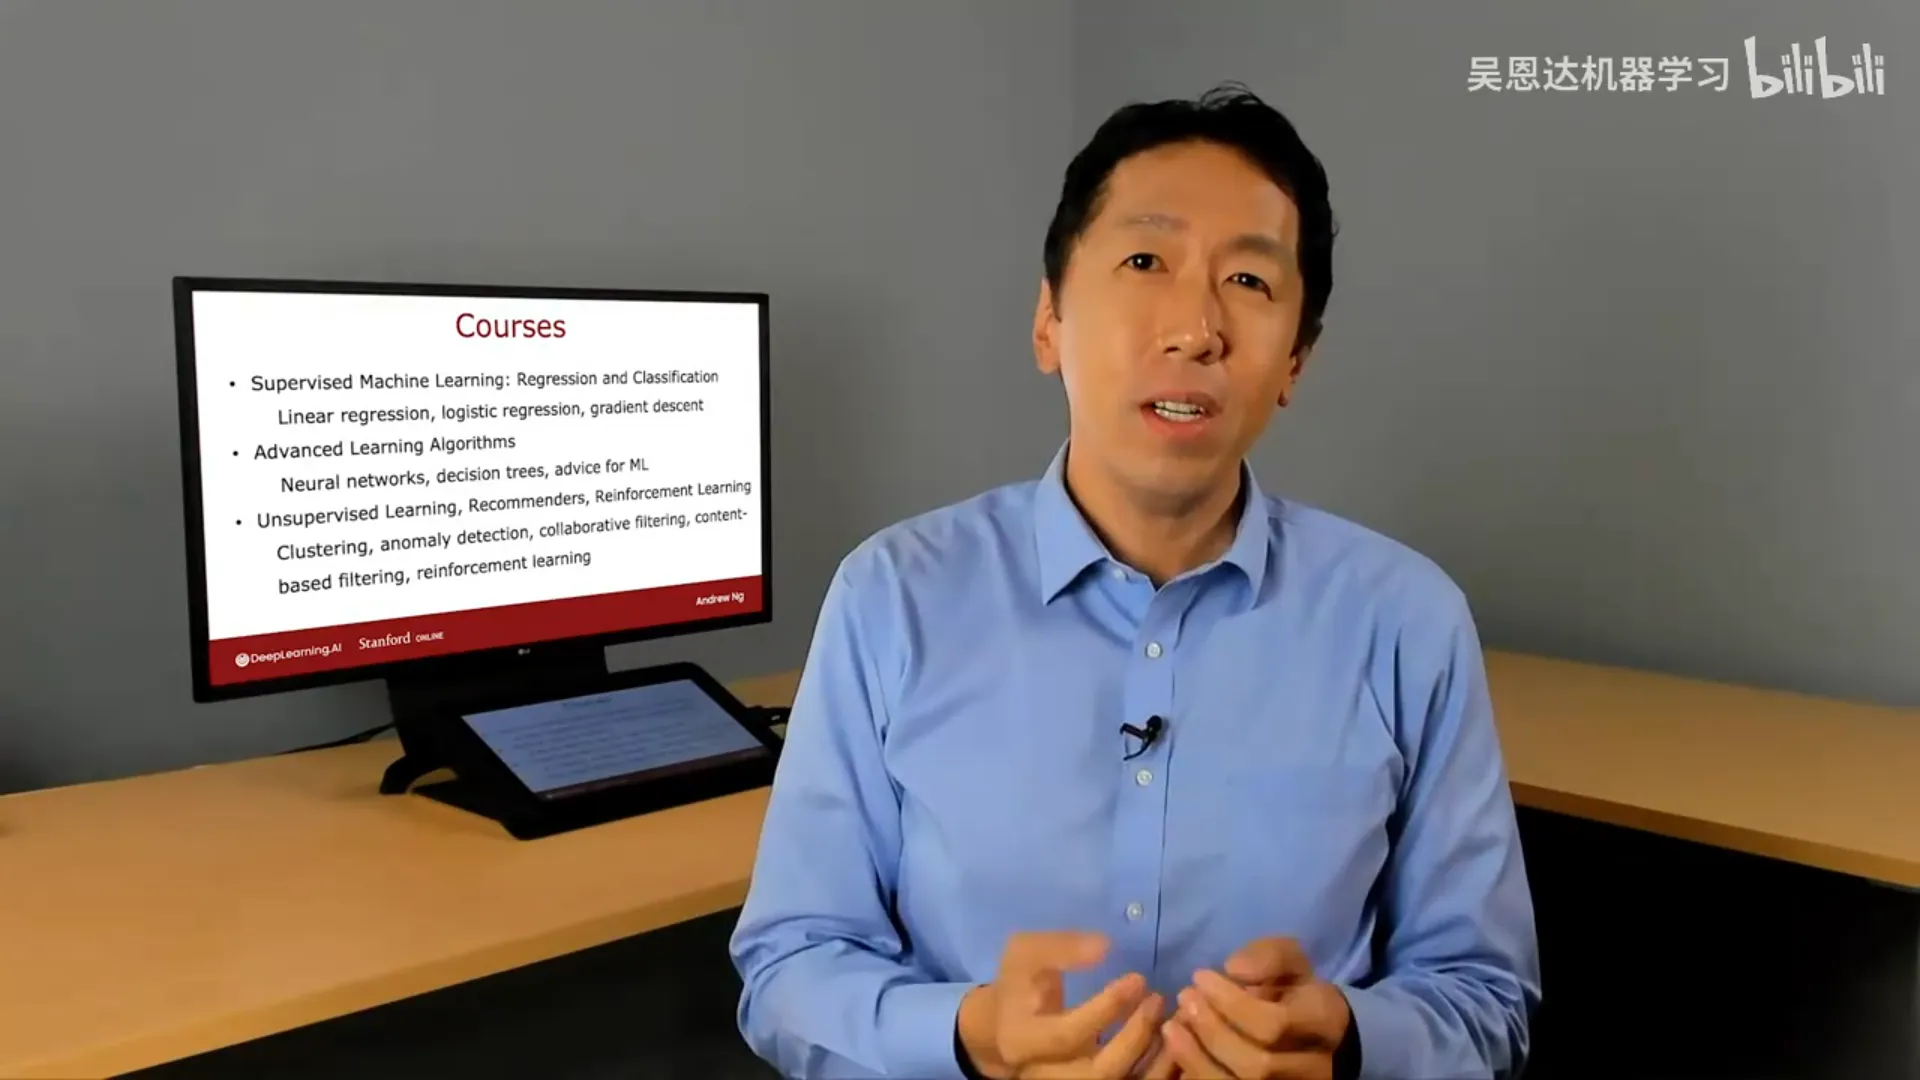
📷 总结:整个专项三门课的知识地图
回到原视频 (00:01:23)
自测与思考题(进阶)
- 推导:K-means 的失真函数 $J=\frac1m\sum_i\lVert x^{(i)}-\mu_{c^{(i)}}\rVert^2$;固定质心时,为什么「把每个点分给最近质心」最优?
- 选择:异常检测 vs 监督学习——当正类样本很多、且未来异常类型可能变化时,选哪个?为什么?
- 理解:协同过滤是怎么「在没有显式特征的情况下同时学出 $w,b,x$」的?
- 参数变化:DQN 里 mini-batch 越大,随机梯度的方差如何变?
- 解释:软更新 $W:=0.01W_{new}+0.99W$ 为什么能让 Q 收敛得更稳?
参考答案要点
- 固定质心 $\mu$ 时,$J$ 是各点距离平方之和,各项独立,所以每项只需选最近的质心即可令该点和最小 ⇒ 全局最小。
- 选异常检测:正类样本多时监督学习难处理极偏斜;异常检测建模 $p(x)$,能发现没见过的异常类型,更鲁棒。
- 把每部电影的特征 $x^{(i)}$ 也当作可学参数,与 $w^{(j)},b^{(j)}$ 一起放进同一个代价函数,用梯度下降联合优化(互相提供监督信号)。
- batch 越大,$\mathrm{Var}(\hat g)\propto1/B$ 越小 ⇒ 梯度更稳,但每步更贵。
- 它不直接覆盖旧值,而是加权平均:即便新网络偶尔更差,也只以 1% 的影响改变 Q,避免 Q 被单次坏更新带崩,从而更渐进、更稳定。
附:来源与参考
- 课程:Machine Learning Specialization(DeepLearning.AI / Stanford Online,2022 新版),讲师 Andrew Ng
- 课程主页:https://www.deeplearning.ai/specializations/machine-learning
- 视频来源:Bilibili 搬运合集
BV16jyuBBEom(本册对应分P p101–p142) - 参考笔记(2014 版课程):https://github.com/fengdu78/Coursera-ML-AndrewNg-Notes
- 本册涉及的方法/工作:K-means 聚类、高斯分布/最大似然估计、密度估计、协同过滤、基于内容的过滤(两塔网络 + 点积)、均值归一化、TensorFlow 自动微分(GradientTape)、MoviesLens 数据集(Harper & Konstan)、马尔可夫决策过程(MDP)、Bellman 方程、Q 函数、DQN(Mnih 等)、ε-贪婪、小批量、软更新
版权说明:课程视频、字幕与讲义版权归 DeepLearning.AI / Stanford 所有。本电子书为个人学习所做的中文书面重构,未获授权,不得用于任何商业用途或公开传播。书中截图取自对应分P视频画面,并标注「分P @ 时间」以便回源核对。