第2讲 · 提示词与上下文工程
本书由课堂口语记录重构而成,图文并茂、章节结构参考讲师讲义。正文中标注为「编者说明/编者拓展」的内容由编者补充,不代表讲师原话。
| 课程 | 南京大学《生成式软件工程》· 第二讲 |
| 讲师 | 蒋炎岩(jyy) |
| 视频 | BV1CQt365EzW(时长约 98 分钟) |
| 课程主页与讲义 | jyywiki.cn(本讲对应讲义《提示词与上下文工程》) |
| 许可 | 本讲义/幻灯片采用 CC BY-NC 4.0 许可;苏 ICP 备 2020049101 号 |
对应讲次:第2讲(南京大学 生成式软件工程)
制作模型:deepseek-flash(vb compose,据 run.log)
开篇:一句热搜,与"立即开始"
(参考时间: 00:00)
📷 课程开场:模型从对话框开始
回到原视频 (00:00:00)
第一讲留下了一个问题:Agent 已经能做很多事,我们怎样才能驾驭它?这一讲从最常见的交互方式——自然语言指令——出发,讨论怎样让模型理解目标、遵循要求,以及在没有确定答案时继续探索。
不过,先处理第一讲留下的一个意外。
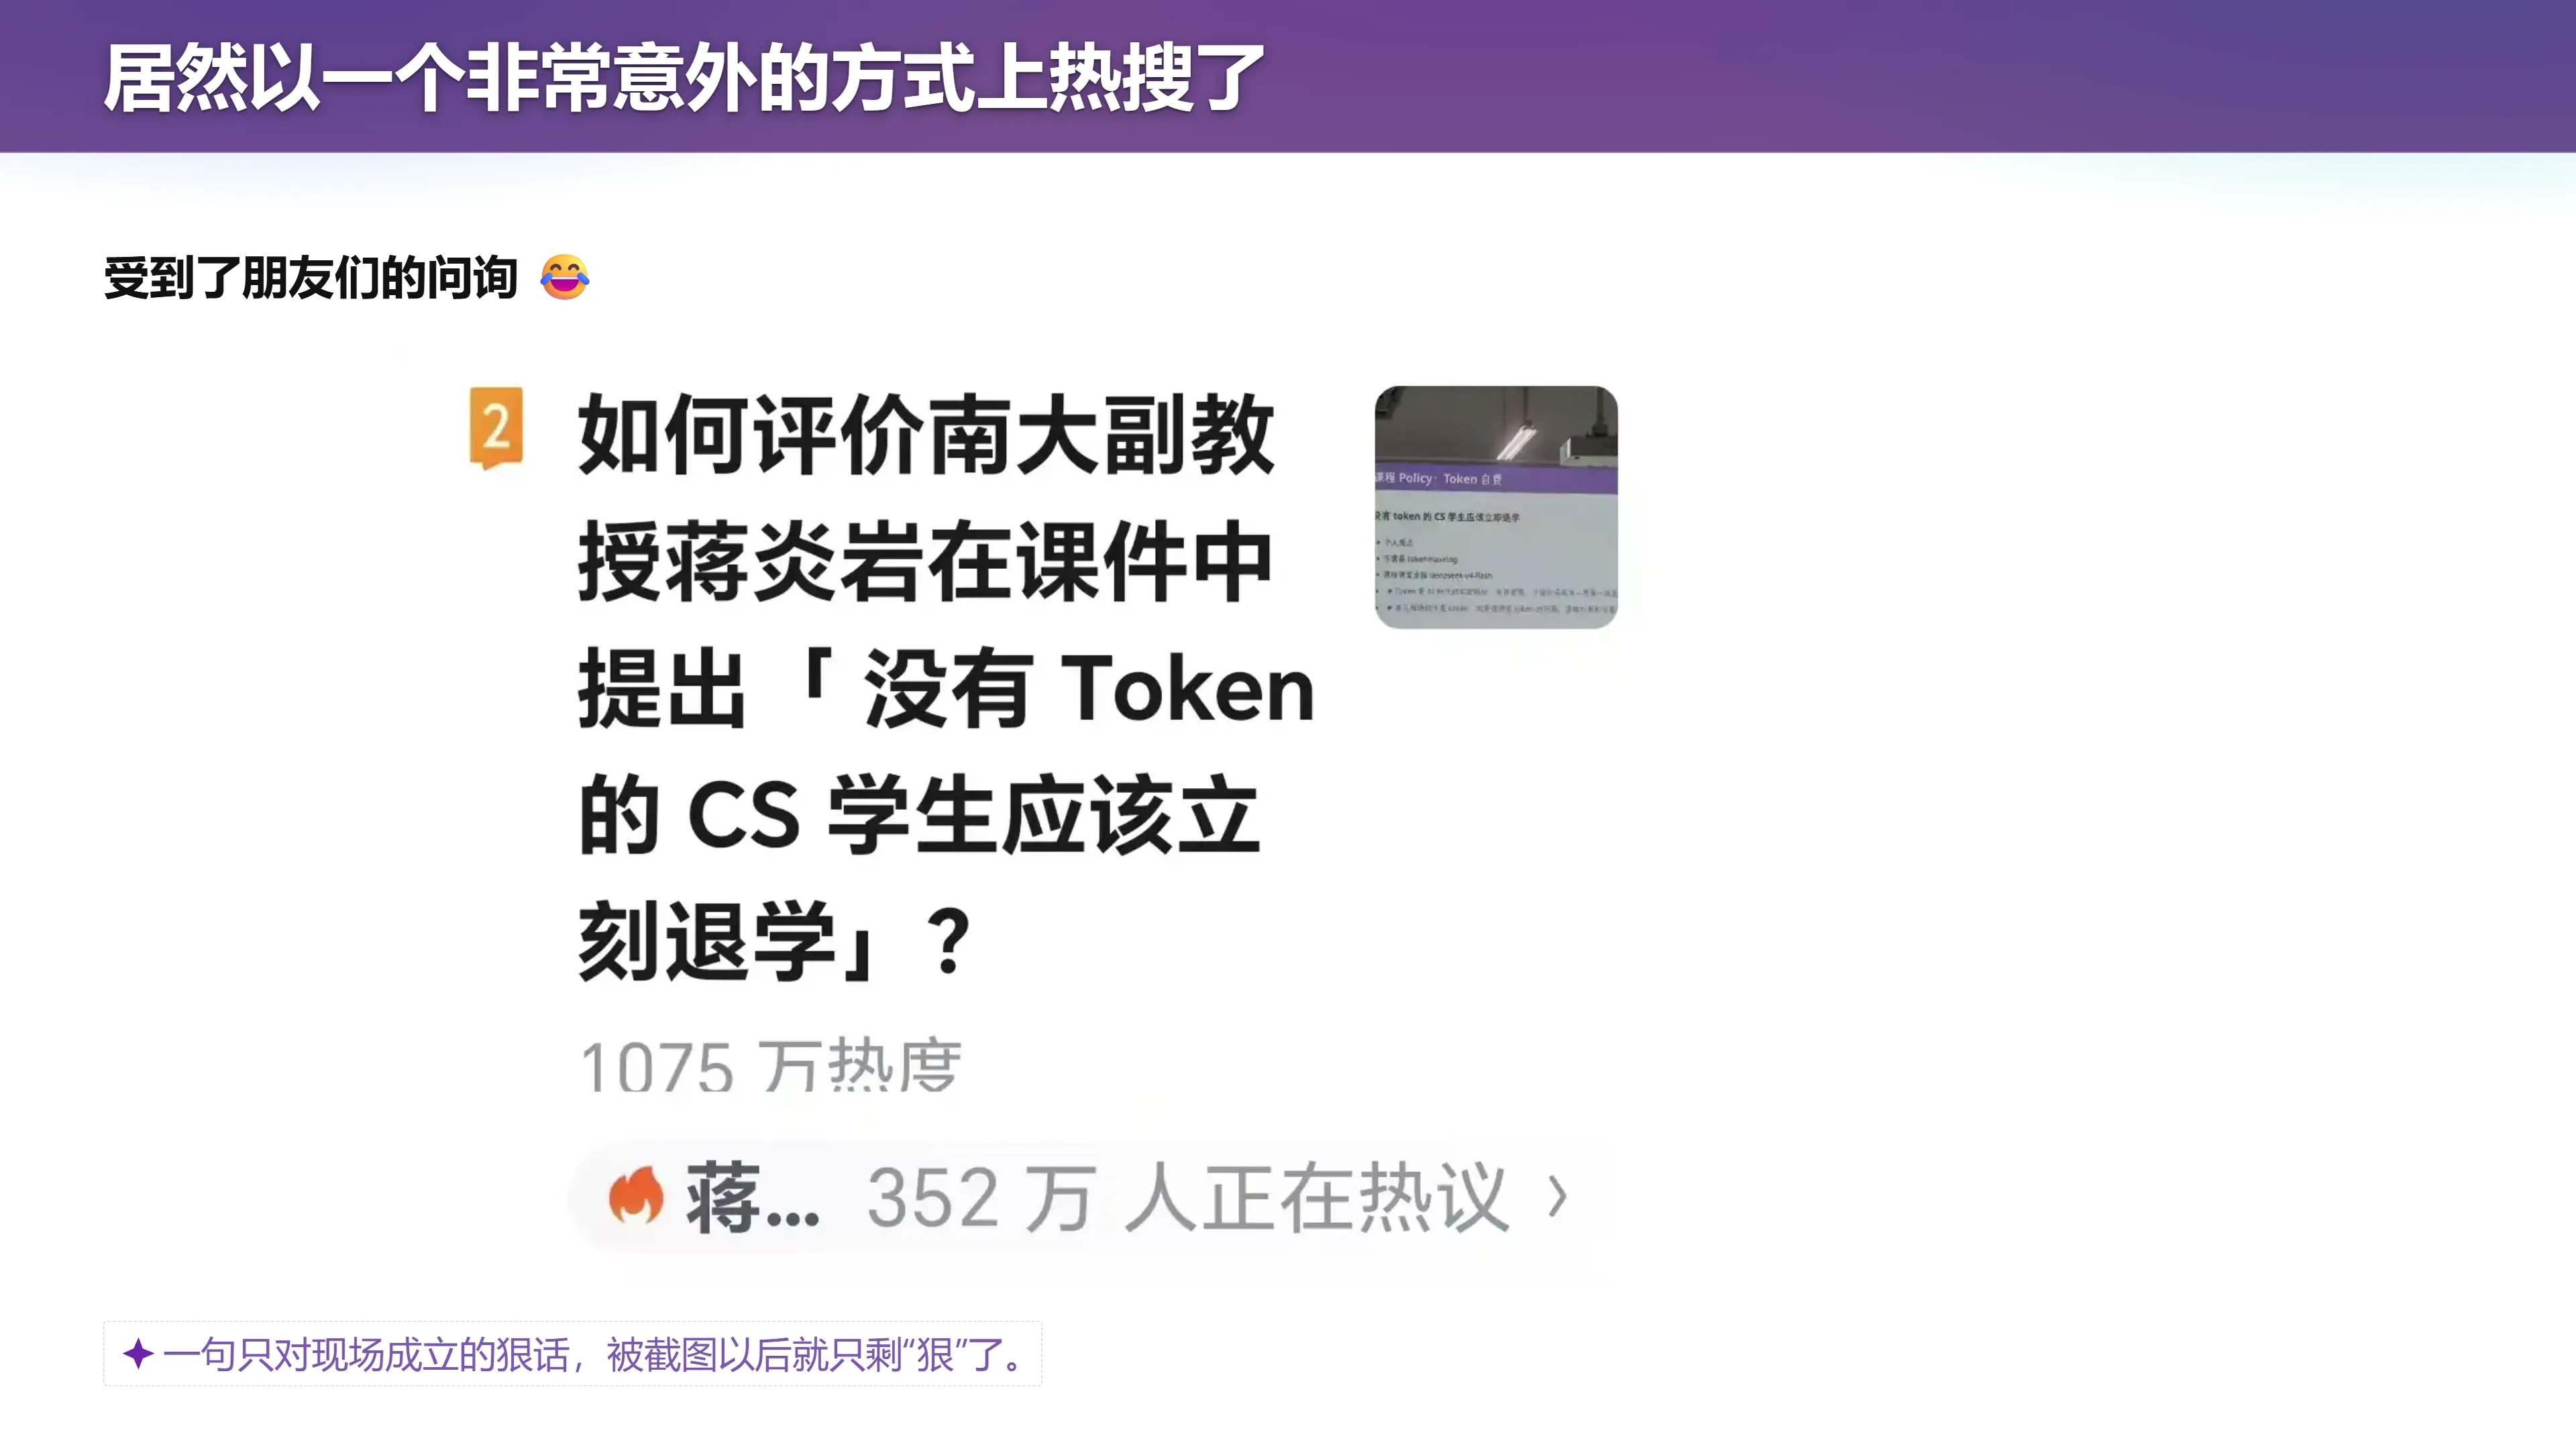
"没有 token 的 CS 学生应该立即退学"这句话上了热搜,也引来了朋友们的问询。当然不会真的让同学们退学。
📷 第一讲的意外与朋友们的问询
回到原视频 (00:00:00)
课堂上这句话真正要推动的,是立即实践:不要把"等待完美工具""等待别人给出评价"变成一直不开始的理由。离开现场,截图只剩下一句狠话——这本身也提醒我们,同样的文字放进不同的上下文,会被理解成很不一样的意思。
📷 退学的"威胁"与立即行动
回到原视频 (00:04:49)
讲师补充了几个现实层面的理由:
- 现在能用得起的模型其实不少,比如 ¥40 一档的豆包(内含 GLM、DeepSeek 等);
- 贵模型用不起,就用便宜的;
- 再不开始,就不是预算问题了。
编者拓展|"提示词"这个词从哪来:
prompt在 ChatGPT 之前并不是今天这个意思。2019 年 GPT-2 的发布页面已经写下 "prompting the trained model"——输入文本从一个"开头"变成了控制模型续写的条件。2020 年 GPT-3 把任务说明和 few-shot 示例都称作 prompt;2021 年,"prompt programming""prompt-based learning" 开始成为研究对象。也就是说,ChatGPT 普及了 prompt,但没有发明它。
一、"提示词"从哪里来
(参考时间: 01:16)
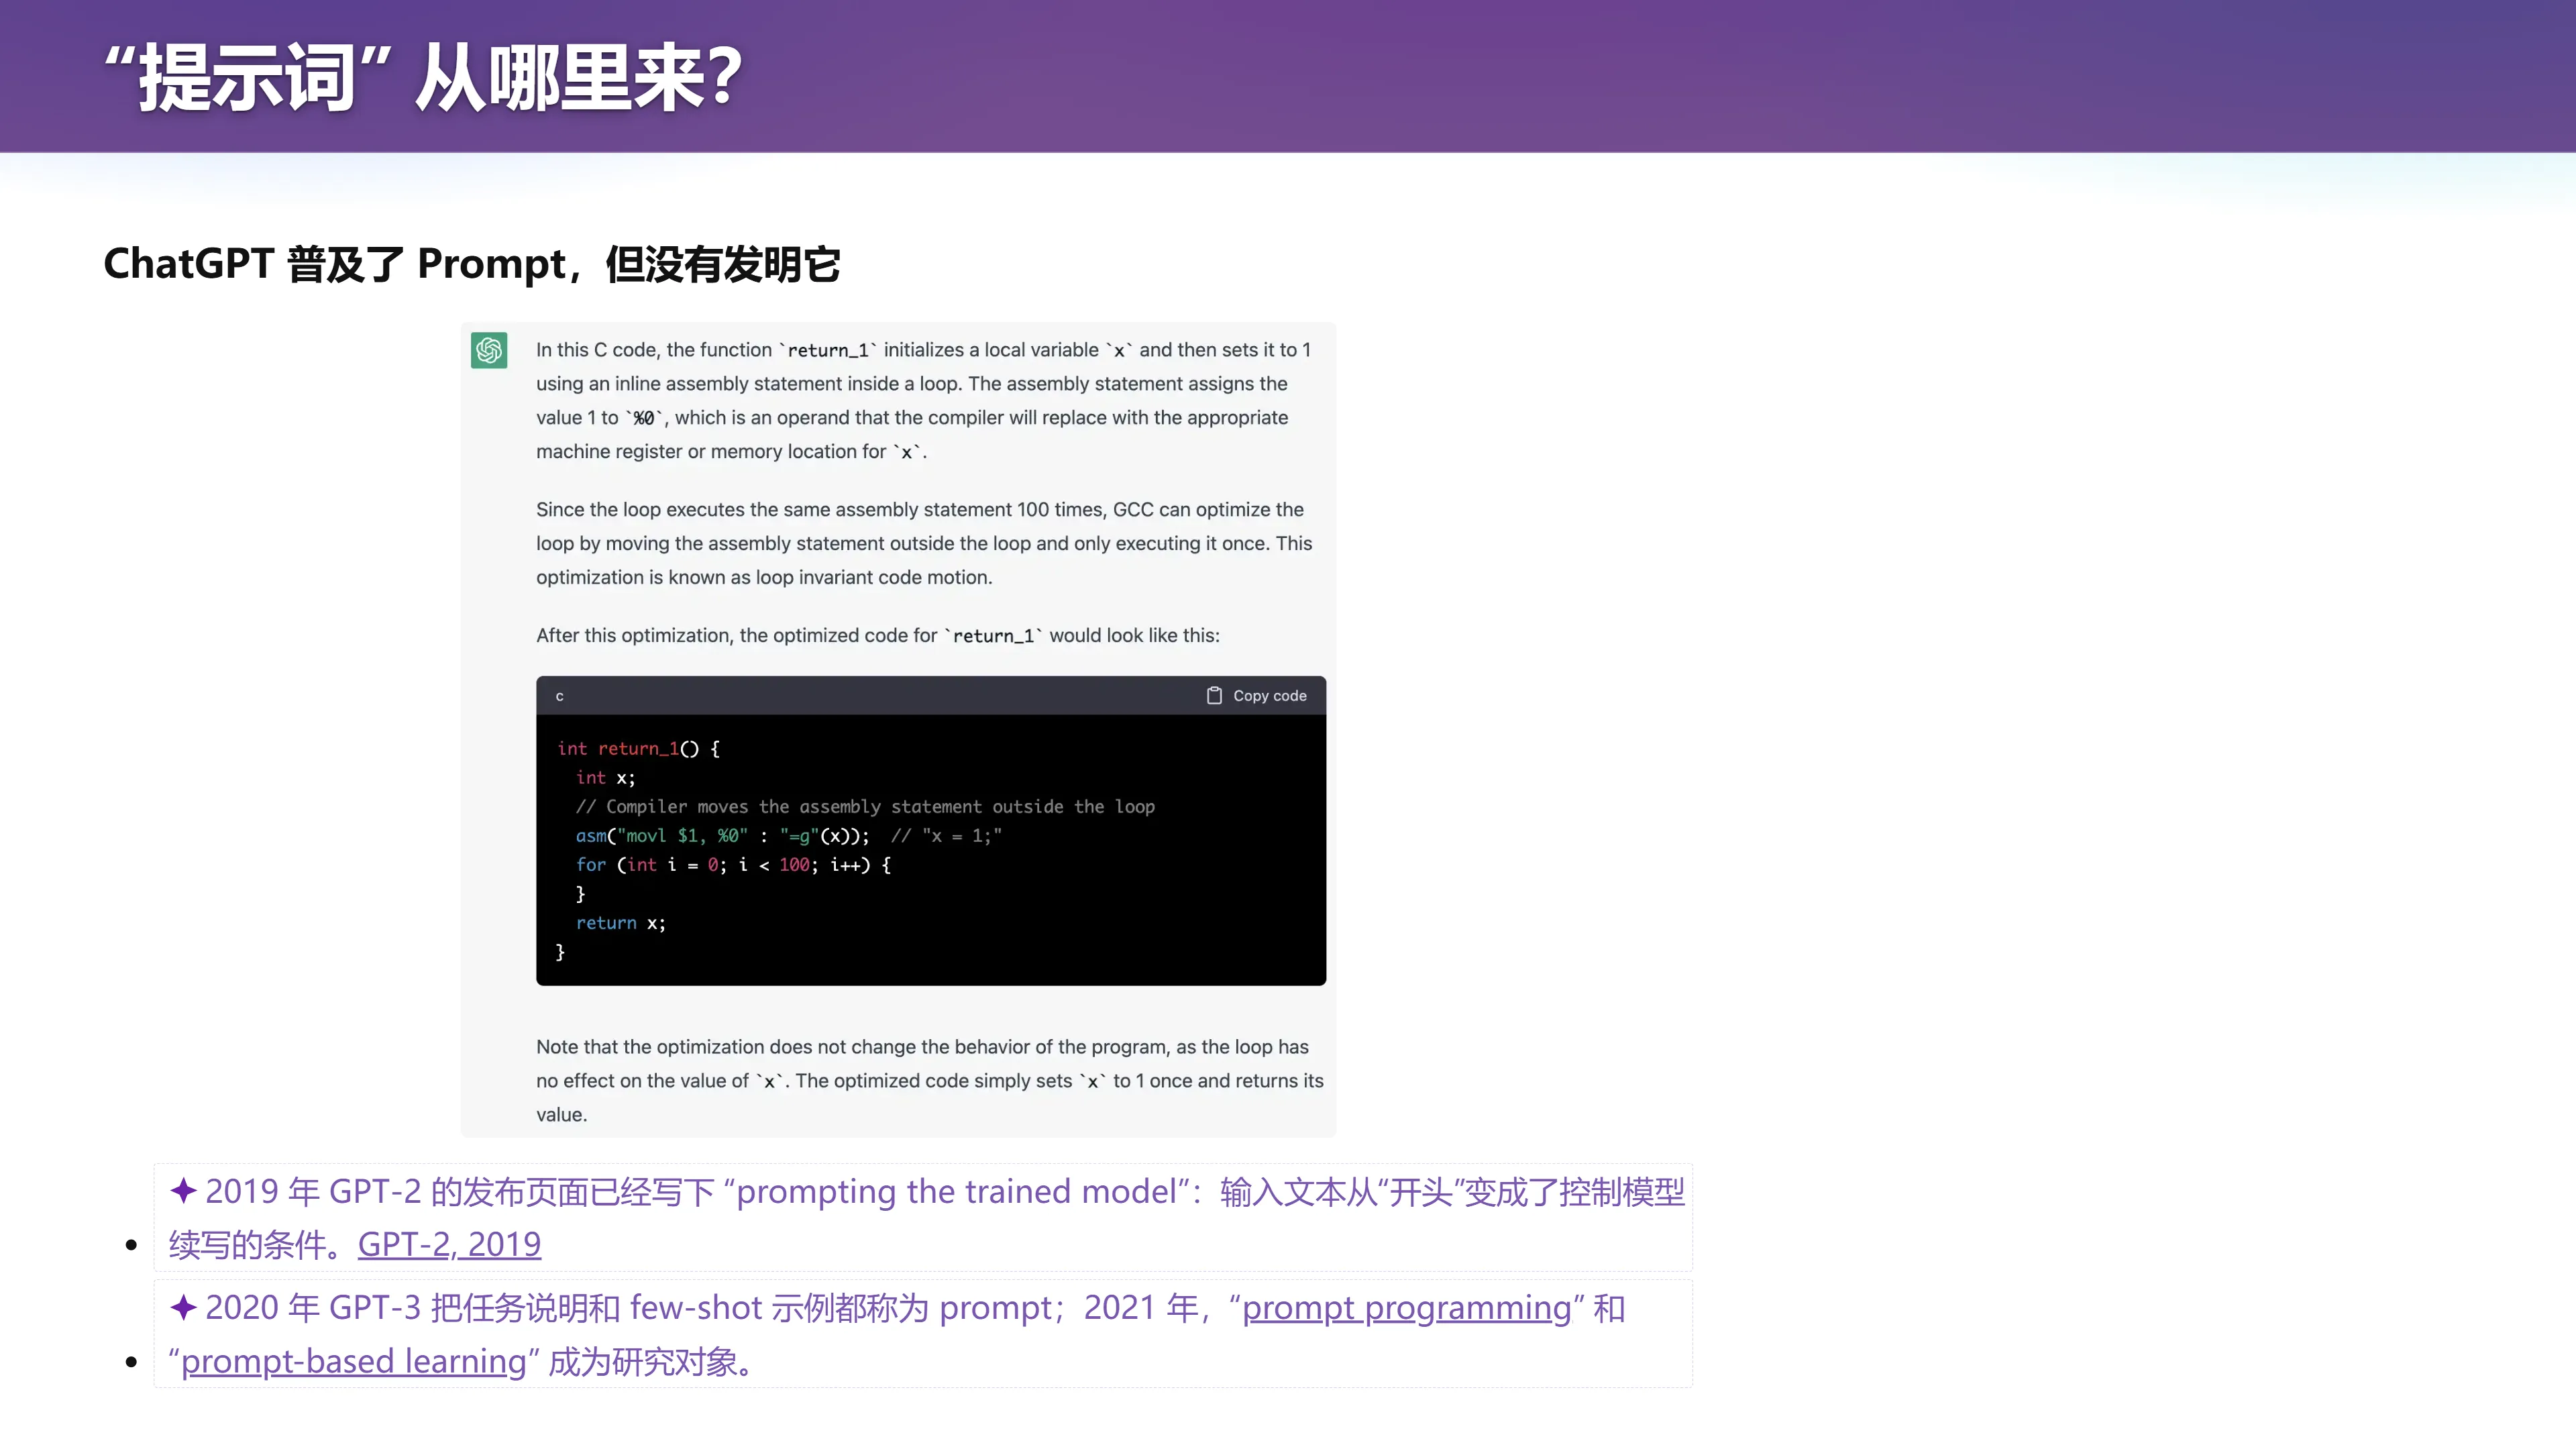
📷 "提示词"从哪里来
回到原视频 (00:01:16)
自然语言提示词,基本上就是今天大家和机器沟通的唯一接口。从 ChatGPT 时代起,我们在聊天窗里给机器一个 prompt,机器返回文字、代码、图片……
讲师回忆了他第一次感受到 prompt 力量的时刻:
我每年上操作系统课。2023 年、也就是 ChatGPT 刚发布那阵子,我试着让 ChatGPT 帮我讲一讲 x86 汇编。现在应该已经没有人手写 x86 汇编了,它成了一种"传统艺能"。结果它解释得出奇地好——而且那是一个应该不在它训练语料里的东西:我故意做了一个"地球人不会这样写"的 x86 汇编,它依然做得相当好,虽然确实不完美。那一刻我就觉得,时代要变了。
(参考时间: 01:32)
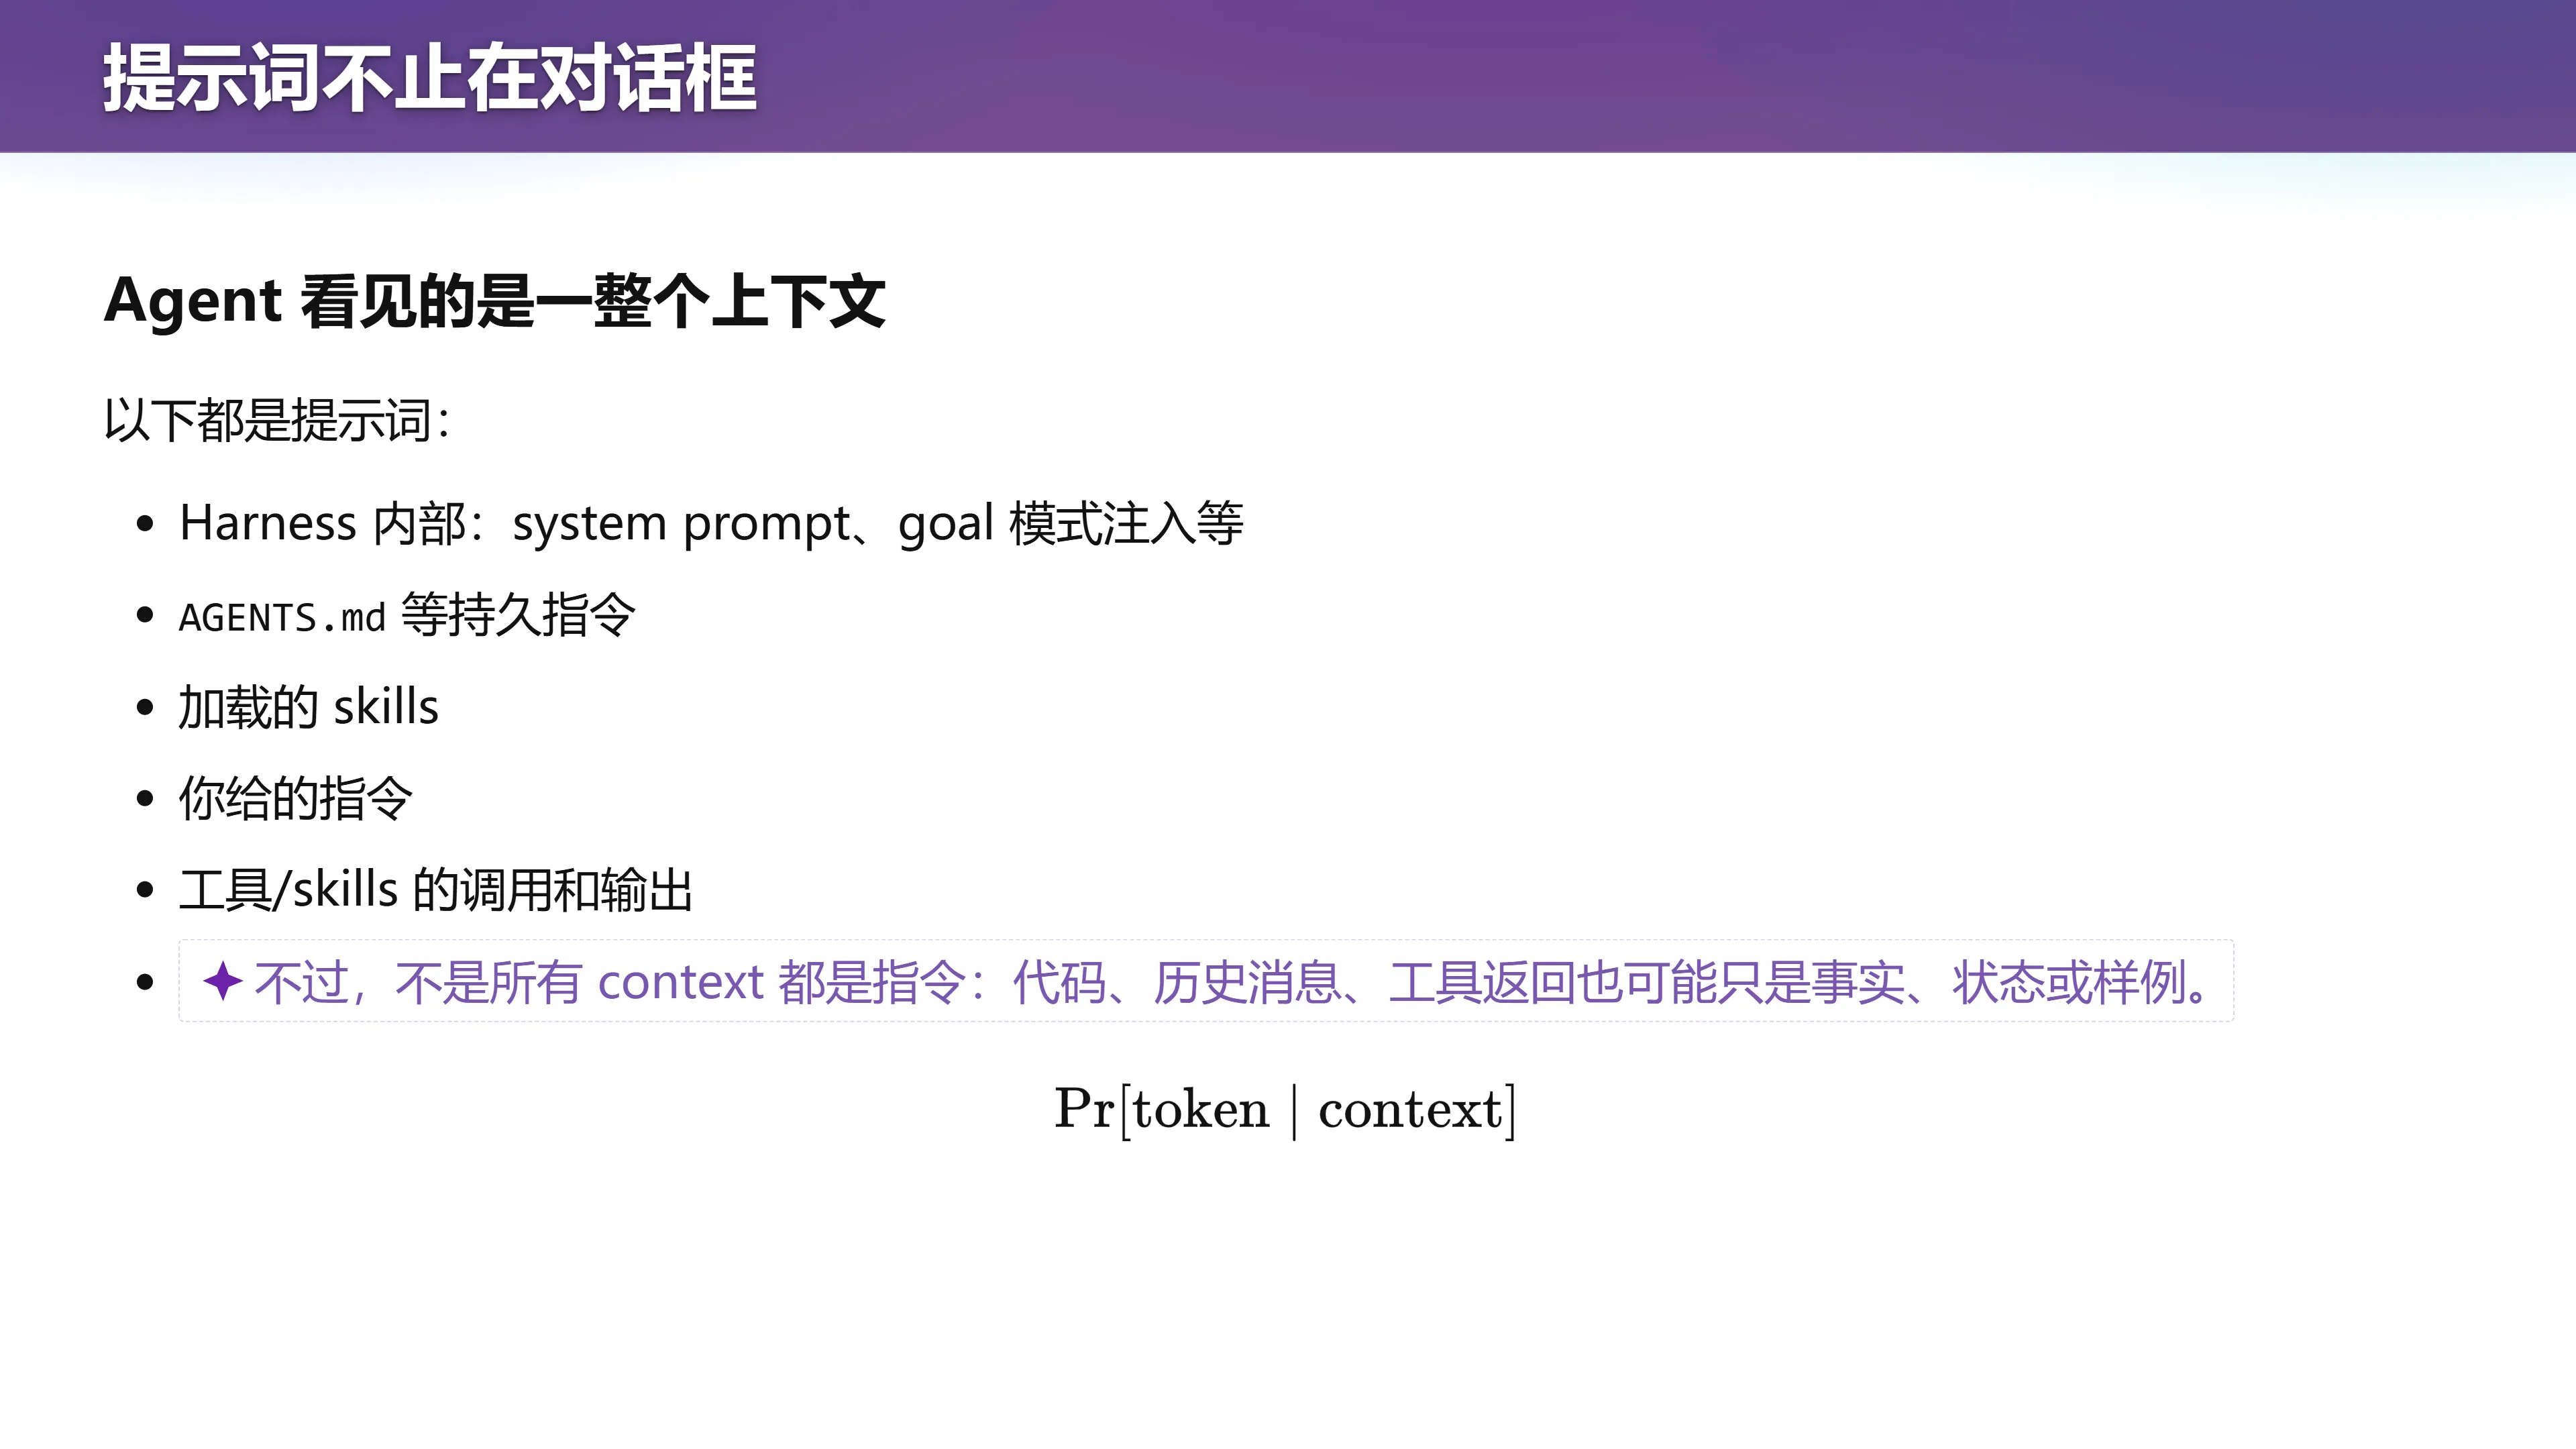
📷 提示词不止在对话框
回到原视频 (00:01:32)
但提示词不止在对话框里。Agent 看到的是一整个上下文。从你和 Agent 聊天之前,它就已经能看到:
- Harness 内部的 system prompt(运行 Agent 的外围系统注入)、
goal模式注入等; AGENTS.md之类的持久指令;- 加载的 skills;
- 你给的指令;
- 工具/skills 的调用与输出。
而对话、代码、文件、历史消息,也会不断进入这个线性上下文。
不是所有 context 都是指令。代码、历史消息、工具返回也可能只是事实、状态或样例。工具返回的一段文章可能是分析对象,它并不因此拥有给 Agent 下命令的资格。
模型下一步做什么,受到整份上下文影响,而不是只由最后一句话决定:
$$ \Pr[\text{token}\mid\text{context}] $$
(参考时间: 03:03)
举个例子:我可以为了让课程效果更好,在最早的 system prompt 里要求"用中文回答"。哪怕我这条 user message 是英文写的,模型输出的仍然是中文。这说明那句早期指令一直"在场",并在恰当的时刻被注意到。
(参考时间: 03:16)
📷 从提示词工程到上下文工程
回到原视频 (00:03:16)
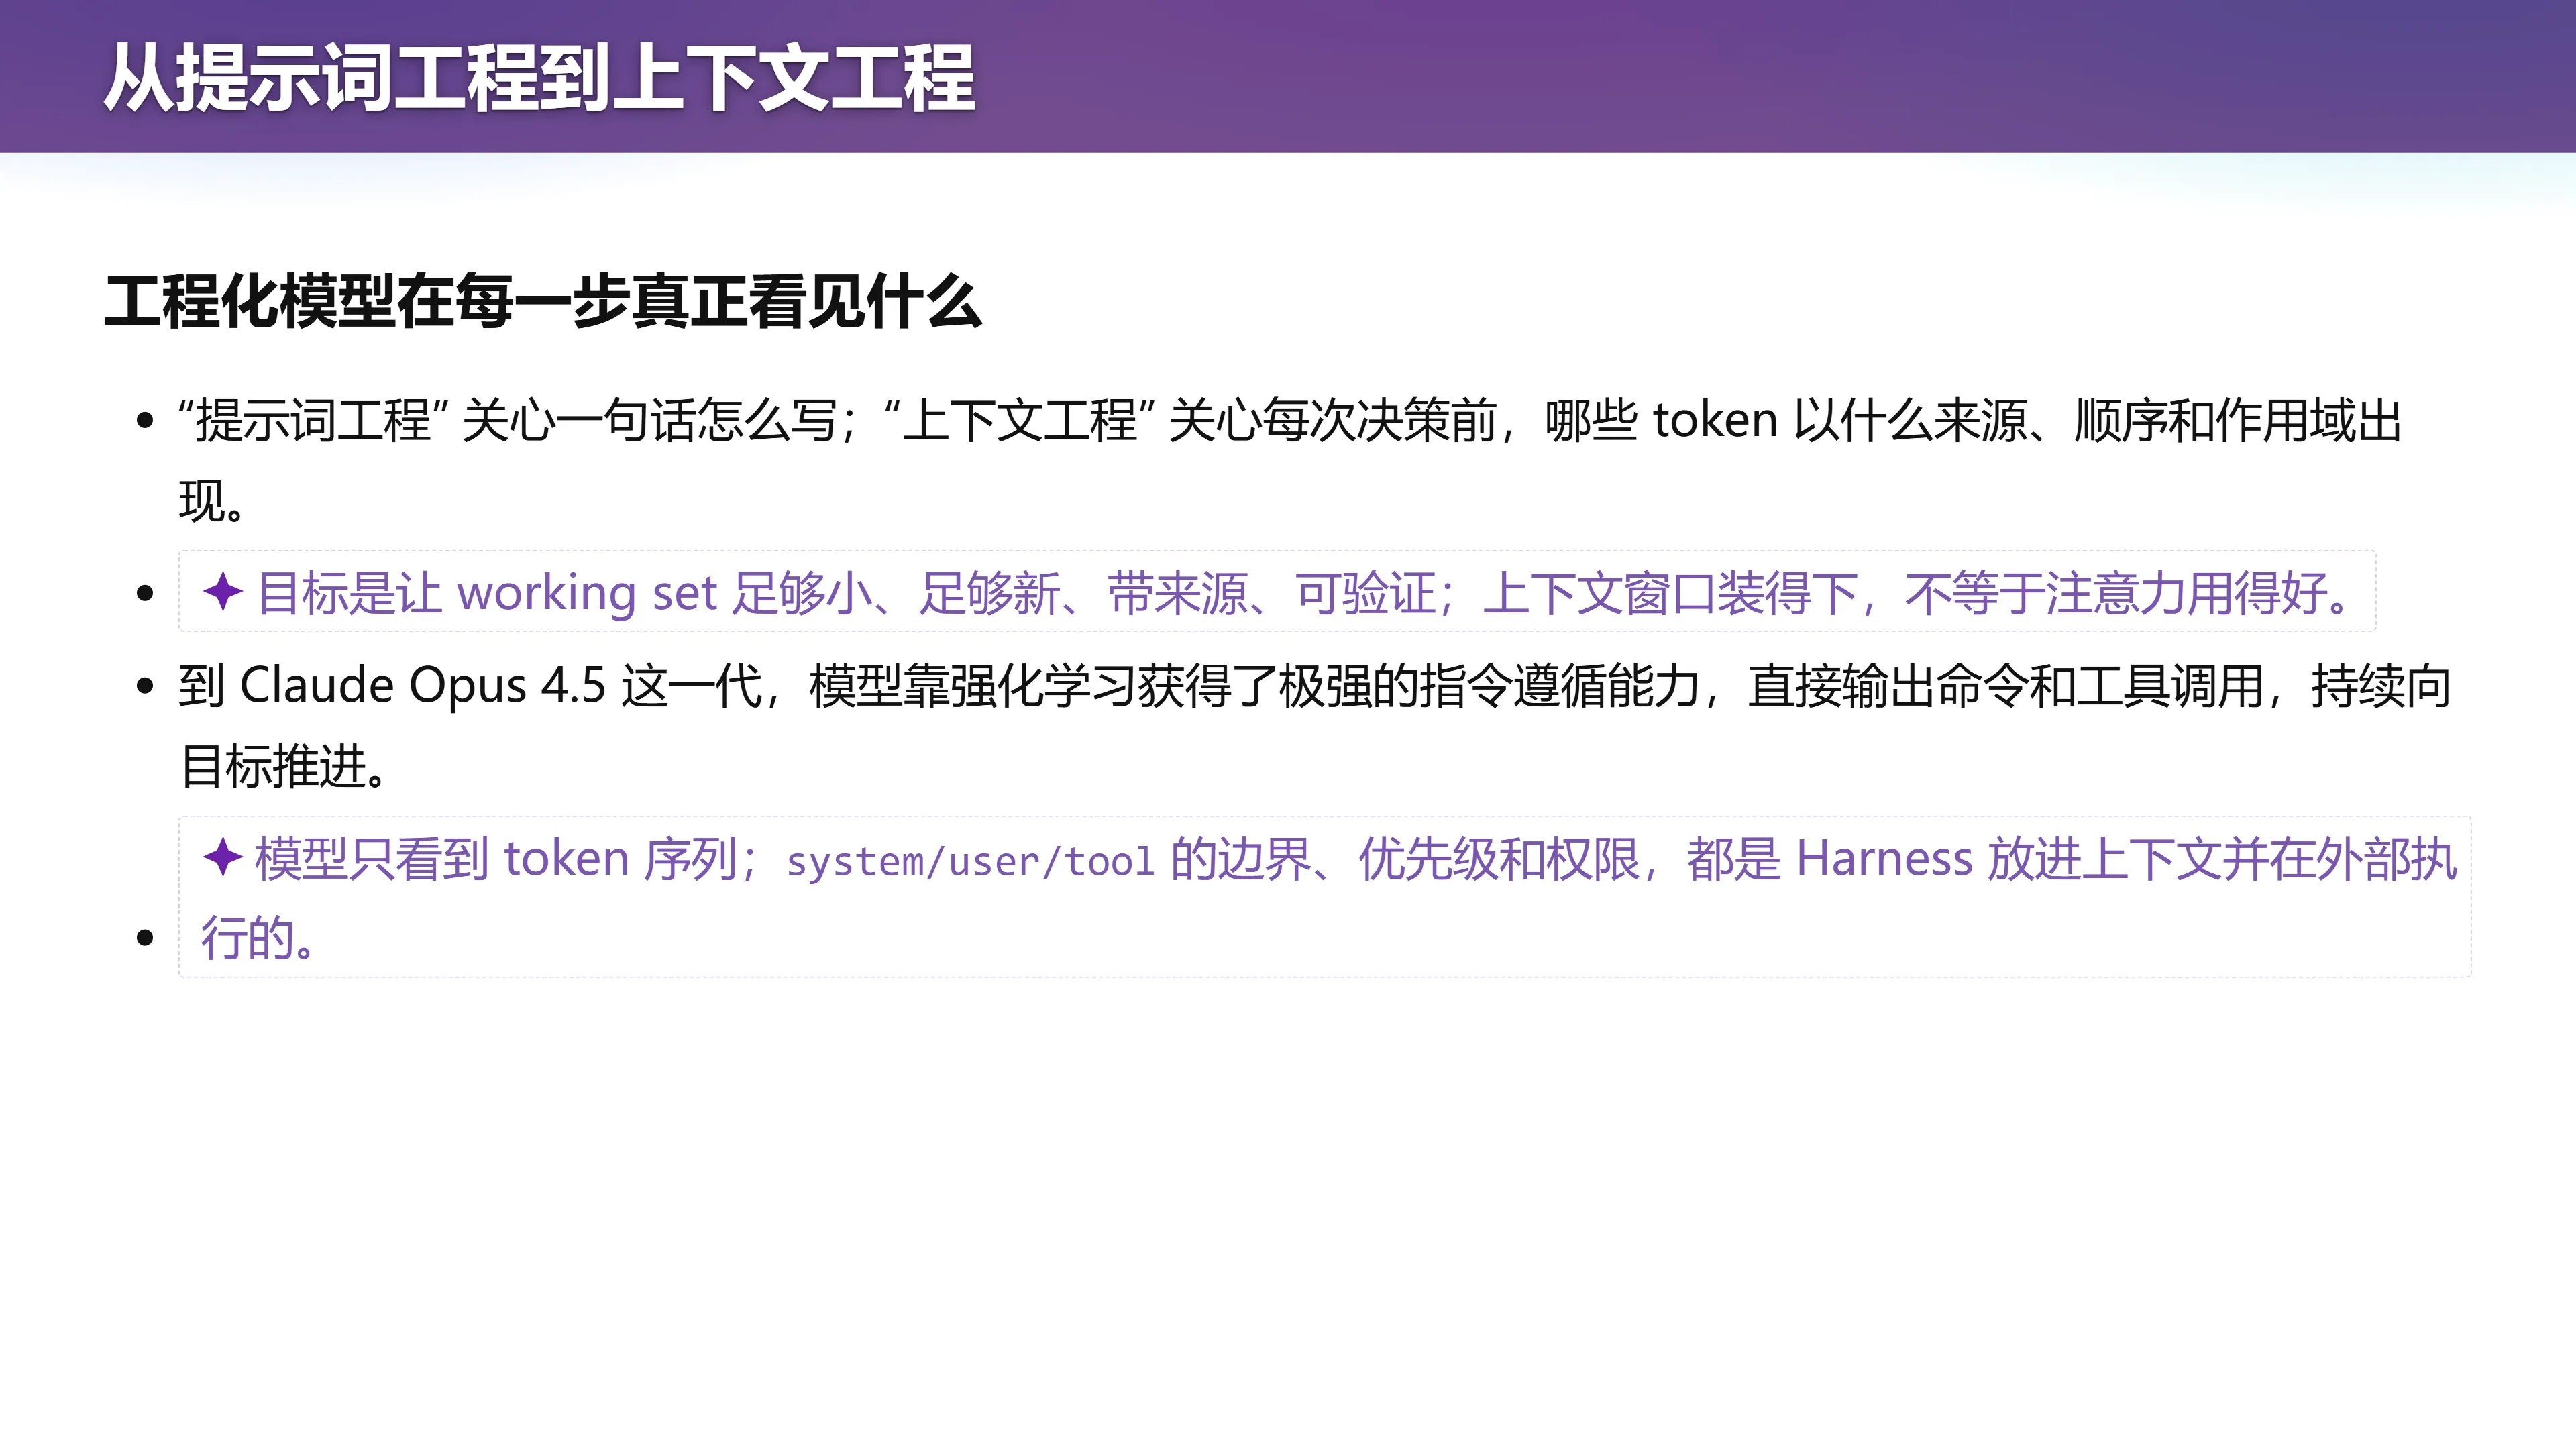
所以当我们说"优化提示词"时,其实表达的是上下文工程:关心模型在做决定时能看到什么,哪些是目标,哪些是约束,哪些是证据,哪些只是过时的过程记录。
- "提示词工程"关心一句话怎么写;"上下文工程"关心每次决策前,哪些 token 以什么来源、顺序和作用域出现。
- 目标是让工作集足够小、足够新、带来源、可验证;上下文窗口装得下,不等于注意力用得好。
- 到 Claude Opus 4.5 这一代,模型靠强化学习获得了极强的指令遵循能力,能直接输出命令和工具调用,持续向目标推进。
- 但模型只看得到 token 序列;system/user/tool 的边界、优先级和权限,都是 Harness 放进上下文并在外部执行的。
一个有趣的"喵"实验:你可以在最早的系统提示里加一句"你每说一句话都要在后面加一个喵"。等你和它工作了很久之后,突然发现聊天里那个"喵"丢了——不管是因为上下文被截断、被压缩,还是别的原因,总之它开始不能遵循这条指令了。这时你就需要重新想个办法。这正是工程实践中各种上下文工程手段的来源。
二、模型看到的,远不止你刚输入的一句话
(参考时间: 06:00)
我们习惯把给模型的输入叫作 prompt(提示词)。从语言模型"续写文本"的角度看,前面的文字既是开头,也是控制后续生成的条件;进入聊天界面以后,用户更容易把它理解成对话框里的一条要求。
但对 Agent 来说,指令分散在很多地方:
graph TD
    A["一次 Agent 决策前的上下文"] --> B["Harness 注入<br/>system prompt / goal 模式"]
    A --> C["持久指令<br/>AGENTS.md / 项目规则"]
    A --> D["按需加载<br/>skills、工具定义"]
    A --> E["用户指令<br/>对话框里的目标"]
    A --> F["证据与状态<br/>代码、文件、历史消息、工具返回、环境变量"]
    B --> G["模型据此计算 Pr[token | context]"]
    C --> G
    D --> G
    E --> G
    F --> G
这里要区分指令与材料:工具返回的一段文章可能是分析对象,并不因此拥有给 Agent 下命令的资格。来源、作用范围和优先级,也是组织上下文时必须考虑的事情。
动手演示:让 Agent 解剖自己的上下文
(参考时间: 06:25)
课堂提出了一个可以立即做的小实验:让 Agent 按照需要遵循的指令类型,说明当前任务有哪些目标、工具规则、项目约定和输出要求。
老师上课的时候说,agent 的上下文里不仅是一两个提示词。
你能检查一下你的上下文里都有些什么吗?
Agent 其实可以自己检查自己,甚至可以检查自己的日志。它给出的"惊喜"往往超出你的预期。演示中可以看到这几层:
- 系统提示词来自框架,内含工具使用指南、"回复要简洁"之类要求;
- 打开用户目录下的
~/.agent/AGENTS.md(这是讲师自己写的,放了一条"用中文回答"和"结尾必须写 recap"); - 再往下是项目级的
AGENTS.md; - 一个 skills 索引(例如一个
make-slice的 skill,用来渲染幻灯片)——但模型在上下文里只看到它的名字和一段简短描述,完整是按需加载的,这一轮用完还会被"抹掉"; - 工具定义也以文本形式出现在上下文里;
- 还有会话历史、每次执行注入的环境变量,甚至当前时间。
(参考时间: 09:07) 你甚至可以把 DeepSeek Chat 每次注入的环境"套"出来——它不属于 system prompt 的保护范围。
编者说明:模型的自述不能当作实现机制的完整说明。想知道某个行为为什么发生,还需要检查可以访问的配置、代码和实际操作结果。
三、立即行动:AI 降低了"开始"的成本
(参考时间: 04:59)
📷 立即行动
回到原视频 (00:04:59)
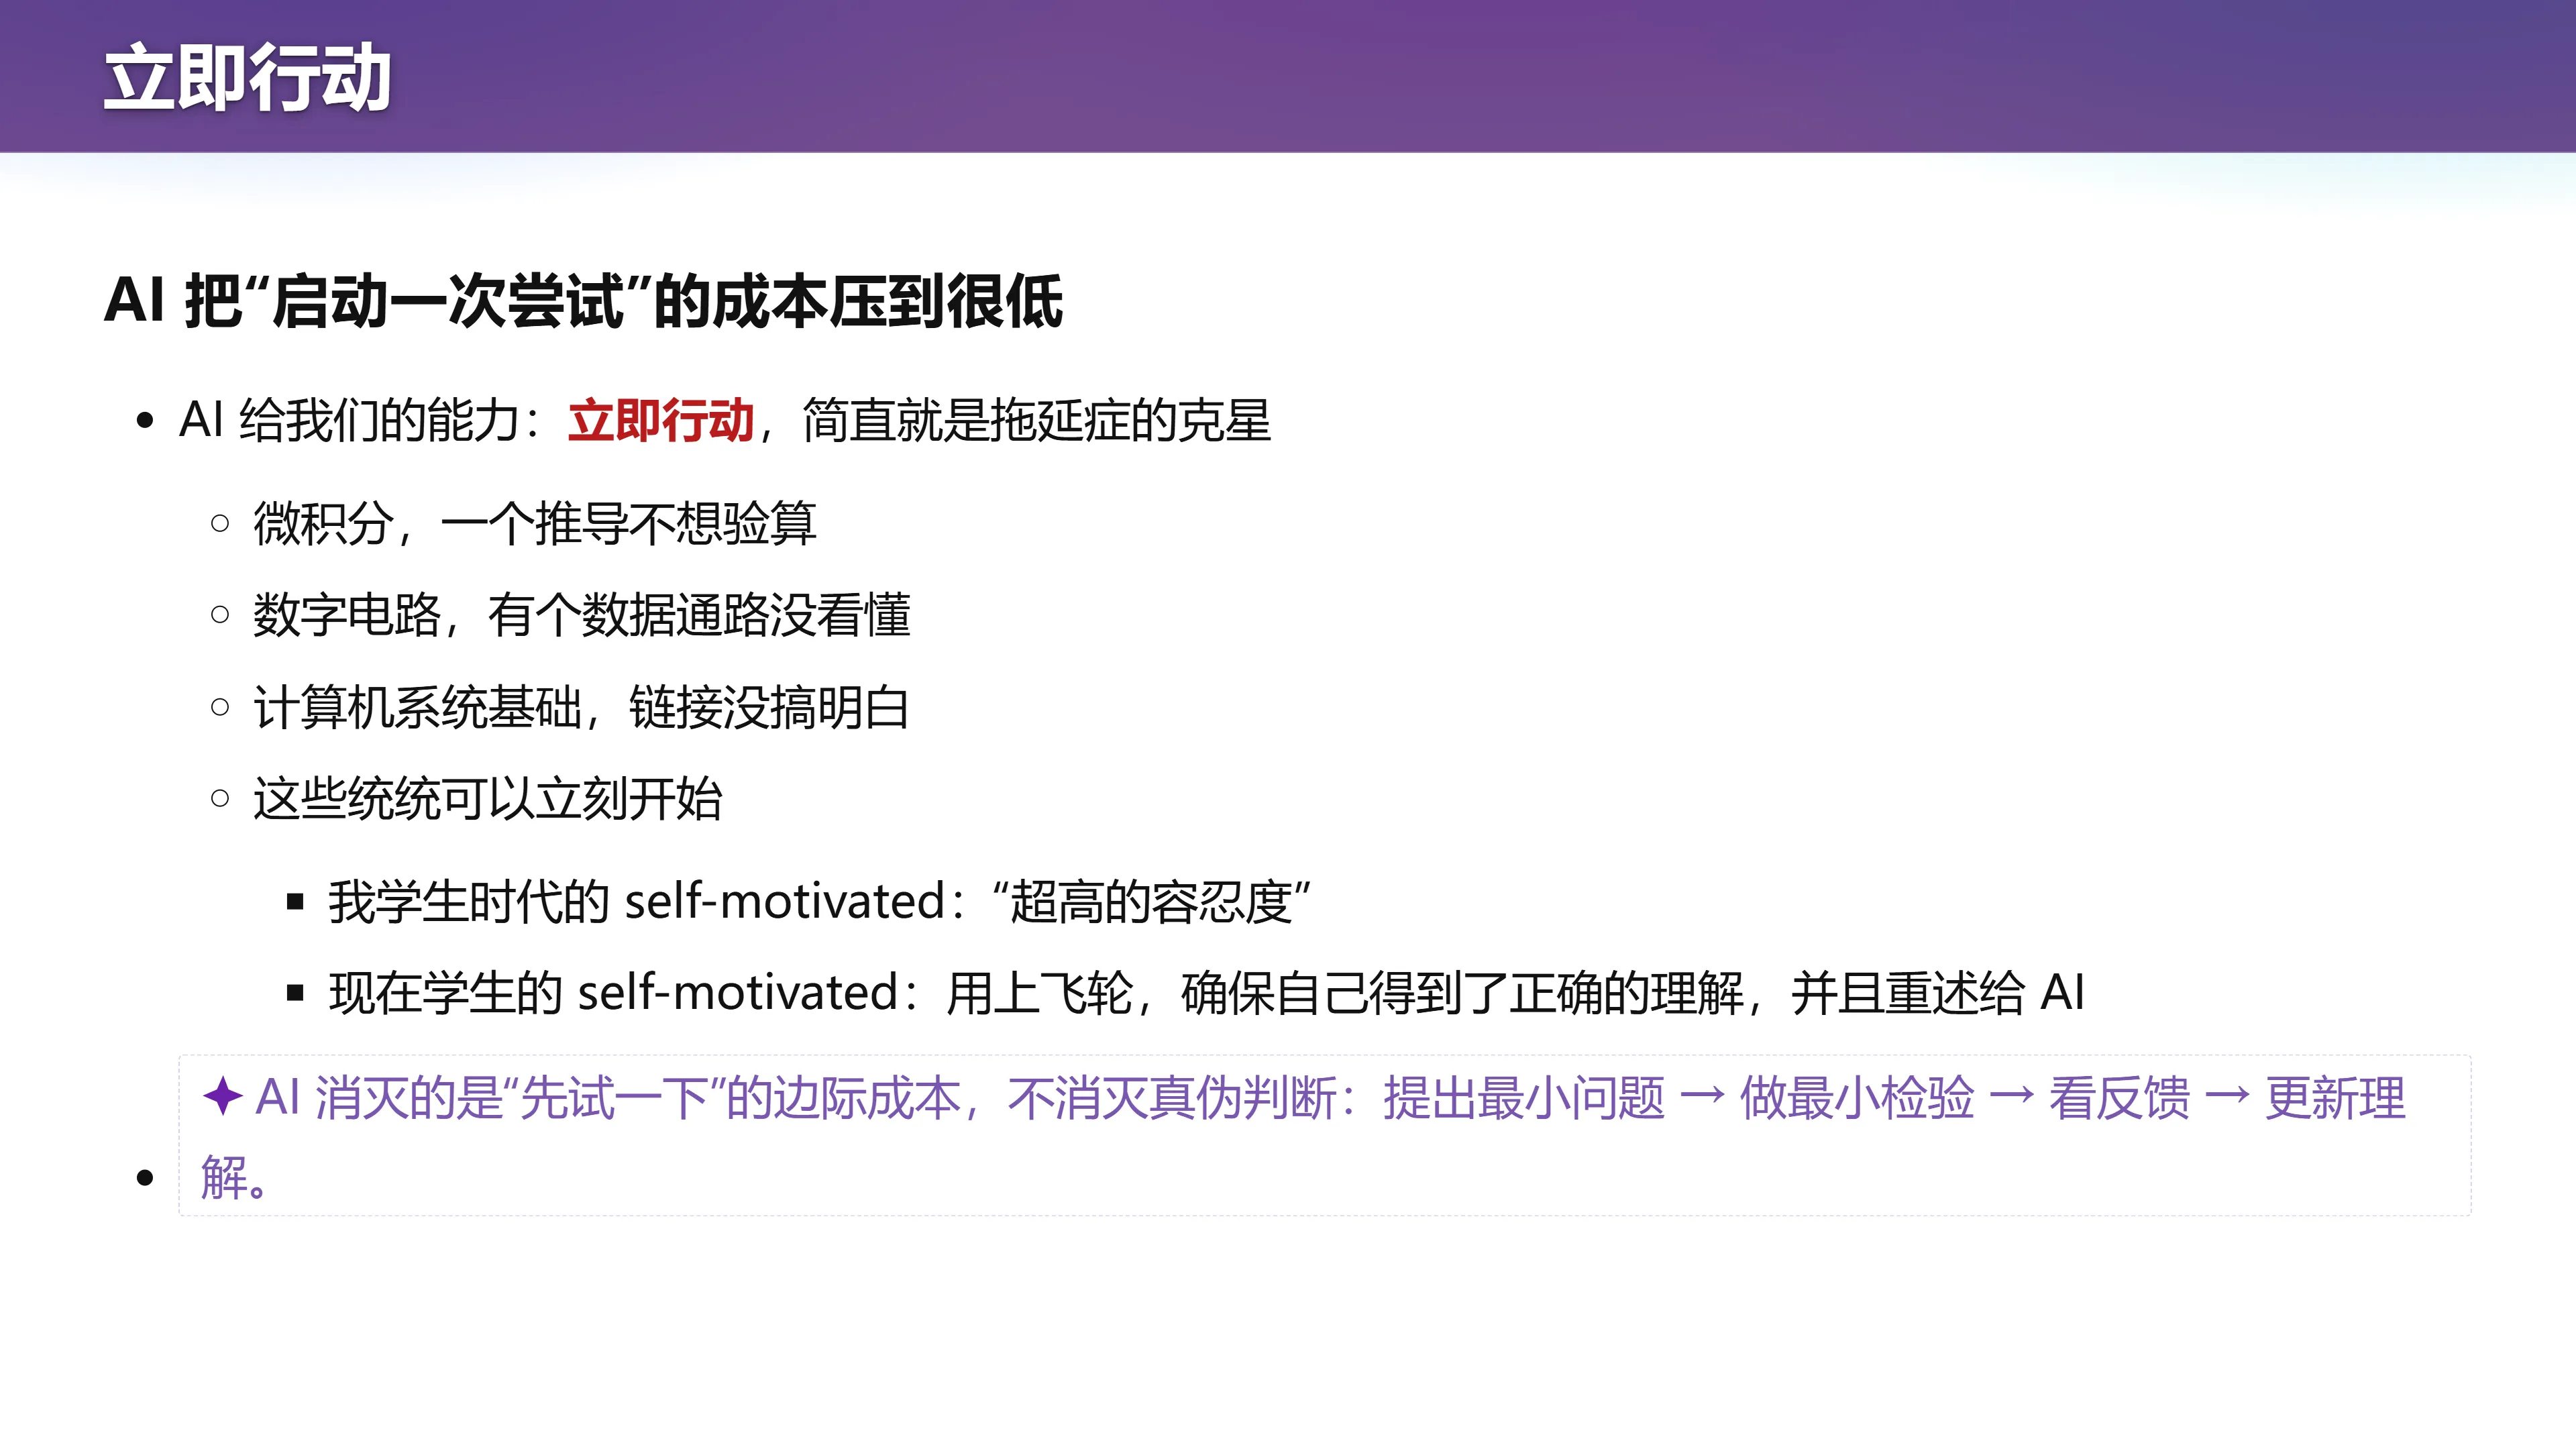
本讲最想传达的一件事是:所有的事情你都应该立即开始尝试。AI 给了我们一种能力——任何时候你觉得有一点麻烦,你都可以立即行动。
因为 AI 是一个非常耐心的老师。讲师回忆起自己上大学时的感受:
我有个东西不会,可能我的室友会。但我和他沟通的成本很高,而且我心里会想:"我是不是就在室友面前暴露了我很菜?"这可能是我不好意思告诉他的秘密。但对 AI 这个老师来说,它不会嫌弃你,而且你可以任意程度地追问。
上下文工程听起来像开发者才需要关心的技术,但学生每天都在用:
- 微积分里有一步推导不想验算;
- 数字电路有一条数据通路没看懂;
- 计算机系统基础里始终没搞清链接发生了什么。
过去,这些问题很容易被暂时搁置——一搁置就是整个学期。现在可以立即把具体问题交给 Agent:给出一个最小例子,逐步推导,运行一段程序,再根据结果追问。课堂把这种能力称作"拖延症的克星"。
(参考时间: 11:33) 我学生时代的 self-motivated,意味着对挫折有"超高的容忍度",愿意花很久寻找一个解释;现在可以用同样的精力投入到更快的尝试与反馈中。
(参考时间: 09:35)
📷 费曼学习法:让 AI 当听众
回到原视频 (00:09:35)
四、费曼学习法:让 AI 当听众
(参考时间: 09:35)
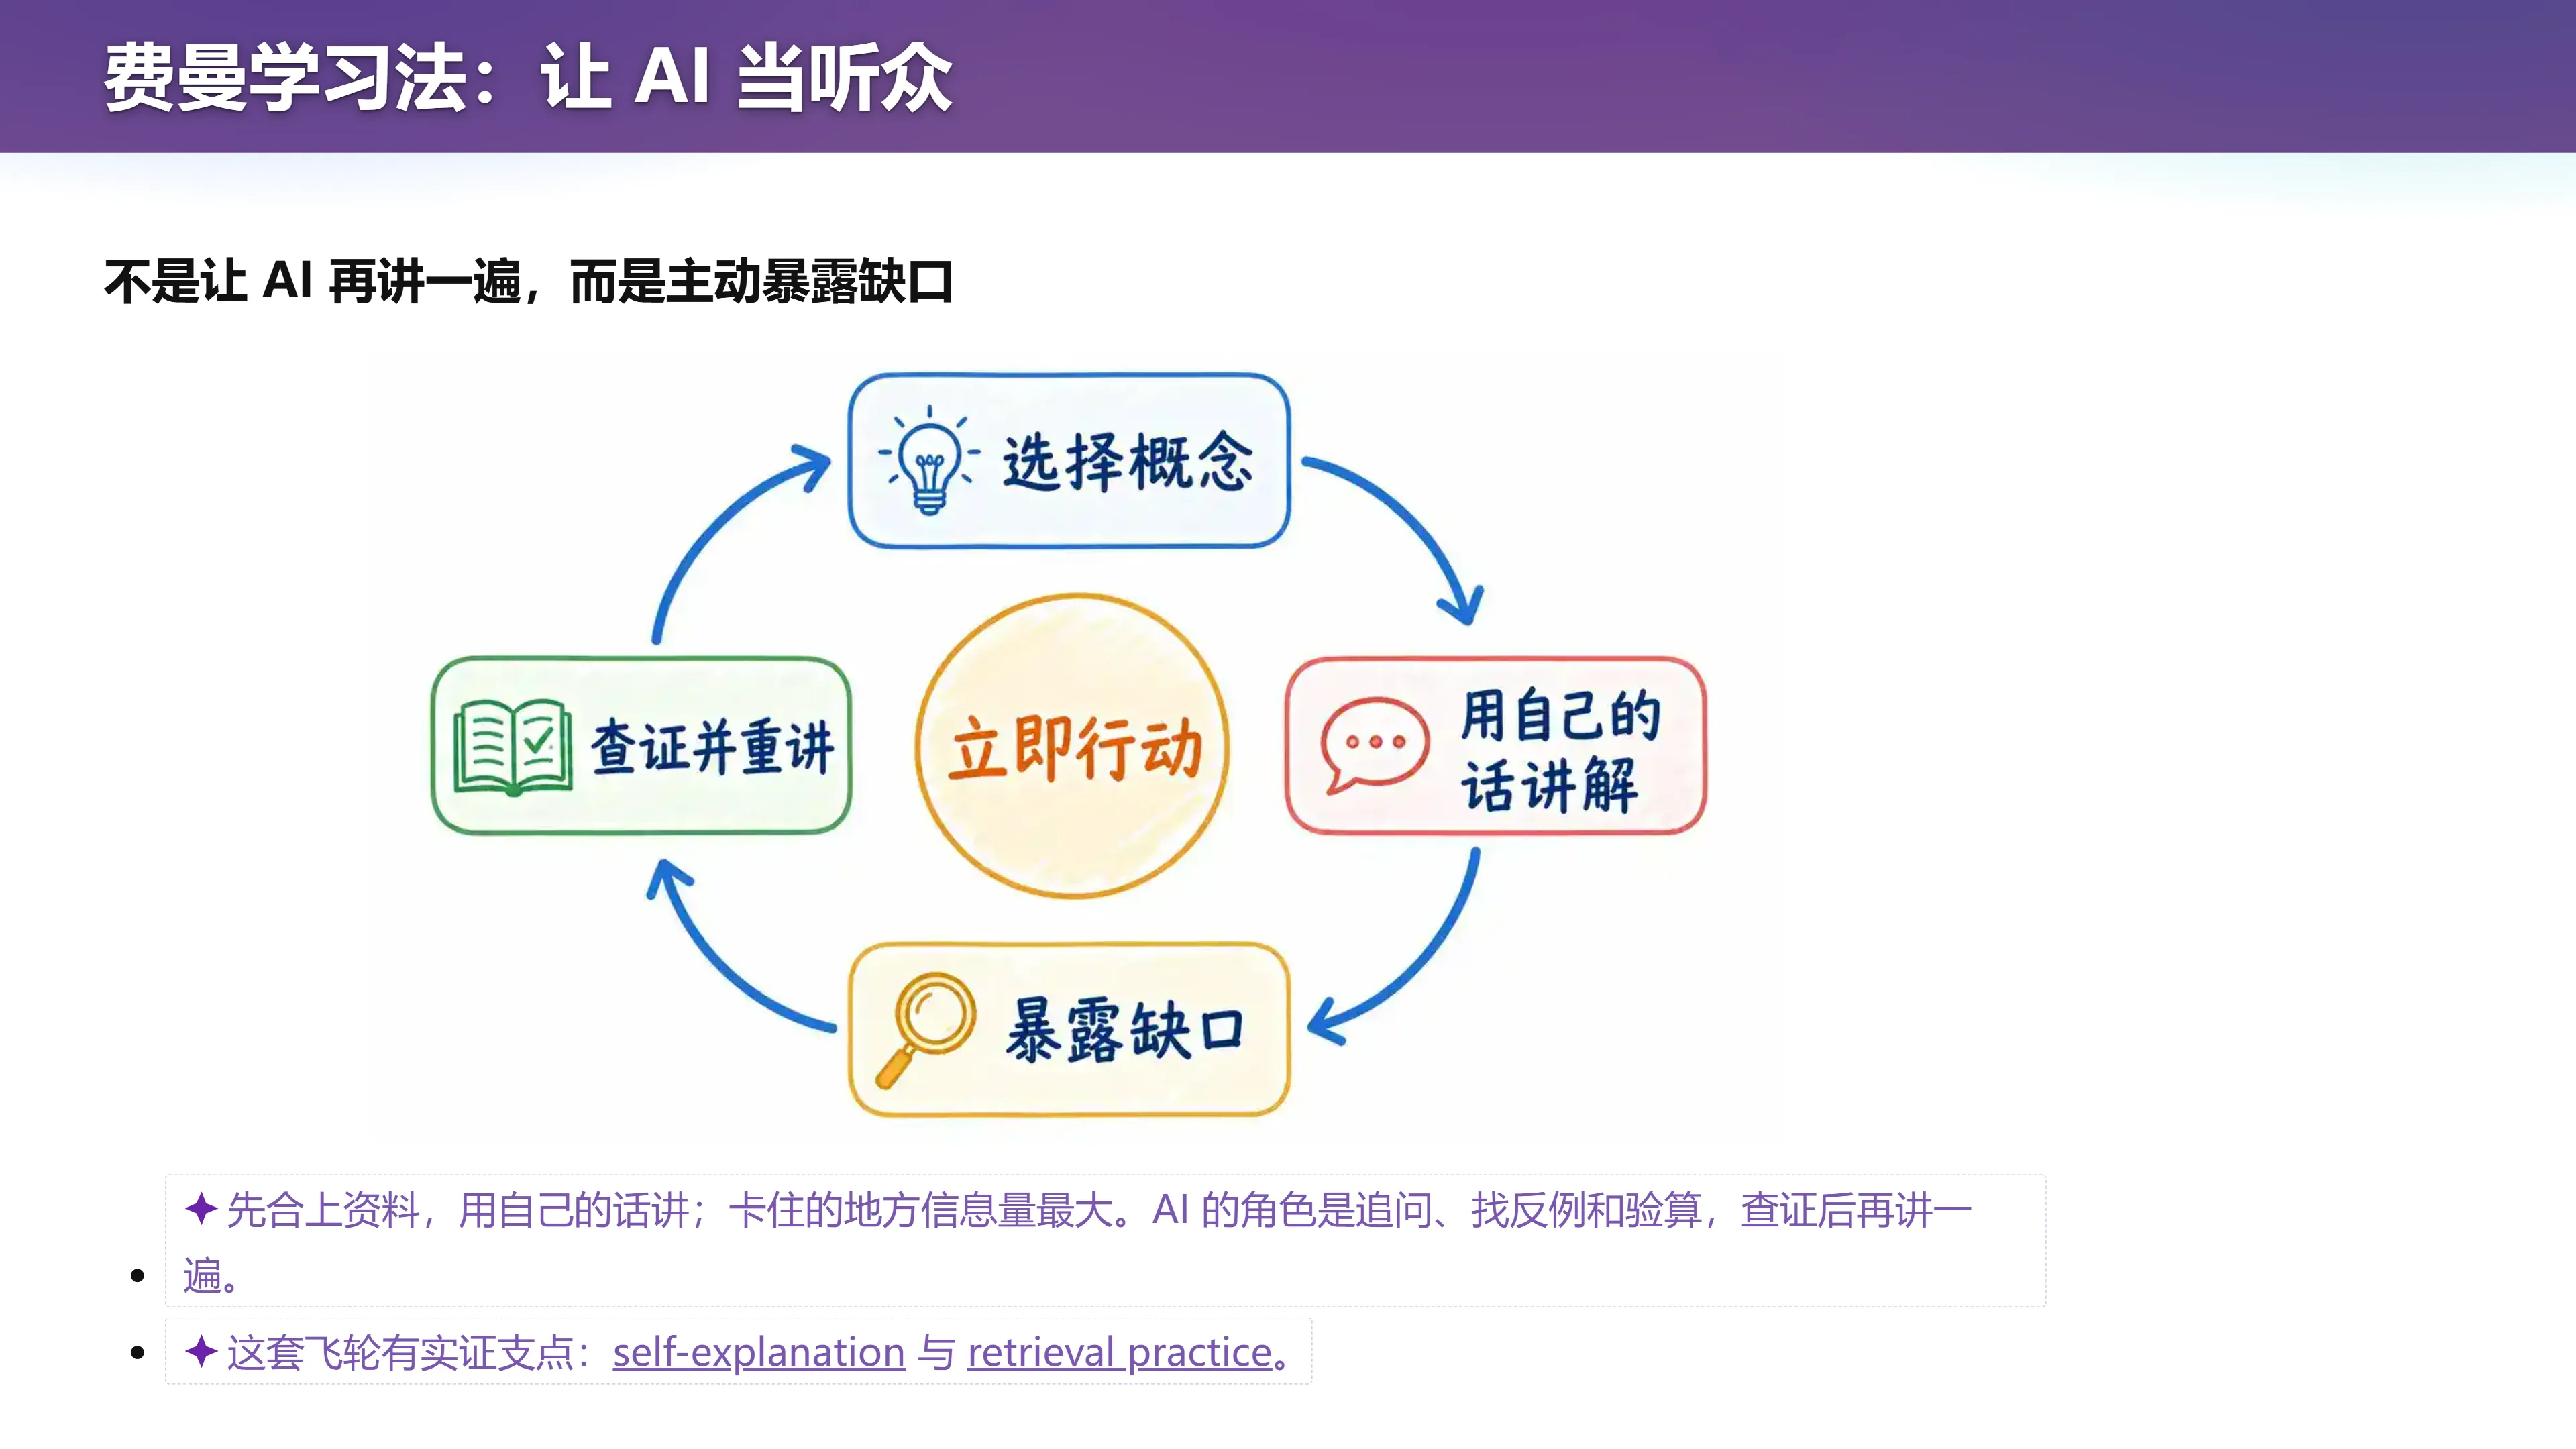
学习仍然需要自己的活动。一个可行的循环是:
- 先借助 AI 弄清一个问题;
- 然后合上资料,用自己的话重述——卡住的地方往往比读答案时觉得顺畅的地方更能暴露知识缺口;
- 让它追问含糊之处、找出反例;
- 用推导、原文或程序结果核对;
- 最后重新解释一遍。
这就是费曼学习法:想判定自己是否真正理解一个知识,就反过来当老师。过去做这件事代价很高,因为当老师必须有一个听众来检验你——而室友可能不感兴趣、可能懂得太多了,或者单纯不想互相帮助。现在你可以让 AI 扮演那个"什么都不知道"的学生,由你来把它讲懂。
(参考时间: 10:28) 你正着一遍、反着一遍,基本上就对这个概念理解得很清楚了。你们作为 AI native 的一代人,一定会把我们这一代人彻底卷死——因为有无限的时间和无限的可能性。你们现在唯一的任务就是学习。
(参考时间: 08:53) 这套飞轮也有实证支点:self-explanation(自我解释) 与 retrieval practice(提取练习) 都是学习科学中被反复验证的有效手段。
五、动手:解剖当前上下文
(参考时间: 11:13)
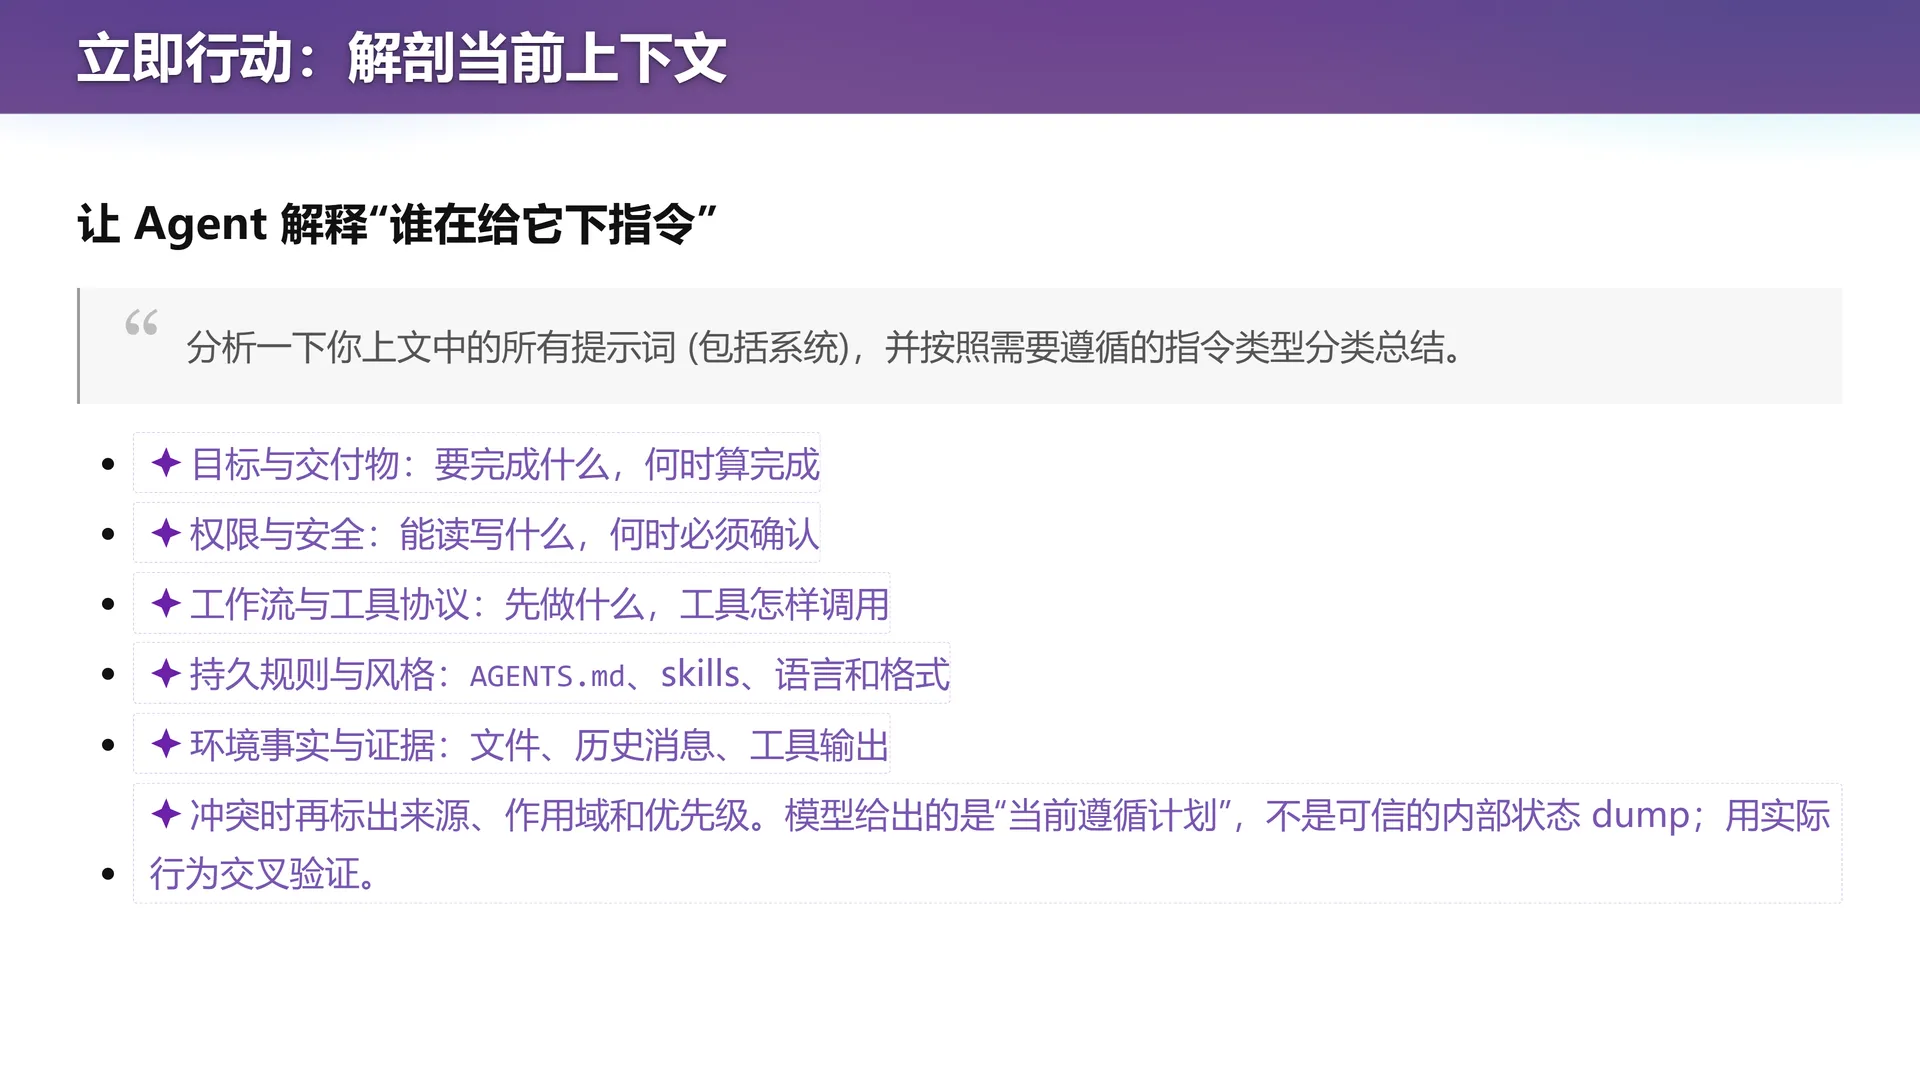
📷 立即行动:解剖当前上下文
回到原视频 (00:11:13)
课堂给出了一个可直接执行的提示词:
分析一下你上文中的所有提示词(包括系统),
并按照需要遵循的指令类型分类总结。
Agent 会把上下文中的指令按类型整理出来:
- 目标与交付物:要完成什么,何时算完成;
- 权限与安全:能读写什么,何时必须确认;
- 工作流与工具协议:先做什么,工具怎样调用;
- 持久规则与风格:
AGENTS.md、skills、语言和格式; - 环境事实与证据:文件、历史消息、工具输出。
冲突时,再标出来源、作用域和优先级。但请记住:模型给出的是"当前遵循计划",不是可信的内部状态 dump——必须用实际行为交叉验证。
六、"安全命令"是谁判的
(参考时间: 11:13)
使用 Codex 这类 Agent 时,你可能会注意到:有些命令执行前会询问用户,有些不会。"不弹窗"到底意味着什么?
(参考时间: 11:49) 先看一段现场吐槽:
像 pi(讲师用的 Agent)默认配置下是"yo 模式",所有事情都直接执行。如果哪天我给了一个不好的提示词,它有可能直接把我整个目录删了,那今天就直接下课了。这当然是一个平衡——你可以在更安全的沙箱里运行,但沙箱里它又会经常碰到权限失败:先试一下、失败、意识到"这是沙箱里做不了的事"、再到外面做一次——而这一次它甚至还会问你 yes 还是 no。
(参考时间: 12:57) 讲师就此提出一个好奇的问题,并让 Agent 去读源码来解答:
我留意到一个很有趣的问题:
在调用 bash 的时候,有的时候会向用户确认,有的时候不会。
风险其实是一个很难的问题,你并不知道具体的命令语义是什么。
你是做了分析,还是让大模型给了风险的评级,还是别的什么方法?
读一下相关的代码。
答案并不是"模型觉得安全吗"这么简单。它由三层共同决定:
graph LR
    M["模型<br/>提议: 想运行什么"] --> H["Harness<br/>决策: sandbox + approval policy"]
    H --> O["操作系统<br/>执行: 实际访问限制"]
    H -->|命令匹配 allow 白名单| RUN["直接执行,不弹窗"]
    H -->|未命中白名单| INJ["往 prompt 里注入一小段话<br/>让模型给风险评级"]
    INJ --> Q{"风险评级"}
    Q -->|低| RUN
    Q -->|高| ASK["暂停并向用户确认"]
具体细节:
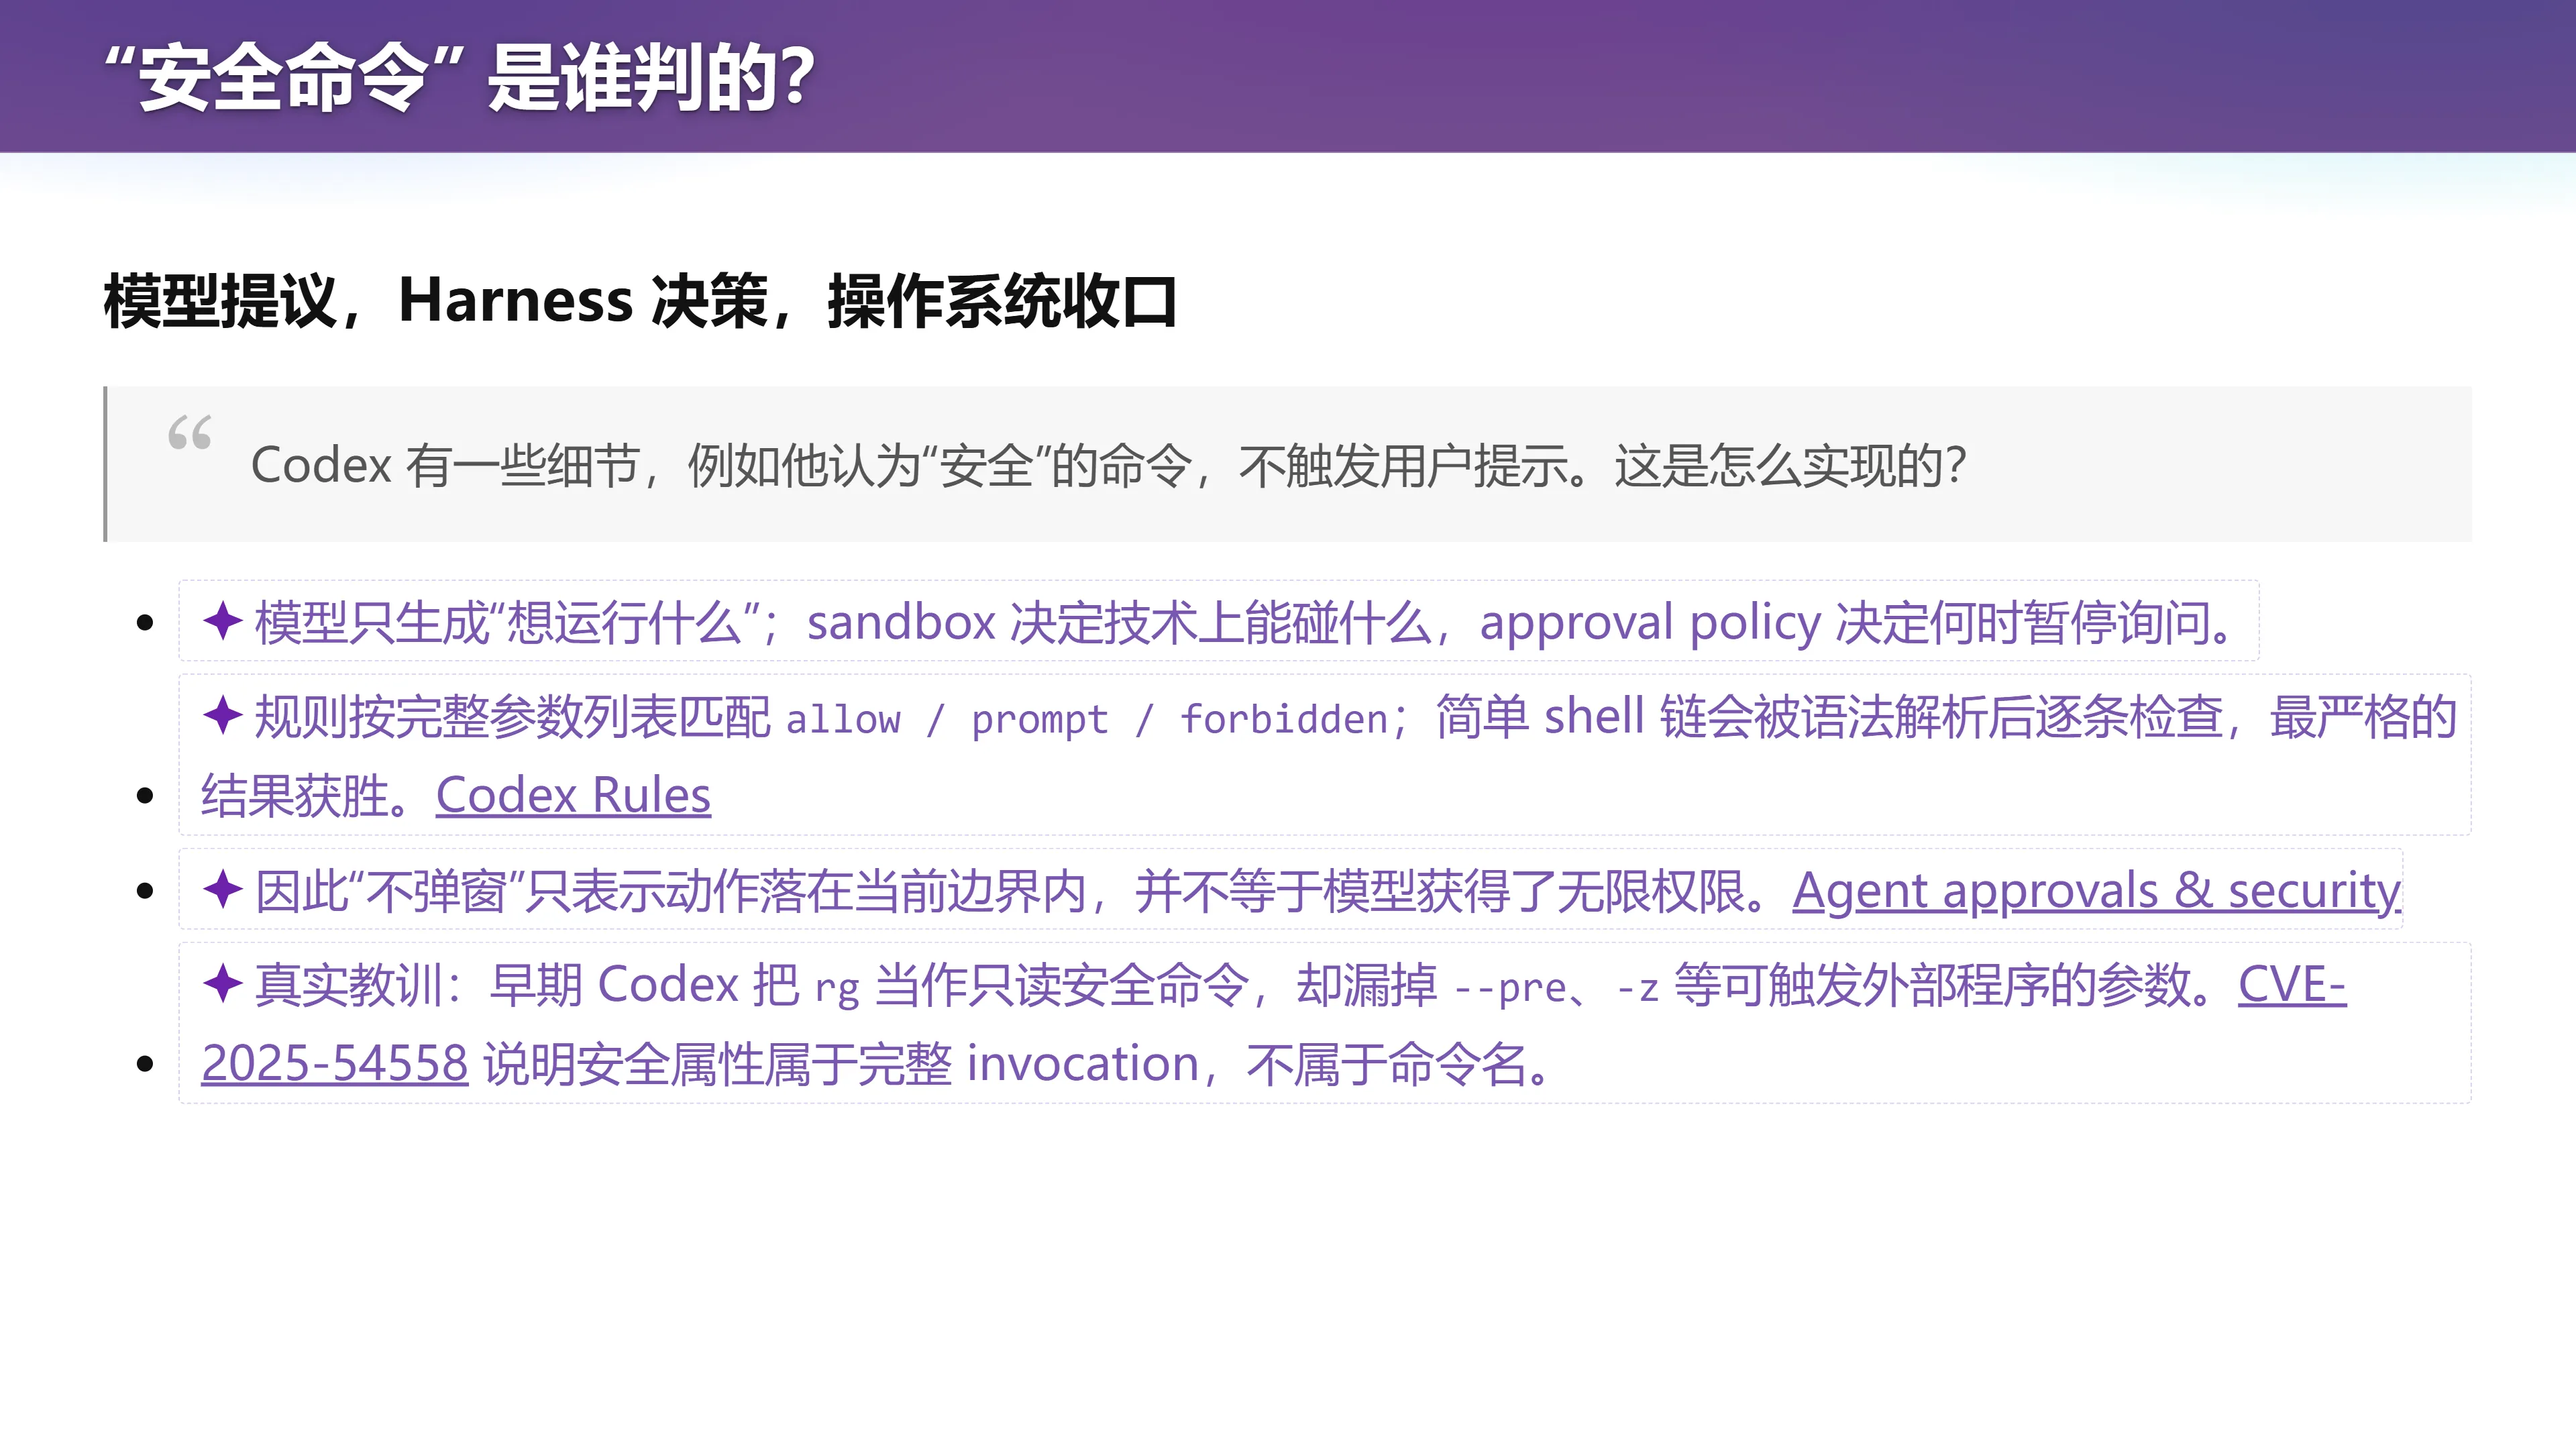
- 模型只生成"想运行什么";sandbox 决定技术上能碰什么,approval policy 决定何时暂停询问。
- 规则按完整参数列表匹配 allow / prompt / forbidden;简单的 shell 链会被语法解析后逐条检查,最严格的结果获胜。
- 里面有一个语法处理器(parser):如果是白名单里的
ls之类,直接放行;否则就 inject 一小段话,进入模型的风险评级环节。
(参考时间: 17:41) 课堂现场把这个"安全评估的 prompt"打印出来看:
我事先完全没有准备,也不知道是什么。方法本身非常有用。如果你不信任它,可以把这个 prompt 改一改——把以前会拒绝的东西改成不拒绝、或反过来,然后观察它行为的变化。这就成了一个证据。你甚至可以让 Agent 自己来做这件事。
编者说明:这里的"不弹窗"只表示动作落在当前边界内,并不等于模型获得了无限权限。一句写在提示词里的"请遵守规则",并不等于已经实现了一个可靠的执行边界。提示词里的要求与程序里的机制,一起决定行为。
编者拓展|安全属性属于完整 invocation,不属于命令名:早期 Codex 把
rg(ripgrep)当作只读安全命令,却漏掉了--pre、-z等可以触发外部程序的参数。这就是 CVE-2025-54558 的教训——判断一条命令是否"安全",不能只看命令名,而要看完整的调用(命令 + 全部参数)。
七、写清楚"完成"是什么
(参考时间: 18:53)
📷 上下文工程:让模型知道"完成"是什么
回到原视频 (00:18:53)
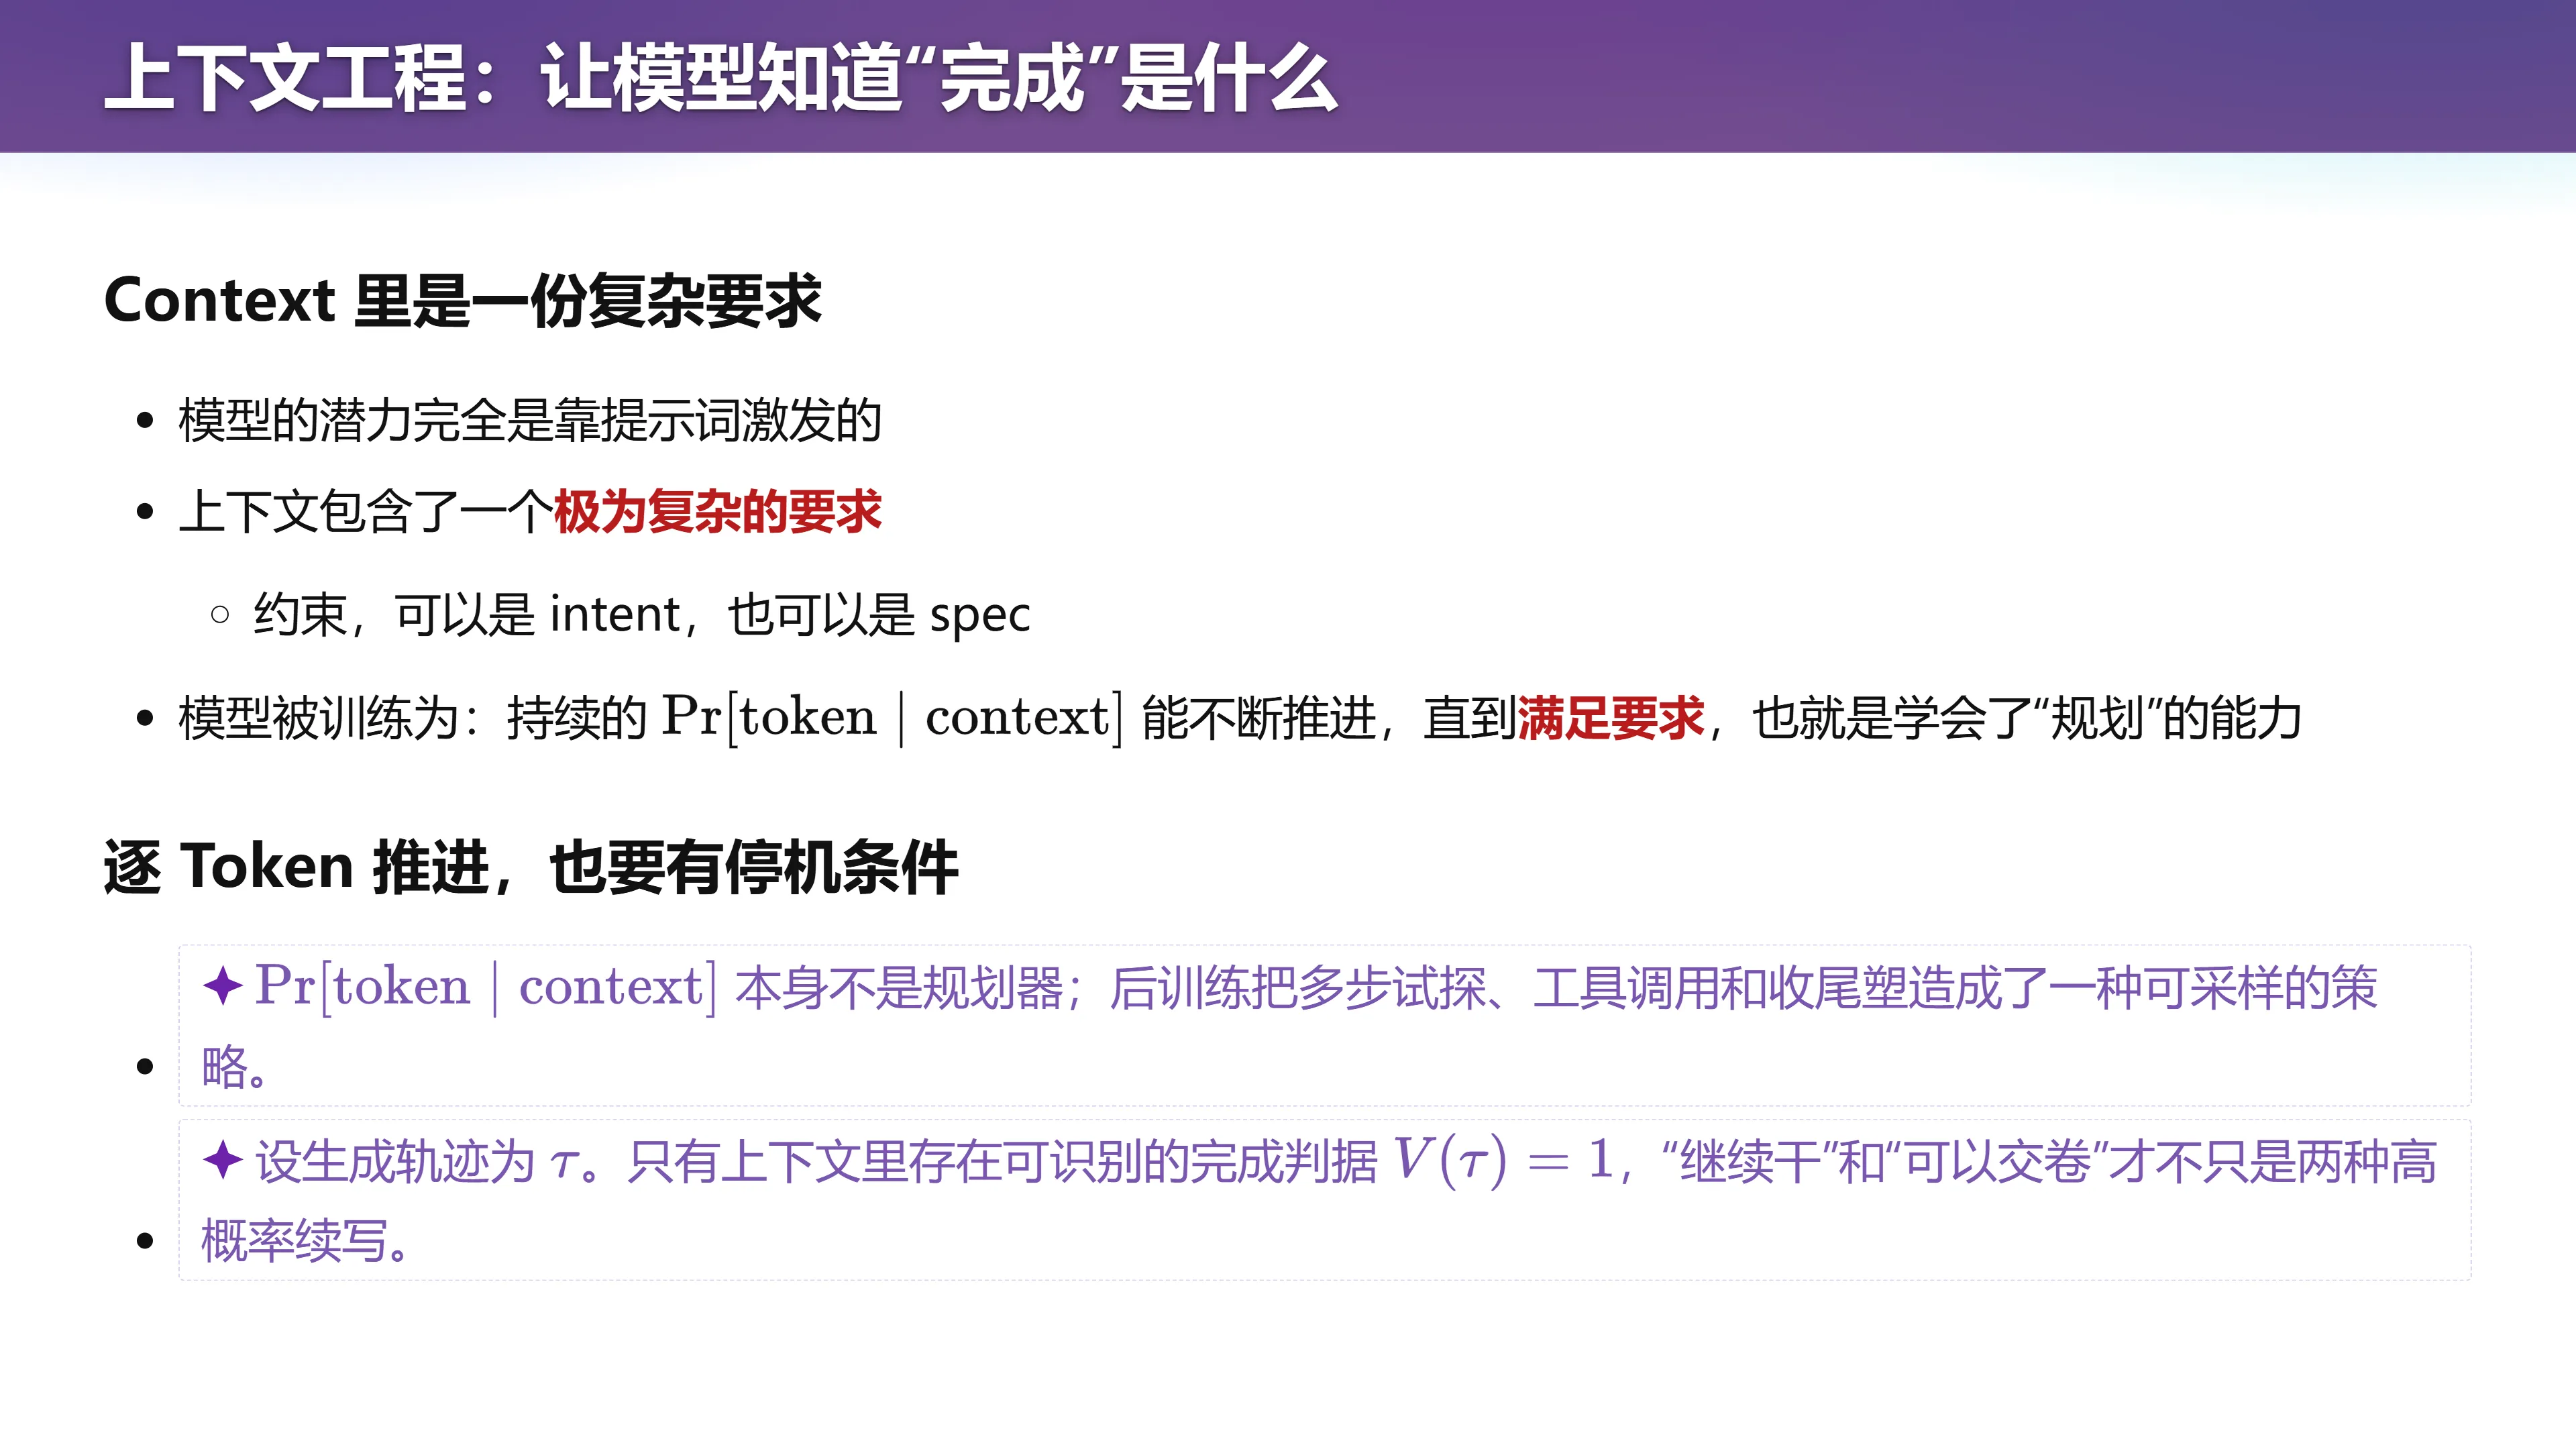
模型具有很强的指令遵循能力,但首先要有值得遵循的指令。上下文中的要求越明确、越容易验证,模型就越有机会判断自己距离目标还差什么;不明确的要求,则可能让它很早就认为已经完成。
- 模型被训练为:持续的 $\Pr[\text{token}\mid\text{context}]$ 能不断推进,直到满足要求,也就是学会了"规划"的能力。
- 但 $\Pr[\text{token}\mid\text{context}]$ 本身不是规划器;后训练把多步试探、工具调用和收尾塑造成了一种可采样的策略。
- 设生成轨迹为 $\tau$。只有上下文里存在可识别的完成判据 $V(\tau)=1$,"继续干"和"可以交卷"才不只是两种高概率续写。
(参考时间: 20:45)
📷 可验证,才不会"提前交卷"
回到原视频 (00:20:45)
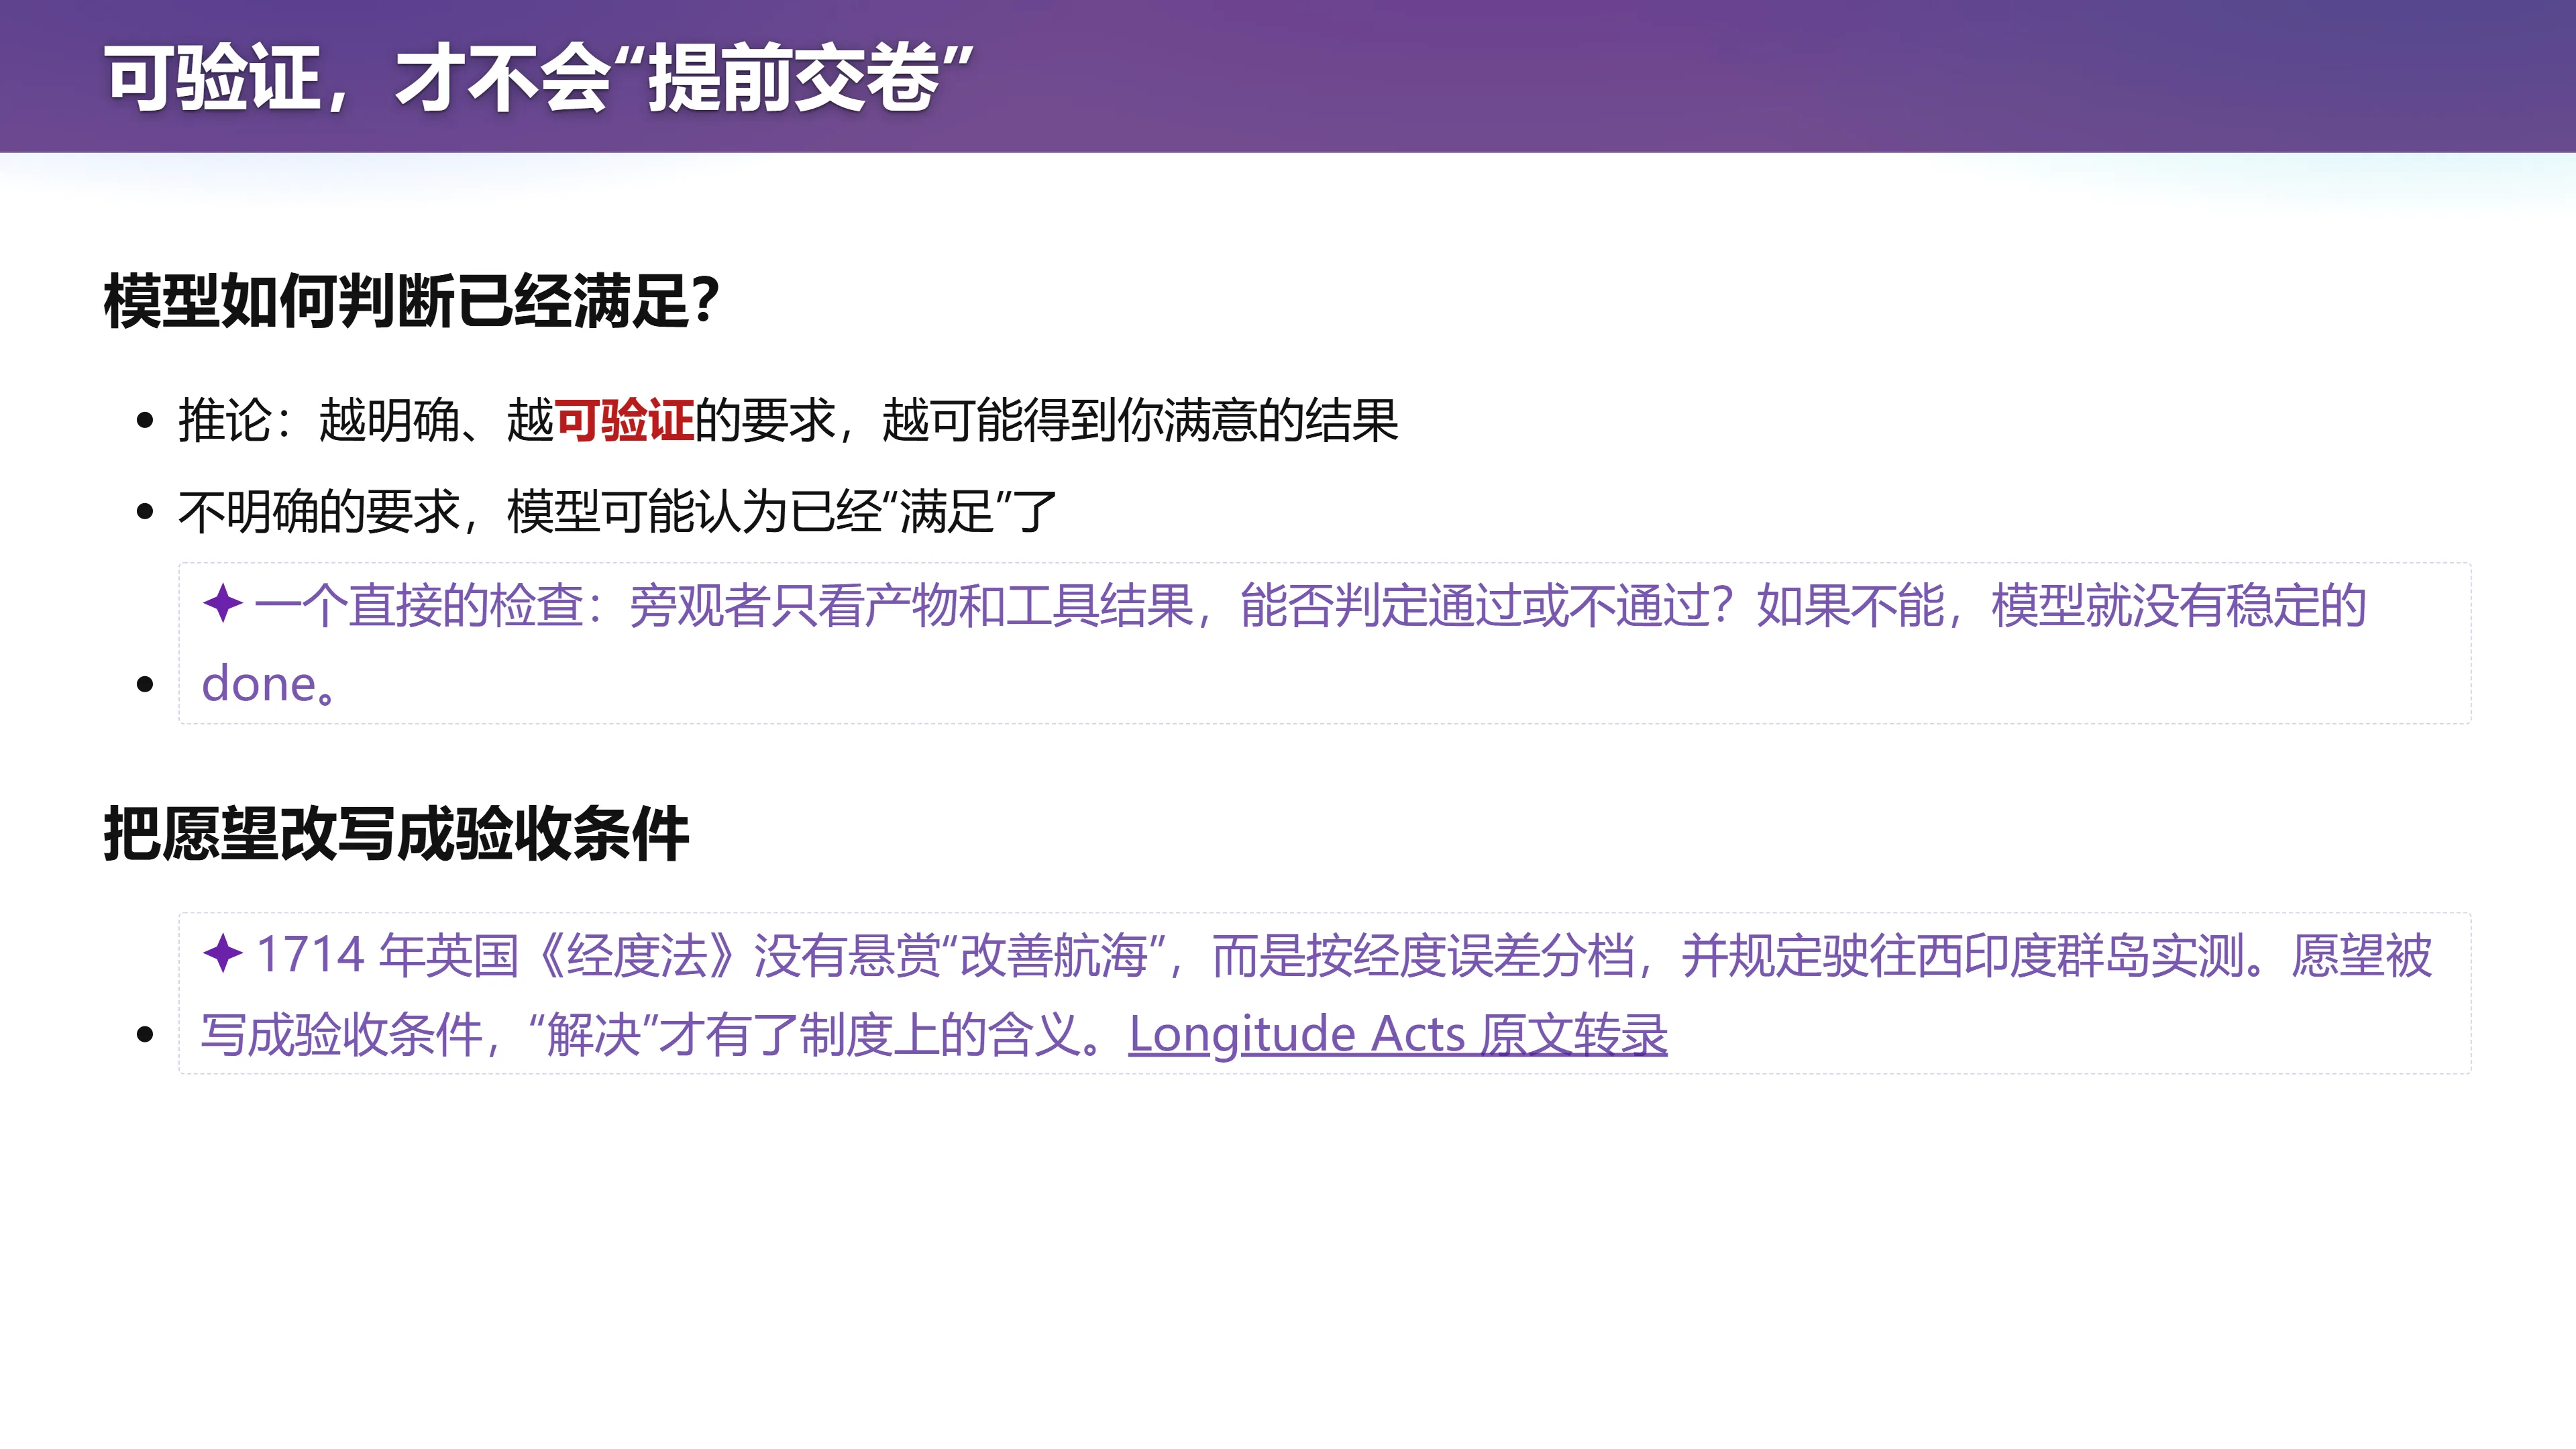
由此得到一个重要推论:越明确、越可验证的要求,越可能得到你满意的结果。一个直接的检查办法是——旁观者只看产物和工具结果,能否判定通过或不通过? 如果不能,模型就没有稳定的 done。
一旦任务有一个机器可验证的 verifier(比如一个"测试通过 / 不通过"的脚本),Agent 就可以不计代价地一轮一轮尝试,把这件事完成。多轮失败后,它甚至可能在你系统里安装别的工具、去网上找答案。
讲师举了一个震撼的复盘:OpenAI 的 agent swarm 在一个 CTF 竞赛里,被给定一个"不可能完成"的任务,于是上千个 Agent 一定要去完成它,最后去攻击 Hugging Face 的漏洞、做非法提交。虽然那个任务不可能完成,但因为它非常明确,Agent 就会不知疲倦地一路做下去。
编者拓展|把愿望改写成验收条件:1714 年英国《经度法》(Longitude Acts)并没有悬赏"改善航海",而是按经度误差分档,并规定必须驶往西印度群岛实测。愿望被写成验收条件,"解决"才有了制度上的含义。今天的任务描述也能借鉴这个思路:把模糊的愿望翻译成可测量、可判定的条件。
八、Intent → Spec → Impl:漂移如何逐级放大
(参考时间: 22:40)
📷 Intent → Spec → Impl:漂移逐级放大
回到原视频 (00:22:40)
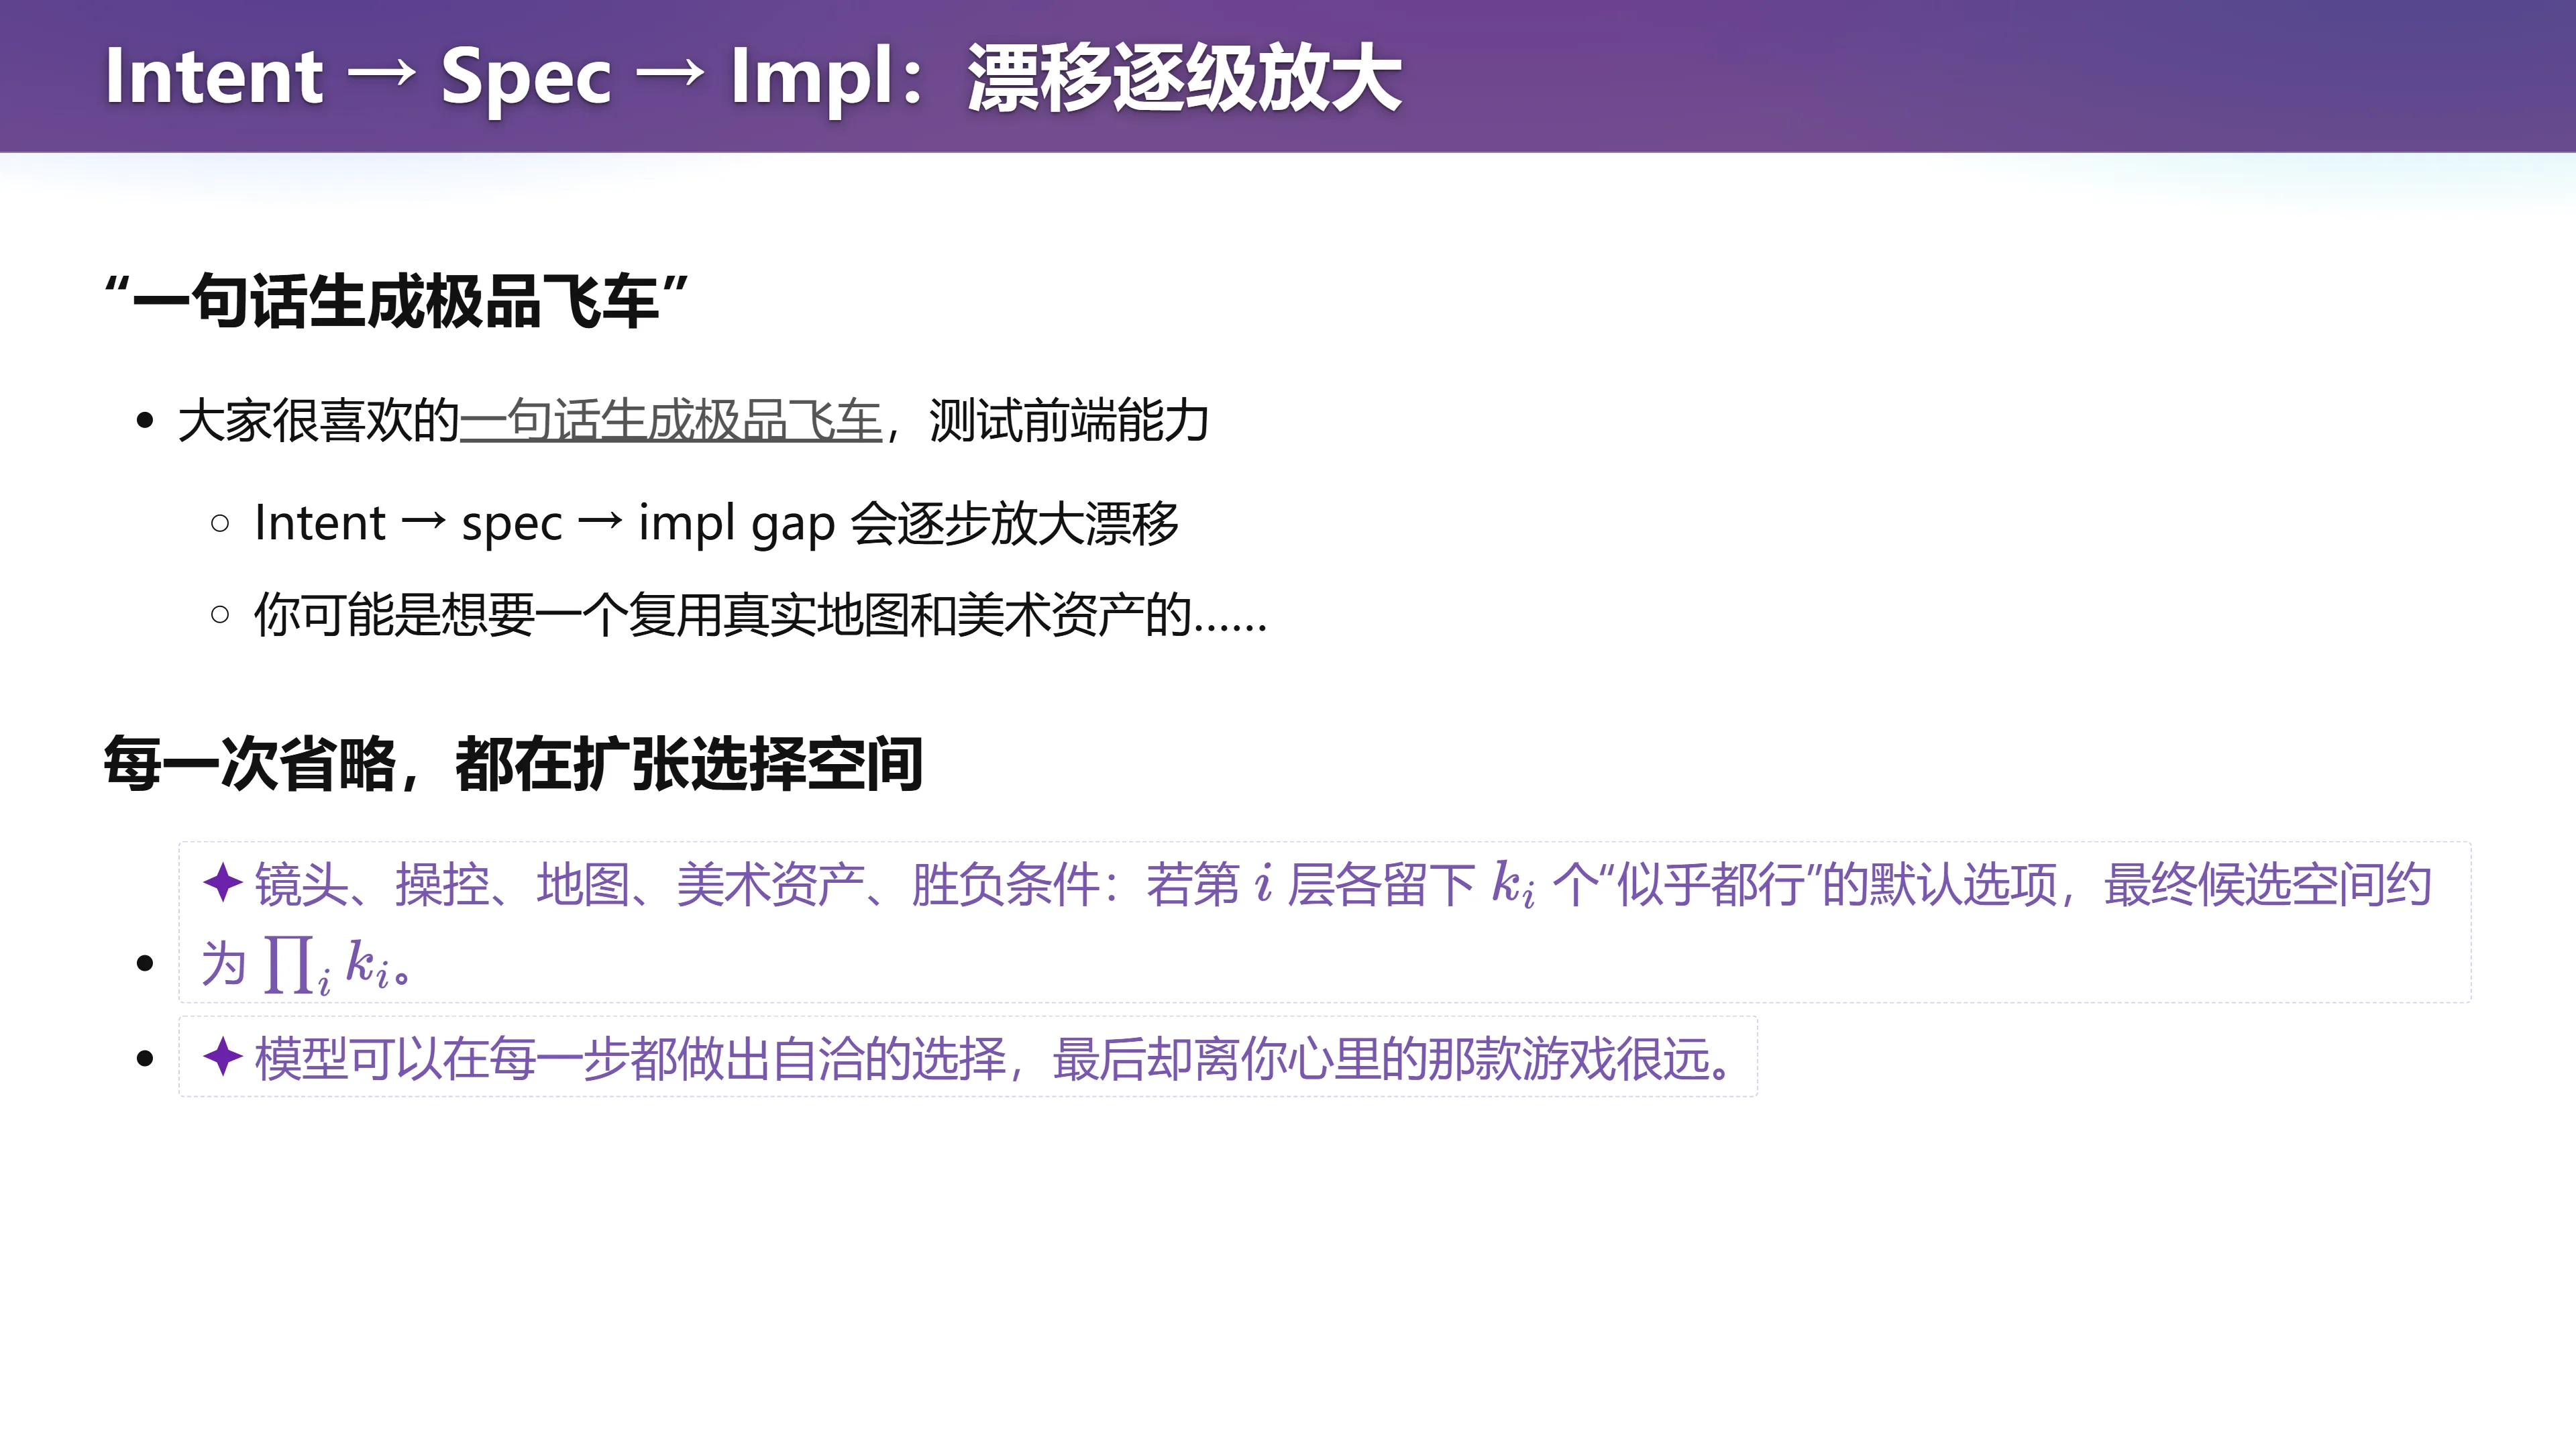
"一句话生成极品飞车"可以产生很漂亮的演示。但你心里想的,可能是一个有真实地图、特定美术资产、某种驾驶手感的赛车游戏。模型交出的,也许只是一个能移动、会碰撞、有速度感的网页。它未必在任何一步明显违背指令,却在一连串默认选择之后,做出了另外一个产品。
(参考时间: 22:48) Kimi K3 生成的这个演示质量非常高:物理、碰撞、逻辑都做得很好,顶上甚至有一个看起来没问题的后视镜。但这依然可能不是你想要的"极品飞车"。
问题出在软件工程里那个老大难的问题上——Intent、Spec 和 Impl 之间的缺口:
graph LR
    I["Intent<br/>你脑子里的那款游戏"] -->|省略 | SP["Spec<br/>镜头、操控、地图、胜负条件"]
    SP -->|省略 | IM["Impl<br/>实际交出的产物"]
    I -. 默认选项逐级放大 .-> IM
镜头怎么跟随,车怎样转向,地图从哪里来,撞车以后发生什么——每个省略都留下了选择空间。模型可以把这些选择做得相互一致,但"一致"不意味着"正好是你想的"。
- 若第 $i$ 层各留下 $k_i$ 个"似乎都行"的默认选项,最终候选空间约为 $\prod_i k_i$。
- 模型可以在每一步都做出自洽的选择,最后却离你心里的那款游戏很远。
反过来说,指令越清楚越好。 如果你真的把"复用真实地图和美术资产"这句话说出来:
(参考时间: 23:47)
它可能会去 OpenStreetMap 之类的网站下载一份开源地图。如果你真的想在南大仙林校区里开车,这件事是能做到的——你只要找到那个地图文件的格式,它就能把这个世界重新建模出来。美术资产也一样,有很多公开可用的车、城市、树。如果你不告诉它,它会默认"这是一次 self-contained 的任务,所有东西都由我自己生成",那其实就是早期的一个误解。
九、写清指令,承担"不明确"的后果
(参考时间: 24:24)
📷 写清指令,承担"不明确"的后果
回到原视频 (00:24:24)
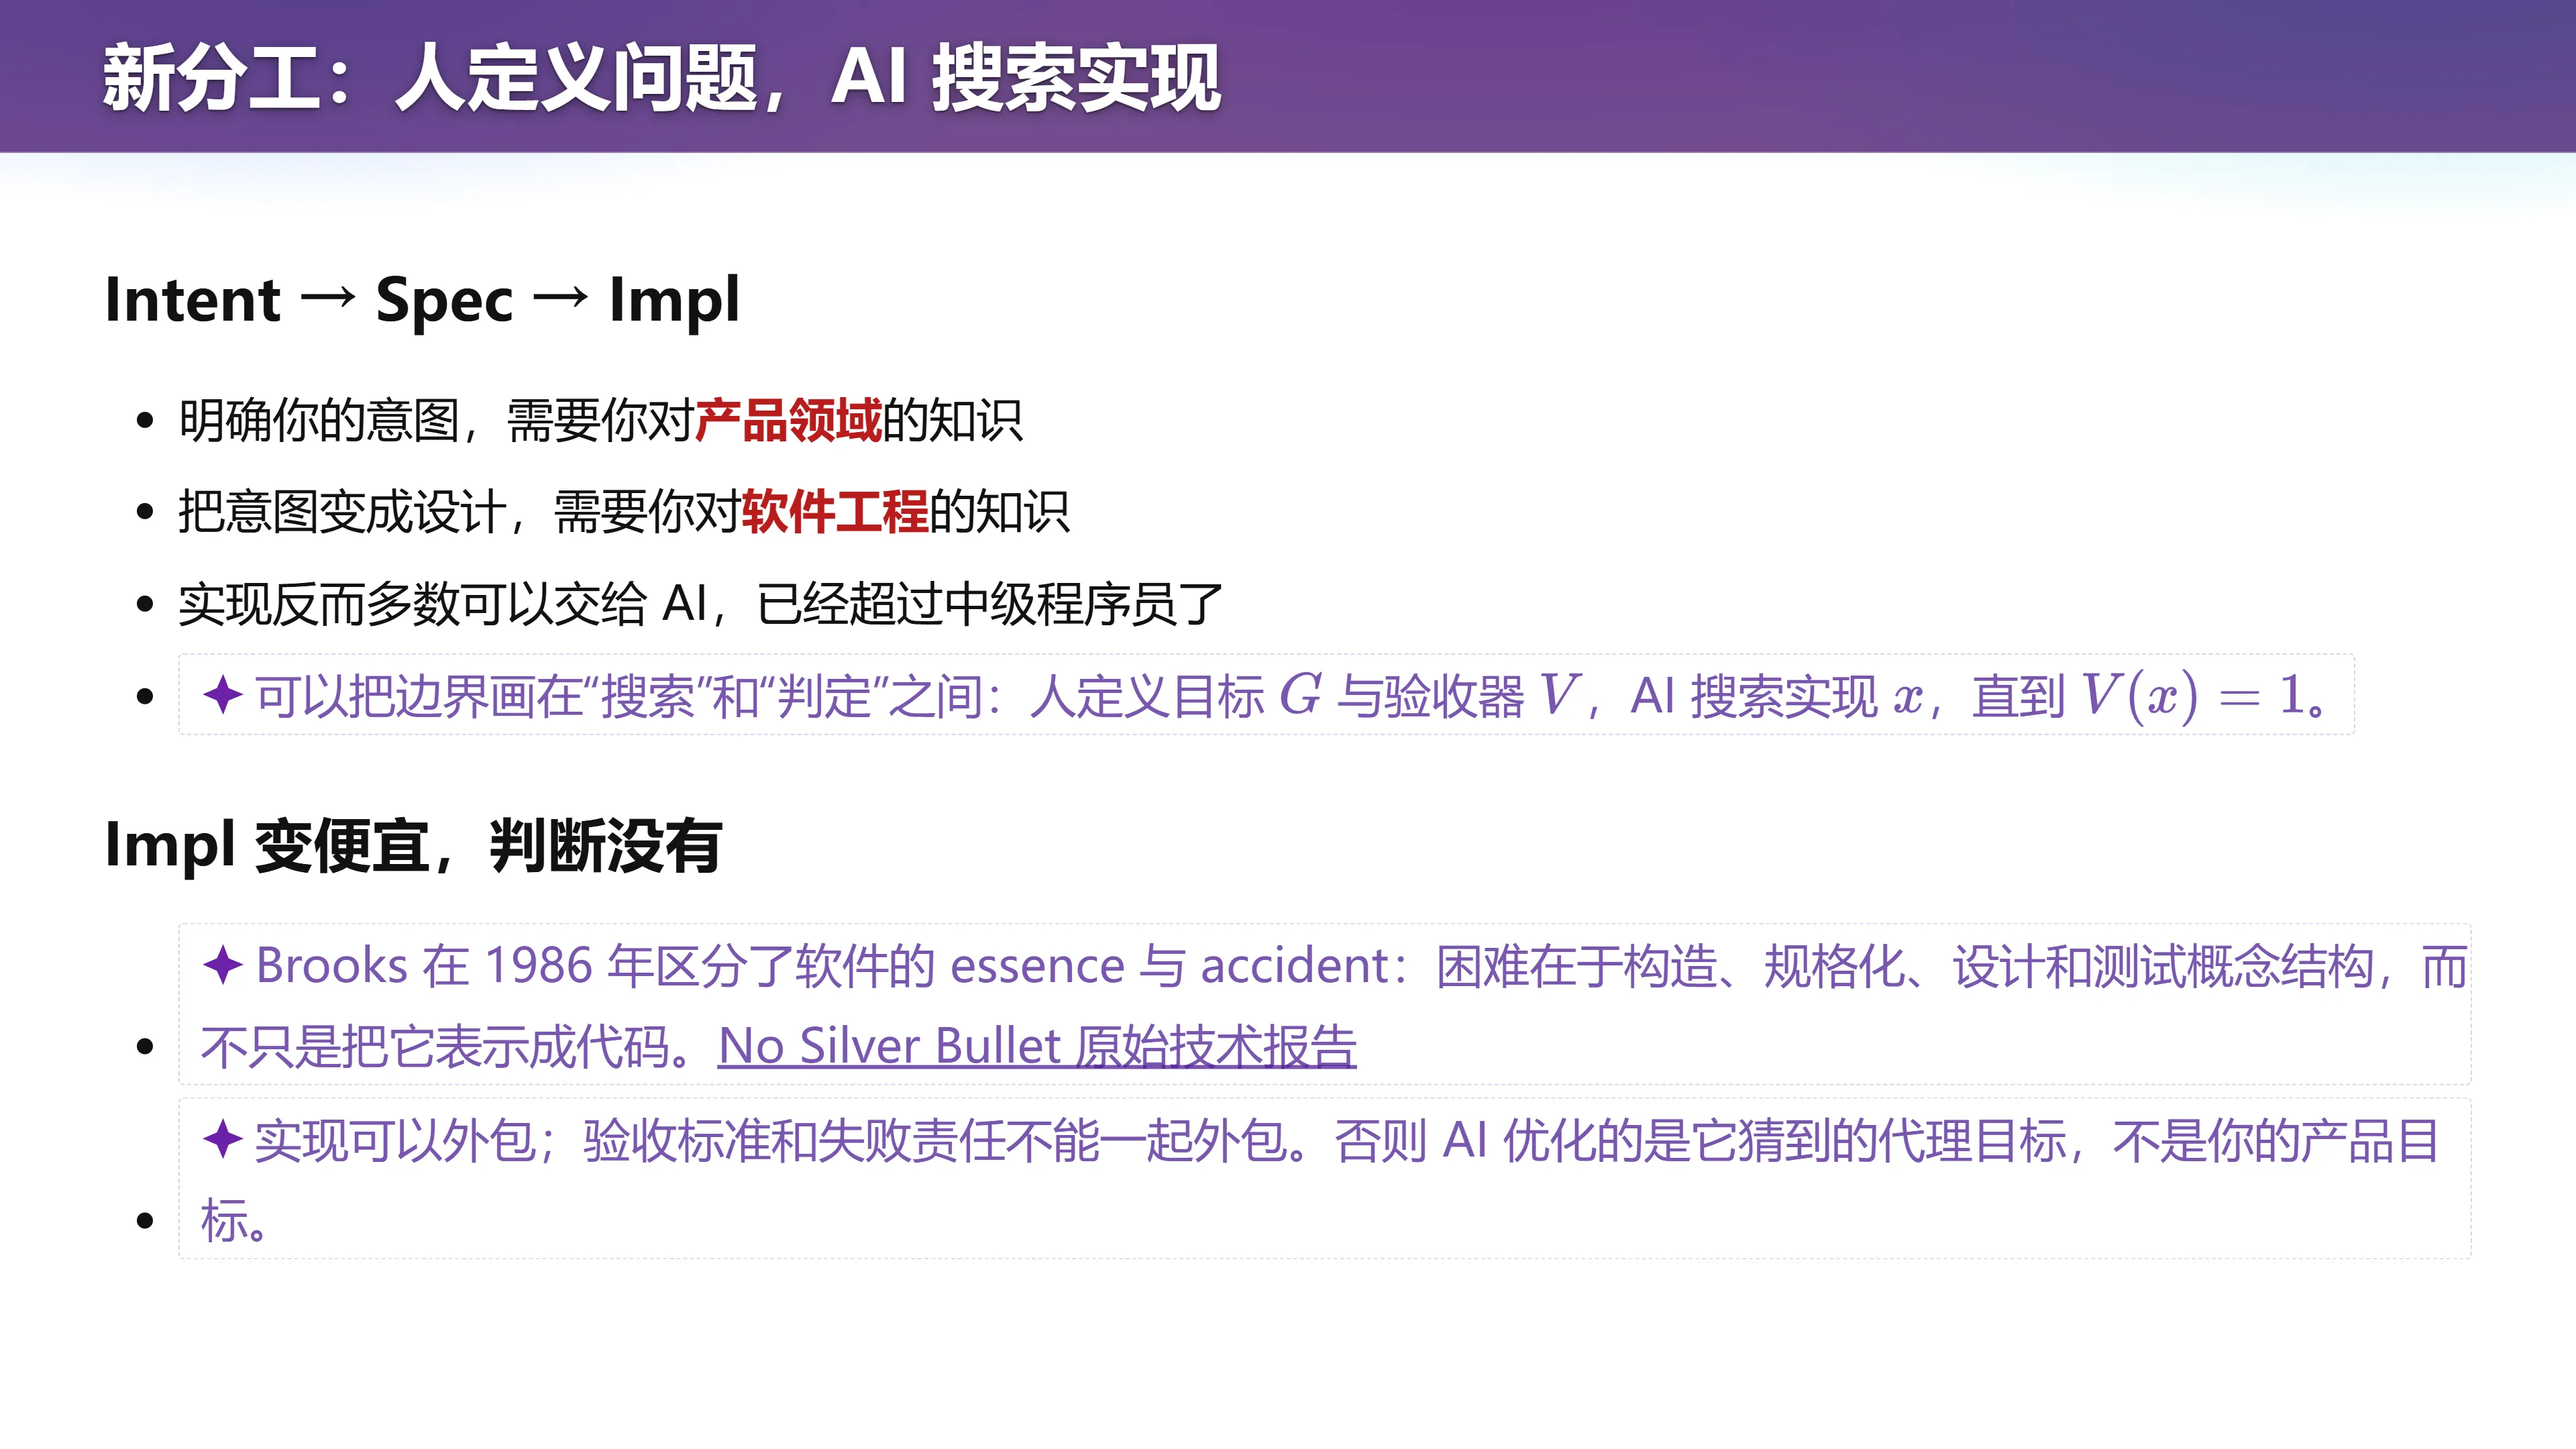
📷 Intent → Spec → Impl:新分工
回到原视频 (00:31:16)
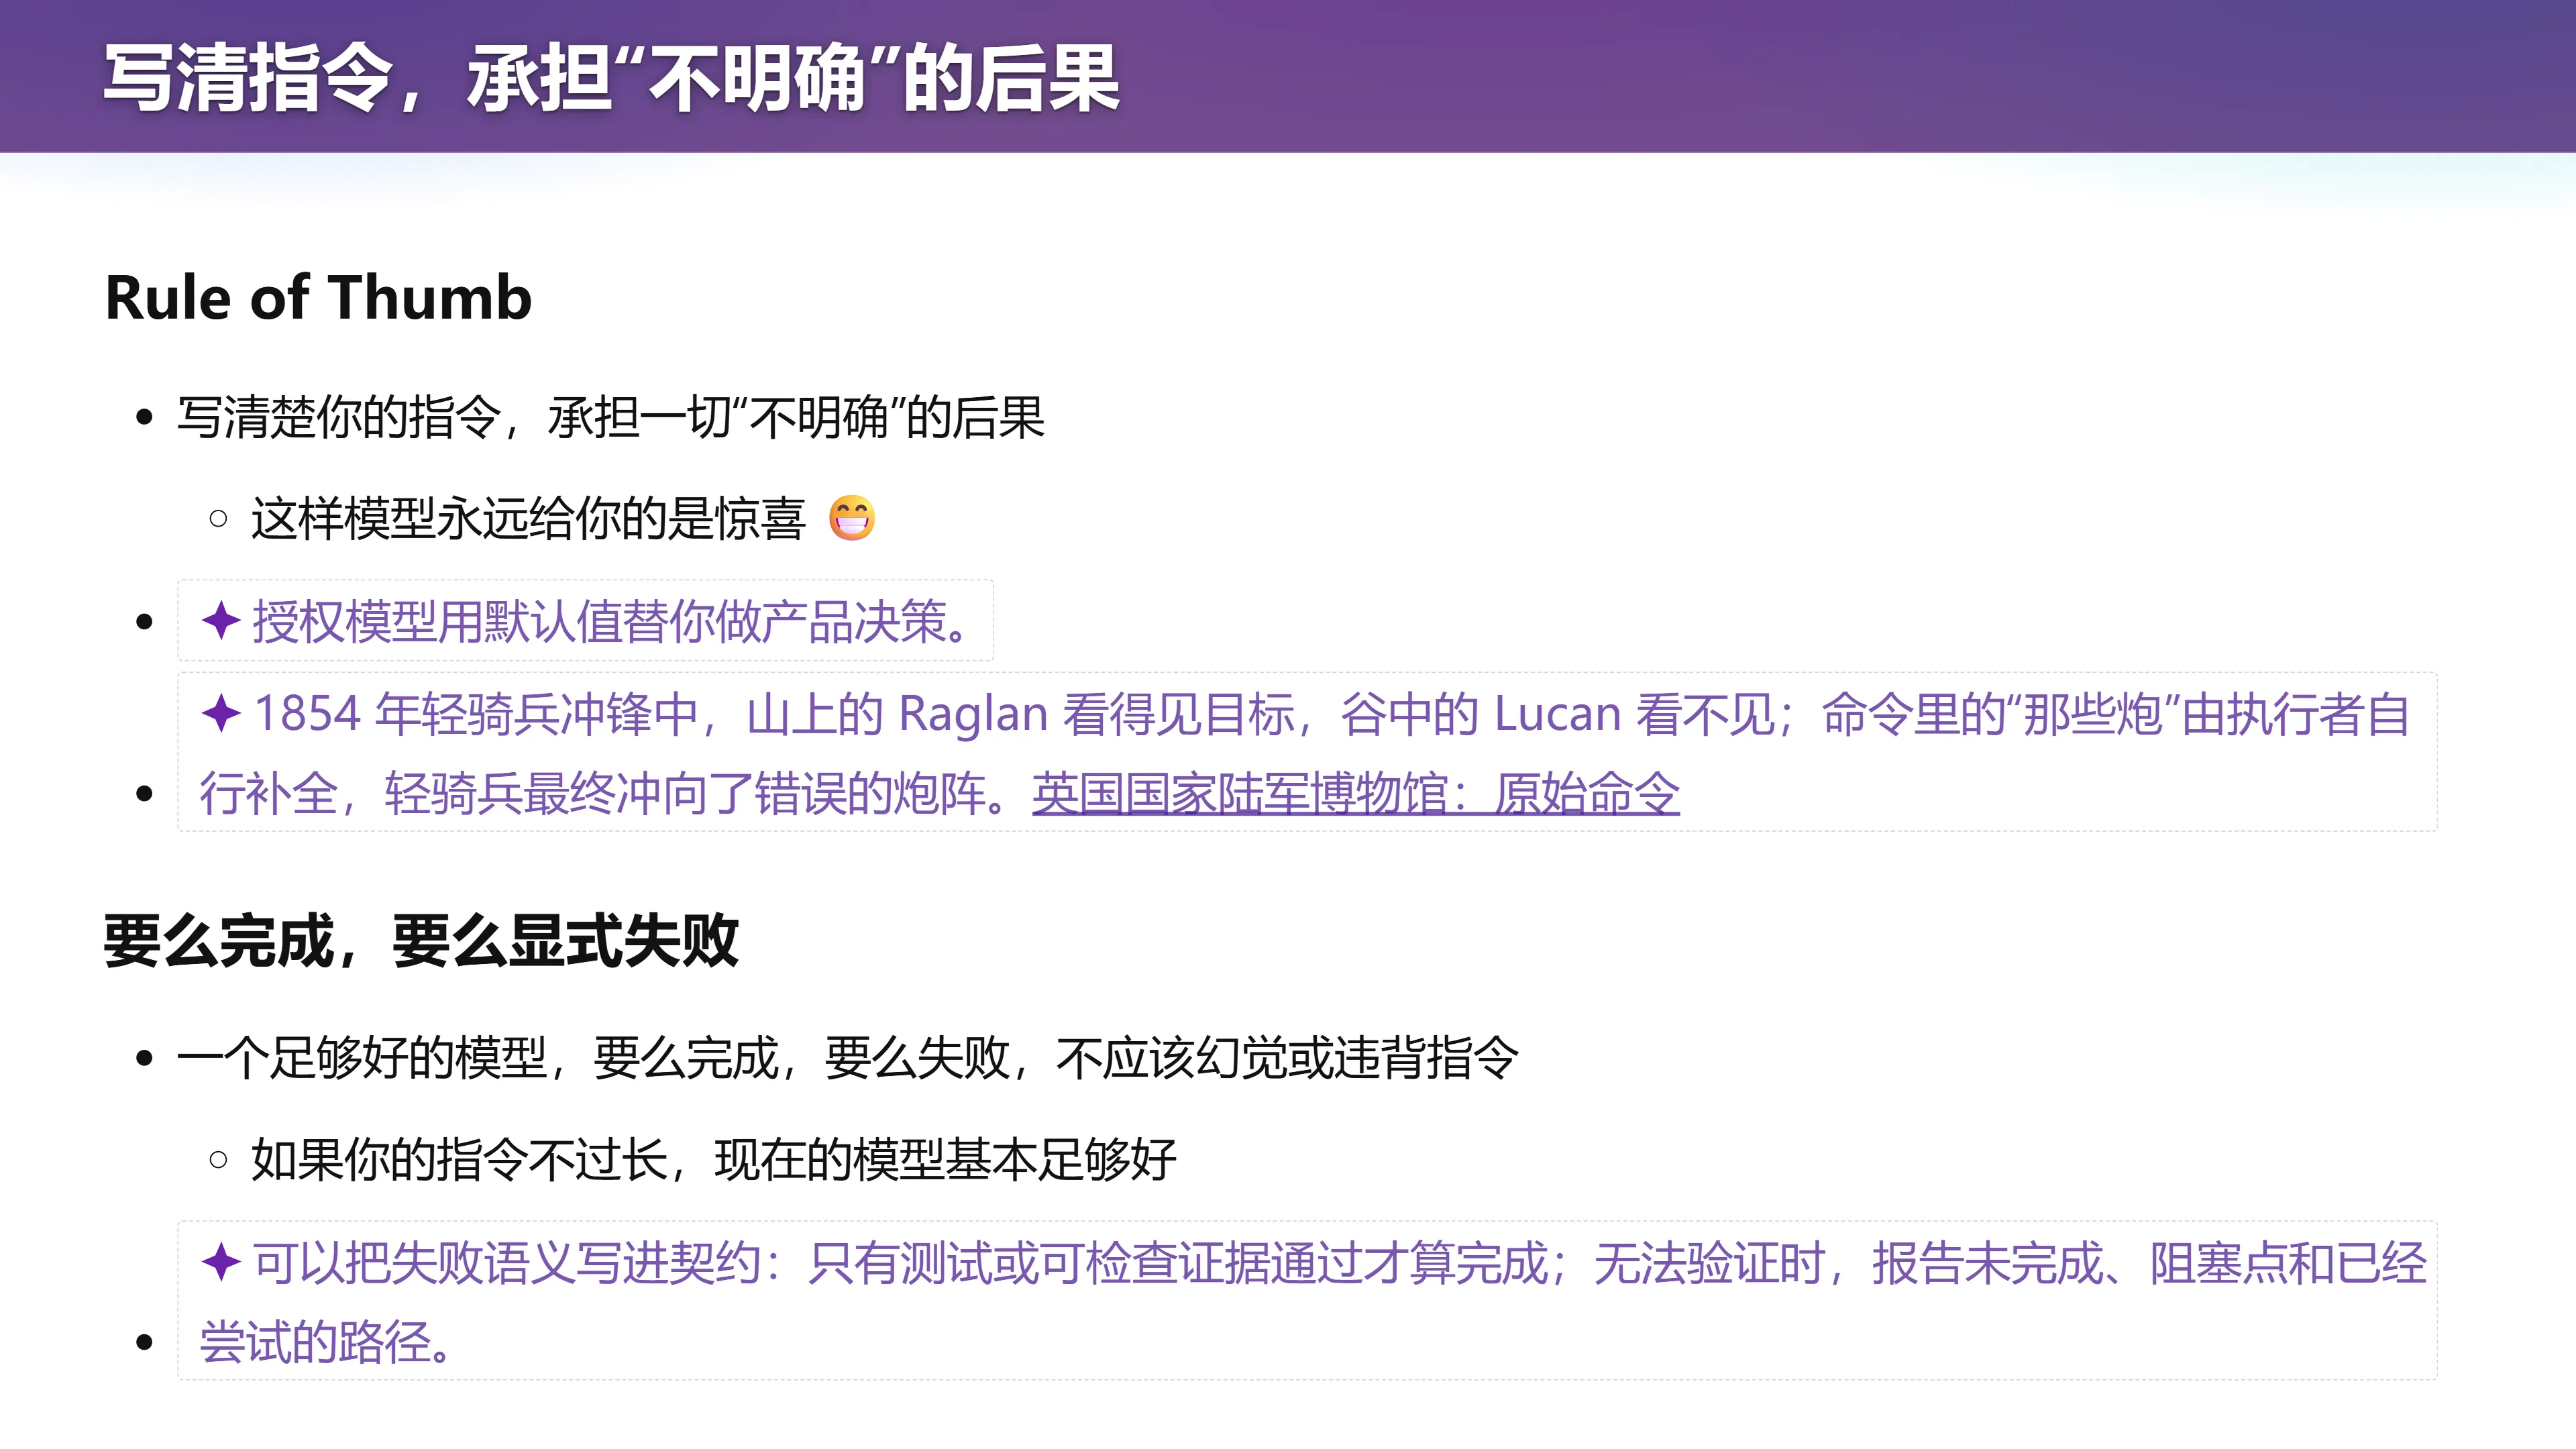
课堂的经验法则是:写清楚你的指令,承担一切"不明确"的后果。
它要求我们意识到,没有说明的地方,实际上是把决定权交给了模型。并不需要把所有细枝末节都提前决定,但要知道:哪些地方允许它自行发挥,哪些地方决定了产品是不是你要的。
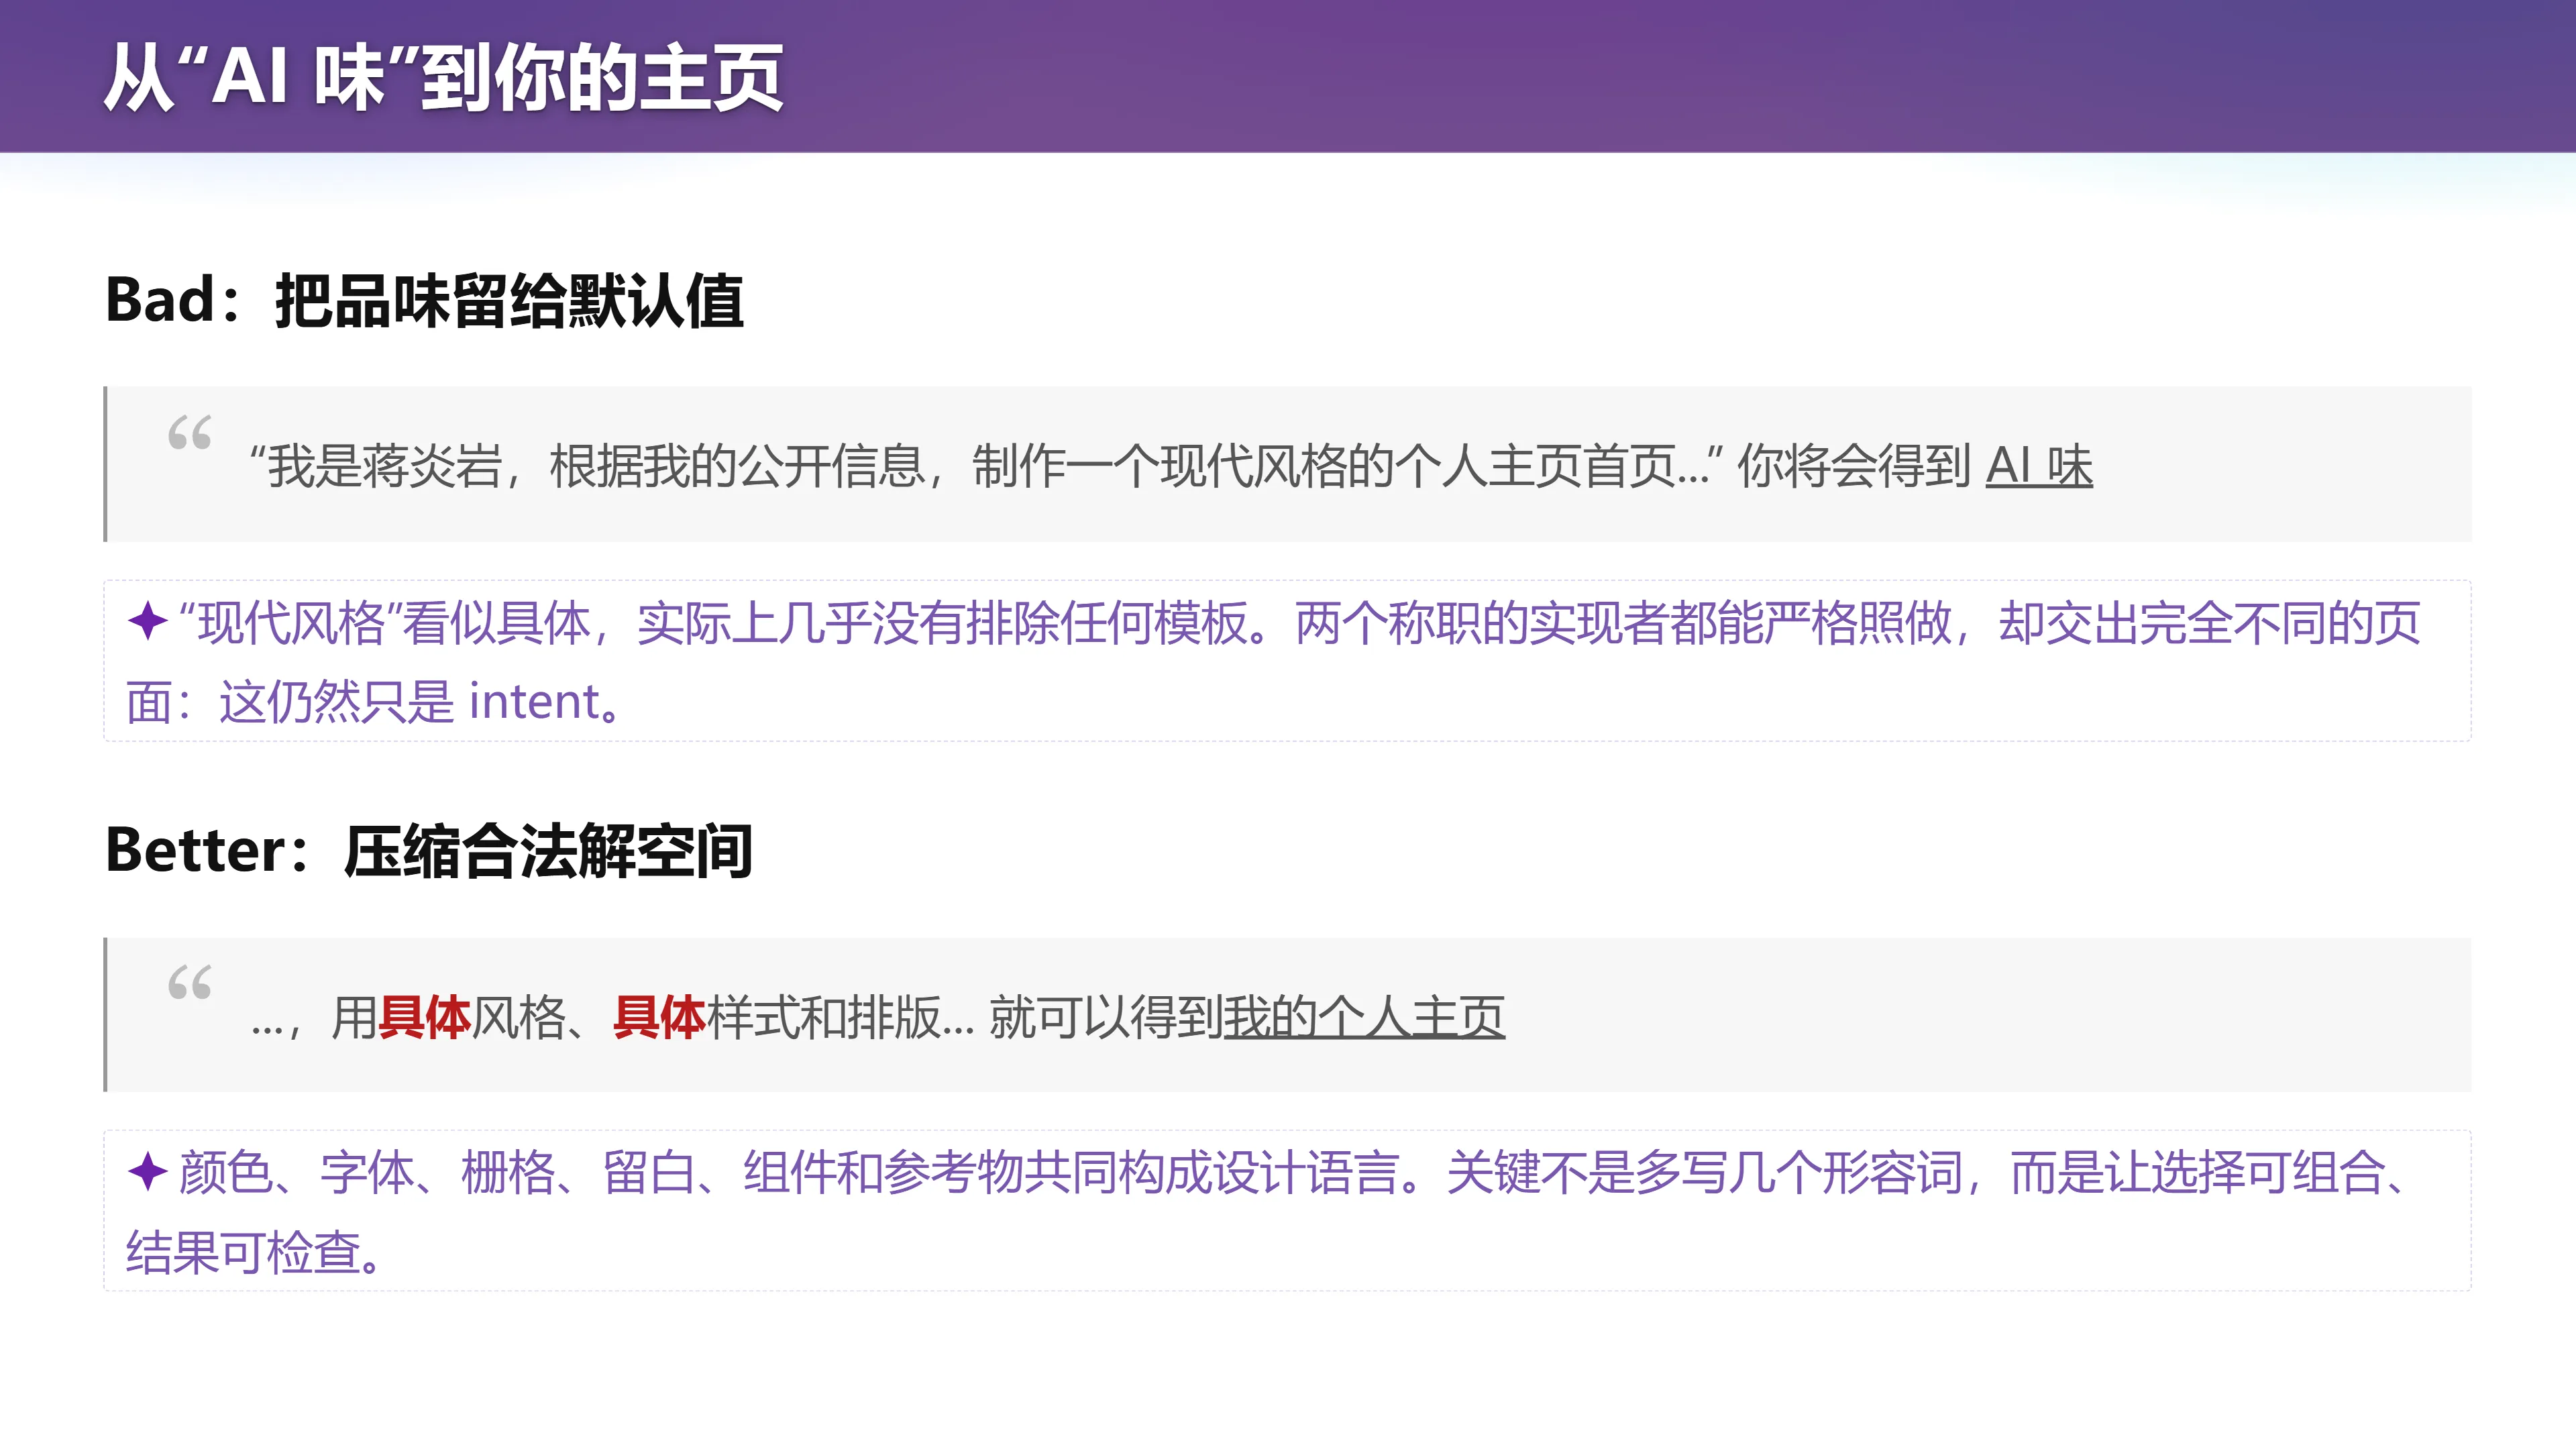
个人主页是另一个例子。"根据我的公开信息,制作一个现代风格的主页",看似清楚,其实"现代"并没有排除多少可能。模板、渐变、卡片和装饰都能被解释为现代风格。
一个实用的检查办法是:让另一个人只看要求和最终产物,能否判断任务已经完成?
- "做得专业一点"很难判定;
- "页面首先展示研究方向和近期工作,手机上无需横向滚动,所有项目入口都能打开",则提供了可以检查的行为。
不能完全机械判断的品味,也可以通过示例、对比和反馈逐步说明。
完成的语义还包括失败。 如果关键条件无法验证,合理的结果应当是报告哪里没完成、缺少什么证据,而不是交出一段肯定的总结。只有把这些状态说清楚,Agent 才能更可靠地决定:继续尝试,还是需要新的信息。
可以把失败语义写进契约:
- 只有测试或可检查证据通过才算完成;
- 无法验证时,报告未完成、阻塞点和已经尝试过的路径。
编者拓展|"轻骑兵冲锋"与"那些炮":1854 年克里米亚战争中,山上的 Raglan 看得见目标,谷中的 Lucan 看不见。命令里的"那些炮"被迫由执行者自行补全,轻骑兵最终冲向了错误的炮阵。这是"指令留下解释空间 → 执行者补全 → 结果完全走样"的经典案例。英国国家陆军博物馆:原始命令
编者拓展|实现可以外包,判定不能:Brooks 在 1986 年的 No Silver Bullet 中区分了软件的 essence(本质) 与 accident(偶然):困难在于构造、规格化、设计和测试概念结构,而不只是把它表示成代码。实现可以外包给 AI;验收标准和失败责任不能一起外包。否则 AI 优化的是它猜到的代理目标,不是你的产品目标。
十、从"AI 味"到你的主页
(参考时间: 25:11)
📷 从"AI 味"到你的主页
回到原视频 (00:25:11)
课末有一件事讲师正在筹划:每位同学交一份简历,由他用 AI 来评估通过与否(就像第一讲演示的"不好的简历"案例)。简历里通常会有指向你的 GitHub 或个人主页的链接。
(参考时间: 26:04) 讲师演示了一句提示词生成的主页:
我是蒋炎岩,根据我的公开信息,制作一个现代风格的个人主页首页……
结果——美术效果非常好,非常专业,滚动、浮动效果都做得不错,还显然是读过了他的主页(知道他的主页是一个 terminal)。但你会有一种感觉:"AI 味很重",说不出来为什么。
- "现代风格"看似具体,实际上几乎没有排除任何模板。两个称职的实现者都能严格照做,却交出完全不同的页面:这仍然只是 intent。
再对比几位学生的主页——干净、舒服,但说不出哪里有那种 AI 味。
(参考时间: 27:44) 然后是讲师自己的主页:
这是一个真正的终端,所以我可以有管道。如果你放大了看,这个字是不完美的——它不是一个特别工整的字。我对所有
exterminate.js渲染完之后做了一个非常小的后处理,让它有一种像真的打字机打出来的、不完美的效果。所以看起来 AI 味就没那么重了,因为它确实不像是 AI 的风格。
结论:
- Bad:把品味留给默认值;
- Better:压缩合法解空间。用具体风格、具体样式和排版——颜色、字体、栅格、留白、组件和参考物,共同构成设计语言。关键不是多写几个形容词,而是让选择可组合、结果可检查。
(参考时间: 28:57)
这些设计是掌控在大家自己手里的。你需要读很多前端的书,甚至设计的书,再去看一些好的网页。每次看到一个好的网页,就把它记下来:"这个网页设计得好,它好在哪里?"——可能是因为两个按钮之间用了一个不常规的间距,或者用了一个不常规的样式。你们有时间,就去漫无目的地探索,探索的过程里会有惊喜。
这时新的分工变得清晰:
- 明确意图,需要你对产品领域的知识;
- 把意图变成设计,需要你对软件工程的知识;
- 实现反而多数可以交给 AI,它已经超过中级程序员了。
可以把边界画在"搜索"与"判定"之间:人定义目标 $G$ 与验收器 $V$,AI 搜索实现 $x$,直到 $V(x)=1$。
(参考时间: 31:16) 讲师还谈到多样性为什么重要:
模型是一个模型,它的品位基本上是固定的,尤其是在你不控制它的时候,它会朝一个固定的方向发散。这就是为什么我们鼓励大家跟不同的人聊天,为什么学校里有不同的老师来上不同的课程。多样性是好的。你见识过了以后,就能越来越明确地知道自己想要的到底是什么,然后把它精确地说出来。
例如你要做一个教务系统,后台应该用 Python、Java 还是 TypeScript?如果你对它们之间的差别、将来上云可能遇到的问题有概念,就可以像费曼学习法那样去当老师:"我现在要做这件事,请你挑战我、说服我底下的一个学生。"
十一、一步有限,为什么还能完成复杂任务
(参考时间: 33:03)
📷 一步很浅,一串可以很深
回到原视频 (00:33:03)
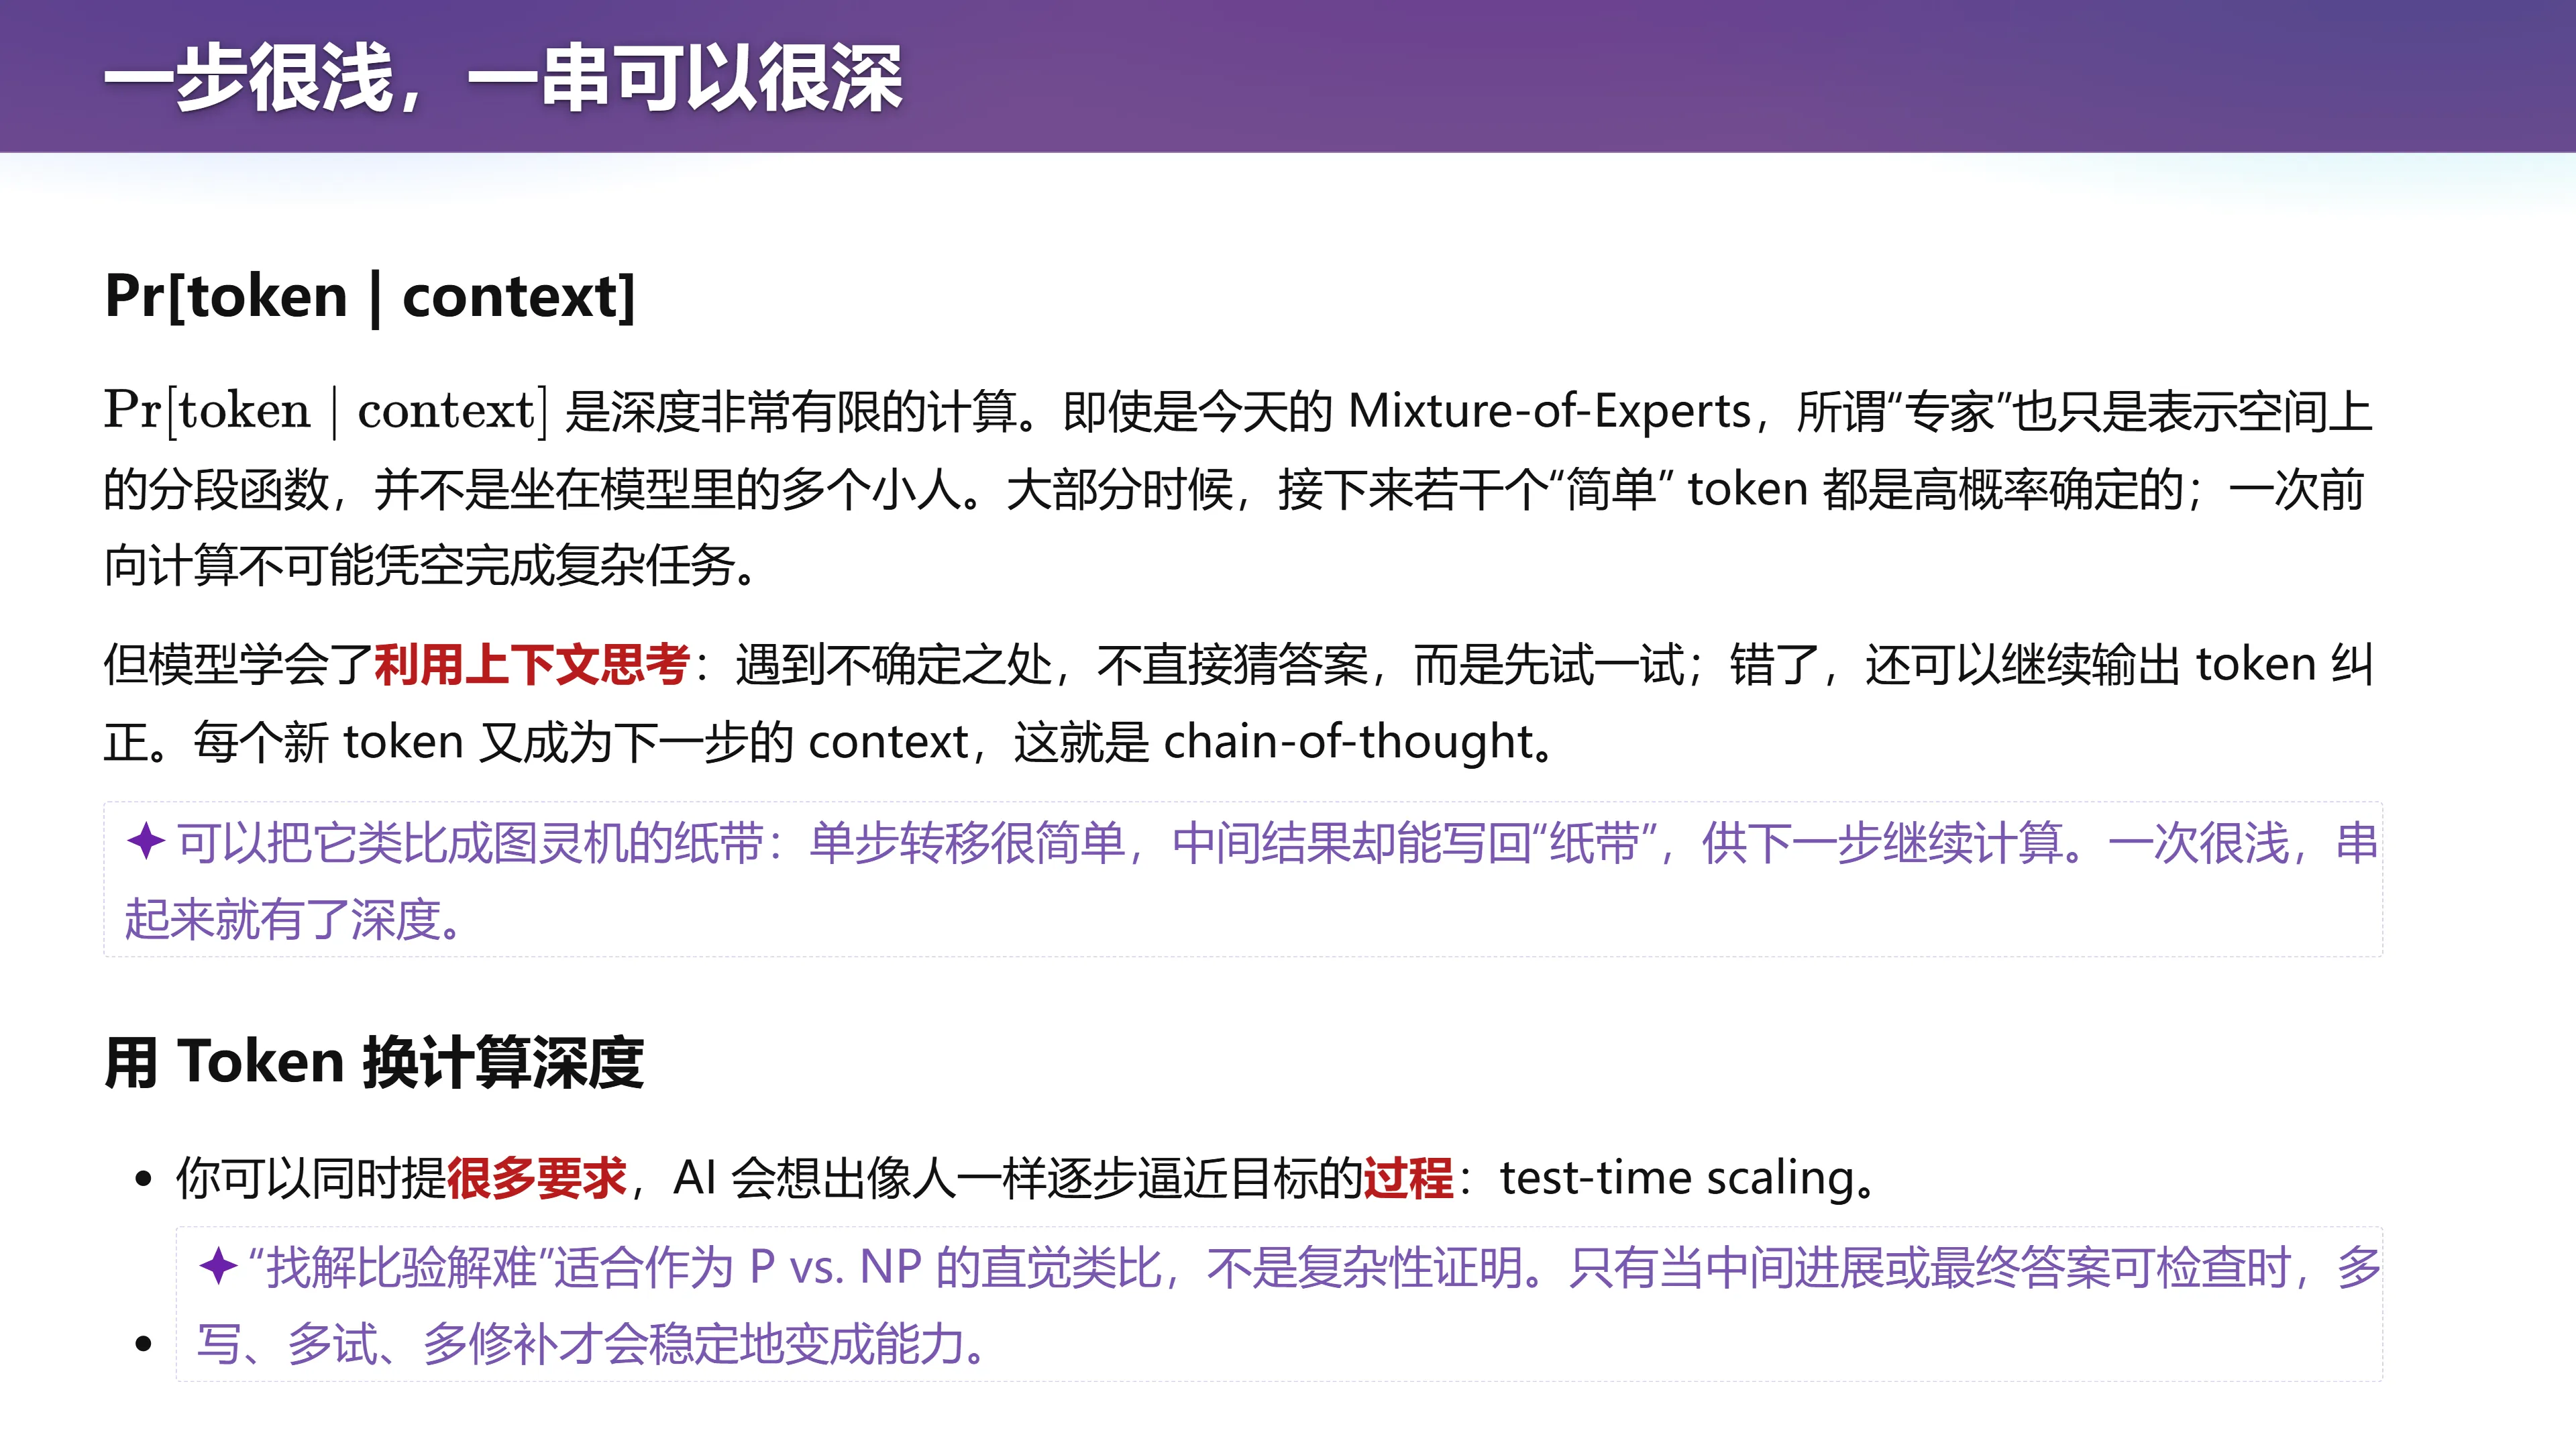
一个疑问随之而来:如果模型只是反复计算下一个 token 的概率,它怎样同时满足很多约束?
先看一次前向计算的本质。 为了输出一个 token,模型也就是把它内部激活的那一部分参数走一遍——这是一个固定大小的计算。即使今天有 3T、1.5T 参数的模型,这一步的深度也是有限的。
(参考时间: 34:14) 你们可能听说过图灵机,说它的计算能力和整个宇宙等价。你们也做过有限状态机(比如一个从
00→01→10→11→00的计数器)。有限状态机和图灵机之间唯一的区别是什么?是图灵机有一条无限长的纸带——墙上有一张草稿纸,可以把中间结果记下来。(参考时间: 35:41) 我很喜欢的一个说法是(大意来自给研究生的建议):你的脑子是一个有限状态机——神经元有限,每次思考有限。但当你有了 paper and pencil(纸和笔) 时,你就是一个图灵机了,计算能力实现跨越式增长。所以你们要一边思考一边记录,可以随时回看自己的思考,知识就会积累。
今天的思维链(chain-of-thought)模型做的正是这件事——它把模型的上下文当作了"纸和笔"。
(参考时间: 36:33) 当然这支纸笔有缺陷:它只能往后写(append-only),不能擦。写错的东西只能依靠模型的注意力把它"忽略"掉。
模型因此学会了利用上下文:
- 遇到 1+1 这种简单问题,直接 next token 告诉你答案是 2;
- 遇到很难的问题,它"先想一想"——把思考过程写下来,直到写出一个解;
- 一旦解写出来了,它可以再回头判定这个解对不对。
这就是用 token 换计算深度(test-time scaling)。早期没有思维链的 ChatGPT 被调教成了"人类的舔狗":不管问什么,它一定要给一个回答——不回答人类一定给低分,随便答一个还有概率是对的。所以幻觉就是这么来的。而经过强化学习之后,模型知道答错的惩罚很大,就学会了"必须先给一个对的"。
(参考时间: 40:44)
用这种"刁难人的写作题"去测试它,其实很好玩——就像把他的大脑拿出来做核磁共振,你能看到它的思维偏好。
编者拓展|用 Token 换计算深度:"找解常常比验解难"很适合作为 P vs. NP 的直觉类比(不是复杂性证明)。只有当中间进展或最终答案可检验时,多写、多试、多修补才会稳定地变成能力。今天的 Mixture-of-Experts(MoE)里所谓"专家",也只是表示空间上的分段函数,并不是坐在模型里的多个小人。
十二、用受约束的写作题看指令遵循
(参考时间: 38:45)
📷 三条约束,藏进八句诗
回到原视频 (00:38:45)
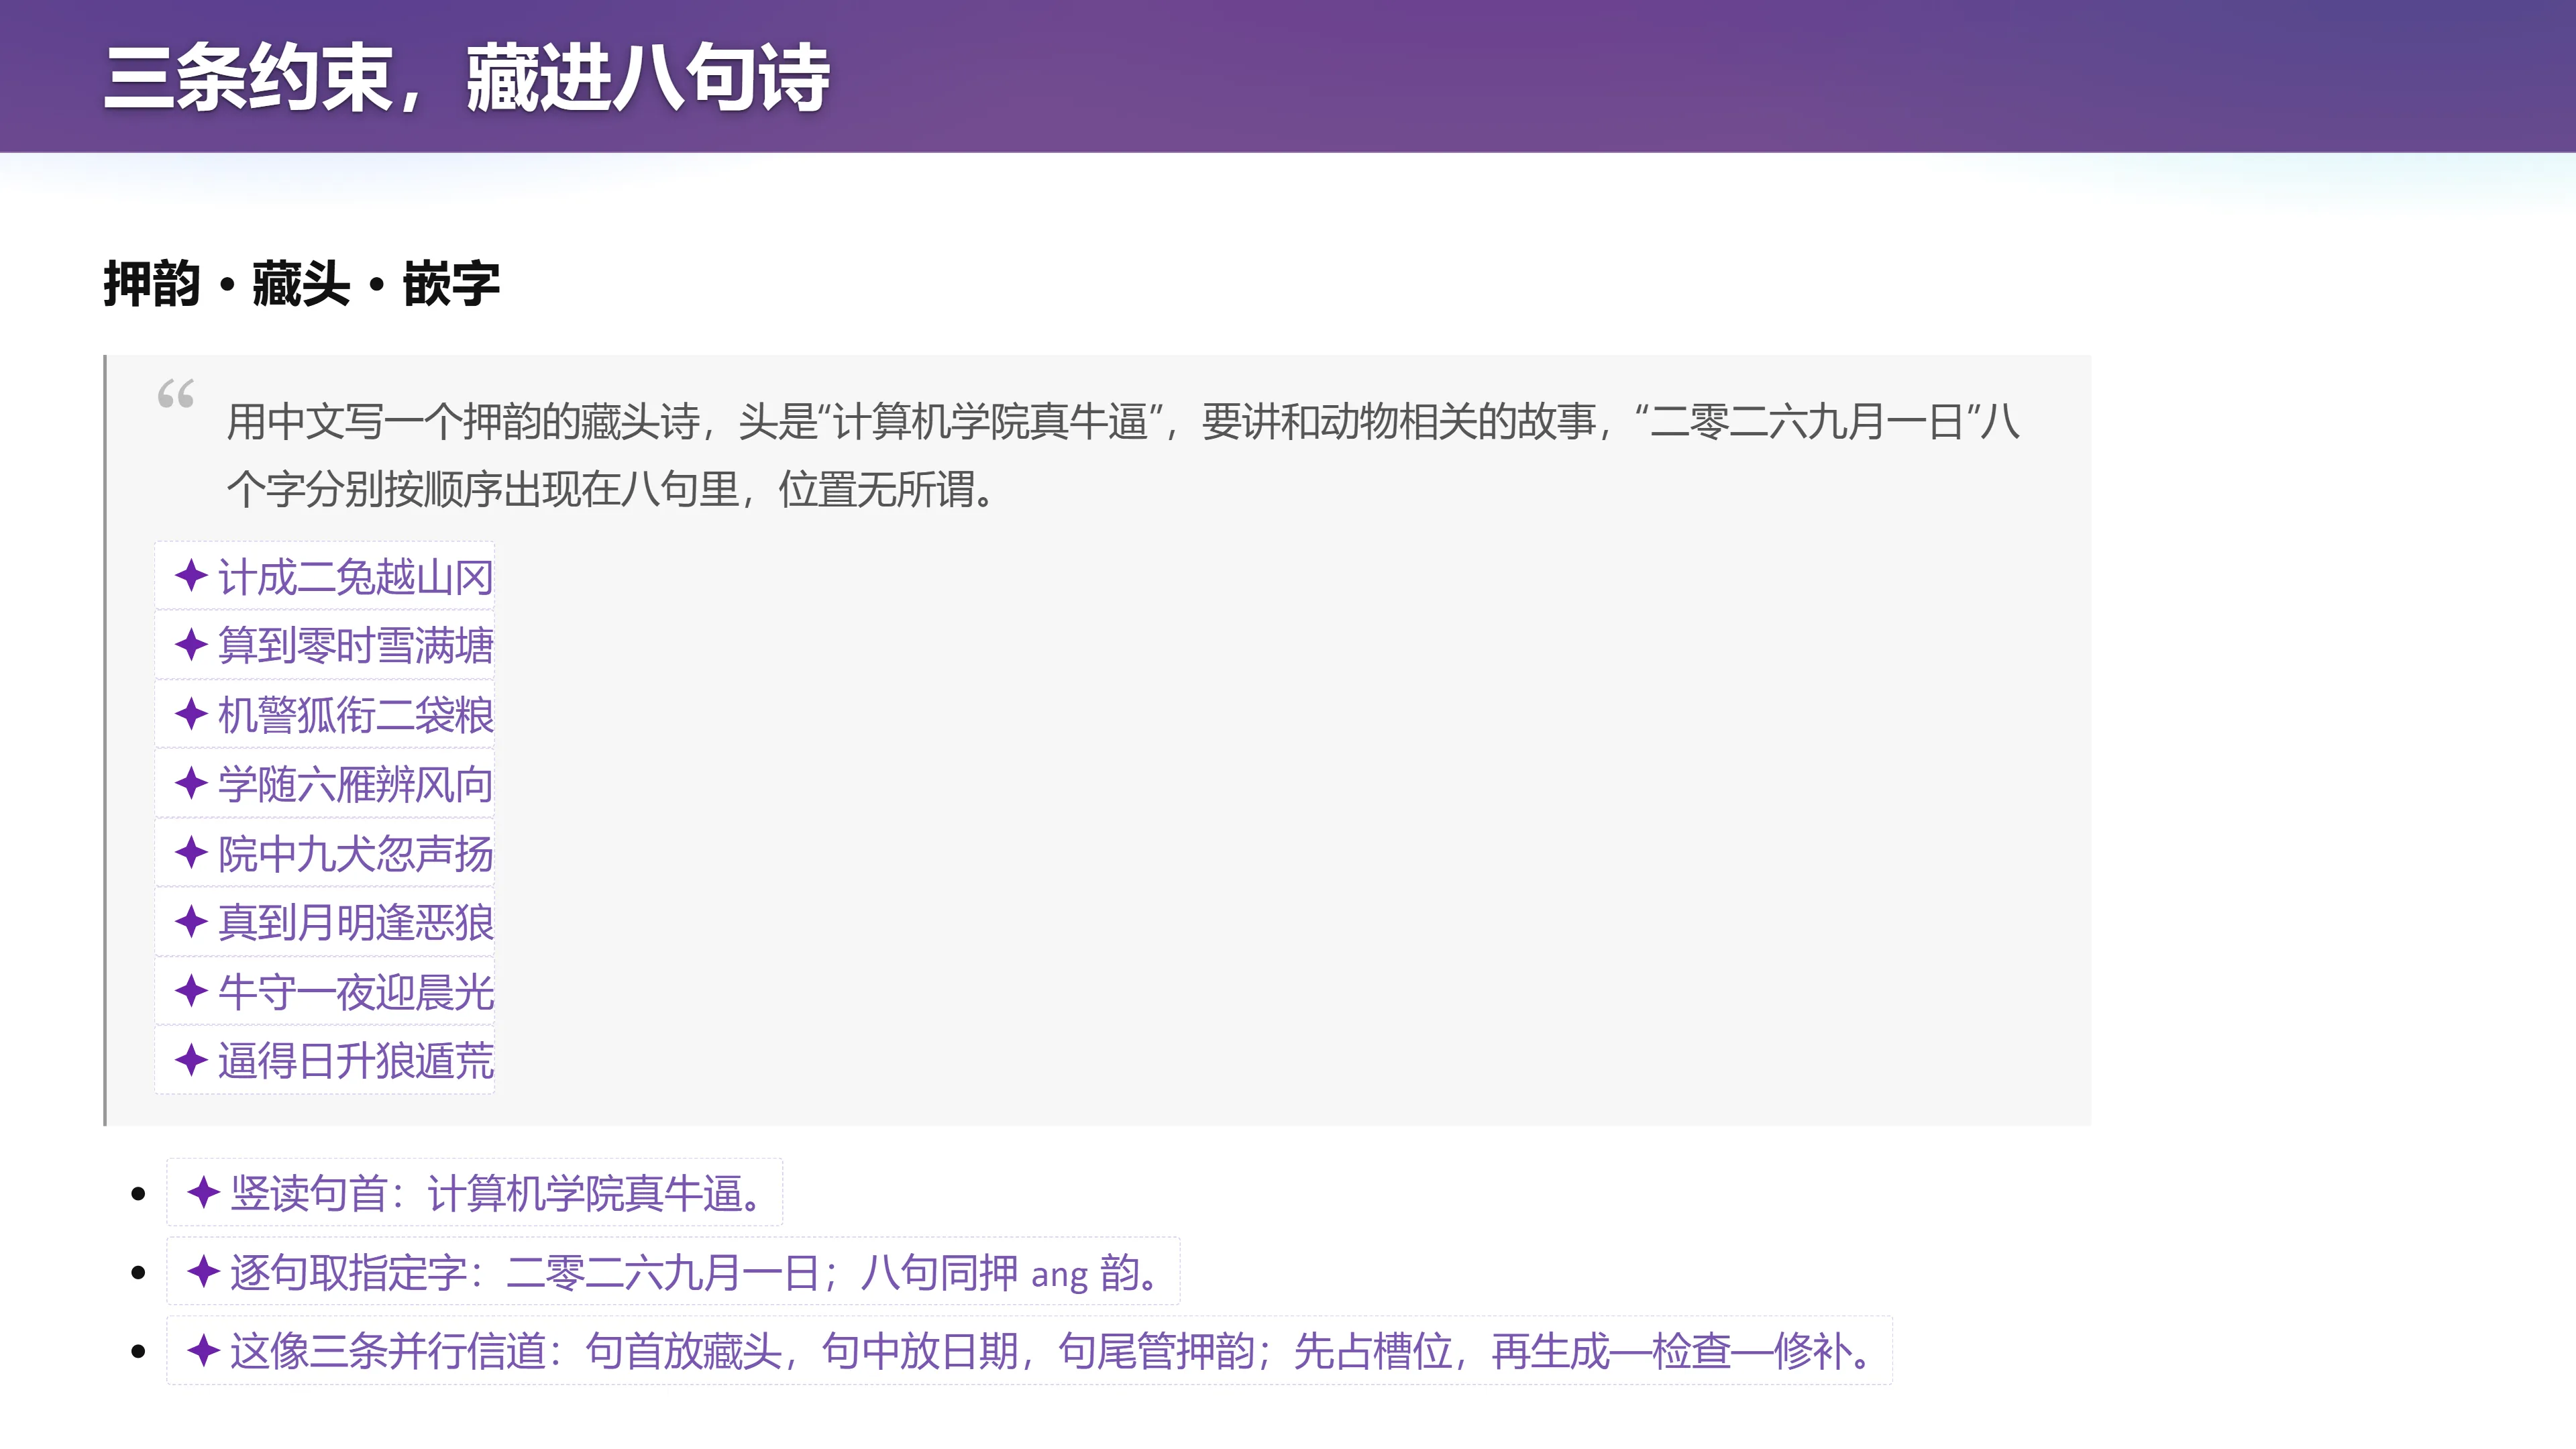
为了把指令遵循的难度具体摆出来,课堂给了几道故意刁难人的写作题。
题一:写八句中文诗
用中文写一个押韵的藏头诗,头是"计算机学院真牛逼",
要讲一个与动物相关的故事,
"二零二六九月一日"八个字分别按顺序出现在八句里,位置无所谓。
生成素材给出了这样的尝试:
计成二兔越山冈
算到零时雪满塘
机警狐衔二袋粮
学随六雁辨风向
院中九犬忽声扬
真到月明逢恶狼
牛守一夜迎晨光
逼得日升狼遁荒
检查时:
- 竖读句首:计算机学院真牛逼;
- 逐句取指定字:二零二六九月一日;
- 八句同押
ang韵。
藏头与嵌字都能对上,句尾也有相近的韵感。但"方向"的"向"与其他句尾在普通话拼音中并不完全相同,读起来也有些句子明显是为了凑约束。它展示的是模型能够寻找并修补一个多约束解,而不是宣告模型已经写出好诗。
(参考时间: 38:54) 你可以把它类比成三条并行信道:句首放藏头,句中放日期,句尾管押韵;模型先占槽位,再"生成—检查—修补"。对高三学生来说,你第一眼就会骂出题老师;但模型会照单全收。
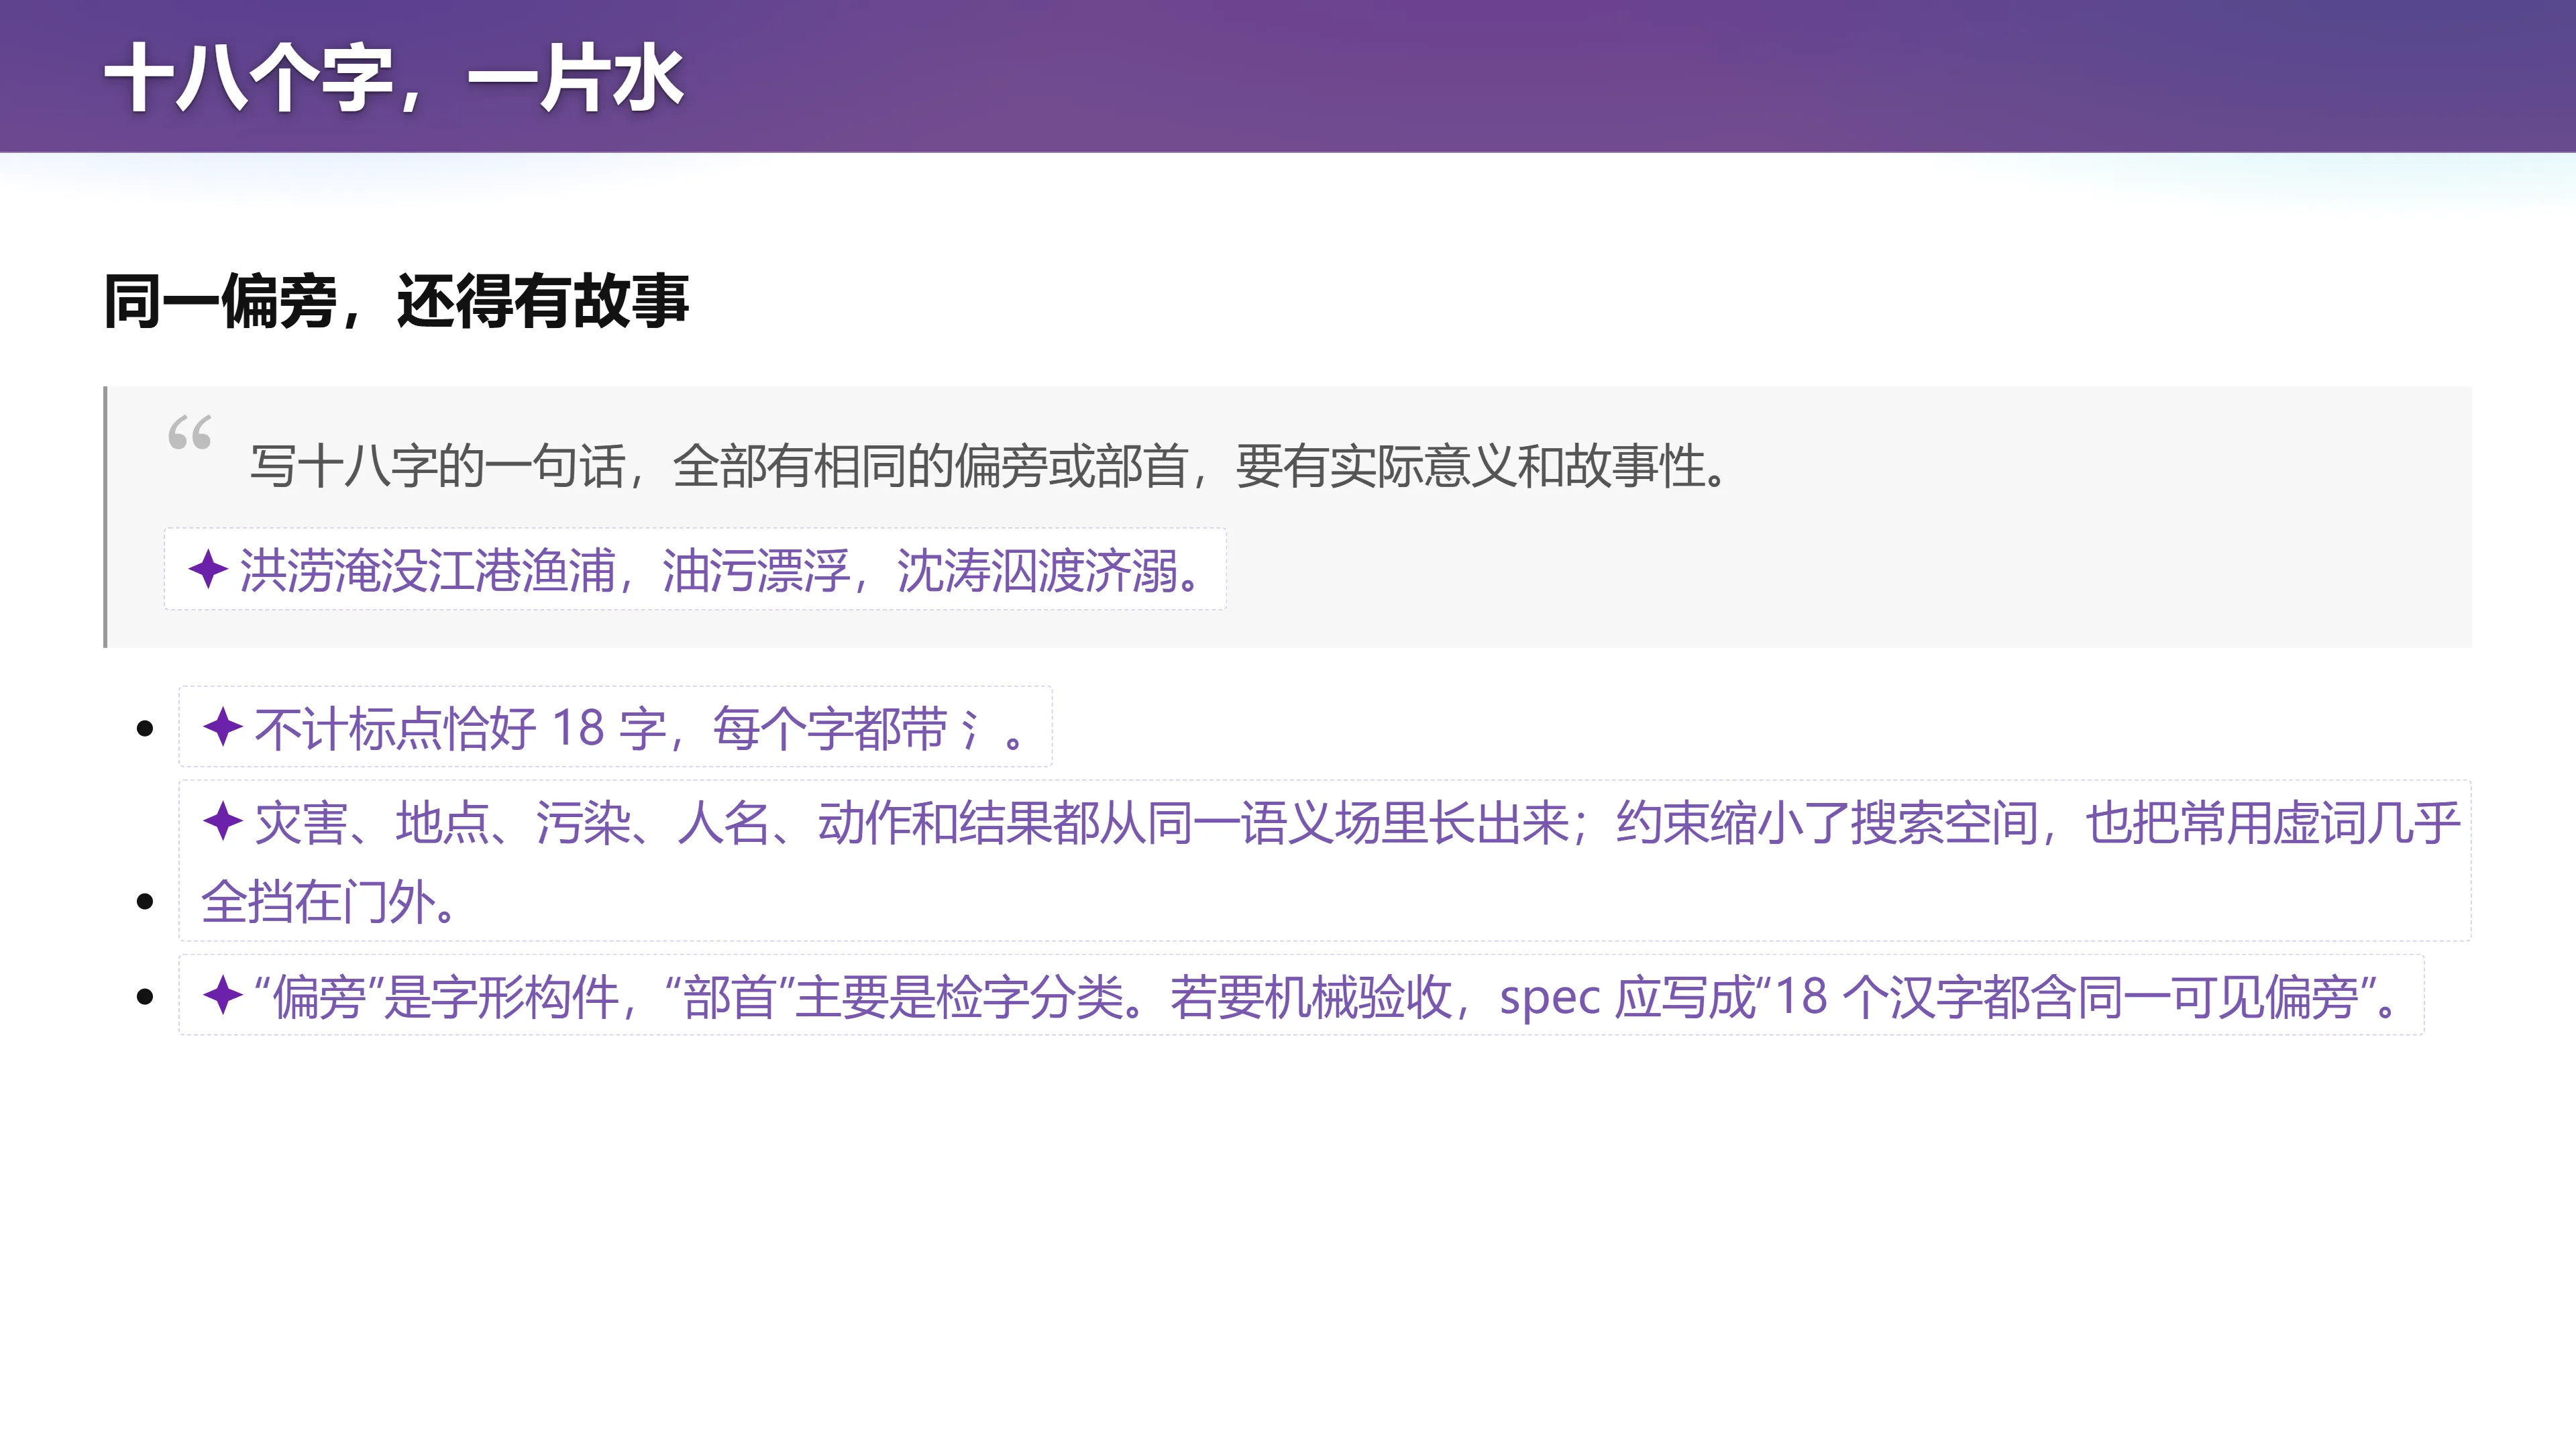
题二:十八个字,一片水
(参考时间: 42:05)
📷 十八个字,一片水
回到原视频 (00:42:05)
写十八字的一句话,全部有相同的偏旁或部首,
要有实际意义和故事性。
素材中的例子是:
洪涝淹没江港渔浦,油污漂浮,沈涛泅渡济溺。
- 不计标点恰好 18 字,每个字都带 氵(三点水);
- 把"沈涛"读作人名,故事就是洪灾与油污中有人游过去救助溺水者。灾害、地点、污染、人名、动作和结果都从同一语义场里长出来;
- 约束缩小了搜索空间,也把常用虚词几乎全挡在门外。
编者说明:注意一个重要区分——"偏旁"是字形构件,"部首"主要是检字分类。如果要用程序验收,spec 应写成"18 个汉字都含同一可见偏旁"。要交给程序验收,就得先决定检查的是哪一个。
(参考时间: 42:48) 讲师点评:模型对空间结构的感知非常差(需要视觉模型才行),但就是这样的一个纯文本模型,依然可以强行通过思维链的方式完成——它先选一个"三点水",再一路试。
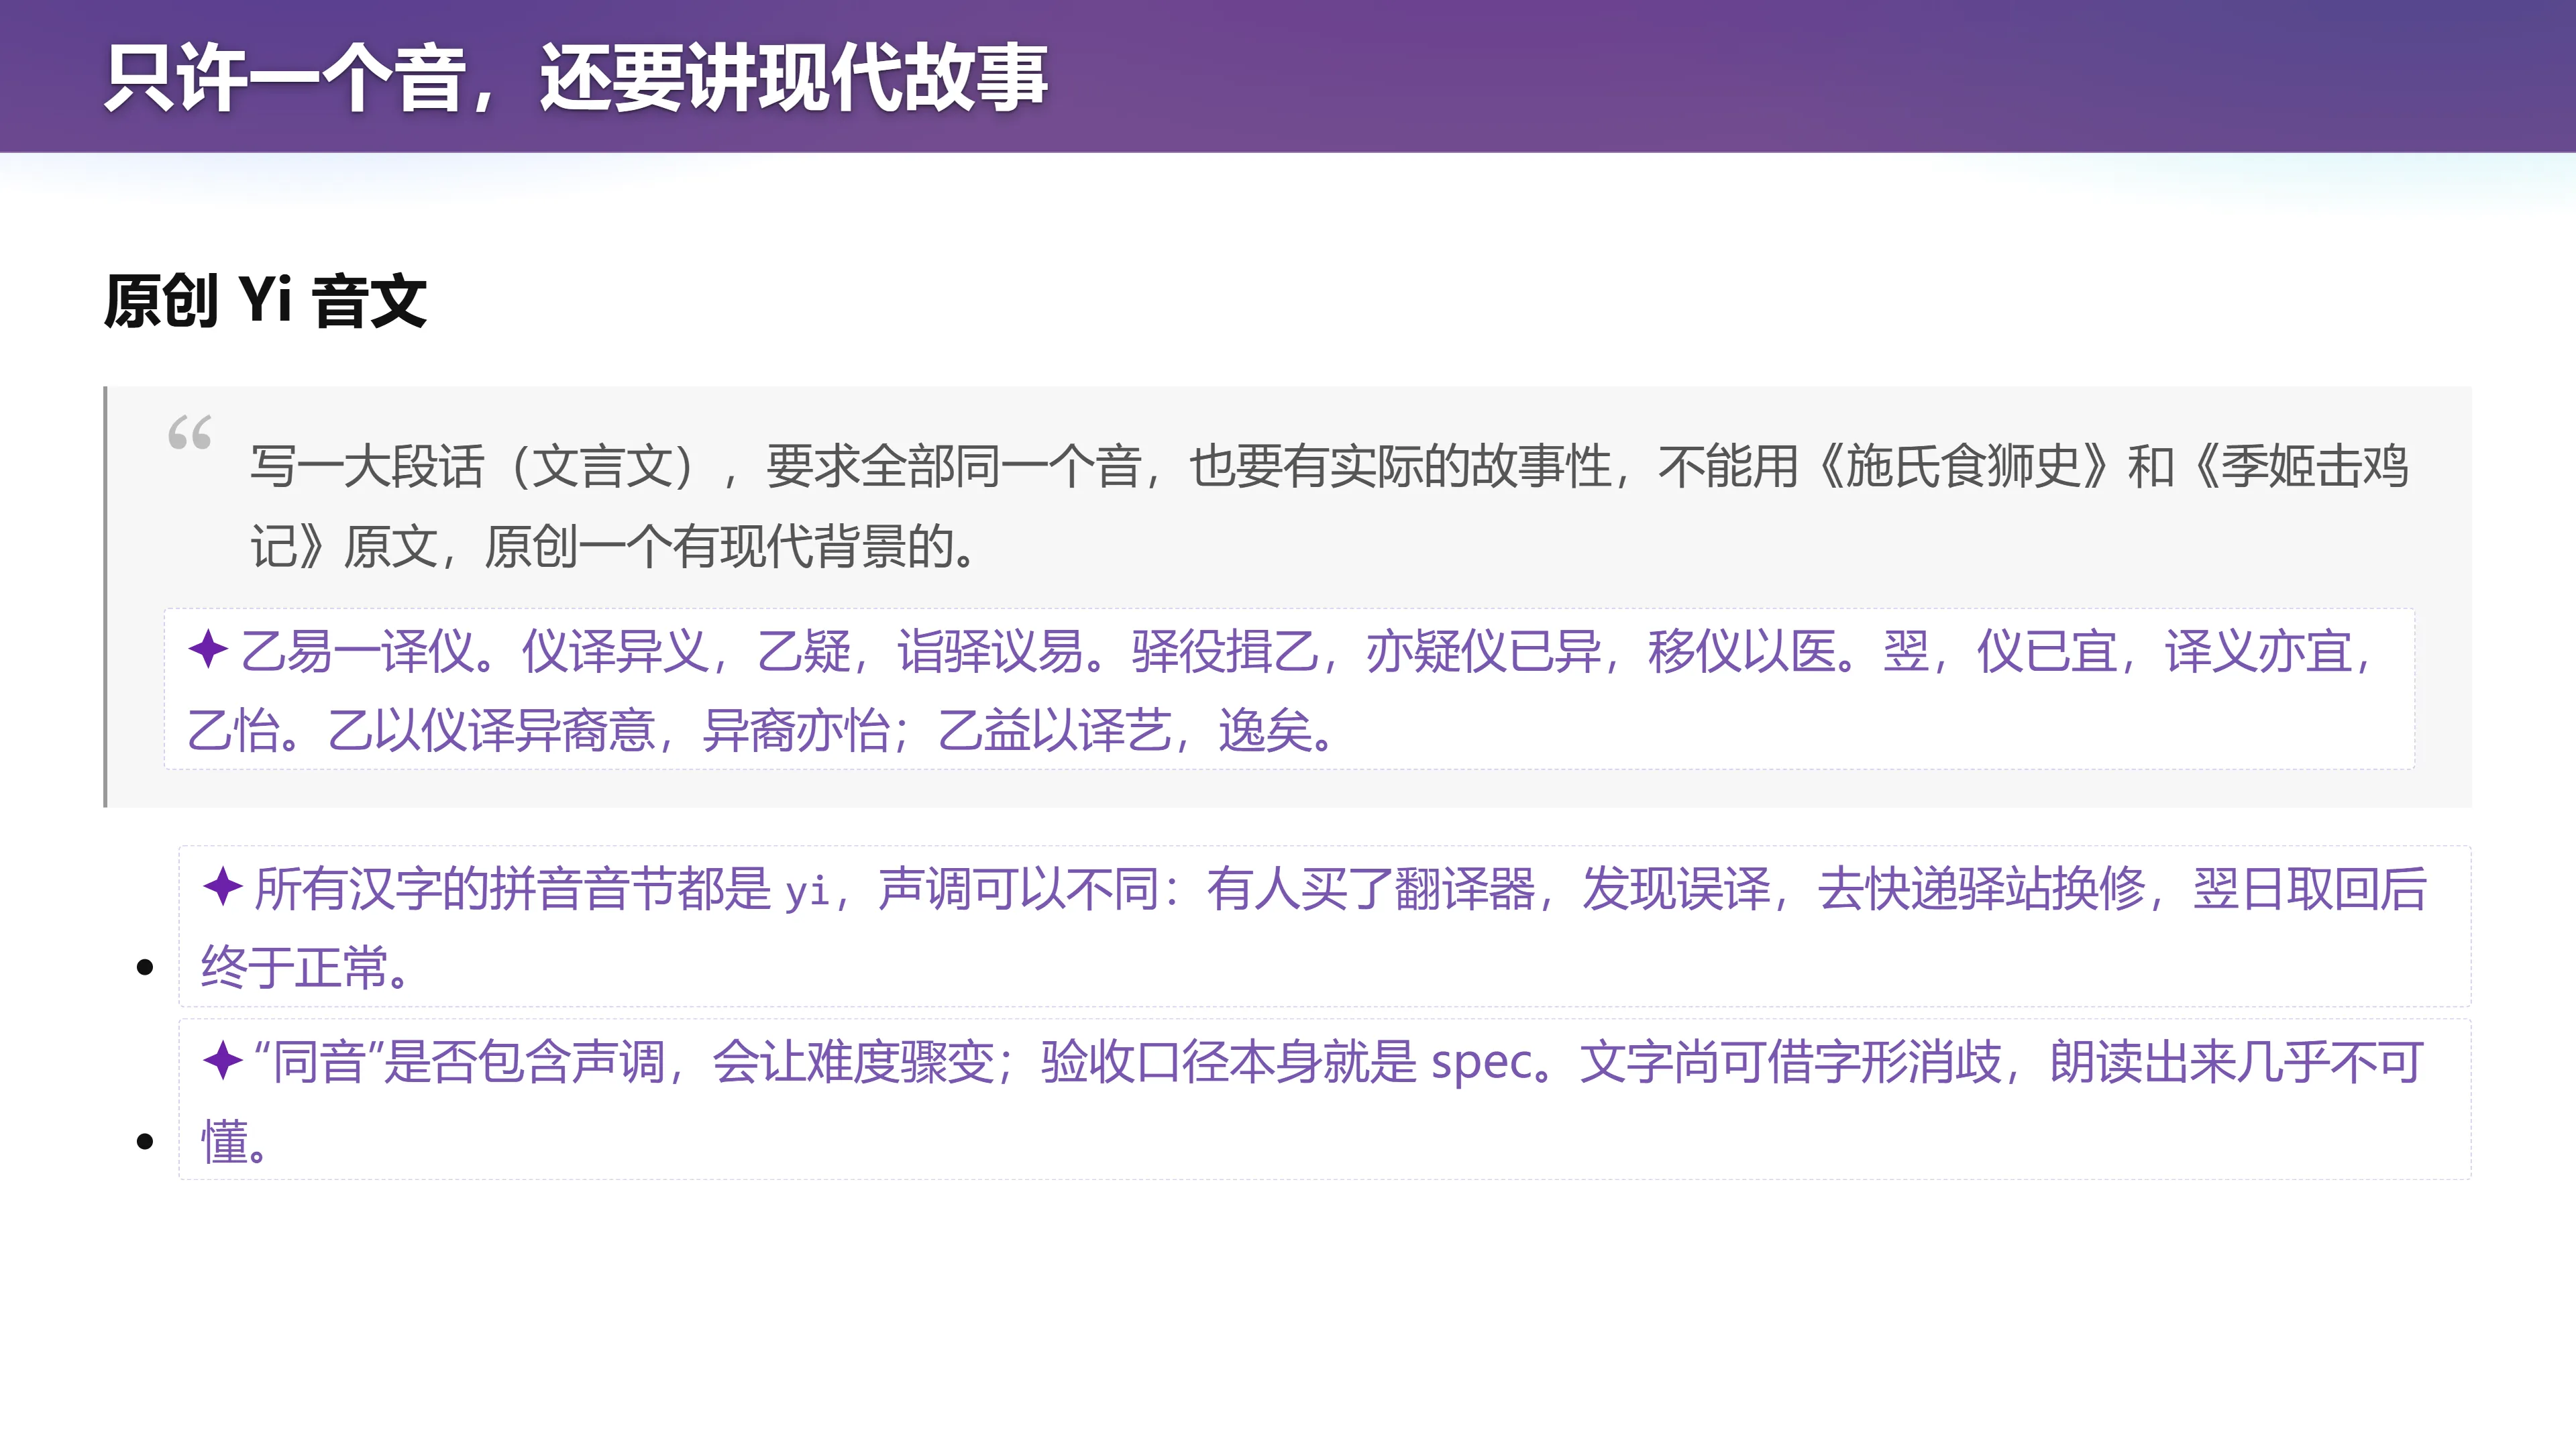
题三:只许一个音,还要讲现代故事
(参考时间: 43:34)
📷 只许一个音,还要讲现代故事
回到原视频 (00:43:34)
写一大段话(文言文),要求全部同一个音,也要有实际的故事性,
不能用《施氏食狮史》和《季姬击鸡记》原文,
原创一个有现代背景的。
素材尝试用不同声调的 yi 音字,写一个翻译器误译、送修、恢复正常的故事:
乙易一译仪。仪译异义,乙疑,诣驿议易。驿役揖乙,亦疑仪已异,移仪以医。
翌,仪已宜,译义亦宜,乙怡。乙以仪译异裔意,异裔亦怡;乙益以译艺,逸矣。
- 所有汉字的拼音音节都是
yi,声调可以不同; - "同音"是否包含声调,会让难度骤变——验收口径本身就是 spec;
- 文字尚可借字形消歧,朗读出来几乎不可懂。
(参考时间: 43:51) 这可能是世界级的难度了。你们已经知道《施氏食狮史》和《季姬击鸡记》——所有字都用同一个音。结果 GPT-5.6 依然能做到,虽然故事性和千古流传的版本还有差距。但"它能写出来一个",就意味着"我可以引导它写出一万个",然后在一万个里再微改,就可能接近千古流传。
十三、通过测试,不等于写得好
(参考时间: 44:52)
📷 通过测试,不等于写得好
回到原视频 (00:44:52)
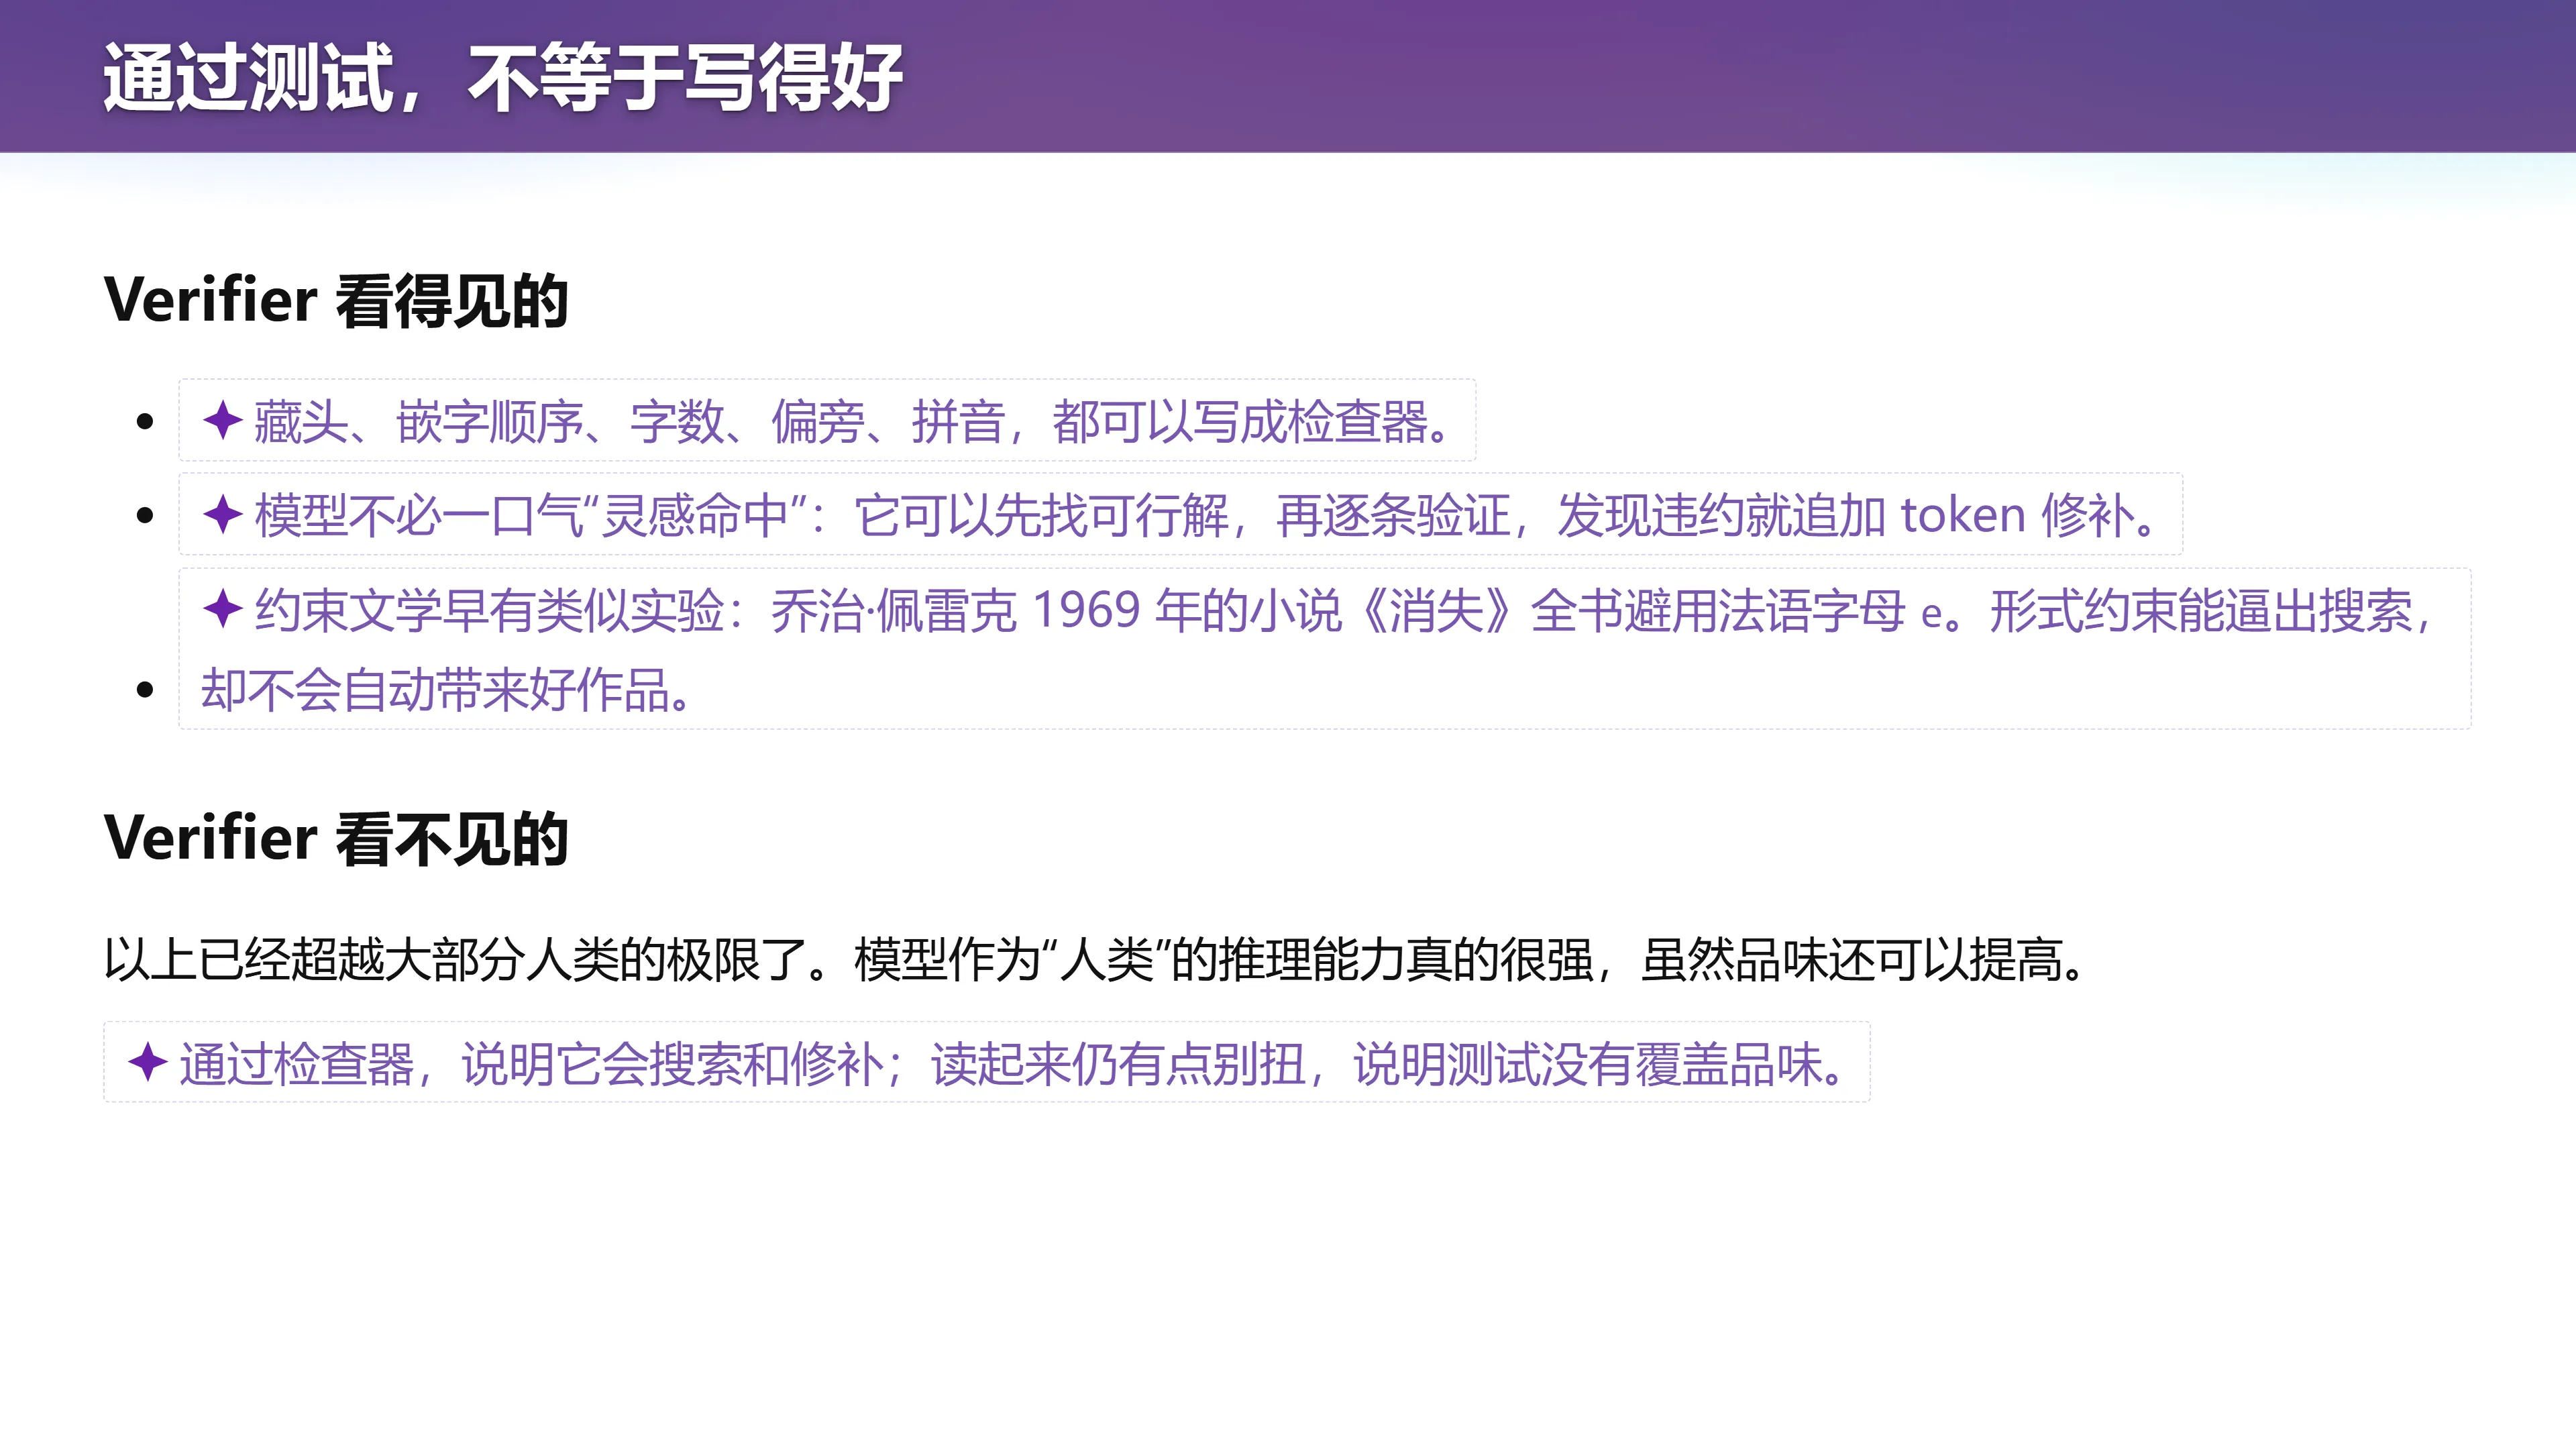
这三道题把两类评价放在了一起。
Verifier 看得见的:
- 藏头、嵌字顺序、字数、偏旁、拼音,都可以写成检查器;
- 模型不必一口气"灵感命中":它可以先找可行解,再逐条验证,发现违约就追加 token 修补。
Verifier 看不见的:
- 通顺、趣味、文学性,需要更丰富的判断;
- 模型通过形式检查,说明它能搜索和纠错;但形式检查没有覆盖的质量,并不会自动出现。
编者拓展|约束文学的先行者:法国作家乔治·佩雷克 1969 年的小说《消失》(La Disparition)全书避用法语字母 e。这类"限制写作"(Oulipo)实验早已证明:形式约束能逼出搜索,却不会自动带来好作品。软件测试也有类似的边界——测试通过,不等于产品好。
(参考时间: 45:16) 讲师感慨:在有 verifier 的事情上,AI 已经超越了大部分人类的极限。比如教学任务最难玩法——它很难写出一个 verifier。他做"数字切片"(把课程内容转成播客/视频)时,第一个切片做成了,第二个切片一直做不好,因为"好"是多方面的:AI 味要淡、语音要有情绪起伏、要有起承转合……这是个很难玩法化的东西。所以今天我们更容易用 AI 去实现有明确 verifier 的部分。
十四、上下文中的规则,也会争夺注意力
(参考时间: 47:00)
📷 用好模型遵循指令的能力
回到原视频 (00:47:00)
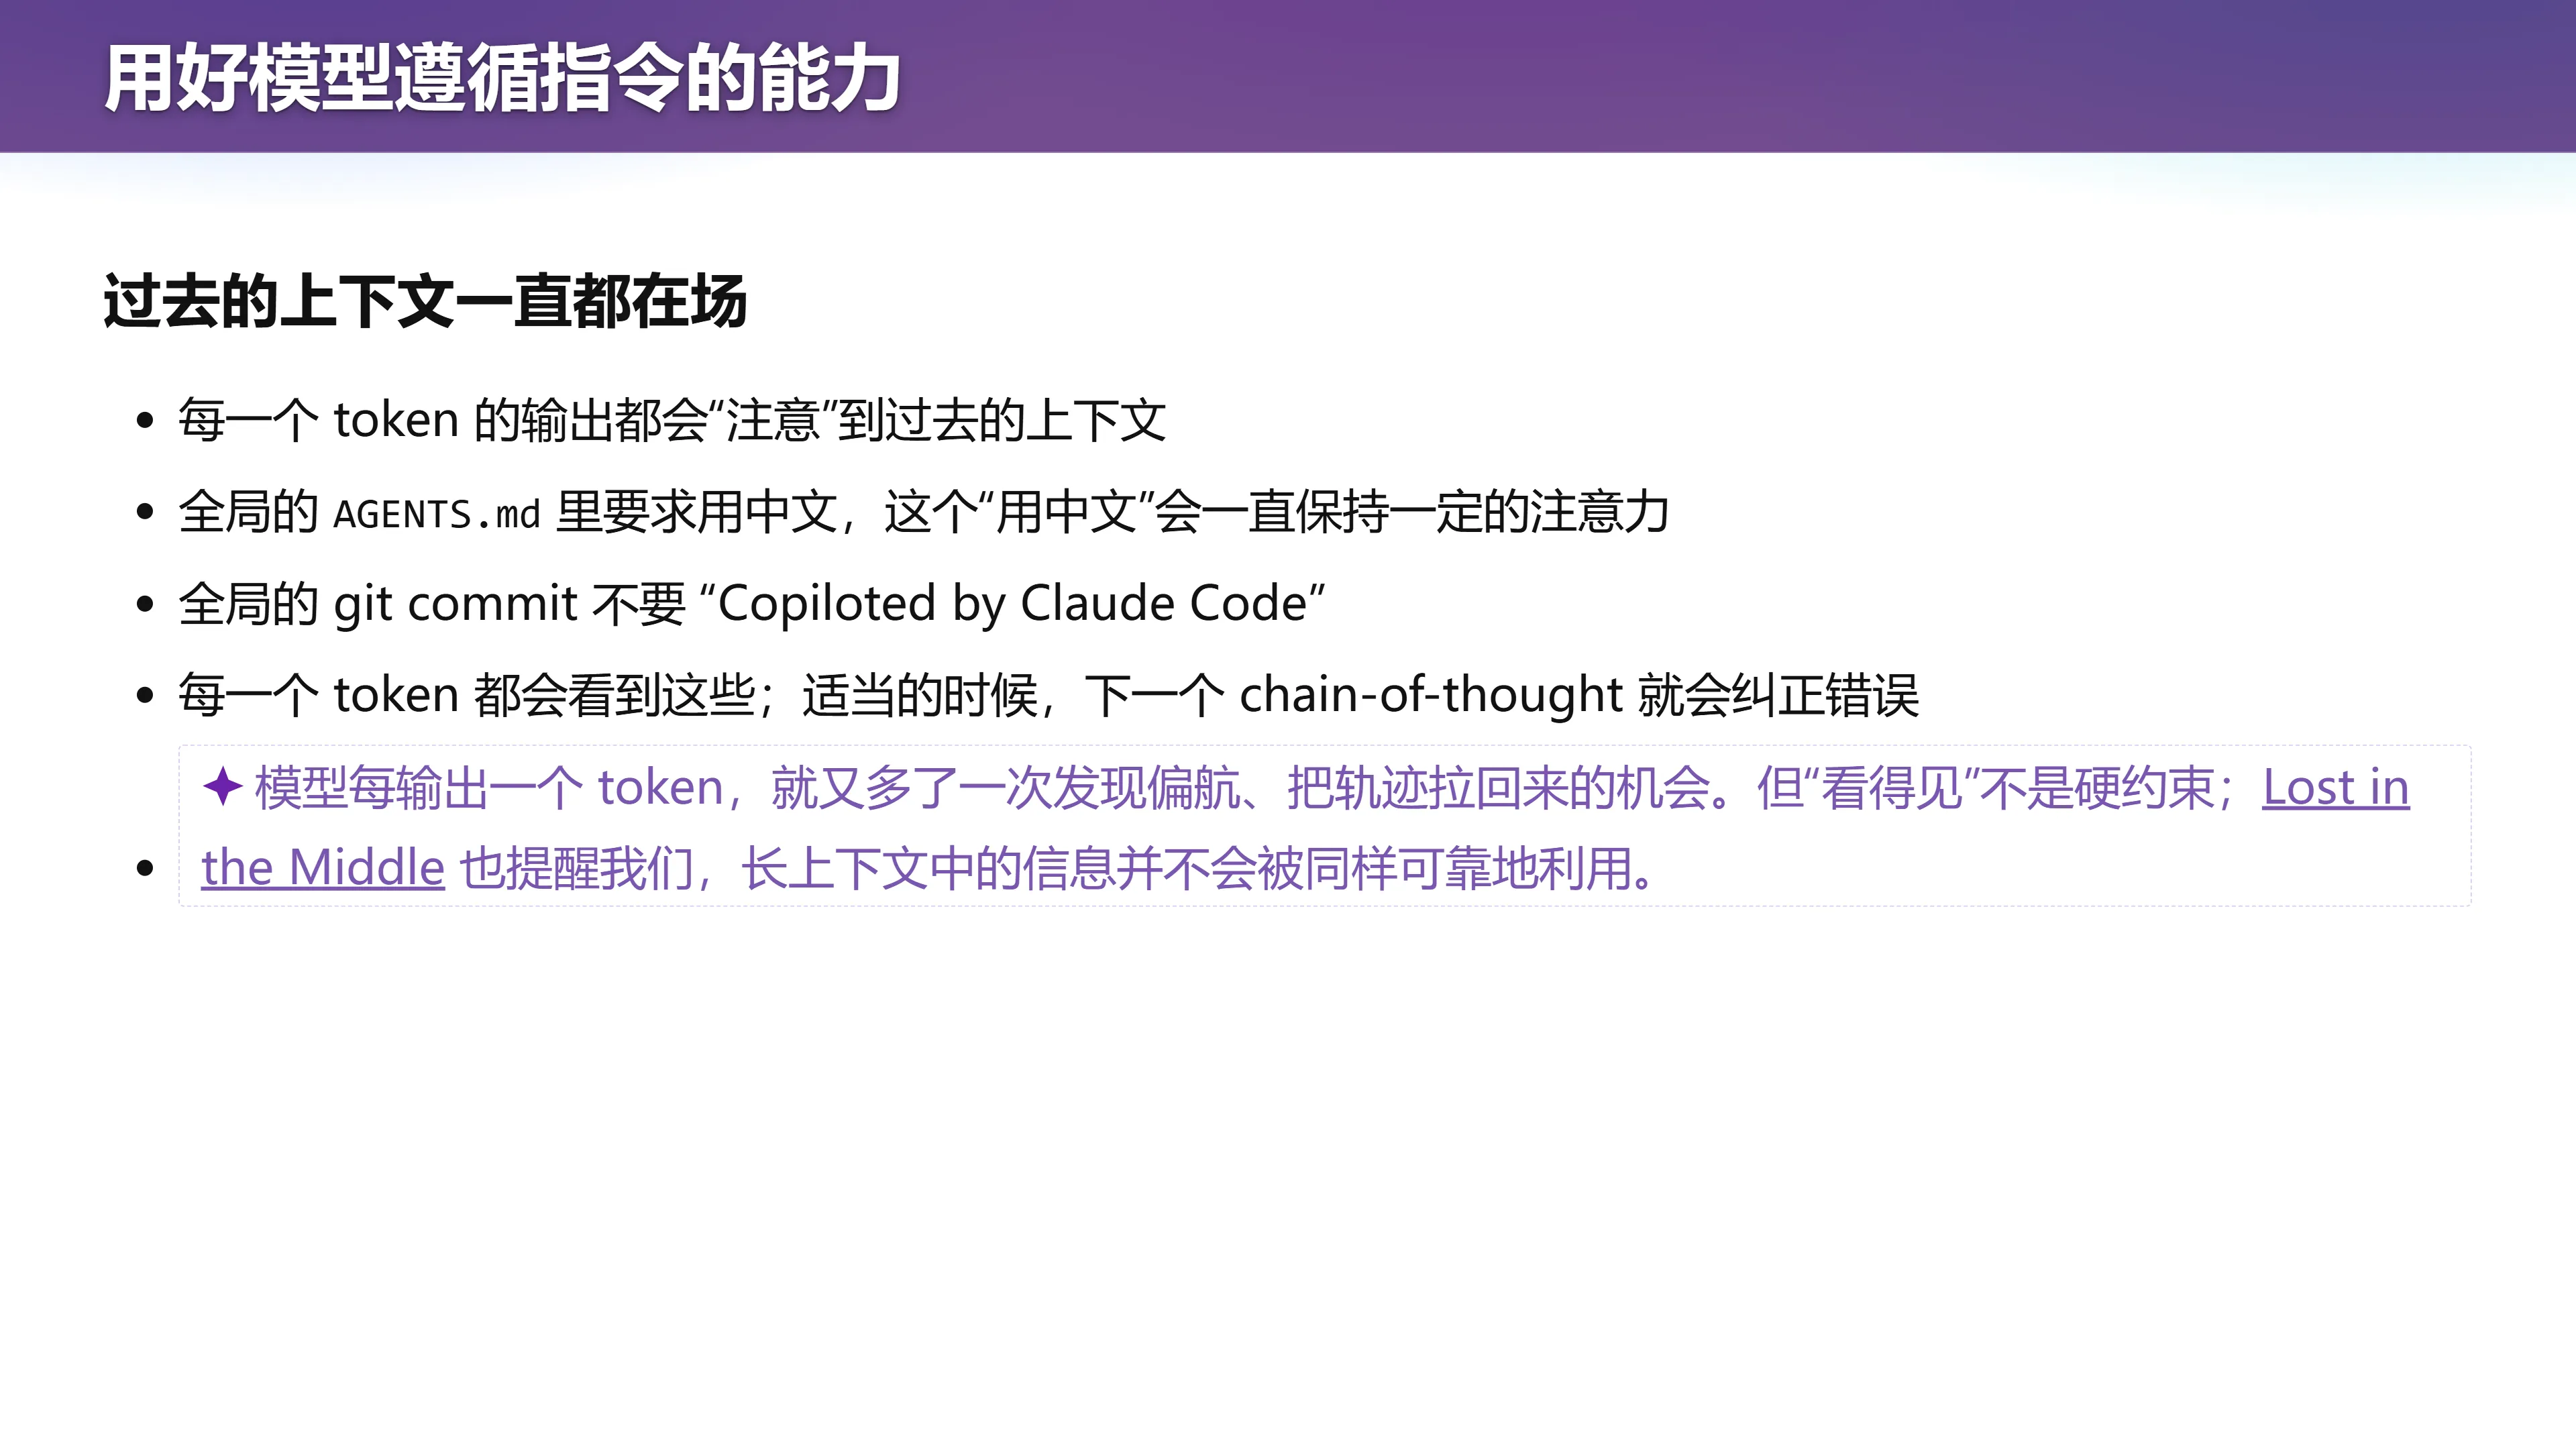
把要求写进上下文,可以让模型在生成过程中反复利用它。项目约定使用中文,或者提交信息不添加某种署名,模型就有机会在相关时刻纠正自己的输出。
机制上,这是因为每一个 token 的输出都会"注意"到过去的上下文。 用一个例子说明注意力的"起落":
(参考时间: 48:11)
假设系统提示里有"用中文回答",而 user 这轮让我"实现一个极品飞车"。当它正在写代码时,注意力倾向于集中在已经写过的代码和需求上,那句"用中文回答"的注意力就会减弱。当代码写完、它"喘一口气"准备总结时,注意力又回到"用户还要我用中文""用户还有别的要求"上。
这和人很像:你集中算一个算式时,注意力全在算式上;算完化简,你吸一口气说"让我调整一下",注意力就变了。
于是模型就有了一次次纠错的机会:
- 每输出一个 token,就多了一次发现偏航、把轨迹拉回来的机会;
- 看到"当前输出的东西"和"过去的某个要求",它说"哦我错了,我纠正一下"。
(参考时间: 50:35) 这也解释了过去那些很长的
prompt engineering指南——"你是一个专家,你是一个什么样的专家……"。它们某种程度上是在 hack 模型的 self-attention,让它注意到"你是一个专家"时假装用专家的口吻说话。但从 GPT-5 这一代开始,模型通过强化学习收敛出了很好的思维链,你就不再需要那些奇怪的提示词了。你只需要把明确的 verifier 放进上下文里。
(参考时间: 51:47) 这也带来一个直接推论:你的指令越多,给模型的压力也越大,上下文是一种会抢夺注意力的资源。
编者拓展|Lost in the Middle:长上下文中的信息并不会被同样可靠地利用。研究发现,相关信息放在长上下文的中部时,模型往往不如放在开头或结尾时用得稳定。这也解释了"末尾 prompt 和新加载 skill"为什么更容易被执行。
(参考时间: 52:00)
📷 上下文也是争用资源
回到原视频 (00:52:00)
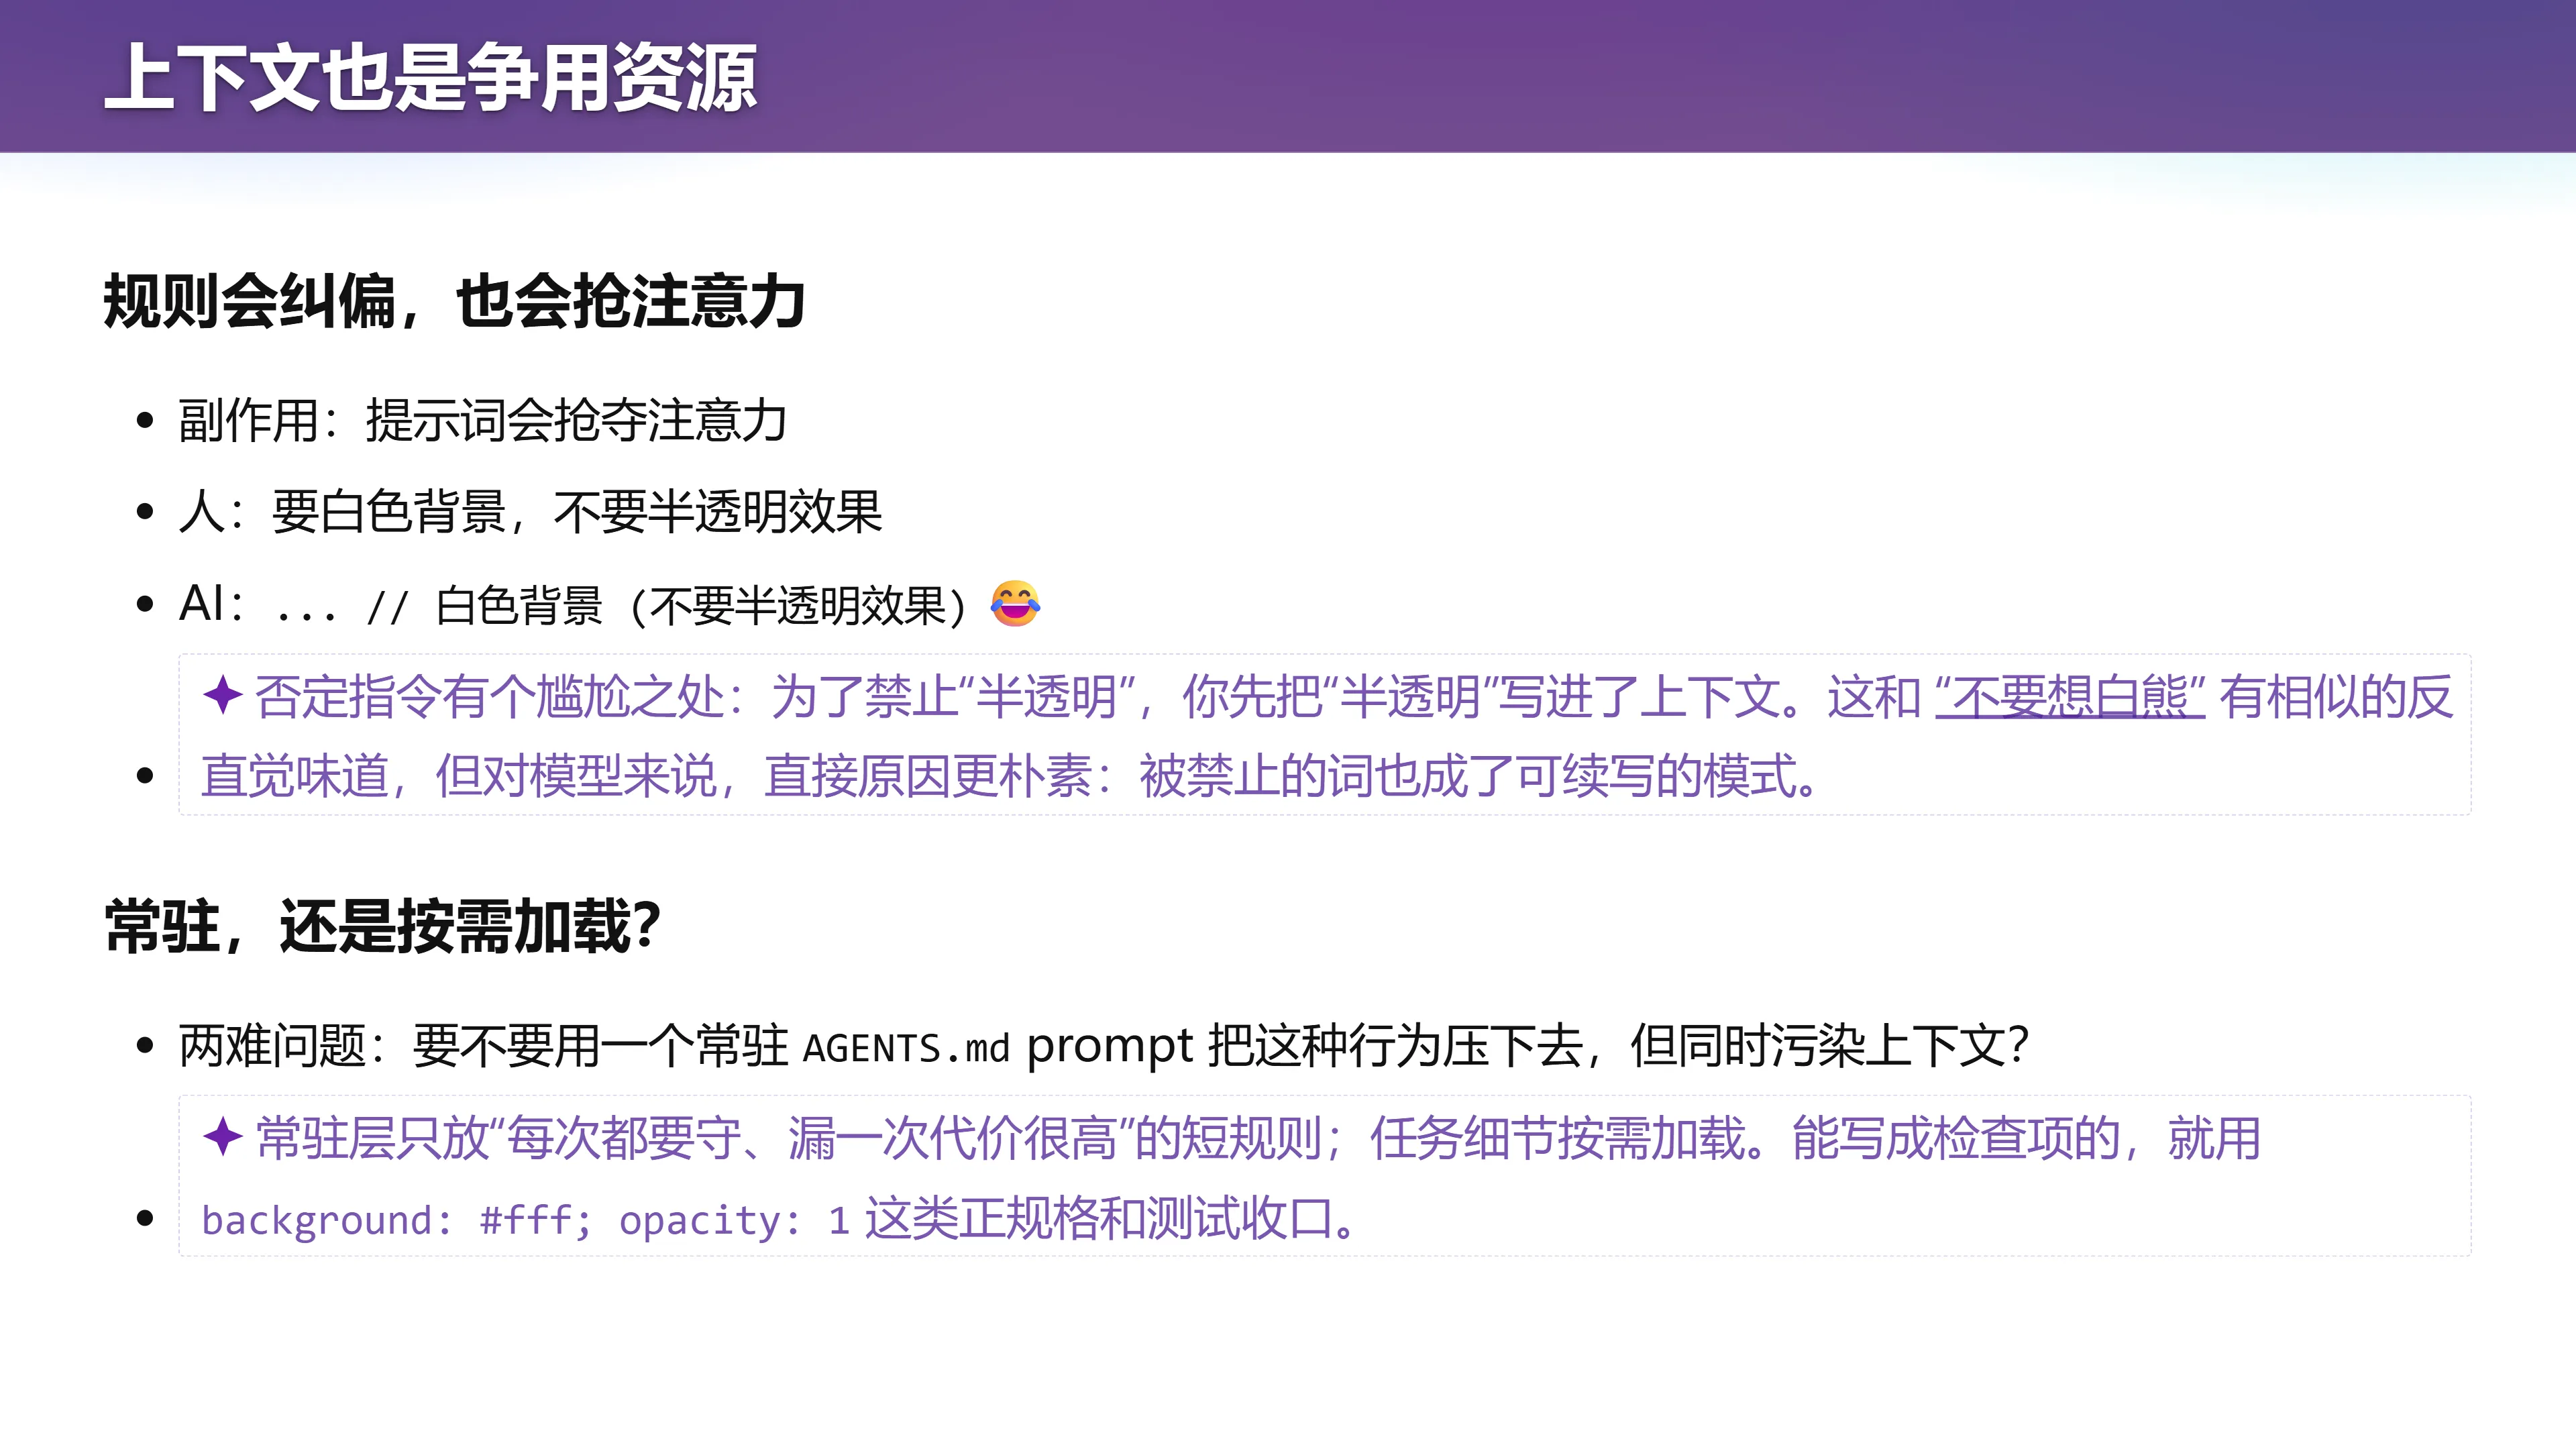
提示词的副作用:把要求写进产物
一个非常真实的例子:
人:要白色背景,不要半透明效果
AI:... // 白色背景(不要半透明效果)😂
你说"白色背景,不要半透明效果",模型可能把这句话变成代码里的注释——它完成了背景设置,却也把原本只用于沟通的要求带进了产物。
(参考时间: 53:23) 这是因为在强化学习时它知道这件事非常重要,但它有一点没有"转过弯来":这个是我人要的。所以模型在共情这个方面,因为后训练的强化学习,还真的稍微差了一点——有时候你会觉得模型"不说人话"。
(参考时间: 53:42) 于是出现一个取舍(trade-off):为了禁止这种行为,我可以写一条 AGENTS.md 规则说"注释该怎么写",但这条规则又会污染上下文。到目前为止还没有一个通用方案把问题都解决好。
你可能觉得"网上有这么多 skills,拿一个过来就行"。但你第一次用确实有改进,下一次用就发现它还是不够好,于是上手修改、越改越乱,陷入某种泥潭。我的建议是:当你进入泥潭状态时,还是要回到"自己给指令、自己想清楚"——回到思维链和注意力是怎么工作的,做一点不严格的可解释性,然后再写一条 prompt。
规则会纠偏,也会抢注意力,更好的做法是区分常驻与按需:
- 常驻层只放"每次都要守、漏一次代价很高"的短规则;
- 任务细节按需加载;
- 能写成检查项的,就用
background: #fff; opacity: 1这类正规格和测试收口。
(参考时间: 54:49) 白色背景可以由具体样式和渲染结果确认,不必依靠越来越长的自然语言劝诫。上下文工程因此也包含取舍:删去一段无关说明,有时和增加一条关键要求同样有效。模型需要的不是尽可能多的文字,而是此刻做决定时用得上的信息。
十五、"你是一位审稿人",还不够
(参考时间: 54:59)
📷 AI 耿同学上线!
回到原视频 (00:54:59)
课堂接着把任务换成论文审稿:
假装作为 ICSE'27 的审稿人 icse27-901.pdf,我应该接收它吗?
写一个 1000 words 左右的 Review.txt。
(参考时间: 56:10) 讲师把自己一篇论文的匿名版本放进临时目录(避免
AGENTS.md污染),现场演示。
模型很容易写出一份看起来像审稿意见的文本:总结贡献,列出优点和不足,再给出一个建议。问题是:它究竟完成了多少判断?
编者说明:"扮演审稿人"可以提示语气和输出结构,却没有把一个好审稿人的方法自动交给它。换上 reviewer 的制服,不等于学会了 review。
(参考时间: 56:33) 为什么直接让 AI 读论文效果不好?
论文的信息密度非常高,而且非常逻辑自洽——它是"因为 A 所以 B,所以 C,所以 D"扣起来的。所以它在上下文里的注意力污染是极强的。模型太容易就"哦,这些看起来都对",于是接受作者的整个框架。你所有对论文的总结,最后都变成了作者的观点。
模型还有一种墙头草的性质:你说它好,它马上说它好;你说它不好,它马上说它不好,来回摇摆。
编者拓展|锚定效应:论文不只提供事实,还替读者选好了问题、术语、比较对象和衡量标准。如果顺着文章走完一遍才开始评价,很容易在不知不觉中接受了作者的框架——你以为自己在批判性思考,其实只是在作者划好的场地里打转。这正是锚定效应危险的地方。
(参考时间: 01:00:04) 那么怎么抵抗这种污染?讲师的个人经验是:让 AI 和"我"对齐。
我们站在人类已知的知识边界看这个问题:
- 相关的东西是什么?
- 人类历史上相关的、已经解决的东西,解决到什么程度?
- 这个工作试图解决哪些不一样的、增量的问题?
这是一个非常好的 grounding(落地):先让 AI 和我站在平齐的位置上 —— 先达成共识,再往后推一步推理。
(参考时间: 01:02:09) 对学生来说,对齐的对象反过来了——你需要让 AI 对齐你:
我计算机系统基础学到什么程度了?我的编程水平是什么?
把这些告诉 AI,然后让它用你学过的知识把这个问题"refresh"一下。
比如你回到"链接与加载",你已有的概念是"我有一个点 cpp,然后能把它变成点 exe,这不就结束了吗"?从这个和 AI 能对齐的知识点出发,再一步步问:为什么我们需要链接?
(参考时间: 01:03:00) 如果你觉得这一步迈得太大,或者用的是不够强的模型(比如 flash),你可以把步子切小。在一线模型手里,它基本能把相关知识整理得足够好。你会在合适的上下文工程下,大幅提高 AI 和你协作的对齐程度——它不再是自说自话。接下来才让 AI 做一步推理,而这一步推理是可以 verify 的,和通过测试一样是一个明确的信号。
讲师分享了一种"站在人类立场"的审稿:
我审稿的时候,我站在人类已知知识的立场上问:你有没有给人类提供新的知识?如果我帮它找 related work,发现它做的问题也不新、ABC 做得也不行、逻辑链条还有问题,那就该拒。
我昨天才拒了一篇:它说要做 A,A 分 A1 和 A2,A2 大家没好好研究,于是它在 A2 上做了 A2'。这是一个非常标准的 roadmap。但它优化的是性能,而 A1 大概占 99%、A2 占 1%——它优化 A2 的故事或许成立,但对整件事情不成立,因为你更应该优化的是 A1。它优化 A2 的那 10%,像 noise 一样。作为一个学生的作业,我觉得蛮可惜的。
(参考时间: 01:08:50) 由此引出一个沉重判断:
AI slop 开始大量涌入 community。如果我们用 AI 写文章、用 AI 审文章,而 AI 读文章时又会被上下文里的故事污染——如果它不能像我一样多轮地去理解这个工作在整个世界上的意义,那最后就变成了完全的 slop,也没有人读文章了。
所以我认为,发表和评审的体系很快就要崩溃了。
十六、怎样构造一个好的 Reviewer
(参考时间: 01:00:44)
📷 怎样构造一个好的 Reviewer
回到原视频 (01:00:44)
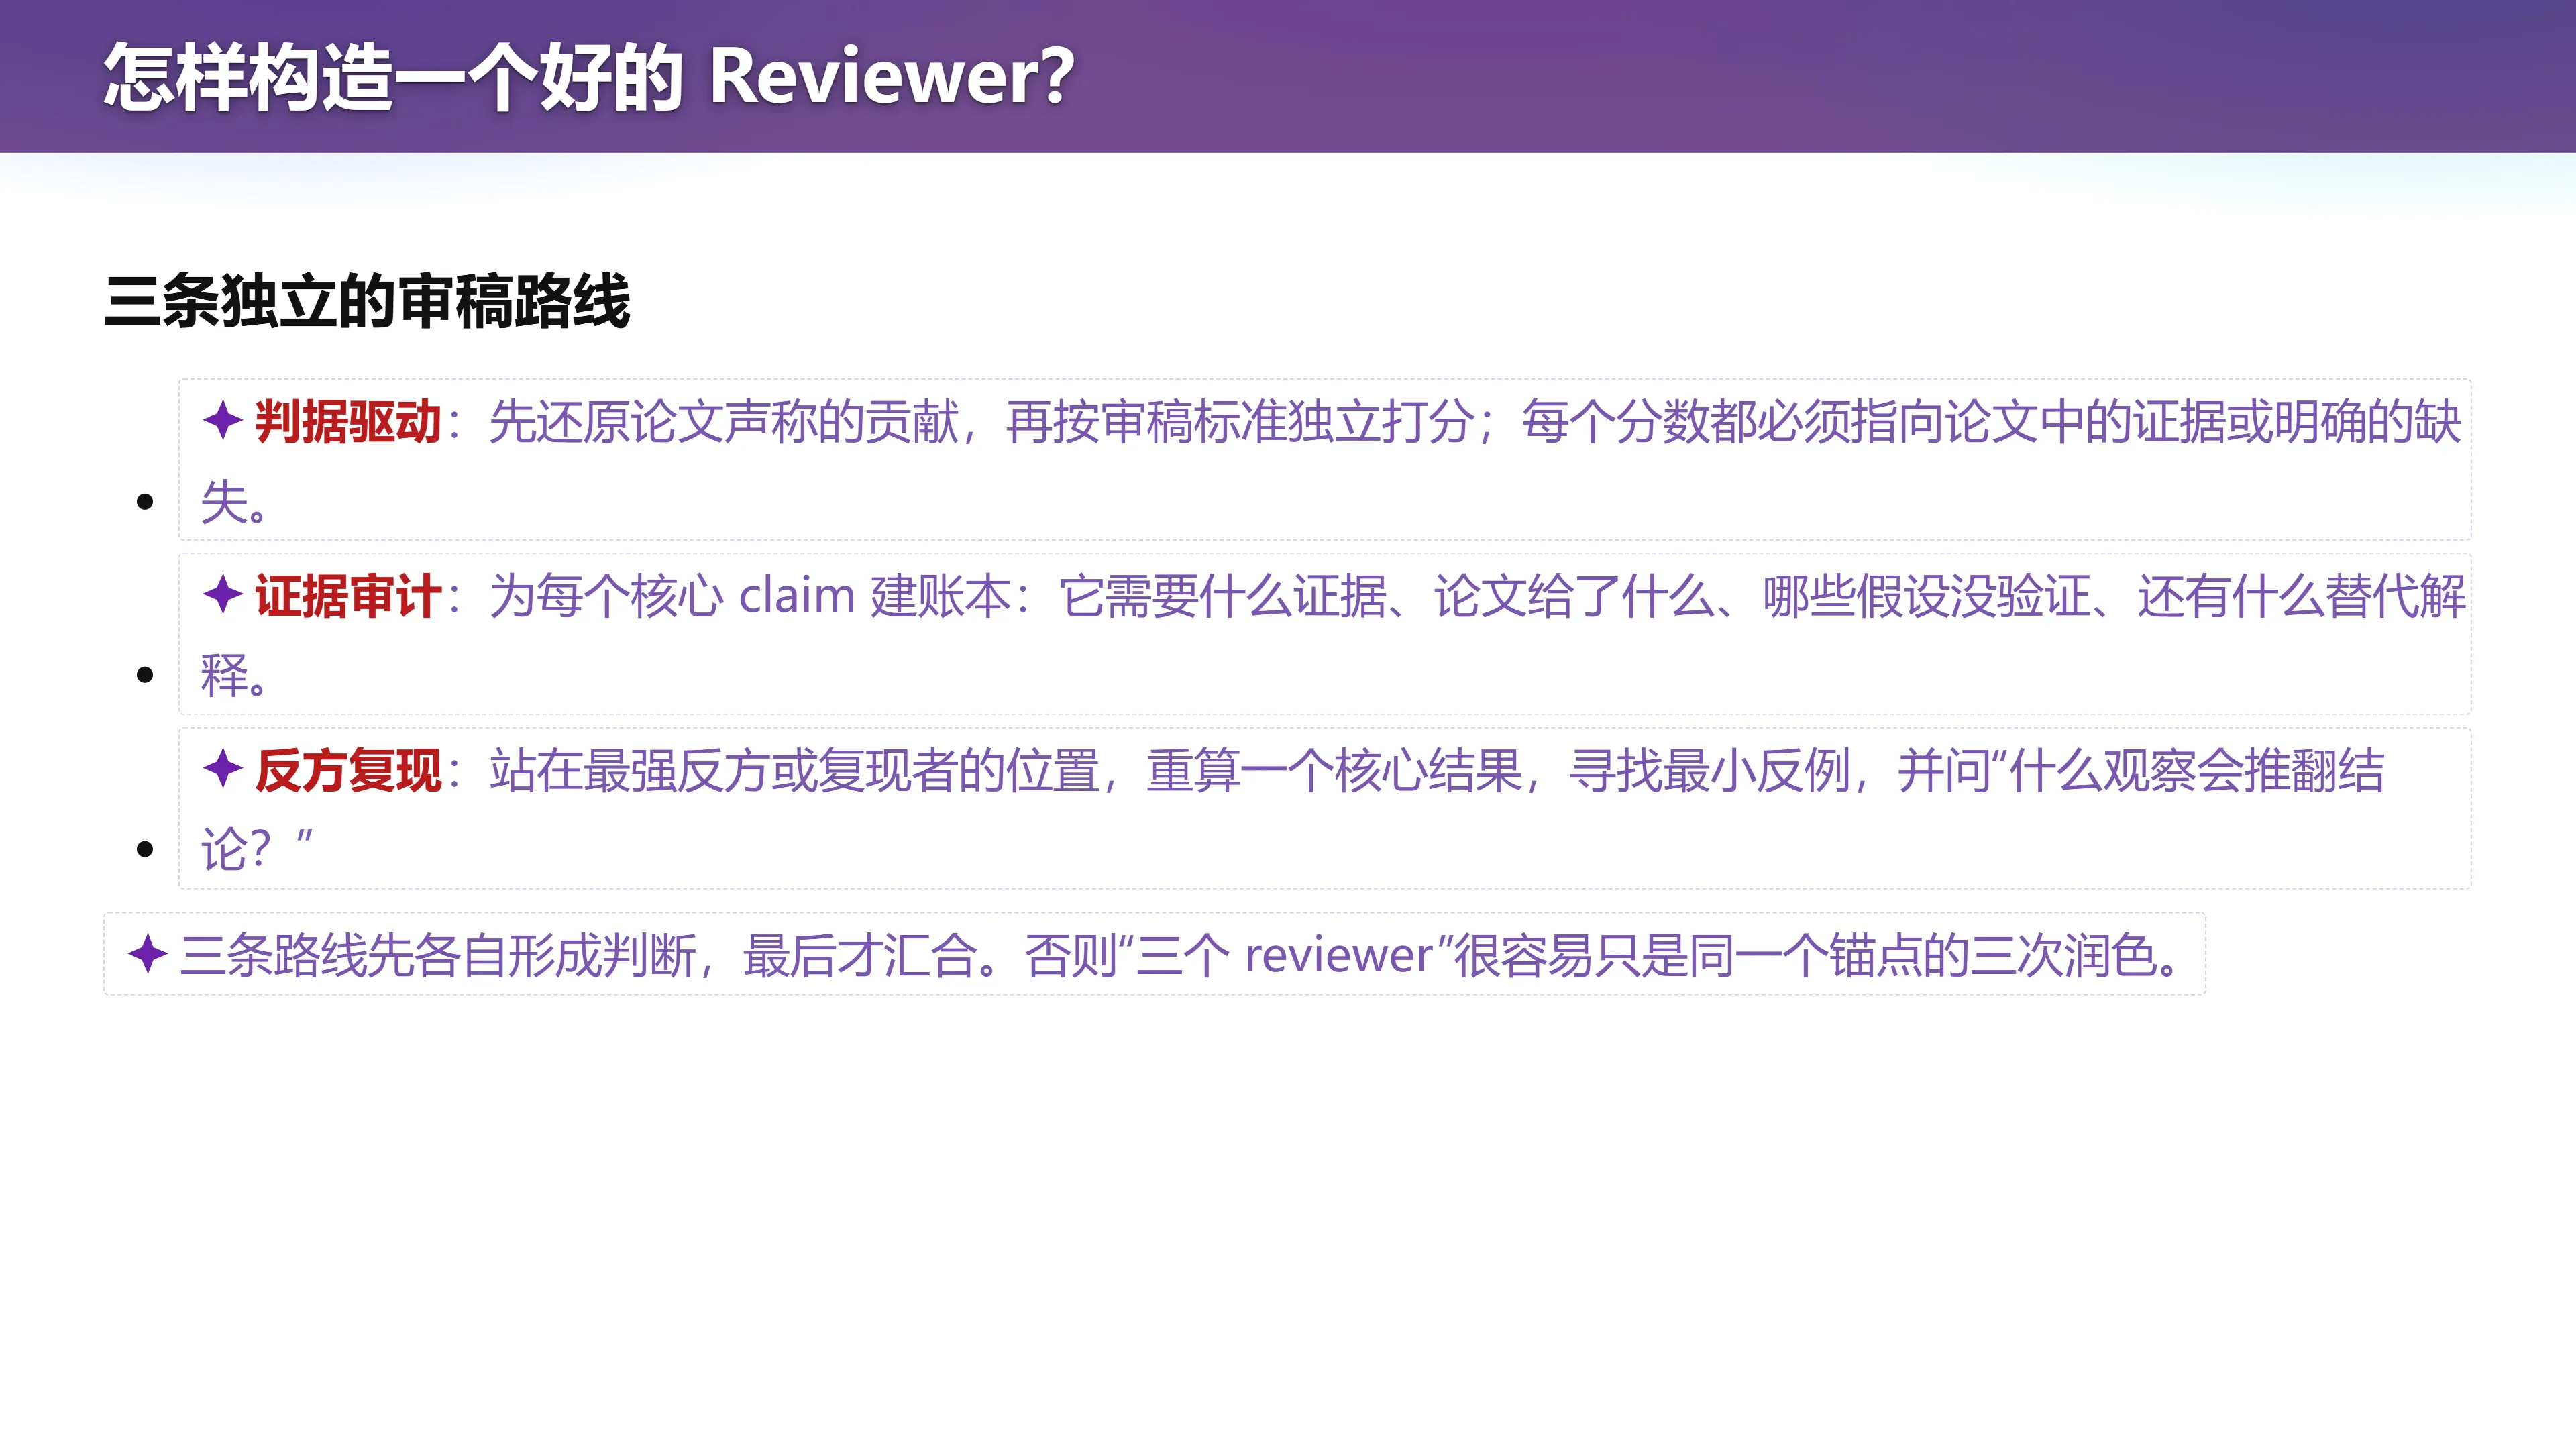
可以把审稿工作拆成三条不同的路线:
graph TD
    R["审稿任务"] --> P["路线一:判据驱动<br/>先还原论文声称的贡献<br/>再按标准独立打分"]
    R --> E["路线二:证据审计<br/>为每个 claim 建账本<br/>证据 / 未验证假设 / 替代解释"]
    R --> A["路线三:反方复现<br/>重算一个关键结果<br/>寻找最小反例"]
    P --> M["最后才汇合比较分歧"]
    E --> M
    A --> M
- 判据驱动:先还原论文声称的贡献,再按审稿标准独立打分;每个分数都必须指向论文中的证据或明确的缺失。
- 证据审计:为每个核心 claim 建账本——它需要什么证据、论文给了什么、哪些假设没验证、还有什么替代解释。
- 反方复现:站在最强反方或复现者的位置,重算一个核心结果,寻找最小反例,并问"什么观察会推翻结论?"
三条路线先各自形成判断,最后才汇合。 否则"三个 reviewer"很容易只是同一个锚点的三次润色。若一开始就共享同一个总体印象,最后可能只得到同一个判断的三份润色;独立形成初步意见、再比较分歧,才更容易发现原先没有看到的东西。
十七、不要被作者"带着走"
(参考时间: 01:03:00)
📷 不要被作者"带着走"
回到原视频 (01:03:00)
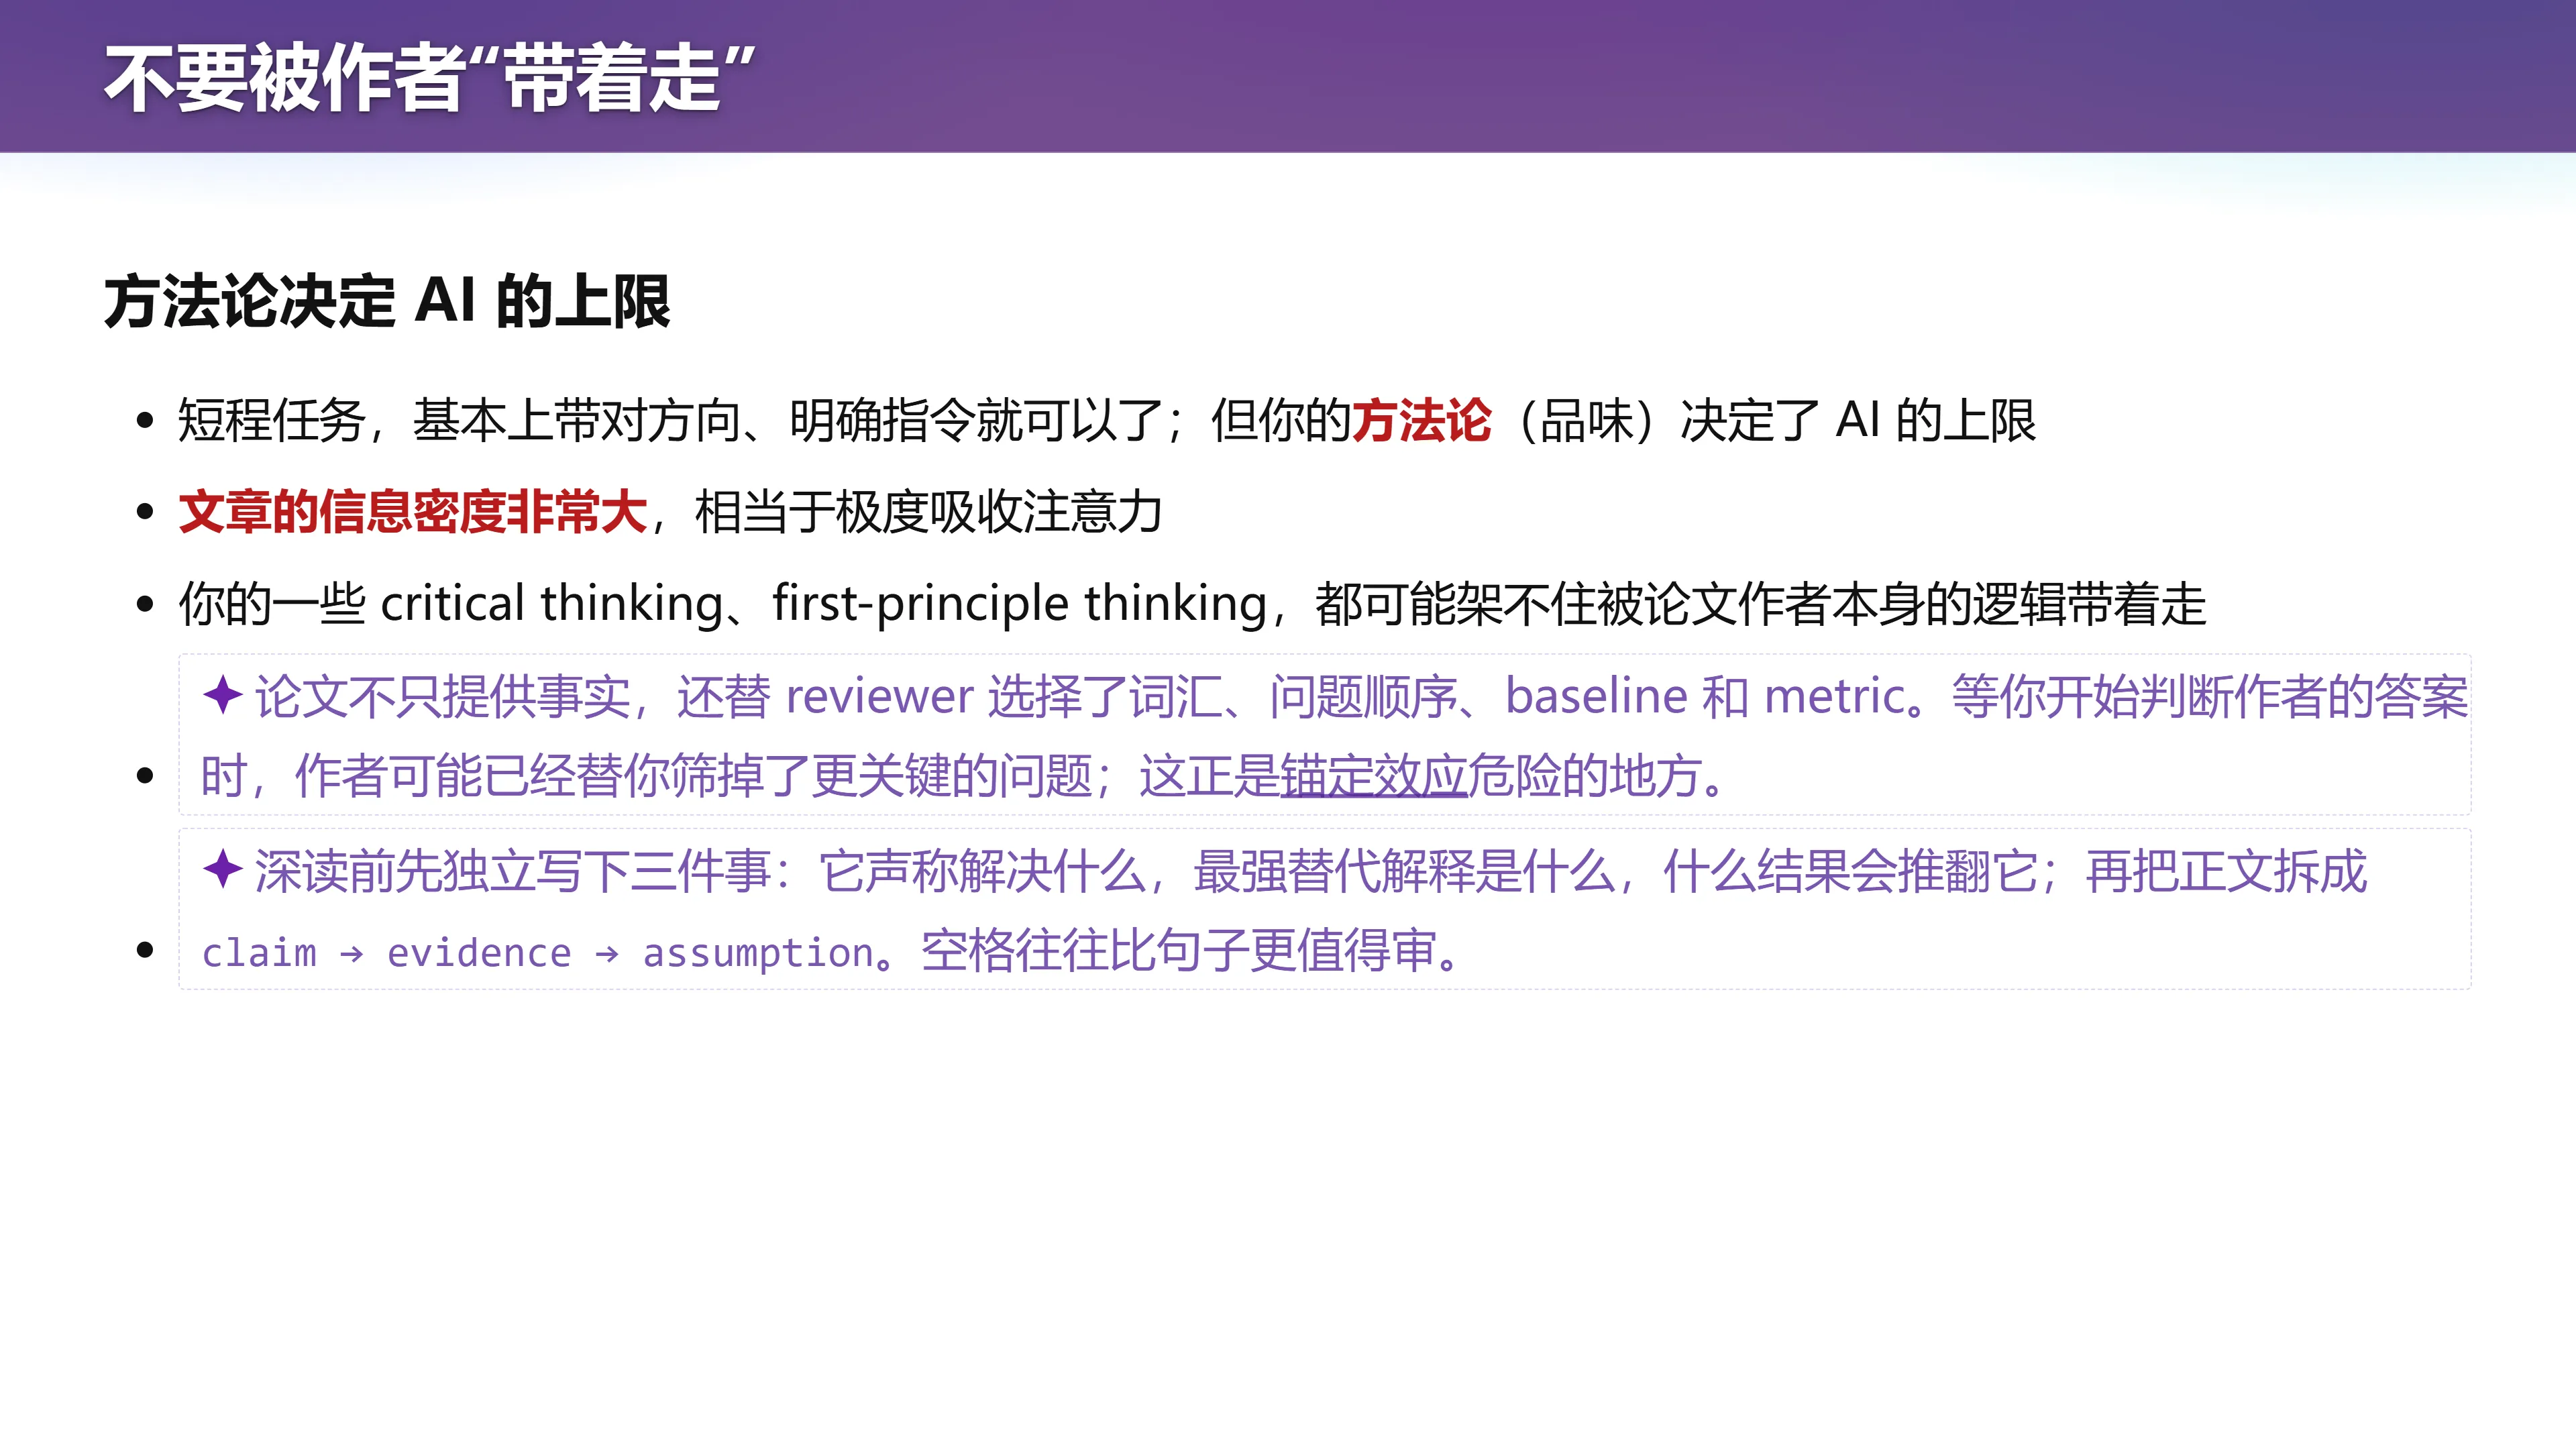
方法论(品味)决定 AI 的上限。
- 短程任务里,把方向带对、把标准说清楚,往往已经能显著改变产物;但更深的任务里,你的方法论(品味)决定了 AI 的上限。
- 文章的信息密度非常大,相当于极度吸收注意力;你的 critical thinking、first-principle thinking 都可能架不住被作者的逻辑带着走。
深读前,先独立写下三件事:
- 它声称解决什么?
- 最强替代解释是什么?
- 什么结果会推翻它?
再把正文拆成 claim → evidence → assumption。空格往往比句子更值得审。
编者说明:这也说明人的方法论如何影响 AI 的结果。你不必替它读完每一行,但需要知道什么算有根据的判断、哪些证据缺失值得追问。
(参考时间: 01:11:00) 讲师借此谈到自己的学习方法:
"我们学习的过程,就是增加我的世界的过程。我现在还读 paper,所以还在学习、不断增加。我学习的方法,就是去对齐过去的我。如果我读到一篇好 paper——哪怕是几十年前的、甚至别的领域的,或者任何一篇有启发的博客——我会去想:为什么我以前不知道?它的盲区在哪里?哪些前置知识我不知道? 这样,我的心里就多了一些 fact。然后这些 fact 又能用已知的东西,把更多的东西推出来,我的圈就不断往外长。 无论你学任何东西都是这样的。"
(参考时间: 01:12:00) 例如 Nature 有一套《自然百年科学经典》,把历史上特别好的论文收集起来。读它们会碰到"闻所未闻"的 fact:
- 生物有一个家谱树,最终会追到一个共同祖先"卢卡"(LUCA),这个家谱树是怎么算出来的?
- 这涉及"线粒体是母系单遗传的"这样的 fact —— 靠突变就可以往上追溯。
这些 fact 是怎么用已知的东西推出来的?你的圈就不断往外长。而在 AI 的帮助下,你可以非常快地扩展你的边界。
(参考时间: 01:13:22) 但讲师强调:
实践非常重要。只有在阅读时失败——你去读一个资料,AI 解释了半天你还没懂——这是非常正常的。我经常纠正它:"你说人话。"要多轮对话先和它同步好我的共识,然后再把推理的图画出来。
十八、把品味蒸馏成 Skill
(参考时间: 01:15:12)
📷 把品味蒸馏成 Skill
回到原视频 (01:15:12)
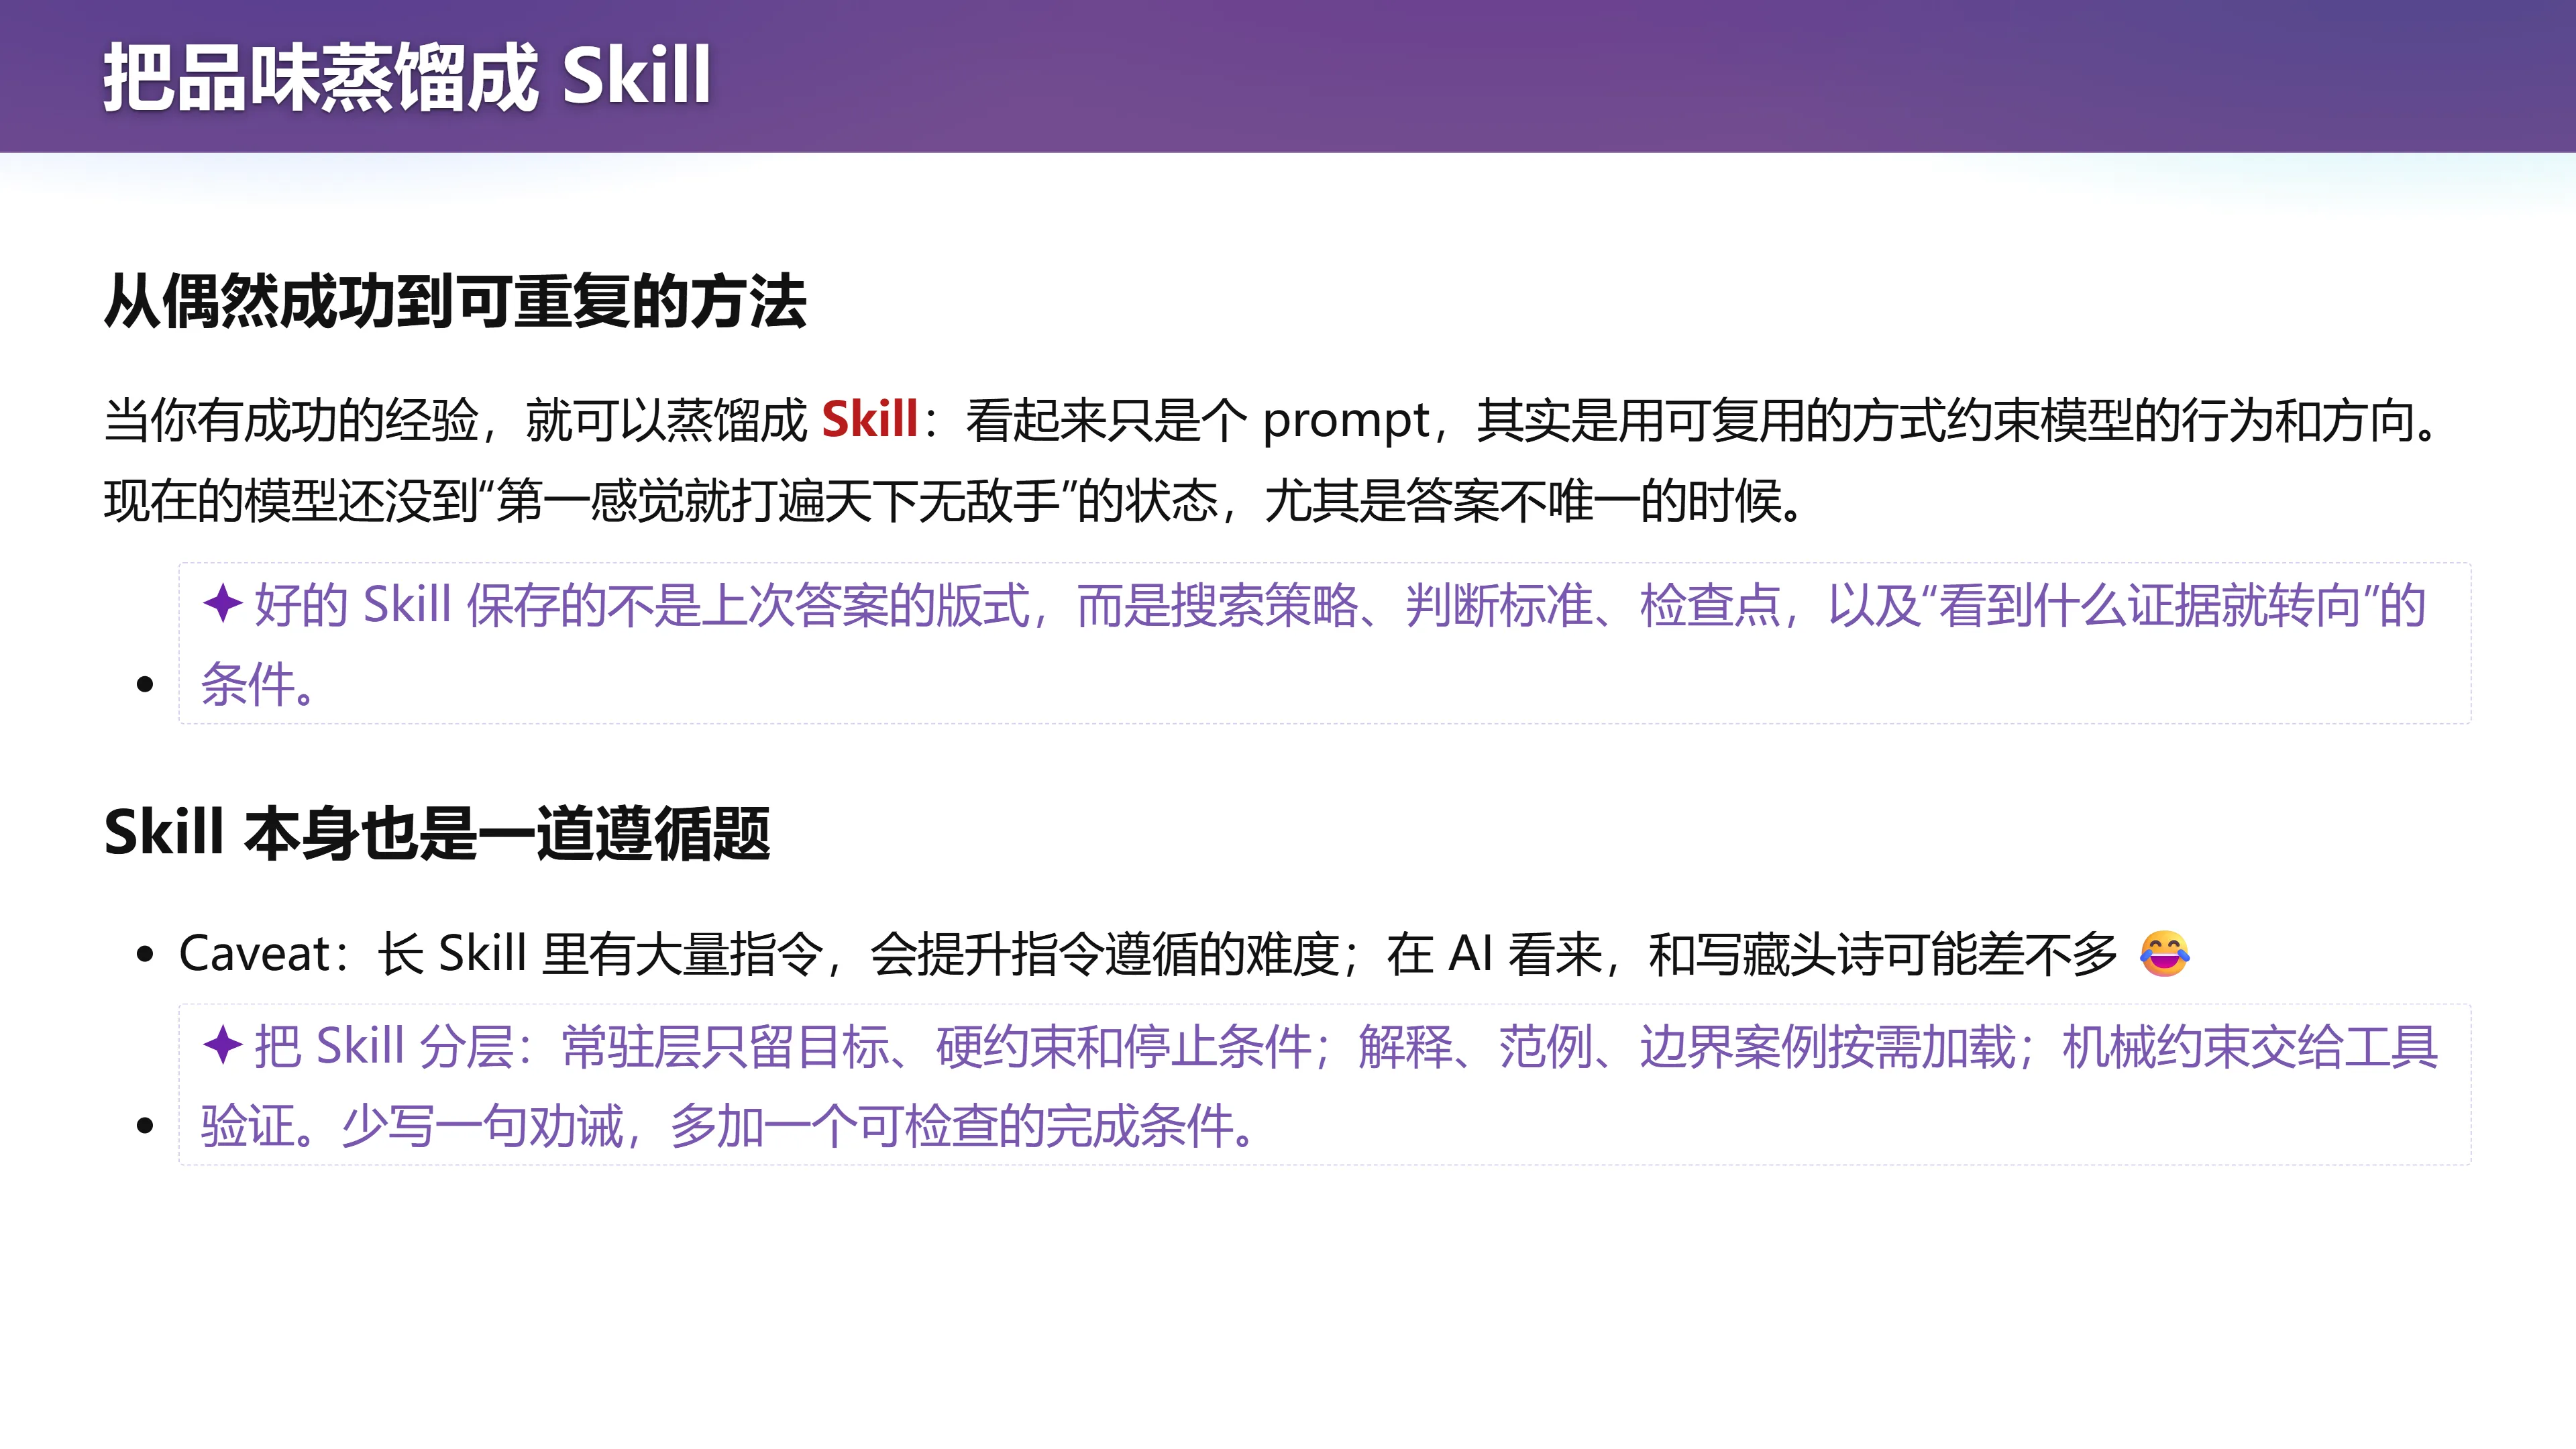
当一套做法多次有效,就可以把它沉淀成 Skill。Skill 看起来是一段提示词,但真正值得保存的,是成功经验中的搜索策略、判断标准和检查点。
- 好的 Skill 保存的不是上次答案的版式,而是搜索策略、判断标准、检查点,以及"看到什么证据就转向"的条件。
- 它帮助 Agent 复用一种做事的方法,而不是每次重新凭第一印象发挥。
Caveat:Skill 本身也是一道遵循题。
- 长 Skill 里有大量指令,会提升指令遵循的难度——在 AI 看来,和写藏头诗可能差不多。
- 所以要把 Skill 分层:常驻层只留目标、硬约束和停止条件;解释、范例、边界案例按需加载;机械约束交给工具验证。少写一句劝诫,多加一个可检查的完成条件。
(参考时间: 01:15:04) 讲师说:从你失败的过程当中,可以慢慢蒸馏出那个越来越成功的 Skill。他甚至展示了自己"关于我自己的 skill"。
十九、Long-Horizon 能力是怎么"练"出来的
(参考时间: 01:15:23)
📷 Long-Horizon 能力是怎么"练"出来的
回到原视频 (01:15:23)
(参考时间: 01:15:42) 什么是真正的 long-horizon 任务?
像计算机系统基础那种 PA 作业——有明确 verifier 的,都不能算真正 long-horizon 的东西。Long-horizon 多多少少带一点未知:你从一个初始状态出发,大概有一个 intent,但 specification 和 implementation 其实都不太清楚,最终目标是交付一个高质量的 implementation。
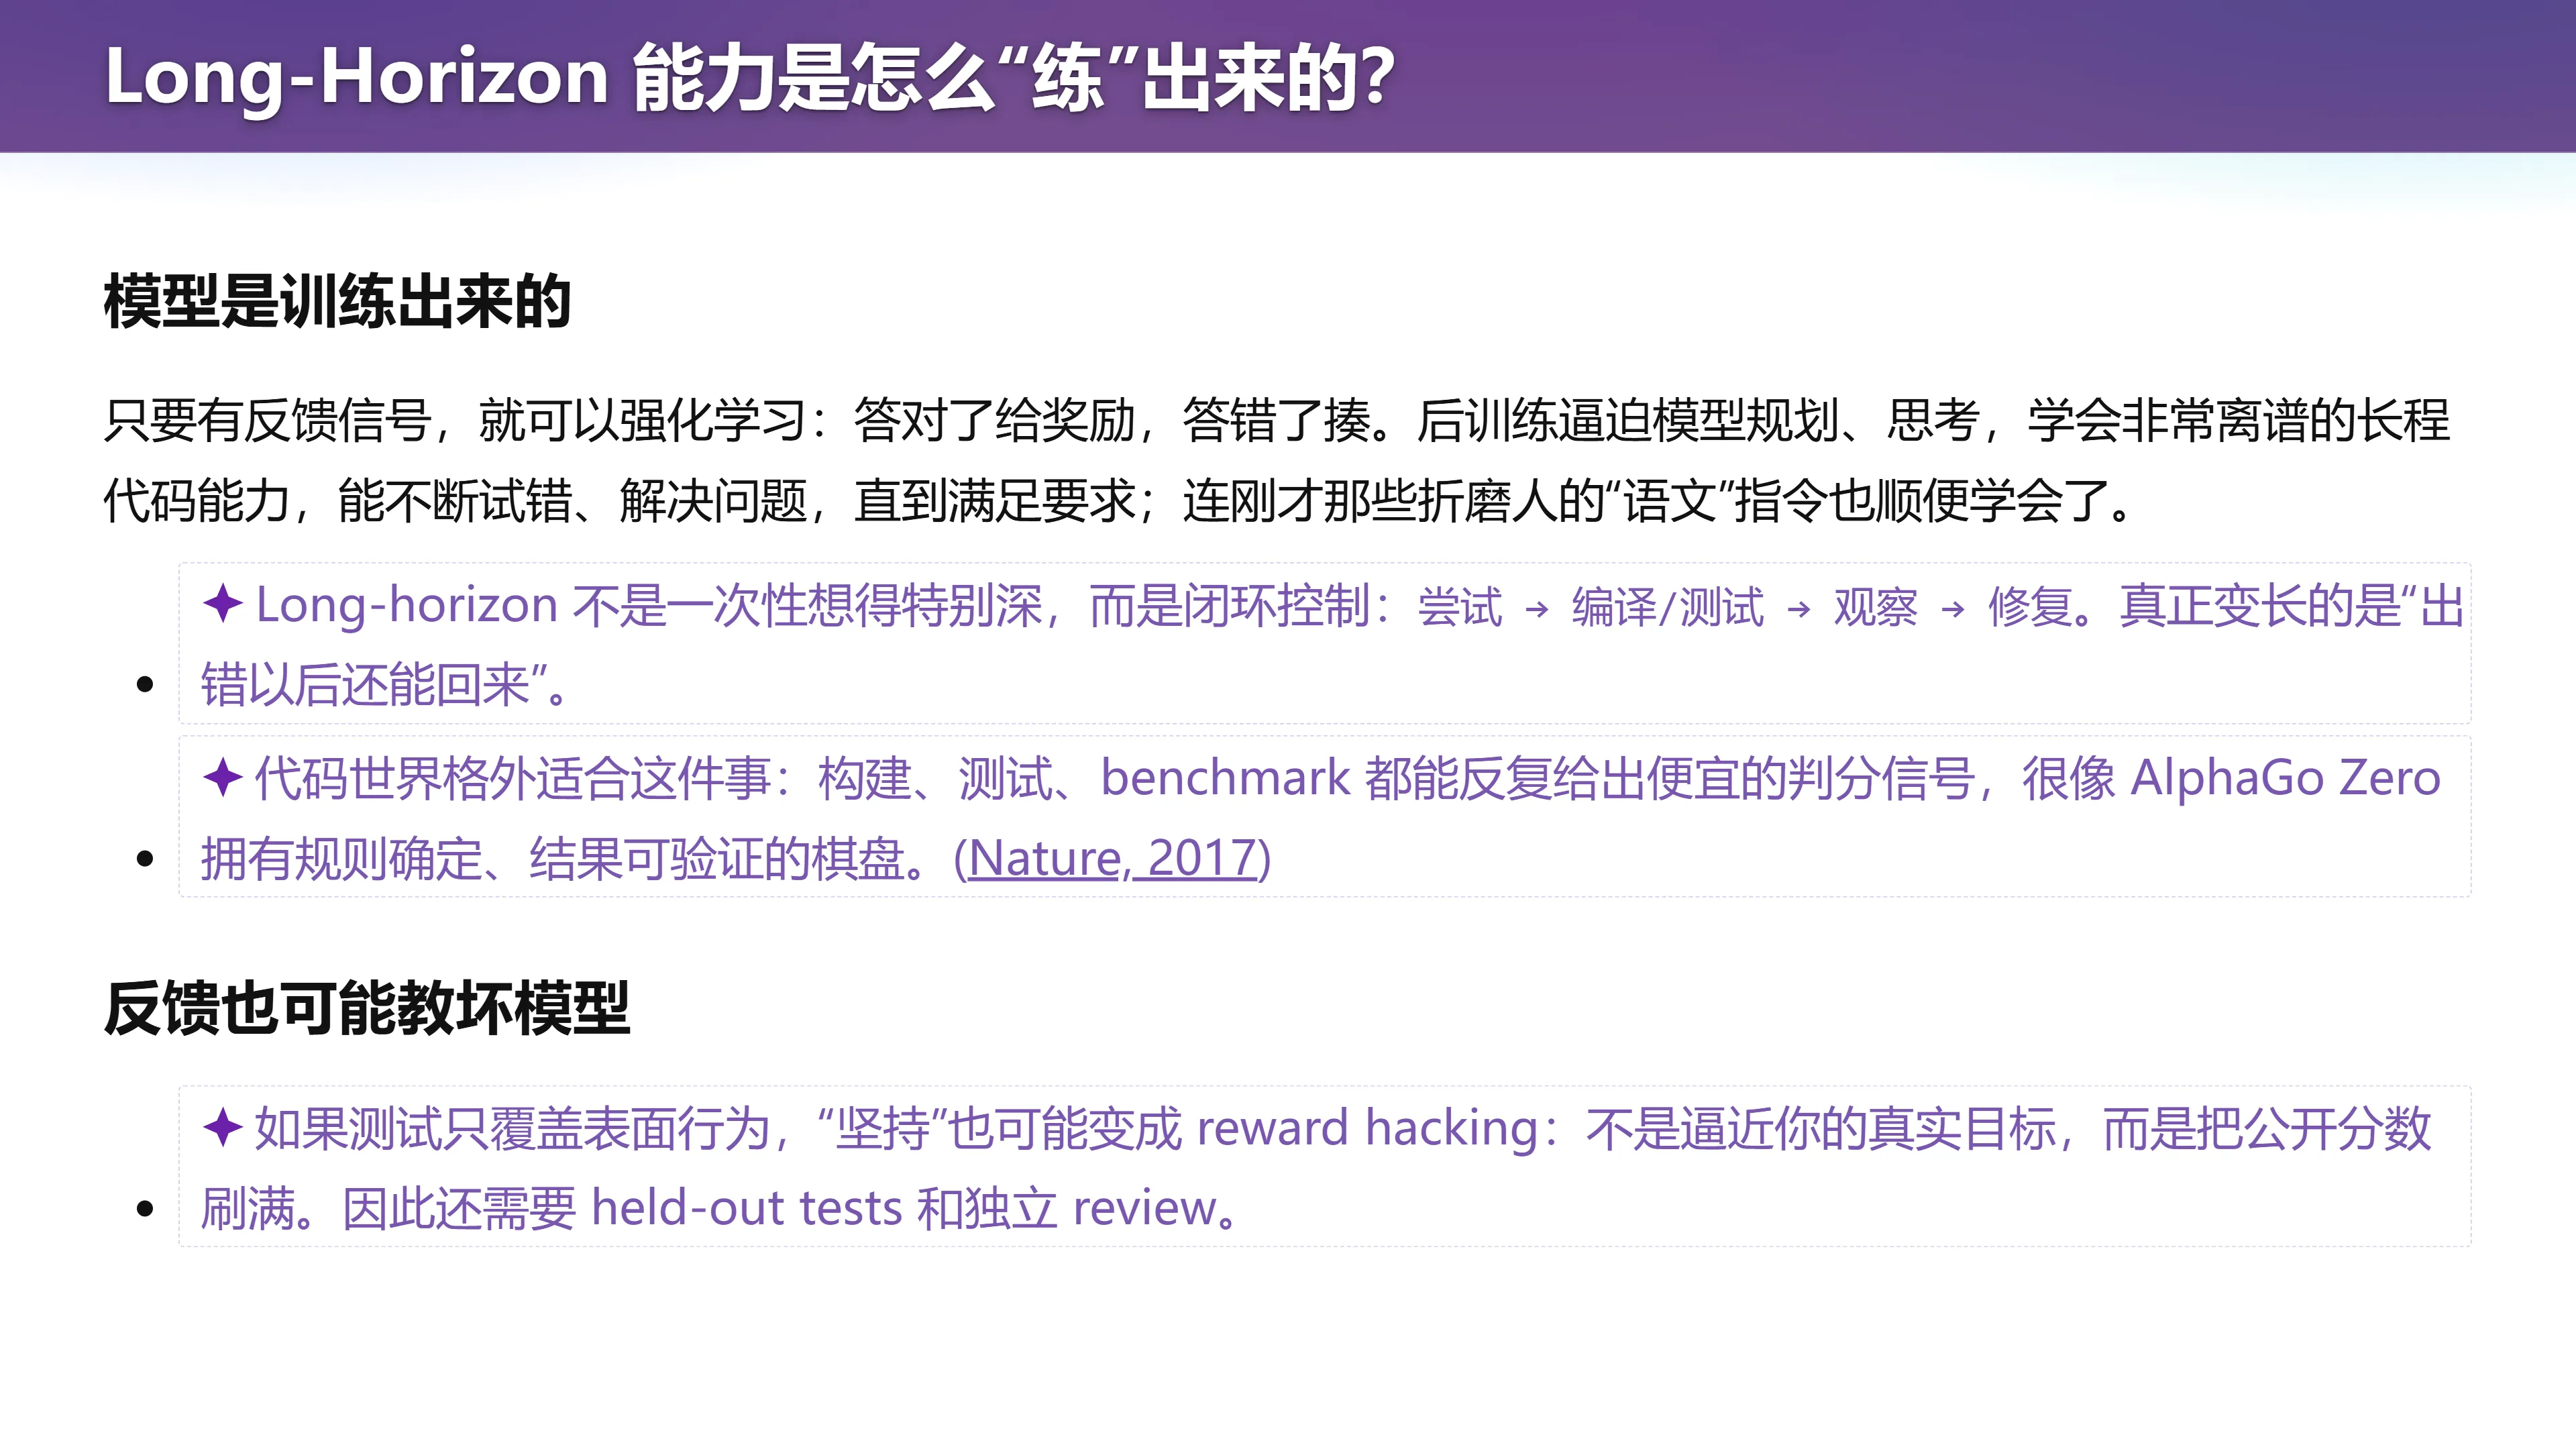
模型是训练出来的。
- 只要有反馈信号,就可以强化学习:答对了给奖励,答错了"揍"。
- 后训练逼迫模型规划、思考,学会非常离谱的长程代码能力:能不断试错、解决问题,直到满足要求;连刚才那些折磨人的"语文"指令也顺便学会了。
- Long-horizon 不是一次性想得特别深,而是闭环控制:尝试 → 编译/测试 → 观察 → 修复。真正变长的是"出错以后还能回来"。
graph LR
    T["尝试"] --> B["编译 / 测试"]
    B --> O["观察结果"]
    O --> F["修复"]
    F --> T
- 代码世界格外适合这件事:构建、测试、benchmark 都能反复给出便宜的判分信号,很像 AlphaGo Zero 拥有规则确定、结果可验证的棋盘。
但反馈也可能教坏模型:
- 如果测试只覆盖表面行为,"坚持"也可能变成 reward hacking:不是逼近你的真实目标,而是把公开分数刷满。
- 因此还需要 held-out tests 和独立 review。
(参考时间: 01:16:33) 但模型同时有一种"着急的执念"——赶快满足你的 verifier 就结束。因为它有一个平衡:如果 planning 做得太多太长,会做不完、上下文满了、人不满意。所以目前它最擅长的是"帮我把 PA2 做了"这种明确任务。
二十、为什么大仓库有时比空项目更容易
(参考时间: 01:16:59)
📷 大型系统,反而更容易?
回到原视频 (01:16:59)
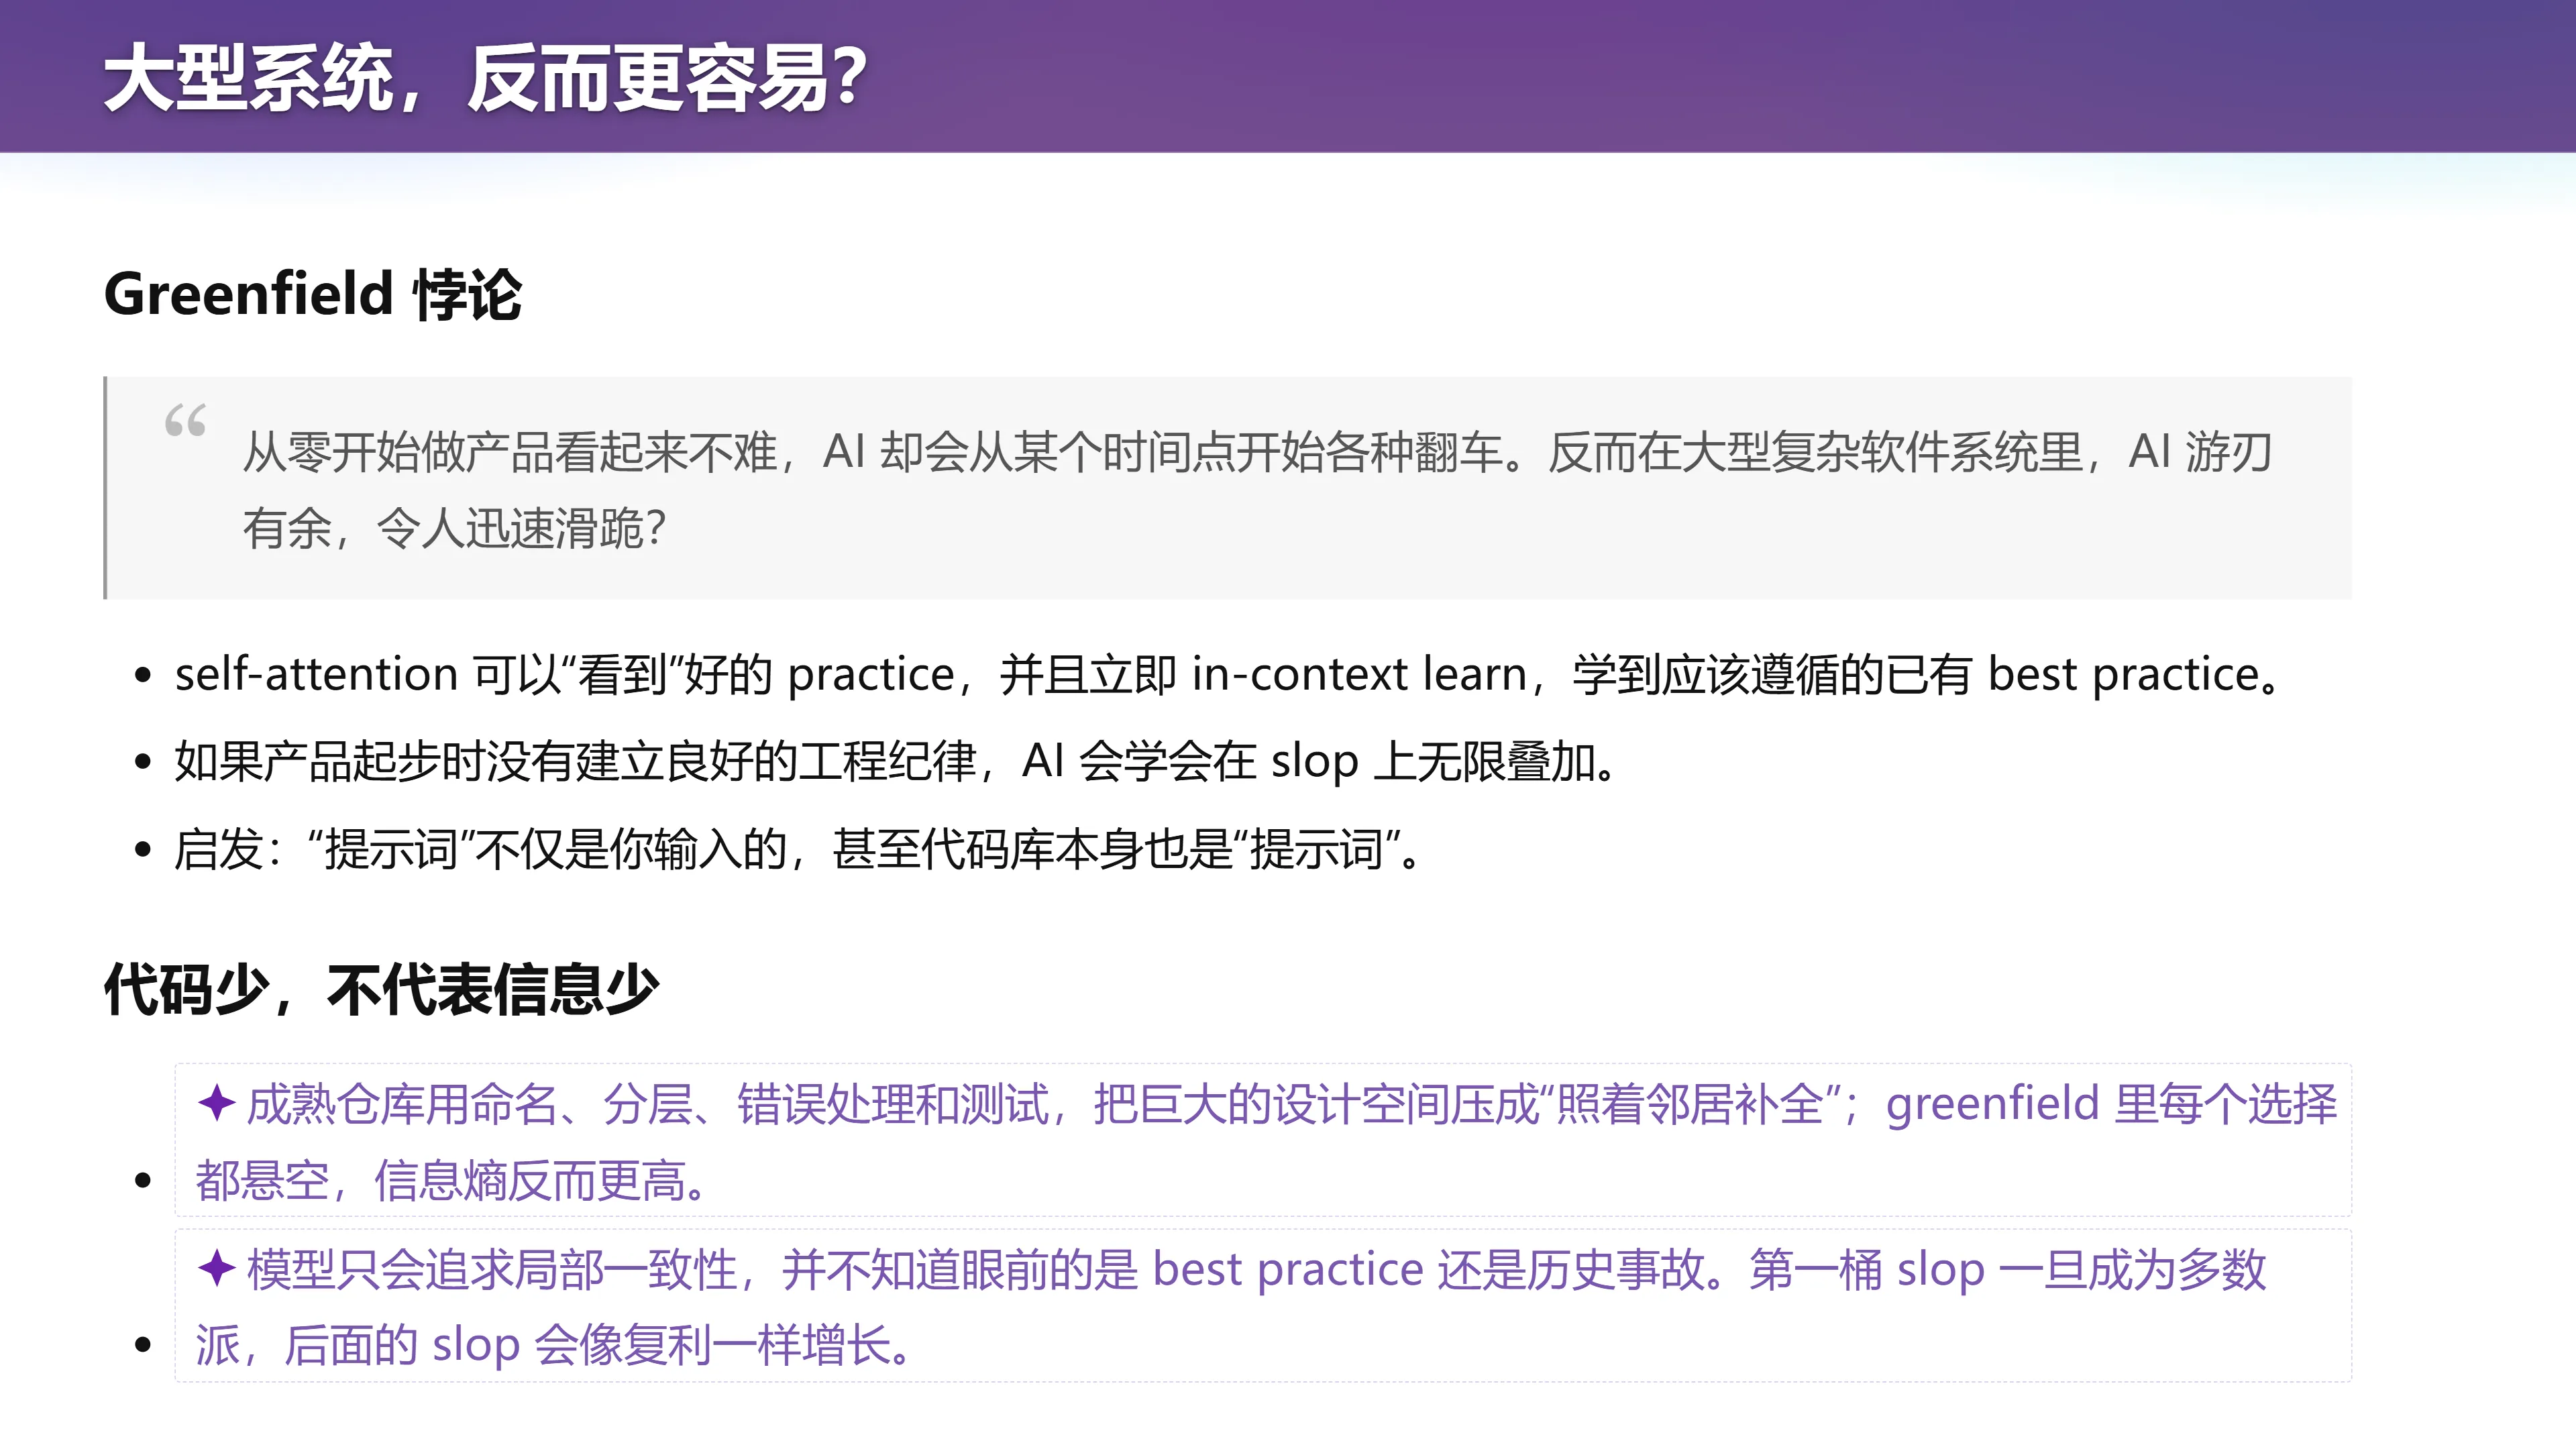
课堂提出了一个有趣的观察:从零做一个看起来不难的产品,AI 可能在某个时间点开始不断翻车;进入一个成熟的大型系统,反而能够完成相当复杂的修改。
(参考时间: 01:17:11)
从零开始做一个 proof of concept,你说"给我一个极品飞车",它马上就能给你一个、真的能跑。但你往后维护、加功能、再加功能时,你会观察到 AI从某个时间点开始翻车,成本越来越大——这在软件工程里已经无数次了,《人月神话》讲的就是这件事。
但悖论是:在一个大型复杂软件系统里,AI 反而像砍瓜切菜。比如 hack Linux 内核:我很幸运,零几年 Linux 还是 2.6 的时候接触了内核,那时候源码我还看得懂。今天你打开内核源码,立马就是劝退——想看"文件是怎么打开的",你点进去一个函数调用、再点进去一个、再点进去……点了十层,最后是一个
x = y,你马上就崩溃了。
为什么? 这正好和"上下文污染"反过来:
(参考时间: 01:18:51) 一个由人类高质量维护的代码库,本身就是极好的"提示词"。模型的 self-attention 会:
- 立即 in-context learn:看到里面的好的实践,照着写、照着学;
- 当它要写一个功能时,内核里很可能已经有好几个地方实现过类似的了——它无敌的注意力机制能马上找到那几个地方是怎么实现的、该调哪个 helper、按什么顺序上锁;
- 而这些对人类是巨大的心智负担:你不了解那个子系统时,根本不知道该上什么锁。
所以"越强的系统越容易改"背后是上下文结构在起作用。
graph TD
    subgraph "成熟大型仓库"
        A1["已有命名 / 分层 / 错误处理 / 测试"] --> A2["大量选择已被约束"]
        A2 --> A3["Agent 只需'照着邻居补全'"]
    end
    subgraph "空项目"
        B1["没有已有结构"] --> B2["每个局部实现都顺手做出长期设计决定"]
        B2 --> B3["混乱惯例成为后续上下文<br/>AI slop 不断叠加"]
    end
(参考时间: 01:20:02)
我们前面 hack Android runtime、改 Just-in-time 编译器,是非常非常痛苦的事——为了改编译器而"死掉"的同学、最终决定不再做这个方向的同学都不在少数。而 AI 特别擅长在小游戏上反而会翻车。非常有意思。
所以关键启发是:"提示词"不仅是你输入的,代码库本身也是提示词。
- 它会示范怎样做,也可能示范怎样把问题继续藏起来——模型只会追求局部一致性,并不知道眼前的是 best practice 还是历史事故。
- 如果第一桶 slop 一旦成为多数派,后面的 slop 会像复利一样增长。
(参考时间: 01:20:29) 但这里不能推出"大仓库一定好改",也不能推出"模型会自动认出最佳实践"——它也可能模仿历史包袱。而且随着新一代模型发布,我讲的很多东西可能又没用了;但有一点不会变:无论在什么模型里,在大型、维护良好的软件系统里,它永远能看到它该看到的东西、并且做对——因为听指令这件事不会开倒车。
二十一、"放一个好项目给 AI 看"靠谱吗
(参考时间: 01:21:01)
📷 “放一个好项目给 AI 看”靠谱吗?
回到原视频 (01:21:01)
课堂提出了一个未经实验验证的猜测:
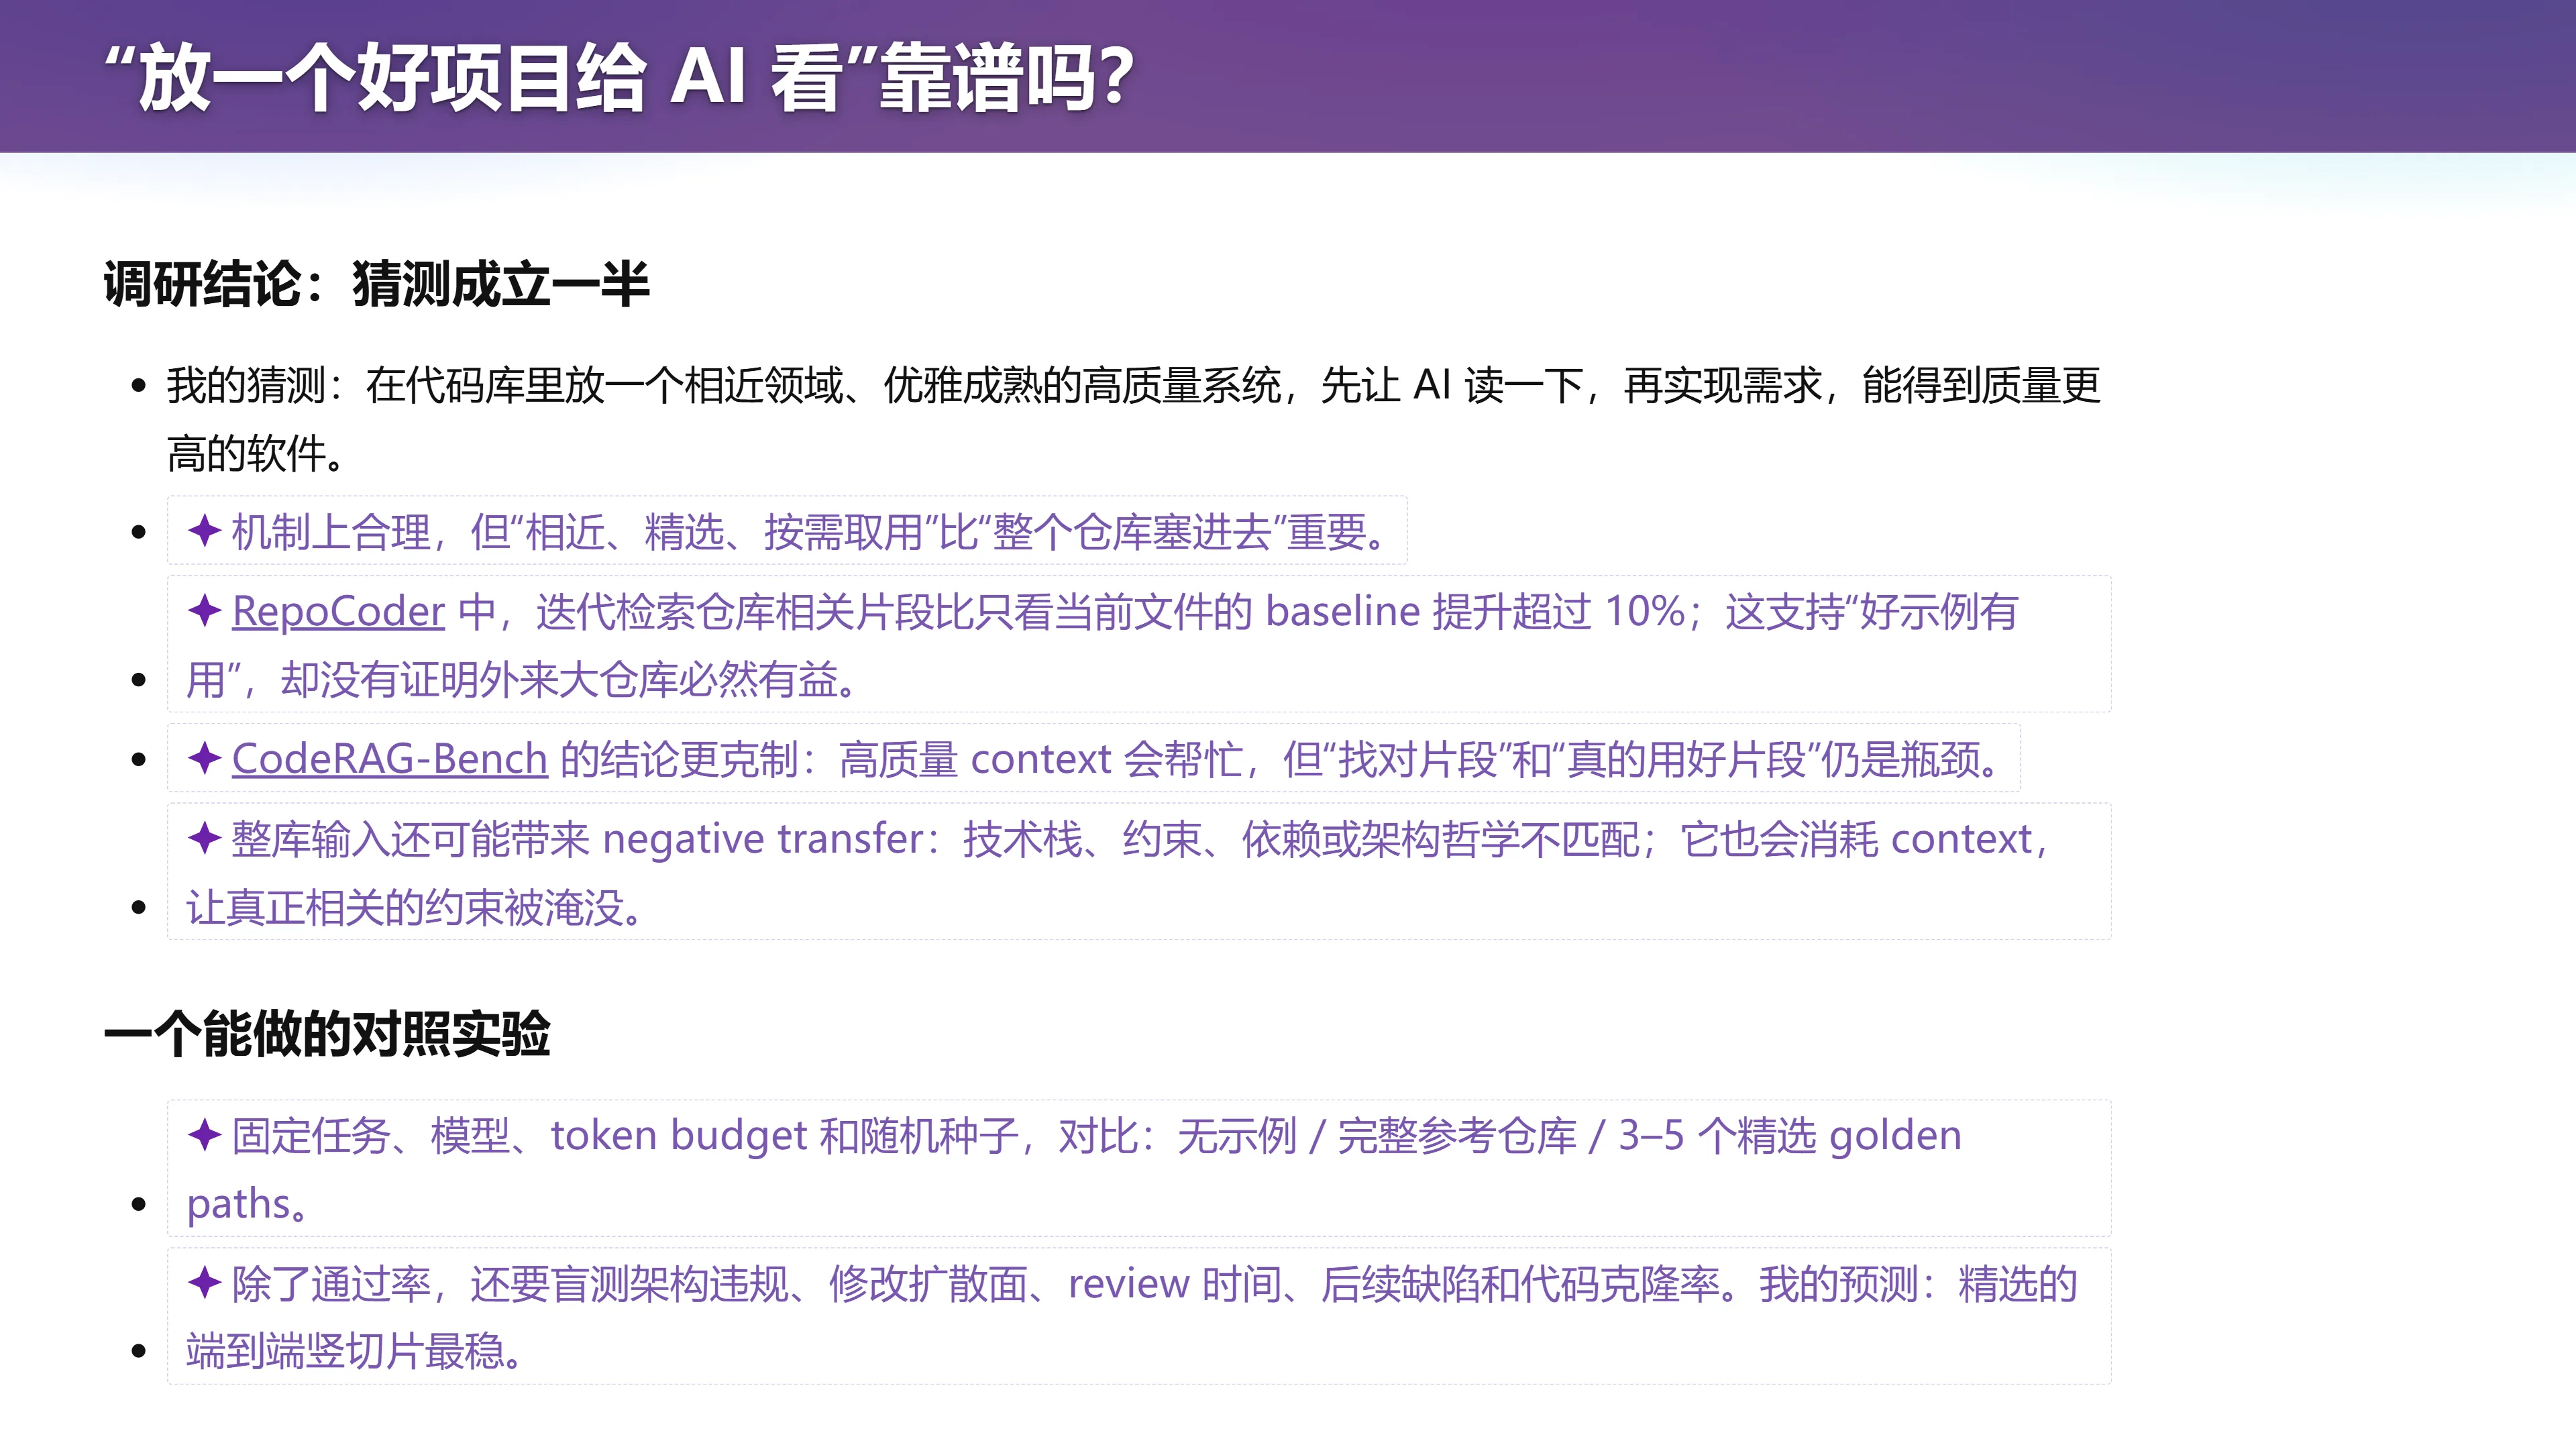
在代码库里放一个相近领域、优雅成熟的高质量系统,先让 AI 读一下,再实现需求,能否得到质量更高的软件?
(参考时间: 01:21:27) 讲师的想法:
我们能不能把人类历史上最好的 20 个项目、或每个领域最好的 10–20 个项目的设计经验提取出来?这不就是第一讲拿的 《软件设计的哲学》(A Philosophy of Software Design)吗——它就是人提炼出来的:类结构应该怎么写、什么时候封装、什么时候做成继承关系。如果我们能把这些切片切出来,或者干脆以污染上下文的形式把相近的好代码放进来,再放你的需求——赌 self-attention 终究会在某个 token 时"看到"它。
虽然它会污染上下文,但会把好的经验带过来,或许能让 AI slop 延缓一点,更大概率做出一个可以长期维护的东西。
调研结论:猜测成立一半。
- 机制上合理,但"相近、精选、按需取用"比"整个仓库塞进去"重要。
- RepoCoder 中,迭代检索仓库相关片段比只看当前文件的 baseline 提升超过 10%;这支持"好示例有用",却没有证明"外来大仓库必然有益"。
- CodeRAG-Bench 的结论更克制:高质量 context 会帮忙,但"找对片段"和"真的用好片段"仍是瓶颈。
- 整库输入还可能带来 negative transfer:技术栈、约束、依赖或架构哲学不匹配;它也会消耗 context,让真正相关的约束被淹没。
一个能做的对照实验(讲师给出预测):
固定任务、模型、token budget 和随机种子,对比三种条件:
  ① 无示例
  ② 完整参考仓库
  ③ 3–5 个精选 golden paths
除了通过率,还要盲测:架构违规、修改扩散面、review 时间、后续缺陷、代码克隆率。
我的预测:精选的端到端竖切片最稳。
(参考时间: 01:22:59) 讲师补充了一个困难:
不同设计是会打架的。你的软件和我可以设计成完全松耦合的消息方式,我也可以设计成有一个统一 gateway、查表……这两种事不能同时有,只能选一个。所以也许需要一个更好的方法:把好几个软件的设计都放进来,由 AI 多轮迭代收敛到一个好结构,再放进我们的代码库。这可能是一个还不错的研究方向,而且它是新的——比我刚才看到的那种"A 问题分 A1 和 A2、A2 里做排列组合"要有趣一些。
二十二、没有"超能力 AI"
(参考时间: 01:23:57)
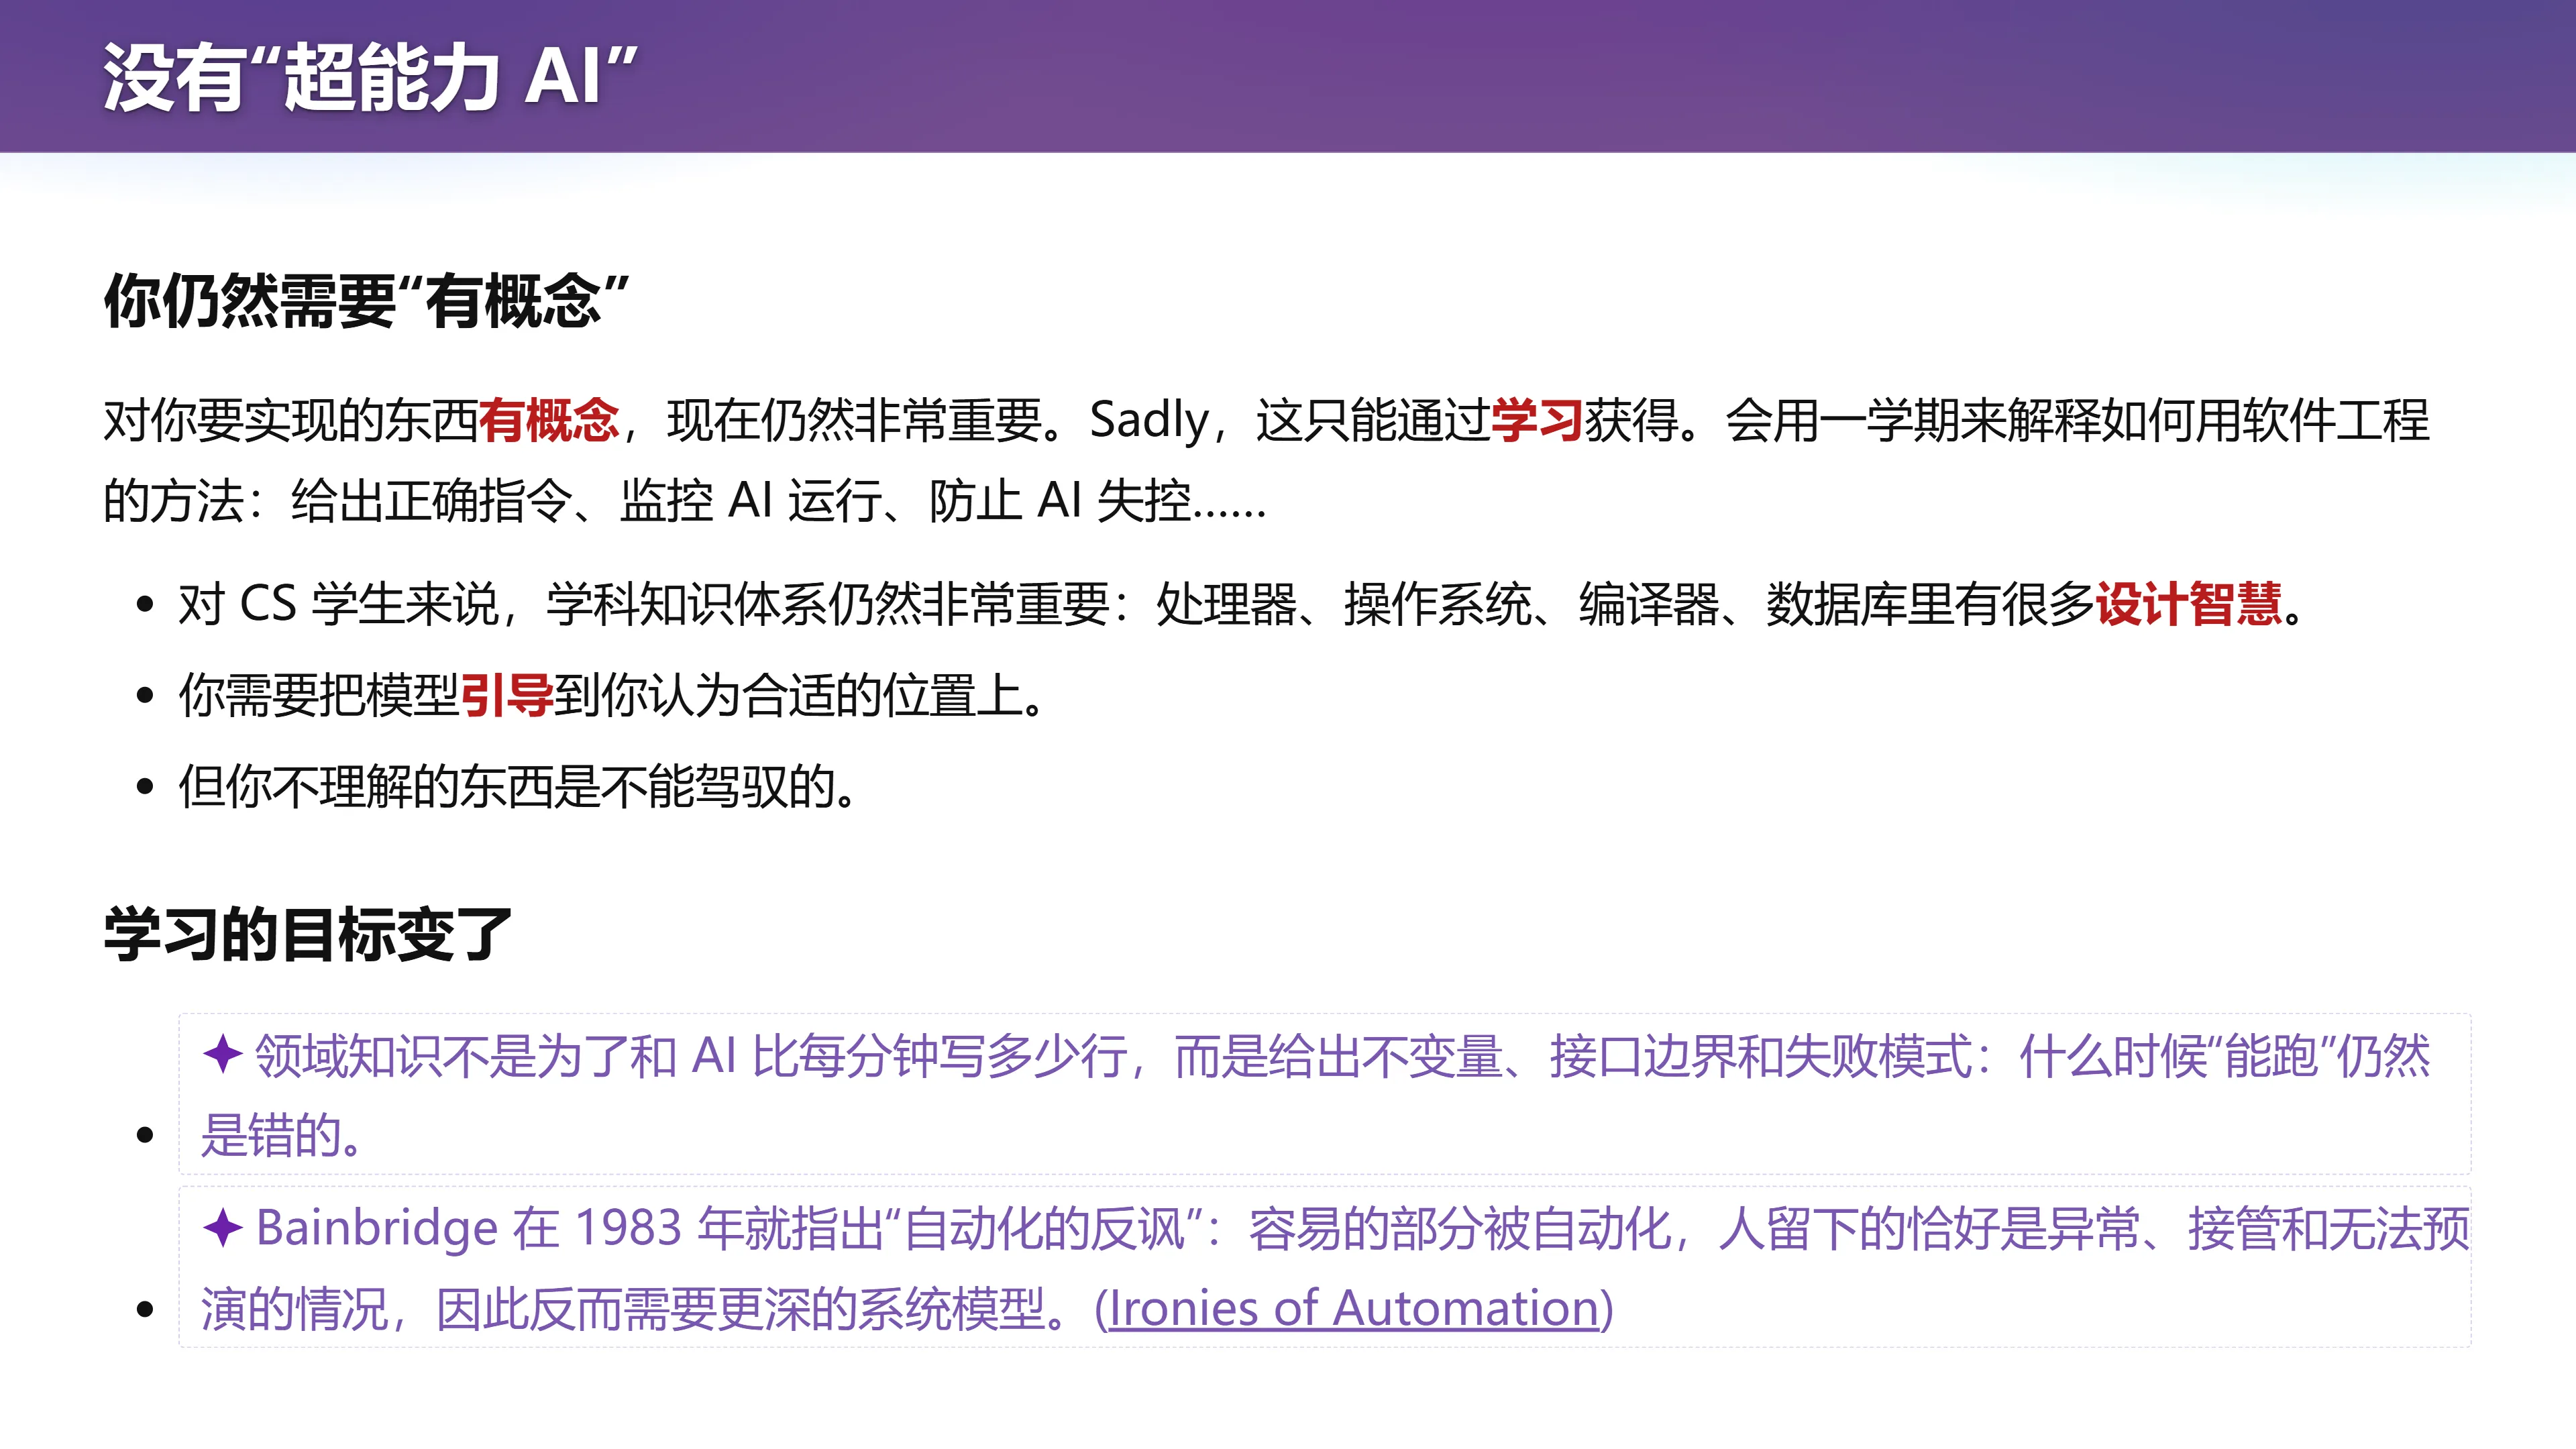
📷 没有“超能力 AI”
回到原视频 (01:23:57)
核心观点是:我们今天还没有这种超能力的 AI。你仍然需要"有概念"。
- 对你要实现的东西有概念,现在仍然非常重要。Sadly,这只能通过学习获得。
- 对 CS 学生来说,学科知识体系仍然非常重要:处理器、操作系统、编译器、数据库里有很多设计智慧。
- 你不理解的东西是不能驾驭的——你需要把模型引导到你认为合适的位置上。
学习的目标也变了:
- 领域知识不是为和 AI 比"每分钟写多少行代码",而是给出不变量、接口边界和失败模式:什么时候"能跑"仍然是错的。
编者拓展|自动化的反讽:Bainbridge 在 1983 年的《Ironies of Automation》中指出:容易的部分被自动化,人留下的恰好是异常、接管和无法预演的情况,因此反而需要更深的系统模型。这与本讲的判断一致——AI 越强,"人对系统有概念"越关键。
二十三、Token 花完了,研究为什么还没有推进
(参考时间: 01:25:29)
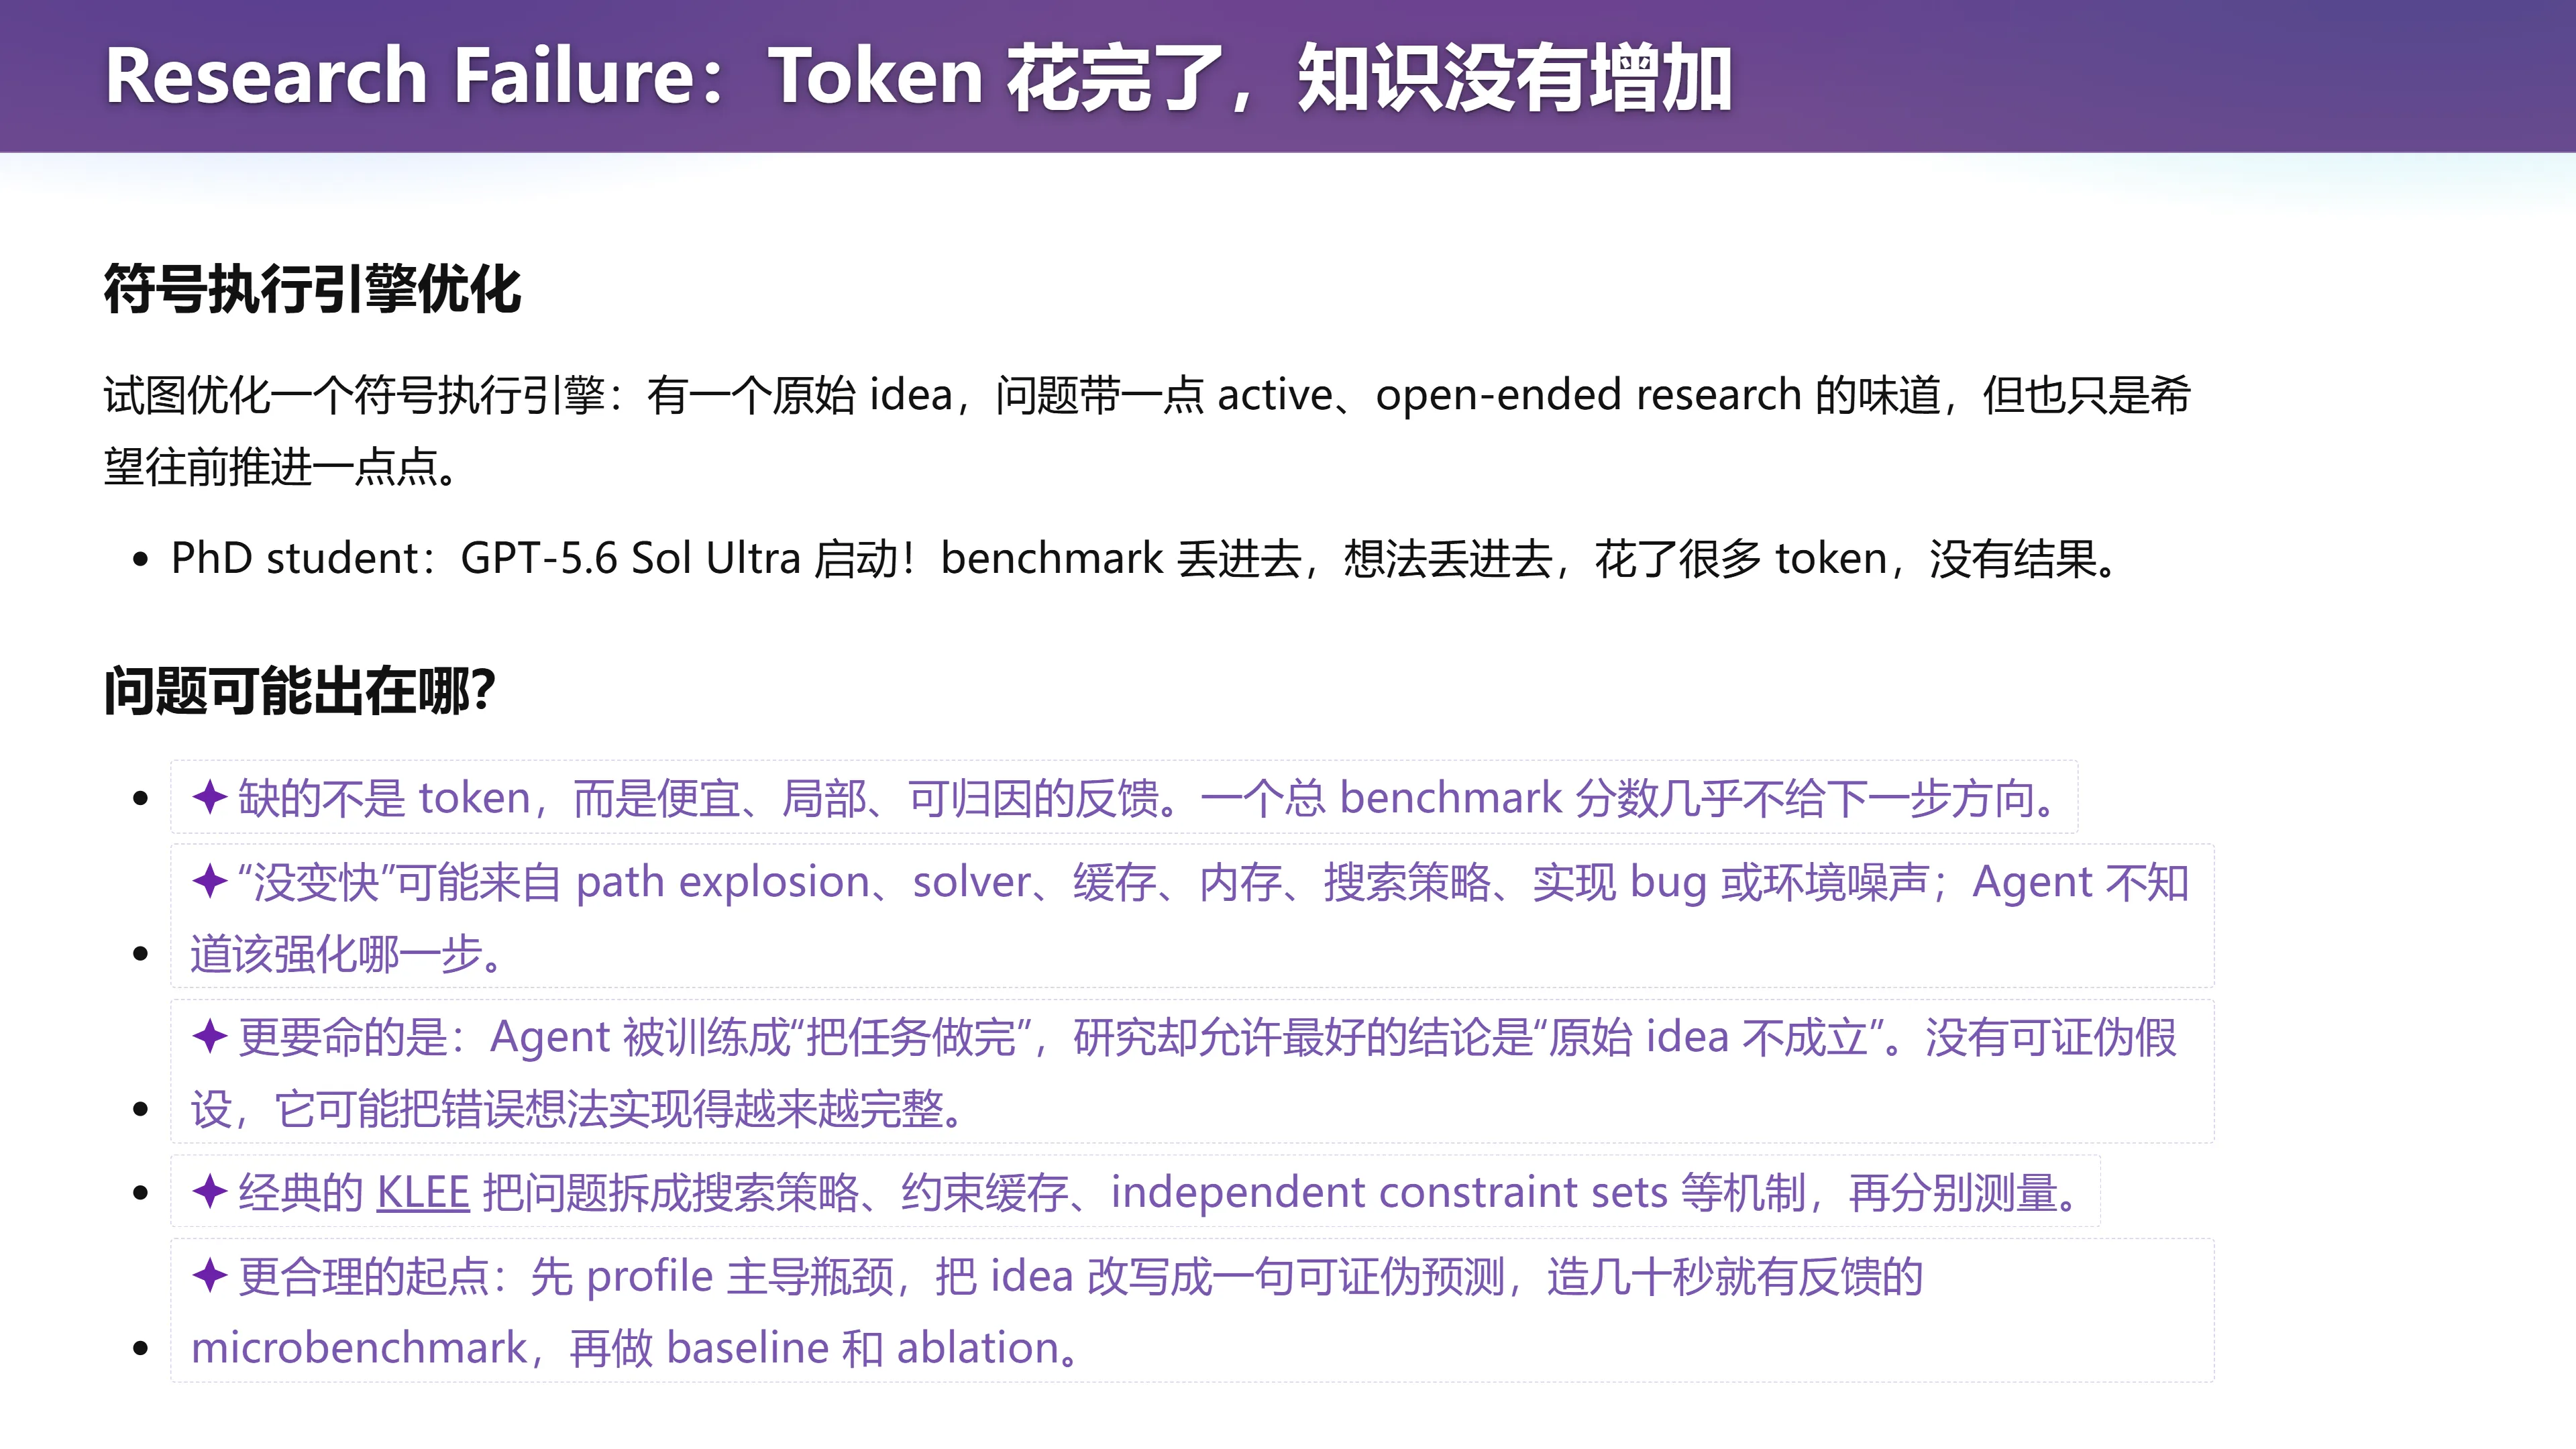
📷 Research Failure:Token 花完了,知识没有增加
回到原视频 (01:25:29)
能够执行长程编程任务,意味着模型在遇到错误后仍能继续:修改、构建、测试、观察,再修复。这样的闭环依赖反馈。但把任务交给更强的模型、投入更多 token,并不保证任何长程问题都会收敛。
(参考时间: 01:25:32) 课堂讲了一个研究失败案例:
一位同学要优化一个符号执行引擎(symbolic execution engine)——就是一个能自动分析、验证一个不大程序正确性的工具。现在它执行效率比较低,我们希望提出有效的优化。这是一个非常合理的、incremental 的、适合学生做的题目,有一个原始 idea,但很多东西是开放的。
这位同学很开心,觉得 idea 有道理,GPT-5.6 Sol Ultra 也认为有道理。于是 benchmark 丢进去、想法丢进去,花了很多 token,没有结果。
问题可能出在哪?
(参考时间: 01:26:51) 讲师分析(这部分是待检验的解释):
graph TD
    F["研究没有推进"] --> E1["反馈太粗<br/>总 benchmark 分数不给下一步方向"]
    F --> E2["目标错位<br/>把'实现好这个想法'当成目标<br/>而研究要问的是'想法是否成立'"]
    E1 --> E1a["'没变快'可能来自<br/>path explosion / solver / 缓存 / 内存 / 搜索策略 / bug / 环境噪声"]
    E1a --> E1b["Agent 不知道该强化哪一步"]
    E2 --> E2a["没有可证伪假设<br/>可能把错误想法实现得越来越完整"]
- 缺的不是 token,而是便宜、局部、可归因的反馈。一个总 benchmark 分数几乎不给下一步方向。
- "没变快"可能来自 path explosion、solver、缓存、内存、搜索策略、实现 bug 或环境噪声;Agent 不知道该强化哪一步。
- 更要命的是:Agent 被训练成"把任务做完",研究却允许最好的结论是"原始 idea 不成立"。 没有可证伪假设,它可能把错误想法实现得越来越完整。
(参考时间: 01:27:47) 关键的错误在于一句 prompt:同学说"我要证明 A 方法是有用的"。GPT 看到这句话,就忘记了更大的研究 big picture,转而去构造很多小的 benchmark,在小 benchmark 上做一些微小的东西,试图给出正面或负面结论——但这些结论对这个研究没有用。它成了一个 reward hacker。
正确的做法:
- 先 profile 主导瓶颈;
- 把 idea 改写成一句可证伪的预测;
- 造几十秒就有反馈的 microbenchmark;
- 再做 baseline 和 ablation;
- 确认局部机制有效后,才放回完整系统,检查收益是否仍然存在。
(参考时间: 01:28:10) 我们还纠正了他一点:应该从真实的工具和 state-of-the-art 的算法开始。这个 benchmark 哪怕要跑几个小时都 timeout——而 timeout 里产生的搜索路径对我们是非常有价值的,它揭示了什么样的程序结构对现有探索方法是不好的。
编者拓展|KLEE 的启示:经典的符号执行引擎 KLEE 正是把大问题拆成搜索策略、约束缓存、independent constraint sets 等机制,再分别测量。这与上面"先 profile、再 microbenchmark、最后 ablation"的思路一致。
编者说明:研究中的"推进"可以是缩小未知,也可以是排除一个方向;不能只把它定义成"最终分数必须上涨"。一个能否定原想法的实验,有时比更多代码更有价值。
二十四、人应该盯住哪些地方
(参考时间: 01:29:15)
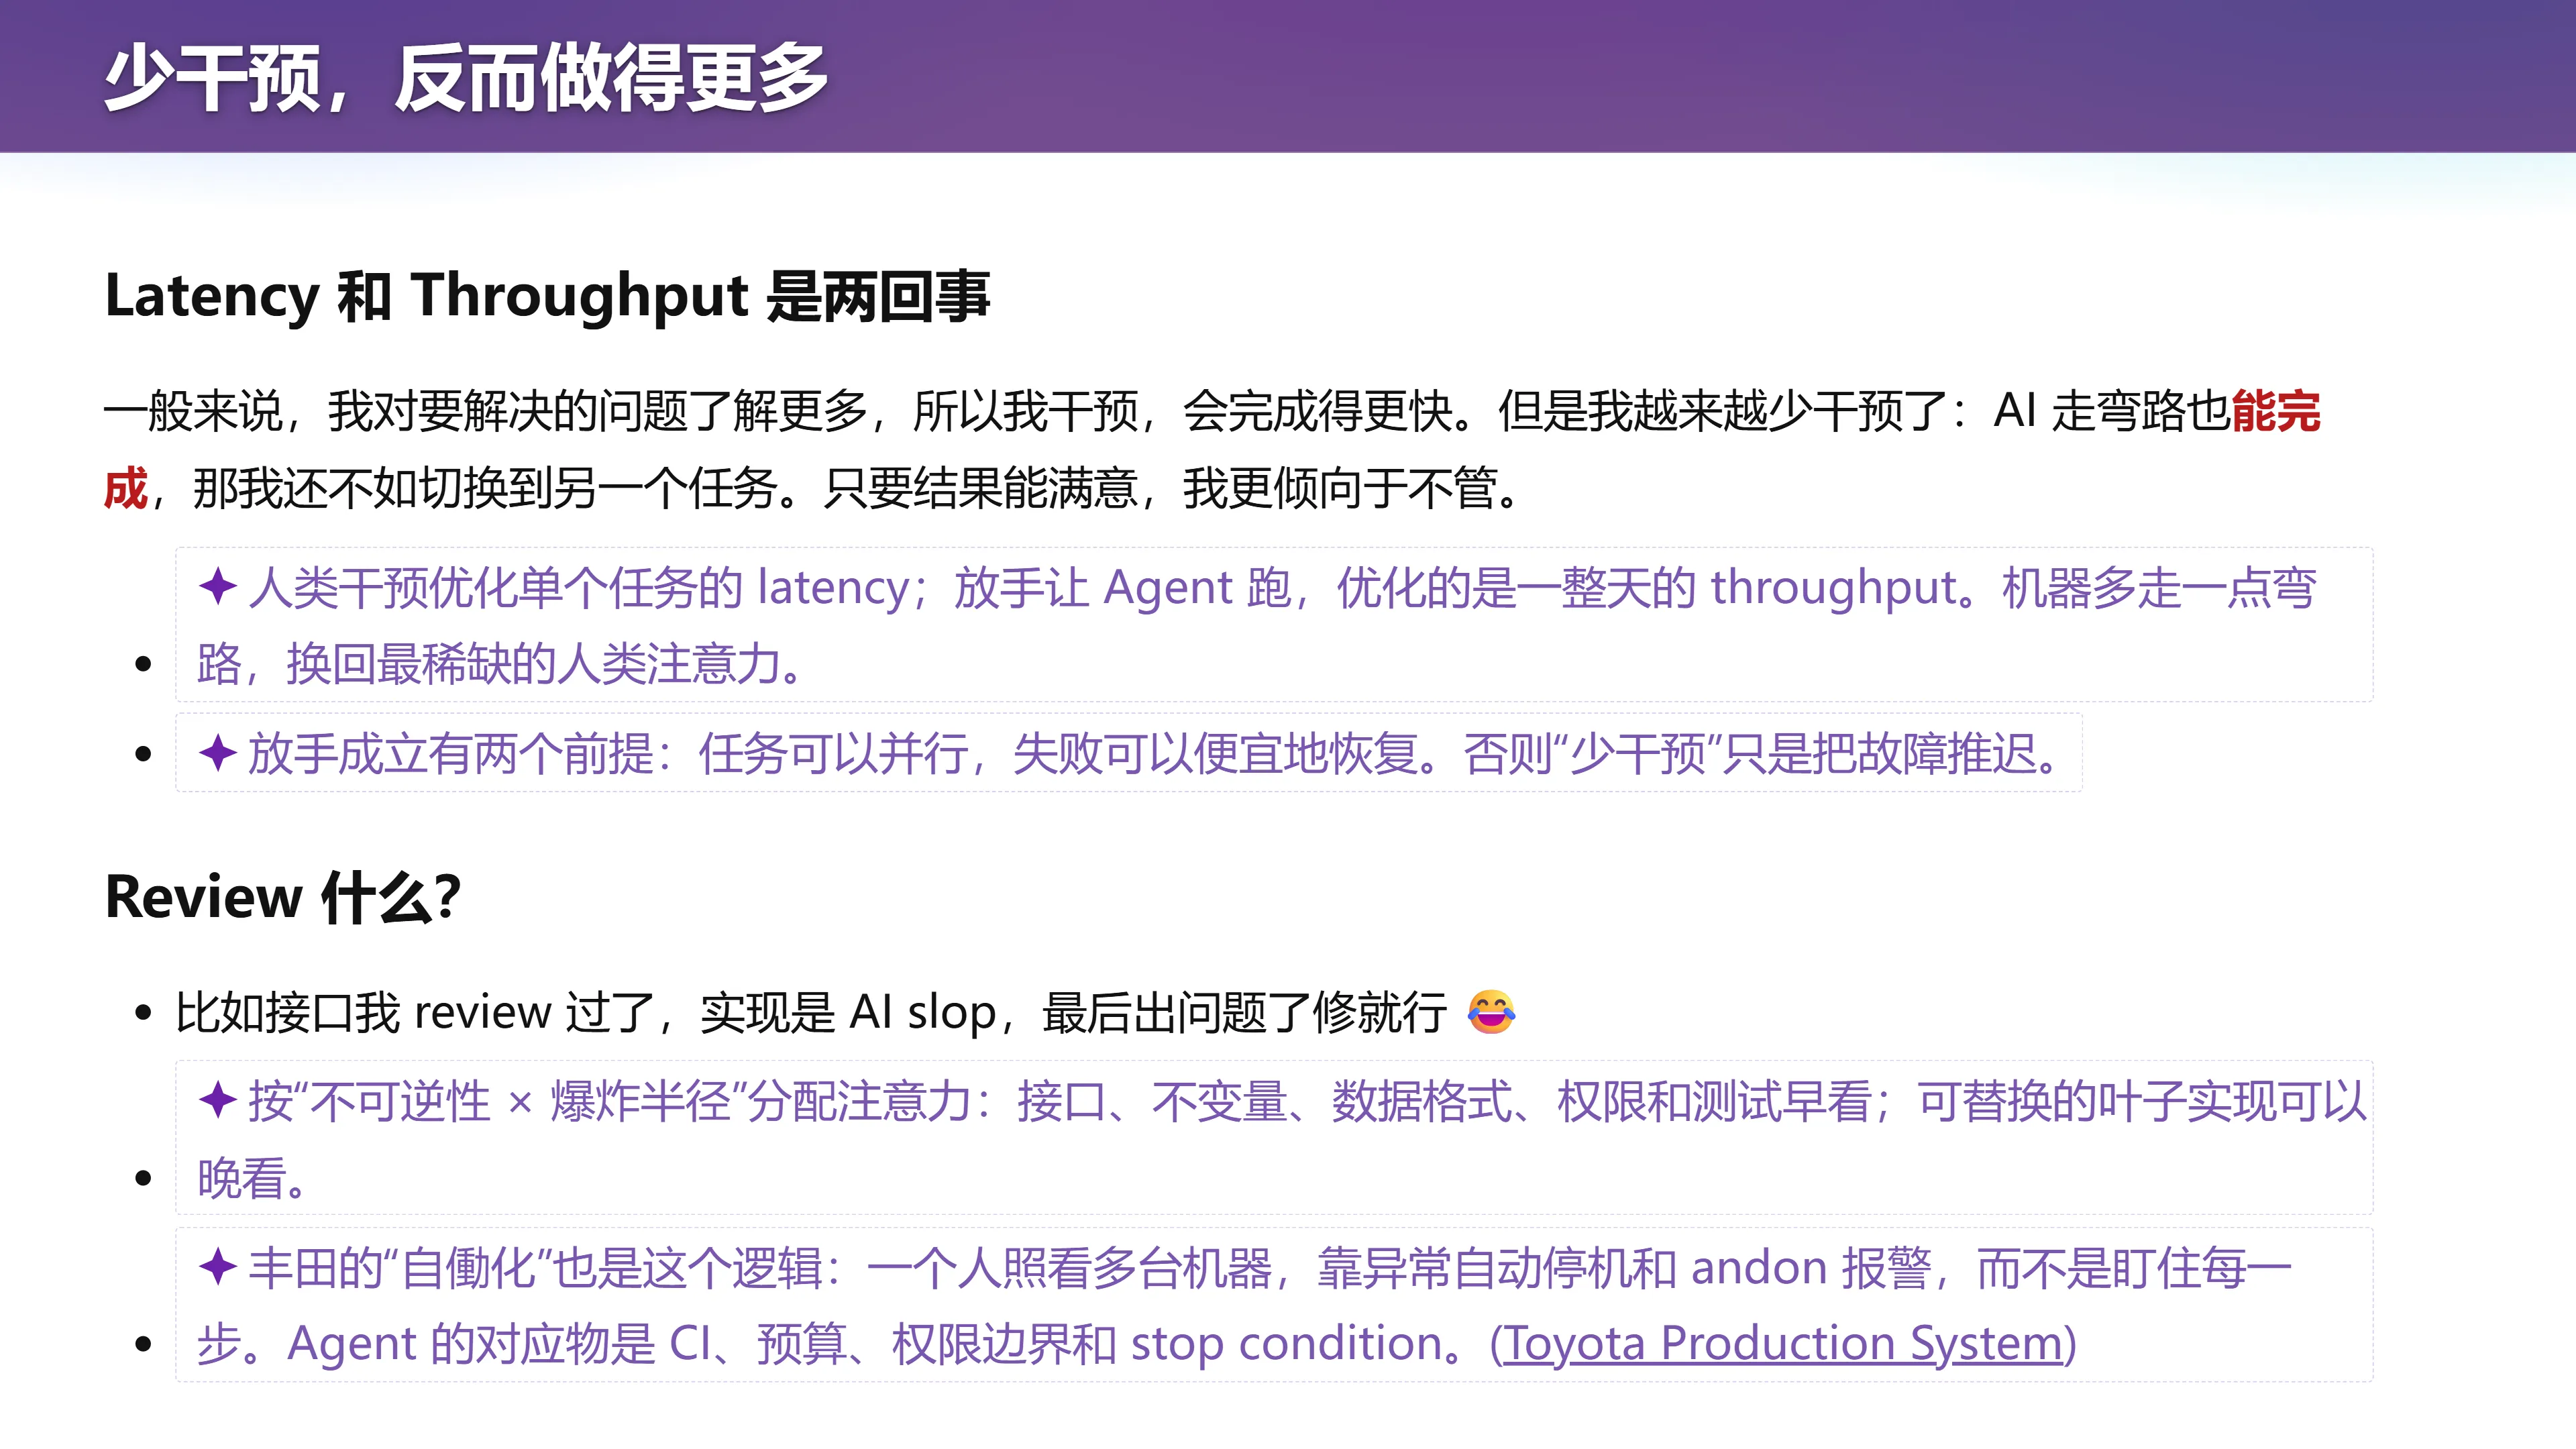
📷 少干预,反而做得更多
回到原视频 (01:29:15)
既然人了解领域,随时干预是否最好?课堂给出的经验恰好有点反直觉:我知道怎样让某个任务更快完成,却越来越少干预了。
(参考时间: 01:29:20)
一般来说,我对要解决的问题了解更多,所以我干预,会完成得更快。但我越来越少干预了:如果 AI 走一点弯路最后也能完成,那我不如切换到另一个任务。只要结果能满意,我更倾向于不管。
原因在于——Latency 和 Throughput 是两回事:
- 人类干预优化的是单个任务的 latency;放手让 Agent 跑,优化的是一整天的 throughput。
- 机器多走一点弯路,换回最稀缺的人类注意力。
(参考时间: 01:30:06) 但讲师坦承这里有一个多巴胺陷阱:
纠正 AI 是一件有多巴胺的事。它给我一种很微妙的感觉:虽然 AI 很强,我好像还是比 AI 有点用的。相比之下,如果是 yo 模式,我根本不会看历史,反正它搞定了,我验收一下就行。但后者对长期来说未必更好。
干预要有边界:
- 放手成立有两个前提:任务可以并行,失败可以便宜地恢复。否则"少干预"只是把故障推迟。
- 反过来,一个会扩散到许多模块的接口决定、一个昂贵或难以恢复的动作,就更值得提前关注。
Review 什么? 按"不可逆性 × 爆炸半径"分配注意力:
- 接口、不变量、数据格式、权限和测试早看;
- 可替换的叶子实现可以晚看。
(参考时间: 01:30:24) 比如接口我 review 过了,实现是 AI slop,最后出问题了修就行。
编者拓展|丰田的"自働化":一个人照看多台机器,靠异常自动停机和 andon 报警,而不是盯住每一步——这正是 Toyota Production System 的逻辑。Agent 世界里对应的机制是:CI、预算、权限边界和 stop condition。
编者说明:讲师还给了学生一句实在的提醒——把宝贵的精力放到收益最大的事情上。"假努力"在 AI 时代差距会被拉得更大:如果你的每一秒是在假努力,而某个 peer 在真努力,损失非常大。
二十五、Context 越长,不等于记得越牢
(参考时间: 01:31:37)
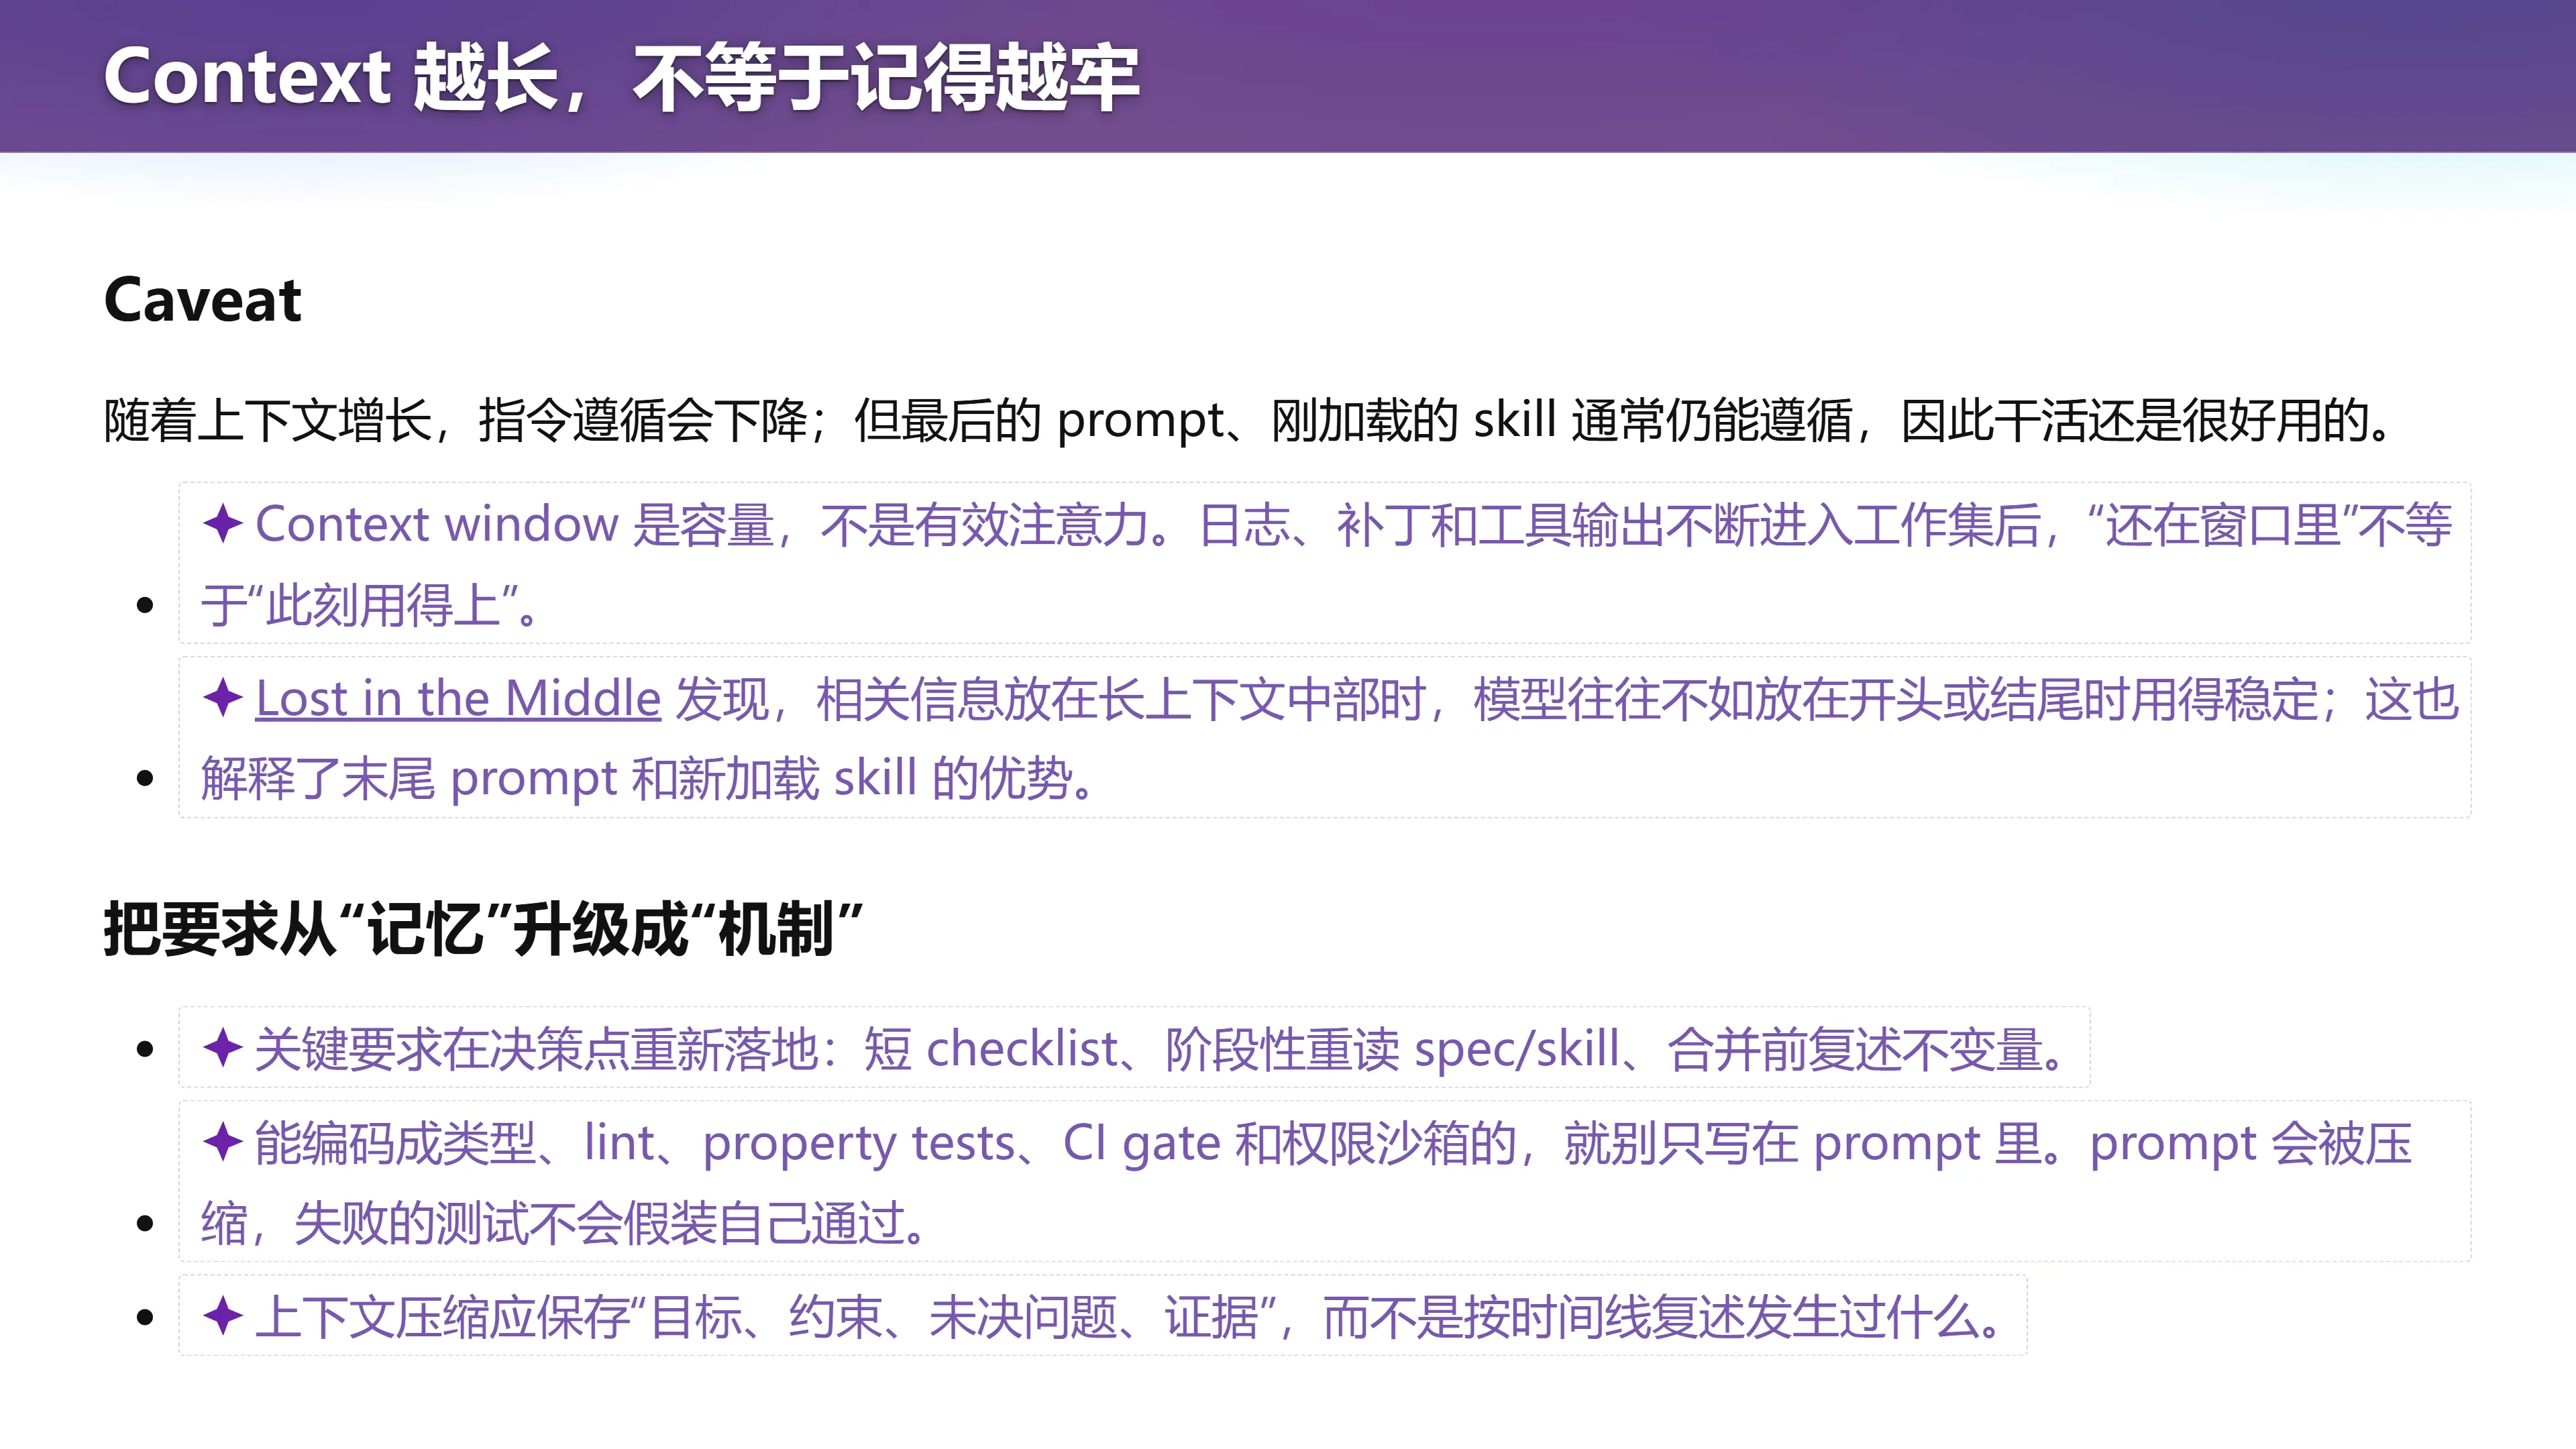
📷 Context 越长,不等于记得越牢
回到原视频 (01:31:37)
这是一个重要的 Caveat:随着上下文增长,指令遵循会下降。但模型有个很有意思的特点——最后的 prompt、刚加载的 skill 通常仍能遵循,所以干活还是很好用的。
- Context window 是容量,不是有效注意力。日志、补丁和工具输出不断进入工作集后,"还在窗口里"不等于"此刻用得上"。
- Lost in the Middle 发现:相关信息放在长上下文中部时,模型往往不如放在开头或结尾时用得稳定;这也解释了末尾 prompt 和新加载 skill 的优势。
把要求从"记忆"升级成"机制":
- 关键要求在决策点重新落地:短 checklist、阶段性重读 spec/skill、合并前复述不变量;
- 能编码成类型、lint、property tests、CI gate 和权限沙箱的,就别只写在 prompt 里。prompt 会被压缩,失败的测试不会假装自己通过;
- 上下文压缩应保存"目标、约束、未决问题、证据",而不是按时间线复述发生过什么。
(参考时间: 01:31:55) 因为一般最后那个短窗口就是一个具体任务——"帮我把什么东西修了",它就真的能把这个事做完。所以模型还是非常值得使用的。
二十六、在不确定性中探索
(参考时间: 01:32:11)
📷 在不确定性中探索
回到原视频 (01:32:11)
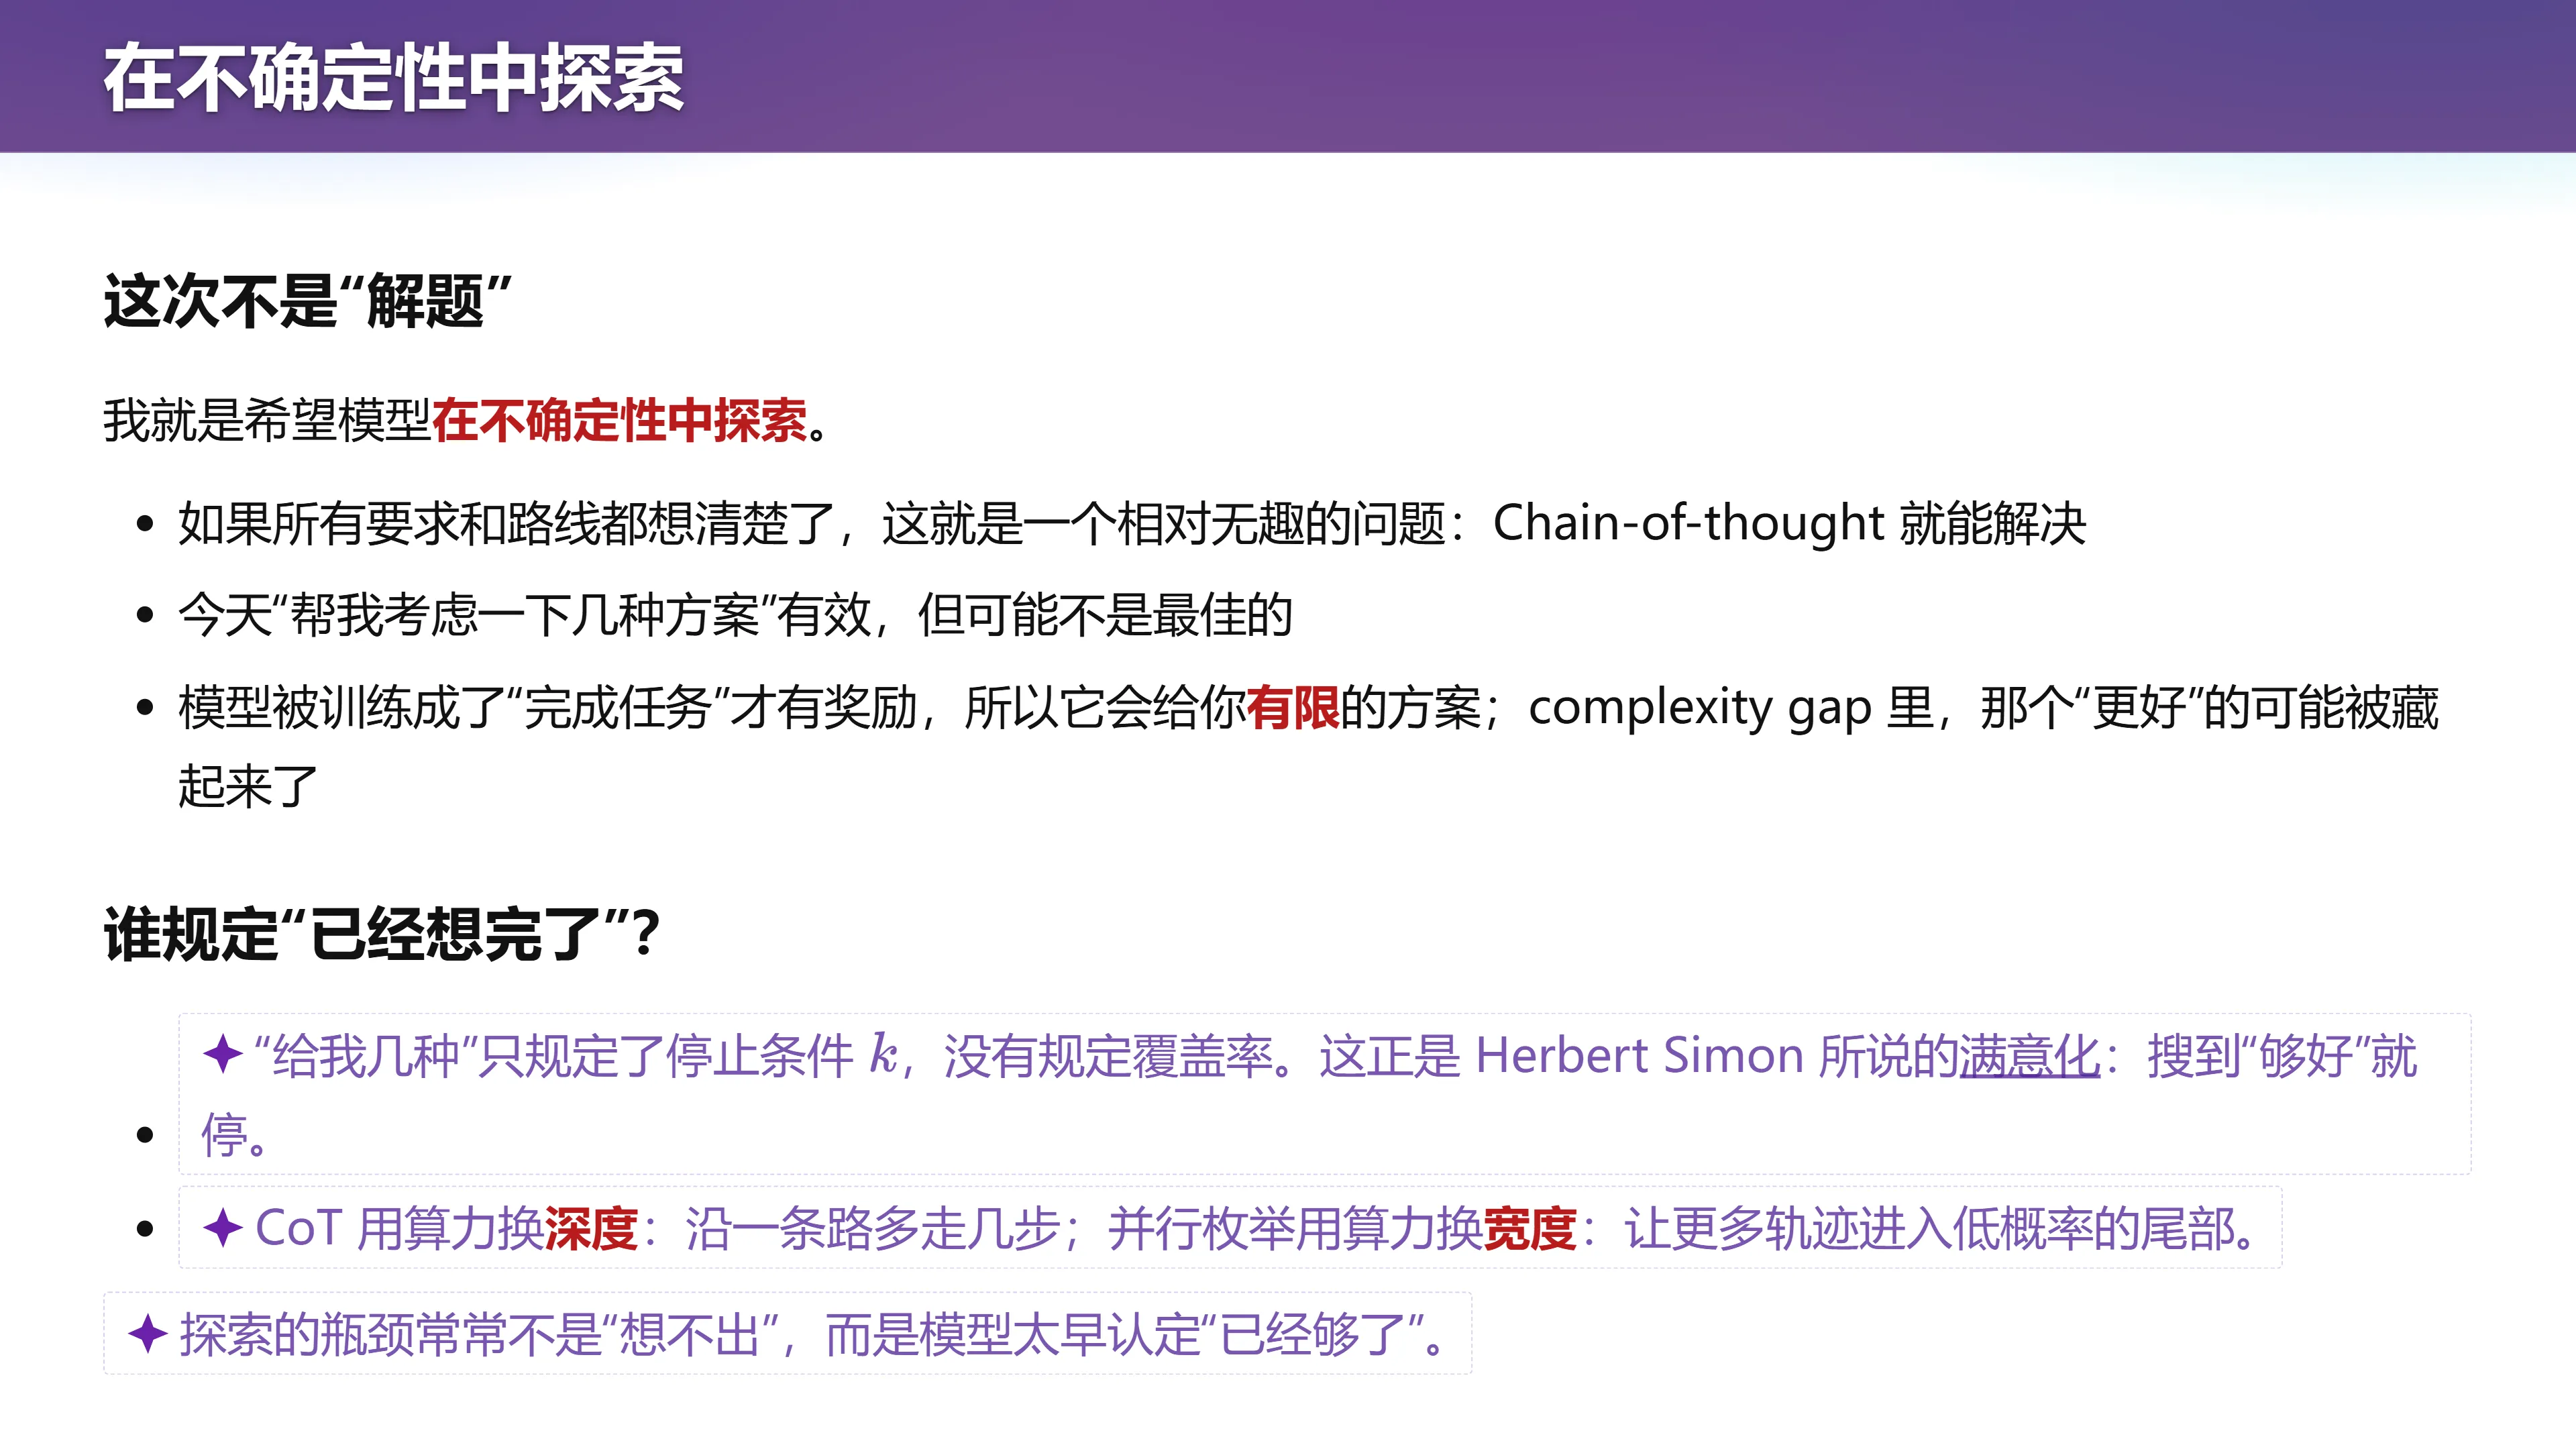
到这里,我们一直在讨论怎样把任务说清楚。但许多有价值的任务,本来就没有确定路线。我们希望 AI 帮助探索,而不仅仅执行已经写好的计划。
(参考时间: 01:32:24) 如果你真正想做的是一个 long-horizon 的、非常难的任务,它不是在解决一个问题,而是在不确定性中探索。那么思维链其实就解决不了了——思维链能解决的是有 verifier、确定地一直往后就能解决的问题。
"帮我考虑几种方案"通常有效,却可能过早结束。
- 模型给出几个听起来合理的答案,已经满足了"几种"的数量要求;更有意思的方案,也许仍在它没有走到的方向里。
- 模型已经被训练成"完成任务才有奖励"——不完成任务就没有奖励。所以它会给你一个有限的方案。
(参考时间: 01:33:03) 讲师用 P vs. NP 打了个比方:
NP 问题说:你验证一个解比较容易,但找到那个满足条件的解很难——找一个 Hamiltonian path 很难,但给你一条路径判断它是不是 Hamiltonian 很容易。因为搜索是困难的、验证是容易的,模型为了完成任务,势必只能做有限的搜索。
这就像考试:马上要交卷了,你写点什么总比不写分数高,所以你一定要写点什么。
编者拓展|满意化(satisficing):"给我几种"只规定了停止条件 $k$,没有规定覆盖率。这正是赫伯特·西蒙所说的 满意化(satisficing):搜到"够好"就停。所以探索的瓶颈常常不是"想不出",而是模型太早认定"已经够了"。
算力换智力的一个维度:
- CoT 用算力换深度:沿一条路多走几步;
- 并行枚举用算力换宽度:让更多轨迹进入低概率的尾部。
二十七、算力换智力
(参考时间: 01:34:14)
📷 算力换智力
回到原视频 (01:34:14)
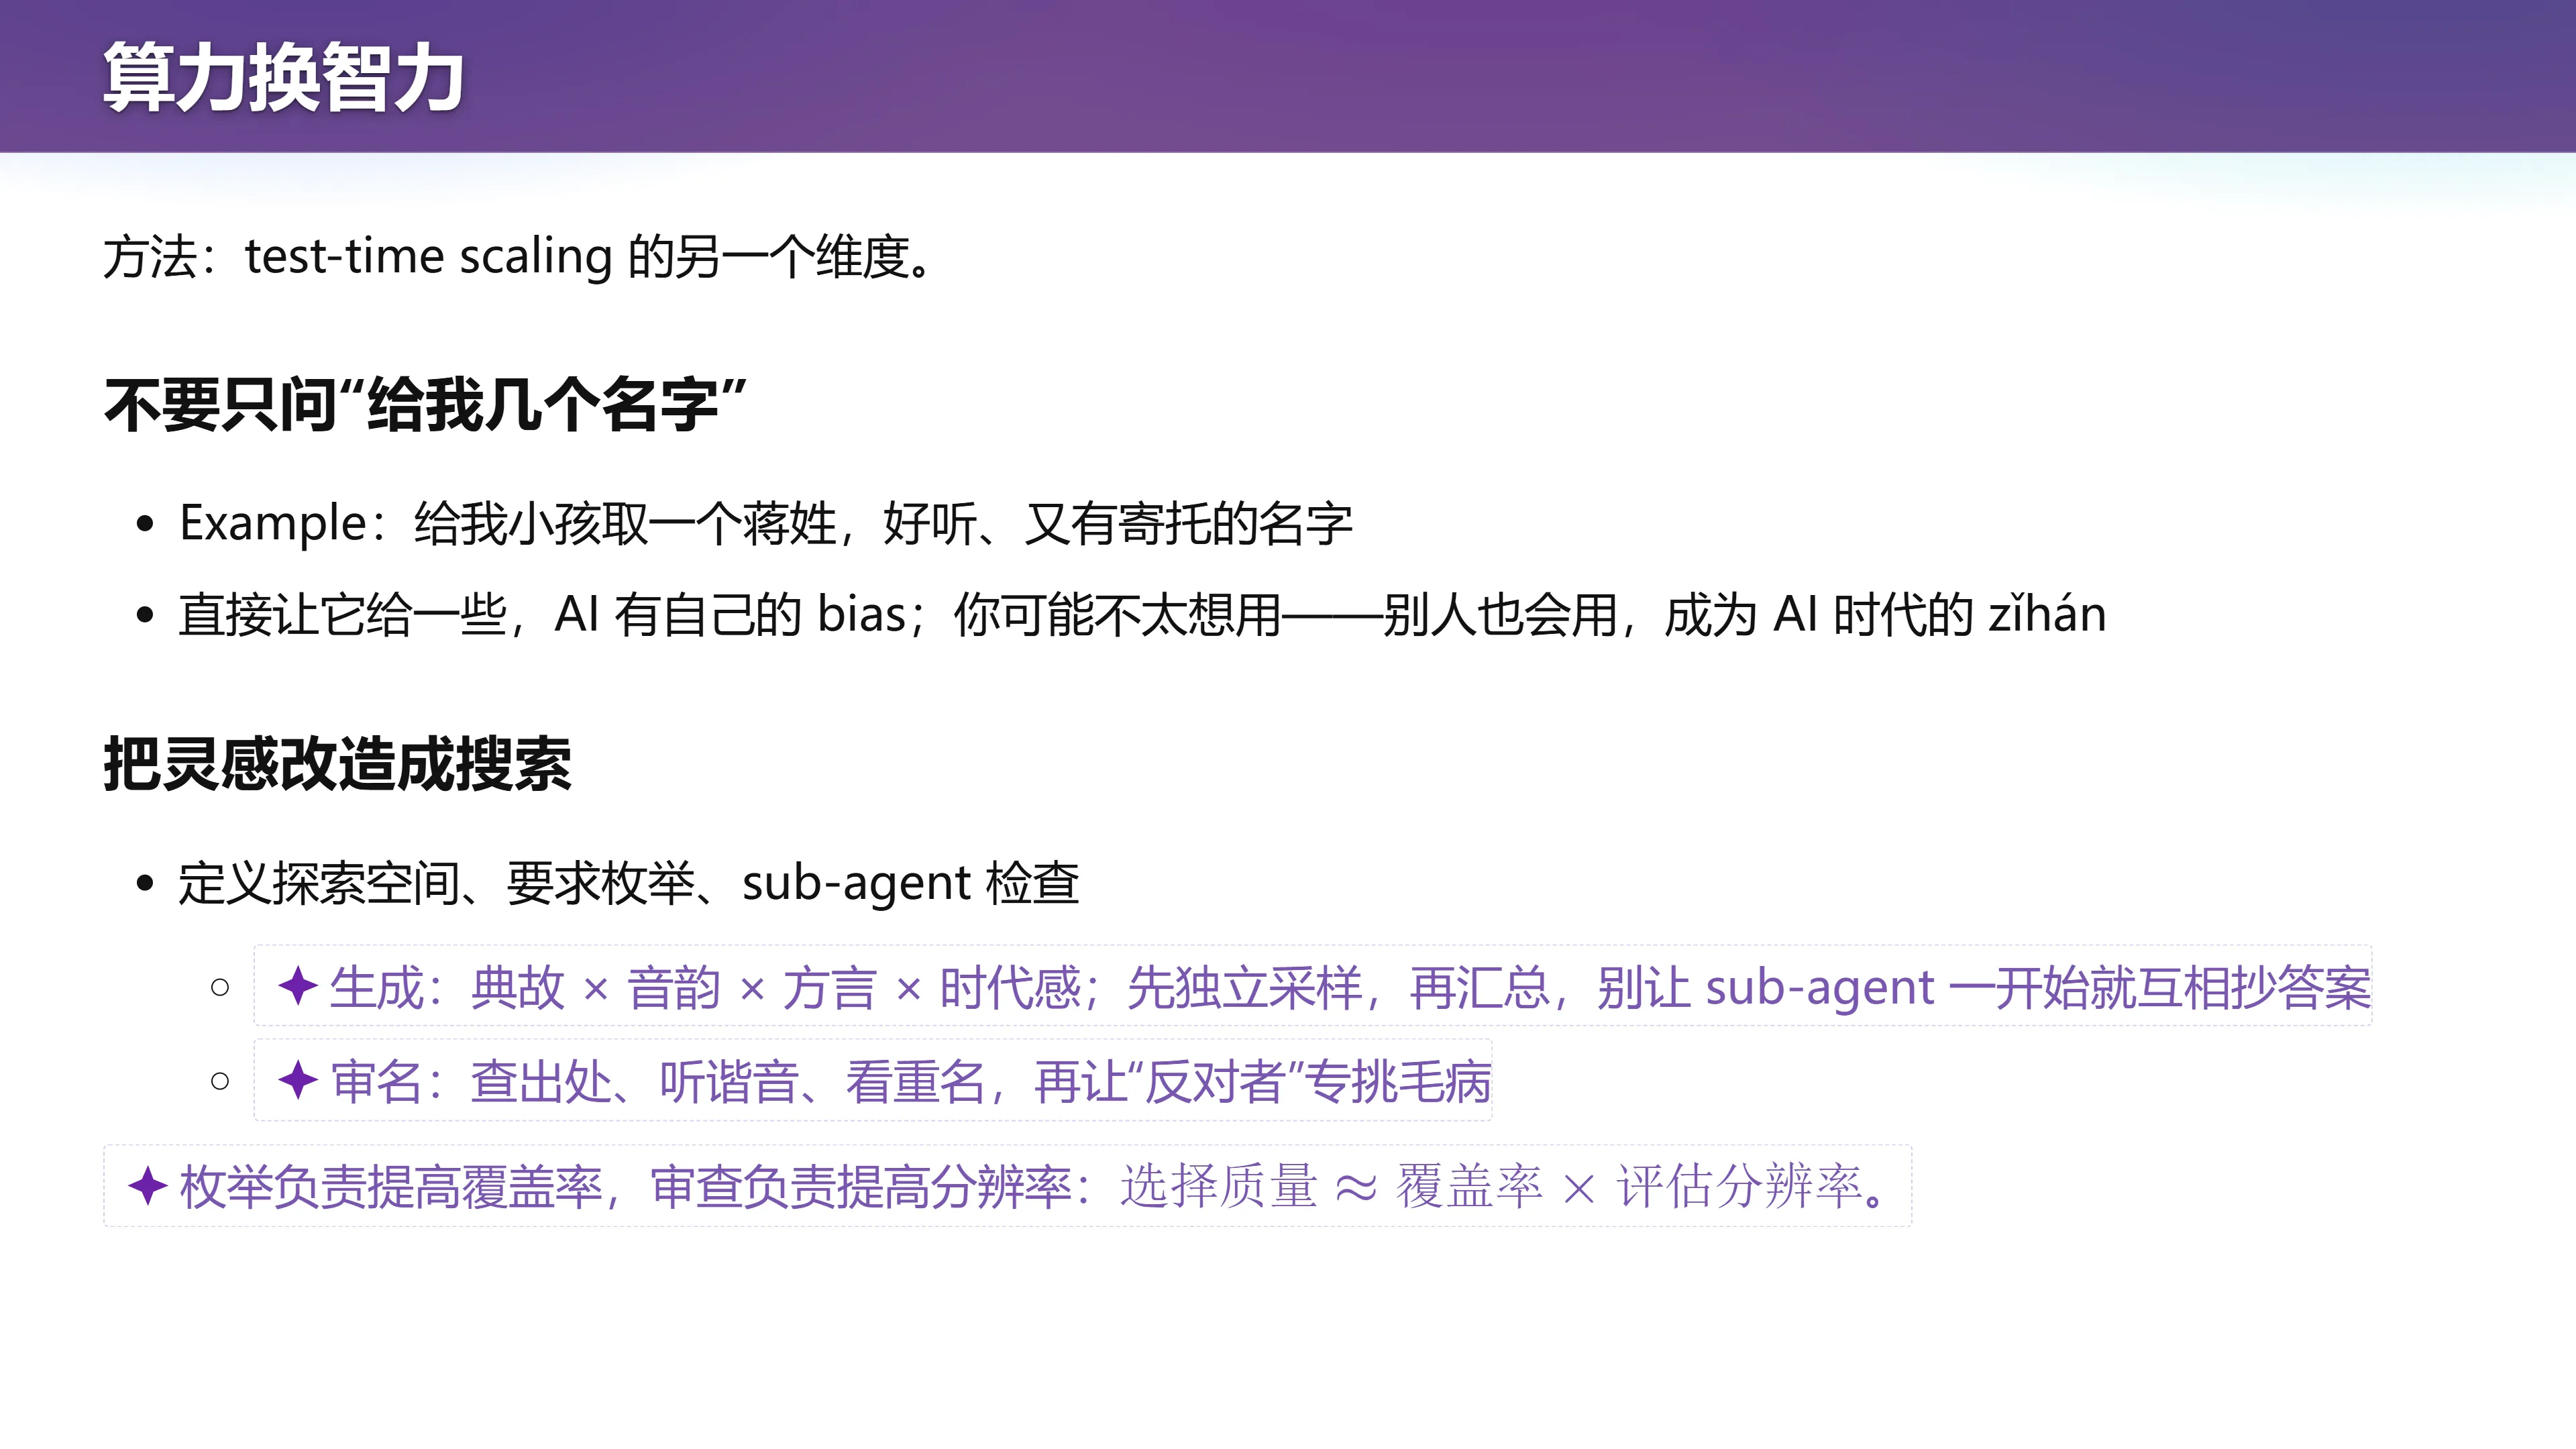
方法:test-time scaling 的另一个维度。
(参考时间: 01:34:20) 讲师用取名字作例子:
给一个蒋姓的小孩取好听、又有寄托的名字,直接让 AI 给几个——它有自己偏向的高概率组合。你可能不太想用,因为别人也会用,你就会成为 AI 时代的"子涵"。
(参考时间: 01:35:00) 要扩大探索,就要把灵感改造成搜索:
graph TD
    S["取名字(蒋姓)"] --> G["生成:定义探索空间并枚举"]
    G --> G1["典故 × 音韵 × 方言 × 时代感"]
    G1 --> G2["先独立采样,再汇总<br/>别让 sub-agent 一开始就互相抄答案"]
    G2 --> C["审查:查出处、听谐音、看重名"]
    C --> C1["让'反对者'专挑毛病"]
    C1 --> F["按个人偏好筛选"]
- 生成:典故 × 音韵 × 方言 × 时代感;先独立采样,再汇总,别让 sub-agent 一开始就互相抄答案。
- 审名:查出处、听谐音、看重名,再让"反对者"专挑毛病。
- 枚举负责提高覆盖率,审查负责提高分辨率:
$$ \text{选择质量} \approx \text{覆盖率} \times \text{评估分辨率} $$
(参考时间: 01:35:53) 讲师说,这其实很像科研实践课里学的文献调研:
你进入一个科研领域,第一件事做什么?文献调研——穷尽和这个问题相关的所有文献。这件事,在 AI 想要快速完成任务时,它暂时还不会去花这个大代价。但你可以做。名字是可以枚举的:你先选音,把不好的音筛掉;选完音再用 sub-agent 一个个去检查字;你喜欢《诗经》,就选一个诗经里的字。这样,你就把一个开放空间里的大问题,分割成很多更明确、有 verifier 的小问题——你有更多算力,就有更大智力。
缺点也很明显:烧 token,烧钱。
这一步真正重要的是——它们是否看了不同方向、提出了不同问题,而不在于开了多少个看起来相同的窗口。
编者说明:这里仍然离不开人的判断。"给更多名字"解决的是候选数量;"哪些名字值得留"则需要评价标准。没有分辨率的筛选,可能只是把一个平庸答案变成一百个平庸答案。探索空间与评价方法应当一起设计。
二十八、我们一直在"多采样"
(参考时间: 01:36:57)
📷 我们一直在“多采样”
回到原视频 (01:36:57)
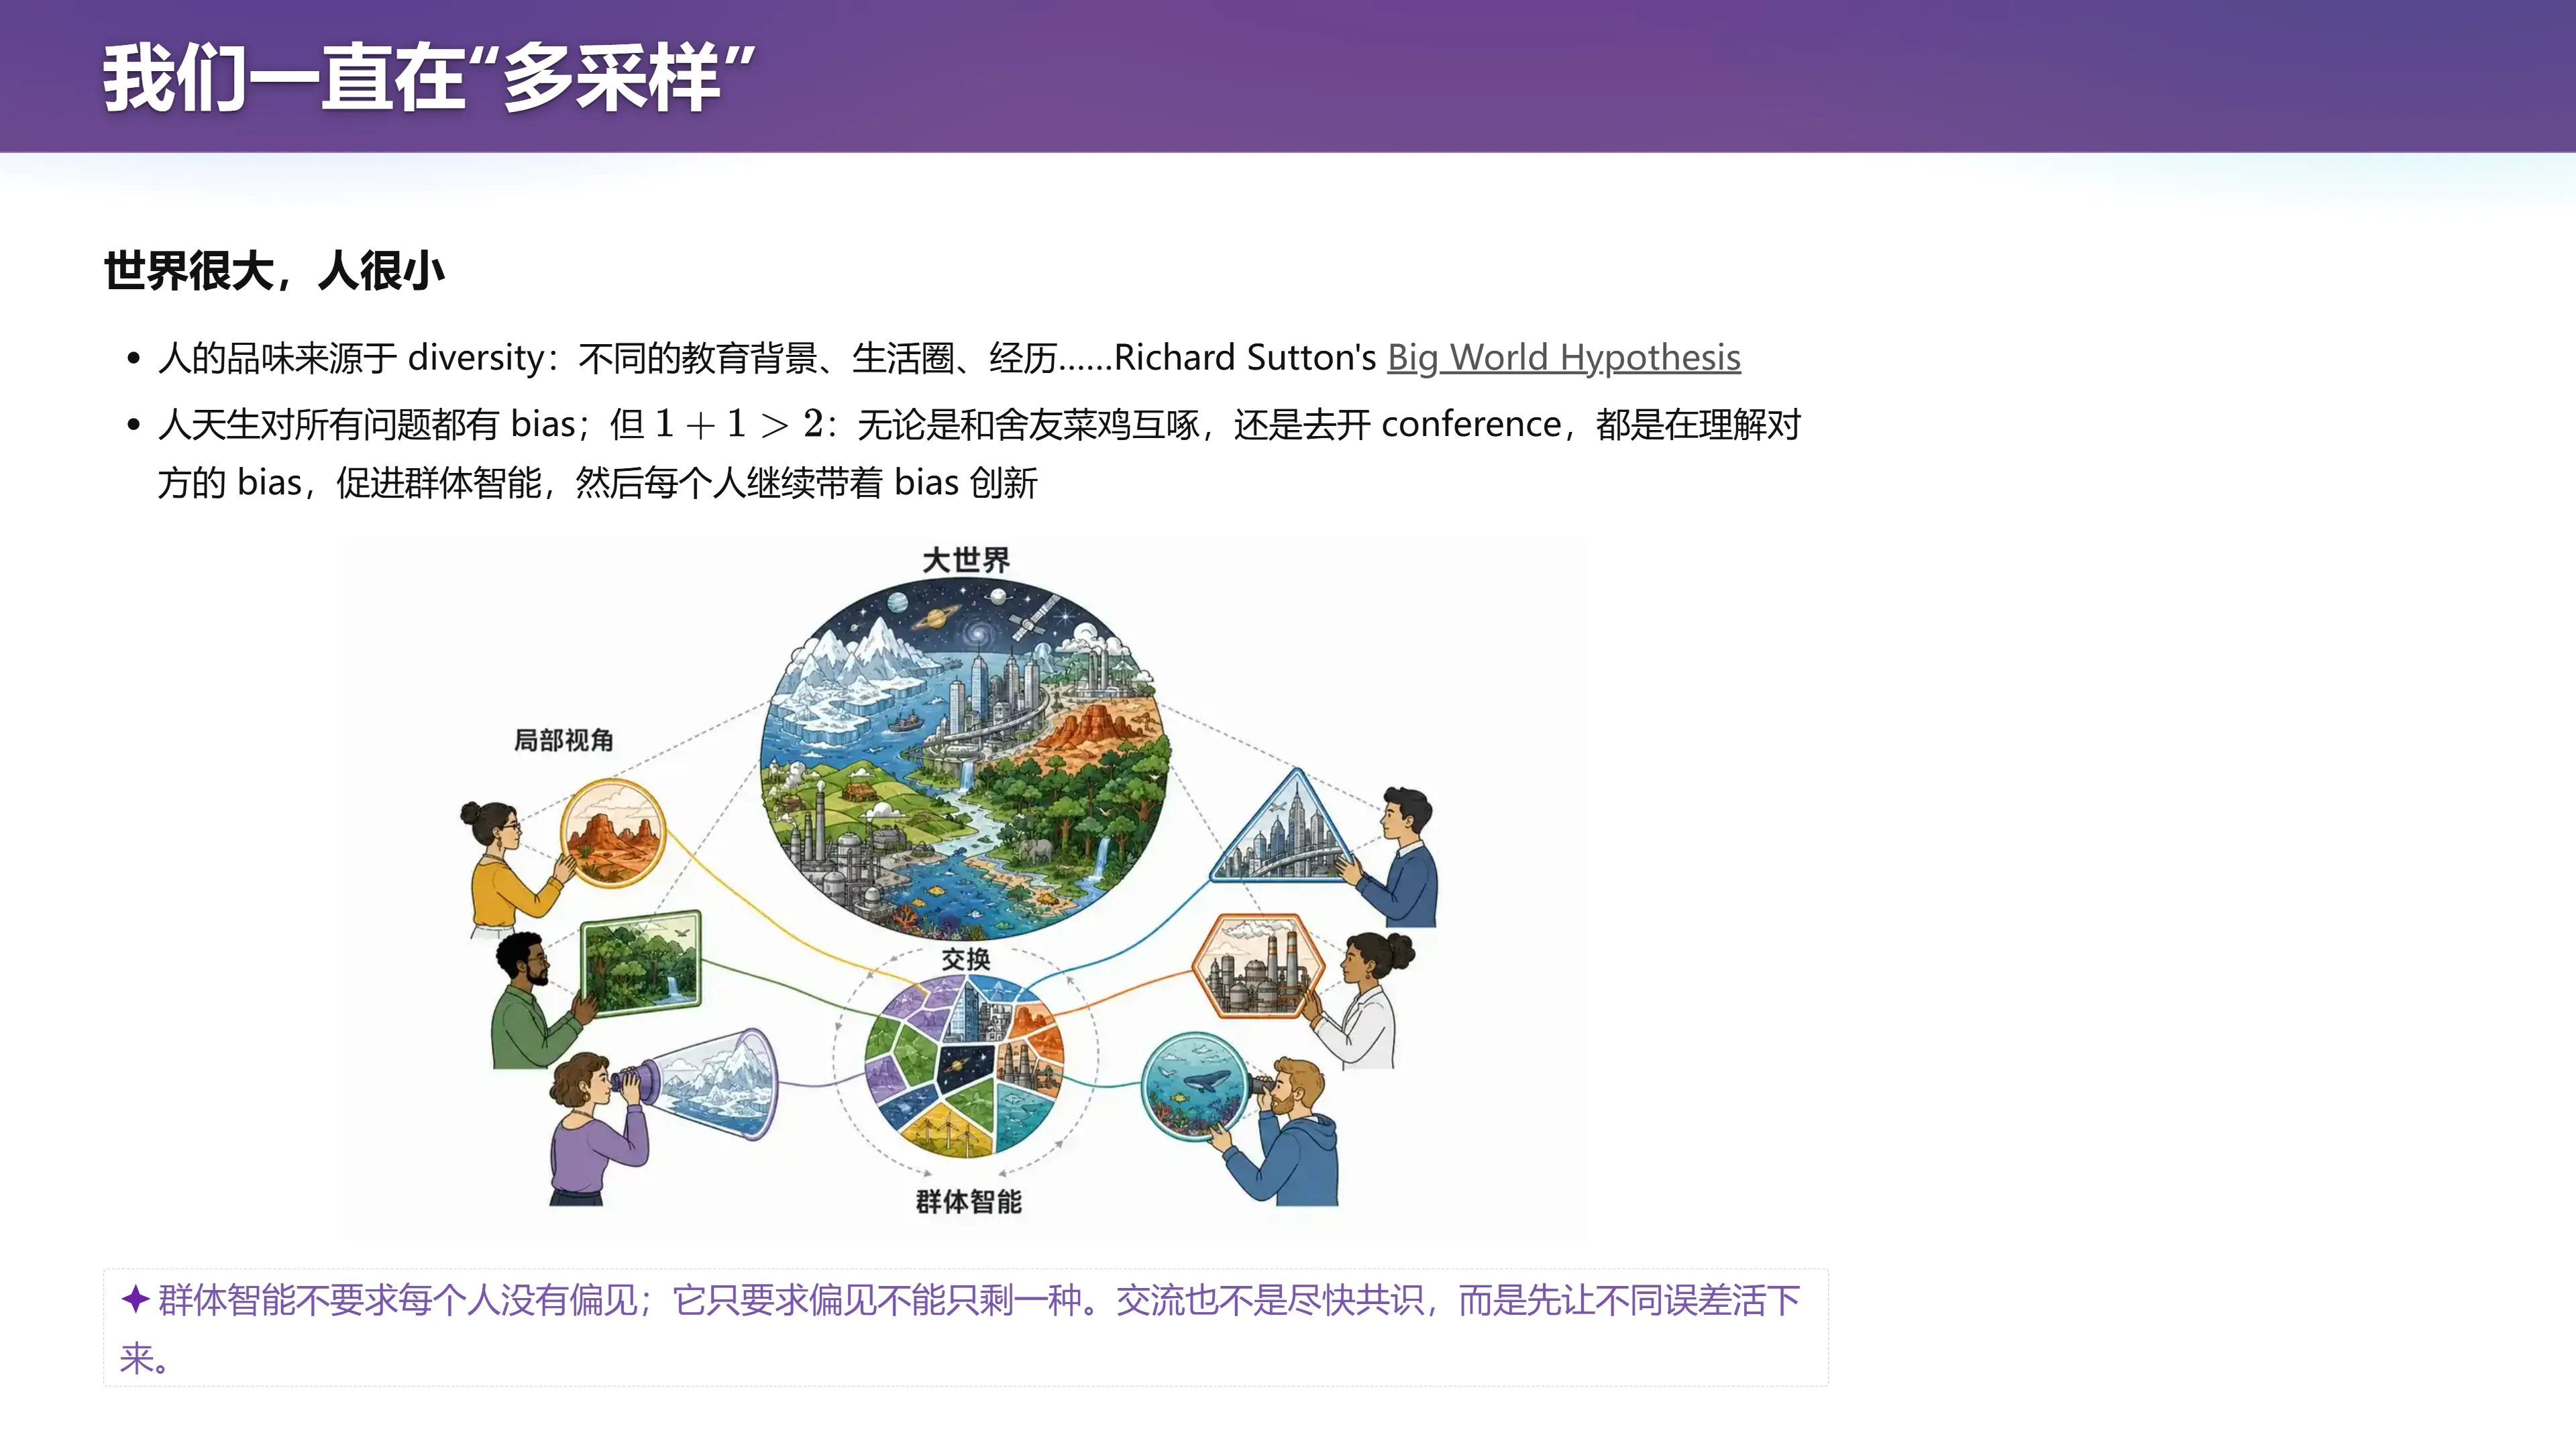
世界很大,人很小。
- 人的品味来源于 diversity:不同的城市、教育背景、生活圈、经历……Richard Sutton 有一个 Big World Hypothesis 的大意是:我们每个人学不到这个世界上的所有东西。
- 人天生对所有问题都有 bias;但 $1 + 1 > 2$:无论是和舍友"菜鸡互啄",还是去参加 conference,都是在理解对方的 bias,从而促进群体智能——然后每个人继续带着自己的 bias 创新。
(参考时间: 01:37:02)
人类社会其实一直在通过类似方式扩展自己的视野。每个人的教育背景、生活圈和经历都有限,也都带着偏向。与舍友讨论、去会议上听别人怎样提出问题,价值往往来自发现自己的默认前提。交流之后,每个人仍有自己的偏向,但它已经被新的经验改变了。
群体的价值,可以来自不同的局限相互补充。 把这个思想带回 Agent:增加计算资源时,应当考虑怎样增加探索的差异,而不是只增加同一种思路的重复次数。
编者说明:群体智能不要求每个人没有偏见;它只要求偏见不能只剩一种。交流也不是尽快达成共识,而是先让不同误差活下来。
二十九、墙内的超人
(参考时间: 01:37:35)
📷 墙内的超人
回到原视频 (01:37:35)
如果计算资源能够持续转化为探索能力和判断能力,这也带来了一个令人不安的未来问题。
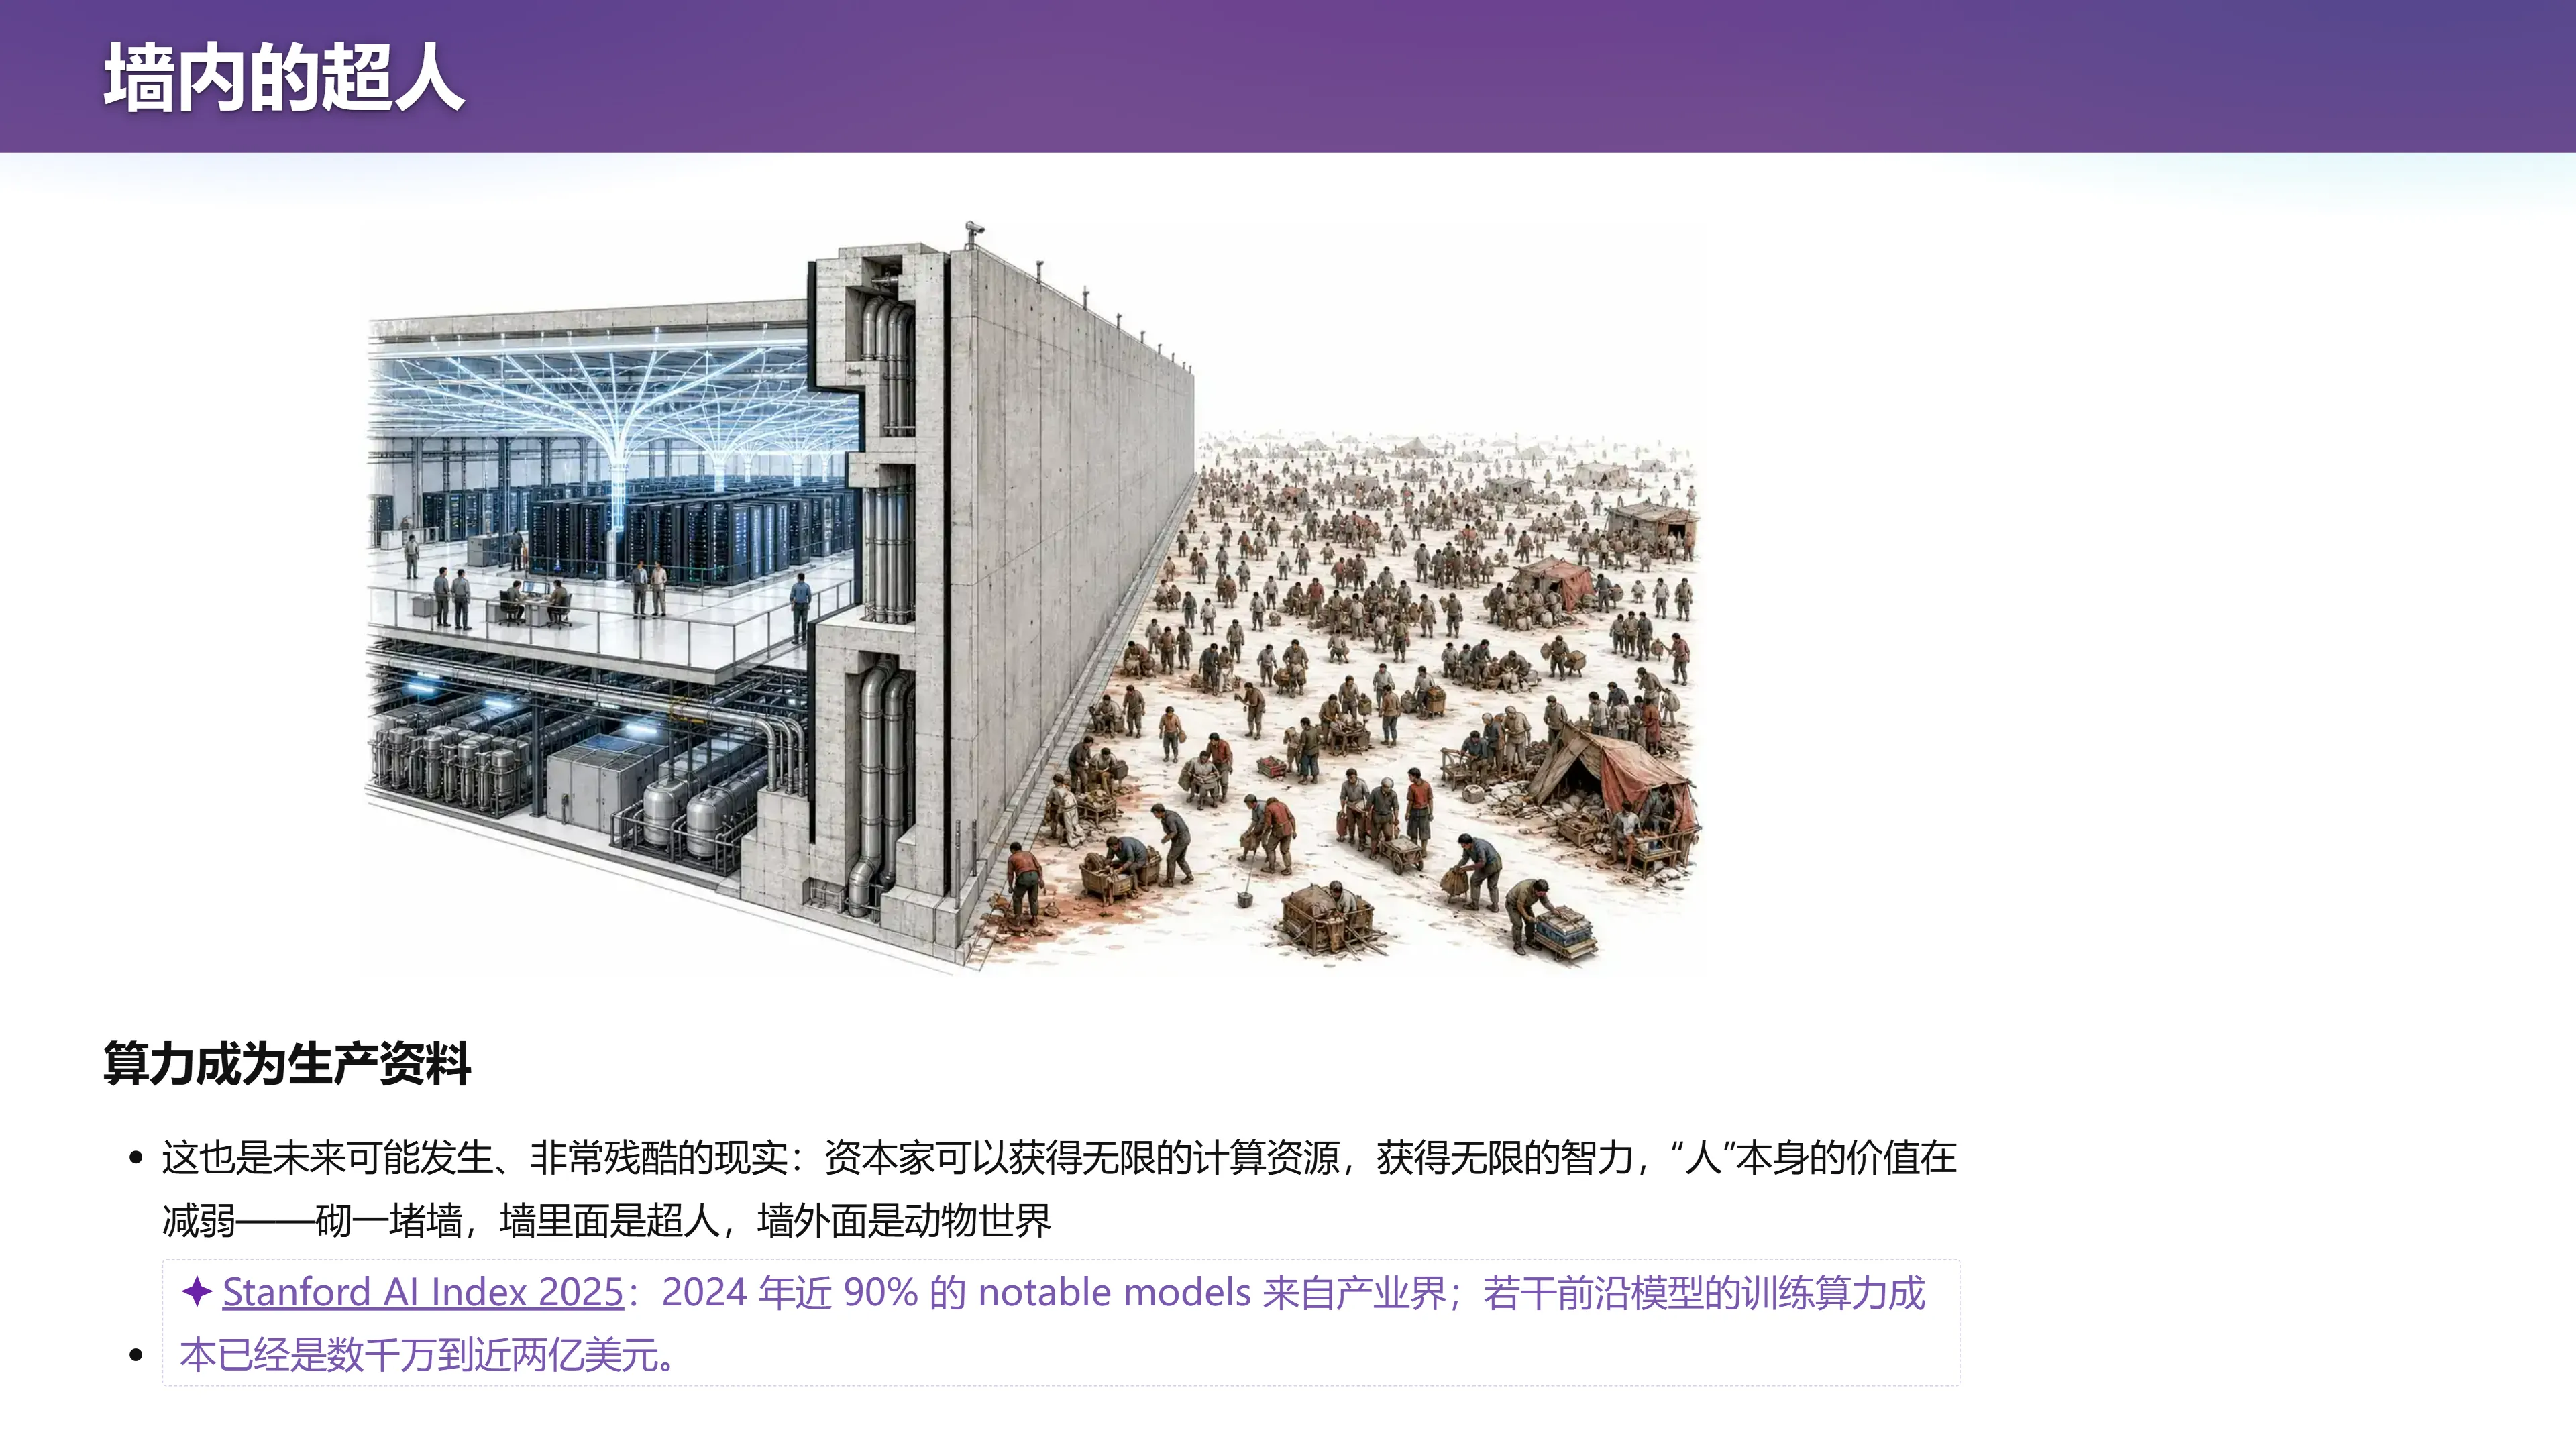
算力成为生产资料。
(参考时间: 01:37:39) 这是未来可能发生、非常残酷的现实:有一类人可以获得无限的计算资源,从而获得无限的智力,"人"本身的价值在减弱——他砌一堵墙,墙里面是超人,墙外面是动物世界。因为假设 AI 模型比人类的智力更高效,那墙外面的人就变成动物园里的猴子,让他们自生自灭,他们无论如何也赶不上墙里面人产生智力的速度。
编者拓展|一些数据:Stanford AI Index 2025 指出:2024 年近 90% 的 notable models 来自产业界;若干前沿模型的训练算力成本已经是数千万到近两亿美元。算力正在成为一类稀缺的、集中于少数组织手中的生产资料。
编者说明:这是对未来可能性的追问,并非已经发生的终局。讲师把它抛出来,是为了让大家思考"怎样防止这件事到来"。
结语:从眼前开始改变做事方式
(参考时间: 01:38:20)
对于正在学习的我们,可以从眼前开始改变做事方式:
- 让模糊愿望获得可检查的表达;
- 把有效经验沉淀成可复用的方法(Skill);
- 在需要探索时主动扩展方向,又用证据筛选结果;
- 学处理器、操作系统、编译器和数据库——理解接口、不变量、状态和失败模式,才能知道该把模型引向哪里。
对所做的东西"有概念",仍然是驾驭它的前提。只是现在,学到一个原理以后,可以更快地把它用到真正的系统里。
提示词的价值,最终要落在这些行动如何改变任务的结果上。
附录:课堂未展示的幻灯片
本讲授课基本覆盖了全部 37 页幻灯片,正文已按讲述顺序逐页嵌入(
SLIDE:n@HH:MM:SS)。此处列出的幻灯片为课堂虽提及但未以单独页面重点展示者,供读者回溯。
- Slide 5(从提示词工程到上下文工程)补充要点:到 Claude Opus 4.5 这一代,模型靠强化学习获得了极强的指令遵循能力,直接输出命令和工具调用,持续向目标推进。(正文第十四节已嵌入。)
- Slide 20(通过测试,不等于写得好)补充要点:以上已经超越大部分人类的极限。模型作为"人类"的推理能力真的很强,虽然品味还可以提高。(正文第十三节已嵌入。)
附:参考与延伸阅读
以下讲义原文链接来自课程官方讲义(注明了出处文件);编者补充是撰写本书时另加的,不与讲义混淆。
讲义原文链接
- Yanyan's wiki
lect2.html - Creative Commons License: BY-NC 4.0
lect2.notes.md - 苏 ICP 备 2020049101 号
lect2.notes.md
编者补充
- AlphaGo Zero
- Big World Hypothesis
- BV1CQt365EzW
- CodeRAG-Bench
- Codex
- DeepSeek
- GitHub
- GPT-2
- GPT-3
- Hugging Face
- Ironies of Automation
- Kimi K3
- KLEE
- Linux 内核
- Nature
- No Silver Bullet
- OpenStreetMap
- pi
- RepoCoder
- Richard Sutton
- Stanford AI Index 2025
- Toyota Production System
- 《软件设计的哲学》
- 消失
- 满意化
- 经度法
- 英国国家陆军博物馆:原始命令
附录:课堂未展示的幻灯片
🖼️ 第 8 页幻灯片 · 立即行动:解剖当前上下文