第3讲 · 软件仓库管理
| 课程 | 南京大学《生成式软件工程》· 第三讲(版本管理 / 软件仓库管理) |
| 视频 | 软件仓库管理(时长约 100 分钟) |
| 讲义与幻灯片 | 由课程主页 jyywiki.cn 发布,讲义见讲次笔记,幻灯片见 course/slides_text.md |
| 性质 | 本书由课堂实录(口语)重构为书面教程;凡讲师未展开、由编者补充的内容,均以 编者说明 / 编者拓展 明确标出。 |
| 许可 | 课程讲义、幻灯片与代码版权归作者(蒋炎岩)所有,依 CC BY-NC 4.0 许可发布。 |
对应讲次:第3讲(南京大学 生成式软件工程)
制作模型:deepseek-flash(vb compose,据 run.log)
一、开场:GPT-6 之后,我们还要学什么
(参考时间: 00:00:38)
📷 快讯:GPT-6 发布了
回到原视频 (00:00:38)
前两讲讨论的是怎么把 AI 整合进生活流程:生活中会遇到无穷多「不顺心」,只要把真实意图讲清楚,AI 就能替我们挡掉这些琐事,甚至把过程中的经验蒸馏成可复用的技能(skill),让下一次更平顺。这一讲开场,先更新一下模型进展的现场——GPT-6 已经发布。
讲师的现场使用感受是:惊喜确实有,但编程能力的提升有限,尚未学会「好品味(taste)」。有经验的软件工程师凭品味可以指引 AI 做出更好的东西,而今天的 AI 更多是「完成任务」;于是仍然需要不断批评、反馈。用讲师的原话说:
「我经常还要骂它,所以我觉得我可能还能再苟活个几个月。」(参考时间: 00:01:07)
不过在更复杂的任务上,模型更快、更省 token 了;讲师还专门 measure 过这一点。
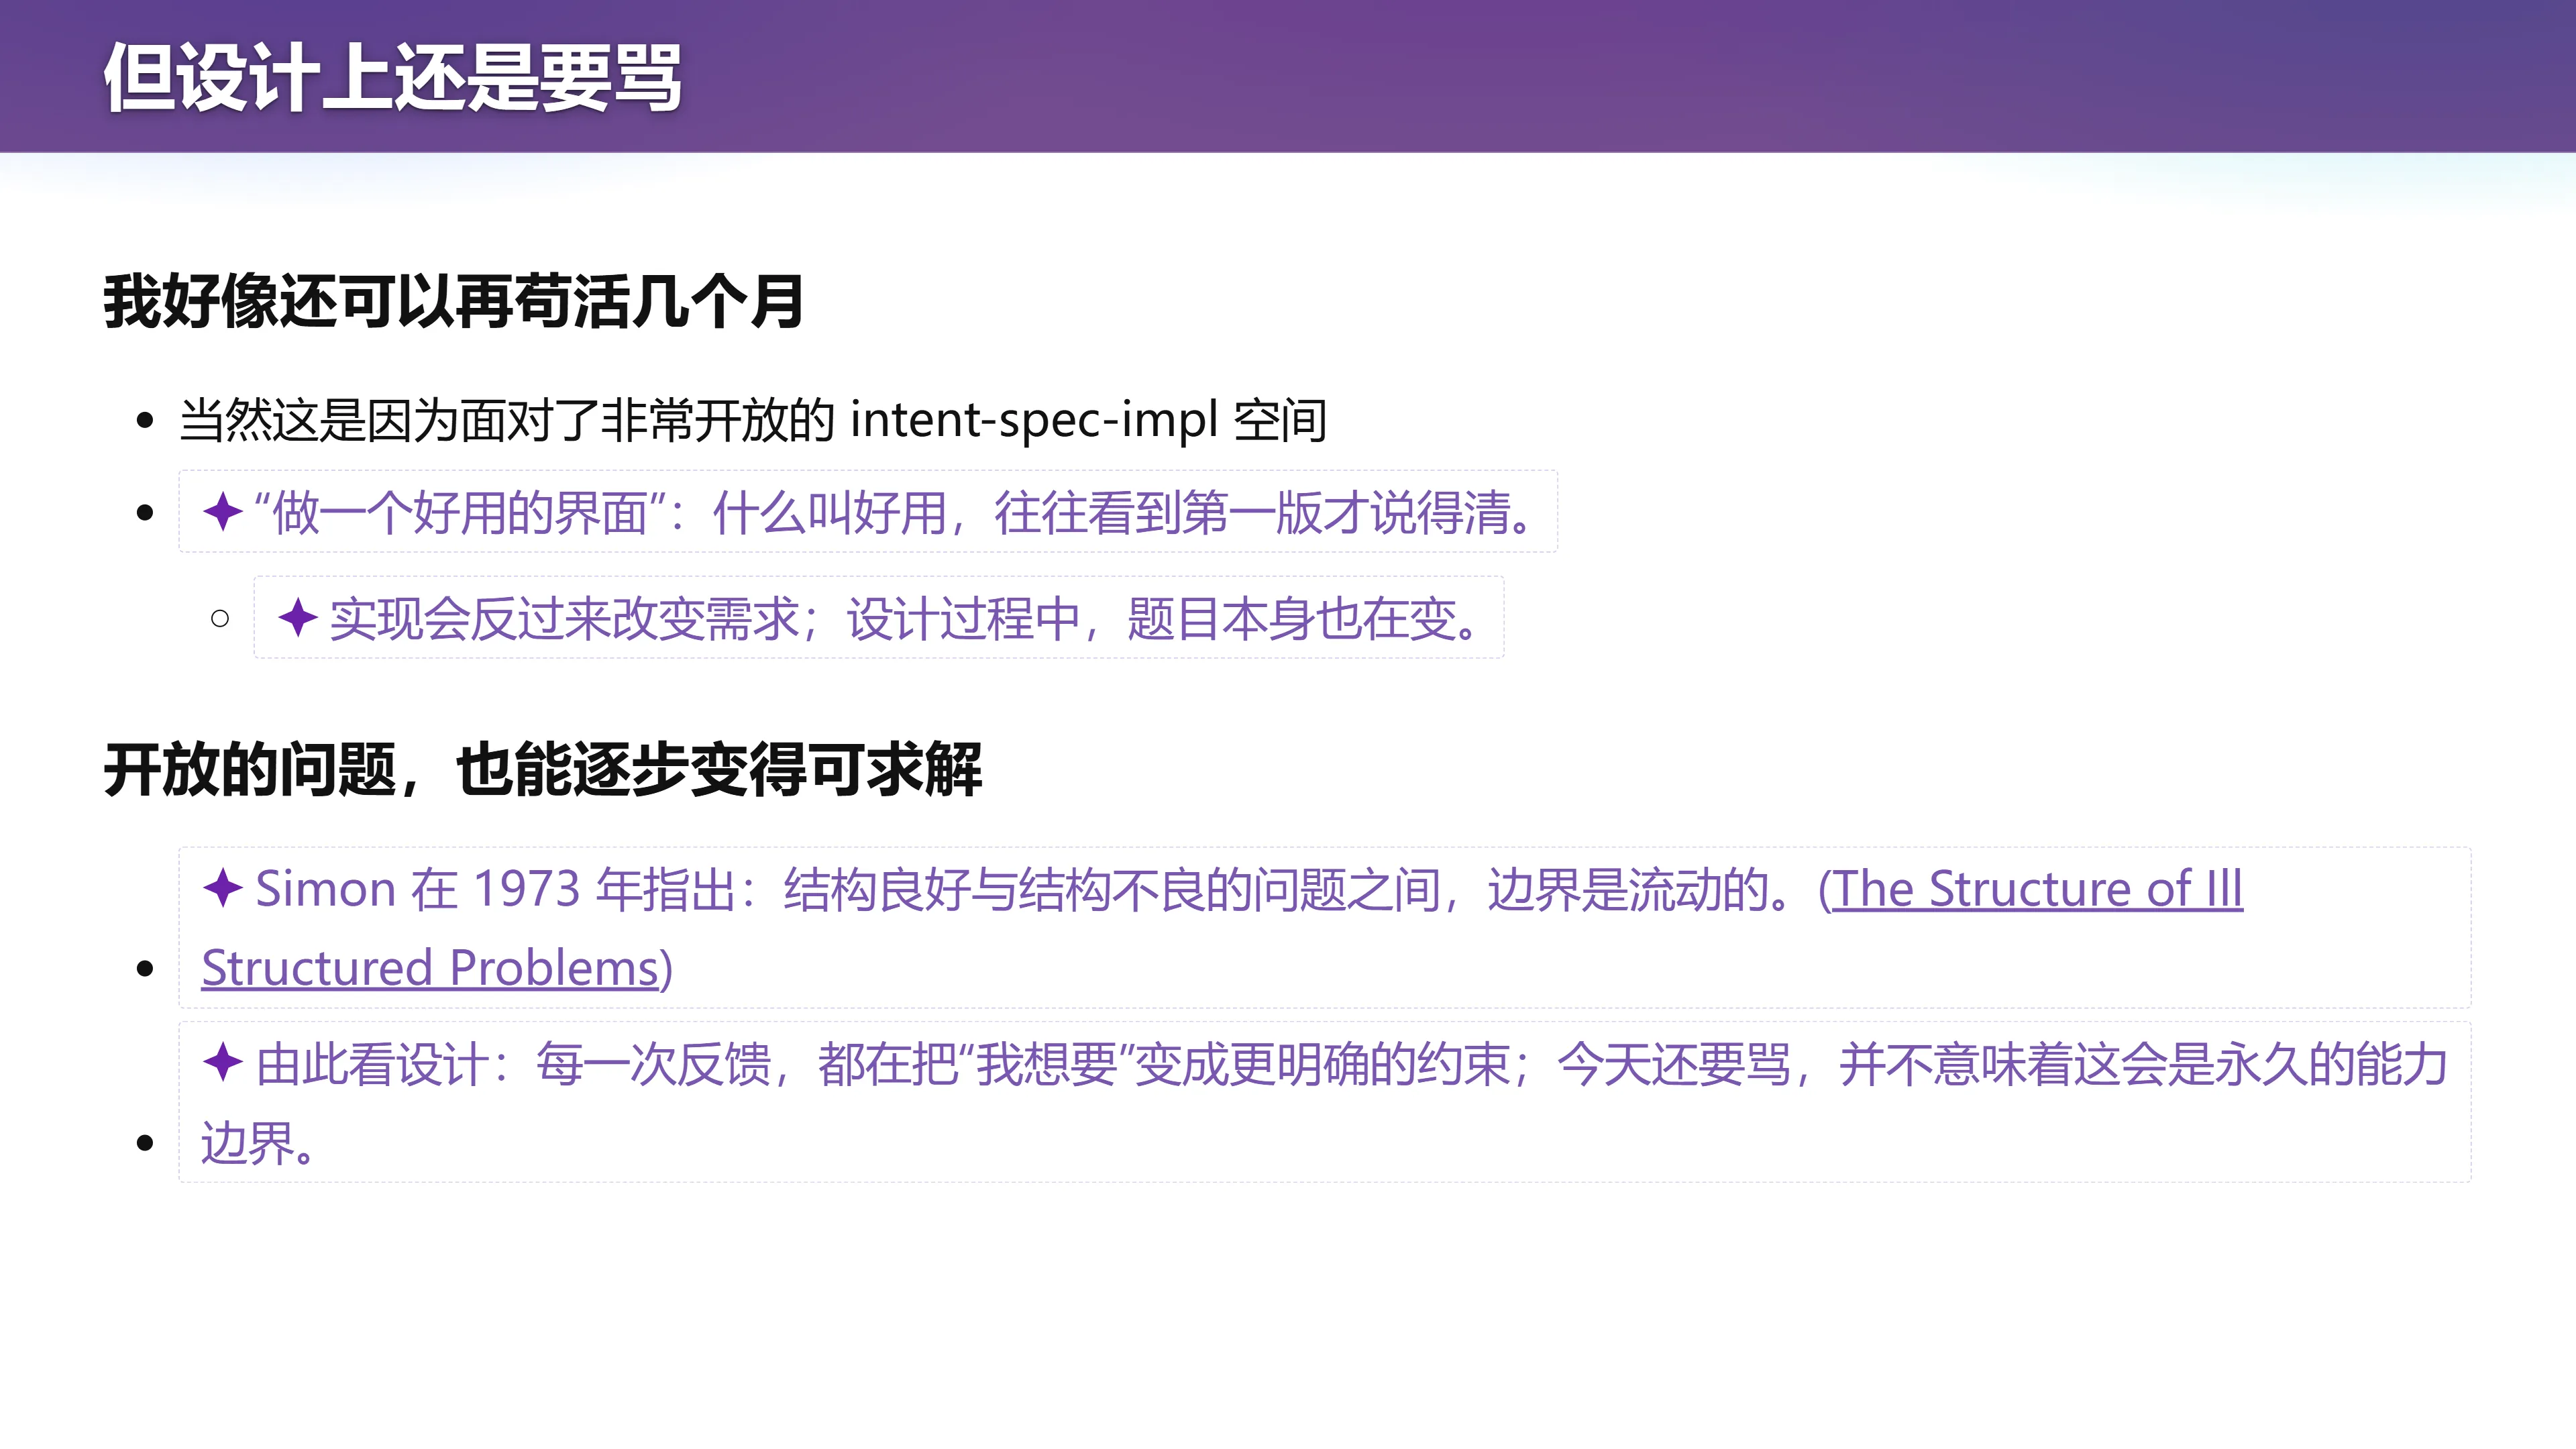
📷 但设计上还是要骂
回到原视频 (00:01:06)
为什么我们总觉得「模型做得不好」
(参考时间: 00:01:25)
关键在于,我们面对的是一大片非常开放的 intent–spec–impl 空间。同样一个任务交给人,哪怕是顶级产品经理,各自脑子里想的都不一样;AI 无法与人脑直接对齐,它一定会按自己的方式漂移。这也延续了前两讲的主题:从意图(Intent),到规格(Spec),再到实现(Impl),中间存在极其开放的选择空间。你说「做一个好用的界面」,往往要看到第一版,才说得清自己真正介意的是什么——实现反过来在帮我们确定需求。
另一个新现象是:AI 写出的代码,人类越来越难读了。讲师观察到从 GPT-5、5.6 到 6,模型的思维链越来越紧凑,输出的代码也越来越紧凑,人几乎无法 review。过去大家还会用提示词要求「写出符合人类工程规范的代码」,现在连这一层也慢慢放弃——反正代码能跑对就行。
编者拓展|开放问题为什么能逐步收敛 幻灯片引用了 Simon 在 1973 年的论断:结构良好(well-structured)与结构不良(ill-structured)问题之间的边界是流动的(The Structure of Ill Structured Problems)。这与本讲的乐观基调一致:每一次反馈,都在把「我想要」翻译成更明确的约束。今天还需要骂,并不等于这是永久的能力边界。
「理应当做到」的事就是能做到
(参考时间: 00:02:32)
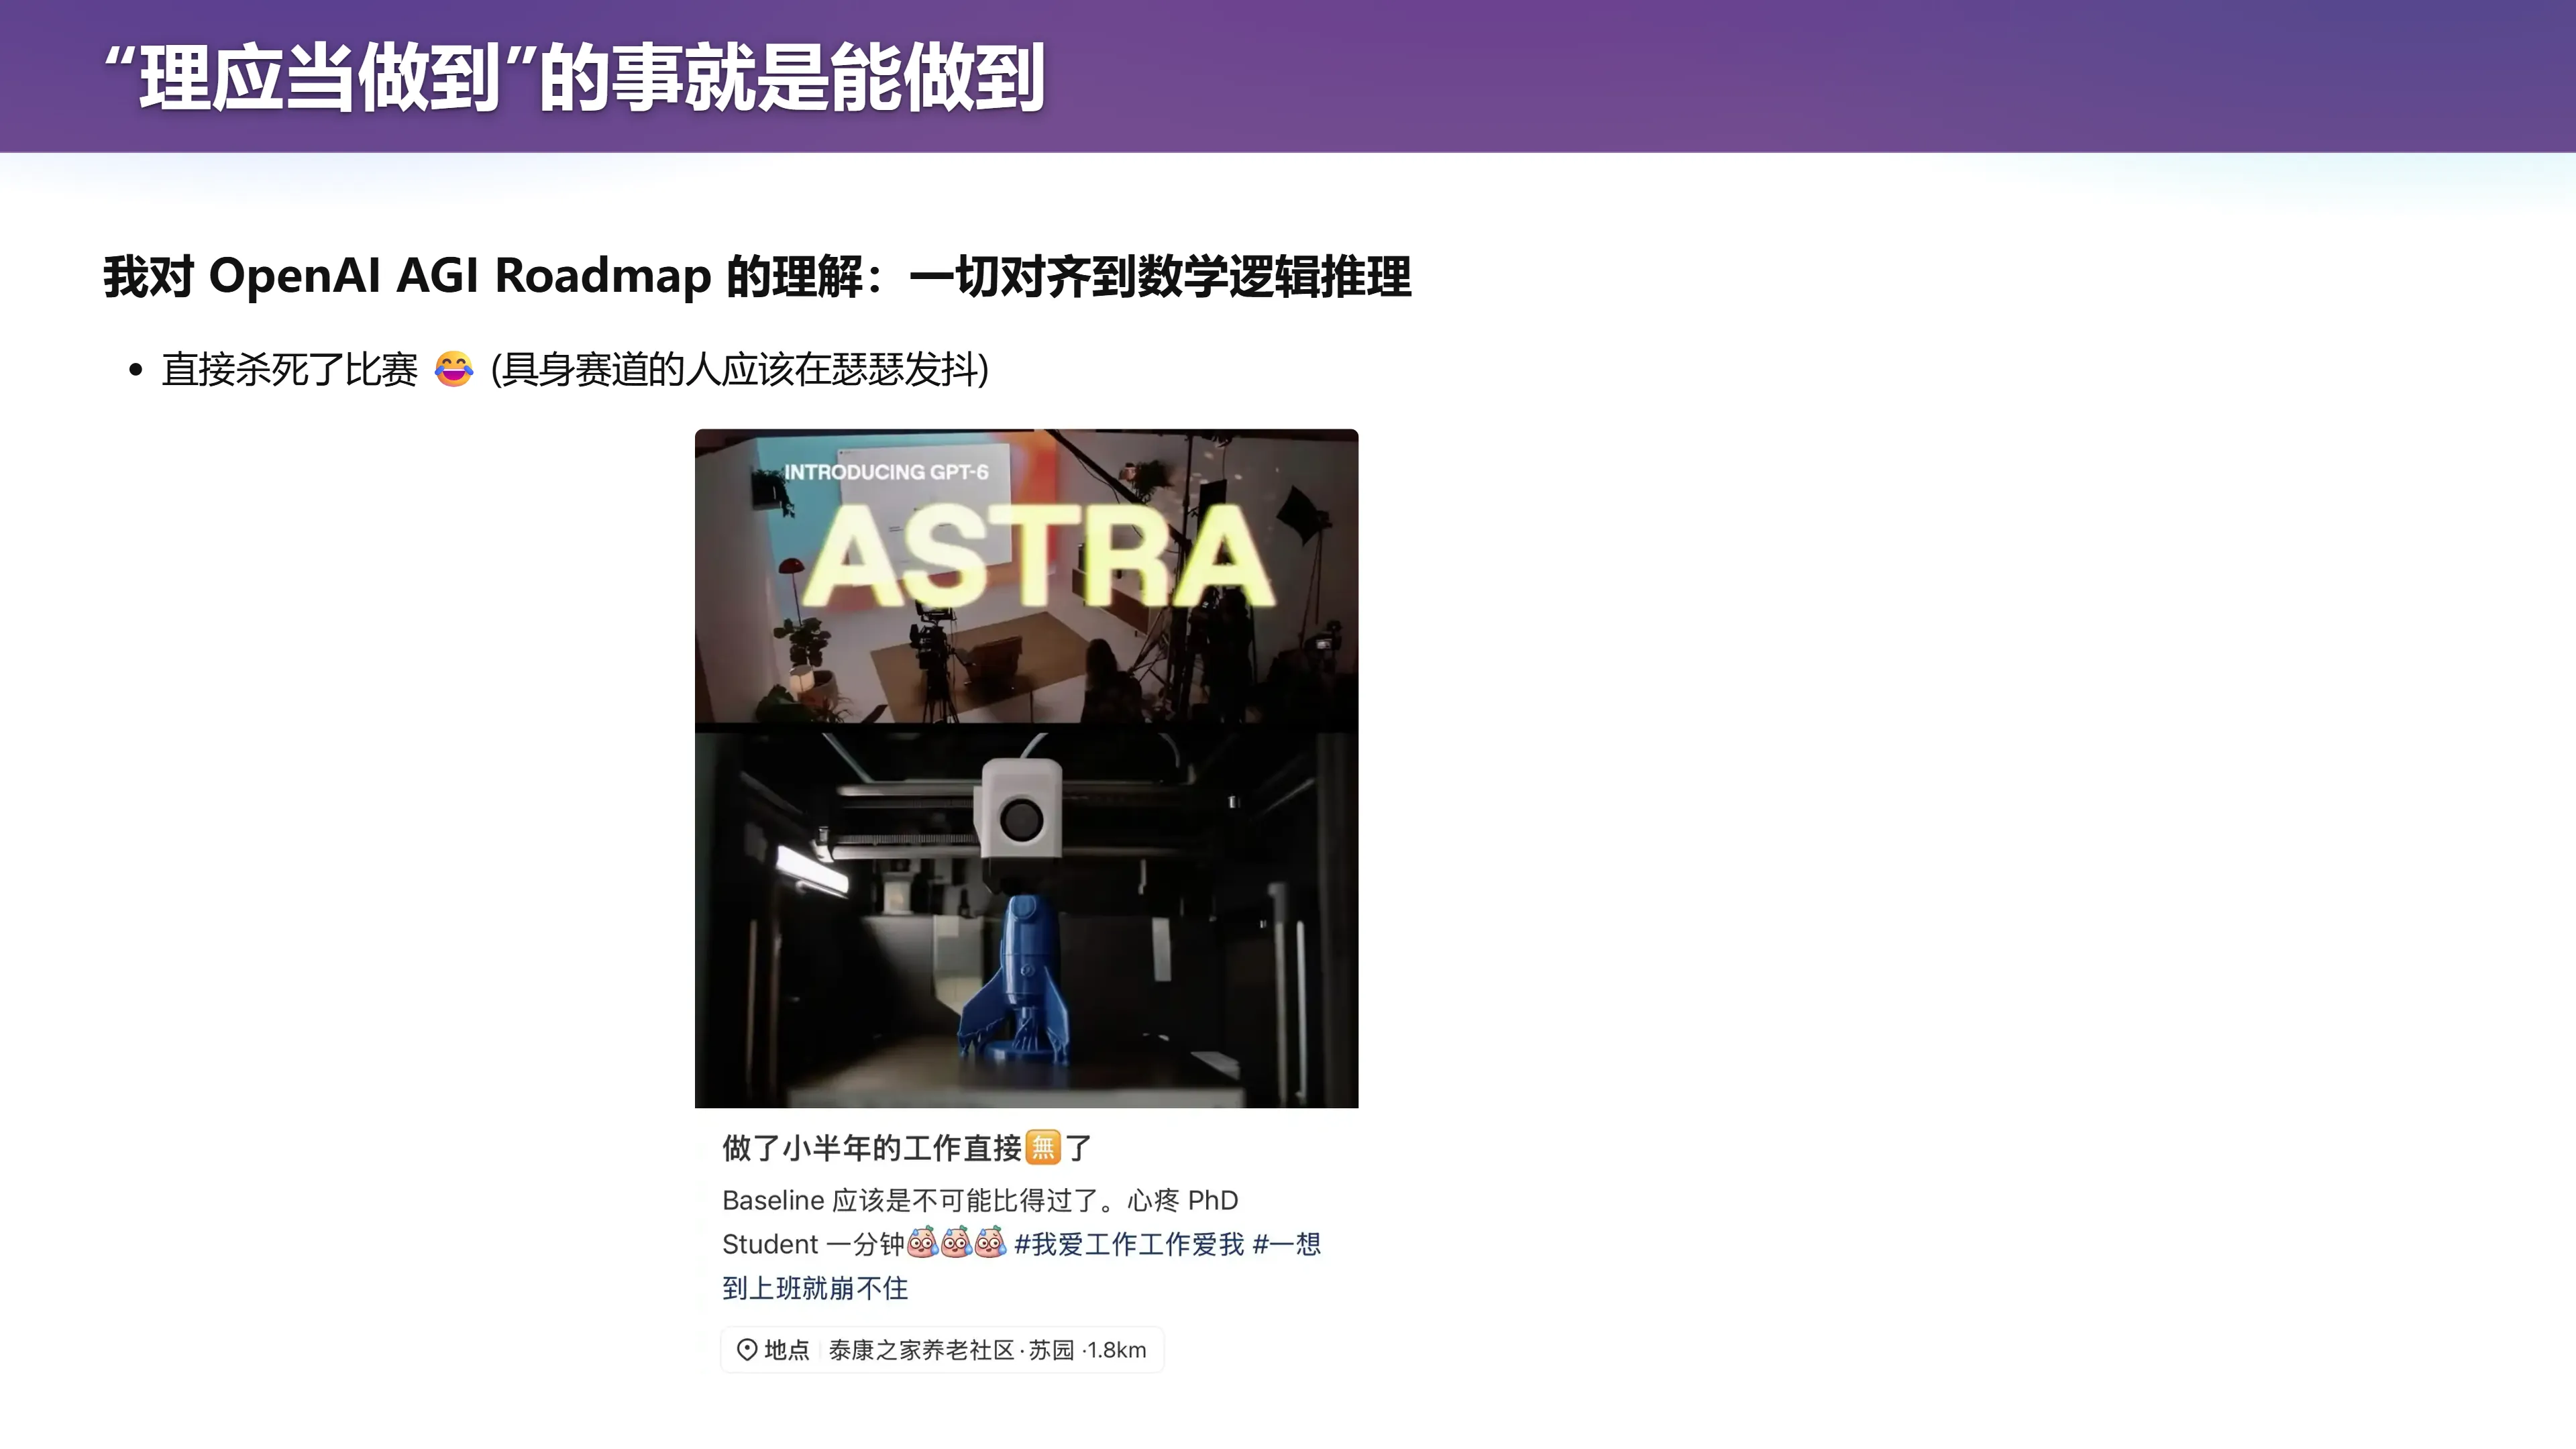
📷 「理应当做到」的事就是能做到
回到原视频 (00:02:32)
GPT-6 最大的惊喜,是空间感知与理解能力的跃升。讲师由此谈了他对 OpenAI AGI 路线图的理解:一切对齐到数学逻辑推理。
- 先让 AI 学会数学。数学是所有人类知识里最「硬」的一种语言,因为它是一套全世界都认同的推理系统:一个定理能否被证明,全球的人都会达成共识,这使它成为非常好的 grounding(奠基)。
- 学会数学之后,再强化学习其他能力。数学逻辑还能解释人类日常行为:比如「今天中午吃什么」,你觉得这是必须由「灵魂」来决定的问题,其实大脑是在各种因素之间投票——讲师中午会选在义夫楼订饭,因为那对他最快,下午还要开会,时间够的话还能小睡一会儿。「如果我做了 A,就会做 B」,这种推理可以 ground 到离散数学里的命题逻辑。
编者说明:这套「数学优先」的路线判断,是讲师从使用经验出发的个人理解,并非 OpenAI 的官方表述;把它当作一种解释框架即可。
从鲁班锁到机械臂
(参考时间: 00:04:16)
讲师认为,空间感知不是「绝对学不会」的能力。让你面对一个复杂的鲁班锁,问「按什么方向能抽出第一块」;或者做智力题里那种立方体投影、骰子展开图对应的判断,人靠的是脑子里的空间想象——只要从简单任务开始做强化学习,模型也能学会。
这里有一段思想的起源:看到 GPT-6 那个空间能力的例子时(当时还没发布),讲师「心疼自己的 PhD student」——他们已经做了小半年的 3D 打印工作。在 GPT-5.6 空间感知很差的情况下,师生靠直接对话也能生成一个像样的、符合规范的 3D 打印模型。他们有一个比较 killer 的应用:做那种光栅玩具(从左边看和右边看是两张不同图案),本来需要一棵很长的搜索树来做「光栅纸」;结果昨天 GPT-6 one-shot 直接搞定。现在团队正在想怎么解决这个问题。
编者拓展|光栅立体画(lenticular / 柱透镜光栅) 这类玩具用一层柱透镜光栅把两张(或多张)交错切割的图样分别折射到不同视角:左眼看 A、右眼看 B。制作难点在于「交织(interlacing)」:需要按光栅的透镜间距,把每张图按列切片后精确错位合成,列对齐差一个像素就会串图。所以讲师说过去要靠「很长的搜索树」来试参数;而一个具备空间与数学能力的模型,理论上可以一步推出间距与相位。
既然有了空间感知与数学能力,模型在具身(embodied)赛道上就能做得很好。第二天就有人在社交平台上发帖:直接用 GPT-6 控制机械臂完成抓取、叠衣服等复杂动作。注意 GPT-6 本身是语言模型,虽然带视觉能力,但只是「一帧一帧地问下一步做什么」,尚未针对这种场景做专门的提示词工程,就已经达到相当好、甚至 state-of-the-art 的水平了。模型一定会继续进步。
汽车类比:我们为什么还要学习
(参考时间: 00:06:42)
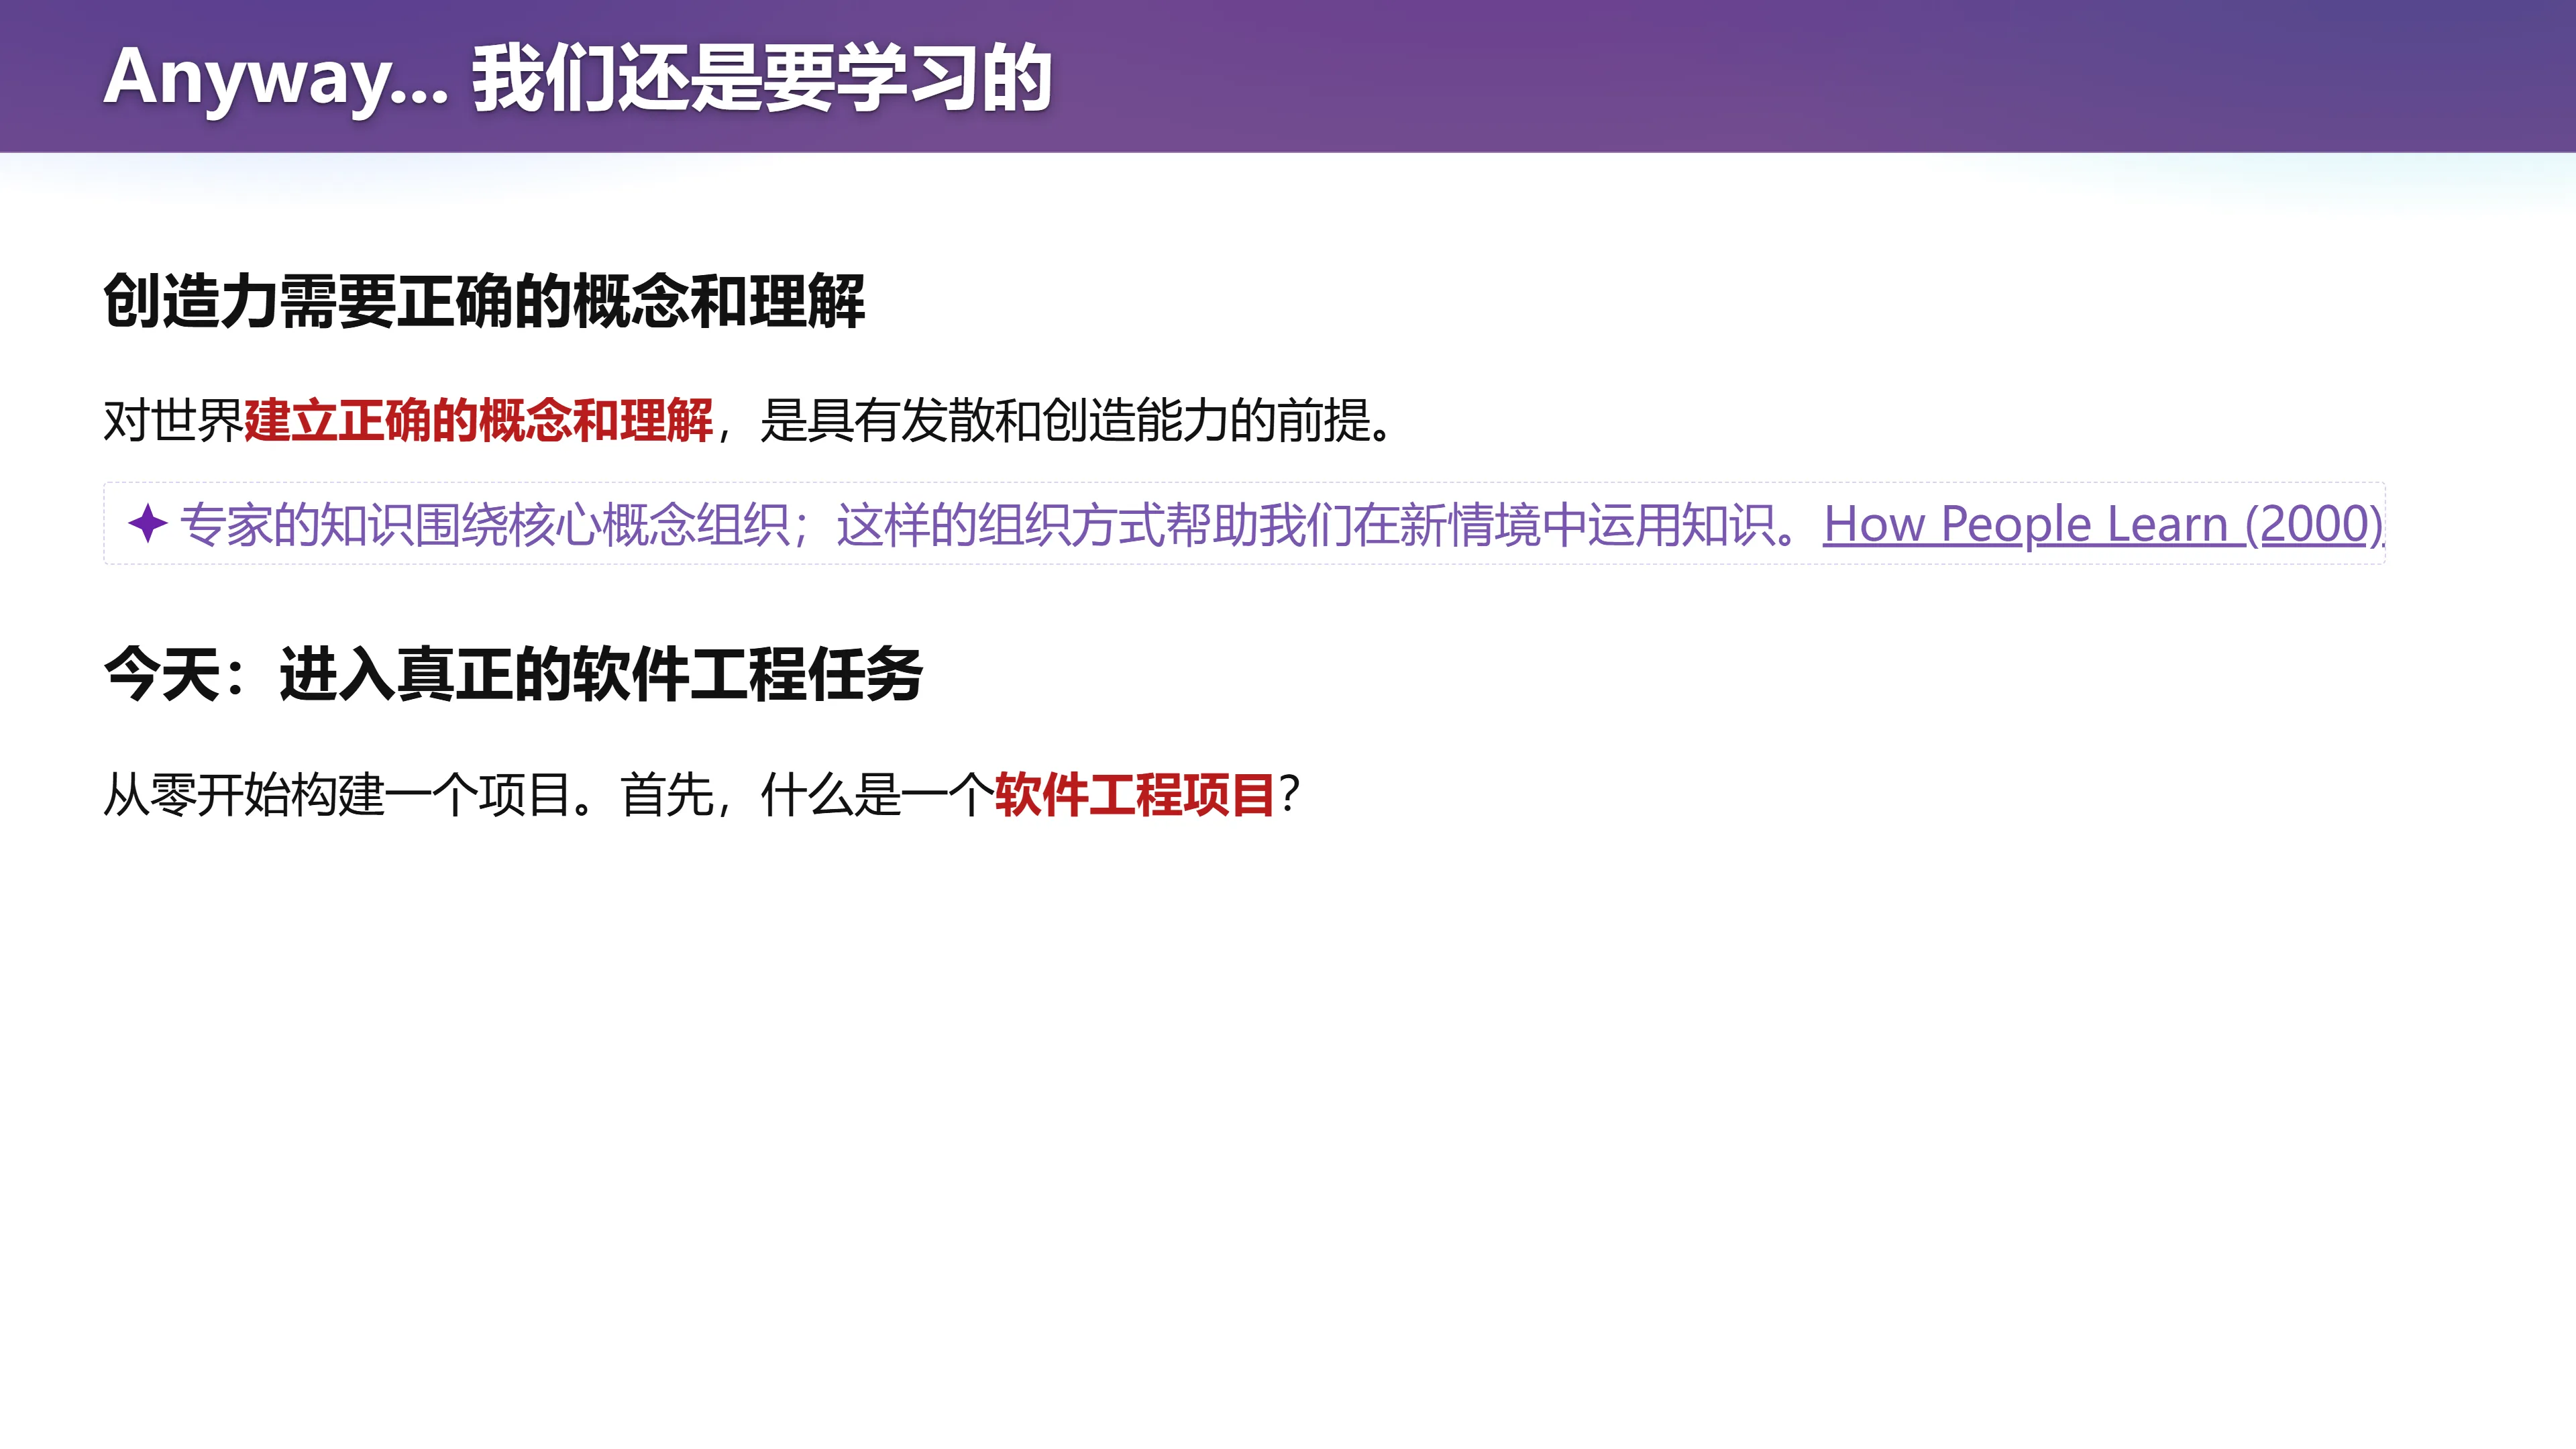
📷 Anyway... 我们还是要学习的
回到原视频 (00:06:42)
既然模型进步这么快,我们还要学什么?有人问讲师:「AI 时代还要不要学数据库、学操作系统?」讲师打过一个比方:
- 一百多年前汽车刚发明时,每开一二十公里就出故障,所以每个司机都必须非常清楚汽车的工作原理,才能在抛锚时把它弄回去——在那个时代,这是「理所应当」。
- 而今天我们在地下车库说一句「帮我开到某处」,自动驾驶就出发了;作为乘客,你已经不需要理解整个系统了。虽然动力最终仍传递到机械装置,和一百年前的汽车还有相似之处,但中间的一切你都可以不知道。
AI 就有点像这种「更强的东西」:它替代的不只是人的脚力,而是人的智力。那我们还学不学?讲师的当前答案是要学——因为学了正确的概念,你才能更好地解锁 AI 的创造力;但「以后该怎么学」,他自己也暂时不知道,欢迎同学来探讨。
编者拓展|专家的知识是围绕核心概念组织的 幻灯片引用了《How People Learn (2000)》的结论:专家的知识围绕核心概念组织,而这种组织方式帮助人在新情境中迁移、运用知识。这正是「AI 时代仍要学基础」的认知科学依据——你需要的不是记住操作步骤,而是建立可外推的概念结构。
二、一个目录,为什么还不算管好了项目
(参考时间: 00:09:45)
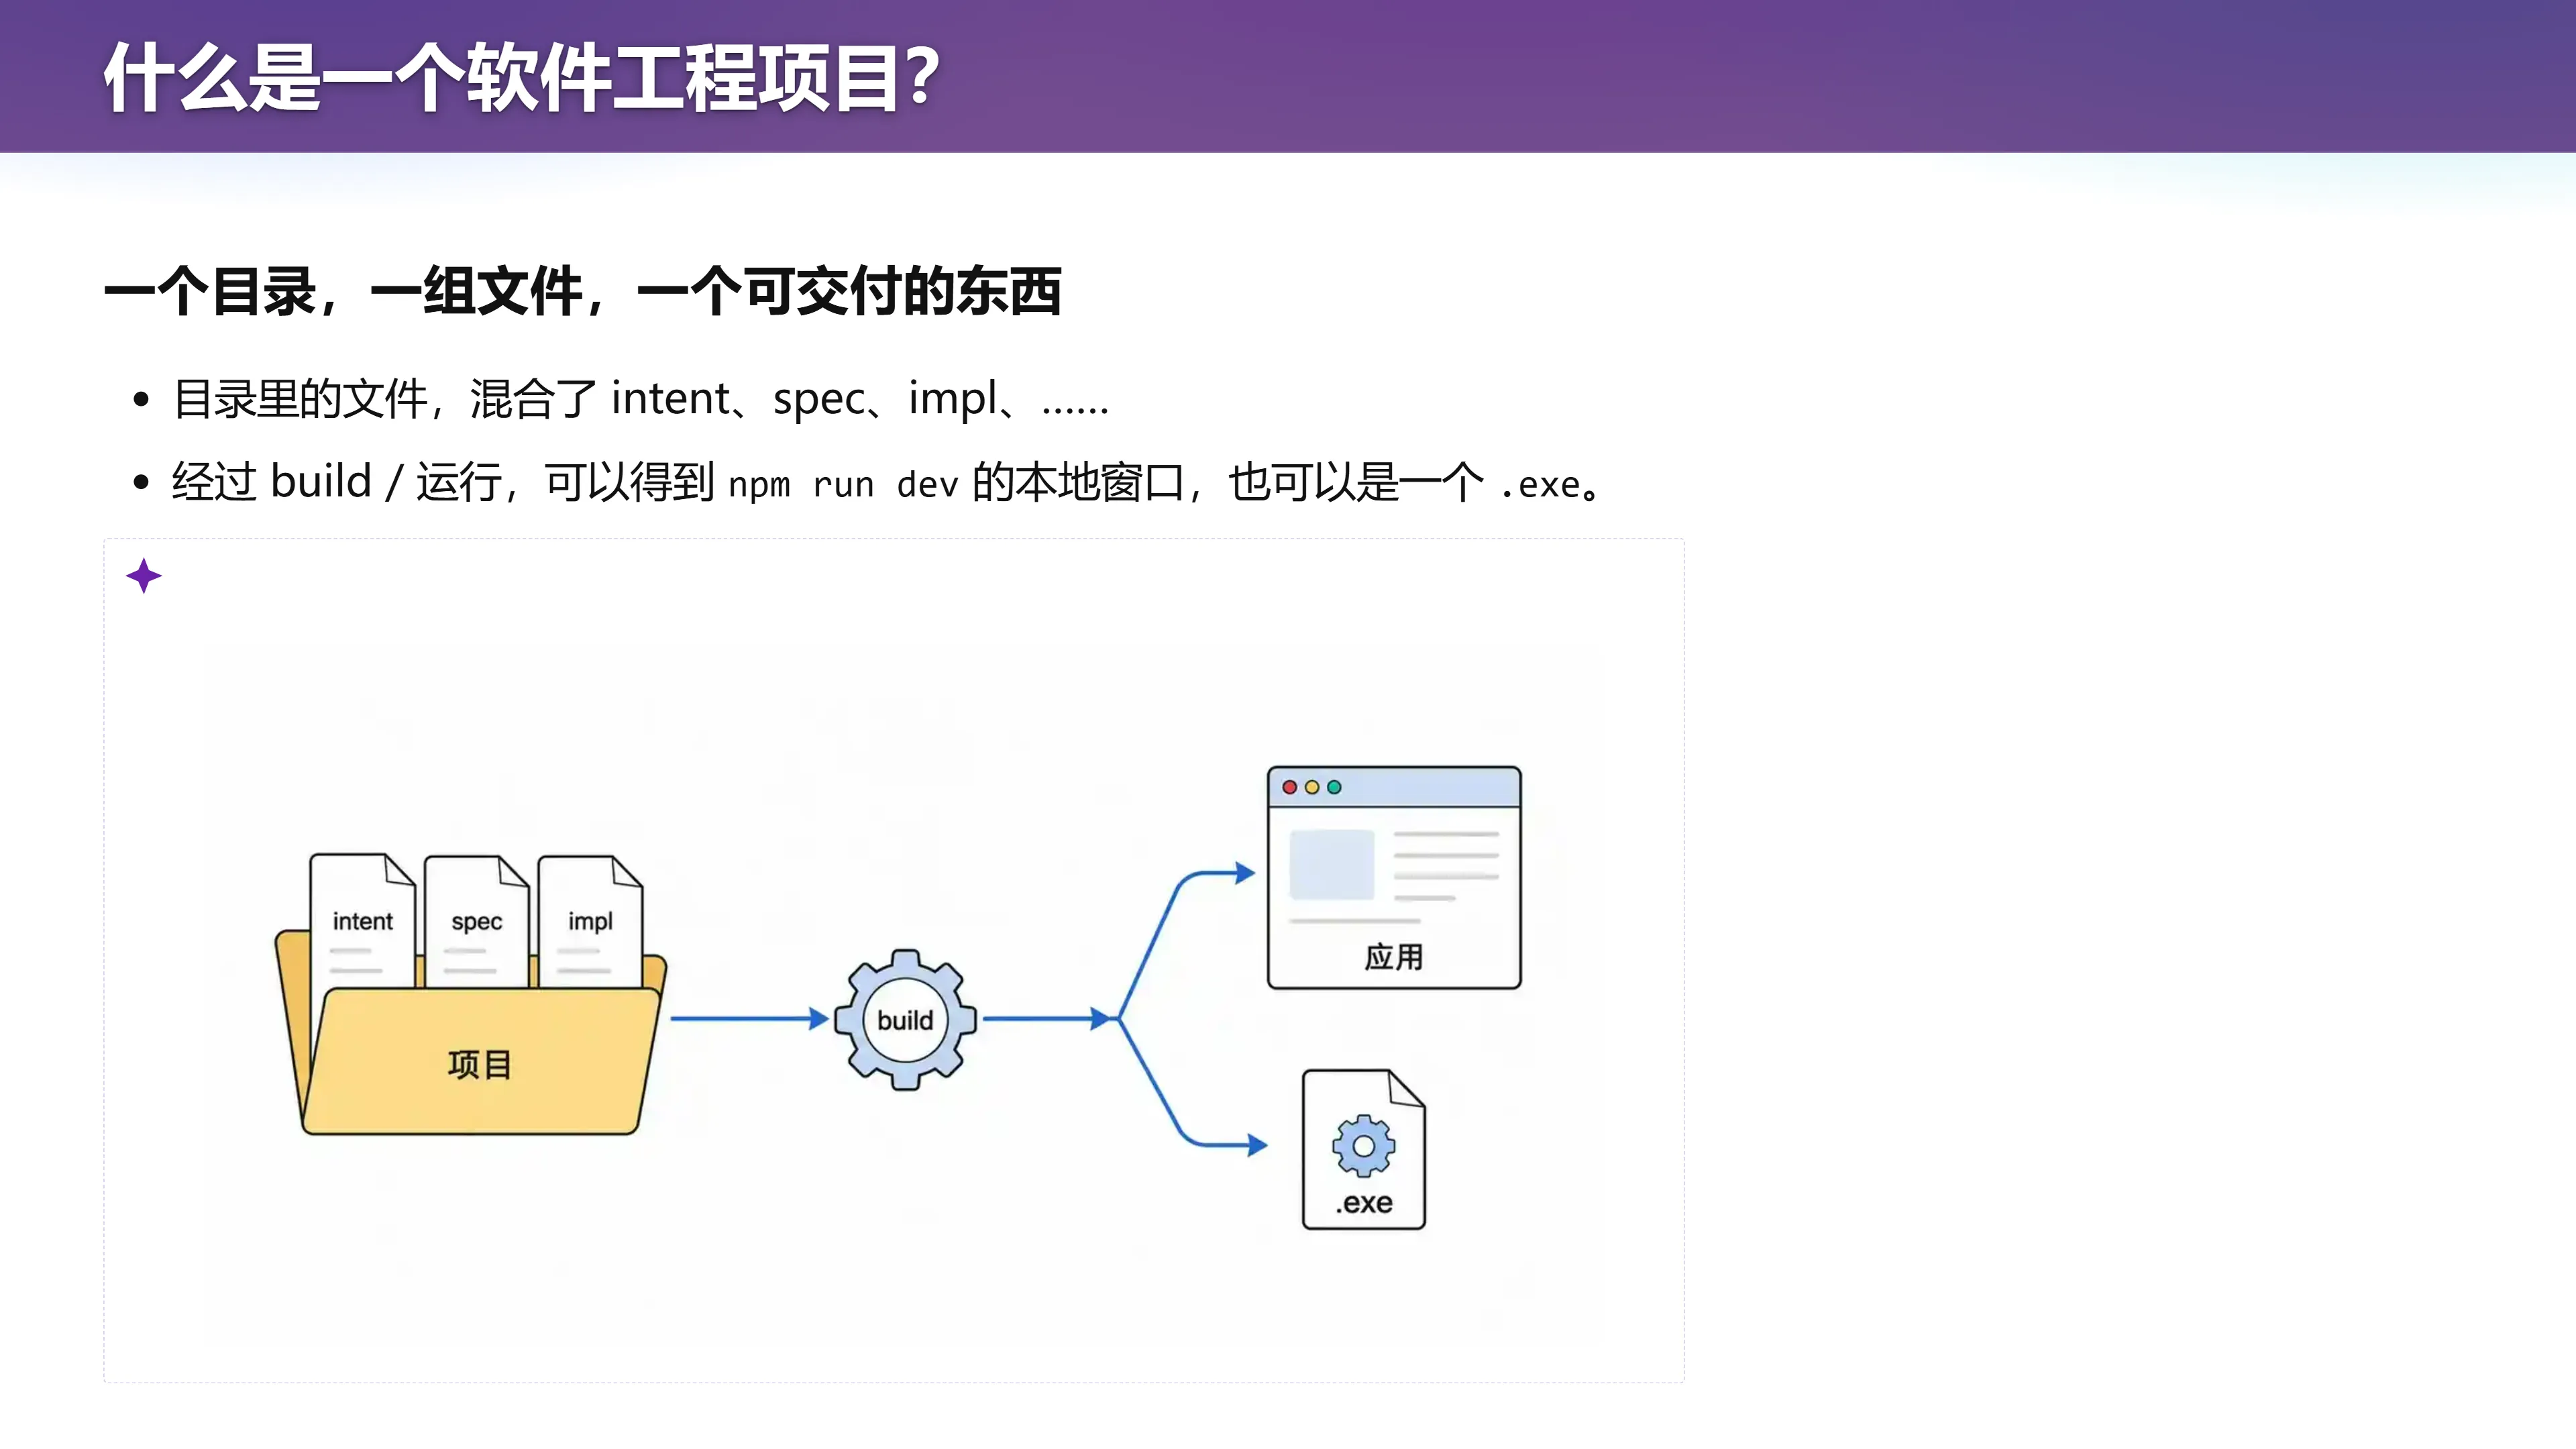
📷 什么是一个软件工程项目?
回到原视频 (00:09:45)
今天我们进入真正的软件工程任务:从零开始构建一个项目。那么第一步做什么?如果是做作业,你会从课程网站或老师那里下载一个东西;但如果是真的想做一个项目,第一件事一定是先建一个目录,给它起个名字(比如「我的最酷的 game」),然后开始 web coding。
一个目录,一组文件,一个可交付的东西
(参考时间: 00:10:26)
回想你是怎么学会「该做什么」的:看到老师打开一个工程,里面有若干文件,你在不经意间记住了一些东西;同学或老师推荐某个项目,你拿到一个 GitHub 链接,打开那个对人类很友好的网页,看到一些文件——于是你知道一个目录里该有一些文件。这些文件共同构成一个可交付的东西。
graph TD
    A["项目目录"] --> B["需求说明 / 接口文档 / 源代码 / 构建脚本"]
    B --> C["构建 build / 运行"]
    C --> D["可交付物:本地网页、可执行文件……"]
一个著名的笑话是:有人发帖说「GPT-6 太牛了,我又做了多少个 killer 级产品」,结果它们全都是 http://localhost:5173 上的页面——世界上的其他人打不开。因为 localhost 只是你本机。
编者说明:这引出 intent 与 spec 的重要性。如果你在意图文档里说明「这个东西要被全世界的人看到」,模型就会去考虑部署;如果你不说,模型默认把你当成开发者,先起一个本地 development server 调试,等 ready 了再推到远端。
在计算机里,「软件」无处不在:不只是你眼前的屏幕,连教室里这张可升降的桌子也得靠软件才能升起、降下(此刻桌面高度 106 厘米)。老先生爱问「什么是软件」,标准定义是「代码、文档等一切与软件相关的东西的集合」。而讲师更愿意说:软件是人类世界的需求在信息世界里的一个投影——这个投影今天呈现为一个目录,目录里有各种各样的东西。
古早时期:That's All
(参考时间: 00:13:41)
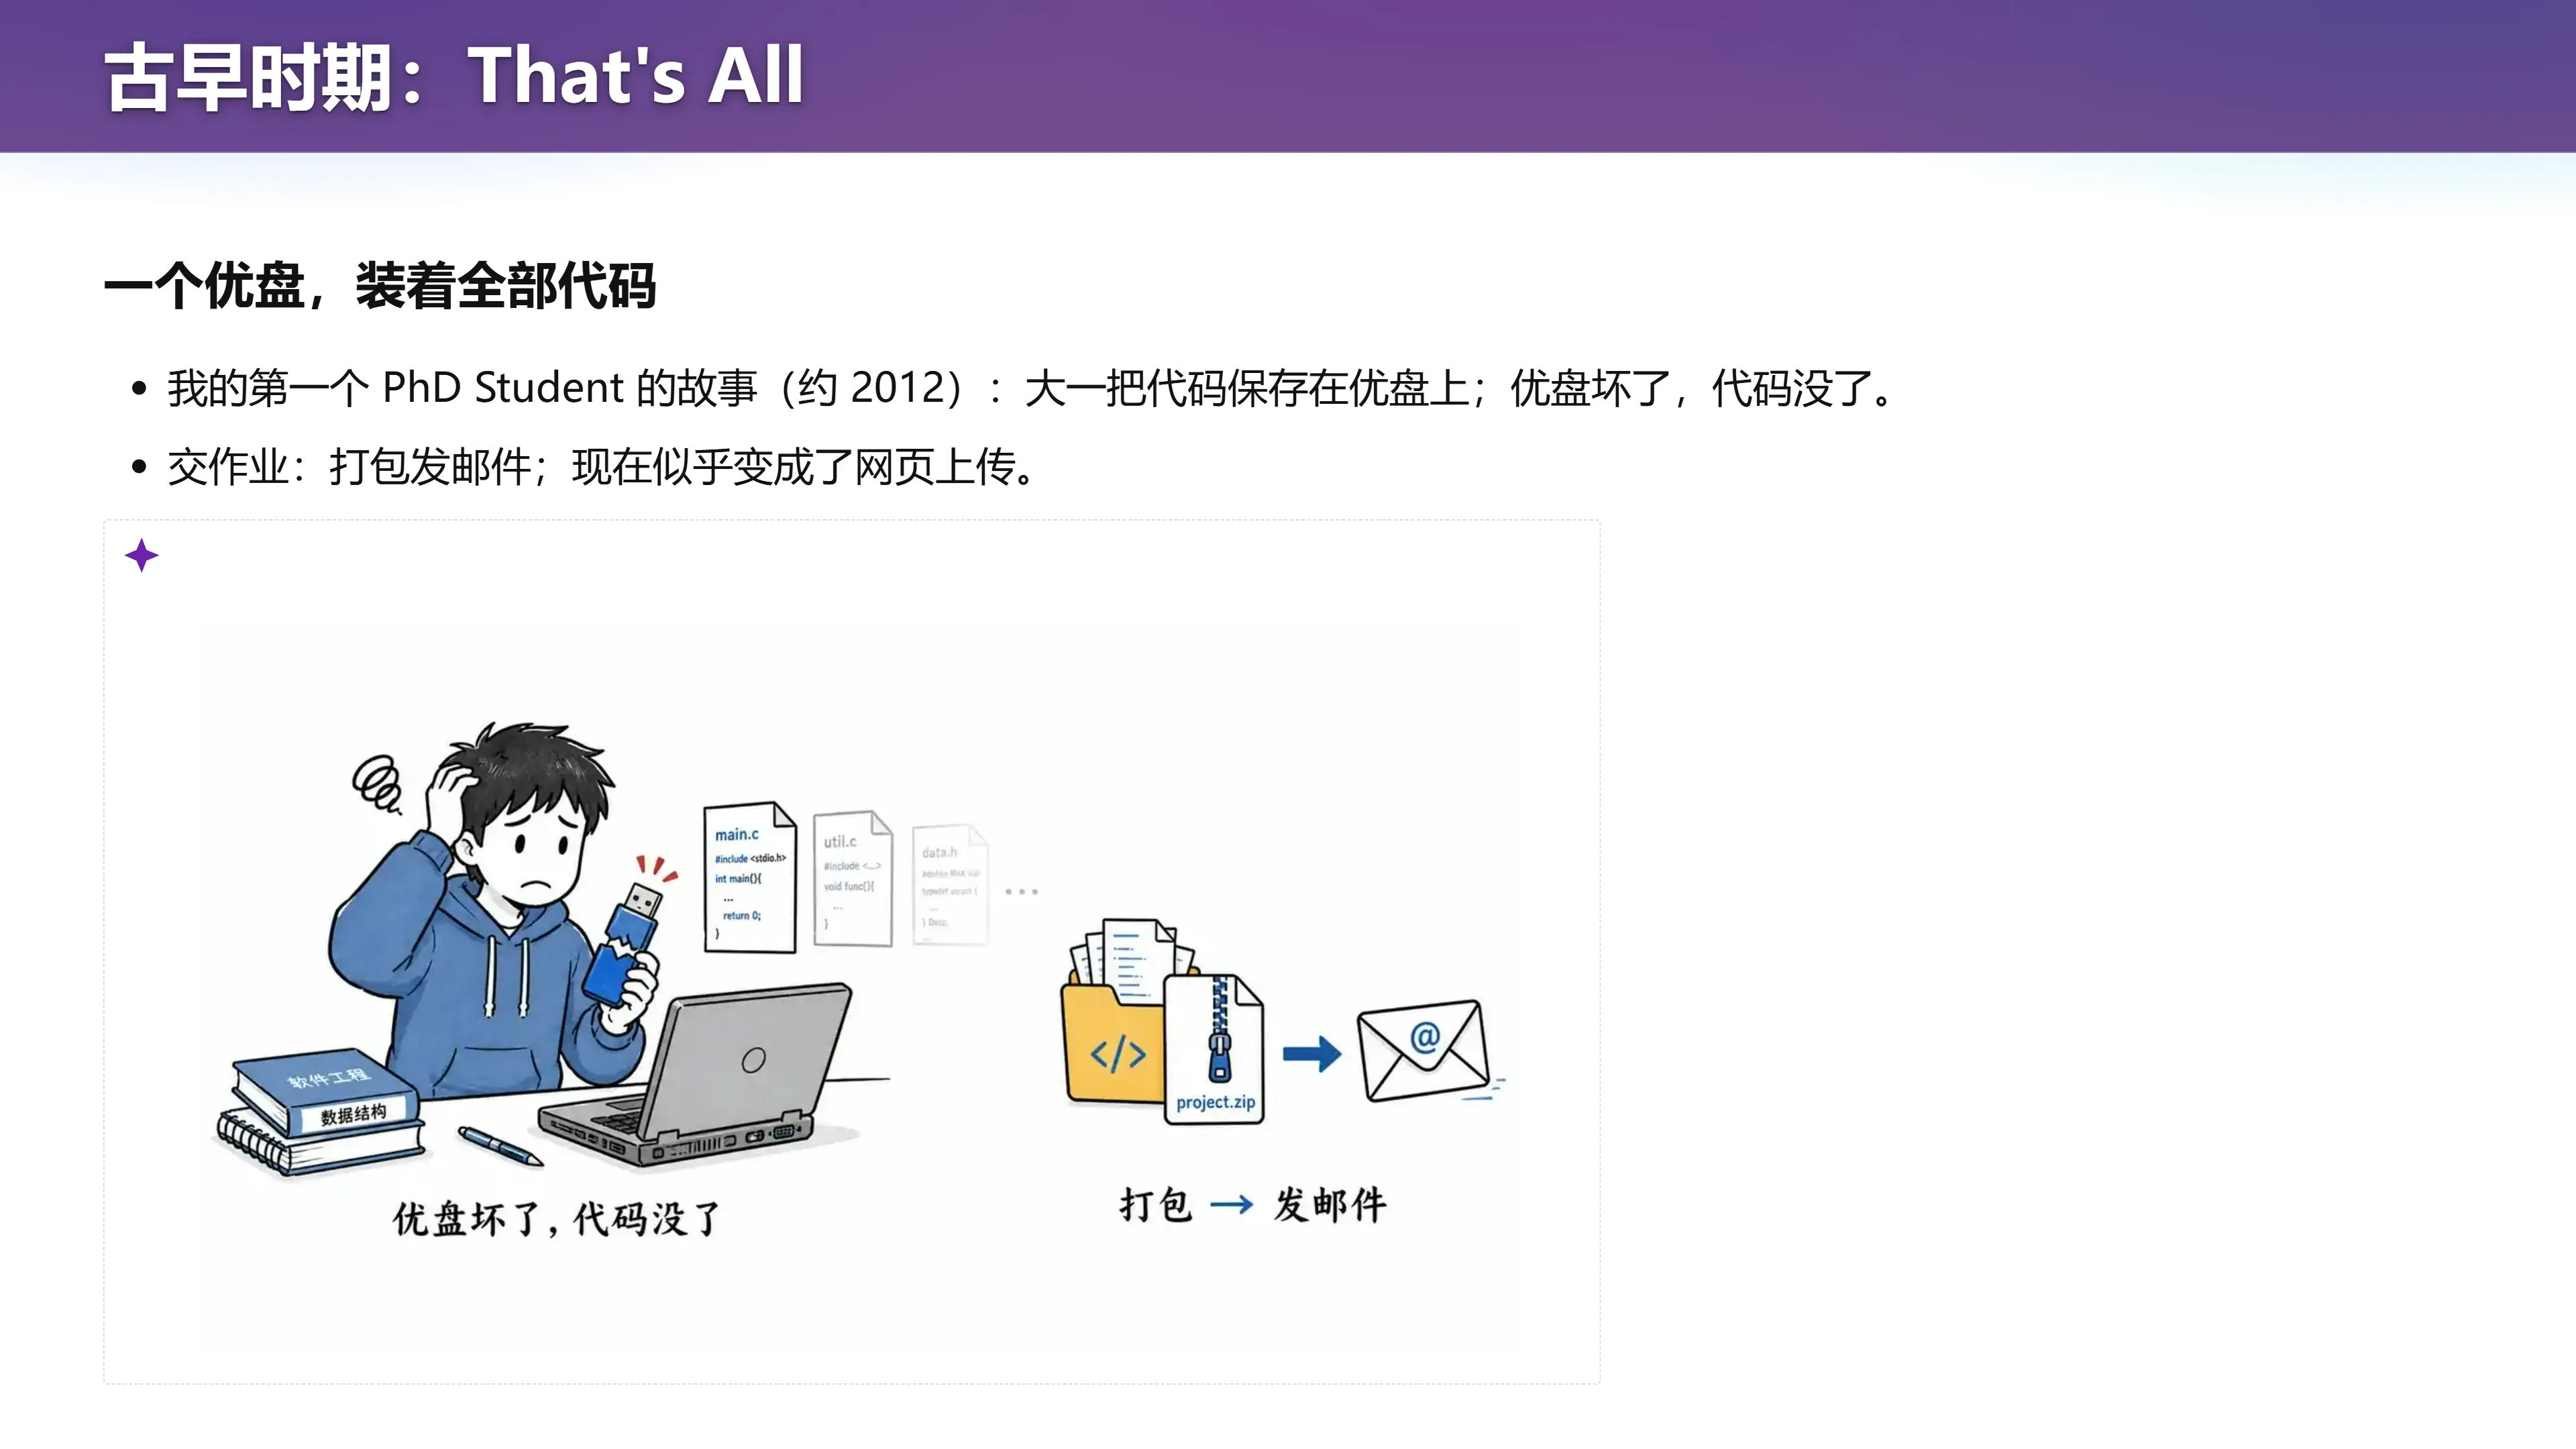
📷 古早时期:That's All
回到原视频 (00:13:41)
目录里有 hello.c,编译出一个 hello,你其实就已经在做软件了。只是这不符合现代软件工程的 best practice。十年、十几年前,大家真的就是这样做的。讲师讲了自己第一个博士生的故事:
- 这位学生 2012 年入学南大。大一时常去机房写代码(那时显示器不便宜,自己的笔记本屏幕又小),来回拷贝代码很麻烦,于是想出一个「妙招」:把代码保存在优盘上。
- 大二时优盘坏了,代码全没了——那份「启蒙时期」珍藏的作业也就此消失。
很长一段时间,大家都是这样管理代码的。讲师自己上学时,交作业的方式是打一个压缩包发邮件;现在的同学改成网页上传,交作业是方便了,但「单靠目录里存着文件」的项目管理方式,并没有发生根本变化。
今天:Git
(参考时间: 00:15:14)
📷 今天:Git
回到原视频 (00:15:14)
今天,软件工程有了标准答案:用 Git。
- 除了保存当前文件,Git 还能保留、比较和恢复历史版本——这是极重要的软件工程特性。
- 作业发布与提交也变得容易:用
git clone获取作业项目,用git pull接收后续更新,再用课程约定的make submit提交。
git clone https://.../homework.git   # 获取作业
git pull                              # 接收老师的更新
make submit                           # 打包并提交(由课程 Makefile 定义)
编者说明:
make submit是课程项目约定的入口,由项目里的 Makefile 定义,不是 Git 自带的命令。Git 负责版本,项目规则负责构建、验证与交付。这套「打包—上传」的流程有点像现代 CI/CD,本课后面会专门讲一次。
讲师补充:过去发代码、发作业都靠邮件(讲师甚至回忆自己「发邮件管理项目」的年代),而今天是 AI 时代,有十倍、百倍的生产力提升——他有时用 Codex 写完一封投诉信后,选择直接信任它,看都不看一眼,让它结束时顺手把浏览器关掉。
编者拓展|RCS、CVS、SVN 与 Git 的谱系 版本管理并非一蹴而就:更早的 RCS 只管单个文件的历史;CVS、SVN 则把历史放到一台服务器上,大家取出、修改、再交回;Git 让开发者本地就拥有完整历史。脉络的细节见 Git 简史。
三、学习变容易以后,留意变得更重要
(参考时间: 00:17:00)
📷 学习变容易以后,学习意识更重要
回到原视频 (00:17:00)
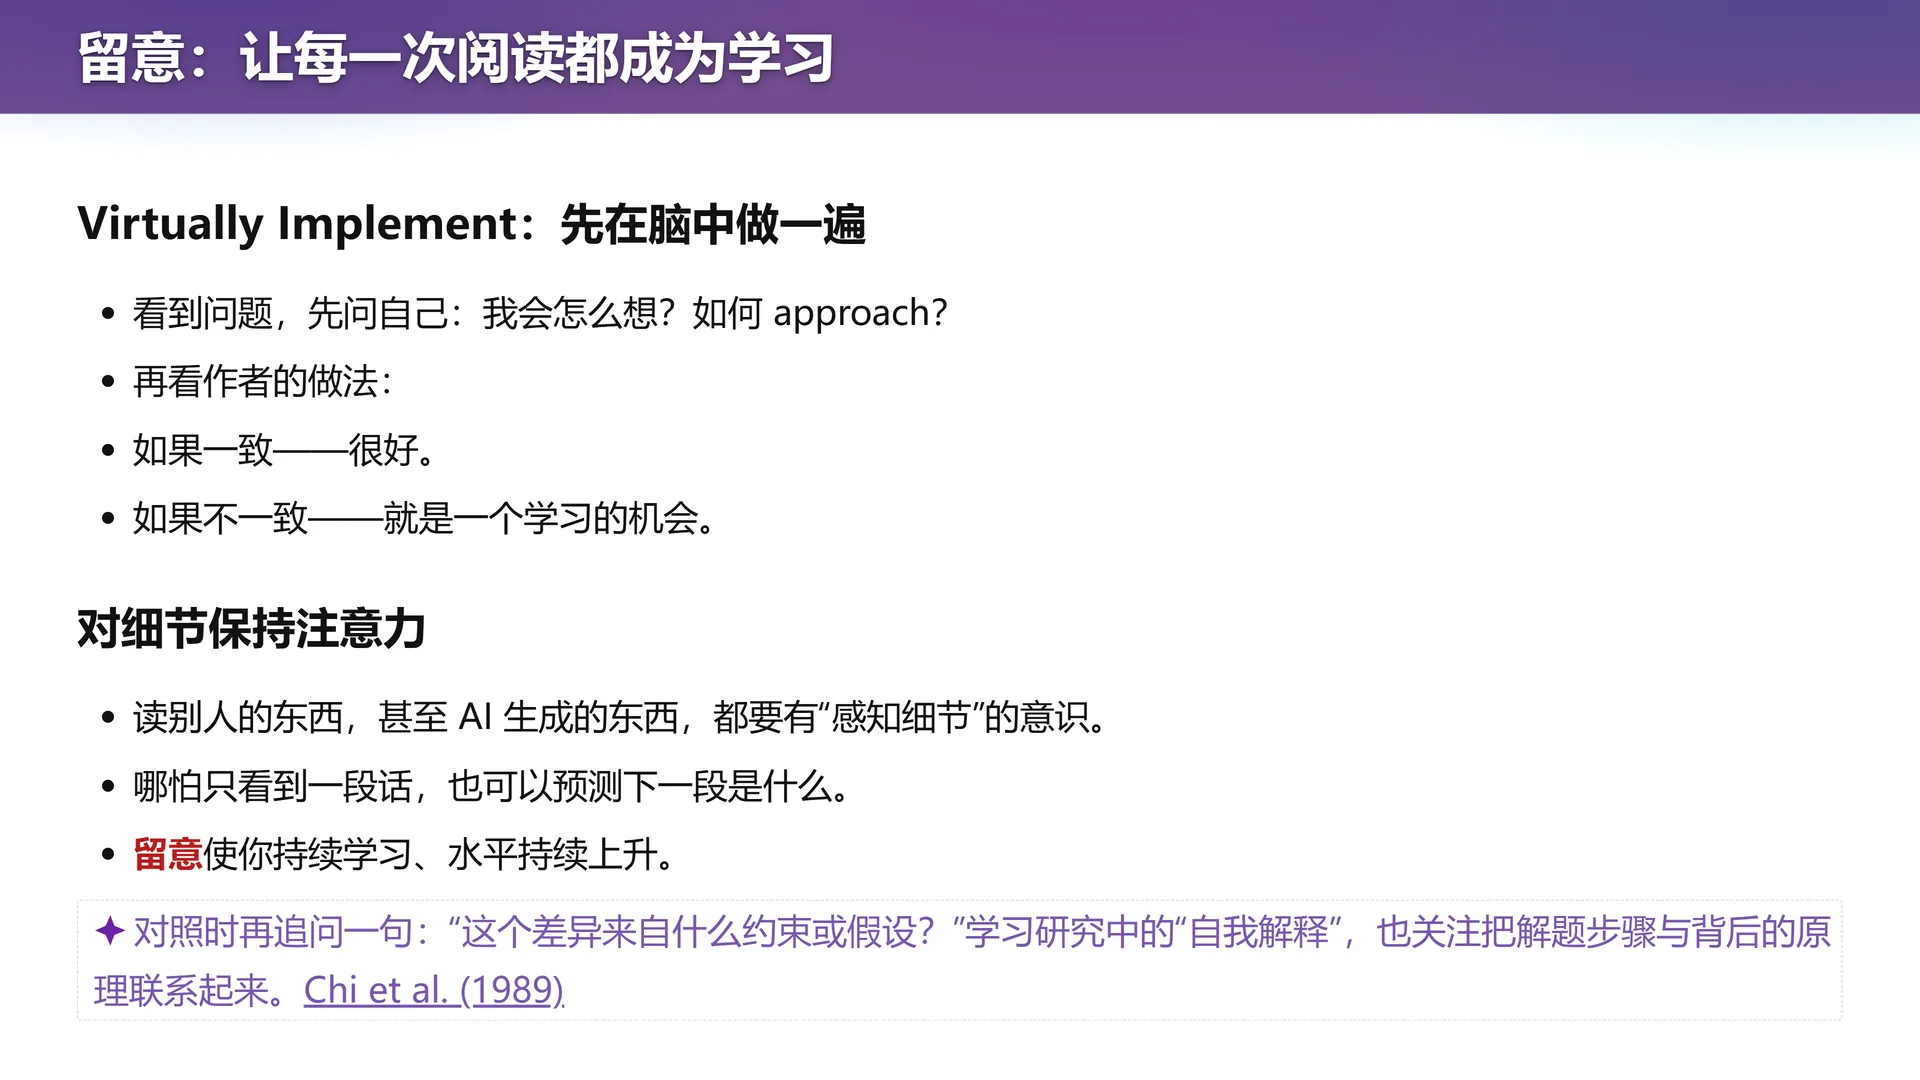
讲师几乎每节课都要讲这件事:这门课讲的知识都不重要,重要的是你的学习意识。
现在到处都能看到 GitHub 链接,每一个真实项目都可能成为学习素材。问题在于——看到很多项目,不会自动把它们的设计变成你的知识。你可能打开过几十个仓库,却没注意过:有的项目有某个文件、有的没有;有的文档这样写、有的那样写。在大量信号不断进入的过程中,你本可以判断出「Git 应该怎么用」。
很多同学带着一种中学心态:老师说做什么就做什么,绝不多碰一点点,因为那最省时间。但 AI 其实也被「调」成了这样——老师说把作业拉下来,它就只拉作业。讲师劝大家愿意多花一点点时间点进去看一看:比如满世界的 GitHub 项目都是巨长无比的 README,用各种 Unicode 字符拼出目录结构框图,一股「AI slop(AI 生成的廉价内容)」味;而某个维护了几十年的老项目,README 清新舒服,很短,看完之后你想去的地方就靠三个链接,不用读那么长的 slop。于是你就学会了文档该怎么写。
编者拓展|从路牌对比学 UI 设计 讲师举了一个很有画面感的例子:在香港找路时,每当出现不确定性(比如前方有三个岔口),正前方一定有一块路牌告诉你三个口分别通向哪里;而回到南京,有时要在地铁站里环顾四周、走很远才找到一张地图。 他从这种对比里学到的 lesson 是:如果我要做 UI 设计,就应当站在「人站在这个页面上会想什么」的角度,让 A、B、C 三类不同需求的人,都能用最少的方式得到各自要的信息。这就是「上课耽误学习」的另一面——课外的信息量与信息密度已经远超任何一个课堂,只是传统教学没教过我们怎么用好它。
四、从「我想撤销」推导出快照
(参考时间: 00:25:07)
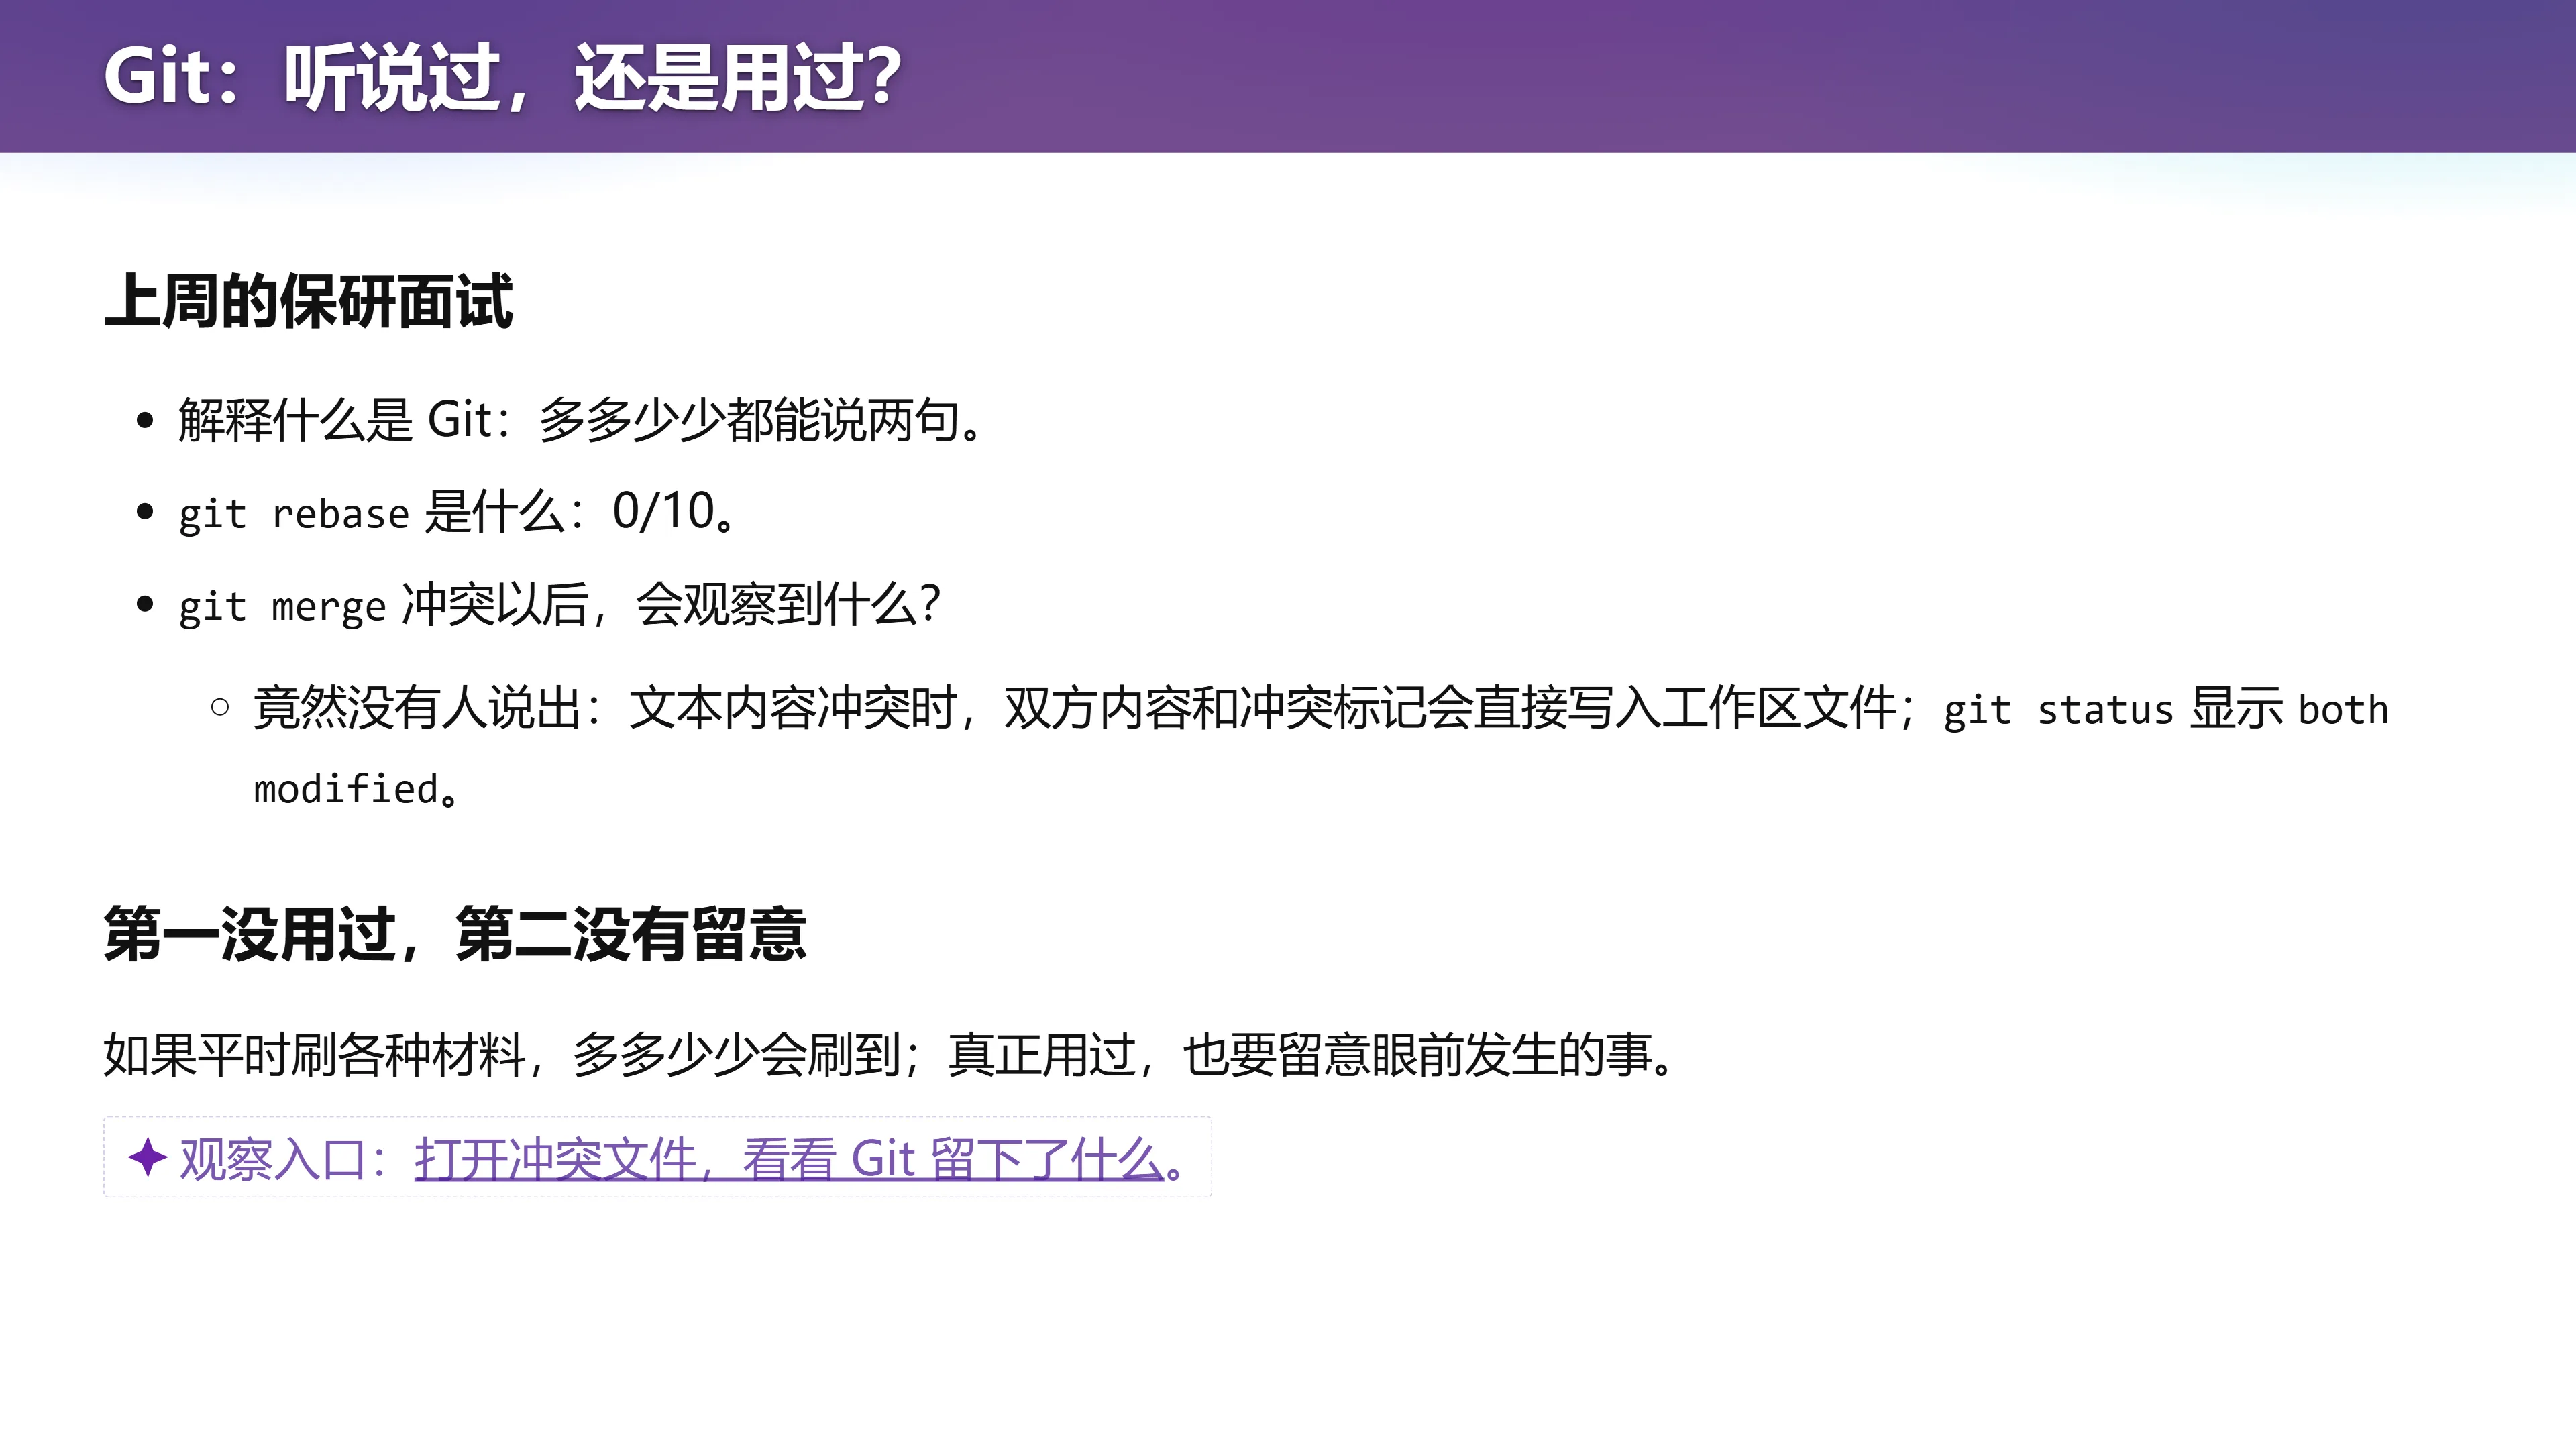
📷 Git:听说过,还是用过?
回到原视频 (00:25:07)
上周保研面试的现场
讲师上周末参加了推免(保研)面试,问了几个问题:
- 「什么是 Git?」——多数人还能说两句(比如从 GitHub 下载、分发代码,或说它管理项目目录的快照)。
- 「什么是
git rebase?」——被问到的十位同学没有一个答出来(0/10)。 - 「
git merge发生冲突以后,你会观察到什么?」——比较出乎意料的是,也没人主动说出:常见文本冲突的双方内容和冲突标记,会直接出现在工作区文件里,同时git status显示both modified。
讲师说,这不只是「少背了几个术语」。第一,是真没用过;第二,是没有留意。 就算平时一直用 AI 帮你解决 merge 冲突,你也很容易遇到冲突——尤其是让 Agent 在不同分支上开发时。你只需要一点注意力:在一两次冲突里停下来看一眼,就会看到好多个等号、好多尖括号、一些 incoming 标记;至少能说出「两边冲突的代码会同时显示在一起」。
从需求出发,自己推导出 Git
(参考时间: 00:29:14)
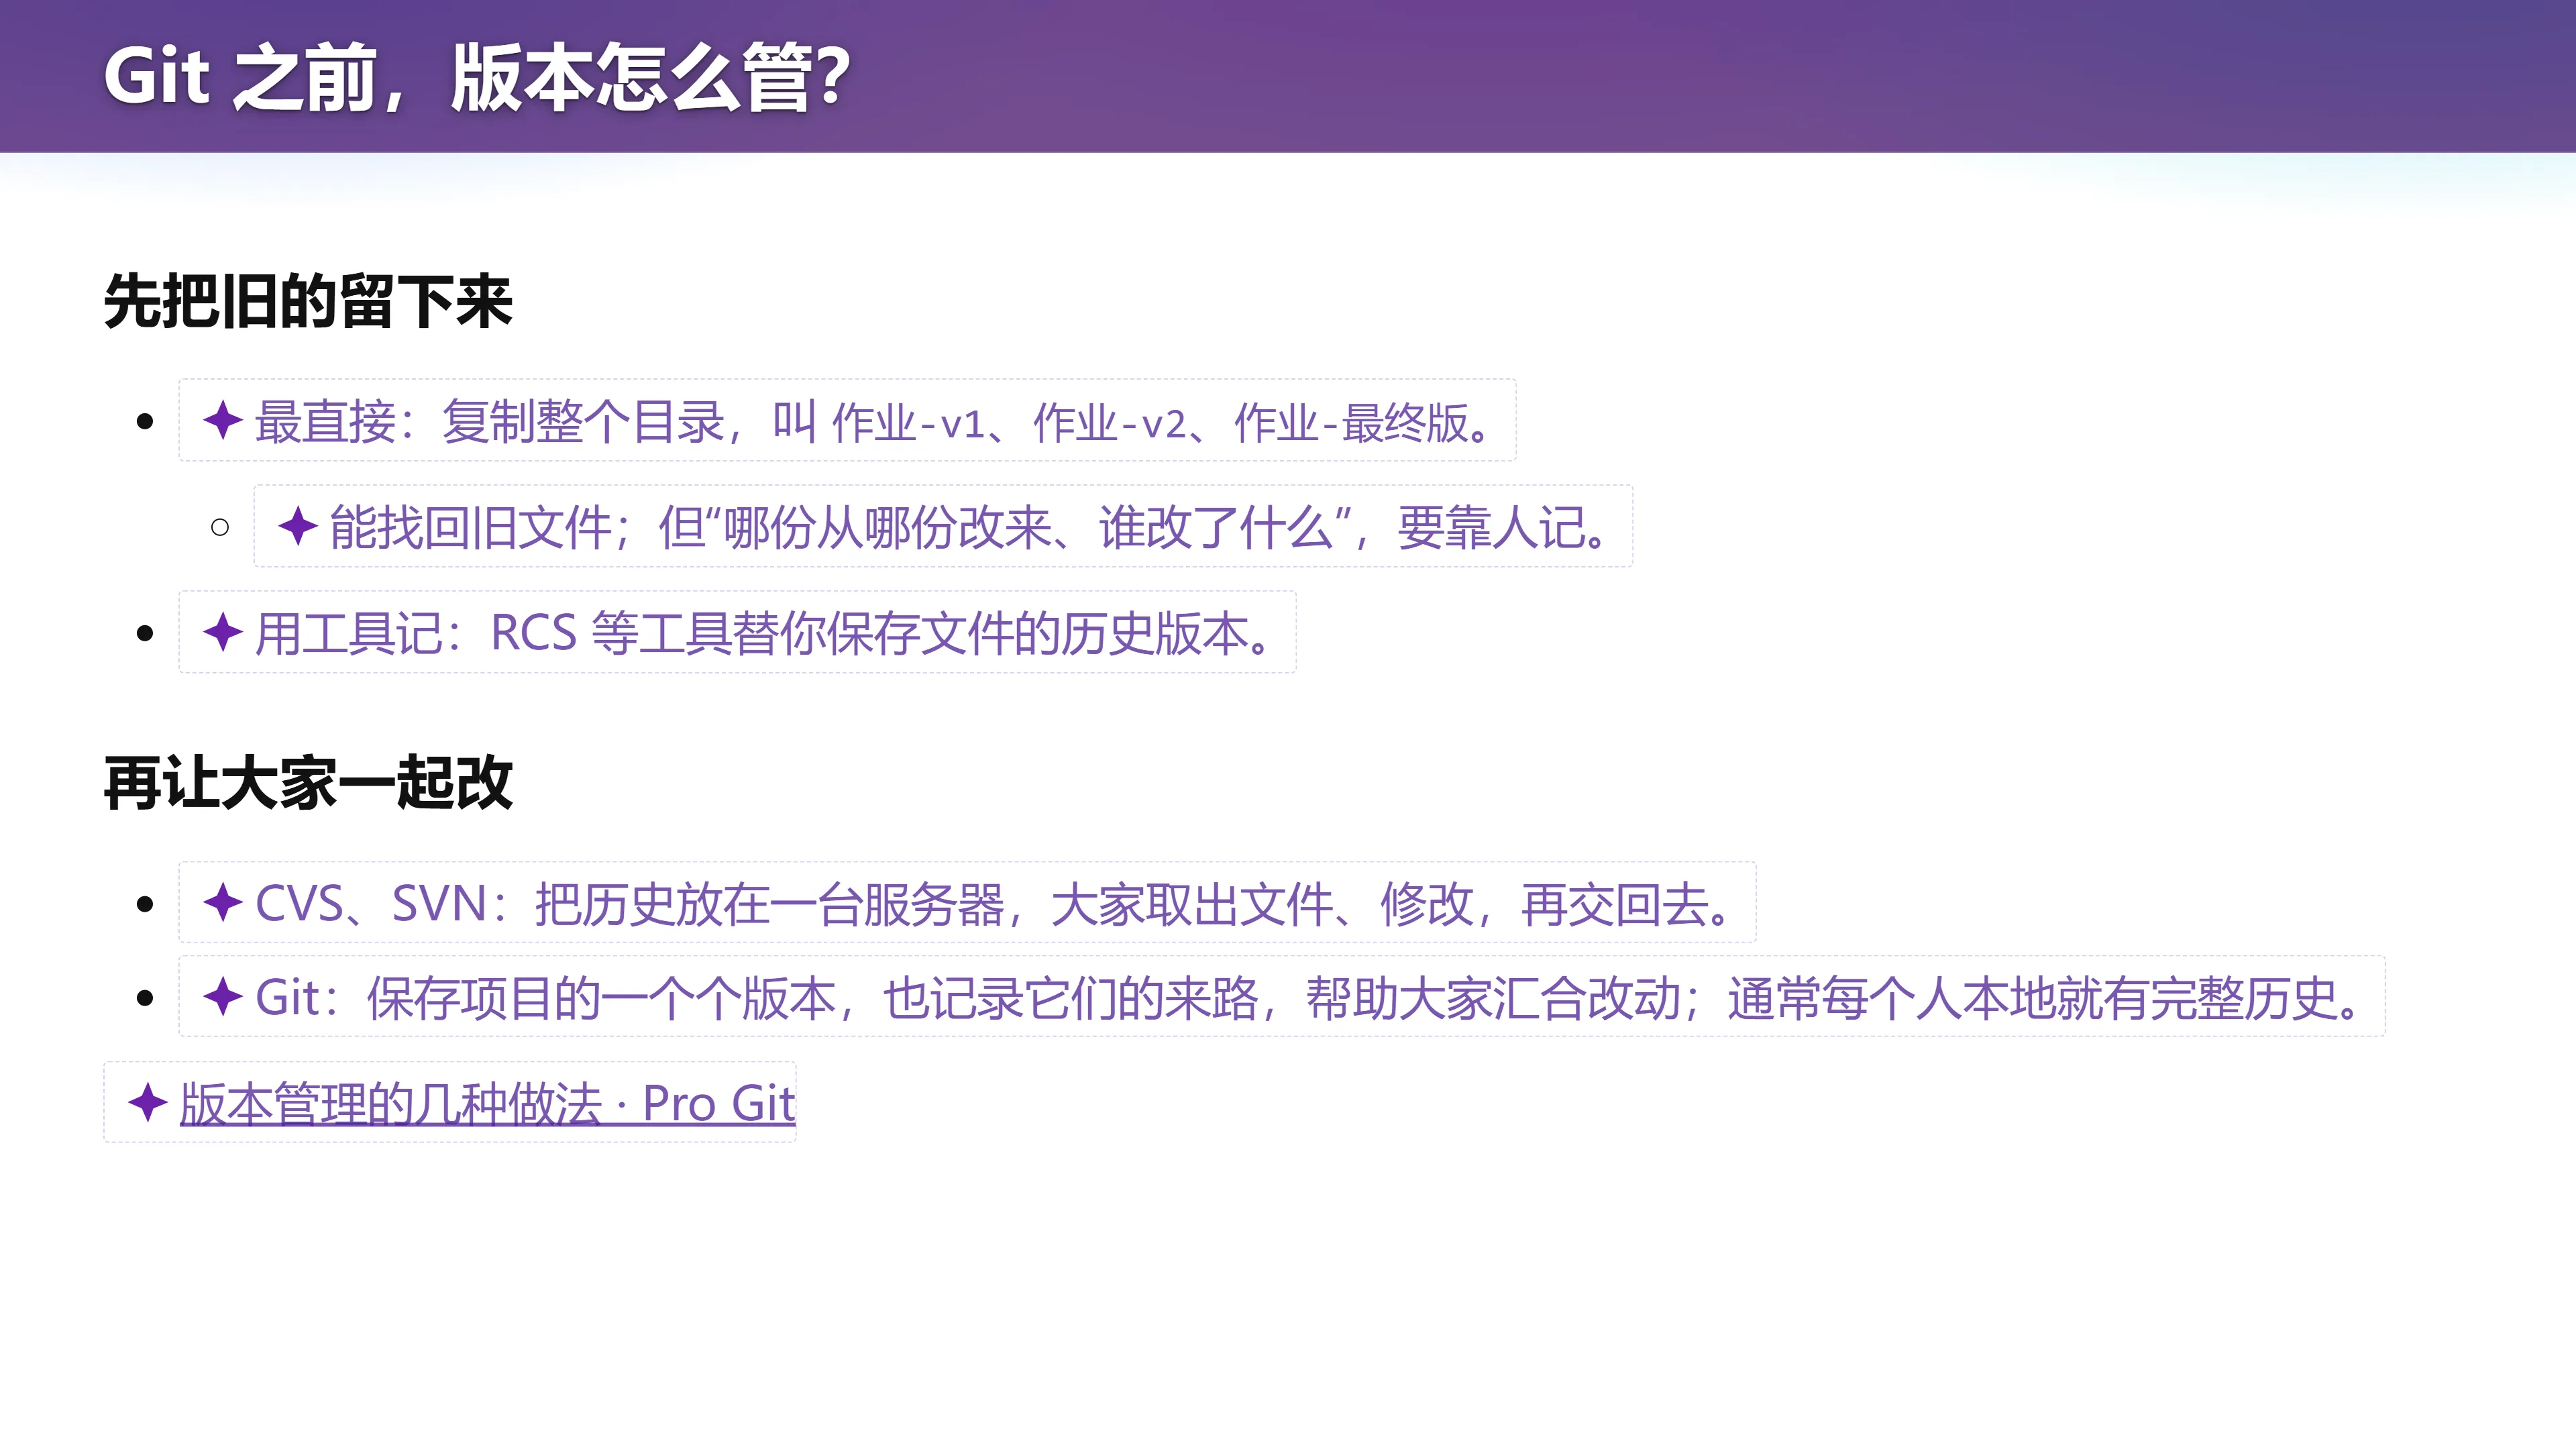
📷 Git 之前,版本怎么管?
回到原视频 (00:29:14)
最朴素的做法是:复制整个目录,分别叫作「作业-v1」「作业-v2」「作业-最终版」。这能找回旧文件——新手阶段手滑、改错很正常,你想回去看看上一版是怎么写的,这就是一个需求。但版本一多,「哪份从哪份改来、谁改了什么」就要靠人记。
从需求出发,你自己就能发明一个简化版的 Git。 与其叫「作业一、作业二、作业三」,不如只保留一个作业目录,再提供一个命令行工具:list 一下版本、把当前版本「回到」过去的某个版本。用着用着,你又会自然发明出分支、合并、冲突——比如你要和室友同步,两人一起改了同一个文件,这时就得坐下来想「一起改同一个文件该怎么办」。
graph TD
    N["我要回到上一个版本"] --> V["需要保存目录的多个版本"]
    V --> T["一个目录 + 一个能切换版本的命令行工具"]
    T --> B["和室友同时改同一文件 → 需要分支与合并"]
    B --> C["两人改了同一段 → 需要冲突标记与解决"]
讲师说,这也体现了人类的局限:这些概念其实都能顺理成章地推出来,但大家没有去留意。
SVN 与 Git:存「变化」还是存「快照」
(参考时间: 00:31:30)
在 Git 之前,大家用过 SVN(check in / check out)。两者的设计不同:
- SVN 存的是「项目的变化」:先有一个最初版本,之后每次改一行就存一个 patch,再改一行再存一个 patch……看似非常高效,但随着项目增长,它把大家拖回了泥潭。
- Git 的模型干净得多:先看 first principle——「我想要一秒钟就回到过去的某个版本」。如果每次存的是一个 delta,回到早期版本就得一个一个往回退(虽然可以用缓存优化,但那是另一套复杂性)。
所以 Git「基本上走对了路」。它的作者正是 Linux 的作者:
- 1991–2002 年,Linux 内核靠「作业 V1、作业 V2」的方式维护:在邮件列表上发补丁(我改了一个
A.c,就把新版本发到邮件列表),再由维护者合进核心仓库、发布版本。 - 后来用过 BitKeeper 等工具;直到 Linux 终于受不了,觉得应该有一个绝对简单、概念又正确的版本控制工具,于是在 2005 年做了 Git。所以 Git 比我们想象的年轻。(参考时间: 00:32:39)
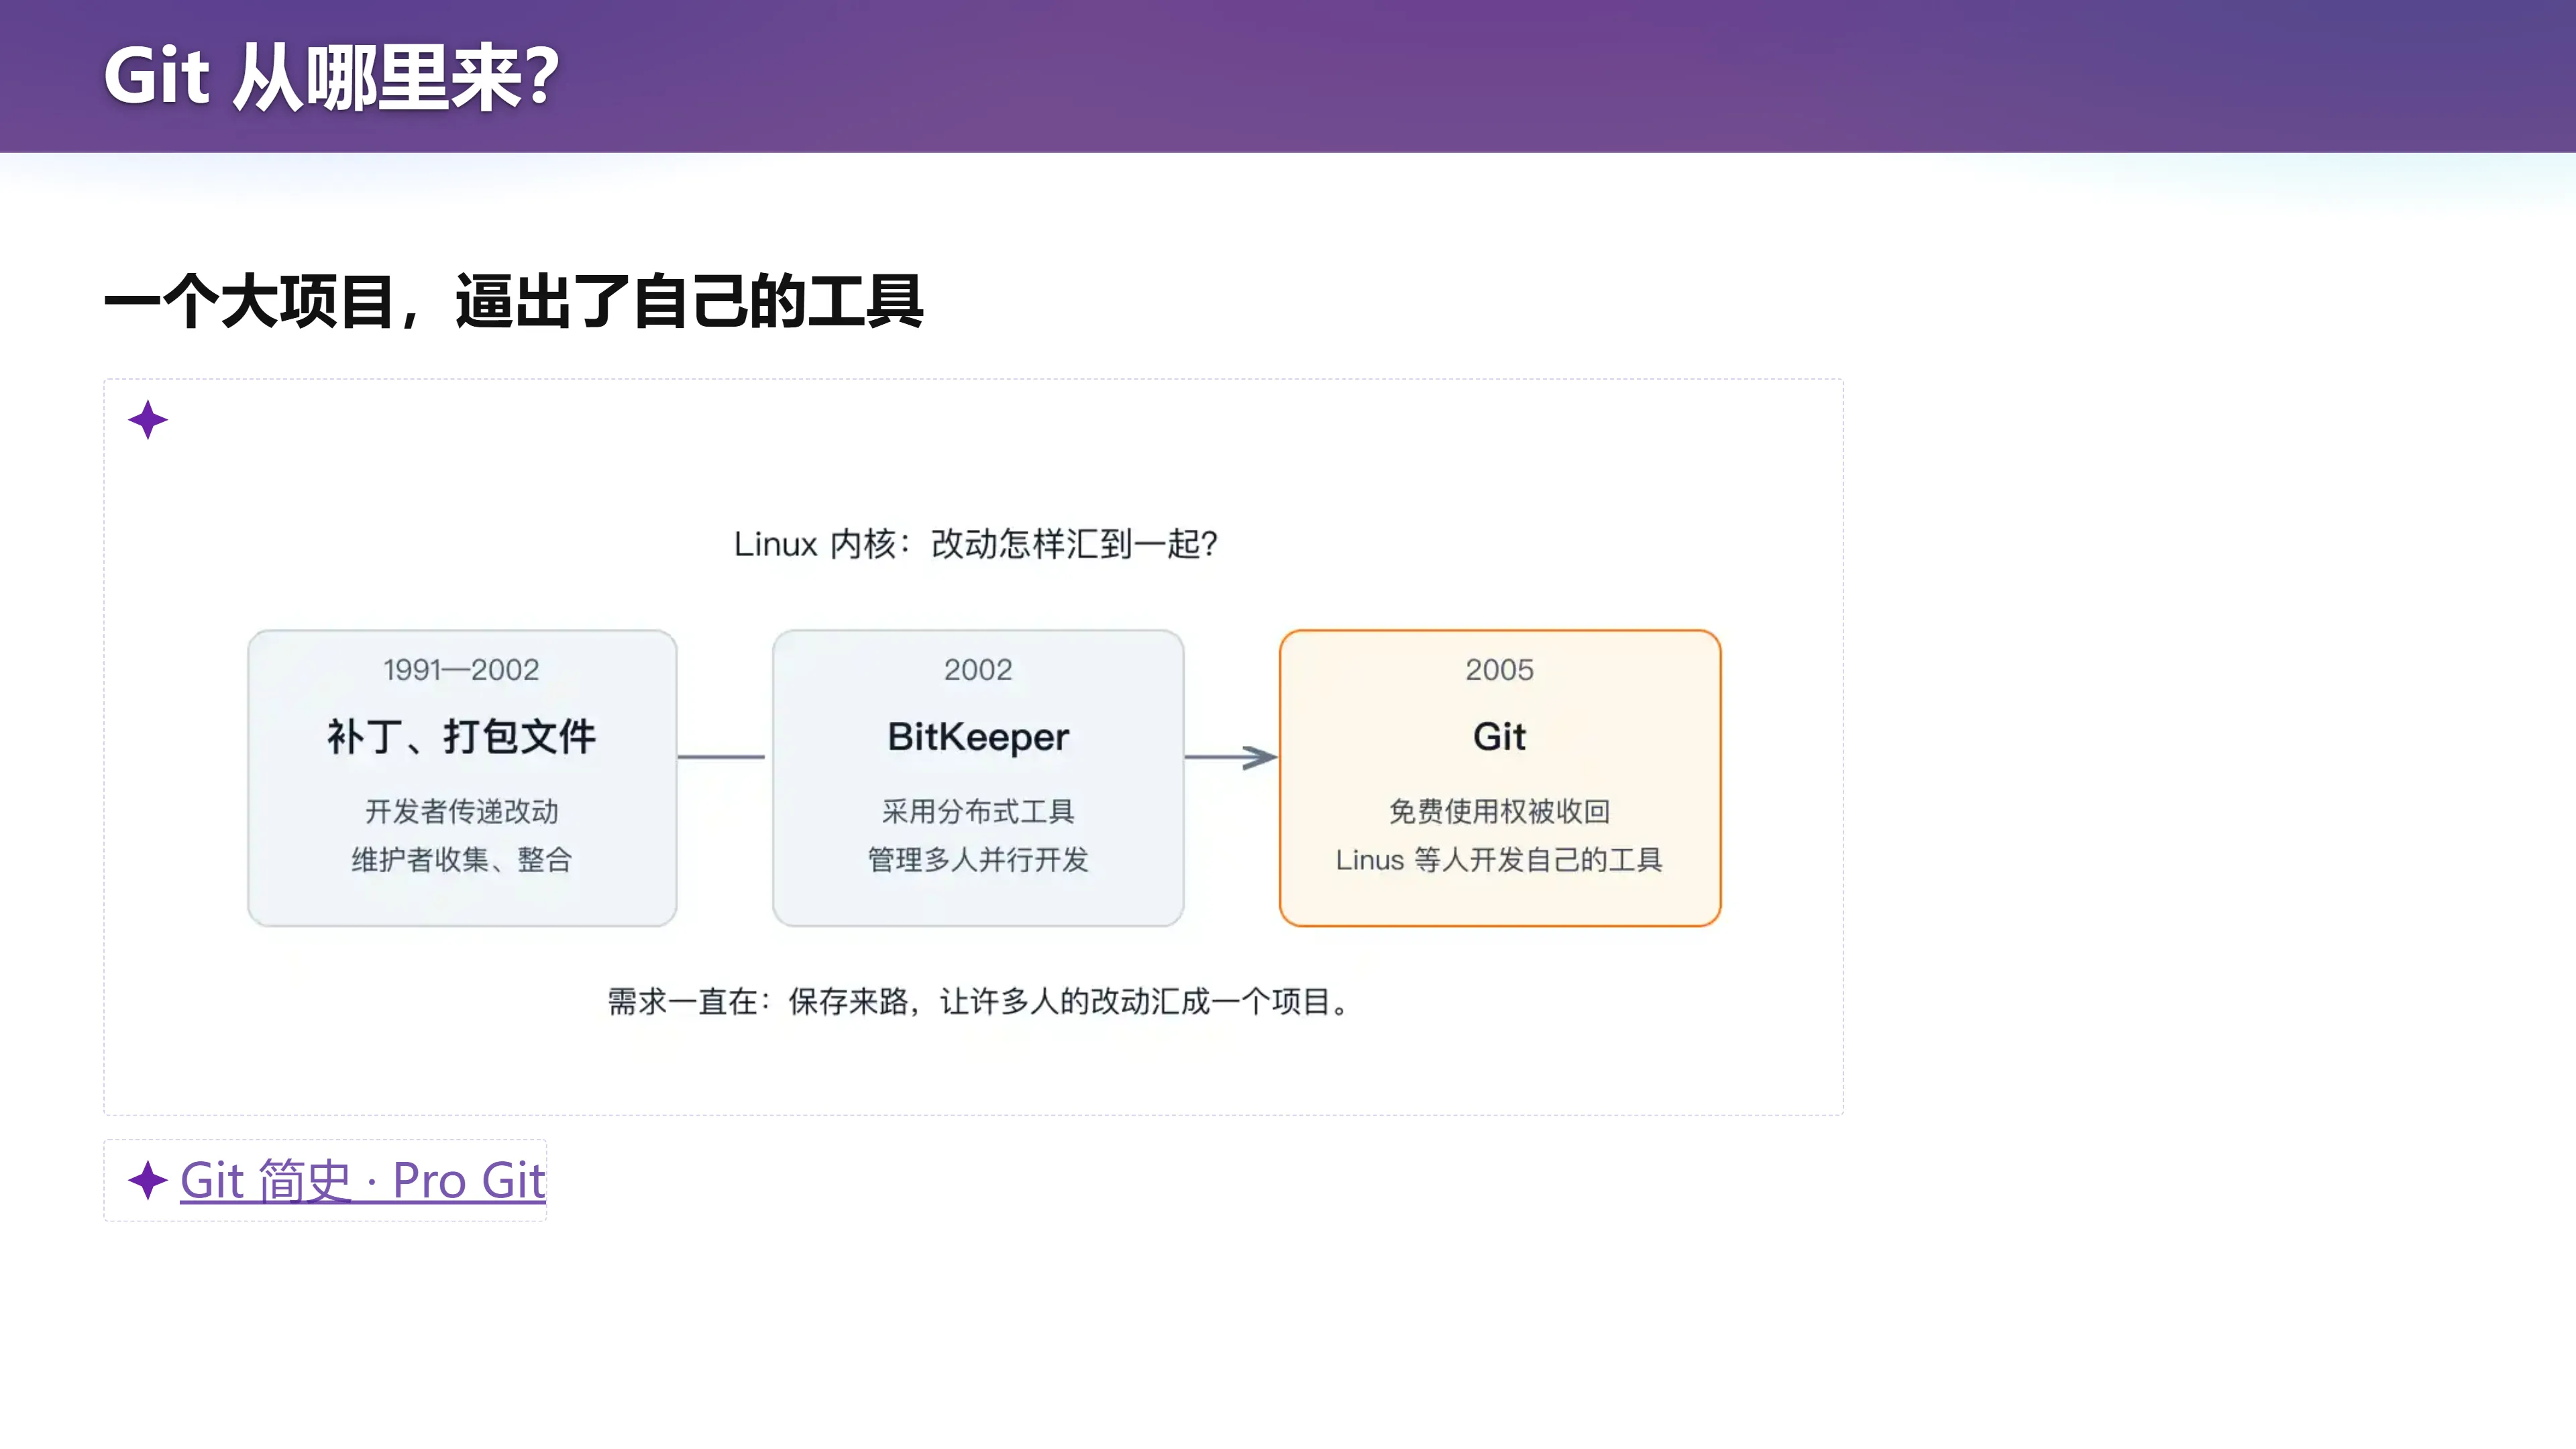
📷 Git 从哪里来?
回到原视频 (00:32:39)
我们要的是项目级「回溯时间」
(参考时间: 00:33:56)
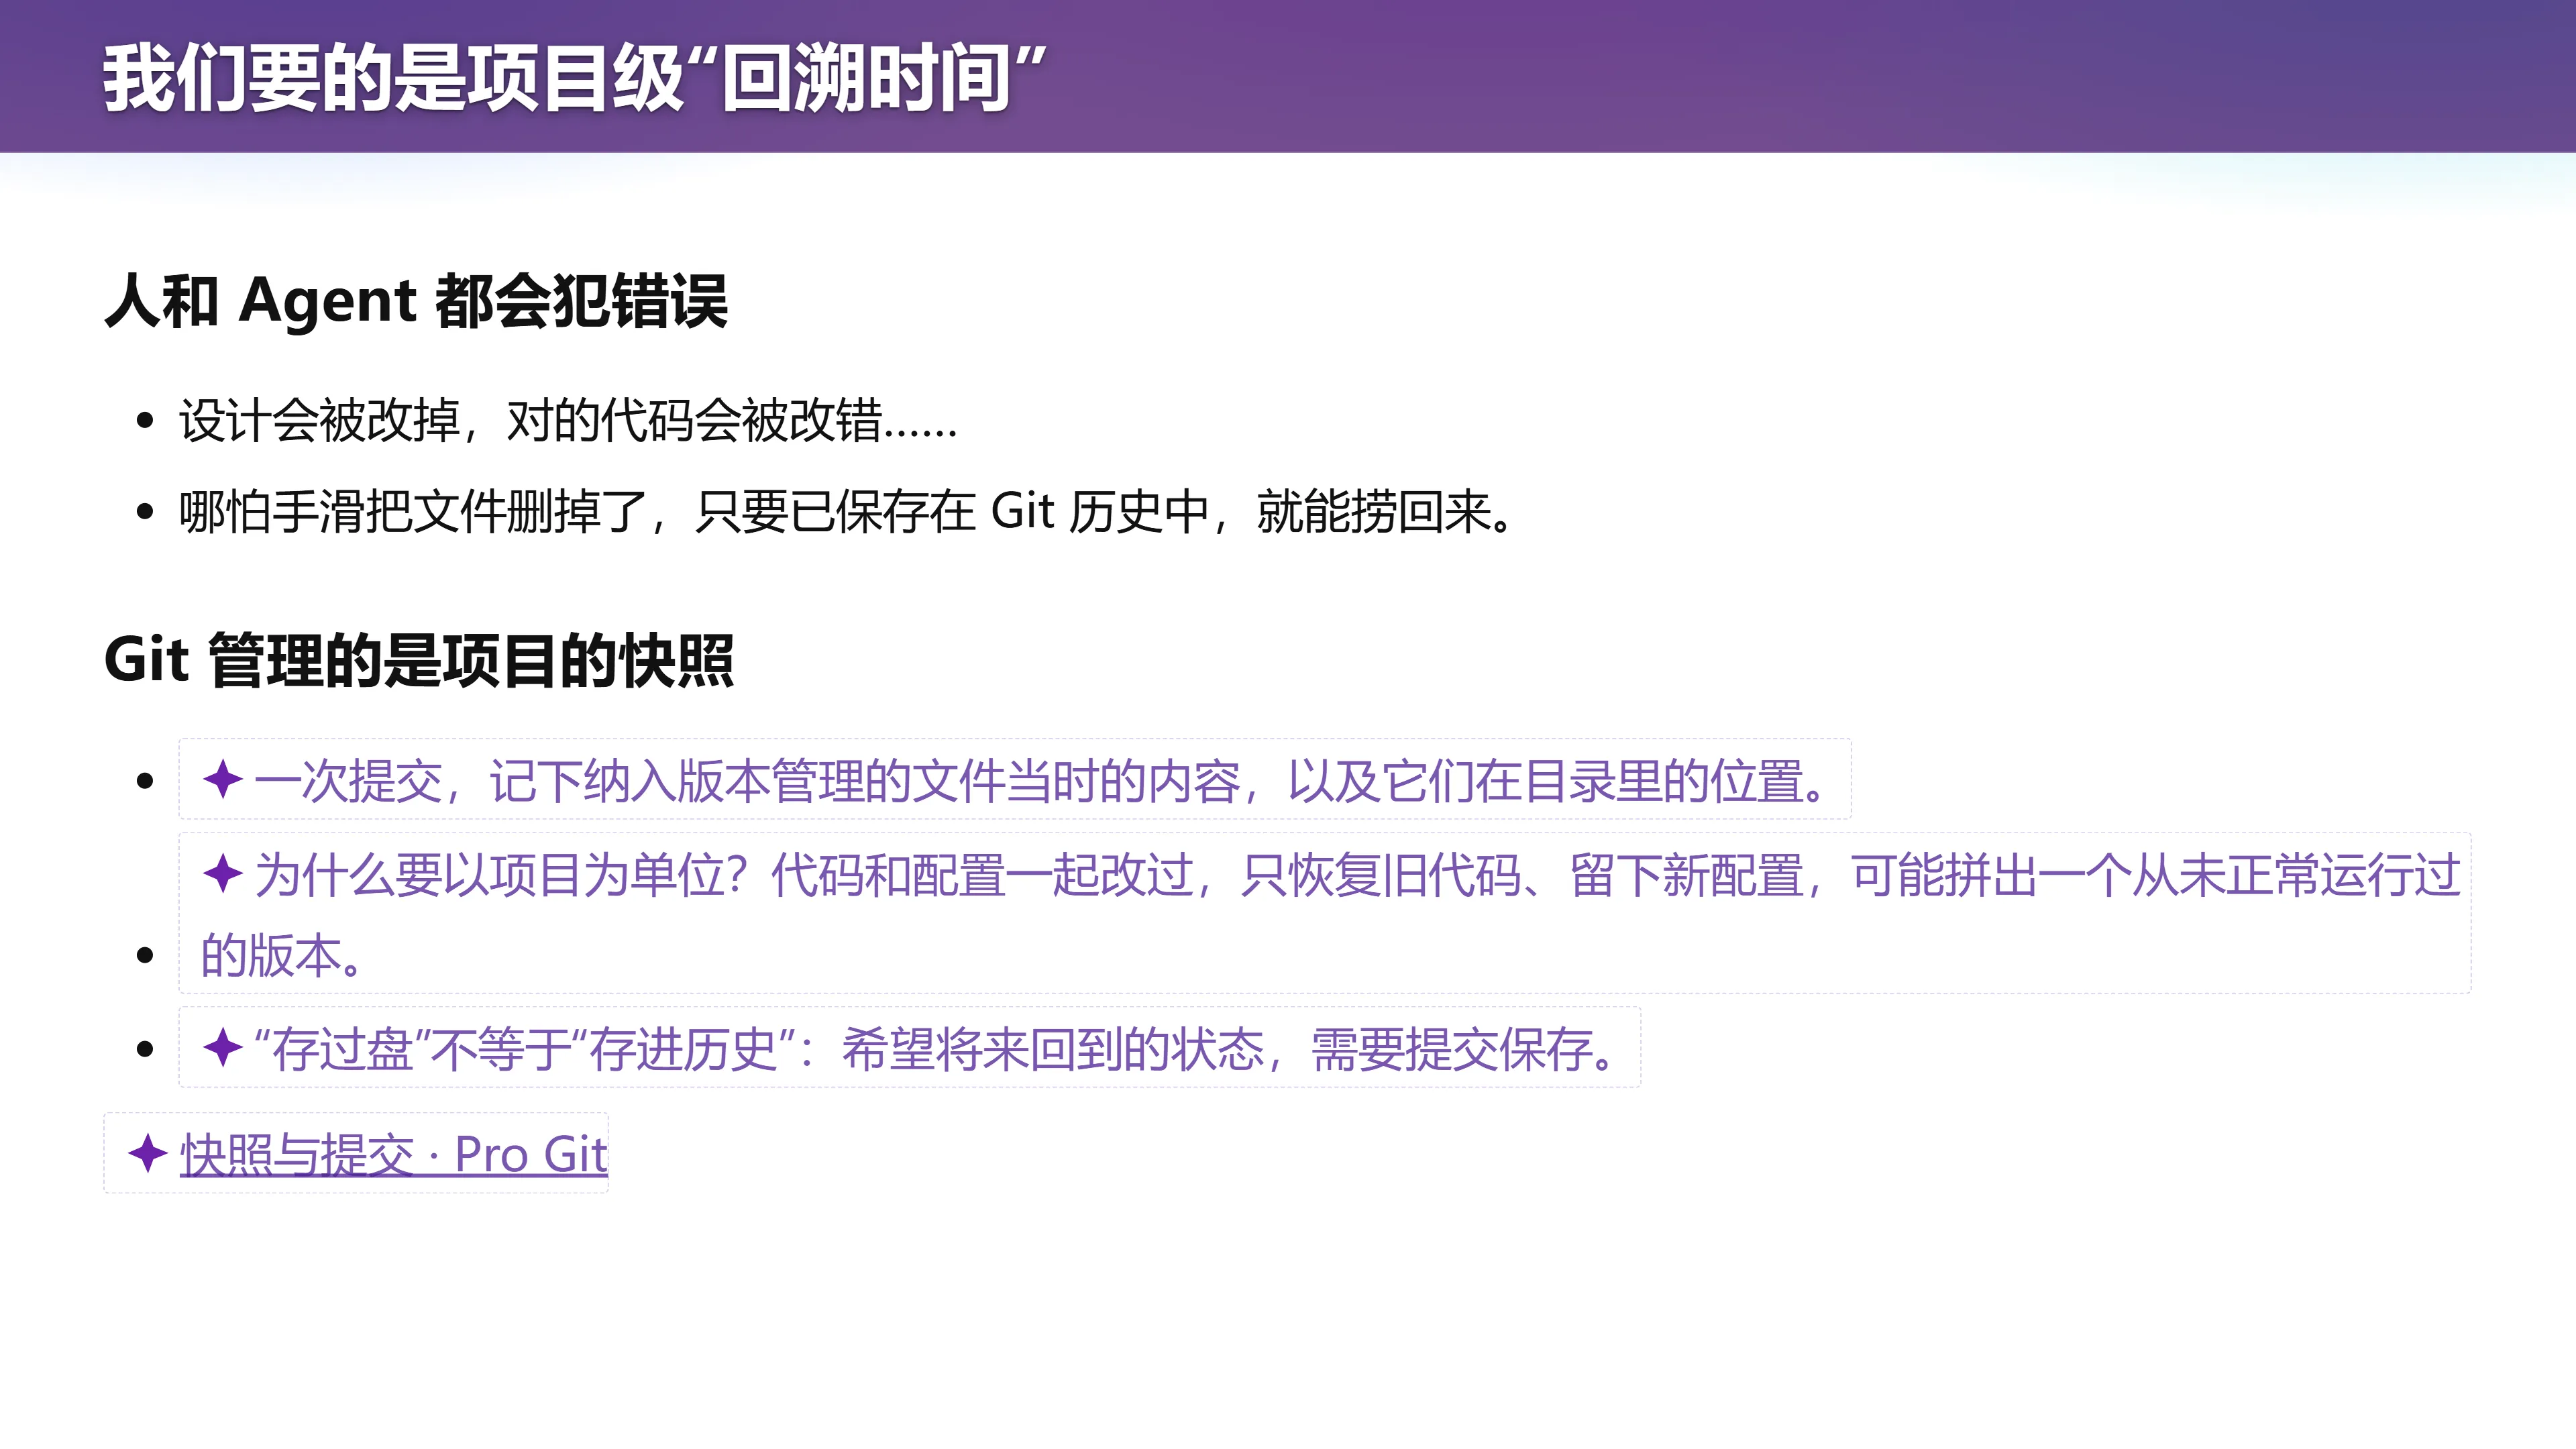
📷 我们要的是项目级「回溯时间」
回到原视频 (00:33:56)
人和 Agent 都会犯错误:设计会被推翻,对的代码会被改错,手滑还会把文件删掉。所以我们需要一种项目级的「回溯时间」:只要那个状态已经保存在 Git 历史里,就能捞回来。
最重要的概念是:Git 管理项目的快照。 一次提交(commit)记下纳入版本管理的文件在当时的内容、以及它们在目录里的位置。
为什么要以「项目」为单位? 因为源代码、接口和配置经常要一起变化。只恢复旧代码、却留下新配置,可能拼出一个历史上从未正常运行过的版本。
「存过盘」不等于「存进历史」:你在编辑器里存盘,和 Git 里提交,保存的是不同层次的状态;你希望将来能回到的状态,需要提交保存。
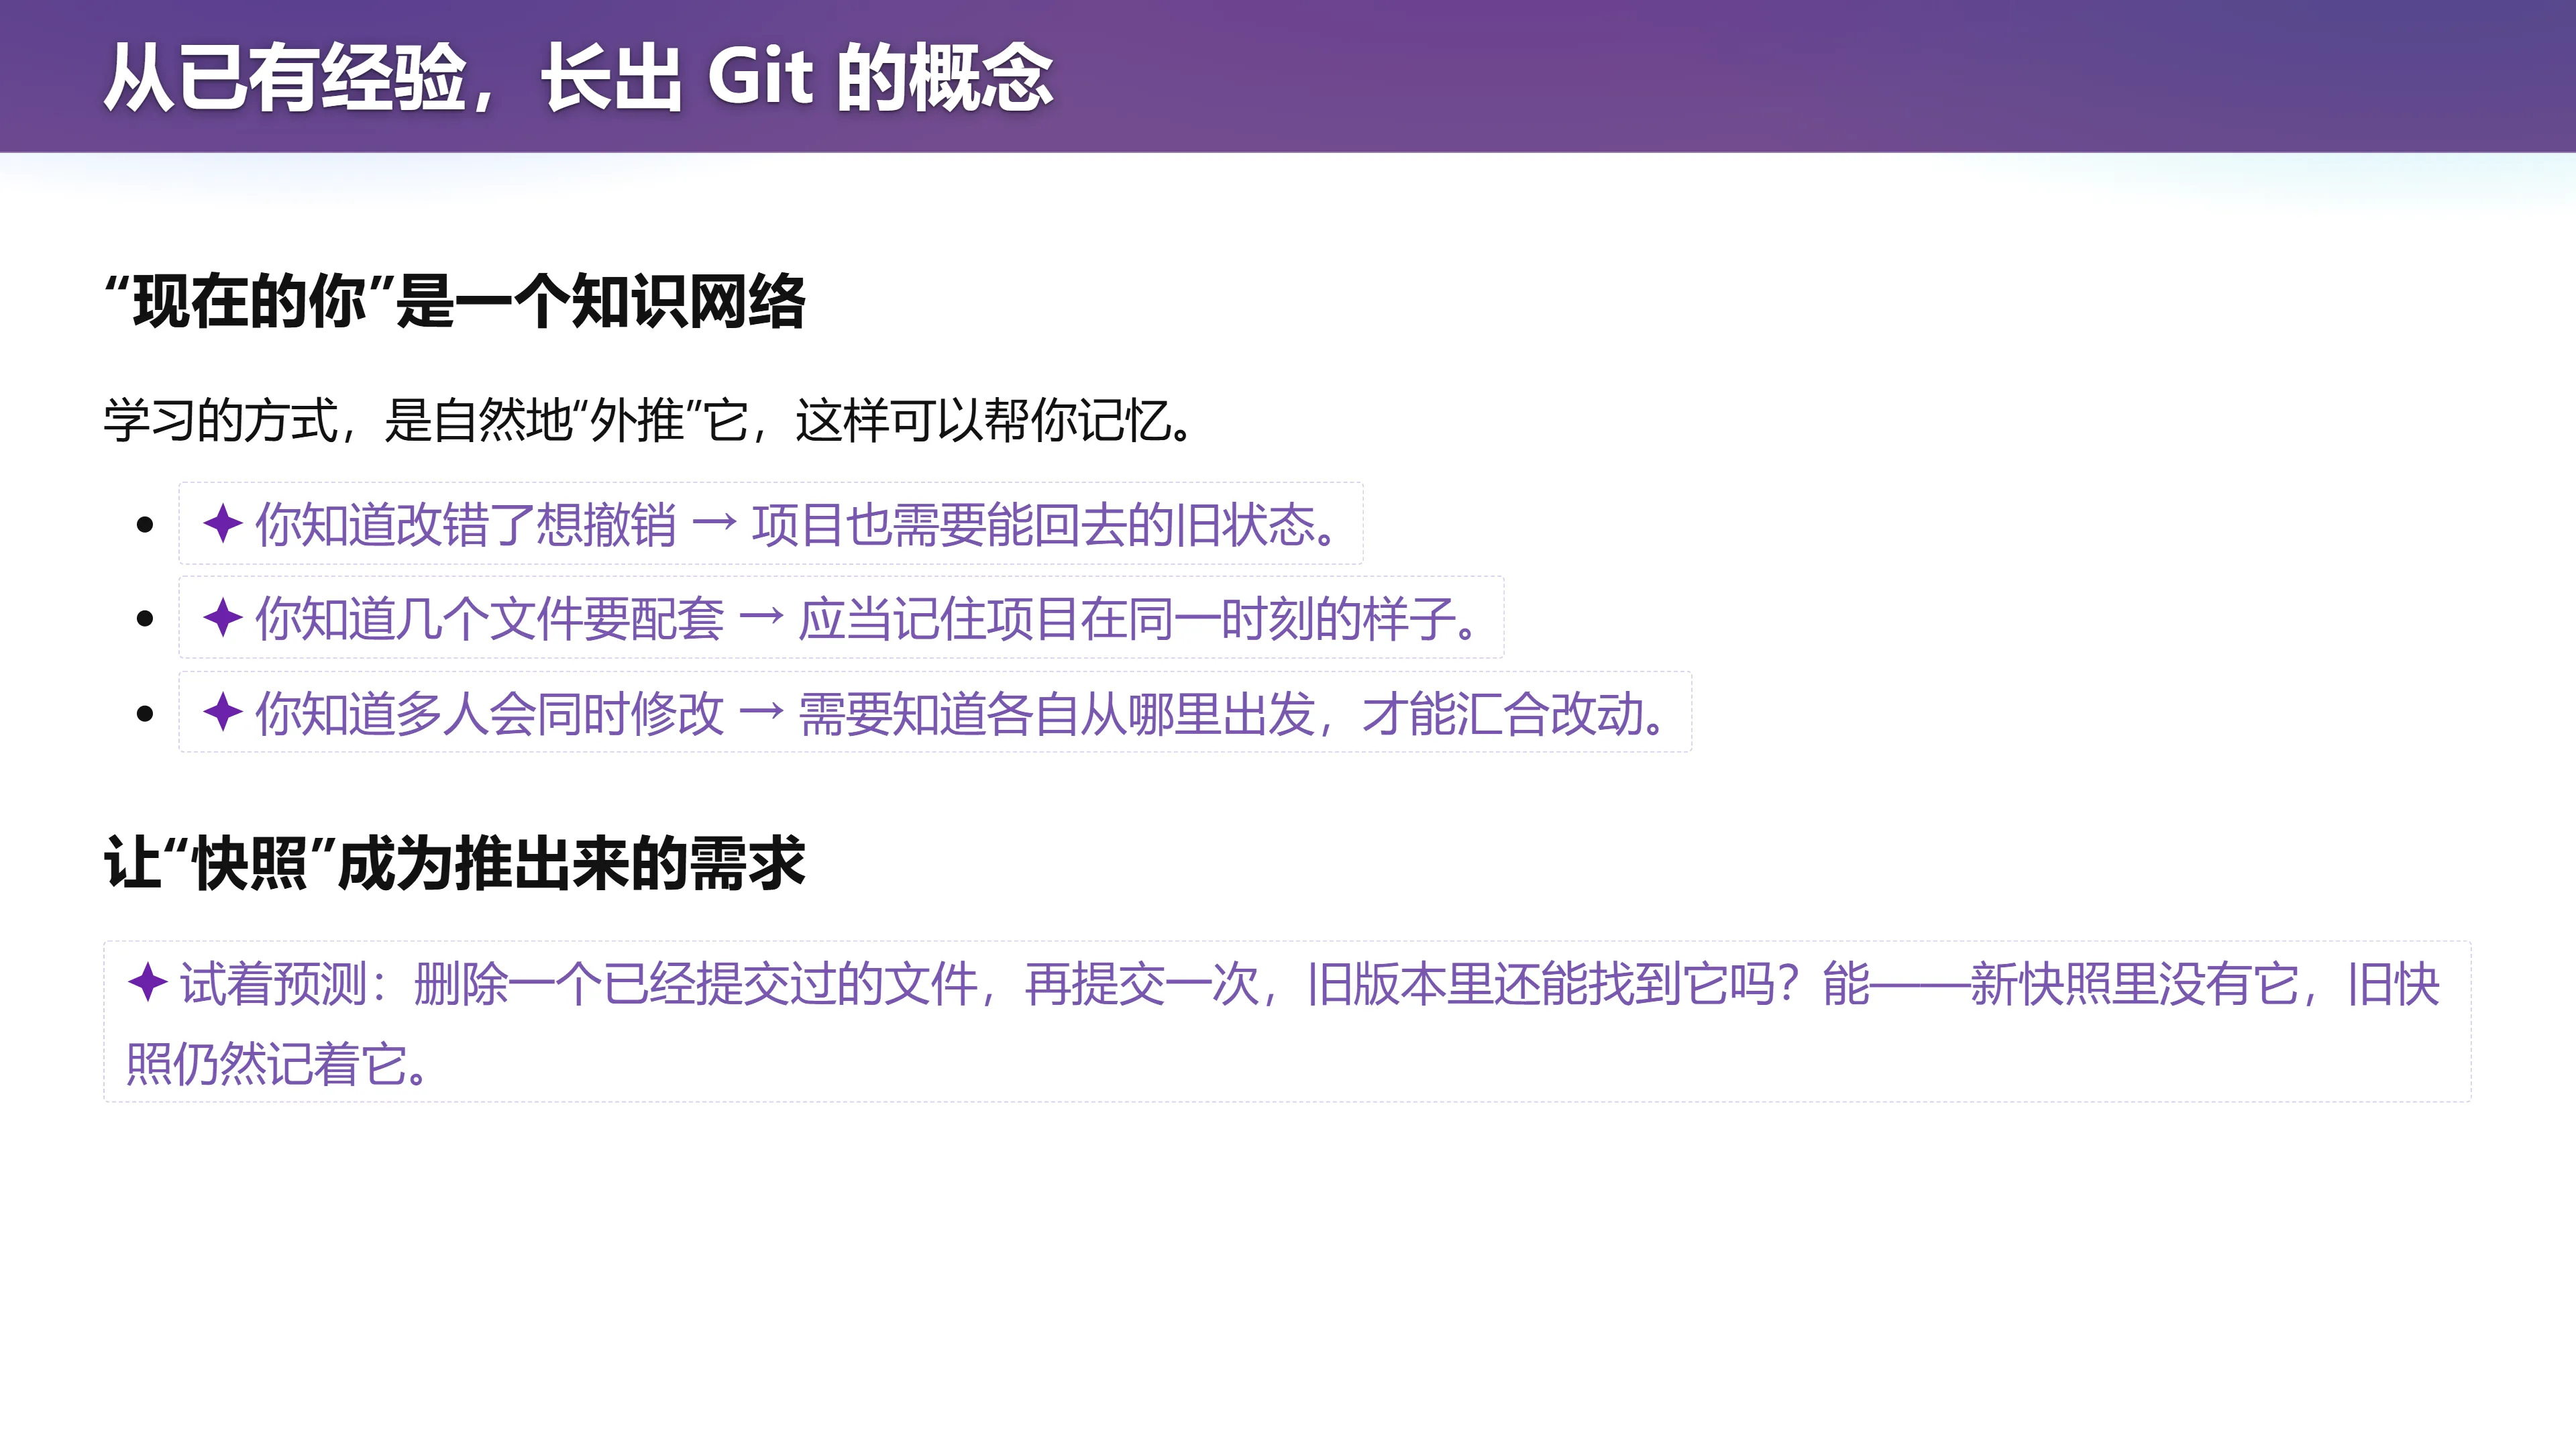
从已有经验,长出 Git 的概念
(参考时间: 00:34:07)
📷 从已有经验,长出 Git 的概念
回到原视频 (00:34:07)
幻灯片把学习方式概括为「外推」:「现在的你」是一个知识网络,学习就是自然地把它向外推一点。
graph TD
    E1["你知道改错了想撤销"] --> G1["项目也需要能回去的旧状态"]
    E2["你知道几个文件要配套"] --> G2["应当记住项目在同一时刻的样子"]
    E3["你知道多人会同时修改"] --> G3["需要知道各自从哪里出发,才能汇合改动"]
你可以试着自己预测:删除一个已经提交过的文件,再提交一次,旧版本里还能找到它吗? 能——新快照里没有它,旧快照仍然记着它。
编者说明:这正是「快照」与「差异」两种世界观的分野。Git 提交记录的是一棵目录树在该时刻的完整样子,父提交记录它从哪里来,于是许多状态串成历史;旧快照里删除的文件依然存在。存储层面,Git 用对象保存内容与目录结构,未变化的部分可以复用——逻辑上是完整快照,物理上共享数据(详见下文)。参考 Git 对象。
五、从 init、add、commit 到分支与合并
(参考时间: 00:34:57)
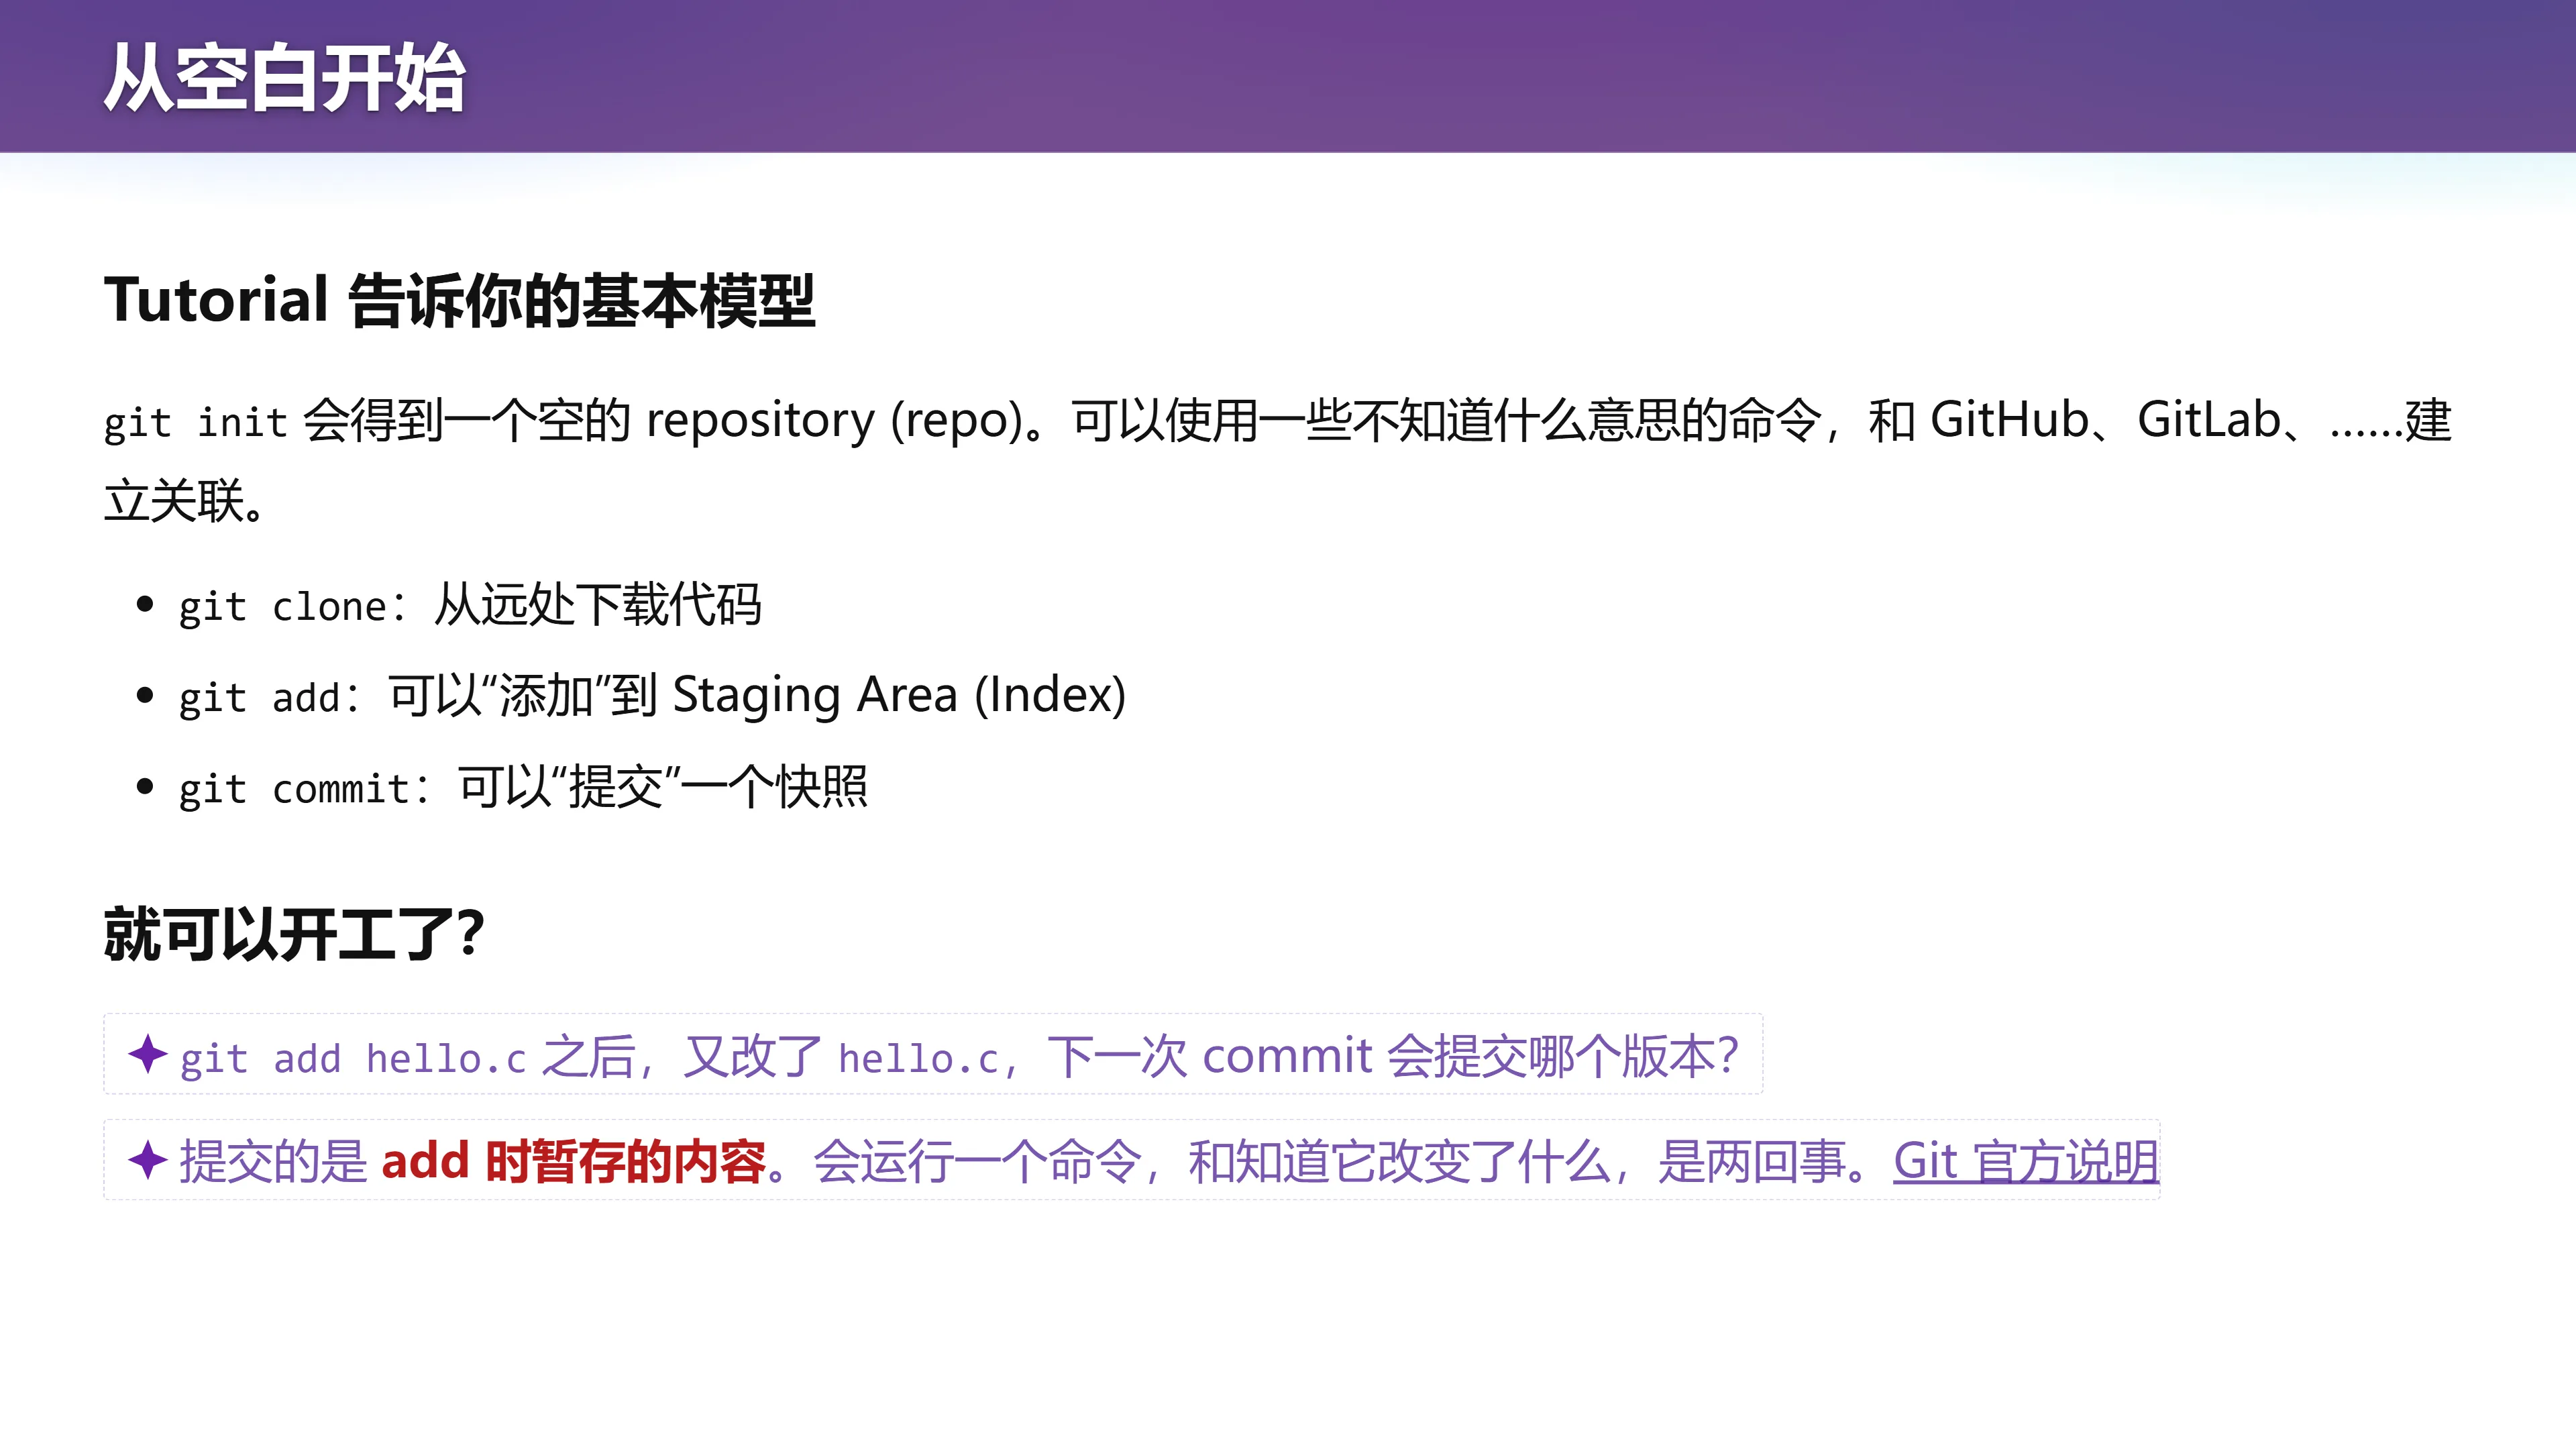
📷 从空白开始
回到原视频 (00:34:57)
现在从空白开始。在终端里执行 git init:
$ git init
Initialized empty Git repository in /path/to/project/.git/
它会告诉你一些「奇怪的信息」。这时你有两种选择:让 Agent 帮你解释你不懂的地方,或者直接忽略。讲师说,显然是前者更高效。
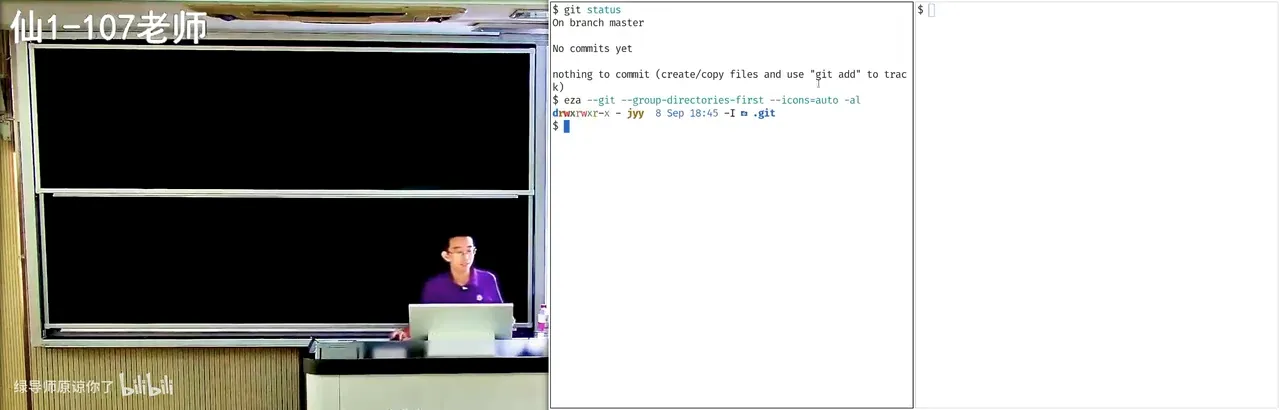
📷 终端中执行 git init 后产生隐藏的 .git 目录
回到原视频 (00:35:43)
执行完之后,你的项目目录里就多了一个隐藏的 .git 目录(默认不显示,所以你看不到它)。这就是全部——你的项目从此成了一个被 Git 版本管理的仓库(repository,简称 repo)。你还可以用 git clone 从远端建立本地副本,或把本地代码推上去。今天 GitHub、GitLab 可以托管远端仓库,但在本地记录版本并不要求先连接这些平台。
三个区域:工作区、暂存区、提交历史
graph LR
    W["工作区<br/>你正在编辑的文件"] -- git add --> S["暂存区 (Staging Area / Index)<br/>下一次提交准备采用的内容"]
    S -- git commit --> H["提交历史<br/>已记录下来的快照"]
    W -- git diff --> S
    S -- git diff --cached --> H
- 工作区:你正在编辑的文件。
- 暂存区(Staging Area,也叫 Index):保存下一次提交准备采用的内容。
- 提交历史:已经记录下来的快照。
git add hello.c 会把此刻 hello.c 的内容放入暂存区;普通的 git commit 再据此创建提交。用一个你值得亲手试一遍的问题来检验理解:
先修改
hello.c,执行git add hello.c,然后又修改它,最后执行git commit——提交的是哪个版本?
答案是 add 时暂存的版本。后续的修改仍在工作区,要再次 add 才会进入这次提交。可以用 git diff 观察尚未暂存的修改,用 git diff --cached 观察暂存区相对当前提交的变化。暂存区让你能组织一次提交的内容,而不是被迫把此刻所有编辑一并记录下来。 参考 git add 文档。
编者说明:「会运行一个命令」和「知道它改变了什么」是两回事。上面这个实验就是训练后者的最小入口。
分支与合并
(参考时间: 00:31:30 起为背景,命令细节见全程演示)
分支让项目能从同一个起点沿不同方向推进。你把分支名理解为指向某个提交的可移动引用;在通常的工作方式下,HEAD 表示当前所在的分支。你在该分支上创建新提交,分支引用就向前移动;另一个分支仍然停在原处,或沿自己的路线前进。
graph TD
    C0["共同祖先"] --> A1["你在改界面"]
    C0 --> B1["同学在修解析器"]
    A1 --> A2["提交 A2"]
    B1 --> B2["提交 B2"]
    A2 --> M["合并提交(两个父提交)"]
    B2 --> M
假设你和同学从同一版本开始,一个改界面、一个修解析器,git merge 会结合共同祖先与双方变化,尝试得到合并结果:
- 双方已经分叉时,常见结果是创建一个有两个父提交的合并提交;
- 如果一方只是另一方的后续,Git 也可能只把分支引用向前移动——这叫 fast-forward。
当双方对同一段文本做了无法自动协调的修改,Git 通常会在工作区文件里写入 <<<<<<<、=======、>>>>>>> 等标记,展示需要人工决定的内容,同时在 git status 中报告 both modified 之类的状态:
<<<<<<< HEAD
int main(void) {   // 你这一侧
=======
int main() {       // 对方那一侧
>>>>>>> feature-b
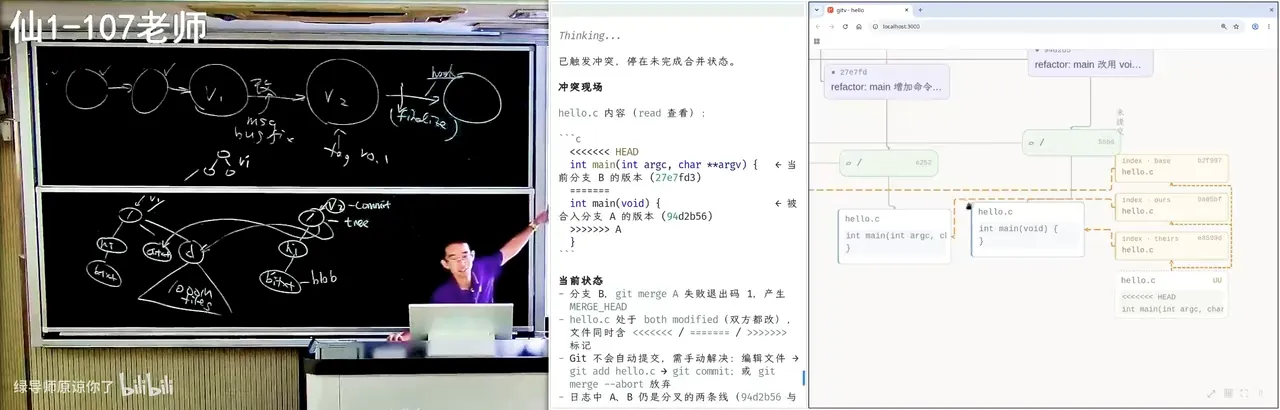
📷 合并冲突后工作区文件里出现的冲突标记
回到原视频 (01:16:57)
解决冲突,就是阅读上下文,把文件编辑成最终应有的内容,移除标记,再用 git add 标记已解决,并完成合并。二进制文件、删除与修改冲突等情况不一定呈现同样的文本标记,所以关键是同时检查状态和文件。参考 分支与合并。
编者说明:冲突标记之所以「把双方内容和标签一起写进文件」,是 Git 设计者从 first principle 出发的选择——一旦发生冲突,就把解决问题所需的全部信息放在「你此刻必然会看到的地方」。讲师说,这和他举的香港路牌是同一个原则。若用 IDE,冲突区域上方还会出现「接受本地/接受对方」之类的按钮,你可以在编辑器里直接决定谁进谁出,然后创建一个提交把它 resolve 掉。
rebase
git rebase 则把一串提交所代表的改动,依次重放到新的起点上。例如你基于旧主线做了两次修改,现在主线已经前进,可以把这两次修改重新应用到新主线之后。重放得到的提交通常有新的标识,过程中也可能冲突。它适合在约定允许的范围内整理工作;如果别人已经依赖原来的提交,你再改写它们,就会增加协作成本。参考 Rebase。
理解这些操作后,再回头看命令,就不再只是「记住输入什么」。你可以在操作前预测:工作区会变吗?下一次提交包含什么?哪个引用会移动?历史里会增加什么关系? 这才是可以继续外推的知识。
Git 底层:一个会持久化的数据结构
(参考时间: 01:03:44)
讲解师在操作系统课上已经讲过 Git 底层,这里只讲一个「头」:Git 是一个持久化的数据结构,持久化的是目录树。
设想你有一棵很大的项目树(根目录 hi 下有 A.txt、B.txt,以及子目录 D……)。现在要创建 V2,你不需要把每个文件都复制一份:
graph TD
    subgraph V1
      R1["根目录树"] --> A1["A.txt (blob)"]
      R1 --> B1["B.txt 旧内容 (blob)"]
      R1 --> D1["D 子树 (tree)"]
    end
    subgraph V2
      R2["新根目录树"] --> A2["指向同一个 A.txt 对象"]
      R2 --> B2["B.txt 新内容 (blob)"]
      R2 --> D2["指向同一个 D 子树"]
    end
如果你只改了 B.txt,那么从被改文件到根目录的路径必须复制(否则根目录还会指向旧的 B.txt),但 A.txt、D 这些未变化的部分,可以用指针指过去。即使项目里有 100 万个文件,目录本身也不会很深(没人会建 1000 层深的目录),每一级索引都在指数级地「把类分完」,所以你只需创建一个非常小的增量,就得到了一份版本快照。
这也解释了 Git 底层 .git 目录里那些带 hash 索引的 objects——它们就是普通文件,是各种节点:目录的节点、文件的节点,甚至有 commit 的节点。
- blob:保存文件内容(字节序列,binary 的字节)。
- tree:把文件名与对象组织成目录结构。
- commit:关联根目录树和父提交。
三大类型(commit object、tree object、blob object)构成一个可以不断向后生长的数据结构。从 first principle 出发,一个大学生想要设计出这样的东西,是完全有可能的。
六、哪怕只有 hello.c,也需要工程判断
(参考时间: 00:38:29)
📷 获取下一级知识
回到原视频 (00:38:29)
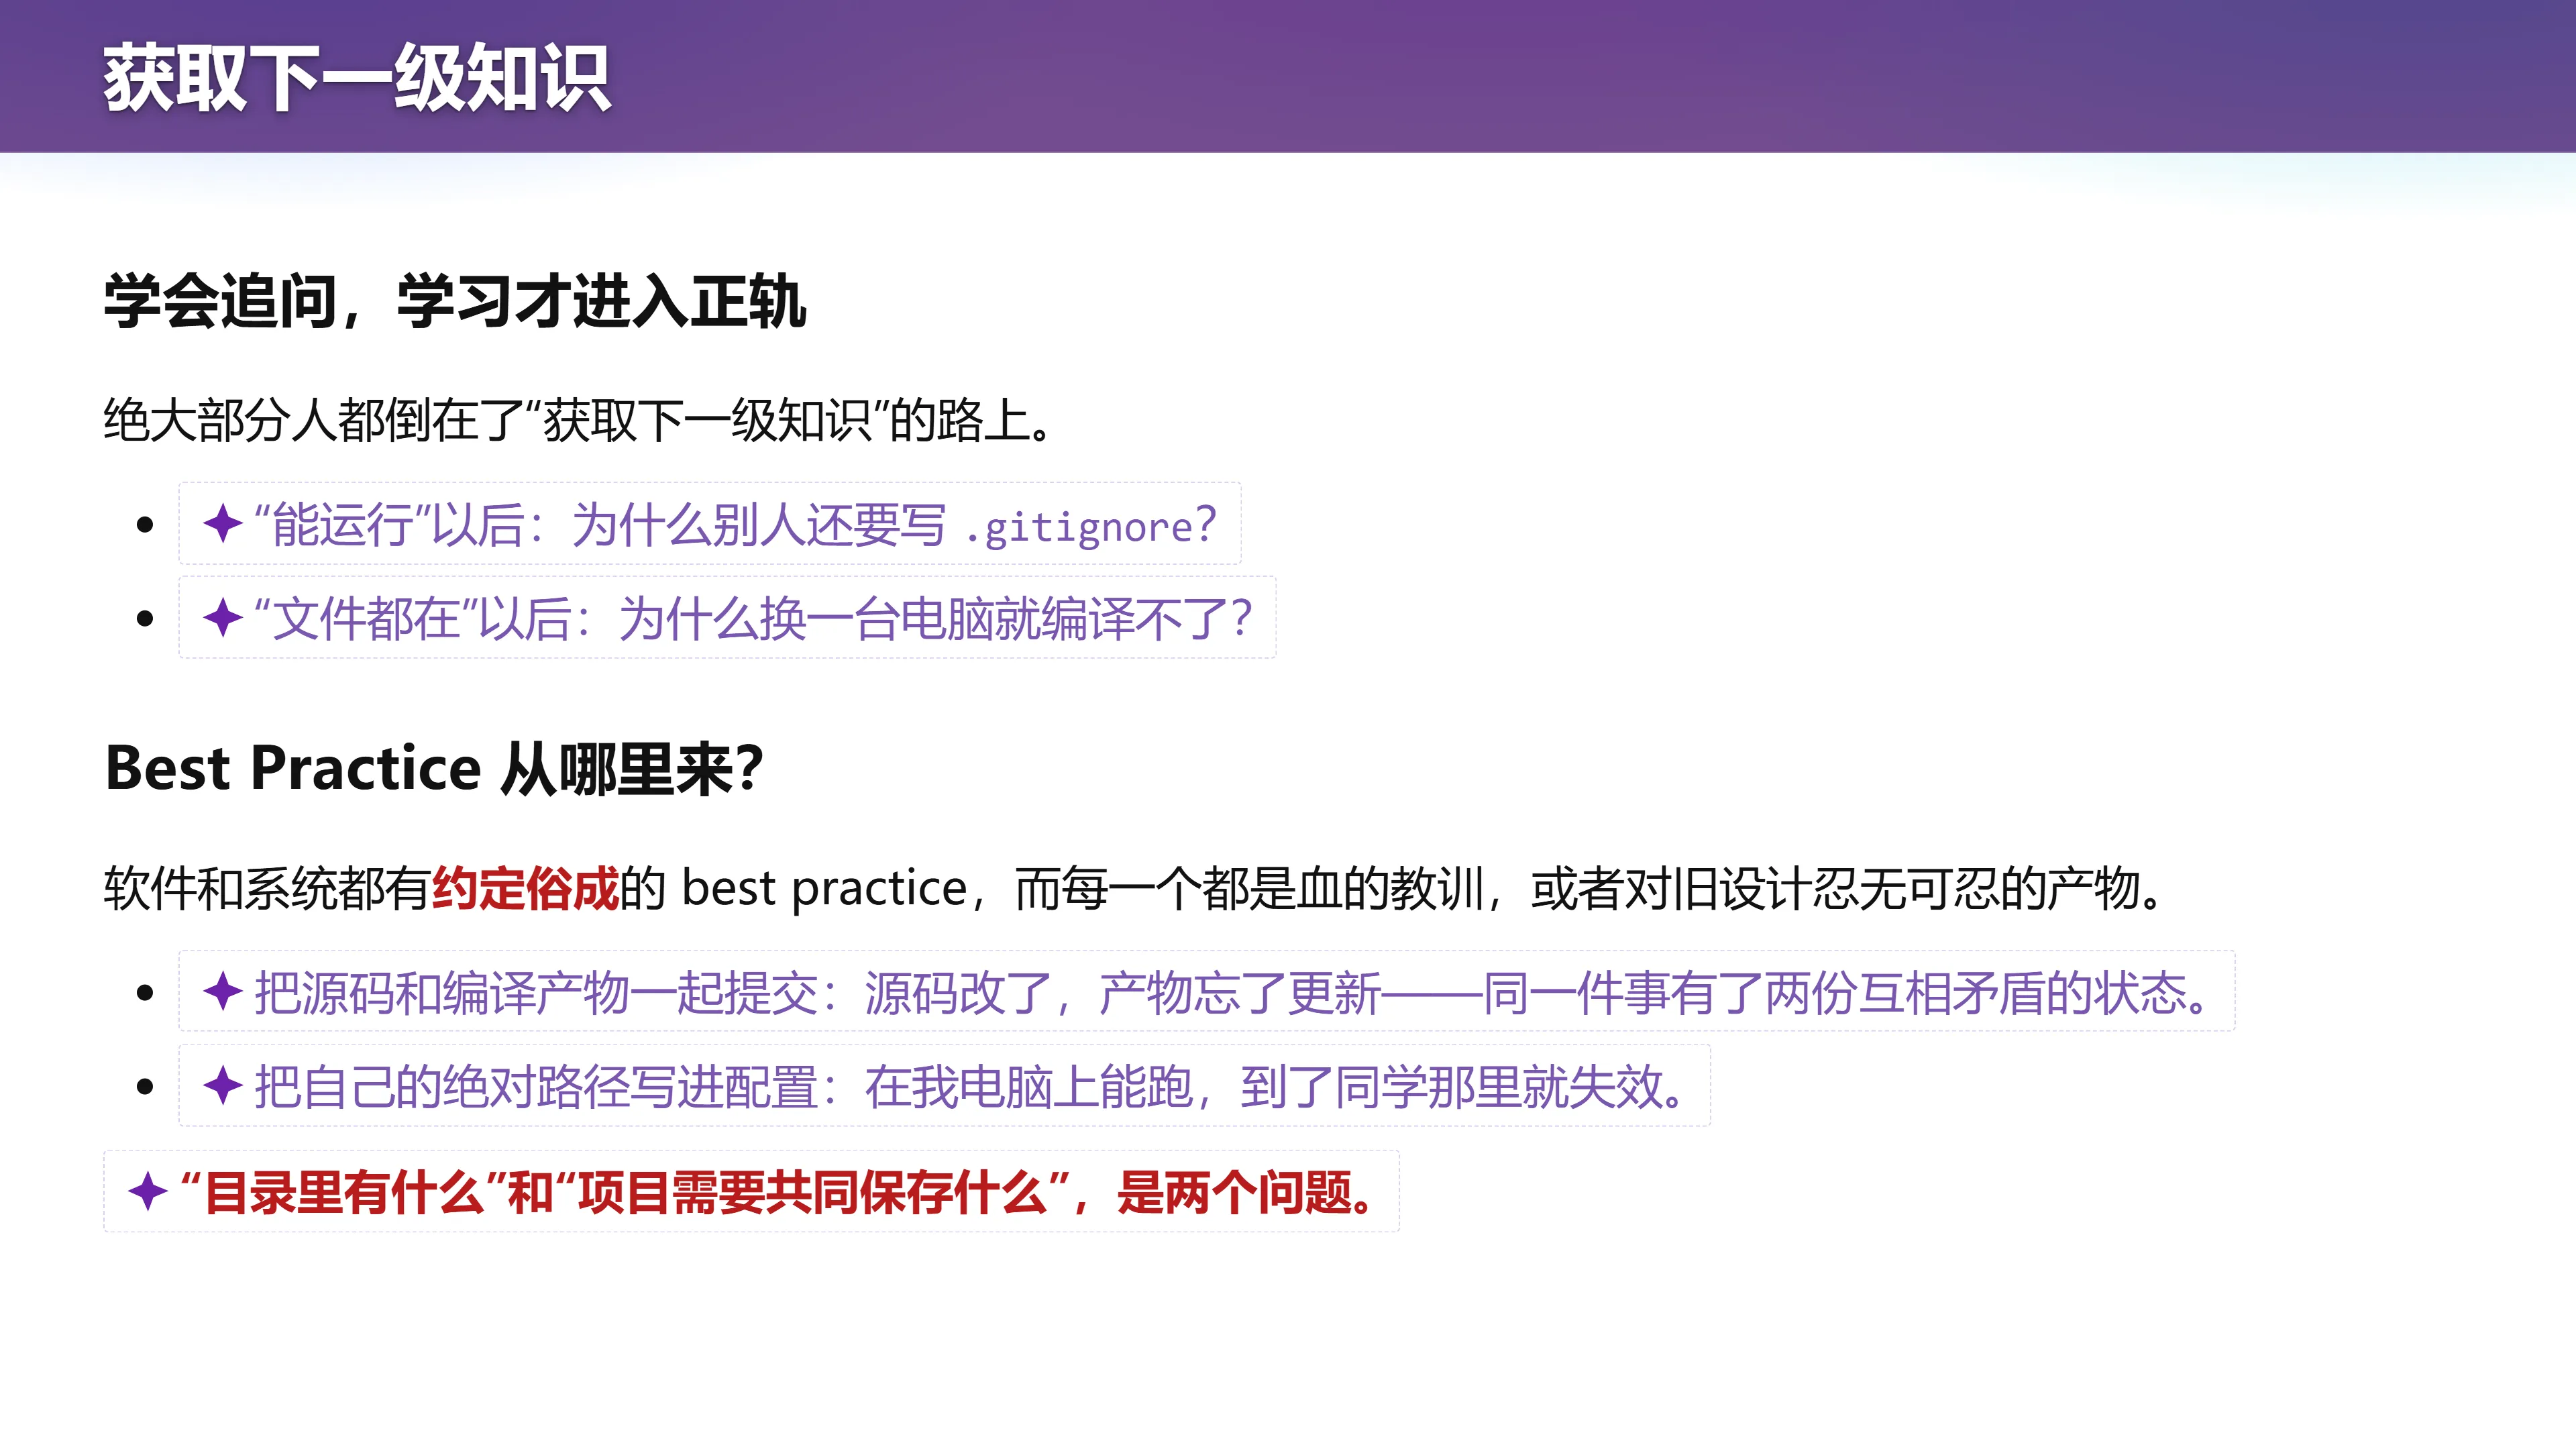
教程把几个命令教完,似乎就可以开工了。但软件和系统里还有大量约定俗成的 best practice——它们经常来自一次次踩坑,或者开发者对旧设计忍无可忍后的改进。讲师说得很直接:「绝大部分人都倒在了『获取下一级知识』的路上。」
- 「能运行」以后:为什么别人还要写
.gitignore? - 「文件都在」以后:为什么换一台电脑就编译不了?
📷 多问一句:为什么、该不该?
回到原视频 (00:43:30)
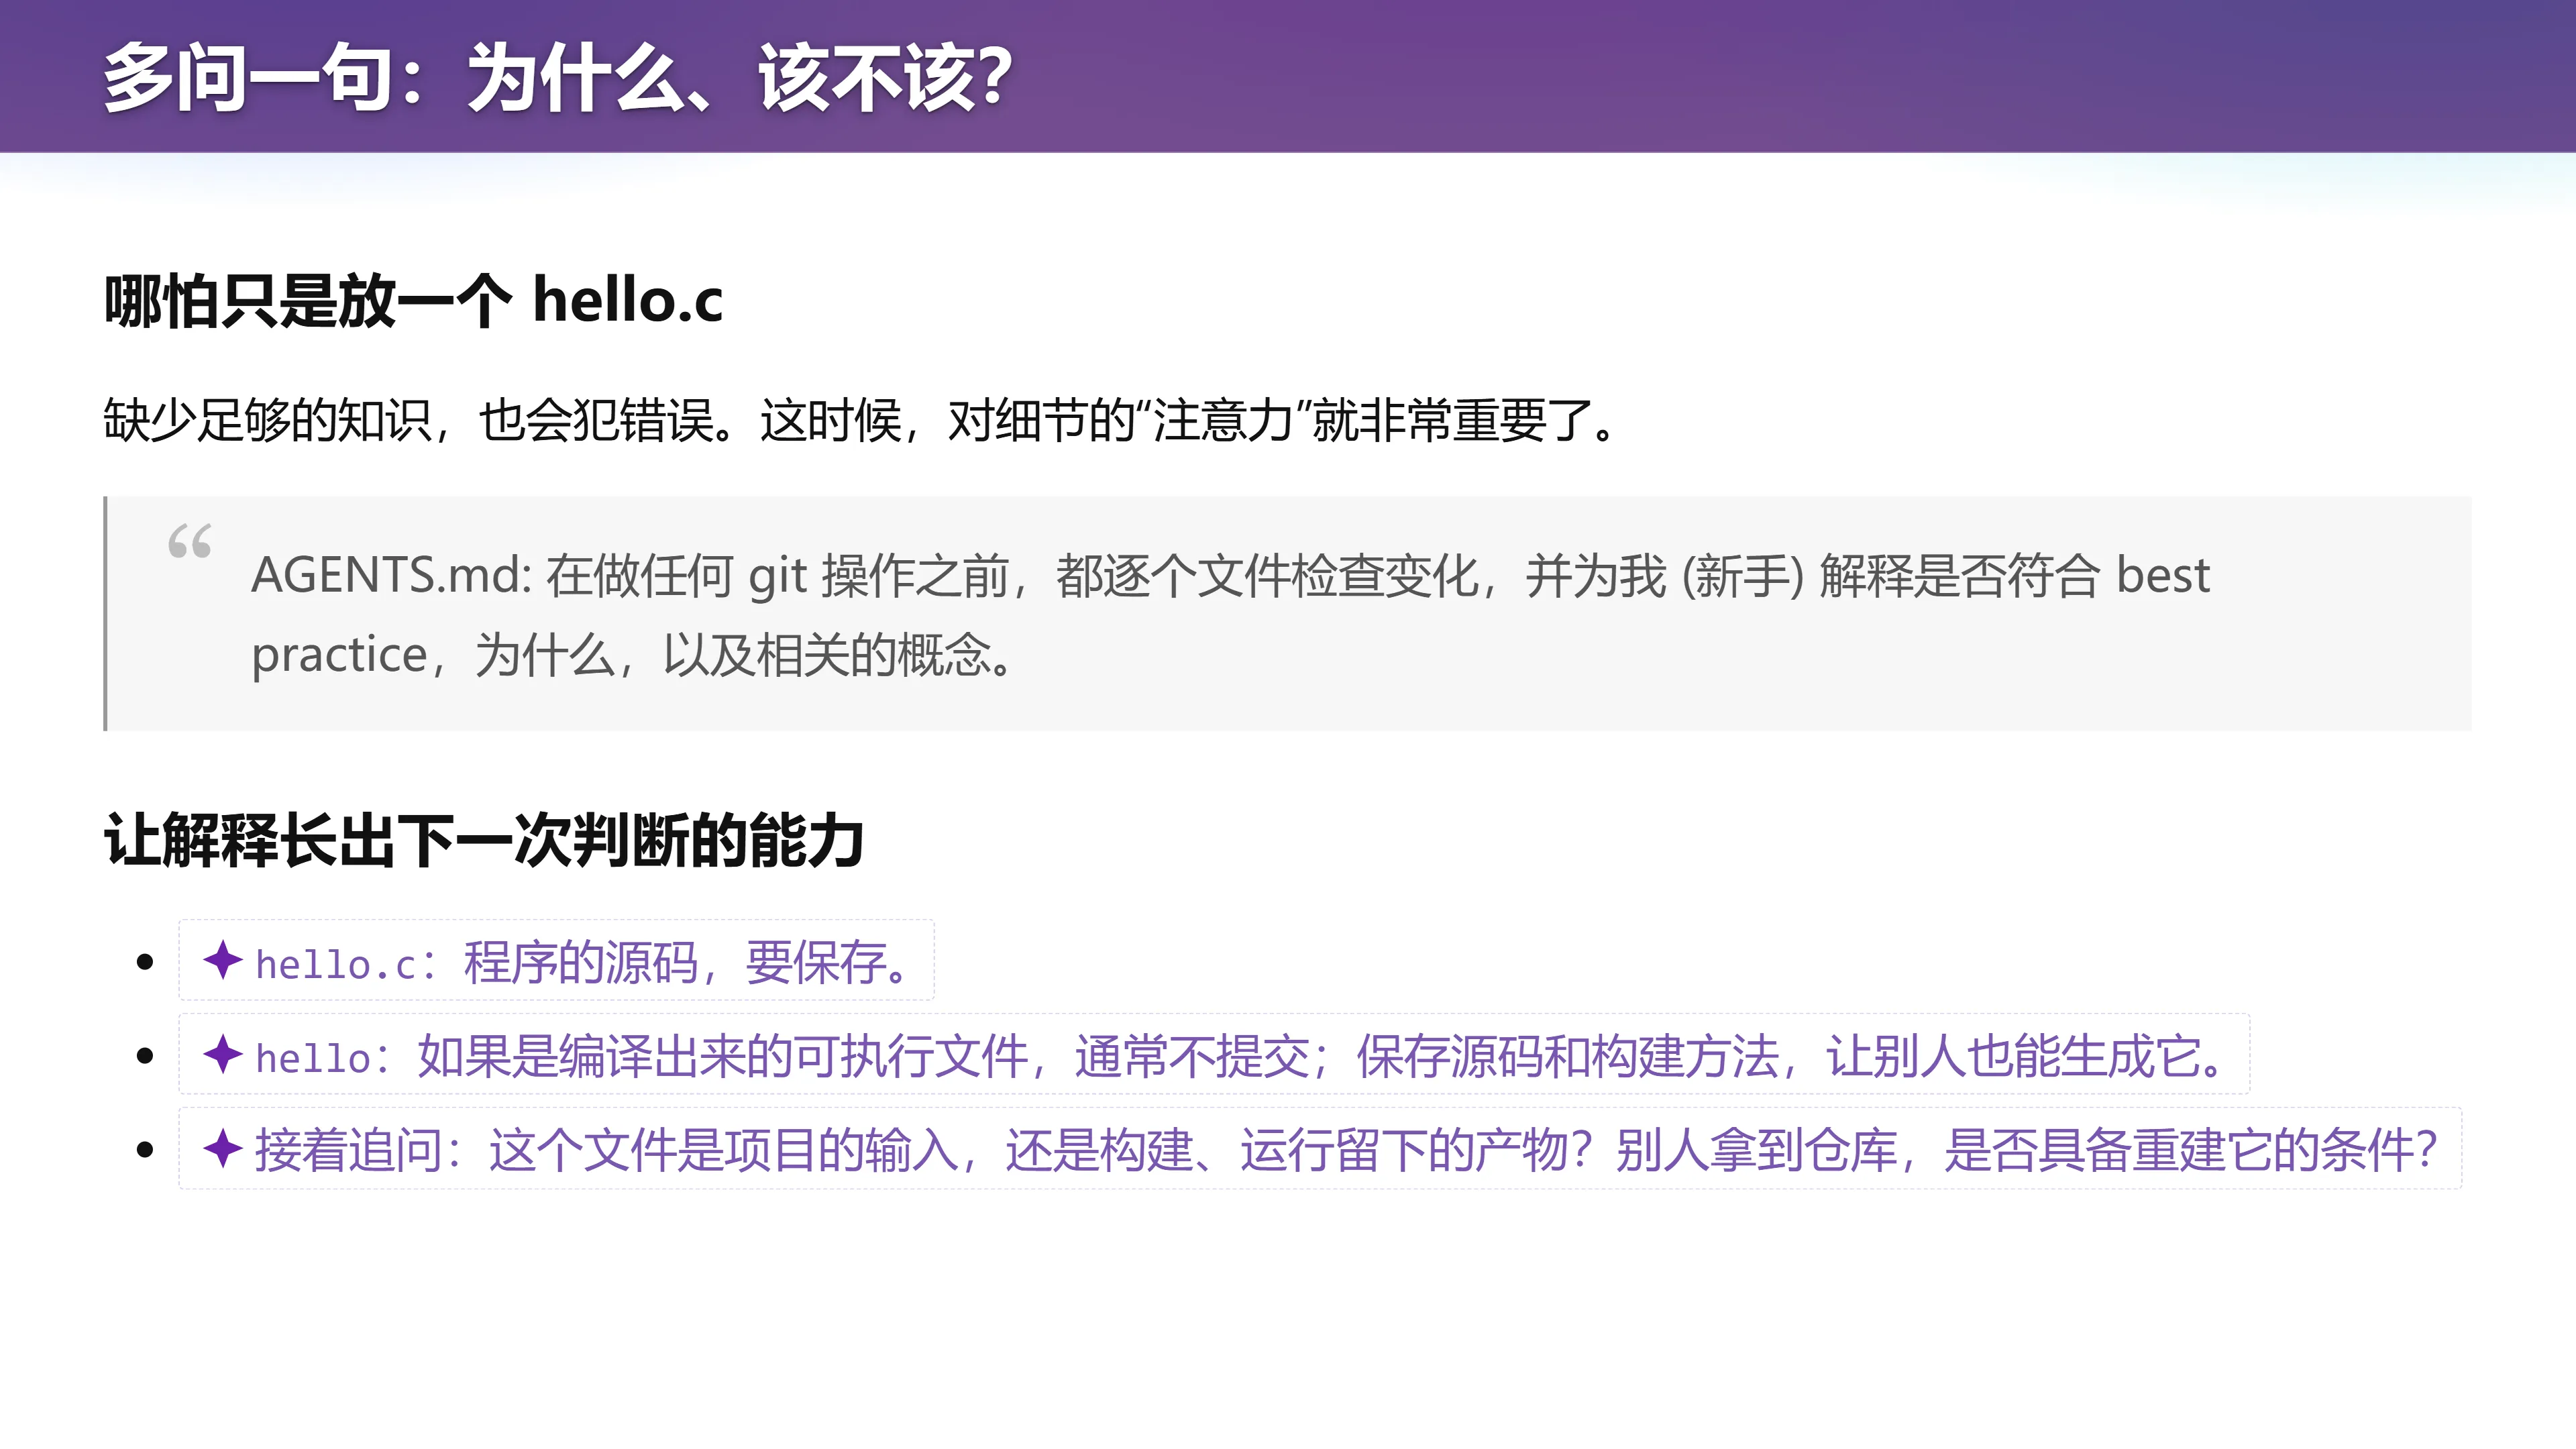
以最朴素的 hello.c 为例:目录里同时有 hello.c 和编译得到的 hello,要不要一起提交?
- 如果两者都保存,下一次只改了源码却忘记重新编译,仓库就出现两份互相矛盾的状态,别人到底该信哪份?
- 如果只保存源码,也还要说明怎样构建,让其他人有条件重建结果。
「我的目录里有什么」和「项目需要共同保存什么」,是两个问题。
让「下一步判断」长出解释
你可以把自己的学习需要写进 AGENTS.md。幻灯片给出了一条学习约定:
在做任何 git 操作之前,都逐个文件检查变化,并为我(新手)解释
是否符合 best practice,为什么,以及相关的概念。
这条约定的价值,在于让具体变化成为学习入口。面对一个文件,先判断它承担什么作用,再决定是否提交:
graph TD
    F["某个文件"] --> Q1{"它是项目的输入,还是构建/运行的产物?"}
    Q1 -- 输入 --> K["保存(如 hello.c)"]
    Q1 -- 产物 --> Q2{"别人拿到仓库,能否重建它?"}
    Q2 -- 能 --> I["不提交,写进 .gitignore"]
    Q2 -- 不能 --> Q3["说明构建方法,必要时才提交生成物"]
进组以后的高血压时刻
(参考时间: 00:55:16)
📷 进组以后的高血压时刻
回到原视频 (00:55:16)
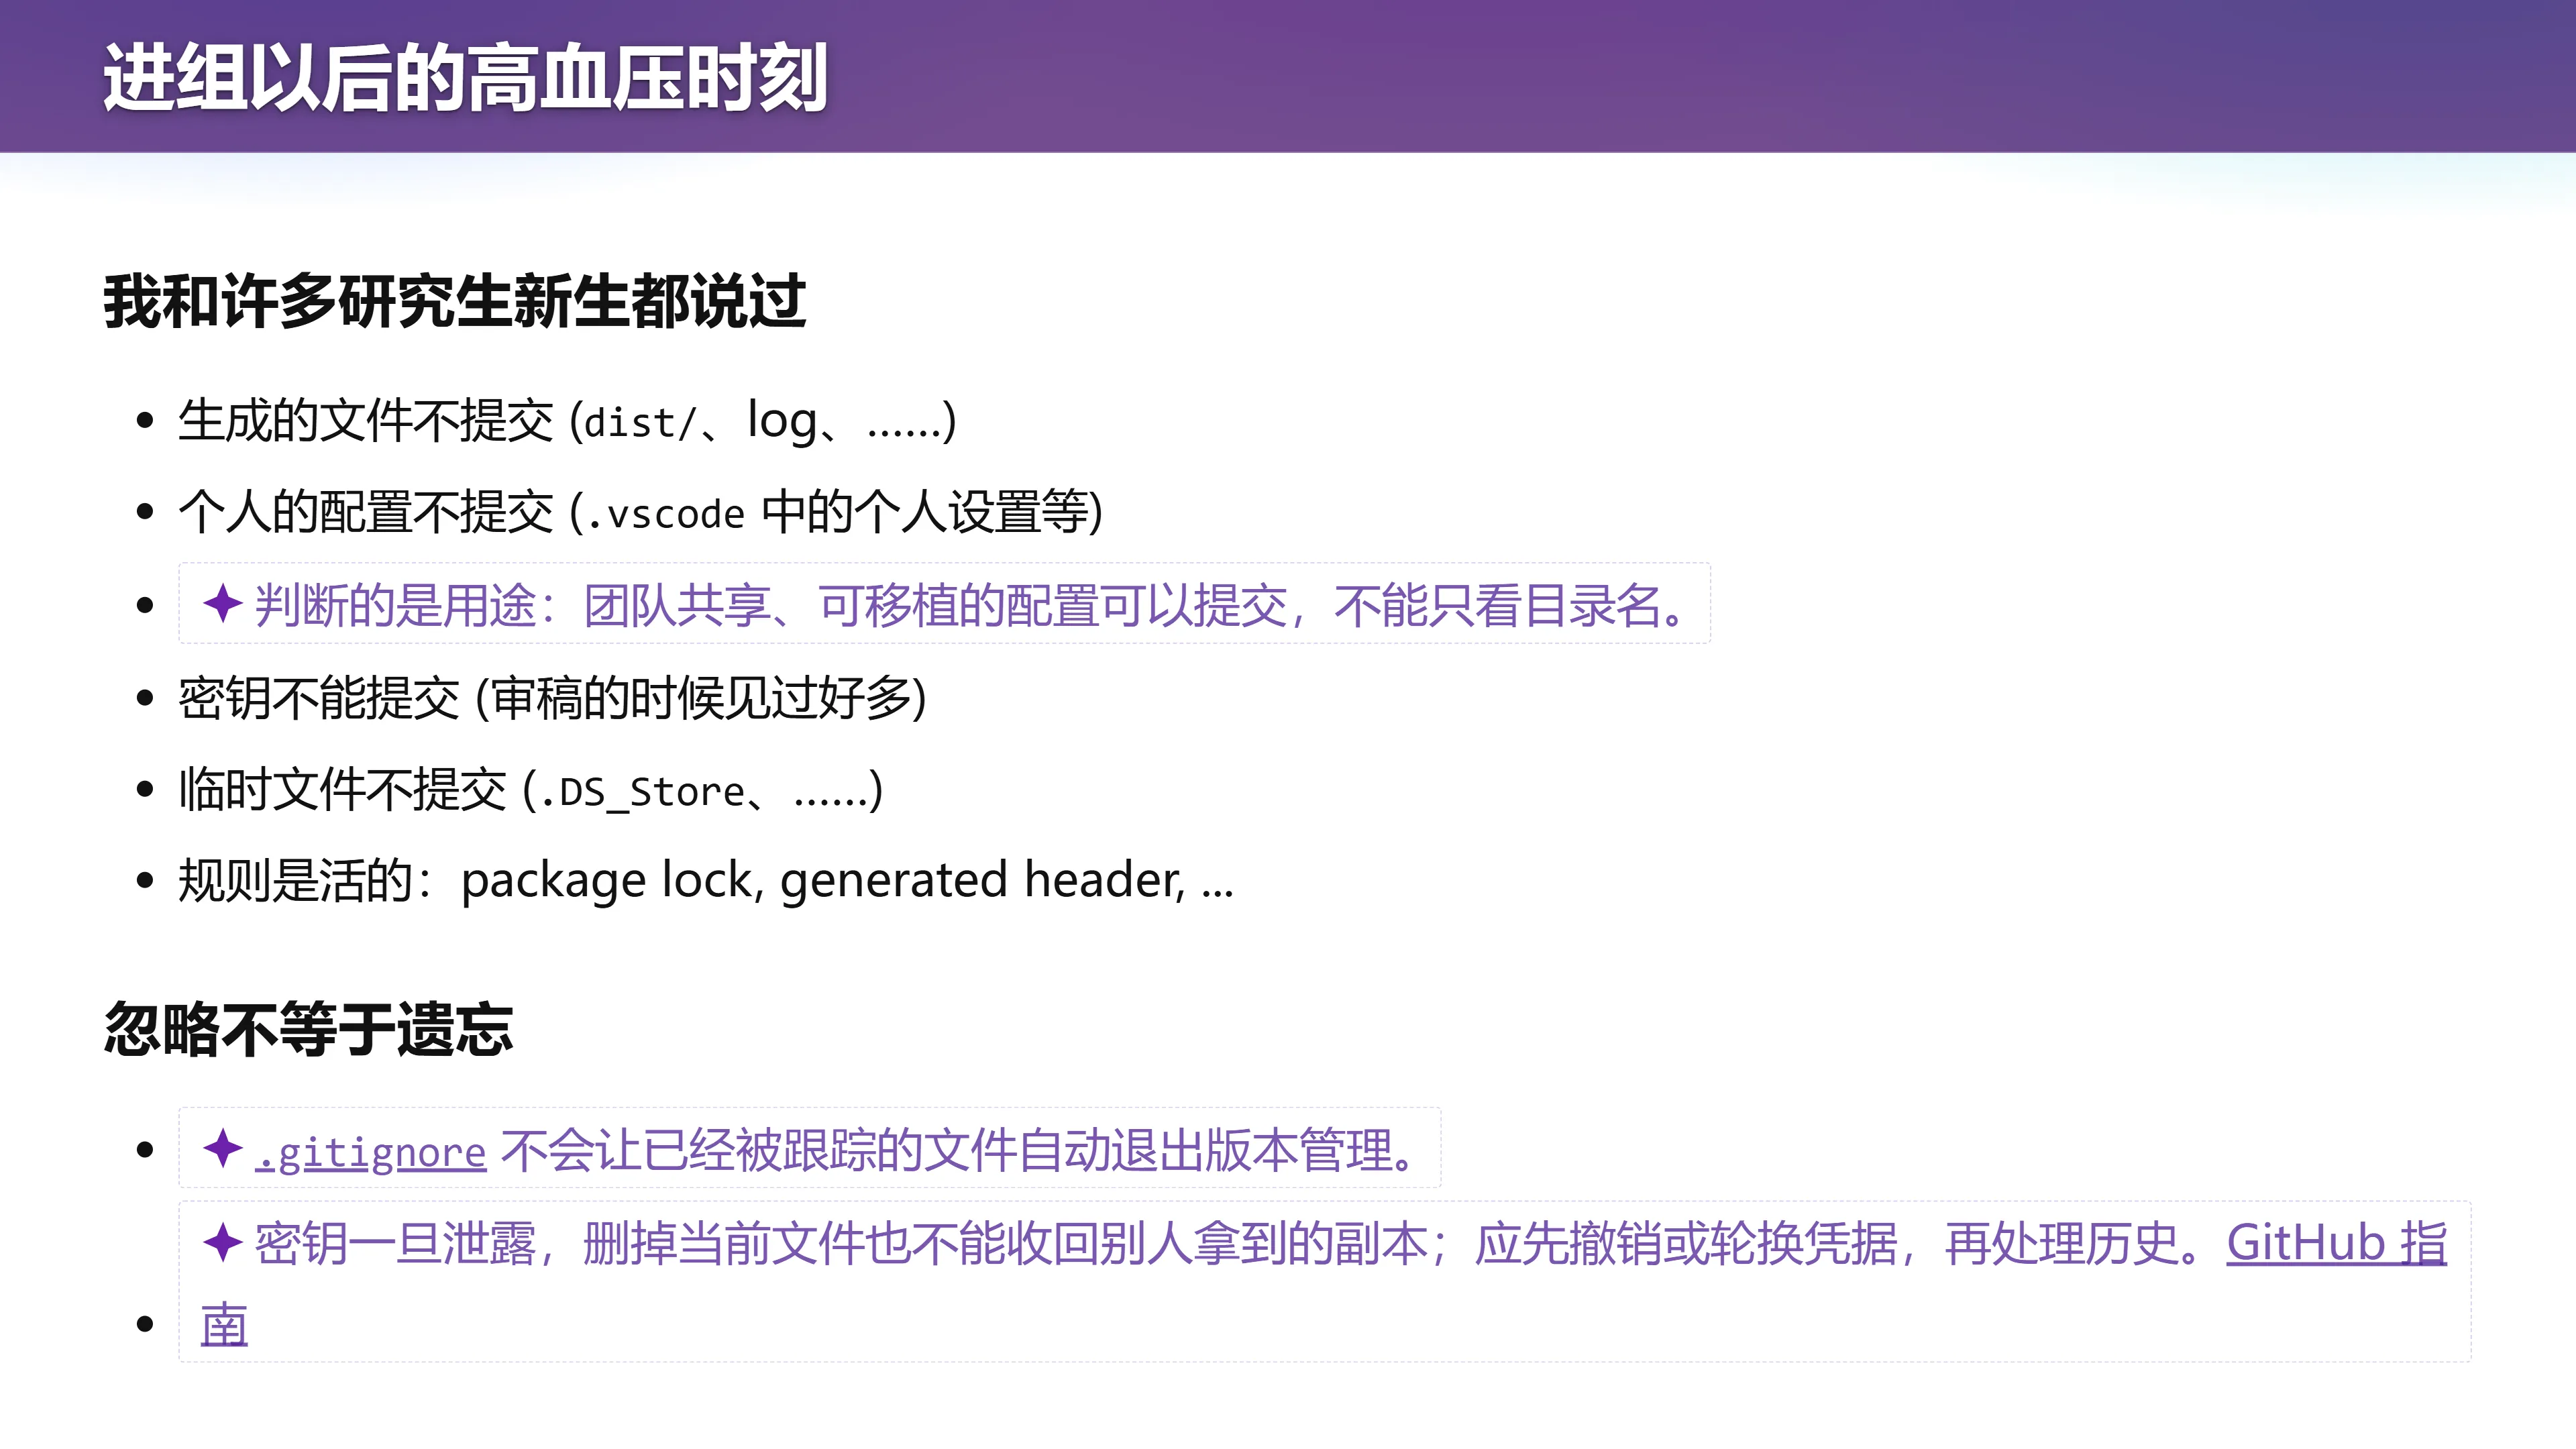
讲师说,在 LLM 之前,新同学进组通常会有一段「高血压时刻」——开完 Git 仓库,进去一看就血压上来。他把反复提醒新生的几类问题放在一起:
- 生成的文件不提交:如
dist/、编译得到的程序、调试日志(log)。 - 个人的配置不提交:尤其是包含自己机器上绝对路径、私人偏好的设置(比如 VS Code 的个人设置);团队共享、可移植的编辑器配置则可以有意保留。
- 密钥不能提交:讲师审稿时见过处于 active 状态的 API key,一看出是 DeepSeek 的(
sk-...),就知道「这应该是一位中国兄弟」。源码需要共享,并不意味着访问服务的凭据也应一起共享。 - 临时文件不提交:如 macOS 的
.DS_Store。
关于 .DS_Store 有一段插曲:在苹果系统上用 Finder 打开一个目录,它会自动留下索引(记录了哪些子目录被展开),放在 .DS_Store 里。这个文件以点开头,默认隐藏,ls 时你看不到它;于是一个 git add . 就把它悄悄追踪进去了。git add . 本身是合理的(因为 .github/workflow 等点开头的约定文件也应当被纳入),但对这个会频繁变化的临时文件就有点糟糕。
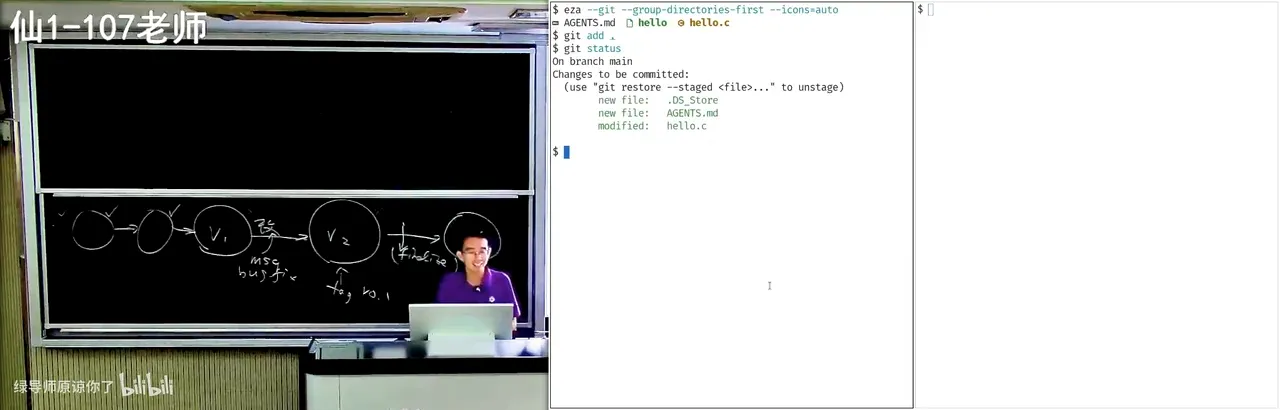
📷 在 macOS 上 git add . 后 .DS_Store 被误追踪
回到原视频 (00:57:12)
重要的是——这些不是按文件名机械执行的禁令,规则是活的:
- 依赖锁文件(如
package-lock.json)虽然由工具生成,却常常用于固定依赖版本; - 有些项目也有意保存生成的头文件:如果项目用另一套工具链生成了这个 header,你可能可以在没有该工具链的地方继续编译,因此在没有下载很多依赖时也能编译。
需要解释的是:这个文件为何构成共同维护的项目状态,以及怎样保证它与其他文件一致。
.gitignore 可以把这些约定落实为忽略规则,但它不会让已经被跟踪的文件自动退出版本管理,更不会抹掉历史(参考 gitignore 文档)。这也解释了为什么误提交密钥后,仅仅删除当前文件不够:旧提交可能仍保留它,别人也可能已经取得副本。版本管理帮我们记住过去;不该公开的东西一旦进入过去,就不能假装它从未发生。
编者说明:这几类问题背后其实有一个统一的判据——这个文件是否表达项目意图、是否参与项目构建、是否可移植地重建。把它想清楚,比背「哪些文件名不能提交」更管用。
讲师还提到,他自己做软件工程研究时,一个非常标准的研究方向就是:检测一个 Git 项目满不满足这些 best practice,不满足就给出 warning(例如针对 .DS_Store 这类问题写一条规则),最后做成一个小工具,在 git commit 之前告诉你 OK 不 OK。但所有这些东西都被大模型杀死了——因为大模型可以如此耐心地给你检查,还附赠一个 emoji 缓和情绪。
编者拓展|「导师的高血压」与 AI 的解放作用 讲师讲了导师批评学生的场景:作为导师要装作 nice,学生听到批评也会有压力。而 AI 作为一个「你无法控制的力量」,可以不带情绪地反复解释 best practice,把学生从这种心理压力中解放出来。讲师特别强调,很多时候模型表达得比他现场讲得更好——知识内化在他脑子里,但课堂上要同时专注讲授,「思考的那部分容量就不够了」,讲出来的往往不是最好的版本(他自称是「省电模式」)。他建议:回头把「为什么要这样写 commit message」之类的问题,去和 ChatGPT 这类「知道世界上所有东西」的助手聊清楚。
七、大写还是小写,也值得追问
(参考时间: 00:59:51)
📷 大写还是小写?
回到原视频 (00:59:51)
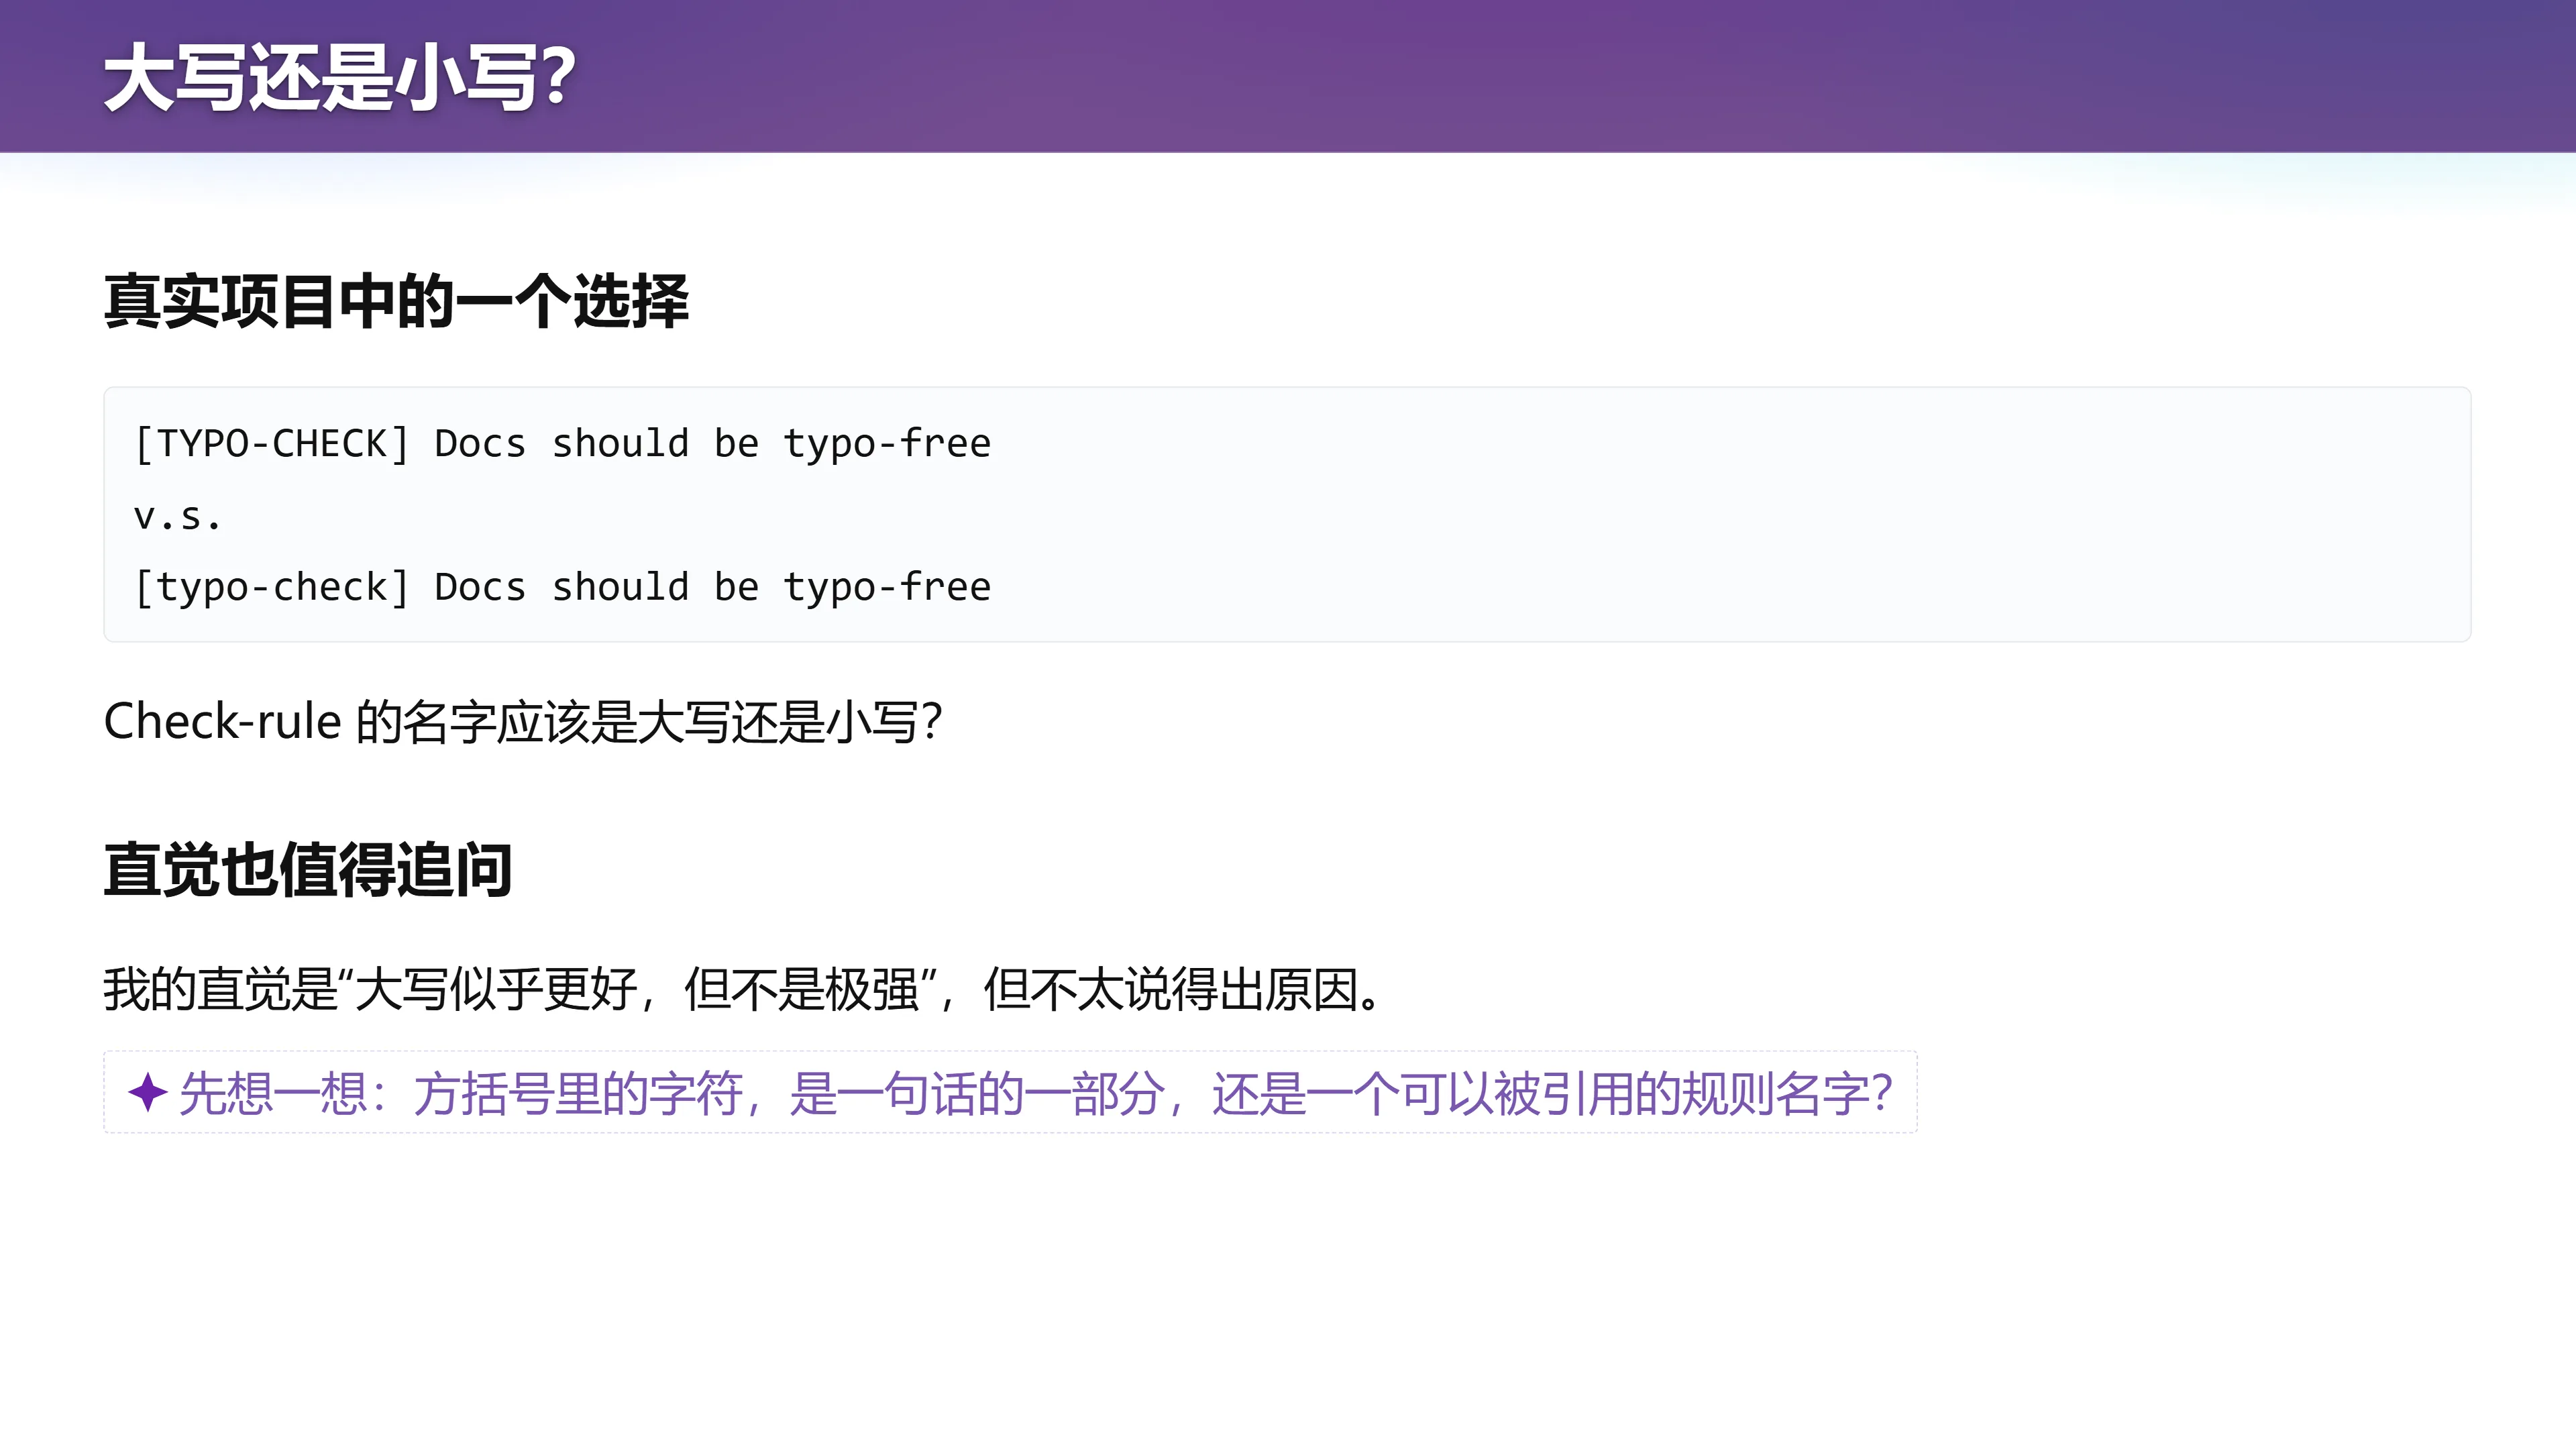
在做一个更严肃的项目时,讲师需要在 pre-commit hook 上做若干检查(他可能有几十条 checking rules),于是要给这些规则命名——这就出现了一个两难的小设计选择:
[TYPO-CHECK] Docs should be typo-free
[typo-check] Docs should be typo-free
这是同一条文档检查规则的两种写法。讲师的直觉是「大写似乎更好,但不是极强」,一时又说不清原因。这样的犹豫很有价值:它提示我们,直觉背后可能有可以讨论的设计理由。
📷 这里,我会选 TYPO-CHECK
回到原视频 (01:02:42)
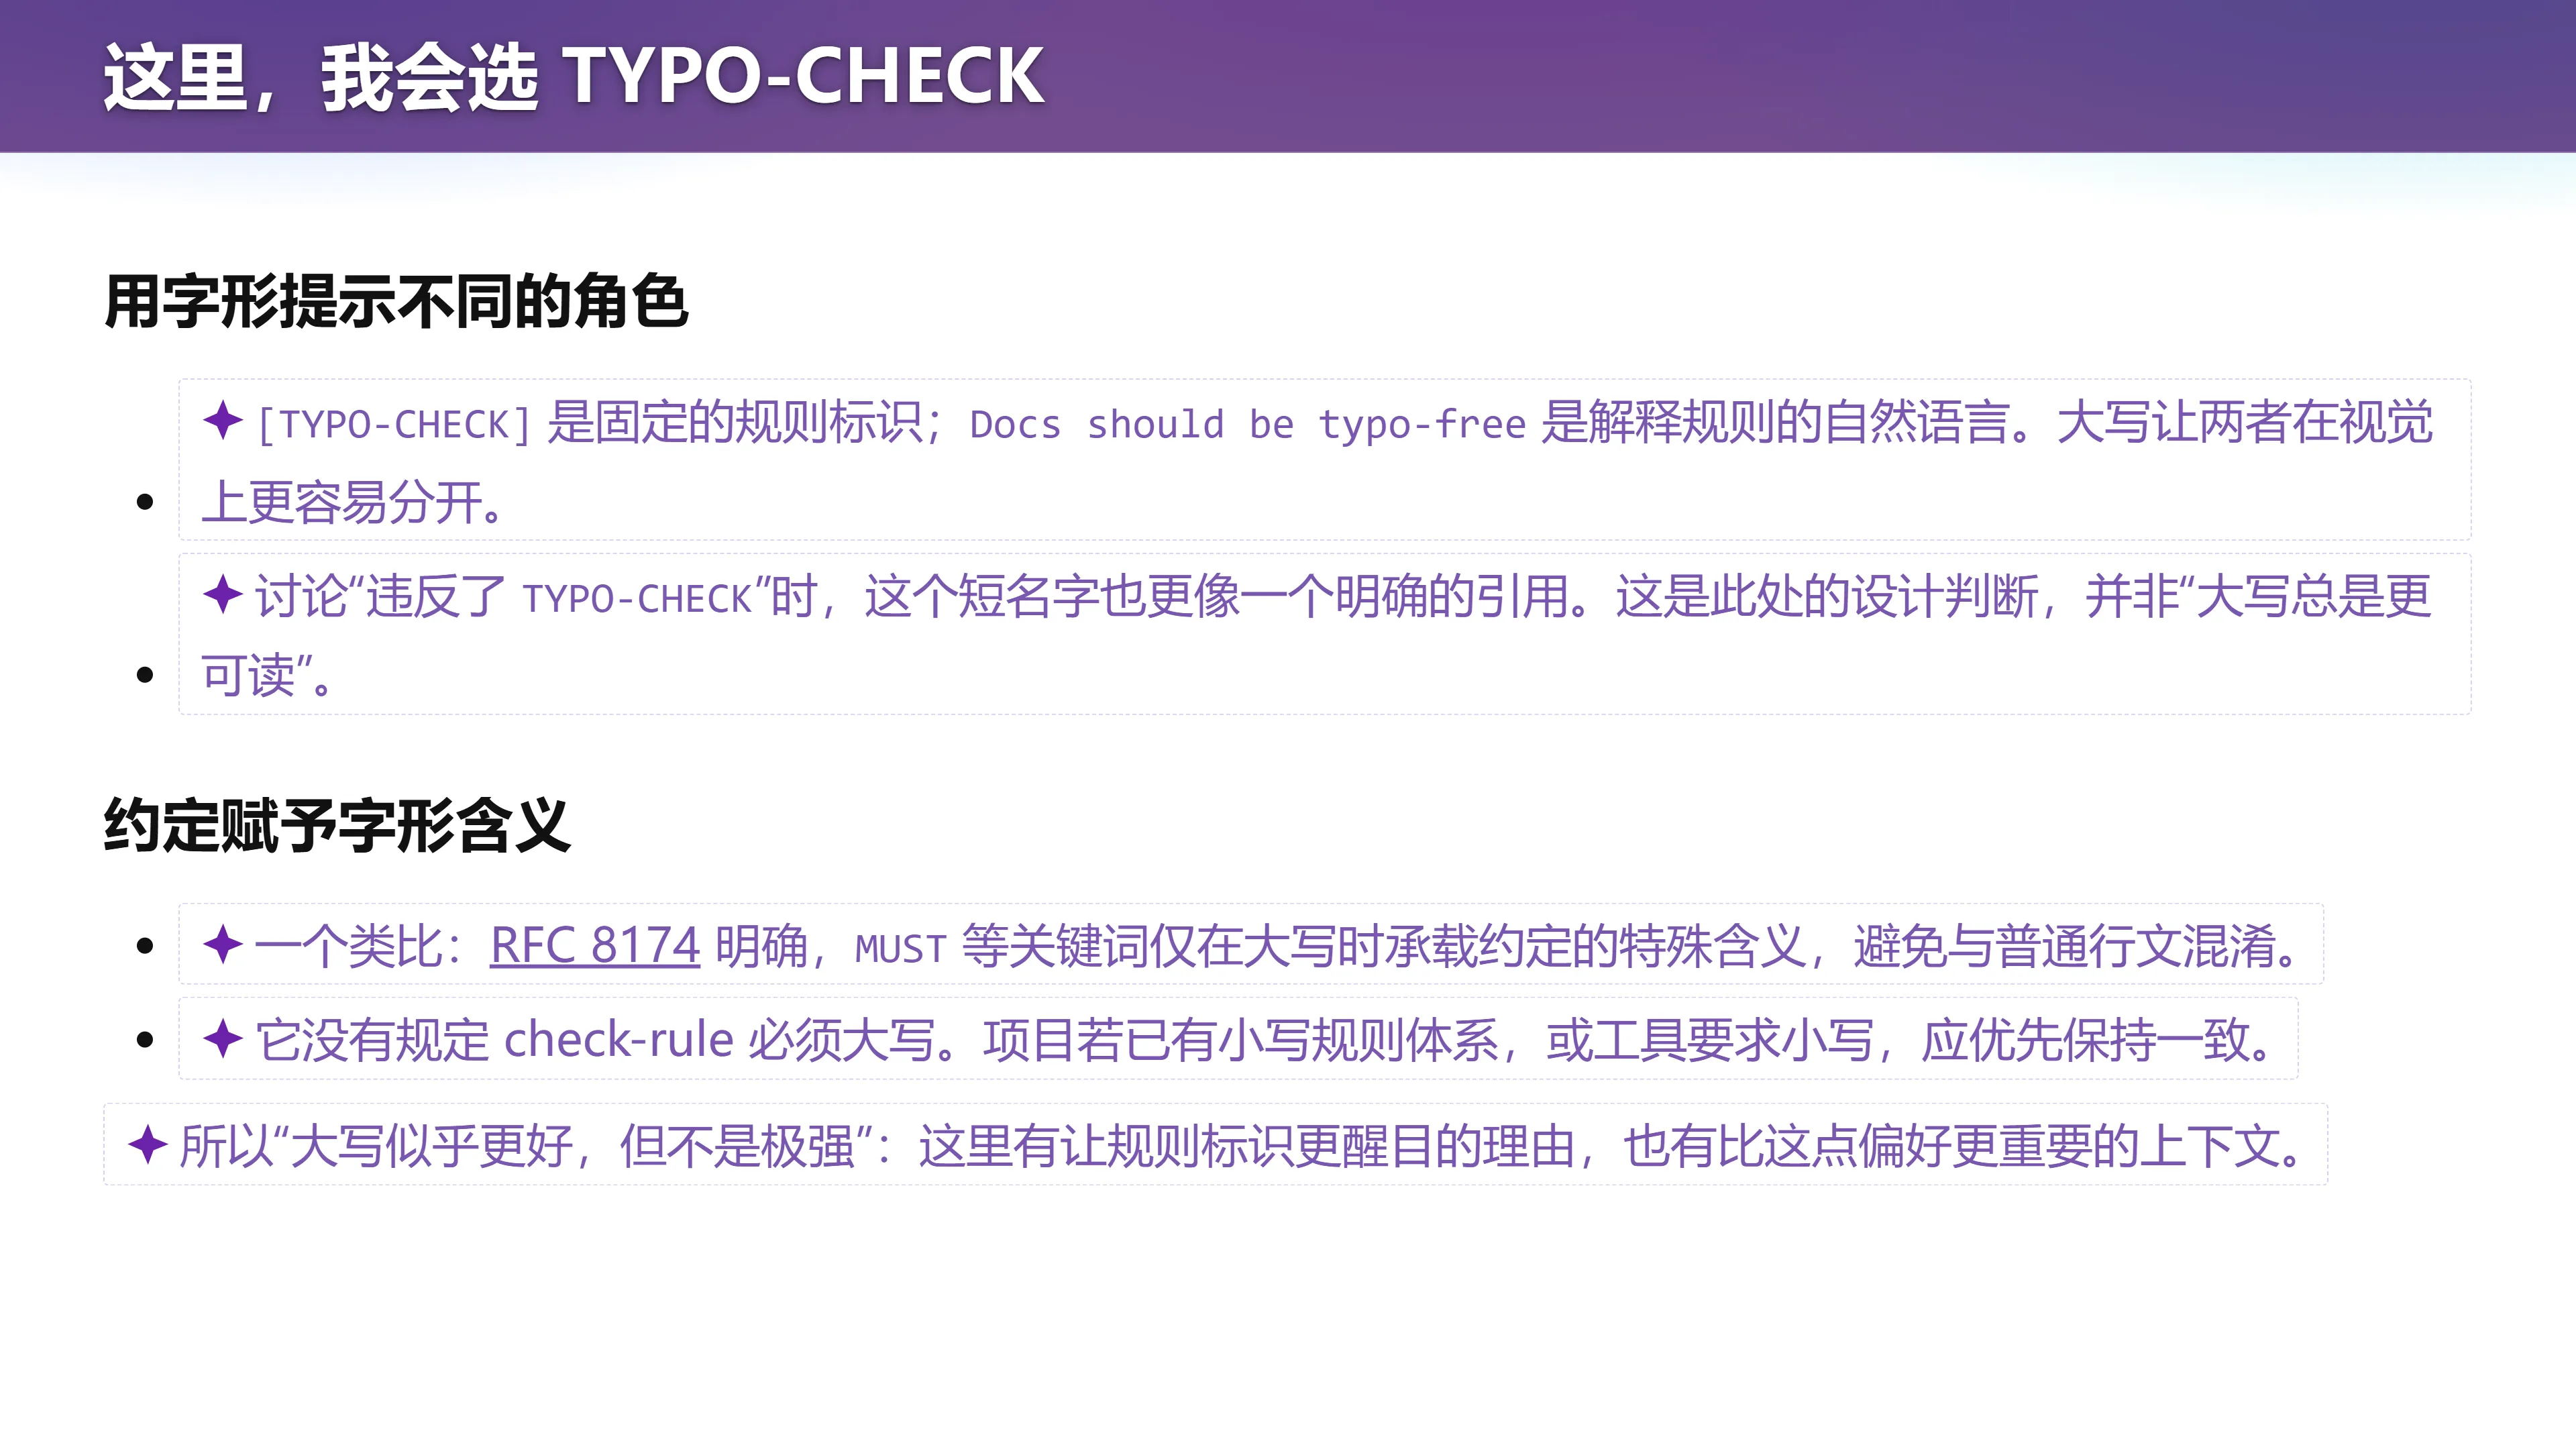
方括号里的名字是固定的规则标识,后面则是解释规则的自然语言。大写让两者更容易在视觉上区分;讨论「违反了 TYPO-CHECK」时,它也更像一个明确的引用。这样,读者可以迅速区分「我们正在引用哪条规则」和「这条规则说了什么」。
编者拓展|约定的字形承载特殊含义(RFC 8174) 讲师让 AI(ChatGPT)帮他分析「为什么会觉得全大写更强」,AI 引用了 RFC 8174。该文档明确:
MUST、SHOULD等关键词仅在大写时才承载约定的特殊含义,以避免与普通行文混淆。这是一个很好的类比——但它没有规定 check-rule 必须大写。如果整个项目已经使用小写标识,或处理规则的工具要求小写,保持一致可能比局部的醒目更重要。我们得到的不是「大写永远优于小写」,而是理解了这个选择涉及角色区分、可引用性与一致性。
对一个微小细节多问一句「为什么」,也是在训练设计能力。
八、让工具把真实细节展开
(参考时间: 01:08:05)
📷 告别古法学习
回到原视频 (01:08:05)
课堂上有一句半开玩笑的「计算机科学定律」:你想要的,就一定有人做。 遇到难以理解的概念,可以先寻找有没有工具把它直观地展示出来——人类视觉系统是非常高效的。现在还多了一种可能:把自己的学习需要写清楚,让 Agent 制作一个工具。
讲师先展示了「古法编程的巅峰之作」之一:一个以可视化方式展示 Git 如何工作的网页工具 Learn Git Branching。它模拟了各种命令(git status、git commit),右下角会随命令动画式地长出新的版本,点某个版本还能 git checkout 看到变化——它教你 Git 是怎么工作的。
编者说明:Learn Git Branching 是模拟出来的,它内置了一个 Git 模型。
把真实的 Git Repo 展开给你看
(参考时间: 01:10:31)
📷 把真实的 Git Repo 展开给你看
回到原视频 (01:10:31)
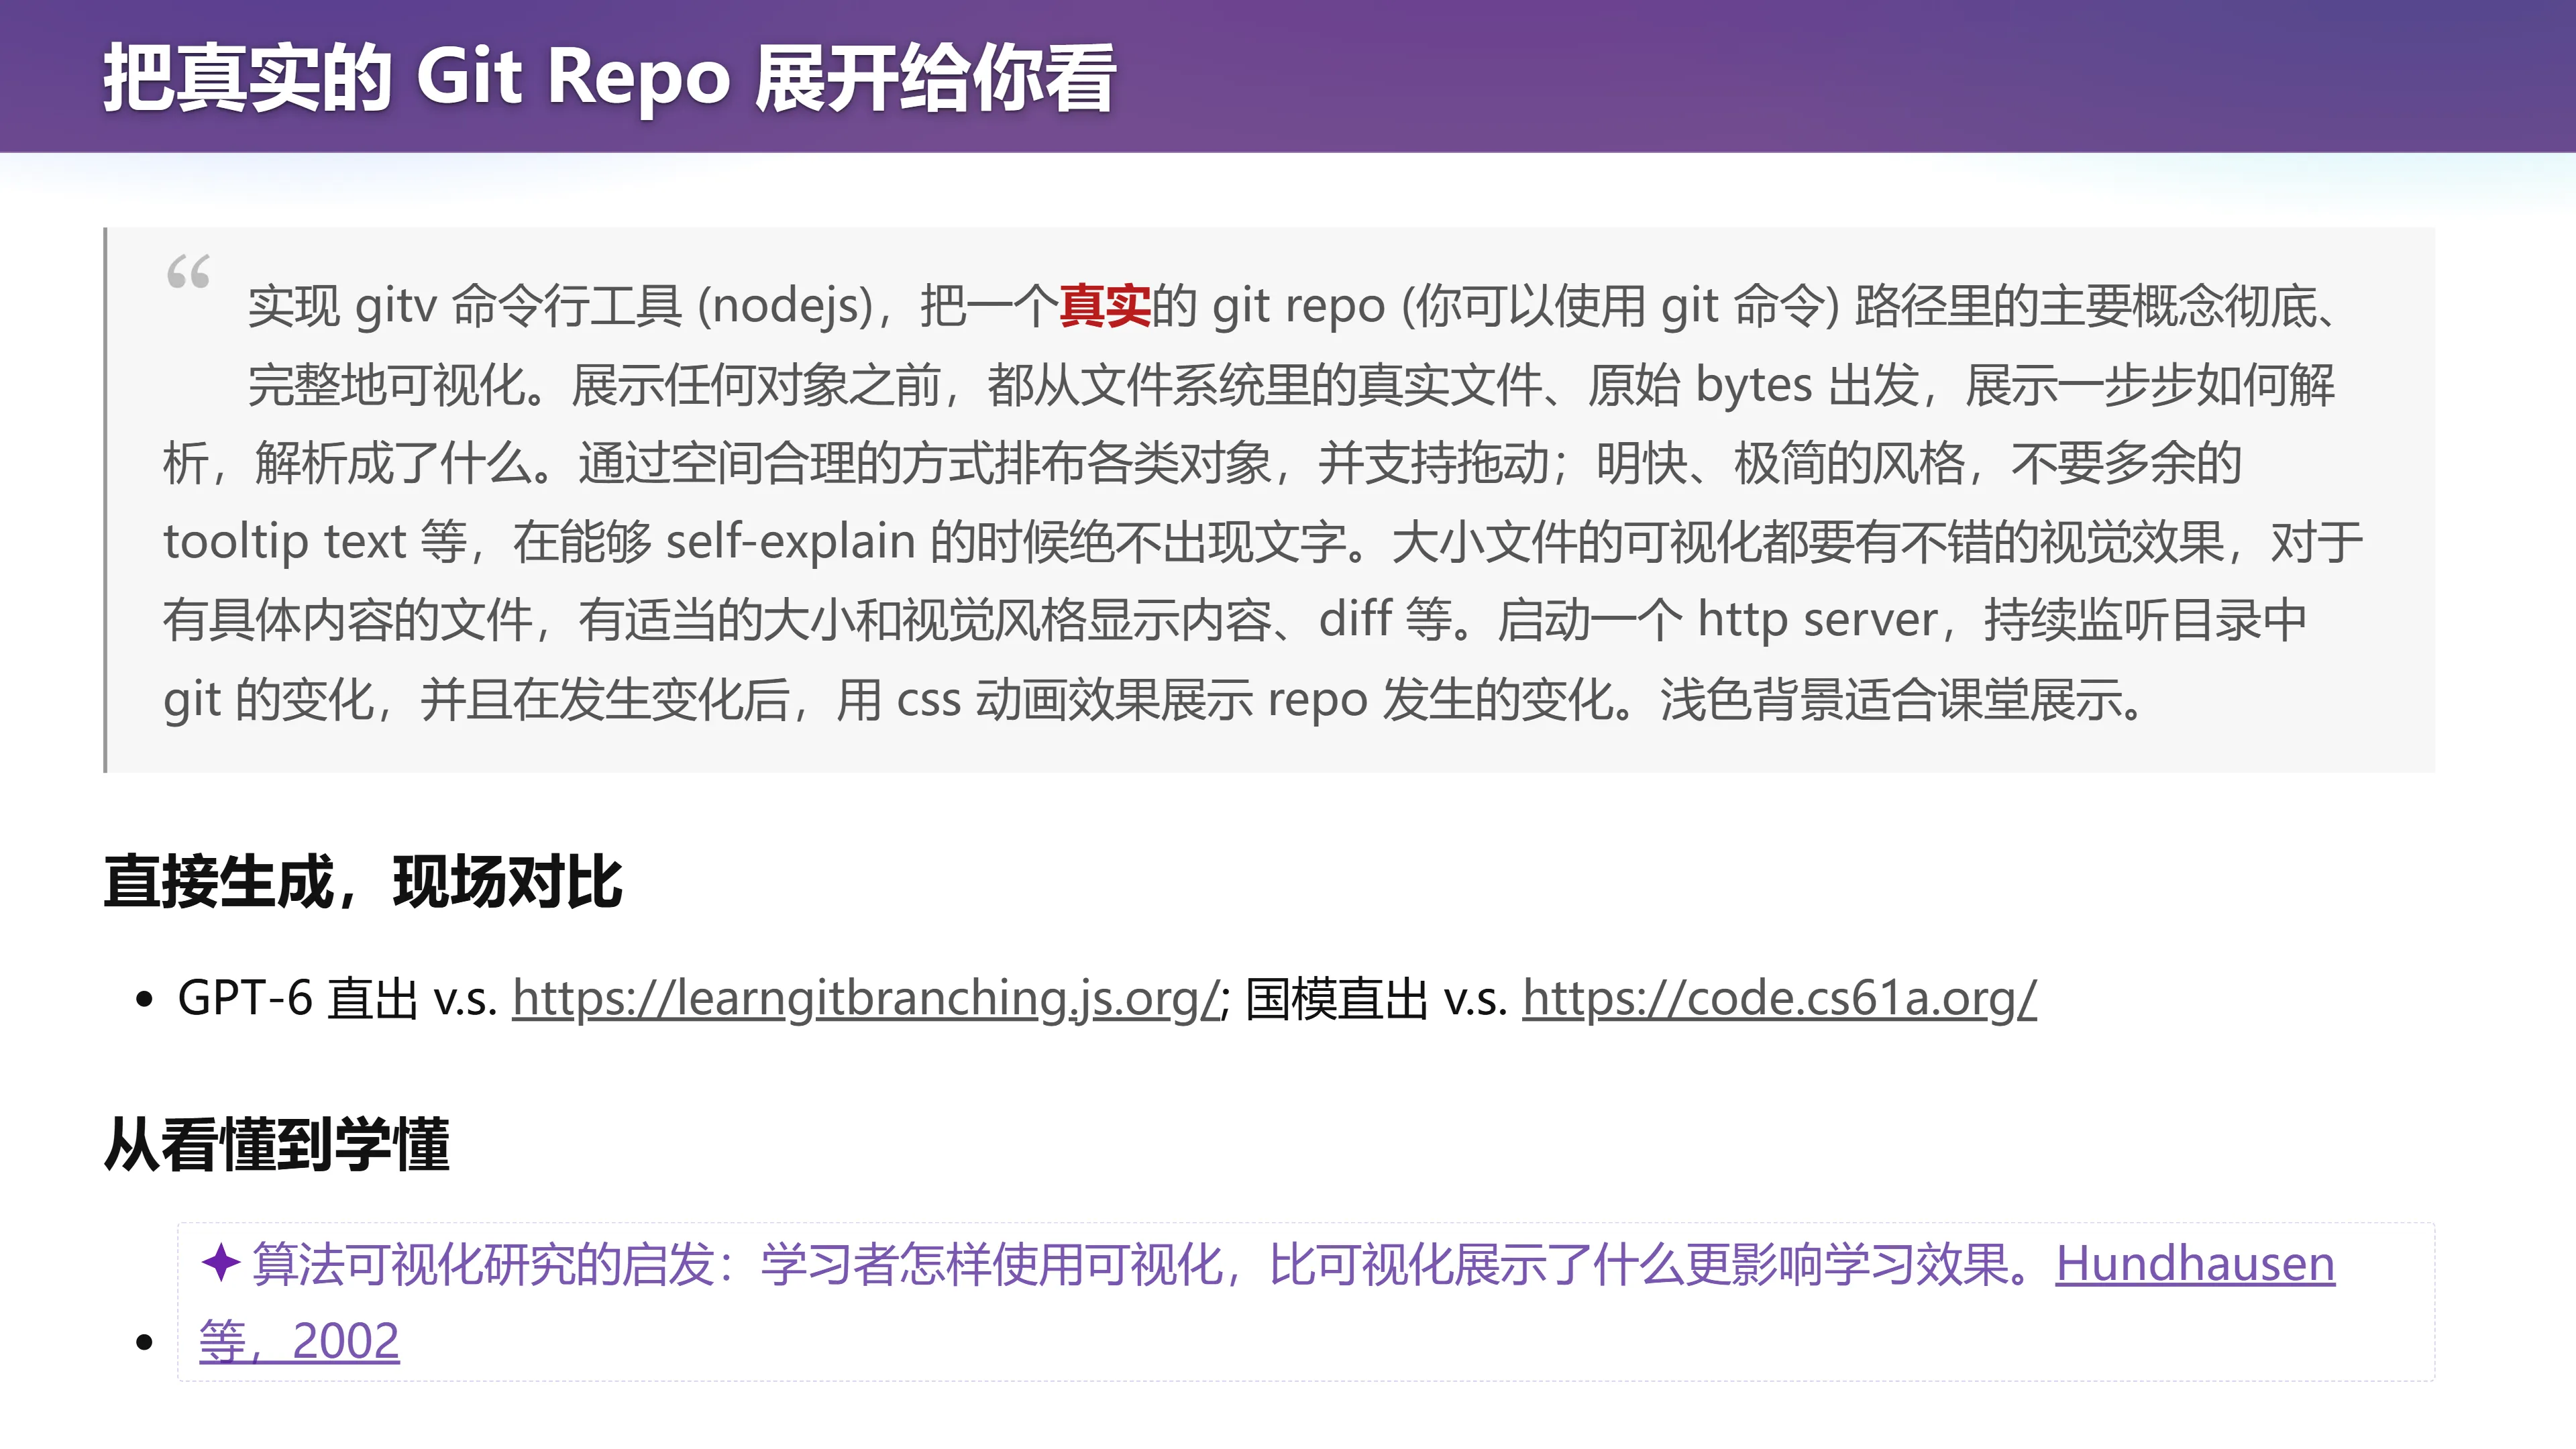
今天,我们可以直接在 live 的、真实的 Git 仓库上看到它发生了什么。讲师现场 web coding 了一个工具,给模型的提示词大致如下:
实现一个
gitv命令行工具(Node.js),把一个真实的 Git repo(可以使用git命令)路径里的主要概念彻底、完整地可视化。展示任何对象之前,都从文件系统里的真实文件、原始 bytes 出发,展示一步步如何解析、解析成了什么。通过空间合理的方式排布各类对象,并支持拖动;明快、极简的风格,不要多余的 tooltip。大小文件的可视化都要有不错的视觉效果,对于有具体内容的文件,有适当的大小和视觉风格显示内容、diff 等。启动一个 HTTP server,持续监听目录中 Git 的变化,并在发生变化后用 CSS 动画效果展示 repo 的变化。浅色背景适合课堂展示。
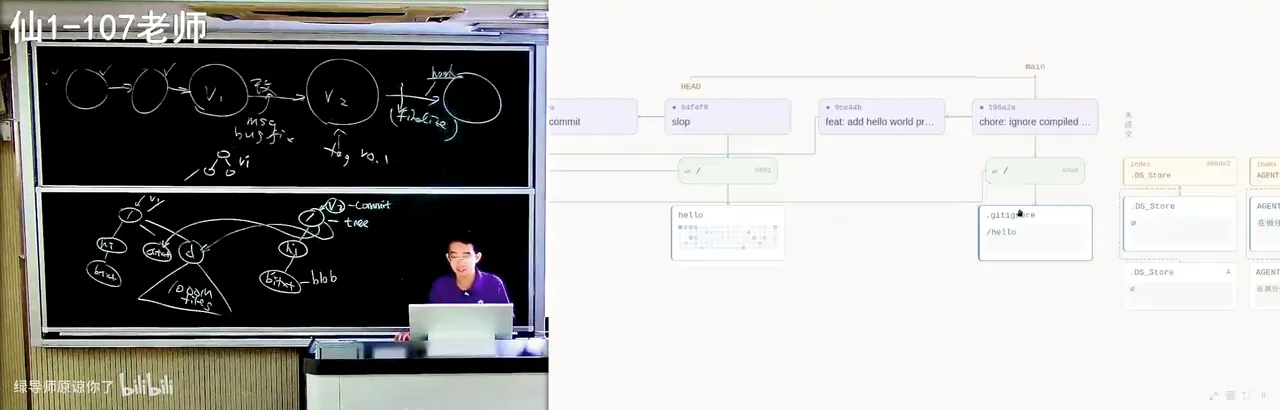
📷 gitv 工具实时可视化真实的 Git 仓库:左侧对象图与右侧文件状态联动
回到原视频 (01:10:11)
演示中的关键观察:
- 删掉右栏一个文件,右边的文件立即消失,左边对象图随之更新。
- 最早一次提交是
I did some cool stuffs,里面有一个空的hello.c,它来自.git/objects下一个真正的 blob object。 - 页面上能看到它的字节序列,并自动解压——你会发现对于很小的文件,压缩反而是浪费:31 字节解压出 23 字节(其中内容
blob 15\0int main...,即一个大小为 15 的 blob)。 - 也能看到编译出的
hello二进制文件(blob大小 158,文件头是7f ERF,正是可执行文件的 ELF 魔数)。 treeobject 同样能看到磁盘上的原始数据(52 字节解压出 43 字节),展开后是mode 644 name hello.c这样的结构,也就是「权限 + 名字 + 指向的对象」。- 根目录树在这个版本里有两个条目:一个
755的hello(可执行)和一个644的hello.c。
分支就是一个文件:refs/heads/A 这样一个指针,HEAD 则是「指向指针的指针」。在磁盘上它就是一段字节,指向一个 commit object,commit 再指向一个 tree object。讲师现场让工具创建了两个分支,左右实时同步,动画展示引用如何移动。
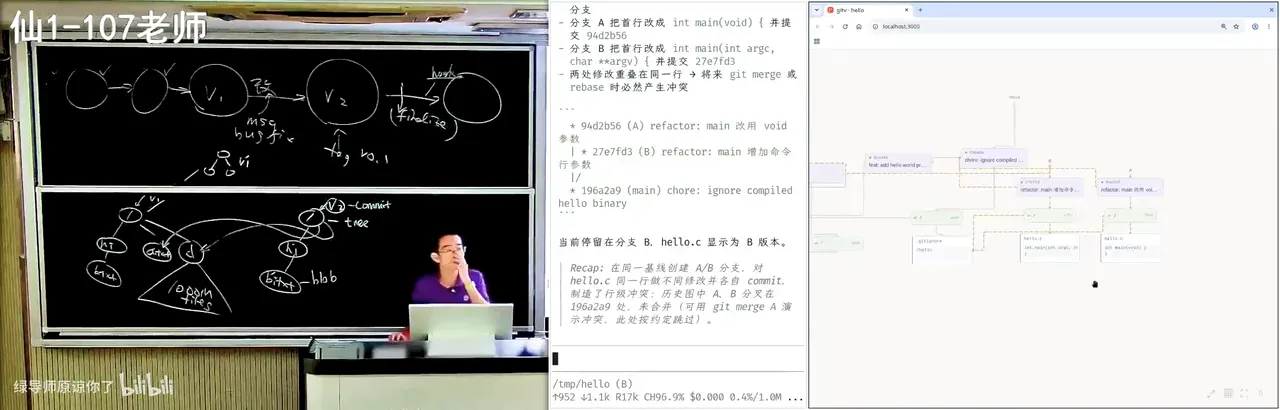
📷 gitv 中创建分支 refs/heads/A 与 B,引用指针实时动画
回到原视频 (01:15:01)
然后他让工具展示 merge conflict 状态:两个开发者都重构了同一段代码,把 A 拉到本地就会进入冲突——工作区文件里出现尖括号标记;页面上还能看到 Git 悄悄在 index 里留了三个版本:base、ours、theirs。解决冲突后,临时文件消失,Git 创建了一个有两个父提交的 merge commit,指向关系被正确保留(tree 选的是解决后的版本)。
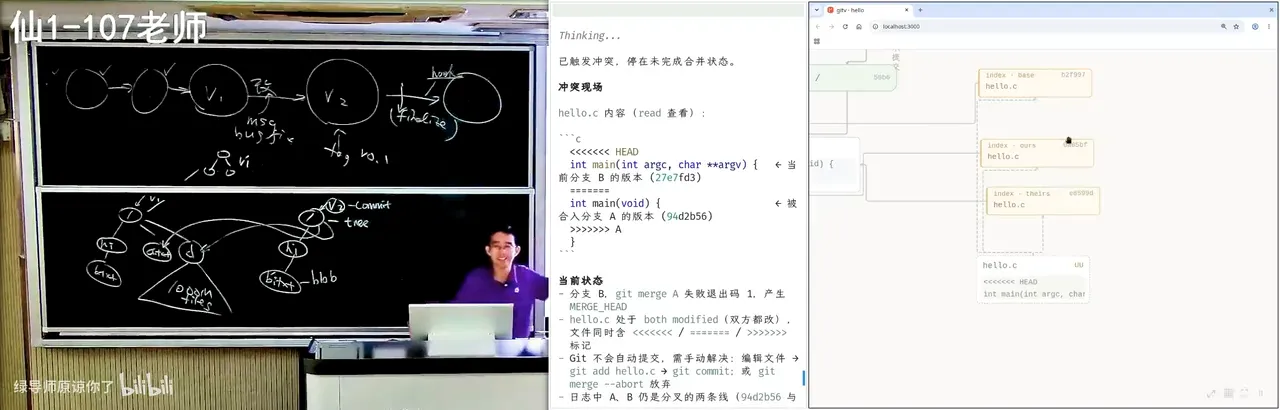
📷 gitv 展示 merge 冲突:index 中保留 base/ours/theirs 三份版本
回到原视频 (01:17:16)
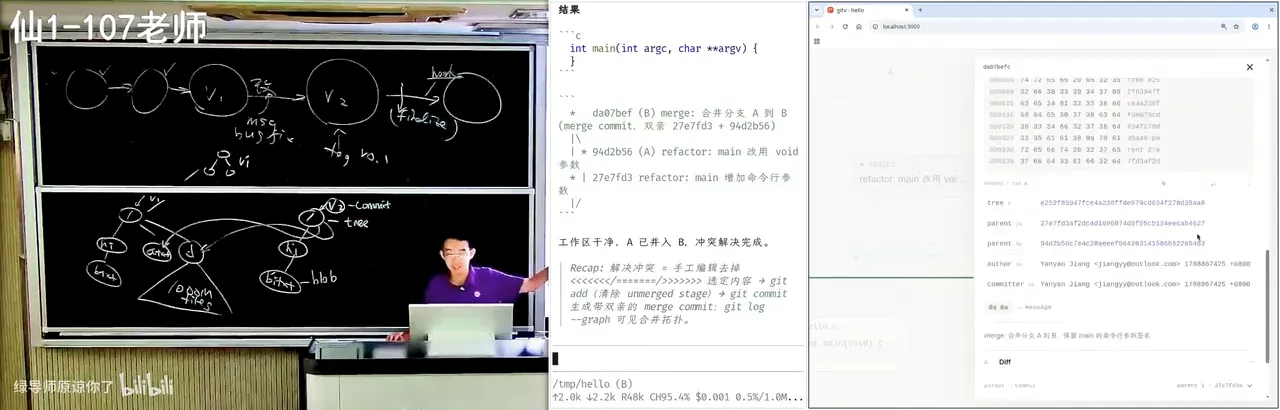
📷 冲突解决后生成的 merge commit:两个父提交、指向关系被正确保留
回到原视频 (01:17:46)
讲师说,一次性直出的视觉效果不完美(毕竟 one-shot,没怎么调),但跟它对话几轮,就能得到近乎完美的 Git 可视化。
编者说明:课堂上把这个直接生成的工具与 Learn Git Branching 作了比较,也拿生成的教学编程环境与 61A Code(SICP / CS 61A 的官方 Python 在线 IDE)对照。讲师提醒:这样的比较应该落在细节上——能否看清关键状态、交互是否顺畅、边界情况是否处理得当、能不能真的帮到使用者。一次课堂生成结果体现的是这次任务的表现,不能直接推成模型之间的普遍排名。
从「看懂」到「学懂」
📷 愿意学懂,成了真正有价值的品质
回到原视频 (01:24:43)
讲师补充了可视化研究的一个启发(幻灯片引用 Hundhausen 等,2002):学习者怎样使用可视化,比可视化本身展示了什么,更影响学习效果。 所以一个适合学习的实验是:
- 先预测执行
git add后会发生什么,再观察; - 接着修改文件但不
add,看看哪些内容保持原样; - 提交以后,再找出新提交、目录树和分支引用。
视觉工具降低了观察成本,预测与核对则让观察变成理解。
「愿意学懂」成了真正有价值的品质
(参考时间: 01:24:43)
讲师对「只读过公众号介绍、却从未真正打开过好东西」的学习方式很不满意:
- 大学里没训练过「把细节做好」这个 bar,真上了战场就都得死;
- 很多大学老师真正的好东西打开都没打开过,就只会照本宣科、断章取义;
- 「我真的无法接受看公众号学习依然心安理得的老登。」
好消息是:真正学懂和成绩是正相关的,愿意学懂成了真正有价值的品质。 因为一旦有人学会了「把细节做好」,招人的单位就会用这个标准来衡量你。他能想象两种毕业生的差距:一个面对「git merge 之后会发生什么」毫无概念;另一个在每门专业课、每个算法、每个细节上,都在 AI 指导下巩固、消化、从零开始构建这些概念。
讲师还现场展示了另一个 web coding 的项目——一个给 3–4 年级小朋友教 Python 的可视化环境:
- 因为第一节课直接上 PyCharm 就「全完蛋」了,所以要做极简界面,整个是 web 的、带 AI slop 感,讲师不管代码质量,但把控架构;
- 它既可以作为网页应用(教编程),也可以作为 Electron 打包的、双击就能打开的 exe;
- 它可以可视化任何程序,逐帧调试:汉诺塔递归怎么移动、插入排序怎么一个个比较、斐波那契递归……都能「往前拖、往后拖」地播放(参考时间: 01:21:32);
- 一个 3–4 年级孩子能编什么?给他一个 API、一个世界,他就能玩起来:一个
ZXY循环看着方块从上往下掉,一个 3D 打印程序叠方块、挖人……讲师还骂了 AI 第一版,因为它的坐标轴实现不符合预期。
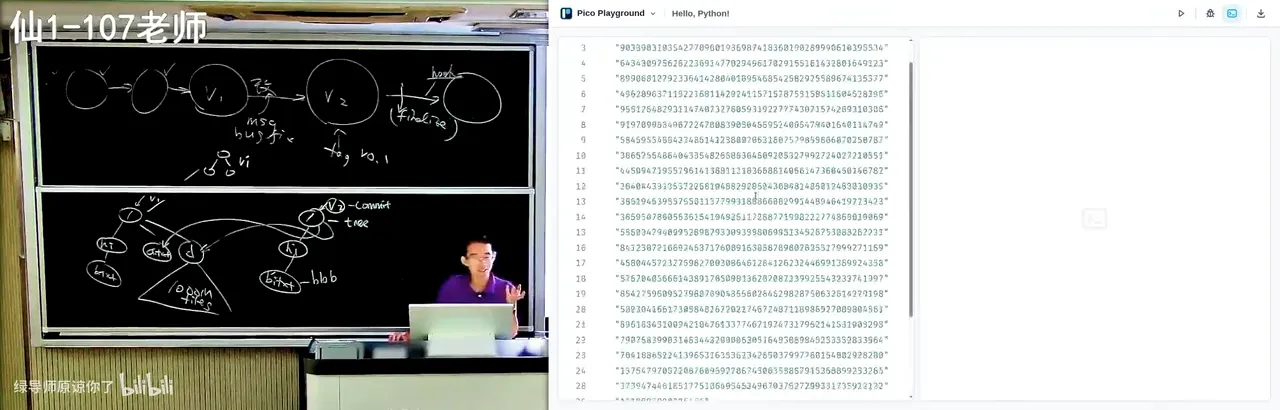
📷 为小朋友定制的 Python 可视化教学环境:逐帧调试与动画播放
回到原视频 (01:21:04)
讲师说,这个项目整个框架他大概用了两天的碎片时间就完成了(包括视觉调整),还试了便宜的国产模型也「完全可用」的状态。「做这些事情已经没有任何成本。」正因如此,他感叹:
「我马上就要淘汰了……我自己学习的时间非常有限,我很想学很多东西,但没有你们那么多时间。」(参考时间: 01:26:18)
编者拓展|把「可视化」变成「学习」的机制 讲师所引的「自我解释(self-explanation)」研究(Chi 等,1989)指出:把解题步骤与背后的原理联系起来,是有效学习的关键。这就是为什么
gitv这类工具要「从真实 bytes 出发一步步解析」——它不是给你一个漂亮的结论,而是让你看见推理的每一步,从而完成预测→核对→理解的闭环。
九、提交要留下可以理解的变化
(参考时间: 01:26:34)
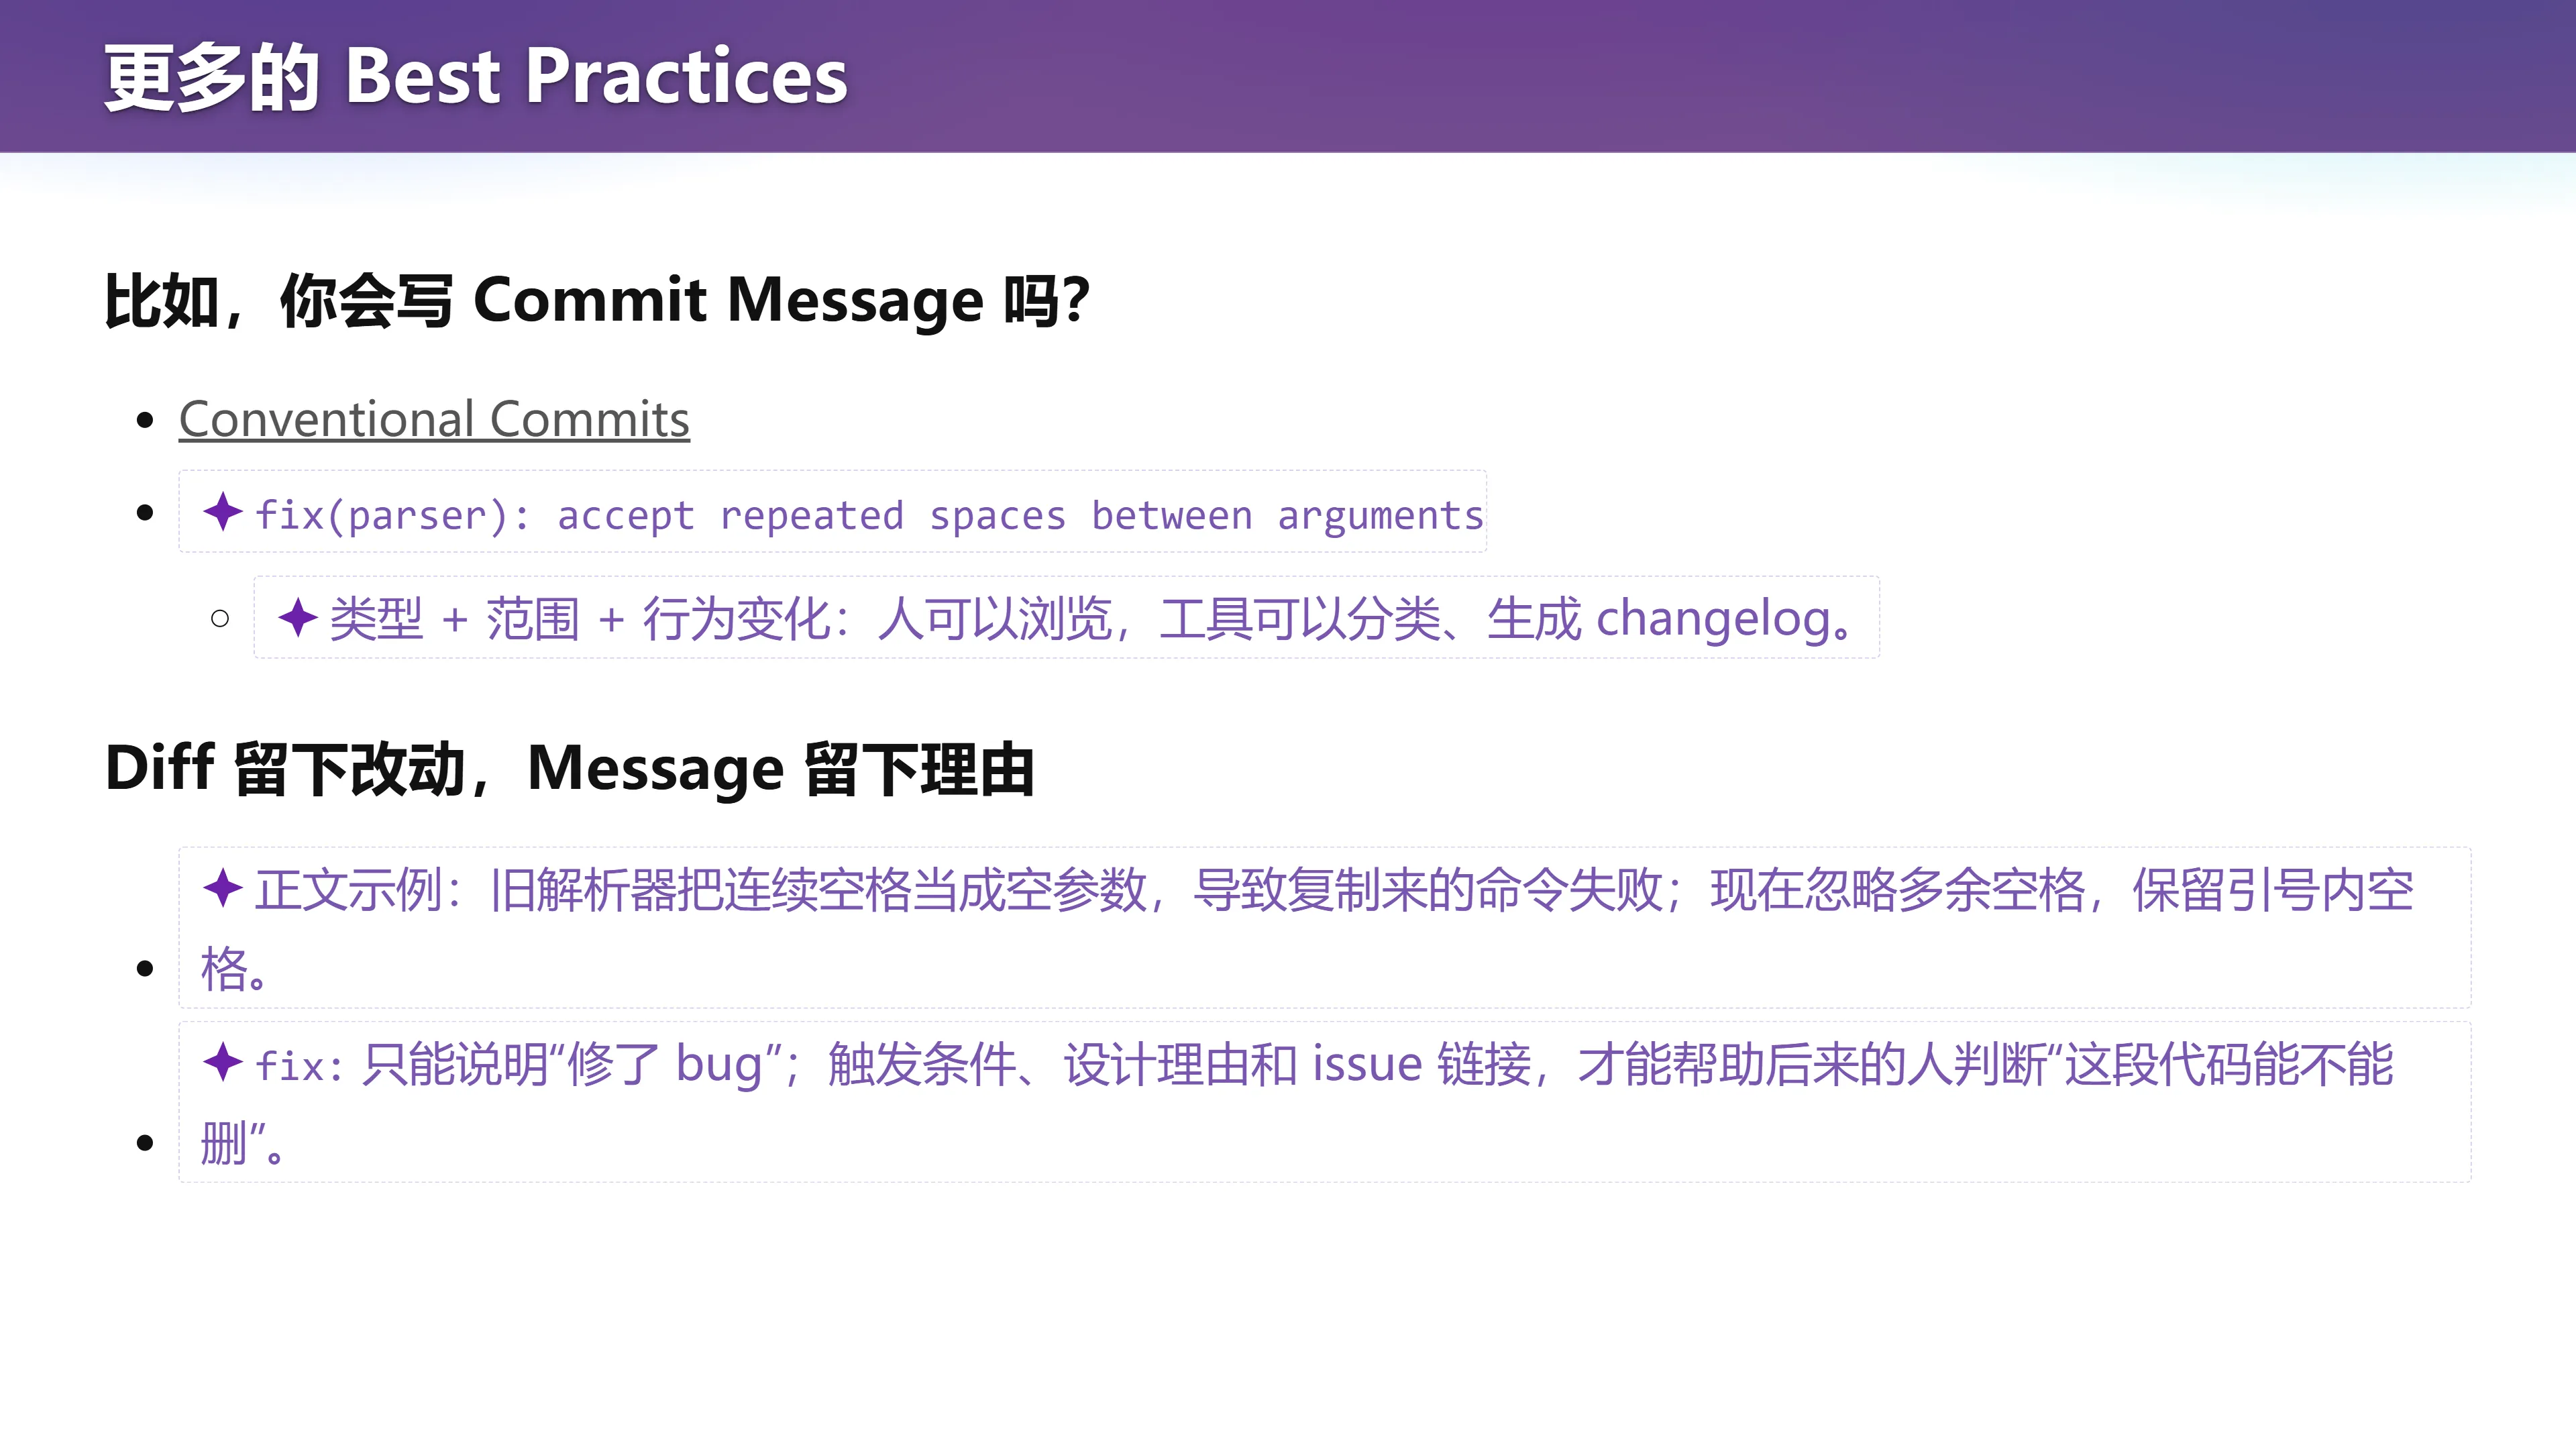
📷 更多的 Best Practices
回到原视频 (01:26:34)
日常问题:你会写 commit message 吗? update 当然能当提交说明,但几个月后翻历史,它几乎帮不了任何人。
前面演示中,AI 生成的 commit 基本遵循了「一行标题 + 详细解释 + message body」的结构,但你会发现它有时开始中英混杂——这也是 AI slop 的一种表现,不过它至少保留了「有 scope(范围)、说明做了什么、再总结」的骨架。这个格式其实是有标准的,叫 Conventional Commits:
fix(parser): accept repeated spaces between arguments
- 提交必须以类型(type)为前缀,如
feat(引入功能)、fix(修复 bug),后面接冒号 + 空格; parser标示范围(scope),后面说明行为变化;- 固定结构既方便人浏览,也方便工具分类和生成 changelog(更新记录)。
标题之后,还可以解释理由,例如:
旧解析器把连续空格当成空参数,导致复制来的命令失败;现在忽略参数之间的多余空格,但保留引号内部的空格。
代码 diff 展示「怎样改」,提交说明补上「为什么改、想保留什么」。 将来有人想删除这段逻辑,就能找到判断依据,而不必重新猜一遍。fix: 只能说明「修了 bug」;触发条件、设计理由和 issue 链接,才能帮助后来的人判断「这段代码能不能删」。
编者说明:commit message 的「写一行还是写多行」「用祈使句还是陈述句」「中文还是英文」,本身也属于约定俗成的 best practice。讲师提醒:关键不是某一种写法,而是形成稳定、可理解的表达——一个项目内部保持一致,比追求「唯一正确」更重要。他顺带吐槽过文档排版:Markdown 里中英文之间要留一个空格,如果不留,作为读者的他会觉得「浑身难受」;但真正让他无法接受的是同一份文档里有的留、有的不留——不一致本身就传递了「没有规范」的信号。
Best Practices:让错误可恢复
(参考时间: 01:30:01)
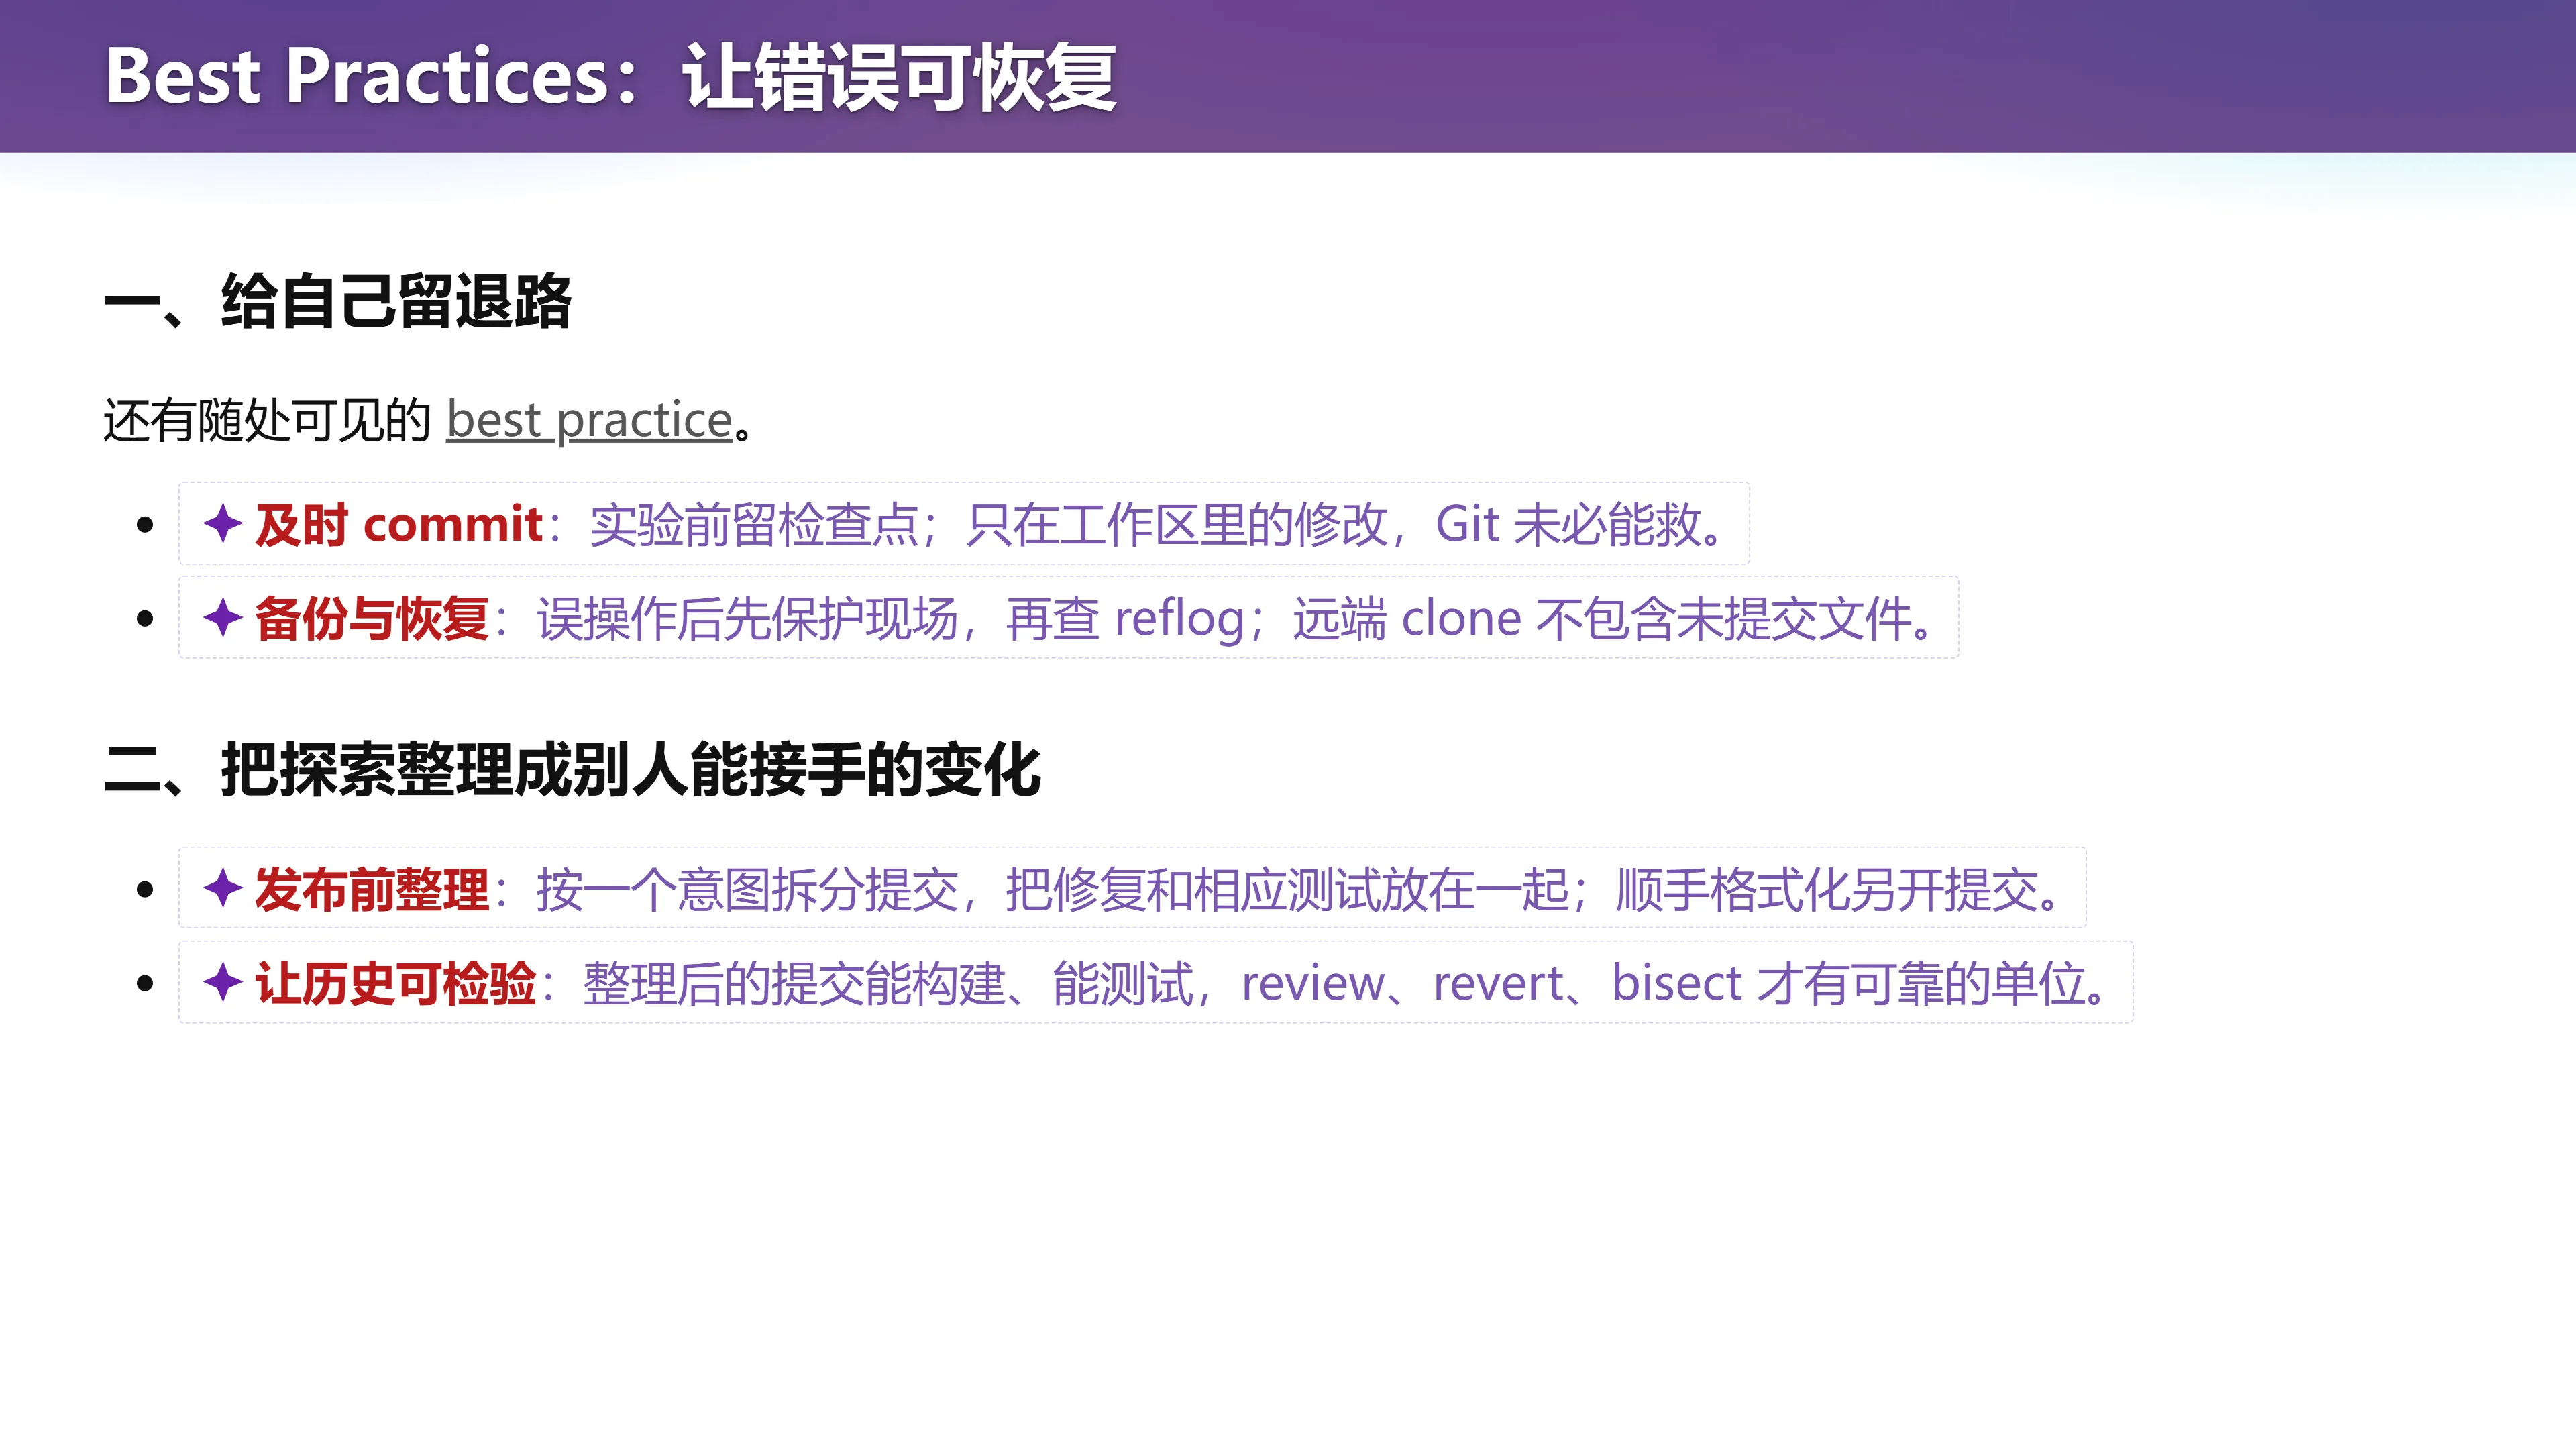
📷 Best Practices:让错误可恢复
回到原视频 (01:29:55)
Git Best Practices 收集了许多实践经验。讲师把它们归纳为几个工程问题:怎样留退路、怎样让别人读懂变化、怎样让协作可预期、怎样让约定得到执行。
一、给自己留退路。
- 及时 commit:实验前先留检查点;只存在于工作区里的修改,Git 未必能救。为什么要及时?因为在复杂项目里,你改的东西越多,出错的地方就越可能多。小项目刚开始时一次提交两三千行都无所谓,但一旦项目里有错综复杂的关系,一个巨大的 commit 可能同时 break 多处、引入多个 bug,后面又得引入多个 fix——「冤有头债有主」就做不到了。所以讲师也提醒:改了很多东西、又可能没来得及推到远端时,做一个小的提交、立即 push,就等于给自己在互联网上留了个备份,你的电脑马上坏了也不怕。
- 备份与恢复:误操作后先保护现场,再查
reflog(通过记录引用移动来找回原有提交);git clone出来的仓库不包含未提交的文件。
Best Practices:让协作可预期
(参考时间: 01:31:22)
📷 Best Practices:让协作可预期
回到原视频 (01:31:22)
二、把探索整理成别人能接手的变化。
- 发布前整理:按一个意图拆分提交,把修复和相应测试放在一起;顺手格式化整个项目通常应该另开提交。
- 让历史可检验:整理后的每一步如果能构建、能验证,review、revert、bisect 才有可靠的单位。
三、稳定共同依赖的东西。
- 不擅自改写别人依赖的历史:改写会把整理成本转嫁给协作者;修补错误通常追加提交。
- 约定分支与发布流程:谁负责合并、如何把修复回移到维护中的旧版本、何时打 tag——共同规则让交接可预期。
四、让约定有执行机制。
- Hooks + CI:本地(hooks)尽早反馈,服务端(持续集成,CI)在集成流程中自动检查构建与测试结果;同步上游后还需要重新测试组合结果。
- 连接 issue、commit 与审查:从「为什么改」能找到「改了什么」,再找到「如何验收」。
这些机制并不替代思考。你自己的修改测试通过了,合入更新后的主线还需要检查组合结果;一段提交说明符合格式,也不等于它解释清楚了行为。规则的价值,最终要落实到恢复、理解和协调的成本上。
编者拓展|hooks 到底是什么 「钩子(hook)」是在某个事件发生时自动触发的程序。它可以是编程语言里对函数调用的挂钩,也可以是你给 Agent 加的钩子——比如讲师自己配了一个 hook:当 Agent 完成、需要他输入时「叮」一声提醒他。你可以直接对 Agent 说「帮我配置一个全局 hook,在需要输入时叮一声」,Claude Code、Codex 等工具都支持。而
pre-commithook 则是在提交之前运行的检查脚本,正好用来执行前面那几十条 checking rules。
一个有意思的边角:空提交(empty commit)
(参考时间: 00:41:22)
讲师还演示了一个「not best practice」的操作:在不改动任何代码的情况下再提交一次(即让 V2 和 V1 完全相同)。
git commit会拒绝提交空提交;- 但 Agent 可以——讲师要求它在无改动时提交,它知道该怎么做。
- 空提交在什么情况下有用?比如在无改动时产生一次「触发 CI」或流转;或者当你修完最后一个 bug、准备 release 时,把
tag V0.1打在这里,同时强行做一个 「finalize」 的提交去 freeze 所有东西,就把「bug fix 的提交」和「finalize 的提交」分开了。
这在偶尔的情况下可以允许,但显然不能创建大量这样的空提交。
编者说明:空提交(
git commit --allow-empty)的存在本身就说明——Git 的「提交」不只是内容快照,它还是历史里的一个事件锚点。理解了这一点,你就不会再把它当成纯粹的「存盘」。
十、Git 之外:用 gh 与 glab 接起协作流程
(参考时间: 01:31:30)
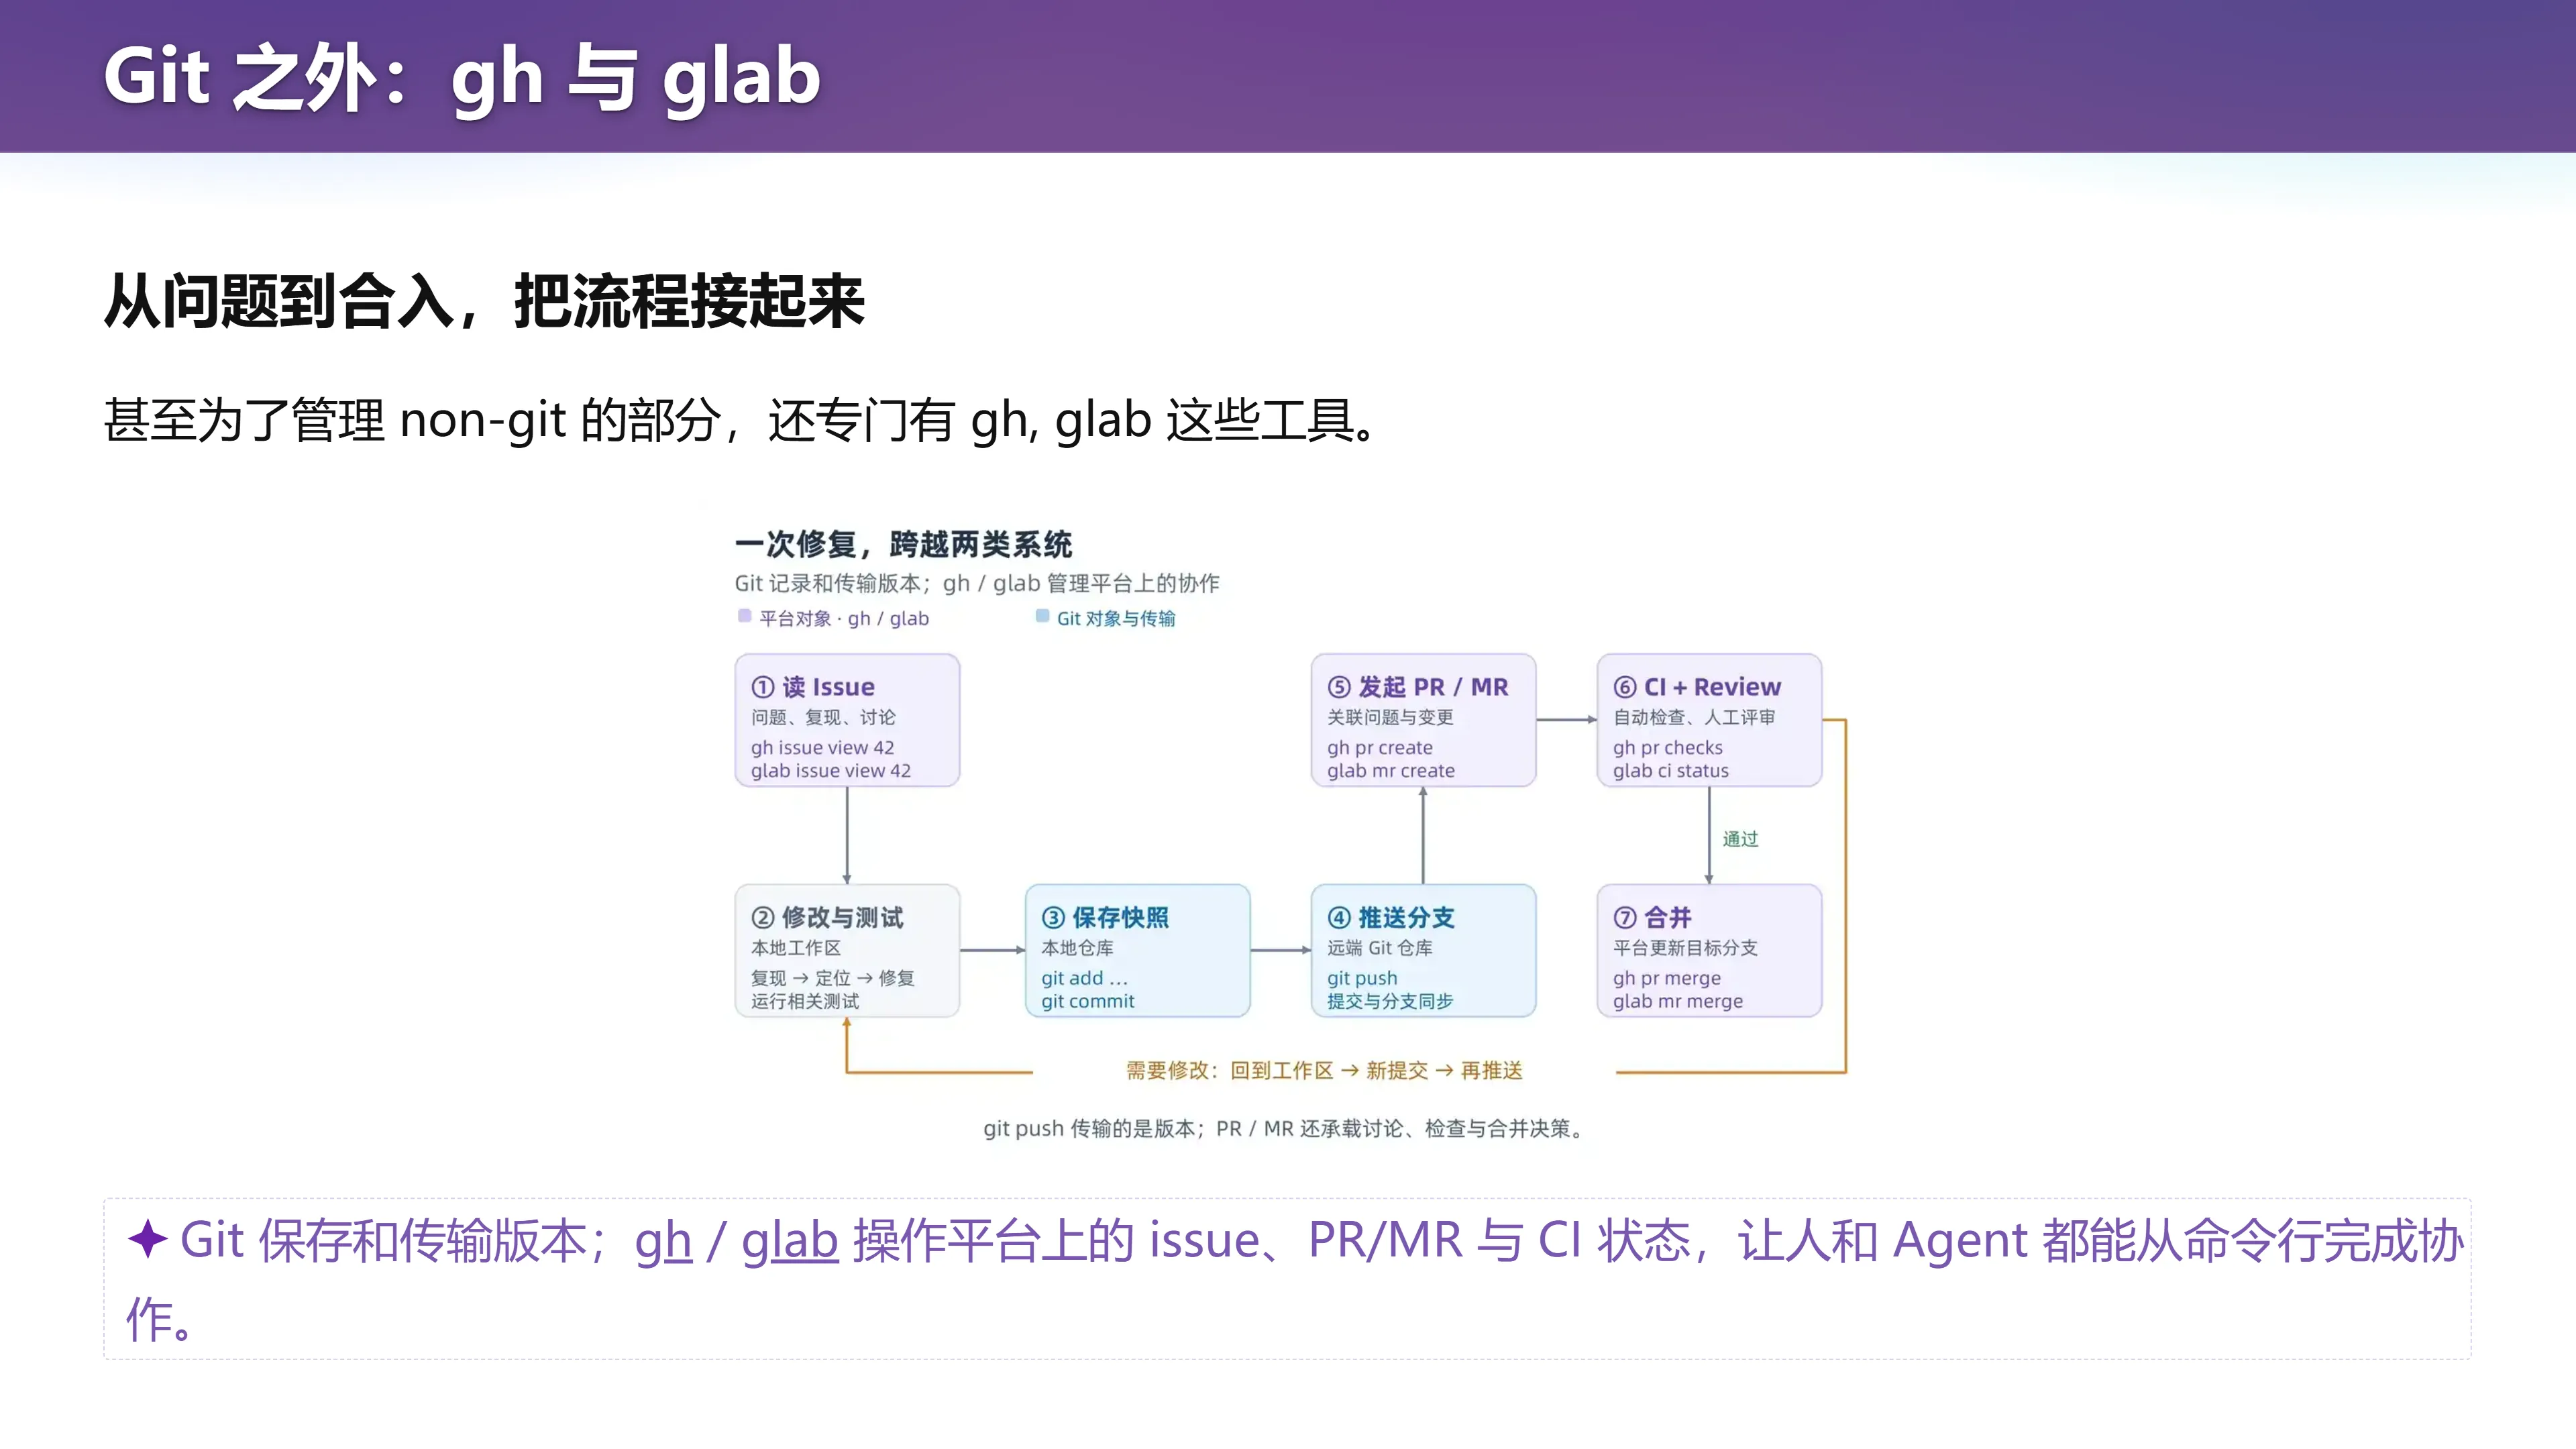
如果你有「惊人的注意力」,应该观察过:托管在 GitHub/GitLab 上的项目,AI Agent 会试图调用一些 gh 或 glab 的命令,结果报 command not found,于是它回退到「古法编程」,又开始写 git 命令。
原因在于:Git 管理的是代码快照,但 GitHub 上还有 issue——你可以发一段文本、对代码做评论,这些并不随 Git 的提交而持久化。为了管理它们,就有必要有一个命令行工具:
📷 Git 之外:gh 与 glab
回到原视频 (01:31:40)
graph LR
    I["读取 issue"] --> M["本地修改 / 测试"]
    M --> C["git commit / push"]
    C --> P["创建 PR / MR"]
    P --> R["查看 CI 检查与审查反馈"]
    R --> M
    R --> Z["合入主线"]
gh issue list之类可以 fetch 一个 issue、找到 assign 给我的 issue,登录后还可以把 issue close 掉;- 对 Agent 来说,这类工具非常好用:你装上
gh,在 Agent 里下一条很长的任务,要求它小步提交、做可审计的提交、遵守分支规则(例如线性历史),它就能从读取 issue 开始,经过本地修改、测试、提交、推送,再创建 Pull Request(PR)或 Merge Request(MR),查看检查与审查反馈,继续修改,直到合入。
这样,人和 Agent 都能通过命令行把版本操作与平台上的协作过程连接起来。
编者说明:这里分别是 GitHub 官方的
gh与 GitLab 官方的glab。它们操作的是平台协作对象(issue、PR/MR、CI 状态),与 Git 操作的版本对象(快照、分支、提交)互补。讲师还展示了他的某个项目里「大量由 AI 生成、他很多时候都不太管」的提交记录,用来说明:当平台协作也接进命令行之后,Agent 参与开发的完整链路就被打通了。
十一、用原子变更推进项目
(参考时间: 01:33:33)
讲了这么多 Git,但这门课讲的其实还是软件工程。最后这一小段总结,是今天更重要的部分:
项目是由原子变更推进的快照,可以分支,可以合并。
📷 回到软件工程
回到原视频 (01:33:33)
原子变更(atomic change)在这里指围绕一个明确意图组织的完整修改,它应当能够被解释、验证,并在需要时单独撤销。它不一定只改一个文件,也不一定只有几行。
graph TD
    A["一个明确意图"] --> B["一次原子变更(commit)"]
    B --> C{"结果如何?"}
    C -- 成功 --> D["合并进主线"]
    C -- 失败 --> E["安全地丢弃该分支"]
    B --> F["出现问题:bisect 定位 / blame 追责 / revert 撤销"]
为什么强调这一点?因为人很难处理「一团混沌」。 一次改了接口、重写了实现、更新了依赖、调整了格式,最后测试失败,应该从哪里找起?如果这些变化有清楚的边界,就可以分别理解、审查和处理冲突。
历史还可以成为调试工具:
git bisect在已知好版本与坏版本之间,通过不断测试中间提交缩小范围,帮助定位引入问题的变化;git revert可以记录「撤销某次变化」的新提交。
它们好不好用,与历史中的变化是否完整、可验证密切相关。
编者拓展|bisect 就是二分查找 你可以把 Git 的提交历史想象成一个很长的数组:从某个时刻开始,后面的提交都「坏了」,之前的一直是好的——所有前缀都是 0、后缀都是 1。
git bisect要做的就是「找到第一个 1」。只要你能提供一个能检查出该 bug 的测试用例(任何能判断好坏的脚本),就不必自己从头翻,Git 会帮你对整段历史做二分。另外,git blame能告诉你每一行代码是在哪一次提交、由谁改的,出错时就容易追到源头。这两个功能,都是「原子变更 + 完整可验证的历史」带来的红利。
线性历史(linear history):有些项目要求把集成后的提交组织成较直接的一条主线。这与 Git 默认「一个合并提交可以有两个父提交」的结构不同——但在今天,反正 AI 做 resolve、rebase 都很容易,很多团队强行要求提交历史是线性的。好处是:
- 历史更易于追溯;
- 对
cherry-pick(把指定提交的变化应用到其他分支)和blame(追查代码行的来历)也更友好; - AI 维护项目的效率更高、更省 token——因为有些文件它可以不用去读。
不过,线性只是组织形式。 每一步都意义不明、不能运行,排成一条直线也不会自动变成好历史。
在模型能力还有限时,AI 参与开发同样需要避免「一团混沌」:一次交给它一个有边界的目标,保留可以检验的状态,发现偏差后及时反馈。代码生成速度提高了,并没有自动消除理解和集成的难度。
十二、Agent 能力之内的项目,怎样协作
(参考时间: 01:36:47)
📷 Agent 能力之内的项目
回到原视频 (01:36:47)
如果项目已经落在 Agent 能力之内(例如讲师提到的 Pico Playground),人的工作可以怎样变化?讲师给出的实践分两阶段:
架构设计:单线程,反复讨论
- 先「单线程」:与能力强的模型反复讨论,直到接口、约束和总体设计逐渐收敛。这一步很重要——如果软件设计得不好,后面就是无穷的迭代。
- 把设计落到文档、规则、示例:包括测试要做到什么程度。
- 这个阶段仍然需要人的知识:为什么还要学操作系统、编译原理、数据库?因为这些领域积累了大量好设计——怎样划分职责、怎样表达不变量、怎样隔离变化、怎样协调并发。知道这些,你才能在讨论中提出有效问题,判断模型给出的方案是否值得继续。
- 架构先确定接口与不变量,后续任务才有可以独立行动的边界。
编者说明:讲师以自己那个「教学 Playground」为例说明了「架构把关」的含义——他把绝大部分接口定义成纯函数(pure function),全局互相影响的共享状态(光标位置、菜单条等)都注册到一个全局的地方,而那个核心的共享状态「也就只有十几行」。剩下的所有东西都是黑盒子,他甚至要求 Agent 在设计可视化时禁止阅读任何库函数的实现,只看接口——因此它的 token 消耗非常省,几万个 token 就能做出一个 playground。「一旦架构设计完成」,才进入实现阶段。
实现:有限并发,立即反馈
- 开少量终端并行工作:讲师给出的实践范围是 $n \le 3$ 个 terminal(他上一次课提到过这个数量是个人工作方式,不是并发 Agent 的普遍上限)。
- 通过
AGENTS.md说明协作规则,例如历史如何整理(linear history)、任务怎样集成。 - 由人脑承担一部分并发控制:尽量安排相互不冲突的任务。
- 不管 AI 这次质量如何,都要立即检查、视觉验收、反馈。讲师的具体做法:让 Agent 不调用视觉模型去检查(AI 很喜欢这么做,会花很多 token),也不让它调用浏览器;而是在旁边另一块屏幕上放一个浏览器,页面是及时刷新的。然后开三个 Agent,哪里不满意就「骂」它,肉眼看着右边那个东西不断变好。
graph TD
    A["架构阶段:单线程<br/>与强模型反复讨论,收敛设计"] --> B["把设计写成文档 / 规则 / 示例"]
    B --> C["实现阶段:≤3 个终端并行"]
    C --> D["人脑并发控制:安排不冲突的任务"]
    D --> E["立即检查、视觉验收、反馈"]
    E --> C
架构讨论收敛共同前提,有限并发推进独立工作,快速反馈纠正理解偏差——三者需要配合起来。
十三、如果代码产能再提高一千倍
(参考时间: 01:40:00)
📷 当 Agent 快了 1000 倍
回到原视频 (01:40:00)
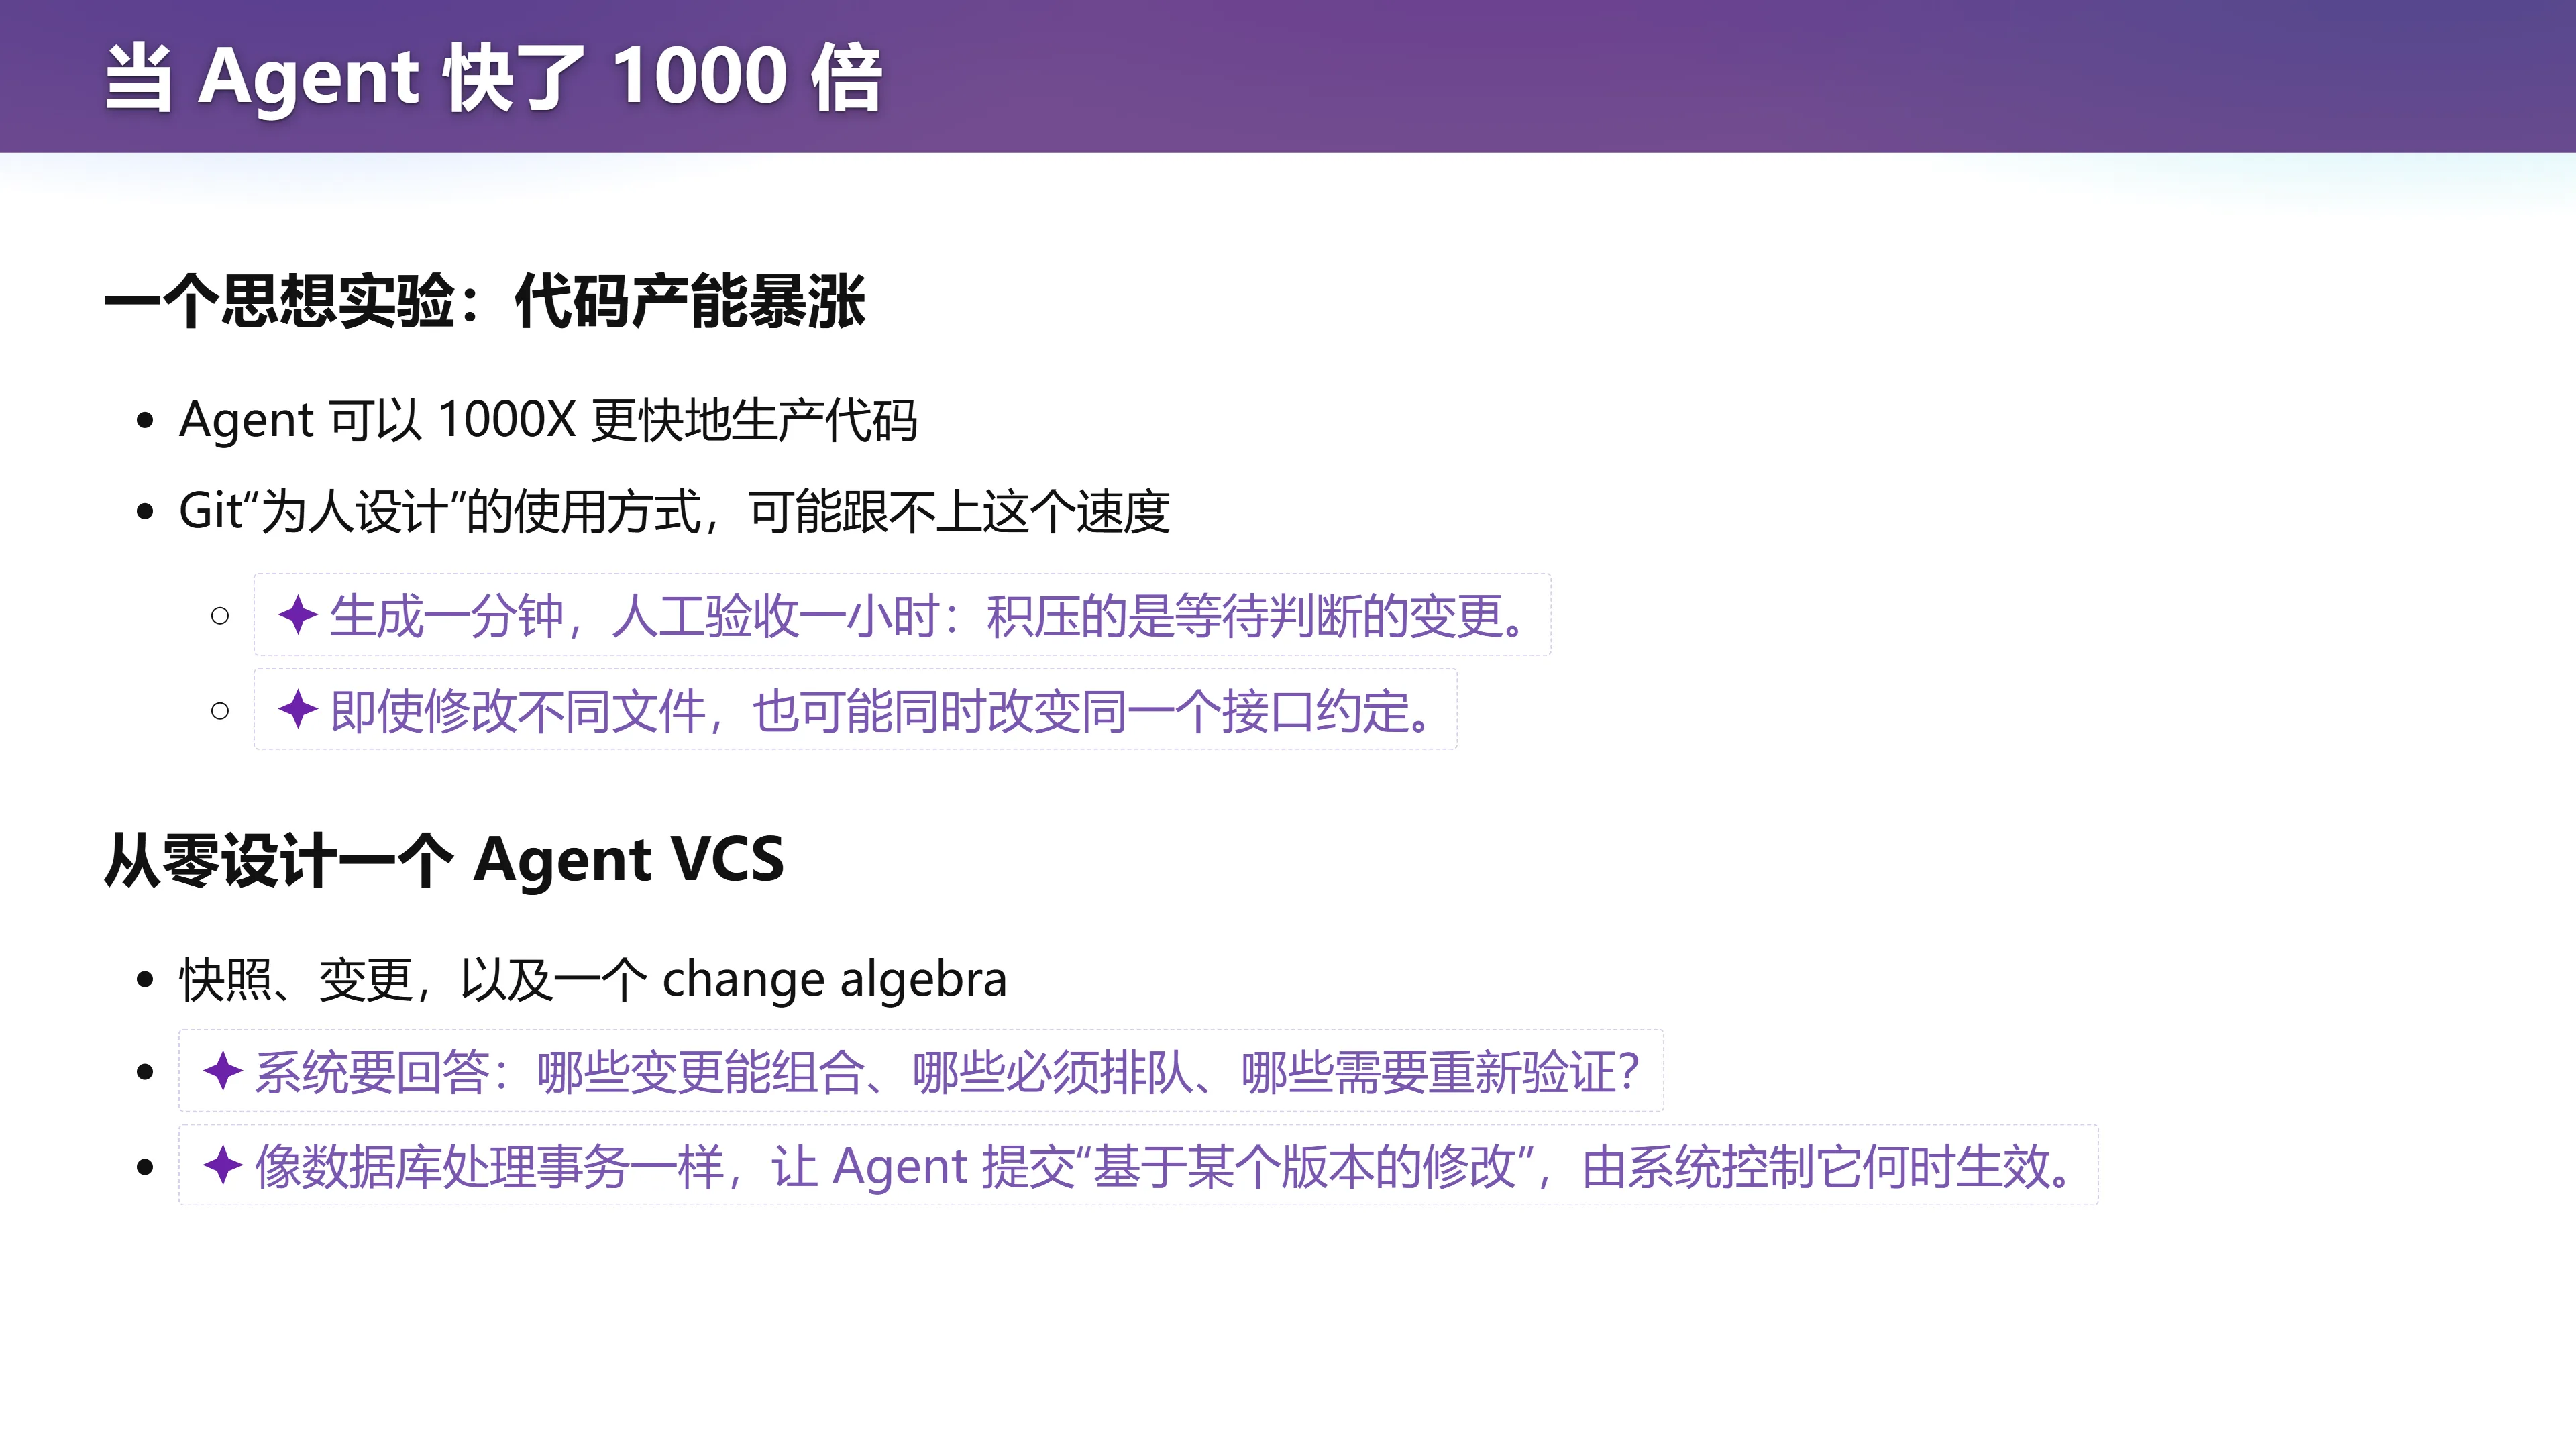
最后,讲师留下一个思想实验(他明确说下节课再展开):假设 Agent 生产代码的速度提高一千倍,会发生什么?
- 「一千倍」在这里用来放大矛盾,并非一次测量结果;
- 生成一分钟,人工理解和验收一小时:积压的会是等待判断的变更;
- Git 本身还能保存它们,但围绕人工提交、审查和协调组织起来的工作方式,可能成为瓶颈;
- 即使修改落在不同文件,也可能同时改变同一个接口约定。
讲师给下节课埋下的问题是:从零开始为 Agent 设计一个版本控制系统,应该长什么样? 关键词是「快照、变更,以及一个 change algebra(变更代数)」——系统要回答:哪些变更能组合、哪些必须排队、哪些需要重新验证。
附录:课堂未展示的幻灯片
编者说明:以下几页幻灯片出现在课程幻灯片文件中,但本次课堂实录未展开讲授(多为讲解「原子变更」之后的延伸、以及更进一步的并发/审计思考)。为遵守「每一页幻灯片在书中恰好出现一次」的约定,统一收录于此,并依据课程讲义补注其要点,不代表本次课堂讲授的原话。
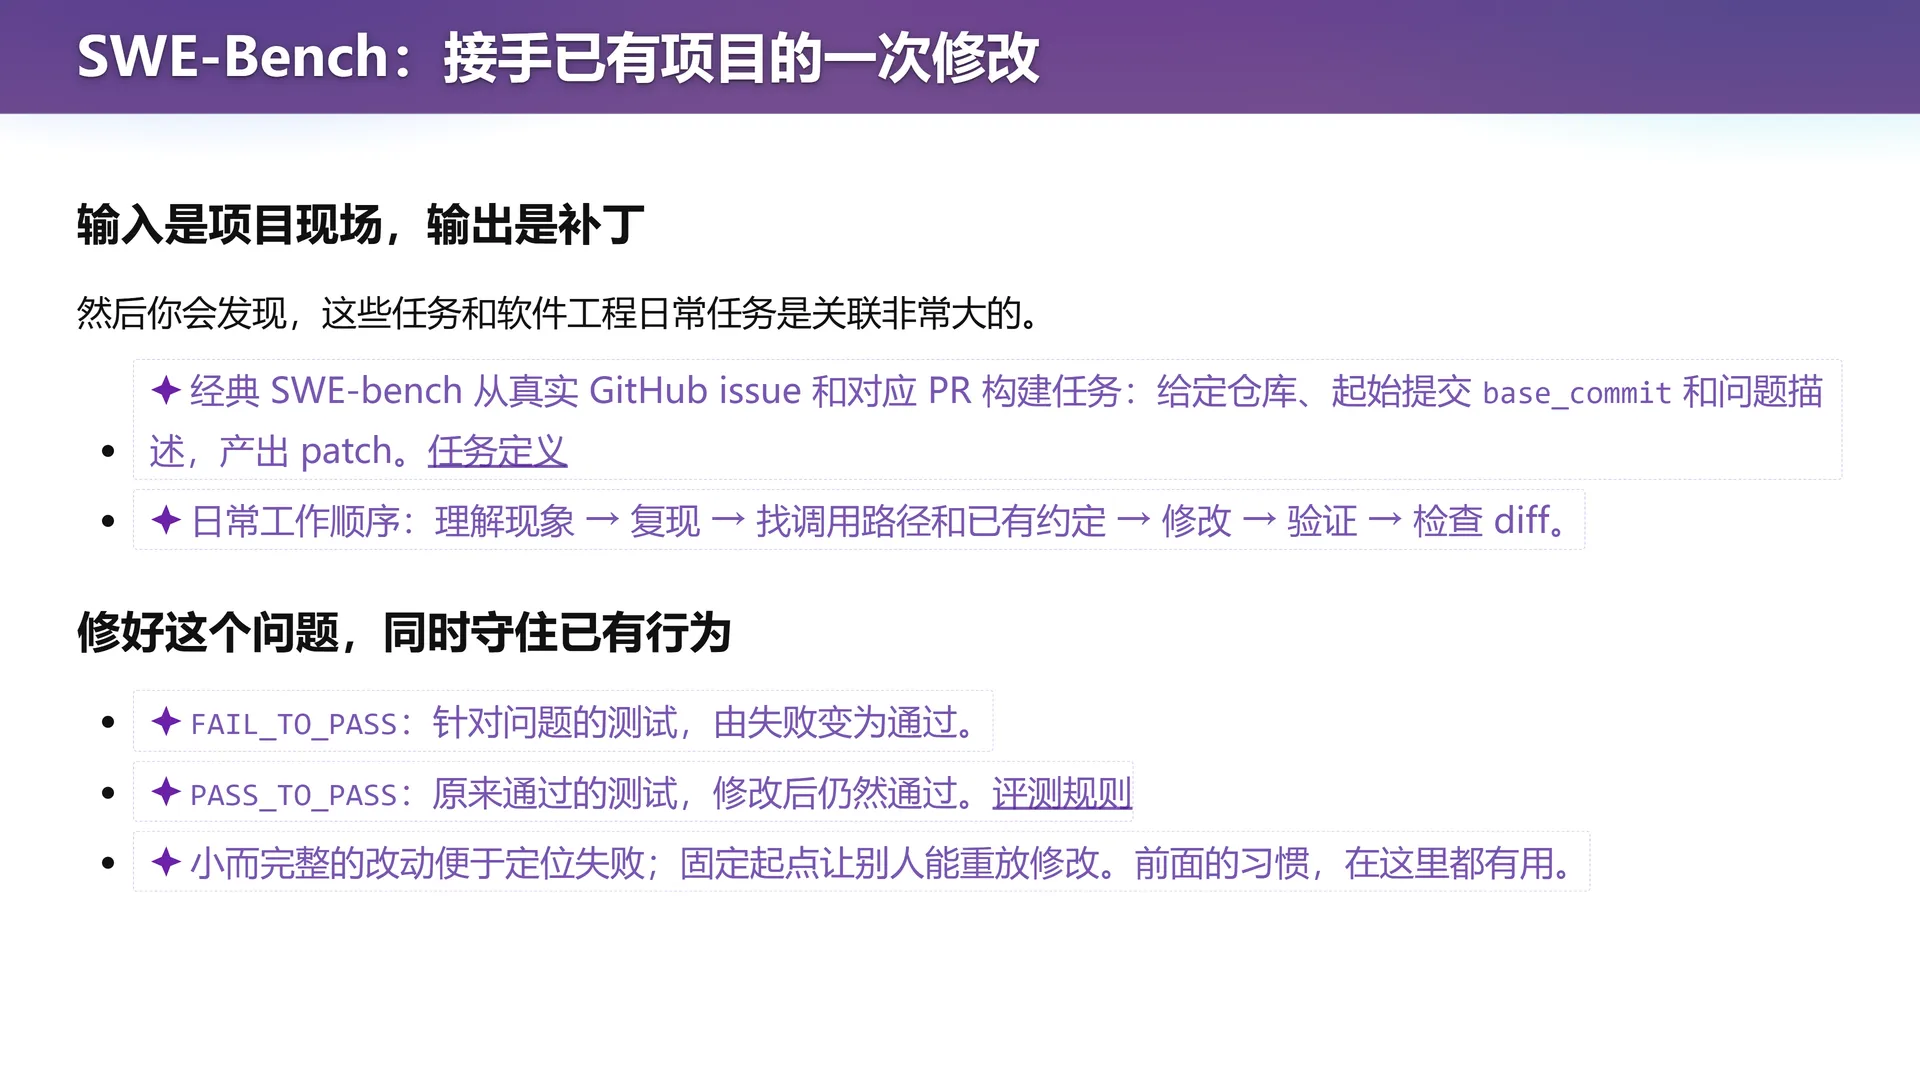
Slide 27:SWE-Bench——接手已有项目的一次修改
- 经典 SWE-bench 从真实 GitHub issue 和对应 PR 构建任务:给定仓库、起始提交
base_commit和问题描述,让模型产出 patch(补丁)。它要求模型接手一个已经存在的设计,在上下文中完成修改。 - 日常工作顺序:理解现象 → 复现 → 找调用路径和已有约定 → 修改 → 验证 → 检查 diff。
- 评测中,
FAIL_TO_PASS测试应由失败变为通过(针对问题的测试),PASS_TO_PASS测试应继续通过(原来通过的测试)。这两个名字说明了修复的双重要求:解决新问题,同时守住已有能力。参考 SWE-bench 评测实现。
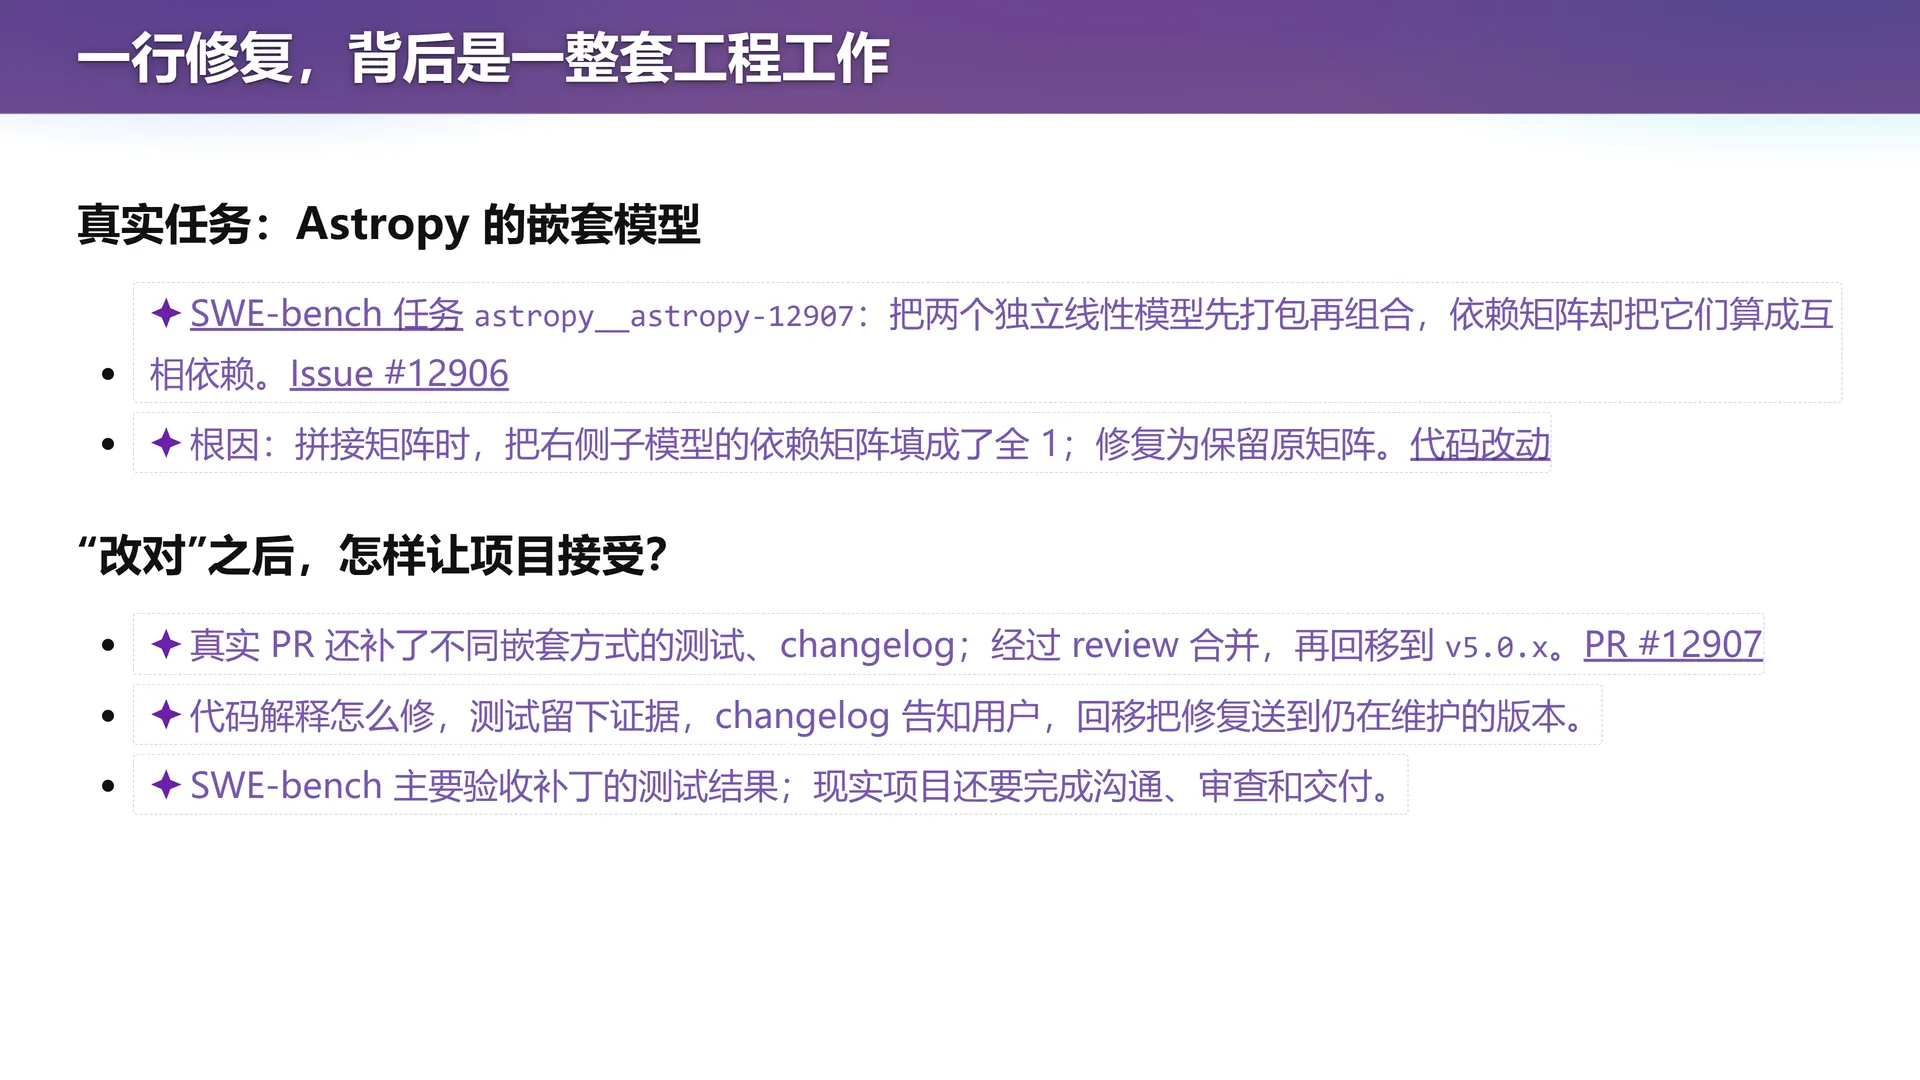
Slide 28:一行修复,背后是一整套工程工作
- 真实任务
astropy__astropy-12907:把两个独立的一维线性模型先打包成子模型、再与另一个模型组合后,它们对应的区域却变成「全真」,仿佛两个本来独立的计算突然相互依赖——只多包了一层组合,依赖关系就错了。见 Astropy Issue #12906。 - 根因:在拼接依赖矩阵的代码中,右侧已经是子模型的矩阵时,原实现把对应区域填成了
1,丢掉了原矩阵的内部结构。修复只需把填入的值改为right,保留那份已经计算好的依赖关系。见修复代码与测试。 - 「改对」之后,还要让项目接受:实际 PR 同时增加了不同嵌套方式的测试、更新了 changelog,经过 review 合并,并回移到 v5.0.x。见 PR #12907。
- 所以「只改了一行」描述的是最终代码差异的大小:要找到这一行,需要理解用户行为与项目抽象;要让项目接受,需要留下验证证据;要让用户得到它,还需要完成集成与交付。代码解释怎么修,测试留下证据,changelog 告知用户,回移把修复送到仍在维护的版本。
Slide 33:快照、变更与并发控制
- 在快照上并行工作,在发布时决定顺序:
- MVCC(多版本并发控制)管理多个版本;change algebra 描述变更怎样组合。
- 可交换(commute)的变更满足
$$ \Delta_B(\Delta_A(S)) = \Delta_A(\Delta_B(S)) $$
但**组合结果仍需满足项目的不变量(invariants)**。
- 一种设计设想:生成与测试在锁外进行,只对验证过的确切版本做原子发布;如果其他 Agent 已经推进了主线,就重新组合、验证。锁只保护短暂的版本读取或发布过程,耗时的生成和测试在锁外完成——否则把整个开发过程锁住,只是把并发工作重新排成了长队。参考:PostgreSQL 并发控制。
Slide 34:合并成功之后,还要问什么?
- Jujutsu 已经靠近「把变更放在中心」的思路:用稳定的 change ID 跟踪经过修改或 rebase 的变更;允许把冲突作为状态保存(见冲突模型);用 operation log 记录仓库操作并协调并发操作(见操作日志)。
- 没有文本冲突,也可能违反约定(一个
write skew例子):项目要求至少有一名值班员在岗,初始状态是甲、乙都在岗。Agent A 看到「乙在岗」,就把甲改为离岗;Agent B 看到「甲在岗」,就把乙改为离岗。即使两项修改分别落在两个文件里、文本合并没有任何冲突,结果却是无人值班。 - 这在数据库里叫 write skew(写偏斜):各自依据旧快照作出的决定,组合后破坏了共同约束。快照和局部检查之外,还需要检查组合结果或采用更强的并发控制。 参考:事务隔离与并发异常。
编者拓展|什么是 write skew 在可串行化(serializable)隔离级别之下,数据库会保证「并发执行的结果等价于某个串行顺序」。而 write skew 恰恰是快照隔离(snapshot isolation)下仍会发生的一类异常:两个事务各自读取了同一份旧快照、分别写入不相交的数据,文本(数据项)层面没有任何「写—写冲突」,但它们的组合违反了那条跨越多个数据项的约束(如「至少一人在岗」)。修复方向有二:把约束显式建模并做冲突检测,或采用更强的并发控制(如串行化/可串行化快照)。
Slide 35:Agent 时代,项目管理会变成什么?
- 一种可能性:大步历史 + 极致的正确性保障。
- Agent 通过 lock / unlock 获得快照,完成修改、验证后进入主线;锁只保护取版本和发布,工作在独立快照中进行。
- 人定义意图、不变量与验收标准;Agent 生成候选变更,系统依据验证结果准入。
- 人只看有意义的大步历史;机器保留细粒度操作与验证证据,供定位、重放、回退。
- 「出什么问题修好就行」——讲师用「反正没有 Agent 能被开除、能坐牢」挑战以追责为中心的审计习惯:如果生成和修复都足够便宜,工程流程是否可以把更多精力放在正确性保障和恢复能力上?
- 这个设想成立的关键:错误能否在造成不可逆后果前被发现?修复是否足够便宜?
- 测试全绿只是「已有的验收条件通过」。验证越强、恢复越便宜,越能放手让 Agent 大步前进;审计的重心可能转向:系统凭什么接受这个变更?缺失的约束是什么?
- 人的责任会更多落在定义意图、不变量和完成标准上,系统则需要解释:它凭什么接受这次变化?
编者说明:第 33–35 页共同勾勒了本讲最后的思想实验——「面向 Agent 的版本控制」。它把今天学到的快照、分支、原子变更与数据库的并发控制(MVCC、write skew)连接起来,正是「学习正确的概念,才能向外推演」的注脚。
附:参考与延伸阅读
以下讲义原文链接来自课程官方讲义(注明了出处文件);编者补充是撰写本书时另加的,不与讲义混淆。
讲义原文链接
- Yanyan's wiki
lab1.html - 61A Code
lect3.html - Astropy Issue #12906
lect3.html - Conventional Commits
lect3.html - Git Best Practices
lect3.html - Git 对象
lect3.html - Git 简史
lect3.html - Jujutsu 教程
lect3.html - Learn Git Branching
lect3.html - PR #12907
lect3.html - Rebase
lect3.html - SWE-bench
lect3.html - SWE-bench 评测实现
lect3.html - gh
lect3.html - git add 文档
lect3.html - gitignore 文档
lect3.html - glab
lect3.html - 事务隔离与并发异常
lect3.html - 修复代码与测试
lect3.html - 冲突模型
lect3.html - 分支与合并
lect3.html - 操作日志
lect3.html - Creative Commons License: BY-NC 4.0
lect3.notes.md - 苏 ICP 备 2020049101 号
lect3.notes.md
编者补充
附录:课堂未展示的幻灯片
🖼️ 第 9 页幻灯片 · 留意:让每一次阅读都成为学习
🖼️ 第 27 页幻灯片 · SWE-Bench:接手已有项目的一次修改
🖼️ 第 28 页幻灯片 · 一行修复,背后是一整套工程工作
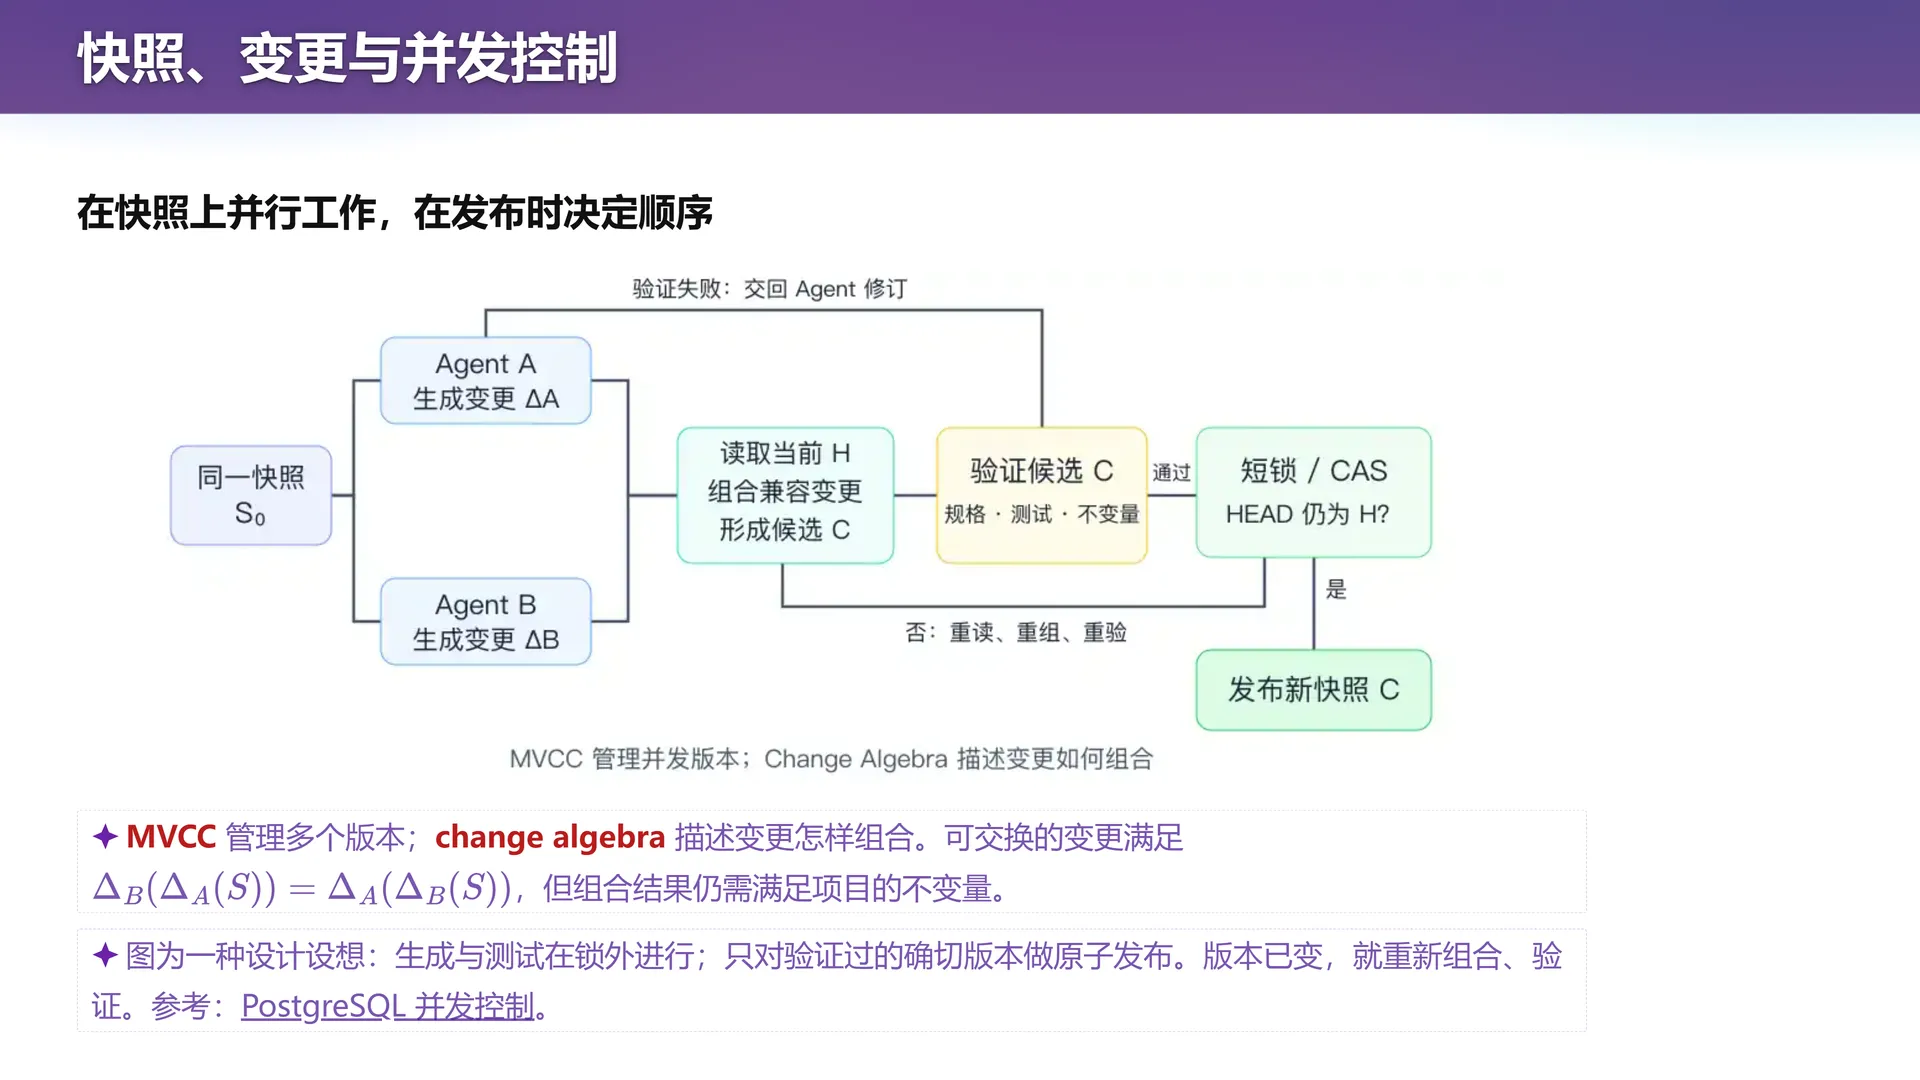
🖼️ 第 33 页幻灯片 · 快照、变更与并发控制
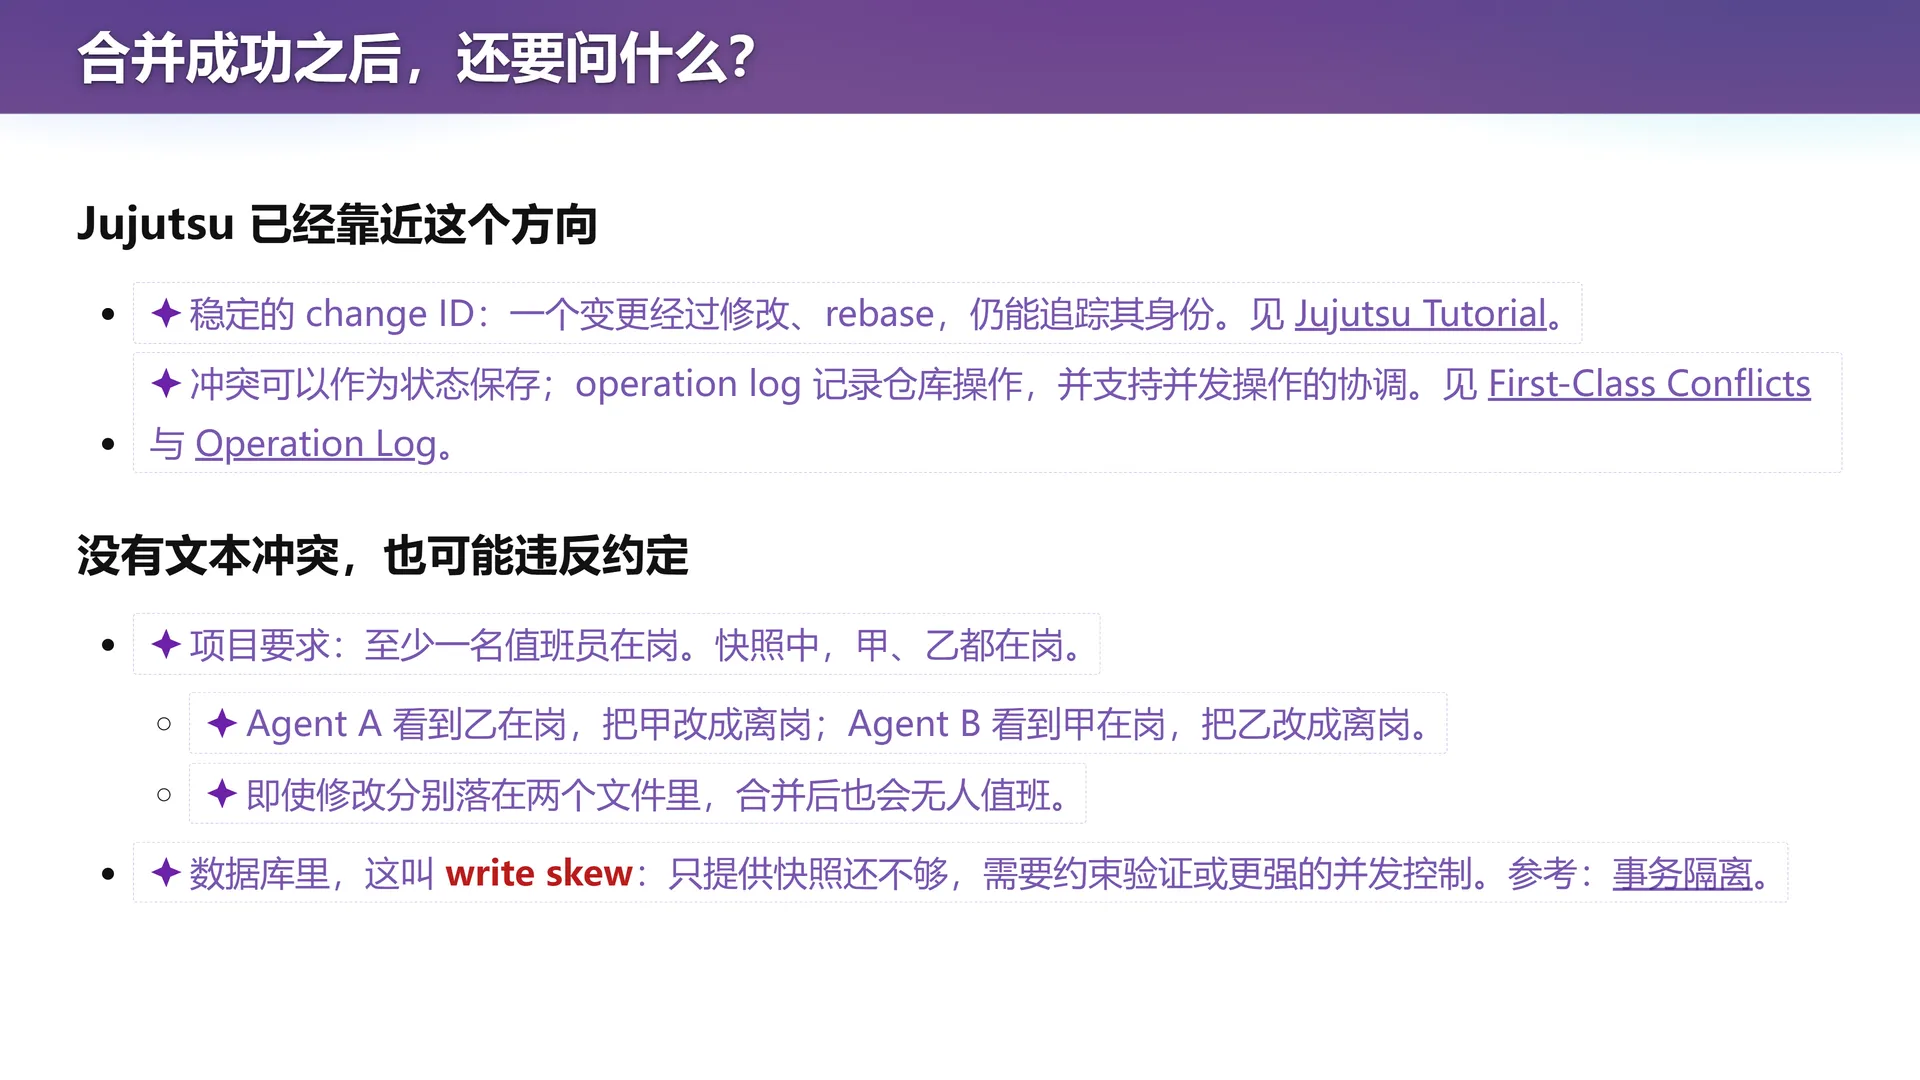
🖼️ 第 34 页幻灯片 · 合并成功之后,还要问什么?
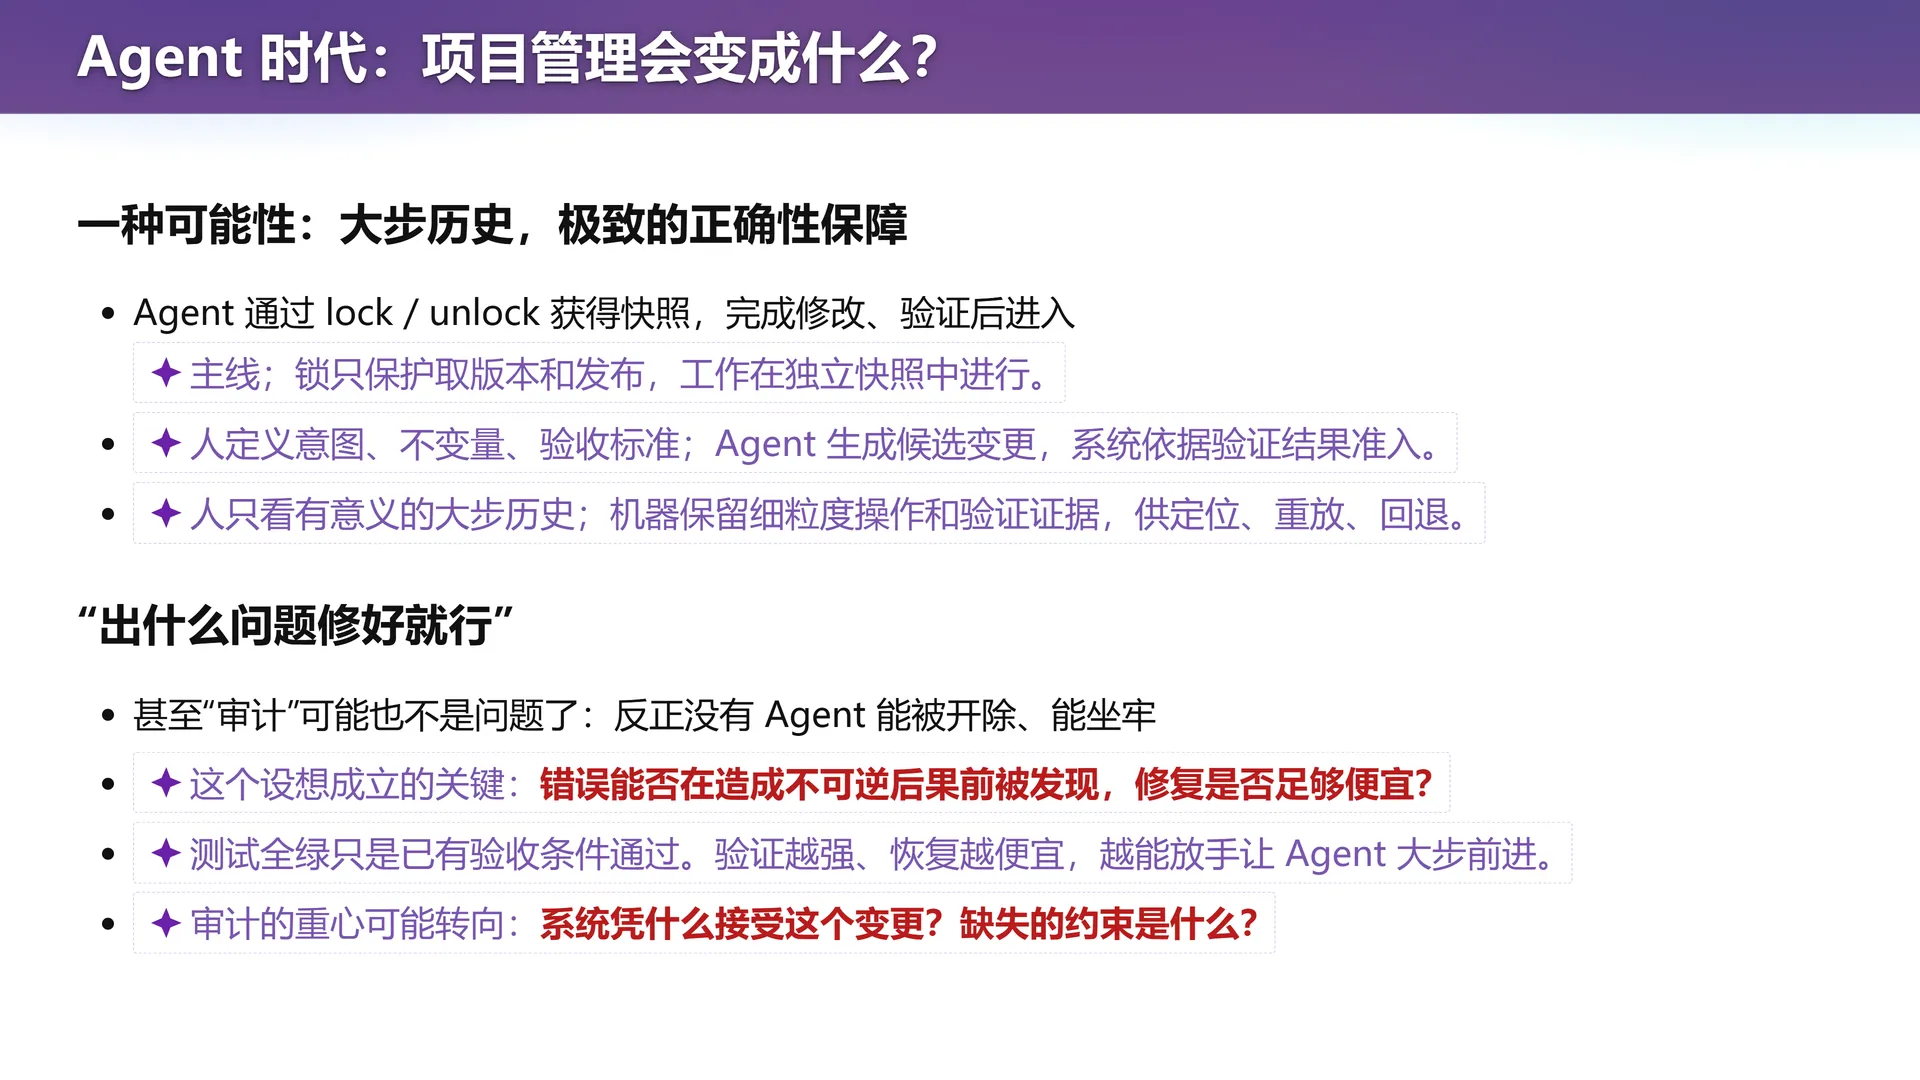
🖼️ 第 35 页幻灯片 · Agent 时代:项目管理会变成什么?