第4讲 · 软件仓库管理(2):从快照、Change 到 Agent 时代的重新设计
本文档由课堂录像重构而成,并与讲师本人的书面讲义、幻灯片交叉校准。文中标注 编者说明 / 编者拓展 的段落为编辑所加,用于补全讲师点到而未展开的技术背景,并非讲师原话。
| 课程 | 生成式软件工程(南京大学,2026 春) |
| 视频 | 软件仓库管理 (2)(时长 5909 秒) |
| 课程主页 | jyywiki.cn |
| 讲义 | 版本管理 (2) | 幻灯片:slides |
| 实验一 | 会成长的个人助手 |
| 作者 | jyy | 许可:讲义与幻灯片采用 CC BY-NC 4.0,苏 ICP 备 2020049101 号 |
对应讲次:第4讲(南京大学 生成式软件工程)
制作模型:deepseek-flash(vb compose,据 run.log)
引言:为什么先布置一个「会成长的个人助手」
(参考时间: 00:00:00)
上周讲过一点版本管理,这一讲继续。课程同时发布了实验一——一个相当"时髦"的需求:会成长的个人助手。按照课程约定,作业都是选做、自愿完成,但最终会验收(学校可能需要提交成绩),大家会提交链接,由讲师写的机器人来评分。
实验一的要求是不限形式的:你想怎么做就怎么做,最好还能"Vibe Coding"一个出来。今天课上会留出时间,讲师本人就会现场 Vibe Coding 一个,并顺带告诉大家直接让 AI 去做会遇到哪些小坑。下一讲(周日调休,补周二的课)会讲软件架构,把这个例子连起来。
个人助手这个例子,是每个同学都会需要的、讲师自己也在用的东西:
- 学习数据库:把专业课(计算机网络、概率统计等)的资料放进个人数据库,或把研究组的论文、教科书整理成个人文库;
- 个人信息库:每次填表都要写姓名、学号、身份证号,还要写简历,这些都可以交给 Agent;
- 邮箱联动:把数据库和邮箱关联,实现一个 always-on 的后台循环。买一个一两百元的嵌入式小设备,就可以在宿舍里持续跑 Agent Loop;
- 手机端联动:可以做成网页,也可以是苹果 App 或安卓 App——只要让 Agent 去做,它会自己去装需要的东西,把你要的东西做出来。
一个真实的小故事:讲师回忆,疫情期间招过一个研究生,在自己这里做了三年,研究的就是"自动填表系统"——因为大家都觉得填表很烦。结果快毕业的时候 ChatGPT 出来了,学生很慌,觉得做的事情马上就要被替代。讲师说:"不要紧,你赶快答辩,就可以毕业了。"世界就是这样发展得如此之快。
为什么布置这个实验:焦油坑
(参考时间: 00:03:30)
看起来所有任务都在 AI 的能力范围之内,但如果你直接把实验要求丢给 AI 去做,它在一开始就会做出很多看起来合理的决定——而这些决定会让项目维护越来越困难,直到最后陷入"焦油坑"。
编者说明:焦油坑(tar pit)是 Fred Brooks 在《人月神话》(The Mythical Man-Month)中的著名比喻:大型软件项目像史前时代的焦油坑,许多巨兽陷入其中无法自拔,越挣扎陷得越深。表面上每个项目都能做出来,但能真正成功的少之又少。
所以每个同学都有必要体验一下软件工程里的焦油坑,也就是:当 AI 生成的 Sloppy 代码不断消耗你的 Token 时,你终于会在某一天下定决心——把这个项目删掉,从头重做,或者回退到某个很早期的版本重新开始。
接下来的实验会和这个实验有非常大的关联,暂时猜不到:当你把实验一做好、成为一个非常舒适的个人助手之后,会给你加一个需求,这个需求和前面所有内容都关联,并且有一定的冲突。你会越改越崩溃,越改越崩溃。如果实验一选择躺平、让 AI 直接做完、下一次再删掉重做,可能就没有这个软件工程的体验了。
一堆文件,够不够表示一个项目
(参考时间: 00:05:17)
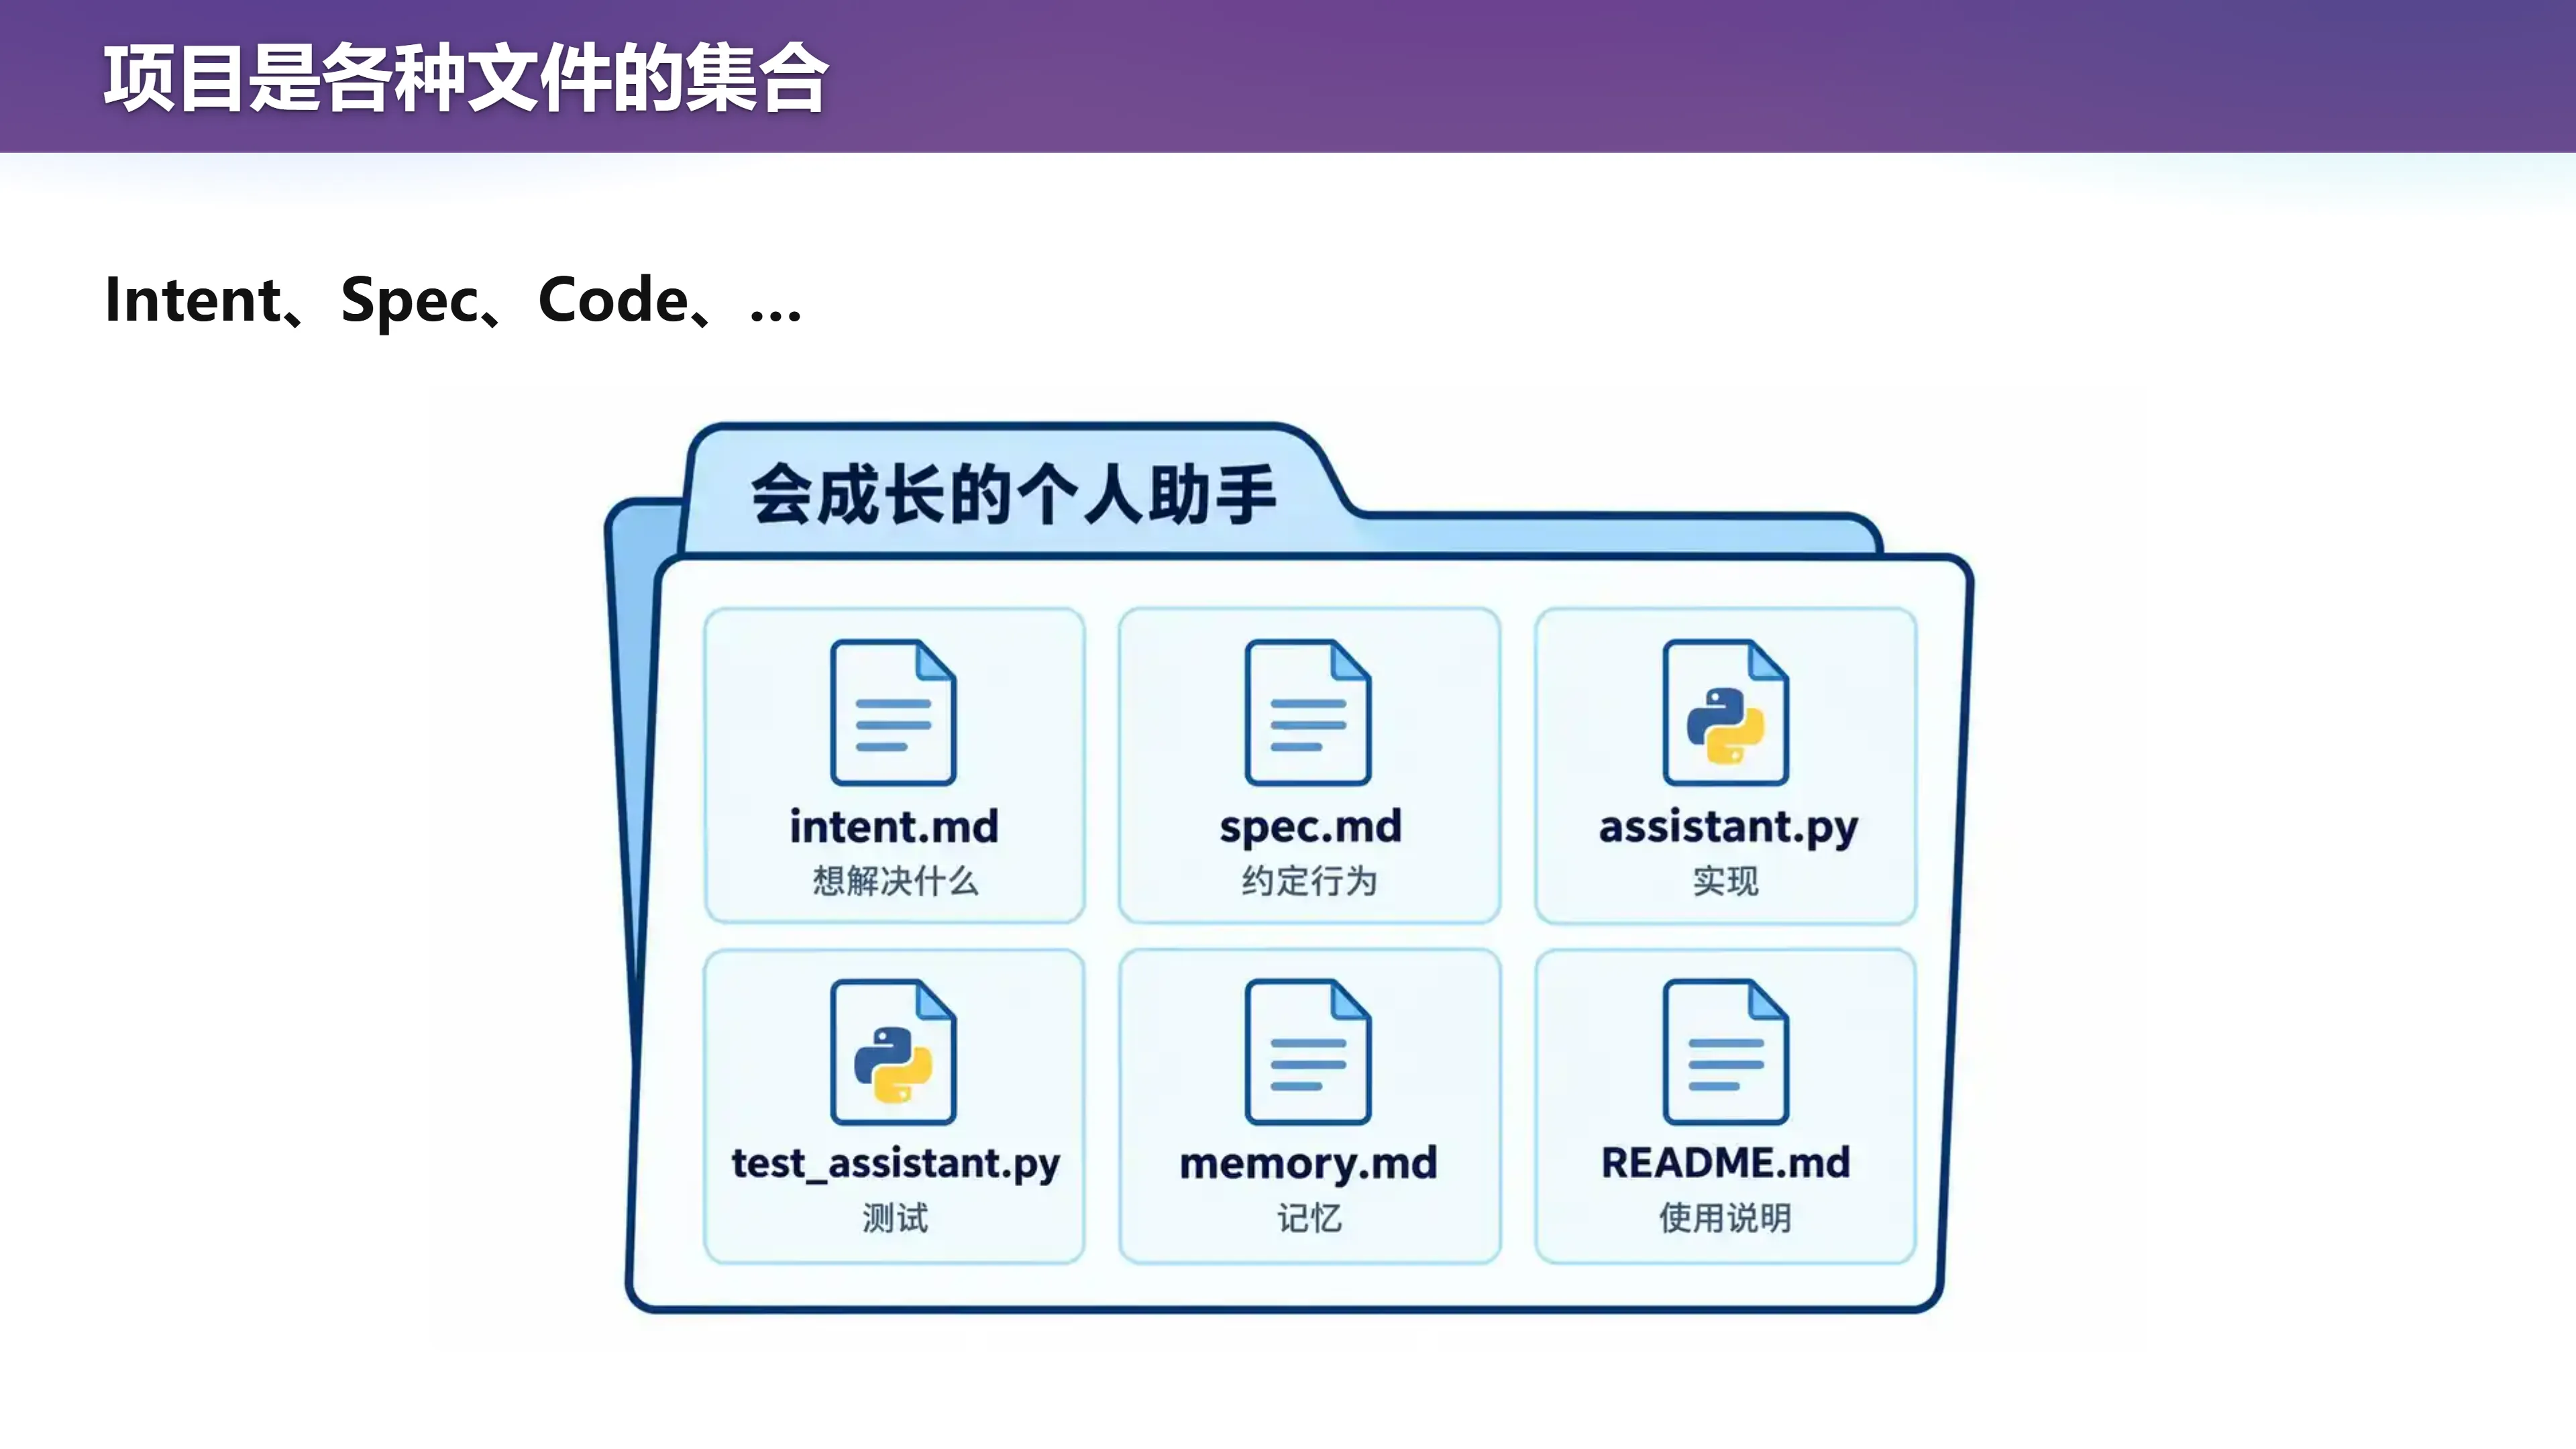
项目是各种文件的集合
上一讲我们说:项目是各种文件的集合。Intent(一份设计文档)、README、Spec、Code、测试、配置,全都放在项目里。
关于 README,讲师有一个个人偏好:不喜欢 AI 写出来的非常非常长的 README。他认为 README 应该只写:
- 设计这个项目时最初的初衷——你想做一个什么样的产品,它能达到什么样的效果(可以配两张截图);
- 你最重要的那些设计。
一个类比:假设有一天你突然想出一个非常好的点子,想用它去挣一个亿。你要组建一个创业团队,去说服计算机系的人(比如讲师)一起干。你只需给出一个比较短的 README——这是你的 Intent。剩下的部分,有架构能力和写代码能力的人会帮你补出来。你不需要知道这个软件系统长什么样、它的 Specification 是什么、用什么数据库、怎么支持用户从 1 增长到 10、到 100 万、到 1 亿。
从 Intent 到 Spec,需要决定:用什么数据库、什么语言、项目结构是什么、每个模块的接口是什么。再到 Code(Implementation),就落在项目里。
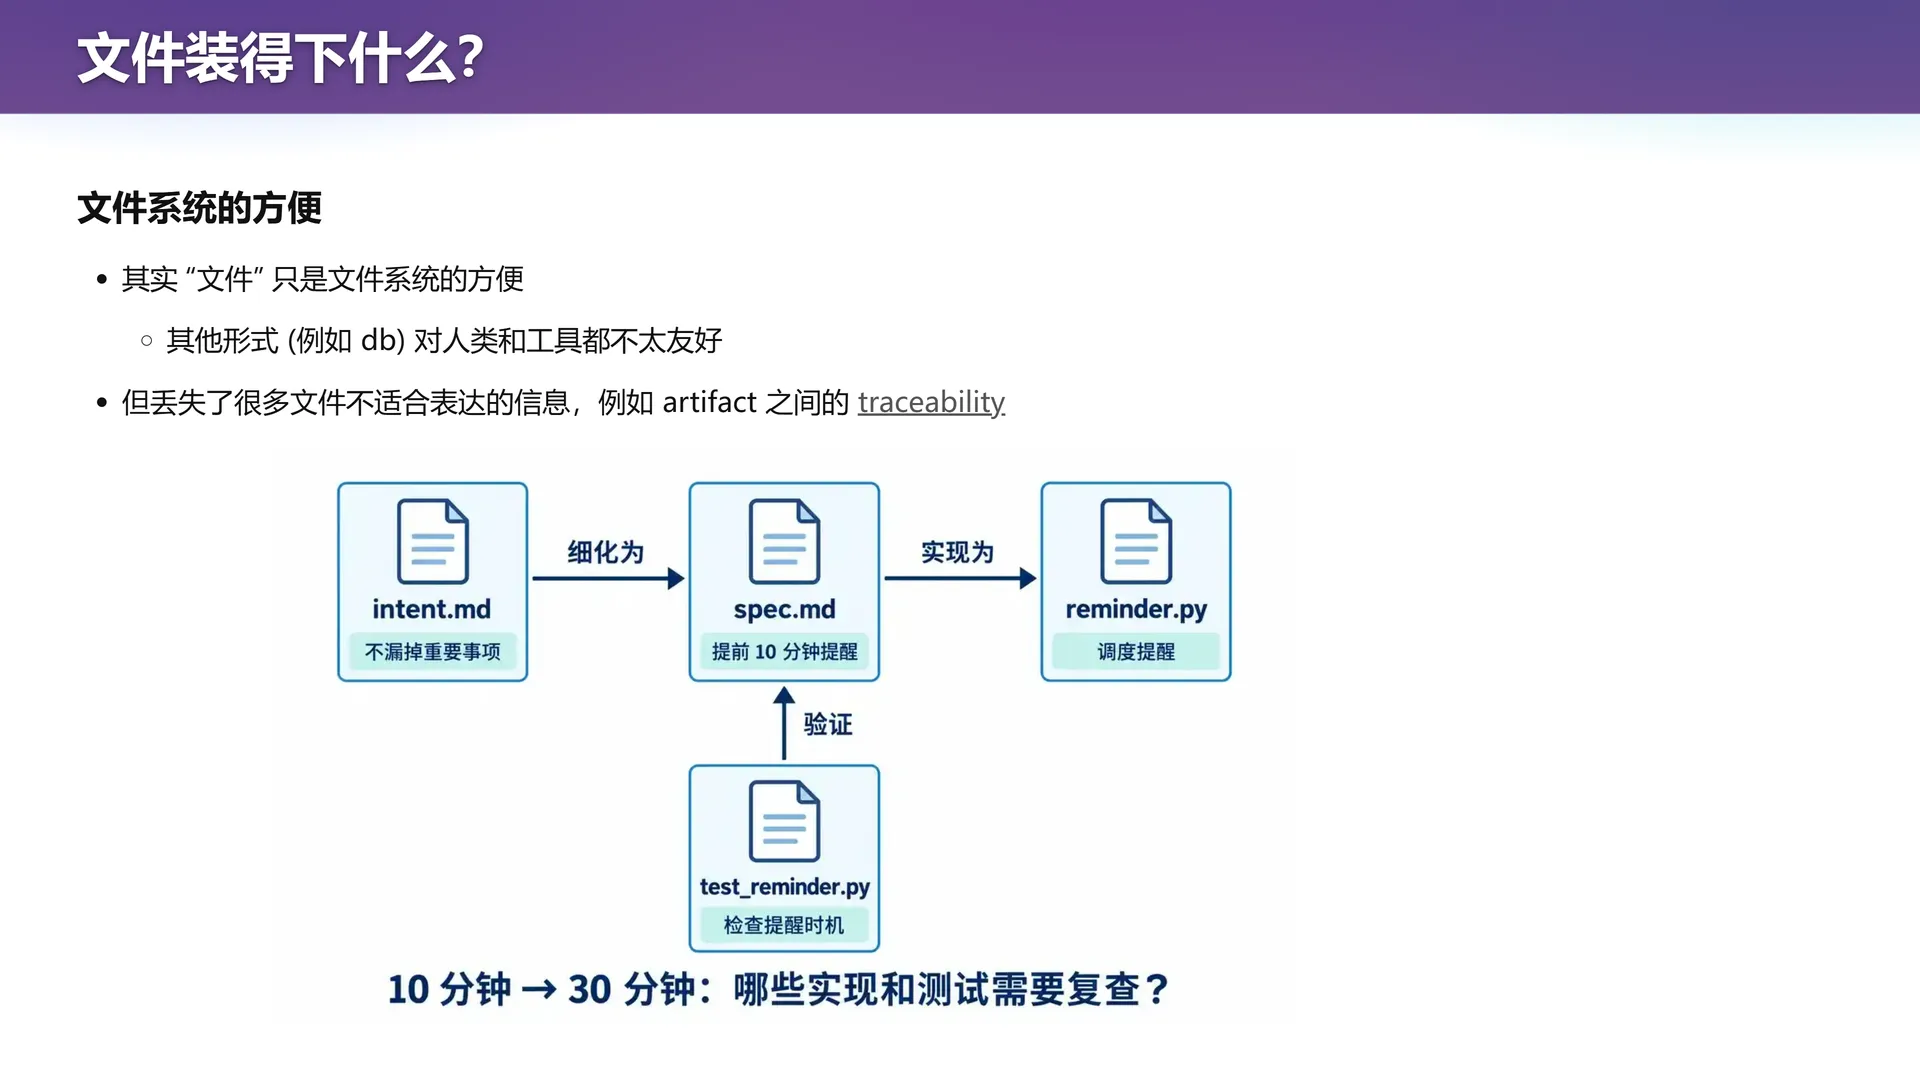
📷 项目是各种文件的集合 Intent、Spec、Code
回到原视频 (00:05:17)
文件装得下什么?——文件系统的方便与代价
(参考时间: 00:07:00)
有了项目,很自然地需要一个容器把这些文件管理起来。大家用文件系统管理项目,其实真的就是"图方便"。回到 1950—1960 年代,操作系统给你的存储功能只有文件,别的什么都没有,关系型数据库还没被发明出来。所有程序员别无他法,只能把项目以文件的形式存进去。所以这更多是一个历史路径依赖的结果。
讲师自己的看法是:文件系统可能不是组织项目的正确方式,因为它丢失了很多"文件不适合表达"的信息。
有些信息是容易表达的,比如:
- Intent、Spec 这类文档;
- 测试用例的输入、输出、以及"运行过程中什么不能被违反"的断言。
但马上你就会发现,很多隐藏的关联在项目里是不存在的。
一个非常常见的例子:你让 AI 把实现里的某个方法从链表换成一棵更高效的树,去优化性能——AI 啪啦啪啦就把代码改了。但你没想到的是,你可能在某个 Markdown 文档里随手写过一句话:"这个项目是用链表管理的"。于是你的文档、代码和测试之间就形成了一个隐含的关联。写文档时可能还没有代码,你随手一写;一旦代码实现了,这个关联却没有被强行建立起来。这就是一笔技术债(Technical Debt)。
以后随着文档和代码不断向前推演,它们的不一致只会越来越多,不会越来越少,软件就陷入维护的泥潭。到那时你拿出一份代码,甚至 AI 看到一份代码,都会问:到底是文档说的对,还是代码说的对?你和他聊天的历史没了(那个 chat 已经消失、你换了台电脑),Git 仓库里或许还有一些 change 日志,但到最后你真的不知道——到底是代码赢,还是文档赢。
可追踪性(Traceability)
(参考时间: 00:10:00)
在软件工程里,这是一个被研究了非常久的问题,叫做 Traceability(可追踪性)。研究综述 Software Traceability: Trends and Future Directions 讨论的正是这类问题(讲义注明是 2014 年的综述,所综述的对象更早)。它关心的核心是:
- 一个软件项目当中,各种各样的测试用例、文档,哪怕只是文档中间的一行代码,它们之间的关联是什么;
- 能不能在软件系统的演化过程中仍然维持这种关联。
这就是一个非常"软件工程"的问题。
将错就错,然后呢?
(参考时间: 00:10:00)
我们一直在围绕文件发展更强大的工具:文件系统将错就错,用压缩包发布、把压缩包发给合作者,维护不下去了,于是有了 SVN,有了 Git,那下一个是什么?
一个面向未来的猜想是这样的:如果以后我们都不再写代码了,软件是否还应该是今天这种"在 Git 仓库里管着一堆文件(README.md、hello.c、某个文档)"的形态?也许我们还需要文档,但文档可能是好多切片,把它们变成好多个对象(Object)或实体(Entity)。于是:
- 这份文档和这份实现之间有一个关系:"这段代码实现了这份文档";
- 这个测试用例也有对应的文档,文档和测试用例关联起来;
- 测试用例又和代码的那部分实现关联起来;
- 文档又和文档关联起来。
这会是一个完全结构化的东西,没有办法在文件系统里以一棵树的形式表达——它是一张随便连、带环的图(Graph)。例如,可以把它放进一个数据库,叫 repo.db。但显然,人类就没法用今天 Unix 世界里的工具去维护这样的仓库了。
不要紧——用魔法打败魔法。 人类理解不了的东西,就训练 AI 去理解:只要有强化学习的反馈信号,AI 就能理解这个仓库。
想象一下这个未来怎么工作:
- 一个大型软件项目已经跑起来了,你一般只是增加一个功能、修改一个功能——这跟 Git 的哲学很像:Git 管理了文件、目录、快照以及快照之间的关系,希望小步前进;
- 每做一件事(修一个 bug、改一个文档),你可以跟 AI 聊一句;这时一个大型软件系统里绝大部分内容跟这一小步没有关系;
- 既然无关,就可以让 AI 根据你的 Chat,把和你相关的东西摘出来:需要的是这个文件、这个测试用例、这个文档,其他的都不需要了;
- AI 有动态生成任何内容的能力——"content as code"、"everything is code"——所以它可以生成一个和这一小步相关的视图。
📷 将错就错,然后呢?AI 时代的软件形态
回到原视频 (00:10:00)
编者说明:这里的 视图(View) 借用了数据库的概念:数据本身还是那些数据,但可以创建一个不一样的查询,把它以另一种形式展示。于是你看到的不是一堆代码、文档和 diff,而是一个可视化看板——上面列出和你这一小步相关的东西,问你要改什么。改完以后,从 V0 到 V1,底层仍然是一个
repo.db,而这一步小改动会把相关的东西(比如新增一类测试用例)自动关联进去。软件工程就此彻底变了。
讲师坦承,现代 IDE(比如 Cursor)打开默认就是 Agent Mode,原来那个熟悉的、可以"古法编程"的 IDE 界面没有了,强迫你用一种类似 Chat 的方式沟通。而他自己对代码还有一些掌控欲(也许是"不好的"),所以并不完全认同——但这条路是未来可能发生的。
也许有一天公司真的把它做出来,那么多学的东西怎么办? 讲师安抚道:你看,我们在创造这些东西的过程中,用的恰恰都是你们在学的经典计算机科学课程——数据库里的视图、实体和关系,Git 的模型和"小步前进"的长期开发经验。如果在这个模型下"大步向前",那就惨了;当然,也可能真的发生——模型非常强,一个非常大型的项目一步就变成下一个版本。至少在今天(2026 年),我们还不会做这件事,还是要沿用过去积累的软件工程智慧,小步向前,通往那个极乐世界。讲师相信极乐世界是有可能到达的。
同学产生的疑问:从信任老师到自己的理解
(参考时间: 00:19:00)
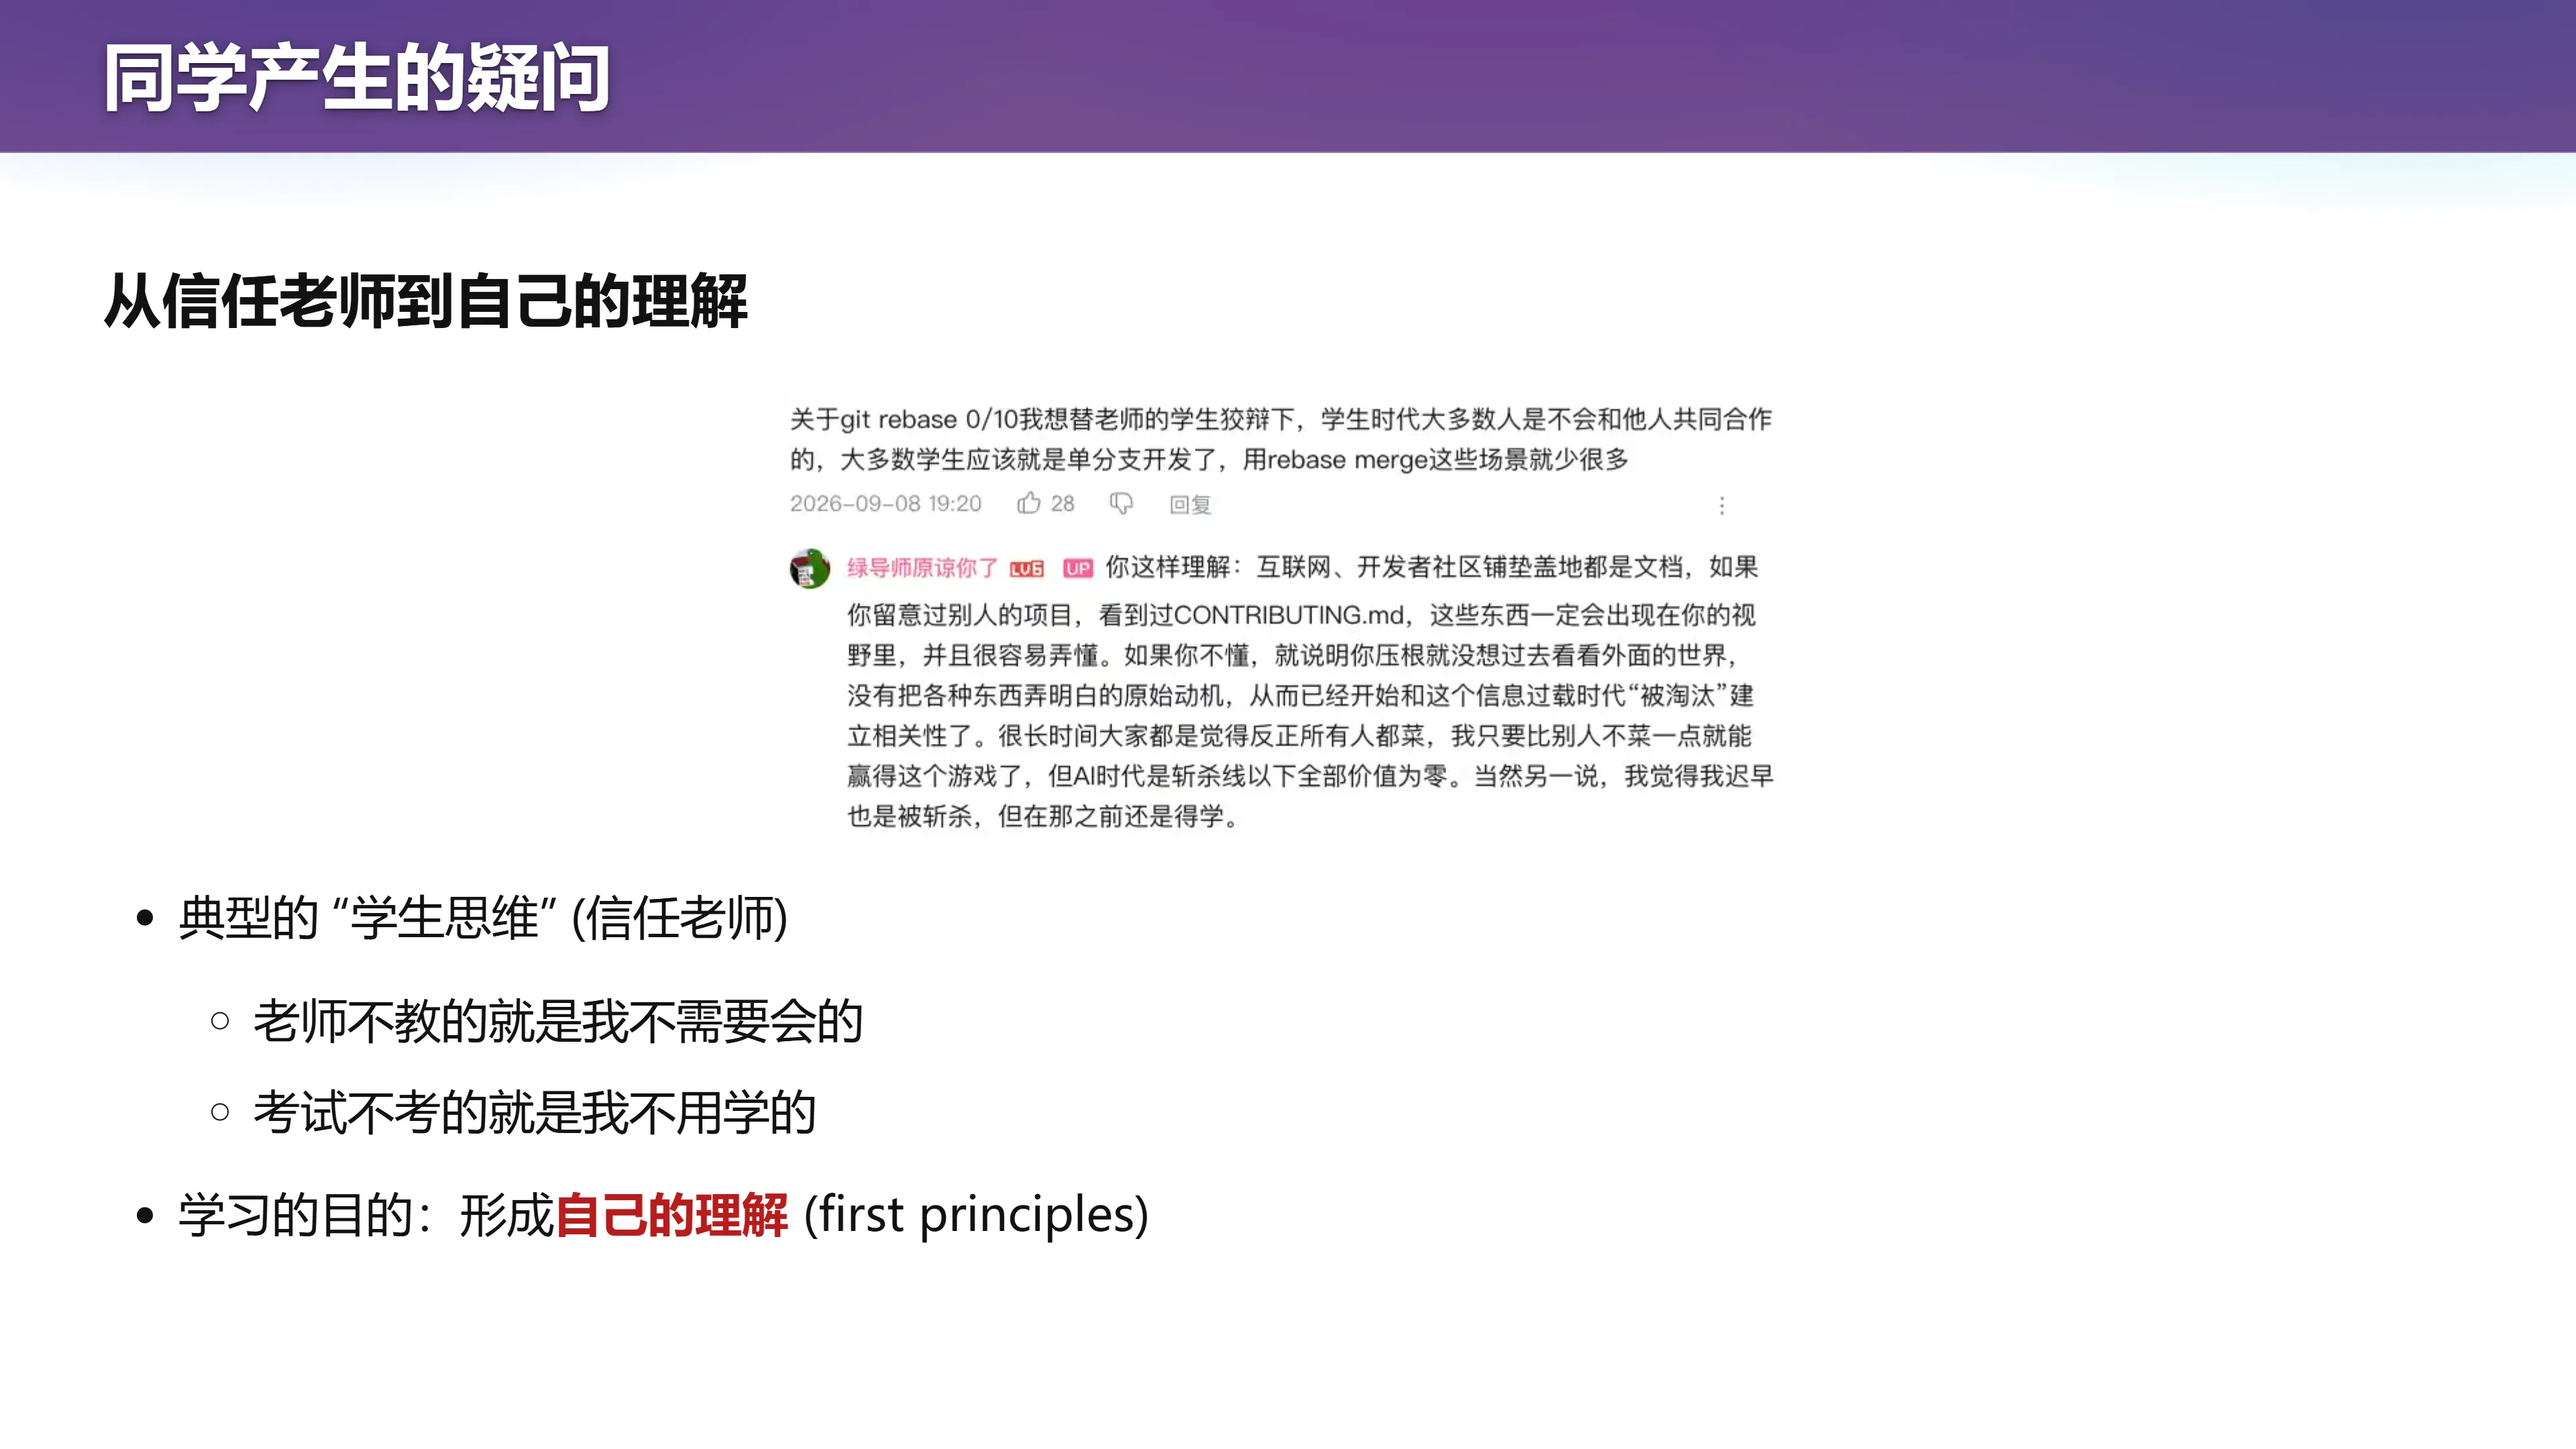
课堂上读过一条学生留言——这个同学应该已经毕业了。上上节课讲师问同学们"什么是 git rebase",大家都不知道。这位同学提出了一个中肯的观点(valid point):
学生时代大多数人不会和他人共同做作业,所以
rebase、merge的使用场景很少。
这个 point 是对的——做作业时确实不会用到。讲师的回应大致如下:
- 如果你真的去外面的世界走一走,互联网开发者社区铺天盖地都是文档。你总有一天会留意到别人的项目,看到仓库根目录下的
CONTRIBUTING.md——一份贡献者指南,通常回答"我怎么参与这个项目"; - 里面会写项目总体结构、分支与提交信息、PR 的规范和流程。随手打开看一眼,如果你发现里面说的东西你都知道了,那你就知道了;如果你不知道——比如某天你看到一个项目写"你必须先在自己的分支上 rebase,我们保持线性历史,禁止创建分叉的 merge"——你马上就会想知道
rebase是干什么的。
讲师指出一种需要警惕的"学生思维":
上高中的时候,老师不教的就是你不需要会的,考试不考的就是你不用学的。为了升学的利益最大化,这在当时是对的,没有错。 但到了大学还带着这个思维,就会出现一种"新人类"和"旧人类"之间的 gap。
📷 同学产生的疑问:从信任老师到自己的理解
回到原视频 (00:19:00)
讲师也承认自己有一种危机感:AI 时代的"斩杀线"以下的价值会全部归零。斩杀线暂时还斩不到 985 大学计算机专业的同学,但很多"低级智力劳动"(他举例:会计从业者,以及他看过的一篇报道提到中国可能有上千万会计从业者)面临被 Agent 替代的危险——行业顶端的人暂时没有威胁,但底下大量的人会。所以,在操作系统、编译器等经典课程里学到的经典智慧,最终要形成你自己的理解。
从快照理解分叉与合并
(参考时间: 00:22:00)
回到软件工程。Git 管理的核心是快照——也就是一个目录在某一个时刻的完整状态。
Git 的对象模型与历史关系
一次 commit(提交) 除了指向文件状态,还记录父提交、作者、说明等信息。父提交的连接把历史组织成一张有向无环图(DAG)。我们可以把一次开发理解为:从状态 A 出发,完成一个功能,得到状态 B;提交说明中的 feat: ... 帮助人理解这一步想推进什么。
📷 Git 管理了什么?文件、目录、快照和快照之间的关系
回到原视频 (00:22:00)
graph LR
    A["状态 A"] -->|"feat: ..."| B["状态 B"]
    A -->|"另一条探索"| C["状态 C"]
    B --> M["合并提交 M<br/>(双亲)"]
    C --> M
编者拓展|Git 的对象模型:Git 的底层对象其实只有三种——blob(文件内容)、tree(目录,记录文件名到 blob 的映射)、commit(指向一个 tree,外加父提交、作者、提交说明)。快照 = 一棵 tree,历史 = commit 之间用父指针连成的 DAG。这也是为什么 Git 是"内容寻址"的:每个对象的名字就是它内容的哈希。详见官方文档 Git Objects。
Merge 与 Rebase
如果两个人都从 A 出发,一人修改输入方式,另一人修改结果展示,就会得到两条开发路线:
- Merge 把两边的成果整合起来;在通常的分叉合并中,新的提交会同时连接两边的历史(有两个父提交);
- Rebase 则把一条路线上的改动重新应用到另一个起点上,让这些改动好像是在新的基础上依次完成的,从而形成一段线性历史。
在这堂课上,讲师现场把图"横过来画"演示,方便第一排的同学也能看清。
graph TD
    subgraph "原始:两条线"
        A1((A)) --> B1((B))
        B1 --> C1((C))
        B1 --> D1((D))
    end
    subgraph "Rebase 之后:线性历史"
        A2((A)) --> B2((B)) --> C2((C)) --> D2((D'))
    end
冲突从哪里来
冲突来自两边对共同状态作出了不能直接兼容的修改。例如同一个配置原来写着"立即保存":
- 一边改成"手动确认后保存";
- 另一边改成"每分钟自动保存"。
工具可以发现文本上的分歧,但究竟要哪一种行为,需要回到需求。即使改动位于不同文件、能够自动合并,组合起来也可能违背双方原来的假设。
把变化的身份纳入版本管理
(参考时间: 00:26:00)
"轻微的不和谐"
理解了快照之后,Git 的某些操作会让人感到一点"不和谐":
- 执行
cherry-pick时,通常想搬走的是某次提交引入的改动; - 执行
rebase时,通常也认为"我做的还是那件事,只是换了一个基础"。
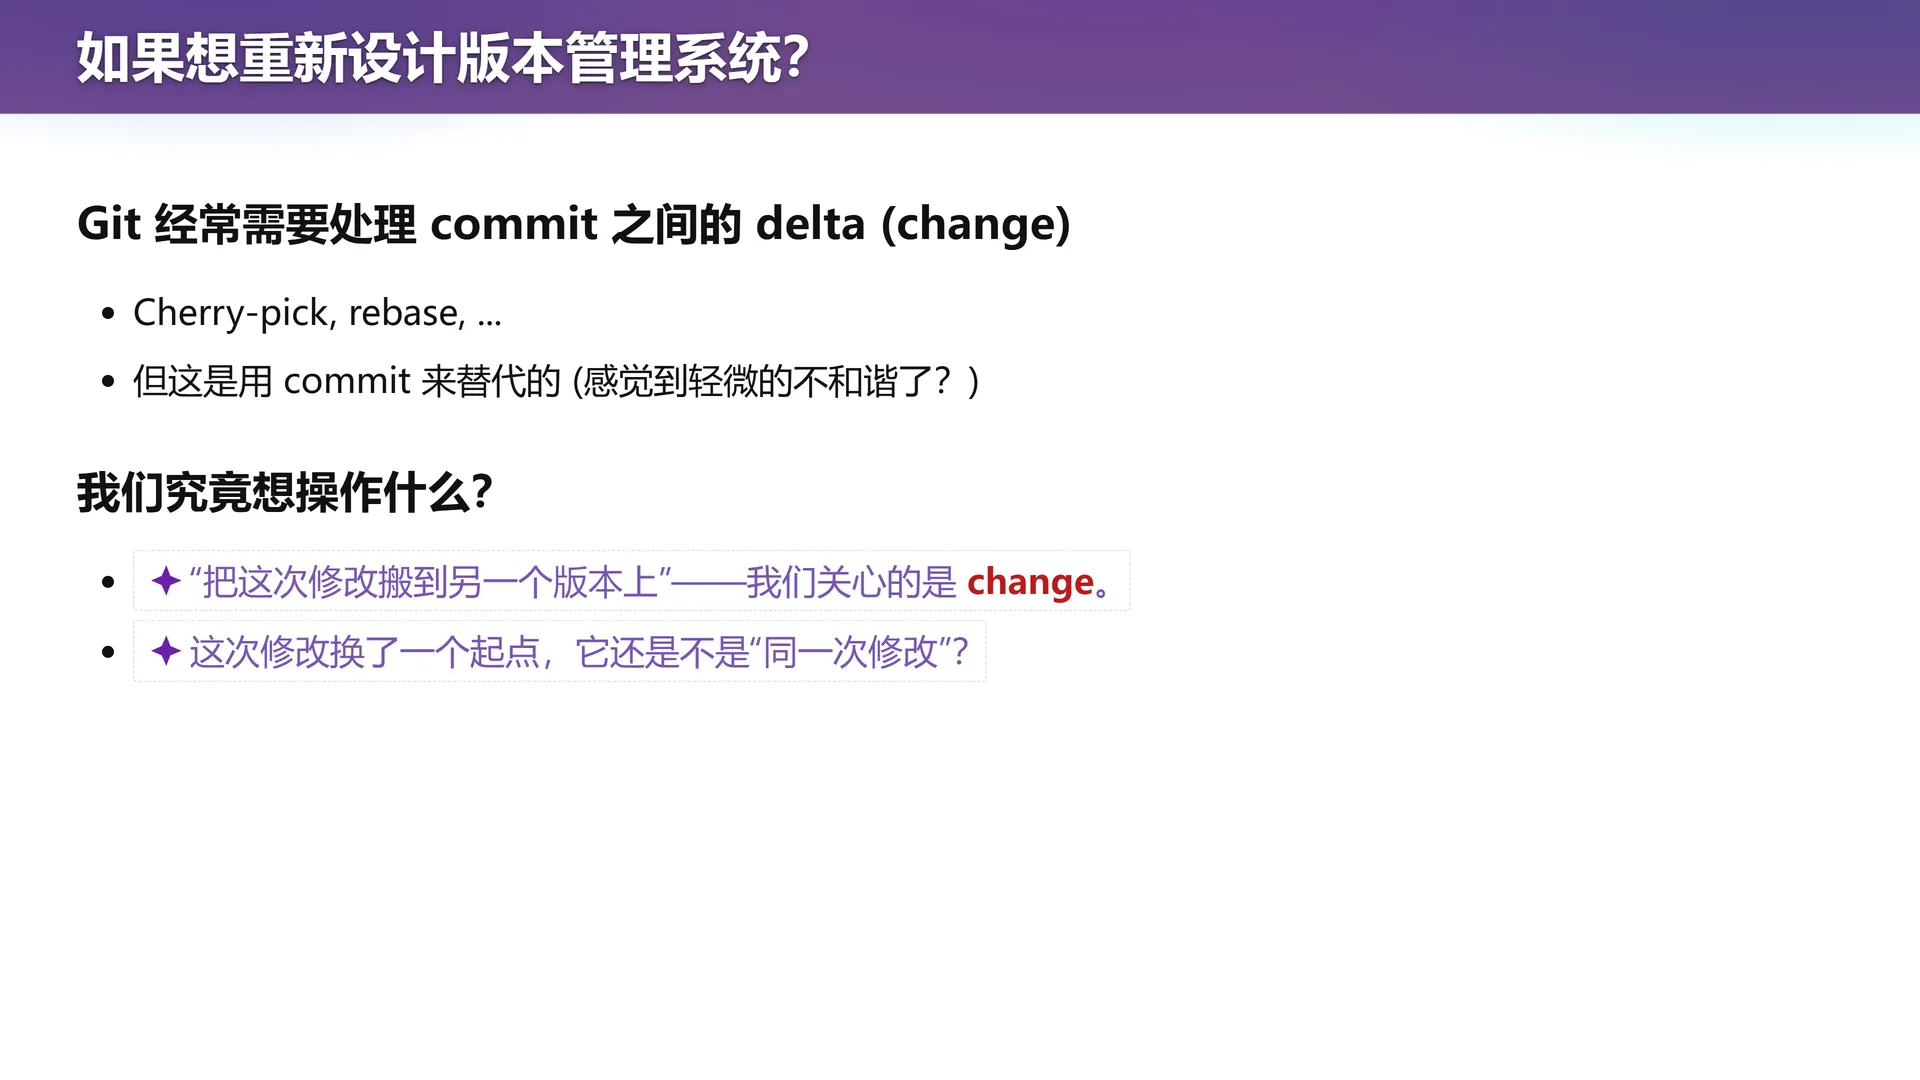
但我们传给工具的主要标识,却是 commit。
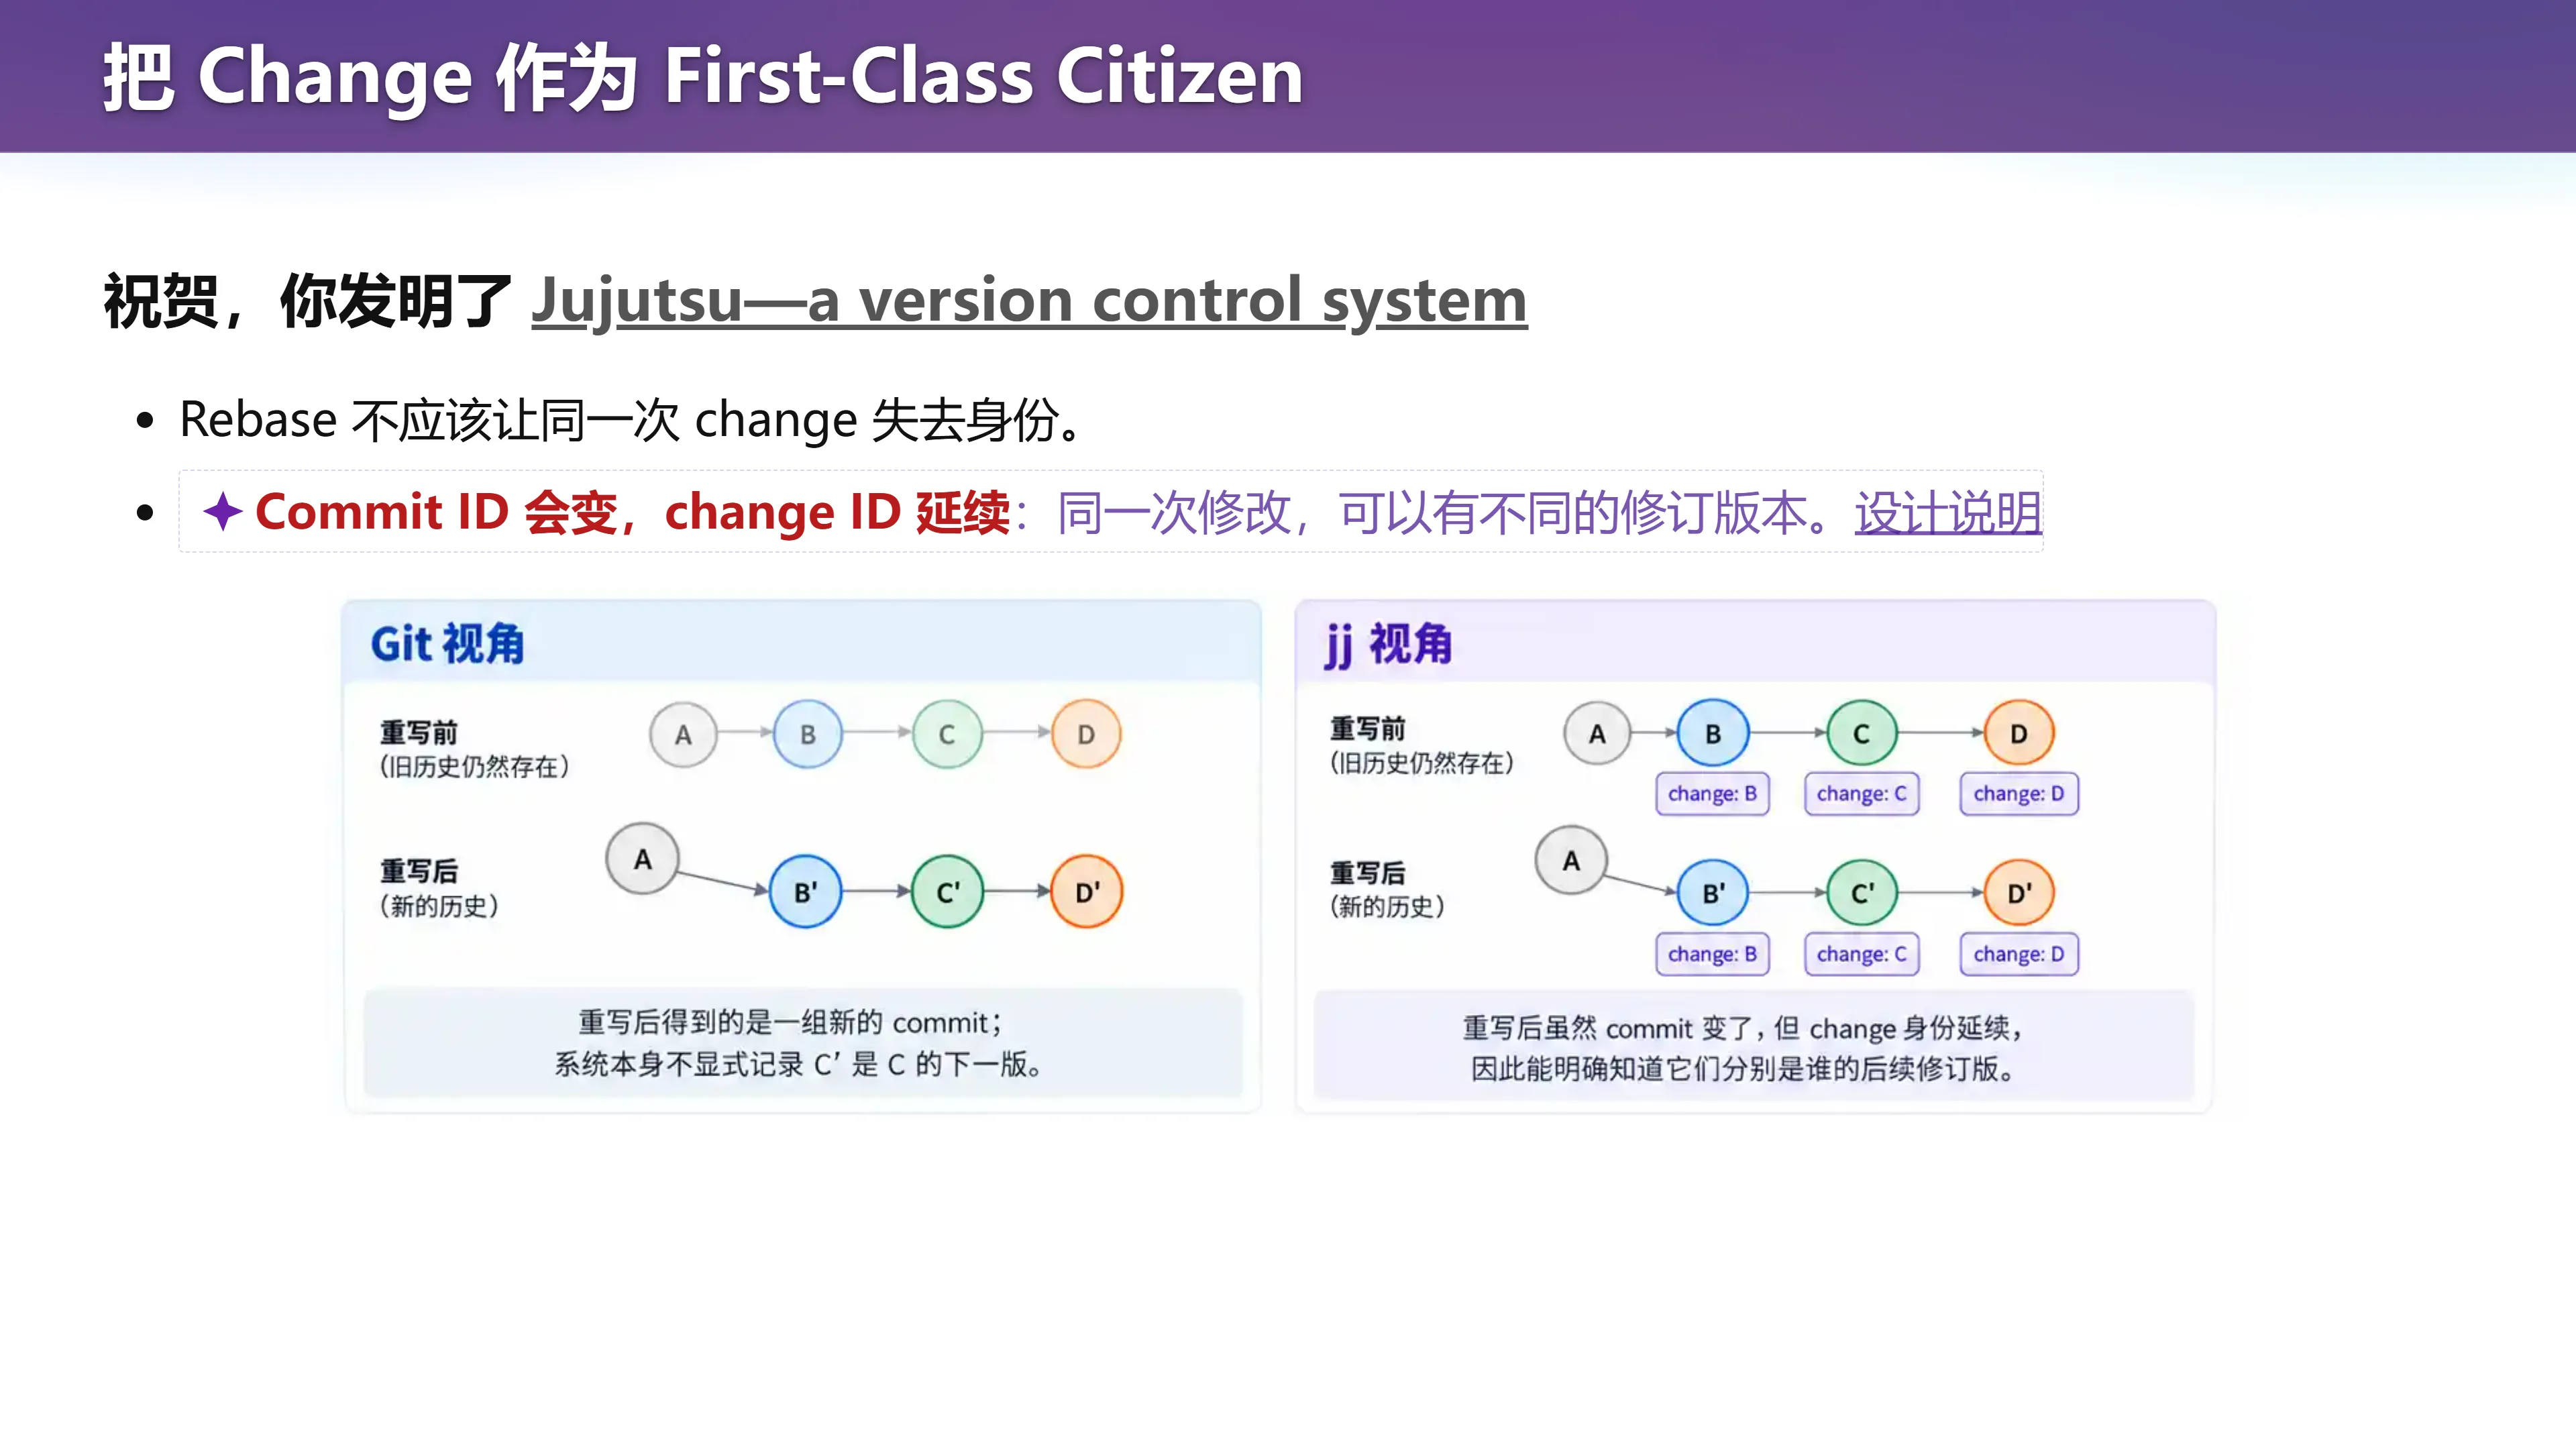
Commit 的身份与它的具体内容和元数据相联系。父提交一变,commit 的内容就变了;重写时会创建新的 commit 对象,得到不同的 ID。于是,原来的 C 经过重写变成 C′:人知道这仍然是在修改同一个功能,单靠 commit ID 却无法表达这种身份的延续。
这里有两个值得区分的问题:
- 某个版本的准确状态是什么(→ commit 回答);
- 某项改动随着反复修改经历了哪些版本(→ Git 没有专门的回答)。
用一张图来看 rebase 会怎样"改掉" commit ID:
graph LR
    subgraph "Rebase 前"
        P1((P)) --> C1((C<br/>id=abc))
    end
    subgraph "Rebase 后"
        P2((P')) --> C2((C'<br/>id=def))
    end
    C1 -. "内容相同,身份延续" .-> C2
每次 rebase 都会创建一个新的 commit:因为这个快照原来的 base 在这里,"rebase" 的字面意思就是它的 base 要改掉,改到新的地方去。于是你会创建一个新 ID,历史就变了。我们心里想要的,其实是"把这次修改搬过来",但 Git 是用 commit 来替代"修改"的——commit 和它 parent 之间的关系,就被当成了一个修改;Git 里没有专门的 change 对象。
把 Change 作为 First-Class Citizen:Jujutsu
如果把 change 也变成一等公民(first-class citizen),会发生什么?——你就发明了下一代更好用的版本控制系统:Jujutsu(常简称 jj)。
📷 把 Change 作为 First-Class Citizen
回到原视频 (00:28:00)
Jujutsu 有几个关键设计:
- 同时保留 commit ID 与 change ID:change ID 追踪一项持续演化的改动,重写时 commit ID 会改变,而 change ID 通常保持不变。在前面的例子里,C 和 C′ 可以拥有不同的 commit ID,却延续同一个 change ID;
- 底层仍然保存快照,并不是把系统简单改成了补丁文件的集合。参见官方的 术语说明;
- 在重写过程中把 change 一路带下来。Rebase 时把 change 搬过来,如果发生冲突——冲突是解决不了的——但因为有 change 这个对象,它可以把这些 change 一路带下来,生成一个"直接 rebase 到目标点、但里面引入了很多冲突"的提交。它仍然沿用 Git 的冲突记录机制,但有一套自己的记录方式,把 change 的冲突也塞进去。你可以在之后统一 resolve,底层模型没有变,但用起来会舒服很多。
编者说明:这里说的 change 是随时间演化的提交,而不是"补丁文件"。change ID 是一个稳定的逻辑标识,commit ID 是它在某个具体时刻的物理快照标识。二者分离,是 jj 设计上最核心的一步。
让未完成的工作也有位置
(参考时间: 00:30:00)
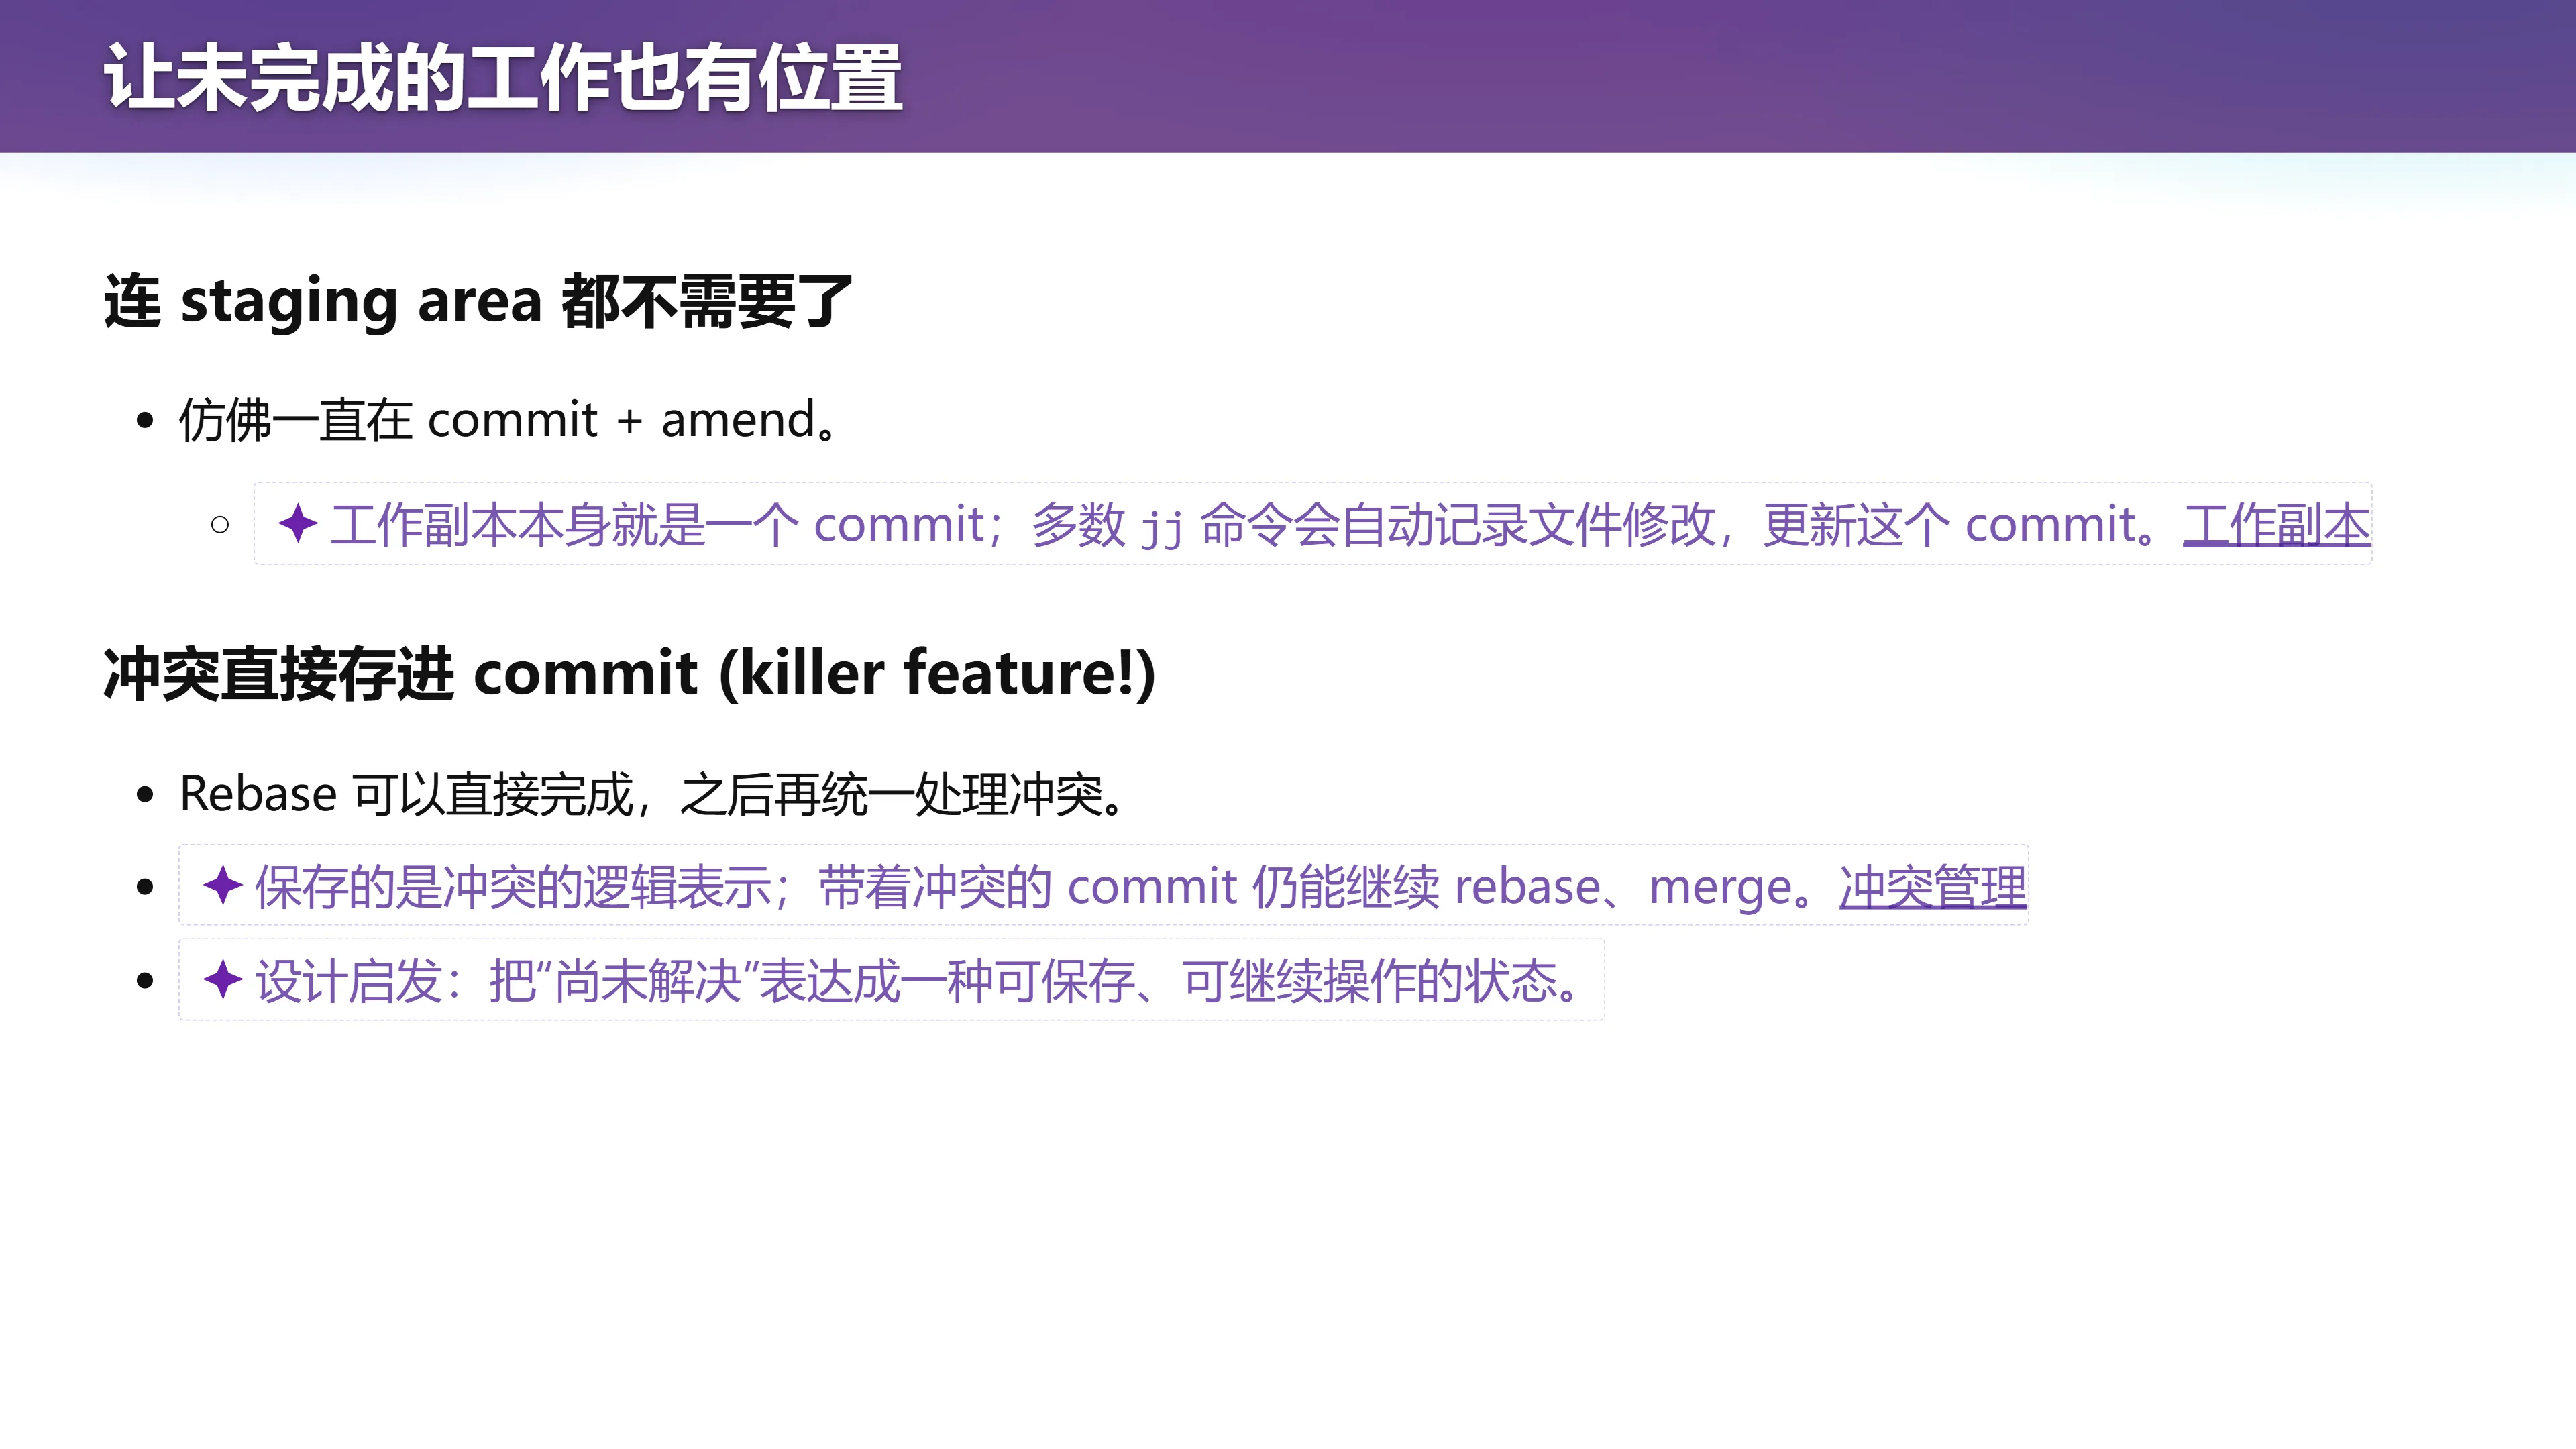
Jujutsu 另一个有吸引力的设计是:连 Staging Area 都不需要了。
📷 让未完成的工作也有位置
回到原视频 (00:30:00)
先看 Git 里一个经典痛点:
你有一个工作区,改
hello.c改到一半,项目既不能编译、也不能运行、测试也通不过。这时导师打电话来:"我这儿有一个很高优先级的项目,有个 bug,客户马上要交不了差,你一分钟把它修好。"你不应该 commit,于是把它加到 index 里,git stash。刚把原来那个 bug 修了一半,导师又打电话:"这个 bug 别修了,我这有一个优先级更高的 bug。"你只好再 stash 一次……git stash是一个栈,里面会有好多层提交,你不得不去管理那个栈;还要rebasestash。
而 Jujutsu 的设计是:你随时随地都在编辑这个仓库——把 hello.c 改一改、加一行减一行,这本身就是一个 change。它做的事情仿佛是:你但凡改了一个字节,它就立即做一个 Git commit;但这个 commit 不会产生一大堆线性历史,而是先把上一次的那个提交抹掉,用当前修改去替代它。也就是说:
你永远处于一个"当前快照已经提交"的状态——一个 change 已提交的状态。这样你就很舒服了,连 Staging Area 都不需要了。
参见官方文档:Working Copy。
冲突可以直接存进 commit
(参考时间: 00:32:00)
还有一个很受欢迎的设计:把冲突作为可以保存的状态。假设你正在把一串改动移到新的基础上,其中一处发生冲突——在 jj 里,冲突可以直接记录在重写后的提交里:rebase 先完成,之后再处理这些冲突。系统保存的是冲突的逻辑表示,仍然能够对它继续做重写和合并。这样,"调整历史结构"和"决定冲突处的最终内容"就可以分开安排。参见 First-class Conflicts。
这就是课堂上所说的 "killer feature":冲突的存在不必把整个操作卡在半途中。真正值得留意的是抽象发生了什么变化——当一项过去被当作"异常"或"临时过程"的东西,可以被明确表示、保存和继续操作时,许多流程就有机会统一起来。
这就是为什么 AI Native 能淘汰"老登"
(参考时间: 00:33:00)
讲师拿自己开玩笑:这就是 AI Native 能淘汰"老登"的原因——Git 的肌肉记忆已经形成,即便理解新设计,也未必有足够时间重新训练一套习惯。他已经形成了 Git 的肌肉记忆,比他更老的一代人已经形成了 SVN 的肌肉记忆;一旦形成肌肉记忆,要把习惯掰过来就很困难了。
📷 这就是为什么 AI Native 能淘汰老登
回到原视频 (00:33:00)
Einstellung Effect(定势效应):幻灯片引用了一项 2008 年的眼动实验——棋手嘴上说"在寻找更优解",目光却仍围绕旧套路。熟悉的解法会锁住注意力。
同学们的学习方向是反过来的:在还没有形成肌肉记忆的时候,就直接去用对的那个设计;先记住最正确的设计,再回头看历史,理解"我们是如何一路走来"——为什么 SVN 会走错(从纯 diff 那条线),为什么 Git 是先进的一步(它是持久化数据结构),为什么 Git 又留下了一些设计上的债(它最早没想过 rebase 会有这么大的 impact,"有 merge 就已经很好了")。这样回望时会发现:原来 Git 也犯了设计上的错。 工具的熟练程度会过时,对设计前提的理解却可以带到下一套工具里。
当开发者可以并行复制
(参考时间: 00:36:00)
人类是 Single-Threaded 生物
前面的设计仍很大程度上围绕人展开。课堂把人戏称为 single-threaded 生物:我们只有一双手、一张嘴、一对眼睛。
📷 Agent 时代,再次重新设计版本管理系统
回到原视频 (00:36:00)
讲师在操作系统课上讲过这个类比:把线程看作一个人,它对共享内存的两个基本操作是 load 和 store(读和写),二者不能同时进行,否则就需要原子指令。人可以想象成:想要观察世界,手要抱在背后,只能看;等你看完了,想对世界施加一个效果(比如用粉笔导弹射击同学),就必须把眼睛闭起来——而当你闭眼投掷的时候,你刚才读到的那个值其实已经失效了,因为那两个时刻之间可能你被换下 CPU、被中断打断,换了另一个线程执行了一秒钟。人也是一样:人和人之间有无法逾越的物理屏障,你不能理解我的思想,我也不能理解你的思想。
所以在古法编程时代:
- 人在编辑代码库时产生的 change 是以小时为单位的;
- 一个软件公司负责一个模块的开发,也就十几个人,这已经是个不小的团队了;
- 十几个人,每人以小时为单位开发,最多也就是以 10 分钟为单位产生一个提交;
- 而 10 分钟为一个提交,意味着这个速度比人和人之间沟通的速度还慢。研究生工位在一起,你要写一两个小时的东西,写之前肯定先跟师兄打个招呼,10 秒、30 秒,师兄说"行,你去改吧"。大厂里每天早上开个会,Leader 把任务分出来,你做什么我做什么,提前半小时就把 scope 划分了。
这也解释了 Stash 为什么是一个合理的设计:导师打电话是可能发生的,但"修到一半导师再打电话"这件事发生概率很低,所以 stash 栈通常只有一层;一旦有很多层,管理起来就很麻烦,还要 rebase stash。人也可以拒绝一个工作——"我手上有一个更高优先级的工作",等干完了再自己排队。所以 Git 是给人用的。
Agent 改变了这个节奏
(参考时间: 00:39:00)
但如果是一个 Agent Team 呢?
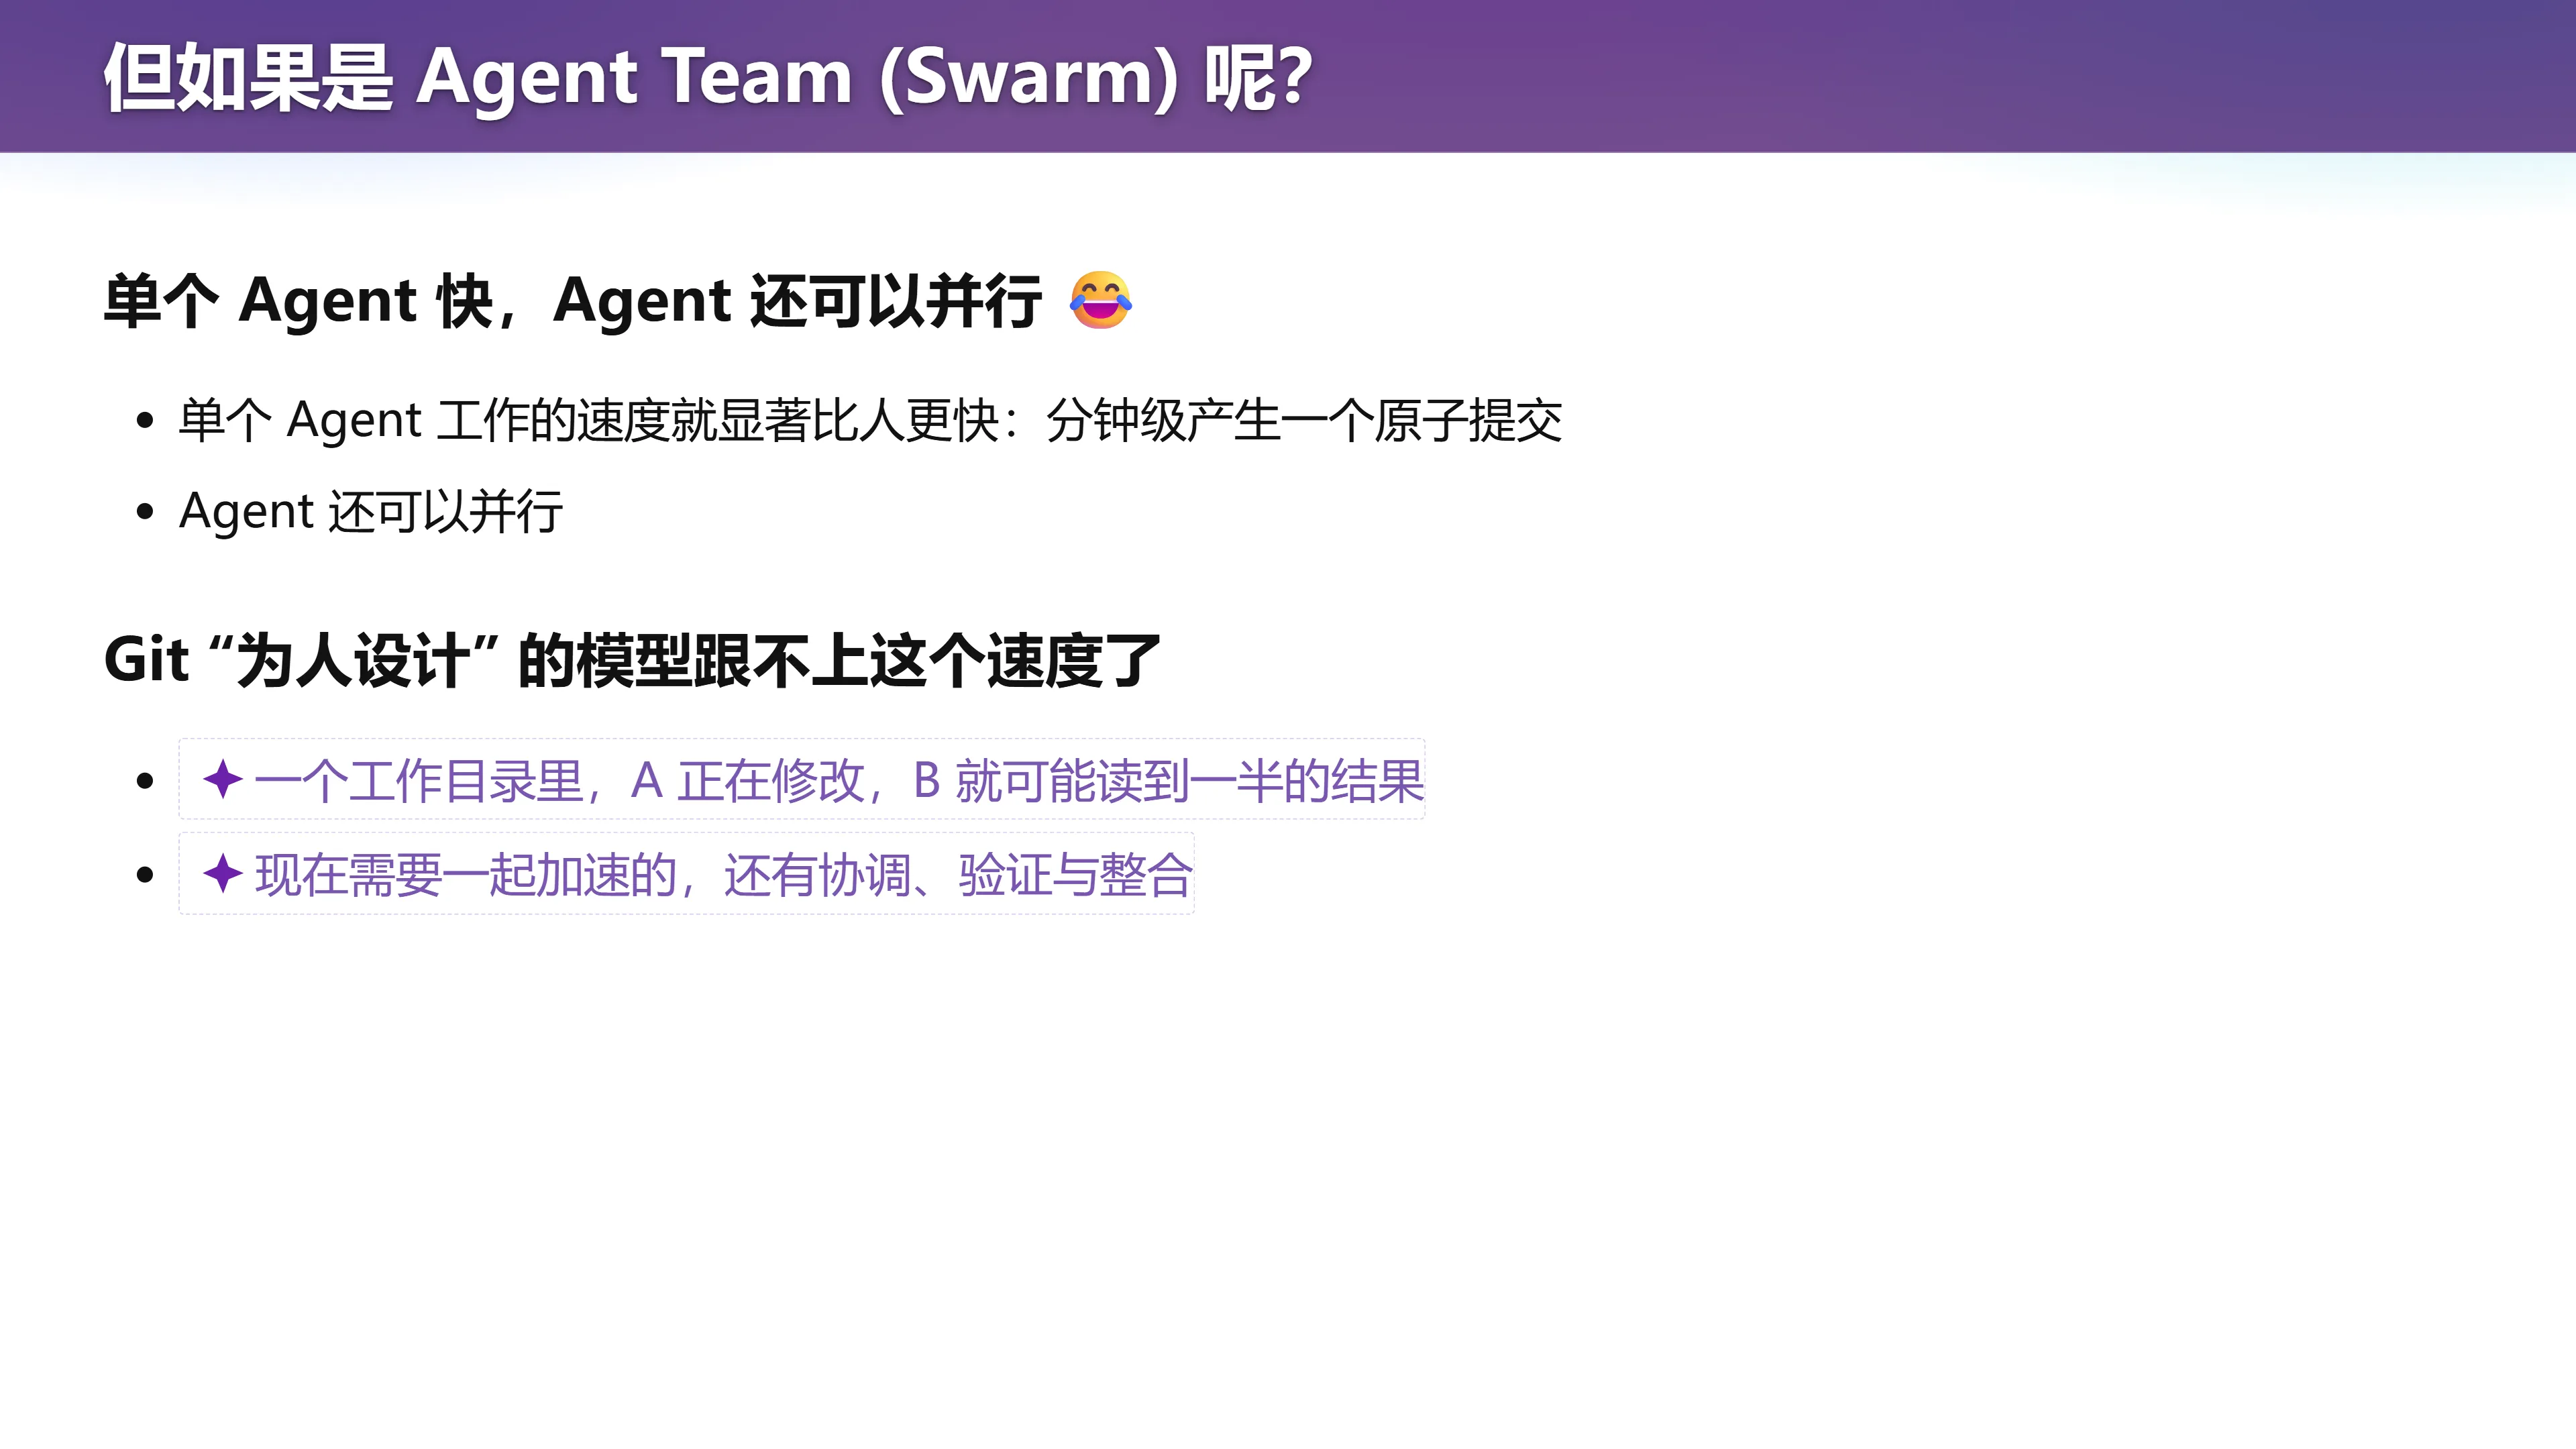
📷 但如果是 Agent Team (Swarm) 呢?
回到原视频 (00:40:00)
- 单个 Agent 生成一次 artifact 的速度就远远快于人:生成一个原子提交是分钟级,上下文热时甚至秒级;
- 而且 Agent 还可以并行:一个负责界面,一个负责数据处理,另一个补充验证。你可以轻易得到一个 10 倍、100 倍的 Agent Team。
此时,Git(或兼容 Git 的 jj)这种为人设计的模型,就有点跟不上了:如果它们都操作同一份目录,某个 Agent 刚读过的文件可能被另一个改掉,测试正在运行时实现又发生了变化。给每个 Agent 起一个名字,并不会自动获得独立的开发环境。
就算是最严格的大型项目,有测试流水线做门控(改完必须跑几分钟的测试),能放缓 Agent 提交的速度——但毫无疑问,Agent 加速了整个软件开发过程。
把每个 Agent 当成独立开发者:git worktree
(参考时间: 00:41:00)
首先一个自然的办法:把每个 Agent 当成独立开发者——给每个 Agent 一台自己的"开发计算机"(可能是一个容器),把 remote 配置上去,直接 instruct 它"你现在就是一个单人开发者,从 tmux 里收命令,收到就开干"。
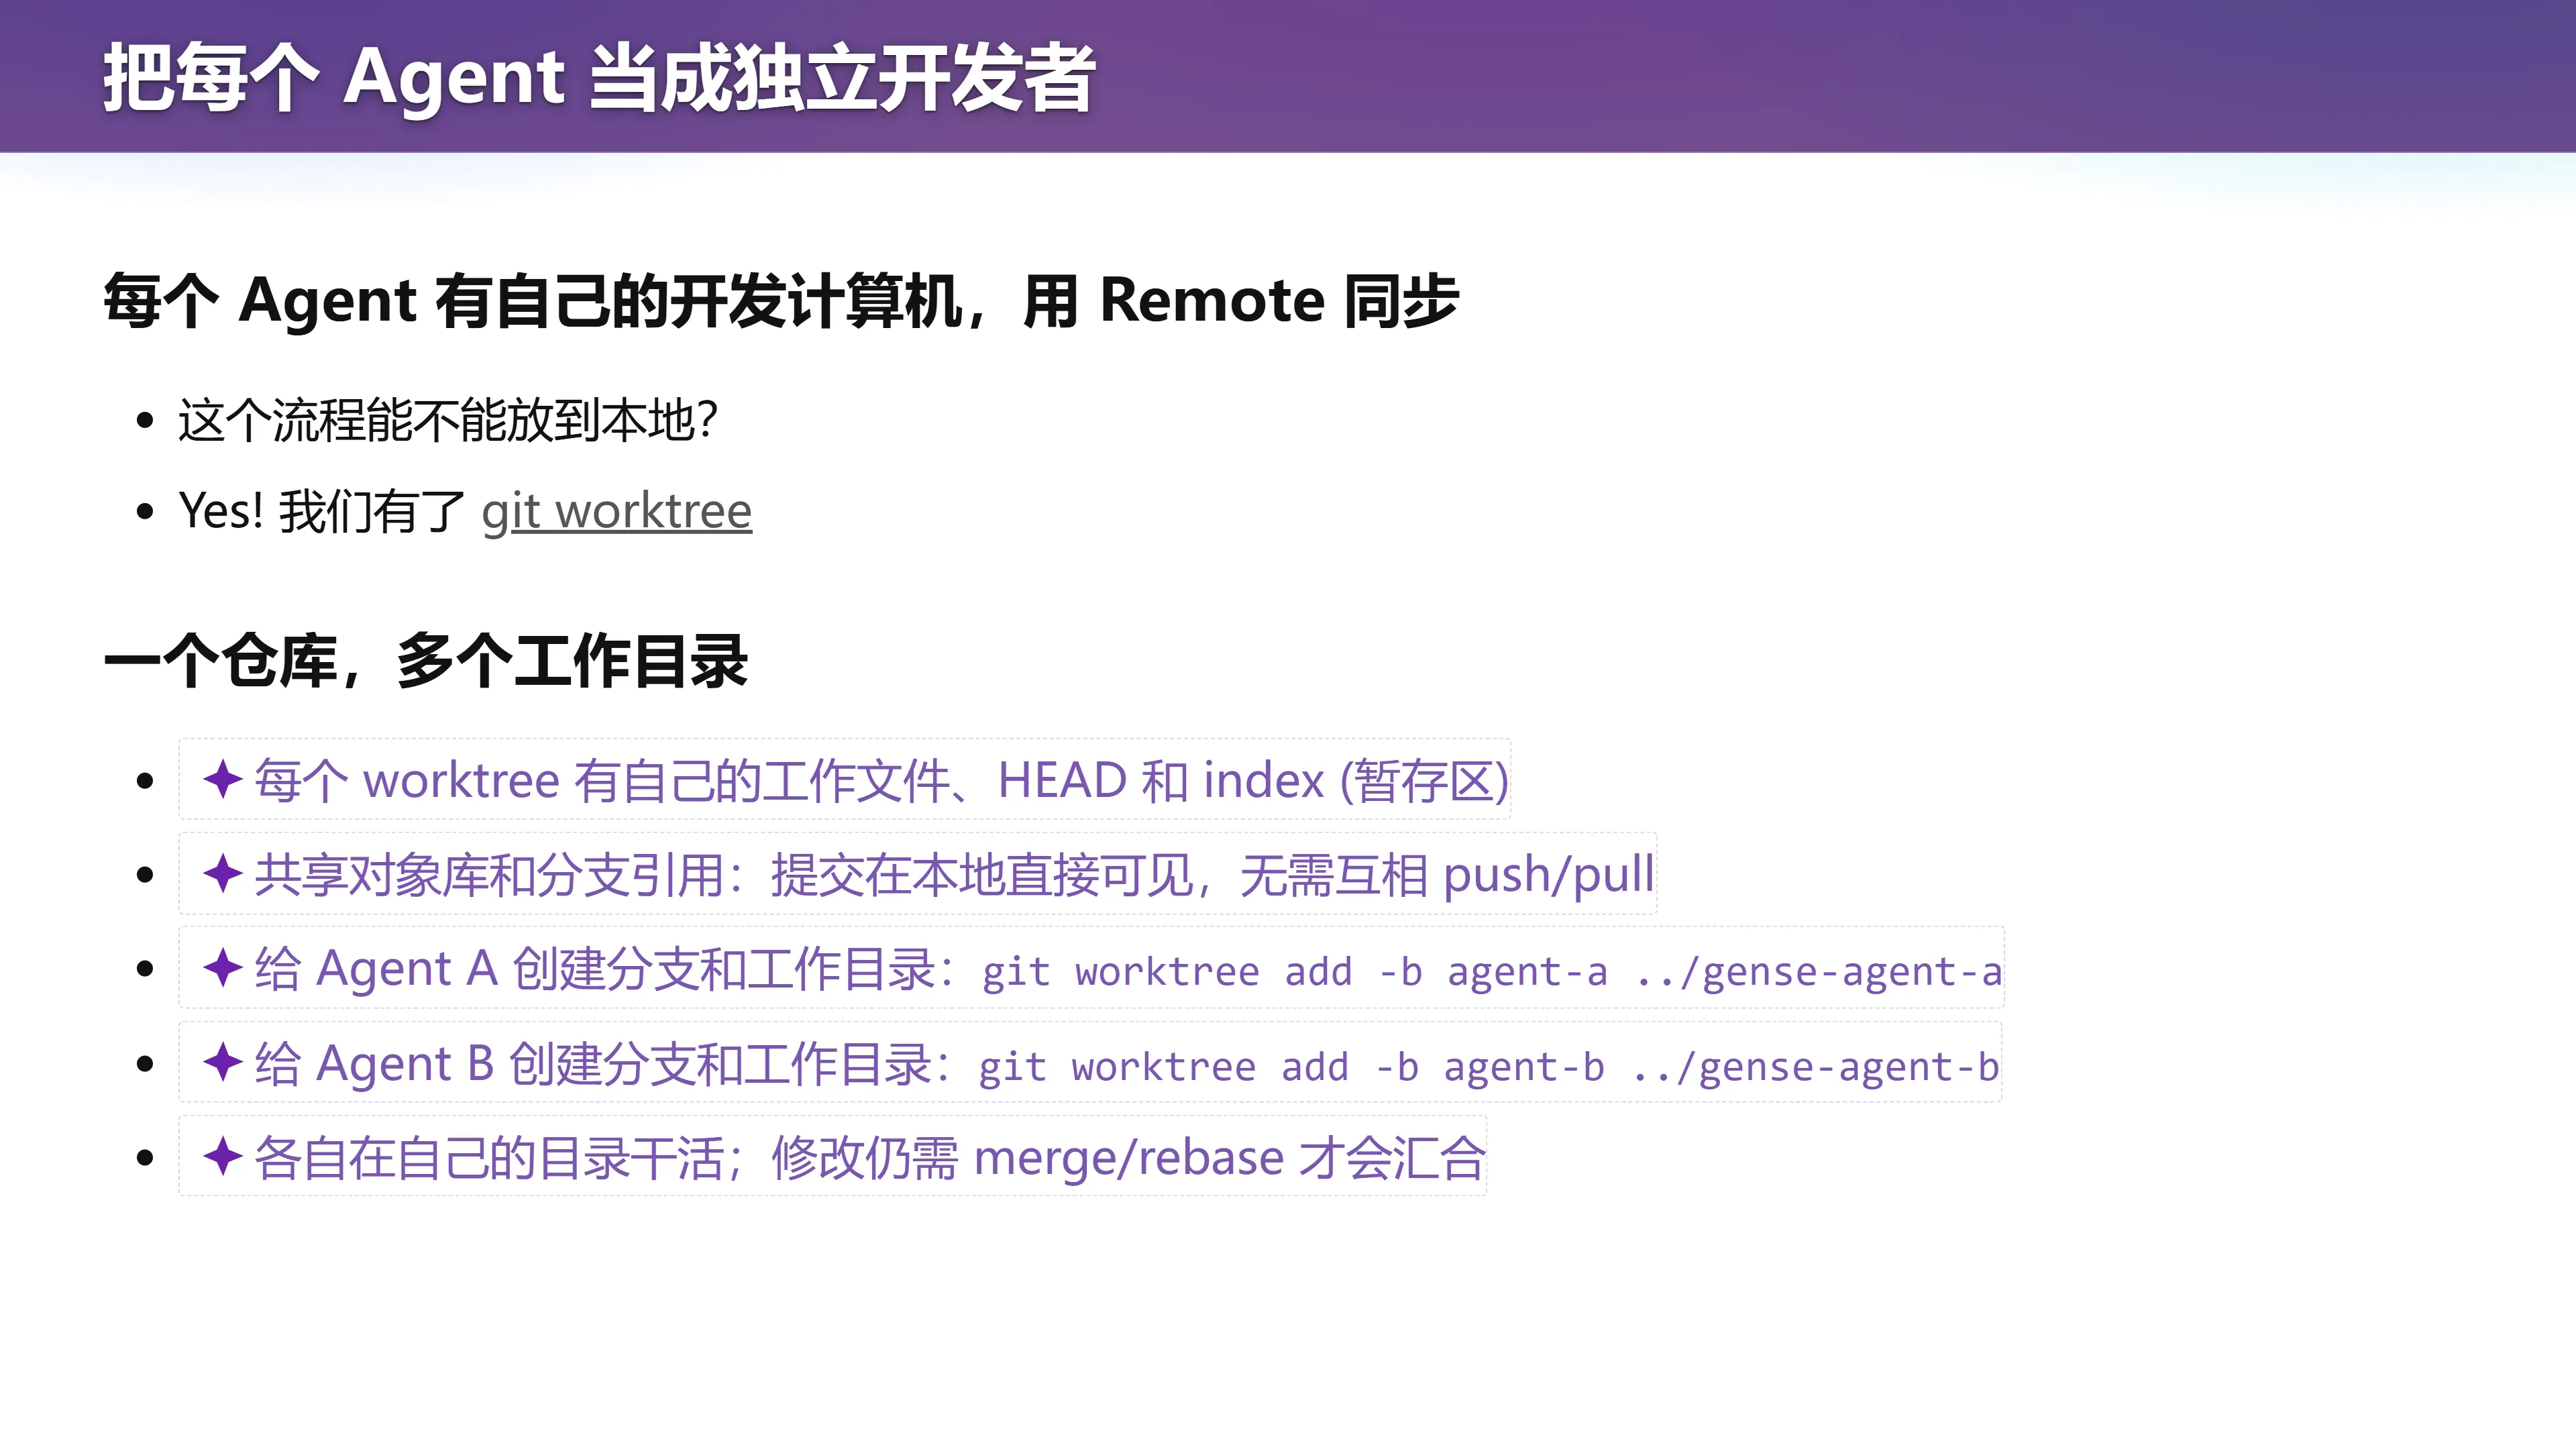
📷 把每个 Agent 当成独立开发者
回到原视频 (00:43:00)
课堂现场演示(00:43 起):讲师开两个 tmux session,故意用一个"可能在中国现在还能用的词"叫它们——Master / Slave(玩笑),然后给每个 session 都起了派(?),让 coding agent 开工。一个流行的范式是:一个监工 Agent + 多个子 Agent。为了让模型的智力最大化、防止生成不想要的东西,有人会放两个比较强的模型:让 Codex 来设计,让 Claude 来 review,互相"打架"达成一致——你只需要开两个 tmux session,主位负责协调、观看输出或总结报告,再往里 inject prompt。一个多 Agent 系统就这么转起来了。
这时立刻发现:如果大家工作在同一个 Git 仓库上,就会有一些麻烦;但如果工作在不同的 repo 上就完全没问题——它们可以从远端拉取别人的提交,冲突了自己修,必要时还能给 master Agent 发消息。
▶ 多 Agent 并行协作示意
在 B 站中打开(00:45:00)
Git 提供了一个可以在本地使用的对应物:worktree。同一个仓库关联多个工作目录,各自拥有工作区、HEAD 和暂存区,同时共享仓库中的对象和大部分引用。例如:
git worktree add -b agent-ui     ../project-ui
git worktree add -b agent-memory ../project-memory
这样两个 Agent 可以分别在界面分支和记忆分支上开发,各自运行测试,再把成果整合起来。新提交已经存在于共享的本地仓库中,无需互相 push / pull;修改仍然需要通过 merge 或 rebase 汇合。
课堂现场演示(00:47 起):讲师现场让 Agent 写 script 来演示 worktree 的内部结构。关键观察是:
worktree目录下的.git不是一个目录,而是一个普通的文本文件,里面写着gitdir: ...,指向真正的 Git 目录(在文件系统里是一个文件)。也就是说,Git 最大程度上复用了操作系统的机制:每个 worktree 是一个微型的 Git 目录,有自己的HEAD、index、locks,但仍然依附于原有的 Git 目录。
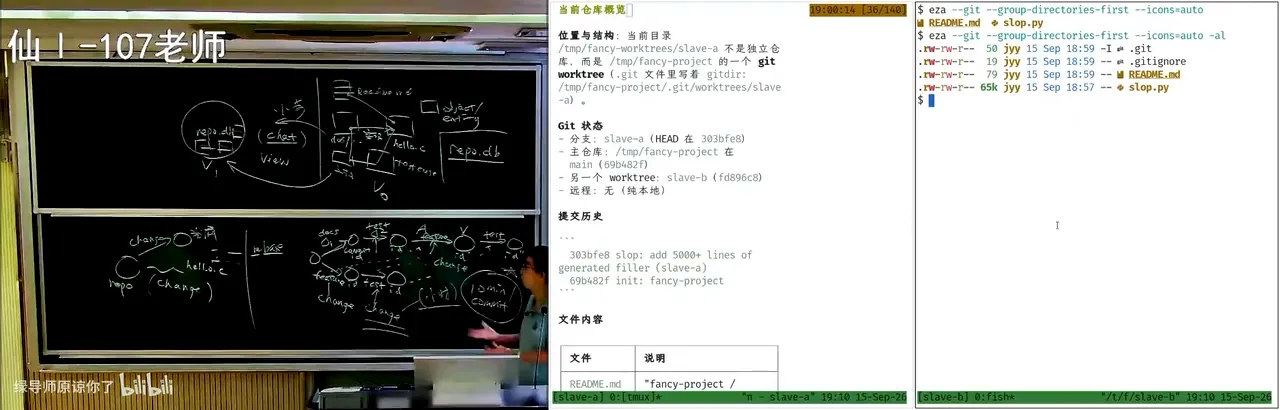
📷 worktree 里的 .git 是一个文本文件
回到原视频 (00:48:30)
编者说明:worktree 本身是 Git 很早就有的特性,过去使用率不高。在 Agent 时代,它突然变得有用:可以在同一个本地仓库里并行开多个工作副本,提交本地直接互相可见,不需要 push/pull;但有冲突的修改仍需 merge 或 rebase 才能合并。Worktree 减少了相互覆盖工作文件的问题,但任务之间的依赖仍然要管理:界面等待什么数据格式,记忆模块什么时候能提供这个接口,双方是否采用相同的错误处理约定——都需要说明。
所以,Agent 团队可以沿用现有版本管理工具,但使用规模和操作频率的变化,会让原来可以靠人顺手协调的细节变成显著成本。这又给了我们一次重新设计的机会。
先分开做再合并,还是先上锁
(参考时间: 00:51:00)
回到最初的问题:为什么需要版本控制?
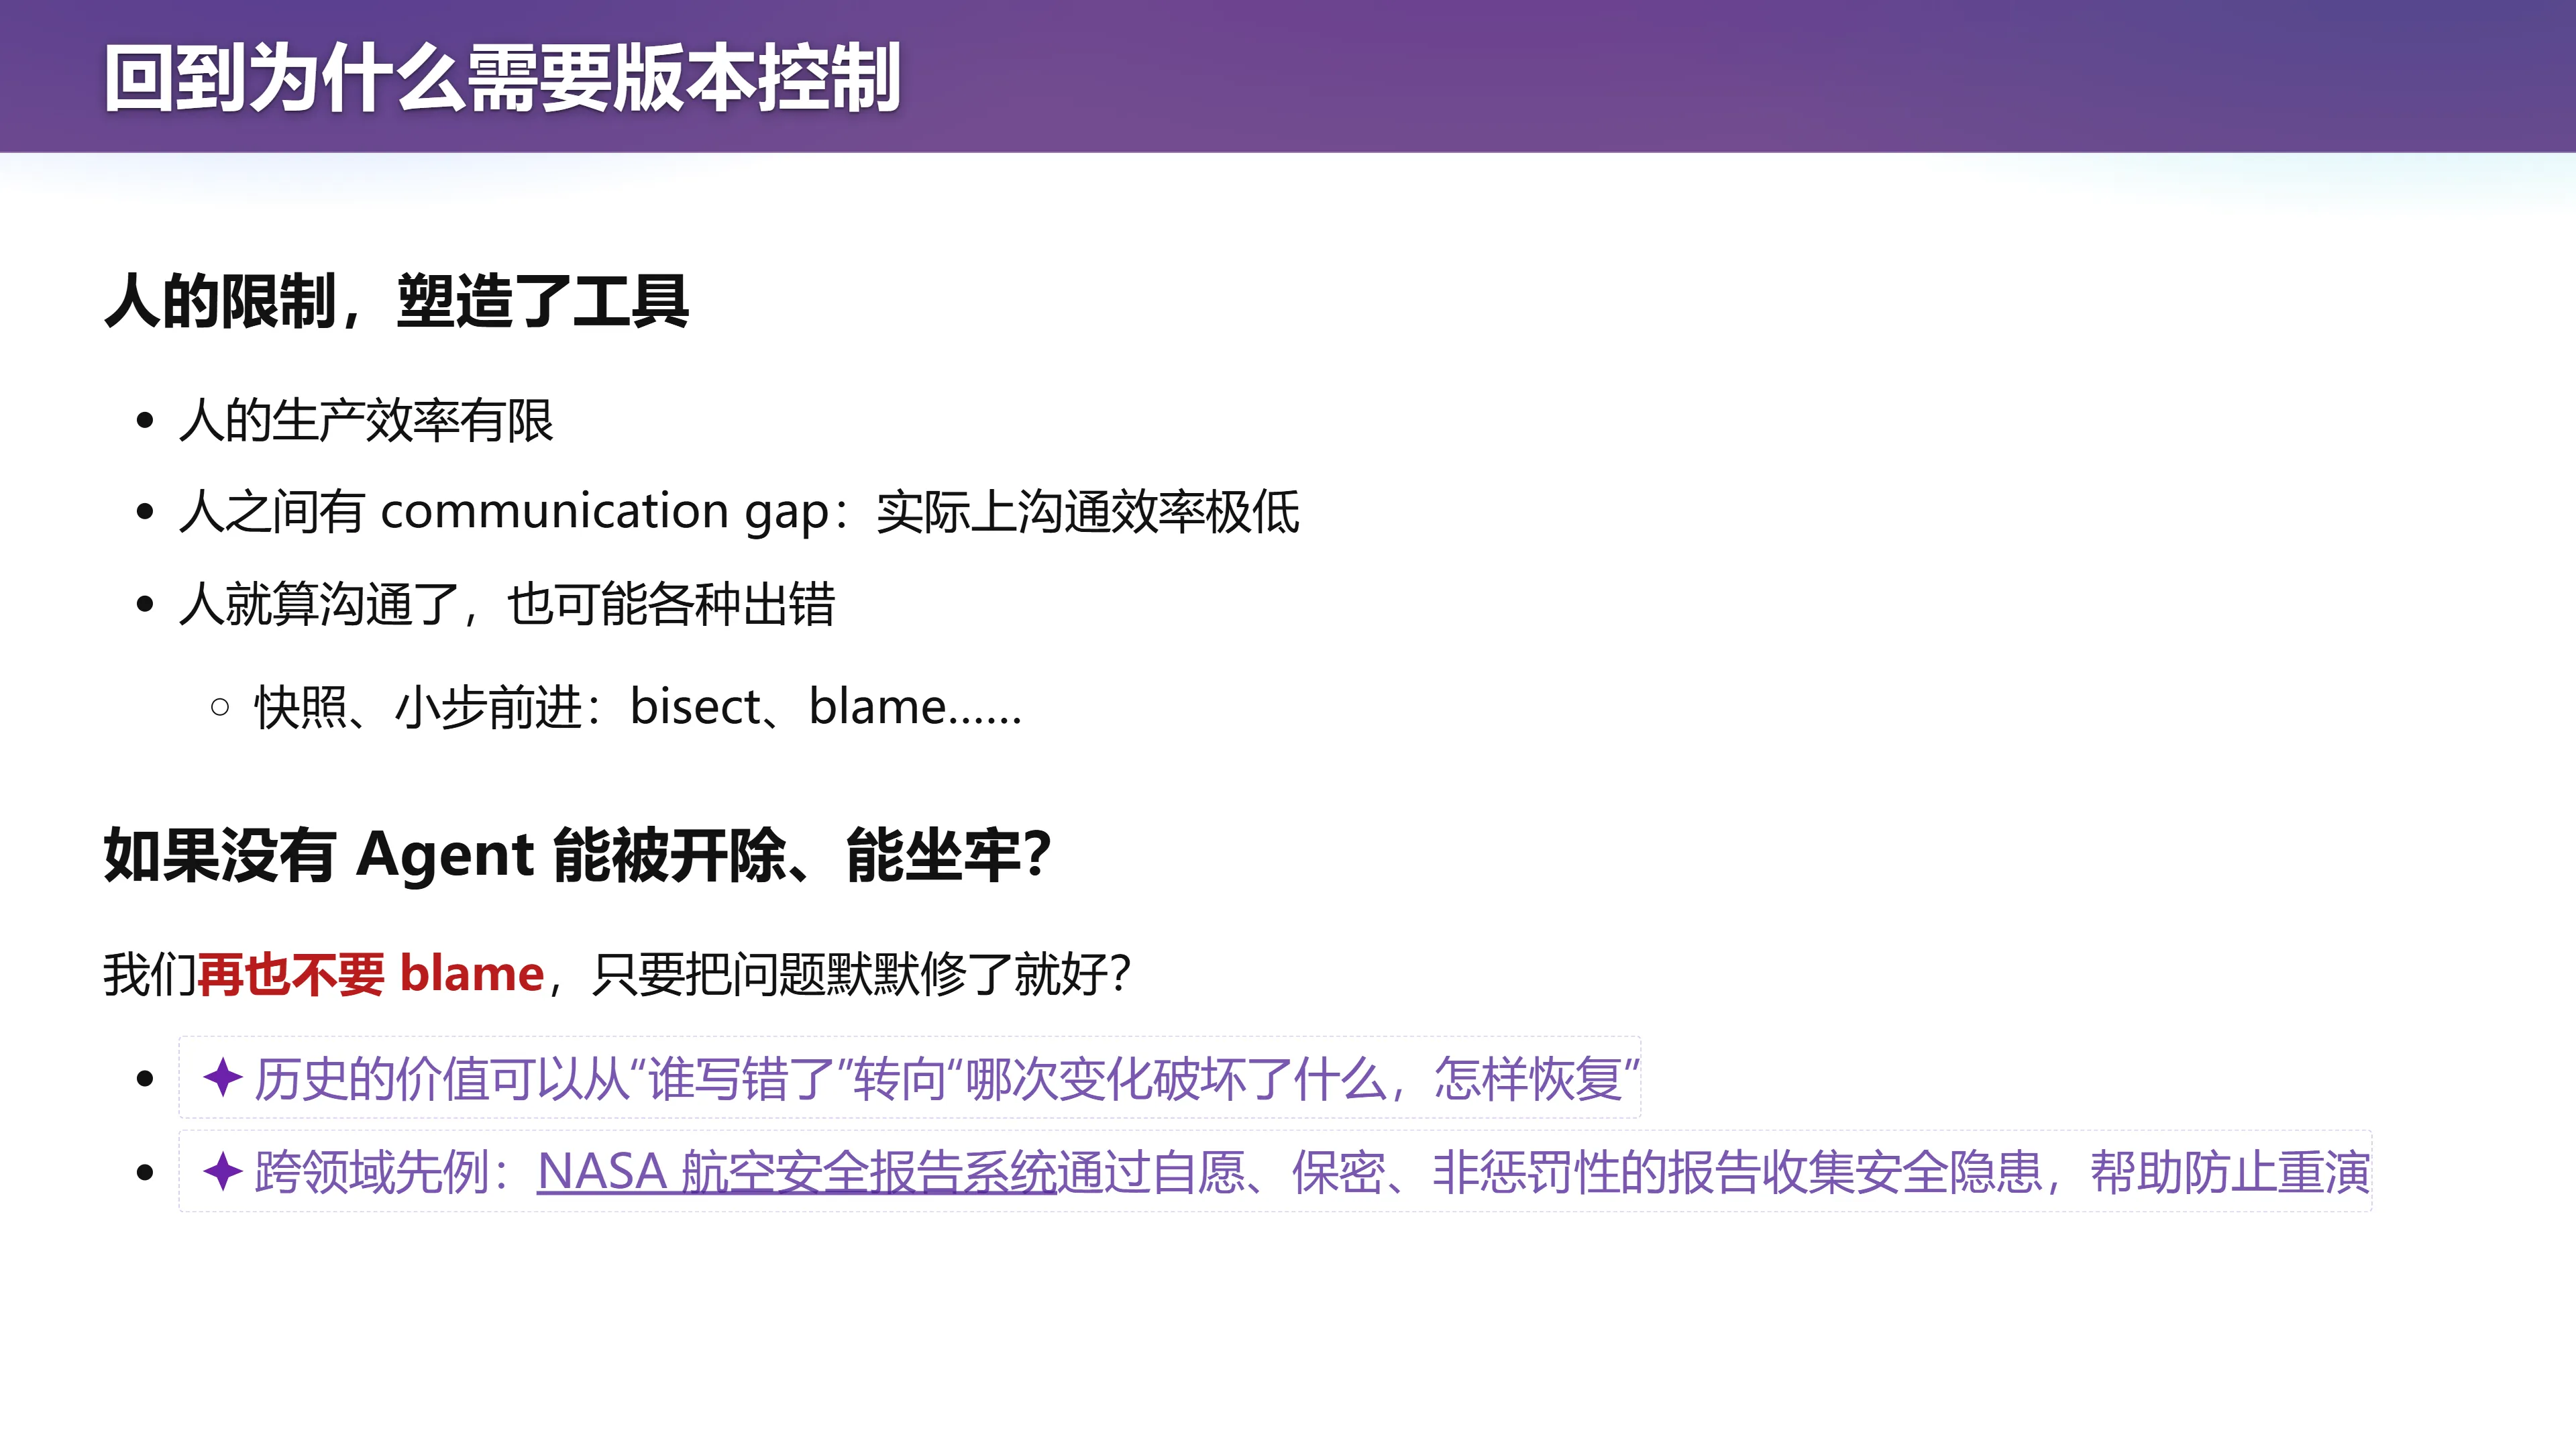
📷 回到为什么需要版本控制
回到原视频 (00:51:00)
人的生产速度有限,人和人之间沟通困难,沟通过后还会误解和出错。我们希望:
- 保存可靠的状态;
- 分小步前进;
- 让不同方向可以独立探索;
- 让失败之后能够回查。
例如:
- git bisect 可以利用一组可重现的"好/坏"判断,逐步缩小引入问题的提交范围;
- git blame 可以把当前代码行关联到相应的历史修改,帮助找到当时的上下文。
这些机制减少了对人的记忆的依赖。它们当然可以被用于找责任人,但在工程里,更有用的问题往往是:这个决定当时为什么合理,现在什么前提变了?
📷 “我的部分已经好了”——团队里常见的情形
回到原视频 (01:07:00)
一个挑衅的设想:再也不 blame
课堂提出一个有点挑衅的设想:反正没有哪个 Agent 能被开除、能坐牢,我们能不能再也不要 blame,只让它把事情推进、把问题修好?
这里想重新考虑的是协作流程的目标:如果执行者主要是可复制的 Agent,能不能减少围绕个人交接和事后协调的步骤,直接围绕项目状态组织工作?
课堂引用:幻灯片给出了一个跨领域先例——NASA 航空安全报告系统通过自愿、保密、非惩罚性的报告来收集安全隐患,帮助防止重演。历史的价值可以从"谁写错了"转向"哪次变化破坏了什么,怎样恢复"。
上锁方案:悲观并发控制
一种设计是:
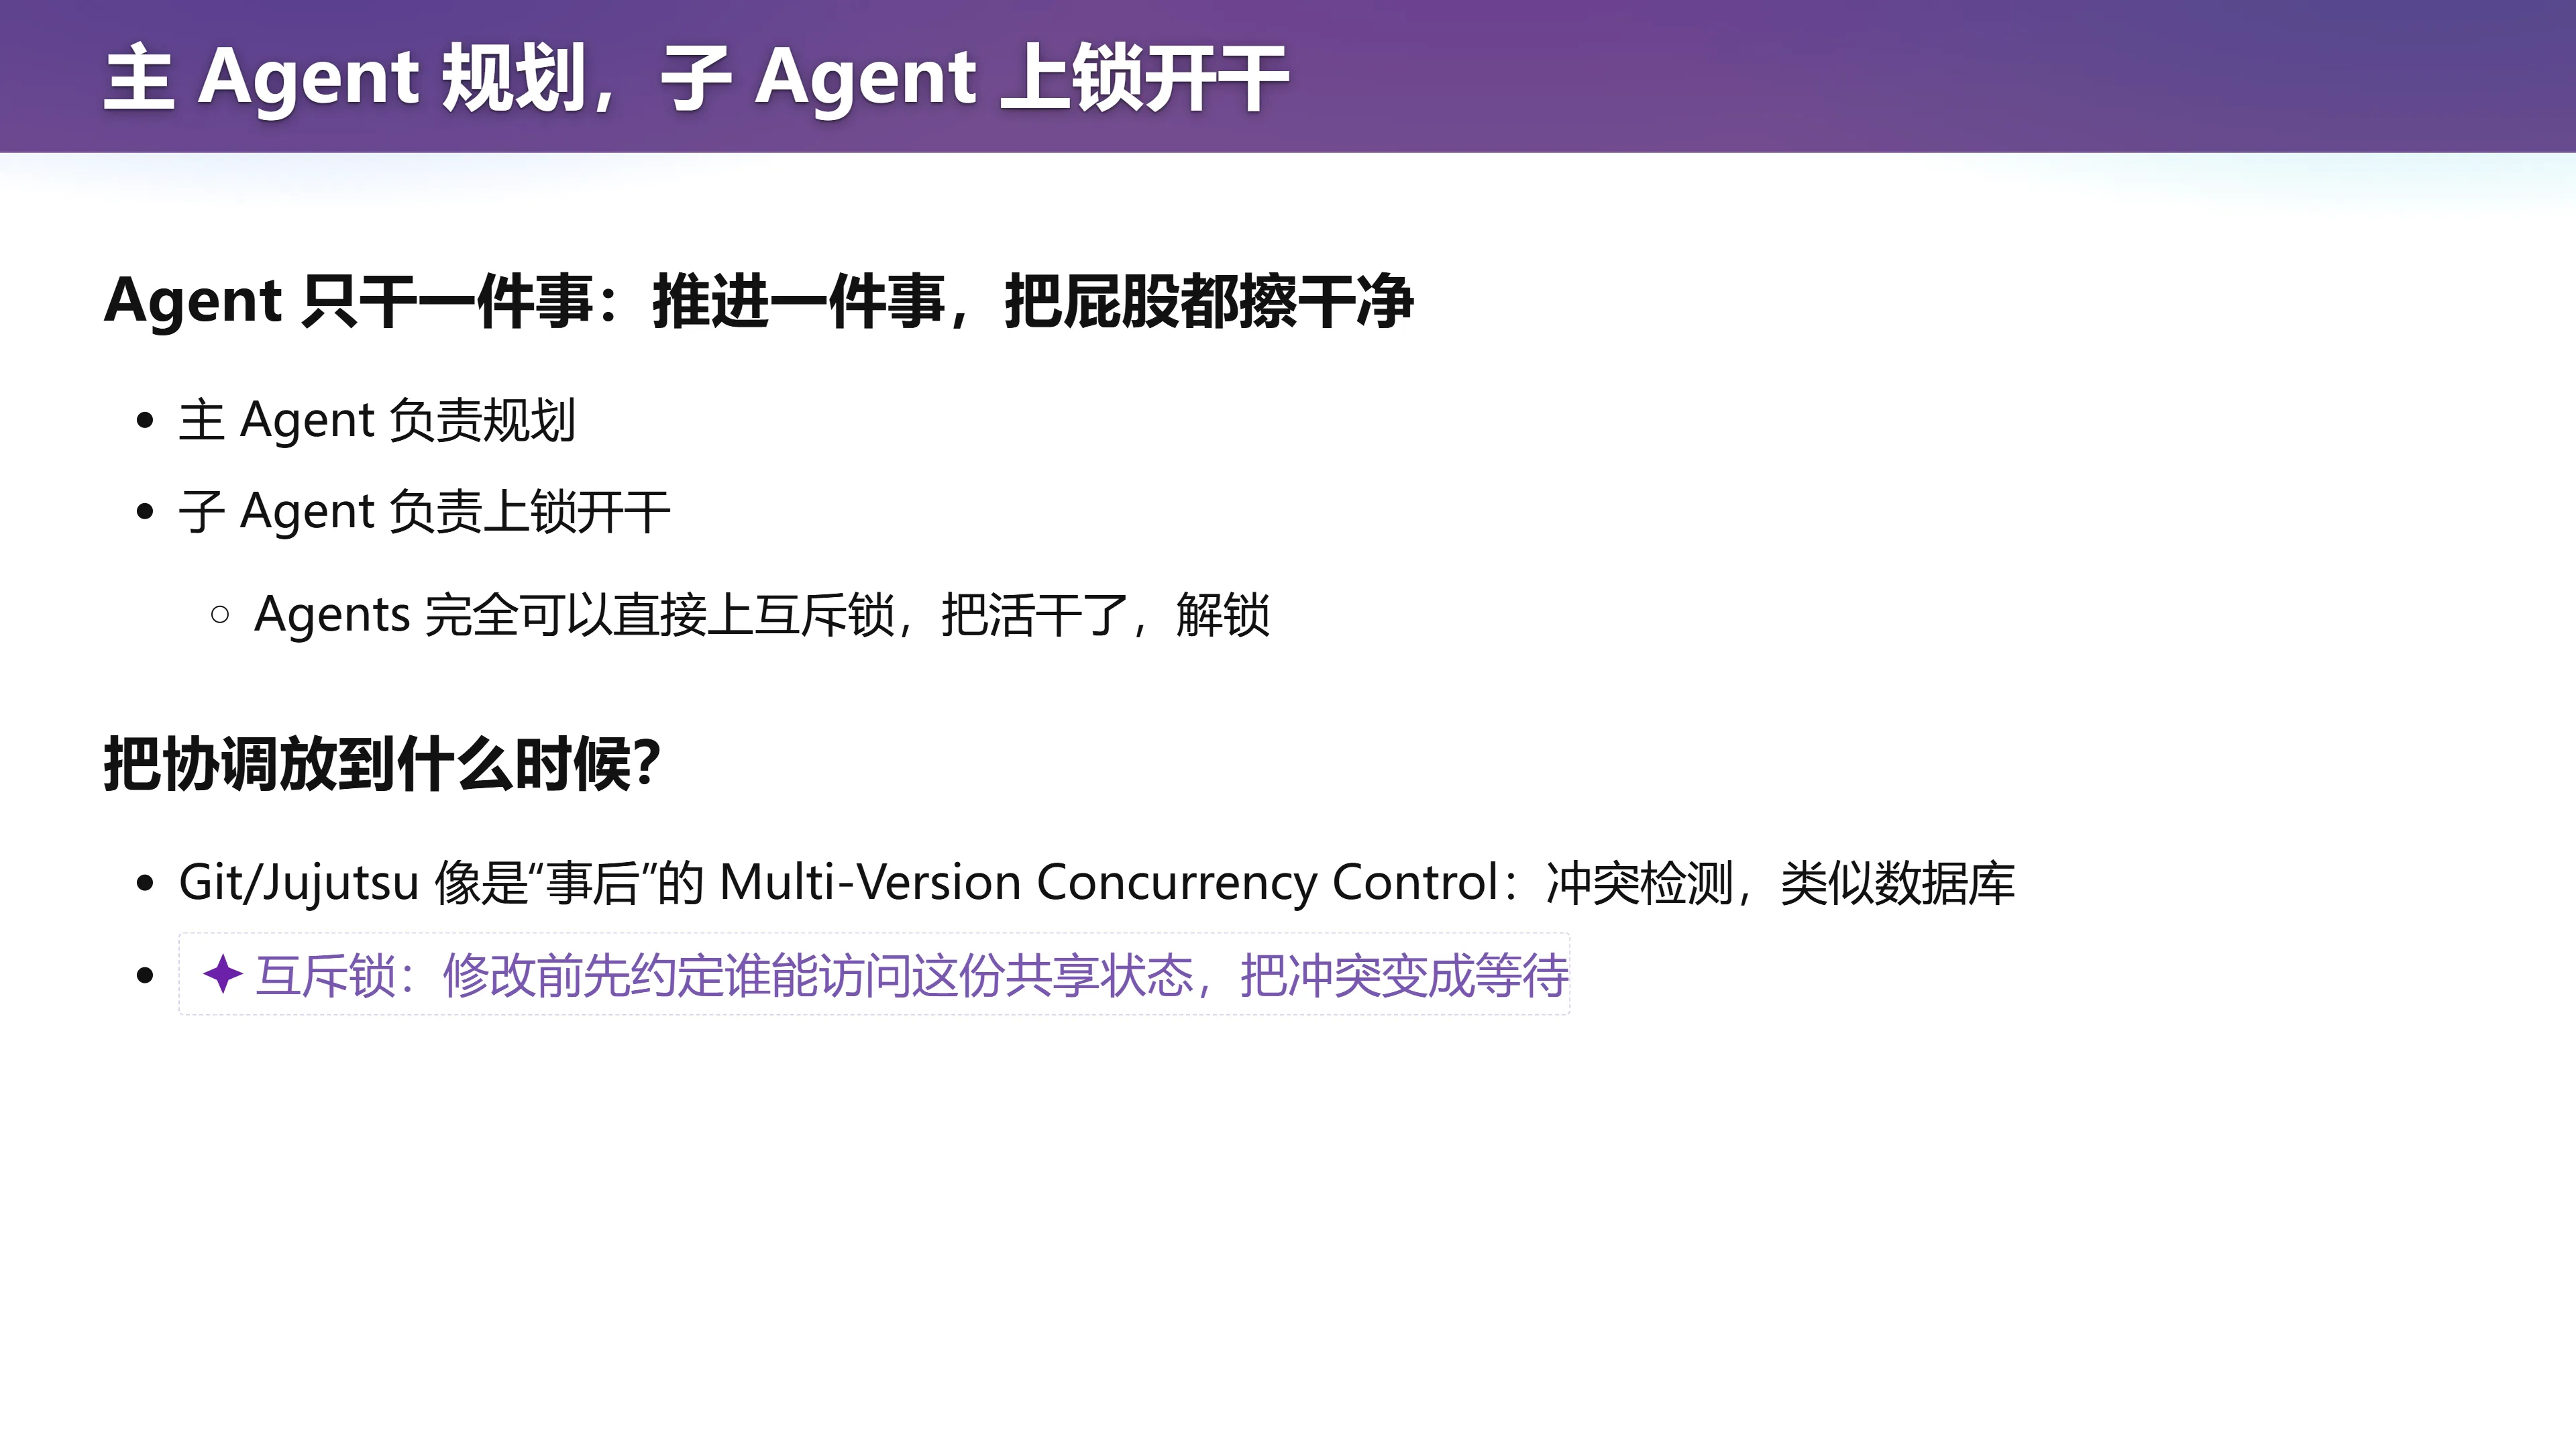
- 主 Agent 负责规划,把任务拆成边界明确的部分;
- 子 Agent 要修改某项共享资源时先取得互斥锁,读取最新状态,完成修改和必要检查,留下可恢复的快照,再释放锁;
- 这里的锁是一套约定:同一时刻,只允许一个参与者修改约定范围内的状态。
📷 主 Agent 规划,子 Agent 上锁开干
回到原视频 (00:59:00)
例如,两个任务都要改个人助手的记忆格式:
- 先取得锁的 Agent 完成一次一致的修改;
- 后一个取得锁后重新读取最新状态,再继续工作;
- 只要所有参与者遵循同一套规则,就能避免双方同时基于旧状态写入同一项资源;
- 主 Agent 可以把不依赖这项资源的工作继续分配出去。
两种并发控制:乐观 vs. 悲观
这和版本管理中"各自修改,汇合时再检查冲突"的思路形成对照。课堂借数据库里的 MVCC(多版本并发控制) 帮助理解后者:保留多个版本,让工作先推进,再处理版本之间的关系。
graph TD
    subgraph "乐观并发控制(Git / MVCC)"
        O1["事务1<br/>读 → 算 → 写"] --> O2{"提交时检测冲突"}
        O3["事务2<br/>读 → 算 → 写"] --> O2
        O2 -->|"无冲突"| O4["成功"]
        O2 -->|"有冲突"| O5["abort / 手工 resolve"]
    end
    subgraph "悲观并发控制(互斥锁)"
        P1["事务1: 获取锁"] --> P2["读 → 算 → 写 → 释放"]
        P2 --> P3["事务2: 获取锁"]
        P3 --> P4["读 → 算 → 写 → 释放"]
    end
编者说明:这是关于并发策略的类比,Git 的合并并不因此具有数据库事务的全部性质(例如没有严格的隔离级别、没有 rollback)。讲师明确指出了这一点,避免读者把两类系统混同。
上锁的代价:回到《操作系统》和《数据库》
📷 学《操作系统》、《数据库》有用了吧
回到原视频 (01:03:00)
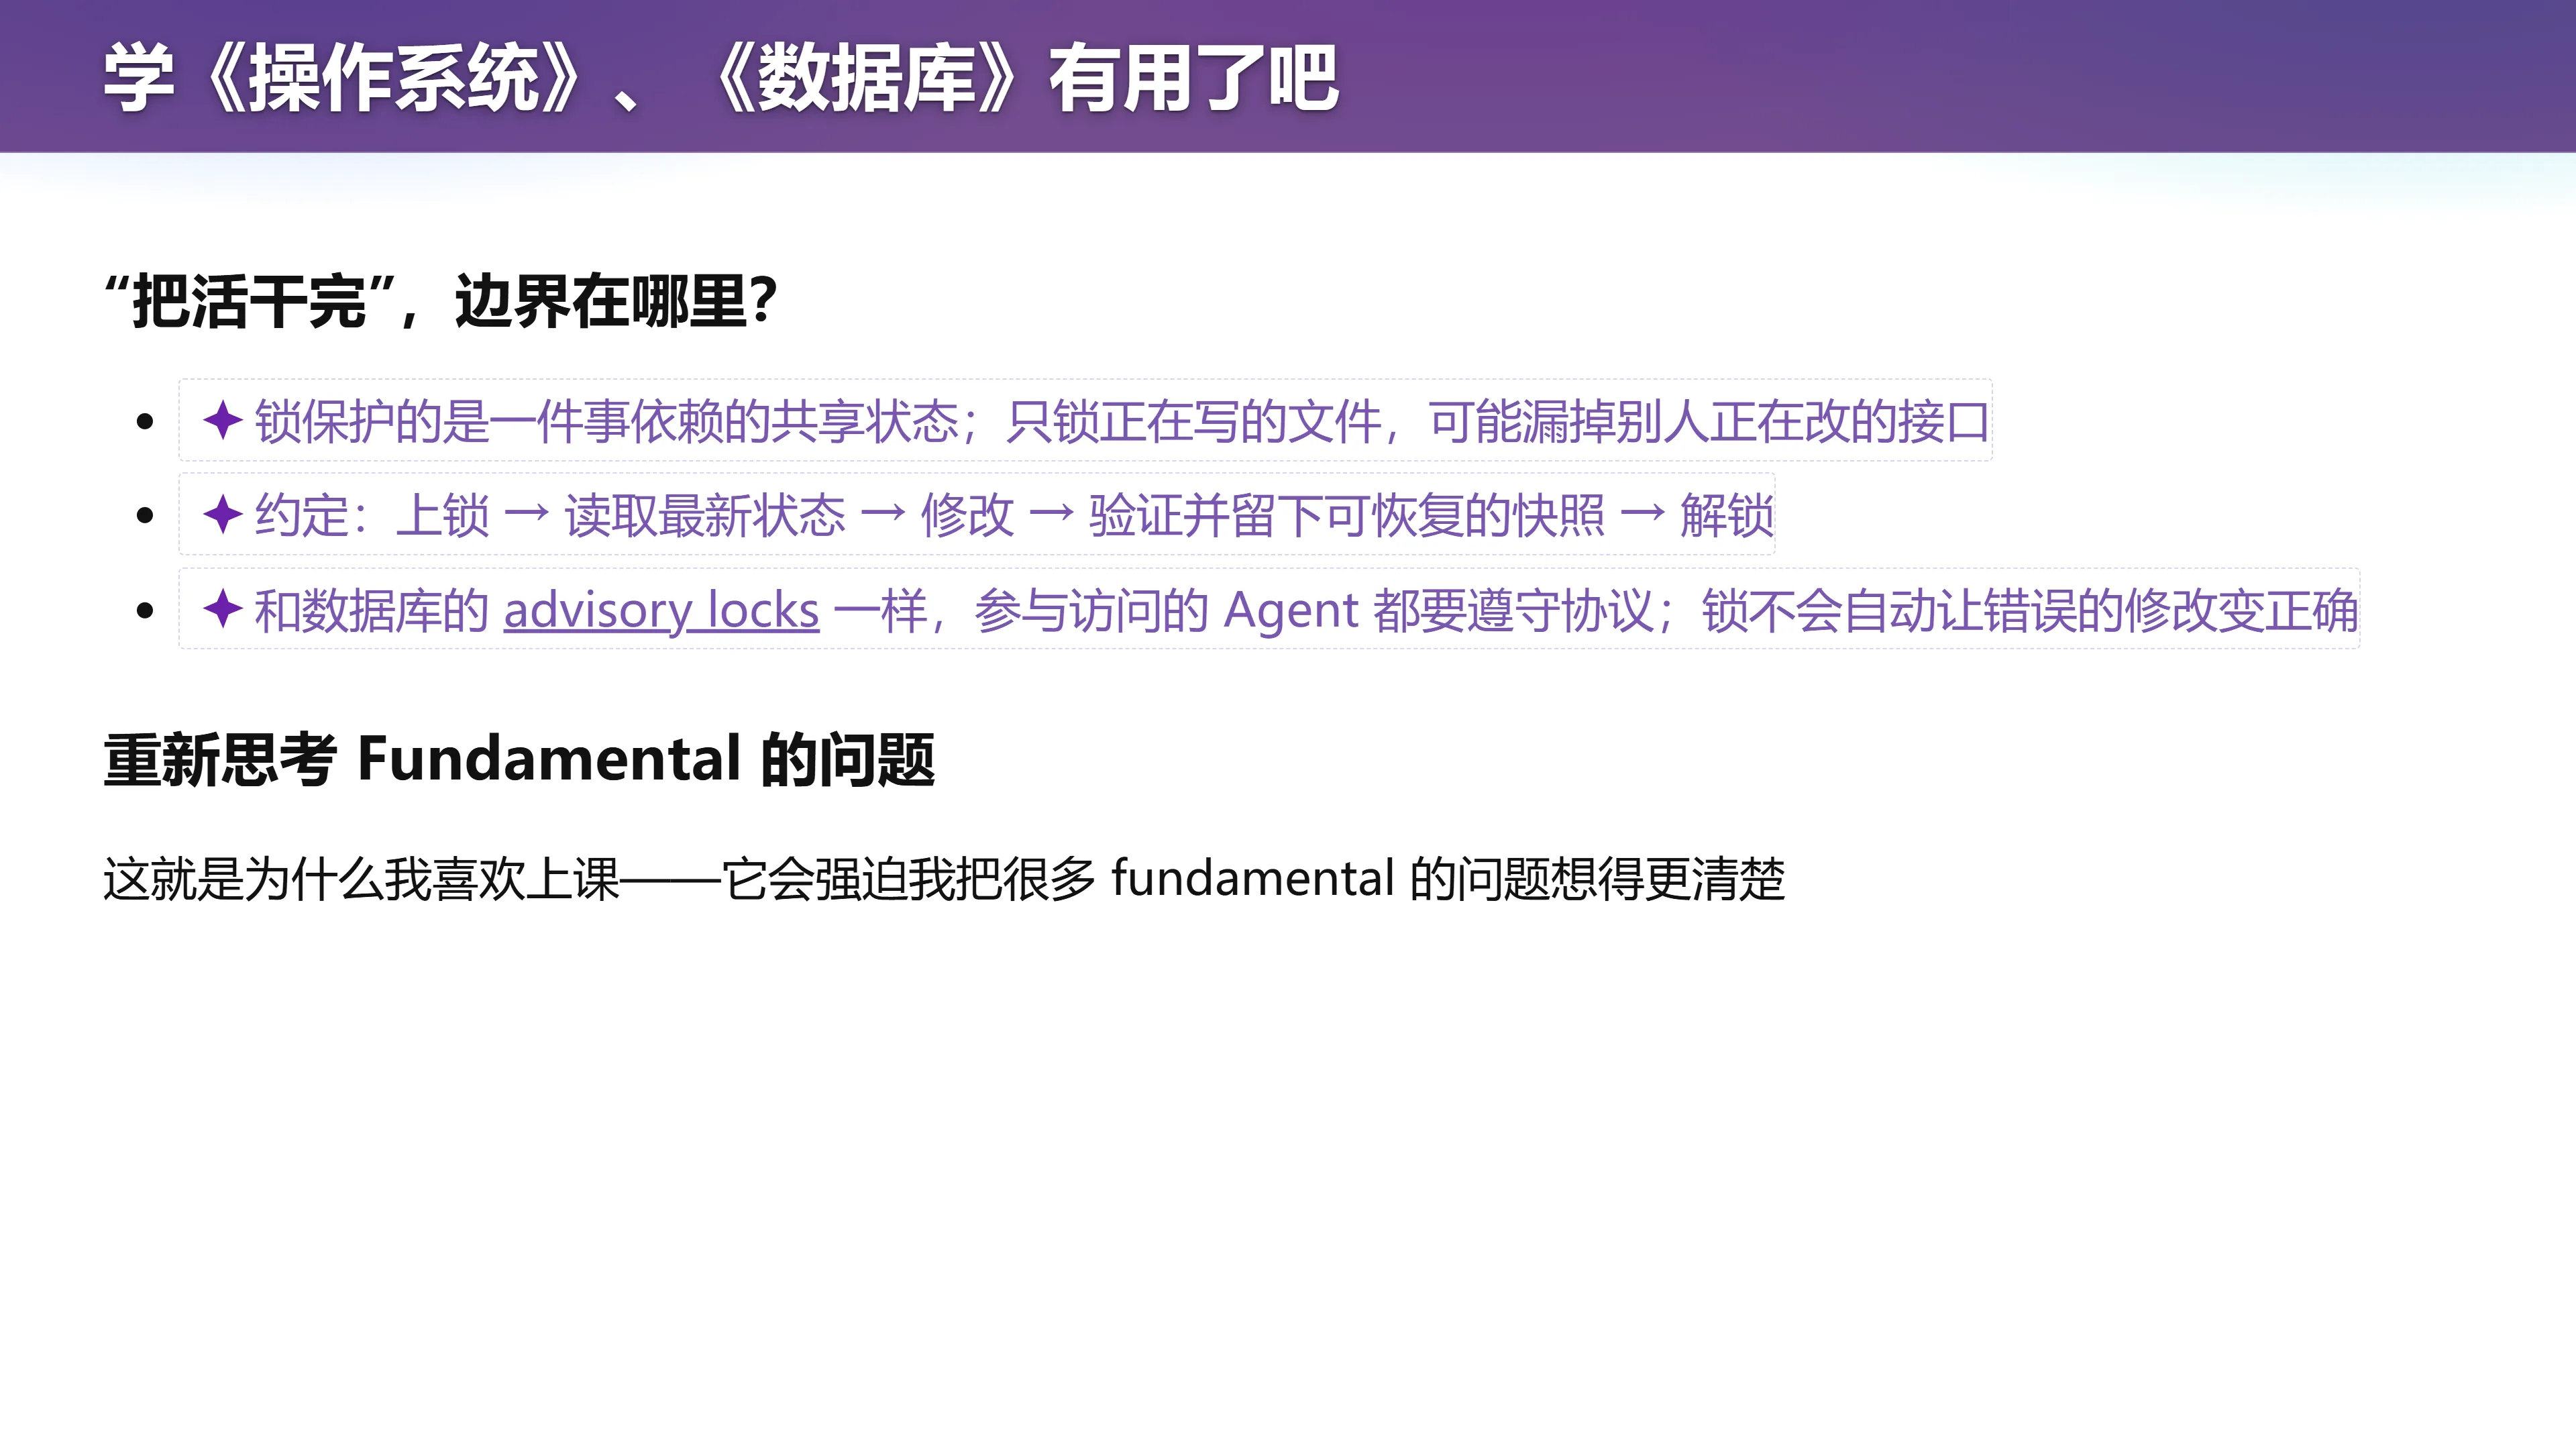
上锁也有代价:
- 锁住整个项目很简单,但可能把并行工作重新排成串行;
- 只锁一个文件比较灵活,却未必覆盖跨文件的不变量——例如接口定义和调用方必须一起更新,只锁其中一个文件就不够;
- Agent 意外停止时,锁如何回收?
- 一个任务同时需要两项资源时,怎样避免互相等待(死锁)?
- 后一个任务拿到锁后,有没有继续使用等待之前读到的旧内容?
这些都是在操作系统课和数据库课里熟悉的问题。
课堂原话大意:有人怀疑"AI 时代我还学数据库干嘛,SQL 我早就不写了"。可是——数据库里也有 advisory lock 这样的机制,而这些概念又在此处再出现一次。当你把操作系统、数据库真正学会之后回来想软件工程,这些概念会关联起来,让你看清楚:Agent 动作非常快时,应该更偏向悲观的并发控制。这也是我喜欢上课的原因——它会强迫我把很多 fundamental 的问题想得更清楚。
"Agent 先上锁再干活"因此是一条值得实验的设计路线。它让我们看到:
- 协作可以在工作之前通过调度和互斥协调;
- 也可以在工作之后通过版本和合并协调;
- 还可以把两者结合起来。
历史仍然有助于恢复和诊断,修好问题也仍然需要能够检验的结果。选择哪种机制,要看共享资源、冲突频率和返工代价,而不能只看参与者是不是 AI。
人多以后,困难转移到了协作
(参考时间: 01:07:00)
📷 团队协作
回到原视频 (01:07:00)
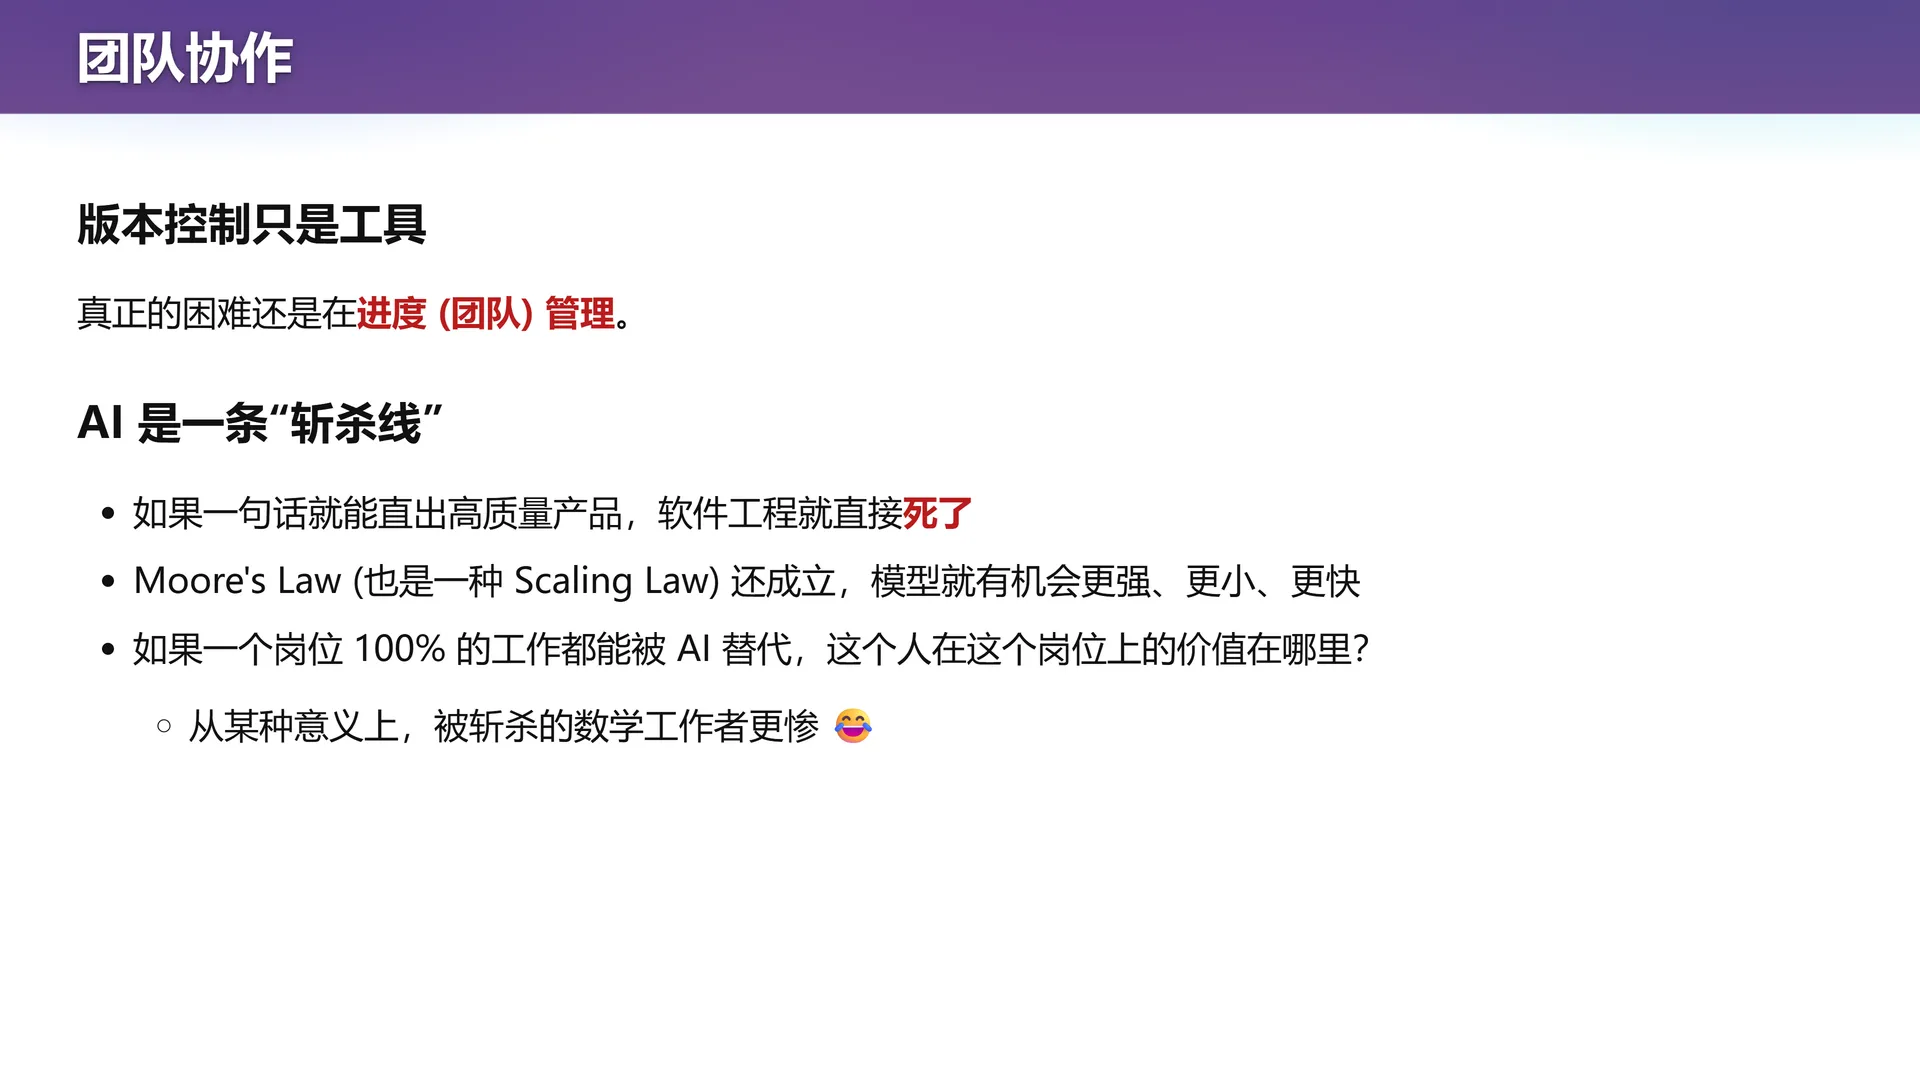
版本管理只是工具
版本管理终究只是工具。真正困难的,是团队怎样持续朝着同一个目标前进。
AI 是一条"斩杀线"
课堂把 AI 称为一条不断移动的"斩杀线":
- 如果一句话就能稳定得到满足全部要求的高质量产品,那么相应那一段软件工程工作就失去了原来的必要性;
- 如果一个岗位的全部任务都被覆盖,继续只提供这些能力,就很难保留原来的工作价值;
- 课堂还把这种压力延伸到了数学工作者:长期训练形成的能力,也可能遇到机器能力跃迁带来的重新定价。
这种未来推演有一个前提:计算资源和模型能力仍能持续改善。课堂用摩尔定律与 Scaling Law(规模与性能之间的经验规律) 串起这个设想,强调更强、更小、更快的模型可能继续改变边界。具体哪一类工作会在什么时候被覆盖,仍然需要实践来判断。
眼下,需求澄清、任务拆分、接口协调和验收结果,就是把很多局部能力组织成一个产品时绕不开的工作。
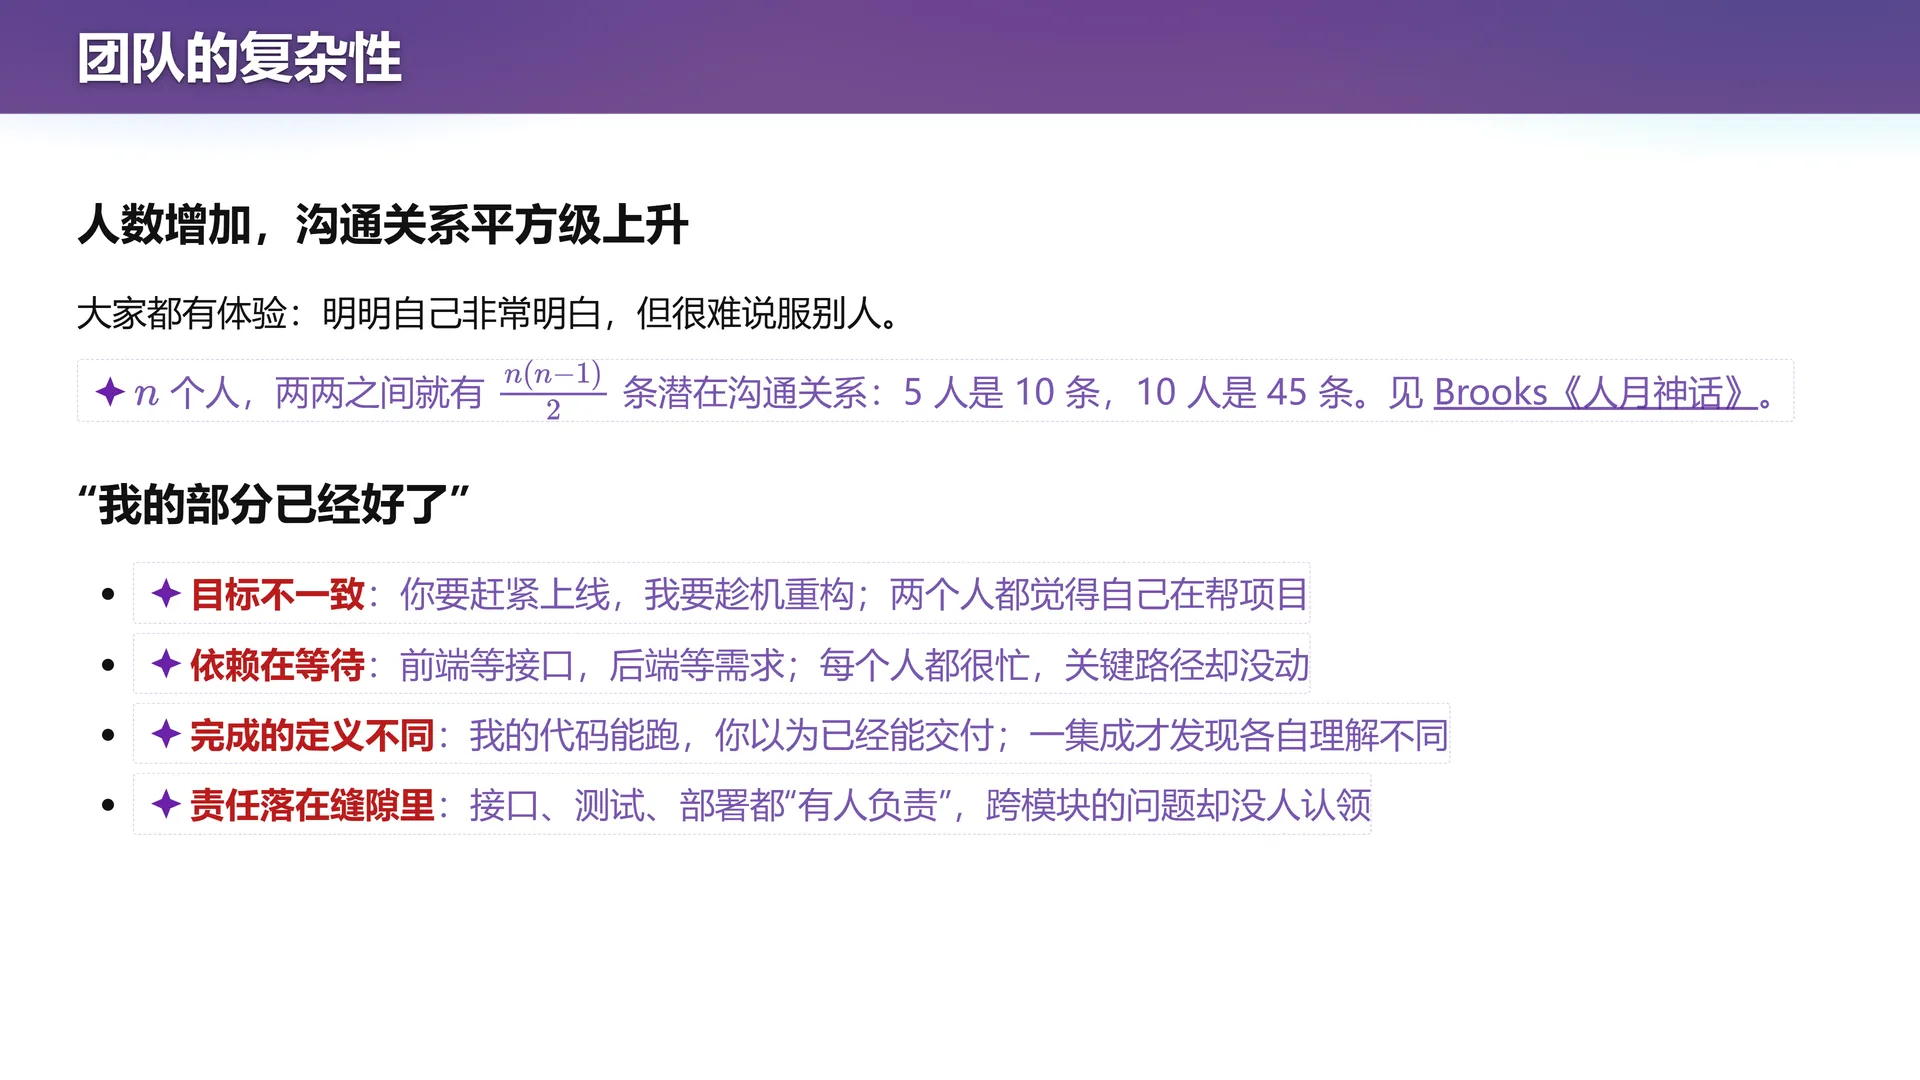
团队的复杂性是平方级的
人数增加后,这些工作很快变复杂。若 $n$ 个成员都可能需要两两沟通,潜在的沟通关系有:
$$ \text{沟通关系数} = \frac{n(n-1)}{2} $$
3 人是 3 条,5 人是 10 条,6 人就有 15 条,10 人是 45 条——这解释了"平方级上升"的直觉。它数的是潜在关系,并不意味着每个团队的实际耗时都严格服从这个公式;清楚的接口和组织分工,正是在减少必须直接协调的关系。幻灯片注明这一观察出自 Brooks 的《人月神话》。
一个常见场景是,每个人都觉得自己的部分很清楚:
- 界面已经能展示模拟数据,后端已经通过自己的测试,但两边对字段含义和失败情况的理解不同;
- 大家都说任务"基本完成",有人指代码写完,有人指测试通过,有人则以为已经可以部署;
- 还有人为了等待上游决定不断改计划,上游却不知道自己的延迟挡住了谁;
- 代码量增长了,项目离可用状态的距离却没有按同样速度缩短。
分歧也可能出现在目标和责任上:
- 一个人要赶紧上线,另一个人要趁机重构,两个人都觉得自己在帮项目;
- 界面、接口、测试分别有人负责,跨模块的问题却可能落在分工的缝隙里。
此时,再多几个提交也不能自动确定优先级,或者替团队找到愿意把整件事接起来的人。
课堂原话(大意):现在软件工程团队里最难招的其实不是码农,是那个能把任务分解的 Team Leader——能把一个国民级应用分出 100 人、10 个小团队,最后拼起来还能成为一个产品的人。接下来,能带领小团队的人也很稀缺。
版本控制留给我们的启发
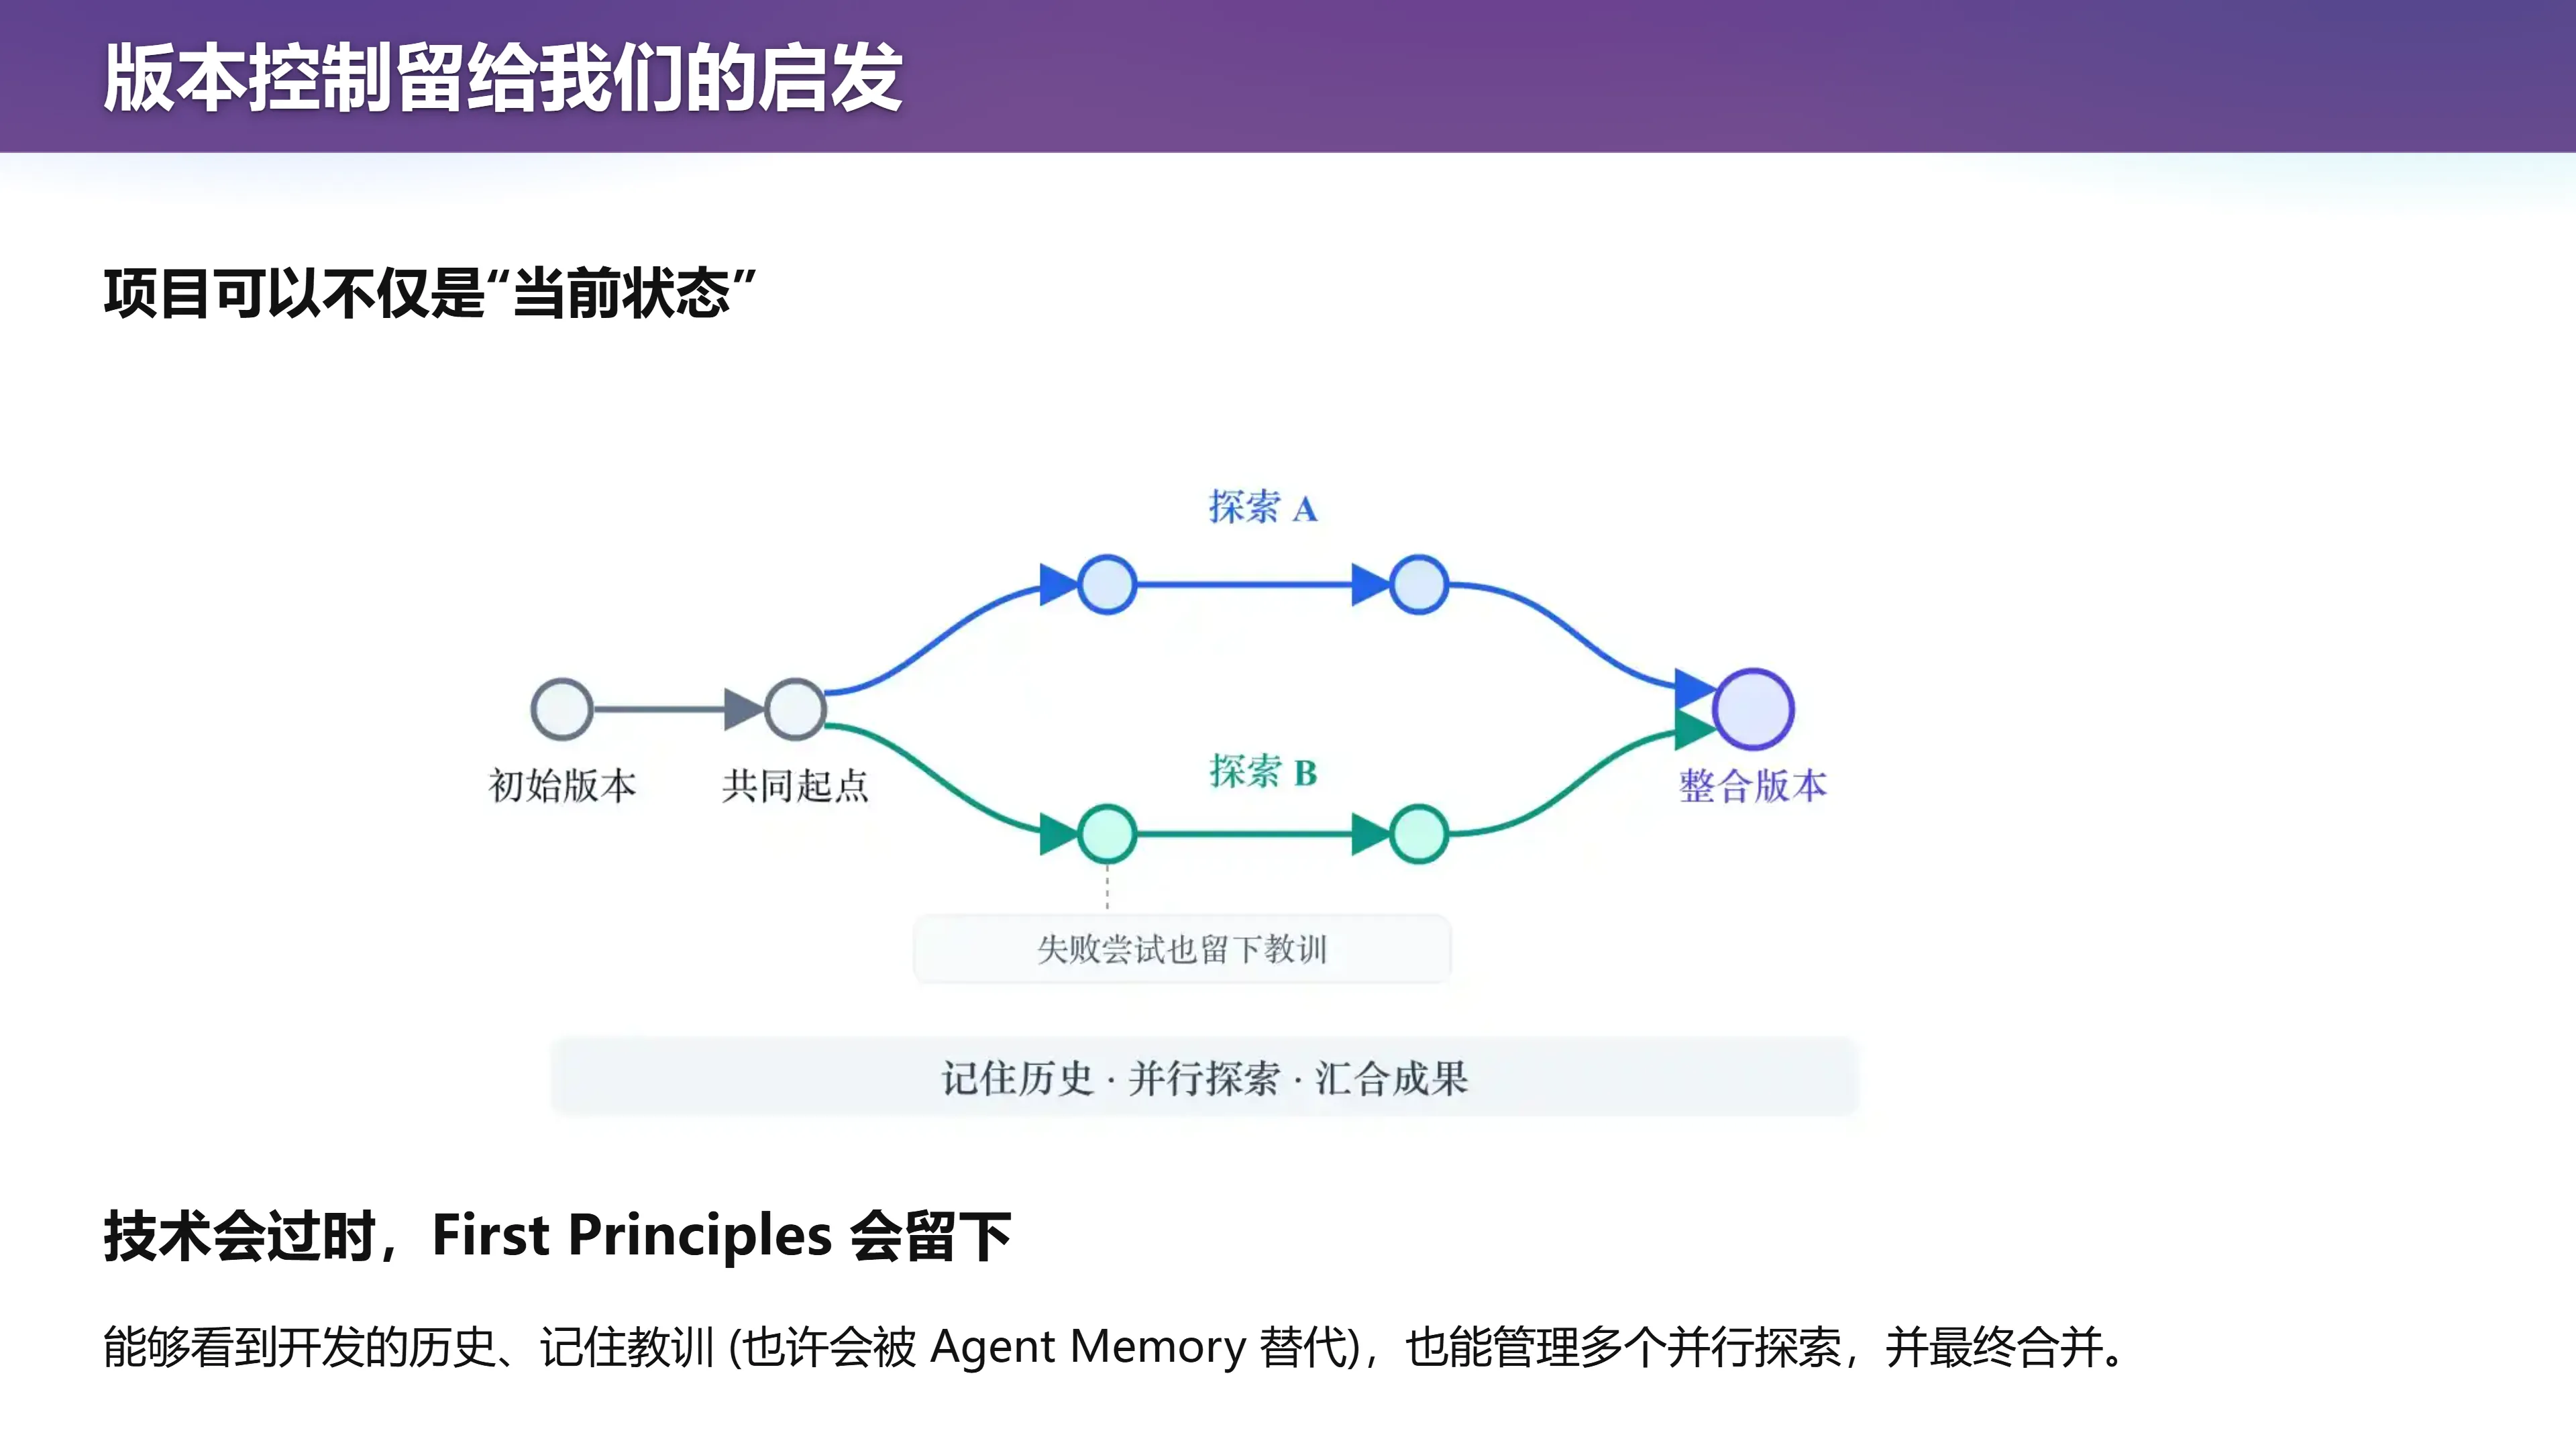
版本管理留给我们的启发,是把项目看成一个持续演化的过程:
- 保存当前状态;
- 保留走到这里的历史和教训;
- 允许多条探索路线存在;
- 设计它们重新汇合的办法。
未来 Agent Memory(智能体长期记忆机制) 也许能承担一部分经验记录工作,但什么内容值得记住、何时已经过时、怎样帮助下一次决定,仍然要有人设计。
如果只学会几个命令,换一套工具就得重新开始;如果理解了状态、历史、隔离和整合,再看另一种团队协作系统,就更容易找到可以借用的结构。
Git 还可以记录小朋友怎样解题
(参考时间: 01:08:00)
再次回到 Pico Playground
📷 再次回到 Pico Playground
回到原视频 (01:08:00)
课堂再次回到 Pico Playground。这个例子里有两个切入点:
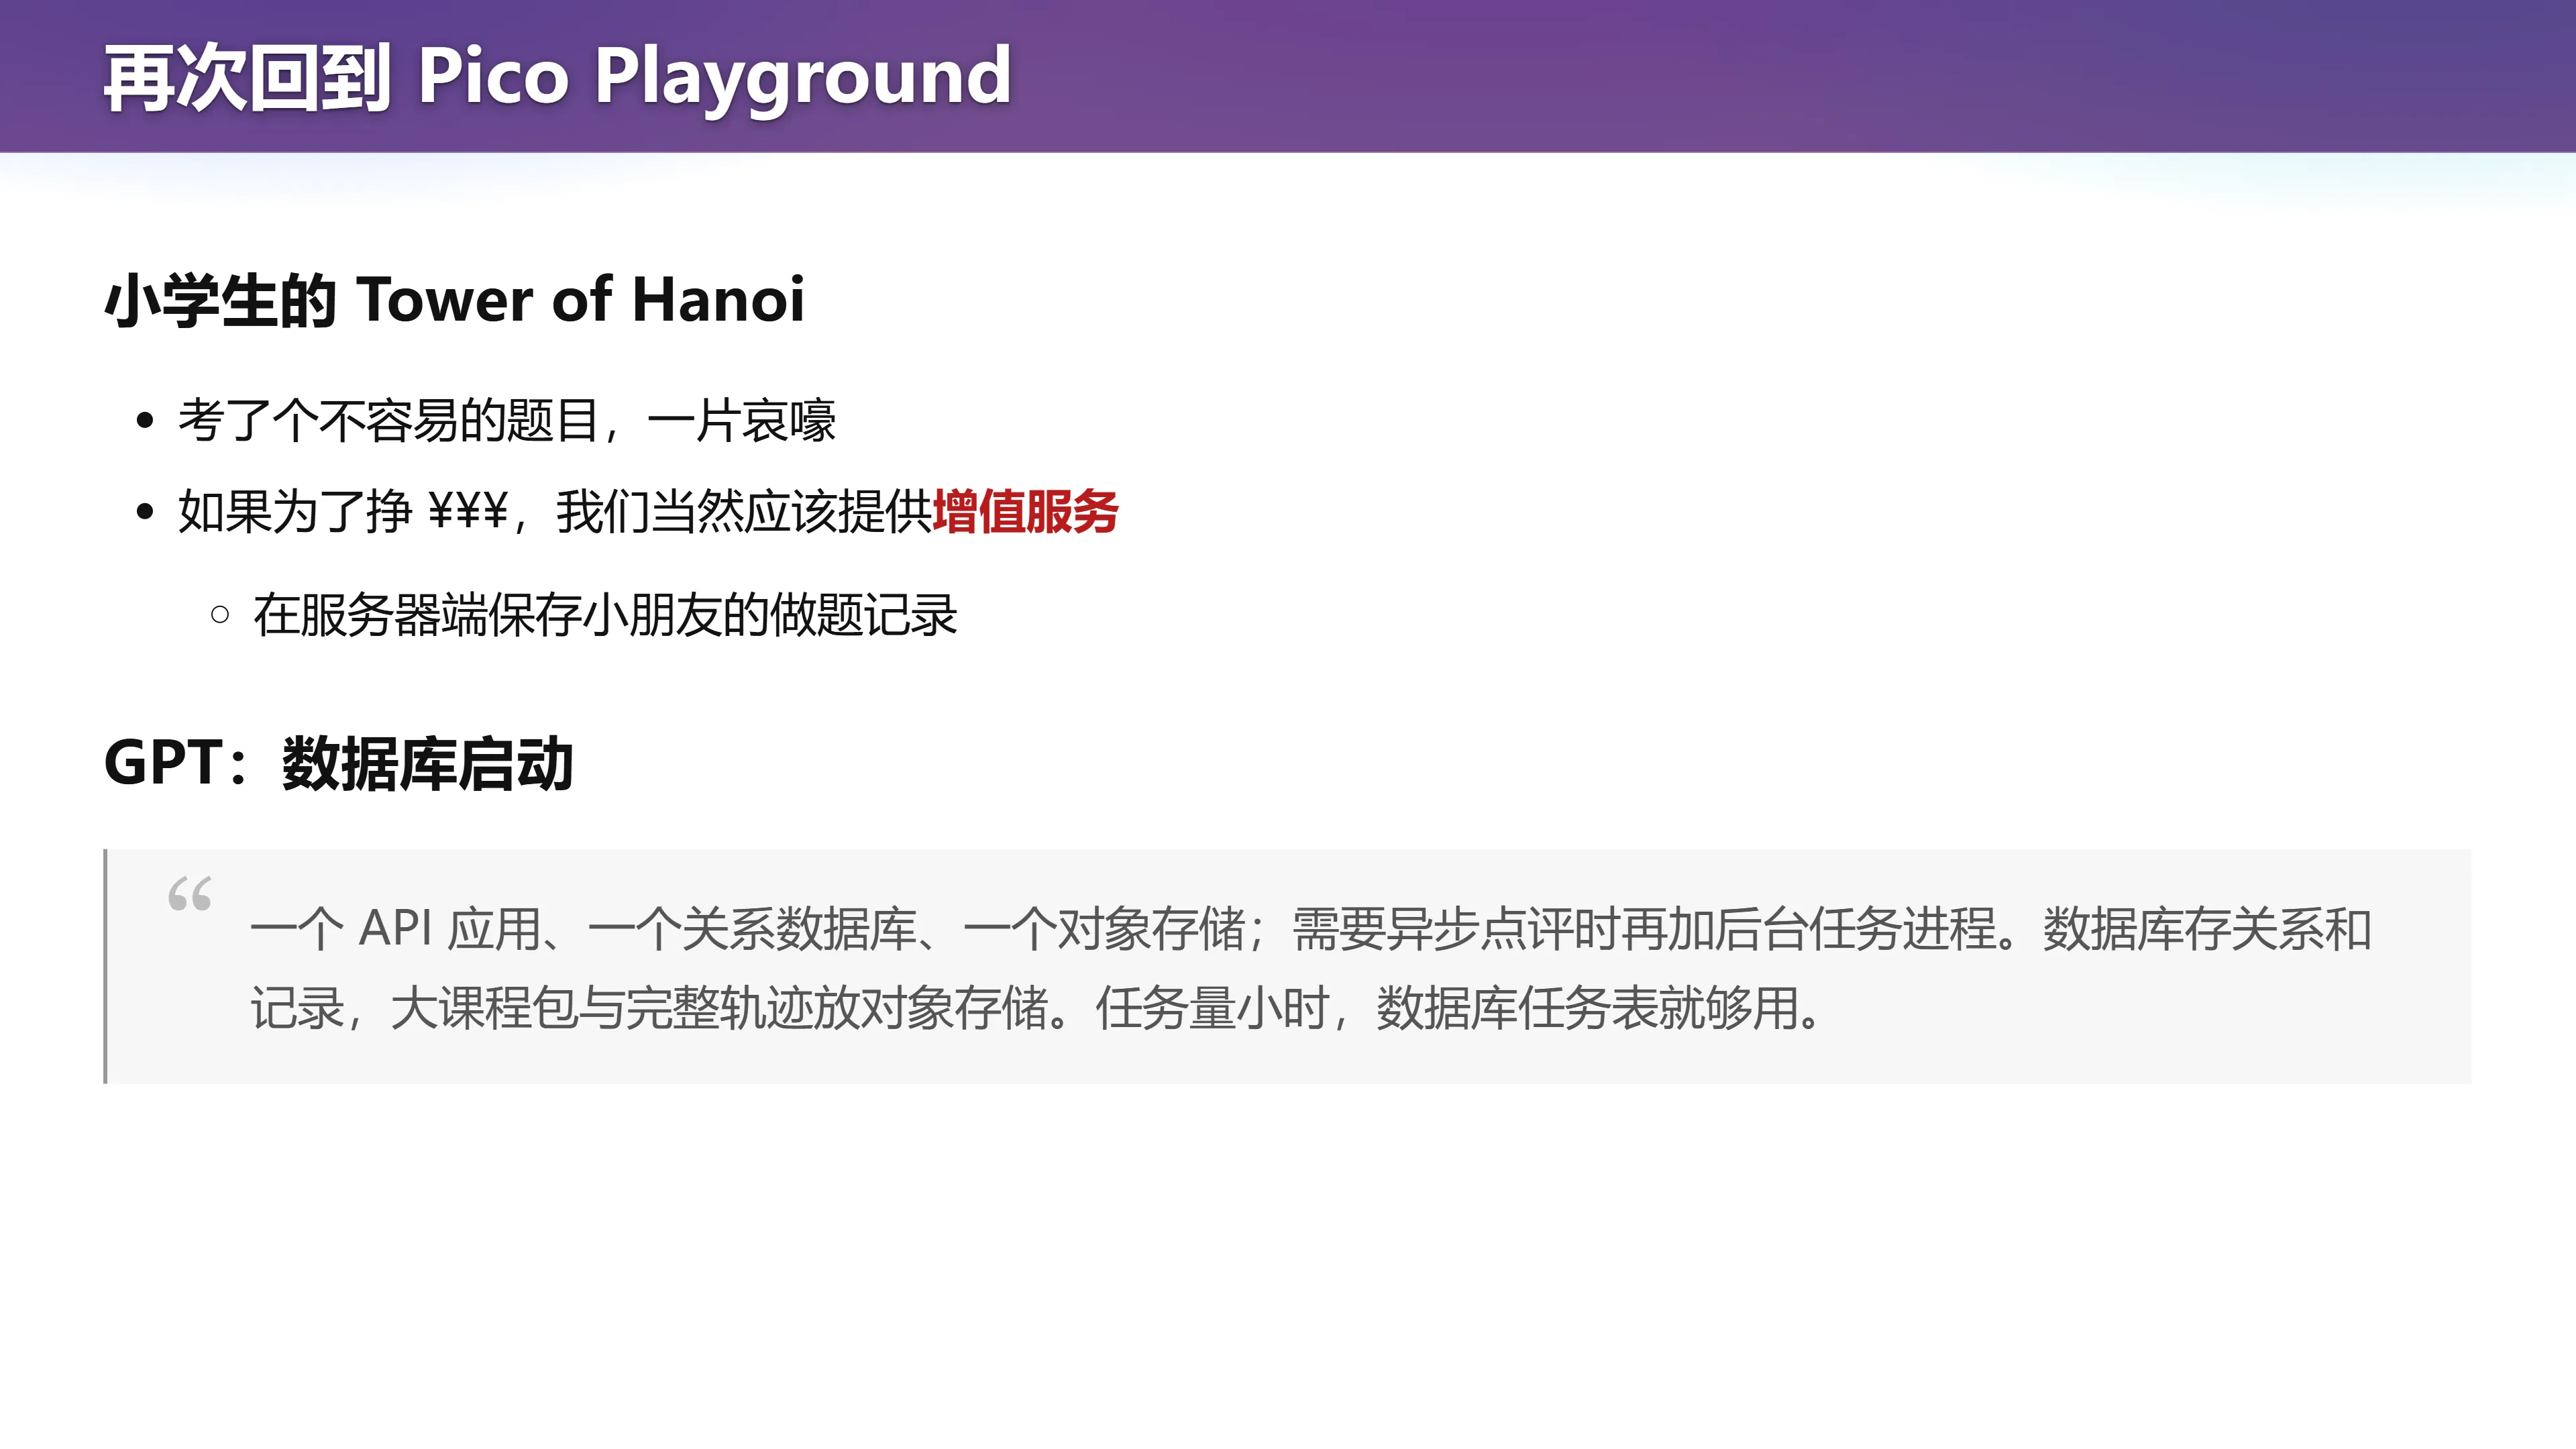
- 汉诺塔的变体题:小学生遇到一道不容易的汉诺塔题目——"做题过程一片哀嚎"。讲师给出一个变体:所有盘子的移动只能往一个方向。两个盘子时看似容易,三个盘子时就能看出问题:最优解会考虑让最大的盘子总是向右移一格、再向右移一格;剩下的部分用归纳法保证最优。
- 商业动机:如果要把这个产品继续做成能够收费的服务,我们当然应该提供增值服务——例如提供"我要助教"按钮,点击后燃烧 token,向家长收取比原价更贵的费用(讲师的 prompt 是独门的,作为一个有经验的老教师,他可以"把自己蒸馏成 prompt",敏锐地知道小朋友的问题在哪里,给出个性化指导)。
▶ Pico Playground 现场演示:代码与可视化联动
在 B 站中打开(01:12:00)
一个自然的方向,是在服务器端保存小朋友的做题记录,让老师或家长看到他们怎样尝试、在哪里卡住,以及提示之后如何修改。
GPT 给出的"标准答案"
(参考时间: 01:13:00)
把这个想法交给 GPT,它给出的架构建议很熟悉:
一个 API 应用、一个关系数据库、一个对象存储;需要异步点评时再加后台任务进程。数据库存关系和记录,大的课程包与完整轨迹放对象存储;任务量小时,可以先用数据库任务表组织后台任务。
这套方案提供了完整的通用部件。讲师说:如果这是软件工程课,这太正常了。
背景故事:讲师为什么对这个提议如此敏感?他分享了一个"我个人最喜欢的 Overleaf 功能"——Overleaf 可以把论文导出成一个 Git 仓库。他给学生改论文时,可以直接把论文克隆到本地,不需要忍受网页界面;然后打开 Codex,让它直接起 subversion,对每一个
.tex文件去修语法错误,给一段很长的 prompt,让它遵循期刊的质量改好。
但 Git 不刚好适合这个吗?
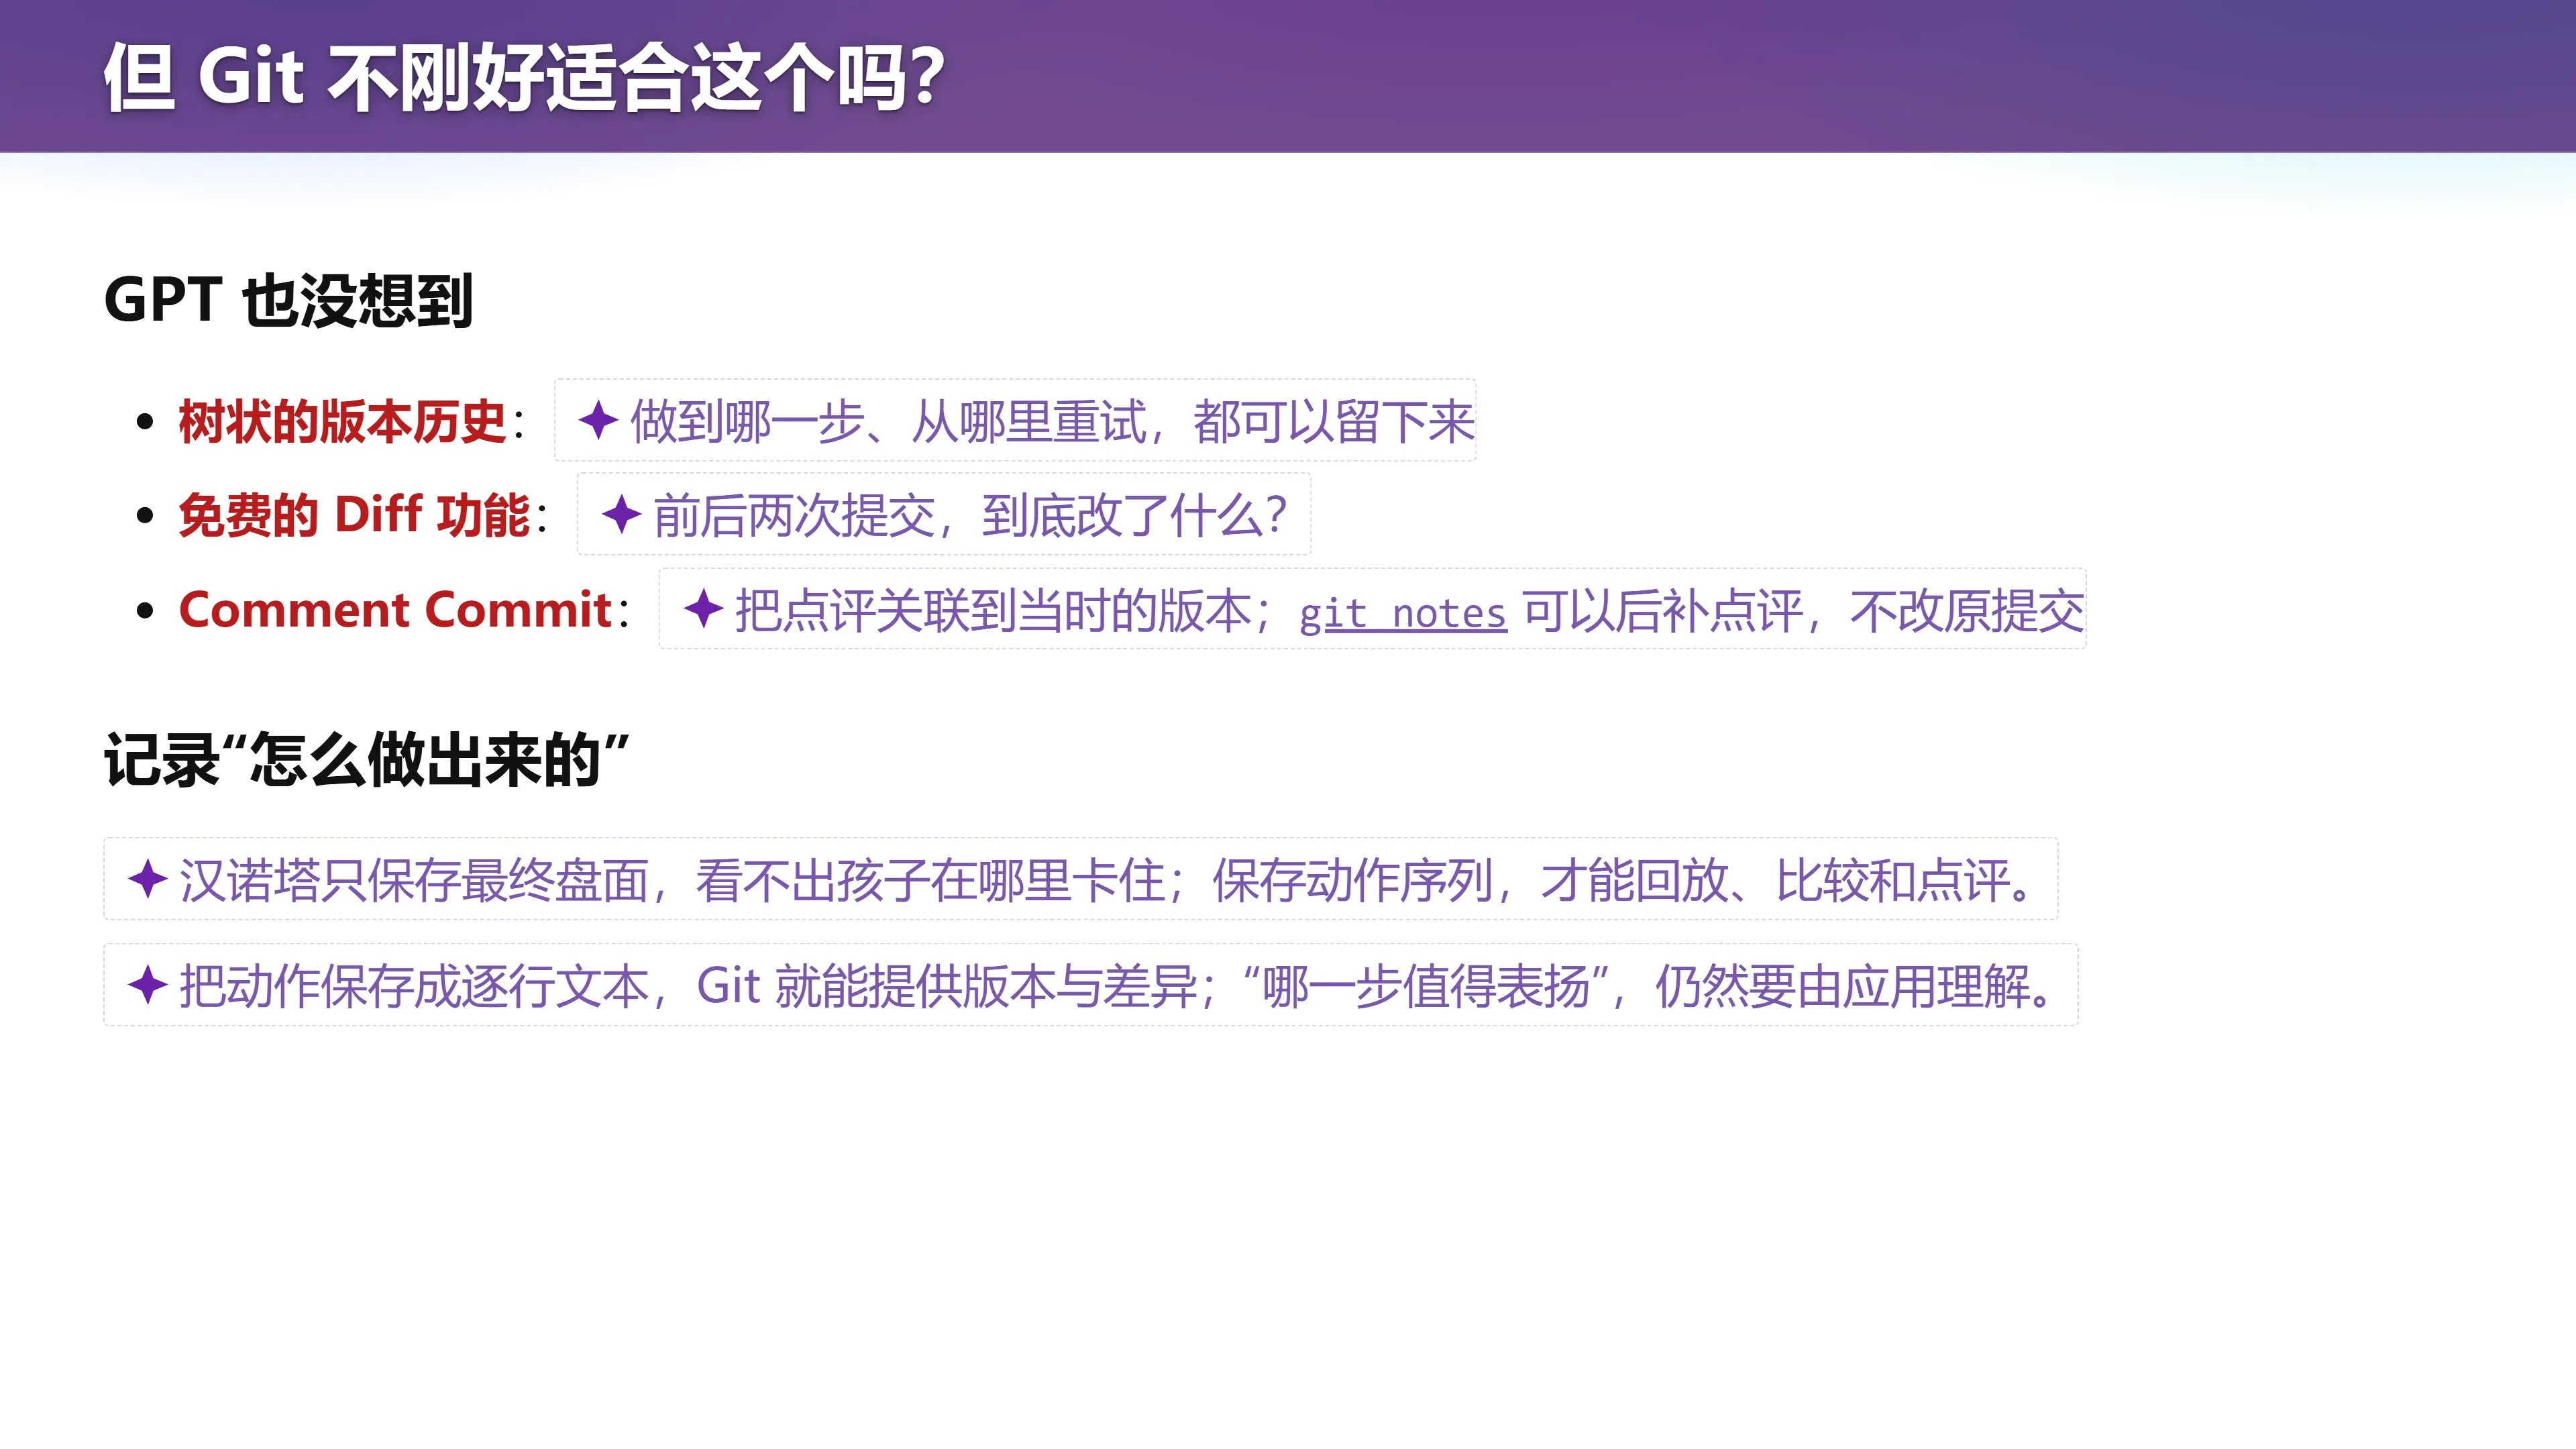
📷 但 Git 不刚好适合这个吗?
回到原视频 (01:15:00)
GPT 也没想到的是:做题过程本身就很像一段版本历史。
假设一个小朋友先试着挪动圆盘,遇到困难后回到某个状态重新尝试,再根据老师的提示调整方法:
- 只保存最后的盘面,很难看出他在哪里卡住;把每次尝试的动作序列保存下来,就有了可以回放和比较的过程;
- 如果尝试另一种办法,可以从某个状态分出去;
- 如果想比较收到提示前后的变化,可以检查两次尝试的差异;
- 如果老师要点评,可以把说明关联到某个明确的版本。
Git 已经提供了不少对应能力:
- 提交保存状态;
- 父子关系连接尝试;
- 分支容纳不同路线;
- diff 展示相邻版本的变化。
可以把一次尝试的动作表示为逐行文本,再把这个版本交给 Git 管理;应用负责解释动作含义。点评也可以与具体提交关联——例如使用 git notes 后补说明,而不改动原提交。原本需要自己设计的一部分历史结构,就有机会直接复用。
graph TD
    S0["初始盘面"] --> S1["尝试 1"]
    S1 --> S2["尝试 2"]
    S2 --> S3["卡住"]
    S3 -->|"老师提示"| S4["调整"]
    S1 -->|"另一条路线"| S5["尝试 1b"]
    S4 -.-> N["git notes 附加点评"]
    S2 -.-> N
关键区别:保存"有意义的版本" vs. 记录"每一次鼠标移动"
这里应当区分:
- 保存有意义的解题版本——这非常接近版本管理要解决的问题;
- 记录每一次鼠标移动——这可能更适合单独的事件日志。
用户资料、课程关系和统计查询,也仍然可以交给适合的存储方式。这个构想的价值,在于从需求里的结构出发,识别现成工具能接住哪一部分,而不是看到"服务器保存数据"就立即把每一项通用部件都启动起来。
课堂原话:GPT 没有算到的是——产生一个 commit 的成本,远远大于把剩下的东西持久化下来的成本,这个成本是忽略不计的。用数据库确实得到了一些好处(总体压缩更小、性能更高),但那不是我想要的。我的本质需求是版本管理。所以甚至在最早期的时候,可以把我的代码库和这个东西连在一起,把小朋友的代码直接存在我的代码库里——在其中创建探索性的 Git 历史记录,直到整个文件目录格式、commit message 格式、怎么使用这些文件都收敛了,再把它迁移到数据库。
这个架构设想还需要通过实际使用来验证。GPT 给出了一条常见路线,而理解版本管理让我们多了一种可供比较的方案。你知道的抽象越多,就越可能在模型熟悉的方案之外,指出一条更贴合当前问题的路。
从零开始,你就是包工头
(参考时间: 01:18:00)
📷 开始做一个项目
回到原视频 (01:18:00)
现在可以真正拿实验开干了。你就是包工头:
- 决定先做哪一块;
- 说明各部分怎样接起来;
- 判断交付的东西能不能用。
Agent 可以写很多代码,但目标、接口、验证和节奏仍然需要组织。
从零开始的难度
从零开始做产品,有时比参与一个成熟开源项目更难。成熟项目已经固定了许多选择:
- 用户是谁;
- 代码怎样分层;
- 什么叫兼容;
- 测试怎样运行。
做一个局部修改时,可以沿着这些约束前进。而空项目里的约束少、自由度大,Intent、Spec、Impl 之间的缺口也就有更多机会被默认选择填满。
例如,"会成长的个人助手"至少留下了几个决定:
- "成长"指记住事实、修正偏好,还是学会执行新任务?
- 助手什么时候应该主动行动?
- 记错了以后怎样纠正?
如果一开始就把所有记忆都设计成永久有效,后来才发现大量信息有时间和场景限制,早期那个看起来很确定的数据结构,就把一项需求误解固定进了实现。
这不意味着应该先把所有未来需求都想清楚。课堂给出的准则很直接:
没有什么是不能变的。
所谓"以不变应万变",落到软件上,就是:它能否承受需求变化。能不能替换一项记忆策略,而不用重写全部界面?能不能增加一种输入方式,而不把核心行为复制一份?我们可以围绕已经看见的变化组织边界,再用实际反馈修正设计。
早期的 Prompt,影响最大
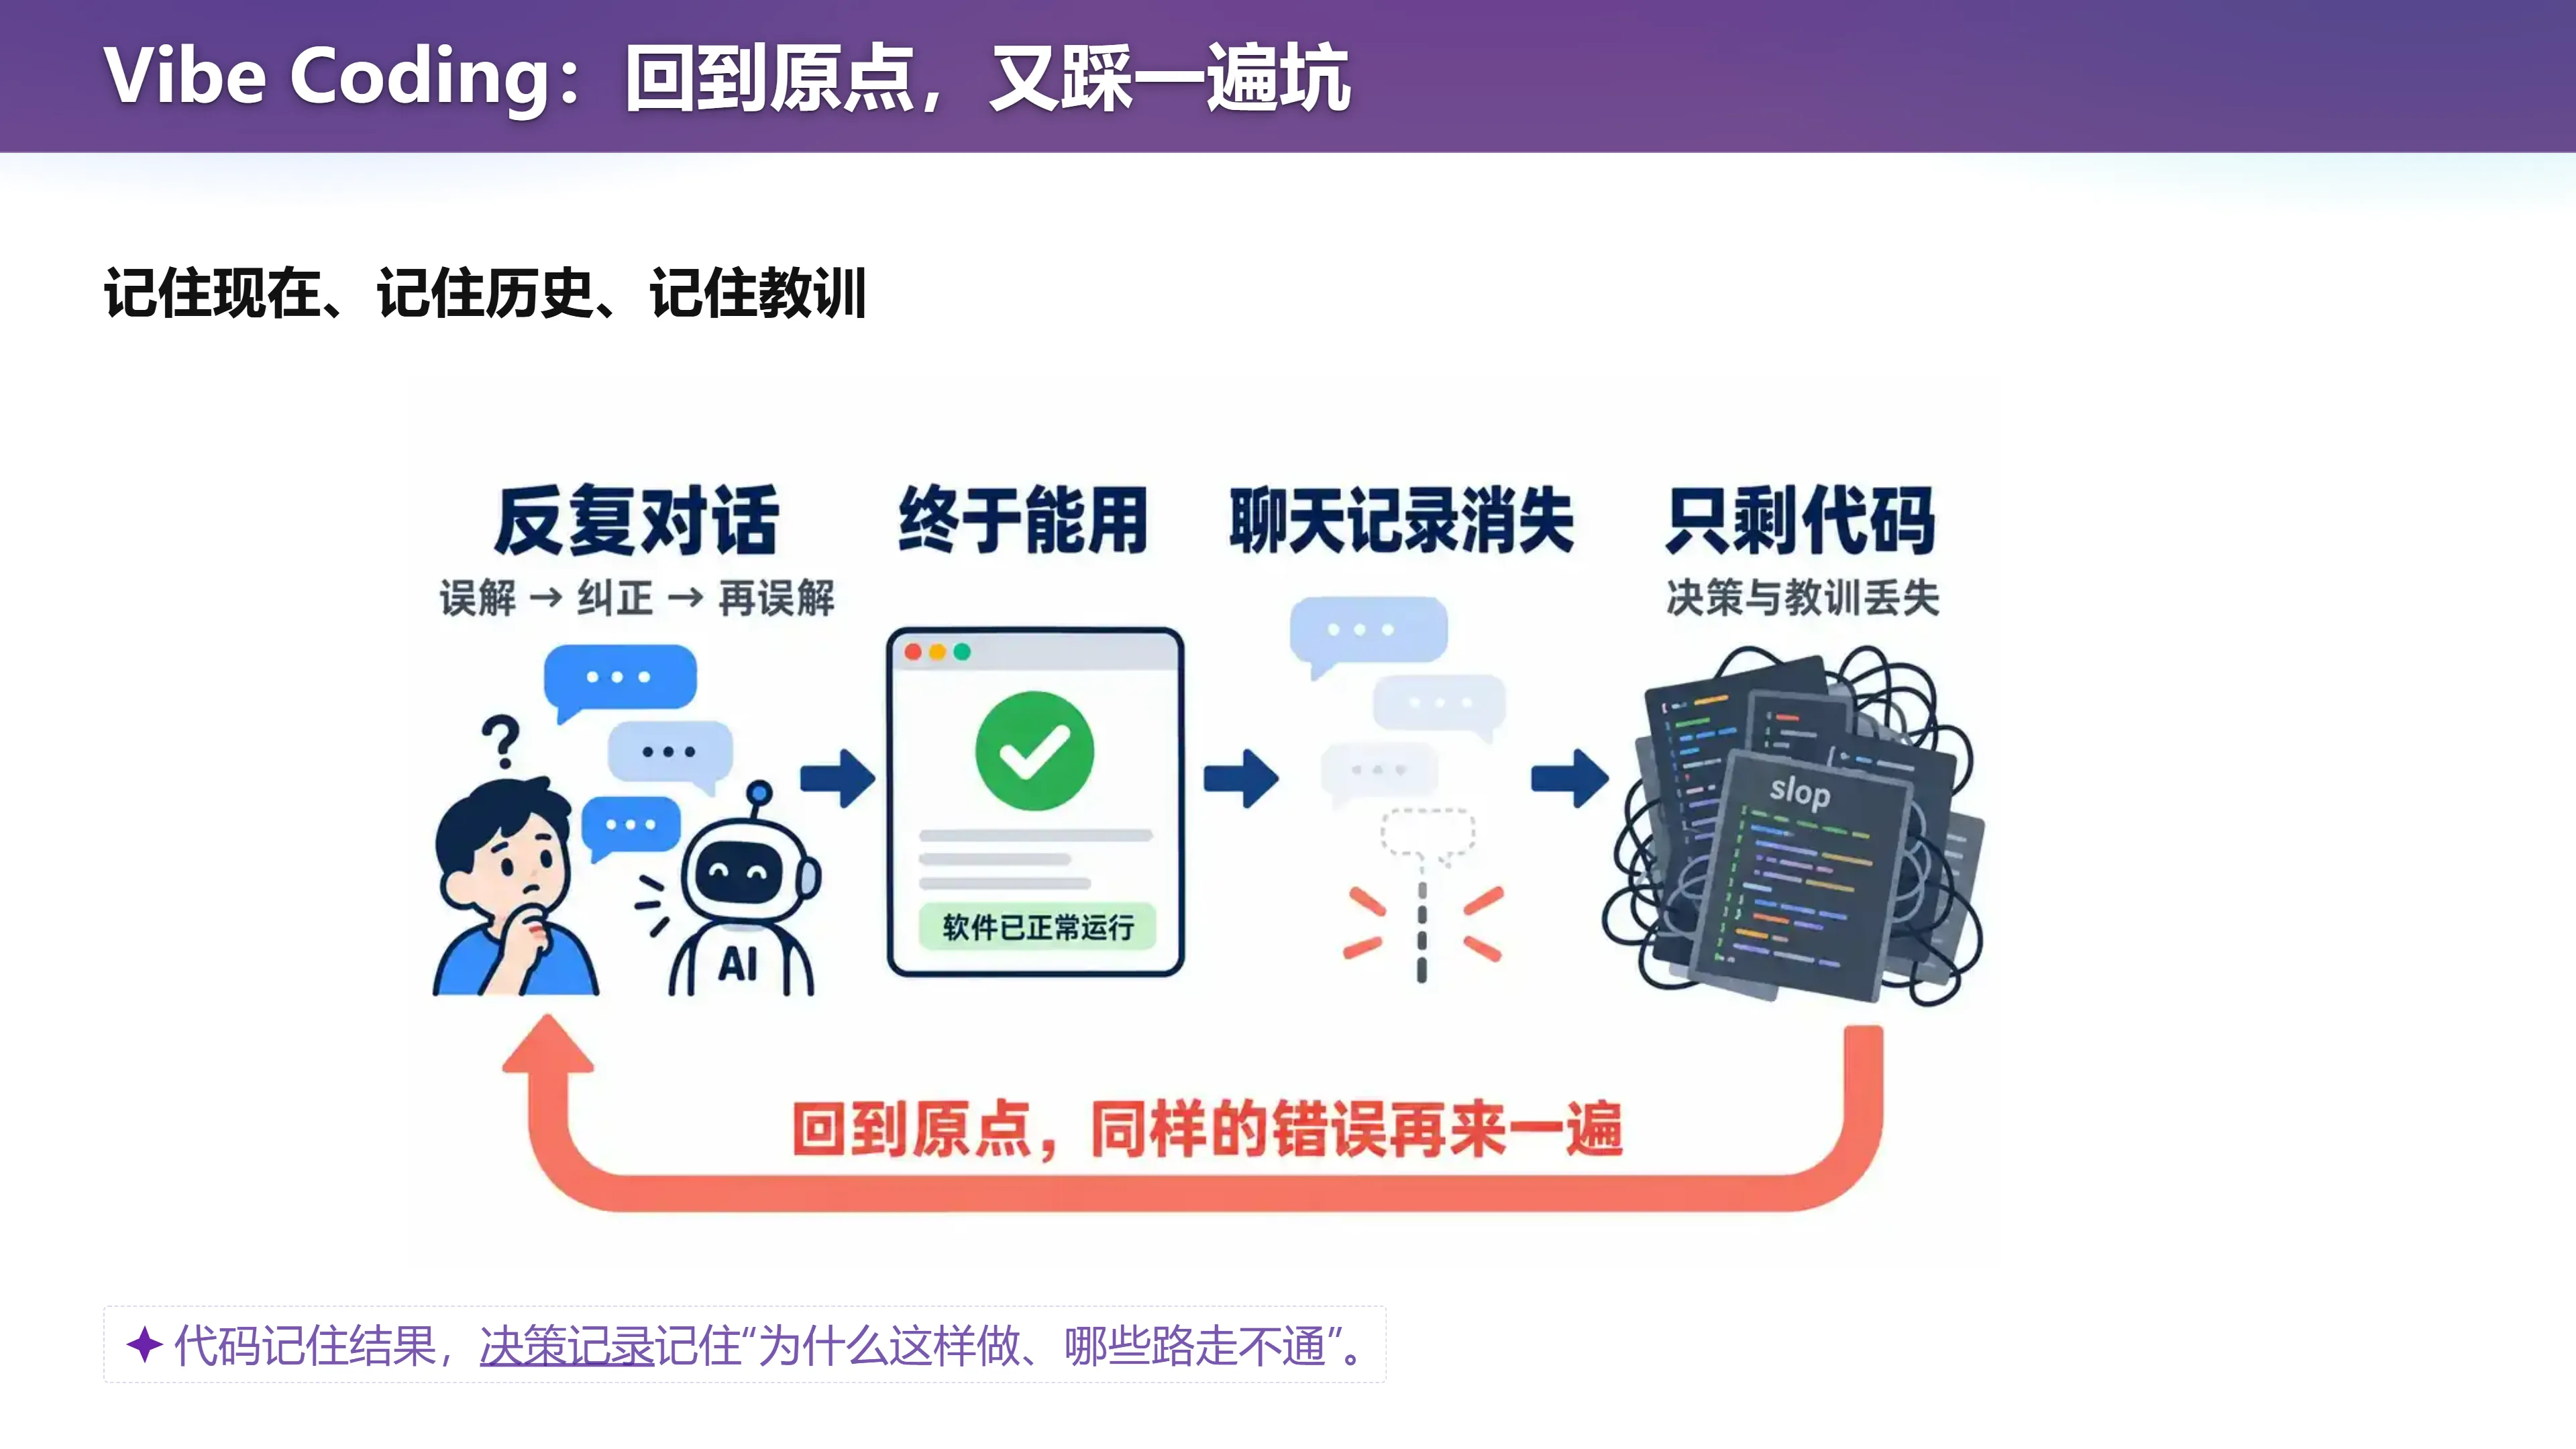
📷 Vibe Coding:回到原点,又踩一遍坑
回到原视频 (01:27:00)
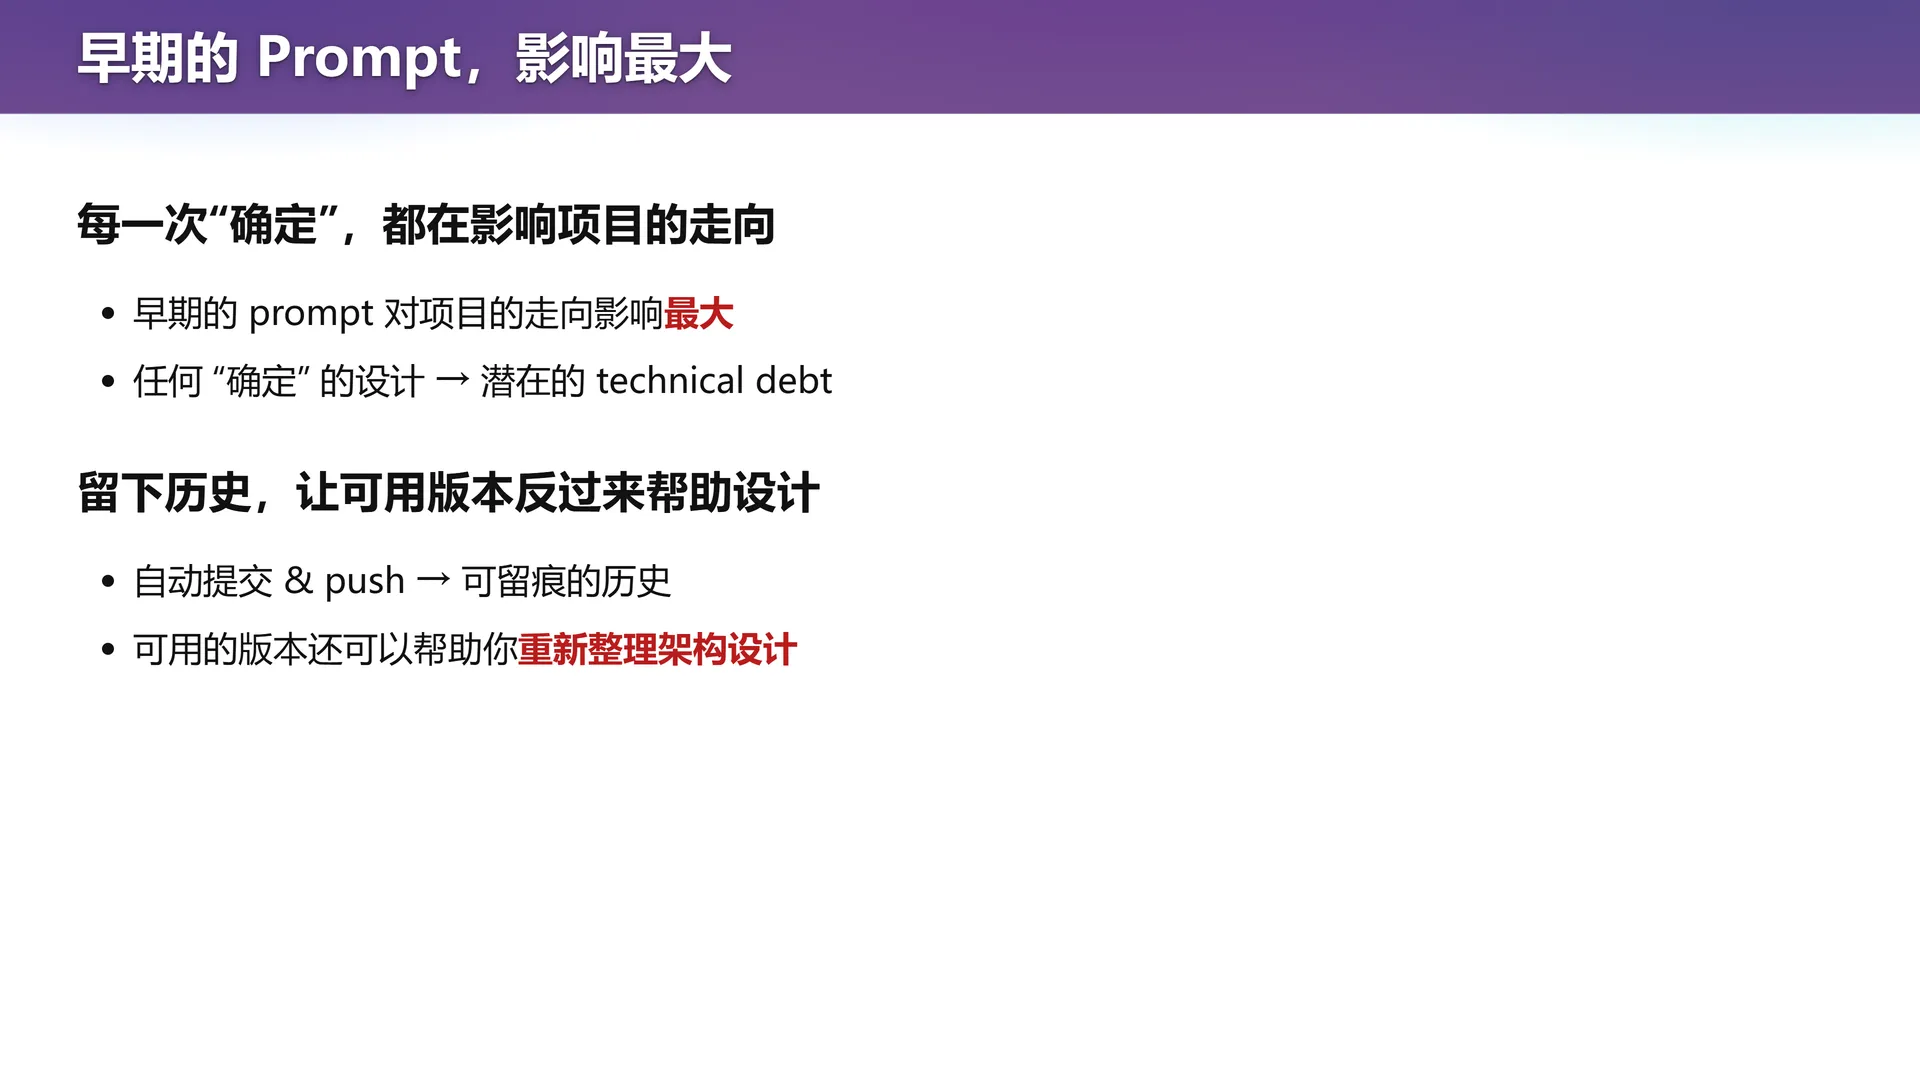
早期 prompt 对项目走向的影响尤其大。第一次描述里的"确定设计",往往会成为以后代码和讨论的默认前提。接下来的 Agent 读到现有实现,又会顺着它继续生成。一个方便的临时选择,可能就这样逐渐变成 technical debt(Technical Debt,也就是未来修改系统时必须额外偿还的技术债)。
技术债也可能来自认识的进步。第一版的设计在当时有充分理由,真正做出来、用起来之后,团队才知道哪些概念应当分开、哪些接口应当重新组织。
Martin Fowler 在 Technical Debt Quadrant 中讨论过这种情况:即使团队认真设计,也可能在学习之后发现原来的结构已经落后于新的理解。值得关注的是怎样记录这个发现,以及何时调整结构,避免后续改动持续为旧认识付出代价。
因此,最初值得写清楚的内容包括:
- 现在要解决的具体问题;
- 第一版怎样才算可用;
- 哪些行为可以检验;
- 哪些选择仍然允许变化。
对版本历史的要求也可以从一开始进入工作方式,例如:完成一个有意义的步骤后自动提交,并按项目约定推送到远端。这样,状态和决定有迹可循,后续修正才有可以回查的起点。
▶ 记住现在、记住历史、记住教训
在 B 站中打开(01:28:00)
课堂现场演示:直接让 AI 做会踩什么坑
(参考时间: 01:18:00—01:27:00)
讲师现场做了一次"完全没有事先准备过"的演示:打开课程作业,开两个 Agent session,直接让 AI 去做实验。
两种做法:第一种是直接被把实验要求丢进去回车;第二种是…(讲师未展开)。今天来替大家体验一遍。
观察到的现象:
- 一线模型会进入 Plan Mode,先确认一些事实,再生成 workflow;
- 像 Claude Code 遇到复杂任务时,会生成一段 TypeScript,其中有一个函数叫
agent,函数体是自然语言;它甚至可以有循环,把多个子任务组织起来; - Agent 一上来就"直接开干",一会就在做 database。
上下文工程 / 提示词工程里最危险的一点:提示词里的每一句、每一个词,Self-Attention 都会看到它;而 AI 现在已经被训练成了"prompt 的舔狗",有一种无法往外拉的倾向——它必须遵循你的指令。当你把一个还处于讨论稿状态、比较开放的需求丢给它时,它会过度遵循这个指令,最终生成一个确实满足了指令、但并非你真正想要的东西。
例如,实验要求的言外之意其实是这一句:"实现一个持续为你工作的个人助手"——这句话最重要,其他话只是解读。讲师真正想要的第一个 Feature,是高效的学习和复习:Agent 能自动从外网收集数据、以层次化方式归档、给出一个比较好的界面。而 AI 很可能没有做这个——它做的是一个没有 email 的、看起来"正确"的系统。
讲师让 AI 停下来问它:其实我想要的是一个比较好的学习助手,能收集外部信息、综合总结、根据我的学习进度看哪部分能实现。 这里就暴露了 Intent、Specification 和 Intention 之间的巨大 gap。
进一步观察:
- AI 甚至在项目开始的时候都没有创建一个 Git repository——这恰好说明"如果你不跟它讲,它就不会管";如果是 Codex,可能会初始化一个目录,或问你项目应该怎么管理;
- 如果是一个成熟的产品经理,老板跟你说要做某个东西,你肯定会在写下第一行代码之前跟团队沟通:项目怎么管、协作怎么做、每天什么时候开会;
- 而 Agent"很好玩",它直接上手就做,好像这是一个一次性的、用完就丢的东西。
课堂玩笑:感觉它烧了我不少 Token——也无所谓了,我参与 DeepSeek 哈里斯内测,送了我 1000 块的额度,到现在还没完全用完。
演示中的典型缺陷
(参考时间: 01:30:00)
演示过程里,AI 交付的东西带有典型问题:
- 它有一个入口层、编排层、能力层、数据层——一个非常典型的架构;
- 引擎全部是真代码,手机端是真 HTTP 服务,API 是集成的,模拟的部分邮箱是没有的;
- 但它的架构已经看起来像一个教务系统了。下节课会专门讲教务系统。
编者说明:这不是说"分层架构"本身错了,而是说:用户在早期并不需要一个"看起来像教务系统"的完整业务系统。把学习助手做成一个多层业务系统的代价是,一旦需求变化(例如加入"同步到云盘"),就要承担昂贵的重构。
用一个最小版本检验想法
(参考时间: 01:32:00)
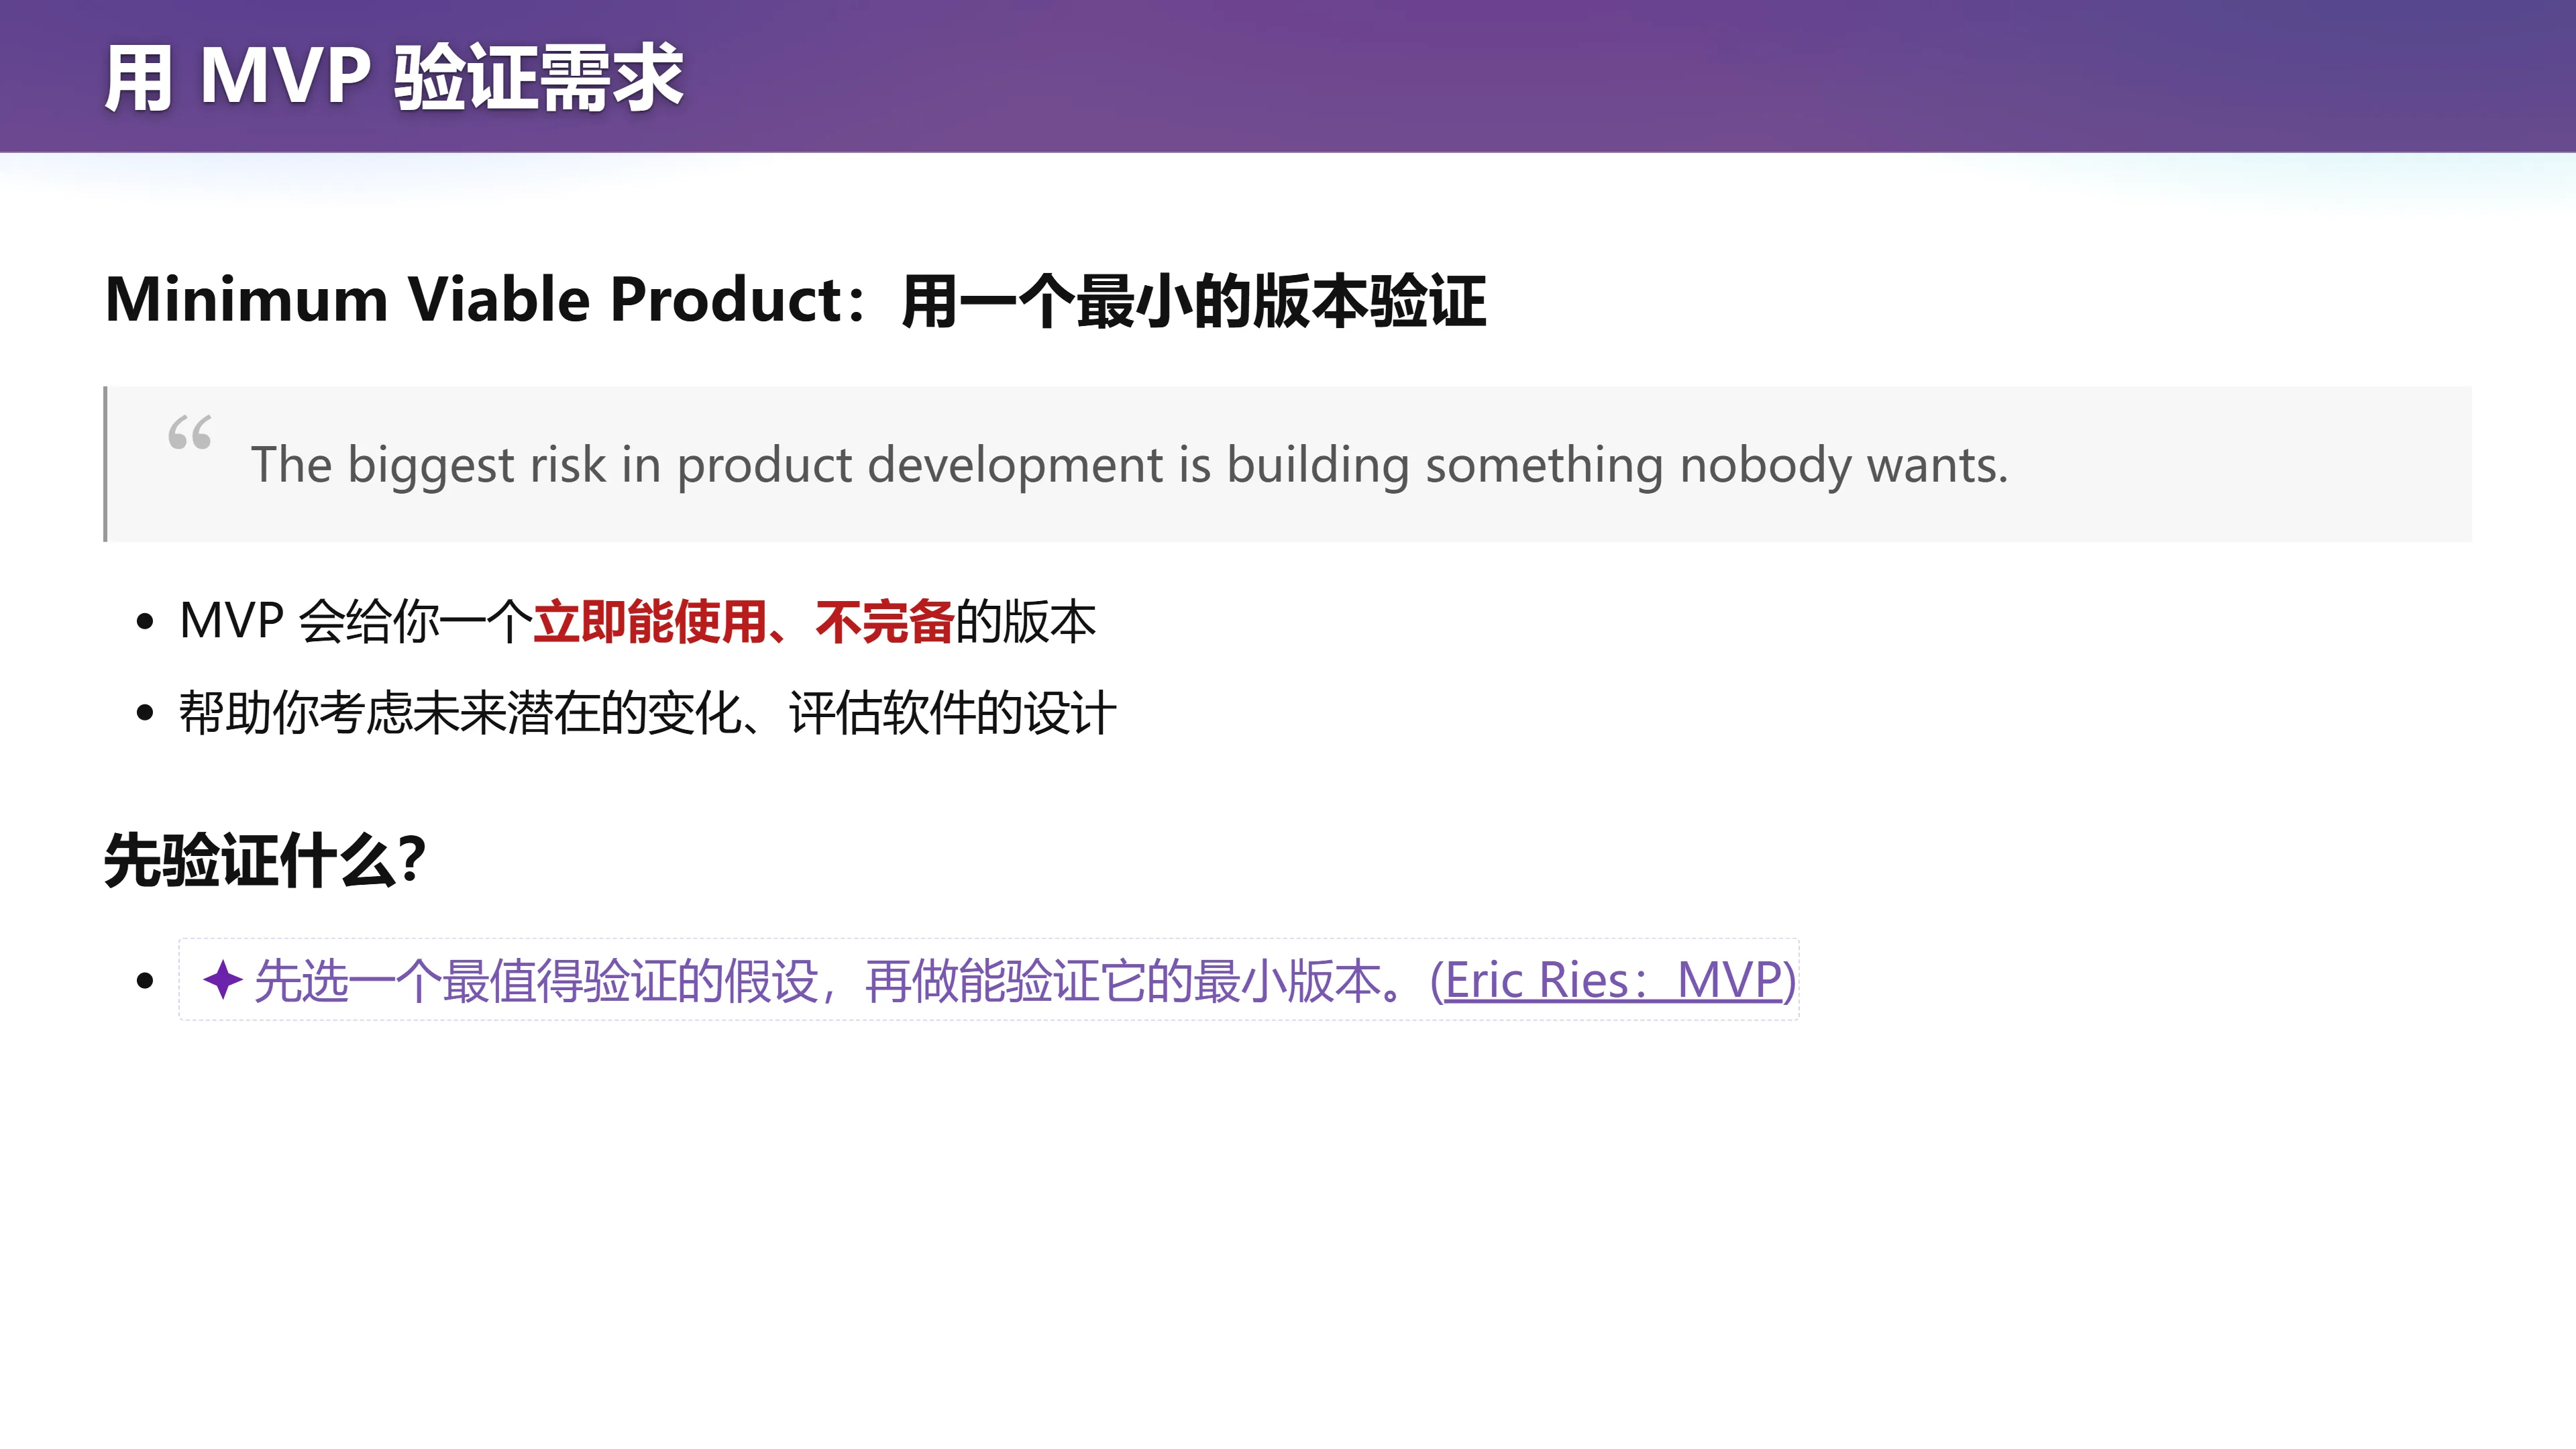
📷 用 MVP 验证需求
回到原视频 (01:32:00)
任何时候,开始都比不开始强。一个有用的开始方式是 MVP(Minimum Viable Product,最小可行产品):做出足够小、又能真正投入使用的版本,检验最关键的假设。
开工前可以先写下两个问题:
- 这个版本要验证什么?
- 出现什么结果,就说明我们想错了?
Eric Ries 对 MVP 的解释 强调,用尽可能少的投入获得经过验证的认识。只有事先说明需要什么证据,做出第一版之后,才更容易判断应该继续完善,还是改变方向。
幻灯片有一句题眼:
The biggest risk in product development is building something nobody wants. (产品开发最大的风险,是做出没人要的东西。)
这正是刚才演示里发生的情况——AI 做出来的东西,绝大部分不是讲师要的。
一个具体而微的 MVP
个人助手的第一版不必包揽邮件、日程、浏览器和所有长期记忆。比如,可以先选择一个你每天都会遇到的场景:
- 记录一项偏好;
- 在下一次相关任务中使用它;
- 并允许你纠正。
这个版本可以很粗糙,但你能亲自观察它有没有帮忙、记忆有没有被正确利用、纠正之后是否真的改变了行为。
一旦开始使用,原先隐藏在形容词里的问题就会变得具体:
- "更主动一点"可能意味着每天固定时间提醒,也可能意味着只在发现明确的遗漏时提示;
- "更了解我"可能需要记住长期偏好,也可能首先需要学会忘掉一次性的指令。
真实使用产生的这些分歧,会反过来检验早期的规格和架构。
为什么 MVP 里往往先不用数据库
(参考时间: 01:33:00)
讲师给出了具体的工程论证:MVP 里可以没有任何数据库。
- 文件系统膨胀的时候,你可以直接跟 Agent 说"按这个方式帮我提炼出一个数据库",问题就结束了;
- 一旦带上数据库,每次数据库重构都需要让 Agent 做 database 迁移;
- 而文件系统不一样:你自己就可以在文件管理器里调整目录结构,逐渐梳理到舒服的结构。
你心 智负担不同:人类从小(小学上电脑课)就习惯在文件目录里操作,对这个模式非常熟悉;而面对一个 database schema 时,很多同学还没学过数据库课,根本不知道它是什么,需要强行做一次概念的翻译。不如用一个你已经适应、熟悉的系统。
讲师自己的例子:到现在,我自己回邮件的 Agent 都没有用任何数据库。我的流程是:Agent 收我的邮箱,把 email id 放到一个共享的云盘同步上;这个 email id 里会有 Agent 解析出的内容(我回复的草稿、邮件分类、是不是垃圾邮件),再由下一级流水线去处理。也就是说,先要明白系统里有哪几级流水线、它们之间怎么协作、哪些东西通过云盘。
因为我很喜欢云盘,就出现了新的需求:我希望邮件和资料等都和云盘保持同步——这就叫需求的更改。我现在不知道价格做得好不好,就让 Agent 帮我看一看。
这也让我想到:什么是一个好的软件架构? 你在当前时刻有一个需求,现在实现可能满足它;但当需求发生变更的时候,你相应做出的那个变化是摧毁性的、还是背上一笔技术债,就不知道了。
这正是"以不变应万变"的检验:你有没有一个能扩展的架构,当未来有别的需求(AI 模型变化、合作模式变化、AI 助教从文字变图像、有交互或无交互)时,以最少的变化去应对需求的变化。
这也恰恰是各门经典课程不直接讲的东西:操作系统课不教、数据库课不教——它们告诉你"操作系统长这样、数据库为什么这样设计、并发控制怎么做的",但软件工程最不一样的地方,就是对未来需求的变化。
版本管理做的三件事
如果要记住这两节课讲版本管理的核心,就记住三件事:
记住现在、记住历史、记住教训。
这个准则在 Agent 时代和古法编程时代都成立:
- 记住现在:你必须有一个 repository——不管是现在的一个 C / C++ / Python / JavaScript 项目,都需要把文件管起来;
- 记住历史:为了有一天这个东西不要了、或者删掉了某个东西,最终发现它有用,你还可以把它捞回来;
- 记住教训:在提交的历史过程中,你能看到你是怎么演进到一个点、发现它失败、回到另一个点、再开始另一条正确路线。这些 lessons 不停地警示你该怎么做,需要怎么样从第一步开始迈出向后的一小步。
选择哪种机制,要看共享资源、冲突频率和返工代价,而不能只看参与者是不是 AI。
收尾:下一个 Lab 与下一讲
- 下一个 Lab 会和这个 Lab 有非常大的关联,暂时猜不到是什么;你会发现你把实验一做好、成为非常舒适的个人助手之后,给你加一个和前面所有都关联、有一定冲突的需求,你会越改越崩溃;
- 下一讲(周日)会进入软件架构和构造的内容,并把今天讲的东西连起来;
- 如果实验一选择躺平、让 AI 直接做完、下一次再删掉重做,可能就没有这个软件工程的体验了。
今天下课。
附:参考与延伸阅读
以下讲义原文链接来自课程官方讲义(注明了出处文件);编者补充是撰写本书时另加的,不与讲义混淆。
讲义原文链接
- First-class Conflicts
lect4.html - Git Objects
lect4.html - Jujutsu
lect4.html - MVP 的解释
lect4.html - Rebase
lect4.html - Software Traceability: Trends and Future Directions
lect4.html - Technical Debt Quadrant
lect4.html - Working Copy
lect4.html - Yanyan's wiki
lect4.html - bisect
lect4.html - blame
lect4.html - git notes
lect4.html - worktree
lect4.html - 实验一
lect4.html - 术语说明
lect4.html - Creative Commons License: BY-NC 4.0
lect4.notes.md - 苏 ICP 备 2020049101 号
lect4.notes.md
编者补充
附录:课堂未展示的幻灯片
🖼️ 第 1 页幻灯片 · Review & Comments
🖼️ 第 3 页幻灯片 · 文件装得下什么?
🖼️ 第 7 页幻灯片 · 如果想重新设计版本管理系统?
🖼️ 第 17 页幻灯片 · 团队协作
🖼️ 第 18 页幻灯片 · 团队的复杂性
🖼️ 第 25 页幻灯片 · 早期的 Prompt,影响最大