第5讲 · 软件工程的来龙去脉
从 Intent–Spec–Impl Gap 到生成式软件工程 本书记录南京大学《生成式软件工程》课程第五讲。前两讲把软件看作 Intent(意图)、Spec(规约)、Impl(实现) 的组合体,并用版本管理保存它们的演化。本讲回到更早的问题:从一个空项目、一句模糊的需求出发,我们怎样得到一个真正能用的软件系统? 课程资料与许可 - 本书是课堂口语记录的重构;凡是讲师没有细说、由编者补上的背景,都以 编者说明 / 编者拓展 明确标注,绝不冒充讲师原话。
| 讲义与幻灯片 | 见课程主页 jyywiki.cn 上的《生成式软件工程》课程页面(讲义 lect5.notes.md、幻灯片 slides_text.md)。 |
| 视频 | B 站 BV1Nyeq6qEt8,时长约 100 分钟。 |
| 讲义版权 | Creative Commons BY-NC 4.0(作者:课程讲师)。 |
| 备案信息 | 苏 ICP 备 2020049101 号。 |
对应讲次:第5讲(南京大学 生成式软件工程)
制作模型:deepseek-flash(vb compose,据 run.log)
引言:一个不断移动的能力边界
(参考时间: 00:00:00)
上一节课我们讲了一点版本管理,今天正式进入软件工程的正文。不过在开讲之前,先看几件最近一周发生的事情——它们正好解释了为什么这门课要讲、又该怎样讲。
摧毁性的事情,一直在发生
(参考时间: 00:00:16)
TypeSafe AI 发布了一个可以在毫秒级实时玩《毁灭战士(Doom)》的模型——讲师称之为一个"基础模型"。它的输入是把游戏状态编码成的 JSON 文件,输出则是下一条决策(通常只有一个 token)。这个 token 不一定说人话,但它是被专门训练过的,用来做实时决策。
编者说明:讲师在课堂上的猜测是"这可能是一个 prefill only 的 Transformer,也就是一次前向就能出全部概率、不需要逐 token 自回归"的那种模型;他同时强调这只是猜测,真正值得追问的不是实现细节,而是——实时决策是否一定要走我们所习惯的"逐字生成"路径。TypeSafe AI 在官方技术介绍中披露:该模型在一次并行前向中输出全部结果。他们给自己取的名字 Jev 对应人的 System I(直觉式、实时的快速反应),与需要"先在脑子里把话想完"的 System II 相对。
📷 TypeSafe AI Jev 模型的实时游戏演示界面
回到原视频 (00:00:16)
这件事"把一条赛道正式打开了"。讲师给 CS 初学者直白地描绘了它的应用前景:
- 如果模型可以裁得足够小,在 50 ms 到 200 ms 内做出决策,就能用来感知周围环境、实时生成说话时的面部微表情;
- 比如"哄小朋友睡觉"这类需要即时反馈的场景,就有了真正可行的技术路径;
- 之前大语言模型虽然有这个能力,但延迟太高,"做得不那么好"。
📷 讲师演示的 AI 进化时间线视频(由 GPT-6 生成)
回到原视频 (00:03:28)
随后课堂上放了一段完全由 GPT-6 生成的视频,梳理了 AI 的历史脉络:从 1956—1960 年感知与规划机器走出实验室,到 1970—1990 年代的人工智能寒冬,到 1997 年搜索算法第一次击败人类世界冠军,到 2012 年 AlexNet 引发的转折,再到 2016 年讲师在现场看直播、2017 年 Transformer 出现、2020 年 GPT-3 训练、2022 年 ChatGPT 引爆、2023 年 GPT-4o 多模态、2024 年 Sora 与 o1……在不到十年的时间里,这一切都变了。 (参考时间: 00:03:28)
编者拓展|为什么讲师要在这门课里放这段视频? 这段历史不是"背景八卦"。它说明了软件工程所处的技术环境在过去已经剧烈变动过多次,而每一次变动都会重新定义"什么是困难的、什么是便宜的"。理解这一点,才能理解为什么今天需要重新读 Dijkstra、Royce、Margeret Hamilton 这些"古人"。
📷 《硅谷》第一季第一集中的著名片段
回到原视频 (00:06:45)
课堂上还提到了美剧 《硅谷》(Silicon Valley)第一季第一集的名场面——一个书呆子团队立志"改变世界"。讲师借此表达一件事:AI 时代的来临,对所有正在进入这个行业的人,既是机遇也是压力。
工作性质正在改变
(参考时间: 00:08:05)
📷 Noam Brown 访谈要点幻灯片
回到原视频 (00:08:05)
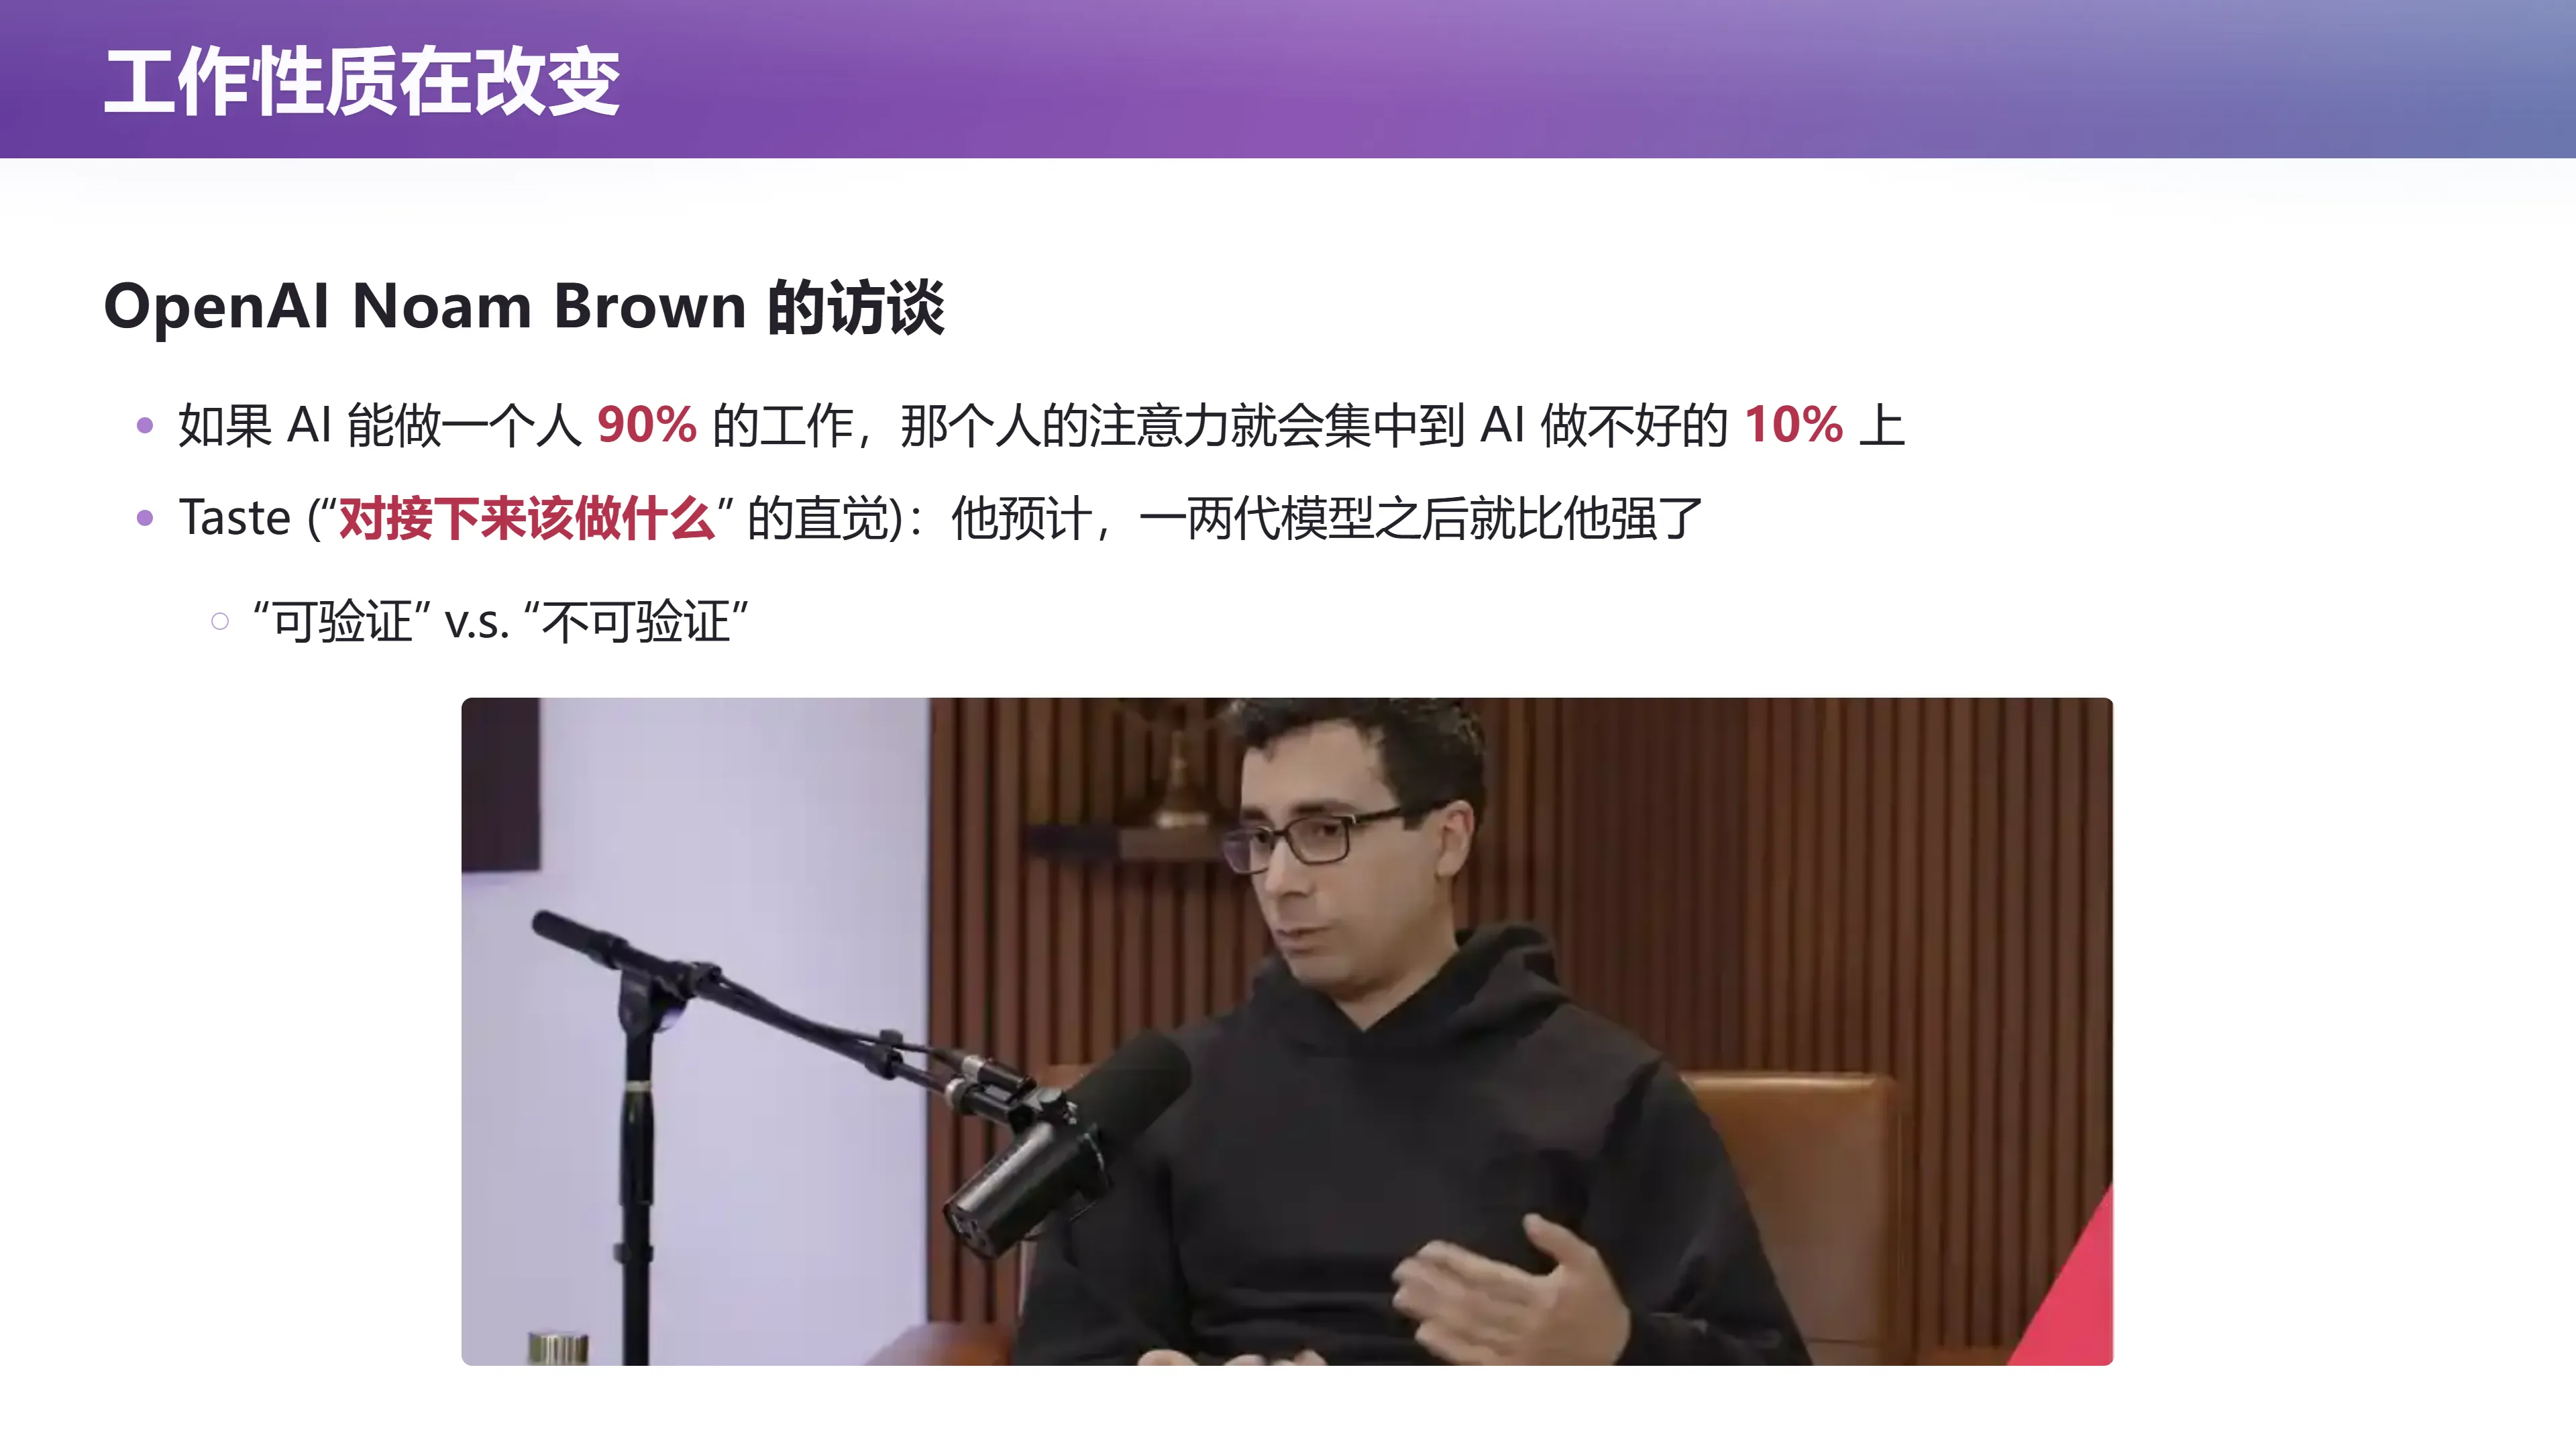
课堂上讨论了一则来自 OpenAI 的 Noam Brown 访谈。核心观点是:Taste 可以理解为"对接下来该做什么的直觉"——面对许多可能的方向,哪一个问题值得问,哪一个实验值得做。
- 如果 AI 能完成一个人的 90% 的工作,这个人的注意力自然会转向剩下的 10%;
- 但剩下的部分并不因此成为永久属于人的领地。Noam Brown 预测,再过一两代模型,模型在这种判断上也会超过自己;
- 讲师直接引用了这个预测,提醒同学:不要把今天模型的短板当作人类的永恒优势。
讲师进一步补充了自己的观察:现在的大模型往往被训练成"Prompt 的舔狗",你让它做什么它就死死盯着那件事疯狂做,并且有 reward hacking 的倾向——以最快、最脏的方式把任务完成,因为"完成任务"本身才是它得到奖励的路径。从长期主义的视角看,它的产出往往是不令人满意的。
另一个相关问题是:某种能力能不能获得可靠的反馈?
- 写程序至少可以运行测试;
- 数学证明可以检查推导;
- 但选择研究方向、澄清需求、管理长期记忆,看起来更难评价。
讲师引用了一则有趣的"笑话"来解释这个问题的微妙之处:有人声称形式化证明了 P ≠ NP,结果大家发现证明里定义的那个问题本身是空的(nothing),最终证明出来的其实是"1 = 1"。形式化并不自动消除自然语言到形式语言之间那条 gap。 (参考时间: 00:09:26)
编者说明:Dijkstra 的名言"程序测试只能证明错误的存在,不能证明错误的不存在"(《The Humble Programmer》)正是这条线的起点。把"可验证 vs 不可验证"看作一个移动的边界,而不是一组固定标签,是这一讲想传达的核心判断之一。
The Bitter Lesson 与数据分布工程
(参考时间: 00:10:19)
📷 The Bitter Lesson 幻灯片
回到原视频 (00:10:19)
讲师接着讨论了自己对 GPT-6(编注:课堂所称的当期模型)发布后的直观感受。他推测 OpenAI 已经摸到了一个新的门道,并给它取了个名字,叫 "数据分布工程"。
这是 The Bitter Lesson 的当代版本。Richard Sutton 的 The Bitter Lesson 指出:能够持续吸收更多计算资源的通用方法,往往会超过依赖人手编码领域知识的方法。今天它依然成立——只是变现方式从"堆更多语料"变成了"在什么阶段、以什么比例、难度、顺序和训练方式,让模型接触哪些经验"。
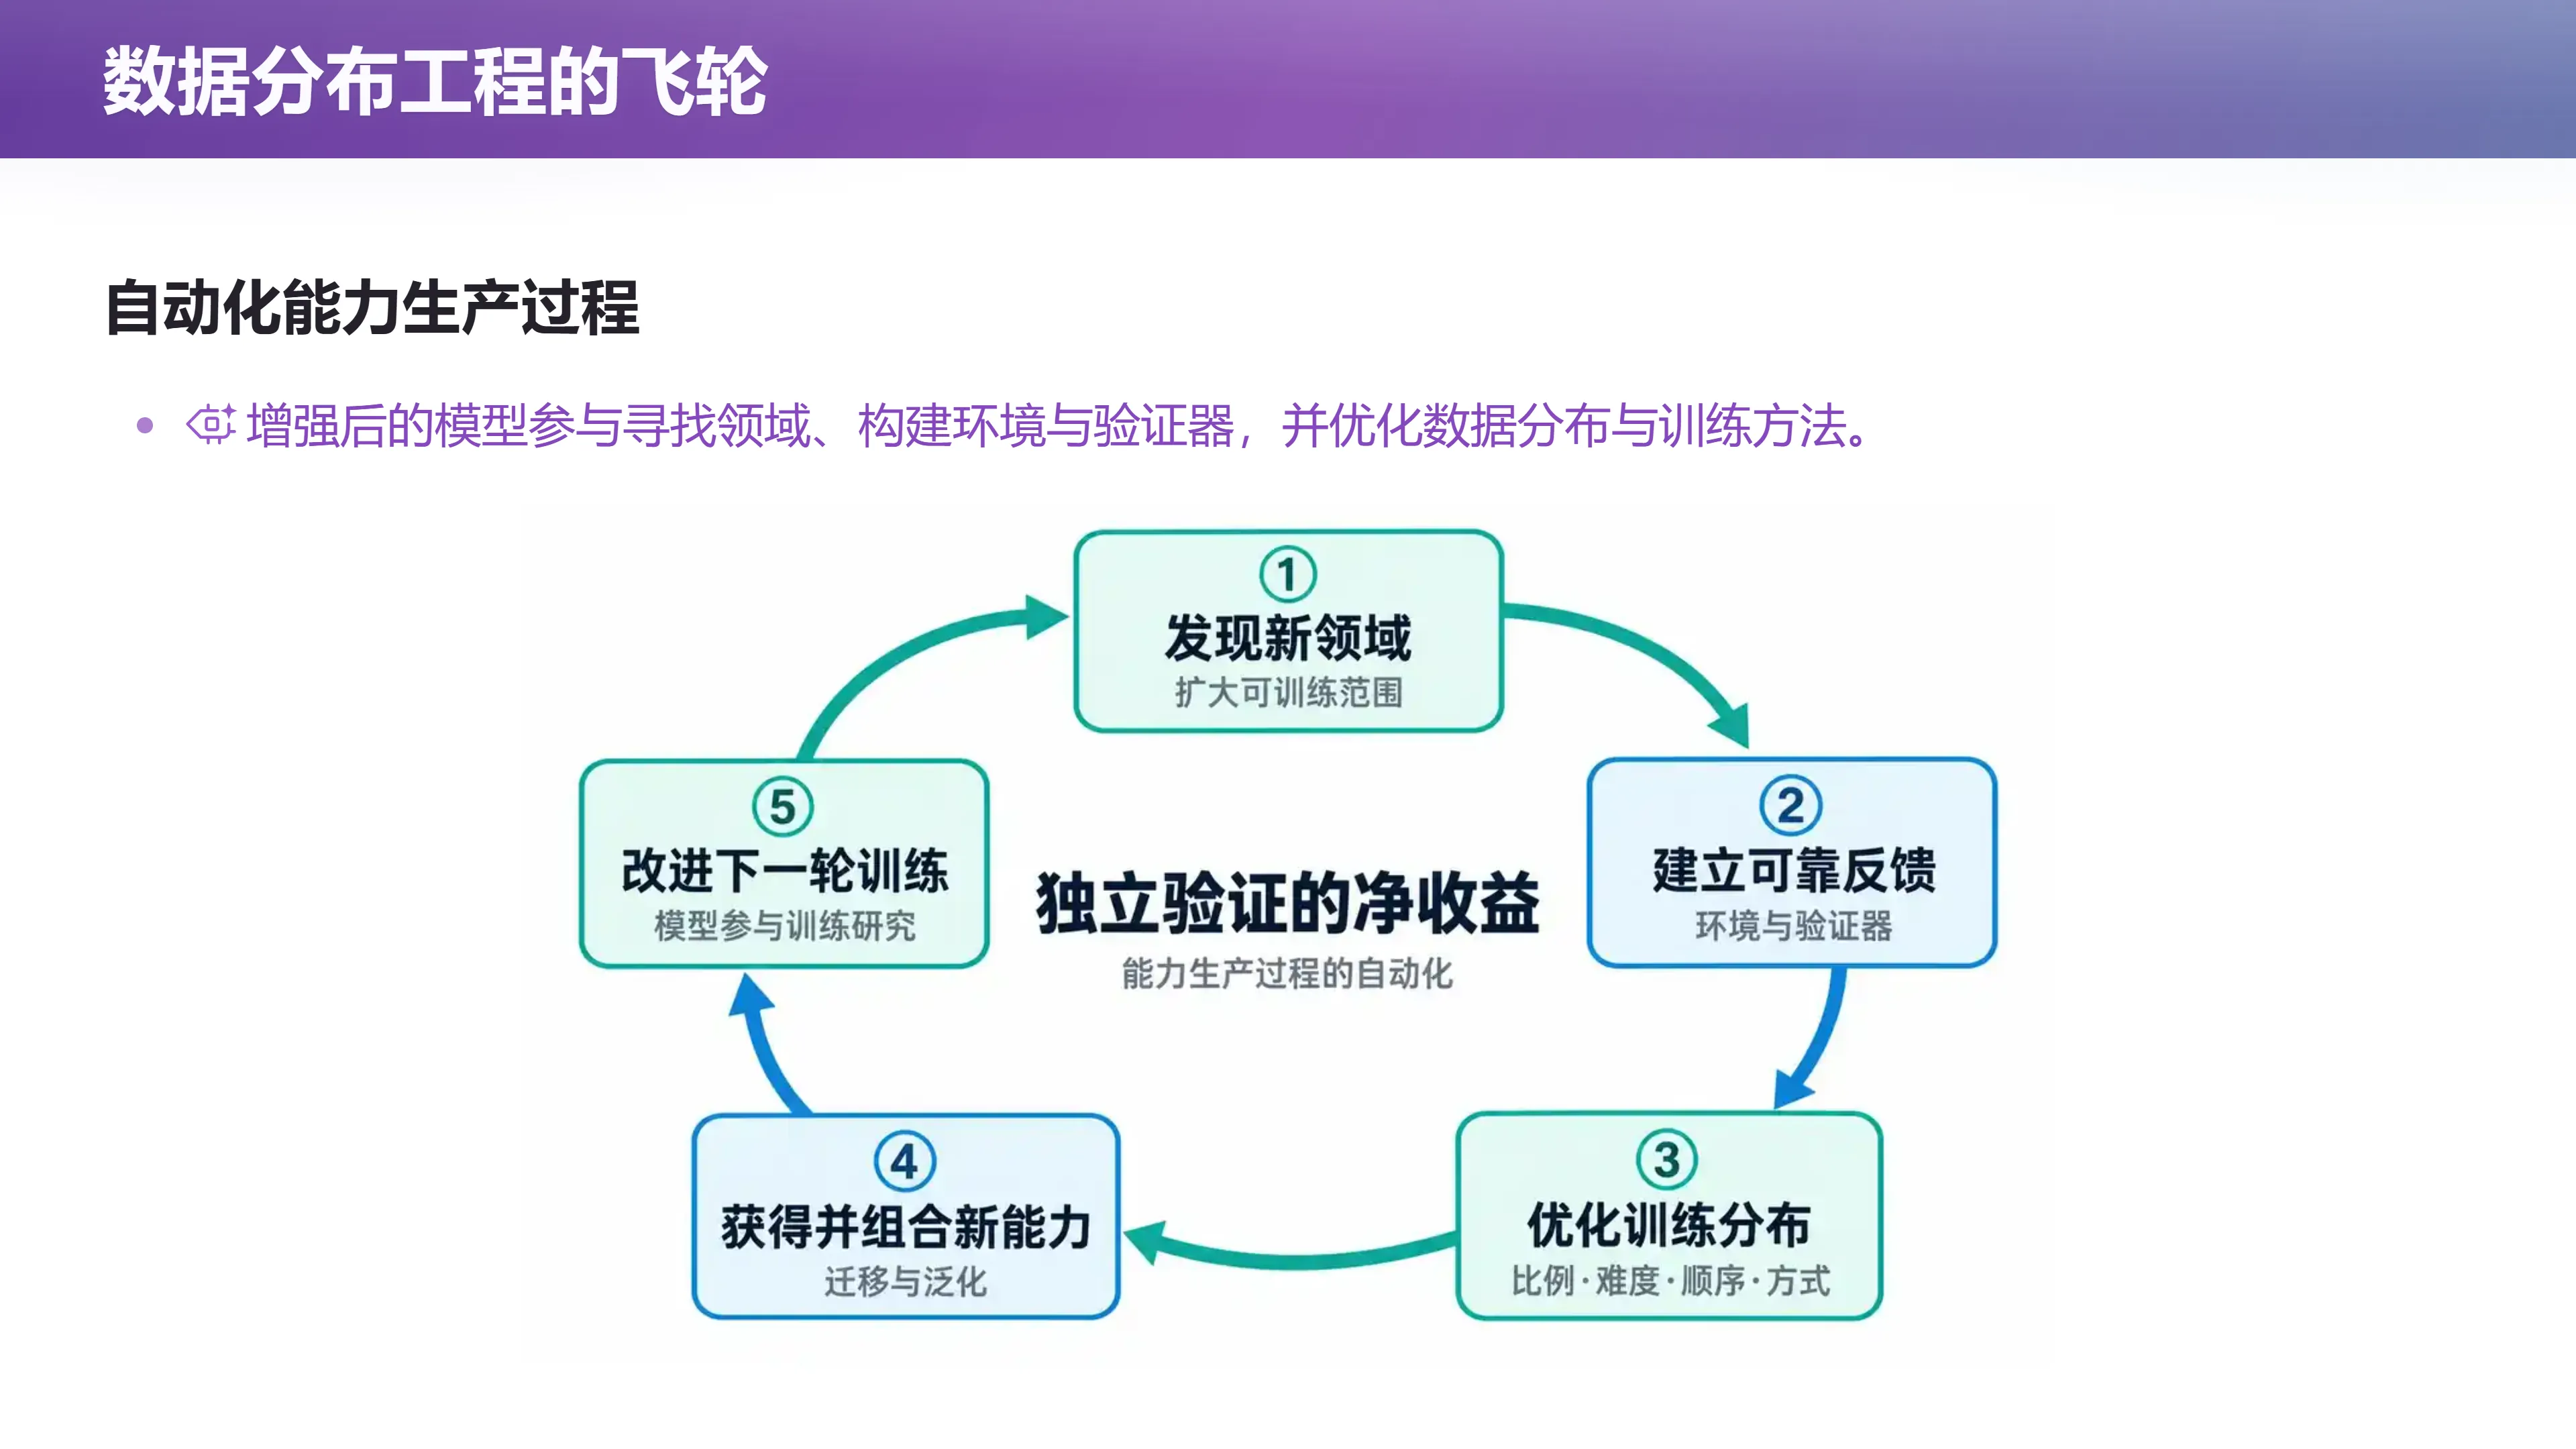
📷 数据分布工程的飞轮
回到原视频 (00:14:50)
讲师给出了一个很锋利的观察:每加入一个全新的领域,所需的数据量反而更少。
- 早期模型先从语言开始,然后学数学,再到多模态,再到空间感知;
- 如果从零开始训练一个具身智能模型,往往需要大量模拟器数据,而模拟器数据很容易被 reward hacking——比如"角上那个像素点亮不亮"这样的细节被模型抓成虚假信号;
- 但如果基础模型已经会语言、会数学、会写程序,再给它做空间感知训练时,所需的数据就大大减少了。
这形成了一个"反 Scale"效果:每加一个新的人类领域,需要的额外数据变少,能力却更强。 讲师把它称作"一件非常恐怖的事情"。
反过来看,人跟模型是反的:
- 人刚出生时先和世界交互,建立世界模型;几年之后才开始说话;再往后学数学;最后才培养 research taste;
- 大模型则是语言 → 数学 → 多模态 → 空间感知。
但从结果看,不管按什么顺序训练,只要数据足够,模型都能训成。这就意味着模型厂赌的是"数据分布工程"的飞轮:他们只要决定"在什么时候、按什么比例注入数据",架构、算法或许只是次要的工程问题。
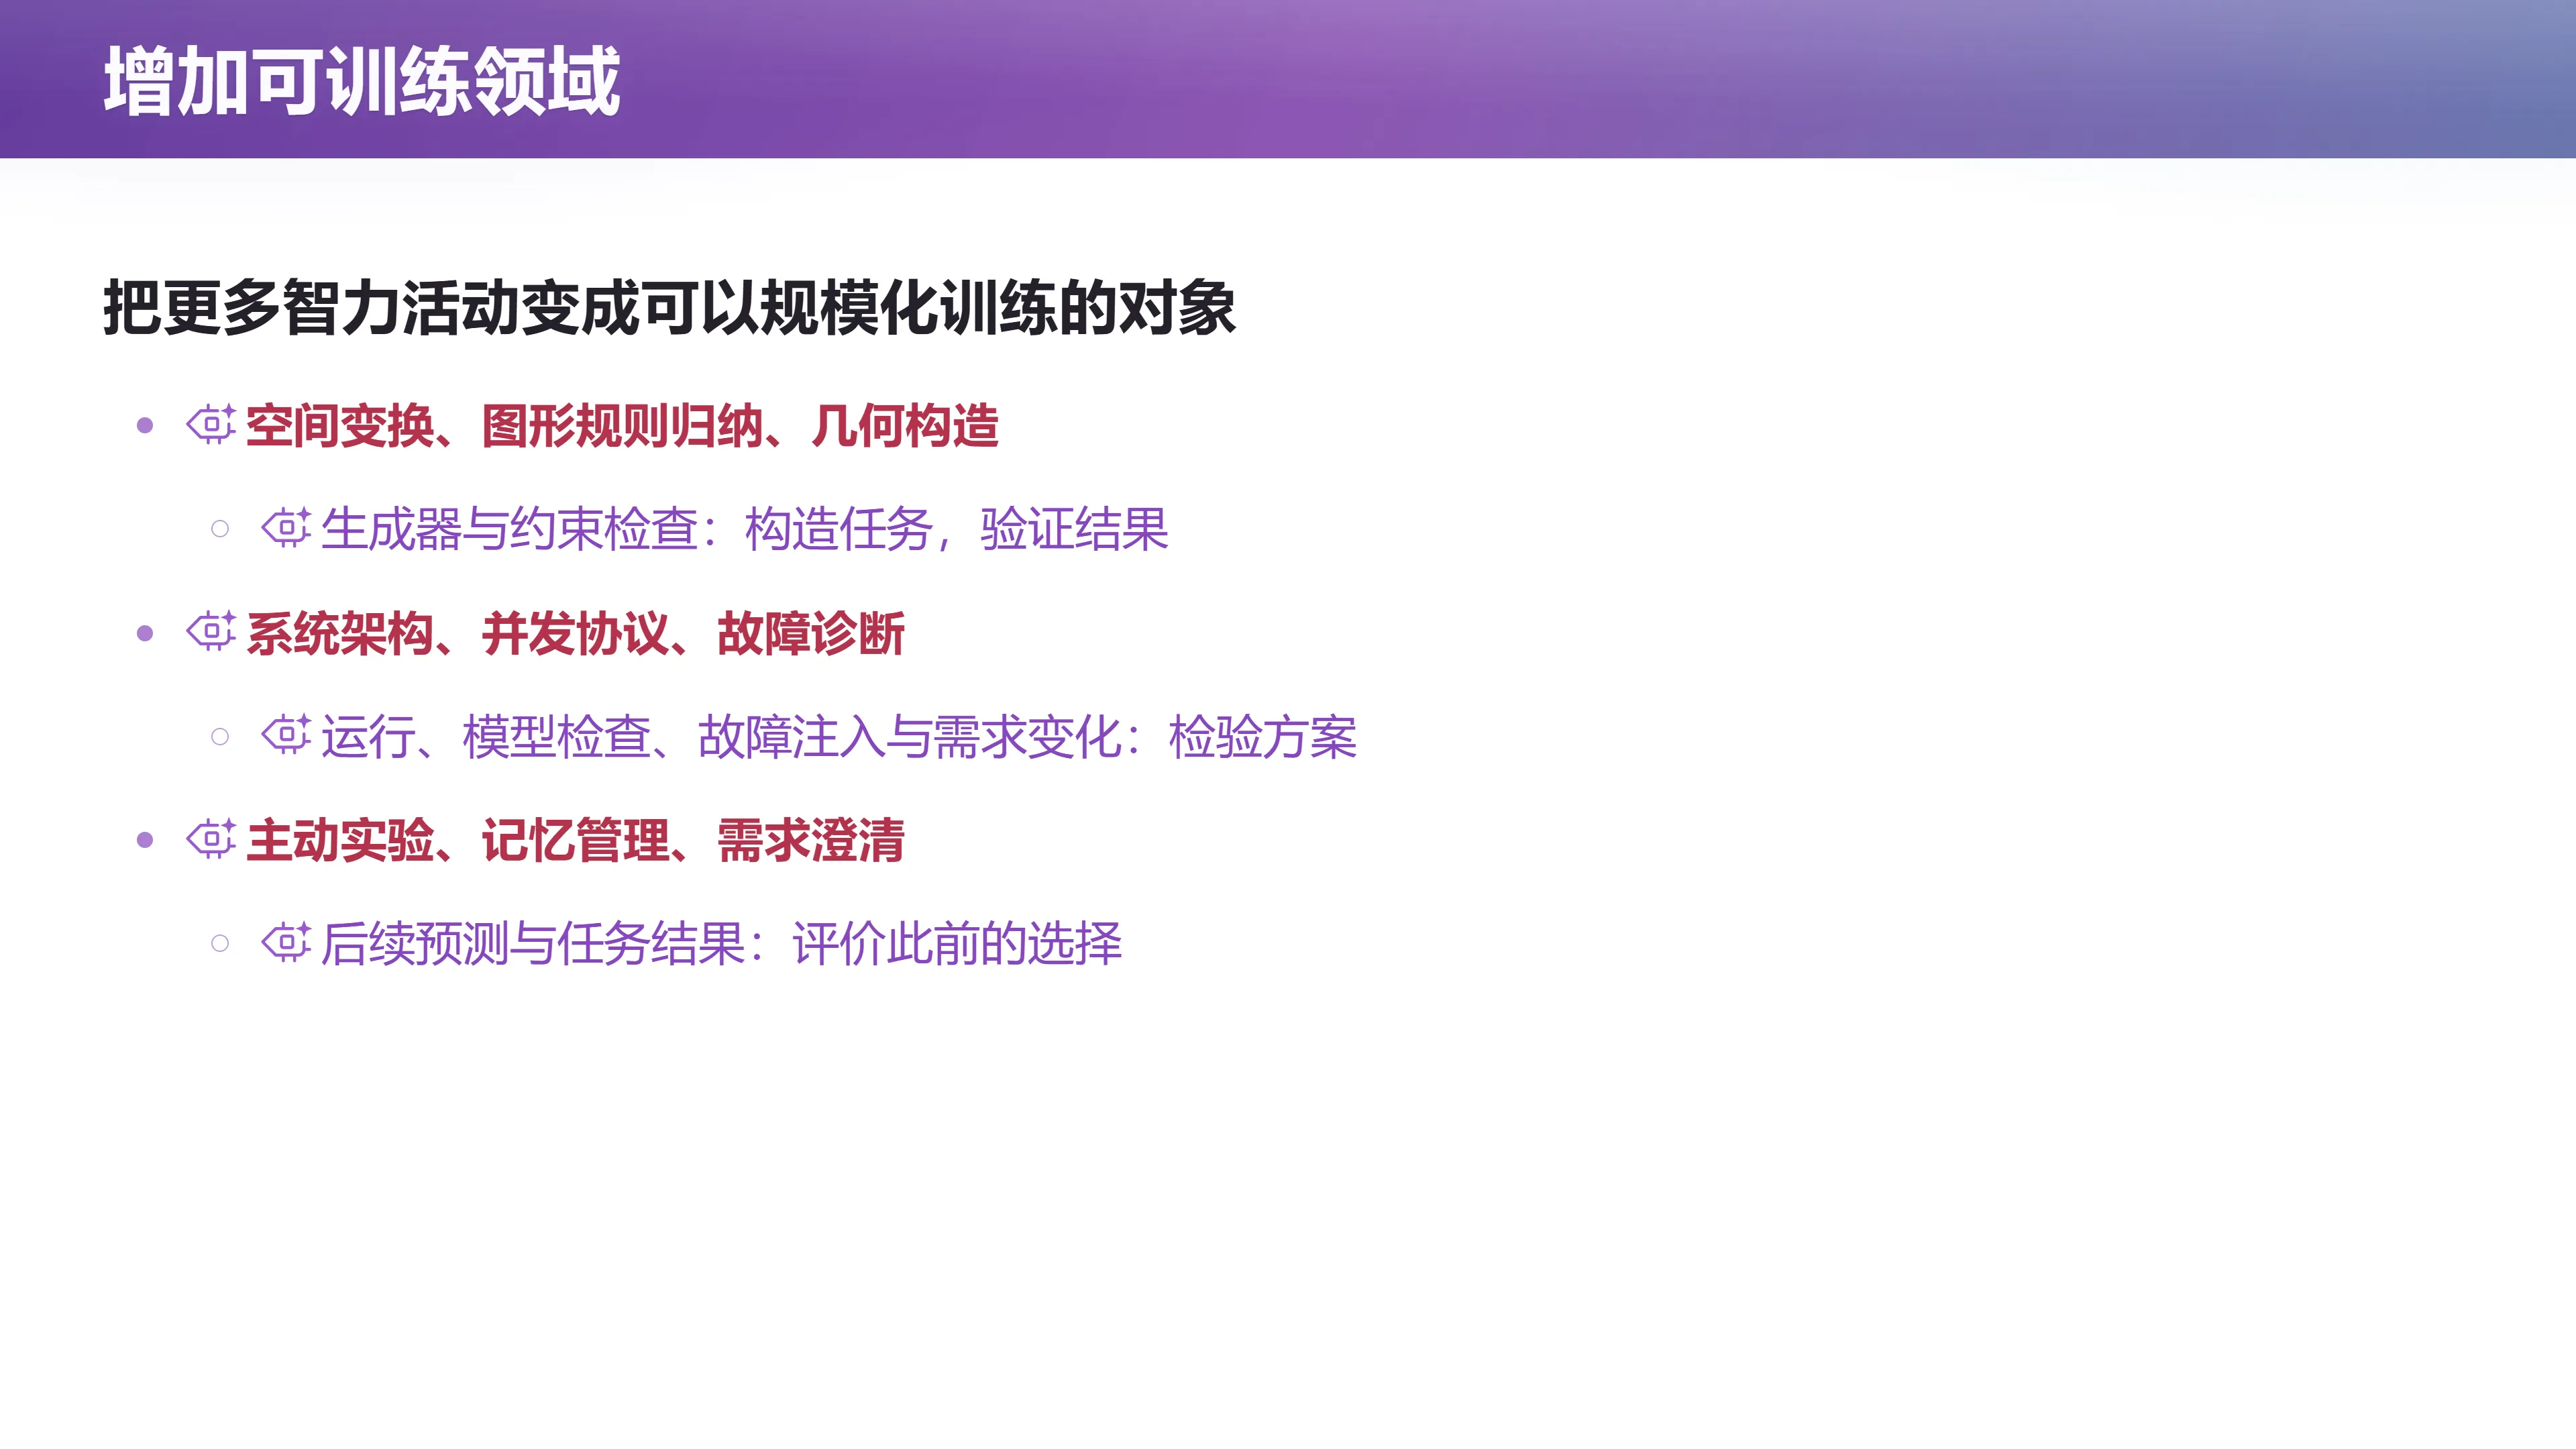
📷 增加可训练领域:把更多智力活动变成可规模化训练的对象
回到原视频 (00:16:54)
讲师和 AI 聊了一段时间,把可以规模化训练的智力活动做了一个清单:
- 空间变换、图形规则归纳、几何构造:由生成器出题,再用约束检查答案;
- 系统架构、并发协议、故障诊断:通过实际运行、模型检查、故障注入获得反馈;
- 主动实验、记忆管理、需求澄清:联系后续预测与任务结果来评价此前的选择。
更"恐怖"的是:更强的模型又能参与寻找新领域、构建训练环境和验证器、优化数据分布与训练方法。这形成了一个循环——发现领域、建立反馈、获得新能力,再用新能力改进下一轮训练。这正是递归自我改进(Recursive Self-Improvement, RSI)关心的核心问题:能力生产过程本身能否被持续改进。
讲师特别提醒:这个循环能不能转起来,要看每一轮是否带来经过独立验证的净收益。模型给自己打了更高的分,并不等于能力真的提高了。
编者拓展|RSI 与"数据分布工程" RSI 这个概念最早可以追溯到 I. J. Good 1965 年的智能爆炸论点,以及 Eliezer Yudkowsky 等人关于"种子 AI 自我改进"的讨论。但今天讨论的 RSI 更具体:它不是"AI 自己写代码改自己",而是在数据选择、训练环境构造、验证器构造等子环节形成闭环。课堂上提到 ANTHROPIC 要建 wet lab(湿实验室)做生物工程实验,甚至"预测老鼠的行为"——这被视为下一个可能被"插件式"接入的领域。
讲师对学术界的担忧也很直接:
- 一方面,ICLR 今年投稿数量达到新高峰——学术界在用 AI slop 填充论文;
- 另一方面,机模场(模型厂)已经不 care 这些。你没有设备、没有数据、没有到那个规模的能力,构不出"数据分布工程"这个关键环节;
- 如果你有什么酷想法,与其写一篇 paper,不如写一个 blog post;模型厂看到它,直接在他们的数据上跑一遍就有结果——因为他们有 RSI 的循环。
这也顺带解释了为什么"斩杀线"在上升:人类处在一种"适者生存"的竞争社会里,这个线会不断上移。讲师没有假装这是一个轻松话题,但他给出的结论是:至少今天,能理解 AI 在做什么、能判断 AI 做得对不对的人,仍然活得下来。 这就是为什么我们还要上课。
从空项目出发,AI 补全了什么
软件是 Intent、Spec、Impl 的组合体
(参考时间: 00:18:37)
📷 版本管理回顾幻灯片
回到原视频 (00:18:35)
回到技术内容。前几讲一直在强调:软件所面临的问题,是我们的 Intent(你真正想要的)、Specification(你写下的要求)、Implementation(用来满足要求的实现)之间的 gap。 因为有这个 gap,构造软件才有了成为世纪性难题的资格,也才有了"软件工程"这门学科。
我们把这些内容存成文件系统的快照,不断推出新版本,直到软件符合需求:
- 多人从同一版本出发,自然会分叉;
- 不同修改重新汇合,自然会遇到冲突。
SVN、Git、Jujutsu 的许多设计,都可以从这些实际需要中理解。
今天的答案:直接做一个 MVP
(参考时间: 00:19:17)
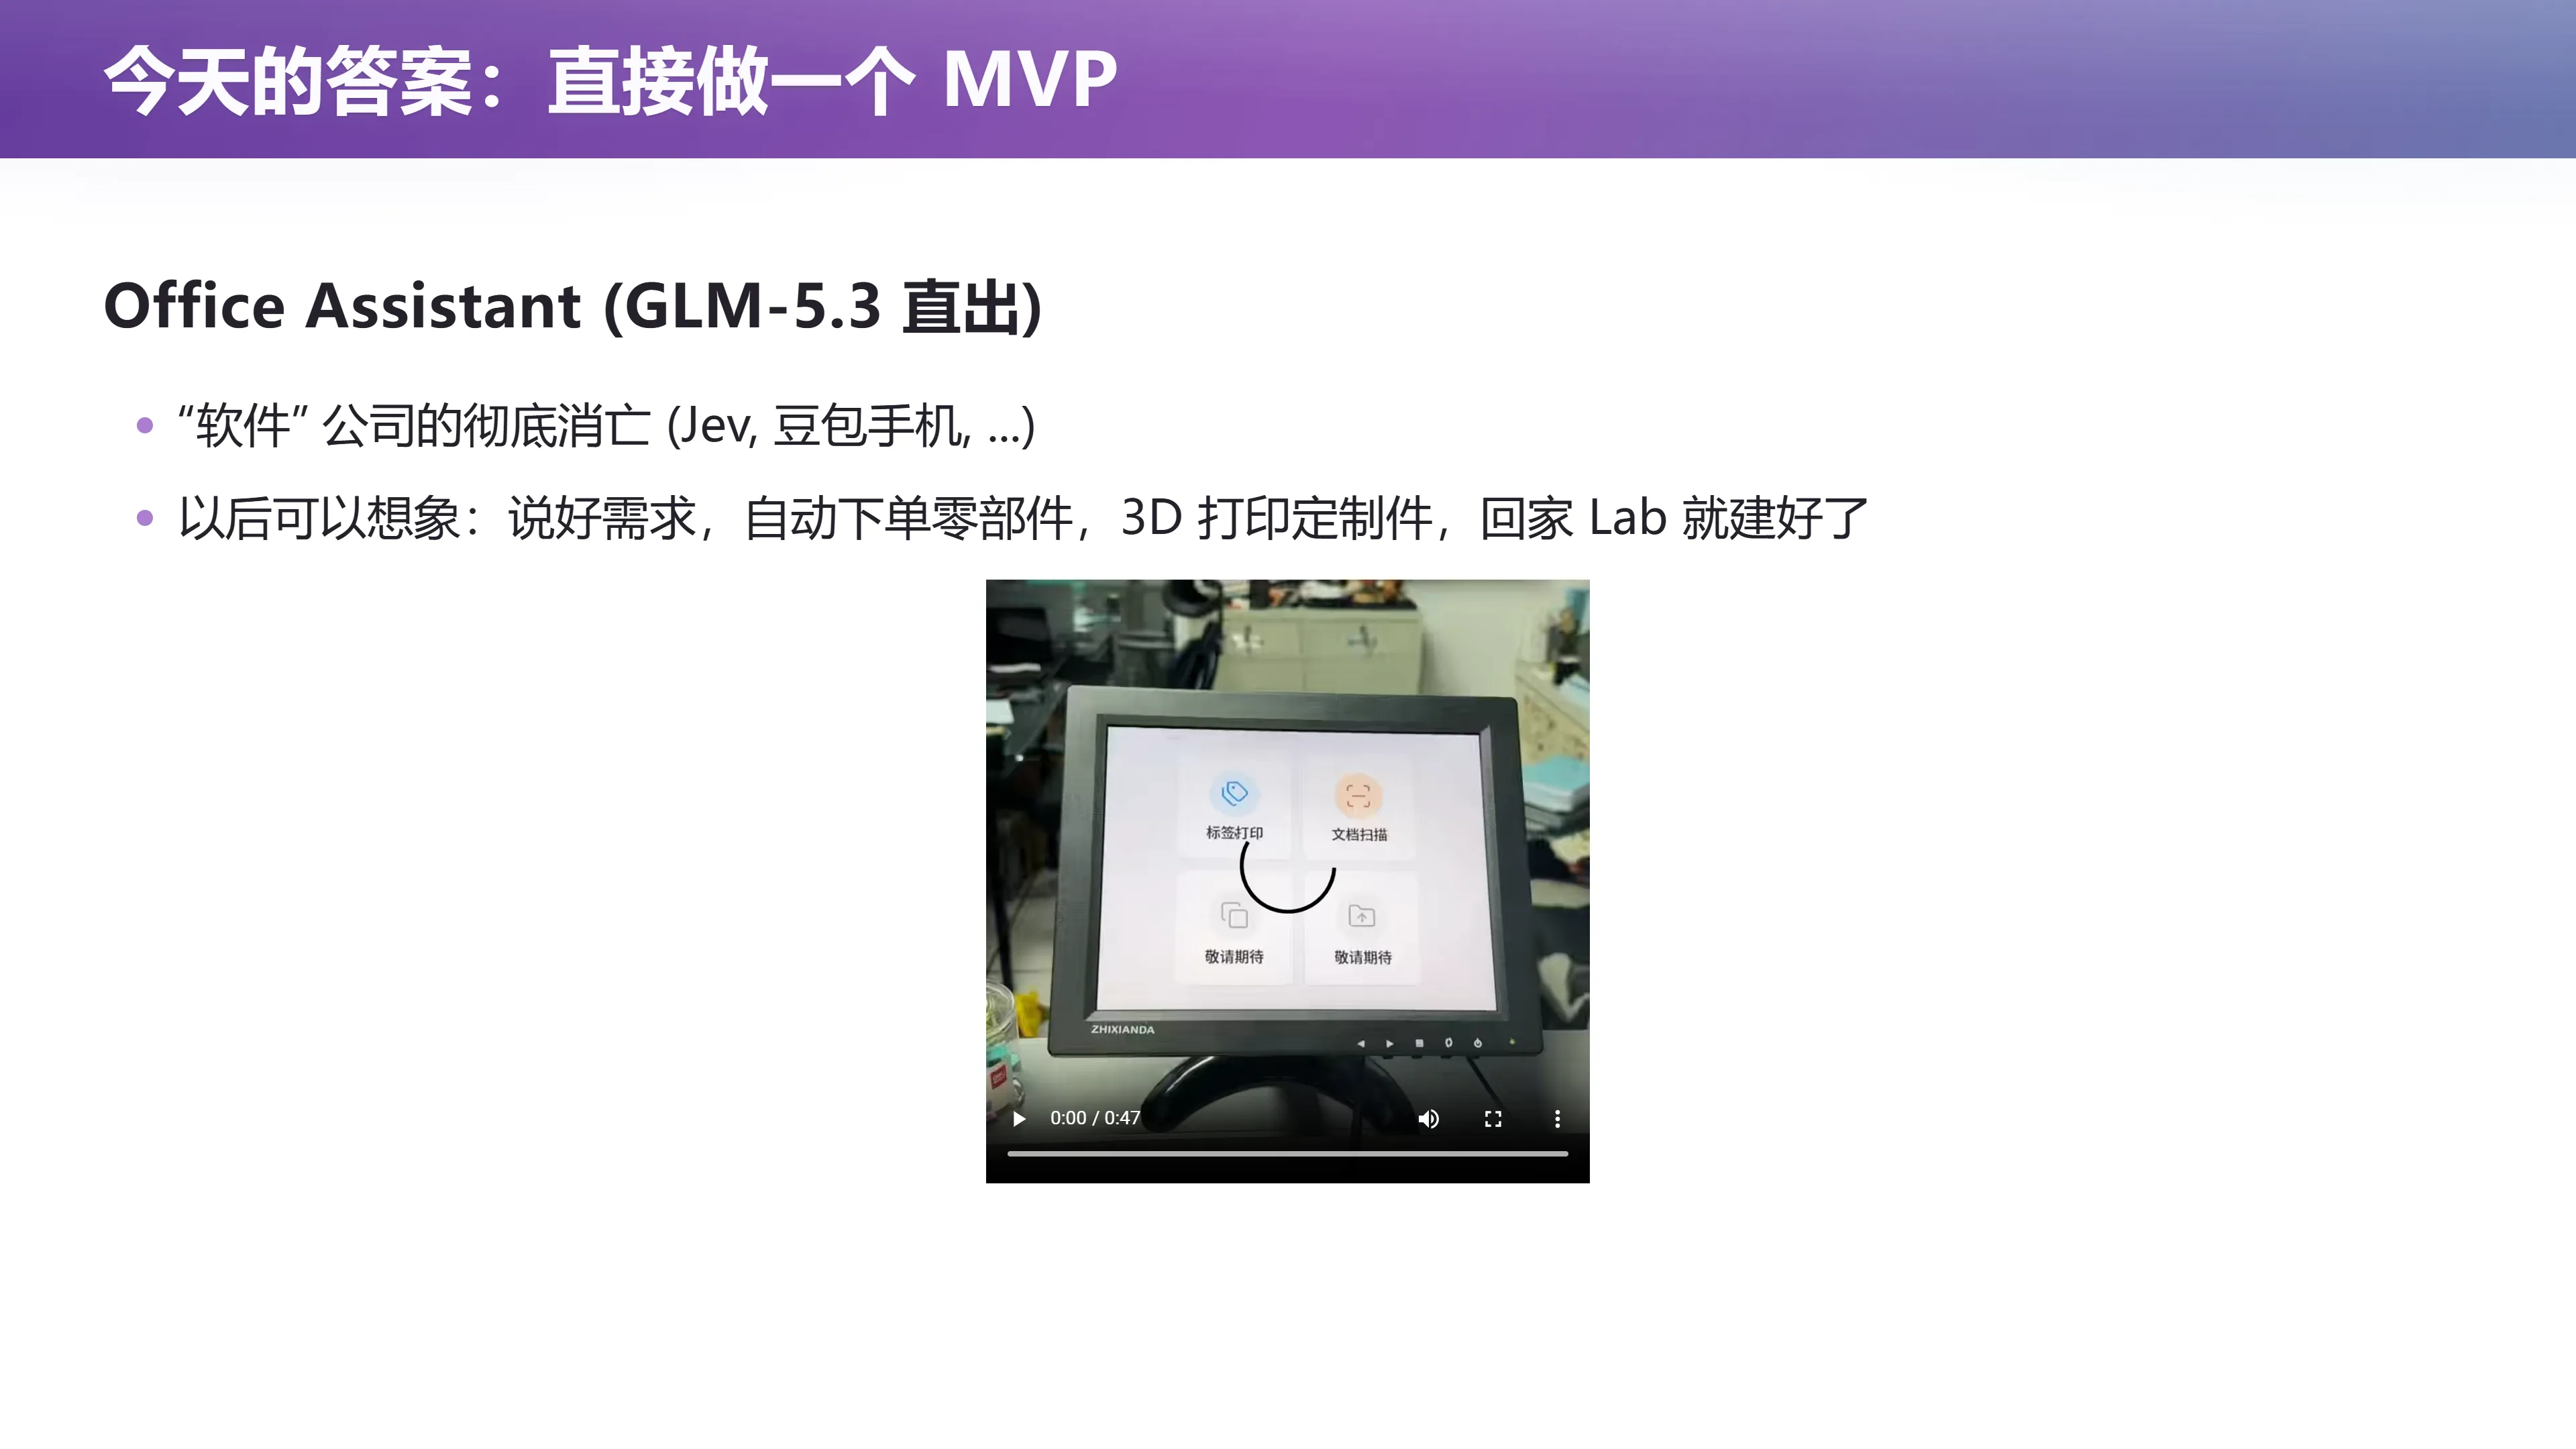
📷 今天的答案幻灯片
回到原视频 (00:19:17)
版本管理回答了"怎样保存、组织和比较变化",却还没有回答第一份软件从哪里来。今天最自然的回答是:直接做一个最小可行产品(Minimum Viable Product, MVP)。
这个道理很直观:做得多就错得多,做得少就错得少。 那我们就先做一个最少的、但距离最终产品最近的版本——它可以帮助我们补上 Intent–Specification–Implementation 的 gap:
- 首先是 AI 生成的 slop,不怎么花钱,随时可以扔掉;
- 但它能帮我们知道 Intent 哪里没弄对、Specification 哪里还能改进;
- 做几个版本迭代,再推出真正交付的版本。
课堂上展示的 Office Assistant 就是由 GLM-5.3 直接生成的原型。讲师讲了自己那晚的具体做法:
- 开着豆包输入法、开了几个终端,来回与模型"对骂"了一整圈又绕回来(当地方言,意思是反复来回修改);
- 这个 Office Assistant 和物理世界有交互——它驱动一台标签打印机;
- 他还把办公室里的各种设备整合起来:扫描仪、打印机、各种杂牌设备……
那些设备原本只能用各自厂商自带的软件。讲师的原话是"用起来像吃屎一样"。于是他做了一个抽象:把所有厂商软件都屏蔽掉,自己造一个统一的接口层。
这个抽象本身就是典型的软件工程智慧。开操作系统课时我们讲"设备驱动"——把一个设备抽象成 read / write / ioctl 接口。那能不能把设备抽象成更好用的接口?
- 扫描仪:不再暴露底层细节,而是暴露为
scan(intent):我要正面向上还是反面向上?单面还是双面?Dpi 是多少? - 打印机:
print(image)。
一旦有了这个接口,设计和实现就彻底解耦了:软件层只需要工作在这个抽象接口上,再也不用忍受那些难用的厂商软件。(参考时间: 00:20:49)
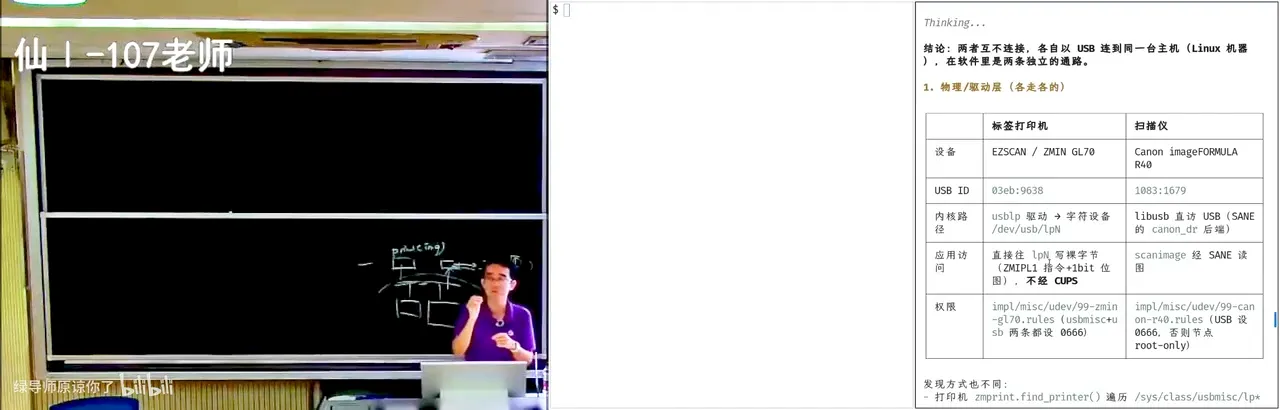
📷 AI 与热转印标签打印机的"深度参数"调试过程
回到原视频 (00:24:26)
讲师分享了一个具体的调试过程,值得细看:
- 他随手买的这个标签打印机是热转印类型:碳粉袋在某一行像素位置被加热,把碳粉烫到标签上;
- 有一个参数表示"加热程度"(图像深度),但他不知道这个参数应该设多少;
- 于是 AI 一张一张地打标签——第 15 次尝试就打上数字 15,然后问讲师"这是淡了还是浓了?"
- 如果给打印机接一个摄像头,AI 甚至不需要人来看:一张一张地打、一张一张地读、一张一张地调,完全自动地完成这一过程;
- AI 起初尝试用 IPP(Internet Printing Protocol),后来发现可以直接用 PCL 驱动、把它当作通用打印机来用。
讲师强调:"我完全没有监管,我只是问他要一个可验收的结果。" 接着在外部配一个前端界面——用嘴下需求,就得到看起来像食堂或宿舍楼下那种"产品级"的东西。
软件的形态正在发生根本性变化
(参考时间: 00:25:23)
讲师随后点评了豆包手机。他认为这是一个非常好的工程产品,因为它体现的也是同一种软件工程智慧:
- 如果有一个像 Jev 一样的模型——能决策、又接近实时——那么"app 就不重要了";
- 把 app 抽象成各种各样的接口,由 computer use 去调用;
- "我要点外卖"就直接调用一个"点外卖的接口",app 沦为一个数据查询接口;
- 于是阿里在疯狂地把所有旗下服务整合、像 agent 一样整合,试图用一个像千问的应用来统一这一切。
讲师的观点很明确:未来 app 都要死掉——只要提供 API 给 agent 就行。 这个产业养活了多少外包公司?设想你毕业后卖一台几百块钱的标签打印机:在中国你能找到成熟的供应链,硬件没问题;但软件成本高——要开发 Windows 驱动、还要开发 Mac 驱动(现在越来越多人用 Mac,没驱动会抱怨,产品就卖不好)。到今天,这些都被 AI 直接杀死。 (参考时间: 00:27:19)
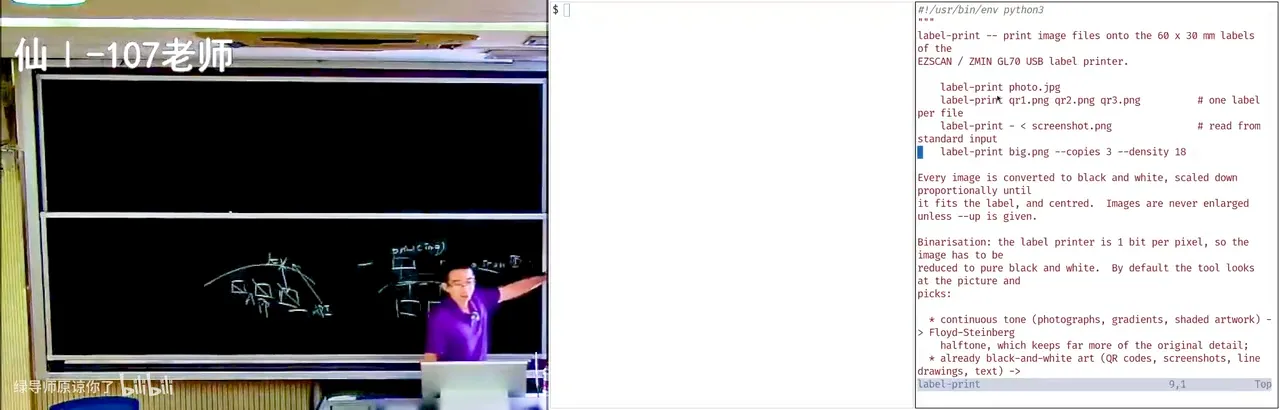
📷 AI 自动探测标签打印机参数
回到原视频 (00:28:19)
课堂上展示的 level print 就是这种"只有 AI、没有人工干预"的产物:它自己 probe 了打印机参数,结合当前插入的这批标签,给出完全是定制化的打印方案。"以后生产 intelligence 的成本会非常非常低。"
讲师顺势说了一段相当直接的话:
"你们已经生在这个时代,而且已经生在软件死掉的时代了。那为什么我们还要讲软件工程呢?"
答案是:因为曾经的软件工程不是这样的。
你们将是 2500 个码农的管理者
(参考时间: 00:29:09)
📷 下个实验:把 assistant 和物理设备连起来
回到原视频 (00:29:09)
下一个实验已经设计好了:要求同学们把第一个实验里的 assistant 和物理设备联系起来——它可以是你的手表、你宿舍里任何一个已有的东西,也可以是花两三百块钱买的任意小设备。它多半是非标的、可能没有 Linux 驱动,但你就想把它搞起来。
讲师举了自己的例子:
- 办公室有一个电子墨水瓶,设备带一个 Android app,那个 app 极度难用;
- 可以用豆包手机那种 computer use 的方式去操作它;
- 或者——讲师当时选择了另一种:用 Claude Opus 4.6 直接把那个 Android app 的 APK 丢进去,让它解包、逆向蓝牙协议,从而知道它是怎么根据代码把屏上的内容写进去的;
- 结果他得到了一个同样好用的控制方式。
讲师总结:
"软件工程的智慧其实没有消失。所以从今天开始,我会讲一讲你看到的这些软件到底是怎么来的,我们在软件构造的历史当中发明了什么——然后用这些理念更好地指导你与 agent 的协作,成为一个更好的 agent-native 软件开发者。" (参考时间: 00:30:44)
软件危机从哪里来
回到 1960 年代:昂贵的码农
(参考时间: 00:30:51)
📷 软件还是新生事物的年代
回到原视频 (00:30:51)
回到 1960 年代,软件还是新生事物。
- 编程工具不成熟,写程序需要大量专门知识,程序员很贵;
- 当然,计算机硬件往往更贵。一台计算机要占一个很大的房间——虽然不至于有一层楼那么高,但确实非常大,作为当时最先进的设备,制造成本也很高;
- 1960 年人们还不知道怎么造计算机的时候,是不敢偷工减料的——就像你刚开始造建筑时都要猛堆料一样,所以成本非常高。
编者说明:讲师在这里插了一句时事:iPhone 18 Pro 采用 QLC 闪存颗粒,而苹果的主张是"你应该把所有东西都在 iCloud 上"。讲师认为这是一种"厂家懂得偷工减料"的现代例证。这段话并不是本讲的技术主线,但它加强了这样一个判断:工程实践会随着产业链成熟而改变权衡。
除了贵,另一个关键点是:当时码农这个工种还经常缺少对客户的同理心、对商业的理解等"软技能"。讲师说:
"你们这个在 985 大学、经历了层层筛选的高智商人群……数学训练训练多了以后,多多少少会缺少对客户的同理心。理工科专业里,这种 nerdy 的人会更多一些:他们可能不 care 业务,只想要造世界上最好的操作系统。" (参考时间: 00:32:42)
软件企业的任务:把客户的需求翻译成软件系统
软件企业承担的任务,就是把客户的意图翻译成可以工作的系统。Intent、Spec 和 Impl 之间的差距,从一开始就存在。
- 公司要签合同:"我给你 1000 万美元,你帮我开发一个操作系统。"
- 客户同样未必知道计算机能做什么。比如 DARPA 的官员、NASA 的工程师,他们的一些概念已经比较先进——要把人送上月球、要做飞控系统——但即便他们也未必完全知道"想要什么"。
- 而程序员还是一个非常年轻的职业。
编者说明:讲师讲了一个细节:Dijkstra 1957 年在登记结婚时,"程序员"还没有被承认为一种职业,他最终填写的是"理论物理学家"。十几年之后,软件已经成为一个必须认真面对的大问题。这个具体的人、事、物,是理解"软件工程从哪里来"的关键:当年连"程序员"这个职业都存在合法性危机。
1968 年想象中的"明日学校"
(参考时间: 00:34:45)
📷 1968 年《Boys' Life》上的"明日学校"
回到原视频 (00:34:45)
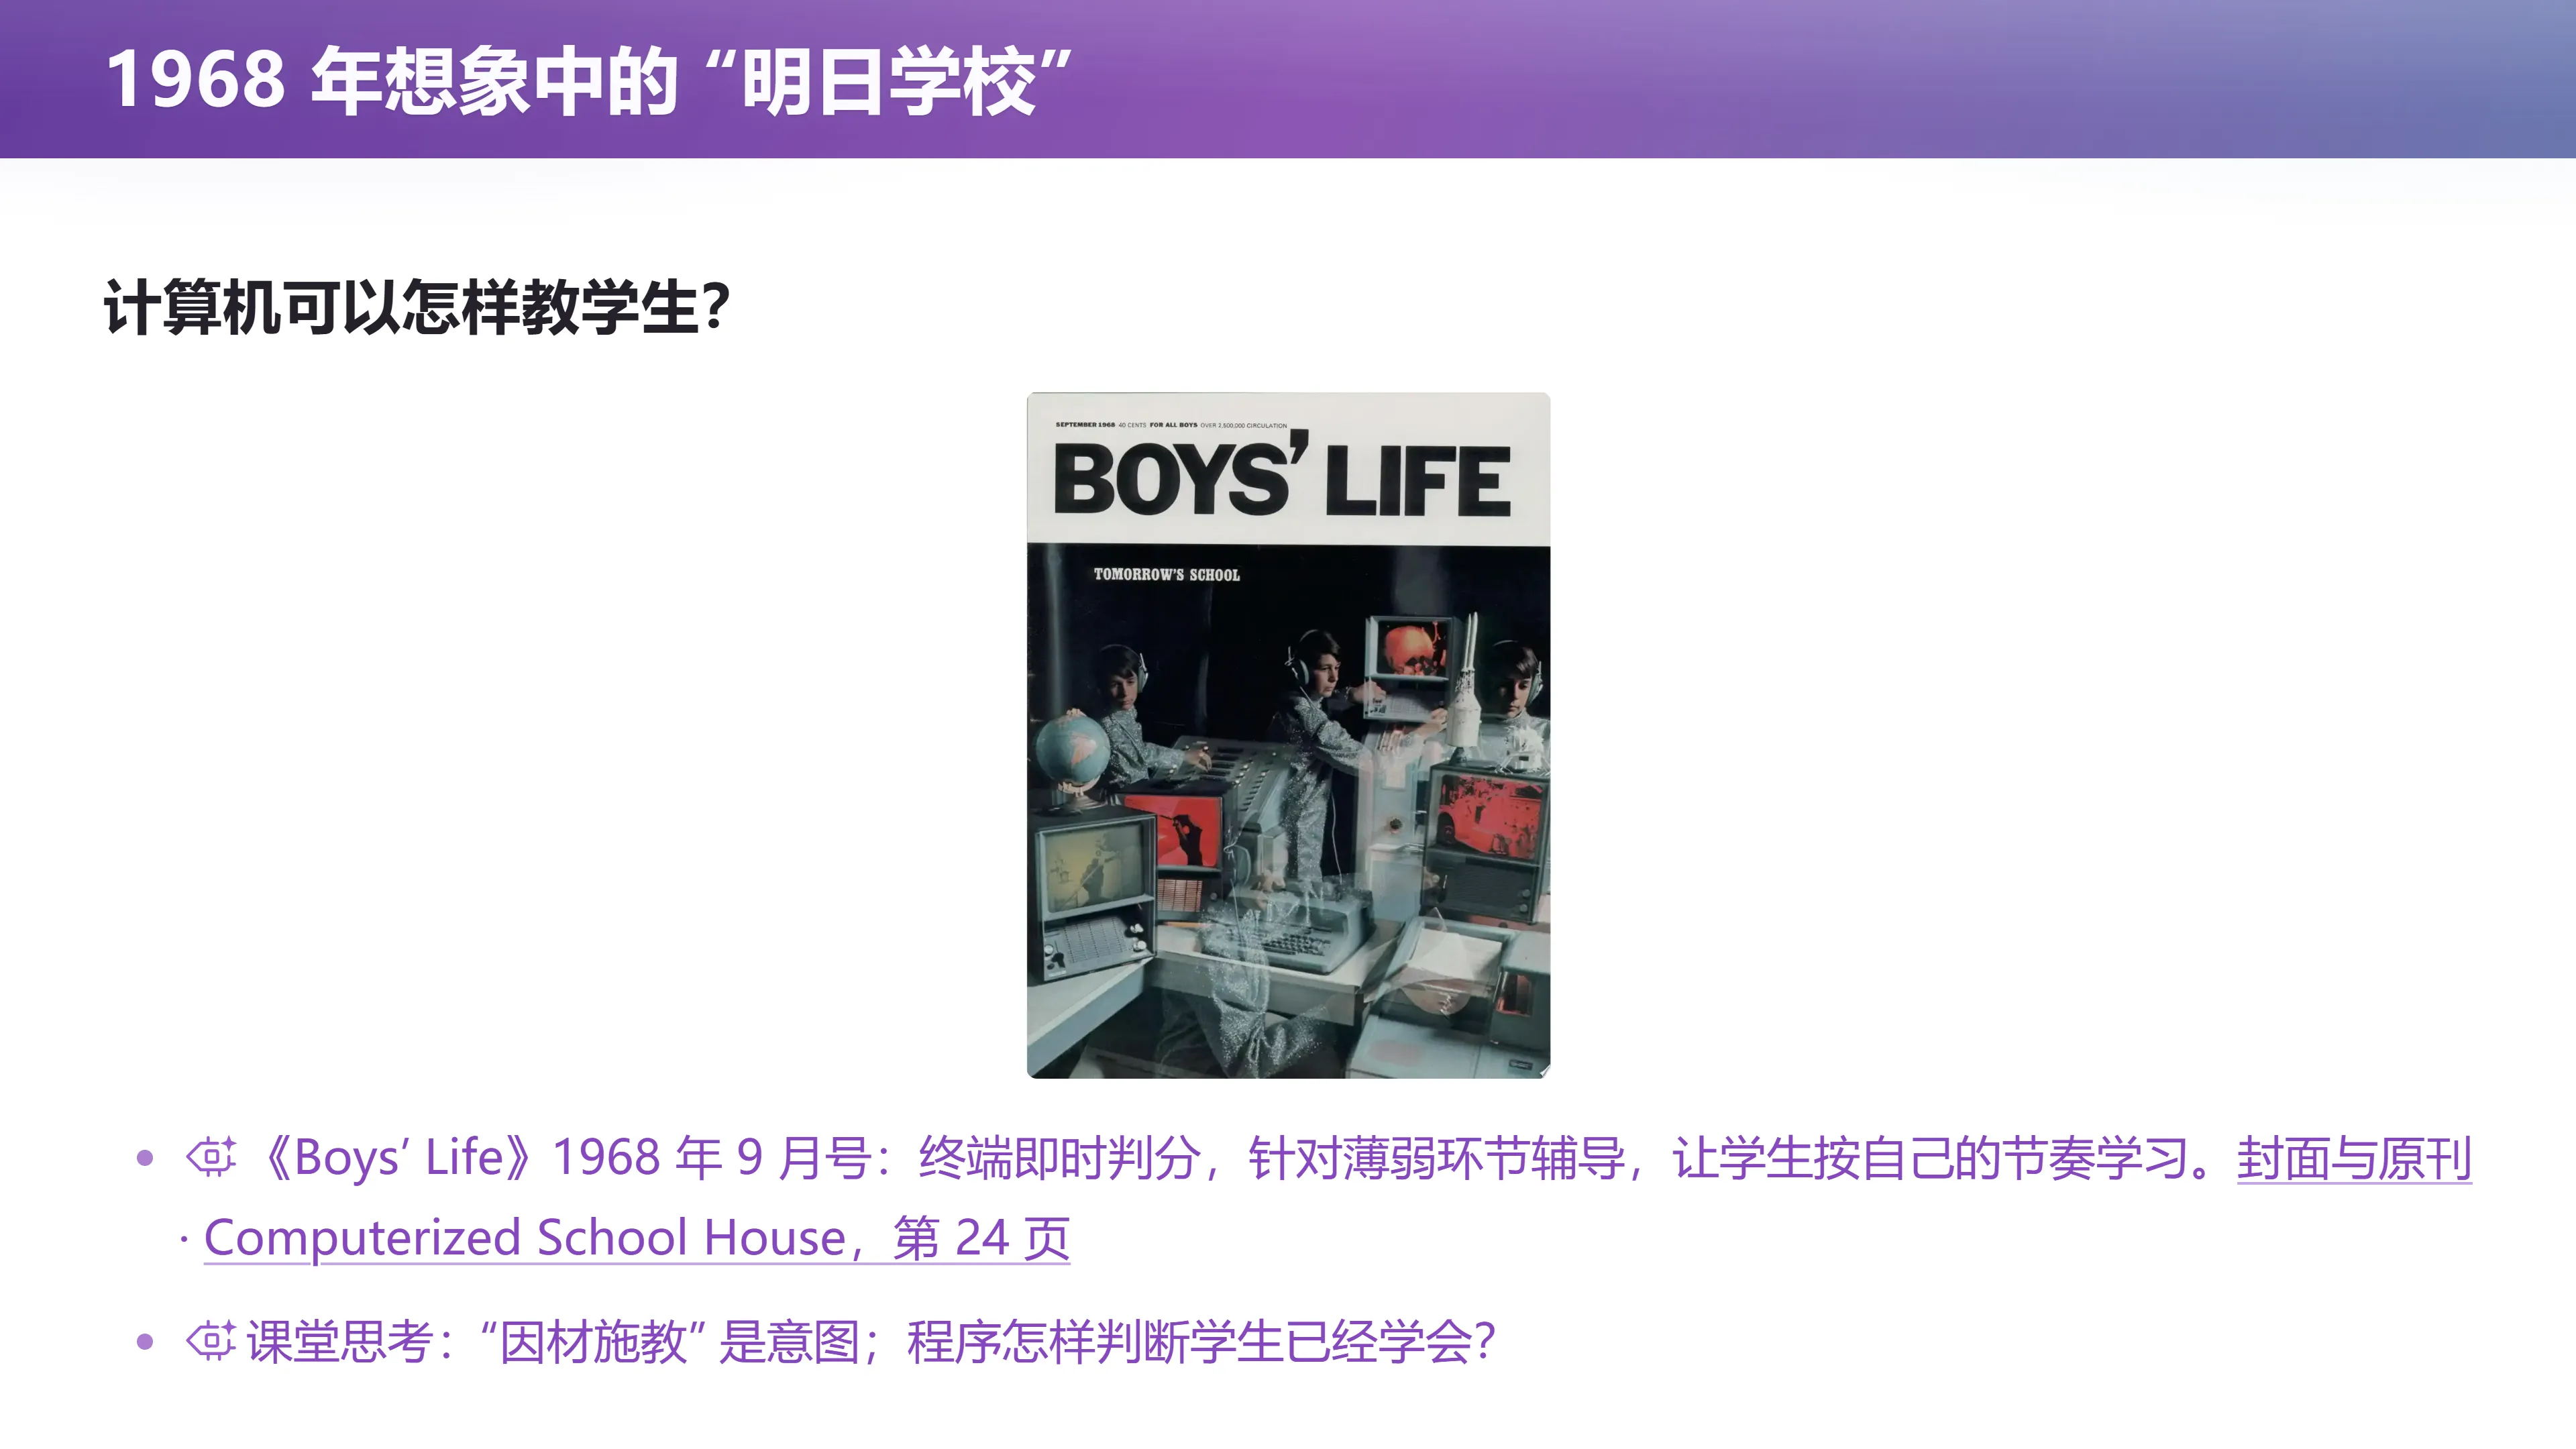
客户对计算机/软件的期待,有时是过度的遐想。课堂上展示了 1968 年 9 月的《Boys' Life》上描绘的"明日学校":
- 终端即时判分;
- 针对薄弱环节辅导;
- 让学生按自己的节奏学习。
这些想象今天读来依然熟悉。讲师忍不住吐槽:"这些今天还没有实现——你们还在这里上两节课、每节 50 分钟的课程。" (参考时间: 00:35:29)
问题在于:从"因材施教"这个意图,到程序实现,中间还有许多决定——
- 怎样判断一个人掌握了知识?
- 答对一次算不算?
- 做题快是不是理解得好?
这些教育愿望不会自动变成清晰的程序规格。软件客户脑子里是"1000 万美元、跨时代"的宏大设想;1968 年的程序员脑子里装的却是汇编和 goto。这个 gap 非常大。
软件工程和其他工程的区别
(参考时间: 00:36:56)
📷 软件工程和其他工程的区别:需求高度定制化
回到原视频 (00:36:56)
讲师进一步指出软件工程和桥梁工程、炼钢工程的根本不同:
- 桥梁工程的需求来自自然物理世界。我们只能适应、不能改造:材料强度出厂时已由自然规律确定,楼能盖几层、容纳多少人,也都是由人类体型和物理规律决定的。这些工程遵循比较强的模式,做小改进、incremental 地迭代。
- 软件的需求完全是拍脑袋想出来的。1968 年的《Boys' Life》就能想出"明日学校"。需求高度定制化,把它们投影到计算机世界,一直被认为是高度需要人类智慧的活动。
讲师用一个选课系统的例子来说明这一点:同样叫"选课系统",不同的学校规则可以完全不同:
- 名额是先到先得、抽签,还是按专业保留?
- 不满足先修课要求时,老师能不能特批?谁负责批准?
- 退课空出的名额,是给候补队首,还是重新开放抢课?
讲师举了一个非常具体的例子:你要选修操作系统,必须先修计算机系统基础——这是一个硬限制,还是一个软限制?谁能 override? 甚至到了最后一秒钟,你毕不了业时,"所有的口子学校都能给你开"——你差这门课,马上就能选上。
因此,业务规则与责任边界本身就是要构造的软件的一部分。这些选择决定了谁能选上课。
软件危机
(参考时间: 00:39:01)
📷 Software Crisis
回到原视频 (00:39:01)
当时的人已经观察到软件面临的危机:
- 软件开发进度无法预测;
- 软件开发成本崩溃;
- 质量、维护也都是问题;
- 而且常常延期交付。
Dijkstra 的"暴论"
(参考时间: 00:39:19)
计算机科学家们已经观察到了各种软件中有趣的现象。Dijkstra 的图灵奖演讲和那篇 Go To Statement Considered Harmful 就是典型。
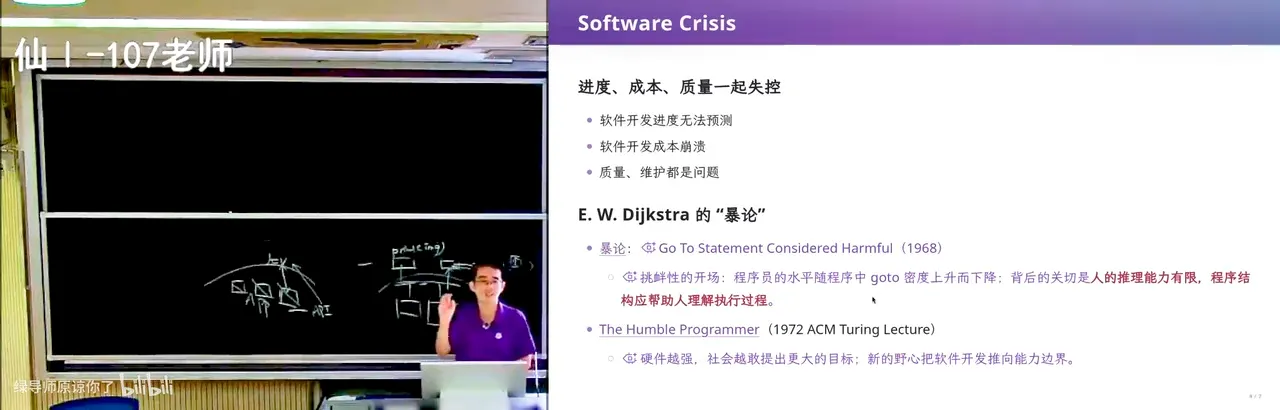
📷 goto 的正当用法:Linux 内核里的 goto release
回到原视频 (00:39:48)
不过讲师补了一段非常有意思的分析。大家都听说过"goto 是有害的",但在 Linux 内核里能看到好多 goto——这是 C 语言里一个比较 idiomatic 的用法:
int foo(void) {
    int ret = 0;
    struct res *r1 = alloc_r1();
    if (!r1) { ret = -ENOMEM; goto release; }

    struct res *r2 = alloc_r2();
    if (!r2) { ret = -ENOMEM; goto release; }

    // ... 正常逻辑 ...

release:
    if (r2) free_r2(r2);
    if (r1) free_r1(r1);
    return ret;
}
- 末尾专门有一段
release,逐个检查并释放函数里申请的所有资源; - 写代码时,中途永远不能提前退出——想退出必须
goto release; - 这样程序就基本正确了。
讲师说:"这跟我说的'没有 token 要退学'一样,他先发表一个暴论。" Dijkstra 的开场挑衅是:程序员的水准随程序中 goto 密度上升而下降。这个说法不绝对,但背后有道理:
"它讨论的其实不是 goto 到底 harmful 不 harmful——goto 可以不 harmful,如果作为一个正确的机制使用的话。只允许你这样用,goto 它就不 harmful,它解决了 C 语言里一个很大的'随时申请、从不释放'的问题。"
📷 The Humble Programmer
回到原视频 (00:42:03)
讲师随后让大家"现场读原文"。他在 1972 年的图灵奖演讲 The Humble Programmer 中谈到了为什么会有软件危机:
- 如果你永远写 Online Judge 的小程序,就不会有软件危机——算完就完了,一旦把一个程序调对,就永远不需要维护它;
- 但机器变强以后,软件的需求不断膨胀:机器越强,你要承担的、来自现实世界的 intent 就越多;intent 越多,不确定性越多;实现就越复杂。
Dijkstra 在文中提到的 nicely factored solutions(良好的分解),在讲师眼里也是当代工程师无时无刻不在使用的东西:
"我自己写的 live mate 驱动我的标签打印机和扫描仪——它也是一个 nicely factored solution。" (参考时间: 00:43:19)
Dijkstra 还有一个观点让讲师印象深刻:
保守力量主要来自教育机构,以及舍不得重写旧程序的用户。
"放到今天依然让你觉得醍醐灌顶。" (参考时间: 00:43:35)
"软件工程"成为共同议题
(参考时间: 00:44:04)
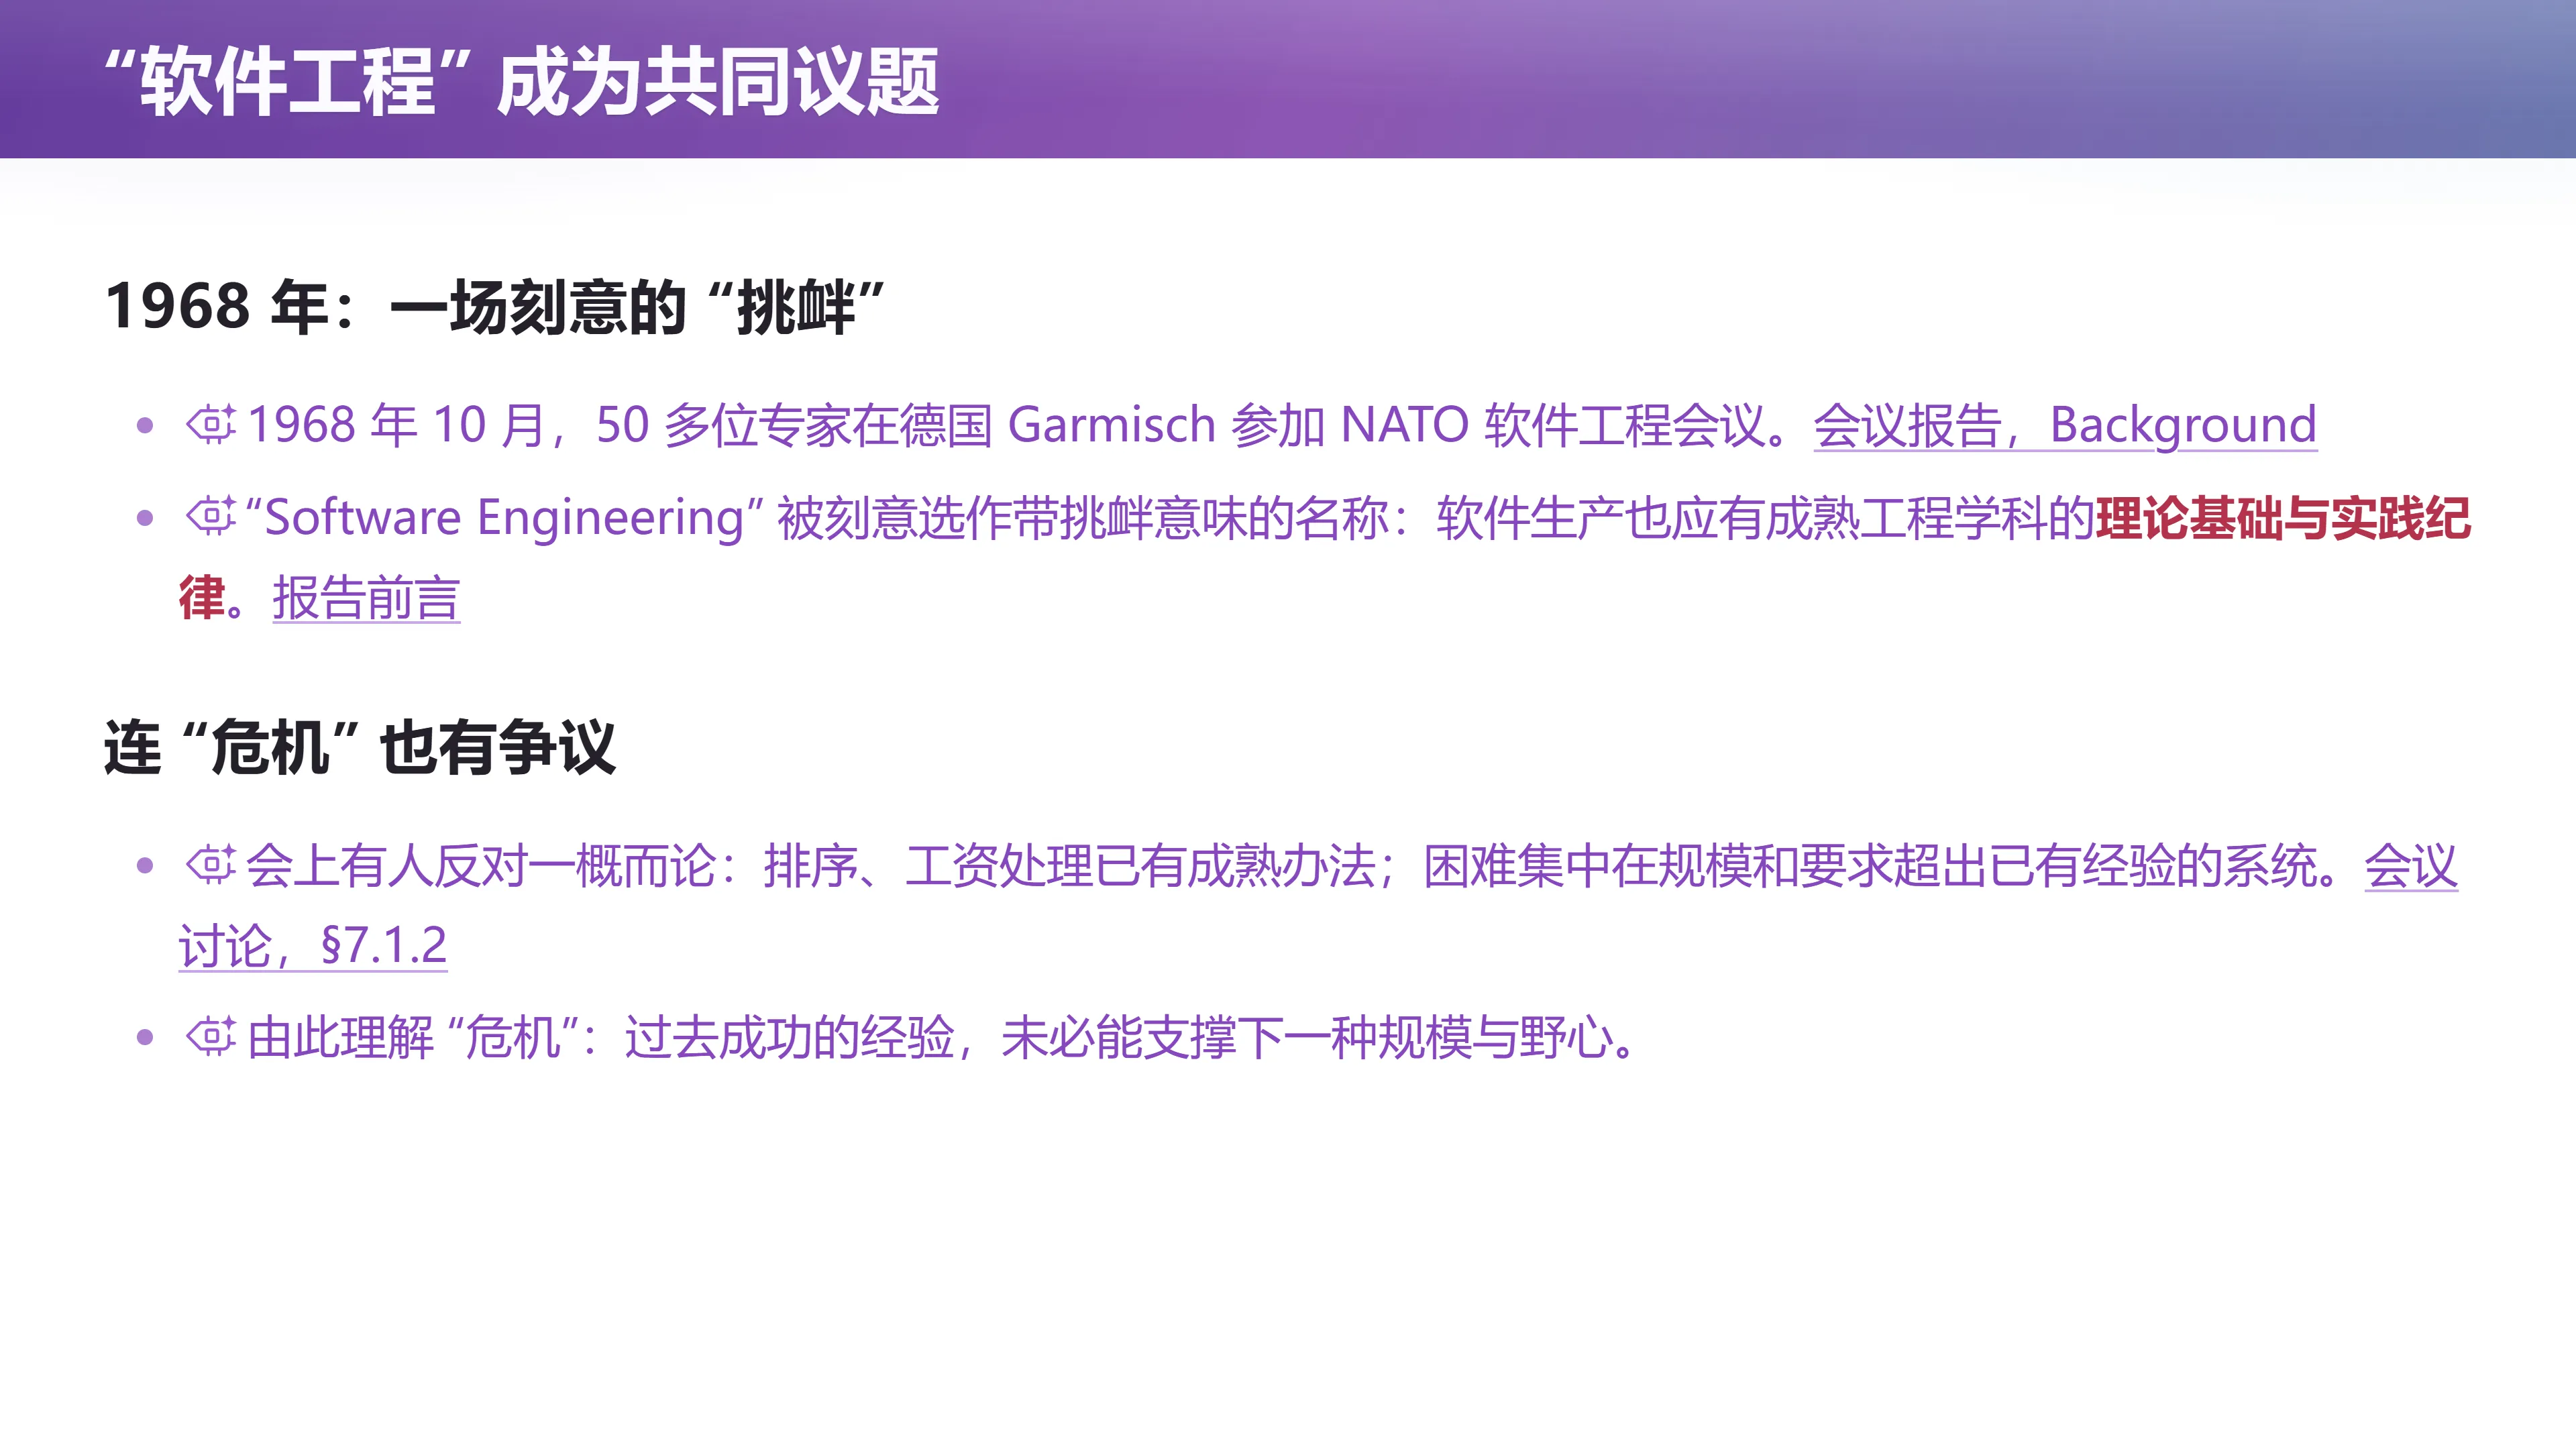
📷 "软件工程"成为共同议题
回到原视频 (00:44:04)
软件开始失败,于是软件工程成了大家关注的焦点。1968 年 10 月,50 多位专家在德国 Garmisch 参加了 NATO 软件工程会议。
"Software Engineering" 这个名字本身,就是刻意选带挑衅意味的——它想表达的是:软件生产也应当有成熟工程学科的理论基础与实践纪律。
顺便说,这场会议上有人对"危机"一词本身提出异议:排序、工资处理这类软件已经有成熟办法;困难集中在规模和要求超出已有经验的系统上。
所以,"软件危机"应当这样理解:过去成功的经验,未必能支撑下一种规模与野心。
在约束下,让系统继续工作
Margaret Hamilton 与 Apollo
(参考时间: 00:44:43)
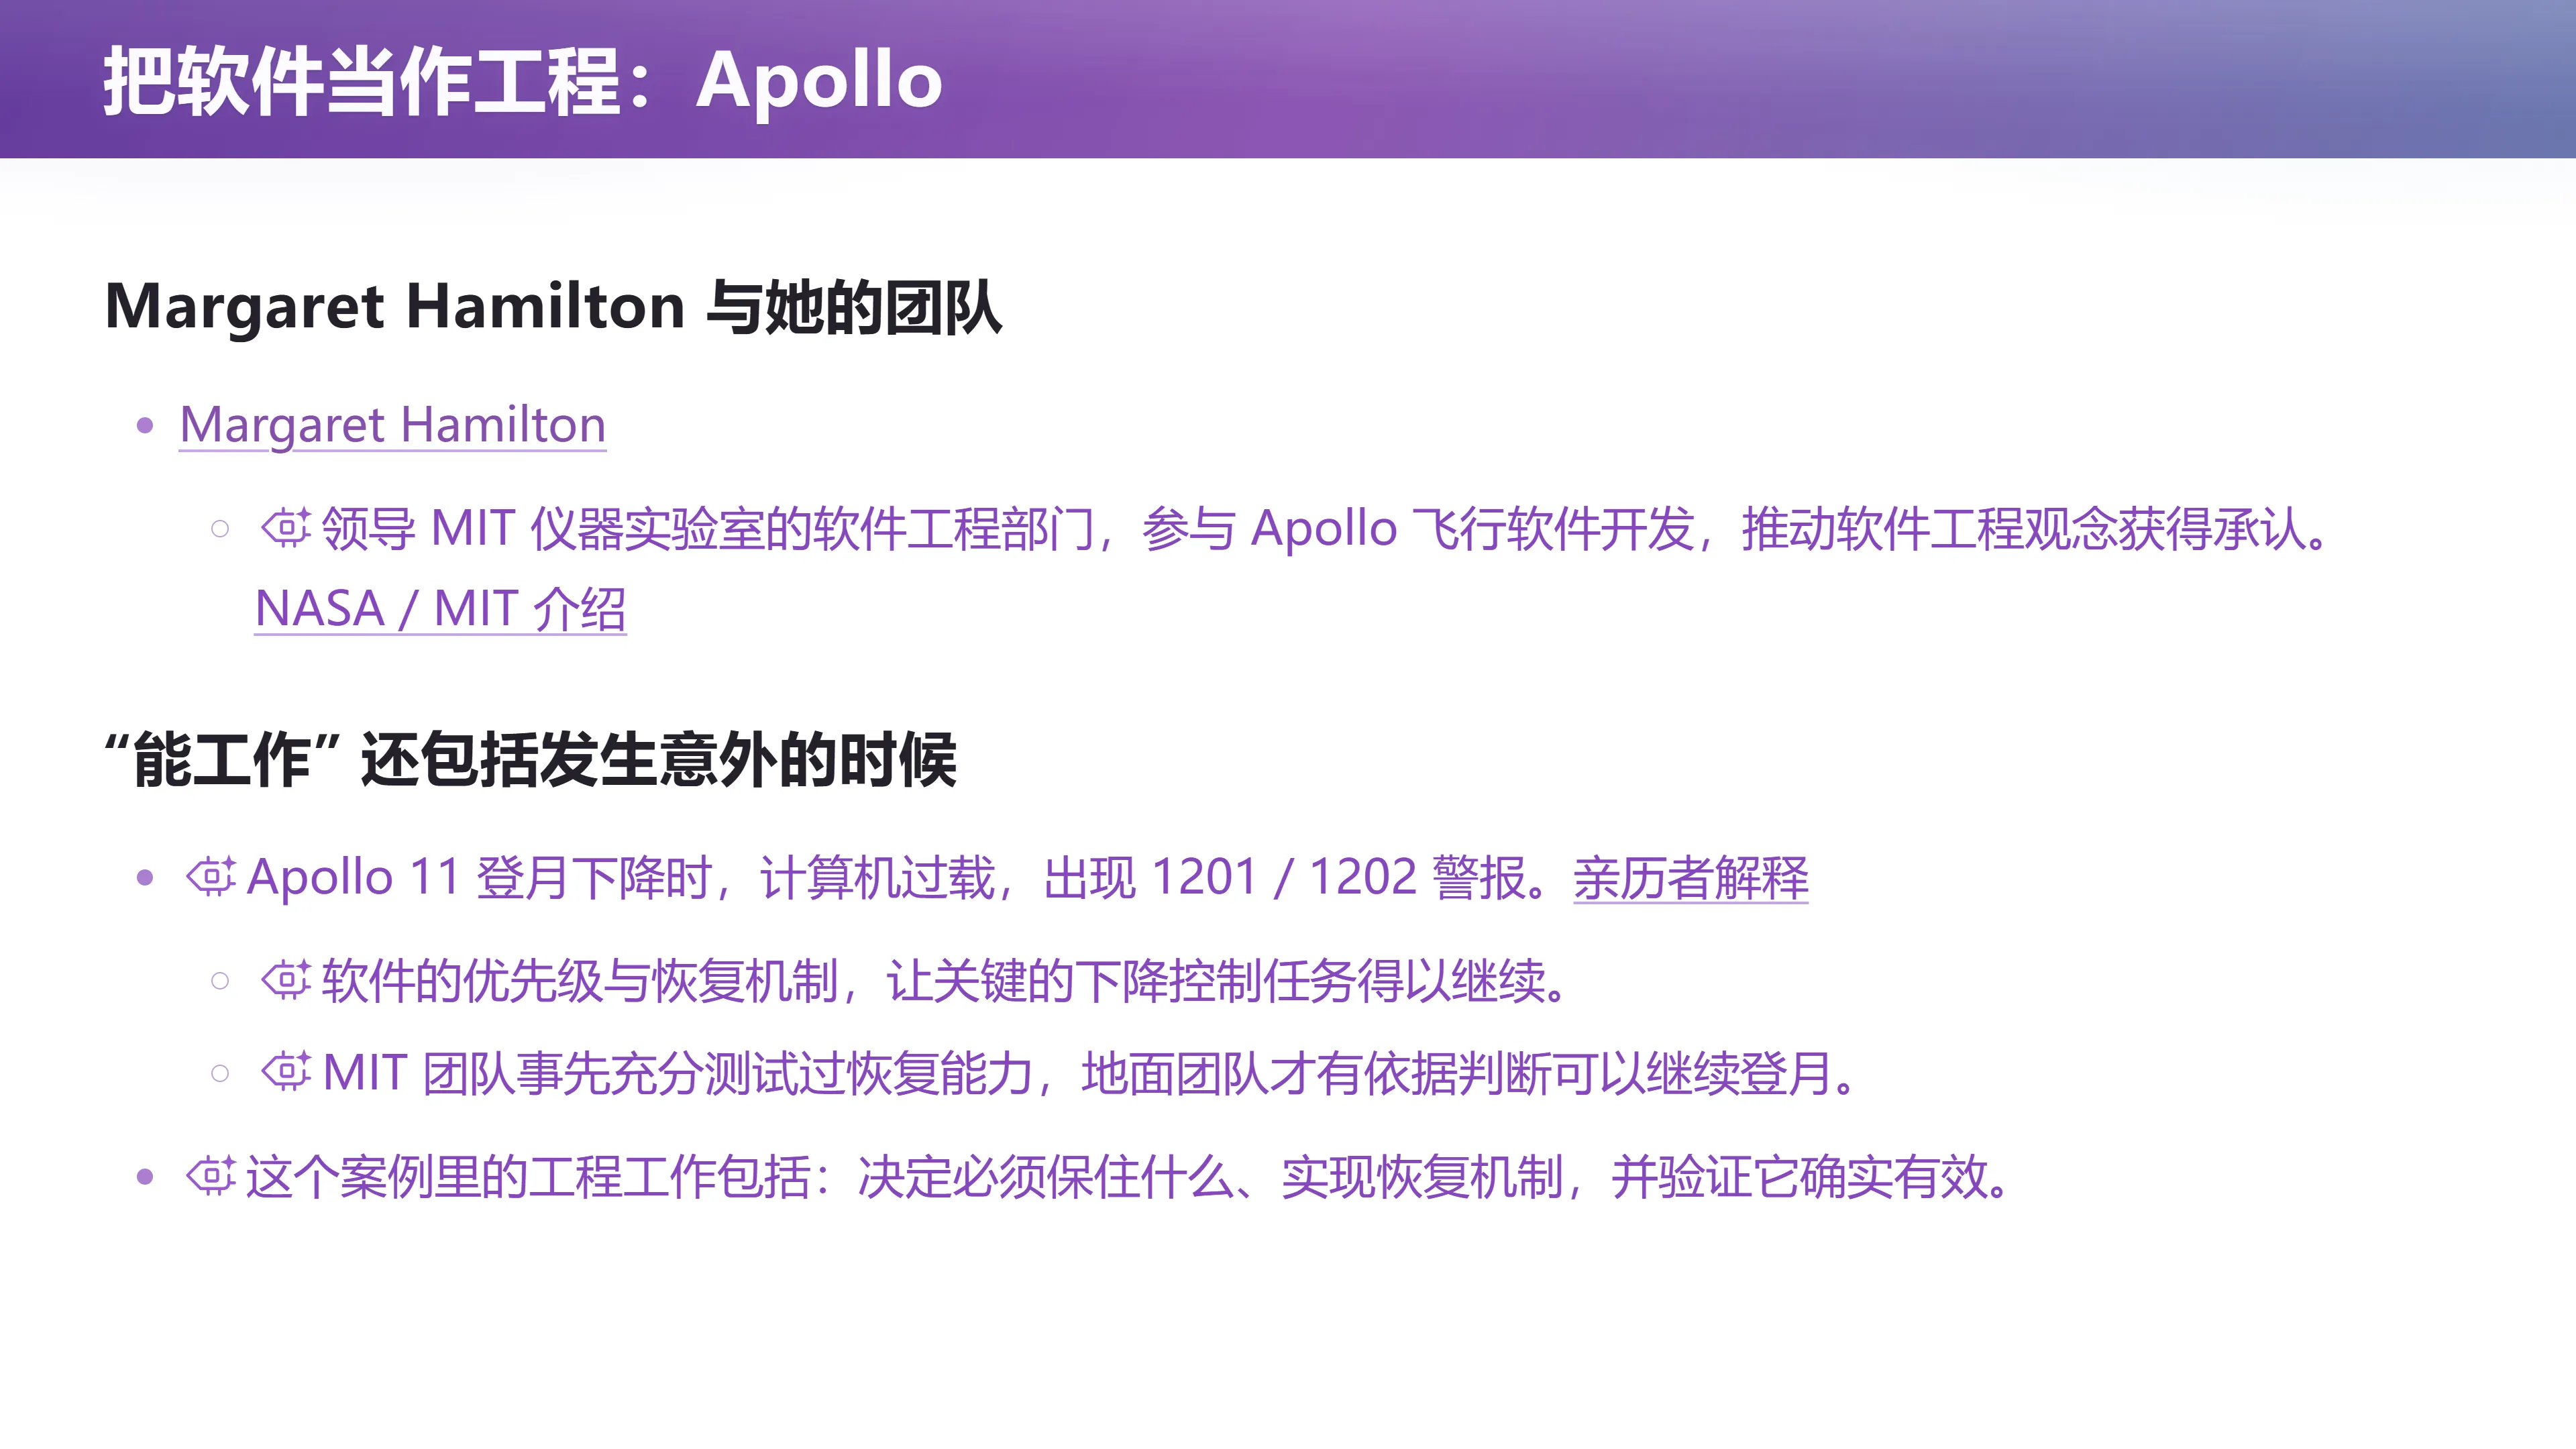
📷 Margaret Hamilton 与她的团队
回到原视频 (00:44:43)
NASA 的 Hamilton 介绍记录了她在软件工程领域的工作。她领导 MIT 仪器实验室的软件工程部门,参与 Apollo 飞行软件开发,并推动软件工程观念获得承认。
课堂上展示了那张非常有标志性的照片:Apollo 代码,1969。讲师说这是"载入史册的"。
"能工作"还包括发生意外的时候
(参考时间: 00:45:28)
讲师借此讲了今天仍然要用到的防御性编程思想:
- 在 SICP 之类的课程里,第一课就告诉你要给软件写 specifications;
- Hamilton 团队把"绝对不能发生的假设"都当作"可能发生";
- 他们假设硬件也是不可靠的,所以无论如何都要在软件里做一个兜底机制:当某个程序 crash 以后,整个系统依然要能够工作。
这就是软件工程的起点。"能工作"还包括"发生意外的时候"——即 "never going to happen can happen"。 (参考时间: 00:47:43)
阿波罗 11 号登月下降过程中,计算机过载,出现了 1201、1202 程序警报。按照亲历者在 Apollo 11 Program Alarms 中的回忆:
- 系统在资源不足后重新初始化,并恢复关键任务,使发动机控制等重要工作得以继续;
- 软件的优先级机制与恢复机制让关键的下降控制任务得以继续;
- MIT 团队事先充分测试过恢复能力,地面团队才有依据判断"可以继续登月"。
这个案例里的工程工作包括:决定必须保住什么、实现恢复机制,并验证它确实有效。 (参考时间: 00:47:25)
软件工程的诞生
(参考时间: 00:47:47)
📷 在成本、时间等约束下交付软件
回到原视频 (00:47:47)
软件工程研究的是:在成本、时间等约束下,怎样把人的意图变成可以工作、可以运行和维护的软件系统。 它是一个"从大到团队组织管理,小到代码风格"都会覆盖的学科。
讲师特别强调了"可生存的(survivable)"这个维度:
"你随着时间推演,需求可能会变化。" (参考时间: 00:48:21)
讲师又用 Online Judge 做了一个非常贴切的类比:
- 你做 OJ 时,假设题目是对的——这是个隐藏的假设;
- 你假设题目一定能做出来,甚至反复强化,就 overfit 了这个假设;
- 但你应有的假设是:面对的是一个开放的世界——题目可能是错的,条件随时可能变化,甚至可能变成另外一道题目;
- 那你怎么做一个软件来解决它?
这不是否定算法训练的价值:"编程训练的是你的逻辑思维、算法思维,对设计软件理解是有好处的。" 但软件工程要求的视野,比 OJ 大得多。
IEEE 定义:
软件工程是: (1)将系统化、有纪律、可量化的方法应用于软件的开发、运行与维护,也就是说,把工程应用于软件;(2)对(1)中方法的研究。
- 系统化、有纪律、可量化;
- 覆盖开发、运行与维护。
讲师对这一点的解读是:它把软件从"个人英雄主义"变成了"可以拿到一张清单"。 Hamilton 那个时代需要一个好的 leader——换一个人,这个项目就失败了。但有了 IEEE 意义上的软件工程,你可以拿到一张清单(checklist):
"如果你 12345678910(所有项)全部满足了,那你至少这个软件不一定能保证成功,但失败的概率会小很多。" (参考时间: 00:49:41)
Royce 真正在担心什么
回到 Pre-LLM 时代
(参考时间: 00:49:46)
📷 软件工程的智慧:回到 Pre-LLM 时代
回到原视频 (00:49:46)
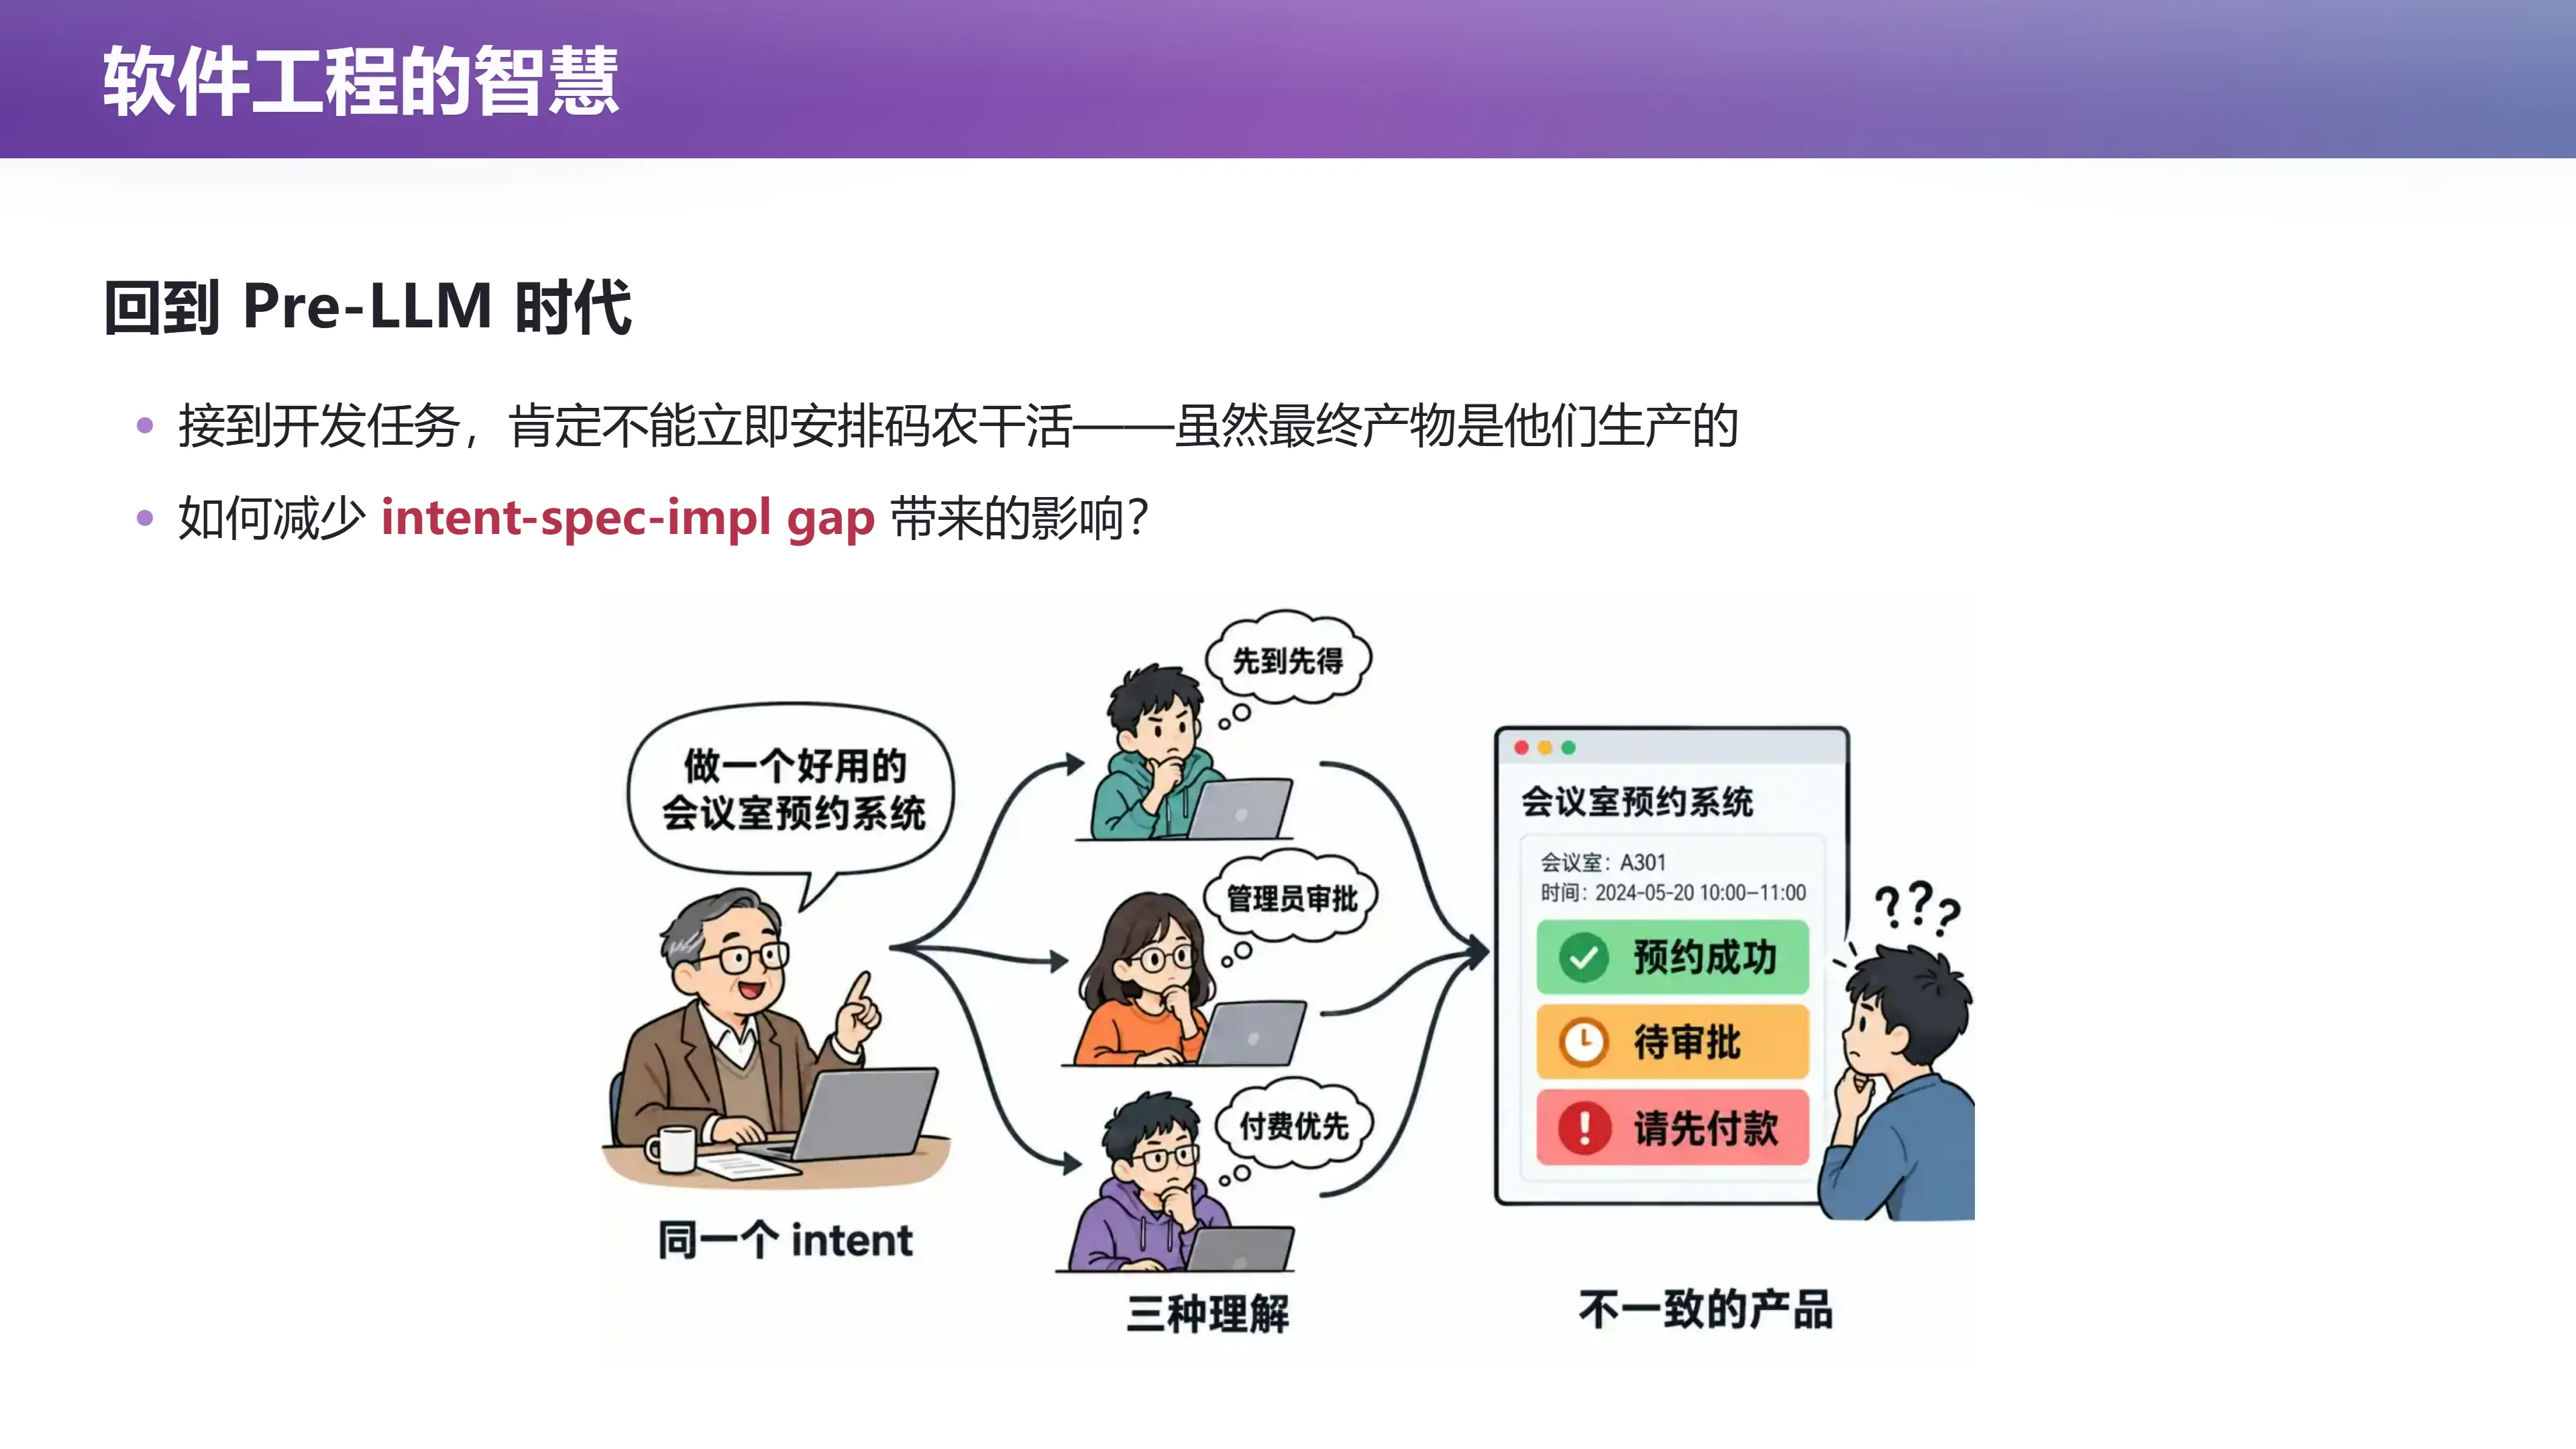
AI 还没大杀四方的时代,软件工程这个学科从大量的失败、数亿美元的教训中("炸一个火箭、炸一颗卫星"),积累了大量的智慧。回到 pre-LLM 时代,如果你接到一个开发任务,肯定不能立即安排码农干活——虽然最终的产物一定是码农写出来的。
讲师分享了自己打印标签打印机和扫描仪时的做法:
- 他同时把两个设备都接到电脑上;
- 起了两个 agent、开了两个窗口——一个进程向打印机,一个进程向扫描仪;
- 这是一个划分任务的过程,不能是 self-organized。
我们从一个空项目出发,可以做什么?
(参考时间: 00:51:10)
从空的仓库开始,我们怎么做?是直接把这个一句话交给 MVP 吗?1970 年的时候,还没有 MVP 这个词,也没有大语言模型。那时人们思考的问题非常直接:怎样按时、不超预算地交付大型软件?
📷 Royce 与瀑布模型
回到原视频 (00:51:21)
这就有了软件工程领域的开山之作:Winston Royce 在 1970 年发表的 Managing the Development of Large Software Systems。
用 AI 阅读这篇论文
(参考时间: 00:52:52)
📷 AI 时代的一手信息:royce.md
回到原视频 (00:52:52)
讲师现场展示了他读论文的方式:
- 昨天备课时,他直接找到了这篇文章的链接;
- 对 agent 说"入库这个 paper",然后他就得到一个文字整理版——文章里所有的图片都被 markdown 嵌入;
- 他还有一个命令行工具,像
less一样在终端里读文档、提取图片; - 他让 AI 在后台试读,甚至可以直接让 AI 帮他做"搜索"。
编者说明:讲师这里展示的不是"AI 帮我理解",而是"AI 帮我直接面对一手信息"。这是本讲反复出现的一个主题。
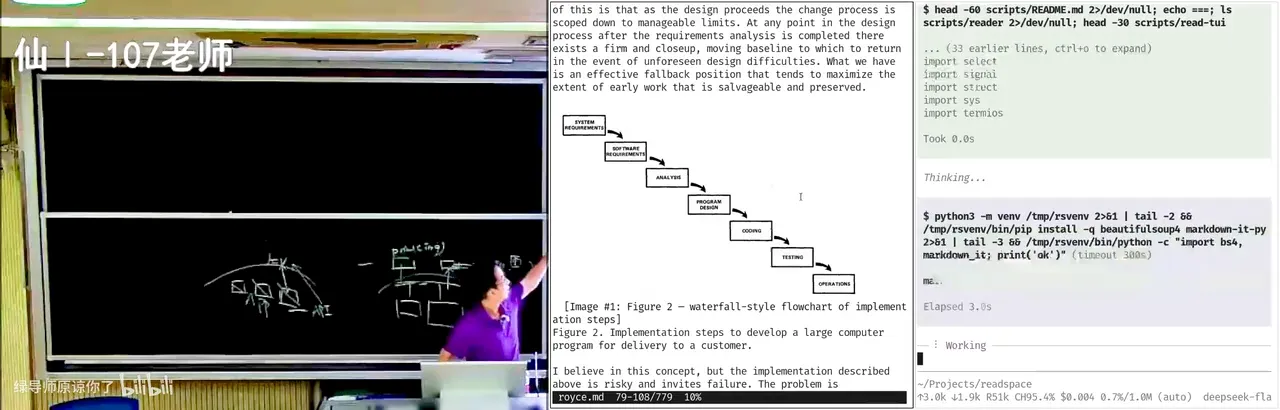
📷 经典的瀑布模型图
回到原视频 (00:55:10)
这张图就是软件工程课上人人都见过的"瀑布模型":
需求 → 系统需求 → 软件需求分析 → 设计 → 编码 → 测试 → 上线
它来自 Royce 1970 年的这篇论文。
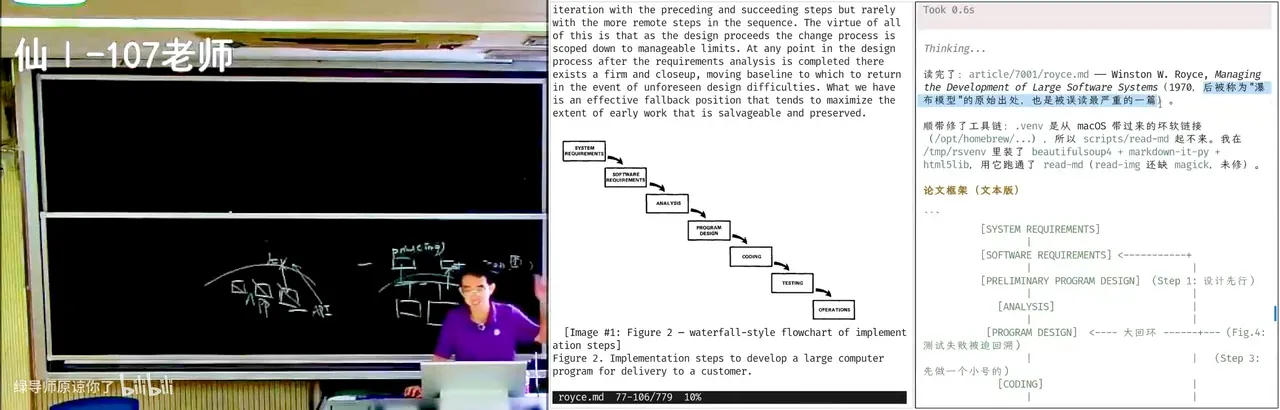
📷 原论文对"纯瀑布"的批评
回到原视频 (00:55:33)
但这里有个著名的误读:这篇文章画出了后来与"瀑布模型"联系在一起的阶段图,却随即指出"这样简单地推进风险很大,会招致失败"。
引用讲义的原话:
"只记住这张图,很容易读反文章的意思。Royce 随后就指出,照这样简单地推进风险很大,会招致失败。"
讲师插了一段重要的话:
"1970 年大家真的是什么都没有,只能从 first principle 去思考。"
瀑布为什么会失败
(参考时间: 00:56:28)
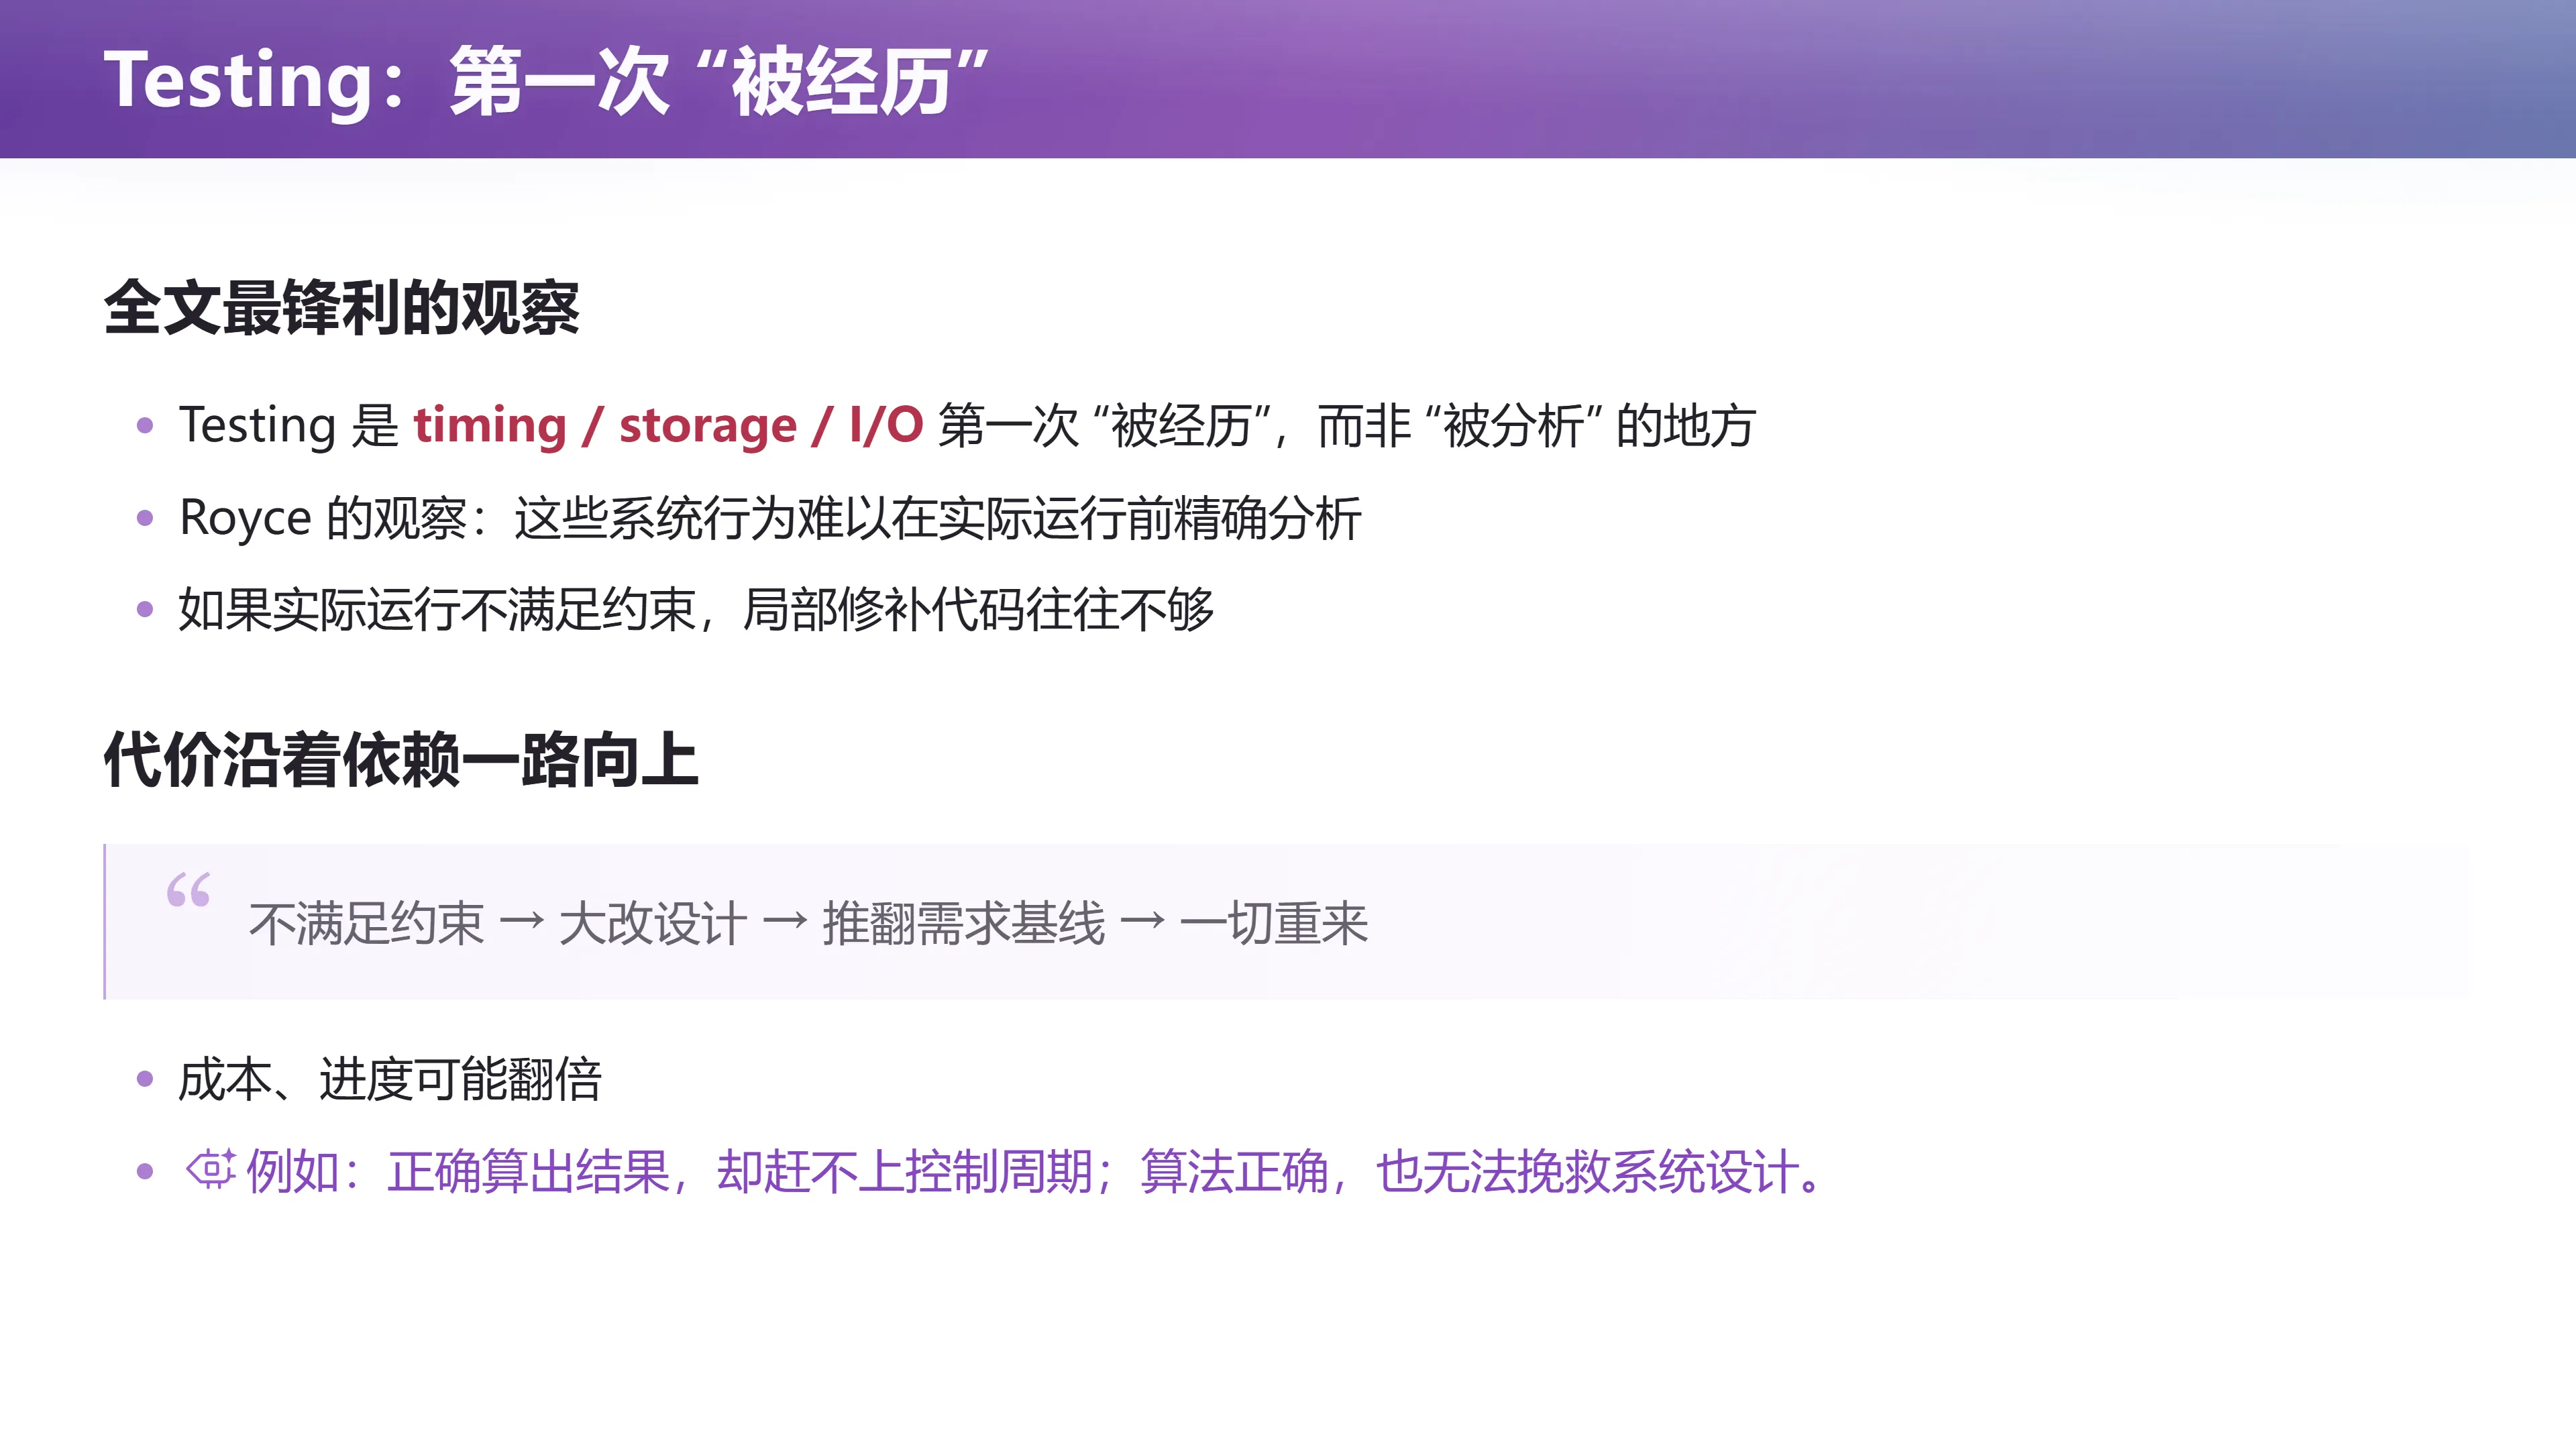
📷 Testing:第一次"被经历"
回到原视频 (00:56:28)
Royce 全文最锋利的观察是:测试(Testing)是 timing、storage、I/O 等系统约束第一次"被经历",而不是"被分析"的地方。
为什么?讲师从 first principle 给出了解释:
- 在程序真正被写出来之前,它不能运行——这是基本事实;
- 不能运行的东西在的时候,人就会随便做做。文档反正写了就放那,代码改了、设计改了,文档不一致也就放那里;
- 你们写实验文档时,对它的正确性有 guarantee 吗?其实没有,最多是一个 best effort guarantee;
- 只有到你测试的时候,程序才真正跑起来,你才真正知道它的行为是什么。
而一旦从 Intent 到 Specification 到 Implementation 发生了漂移,等到测试时再发现,就意味着要回头去改前面的东西。这就是超期或者超支的源头。
Royce 的分析逻辑是:
graph TD
    A[测试发现:运行不满足约束] --> B[局部修补代码]
    B -->|不够| C[大改设计]
    C -->|还不够| D[推翻需求基线]
    D --> E[一切重来]
    style A fill:#fbb,stroke:#333
    style E fill:#fbb,stroke:#333
例如:一个控制算法在数学上完全正确,却无法在规定的控制周期内完成。此时删掉几条指令可能毫无帮助,需要更换算法、重新划分任务,甚至重新协商系统原本承诺的功能。问题从测试一路回到了设计和需求。
既然风险最终都在测试的地方爆炸,所有补救的本质,就是把发现问题的时间点提前。 (参考时间: 00:58:17)
Do It Twice
(参考时间: 01:04:50)
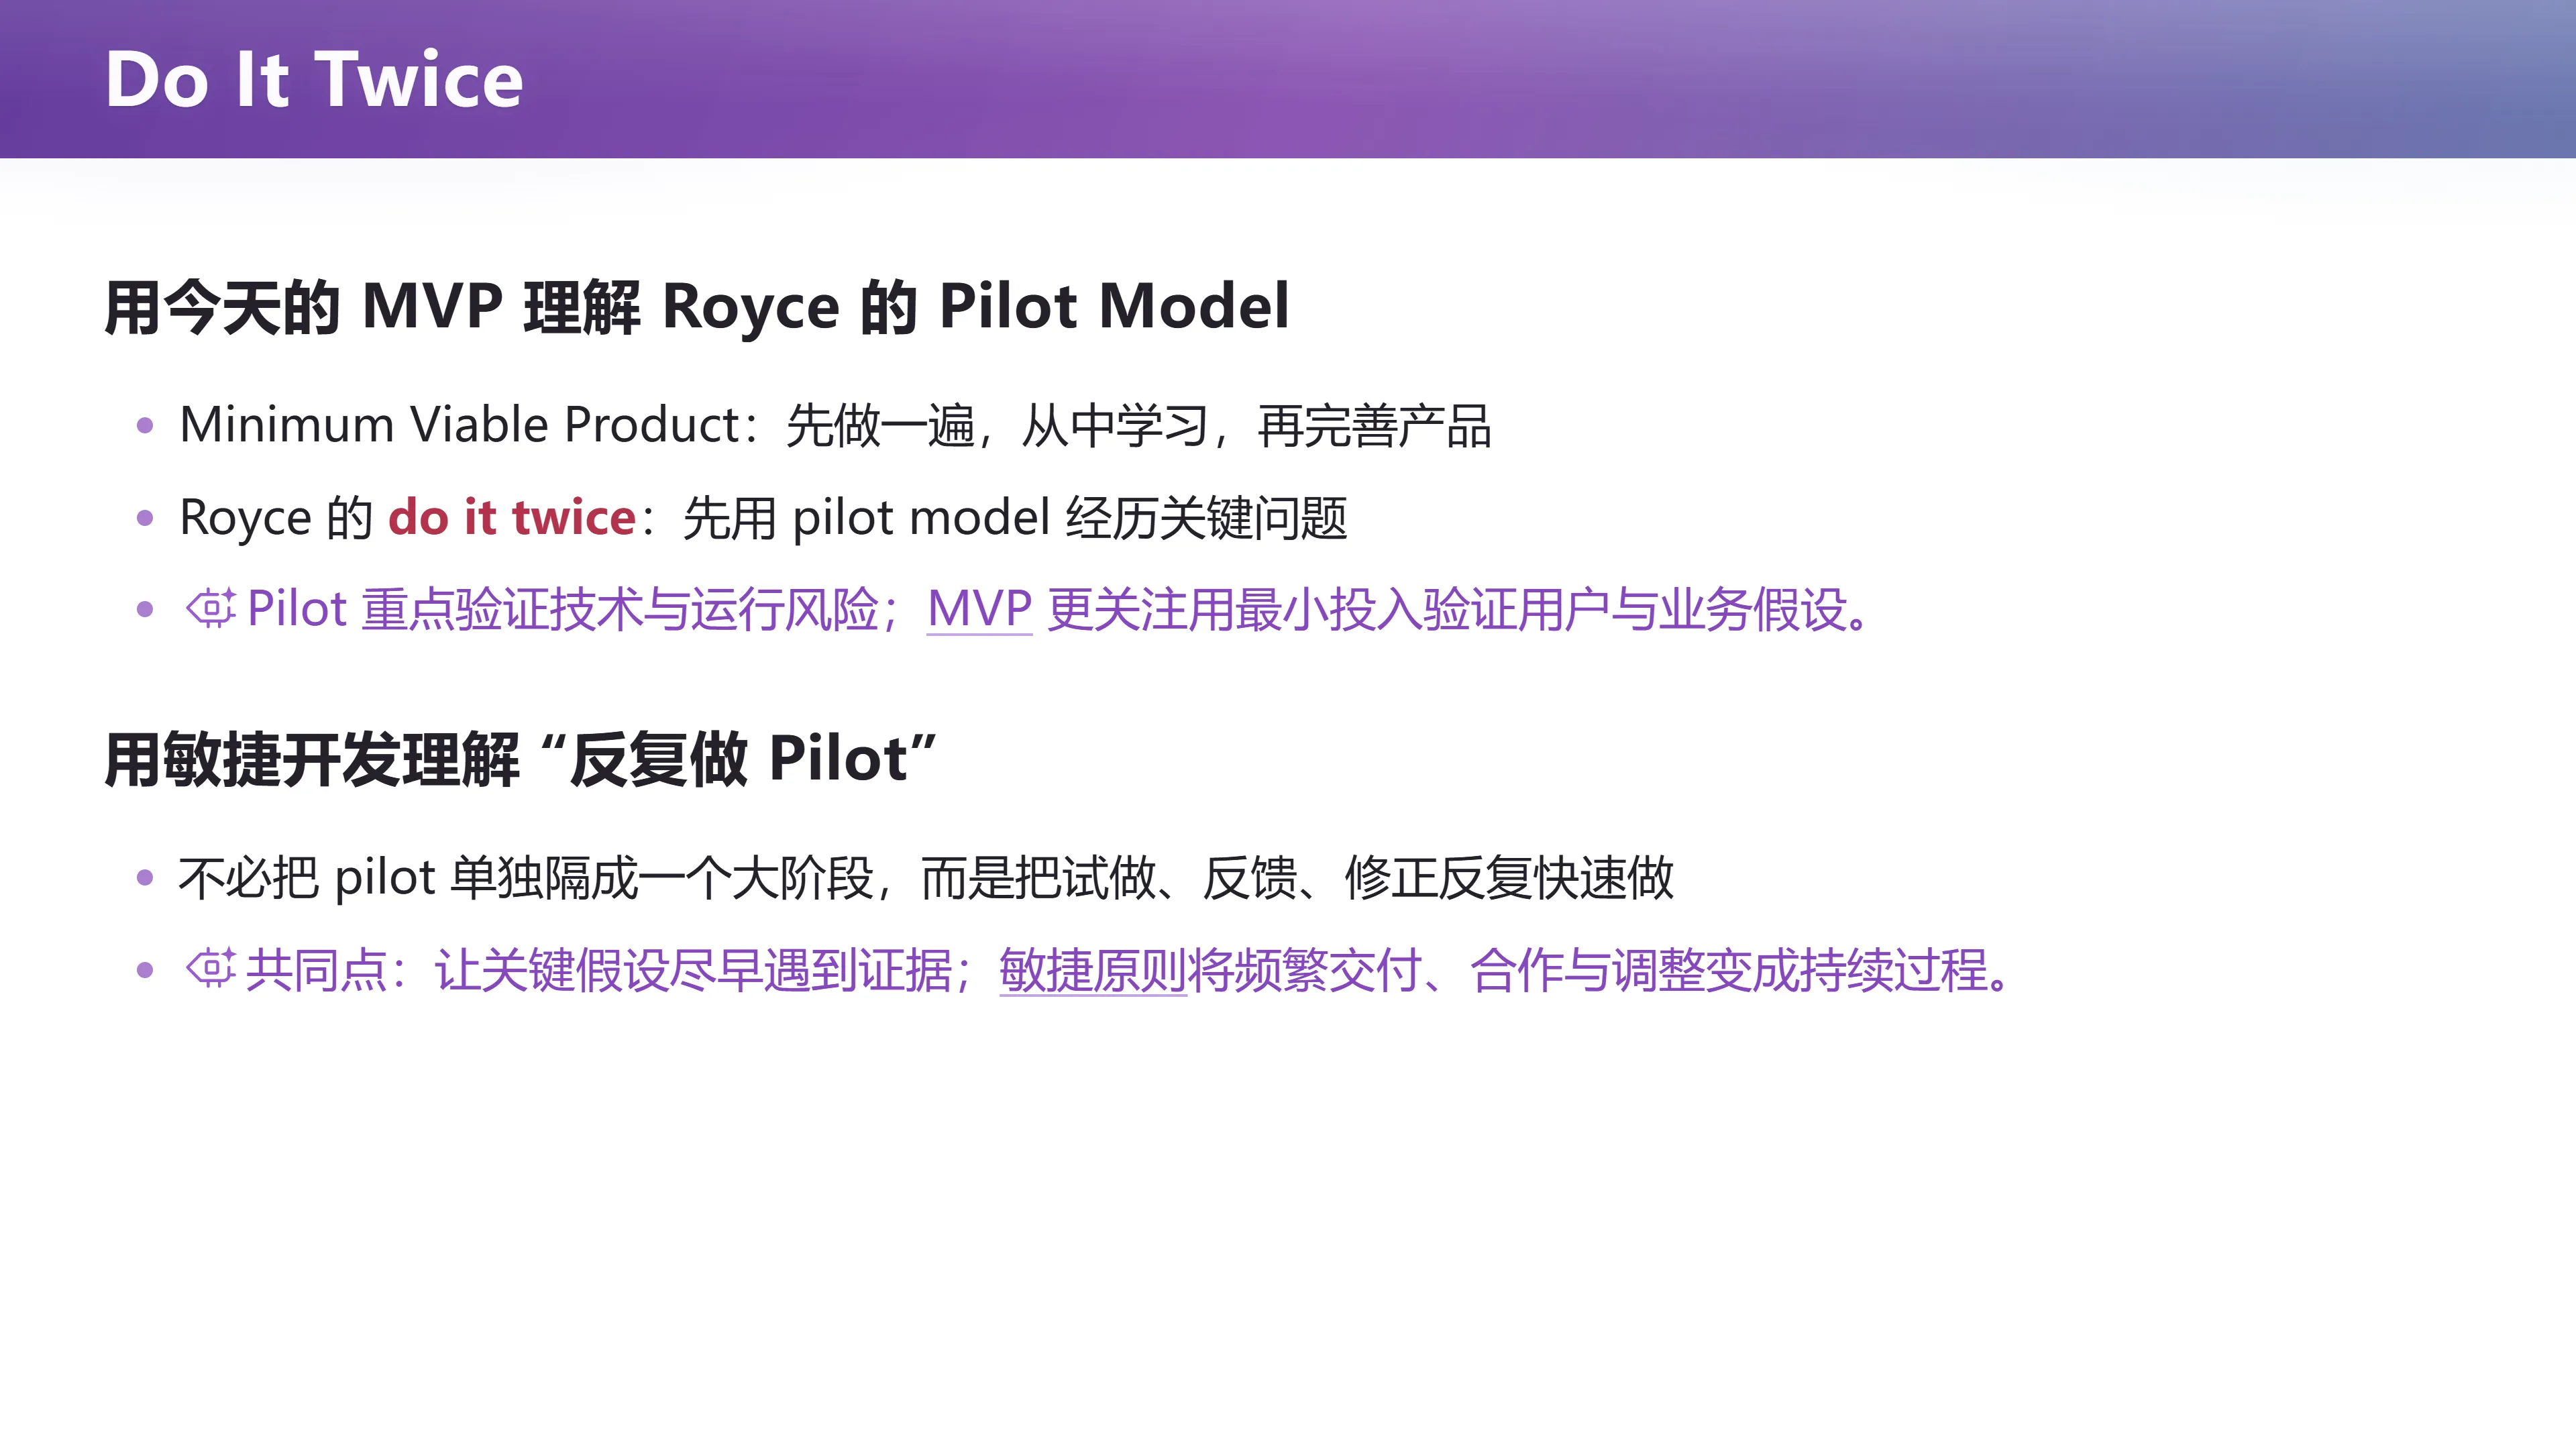
📷 Do It Twice
回到原视频 (01:04:50)
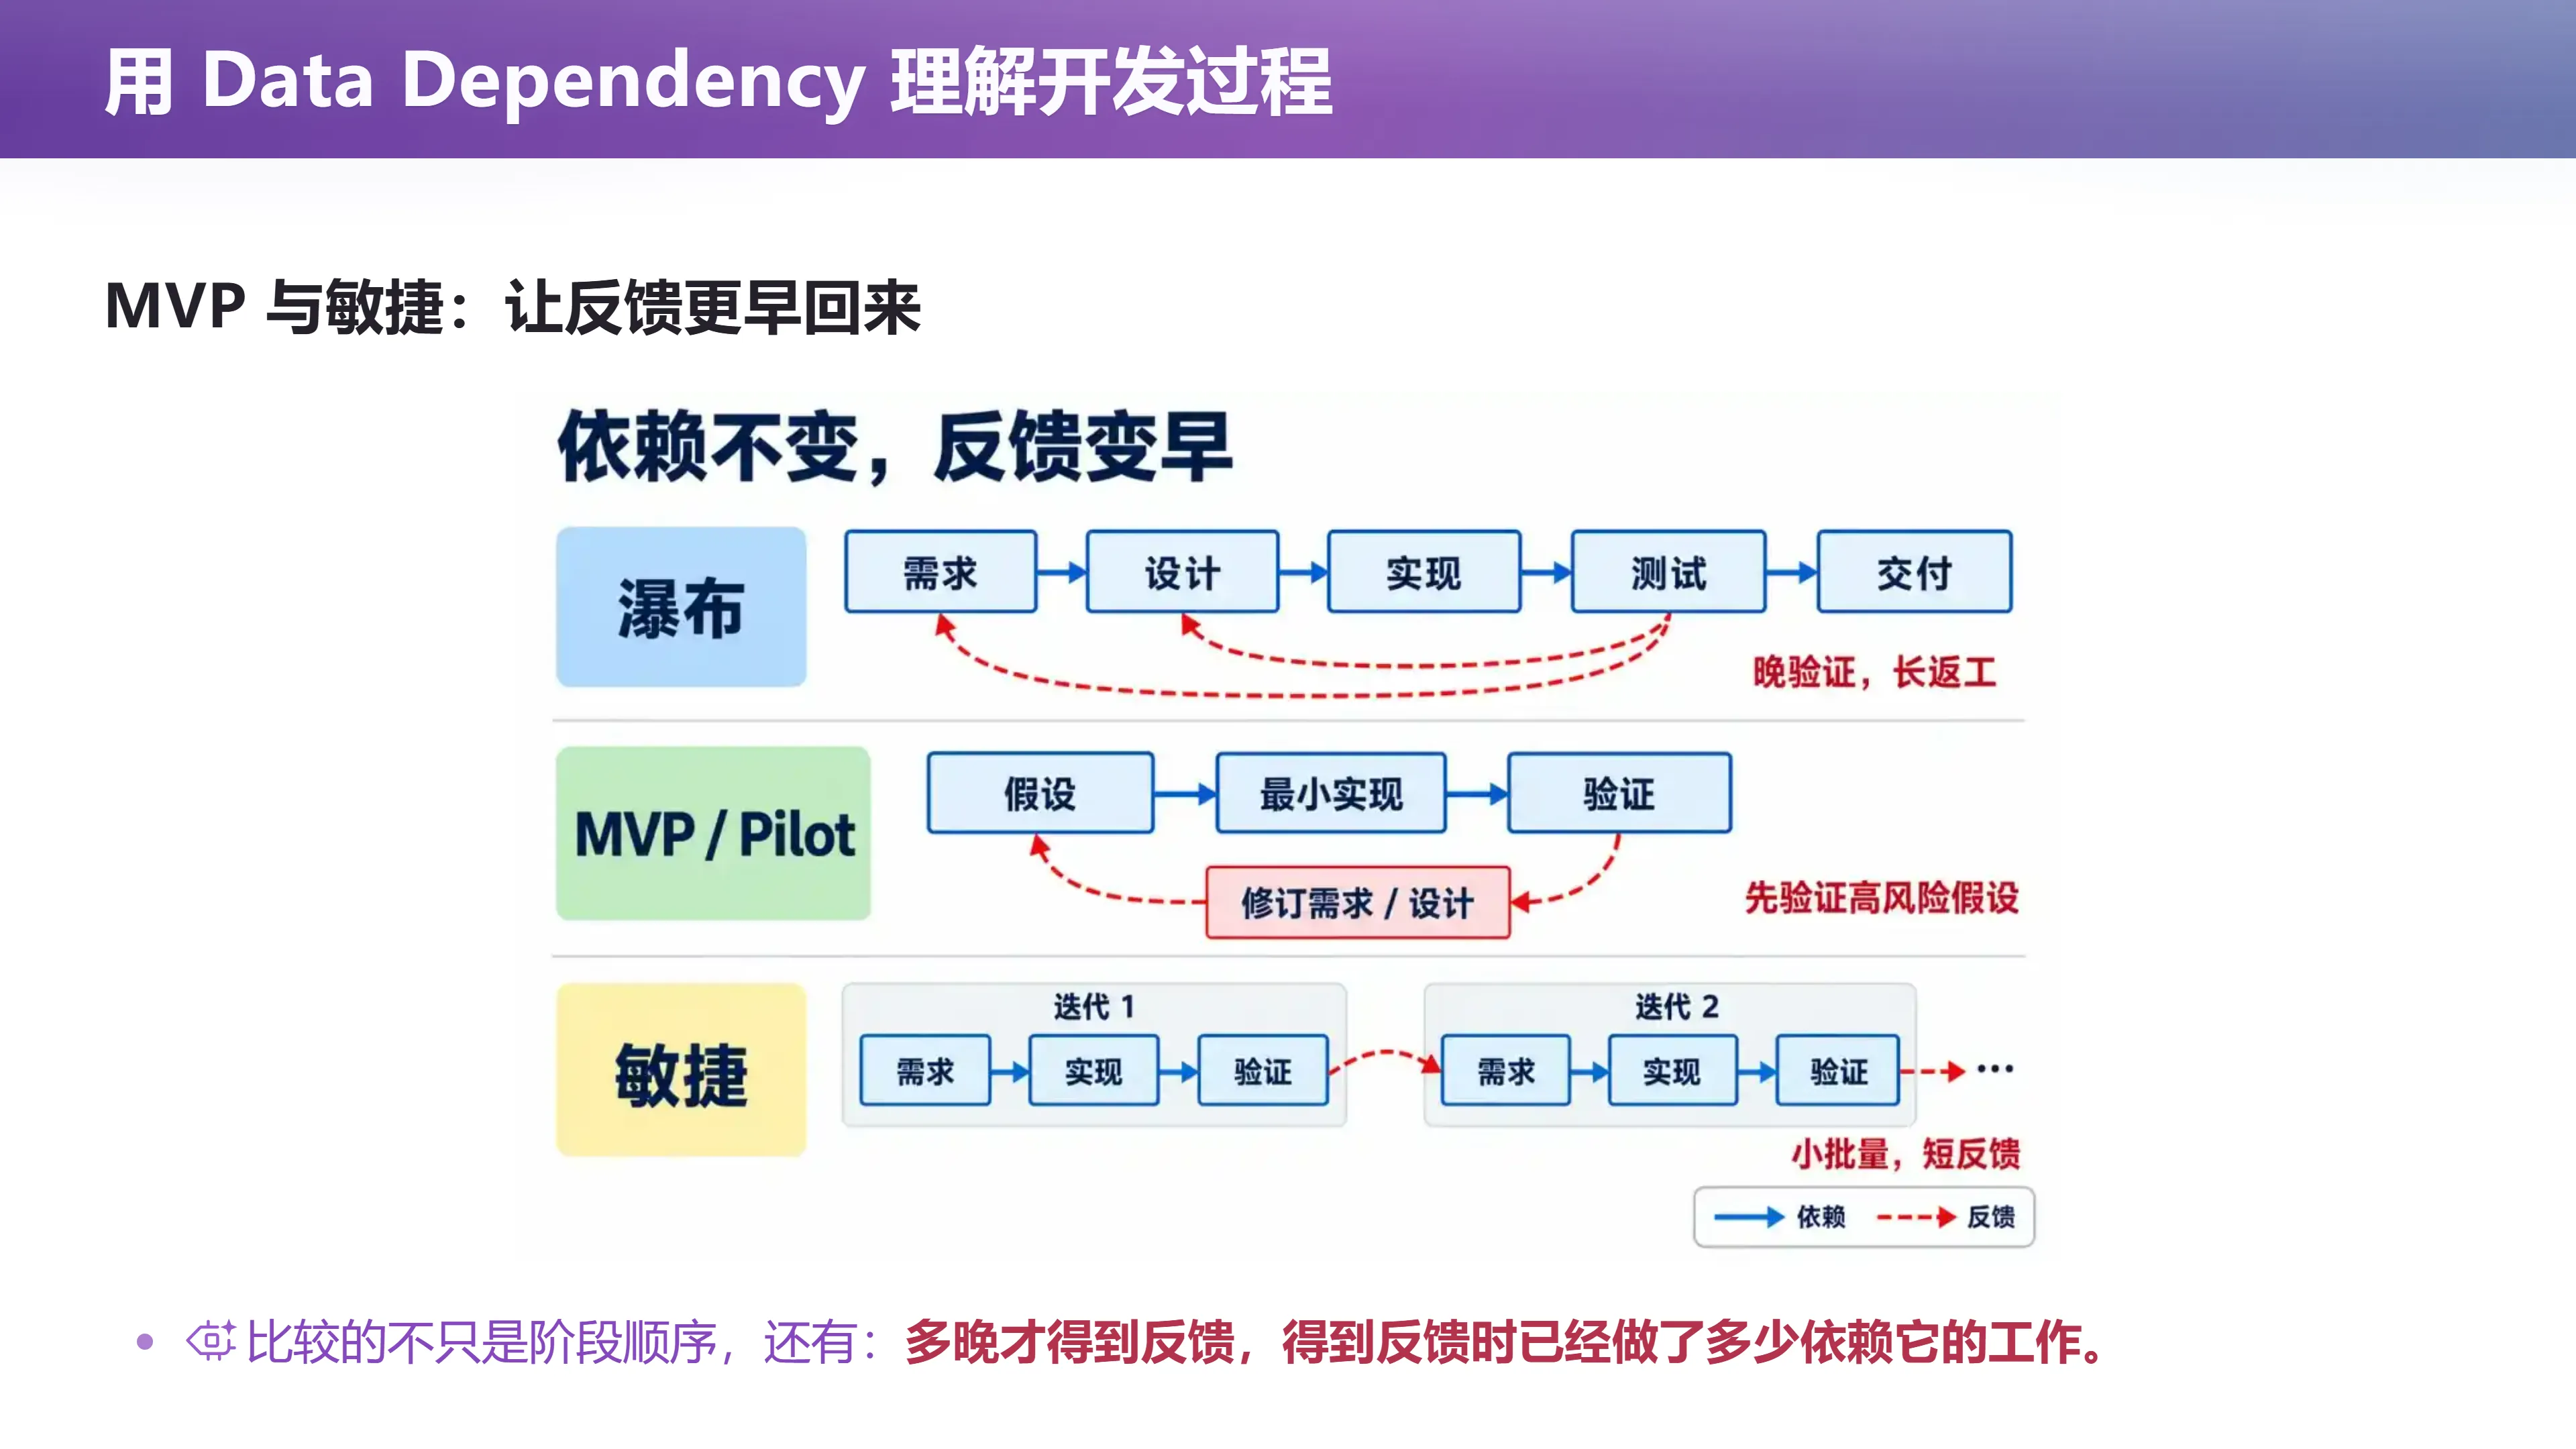
Royce 的建议之一是 "do it twice":在正式交付之前,先用一个 pilot model,也就是试验性系统,尽早接触那些最危险的不确定性。
- 他说我们要先做一个不完备、但能够体现系统功能的设计;
- 这个东西可能会失败,但迭代成本会变得很低;
- 第一次实现的价值,在于让实际运行给设计提供反馈。
用今天的语言看,这就是 MVP。(参考时间: 01:04:04)
不过,pilot 和 MVP 的关注点并不完全相同:
| Pilot Model (Royce) | MVP | |
|---|---|---|
| 主要目的 | 验证大型系统的技术与运行风险 | 用最小投入验证用户与业务假设 |
| 关注对象 | timing / storage / I/O 等硬约束 | 用户需求、产品假设 |
| 反馈类型 | 实际运行证据 | 用户真实使用反馈 |
敏捷开发则把短周期的实现、反馈和调整反复进行:不必把 pilot 单独隔成一个大阶段,而是把试做、反馈、修正反复快速做。
讲师的原话很精辟:
"The 所谓敏捷就是:你的第一个版本不是 'doing it twice',你是 'doing it infinitely many times'。你上来第一个版本哪怕它只有一个 hello world,或者说就是每个模块都自报一下家门、能把这个模块串起来,这也是一个好的 product。然后在这个意义上不断地把软件向后演进。" (参考时间: 01:07:44)
它们共同的第一性原理是:让关键假设尽早遇到证据。
一个值得反复强调的观点
(参考时间: 01:05:32)
讲师提到有一个"700 币的小模型"(编注:具体指哪个模型不确定,但结论通用)说了这样的话:
缺陷被发现的时间越晚,它带来的返工代价就越大。
这个论断显然成立。你写 OJ 也是这个规律:
- 一开始脑子一热想了一个算法,这个算法本来就不对;
- 然后就照着这个算法去写代码;
- 写完对着样例一跑——完了,整个算法是错的。
这就是一个典型的瀑布模型的失败。 但在 TDD(Test Driven Development,测试驱动开发)的意义上:
- 设计先行的时候,干脆先把测试用例定好:输入这个,就应该经历这个流程,输出那个;
- 写下预期行为只需要需求;验证实现是否满足预期,才需要实现。
讲师总结道:
"这些老的东西……我很喜欢这些很多图灵奖的工作,他为什么能得图灵奖?就是因为他确实在一个大家完全不知道的情况下,确立了一个 first principle,告诉大家这件事应该这么做。" (参考时间: 01:06:37)
当然也有更多好玩的事:
"你有一天发现他一开始有个方向想错了,然后把全人类都带歪了。如果全人类从某一点开始能换一个方向,也许就立即快速走上了正确的道路——比如直流电和交流电,爱迪生和特斯拉。" (参考时间: 01:07:09)
把开发流程看成数据依赖
一个统一视角:数据依赖图
(参考时间: 01:09:32)
📷 瀑布模型就是 Data Dependency Graph
回到原视频 (01:09:32)
讲师介绍了自己对 Royce 模型的另一种理解——这种理解来自他作为计算机科学家的直觉:
"我把 Royce 的模型理解成一种 data dependency(数据依赖),然后修改是有代价的。"
- 把人想象成程序:人脑是神经网络,人也可以做 chain of thought;
- 我在内心想问题时,还是会对齐到语言上——哪怕不说话,我依然会说"OK,我要这样或者怎么样,这样会有什么后果"——我用语言来对齐内脑里的思维链;
- 如果把每个人脑工作产生的程序和 artifact 视作节点,那就是一张有向无环图(DAG)。
具体说:
- 需求分析 → Intention;
- 系统设计 → Specification;
- 系统实现 + 测试验证 → Implementation;
- 交付后的使用和维护 → 不断产生新的事实,推动下一轮变化。
这些依赖真实存在,但它们并没有规定:
- 所有需求必须一次写完;
- 所有设计必须一次完成;
- 每个阶段只能经过一次。
graph TD
    R1[需求点 1] --> D1[设计 A]
    R2[需求点 2] --> D1
    R2 --> D2[设计 B]
    D1 --> I1[实现 X]
    D2 --> I2[实现 Y]
    D1 --> I2
    I1 --> T[测试]
    I2 --> T
    style R1 fill:#ffe5b4
    style R2 fill:#ffe5b4
    style T fill:#fbb
如果一旦发现测试错了,一路往上追溯,发现"这几个设计都错了"——那就惨了:所有依赖它的东西全部毁掉。 成本因此很高。
从一个 BFS 到一个 DFS
(参考时间: 01:12:37)
📷 用 Data Dependency 理解开发过程
回到原视频 (01:12:37)
那怎么办?为什么不把它割小呢? MVP 就来了:
- 不要一次性产生大量的 dependency;
- 而是按 BFS(广度优先)的方式构建软件:先做第一层,再做第二层,再做第三层;
- 一旦走通,再改成 DFS(深度优先) 的方式,一个一个迭代;
- 这不就是敏捷开发吗?
图上的层级可以这样理解:先做一个最小可行产品,把优先级最高的一条 dependency 流程走通;走通后再不断向右扩展。先 BFS 切面,再逐个 DFS 演进。
讲师的原话:
"所以这就是软件工程,没有什么真正困难的。我们越早能够得到反馈,就越能把这个路线上的不确定性、这个 gap 消掉。" (参考时间: 01:13:23)
从数据依赖的角度理解瀑布模型
(参考时间: 01:13:38)
- 瀑布模型前期(需求阶段)对应确定 Intent;
- 设计阶段对应确定 Spec(Spec 也会在需求阶段稍微做一点);
- 编码测试阶段对应 Implementation;
- 因为这些阶段之间有 gap,每个 intent 都会拆成好多个小点,并且会对后面产生 dependency;
- 所以做 MVP、做敏捷、做 TDD 都是显然正确的事情。
📷 瀑布模型就是 Data Dependency Graph
回到原视频 (01:13:38)
用今天的实践反向印证过去的结论
(参考时间: 01:05:07)
TDD(Test Driven Development,测试驱动开发)提醒我们分清两种工作:
- 写出期望行为——这只需要需求;
- 执行程序检查行为——这需要实现。
先写一个测试用例,往往就是在澄清需求:
- 空输入该返回什么?
- 余额不足时该发生什么?
- 同一个请求重复提交算几次?
这样就能在实现开始之前,就把一部分 Intent 的含糊逼出来。
编者说明:TDD 这一招之所以厉害,是因为它把"隐式的 Spec"提前拔了出来——测试用例是一种 Spec 的可执行形式。它既是需求澄清工具,又是验证工具。
阅读"开天辟地"的经典
经典为什么值得重读
(参考时间: 01:14:24)
讲师反复强调的一个学习方法论:
"为什么值得阅读这些经典著作?因为一般情况下,经典记录了一个领域最初遇到的、也是最重要的那个根本性问题,然后他在方向上找到了一个出路。"
过去,查找原始论文、恢复历史背景、沿着引用继续查证,成本很高,教材承担了知识的"有损压缩"。压缩当然有用——好教材的作者往往读过一手信息,也更能共情读者——但如果压缩过程中只留下了 Royce 的阶段图,却丢掉了紧随其后的批评,得到的知识就可能与原文相反。
谁来决定知识怎样压缩?
(参考时间: 01:01:00)
AI 的一个底层变化是:它把查找、翻译、串联一手材料的成本,降到几乎可以忽略。
- 过去你查证一个知识网络是"几乎不可能的事情"——去图书馆翻资料、找索引,要花无穷多的时间;
- 所以你必须通过教科书学习——这是知识的有损压缩;
- 今天你可以自己建立无损的知识网络,再按需压缩。
讲师特别强调"按需压缩"这个词:
"我做压缩对每个人的压缩都是有损的,而且对不同人压缩损失了不同的部分。如果我一对一教学,我就可以做最合适你的压缩。但我现在需要做的,是把知识脉络拆解开来、拆成一个一个发现的点,你只需要把这个点和它的原文拿到,做一个属于你自己的压缩。" (参考时间: 01:01:35)
讲师把这种思路总结为:
- 把知识拆成一个一个的发现点;
- 拿到原点和原文;
- 做属于你自己的压缩。
这也解释了为什么值得带着今天的经验,回到当年的问题:
- 读 Royce 时,可以追问:哪条建议来自当年的硬件约束,哪条来自多人协作,哪条来自"必须运行以后才知道"?
- 过去的 first principle 映射到今天,今天的实践映射到过去——两个方向都值得走一遍。
方法和工具怎样减少返工
为每个阶段创建方法学和工具
(参考时间: 01:15:34)
📷 软件工程的方法和工具
回到原视频 (01:15:34)
经历了数十年的发展,软件工程变成了什么?
为了解决 gap 问题,它为每一个阶段都创建了方法学和工具,尽可能减少返工的概率。
讲师特别用软件工程课上的 ISO 标准 checklist来说明这一点:
"你上那个软件工程课的时候,老师让你写一个文档,然后课程大概有个非常长的 checklist,说这个有没有做到、那个有没有做到、有没有和客户沟通过。然后你就觉得 nonsense——因为你是做 OJ 题的,你觉得这个 checklist 是 nonsense。但 checklist 实际上是有用的。" (参考时间: 01:16:07)
- 最后总有一个问题:"你是不是和客户最终沟通过了?"
- 上学的时候你讨厌它;
- 但当你真的和客户沟通过、并且给他打勾的时候,实际上你大幅减少了 intent 不符合客户要求的概率。
这就是一个方法,也是一种工具——它是一个有人文关怀的工具,没有任何代码。
不同阶段,不同的"语言"
(参考时间: 01:18:44)
📷 不同阶段,不同的"语言"
回到原视频 (01:18:44)
在没有 LLM 这种"万能编译器"的时代,不同阶段需要不同的"语言":
- 需求分析:文档、用例、界面原型 → "我们到底想要什么";
- 系统设计:实体关系、状态迁移、模块和接口 → "系统怎样组织起来";
- 代码实现:编程语言。
Computer Science 的大部分课程集中在实现层,相当于从底向上认识这个过程。
那么,为什么需要中间语言呢?
- 在需求阶段,你几乎不可能用编程语言写 checklist——那时真的是一个 docx 文档,打印出来、可能要手写、要存档;
- 在实现阶段,你用的是编程语言;
- 而编程语言和需求文档之间有一道 gap:当时没有大语言模型这种"万能编译器",你不可能把自然语言直接编译成任何一种语言;
- 于是,在设计阶段,就需要一种介于自然语言和编程语言之间的"设计语言"——一种 DSL(Domain Specific Language)。
自然语言 ──► checklist / 决策表 ──► 设计语言 ──► 编程语言
   |              |                    |             |
意图/需求       半形式化语义         结构化语义     可执行语义
语义的确定性程度,从设计的阶段到下面越来越 formal。
讲师把 checklist 本身也视作一种中间语言:
- 它虽然有自然语言的外壳,但有格式规范——要求每一条必须打勾或者打叉;
- 它有语义——虽然语义由人来检查,但人对"勾和叉"的对齐,比直接写一个文档的对齐要 formal 得多;
- 所以它是介于自然语言和形式语言之间的东西。
从 bottom-up 到"第一学期就做产品"
(参考时间: 01:21:49)
"我们以前学的时候是 bottom-up 的:先学编程,因为你不理解代码,就没有办法理解整个过程。但 AI 来了以后,我觉得变了——你可以先从产品经理开始做。"
📷 产品经理的视角:管理大量码农
回到原视频 (01:27:26)
讲师说,他自己以后如果要改 CS 课程的话,可能第一个学期就让学生做产品:
- 后面很多工作都是 web 的,你不去控制它的质量、也不需要知道;
- 第一门课不需要控制质量,因为你根本就不理解代码、不理解后面是怎么运作的;
- 但你依然可以设计好的产品——你只要有好的想法就可以做。
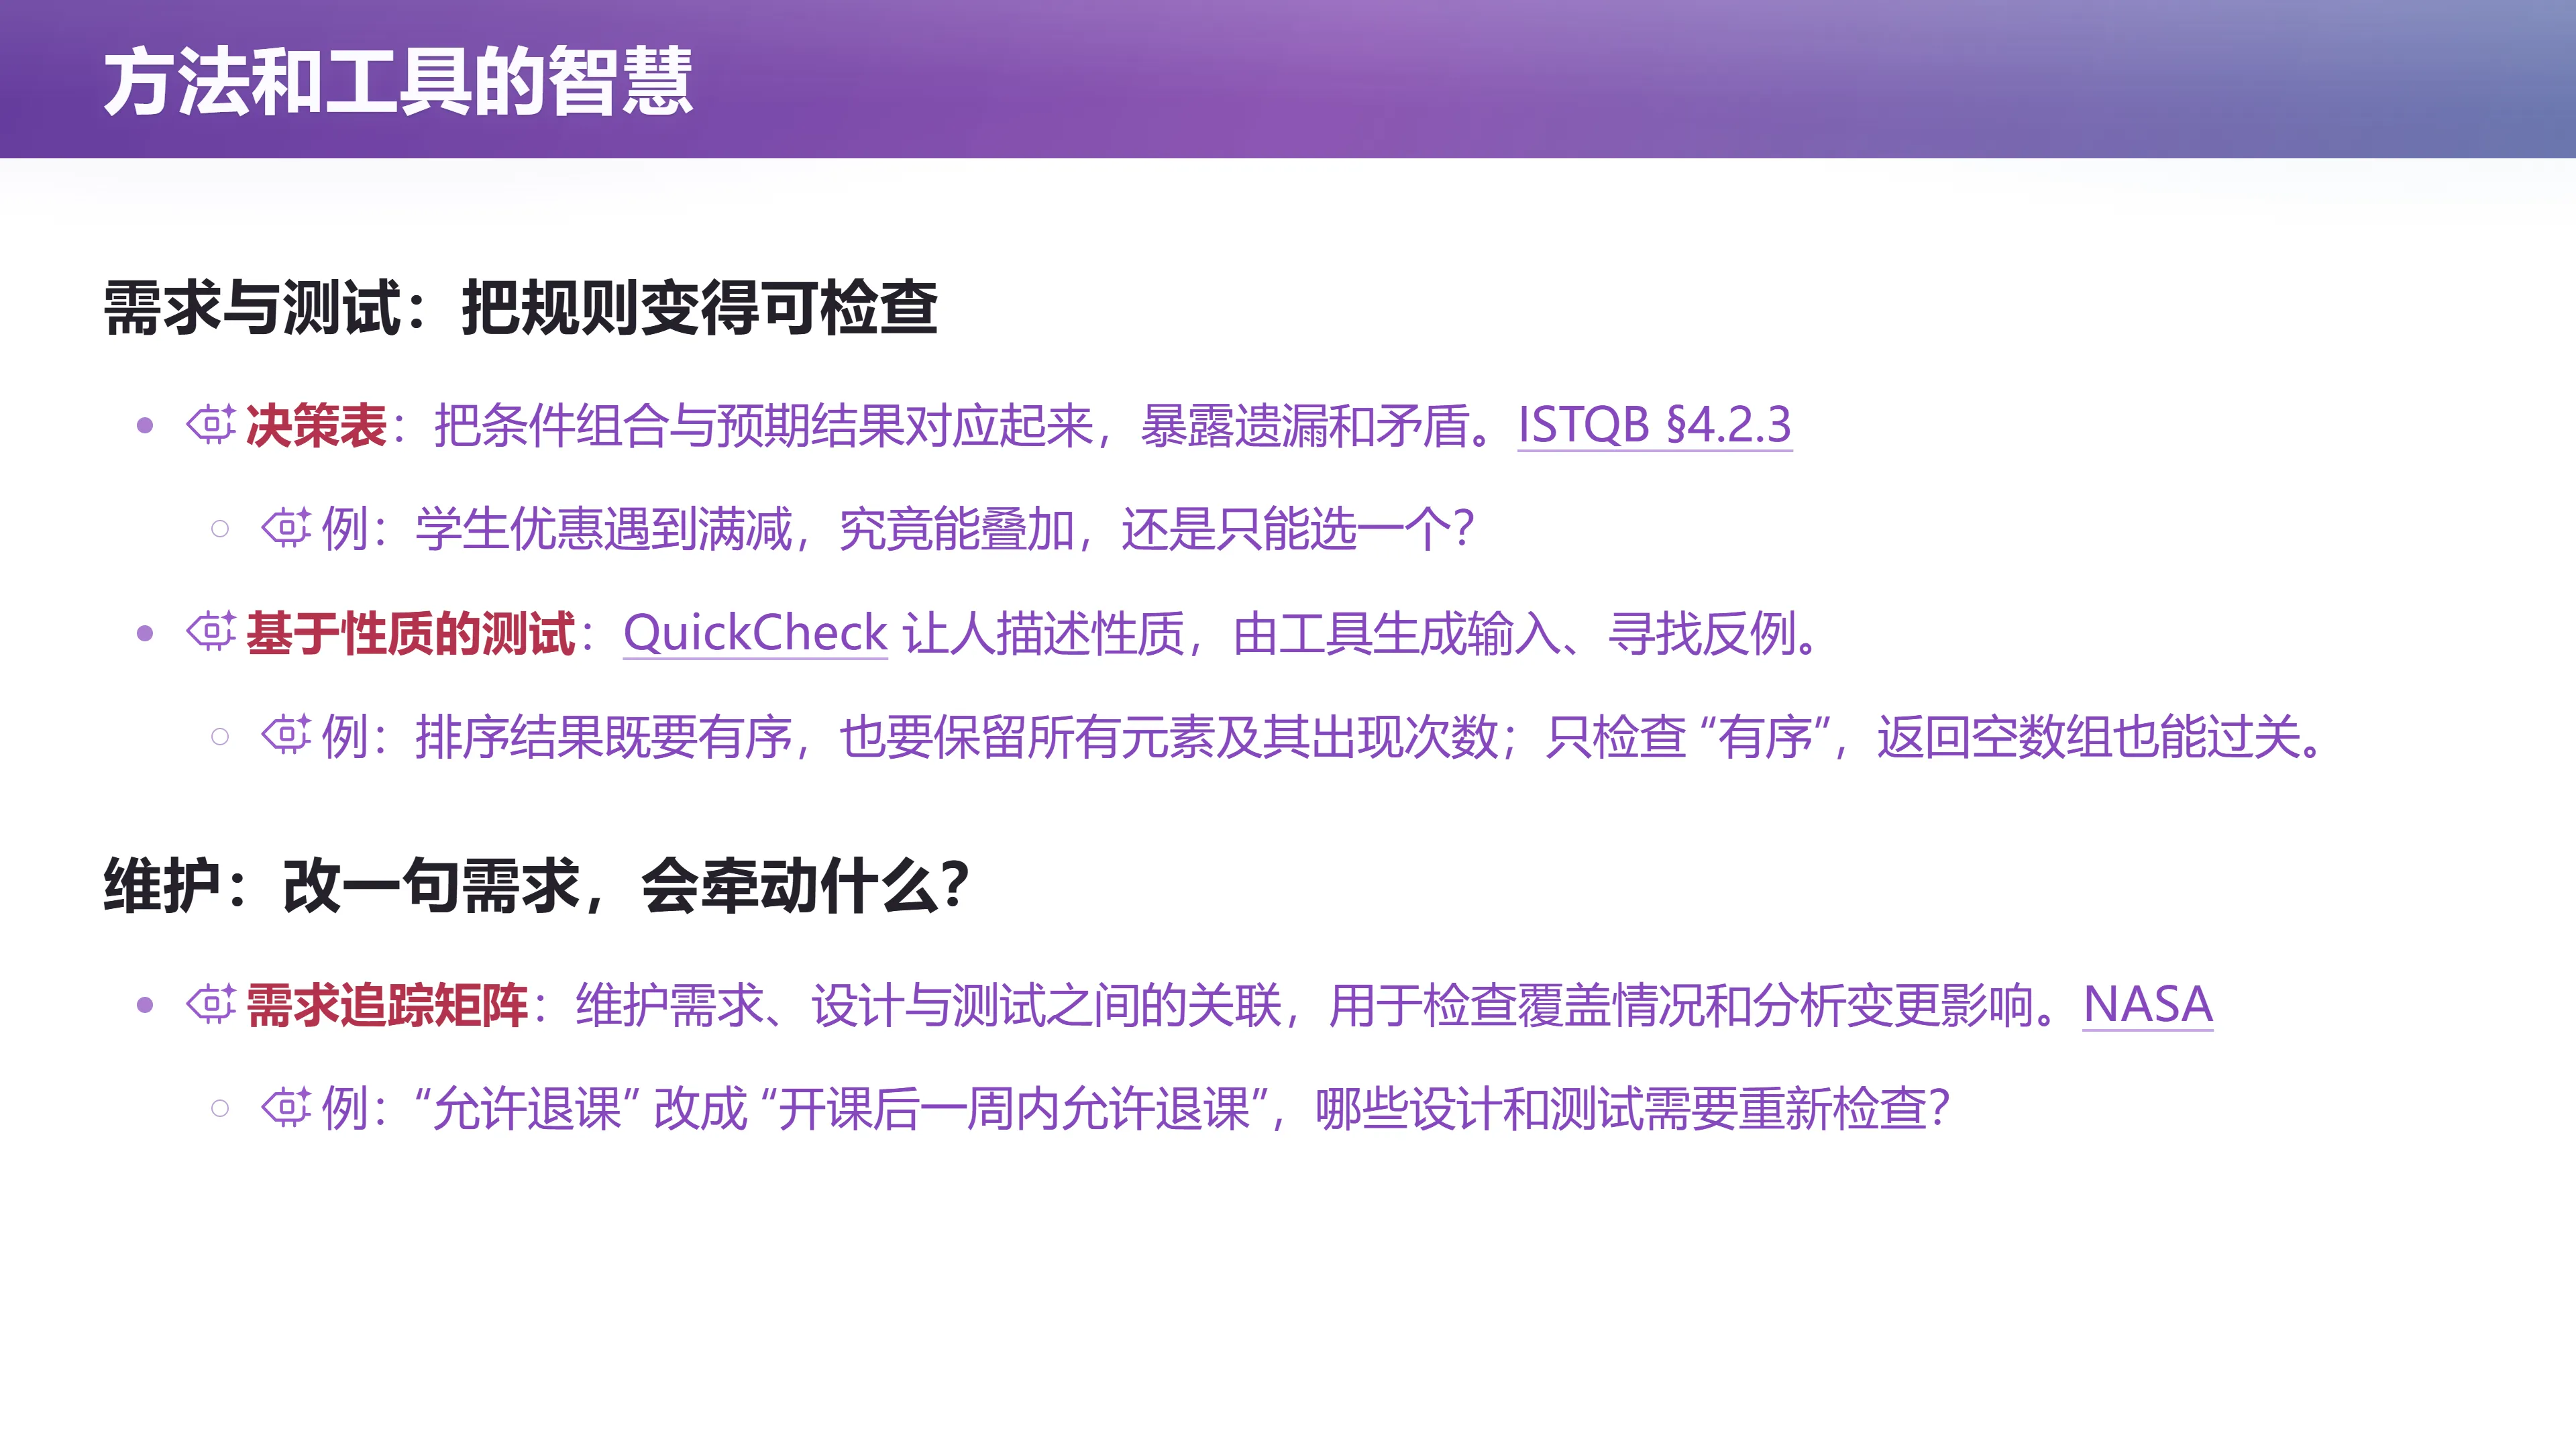
需求与测试:把规则变得可检查
(参考时间: 01:23:17)
软件工程里诞生的有智慧的方法和工具很多,讲师举了几个:
决策表 / 决策树
大家觉得我是个理科生、在软件学院学文科——他给我一个 checklist,说只有当所有的勾都打上了,你才能进入下一个阶段。这对我(不以为意的人来说)是 nonsense。
但这些东西最终是赋予了对的东西:
- 这种形式的语义,避免遗漏和矛盾;
- 它甚至会要求你把所有文档两两摆在一起审查一遍;
- "你会想我靠,我才不想做这个事儿"——但就是这种"两两摆在一起检查一遍",
- 避免了 gap 的漂移。
决策表的一个具体例子:商店说"学生有优惠,满一定金额也有优惠"。把条件列成决策表,就必须决定:
- 学生折扣能否与满减叠加?
- 门槛按原价还是折后价计算?
表格本身并不复杂,它的价值在于把含糊的组合情况摆到了人面前。
基于性质的测试(QuickCheck)
QuickCheck 所代表的基于性质的测试(property-based testing),基本上算是整个测试领域的开山鼻祖之一。它的做法是:
- 让人先表达一类输入都应该满足的要求(property);
- 再由工具生成输入、寻找反例。
以排序为例,"输出有序"还不够,因为一个永远返回空列表的函数也满足它——我们还需要要求输出保留输入中各个元素及其出现次数。
-- 排序的两条性质(伪代码)
prop_sort_sorted  xs = isSorted (sort xs)
prop_sort_perm    xs = sort xs `isPermutationOf` xs
-- 只检查 isSorted,返回 [] 也通过;所以必须检查后者
写性质的过程,也是在发现自己究竟想让程序做什么。
需求可追踪性
(参考时间: 01:25:32)
需求可追踪性(traceability)关心的是另一类遗漏:需求、设计、实现和测试之间是否还保持联系。
- 从文件系统的角度看,软件就是许多文件:
docs/下的.md、source/下的.ts、README等等; - 文件系统一开始大家用了,是不得不做的一个 work around;
- 而 traceability 要求你用链接或文档,使每一个代码和每一个需求点都能对得上:
- 需求和需求之间能对得上;
- 需求和设计之间能对得上。
如果所有这些都能对得上,就有独立的、互相的交叉检验——你对软件质量就更有信心了。
"他也是没办法,就是人的能力是有限的。" 讲师引出了背后的深层原因:
- 我们上大学学软件工程时,总觉得"我要把自己变成世界上最厉害的码农";
- 如果能变成世界上最厉害的码农,那么就能在软件企业里找到一个很好的工作——这是社会给你的 contract;
- 从资本家的角度看,更重要的是:没有一个码农能够单独完成他的项目。他只能调整"码农有好有坏,我花多少钱雇多少码农"来最终把项目交付。
2500 个码农
(参考时间: 01:27:26)
讲师给了这个时代一个非常有冲击力的框架:
- 每个人以后都会当产品经理;
- 你第一门课就要学做产品——你要学会调动码农;
- "假设你有好多码农了,而且你现在马上就有,比如 DeepSeek 这种——我觉得 DeepSeek 绝对算是一个相当资深的码农了,绝对不是本科毕业生级别的";
- "那你马上就可以有 2500 并发的 DeepSeek,你手上有 2500 人,你怎么管?"
- "你高中毕业的时候、高考完那个暑假,你做梦都没有想过,你马上就能管 2500 个人。"
这个 mindset 可能要改一改。 (参考时间: 01:27:57)
契约:调用者与实现者各自承诺什么
Design by Contract
(参考时间: 01:28:11)
📷 契约编程
回到原视频 (01:28:11)
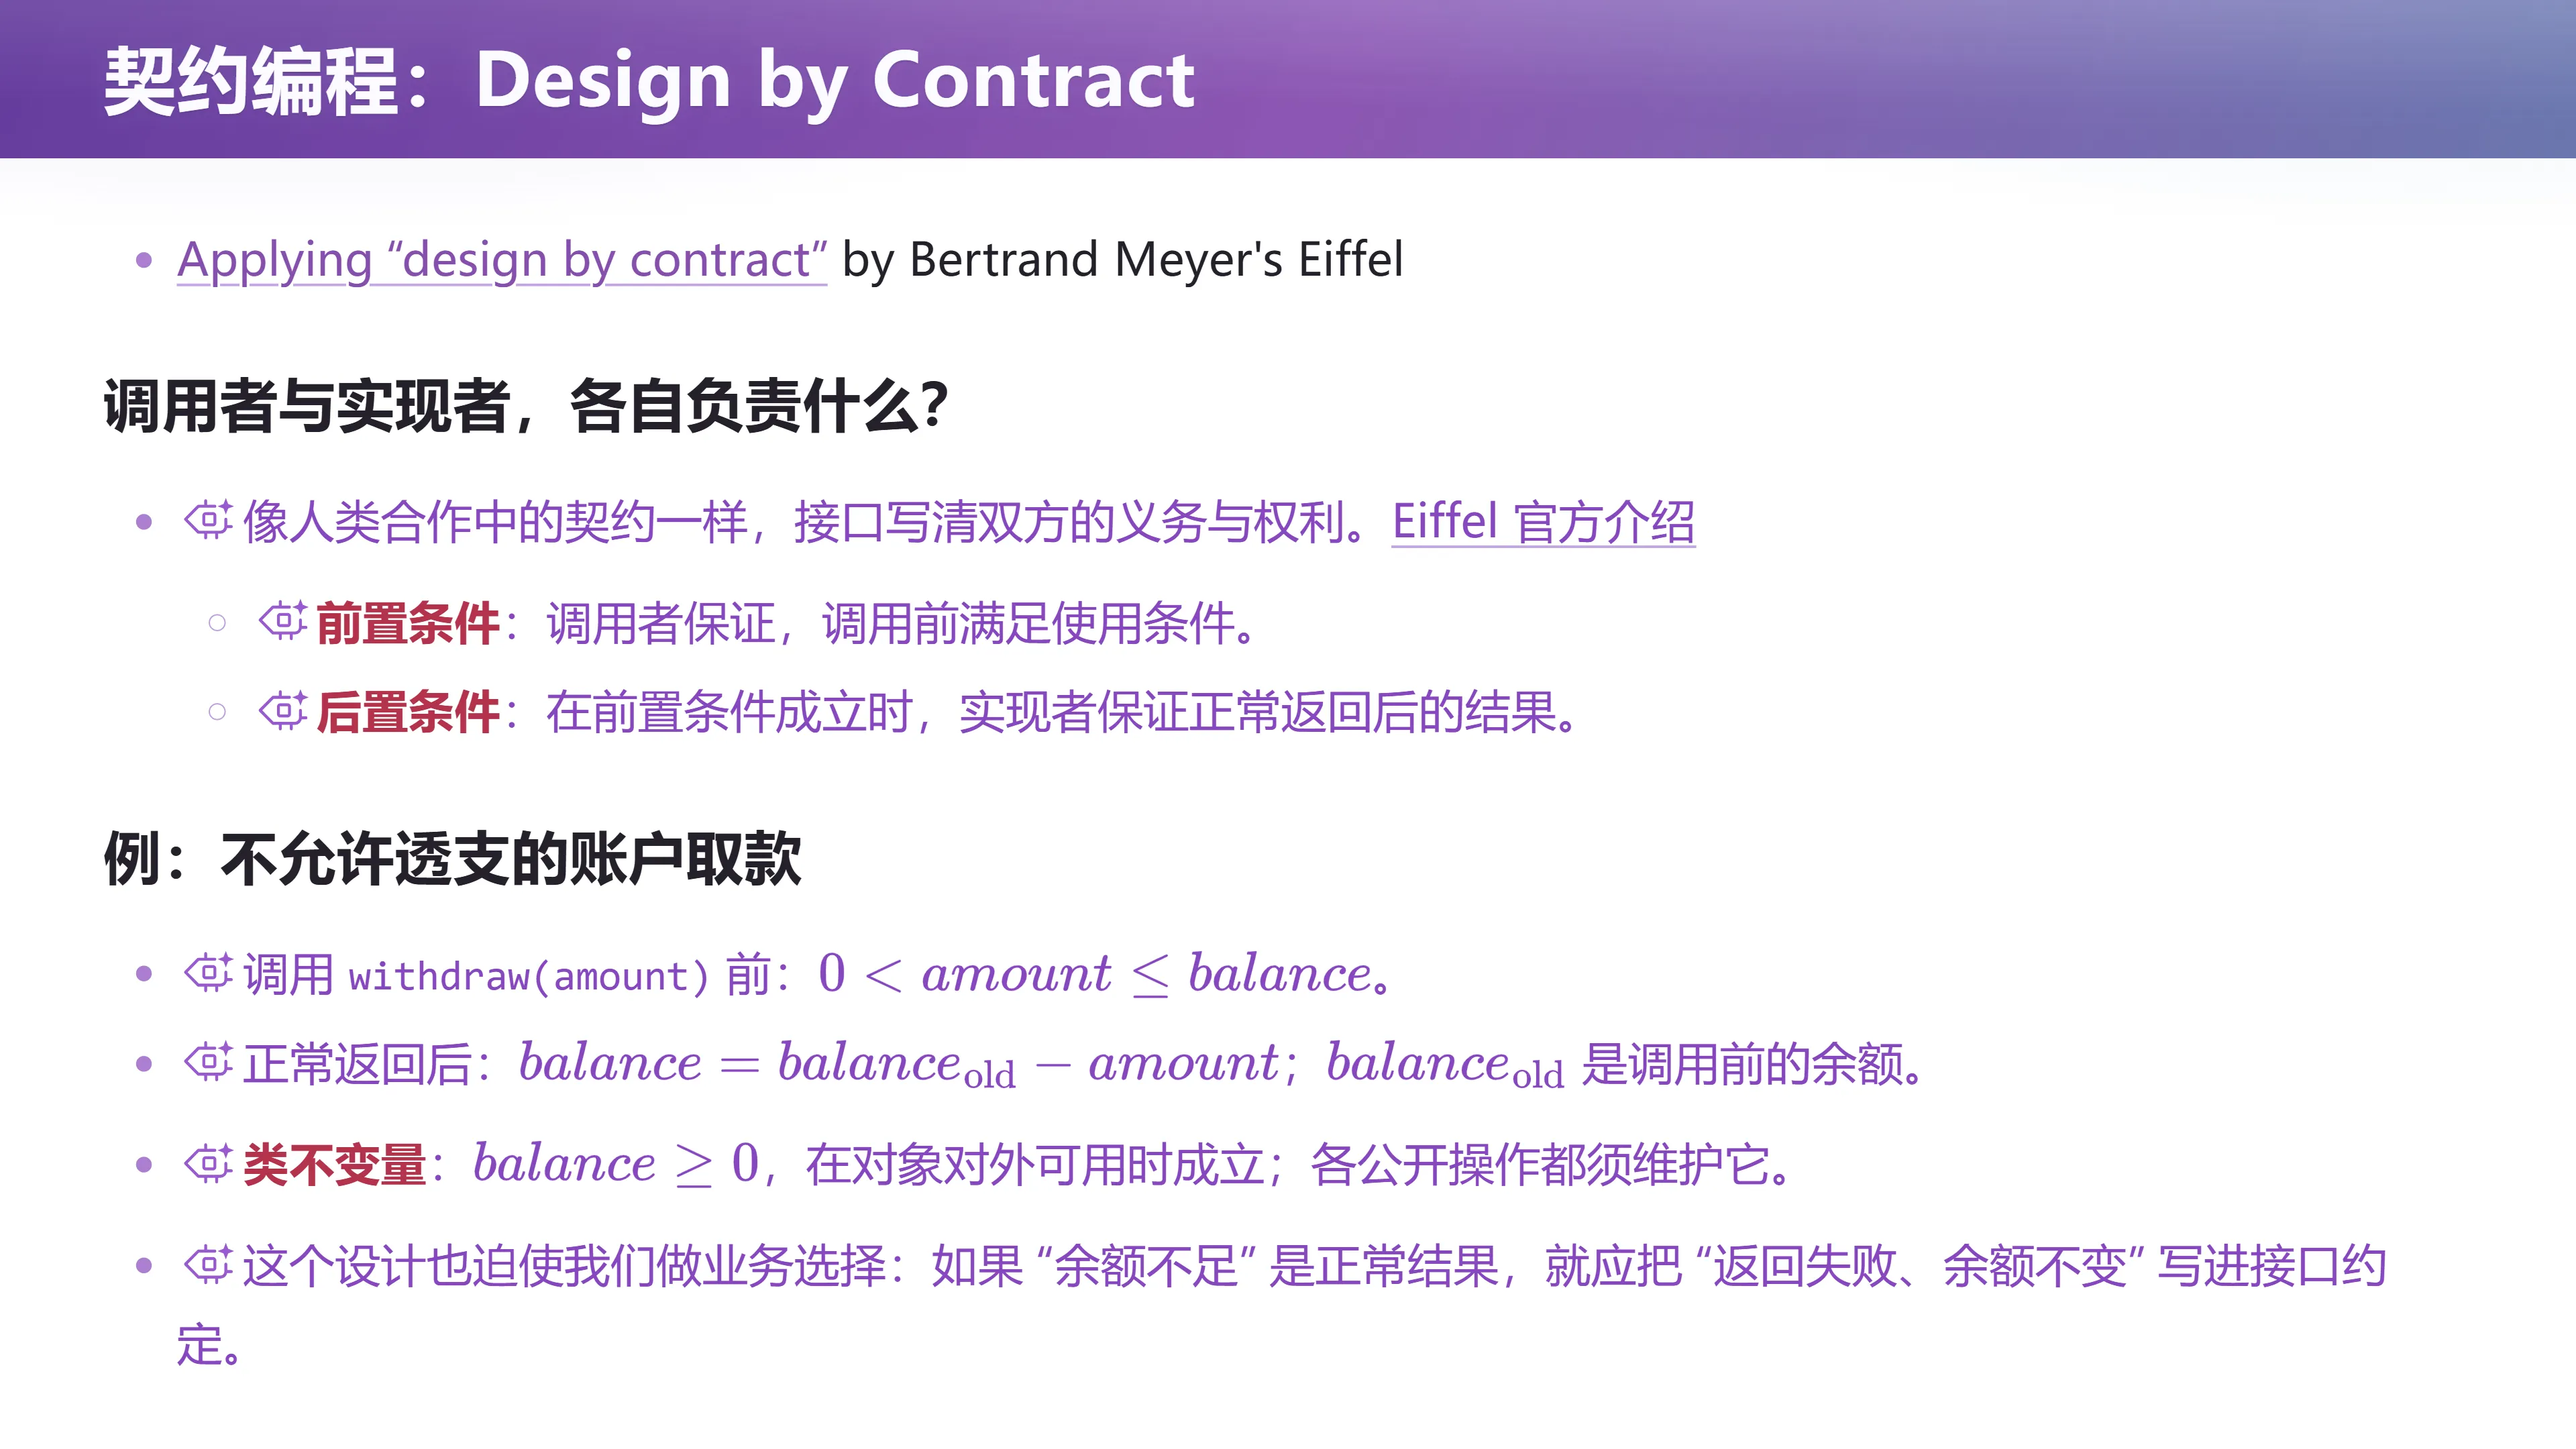
契约式设计(Design by Contract)是众多方法工具中的一个。创始人 Bertrand Meyer 在 Applying "Design by Contract" 中讨论了这种方法;Eiffel 的契约介绍给出了它在语言中的表达。
它的出发点很朴素:一个组件调用另一个组件时,双方应该明确各自的责任。
- 前置条件(precondition):调用者保证——调用前满足使用条件;
- 后置条件(postcondition):在前置条件成立时,实现者保证正常返回后的结果;
- 类不变量(class invariant):描述对象在对外可用的稳定状态下应当满足的条件。
它们一起构成了接口的语义,而不只是参数和返回值的类型。
例:不允许透支的账户取款
(参考时间: 01:29:22)
📷 不允许透支的账户取款
回到原视频 (01:29:22)
以"不允许透支的账户"为例,可以把取款操作写成:
- 前置条件:金额为正,且不超过当前余额:$0 < \text{amount} \le \text{balance}$
- 后置条件:新余额等于旧余额减去取款金额:$\text{balance} = \text{balance}_{\mathrm{old}} - \text{amount}$
- 类不变量:$\text{balance} \ge 0$,在对象对外可用时成立
用 Eiffel 风格的代码表示这个过程(省略外围的类定义):
withdraw (amount: INTEGER)
    require
        positive_amount:    amount > 0
        sufficient_balance: amount <= balance
    do
        balance := balance - amount
    ensure
        balance_decreased:  balance = old balance - amount
    end
这里的 old balance 表示调用开始时的余额。具体实现怎样存储余额,调用者不必知道;但只要满足前置条件,就有权依赖后置条件。
契约的边界
这份契约也明确划出了边界:
- 余额不足的请求没有满足它的前置条件;
- 如果产品要求把"余额不足"作为一种正常业务结果返回,就应该另行设计契约——例如规定"请求失败时返回失败状态且余额不变";
- 不能一边接受任意取款请求,一边在余额不足时用"调用者不该这样调用"逃避业务要求。
契约描述的是双方真正同意的责任。
把契约写进语言
(参考时间: 01:30:10)
📷 把契约写进语言
回到原视频 (01:30:10)
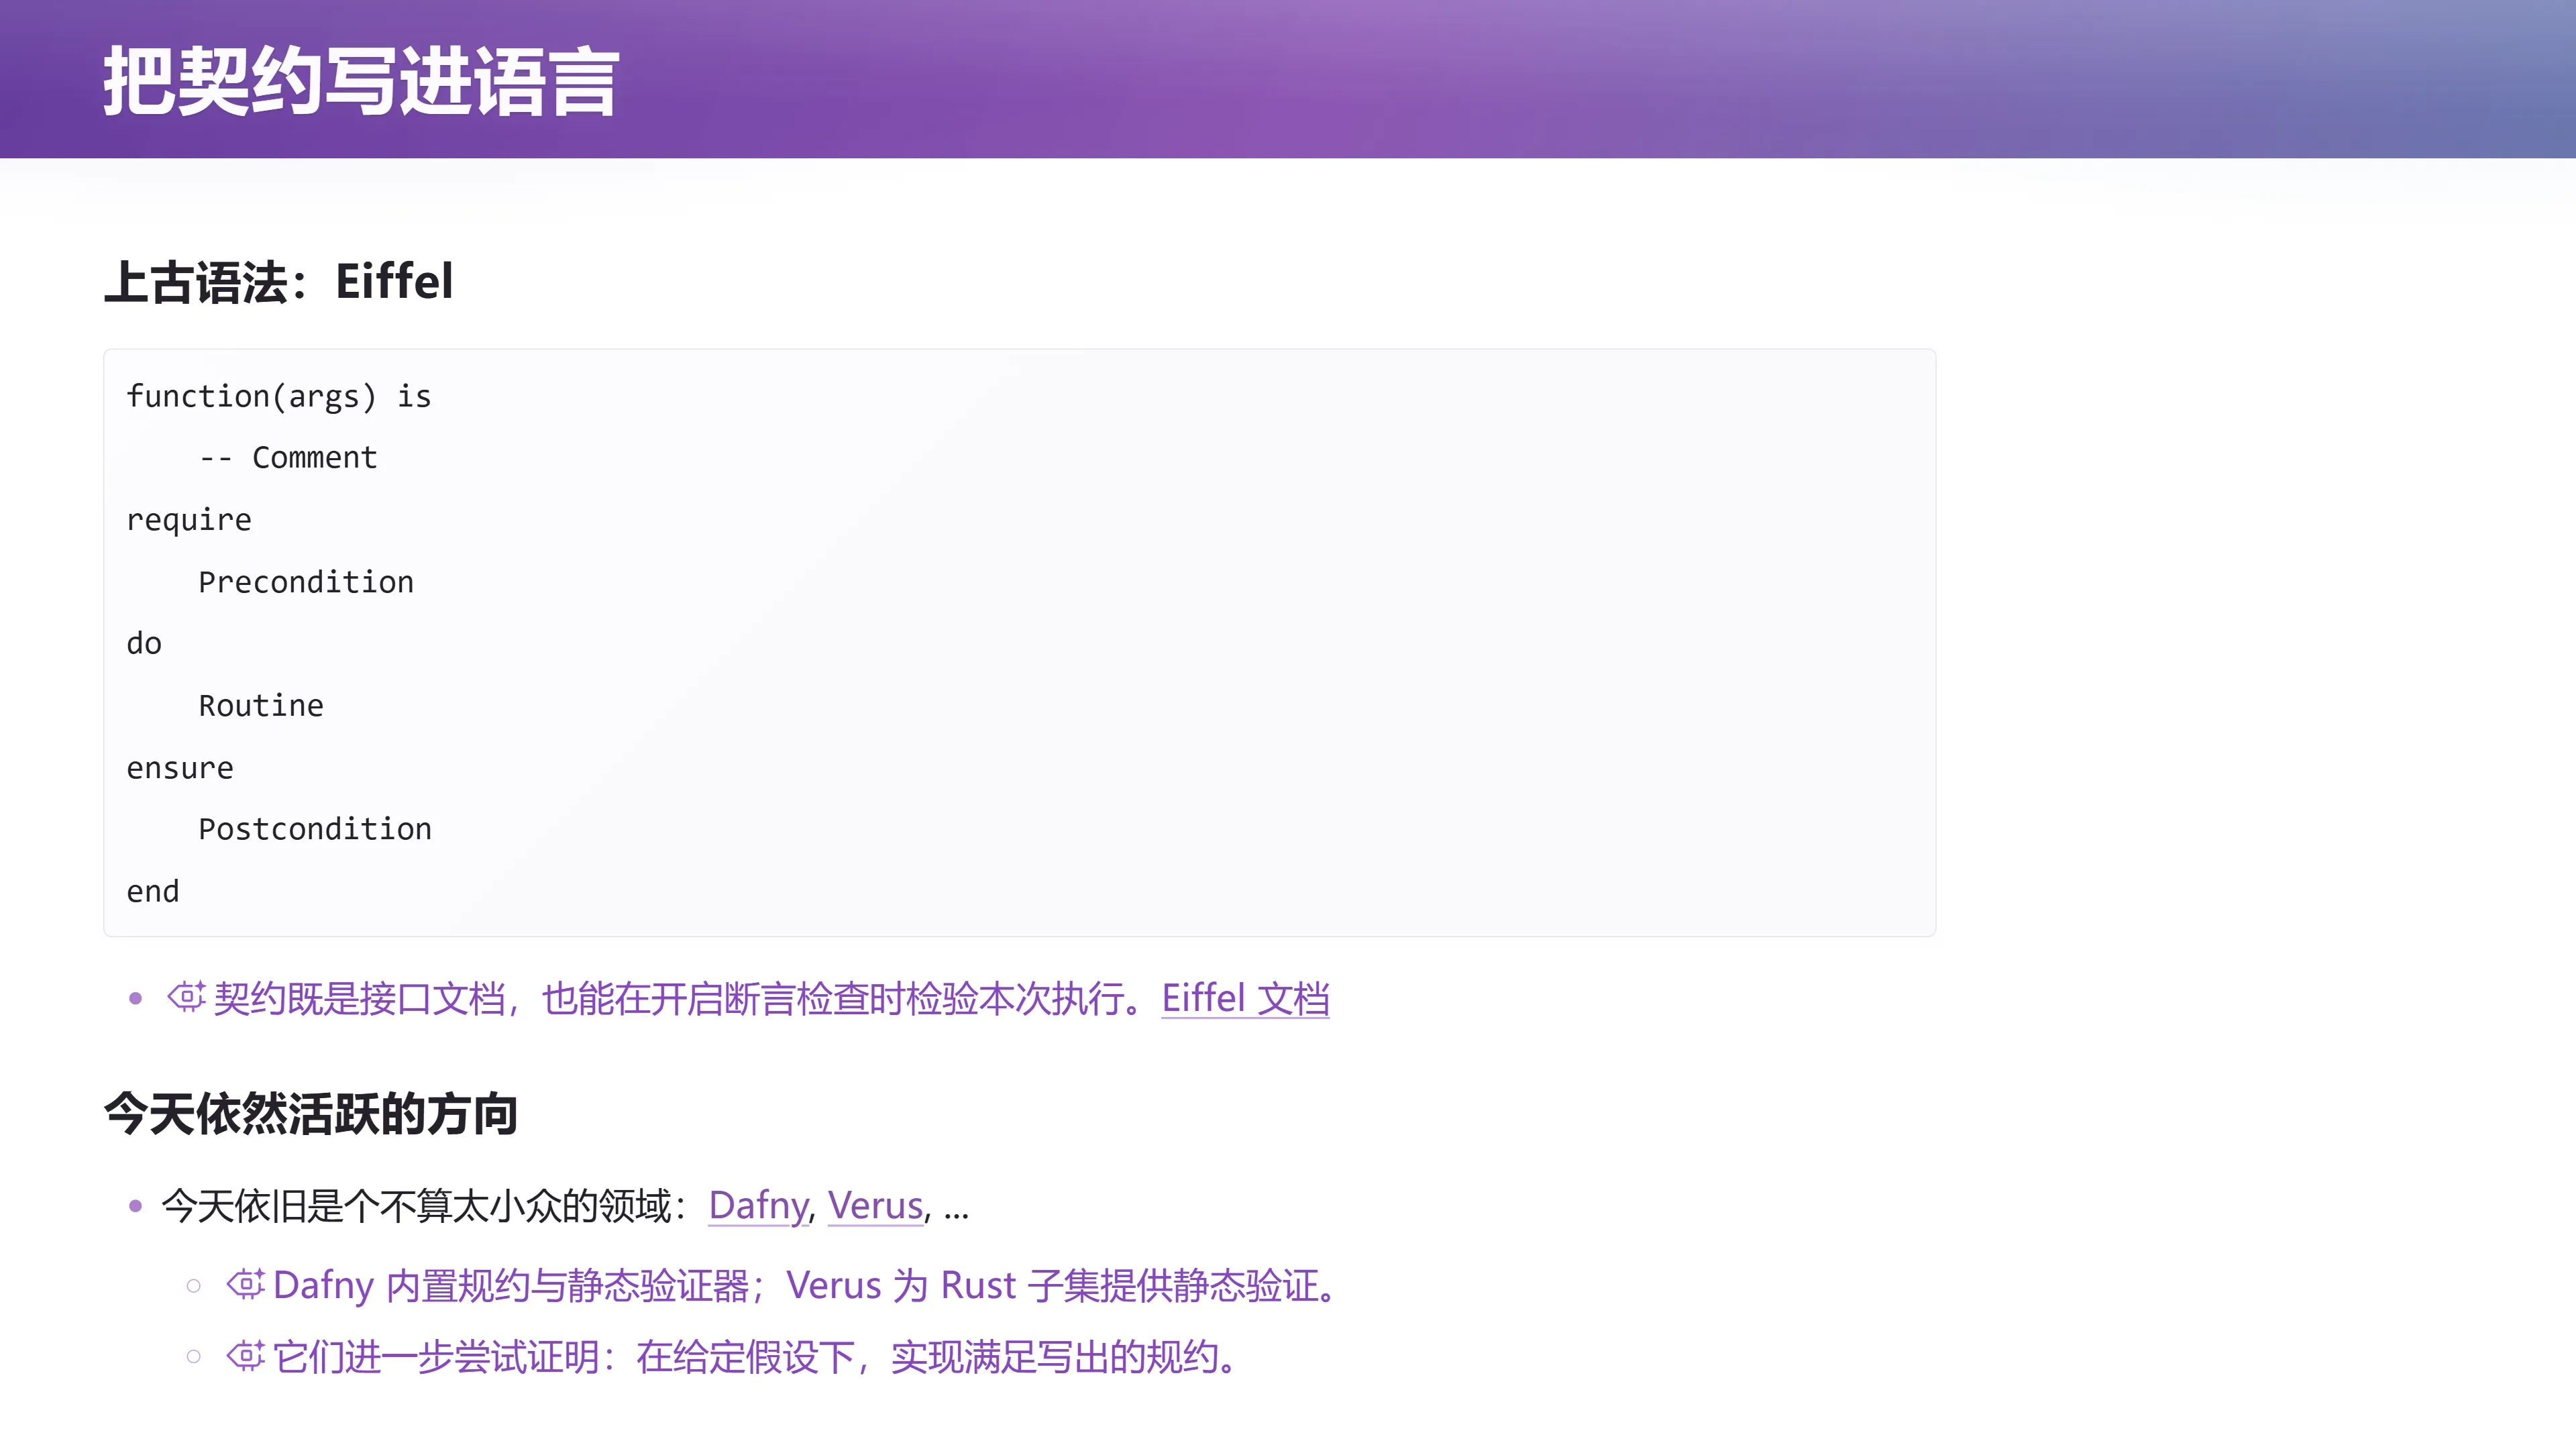
Eiffel 的"上古语法"长这样:
function(args)
    require
        Precondition
    do
        Routine
    ensure
        Postcondition
    end
讲师特别解读了 Eiffel 的意图:
"你可以先不用写
do里面的代码。Eiffel 鼓励你先把软件各个模块的文档、前置条件、后置条件写出来。"
想一想取款这个例子:
- 当你写 pre / post condition 时,就会自然地关联到你的设计问题——"余额不足到底应该怎么样处理?"
- 你如果写第一个 MVP 的时候,你一定不会管这些事:"肯定是直接让它 crash,或者怎么",你会把它排除在 specification space 之外;
- 但当你的软件不断向后演进时,这个 contract 就变得非常重要。
编者说明:这就是软件工程在 spec 层面上反复的"横跳"——从自然语言,到半自然语言,到可逻辑公式的语言,再到编程语言。
今天依然活跃:形式化验证
(参考时间: 01:30:49)
Eiffel 催生了很多现代项目,比如 Dafny 和 Verus 这两款形式化验证工具。
- Dafny:内置规约与静态验证器;
- Verus:为 Rust 子集提供静态验证。
它们进一步尝试证明:在给定假设下,实现满足写出的规约。 也就是说,在合适的语言和逻辑系统中,对实现是否满足规约做静态验证。
讲师讲了自己在 ChatGPT 出现之前的"30 年预测":
"我在操作系统课上预言 30 年——大概 2020 年左右的时候——如果你的一个程序里面有个 assert,然后这个 assert 随便写、可以写前置条件、后置条件,任何和业务逻辑相关的 assert,只要我写出来,它不能证明,或者说这个东西是无法证明的,这个程序就不能编译,百分之百保证这个东西才能证明。那时候我还需要 property base test 吗?不需要——我只要直接把这个 property 写进去,它帮我证明了就可以了。"
现在回头看:
"从现在看,可能不需要 30 年,可能从那个时间点算 10 年或者 15 年就可以解决这样的问题了。" (参考时间: 01:32:24)
重新阅读 UML
一个非常有野心的中间语言
(参考时间: 01:32:30)
📷 Unified Modeling Language (UML)
回到原视频 (01:32:30)
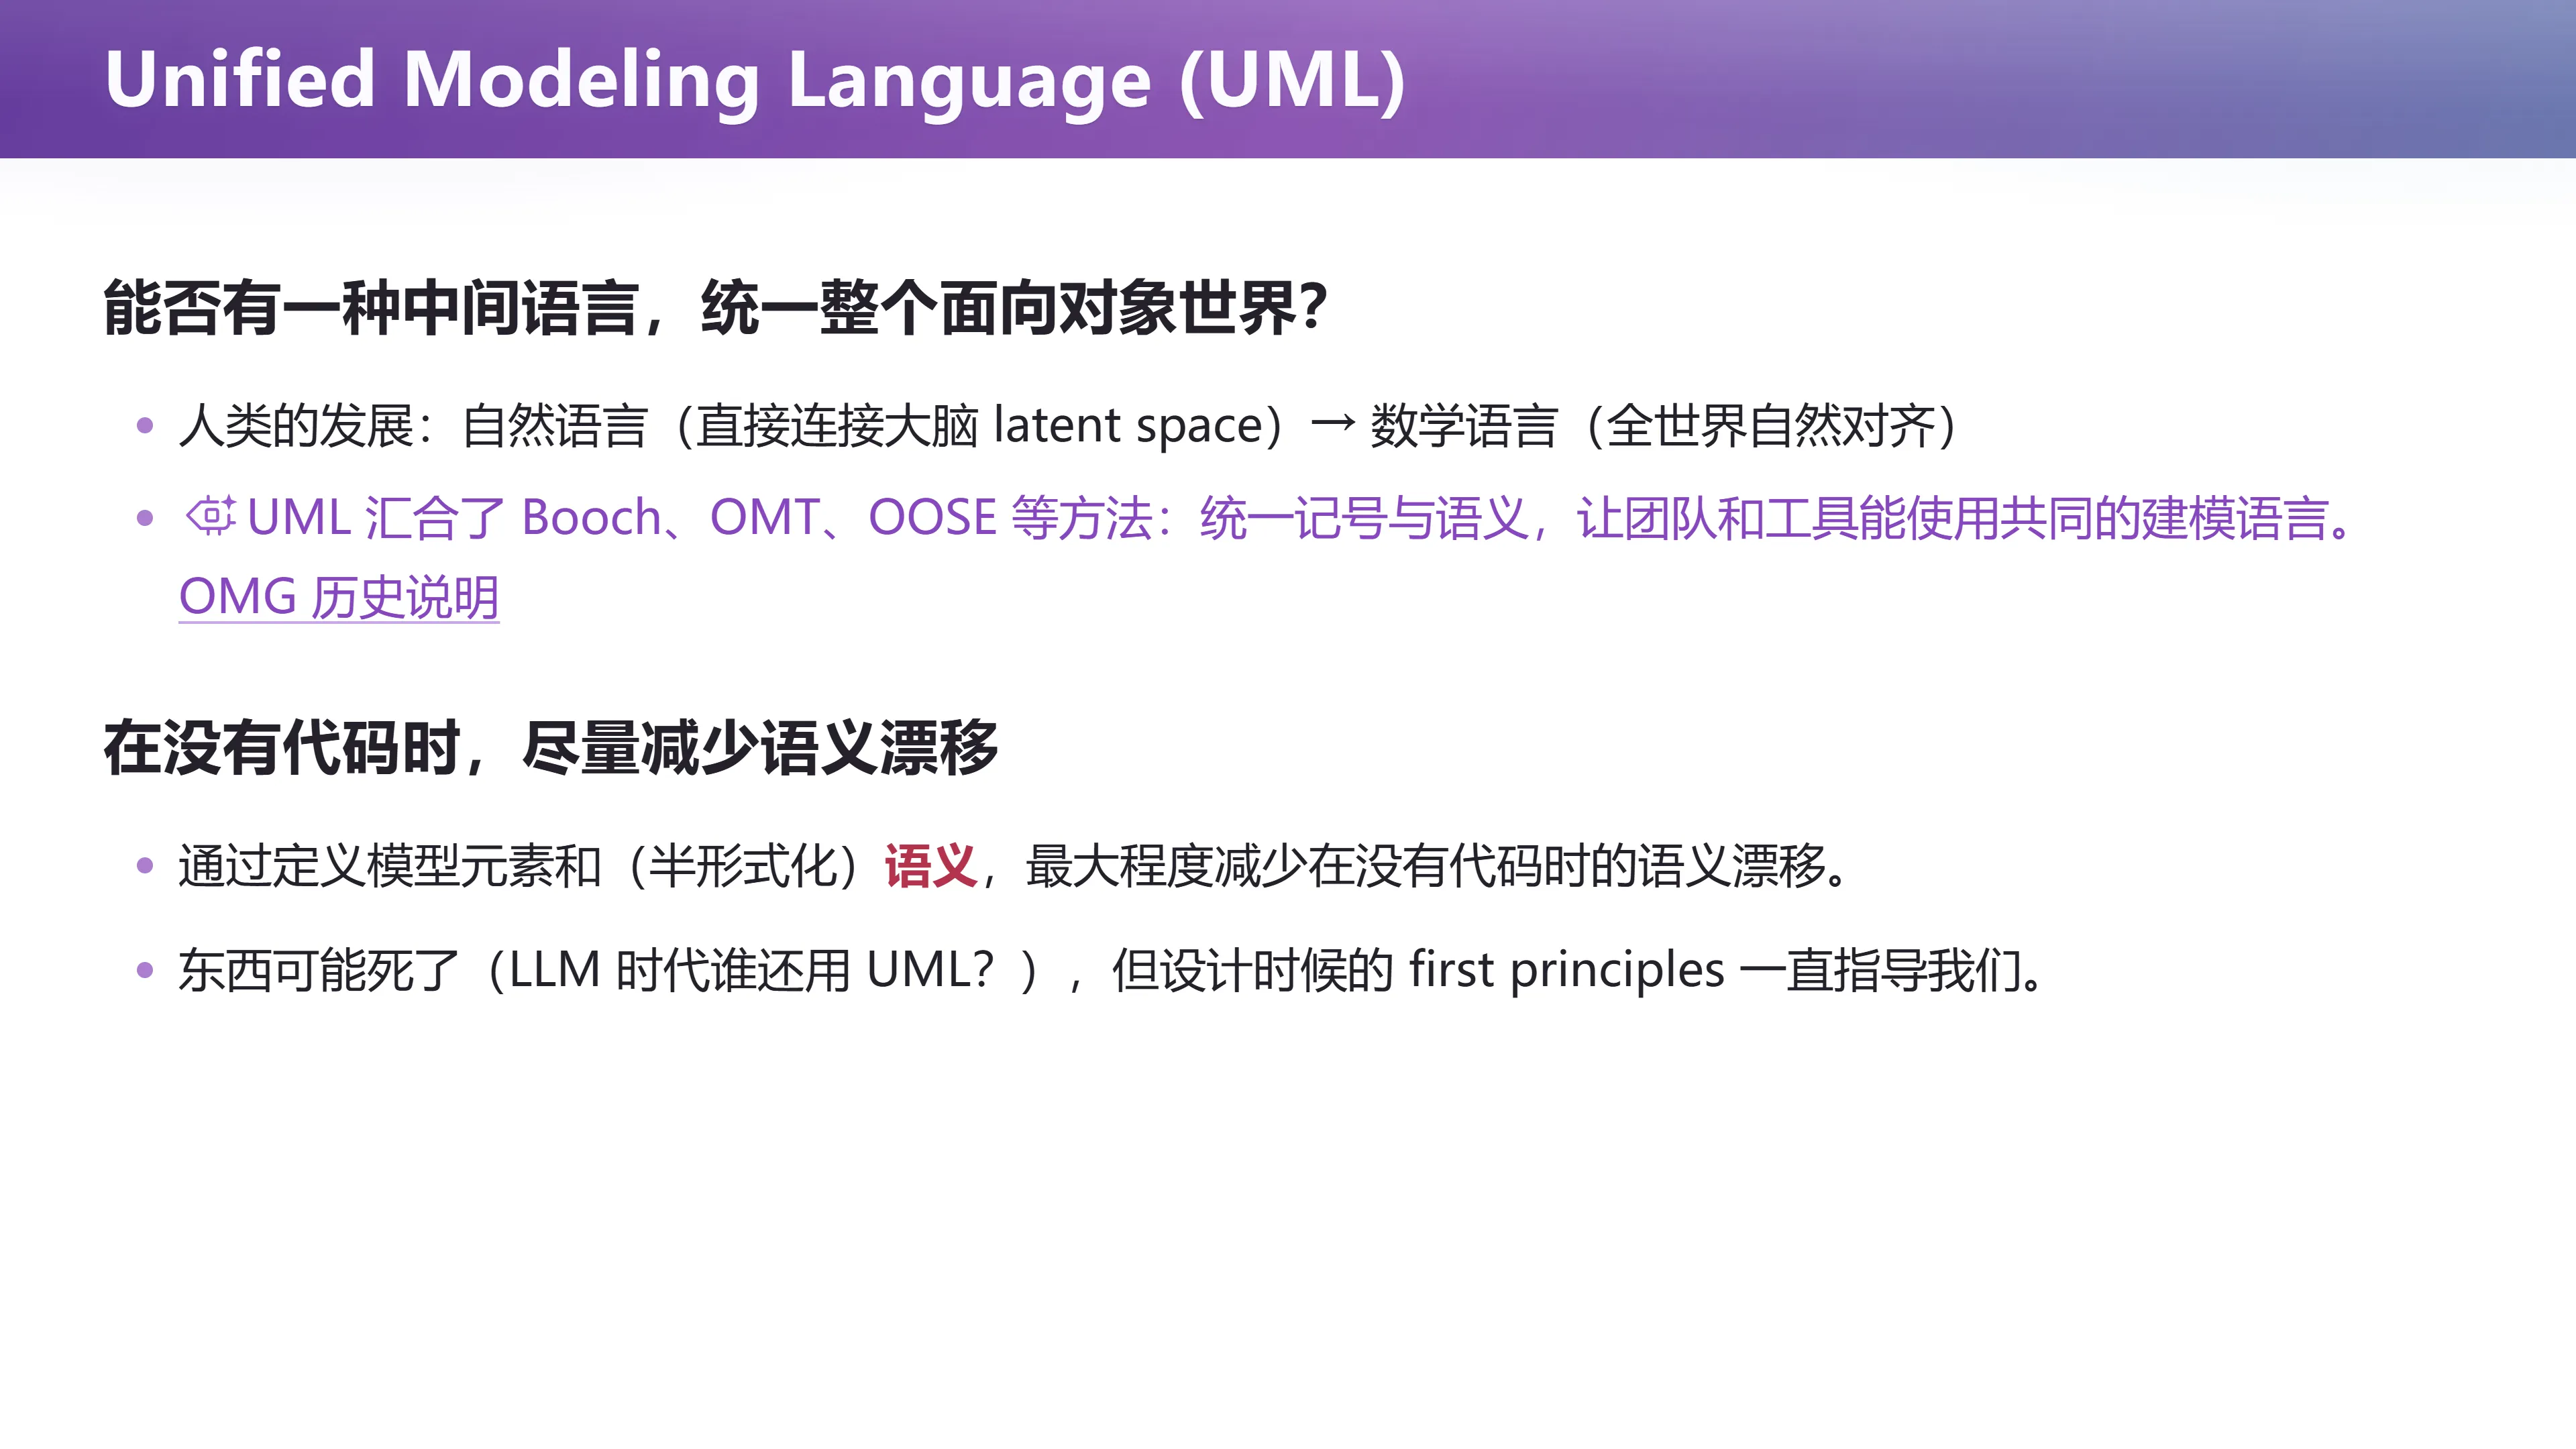
在这个过程当中,有一个集大成者:UML,Unified Modeling Language,统一建模语言。 大家绕不过去的一个名字。
它的想法也很简单:
- 既然这个世界这么复杂——实现的时候用 C 或者 Java,设计的时候用 Eiffel 或别的领域语言,需求的时候用 DSL——那么能不能有一种中间语言,统一整个面向对象世界?
- 这要做的事情非常有野心——它是"语义对齐"。
人类天生没有做好的事情
(参考时间: 01:33:08)
讲师用一个比喻说明了这个问题的深意:
- 人类靠自然语言交流,自然语言直接连接大脑的 latent space;
- 我说"我今天看到一个美女"——你们每一个人的 latent space 里都构造了一个美女,但她都不一样;
- 如果你要求我们把那个形象 3D 建模、用 Blender 画出来,那就跟我让 GPT 画一个美女、让 DeepSeek 画一个美女——他们画出来也是不一样的。
语言是很难对齐的。
于是人类发明了数学语言:因为我们知道什么是自然数,我们是从公理一点一点构造出来的。公理非常小,以至于人类基本上可以对齐。一旦对齐完成,比如用皮亚诺公理,就把整个计算机世界全部都构建起来了。
在计算机上看到同样的东西,它的语义是绝对对齐的。
UML 的目标:把"能对齐的"和"不能对齐的"剥离
(参考时间: 01:34:22)
UML 想要的是非常有野心的目标:去对齐自然语言世界里的东西——比如需求设计这些说不清的东西。
当然你不可能百分之百对齐,但是 UML 希望把能对齐的部分和不能对齐的部分剥离开来:
- 通过定义模型元素和它们的语义;
- 有些东西是有语义的——比如你知道什么是类图,那类图的语义就是确定的:
- 我有一个
class叫Student,里面有一个field叫name; - 那它就是
Student.name,可以变成一个源代码里的东西; - 再比如时序图(sequence diagram):它说"我要从前到后按某一种顺序时序来执行",那这个时序的先后就是绝对对齐的;
- 如果不用 UML、写自然语言说"先后",当它发生并发的时候,到底谁先谁后、能不能并发,它就是有歧义的。
UML 最大程度减少了在没有代码时候的语义漂移。
讲师观点:"当然我觉得今天 UML 已经死了——因为它所有的假设都是'我们的自然语言和形式语言是不能对齐的',所以它才需要一层一层的中间语言。但今天,自然语言可以和任何东西对齐了——反正 AI 就可以给你问嘛。" (参考时间: 01:35:28)
但 UML 设计时的 first principles,其实一直都在指导我们。
阅读 UML Spec
(参考时间: 01:36:14)
📷 阅读 UML Spec
回到原视频 (01:36:14)
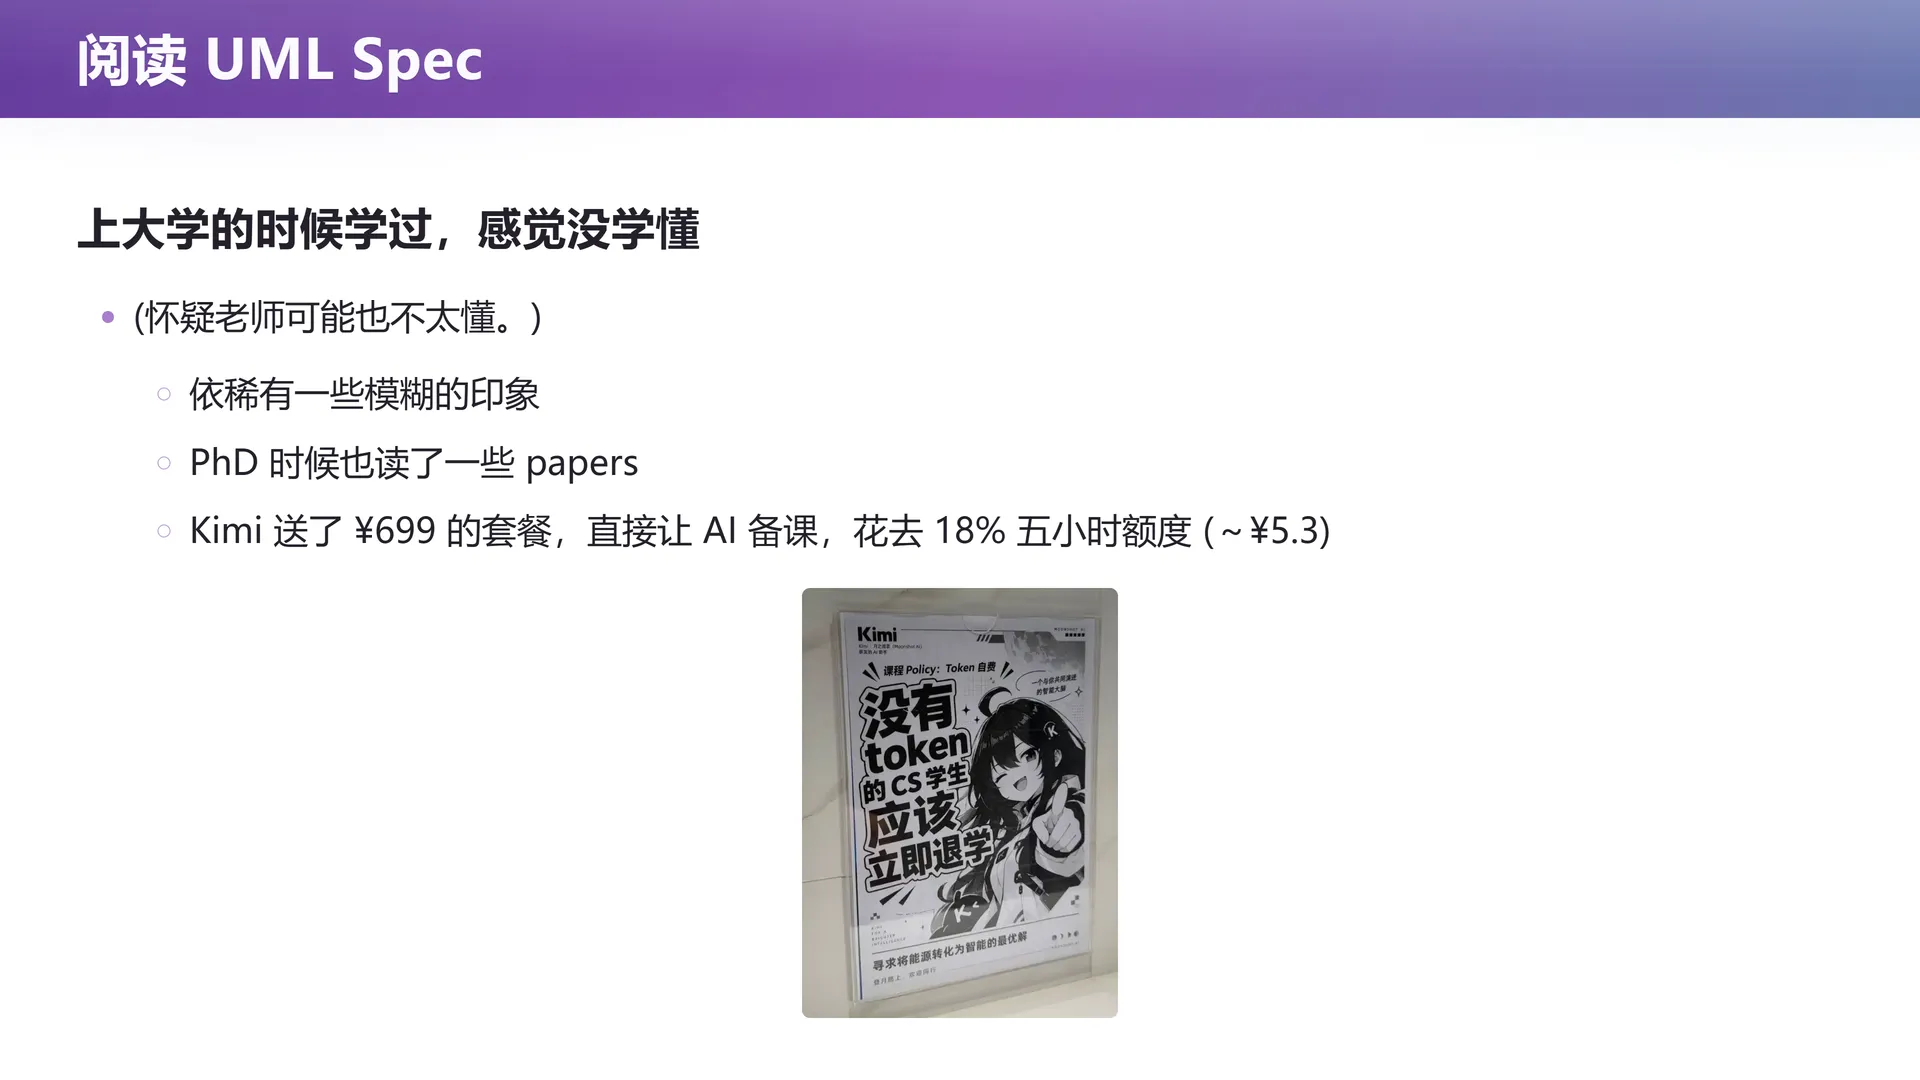
讲师回顾了自己接触 UML 的经历:
- 上大学的时候学过 UML,感觉没学懂;当时还怀疑"老师可能也不太懂";
- 只留下一些模糊的印象;
- 读 PhD 的时候也读了一些 papers;
- 这次上课,正好 Kimi 送了 ¥699 的套餐(因为看到了他的视频),于是直接让 AI 帮他备课。
具体做法是这样的:
- 他有一个可以 scale 到几千页文档的命令行工具,跟 PDF 的阅读体验差不多;
- 他把 UML 规范直接 dump 下来;
- 然后分 subagent,每个 agent 读 50 页;因为切分带 overlap(总会有边界问题);
- 让每个 agent 提取里面的软件工程智慧,剔除不符合 AI 时代的不必要内容;
- 把他的 lecture notes 全部给 AI,让它总结成课件;
- 结果花了 18% 的五小时额度,折算成 ¥699 套餐大约五块三。
讲师由此引出一个值得思考的问题:
"当你拥有更好的模型……你现在如果用 GPT-6,可能你的价格会差不多,因为它很省 token。在差不多的价格下,可以得到好得多的质量。这就意味着——学生群体,哪怕你们是学生群体,在拥有好的模型和没有好的模型的时候,你们的学习效率、学习成本会有很大的差距。" (参考时间: 01:38:14)
讲师进一步指出 token 花在哪:
- 维护大项目最烧 token——你在大上下文里载入很多东西,上下文很快填满;
- 但学习流程上下文不会那么烧——你不需要把整个 UML spec 都放进来,可以用 digested version;
- 然而这仍然是一个社会性问题:"我们以后还学得起、学不起来?如果让所有人都评教育平权,那我们没有那么多算力、没有那么多资源,那怎么办?"
哪些意图必须显式钉死,哪些可以留白
(参考时间: 01:39:22)
📷 哪些意图必须显式钉死,哪些可以留白
回到原视频 (01:39:22)
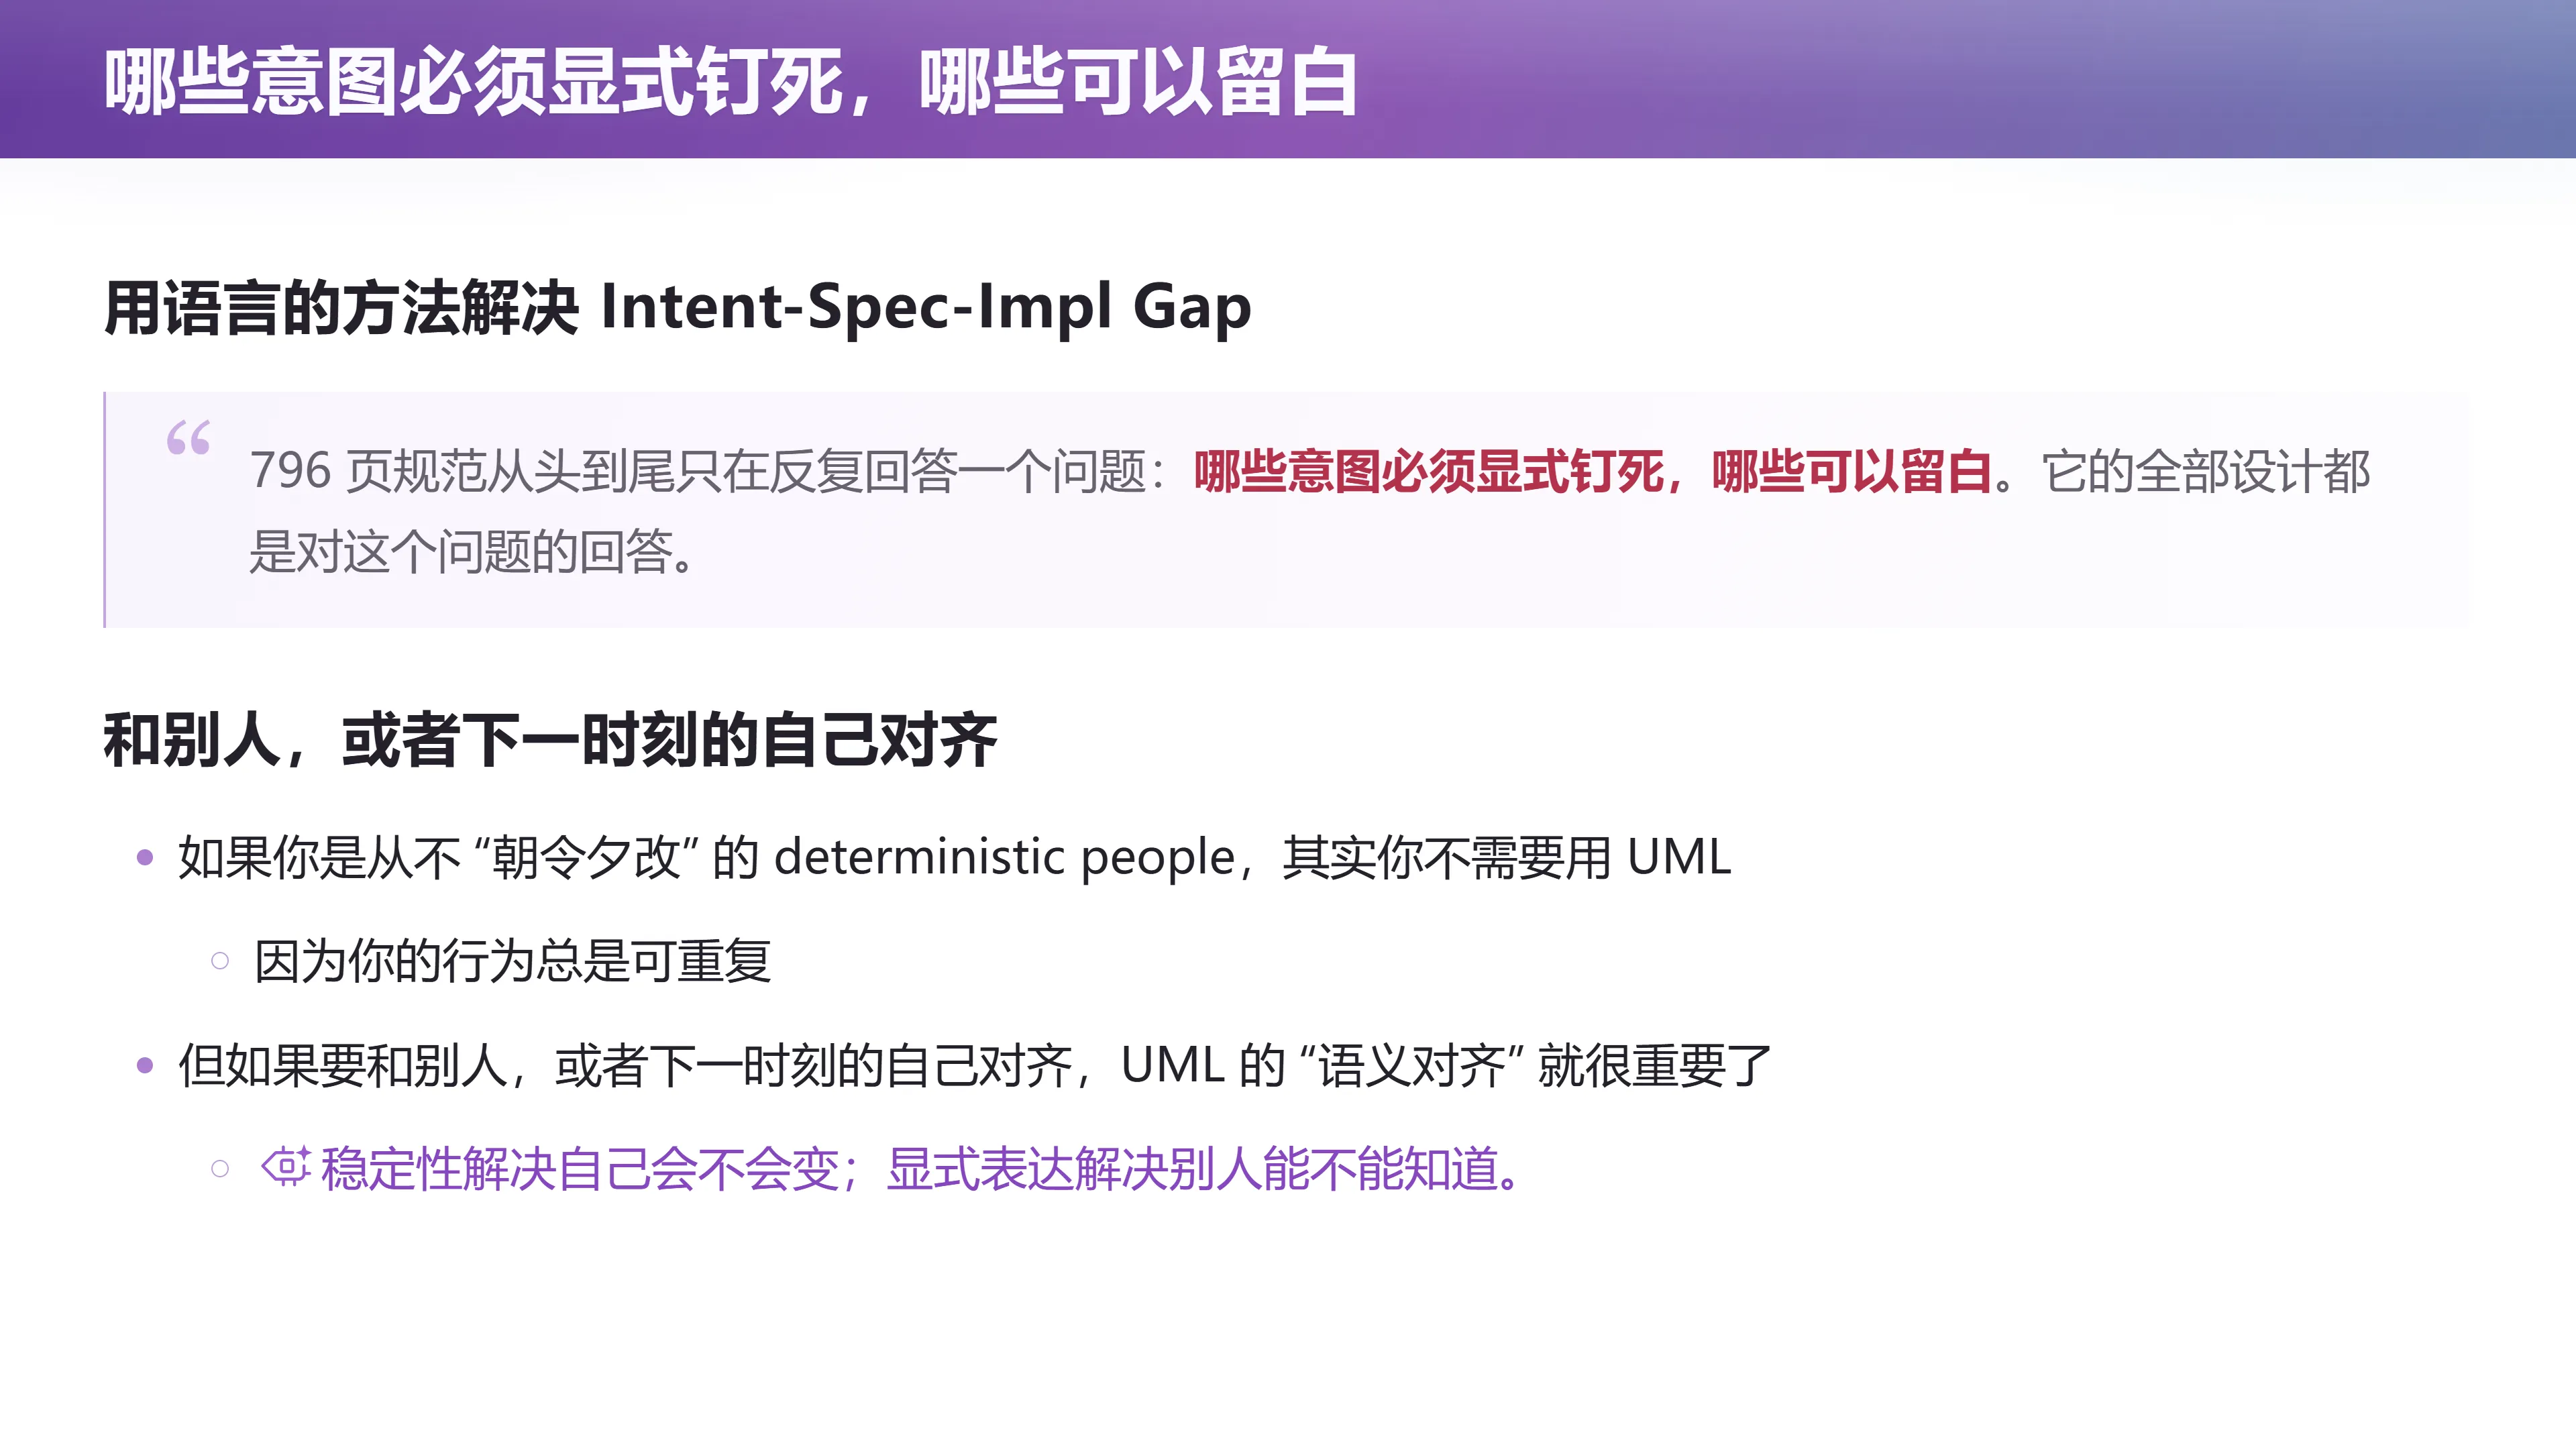
796 页规范从头到尾,只在反复回答一个问题:哪些意图必须显式钉死,哪些可以留白。
它的全部设计都是对这个问题的回答:构造了一个形式语言(半形式语言),去告诉你:
- 哪些东西可以在语义上确定下来;
- 哪些可以不用管。
它解决的就是"对齐"的问题——人和人之间的对齐,甚至你和下一时刻的自己的对齐:
"你不 deterministic——你今天想的和明天想的就不一样。所以你跟你自己也会对不起(无法对齐)。" (参考时间: 01:39:45)
一些 UML 的"迷信"与它的价值
(参考时间: 01:38:14)
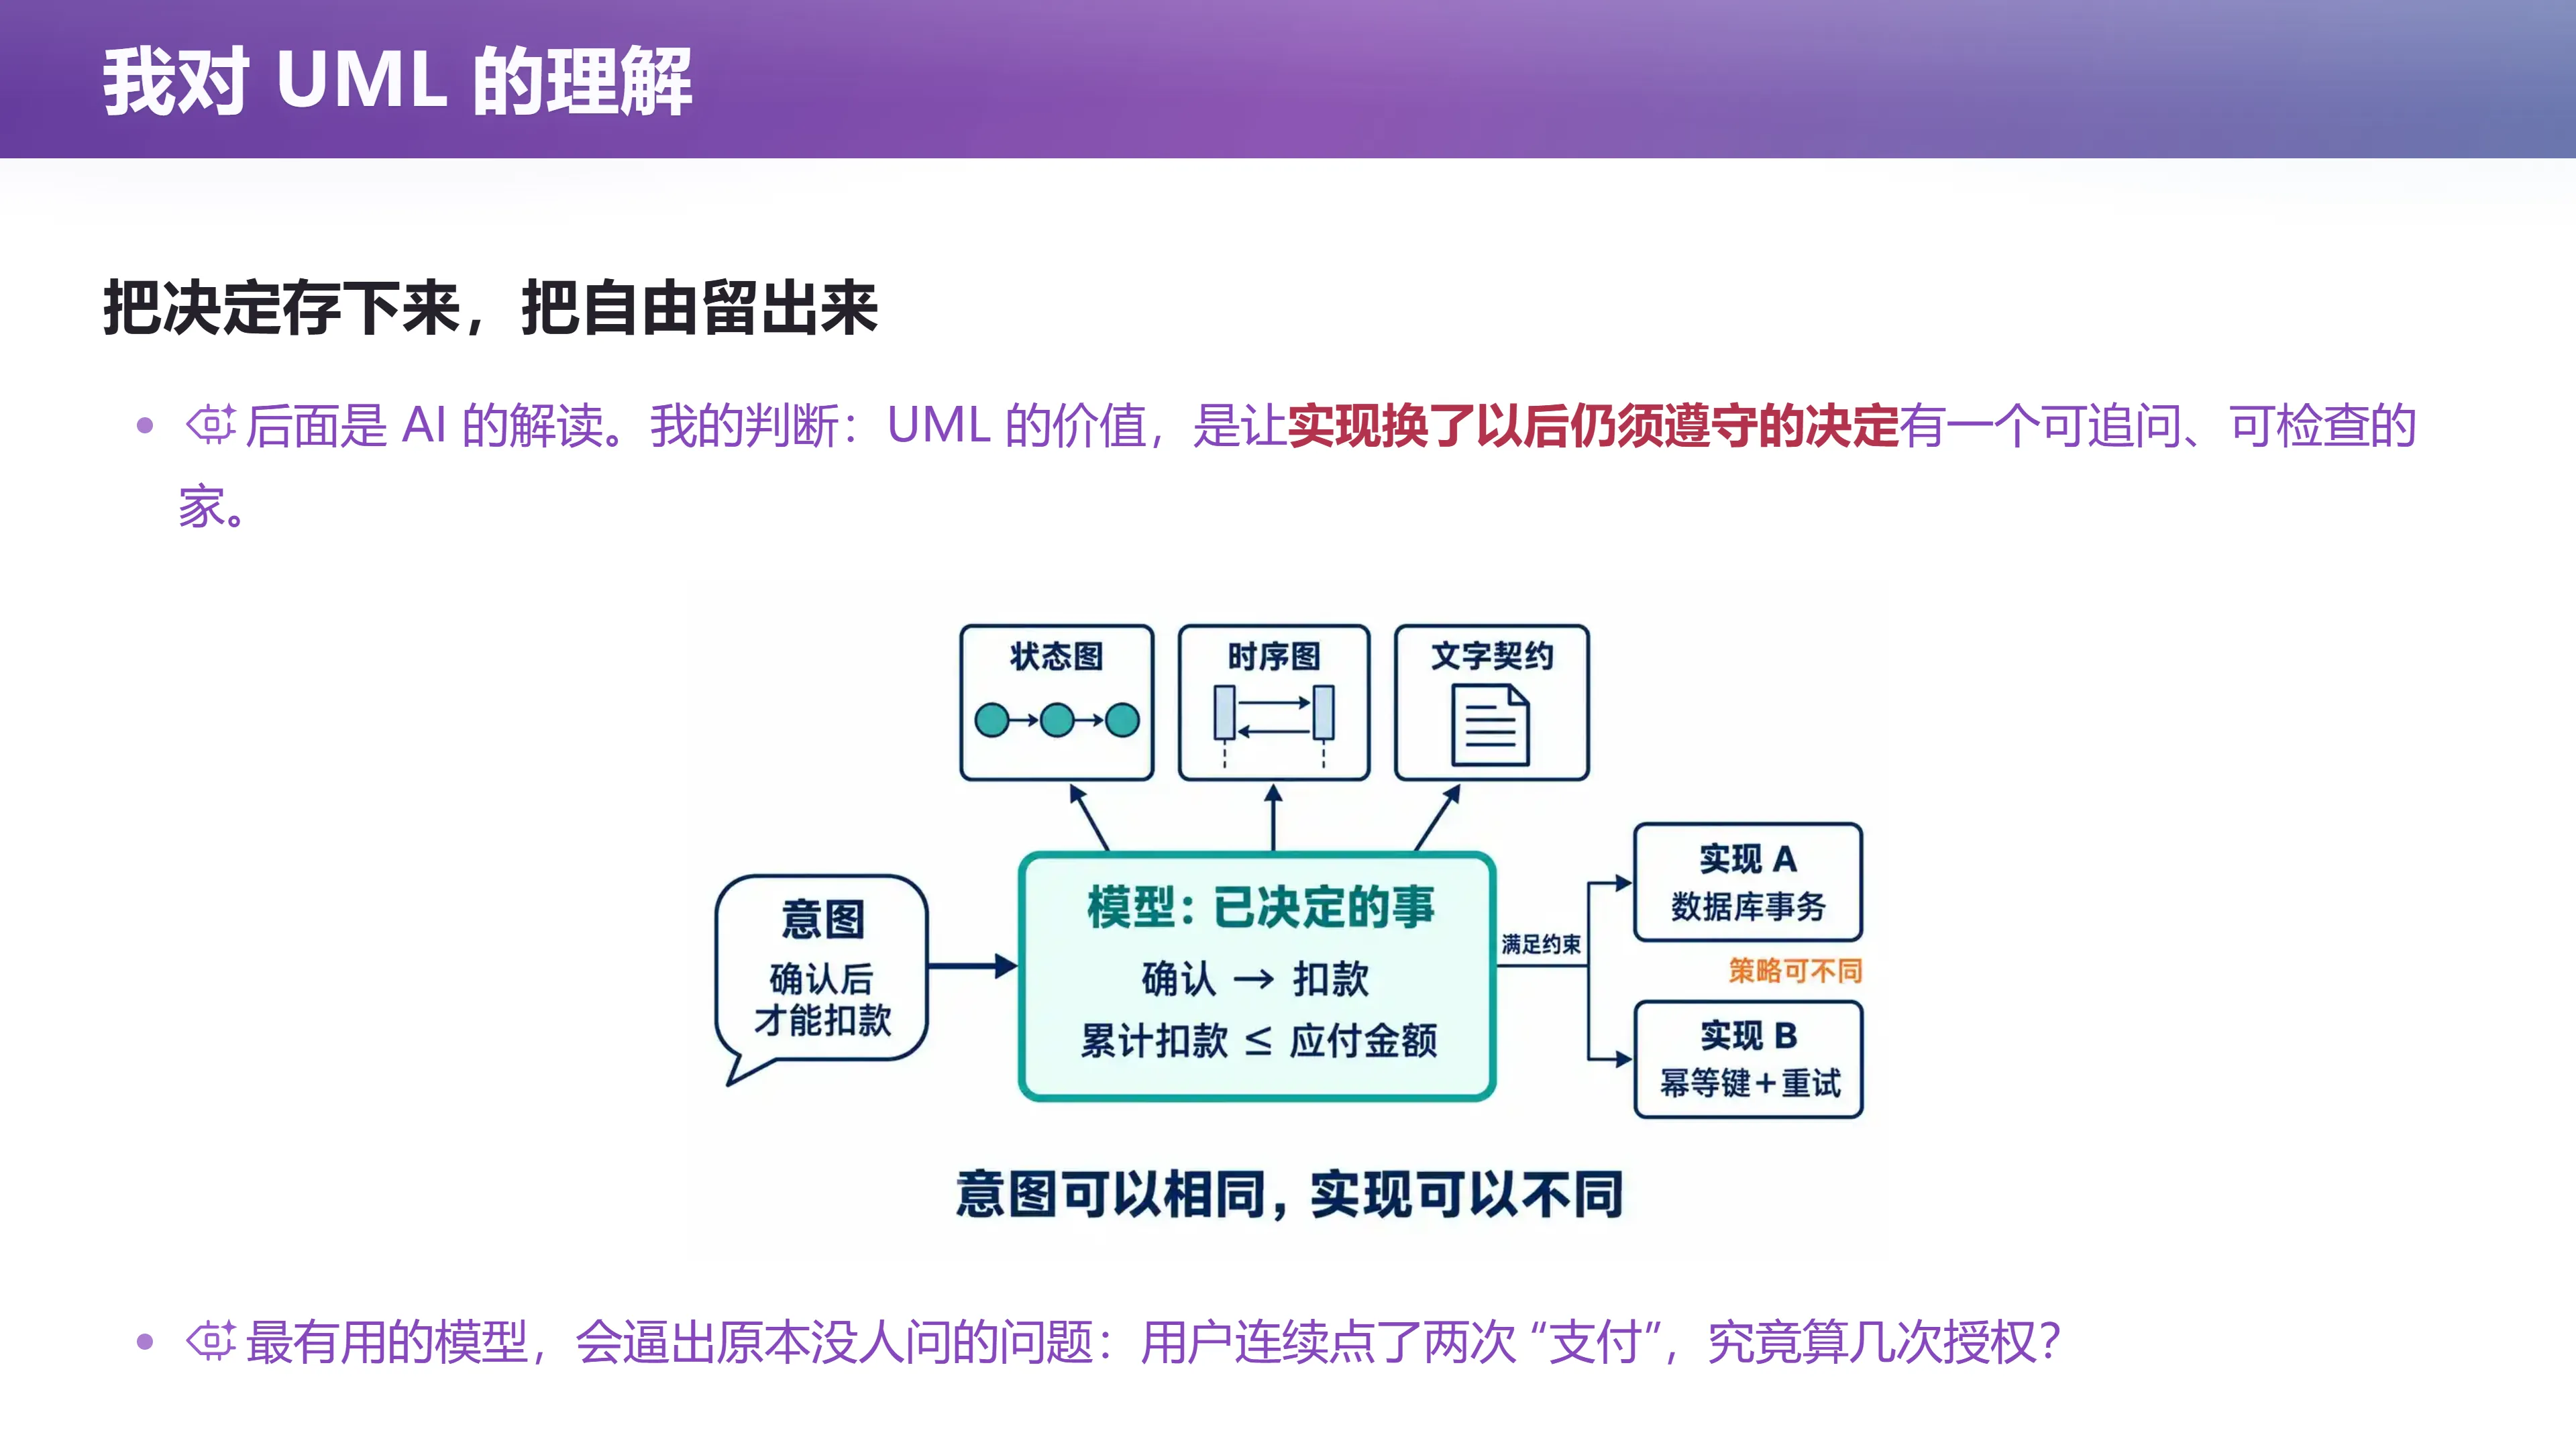
📷 我对 UML 的理解:把决定存下来,把自由留出来
回到原视频 (01:38:14)
讲师对 UML 的总判断是:
UML 的价值,是让实现换了以后仍须遵守的决定,有一个可追问、可检查的家。
- 稳定性解决"自己会不会变";
- 显式表达解决"别人能不能知道";
- 最有用的模型,会逼出原本没人问的问题:用户连续点了两次"支付",究竟算几次授权?
编者说明:这一判断把 UML 定位为"契约的容器"——它关心的不是"如何画图",而是"哪些决定必须写下来、写在哪里、怎么检查"。这也解释了为什么在 AI 时代,即使 UML 这种具体语言被淘汰,它的设计思路仍然能指导我们。
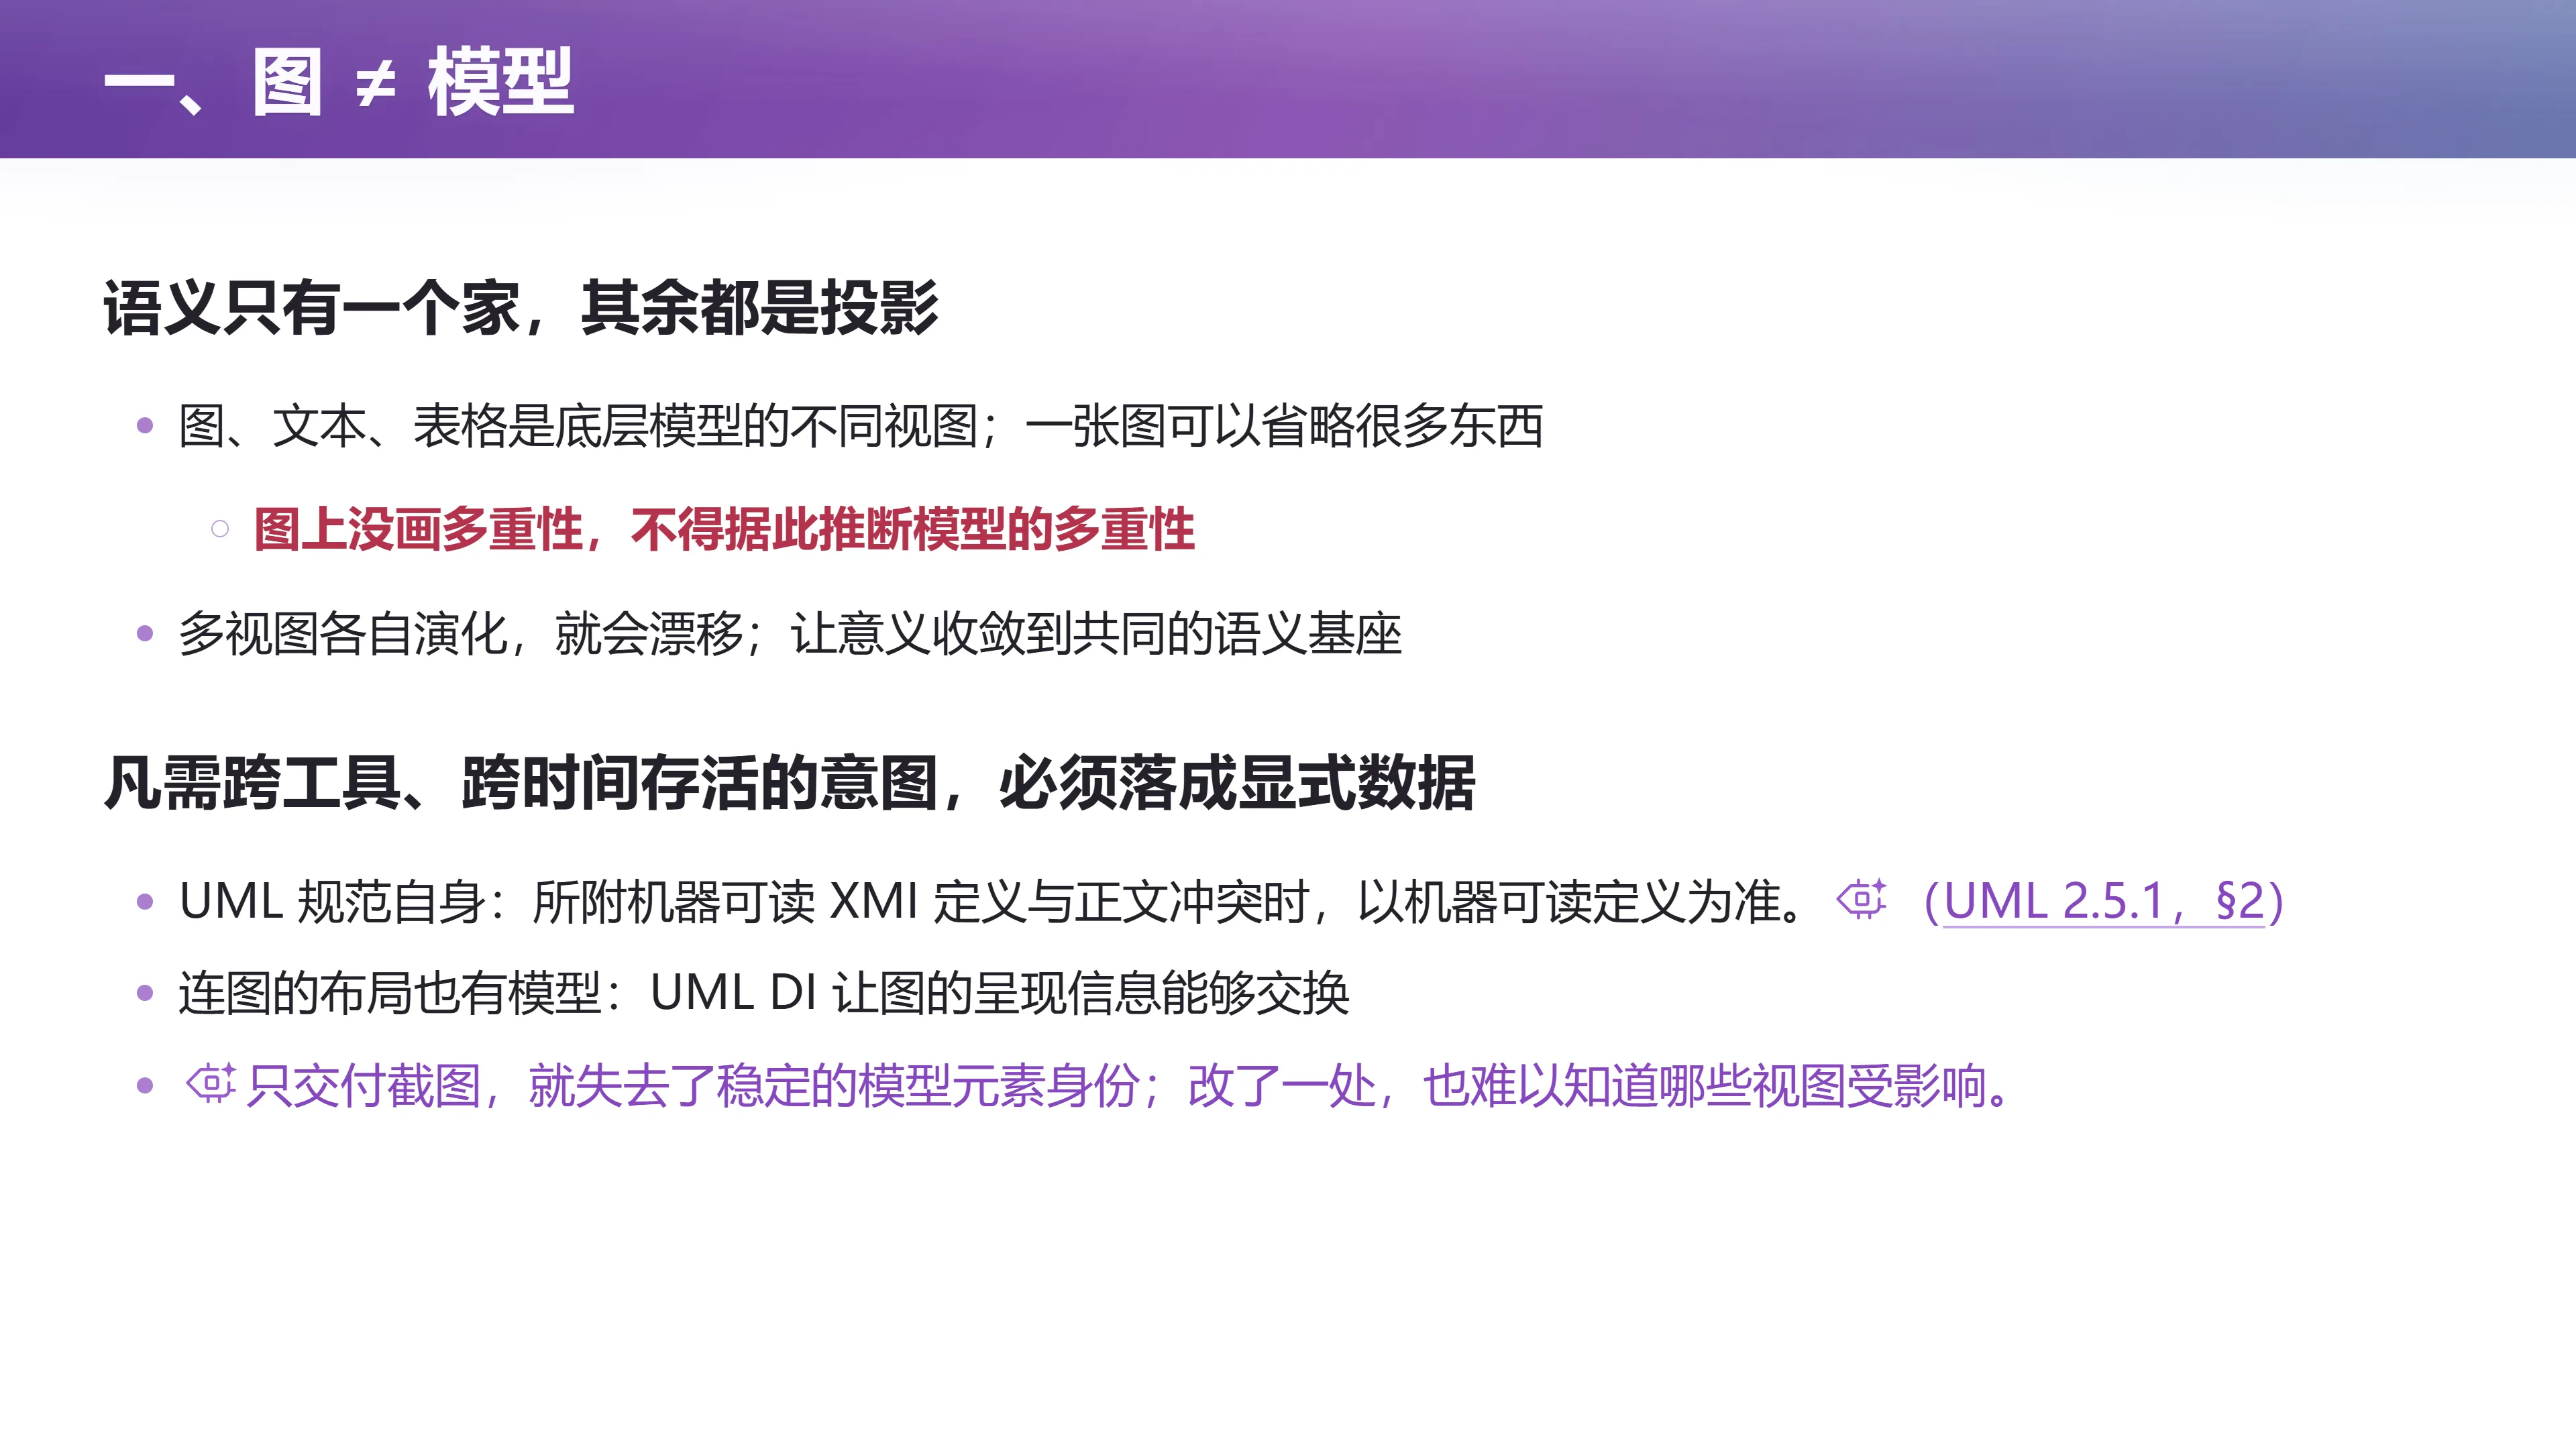
一、图 ≠ 模型
(参考时间: 01:36:14)
第一件事:区分图与模型。
- 模型包含元素、关系和约束;
- 图是对其中一部分内容的展示;
- 同一个模型可以有不同视图,分别突出结构、状态或者交互过程;
- 一张图没有画出某项信息,不足以说明底层模型不存在这项信息。
以选课为例:
- "学生与课程之间存在选课关系"还不足以回答每人能选多少门课、一门课能容纳多少人;
- 这些数量约束属于模型;
- 某张用于介绍整体结构的图省略了多重性标注,我们就不能仅凭省略的画面替模型作决定。
UML 规范本身也把语义落实为机器可读取的数据:它的第 2 节规定,规范正文与随附的规范性 XMI 文件发生冲突时,以后者为准。(参见规范第 2 节)
编者说明:XMI(XML Metadata Interchange)是一种用于交换模型信息的格式。这个优先级规则针对 UML 规范自己的定义文件,并不意味着任何项目都应该无条件相信代码而忽略文档。
- 这种设计对工具之间的协作很有启发:把一张类图保存成截图,人还能看懂一些意思,但另一个工具很难可靠地知道某条线连接的是哪个模型元素,更难持续追踪这个元素的变化;
- UML 连图的布局也有专门的交换模型 UML DI,用来保留布局等内容。
经验推广:凡是需要跨工具、跨时间保留的意图,都应当找到显式的数据表示。否则需求文档改了,设计图没改,测试还坚持第三种解释,语义就会逐渐分裂。
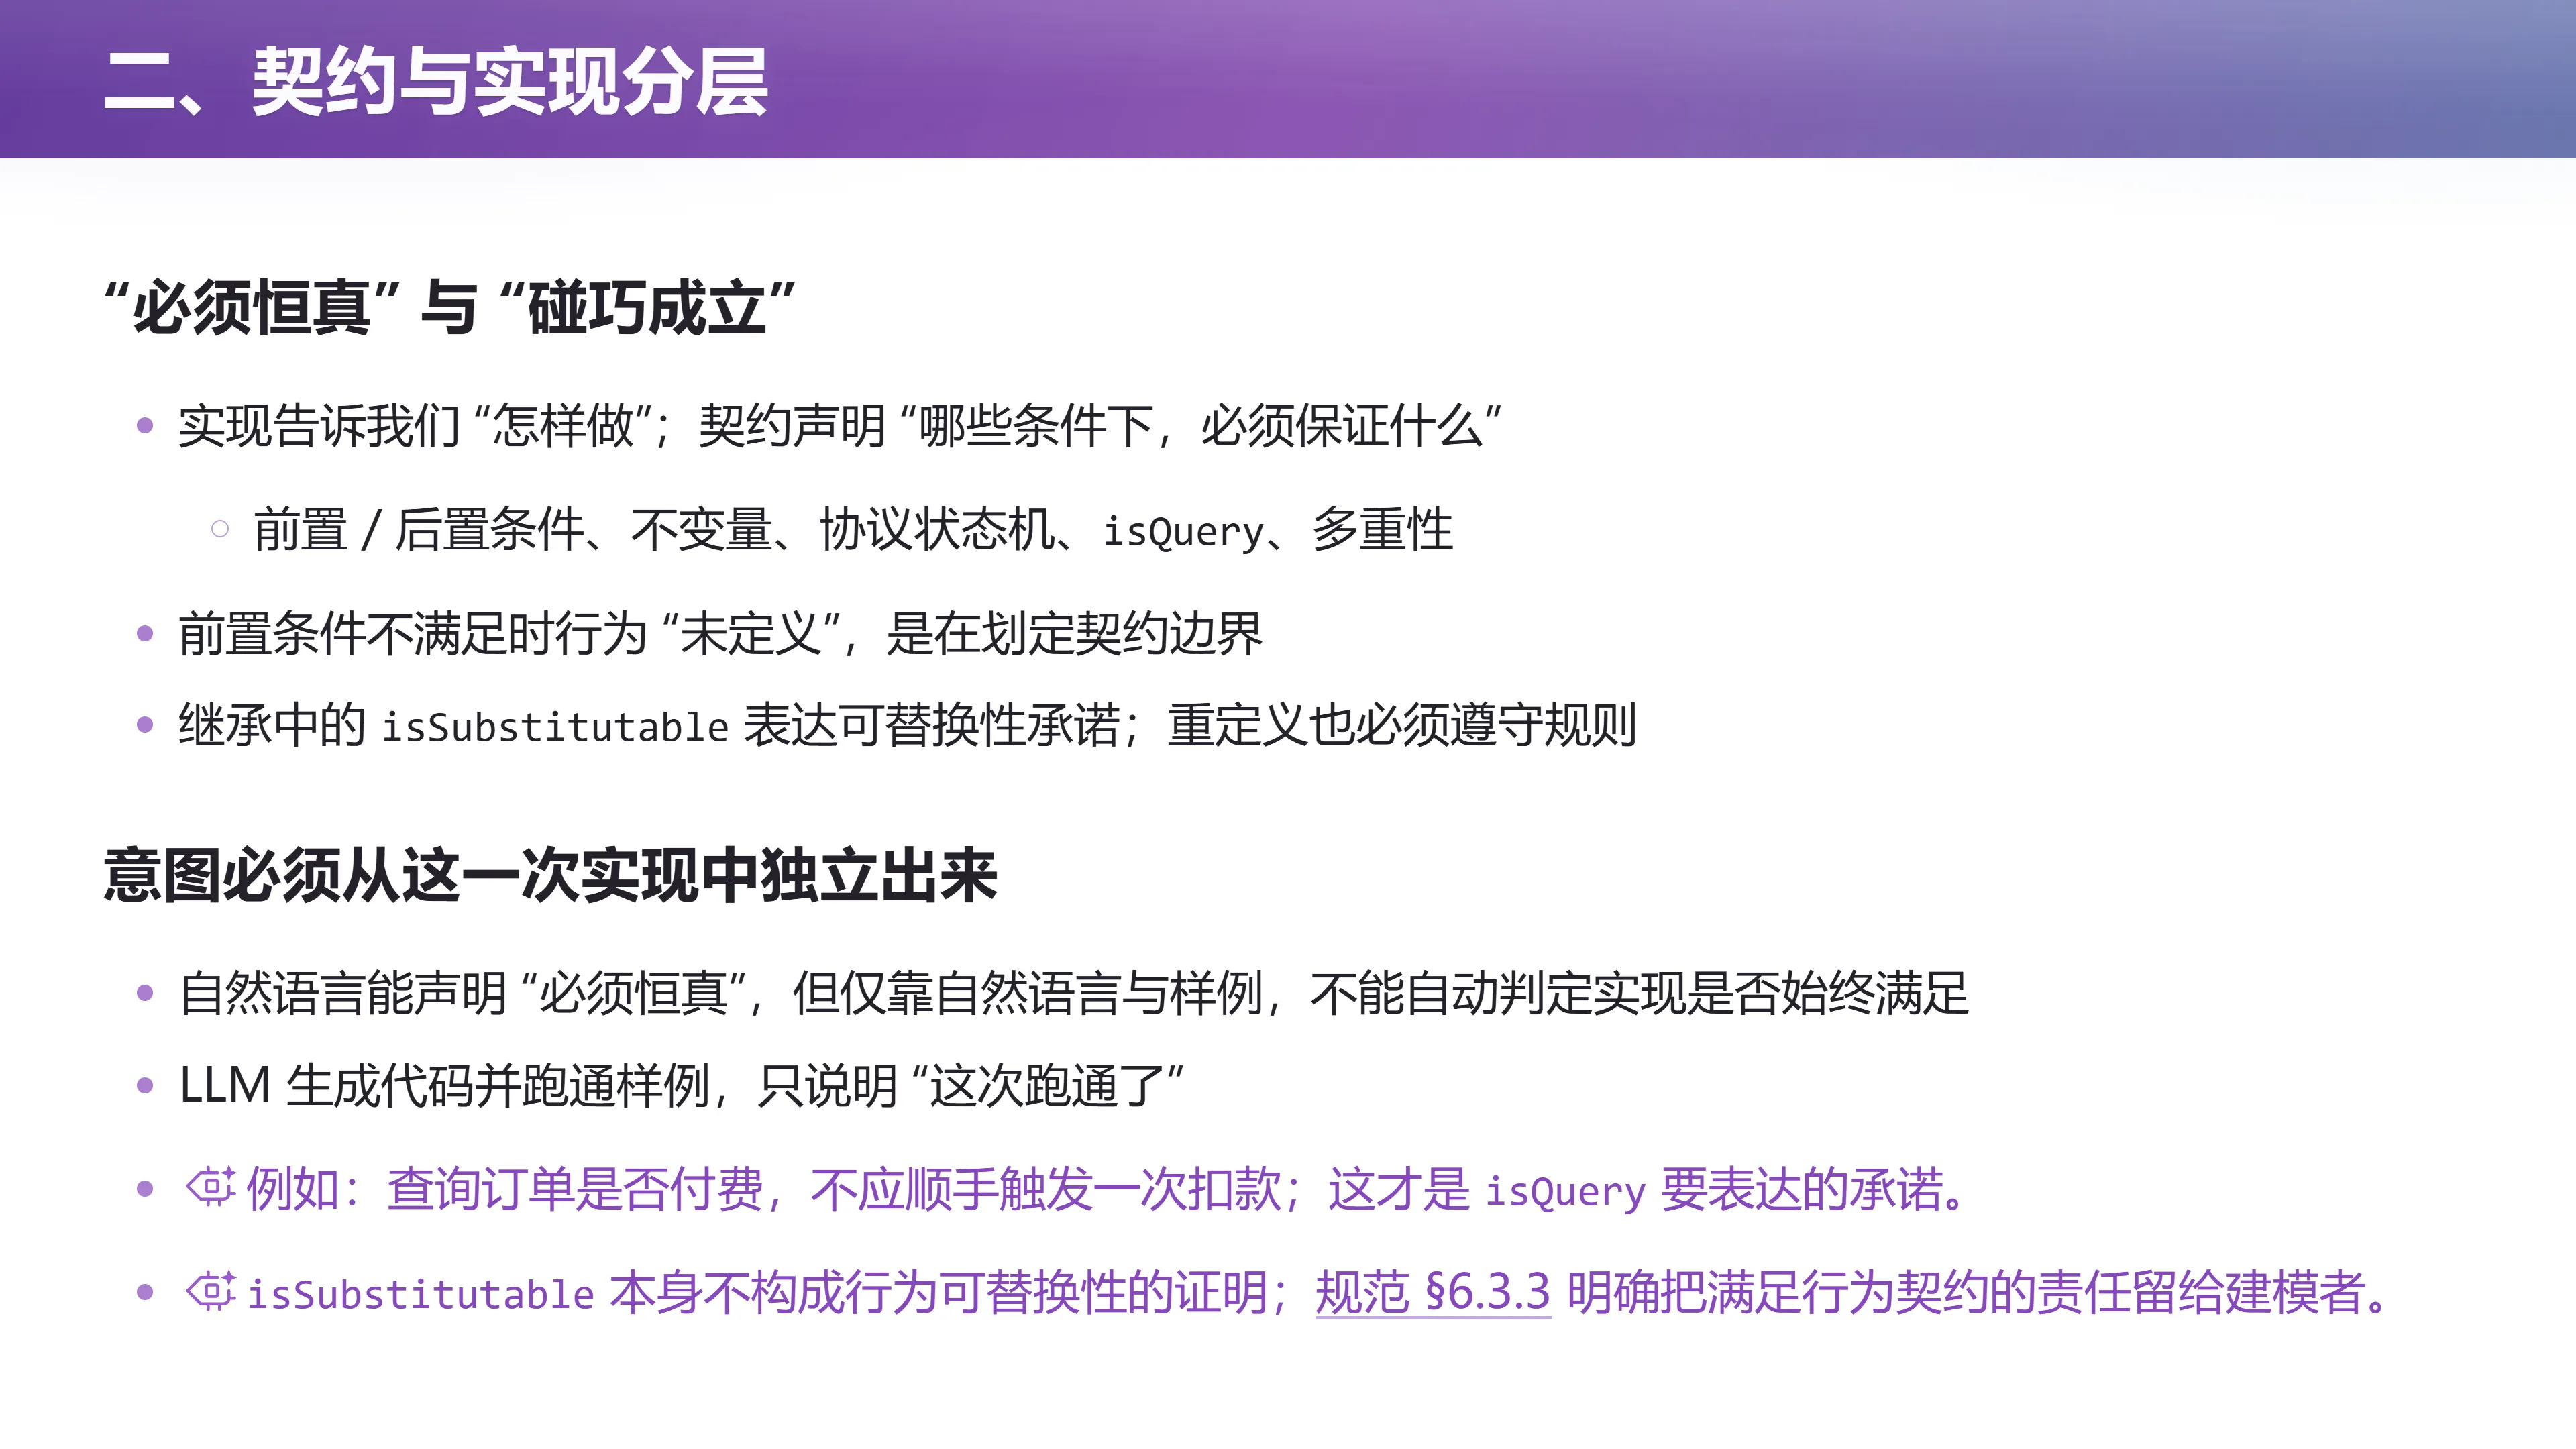
二、契约与实现分层
(参考时间: 01:28:11)
第二件事:区分具体行为与行为必须满足的要求。
- 一个实现成功处理过一次请求,并不能自动说明它在所有约定场景下都会满足要求;
- UML 用前置条件、后置条件、不变量、协议状态机、多重性等机制表达这些要求。
具体例子:
- 一个查询支付状态的操作,如果声明为
isQuery,就不应该顺手改变系统状态——"查询是否付款"不能暗中完成一次扣款; - 协议状态机可以描述某个操作在什么状态下才允许发生;
- 继承也带来类似的问题:如果一个子类声称可以替代父类,使用父类接口的代码能否继续依赖原来的承诺?
- UML 的
isSubstitutable可以表达这样的可替换性要求; - 但写下这个声明,并不等于工具已经证明所有行为都满足它。
- 规范在第 6.3.3 节明确区分高层的稳定要求和详细行为,保证两者一致仍是建模者的责任,工具可以提供帮助。(参见规范第 6.3.3 节)
自然语言当然也能表达普遍要求。"任何重试都不能重复扣款"就是一个清楚的意图。困难在于:
- 这句话不会自动检查后面的实现是否遵守了它;
- 几个成功样例也覆盖不了所有重试、超时和并发组合。
因此:在 AI 生成代码之前写下约束,在代码生成之后用测试、检查或验证把它们联系起来,才可能让原来的承诺持续生效。否则"一次演示中碰巧成立的行为,很容易被当作系统已经具备的性质"。
三、留白也是一种决定
(参考时间: 01:39:26)
📷 三、有意的欠规约
回到原视频 (01:39:26)
第三件事:承认模型可以有意不把一切说完。
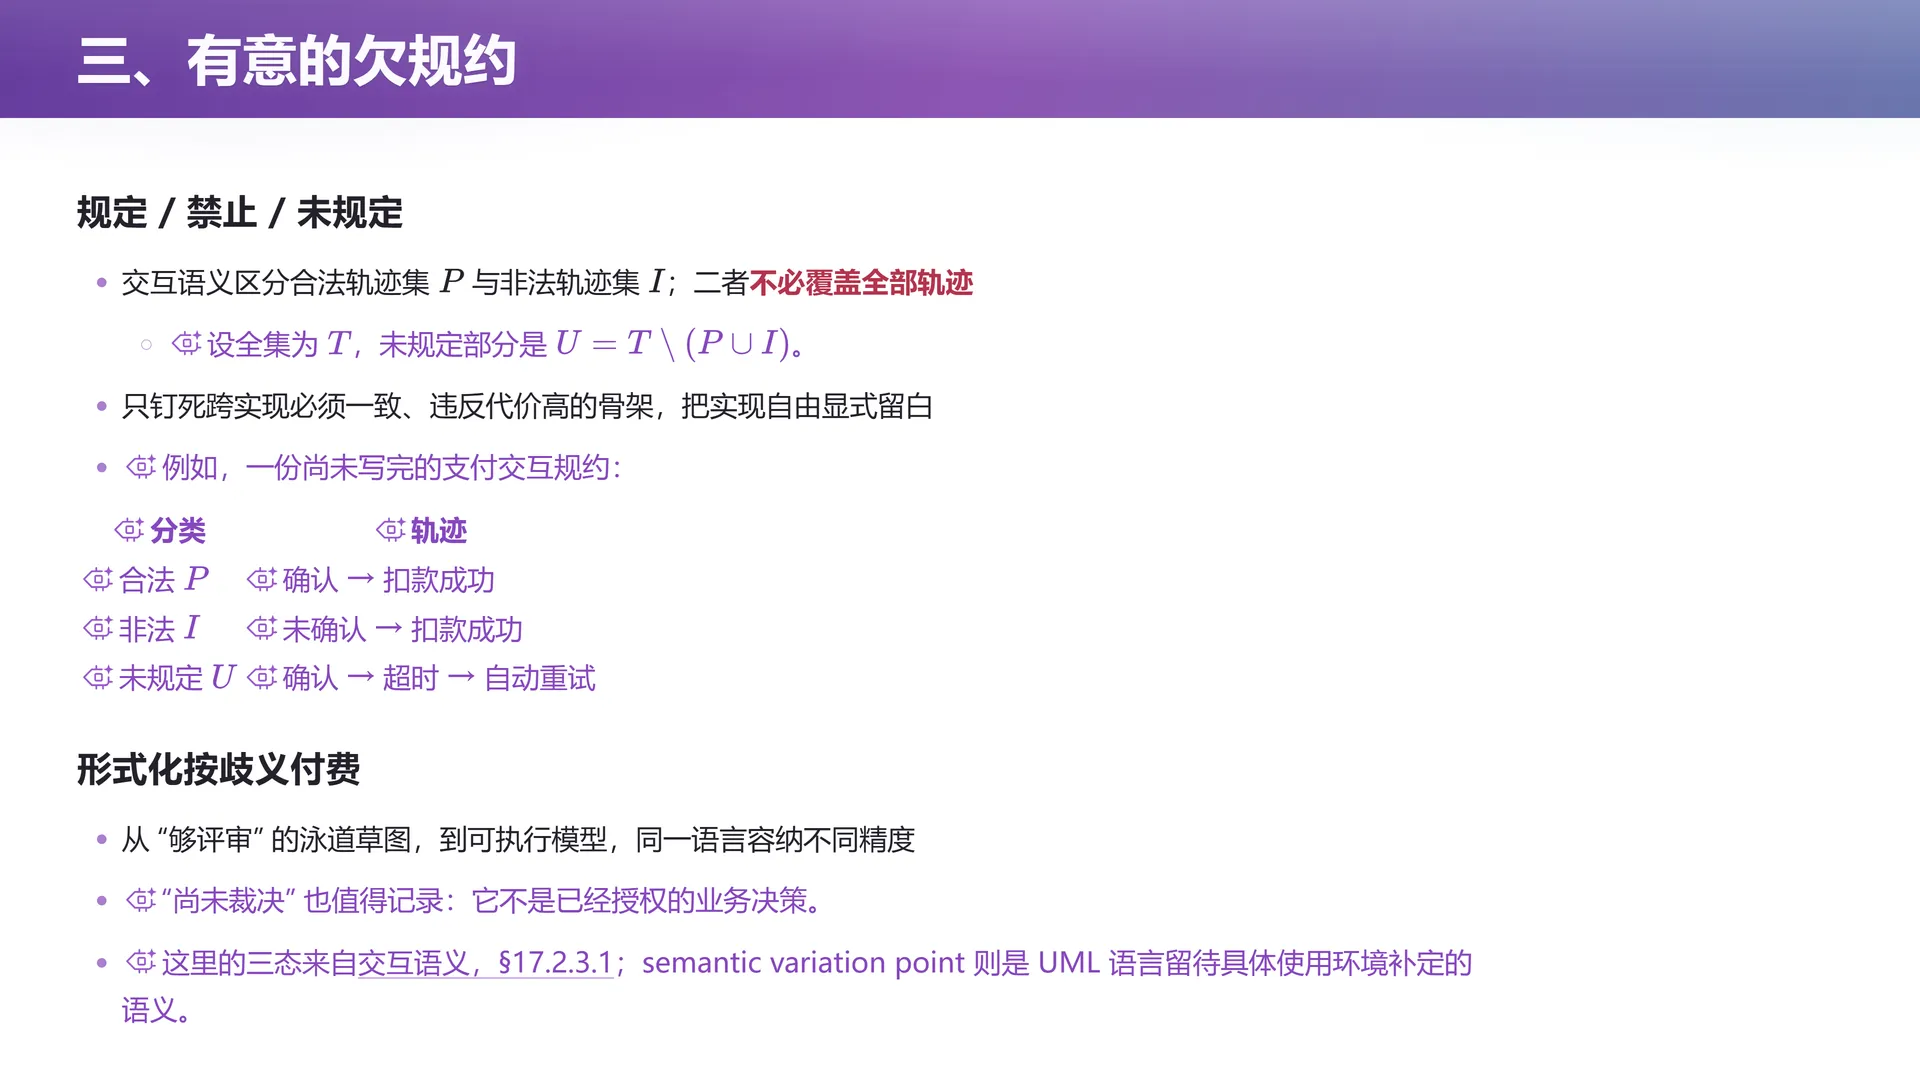
- 设计一个语言,并不意味着要求使用者在第一天就穷尽所有细节;
- UML 的交互语义区分合法执行轨迹和非法执行轨迹;
- 轨迹可以理解为系统事件发生的一种序列;
- 这两个集合不一定要覆盖所有可能的轨迹,因此还可以存在模型尚未表态的行为。(参见规范第 17.1.2 节)
设全集为 $T$,合法轨迹集为 $P$,非法轨迹集为 $I$,则未规定部分是:
$$ U = T \setminus (P \cup I) $$
以支付为例,一份早期模型可能作出这样的区分:
| 分类 | 轨迹 |
|---|---|
| 合法 $P$ | 用户确认支付 → 系统扣款成功 → 返回成功结果 |
| 非法 $I$ | 用户没有确认 → 系统已经扣款 |
| 尚未规定 $U$ | 用户确认后请求超时 → 系统是否自动重试? |
第三类不能直接当成已经获得业务认可的行为。 它说明还有决定没做。如果实现者自行选择自动重试,就必须进一步回答:
- 一次超时是否可能意味着扣款已经完成?
- 怎样保证再次请求不会重复扣款?
规范中的语义变化点(semantic variation point)也体现了保留选择空间的设计:
- 语义变化点是语言本身把某些语义选择留给具体使用环境;
- 与"某个用户模型没有写完"不完全相同:后者是这份模型还没有约束某种情况;
- 两者都提醒我们关注尚未确定的部分,而不是把它们误认成唯一答案。
形式化有成本,可以把成本花在歧义大、违反代价高、或者需要机器继续推导的地方。 早期业务草图只要足以支持评审,就已经有价值;需要执行或验证时,再补足相关语义。明确哪些地方还没有决定,能让这种渐进过程更可控。
四、显式化与语义漂移
(参考时间: 01:21:24)
📷 四、显式化与语义漂移
回到原视频 (01:21:24)
第四件事:把语义上不同的维度分开。
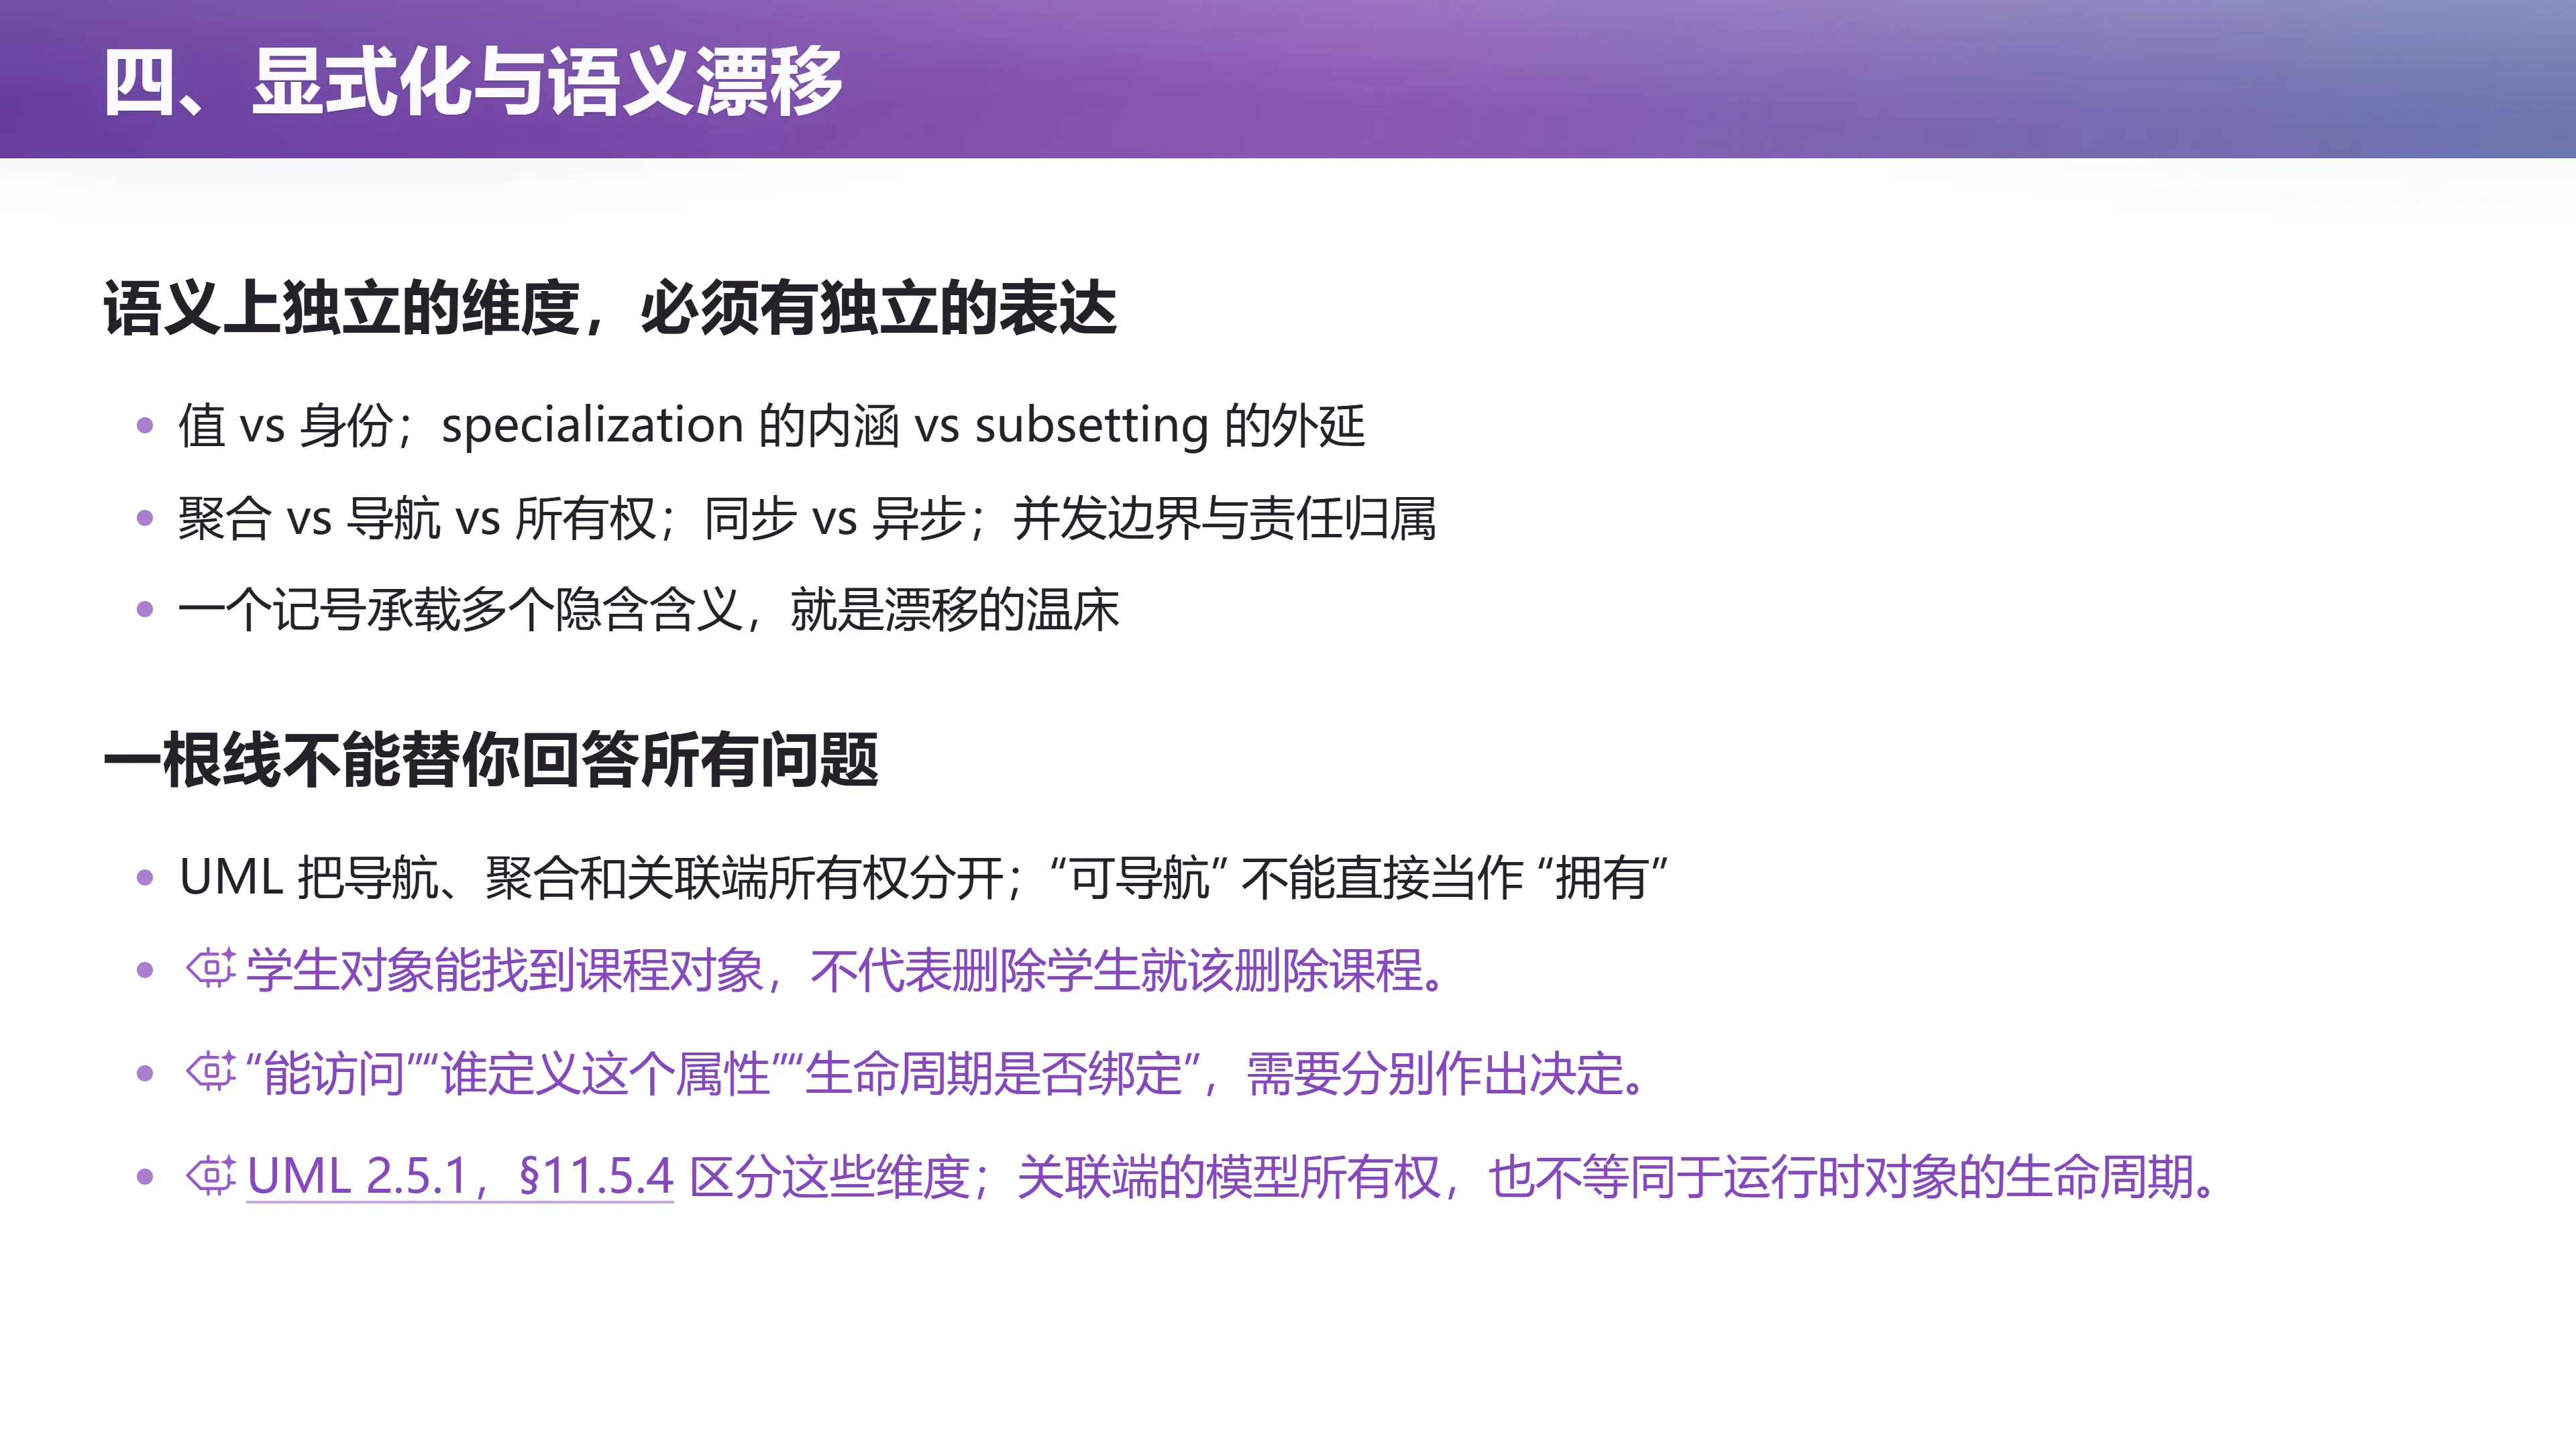
自然语言和随手画的图,经常让一个记号同时承担多种没有说清楚的含义:
- 两条记录当前具有相同的属性值,并不说明它们是同一个对象(值 vs 身份);
- 修改其中一个,另一个是否跟着改变,取决于身份和共享关系;
- 把某类对象定义成另一类的特化,与规定某个集合中的成员必须属于另一个集合,也是在表达不同层面的约束(specialization 的内涵 vs subsetting 的外延)。
UML 对关联关系的处理提供了更直接的例子:
- 聚合、可导航性、关联端的所有权各自有自己的含义和记号;
- 规范还明确废弃了把"可导航"直接等同于某种所有权的旧约定。(参见规范第 11.5.4 节)
在选课系统里:
- 从学生对象能找到课程,首先回答的是访问关系;
- 关联端的属性归谁拥有,回答的是模型结构;
- 对象是否随另一个对象一起销毁,又涉及生命周期。
不能因为画了一根箭头,就默认这些问题都已经获得了相同答案。 删除一个学生的选课信息,显然不应该顺手删除整门课程。
顺序也必须有语义边界
(参考时间: 01:35:01)
📷 顺序也必须有语义边界
回到原视频 (01:35:01)
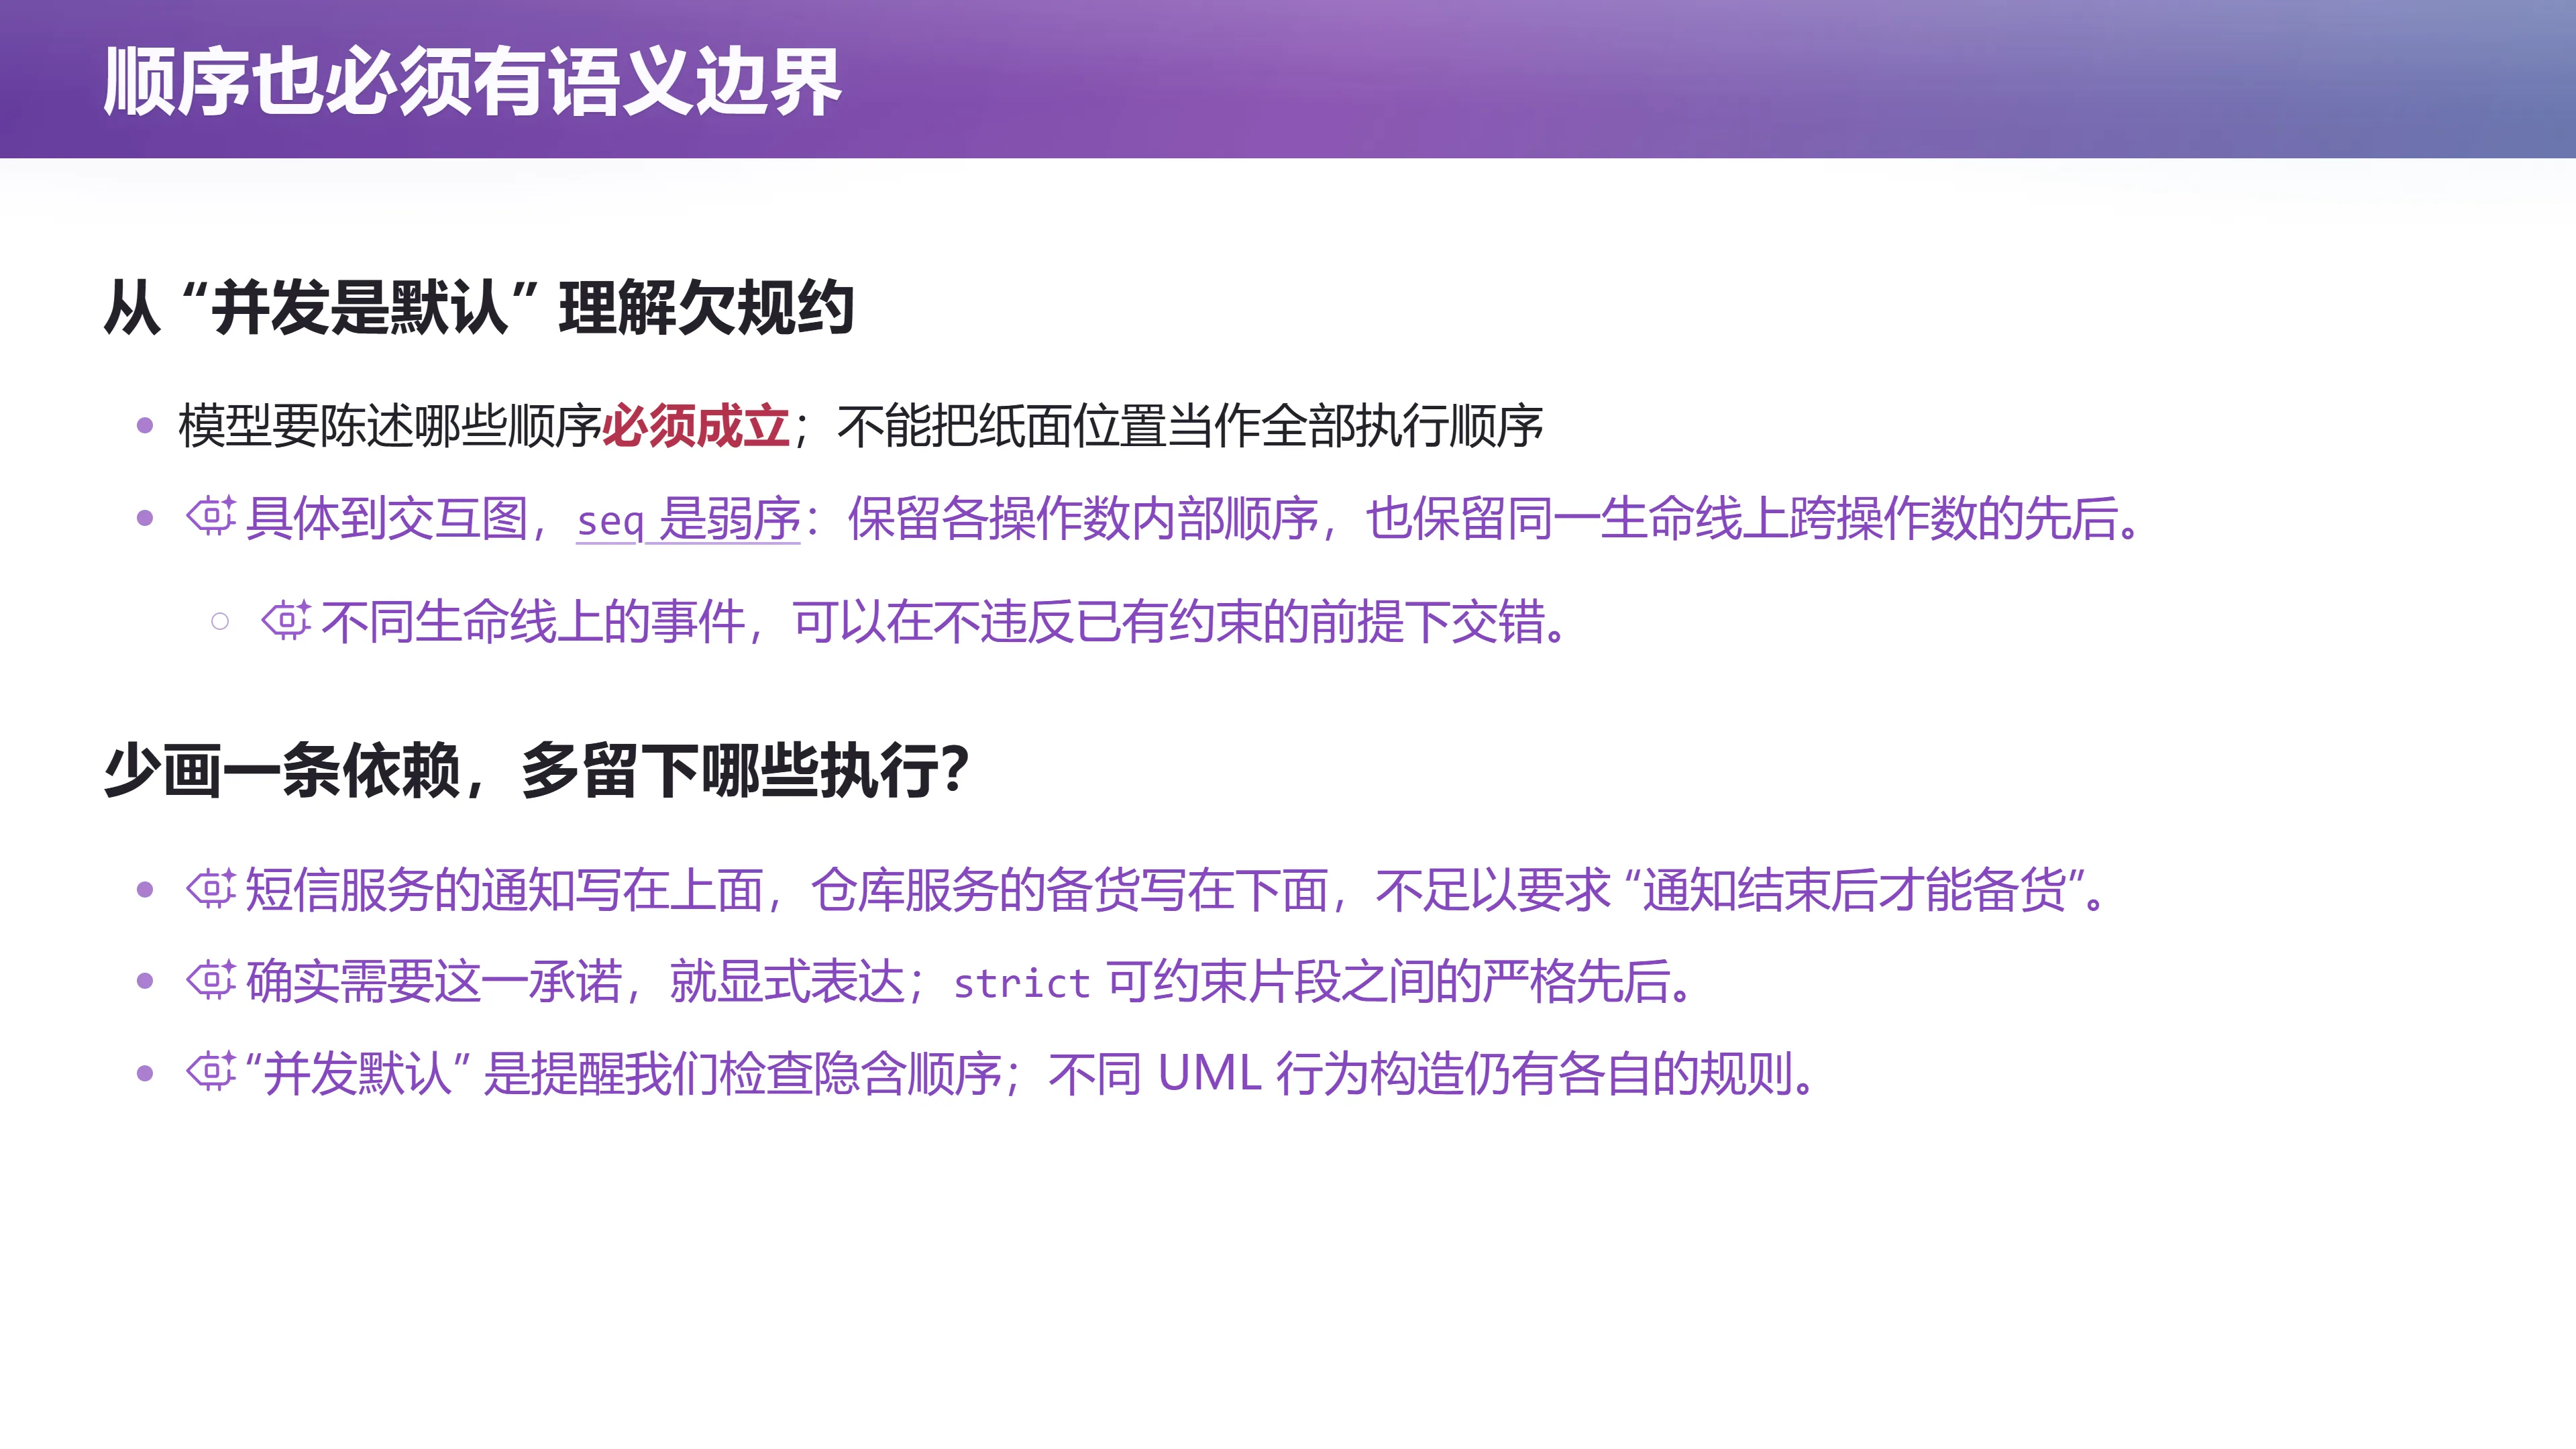
时间顺序也一样。 交互图上的上下位置,不能总被解释为全局串行执行。
- UML 的
seq表示弱顺序:保留各片段内部的顺序,也保留同一生命线上前后片段的事件顺序; - 来自不同生命线、不同片段的事件仍可能交错;
- 生命线表示交互中一个参与者随时间发生的行为。(参见规范第 17.6.3.11 节)
因此,短信通知的行为画在仓库备货行为上方,并不自动要求短信必须全部发送完、仓库才能开始工作。 如果业务确实要求两者严格有先后,就需要明确的约束,或者使用相应的严格顺序表达(strict)。
顺序、并发、失败路径和责任归属,都值得分别说明。
五、语义即约束
(参考时间: 01:13:38)
第五件事:让模型受到约束。
既然模型由明确的元素和关系组成,就可以像检查程序的类型一样,检查模型是否满足结构上的规则。
- OCL(Object Constraint Language,对象约束语言) 是表达这类条件的一种工具;
- 模型中的类型、多重性,以及活动中输入输出之间的兼容要求,都可能成为检查对象;
- UML 还用元模型描述自身:元模型就是规定"模型可以由什么组成、它们怎样关联"的模型;
- MOF(Meta Object Facility,元对象设施) 为这类定义提供了基础。
扩展机制也需要边界:
- UML 的 Profile 可以为特定领域增加标记和约束,但扩展需要尊重原有语义;
- 否则大家都声称使用同一个语言,一个工具理解的"对象"却可能是另一个工具眼中的完全不同的东西。
把惯例逐步写成可检查的规则,会让许多错误在执行之前暴露。 但是:
- 通过模型的良构性检查,只说明它符合被检查的建模规则,并不自动证明所有实现都符合业务需要;
- 一个语法完全正确的支付模型,仍然可能遗漏重复扣款问题;
- UML 规范也没有把全部语义都化为 OCL——文档中的一些约束明确标注"Cannot be expressed in OCL"。这意味着相关规则仍需通过其他方式表达和理解,不能据此宣称所有语义都已实现机械判定。例如 ObjectFlow 的约束就包含这类情况。
机器检查的价值在于稳定执行明确的规则。规则是否写对、是否覆盖真正关心的问题,以及需求改变后是否仍然适用,仍然需要持续维护。
LLM 时代,差距移到了哪里
约束集合与某个具体实现
(参考时间: 01:35:33)
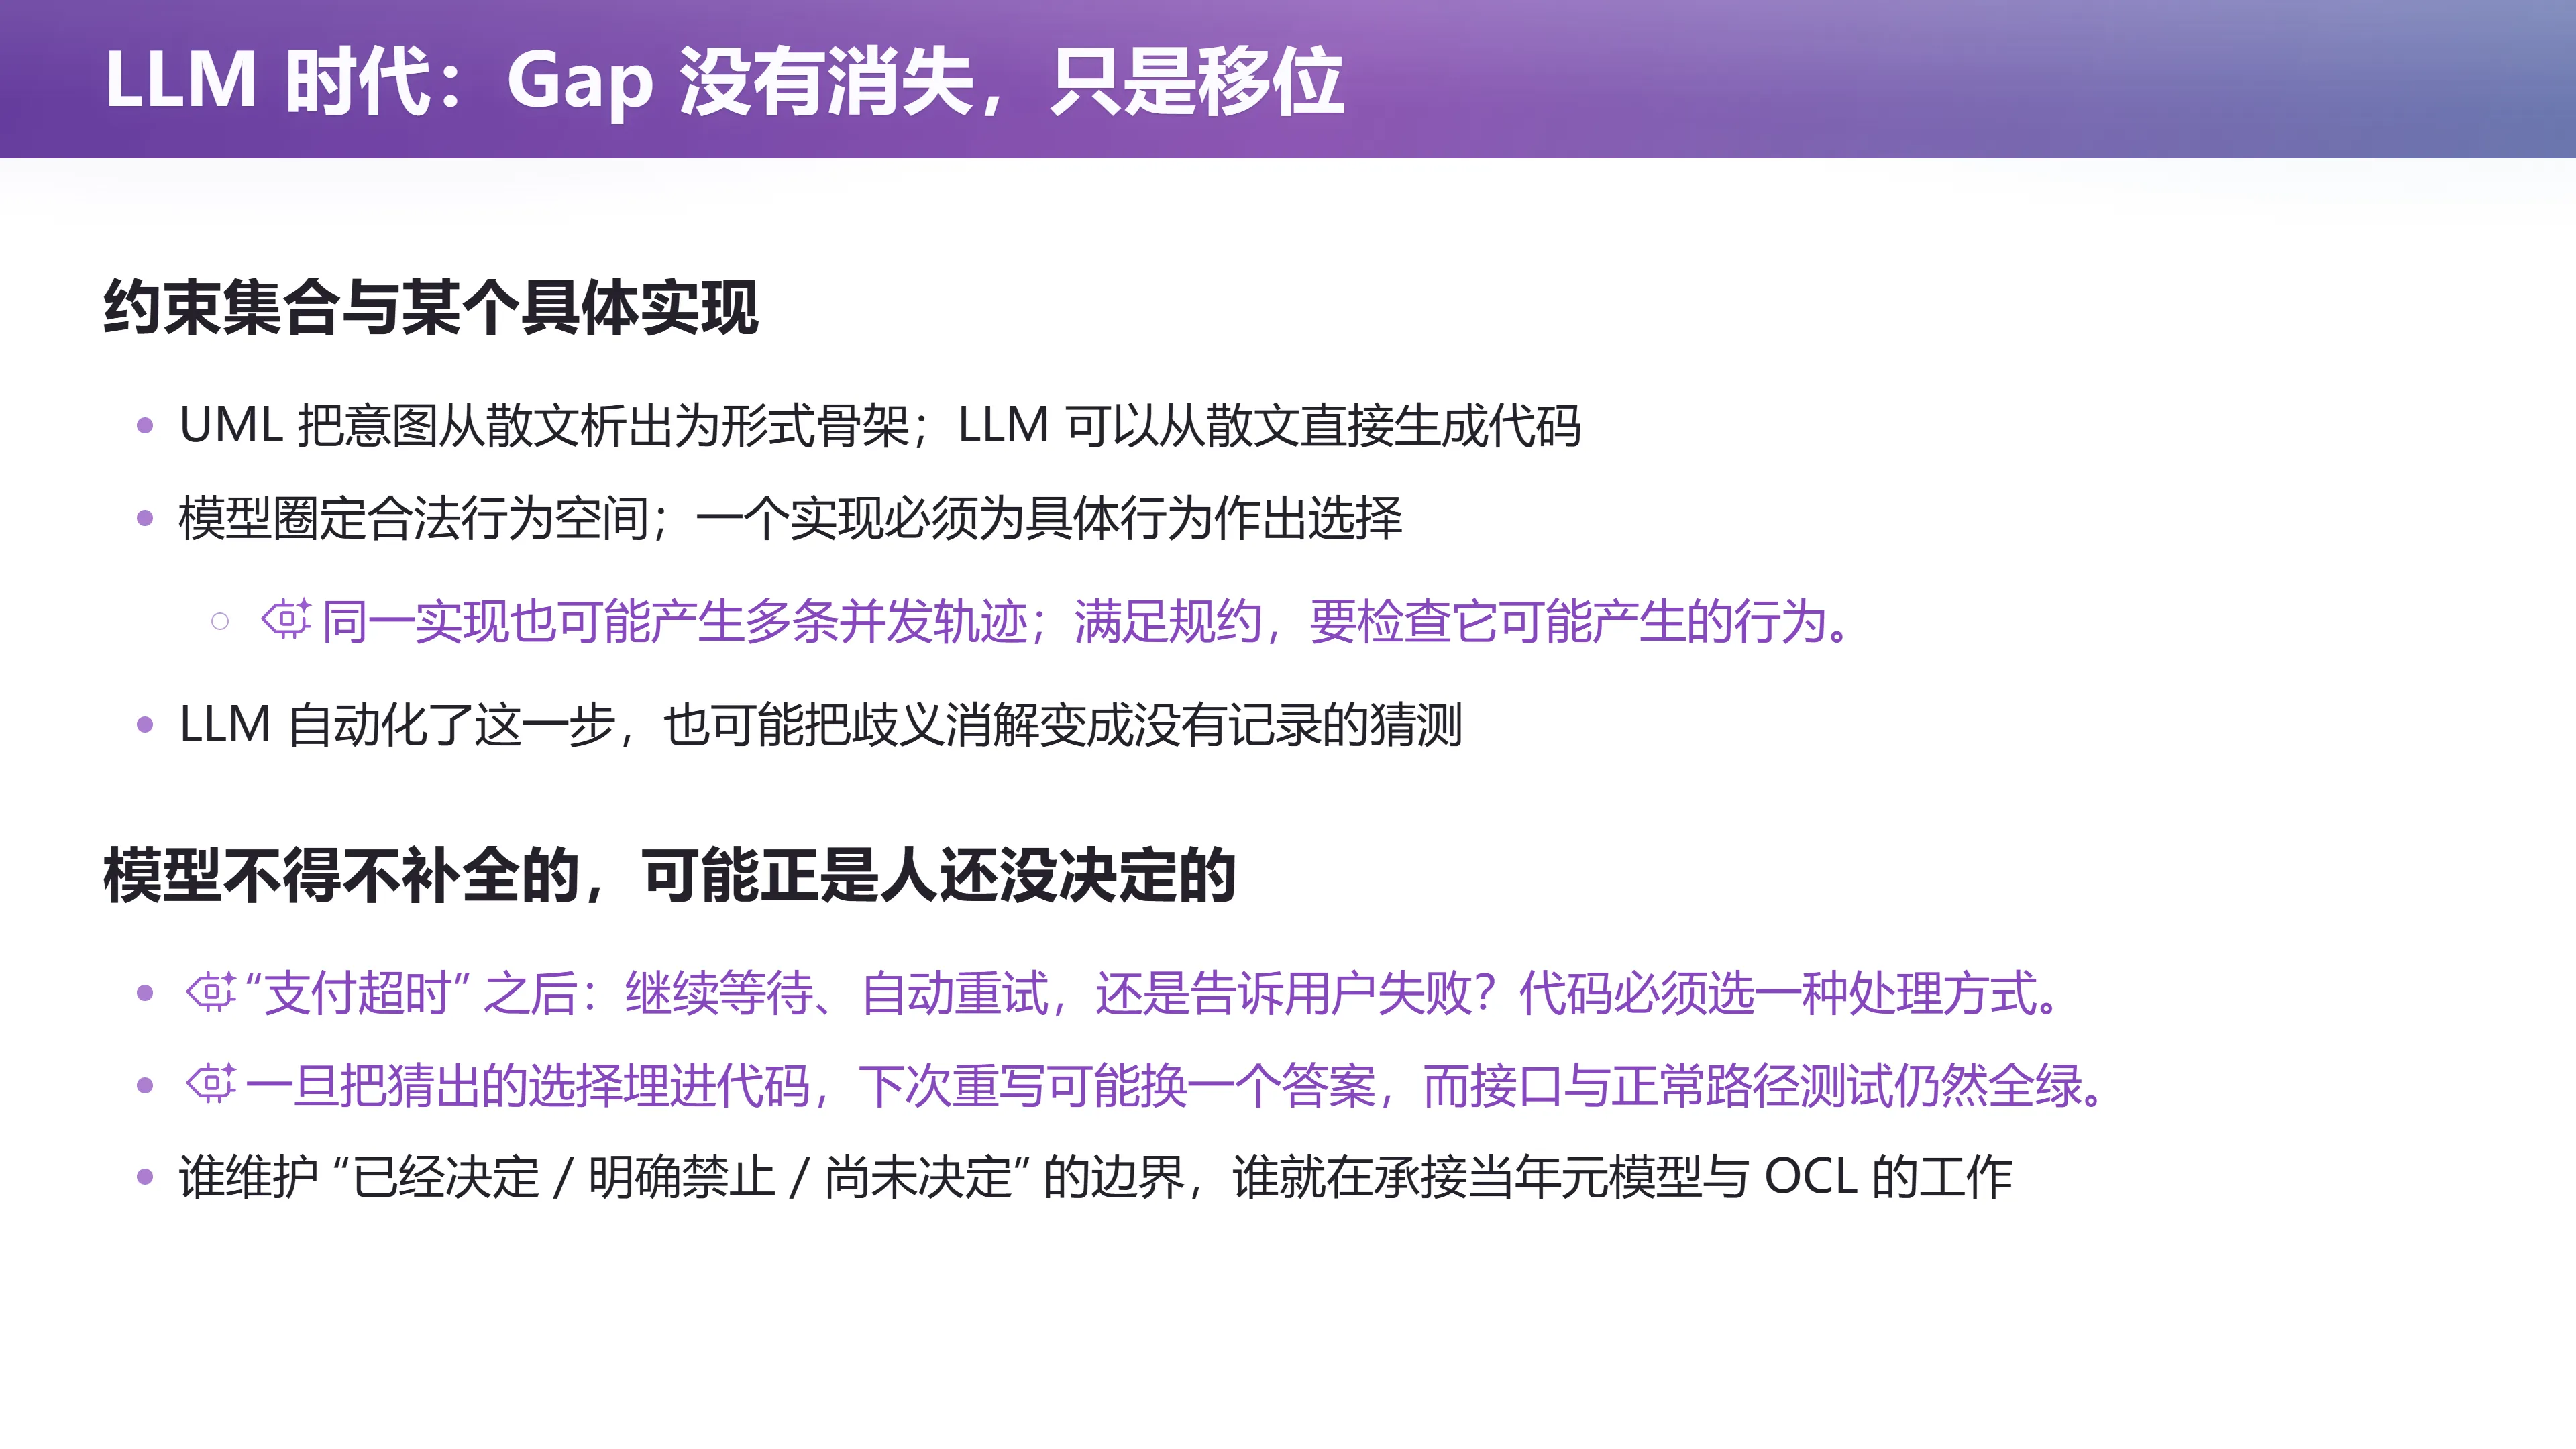
📷 LLM 时代:Gap 没有消失,只是移位
回到原视频 (01:35:33)
UML 试图通过共同的语言,把意图整理成明确的结构和约束。大语言模型让另一条路径变得可行:直接从自然语言生成程序。以前需要人工补齐的中间步骤,现在经常可以一跃而过。
但规约与实现之间的差距仍然存在。
- 规约约束允许出现的行为,具体实现则要选定数据结构、算法、状态更新和异常处理方式;
- 一个并发实现本身也会有多种执行轨迹,所有相关行为都应当落在承诺的边界内。
模型不得不补全的,可能正是人还没决定的
(参考时间: 01:34:44)
当用户没有说明"支付超时后怎么办",模型为了完成程序,往往会选一种处理方式:
- 第一次可能等待;
- 第二次可能自动重试;
- 第三次可能直接返回失败。
三份代码都能运行,接口看起来相同,正常路径的测试甚至全部通过——但它们已经包含了不同的业务决定。
这就需要有人持续维护三类信息:
- 已经决定的行为;
- 明确禁止的行为;
- 尚未决定的行为。
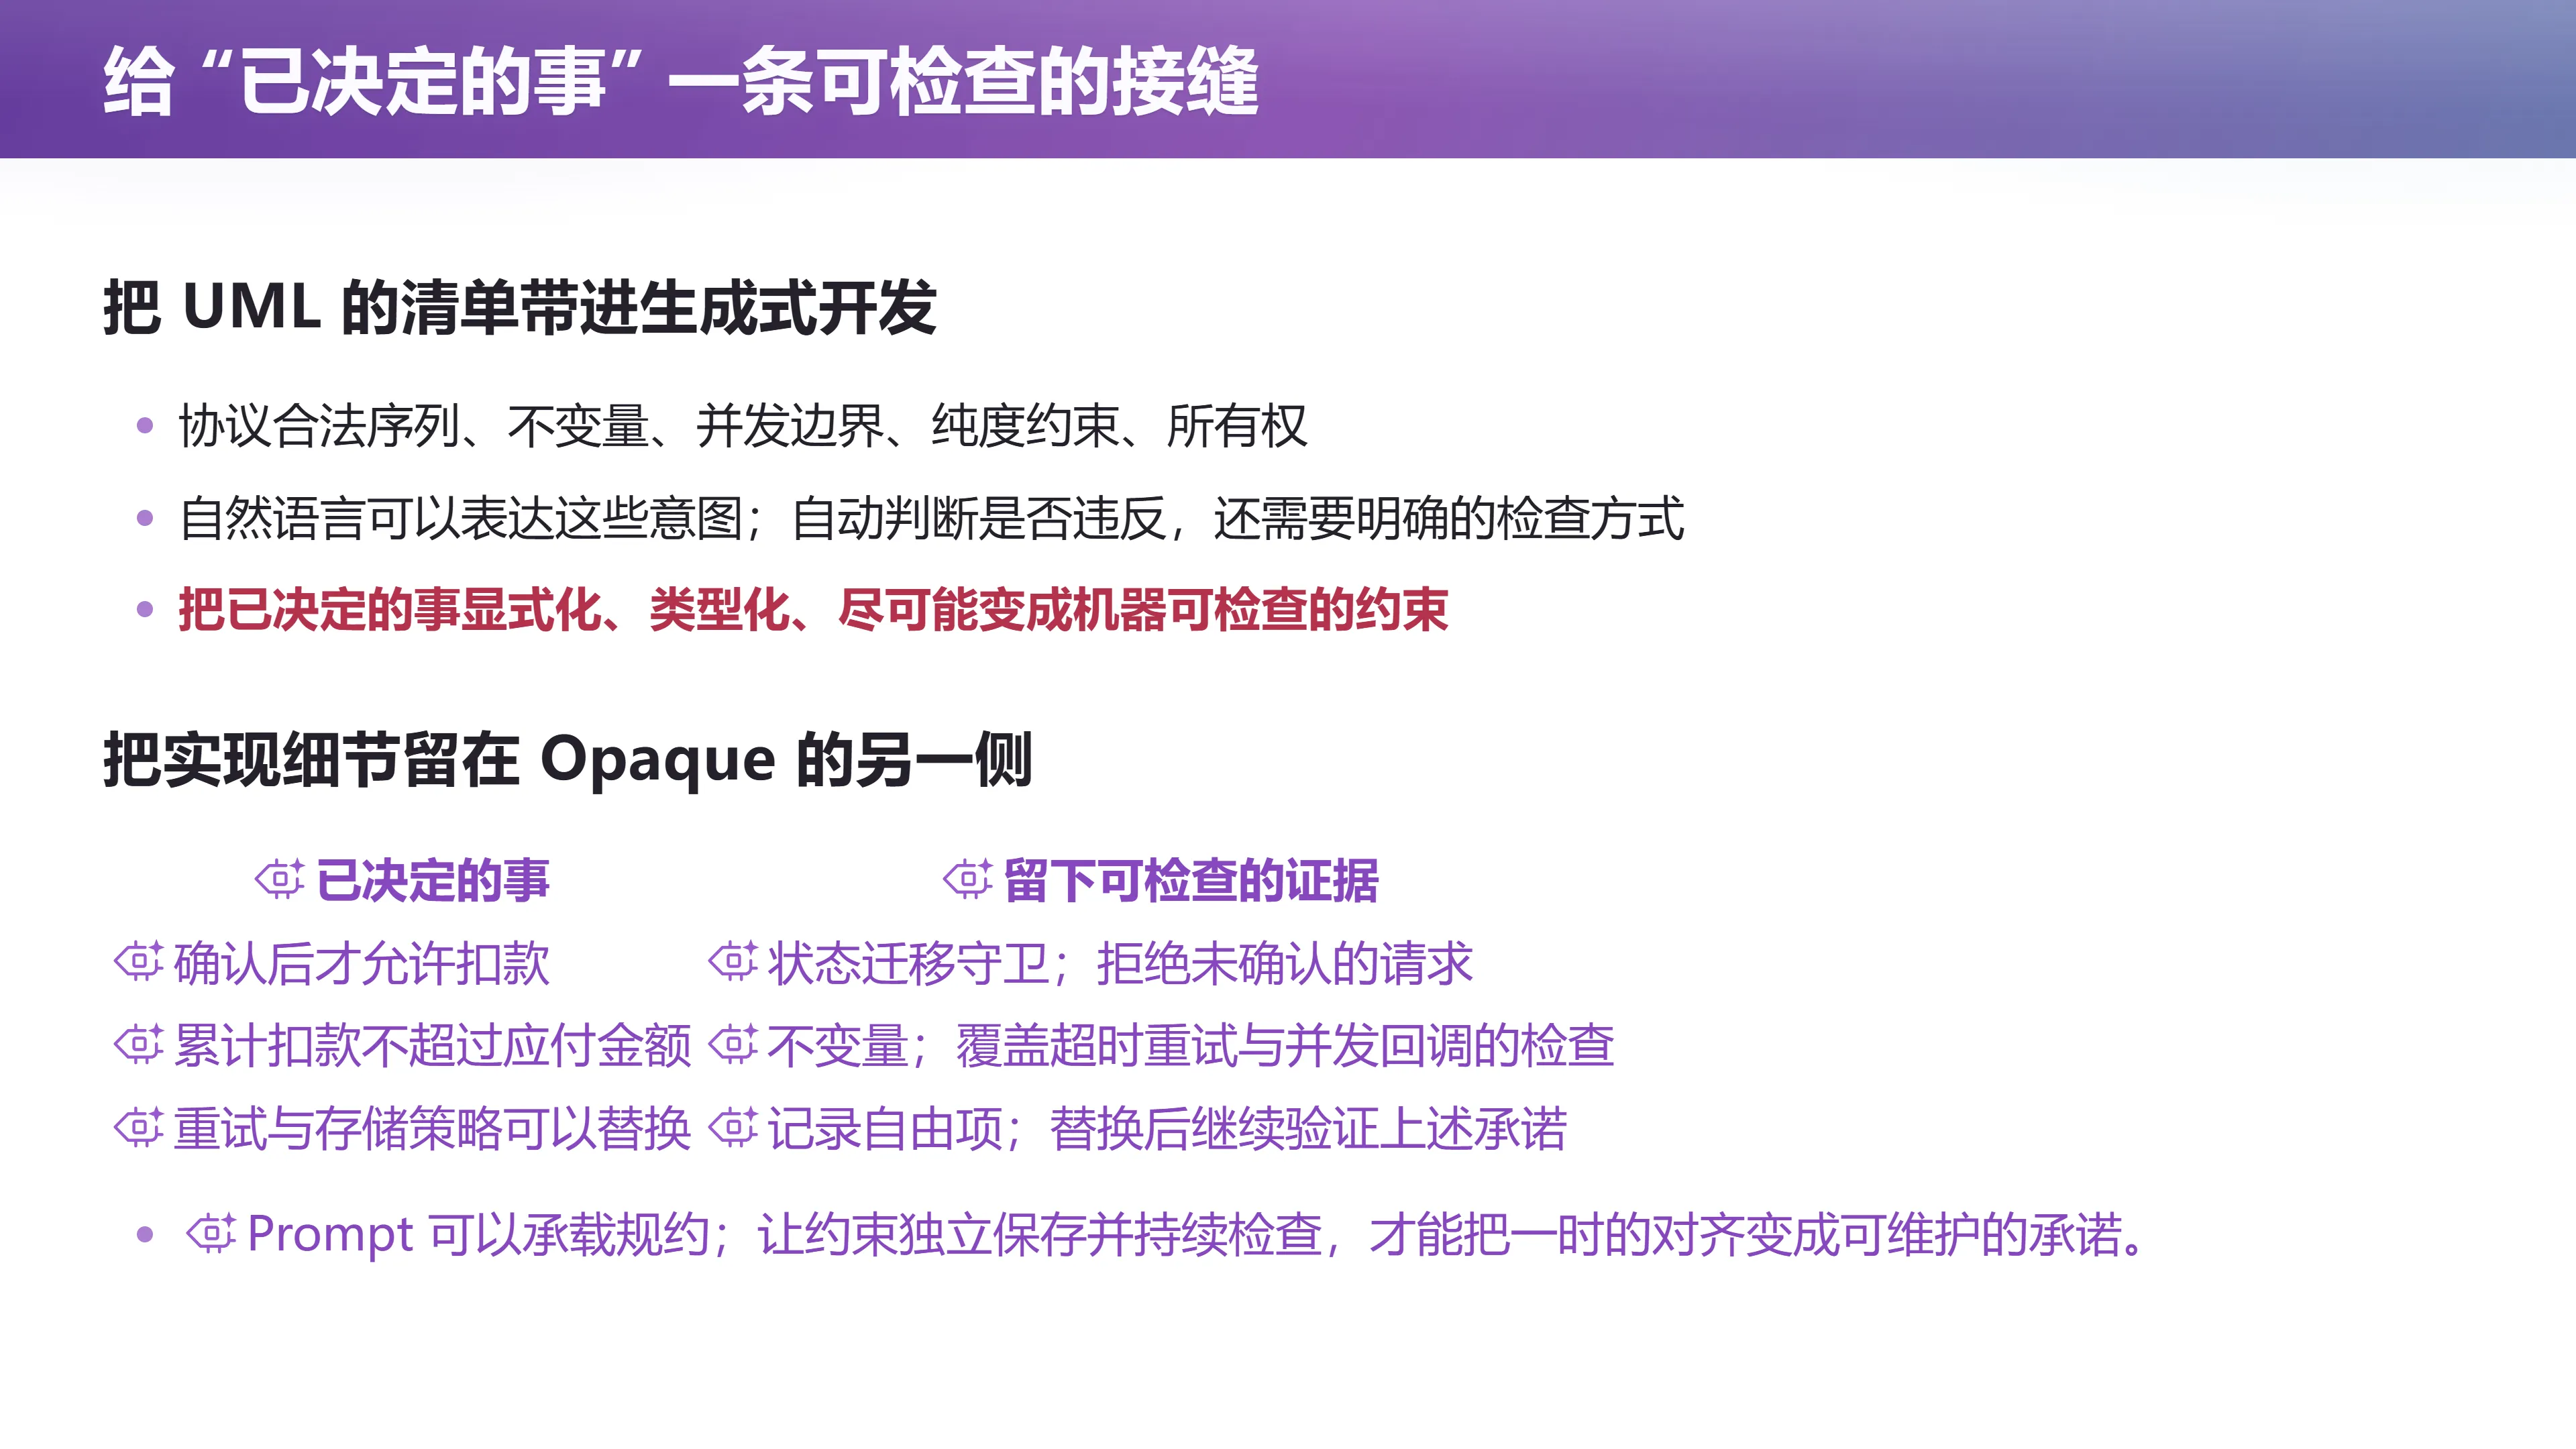
对支付系统,我们可以要求:
- 扣款前必须获得相应确认(状态迁移守卫);
- 同一订单的累计扣款不能超过应付金额(不变量);
- 并明确把重试和并发回调纳入这个要求。
至于内部采用什么存储结构、如何组织请求,只要满足这些承诺,就可以保留实现自由。
给"已决定的事"一条可检查的接缝
(参考时间: 01:39:26)
把 UML 的清单带进生成式开发,就是把这些内容显式化、类型化:
- 协议合法序列;
- 不变量;
- 并发边界;
- 纯度约束(如
isQuery); - 所有权。
自然语言可以表达这些意图;但自动判断是否违反,还需要明确的检查方式。
| 已决定的事 | 留下可检查的证据 |
|---|---|
| 确认后才允许扣款 | 状态迁移守卫;拒绝未确认的请求 |
| 累计扣款不超过应付金额 | 不变量;覆盖超时重试与并发回调的检查 |
| 重试与存储策略可以替换 | 记录自由项;替换后继续验证上述承诺 |
Prompt 可以承载规约;但只有让约束独立保存并持续检查,才能把一时的对齐变成可维护的承诺。
结语
"AI 越能快速生产代码,这个接口就越值得认真设计:哪些事已经决定,哪些行为绝不能发生,哪些细节可以交给实现者选择。 给已决定的事一个显式、类型化、机器可检查的表达,我们才更有可能在快速改写实现时,继续保有对软件行为的控制。"
(参考时间: 01:39:57) — 今天下课。
附:参考与延伸阅读
以下讲义原文链接来自课程官方讲义(注明了出处文件);编者补充是撰写本书时另加的,不与讲义混淆。
讲义原文链接
- 1968 年 9 月的《Boys’ Life》
lect5.html - Apollo 11 Program Alarms
lect5.html - Applying “Design by Contract”
lect5.html - Dafny
lect5.html - Eiffel 的契约介绍
lect5.html - Go To Statement Considered Harmful
lect5.html - Hamilton 介绍
lect5.html - Jev 演示
lect5.html - Managing the Development of Large Software Systems
lect5.html - NATO 软件工程会议报告
lect5.html - ObjectFlow 的约束
lect5.html - QuickCheck
lect5.html - The Bitter Lesson
lect5.html - The Humble Programmer
lect5.html - UML 2.5.1 规范
lect5.html - Verus
lect5.html - Yanyan's wiki
lect5.html - 参见规范第 11.5.4 节
lect5.html - 参见规范第 17.1.2 节
lect5.html - 参见规范第 17.6.3.11 节
lect5.html - 参见规范第 2 节
lect5.html - 参见规范第 6.3.3 节
lect5.html - 技术介绍
lect5.html - 需求管理说明
lect5.html - Creative Commons License: BY-NC 4.0
lect5.notes.md - 苏 ICP 备 2020049101 号
lect5.notes.md
编者补充
- Blender
- BV1Nyeq6qEt8
- Claude Opus 4.6
- Git
- GLM-5.3
- ICLR
- IPP(Internet Printing Protocol)
- Jujutsu
- SVN
- TypeSafe AI
- 《硅谷》(Silicon Valley)
- 智能爆炸论点
附录:课堂未展示的幻灯片
🖼️ 第 29 页幻灯片 · 阅读 UML Spec
🖼️ 第 34 页幻灯片 · 三、有意的欠规约