第6讲 · 需求和架构(一)
| 课程 | 生成式软件工程(NJU)· 第六讲 |
| 视频 | 需求和架构 (1) — BV1Rch76WEfQ |
| 课程主页 / 讲义 | jyywiki.cn/GSE/2026/lect6.md | 上一讲 lect5.md |
| 许可 | 讲义内容以 CC BY-NC 4.0 发布,作者为课程讲师;本书为课堂口头讲述的书面重构,若与讲义有出入,以讲义为准。 |
| 备案 | 苏 ICP 备 2020049101 号 |
对应讲次:第6讲(南京大学 生成式软件工程)
制作模型:deepseek-flash(vb compose,据 run.log)
回顾:从上一讲的三个关键词说起
(参考时间: 00:00)
📷 上一讲的三个关键词:Intent–Spec–Impl Gap、瀑布模型、Data-Dependency Graph
回到原视频 (00:00:00)
上一讲讨论了软件工程的来龙去脉:软件危机是怎么出现的,为什么人们需要一个"工程化"的方法来做软件。我们也回过头去读了 Royce 那篇老论文——他期望的路径大致是:先有一个 intent(意图),走向 spec(规约),再走向 implementation(实现),最终产出软件;软件上线后还需要维护,生命周期并没有结束。
意图、规约与实现之间的裂缝
很自然地,这条路就呈现出一个瀑布似的过程。
📷 瀑布式的 intent → spec → impl 流程,以及由此形成的数据依赖网络
回到原视频 (00:00:40)
在需求 / 设计阶段,我们获得对软件的一些认识;这些认识逐渐进入 specification 的空间,形成彼此依赖的关系。到了系统实现阶段,又会冒出各种模块、函数、代码、测试……所有这些 artifact 之间,直接或间接地存在 data dependency,最终交织成一张错综复杂的网络。这就是软件工程的起点。
Royce 正是批判了这个模式:如果按这样开发,当你在很后面才发现某处错了,错误会沿着依赖关系一路回溯到前面的某个决定;而那个决定一旦被证明是错的(设计不合理、实现达不到预期、需求或设计做错了),它下游的一大片东西都会失效,你需要重做,付出大量成本。
于是软件工程诞生了——它研究的是:在做需求分析、做系统设计、做系统实现时,我们有什么方法?既有"人文关怀"式的(比如给产品经理一张 checklist、教他怎么管人),也有技术性的(怎么写测试、能不能做自动化测试和自动化分析)。
在那个年代,软件工程提出了不少重要概念,其中一个叫 traceability(可追踪性):理想情况下,每个测试用例、每段代码都应当能 trace 回到做过的某个设计决定。这样"我改它会影响谁""我改设计会影响哪些测试用例"就能被维护起来。如果能进一步用一个结构化的、有语义的语言来表示这些关系,显然更好——所以就有了 UML,它试图去对齐全世界的软件工程实践。
编者拓展|UML 是什么 UML(Unified Modeling Language,统一建模语言)是一套图形化的建模记号,用类图、时序图、用例图、状态图等描述系统的结构、行为与交互。它本身不是编程语言,而是一种让不同角色(客户、产品经理、架构师、开发者)能指着同一张图对话的共同语言。UML 在 1997 年被 OMG 采纳为标准,与过程方法 RUP 一同流行。近十余年,它在敏捷、轻文档的团队里使用得越来越少,但"用一张显式的图代替一段含糊的自然语言"这个思想,仍然沉淀在事件风暴、C4 模型等现代实践里。
软件不软
(参考时间: 00:03:24)
📷 软件工程的基本观察:软件不软
回到原视频 (00:03:24)
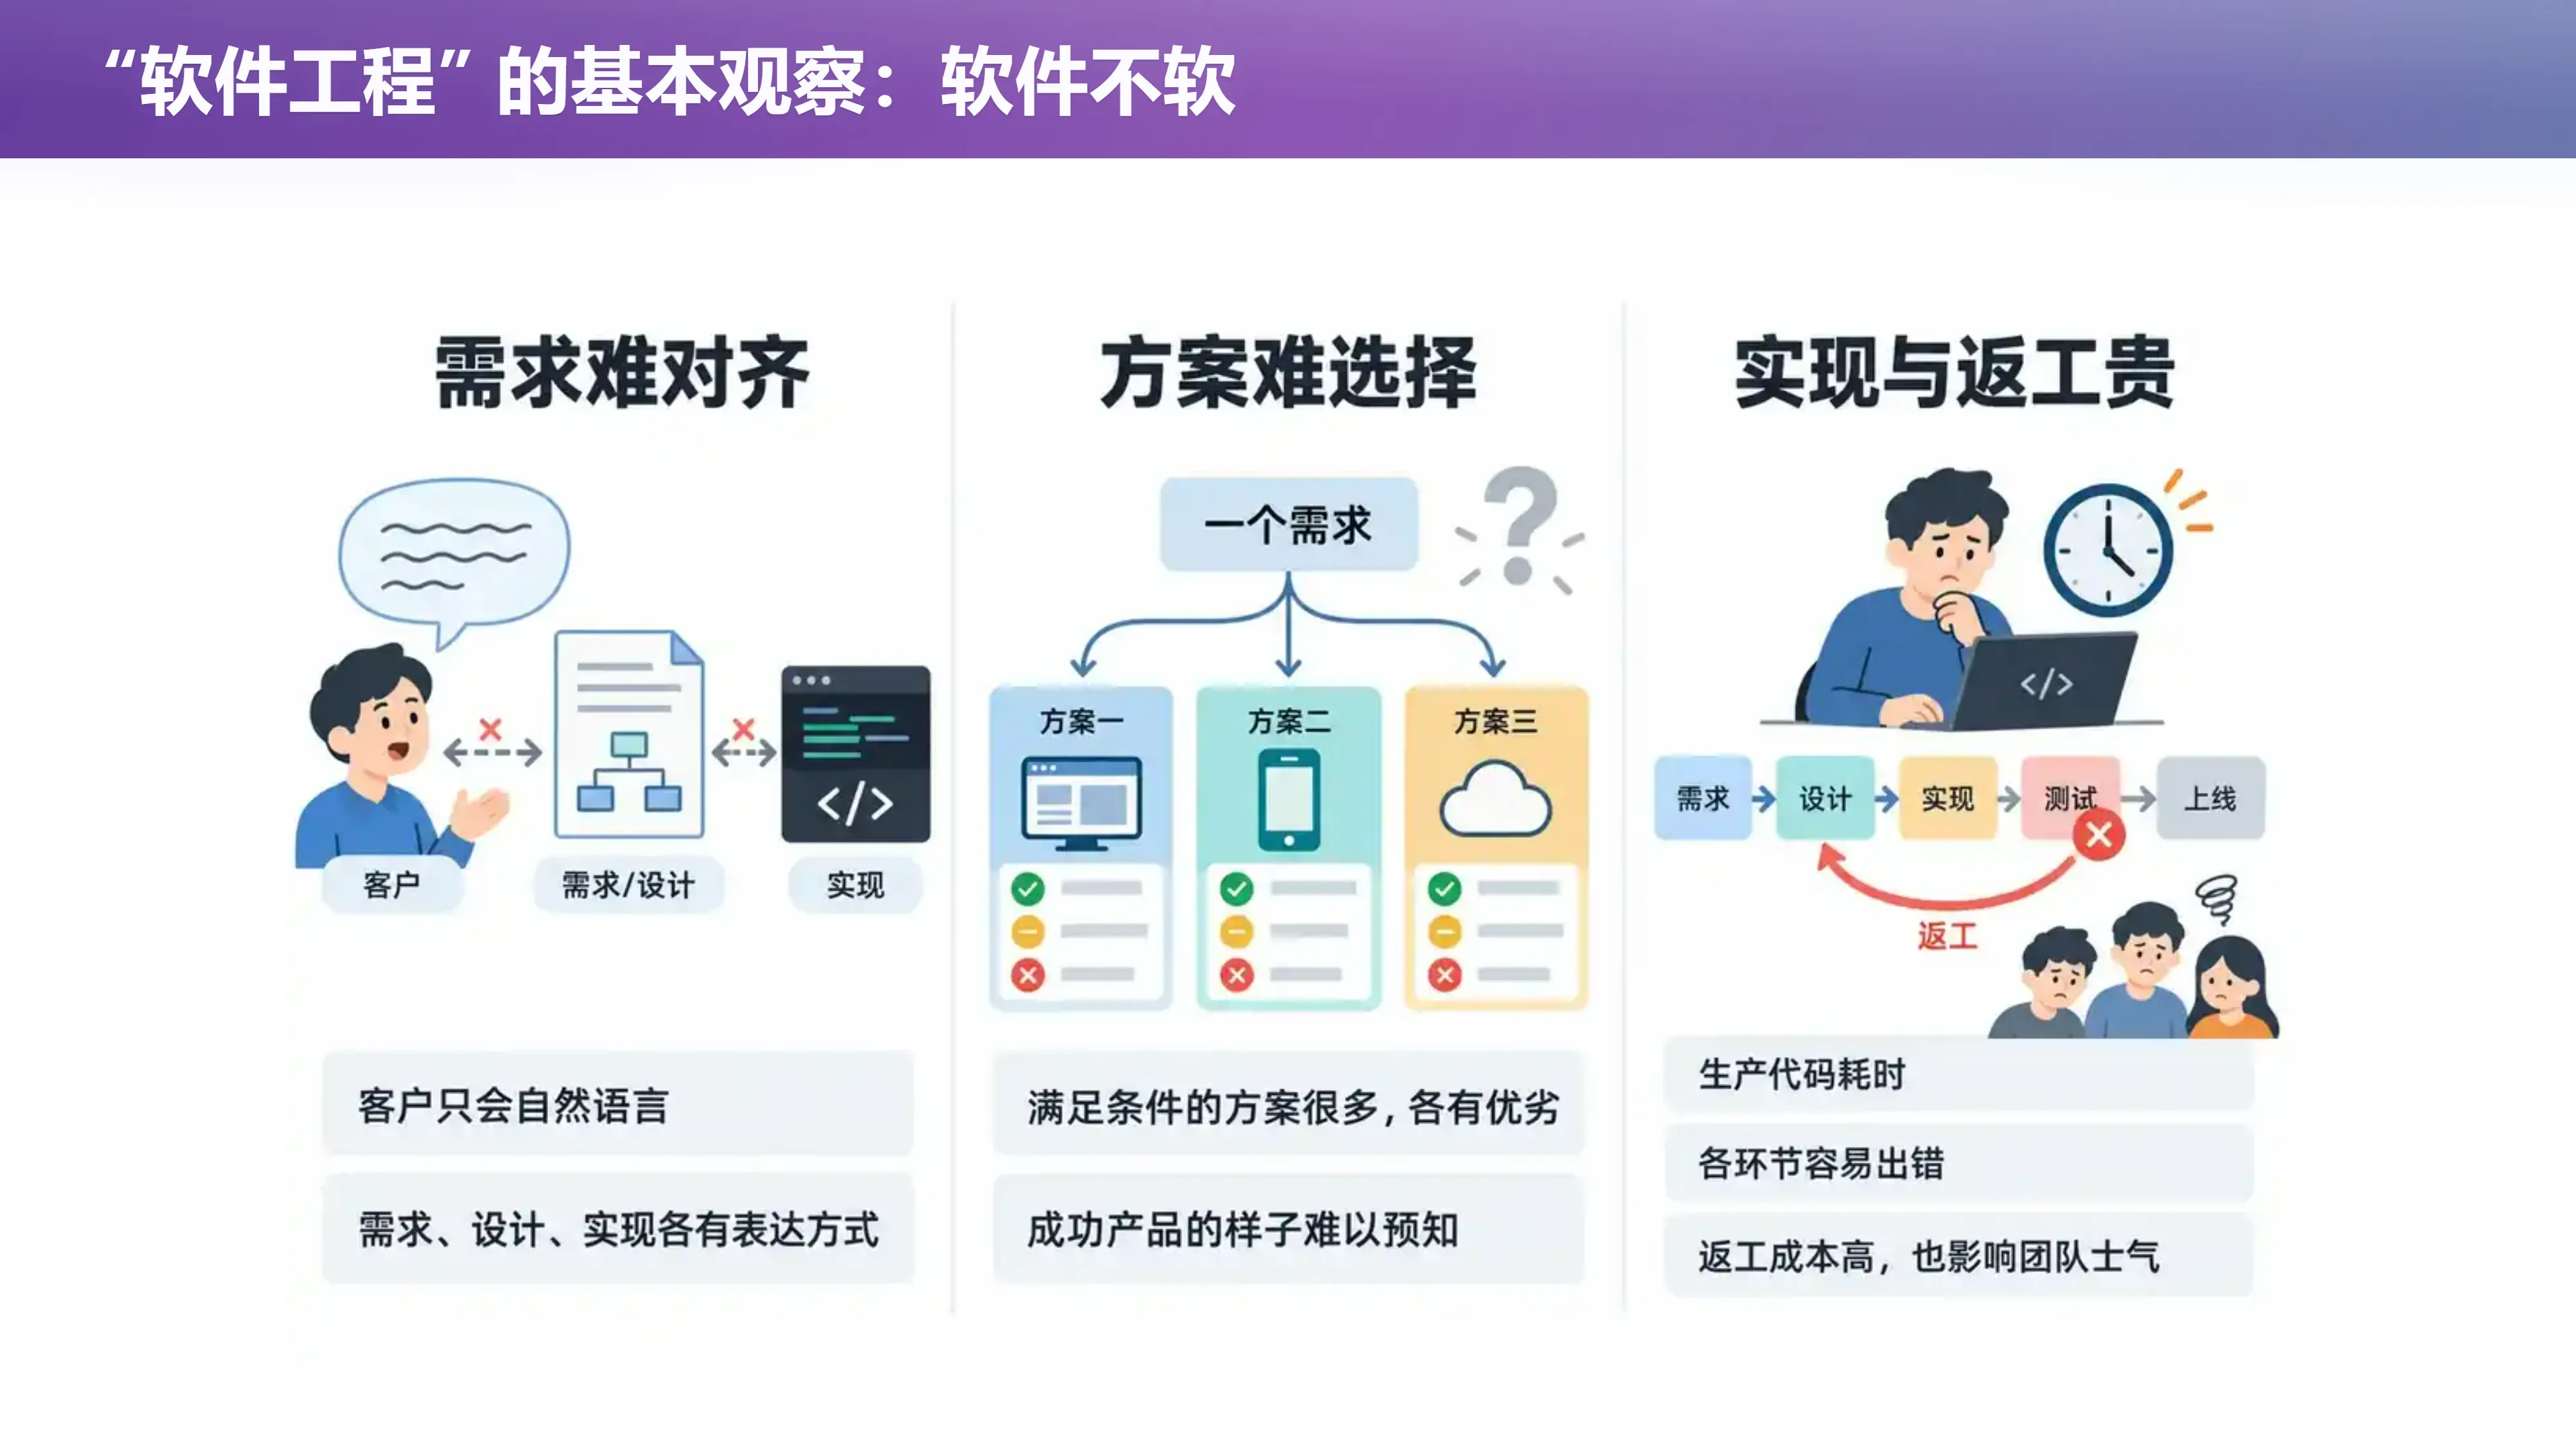
软件工程还有一个本质上的困难来源:软件根本不"软"。
我们说什么东西是软的?你们现在坐的椅背就是软的——你对它施加压力,它瘪下去;你起身,它又弹回来,下次坐还是好的。但软件完全不同:它是纯粹的逻辑制品,容不下任何细微的差错。
讲师举了一个极端的例子:假设你写了个程序,从 stdin 读入 $n$。如果 $n = 1$,循环会从数组里读一个元素。这时候,如果你的程序跑在卫星上,一粒宇宙射线打中了内存,把那个 1 的无符号整数最高位翻成了 1——它瞬间变成一个巨大无比的数,整个程序就彻底 collapse 了:它会无穷无尽地往输入里读数,读了一千个数字之后触发一个 memory error。
编者说明:这种由高能粒子引起的单个比特翻转,在工程上称为 SEU(Single Event Upset)。在航天、航空、高可靠服务器中,它通过 ECC 内存、三模冗余、巡检与重试等手段缓解——这也正是"软件不软"的一个侧面:软件开发时几乎从不会考虑内存里发生一个 bit 翻转,可程序却必须在这种物理噪声下依然保持语义正确。
这不是纯粹的假想。在数据中心里也会观察到类似现象:处理器制程越先进、指令密度越高,某些指令在热噪声下就可能产生 silent error——同一条指令在这台机器和那台机器上执行结果不同,甚至要服务器跑一段时间后才暴露出来。软件既然是承载人类智慧的产物,又要承载客户涌来的需求,那么"软件"这东西天生就既不软、也不宽容。
软件工程方法与研究的困境
(参考时间: 00:06:00)
软件工程是一个关乎整个软件生命周期的学科。但你们被迫只能"从底下开始学"——因为如果你不理解代码是什么、写不出代码、没有体会过写软件痛苦,你是不可能做好一个产品经理的。你设想"这件事应该能办到""花多少成本大概能办到",如果没有一手经验,这些判断就是空的。所以你们进来先学 C 语言:一门老、基础、已经算不上主流的语言。然后在这个基础上不断叠加新知识——知道世界是怎么失败的、新语言为什么被创造出来,一点一点往上走。
今天要讲的需求、产品、架构,正处在从 intent 走向 spec 的那一段,它决定了一个软件系统从零开始的方向。船往东南西北哪个方向开,影响极大。
然而,需求、产品、架构极难做定量研究。你很难设计一个像比较算法运行时间那样的统一实验来回答:"这个架构今天写起来很顺手,三年后是否还合适?""一个需求分析方法让产品成功了,究竟是方法有效,还是参与者本来就更有经验?"
课堂里那句调侃——"学校里的软工人都不在做软工"——指向的正是这种张力:容易量化的研究对象,并不一定就是软件生产中最关键的困难。大家的研究大多集中在和编码、实现相关的方向;也有人做"缺陷预测"这类题目,说"traceability 很重要,那能不能训练一个神经网络从数据里直接推导出依赖关系"。能预测一些缺陷,并不自动意味着你知道客户要什么、产品该长什么样。
编者拓展|Wicked Problems(棘手问题) 这里引用的是 Rittel 与 Webber 1973 年的经典论文 Dilemmas in a General Theory of Planning(原文)。他们区分了两类问题: - Tame problems(温驯问题):目标明确、可以完整形式化、有确定的"解出/未解出"判据——比如解一道数独。 - Wicked problems(棘手问题):问题本身的定义就取决于各方立场;没有"停止规则",只能"够好了";每个解都是一次不可逆的干预;不存在一劳永逸的"正确解"。
城市规划、公共政策、教务系统这类业务软件,处理的正是后者。这解释了一个关键事实:"把一个系统做对"的判据本身就要先被多方协商出来。这也是"客户说不清楚需求"和"客户之间说不清楚谁对"这两件事的公共根源。
代码便宜以后,什么变得更贵
(参考时间: 00:08:57)
📷 Agentic AI:软件生产力的杠杆
回到原视频 (00:08:57)
讲师分享了一段他最近的真实工作状态:让 AI 生成代码,只要把边界划定清楚,他已经真的不怎么看具体实现了。前一天让模型写的代码,复杂度已经"超越人类能够理解的范畴",但它是对的,而且可以比较放心地信任它——前提是边界清楚、并且知道怎么做好的 validation。把 agent 的 swarm 铺开去实现,也能获得一定质量保证。
那么,除去"写代码"这件事,剩下的压力在哪里?
需求、产品设计与架构是真正的杠杆
首先要承认,MVP(Minimum Viable Product,最小可行产品)没有问题。做一个 MVP,可以让你快速找到从 intent 到 specification 到 implementation 的一个切片,在这个切片上走完软件的完整流程。只是它不完备。
做 MVP 时,你一定会先做最重要的功能。你不会在做 MVP 的阶段就去纠结按钮的样式长什么样——因为这是有依赖的:按钮样式依赖整个界面设计,界面设计又依赖所有功能的实现。如果上面的设计还没定,你去调按钮样式,等设计一变,这份劳动很可能就作废了。人有一个本能:不要去做一件你马上要扔掉的东西。
但今天的 AI 有一个特点:除非你显式地用 prompt 告诉它——哪怕是几个字——它不会主动从需求、产品设计、架构的角度去做判断。同一个 MVP 需求,你加上"用 client-server 架构"或者"用 CRUD 架构"这几个字的 prompt,就会得到完全不同的系统。它们功能上可能看起来差不多,但内部结构截然不同:
graph TD
    A["同一份 MVP 需求"] --> B["prompt: 命令行工具"]
    A --> C["prompt: client-server"]
    B --> B1["单个 main.py + 命令行解析库"]
    C --> C1["先设计数据存储,选定一个数据库"]
    C1 --> C2["生成 db.ts / models 等数据层文件"]
    C2 --> C3["这些文件进入 Agent 上下文<br/>后续每个需求都带着它们"]
而这些散落的决定不会消失,它们会变成技术债(Technical Debt)。文件一旦被写出来,就进入了 agent 的上下文;你每往后做一个需求,都会带上之前的所有历史。
技术债的决定性来源:需求与产品
那决定的来源是什么?是需求。
讲师举了自己的例子:他到底要一个什么功能的 agent?他显然是写了需求的。但需求要有自己的版本——你想要的是一个帮助学习的工具,还是你在课题组里对读研究论文有强烈需求?不同需求下,软件的走向必然不同。再加上产品设计:这个产品是只有你自己用,还是要给别人用?
讲师原话大意:我自己有很多用得非常顺手的工具,但想给另一个人用,他就用得不舒服——因为我有自己的知识和偏好。比如我喜欢的命令行工具,非技术人员看了肯定受不了。
所以,需求、产品设计和架构这三段,是撬动软件生产力真正的杠杆。哪怕只是几个字的差别,也会对 AI 生成的走向、技术债的累积带来巨大影响。
一段未遂的翻车:日志与技术债
(参考时间: 00:14:13)
讲师插叙了一件真实发生的事:直播过程中他的系统 UI 还在正常工作、OBS 还在正常推流,但鼠标键盘全都不响应了,插上新鼠标也没用,他甚至不知道发生了什么。
这件事本身就是一个软件工程实践:出了问题你要去看日志——这意味着你在写软件的时候就要输出足够多的日志。而这恰恰是 AI 的一个典型盲区:如果你不告诉它,AI 不会主动加日志,它会生成一个没有任何日志的软件系统。这同样是技术债。
📷 上课时演示"AI 教务系统"的现场
回到原视频 (00:15:00)
编者说明:这三段看似闲聊,其实是本讲的一条暗线。没有日志 = 无法定位问题 = 无法解释系统为什么变成现在这样。这个主题在后面的教务系统一节会以更大的尺度重现:当"当前状态"丢掉了历史,系统也就失去了自我解释的能力。
需求工程:从身边的教务系统开始
(参考时间: 00:15:00)
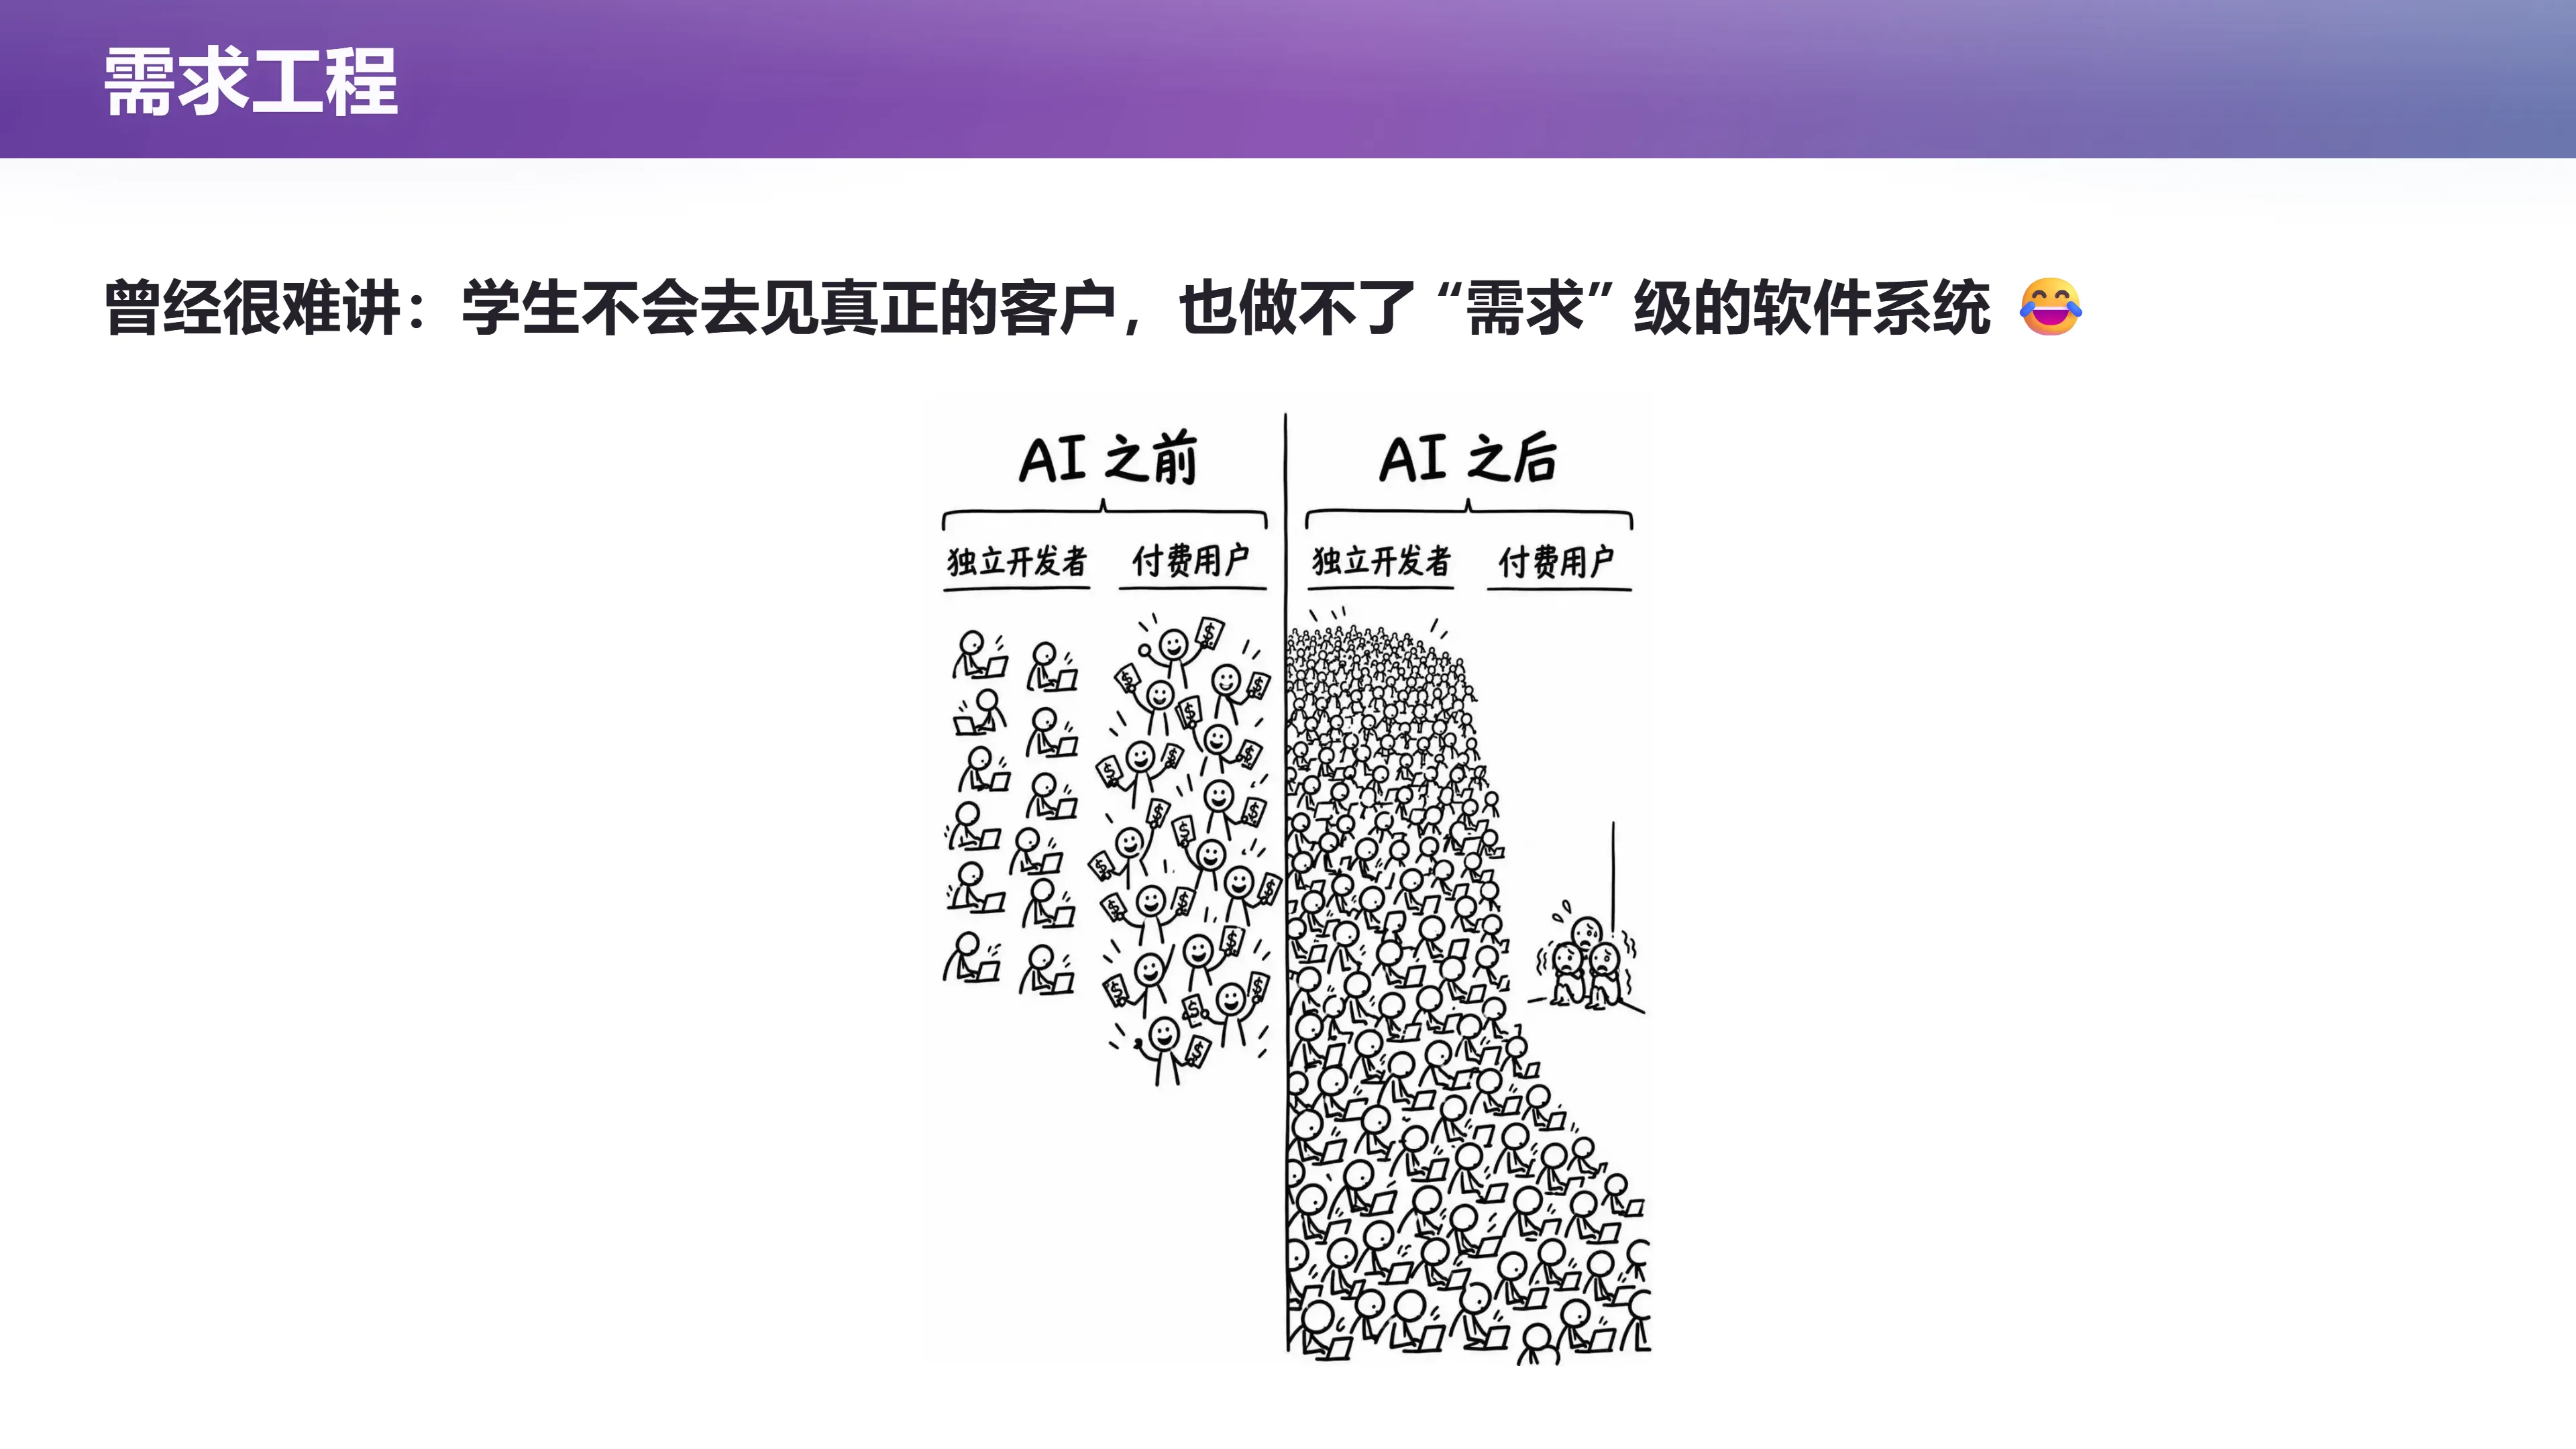
需求工程曾经很难讲。原因很朴素:学生不会去见真正的客户,也做不了需求级的软件系统。从你刚开始学编程语言,到毕业时能力的增长,不足以让你去面对一个真正的软件客户。你也不敢拍着胸脯说"这个给我 20 万,我找几个同学把南大的教务系统包了"——签了合同、逾期交付、达不到功能与非功能要求,你就傻眼了。
不过现在事情有点变了。AI 出现之前,只有很少量精英独立开发者,经历了几年开源社区洗礼后终于觉得自己可以独立开发、并有付费用户;现在独立开发者数量爆炸式增长。你不敢接的活,agent 敢。
教务系统:史诗级的需求爆炸
(参考时间: 00:15:48)
📷 来看看教务系统吧:史诗级的需求爆炸
回到原视频 (00:15:48)
讲师选择了自己比较喜欢的例子:教务系统。他称其为"史诗级的需求爆炸"。
他当场登录南京大学的教务系统演示:
- 系统里现在有了 AI 助手("隐藏的 AI 功能")。讲师对着它问:"仙林教学楼的灯一直没有解决,我应该打电话给谁?" AI 回答"基建处"——但讲师说他在平台上提了,基建处把他打回来了,说不归他们管。
- 问"我现在在上什么课",AI 正确加载了他的上下文,返回教师课表(本科),这正是他本人的课表。
- 讲师感慨:这个系统肯定花了很多钱。 这钱某种程度上还不如变成 token 补贴给大家——如果他用付费 agent 去找一下,可能就一毛钱两毛钱。
在"我的教学任务"页面里,功能更是一层叠一层:编辑联系方式、当前教学学期、最新排课学期、历史授课信息、期末考试签到表、编辑教材、查看大纲、助教管理、教学班搜索……讲师随手点了几下:
- 编辑教材进去是一个新页面,带弹窗——但报错了。"曾经好像是可以的。好,我们已经成功发现了一个 bug。"
- 查看大纲等了很久页面才刷新出来,且提示"仅展示最新一个教学班"。
- 助教管理里出现了一个教学班名称写着
JX...之类的记录,讲师感叹"教学班名称堪比 agent"。 - 点"新增"提示"请在可维护时段内操作"。
讲师顺势讲了一个需求叠加的典型故事:疫情之前教务系统里没有 MOOC 功能。 疫情期间领导说"要为老师添加 MOOC",于是加了 MOOC;加完 MOOC 之后需要 MOOC 的助教;而 MOOC 的助教不能当成普通教学班的助教来处理——于是系统里又多了一条分支。这就是需求不断叠加的过程。
让 AI 去调研需求,生成一份"需求说明书"
(参考时间: 00:23:20)
讲师做了这样一件事:他让 GPT 起一个 agent,去爬取并探索教务系统中与教师相关的功能(注意,只限教师相关的部分),最后输出一份需求说明书。
结果相当不错。他展示了一份《南京大学本科教学服务平台需求说明书》,目录结构包括:调研方法、证据边界、业务目标、成功标准、详细用例规约、功能需求目录,以及术语表与配套文件。
讲师点评:
- "GPT 懂软件工程。" 它为什么要写这么多?在我们看来,这已经像一个做完的系统、完全是 slop。但如果你真要面对客户做一个工程,术语表就很重要——客户看不懂某个词时可以去查,一对齐就通了。
- 功能需求目录里有 traceability:每一条需求都有编号 ID。比如"当一个服务支持多种已分配身份时,提供身份选择,并显示当前身份"——这正是讲师在演示时看到过的界面。这种形式语义的 ID 让需求可以追踪,而不是只靠自然语言里一句"教学班和学生管理有关"。
- 后面还有验收场景和需求清单 checklist。checklist 的作用是把前 20 个需求分给一个团队、后 20 个分给另一个团队,然后 track 每个人的进度,你作为管理者就知道哪个团队落后了。
讲师坦承:这类条目一条条往下写,对同学们来说是极其枯燥的事情("你不如去做一道没见过的算法题,还能让保研机试多拿点分"),但量变引起质变。你们在《计算机系统基础》课上写 NEMU、写调试器、写指令解释器时,其实第一次见到了一份比较长的 specification——课堂设计上,在那之前 OJ 的需求文档都非常短,只给你输入输出接口。当系统大到一定程度,你做的训练都是相通的:学计算机系统基础这门课,一定程度上也是在学软件工程。
让 AI 照着需求文档直接实现
(参考时间: 00:29:27)
讲师又让 GPT 起了一个 sub agent,不许它看任何其他教务系统,只根据这份需求说明书实现一个假的教务系统。结果:
- 返回"全部教学任务"→"我的教学任务"→ 本科教材管理(《软件工程实践者的研究方法》),能编辑、能保存记录。
- 学生名单里,名字起得"还挺文雅的",也带着模型的个人偏好。
- 讲师试图记录一次缺课,输入一个荒谬的数字——模型没有阻止他,"这个数字已经超过了所有学期上课次数的总和,但你可以看到软件工程的魅力时刻:当需求是清楚的时候,编码、traceability、测试,AI 都能帮你搞定。"
从入学到毕业的总需求分解
(参考时间: 00:32:35)
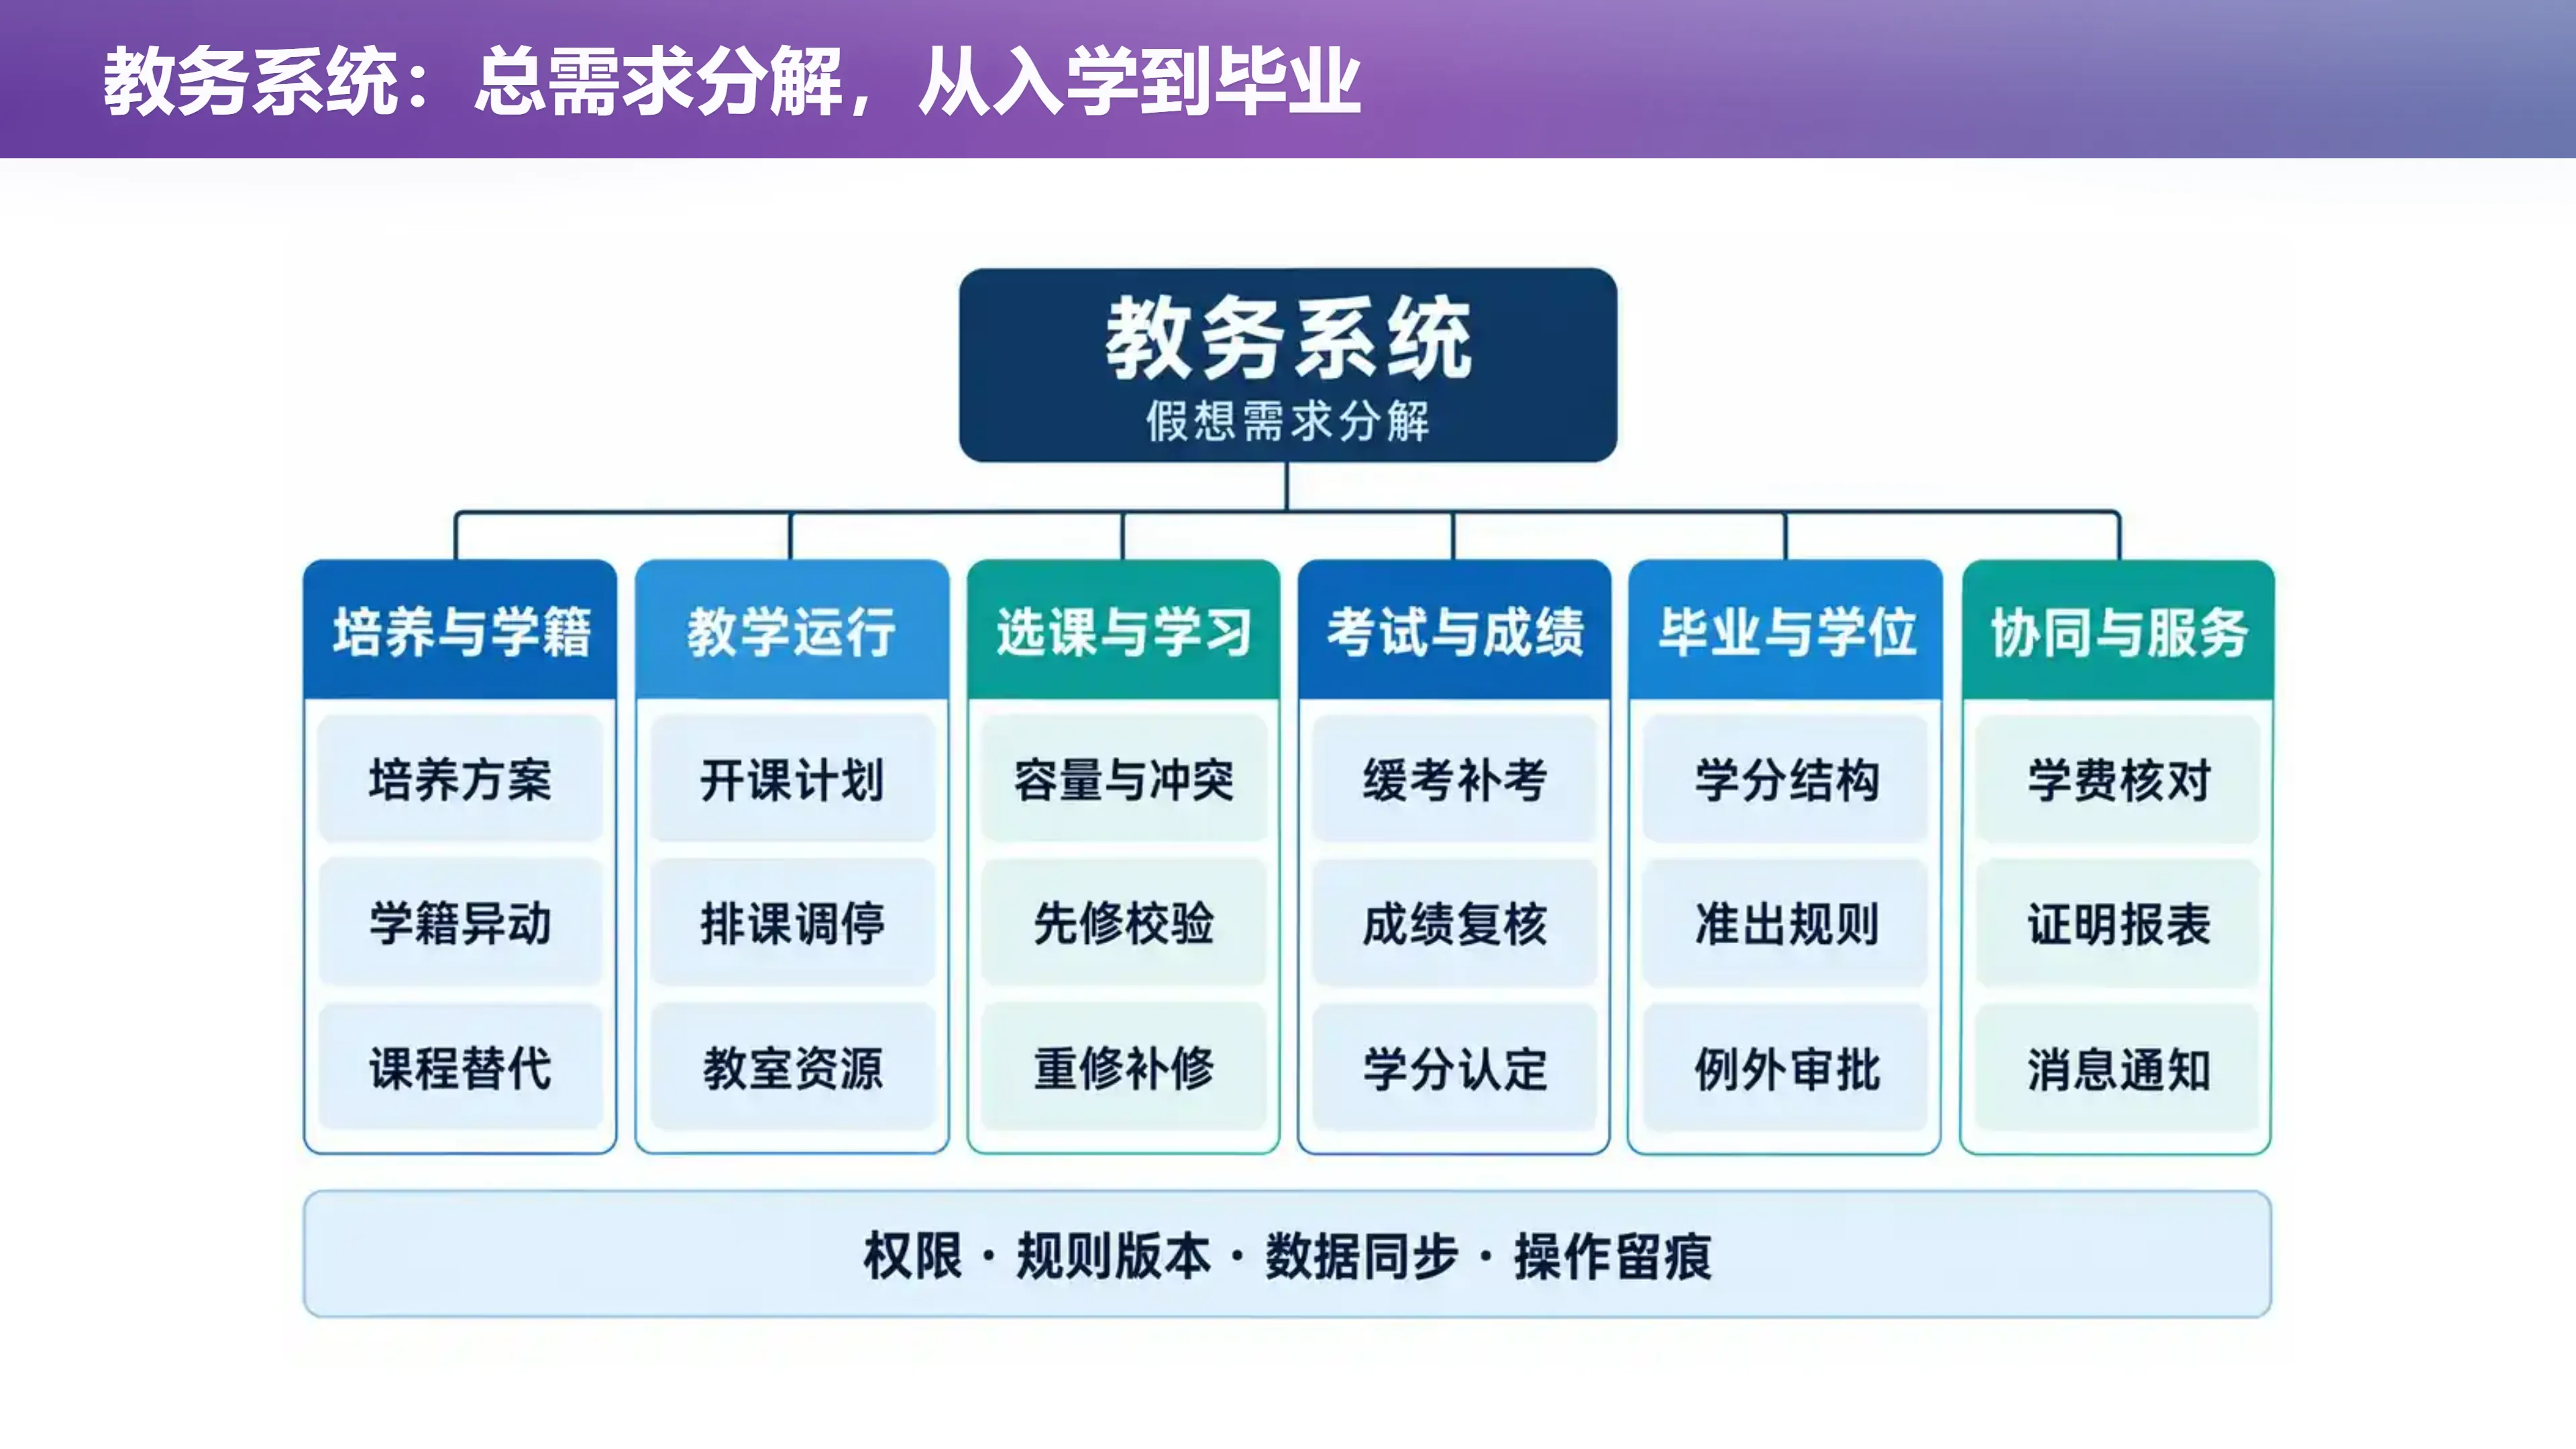
📷 教务系统:总需求分解,从入学到毕业
回到原视频 (00:32:35)
从入学到毕业,学生会经历:学籍登记 → 培养方案选择 → 选课 → 考试 → 成绩认定 → 毕业审核。教师要开课、管理名单、登记成绩;教务员要排课、处理学籍变化和各类申请;教务处要执行政策、汇总统计;财务和辅导员又各有业务。这几张表和页面背后,连着许多不同的参与者,还牵扯权限规则、版本、数据同步、操作留痕。
需求无非就是通过无尽地和客户沟通,把客户想要什么想清楚。 小到你界面上要不要放一个"当前学期 / 学年"、某个地方要不要有一个修改按钮,都要和用户对齐——因为你的用户不是你自己。
讲师在这里特别提到了一种 CS 同学普遍缺乏的软技能: "你要有同理心。你不是说'我是个 geek,我就假设所有人都会写程序'。你要考虑那个教务员——她可能是本科学历,今年 53 岁,还有两年退休,一位优雅的女士。她上大学的时候可能都没操作过电脑。我们要设计一个教务系统,要为她设计,也要为年轻人设计。怎么得到那张表,完全是另外一个问题。"
教务系统的需求泥潭
(参考时间: 00:34:16)
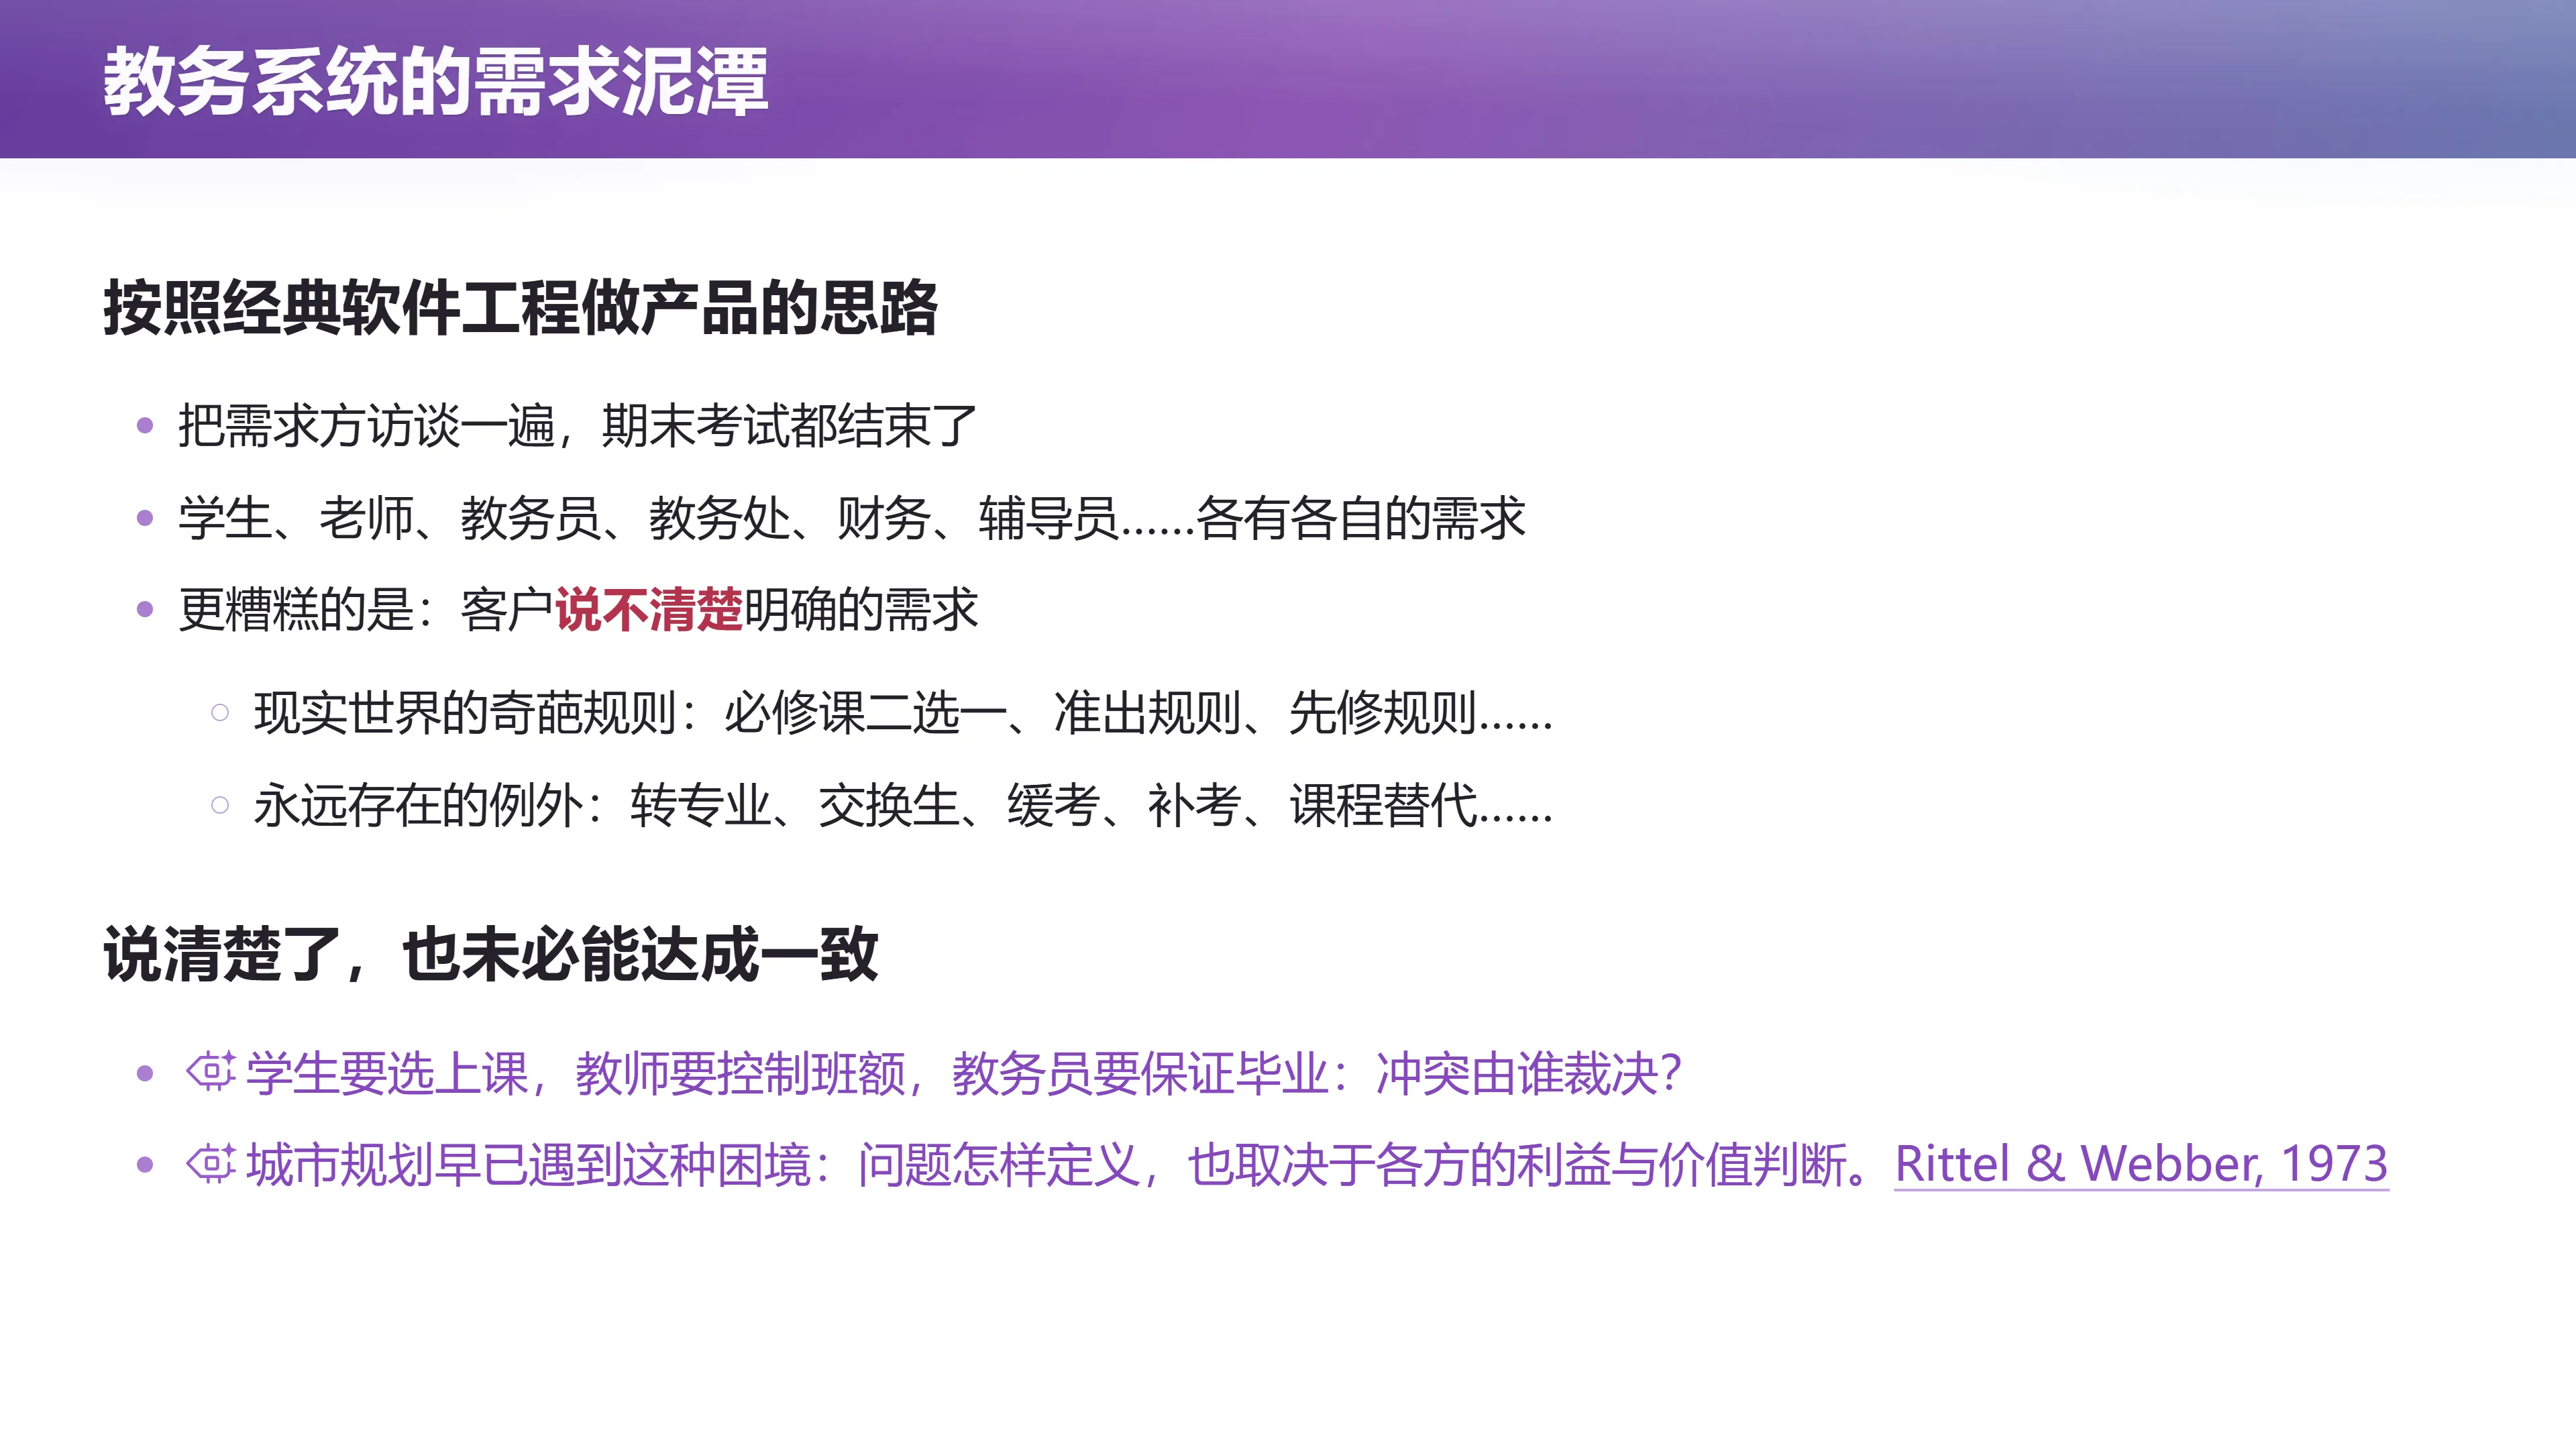
📷 教务系统的需求泥潭
回到原视频 (00:34:16)
经典做法:把需求方访谈一遍
按照经典软件工程做产品的思路:把需求方逐一访谈一遍,可能期末考试都结束了。
学生、老师、教务员、教务处、财务、辅导员……各人有各人的需求。更麻烦的是客户常常说不清楚完整的需求:一个人熟悉自己每天处理的普通情况,却未必能立刻列出所有例外;不同人即便都说清楚了,也未必能达成一致。
现实世界的规则本身就千奇百怪:必修课二选一、准出规则、先修规则……而永远存在的例外有:转专业、交换生、缓考、补考、课程替代……
即便都说明白了,冲突依然存在:学生希望选上课,教师希望控制班额,教务员希望学生按时毕业。这几个要求遇到同一门满员的必修课时,就需要有人作出业务决定——而"谁来裁决",本身就是一个没有技术答案的问题(回到 Wicked Problems)。
培养方案:每一条单独看都不难
(参考时间: 00:35:53)
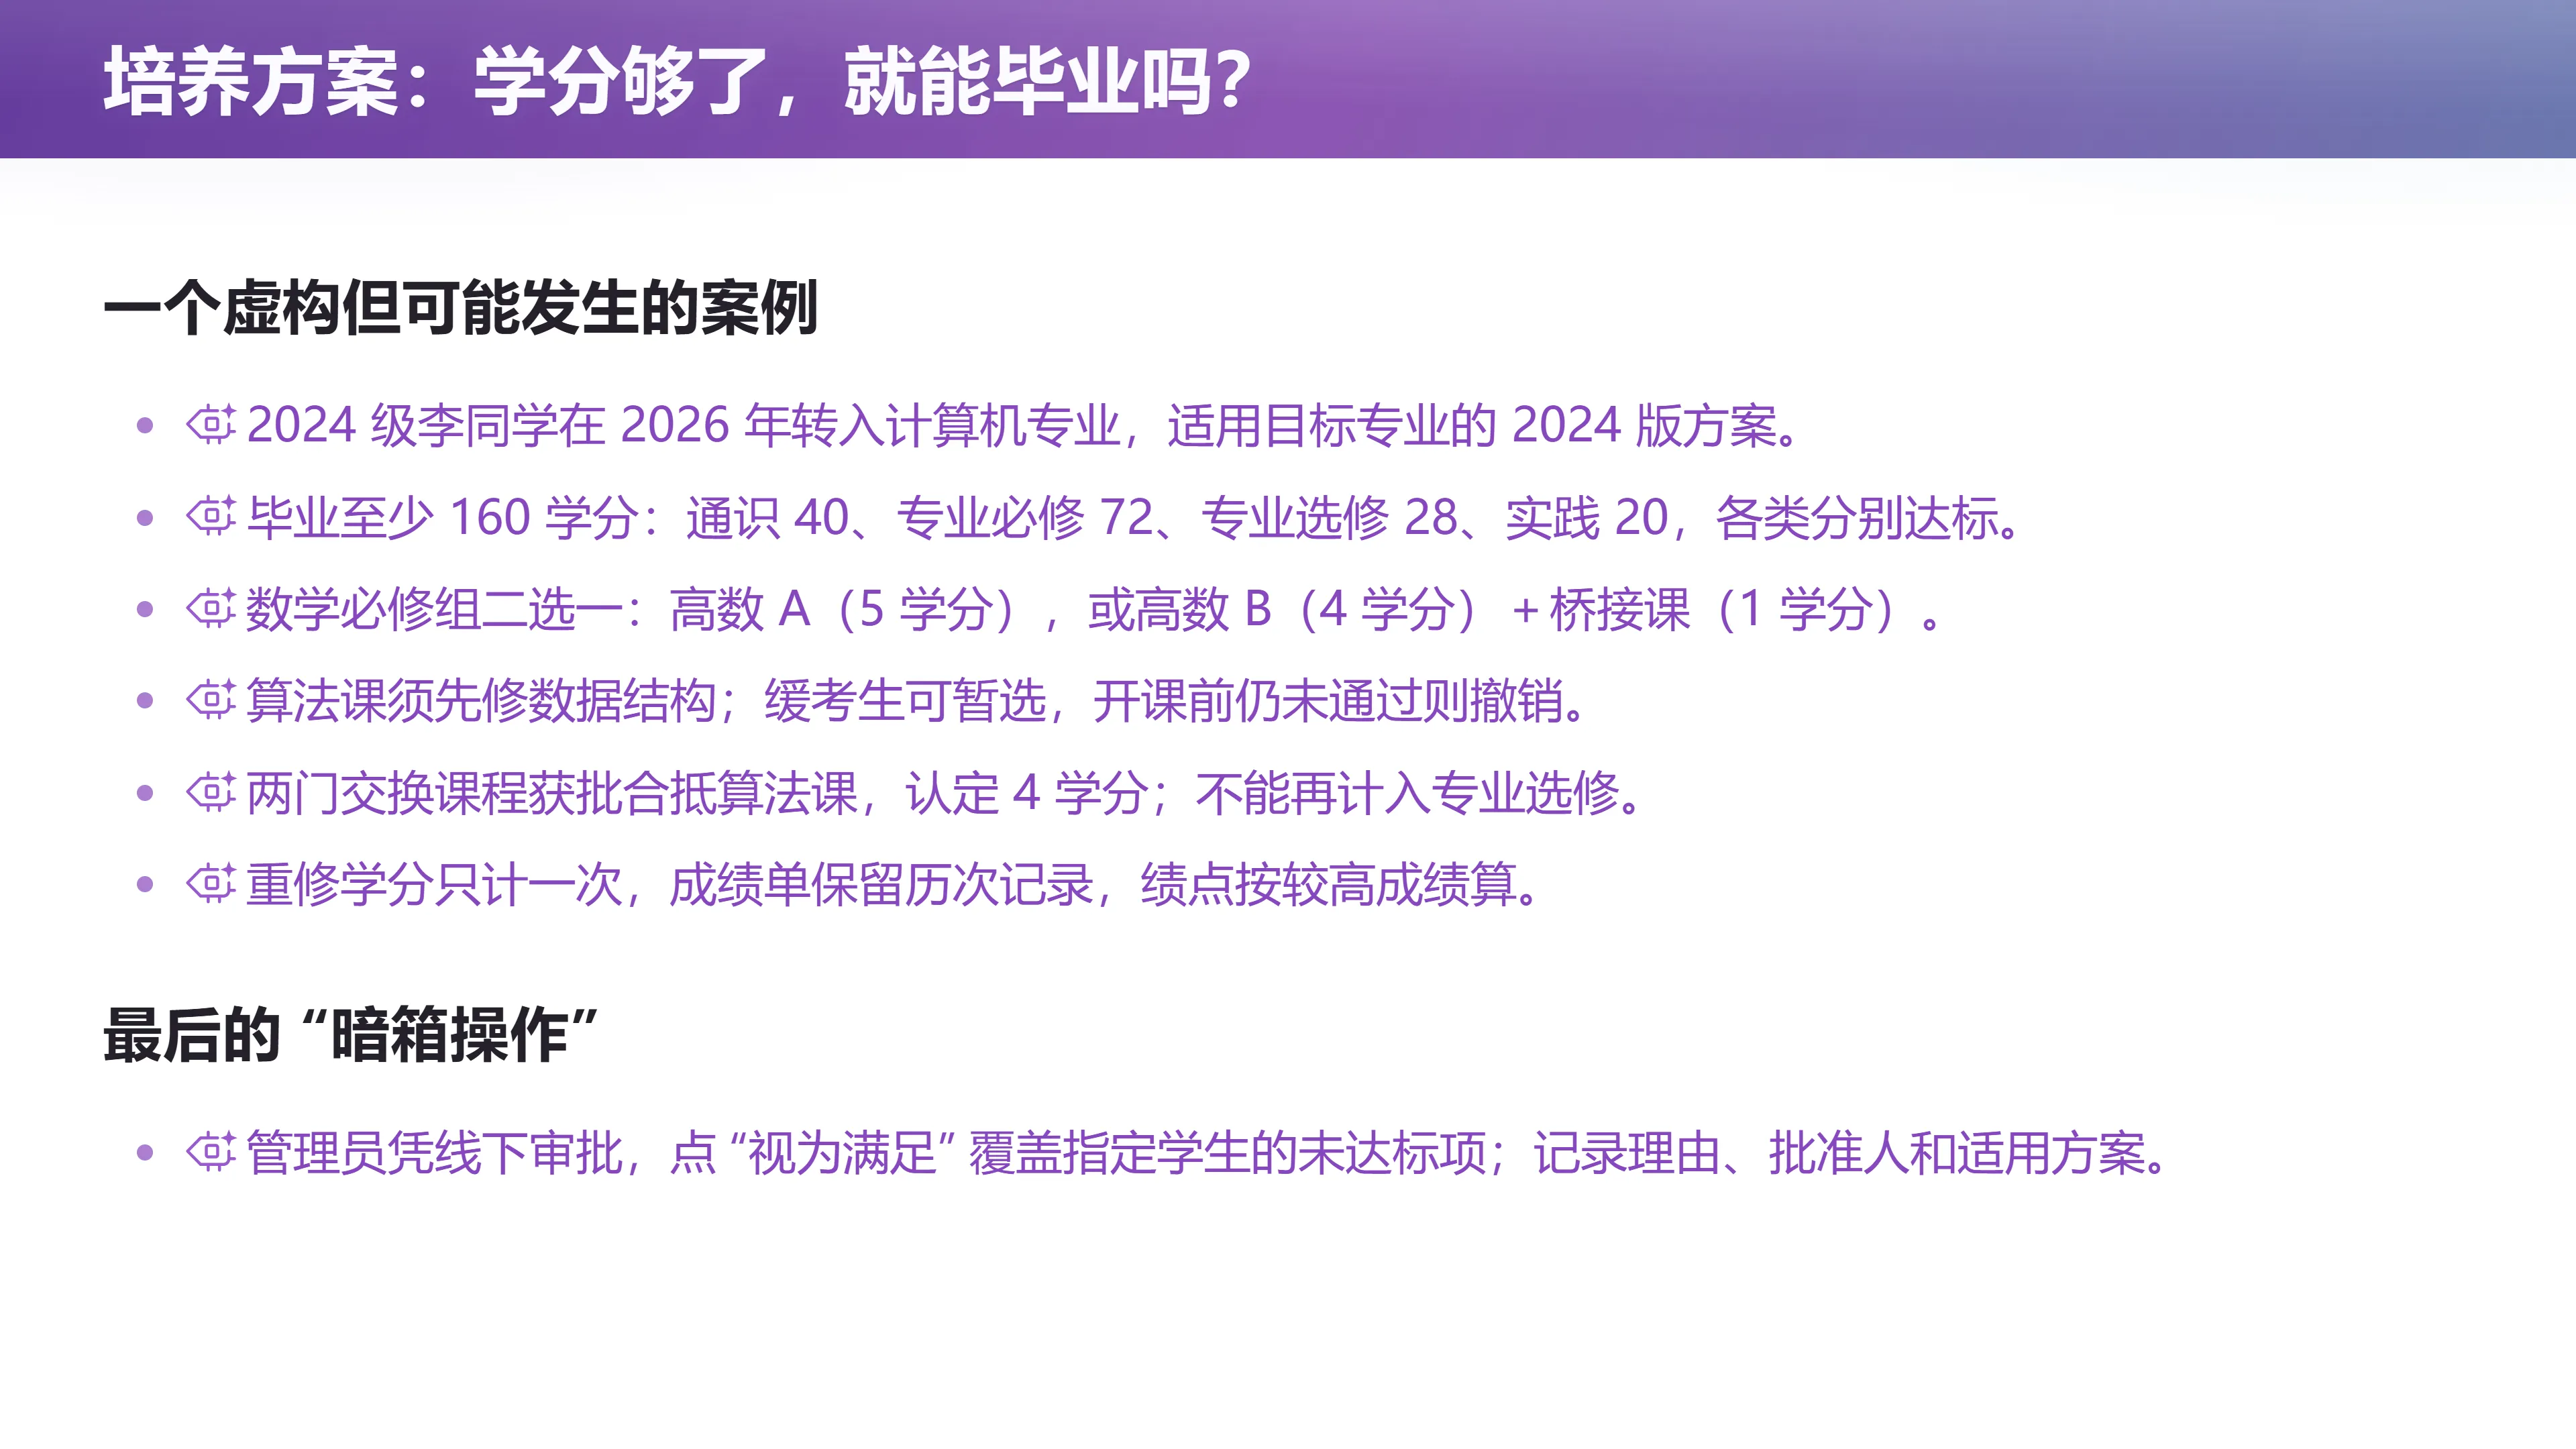
📷 培养方案:学分够了,就能毕业吗?
回到原视频 (00:35:53)
讲师构造了一个虚构但很可能发生的案例:一位 2024 级学生在 2026 年转入计算机专业,适用目标专业的 2024 版培养方案。规则如下:
- 毕业至少需要 160 学分,其中通识 40、专业必修 72、专业选修 28、实践 20,每一类都要分别达标。
- 数学要求可以用 5 学分的高数 A 满足,也可以用 4 学分的高数 B 加 1 学分的桥接课满足。
- 算法课要求先通过数据结构;缓考学生可以暂时选课,但开课前仍未通过就要撤销。
- 两门交换课程经过批准,可以合抵一门 4 学分的算法课,但不能再把同一份学分计入专业选修。
- 重修只计一次学分,成绩单保留历次记录,绩点按方案规定的较高成绩计算。
真正的困难在于它们会相遇
每一条单独看都不难。真正的困难在于它们会相遇:
转专业学生恰好参加过交换,交换课程还没有完成认定,先修课正在等待缓考成绩——而此时选课窗口却马上关闭。
更现实的是,总有某种经过线下批准的特殊情况,没来得及变成系统里的规则。最后只能留一个"视为满足"的兜底入口,也就是大家调侃的"暗箱操作":
- 管理员凭线下审批,点击"视为满足"覆盖指定学生的未达标项;
- 记录理由、批准人和适用方案。
这个入口也有需求:谁有权批准?豁免哪一项要求?适用于哪个学生和哪一版方案?理由是什么? 若系统不能表达这些内容,工程师就只能直接改数据库,把当前问题先救过去。
graph TD
    A["一次毕业审核"] --> B["事实层<br/>课程成绩 / 学分认定 / 交换认定"]
    A --> C["规则层<br/>2024 版培养方案 / 专业规则"]
    A --> D["决定层<br/>人工豁免 / 视为满足 / 正式审核"]
    B --> E["结论:can_graduate"]
    C --> E
    D --> E
    E -.->|"当前状态只保留结论"| F["历史与依据丢失"]
一次把缺课次数改成 -1 的经历
(参考时间: 00:40:53)
📷 勉强实现需求,然后进入焦油坑
回到原视频 (00:40:53)
讲师讲了一段很有冲击力的亲身经历:
开始上课的第一天,应该是 2018 年,那时候还是一个老版的教务系统——跟我上学时候的教务系统差不多。我第一次用老师端,发现很好玩:可以给学生设置缺课次数。
我不知道为什么要做这个需求。如果是我来做需求,我不会把"缺课次数"这个 feature 放进教务系统——学生缺课就缺课吧,你留个签到表、点名表作为证据就可以,扫描一下就能处理。学生手册里写着:无故缺课达到一定次数就可以开除。
然后我就试着绕过了前端的校验——我输入一个非常大的缺课次数,它直接拒绝我了,说明它前后端都做了校验。我改成把一个同学的缺课次数从 0 改成
-1,这好像也不是什么有害的操作。结果,所有能够选出这位同学选课记录的页面,全部 crash 了,直接 500。我只好打电话给教务说系统崩溃了。第二天工程师登录到数据库,把那条
-1的记录修好了。
讲师强调:我们没有据此定位某一处具体代码错误。但可以看到的是——某个看似局部的数据假设,已经被许多功能共同依赖。一个特殊值进入系统,问题就沿着这些依赖扩散。
graph LR
    V["缺课次数 = -1<br/>(越界值进入系统)"] --> D1["选课记录查询"]
    V --> D2["成绩单生成"]
    V --> D3["点名册导出"]
    V --> D4["毕业审核"]
    D1 --> X["500 Internal Server Error"]
    D2 --> X
    D3 --> X
    D4 --> X
功能勉强做全,例外靠补丁维持,改一个地方又牵动其他地方,软件就逐渐进入了焦油坑。
编者说明:这段经历的关键不是"少写了一个
>= 0的校验"。真正的要点是依赖没有被显式管理:一个字段的取值范围假设是隐式契约,当它被破坏时,没有任何机制告诉你"哪些下游会受影响"。同样的问题在三十年前的瀑布模型分析里就已经被指出(data dependency),只是它在今天仍然以 500 错误的形式出现在我们眼前。
Agentic AI 时代的 MVP 与没有银弹
(参考时间: 00:42:48)
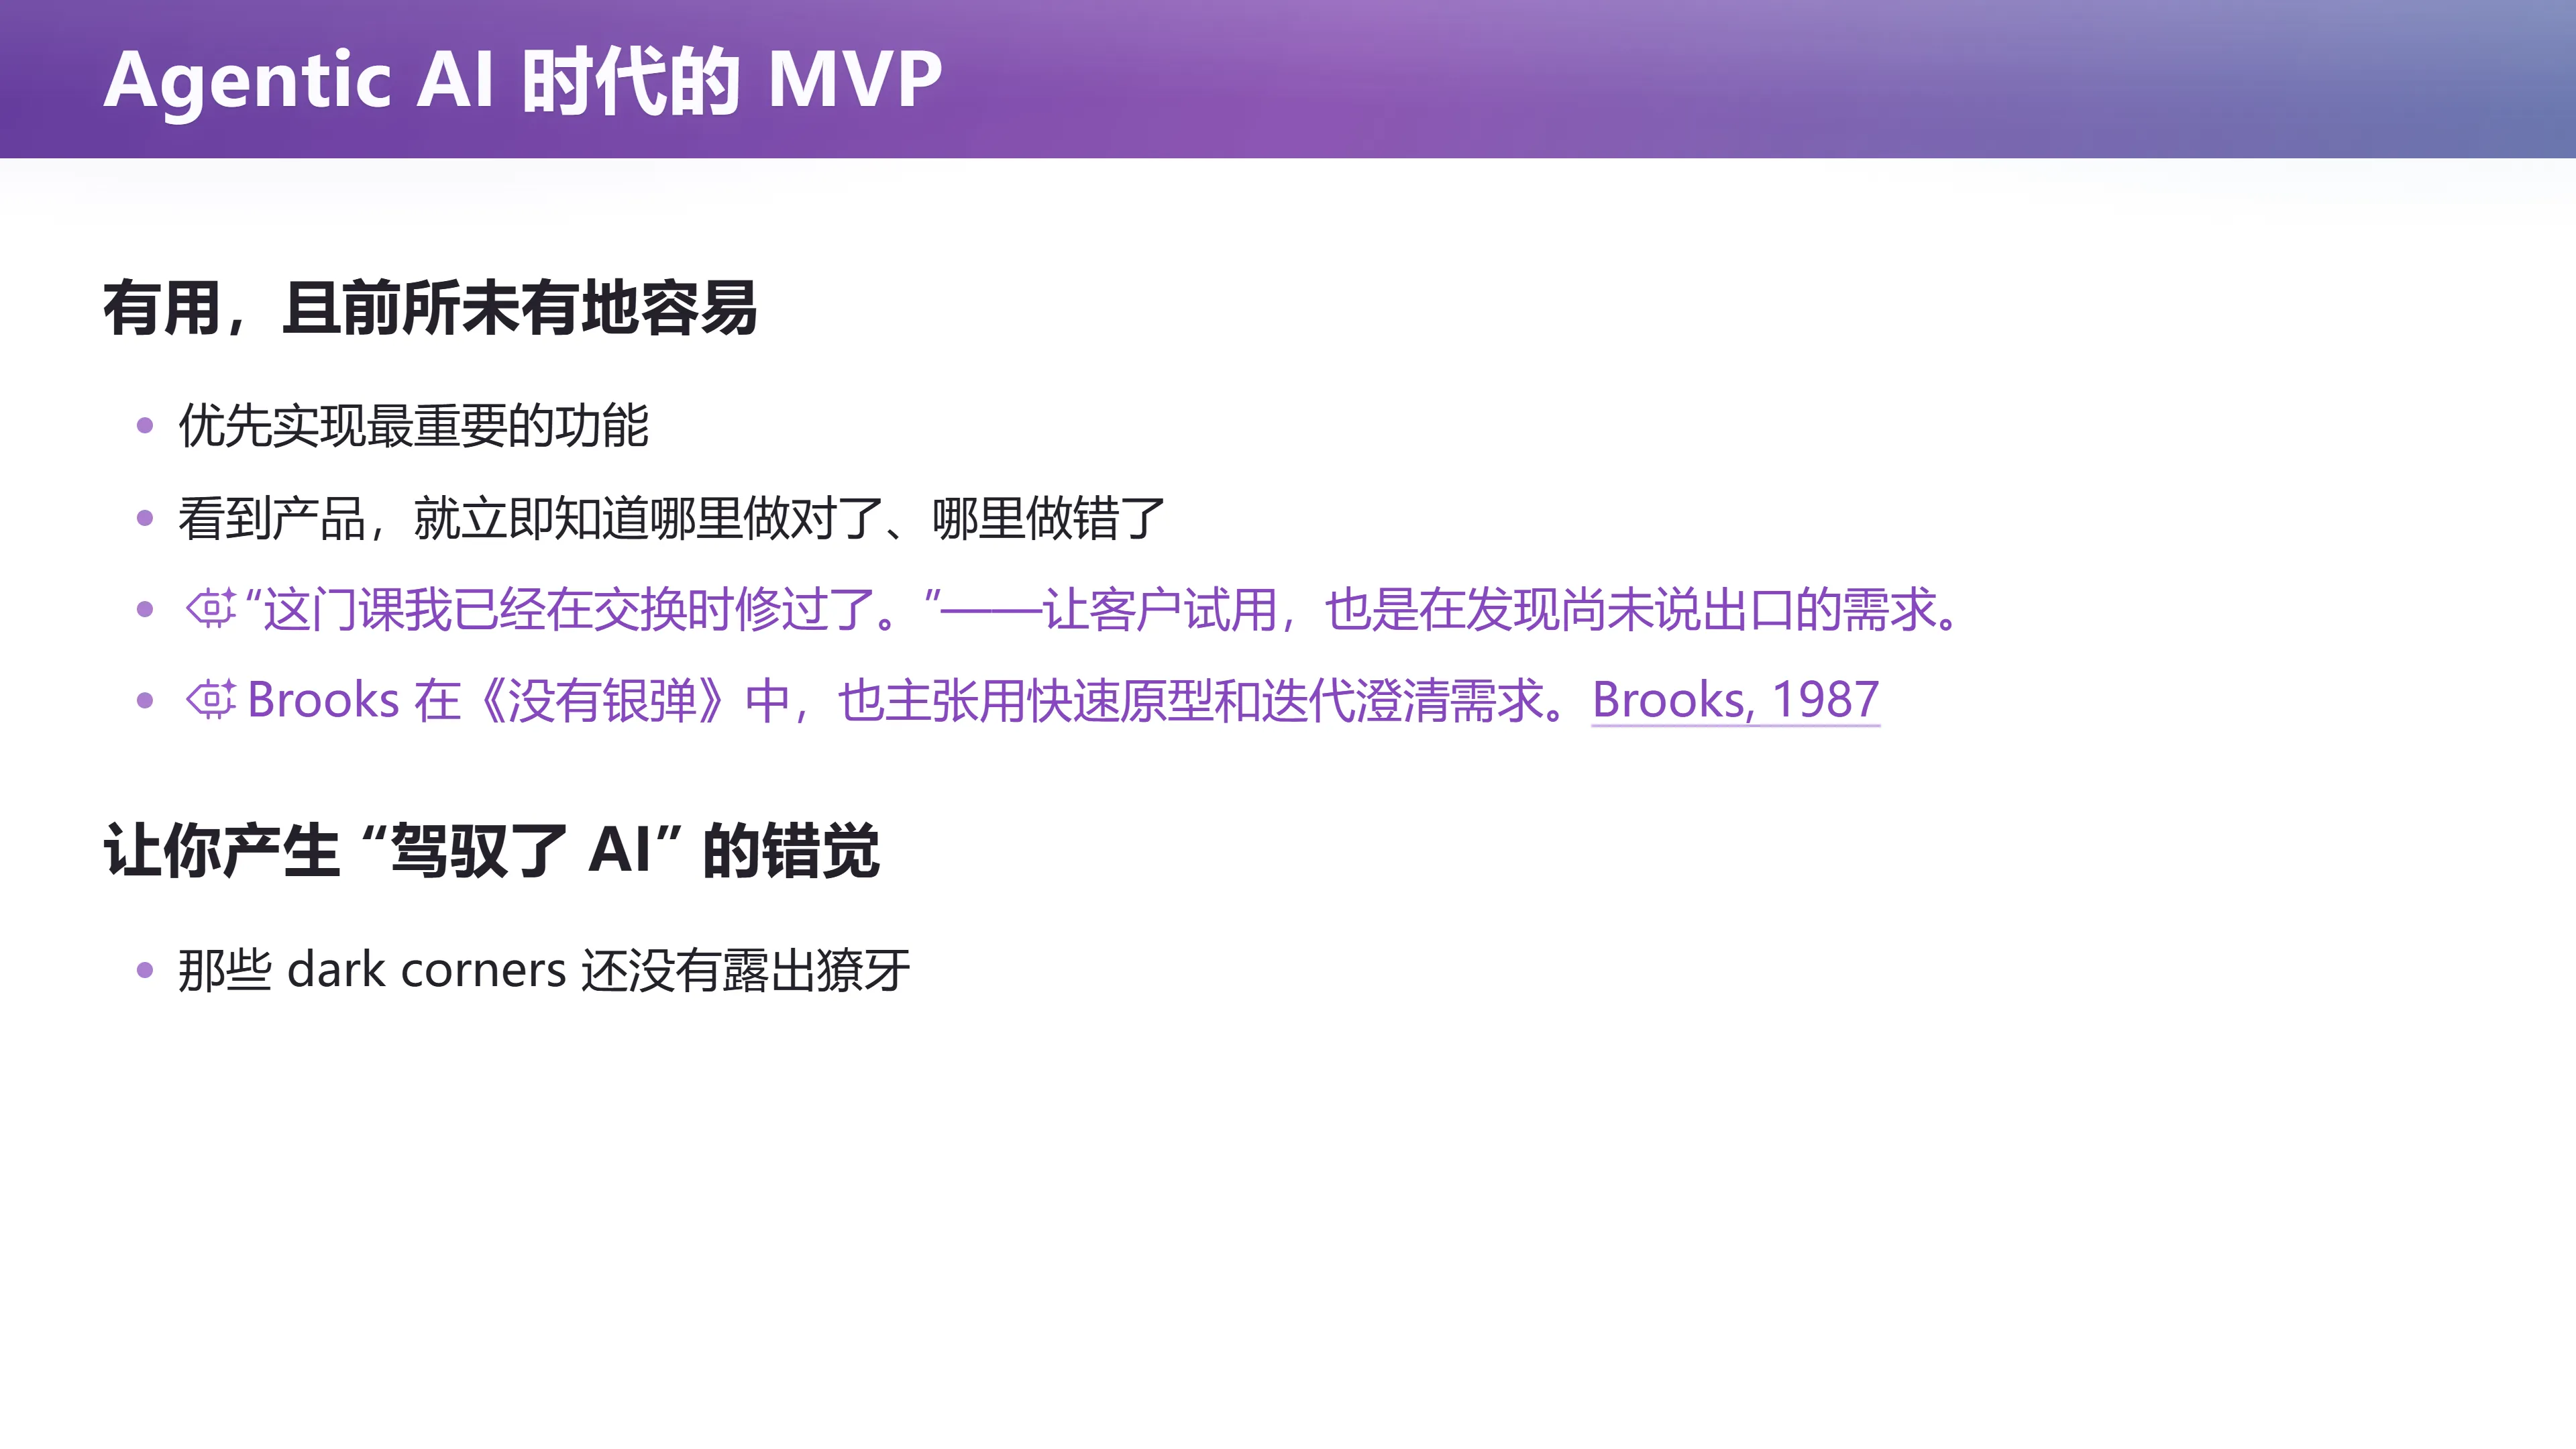
📷 Agentic AI 时代的 MVP:有用,且前所未有地容易
回到原视频 (00:42:48)
MVP 是正确且前所未有地容易的。 优先实现最重要的功能,把一个可操作的产品交给用户,马上就能知道哪里做对了、哪里做错了。看到课表、选课按钮和毕业审核结果,用户立刻就能指出:
"这门课我在交换时已经修过了,为什么系统还要求我再修一次?"
让客户试用,本身就是在帮助我们发现还没说出口的需求。
编者拓展|Brooks 与《没有银弹》 这里呼应的是 Fred Brooks 1987 年的经典论文 No Silver Bullet — Essence and Accident in Software Engineering(可在线获取)。Brooks 把软件开发的困难分为两类: - 本质困难(essence):把复杂的概念结构精确地概念化、表达出来。需求冲突、概念完整性、变更传播,都属于这一类。 - 附属困难(accident):把概念表示翻译成机器可执行的代码。编译、语法、性能调优在很大程度上属于这一类。
他的预言是:十年内,没有任何单一技术(银弹)能让软件生产率提高十倍。今天的 Agentic AI 大幅降低了"附属困难"的成本——这正是它能带来巨大价值的原因;但"本质困难"并没有被消掉,只是被更清晰地暴露出来。
需求变了以后怎么办
(参考时间: 00:43:30)
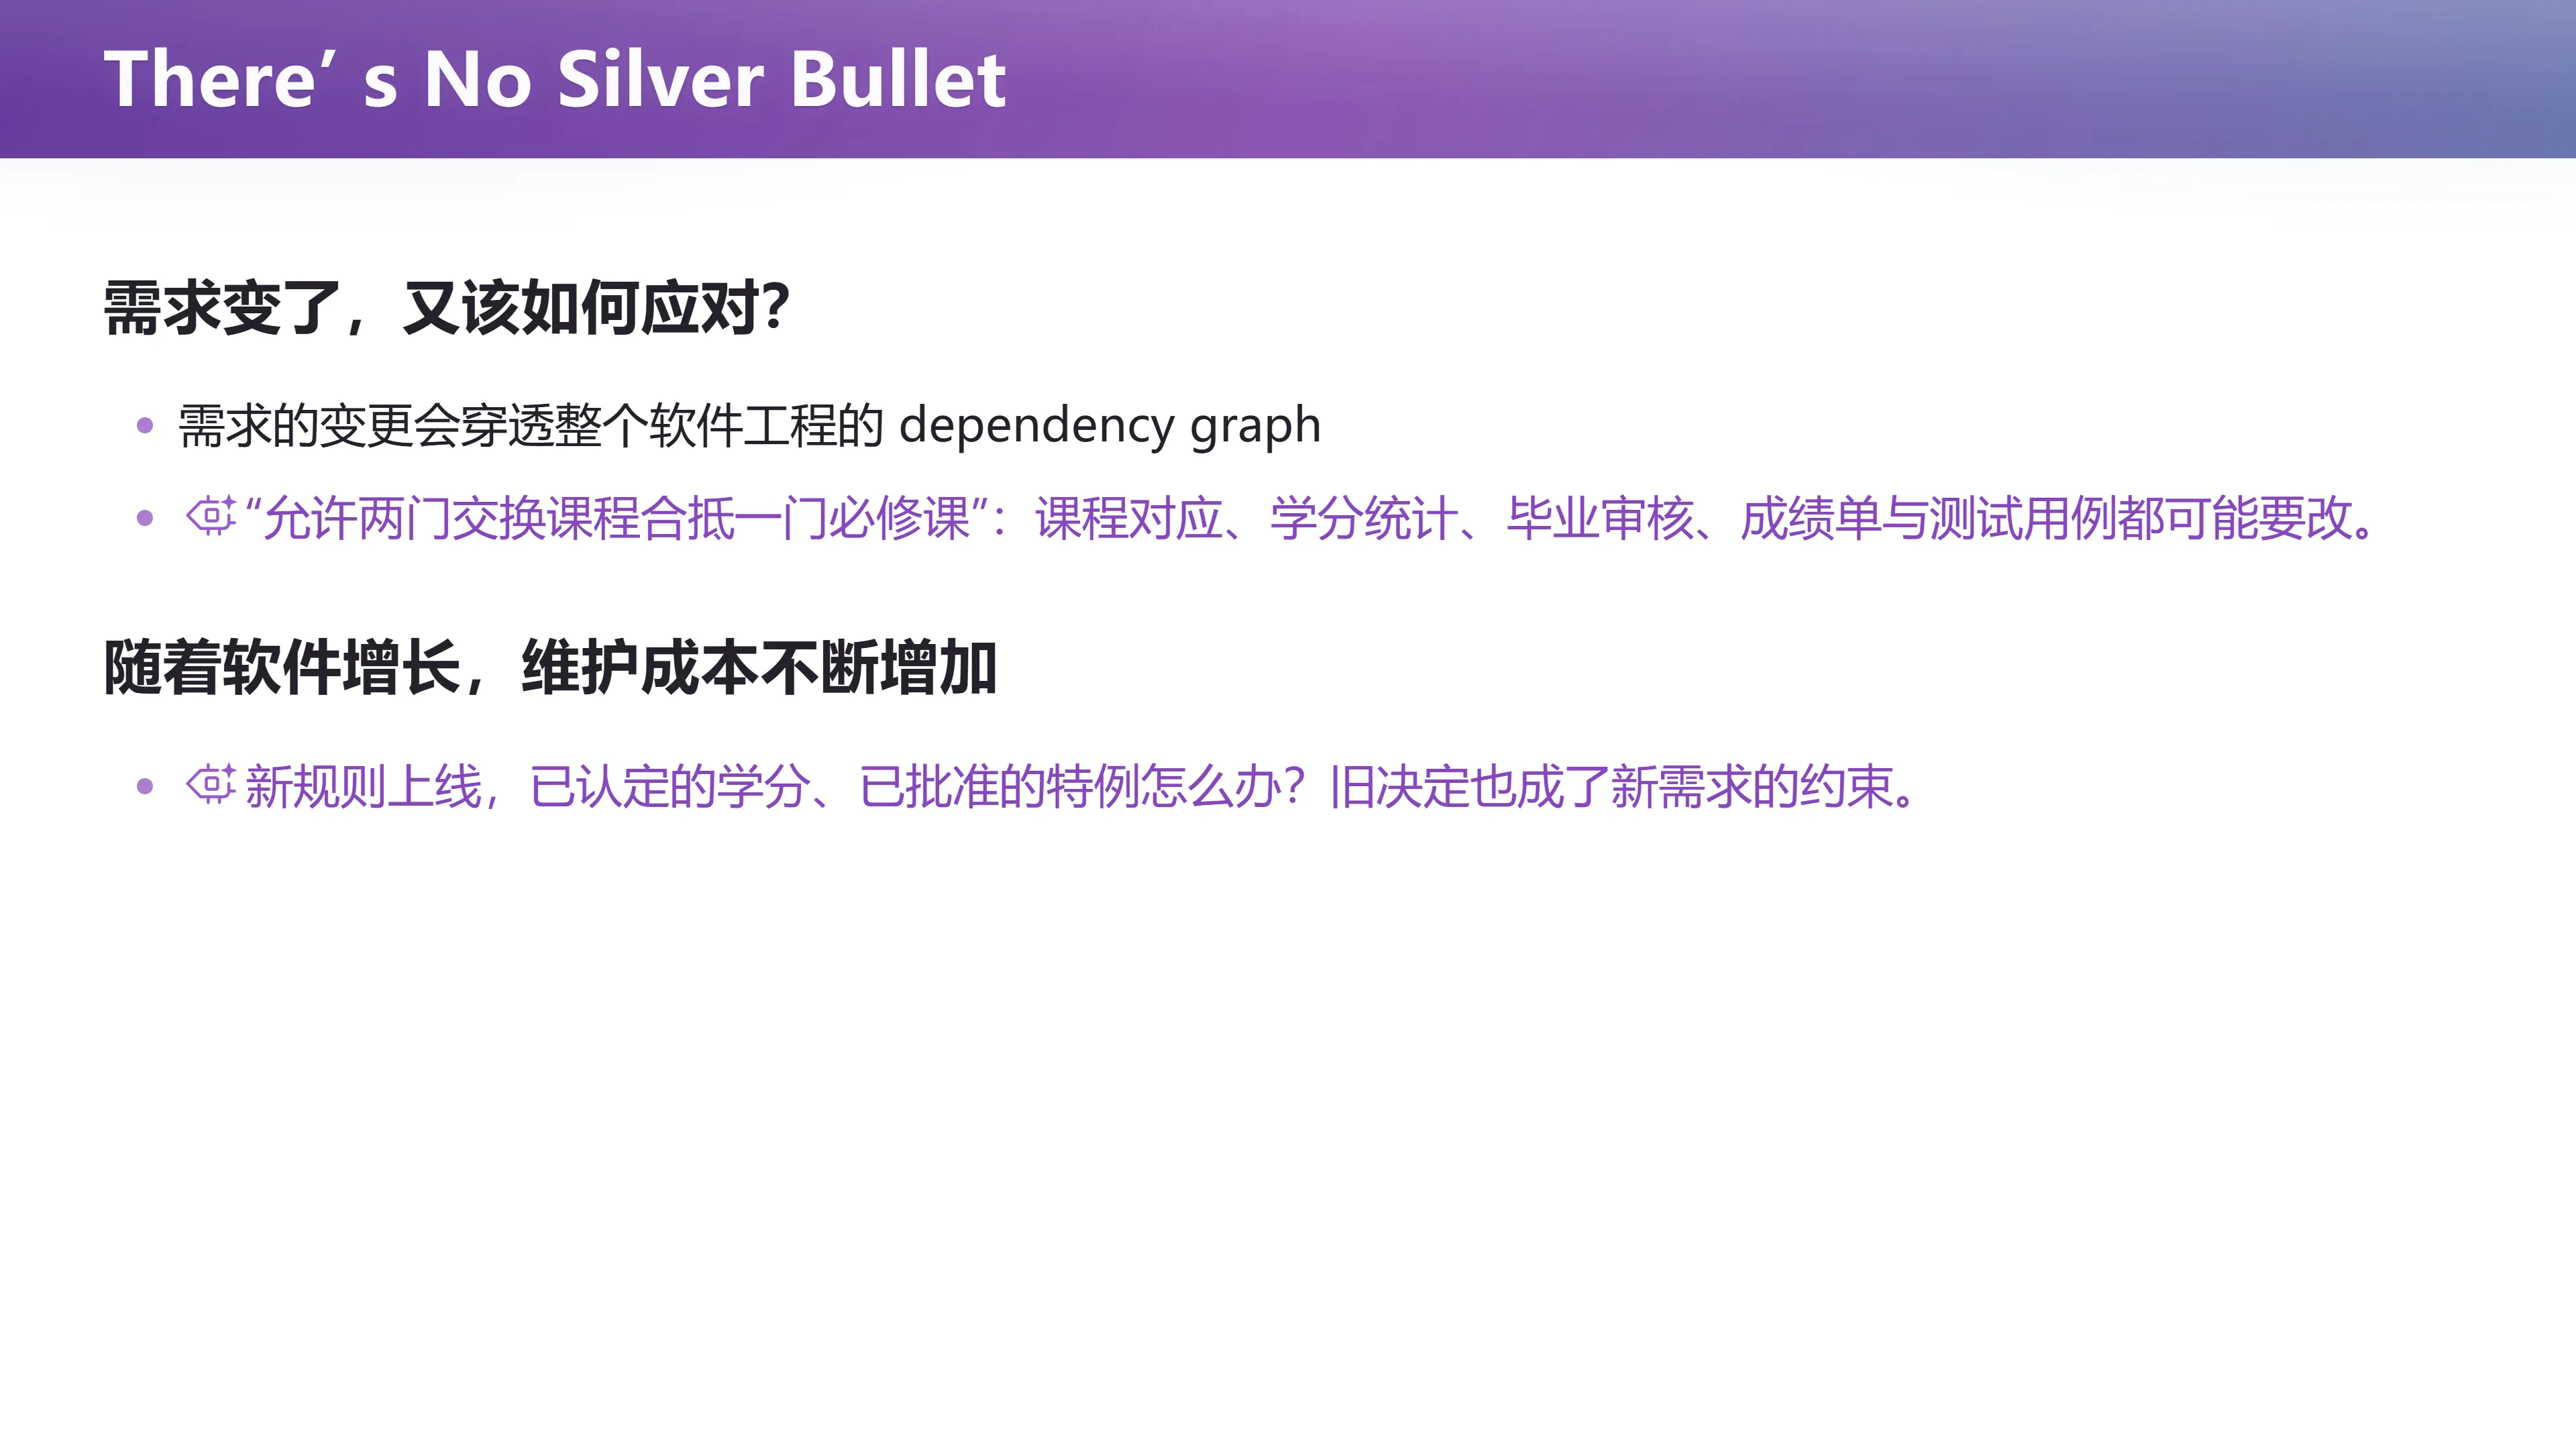
📷 There's No Silver Bullet
回到原视频 (00:43:30)
第一次顺利运行,也容易让人产生"我已经驾驭了 AI"的错觉——因为 AI 确实可以往后修,你迭代三个版本它都能接着改。但一旦系统在真实环境里运行足够长的时间,原来的设计不起作用的时候,你就面临麻烦了。
讲师给了一个具体的需求变更例子:把"一门交换课程替代一门本校课程"改为"允许两门交换课程合抵一门必修课"。受到影响的不只是一个下拉框:
graph TD
    R["需求变更:<br/>两门交换课合抵一门必修课"] --> A["课程对应关系"]
    R --> B["学分计算"]
    R --> C["毕业审核规则"]
    R --> D["成绩单显示"]
    R --> E["相关测试用例"]
    R --> F["已认定学分是否重算?"]
    R --> G["已批准特例是否继续有效?"]
    style R fill:#ffe6cc
上一讲讲过的数据依赖图在这里再次出现:一个结论以另一个结论为前提,需求变化就可能沿着依赖关系穿透整个系统。软件增长得越快,未管理的依赖也可能积累得越快。
银弹是什么
(参考时间: 00:43:37)
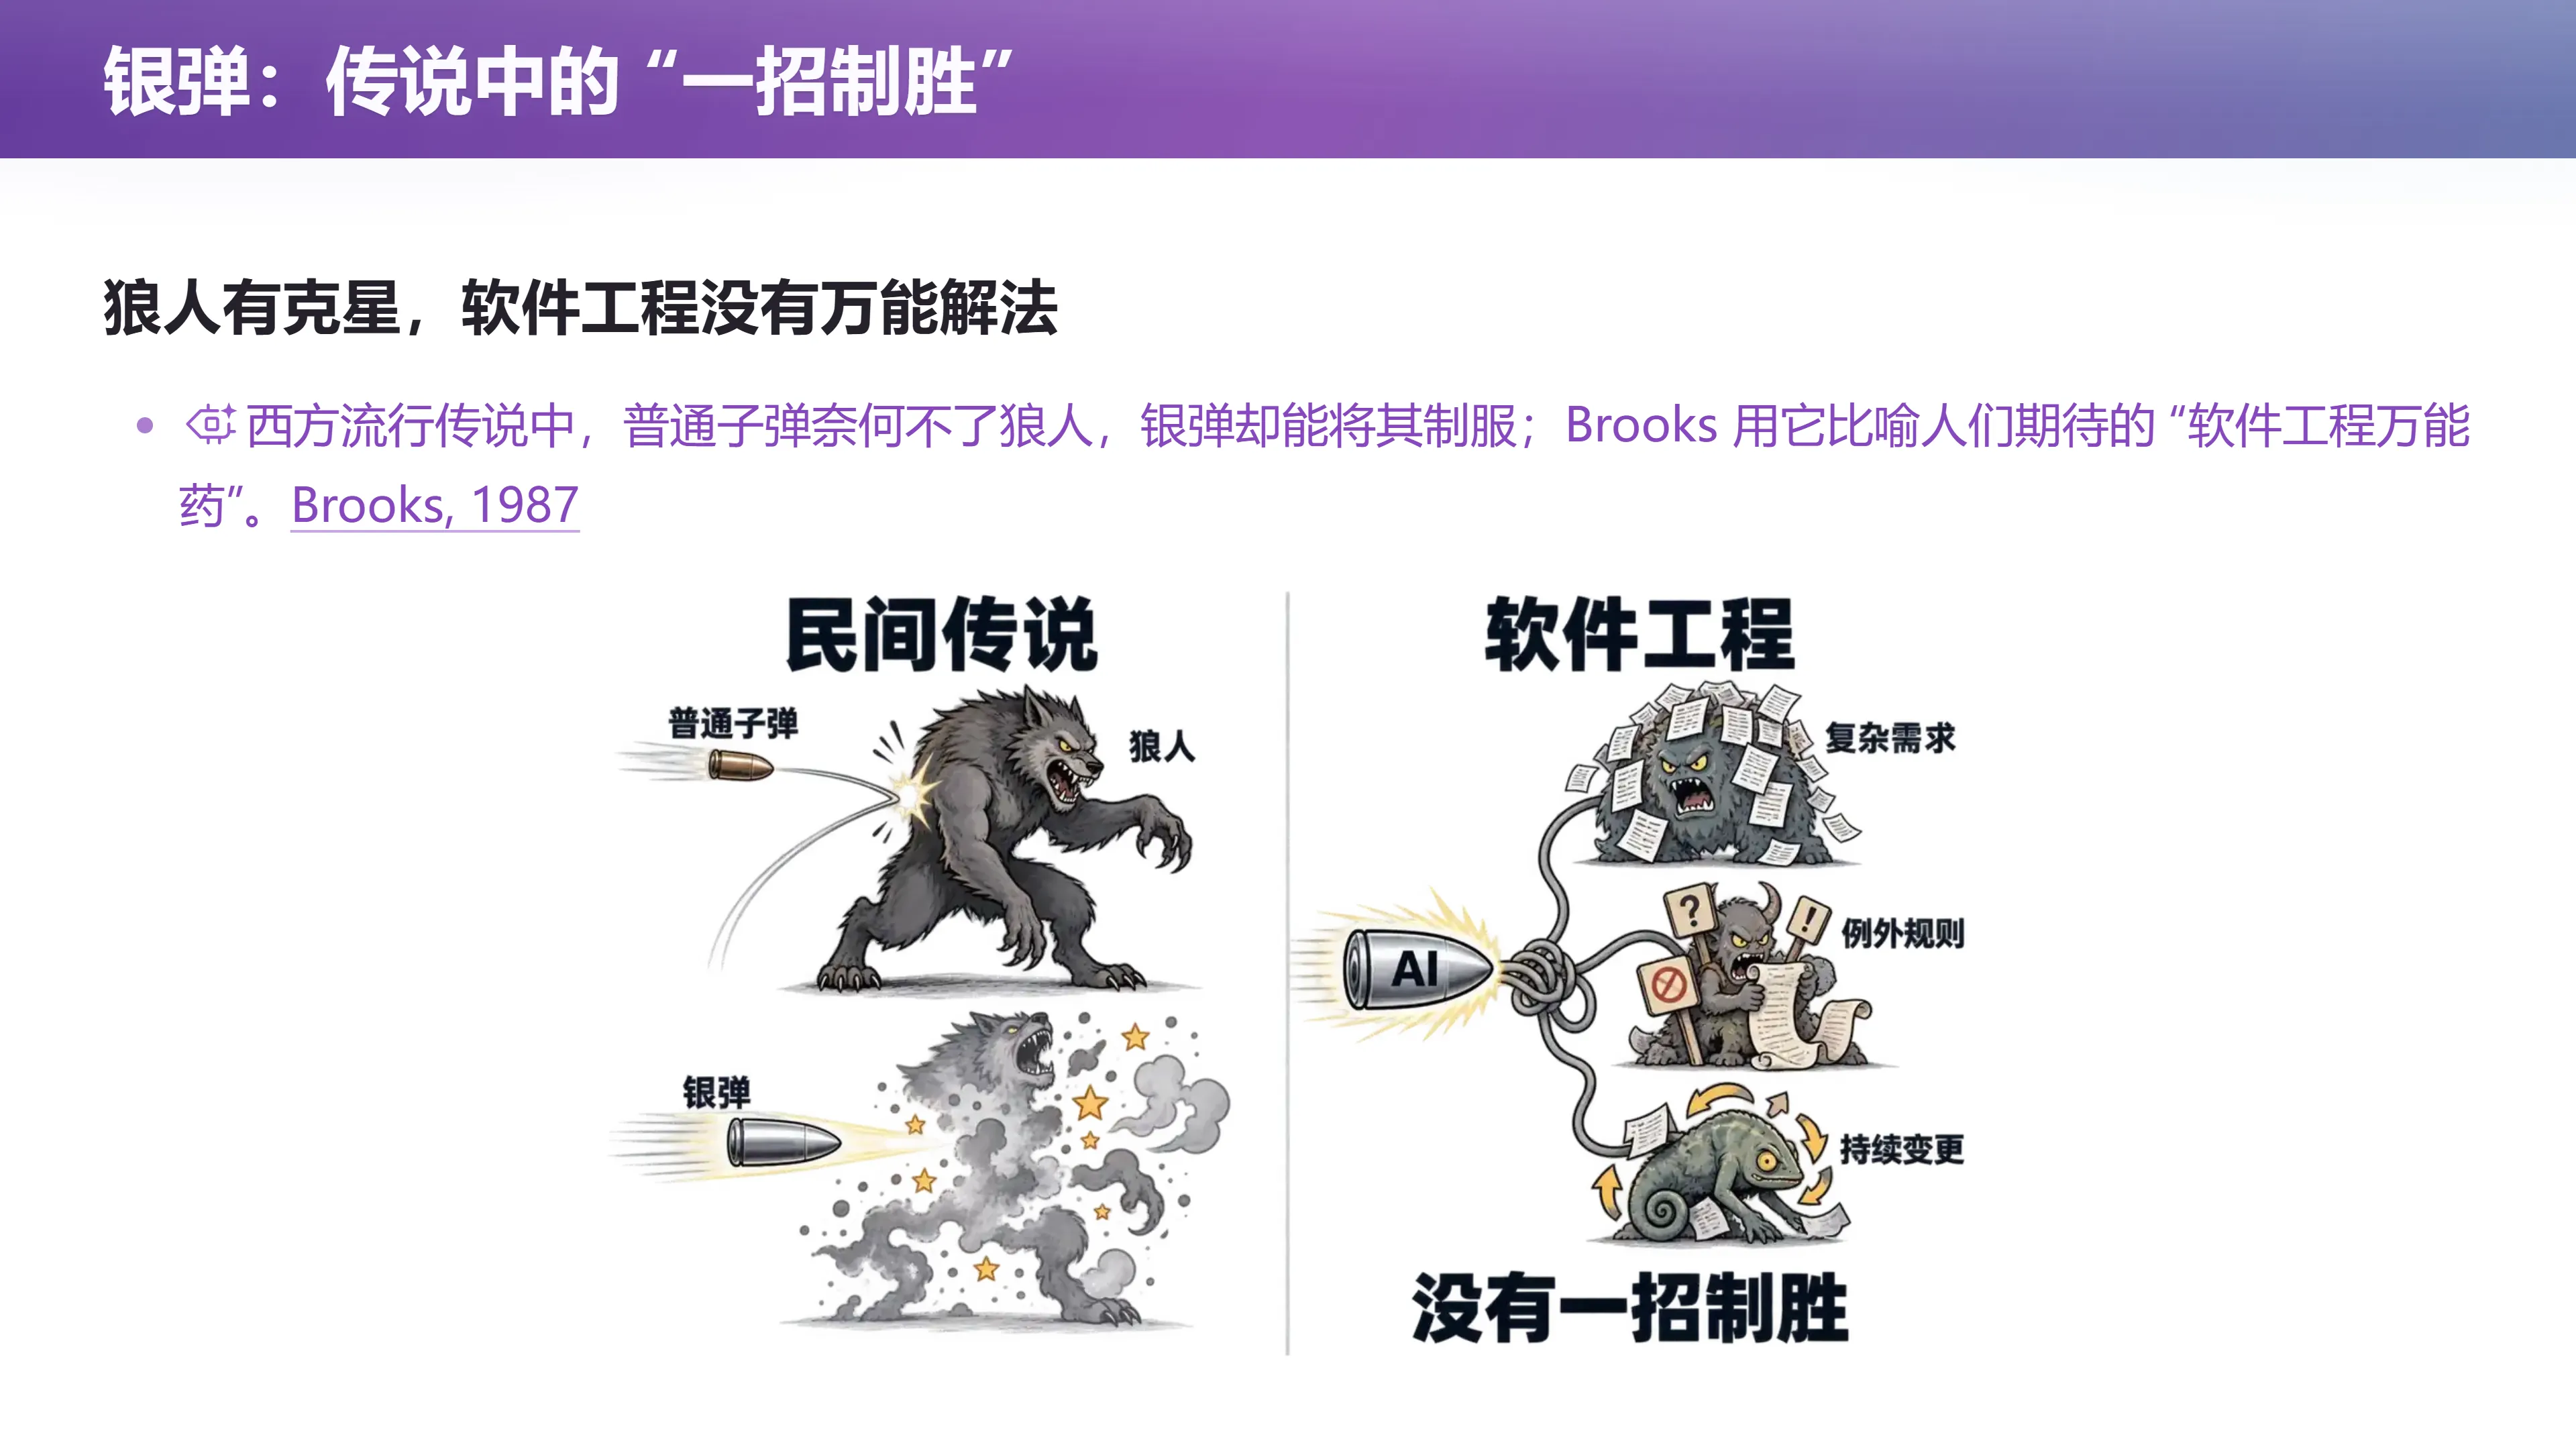
📷 银弹:传说中的"一招制胜"
回到原视频 (00:43:37)
"银弹"(silver bullet)借用了西方民间传说:普通的子弹奈何不了狼人和吸血鬼,只有银制的子弹能制服它们。Brooks 用它比喻人们期待的"软件工程万能药"。
狼人有克星,软件工程没有万能解法。 快速生成原型很有价值,但需求冲突、历史包袱和持续变化,仍然要有人处理。
编者说明:值得一提的是,Brooks 的原文中,被他点名"不是银弹"的技术包括:Ada 等高级语言、面向对象编程、人工智能、专家系统、自动编程、图形化编程、程序验证、环境与工具。四十年后,"自动编程"这一条显得格外值得玩味——它确实改变了成本结构,但需求与架构的困难依然在原地。
架构:从最小的代码开始
(参考时间: 00:44:28)
📷 软件架构:真正决定软件品味和能走多远的决定性因素
回到原视频 (00:44:28)
那解决上面这些问题的方式是什么呢?是架构。
当我们谈到"架构师",脑海里冒出来的往往是:画框图、数据库、微服务、流式数据处理、选哪个应用框架……搭起来就"解决"了这个教务系统的问题。但架构不是玄学,也不必然是这些大词。
架构在本质上就是怎样去控制一个东西的复杂性。 从你第一次开始设计任何代码、任何系统的时候,无论它多小,里面都已经有架构的思维。
四个函数也是架构
(参考时间: 00:45:42)
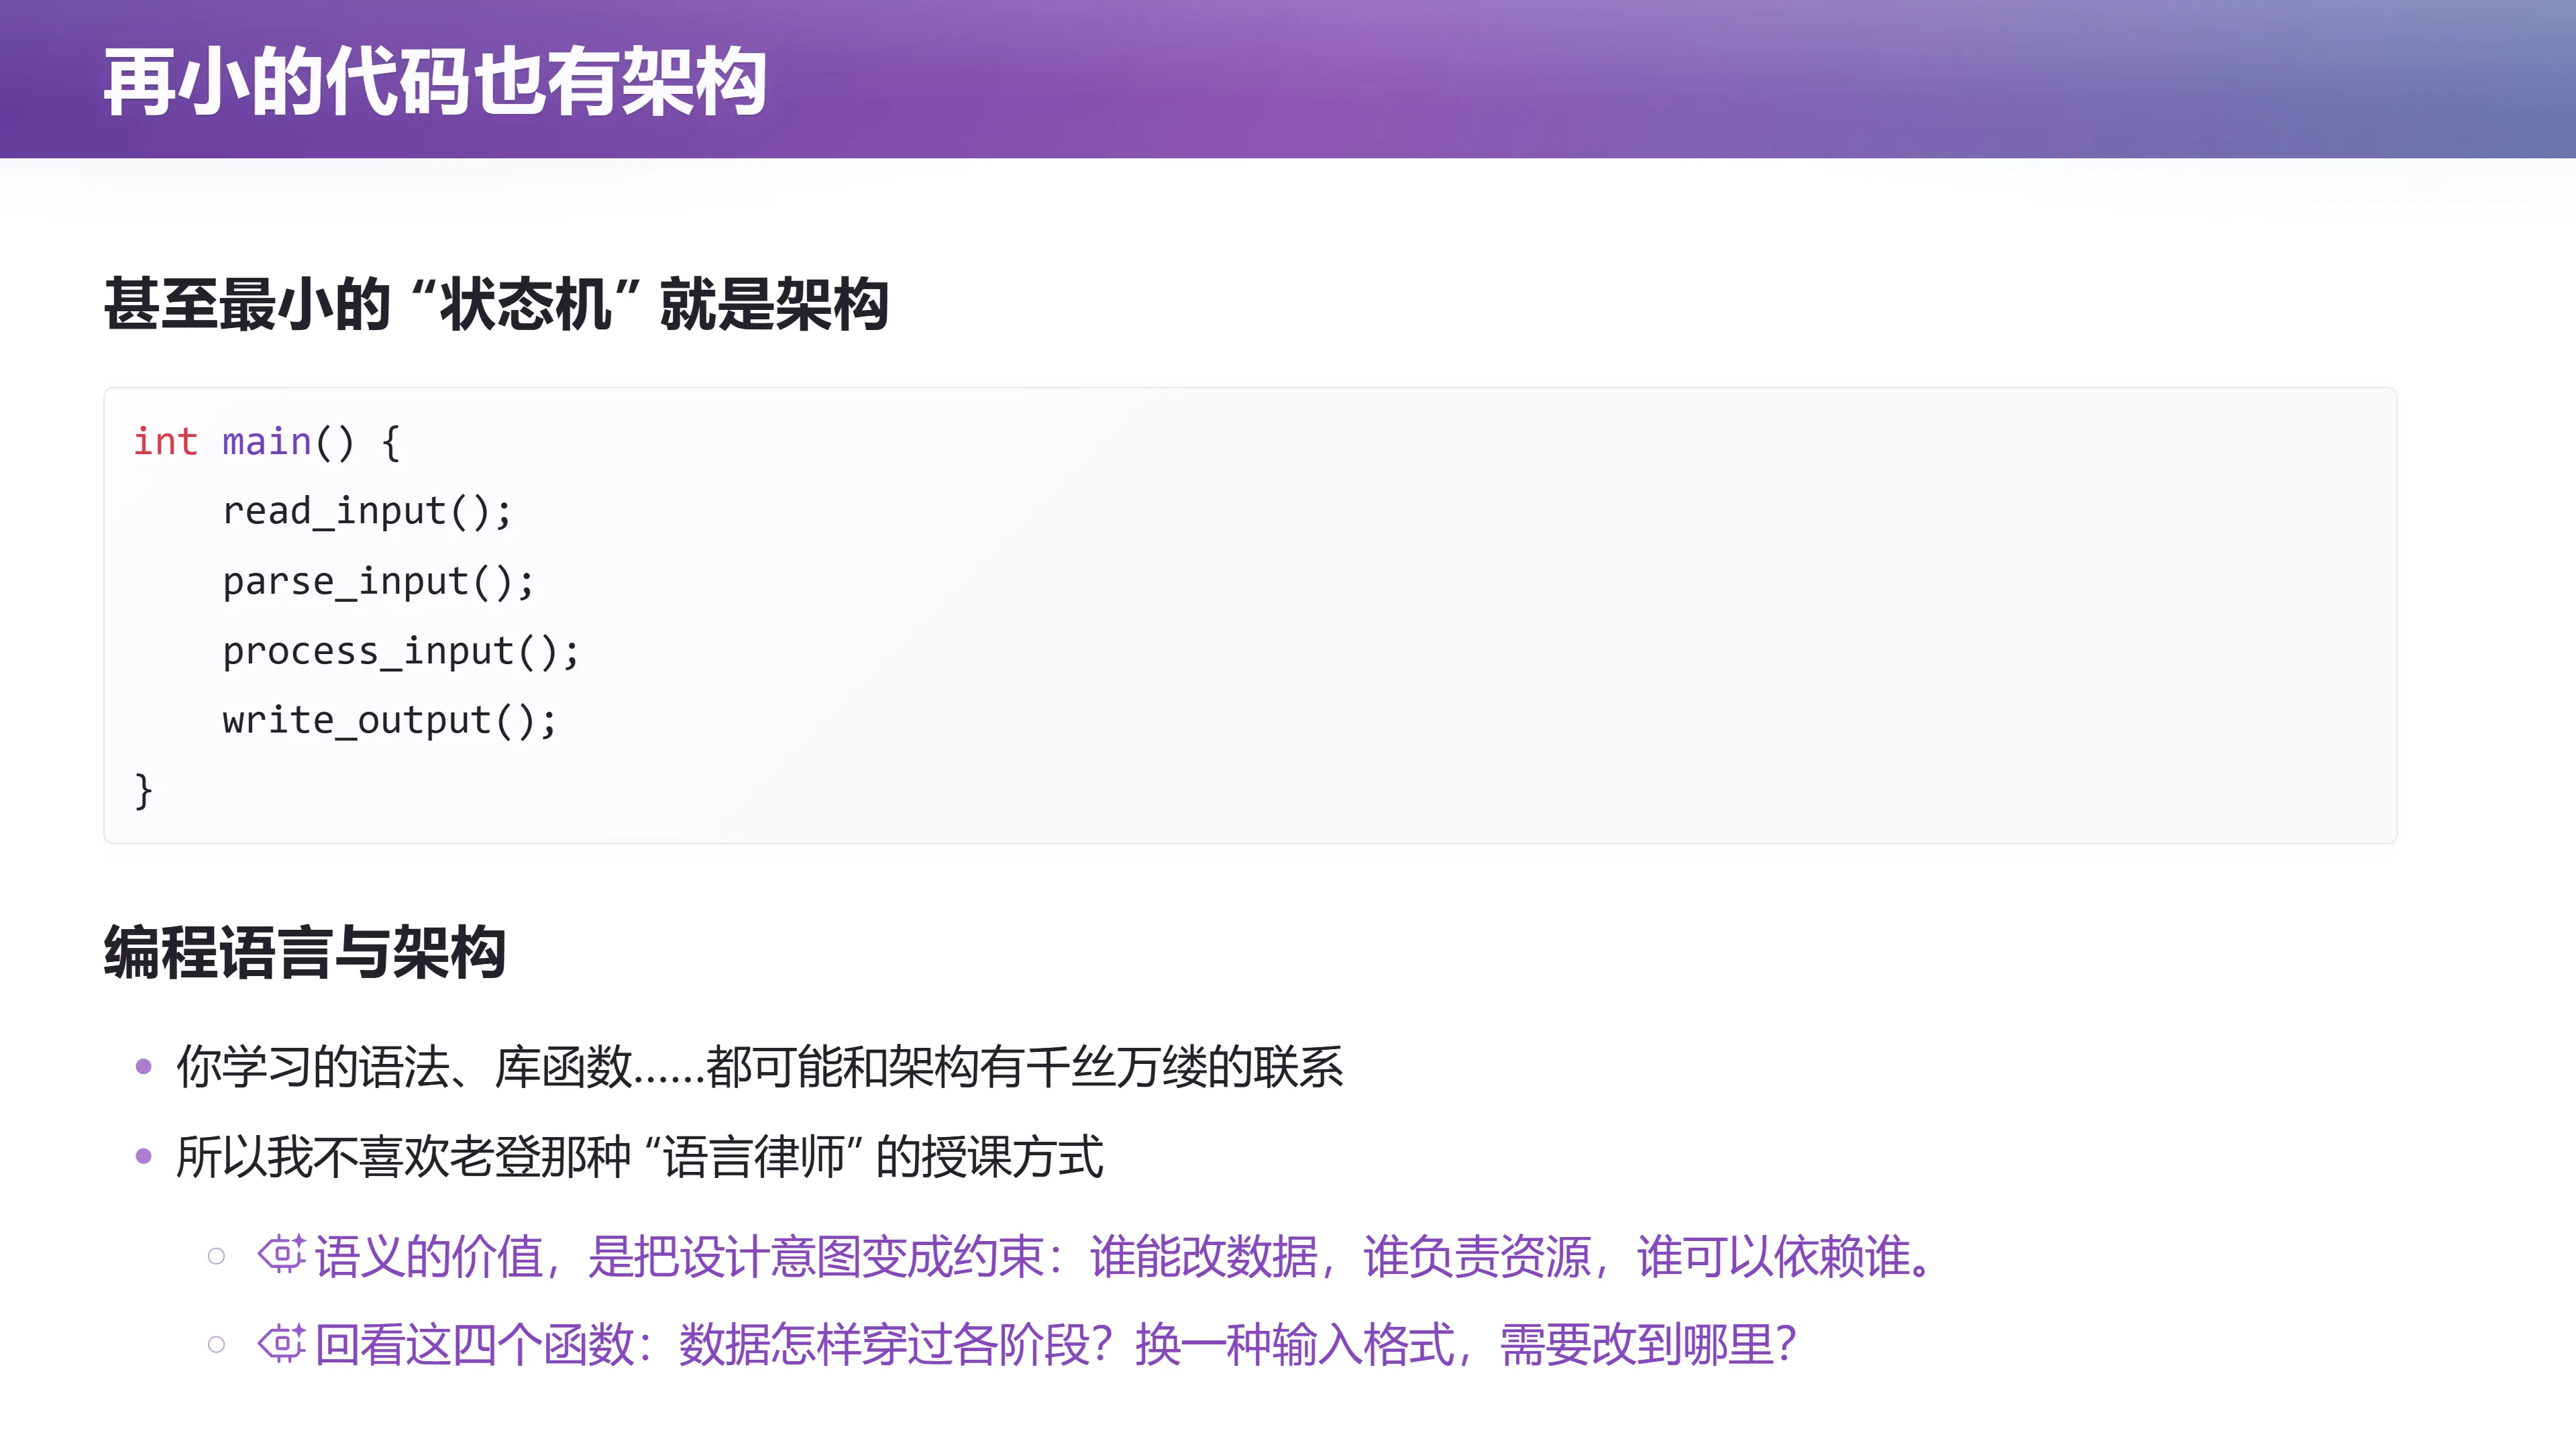
📷 再小的代码也有架构:甚至最小的"状态机"就是架构
回到原视频 (00:45:42)
不必等到有数据库、微服务和流式数据处理,才开始谈架构。讲师举了一个最小的例子:
int main() {
    read_input();
    parse_input();
    process_input();
    write_output();
}
一个小程序也可以先读取输入,再解析、处理,最后输出。这几个阶段一旦成为明确的边界,我们就有机会分别考虑:
- 换一种输入格式,需要改到哪里?
- 核心算法是否必须知道结果最终写到终端还是文件?
- 错误应该由谁处理?
graph LR
    IN["输入"] --> R["read_input()"]
    R --> P["parse_input()"]
    P --> PR["process_input()"]
    PR --> W["write_output()"]
    R -.->|"换输入格式<br/>只改这里"| R
    W -.->|"换输出目标<br/>只改这里"| W
当然,把代码切成四个函数,还不能保证边界真的存在。如果它们随意修改同一批全局变量,每一步都依赖其他步骤的内部细节,变化仍然会四处传播。架构的价值要落实到:数据怎样流动、谁拥有状态、谁可以依赖谁。
编者拓展|Parnas 1972 与信息隐藏 幻灯片引用的是 David Parnas 1972 年的论文 On the Criteria To Be Used in Decomposing Systems into Modules(原文)。它提出了一个当时反直觉的观点:模块不应该按照"处理流程的步骤"来划分(比如上面的 read / parse / process / write),而应该按照"可能变化的设计决定"来划分,并把每个决定隐藏在模块接口之后。
这个想法的威力在于:当那个决定真的变了(输入格式变了、存储引擎换了、组织改名了),变化只需要落在一个模块里,而不是沿着流程穿透所有步骤。本讲后半段所有内容——IR 的模块划分、事件溯源、DDD 的限界上下文——本质上都是这一条准则的不同实现。Parnas 的论文因此常被视为"软件架构"作为独立学科的起点。
从 argc/argv 到 getopt:一个解析架构
(参考时间: 00:46:42)
讲师又举了一个几乎每个同学都写过的例子:命令行的 main(argc, argv)。
int main(int argc, char **argv) { ... }
这是操作系统和进程之间的约定:操作系统把参数以字符串数组的形式传过来。那你们怎么处理参数呢?第一反应是 strcmp 吗?
"你想想,如果你今天在保研面试现场,题目要求你处理这个
argv,你会strcmp吗?然后你就会想起,这个世界上有一个东西叫 getopt。"
getopt 就是一个架构:它把argv 解析这个复杂问题隔开。argv 的形态本身非常复杂——有 -h、--help、-o file、--output=file 各种组合,还可能混排。这套约定背后有 POSIX 标准(POSIX 规范)作为依据。有了它,你在业务代码里只需要写一个 while 循环加一个 switch-case:
int opt;
while ((opt = getopt(argc, argv, "hv:f:")) != -1) {
    switch (opt) {
        case 'h': usage(); break;
        case 'v': verbose = atoi(optarg); break;
        case 'f': filename = optarg; break;
        default:  usage(); return 1;
    }
}
编者说明:
getopt把"解析后的选项"作为一类新的状态暴露给业务逻辑(一种parsed state),业务逻辑只依赖opt、optarg这些稳定的量,而不依赖"参数字符串当时长什么样"。这就是信息隐藏在最小尺度上的样子,也是讲师接下来所有例子的共同模式。现代 C++ 里对应的库是CLI11、cxxopts等,但思想完全一致。
你以为自己只是学了个库函数,其实学到了一种 parser 的架构模式。在你看到的任何一个好的、符合 best practice 的代码里,背后都有架构设计,而背后都映射到需求。需求不是一个只在"做一个大系统"时才存在的东西;在任何一个模块里,你都可以谈需求、谈架构、谈优雅。
讲师借此表达了对某种教学方式的不满:"我很讨厌那种'语言律师'式的授课方式。曾经我和学院的老教师有过比较大的分歧。比如我说我们要讲 C++ 11/14/17 里的一些特性以及它们该怎么用,老教师的回应是'我讲了呀,我怎么没讲呢'——他讲什么?他讲
auto f = [](int a, int b) { return a + b; };,没了。这讲了和没讲有什么区别? 你在学习的时候看到的每一个东西——GitHub 上一个好项目的 README、一个getopt——再往后想一想:诶,这确实是一种模式,这种把复杂字符串变成简单解析状态的模式,就是一种抵抗需求变化的方式。"
十行汉诺塔:同一个问题的四种表达
(参考时间: 00:50:51)
📷 10 行的架构例子:架构关乎你对需求"掌控到什么程度"
回到原视频 (00:50:51)
现在把规模放大一点,看一个"十行代码"的架构例子:非递归汉诺塔。
讲师说,他刚开始上课的时候问过自己的研究生:"让你写个非递归的汉诺塔,你能写出来吗?"研究生摇头。于是这就变成了上课时的一个例子。
汉诺塔问题本身很简单:把一叠盘子从 A 柱移动到 C 柱,借助 B 柱,每次只能移动最上面一个盘子,而且大盘不能压在小盘上。
递归解法非常自然:先搬走上面的 $n-1$ 个盘子,再搬最大的盘子,最后把那 $n-1$ 个盘子搬回来。
def hanoi(n, src, dst, aux):
    if n == 1:
        print(f"{src} -> {dst}")
    else:
        hanoi(n - 1, src, aux, dst)
        hanoi(1, src, dst, aux)
        hanoi(n - 1, aux, dst, src)
但要求"不使用递归"时,很多人却突然不知道该怎么写了。讲师说:你们写不出来,是因为对"递归"这件事理解得不够深。 同一道题,换一种表示,难度就可能改变。
编者拓展|为什么"换表示"能改变难度 幻灯片引用的是 Zhang & Norman 1994 年的实验 Representations in Distributed Cognitive Tasks(原文)。他们用"汉诺塔同构变体"(如"传教士与食人族""茶杯与托盘")做实验:规则完全相同、只是表面表示不同的问题,人们的解题难度和错误率显著不同。
结论是:人的推理能力依赖外部表示作为认知资源。一个"好表示"会把约束直接"长在"结构里(例如把盘号直接编码在步号里),而一个"坏表示"要求解题者在心里反复模拟。这就是后面三个 AI 答案与讲师答案之间差异的真正来源——它们并不是"代码风格"的差异,而是把复杂性放在哪里的差异。
第一种看法:数学规律
(参考时间: 00:52:01)
📷 GPT-6:数学规律
回到原视频 (00:52:01)
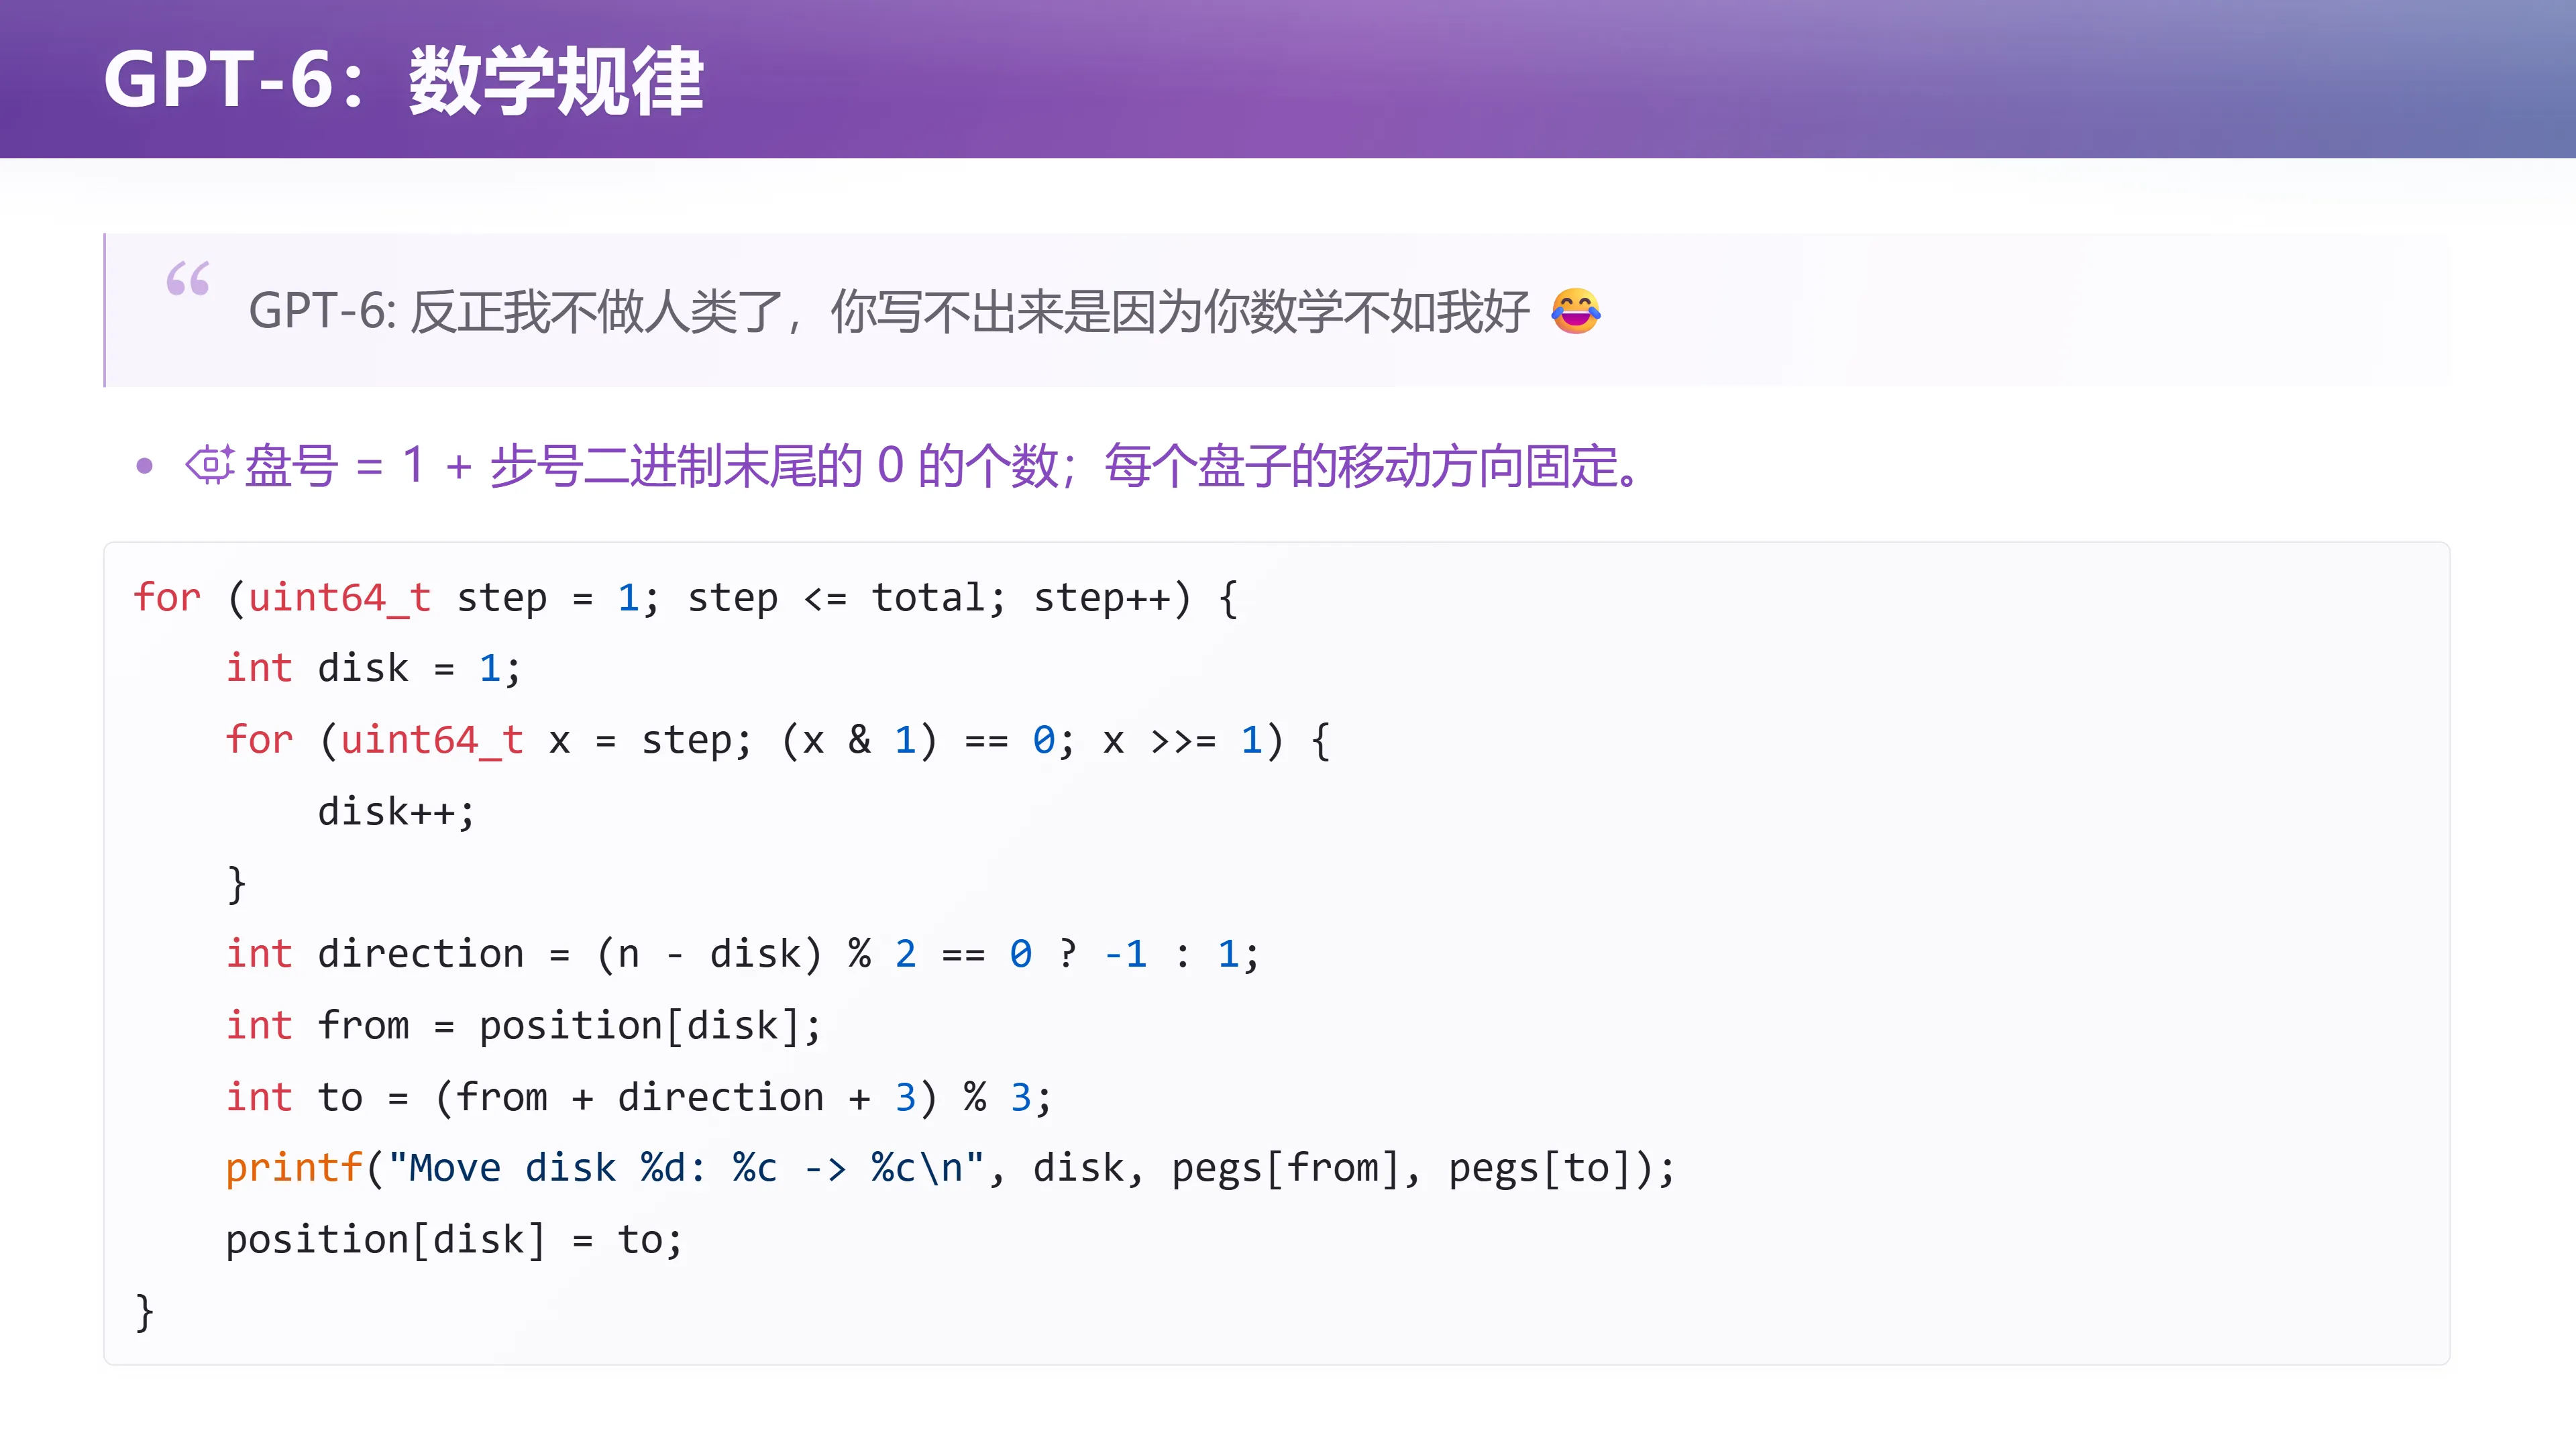
讲师让模型来做这道题。GPT-6 的选择是:直接找出移动序列的数学性质。
"GPT-6 说:反正我不做人类了,你写不出来是因为你数学不如我好。😂"
它的结论是:
- 第
step步移动的盘号 =step的二进制表示末尾连续零的个数加一。 - 每个盘子沿 A、B、C 构成的环移动,方向固定,由总盘数和盘号的奇偶关系决定。
用中文验证一下:三层汉诺塔的步号从 1 到 7,对应盘号恰好是 $1, 2, 1, 3, 1, 2, 1$。而 $1, 2, 4$ 的二进制末尾零个数分别是 $0, 1, 2$,加一就是 $1, 2, 3$;$3, 5, 6, 7$ 的二进制末尾零个数都是 $0$,加一就是 $1$。完全吻合。
for (uint64_t step = 1; step <= total; step++) {
    int disk = 1;
    for (uint64_t x = step; (x & 1) == 0; x >>= 1) {
        disk++;
    }
    int direction = (n - disk) % 2 == 0 ? -1 : 1;
    int from = position[disk];
    int to = (from + direction + 3) % 3;
    printf("Move disk %d: %c -> %c\n", disk, pegs[from], pegs[to]);
    position[disk] = to;
}
讲师点评:你看不明白,但 highly optimized,极度最优。 这段程序之所以短,是因为对问题的理解已经承担了原来需要代码处理的复杂性。代价则是必须解释和验证这些规律;若游戏规则变了,原来的数学结构未必还能使用。短代码也没有消除指数级的移动次数。
第二种看法:任务栈
(参考时间: 00:52:54)
📷 DeepSeek:任务栈
回到原视频 (00:52:54)
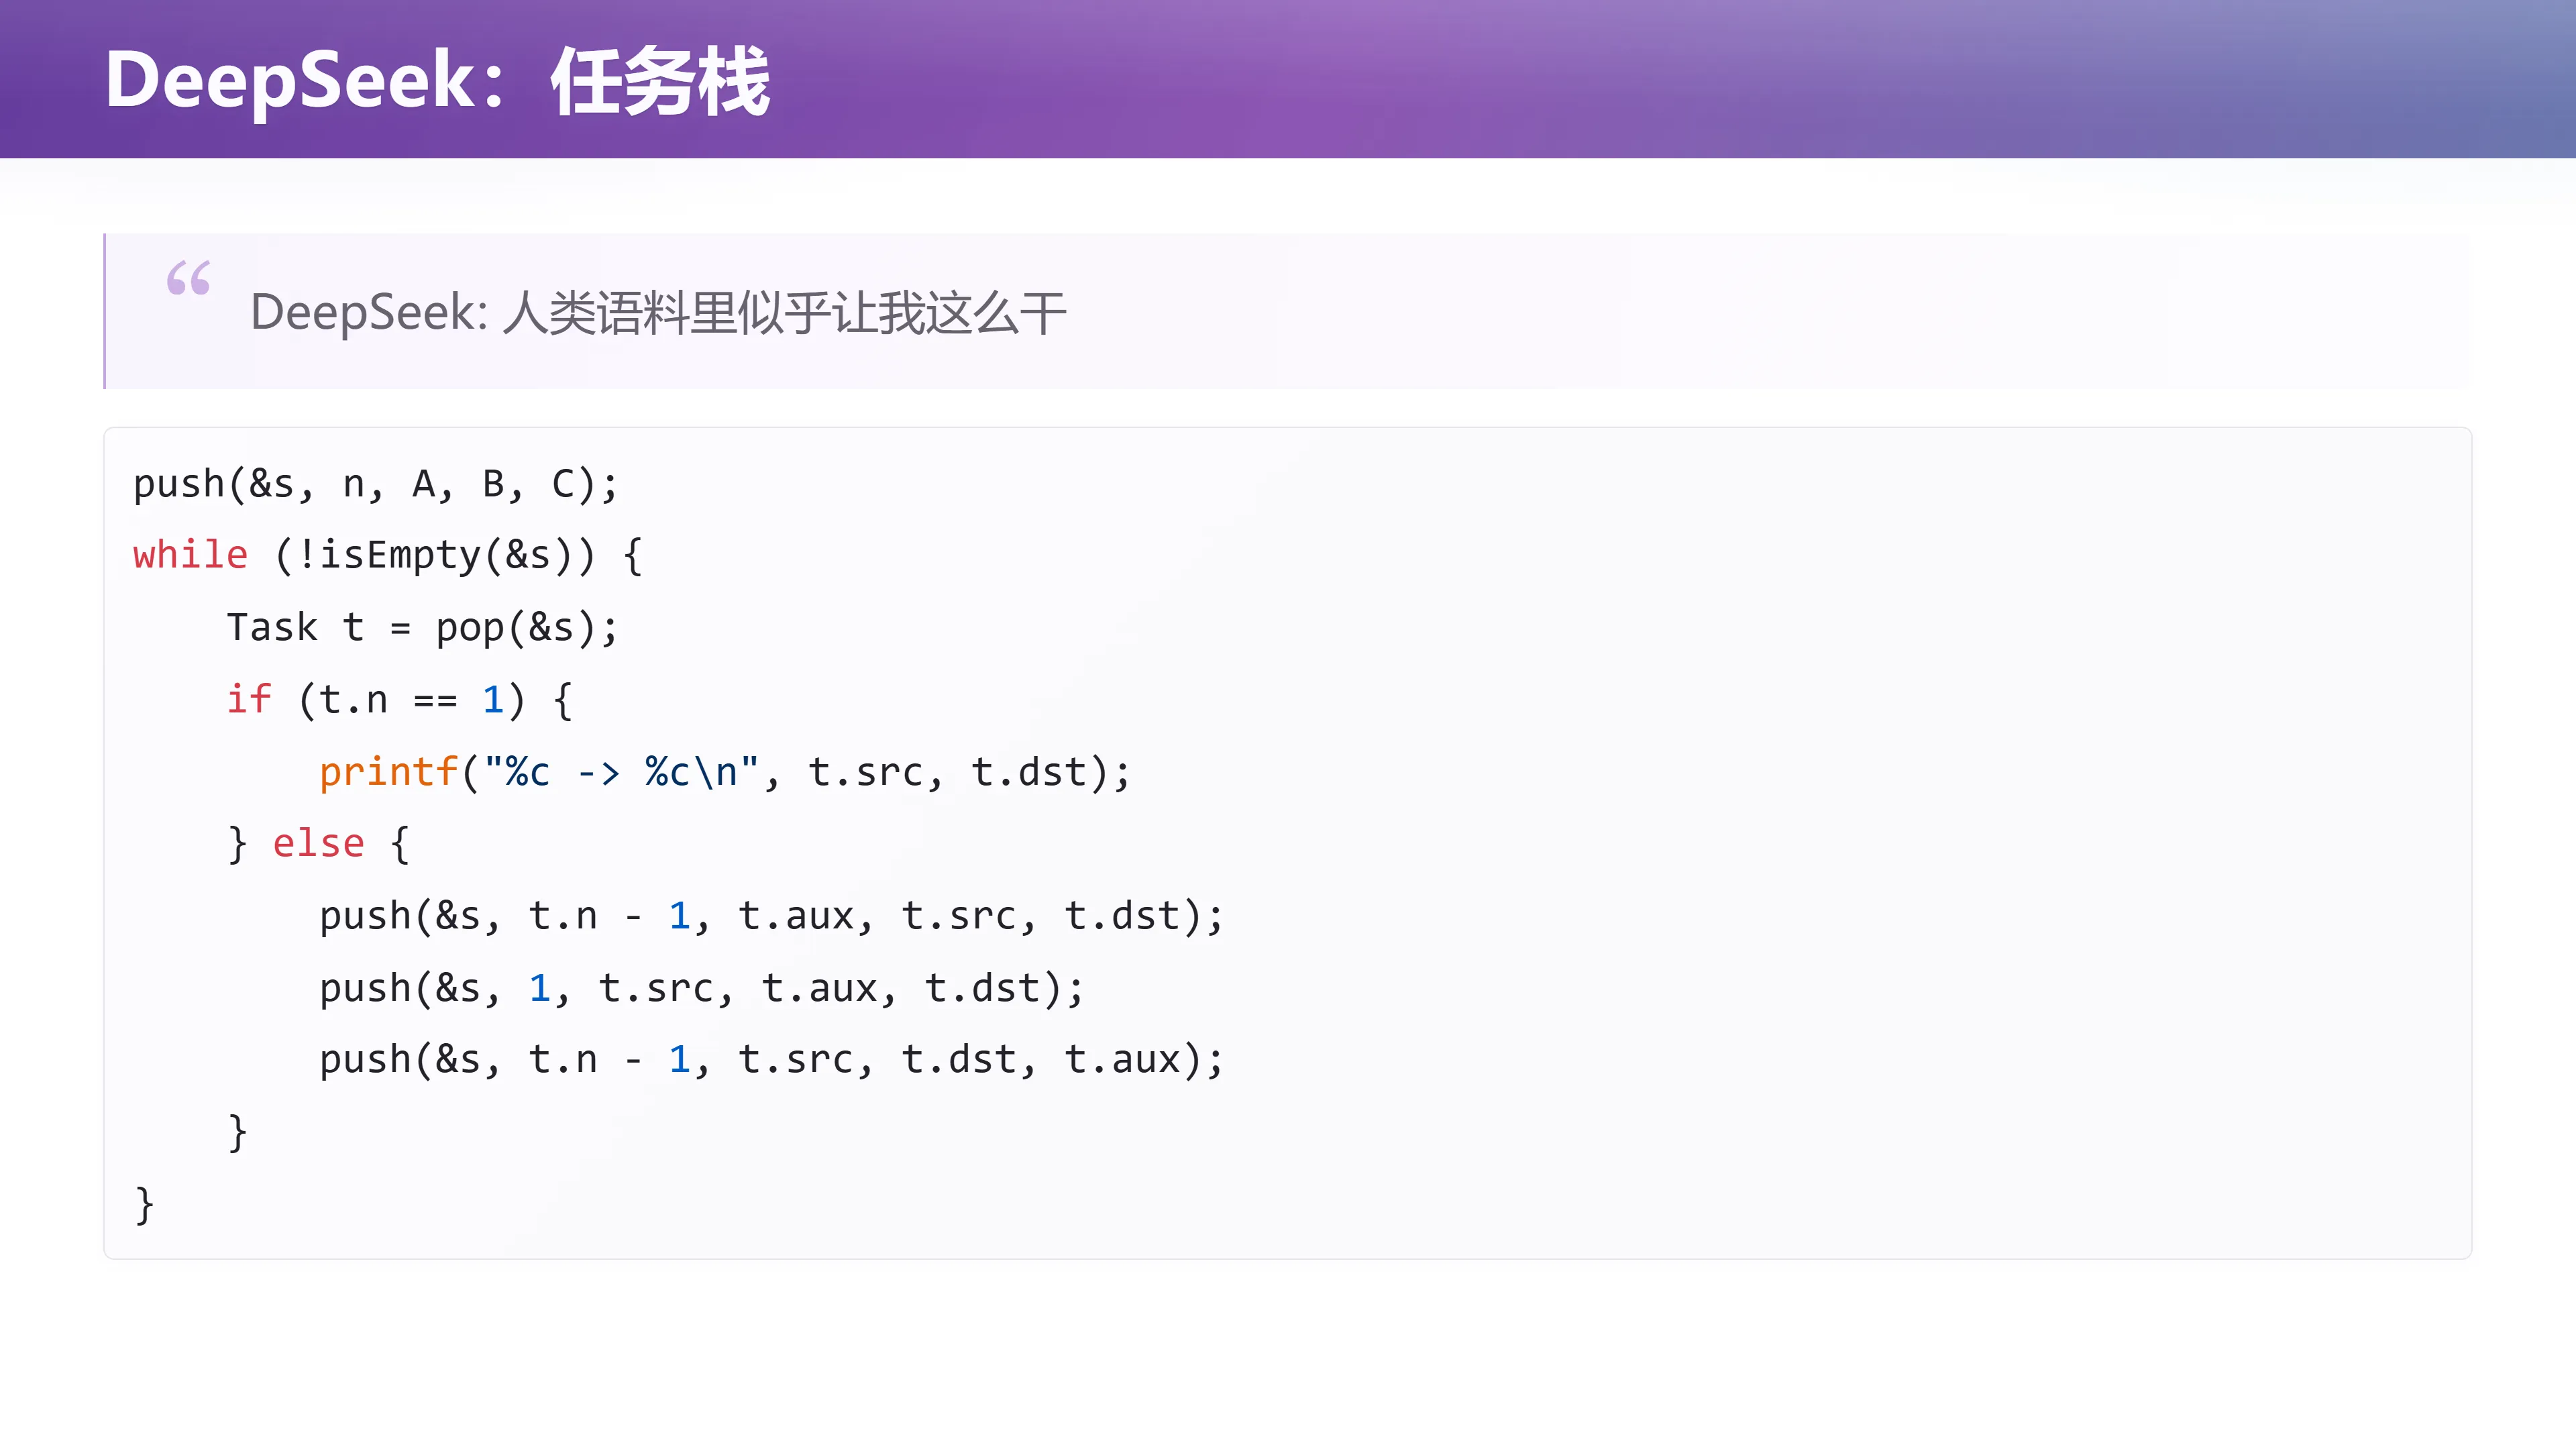
DeepSeek V4 Flash 走的是另一条路,而且"更有人感":
"人类语料里似乎让我这么干。"
它写的是一份非常优雅、几乎可以看作标准答案的代码——把"还没做完的任务"用栈存起来。一个任务记录盘数、起点、终点和辅助柱。
push(&s, n, A, B, C);
while (!isEmpty(&s)) {
    Task t = pop(&s);
    if (t.n == 1) {
        printf("%c -> %c\n", t.src, t.dst);
    } else {
        push(&s, t.n - 1, t.aux, t.src, t.dst);
        push(&s, 1, t.src, t.aux, t.dst);
        push(&s, t.n - 1, t.src, t.dst, t.aux);
    }
}
注意压栈顺序:因为后放入的先取出,必须按执行顺序的反方向压栈——先要执行的是"把上面的盘子移到辅助柱",所以要最后压入它。
讲师点评:递归所表达的任务结构还在,只是等待执行的工作由我们显式保存了。 它不依赖前一种解法的步号规律,只需要把熟悉的递归分解说清楚。这条路之所以"正确且有品位",是因为它在语料里反复学到过一句话:"递归是栈。"
graph TD
    T["任务: 移动 n 个盘, src→dst, 辅助 aux"] --> A["子任务 1<br/>移动 n-1 个盘, src→aux"]
    T --> B["子任务 2<br/>移动 1 个盘, src→dst"]
    T --> C["子任务 3<br/>移动 n-1 个盘, aux→dst"]
    A --> A1["继续分解…"]
    C --> C1["继续分解…"]
    style B fill:#e6f3ff
第三种看法:抽象机器
(参考时间: 00:53:15 / 00:54:00)
📷 绿导师:抽象机器
回到原视频 (00:54:00)
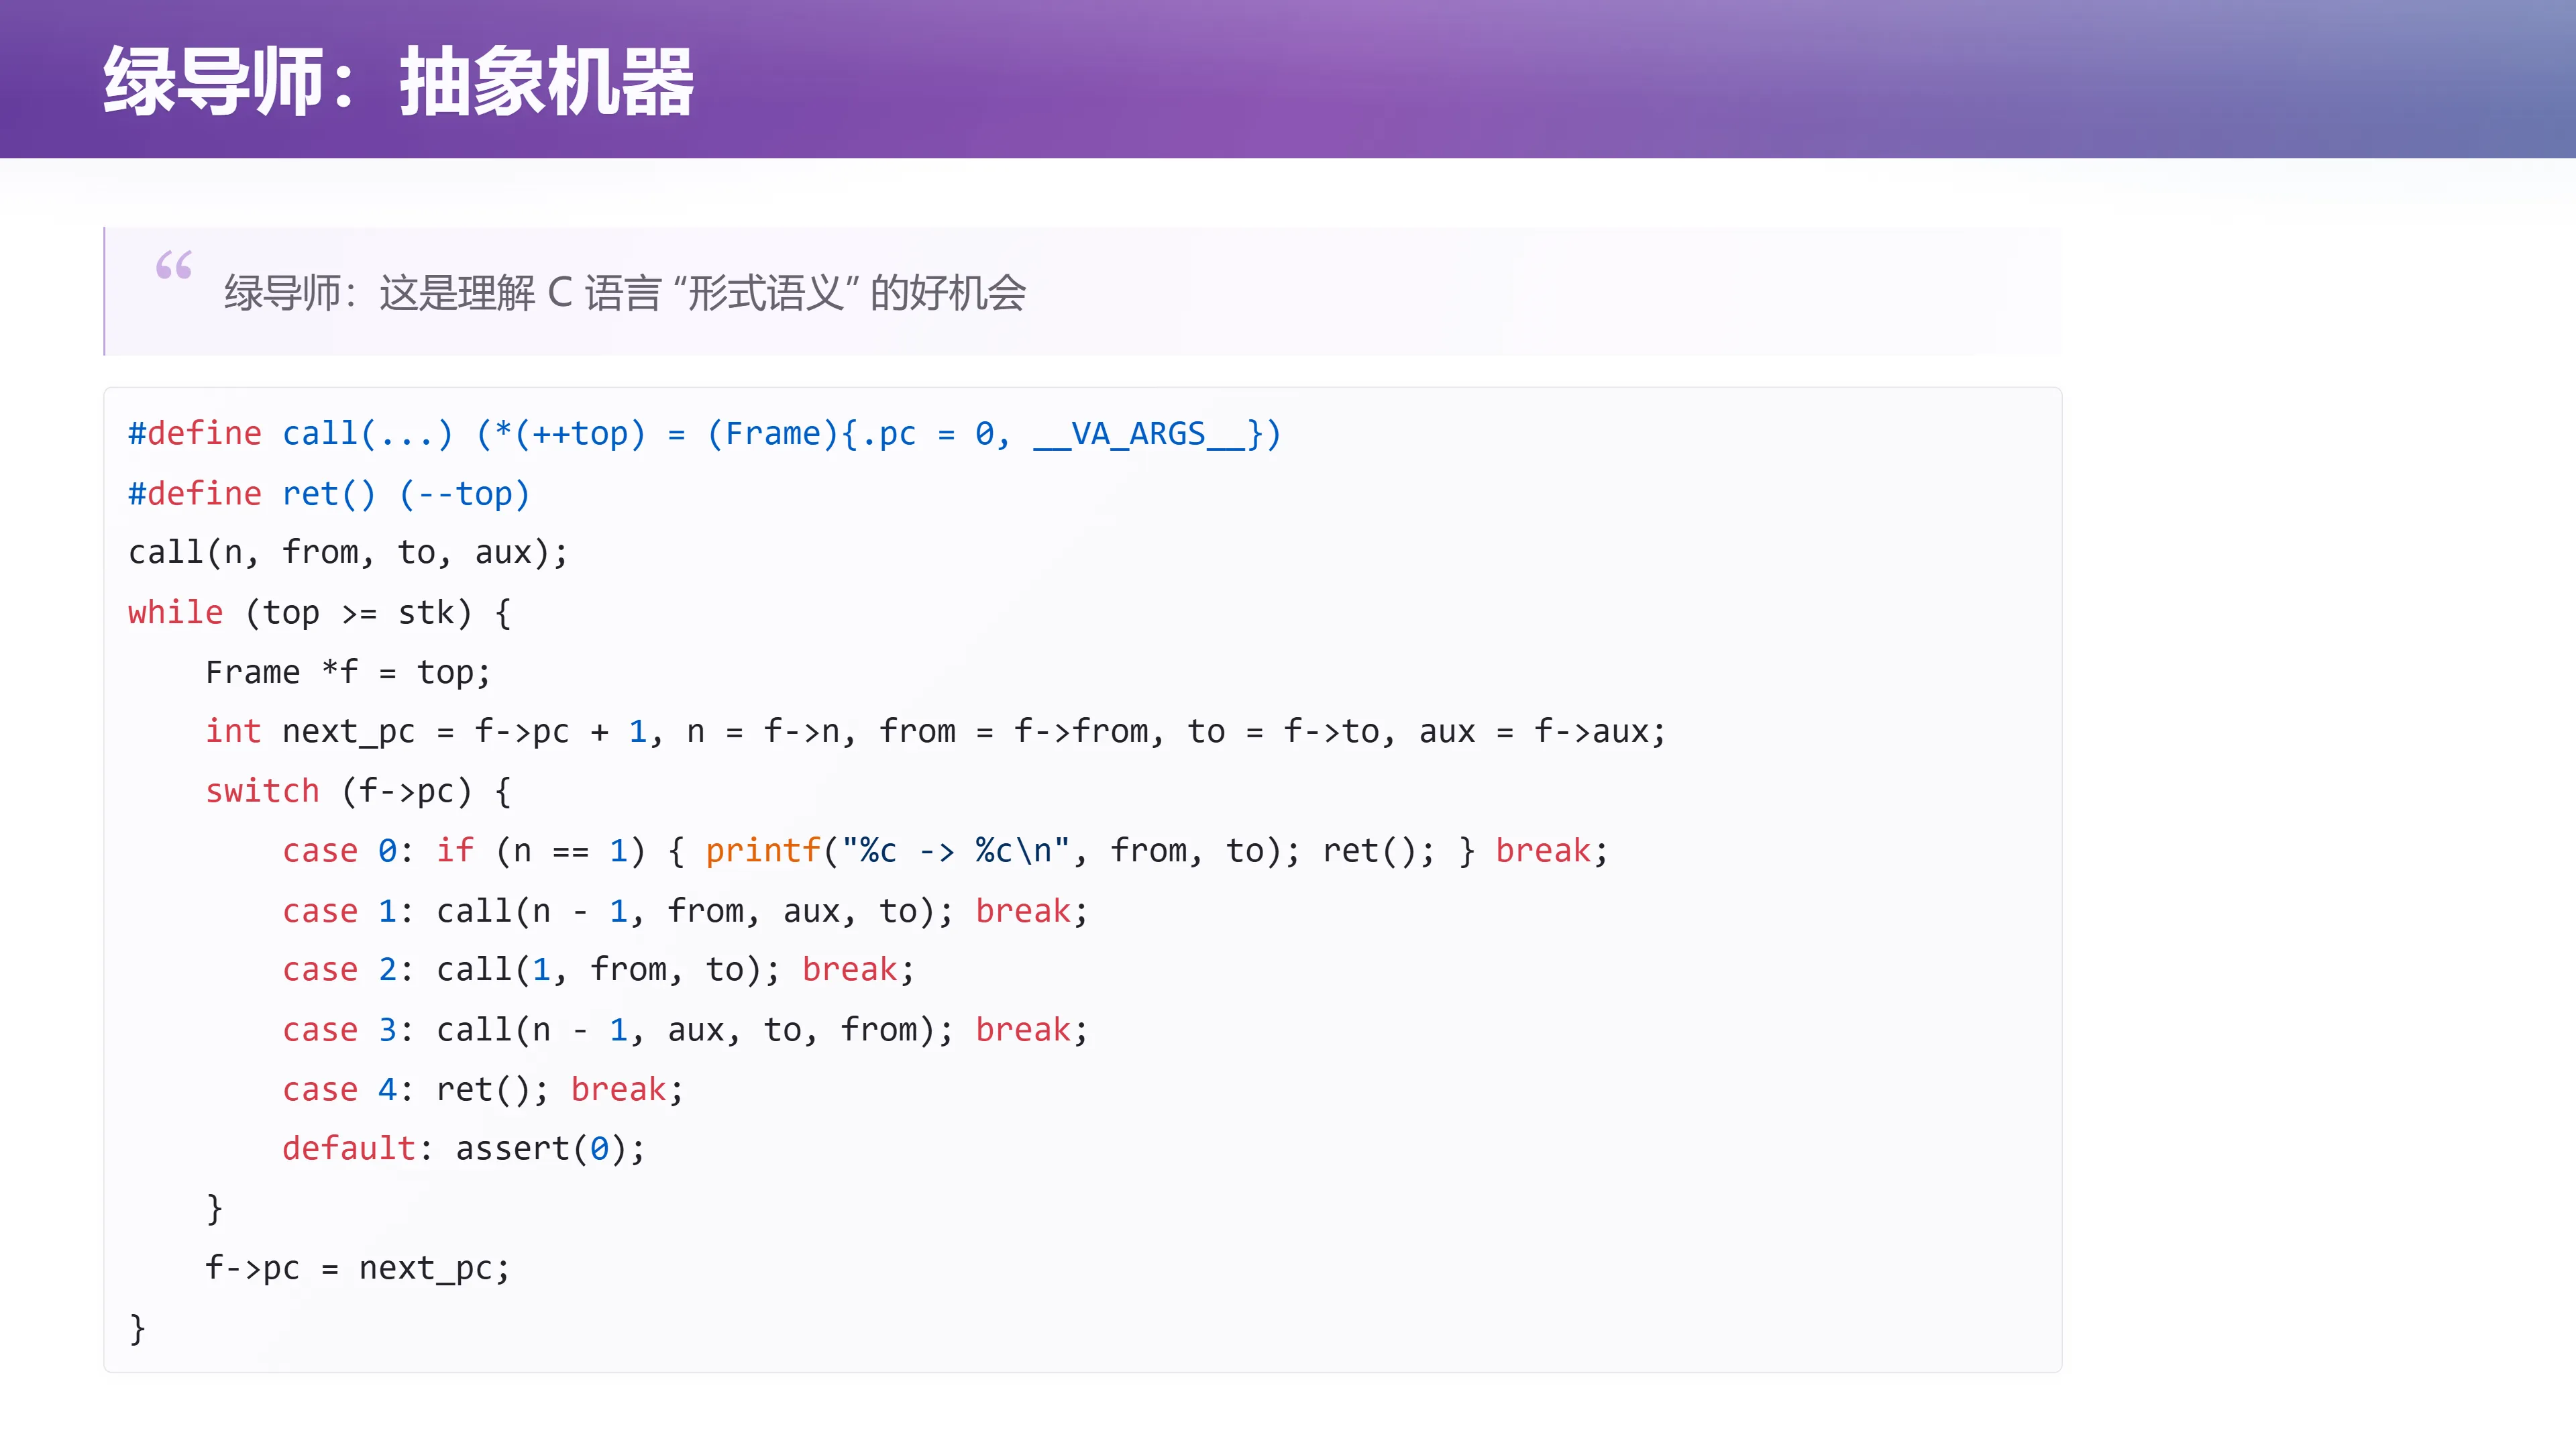
讲师自己的解法走的更远——直接模拟函数调用的执行过程。
每一层调用用一个栈帧表示,保存 n、三根柱子的角色,以及程序计数器 pc。程序计数器表示"这层函数执行到了哪一步"。遇到调用,就压入新的栈帧;遇到返回,就弹出栈帧;重新轮到上一层时,根据它保存的 pc 接着执行。
#define call(...) (*(++top) = (Frame){.pc = 0, __VA_ARGS__})
#define ret() (--top)

call(n, from, to, aux);
while (top >= stk) {
    Frame *f = top;
    int next_pc = f->pc + 1, n = f->n, from = f->from, to = f->to, aux = f->aux;
    switch (f->pc) {
        case 0: if (n == 1) { printf("%c -> %c\n", from, to); ret(); } break;
        case 1: call(n - 1, from, aux, to); break;
        case 2: call(1, from, to);          break;
        case 3: call(n - 1, aux, to, from); break;
        case 4: ret(); break;
        default: assert(0);
    }
    f->pc = next_pc;
}
这时,我们其实构造了一台很小的抽象机器。 函数调用和返回都变成了状态转移,"非递归汉诺塔"也就成了理解程序执行语义的机会。类似的办法可以解释更一般的递归过程,而不只服务于这一道题。
讲师的自我评价是:
"作为一个架构师,架构关乎的是你对需求掌握到什么程度。我要写一个非递归的汉诺塔,我想的是:为什么大家写不出来? 是因为你对递归这件事理解得不够深。所以我故意把程序建模成一个状态机——上过我课的同学都见过这个代码。C 语言是有一个形式语义的,一个 single step 就是它的 operational semantics(操作语义);
hanoi(n-1, ...)在程序语言的世界里是一个 well-defined 的一步操作。所以只需要模拟这一步。当你理解了 C 语言的解释器,你就很容易把任何代码做这种翻译。我当时讲的其实是两个互相调用的函数(F 调 G,G 调 F),把它翻译成状态机表示毫无难度。如果你觉得这段代码对汉诺塔来说 overkill 了,那也对——它可以从一个更通用的机器通过一个 simplification 得到。这是理解 C 语言形式语义的好机会。"
编者拓展|操作语义、小步语义与抽象机器 讲师提到的几个术语来自程序语言理论: - 操作语义(operational semantics):用"抽象机器如何一步步执行"来定义语言含义。 - 小步语义(small-step semantics):把执行定义为从配置到配置的一步关系 $\langle \text{code}, \text{state} \rangle \to \langle \text{code}', \text{state}' \rangle$。递归调用这一步,恰好对应"压入一层新栈帧 + 把 pc 置零"。 - 机器:这里构造的
Frame+pc+ 显式栈,就是一台"带程序计数器的最小机器"。递归与非递归的差别,本质上是"谁来保管未完成的工作"——由语言的调用栈保管,还是由我们自己的数据结构保管。一旦把这一点想清楚,"非递归化"就变成了一道机械的翻译题:把 PC、环境(局部变量)、调用栈三样东西显式化。这也是编译器做 CPS 变换 / 闭包转换 时的核心手法。
第四种:CSDN 上的"训练未收敛"
(参考时间: 00:55:42)
讲师还在百度上搜了一下"非递归汉诺塔"。百度第一个条目还是递归汉诺塔,往下找到 CSDN 的第一篇非递归汉诺塔文章,看到了一份代码:
- 出现了一个名为
move的东西——但std::move本来就有别的语义; - 右侧评论区看起来像是 AI 生成的,"给你营造一种 CSDN 博客质量很高的感觉"。
讲师点评得很直接:
"这个甚至比 AI slop 还要问题严重。如果你上学的时候被这种 slop 污染了,你还不如跟 AI 学——跟 DeepSeek 学都很好。不要跟 GPT-6 学,它已经不当人了。"
复杂性被放在哪里
(参考时间: 00:56:43)
📷 同一个汉诺塔,四种表达:选择一种表示,就是选择把哪些事情变得容易
回到原视频 (00:56:43)
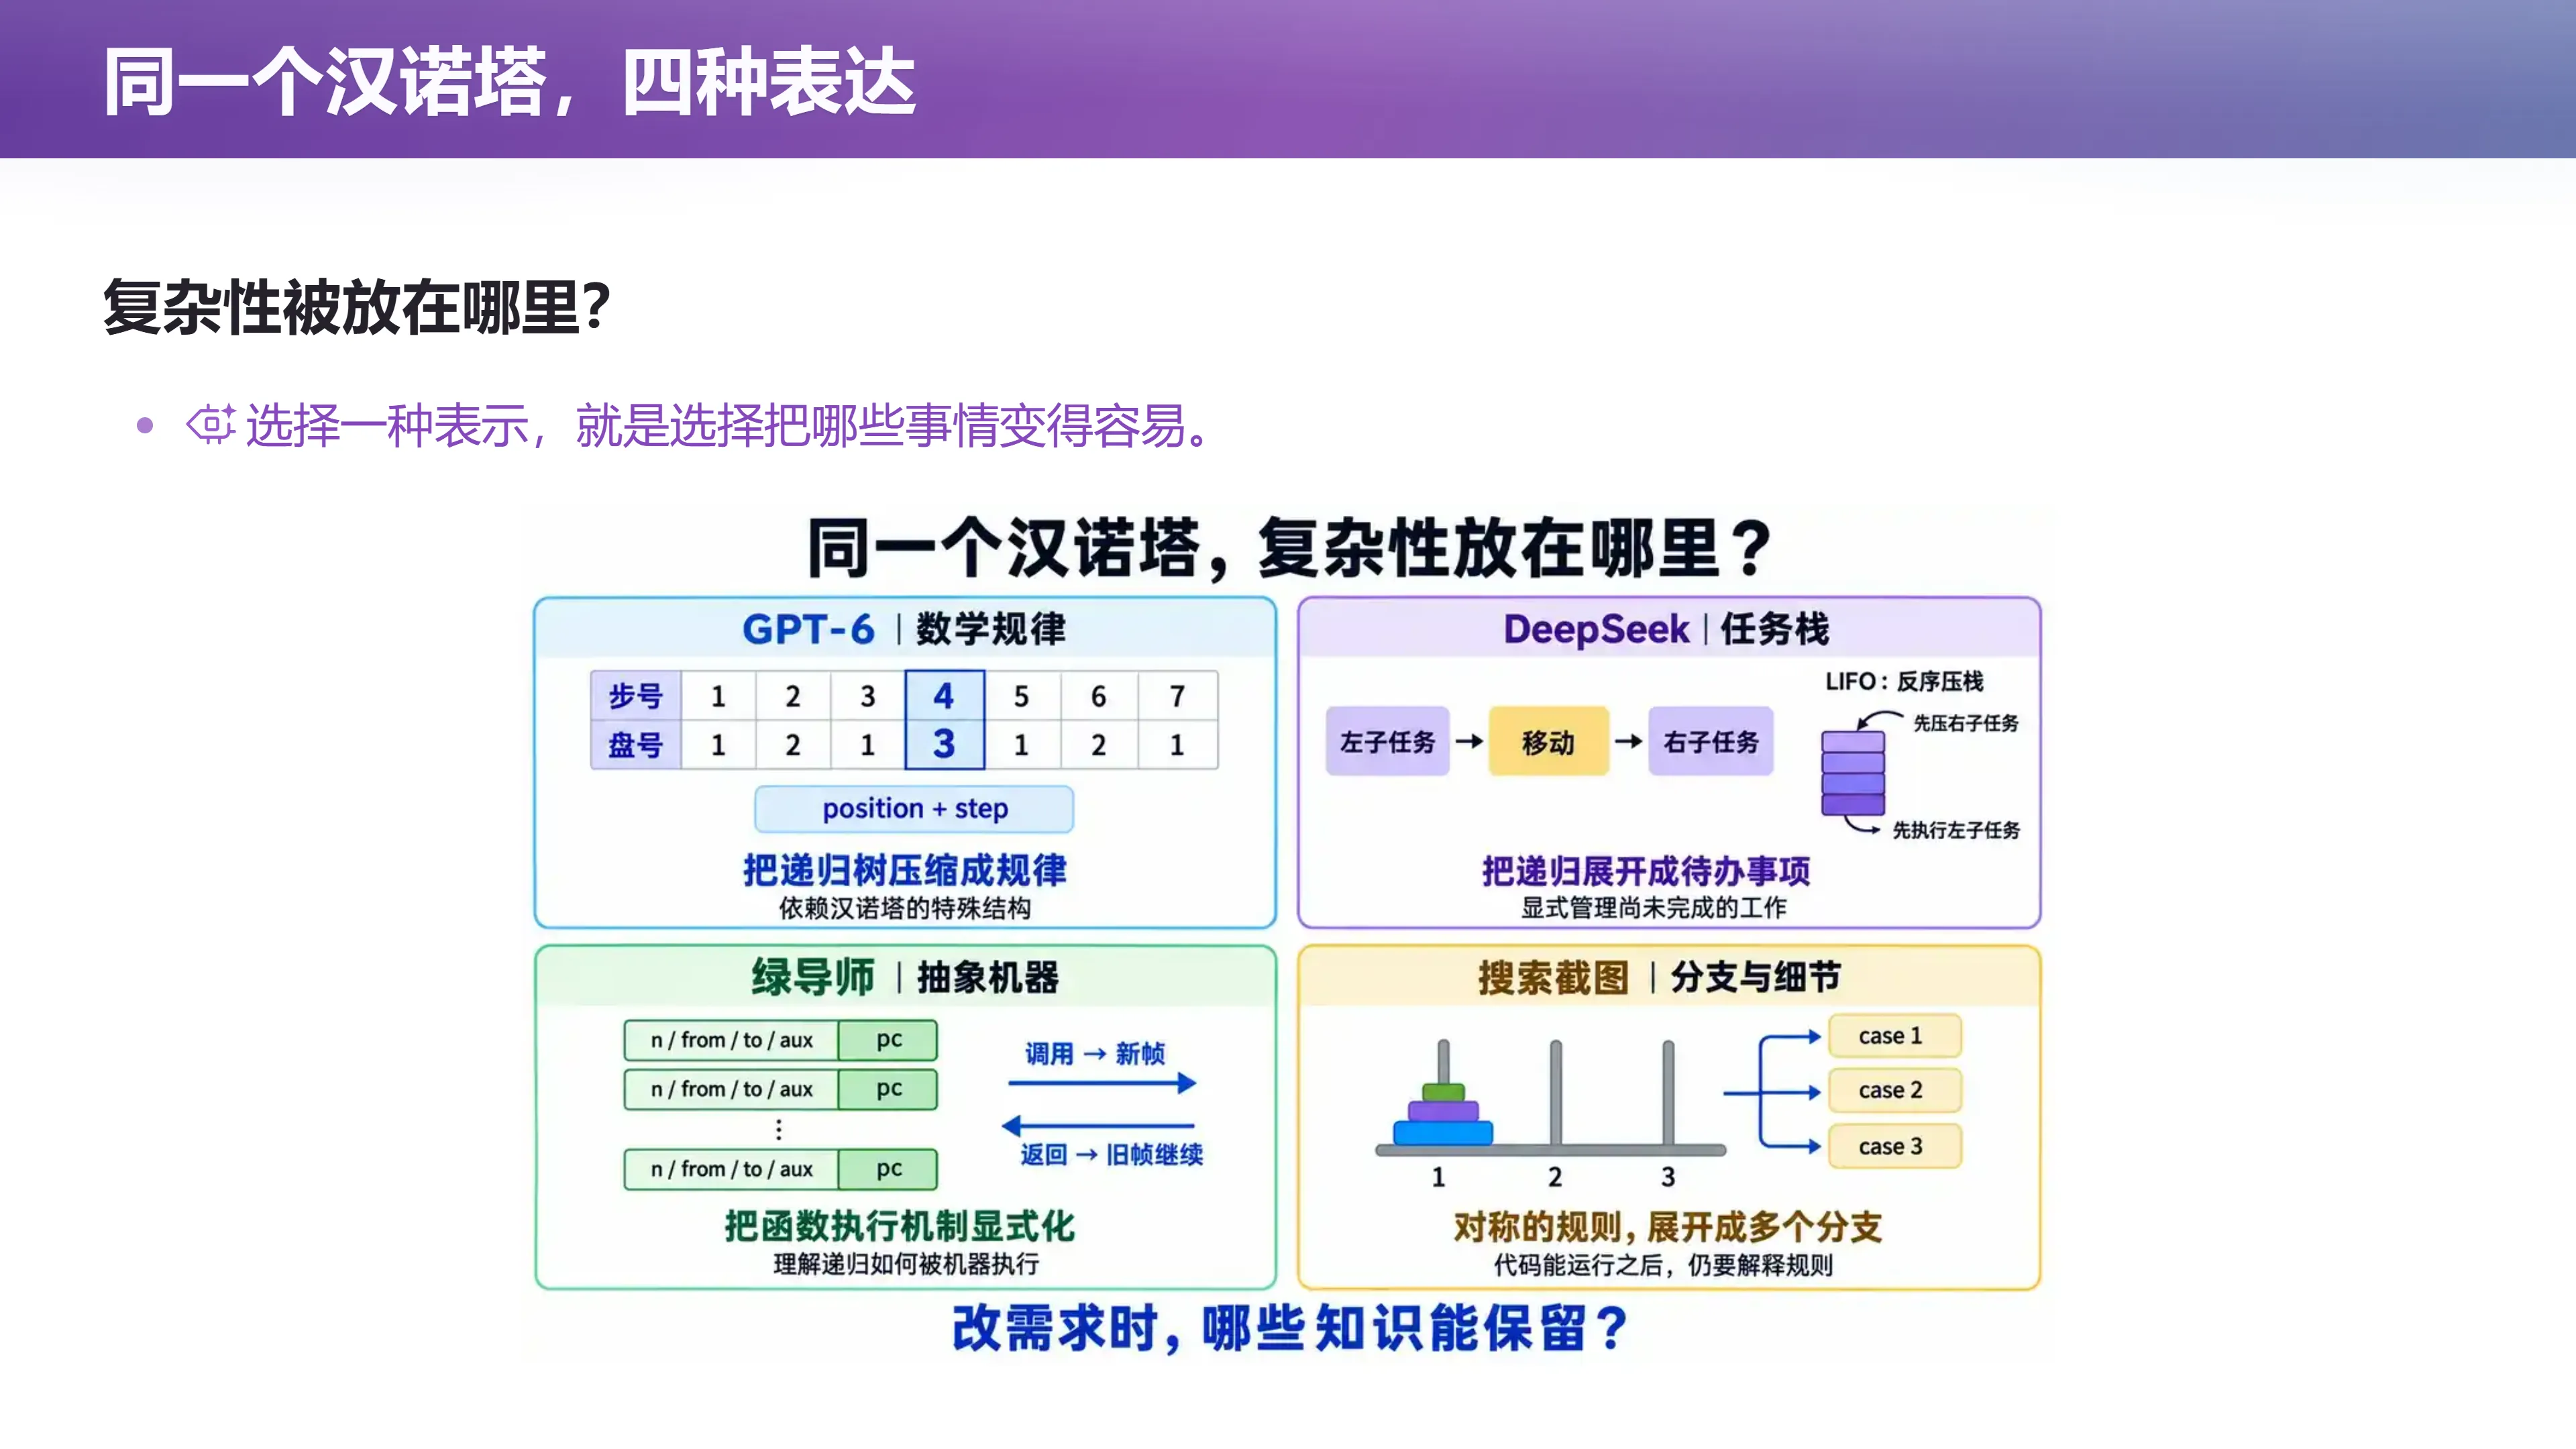
四种写法分别把复杂性放在不同地方:
| 表达 | 复杂性放在哪里 | 代价 |
|---|---|---|
| 递归 | 语言的调用栈 | 题目不允许时无法直接用 |
| 数学规律(GPT-6) | 数论性质与环方向 | 必须解释和验证规律;规则一变即失效 |
| 任务栈(DeepSeek) | 显式的任务分解 | 需要理解"反序压栈" |
| 抽象机器(讲师) | 栈帧 + 程序计数器 | 相对这道题而言 overkill,但可推广 |
课堂用不同模型给出的代码作了对照,但有价值的部分在这些表示方法本身。 若只盯着眼前该写哪个 if,很容易陷入越来越多的分支;换一种表示,问题可能突然变得简单。架构关乎的,正是我们对问题掌控到了什么程度。
两千行二维码程序:我们真正需要的是一个编译器
(参考时间: 00:57:46)
📷 2,000 行的架构例子:刚才我们展示了"跳出问题看问题"
回到原视频 (00:57:46)
从汉诺塔向外看,可以看到一条层级:
graph BT
    A["代码本身"] --> B["代码之外:客户的规律"]
    B --> C["客户之外:社会运行的规律"]
    C --> D["社会之外:宇宙的规律"]
讲师说:
这种'跳出问题看问题'的能力从哪里来? 从你学过的每一个东西上来。如果它是好的、优雅的,它就促使你去思考这个问题。压缩就是智能——你把它压缩了,你的 first principle 就在那里,你总是从 first principle 去推导该怎么做。
这些能力是你在学校的学习、社会上的积累共同赋予的。比如你必须要和教科书、做题之外的人打交道,你才知道一位马上要退休的、优雅的教务老师是怎么看教务系统的。她的想法可能和你的不一样——你的想法总是"数据库要最高性能",而她只是想要那个字大一点、点鼠标的时候不要手滑到旁边那个按钮上。这是共情别人的能力。
至于这种跨层次选择表示的能力,未来能否也通过强化学习不断改进,是值得继续观察的问题——不能把今天的能力边界当成永久边界。
需求:在 Excel 单元格里显示二维码
(参考时间: 00:58:59)
📷 QRCode Generator 的复杂性
回到原视频 (00:58:59)
具体需求:在 Excel 中输入字符串,由工作表公式计算并显示二维码;修改输入后二维码随之变化。
讲师当场演示:打开那个工作簿,输入一个长字符串,旁边那一格就生成一个可以直接扫描的二维码。
这个需求的特点是非常明确、非常 deterministic:
- 一个输入的单元格;
- 一批"生成 0/1 序列"的中间单元格;
- 一批"显示图案"的输出单元格。
但讲师强调:这里面是有架构考虑的。
直接写公式为什么会崩
让 Agent 直接写出所有公式,很快就会碰到长公式的脆弱性。括号、引用、数组运算和算法步骤缠在一起,模型可能花大量时间与不配对的括号搏斗。
讲师的原话:"你会得到一个……就好像偷了一个 Lisp 程序。"
"因为它最后一页是这样的"——公式长到什么程度呢?讲师打了个比方:就好比让你们用 Brainfuck 去实现一个 nontrivial 的程序(比如那个流传很广的"Brainfuck 里跑毁灭战士"),写出来的东西就是这个样子。
编者说明:Brainfuck 是一种极简的深奥语言,只有 8 个指令字符。用它写 nontrivial 程序,代码会退化成"能跑但完全无法阅读"的形态,这与"在 Excel 公式里硬塞一个二维码编码器"是同一类问题:语言提供的表达能力与问题的结构不匹配。
即便公式终于能运行,下一次需求变化仍然很痛苦:
- 兼容更老版本的 Excel,或者利用新版本 Excel 的特性;
- 把二维码从一个位置移到另一个位置;
- 换一种计算方法;
- 再增加一个字符串输入单元格。
"原本看似局部的修改,都可能穿过整片公式。"
讲师在这里插了一段很生动的例子:Excel 从 2019 到 2023 一直在增加新功能。以前查找学号对应的成绩要用 VLOOKUP,后来微软终于受不了了,推出了 XLOOKUP。 讲师问"有没有同学知道",没人知道——他笑着说"说明你们都不是 Excel 的 power user,太好了,你们是 agent 时代的第一类人:你要干什么,只要跟 agent 说就行了,你永远不需要再学一个像吃屎一样的语言了"。
于是需求立刻变得模糊:我到底是要兼容旧版本标准(发给教务老师也能打开),还是要做一个自己即抛的小工具(用最新语法实现最简单的公式)?如果 AI 给你写的是 Excel 2023 的公式,你突然说"要改成 2019、2003",全完蛋——设计实现会从头回到原点。
跳出问题看问题:这是一个编译问题
(参考时间: 01:04:37)
📷 我们其实要实现的是"编译器"
回到原视频 (01:04:37)
讲师让模型给出一份"从字符串到二维码"的伪代码。他给出的是一个完全清楚的问题——二维码是有完整规范的。模型很快给了一份很短的伪代码:
- 输入参数:版本、纠错等级、掩码、大小;
- 数据编码:模式指示符、长度、8 位字节;
- 纠错码:一个多项式运算(把数据多项式乘以 $X^{26}$,对生成多项式取模),追加 26 个纠错码字;
- 最后把码字放进矩阵里。
编者说明:这里描述的正是 ISO/IEC 18004 定义的 QR 码编码流程的一个切片。以版本 5、纠错等级 L 为例:总共 134 个码字,其中数据码字 108、纠错码字 26——与讲师口中的"乘以 $X^{26}$、134 个码字"完全吻合。 纠错码的计算在有限域 $\mathrm{GF}(2^8)$ 上进行:
$$ \text{ECC}(D) = \bigl( D(x) \cdot x^{k} \bigr) \bmod g(x) $$
其中 $g(x)$ 是由 $k$ 个一次因子 $\prod_{i=0}^{k-1}(x - \alpha^i)$ 张成的生成多项式,$\alpha$ 是 $\mathrm{GF}(2^8)$ 上的本原元。这些"码字"随后还要经过掩码选择、格式信息、定位图案、时序图案、对齐图案的填充,才成为最终的 37×37 模块矩阵。
那么,"这么简单的东西,在 Excel 里实现为什么这么困难?这个 gap 到底在哪里?"
如果你跳到问题外面,就很容易看出来了:
- 二维码容易用算法来描述——写成 Python(比如
qr.py)再容易不过了; - 但我们的要求是 Excel:不存在任何一个翻译器、一个编译器,可以把 Python 编译成 Excel。
- 用大模型直接把伪代码/自然语言"编译"成 Excel 公式,我们也看到了它的失败模式:需求一漂移就完蛋。
所以显而易见的问题是:
我是不是可以在 Python 和 Excel 中间,构造另外一个语言? 这个语言既可以很容易地翻译成 Excel,又可以继承一定的 Python 能力。
我要的东西其实是一个中间的编程语言(IR)。
中间表示:一张可检查的计算图
(参考时间: 01:07:41)
讲师的设计是:引入中间表示(Intermediate Representation, IR)。
你们都写过表达式求值程序——那就做一个表达式树。比如:
- 一个异或节点:$\text{BitXor}(a, b)$
- 一个取字符串中某字节的节点:$\text{ByteAt}(s, i)$
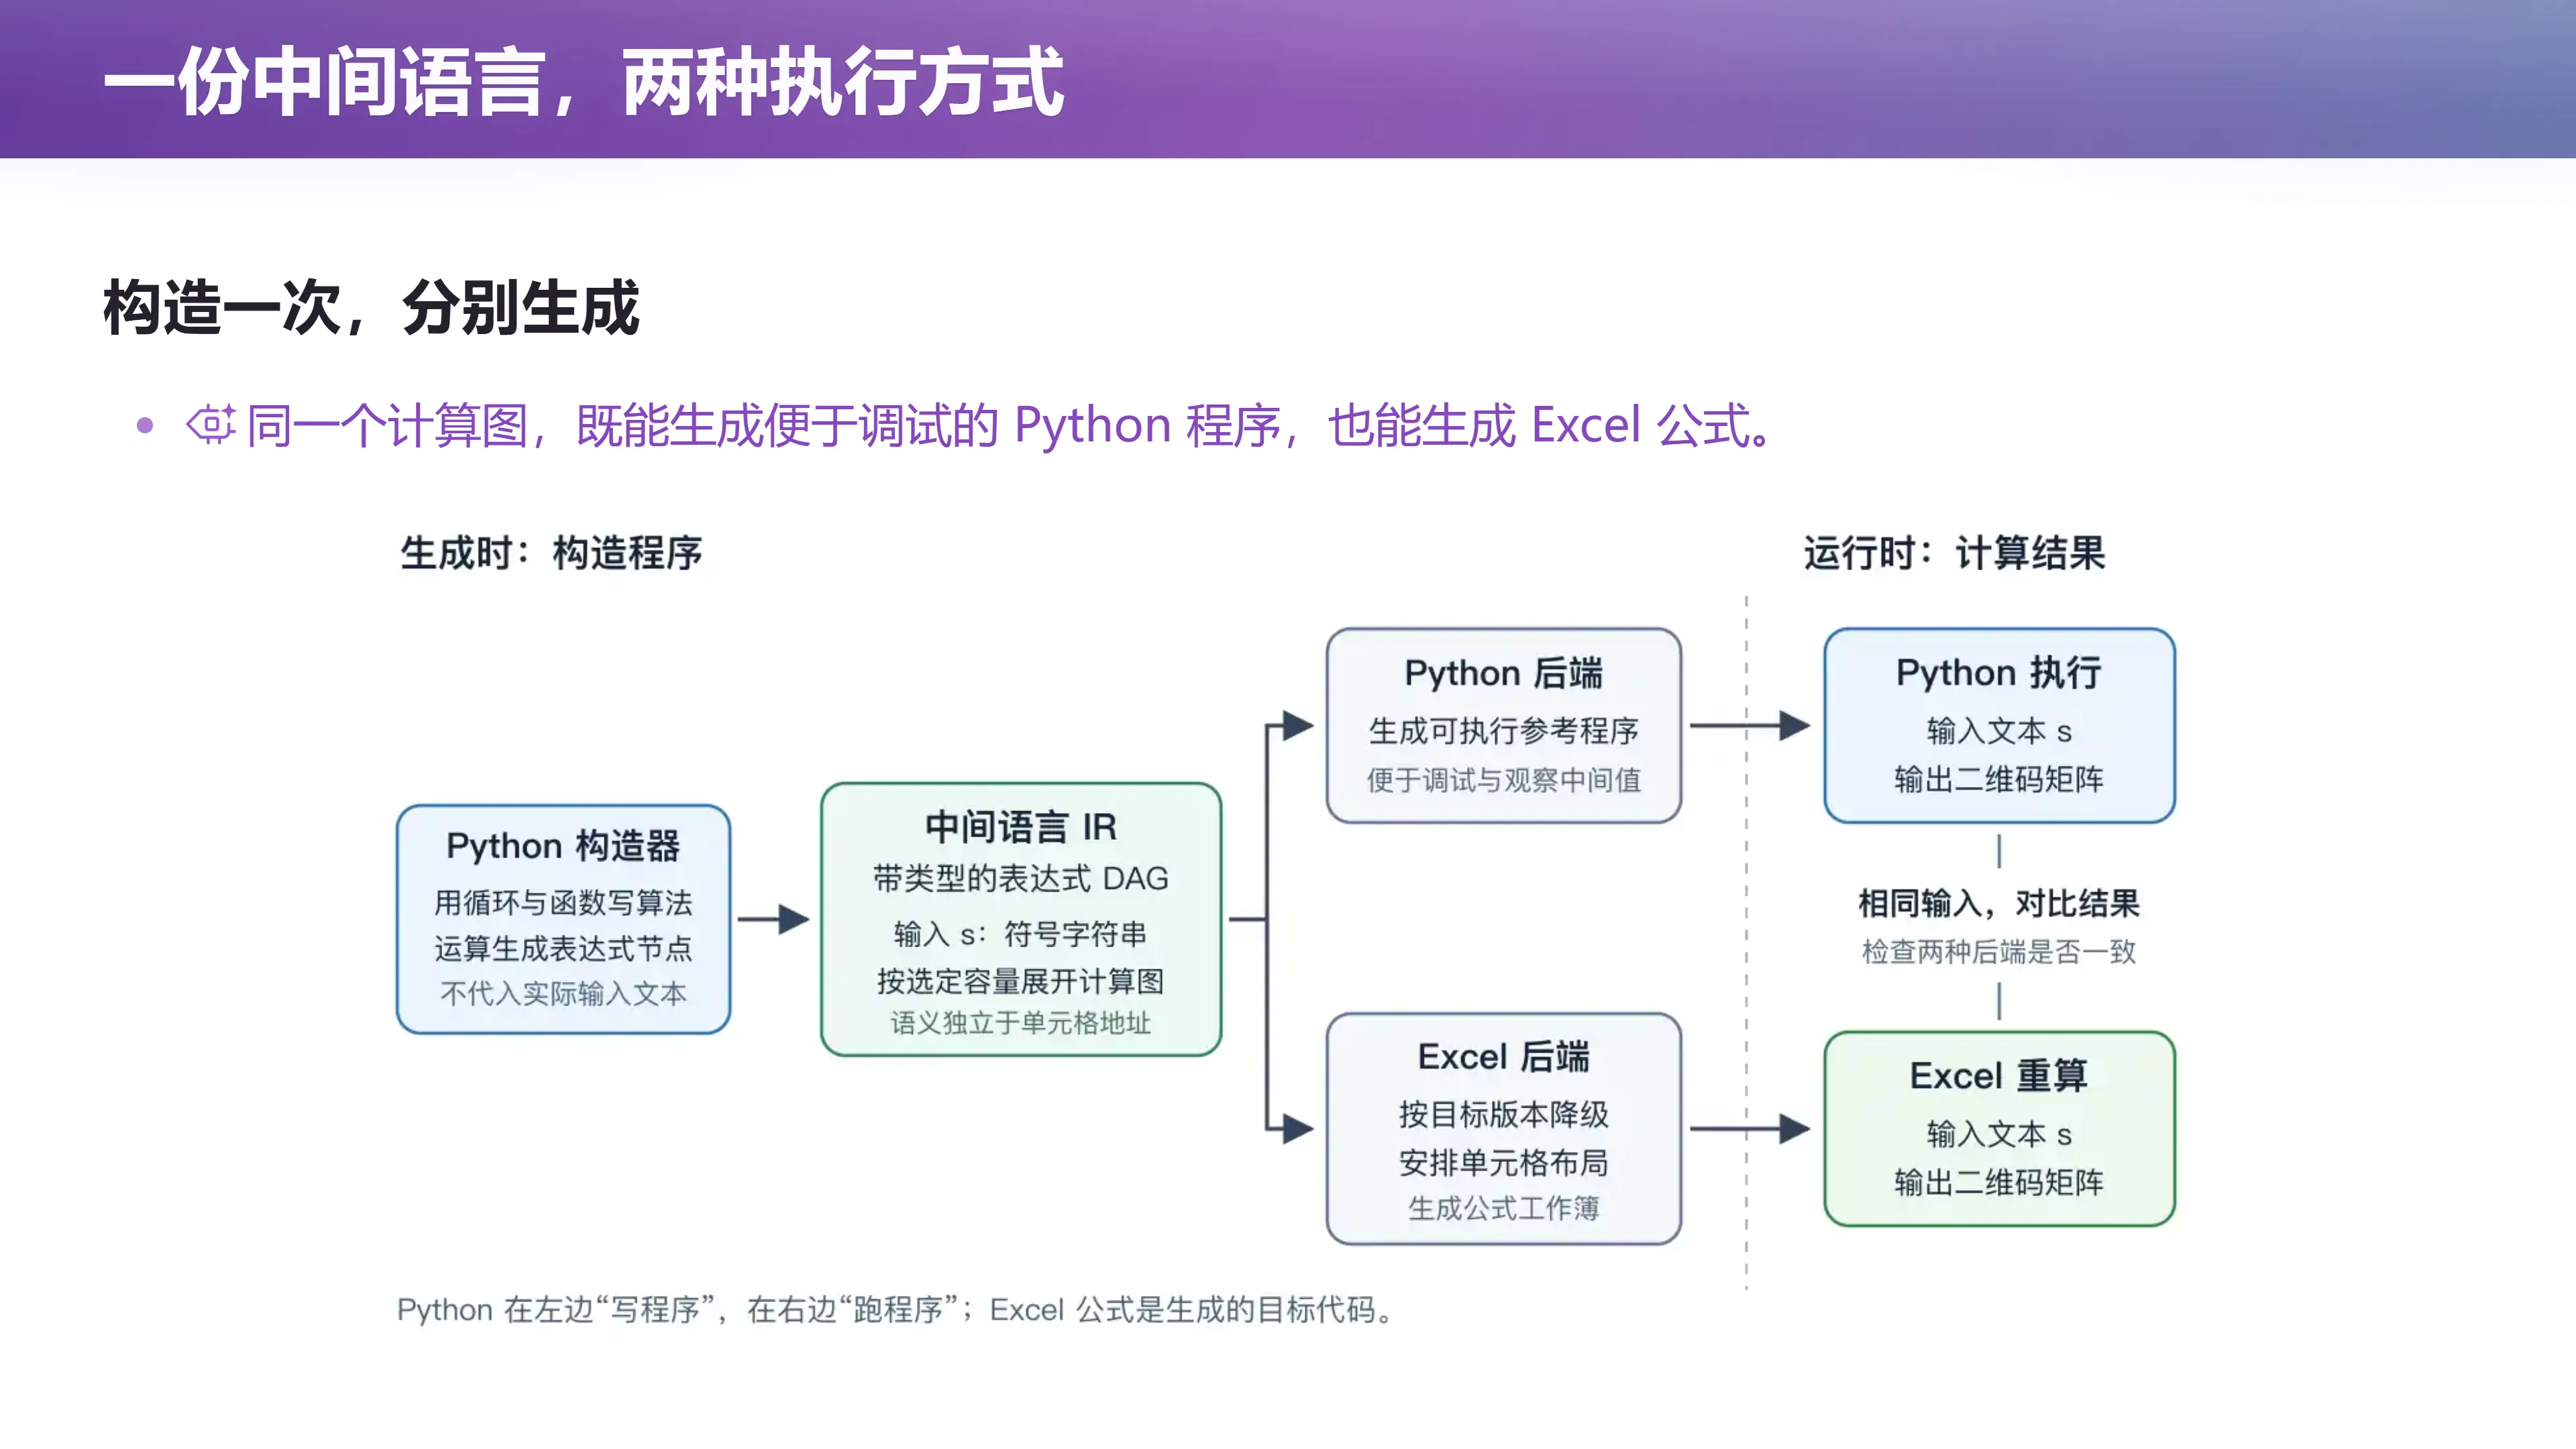
这就是一个小的编程语言。而这个语言显然很容易翻译成 Python:把表达式树递归 dump 出来,根据节点拼字符串即可。它也可以翻译成 Excel——只要规定"每个节点都有一条翻译成 Excel 的规则"(结果可以放进任意一个格子),就能把子节点所在格子的公式拼接成父节点的公式。
于是这套架构就成立了:
graph TB
    LLM["大语言模型<br/>生成算法逻辑"] --> IR["中间表示 IR<br/>(计算图 / 表达式树)"]
    IR --> PY["Python 后端<br/>(用于验证)"]
    IR --> XL["Excel 后端<br/>(用于交付)"]
    PY --> V["跑通、比对、定位错误"]
    XL --> D["生成工作表公式"]
    V -.->|"验证通过后再写 Excel"| D
    style IR fill:#fff2cc
构造一次,分别生成。 讲师说:
"我让大语言模型生成这个语言的二维码计算逻辑,然后用把语言翻译成 Python 来验证——看我的逻辑写得对不对。等逻辑对了,我再去写 Excel。你看到这样的架构,不就是我们刚才在第一个最小的例子里讲的
getopt吗?"
而这也解释了"架构的能力从哪里来":你作为大学生,其实是一个 unsupervised learner,作为一个神经网络,你看的好的东西多了,你自然就能泛化。 当然,看得多的时候,你要有意识地去看这个东西为什么好、为什么要这样。你回头突然有一天就会想通——看到某一个 blog,或者听我上课的时候,突然就想通了一件事,原来这个世界上大家做的事情都是差不多的。
一份中间语言,两种执行方式
(参考时间: 01:10:39)
📷 一份中间语言,两种执行方式:构造一次,分别生成
回到原视频 (01:10:39)
这里有一个关键区分:生成时(compile time)与运行时(runtime)。
- Python 中的循环可以按照选定容量,展开二维码计算所需的有限步骤;
- 用户将来输入的字符串则要保留为符号输入;
- 由字符串内容决定的分支,也必须变成图里的条件选择节点,例如
Select(cond, a, b),留给 Excel 在重算时判断。
否则生成器只是提前算出了一张固定二维码,并没有实现原来的需求。
📷 用高级语言构造中间语言:Python 的函数和循环负责构造计算图
回到原视频 (01:11:00)
编者说明:这里区分的是部分求值(partial evaluation / staging)的经典问题。生成器知道的信息(版本、纠错等级、掩码、常量表、定位图案)可以在生成时算掉;只有随用户输入而变的部分必须留到运行时。把"什么时候算"这件事显式建模成"哪些节点留在图里、哪些节点被折叠",正是编译器中 staging / 部分求值 的核心。
让需求变更找到自己的位置
(参考时间: 01:11:00)
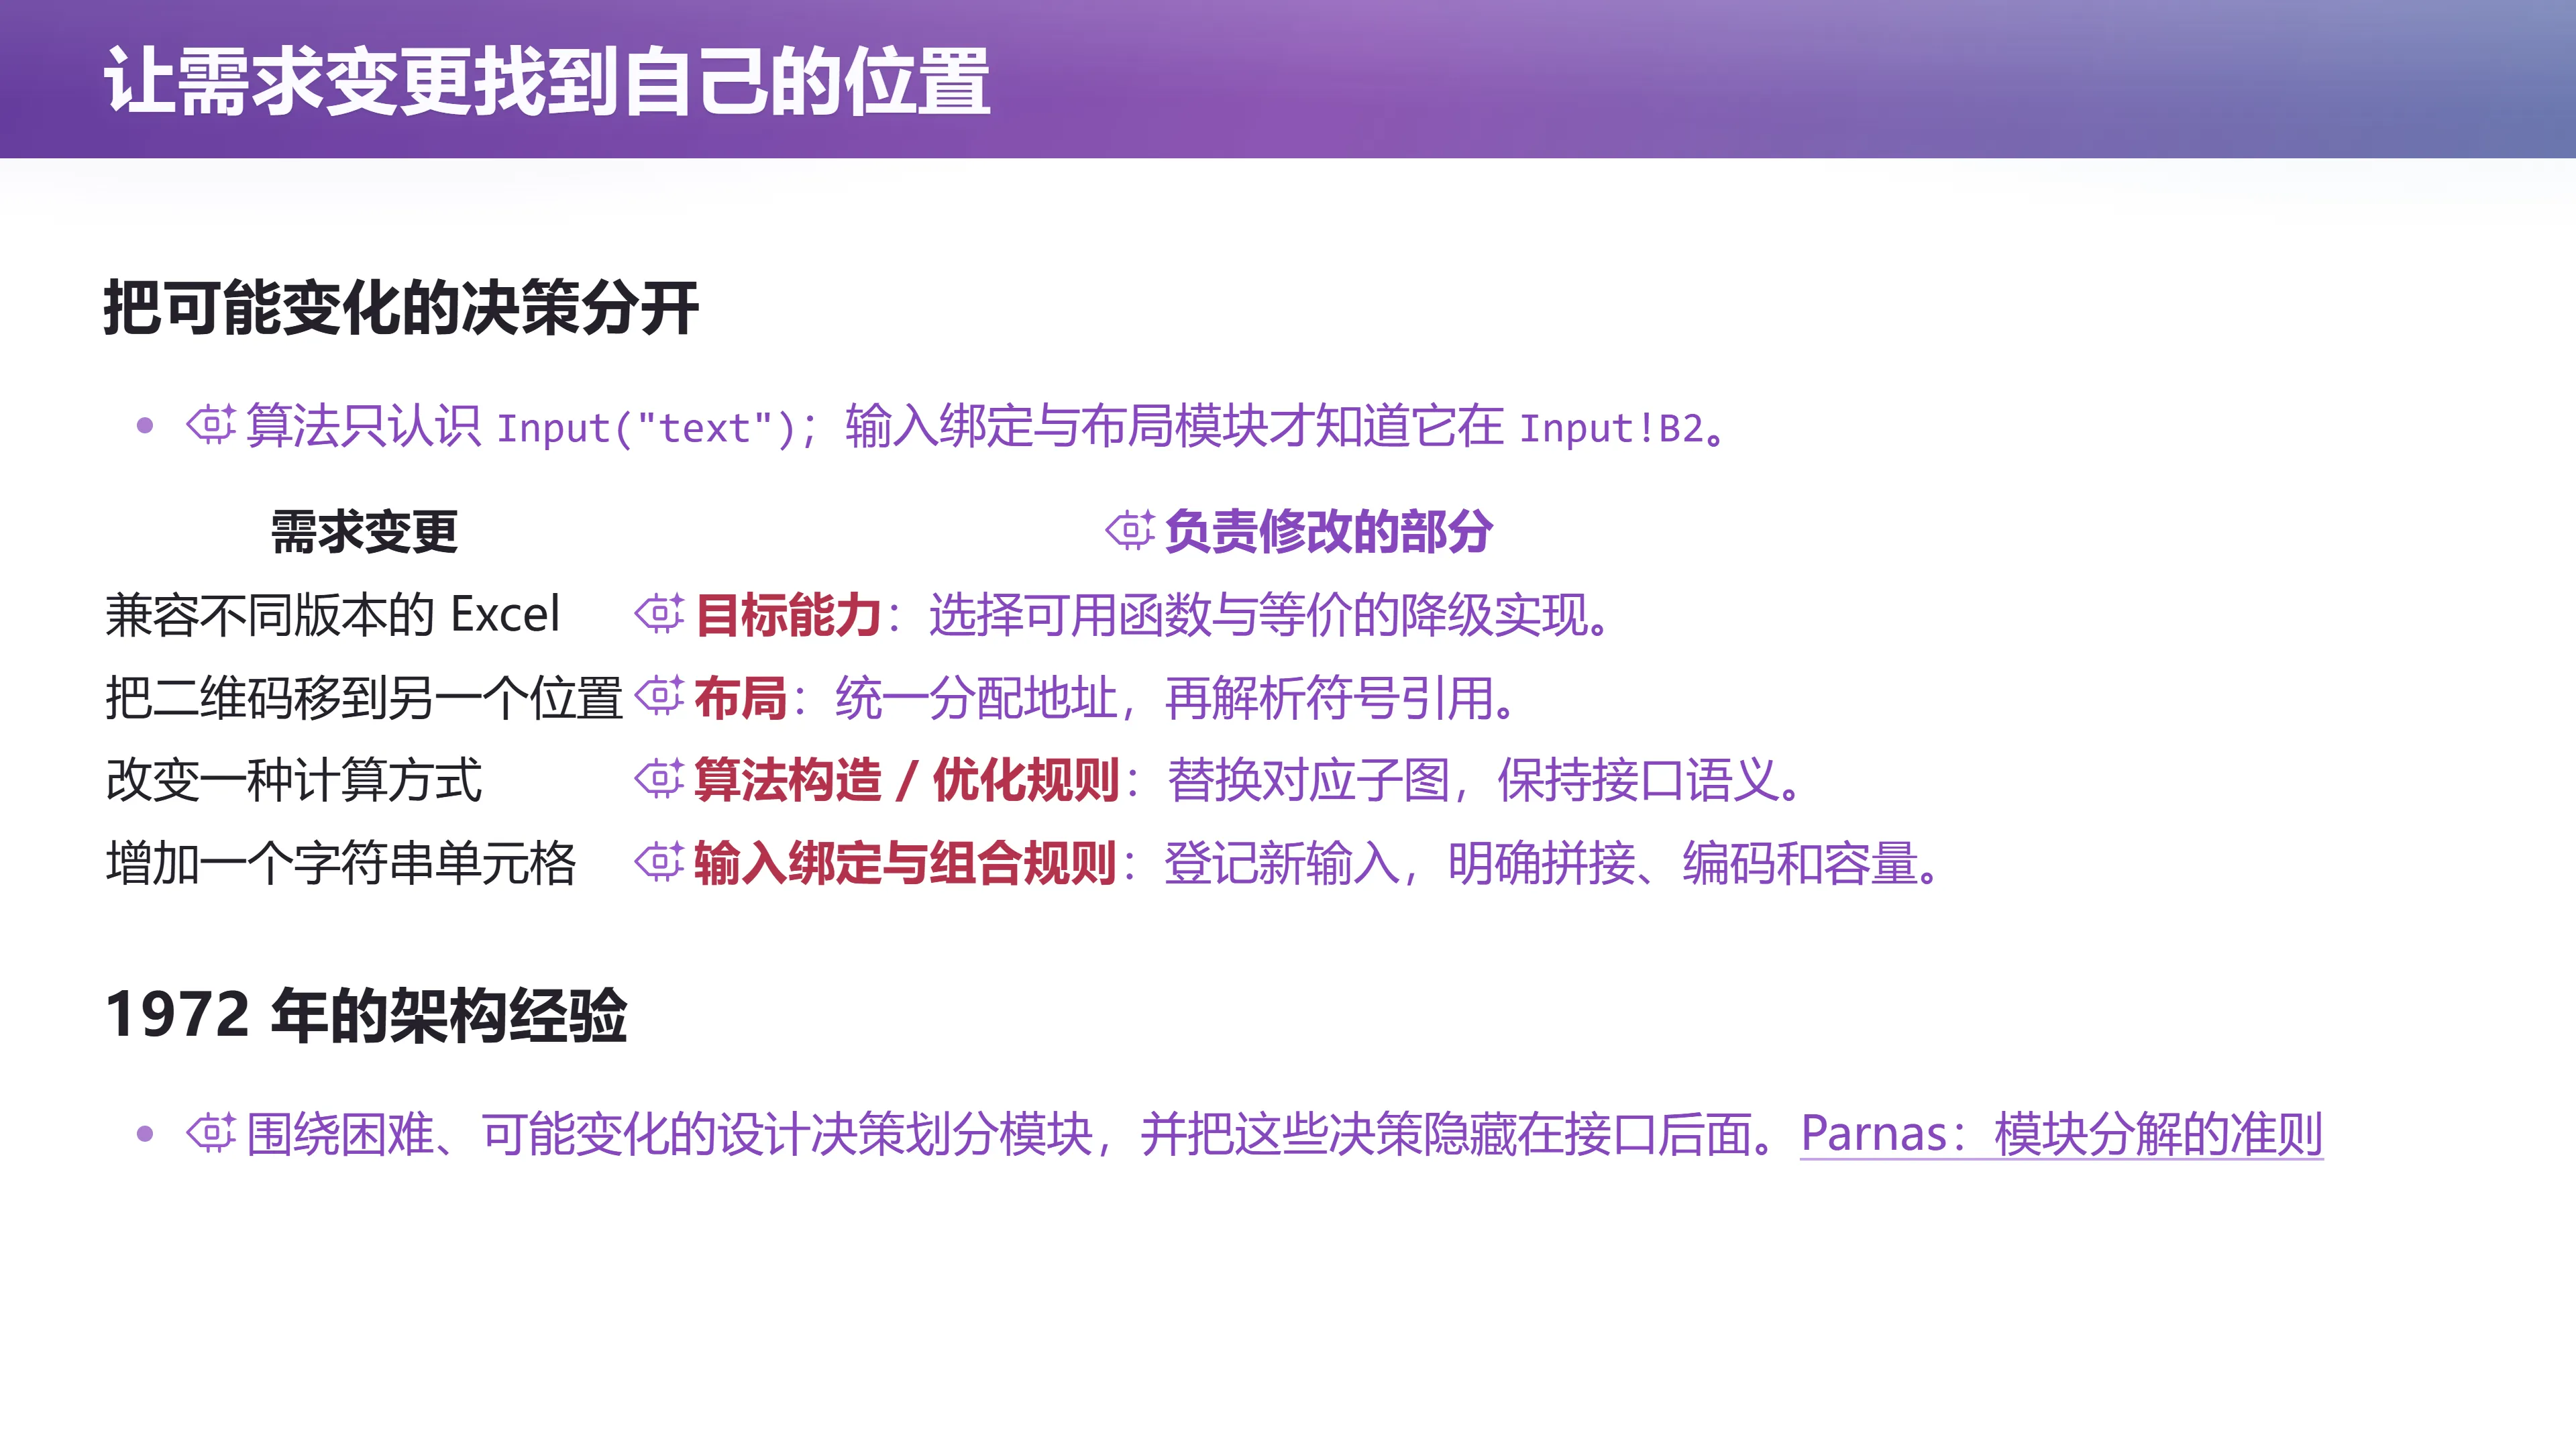
有了中间表示,几类变化就可以找到各自的位置。这正是 Parnas 那条准则的当代应用:围绕困难、可能变化的设计决策划分模块,并把这些决策隐藏在接口后面。
| 需求变更 | 负责修改的部分 |
|---|---|
| 兼容不同版本的 Excel | 目标能力:选择可用函数与等价的降级实现 |
| 把二维码移到另一个位置 | 布局:统一分配地址,再解析符号引用 |
| 改变一种计算方式 | 算法构造 / 优化规则:替换对应子图,保持接口语义 |
| 增加一个字符串单元格 | 输入绑定与组合规则:登记新输入,明确拼接、编码和容量 |
举例来说:算法只认识名为 text 的输入(Input("text")),输入绑定模块才知道它位于 Input!B2;布局模块分配中间结果和最终图案的位置,生成公式时再解析地址。
中间语言要有明确的语义
(参考时间: 01:11:30)
📷 中间语言要有明确的语义:一个可检查的计算图
回到原视频 (01:11:30)
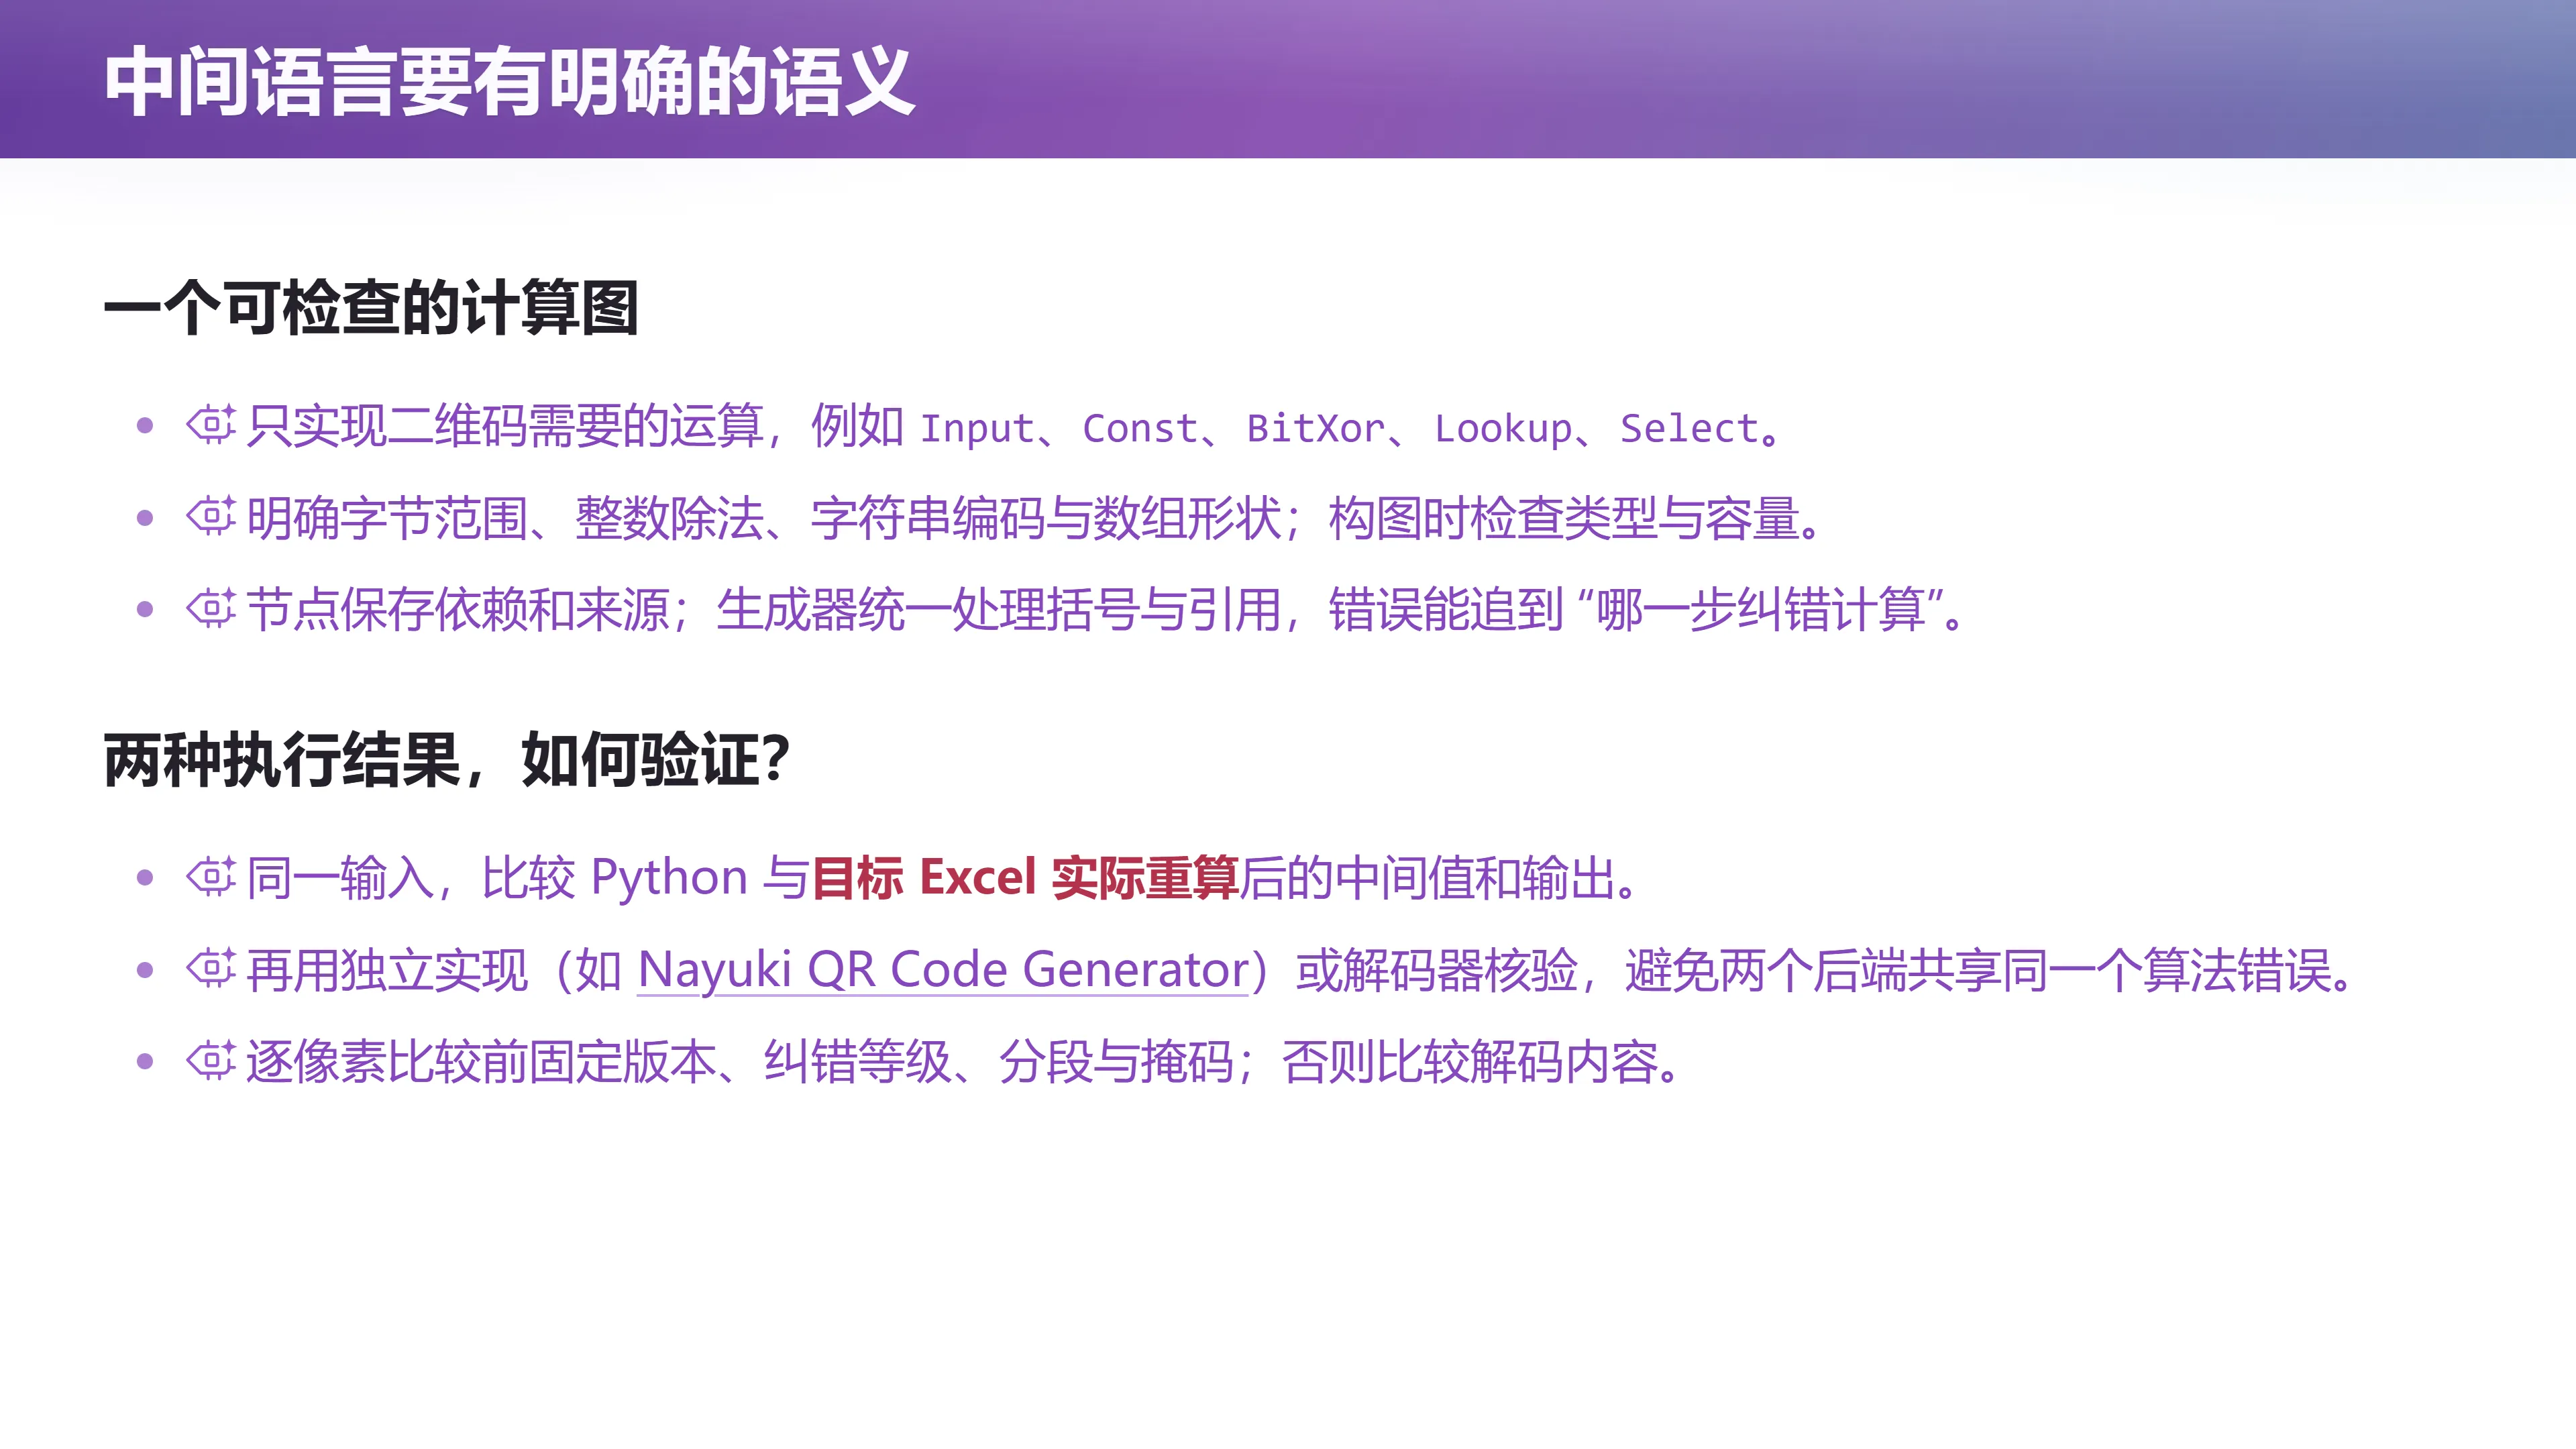
中间表示也需要自己的语义:
- 只实现二维码真正需要的运算,比如
Input、Const、BitXor、Lookup、Select; - 字节的取值范围、整数除法、字符串编码、数组形状,都不能交给两个后端各自猜测;
- 构图时可以检查类型和容量;
- 节点还可以保存来源,使错误能够追溯到某一步计算;
- 括号和单元格引用由生成器统一处理,算法作者就不必在每个地方重新处理这些细节。
两种执行结果,如何验证?
- 给定相同输入,比较 Python 的结果与目标 Excel 实际重算后的结果,必要时逐个比较中间值;
- 不过,两个后端可能共享同一个算法错误,因此还应通过独立实现(如 Nayuki QR Code Generator)或二维码解码器核验内容;
- 若要逐格比较两张二维码,则需要固定版本、纠错等级、编码分段和掩码等选择,否则外观不同也可能都正确。
编者说明:这里描述的是编译器工程中标准的 差分测试(differential testing) 与 元测试(metamorphic testing) 思路。前者的前提是两个实现"犯错方式不同"——如果它们共享同一份算法理解(比如都从 LLM 生成),差分测试就会失效。所以"用独立实现/解码器核验"这一步不可省。
性能优化也有自己的位置
(参考时间: 01:12:00)
📷 性能优化也有自己的位置
回到原视频 (01:12:00)
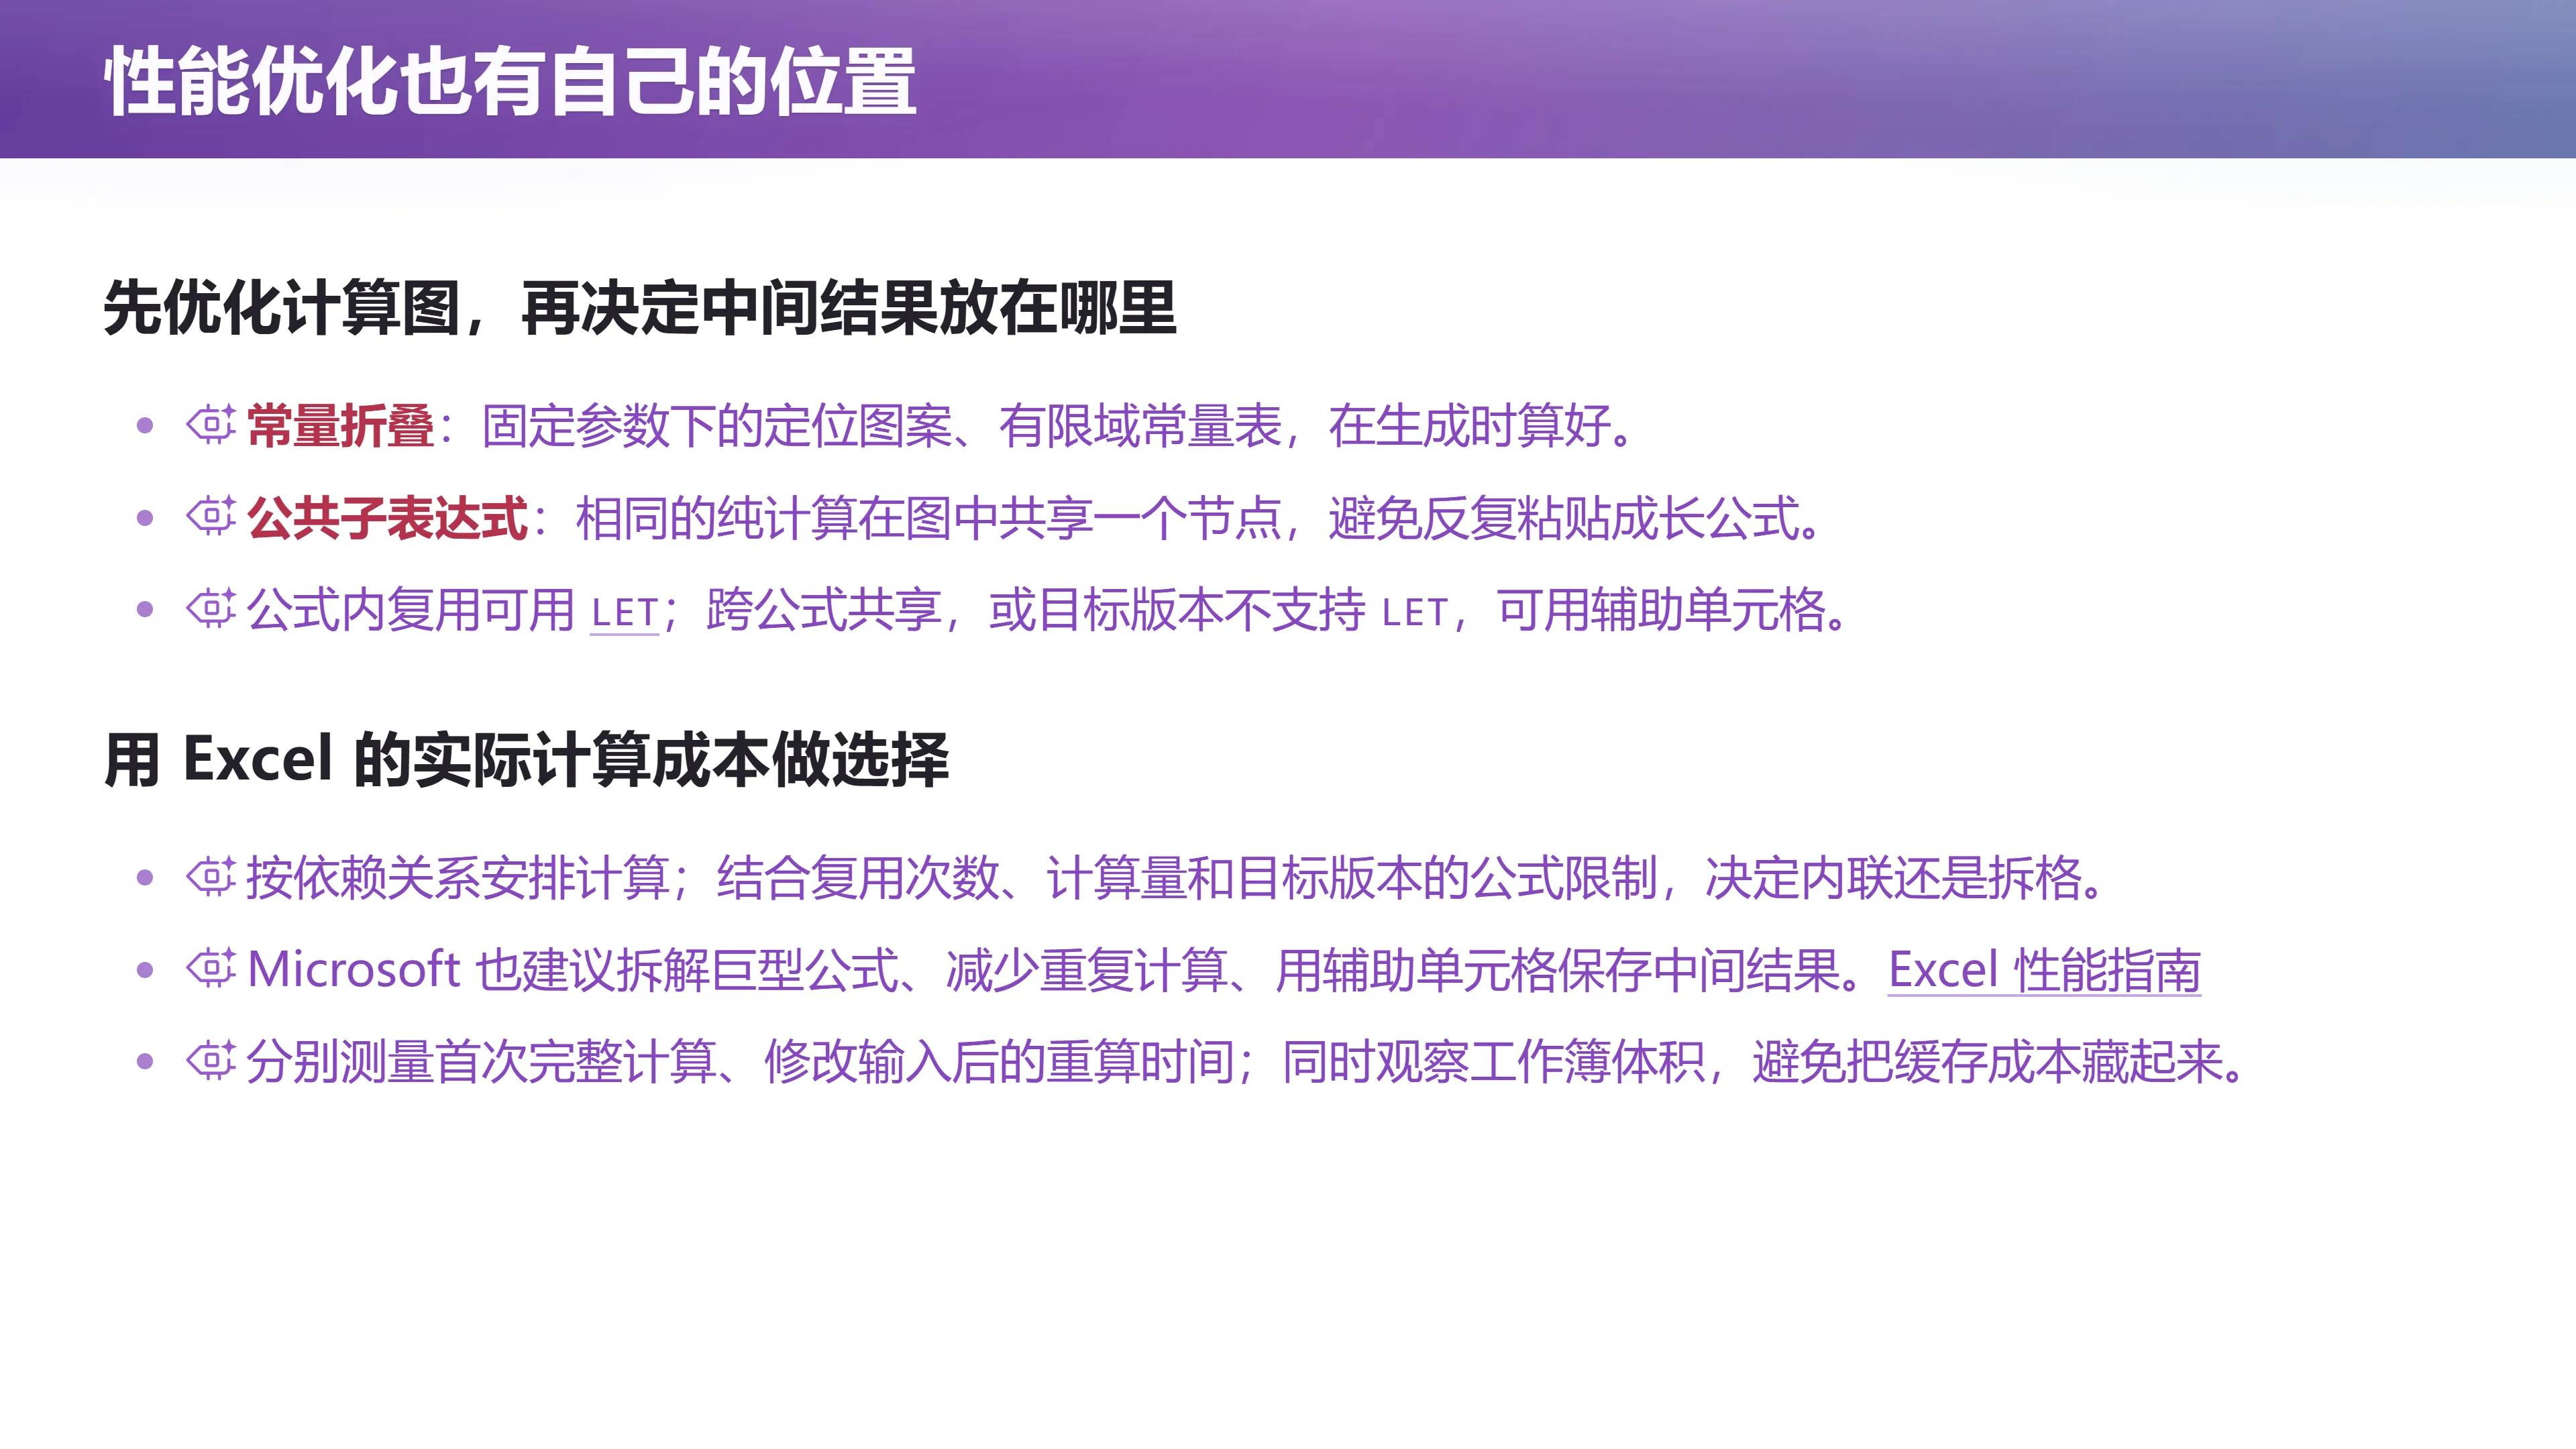
性能优化也有了明确的位置。先优化计算图,再决定中间结果放在哪里。
- 常量折叠(constant folding):与输入无关的内容在生成时算好。比如固定参数下的定位图案、有限域常量表。
- 公共子表达式(common subexpression elimination):重复的纯计算可以共享一个节点,避免把同一段长公式到处粘贴。
- 公式内复用可以用 Excel 的
LET;跨公式共享、或目标版本不支持LET,则用辅助单元格。
生成工作表时再根据复用次数、计算量和目标版本的公式限制,决定哪些计算内联、哪些中间结果放到辅助单元格中。
Microsoft 的 Excel 计算性能指南也建议减少重复计算、拆解巨型公式,并通过测量检查修改的效果——分别测量首次完整计算和修改输入后的重算时间,同时观察工作簿体积,避免把缓存成本藏起来。
讲师在这里顺带提了一句:"这些概念在计算机系统课上学过的 profiling-guided optimization,全都能用上。一个好的架构可以承载需求的变化——未来 Excel 版本改了?没问题,我无非就是把一些算子用另外一种方式去实现。"
说到这里,讲师还打了个岔:"你发现今天 AI inference 也在干这个事——算子、后端、图优化,人类就是这样啊。"
这套设计的价值在于:一次需求变化可以主要落到负责它的模块。 我们仍然需要验证整个结果,但不必每次都重新与所有公式搏斗。
五十万行教务系统:当前状态里藏着什么
(参考时间: 01:12:33)
📷 500,000 行教务系统的例子
回到原视频 (01:12:33)
把规模继续放大到 50 万行的教务系统,架构仍然是怎样看待问题的选择。
说到"架构",大家马上想到数据库、微服务、流式数据处理。但讲师说:"在我开始看架构之前,我们先来看一下 AI 实现了一个什么样的架构。"
AI 生成的教务系统用了什么架构
(参考时间: 01:13:15)
📷 GPT 生成的教务系统代码
回到原视频 (01:13:20)
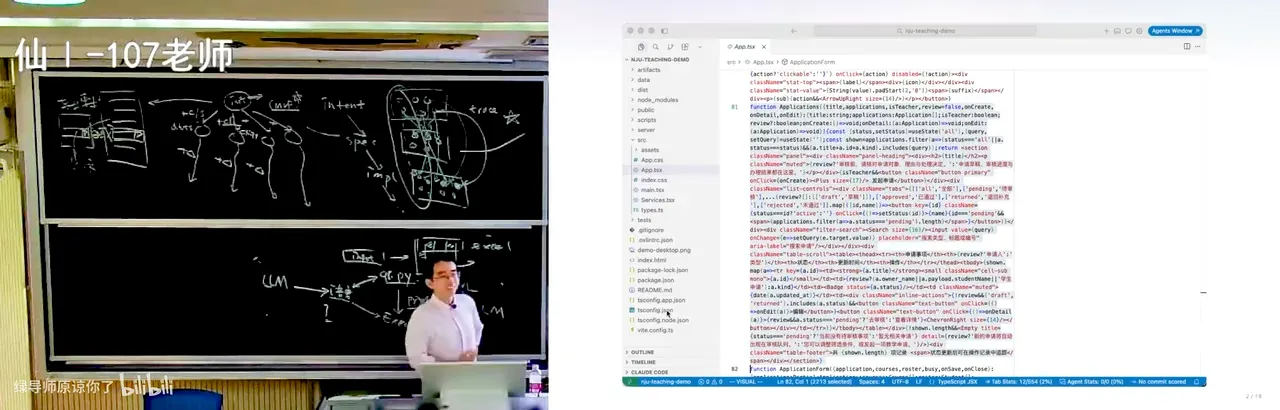
讲师展示了他让 AI 生成的"假教务系统"的源码。他在生成过程中截了一张图发到小红书,配文是"GPT-6 说我不做人了"——呼应前面汉诺塔那一幕:在数学上我能想清楚、数学上是对的,那我不就是对的吗?毫无破绽。
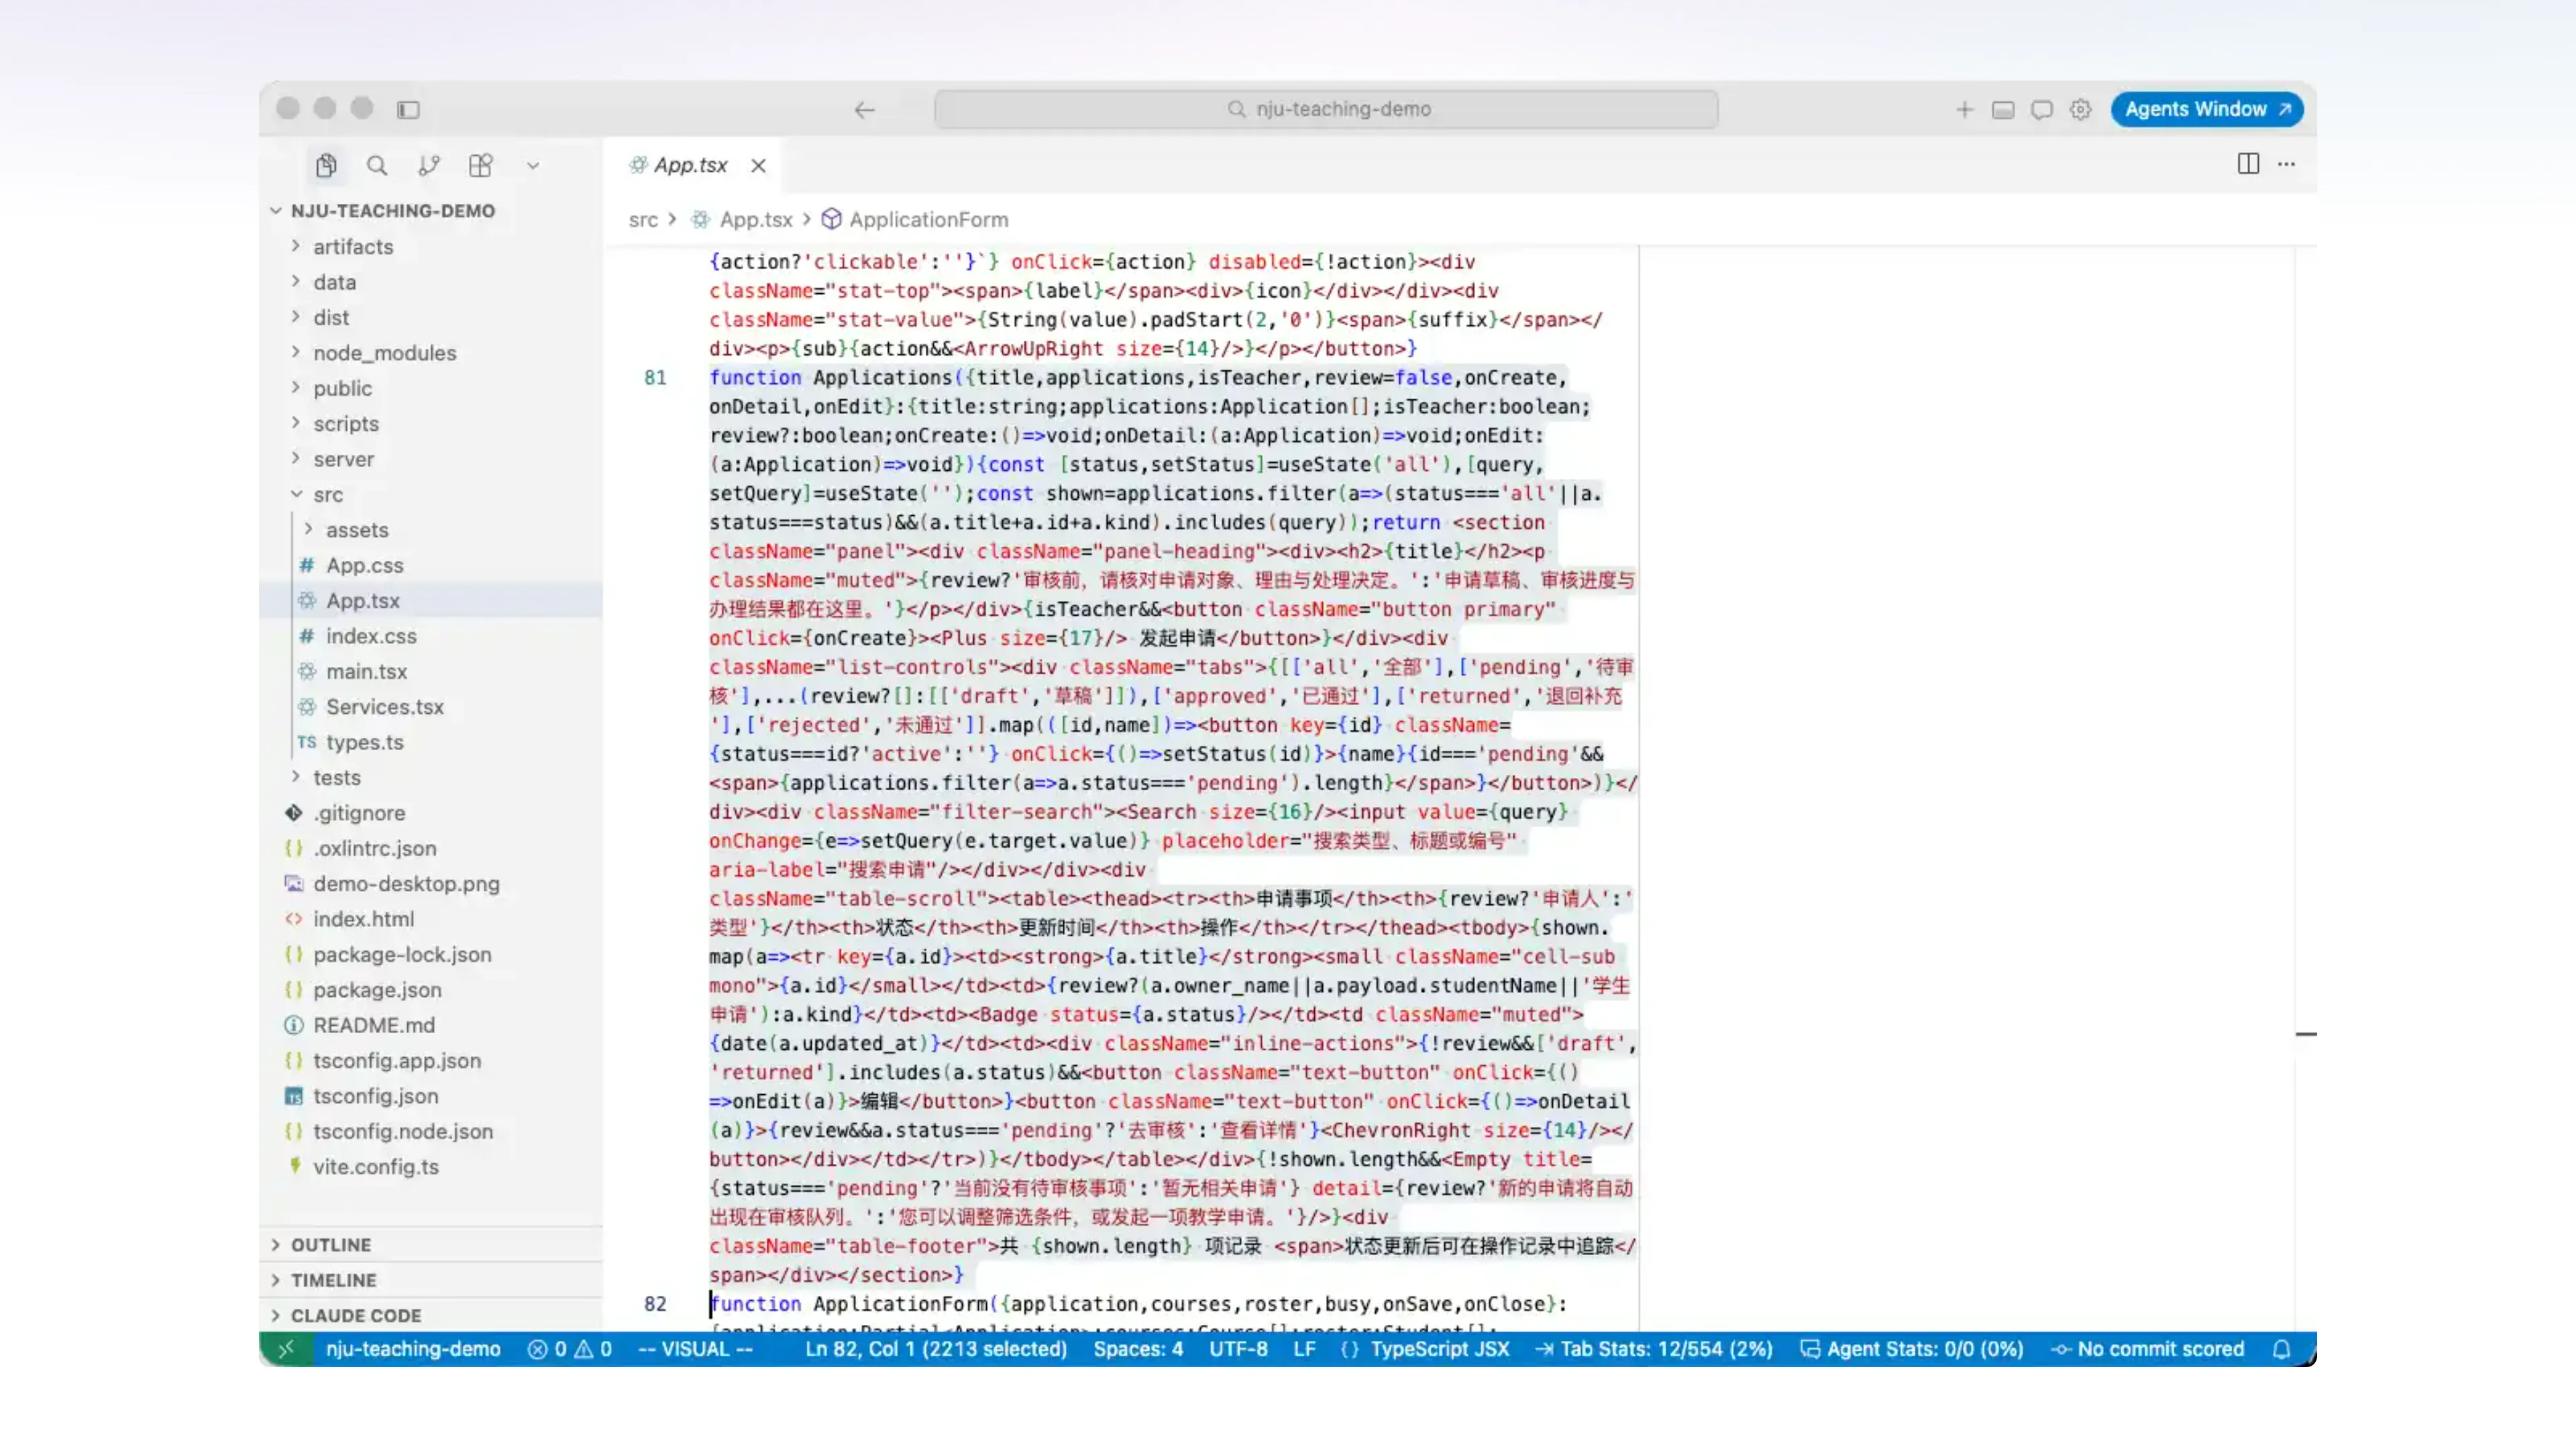
代码里有一个函数叫 functionApplications(,后面"啪啪啪啪啪"接了一大串。讲师说 GPT 还很贴心地用代码格式化工具帮他格式化过了。
📷 AI 生成的教务系统:几个大文件组成的单体
回到原视频 (01:13:40)
现在的 Java demo 大概是这样:
- 一个约 83 KB 的
.tsx; - 一个约 38 KB 的 service 文件;
- 整体还是一个 monolithic(单体) 的结构——但"还是很有水准的"。
讲师觉得它真的很厉害——这个东西能跑对,还是相当了不起的。
📷 新增功能,越来越像拆盲盒
回到原视频 (01:15:15)
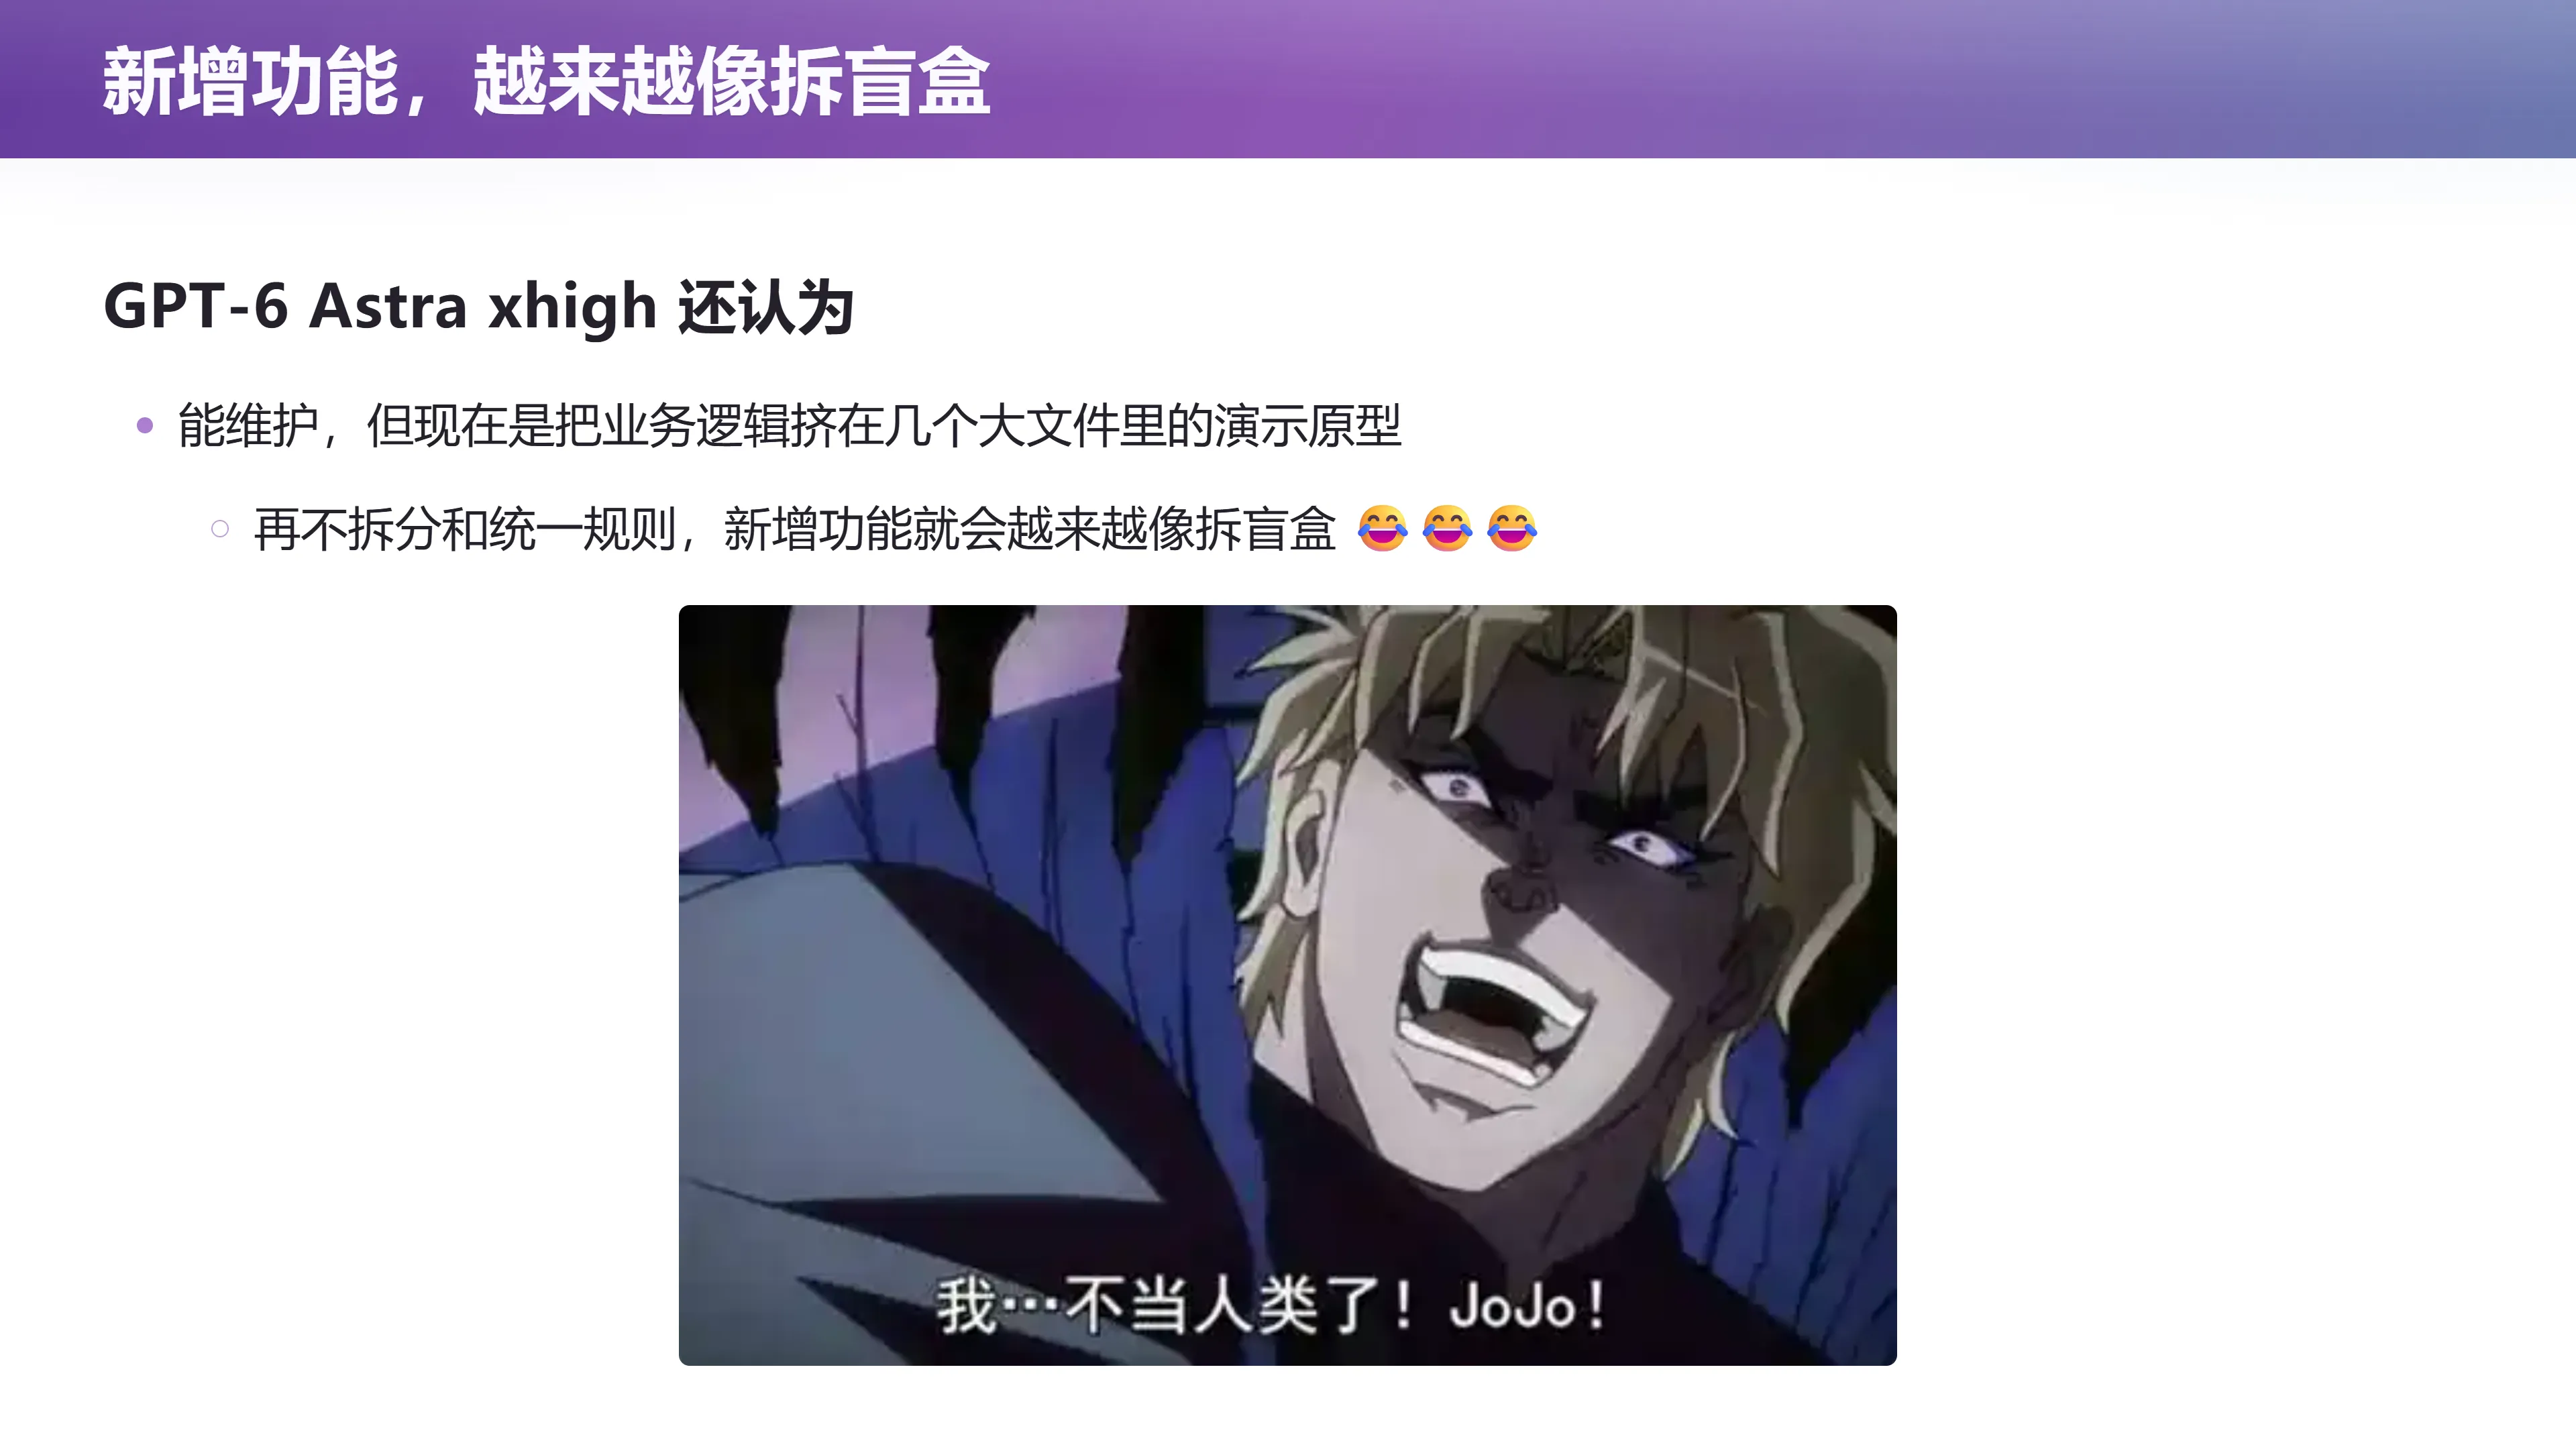
然后他在一个独立的 session 里问这个模型:"这个教务系统使用了怎样的架构?" 又问了:"这个软件能维护吗?"
模型的回答(讲师大受震撼):
"能维护。现在只不过是把业务逻辑挤在几个大文件里的演示原型。" "经典三层单体、前后端分离,而且有几个生产级横切设计:乐观锁、idempotent(幂等)、事务、审计、统一错误处理。" "数据驱动、横向扩展、扩展性很好。"
讲师点评:
- "肯定我会在某一次课的时候来讲讲这些(乐观锁、幂等、事务、审计),这至少要摸爬滚打几年才能理解的设计,它居然有。它有软件工程的直觉。"
- "当然也有差的一面——它自己也说:'再不拆分和统一规则,新增功能就会越来越像拆盲盒。' 😂"
- "很快 AI 生成生产软件的方式就要超过人类了。"
但讲师话锋一转:
"但是,如果我跳出问题看问题,我觉得这还不是一个非常好的架构。因为它本质上是一个 CRUD 的架构。"
CRUD:用当前状态描述世界
(参考时间: 01:16:28)
📷 CRUD 架构:用"当前状态"描述整个世界
回到原视频 (01:16:28)
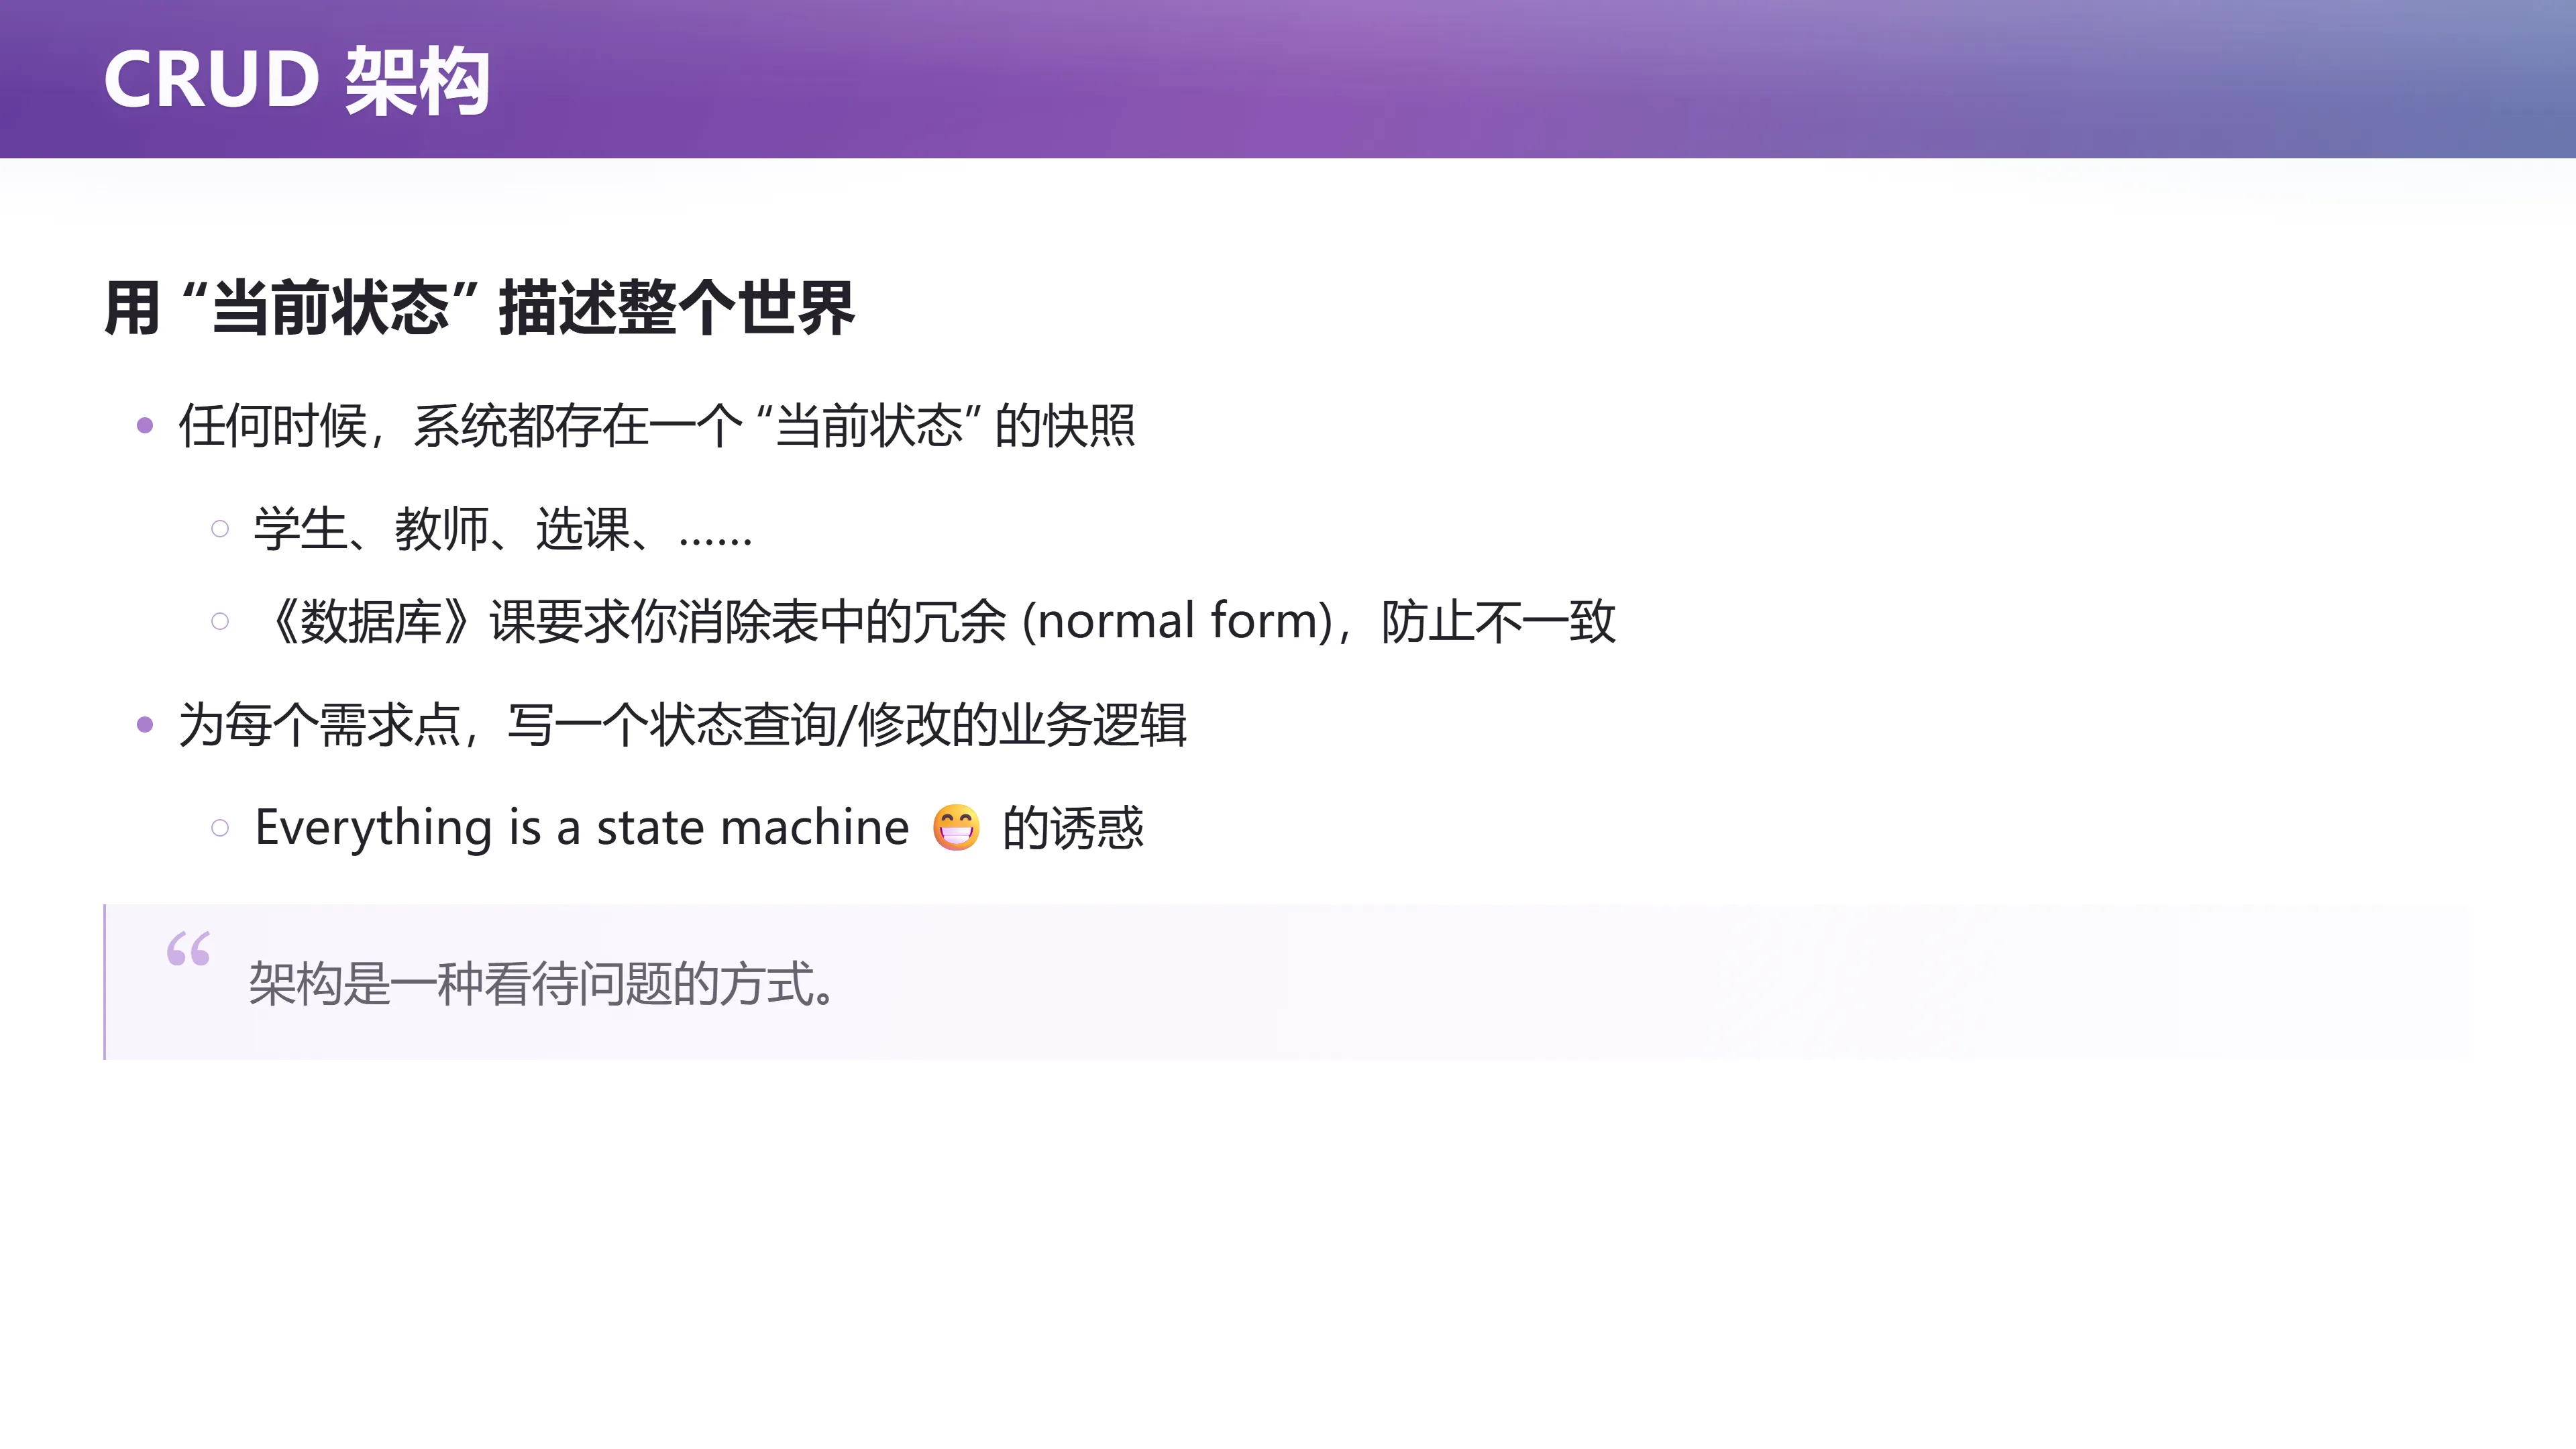
CRUD 架构(Create / Read / Update / Delete)的基本原理是:
我们的软件是物理世界过程在信息世界里的投影。物理世界是有状态的——"Everything is a state machine",我自己也是一个 state machine。于是软件系统很容易被建模成一个状态转移系统(state transition system)。
- 任何时候,系统都存在一个"当前状态"的快照:现在有哪些学生、教师、课程和选课记录;
- 持久状态一般用数据库保存,一张表表示学生(学号、姓名、院系……),一张表表示学院,一张表表示选课;
- 《数据库》课要求你消除表里的冗余(normal form),防止不一致。
graph LR
    S0["状态 S₀<br/>(数据库快照)"] -->|"DELETE:张三退学"| S1["状态 S₁<br/>(A 的记录不存在了)"]
    S1 -->|"插入:张三复学"| S2["状态 S₂"]
    S0 -.->|"历史丢失"| X1["❌"]
    S1 -.->|"历史丢失"| X1
    style X1 fill:#ffcccc
为什么数据库课要求消除冗余?
讲师的原话:"你最好不要在一张表里用姓名来引用一个学生,因为学生可能会重名,就算不重名也会带来麻烦。更好的是不放姓名,而是放一个学生 id,比如 1234——这个 id 就相当于一个链接,指向学生的信息。其实就是铲除冗余的 dependency:我一个地方改了,就不需要改另外一个地方。
如果这个学生真的改名字了——不要笑,这件事在中国是合法的——那你只改一处就行,再记一个曾用名。但如果你在两个地方都存了名字,那对不起,两个地方都要改。这就是一个很大的代价。"
然后,每当一个需求出现,就为它写一段查询或修改这些记录的业务逻辑。"只要为每个按钮找到对应的状态变化,一个功能似乎就完成了。" 数据库课程的范式则帮助我们减少冗余以及由此产生的更新异常。对于简单的数据维护,这种组织方式十分直接。
讲师在这里提了一个值得注意的心态问题:"Everything is a state machine 😁 的诱惑。" 状态机视角太自然、太好用了,以至于人们很容易以为"世界就是一张表的当前状态"。
当前状态里混着事实、规则和决定
(参考时间: 01:19:44)
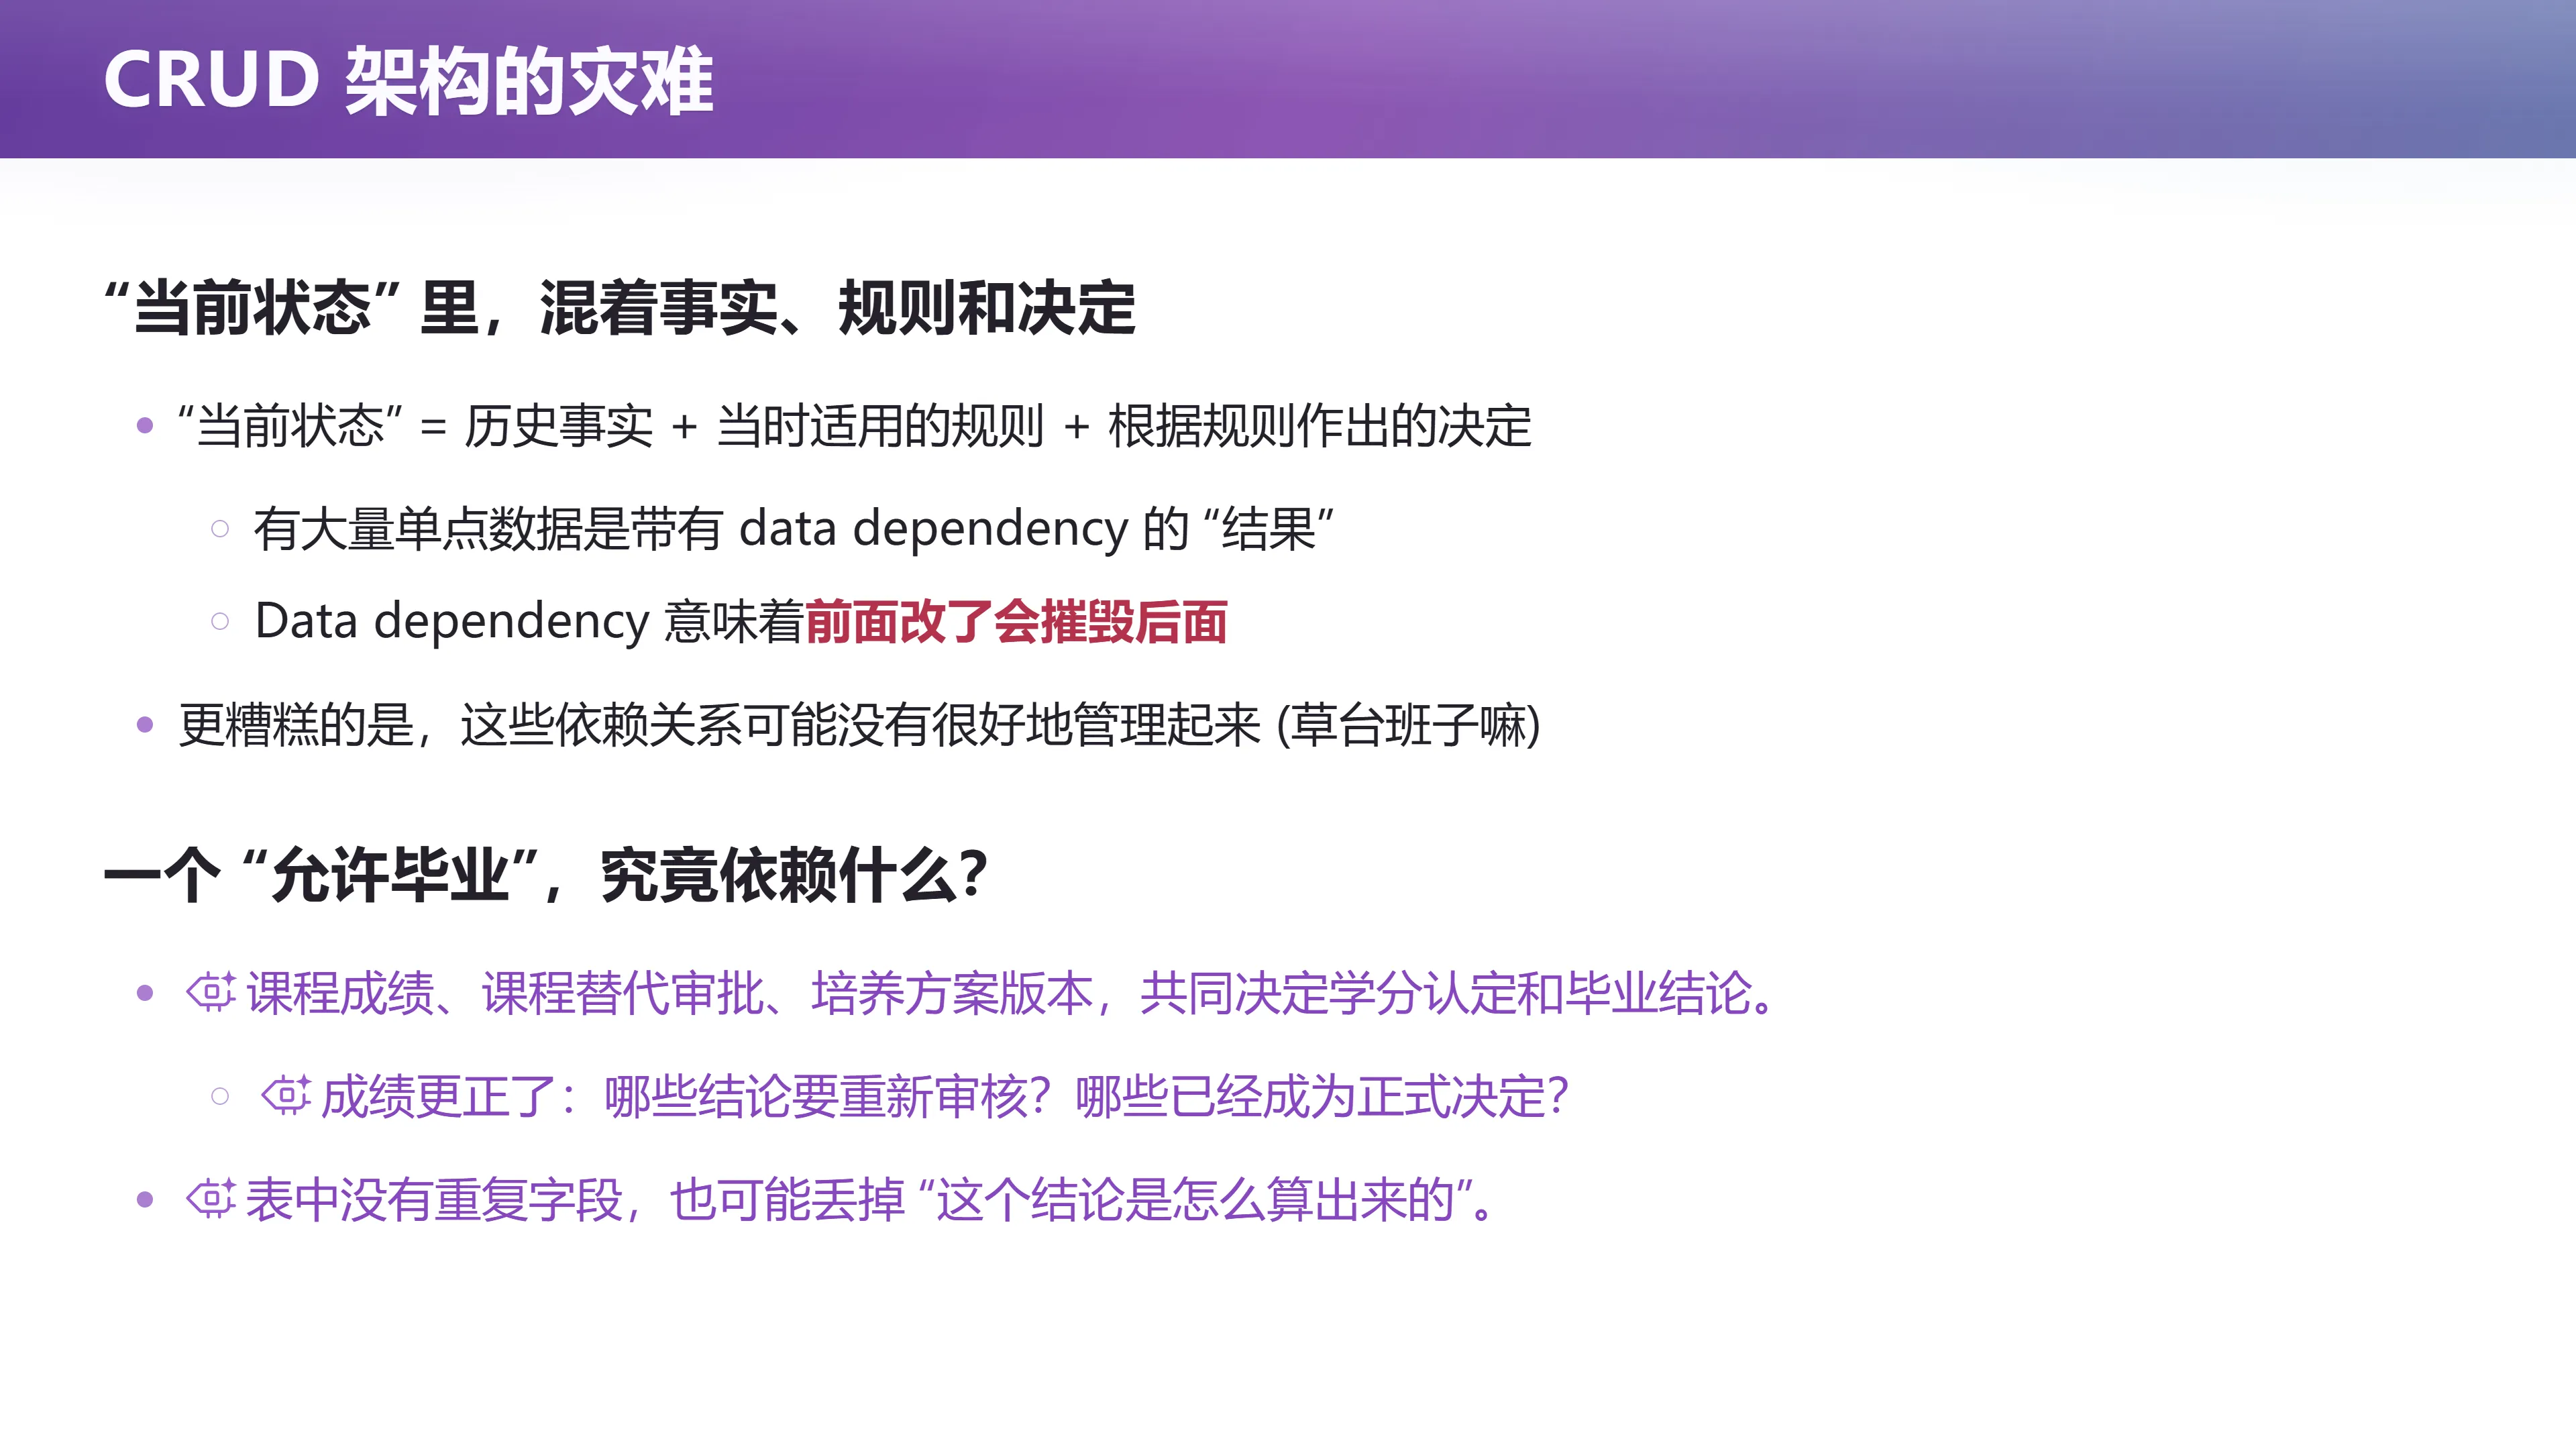
📷 CRUD 架构的灾难:当前状态里混着事实、规则和决定
回到原视频 (01:19:44)
但教务系统里的许多字段,已经是推理和决策的结果。
举例来说,假设学生表里有一列叫 can_graduate:
- 它是一个
true / false; - 但它可能依赖学生的课程成绩、课程替代审批、培养方案版本和人工豁免;
- 它实际上把历史事实 + 当时适用的规则 + 根据规则作出的决定压缩成了一个当前值;
- 而且它往往是增量算出来的:每当修了一个学分、毕业设计状态改变,系统都要重新计算一次这个"能否毕业"的逻辑。
graph TD
    G["can_graduate = true"] --> A["课程成绩"]
    G --> B["课程替代审批"]
    G --> C["培养方案版本"]
    G --> D["人工豁免 / 特批"]
    A -.->|"成绩更正?"| Q1["哪些学分认定要重算?"]
    B -.->|"撤销认定?"| Q2["哪些毕业审核要复核?"]
    D -.->|"决定已发布?"| Q3["还能不能直接覆盖?"]
    style G fill:#ffe6cc
这又是数据依赖:
- 成绩更正以后,哪些学分认定需要重新计算?哪些毕业审核需要复核?
- 某个决定如果已经正式发布,还能不能直接覆盖?
- 即使数据库表没有重复字段,如果没有保存这些依赖,我们仍然不知道一个结论从哪里来,也不知道前面的变化会破坏哪些后续结论。
编者说明:注意这里和"数据库范式"的关系。范式消除的是同一时刻的冗余(横向),而这里丢失的是跨时间的依赖(纵向)。一张完全符合 3NF、BCNF 的表,仍然可以把
can_graduate这样的派生值存成一个孤立的标量,从而丢掉它是怎么算出来的。范式解决不了这个问题。
软件是现实过程的有损投影
(参考时间: 01:22:21)
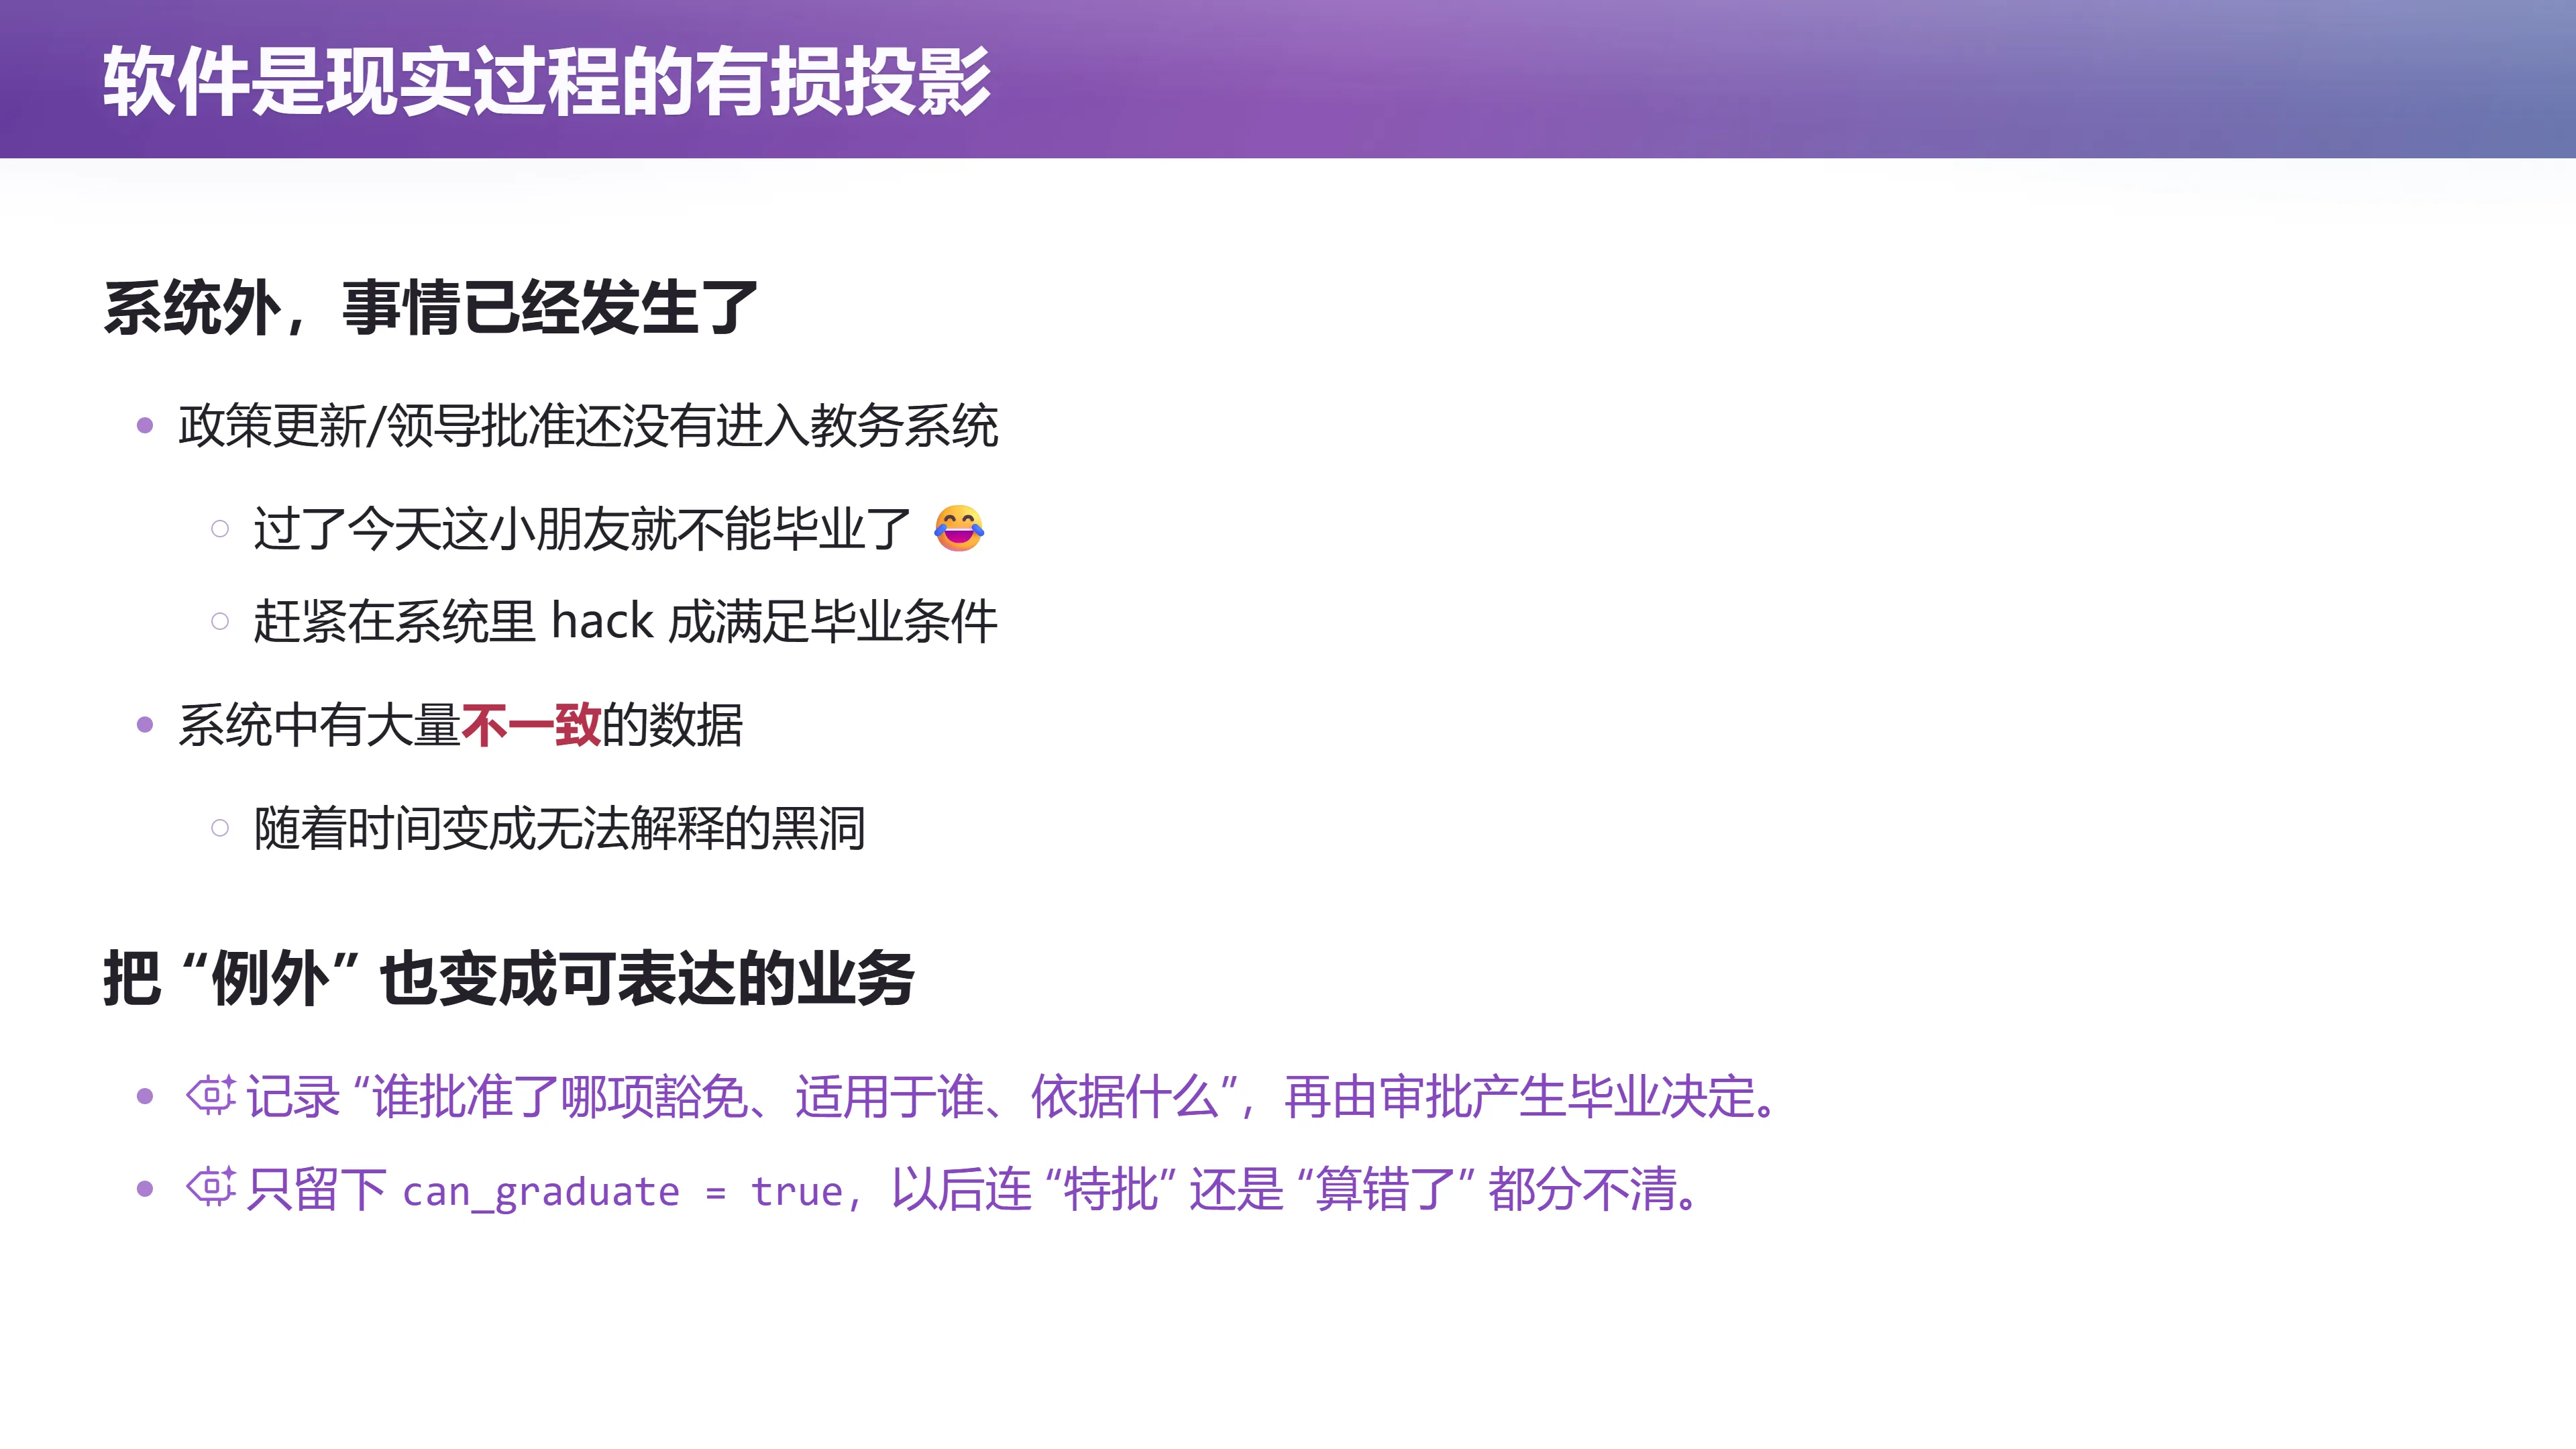
📷 软件是现实过程的有损投影
回到原视频 (01:22:21)
更麻烦的是:软件只是现实过程在信息世界中的有损投影。
graph LR
    W["物理世界<br/>事实已发生"] -->|"有损投影"| S["信息系统<br/>只保留部分状态"]
    W -.->|"无法建模的部分"| H["人工 hack / 手改数据库"]
    H -.->|"不一致数据积累"| B["无法解释的黑洞"]
    style B fill:#ffcccc
课堂上政策已经更新、领导已经批准,系统却还没来得及表达它。眼看今天不处理学生就不能毕业了,工程师只能先把数据库改成"满足毕业条件"。
讲师举了几个非常"现实"的例子:
- 新培养方案已经通过、学期已经开始、课都已经在上——但数据还没导入教务系统;
- 开学第一周,仙林这一片教学楼还在装修、教室不能用——教务系统显然没有对这一点建模,最后只能靠人工手改、重新安排教室,"然后我第一周就去另外一个教室上课了"。
如果最后只留下一个布尔值,几个月以后就难以分辨:这是正常审核、正式特批,还是一次救火时的误操作?
"明明这个同学不该毕业的,他为什么毕业了?明明这个同学没有交学费,应该毕不了业的,为什么他能毕业?系统里就无数这样你想都不能想的不一致。"
程序还能运行,数据却逐渐变成无法解释的黑洞。 继续让 AI 修修补补,可以消除眼前的一些报错,却未必能补回已经丢失的业务含义。
正确的方向是:把"例外"也变成可表达的业务。
- 记录"谁批准了哪项豁免、适用于谁、依据什么",再由审批产生毕业决定;
- 而不是只留下
can_graduate = true——那样以后连"是特批"还是"算错了"都分不清。
南大没系啦:同一个 dept_id,还是新的?
(参考时间: 01:23:56)
📷 需求的语义,还会变:南大没系啦
回到原视频 (01:23:56)
需求的语义本身还会变化。讲师引用了当时刷屏的《南大没系啦》:计算机系变成了计算机学院。
对师生来说可能是喜大普奔,对教务系统来说却立即出现了一个问题:dept_id 沿用旧的,还是新建一个?
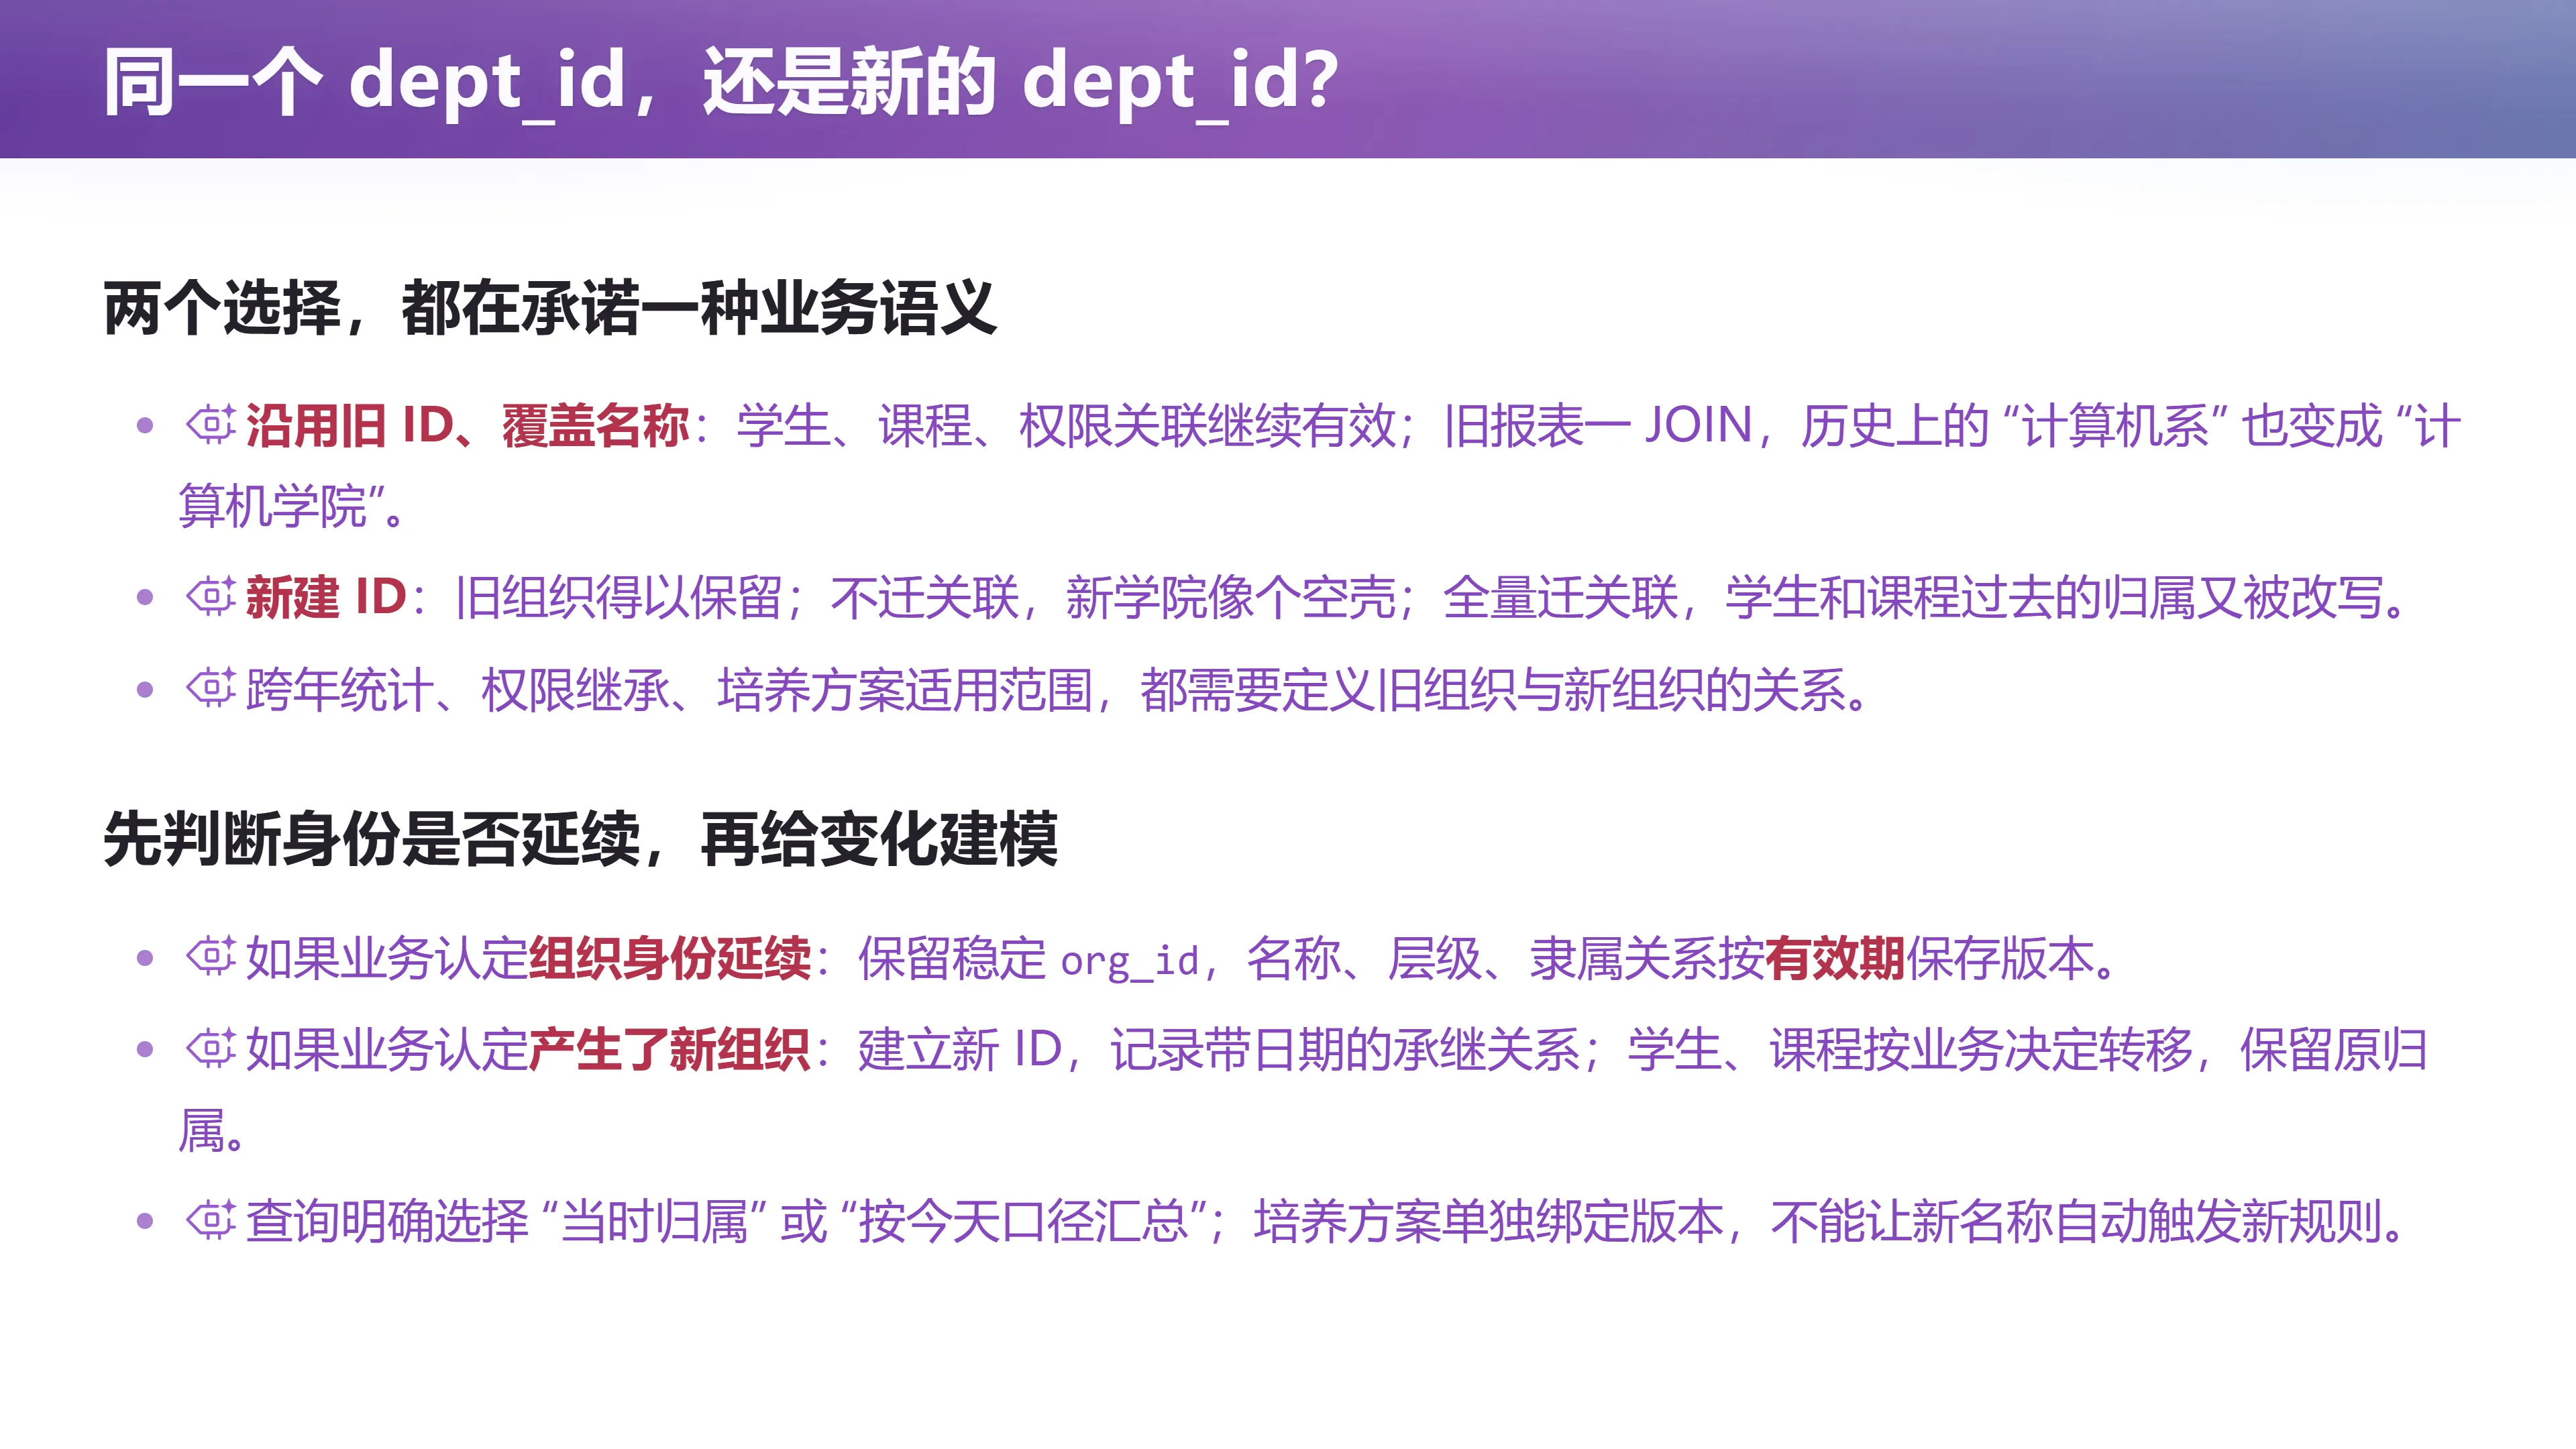
📷 同一个 dept_id,还是新的 dept_id?
回到原视频 (01:24:26)
选择一:沿用旧 ID,直接覆盖名称。
- 学生、课程和权限的关联都可以继续工作;
- 但查询历史成绩单或报表时,只要连接到现在的组织表,过去的"计算机系"也会被显示成"计算机学院"。
- 讲师的原话:"我在 2011 年从南京大学计算机学院毕业——这个就与事实不符了,因为我 2011 年的时候它还是计算机系。"
选择二:新建 ID。
- 旧组织确实保留下来了;
- 但新学院可能变成一个没有学生、没有课程、没有权限关联的空壳;
- 把所有旧关联迁过去,又会改写学生和课程过去的归属;
- 跨年统计、权限继承、培养方案适用范围,仍然需要解释两个组织之间是什么关系。
讲师的结论是:问题的关键在于区分三件事——
- 组织身份(这个组织是否是同一个);
- 组织属性(名称、层级、职责);
- 某个时刻的隶属关系(某个学生在某个时间属于哪个组织)。
具体做法:
- 如果业务认为组织身份延续:保留稳定的组织 ID,让名称、层级等属性按有效期保存版本;
- 如果业务认为产生了新的组织:建立新 ID,记录带日期的承继关系,按业务决定转移相应关联,同时保留历史归属;
- 查询也要说清楚口径:是查看"当时的组织归属",还是按"今天的组织结构"重新汇总?
- 培养方案应有自己的版本,不能因为组织换了名称,就让所有学生自动适用另一套毕业要求。
系统一旦跑起来,修改的代价极高
(参考时间: 01:27:19)
📷 系统一旦跑起来,修改的代价极高
回到原视频 (01:27:19)
代码可以重写,历史不能凭空补出来。
- 数据库迁移、业务逻辑重写都是风险极高的操作;
- 不一致的数据无法解释;
- 同样一个"已毕业",可能来自正常审核、人工特批,也可能只是某次救火;
- 迁移需要决定哪些历史含义继续成立;没有保存的依据,AI 也推不回来。
讲师这里讲了一段他自己的亲身经历:
我读 PhD 的时候,我们隔壁的软件工程组接了学校研究生院教务系统的订单——可能就二三十万。这在定制化软件里其实算比较小的订单,因为你要不停地维护。
那位接活的是我的室友。我经常跟他抬杠,跟他聊研究生院这个系统该怎么设计。我经常"喷"他,因为他是一个非常典型的 CRUD 架构。我说你最后会面临各种各样的问题。
果然,就在那几年,我们的研究生发生了巨大的扩招,又多了很多研究生的类型和培养类型;研究生压力大,经常有调整——这些都是他们在做需求设计的时候始料未及的。最后那个系统就彻底变成屎山,然后就不存在了——现在统一变成公司维护的系统。
软件的设计、实现、维护都是手艺活。 我调侃这个教务系统做得不好,它确实有做得不好的一面;但你反过来想,它作为一个软件工程的实践者——那家公司在 2000 年成立,当时它做的唯一选择就是参考一个已有的企业架构来做教务系统,抢占教育市场的第一桶金。一旦背上这个技术债,它就要在中国大学教育改革这几十年的时间里,不断地扛下所有。
这也是 ERP 类系统的护城河:它们有领域知识,知道这些系统应该怎么把屎山扶起来。
编者说明:ERP(Enterprise Resource Planning,企业资源计划)指覆盖财务、供应链、人力、生产等一整套企业核心流程的集成信息系统,典型如 SAP、Oracle E-Business Suite 等。它们的"护城河"往往不在于某个算法,而在于承接了企业几十年积累的历史数据与业务规则。这恰好映证了本讲的核心论点:可继承的历史本身就是资产,也是迁移成本。
数据结构的两面:从持久化数据结构出发
(参考时间: 01:29:53)
📷 把依赖变成 First-Class Citizens
回到原视频 (01:29:53)
既然依赖和历史如此重要,为什么不把它们变成程序可以明确表示、保存和处理的对象,也就是所谓的 first-class citizens?
讲师的思路是从数据结构课出发的:
我们通常把世界建模成"一个当前状态",对它做一次操作就到下一个状态——这就是经典的 CRUD。但是还有另外一种方式。
持久化数据结构(persistent data structure)可以保留数据结构的历史:
- 一开始只有一个节点;
- 某次操作没有改变某个子树,那就可以直接把这个子树共享过来,不需要复制;
- 当某条路径真的变了,只需要沿着从修改点到根的这条路径长出新的节点,其余部分仍然指向旧结构。
graph TD
    R0["root(版本 0)"] --> L0["左子树"]
    R0 --> Rr0["右子树"]
    R1["root(版本 1)"] --> L1["新的左子树<br/>只改了一条路径"]
    R1 --> Rr0
    R0 -.->|"旧版本仍然可达"| L0
    style R1 fill:#e6f3ff
    style Rr0 fill:#fff2cc
无论树多大,修改一条路径的代价都只是路径长度。 于是"当前状态"和"历史"可以同时存在。
三种等价的视图
(参考时间: 01:31:30)
讲师指出,有三种视图是等价的:
graph TB
    subgraph 三种等价视图
    A["① 存当前状态<br/>(快照)"]
    B["② 存操作的 Delta<br/>(增量)"]
    C["③ 存操作日志<br/>(Event Log)"]
    end
    A <-->|"回放日志可得到状态"| C
    B <-->|"应用 Delta 可得到状态"| A
    C <-->|"对日志求差可得 Delta"| B
- 存当前状态就是 CRUD;
- 存操作日志,就是数据库 / 操作系统课上讲的 write-ahead journal(WAL);
- 存 Delta,就是 Git、SVN 这类版本管理里的思想。
而它们都能帮你回放历史,得到当前状态。
讲师用一个很小的例子说明它的价值:
假设复学这个操作此前没有被考虑过。如果系统是纯 CRUD,删掉张三的记录就等于把他彻底抹掉——他的选课记录也可能一起被删。等他买了 token 又要复学,你得把这些和其他部分的关联重新建起来,那是很大的代价。
但如果你是用"记录所有操作"的方式,你就可以通过 replay 知道张三复学前的状态是什么,然后把这个状态拿过来——它没有丢。
当然,你的逻辑是不能减少的:复学这件事之前没考虑过,你依然要为它写一段逻辑。但是因为事实是不可篡改的、世界里所有东西都是对事实的投影,你好像就有底气了一些。
你就不怕错了,就不会像刚才那样说"我要做一个数据库迁移的时候,我手在抖"——你总知道,任何一步做错了,你都可以很快地退回到过去的一个快照,把逻辑修复好再来。
计算机系 → 计算机学院,也能有解了
有了这套结构,前面那个 dept_id 的难题也相对好解了:
- 在某个时刻记录一个事件:"院系调整";
- 查询过去的一个人时,你查到他过去的版本;
- 并且你知道他经历了这个调整;
- 如果你想要得到当前的信息,你可以让这个人的相关历史投影出来。
"这个同学 2007 年入学、2011 年毕业,这一段时间都是计算机系;计算机系在 2024 年改为了计算机学院。你看到我可以裁出一段和事实相关的历史,把这个相关历史 replay,得到我现在要的状态。我可以查询过去,也可以查询现在——这就是一个好的架构设计。"
把历史保存下来:事件溯源
(参考时间: 01:35:04)
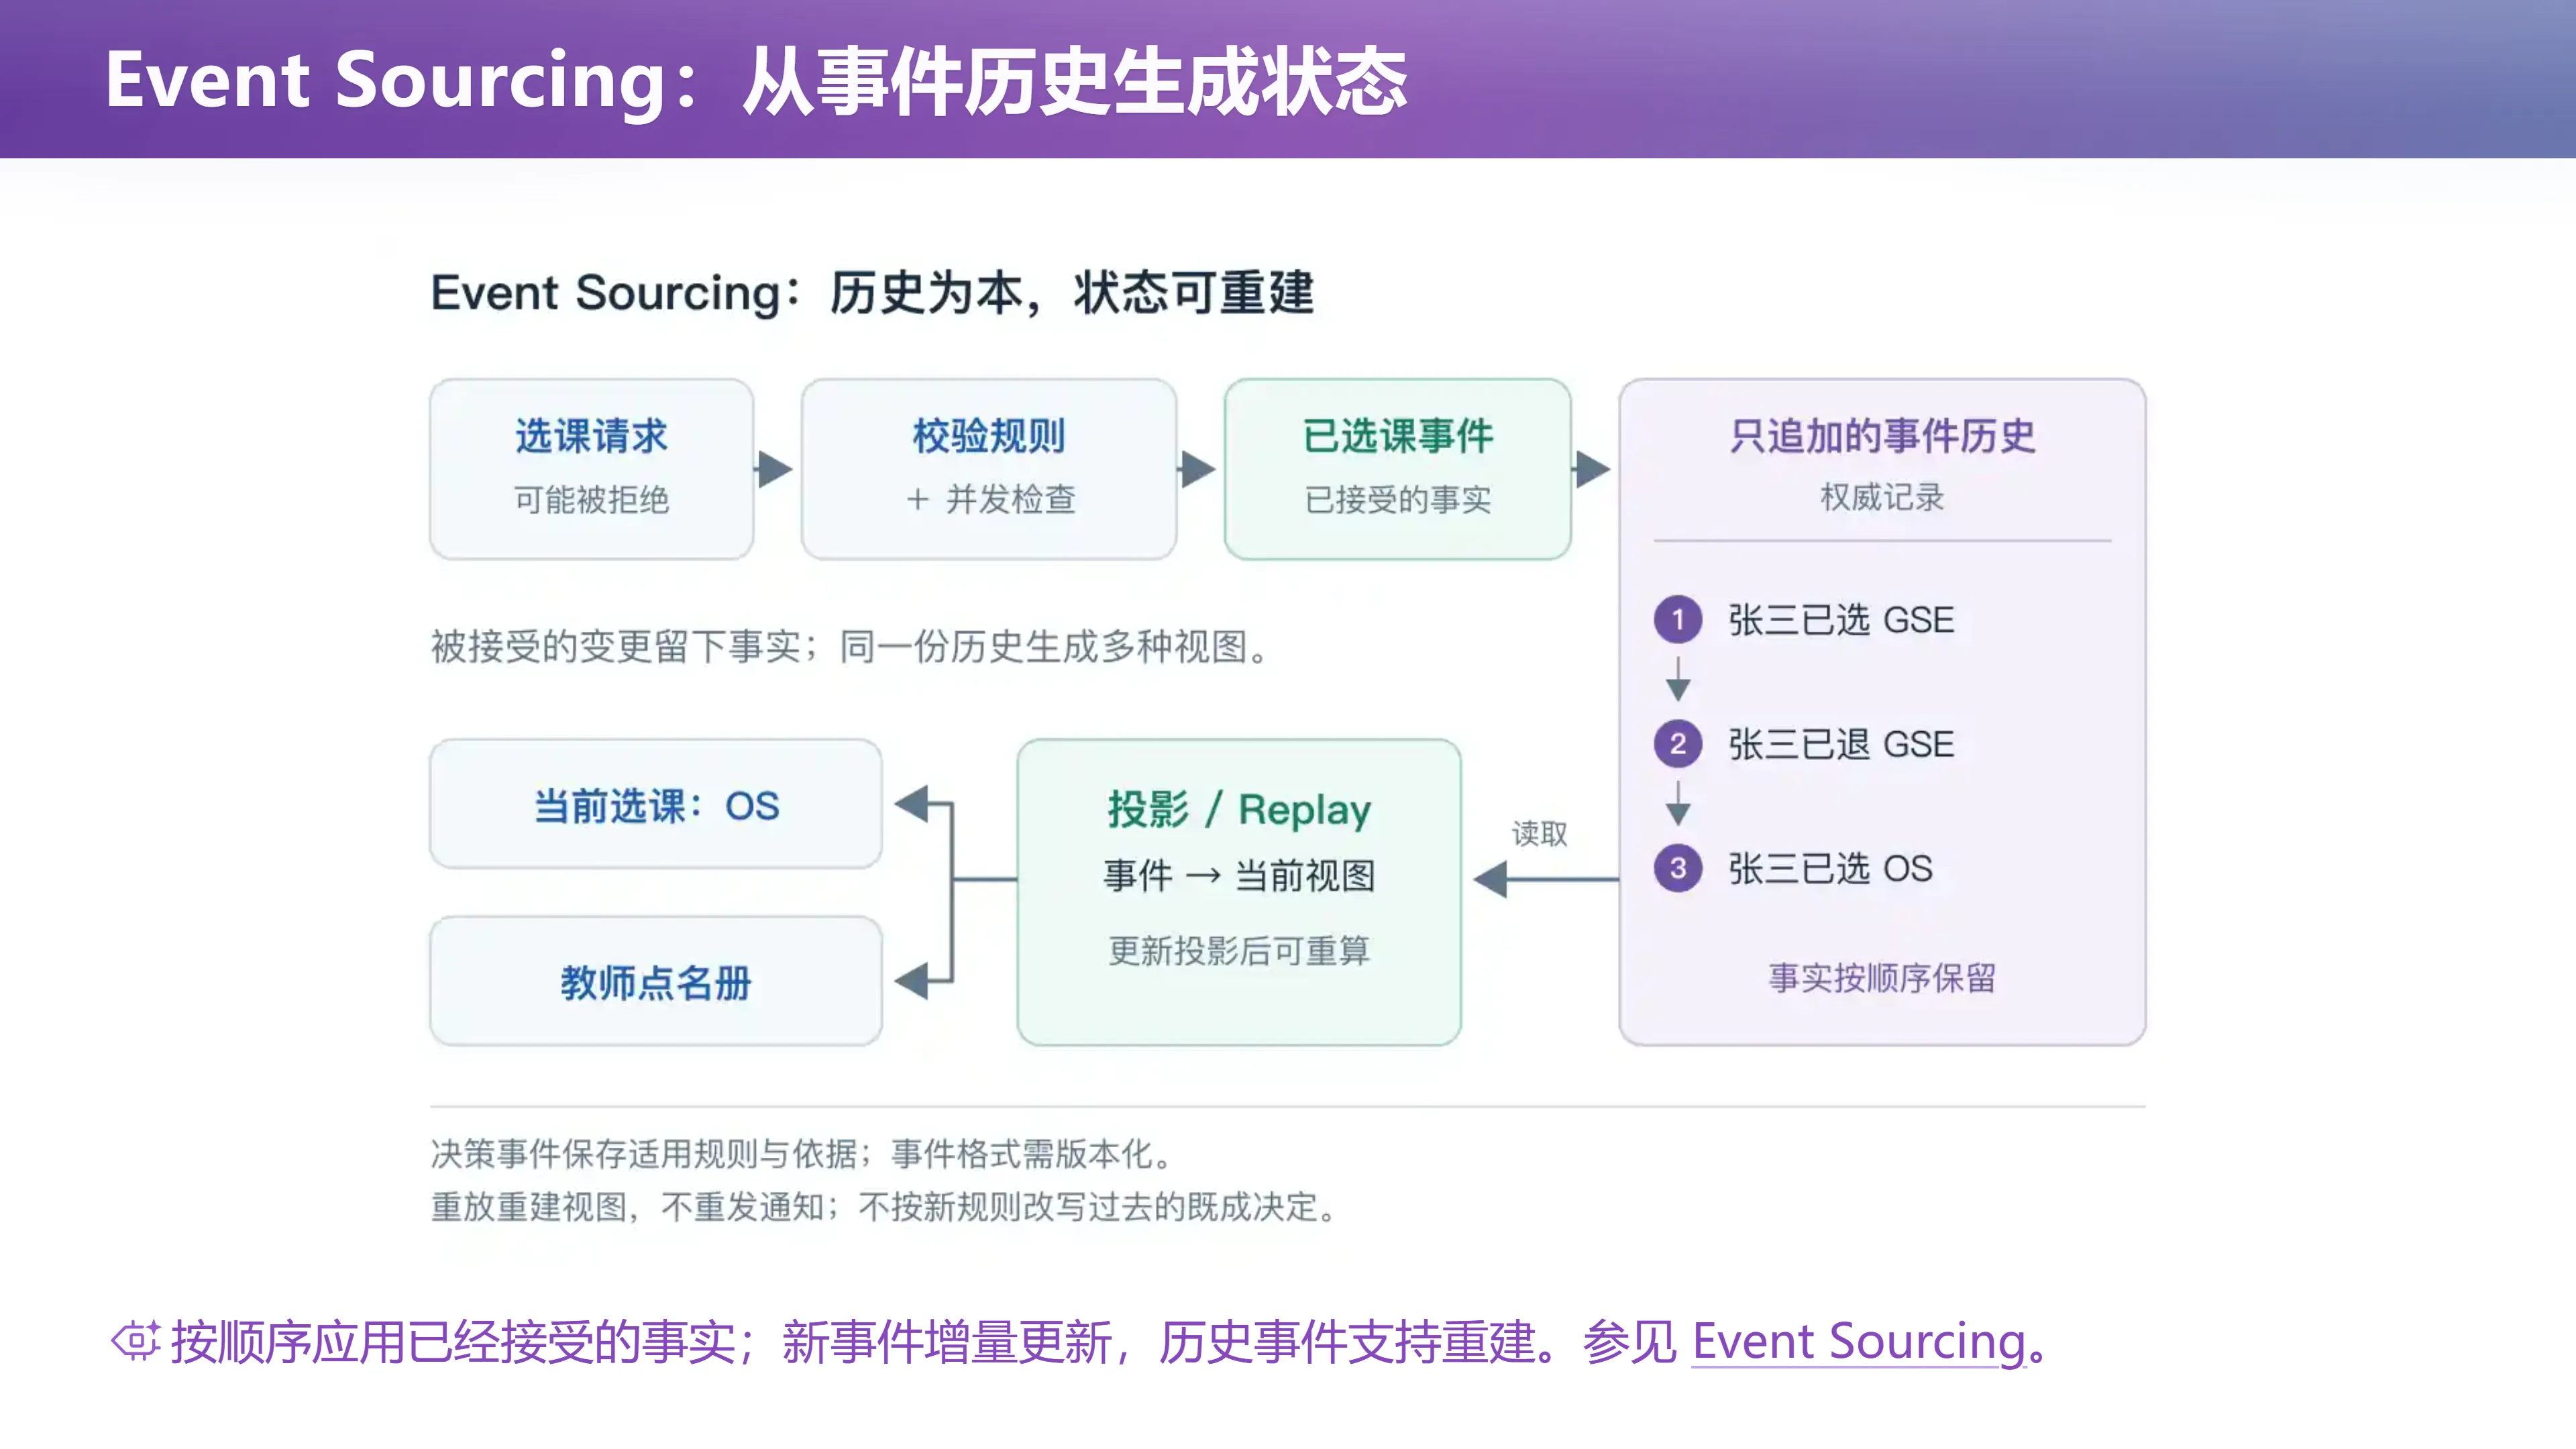
📷 Event Sourcing:从事件历史生成状态
回到原视频 (01:35:04)
祝贺你,你就发明了一个叫 Event Sourcing(事件溯源)的经典设计模式。
它的想法很简单:从历史事件生成状态,而不是直接维护 CRUD 的状态。
数据结构有两种常见的观察角度:
- 我们可以只保存"张三目前选了《生成式软件工程》";
- 也可以保存"张三的选课申请已被接受"这件事,以及后来是否退学、是否再次入学。
把被系统接受的事件依次应用到初始状态上,就可以得到当前状态;改变查询方式,还可以回答过去发生了什么。
账本是一个容易理解的类比:余额告诉我们现在有多少钱,逐笔收支还能解释钱为什么变成了这么多。
编者说明:Martin Fowler 对事件溯源的介绍讨论了这种表示带来的历史查询和重放能力。作为模式名,"Event Sourcing" 由 Fowler 在同名文章(2005)中系统化提出;其思想根源可以追溯到会计复式记账、数据库的 WAL 日志,以及 Lisp 社区对"事件流即程序状态"的探索。
回到教务系统,我们可以记录:选课已接受、成绩已登记、课程替代已批准、毕业审核已完成等事件,再从中构造学生课表、教师点名册或审核视图。
- 把事件转换成某种状态或查询结果的过程,称为 投影(projection);
- 重新应用已有事件的过程,称为 重放(replay)。
按顺序应用已经接受的事实;新事件增量更新,历史事件支持重建。
性能不是问题
(参考时间: 01:35:26)
有人马上会问:每次都 replay 大量事件,会不会有性能问题?
讲师说:这都不是很大的问题。 我们总可以有办法:
- 使用快照(snapshot):记录某个位置的当前状态,从那里往后重放;
- 维护当前结果 + 增量更新:新事件到来时增量更新当前视图,需要重建时再重放相应历史;
- 缓存、批处理等常规手段。
但同时要清醒:
"如果你已经在屎山上,把它改造成 Event Sourcing 会很困难。但如果你从一开始就做 Event Sourcing 的设计,很多事情问题都不会发生。"
重放时,究竟重放什么
(参考时间: 01:35:45)
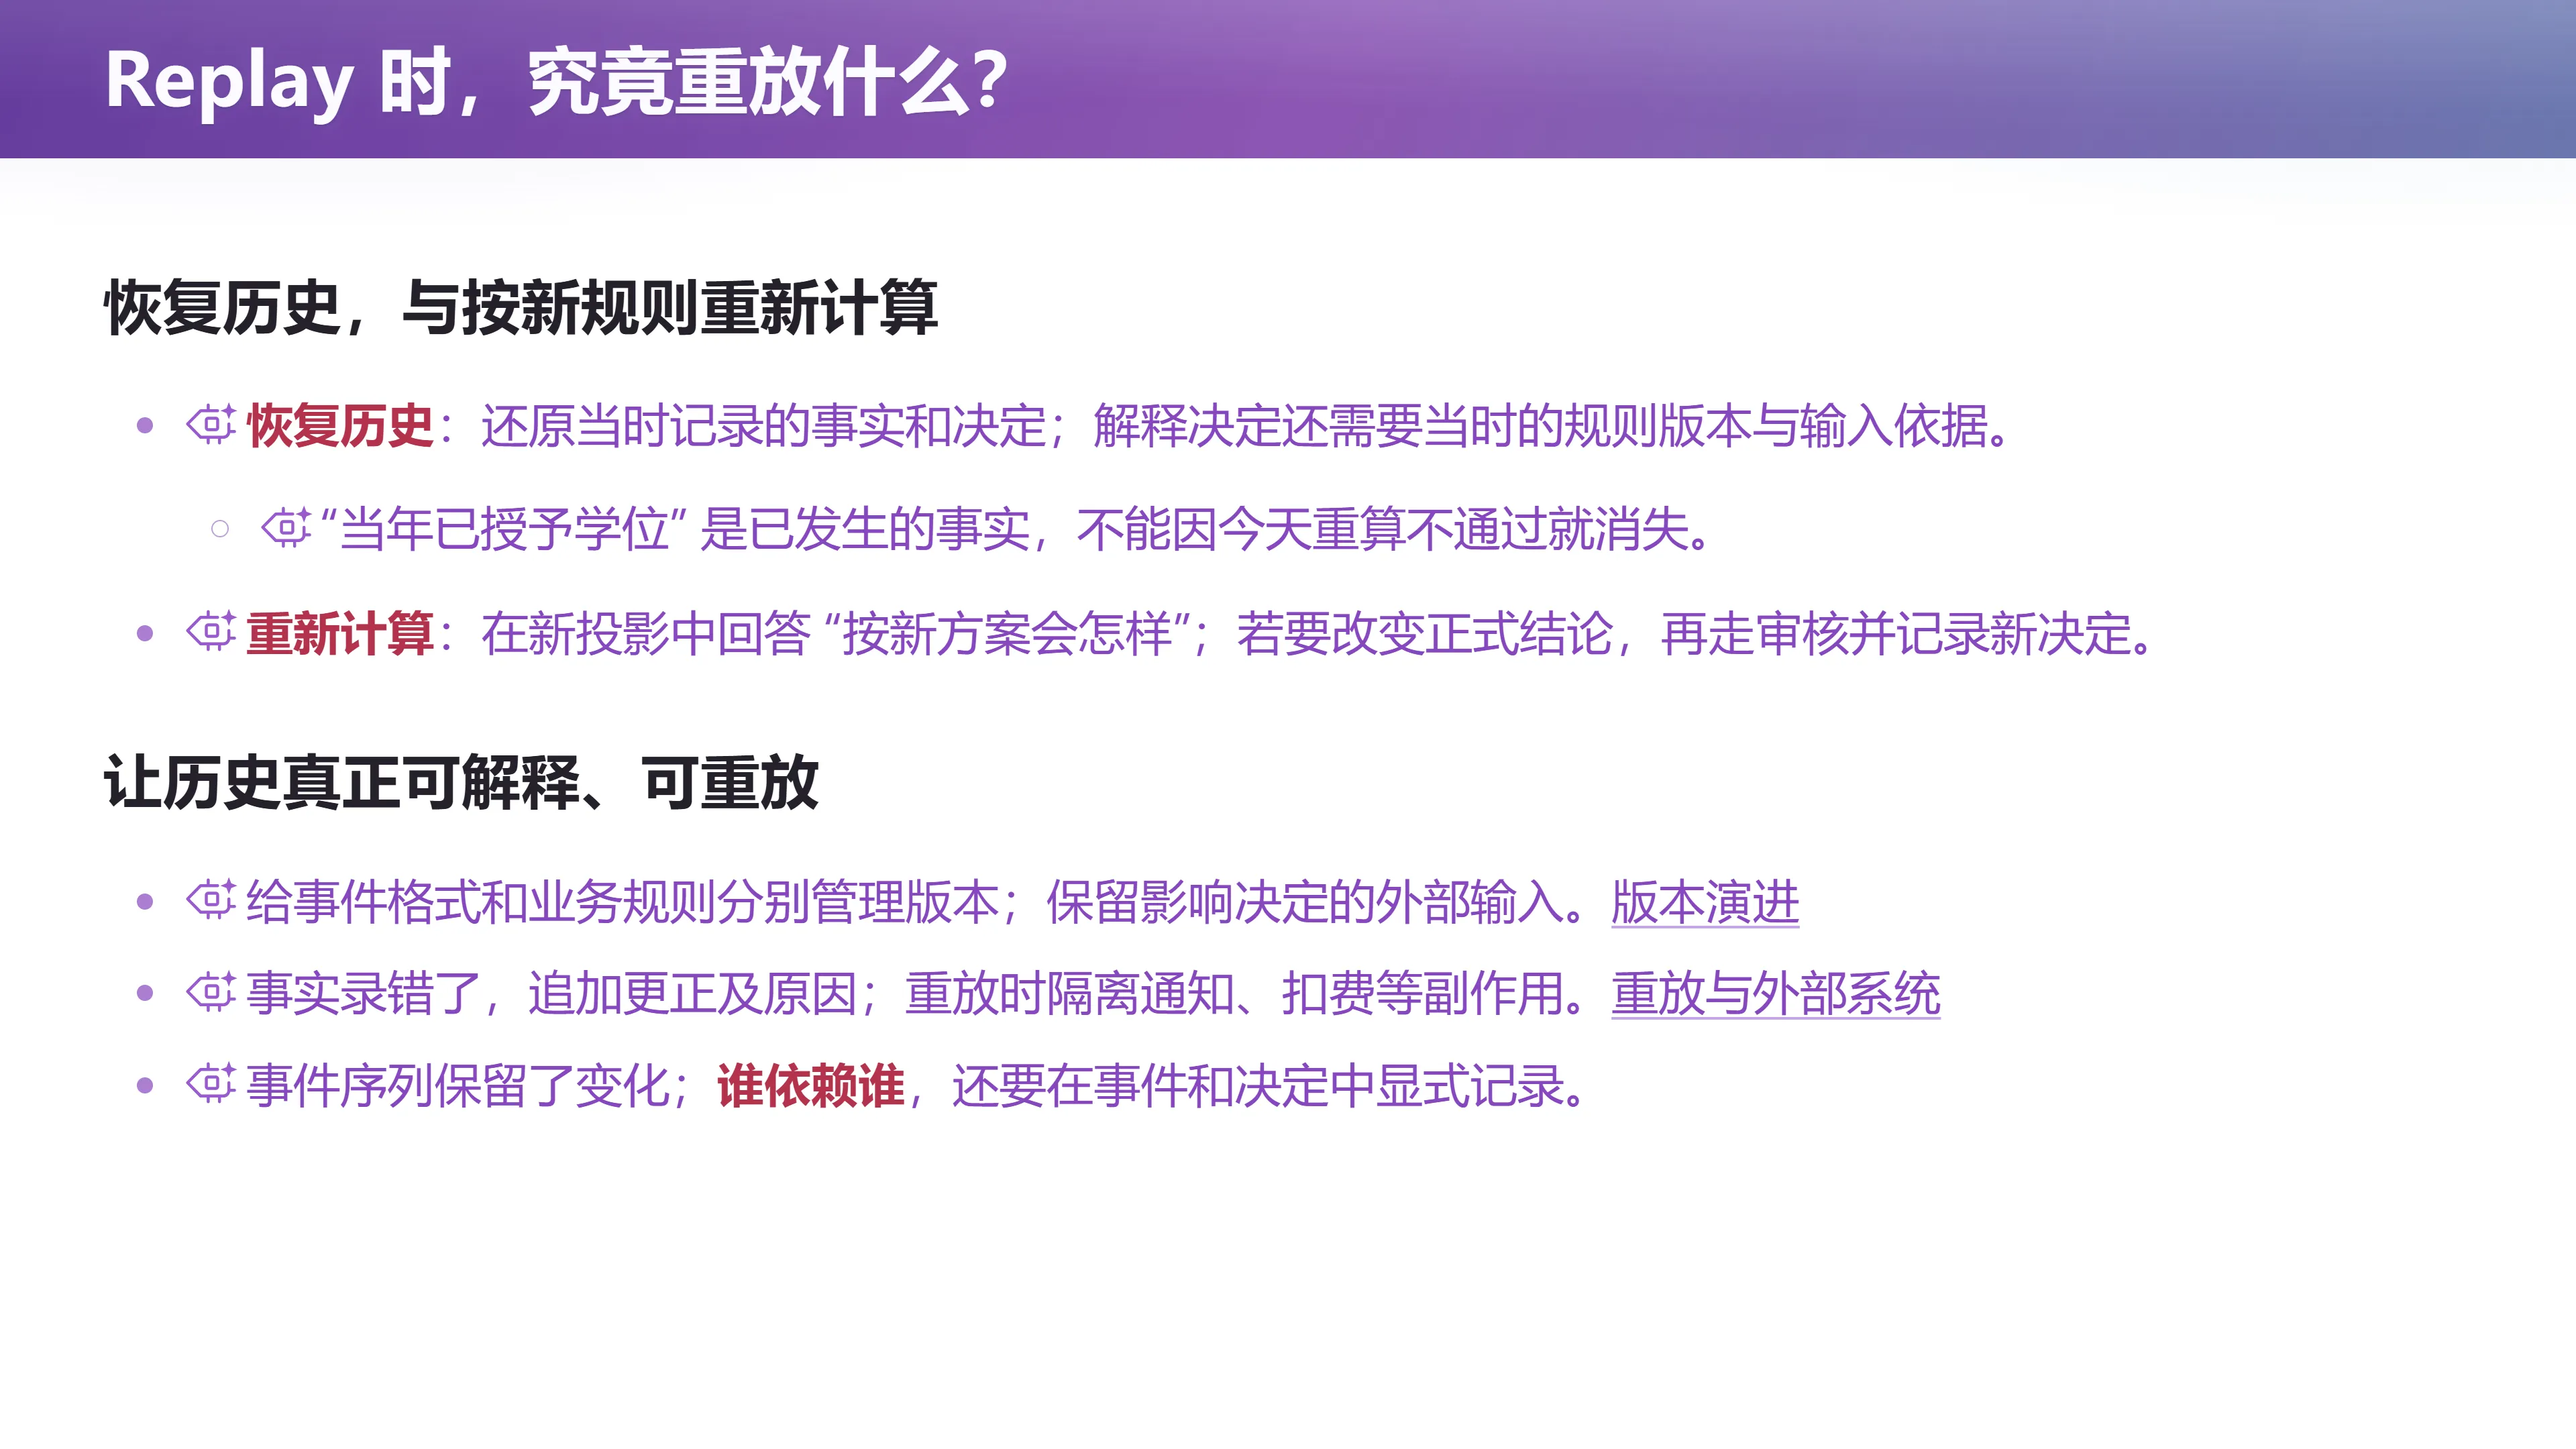
📷 Replay 时,究竟重放什么?
回到原视频 (01:35:45)
保存事件让我们在语义改变时有了更多余地,但不能把它理解成"以后规则随便改,历史自然都能正确恢复"。至少要区分两个问题:
问题一:当时究竟发生了什么,为什么作出那个决定?
要回答它,就需要当时记录的事实、适用规则和有关输入。
问题二:如果用今天的新方案重新审核,会得到什么结果?
这可以通过新的投影或计算得到,但它并不自动改写已经发生的事实。
举例:一位学生已经获得学位。今天换一套规则重算,结果不符合要求,不能因此让"当年已经授予学位"这件事从历史里消失。若业务上需要复核或撤销,应经过相应流程,再记录新的决定。
让历史真正可解释、可重放,还需要额外的工作:
- 事件格式和业务规则各自演化,需要分别管理版本;Microsoft 的事件溯源说明讨论了事件版本、补偿事件和历史格式演进需要付出的成本;
- 事实录错时,可以追加更正事件及其原因,保留原始记录与更正之间的关系;
- 重放要隔离对外部世界的副作用:重建一次选课视图,不能再给所有学生发送一遍短信,更不能重复扣费。若历史决定依赖一个外部查询的结果,也需要保留当时的输入,不能拿今天查到的值冒充过去的依据。这些都是事件重放与外部系统交互时必须处理的问题;
- 事件序列保留了变化;谁依赖谁,还要在事件和决定中显式记录。
- 要沿着依赖找到受影响的结论,还应记录一次学分认定或毕业审核具体使用了哪些输入、哪个规则版本、什么审批依据。
历史保存得越完整,我们就越有机会解释旧决定、比较新方案和修正错误;哪些信息值得保存,仍然是一项架构决定。
CQRS 与 DDD
(参考时间: 01:36:17)
有了这些观察,就容易理解大语言模型出现之前就已经成熟的软件工程实践。
CQRS:读与写,可以有不同的模型
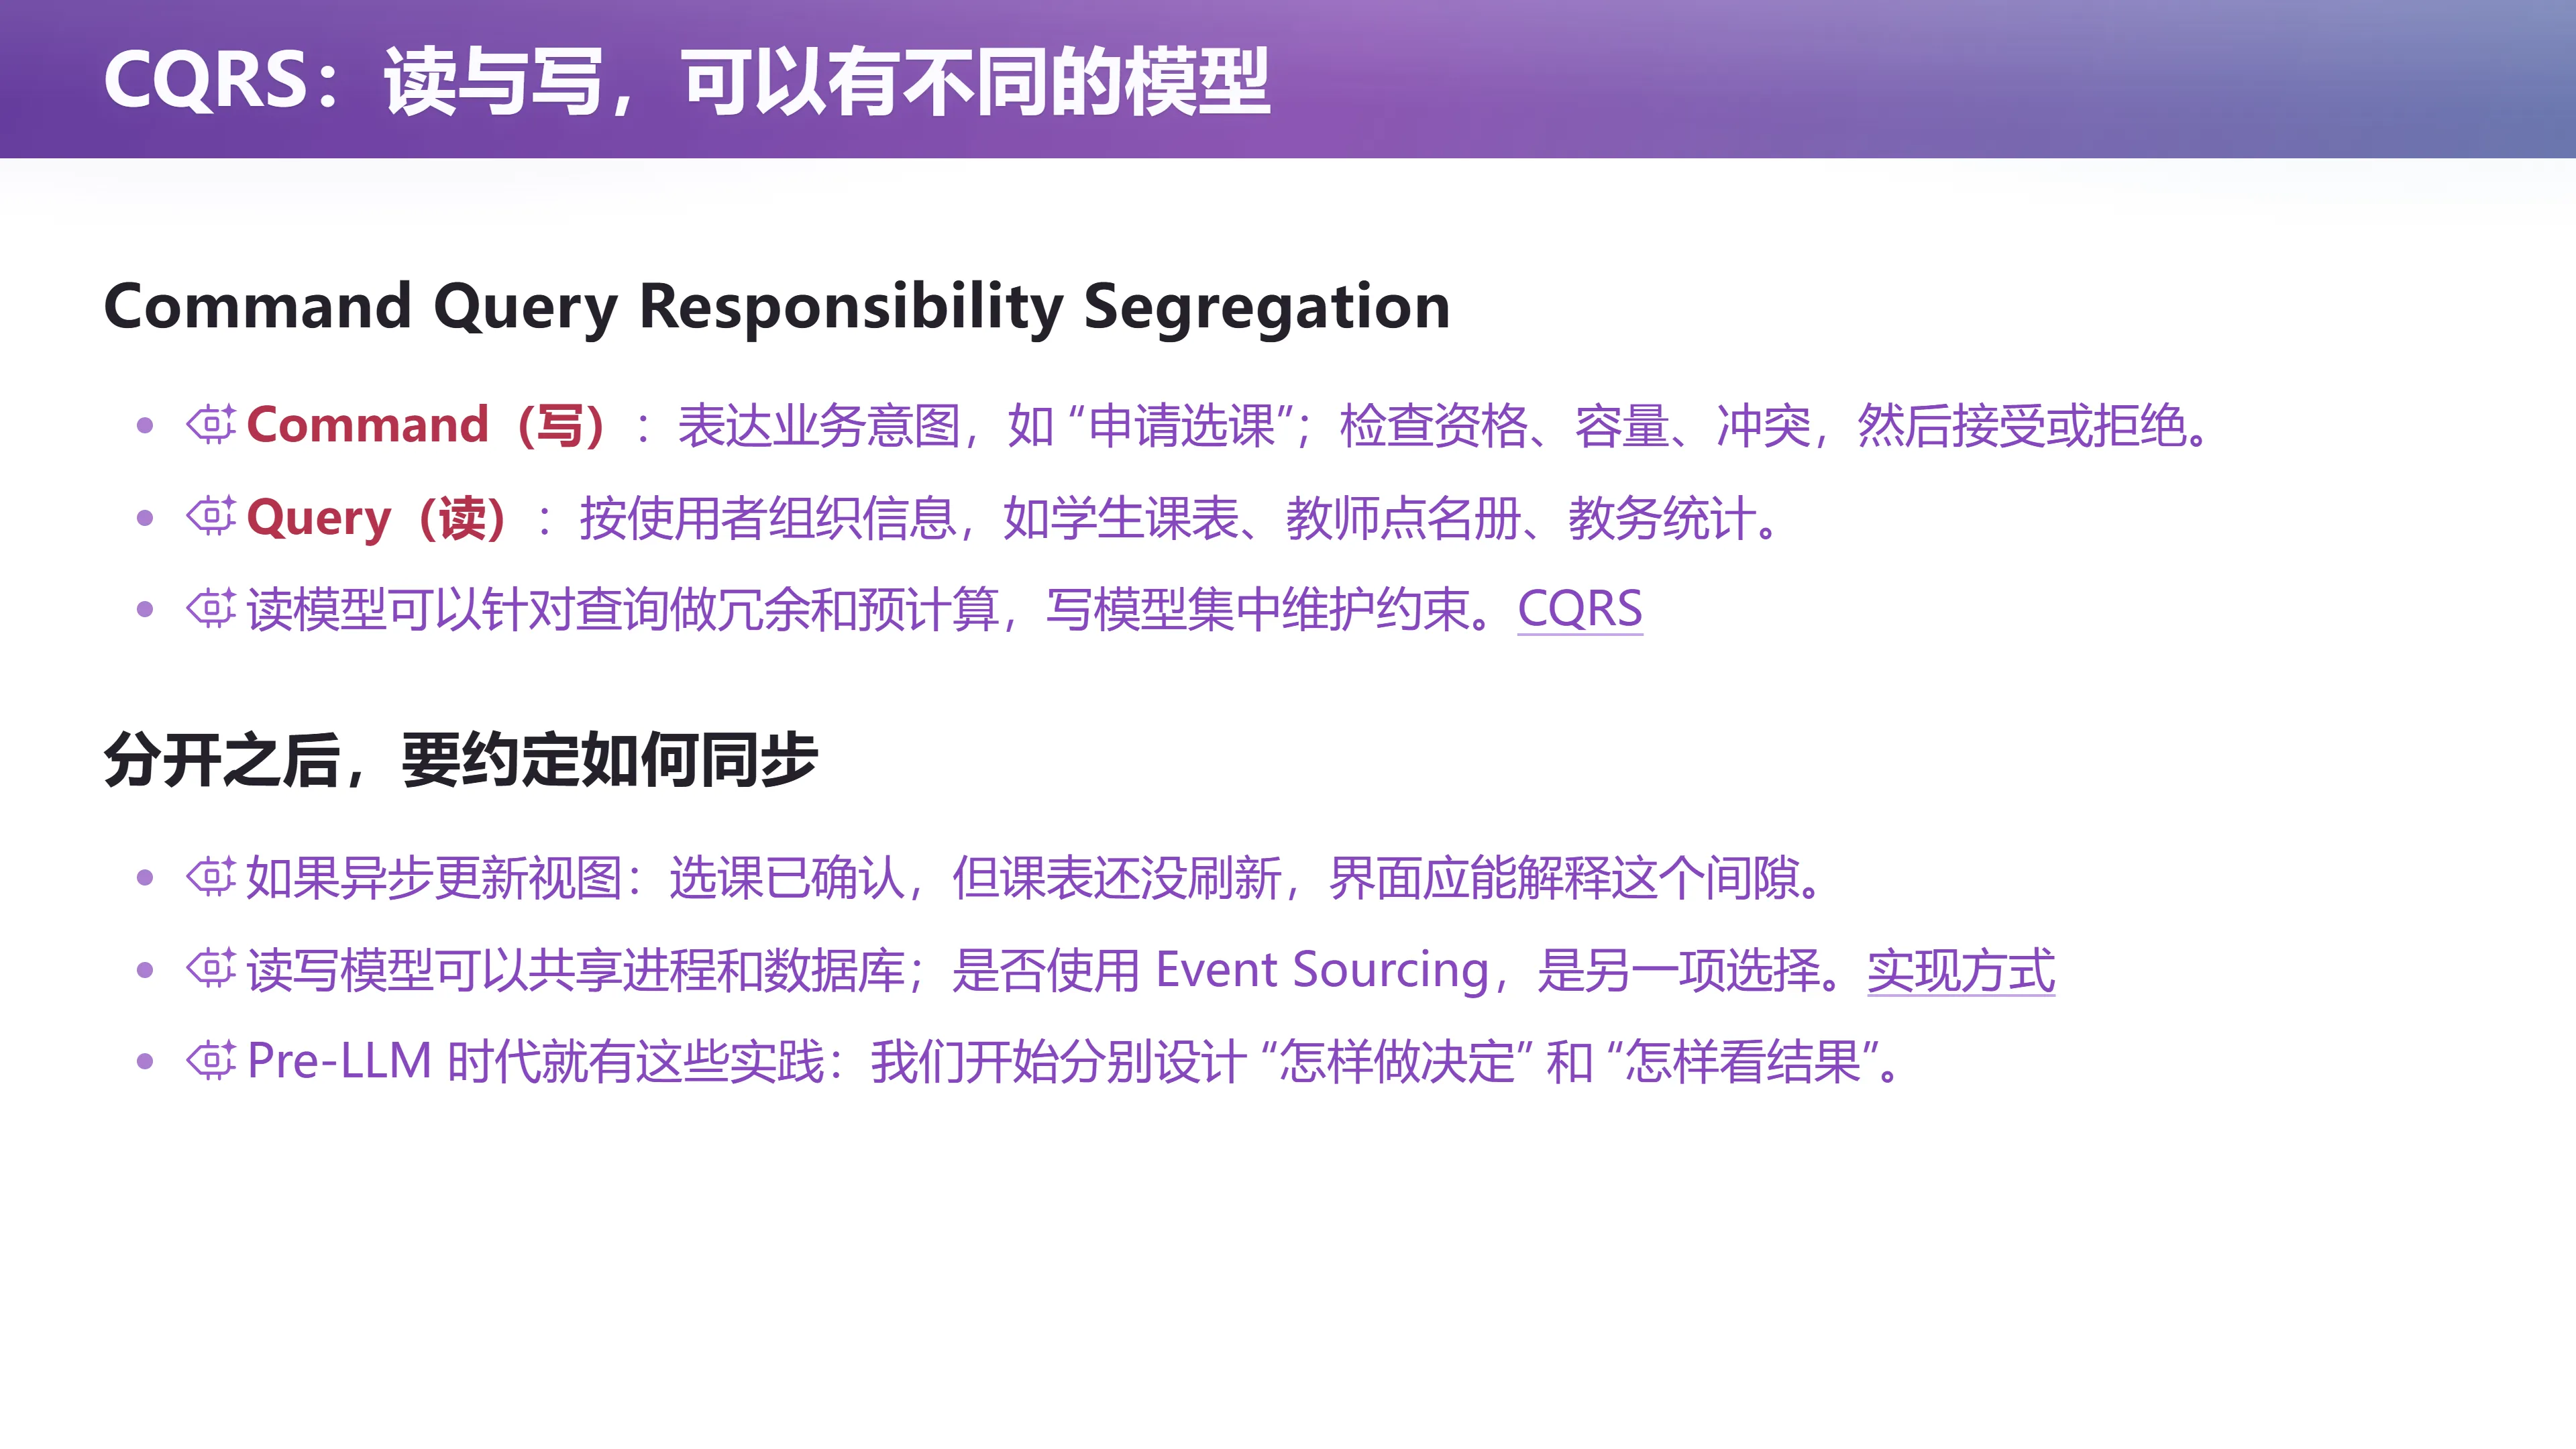
📷 CQRS:读与写,可以有不同的模型
回到原视频 (01:36:17)
CQRS 是 Command Query Responsibility Segregation,命令与查询职责分离。 它把负责接受业务操作的写模型,与负责提供查询结果的读模型分别设计。
- Command(写):表达一个业务意图,例如"申请选课"。写模型检查先修资格、课程容量和时间冲突,再接受或拒绝申请。
- Query(读):服务于不同使用者——学生要看课表,教师要看点名册,教务员要看开课统计。这些结果没有必要被迫使用同一种展示结构。
在这样的设计中:
- 写模型集中维护业务约束;
- 读模型可以为查询准备专门的数据结构,适当冗余或预计算;
- 重点在两类模型的职责分离,而不是物理部署——它们可以在同一个进程、同一个数据库里实现;
- 是否再采用事件溯源,是另一个选择(CQRS 与 Event Sourcing 是独立的)——参见 Microsoft 的 CQRS 说明。
分开之后,要约定如何同步:
- 若读模型通过异步处理事件更新,就可能出现短暂的间隙:选课已经确认,课表还没刷新。界面需要能解释这个状态,系统也要明确"选课成功"究竟由哪个环节确认。
- 不能因为查询视图还没显示这条记录,就让用户误以为没有成功而不断重复提交。
还有一个更硬的约束:并发。
只剩最后一个名额,两位学生同时申请,不能让两人都占位成功。
sequenceDiagram
    participant S1 as 学生 A
    participant S2 as 学生 B
    participant W as 写模型
    participant E as 事件存储
    S1->>W: 申请选课(读版本 v)
    S2->>W: 申请选课(读版本 v)
    W->>E: 尝试追加(期望版本 v)
    E-->>W: 成功,版本变为 v+1
    W-->>S1: 接受
    W->>E: 尝试追加(期望版本 v)
    E-->>W: ❌ 版本已变,冲突
    W->>W: 重新读取、重新判断
    W-->>S2: 拒绝(名额已满)
编者说明:这就是乐观并发控制(optimistic concurrency control):不发锁,而是在写入时检查"我读到的版本还是不是最新"。冲突发生后重新加载、重新判断。讲师强调:"使用事件存储时,也仍然需要并发控制,例如追加前检查所读取的事件流版本,发现已经变化就重新读取和判断。" 事件溯源的并发处理并不会因为数据采用追加方式就自动消失。
由此,系统中哪些部分必须立即保持一致、哪些查询结果允许稍后更新,就成为可以明确讨论的决定。
DDD:让业务概念决定软件边界
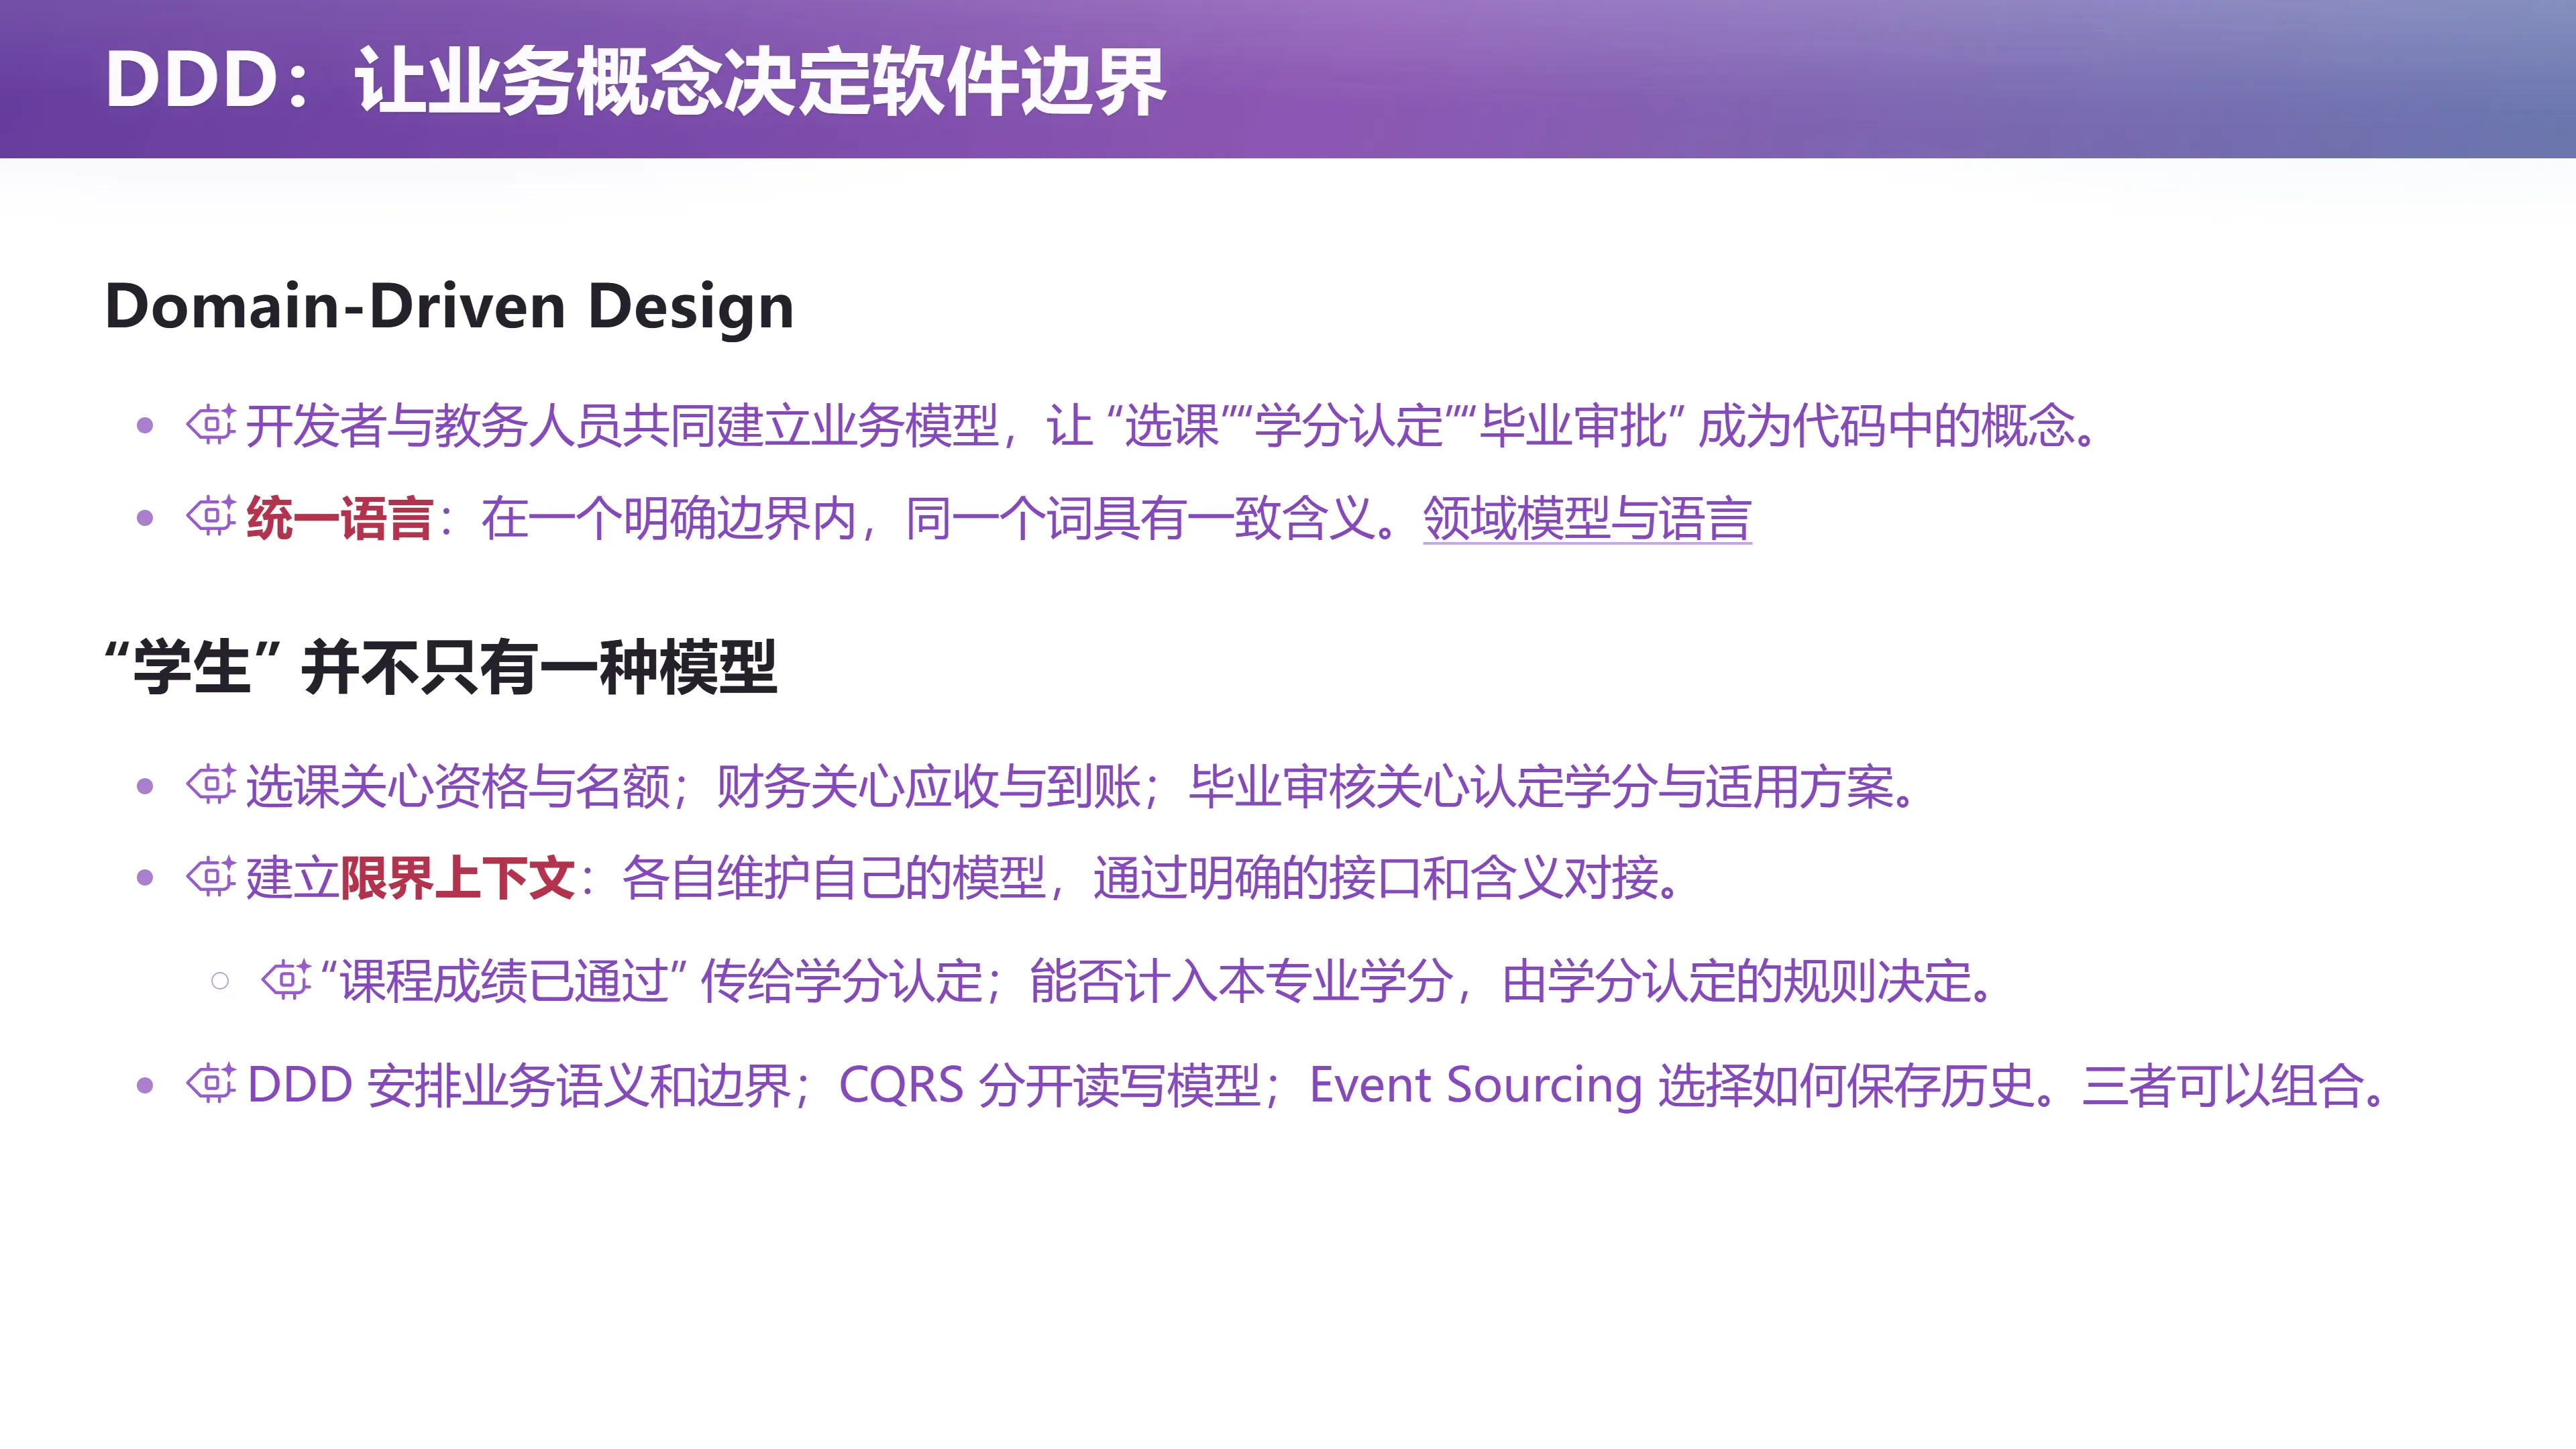
📷 DDD:让业务概念决定软件边界
回到原视频 (01:36:27)
DDD 是 Domain-Driven Design,领域驱动设计。 这里的领域就是软件试图处理的业务世界。
- 开发者与业务人员共同建立模型,让"选课""学分认定""毕业审批"这些概念进入软件的结构和语言,而不是只围绕数据库表名讨论系统;
- 在一个明确边界内,同一个词应当具有一致的含义——这就是统一语言(Ubiquitous Language);
- 但一个庞大的系统不必强迫所有参与者共享一份无所不包的模型。DDD 用限界上下文(Bounded Context)明确模型适用的范围,再描述不同范围之间如何协作。
"学生"并不只有一种模型:
- 选课业务关心学生有没有资格、课程还有没有名额;
- 财务业务关心应收和到账;
- 毕业审核关心认定学分与适用方案。
它们都谈到"学生",但需要维护的状态和规则并不相同。
边界之间传递信息时,也要明确含义:
"课程成绩已经通过"可以成为学分认定的输入,但能否计入某个专业的毕业学分,应该由学分认定的规则决定。如果直接把两个概念压成同一个
passed字段,以后就很难解释"通过了这门课,却仍然不满足这项毕业要求"的情况。
三者的关系:DDD 帮助安排业务语义和模型边界,CQRS 分开接受操作与提供查询的职责,事件溯源则提供保存和重建历史的方式。这些想法可以组合,也可以按具体问题分别采用。
编者拓展|DDD 的来龙去脉 DDD 由 Eric Evans 在 2003 年的同名著作中提出,DDD Reference是作者提供的免费速查。它的核心主张是: 1. 模型必须由领域专家和开发者共同打磨,而不是由一方交给另一方; 2. 语言必须与模型一致,代码里的类名、方法名、模块名都应直接来自业务词汇; 3. 大模型要在限界上下文里分割——"学生"在选课上下文和在财务上下文里可以有不同的类、不同的字段、不同的不变量; 4. 上下文之间通过显式的契约(上下文映射、防腐层)对接,而不是共享数据库表。
这个思想与 Parnas 1972 一脉相承:边界应该画在业务概念上,而不是画在技术分层上。
实践:让下一次需求变化有地方可去
(参考时间: 01:36:35)
讲师在这一段的开头说得很直白:
"这些 fancy 的概念你们其实都不需要,可以去看,但只要你回到最初的第一性原理——你要设计一个 50 万行的教务系统时,跳出这个问题,看到教务系统根源的问题在哪里,你就能做一个正确的架构设计,哪怕你没有听说过这些概念。"
下面的实践,就是把前面的想法落到教务系统上。
让一个结论带着它的依据
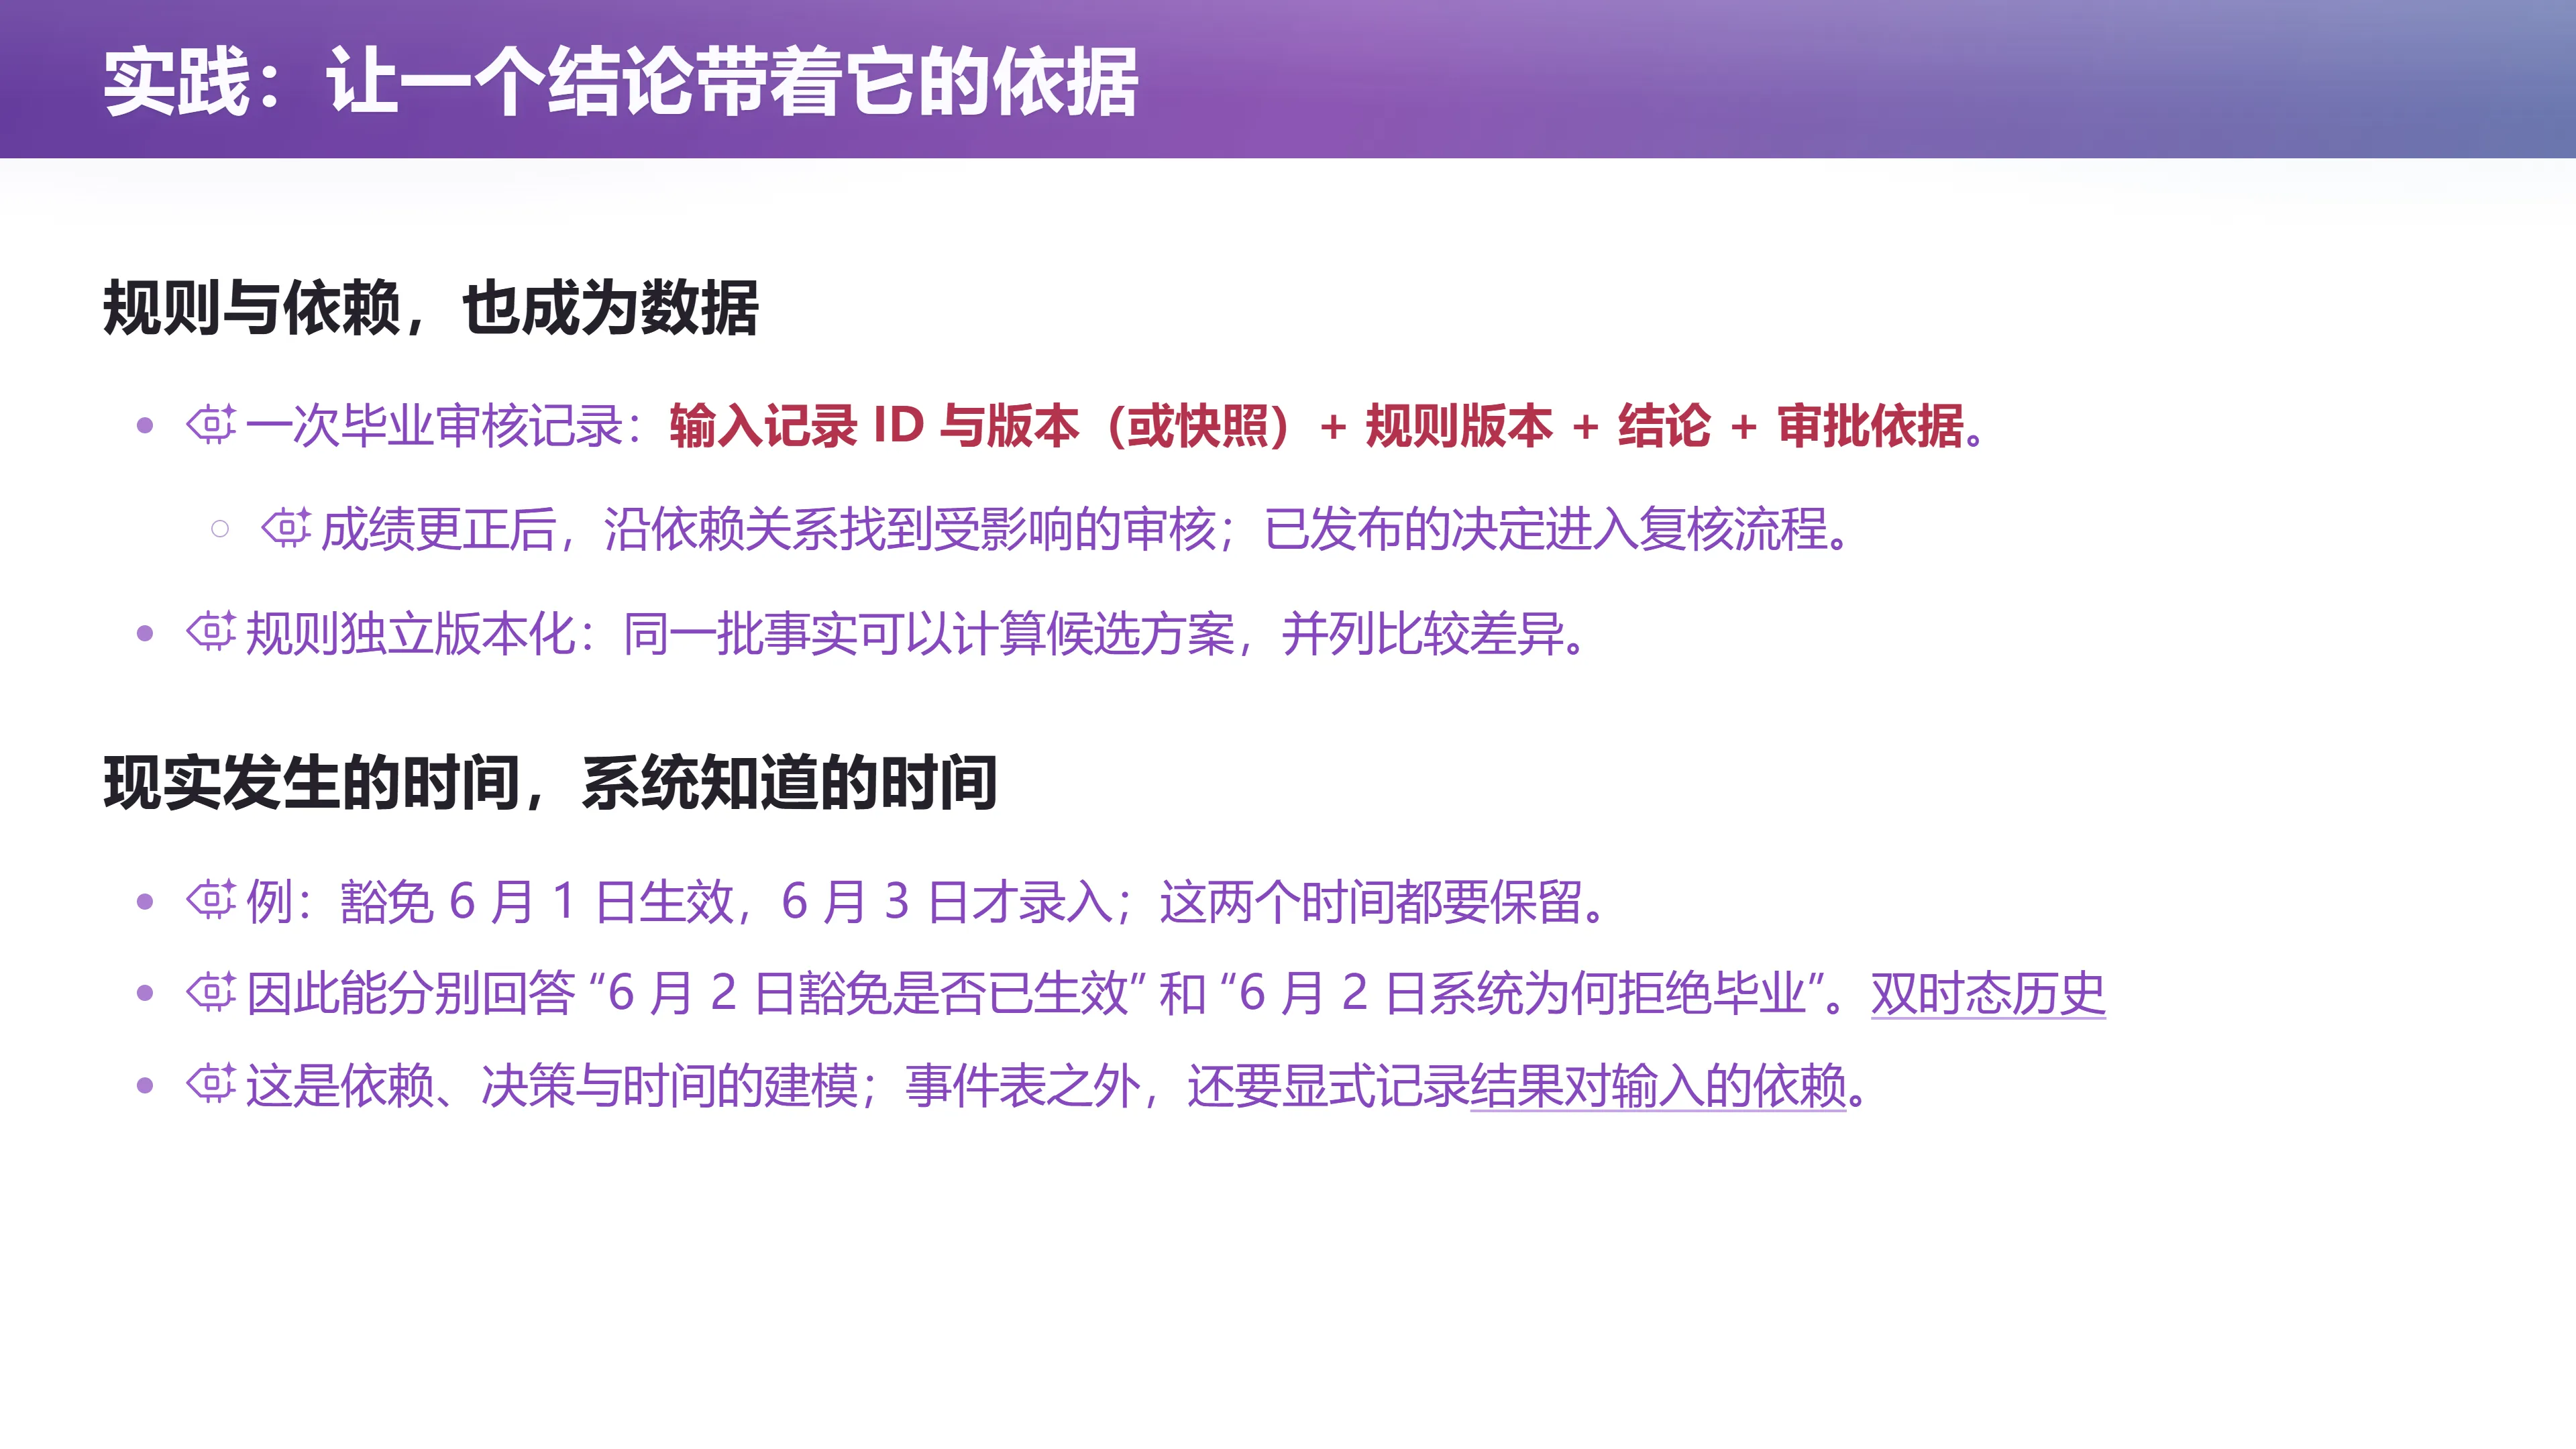
📷 实践:让一个结论带着它的依据
回到原视频 (01:36:35)
规则与依赖,也成为数据。
一次毕业审核除了保存"通过"或"不通过",还可以记录:
- 输入记录的标识与版本(或者当时的快照);
- 规则版本;
- 结论;
- 审批依据。
这样:
- 成绩被更正时,系统能够沿着依赖找到受影响的审核;
- 已经发布的正式决定,则进入复核流程;
- 规则独立版本化:同一批事实可以计算候选方案,并列比较差异。
两个时间:现实发生的时间与系统知道的时间
时间也值得明确表示。
假设一项豁免在 6 月 1 日生效,但 6 月 3 日才录入系统。那么:
- "6 月 2 日豁免是否有效" 和
- "6 月 2 日系统为什么拒绝毕业"
是两个不同的问题。只保存一个时间,可能无法同时解释它们。
业务发生或生效的时间,与系统得知这件事的时间,可以分别保存。
编者拓展|双时态(bitemporal)建模 保存两个时间维度,在数据管理里称为 bitemporal modeling: - 有效时间(valid time):这个事实在现实世界里什么时候为真; - 事务时间(transaction time):这个事实什么时候被系统记录。
只保存一个时间点,会在审计与回溯时踩坑:"系统当时知道什么?"和"世界当时是什么样?"是两个无法互相推导的问题。这也是双时态历史成为金融、医疗、航空航天等受监管领域标配的原因。
注意:这只是依赖、决策与时间的建模——事件表之外,还要显式记录"结果对输入"的依赖。
先决定什么必须一起正确
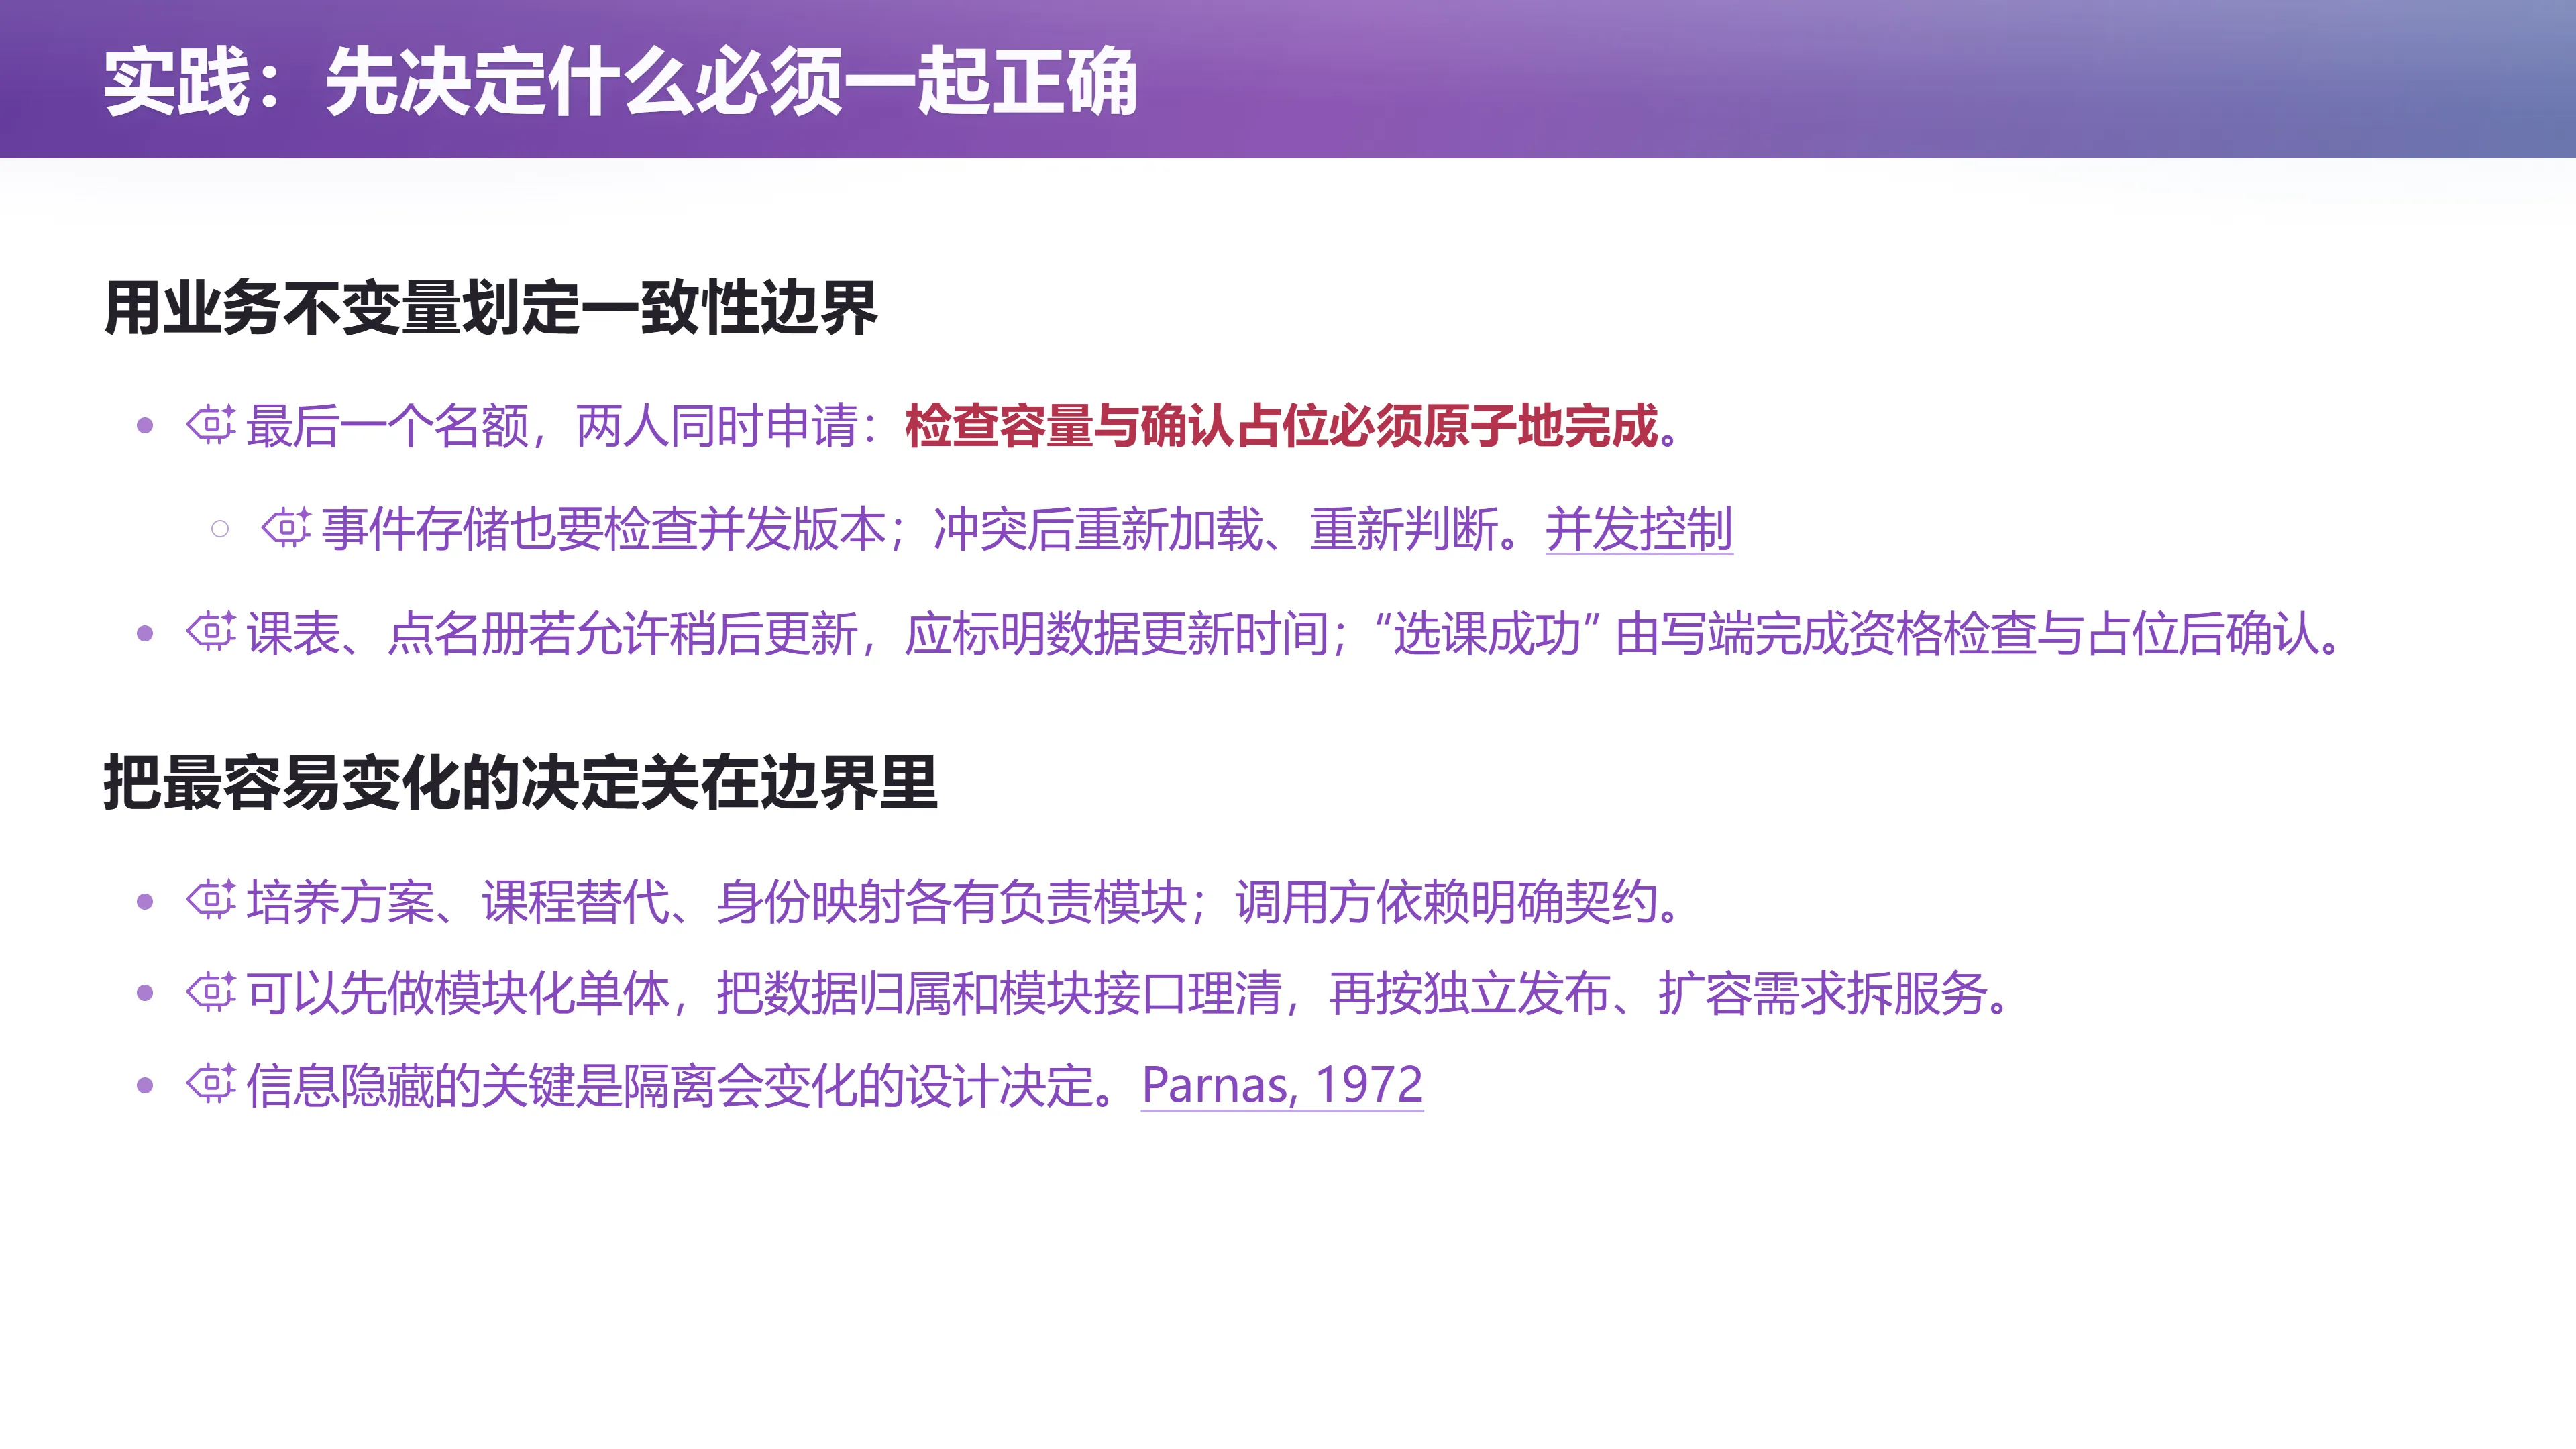
📷 实践:先决定什么必须一起正确
回到原视频 (01:36:40)
用业务不变量划定一致性边界。
- 最后一个名额,两人同时申请:检查容量与确认占位必须原子地完成;
- 事件存储也要检查并发版本;冲突后重新加载、重新判断(即前面的乐观锁思路);
- 课表、点名册若允许稍后更新:应标明数据更新时间;"选课成功"由写端完成资格检查与占位后确认。
把最容易变化的决定关在边界里。
- 培养方案、课程替代、身份映射,各自有负责的模块;调用方依赖明确契约;
- 可以先做模块化单体,把数据归属和模块接口理清,再按独立发布、扩容需求拆服务;
- 信息隐藏的关键是隔离会变化的设计决定(Parnas, 1972)。
编者说明:最后这一条非常重要:把一个大文件拆成许多服务,并不会自动补上原来没有说清楚的业务边界。 微服务不是一个"架构"本身,它只是"边界已经画清楚"之后的一种部署选择。先理契约,再拆部署——顺序反了,只是把单体里的一团乱麻变成分布式的一团乱麻。
让运行中的系统逐步换轨
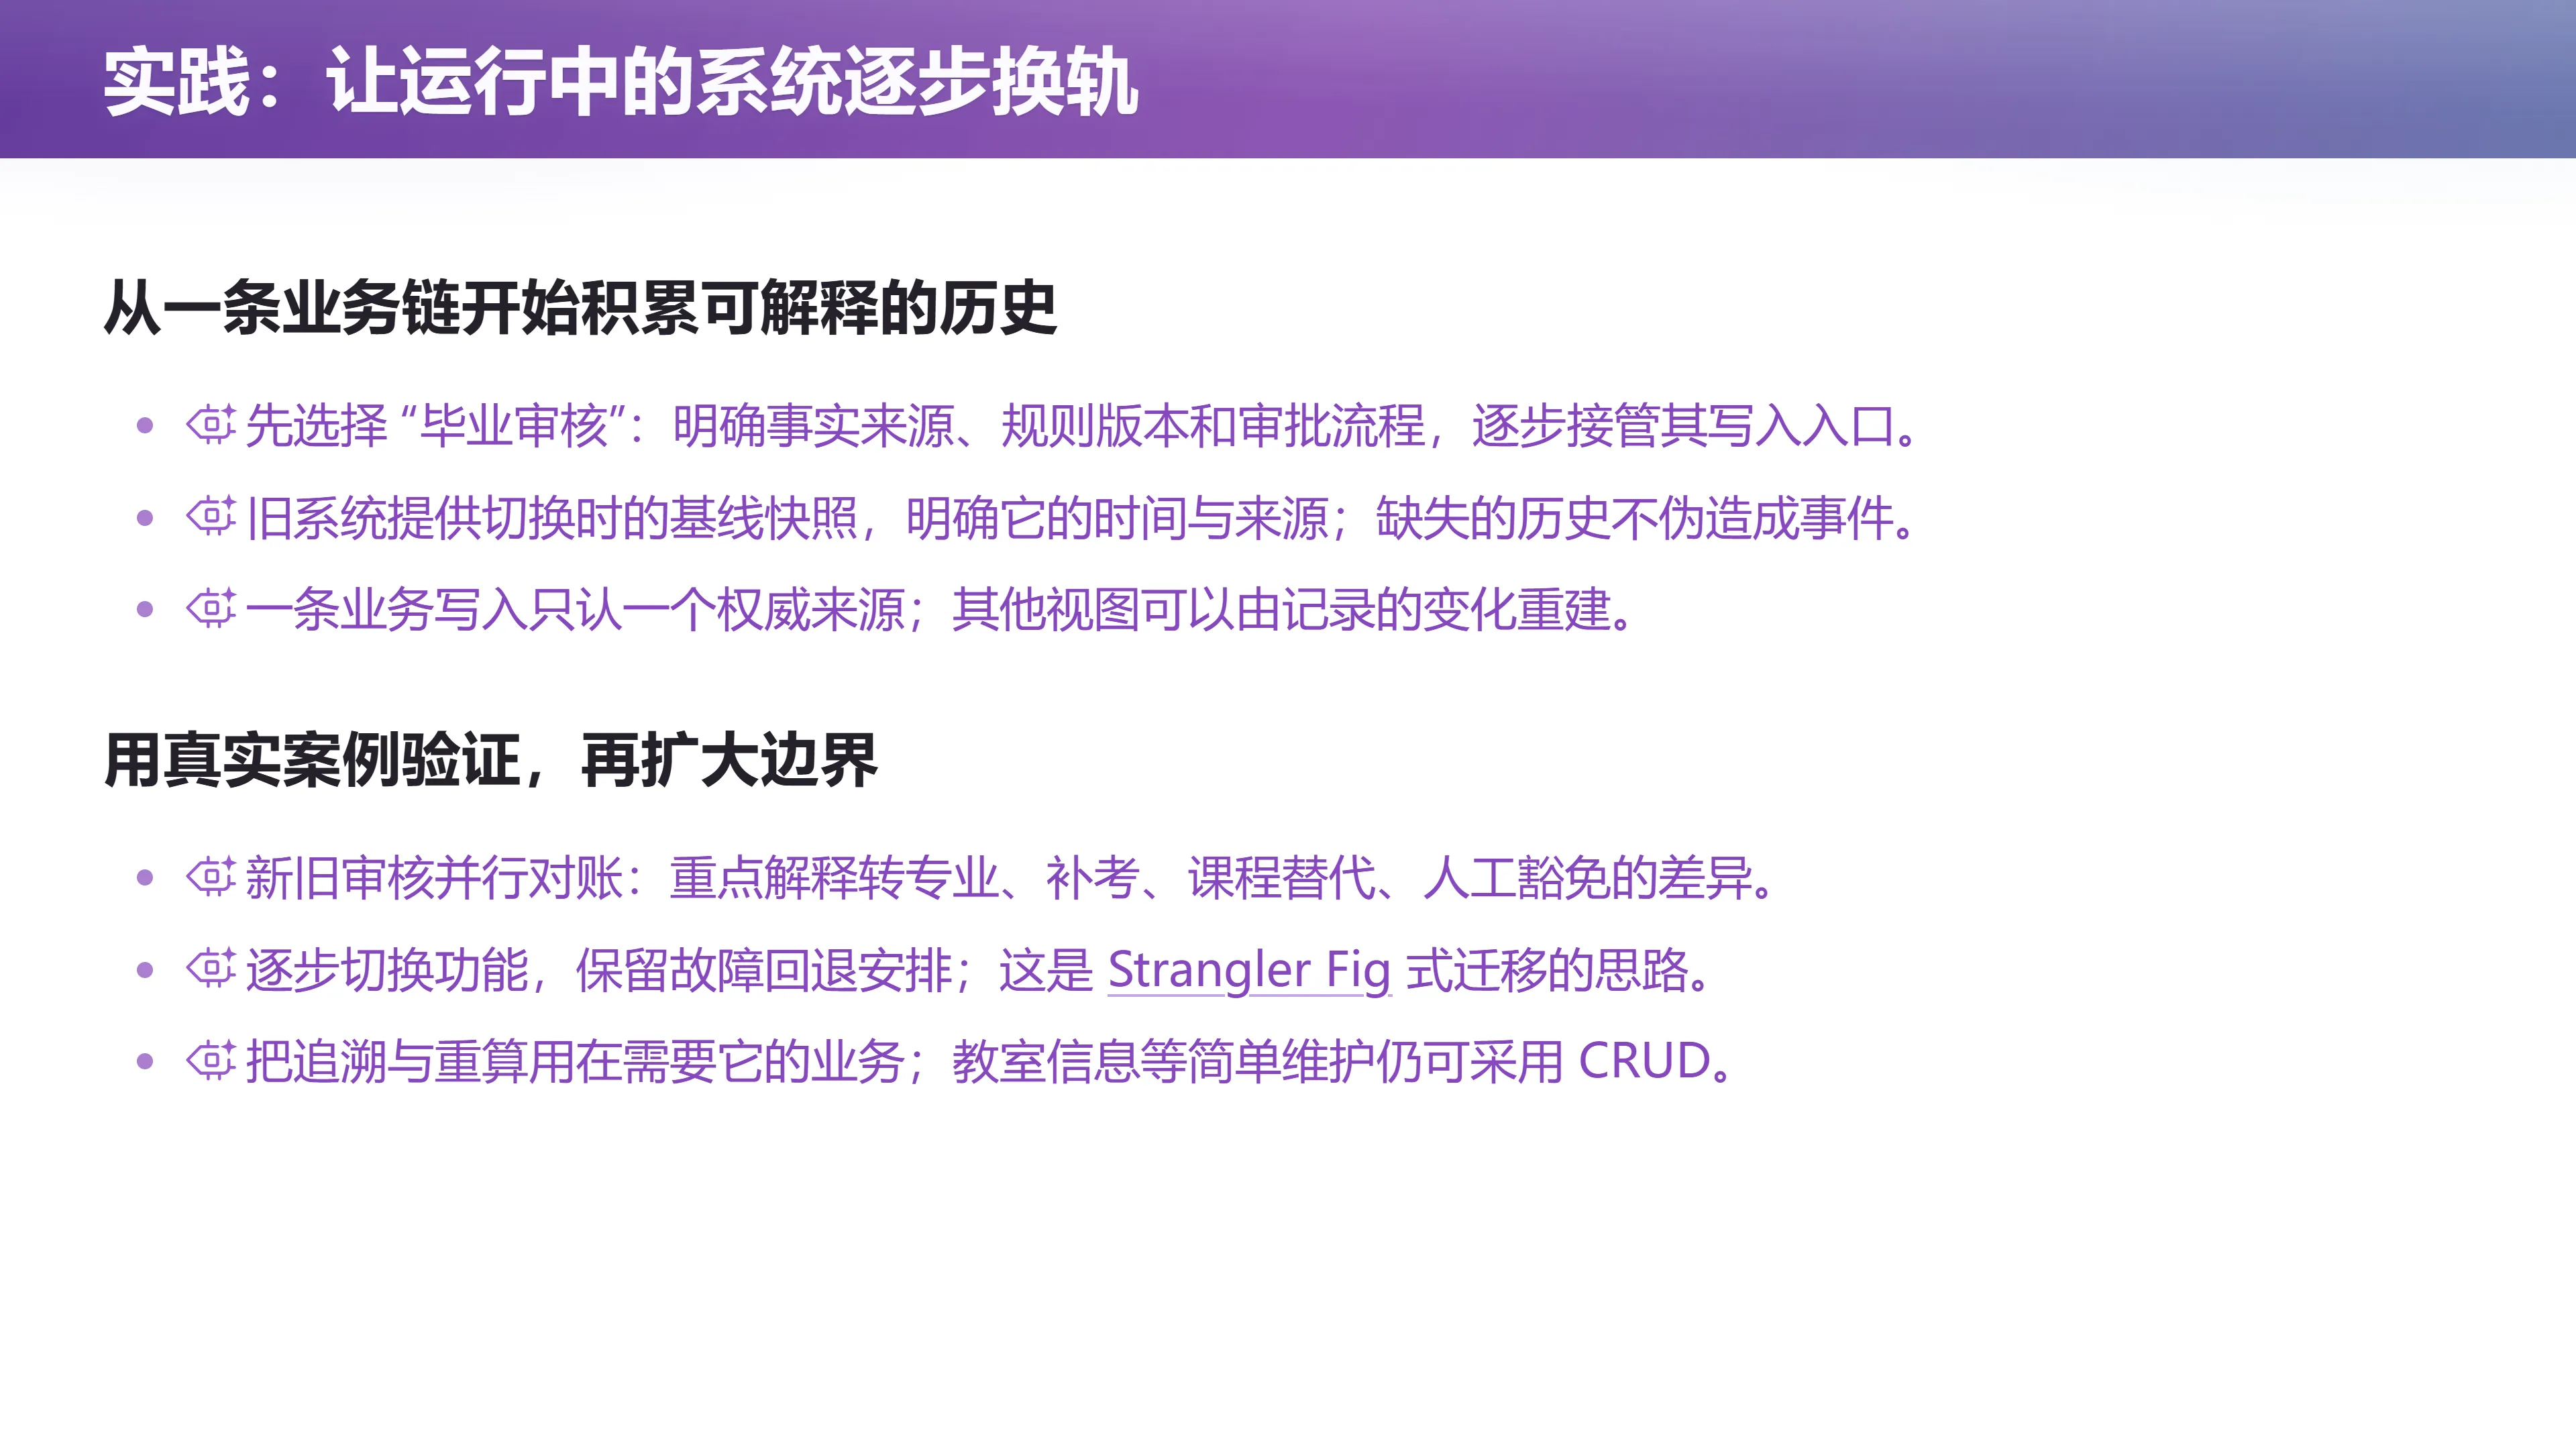
📷 实践:让运行中的系统逐步换轨
回到原视频 (01:36:44)
从一条业务链开始积累可解释的历史。
- 先选择"毕业审核" 这一条链:明确事实来源、规则版本和审批流程,逐步接管它的写入入口;
- 旧系统提供切换时的基线快照,明确它的时间与来源;缺失的历史不伪造成事件;
- 一条业务写入只认一个权威来源;其他视图可以由记录的变化重建。
用真实案例验证,再扩大边界。
- 新旧审核并行对账:重点解释转专业、补考、课程替代、人工豁免案例中的差异;
- 逐步切换功能,保留故障回退安排——这是 Strangler Fig(绞杀榕)式迁移的思路;
- 把追溯与重算用在需要它的业务;教室信息等简单维护仍可采用 CRUD。
编者拓展|Strangler Fig 模式 Strangler Fig Pattern 得名于热带雨林中会包裹并最终取代寄主树的绞杀榕。在系统迁移中,它的做法是: 1. 在旧系统旁边搭一层路由/代理; 2. 把要迁移的功能一项一项引到新实现; 3. 新实现稳定后逐步扩大流量,旧实现逐步退场; 4. 全程可回退,任何一步失败都不必推翻整个迁移。
这与"一口气重写整个教务系统"的大爆炸式迁移(big-bang migration) 形成鲜明对照。后者的风险在于:一旦失败,你没有可回退的状态,而生产系统的历史数据又无法凭空重现。
追溯与重算有成本,可以优先用于确实需要解释依据的业务;每增加一层结构,都应能说明它让哪一种变化更容易处理,以及带来了什么新的维护责任。
结语:几个字的架构,改变整个系统的走向
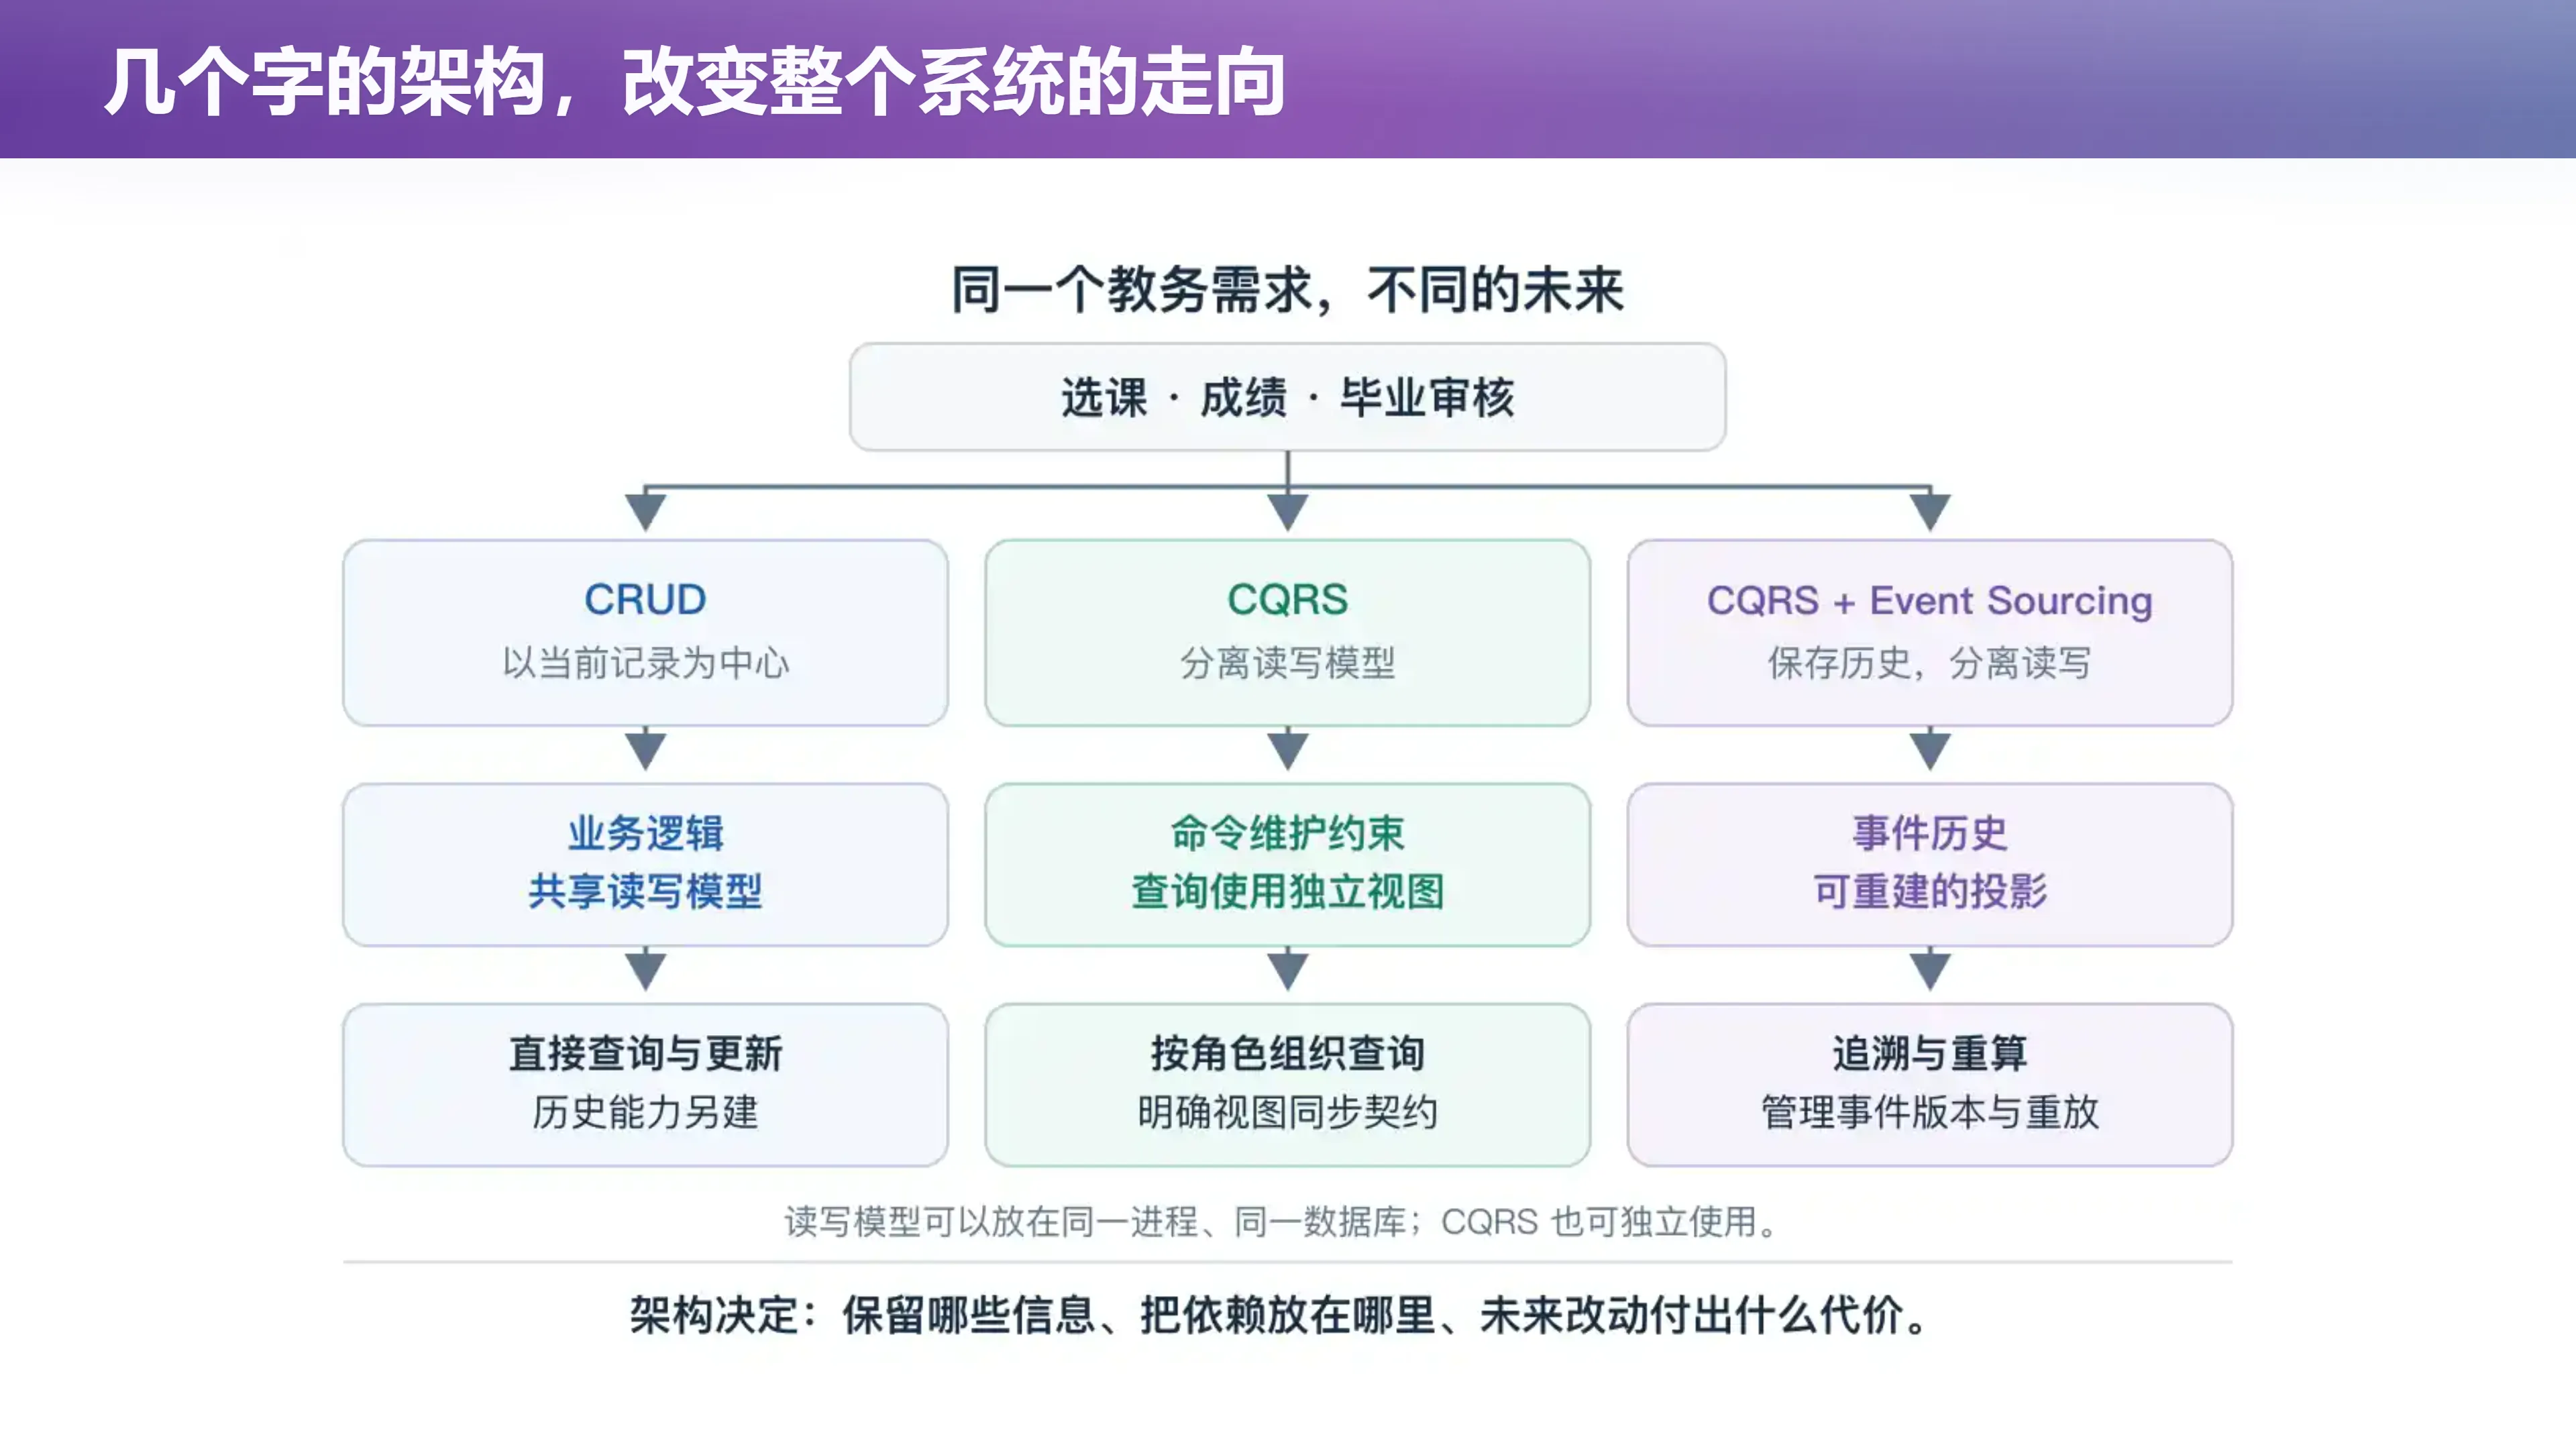
📷 几个字的架构,改变整个系统的走向
回到原视频 (01:36:47)
从十行汉诺塔、两千行二维码程序,到几十万行的教务系统,规模不同,选择表示方式的影响始终存在。
给 AI 增加"采用 CQRS"这样几个字,就可能让它生成一个完全不同的系统。 而这几个字背后需要我们理解的,是:
- 谁维护业务约束?
- 哪些信息应当保留?
- 变化沿什么关系传播?
代码越容易生成,越值得在这些少量但影响深远的决定上花时间。
讲师最后强调:
"其实你们都不需要记住 CQRS、DDD 这些名字,你们可以去看;但只要回到第一性原理——跳出问题看问题,看到根源在哪里——哪怕你没听说过这些概念,也能做一个正确的架构设计。"
附:参考与延伸阅读
以下讲义原文链接来自课程官方讲义(注明了出处文件);编者补充是撰写本书时另加的,不与讲义混淆。
讲义原文链接
- CQRS 说明
lect6.html - DDD Reference
lect6.html - Excel 计算性能指南
lect6.html - Martin Fowler 对事件溯源的介绍
lect6.html - Yanyan's wiki
lect6.html - “南大没系啦”
lect6.html - 上一讲
lect6.html - 事件溯源说明
lect6.html - 事件重放与外部系统交互
lect6.html - Creative Commons License: BY-NC 4.0
lect6.notes.md - 苏 ICP 备 2020049101 号
lect6.notes.md
编者补充
CLI11cxxoptsLET- Brainfuck
- ERP
- getopt
- ISO/IEC 18004
- jyywiki.cn/GSE/2026/lect6.md
- Nayuki QR Code Generator
- POSIX 规范
- Strangler Fig Pattern
- UML
- VLOOKUP
- XLOOKUP
- 原文
- 原文
- 原文
- 可在线获取
- 需求和架构 (1) — BV1Rch76WEfQ
附录:课堂未展示的幻灯片
🖼️ 第 15 页幻灯片 · 好的架构:复杂性有归处,变化有边界
🖼️ 第 21 页幻灯片 · (无标题)