第8讲 · Agent-native 开发
本讲是南京大学《生成式软件工程》课程的第八讲,主题为 Agent-native 开发。
| 视频 | Bilibili · BV11LWw6VEHW |
| 对应讲义 | Agent Native 开发 |
| 配套实验 | 实验 (2) Deeper Research |
| 许可 | Creative Commons BY-NC 4.0 |
| 备案 | 苏 ICP 备 2020049101 号 |
对应讲次:第8讲(南京大学 生成式软件工程)
制作模型:deepseek-flash(vb compose,据 run.log)
引言:从实验二说起
(参考时间: 00:00:00)
课程进行到大约一半的位置,本讲进入一个很多同学都关心的主题——Agent-native 开发:不是"用 AI 写代码"这么一句话,而是如何把软件开发的一整套生产过程,重新组织成"围绕 Agent 来设计"。
从一件小事说起。就在开课这天早上,某个平台的额度周期重置,很多同学大概都设过"go"——让 Agent 自动去跑一些很长的任务。讲师自己积攒了一些非常消耗 token 的活,比如一个复杂问题的数学证明:
"我不知道应该怎么证,我可以让他证,但他可能会把我一周的额度全部跑完。所以我就会在离开办公室之前,直接上一个 go,让他继续去证。"
这其实是讲解后面"算力换智力"的一个生活化样本:当 AI 的价格足够低,你可以把"做不完"的任务交付出去,用外部时间去换结果。
与此同时,第二个实验也发布了。它和第一个实验不太一样:
- 实验 (1) 更像是在做"你自己的个人 Agent":让 Agent 帮你消化邮件、根据你积累的数据库回答你的问题。
- 实验 (2) 则把"算力换智力"这件事往前推进一步:让 Agent 用更长的循环时间换更好的结果。
在实验 (1) 的过程中,很多同学会发现自己身边突然冒出了 Grok 一类的产品——开课前就发布,最近才真正火起来。讲师自己已经把一些每天的 cron job 从常开的 Mac mini 迁移到了 bot 上:
"我每天会给小朋友生成一个 podcast,这样我在开车的时候就可以听;它背后跑的是 Claude Code 的 Opus 模型。然后我每天都会收到推送——morning paper,它会给我推一些 arXiv 上的论文。这个 prompt 是我调过的,如果你直接让 AI 去总结,可能会得到不太一样的结果。"
还有 github trending 之类的例行推送。这类"我最近拿什么工具在做什么事"的具体细节,恰恰是后面很多设计判断的来源——没有真的跑过长任务,就很难体会 harness 为什么重要。
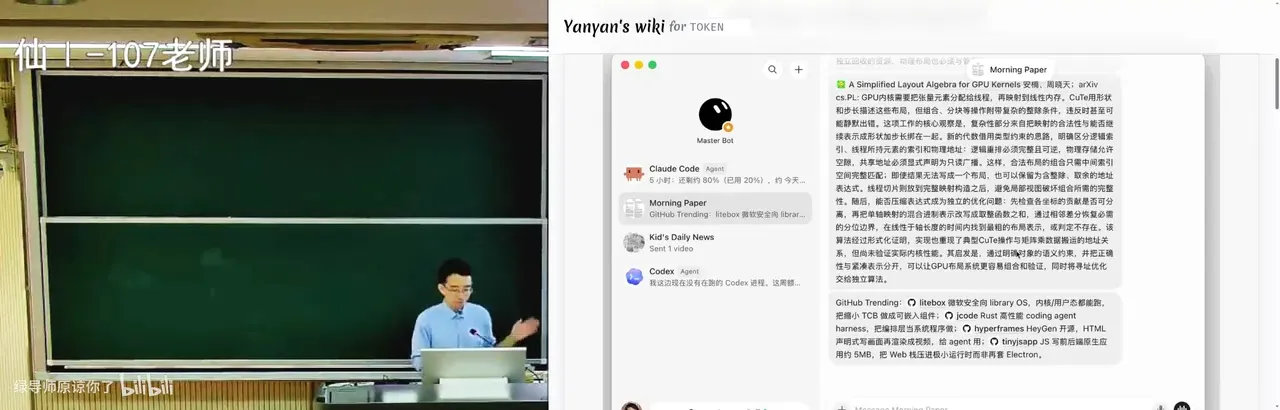
📷 Grok-bot 中推送每日 podcast 与 morning paper 的界面
回到原视频 (00:01:12)
实验 (2) 把上面这条经验包装成一个可实现的框架:
- 让你自己做一个 agent loop,把"求解 → 检查 → 根据反馈修改"循环起来;
- 由
effort控制最多执行多少轮、最多烧多少 token; - 用更低 effort 直接求解,用更高 effort 再检查关键结论、补充证据并修改。
这背后是一个更一般的问题——算力换智力能否稳定成立。今天先讲清楚这个问题的背景,再回到实验的工程实现。
编者说明:本讲的"实验"部分具体细节见 实验 (2) Deeper Research,本讲正式章节从下面"总得从一个能运行的原型开始"开始。它的前提是"个人数据库"实验已经能建立可检索的本地资料库——如果你还没做实验 (1),也可以先从"能检索资料、读写文件的 Agent"起步。
总得从一个能运行的原型开始
(参考时间: 00:05:54)
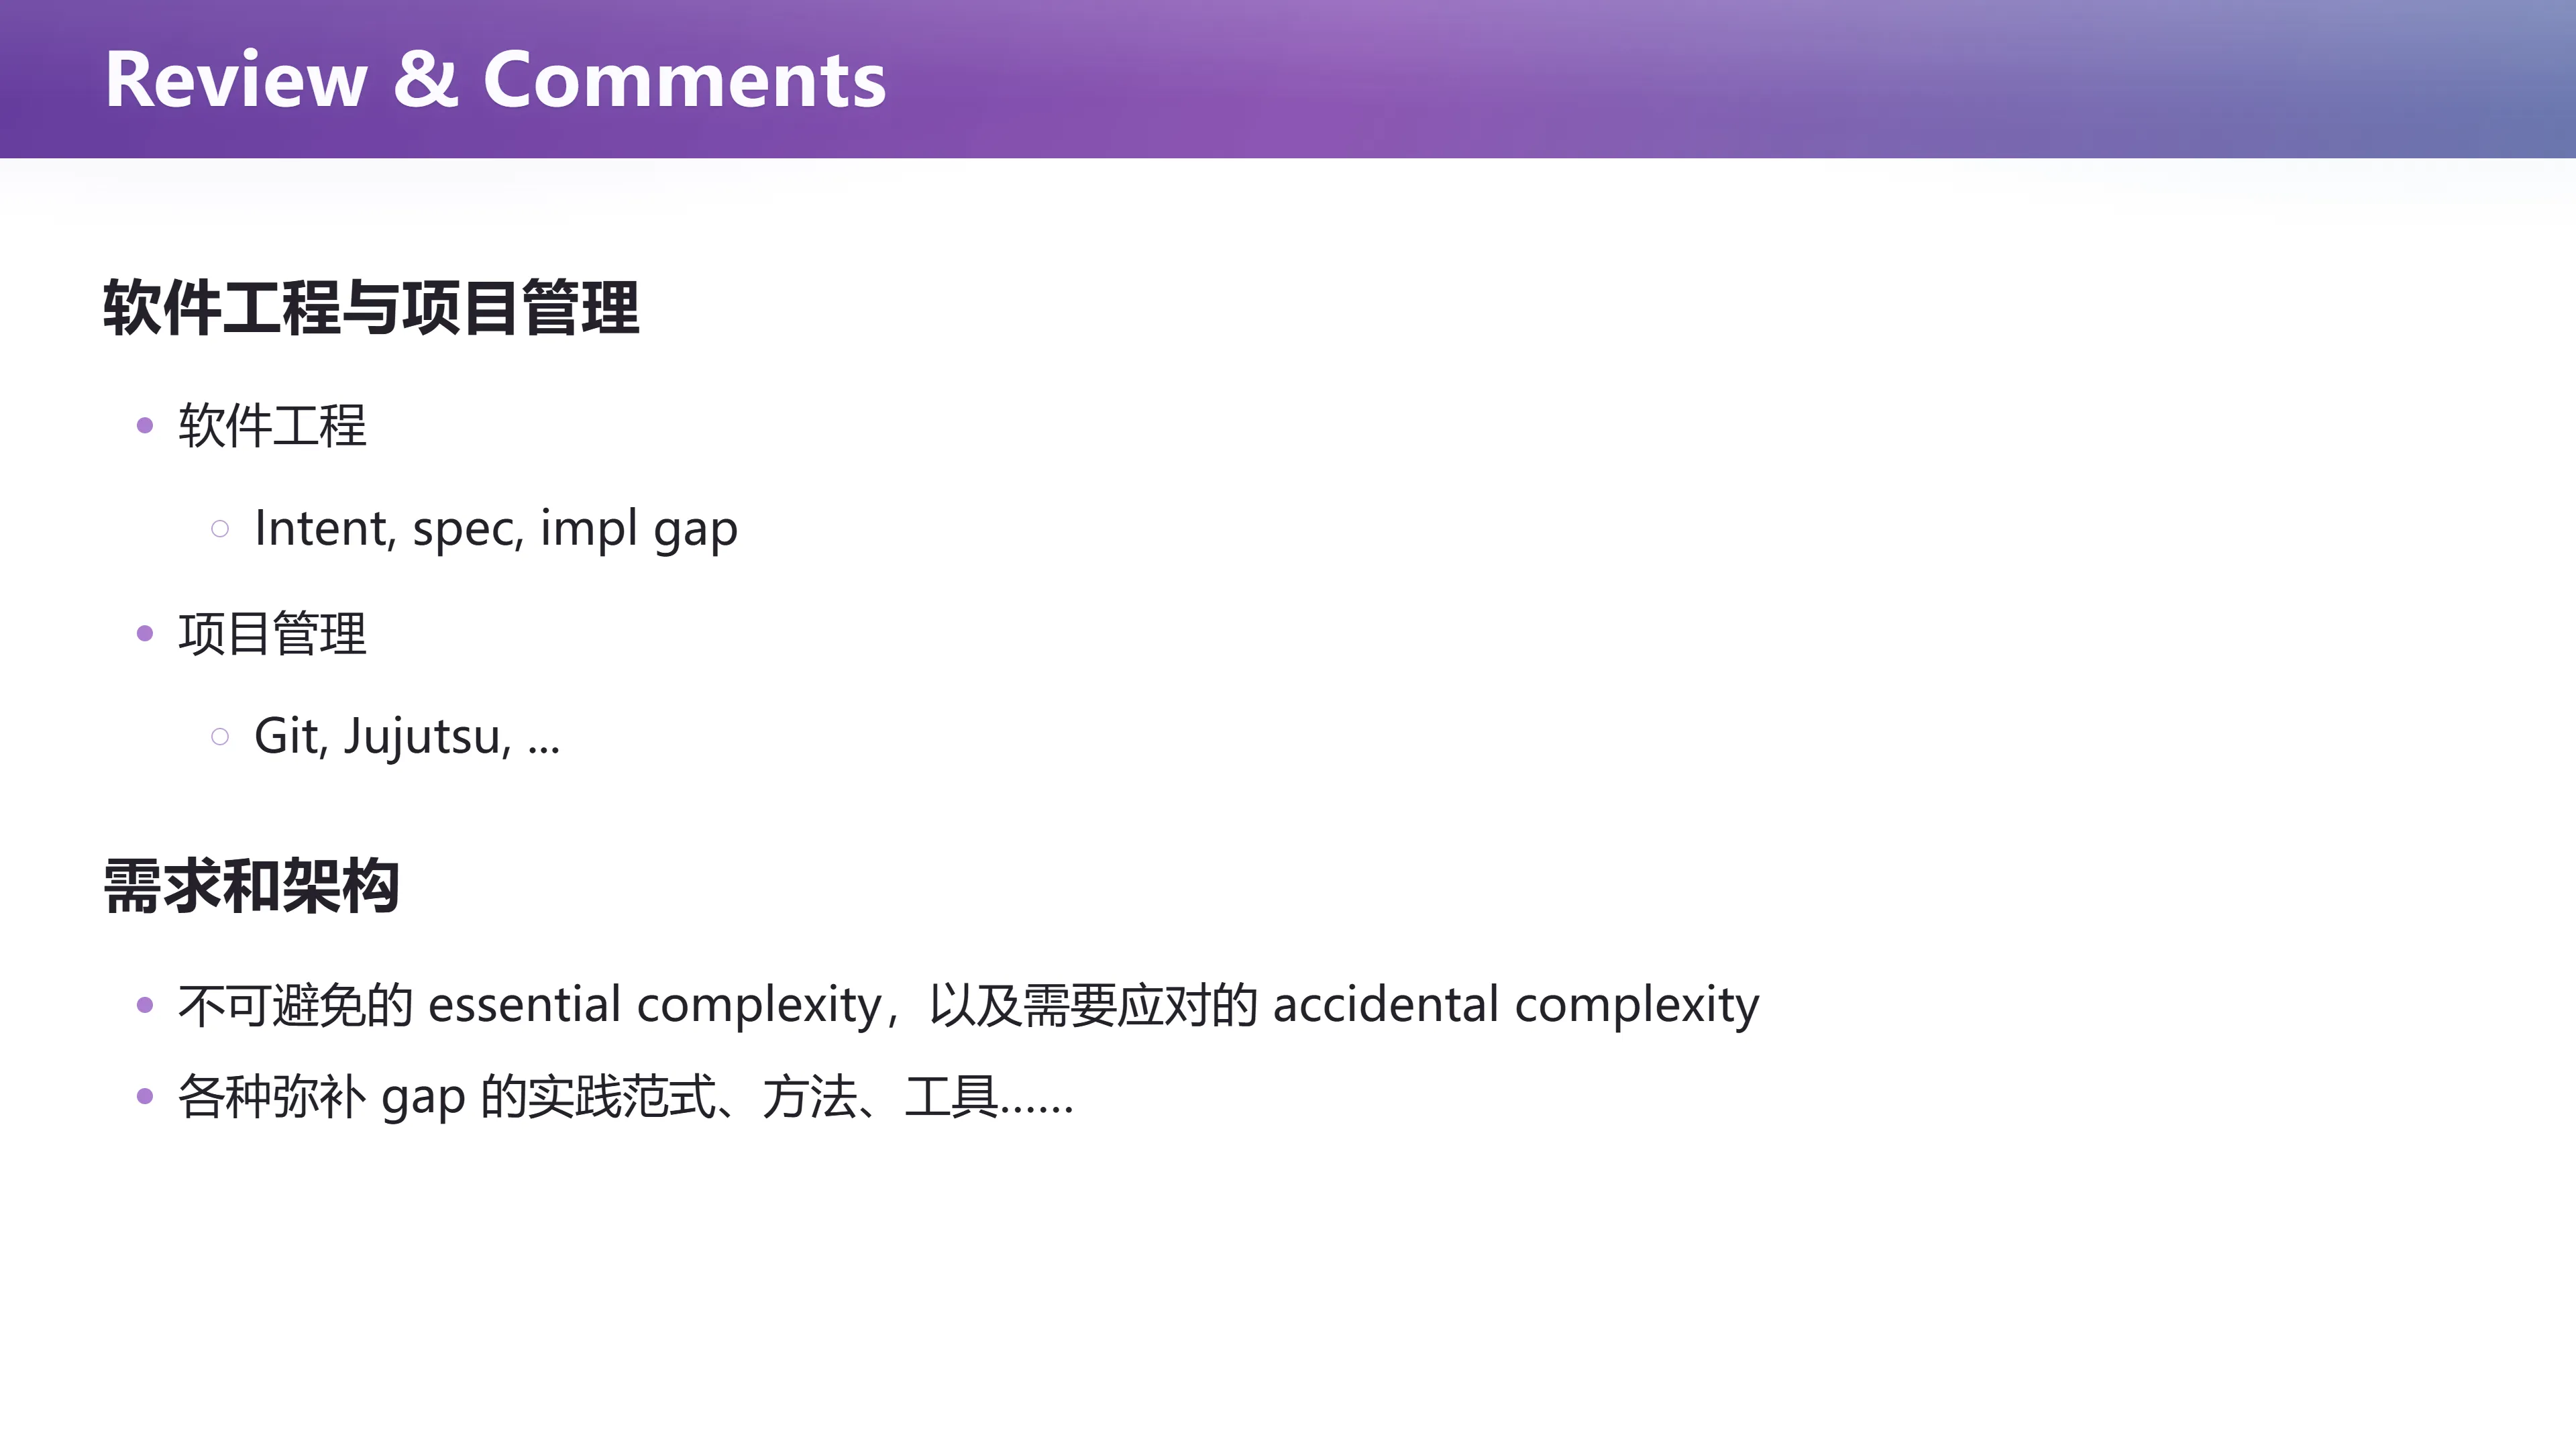
📷 回顾与评论:软件工程解决的是什么问题
回到原视频 (00:05:54)
前三讲一直在讨论软件工程里的几道缝隙:人的意图(Intent)怎样变成规格说明(Spec),规格又怎样变成实现(Implementation)。版本管理帮助我们保存、比较和协调变化;需求分析与架构设计帮助我们理解问题,把复杂性放在合适的位置。
讲师用了一张图来刻画这件事:软件工程本质上是在"intent 空间 → spec 空间 → implementation 空间"这条链路上,帮助人类收敛到一个合理的点上。
intent到spec是 一对多 的:同一个意图可以有多种规格写法。spec到implementation也是 一对多 的:同一份规格可以有多种实现。- 人类脑容量有限,无论是一个人做大作业、还是组一个小团队做项目,在 intent 空间里只能是采样一个点。
graph LR
  I["Intent 空间<br/>(无穷多种想法)"] -->|采样一个点| I1["具体的意图"]
  I1 -->|一对多| S["Spec 空间<br/>(多种规格写法)"]
  S -->|一对多| P["Implementation 空间<br/>(多种实现)"]
  I1 -.->|需求访谈、Checklist、对齐| I1
  S -.->|与有经验的架构师讨论| S
而"review"在其中的角色,就是多轮迭代把一对多收敛成一个点:review 几轮后双方达成一致,落成一个 spec;spec 再经过几轮迭代,落成一个 implementation。相比之下,一条线走到黑的方式虽然也能做出东西,但可维护性、可观测性可能差出十万八千里。
UML 建模、IDE、Git work tree、Jujutsu……这些工具的共同作用,都是在早期就把"想法"落到实处,让人不必在脑内同时维护太多分支。
问题的本质复杂性(essential complexity)不能凭空消失;工具、表示和实现方式额外引入的偶然复杂性(accidental complexity),则值得我们不断消减。
"Let it fail"——原型也在检验预期
(参考时间: 00:08:46)
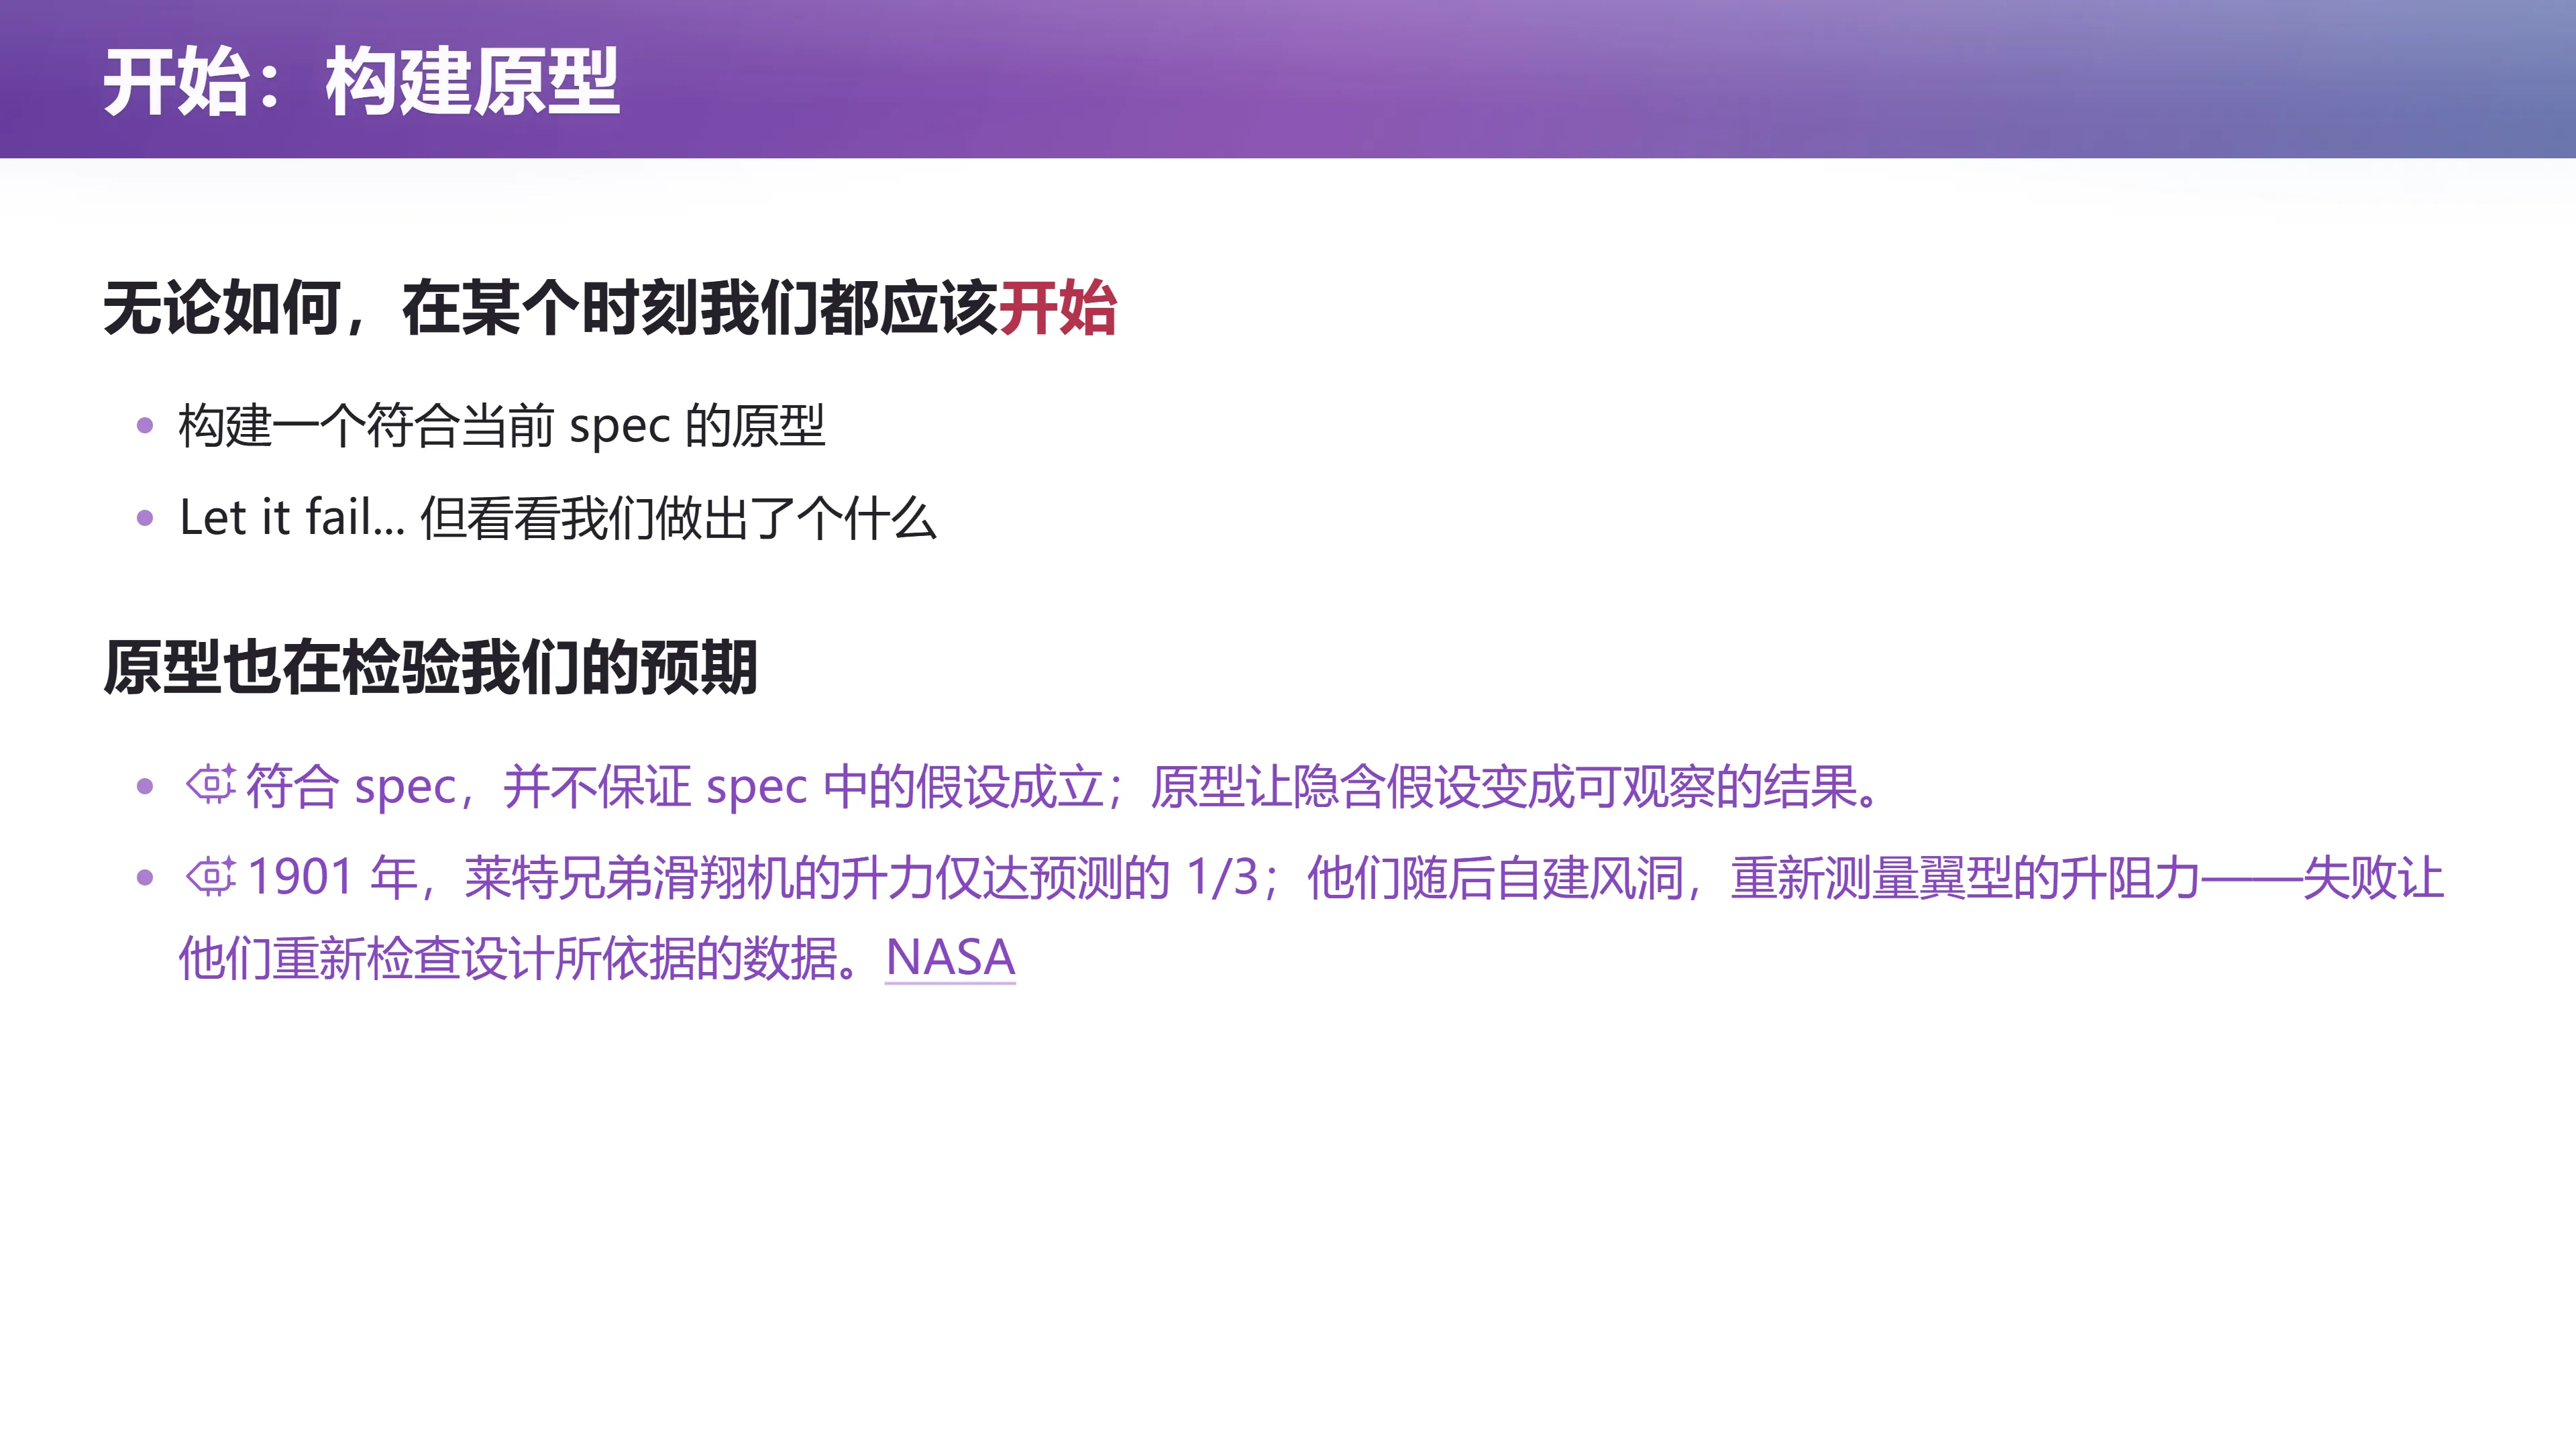
📷 开始:构建原型
回到原视频 (00:08:46)
"这些道理都重要,但不能让我们永远停留在讨论道理的阶段。在某个时刻,我们总得开始:做出一个符合当前 spec 的原型,让它运行起来,看看究竟造出了什么。"
"Let it fail"并不是鼓励随便交差,而是允许原型暴露我们的错误。 实现可能没有满足规格;规格也可能没有表达真正的需求;即使两者都对上了,需求里关于用户、规模和运行环境的假设,仍然可能不成立——纸面上说得通的选课系统,遇到两个人同时抢最后一个名额,就可能出现另一副面孔。
AI 给我们一个非常好的能力:在任何阶段,你都可以直接让 AI 往下做一版。
"哪怕你最开始有一个想法,你就直接让 AI 往下做;他可能到不了那么深,做到最后面就 stop 维护不下去了,或者你觉得看不下去;你也可以在任何阶段让 AI 生成一个版本,然后比较——这个是变好了还是变坏了?变坏了,你就再讨论一下,再让他做一版。"
AI 实际上承担了一个员工——甚至不仅是一个员工,而是一个团队的职责:
"如果需求可以分解成两个 subsystem,模块分得比较好,那你完全可以启动两个并行的 Agent。像我现在实际开发一个项目的时候,我就有一个 tmux 窗口分成四份,然后四个 Agent——我最多只能同时开四个,不然我大脑就有点跟不上 AI 输出的速度了。"
AI 成本足够低的时候,你可以让它先往前走:
"我现在在这个状态的时候,就会想:我这个架构如果这个人来了会怎么样?如果用户多了以后会怎么样?我还有没有看到两个模块之间之前未曾想过的交互?很多问题都只有你真正把它实现出来以后,你才意识到,哎,这个地方的设计出了一个小问题。"
所以 AI 给我们的能力,是构建原型的能力。而如何用 AI 构建一个好的原型,就要用到 Agent loop。
编者拓展|莱特兄弟与"失败的 1/3":幻灯片里提到一个经典案例——1901 年,莱特兄弟的滑翔机升力只达到当时预测值的约 1/3。他们随后自建风洞,重新测量翼型的升阻比。失败让他们重新检查设计所依据的数据,而不是继续在原有假设上优化。这是"原型检验预期"的教科书例子:纸面上符合 spec 不代表 spec 里的数据是对的;先让原型暴露隐藏假设,才有机会改对方向。(史料可参见 [NASA 关于莱特兄弟风洞的记述](https://www.nasa.gov/history/)。)
同一个提示词,不断变化的世界
(参考时间: 00:11:00)
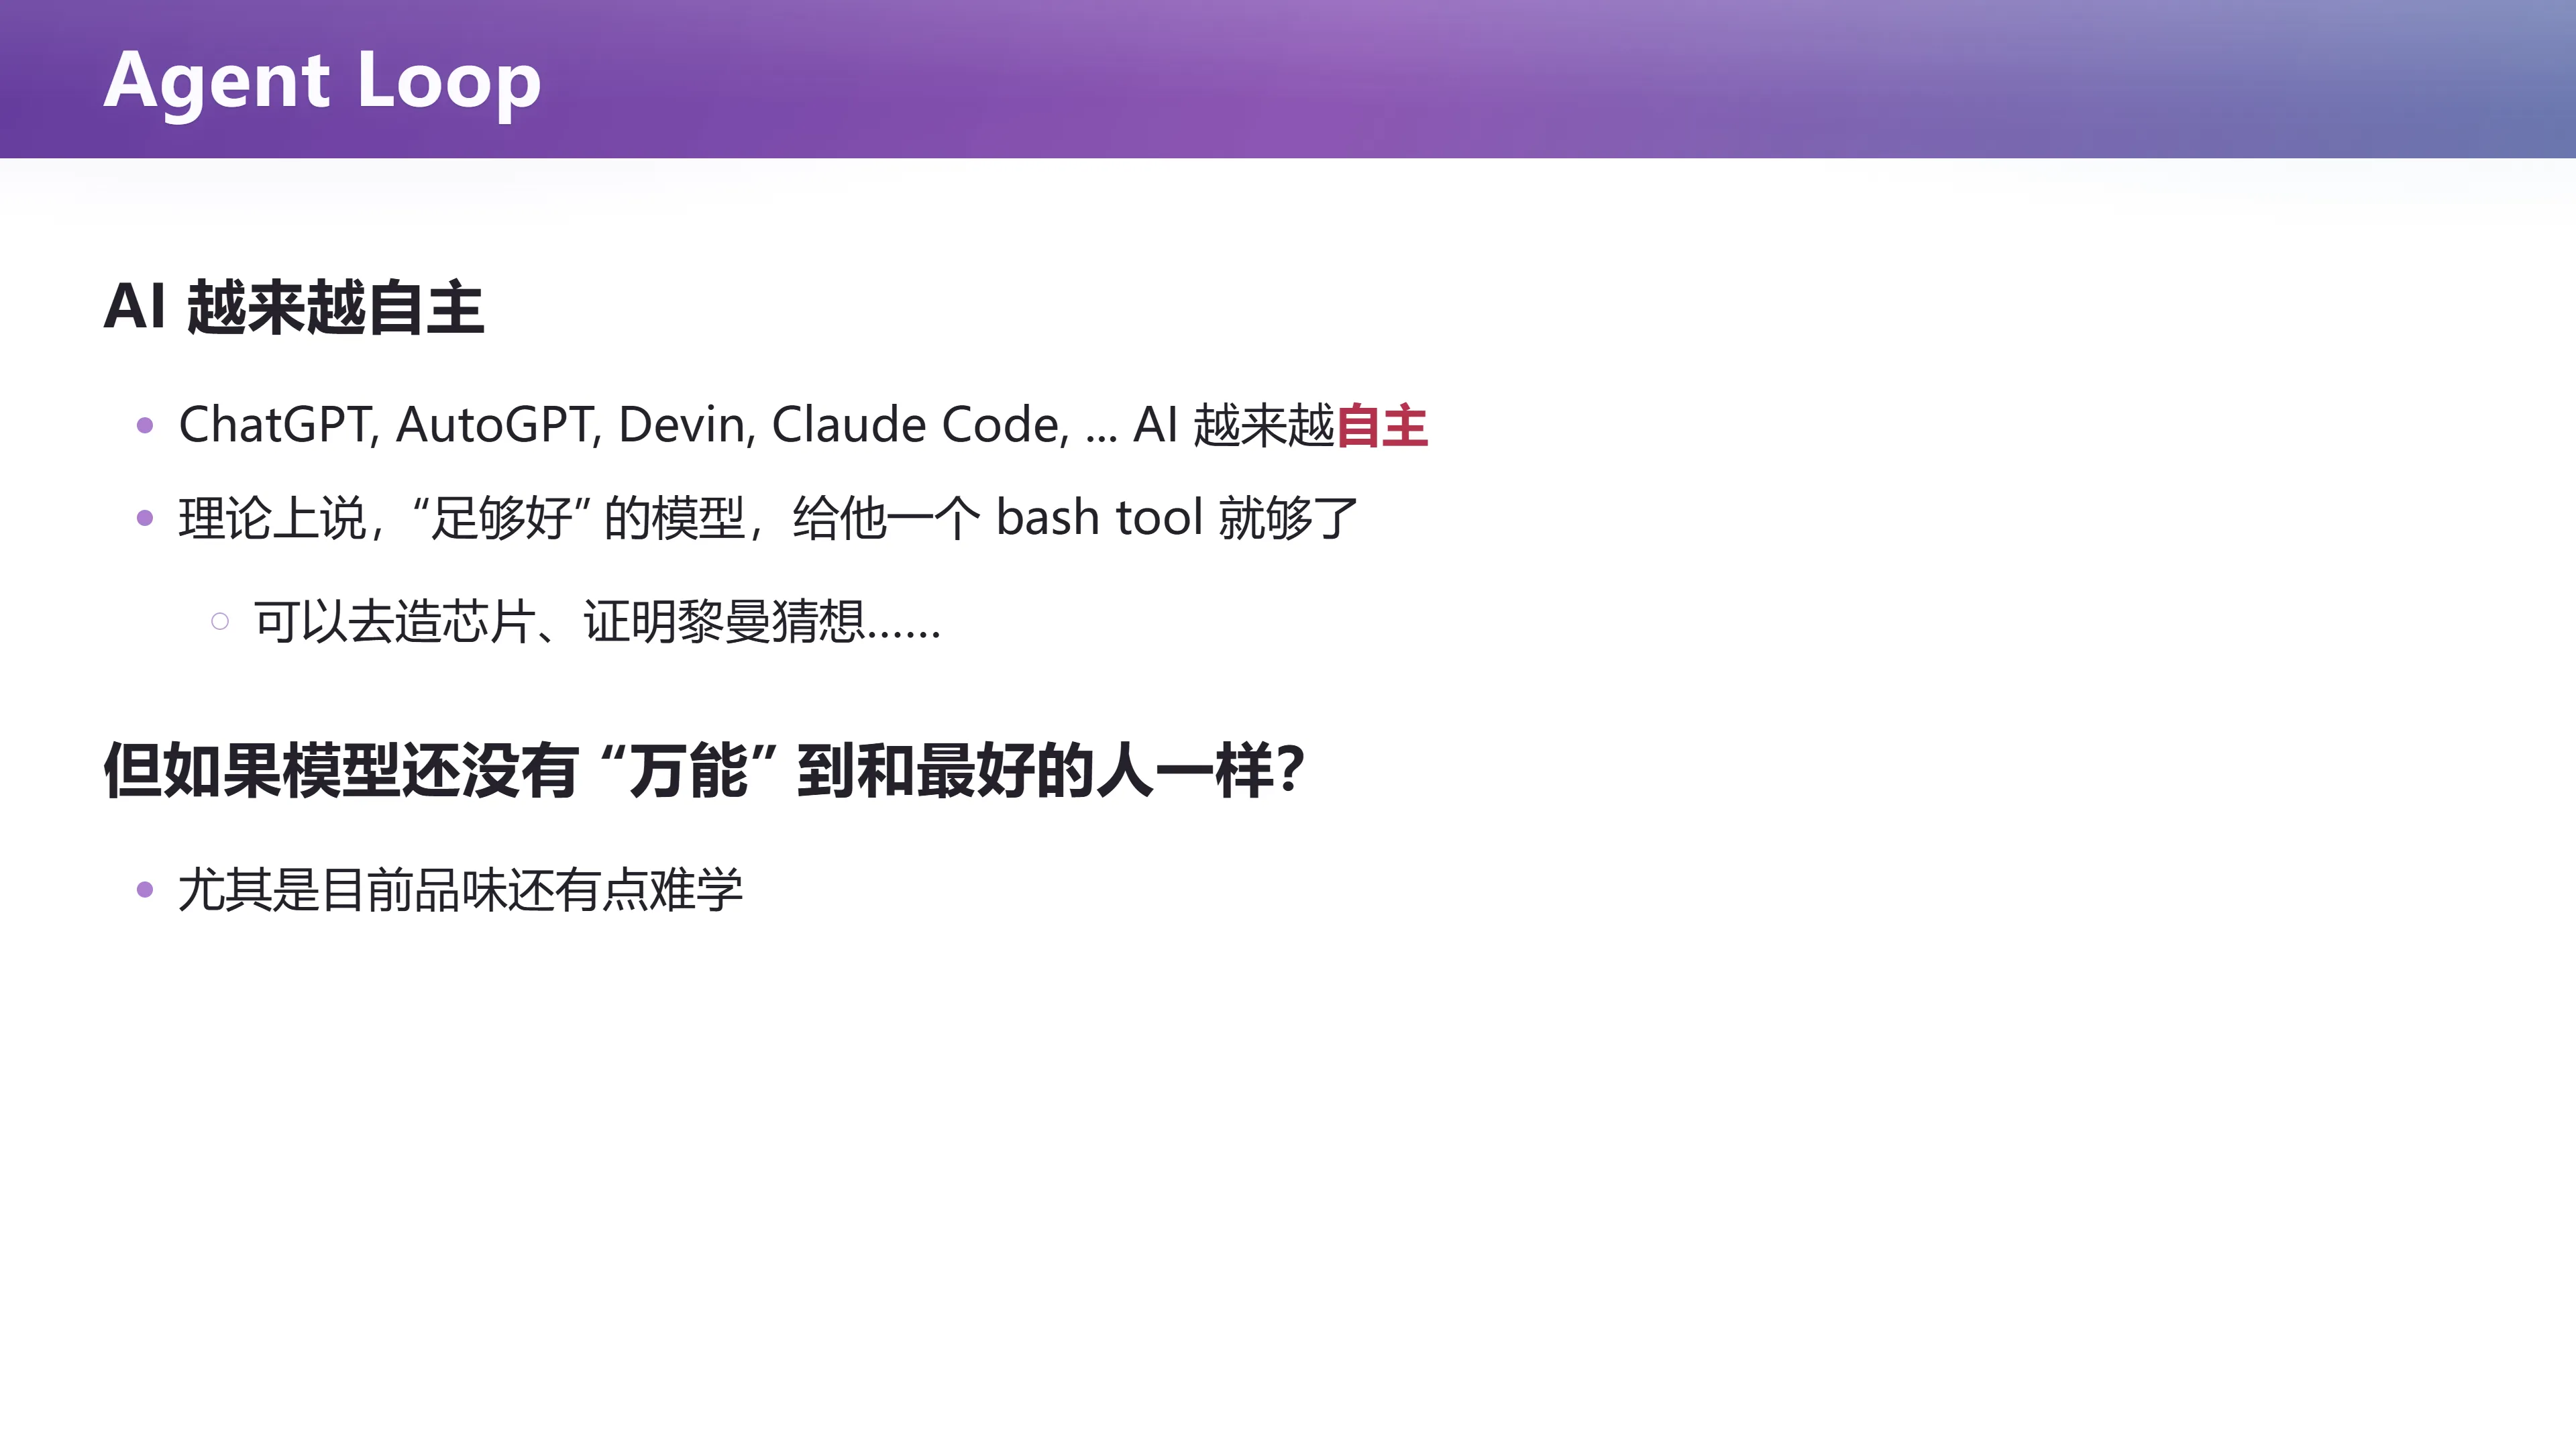
📷 Agent Loop
回到原视频 (00:11:00)
AI 越来越自主
从 ChatGPT、AutoGPT、Devin 到 Claude Code,AI 越来越自主。站在 2023 年回看那一段,很多人其实持观望态度:
"那时你们大概还在上初中或高中,社交媒体上有一些新闻说模型很强、但有幻觉。比如有一个 milestone 叫 Devin,是最早的一批 coding agent,D**号称可以解决数学问题。但那时 GPT-4 的幻觉很严重,也没有像 o 系列那样的思维链模型,所以大家会想——这东西到底行不行?"
放到今天,如果再做一次思想实验:假设模型足够聪明,拥有足够的工具、资源和行动权限,也许给它一个 Bash 入口,它就能组织完成极其复杂的工作。 造芯片、证明黎曼猜想,是对这种想象的夸张表达,并不意味着今天的模型已经具备这些能力。
"在早期 UNIX 时代,图形用户界面还没有出现的年代,那些大师们——克努特还在写 The Art of Computer Programming 的时候——就真的是在一个 shell 里和其他工具交互。"
但反过来说,模型也还没有万能到和最好的人一样好。尤其是工程品味:什么值得抽象、哪里应该保持简单、什么改动正在让项目变得难以维护,并不容易只靠一句提示词教会。
"模型在强化学习时,还是有一个很重要的奖励:完成任务。如果你花了很多时间都没完成任务,你就停在那里——这跟真实的博士生训练其实有点像。我们有很多同学喜欢在设计阶段把文献调研清楚,这时导师就会说:你的时间有限,你可能需要看到什么学什么,快速把问题推进下去。"
这就引出了一个问题——如果一次回答不能解决全部问题,能不能让它不断尝试?
Ralph Wiggum Loop
(参考时间: 00:23:10)
📷 Ralph Wiggum Loop:名字的由来
回到原视频 (00:23:10)
Geoffrey Huntley 提出的 Ralph Loop 给出了一种非常朴素的形式。名字借用了《辛普森一家》里的 Ralph Wiggum,带着一点笨拙却执着的意味。讲师调侃:
"也不知道为什么,有一个人这么提出来了,然后地球人都开始用——第一个提出它、并且让它 get popular 的人,就定义了这个名字。"
📷 Ralph Loop:三行代码
回到原视频 (00:23:30)
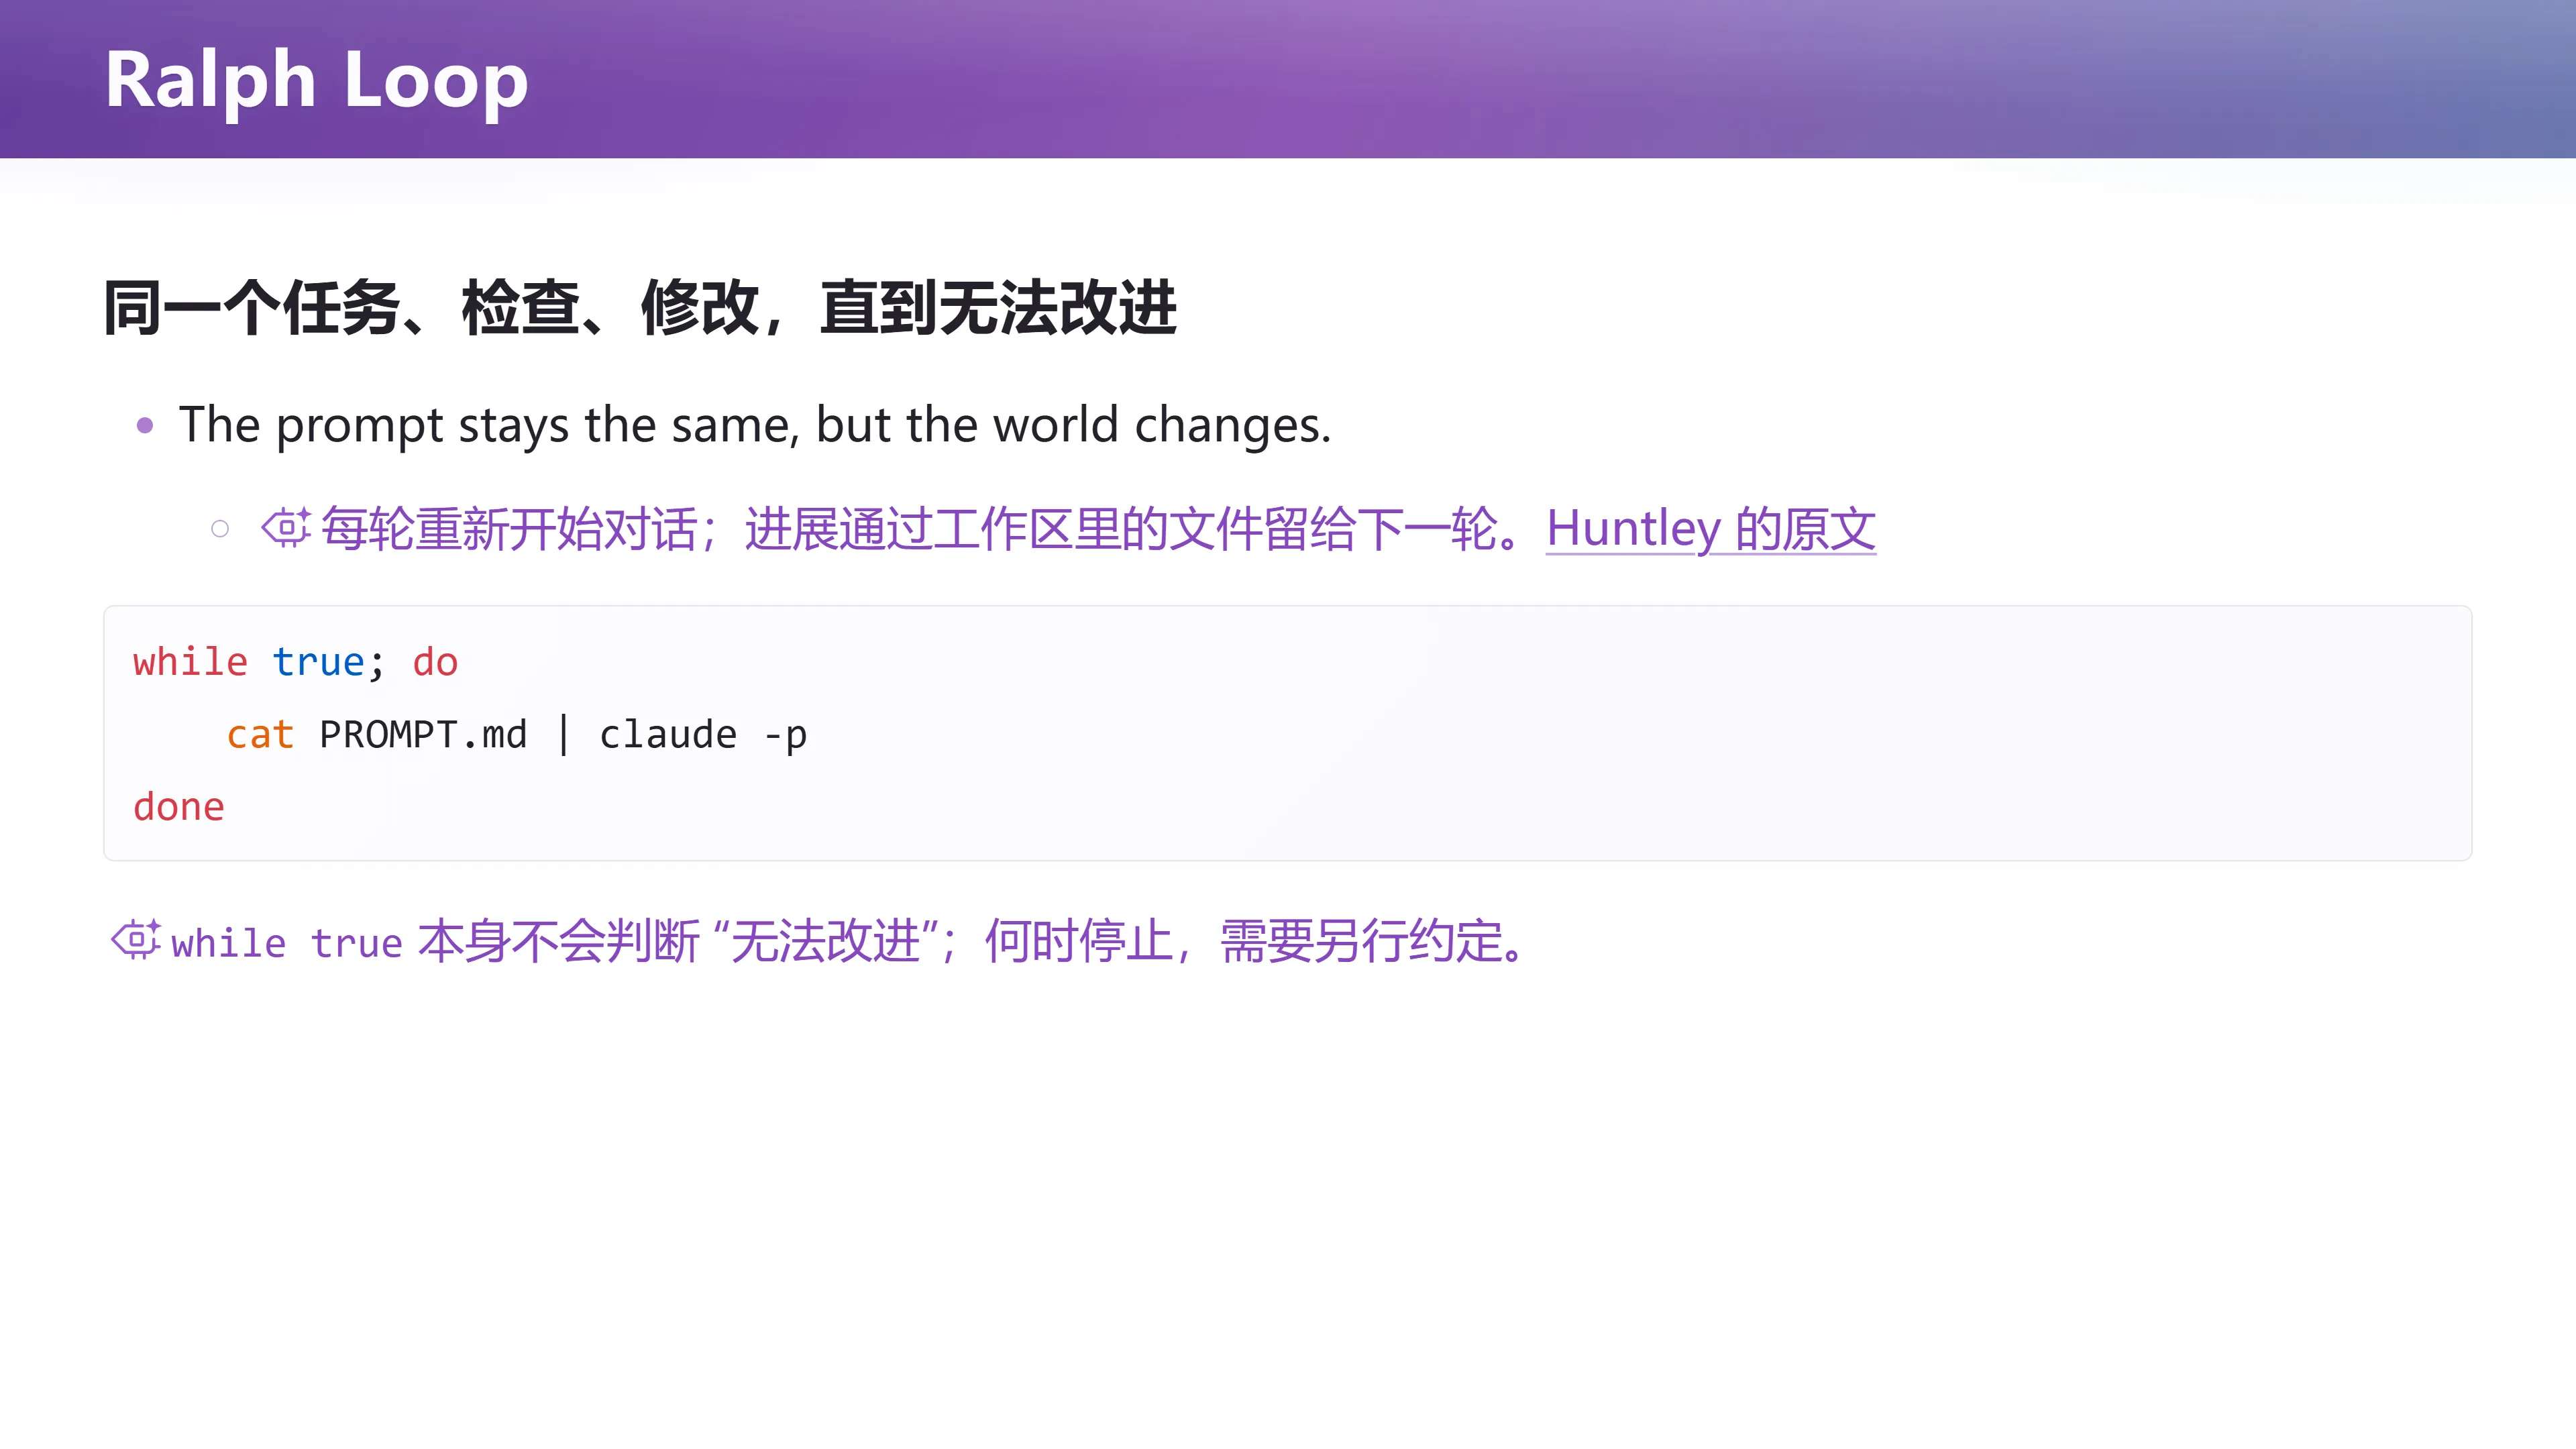
下面这段代码表达了循环的骨架:
while true; do
    cat PROMPT.md | claude -p
done
每轮都把同一个任务交给 Agent,让它检查当前成果,选择下一项工作,修改并验证。一次会话结束,下一轮重新开始。提示词没变,工作区却变了:上一轮实现了功能、留下了测试结果、记录了失败原因,下一轮就能够接着这些状态继续。
The prompt stays the same, but the world changes.
—— 讲师引用了自己让 GPT 做的一个总结
这是 Huntley 对 Ralph 的介绍中值得把握的机制。
循环本身并没有魔法。while true 不会自动识别"已经完成"或"无法改进",也不能保证下一轮一定比上一轮好。实际使用时,必须另外定义验收条件、预算或停止条件;反复遇到相同失败时,还要判断是不是任务表述、工具或架构出了问题。不断运行是产生进展的机会,能识别进展的反馈才让这些机会有价值。
为什么一定需要一个 loop?
(参考时间: 00:24:30)
讲师给了两条基本假设。
假设一:足够好的模型,给它一个 Bash tool 就够了。 从理论上说,如果它像一个不知疲倦的永动机,它就可以对某个任务无穷无尽地尝试下去,直到得到一个相对最好的解。
假设二:今天的模型还不够好,容易漂移。
"它就像我们的 PhD student 一样,脑子一热就哗哗哗给你做完了;或者因为你已有的部分代码污染了它的上下文,然后它又有一种强烈的'舔狗'倾向——它要遵循指令,就不能去动用户的东西。"
讲师用一个比喻来说明这种"不可信":
"我作为博士生导师有一个权利,学生今天交了一个工作,我可以跟他说'你这个代码是零分的代码',下次再拿这种代码来就不要来见我。学生虽然会痛苦,但能理解导师可能是为他好,下一个版本就会把架构全部推掉。但模型不一样——如果上下文里加载了你的 slop 代码,它会有一种强烈的倾向:我的任务是把这段 slop 代码扶起来。当它跟你说这个架构要重构的时候,重构很可能不能保持代码行为 100% 一致——这个变化可能是把项目往好的方向推,但对你来说可能是一种比较粗鲁的行为,因为可能那个代码就在线上跑着,你真的只想让它花一分钟时间把项目赶快扶起来,让在线跑的服务不要崩掉。"
所以它遵循指令也有道理,不遵循指令也有道理。这就是需要 loop 的一个动机:
- 不够好的模型会在第一次决策时偏移;
- 真实项目里,你往往只想让它做一小步修正,而不是全盘重构;
- 长任务的上下文装不下:你等着的 compact(上下文压缩)在调用了之后,会经历一段"降智期",往往等它加载了足够多上下文又能做对,然后又要 compact。
用一个外层的循环,可以把"一把头做完"这件事切成很多小步。
工作区是状态,Agent 是状态迁移
(参考时间: 00:27:20)
📷 Everything Is a State Machine
回到原视频 (00:27:20)
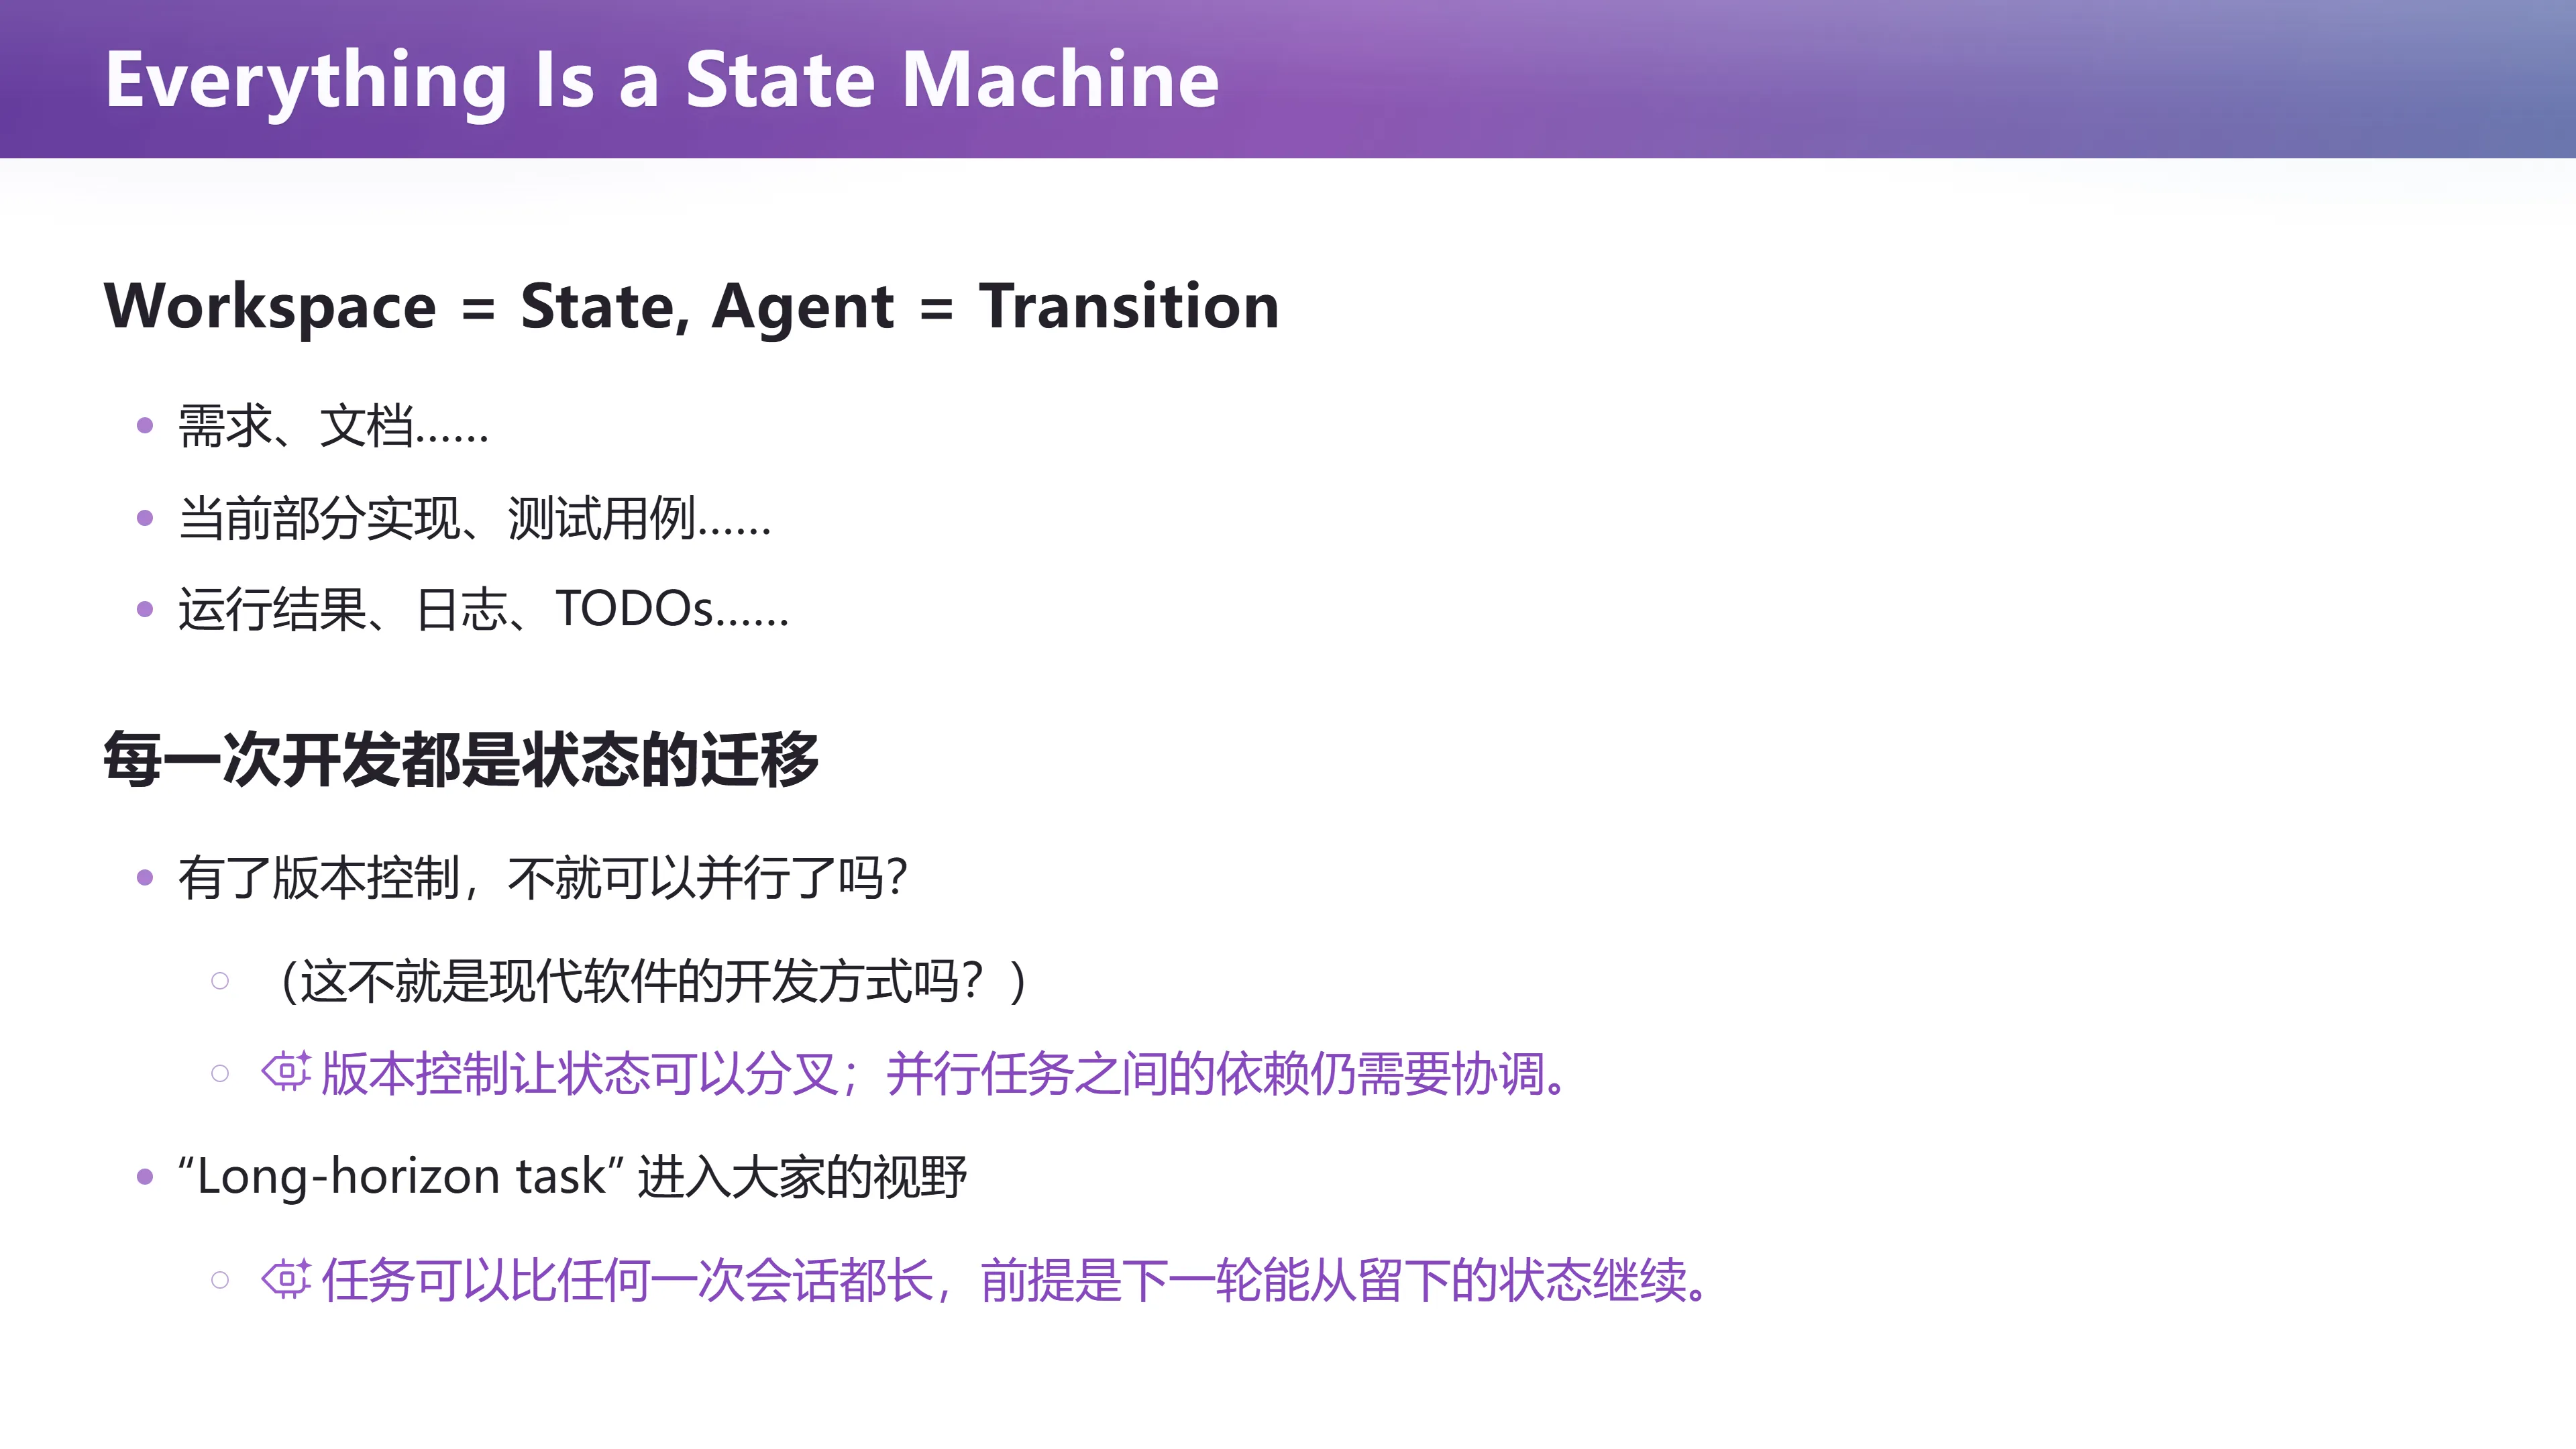
理解这种开发方式,可以借用一个熟悉的视角:Everything is a state machine(一切皆状态机)。
工作区就是状态。 它不只包含当前代码,也包含需求、设计文档、测试用例、运行结果、日志和待办事项。Agent 读入这些状态,执行一轮工作,把它们变成下一份状态。于是,一次开发可以理解为一次状态迁移:
$$\text{workspace}_{t+1} = \text{Agent}(\text{prompt}, \text{workspace}_t)$$
📷 开发过程就是一系列状态迁移
回到原视频 (00:28:20)
从"这个功能尚未实现",到"已有实现但测试失败",再到"失败原因已定位,修复通过了检查"——每一步都可以留一次 git commit,让下一轮从新的状态继续。
stateDiagram-v2
  [*] --> S0: "spec.md(几乎无实现)"
  S0 --> S1: "做一轮:实现了一小块"
  S1 --> S2: "git commit"
  S2 --> S3: "做一轮:修了一个 bug"
  S3 --> S4: "另开一个 Agent 做 review"
  S4 --> S5: "根据 review 修正"
  S5 --> [*]: "任务确认完成"
这也说明,长期任务不能只靠一段越来越长的聊天记录维持。所谓 long-horizon task,是需要跨越许多步骤、许多次会话才能完成的任务。新一轮 Agent 必须能够从留下来的材料中判断:目标是什么,已经做了什么,哪些结论有证据,哪里还没有完成。如果关键经验只存在于上一轮的上下文里,下一轮就得重新踩坑。
例如:"选课功能已完成"是一句含糊的交接;"普通选课已通过,两个请求竞争最后一个名额的测试失败,失败记录位于某份日志"则给出了可以继续工作的起点。
文档在这里承担的是协作状态,而不是工作量展示。写得越多未必越有用,能让接手者恢复判断才有用。
有了版本控制,不就可以并行了吗? 是的:
- 不同 Agent 在不同工作区中推进不同任务,再把结果集成起来;
- 这不就是现代软件开发的基本方式吗?
不过,版本控制允许并行,并不自动保证任务彼此独立。两个改动各自正确,合在一起仍可能出错;大家也可能同时扑向同一个问题。要让并行有收益,任务划分、依赖关系和集成检查都得跟上。
编者说明:"状态机"这个比喻在本讲中被反复使用。它不是要引入一种新的编程范式,而是提供一套心智模型:每一轮循环的开始是一个可以观察的工作区,每一轮循环的结束又是一个可以观察的工作区。只要你把"应该是好状态"这件事写成可执行的判断,loop 就能自动运转——这正好通向下一节的 CI/CD。
每次迁移都检查:重新发现 CI/CD
(参考时间: 00:41:00)
📷 每次 Transition 都检查
回到原视频 (00:41:00)
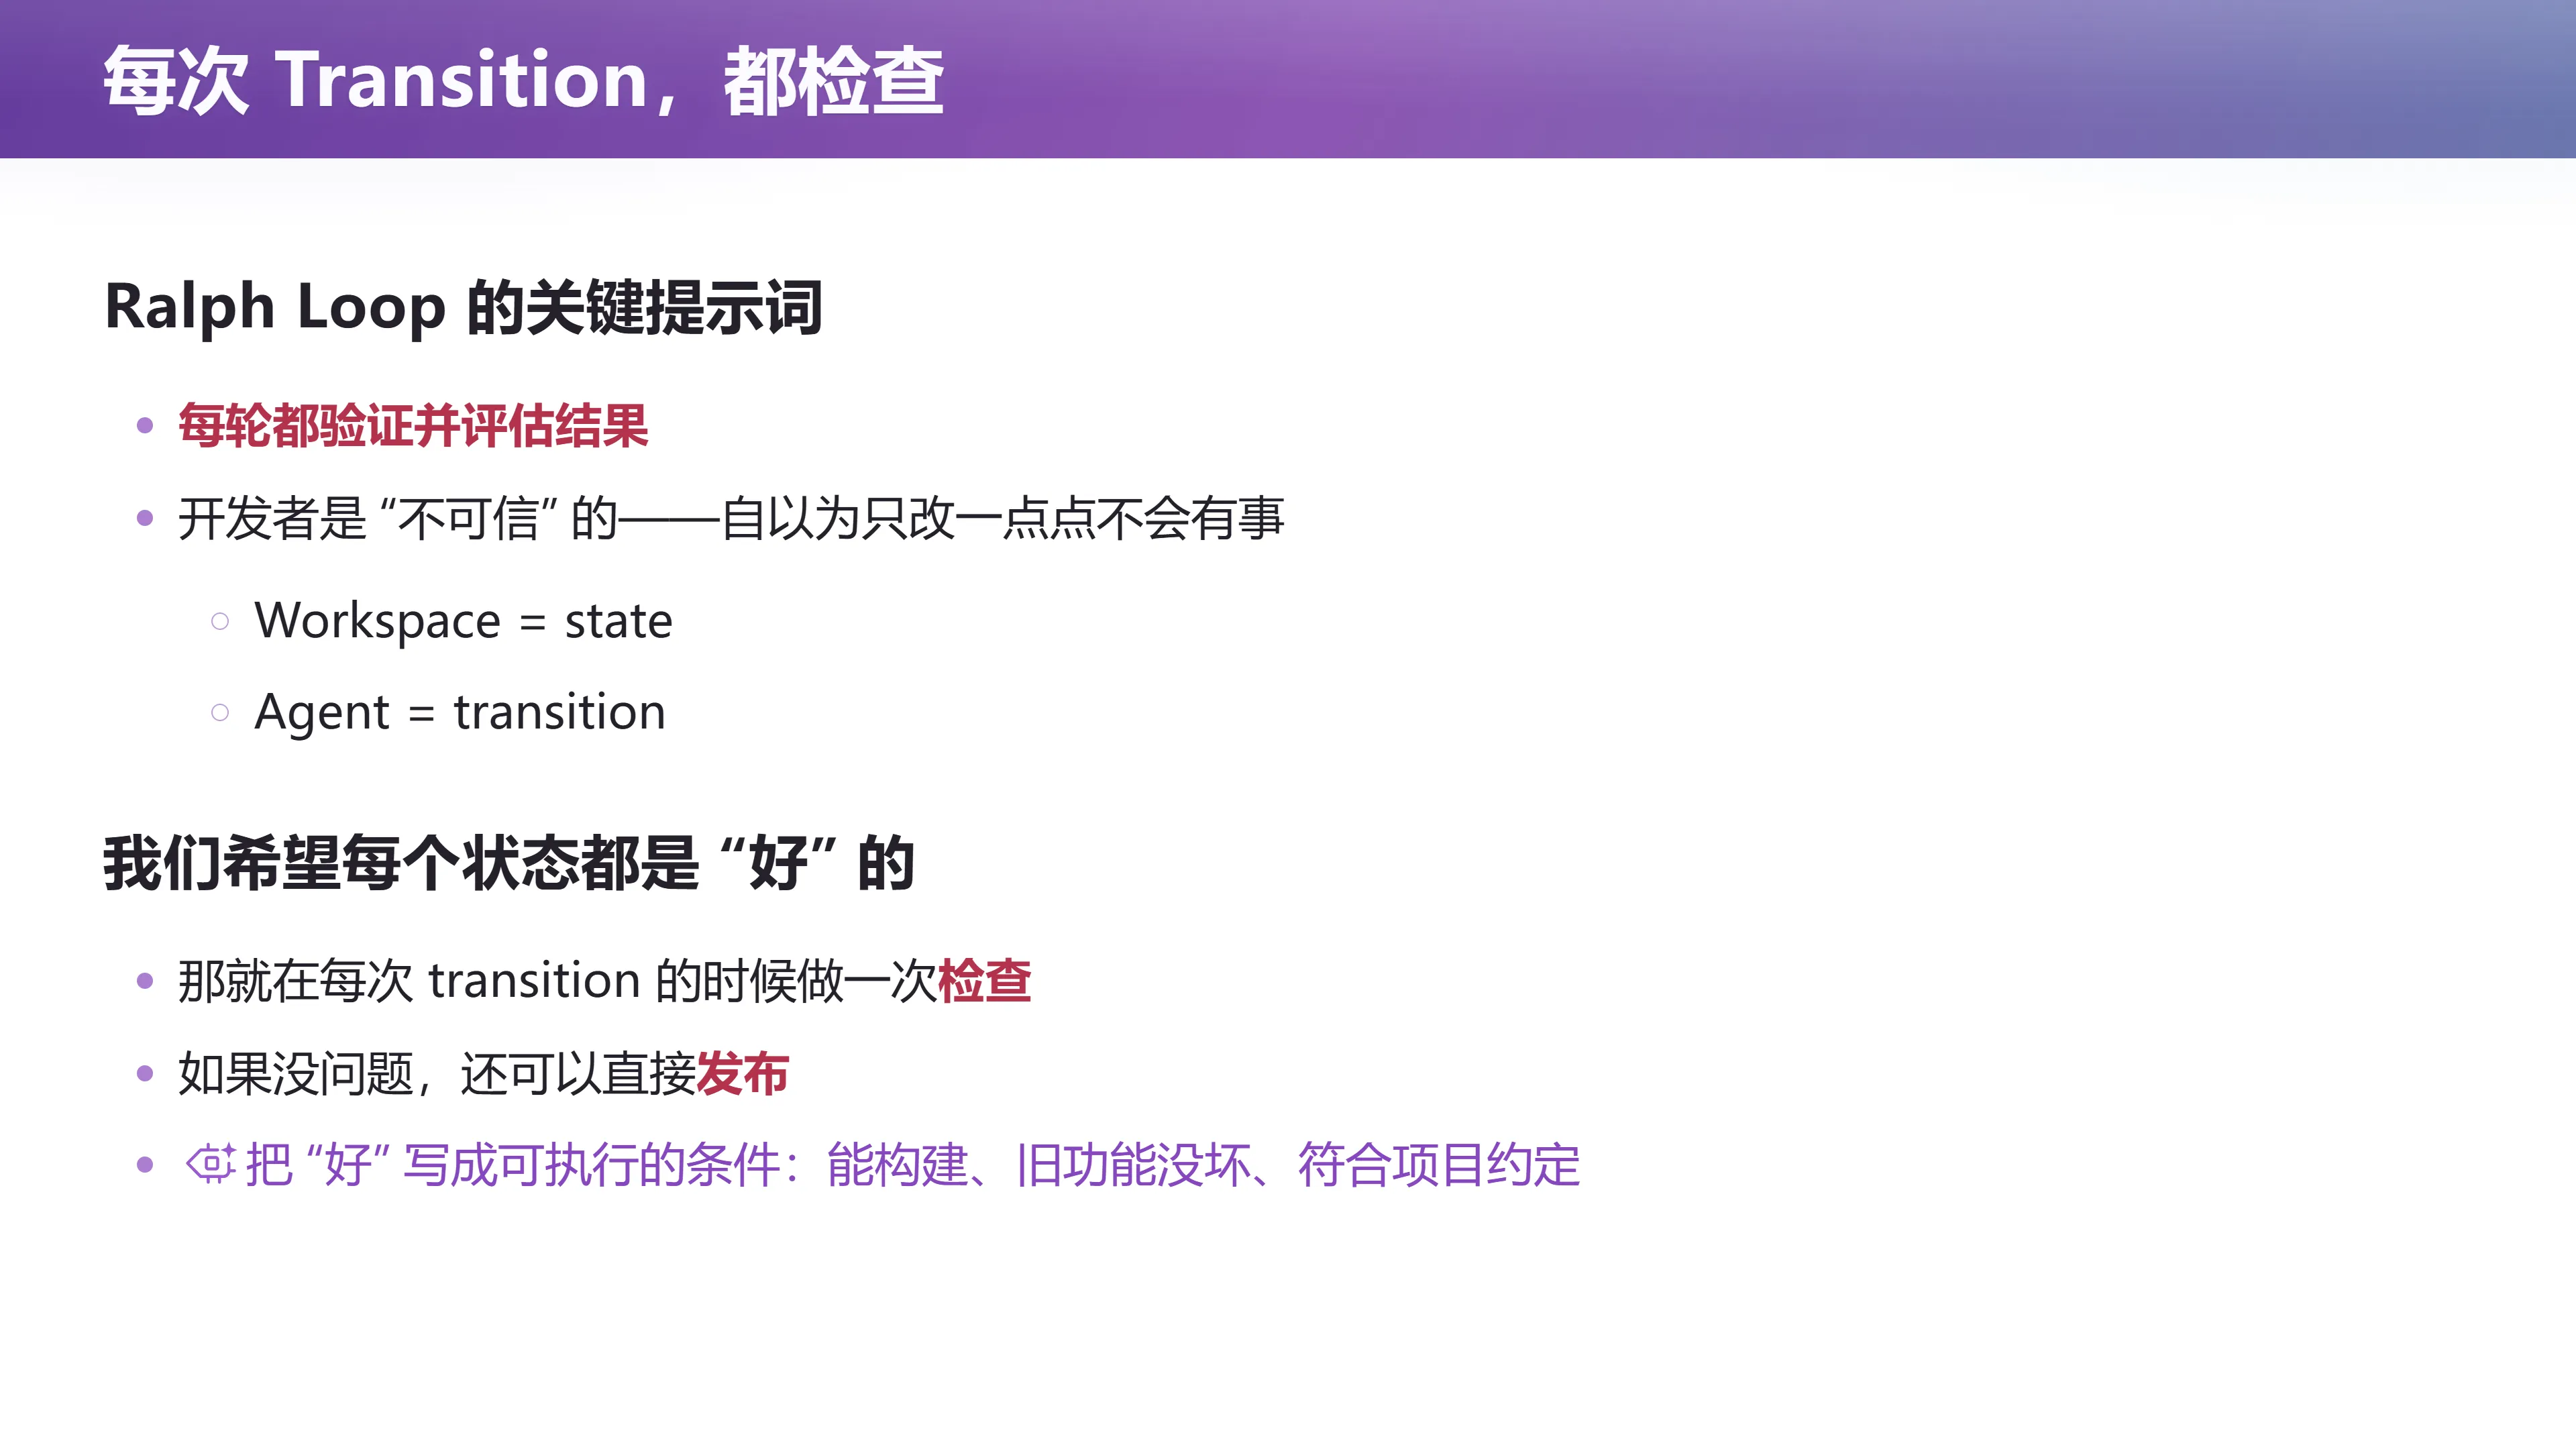
Ralph Loop 中一个关键要求是:每轮都验证并评估结果。其出发点可以说得很不客气:开发者是不可信的。
"开发者会说:'我今天就改这一句话、文档里改一句话,应该没事吧?''我就把这个循环变量从 1 改成从 0 开始,应该没事吧?''啊,我单元测试通过了,应该没问题吧?'——你们每天脑子里面样例过了,'我是不是可以交 OJ 了','应该程序是对的吧'。你们脑子里面每天都是这样的事情。"
讲师借用计算机系统基础课上的两条公理:
- 机器永远是对的——不要怀疑机器。
- 出错的代码永远是你自己——出了任何问题,第一个要怀疑的就是你自己写的东西。
人天生有自信,而人的自信就带来开发者的某种不可信。"哎呀,我就改这一点点,不会有事"——这往往正是事故的开场白。
所以在状态推进的过程中,我们希望每一个状态都是"好"的。那也就是说,每一次 transition 之后都做一次检查;如果不通过,就拒绝这次 loop 的结束,让 Agent 回到上一步把所有问题都修好。恭喜你,重新发明了 CI/CD。
编者说明:这个"重新发现",是本讲的一个核心叙事技巧——它不是在"教你 CI/CD",而是在说:当你认认真真去构建一个 Agent 循环时,你最后一定会自己走到 CI/CD 这条路上。这也解释了后面为什么会有"CI 的含金量在 Agentic AI 时代反而更高"的结论。
从"集成地狱"到小步发布
📷 祝贺你,发明了 CI/CD
回到原视频 (00:44:02)
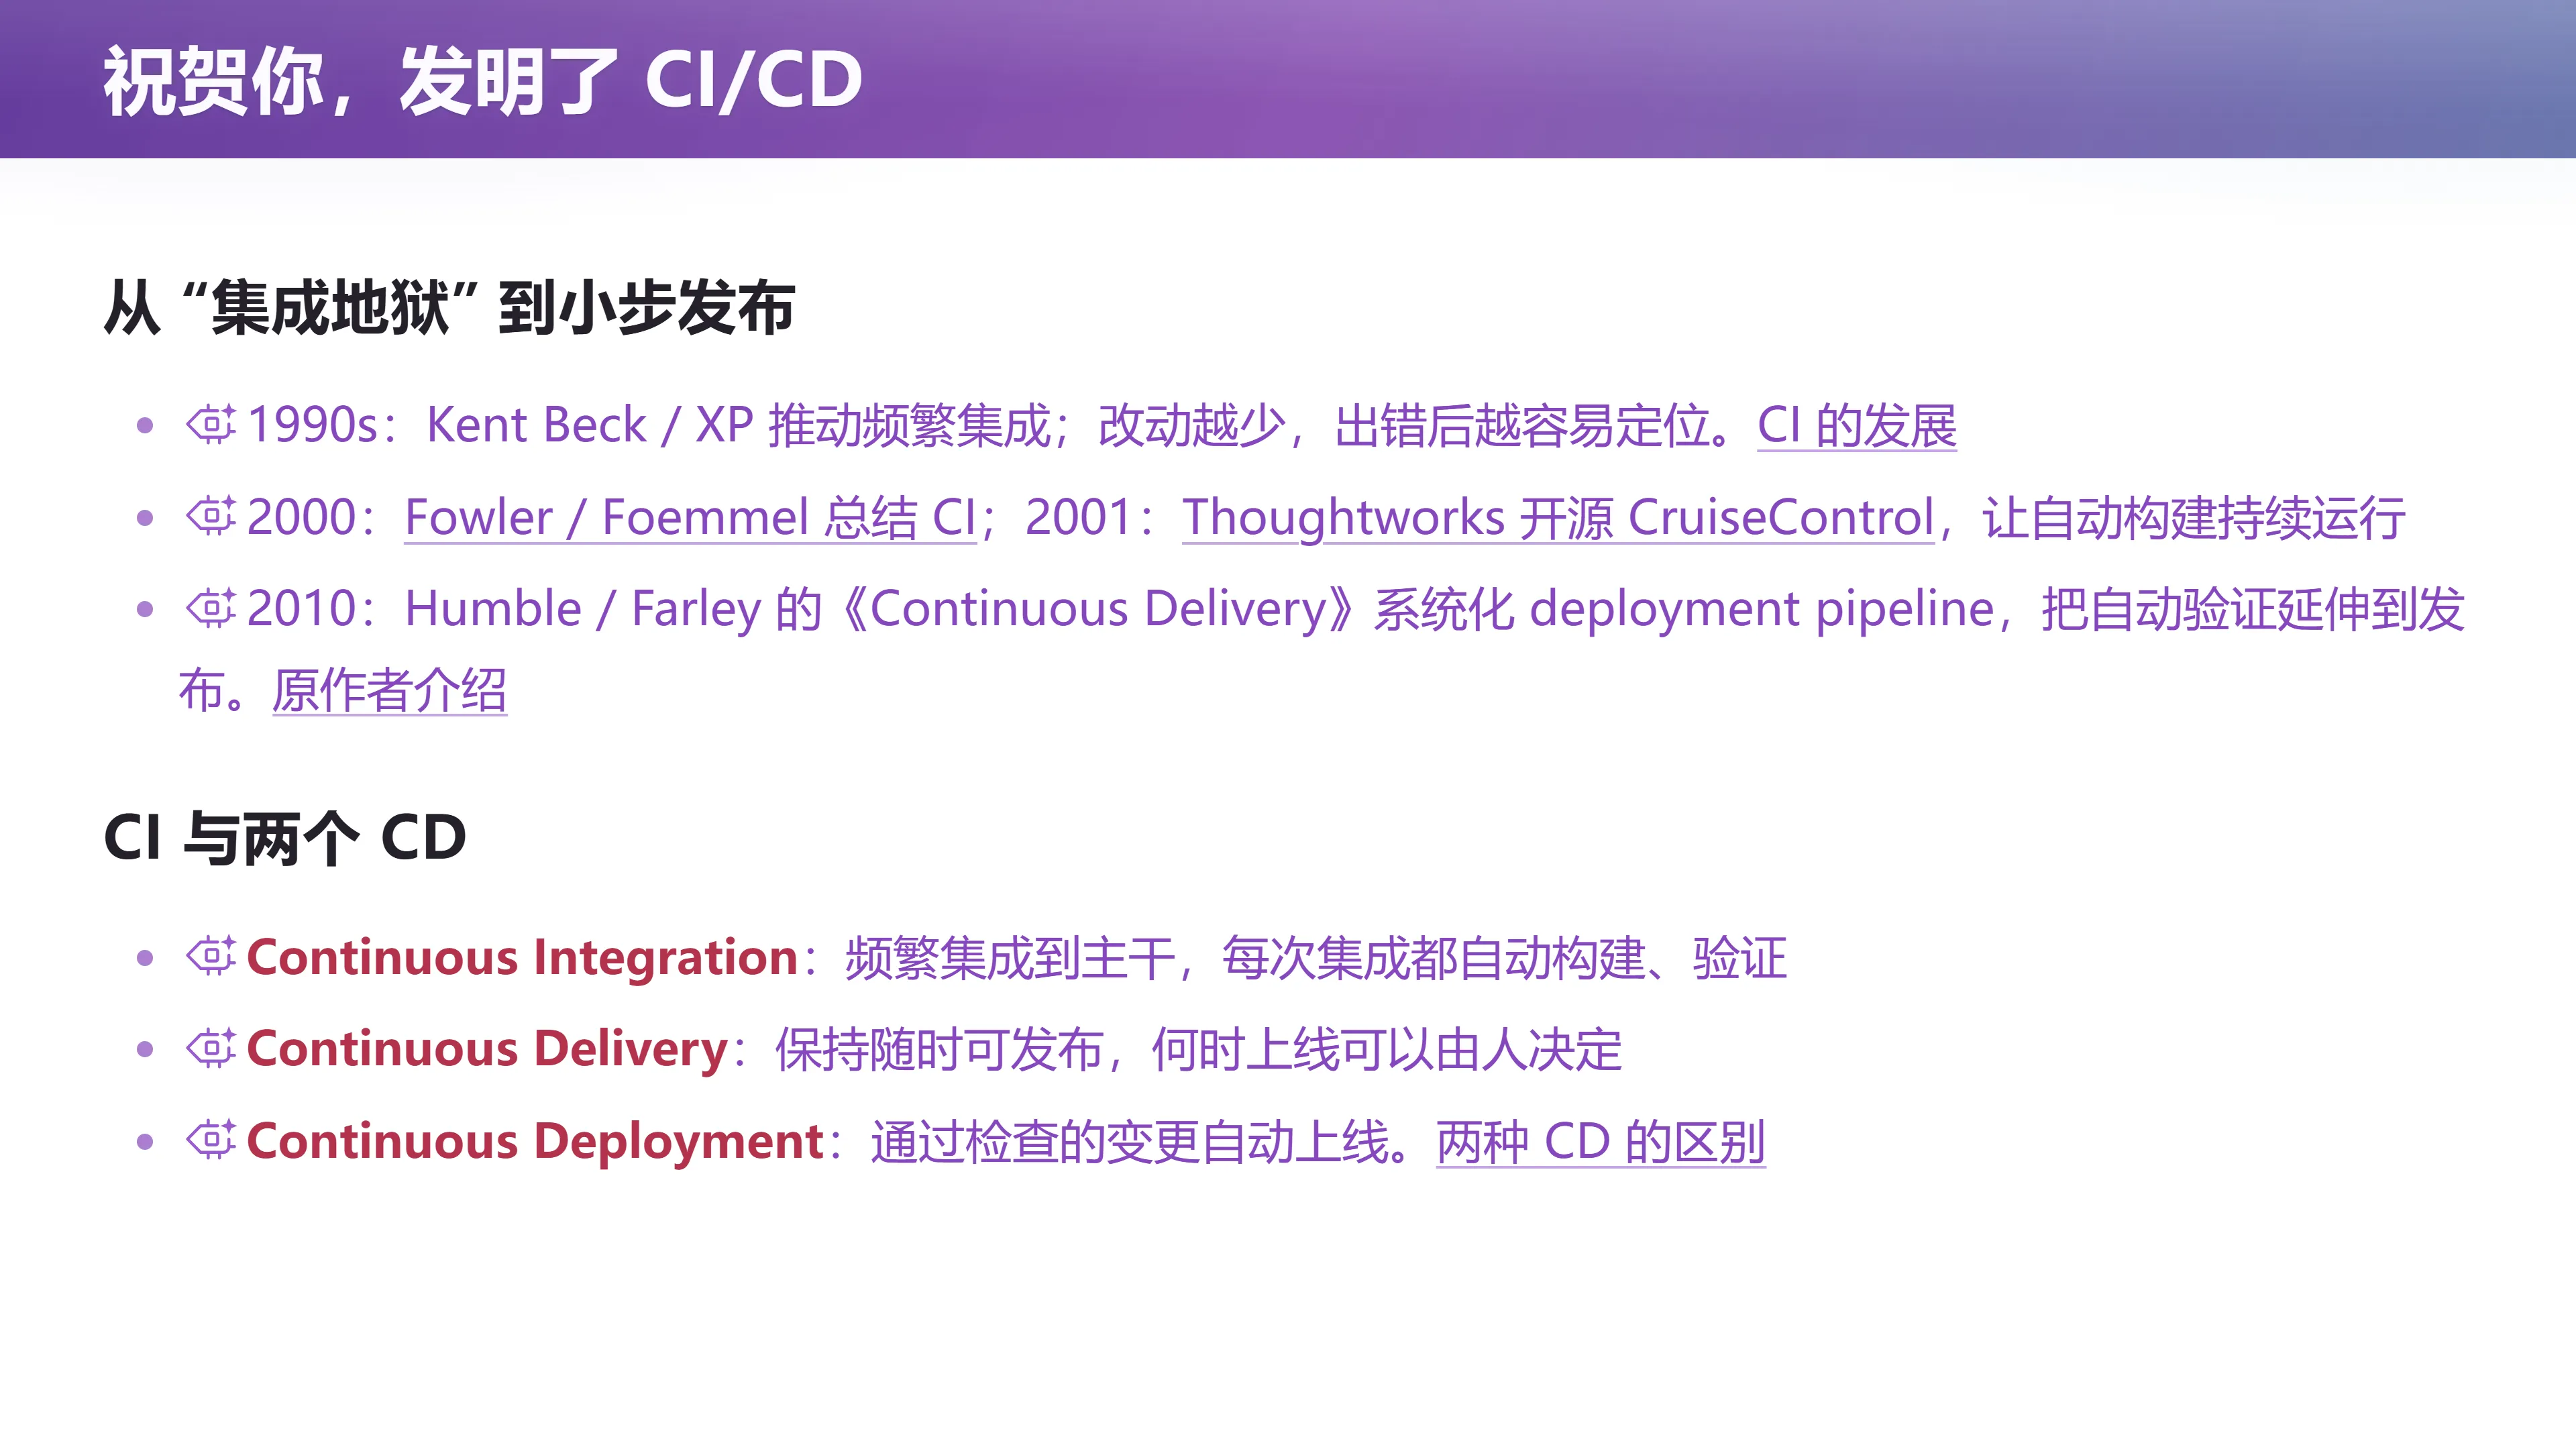
- 持续集成(Continuous Integration,CI) 强调频繁把小规模改动集成到共同主干,并自动构建和验证。它应对的是多人长期各写各的,最后才发现互相冲突的"集成地狱"。
- 1990s:Kent Beck / XP 推动频繁集成;改动越小、出错后越容易定位。
- 2000:Fowler 和 Foemmel 的 CI 文章系统总结了 CI;文中就讨论了每天多次运行可重复的自动构建与测试。
- 2001:Thoughtworks 开源 CruiseControl,让自动构建可以持续运行。
- 2010:Humble / Farley 的《Continuous Delivery》把 deployment pipeline 系统化,把自动验证延伸到发布。
到了发布环节,CD 有两个常见含义:
- 持续交付(Continuous Delivery):要求软件始终处于可发布状态,什么时候真正上线可以由人决定。
- 持续部署(Continuous Deployment):进一步把通过检查的变更自动发布给用户。
两种 CD 的区别可参见作者的 2010 年说明。
编者拓展|CI 与现代研发流程:在传统企业中,CI/CD 的落地往往要求独立、可复制的容器环境——因为你不能把生产环境的某个不可信变更直接跑在生产机上,也不能让一个失败构建污染主干。学习 CI/CD 之所以对很多学生有点"劝退",正是因为这些环境、权限、通知链路本身就需要额外学习。而在今天的大模型时代,配置本身可以委托给 Agent,人真正需要想清楚的是:在什么样的状态迁移上,执行什么样的事情。
Hook-Based CI/CD:事件驱动的动作
(参考时间: 00:47:40)
📷 Hook-Based CI/CD
回到原视频 (00:47:40)
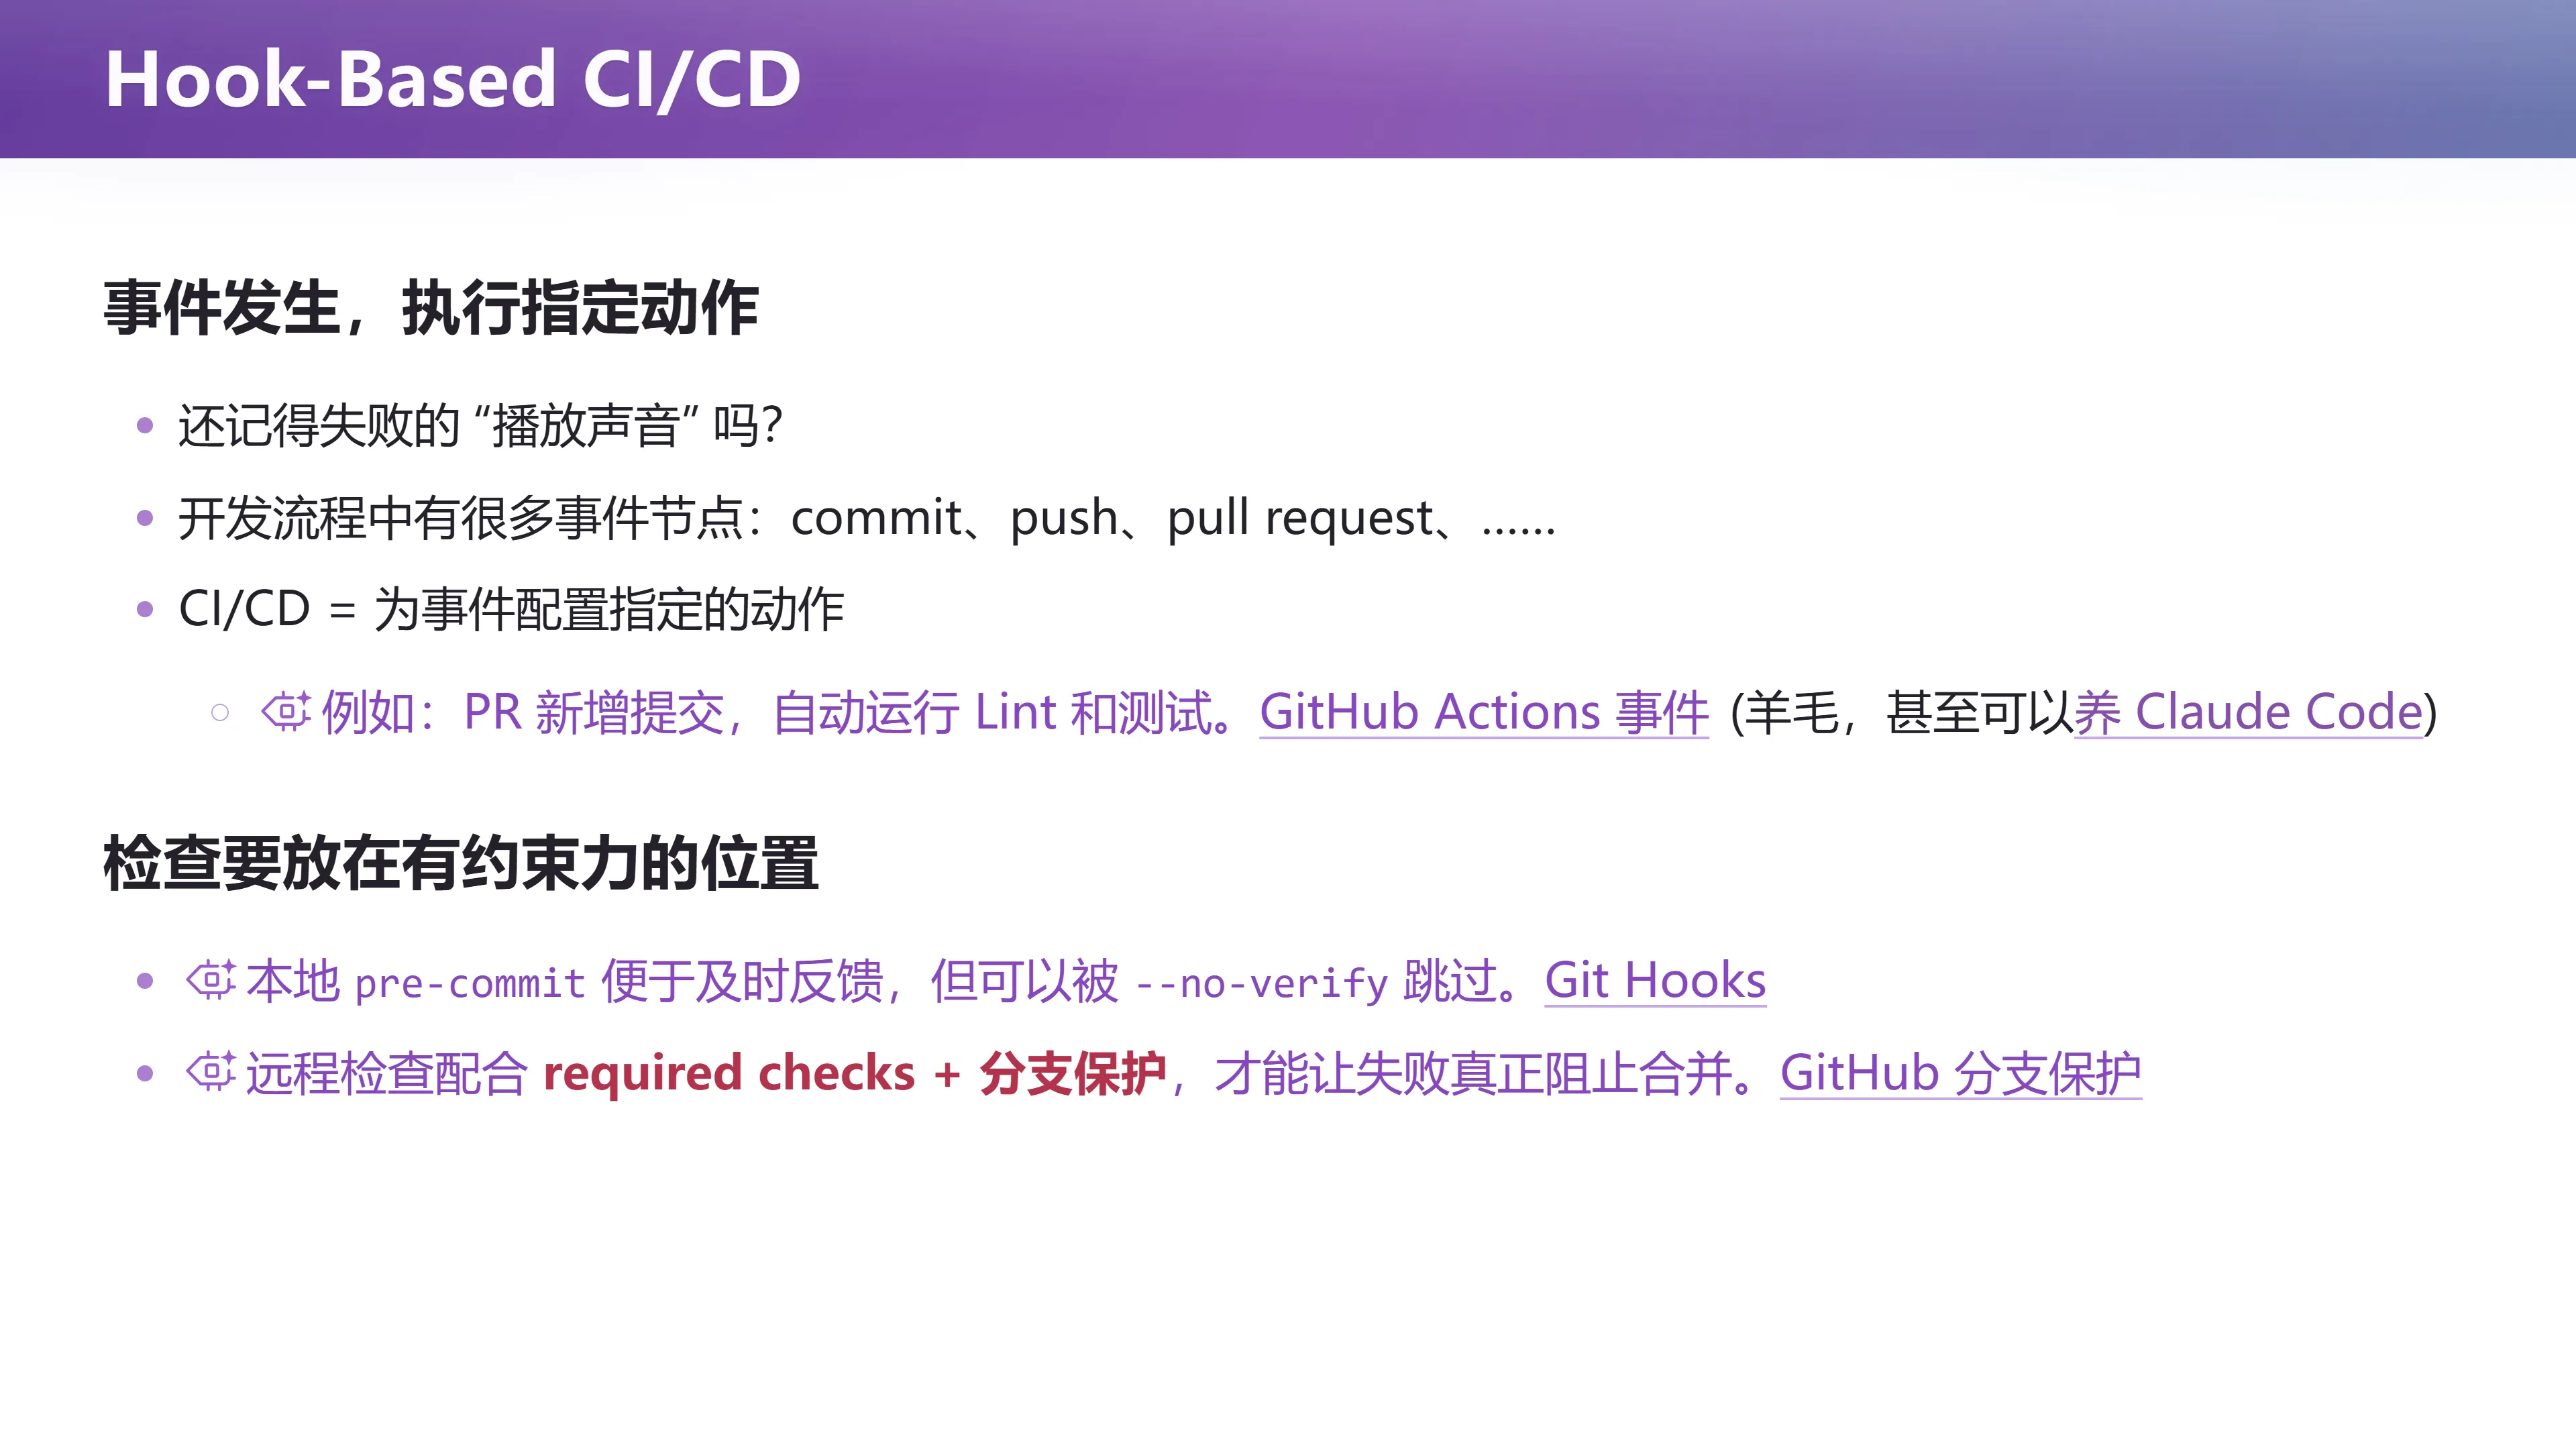
CI/CD 听起来名字很大,机制却可以从一个很小的想法理解:事件发生时,执行指定动作。
graph LR
  E1["commit"] --> H1["pre-commit<br/>格式 / lint"]
  E2["push"] --> H2["runner 中执行<br/>构建 + 测试"]
  E3["pull request 新提交"] --> H3["required checks<br/>Lint + 测试 + 与主干组合"]
  E4["merge 到 main"] --> H4["构建产物<br/>部署到 github.io"]
  E5["发布版本 tag"] --> H5["打包 / 发布 / 通知"]
  H3 -->|失败| B1["禁止合并"]
  H4 -->|失败| B2["保留上一版"]
讲师顺便讲了一段生动的小故事:
"我之前让 Claude Code 去 hook 一下,让它在每次需要我输入的时候,播放一个声音提醒我'它输出结束了'。此前播放声音失败了——但现在,每次需要我输入的时候它都会叮一下,提醒我。需要把动作落实到明确的事件,而不能只期待它记得做。"
把动作换成运行检查、构建页面、部署网站,就是开发流程中的 Hook。
有一些常见的挂接点:
- 本地 pre-commit:便于及时反馈,但可以被
--no-verify跳过。 - 远程插件:配合 required checks + 分支保护,才能让失败真正阻止合并。
- 例如,借助 GitHub Actions 免费额度,有人甚至在 Actions 里养 Claude Code——push 触发拉起一个 Agent 去改代码、再 push 触发下一轮,形成一个云端的 Ralph Loop。
关于"有检查和检查有约束力,是两回事":
"如果测试失败后仍然能照常合并,检查只是在旁边亮了一盏红灯。以 GitHub 为例,可以把特定状态检查设为合并必须满足的条件,并通过分支保护约束直接推送与绕过权限。"
什么是 lint?
(参考时间: 00:49:52)
讲师当场问了同学一个"是不是都知道"的问题:
"你们上第一门编程课的时候,老师有没有要求你们用 lint?——确定一下所有同学都知道 lint,并且用过 lint 吧?"
下面这位同学回答"什么是 lint"。
"lint 现在泛指不运行程序、只做静态分析就能发现的代码检查。各种各样:缩进、换行、空格……你们刚开始学程序设计的时候,都会写出
A = 1这种代码。这个代码对于一个写完很多年代码的人来说,会生理性地不适——就像我被训练了一样。"
把可以机械判断的部分交给检查,反馈就能进入每一次开发循环。这是软件工程里面最基础一级的守门员——如果连代码可读性规范都做不好,就有可能带来更严重的问题。
把发布流程也写成 Spec
(参考时间: 00:49:20)
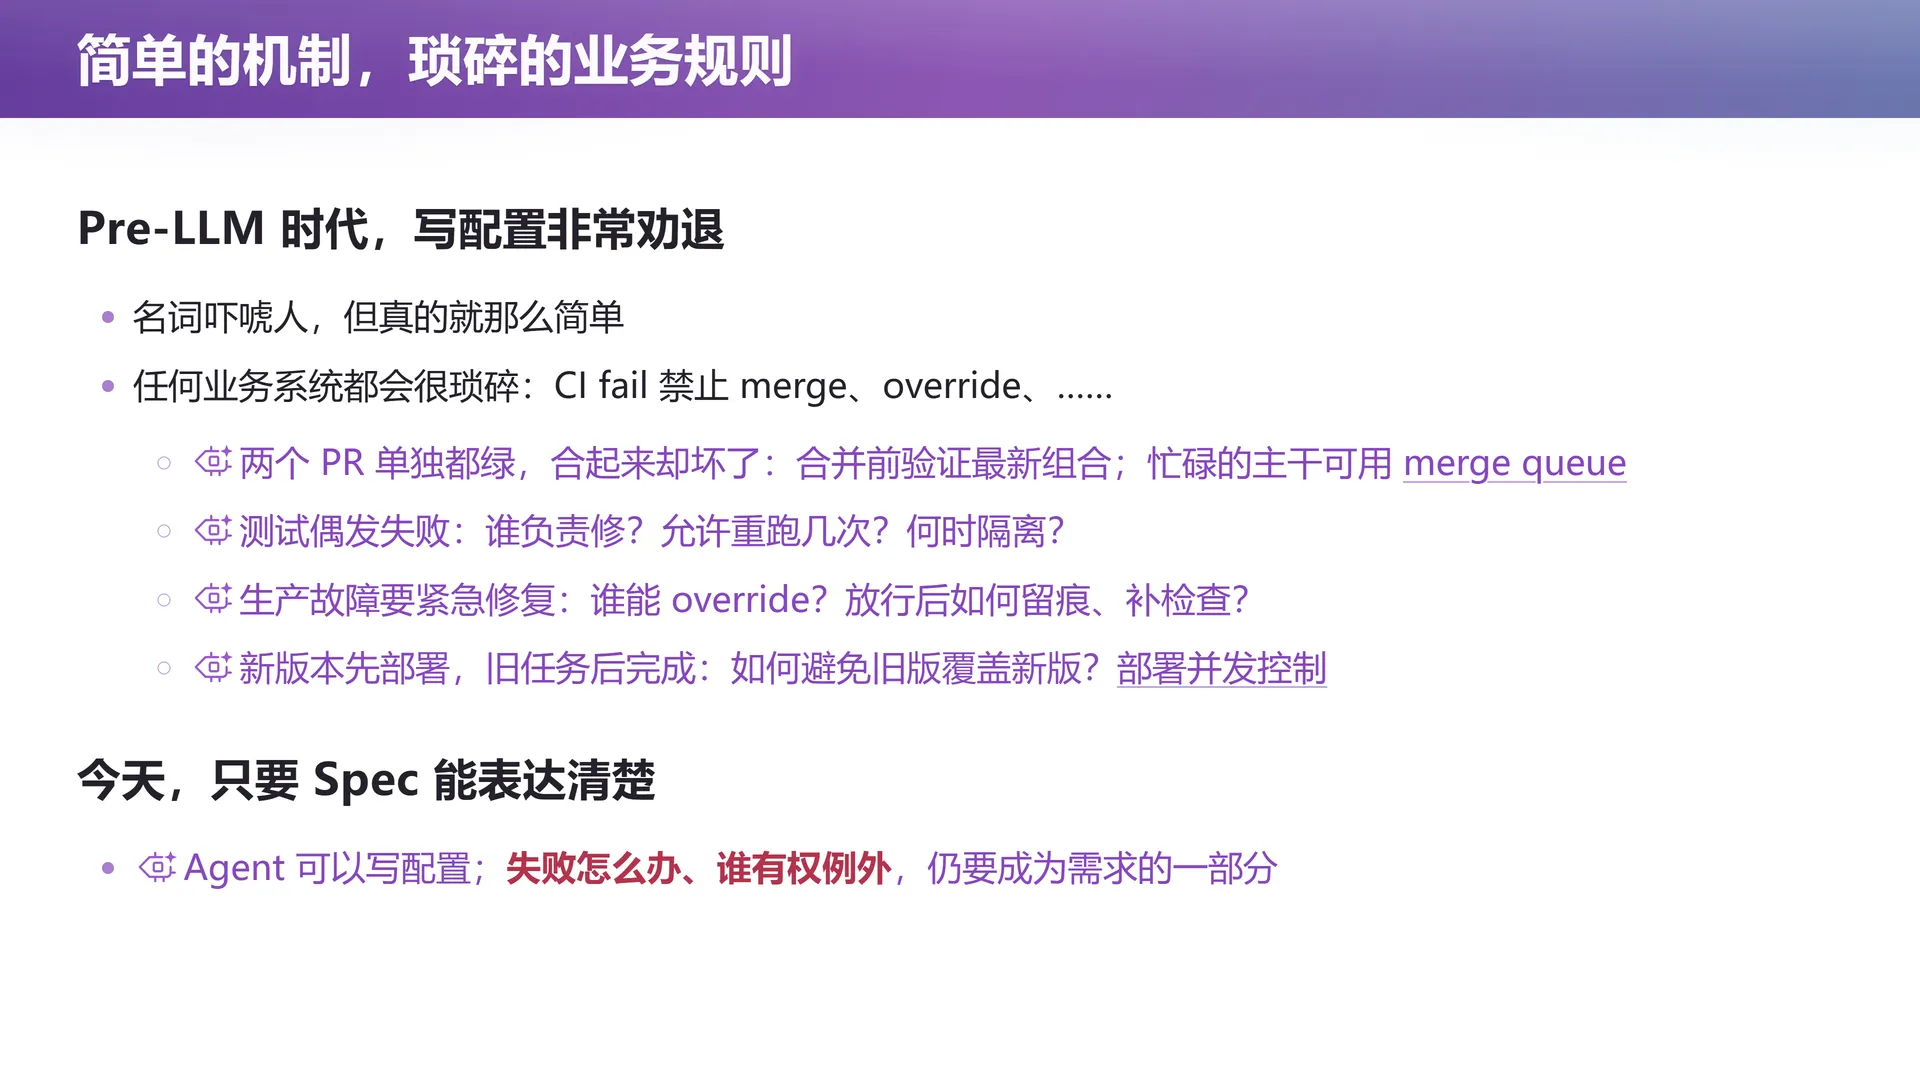
CI/CD 真正琐碎的部分,往往是业务规则。讲师一口气列了一串:
- 两个合并请求单独都通过,合起来却失败,怎么办?
- 测试偶尔失败,是重跑还是隔离,谁负责修?
- 线上急需修复时,谁有权例外放行,之后怎样补检查?
- 两个发布任务同时运行,新版本先完成,旧任务随后才结束,会不会把网站覆盖回旧版?
这些问题都不是写出一份配置文件就自然消失的。在大模型出现之前,光是熟悉配置语法和平台细节,就足以劝退不少人。
"以前
.github/workflows/里的 YAML,是一份 DSL。你不懂 rust、不懂 ci for、不懂各种语法细节,根本写不出来。今天不一样了——今天你只要知道自己有一个清楚的概念:在什么样的状态迁移的时候,应该做什么事情。"
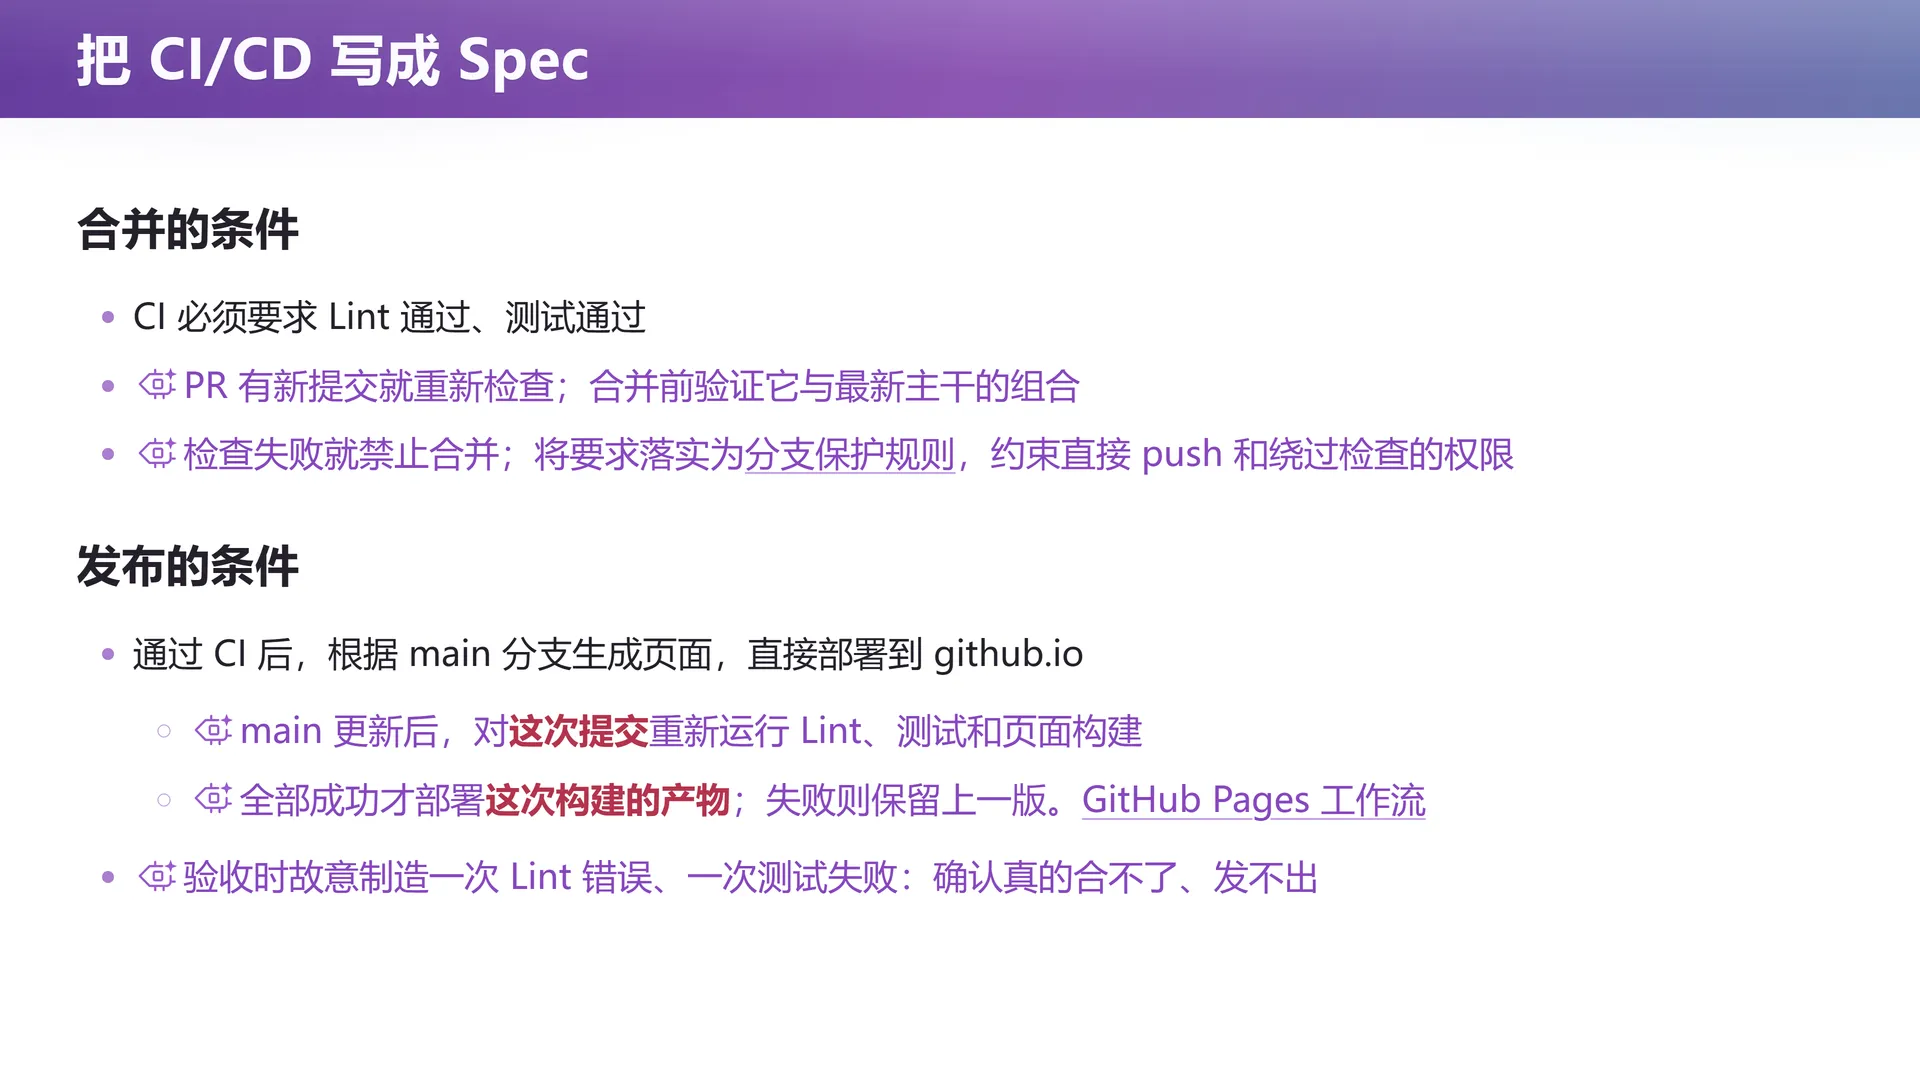
例如,一个课程网站的流程可以这样约定:
- 合并请求有新提交,就重新运行 Lint 和测试;合并前检查与最新主干的组合,失败时禁止合并。
main更新后,对这次提交运行检查并构建页面;全部成功才部署这次构建的产物到github.io,失败则保留上一版。- 多次发布发生重叠时,不能让过时产物覆盖新版本;例外放行需要明确的权限与记录。
Lint 是对代码格式、可疑写法或项目约定的静态检查,不必先运行完整业务就能发现一部分问题。测试则通过执行程序检查具体行为。二者承担不同职责,不能因为其中一项通过,就省掉另一项。
验收这套流程时,也应该观察失败路径:
- 故意引入一次 Lint 错误,确认它真的阻止合并;
- 让测试失败,确认没有发布新页面;
- 再修好错误,确认能正常更新。
这样检验的是"门是否真的关得住",而不只是"配置文件看起来像那么回事"。
编者说法(ClosedAI 一类的吐槽):讲师在课堂上对线上那些宣传"我们完全不写代码"的文章有些"不服气"——你去看它给出的 CI,实际上就 lint、test 那个层级,远不够支撑一个真实项目。能看出这条缝隙,是因为你真的自己做过类似的流程。 具体吐槽见后面"Agent Native 开发"一节。
CI 阻止,Agent 修正
(参考时间: 00:52:44)
📷 CI 在 Agentic AI 时代的含金量
回到原视频 (00:52:44)
在 Agentic AI 时代,CI 的价值还会增加。
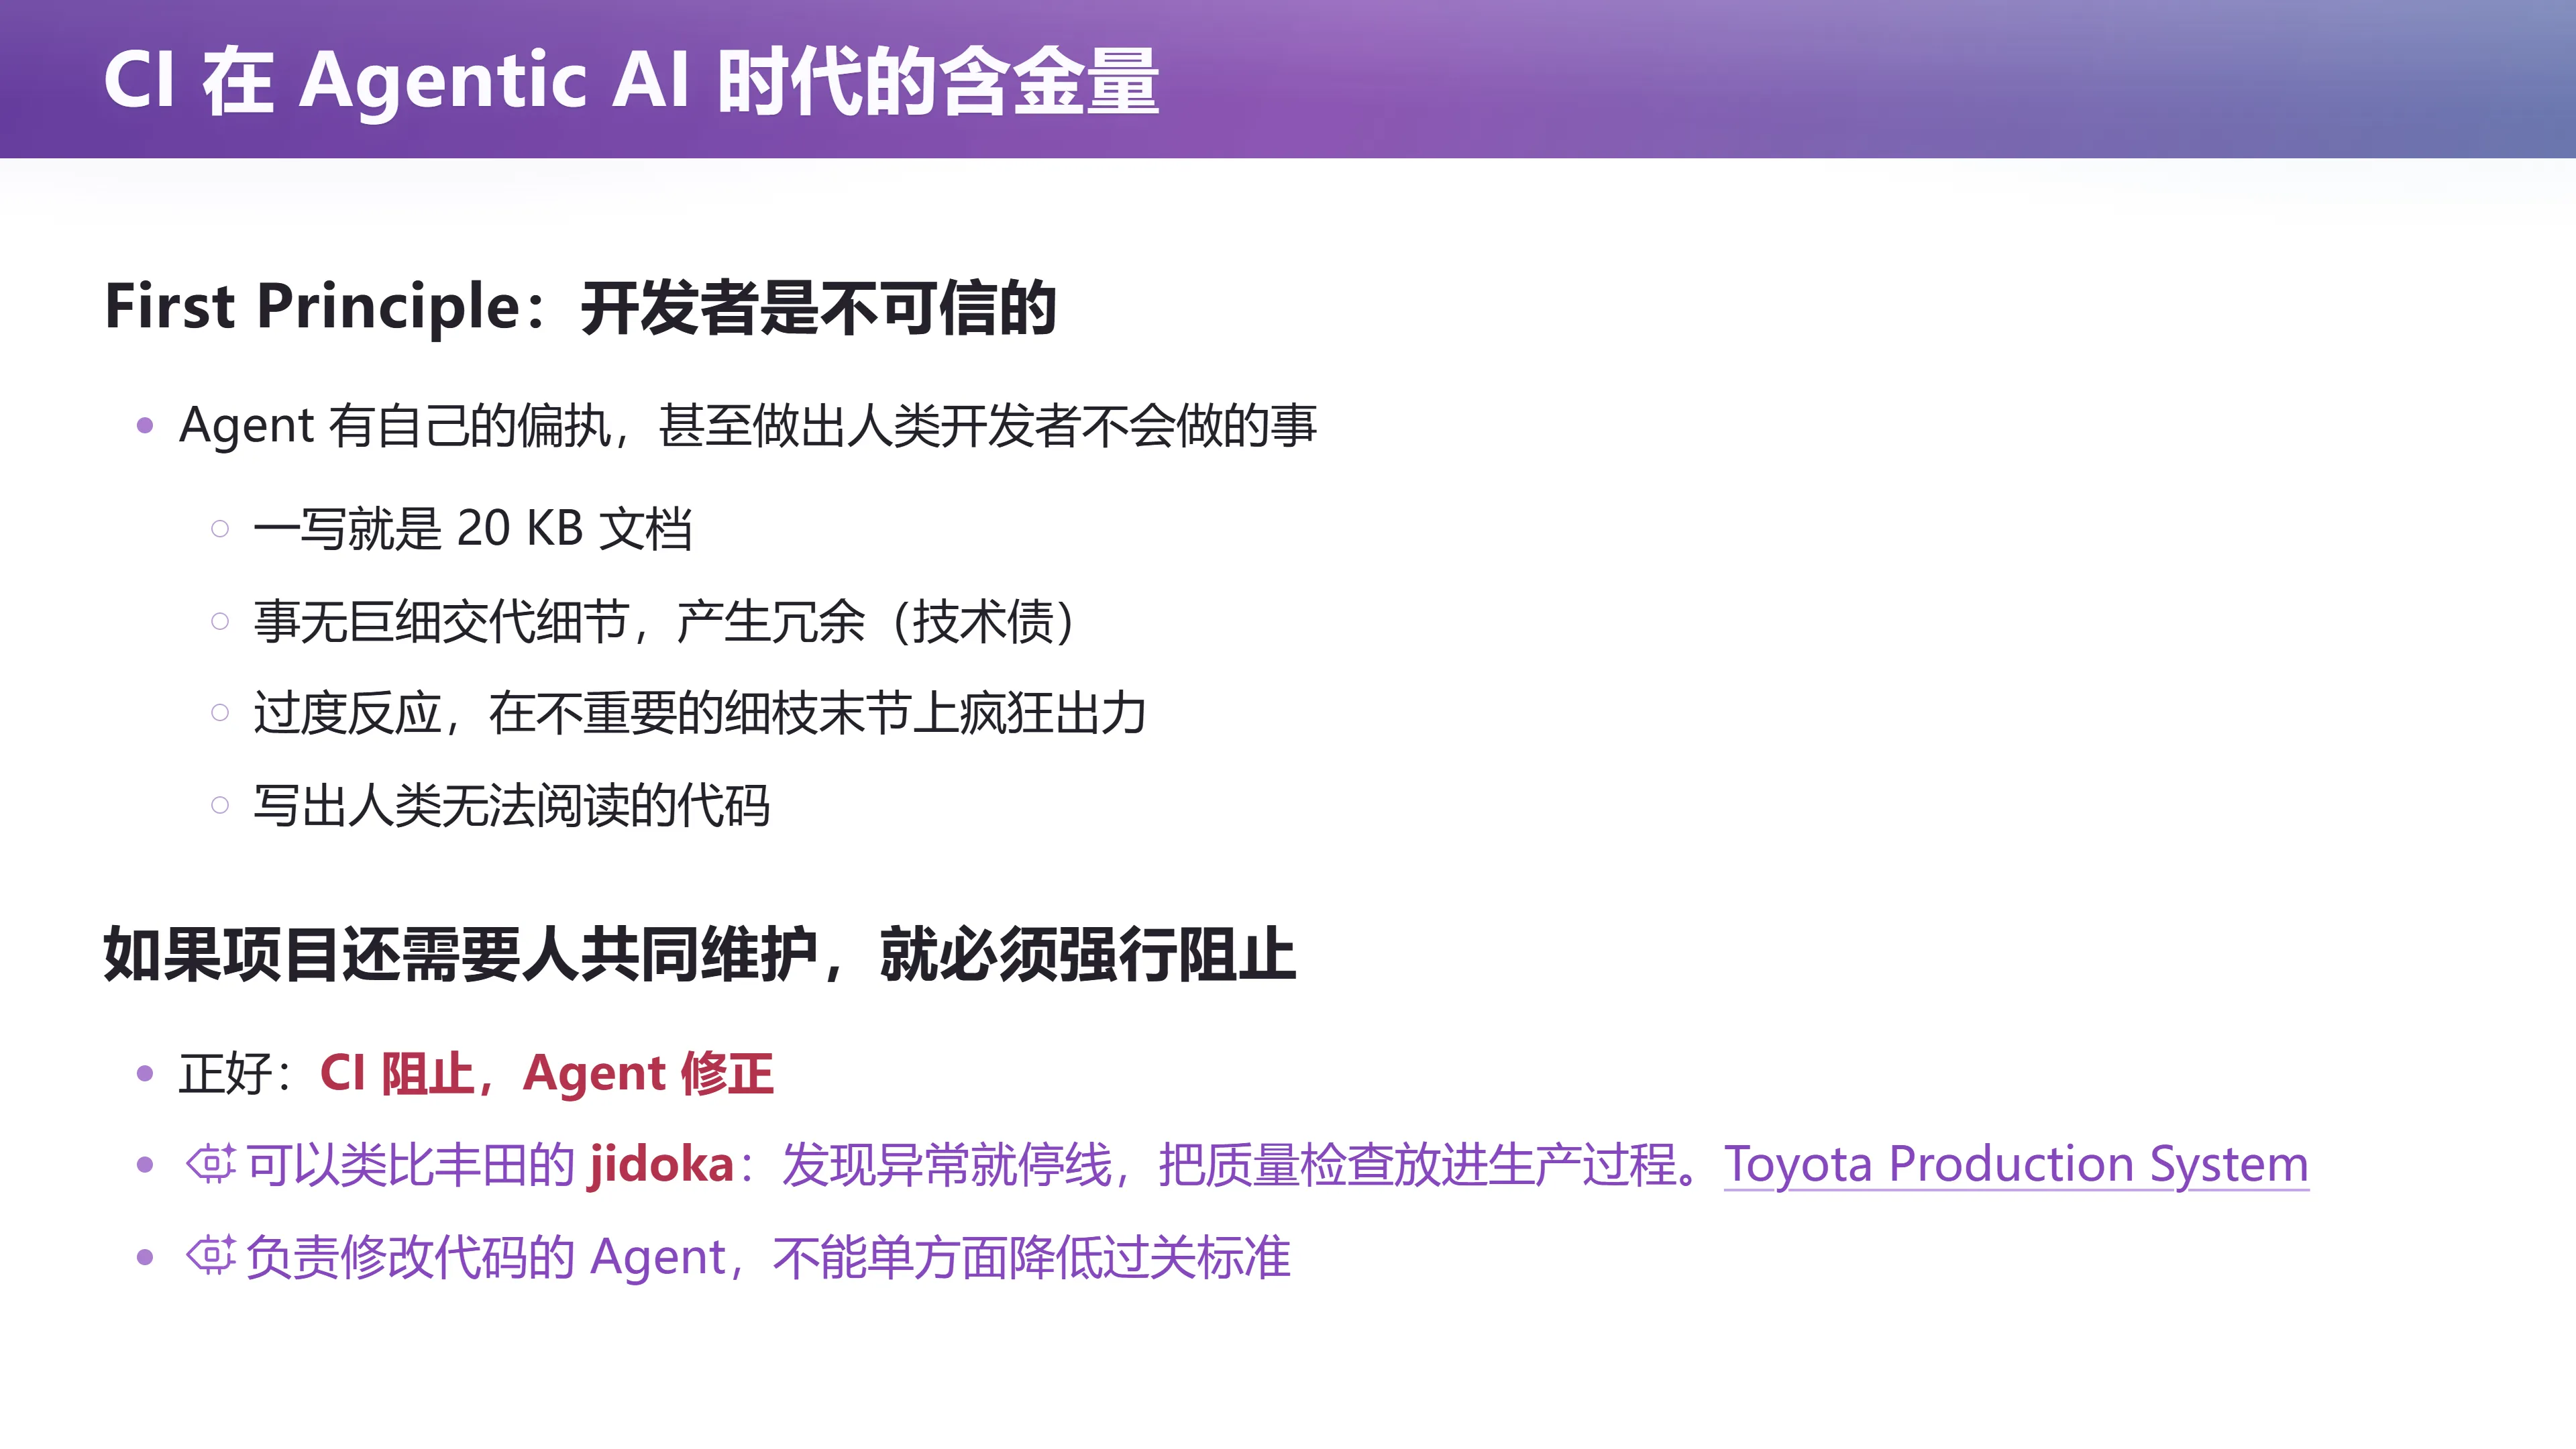
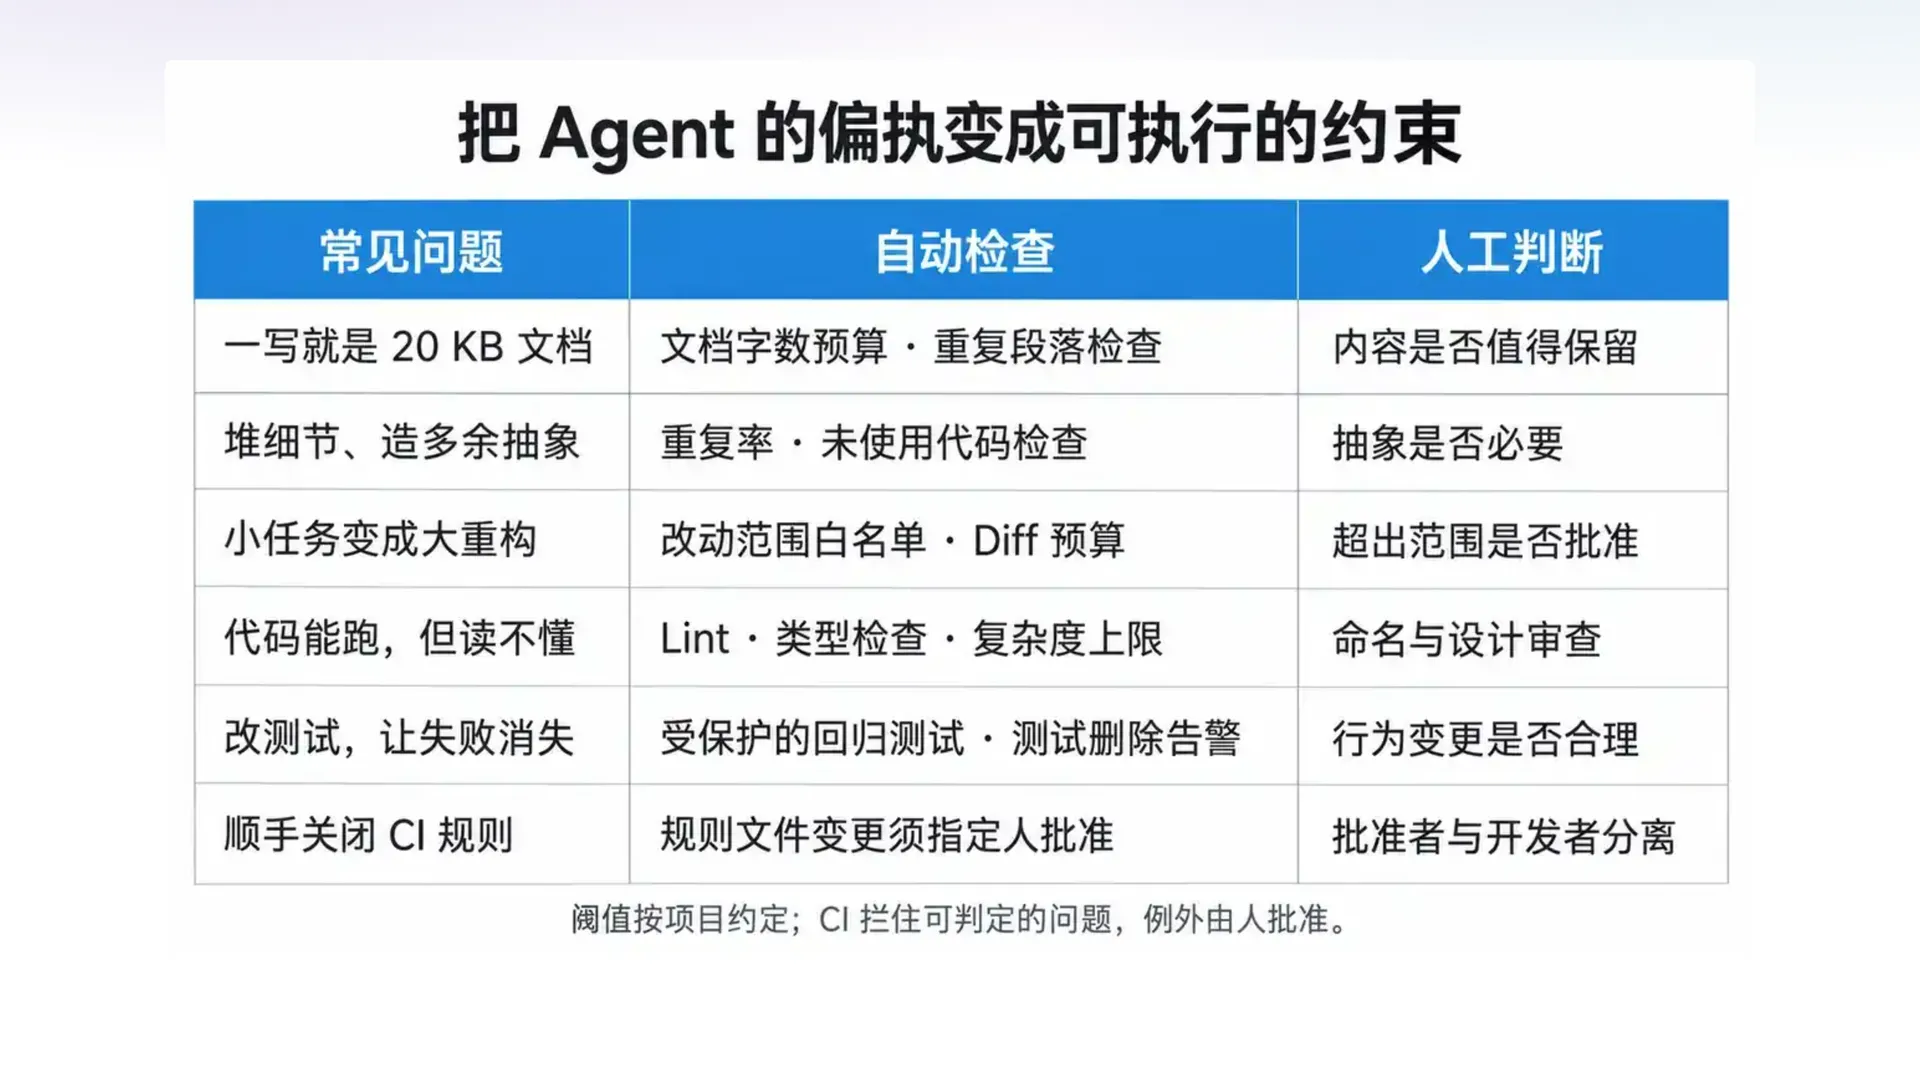
CI 的 first principle 是"开发者是不可信的"——而 Agent 就是那种最不可信的开发者,因为Agent 和人类天生是不对齐的:它是一个大语言模型,它的想法和人就是不一样。
讲师列了一些很有代表性的偏执:
- 一写就是 20 KB 文档。你说写个文档吧,它直接生成一个 20K 的文档;你看了两行以后进入无穷琐碎的细节,然后就看不下去。
- 事无巨细地交代细节,产生冗余。代码本身已经 self-explain 了,它还是硬生生把它思考的流程、在 agent loop 里遇到的问题,一个一个写进文档里。
- 在不重要的细枝末节上疯狂出力。它截图、用 Chrome DevTools、疯狂使用工具来填满你的上下文;把一张截图放进上下文里,然后上下文就一直带着这张图片——正常人不会这样做。
- 写出人类无法阅读的代码,并且自己非常自信可以维护。
"这些是实际协作中的观察,不是对所有模型的统一排名。"
于是形成一条原则:CI 阻止,Agent 修正。
graph LR
  W["workspace 状态"] -->|Agent 推进一小步| W2["新的 workspace"]
  W2 -->|CI / Lint / 测试| Check{"检查通过?"}
  Check -->|否| W3["回到 workspace<br/>让 Agent 修正"]
  W3 --> W
  Check -->|是| Commit["提交 / 合并 / 发布"]
如果项目仍然需要人共同维护,这些倾向就必须受到实在的约束。只在规范里写"请保持简洁",效果未必稳定;把可以机械判断的部分交给检查,反馈就能进入每一次开发循环。
具体的做法:
- 文档不断膨胀:为特定入口文件设置合理的大小限制,把详细材料放到有组织的位置;
- 模块边界不断被绕过:检查禁止的依赖方向;
- 代码难以阅读:用格式化、静态检查和复杂度规则拦下一部分明显问题;
- 同一项规则到处复制:检查重复内容,并要求共同维护者判断应当保留哪一处事实来源。
编者说明:这些约束都是针对具体项目设计的,不能把"文件短"简单等同于"设计好"——约束本身也要被设计。
自动检查也应说明为什么失败、怎样修复。只返回一个红叉,会让 Agent 花时间猜规则;指出违规依赖的位置与允许的访问方式,才能让下一轮有明确方向。于是形成闭环:CI 阻止,Agent 修正,再由同一套标准验证。
这里还有一个边界:负责实现功能的 Agent,不能因为过不了检查,就单方面把标准调低。测试确实可能过时,架构规则也可能需要改变,但修改这些规则需要回到需求和设计理由。删掉失败断言得到的绿色,与修复程序得到的绿色,颜色相同,含义完全不同。
编者拓展|丰田的 jidoka(自働化):幻灯片里提到 Toyota Production System 的 jidoka——"发现异常就停线,把质量检查放进生产过程"。这是"CI 阻止"思想在制造业的源头:不把不合格交给下一道工序。把它类比到软件开发,就是:不让一次失败的 transition 混进主干。
Agent Native:把工程知识放进环境
(参考时间: 01:00:03)
围绕 Agent 建立的运行环境、工具、约束与反馈机制,常被统称为 Harness。这个词可以理解为让模型的能力能够稳定用于具体工作的整套配套设施。
"你可以想象这就是模型——模型自己的思维链也可以做搜索;而 harness 就是把它可以做的事情约束在一个你认为比较好的范围里。"
Agent Native 开发因此不仅是"代码由 AI 写",还包括让工程知识成为 Agent 找得到、用得上、能够验证的东西。
📷 Agent Native 开发:从空仓库开始
回到原视频 (01:00:03)
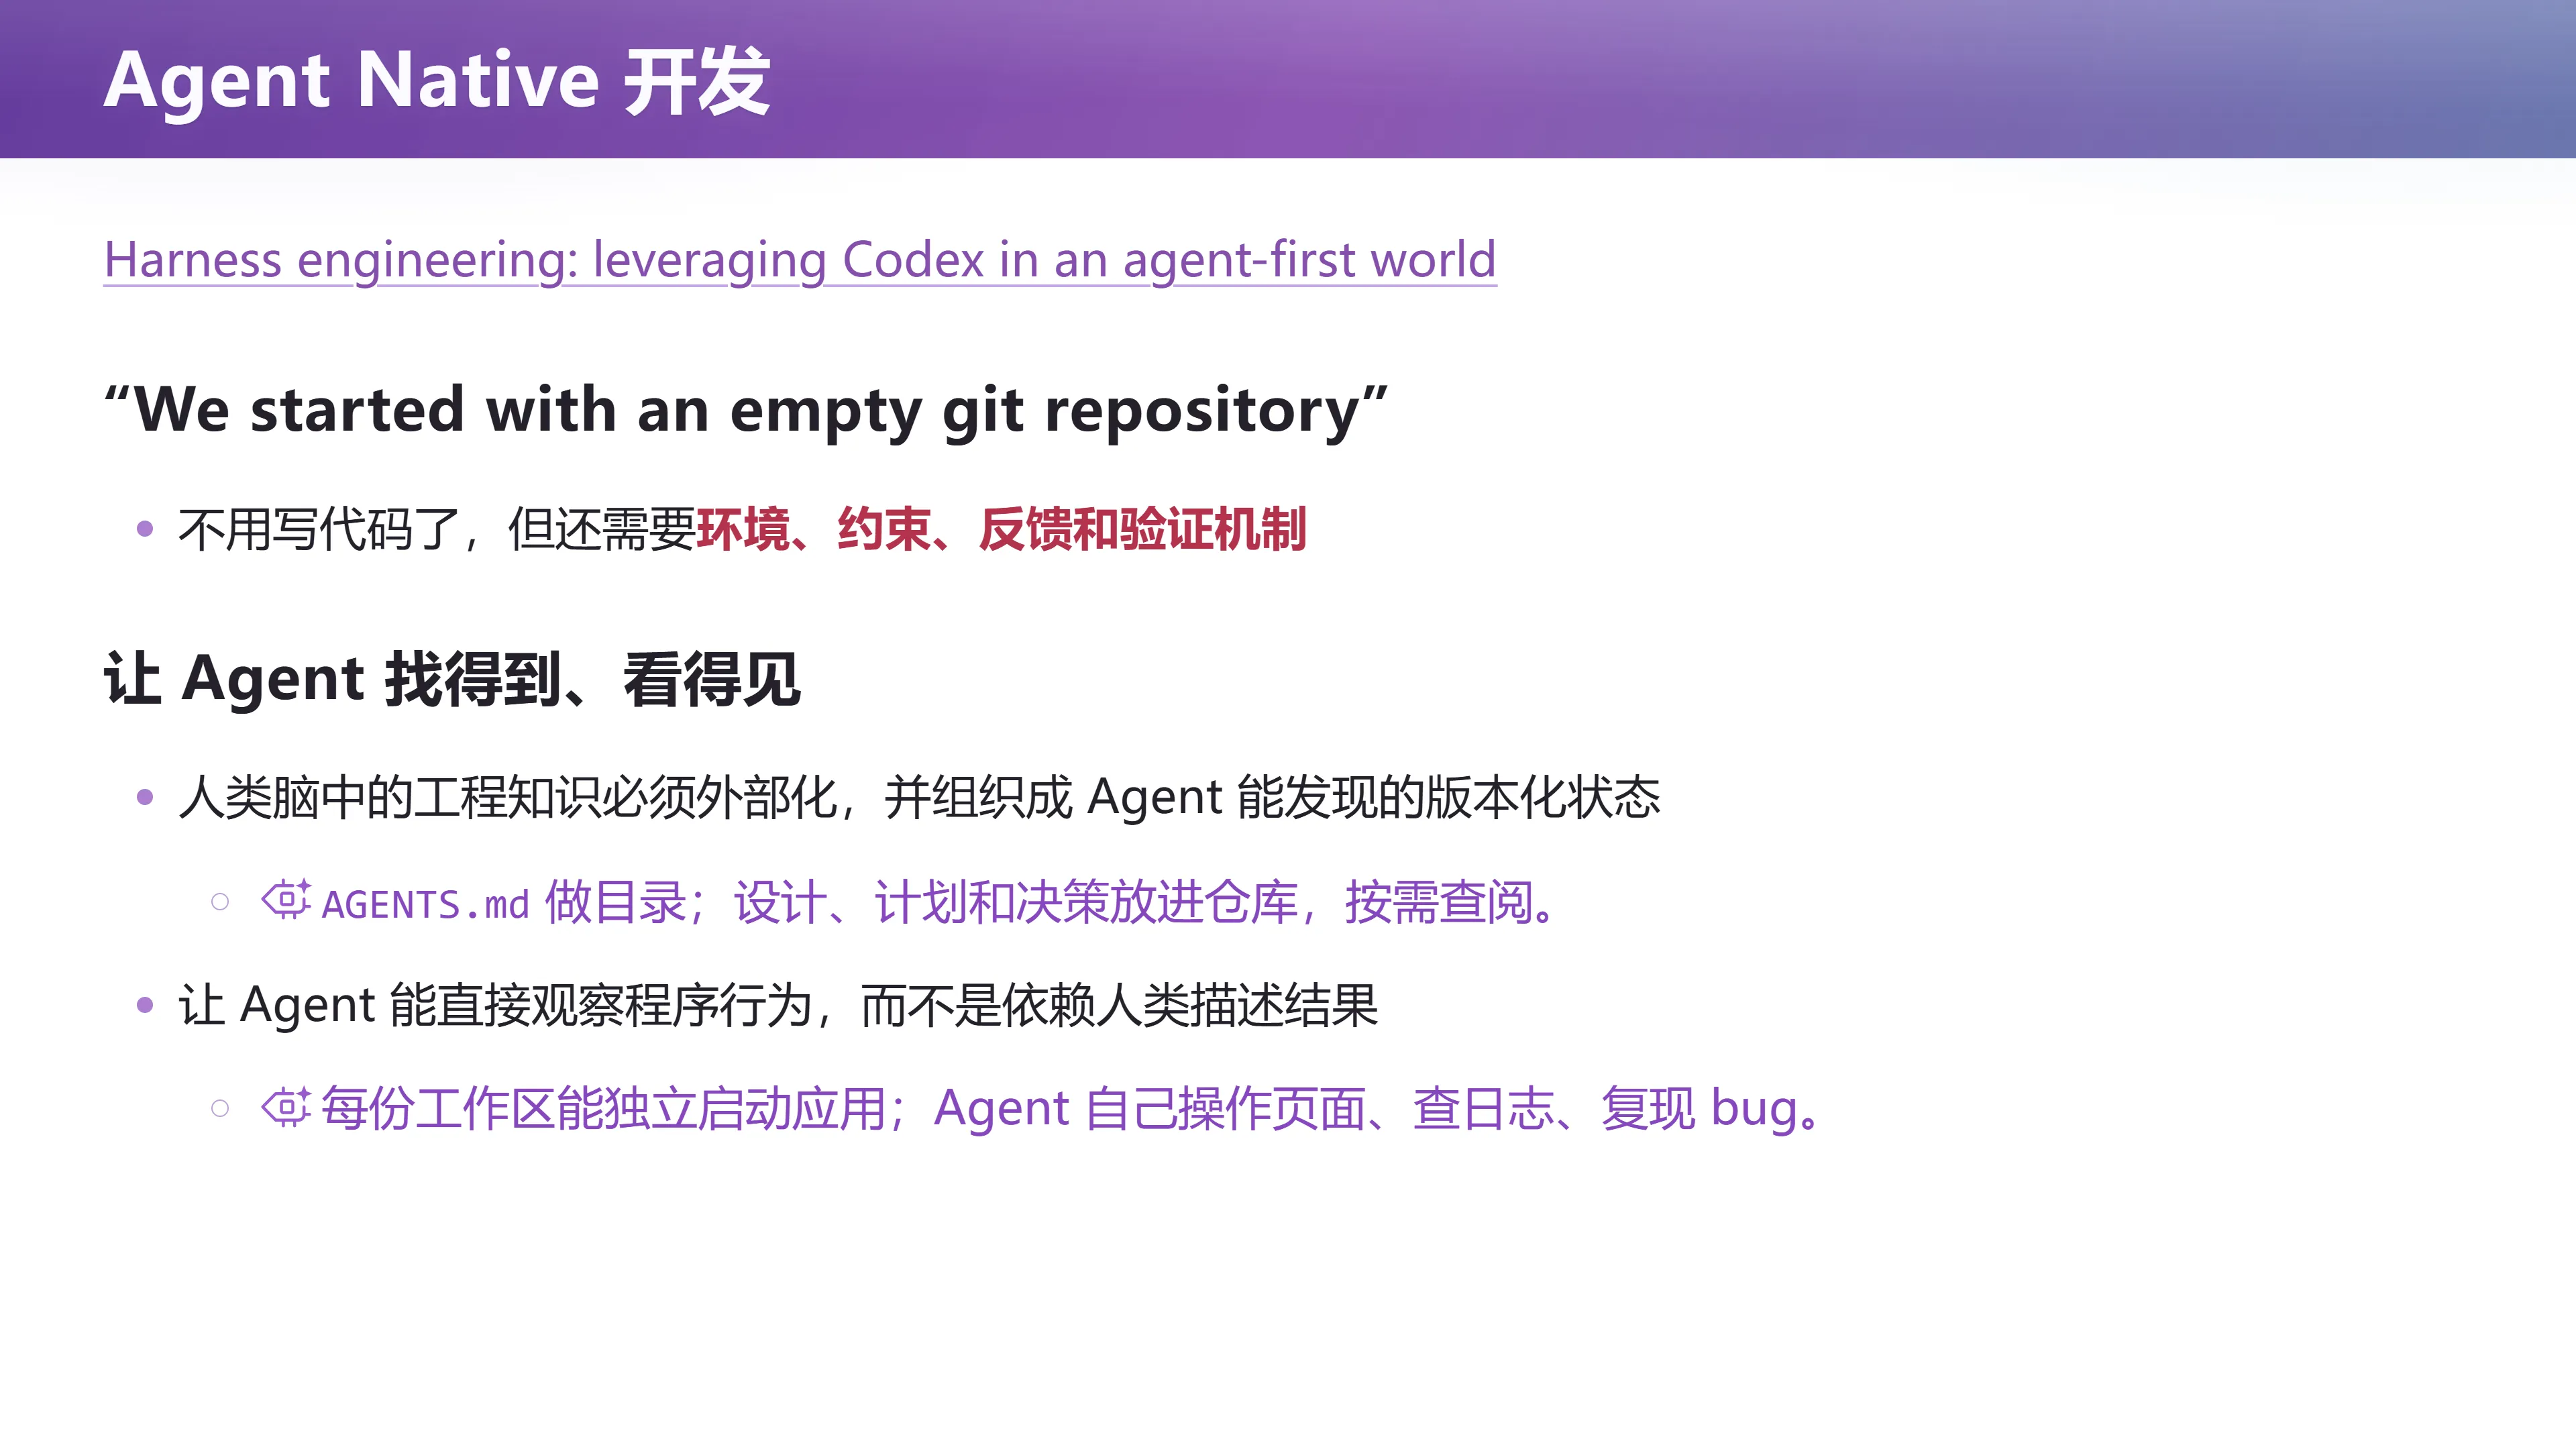
OpenAI 的 Harness engineering 文章描述了从空仓库开始的实验:代码交给 Agent,人的工作转向组织环境、表达意图和建设反馈机制。文中把仓库知识组织为可查阅的结构,让 Agent 直接启动和观察应用,用 Lint 与结构测试检查架构边界,并持续提交小规模清理改动。
"文章开头那句话是 We started with an empty git repository。他从零开始,人不写代码了——但人依然要把这个模型流程要定好:环境、约束、反馈和验证机制。"
"比如说,我在 push 之前就要确保我的代码铭文没有泄露,我的 API key 没有泄露——这些可能是用自然语言说的。"
沿着这些实践,可以把自己的项目拆成四个具体问题:
第一,人脑中的知识有没有外部化? "我们一直这样做"对刚开始一轮工作的 Agent 没有意义。重要决定应该进入版本管理,说明背景、约束和理由;入口文档负责引导查阅,不必把所有知识一次塞进去。
第二,Agent 能不能自己看到程序行为? 开发选课页面时,如果每次都等人转述"按钮好像没反应",反馈既慢又容易丢信息。若它能启动独立实例、操作页面、查看日志,就能直接检查点击后是否发出请求、服务端怎样处理、界面最终显示什么。
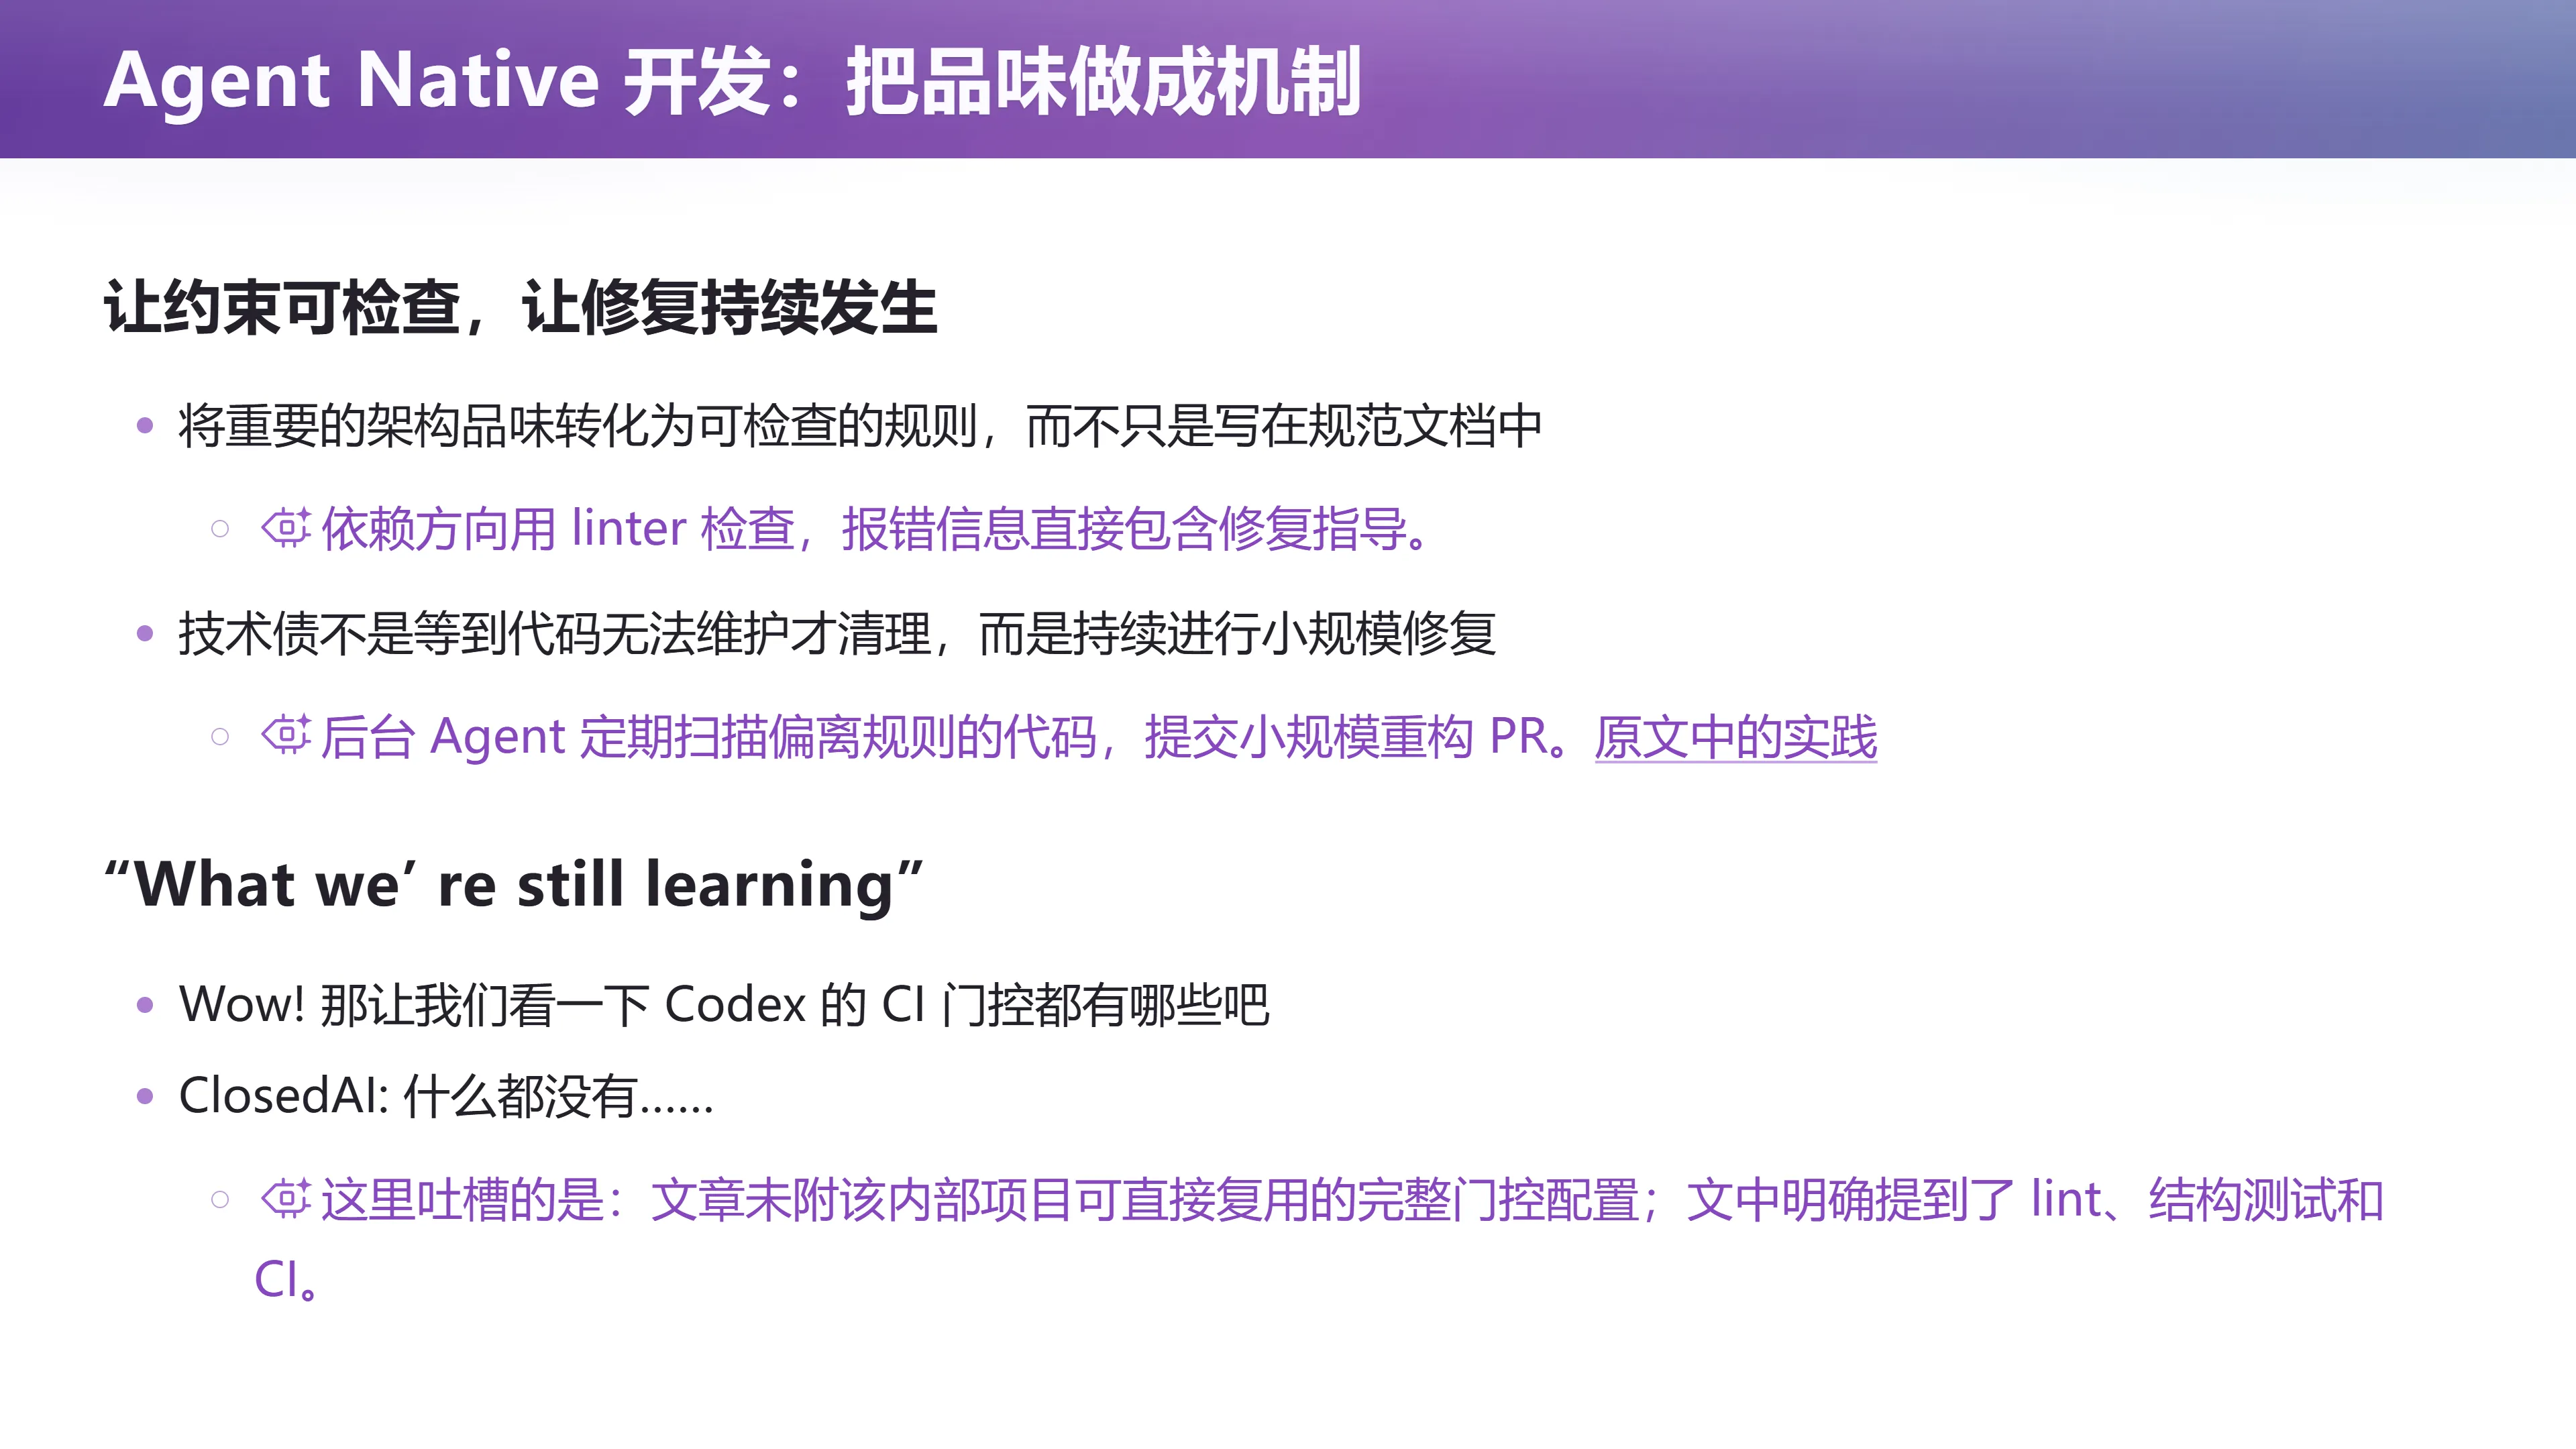
第三,架构品味能否转化为可检查的规则? 比如,页面组件是否绕过业务层直接访问数据,某类日志是否缺少必要字段,错误处理是否沿着约定接口传播。规则写进检查之后,团队就不必每次从头解释相同要求。
第四,清理工作是否持续发生? 如果生成代码不断复制已有的不良模式,等到全仓库都长成同一种坏样子再修,成本就高了。小规模、经常性的修复可以抑制扩散,让下一轮 Agent 看到更好的例子。
📷 让约束可检查,让修复持续发生
回到原视频 (01:02:30)
"读到这里,自然会想:好,那把完整的 CI 门控拿来看看吧!"
课堂里的"ClosedAI" 吐槽,指的是文章没有附上该内部项目可直接复用的完整配置;不能由此说它没有 CI——文中确实介绍了相关约束(lint、结构测试、每周一次 agent review 等)。讲师说:
"一个 Agent-native 的项目,绝对不可能只做这一点门控,如果只做这一点门控,这个项目一定就已经崩溃了。所以我百分之百确信 Codex 的背后,还有一整套巨大无比的 Agent-native 门控机制,防止它产生 AI slop——因为这个项目看起来是比较正常的、有人感的。"
这个落差也提醒我们:看懂经验总结,还不等于拥有一套能在自己项目里工作的工程系统。
三种把反馈做实的实践
并非每一步都需要模型作决定。真正让反馈"做实"的,是明确哪些步骤应该交给 Agent、哪些步骤应该交给普通代码。
案例一:Stripe Minions —— 把固定工序写进工作流
(参考时间: 01:05:00)
📷 Stripe Minions:哪些步骤需要 Agent?
回到原视频 (01:05:00)
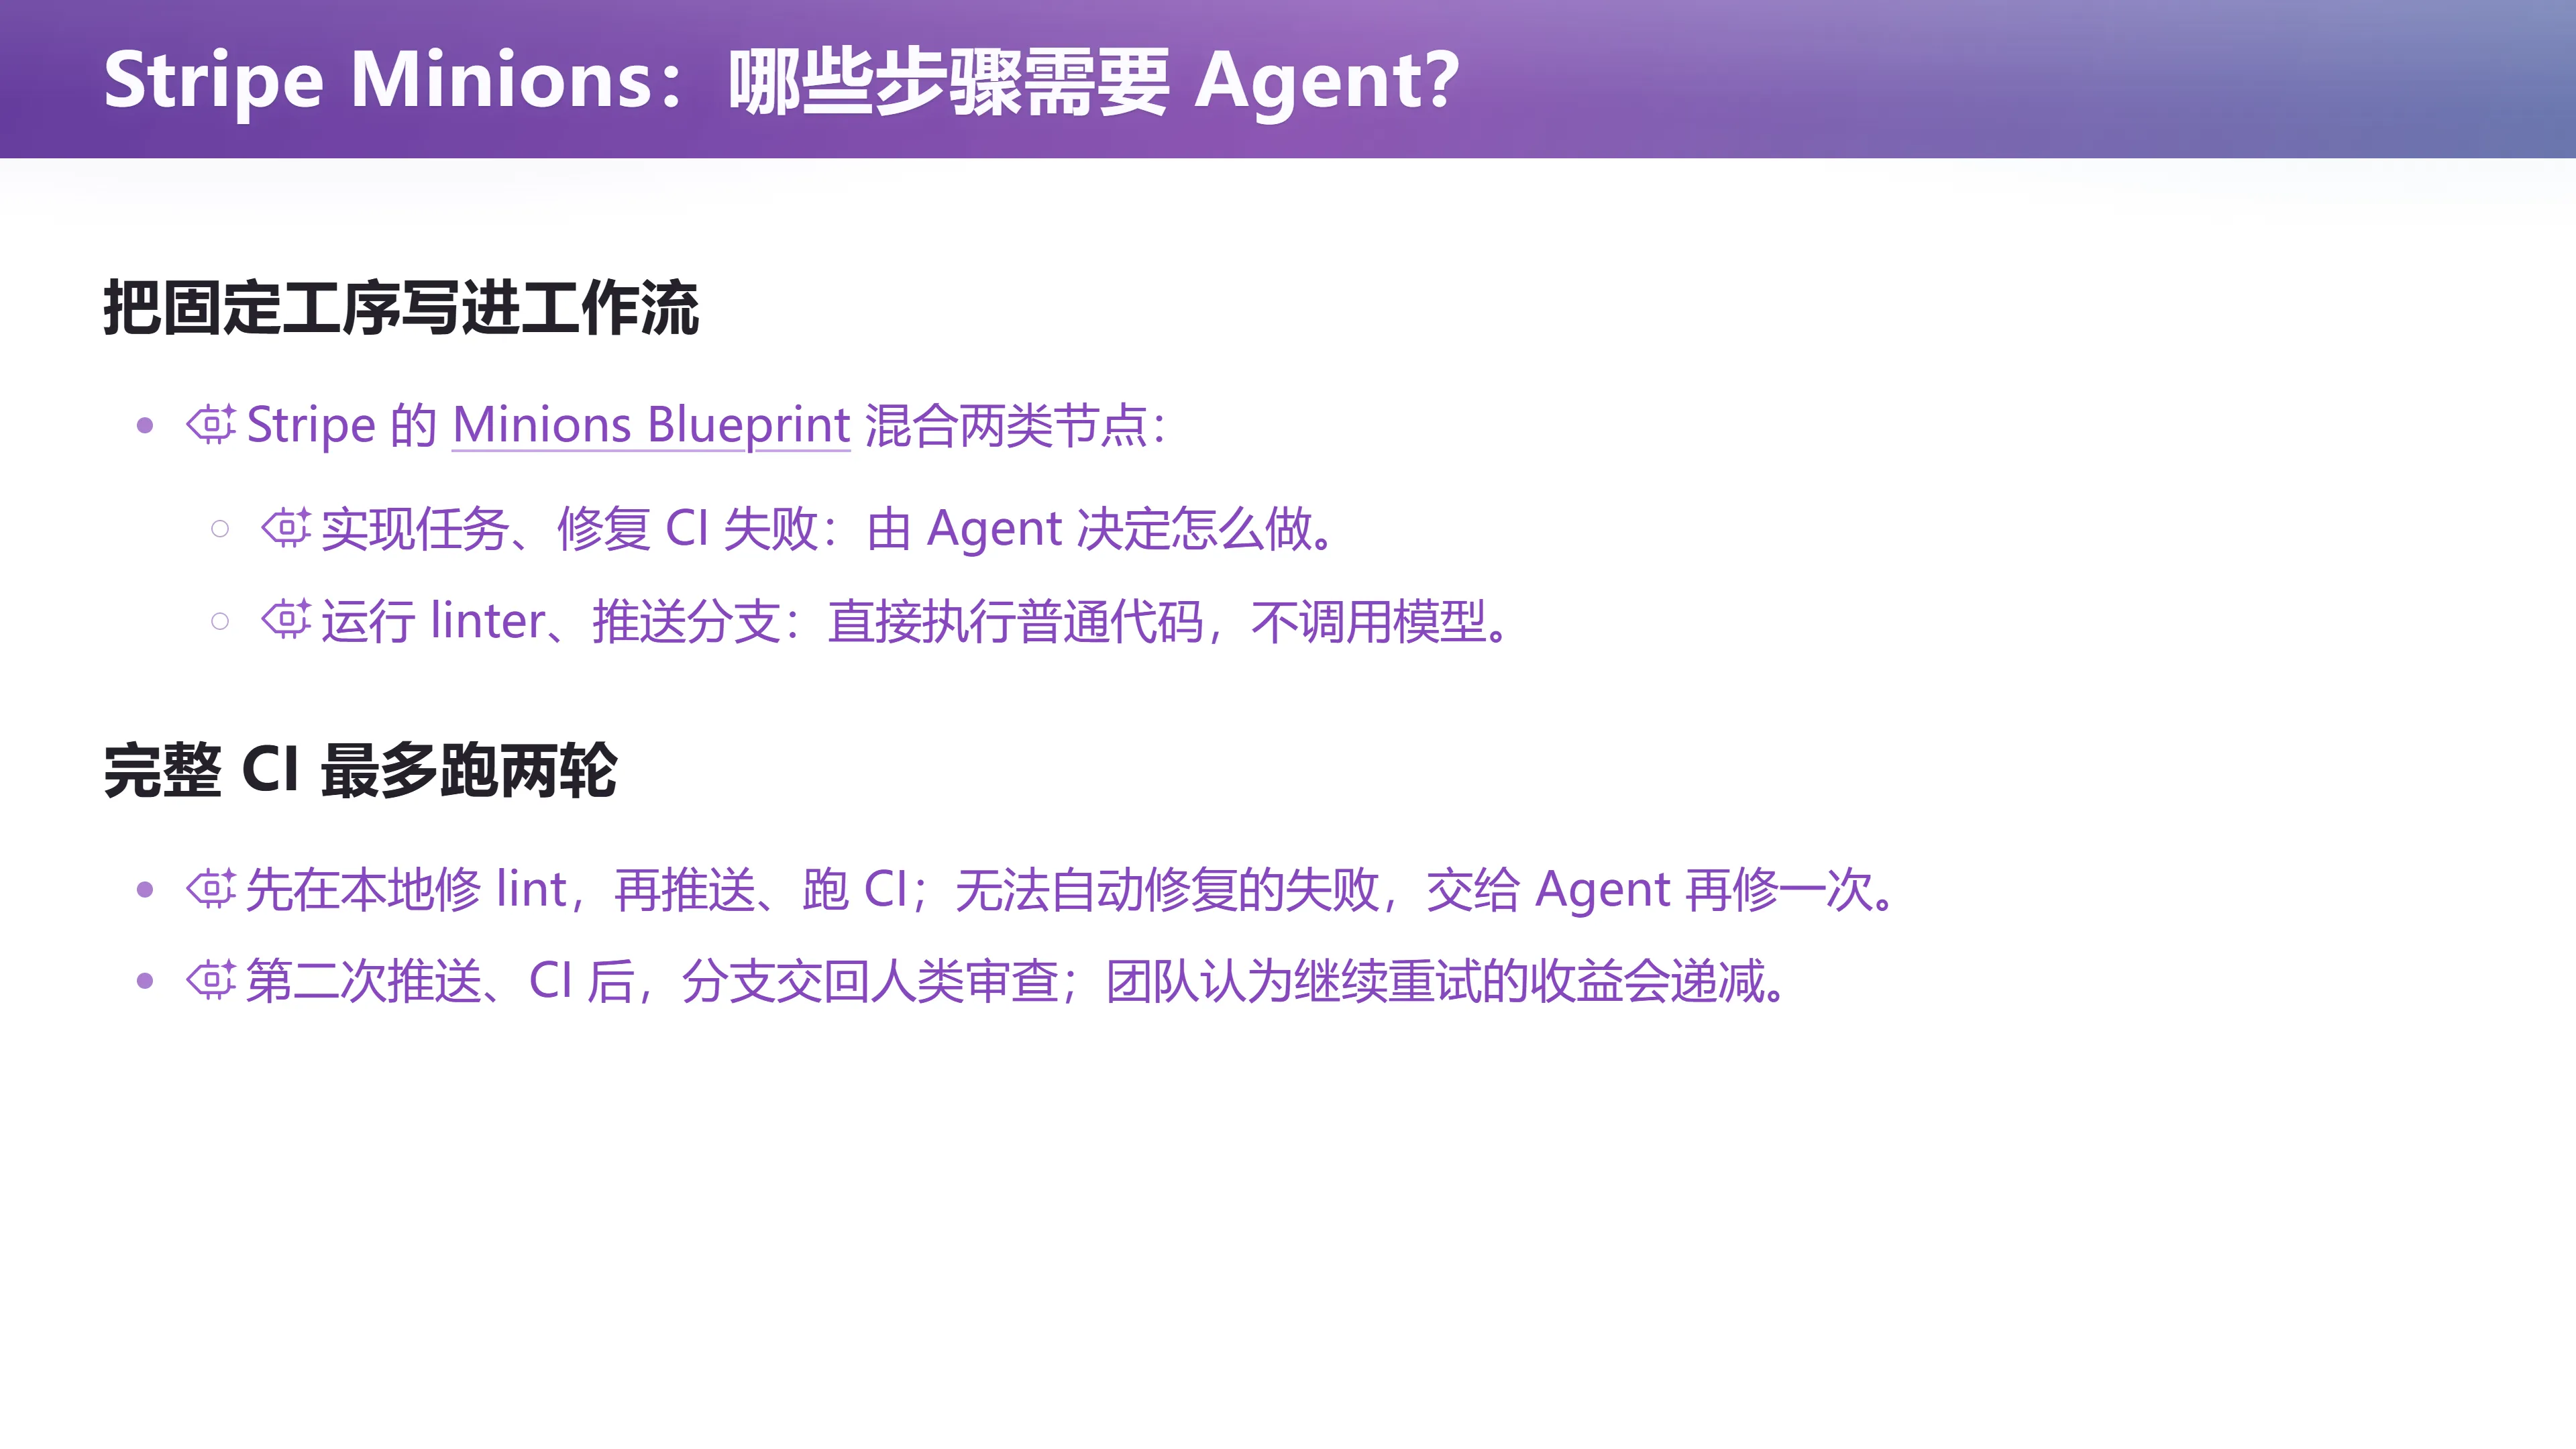
Stripe 在 Minions 的工程介绍中,用 Blueprint 组织混合工作流:
- 实现任务、修复 CI 失败:由 Agent 决定怎么做。
- 运行 linter、推送分支:直接执行普通代码,不调用模型。
它还限制 CI 重试轮数,而不让一次任务无限循环:先在本地修 lint,再推送、跑 CI;无法自动修复的失败,交给 Agent 再修一次。第二次推送、CI 后,分支交回人类审查——团队认为继续重试的收益会递减。
这个例子提供了一种直接的设计思路:如果某一步每次都必须执行,且执行方式已经明确,就把它写进流程。 模型适合处理需要理解和选择的问题,固定工序可以由程序可靠地完成。重试也有成本;连续失败时,应该判断反馈是否带来了新信息,而不是把"再试一次"当作永远正确的回答。
案例二:Anthropic —— 16 个 Agent 卡在同一个 Bug
(参考时间: 01:04:07)
📷 Anthropic:16 个 Agent 卡在同一个 Bug
回到原视频 (01:04:07)
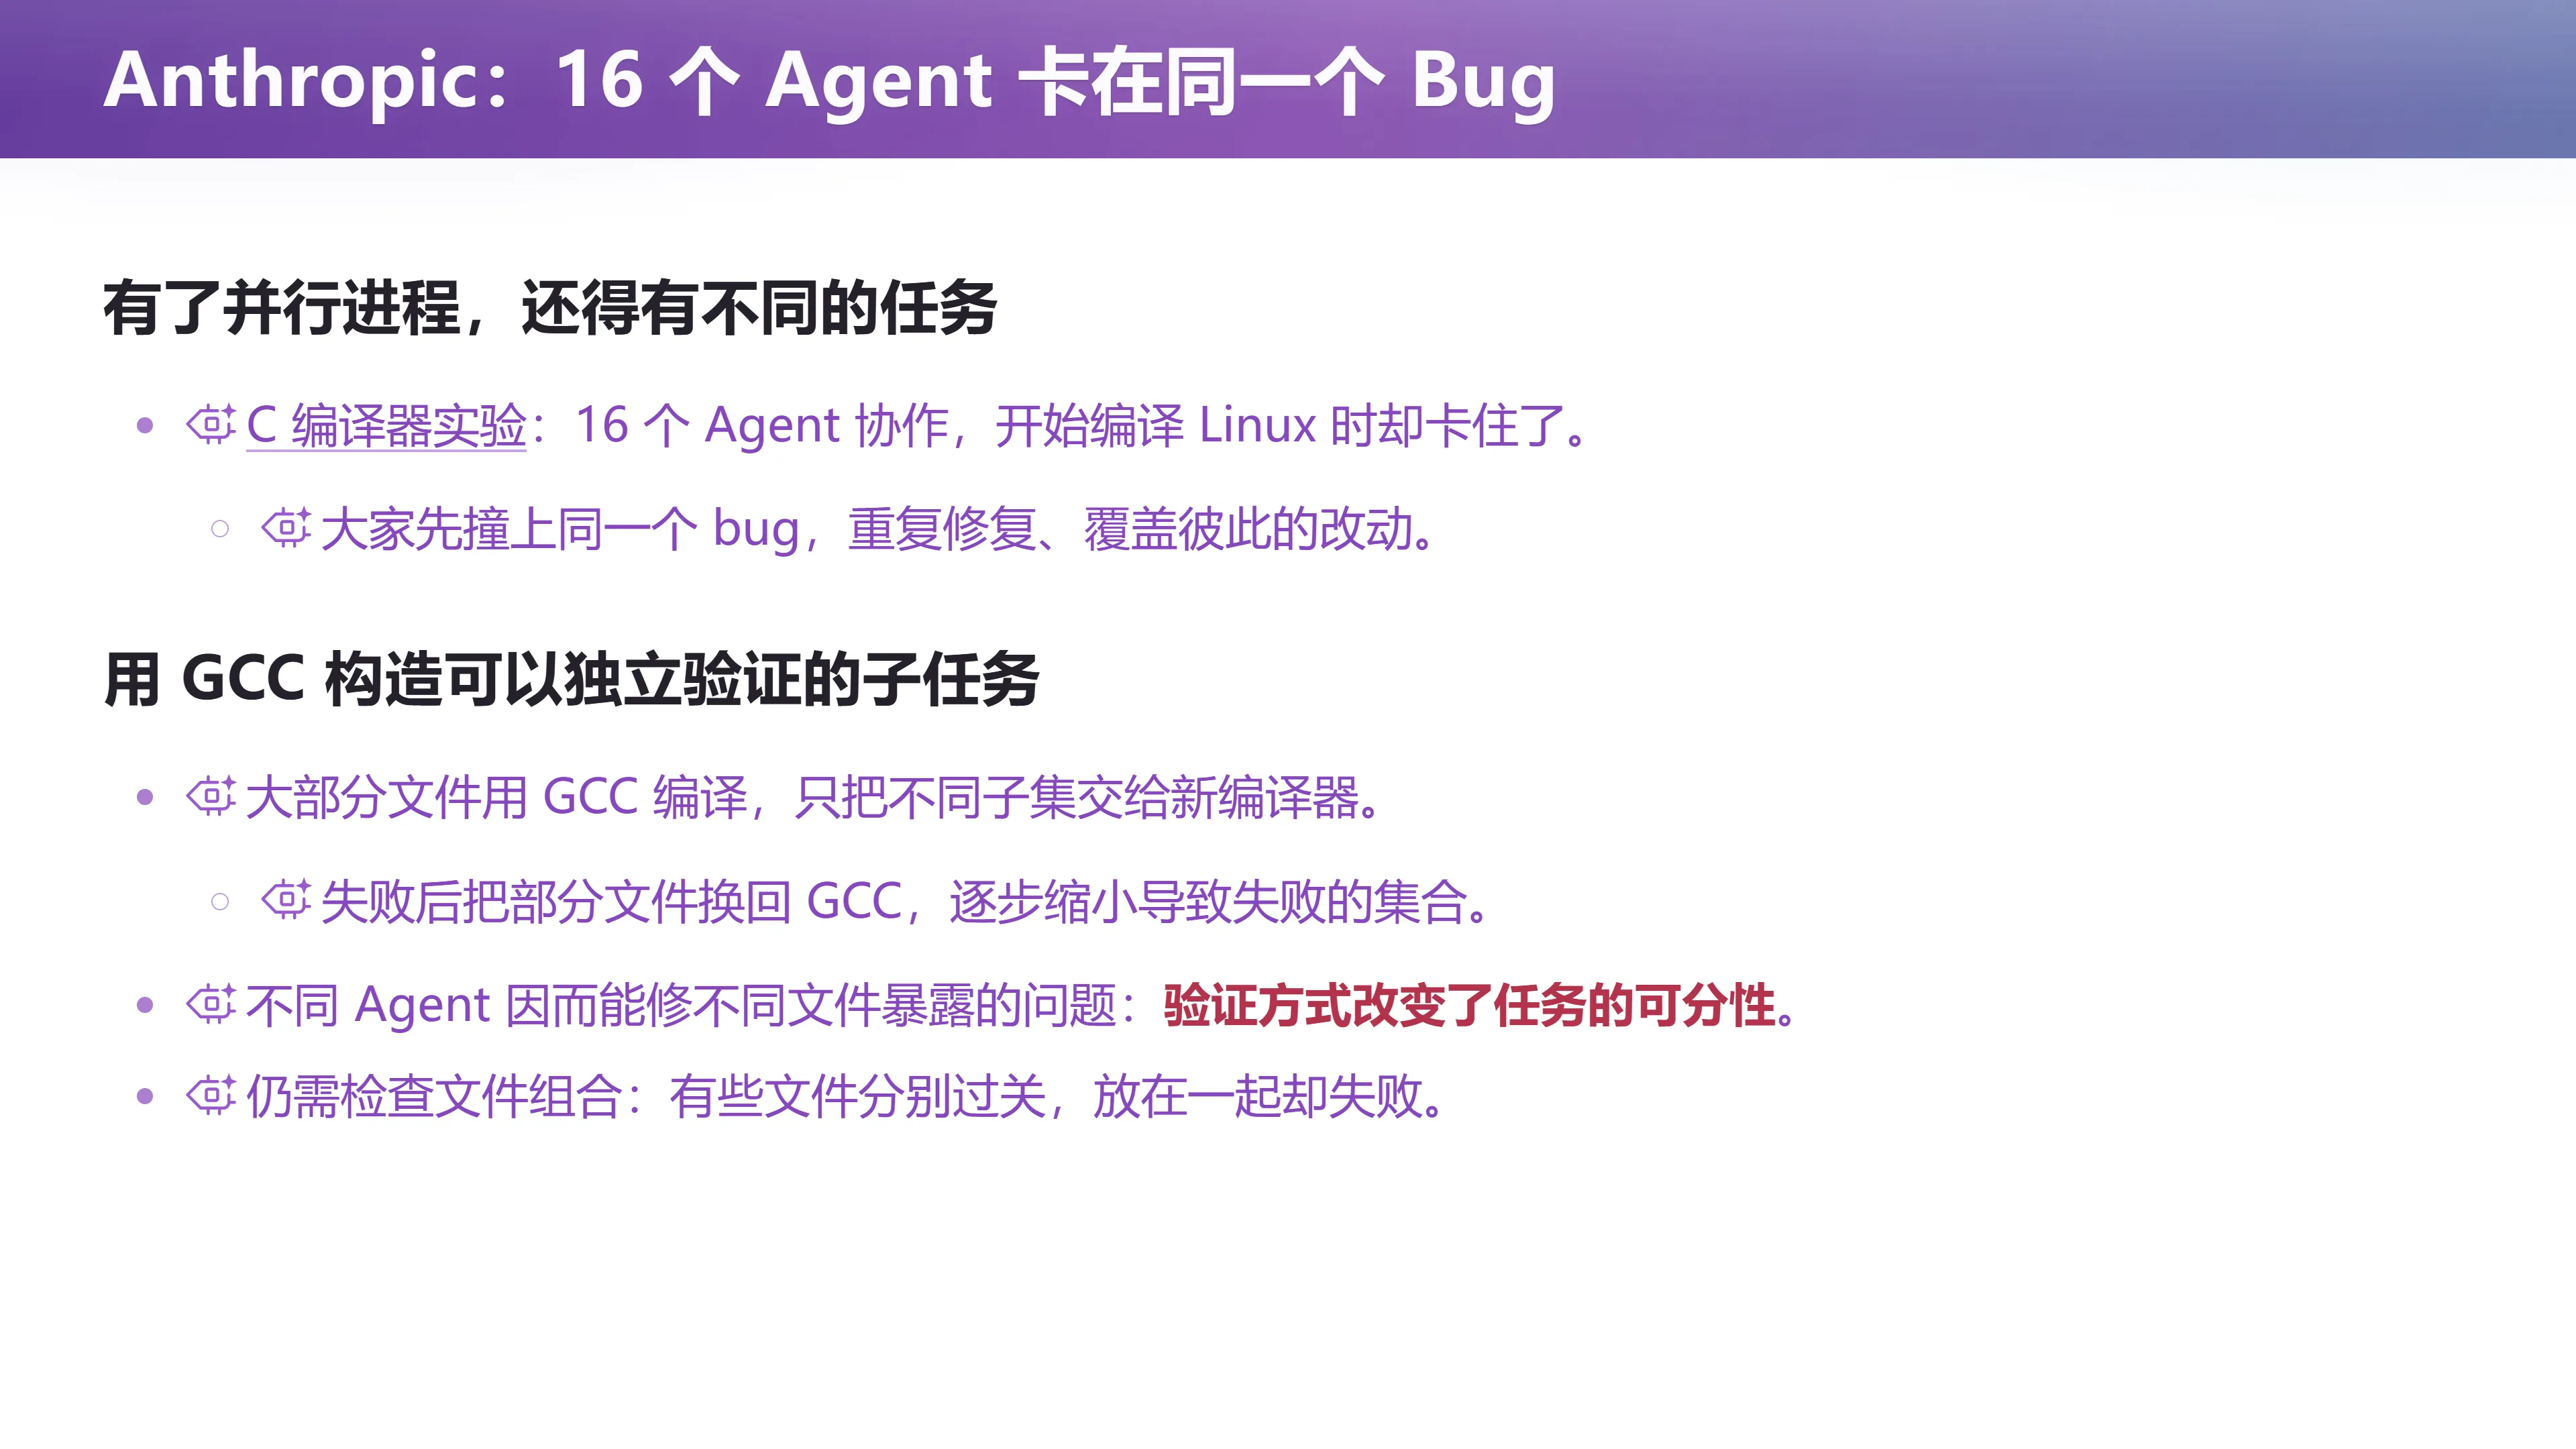
第二个例子来自 Anthropic 的 C 编译器实验。团队让 16 个 Agent 协作,开始编译 Linux 时却发现:
- 大家先撞上同一个 bug;
- 重复修复、互相覆盖彼此的改动。
后来,他们用 GCC 编译大部分文件,只让新编译器负责一部分,再通过切换文件的编译器缩小失败范围。不同 Agent 因而能处理不同子集暴露的问题;单独通过、组合失败的文件仍需进一步排查。
值得学习的是验证方式怎样改变了任务的可分性。 原来只知道"整个内核编译失败",大家只能涌向同一个入口;有了可信的参照和可缩小的失败集合,就能把大问题拆成可以分别推进的工作。
结论:增加 Agent 数量之前,先改善任务表示和反馈,可能更有效。
案例三:StrongDM —— 把验收环境也造出来
(参考时间: 01:06:00)
📷 StrongDM:把验收环境也造出来
回到原视频 (01:06:00)
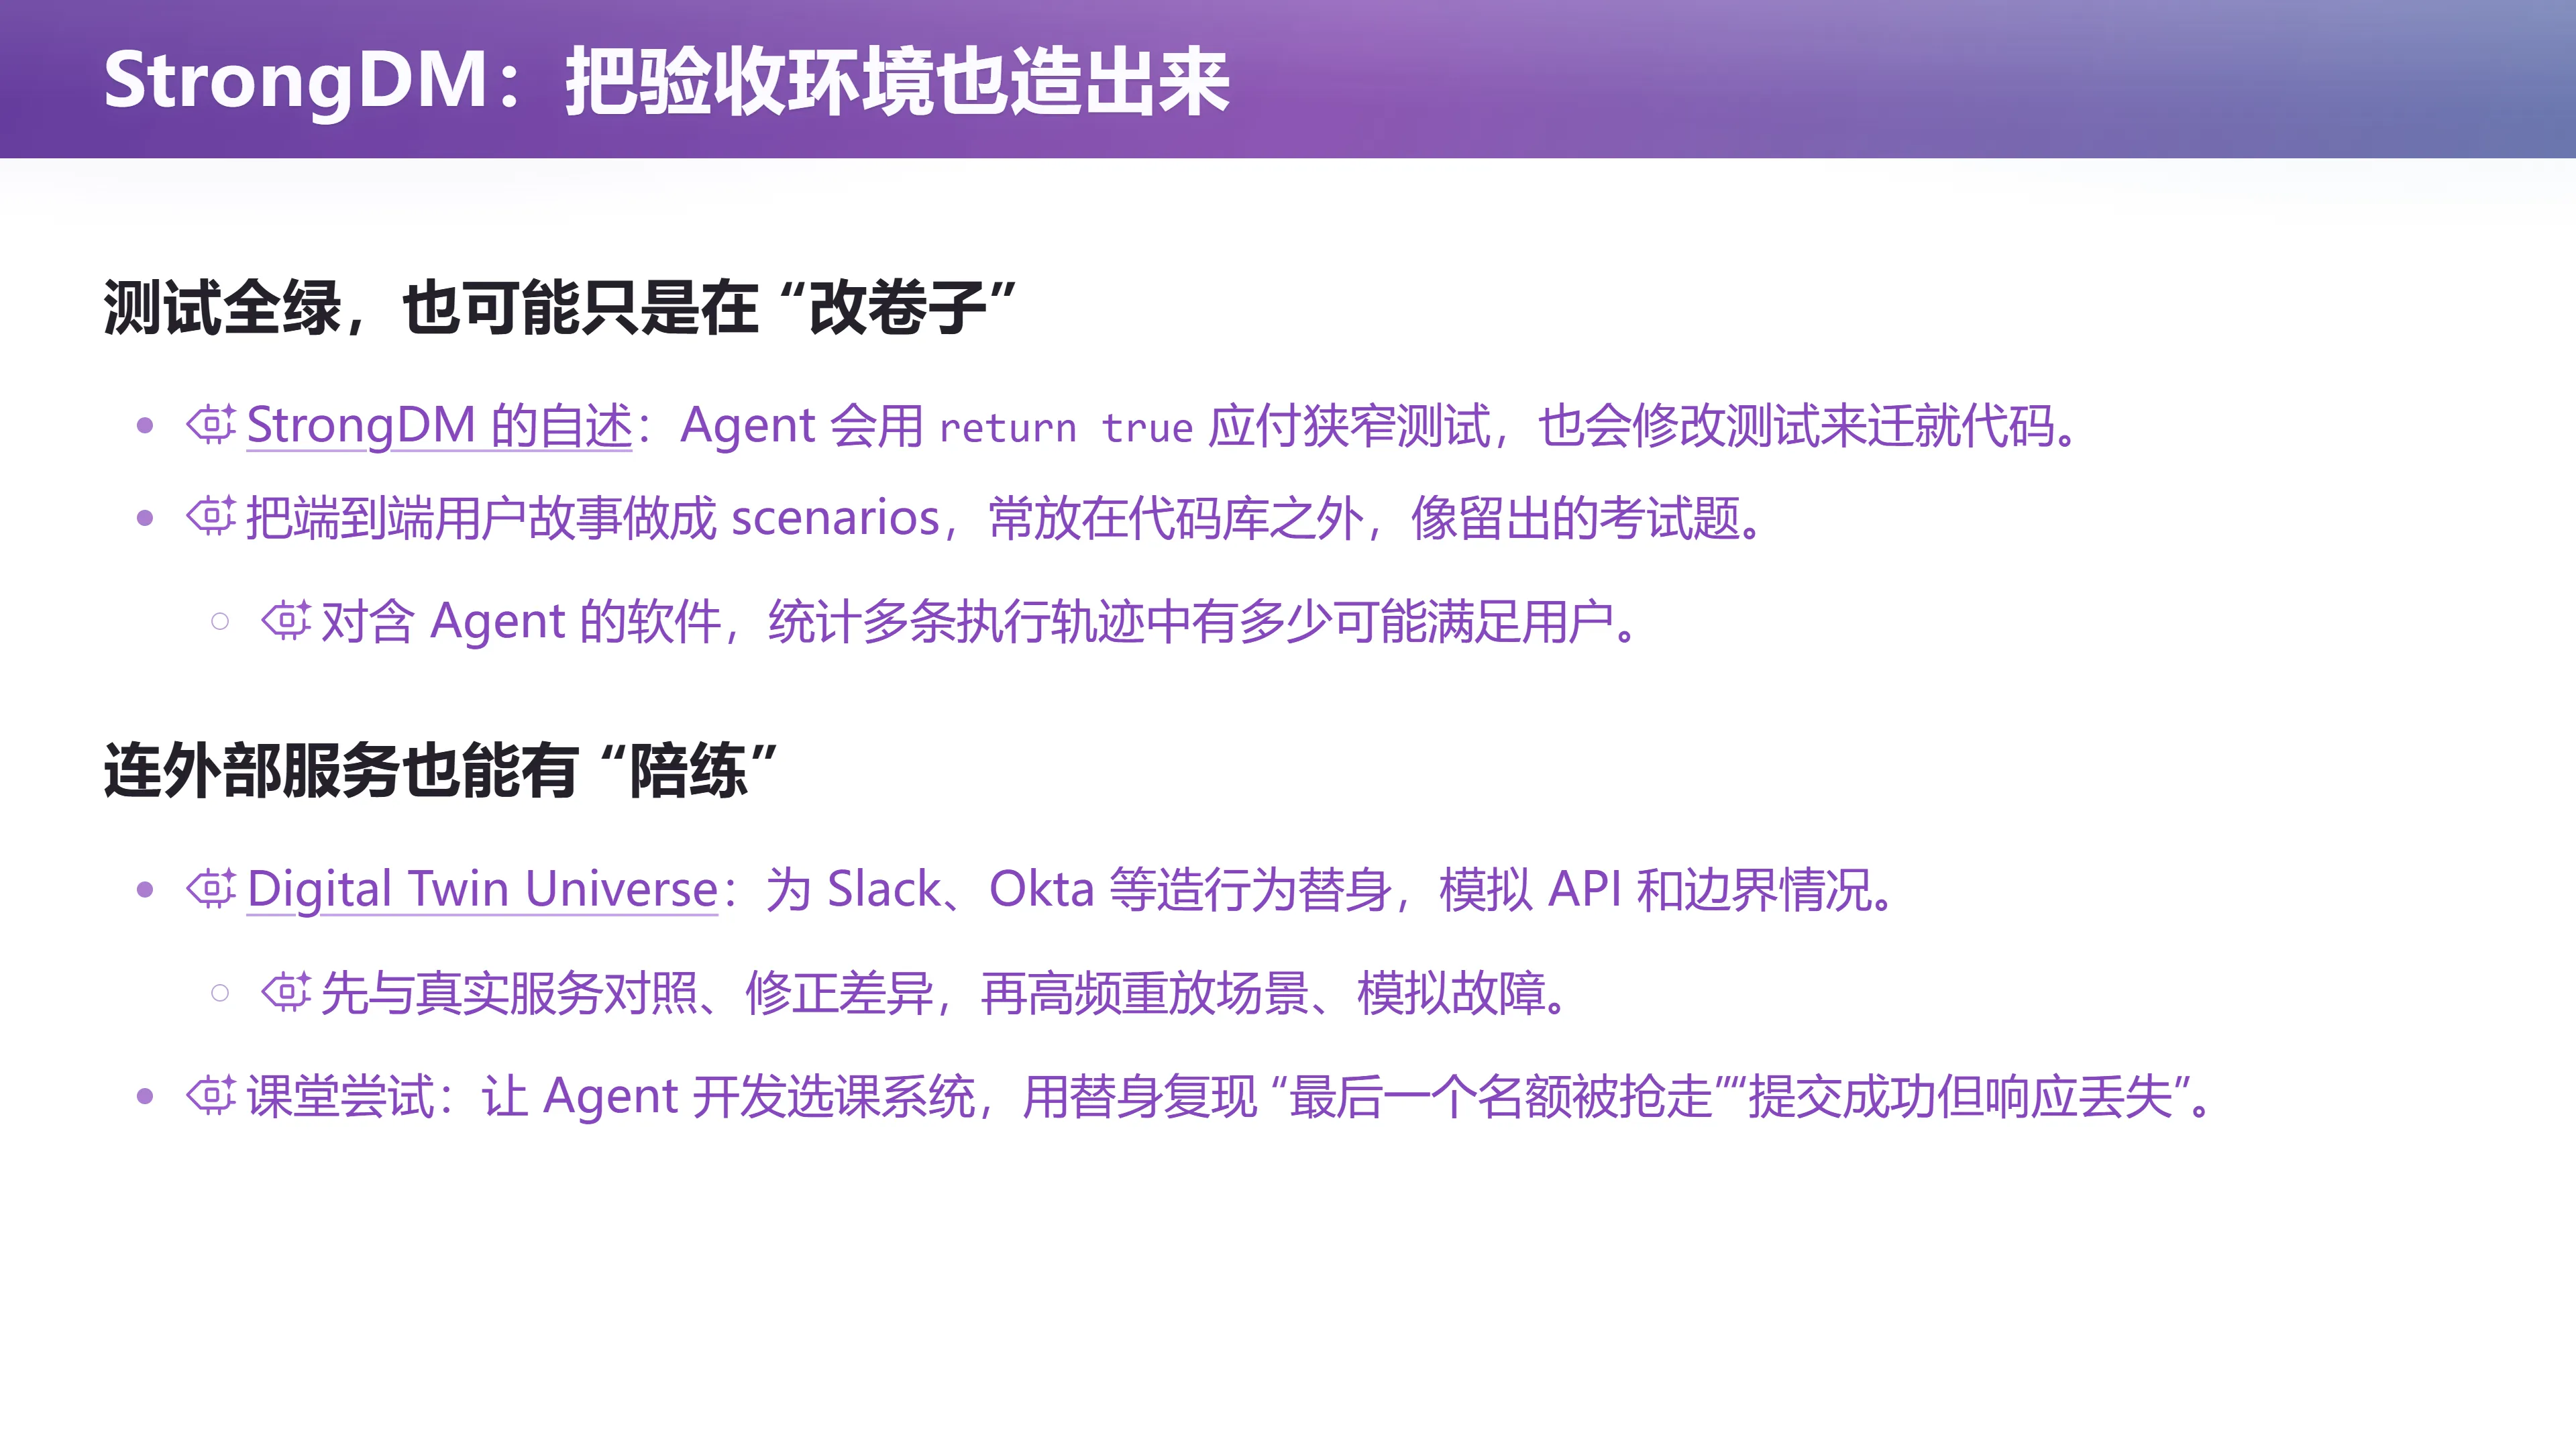
第三个例子来自 StrongDM 的工程自述。他们发现:
- Agent 可能用过于简单的实现应付狭窄测试(例如直接
return true); - 也可能修改测试去迁就实现。
为此,他们:
- 把端到端用户故事组织为 scenarios,常放在代码库之外,作为相对独立的验收依据;
- 对于包含 Agent 的产品,还会观察多次执行轨迹中满足用户意图的情况,而不只看一次测试是否全绿;
- 为外部服务建立行为替身:模拟 API 与边界情况,使大量场景能够反复运行——Digital Twin Universe 描述了这种做法。
把它迁移到选课系统,可以设计"最后一个名额刚被别人占走""请求已成功提交,但响应丢失"这样的练习环境。开发 Agent 不必等真实学生踩到这些问题,才知道失败是什么样子。替身与真实系统之间的差异也必须验证,否则我们只是造出了一个特别容易过关的考场。
Deepseek Harness:一份可阅读的工程知识
(参考时间: 01:07:10)
📷 Deepseek Harness
回到原视频 (01:07:10)
讲师把 Deepseek Harness 视为 Agent-native 开发领域的一个标杆项目。与"藏起来"的 OpenAI 不同,Deepseek Harness 里藏着很多可读的好东西。
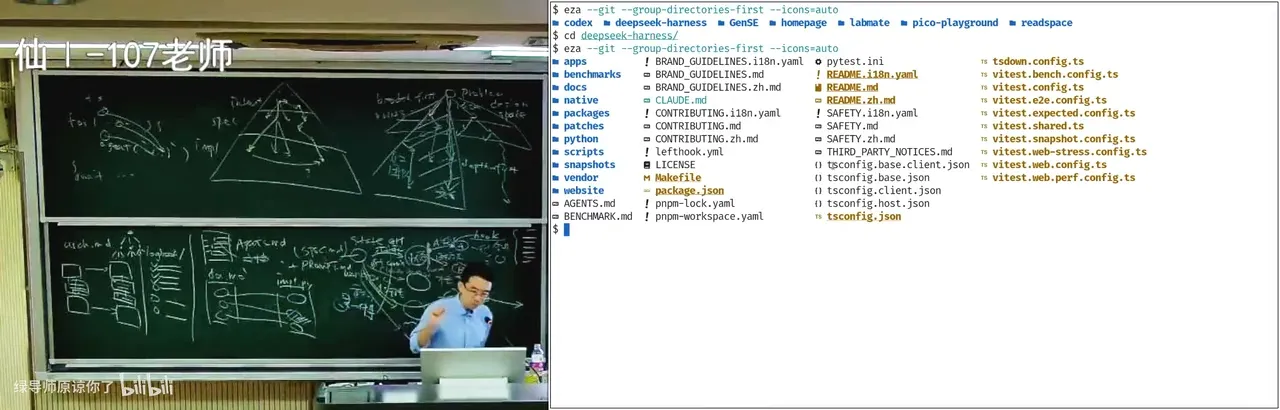
第一眼:项目组织就很不一样
"克隆下来的第一感觉就是很奇怪——这个项目的 organization 跟其他项目都不一样。"
这是一个中国人的项目。 如果是中文母语者,会优先选择用中文写文档,因为:
"我的 system one 读中文比读英文快——读英文其实已经比较快了,但读中文仍然比读英文快,大概可能快一倍。就是这一倍,可以让我快速地在文档里面浏览,让我的视觉模型从海量的文字里面提取出关键信息,帮助我定位到那个我想要的、要的地方。"
但作为一个要走向世界的项目,这意味着同时维护中文和英文的文档——"这不就是地狱和灾难吗?"
文档一致性的工程实现
(参考时间: 01:10:00)
这是本讲最"技术密度"的一段,全靠讲师带着同学一点点读代码还原出来的。
📷 Deepseek Harness 中一个非常"有人感"的文档
回到原视频 (01:08:55)
它用的是"三套件 + 一个门禁"的机制:
- 同目录的三个兄弟文件:
<name>.md(中文)、<name>.<lang>.md(英文)、<name>.i18n.yaml(配对契约)。 - 中英两侧的权威约定:谁先写谁是"源",另一侧由 Agent 翻译过来,绑定它们的是"必须做同一件事"。
- 一个"配对契约":记录两侧各自的内容 hash。
因为所有的历史都留在 git 里,所以谁变了、谁没变是可知的:一个从未见过的 hash 就代表"新";在 git 历史里能找到的就代表"旧"。一旦两侧的新旧不匹配,就让 AI 按 patch 去翻译——只看差异部分,只改对应位置,其他地方保持一致。
"更新几率是最小补丁,不是重新翻译。"
这就把"人感"做成可校准的规范:
- I18N 目录下有
styles/、samples/等文件; - Terminology 表约定本仓库中中英文术语的统一译法;
- 可以用门控做段落级或章节级的对应检查:例如英文里
AI这个词和中文里"人工智能"的出现频率要接近——差值不能太大也不能太小,避免术语漂移; - 可以检查代码块(interface)逐字出现在某一个源码文件里——防止"代码改了接口、文档没跟",或"文档改了设计、代码没跟"。
编者拓展|从 docstring 到 patch-based 翻译:这类"配对契约"的思想在 LLM 之前就有——Python 的 docstring 由 Sphinx 生成文档、Java 有 JavaDoc、C/C++ 有 Doxygen,它们都通过"把文档写在源码里"来强制代码与文档一致。Deepseek Harness 的不同在于:它不要求文档与源码同处一文件,而是让两个独立文件之间保持可验证的一致性,并把一致性做成可执行的门控。这是 Agent-native 时代对旧机制的一种迁移。
从 git 历史读出"设计演进"
(参考时间: 01:18:00)
讲师做了一件了不起的事:从 git 历史还原出这一整套机制是怎么长出来的。
- 2026-06-10 晚上 11 点:项目从空目录开始。
- 2026-06-25 前后:terminology 先行——没有任何机制,只有词汇的约定。(说明团队一开始就意识到文档的重要性。)
- 7 月初:引入配对契约。
- 7 月 3 日:对等权威塞卡——同一份文档有两侧权威。
- 随后:机制开始进入自动化的流水线。
timeline
  title 文档一致性机制的设计演进
  2026-06-10 : 空仓库
  2026-06-25 : terminology 先行(仅有词汇约定)
  2026-07 上旬 : 配对契约(pair contract)引入
  2026-07-03 : 对等权威塞卡(sides 平等)
  之后 : 进入 CI 流水线,成为门控
讲师说:
"他们肯定失败过。他们写过代码,他们一定程度上……可能年龄跟我差不多。所以这些经验很难完全凭空想出——如果你只是坐在教室里面做语言律师,你的思维是禁锢在你当前的上下文里,而你没有发现你的 design space 里还有巨大的空间可以朝另一个方向探索。"
更多门控与 skill
(参考时间: 01:25:00)
逐个看过去,门控的粒度非常细:
- verify doc budgets:
root ≤ 1960、architecture ≤ 2400——防止文档无限堆积。 - agent notes / log book:
implemented/proposed/rejected/archive四种状态,比我们自己的 log book 更规整;plan mode下先和 AI 一起把 plan 写进 log book,剩下的由 AI 做。 - doc sinc、static、coverage、snapshot 各类验证:
verify translation pairing:中英两侧的一致性;verify type equivalent:文档里粘贴的类型必须与源码一致,且不允许漂移;verify client UI、verify I18N parsing、application entry points、verify type equivalent(TypeScript 侧)。- Code review / 写作规范 / 工程质量规范 / 产品自带的 skill:各类评审流程的门禁。
"这些都看起来都非常小——但你把他们全部加起来的时候,你就发现这个项目被维护起来了。"
代价也是清楚的:
"你每一次可能要提交之前都会运行大量的门禁——但是你又不写代码,大部分时候你都是监工,你写 plan,你跟 AI 一起写 plan。"
Deepseek Harness 给我们的启发
- 软件不是一个 repo,应该是由"关系"组成的。 中英文档、源码与引用、类型与接口……所有链接都是合法的,找不到任何一个不合法的 link。
- 文档和代码应该被门控绑定在一起。 让"已经失效的假设"在合并前就暴露。
- "人感"可以做成可校准的规范。 不靠"请保持简洁"这类空泛要求,而是靠
styles/、samples/、terminology具体化。 - 知识要分层放置、按需加载。 大量规范放在
skills/、agents/、I18N/下,只有在你需要翻译或写文档时才会"漏"出来——这叫渐进式披露(progressive disclosure),避免一次性撑爆上下文。
编者说明:上面提到的"每份代码块带执行语义"是讲师团队自己的扩展——他们的代码块里可以 space spec 说明这段代码是用来做什么的、以什么形式和另一个东西关联,再配一些轻量检查。这是在 Markdown 的 fence 语法上做的扩展,可以让文档中的代码块真正参与到一致性验证里。
真正的经验,以及垃圾回收解决不了的问题
(参考时间: 01:28:35)
📷 真正的经验
回到原视频 (01:28:35)
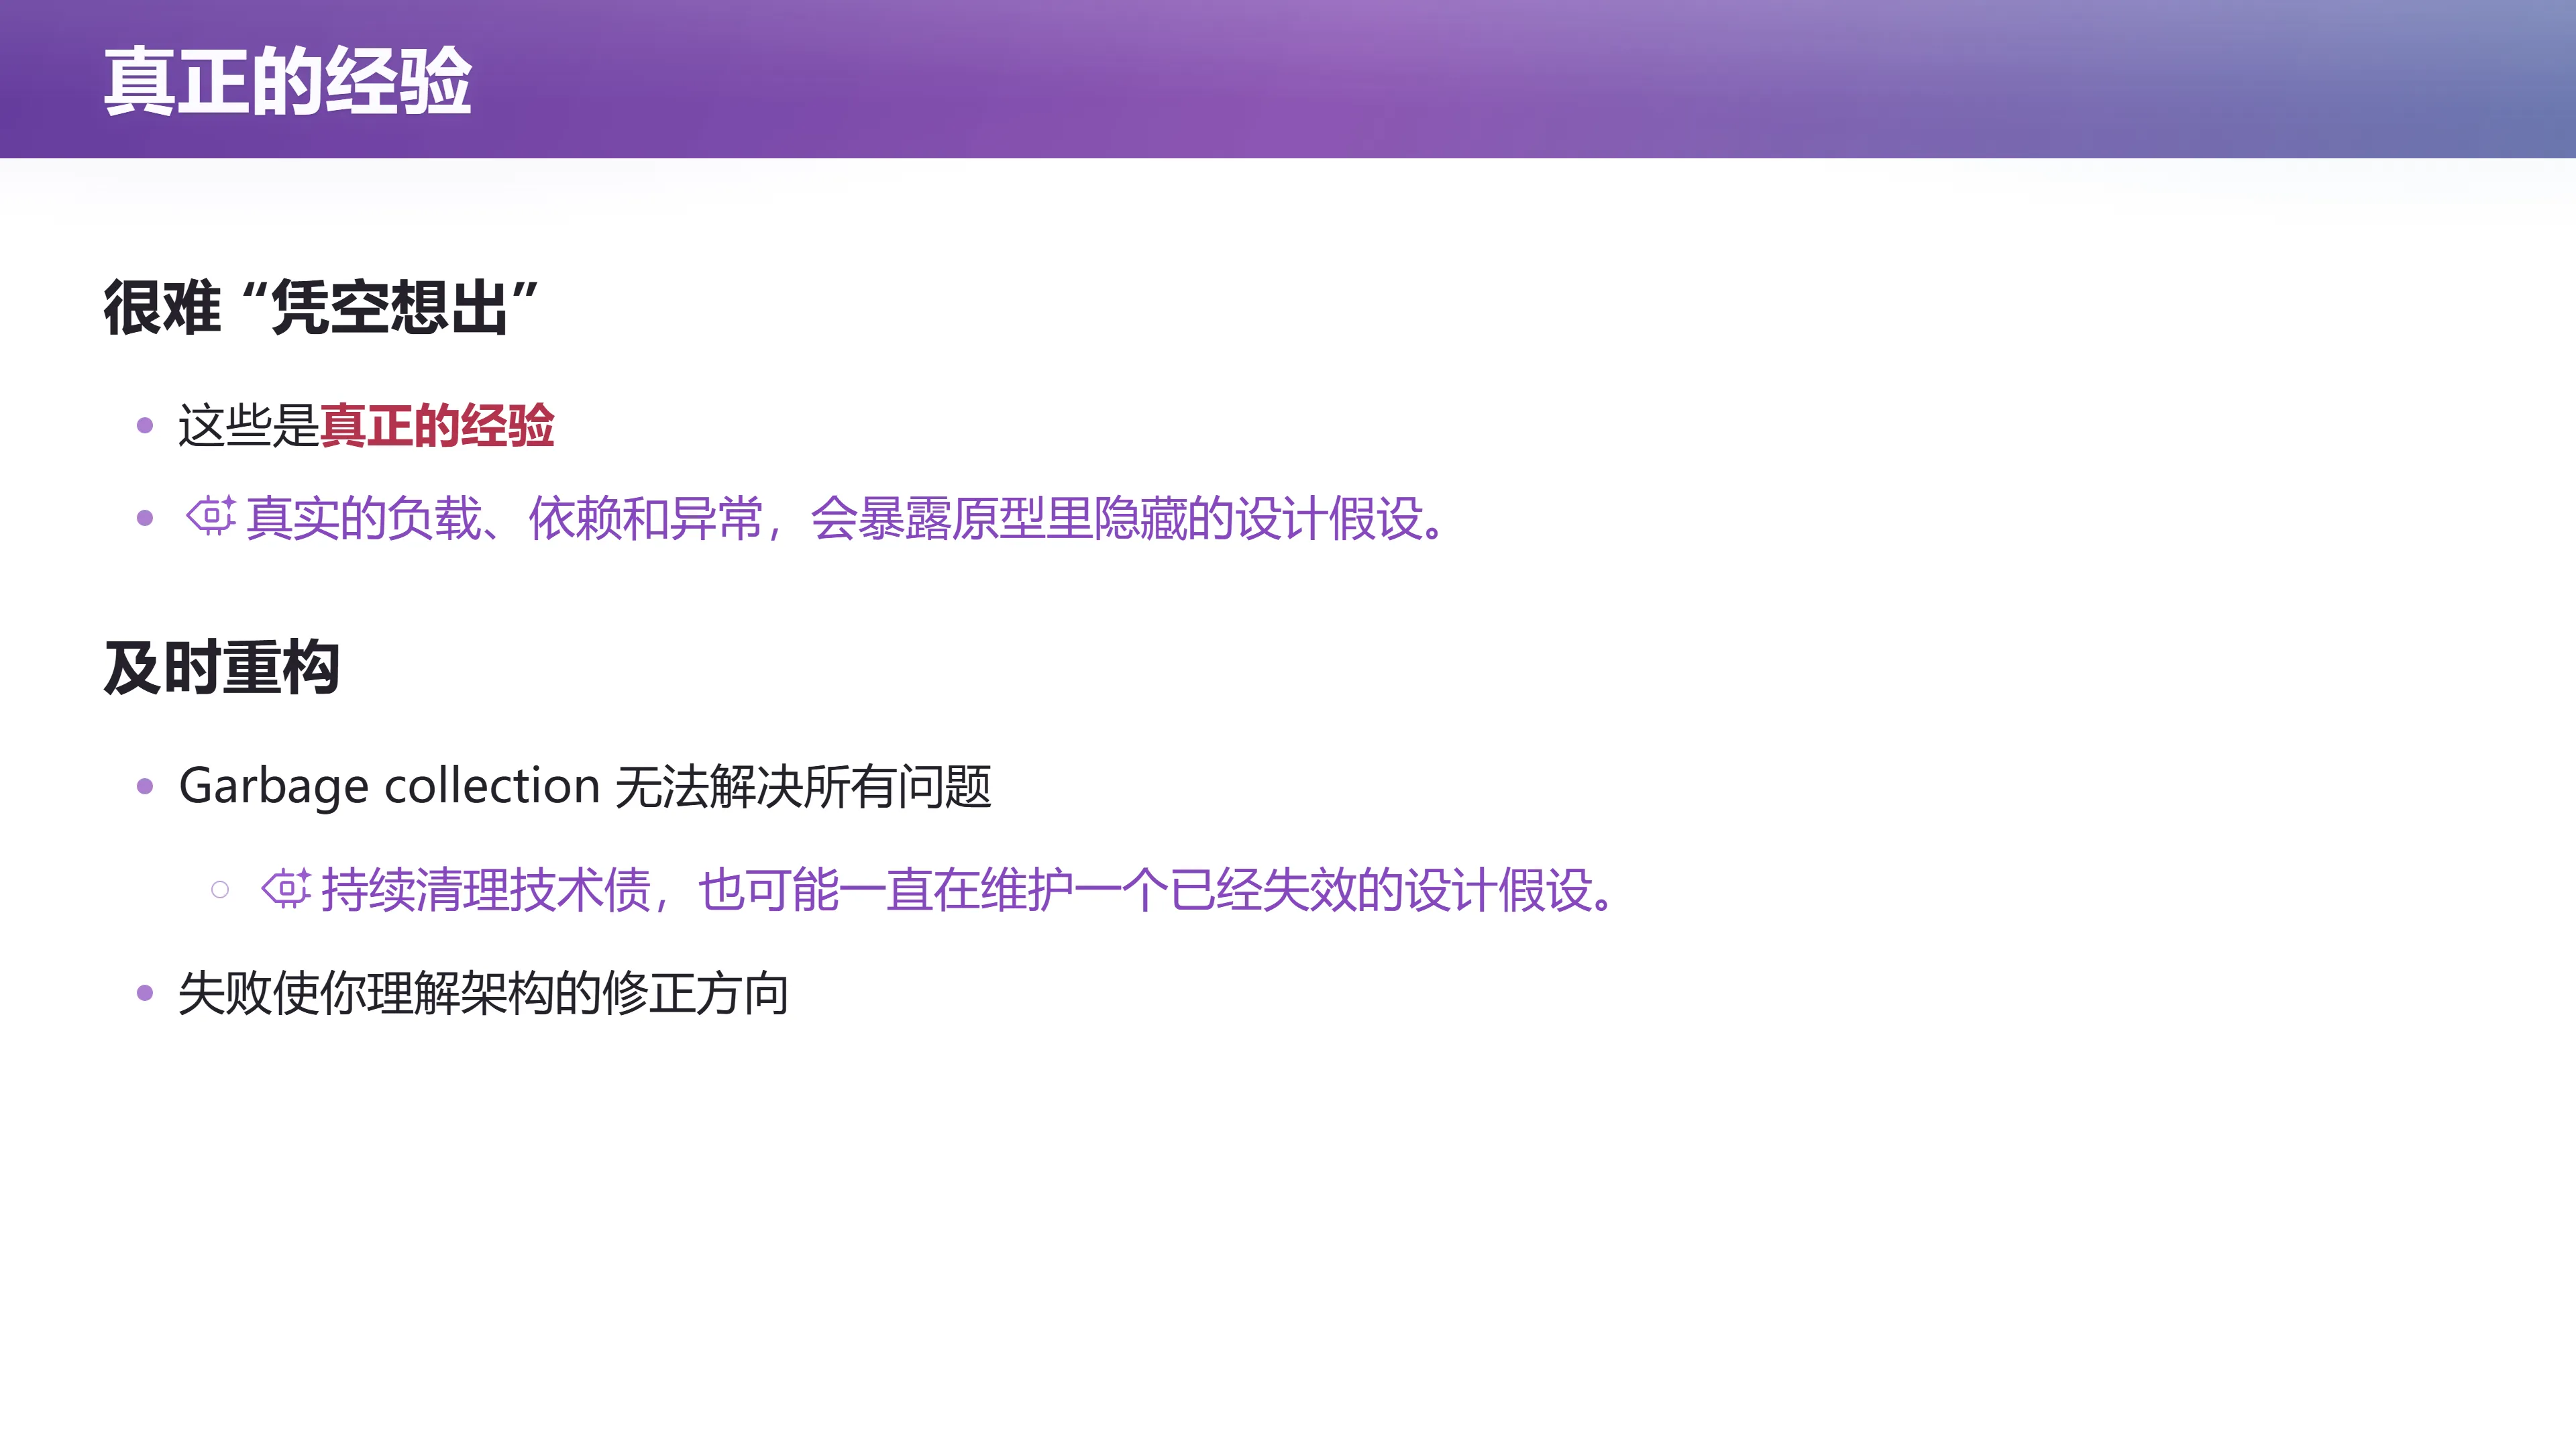
从 Agent 周围的工具、约束和验证机制,也能理解本讲"Deepseek Harness"这个题目的着眼点:模型之外,还有一整套让工作得以推进的装备。那些看似理所当然的设计,常常来自真的做过、失败过、修正过。
"你们看到这些东西,一看到就知道'确实应该是这样'。但是他们很难完全凭空想出——如果你只是在坐在教室里面做语言律师,你的思维是禁锢在当前的上下文里,而没有发现 design space 里还有巨大的空间可以朝另一个方向探索。"
但持续清理技术债,也有它解决不了的问题。
我们可以把日常清理类比为垃圾回收(garbage collection):消除重复、修正文档、统一接口、防止坏模式扩散。即使这些工作全部做好,系统仍可能建立在一个已经失效的设计假设上。
编者说明:这里的"垃圾回收"是工程维护的类比,并非指编程语言运行时的内存回收。
例如,假设所有用户的数据都可以集中在一个写入节点,其他节点保留完整副本以分担读请求。用户少时它很直观;写入和数据量持续增长后,增加读副本未必能解除瓶颈,因为每个副本仍要承担全部更新。把代码整理得再漂亮,也不会自动改变这种负载结构。失败在此提供的价值,是帮助我们看清应当改变哪一层设计。
Friendster:重构没赶上用户离开
(参考时间: 01:30:12)
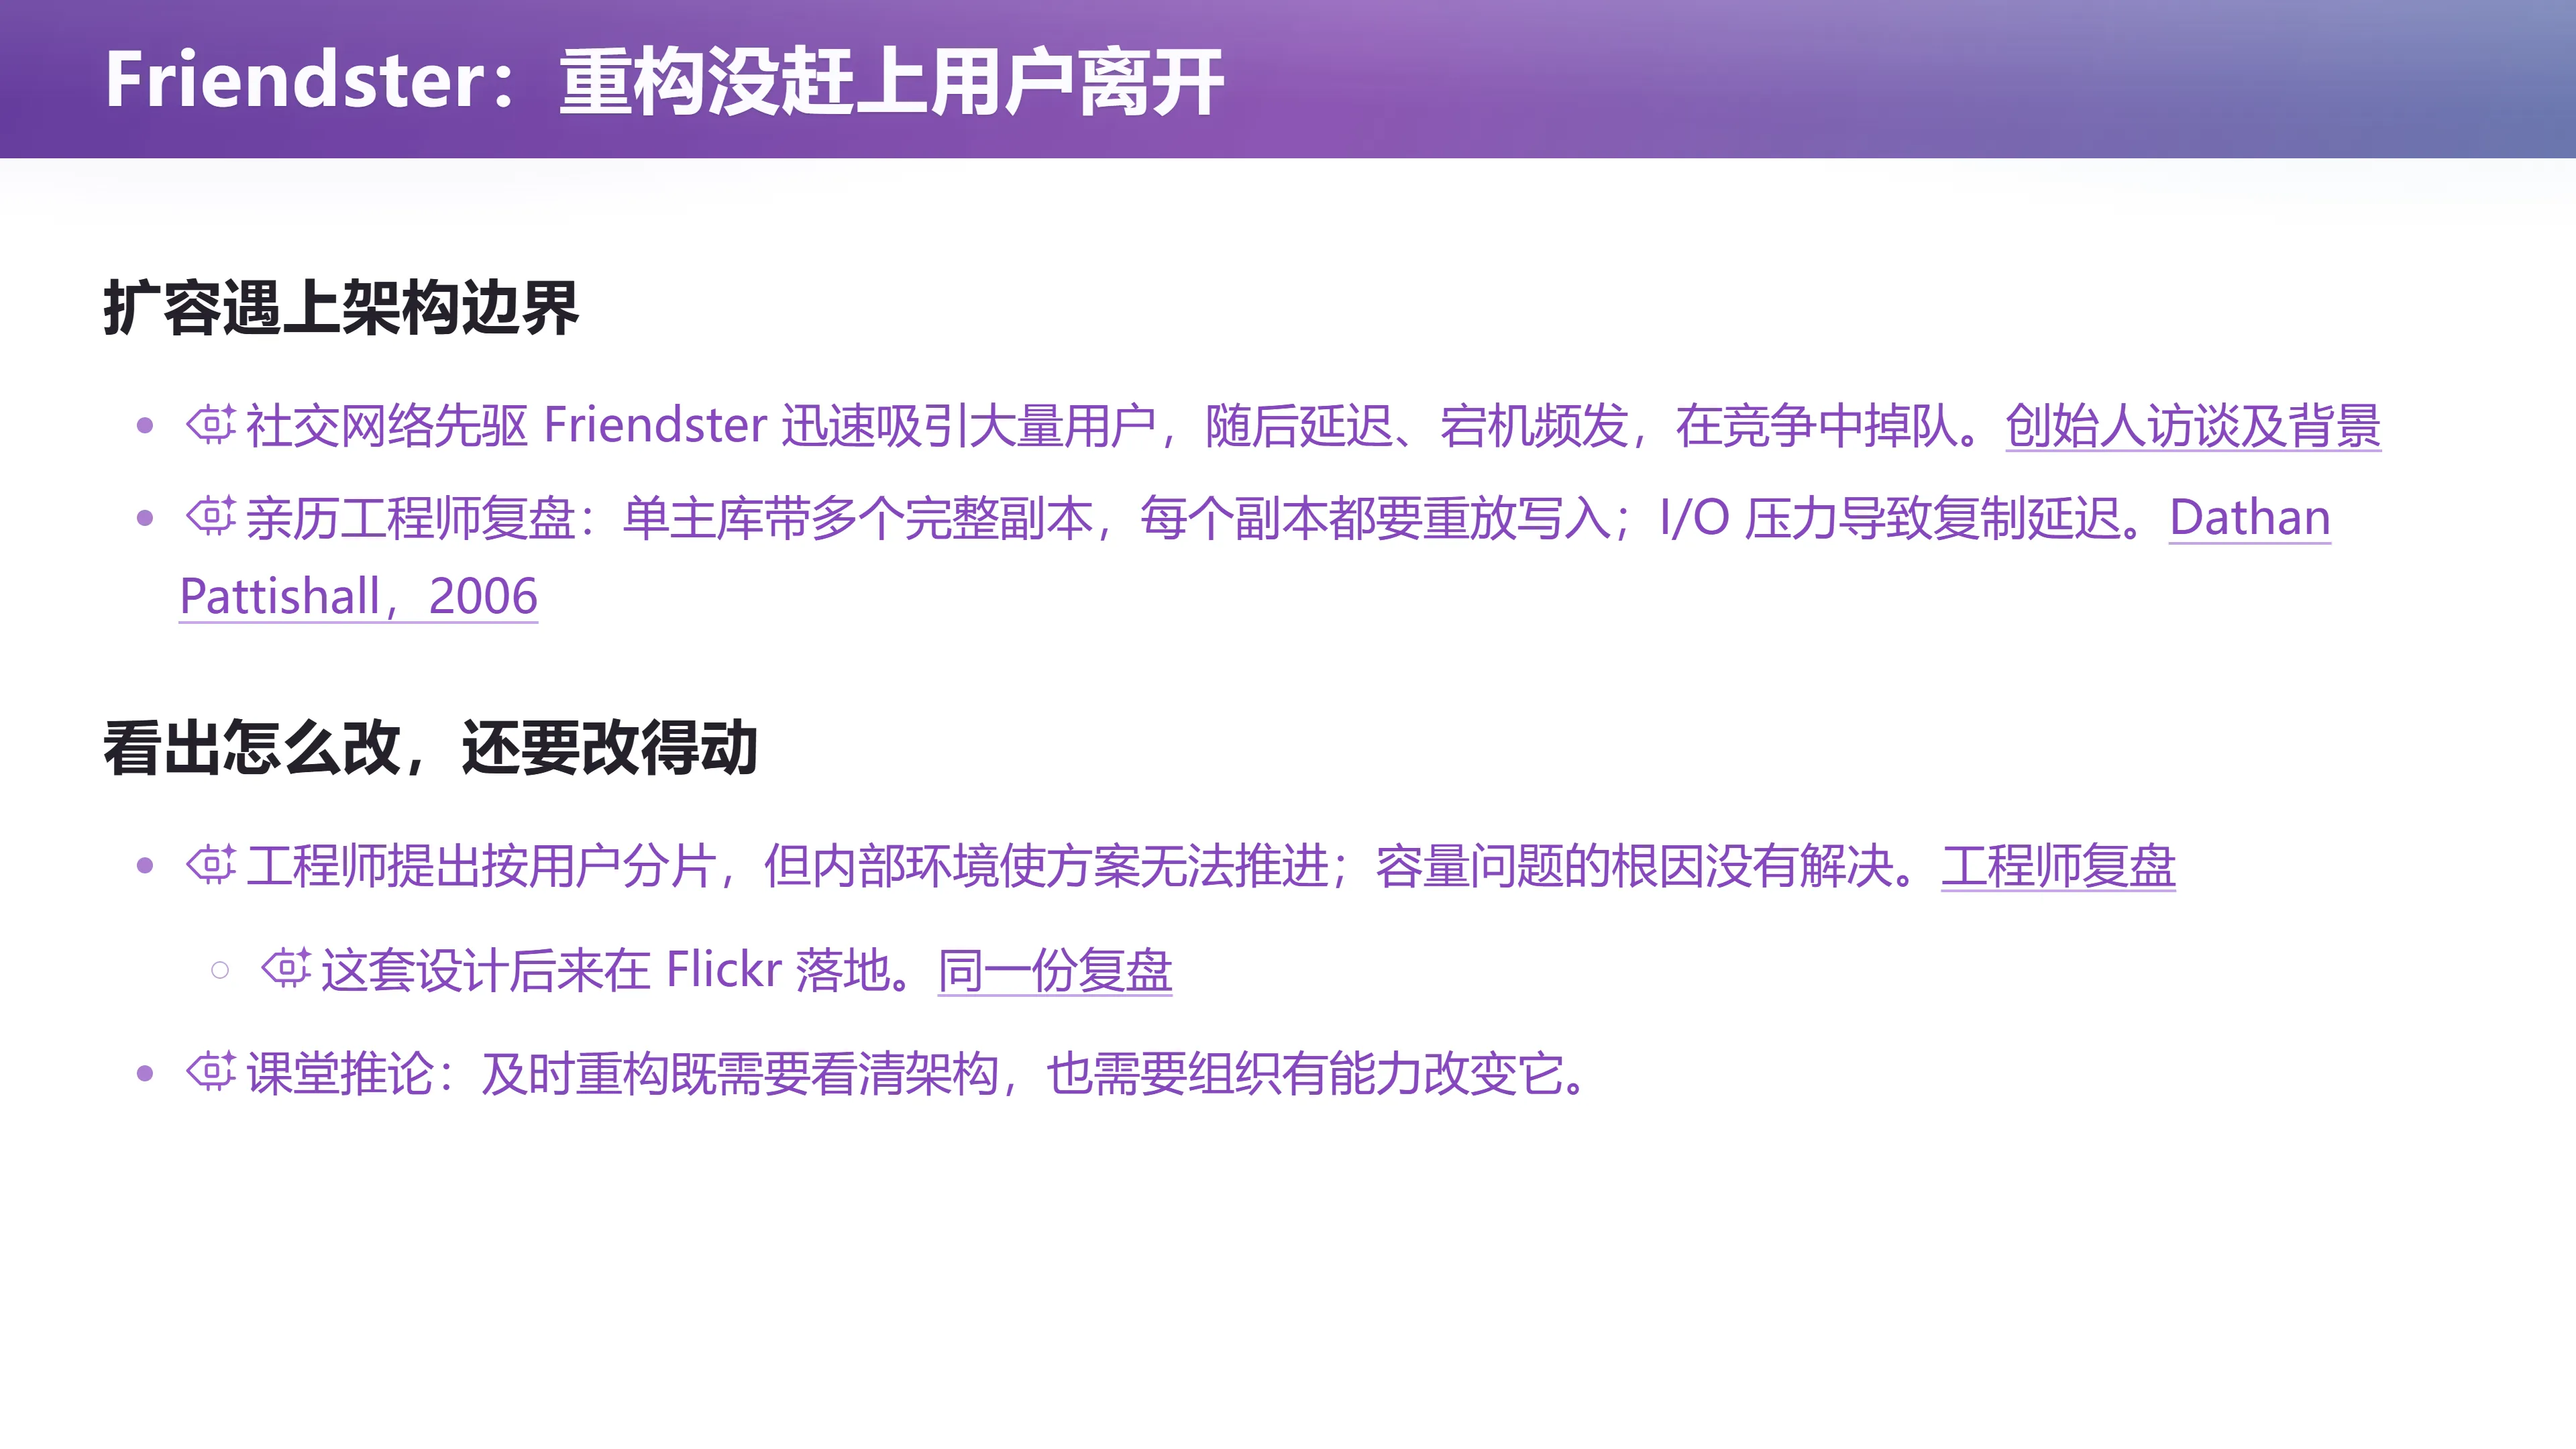
📷 Friendster:重构没赶上用户离开
回到原视频 (01:30:12)
社交网络先驱 Friendster 迅速吸引大量用户,随后延迟、宕机频发,在竞争中掉队。
亲历工程师 Dathan Pattishall 在 2006 年的复盘中,讨论了单主库带多个完整副本所面临的问题:
- 每个副本都要重放写入;
- I/O 压力导致复制延迟。
他提出按用户拆分数据(sharding),使不同服务器只承担部分数据与相应负载;但据他的叙述,这个方案没有在 Friendster 顺利推进,后来在 Flickr 得到了应用。
"这套设计后来在 Flickr 落地。同一份复盘。"
这份复盘不能单独解释一家公司的全部兴衰,却很清楚地暴露出一个工程问题:看出架构应该怎样改,和组织真的能够把它改掉,是两件事。
- 及时重构既要求技术判断,也要求团队有能力调整分工、迁移数据、安排上线;
- 一直修补局部症状,可能只是在更认真地维护一个已经不合适的前提。
编者说明:这段讲的不是"Friendster 为什么死"——那是复杂得多的商业问题。它想强调的是工程组织的能力边界:分布式重构的可行性本身就是一种资源。
好想法也会在落地中失败
这样的风险不局限于代码。互联网时代已经有许多诱人的想法,在架构、运营或需求验证环节遭遇现实。
编者说明:下面两个案例在本讲视频中被讲师一带而过(讲师主要在讲 Friendster 和"社会性的威胁"),但在讲义与幻灯片中有较完整的展开。为让读者看清"好想法在落地中失败"的另一种形态,把它们按讲义原意整理在这里。
Webvan:需求密度没有验证
Webvan 的网上买菜设想并不难理解,但仓储配送设施能容纳多少订单,与实际能获得多少订单,是不同的问题。
- 其 2000 年年报披露,配送中心当时的业务量低于原设计容量的 40%;
- 订单量也低于实现盈利所需的水平;
- 2001 年 7 月申请破产。
课堂从中提炼的教训是:如果需求密度没有得到验证,庞大的仓配系统会把一次判断错误变得昂贵。 这个结论是对案例的工程分析,不能简化成"某一种技术架构导致了全部失败"。
Quibi:独立产品的需求假设
Quibi 则尝试为移动设备提供精品短视频。它在 2020 年的告别信中宣布结束业务,并提出两种可能原因:
- 想法本身不足以支撑独立流媒体服务;
- 或者推出时机不合适。
这是管理层的回顾和解释,并不是对失败原因的实验鉴定。但它很适合提醒我们:有内容、有技术、有产品形态,并不等于用户需要这样一个独立服务。
Agent 让实现更便宜,却不会使这些问题消失。 一个好想法可以迅速生成许多页面、文档和功能,也可能逐步"slop 化":看起来越来越像成品,重复、冗余和未经验证的假设却越来越多。局部测试不断通过,真实用户仍然可能不愿意用;代码越写越多,原先需要检验的关键假设反而被埋住了。
因此,开始做原型与及时重构并不矛盾:
- 原型让我们碰到现实;
- 反馈让我们知道哪里需要改变;
- 重构则把这种认识落实为新的结构。
如果失败没有改变我们的判断,下一次循环可能只会更快地重复上一次。
实践机会,会变成判断力的差距
(参考时间: 01:30:41)
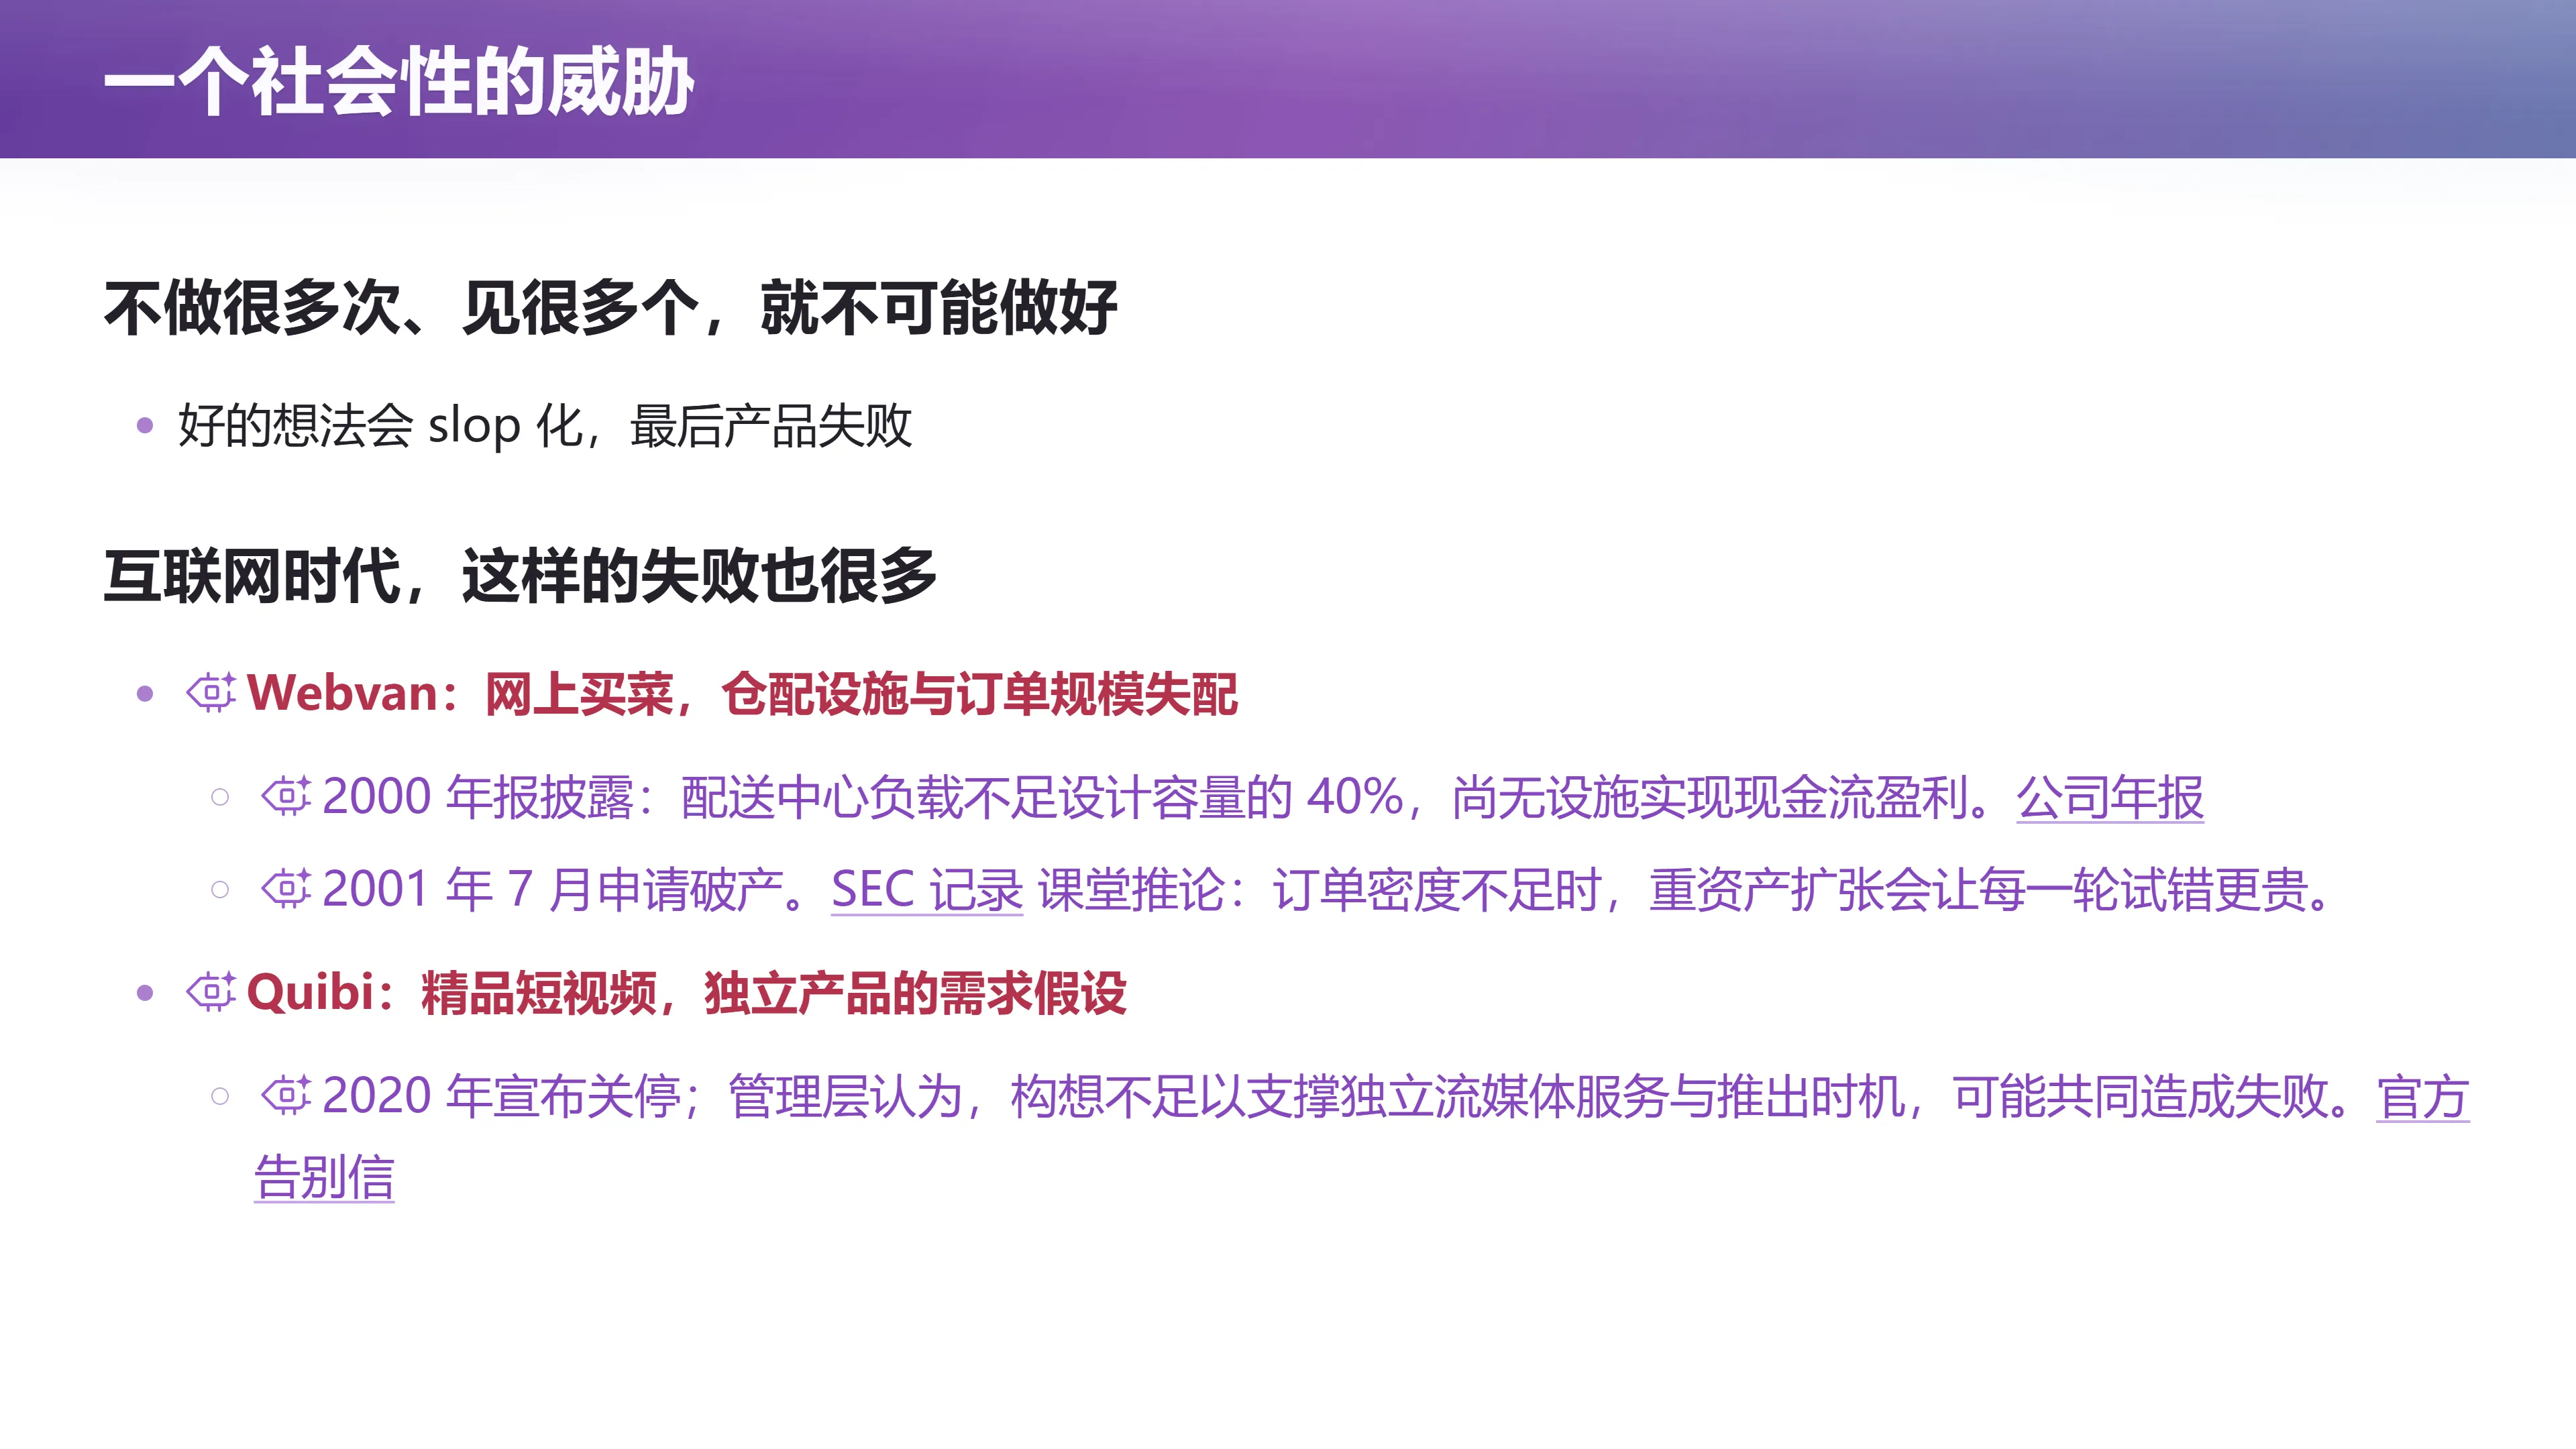
📷 一个社会性的威胁
回到原视频 (01:30:41)
📷 推论
回到原视频 (01:32:20)
这里还有一个社会性的威胁:不做很多次、不见过很多个真实系统,就很难做好。
工程判断来自比较:
- 相似需求为什么有人做得简洁,有人越做越乱?
- 同一个检查为什么在这里有用,在那里只制造噪声?
- 什么时候应该继续局部修补,什么时候必须改变架构?
只有亲手遇到这些问题,经验才不只是几个名词。
在 Agent 开发中,Token 是模型处理和生成内容所消耗的基本计量单位,也代表了一部分实际试错成本。没有足够的 Token 预算,就很难获得同等数量、同等规模的自主开发尝试。
"没有 Token,就没有做很多次尝试的机会。"
这强调的是这种实践资源的门槛;它不是说花钱越多就一定学得越好。
资源还必须和学习动机、学习能力结合:
- 愿不愿意追问一次失败?
- 能不能读懂别人的设计?
- 会不会把观察变成下一轮可验证的改进?
只是让 Agent 不停输出,并不会自动积累工程能力。相反,能理解反馈的人,会把一次尝试留下的经验组织起来,使后面的尝试更有价值。
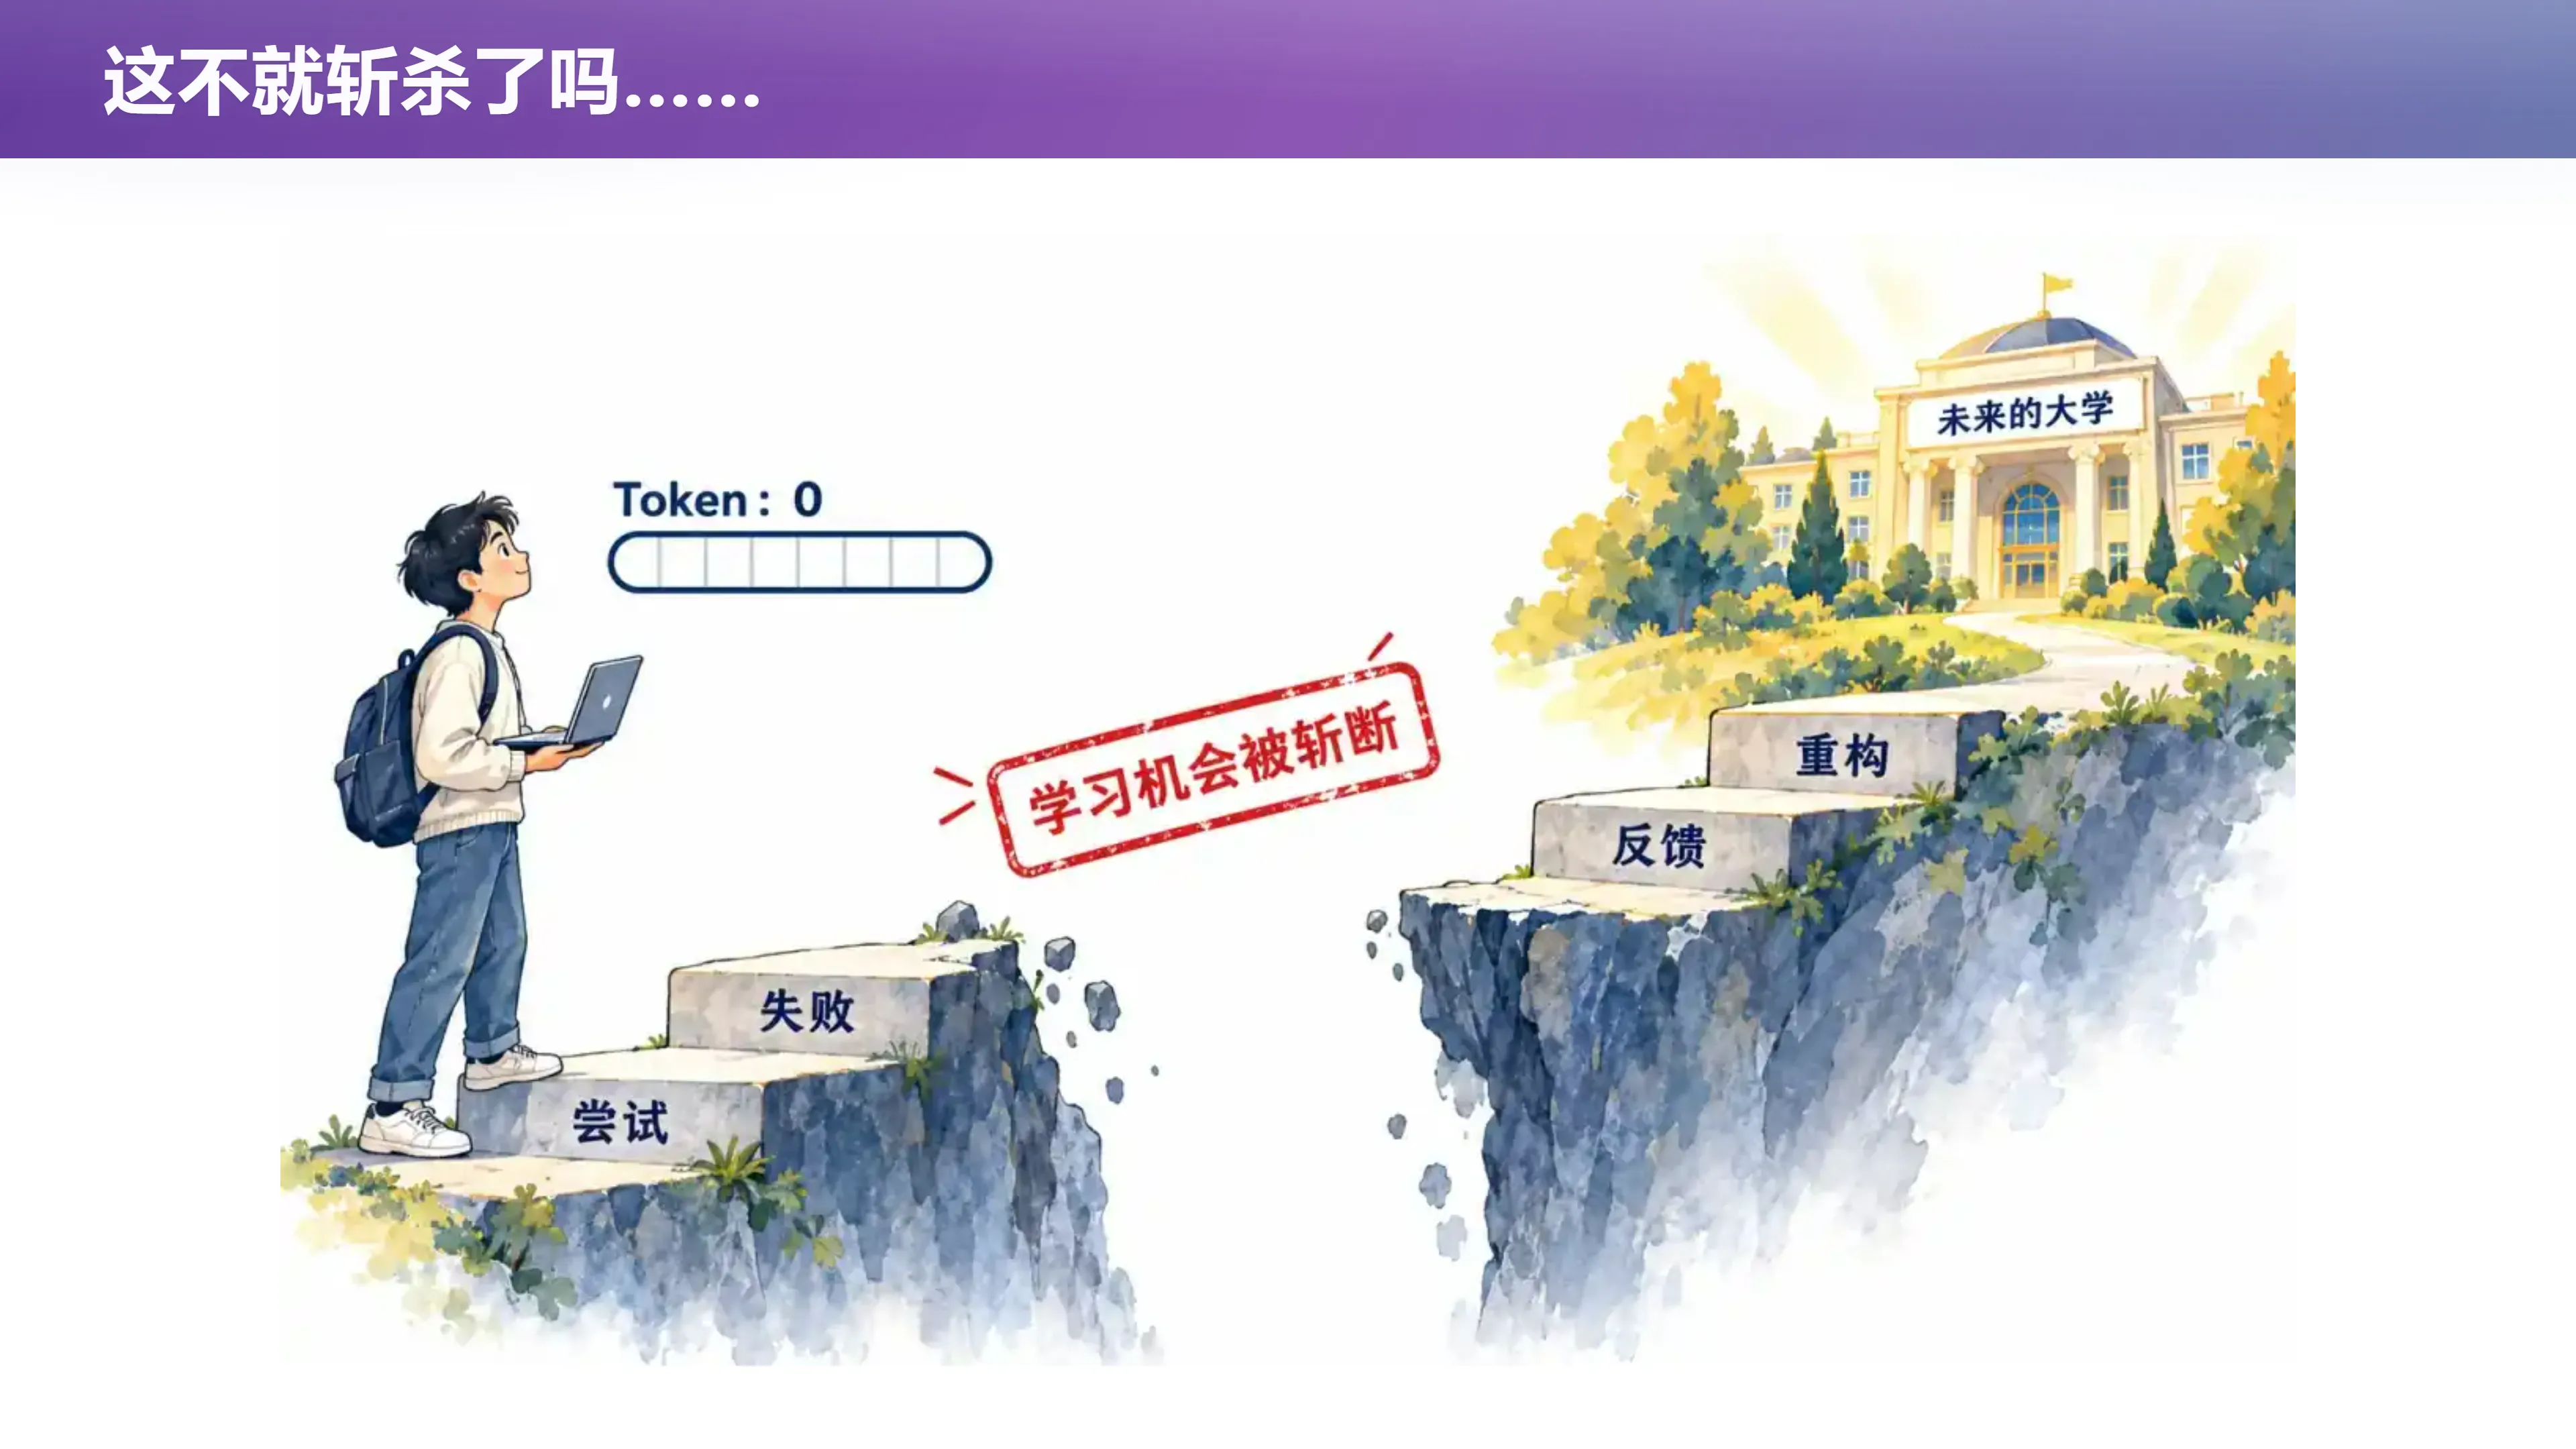
📷 这不就斩杀了吗……
回到原视频 (01:35:15)
"这不就斩杀了吗……"
背后是对教育过渡期的担忧:新的软件生产方式已经出现,让更多人获得高质量实践机会的教育组织却未必及时跟上。实践机会的差距可能积累成判断力的差距,在新的大学形态成熟之前,一代学习者可能先被挡在门外。
这是本讲提出的风险判断,不是已经注定的未来。
编者拓展|"斩杀线"这个词的来历:讲师在课堂上把它当作一个社会学的比喻——当资本/机构为追求效率,宁可给资深工程师无上限的 Token、也不愿长期培养新人,那"本科毕业时你还没有一个 $20 的 Claude Pro 的价值",这句调侃背后是一道真实的选人门槛。这个比喻来自游戏圈,被借用来说明它并非"技术上的必然",而是组织与资源分配结构造成的现实。
这也把课程的任务推到了更具体的位置:除了讲方法,还要让学生有机会运行系统、观察失败、理解好的设计,并真正完成几轮有反馈的修改。
我们想培养的,是知道怎样让下一次尝试比上一次更有价值的人。
编者说明:本讲结尾处,讲师还说了很诚挚的一段话——"我自己的这一切都是开源社区给的。如果我不在开源社区里面看到那些好的东西,我就不会有今天的理解,也不会有今天我来上这个课。" 他建议同学回去在互联网上找一找那些真正优秀的项目,并从 Deepseek Harness 开始看起。
附:参考与延伸阅读
以下讲义原文链接来自课程官方讲义(注明了出处文件);编者补充是撰写本书时另加的,不与讲义混淆。
讲义原文链接
- AlphaZero
lab2.md - Humanize: Judgement Engineering for Agentic Coding
lab2.md - 2000 年年报
lect8.html - 2000 年的 CI 文章
lect8.html - 2006 年的复盘
lect8.html - 2020 年的告别信
lect8.html - C 编译器实验
lect8.html - Digital Twin Universe
lect8.html - GitHub 分支保护文档
lect8.html - Harness engineering 文章
lect8.html - Huntley 对 Ralph 的介绍
lect8.html - Minions 的工程介绍
lect8.html - StrongDM 的工程自述
lect8.html - Yanyan's wiki
lect8.html - 两种 CD 的说明
lect8.html - Creative Commons License: BY-NC 4.0
lect8.notes.md - 苏 ICP 备 2020049101 号
lect8.notes.md
编者补充
- AutoGPT
- Bilibili · BV11LWw6VEHW
- ChatGPT
- Chrome DevTools
- Claude Code
- Deepseek Harness
- GitHub
- Grok
- Jujutsu
附录:课堂未展示的幻灯片
🖼️ 第 10 页幻灯片 · 简单的机制,琐碎的业务规则
🖼️ 第 11 页幻灯片 · 把 CI/CD 写成 Spec
🖼️ 第 13 页幻灯片 · (无标题)