第2讲 · 手把手入门语言建模:从零构建 makemore(bigram 篇)
本电子书由教学视频重构而成。 视频原标题:The spelled-out intro to language modeling: building makemore 书中代码、数据集与图片版权归原作者 Andrej Karpathy 所有。本文为课堂讲解的中文书面重构,仅供学习交流。 书中代码、数据集与图片版权归原作者 Andrej Karpathy 所有。本文为课堂讲解的中文书面重构,仅供学习交流。
| 讲师 | Andrej Karpathy |
| 视频地址 | https://www.youtube.com/watch?v=PaCmpygFfXo |
| 所属课程 | Neural Networks: Zero to Hero — https://karpathy.ai/zero-to-hero.html |
| 官方代码仓库 | https://github.com/karpathy/makemore |
| 本讲配套 Notebook | makemore_part1_bigrams.ipynb;数据集 names.txt |
| 讨论 | Neural Networks: Zero to Hero 官方 Discord —— https://discord.gg/3zy8kqD9Cp |
| 官方推荐的练习材料 | CS231n 的 Python + NumPy 教程(本讲用 torch.tensor 代替 numpy.array,两者设计几乎相同,练一个 ≈ 练另一个,只是函数名与参数等细节有差别)、PyTorch 官方 Tensor 教程、另一份 Tensor 入门 |
| E01 | 训练一个 trigram 语言模型(用两个字符预测第三个)。计数或神经网络都行。评估损失——比 bigram 好多少? |
| E02 | 把数据集随机切成 80% 训练 / 10% dev / 10% 测试,只用训练集训 bigram 与 trigram,在 dev 与测试集上评估。你看到了什么? |
| E03 | 用 dev 集调平滑(或正则化)的强度——试很多取值,看哪个在 dev 上最好。强度变化时,train 与 dev 的损失各呈现什么规律?取最好的设置,最后只在测试集上评估一次。 你能拿到多好的损失? |
| E04 | 我们已经看到 one-hot 向量只是在「选 W 的某一行」,那么显式造出这些向量是浪费的。能否删掉 F.one_hot,改成直接按行索引? |
| E05 | 查文档并使用 F.cross_entropy,结果应当一样。想一想:为什么我们更愿意用 F.cross_entropy? |
| E06 | 元练习!自己想一道有趣/好玩的题,然后做完它。 |
对应讲次:第2讲(Karpathy: Neural Networks — Zero to Hero)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者拓展|📝 本讲的官方练习(Exercises):Karpathy 在这一讲的描述里给了 6 道题,强烈建议动手——它们把「计数模型」和「神经网络模型」两条线都练到了。
写在前面:makemore 是什么
(参考时间: 00:00)
和之前的 micrograd 一样,makemore 是讲师放在 GitHub 上的一个教学项目。它做的事情可以用名字概括:你给它一批东西,它学会生成更多"像那样"的东西。
本讲使用的示例数据集是 names.txt——一份大约 32,000 个英文人名的清单,讲师说这些名字是他从某个政府网站上随机找来的。如果把 makemore 训练在这份数据上,它就能生成听起来像名字、但实际上并不存在的新名字,比如 dontell、irot、zendy 这样的字符串。如果你正打算给孩子取名、又想要一个既好听又不重名的选项,makemore 说不定能帮上忙。
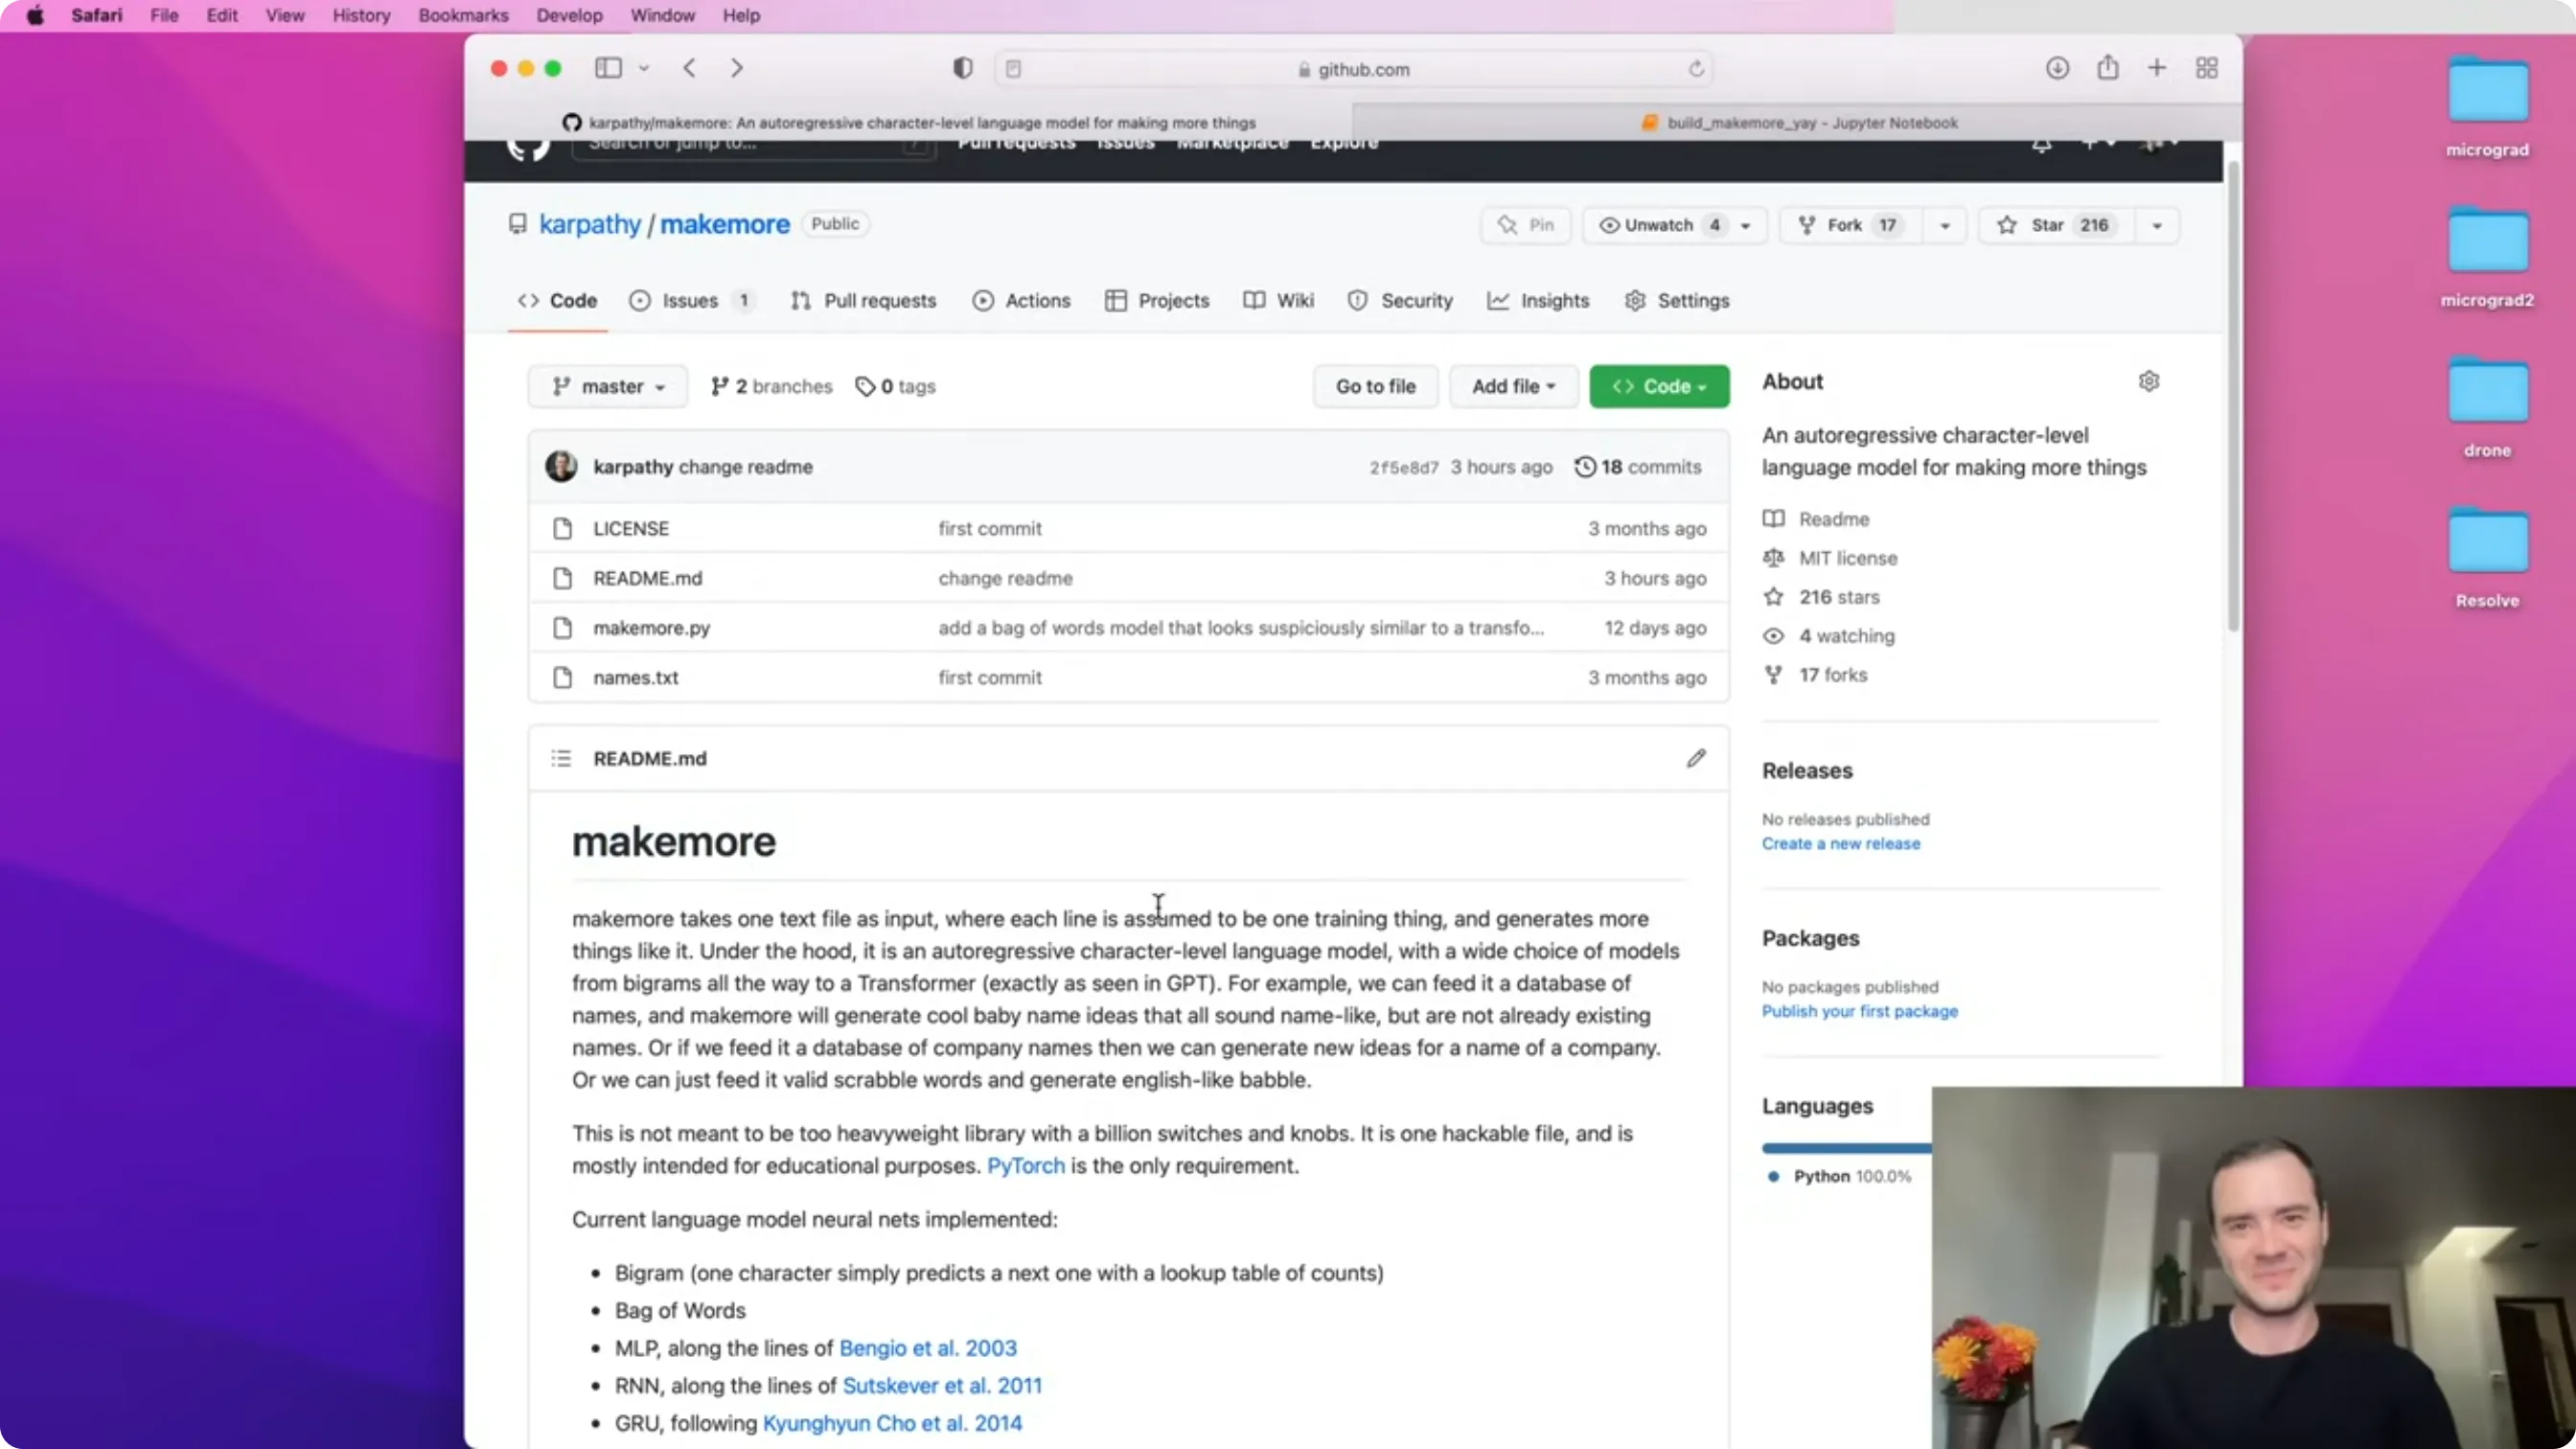
📷 makemore 的示例数据与生成出的新名字
回到原视频 (00:00:27)
编者拓展|makemore 是什么,以及它在整个系列里的位置:
makemore就是把 make more 连在一起写——给一批样本,学会生成「更多像那样」的样本。这一讲是 Zero to Hero 系列的第二站(第一站是
micrograd),也是后面几讲的共同基座:bigram → MLP → BatchNorm → 手写反向传播 → WaveNet → GPT。 👉 它还是全系列里唯一「不用神经网络也能做」的一讲:先用数数(Python 字典 / 二维张量)做一个能跑的语言模型,再把它从零重写成神经网络。这种「先朴素、再升级」的对照,是本讲最值钱的地方。
从字符级语言模型开始
(参考时间: 01:30)
从底层看,本讲要构建的是一个字符级(character-level)语言模型。这意味着:
- 数据文件里的每一行是一条例句:
reese就是一个例子; - 每一条例句都被看作一串单个字符:
r、e、e、s、e; - 模型要学习的,是给定一个(或几个)已有的字符,预测序列中的下一个字符。
这一系列视频会用同一套字符级框架,由简到繁地实现多种语言模型:非常简单的 bigram 与 词袋(bag-of-words) 模型、多层感知机(MLP)、循环神经网络(RNN),一直到现代的 Transformer。事实上,课程最终搭出来的 Transformer 在结构上基本等价于 GPT-2。也就是说,学完整个系列,你会在字符这个粒度上真正理解现代语言模型是怎么工作的。
在这一讲里,我们只做最容易上手的那一步:bigram 字符级语言模型。它是后续所有复杂模型的起点,也是理解"语言建模到底在优化什么"的最好入口。
编者拓展|什么叫「语言模型」,什么叫「自回归」:语言模型就是给一段序列估一个概率——「这句话有多可能」。
自回归(autoregressive)是把它拆成小步:用链式法则把整串的联合概率写成
$$P(x_1,\dots,x_T)=\prod_{t=1}^{T}P(x_t\mid x_1,\dots,x_{t-1})$$
也就是「在给定前文的情况下,预测下一个」。
👉 听懂这一句,后面所有讲都是它的实现。 本讲的 bigram 是它最弱的版本(只看前 1 个字符)。
一、准备数据集:加载并探索 names.txt
(参考时间: 03:03)
和之前的视频一样,我们从一张空白的 Jupyter Notebook 开始。第一件事是把数据集 names.txt 读进来。
我们希望把文件读成一个巨大的字符串,然后再把它拆成"一个名字一行"的列表。做法很简单:
words = open('names.txt', 'r').read().splitlines()
open(...).read()把整个文件读成一个超长字符串;splitlines()按换行把它切成一个 Python 字符串列表,列表里每个元素是一个名字。
先看看前 10 个名字:
words[:10]
# ['emma', 'olivia', 'ava', 'isabella', 'sophia', 'charlotte', ...]
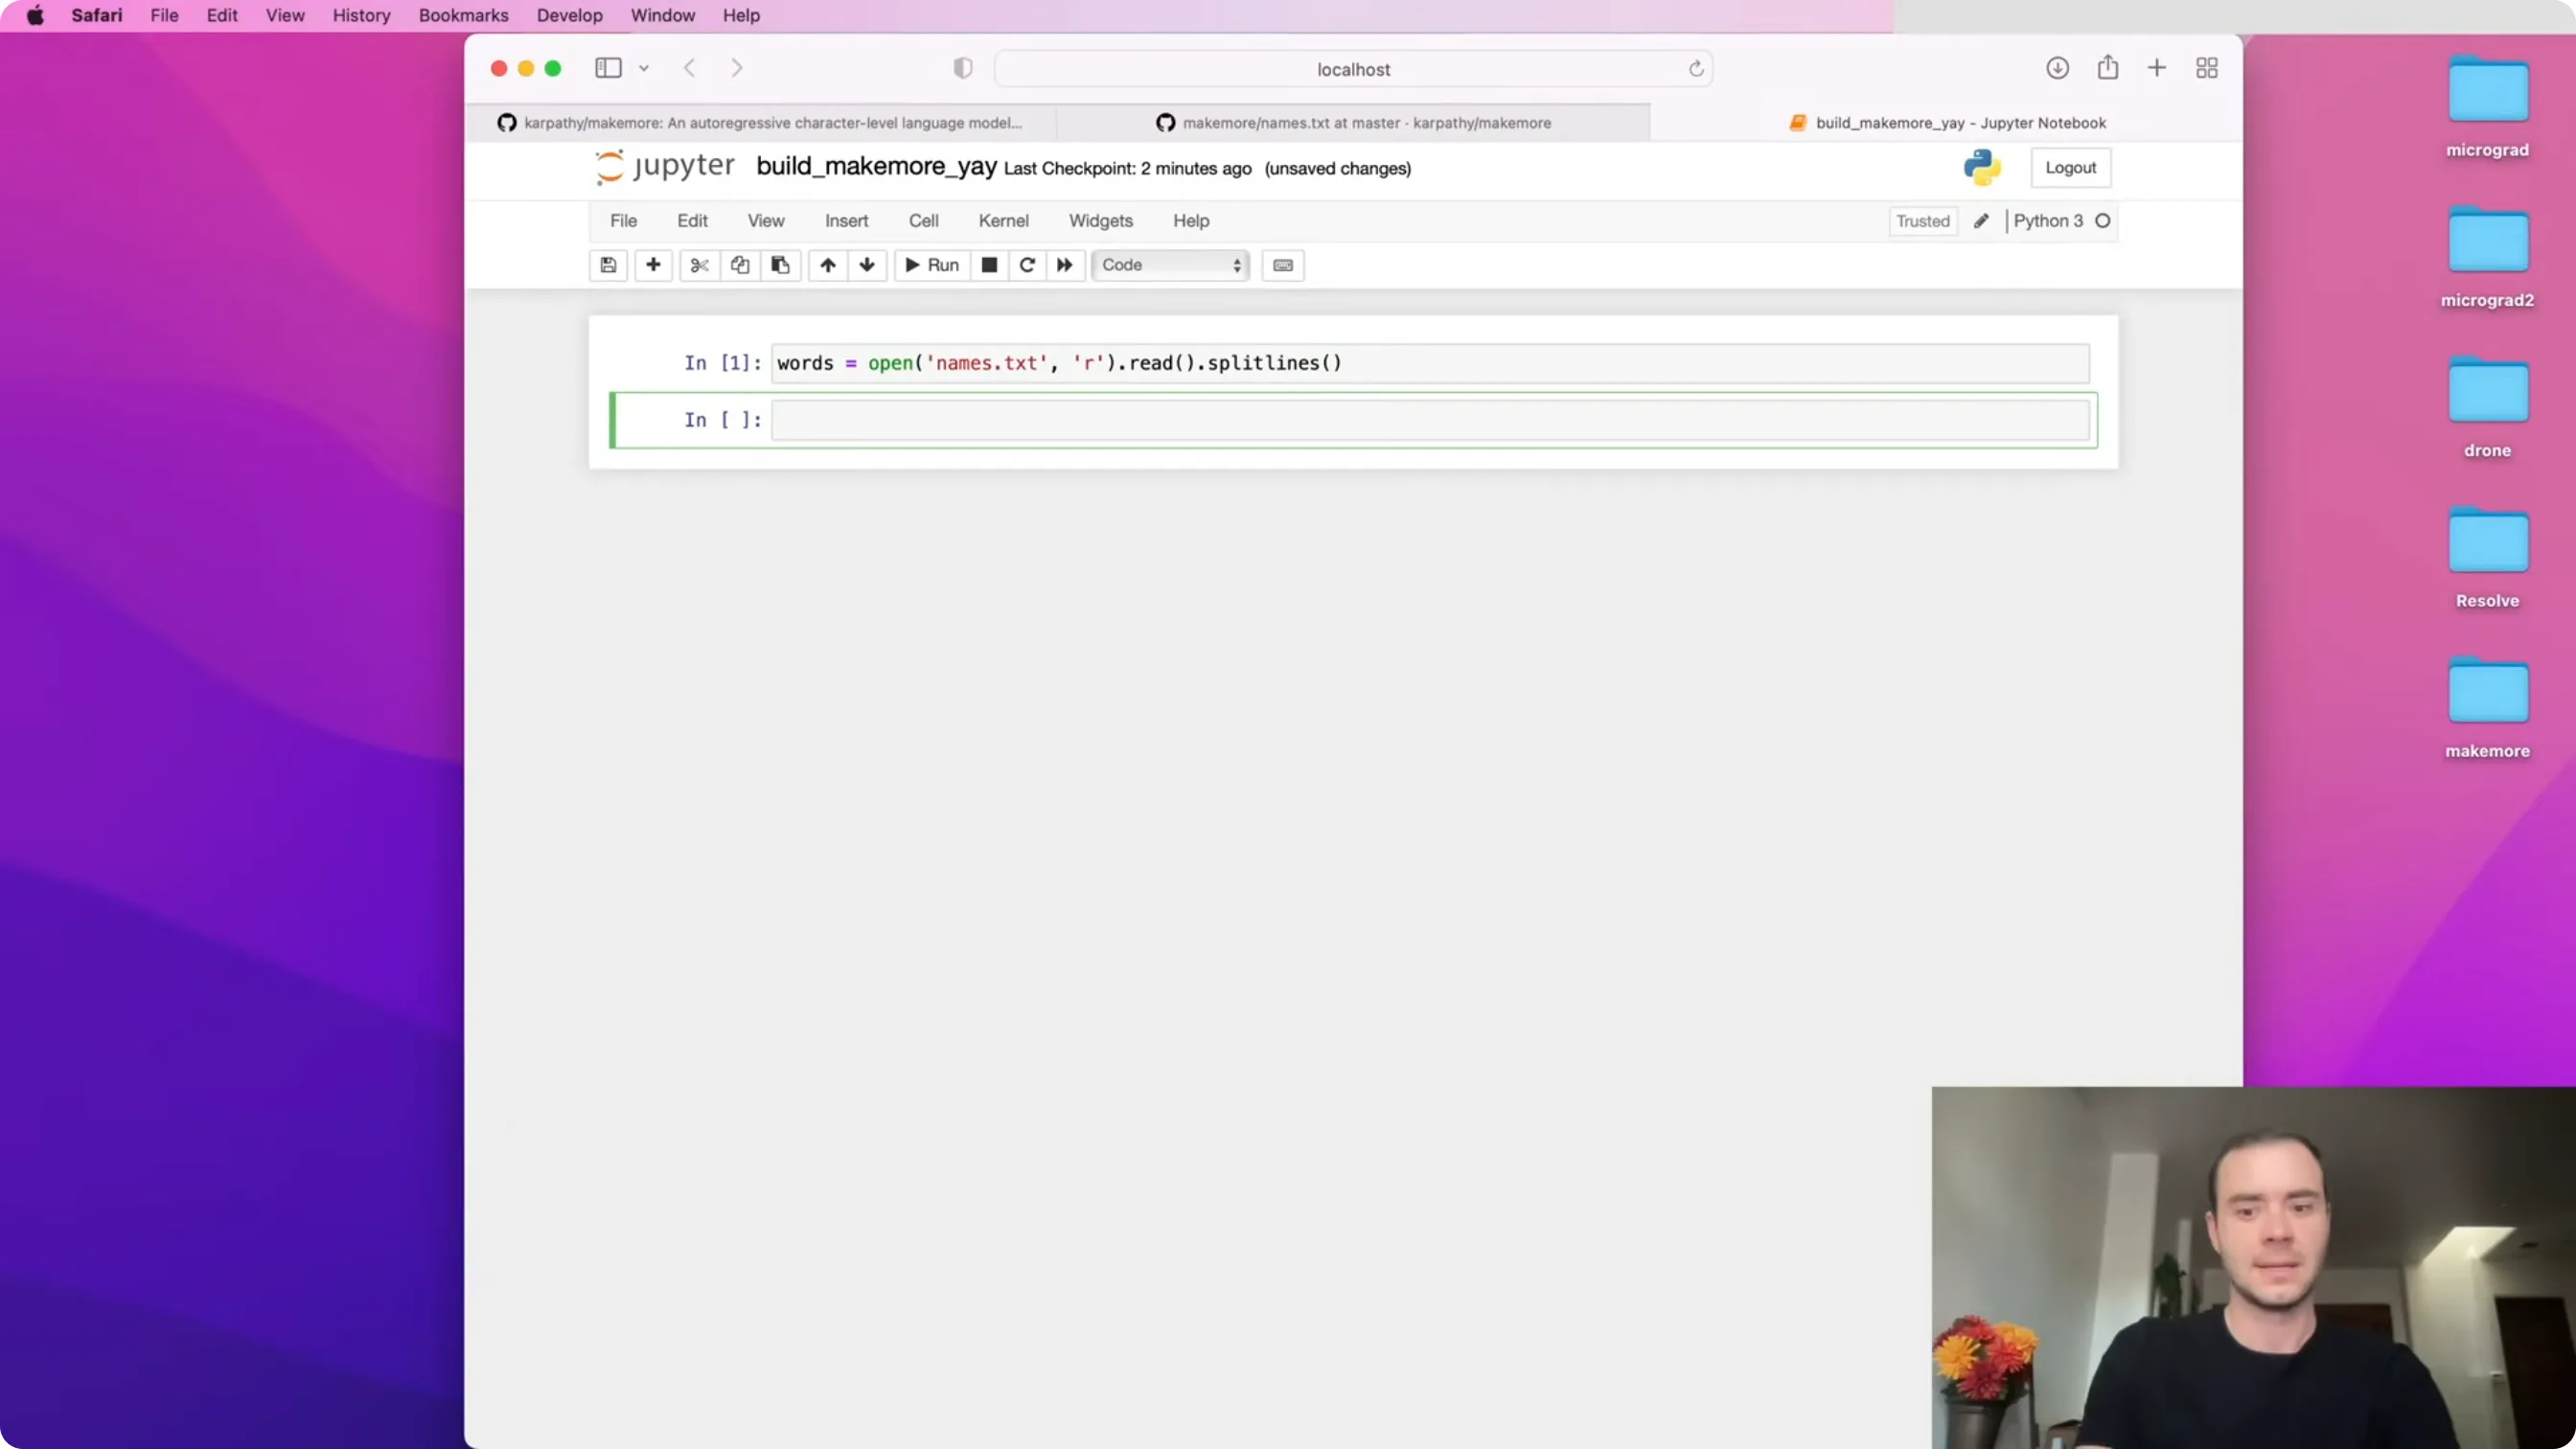
📷 读取数据集并查看前 10 个名字
回到原视频 (00:03:32)
可以看到,列表以 emma、olivia、ava、isabella 这些名字开头——这和文件开头的内容完全对得上。讲师猜测这份数据很可能是按出现频率排序的。
接着了解一些整体统计信息:
len(words)              # 32033
min(len(w) for w in words)   # 2
max(len(w) for w in words)   # 15
- 名字总数约为 32,000;
- 最短的名字长度是 2,最长的名字长度是 15。
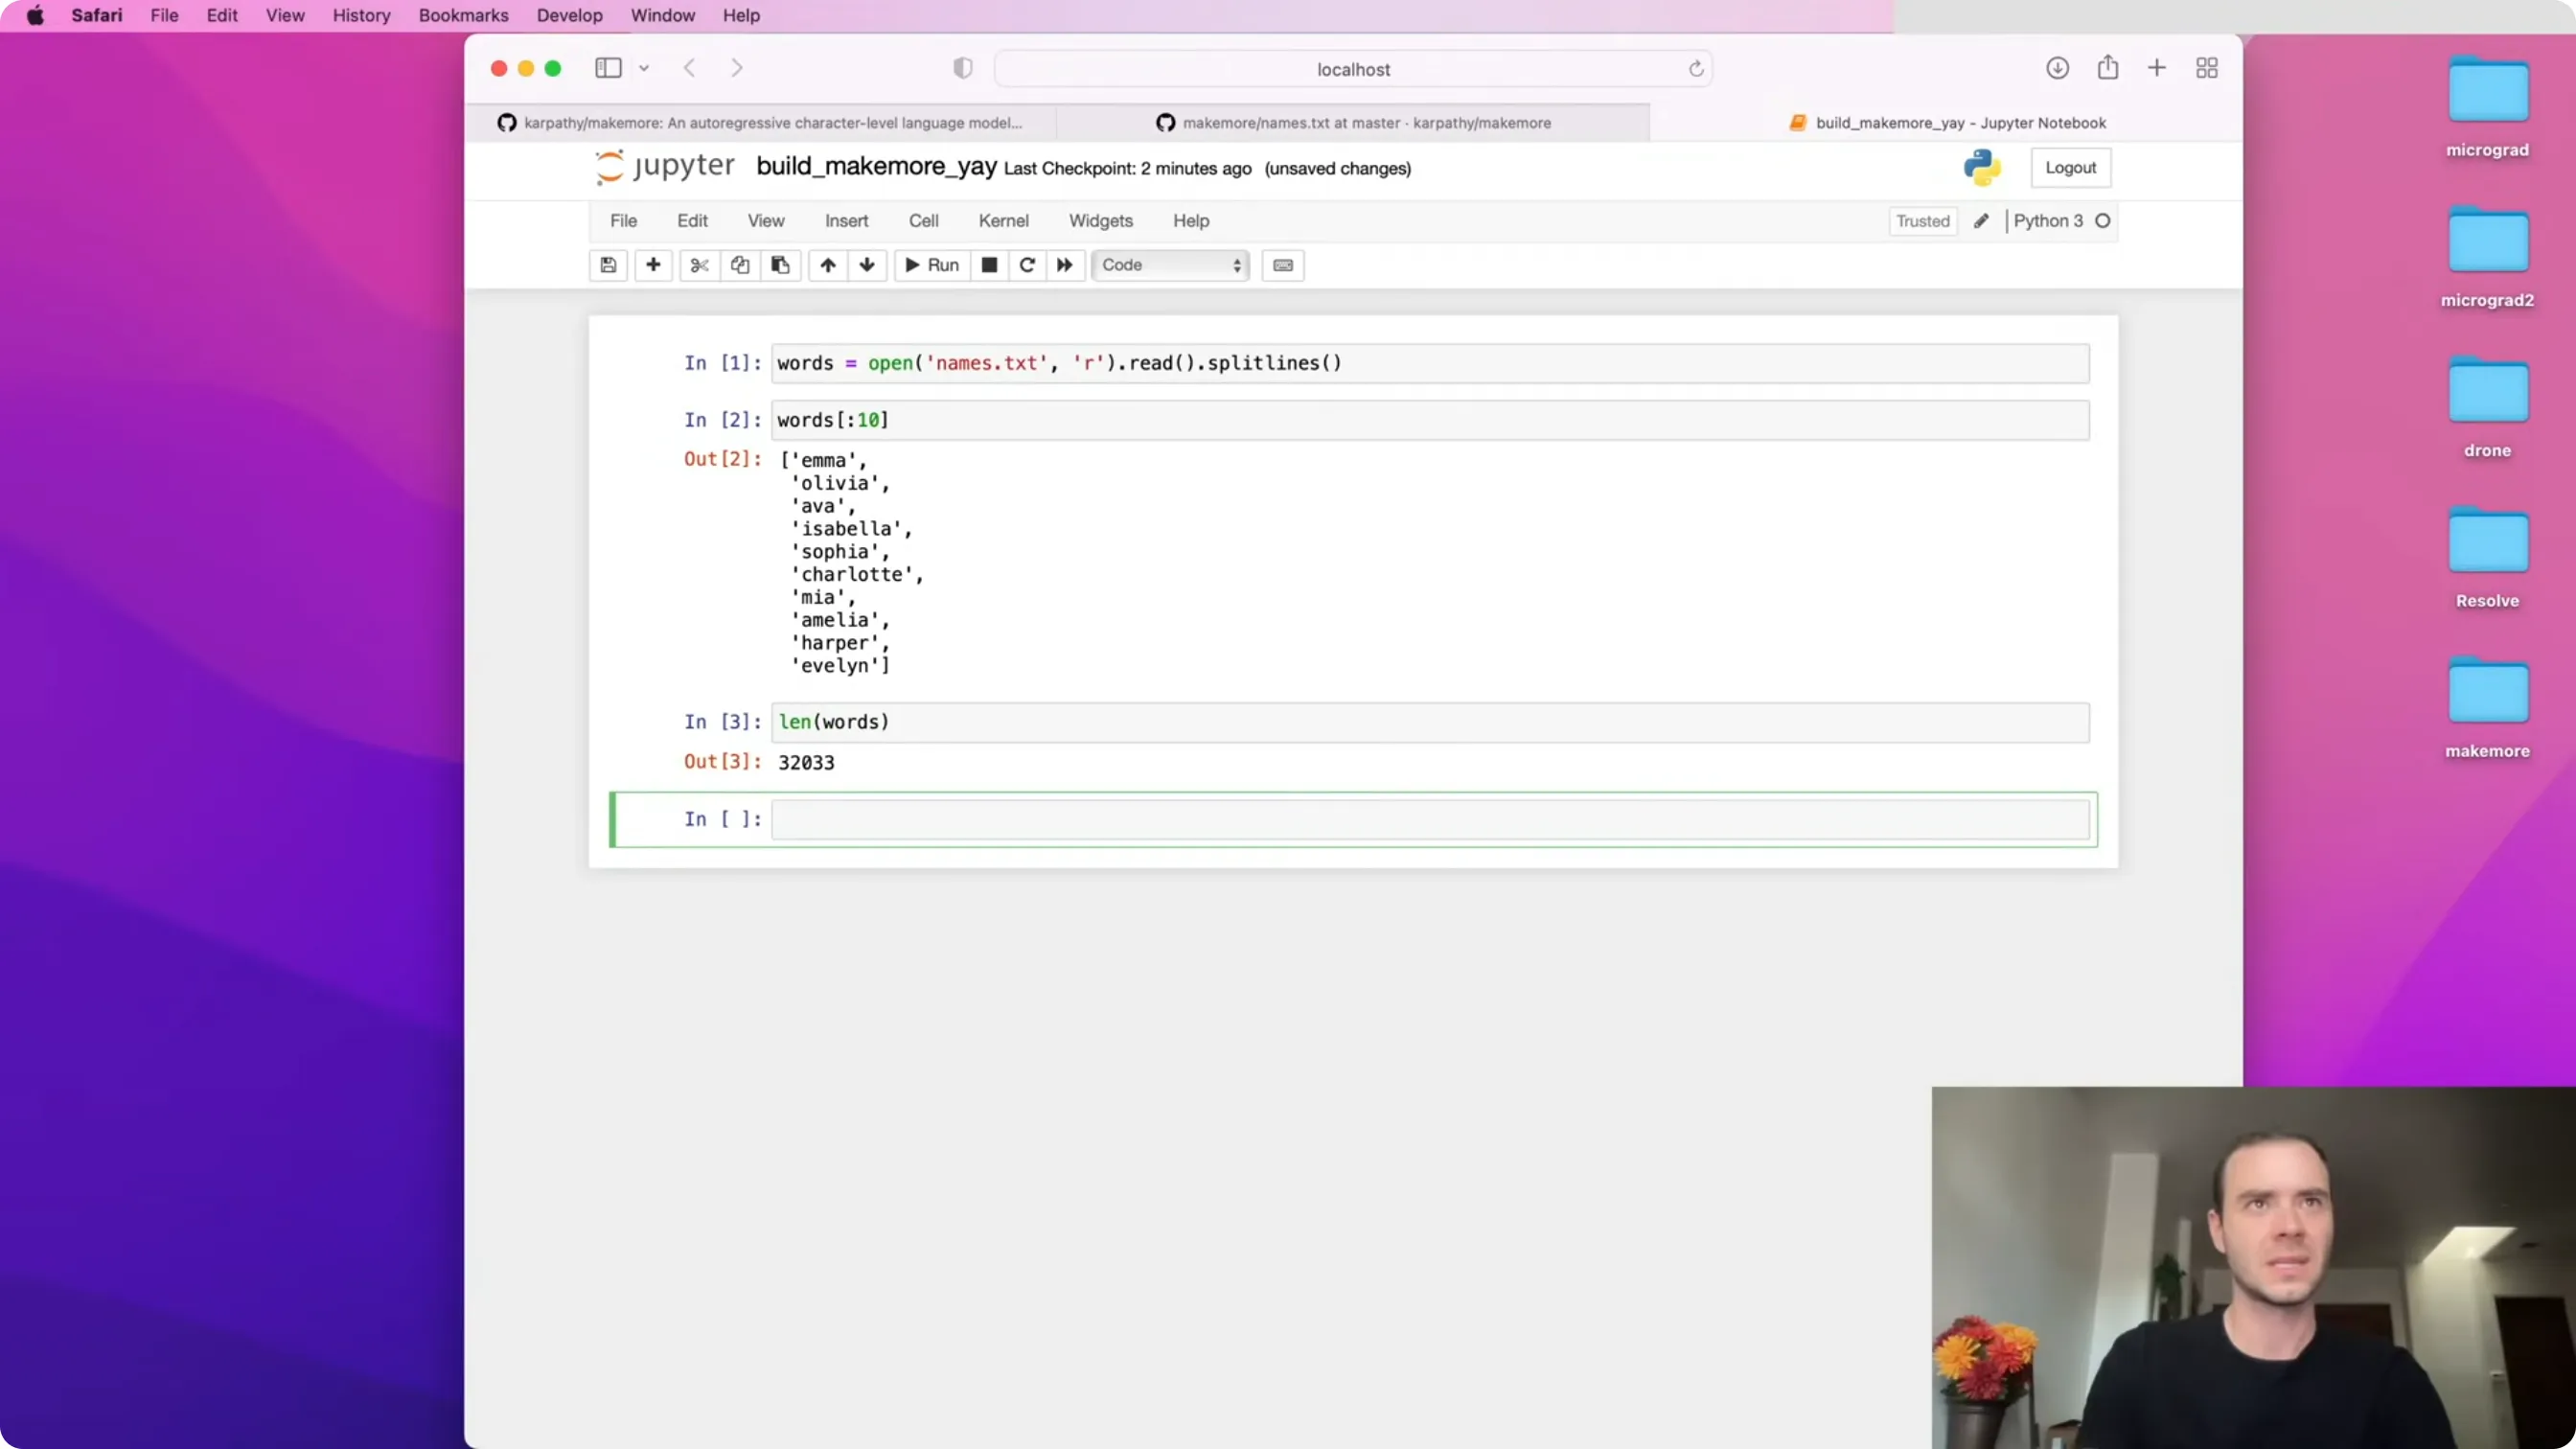
📷 统计名字总数与最短、最长长度
回到原视频 (00:04:06)
有了这些基本信息,就可以开始思考建模了。
二、从单词到 bigram:把一句话拆成很多个训练样本
(参考时间: 04:24)
一个字符级语言模型做的事,是给定前面已经出现的一段字符序列,预测下一个字符。关键在于意识到一件事:
每一个单词,例如
isabella,其实打包(packed)了很多个训练样本。
为什么这么说?isabella 出现在数据里,至少告诉我们这些事实:
- 字符
i非常可能出现在名字的开头; - 字符
s很可能跟在i后面; - 字符
a很可能跟在is后面; - 字符
b很可能跟在isa后面; - …… 一直到
a跟在isabell后面; - 还有一个经常被忽略的信息:
isabella之后,这个词很可能就结束了。
所以一个小小的单词里,其实藏着大量关于"什么字符更可能跟在什么后面"的统计结构。而我们手里有 32,000 个这样的单词,可用来建模的结构非常丰富。
先做一个很弱的模型:bigram
(参考时间: 05:44)
我们从bigram 语言模型开始。所谓 bigram,就是一次只看两个字符:我们只根据"刚刚见过的那个字符"去预测下一个字符,完全不管更早的历史。
- 什么字符容易跟在
r后面? - 什么字符容易跟在
a后面? - ……
这是一个非常简单、非常弱的语言模型,但它是个很好的起点。
编者拓展|bigram 模型的「训练」为什么只是数数:它用的是最大似然估计(MLE)——把频率当成概率:
$$P(\text{下一个}\mid\text{前一个})=\frac{\text{count}(\text{前一个},\text{下一个})}{\text{count}(\text{前一个})}$$
所以这一步没有梯度、没有优化器、没有
backward(),纯粹是统计。 👉 这正好说明:「语言模型」这个概念不依赖神经网络——神经网络只是后面用来换一种更好的参数化方式。
找出数据里的所有 bigram
(参考时间: 06:24)
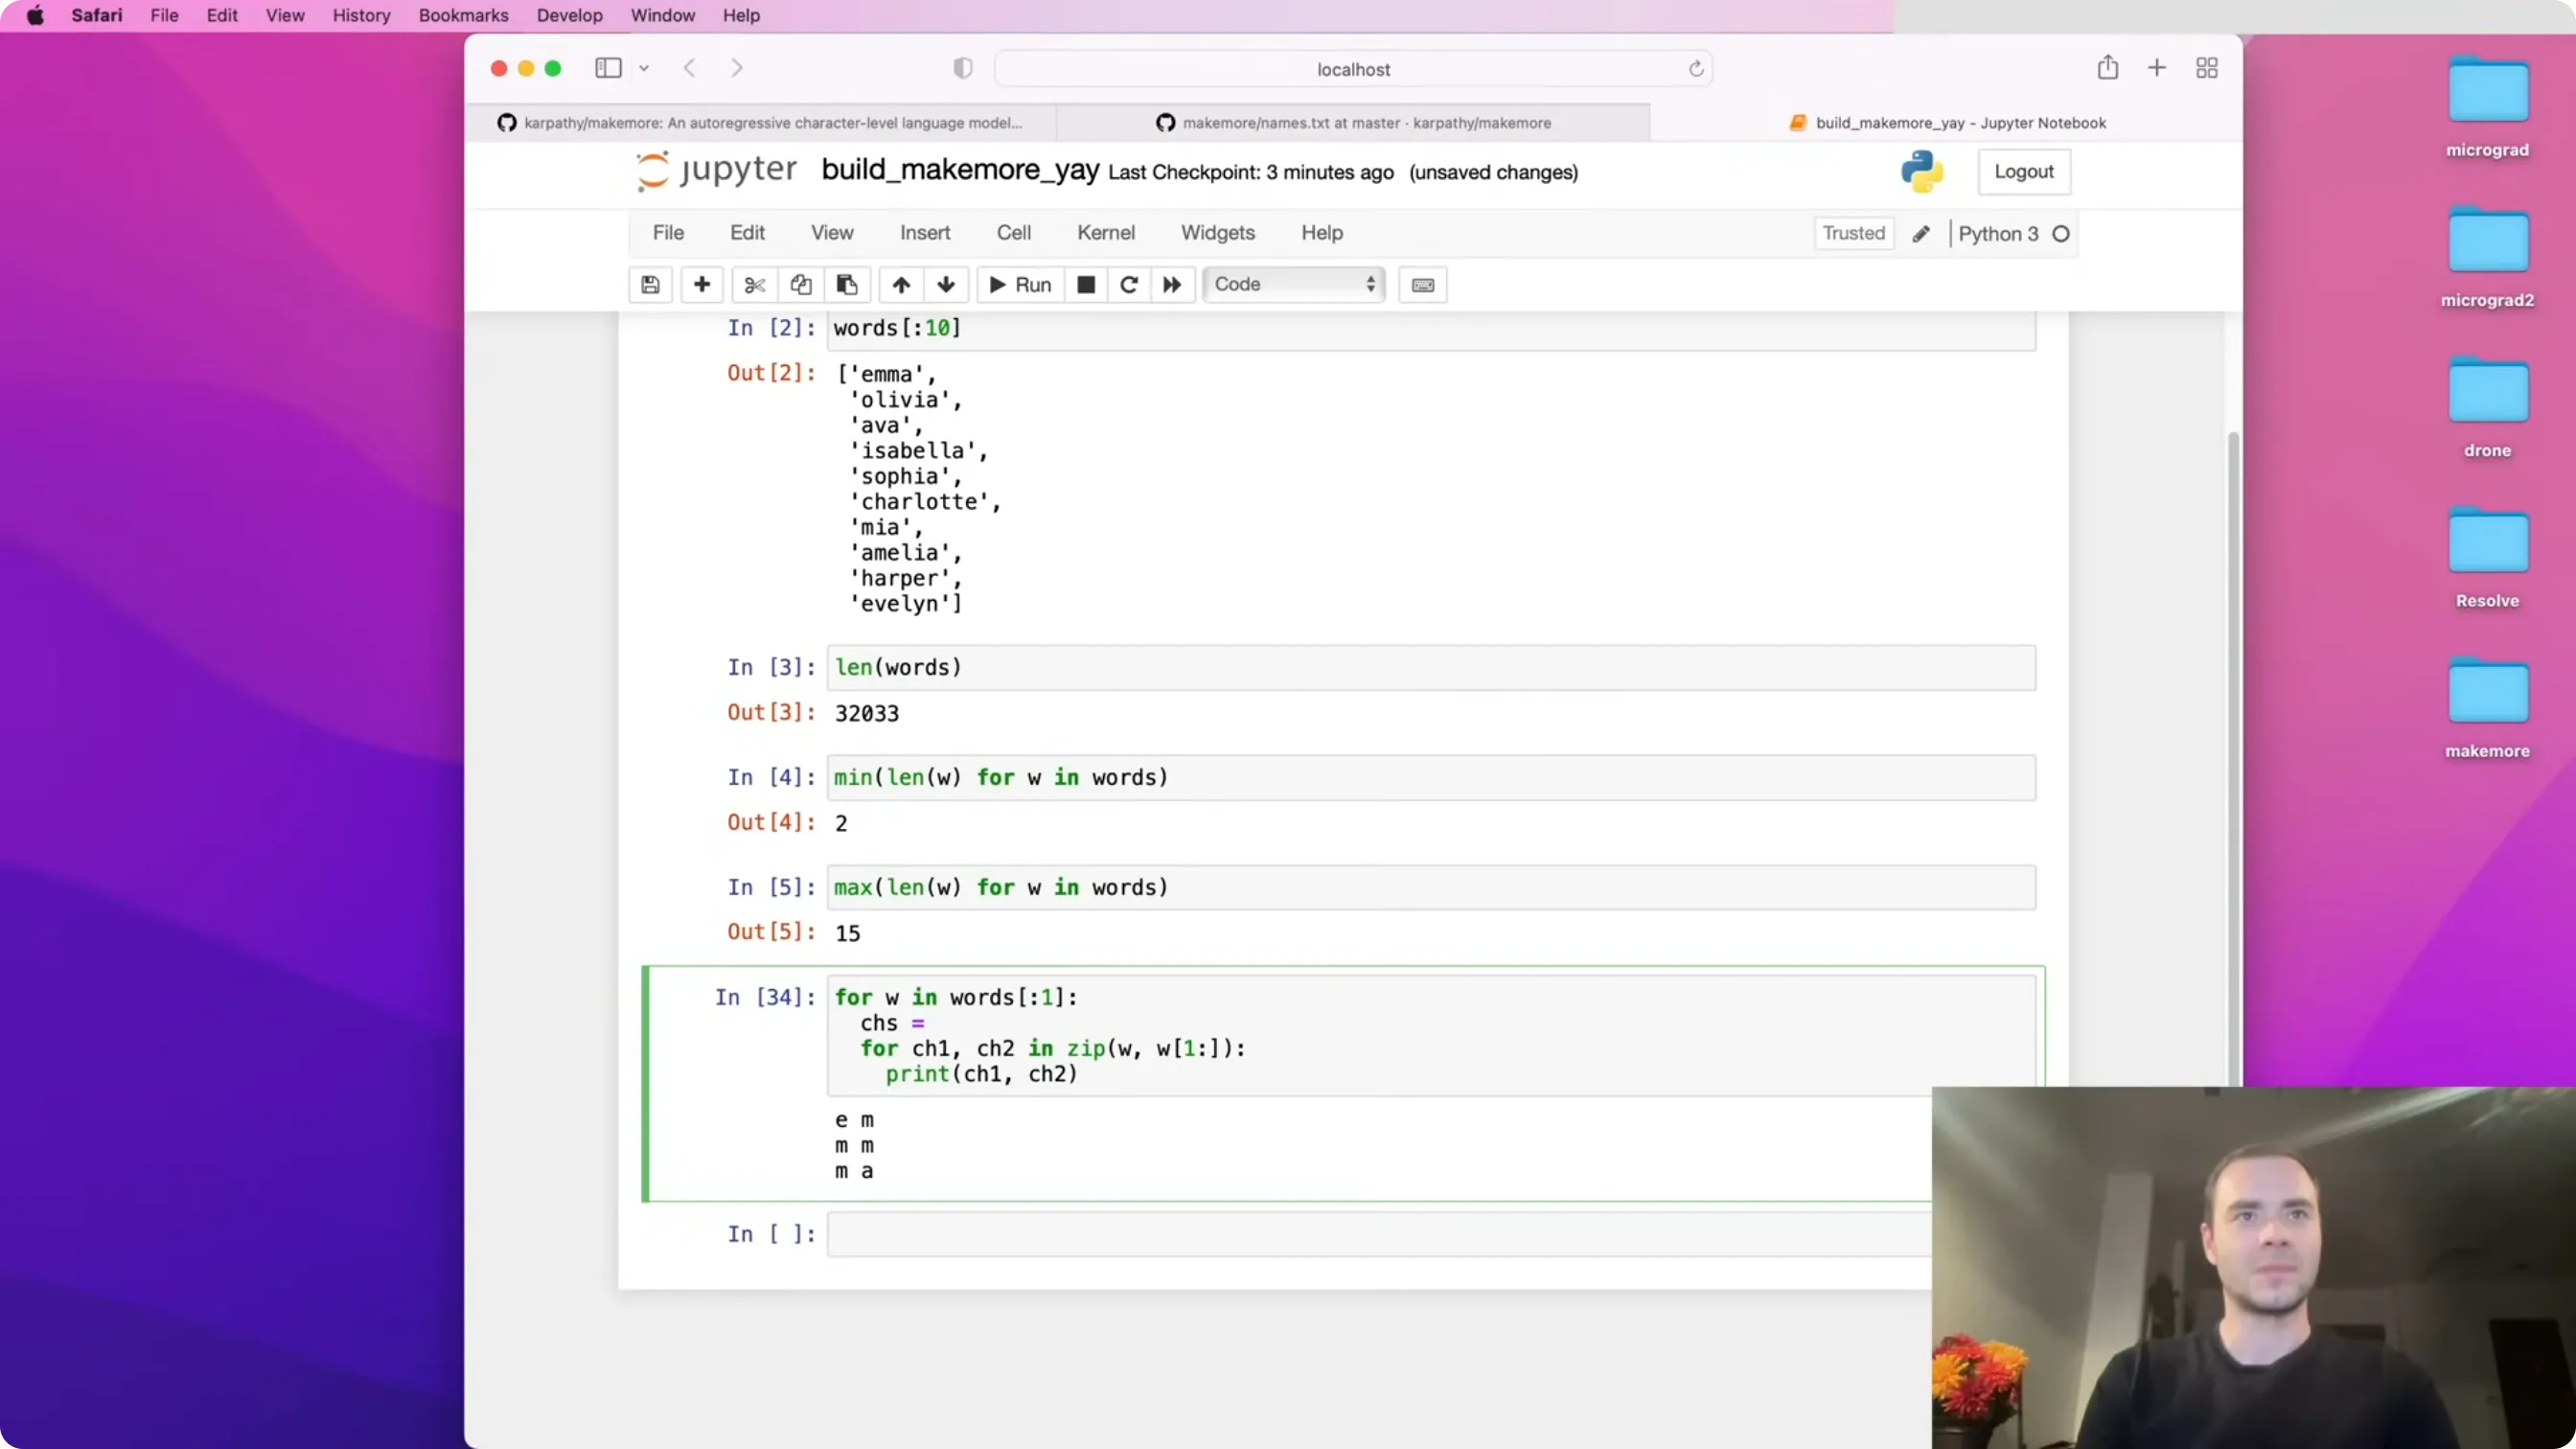
现在先把数据里所有的 bigram(连续两个字符)列出来看看。对每个单词,我们要以"滑动窗口"的方式取出连续的两个字符。Python 里有一个很巧妙的写法:
for w in words[:3]:
    for ch1, ch2 in zip(w, w[1:]):
        print(ch1, ch2)
这里用到了 zip 的一个小技巧:
w是字符串,例如emma;w[1:]是把w向右错开一位得到的字符串mma;zip(a, b)会把两个可迭代对象两两配对,产生(e,m)、(m,m)、(m,a);- 当其中一个迭代器先用完时,
zip就自动停止——所以不会越界。
对 emma 运行这段代码,会打印出 EM、MM、MA。
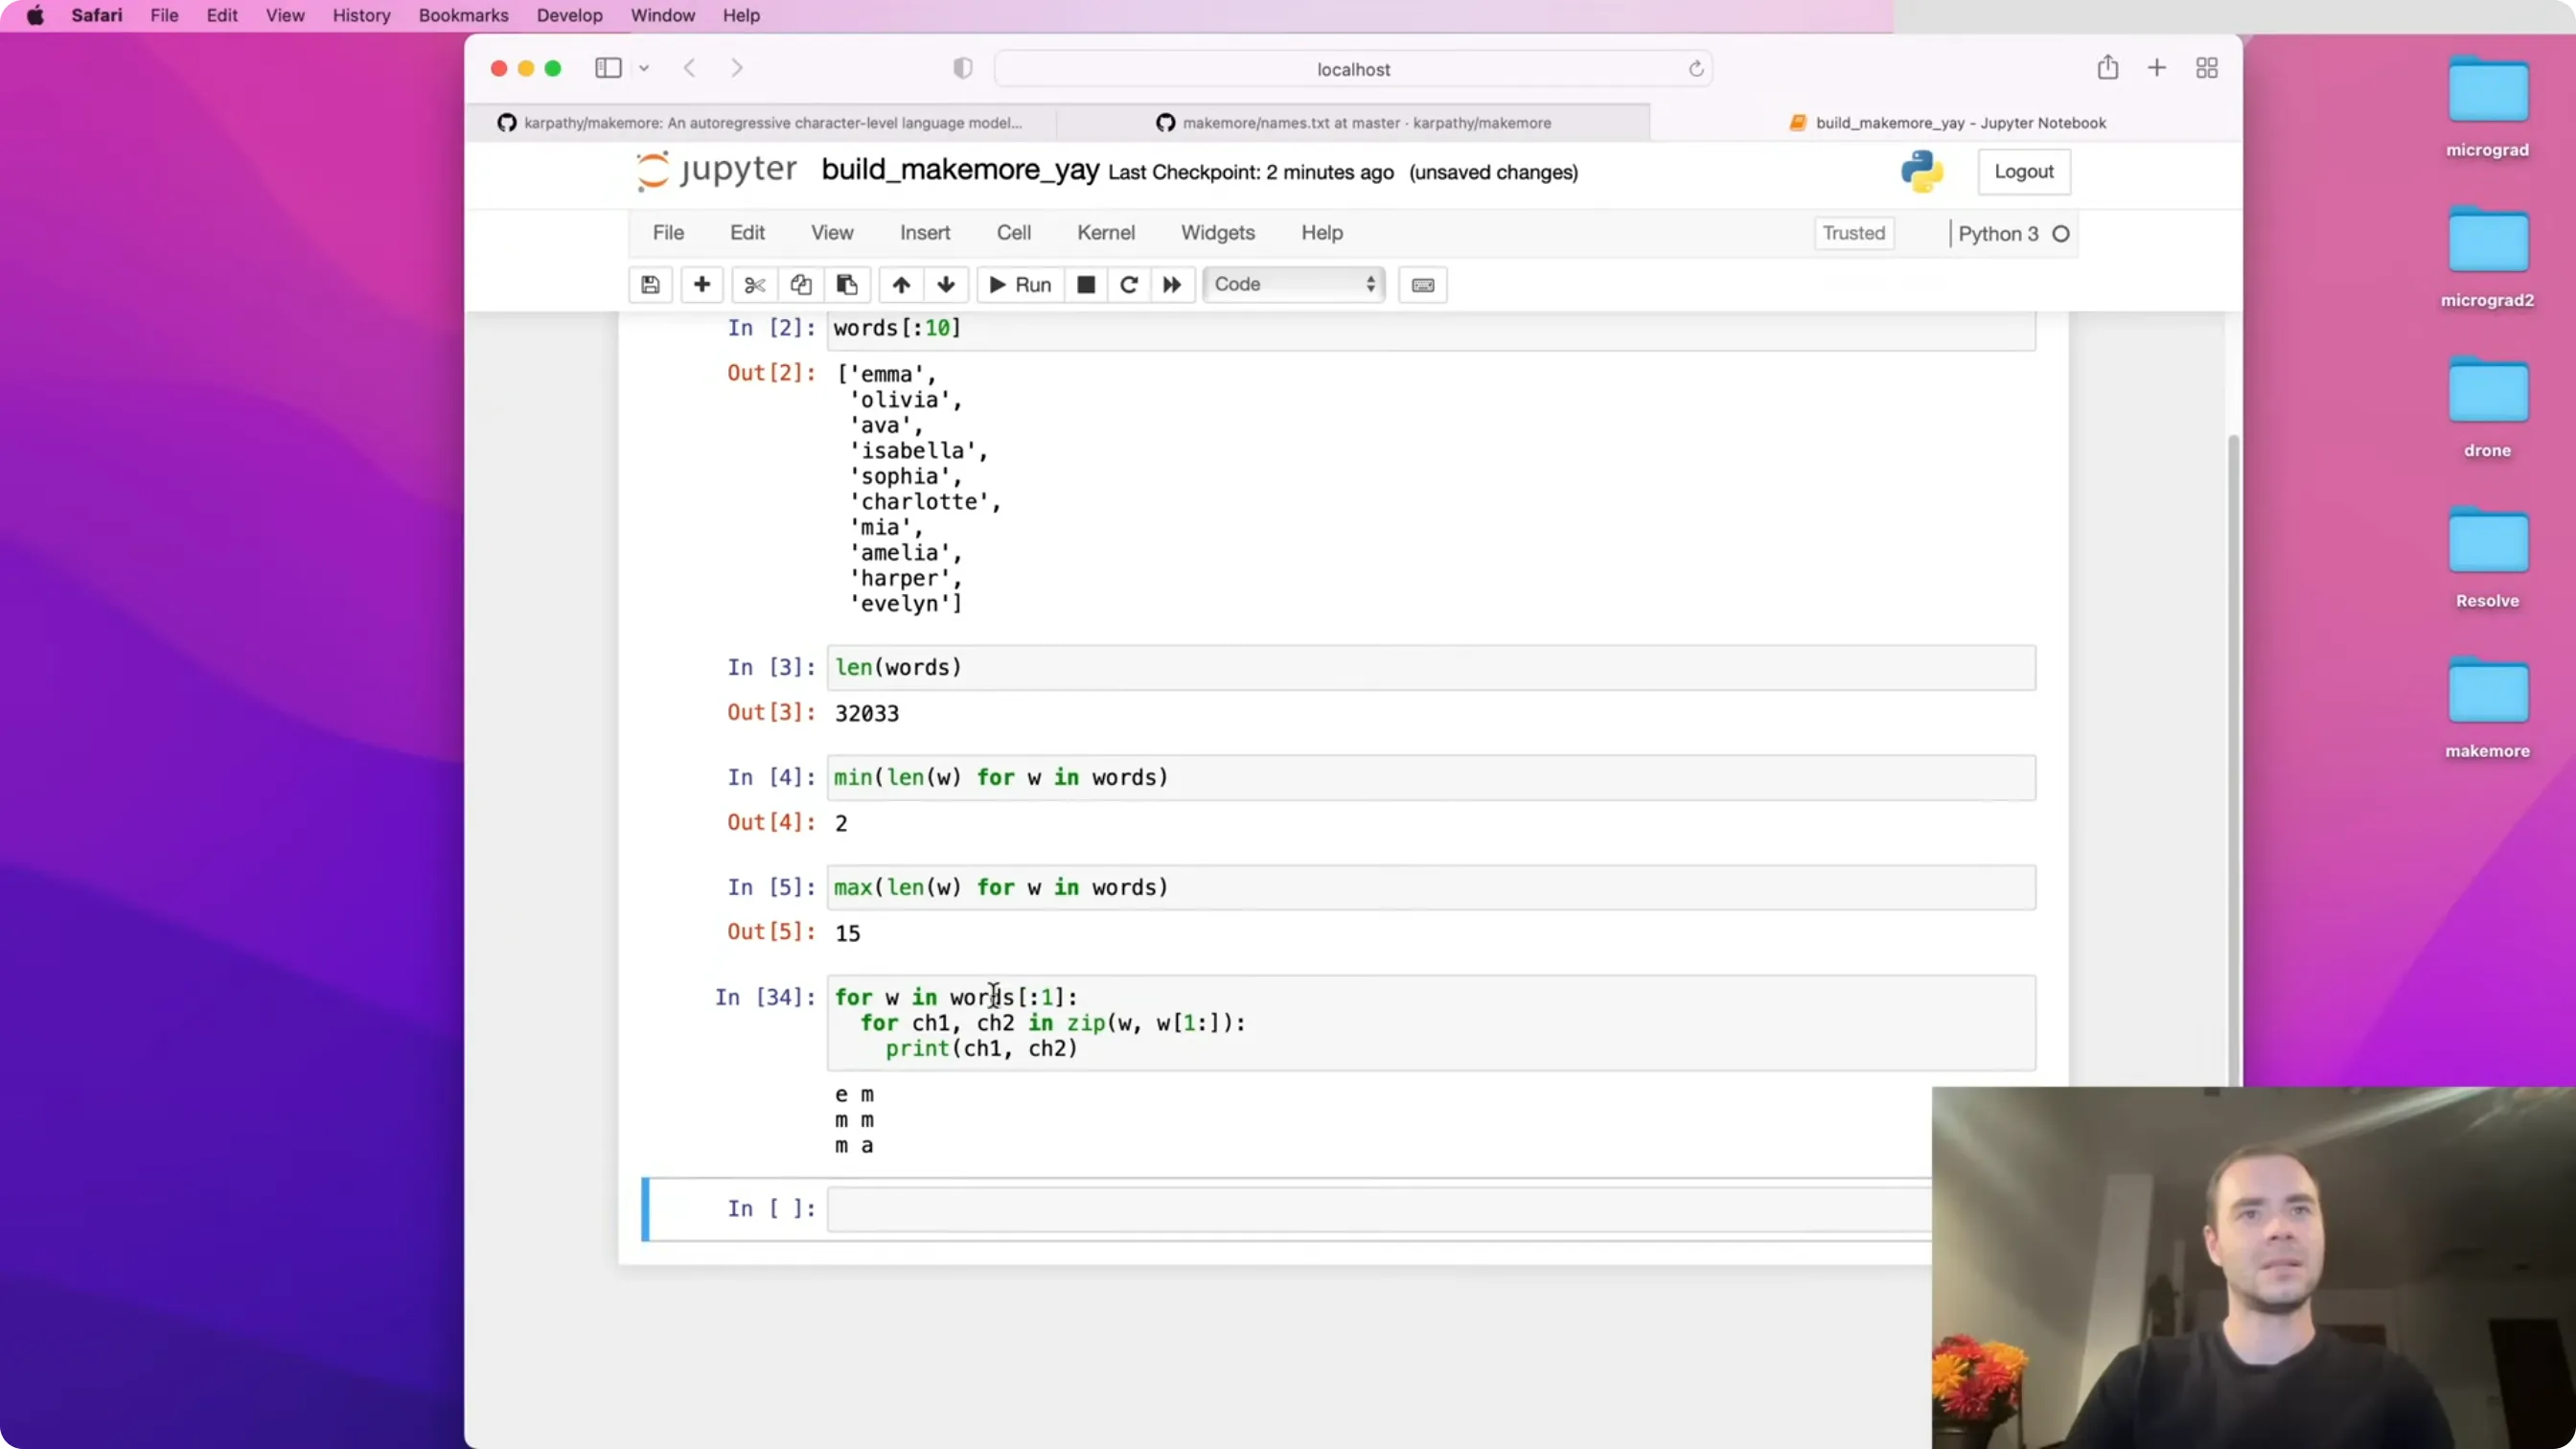
📷 用 zip 滑动窗口打印一个单词内的所有 bigram
回到原视频 (00:07:15)
补上"开头"和"结尾"
(参考时间: 08:03)
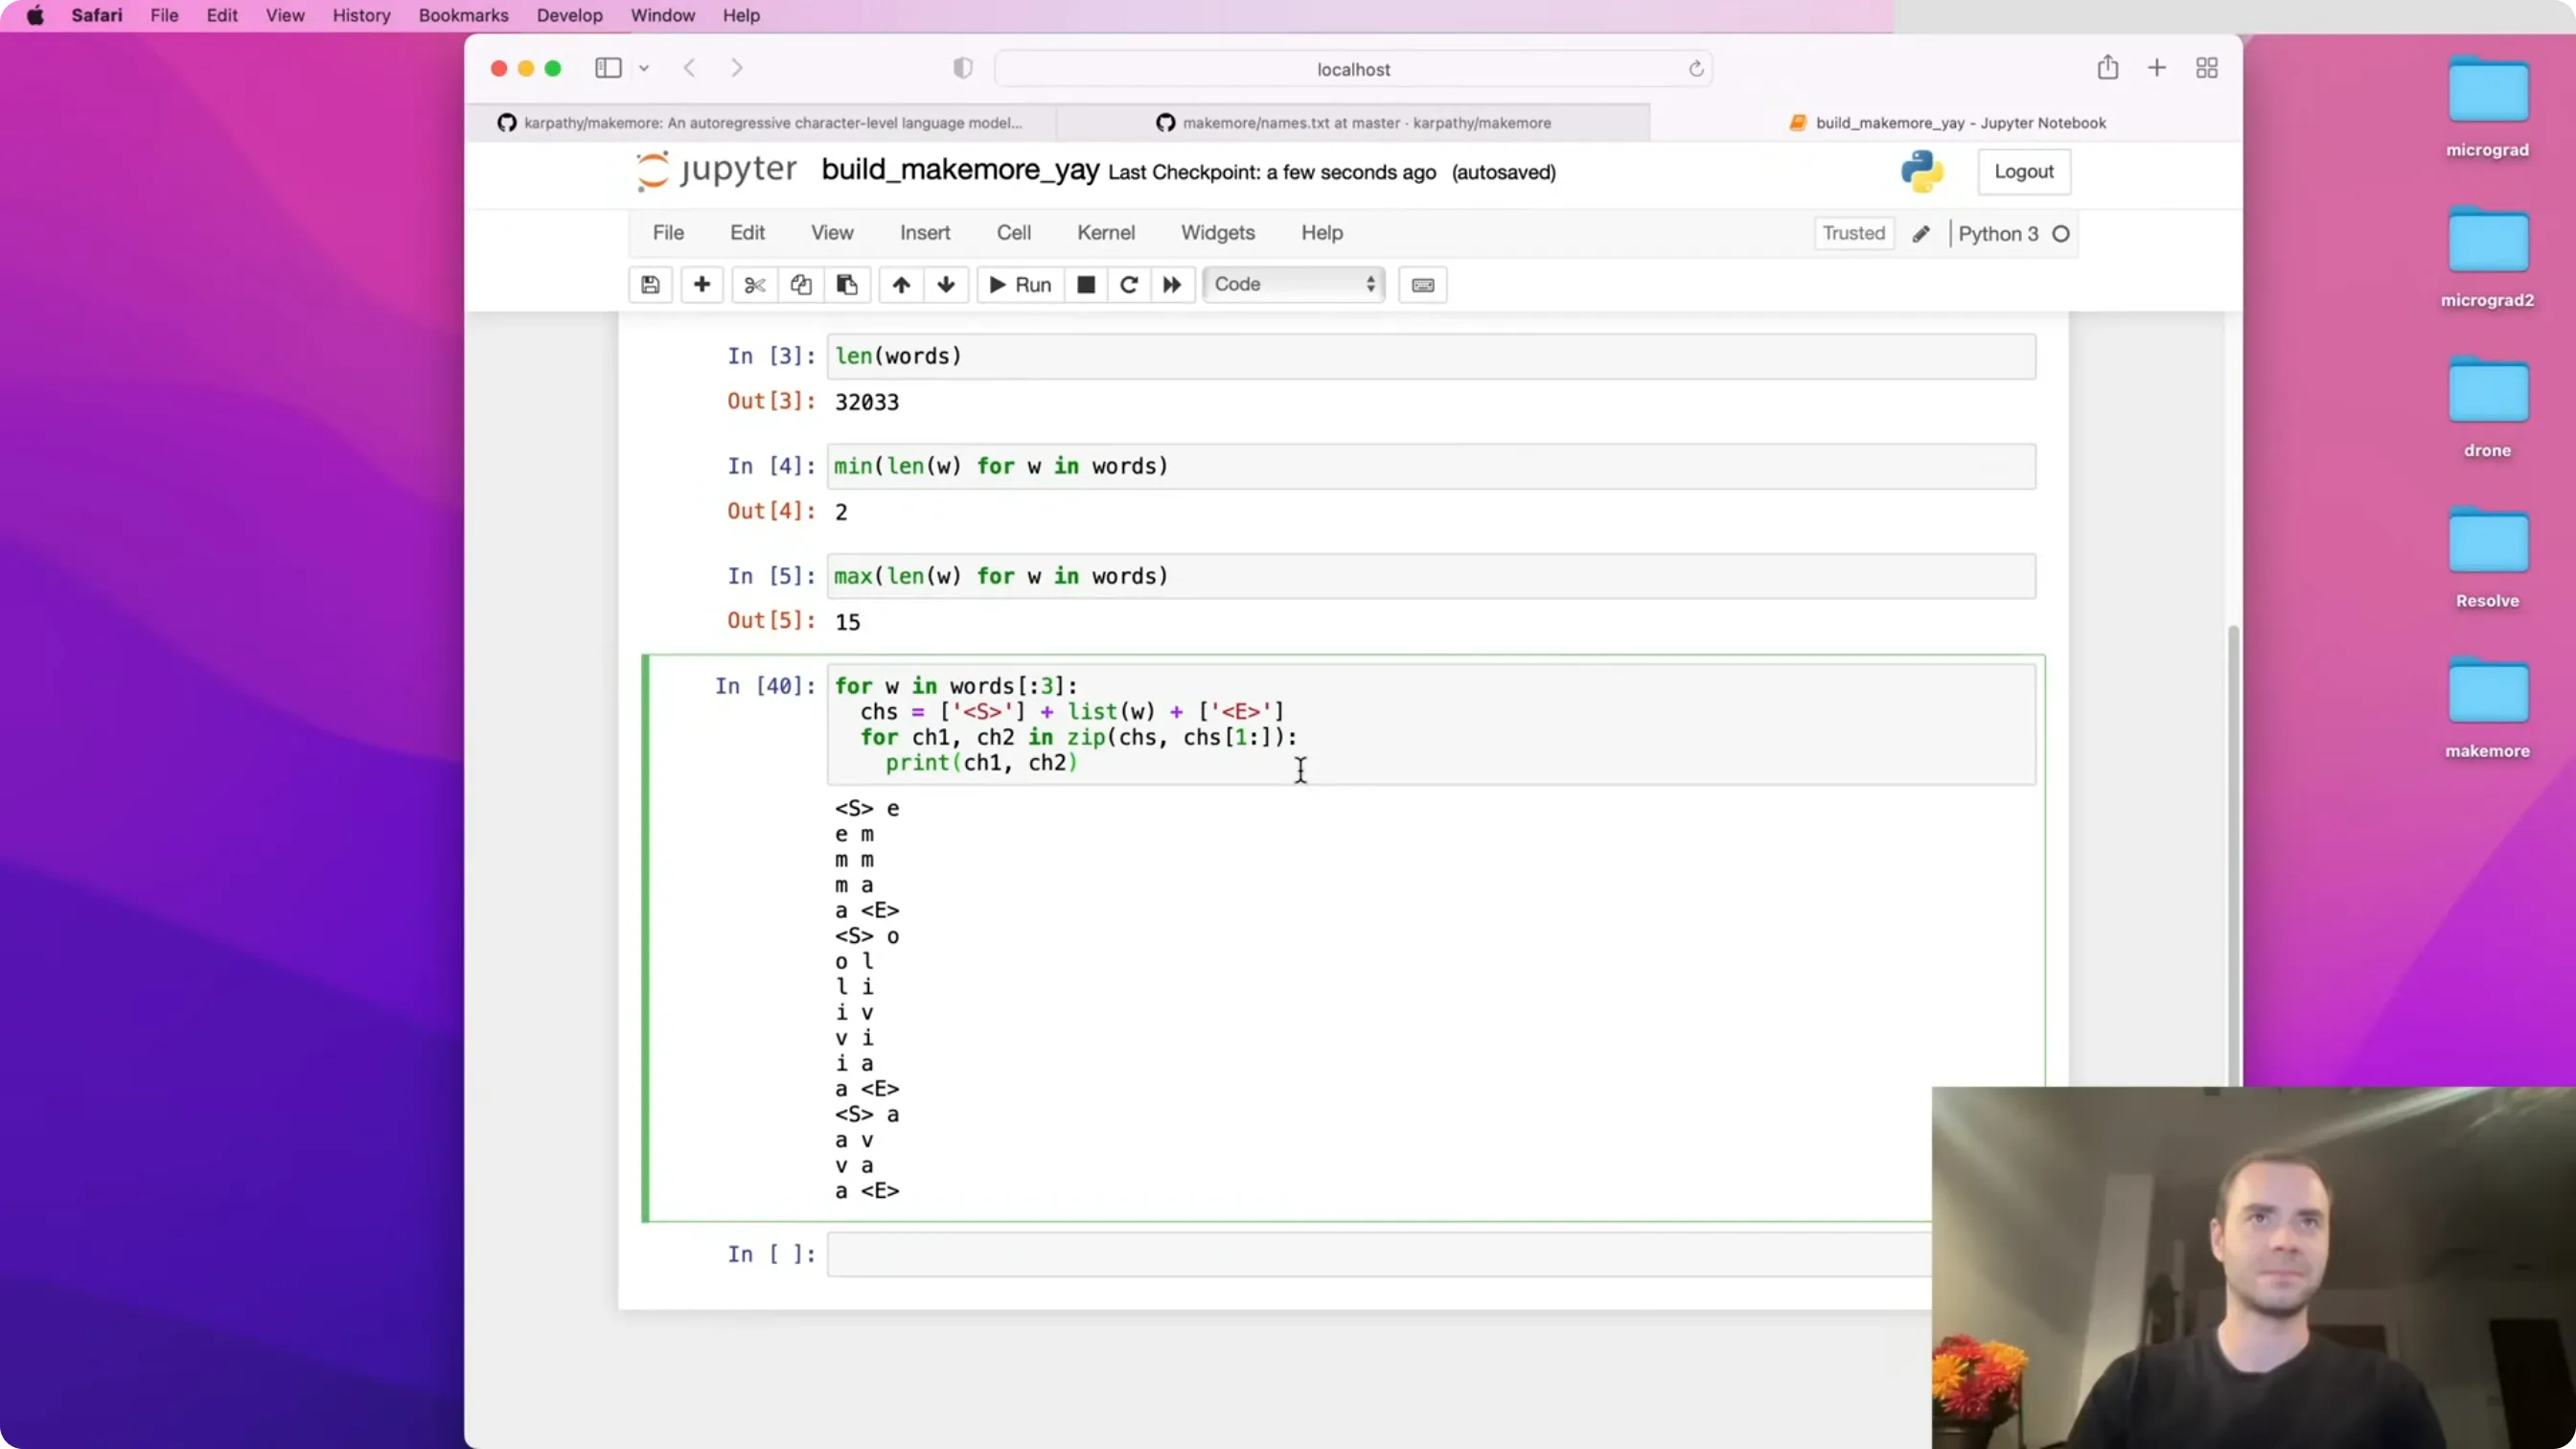
上面漏掉了两个重要信息:单词是从哪个字符开始的,以及单词在哪里结束。为了把它们也编码进去,我们人为引入两个特殊标记:一个表示开始,一个表示结束。
chs = ['<S>'] + list(w) + ['<E>']
for ch1, ch2 in zip(chs, chs[1:]):
    print(ch1, ch2)
list(w)会把字符串w拆成单个字符的列表;用['<S>'] + ...在开头补上起始标记,在结尾补上结束标记;- 这样对
emma来说,第一个 bigram 是<S> E,最后一个 bigram 是A <E>; - 起始标记告诉我们"哪些字符容易出现在开头",结束标记告诉我们"哪些字符后面容易结束"。
📷 为每个单词补上起始与结束标记后再打印 bigram
回到原视频 (00:08:24)
用 <S>、<E> 这种尖括号来标记特殊 token,是自然语言处理里的常见约定。不过后面我们会把它改掉,换成更简洁的写法。
三、第一种实现:用 Python 字典统计 bigram
(参考时间: 09:24)
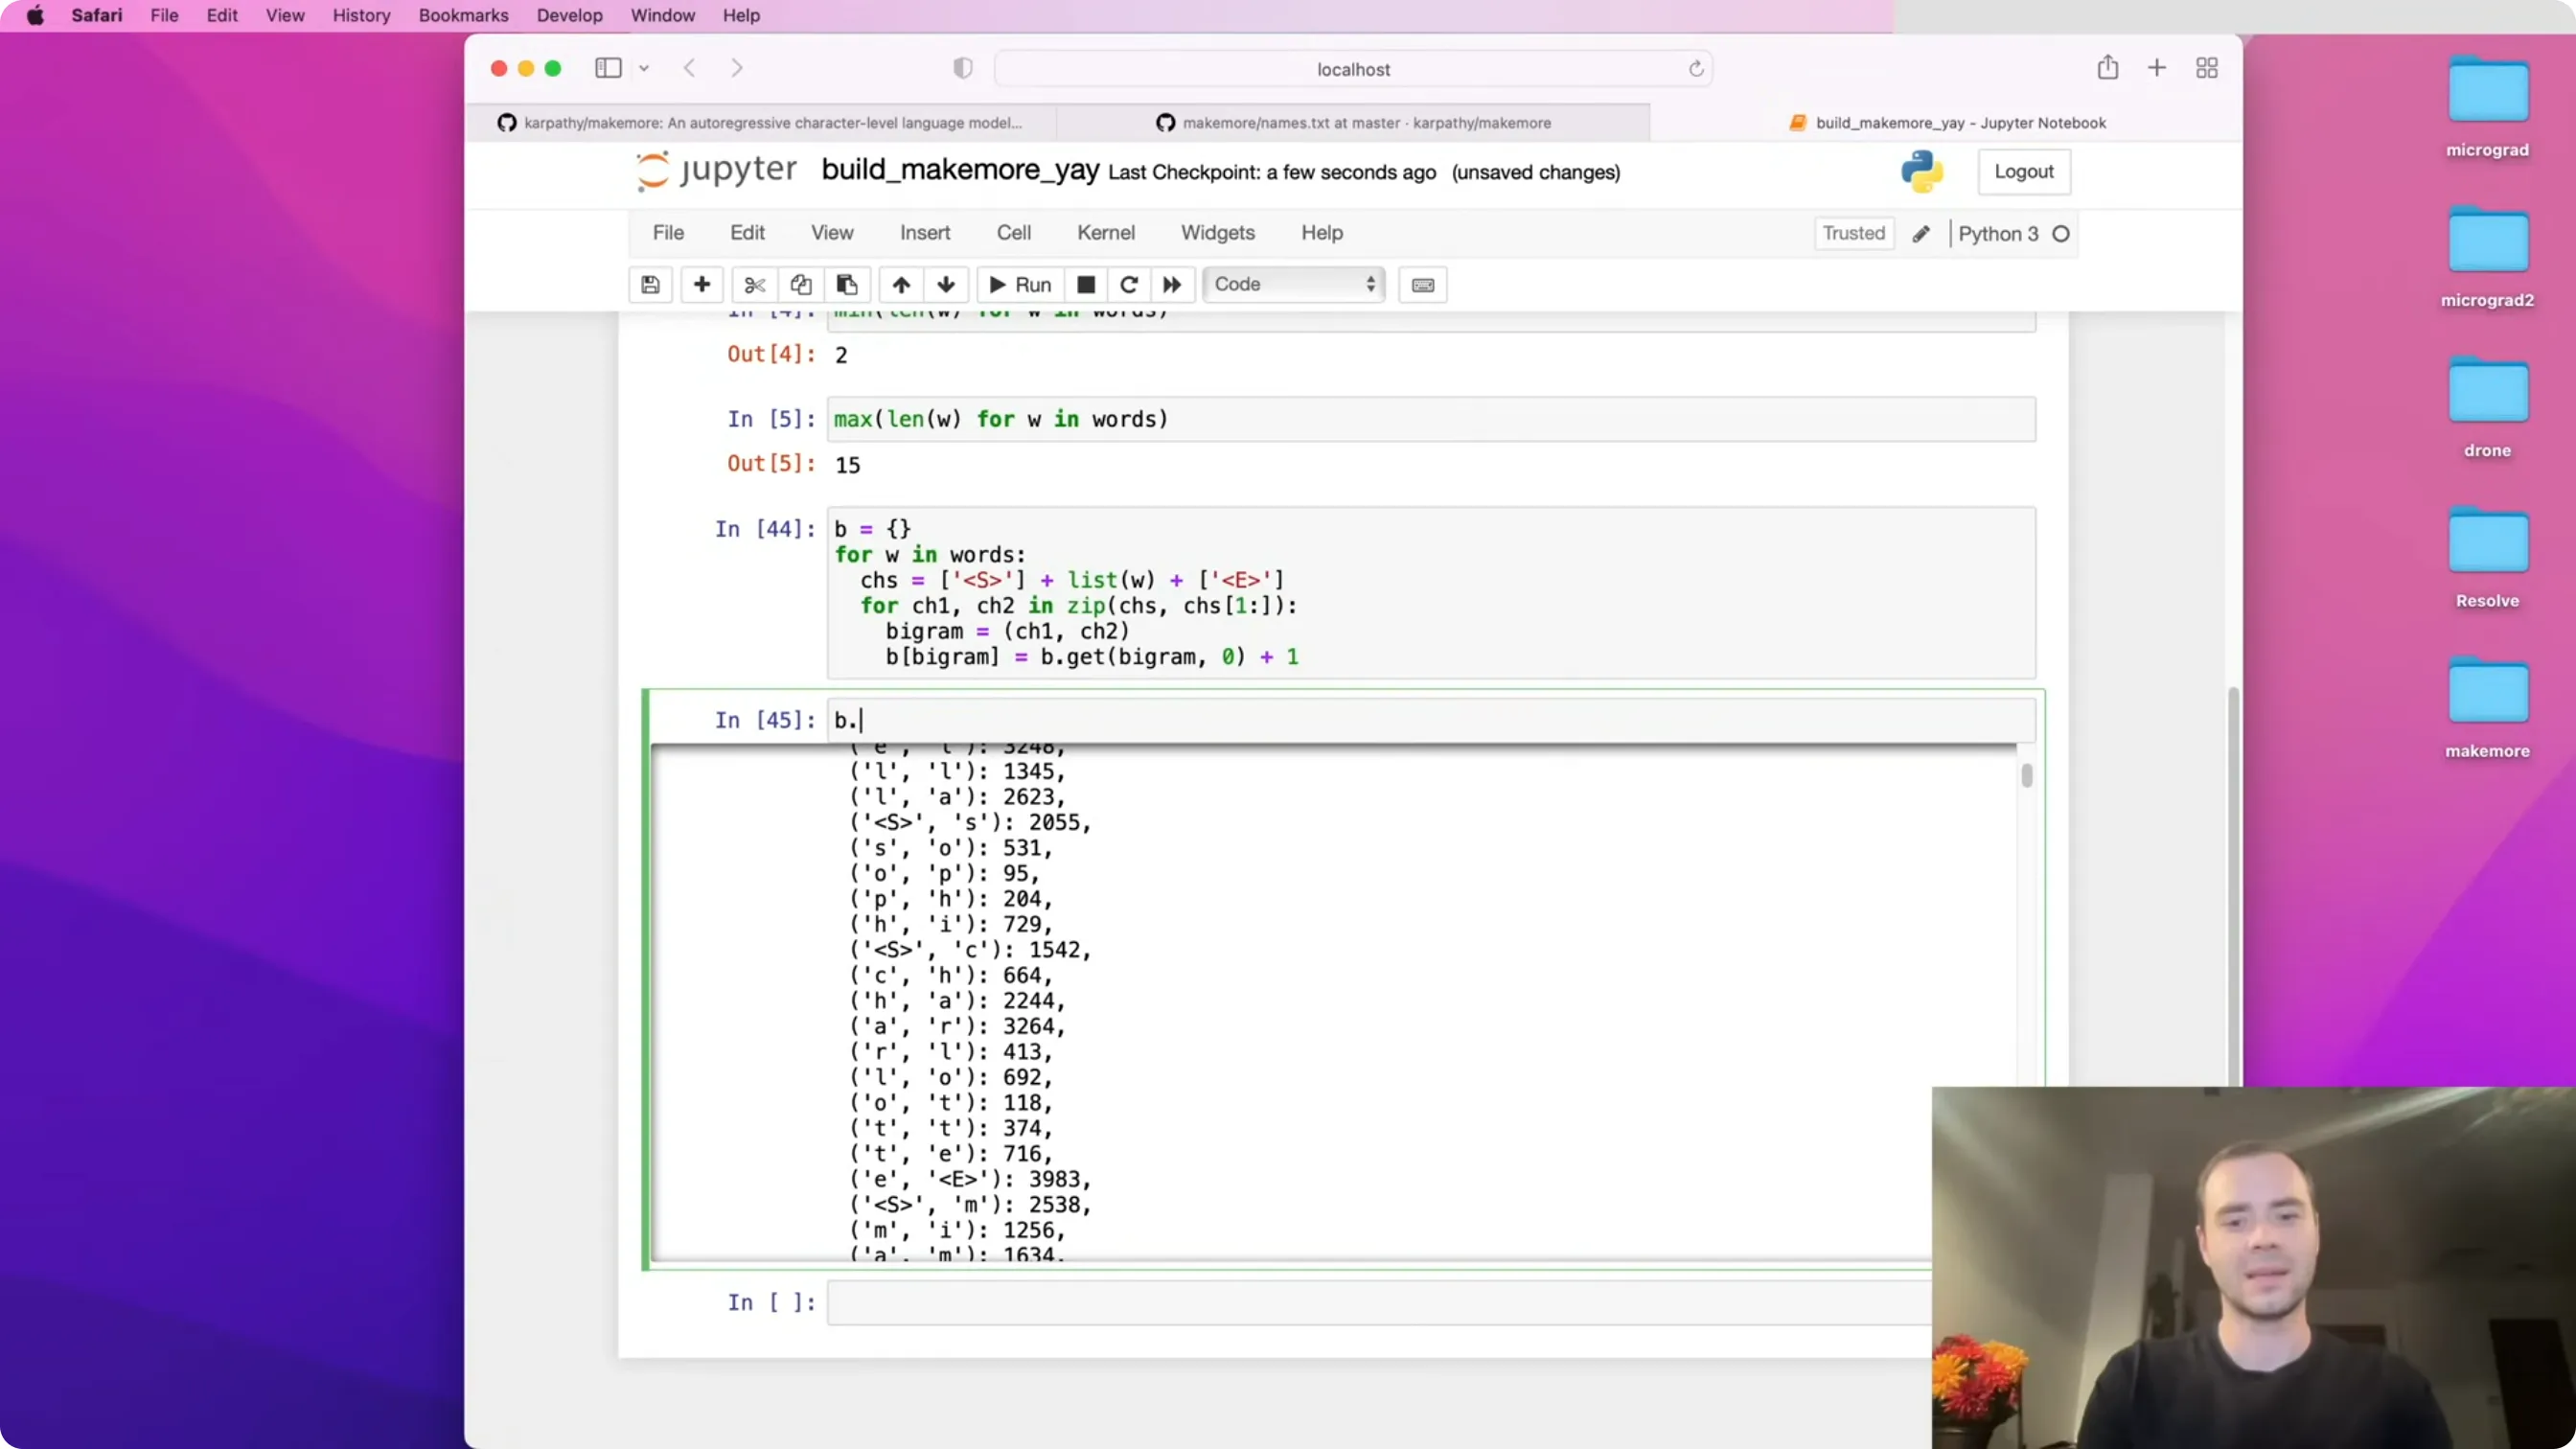
在 bigram 语言模型里,学习"哪些字符容易跟在哪些字符后面"最简单的办法,就是直接数数。我们统计每个 bigram 在整个训练集里出现了多少次。
用一个 Python 字典来维护计数:
b = {}
for w in words:
    chs = ['<S>'] + list(w) + ['<E>']
    for ch1, ch2 in zip(chs, chs[1:]):
        bigram = (ch1, ch2)
        b[bigram] = b.get(bigram, 0) + 1
b.get(bigram, 0) 的意思是:如果这个 bigram 已经在字典里就取出它的计数,否则返回默认值 0,然后再加一。
先在少量单词上跑一下,可以看到很多 bigram 只出现一次。比如 ('A','<E>') 出现了三次——因为 emma、olivia、ava 都以 a 结尾。
📷 用 Python 字典统计 bigram 计数
回到原视频 (00:09:40)
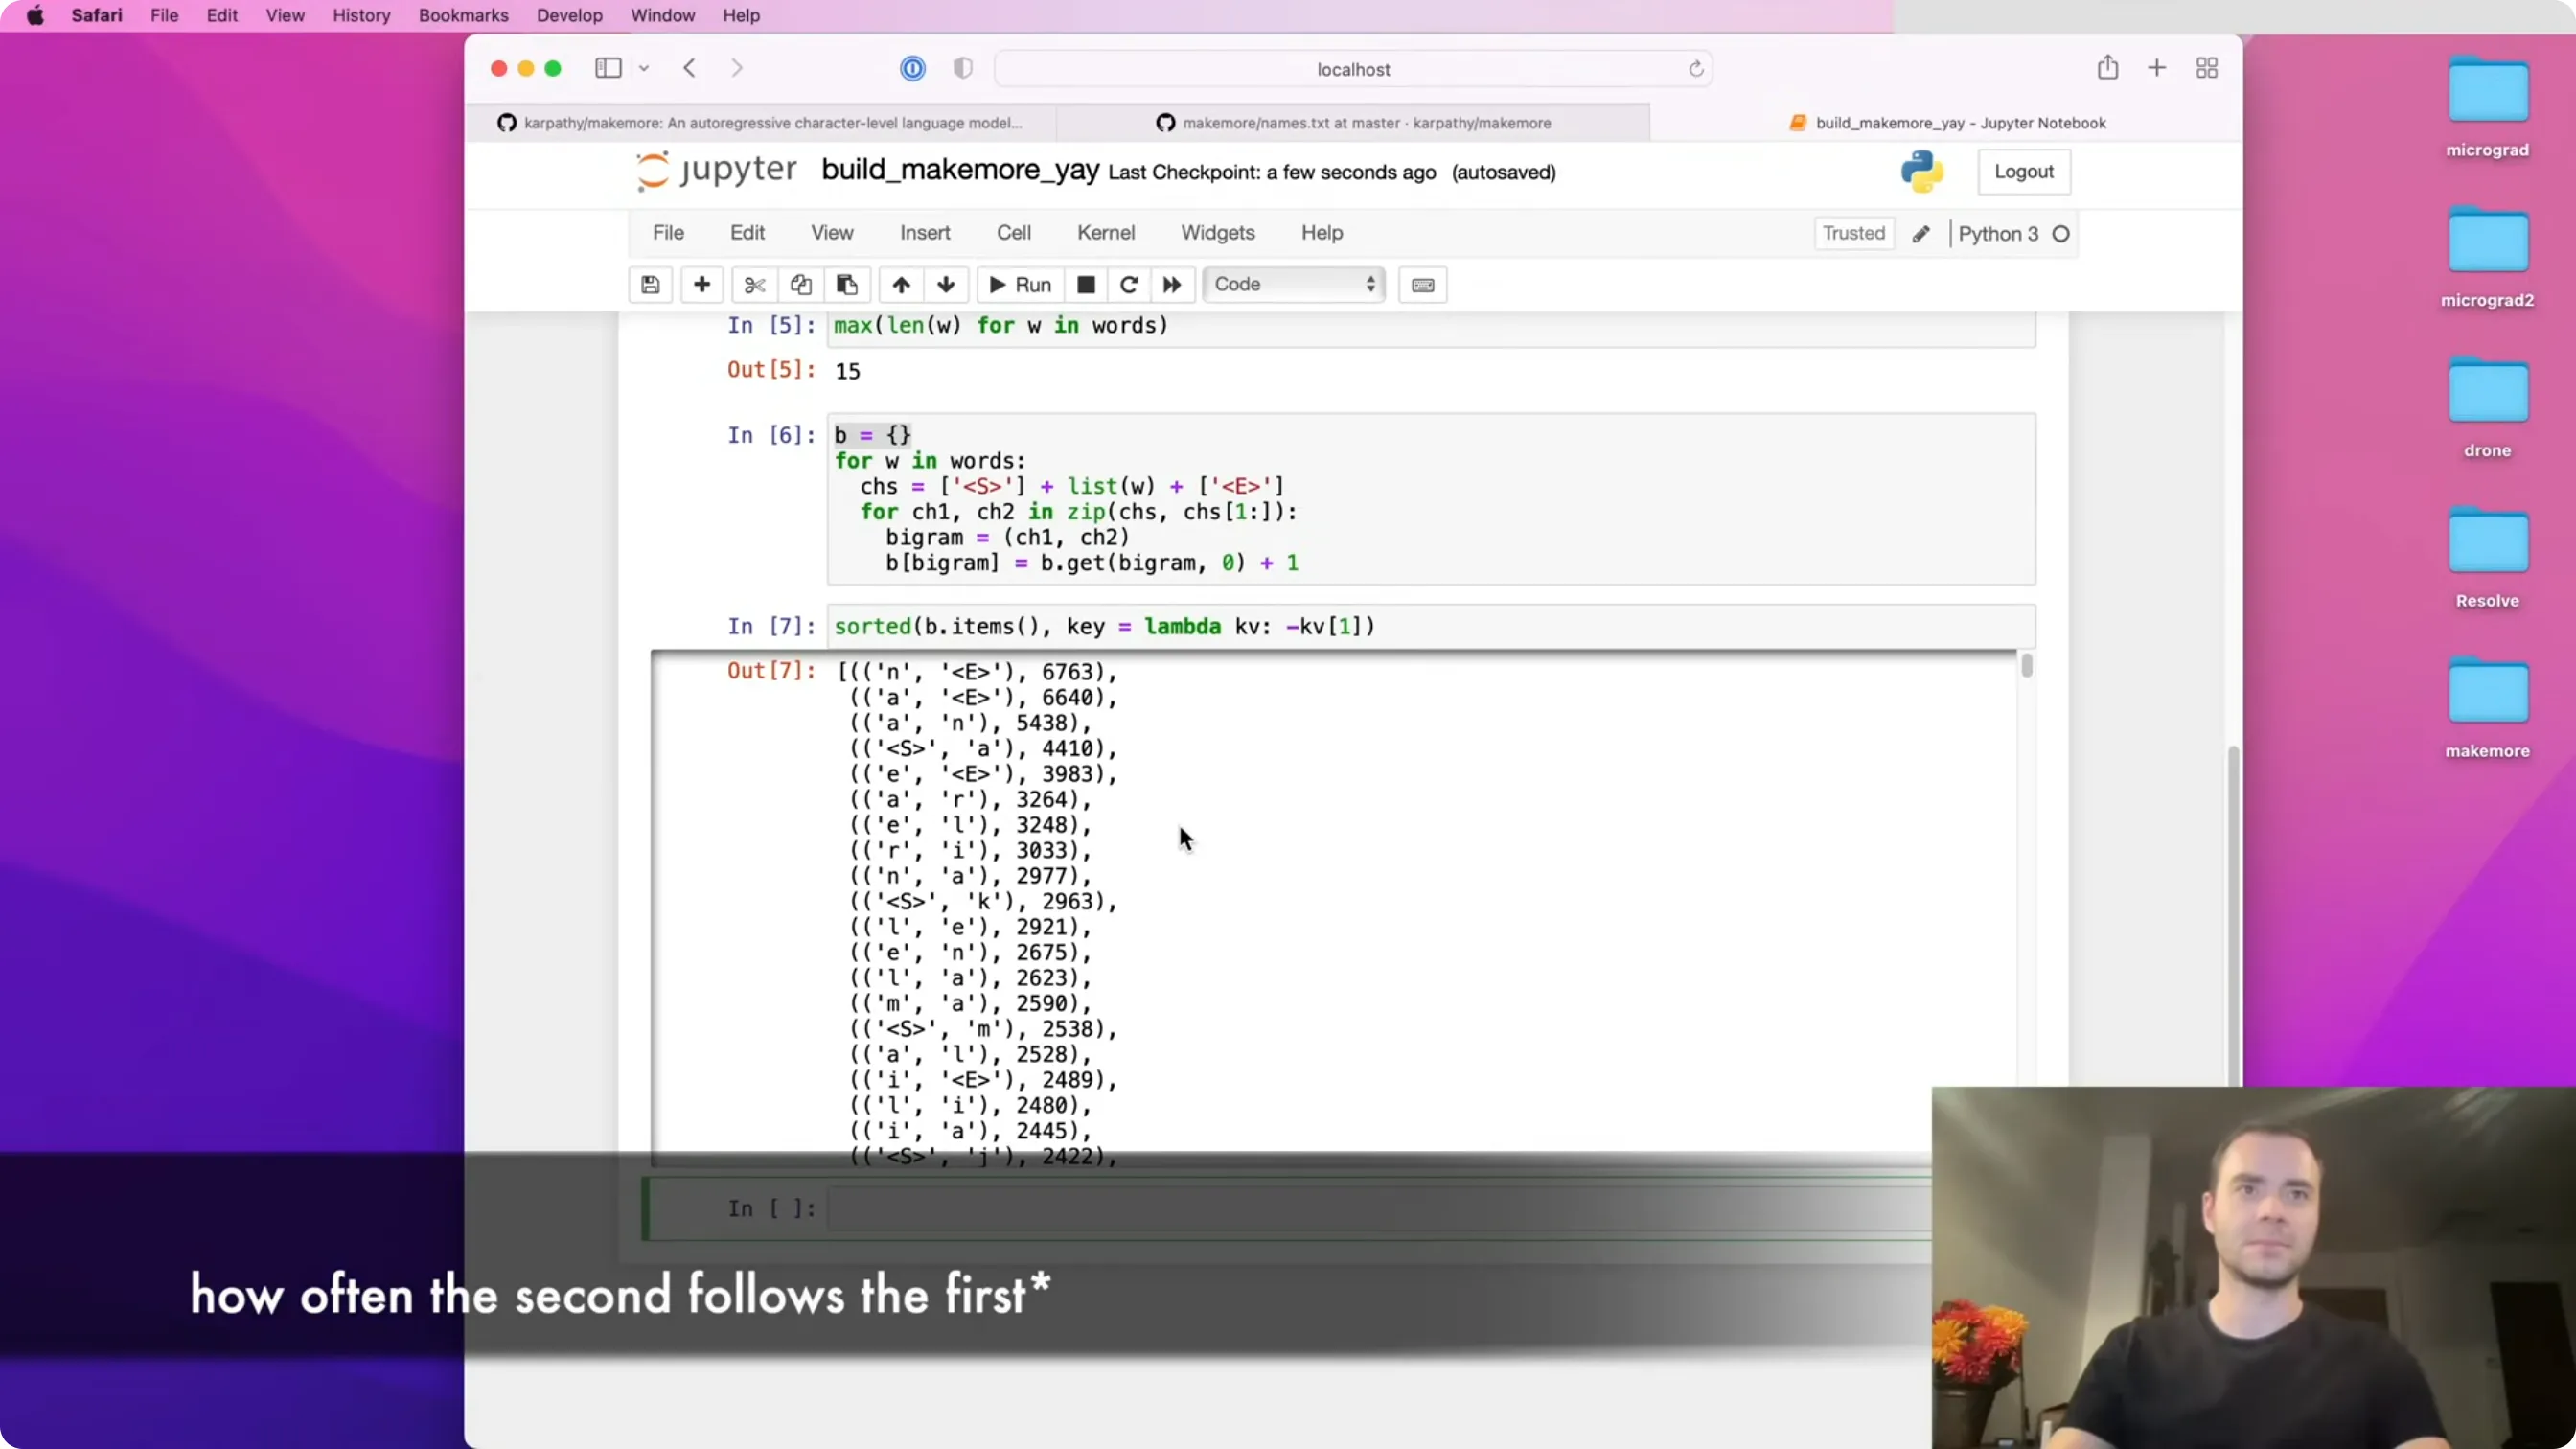
再对全部单词运行一遍,b 里就装下了整个数据集的 bigram 统计。我们还可以排序看看哪些 bigram 最常见、哪些最罕见:
sorted(b.items(), key=lambda kv: -kv[1])
b.items()返回一堆(key, value),这里 key 是字符二元组,value 是计数;sorted默认按元组的第 0 个元素排序,而我们要按计数(第 1 个元素)排,所以用key=lambda kv: kv[1];- 前面加负号
-kv[1]是为了让排序从大到小。
结果里最罕见的是一些只出现一次的 bigram(比如 QNR、DZ);反过来看,最常见的组合包括"n 作为结尾字符"以及"a 后面跟 n"。
📷 对 bigram 计数排序,查看最常见与最罕见组合
回到原视频 (00:11:17)
到这里,我们已经能用字典把 bigram 的统计量算出来。但接下来会换一种更有用的表示方式:二维数组。
四、第二种实现:用二维 PyTorch 张量统计 bigram
(参考时间: 12:45)
把统计信息放进二维数组里会比放在字典里方便得多:
- 行(row)表示 bigram 的第一个字符;
- 列(column)表示 bigram 的第二个字符;
- 每个格子里的数,表示"这个字符对在数据里出现了多少次"。
我们用来承载这个数组的库是 PyTorch。PyTorch 是一个深度学习框架,但它的一部分能力就是 torch.tensor——一种可以高效创建、索引和运算的多维数组。
认识 torch.tensor
先做一些热身,创建一个 3×5 的零矩阵:
import torch

a = torch.zeros((3, 5))
a.dtype   # torch.float32
默认的数据类型(dtype)是 float32,也就是单精度浮点数。但我们现在要存的是计数,所以用整数类型更合适:
a = torch.zeros((3, 5), dtype=torch.int32)
张量可以像数组一样按索引读写:
a[1, 3] = 1     # 第 1 行、第 3 列(都从 0 开始计数)
a[1, 3] += 1    # 变成 2
a[1, 3] += 1    # 变成 3
a[0, 0] = 5
📷 用 torch.zeros 创建张量并按行列索引修改
回到原视频 (00:13:12)
编者拓展|
torch.Tensor与torch.tensor是两个不同的东西(本讲重点讲的坑,这里补上官方依据):
写法 是什么 行为 torch.tensor(data)工厂函数(小写 t) 从你给的数据构造张量,并从数据推断 dtype torch.Tensor(...)类(大写 T,是 torch.FloatTensor的别名)torch.Tensor(3, 4)会造一个 3×4 未初始化张量——里面是内存里的垃圾值,不是 0
torch.Tensor偶尔也能用(因为传数据时会走构造逻辑),但含义与预期不同,报错也难懂。写代码请统一用torch.tensor。
真正要用的数组:28×28
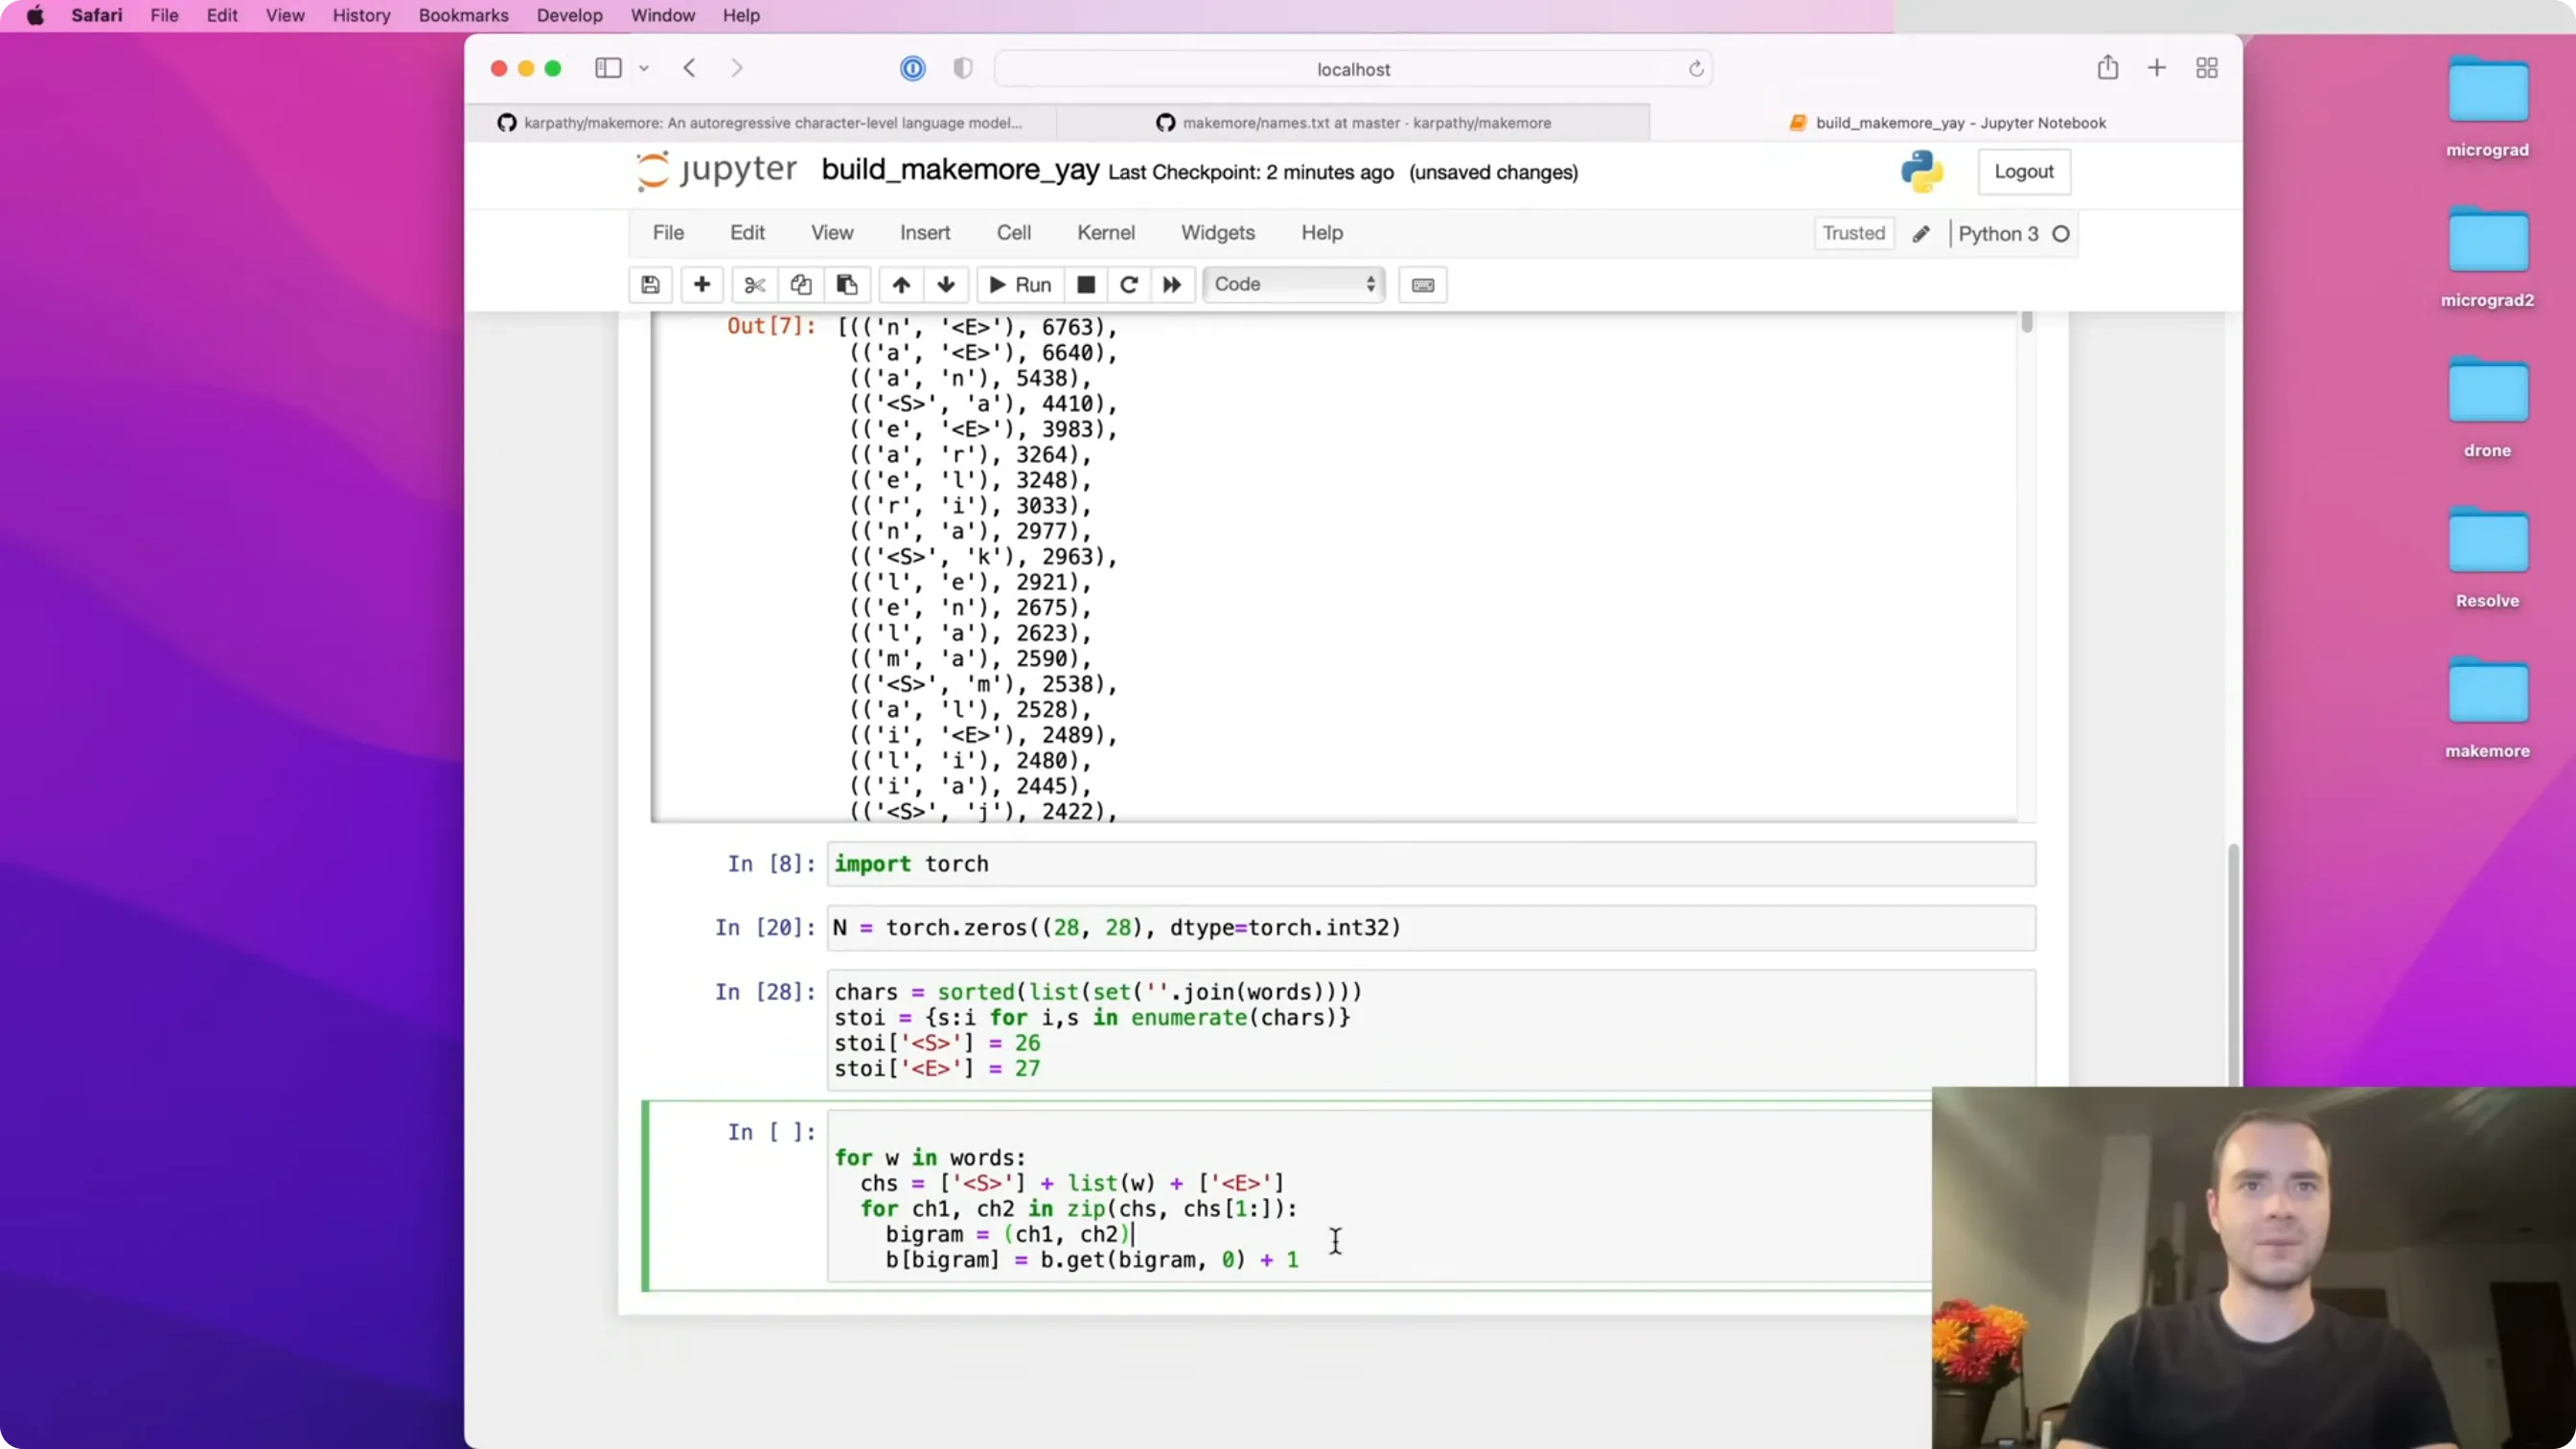
字母表有 26 个小写字母,再加上 <S> 和 <E> 两个特殊 token,一共 28 种字符,所以需要一个 28×28 的数组:
N = torch.zeros((28, 28), dtype=torch.int32)
字符到整数的查找表
张量的索引必须是整数,但我们的字符是字符串。所以需要一张"字符 → 整数"的查找表。做法是:
- 把所有单词拼接成一个巨大的字符串;
- 传给
set去重,得到所有出现过的字符(应该正好 26 个小写字母); - 排序后,用
enumerate建立映射。
chars = sorted(list(set(''.join(words))))
stoi = {s: i + 1 for i, s in enumerate(chars)}   # string to integer
stoi['.'] = 0                                     # 稍后解释这个点号
itos = {i: s for s, i in stoi.items()}            # integer to string
这里先建立 26 个字母的映射,把 26 个字符映射到 1~26;特殊 token 我们暂时先用别的名字。
编者拓展|「词表」(vocabulary)与整数编码:把字符映射成整数用的那张表,就是词表。
- 词表大小 = 模型输出的类别数(本讲是 27:26 个字母 + 1 个
.);- 编码本身没有语义:谁在前谁在后是任意的,只是一个「名字」,不能让模型从
5里读出「比3大」这种含义—— 这也正是后面要用 one-hot / embedding 的原因:把「编号」变成「向量」,模型才能学到东西;- 真实系统里词表会大得多(GPT-2 约 5 万、GPT-4 约 10 万),而且词表是在训练集上离线统计出来的,推理时必须用同一张表。
把计数写进数组
for w in words:
    chs = ['.'] + list(w) + ['.']
    for ch1, ch2 in zip(chs, chs[1:]):
        ix1 = stoi[ch1]
        ix2 = stoi[ch2]
        N[ix1, ix2] += 1
N[ix1, ix2] += 1 就是二维数组的索引方式:第 ix1 行、第 ix2 列,自增一。因为数组一开始全为零,所以直接相加即可。运行完,N 就是一个 28×28、装着整个数据集所有 bigram 计数的数组。
📷 构建查找表并在 28×28 张量中累加 bigram 计数
回到原视频 (00:17:38)
五、可视化 bigram 计数矩阵
(参考时间: 18:19)
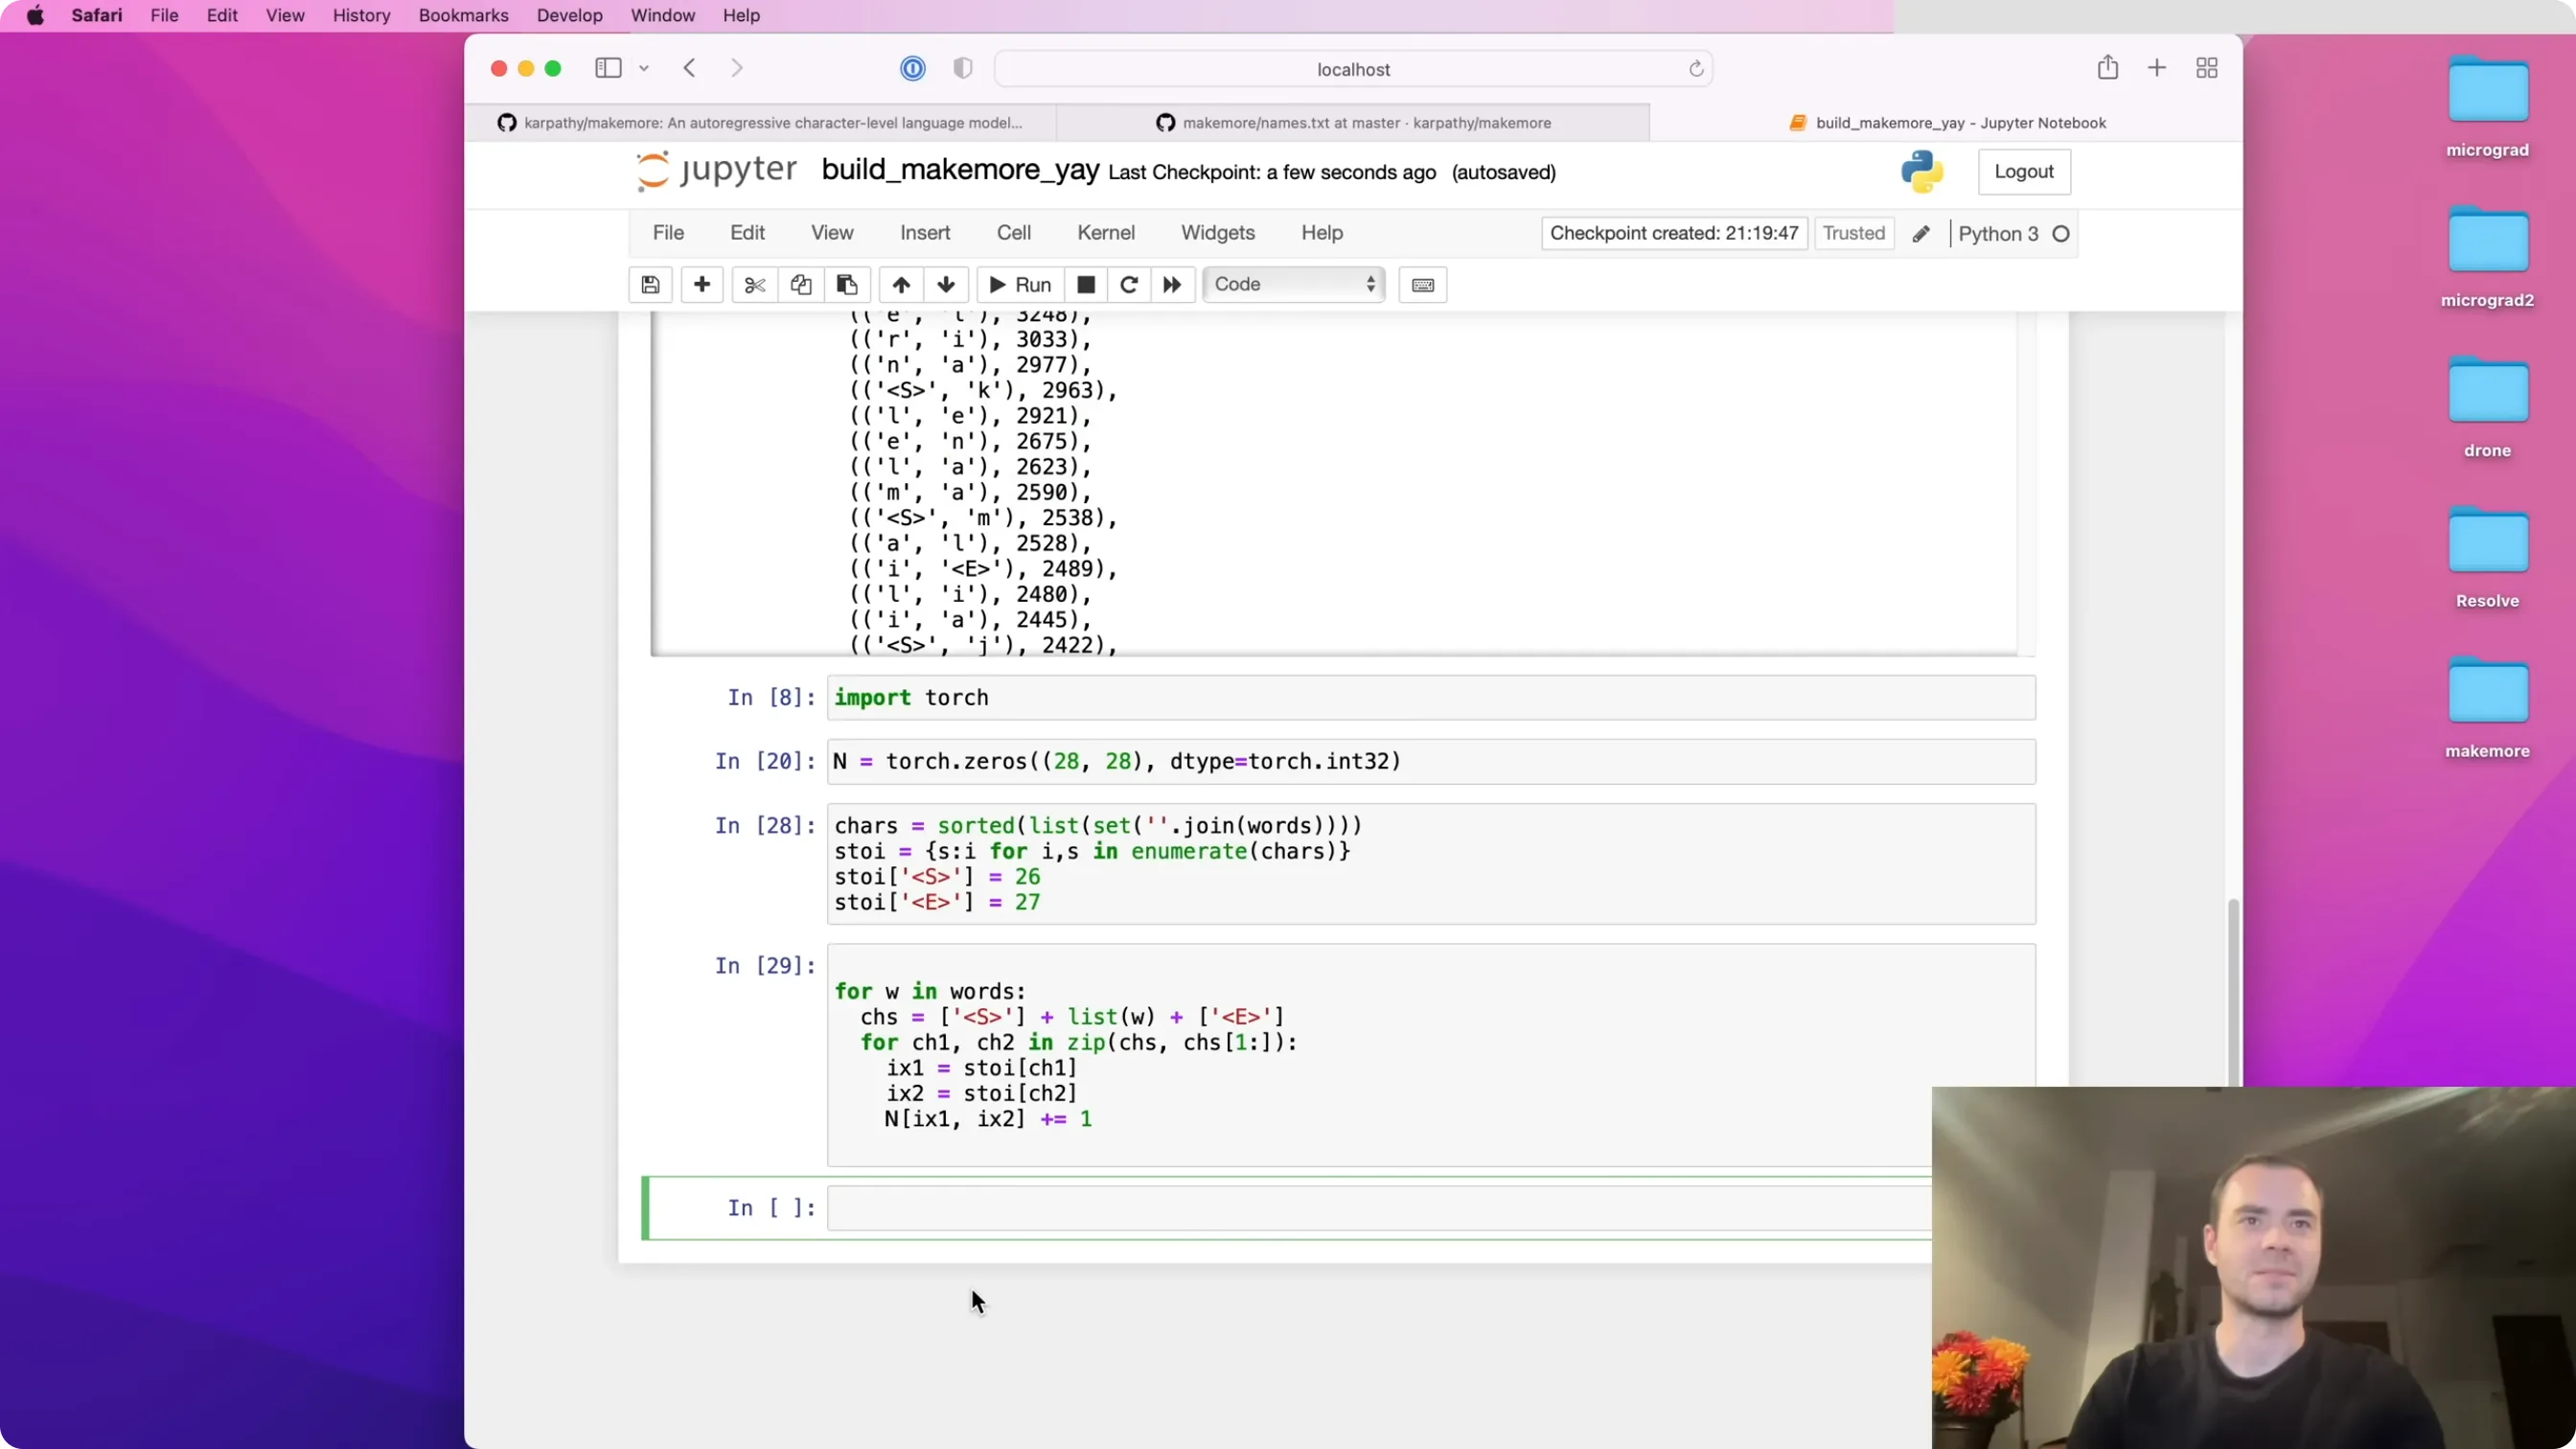
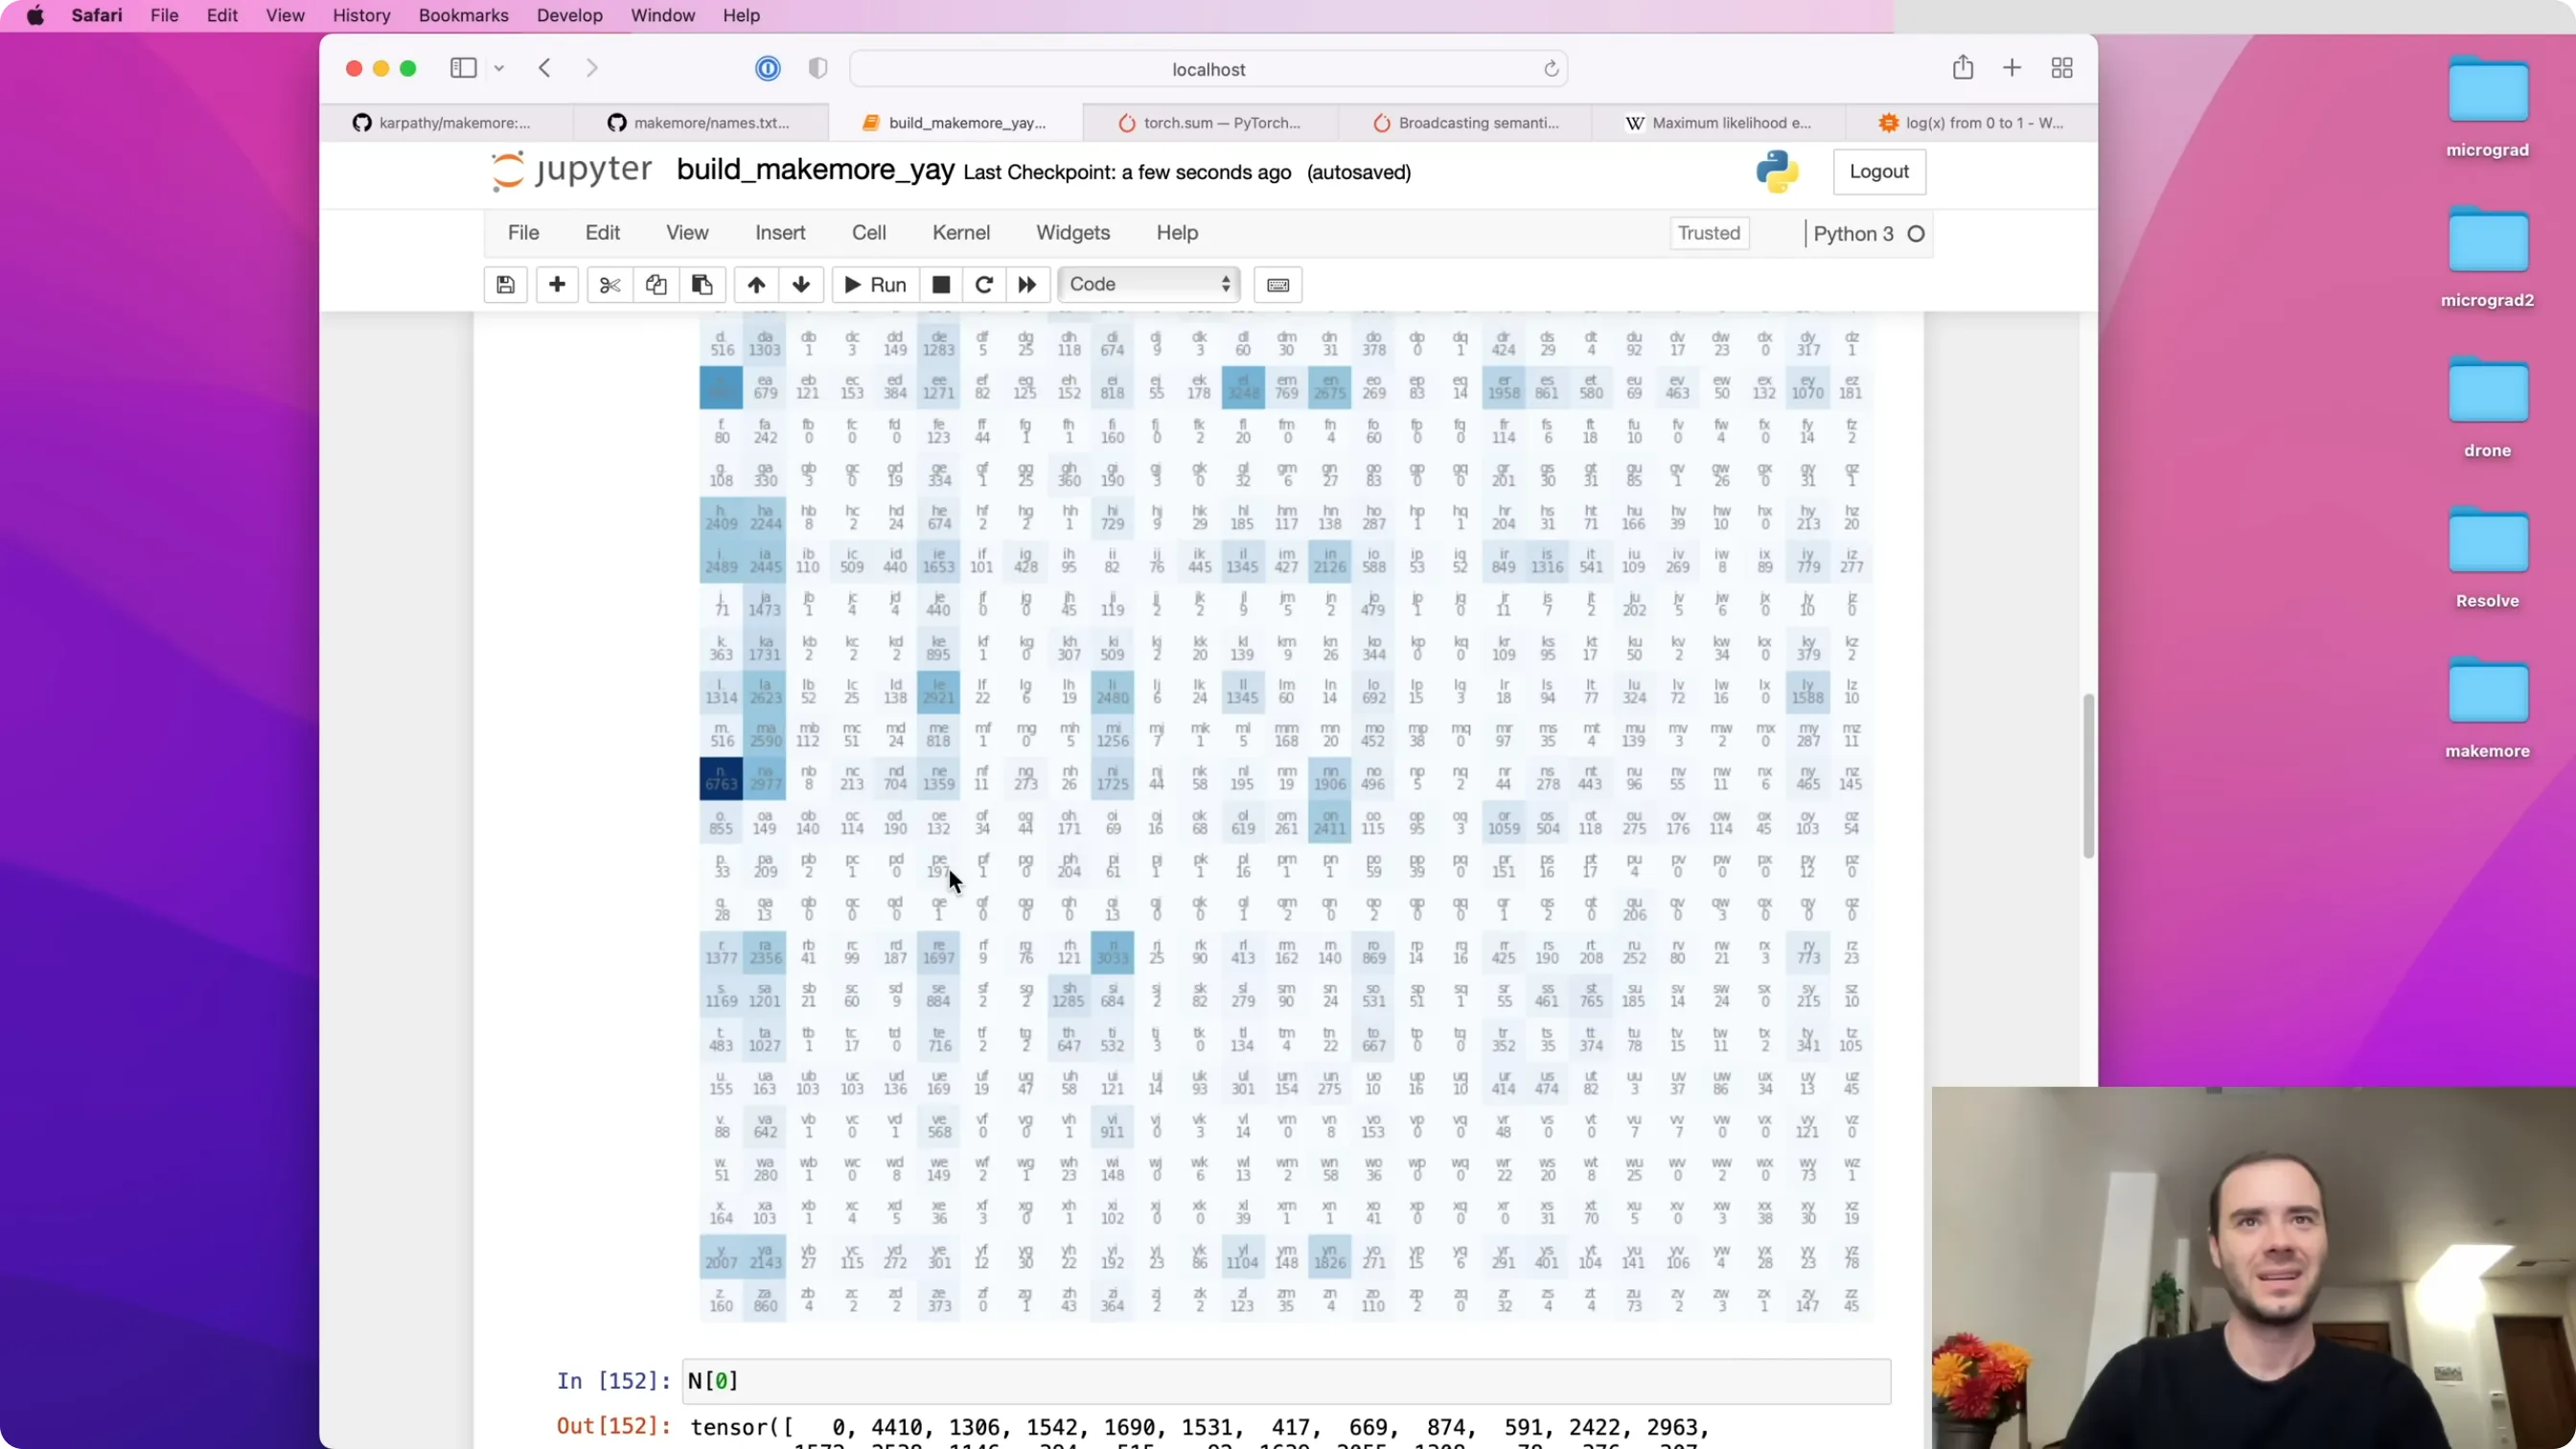
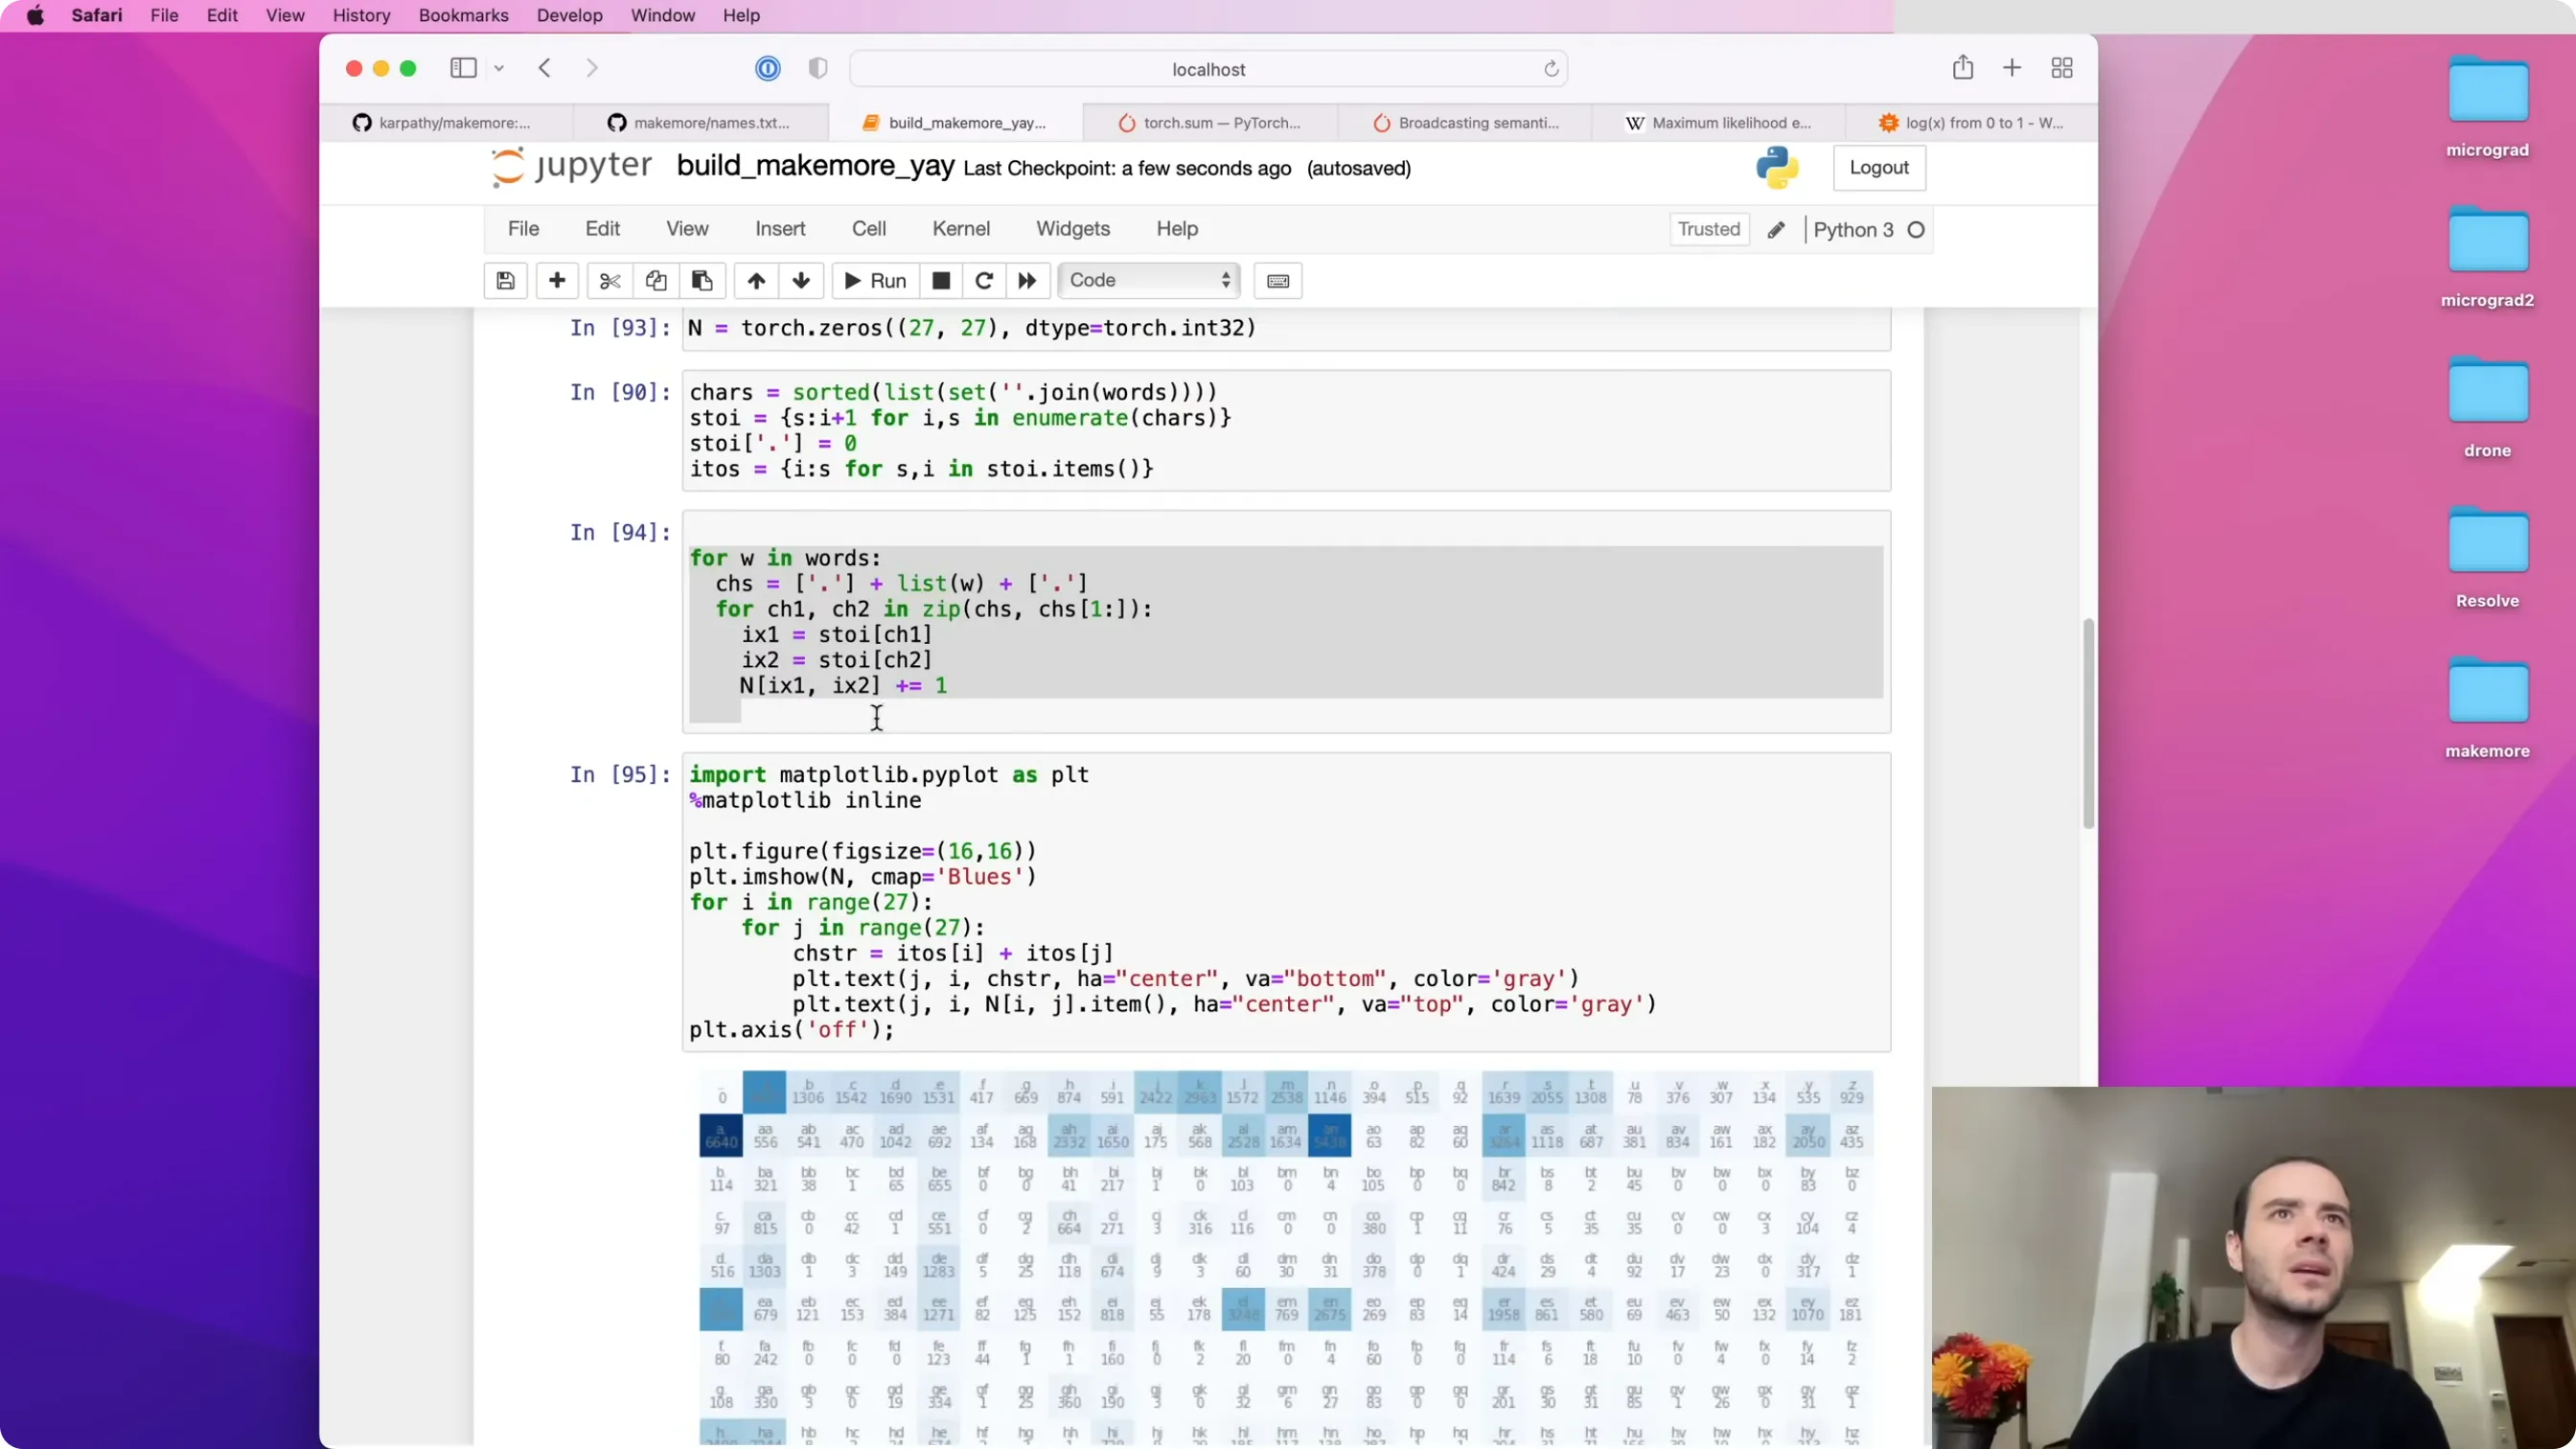
直接打印 N 会得到一大片难看的数字。用 Matplotlib 把它画成热力图就直观多了:
import matplotlib.pyplot as plt
%matplotlib inline

plt.figure(figsize=(16, 16))
plt.imshow(N, cmap='Blues')
for i in range(27):
    for j in range(27):
        chstr = itos[i] + itos[j]
        plt.text(j, i, chstr, ha="center", va="bottom", color='gray')
        plt.text(j, i, N[i, j].item(), ha="center", va="top", color='gray')
plt.axis('off')
这里有一个细节:N[i, j] 即使只是取一个元素,返回的仍然是 torch.tensor,而不是普通的 Python 整数。要把它"弹"成普通整数,需要用 .item()。所以画图时写的是 N[i, j].item()。
📷 用 Matplotlib 把计数矩阵画成带标注的热力图
回到原视频 (00:18:24)
从图上可以读出很多信息,例如:b 跟在 g 后面 0 次、b 跟在 h 后面 41 次、a 跟在 j 后面 175 次……一眼就能看出哪些字符组合常见、哪些罕见。
数组里有一大片"永远为零"的区域
(参考时间: 20:54)
仔细观察这张图,会发现我们做得并不够聪明:
- 有一整行全是零——因为
<E>永远不会是 bigram 的第一个字符(我们总是把它放在末尾); - 有一整列全是零——因为
<S>永远不会是 bigram 的第二个字符(我们总是从它开始); - 右下角还有一小块 2×2 区域,唯一可能非零的是"
<E>后面直接跟<S>",那意味着一个空单词,而我们并没有空单词。
也就是说,我们既浪费了空间,又让 <S>、<E> 这两个特殊记号挤在一起,读起来很别扭。
改用单个点号 .
(参考时间: 22:08)
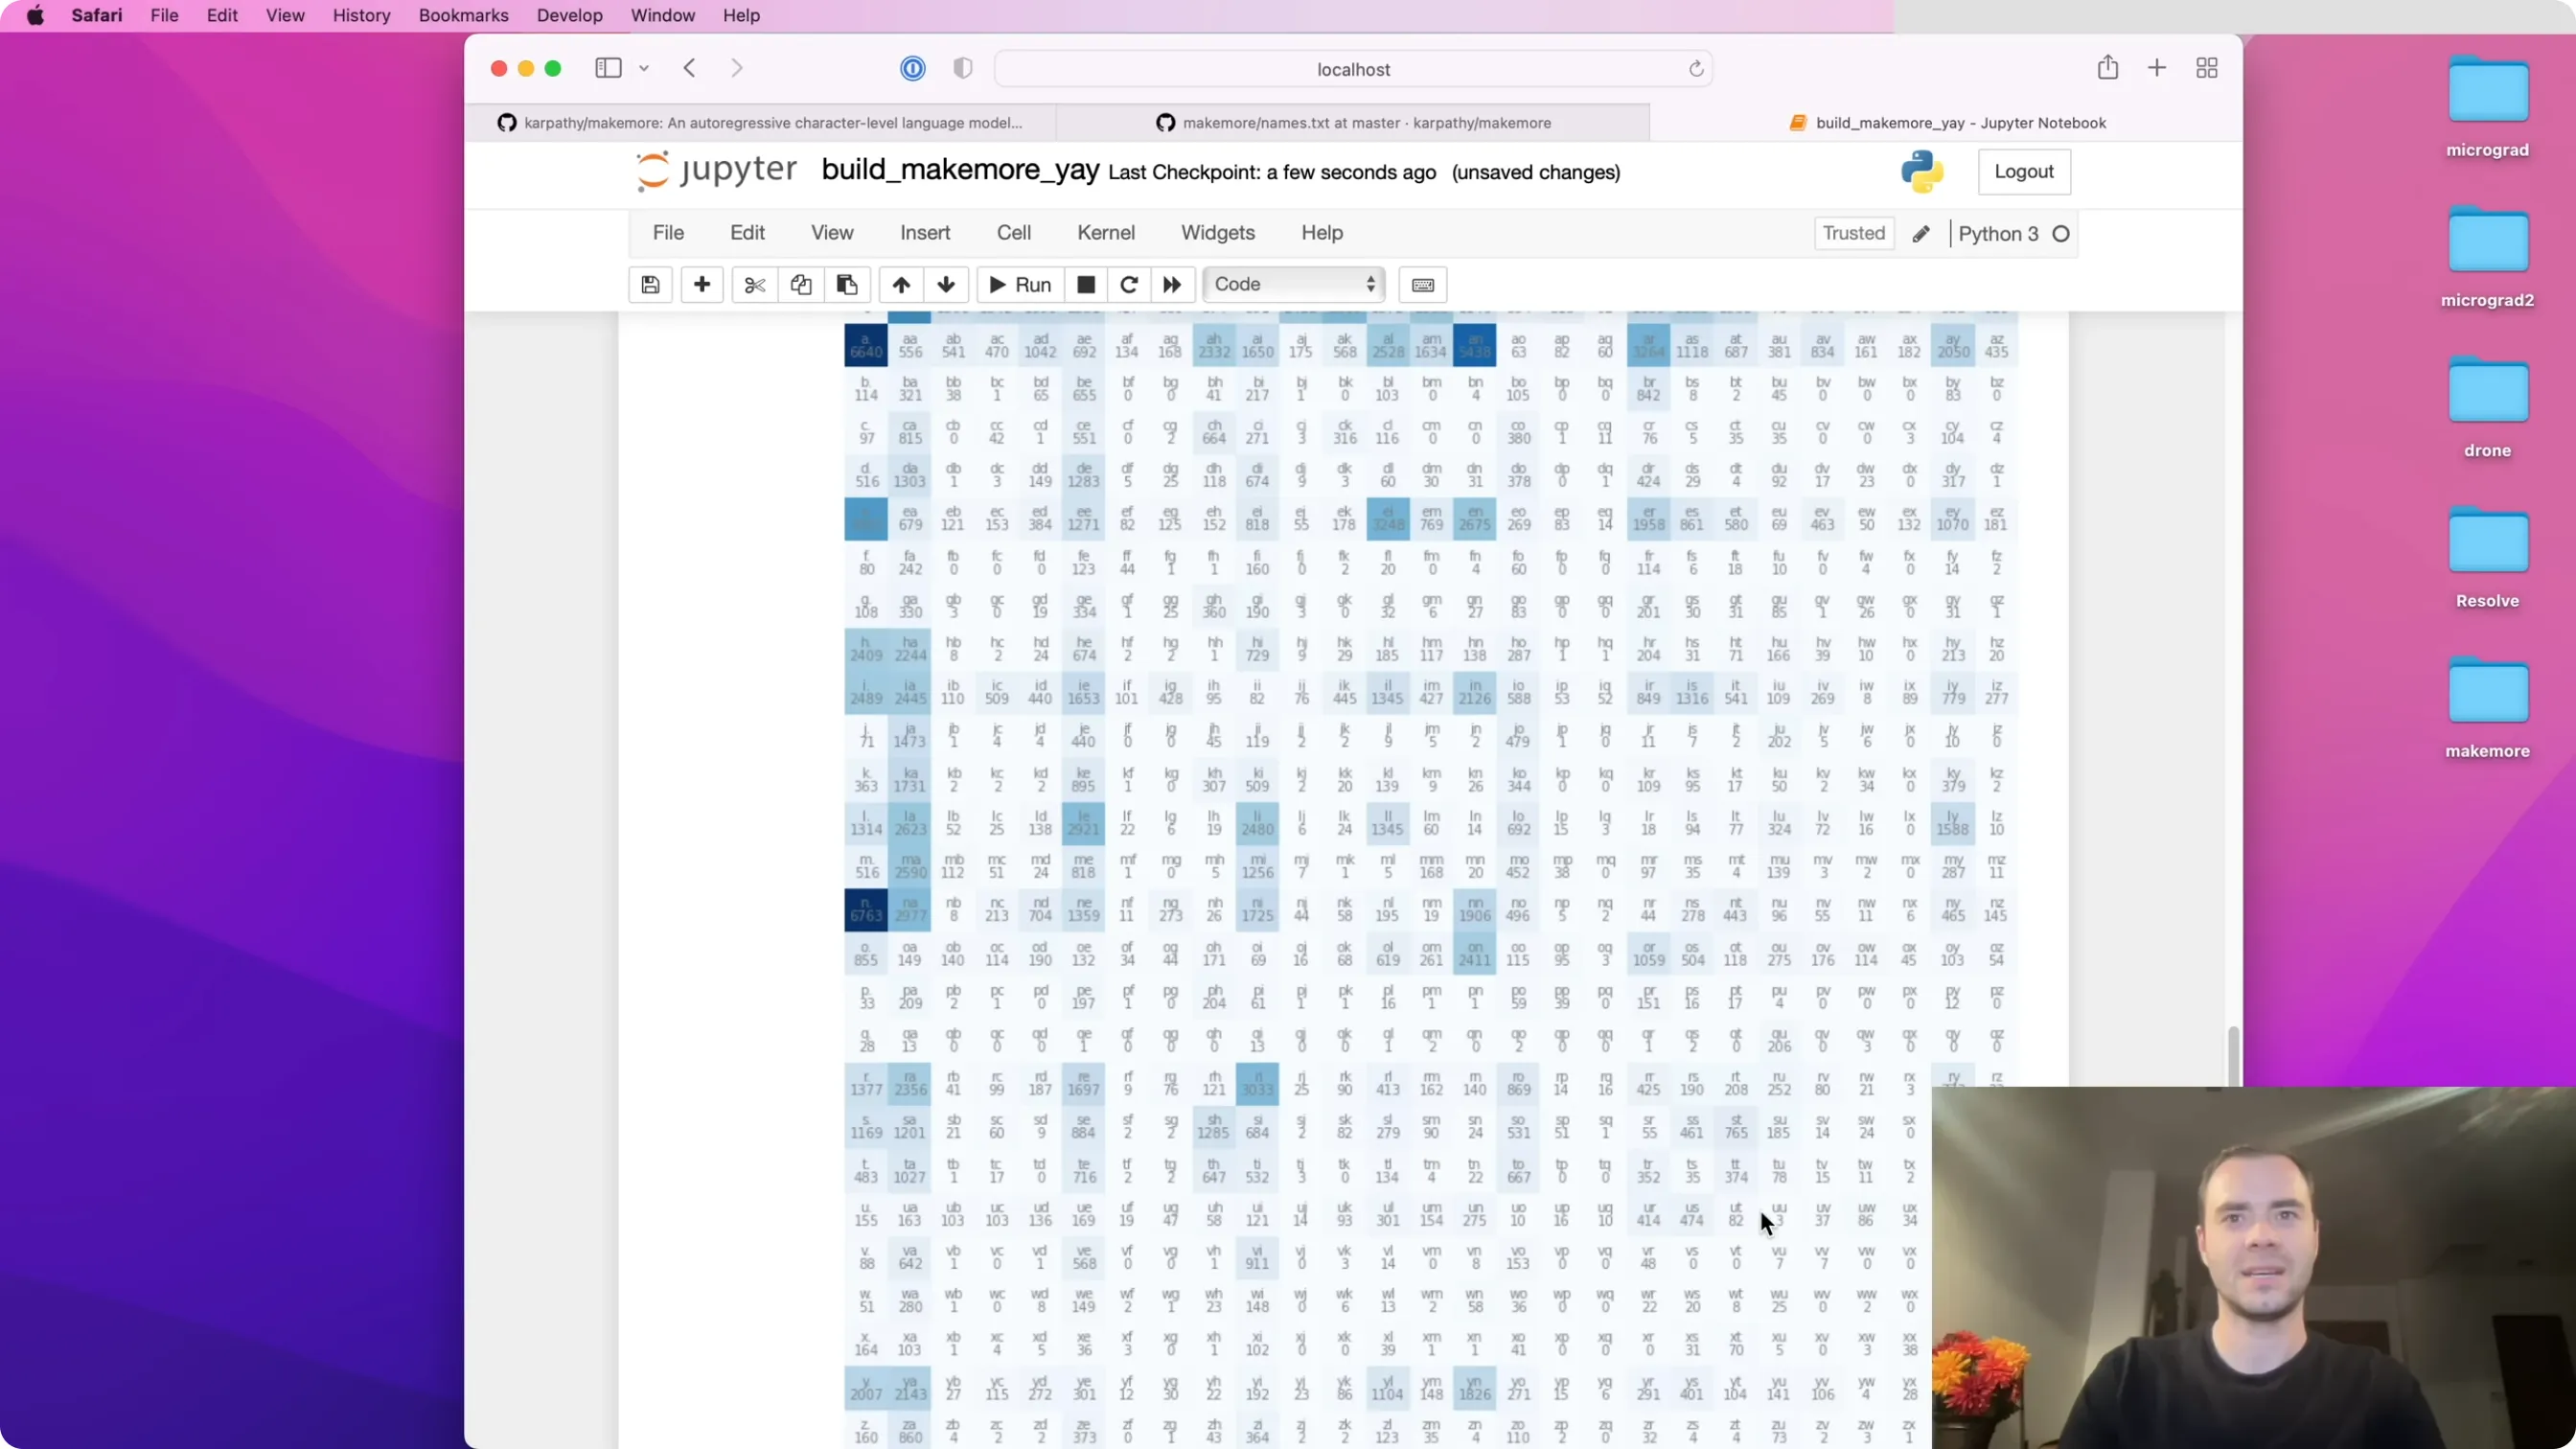
更好的设计是:只保留一个特殊 token,记作 .(点号)。它既表示"句子的开始",也表示"句子的结束"。这样数组就变成 27×27(26 个字母 + 1 个点号)。
为了让显示更整齐,讲师还把点号安排到索引 0,其余字母顺延:
chars = sorted(list(set(''.join(words))))
stoi = {s: i + 1 for i, s in enumerate(chars)}
stoi['.'] = 0
itos = {i: s for s, i in stoi.items()}
这样一来:A → 1、B → 2、……、Z → 26,而 . → 0。
重新统计:
N = torch.zeros((27, 27), dtype=torch.int32)
for w in words:
    chs = ['.'] + list(w) + ['.']
    for ch1, ch2 in zip(chs, chs[1:]):
        ix1 = stoi[ch1]
        ix2 = stoi[ch2]
        N[ix1, ix2] += 1
现在的 27×27 矩阵里:
(., .)永远是 0(因为没有空单词);- 第 0 行是所有单词的首字母计数;
- 第 0 列是所有单词的末字母计数;
- 中间则是"某个字符后面跟某个字符"的统计。
📷 用单个点号取代 S/E 特殊 token 后的 27×27 计数矩阵
回到原视频 (00:23:57)
这张矩阵已经包含了采样所需的一切信息。
六、从 bigram 模型采样
(参考时间: 24:02)
有了计数,我们就能"生成"名字了。基本思路是:从起始 token . 出发,根据当前字符对应的那一行概率,随机抽下一个字符,再不断重复,直到抽到 . 为止。
把计数变成概率
先从第 0 行(起始 token 对应的行)取出来:
p = N[0].float()
p = p / p.sum()
p
N[0]取第 0 行(N[0, :]的简写),得到一个长度为 27 的一维数组;.float()把整数计数转成浮点数,因为接下来要做除法;- 除以
p.sum()就得到归一化的概率分布——各项之和为 1。
📷 取出起始行并归一化成概率分布
回到原视频 (00:24:02)
用 torch.multinomial 采样
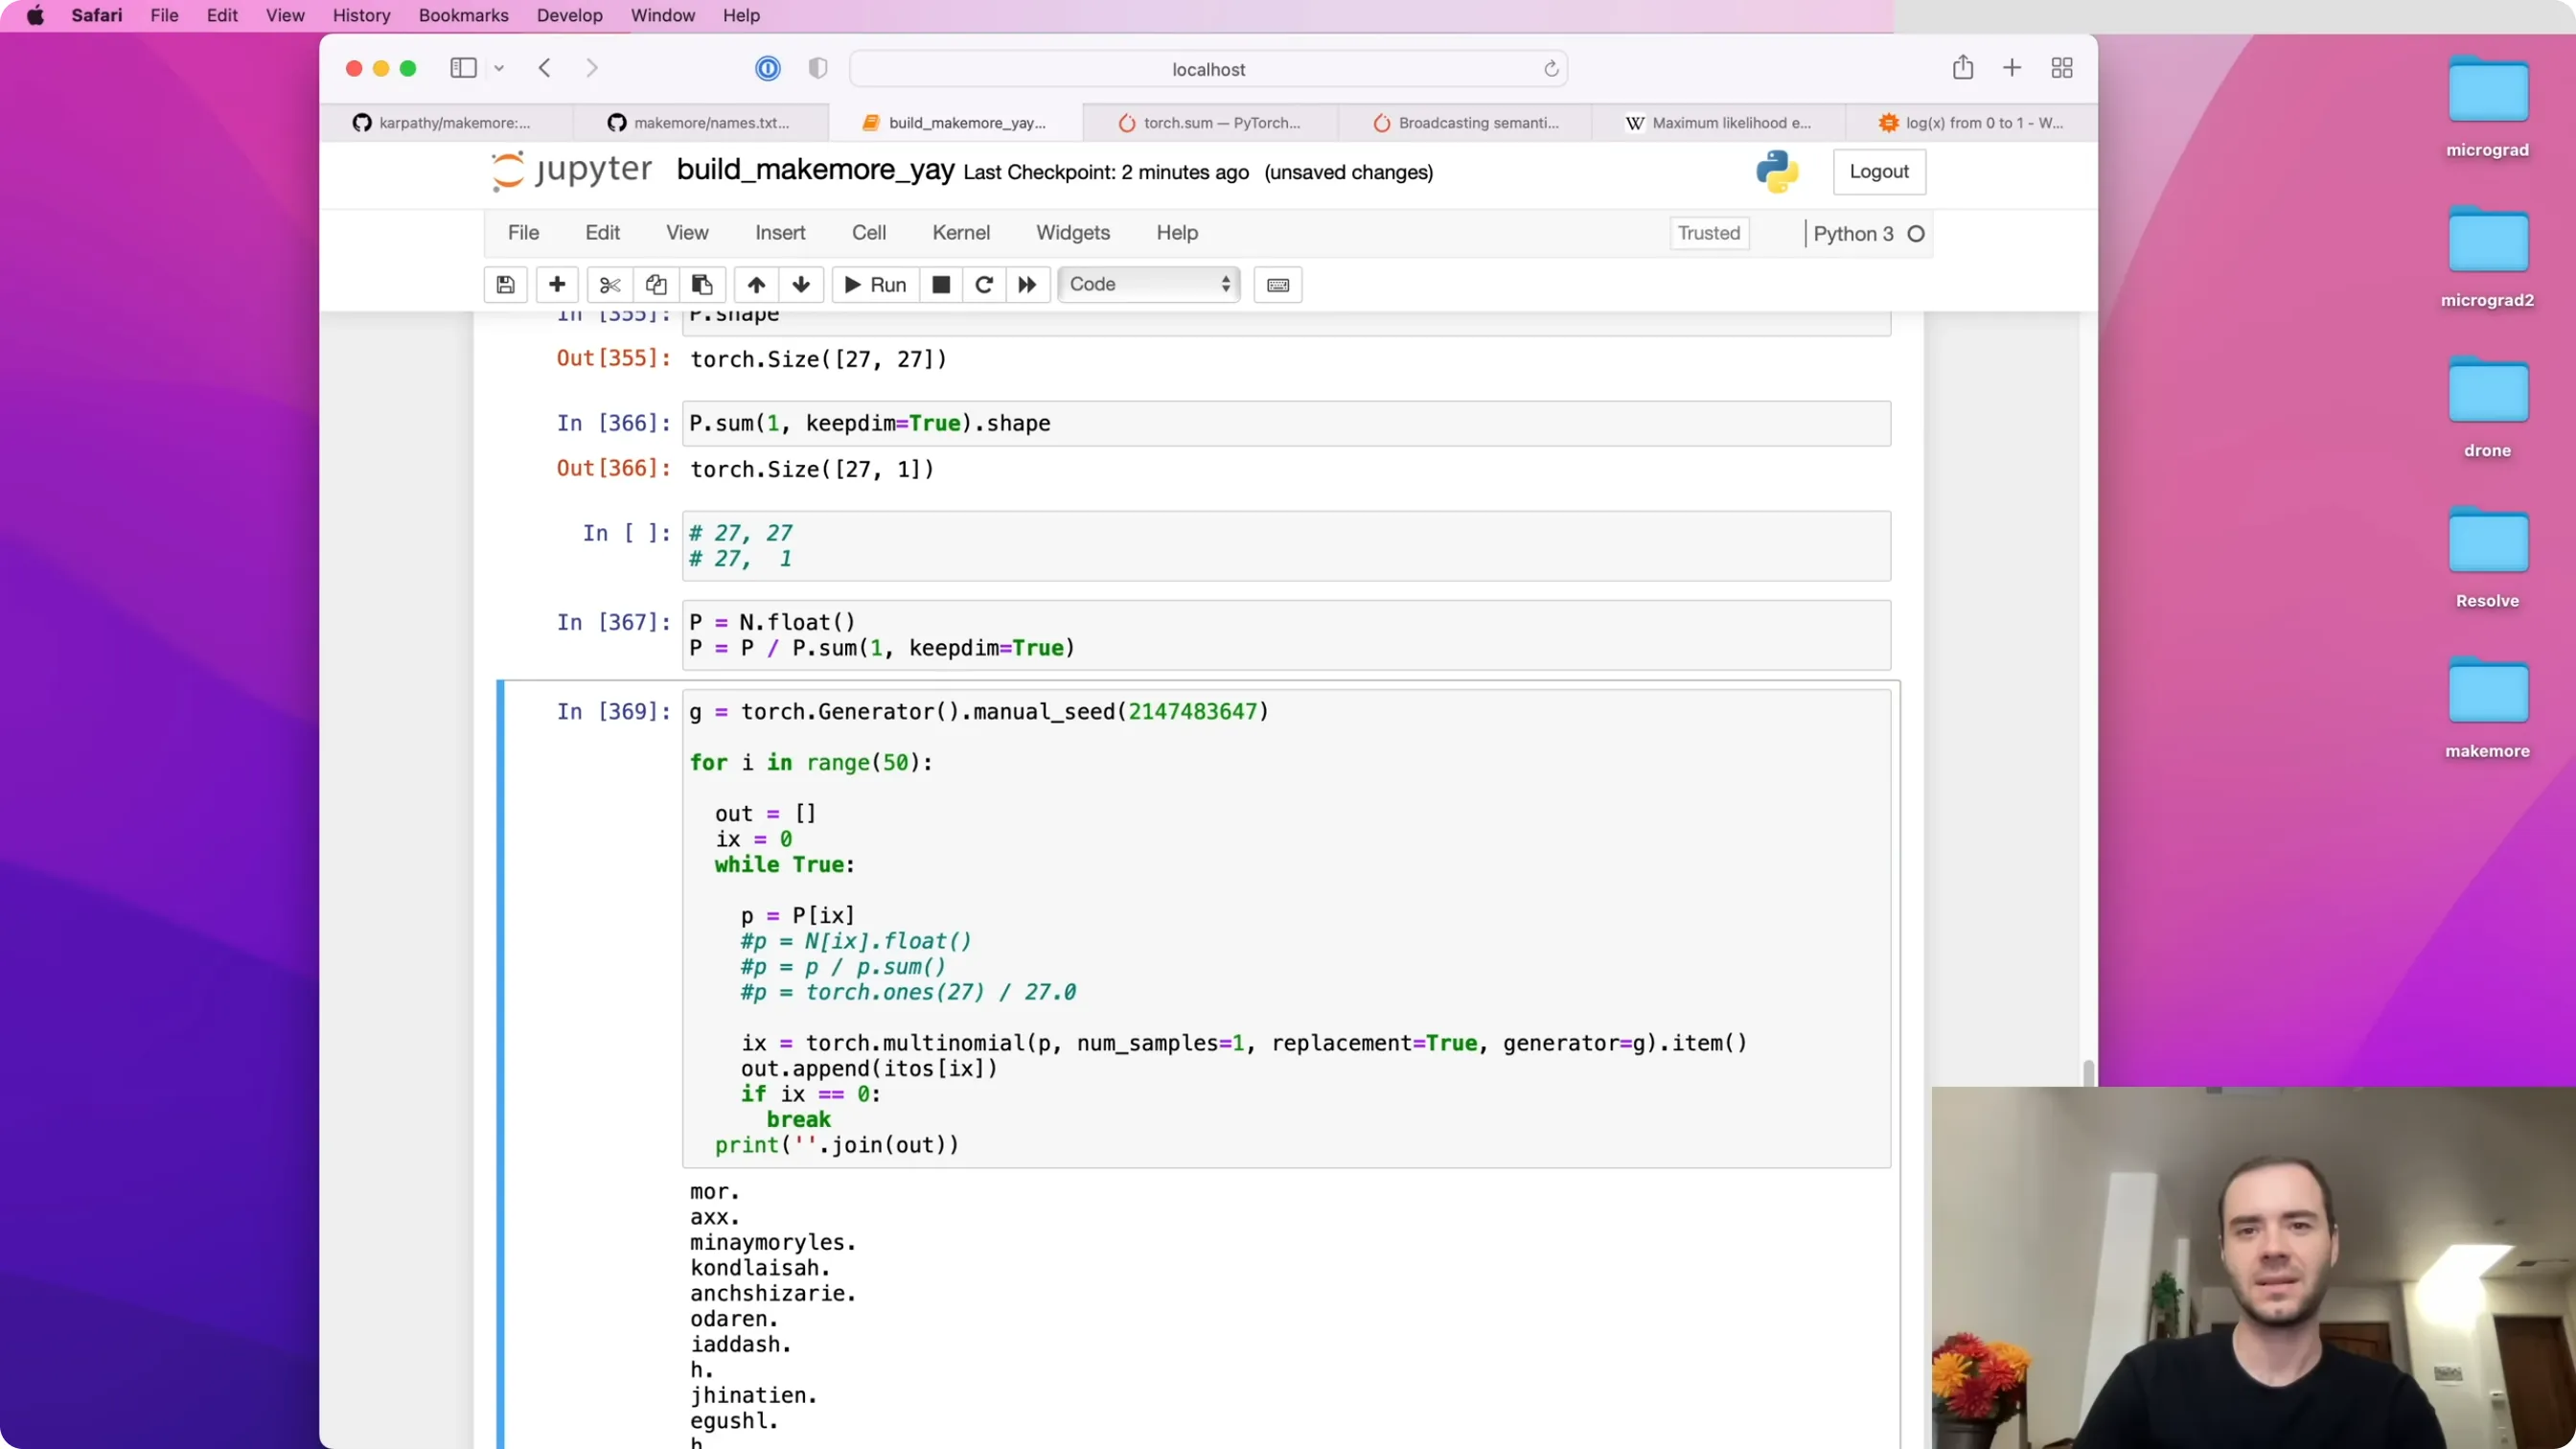
从概率分布里抽样,用 torch.multinomial。为了让每次运行结果可复现,我们固定一个随机数生成器(generator):
g = torch.Generator().manual_seed(2147483647)
ix = torch.multinomial(p, num_samples=1, replacement=True, generator=g).item()
itos[ix]
torch.multinomial接收一组概率,返回按该概率抽出的下标;replacement=True表示"有放回"抽样(抽出的元素放回池子,下次还可能被抽到)。默认是False,这里必须显式设为True;generator=g保证任何人在任何机器上跑都得到相同结果;.item()把张量里那个整数取出来。
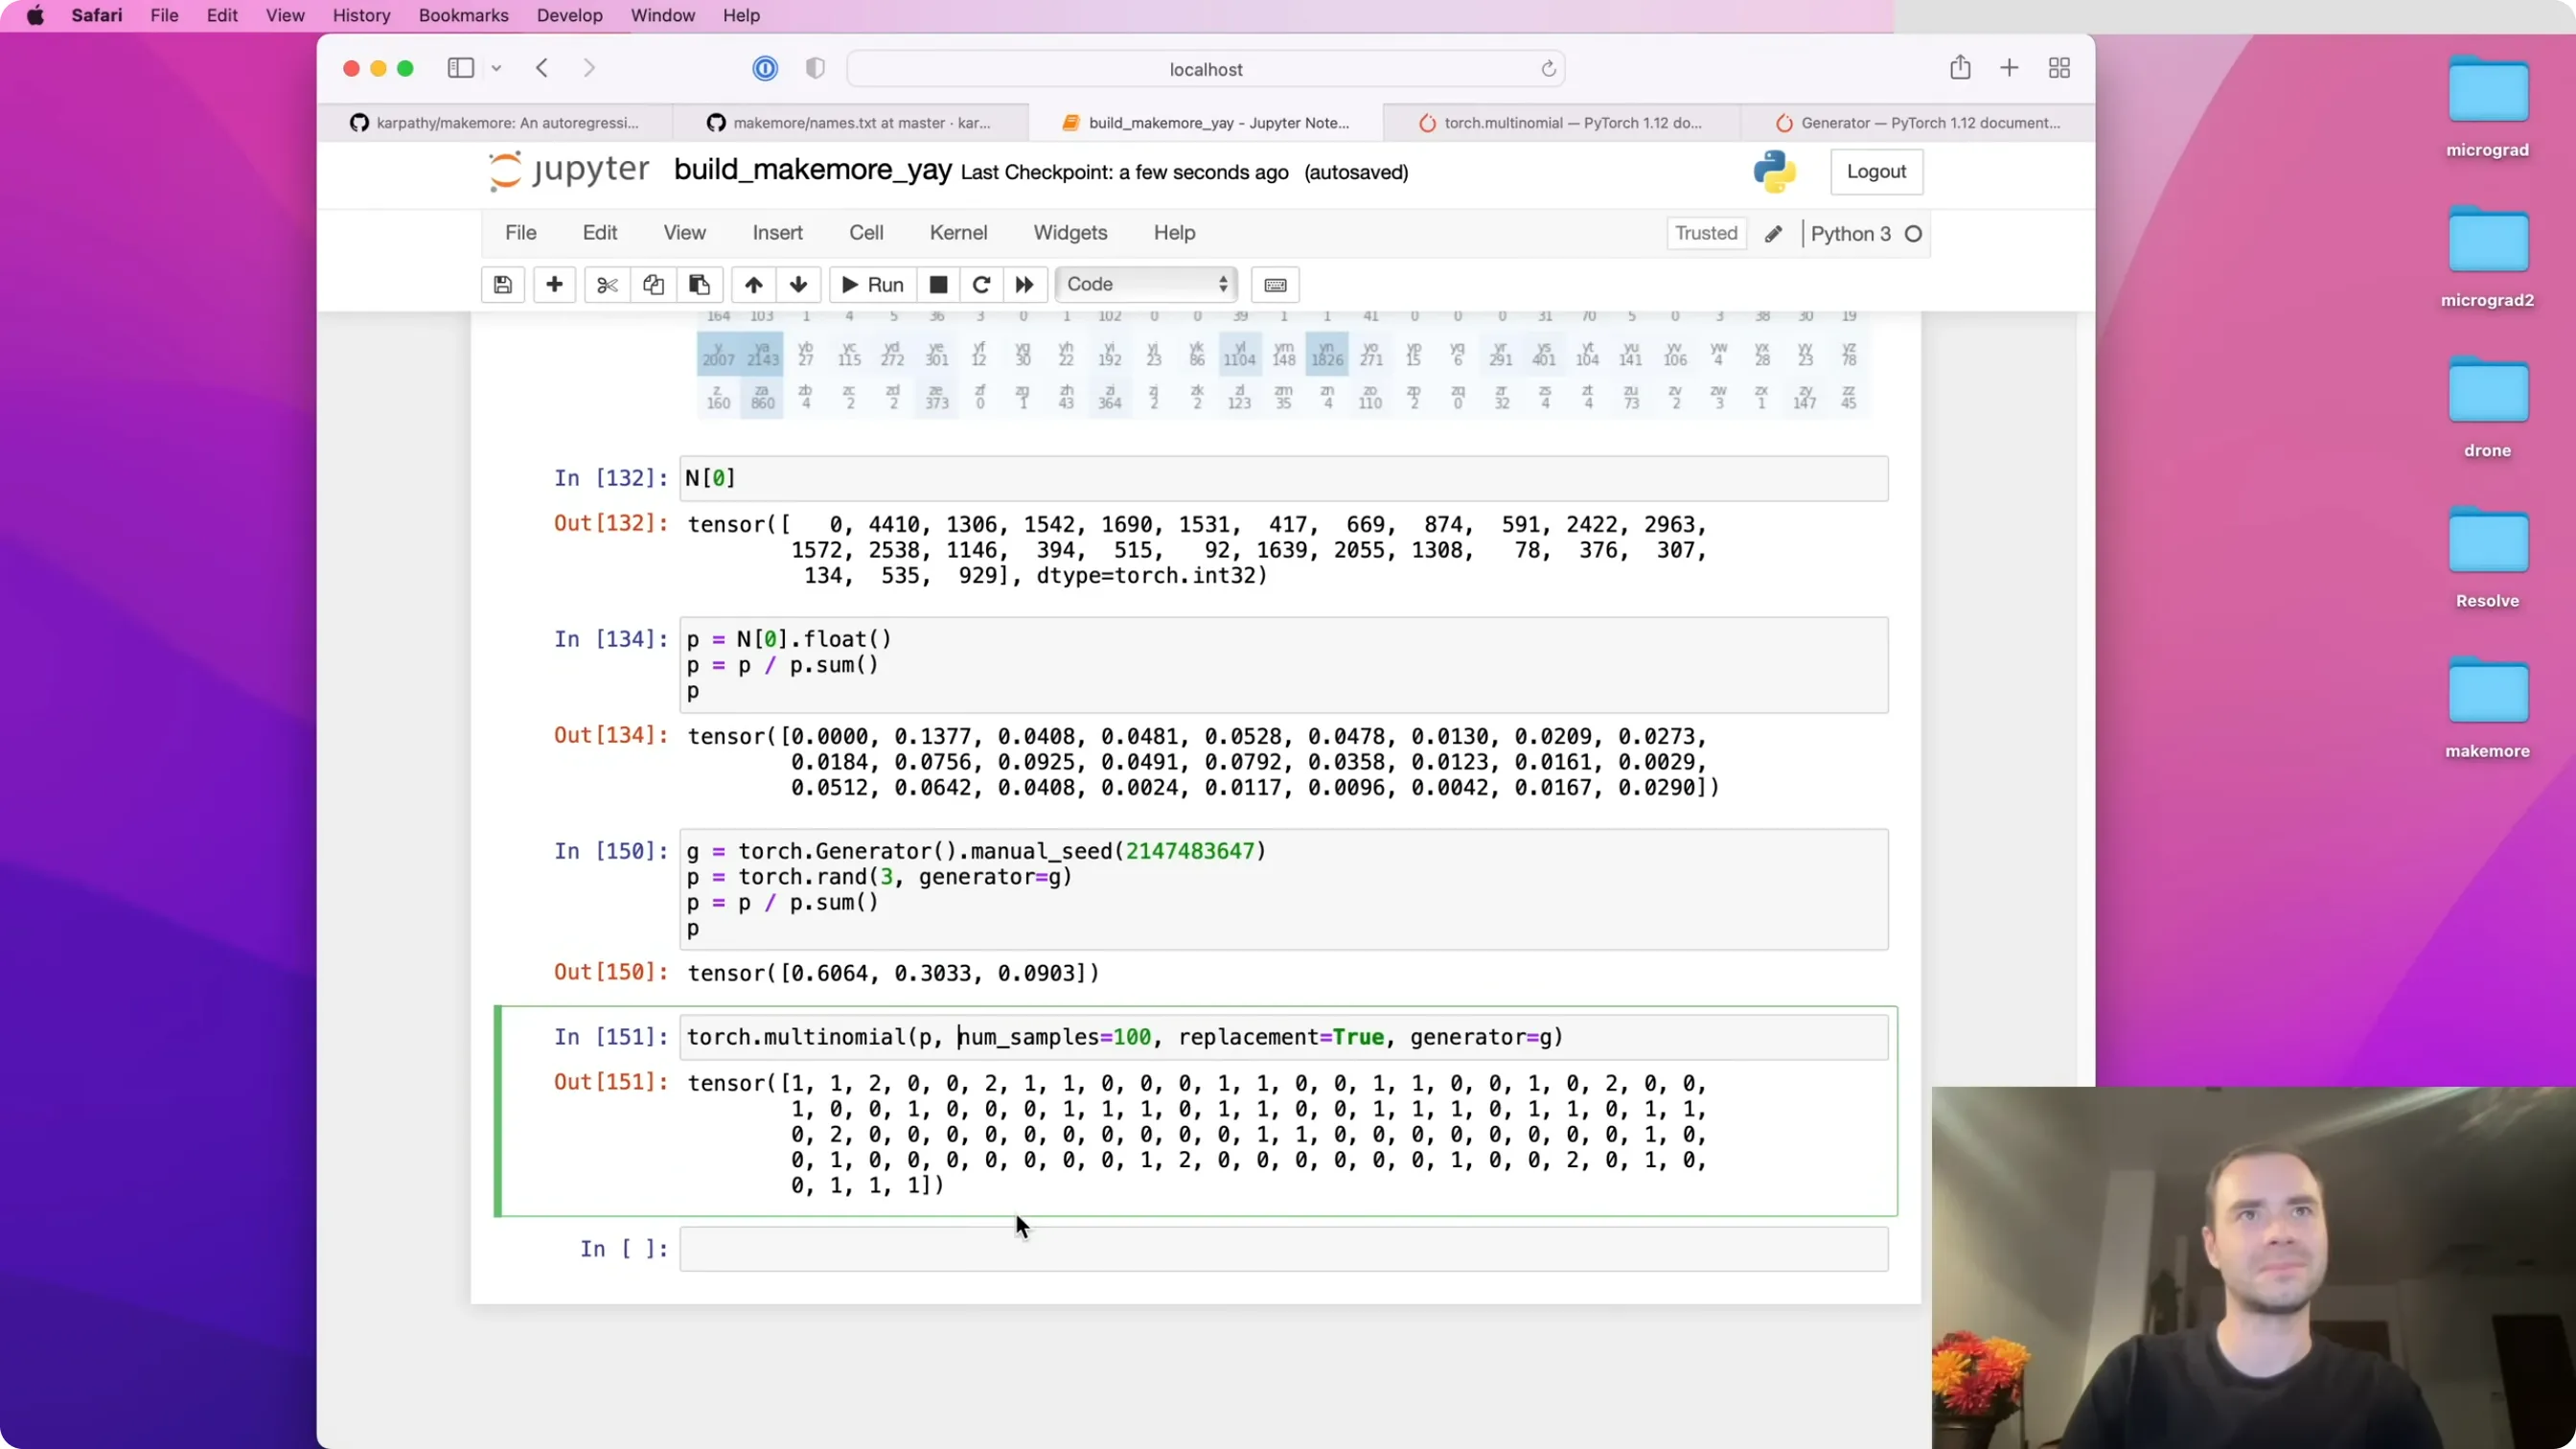
📷 固定随机种子并用 multinomial 从分布采样
回到原视频 (00:29:58)
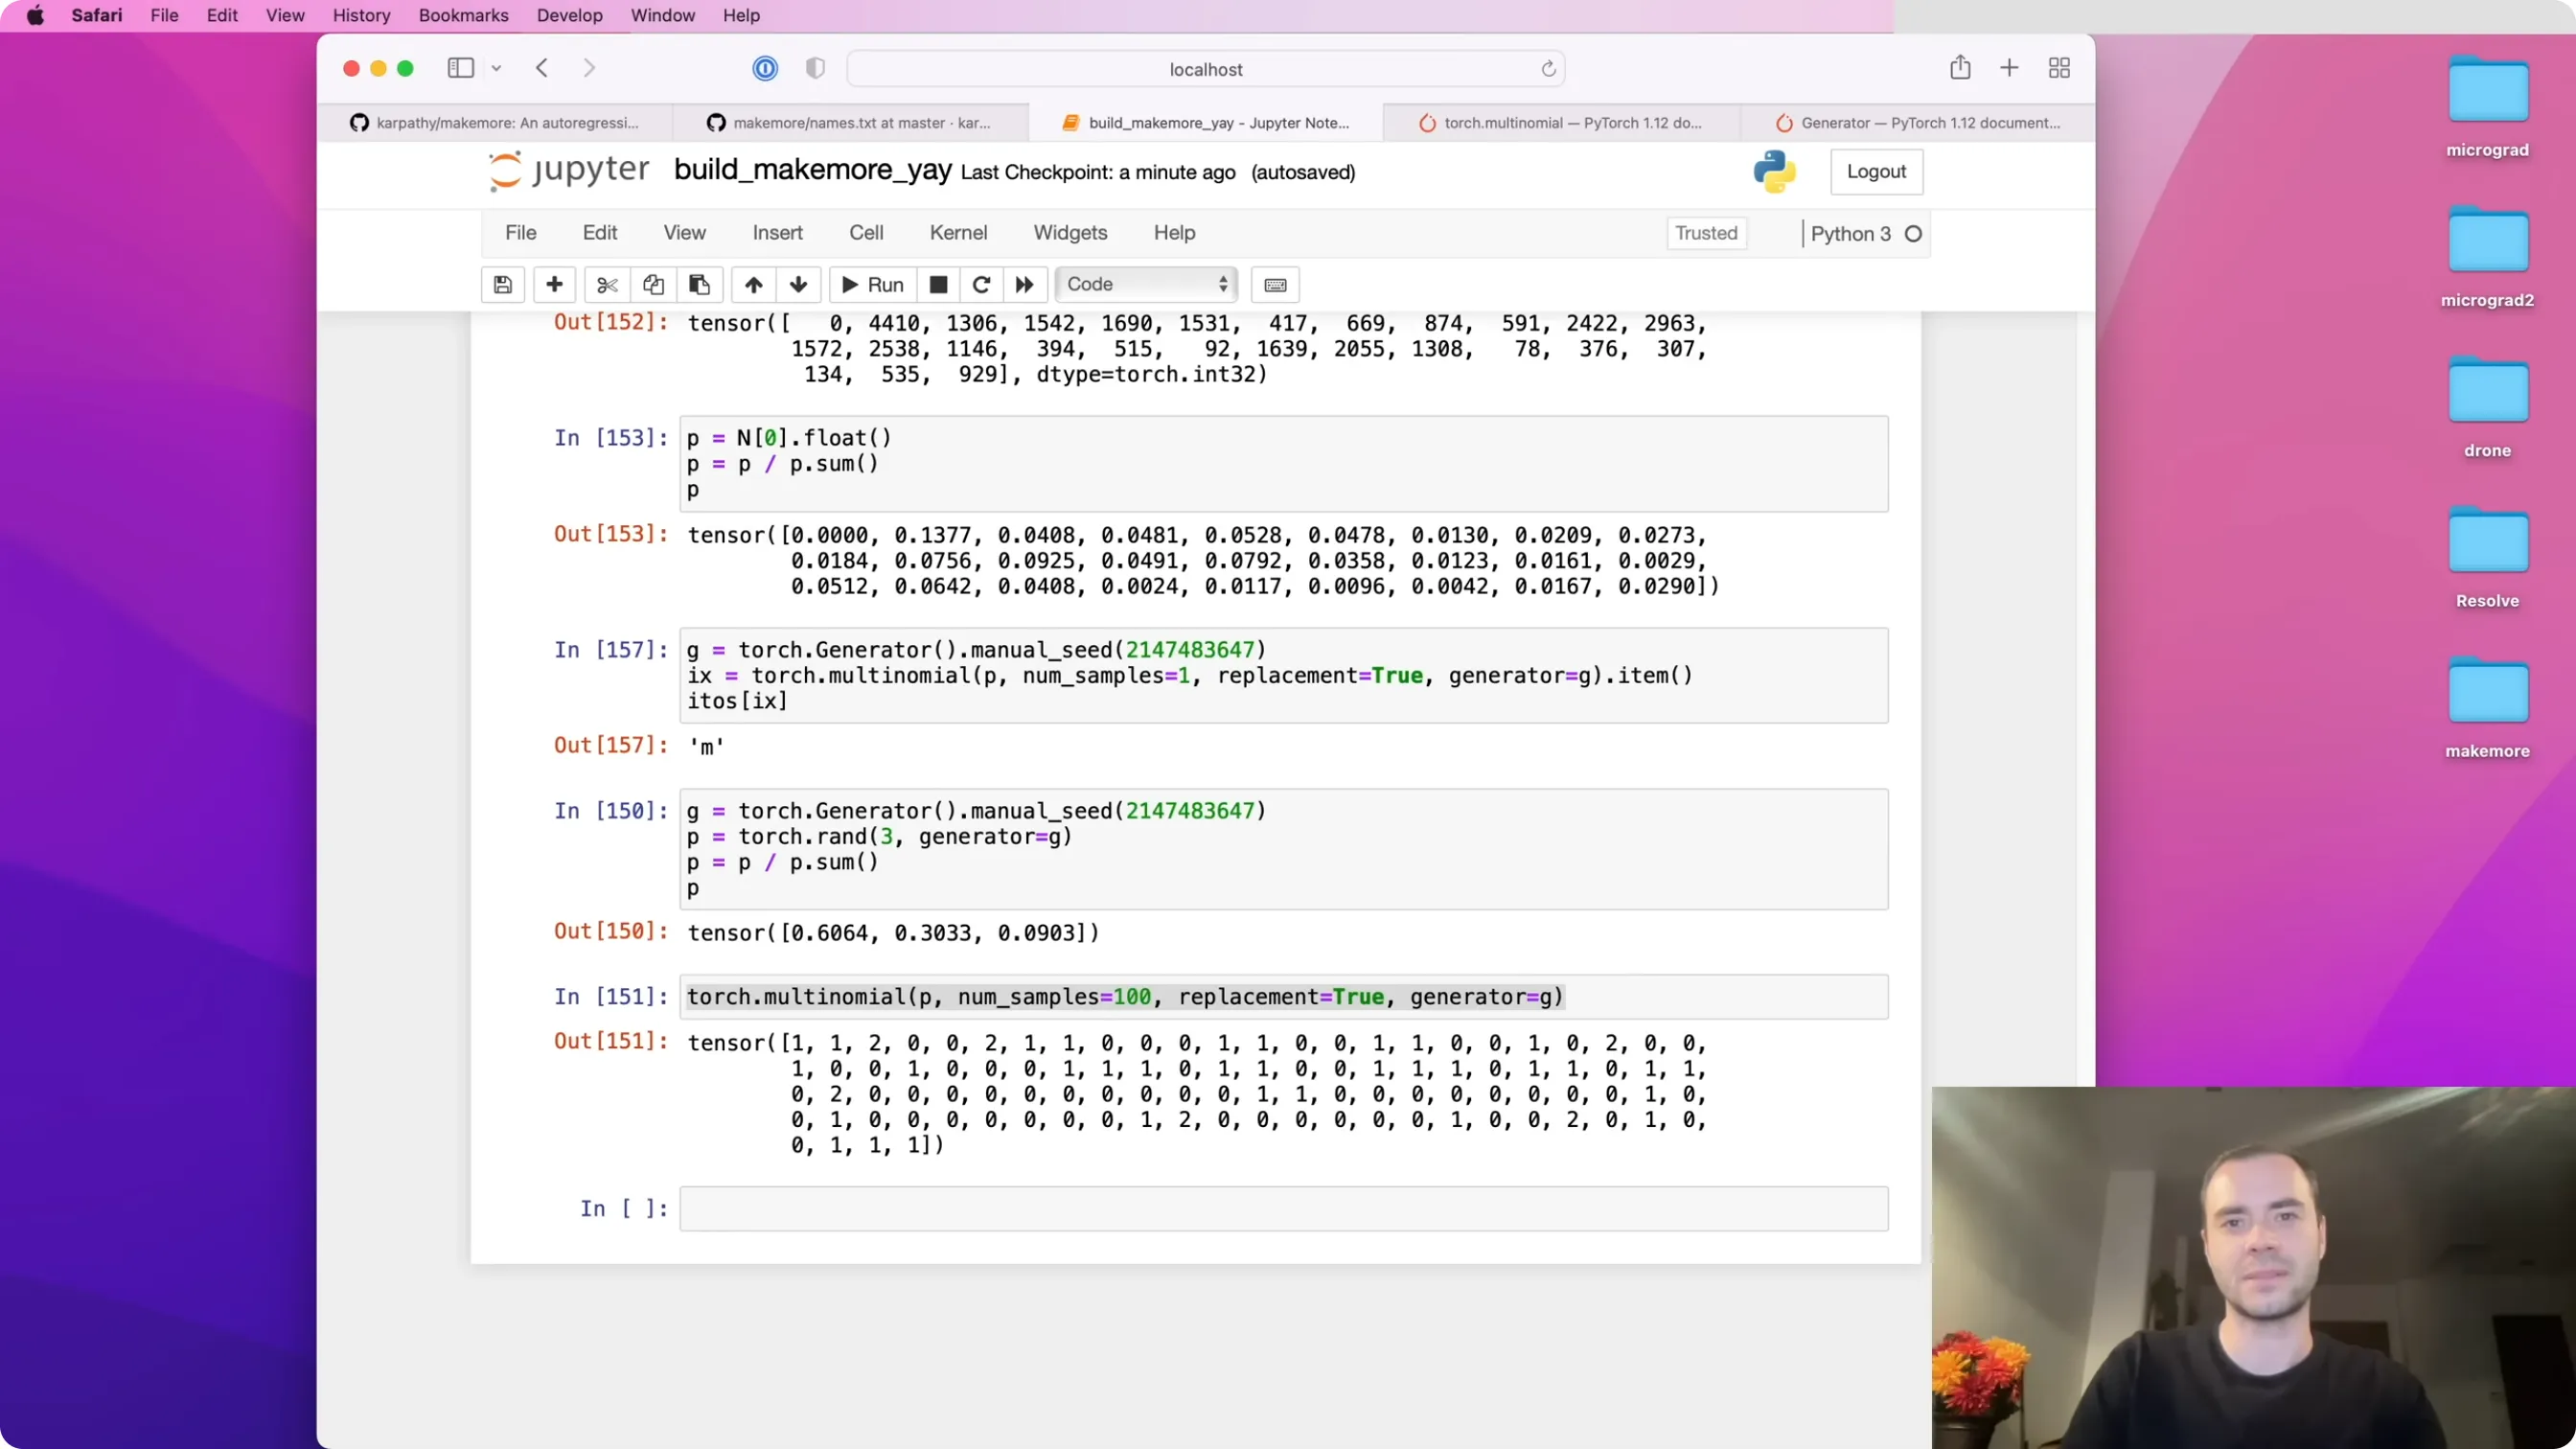
先用一个小例子理解 multinomial。取三个随机数并归一化:
g = torch.Generator().manual_seed(2147483647)
p = torch.rand(3, generator=g)
p = p / p.sum()
p   # 例如 tensor([0.6064, 0.3033, 0.0903])
p 大致是 [0.6, 0.3, 0.1]。抽 100 次:
torch.multinomial(p, num_samples=100, replacement=True, generator=g)
因为第一个元素概率是 60%,所以 0 出现得最多;第二个 30%,出现次数约是 0 的一半;第三个只有 10%,出现次数最少。抽样次数越多,结果的频率就越接近给定的概率。
编者拓展|模型吐出的是「概率分布」,不是「答案」:这是生成模型与分类器最大的差别。
torch.multinomial按概率抽样——同一个分布、每次抽出的结果不同;这正是「同一个问题问两次,ChatGPT 答得不一样」的原因;torch.manual_seed(2147483647)只是把随机数发生器固定住,让结果可复现(方便教学与调试),不是让模型变确定;- 后续讲里的 temperature(温度) 就是调这个分布的「尖锐程度」:越低越保守、越高越发散。
👉 看懂这一点,就明白了「LLM 为什么会胡说」——它一直在抽样。
完整采样循环
把上面的东西串起来,就是一个完整的生成循环:
g = torch.Generator().manual_seed(2147483647)

for i in range(5):
    out = []
    ix = 0                    # 从起始 token '.' 开始
    while True:
        p = P[ix]             # 当前字符对应的一行概率
        ix = torch.multinomial(p, num_samples=1, replacement=True, generator=g).item()
        out.append(itos[ix])
        if ix == 0:           # 抽到 '.' 就结束
            break
    print(''.join(out))
注意:
P是"每行都已经归一化好"的概率矩阵。这里先用P[ix],它的构成在下一章说明。
对 emma 这样的例子,模型可能先抽到 m,再抽到 o、r,最后抽到 .,得到 mor 这样的"名字"。
📷 完整采样循环代码及其运行结果
回到原视频 (00:31:48)
多抽一些:
for i in range(20):
    ...
结果看起来相当糟糕。讲师坦白说,他盯着这些结果看了好几分钟才确认程序没写错——bigram 语言模型就是真的这么差。
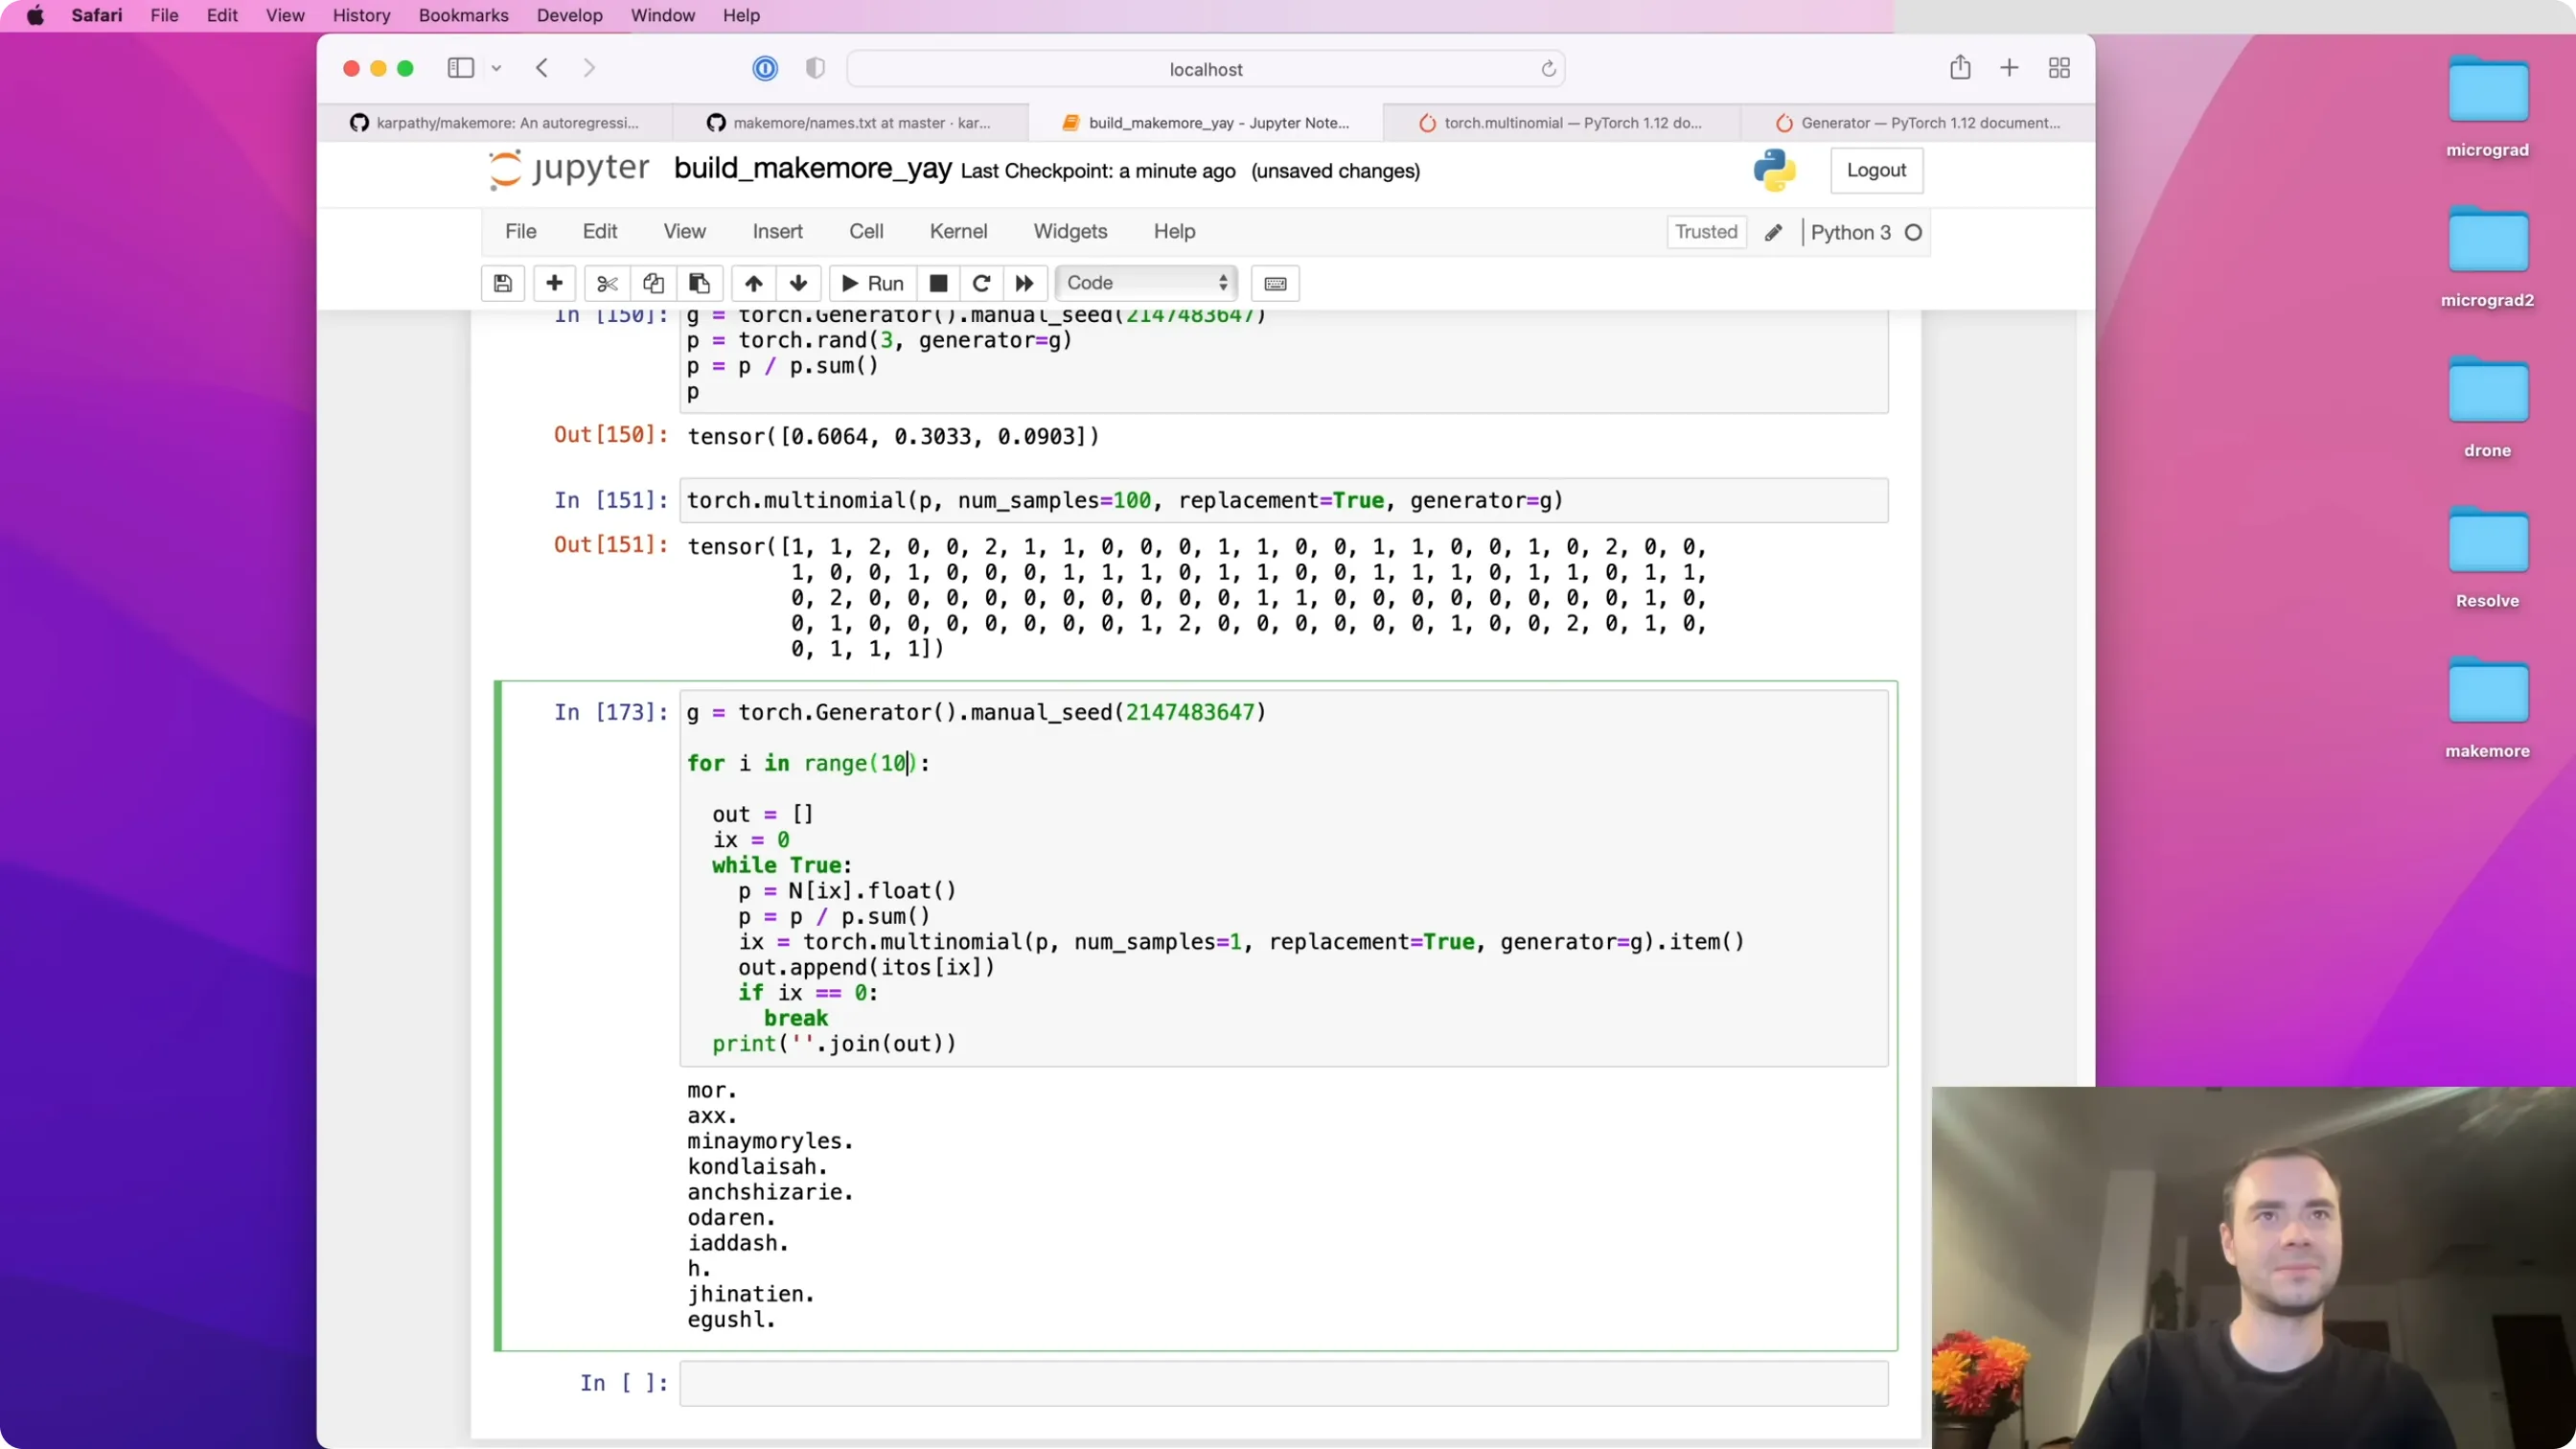
📷 从 bigram 模型批量采样生成的一串"名字"
回到原视频 (00:34:08)
要理解它为什么这么差,得站到模型的视角看:
模型只知道"上一个字符是什么",它不知道这个
H是不是名字的第一个字符。它唯一知道的是"前面出现过H,那么H后面是结尾的概率有多大"。既然H后面确实可以接结尾,它就把H当作整个名字,于是生成了单字母名字。
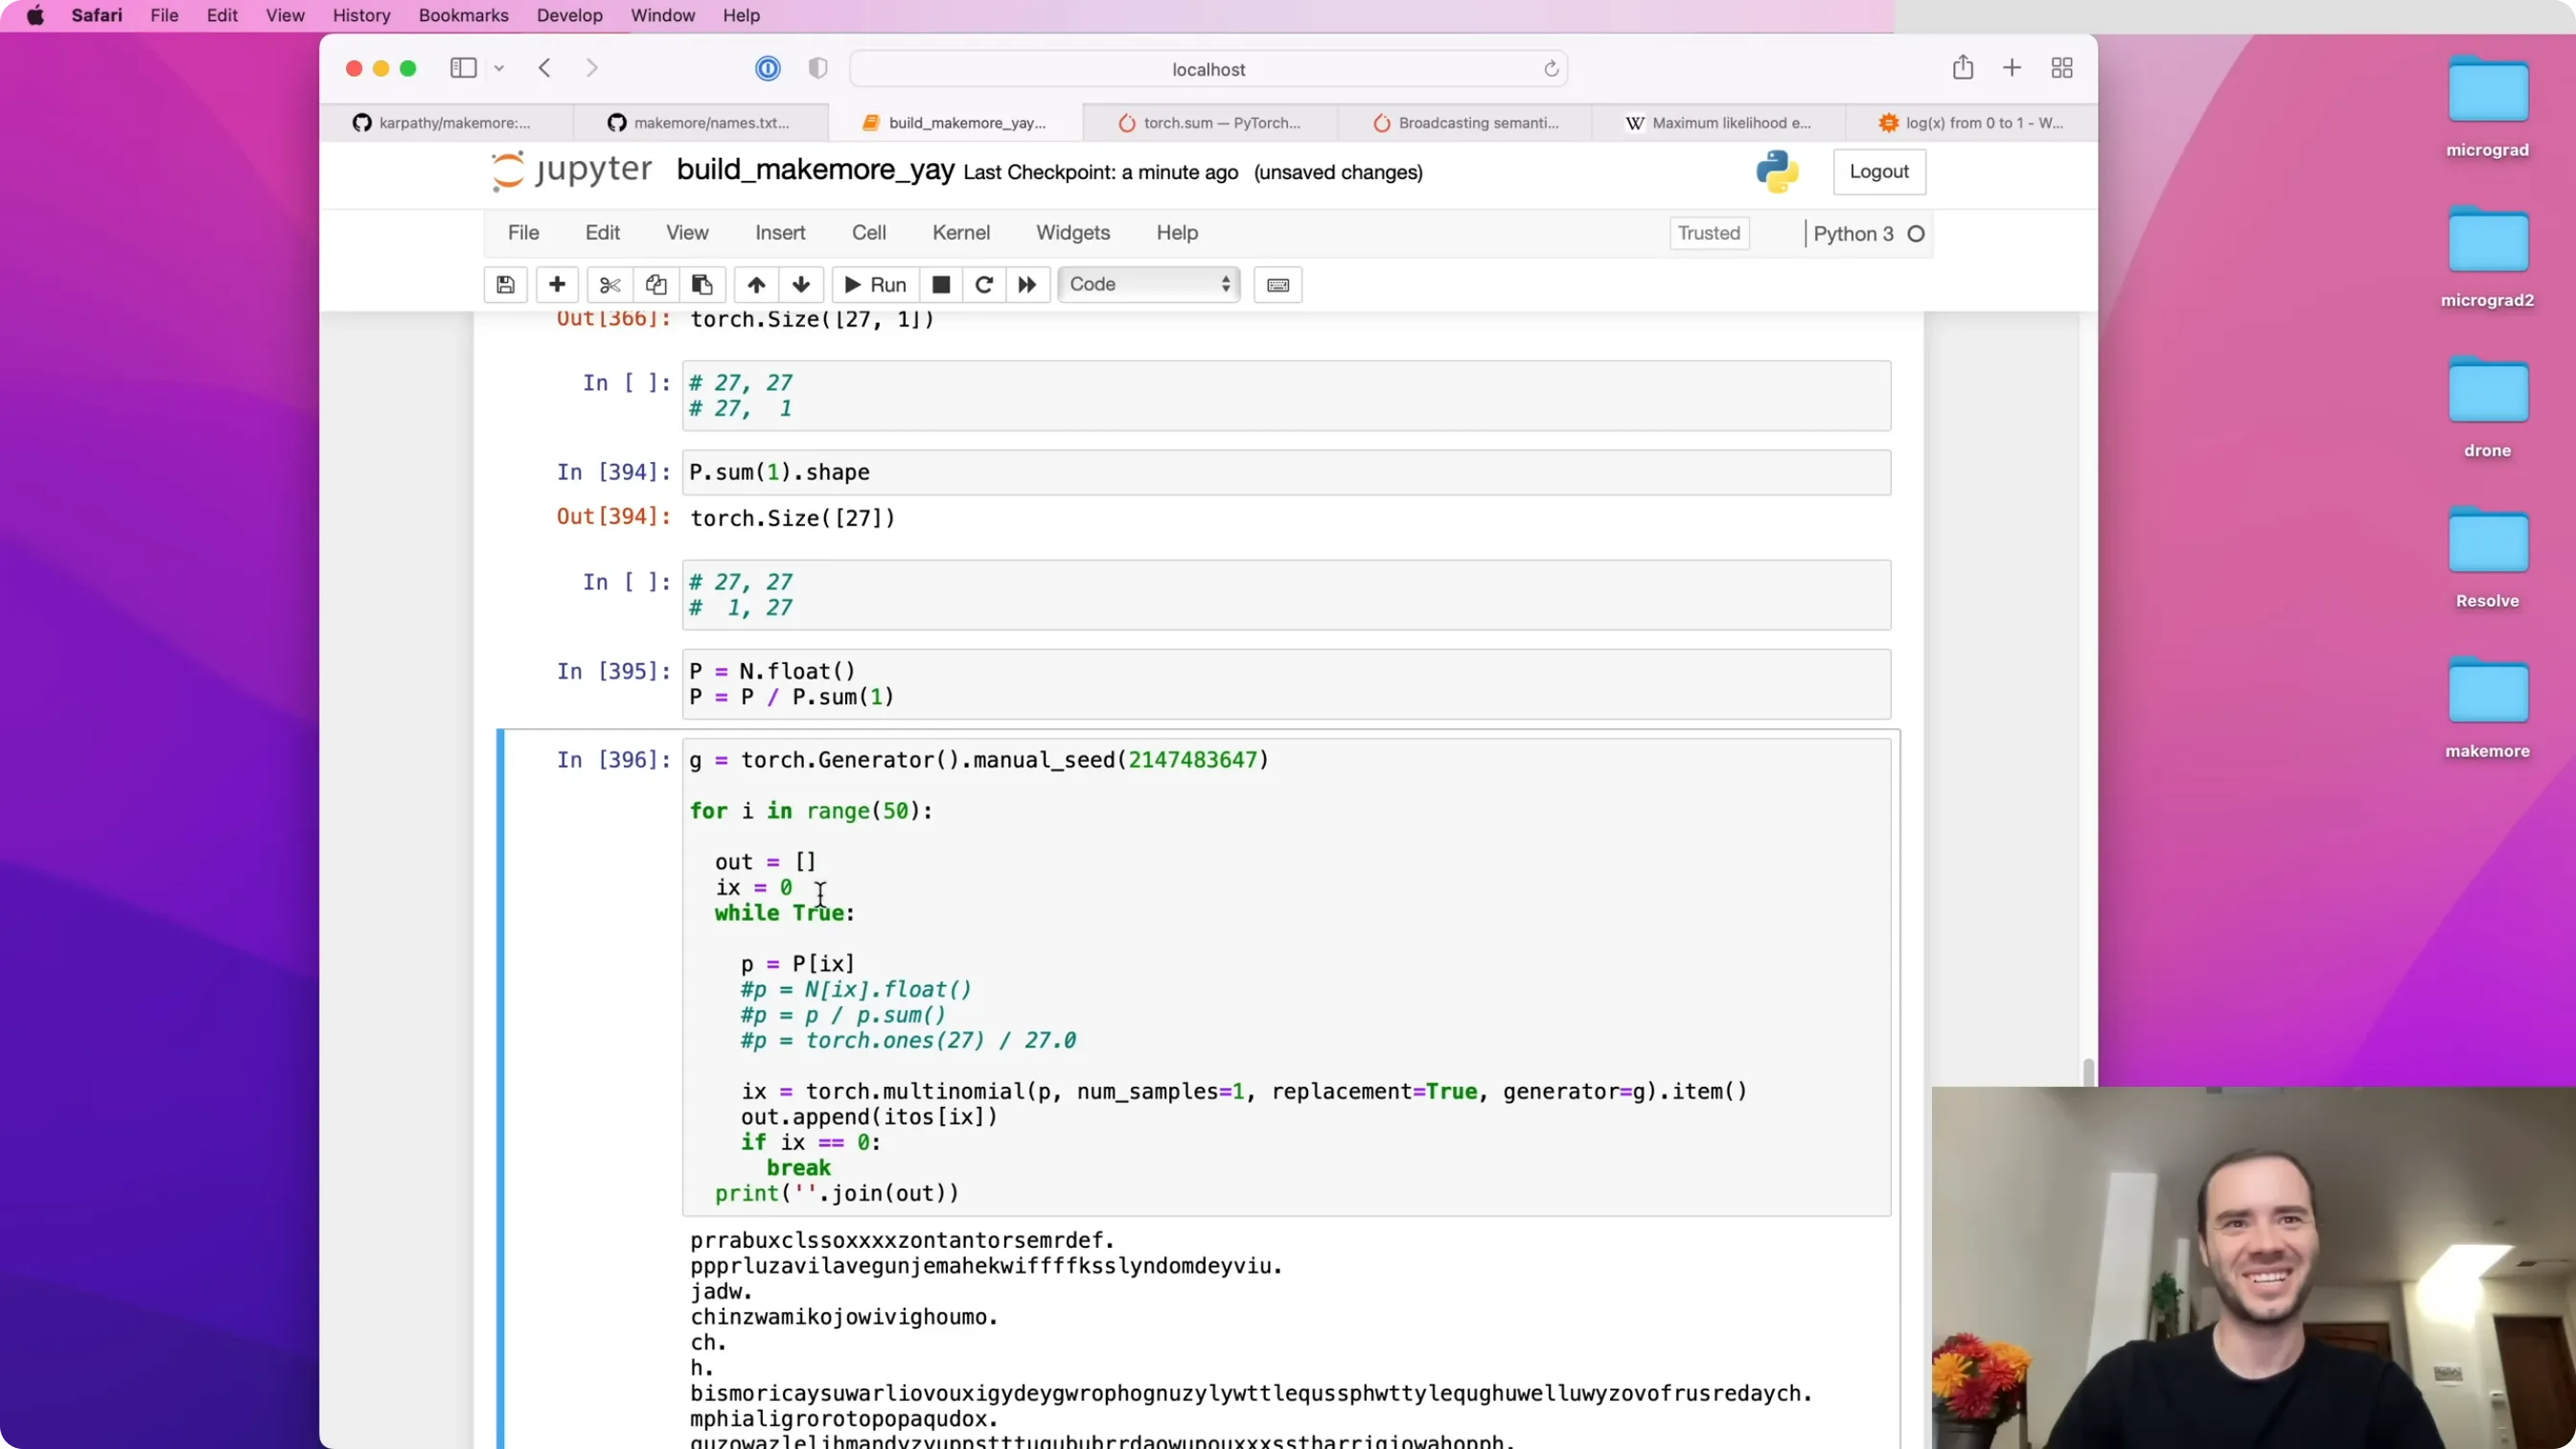
换个角度看,也能确认它确实学到了一些东西。如果让模型完全"未训练"——把概率设成均匀分布:
P = torch.ones(27) / 27.0
那么生成出来的就是彻底的垃圾。而训练过的 bigram 模型生成的结果虽然仍然糟糕,但已经"有点名字的样子"了。这说明模型确实捕捉到了数据里的局部统计结构,只是这个结构太局部、太弱。
七、效率与广播:向量化地归一化所有行
(参考时间: 36:17)
上一章的采样循环有一个明显的浪费:每抽一个字符,都要重新把一整行计数取出来、转成浮点、再除以它的和。对同一个字符,这个过程被反复做了无数遍。
更好的做法是:提前把所有行一并归一化好,存成一个概率矩阵 P。之后采样时直接 P[ix] 取一行即可。
这个改动本可以只为效率,但讲师顺带用它来练习 PyTorch 里一个极其重要的概念——广播(broadcasting)。因为后面要搭到 Transformer,会用到很多复杂的数组操作,必须真正理解广播。
先犯一个错:直接对整张矩阵做 P / P.sum()
P = N.float()
P / P.sum()
N 有 27×27 个数,但 P.sum() 只会把所有元素加起来,得到一个标量。用它去除,等于把所有计数都除以同一个总数——这不是我们想要的。我们想要的是:每一行各自除以该行的和,而且这一步要并行完成。
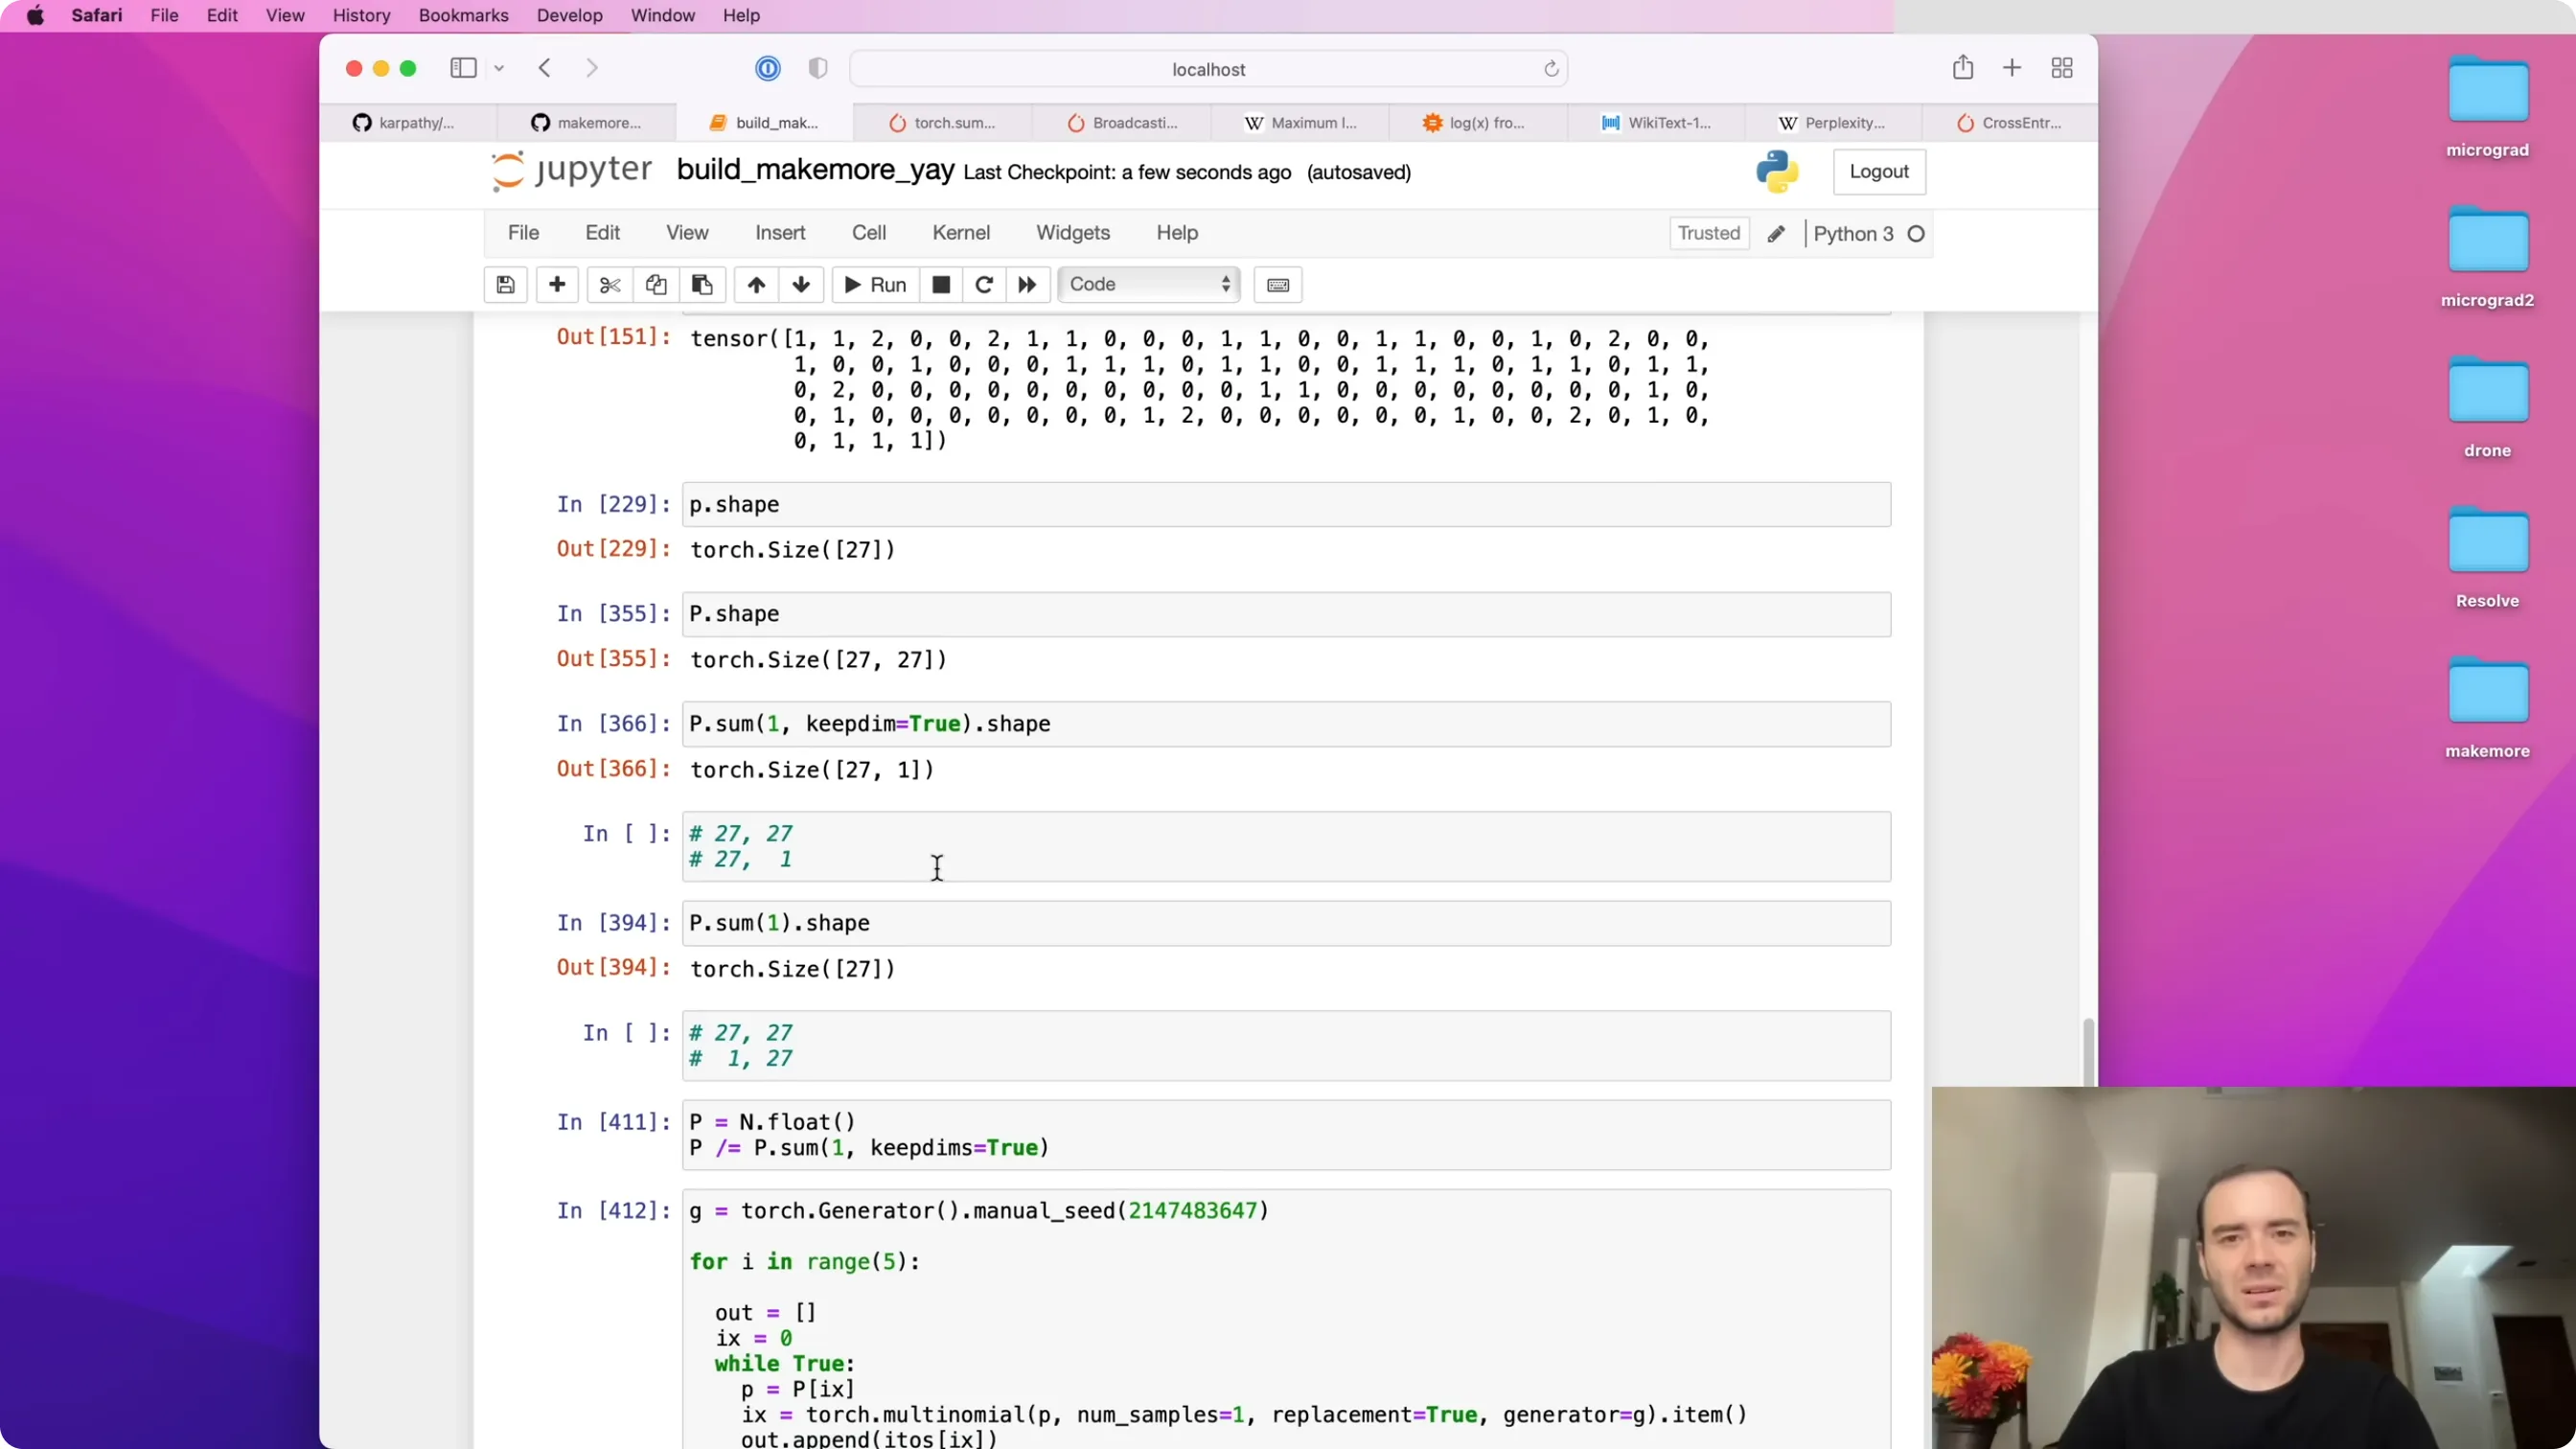
torch.sum 的 dim 和 keepdim
(参考时间: 38:32)
去看 torch.sum 的文档,会发现它可以接收一个 dim 参数,指定沿哪个维度求和。此外还有一个 keepdim 参数:
keepdim=True:求和后该维度保留,长度变为 1;keepdim=False(默认):求和后把该维度挤掉(squeeze)。
对一个 27×27 的矩阵 P:
P.sum(0, keepdim=True).shape   # torch.Size([1, 27]) —— 沿列方向求和,得到行向量
P.sum(1, keepdim=True).shape   # torch.Size([27, 1]) —— 沿行方向求和,得到列向量
P.sum(1).shape                 # torch.Size([27])    —— keepdim=False,1 被挤掉
dim=0是"竖着求和",把每一列压成一个数,得到长条形的行向量;dim=1是"横着求和",把每一行压成一个数,得到长条形的列向量——这正是我们需要的每行之和。
📷 torch.sum 在不同 dim 与 keepdim 设置下的形状变化
回到原视频 (00:41:26)
编者拓展|
dim与keepdim的确切语义(PyTorch 官方定义):
sum(dim=k)会把第 k 维去掉,其余维度保留;keepdim=True不删掉该维,而是把它留成长度 1;- 为什么重要:后续做除法/减法时,形状必须能广播对齐——保留成长度 1 的维才能与「其它维长度 n」正确对齐。
另外注意方向:
dim=0是跳着所有行往下压(得到每列的和),dim=1是沿每行压(得到每行的和)。这个方向感一开始很容易搞反。
广播规则
(参考时间: 42:03)
接下来问:27×27 的矩阵能不能直接除 27×1 的列向量?这取决于广播规则:
- 两个张量都至少有一个维度;
- 从最右边的维度开始,逐维比较:两个维度要么相等,要么其中一个为 1,要么其中一个不存在;
- 满足以上条件才能做逐元素运算,否则报错。
把 27×27 和 27×1 对齐:
27  27
27   1
     ↑ 这一维一个是 1,可以"拉伸/复制"成 27
第二维(最右)不相等,但其中一个是 1,合法;第一维都等于 27,合法。所以运算是允许的。
执行时,广播会把那个长度为 1 的维度复制成 27:也就是把这个 27×1 的列向量复制 27 遍,铺成一张 27×27 的矩阵,然后再做逐元素相除。这恰好就是我们想要的"每一行除以各自的和":
P = N.float()
P /= P.sum(1, keepdim=True)
验证一下:P[0].sum() 应该等于 1。
📷 用广播按行归一化,并验证第一行之和为 1
回到原视频 (00:44:19)
编者拓展|广播(broadcasting)规则本身:两个张量做逐元素运算时,如果形状不同,按以下规则判断能否广播:
- 从最右边那一维开始,逐位向左比较;
- 每一对要么相等,要么其中一个是 1(为 1 的那一维会被「拉伸」到对齐);
- 只要有一对不满足,就报错。
它与 NumPy 的广播规则完全一致(所以官方才推荐用 CS231n 的 NumPy 教程来练)。 👉 关键理解:广播不复制数据(所谓「拉伸」是零成本的视图语义),只有在反向传播时才会真的把梯度加起来。
广播的陷阱:keepdim 漏写会悄悄出 bug
(参考时间: 45:07)
现在讲一个非常容易踩的坑。如果把 keepdim 去掉:
P = N.float()
P /= P.sum(1)     # keepdim 默认为 False!
这段代码不会报错,但结果是错的。原因是:
P.sum(1)的形状是(27,),一个一维向量;- 广播从右对齐时,会默默地在左边补一个 1,把它当成
(1, 27)的行向量; - 于是广播把这个行向量竖直复制 27 遍,去做逐元素相除——结果变成了按列归一化,而不是按行归一化。
验证:P[0].sum() 不再是 1,而是别的数;反倒是第一列的和变成了 1。
讲师特别强调:要敬畏广播。它不会替你检查方向对不对,一旦方向搞反,就会产生非常隐蔽、极难排查的 bug。正确写法必须带上 keepdim=True。
📷 keepdim=False 导致按列归一化的广播 bug 演示
回到原视频 (00:46:48)
就地操作
(参考时间: 49:48)
P = N.float()
P /= P.sum(1, keepdim=True)
这里的 /= 是就地(in-place)操作:它直接修改 P,而不是创建一个新张量再赋值回 P。就地操作有可能更快,也不会额外分配内存。
至此,P 的每一行都是一个合法的概率分布——它就是这个 bigram 语言模型的参数。我们既会训练它(数数 + 归一化),也会从它采样(按行抽样下一个字符)。
八、损失函数:负对数似然
(参考时间: 50:14)
模型好不好,需要一个单一数字来概括。就像 micrograd 里做的那样,我们要定义一个损失函数(loss function)。
先看模型给每个 bigram 分配了多大概率
把之前统计的代码复制过来,但这次不数数,而是查 P:
for w in words[:3]:
    chs = ['.'] + list(w) + ['.']
    for ch1, ch2 in zip(chs, chs[1:]):
        ix1 = stoi[ch1]
        ix2 = stoi[ch2]
        prob = P[ix1, ix2]
        print(f'{ch1}{ch2}: {prob:.4f}')
对 emma、olivia、ava 这几个词,模型给某些 bigram 的概率低到 4% 左右,有些则高达 40%、35%。这里有个很好的"参照尺":
一共有 27 种字符。如果每个字符等概率,那么每个 bigram 的概率大约是 1/27 ≈ 4%。 所以凡是明显高于 4% 的,都说明模型从数据里学到了有用的东西。
📷 查看模型为训练集中每个 bigram 分配的概率
回到原视频 (00:51:17)
从似然到对数似然
(参考时间: 53:11)
在统计建模里,衡量模型质量常用的量是似然(likelihood)——所有样本概率的乘积。似然越高越好。
但直接把 32,000 个 0~1 之间的小数相乘,结果会小到无法表示,非常不好用。于是人们改用对数似然(log likelihood):把乘积变成求和。因为对数的性质:
log(a · b · c) = log(a) + log(b) + log(c)
单个概率的 log 是单调变换:概率为 1 时 log = 0;概率越低,log 越负,趋近于 0 时趋于负无穷。
log_likelihood = 0.0
n = 0
for w in words:
    chs = ['.'] + list(w) + ['.']
    for ch1, ch2 in zip(chs, chs[1:]):
        ix1 = stoi[ch1]
        ix2 = stoi[ch2]
        prob = P[ix1, ix2]
        logprob = torch.log(prob)
        log_likelihood += logprob
        n += 1
编者拓展|为什么处处要取对数:两个很硬的理由——
- 防下溢:概率是 $(0,1)$ 之间的小数。一句长序列的概率是 很多个概率相乘,几十个字之后就会小到 浮点数表示不了(变成精确的 0),于是 $\log 0=-\infty$;
- 把连乘变连加:$\log(ab)=\log a+\log b$。求和数值上稳定得多,而且求导更简单(这也是后面用梯度能训起来的前提)。
还要记住:$\log$ 是单调递增的,所以「哪个序列概率更大」这个排序不会变——最大化似然 与 最大化对数似然 是同一件事。
从对数似然到负对数似然(损失)
(参考时间: 56:37)
我们希望最大化对数似然,但损失函数的语义是"越小越好"(因为我们要最小化损失)。所以取负号,得到负对数似然(negative log likelihood, NLL):
nll = -log_likelihood
print(nll / n)     # 平均负对数似然,也就是损失
总结这一串等价关系:
- 最大化似然(概率乘积);
- ⇔ 最大化对数似然(因为 log 单调);
- ⇔ 最小化负对数似然;
- 实践中人们最小化平均负对数似然,这样数字规模更好看。
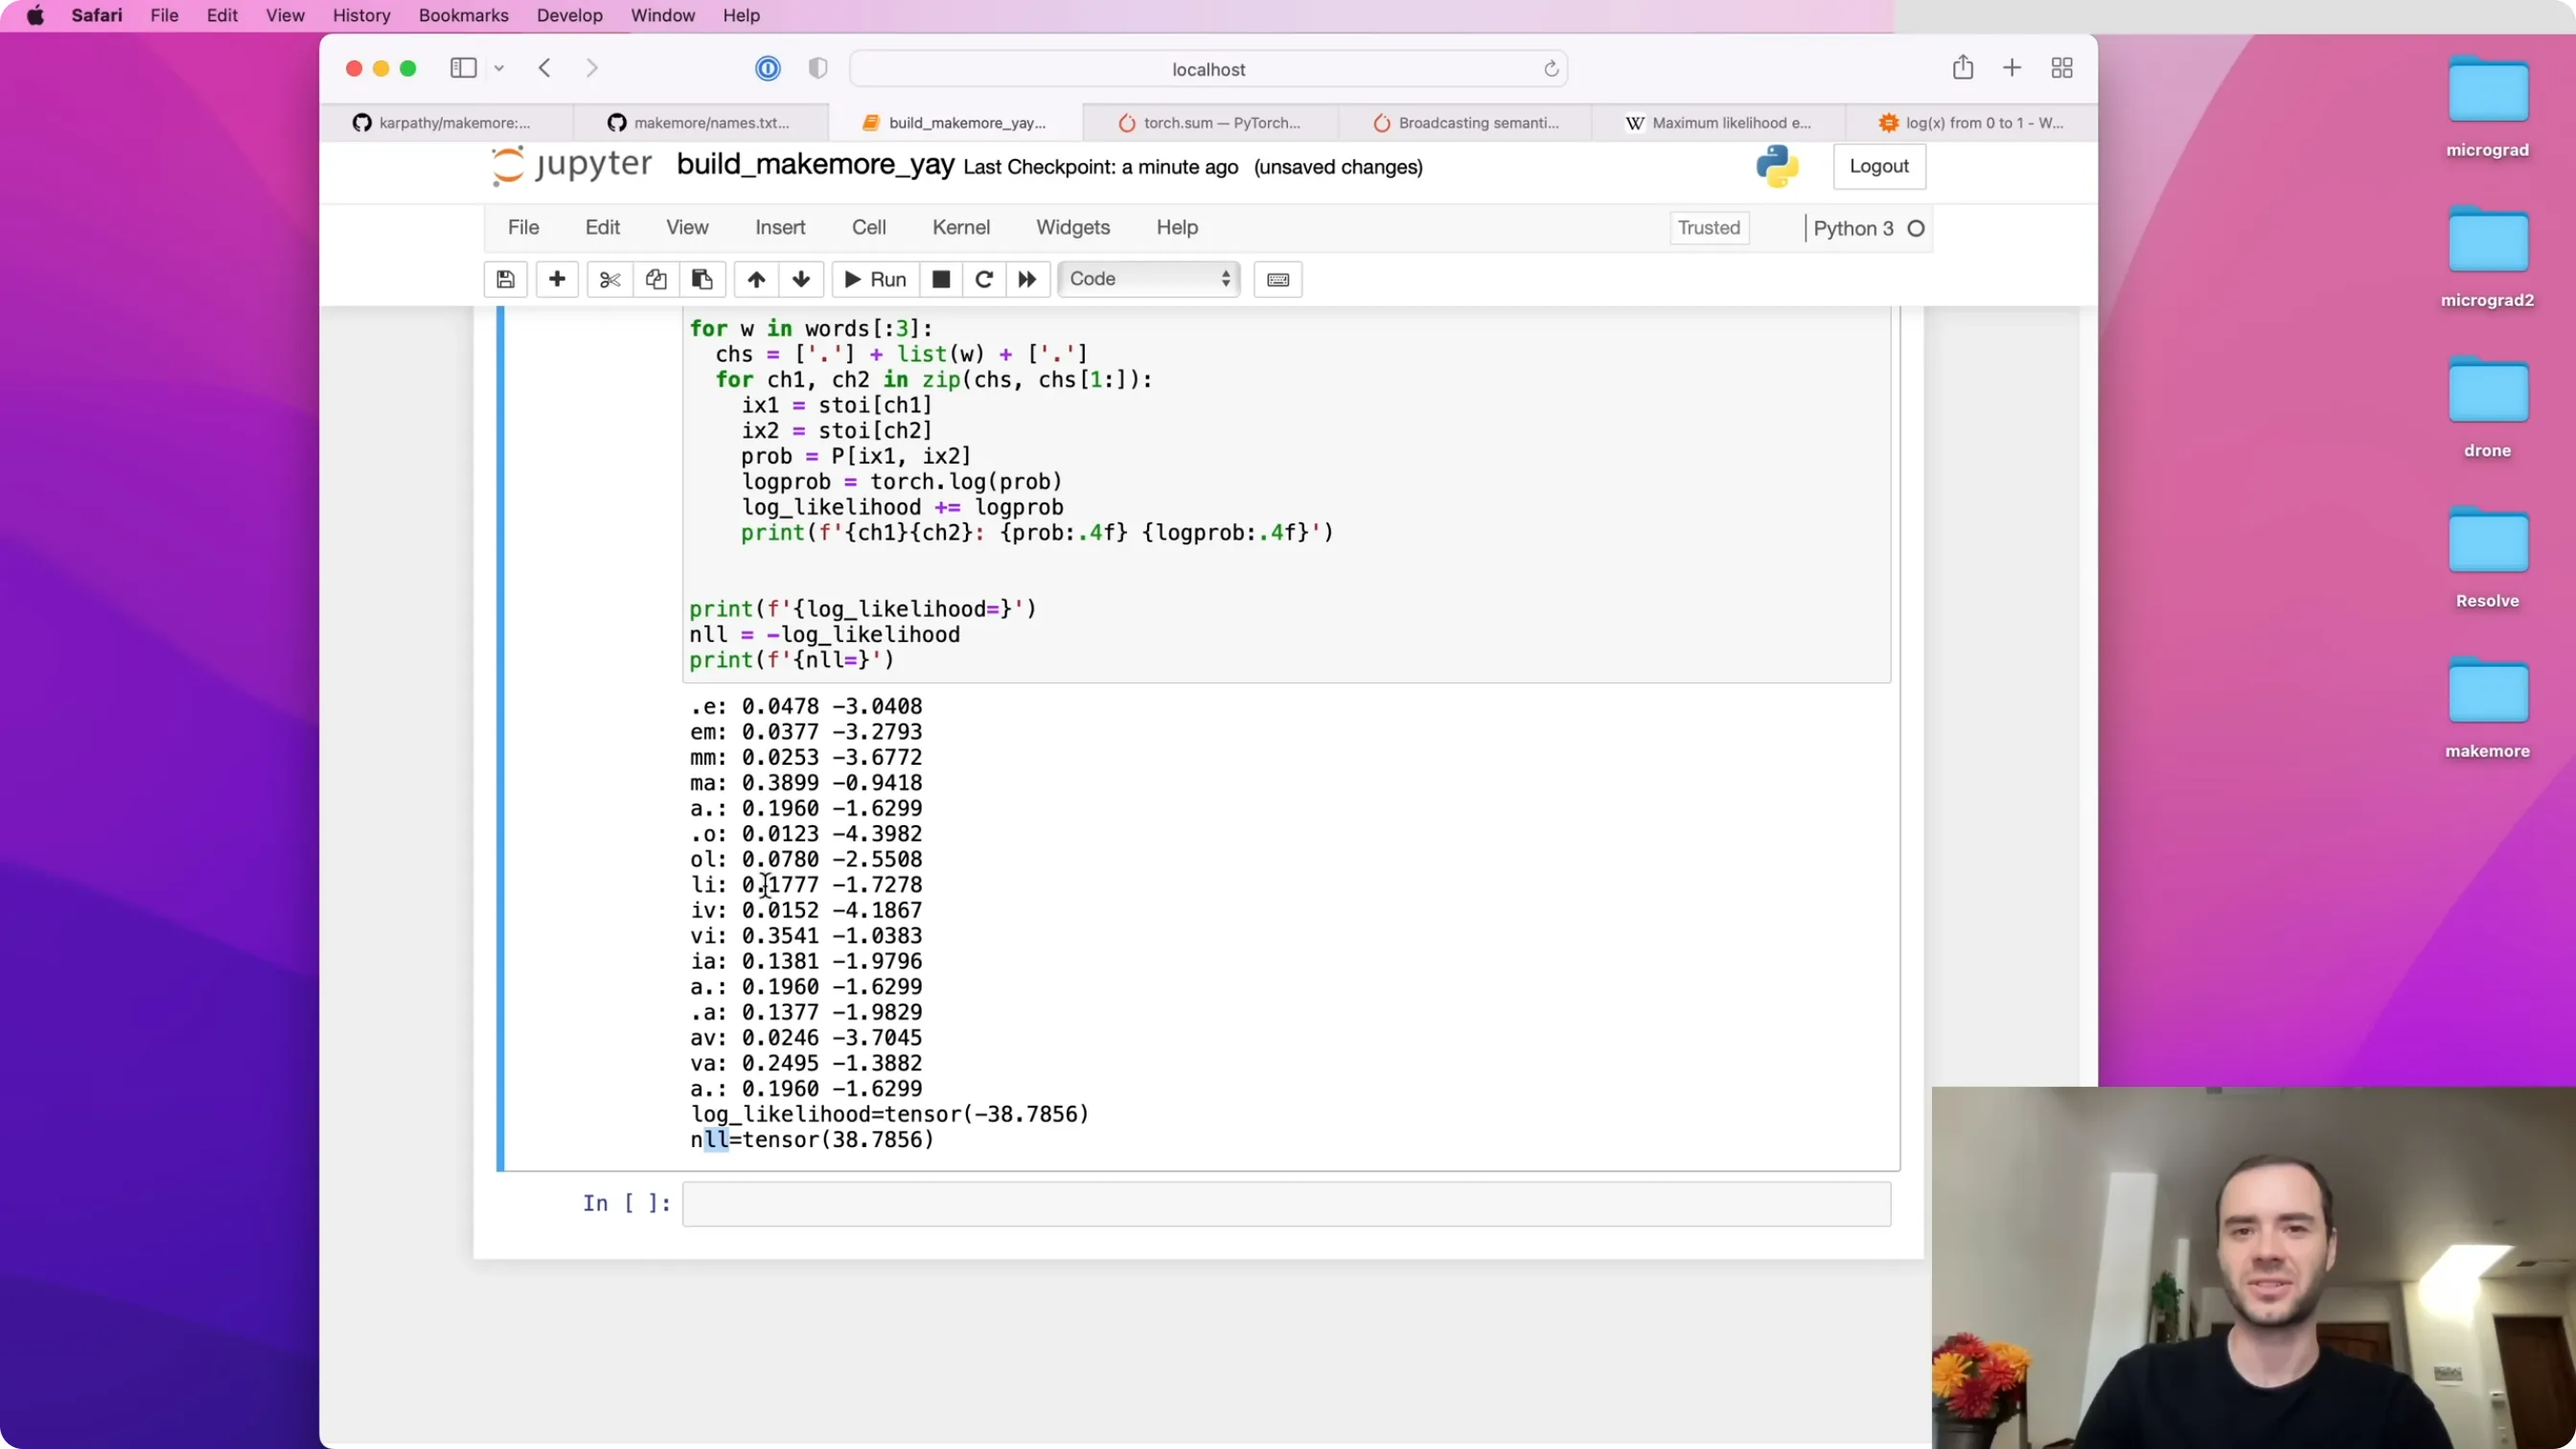
📷 负对数似然的计算与平均损失
回到原视频 (00:57:20)
在全部训练集上算出平均 NLL 约为 2.45。这个数就是模型的"质量分数",越低越好,最低是 0。
编者拓展|负对数似然(NLL)就是交叉熵:这两个名字经常把人绕晕,其实是一回事。
交叉熵的定义是 $H(p,q)=-\sum_i p_i\log q_i$;当 $p$ 是真实标签的 one-hot 分布(只有正确那一类为 1)时,求和只剩一项:
$$H=-\log q_{\text{正确类}}$$
——这正是负对数似然。所以 PyTorch 的
F.cross_entropy算的就是 NLL。再进一步:$H(p,q)=H(p)+\mathrm{KL}(p\,\|\,q)$。其中 $H(p)$ 是数据本身的熵,训练时是常数,所以 最小化交叉熵 = 最小化 KL 散度——也就是「让模型的分布尽量贴近真实分布」。
一个能验算的例子,和一个无穷大的问题
(参考时间: 60:24)
可以用单个单词来验证这套逻辑。比如 andre 是个不太常见的词,它的平均负对数似然大约 3 左右。
但如果在它后面接一个 q,变成 andrejq:
for w in ["andrejq"]:
    ...
损失会变成无穷大(inf)。原因很直接:模型认为 J 后面跟 Q 的概率是 0%(因为训练数据里从没出现过 JQ 这个组合),而 log(0) = -∞。
这在语义上其实很不合理——andrejq 也算个像样的词,模型却斩钉截铁地说它完全不可能。为了避免这种"零概率导致无穷损失"的情况,人们有一个简单有效的技巧:模型平滑。
九、模型平滑:给每个计数加一点"假计数"
(参考时间: 61:50)
做法很朴素:在统计计数时,给每一个 bigram 都加上一个假想的计数,然后再归一化。
P = (N + 1).float()
P /= P.sum(1, keepdim=True)
- 加 1 之后,就不会再有任何一格的概率是 0——
andrejq的损失从无穷变回一个有限的、很大的数; - 加的数值越大,模型越接近均匀分布;加得越小,分布越尖锐。
这就是 模型平滑(model smoothing)。它是一个很常用的小技巧,代价是让原本"绝对确定"的模型变得不再那么绝对。
📷 给所有计数加 1 进行模型平滑
回到原视频 (01:01:50)
平滑之后,再算损失,大约是 2.47(加平滑前是 2.45),数量级一致。
到这里,第一版 bigram 模型就完整了,它一共做了三件事:
- 训练:统计所有 bigram 的出现次数,再把每行归一化成概率分布;
- 采样:按这些分布逐个字符地生成新名字;
- 评估:用平均负对数似然把模型质量压缩成一个数,越低越好。
编者拓展|平滑的来历:Laplace 加一平滑:给每个计数 $+1$,历史上叫 Laplace smoothing(拉普拉斯接续法则,18 世纪为「太阳明天会升起吗」这类问题提出的)。
- 为什么需要它:某个 bigram 计数为 0 → 概率为 0 → 取对数得 $-\infty$ → 整个损失变成无穷大;
- 它做了什么:等价于假设「每个 bigram 已经先验出现过一次」;
- 它与正则化的联系:本讲后面会看到,L2 正则和加一平滑在数学上走的是同一条路(都是给参数加先验),这也是「大模型为什么要 weight decay」的源头。
十、第二部分:用神经网络重新表述 bigram 语言模型
(参考时间: 01:02:57)
前面我们用"数数 + 归一化"这种很直观的方式做出了一个 bigram 模型。现在换一条路:把同一个问题塞进神经网络的框架里。最后会到达一个和之前几乎一样的位置,但过程看起来完全不同——而正是这条新路,才能支撑我们后面一路走到 Transformer。
神经网络的 bigram 模型长这样:
- 输入:一个字符;
- 网络:带参数
W的一层网络; - 输出:下一个字符的概率分布;
- 损失:负对数似然,用来衡量参数好坏;
- 训练:用基于梯度的优化来调整参数
W,让损失最小。
整个流程可以画成下面这样:
graph LR
    A["输入字符<br>(整数索引)"] --> B["one-hot 编码<br>(27 维向量)"]
    B --> C["线性层<br>logits = xenc @ W"]
    C --> D["指数化<br>counts = logits.exp()"]
    D --> E["归一化<br>probs = counts / counts.sum()"]
    E --> F["概率分布<br>(下一个字符)"]
    F --> G["负对数似然损失<br>(用真实标签索引)"]
    G --> H["反向传播 + 梯度下降"]
    H -.更新 W.-> C
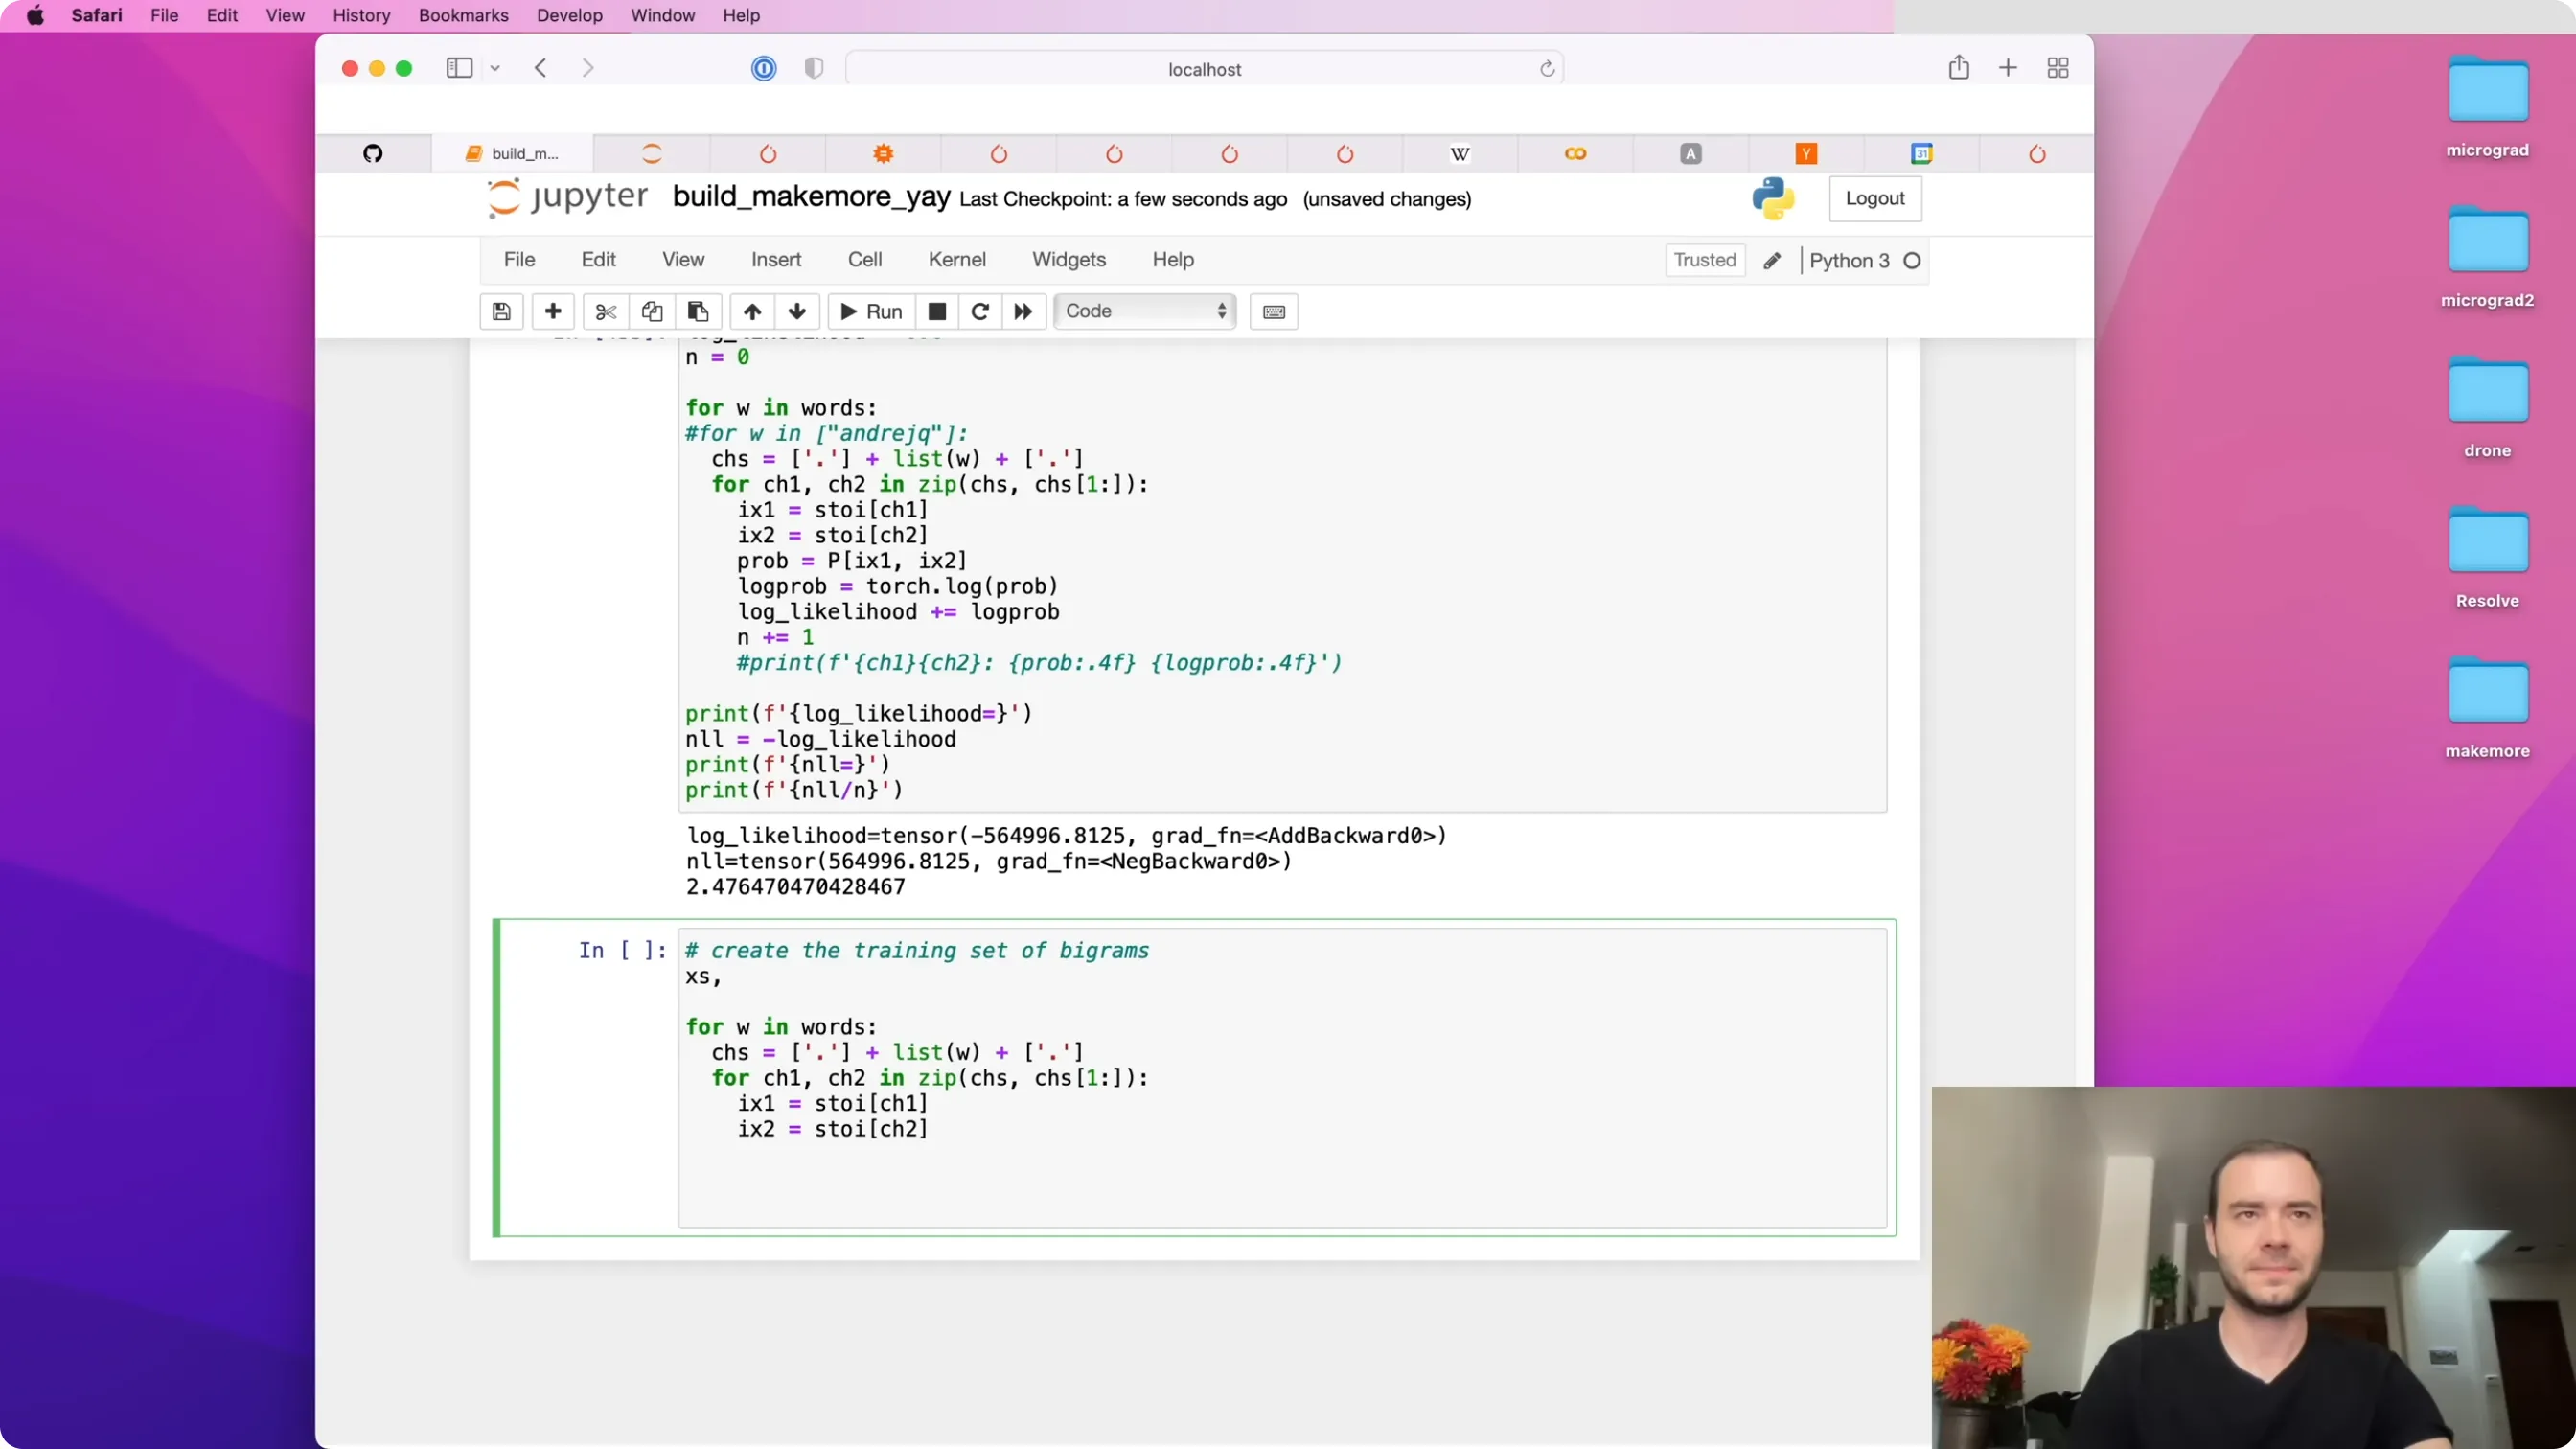
构建训练集:把 bigram 变成 (输入, 标签) 对
(参考时间: 01:05:26)
先从数据里构造训练集。和之前一样的双层循环,但这次不数数,而是把每个 bigram 存成一对 (x, y):
xs, ys = [], []
for w in words[:1]:          # 先只用第一个单词 emma
    chs = ['.'] + list(w) + ['.']
    for ch1, ch2 in zip(chs, chs[1:]):
        ix1 = stoi[ch1]
        ix2 = stoi[ch2]
        xs.append(ix1)
        ys.append(ix2)

xs = torch.tensor(xs)
ys = torch.tensor(ys)
xs是输入(上一个字符的索引);ys是标签(真实的下一个字符的索引)。
对 emma 而言,这两个列表是:
xs = [0, 5, 13, 13, 1]
ys = [5, 13, 13, 1, 0]
也就是说,一个单词里藏着 5 个独立的训练样本:
| 输入 | 含义 | 标签 | 含义 |
|---|---|---|---|
| 0 | . |
5 | e |
| 5 | e |
13 | m |
| 13 | m |
13 | m |
| 13 | m |
1 | a |
| 1 | a |
0 | . |
📷 构建 emma 的 (输入, 标签) 训练集
回到原视频 (01:06:00)
一个 API 陷阱:torch.Tensor 与 torch.tensor
(参考时间: 01:07:55)
讲师在这里插入了一个关于 PyTorch API 的重要提醒。构造张量有两种写法:
torch.tensor(...)(小写 t):会自动推断 dtype;torch.Tensor(...)(大写 T):只返回 float 张量。
torch.tensor(xs).dtype     # torch.int64 —— 我们想要的
torch.Tensor(xs).dtype     # torch.float32 —— 不是我们想要的
官方文档对这个区别讲得并不清楚,讲师建议大家统一使用小写 torch.tensor。他借这一点提醒:读官方文档固然重要,但很多细节散落在各种问答帖和讨论里,要习惯去查、去甄别。
整数不能直接喂给神经网络
(参考时间: 01:10:01)
我们现在手里的是整数(0、5、13 这样的索引)。但神经网络是由一个个神经元组成的,神经元做的事是 W·x + b 这样的加权求和,权重作用在输入上要做乘法。把一个整数索引直接喂进去、再乘以权重,是没有意义的。
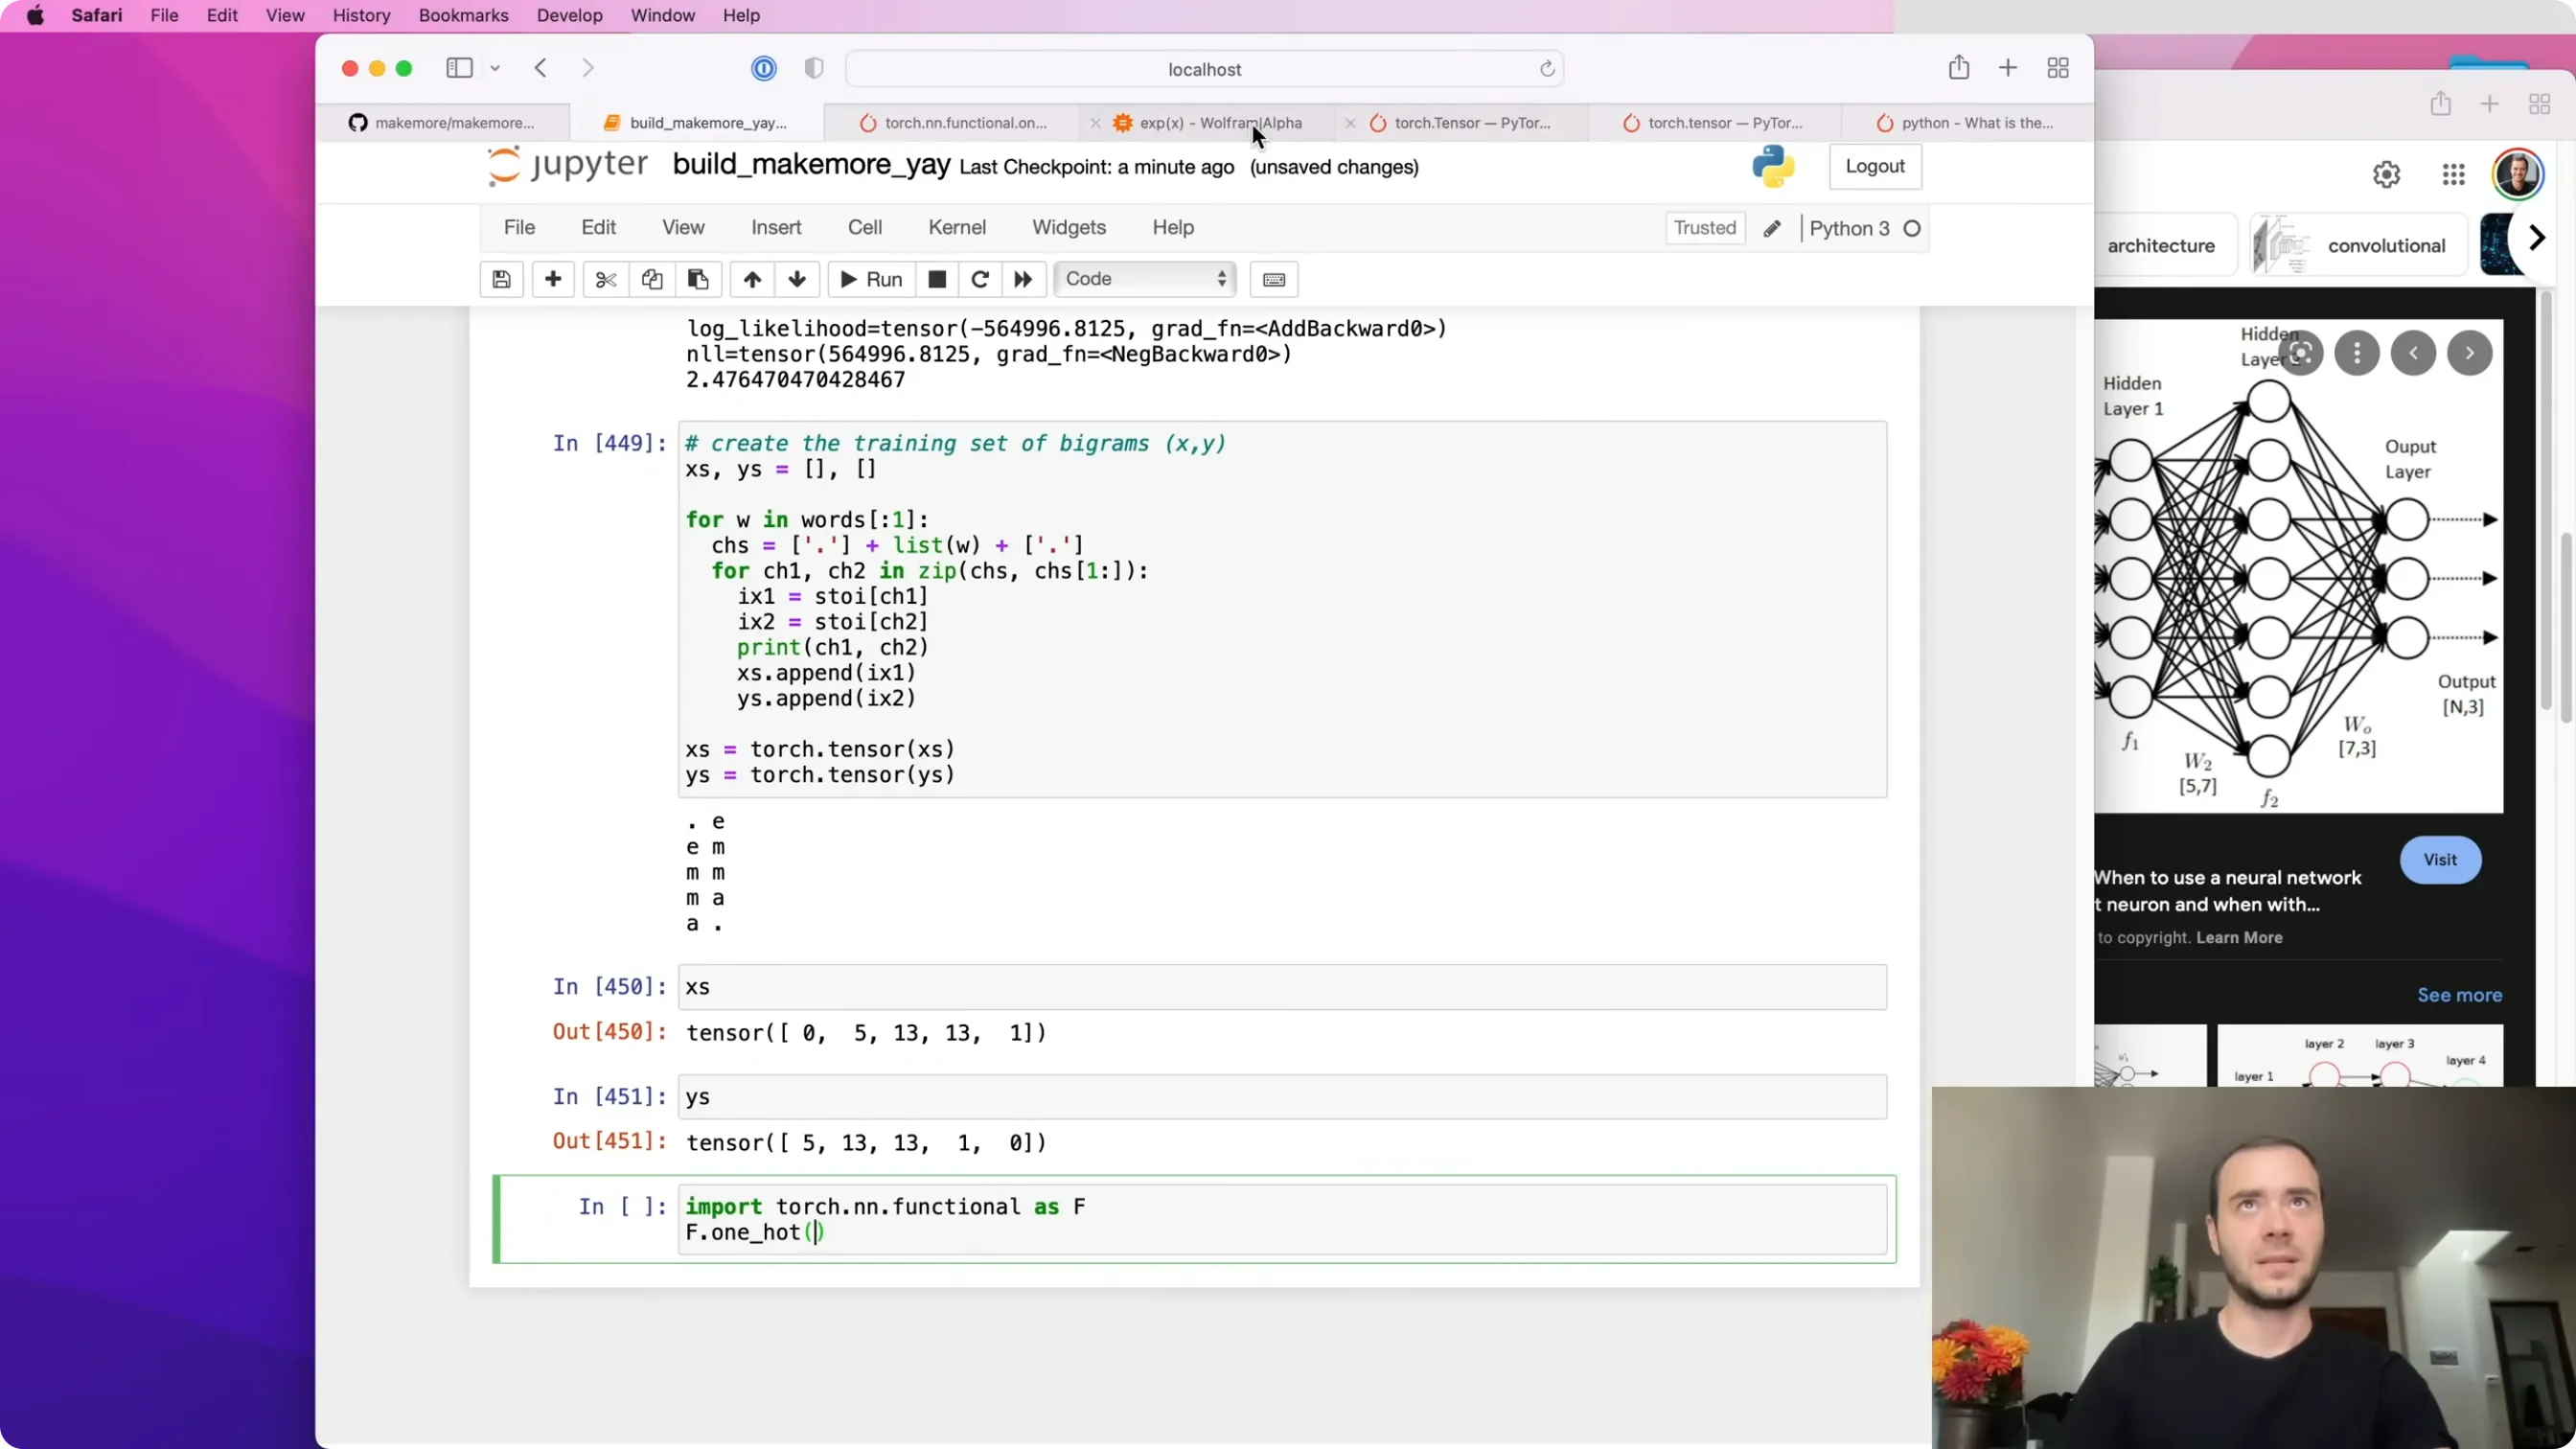
所以要把整数编码成向量。最常用的方式是 one-hot 编码:一个整数对应一个向量,只有对应那一维是 1,其余全是 0。比如整数 13,就变成一个长度 27、只有第 13 位为 1 的向量。
PyTorch 已经内置了这个函数:
import torch.nn.functional as F

xenc = F.one_hot(xs, num_classes=27).float()
xenc.shape     # torch.Size([5, 27])
- 必须指定
num_classes=27,否则它可能只按最大值推断,得到错误的宽度; - 输出的 dtype 是 64 位整数,而神经网络需要浮点数,所以要
.float()。
用 plt.imshow(xenc) 画出来,可以看到 5 行、27 列,每行只有一个亮点。
📷 F.one_hot 编码的结果与其热力图
回到原视频 (01:11:38)
编者拓展|one-hot 的本质,以及它和 embedding 的关系:
- one-hot 就是一个单位向量(只在一个位置上是 1);
one_hot(x) @ W在数学上就是「取出 W 的第 x 行」——所以 E04 让你把它删掉,直接用索引;- 但保留它也有价值:它正是「embedding」的最朴素形式。
nn.Embedding干的事情就是「可训练的选行」:一张可被梯度修改的查找表。👉 这就是为什么后面几讲能直接从 bigram 跳到 MLP:中间差的那一步,就是这个「选行」动作。
十一、单层线性网络:用矩阵乘法一次性算完
(参考时间: 01:13:53)
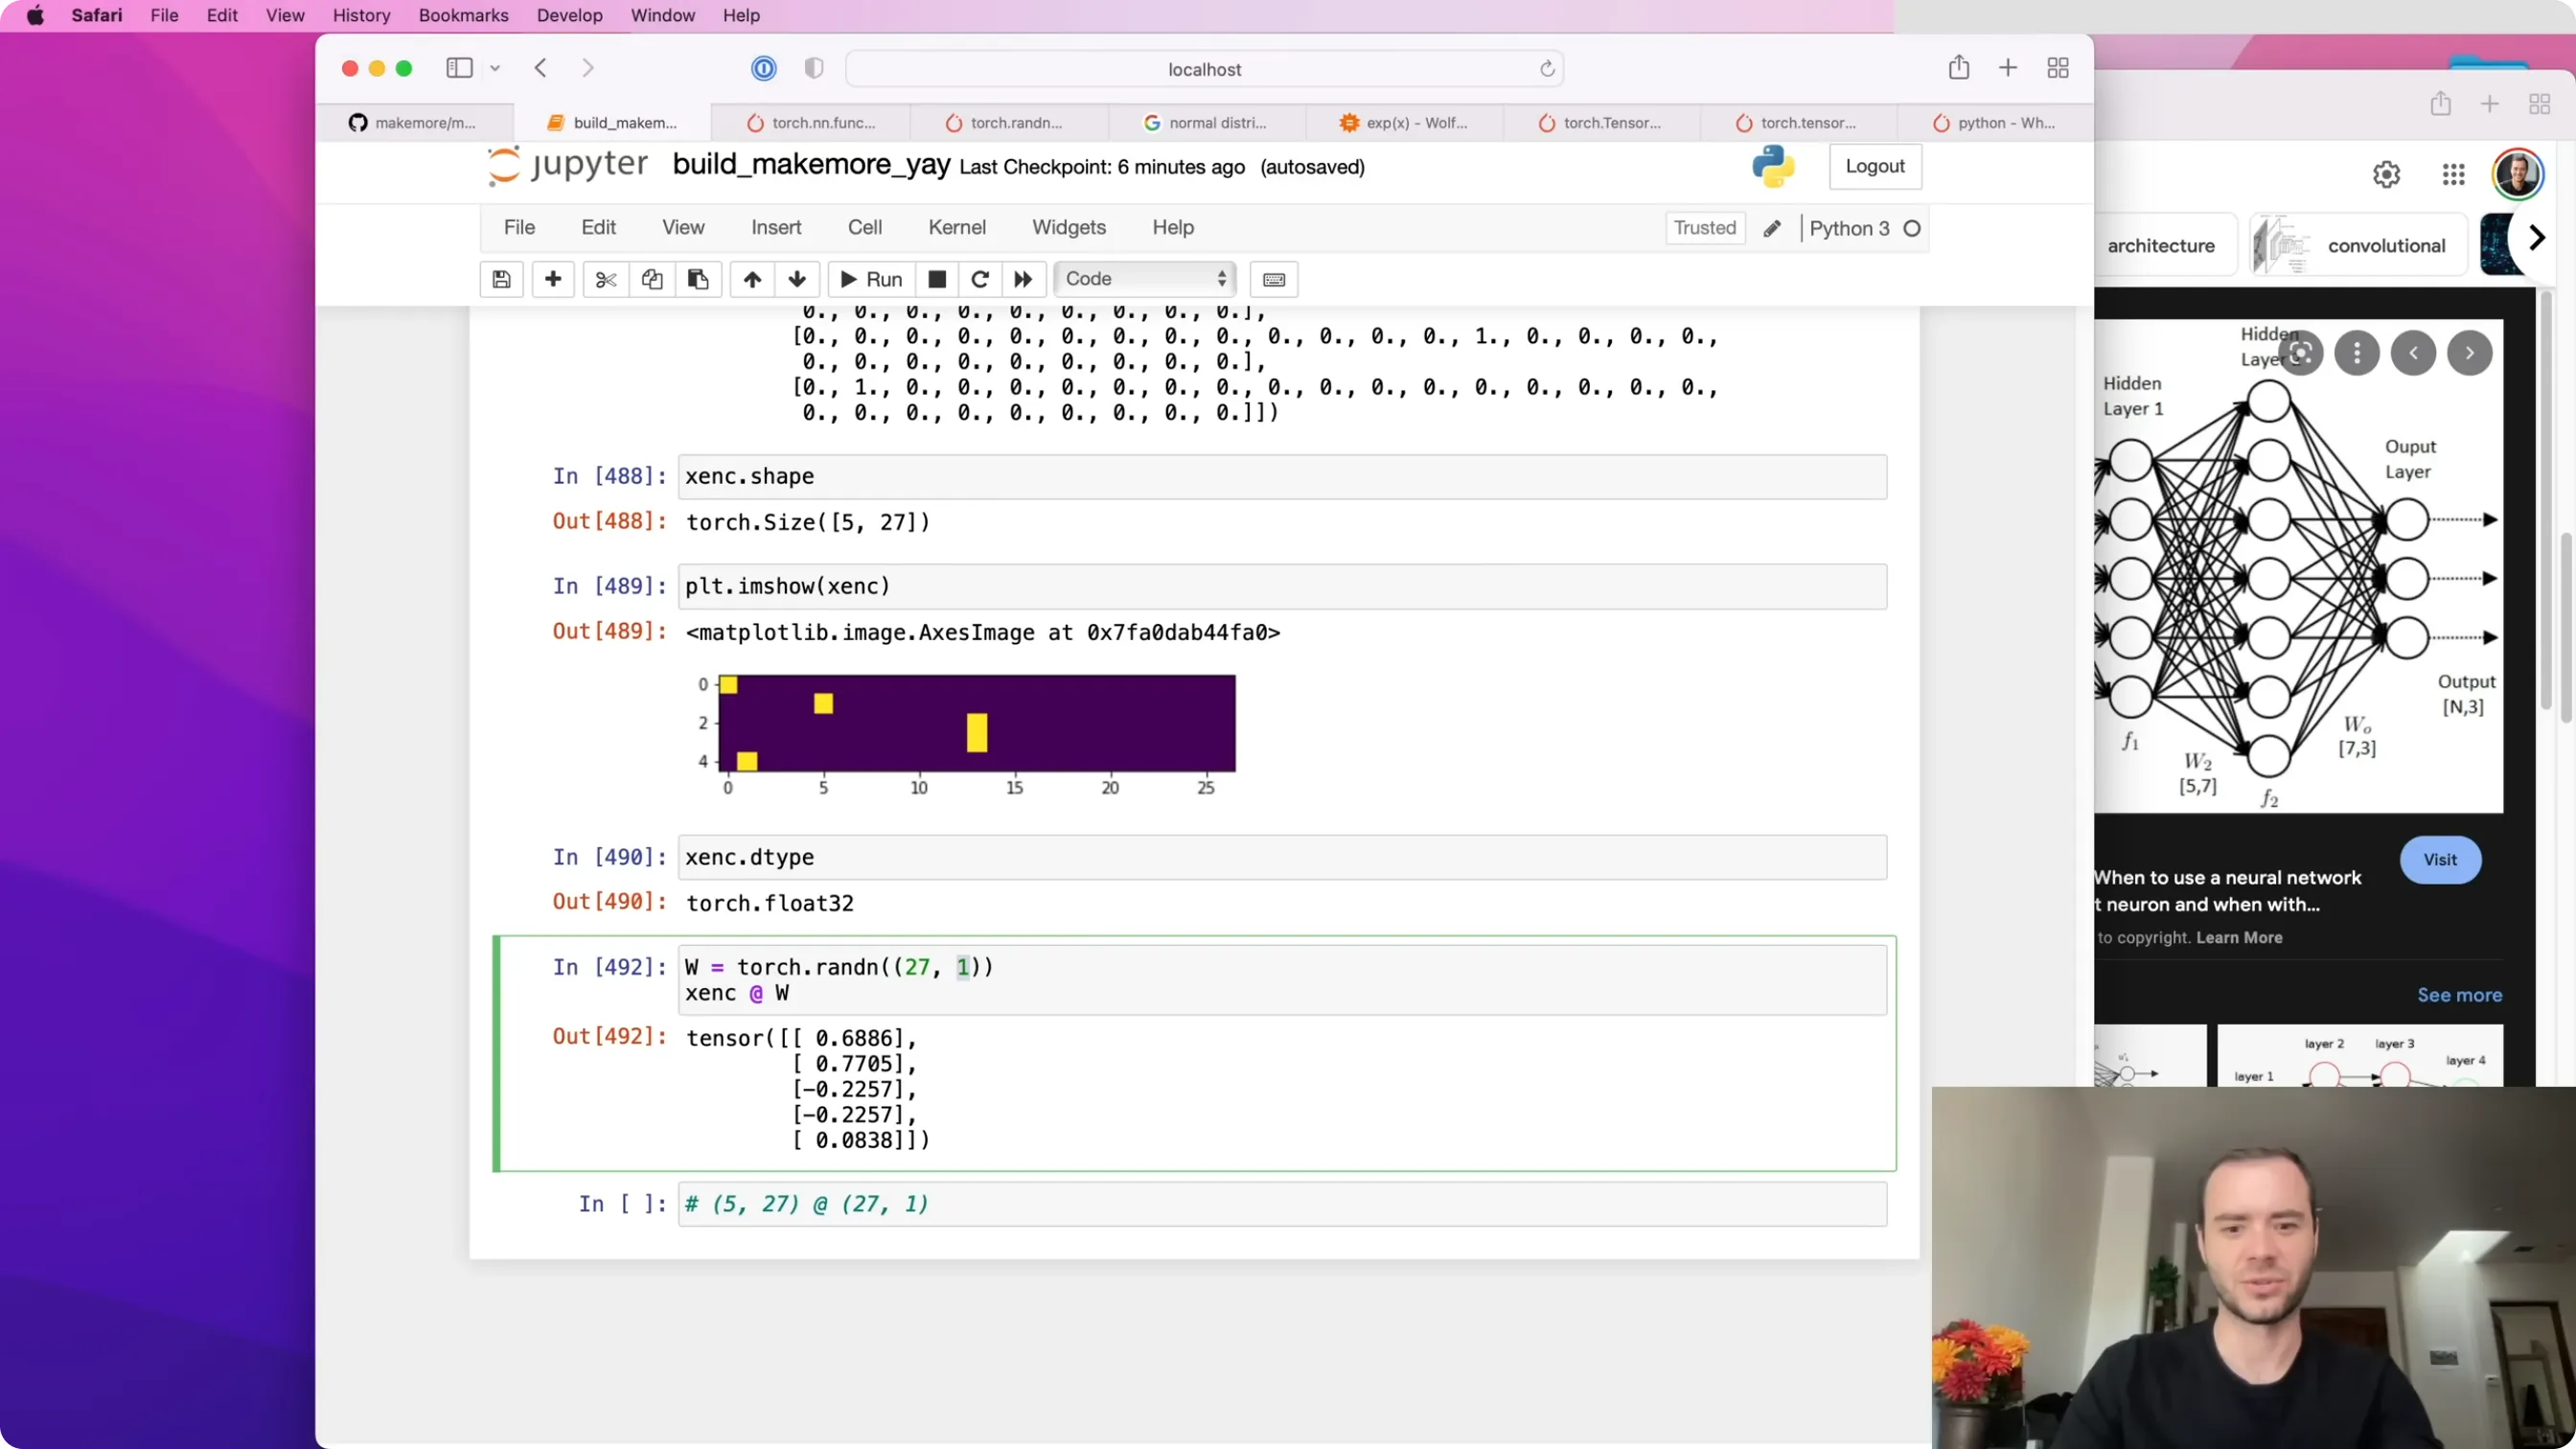
现在先造一个神经元。它做的事就是 W·x(本讲不加偏置、不加非线性),其中 W·x 是点积。
先随机初始化这个神经元的权重:
W = torch.randn((27, 1))
xenc @ W     # shape: (5, 27) @ (27, 1) -> (5, 1)
torch.randn从标准正态分布里取随机数,大部分数在 0 附近,偶尔会有 ±2、±3;@是 PyTorch 的矩阵乘法运算符;(5, 27) @ (27, 1)得到(5, 1):把 5 个输入同时送进这一个神经元,并行算出 5 个激活值。
从 1 个神经元扩展到 27 个
(参考时间: 01:15:52)
我们需要的不是 1 个输出,而是 27 个(对应下一个字符的 27 种可能)。于是把权重扩成 27×27:
W = torch.randn((27, 27))
xenc @ W     # shape: (5, 27) @ (27, 27) -> (5, 27)
(5, 27) @ (27, 27) 得到 (5, 27):
- 每一行对应一个输入样本;
- 每一列对应一个神经元;
- 元素
(3, 13)表示"第 13 个神经元在第 3 个输入上的激活值"。
它其实是"第 3 个输入"与"W 的第 13 列"做点积的结果。矩阵乘法把所有这些点积并行算完了。可以手动验证:
(xenc[3] * W[:, 13]).sum() # 结果与 (xenc @ W)[3, 13] 相同
📷 用 27×27 权重矩阵并行计算 27 个神经元的输出
回到原视频 (01:16:21)
所以整个网络就是:27 维输入 → 一层 27 个神经元的线性层。没有偏置、没有 tanh,只有这一层——这是最简单、最小的神经网络。
十二、把网络输出变成概率:logits 与 softmax
(参考时间: 01:20:38)
现在网络吐出来的 27 个数有正有负,它们既不是概率(概率必须为正、且和为 1),也不能直接当计数(计数要为非负整数)。那该怎么解释这 27 个数?
答案是:把它们解释成 log 计数(log-counts),也叫 logits。也就是说,网络输出的是"取了对数之后的计数"。要还原成计数,就做一次指数化:
logits = xenc @ W            # log-counts(可以为负,也可以为正)
counts = logits.exp()        # 指数化,得到一组非负的"假计数",等价于原来的 N
probs = counts / counts.sum(1, keepdim=True)   # 归一化成概率
exp把整个实数轴映射到正数:负数变到 (0,1),0 变成 1,正数变到大于 1;- 得到的
counts恒为非负,语义上等价于那张计数矩阵N; - 最后按行归一化,就得到概率分布。
对了,最后两行其实一起有个名字——softmax:
# softmax 的两种等价写法
counts = logits.exp()
probs = counts / counts.sum(1, keepdim=True)
softmax 接受一组可正可负的 logits,输出一个合法的概率分布(全为正、和为 1)。它可以接在任何线性层后面,让神经网络输出概率——这是非常常见、也非常重要的一个组件。
关键点:以上每一步都是可微的。 矩阵乘法可微、指数化可微、求和与除法也可微。这意味着我们可以对它们做反向传播,从而用梯度来优化 W。
前向传播总览
(参考时间: 01:26:18)
把前面所有步骤整理成一张图(也就是"前向传播 forward pass"):
graph TD
    X["xs:输入的字符索引<br>(5 个样本)"] --> OH["F.one_hot(xs, num_classes=27).float()<br>xenc: (5, 27)"]
    OH --> L["logits = xenc @ W<br>(5, 27)"]
    L --> C["counts = logits.exp()<br>(5, 27),等价于 N"]
    C --> P["probs = counts / counts.sum(1, keepdim=True)<br>softmax → (5, 27)"]
    P --> LOSS["loss = -probs[torch.arange(n), ys].log().mean()"]
输入是整数索引,经过 one-hot → 线性层 → 指数化 → 归一化,得到概率;再用真实标签去索引"正确字符"对应的概率,取 log、取负、求平均,就是损失。
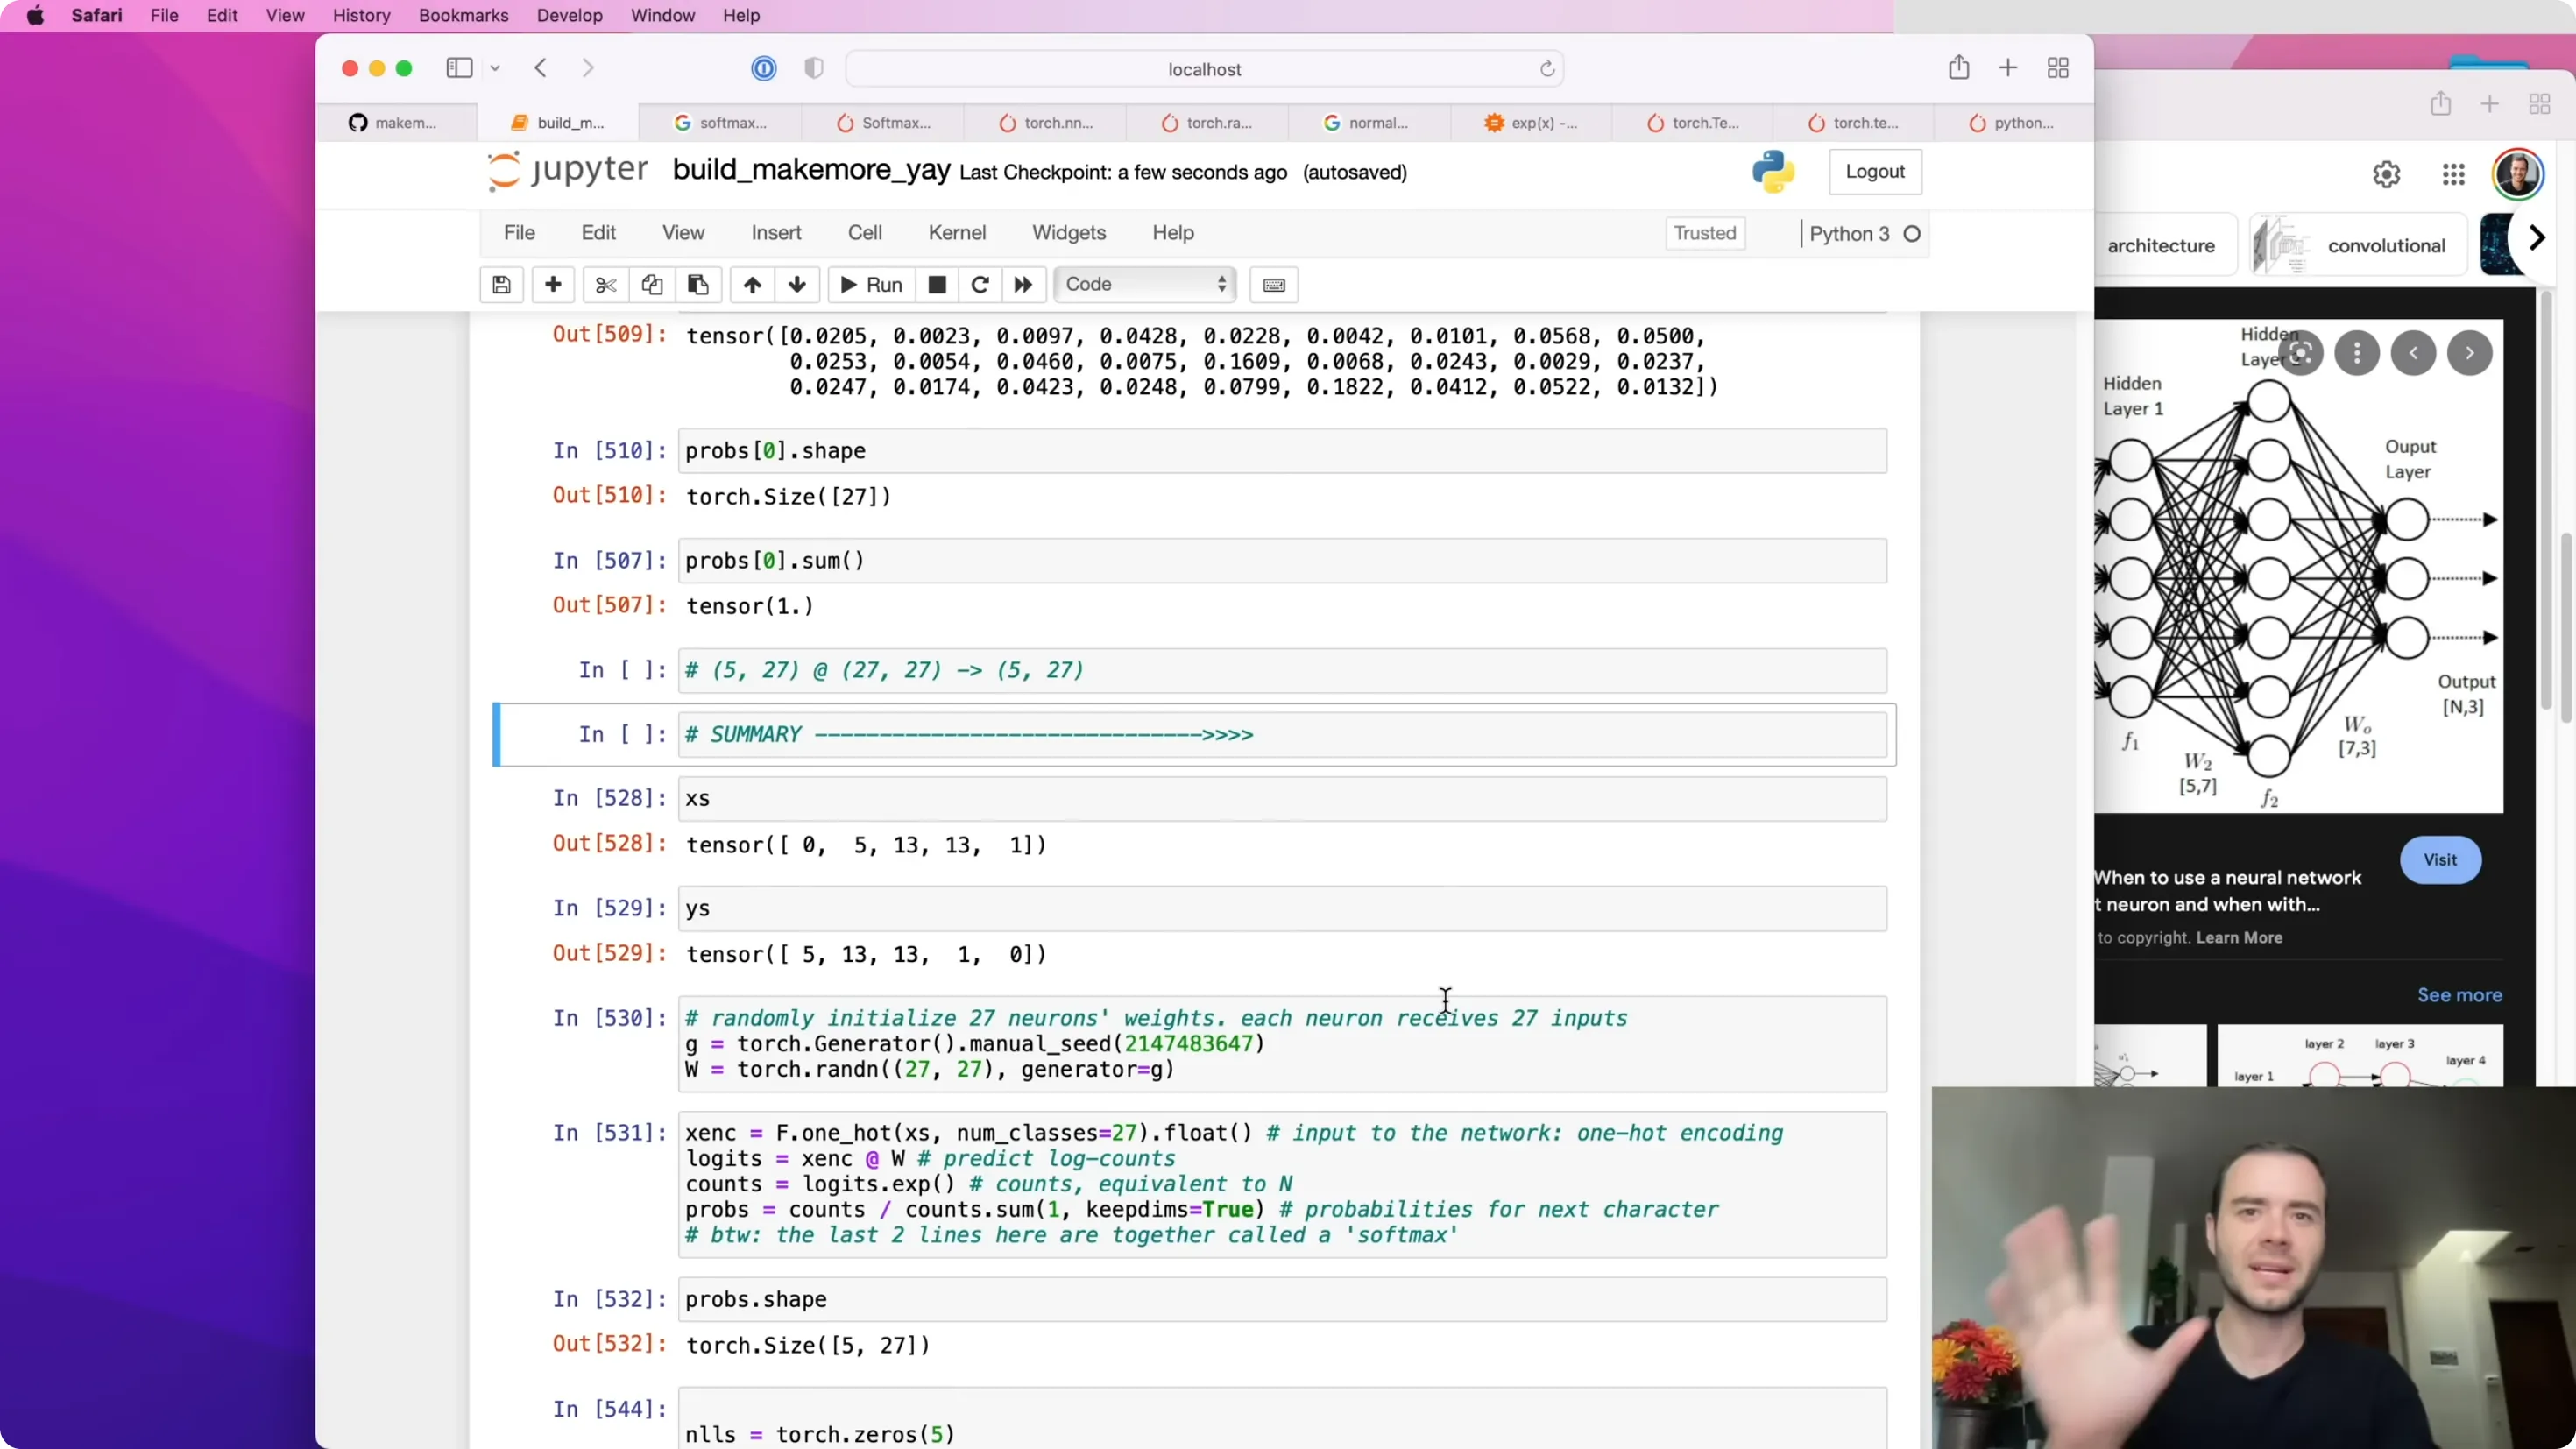
📷 前向传播总览:从输入索引到概率分布
回到原视频 (01:26:18)
拆解一个具体例子:Emma 的五个 bigram
(参考时间: 01:29:06)
用一个具体例子把损失算清楚。emma 有 5 个 bigram:
- 第 1 个:输入是
.(索引 0),标签是e(索引 5)。网络在输入 0 时输出 27 个概率,取索引 5 的那个概率——假设是 0.01(1%),说明网络目前认为e跟在.后面只有 1% 可能,这很糟; - 第 2 个:输入
e,标签m——网络给m的概率也是约 1%; - 第 3 个:输入
m,标签m——约 2%; - 第 4 个:输入
m,标签a——约 7%,这个"碰巧"还不错; - 第 5 个:输入
a,标签.——约 1%。
把每个"正确字符"的概率取 log、取负,再求平均,得到这个单词上的损失约为 3.76。这是一个相当高的损失,说明当前这组随机初始化的 W 很不好。
"猜数字"不是办法
(参考时间: 01:31:34)
既然这组 W 不好,能不能随机多试几组?比如换个随机种子:
g = torch.Generator().manual_seed(2147483648)
W = torch.randn((27, 27), generator=g)
# 损失变成 3.37
或者再试别的种子,运气好损失更低(3.37),运气差损失更高(比如有的种子给出很糟糕的结果)。
讲师明确说:这种"随机尝试、看哪个好"的做法是业余水平(amateur hour)。正确做法是:接受一个随机的起点,然后用损失函数的梯度,引导参数往变好的方向走。
而这正是前向传播已经铺好的路:只要每一步可微,我们就能算损失对 W 的梯度,然后用梯度下降最小化损失。
十三、向量化的损失:把五次循环压成一行
(参考时间: 01:35:49)
在动手做反向传播之前,先把损失算得更"向量化"一些。
损失 = 每个样本"正确字符"对应概率的负对数,再求平均。probs 的形状是 (5, 27),我们要从第 0 行取第 5 列、第 1 行取第 13 列、第 2 行取第 13 列、第 3 行取第 1 列、第 4 行取第 0 列——正好是 ys 里的标签。
手动逐个取太麻烦。PyTorch 支持用"行下标数组 + 列下标数组"做高级索引:
# 行下标就是 0..4,用 torch.arange 生成
# 列下标就是标签 ys
loss = -probs[torch.arange(5), ys].log().mean()
probs[torch.arange(5), ys]一次性取出 5 个"正确字符的概率";.log()取对数;.mean()求平均;- 前面加负号,就是负对数似然损失。
算出来仍是 3.76,和逐个手算完全一致,但写成了一个向量化的表达式。
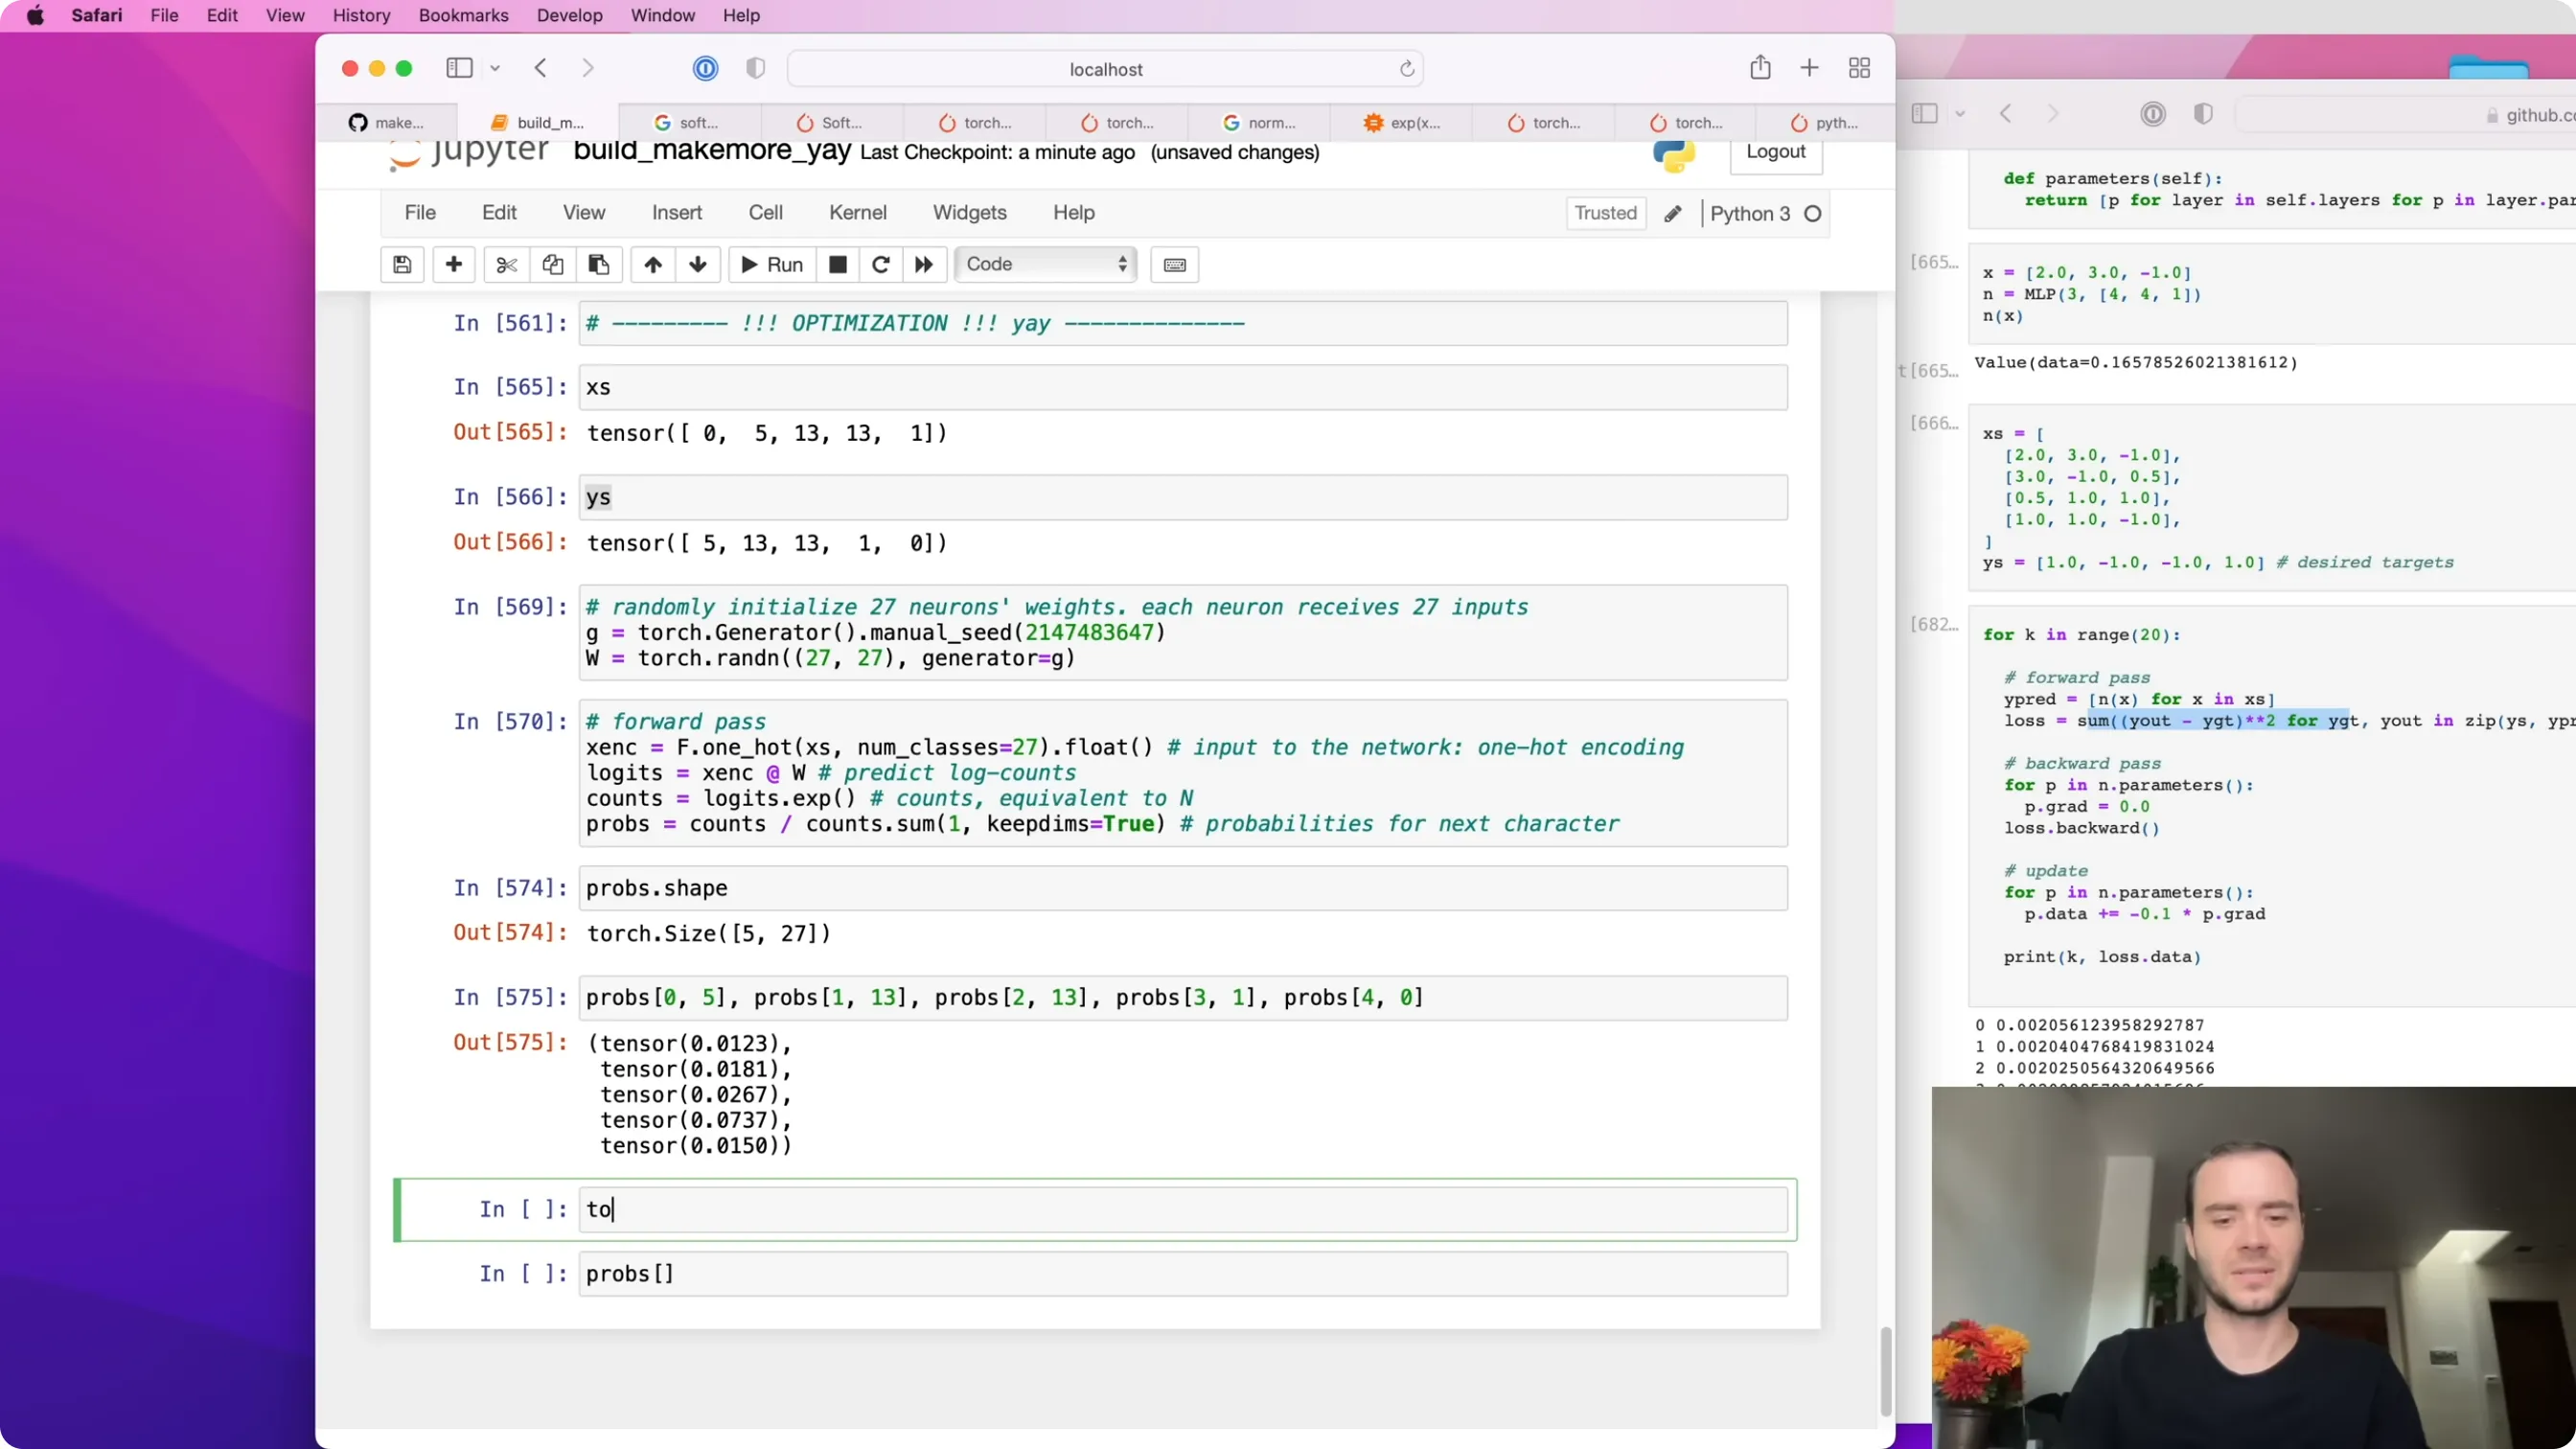
📷 用高级索引把负对数似然损失写成一行
回到原视频 (01:37:30)
顺便对照一下 micrograd 里的做法:当时前向传播得到预测值,损失用均方误差(减去真实值再平方再求和),参数更新用 p.data += -lr * p.grad。这里的骨架一模一样,区别只在于:
- 我们的网络不是多层感知机,而只有一层线性层 + softmax;
- 损失不是均方误差,而是负对数似然(因为这是分类问题,不是回归问题)。
十四、反向传播与参数更新(PyTorch 版)
(参考时间: 01:38:36)
现在让 PyTorch 自动完成 micrograd 里手写的那套反向传播。
第一步,告诉 PyTorch 我们关心 W 的梯度。默认 requires_grad 是 False,必须显式打开:
g = torch.Generator().manual_seed(2147483647)
W = torch.randn((27, 27), generator=g, requires_grad=True)
然后重做前向传播并计算损失:
xenc = F.one_hot(xs, num_classes=27).float()
logits = xenc @ W
counts = logits.exp()
probs = counts / counts.sum(1, keepdim=True)
loss = -probs[torch.arange(5), ys].log().mean()
清零梯度 + 反向传播
W.grad = None      # 把梯度清零
loss.backward()    # 反向传播,填充所有中间量和 W 的梯度
- 梯度清零有两种写法:设成
0,或者设成None。设成None更高效,PyTorch 会把"没有梯度"当作"梯度为零"处理; loss.backward()会沿着前向传播时默默建好的计算图一路回传,把梯度填回W。
做完之后,W.grad 就有了结构,形状和 W 一样是 27×27。每个元素都告诉我们:这个权重对损失的影响有多大。
- 梯度为正:把该权重稍微增大,损失会略微上升;
- 梯度为负:把该权重稍微增大,损失会略微下降。
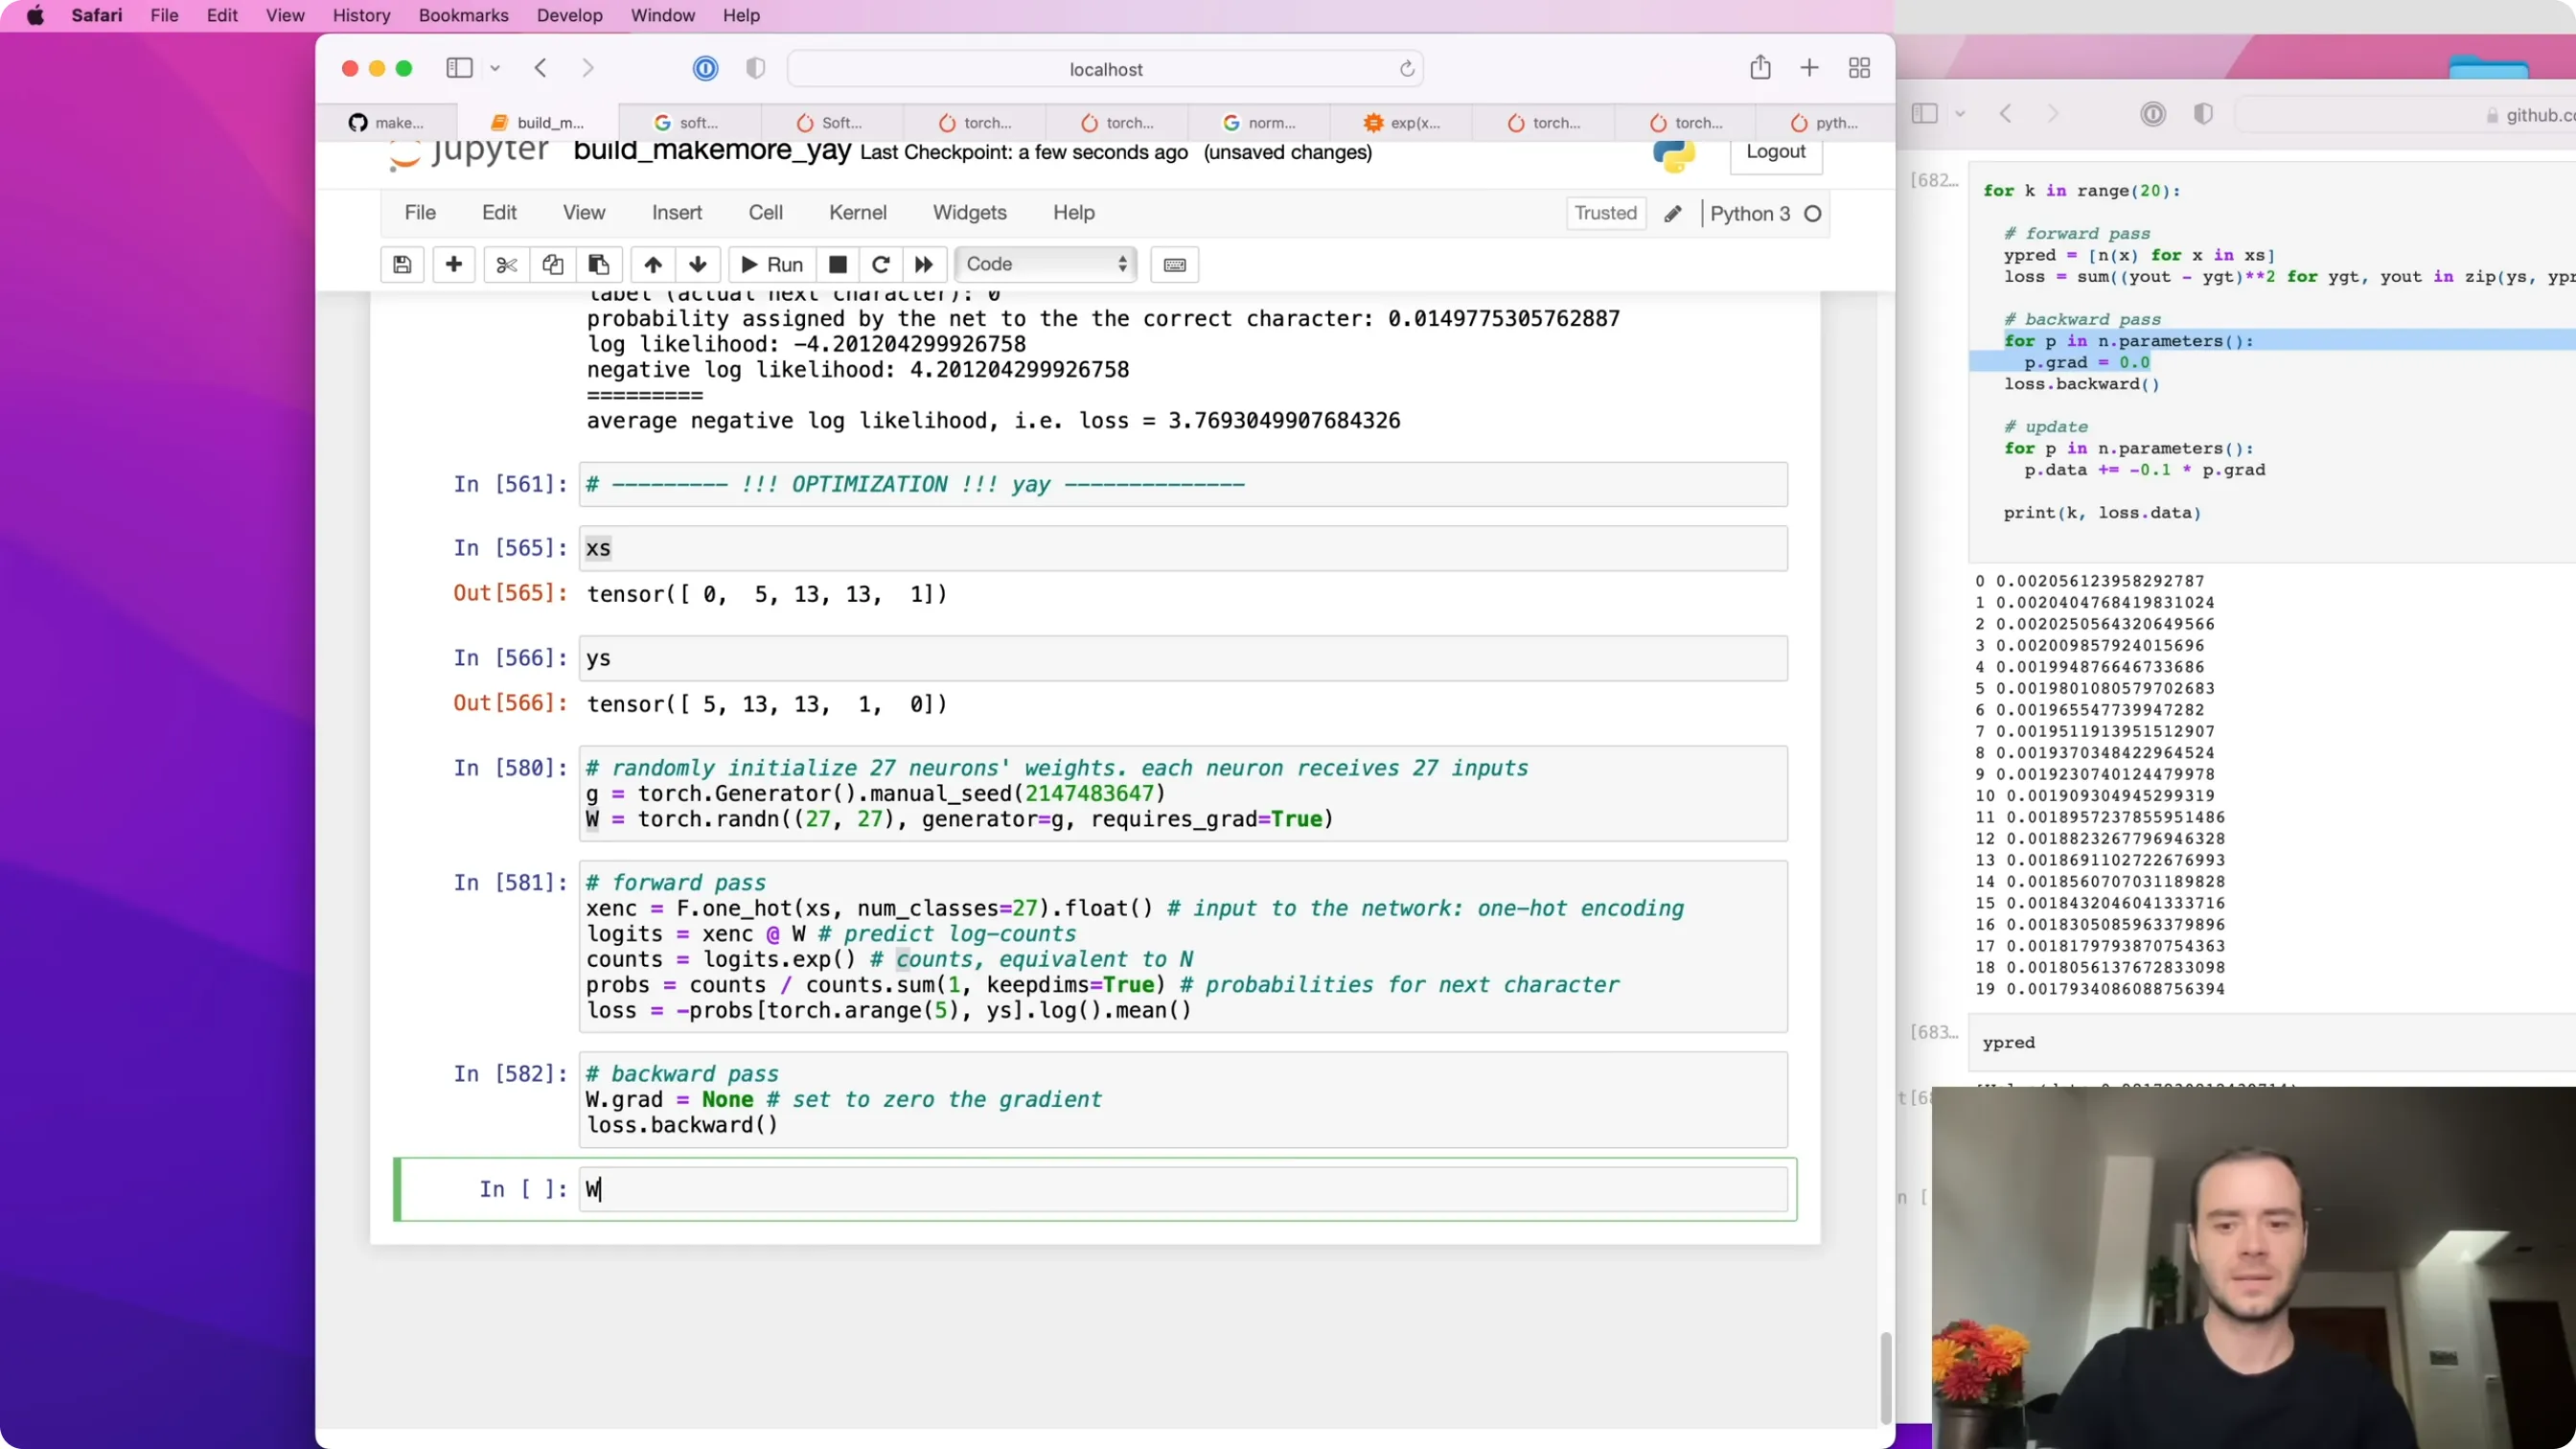
📷 调用 loss.backward() 后查看 W.grad
回到原视频 (01:40:20)
编者拓展|PyTorch 的梯度是「累加」的(本节强调的坑,值得单独记一笔):
loss.backward()会把算出来的梯度加到.grad上,不是覆盖。所以每一轮迭代前必须手动清零:python W.grad = None # 或者:optimizer.zero_grad()忘了清零的后果很隐惟:损失会看起来也在降,但其实是错的(把历史梯度反复叠加),收敛到奇怪的地方。 这是初学者最常踩的 bug 之一,也是后来用optimizer时zero_grad()必顶调用出现的原因。
更新参数
和 micrograd 几乎一样,只是这里只有一个参数张量,不需要循环:
W.data += -0.1 * W.grad
用 W.data 是为了在"就地修改数值"时不干扰自动求导的记录。
更新之后重新跑前向传播,损失应该下降:
3.76 → 3.74 → 3.72 ...
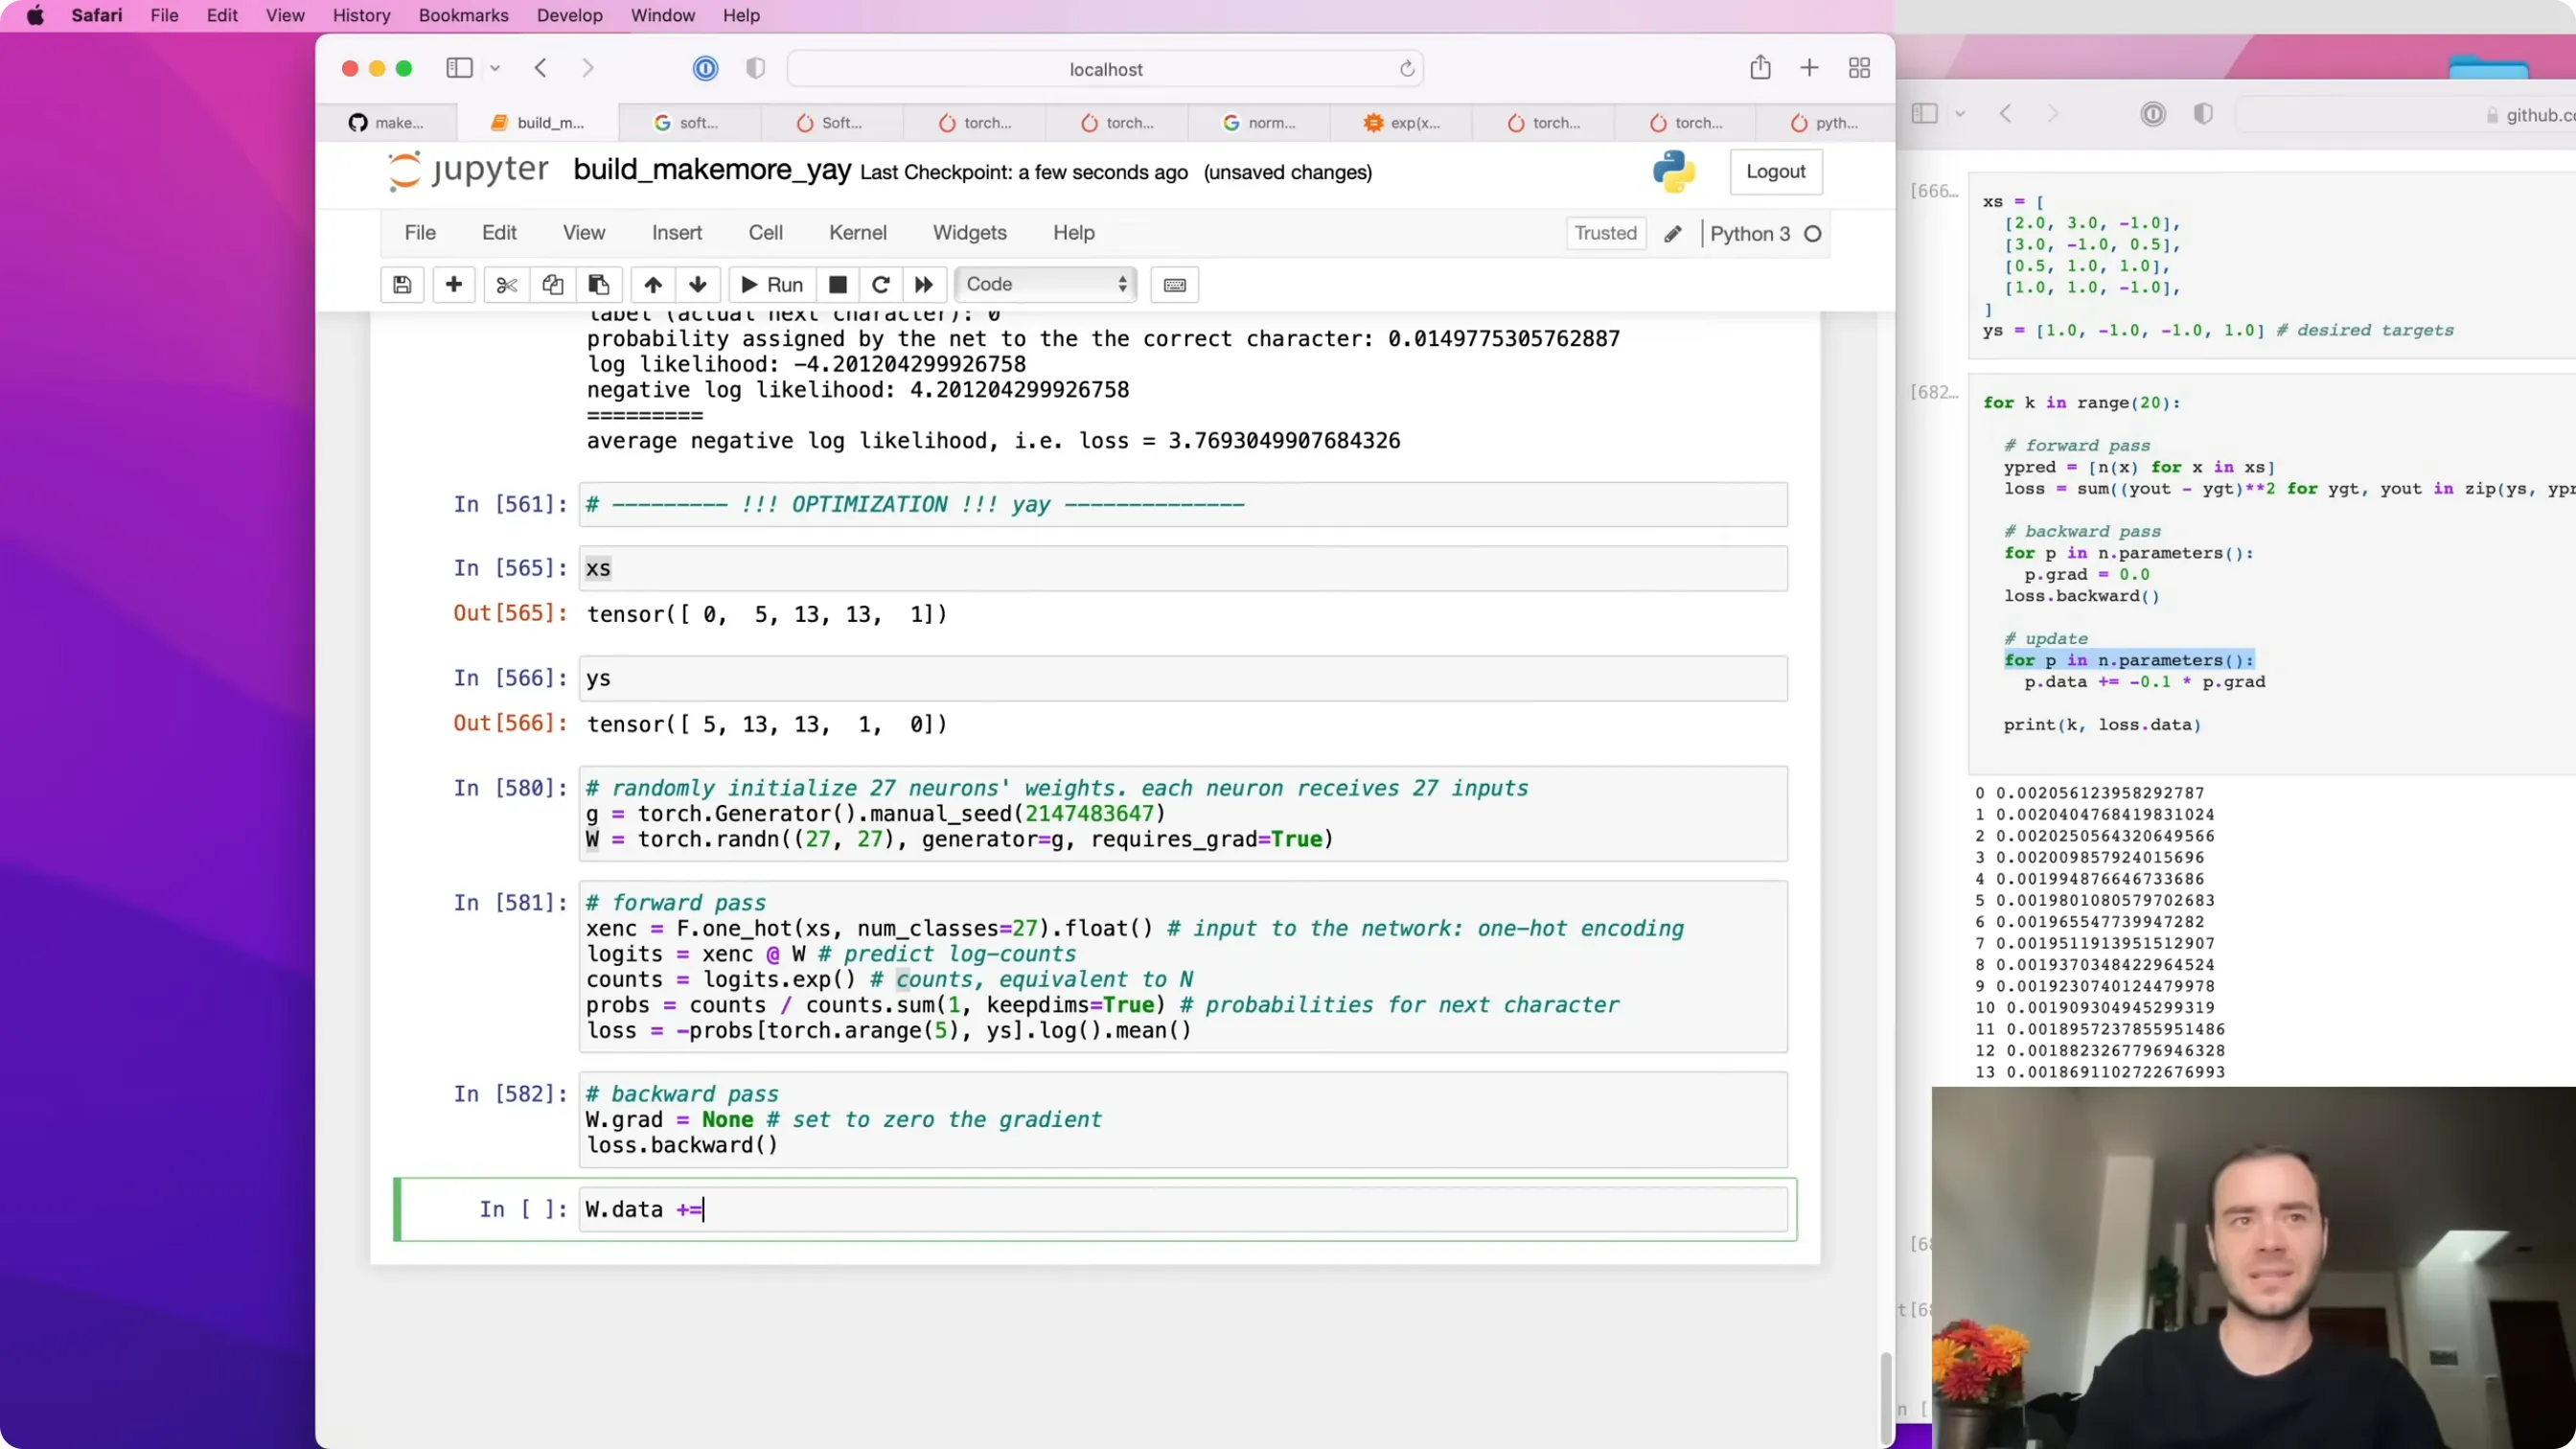
📷 梯度下降更新后损失逐步下降
回到原视频 (01:41:40)
这就是梯度下降(gradient descent):损失越低,说明网络给"正确的下一个字符"分配的概率越高。
编者拓展|训练循环的四步模板(以后每一讲都是这个形状):
text
1. 前向:由输入算出预测与损失
2. 清零:把上一轮的梯度清掉
3. 反向:loss.backward() 算出所有梯度
4. 更新:用梯度改参数(p.data += -lr * p.grad)
👉 区别只在于「模型长什么样」与「梯度怎么算」。本讲接下来的几讲(MLP / BatchNorm / 手写反向传播 / WaveNet / GPT)都是在换第 1 步和第 3 步的实现,循环本身一直没变。
十五、整合:完整的训练循环
(参考时间: 01:42:55)
把前面的碎片拼成一份完整代码。前半段构造全量训练集:
# 构造数据集
xs, ys = [], []
for w in words:
    chs = ['.'] + list(w) + ['.']
    for ch1, ch2 in zip(chs, chs[1:]):
        ix1 = stoi[ch1]
        ix2 = stoi[ch2]
        xs.append(ix1)
        ys.append(ix2)
xs = torch.tensor(xs)
ys = torch.tensor(ys)
num = xs.nelement()
print('number of examples: ', num)   # 228146

# 初始化网络
g = torch.Generator().manual_seed(2147483647)
W = torch.randn((27, 27), generator=g, requires_grad=True)
从 5 个 bigram 变成 228,146 个,代码一个字都不用改——它并不关心里面有多少样本。
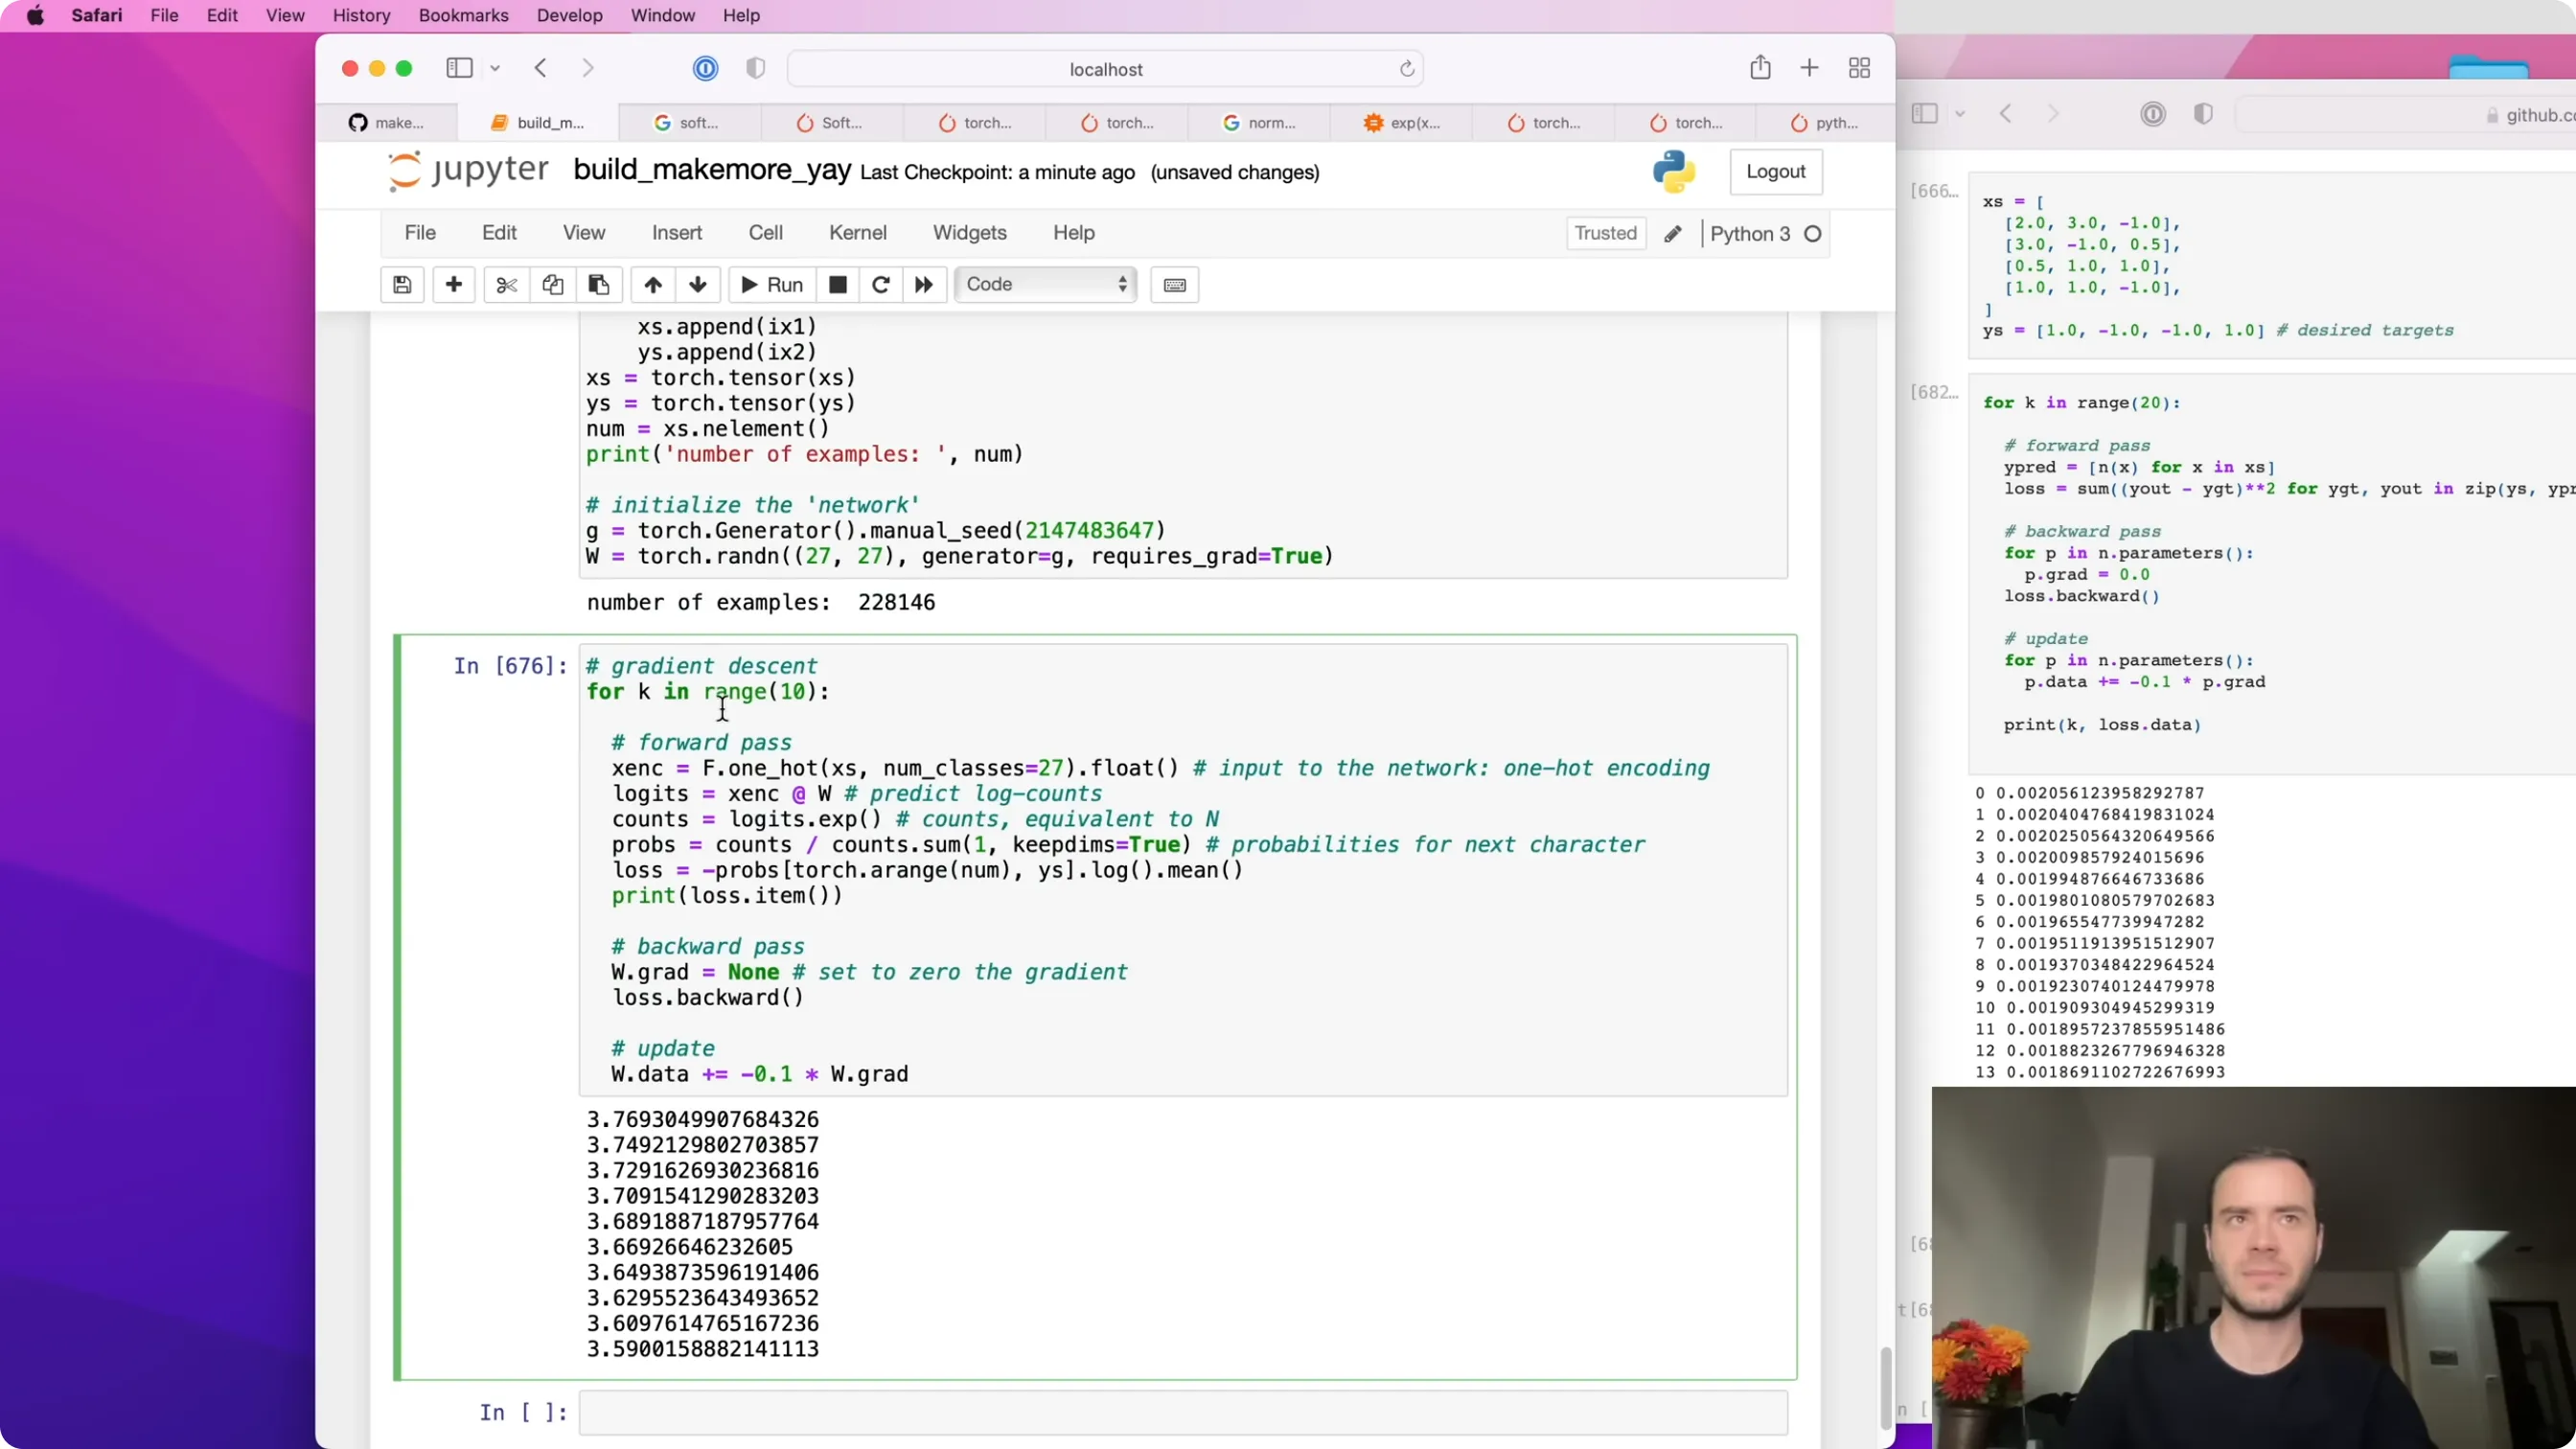
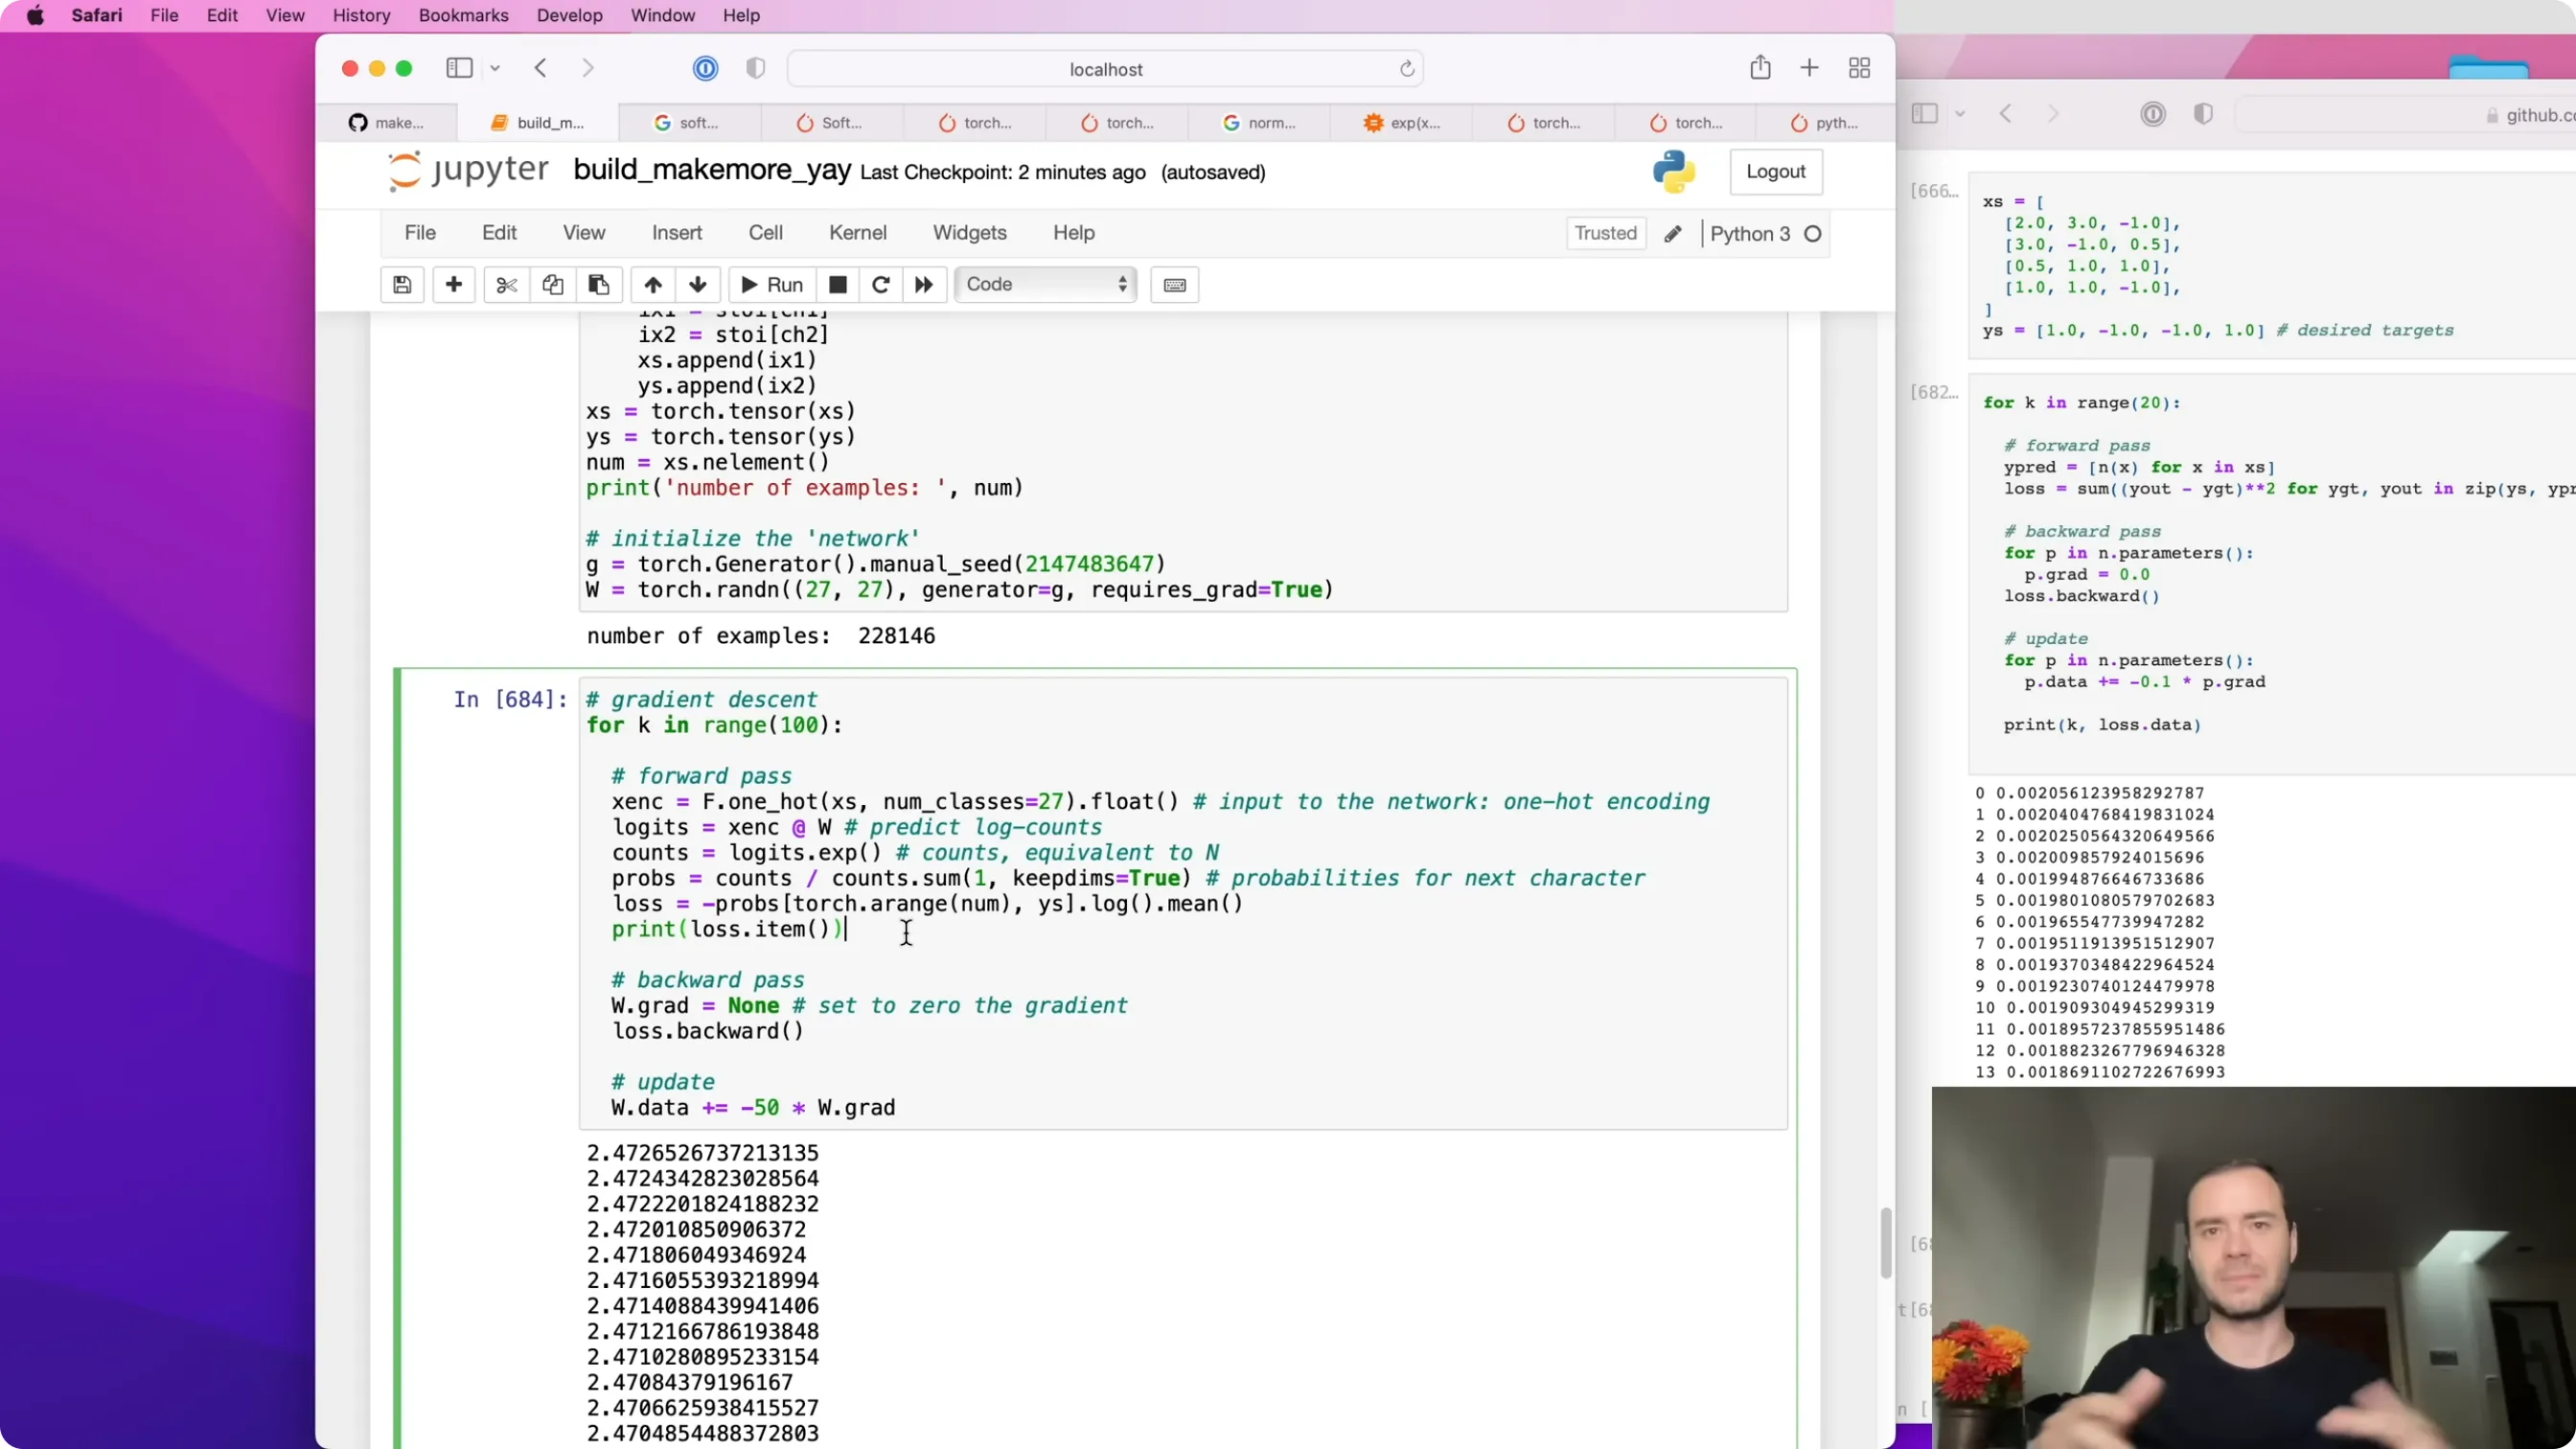
后半段是梯度下降循环(这里同时加上了正则化项,下一章解释):
for k in range(100):
    # forward pass
    xenc = F.one_hot(xs, num_classes=27).float()
    logits = xenc @ W
    counts = logits.exp()
    probs = counts / counts.sum(1, keepdim=True)
    loss = -probs[torch.arange(num), ys].log().mean() + 0.01 * (W**2).mean()
    print(loss.item())

    # backward pass
    W.grad = None
    loss.backward()

    # update
    W.data += -50 * W.grad
一开始用的是很小的学习率,损失下降得非常慢;后来发现这个任务非常简单,可以把学习率调得很大,于是用了 -50。
📷 整合后的完整训练循环代码
回到原视频 (01:43:50)
跑大约 100 次迭代,损失就降到 2.47 左右——和之前"数数 + 归一化 + 平滑"得到的 2.47 几乎一样!不加平滑时是 2.45,也几乎一样。
为什么会一样?因为两种方法用的是同样的信息:都是"看前一个字符、预测下一个字符"。区别只在于:
- 第一种方法显式地统计并归一化;
- 第二种方法用梯度把参数一步步逼近同样的答案。
对 bigram 这种简单问题,"数数"就已经是最优解,所以梯度法收敛到同一个位置。但梯度法的价值不在 bigram,而在于它可扩展:
我们可以不断增加网络的复杂度——从只看一个字符,变成看前 10 个字符、上百个字符,一路搭到 Transformer。而输出永远是 logits,后面接 softmax、算负对数似然、做梯度下降的这套机制永远不变。
相反,"数数"这条路无法扩展:只看 1 个字符时,我们还勉强能维护一张 27×27 的表;但要看前 10 个字符,可能的组合数量会爆炸到无法存表。所以神经网络是更可扩展、也更值得投入的路。
📷 训练全量数据后损失收敛到约 2.47
回到原视频 (01:45:30)
十六、两条重要注记
注记一:one-hot 乘 W,其实就是在"选行"
(参考时间: 01:47:49)
先看这个操作:
logits = xenc @ W
只有一层线性层、且输入是 one-hot 向量时,有一个漂亮的解释:如果 one-hot 向量在第 5 维是 1,那么 xenc @ W 的结果正好就是 W 的第 5 行。因为矩阵乘法的本质是"用 one-hot 向量去挑出一行"。
而回头看第一种方法:我们用上一个字符去索引计数矩阵的某一行,拿到该行的概率分布。这跟现在做的事完全一样:
- 第一种方法:字符 → 查表 → 取一行计数;
- 神经网络:字符 → one-hot → 乘
W→ 取W的一行 → 就是 logits。
所以 W 和那张计数矩阵 N 一一对应,只不过更精确地说:
W.exp()对应计数矩阵N,而W本身对应"log 计数"。
区别在于得到的途径:计数矩阵是把统计结果直接填进去的;而 W 是随机初始化后,由损失函数一步步引导着收敛到同一个矩阵的。这解释了为什么两条路最终得到相同的损失、相同的生成结果。
graph LR
    subgraph 方法一["方法一:计数"]
      A1["字符"] --> B1["索引计数矩阵 N 的一行"] --> C1["归一化 → 概率"]
    end
    subgraph 方法二["方法二:神经网络 + 梯度"]
      A2["字符"] --> B2["one-hot"] --> C2["乘 W 取出 W 的一行<br>(= logits)"] --> D2["exp + 归一化 → 概率"]
    end
    C1 --> E["相同的模型 · 相同的损失 · 相同的采样结果"]
    D2 --> E
注记二:正则化,等价于模型平滑
(参考时间: 01:50:18)
再回看第一种方法里的平滑:给每个计数加一个假计数,加的越多,概率分布越接近均匀。
神经网络框架里也有对应的东西。可以想一下:如果 W 的所有元素都是 0,那么 logits 全为 0,exp(0) = 1,归一化后就是完全均匀的概率分布。所以:
让
W尽量接近 0,就相当于让输出分布更均匀;这正对应"加更多假计数"的平滑效果。
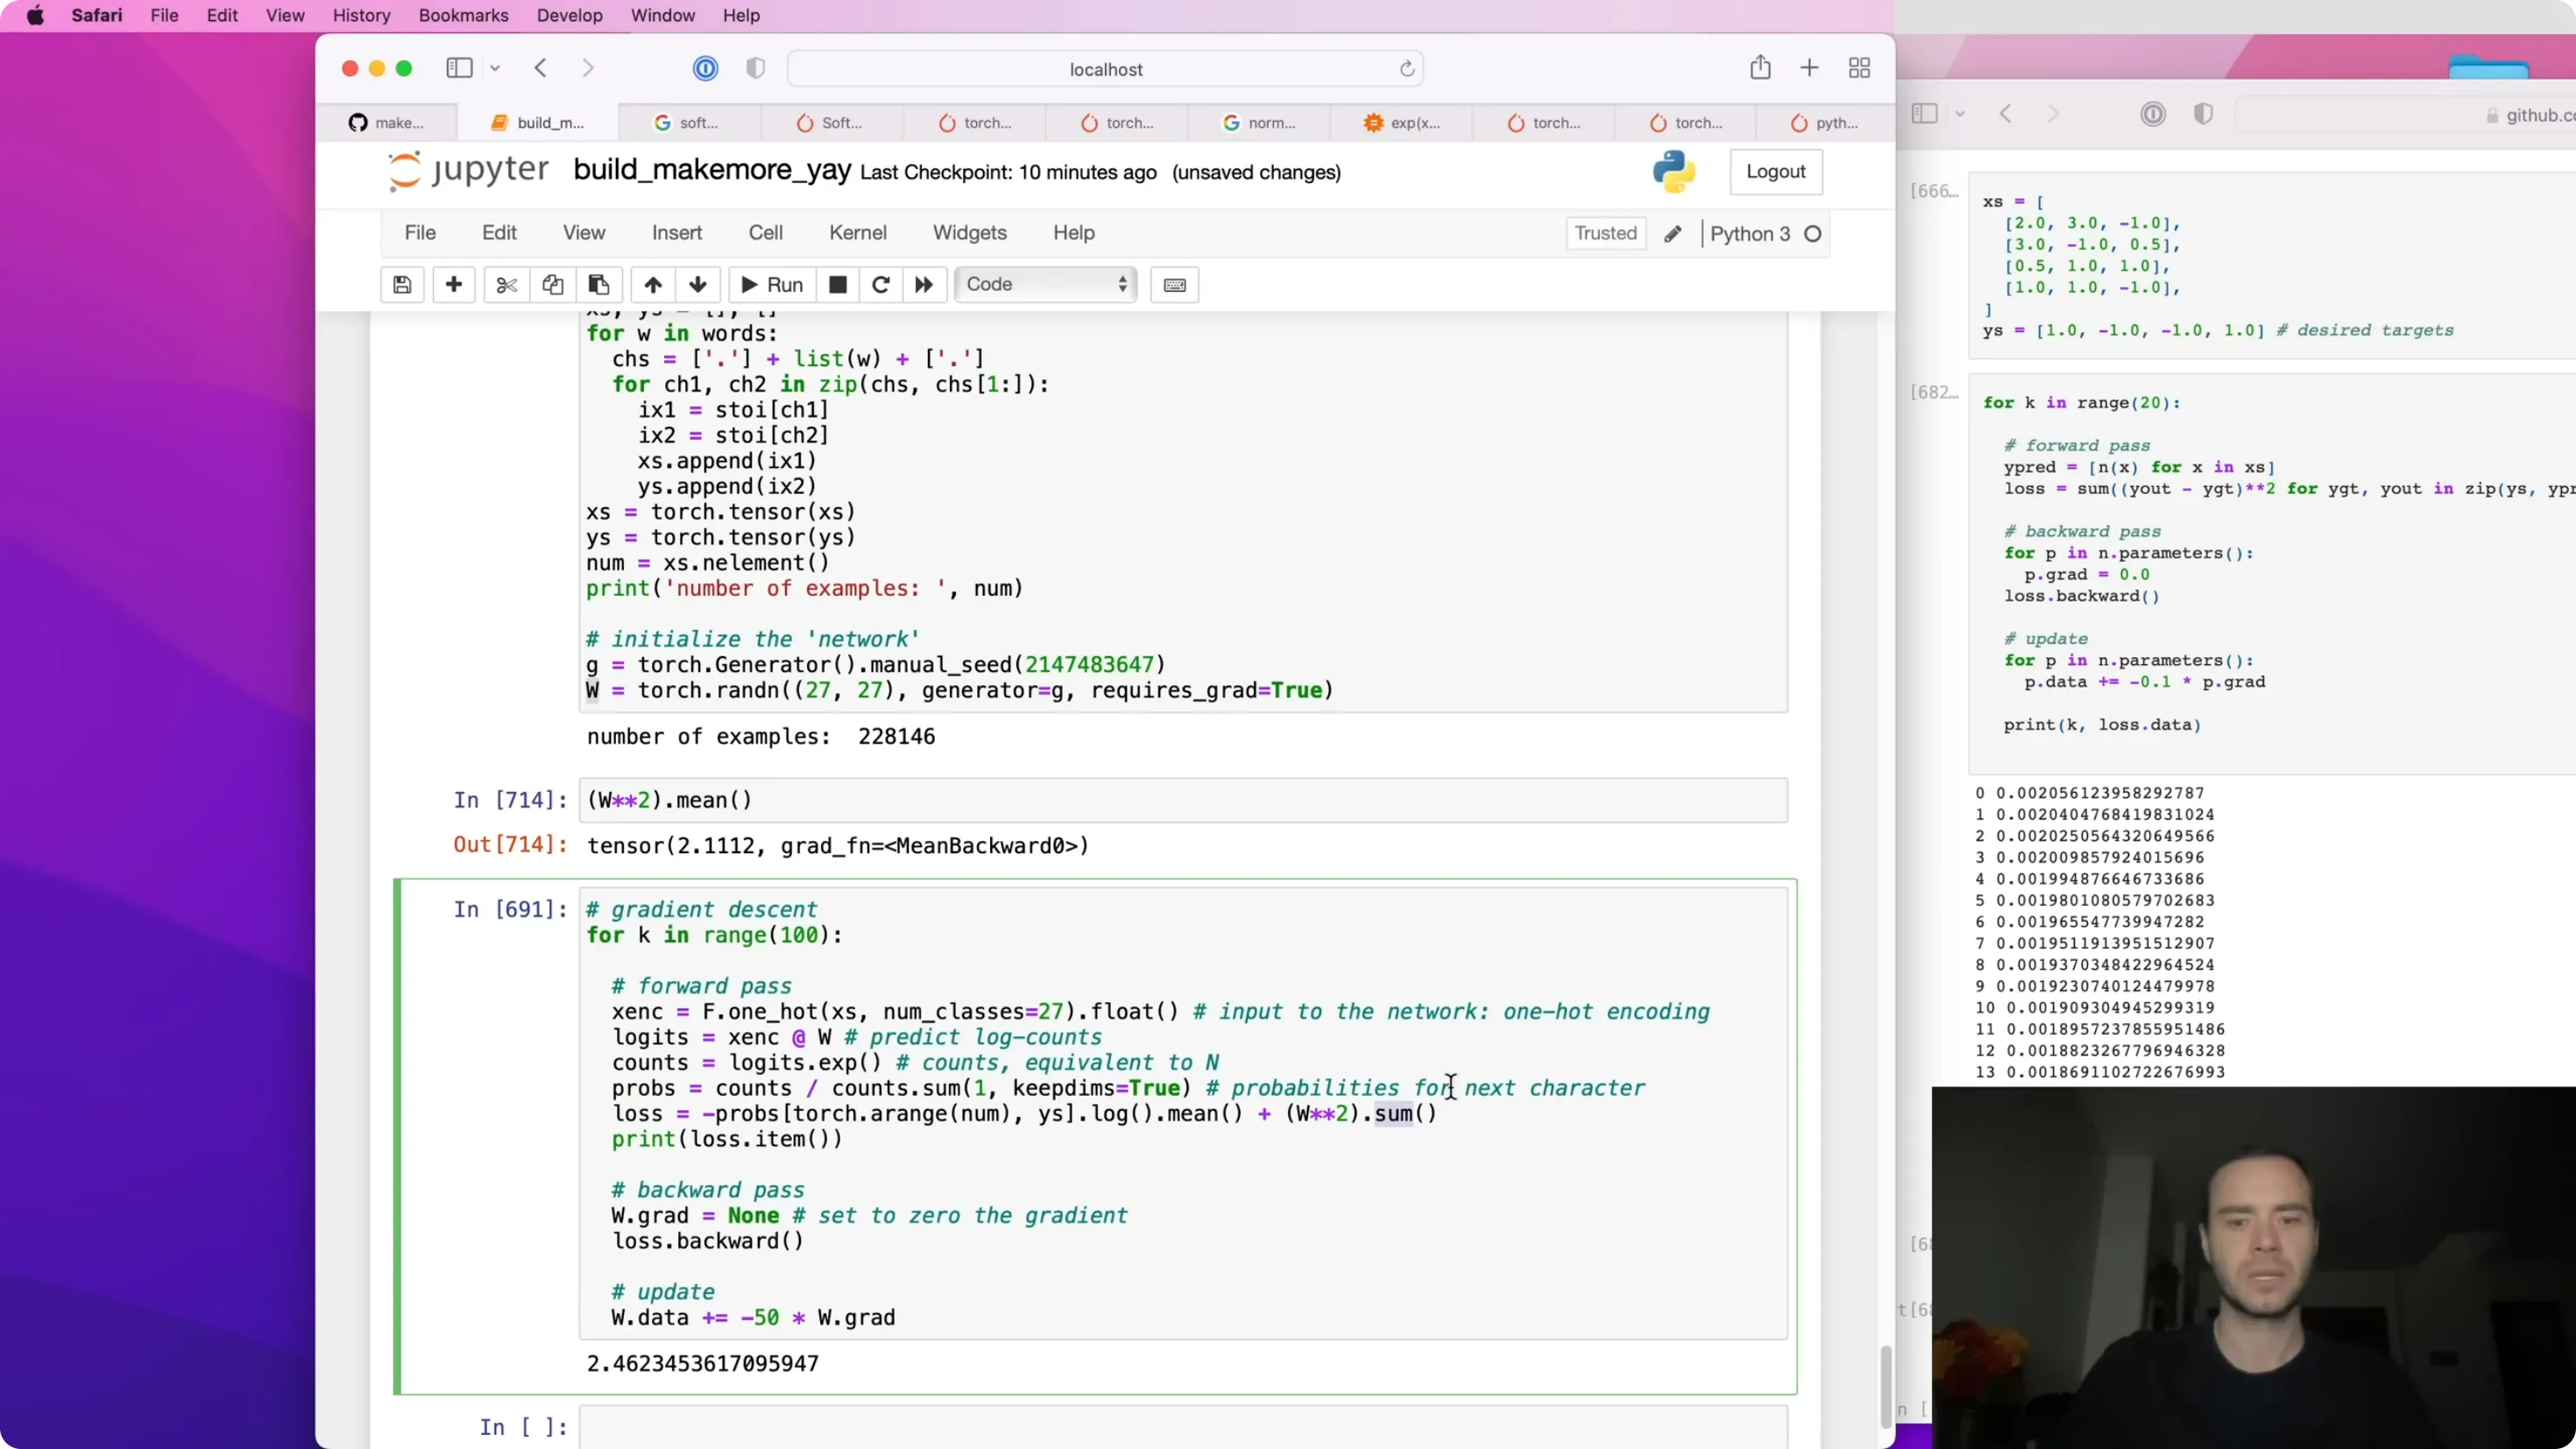
于是我们可以在损失里加一项,主动"把 W 往 0 拉":
loss = -probs[torch.arange(num), ys].log().mean() + 0.01 * (W**2).mean()
(W**2).mean()把所有权重平方后求平均,因此恒为正;- 当
W全为 0 时这一项为 0;W越大,这一项越大; - 前面的
0.01是正则化强度,控制这一项的相对重要性。
这就像给 W 加了一根弹簧:W 被拉向 0,但数据又希望概率匹配统计结果。两股力量拉扯下,得到的分布就是被平滑过的分布。增大正则化强度,等价于增大平滑时加入的假计数。
📷 把模型平滑理解为在损失中加入 W 的正则化项
回到原视频 (01:53:00)
十七、从神经网络模型采样
(参考时间: 01:54:31)
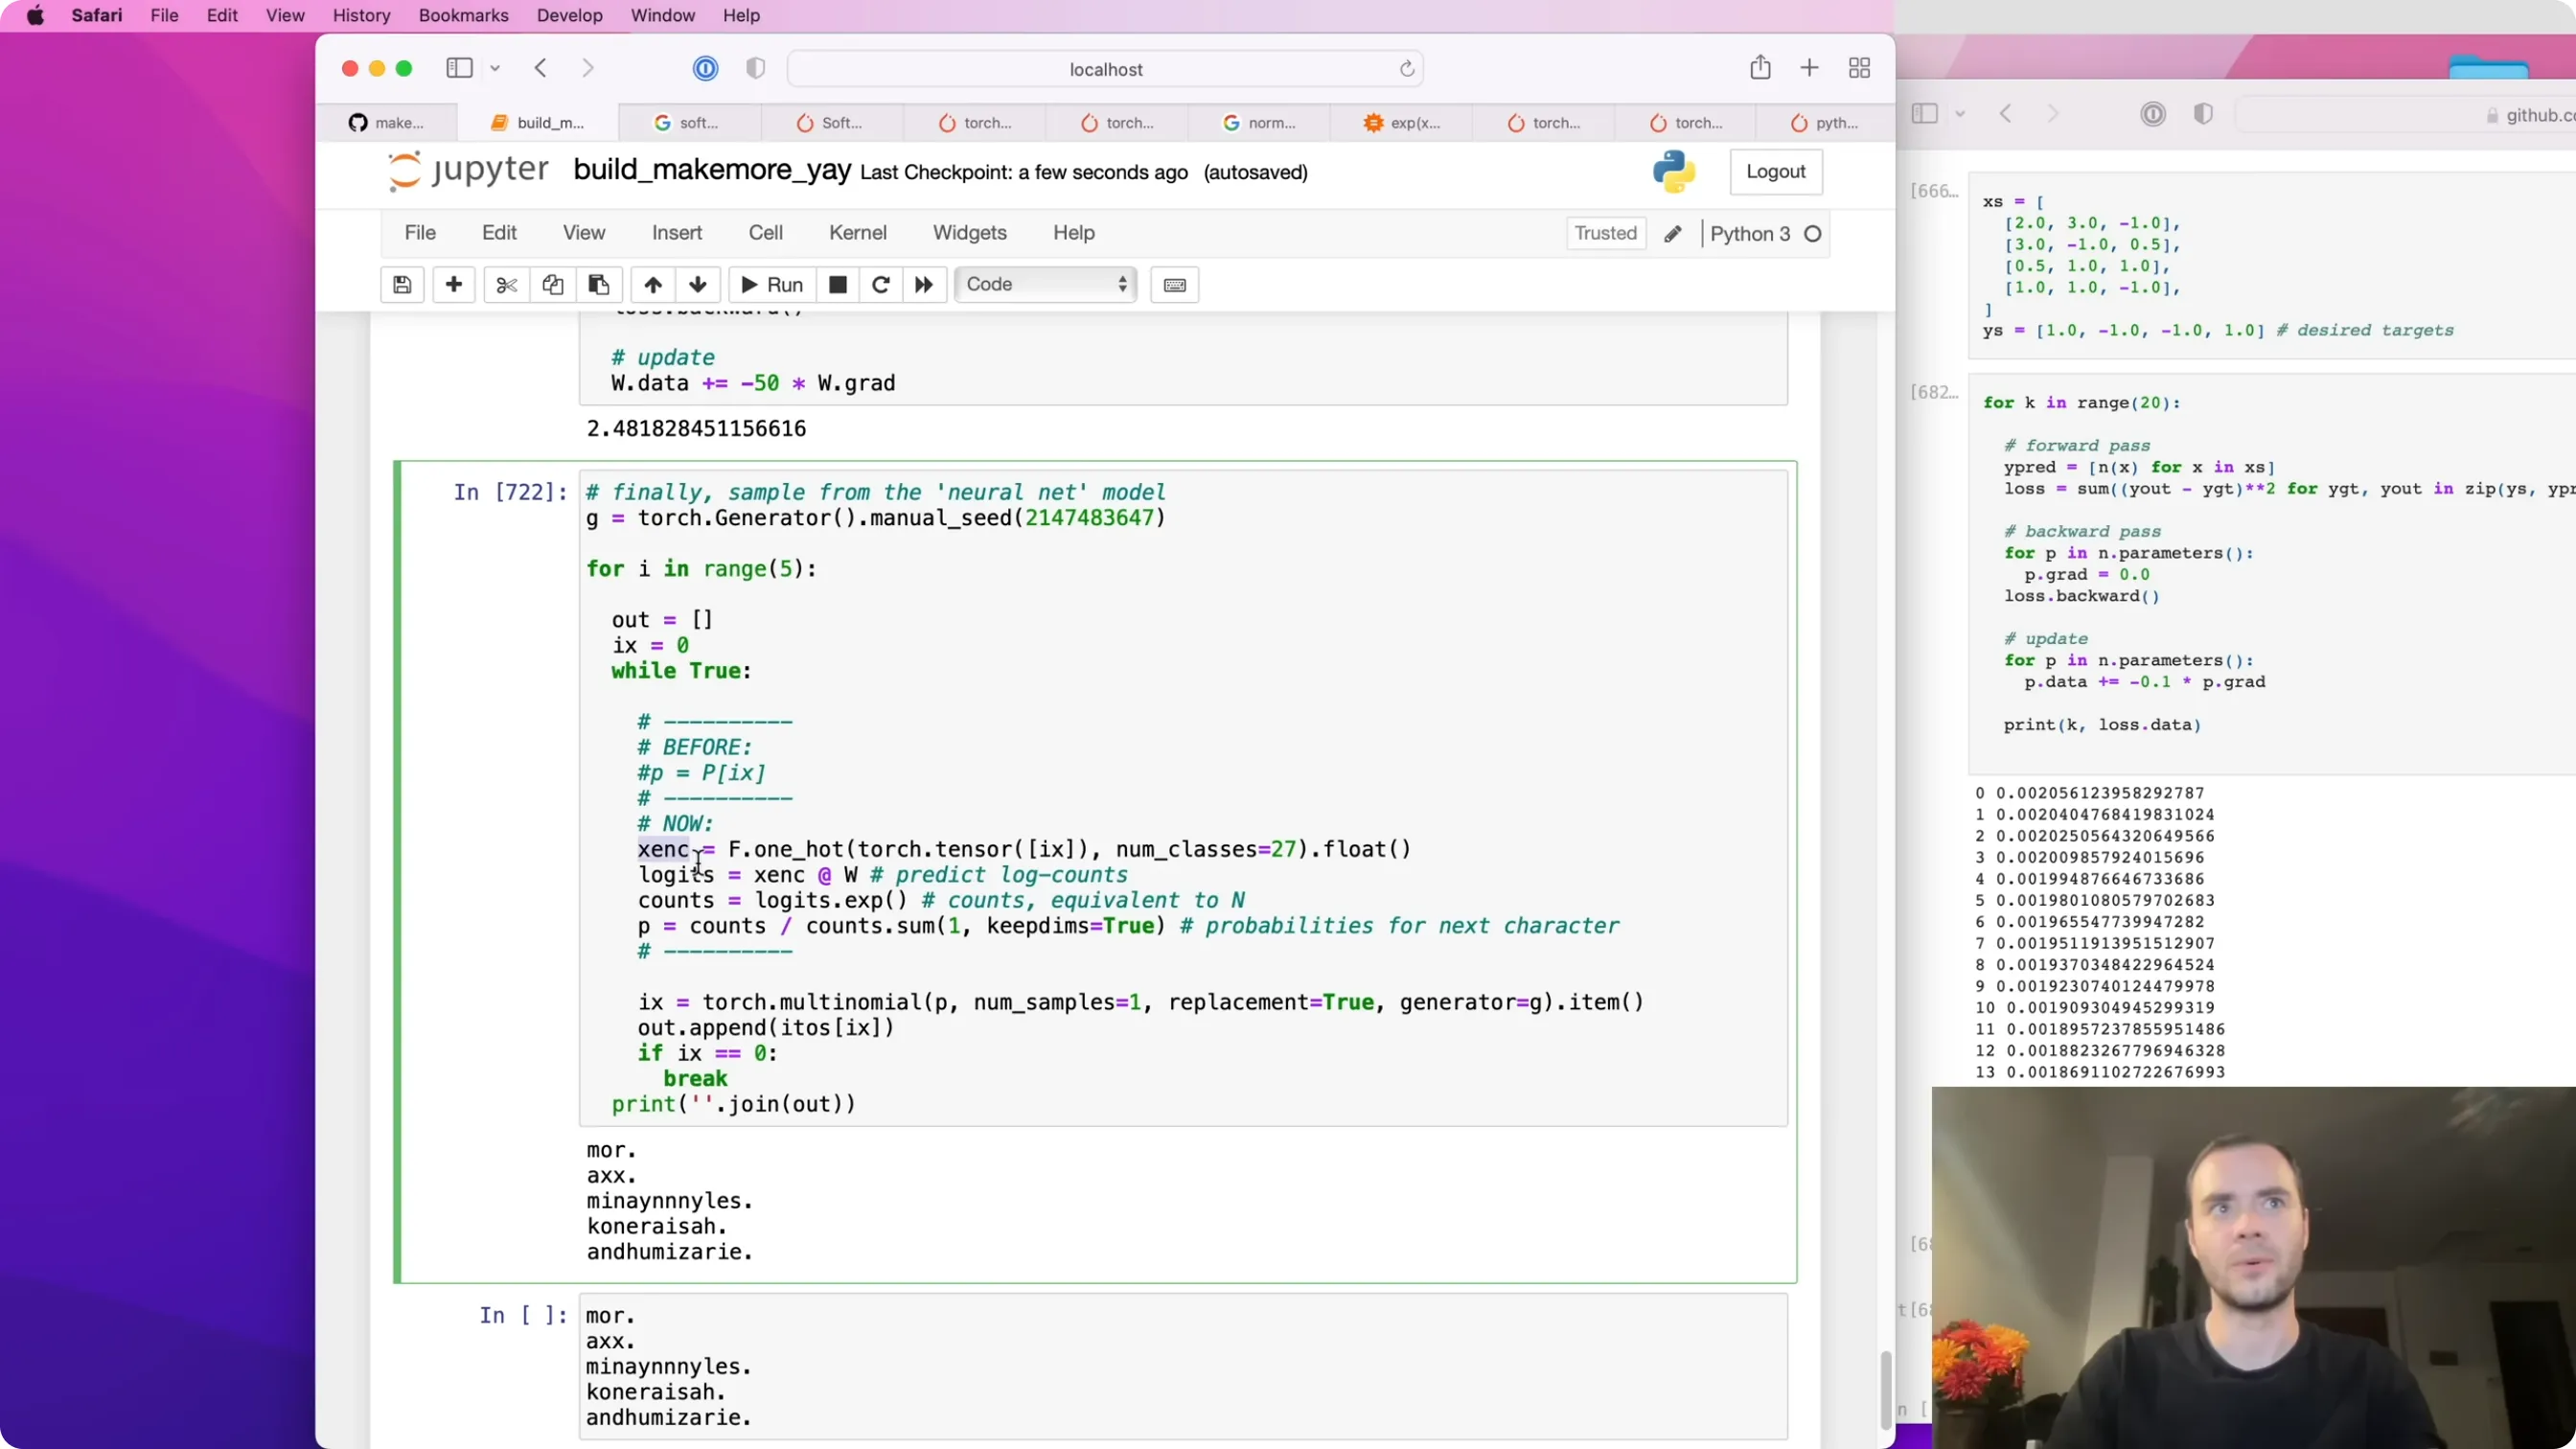
最后,用神经网络版模型采样。采样循环的骨架和之前一样,只是"取一行概率"的两行代码换掉了:
g = torch.Generator().manual_seed(2147483647)

for i in range(5):
    out = []
    ix = 0
    while True:
        # ---------- 之前:直接查表 ----------
        # p = P[ix]
        # ---------- 现在:走一遍神经网络 ----------
        xenc = F.one_hot(torch.tensor([ix]), num_classes=27).float()
        logits = xenc @ W            # 预测 log 计数
        counts = logits.exp()        # 等价于 N
        p = counts / counts.sum(1, keepdim=True)   # 下一个字符的概率
        # --------------------------------------
        ix = torch.multinomial(p, num_samples=1, replacement=True, generator=g).item()
        out.append(itos[ix])
        if ix == 0:
            break
    print(''.join(out))
结果和用计数矩阵采样完全一样。这有点"意料之中的平淡",但也正是最有力的验证:这两个模型真的是同一个模型——损失相同、W.exp() 对应计数矩阵、采样结果也相同。
到此,我们抵达了一个非常重要的认知:在 bigram 这个特例上,查表法和神经网络法是等价的;但神经网络法可以继续长大,而查表法不行。 这才是选择神经网络路线的真正理由。
📷 从神经网络模型采样的完整代码与结果
回到原视频 (01:55:20)
结语与下一步
(参考时间: 01:56:16)
这一讲走过了相当长的路,把语言建模的骨架完整地搭了一遍:
- 介绍了 bigram 字符级语言模型;
- 学会了如何训练它(两种方法:计数归一化、梯度下降);
- 学会了如何从它采样生成新名字;
- 学会了用一个数字——负对数似然损失——来评估模型质量;
- 并且用两种截然不同的路径得到了同一个模型、同一个损失。
接下来的视频会沿着第二条路(神经网络 + 梯度)继续加码:不再只看一个字符,而是把越来越多的历史字符喂进网络;网络本身也会从单层线性层一路复杂化——加隐层、加非线性、加归一化……直至 Transformer。但损失函数、softmax、梯度下降这套框架始终不变,变的只是前向传播里"如何根据前文算出 logits"。
| 组件 | 是否随模型升级而改变 |
|---|---|
| 网络的输入(看几个历史字符) | ✅ 会变 |
| 计算 logits 的前向传播 | ✅ 会越来越复杂 |
| softmax / 归一化 | ❌ 不变 |
| 负对数似然损失 | ❌ 不变 |
| 反向传播 + 梯度下降 | ❌ 不变 |
这正是"从 bigram 走向 GPT"的关键:固定住学习的外壳,只替换内部的计算。下一步,我们就从 bigram 走向 MLP。
附:官方参考与延伸阅读
- 课程主页(Neural Networks: Zero to Hero,本讲的上一讲与后续讲次都在这里):https://karpathy.ai/zero-to-hero.html
- 上一讲 / 前序项目
micrograd:https://github.com/karpathy/micrograd(对应视频 The spelled-out intro to neural networks and backpropagation: building micrograd) - 本讲配套 Notebook:https://github.com/karpathy/nn-zero-to-hero/blob/master/lectures/makemore/makemore_part1_bigrams.ipynb
makemore仓库与完整实现:https://github.com/karpathy/makemore- 数据集
names.txt:取自美国社会保障局(SSA)2018 年最常见的约 32,000 个名字,来源 https://www.ssa.gov/oact/babynames/ - bigram / MLP 语言模型的经典论文:Yoshua Bengio 等,A Neural Probabilistic Language Model (2003),https://www.jmlr.org/papers/volume3/bengio03a/bengio03a.pdf —— 后续 MLP 讲次会直接参考它
- Transformer 的原始论文:Vaswani 等,Attention Is All You Need (2017),https://arxiv.org/abs/1706.03762 —— 整个系列最终要达到的目标
- PyTorch 广播语义(本讲反复强调、务必精读):https://pytorch.org/docs/stable/notes/broadcasting.html
torch.multinomial文档:https://pytorch.org/docs/stable/generated/torch.multinomial.htmltorch.nn.functional.one_hot文档:https://pytorch.org/docs/stable/generated/torch.nn.functional.one_hot.html
版权说明:本书内容依据 Andrej Karpathy 的公开教学视频 The spelled-out intro to language modeling: building makemore 重构,代码与数据集版权归原作者所有,遵循其仓库所附许可(MIT License)。本电子书仅用于学习交流,不用于商业用途。