第3讲 · 手把手语言建模(MLP 篇):从零构建 makemore 的多层感知机
本电子书由教学视频重构而成。 视频原标题:Building makemore Part 2: MLP 书中代码、数据集与图片版权归原作者 Andrej Karpathy 所有。本文为课堂讲解的中文书面重构,仅供学习交流。 👉 E02 特别值得做:它会让你第一次真切感到「初始化没调好,训练一开始就在瞎猜」。
| 讲师 | Andrej Karpathy |
| 视频地址 | https://www.youtube.com/watch?v=TCH_1BHY58I |
| 所属课程 | Neural Networks: Zero to Hero — https://karpathy.ai/zero-to-hero.html |
| 本讲课件 Notebook | https://github.com/karpathy/nn-zero-to-hero/blob/master/lectures/makemore/makemore_part2_mlp.ipynb |
| 🟢 Google Colab(免安装,浏览器里直接跑) | https://colab.research.google.com/drive/1YIfmkftLrz6MPTOO9Vwqrop2Q5llHIGK?usp=sharing |
| 完整实现(makemore 仓库) | https://github.com/karpathy/makemore |
| 📄 必读论文:Bengio et al. 2003 | https://www.jmlr.org/papers/volume3/bengio03a/bengio03a.pdf |
| 讨论区 | 官方 Discord:https://discord.gg/3zy8kqD9Cp |
| 延伸阅读 | PyTorch internals(张量/storage 原理):http://blog.ezyang.com/2019/05/pytorch-internals/ |
| E01 | 调超参数,打败他给出的最佳验证损失 2.2。 |
| E02(初始化) | 他在视频里没有认真处理初始化。(1) 如果初始化时预测概率是完全均匀的,损失应该是多少?我们实际得到多少?(2) 能不能调初始化,让起始损失更接近 (1)? |
| E03 | 读 Bengio et al. 2003,实现并尝试论文里的任意一个想法。它管用吗? |
对应讲次:第3讲(Karpathy: Neural Networks — Zero to Hero)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者拓展|📝 本讲的官方练习(Exercises):Karpathy 在这一讲的描述里给了 3 道题,强烈建议动手做——它们正好覆盖了本讲的三个核心:
引子:bigram 的天花板
(参考时间: 00:00)
上一讲我们用计数和一个单层线性网络实现了 bigram 语言模型:只看前一个字符,预测下一个字符的分布。
问题:只用一个字符的上下文,预测质量很差——生成出来的名字不太像名字。
那多看点上下文行不行?
- 看 1 个字符:上下文有 27 种可能(26 个字母 + 一个特殊符号
.); - 看 2 个字符:27 × 27 = 729 种;
- 看 3 个字符:约 20,000 种。
「表的行数随上下文长度指数增长」——每行的计数样本又太少,整件事就爆炸了。
编者拓展|这就是"维度灾难"在语言建模里的第一次现身:这种「按 (上下文 → 下一词) 计数」的模型叫 n-gram 模型。它的致命伤是:参数(表的行数)随上下文长度指数增长,而每种上下文能观察到的样本却越来越少。所以到 n=3、4 之后就完全不可用了。
Bengio 2003 的关键突破就是绕开这张表:把"词"映射到一个低维稠密向量(embedding),让相似上下文共享统计强度。这也是现代 LLM 的思想起点。
因此今天要做的,是多层感知机(MLP)语言模型——它遵循 Bengio et al. 2003 那篇非常有影响力的论文。
📷 bigram 的上下文表随长度指数爆炸
回到原视频 (00:02:10)
一、Bengio et al. 2003:从"查表"到"嵌入"
(参考时间: 01:48)
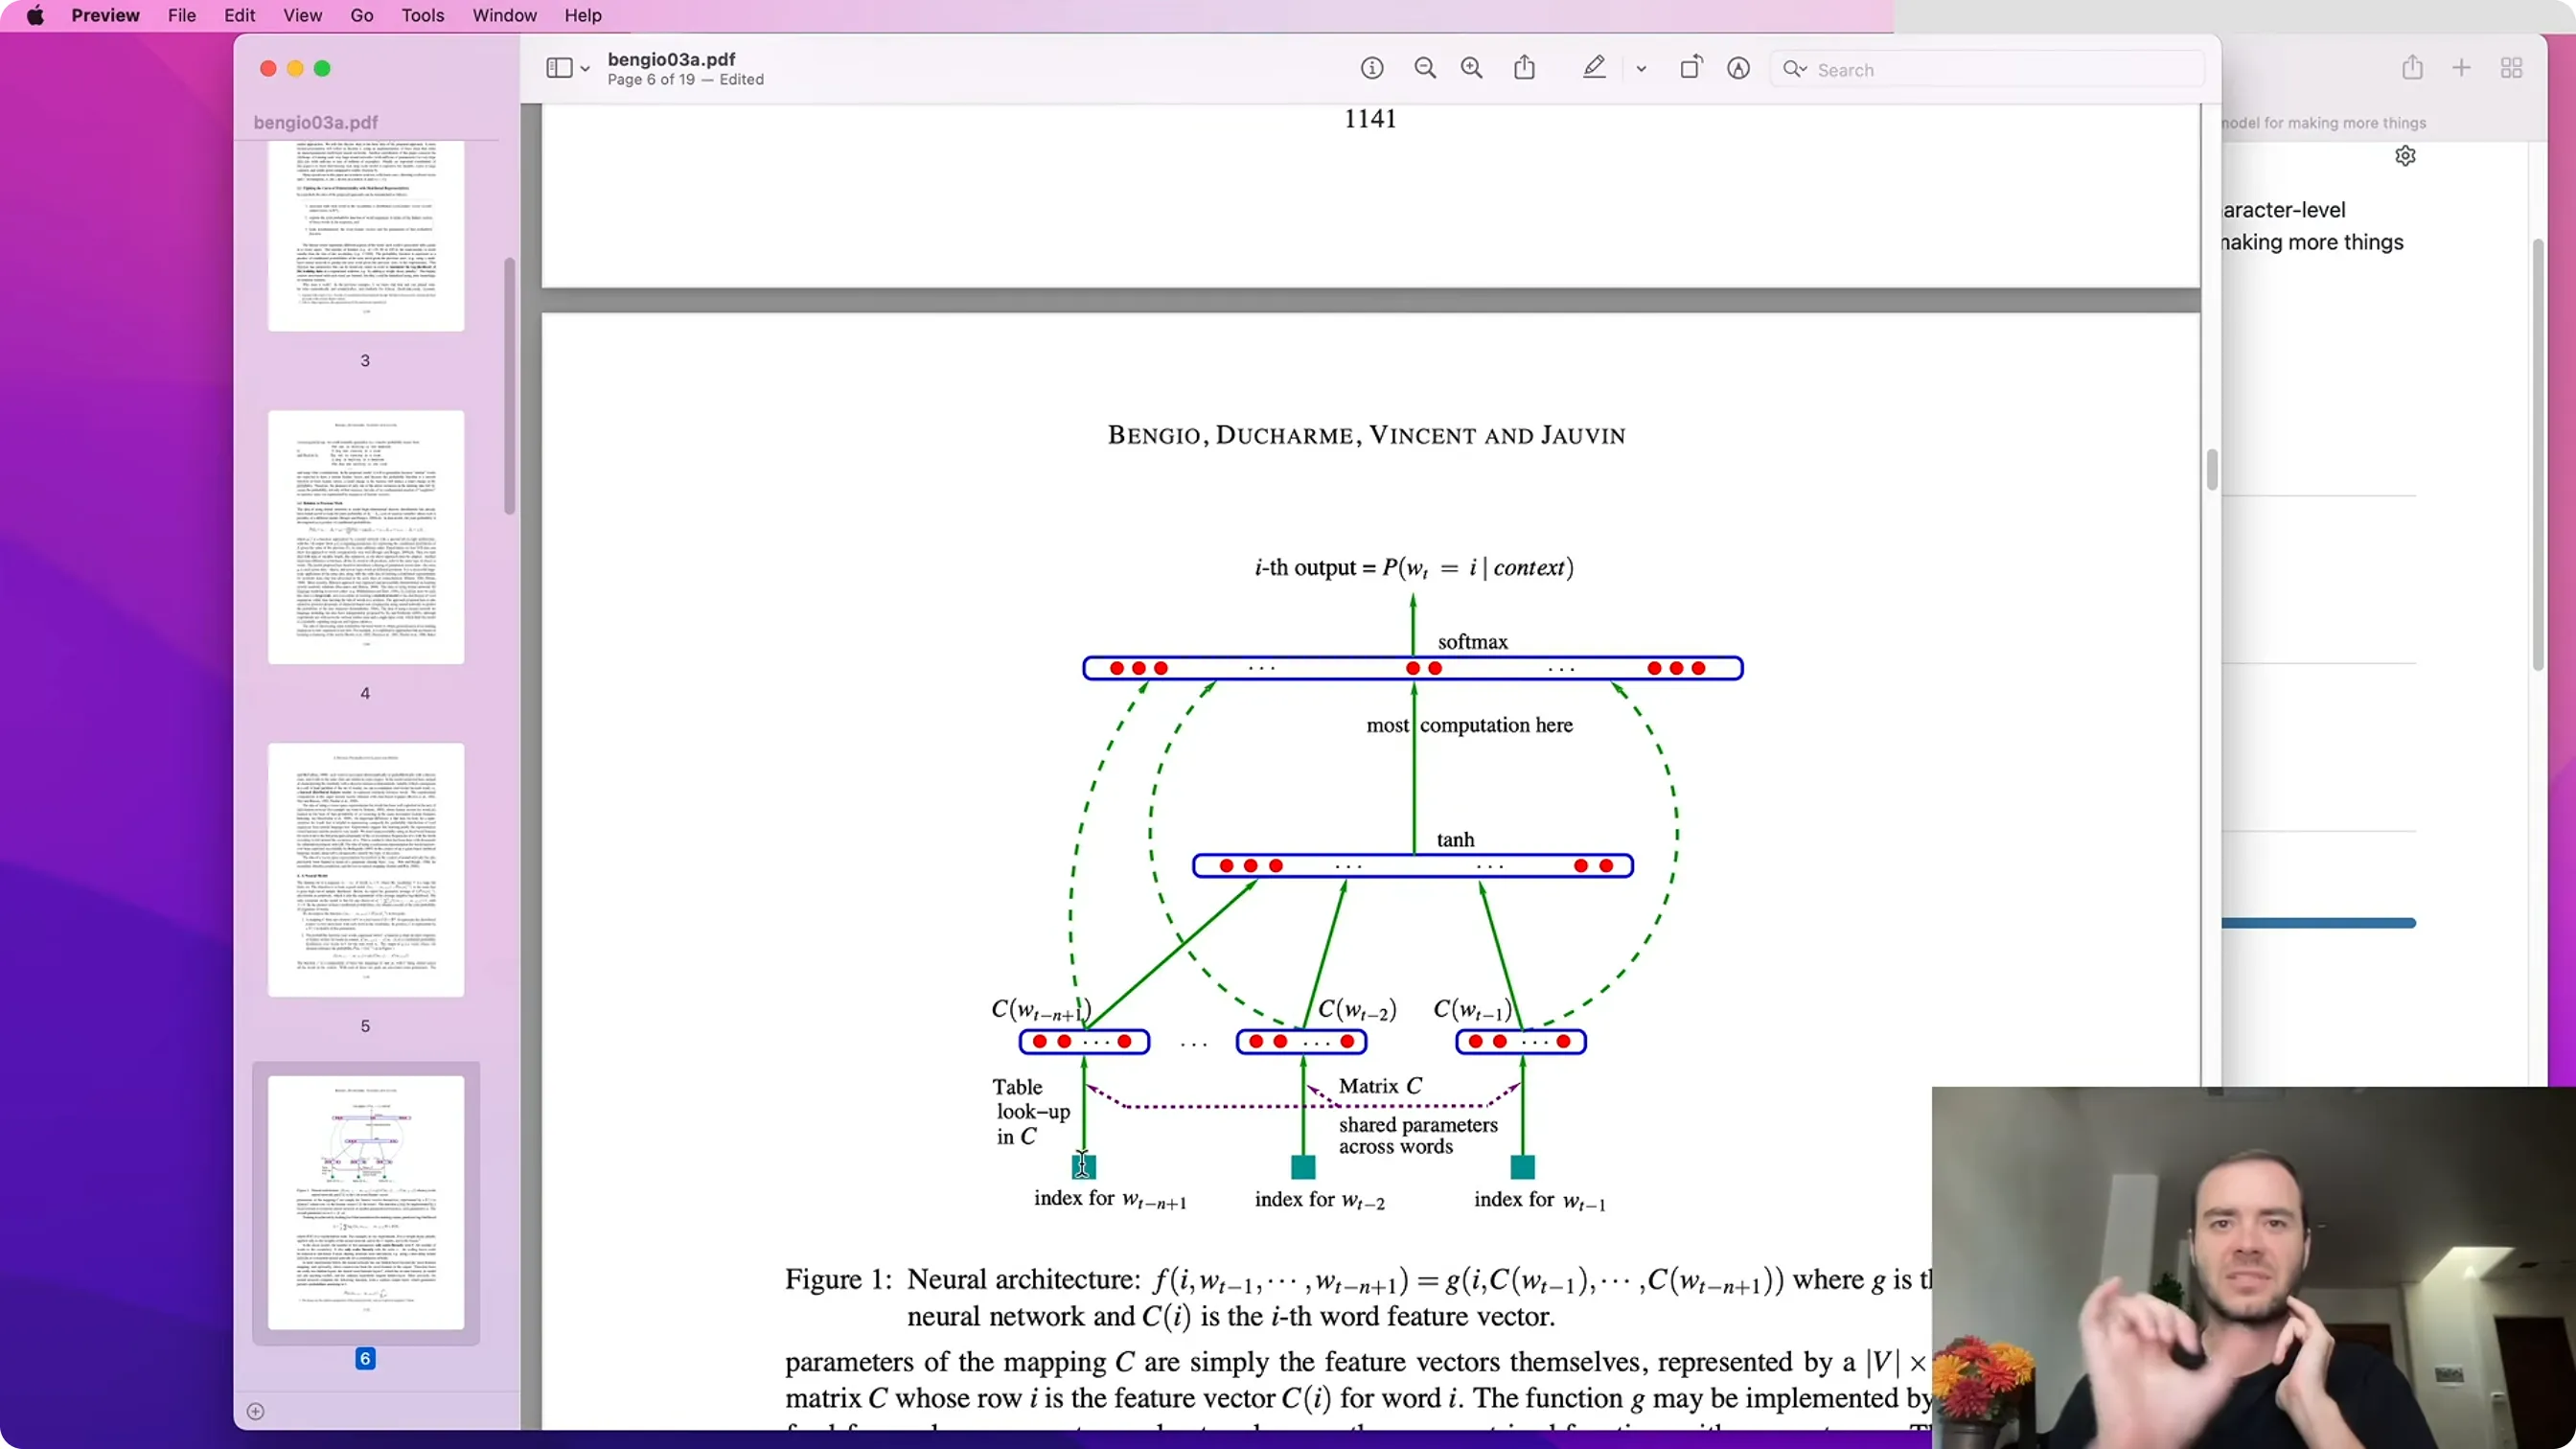
论文解决的问题和我们完全一样,只是它做的是词级(词表 17,000 个词),我们做字符级。
核心思想:给每个词关联一个(比如)30 维的特征向量——也就是把每个词"嵌入"到一个 30 维空间里。
- 一开始,这些向量完全随机初始化;
- 训练时,用反向传播一起调整这些嵌入;
- 于是意义相近的词会慢慢靠到一起,意义不同的词跑到别处。
这为什么能泛化? 论文举了个漂亮的例子:
假设你要预测 "A dog was running in a ___.",而这整句话在训练集里从未出现过(out-of-distribution)。 但你可能见过 "The dog was running in a ___."。如果网络学到
A和The的嵌入很接近(它们常常可以互换),知识就能通过嵌入空间"迁移"过来。同理,网络可以学到"猫和狗都是动物、出现在相似的上下文里"。
换句话说:没见过的句子,也能靠"见过相似的词"来推断。
📷 Bengio 2003 的 MLP 语言模型结构图
回到原视频 (00:06:00)
网络结构(论文的图,也是我们本讲要实现的东西):
| 层 | 说明 |
|---|---|
| 输入 | 3 个前序词的索引(0 ~ 16999 的整数) |
| 查找表 C | 一个 17000 × 30 的矩阵;每个索引取出 C 的一行,得到 30 维嵌入 |
| 输入层 | 3 个词 × 30 维 = 90 个神经元(C 被所有词共享) |
| 隐藏层 | 大小是超参数(比如 100),全连接到 90 个输入,后接 tanh |
| 输出层 | 17000 个神经元(每个词一个),全连接到隐藏层——「大部分计算量都在这里」 |
| Softmax | 把 17000 个 logits 变成概率分布 |
| 损失 | 用真实的下一个词的索引取出它的概率,最大化它(即最小化负对数似然) |
所有参数(输出层 W/b、隐藏层 W/b、嵌入表 C)一起用反向传播优化。
编者拓展|「embedding」到底是个什么东西:一句话——embedding 就是一个"可训练的查找表":把离散的符号(词、字符)映射成连续向量。 - 它没有魔法:就是矩阵
C,C[idx]就是"索引 idx 的向量"; - 但它的威力在于:向量的"邻近"可以表达意义的相似,于是离散符号之间的"知识迁移"变成了连续空间里的几何; - 今天你听说的「词向量」(word2vec、GLoVe)、「token embedding」、「position embedding」,都是这个思想的不同变体。本讲后面会亲眼看到:27 个字符训练完后,元音 a/e/i/o/u 会自动聚成一团,而
q和.跑到很远的地方——没人告诉网络这件事。
二、重建数据集:滑动窗口
(参考时间: 09:03)
新建 notebook,读入 names.txt,建立字符 → 整数的映射(27 个符号)。
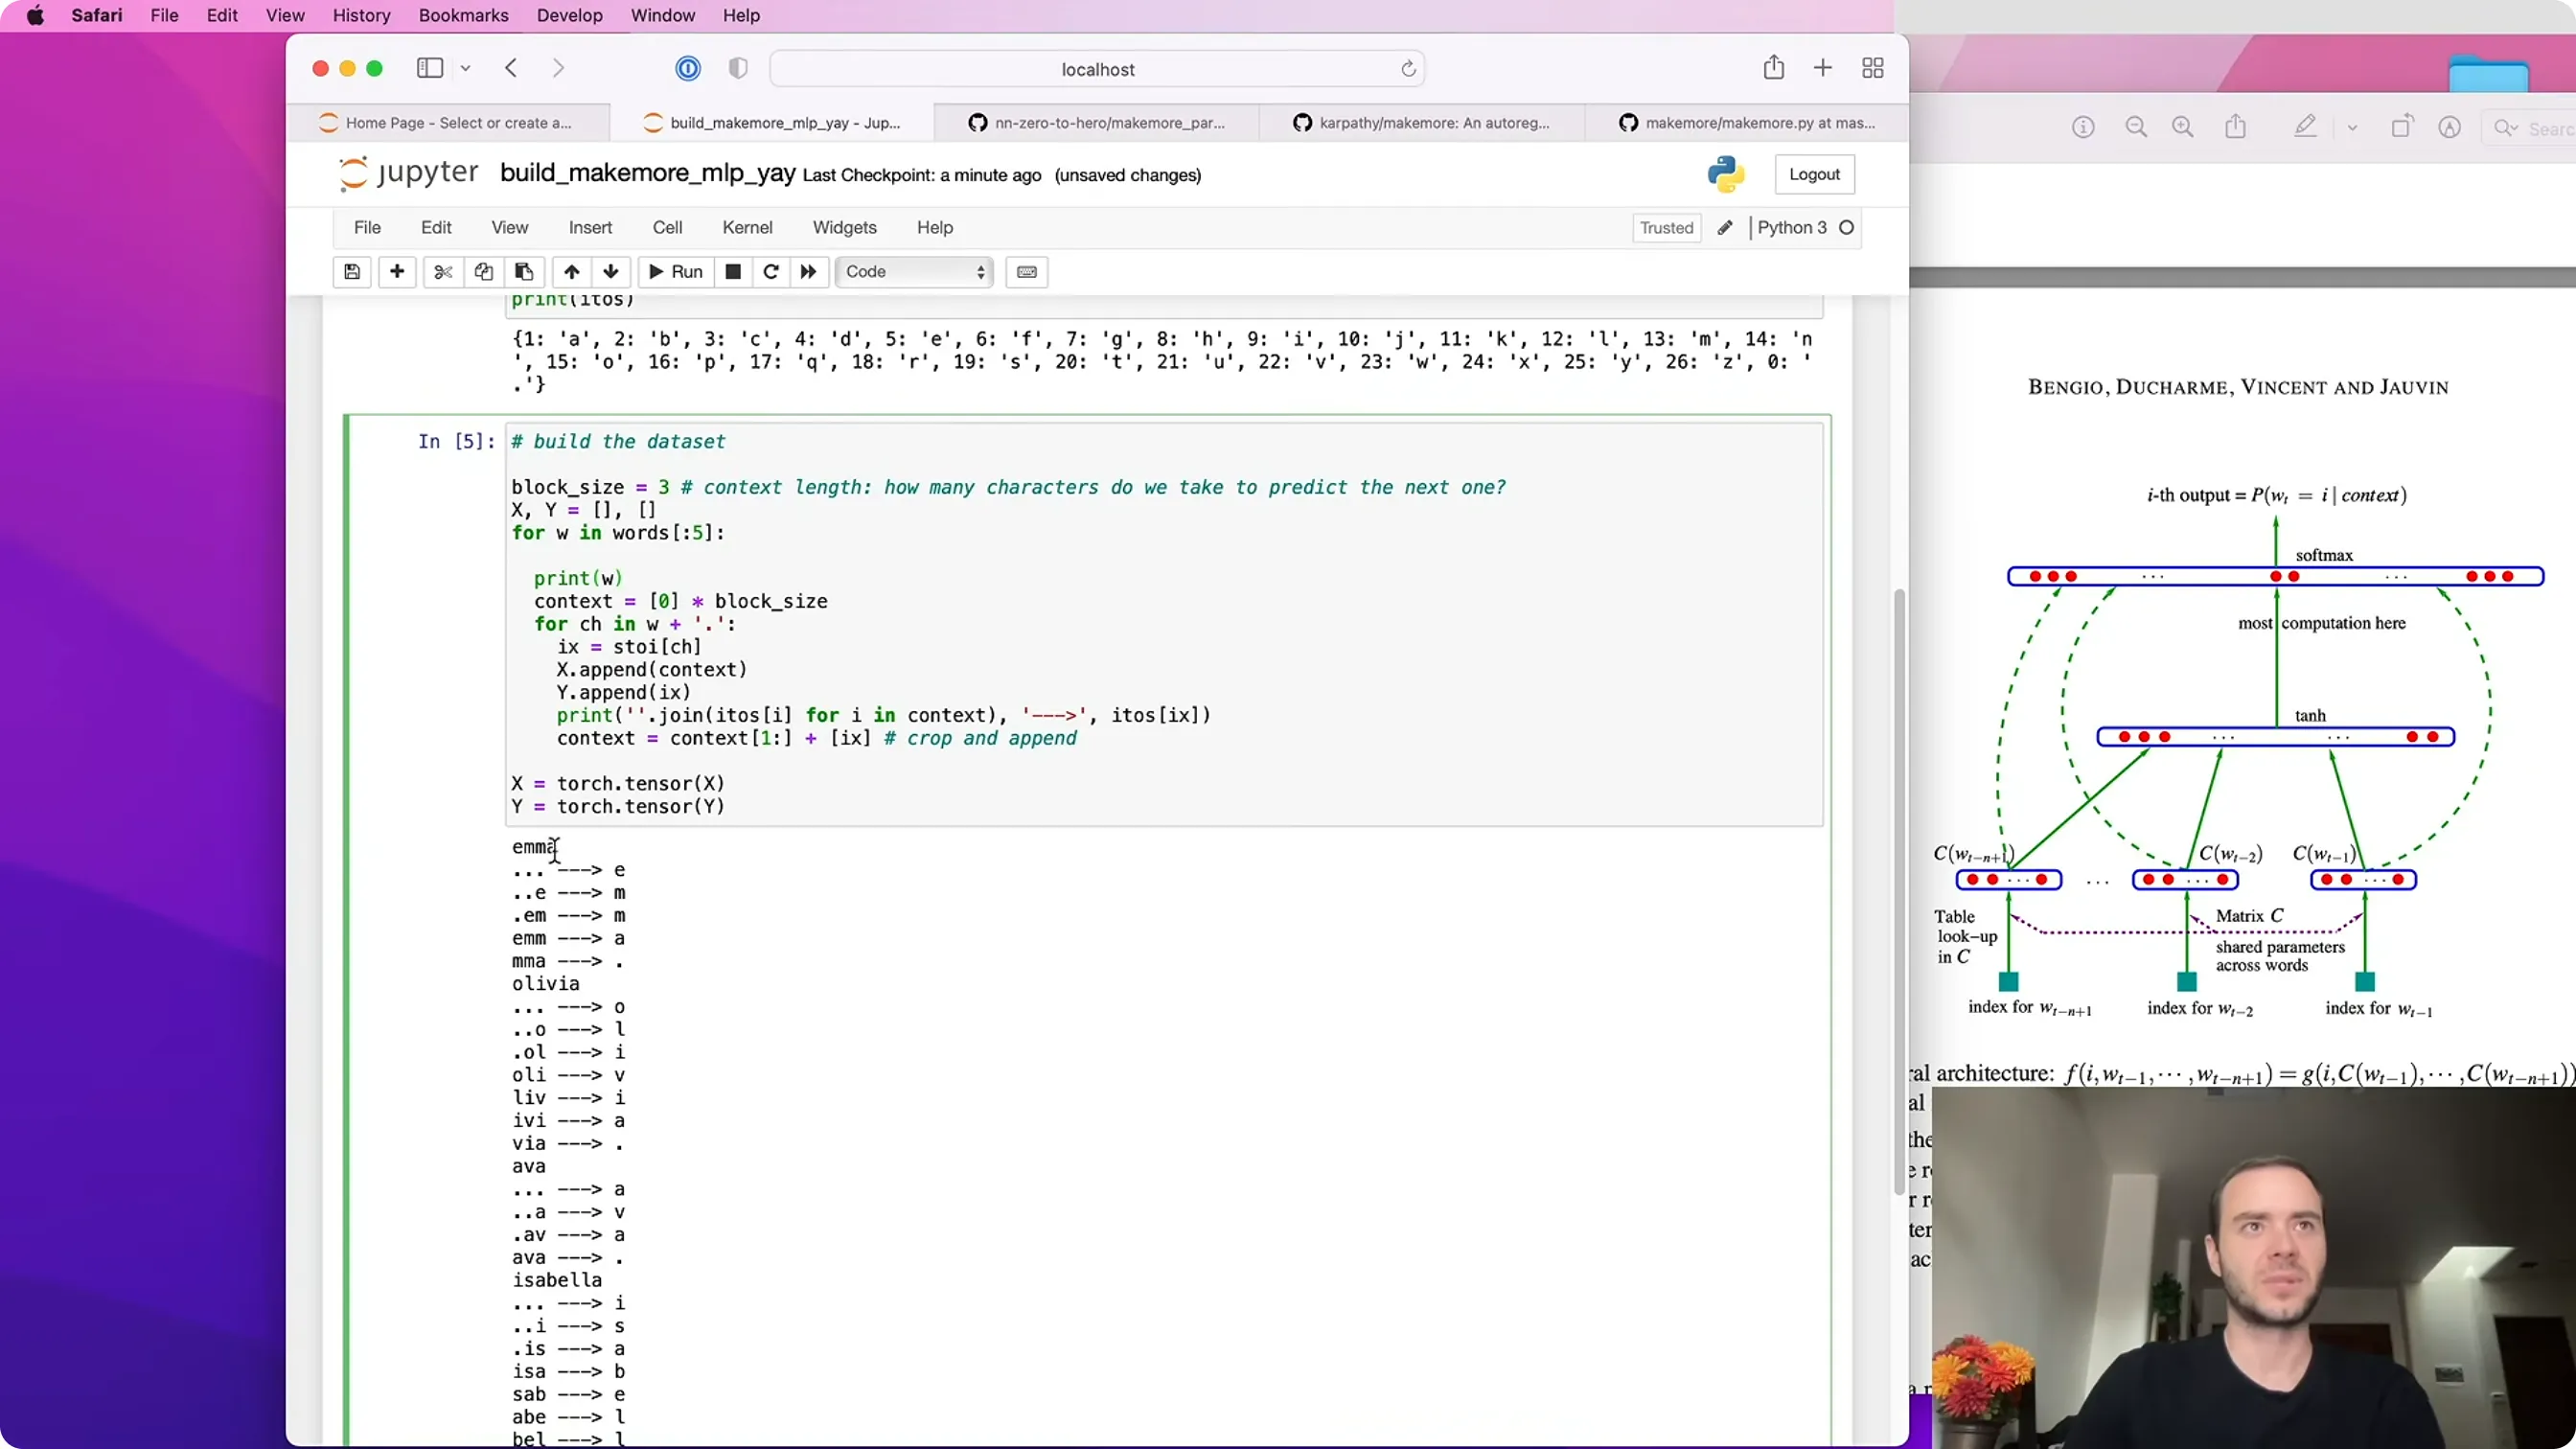
定义 block size(上下文长度) = 3:用前 3 个字符预测第 4 个。
block_size = 3
X, Y = [], []
for w in words[:5]:            # 开发时先只用前 5 个词
    context = [0] * block_size # 用 0(即 '.')填充
    for ch in w + '.':
        ix = stoi[ch]
        X.append(context)
        Y.append(ix)
        context = context[1:] + [ix]   # 滚动窗口
对 emma 一个词,就能造出 5 个训练样本(... → e、..e → m、.em → m、emm → a、mma → .)。
- X 的形状是
(样本数, 3):每个样本是3 个整数; - Y 的形状是
(样本数,):每个样本是一个整数标签。
改 block size 只需要改一个数——4、5、10 都能自动工作,永远用 . 填充。
📷 用滑动窗口从名字里构造 X(3 个整数)与 Y(下一个字符)
回到原视频 (00:10:30)
三、嵌入查找表 C
(参考时间: 12:19)
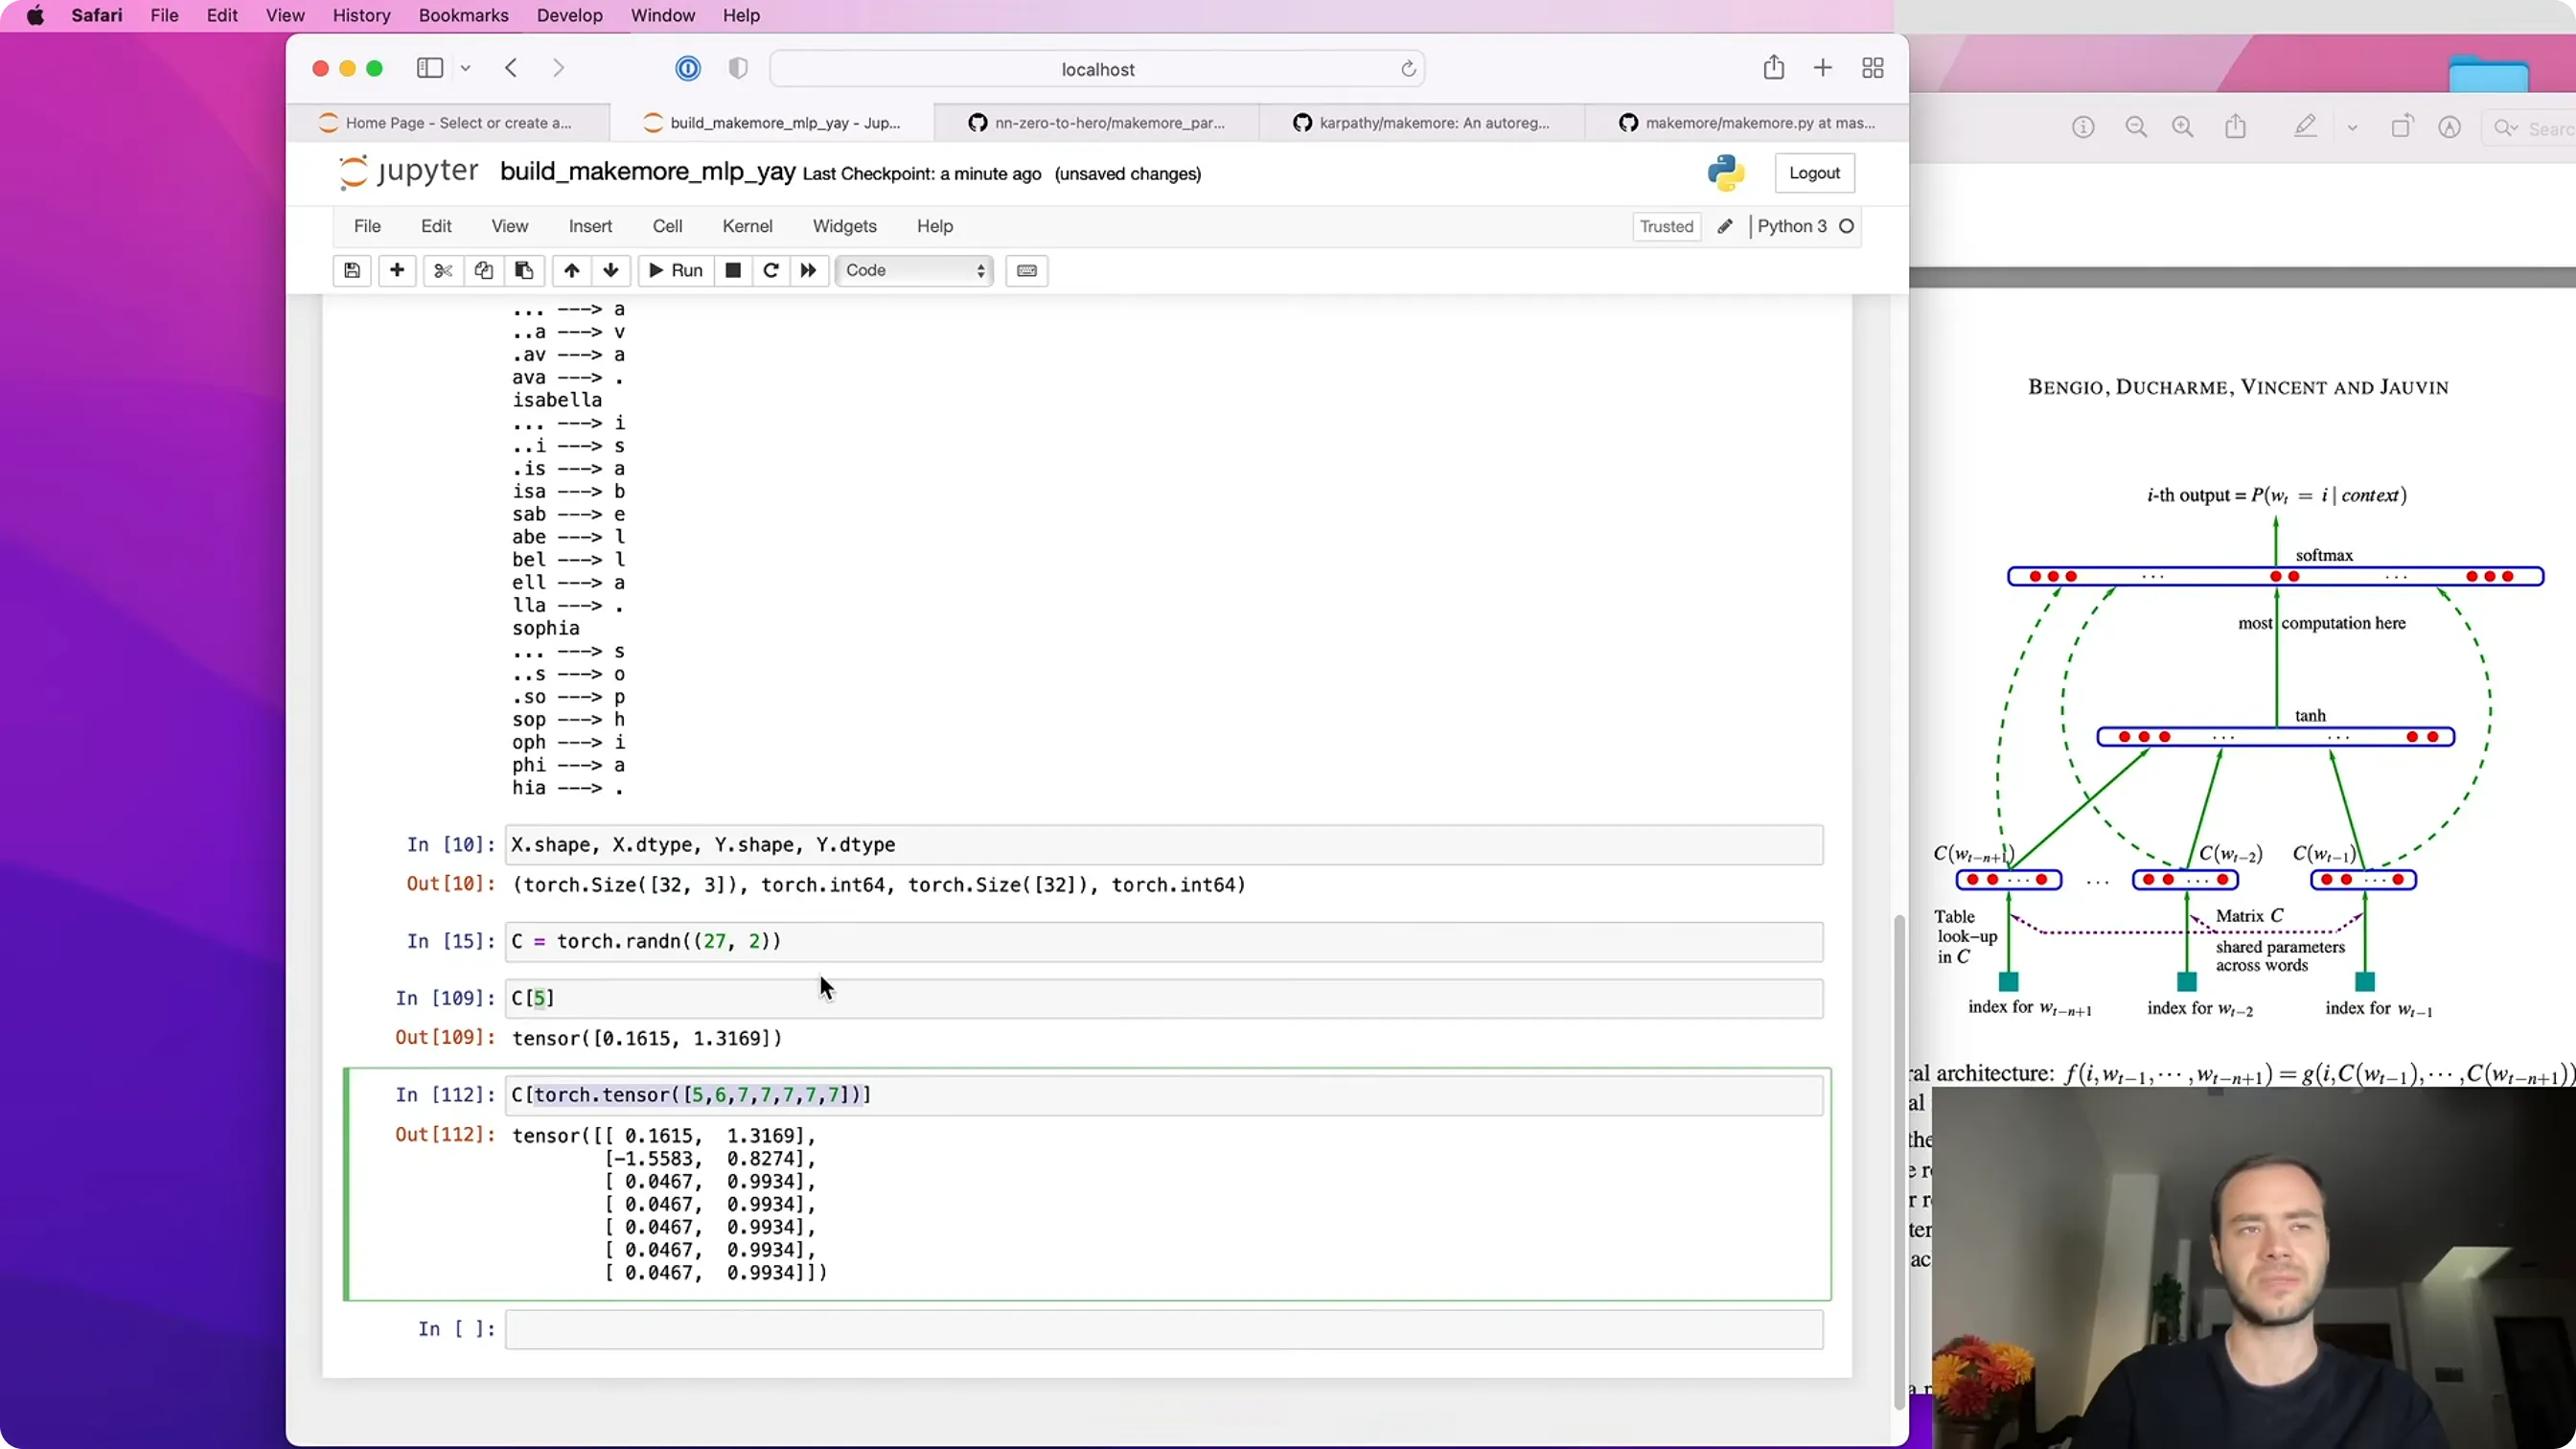
我们只有 27 个字符,先嵌入到一个很小的空间(2 维),方便后面可视化。
C = torch.randn((27, 2)) # 27 行、2 列,随机初始化
对比论文:论文把 17,000 个词塞进 30 维——「一个很小的空间里塞了很多点」。我们只有 27 个字符,2 维就够了。
取出单个索引的嵌入,有两种看起来不同、实际完全等价的写法:
写法 A:直接索引
C[5] # 取 C 的第 5 行
写法 B:one-hot 乘 C
F.one_hot(torch.tensor(5), num_classes=27).float() @ C
结果完全相同!因为 one-hot 里只有一个 1,矩阵乘法把 C 的其余行全掩掉了,只"挑出"第 5 行。
编者拓展|一个重要洞察:嵌入层 = 没有非线性的第一层:上面两种写法等价,意味着——"查表"可以看成"神经网络的第一层":它接收 one-hot 输入、权重矩阵就是
C、没有非线性(纯线性神经元)。但实践中我们只做索引(
C[X]),因为快得多:不必真的把 27 维 one-hot 向量乘一遍矩阵。「我们丢掉了 one-hot 的解释,只保留索引」。
如何一次性嵌入 X 里所有的整数? PyTorch 的索引非常强:
C[X] # X 是 (32, 3) 的整数张量 → 结果形状 (32, 3, 2)
📷 嵌入:CX 一次性把 (32,3) 的整数变成 (32,3,2) 的向量
回到原视频 (00:17:30)
编者说明:PyTorch 不只是支持
C[5],还支持用列表、张量、甚至多维张量索引——所以C[X]一步到位。这正是它"索引很猛(awesome)"的地方。
四、隐藏层,以及 torch.Tensor 的内部结构
(参考时间: 18:35)
隐藏层:输入是 3 × 2 = 6 维,神经元数量是超参数(先取 100):
W1 = torch.randn((6, 100))
b1 = torch.randn(100)
但直接乘会失败:emb 的形状是 (32, 3, 2),而 W1 是 (6, 100)——形状对不上。我们需要先把它拼成 (32, 6)。
做法一(可读但较慢):torch.cat
torch.cat(torch.unbind(emb, 1), 1) # 把 3 个 (32,2) 沿维度 1 拼起来 → (32,6)
(unbind 删掉并返回某维度的所有切片,于是这一段不依赖 block size,比手写下标更通用。)
做法二(更好、更快):view
这引出了 torch.Tensor 的内部原理:
a = torch.arange(18)          # 形状 (18,),底层 storage 就是 18 个数
a.view(2, 9)                  # 只改"怎么看",不改数据
a.view(9, 2)
a.view(3, 3, 2)               # 只要元素总数相同,随便 view
关键:view 不做任何内存拷贝/移动。每个张量底下有一个 storage(永远是一维的),而 view 只是调整几个属性:storage offset、strides、shape——让这一维序列被"看成"不同的 N 维数组。
emb.view(32, 6)               # 等价于上面的 cat,但零拷贝
emb.view(-1, 6)               # 用 -1 让 PyTorch 自己推断那一维
验证:emb.view(32,6) == torch.cat(...) 逐元素相等 ✅。
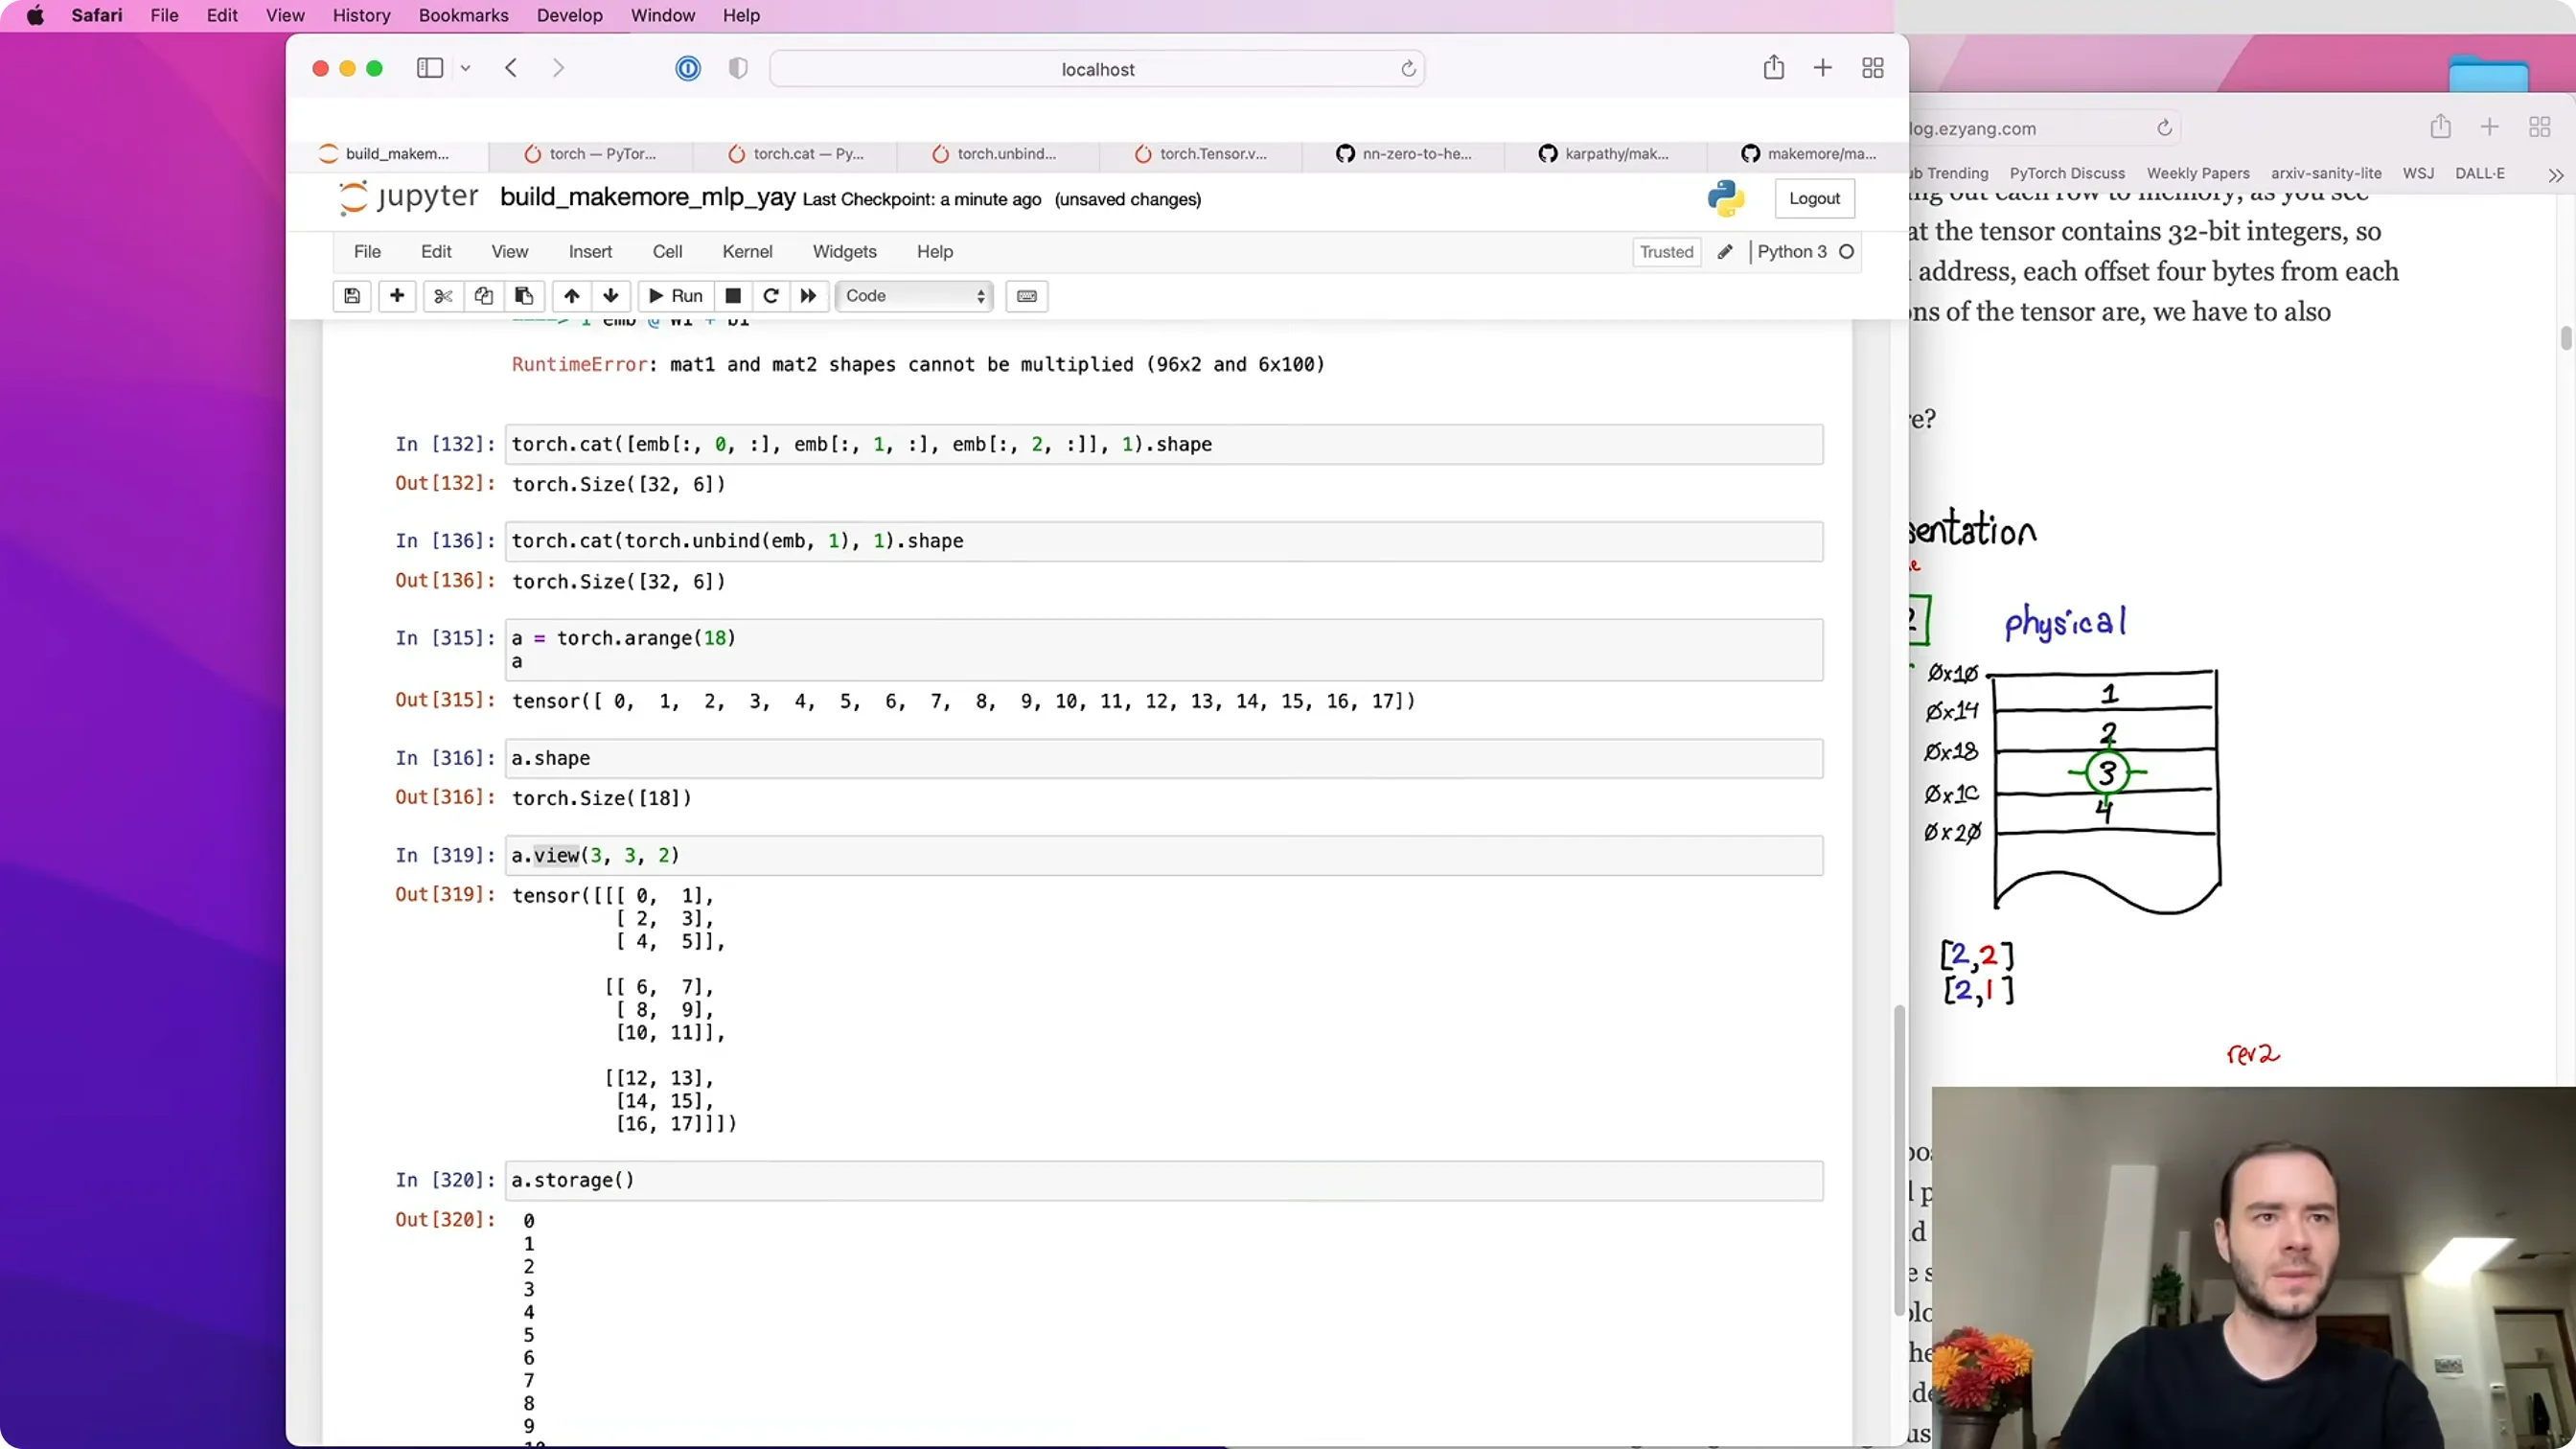
📷 storage / view / strides:view 只改"怎么看",不拷贝数据
回到原视频 (00:24:30)
编者拓展|
view为什么重要:在深度学习里,张量变形(reshape/view/permute)无处不在,而且它们绝大多数是零拷贝的——只改元数据。这带来巨大的性能优势,也带来一大类 bug 的来源(比如view前必须保证内存连续,否则要用.reshape()或.contiguous())。想深入理解:读 PyTorch internals(本讲 front matter 里的链接)——它讲清了 storage / strides / view 的关系,和你在《操作系统》里学的「物理内存 vs 虚拟地址映射」是同一套思想。
隐藏层前向传播:
emb = C[X]                                  # (32, 3, 2)
embcat = emb.view(emb.shape[0], -1)         # (32, 6)
h = torch.tanh(embcat @ W1 + b1)            # (32, 100)
别忘了检查广播:h 是 (32,100),b1 是 (100,)。加法时 NumPy/PyTorch 会右对齐、补一个假维度变成 (1,100),再沿行复制——正好给每一行加上同一个 bias。但一定要自己确认,别"把自己脚打穿"。
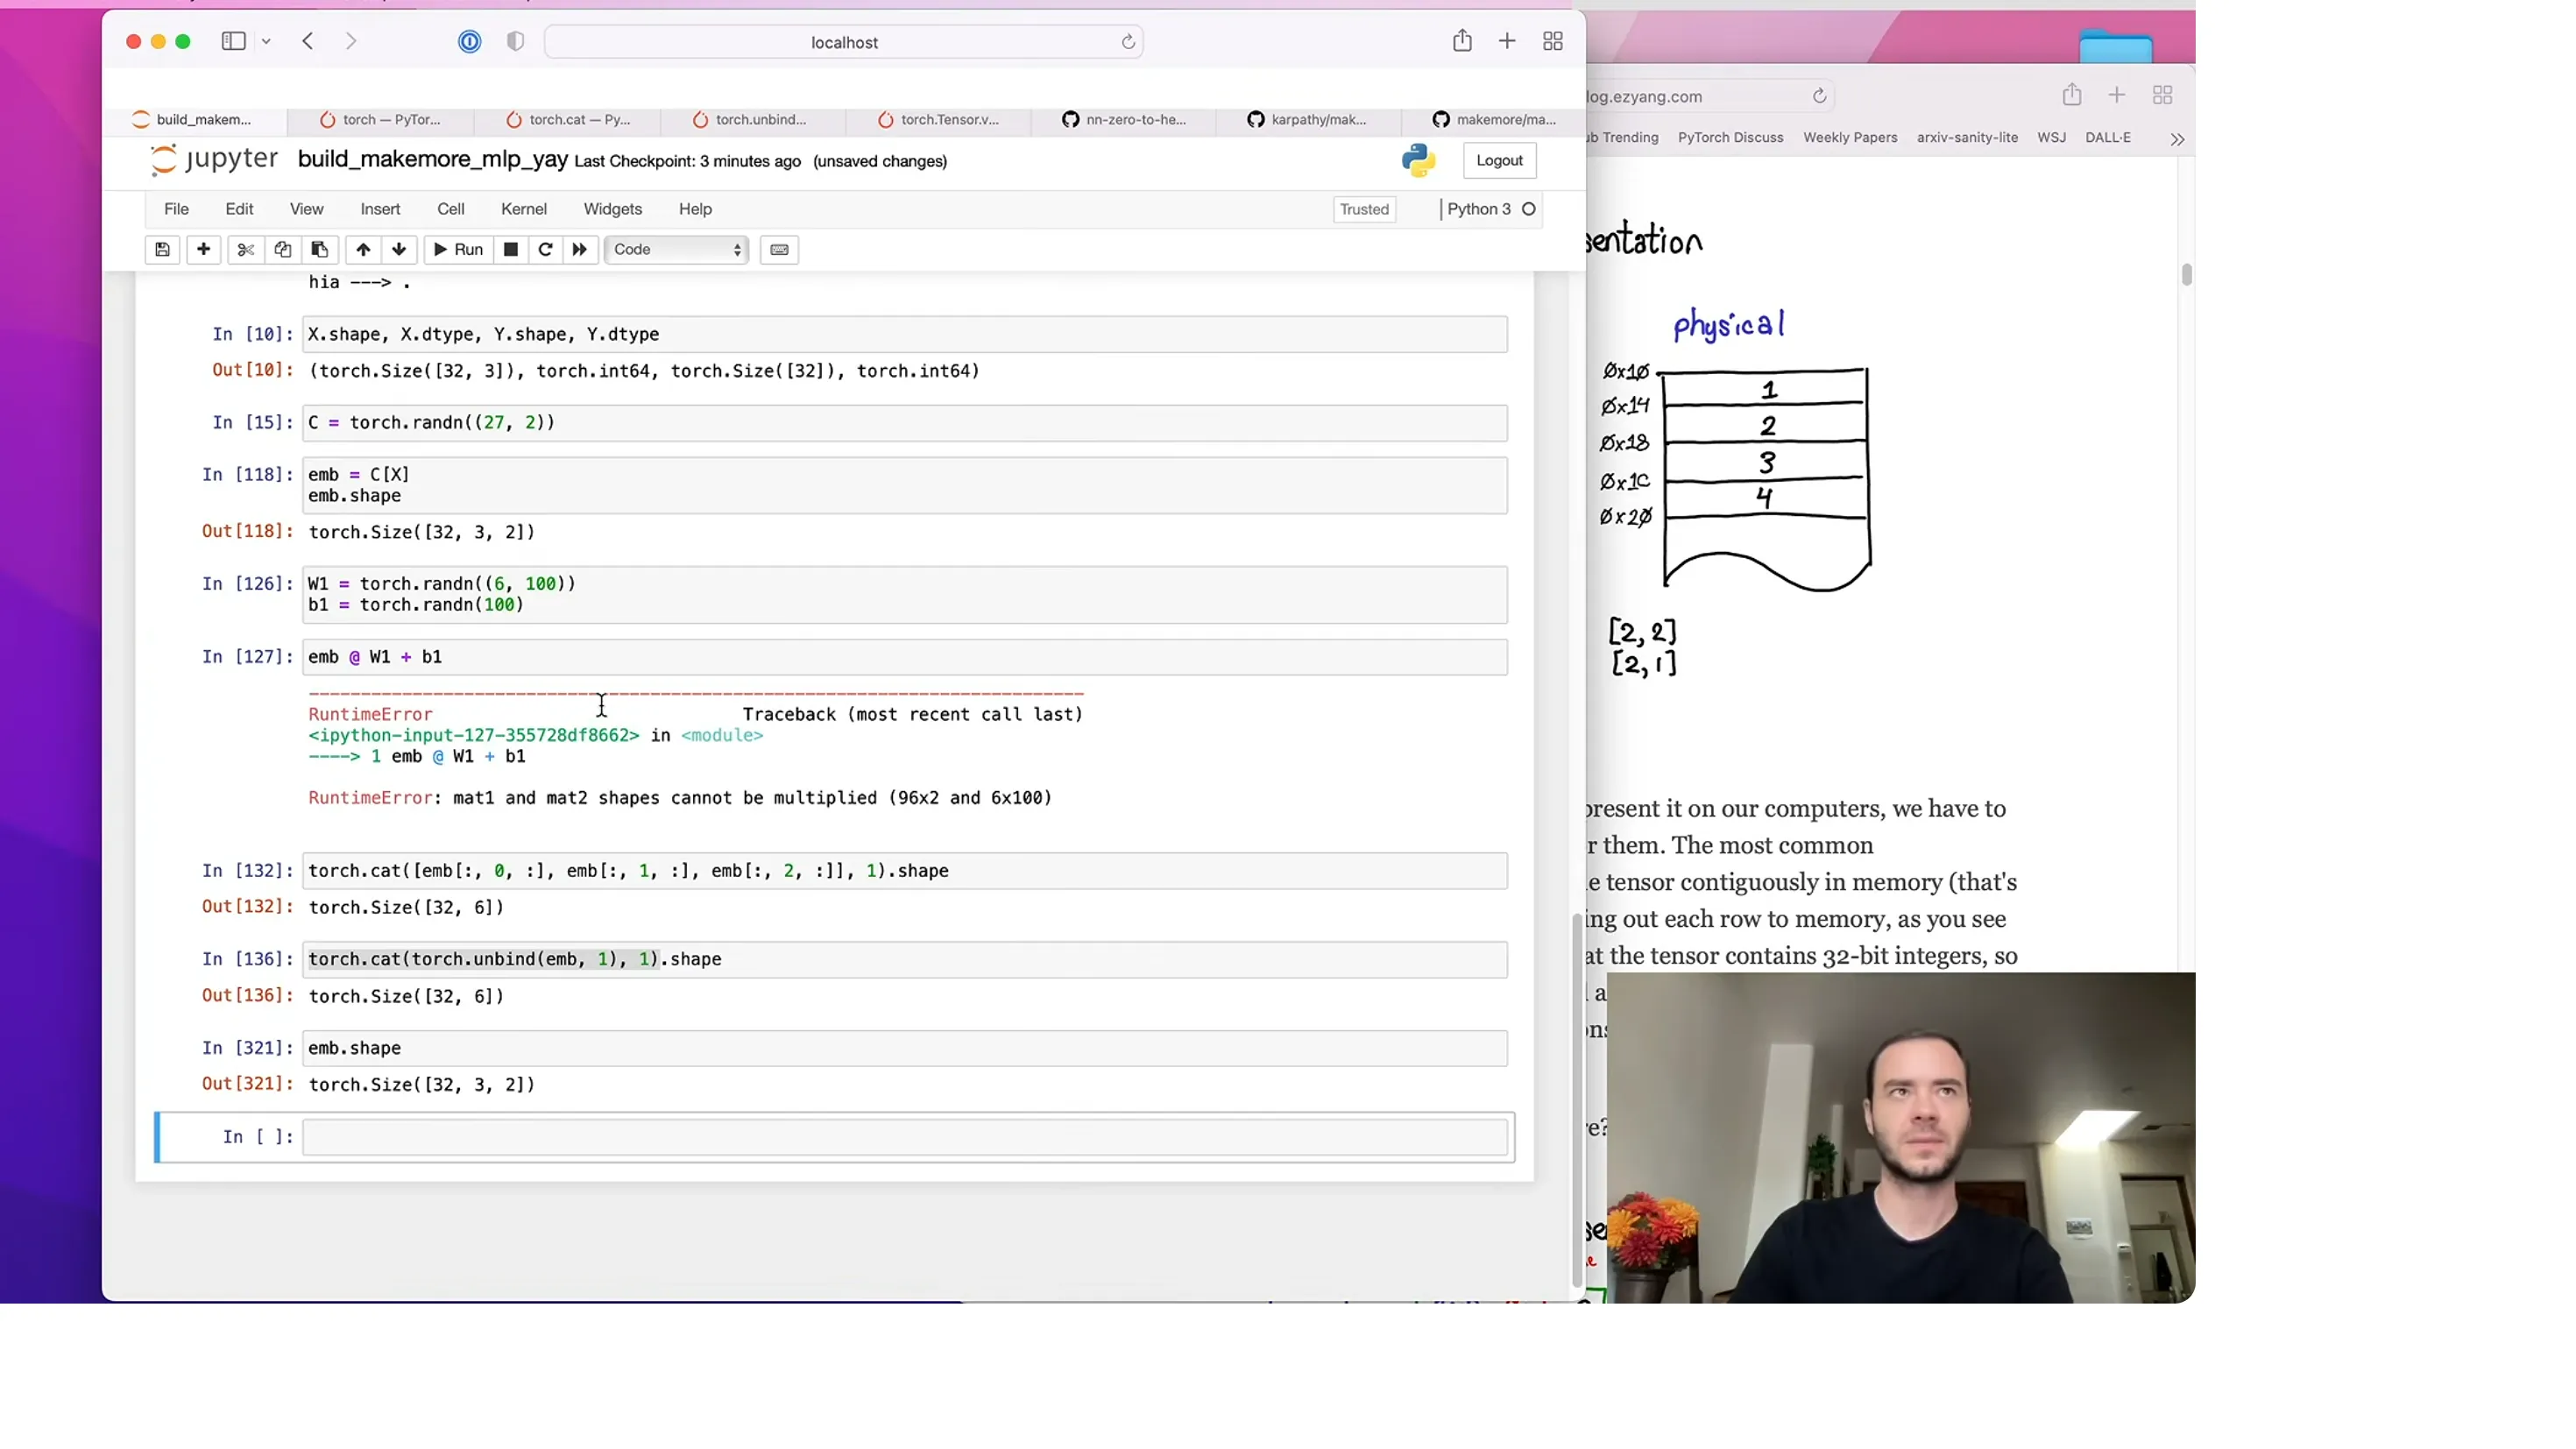
📷 隐藏层:view(32,6) 后 matmul + bias + tanh
回到原视频 (00:26:30)
五、输出层、Softmax 与负对数似然
(参考时间: 29:15)
W2 = torch.randn((100, 27))
b2 = torch.randn(27)
logits = h @ W2 + b2          # (32, 27)
Softmax(和上一讲完全一样):
counts = logits.exp()
prob = counts / counts.sum(1, keepdims=True)   # 每行和为 1
负对数似然(NLL)损失:取正确字符的概率,取对数、求平均、取负:
loss = -prob[torch.arange(32), Y].log().mean()
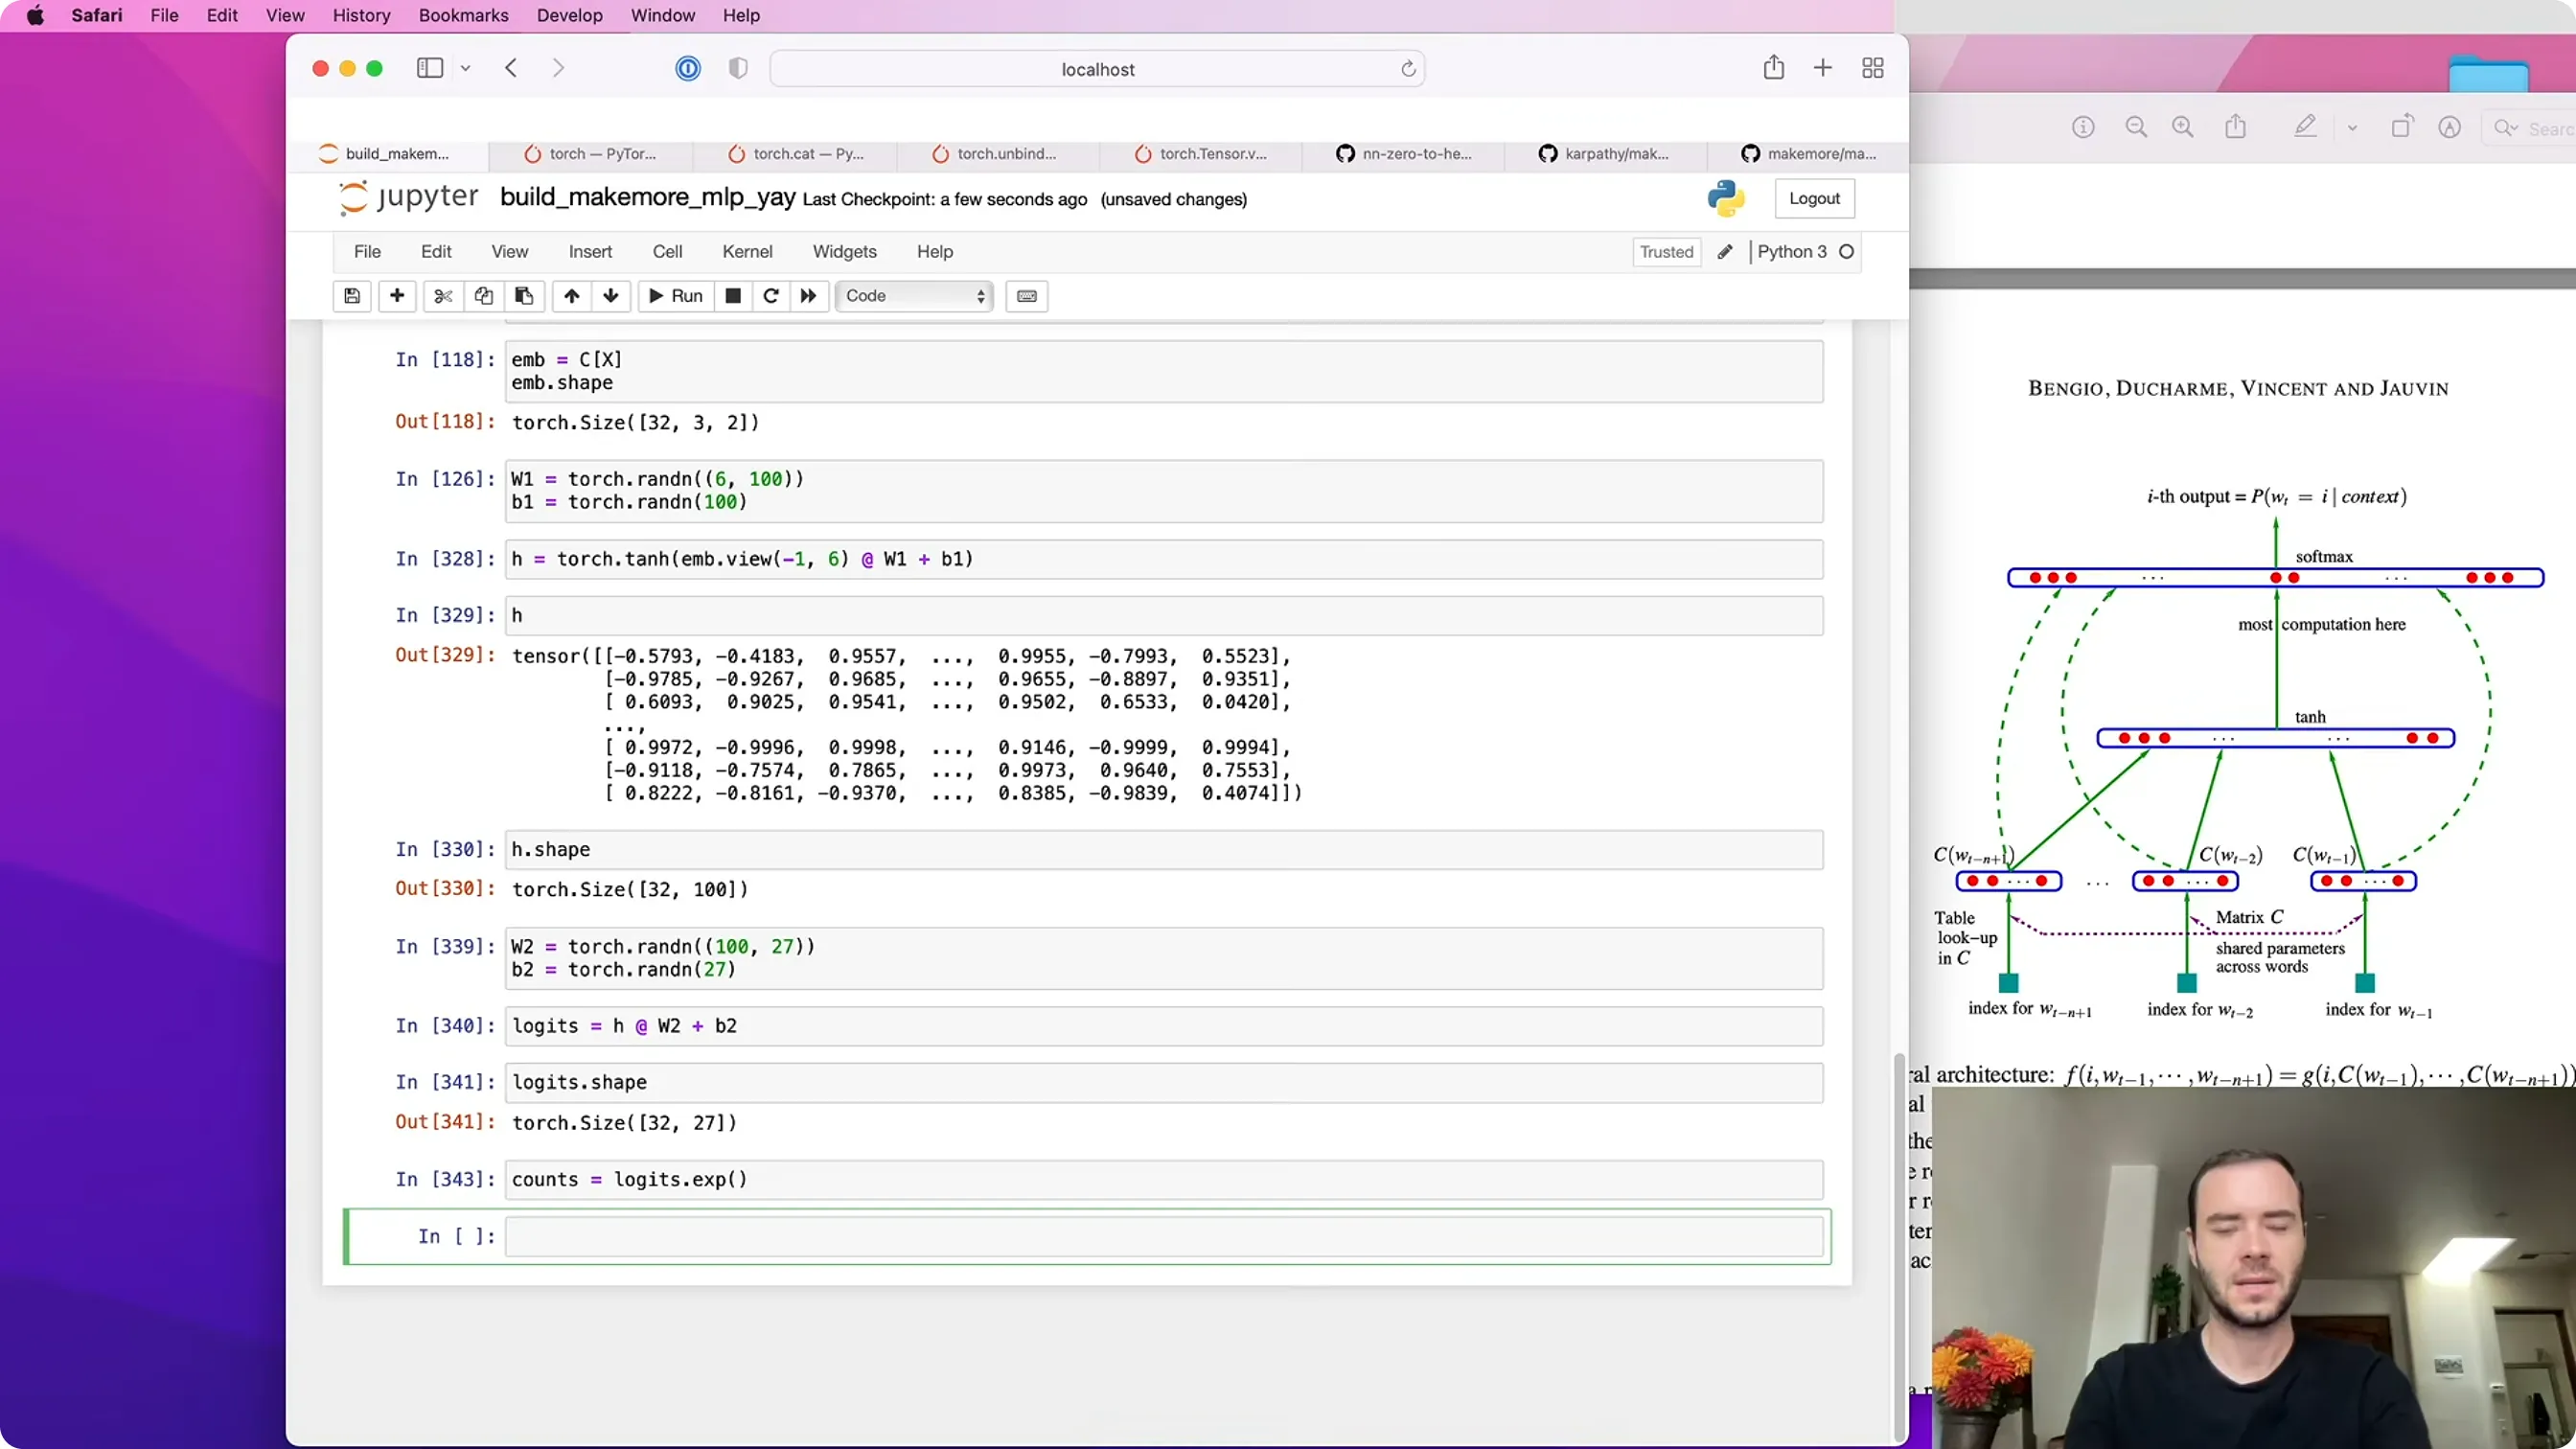
📷 输出层 → softmax → 取出正确类的概率 → NLL 损失
回到原视频 (00:30:00)
整理成"体面"的版本:把参数收进一个列表(总共 约 3,400 个参数),用 generator 保证可复现。
编者拓展|交叉熵 / NLL 的直觉:损失衡量的是「模型给正确答案分配的概率」: - 概率接近 1 → $-\log(p) \to 0$,损失几乎为 0; - 概率接近 0 → $-\log(p) \to \infty$,惩罚极大。
所以最小化 NLL = 让正确答案的概率尽量接近 1。这也是为什么语言模型(包括 GPT)的损失都叫 cross-entropy / NLL。
5.1 用 F.cross_entropy,别自己写
(参考时间: 32:49)
「我们没有在发明轮子」——PyTorch 内置了 F.cross_entropy(logits, Y),结果完全一样,但强烈推荐:
- 前向更快:PyTorch 会把这些操作融合成一个 kernel(fused kernel),不产生大量中间张量(我们手写会新建一堆
counts、prob); - 反向更简单、更快:数学上可以化简——就像 micrograd 里 tanh 的反向只需要
1 - t²,而不必对 exp、加法、除法逐个回传; - 数值更稳定:这是最隐蔽也最重要的一点——看下去就懂。
数值稳定性的演示:取 logits [-2, 3, -3, 0, 5] 时一切正常;但如果某个 logit 变成 +100,$e^{100}$ 超出浮点范围 → inf → 结果是 nan。(负得很多反而没关系——$e^{-100} \approx 0$。)
解法很聪明:由于 softmax 有归一化,给所有 logits 同时加任意常数,概率不变。所以 PyTorch 内部会先减去 logits 的最大值,于是最大的那个变成 0、其余都是负数——永远不溢出。
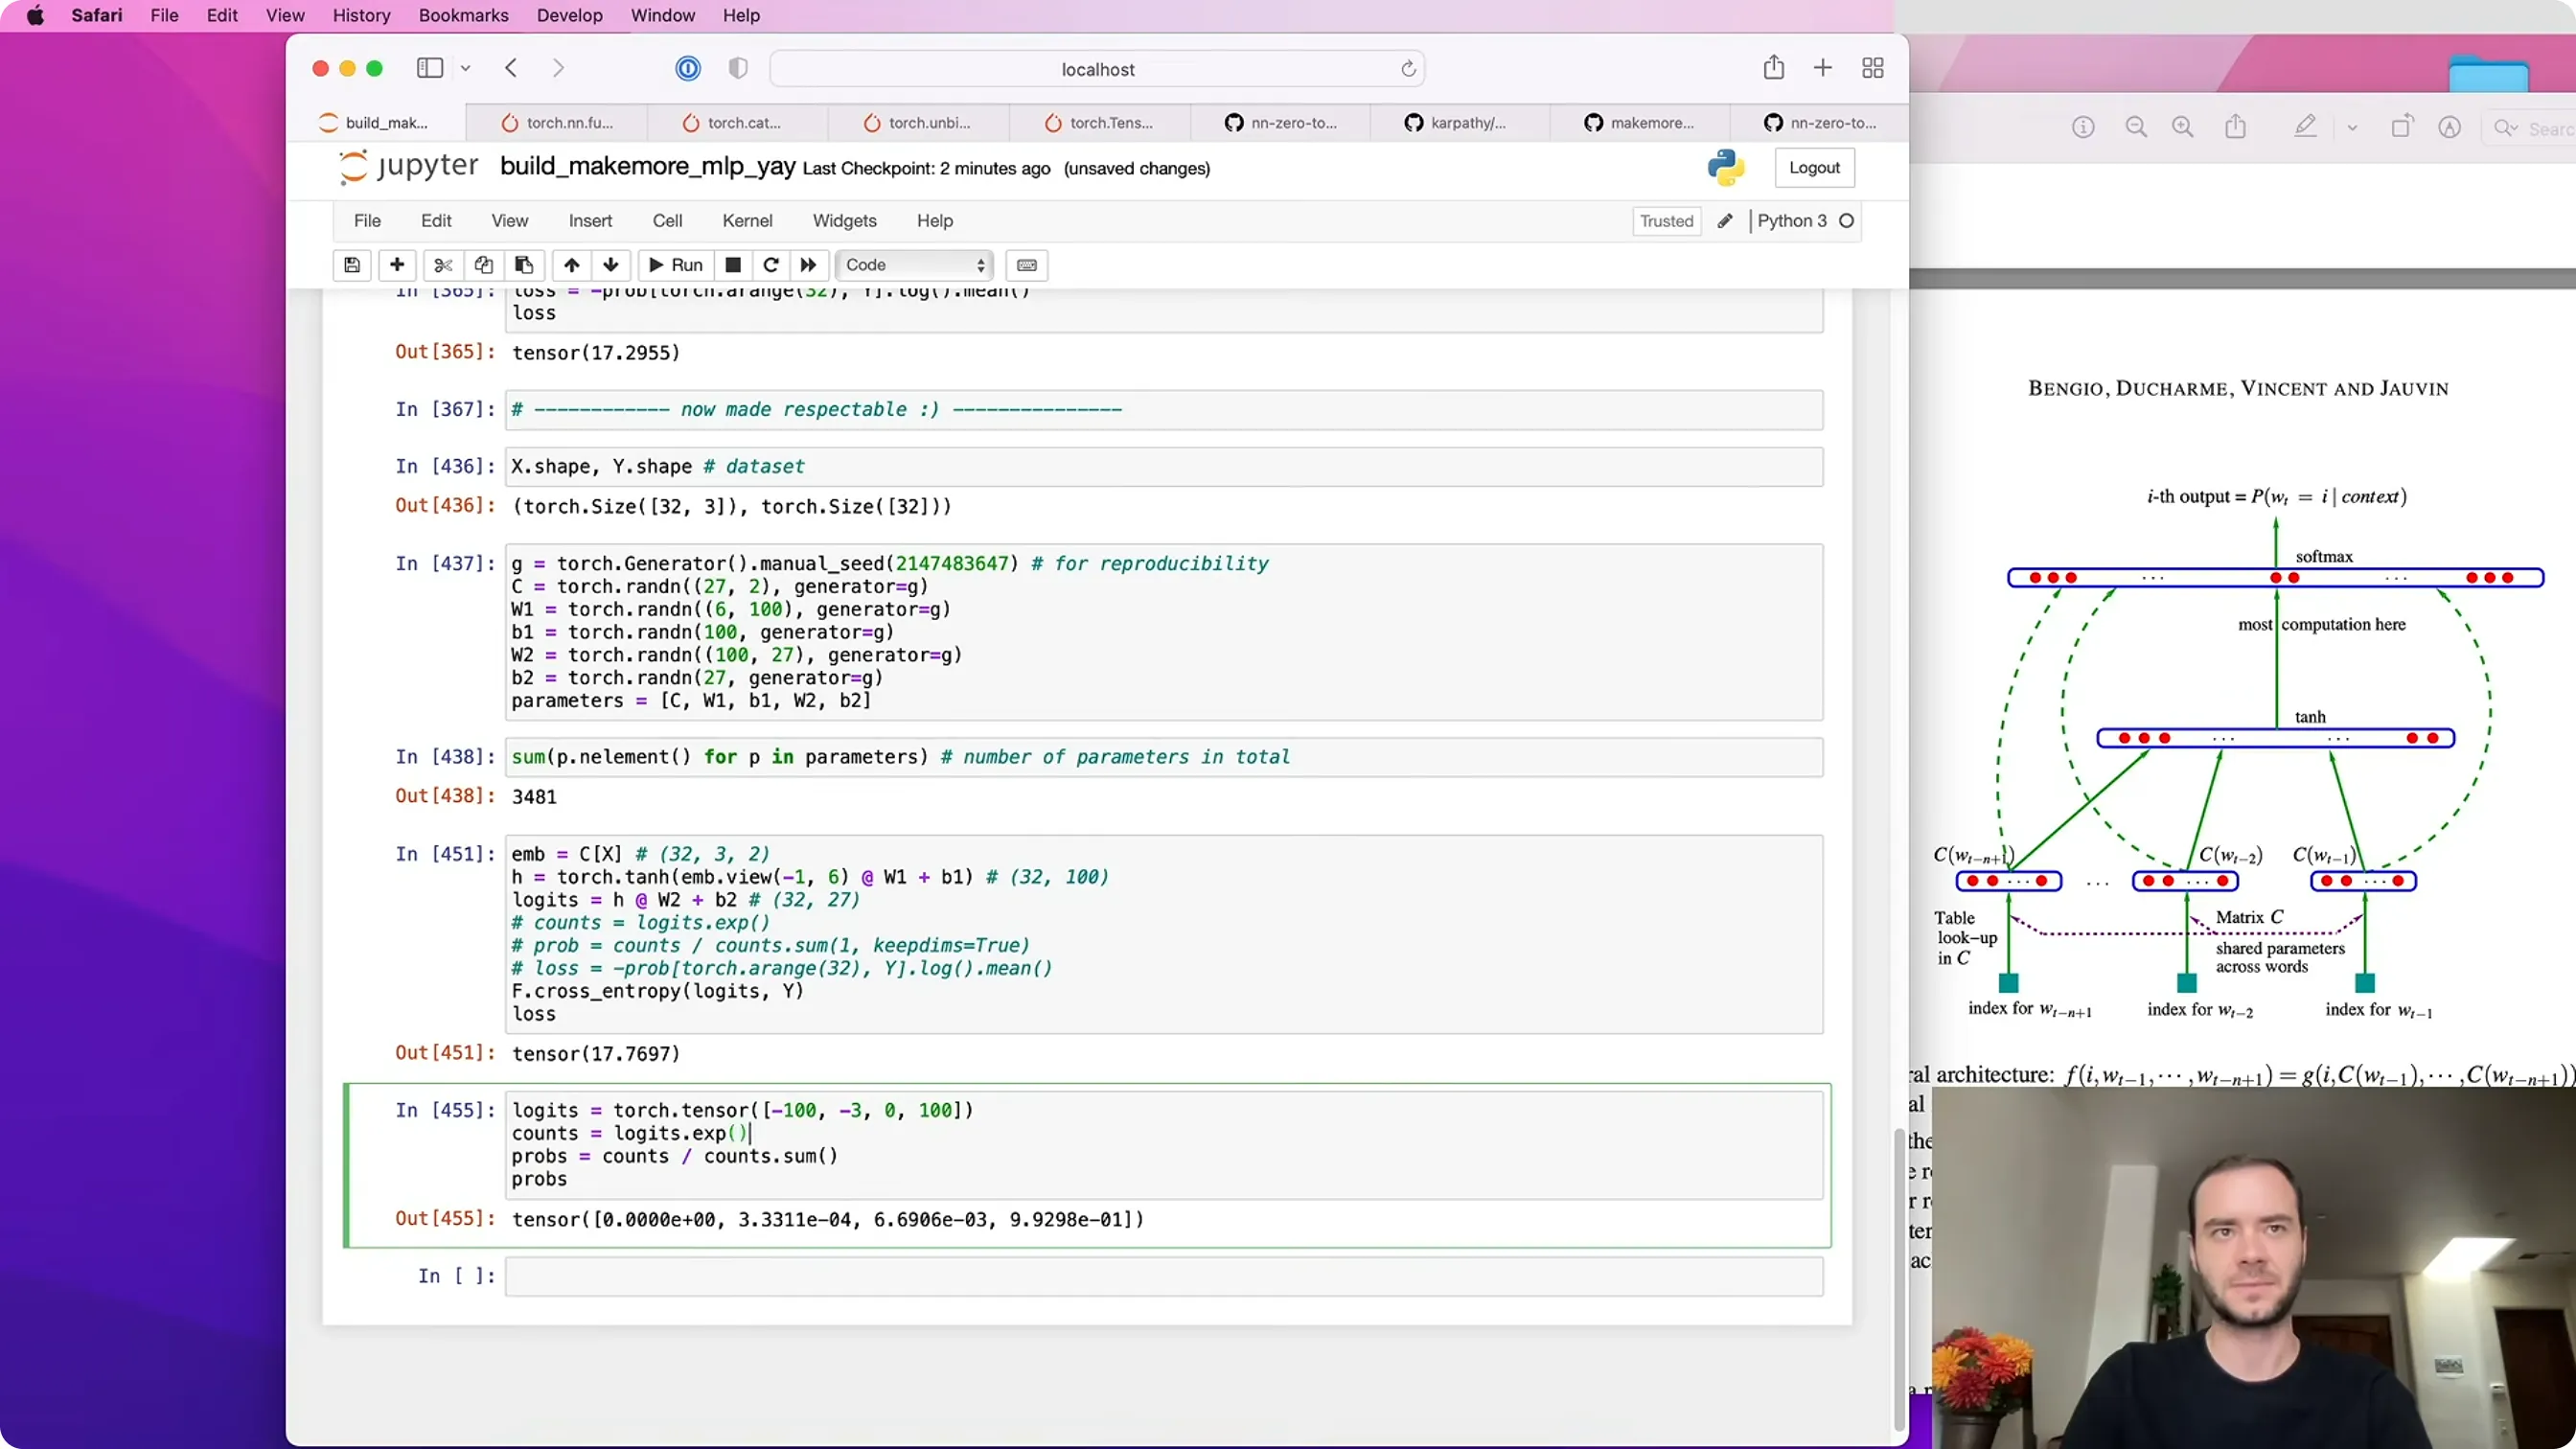
📷 F.cross_entropy 的三点好处:融合 kernel、更简的反向、数值稳定(减去最大值)
回到原视频 (00:36:00)
六、训练循环与「过拟合一个 batch」
(参考时间: 37:56)
for p in parameters:
    p.grad = None           # 清梯度(等价于置零)
loss.backward()             # 反向传播,填 grad
for p in parameters:
    p.data += -lr * p.grad  # 梯度下降:沿负梯度走一步
(还要给每个参数 requires_grad = True。)
先只用 32 个样本:损失从 17 一路降到几乎 0——因为 3,400 个参数 vs 32 个样本,模型太容易记住这一点点数据了。这叫作「overfit 一个 batch」,是调试神经网络的标准第一步:
能不能把一个 batch 训到接近 0 损失? 如果不能,说明代码有 bug(或模型太小)——先别急着上全量数据。
为什么损失到不了恰好 0? 因为相同的输入可能对应不同的标签:... 后面可以是 e、o、a、s……模型只能给它们分配一个折中的概率分布(最优解 = 训练集里各标签的频率)。
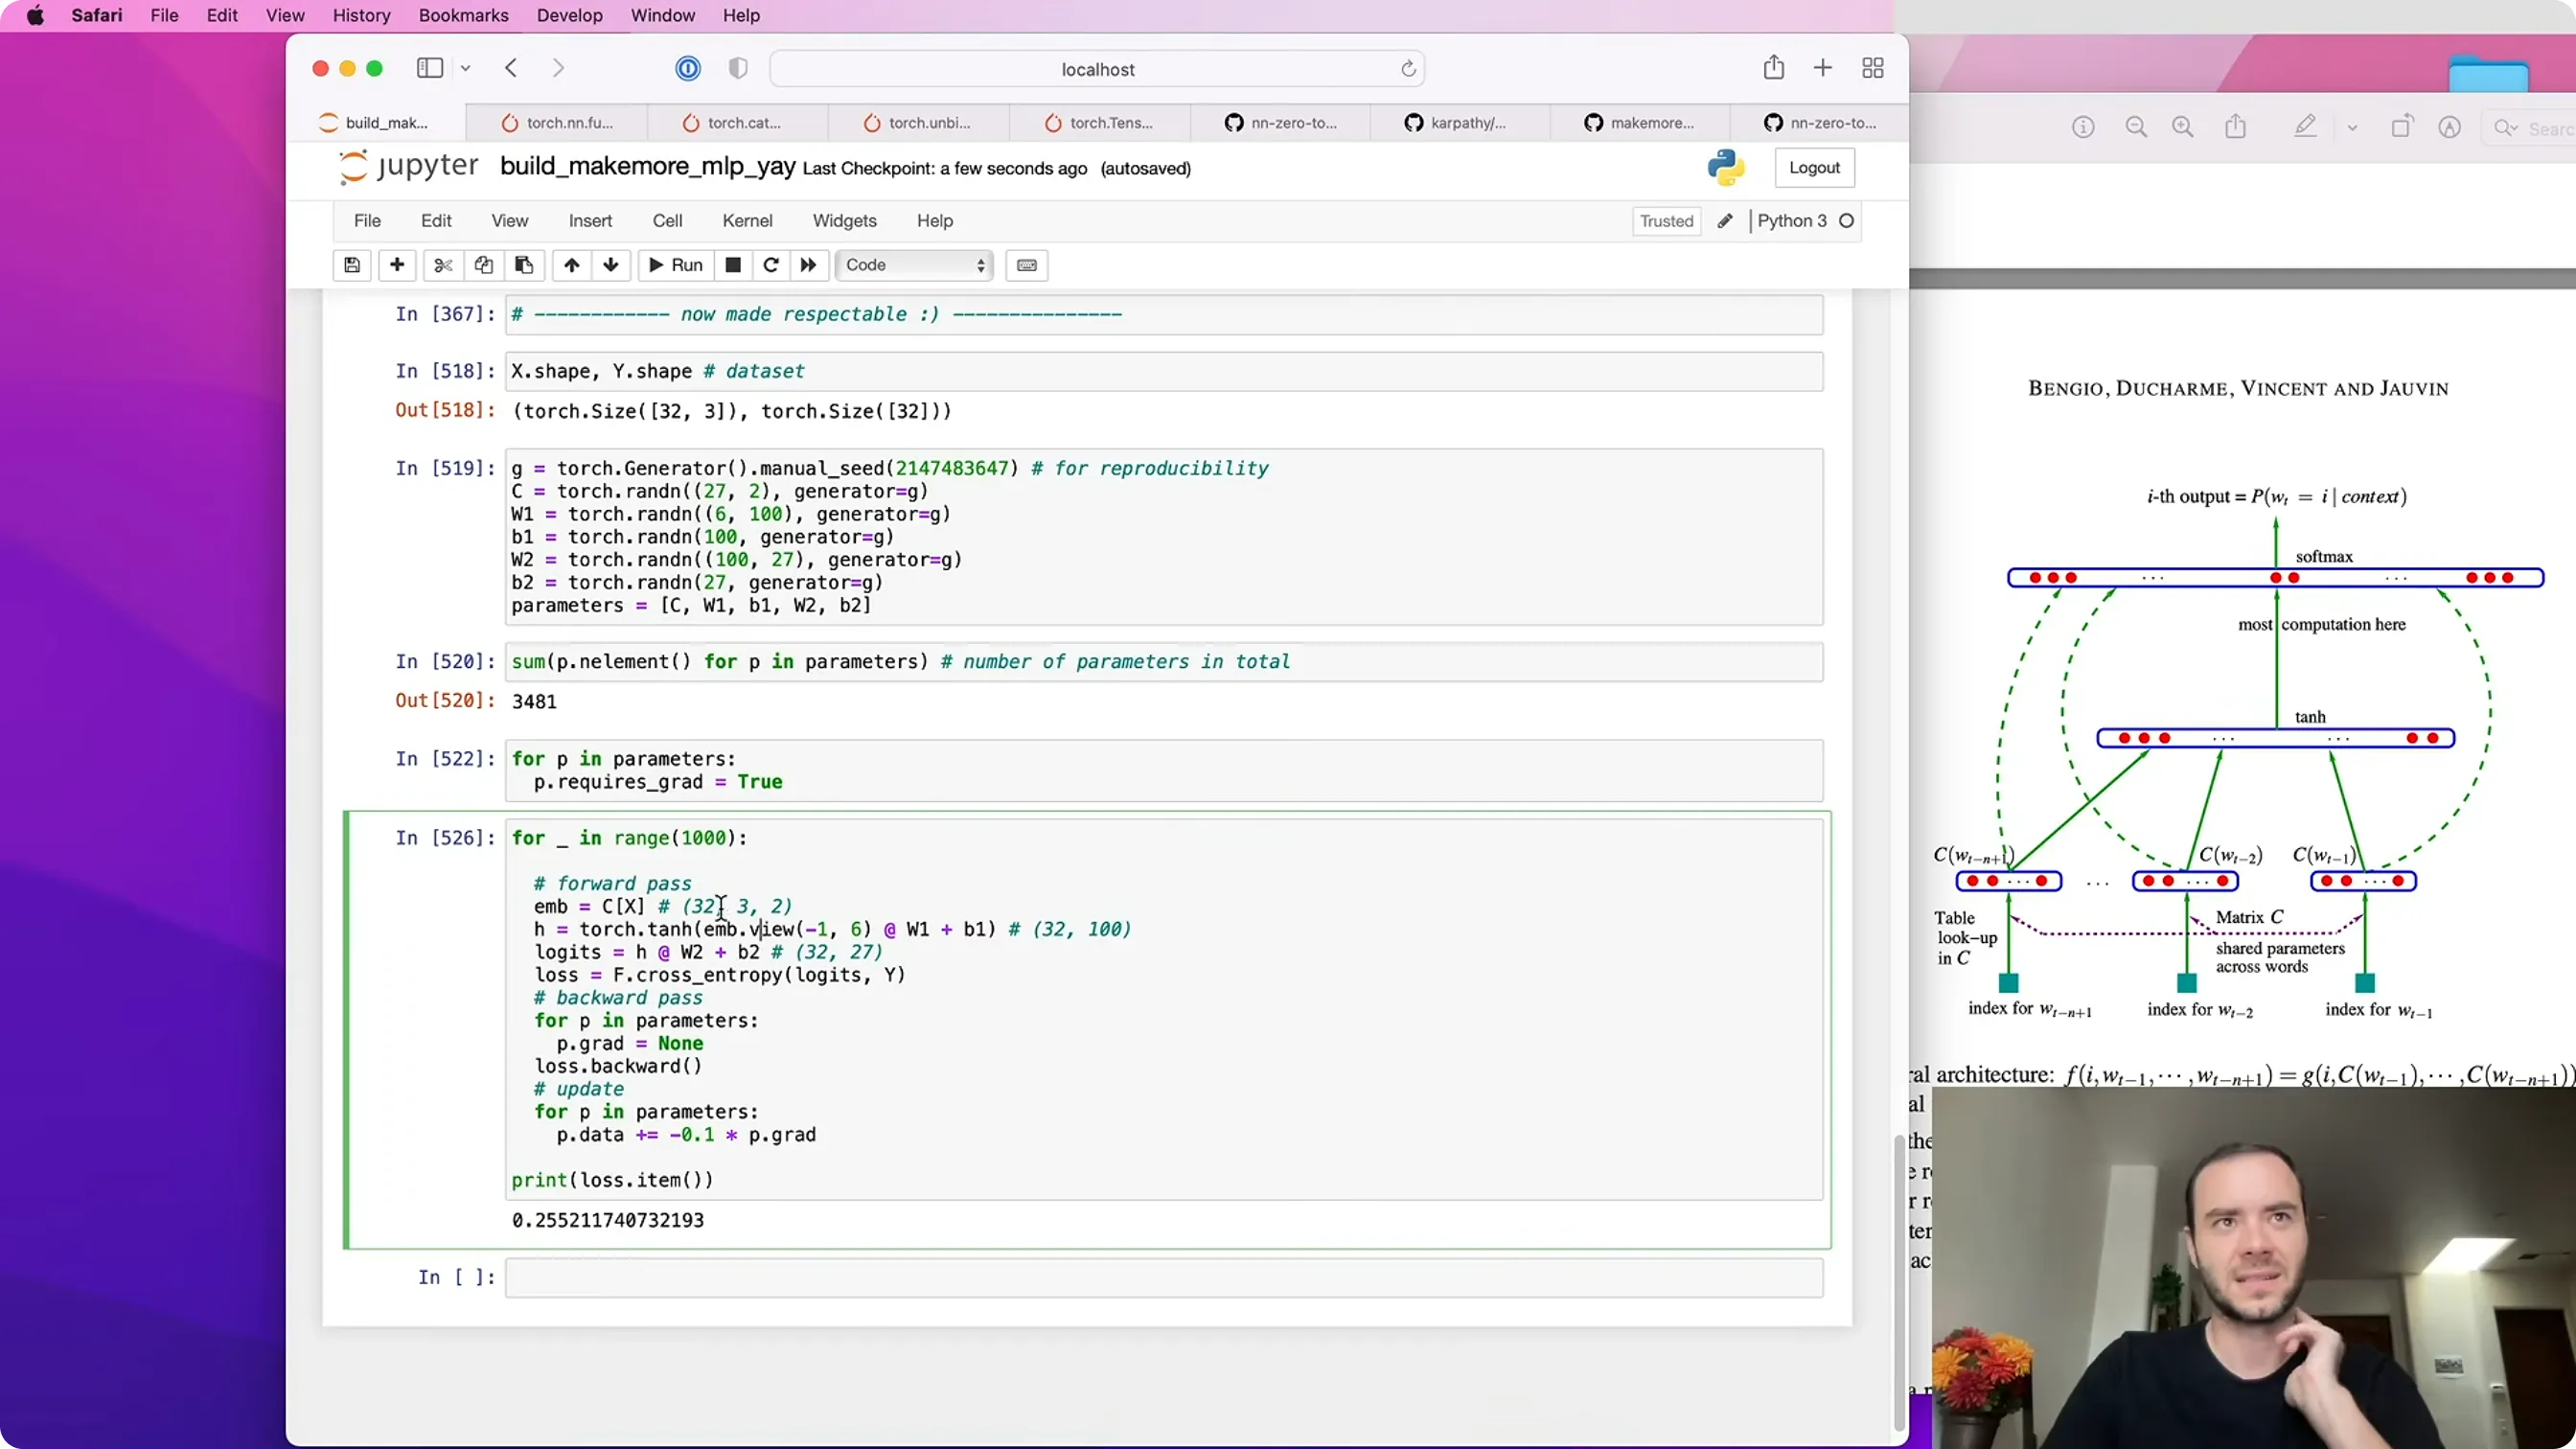
📷 训练循环:zero_grad → backward → update;先把一个 batch 过拟合到接近 0
回到原视频 (00:39:30)
七、全量数据与 Mini-batch
(参考时间: 41:25)
去掉"只用前 5 个词"的限制,用全部数据:样本数从 32 变成 228,146。
但全量前向+反向太慢。实践中人们用 mini-batch:每次随机取一部分样本,只在这部分上做前向/反向/更新。
ix = torch.randint(0, X.shape[0], (32,))
Xb, Yb = X[ix], Y[ix]       # 只取 32 个样本
为什么"近似梯度"反而更好? 小批量算出的梯度方向不那么准,但——
「用一个粗略的梯度多走几步,胜过用精确的梯度少走几步。」
果然,加上小批量后"几乎瞬间"就能跑很多步。
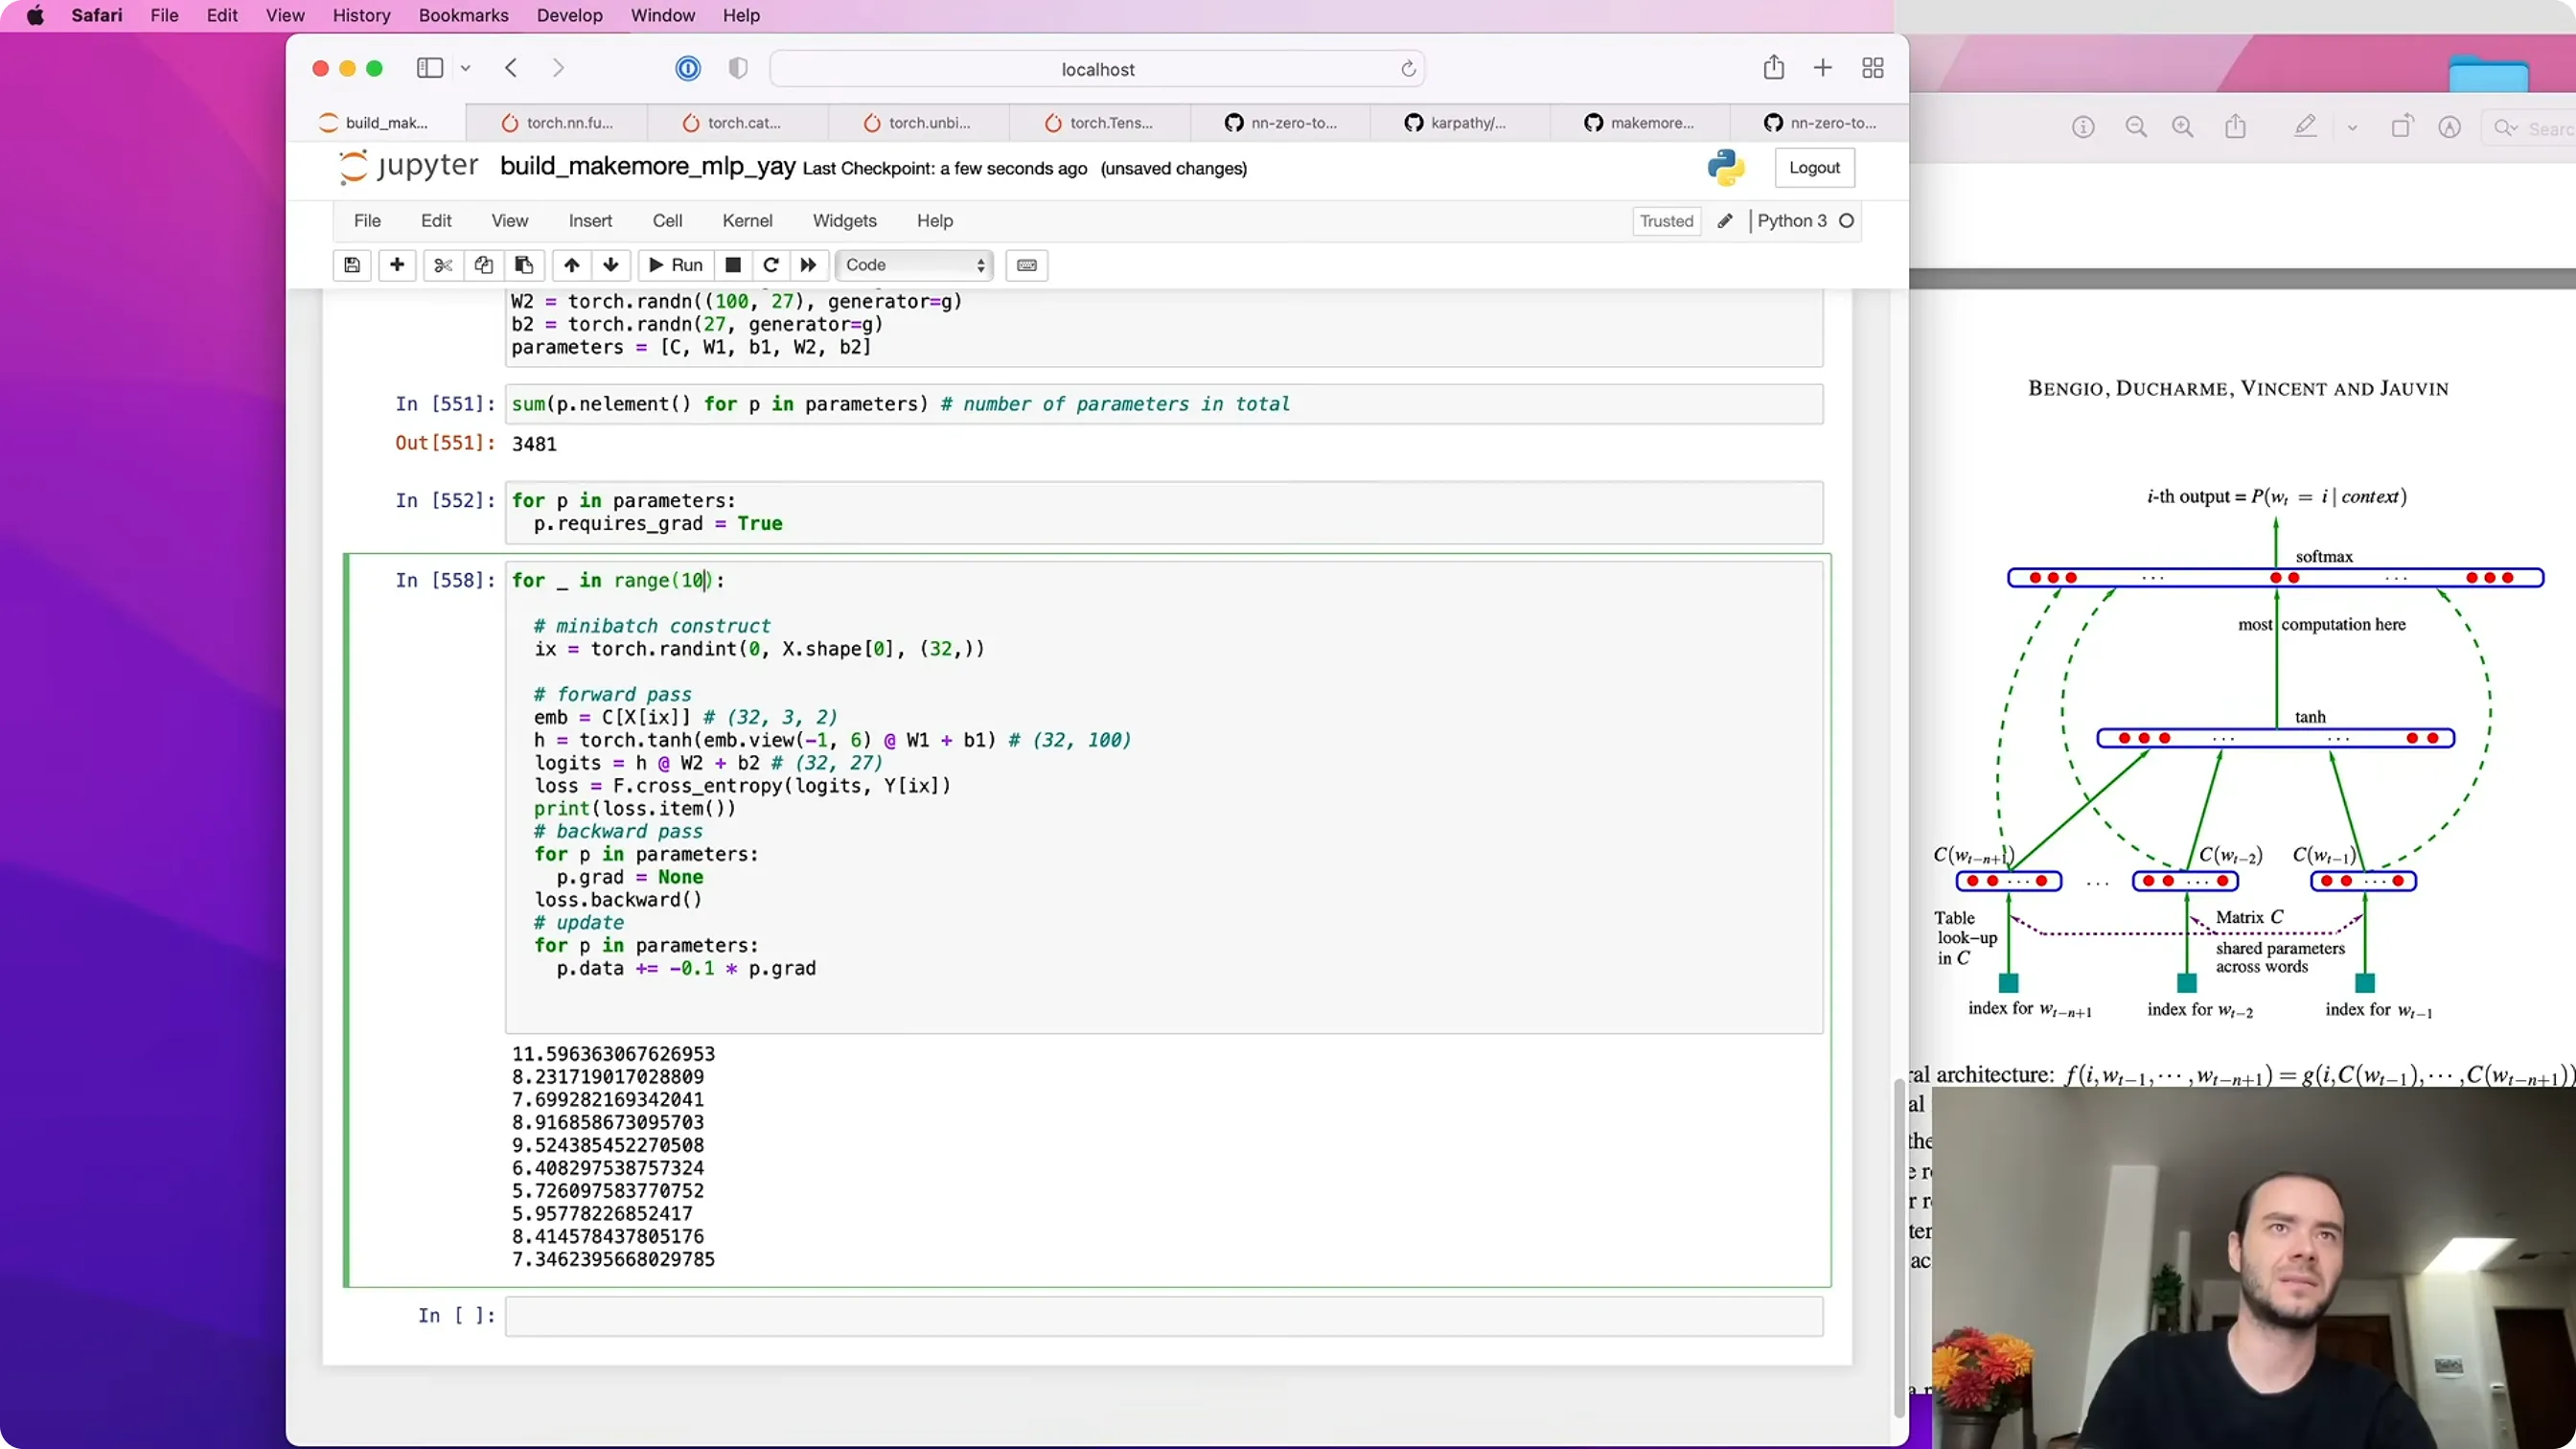
📷 Mini-batch:随机取 32 个样本做前向/反向/更新
回到原视频 (00:44:00)
八、怎么找一个好的学习率?
(参考时间: 45:40)
学习率 0.1 是猜的。怎么科学地确定?
做法:在一个指数间隔的区间里扫一遍学习率,每个学习率都从相同的初始权重出发跑几步,然后画出"学习率 vs 损失"。
lre = torch.linspace(-3, 0, 1000)      # 指数:从 1e-3 到 1e0
lrs = 10 ** lre                        # 真正的候选学习率
图通常长这样:
- 太小的学习率:损失几乎不动("barely anything happened");
- 中间:损失稳稳下降——这是好区间;
- 太大:损失上蹿下跳、甚至爆炸。
本讲的结果:最优大约在 指数 −1,也就是 $10^{-1} = \mathbf{0.1}$——"原来猜的 0.1 还挺好"。
编者拓展|「学习率扫描」是每个深度学习从业者的第一天就会用到的技能:它便宜、直观、几乎总能帮你避开"训练半天没动静"和"损失直接爆炸"两个大坑。
配套的两个常识: - 学习率衰减(learning rate decay):训练后段把学习率调小 10 倍,让模型"慢下来"打磨细节; - 先写一个能过拟合小 batch 的循环,再上全量数据——顺序反了会浪费很多时间。
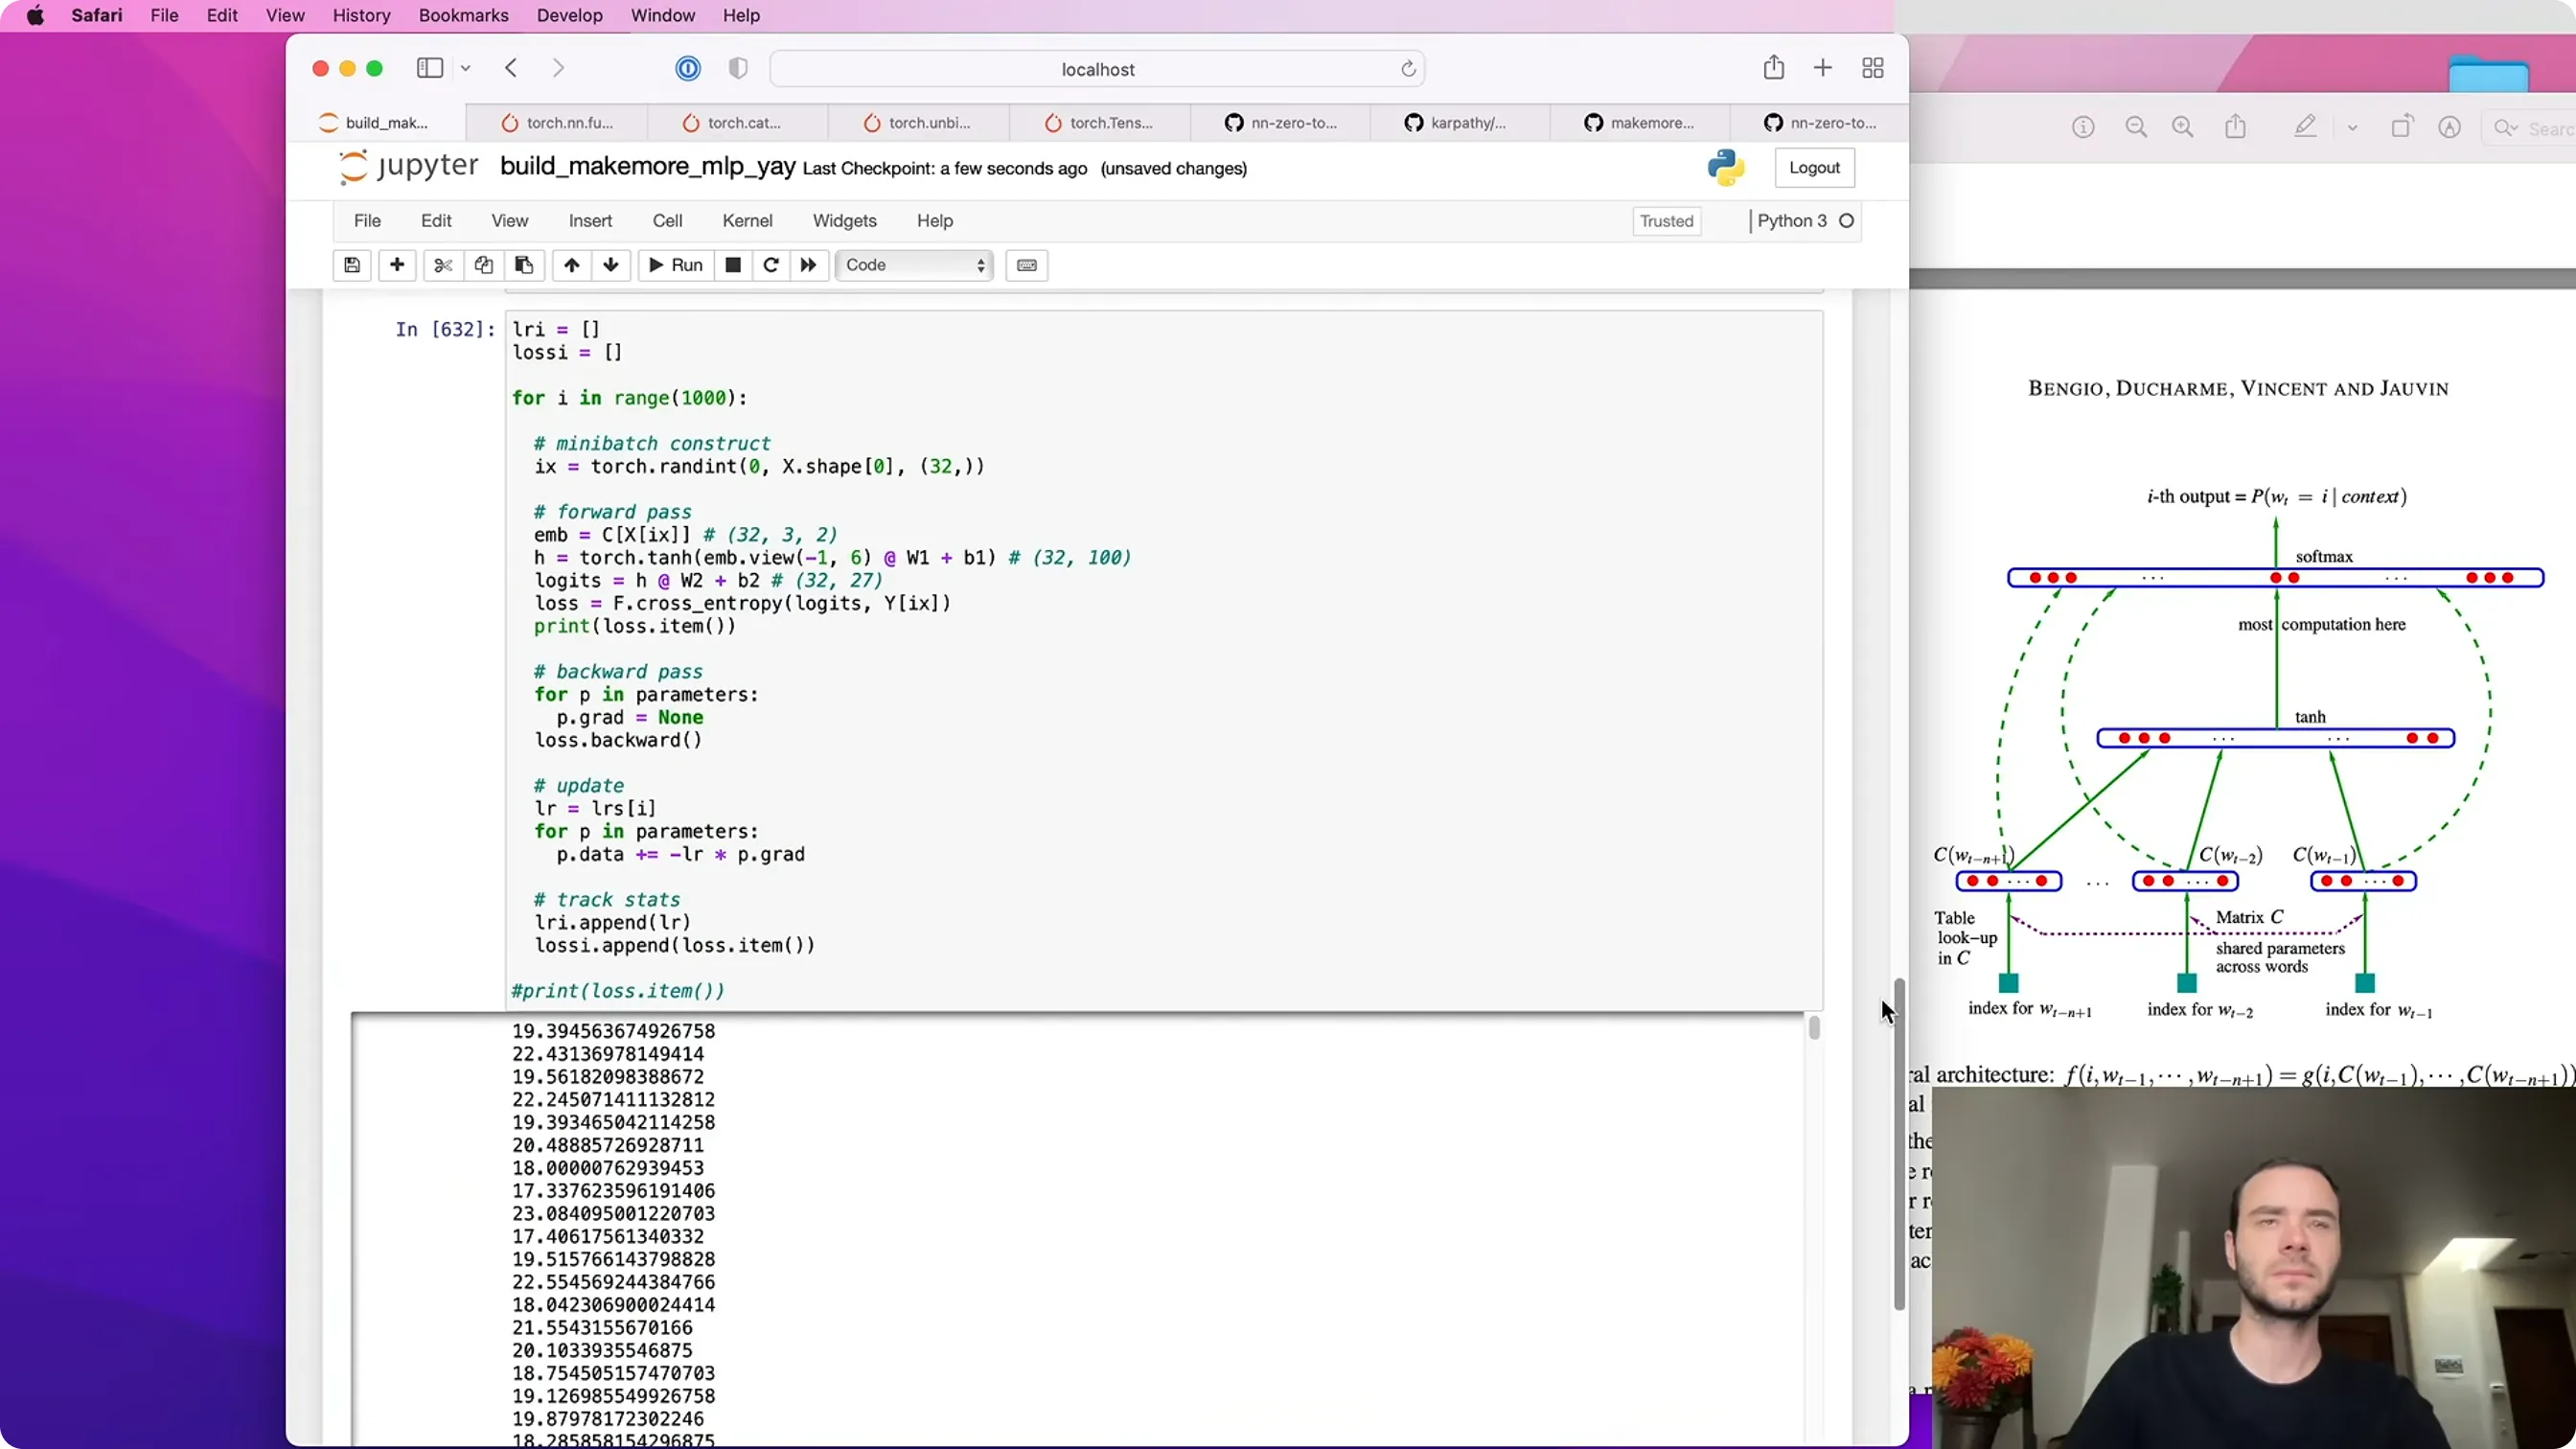
📷 学习率扫描:太小学不动、太大爆炸,凹陷处最好
回到原视频 (00:49:30)
九、划分 Train / Dev / Test —— 为什么必须这样做
(参考时间: 53:20)
前面说"损失 2.3,比 bigram 的 2.45 好"——但这不完全对。
因为模型容量可以无限增大:参数从 3,400 到上万、上百万。参数越多,越容易把训练集一字不差地背下来:
- 训练损失可以低到 0,但采样时只会吐出训练集里的原词;
- 在没见过的名字上评估,损失可能非常高。
所以行业标准是三分数据:
| 划分 | 用途 | 常见比例 |
|---|---|---|
| train | 训练参数(梯度下降) | 80% |
| dev / validation | 调超参数(隐藏层大小、嵌入维度、正则强度、学习率……) | 10% |
| test | 最终评估,只在最后用极少数几次 | 10% |
为什么 test 只能"少用":每次你在 test 上评估、并据此做决定,你就在"训练" test——你开始过拟合测试集。所以 test 只用于最终报告,是"一次性"的。
本讲的做法:把词表 shuffle,前 80% 造 train,中间 10% 造 dev,最后 10% 造 test;训练只在 Xtr/Ytr 上,评估用 Xdev/Ydev。
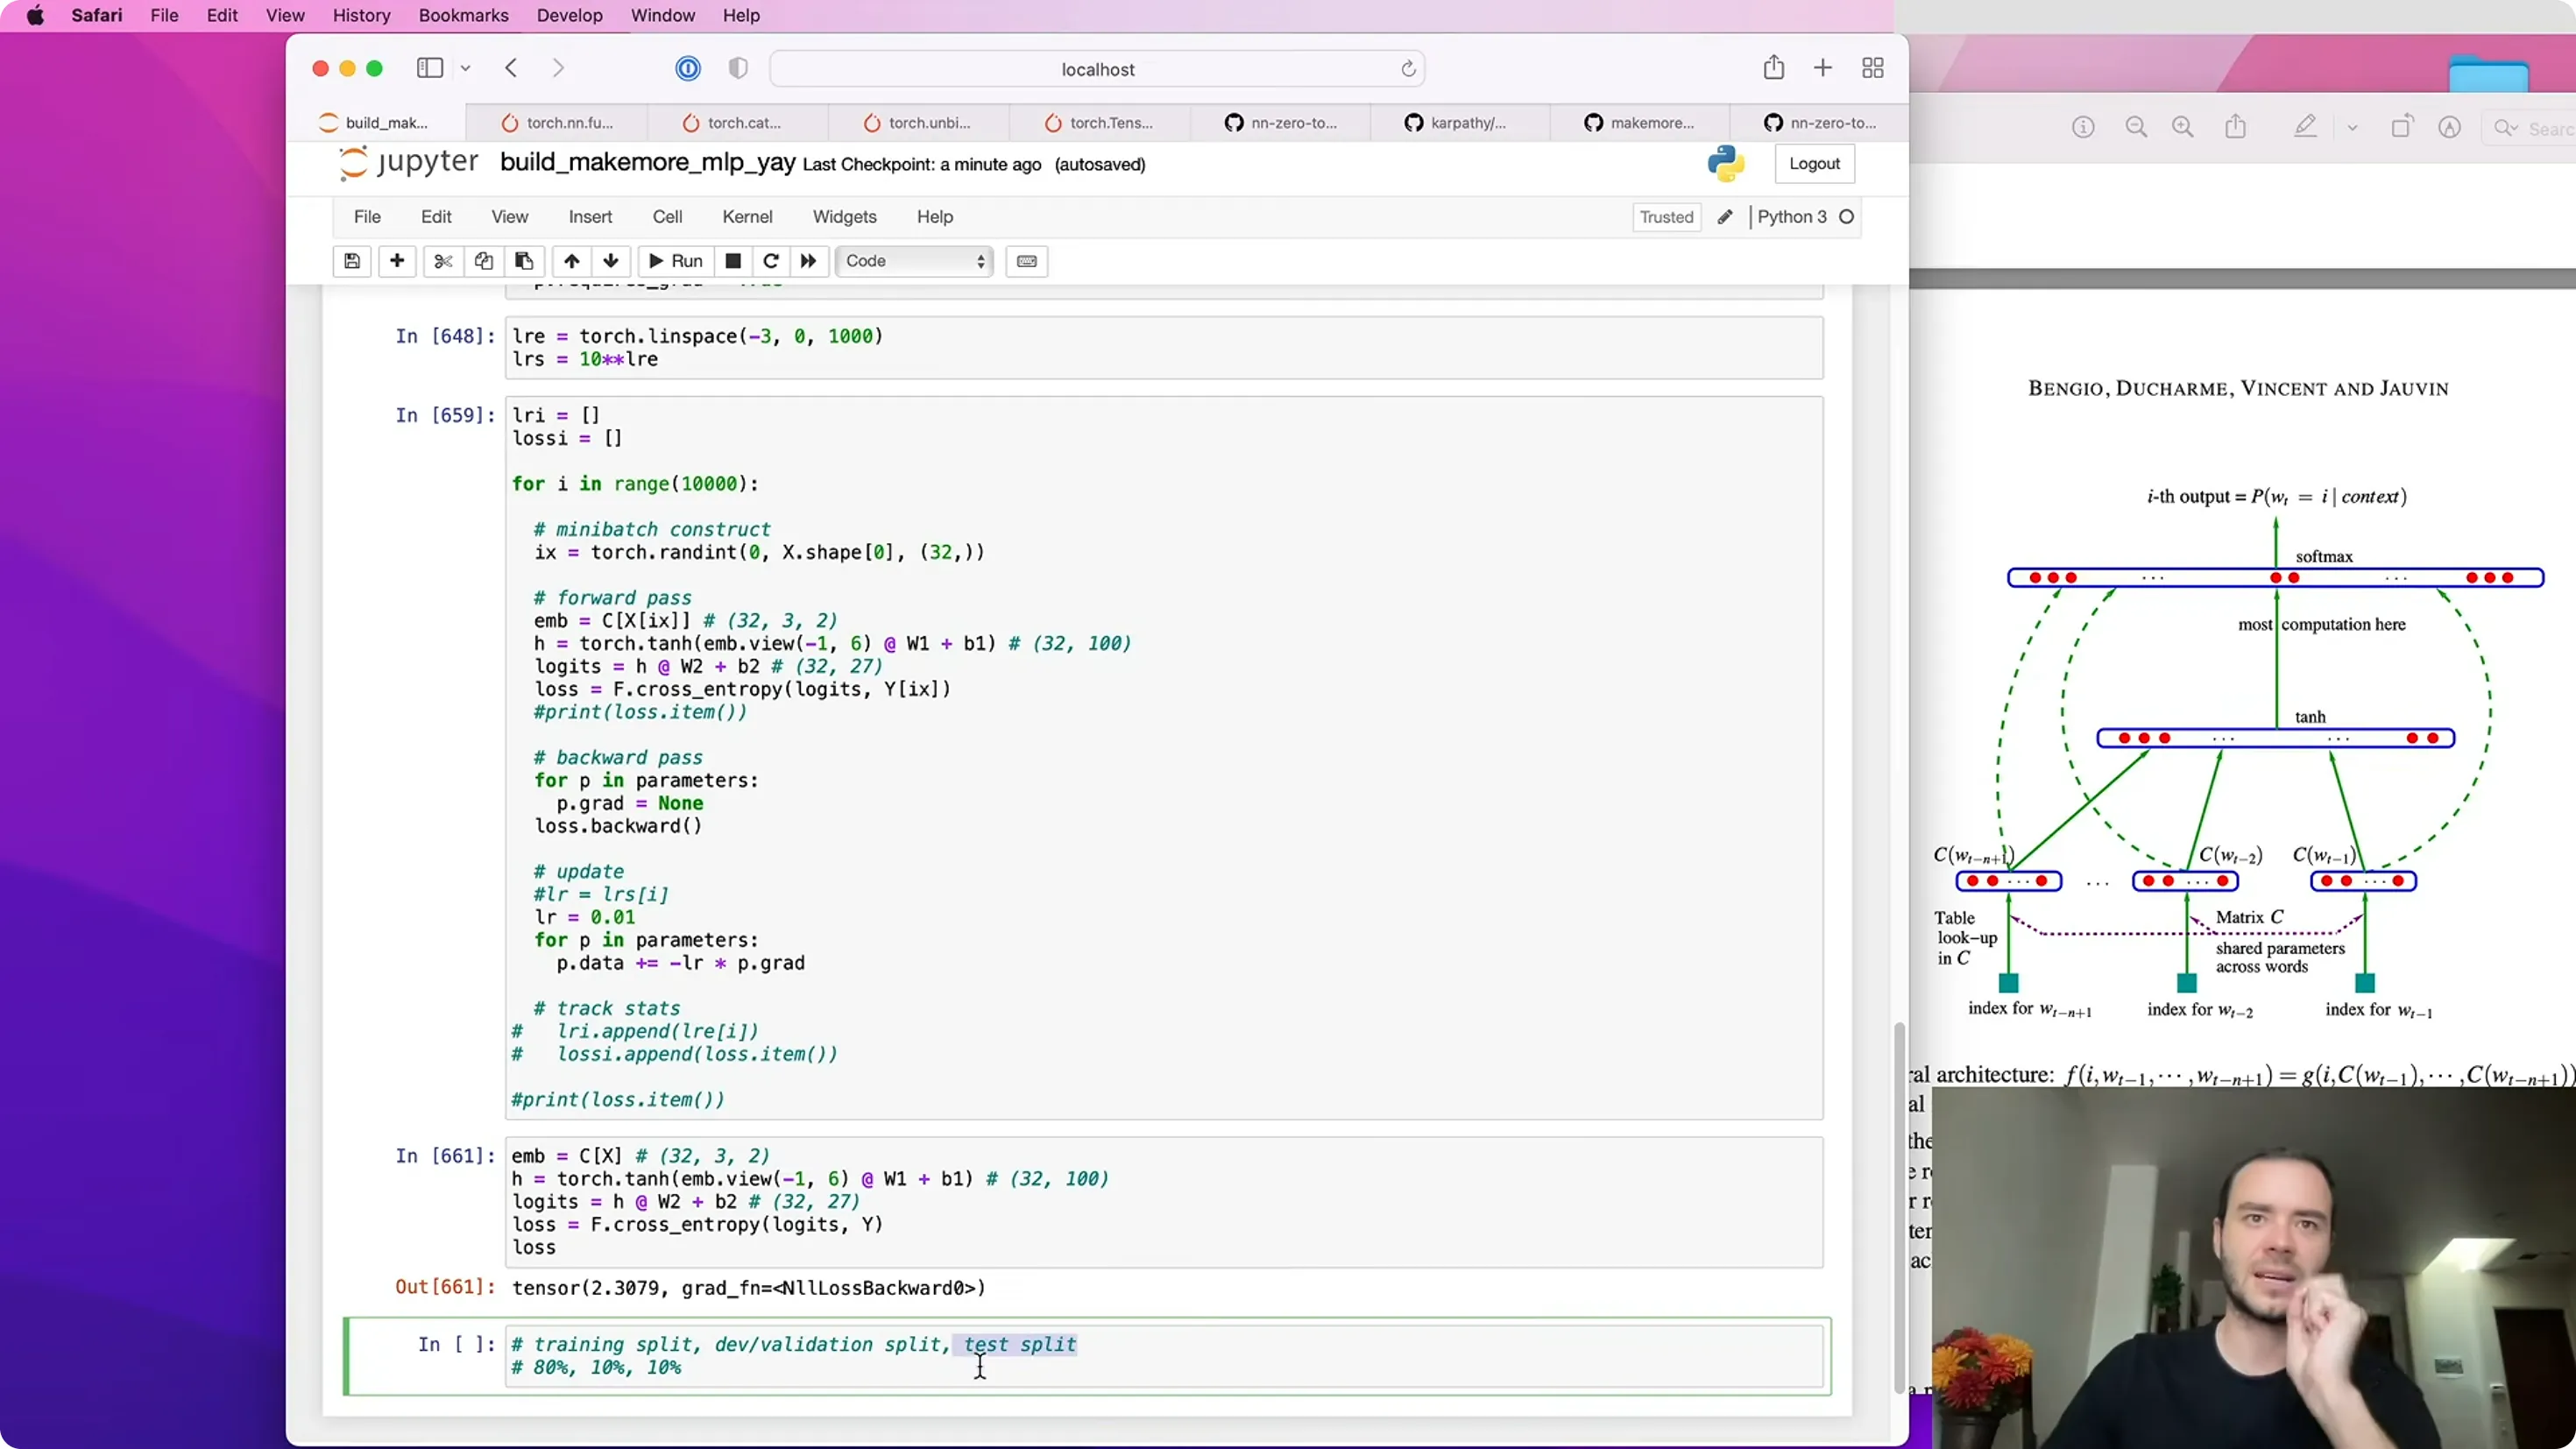
📷 数据三分:train 训参数、dev 调超参数、test 只用于最终评估
回到原视频 (00:56:00)
编者拓展|underfitting vs overfitting,一句话判别: - train 损失 ≈ dev 损失(都不低) → 欠拟合(underfitting):模型太简单,加大模型会有帮助; - train 损失很低、但 dev 损失远高于它 → 过拟合(overfitting):模型太能记,需要更多数据 / 正则化 / 更小的模型。
本讲第一次评估时两者都是 2.3 左右——典型的欠拟合。于是接下来:把模型变大。
十、实验:加大隐藏层、可视化嵌入
(参考时间: 1:00:49)
实验一:隐藏层 100 → 300。参数从 3,400 涨到 10,000。但 dev 损失没有明显改善(依然 2.3 左右)——说明"瓶颈另有其人"。
降学习率能再抠出一点(2.32 → 2.23)。
可视化字符嵌入:嵌入维度是 2,正好可以画在平面上:
- 元音 a、e、i、o、u 聚在一起——网络认为它们相似、可互换;
q跑到很远(它是"例外",总跟着 u);.(句末/特殊符号)也离得很远——它确实是特殊的。
「这不是随机的,这些嵌入是有意义的。」
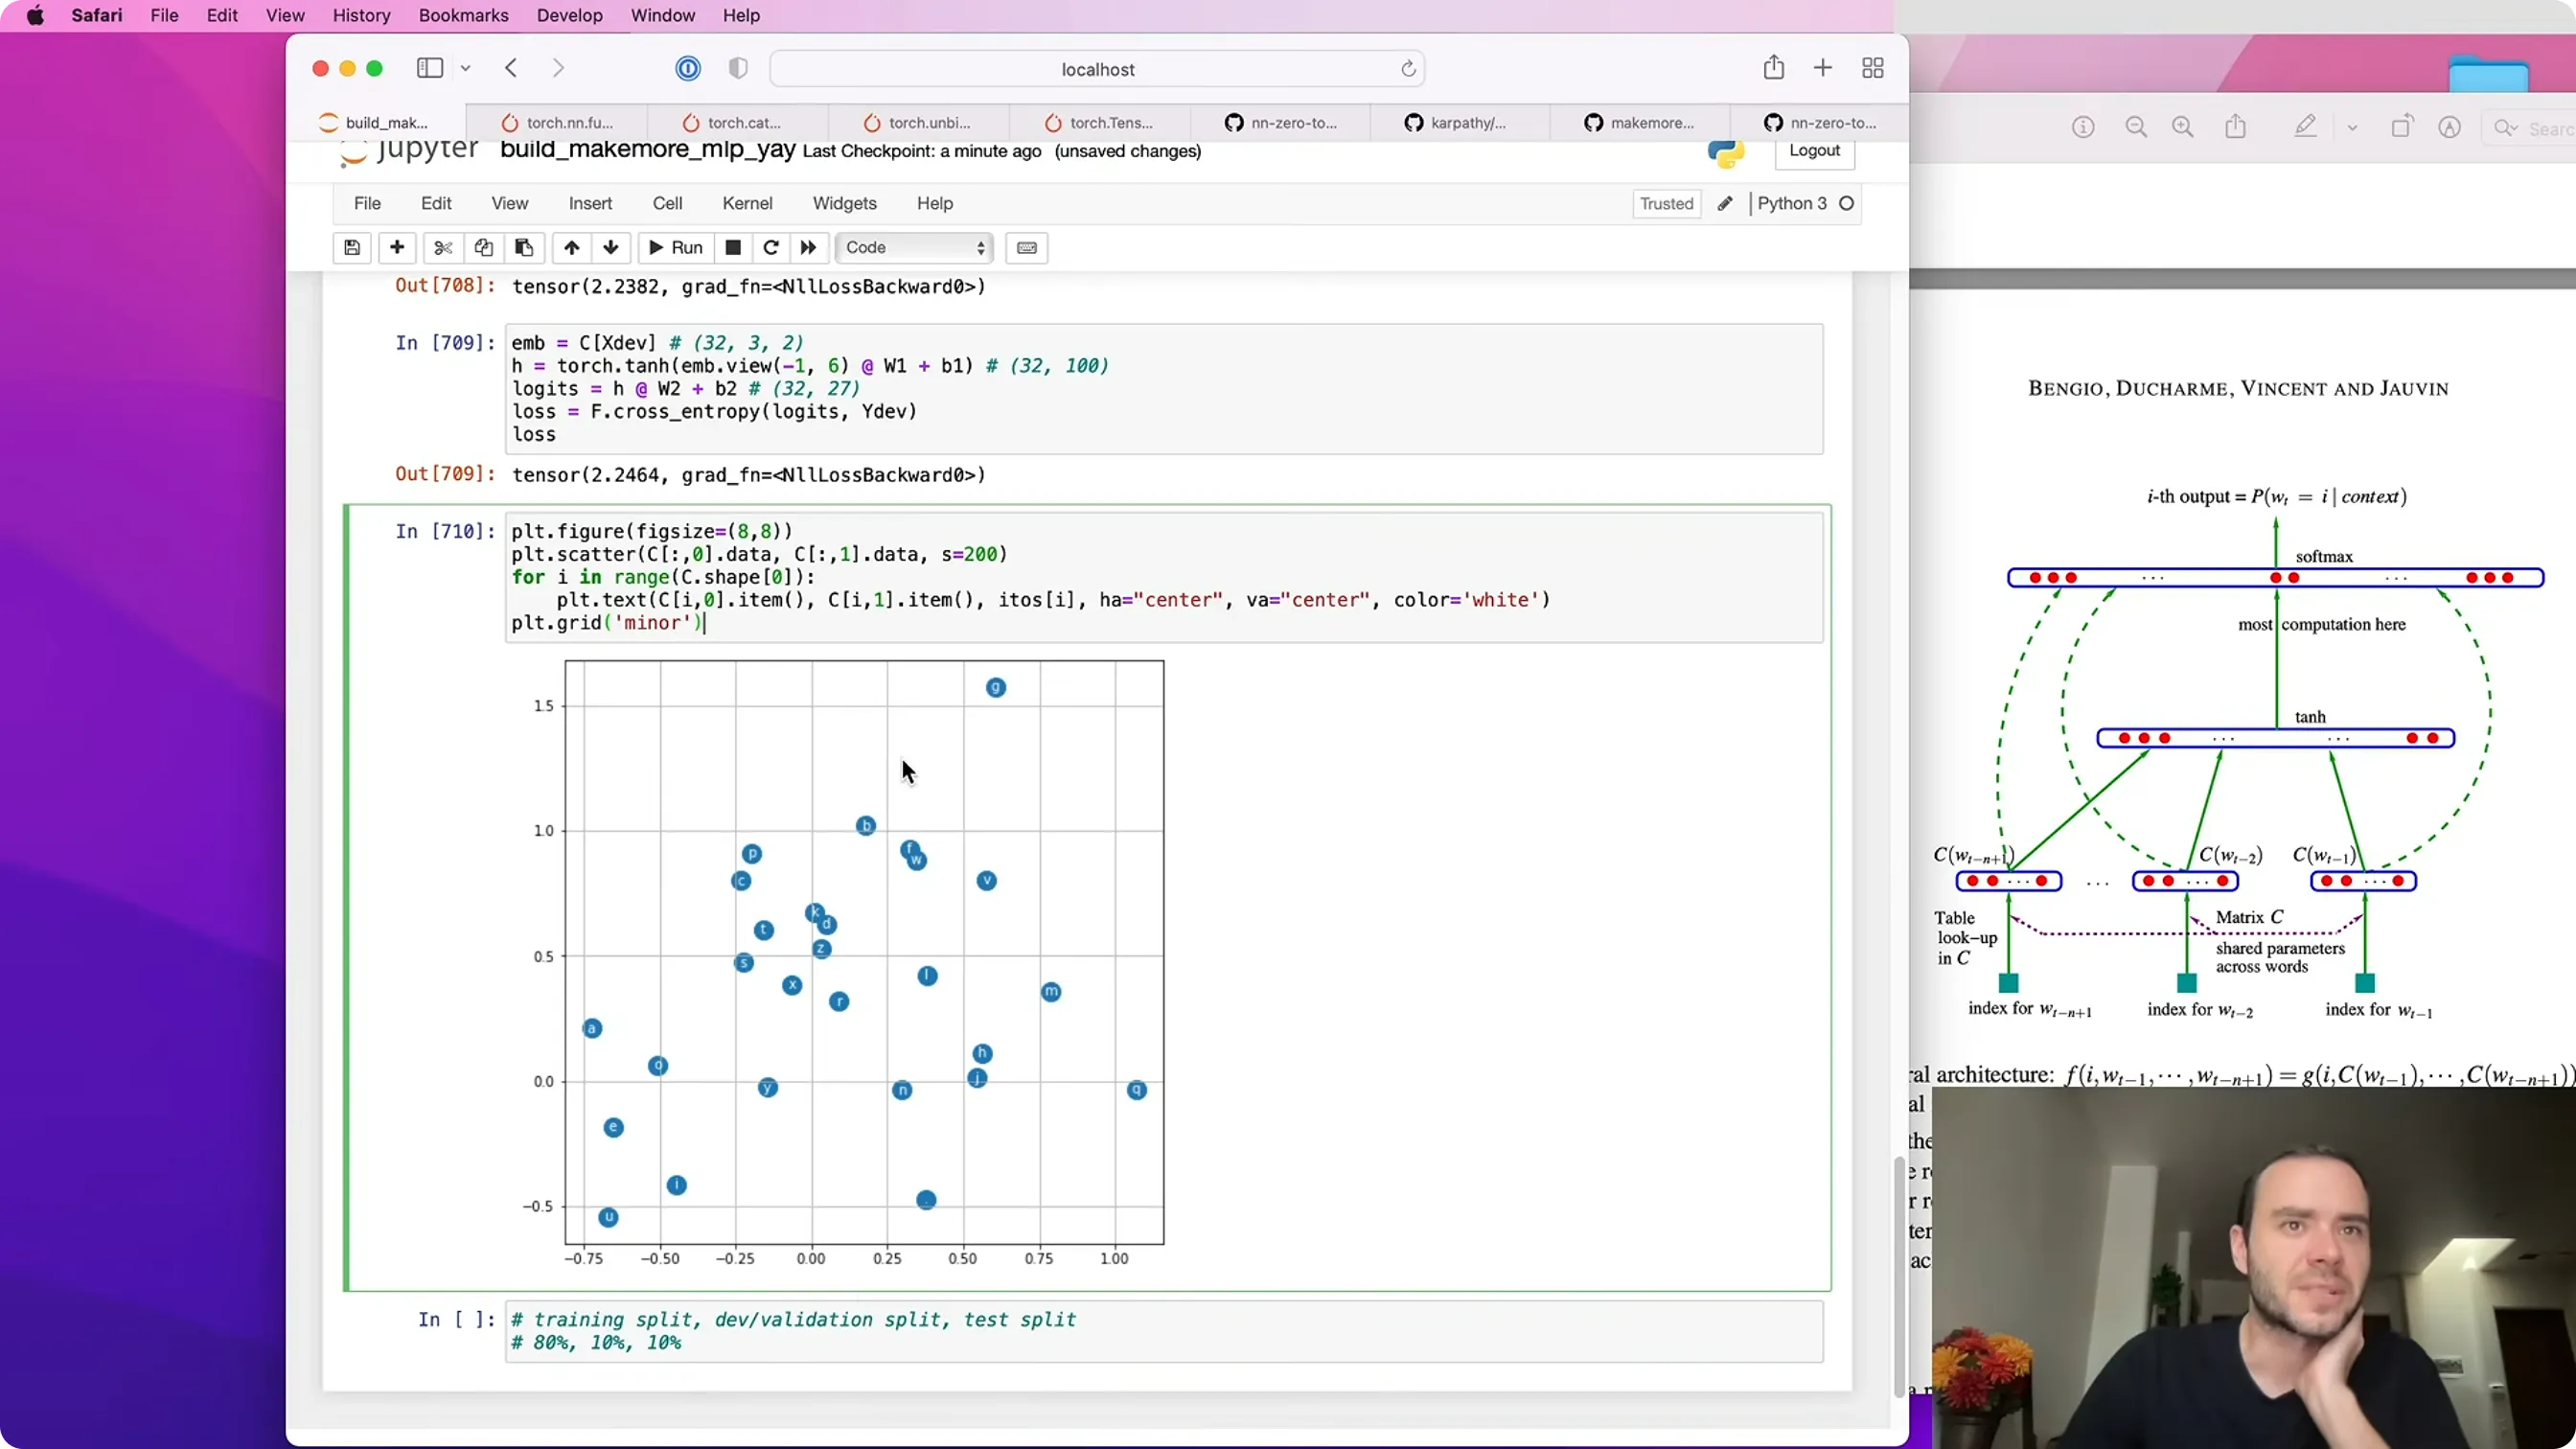
📷 训练后的字符嵌入:元音聚成一团,q 与 . 是离群点
回到原视频 (01:06:00)
编者拓展|为什么"能可视化"这件事本身就值得停下来:嵌入维度 = 2 时,你能用眼睛看见学习的结果。这是一次难得的"看见神经网络在想什么"的机会——元音聚团不是我们编程写死的,而是从 32,000 个名字里自动学出来的。
一旦维度 > 2(下一节就升到 10 维),你就画不出来了——这也解释了为什么降维可视化(t-SNE、UMAP、PCA)在研究和工程里如此常用。
实验二:嵌入维度 2 → 10(隐藏层同时 300 → 200,总参数约 11,000)。
- 训练 50,000 步(并配合学习率衰减:先 0.1,后 0.01);
- 训练损失 2.16,验证损失 2.19——明显好于之前;
- 而且此时train 与 dev 开始缓慢拉开——开始有过拟合的迹象了。
「嵌入的维度很可能就是之前的瓶颈。」
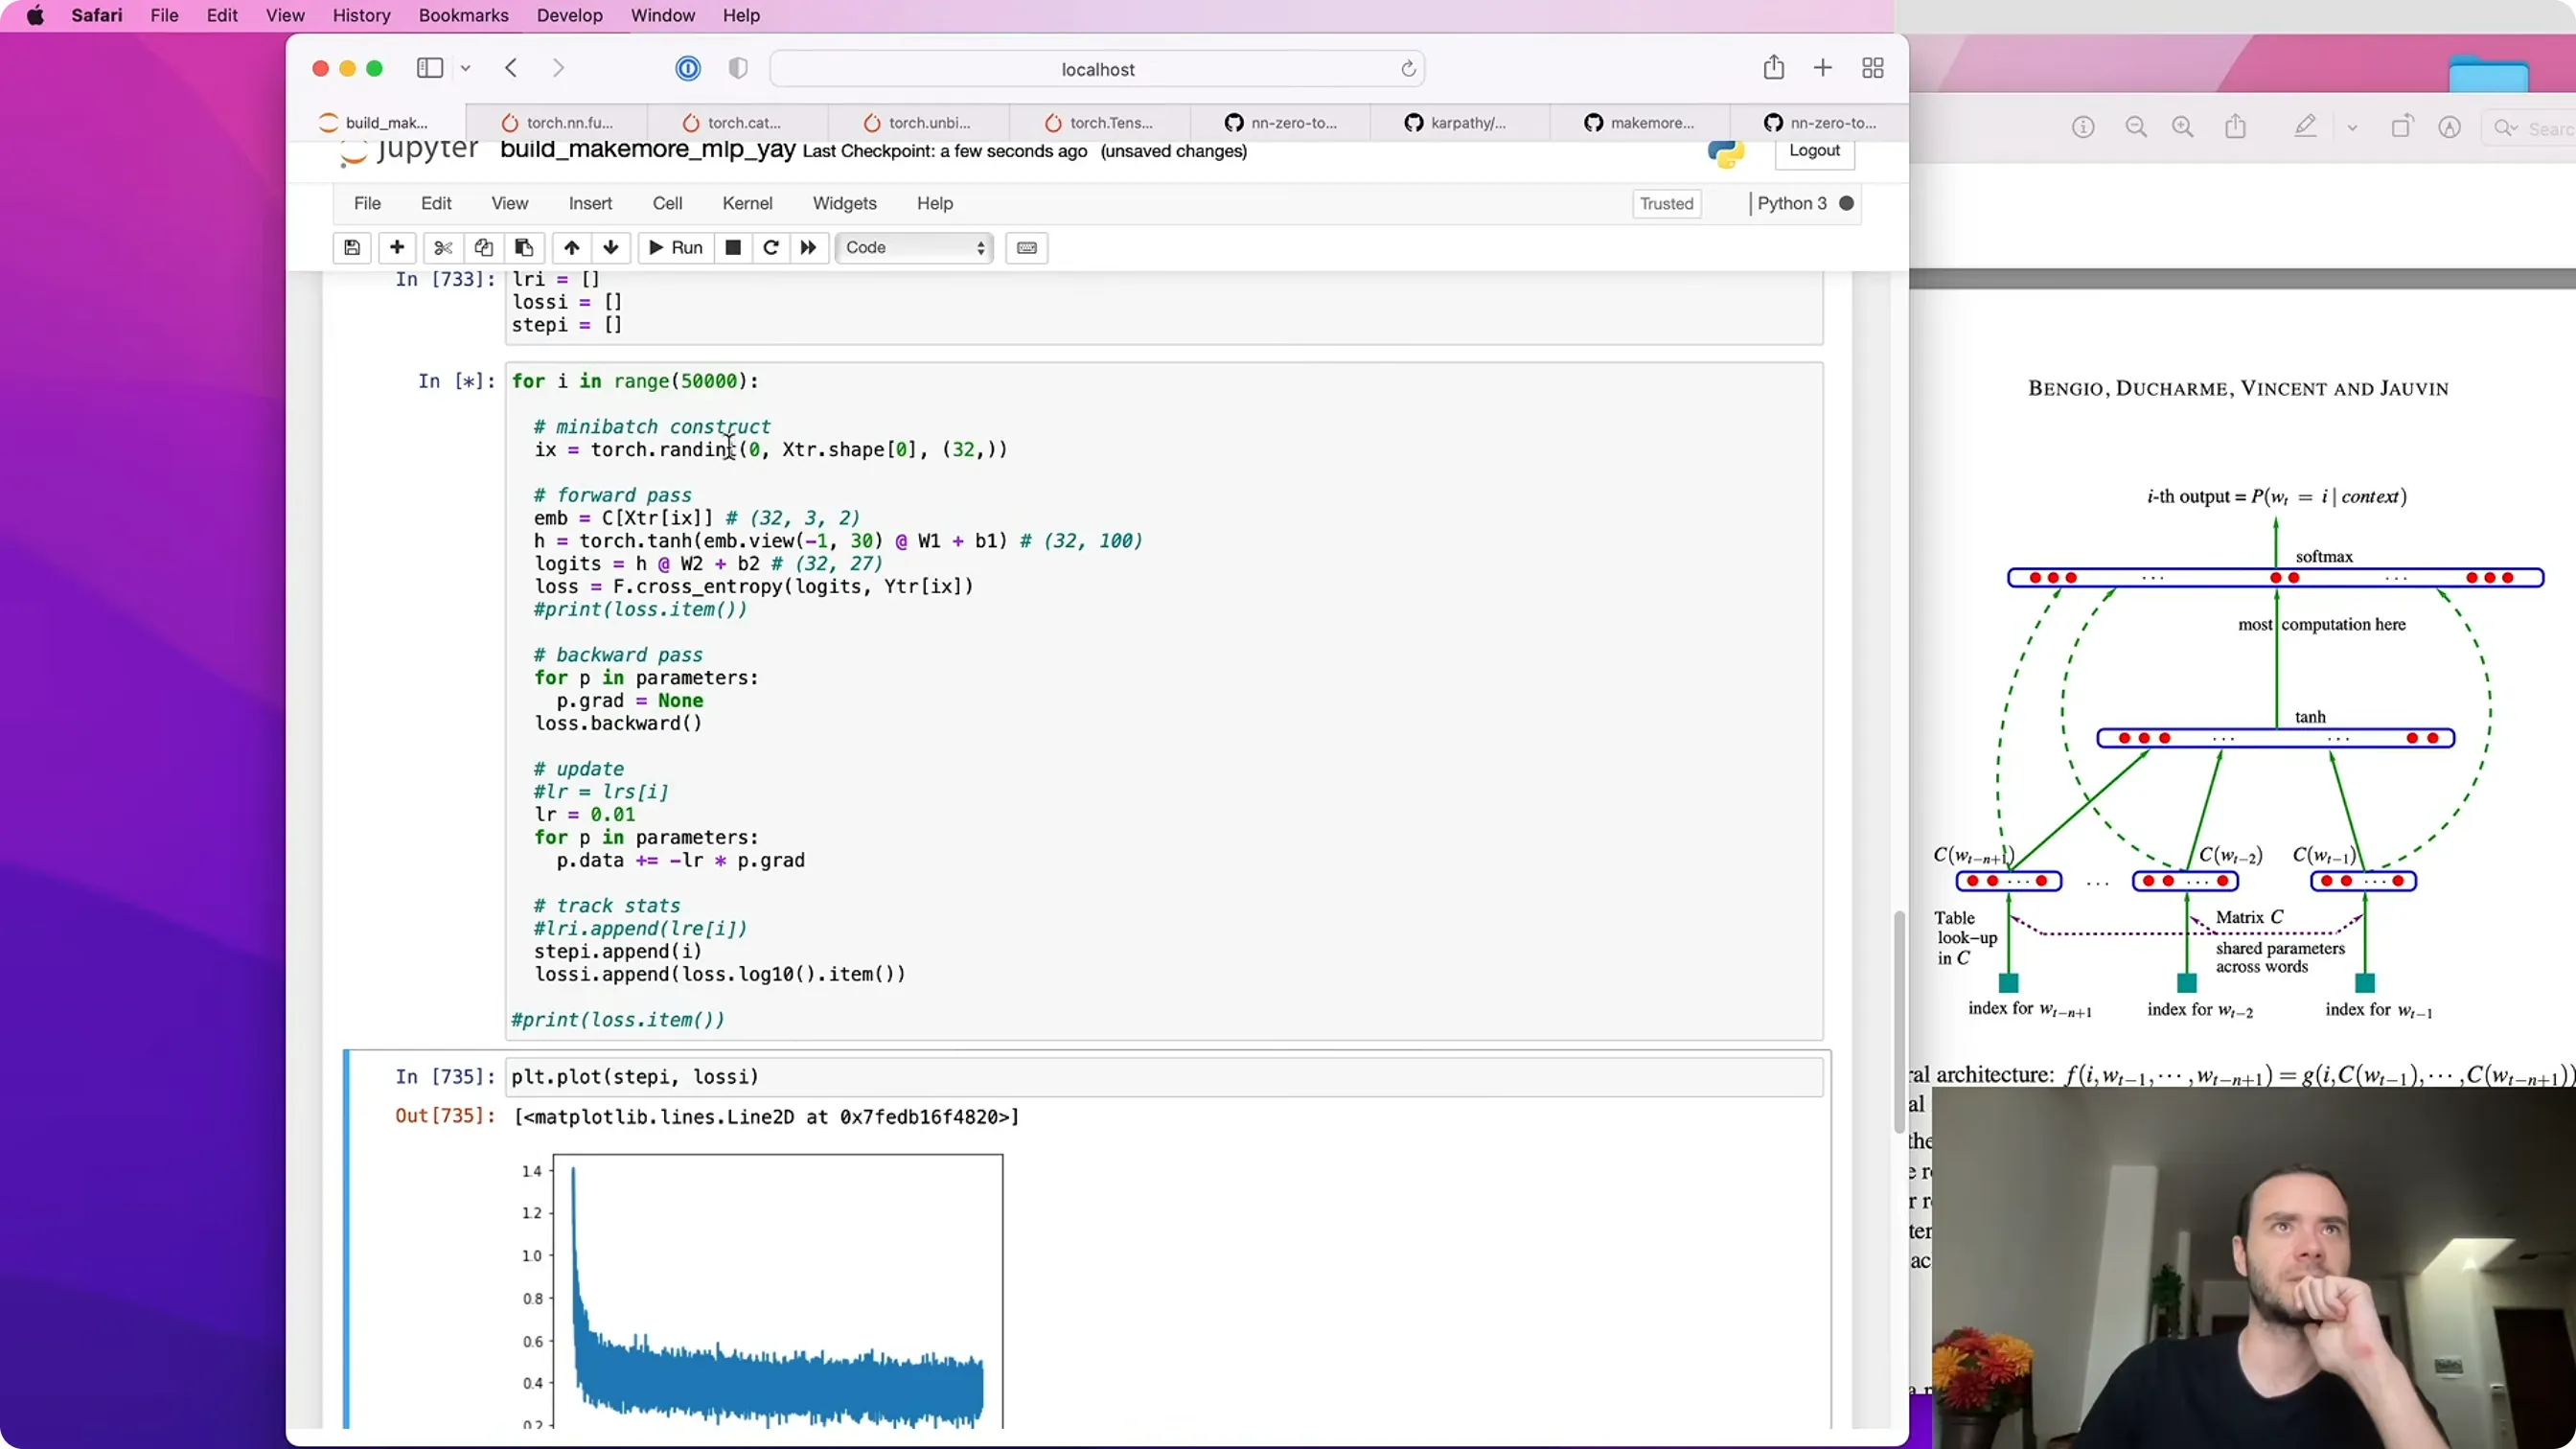
📷 加大嵌入维度到 10:损失进一步下降(2.16 / 2.19)
回到原视频 (01:09:30)
编者拓展|这一个小实验,把"调模型"的方法论讲透了: 1. 先判断是欠拟合还是过拟合(看 train 与 dev 的差距); 2. 欠拟合 → 增大模型(更多神经元、更大嵌入); 3. 每次只动一个旋钮,观察 dev 变化; 4. 收敛后衰减学习率,再刷几轮。
他说自己的最佳验证损失是 2.17,并把"打败它"作为练习留给你(E01)。
十一、总结、采样,以及「练手清单」
(参考时间: 1:11:46)
最终代码(很短):数据准备 → 三组参数(C、W1/b1、W2/b2)→ 前向传播(emb → view → tanh → logits → cross_entropy)→ 训练循环(mini-batch)。
从模型采样:
for _ in range(20):
    out = []
    context = [0] * block_size
    while True:
        emb = C[torch.tensor([context])]        # (1, block_size, emb_dim)
        h = torch.tanh(emb.view(1, -1) @ W1 + b1)
        logits = h @ W2 + b2
        probs = F.softmax(logits, dim=1)        # 同样做了数值稳定
        ix = torch.multinomial(probs, num_samples=1).item()
        context = context[1:] + [ix]
        out.append(ix)
        if ix == 0: break
    print(''.join(itos[i] for i in out))
生成出来的名字明显更像人名了(如 ham、joes、lela)。
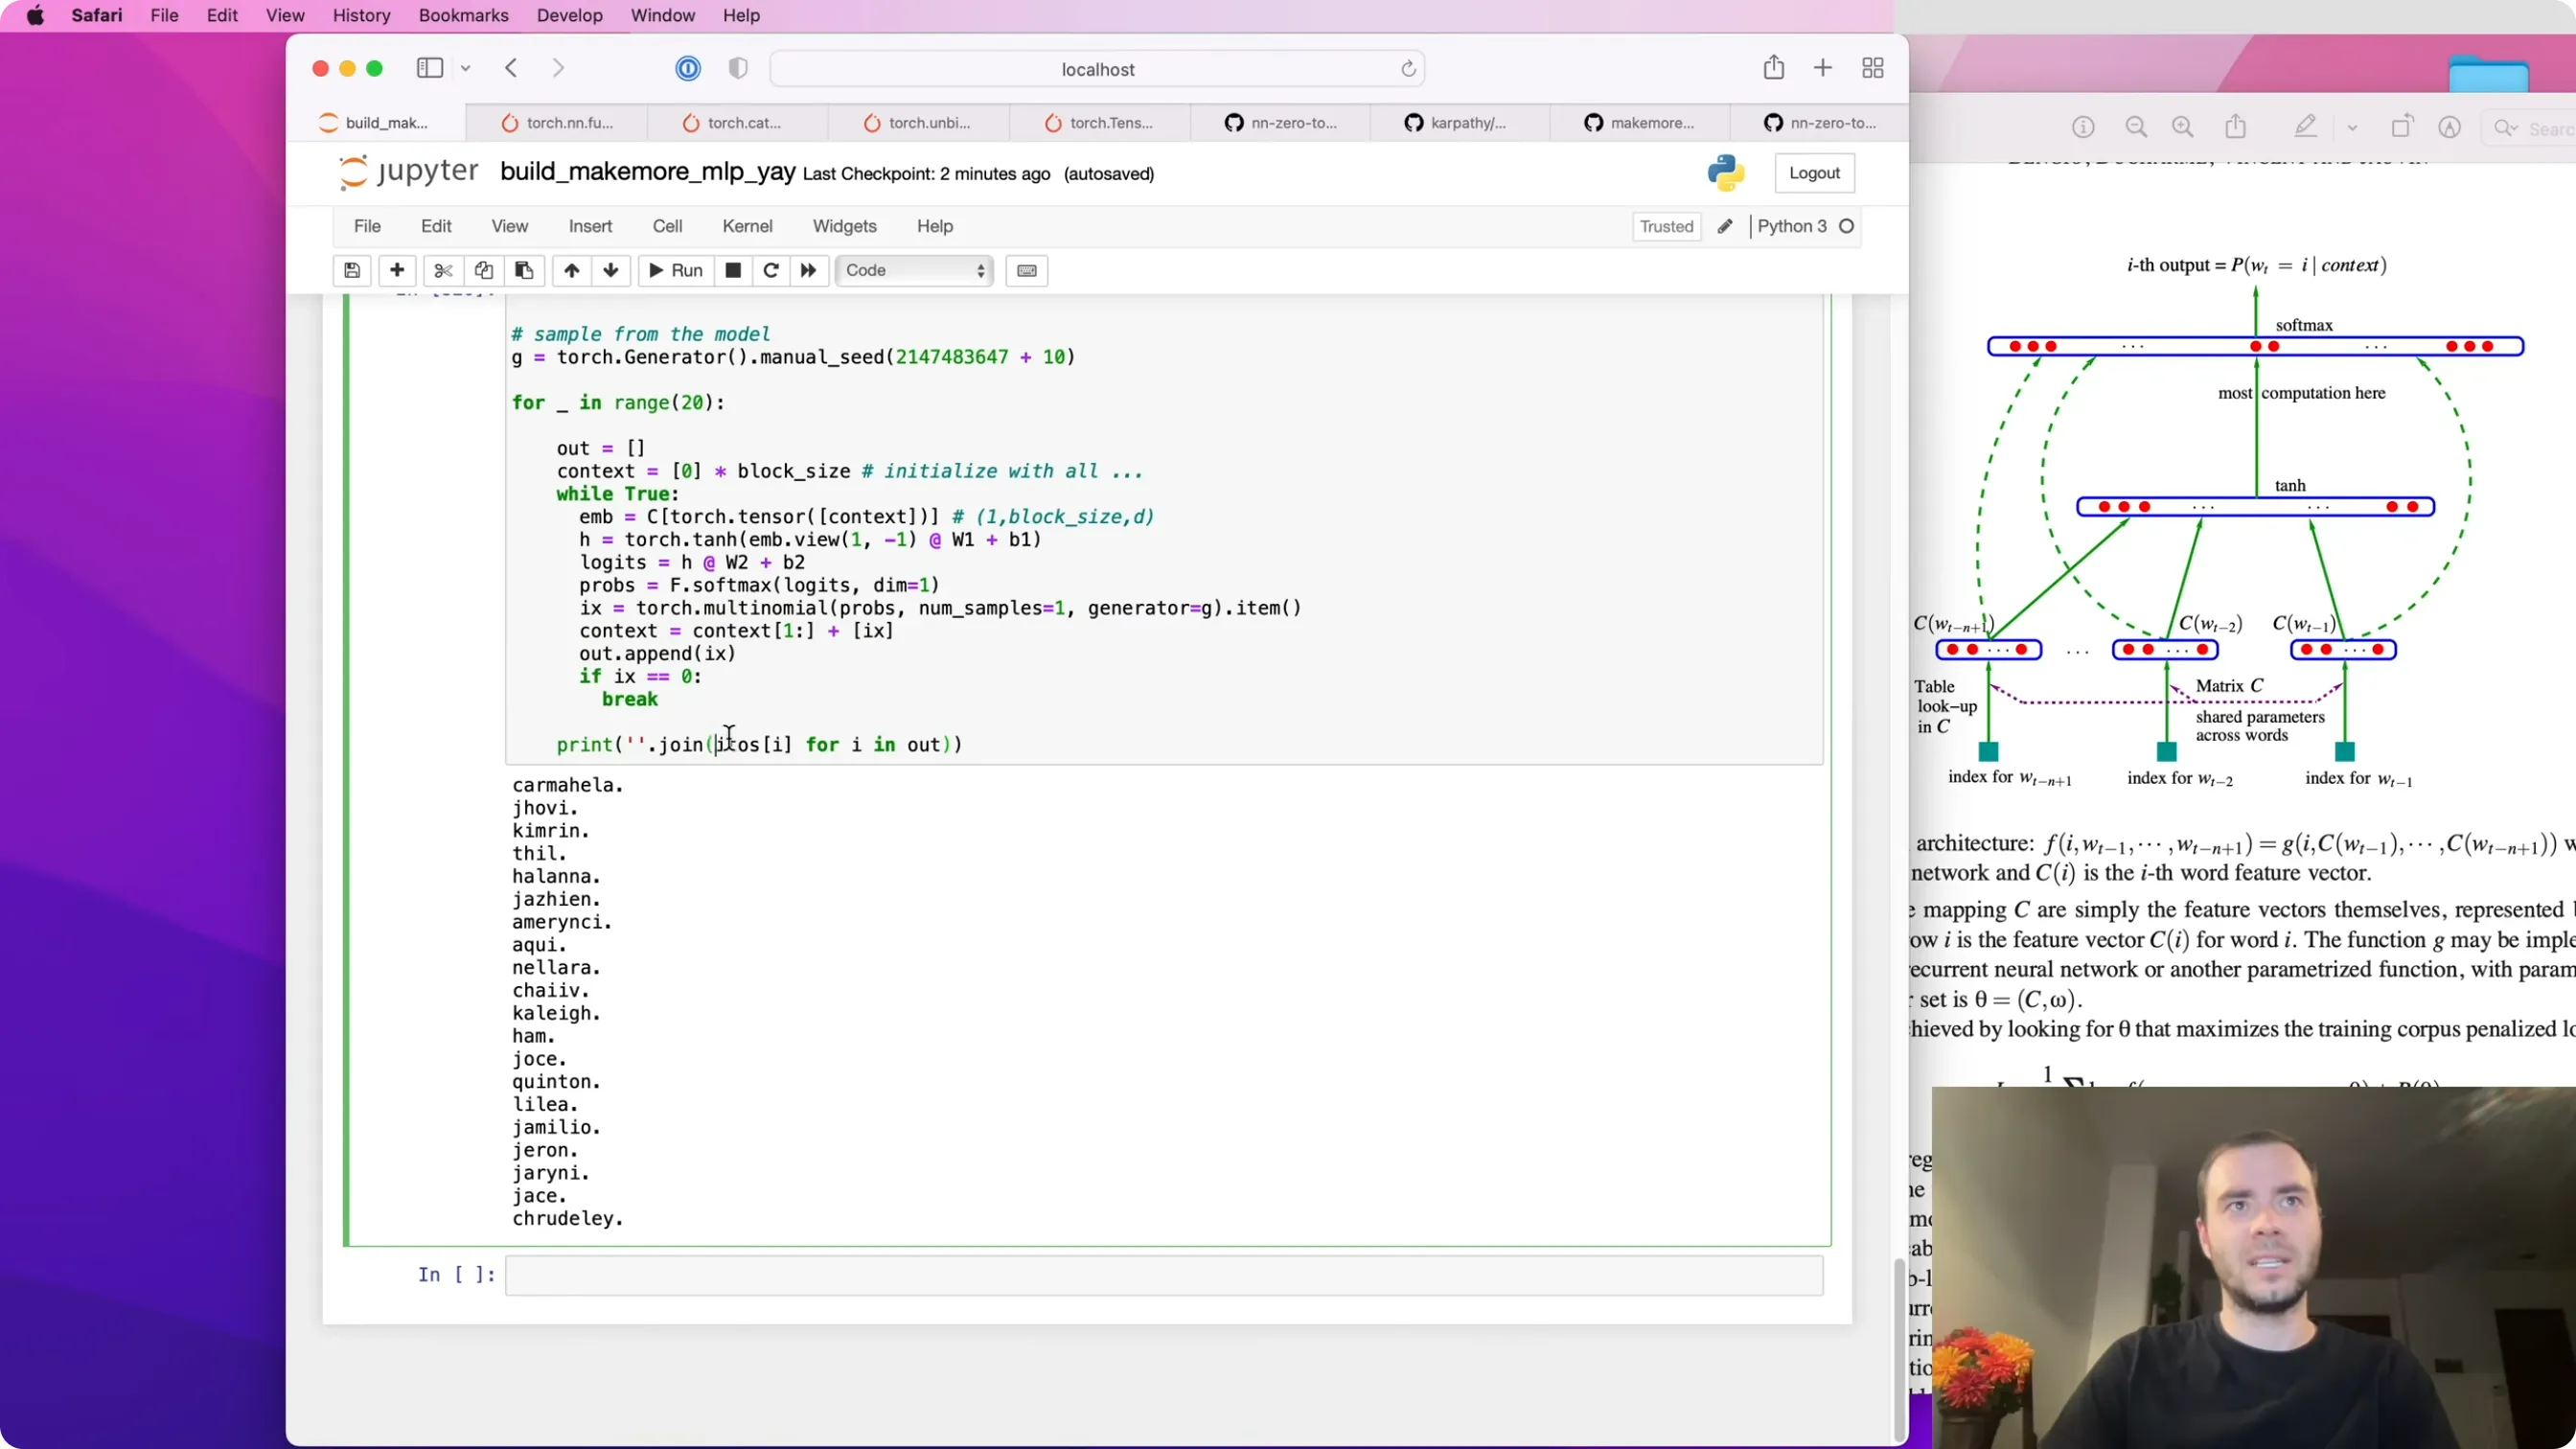
📷 采样:从 `...` 出发,逐步预测并滚动窗口,生成新的名字
回到原视频 (01:14:30)
他留给你的"旋钮"(也是 E01 的解题方向):
- 隐藏层神经元数量;
- 嵌入维度;
- 喂入的上下文字符数;
- 优化细节:训练多久、学习率、如何衰减、batch size。
并再次邀请你读那篇 19 页的论文——「现在你应该能读懂其中的很大一部分了」。
编者拓展|到这里,你已经把"现代语言模型"的骨架装起来了:embedding + MLP + softmax + cross-entropy + mini-batch 梯度下降 + train/dev/test。
后续讲次只是把这个骨架越搭越高: - Part 3(Activations & Gradients, BatchNorm)——让更深的网络能训得动; - Part 4(Becoming a Backprop Ninja)——手写反向传播,彻底搞懂梯度; - Part 5(WaveNet)——用层次化结构扩大上下文; - GPT——把 MLP 换成 Transformer。
但损失函数、优化器框架、训练循环,一路都不变。
附:官方参考与延伸阅读
- 课程主页(Neural Networks: Zero to Hero):https://karpathy.ai/zero-to-hero.html
- 本讲课件 Notebook:https://github.com/karpathy/nn-zero-to-hero/blob/master/lectures/makemore/makemore_part2_mlp.ipynb
- 🟢 本讲 Google Colab:https://colab.research.google.com/drive/1YIfmkftLrz6MPTOO9Vwqrop2Q5llHIGK?usp=sharing
- 📄 Bengio et al., A Neural Probabilistic Language Model (2003):https://www.jmlr.org/papers/volume3/bengio03a/bengio03a.pdf
- makemore 仓库:https://github.com/karpathy/makemore
- PyTorch internals(storage/views/strides):http://blog.ezyang.com/2019/05/pytorch-internals/
torch.Tensor.view文档:https://pytorch.org/docs/stable/generated/torch.Tensor.view.htmlF.cross_entropy文档:https://pytorch.org/docs/stable/generated/torch.nn.functional.cross_entropy.htmltorch.multinomial文档:https://pytorch.org/docs/stable/generated/torch.multinomial.html- 讨论 Discord:https://discord.gg/3zy8kqD9Cp
版权说明:本书内容依据 Andrej Karpathy 的公开教学视频 Building makemore Part 2: MLP 重构,代码与数据集版权归原作者所有,遵循其仓库所附许可(MIT License)。本电子书仅用于学习交流,不用于商业用途。