第8讲 · 从零构建 GPT Tokenizer(分词器)
本电子书由教学视频重构而成。 视频原标题:Let's build the GPT Tokenizer 编者拓展|📝 本讲的官方练习(Exercises)——Karpathy 把它做成了一条四步的渐进路线,写在 minbpe 仓库的
exercise.md里:"Advised flow: reference this document and try to implement the steps before I give away the partial solutions in the video." 卡住了就看
minbpe里的 tests——「我尽量把代码写得干净易懂,随时可以来参考」。 做完你应该能: 1. 复现 tiktoken 的行为(同样的字符串 → 同样的 token); 2.encode后再decode能原样还原; 3. 写出train()函数——注意 tiktoken 官方并不提供训练代码,这是你自己要实现的。
| > (建议的流程 | 先照着这份文档自己实现,别等我在视频里给出部分答案。) |
| 即 | exercise.md 是题面,视频是"部分答案",minbpe 仓库是完整答案 + 测试。 |
| 讲师 | Andrej Karpathy |
| 视频地址 | https://www.youtube.com/watch?v=zduSFxRajkE |
| 所属课程 | Neural Networks: Zero to Hero — https://karpathy.ai/zero-to-hero.html |
| 🟢 Google Colab | https://colab.research.google.com/drive/1y0KnCFZvGVf_odSfcNAws6kcDD7HsI0L?usp=sharing |
| 本讲代码仓库 minbpe | https://github.com/karpathy/minbpe |
| 🎯 练习进度表(先做这个!) | https://github.com/karpathy/minbpe/blob/master/exercise.md |
| 🖥️ tiktokenizer(在线可视化) | https://tiktokenizer.vercel.app |
| tiktoken(OpenAI 官方库) | https://github.com/openai/tiktoken |
| sentencepiece(Google) | https://github.com/google/sentencepiece |
| 完整系列播放列表 | https://www.youtube.com/watch?v=VMj-3S1tku0&list=PLAqhIrjkxbuWI23v9cThsA9GvCAUhRvKZ |
| 讨论区 | 官方 Discord:https://discord.gg/3zy8kqD9Cp |
对应讲次:第8讲(Karpathy: Neural Networks — Zero to Hero)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
一、引子:我最不喜欢的环节
(参考时间: 00:00)
Karpathy 开场就说:
「你们看我这张脸——因为 tokenization 是我做大语言模型时最不喜欢的部分。」 「但遗憾的是,你必须相当细致地理解它——它相当"毛糙、扎手"(hairy, gnarly),有一大堆隐藏的"脚下枪"(foot guns)。而且大模型身上很多古怪行为,追根究底都是 tokenization 造成的。」
上一讲我们其实已经做过 tokenization——但那是一个非常原始的字符级版本:
- 加载莎士比亚文本(一个大字符串);
- 建一个 65 个字符的词表;
- 建一张「字符 → 整数」的查找表;
- 用
nn.Embedding(65, ...)把那 65 行取出来,喂给 Transformer。
「但在实践中,最先进的模型用的是复杂得多的方案——我们不再工作在字符级,而是工作在"块(chunk)"级,而这些块是用字节对编码(Byte Pair Encoding, BPE)之类的算法构造出来的。」
原始动机(来自 GPT-2 论文的 "Input representation" 一节):
- 词表大小 50,257 个 token;
- 上下文长度 1,024 个 token——注意力层里每个 token 最多看到前面 1024 个 token。
「token 是 LLM 的基本单位,甚至可以说是它的"原子"——一切都以 token 为单位。而 tokenization 就是把字符串翻译成 token 序列(以及反过来)的过程。」
规模感:Llama 2 论文里搜 "token" 有 63 处——"token" 这个词是无处不在的。他们说自己训了 2 万亿个 token。
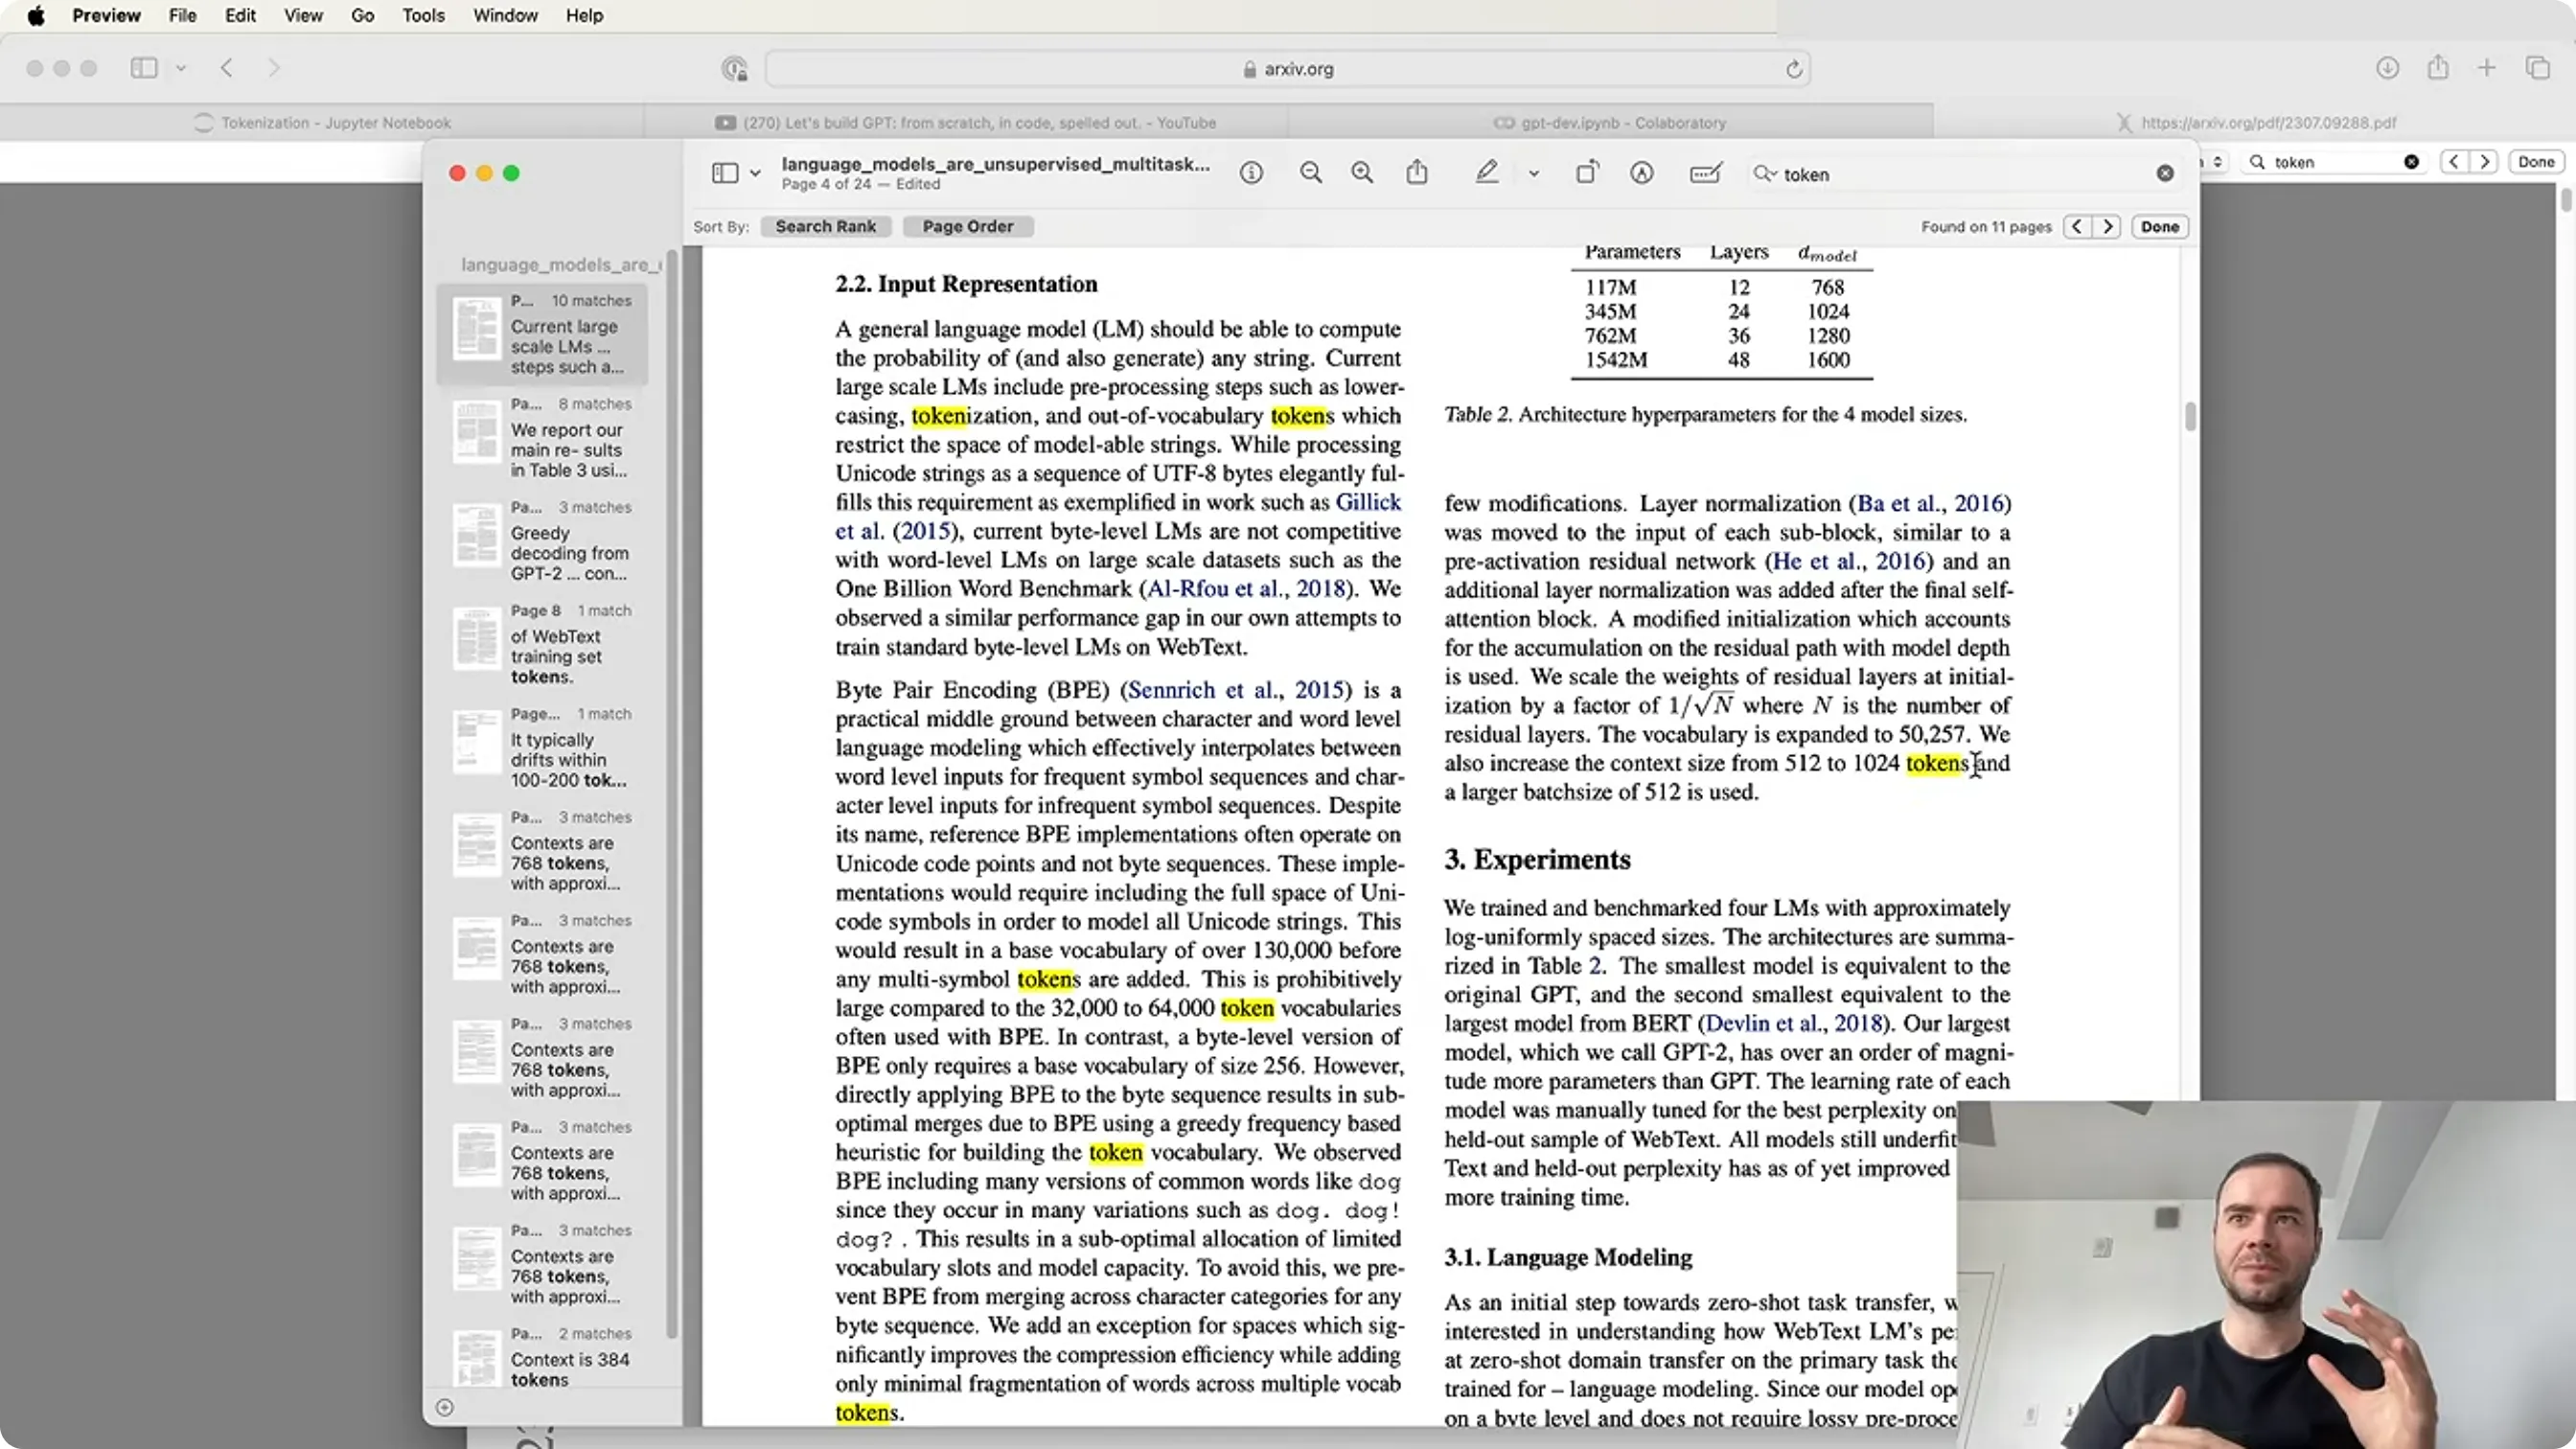
📷 GPT-2 论文的 Input representation:50,257 词表 / 1,024 上下文
回到原视频 (00:03:30)
二、先看看它会出什么"怪事"
(参考时间: 05:50)
Karpathy 打开 tiktokenizer(一个纯前端网页,tokenization 在浏览器里实时跑),逐条展示:
① 英文切分还算合理
tokenization → 两个 token(3642 / 1634)。space 是 token 318、at 是 379……「注意空格是"粘"在后面的那个词上的」。
② 数字的切分完全任意
127 是一个 token,但 677 是两个(6 + 77),804 也是两个。四位数更是各种拆法都有。
「这完全是任意的」,后果是:大模型必须自己想办法把这些不同的切分"对齐"成同一个概念。
③ 同一个词,不同上下文 → 不同 token
egg → 2 个 token;an egg → egg 变成 1 个 token;egg(小写单独)→ 1 个,但颜色不同(是不同的 token ID);Egg 又是另外的 token。
「同一个概念 "egg",在句首、句中、小写、大写、混合大小写,全都是不同的 token、不同的 ID。 而模型必须从原始数据里自己学出"它们其实是同一个东西"。」
④ 非英语更碎
一段韩语的 ChatGPT 介绍——他会带你数:
「同一句话,英语可能是 10 个 token,翻译成韩语或日语往往要多得多的 token」,因为这些"块"被切得更碎。 后果:非英语文本被拉长了——在 Transformer 的注意力里,你会更快耗尽最大上下文长度。 「所有非英语文本,从 Transformer 的视角看,都是被"拉伸"的。」
⑤ Python 缩进:GPT-2 的灾难
一段 Python 冒泡排序:
「看这些空格——每一个都是独立的 token 220(220 220 220 220……)。」 后果:GPT-2 在处理 Python 时极其浪费 token 空间——上下文很快被空格吃光。 「这和编程语言本身、和模型能力都没关系,纯粹是 tokenizer 的设计问题。」
⑥ GPT-2 → GPT-4 的改善
同一个字符串:GPT-2 (50k 词表) 300 tokens → GPT-4 (cl100k_base, 100k 词表) 185 tokens。
「同样的文本被压进了一半的 token——这是更"稠密"的输入,我们大致能看到两倍的文本作为上下文。」 但不是越大越好:「词表变大,embedding 表变大、最后 softmax 的输出也变大……存在一个"甜点":既足够稠密,又保持高效。」
而 GPT-4 对 Python 的空间有专门改进:四个空格被合成了一个 token、七个空格也是——「这是 OpenAI 设计 GPT-4 tokenizer 时的一个刻意选择」,把大量空格合并成一个字符,从而densify(加密)Python。 👉 「从 GPT-2 到 GPT-4,Python 编程能力的提升,不只是模型架构和优化的功劳,很大一部分来自 tokenizer 的设计。」
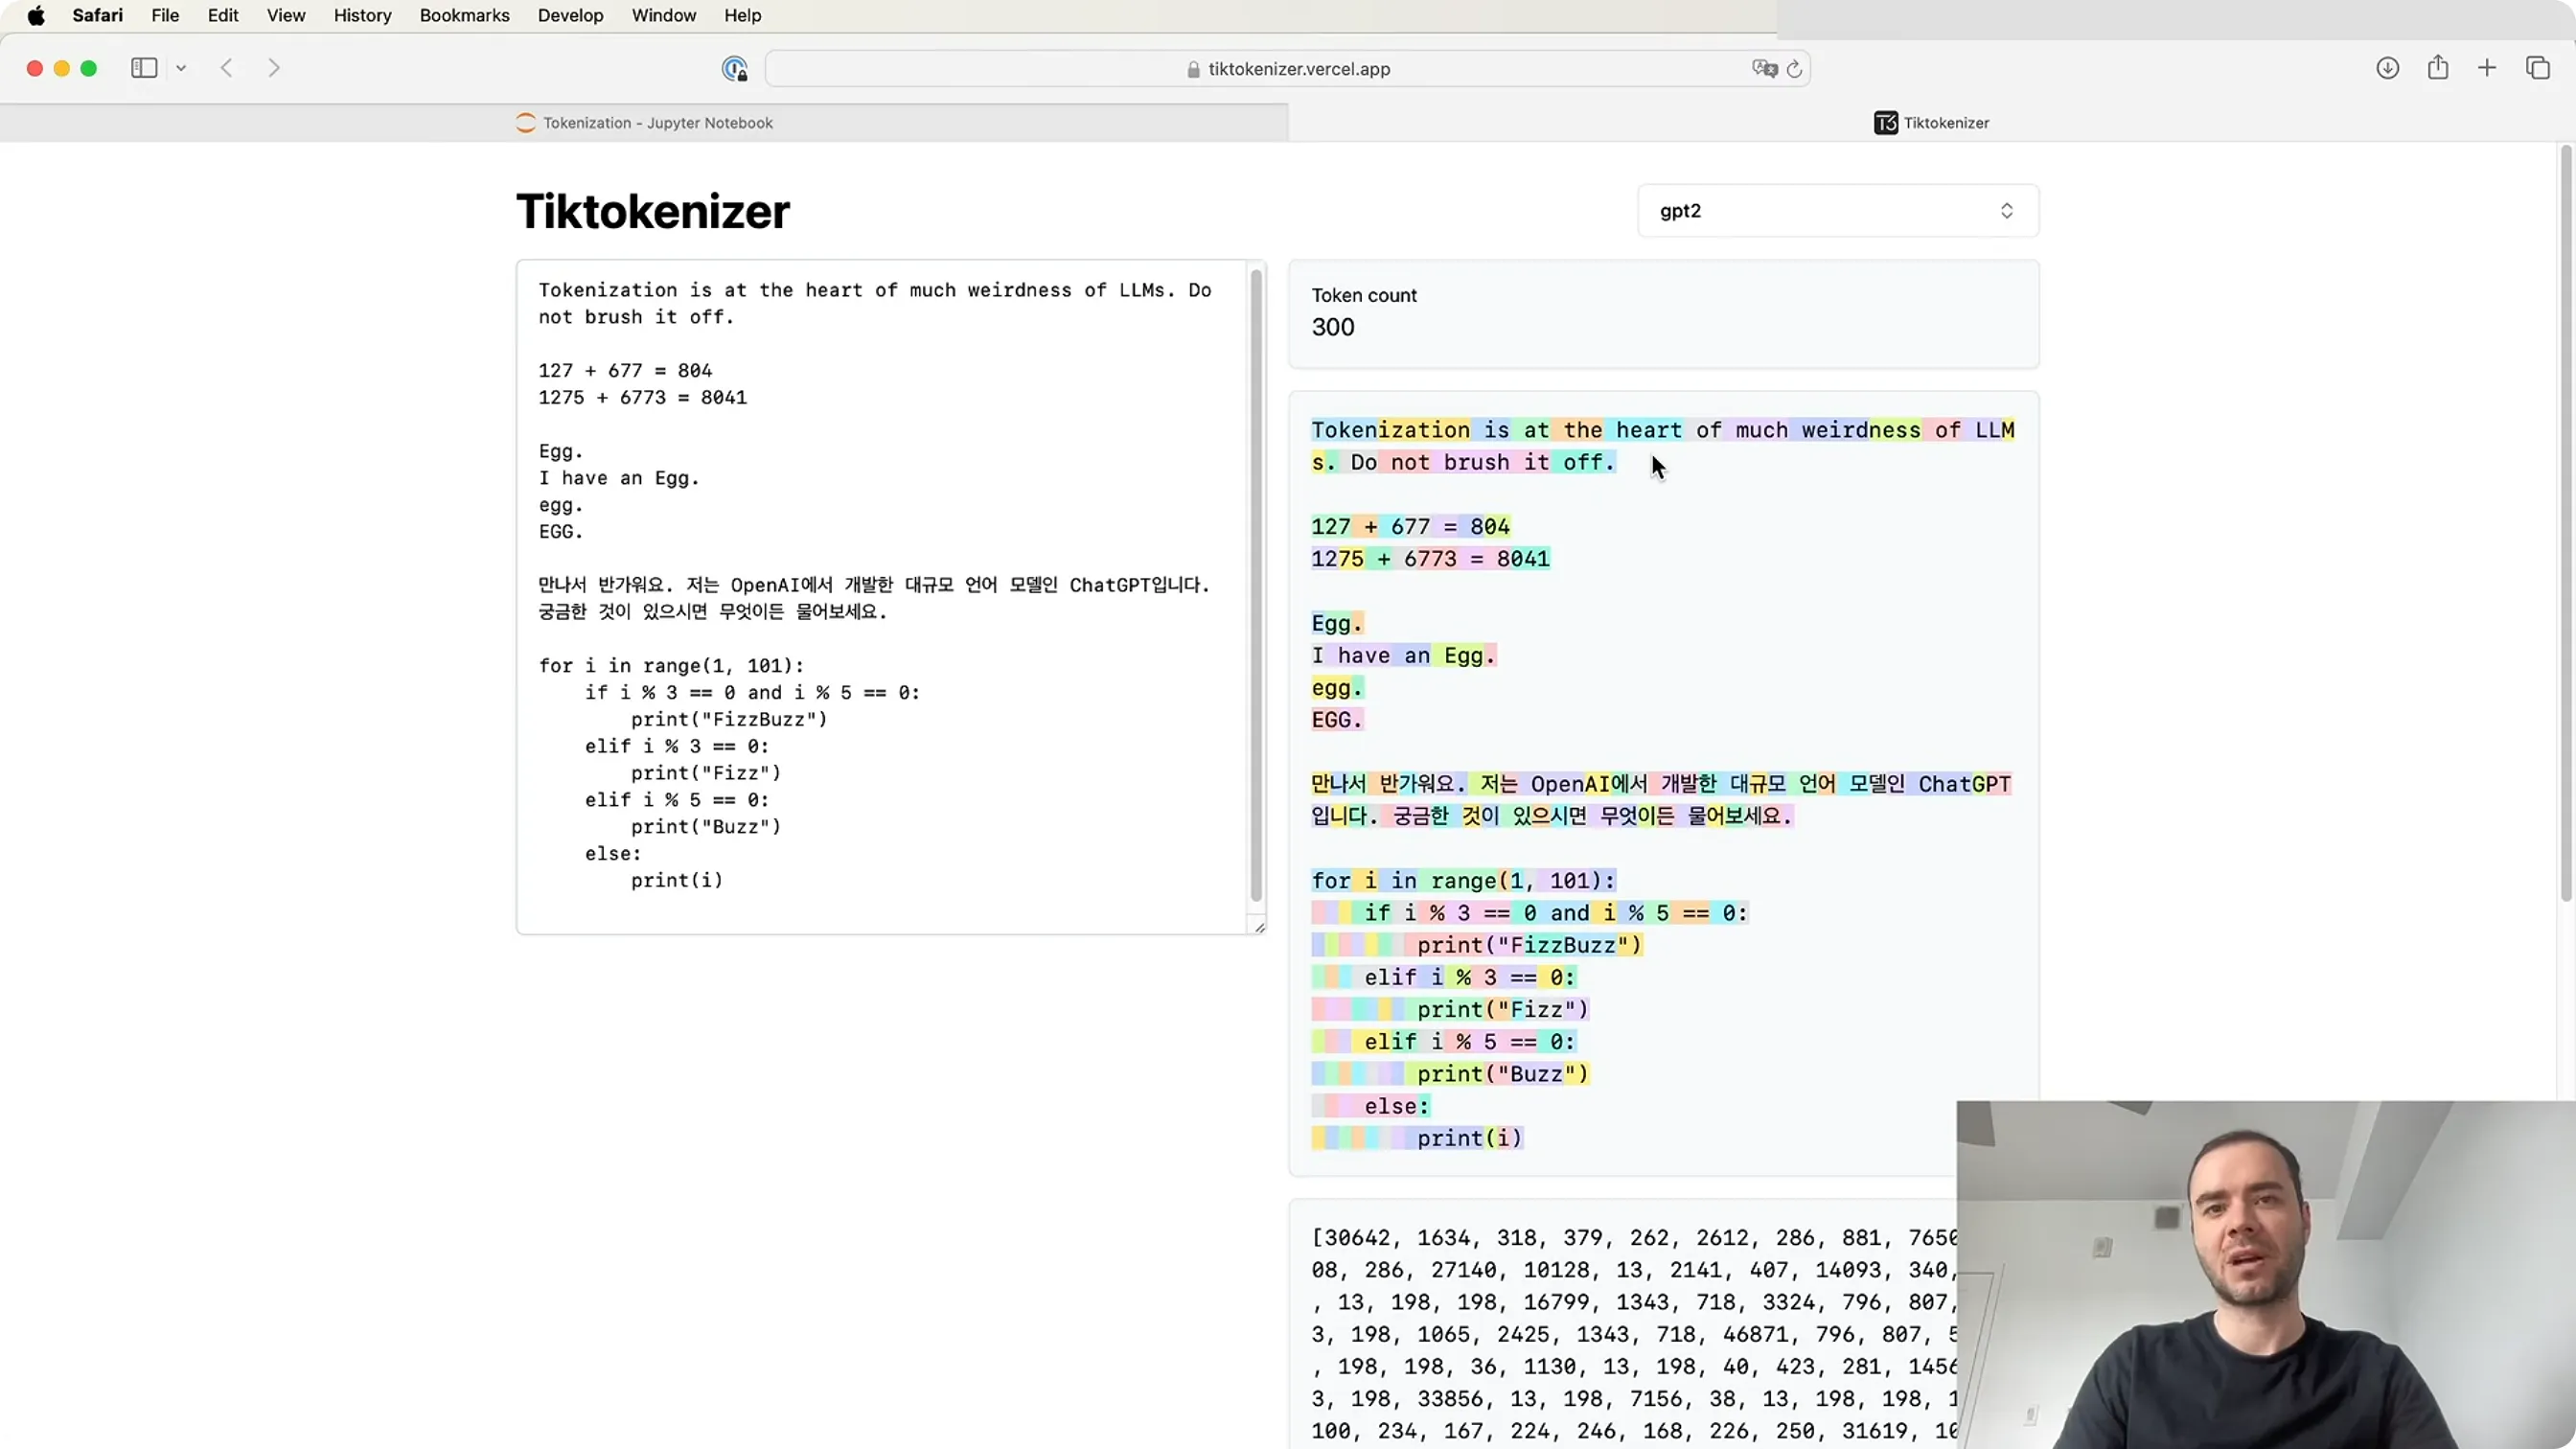
📷 `tokenization` 被切成 2 个 token,空格"粘"在词上
回到原视频 (00:07:20)
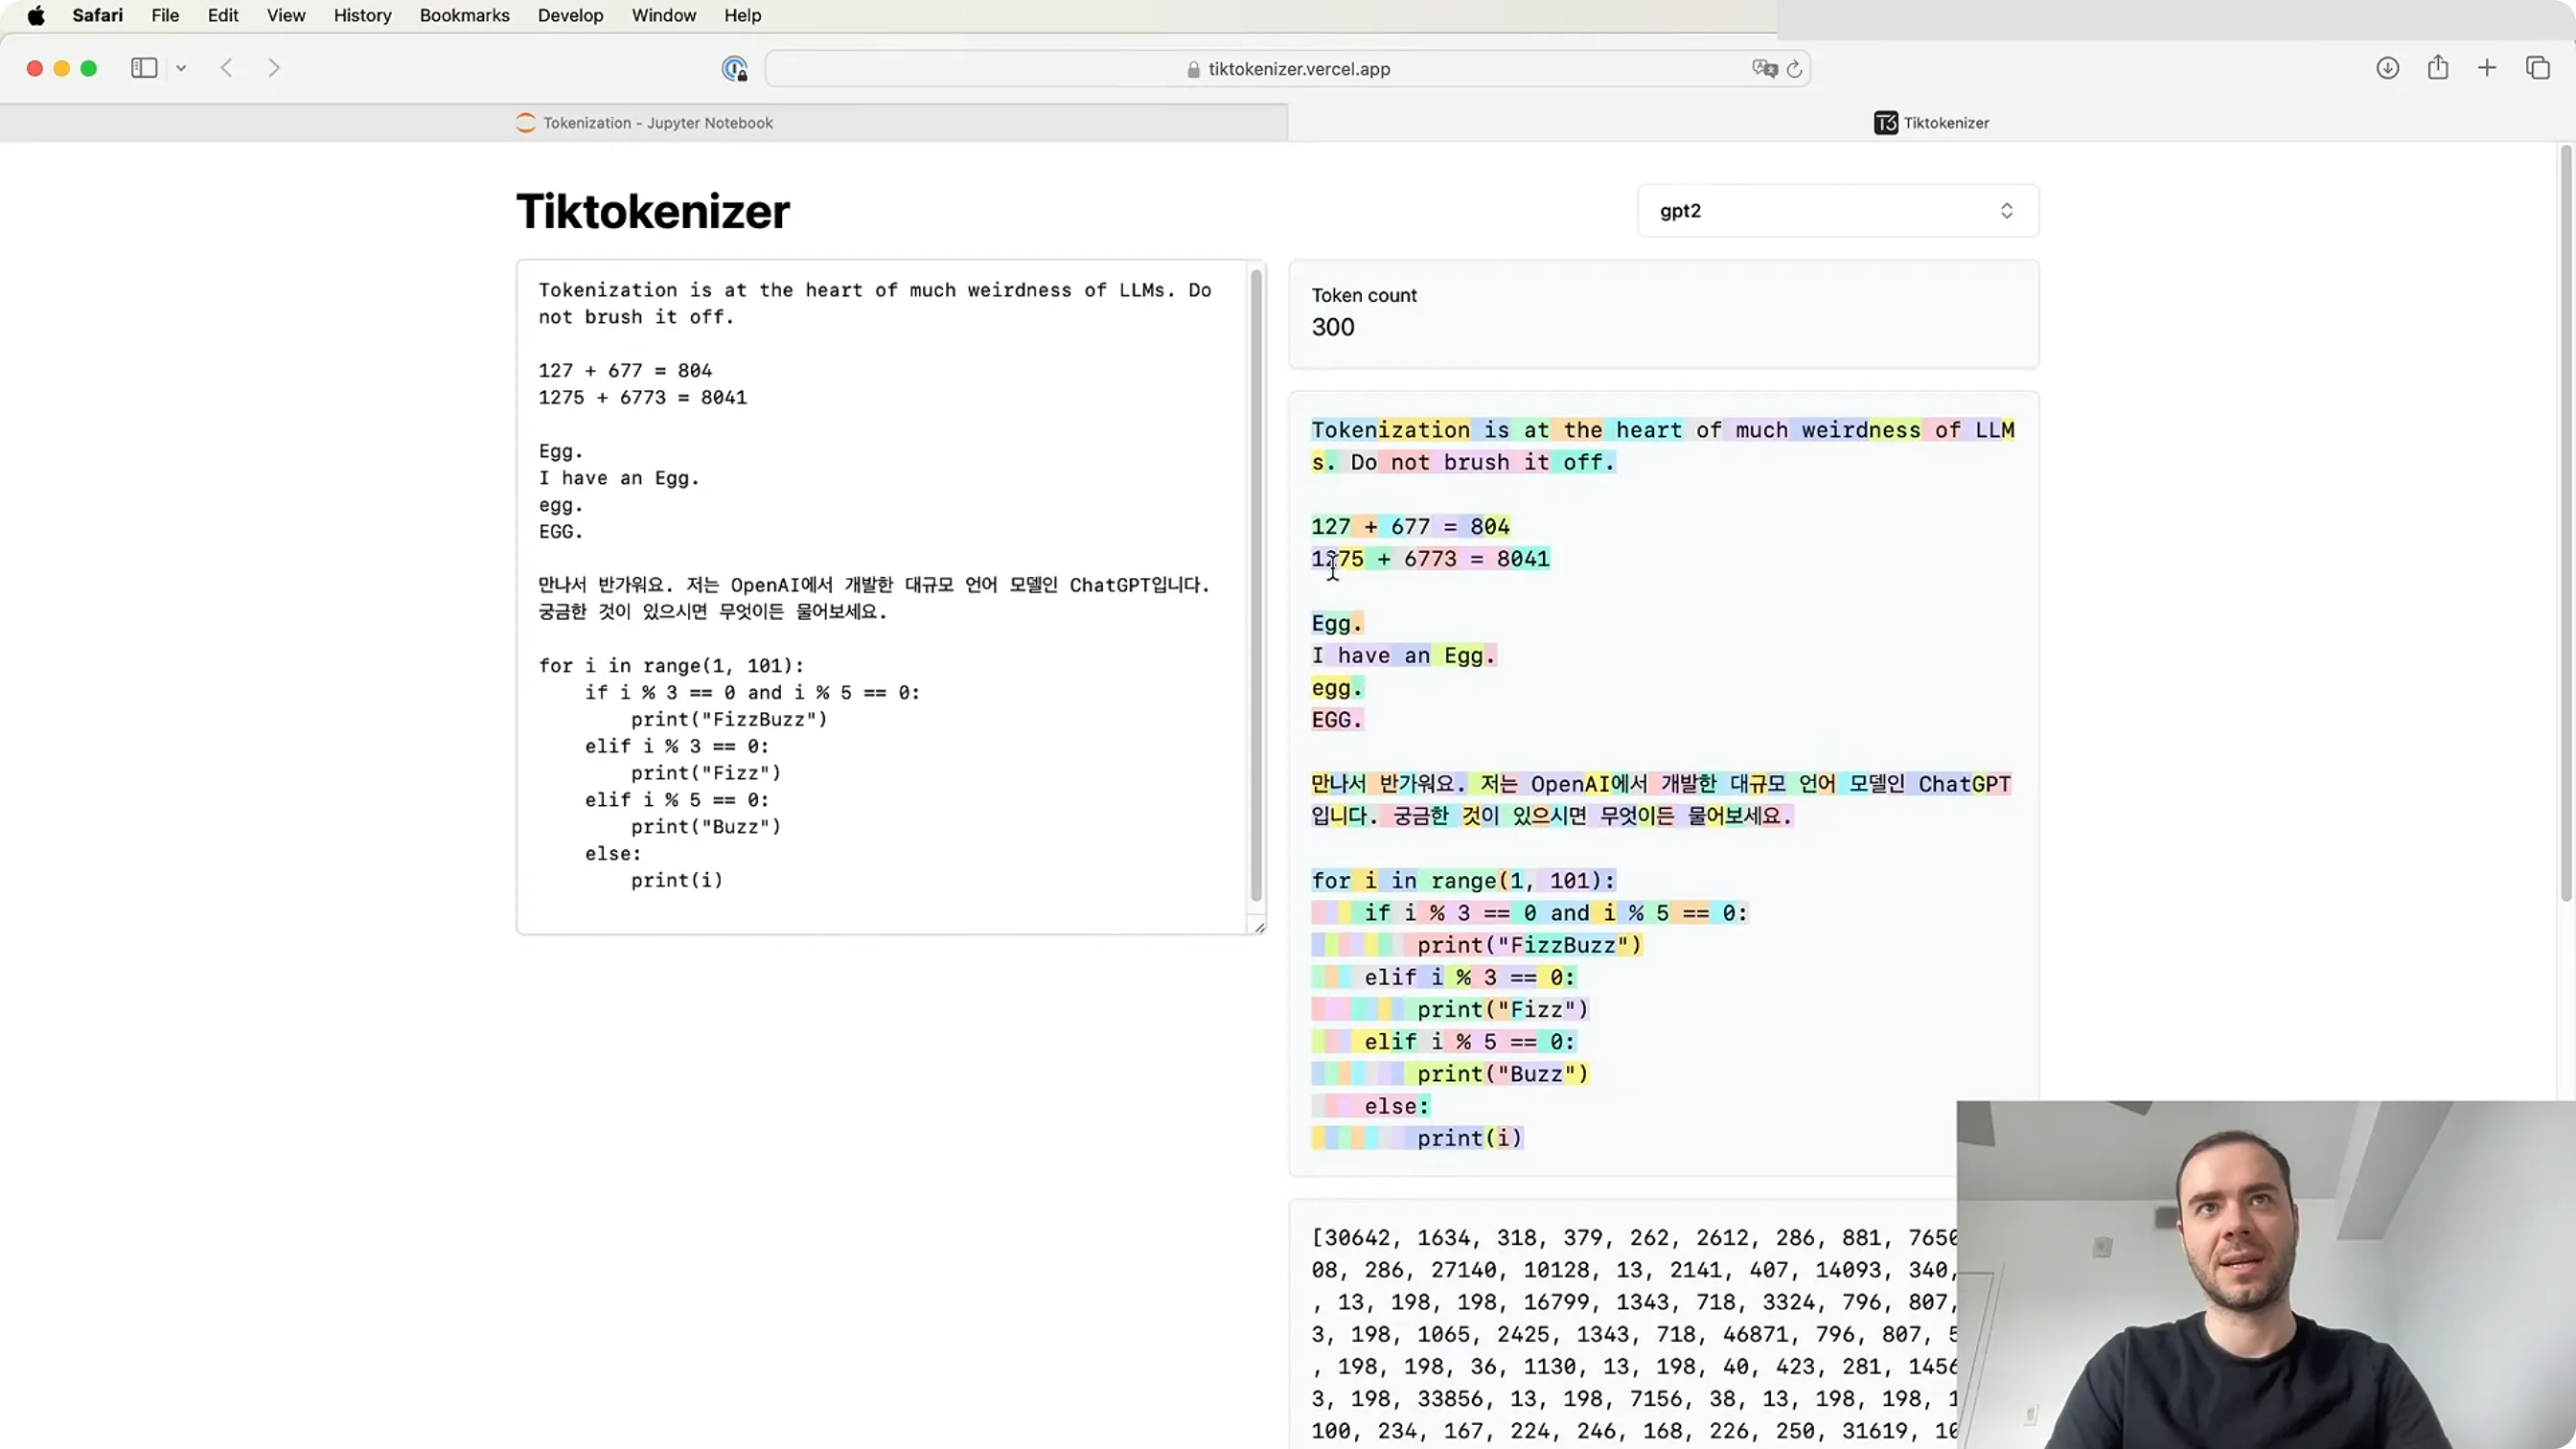
📷 算术:127 是一个 token,677 是两个——完全任意
回到原视频 (00:08:00)
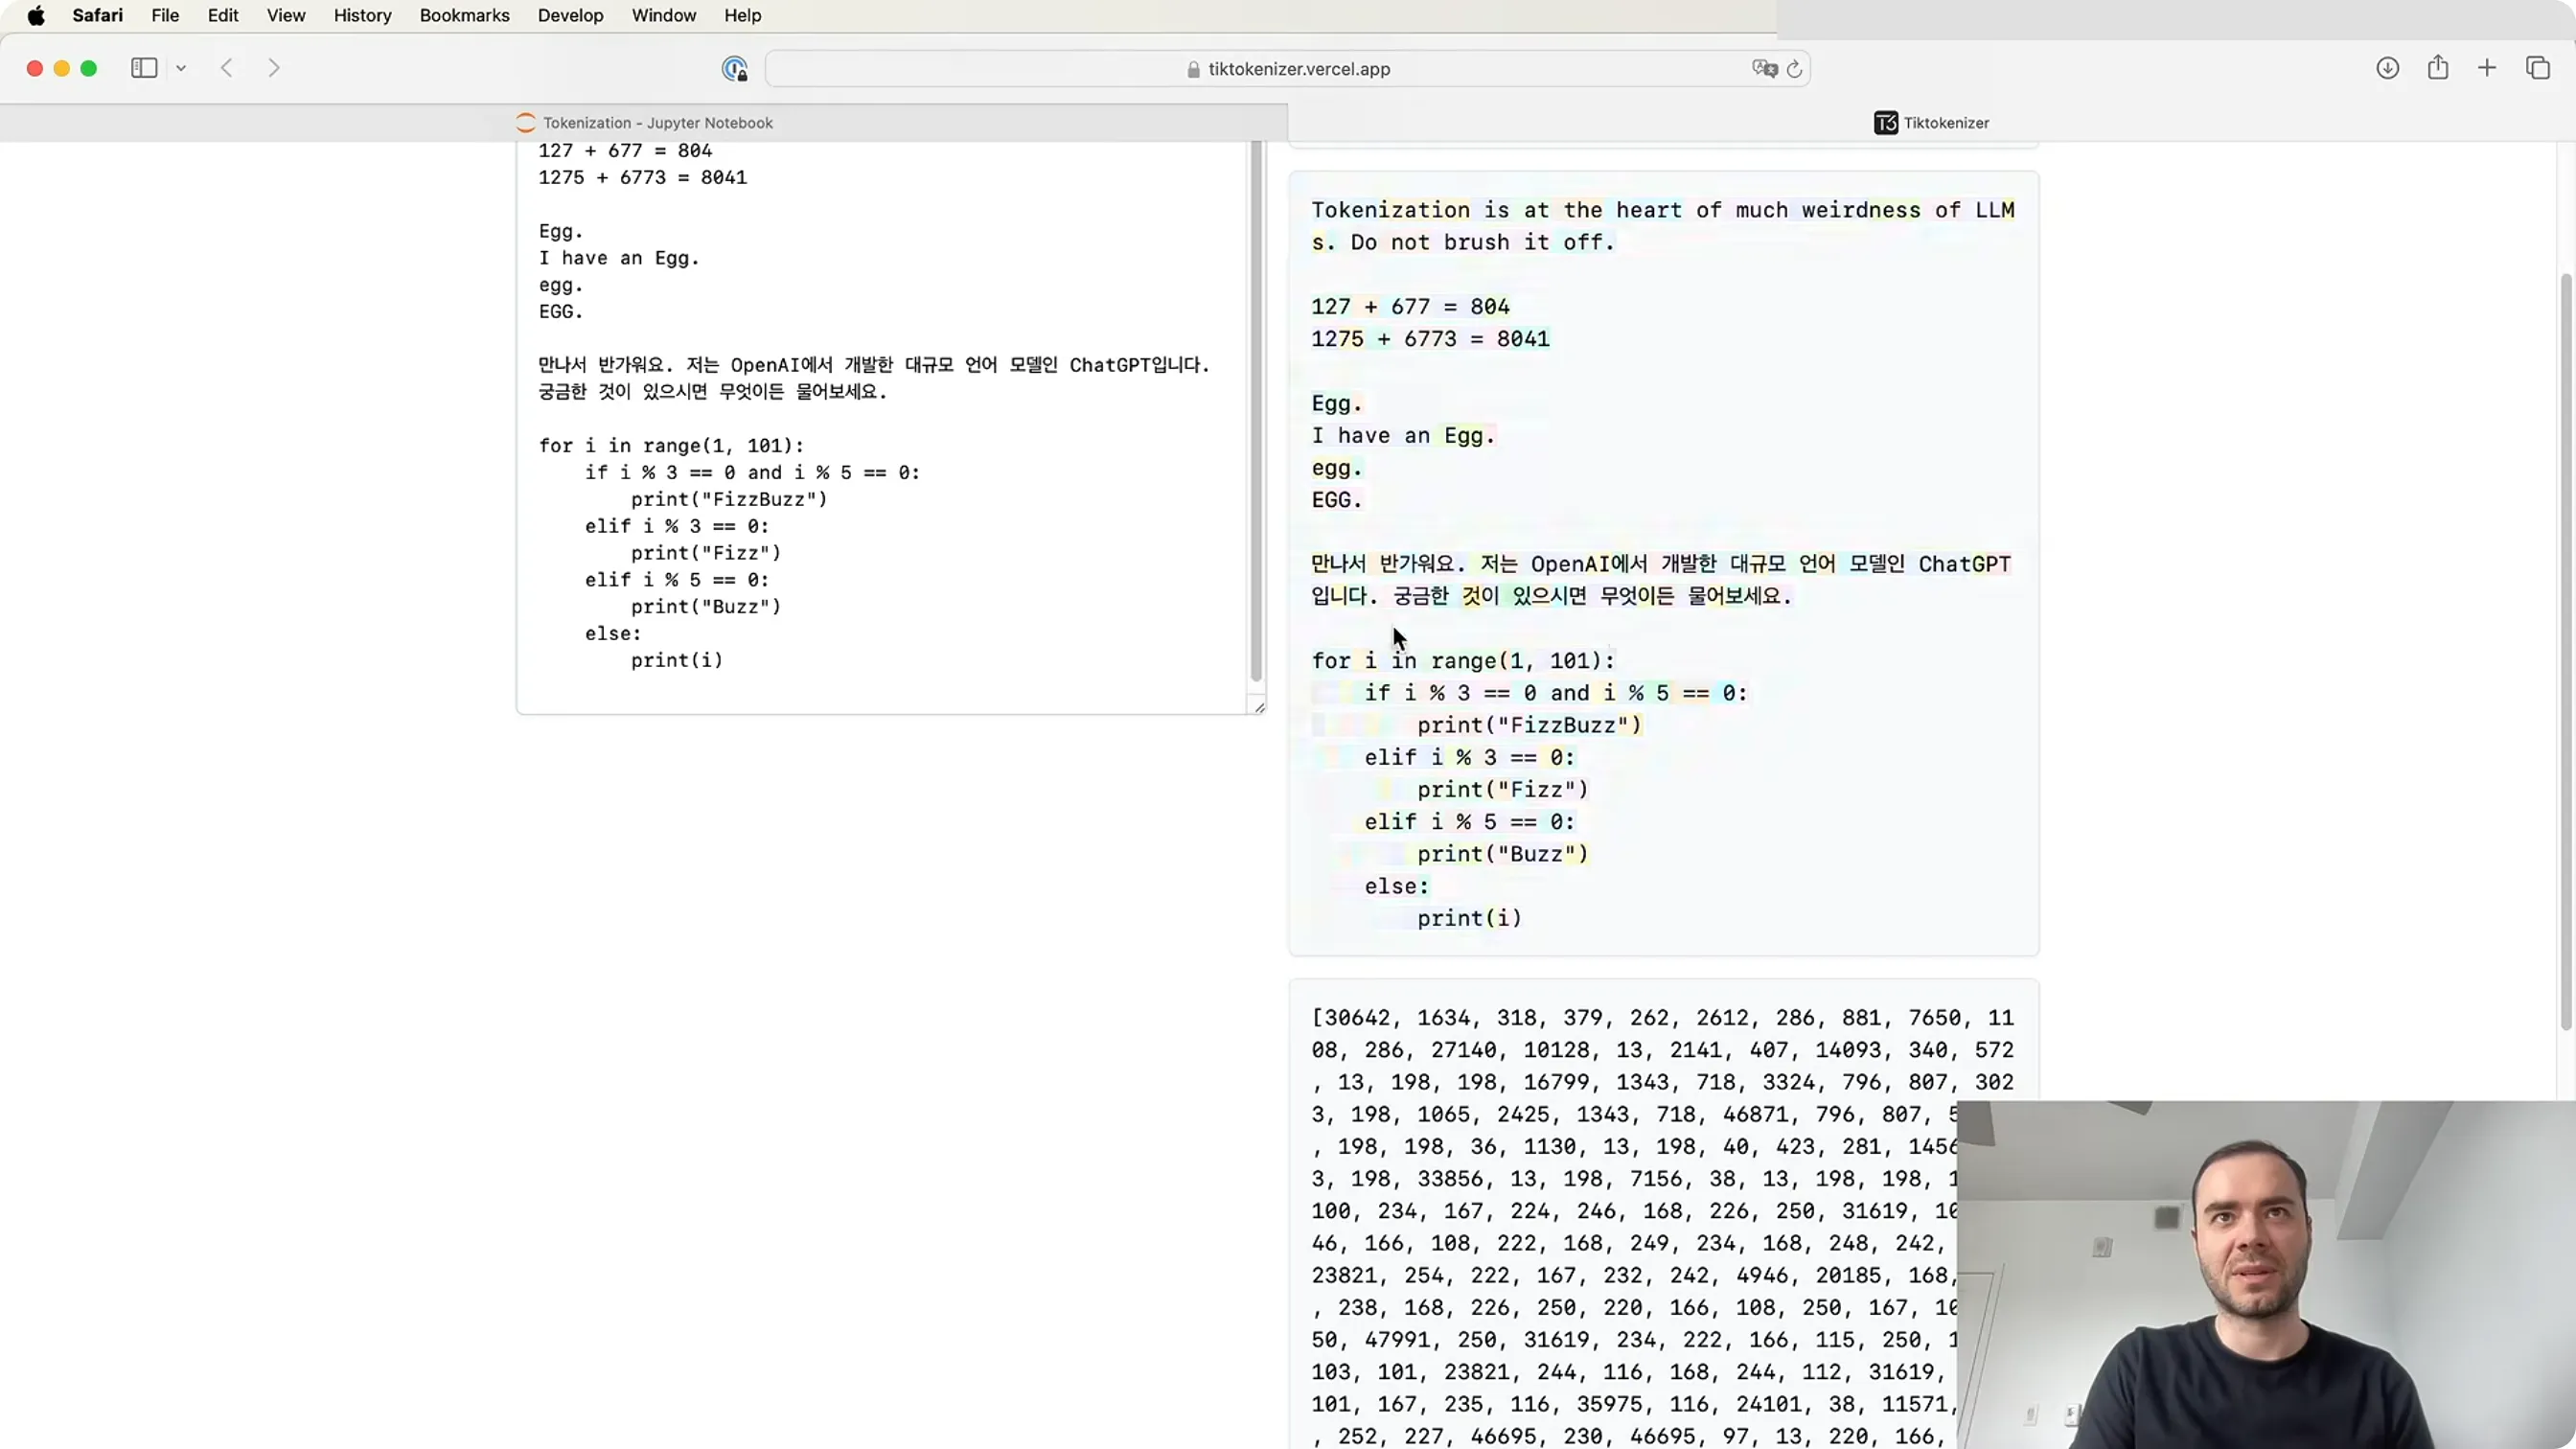
📷 tiktokenizer:FizzBuzz 代码 + 下方 token ID 列表——里面大量 220(空格)
回到原视频 (00:11:30)
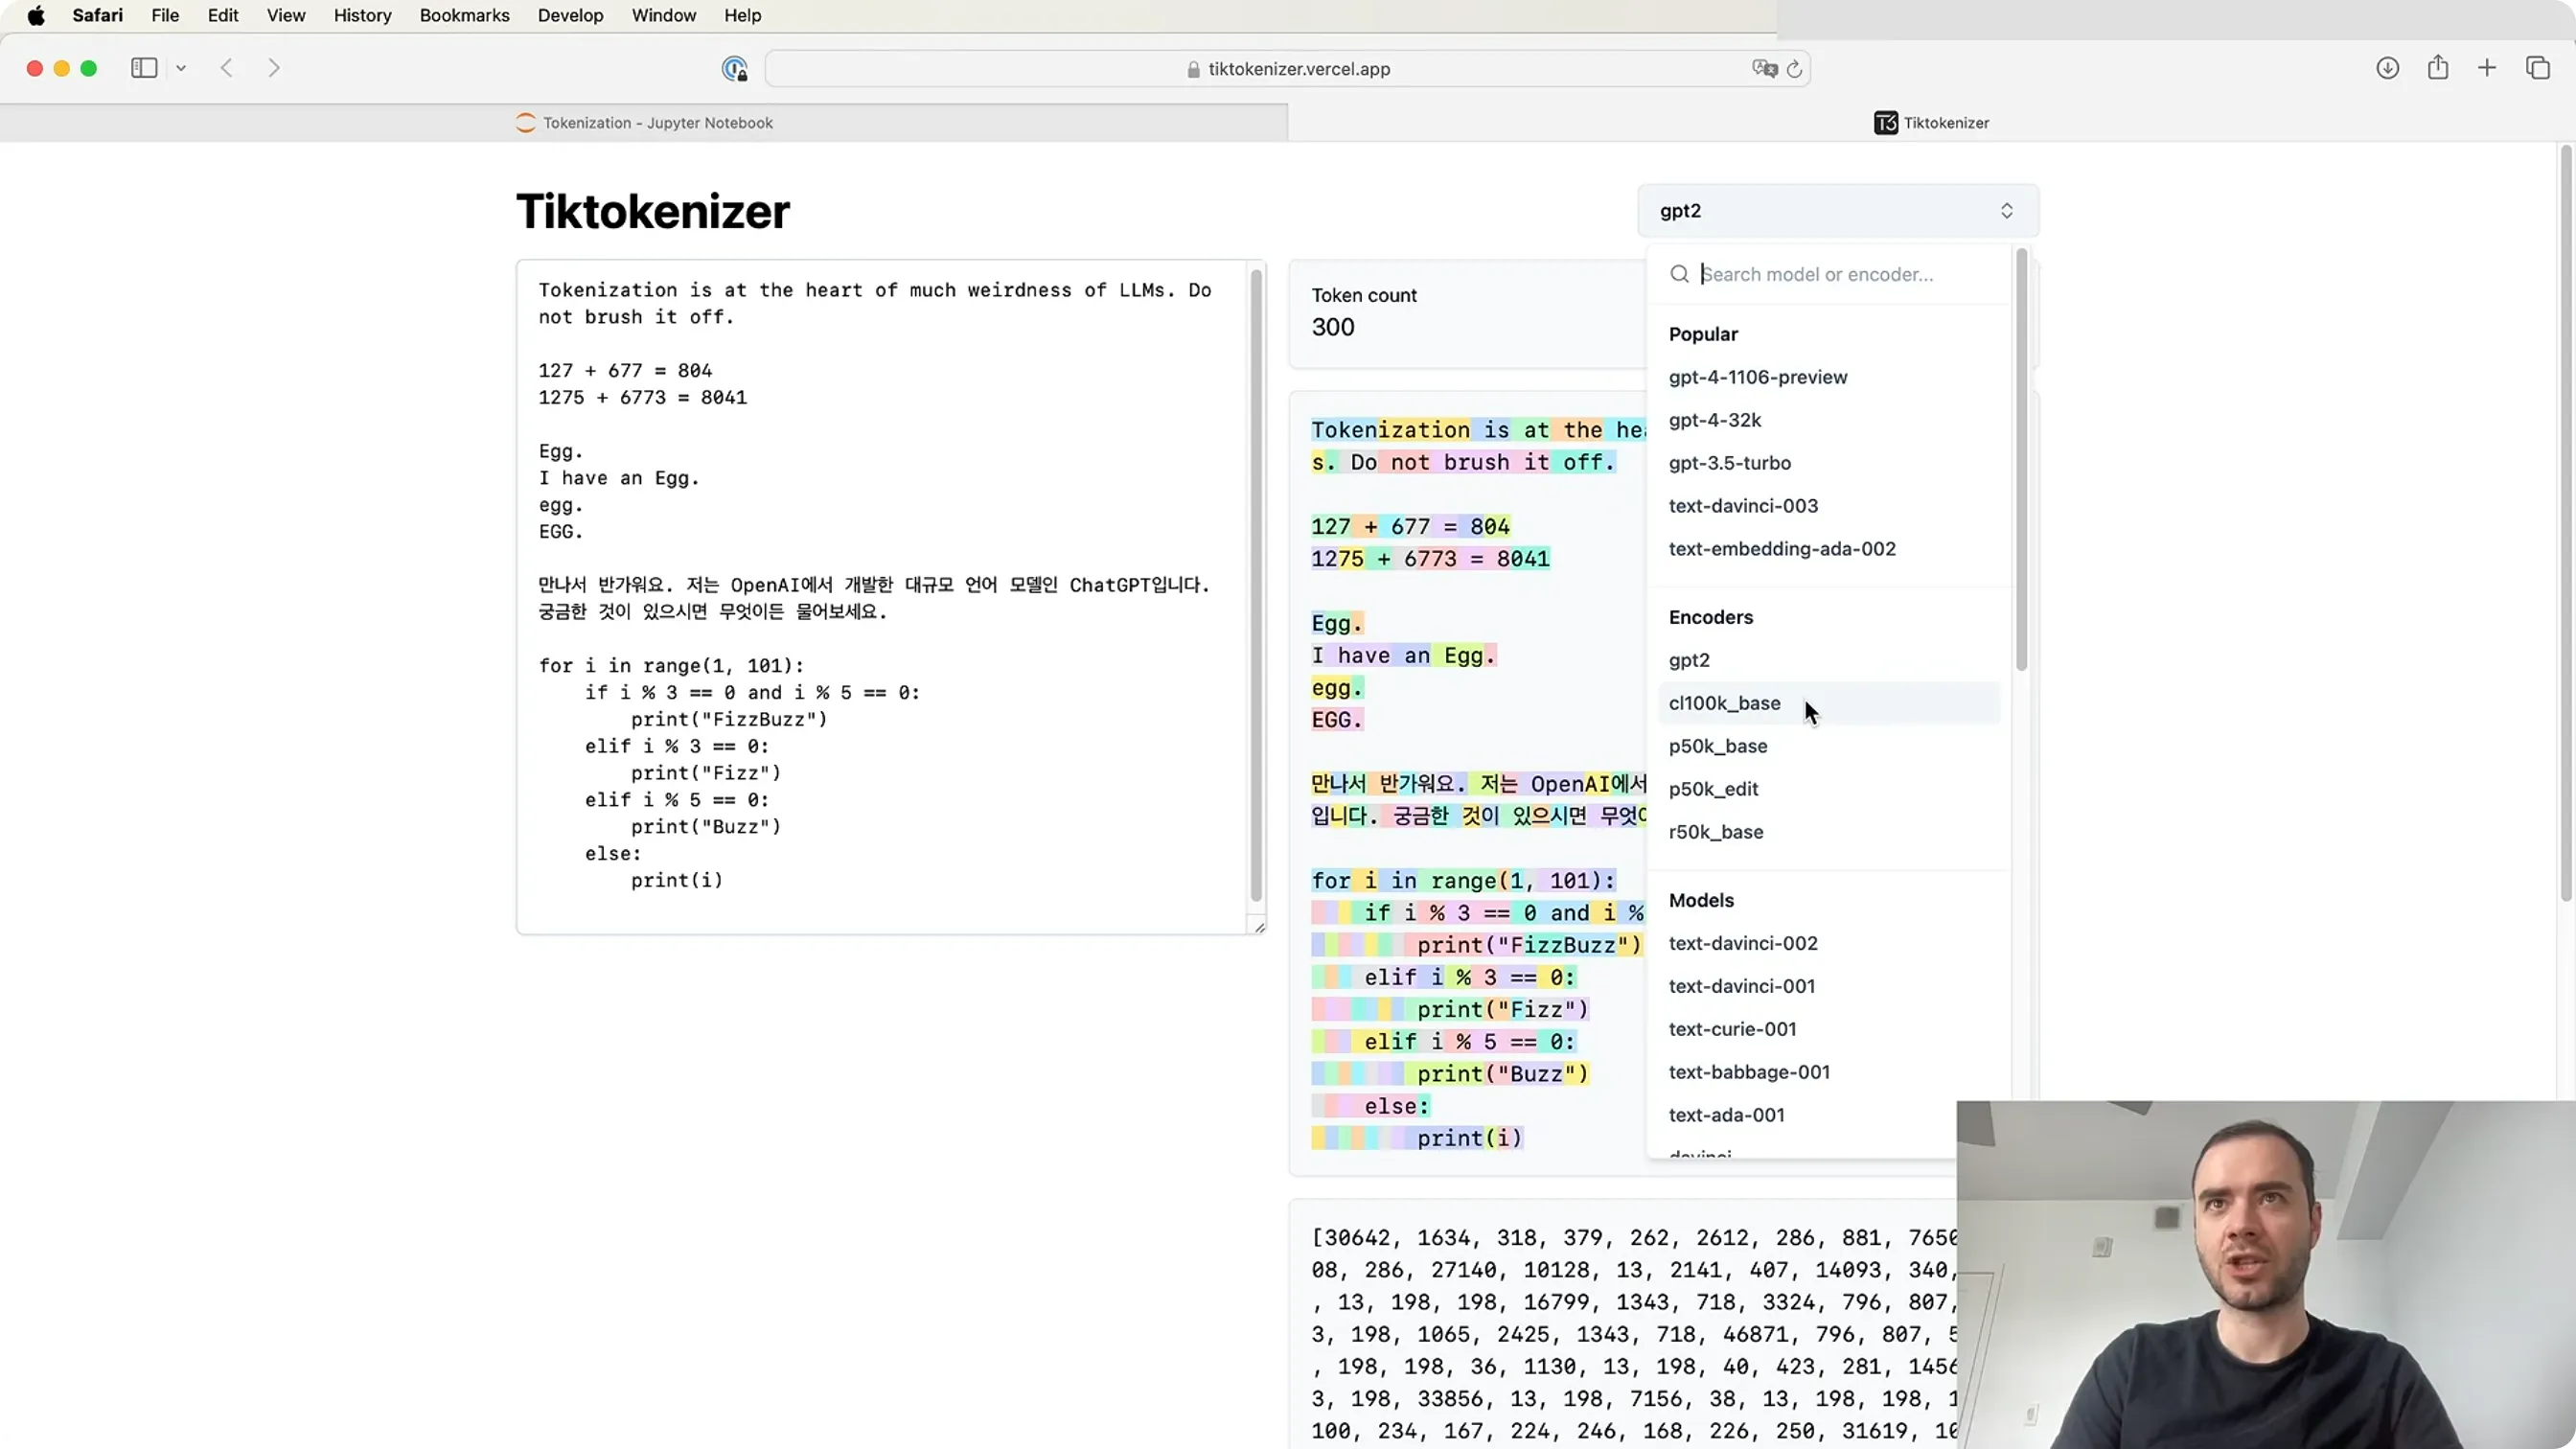
📷 同一字符串:GPT-2 是 300 tokens,GPT-4 是 185 tokens
回到原视频 (00:12:40)
三、字符串、Unicode 与编码
(参考时间: 14:56)
目标:把字符串喂进语言模型。但我们不能只支持英文字母——还要支持韩语、emoji、以及互联网上各种特殊字符。
Python 里字符串是什么?
官方文档:字符串是"Unicode 码点(code point)的不可变序列"。
Unicode 码点:由 Unicode 联盟定义的标准,目前约 150,000 个字符、161 种文字系统,而且标准还活着(最新 15.1 于 2023 年 9 月发布)。
ord('h')        # 104
ord('😀')       # 128512
⚠️
ord只吃"单个码点"的字符——传整个字符串会报错。
为什么不能直接用码点当 token?
- 词表会长到 150,000;
- 更麻烦的是:Unicode 标准一直在变——这不是一个稳定的表示。
所以我们转向"编码(encoding)":Unicode 联盟定义了 UTF-8 / UTF-16 / UTF-32——把 Unicode 文本翻译成字节流。
- UTF-8:变长,1–4 字节;最常用;唯一向后兼容 ASCII 的(这也是它胜出的关键原因)。
- UTF-16:对英文/ASCII 会出现大量
0x00前缀——浪费。 - UTF-32:定长(好),但满屏都是 0——更浪费。
text.encode('utf-8')       # bytes
list(text.encode('utf-8')) # 直接看原始字节
可是——如果直接用 UTF-8 字节,词表就只有 256。 那意味着:
「所有文本都会被拉成非常非常长的字节序列——embedding 表确实很小、输出层也很小,但我们的序列极长,而 Transformer 的上下文是有限的(受注意力计算量限制)。这非常低效,也没法让我们在预测下一个 token 时"看到"足够长的文本。」
结论:我们不想用裸的 UTF-8 字节,但我们想保留 UTF-8 编码——我们需要一个可以自己调的、更大的词表。答案就是 BPE。
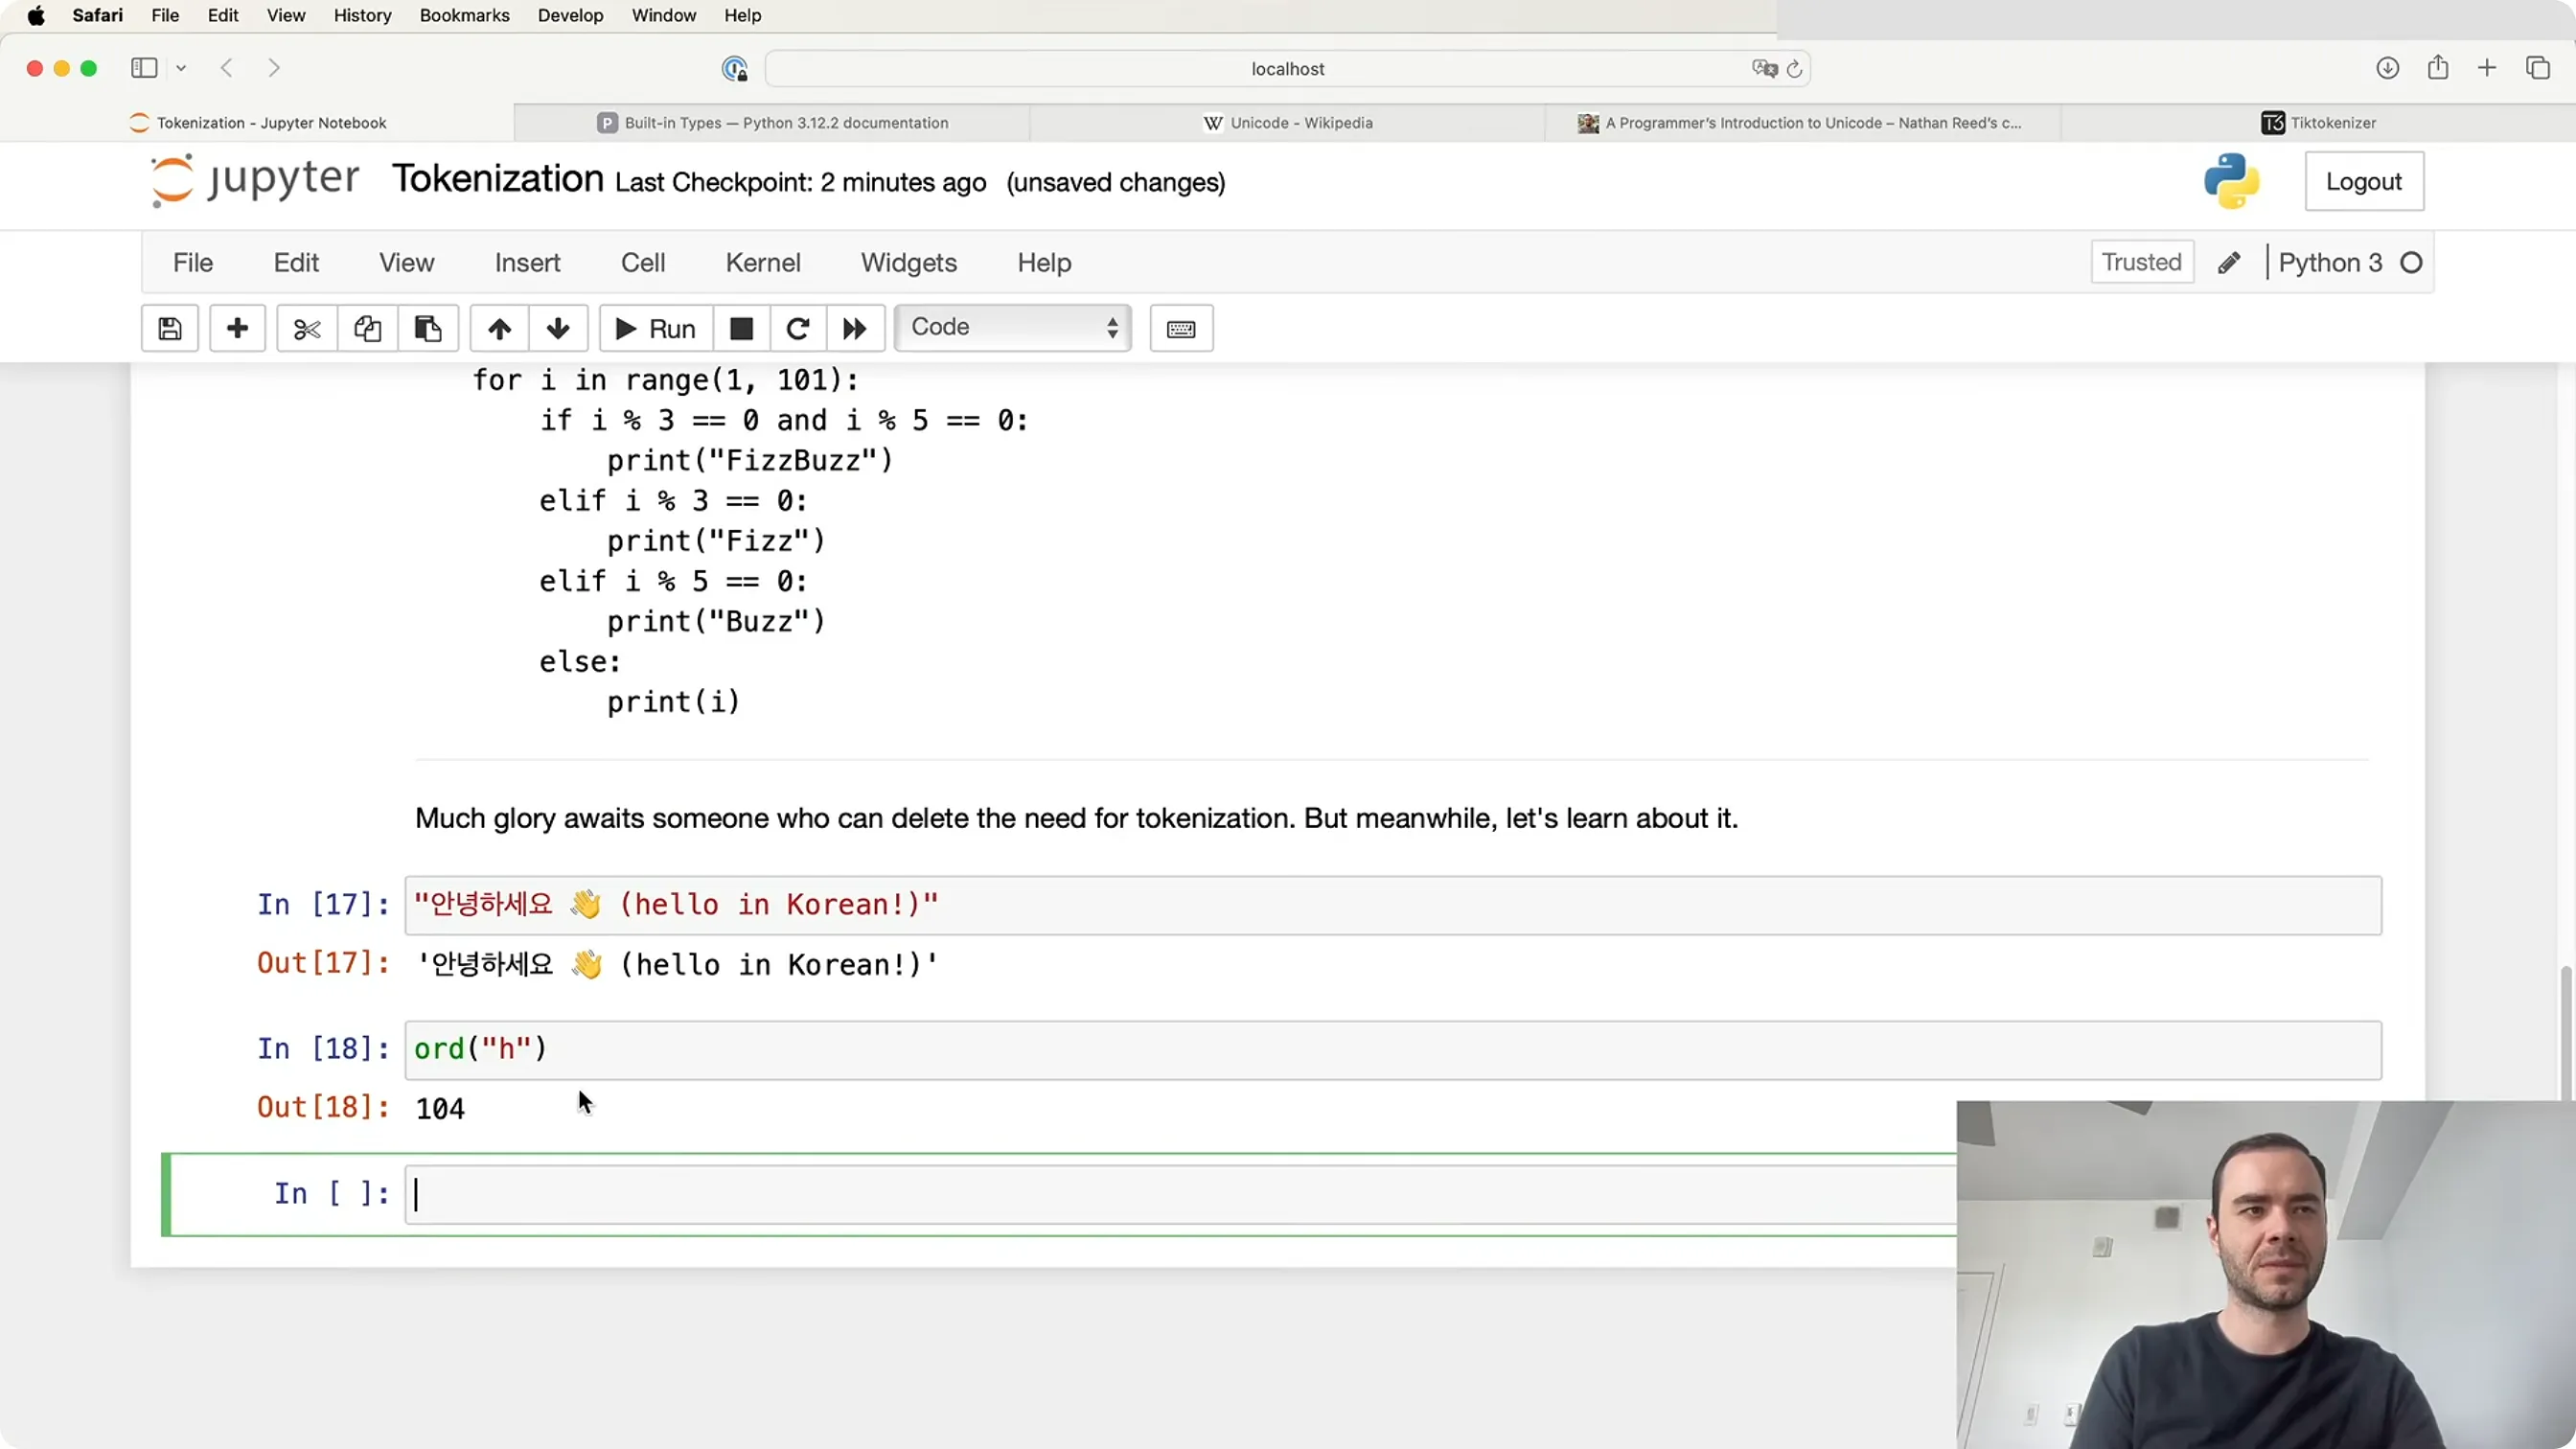
📷 `ord()`:h → 104,emoji → 128512
回到原视频 (00:16:50)
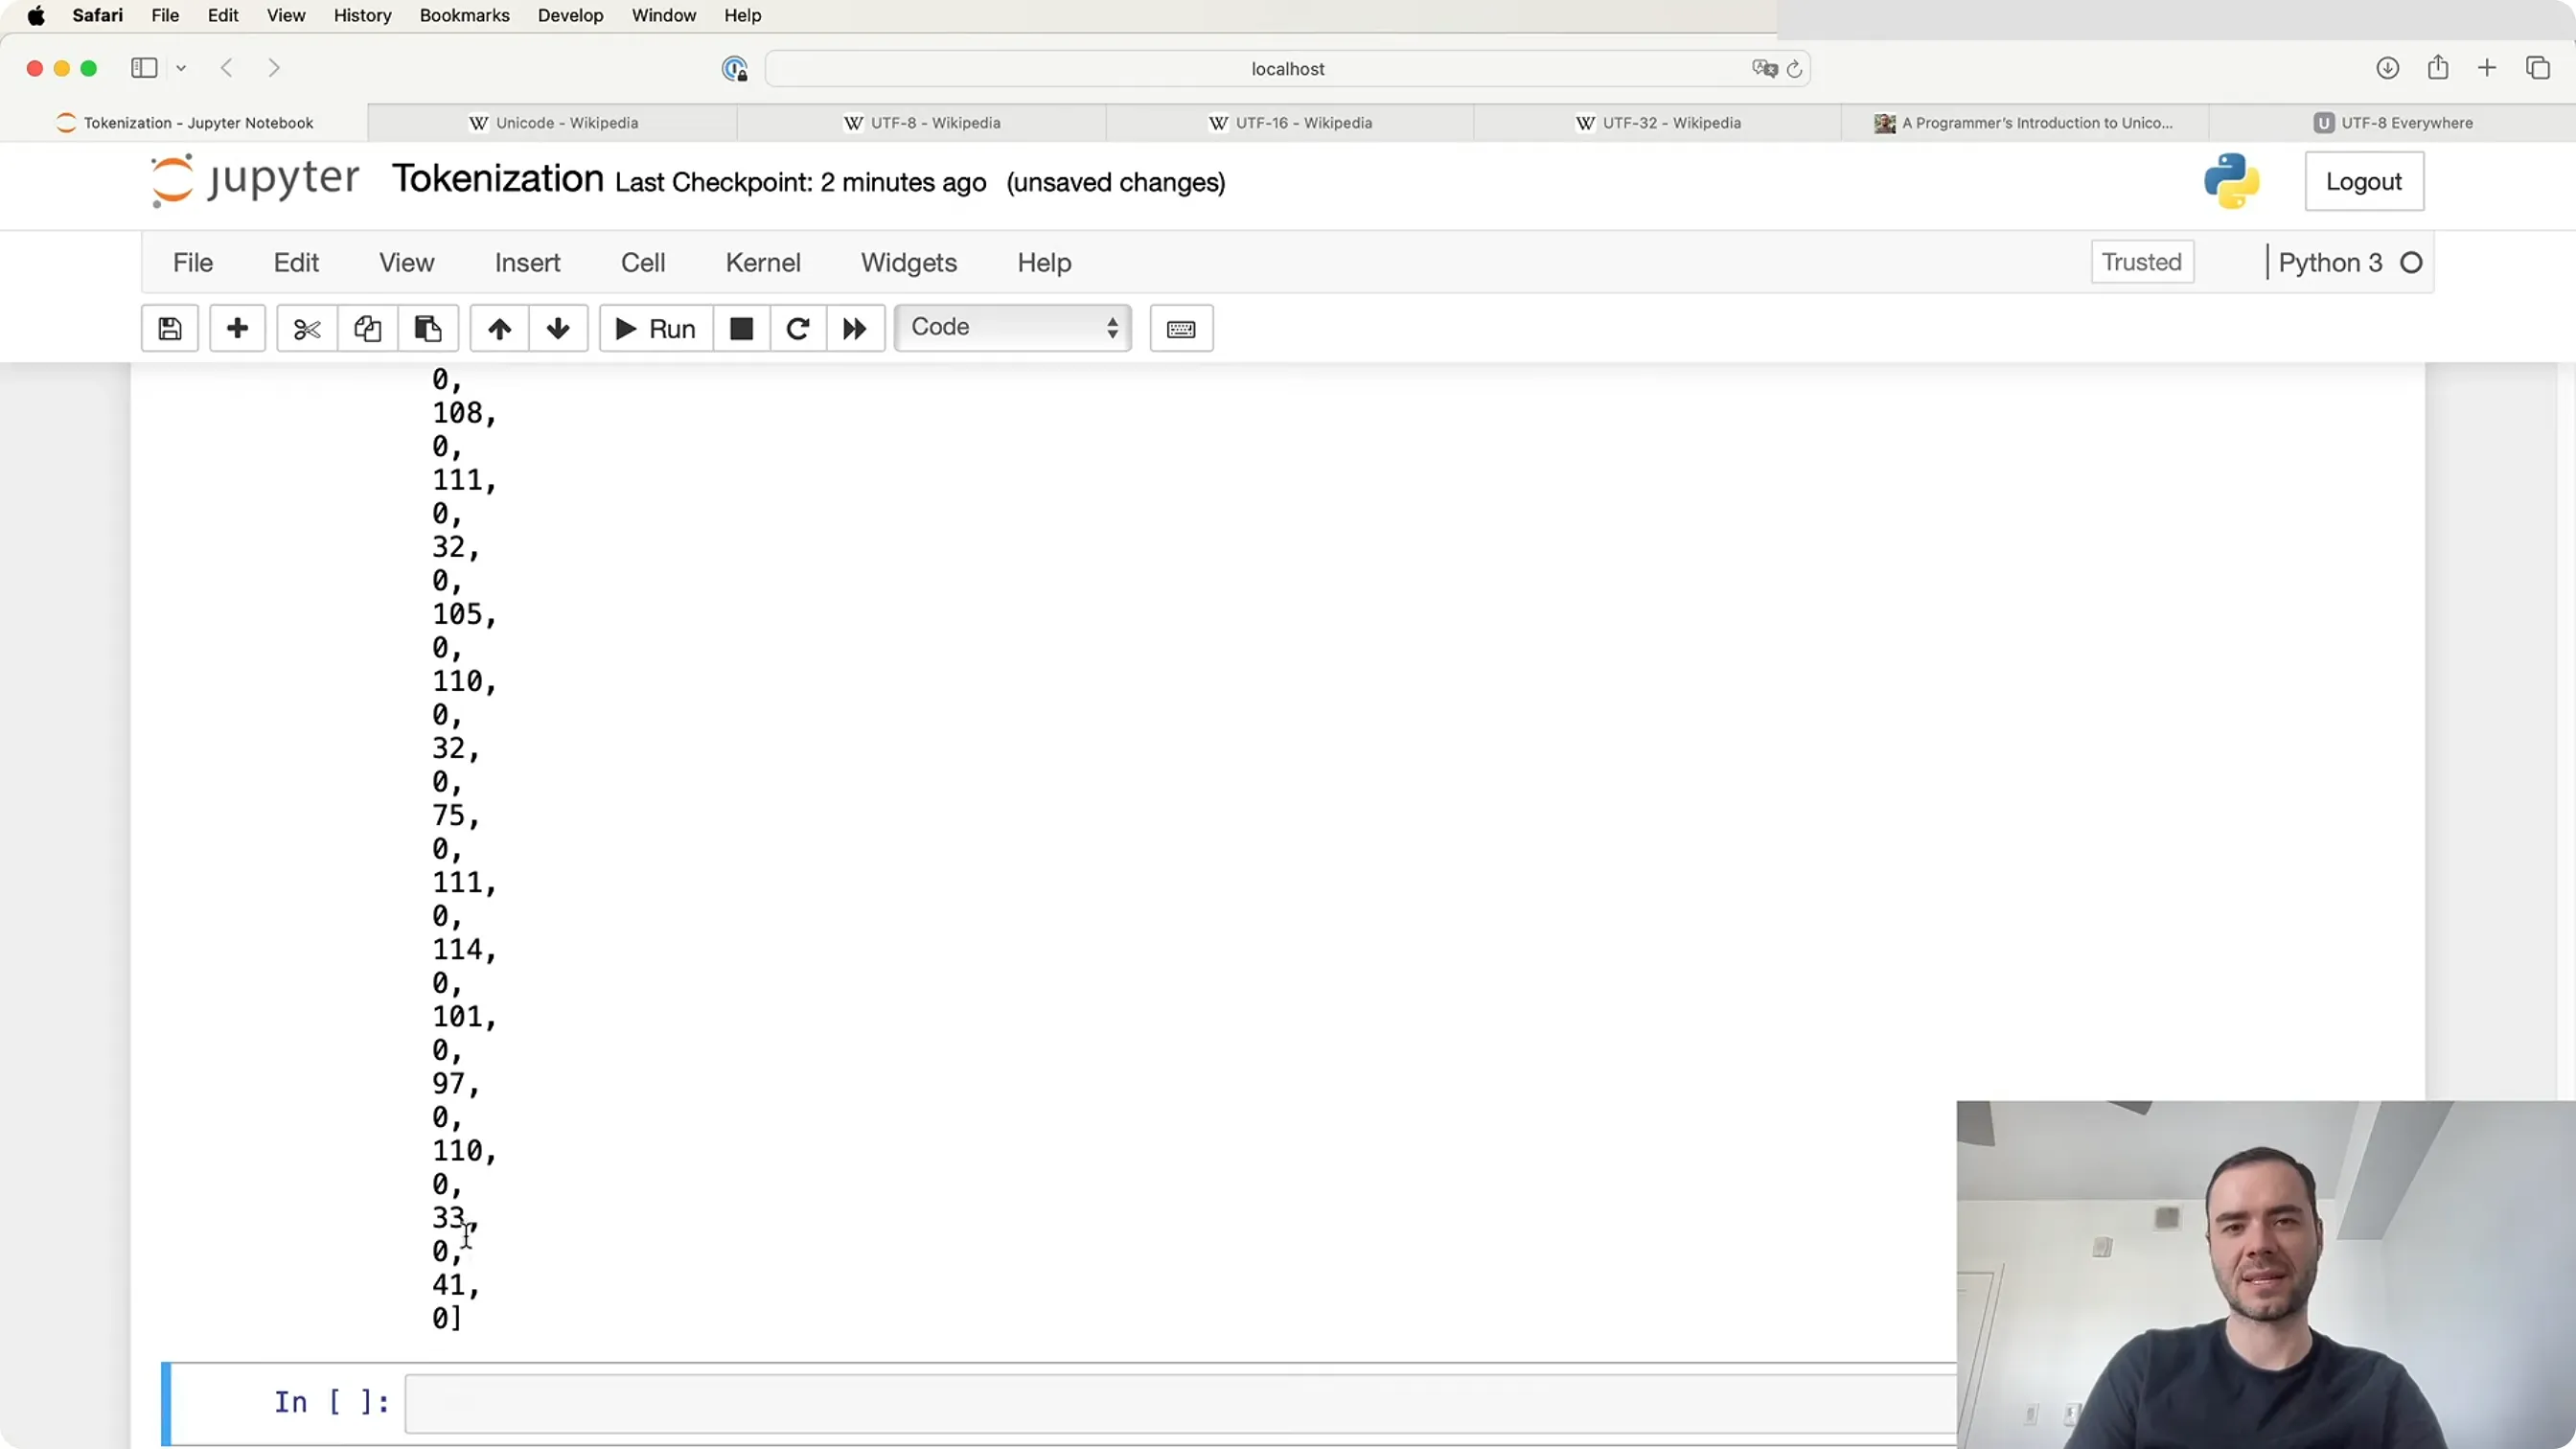
📷 UTF-8(1–4 变长、兼容 ASCII)vs UTF-16/32(大量 0 浪费)
回到原视频 (00:20:50)
3.1 一个"白日梦":干脆删掉 tokenization
(参考时间: 22:47)
「我最想做的事,莫过于把原始字节序列直接喂进语言模型。」甚至还真有一篇论文(tokenization-free autoregressive sequence modeling)做了尝试。
但问题在于:你必须修改 Transformer 架构——因为序列会变得极长,注意力的开销会爆炸。论文里提出了一种分层(hierarchical)的 Transformer 结构来应对。 「tokenization-free 确实会很棒……但遗憾的是,据我所知它还没有被足够多的团队、在足够大的规模上验证过。 我希望能有人做出来。」
四、BPE 算法
(参考时间: 23:50)
核心思想非常朴素:
- 迭代地找出出现最频繁的 token 对;
- 把这一对替换成一个"新铸造(mint)"的 token,追加到词表里。
玩具例子(词表只有 a b c d,序列 aaabdaaabac):
| 轮次 | 最频繁的 pair | 新 token | 序列长度 | 词表大小 |
|---|---|---|---|---|
| 初始 | — | — | 11 | 4 |
| 1 | aa |
Z |
9 | 5 |
| 2 | ab |
Y(= ab) |
7 | 6 |
| 3 | ZY |
X(= zy) |
5 | 7 |
11 个 token、词表 4 → 5 个 token、词表 7。
放到真实场景:从 256 个字节 token 出发,反复找最频繁的字节对、铸新 token、替换——最终得到一个压缩过的训练数据 + 一套可以编解码任意序列的算法。
4.1 动手实现
(参考时间: 27:02)
Karpathy 拿一段博文当训练文本:533 个码点 → UTF-8 后 616 个字节(变长了,因为复杂 Unicode 字符要 2–4 字节)。
第一步:统计相邻对
(参考时间: 28:35)
def get_stats(ids):
    counts = {}
    for pair in zip(ids, ids[1:]):     # 迭代相邻元素
        counts[pair] = counts.get(pair, 0) + 1
    return counts
结果里出现最多的是 (101, 32),出现了 20 次。用 chr() 一看—— 是 e + 空格。
「说明这段文本里很多单词以 e 结尾」(比如
ease)。
第二步:合并
(参考时间: 30:36)
def merge(ids, pair, idx):
    newids = []
    i = 0
    while i < len(ids):
        # 别越界:最后一个元素没有"右邻居"
        if ids[i] == pair[0] and i < len(ids) - 1 and ids[i+1] == pair[1]:
            newids.append(idx)
            i += 2                    # 跳过整个 pair
        else:
            newids.append(ids[i])
            i += 1
    return newids
新 token 的 ID 是 256(原本字节占 0–255)。
验证:长度 616 → 596(正好减 20,与出现次数吻合),且原来的 (101,32) 一对都不剩。
⚠️ 那个
i < len(ids) - 1的边界检查很容易漏——「如果你想写得严谨,这个条件必须加上,否则最后一个元素会越界。」
第三步:加上 while 循环
(参考时间: 34:58)
词表定成 276(= 256 + 20 次合并)。
vocab_size = 276
num_merges = vocab_size - 256
ids = list(tokens)                   # 拷贝一份
merges = {}                          # (int, int) -> int
for i in range(num_merges):
    stats = get_stats(ids)
    pair = max(stats, key=stats.get)
    idx = 256 + i
    ids = merge(ids, pair, idx)
    merges[pair] = idx
几个值得注意的点:
merges其实描述的是一片"森林"(forest),而不是一棵树:「树会有一个根节点和一堆叶子;而我们是从底部的叶子(256 个独立字节)往上,一次合并两个——所以它更像一片森林。」
- 新铸的 token 也能参与后续合并:第 20 次合并就是
(25?, 259) → 275。「每次替换后,这些 token 都有资格参与下一轮合并」——这正是"森林"的由来。
merge函数里也只有严格连续出现时才会被合并:101和32本身仍然可以独立存在。
压缩比:从 24,000 字节 → 19,000 token,压缩比约 1.27。
「合并次数越多,词表越大,压缩比越高。」
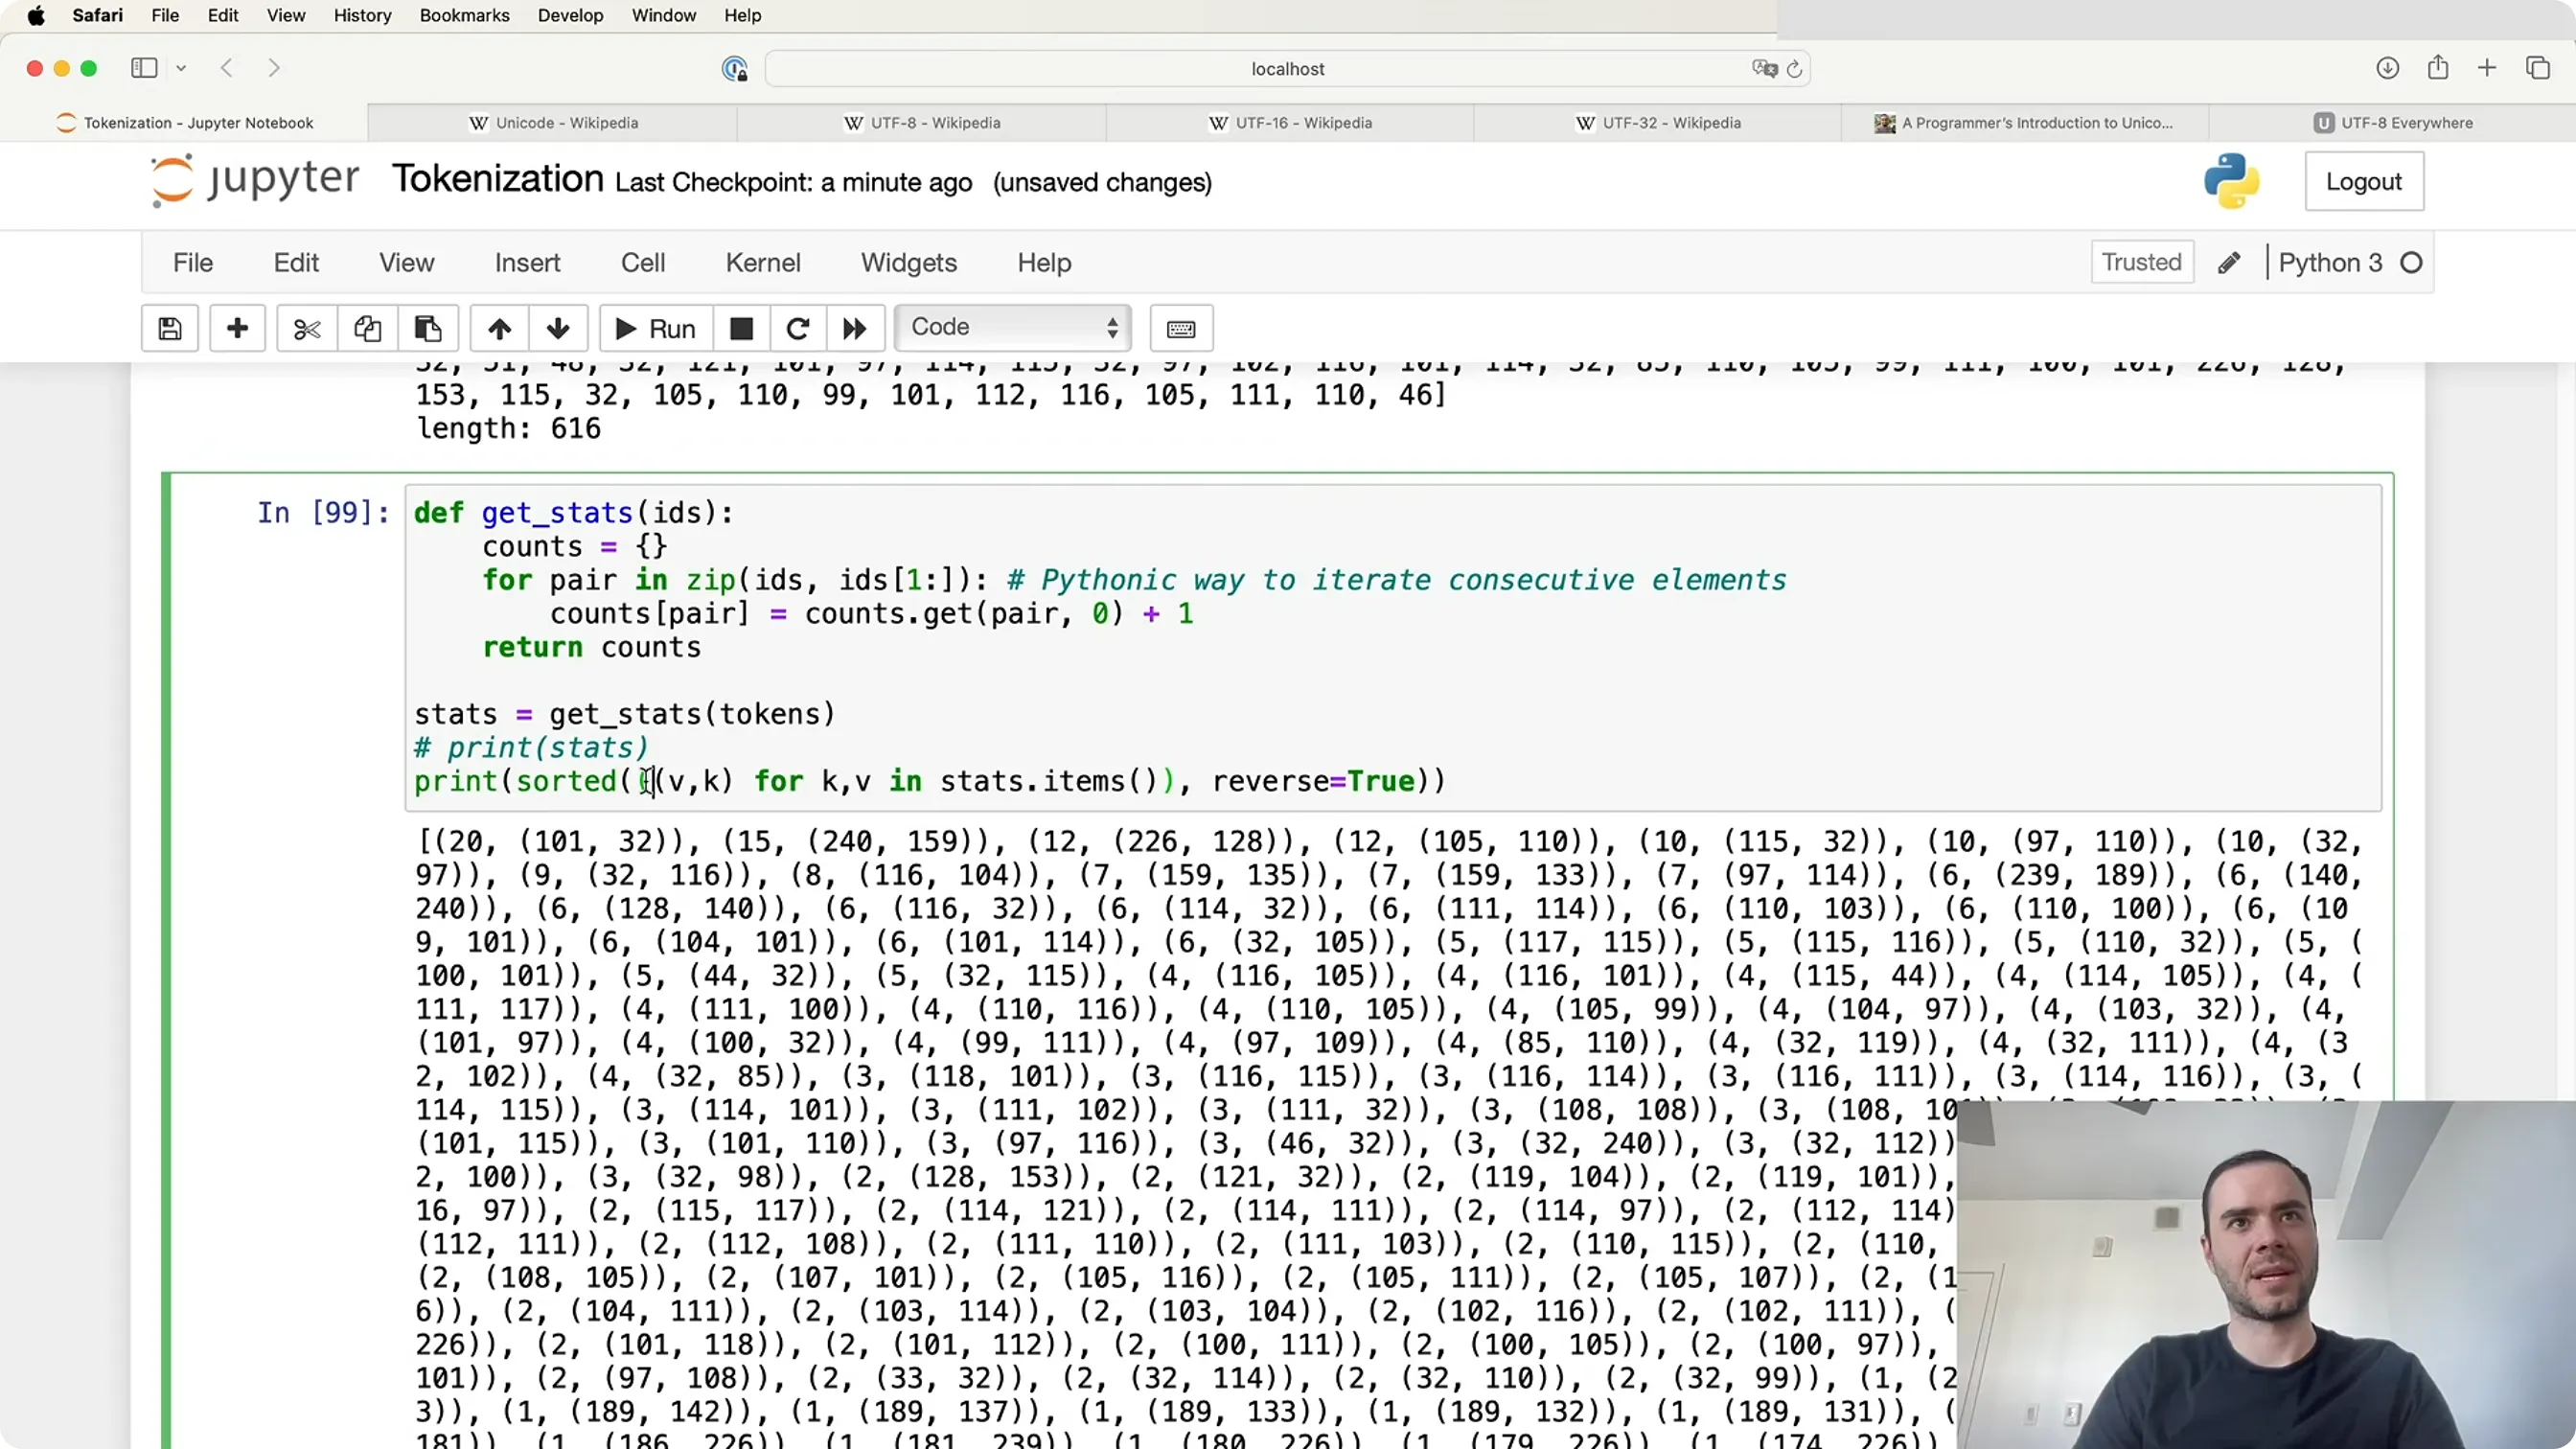
📷 `get_stats` 的输出:`(101, 32)`(即 `e`+空格)出现 20 次
回到原视频 (00:29:30)
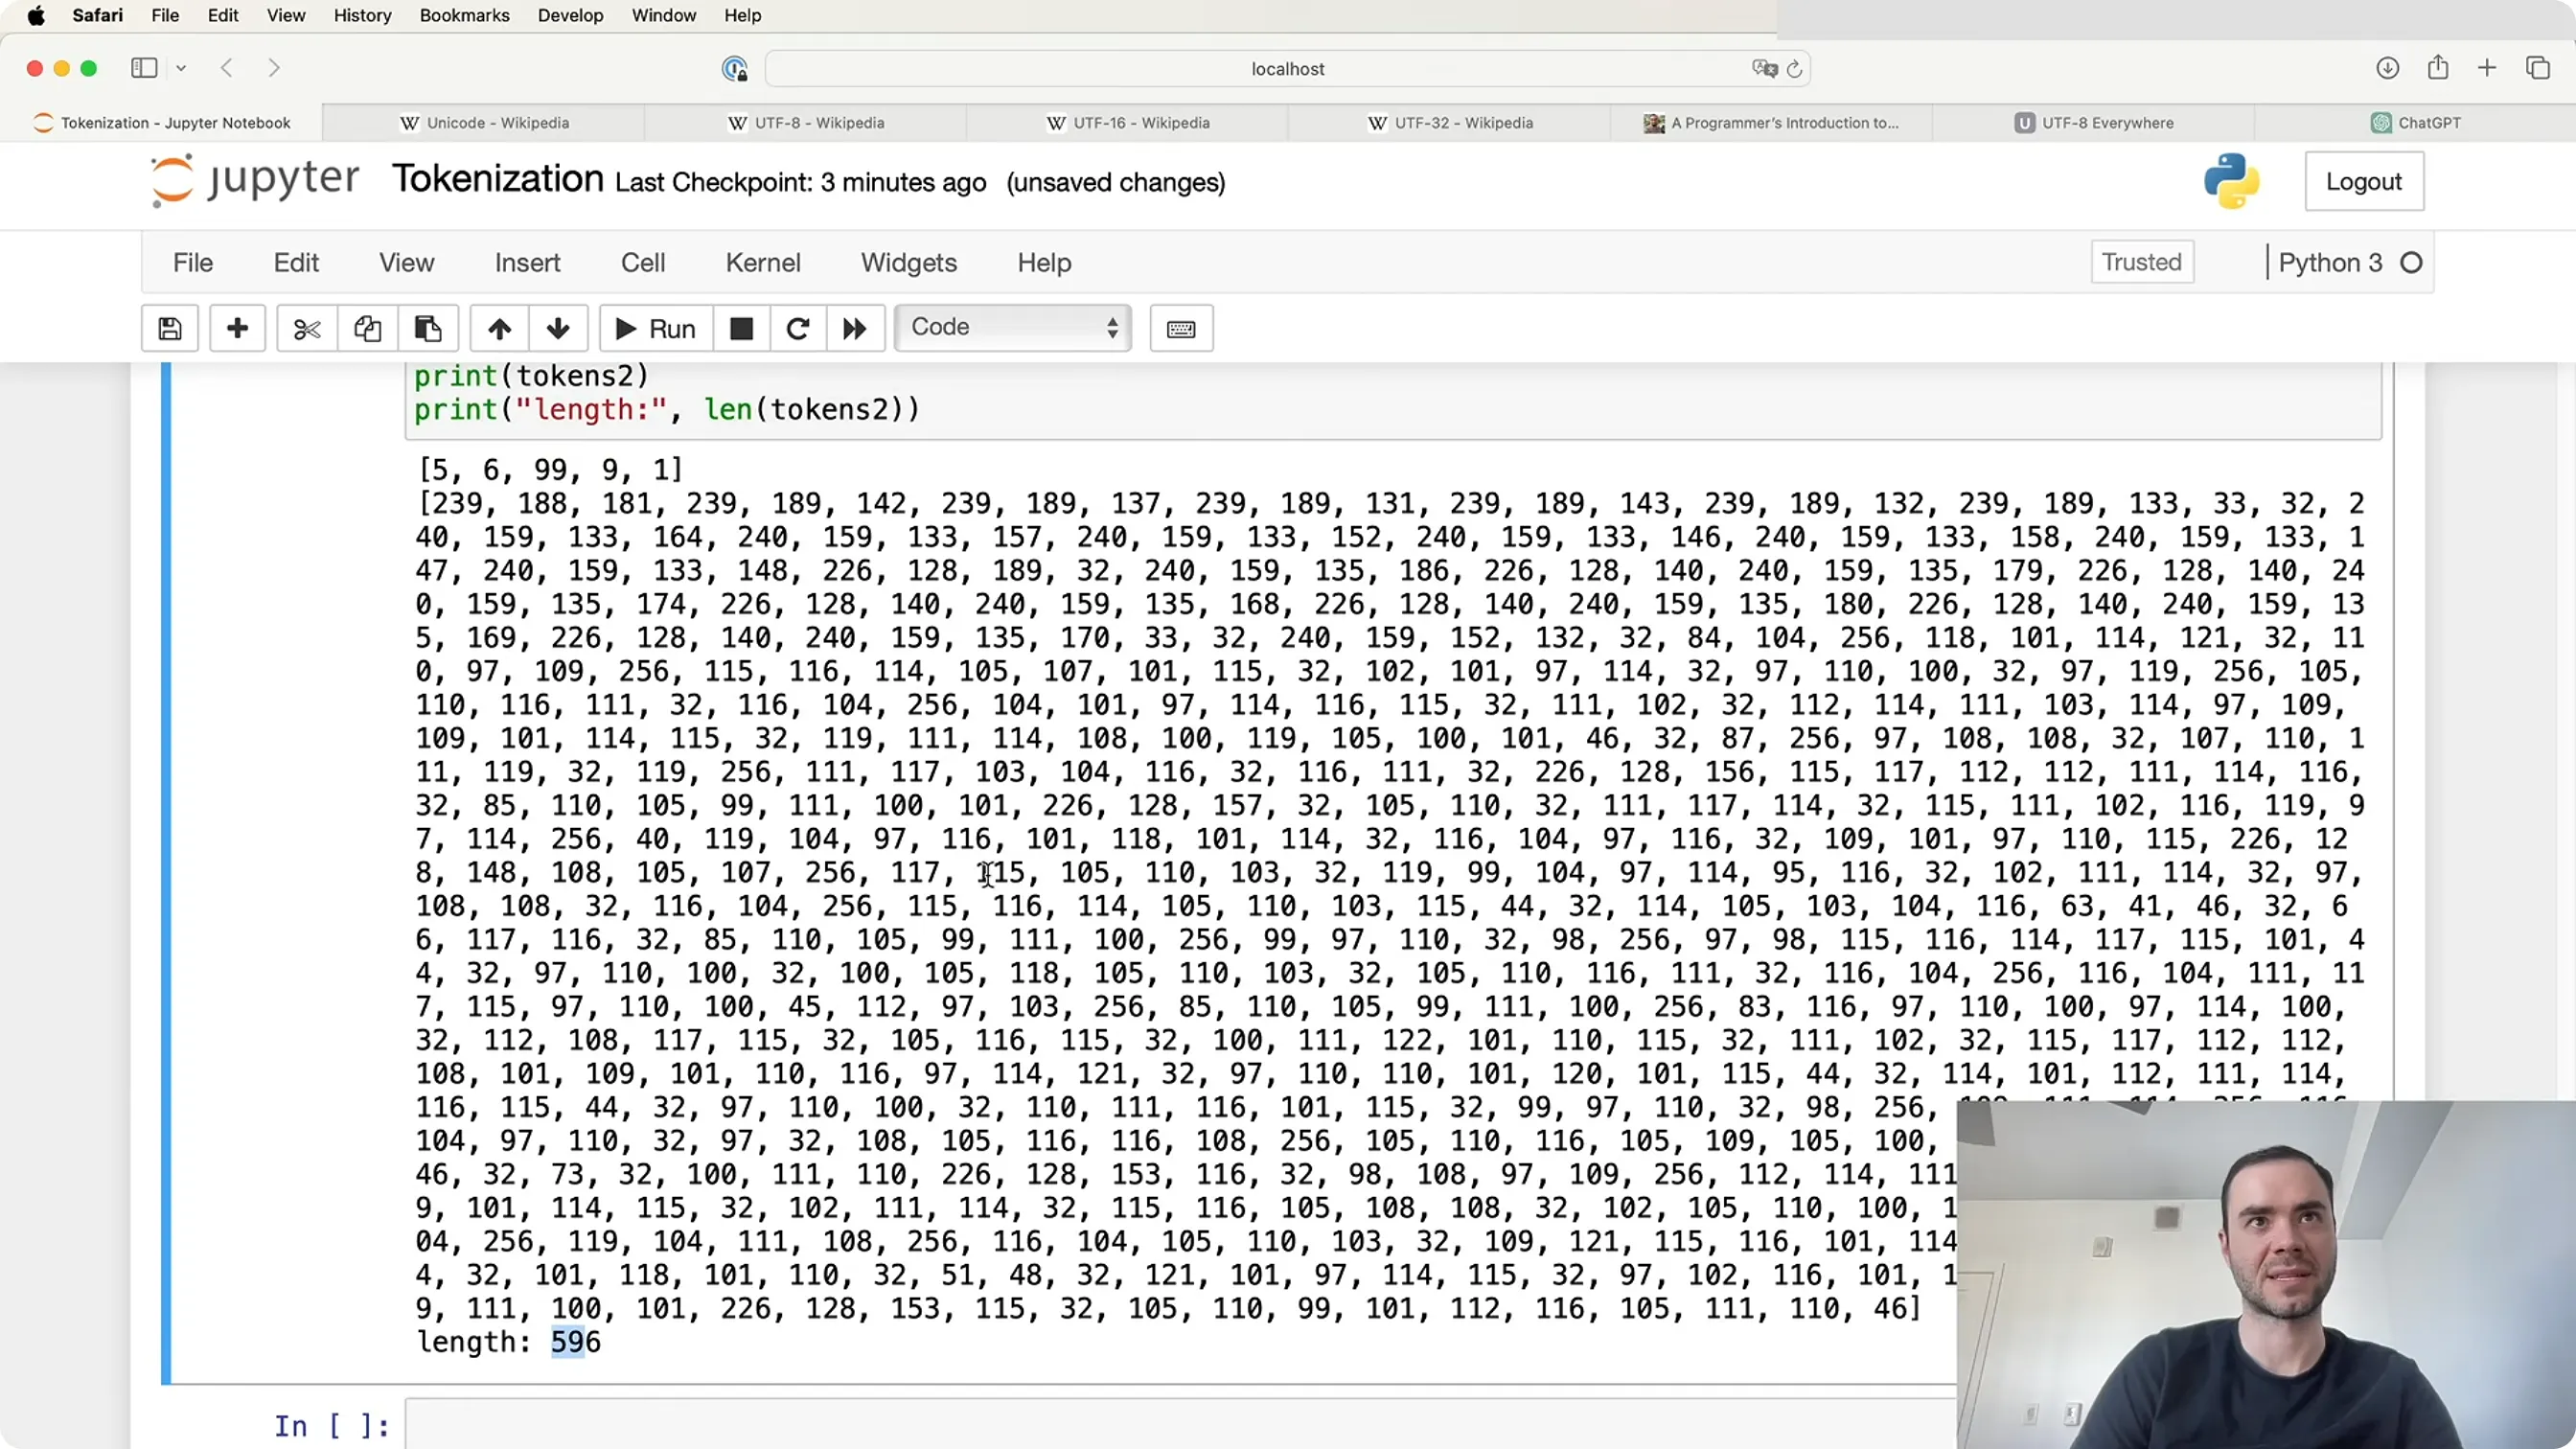
📷 20 次合并后的结果与 1.27 的压缩比
回到原视频 (00:33:50)
五、Tokenization 是一个完全独立的阶段
(参考时间: 39:20)
「整堂课我们都没碰 LLM 本身——我们只是在训练 tokenizer。这是一个完全独立的预处理阶段。」
要点:
- tokenizer 有自己的训练集(可以和 LLM 的训练集不同);
- 训练算法是 BPE,只需要跑一次;
- 训练完后,两个变量就能完整描述一个 tokenizer:
merges(合并表)+vocab(token → bytes); - 两个方向:encode(文本 → token) 和 decode(token → 文本);
- 典型做法:把 LLM 的全部训练数据一次性跑过 tokenizer,得到一个巨大的 token 序列存到磁盘,原始文本就可以扔掉了——LLM 训练时读的就是这堆 token。
一个常被忽视的关键点:tokenizer 训练集的语种配比,决定了各语种在 token 空间里的"密度"。
「如果你在 tokenizer 的训练集里放了大量日语数据,那么就会有更多日语 token 被合并出来,日语的序列就会更短——而这对上下文长度有限的 LLM 是有利的。」
👉 所以"LLM 对某语种表现差",往往不只因为模型看到的该语种数据少,还因为 tokenizer 本身在该语种上"训练不足"。
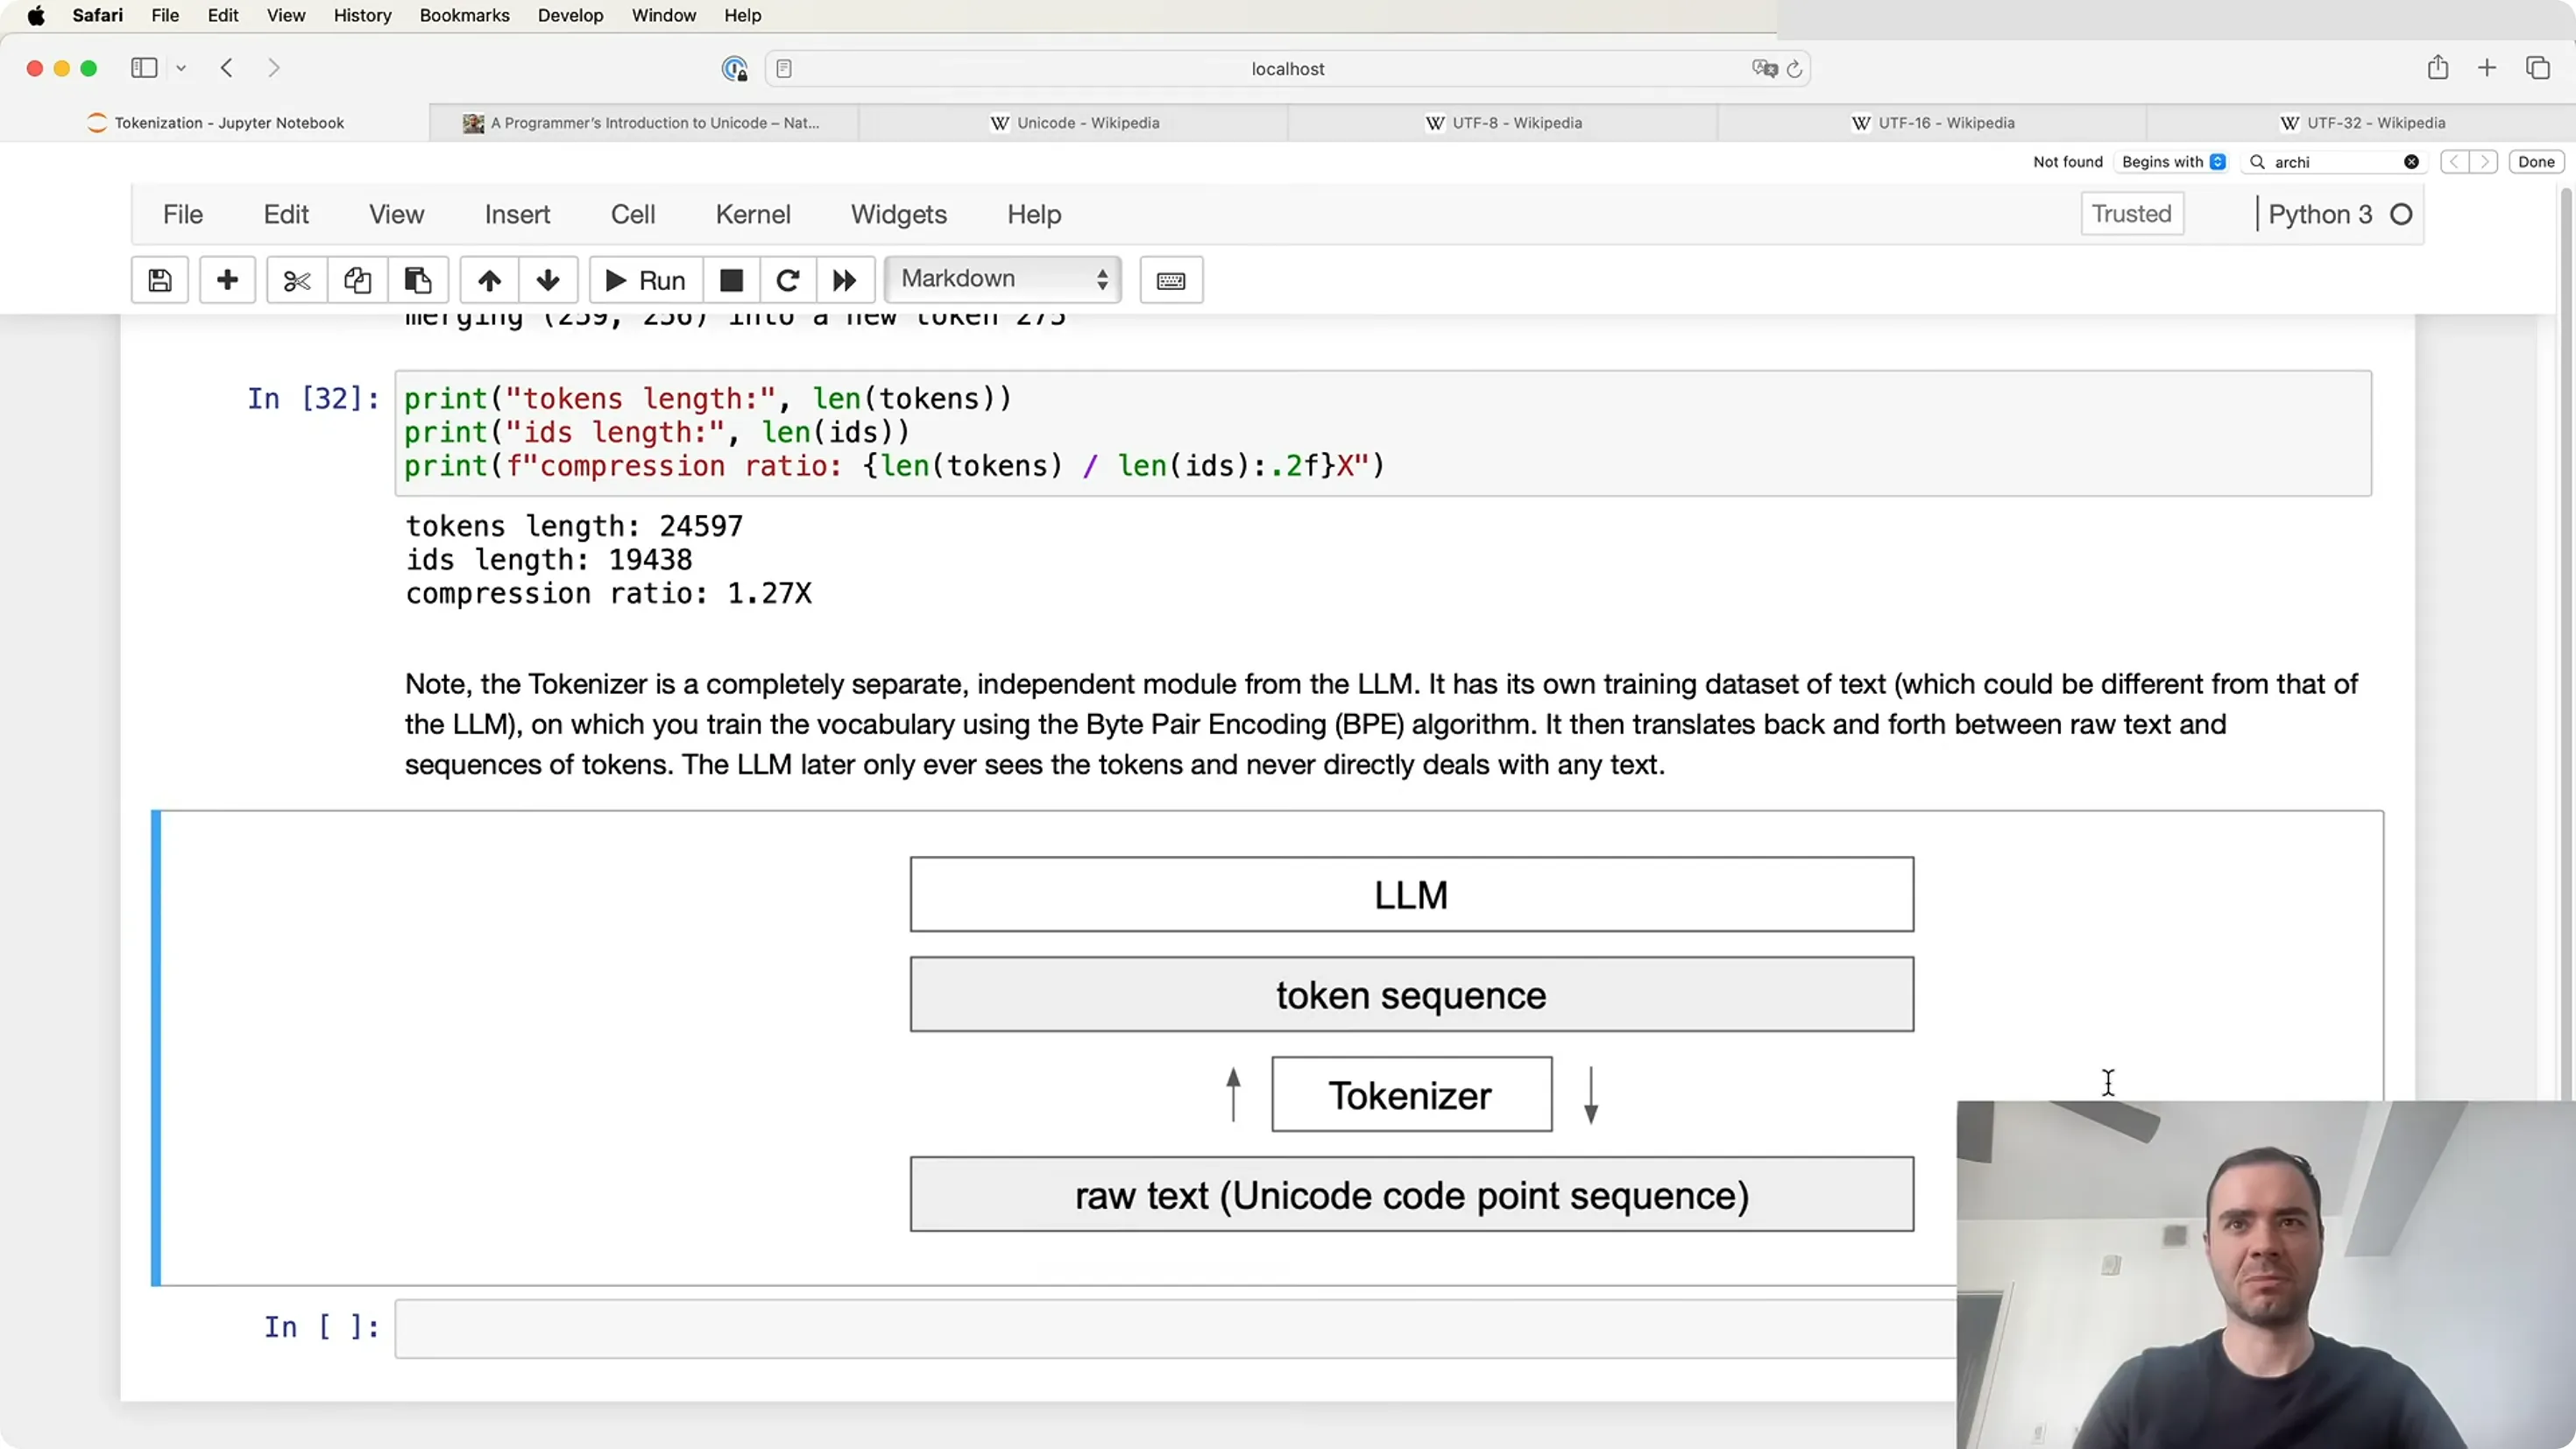
📷 tokenizer 与 LLM 是两个完全独立的阶段
回到原视频 (00:39:30)
六、解码(decode)
(参考时间: 42:47)
目标:给定 list[int],还原成 Python 字符串。
先建一张 vocab(id → bytes):
vocab = {idx: bytes([idx]) for idx in range(256)}     # 0..255 是原始字节
for (p0, p1), idx in merges.items():
    vocab[idx] = vocab[p0] + vocab[p1]                # bytes 相加 = 拼接
⚠️ 这里依赖 dict 的"插入顺序":「从 Python 3.7 起这是有保证的——在此之前,这个迭代顺序可能和插入顺序不一致,那这段代码就会出错。」
解码:
def decode(ids):
    tokens = b"".join(vocab[idx] for idx in ids)
    return tokens.decode("utf-8", errors="replace")     # ← 关键
为什么要 errors="replace"? ——
不是所有字节序列都是合法 UTF-8!
Karpathy 现场演示:decode([128]) 会炸:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0x80 in position 0: invalid start byte
原因:UTF-8 有特定的"信封"结构。128 的二进制是 1 0000000——这个模式不匹配任何一条 UTF-8 规则,所以它是非法的起始字节。
「如果 LLM 以某种糟糕的方式预测 token,这些 token 可能就不构成合法 UTF-8,我们就无法解码它们。」 标准做法就是
errors="replace"——不合法的地方替换成特殊字符�(U+FFFD)。 「当你在输出里看到这种字符,就说明出了问题:LLM 输出的 token 序列不是合法的。」 (OpenAI 发布的代码里也是这么做的。)一个不对称性(很重要):
decode(encode(s)) == s总是成立;但encode(decode(ids)) == ids不成立——因为有些 token 序列根本无法解码。这个映射只有一个方向是恒等的。
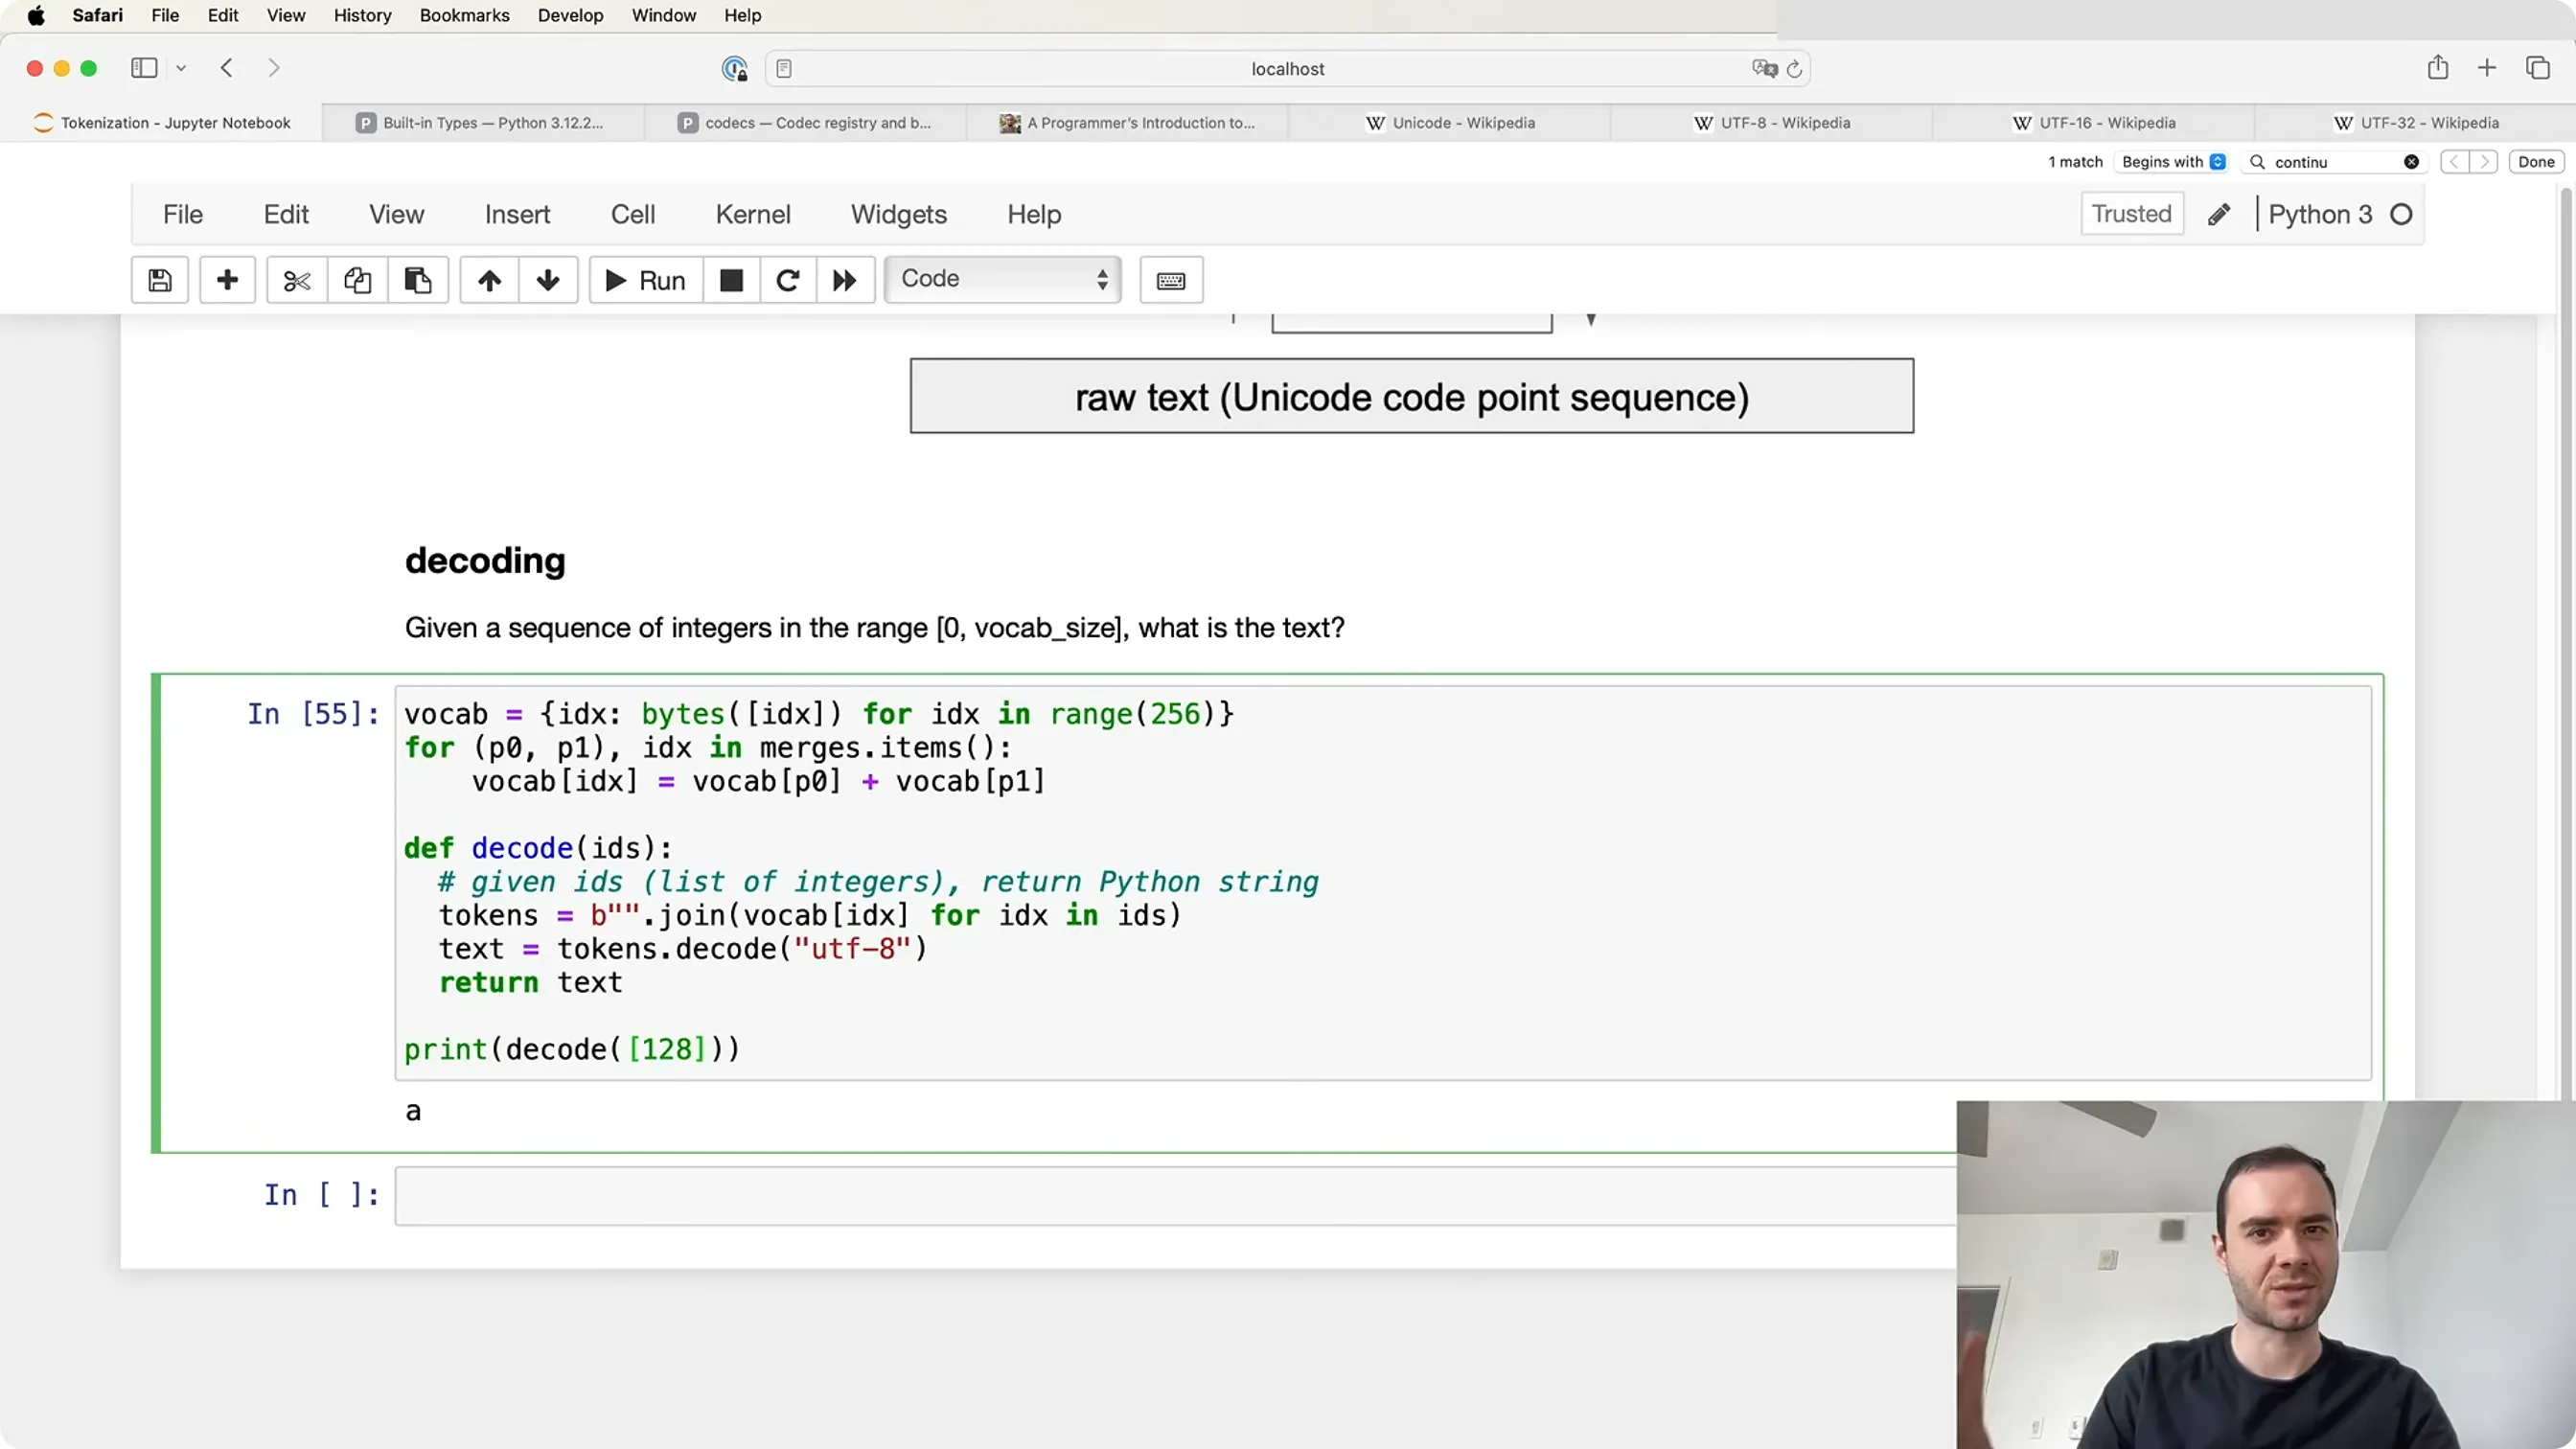
📷 `decode(128)` 报 "invalid start byte"——不是所有字节序列都是合法 UTF-8
回到原视频 (00:45:50)
七、编码(encode)
(参考时间: 48:21)
思路:从原始字节出发,反复应用"最早的那次合并"。
def encode(text):
    tokens = list(text.encode("utf-8"))
    while len(tokens) >= 2:
        stats = get_stats(tokens)                 # 只需要 keys(有哪些相邻对)
        pair = min(stats, key=lambda p: merges.get(p, float("inf")))
        if pair not in merges:
            break                                  # 没有可合并的对,退出
        idx = merges[pair]
        tokens = merge(tokens, pair, idx)
    return tokens
两个关键细节:
- 必须按 merges 的"插入顺序"从小到大做——因为后面的合并依赖前面的结果(
256是前面合并出来的,第 20 次合并要用它)。所以是
min(..., key=merges 里的 index),而不是像训练时那样取"最频繁"的。 float("inf")作为兜底:不在merges里的 pair 根本不可合并,给它们无穷大,保证不会被选中。如果所有 pair 都返回 inf(即没有可合并的了),
min会任意返回stats的第一个 pair——而它不在 merges 里,所以我们据此break。
一个边界特例:如果 len(tokens) < 2(单字符或空串),stats 是空的,min 会报错——所以要提前返回。
验证:
decode(encode(s)) == s✅ 对训练文本成立;- 也对一份没见过的验证文本成立 ✅;
- 反方向不成立(见上一节)。
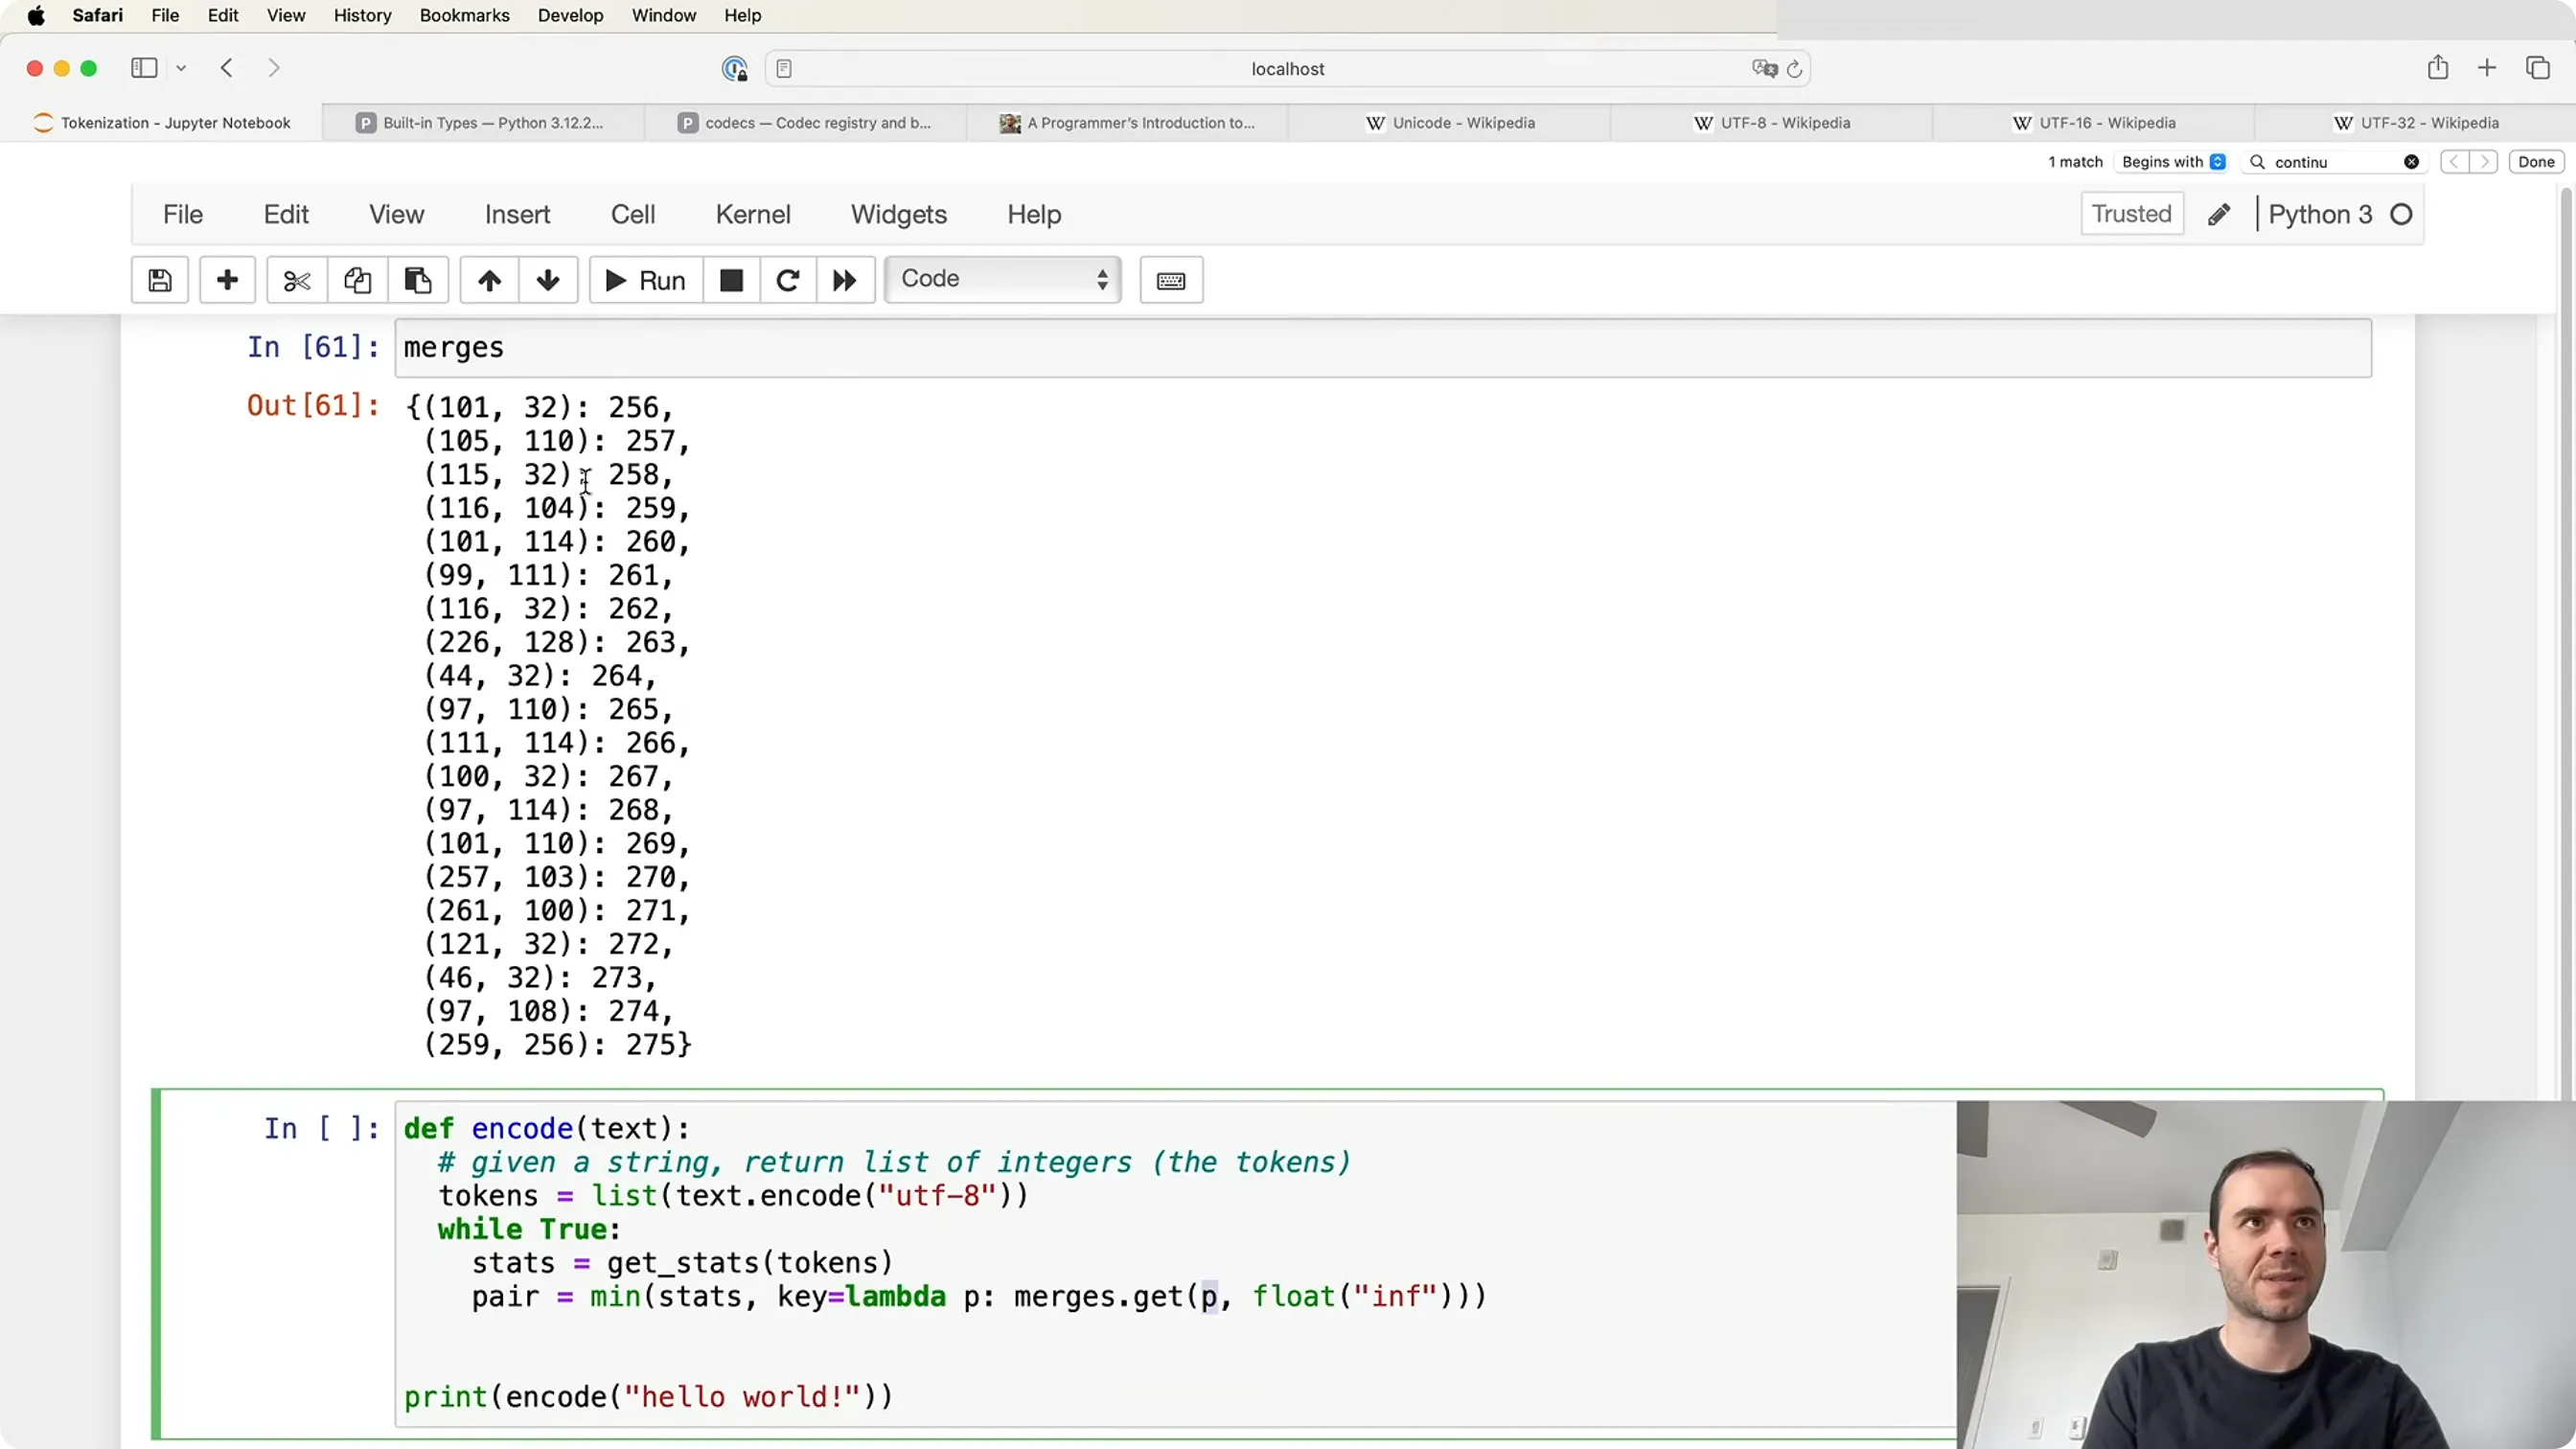
📷 encode:`min(stats, key=lambda p: merges.get(p, inf))`——找"最早的可合并对"
回到原视频 (00:52:00)
八、用正则强制"切分":不要跨类别合并
(参考时间: 57:36)
回到 GPT-2 论文:
朴素的 BPE 会把
dog.、dog!、dog?都各自合并成一个 token——「你会得到一大堆"只差一个标点"的 token,感觉像是把不该聚类的东西聚在了一起——把语义和标点混在了一起。」 他们认为这是次优的(实验也支持)。
解法:在 BPE 之上,再加一层"自上而下"的规则——先按正则把文本切成若干"块",然后在每个块内部独立做 BPE,最后把结果拼接起来。
import regex as re    # 注意:不是内置的 re,而是功能更强的 regex 包
gpt2_pattern = re.compile(r"""'s|'t|'re|'ve|'m|'ll|'d| ?\p{L}+| ?\p{N}+| ?[^\s\p{L}\p{N}]+|\s+(?!\S)|\s+""")

re.findall(gpt2_pattern, "hello world how are you")
# → ['hello', ' world', ' how', ' are', ' you']
逐个模式解读:
| 模式 | 含义 |
|---|---|
's\|'t\|'re\|'ve\|'m\|'ll\|'d |
英文常见缩写——硬编码 |
?\p{L}+ |
可选空格 + 一个或多个"字母"(任意语言) |
?\p{N}+ |
可选空格 + 数字 |
?[^\s\p{L}\p{N}]+ |
可选空格 + 标点(非空白、非字母、非数字) |
\s+(?!\S) |
空白,但不包括最后一个空白字符(否定前瞻) |
\s+ |
兜底:剩下的空白 |
效果:
hello和后面的空格被切进了不同的块,于是e和空格永远不会被合并——这就是"不跨类别合并"的实现方式。那个
\s+(?!\S)更微妙:GPT-2 喜欢"空格 + 单词"这种形式(world是常见 token)。所以当有很多连续空格时,它把最后一个空格留给后面的单词,前面的空格单独成块——这样world这个 token 依然能被复用。
作者的吐槽(很值得读):
- 缩写规则是"硬编码的英文特征",而且 Unicode 撇号
’和大写都不生效:'s会被切开,但’s不会;'s会切开,但'S不会——「它们没有加re.IGNORECASE」。 OpenAI 自己在 GPT-2 代码注释里也承认:"should have addedre.IGNORECASE"。 「这感觉很扎手、也有点"恶心"……而且这些规则本身是高度语言相关的」(不是所有语言都用撇号)。 - 更大的坑:GPT-2 里空格永远不会被合并(永远是 token 220)——「我猜 OpenAI 在某个环节强制了这条规则,但他们在论文和代码里都没说清楚」。
GPT-2 的 tokenizer 训练代码从未公开——他们只发布了推理代码(拿现成的 merges 去切新文本)。「所以我们并不确切知道他们是怎么训的,但肯定不是"切块 + BPE"这么简单。」
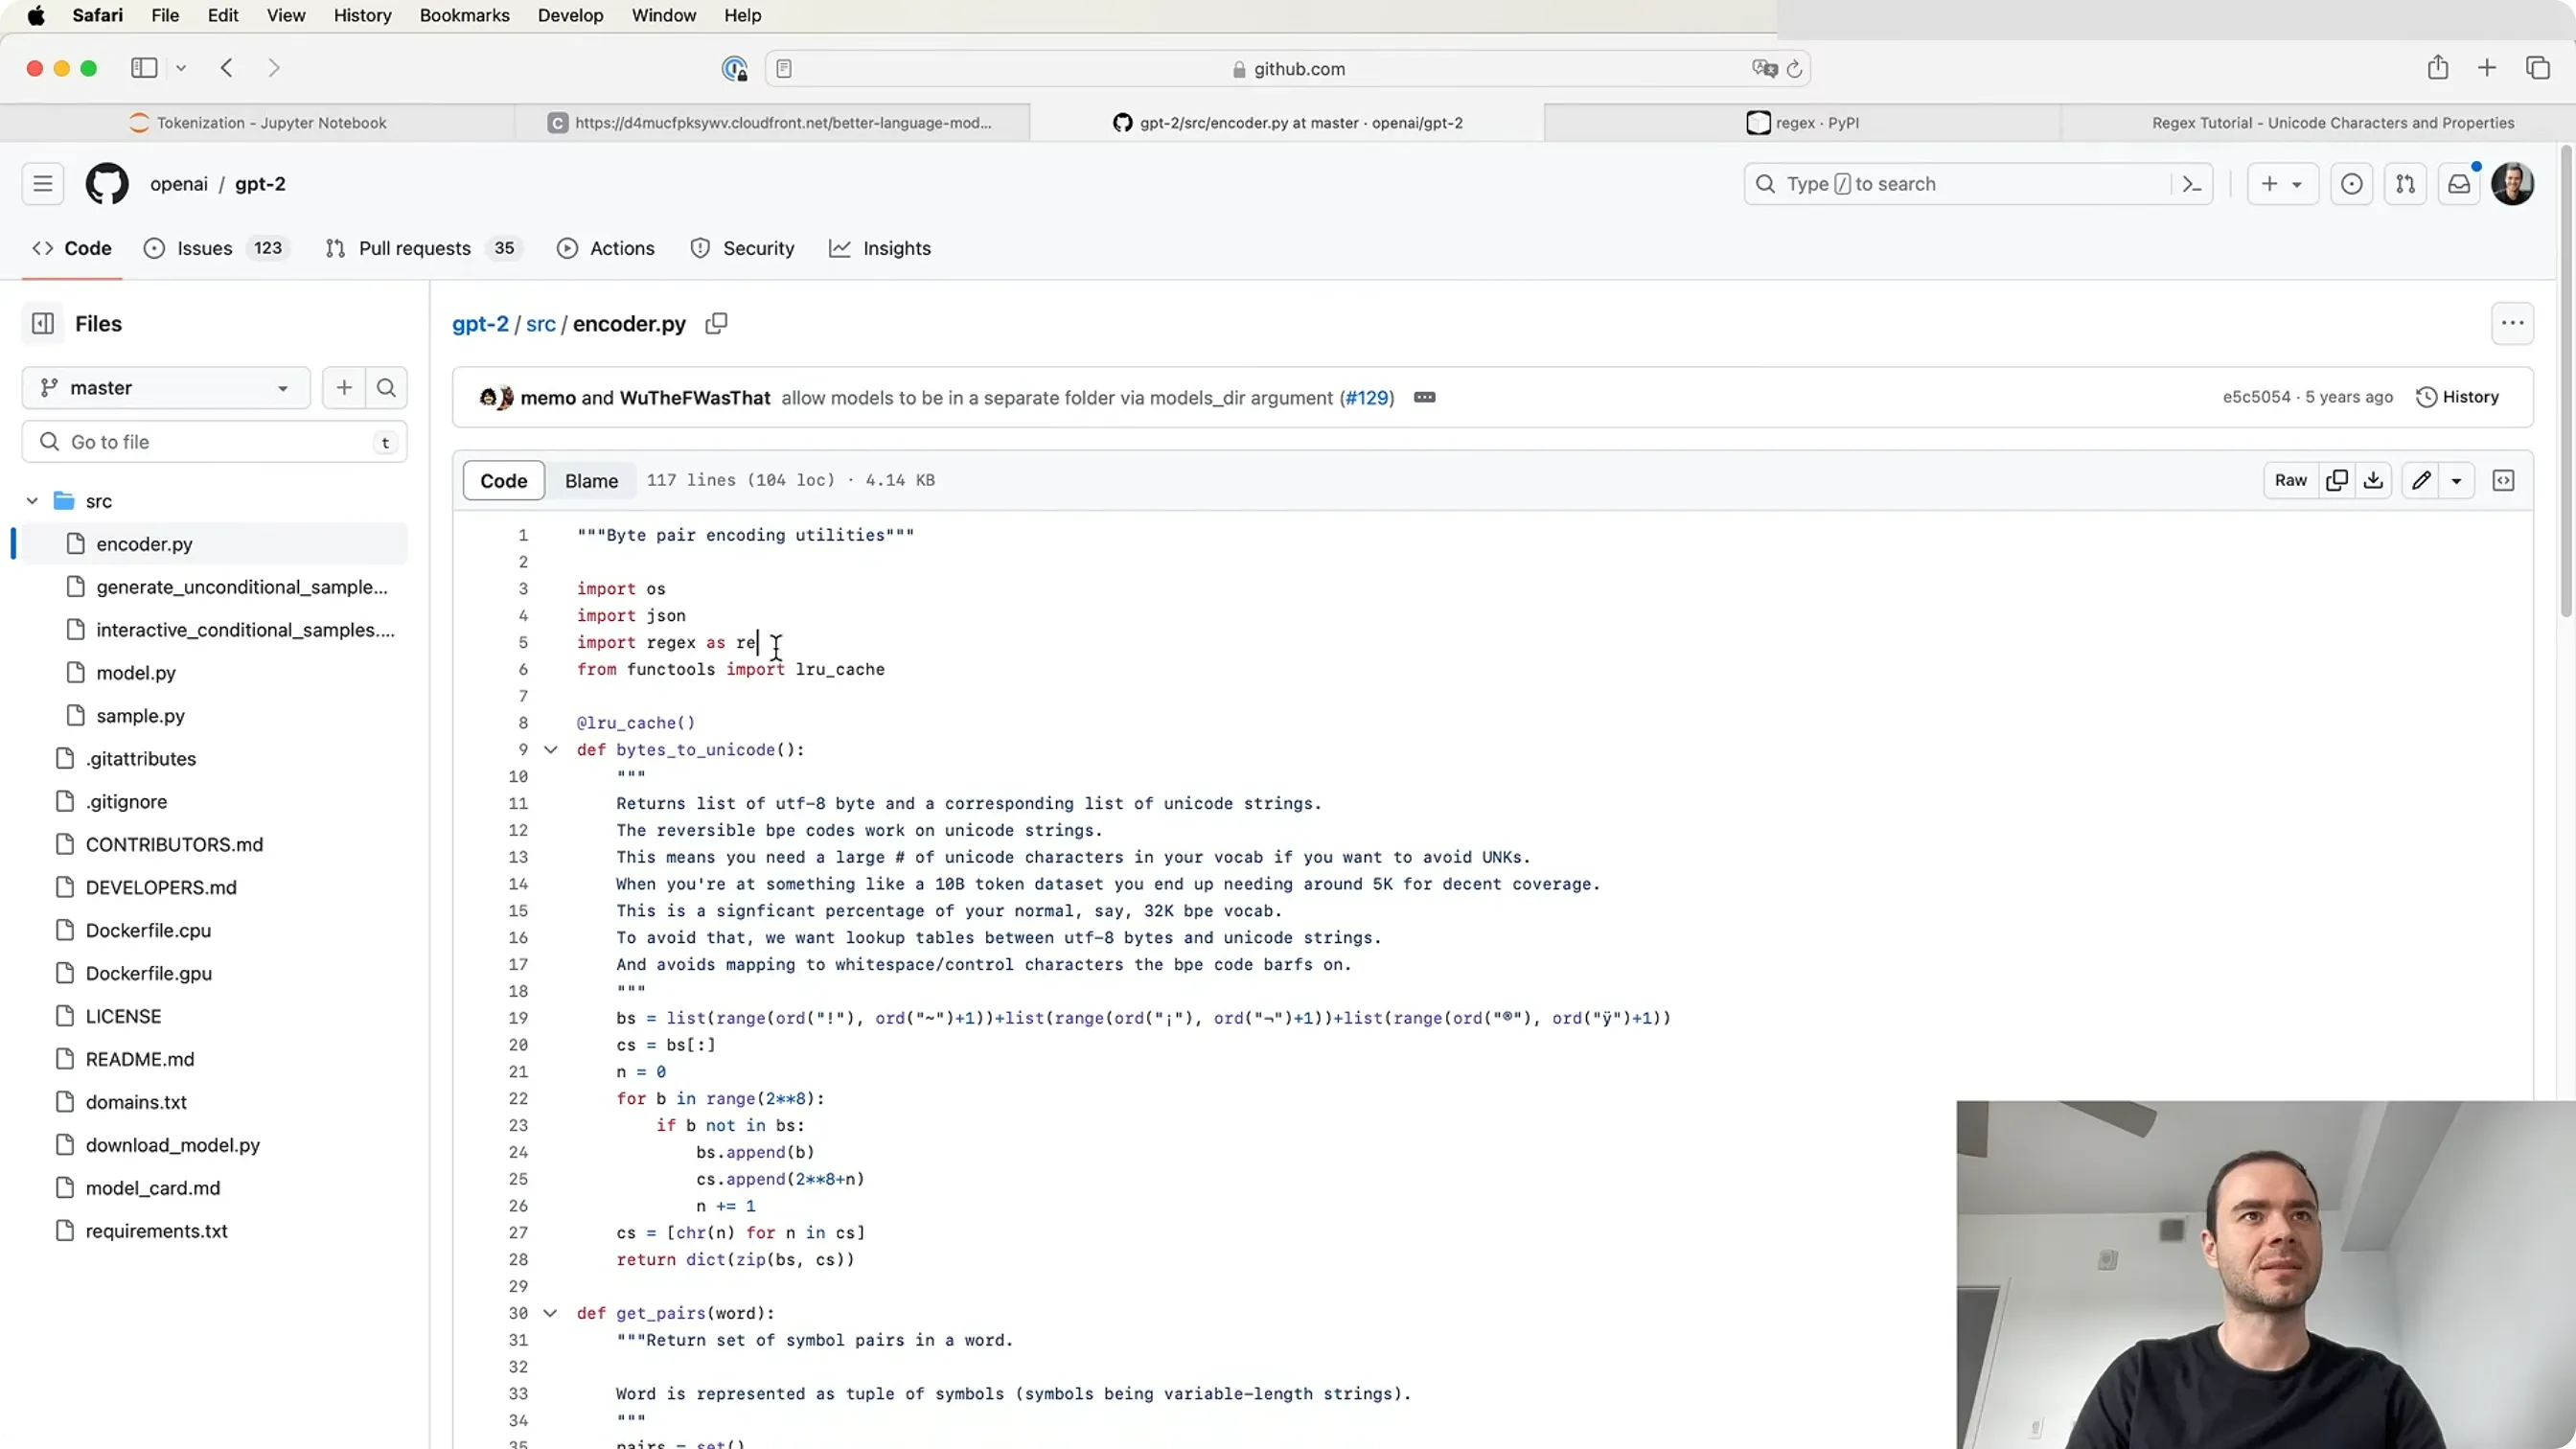
📷 GPT-2 的正则 pattern(`regex` 包,不是内置 `re`)
回到原视频 (01:00:10)
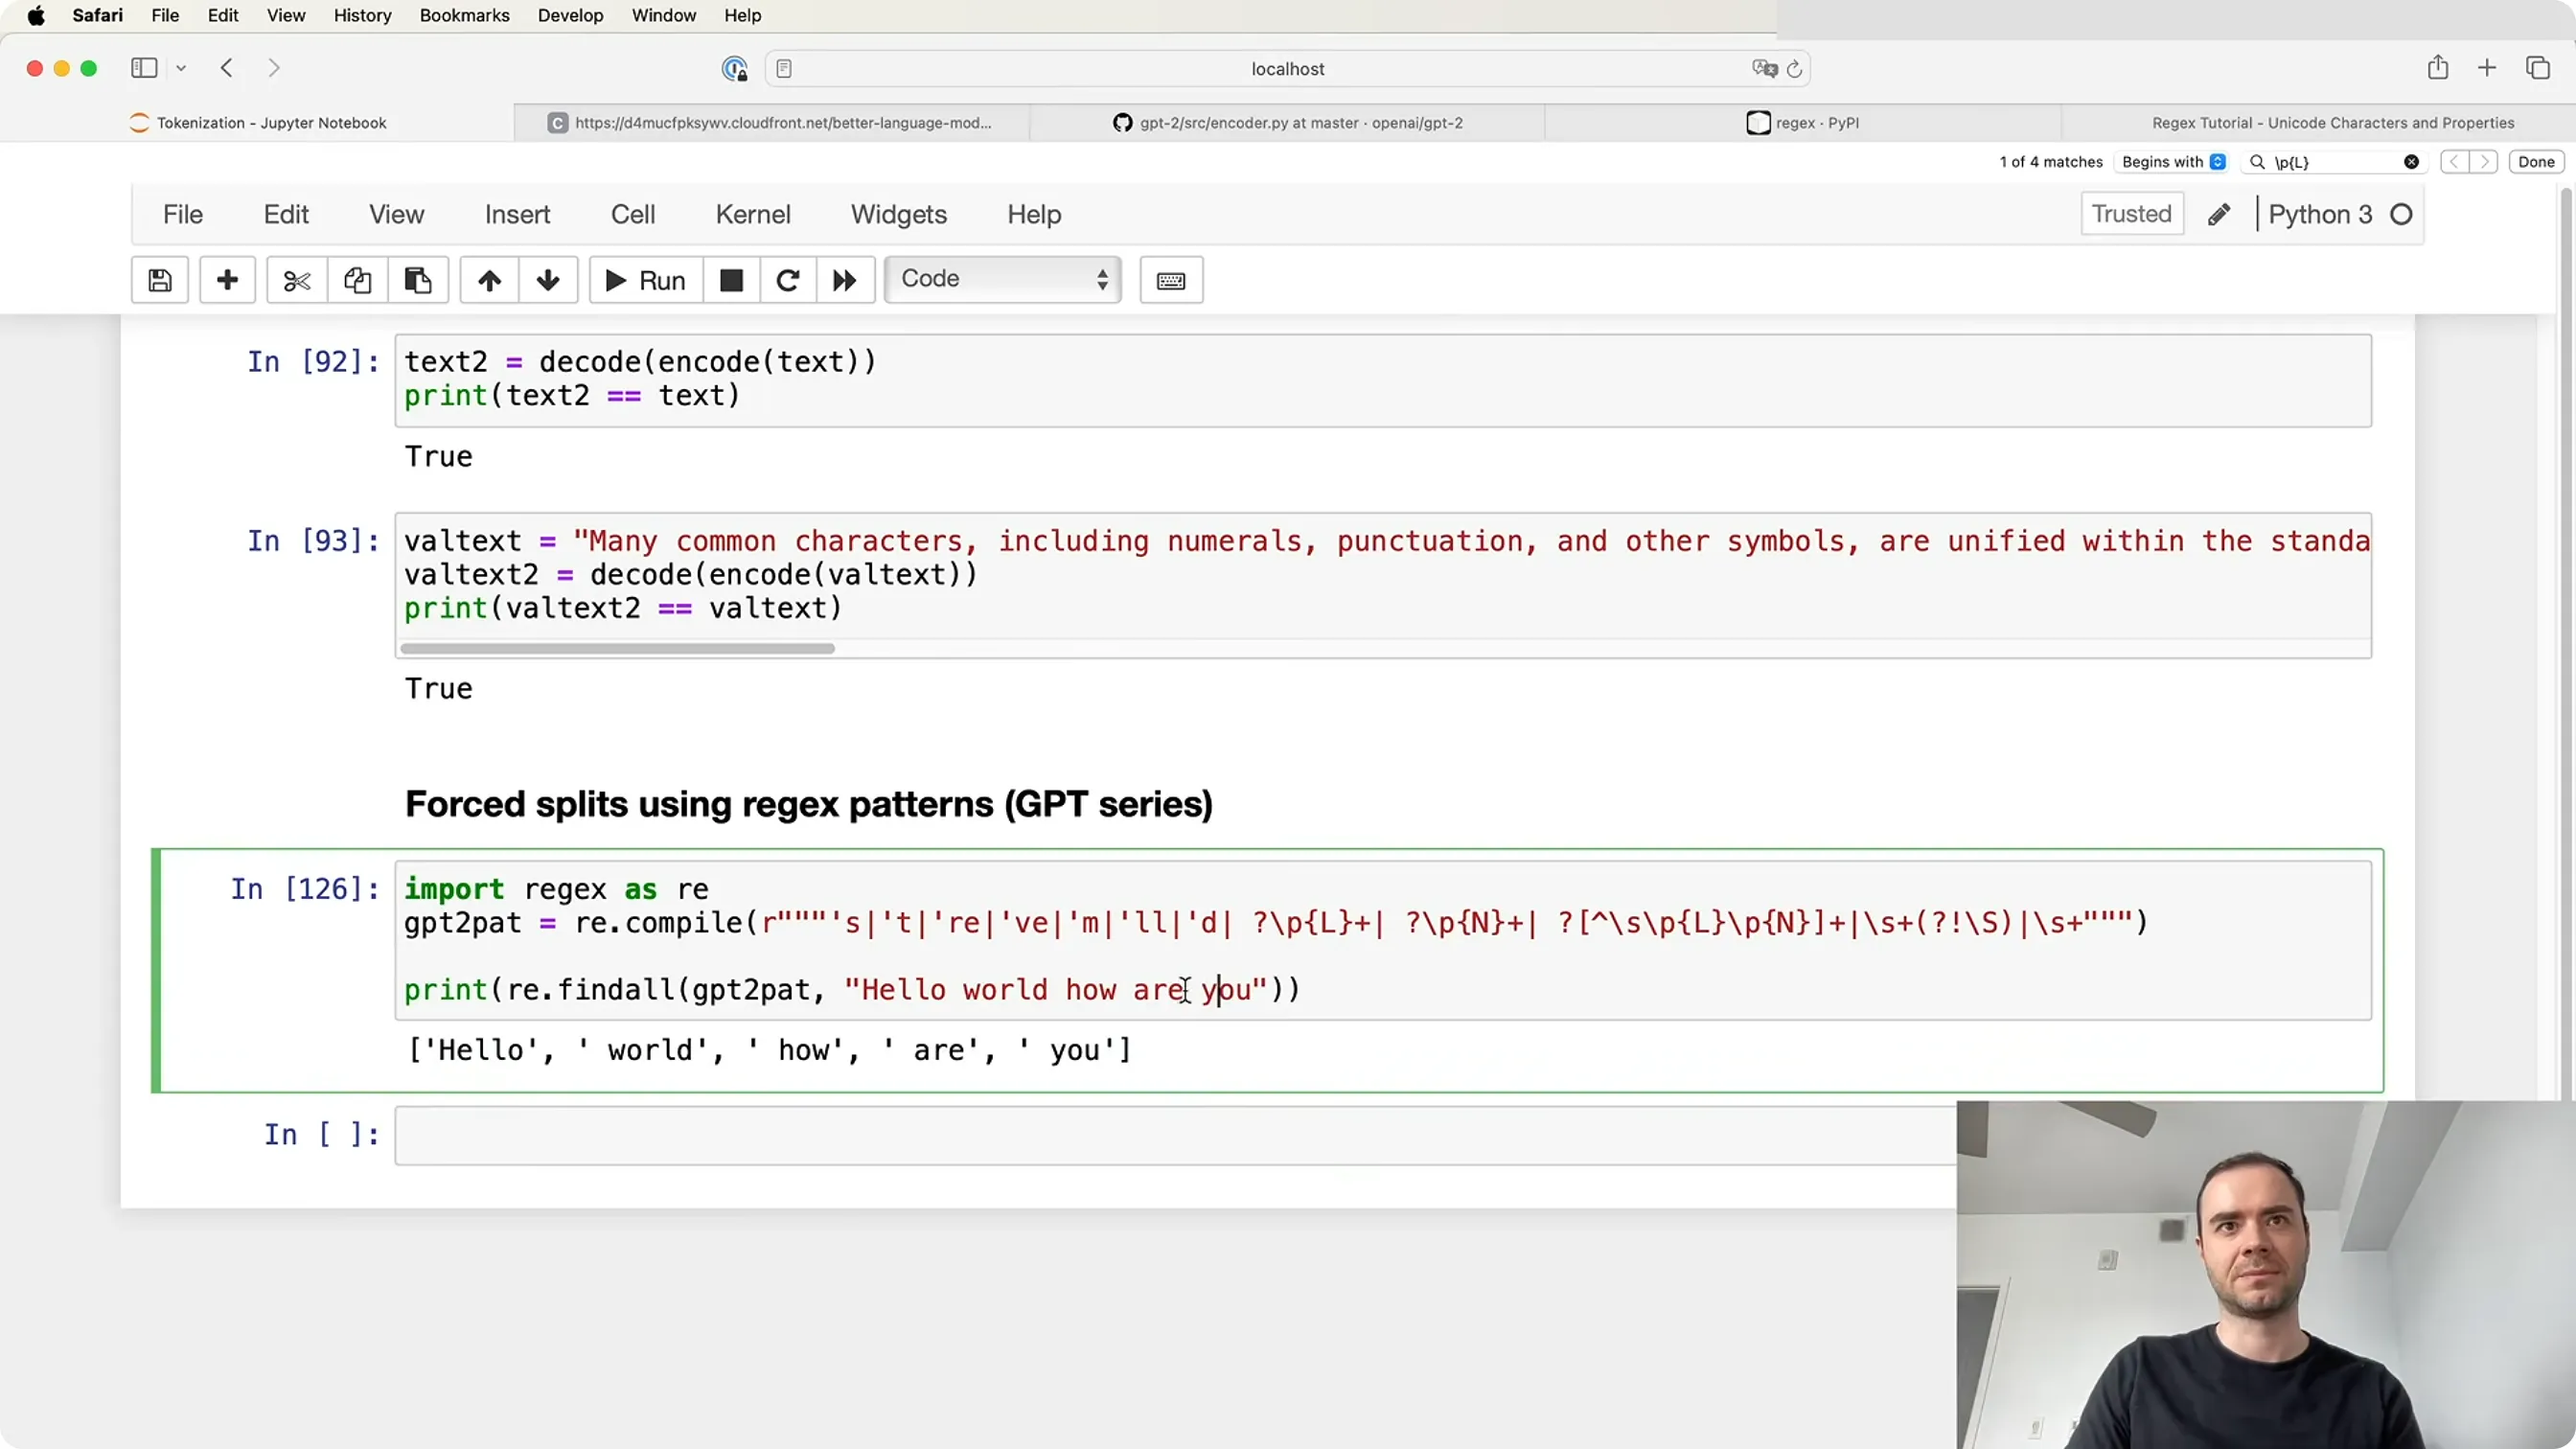
📷 按类别切分的结果:`'hello', ' world', ' how', ' are', ' you'`
回到原视频 (01:04:30)
九、tiktoken,以及 GPT-4 的差异
(参考时间: 1:11:38)
tiktoken 是 OpenAI 官方的 tokenization 库——注意:它只做推理,不做训练。
import tiktoken
enc = tiktoken.get_encoding("gpt2")     # 或 "cl100k_base"(GPT-4)
enc.encode("hello world")
GPT-4 (cl100k_base) 相对 GPT-2 的主要改动(都写在 tiktoken_ext/openai_public.py 里,因为做推理必须公布这些细节):
- 加了
(?i)——大小写不敏感:「我们之前看到的那条吐槽"本该加
re.IGNORECASE"——这里被修掉了」,'s/'D/'M等大小写都能匹配。 - 数字"最多匹配 1–3 位":
「三位以上的数字永远不会被合并」——防止出现超长的数字 token。
- 一大串空格处理规则(他没细讲——「说实话这让我麻木,我建议你打开 ChatGPT 和 regex 文档自己一步步走」)。
- 词表 50k → 100k。
⚠️ 「我们并不知道他们为什么这么做——这些都没文档,我们只拿到了那个 pattern。」
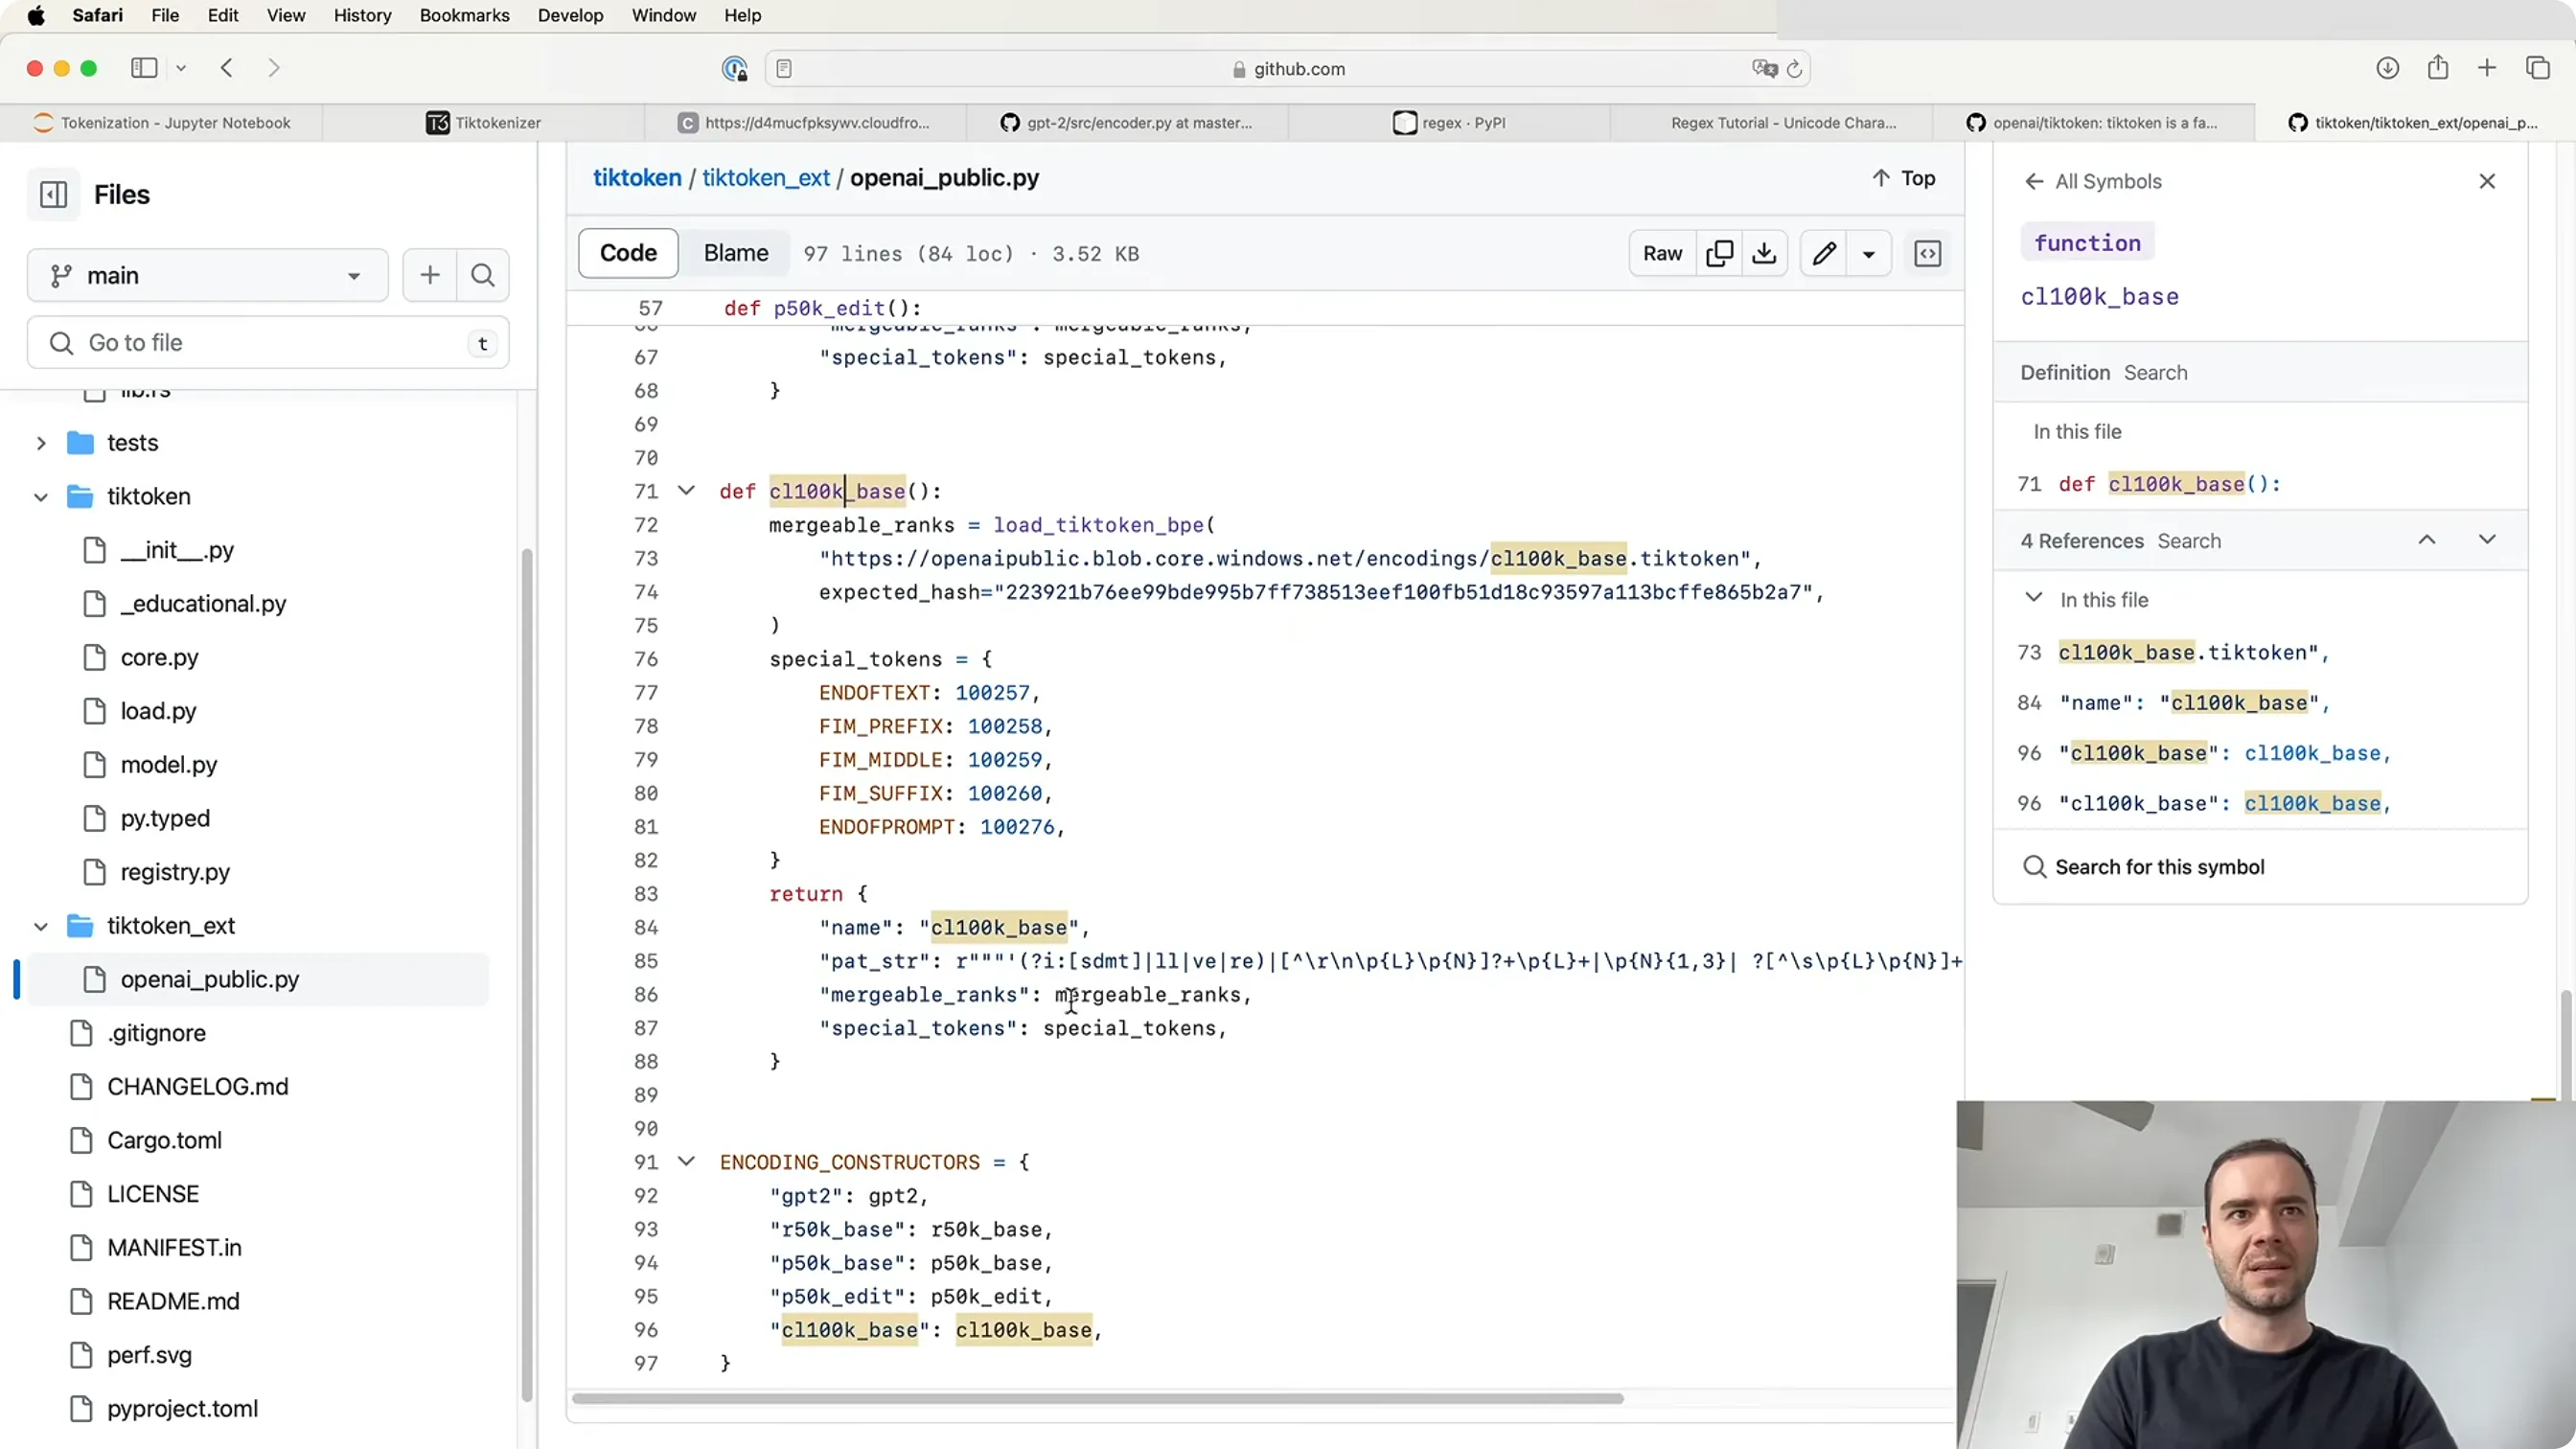
📷 GPT-4 的 pattern:`(?i)` 大小写不敏感 + 数字最多 3 位
回到原视频 (01:13:20)
十、走读 OpenAI 的 gpt2/encoder.py
(参考时间: 1:14:59)
「我个人不太喜欢他们把它叫
encoder.py——这就是 tokenizer,而 tokenizer 是既能 encode 又能 decode 的。」
文件底部的对应关系(非常漂亮):
| OpenAI 的命名 | 我们的命名 |
|---|---|
encoder.json |
vocab(id → bytes) |
vocab.bpe |
merges(合并表) |
「他们做的,就是把我们那两个关键变量存盘再读回来。用这两个变量就能完整表示一个 tokenizer,编解码都行。」
其他地方:
- 还有一对
byte_encoder/byte_decoder——「这是个多余(spurious)的实现细节,一点都不深、也不有趣,我跳过」; - 核心是
bpe()函数:和我们写的循环几乎一样——找下一个该合并的 pair、遍历序列、遇到就合并、一直重复到没有可合并的为止; - 也有
encode/decode,和我们实现的逻辑一致。
「长话短说:他们的代码有点乱,但算法上和我们上面搭出来的东西完全相同。」
十一、特殊 token(special tokens)
(参考时间: 1:18:26)
GPT-2 的 encoder 长度是 50,257。这个数字怎么来的?
$$256\ (\text{原始字节}) + 50{,}000\ (\text{BPE merges}) + 1\ (\text{特殊 token}) = 50{,}257$$
那一个特殊 token 就是 <|endoftext|>:
「它用来分隔训练集里的不同文档。」 我们把所有文档 tokenize 成一条 token 流(ID 范围 0–50256),在文档之间插入
<|endoftext|>。 「这是给模型的一个信号:文档结束了,接下来的内容和前面无关。 之前这件事得靠模型从数据里自己学——现在我们把"文档分隔符"直接给它了。」
关键机制:特殊 token 不走 BPE。
在 tiktokenizer 里,只有当你完整打出
<|endoftext|>时,它才会突然变成 token 50256。 「原因是它根本没经过 BPE 合并——tiktoken(用 Rust 实现的)里有一套特殊处理逻辑,你注册一个特殊 token 之后,它会在字符串里查找它、并直接替换成那个 token。」 ⚠️ 「这套逻辑在encoder.py里是缺失的」——只在 tiktoken 里有。
特殊 token 无处不在——尤其在微调/对话阶段:
ChatGPT 的 tokenizer 里有
<|im_start|>、<|im_end|>等等(im= "imaginary monologue")——每条消息都有开始和结束,用来标记对话的流动。
GPT-4 还多了 FIM 三个 token:<|fim_prefix|>、<|fim_middle|>、<|fim_suffix|>——FIM = fill-in-the-middle(论文另行讨论)。
加特殊 token 需要给模型"做手术":
- embedding 矩阵要加一行(新 token 也要有自己的向量),通常用小随机数初始化;
- 最后那层分类器(lm_head)也要加一列。
「这是一个很温和的"模型手术",很常见——通常是冻结基础模型,只训这些新参数。」
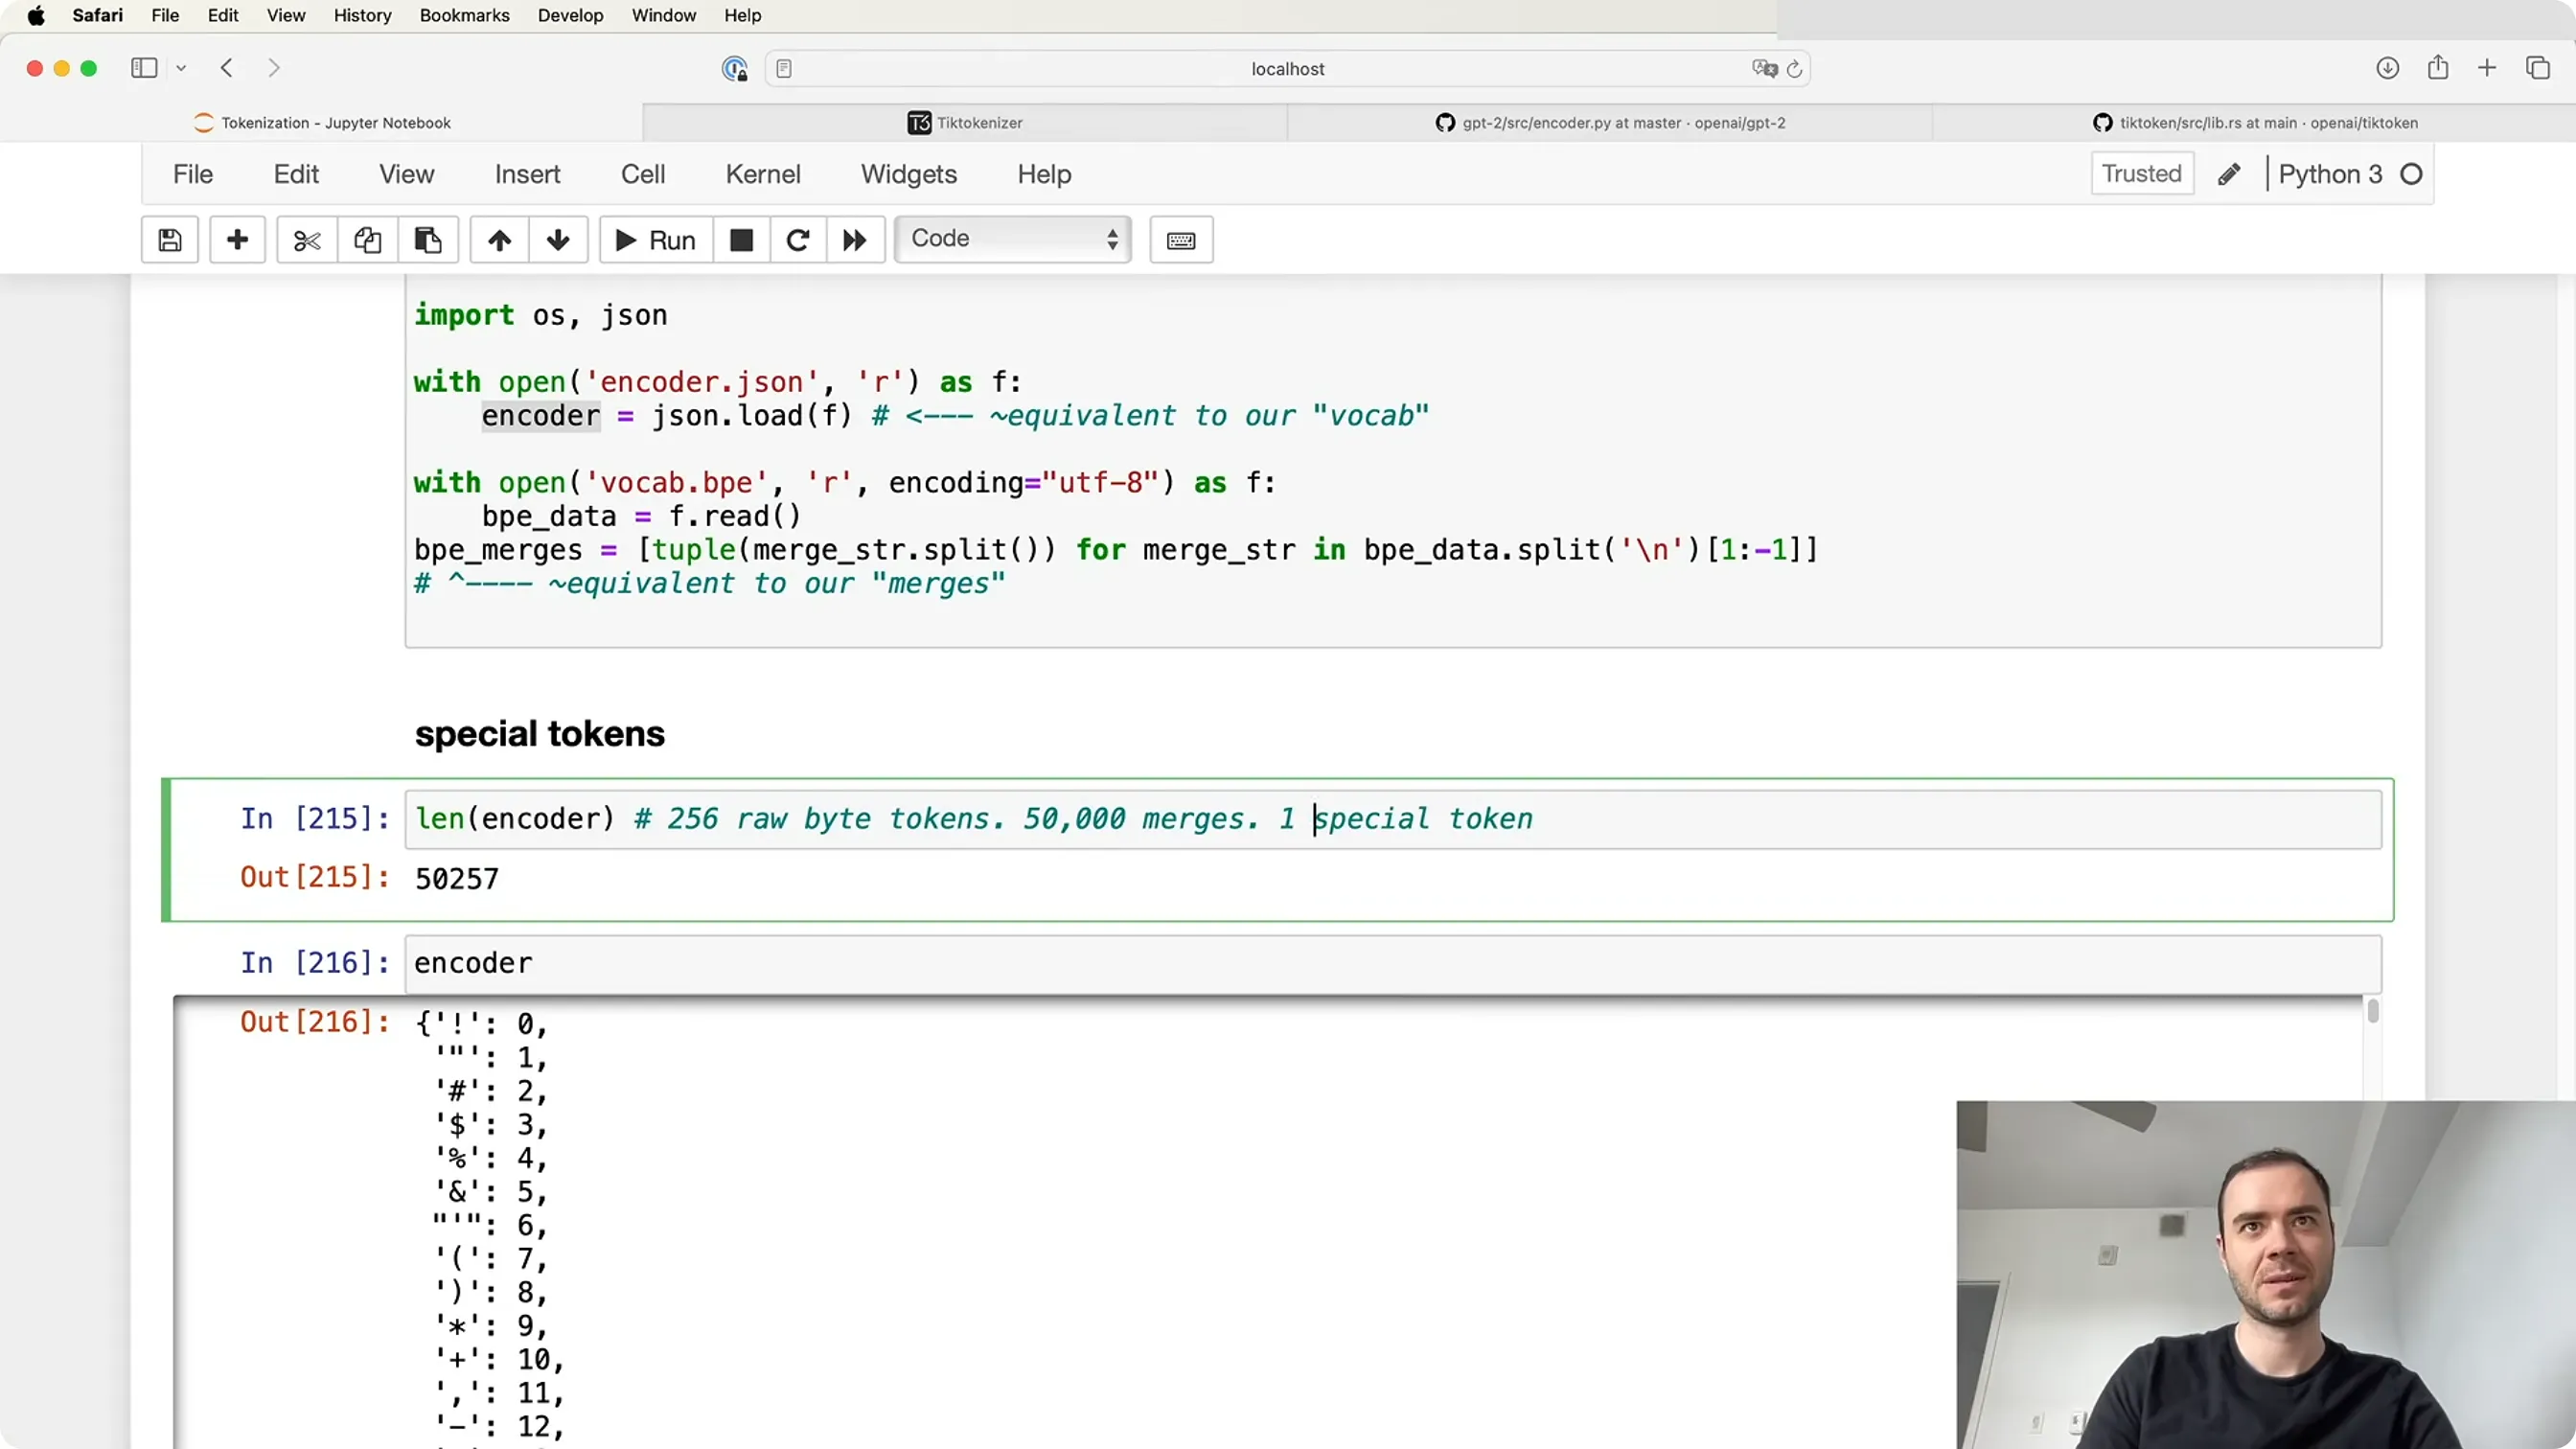
📷 50257 = 256 字节 + 50,000 merges + 1 个 `<|endoftext|>`
回到原视频 (01:19:40)
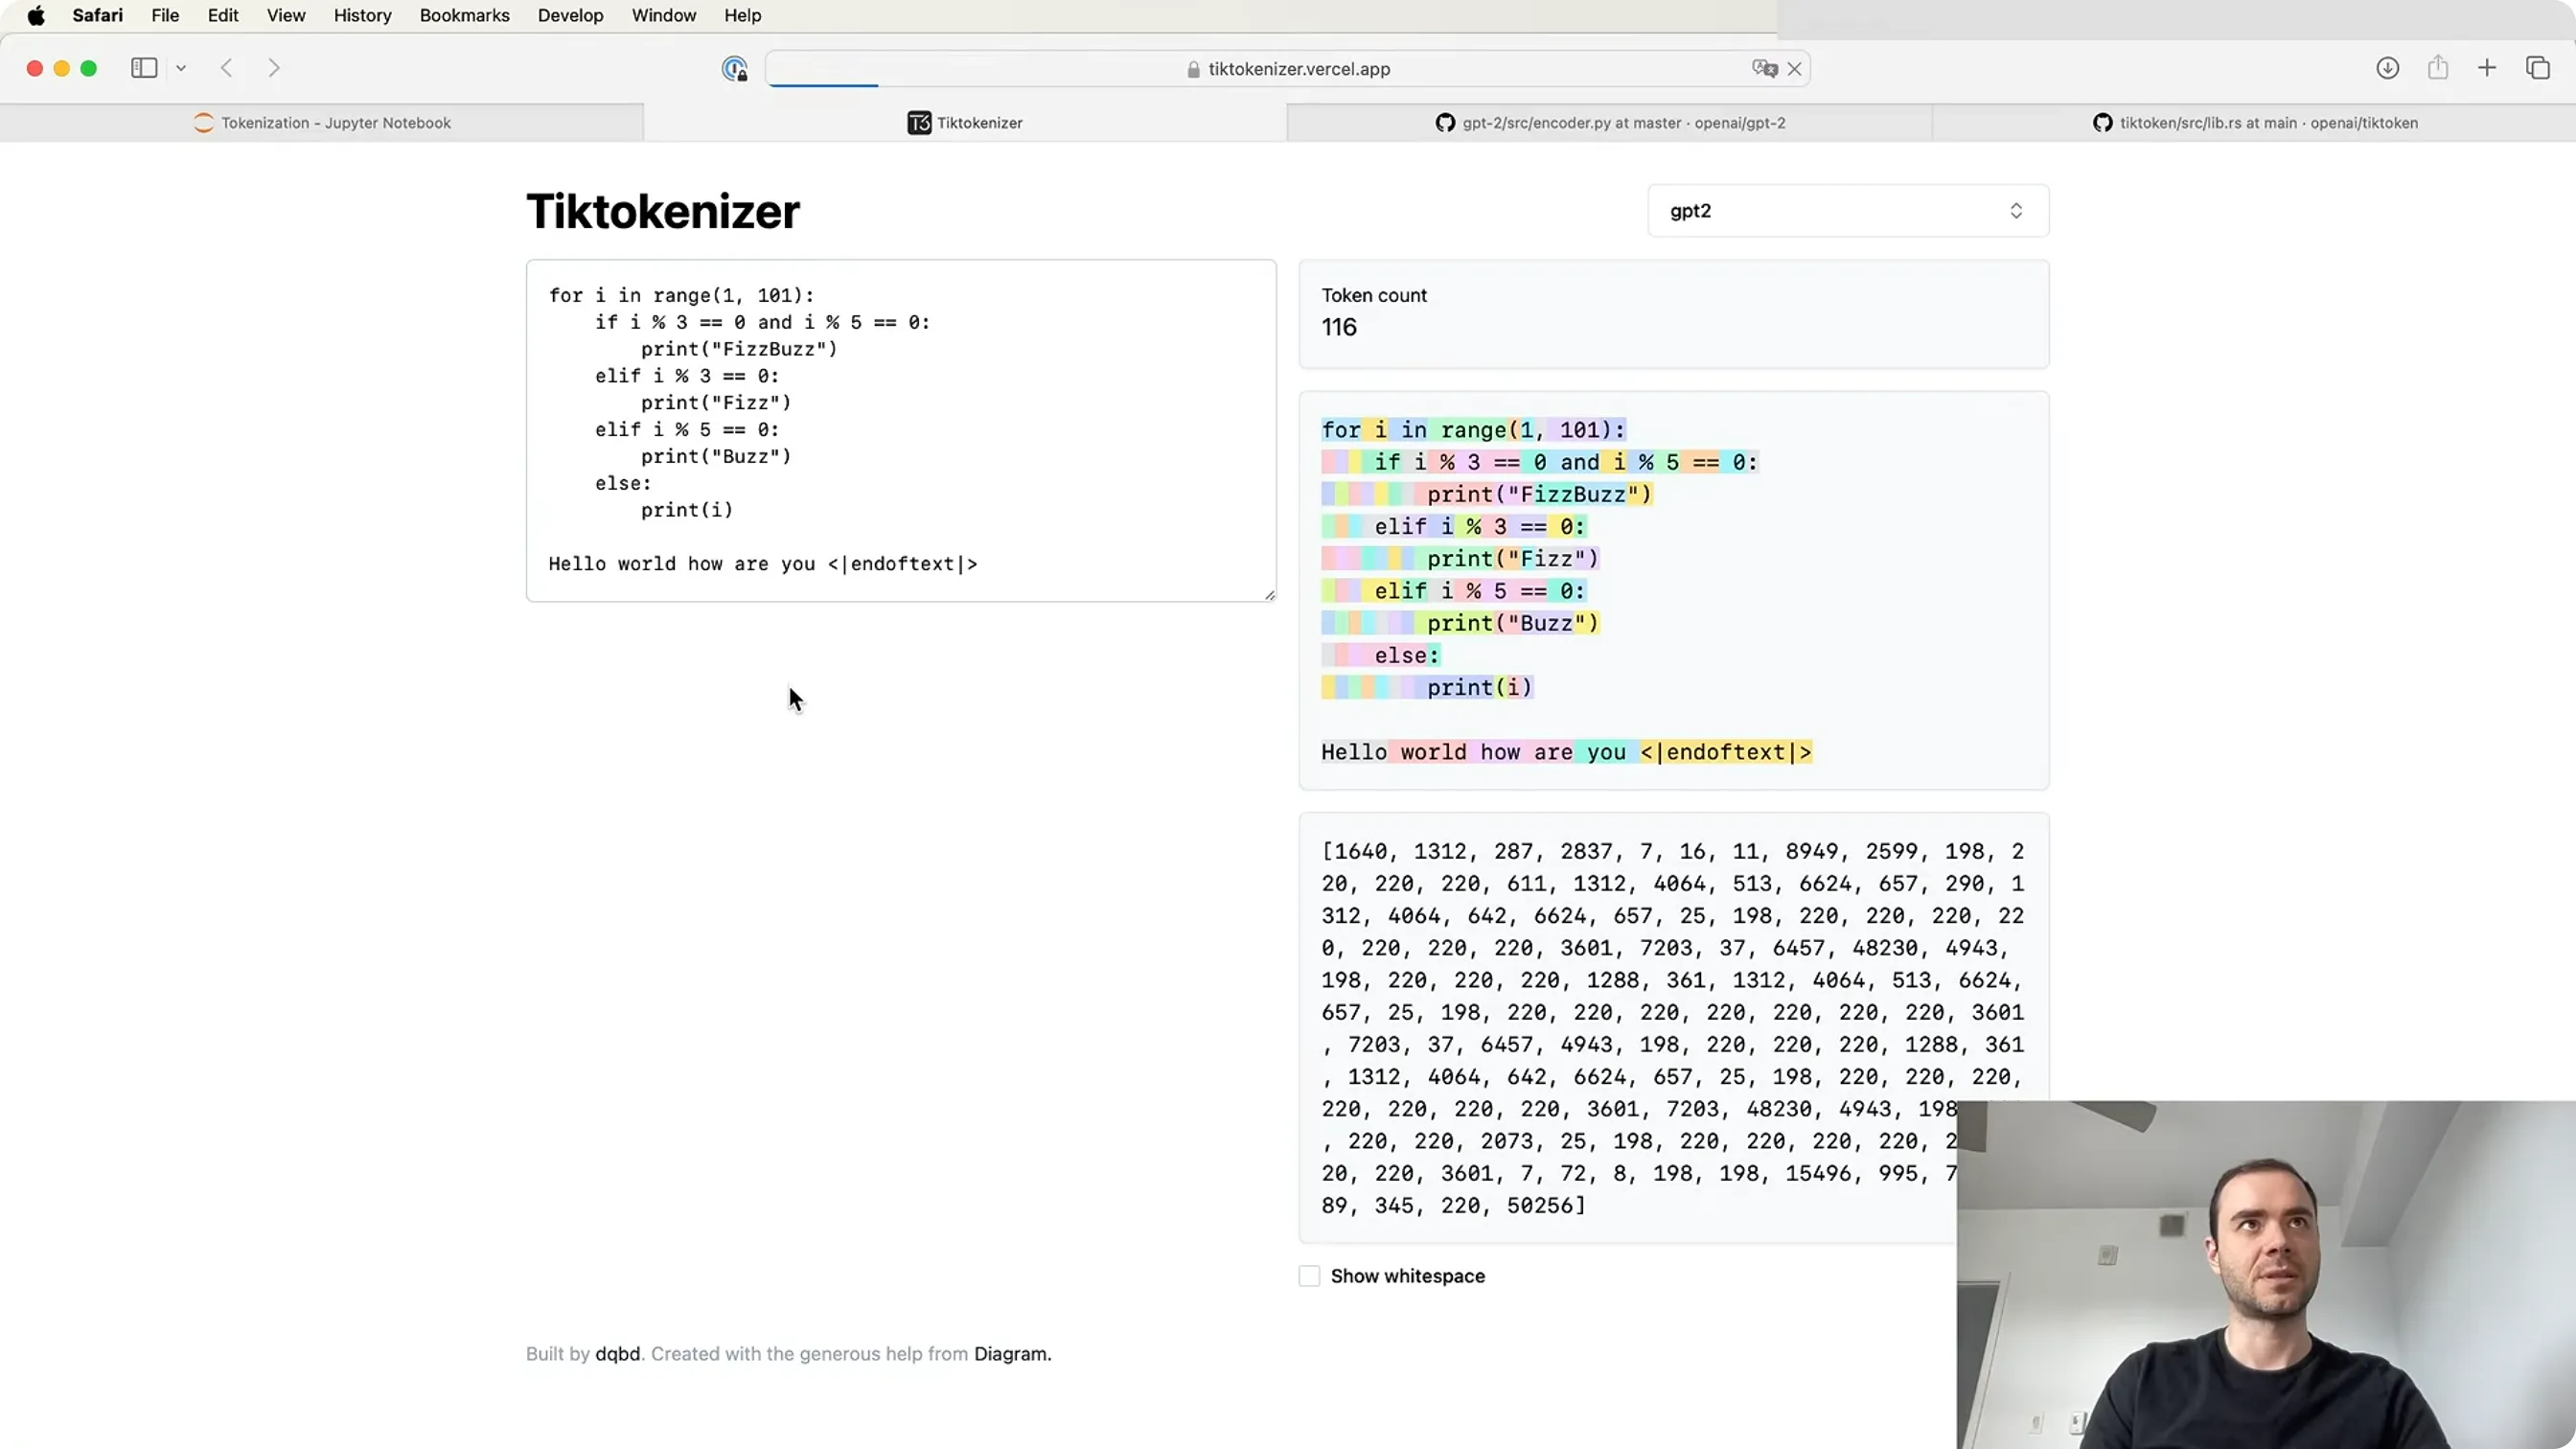
📷 ChatGPT tokenizer 里的 `<|im_start|>` / `<|im_end|>` 等特殊 token
回到原视频 (01:22:20)
十二、练习时间:自己写一个 GPT-4 tokenizer
(参考时间: 1:25:28)
「到这一步,你已经拥有了构建自己 GPT-4 tokenizer 所需的一切。」
Karpathy 发布了 minbpe 仓库,以及那份四步练习进度表(exercise.md):
「你可以严格照着这些步骤走,我在里面写了一些指引;任何时候卡住了,就参考 minbpe 仓库——那些 tests 会很有用,仓库本身我也尽量写得干净易懂。」
做完之后你应该能做到:
- 复现 tiktoken 的行为(同样的字符串 → 同样的 token);
- encode → decode 能还原;
- 写出自己的
train()——「tiktoken 里没有训练代码,但 minbpe 有」,于是你可以训练自己的词表。
一个很有意思的对照:把 GPT-4 的 merges 可视化,它的第一次合并是把两个空格合并成一个 token(即 token 256)。而用 minbpe 在一篇维基百科页面(他选了 Taylor Swift——「不是因为我是 Swiftie,是因为那似乎是最长的维基页面之一」)上训练,也能得到结构相似的词表。
「唯一的不同是训练集——比如我猜 GPT-4 的 tokenizer 训练集里有大量 Python 代码(因为空格 token 很多),而维基页面里这种就少得多。」 「大体上它们看起来一样,因为跑的是同一个算法;你自己训也会得到类似的东西,取决于你用什么数据。」
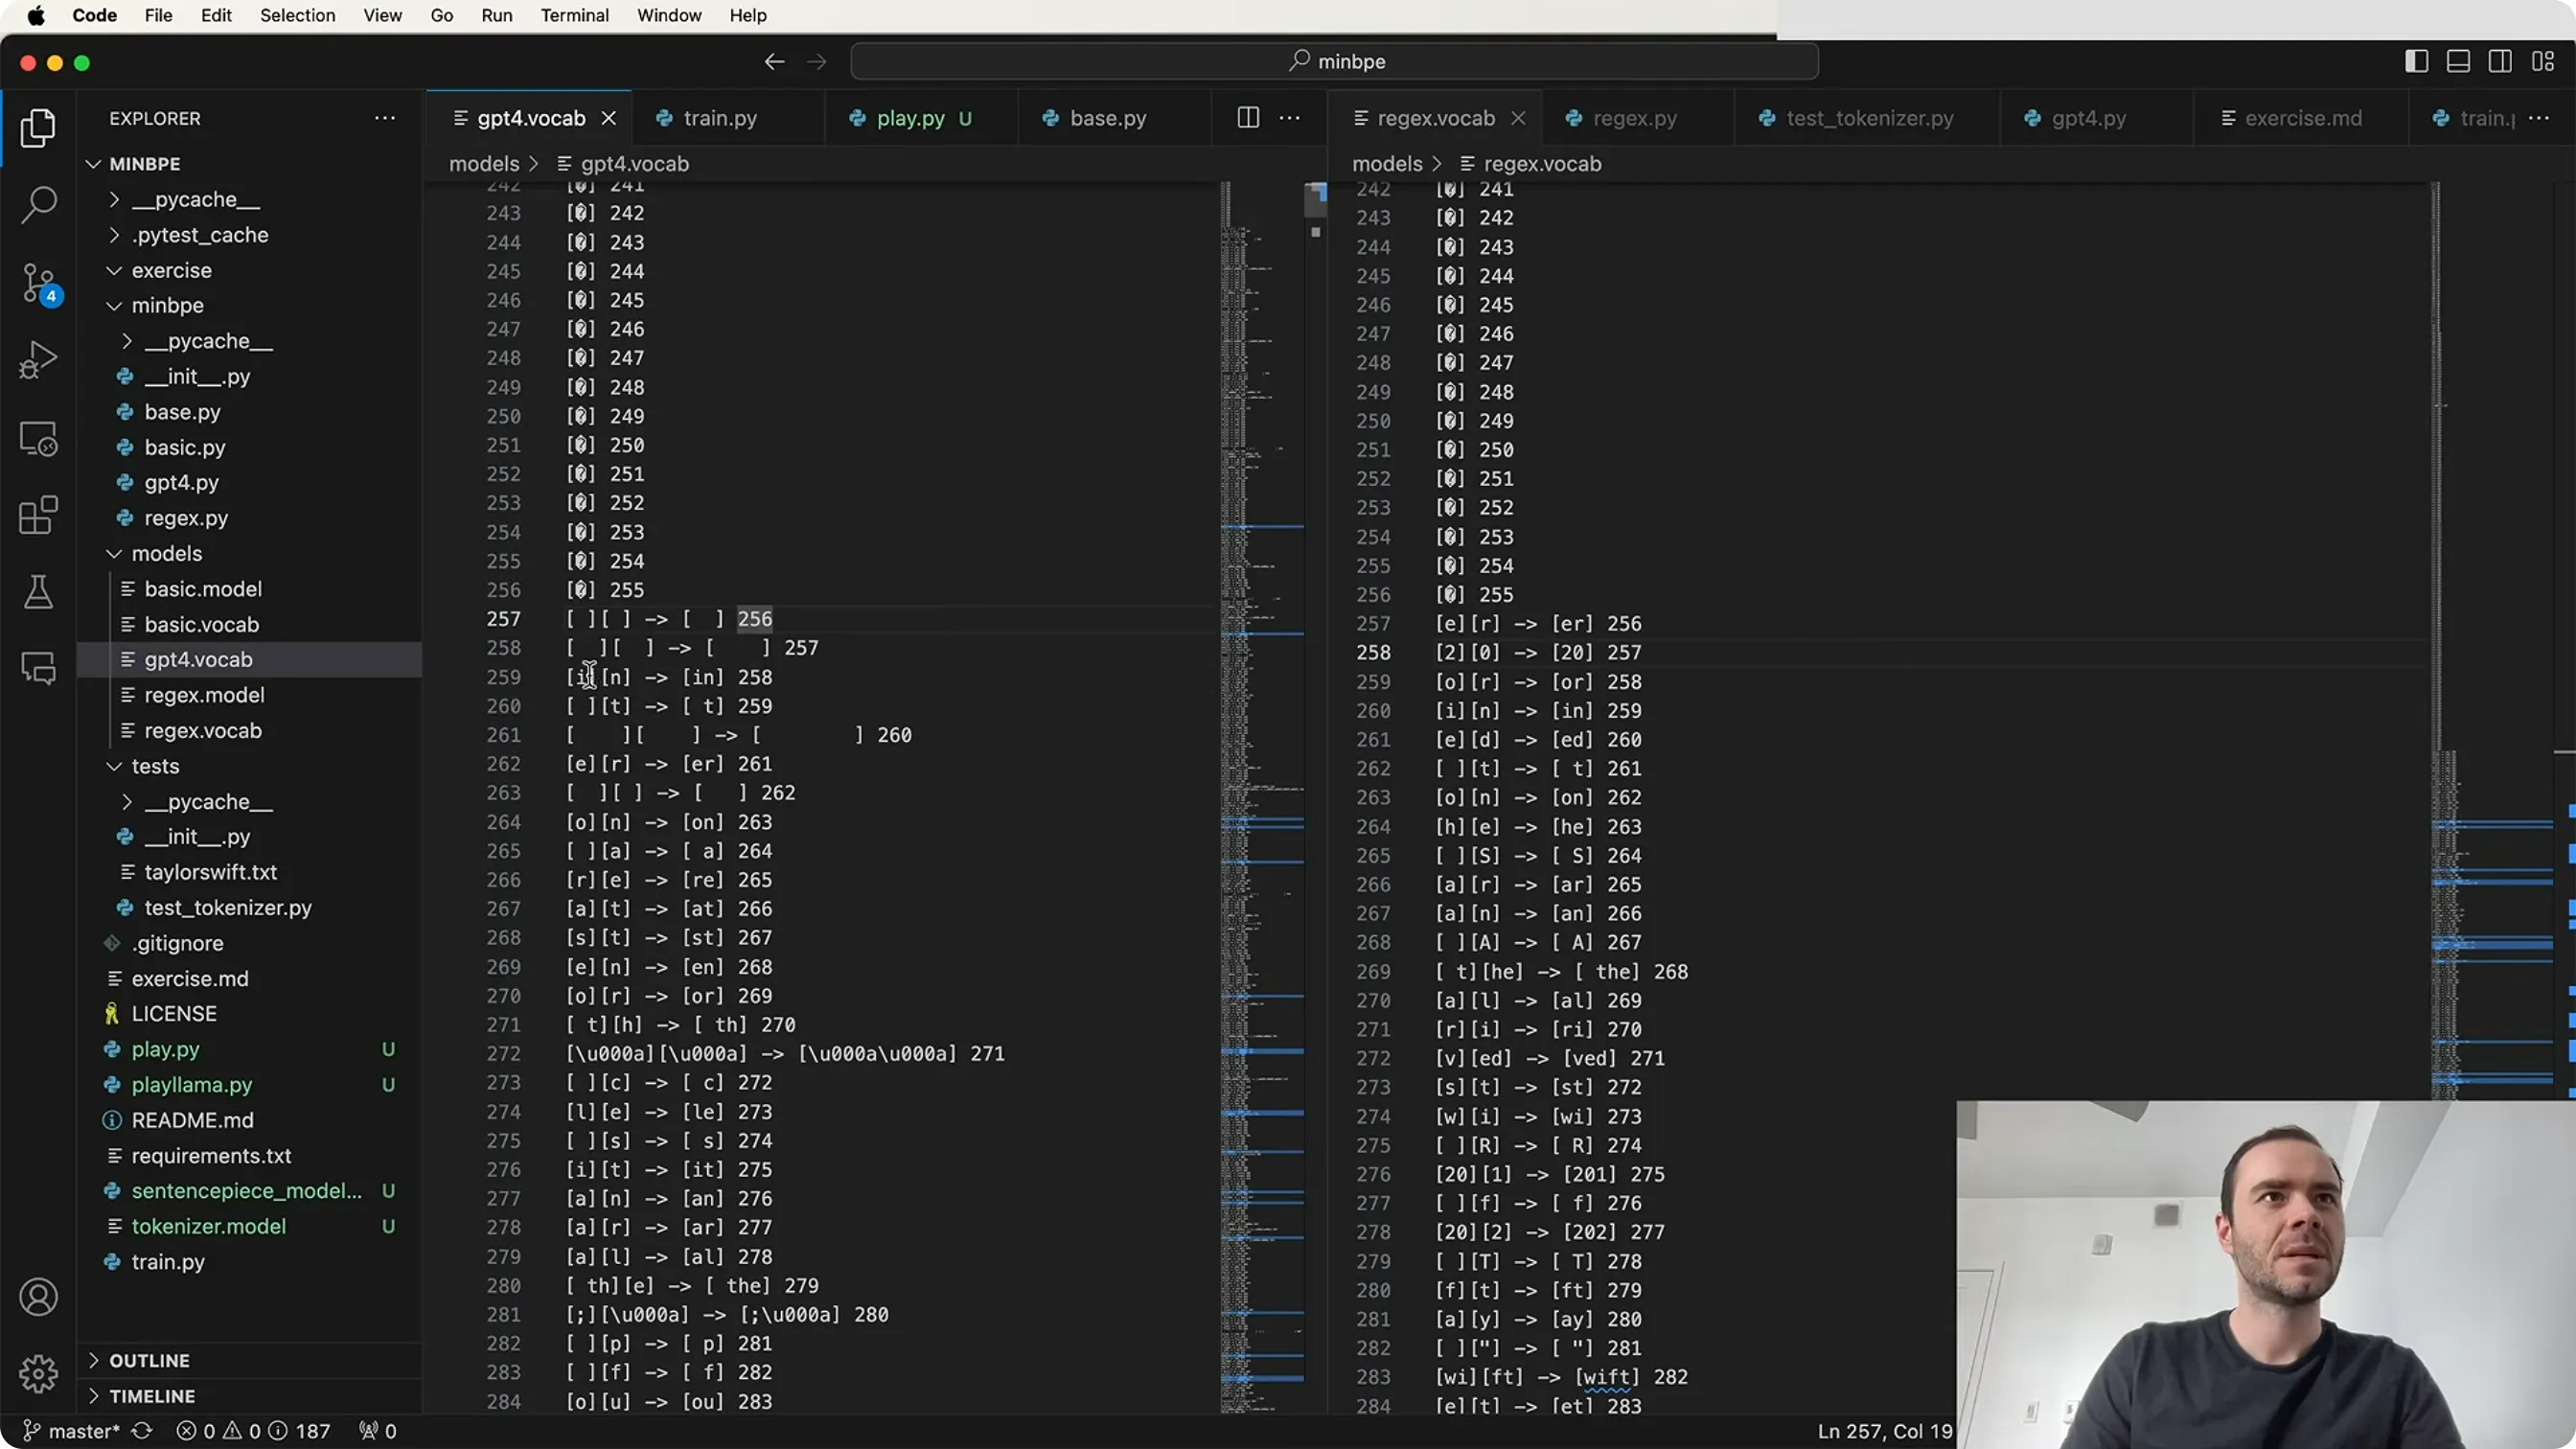
📷 minbpe 里对比 GPT-4 与自训 tokenizer 的 merges 顺序
回到原视频 (01:28:00)
十三、sentencepiece:另一种主流路线
(参考时间: 1:28:42)
sentencepiece 是 Google 的库,Llama / Mistral 系列都在用。和 tiktoken 最大的区别:
- 它既能训练也能推理(tiktoken 只能推理),而且两者都很高效;
- 它支持多种训练算法,其中一种就是 BPE。
根本差异(很微妙但很重要):
| tiktoken | sentencepiece | |
|---|---|---|
| 工作层级 | 先把码点 encode 成 UTF-8 字节,在字节上做 BPE | 直接在 Unicode 码点上做 BPE |
| 稀有字符 | (天然覆盖所有字节) | 由 character_coverage 决定;没覆盖到的码点 → UNK,或者开 byte_fallback 时退回 UTF-8 字节(用特殊 byte token 表示) |
「我个人觉得 tiktoken 的方案明显更干净」,但这是一个"微妙却相当重大"的路线差异。
Karpathy 的实操演示与吐槽:
- sentencepiece 有一大堆配置项——「它在业界存在很久了,试图覆盖大量场景,因此积累了很多历史包袱」。比如
shrinking_factor就和 BPE 无关(那是另一种算法的参数)。 - 他照抄了 Llama 2 的配置(把 Meta 发布的 tokenizer model 文件用 protobuf 打开、逐个对照选项),尽量让 toy 实验与 Llama 2 一致。
normalization规则:在 LLM 之前时代(机器翻译、文本分类)大家喜欢把文本规范化(转小写、合并空格)——「但作为深度学习的人,我倾向于不要碰数据,尽量保持原样」。- "句子"这个概念:「sentencepiece 有"训练多少句子""最大句子长度""打乱句子"这些概念……但在 LLM 语境下这非常奇怪——句子到底是什么?不同语言里概念还不一样。 我就会把一个文件当成一条巨大的字节流。」
- vocab 的排布顺序:特殊 token → byte token(256 个)→ merge token → 单个码点 token。
byte_fallback=True很重要(Llama 2 就是这么做的):关掉它重训后——韩语整段变成
0(UNK)。 「如果所有不认识的稀有字符都映射成 UNK,那语言模型能拿它怎么办?这不是你想要的属性。」所以 Llama 正确地开了byte_fallback。add_dummy_prefix=True:会在文本开头加一个空格——为了让world和world被同样对待。在 tiktoken 里,
world和world是两个完全不同的 token,模型得自己从数据里学会它们其实是同一个概念;add_dummy_prefix就是想对抗这一点。Llama 2 也开了这个选项。
对 sentencepiece 的总评: 「一、有大量历史包袱和容易让人困惑的概念(比如"句子"),藏着"脚下枪"; 二、优点是在业界广泛使用,因为高效、且训练+推理都支持; 三、有些怪癖我觉得不优雅(UNK token 必须存在、byte fallback 的实现方式); 四、而且不得不说,它的文档不太好——我花了很多时间自己可视化、试错才搞明白。」
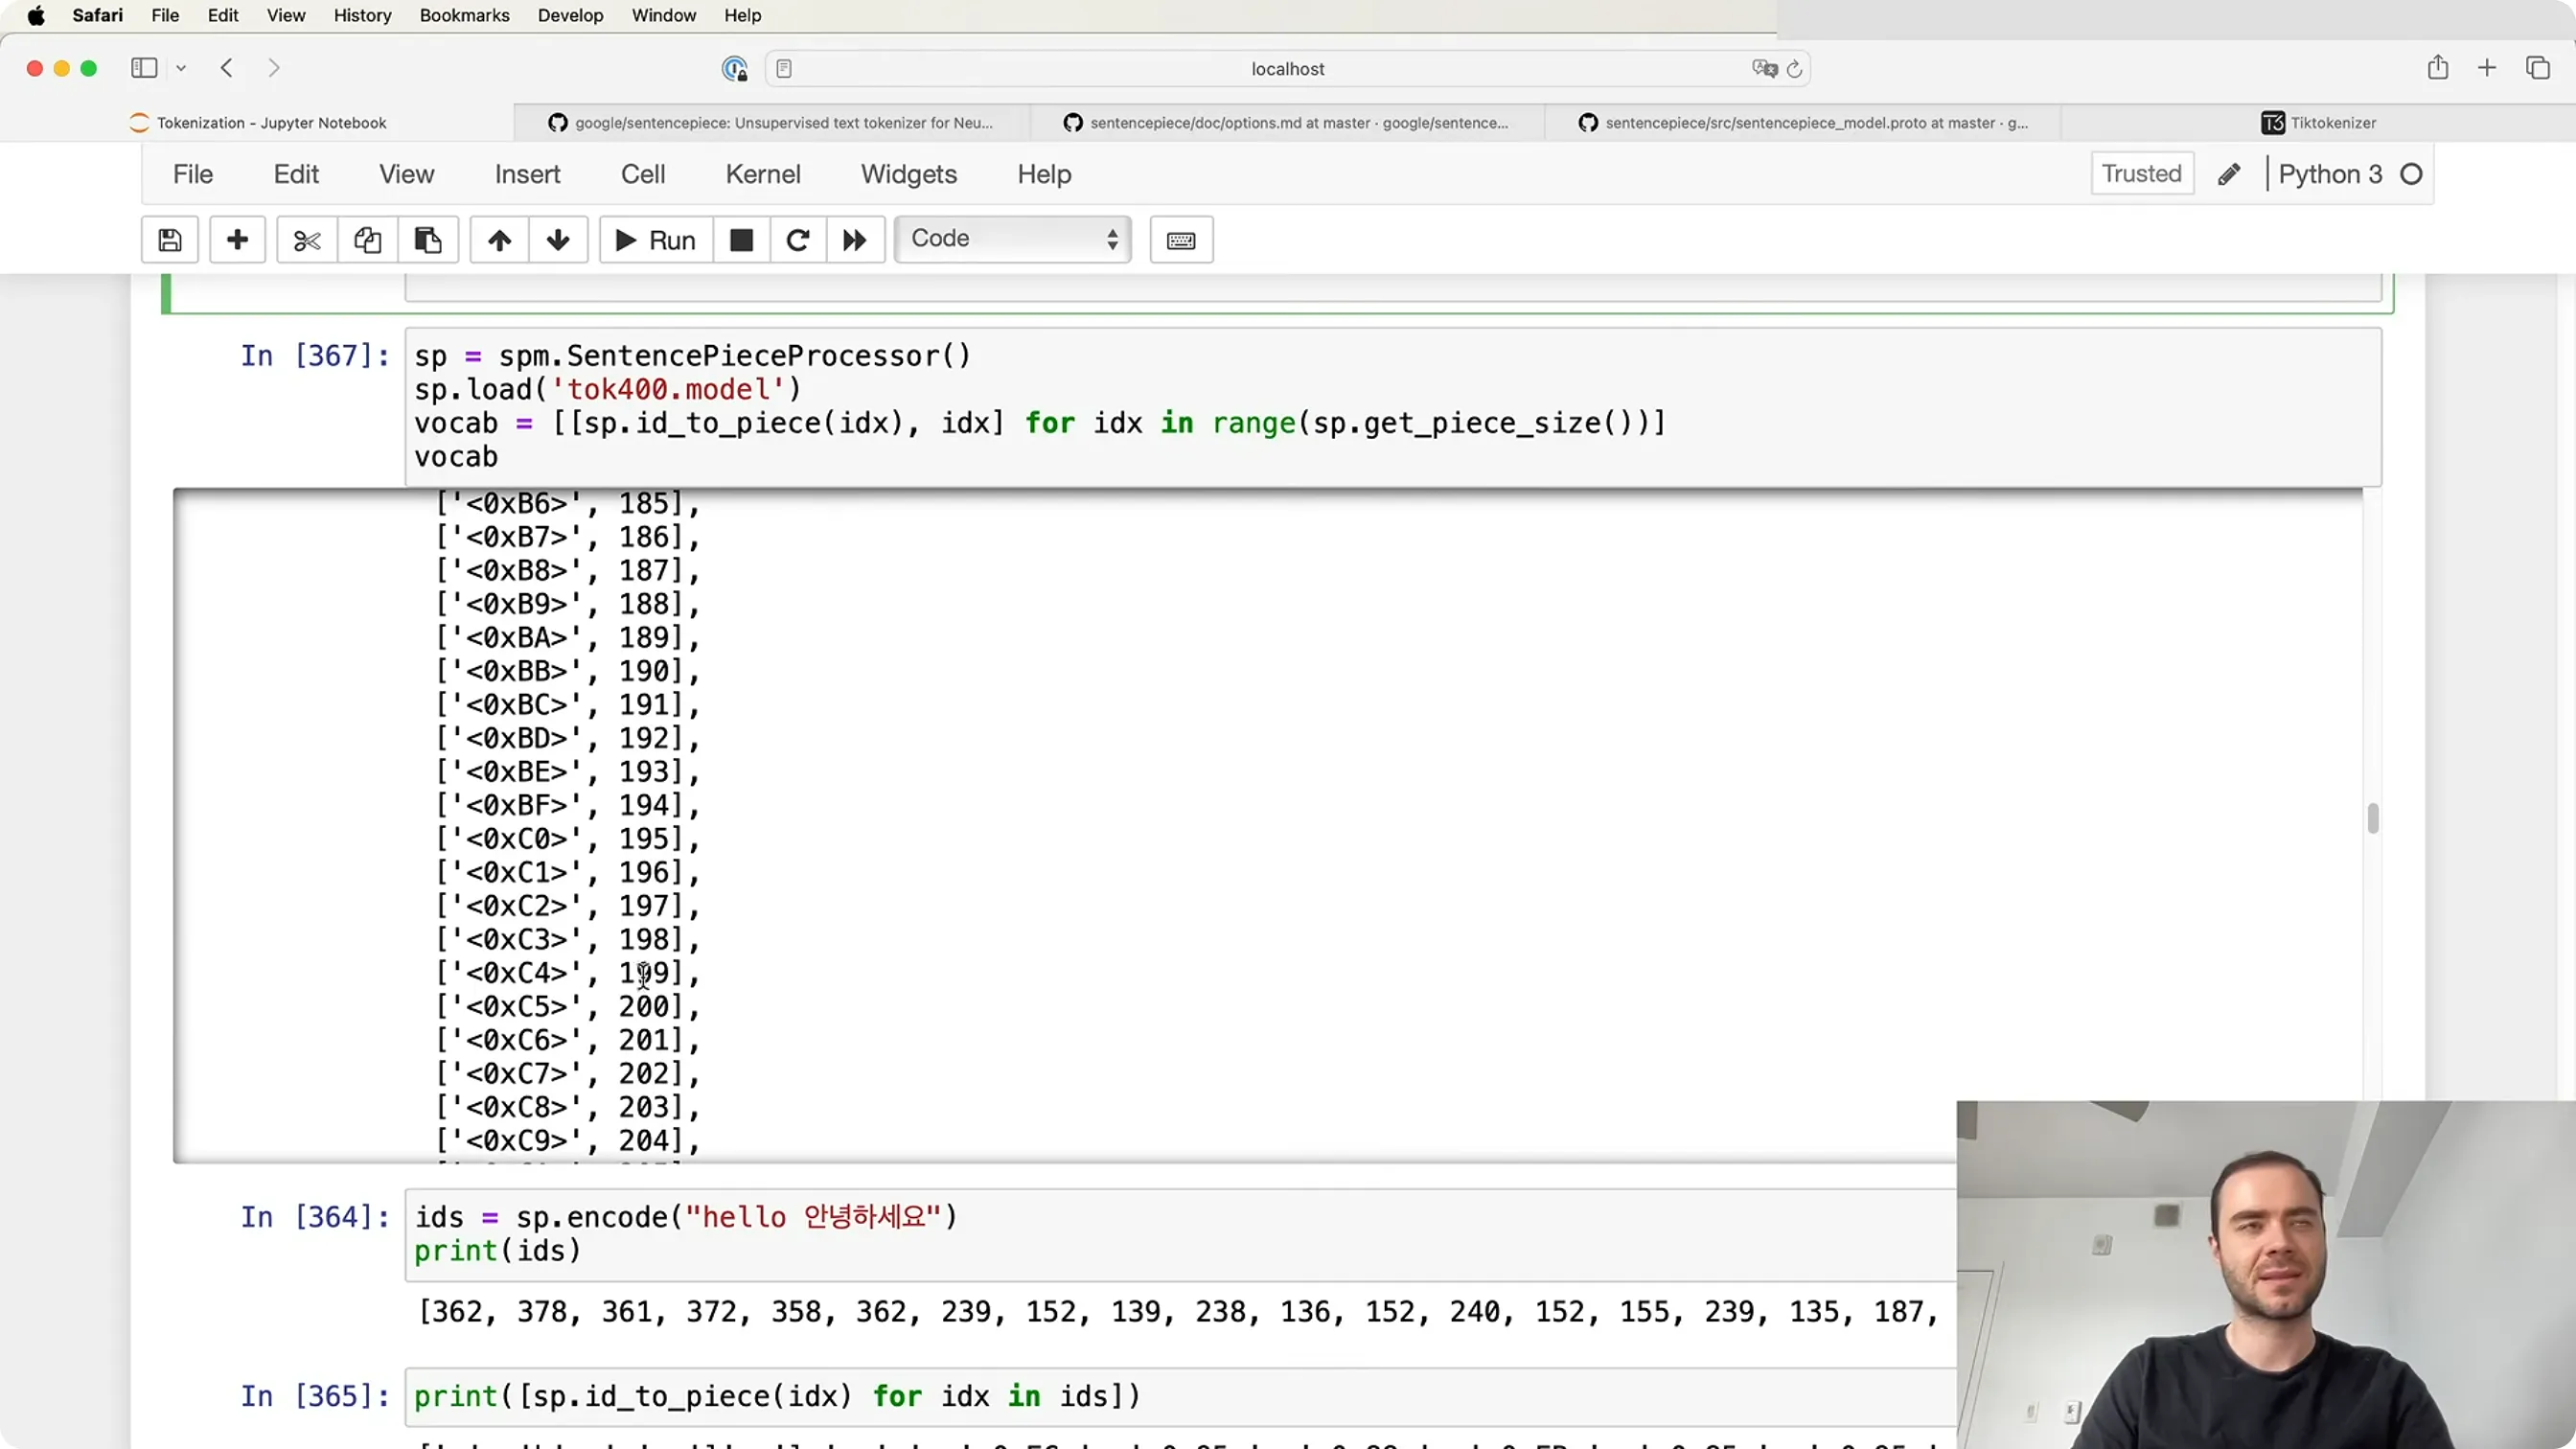
📷 sentencepiece 的 vocab 排布:特殊 token → byte token → merges → 码点 token
回到原视频 (01:37:00)
十四、词表大小到底该怎么定?
(参考时间: 1:43:27)
回到上一讲的 GPT 模型。搜一下 vocab_size 出现的地方——只有两处:
token_embedding_table:nn.Embedding(vocab_size, n_embed)——词表大小就是行数;lm_head:nn.Linear(n_embed, vocab_size)——要为每一个可能的下一个 token 产生概率。
为什么不能无限大?
- 计算更贵:embedding 表更大、lm_head 这个线性层要为每个 token 多做一次点积;
- 参数可能训练不足: 「如果你有一百万个 token,那么每个 token 在训练数据里出现得越来越稀有——它会很少参与前向/反向传播,对应的向量就可能欠训练。」
- 序列会更短(好事),但也可能"把太多信息压进一个 token": 「压得太狠,Transformer 前向传播的"思考量"就不够处理这些信息了。」
「这主要是个经验超参数——在今天最先进的架构里,通常是几万到十万左右。」
如果我们想给预训练模型扩充词表? ——很常见(ChatGPT 微调时就加了很多特殊 token 来标记对话结构、工具调用、浏览器等)。
「做法就是两次 resize:embedding 加行(小随机数初始化)+ lm_head 的权重加列。这是很轻的模型手术。」 「通常会冻结基础模型,只训练这些新参数。」
十五、训练"新 token":一个有意思的设计空间
(参考时间: 1:48:11)
「其实"往词表里加新 token"远不止加特殊 token 这么简单——这里有一整个设计空间。」
例子:用 gist token 压缩 prompt。假设你的应用需要很长的 prompt——「编码它、注意它,一切都变得又慢又重」。这篇论文的做法是:
引入几个新的 token,把它们放进序列里,然后冻结整个模型、只训练这些新 token 的 embedding——通过蒸馏(distillation)优化它们,让模型的行为和"带那条长 prompt"时完全一致。 测试时你就可以扔掉那条长 prompt,只放这几个 token,性能几乎不变。
「这是一类"参数高效微调"技术——不动模型权重、不训 LoRA,只训练 token embedding。」 (这个方向本身可以单独讲一整期。)
十六、多模态的 tokenization
(参考时间: 1:49:58)
「最近有个很重要的势头:怎么让同一个 Transformer 同时处理文本以外的模态——图像、视频、音频?」
正在收敛的共识是:不改架构。
「你依然用 Transformer——只是把你那些输入域"token 化",然后假装它们就是文本 token,剩下的一切照旧。」
- 图像:把图片切成 patch(块),每个 patch 变成一个整数 → 图像的 token。这些 token 可以是硬 token(强制为整数)也可以是软 token(不要求离散,但强制经过瓶颈,如自编码器)。
- 视频:「Sora 那篇论文让很多人惊掉下巴」——里面就提到:LLM 有 text token,Sora 有 visual patch。他们对视频做了同样的切块,得到自己的词表,然后既可以用自回归模型处理离散 token,也可以用扩散模型处理软 token。
「这些都是正在被积极设计和研究的方向,超出了本讲范围,但值得提一句。」
十七、回过头来:这些"怪事"为什么发生
(参考时间: 1:51:41)
这是本讲最有价值的部分——回到开头的那些现象,逐条用 tokenization 解释。
① 为什么 LLM 拼写不好?
去 GPT-4 词表里找较长的 token:default style 本身就是一个 token!
「我的怀疑是:这一个 token 里塞了太多东西,模型不应该擅长和这个 token 相关的"拼写"任务。」
实验:问「default style 这个词里有几个字母 L?」——它数错了(说有 3 个,实际 4 个)。
更狠的实验:让它把 default style 反转——直接做给出的是乱七八糟的字符串。但换个问法:
「第一步:逐字符用空格分开展示;第二步:反转那个列表」 ——它这次做对了。
「它没法直接反转,但一旦先把字符"拆开"列出来,它就能一步步做对。 因为这时每个字符都成了独立的 token,它"看得到"它们了。」
② 为什么非英语更差?
不只是模型看到的非英语数据少——tokenizer 本身也没在非英语上充分训练。
hello how are you是 5 个 token,它的韩语翻译是 15 个 token——3 倍膨胀。 「(韩语的)안녕 就是最普通的"你好",居然要 3 个 token,而我们的 hello 只要 1 个。」 一切都更"膨胀、更发散"——这就是非英语表现更差的部分原因。
③ 为什么算术差?
数字的切分完全任意,而竖式加法是字符级的(要先对齐个位、十位、百位)——「但这些数字的表示完全是任意的,取决于 tokenization 时哪些合并发生了、哪些没发生。」
有一篇很好的博客 Integer tokenization is insane 系统地考察了数字的切分:四位数可能是 1 个 token、或
1+3、2+2、3+1——完全任意。 「这对语言模型绝对是"逆风",它能做到已经很了不起了,但显然不理想。」 👉 所以 Meta 训 Llama 2 时(用 sentencepiece)特意把所有数字逐位拆开——部分就是为了改善算术能力。
④ 为什么 GPT-2 的 Python 差?
「一部分是模型和数据集的问题,但一部分就是 tokenization」——每个空格一个独立 token(220),严重压缩了模型能注意到的上下文长度。
「这几乎就是 GPT-2 的一个 tokenization bug——后来在 GPT-4 里被修掉了。」
⑤ 为什么给模型看 <|endoftext|> 它就"卡住"?
让它打印字符串
endoftext——它先是拒绝、然后干脆不打印。 「我不知道 OpenAI 内部是怎么处理的」,但如果在用户可控的文本里把特殊 token 也解析了,那用户 prompt 就是攻击面。 「如果你想搞乱 LLM,就往里面塞特殊 token 试试。」——这是安全问题。
⑥ 尾随空格(trailing whitespace)的警告
在 completion 里输入 here's a tagline for an ice cream shop(结尾多一个空格):
API 警告:"your text ends in a trailing space which causes worse performance due to how API splits text into tokens"。
为什么? GPT-2 的 token 是"空格 + 词"的形式:o(token 8840)是一个 token。正常的训练数据里是 ... shop 后面接 oh——token 边界落在 o 上。
但你在结尾自己加了一个空格,它就变成独立的 token 220——等于"提前开始了下一个 token"。 「模型见过"单独的 space"的数据非常非常少,于是它被推出了数据分布,接下来发生什么就随意了。」
⑦ 更极端的例子:default cell sta(少了 le)
「我打赌模型在训练集里从没见过
default cell sta这种组合——它总是以完整的default style出现(单个 token)。」 结果:提交后模型立刻输出了 stop token,API 报错 "the model predicted a completion that begins with a stop sequence";再试一次又提示违反使用政策。 「这简直是在给它"脑损伤"——它从没见过这个,它震惊了,只能说 end of text 之类的东西。」他把这类问题统称为"部分 token(partial tokens / unstable tokens)"问题: 要么你"只完成了下一个 token 的前几个字符",要么你手上是"长 token 的一部分"。 如果你去 tiktoken 的 Rust 源码里搜
unstable,会看到一大堆处理代码——而这些完全没有任何文档。 「一个理想的 completion API 应该更聪明:不是"机械地把下一个 token 接上去",而是在所有可能的高概率续写里搜索一个"字符",从而只加一个字符。这非常难描述、也非常扎手,但根源就是 tokenization。」
⑧ 压轴:SolidGoldMagikarp(他最爱的一个)
(参考时间: 2:04:00)
有人在 token embedding 空间里做聚类,发现了一簇非常奇怪的 token:rot、e、stream、Fame、SolidGoldMagikarp、Signet、message……
更诡异的是:你只要让模型复述 SolidGoldMagikarp 这个字符串,模型就会各种崩——回避、幻觉、甚至骂人。
原因(推测,但很有说服力):
SolidGoldMagikarp是一个 Reddit 用户名。 tokenizer 的训练集和 LLM 的训练集不一样: * tokenizer 的训练集里(可能包含大量 Reddit 数据)这个名字出现极多,于是被合并成了一个专用 token——在 5 万词表里占了整整一个位置; * 但 LLM 的实际训练集里(Reddit 数据不在其中)这个 token 从未出现过。后果:这个 token 在 embedding 表里的那一行,从头到尾没有被采样过、没有被更新过——它完全没被训练。 「它就像 C 程序里的"未分配内存"(unallocated memory)——测试时你一触发这个 token,就等于把一行未训练的权重喂进 Transformer,产生未定义行为(undefined behavior)。」
「任何这类奇怪 token 都会触发这种表现,因为本质上模型处于"分布外"。」
👉 这既是 AI 安全问题,也是安全漏洞。
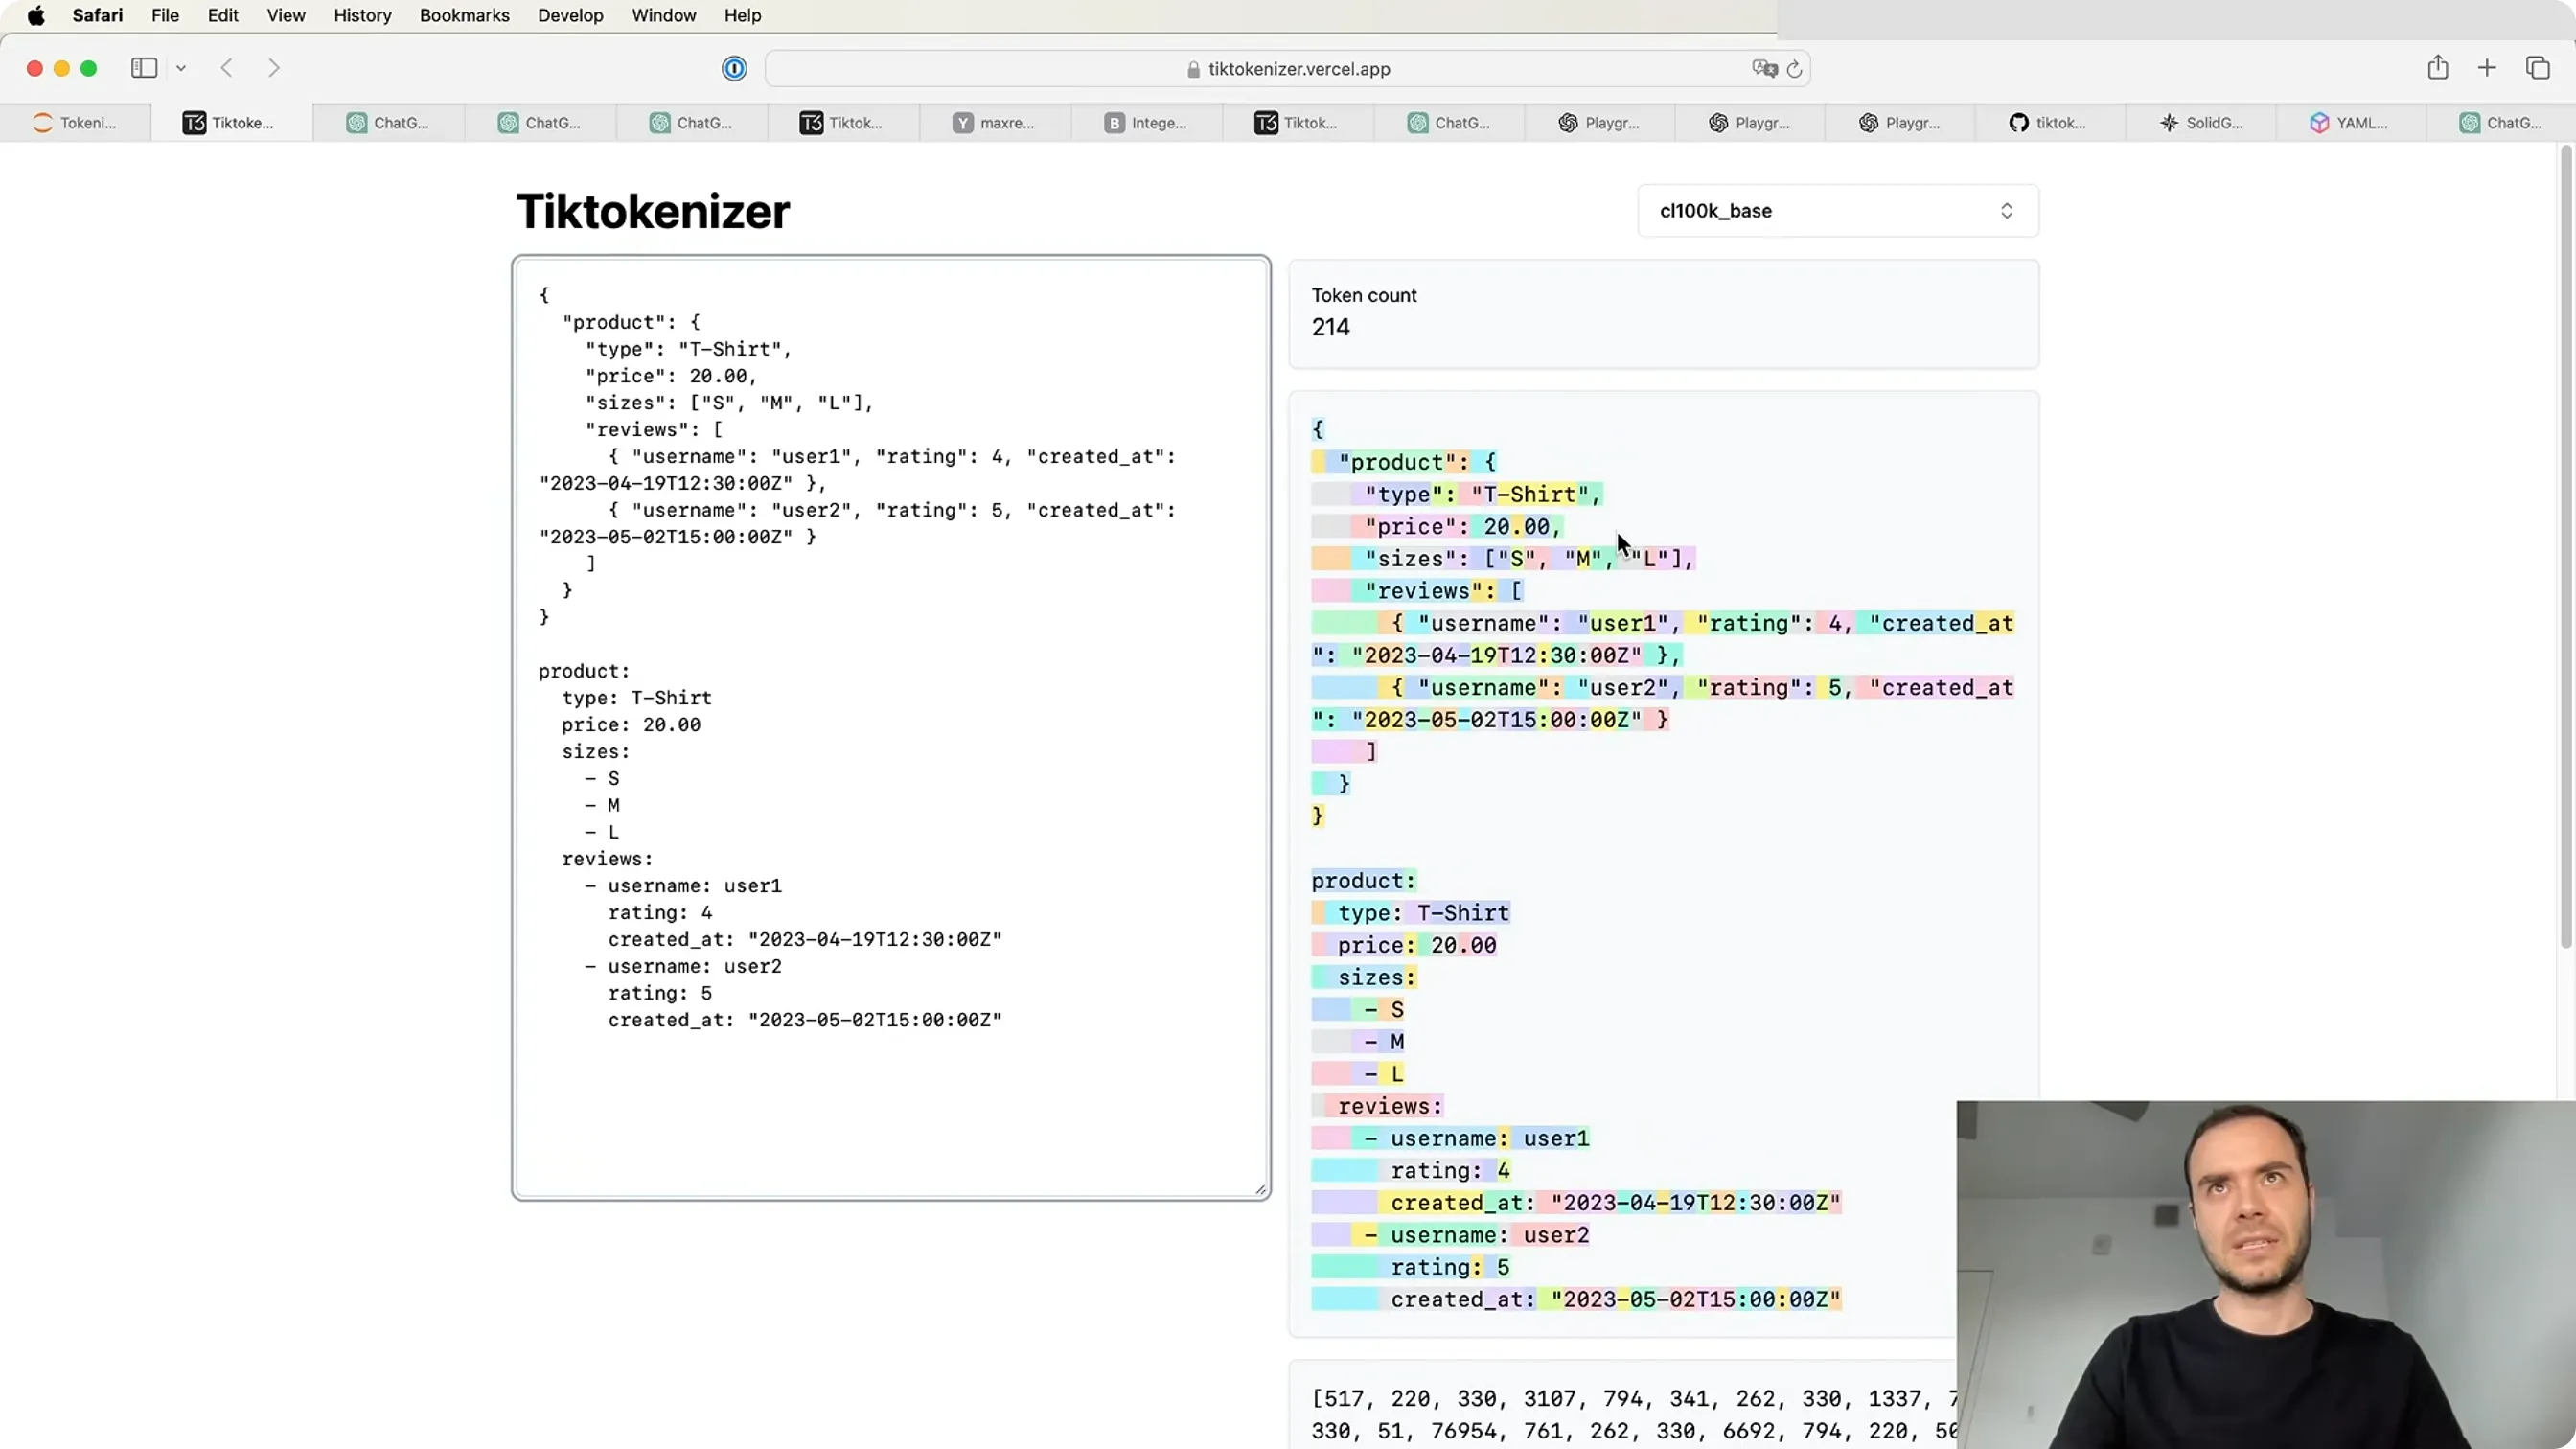
⑨ 最后一条:JSON vs YAML
同样内容的 JSON 是 116 个 token,YAML 是 99 个。
「在"token 经济"里——你按 token 付费、按上下文长度付费、按美元付费——你该优先用 YAML 而不是 JSON。」 「tokenization 密度是你必须时刻关心的事:去找高效的编码方案,多花时间在 tiktokenizer 里测量不同格式的 token 效率。」
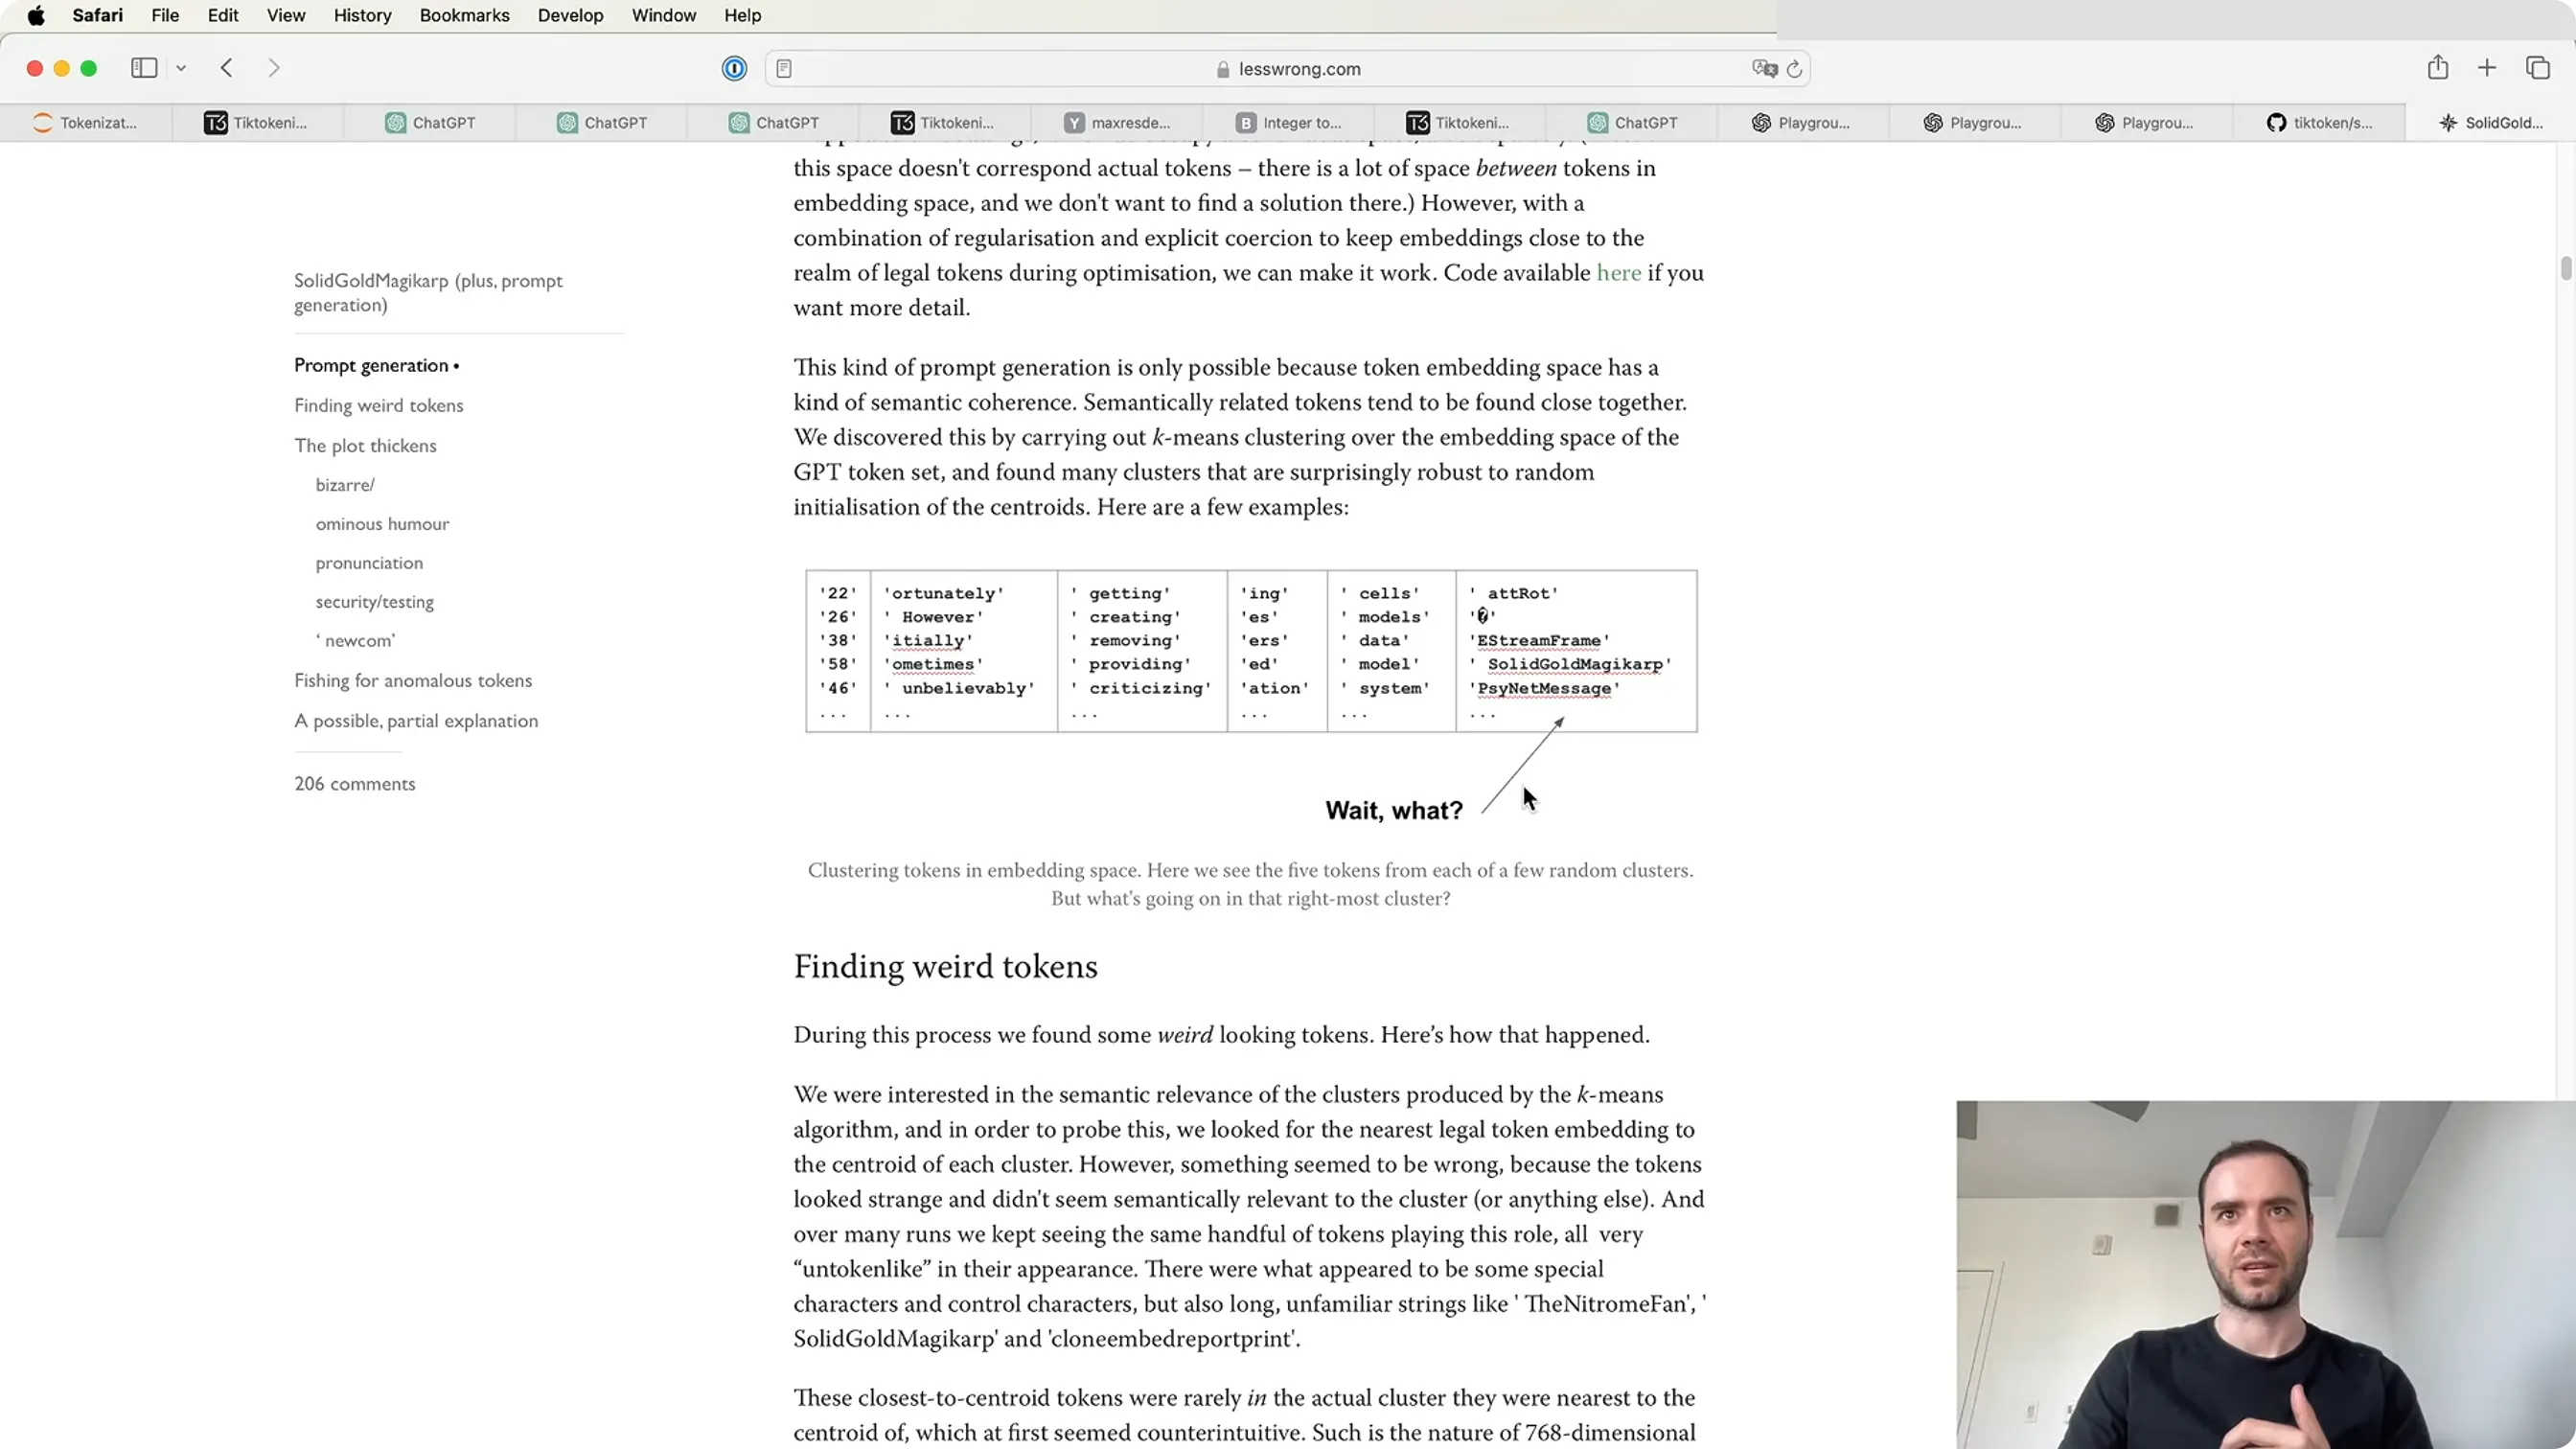
📷 SolidGoldMagikarp:token embedding 空间里那簇"未训练"的奇怪 token
回到原视频 (02:05:30)
📷 同一份结构化数据:JSON 116 tokens vs YAML 99 tokens
回到原视频 (02:09:30)
十八、结语与建议
(参考时间: 2:10:20)
「这就结束了我这段相当长的 tokenization 视频。我知道它很枯燥、很烦人、很让人恼火——我个人非常讨厌这个环节。」
「但我必须说:不要忽视它。 这里有很多"脚下枪"、很多锋利的边角,有安全问题、有 AI 安全问题——就像我们看到的"把未分配内存插进语言模型"那样。 所以它值得你理解。」
「话虽如此——永恒的光荣属于那些能把它整个干掉的人。 我给你们看了一篇尝试这么做的论文,我希望以后能有更多。」
最后给出的实操建议:
- 能复用 GPT-4 的 token 和词表,就复用——直接用 tiktoken,「它是一个非常高效的推理库」;
- 「我也很喜欢 OpenAI 用的这种"字节级 BPE"」;
- 如果因为某些原因你必须从零训词表——用 BPE + sentencepiece。 「但如前所述,我不是 sentencepiece 的粉丝:我不喜欢它的 byte fallback、不喜欢它在码点上做 BPE、它还有一百万个设置——非常容易配错,一不小心就会把句子截断(因为某个你没完全理解的参数)。」 「所以要非常小心那些设置:要么原样照抄 Meta 的做法,要么花大量时间通读 sentencepiece 的代码,确认你用对了。」
- 「但即便设置全对,我仍然认为这个算法不如这边(字节级 BPE)。如果你真的需要训自己的词表,也许最好的办法是等 minbpe 做到足够高效——我希望能继续做这件事。」
「我们真正想要的,是"tiktoken 的推理能力 + 训练代码"——那个东西目前还不存在。 minbpe 是它的一个实现,但目前是 Python 写的。」
附:官方参考与延伸阅读
- 课程主页:https://karpathy.ai/zero-to-hero.html
- 🟢 本讲 Colab:https://colab.research.google.com/drive/1y0KnCFZvGVf_odSfcNAws6kcDD7HsI0L?usp=sharing
- minbpe 仓库:https://github.com/karpathy/minbpe
- 🎯
exercise.md(四步练习):https://github.com/karpathy/minbpe/blob/master/exercise.md - 🖥️ tiktokenizer:https://tiktokenizer.vercel.app
- tiktoken:https://github.com/openai/tiktoken
- sentencepiece:https://github.com/google/sentencepiece
- 📄 GPT-2 论文:https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
- 📄 GPT-3 论文:https://arxiv.org/abs/2005.14165
- 📄 LFQ / VQ-VAE(向量量化,多模态 token 化):https://arxiv.org/abs/1711.00937
- 📄 Sora 技术报告:https://openai.com/research/video-generation-models-as-world-simulators
- Blog:Integer tokenization is insane:https://www.beren.io/2023-02-11-Integer-tokenization-is-insane/
- Blog:SolidGoldMagikarp:https://www.lesswrong.com/posts/aPeJE8bSo6rAFoLqg/solidgoldmagikarp-plus-prompt-generation
- 讨论 Discord:https://discord.gg/3zy8kqD9Cp
版权说明:本书内容依据 Andrej Karpathy 的公开教学视频 Let's build the GPT Tokenizer 重构,代码与数据集版权归原作者所有,遵循其仓库所附许可(MIT License)。本电子书仅用于学习交流,不用于商业用途。