第5讲 · 程序和进程:从 CrazyOS 到 fork / execve / exit
2026 南京大学《操作系统原理》第五讲 · 课堂实录重构
| 主讲 | 蒋炎岩(Yanyan Jiang) |
| 视频 | https://www.bilibili.com/video/BV1N8w9zJENu/ |
| 课程主页 | https://jyywiki.cn/OS/2026/ |
| 本讲讲义 | https://jyywiki.cn/OS/2026/lect5.md |
| 讲义 / 幻灯片作者 | 蒋炎岩,https://jyywiki.cn/ |
| 讲义 / 幻灯片许可 | CC BY-NC 4.0 |
| 图片来源 | 书中插图为课堂演示与讲义渲染图;演示类截图为视频画面 |
对应讲次:第5讲(南京大学 操作系统原理)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者说明:本书由课堂录像的语音字幕重构而成,术语、章节骨架与参考链接已按课程官方讲义(
lect5.md)校准。讲师的口语风格、类比与案例被尽量保留;编辑性的补充一律以「编者说明」或「编者拓展」标出。
引子:一台能编程的「玩具」,和一次澄清
(参考时间: 00:00)
从这一讲起,我们正式进入《操作系统》的正片。开场讲师带来了一台玩具——Book8088:一台真的搭载 8088 CPU 的 16 位计算机(外设则用更现代的方式实现)。
它远不止是个摆设:讲师当场用一条命令画出一条线段,又用两条命令让喇叭发出两个不同频率的声音。这么一台「什么都没有」的老机器,和今天的计算机系统并没有本质区别——LD 工具链、一条 line 11 100 指令、一个「有点像 IDE 的编辑器」,就能做几乎任何事情。「你可以想象,如果那个时候就有 Claude Code,真的可以实现任何东西。」
编者拓展|8088 意味着什么:8088 是 Intel 1979 年推出的 16 位处理器,IBM PC 的心脏。它是实模式(real mode)的:没有保护模式、没有分页、没有 MMU。也就是说,程序对内存的访问是「裸」的——没有虚拟地址、没有权限检查。讲师反复强调这一点,是因为它把「操作系统的虚拟化」这个主题衬托得格外清楚:在一个连 MMU 都没有的机器上,我们凭什么让多个程序「同时」运行?
紧接着是一次迟到两讲的澄清:上一讲那个帮我们「vibe code 一个内核」的模型,如果你直接问它,它会说自己是 Anthropic 的 4.6;但日志里写的是 doubao-seed-2.0-code——它其实调用的是豆包。讲师坦白:豆包是当时最快、上课体验最好的选择,但后续给它更多任务后发现,它和 Anthropic、Codex 这类模型相比智力很低、各种不听指令。「但即便这样一个不听指令的模型,都能帮我做操作系统实验——这世界进步得很快,我们可能都要花点时间赶上它的变化。」
编者说明:注意这里的判断——「不听指令」不等于「没用」。它的强大不在于「乖巧」,而在于在关键问题上能给出可用的代码。这个观察会贯穿整门课。
回顾:操作系统有两个视角,也都有明确的数学模型
在进入正片之前,讲师快速回顾了前两讲的骨架:
- 应用视角:操作系统 = 对象 + API——一堆系统调用和它们操作的对象;
- 硬件视角:操作系统 = 程序——一段被固件加载、在 CPU 上跑起来的普通代码。
两者都有非常明确的数学模型:
graph LR
    A["应用程序"] -->|从 main(argc, argv) 开始<br>执行语句| S["状态机<br>(memory + register)"]
    B["计算机"] -->|从 CPU Reset 开始<br>执行固件指令| S
- 应用程序从一个固定的初始状态(
main的参数)开始,执行语句; - 机器从CPU Reset 开始,执行固件指令。
计算机世界里没有魔法。哪怕今天你不需要亲手弄清楚每一个 bit 的行为(AI 知道),你背后始终要相信:所有事情都是有答案的。有了这个信念,你就可以像第一讲那样,从一个最小的链接脚本、一条 goto 出发,一点一点把系统里所有的谜题解开。
本讲正式进入 虚拟化(virtualization)——OSTEP 三部分(virtualization / concurrency / persistence)的第一部分,核心问题就是:
操作系统怎么把一台物理计算机,虚拟成很多台「程序仿佛独占」的计算机?
这个抽象的名字,叫进程(process)。
一、CrazyOS:用一个程序去模拟操作系统
1.1 一个疯狂的想法
(参考时间: 00:06)
把时间倒回 1980 年代,我们只有一台没有 MMU、没有中断的计算机。问题来了:
如果有一个 C 程序,里面 P1 和 P2 都是死循环——不借助操作系统,能不能让它们「看起来在同时执行」?
直觉上不行:C 程序是顺序执行的,会先跑完 P1 再跑 P2。但讲师提醒我们回忆非递归版的汉诺塔(Tower of Hanoi):
graph TD
    I["解释器主循环"] --> F["取一条语句/指令"]
    F --> E["执行它"]
    E -->|call / return| S["(按约定)调整<br>函数调用的状态"]
    E -->|普通语句| I
    S --> I
任何一个程序,都可以写成一个解释器:取一条语句、执行、再取一条。P1 和 P2 本身也是两个状态机(各有自己的栈和全局变量),那我们完全可以:从 P1 里取一条语句执行,再从 P2 里取一条执行……
编者拓展|「解释器」为什么能统一一切:这背后是一个很深的结论——通用图灵机。只要把「程序」表示成数据(这里是一串指令),再写一个能逐条「取指—译码—执行」的循环,这个循环就能模拟任意一台机器。汉诺塔的非递归版本只是这个思想的一个小例子;而真正的操作系统,本质上也是一个这样的循环,只不过它有硬件帮忙:它不是「解释」指令,而是直接把进程的状态装进 CPU让它跑一会儿。
1.2 CrazyOS:把「单步执行」变成操作系统
(参考时间: 00:11)
于是就有了 CrazyOS——一个死循环:
while (1) {
    p = pickup_one();     // 随便挑一个程序(轮转)
    p->single_step();     // 让它往前执行一条指令
}
如果这条指令是系统调用(syscall),CrazyOS 就替它执行——比如实现一个打印字符的 putchar,或者一个 exit(执行后就把这块内存释放掉,这个程序从此不再被调用)。
这正是操作系统的主循环。区别只在于:
- CrazyOS 是「取一条指令、执行一条指令」;
- 真实操作系统是
p->run_sometime_on_cpu()——把进程的状态装到 CPU 上运行一会儿,发生中断后再换下一个。这个过程叫上下文切换(context switch)。
编者拓展|上下文切换(context switch)到底存了什么:把一个进程「从 CPU 上换下来」时,内核要保存它的全部执行现场——PC、通用寄存器、栈指针、页表基址等;换上下一个进程时,再恢复它自己的现场。同时还要更新内核中该进程的状态(从「运行」改为「就绪」)。这一保存一恢复就叫上下文切换,它是「时间片轮转」「并发假象」得以成立的物理基础,本身也是不小的开销(因此真实系统会尽量避免过于频繁地切换)。
讲师说:这门课不讲上下文切换的实现细节,只建立概念——操作系统把 P1 放到 CPU 上跑一会儿,中断后换成 P2,如此轮转,就制造出了「并发执行」的假象。
好消息是:我们前面已经有了一台现成的「单步执行器」——mini-rv32ima(那个能模拟执行一条 RISC-V 指令的模拟器)。
编者拓展|mini-rv32ima 是什么:它是一个极简的 RISC-V 模拟器(rv32ima:32 位、带整数乘除、原子指令)。它维护一个 CPU 状态结构(
pc和 32 个寄存器)和一块内存,每调用一次就「执行一条指令」。对 CrazyOS 来说,它简直是天作之合:给每个程序分配一份 CPU state 和一份内存,把二进制加载进去,然后不断single_step()——每个程序就成了一个可被独立推进的状态机。
1.3 可怕的 demo:让 AI 写出来
(参考时间: 00:11)
讲师给了一个 prompt,然后 CrazyOS 就被实现出来了:它可以加载命令行里指定的多个 RISC-V 二进制文件(p1.bin p2.bin …),用 mini-rv32ima 单步执行,并处理 syscall。演示里:
p1.c:局部变量x = 0,每次x += 10再打印;p2.c:每次x += 1再打印。
有两个关键函数:
- 头部的
_start——相当于 libc 入口,程序的第一条指令落在这里,它再调用main; - 自己实现的
putchar系统调用——把要打印的字符放到a0、系统调用号42放到a7,然后执行ecall。
编译则是:RISC-V 的 gcc 编译成 ELF,再用 objcopy 把指令序列抽出来变成裸 binary。运行 CrazyOS p1.bin 会打印 10 20 30 …;运行两个 p2 会看到 1 1 2 2 3 3 …;把 P1 和 P2 交替运行,则能看到公平轮转的错觉。
有意思的细节:P2 跑得比 P1 快。原因是 CrazyOS 每次只执行一条指令,而 P1 打印的数字更大、printf 的执行时间更长——所以在「每条指令轮转一次」的公平策略下,两者会逐渐拉开差距(演示里 P2 已经数到 69,P1 才到 61)。这恰好也说明:操作系统的调度策略,会直接影响程序观察到的执行速度。
讲师说:「这就是操作系统的全部。」 理论上,你可以在这个 CrazyOS 的基础上,把 Linux 上所有的东西都实现出来。
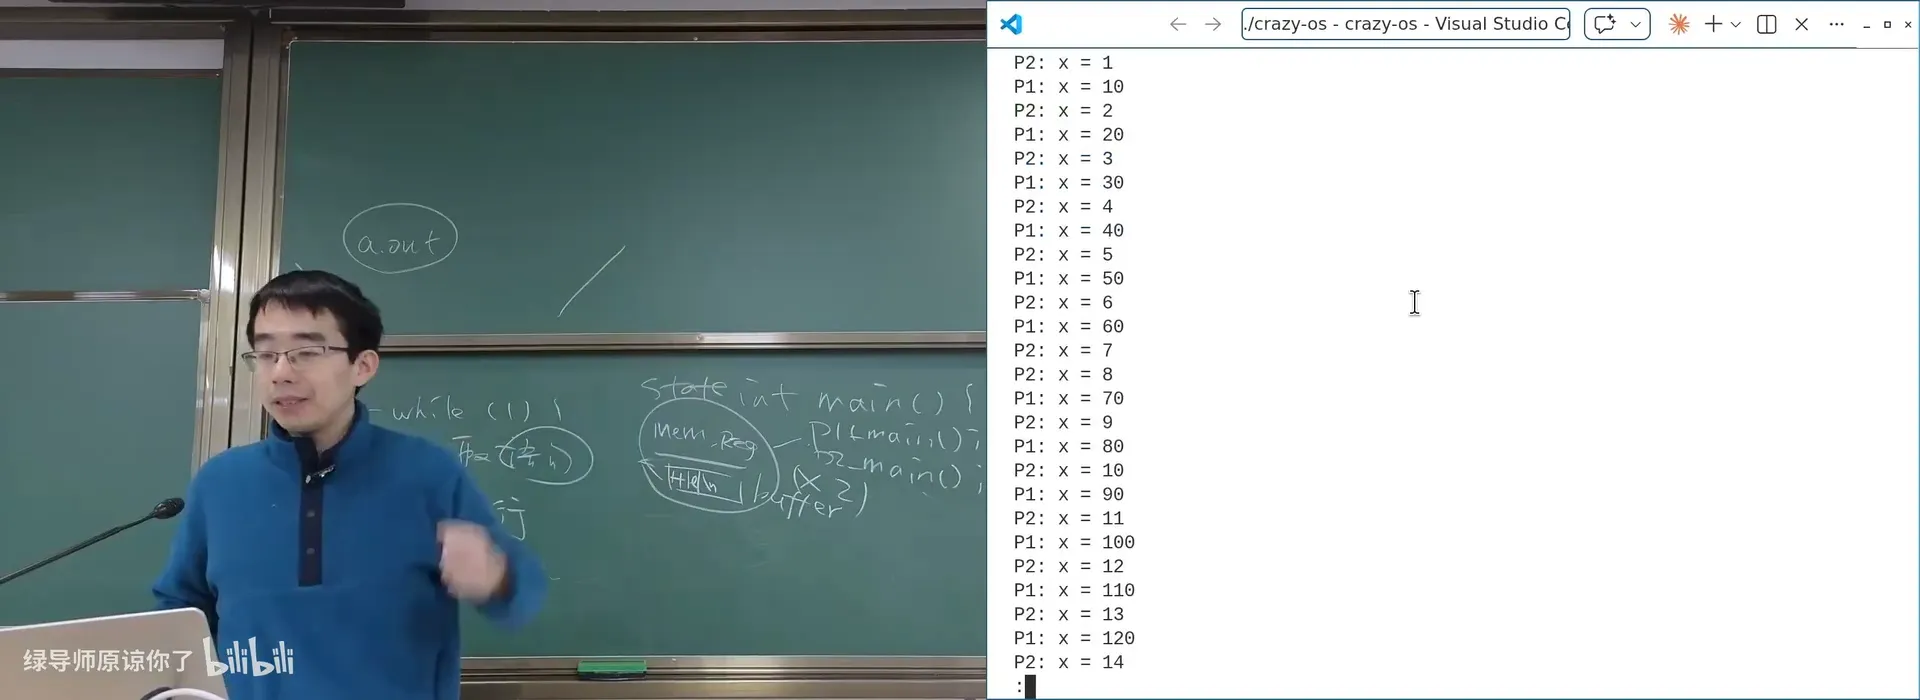
📷 CrazyOS 交替运行 P1 与 P2:公平轮转下的输出
回到原视频 (00:19:30)
1.4 程序 vs 进程
(参考时间: 00:20)
有了 CrazyOS 这个极简模型,两个核心概念就清楚了:
- 程序(program):一个状态机(语义)的静态描述——描述了初始状态和状态迁移规则,像一份「配方」:从这里开始,给我做 A、B、C、D、E,该调系统调用就调,该计算就计算。它本身只是一串字节序列(ELF 文件也好、文本也好)。
- 进程(process):程序运行起来之后的样子——一个「进行中的状态机实例」。同一份程序可以同时跑出多个进程。
graph LR
    P["程序 P1<br>(静态:状态机描述)"] -->|运行/加载| R1["进程 A<br>(一份完整状态)"]
    P -->|再运行一次| R2["进程 B<br>(另一份完整状态)"]
操作系统为每个进程分配资源——一份独立的内存和寄存器,此外还维护一批应用不直接可见的操作系统内部状态。CrazyOS 里那个「每个进程专属的输出缓冲区」(buf)就是最简单的例子:同一个 putchar,P1 和 P2 各有一份缓冲。
于是:
操作系统是一个「无情执行指令的机器」——它和硬件一样,只是一个状态机;区别是它会做进程的分时复用:选一个进程到 CPU 上跑一会儿;如果碰到系统调用,就替它执行系统调用的契约。
二、进程的状态:操作系统到底藏了些什么?
2.1 问出一个好问题
(参考时间: 00:22)
既然操作系统维护了这么多进程状态,那么一个很自然的问题就是:
一个真实的操作系统,进程到底有哪些状态?
讲师说:问出正确的问题,就有最好的答案。 你可以像调试 CrazyOS 一样(gdb 一下、info registers、打印变量)去「探索」——但真实操作系统的进程状态,远不止「内存 + 寄存器」。
2.2 syscall:询问进程自身
(参考时间: 00:28)
如果进程想了解自己的状态(不在它的内存和寄存器里),唯一途径就是系统调用:getpid()、getppid()、getpgrp()、getsid()、getuid()、geteuid()、getgid()、getegid()……
编者拓展|为什么「自己的信息」也要系统调用:进程只能看到自己的内存和寄存器,而「进程号、父进程、打开的文件、运行了多久、占了多大内存」这些信息,都存在内核里。所以哪怕只是问「我是谁」,也必须通过
syscall这个受控接口去问内核。这又一次印证了那句「操作系统 = 对象 + API」:进程本身就是内核管理的一个对象,而 syscall 就是操作这些对象的方法。
2.3 procfs:把进程信息变成文件
(参考时间: 00:30)
另一个更有趣的途径,是 UNIX 从很早就有的发明——procfs。它把内核里的进程信息暴露成一个文件系统,挂在 /proc 下:
/proc/[pid]/          每个进程一个目录
/proc/self/           指向「我自己」
进入 /proc/<pid>/,你会发现一大堆文件:cmdline(启动时的命令行)、status、stat、maps(内存映射)、fd/(打开的文件)……讲师现场用 ps 查到自己的 shell 的 pid,再 cat /proc/<pid>/cmdline,看到的就是这个 shell 是怎么被启动的。
编者拓展|procfs 是一座「宝库」,也有它的脾气:
/proc里的很多文件是伪文件——读它们会触发内核代码,临时生成内容(比如/proc/meminfo、/proc/<pid>/maps)。它是最权威的进程信息来源之一,但格式随内核演进、官方文档零散,所以想认真探索最好去读 Linux 内核文档(man 5 proc也有),而不是只信博客。讲师给出的「正确打开方式」是:让 AI 去读这些文件、读内核文档,再一句一句追问你真正想问的问题。
2.4 从这个模型出发,整门课可以用「问题」组织
(参考时间: 00:27)
讲师展示了 AI 帮他生成的一份「进程到底有哪些状态」的清单:pid、ppid、pgid、uid/euid/gid/egid、cmdline、调度信息、打开的文件(持有的操作系统对象指针)、内存……「一个真实的操作系统里,进程持有的信息比你想象的要多。」
他因此半开玩笑地说:「开局一个 CrazyOS,整个操作系统课可以用 30 到 50 个问题来组织。」 因为有了这个极简模型,你就有了提出正确问题的能力——剩下的,可以追着 AI 一步步问下去。
编者说明:这是本讲乃至整个「AI 时代」学习方法的核心:你负责提出好问题、建立正确的概念模型;把「知识检索」和「细节生成」交给 AI。 后面的每一个系统调用,都可以用这个方式去深挖。
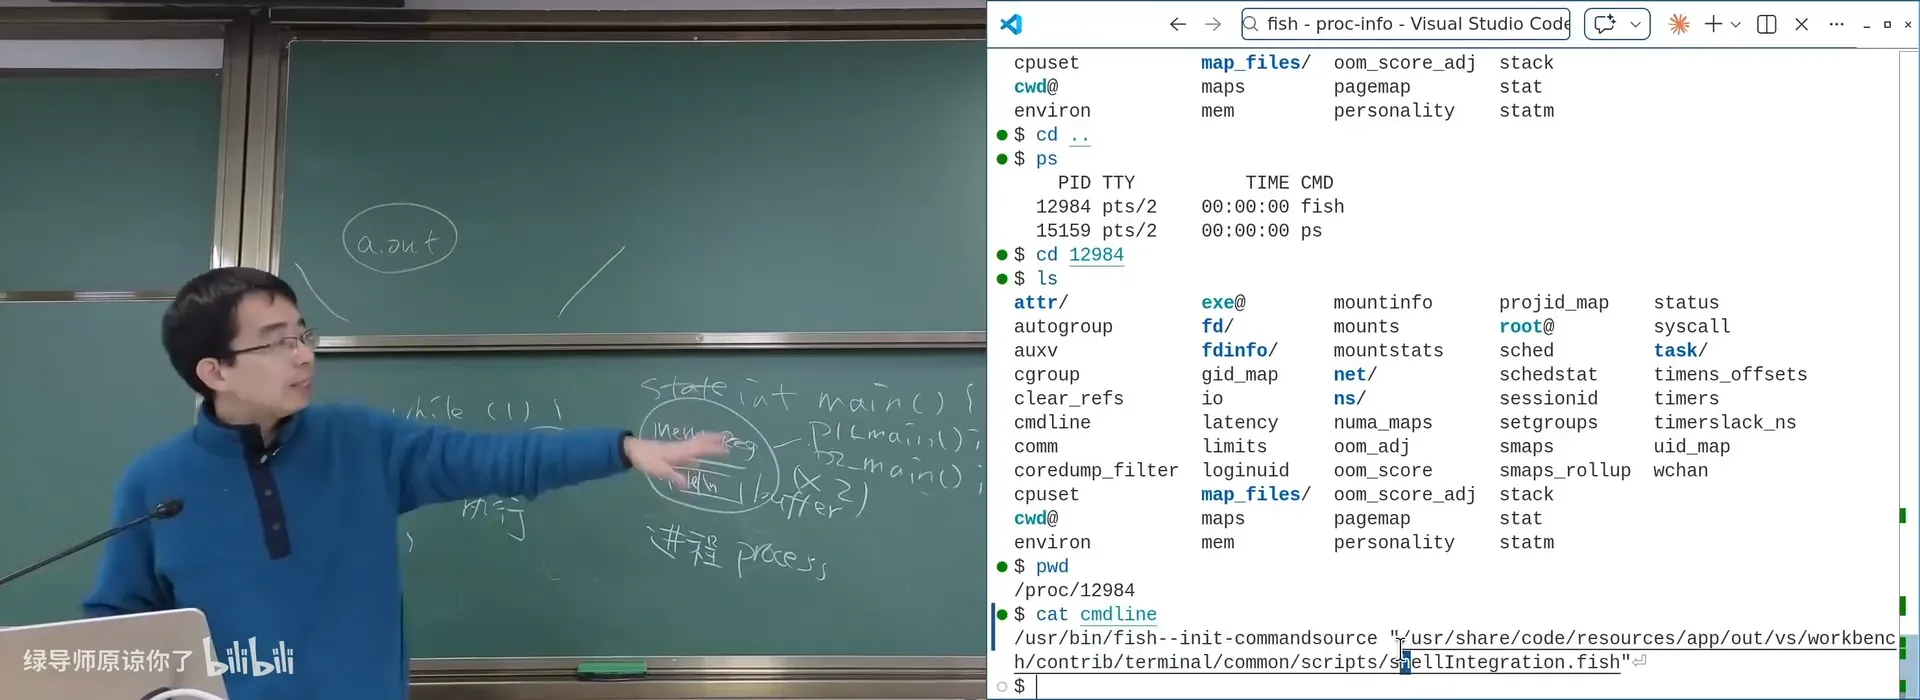
📷 /proc 下的进程目录:cmdline、status、maps、fd 等信息
回到原视频 (00:31:30)
三、进程管理的系统调用
(参考时间: 00:34)
回到主线。因为操作系统启动后只有一个 init(PID 1),世界里的一切进程——shell、VSCode、浏览器——都是从这个「始祖」一级一级孵化出来的。所以操作系统必须提供创建 / 销毁进程的一整套系统调用。
先看看真实的进程世界:ps 出来是一棵树,根通常是 systemd(严格说,Linux 启动的第一个程序不叫 systemd,但最终它会变成 systemd)。你的终端模拟器(比如 foot)孵化出 fish,fish 再孵化出 python3……
编者拓展|PID 1 的来历:内核启动的最后一步,会加载并运行第一个用户态程序(传统上叫
init),它的 PID 恒为 1,且永不退出。之后所有进程都直接或间接由它fork出来。现代发行版里init常常是systemd。这个「单一始祖」的性质非常重要——它保证每个进程的ppid永远有合法归宿(见 §3.4)。
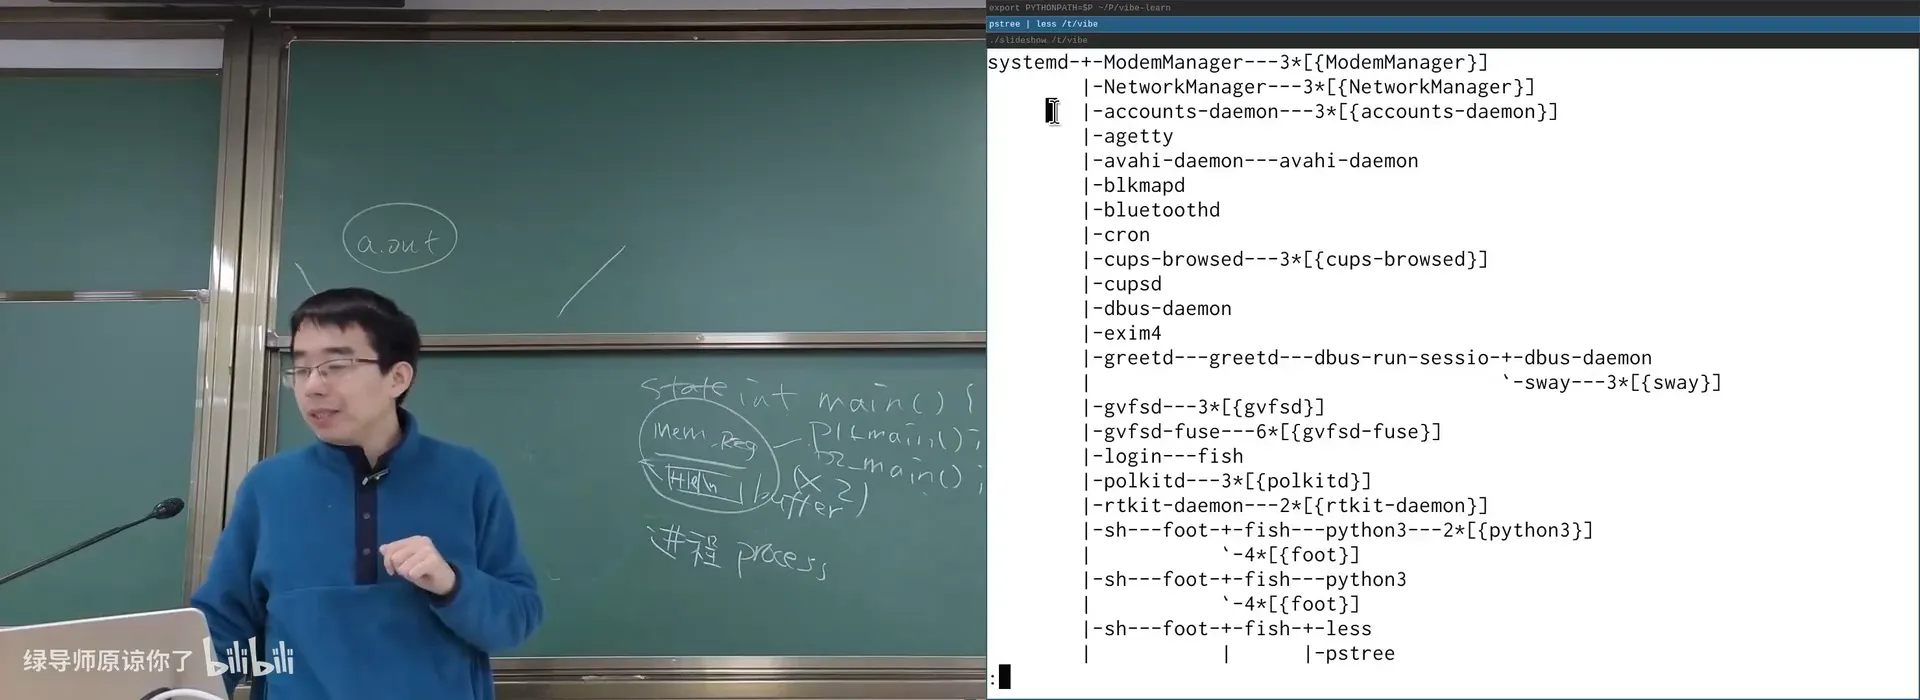
📷 ps 展示的进程树:systemd → foot → fish → python
回到原视频 (00:35:00)
3.1 创建进程:spawn,还是 fork?
(参考时间: 00:36)
现在到了本讲最有意思的设计问题:
如果让你为操作系统设计「创建进程」的 API,你会设计成什么样?
直觉方案:spawn(path, argv) ——直接在系统里创建一个新状态机,从那个程序的初始状态开始执行;配套一个 _exit() 销毁它。这在状态机视角里非常干净。(Windows 就是这么做的:CreateProcess 给你一个 .exe,再给 main 传参,程序就启动起来。)甚至你们在 VS Code 里点「运行」按钮弹出黑窗口,后台执行的就是 spawn。
UNIX 的答案却完全不同,而且更「绕」:
- 复制状态机:
fork() - 复位状态机:
execve() - 销毁状态机:
_exit()
3.2 fork():原封不动地复制一份
(参考时间: 00:40)
UNIX 的想法是:既然「我现在就是一个状态机」,那创建新进程时,干脆把当前状态原封不动地复制一份——内存的每一个字节、寄存器的每一个字节,连同操作系统里为该进程保存的状态,全部拷贝。
graph TD
    A["进程 A<br>pc / 寄存器 / 内存 / OS 状态"] -->|"fork()"| A2["进程 A<br>(原样)"]
    A -->|"fork()"| B["新进程 B<br>(A 的完整副本)"]
原型就是 CrazyOS 里的做法:一个字节一个字节地拷贝。这里有一个很容易被忽略的细节——连操作系统内部的、共享的对象也会被「按住」继承。比如 A 持有一个指向终端(TTY)的指针,那么 fork 出来的子进程默认也输出到同一个终端:「这就是为什么你在 VS Code 里创建子进程,它默认还是输出到同一个终端。」
为了区分「谁执行了 fork、谁是被创建出来的」,返回值被设计成:
编者拓展|
pid_t与「一切皆整数」:pid_t是「进程号」的类型(通常就是int)——说白了,就是内核给你发的一个整数编号。你在本书会反复看到一个模式:操作系统里的对象,往往都先给你一个整数「句柄」(fd、pid……),真正的本体在内核里。这样既避免了直接暴露内核指针的安全风险,也让接口简单、稳定、可跨版本。
- 执行
fork的父进程:返回子进程的进程号; - 新创建的子进程:返回
0; - 出错:返回
-1(errno给出原因,见man fork)。
编者拓展|
errno与perror:C 语言没有异常,系统调用和库函数用返回值表示失败(通常返回-1或NULL),失败的原因则写进一个全局变量errno。perror("fork")会打印「fork: <错误原因>」,strerror(errno)能把错误码转成可读字符串。这是 C 系统编程里最基础的错误处理惯例。
于是编程模型就是那个经典的四段式:
pid_t pid = fork();
if (pid == -1) {          // 出错
    perror("fork");
} else if (pid == 0) {    // 子进程
    // ...
} else {                  // 父进程,pid 是子进程号
    // ...
}
编者拓展|Linux 的 fork 为什么其实很快(copy-on-write):CrazyOS 那种「逐字节拷贝」如果照搬,创建一个进程就要复制几百 MB 内存,代价惊人。真实的 Linux 用的是 写时复制(copy-on-write, COW):
fork之后父子进程先共享同一批物理内存页,只有某一方真正去写某一页时,内核才把那一页复制出来。这带来两个后果:①fork本身极快,几乎与内存大小无关;② 如果一批数据是只读共享的(比如预计算好的素数表),那么无论 fork 出多少个进程,这份数据在物理内存里始终只有一份。这也正是「先算好公共部分、再 fork 分开处理」这种用法的性能基础。编者说明:讲师在课上明确点破了这一点——「Linux 上的 fork 实现非常高效,它没有像 crazyOS 那样逐字节拷贝;如果素数表只读共享,创建一千、一万个子进程,这份大表也只有一个副本。」
3.3 进程树与「孤儿」
(参考时间: 00:45)
既然进程可以再创建进程,全世界的进程就构成一棵进程树:A → B → C。但这里立刻冒出一个棘手的问题:
如果 B 退出了,C 的
ppid是谁?
看似简单(把 C「往上提」一层挂到 A),实际很麻烦:
- 子进程结束通常要通知父进程(通过
SIGCHLD信号,父进程可以捕获);如果自动「往上提」,这个通知就可能发错人;
编者拓展|信号(signal):信号是操作系统发给进程的一种异步通知——像软件层面的「中断」。进程可以注册处理函数(捕获)、忽略或采用默认行为。
SIGCHLD就是「子进程状态改变(退出 / 暂停)」的专用信号;此外还有SIGINT(Ctrl-C)、SIGSEGV(段错误)、SIGKILL(不可被捕获、强杀)等。信号是进程间通信最轻量的一种形式,但也是最难用对的之一。 - PID 会被复用:过一段时间,原来 B 的编号可能被另一个进程占用——如果 C 还记着「我的父亲是编号 X」,那它的父亲就凭空变了。
UNIX 的经典解法是利用「一号进程永不终止」这一事实:任何失去父亲的进程,都会被「过继」给 PID 1(俗称「孤儿进程被 reparent」)。这样,每个进程的 ppid 永远是合法的;发给 1 号进程的消息,它通常会忽略。
编者拓展|孤儿、僵尸与 subreaper:这套机制有三个常被混淆的名词: - 孤儿进程:父进程先退出,子进程仍活着 → 被过继给 PID 1(或最近的 subreaper); - 僵尸进程(zombie):子进程已退出,但父进程还没
wait它,于是它的退出状态暂存在内核里(ps里显示为<defunct>); - PID 命名空间与「unique PID」:PID 会循环复用,内核有专门的机制(pid_namespace,以及/proc/sys/kernel/ns_last_pid)来管理「唯一标识」,避免「父亲编号被复用」这类歧义。讲师说这些细节不会在第一门操作系统课上展开,但「知道存在这件事」本身就是能力边界的一次扩展。
想验证「过继」行为?讲师的做法是:让 AI 写程序——创建一个 5 层的进程树,随机退出其中一些进程,观察退出前后父子关系的变化。程序甚至把结果打成 Mermaid 的树状图,重定向进 Markdown 文件预览,就能亲眼看到那棵树,以及某些节点被挂到 1 号进程下。
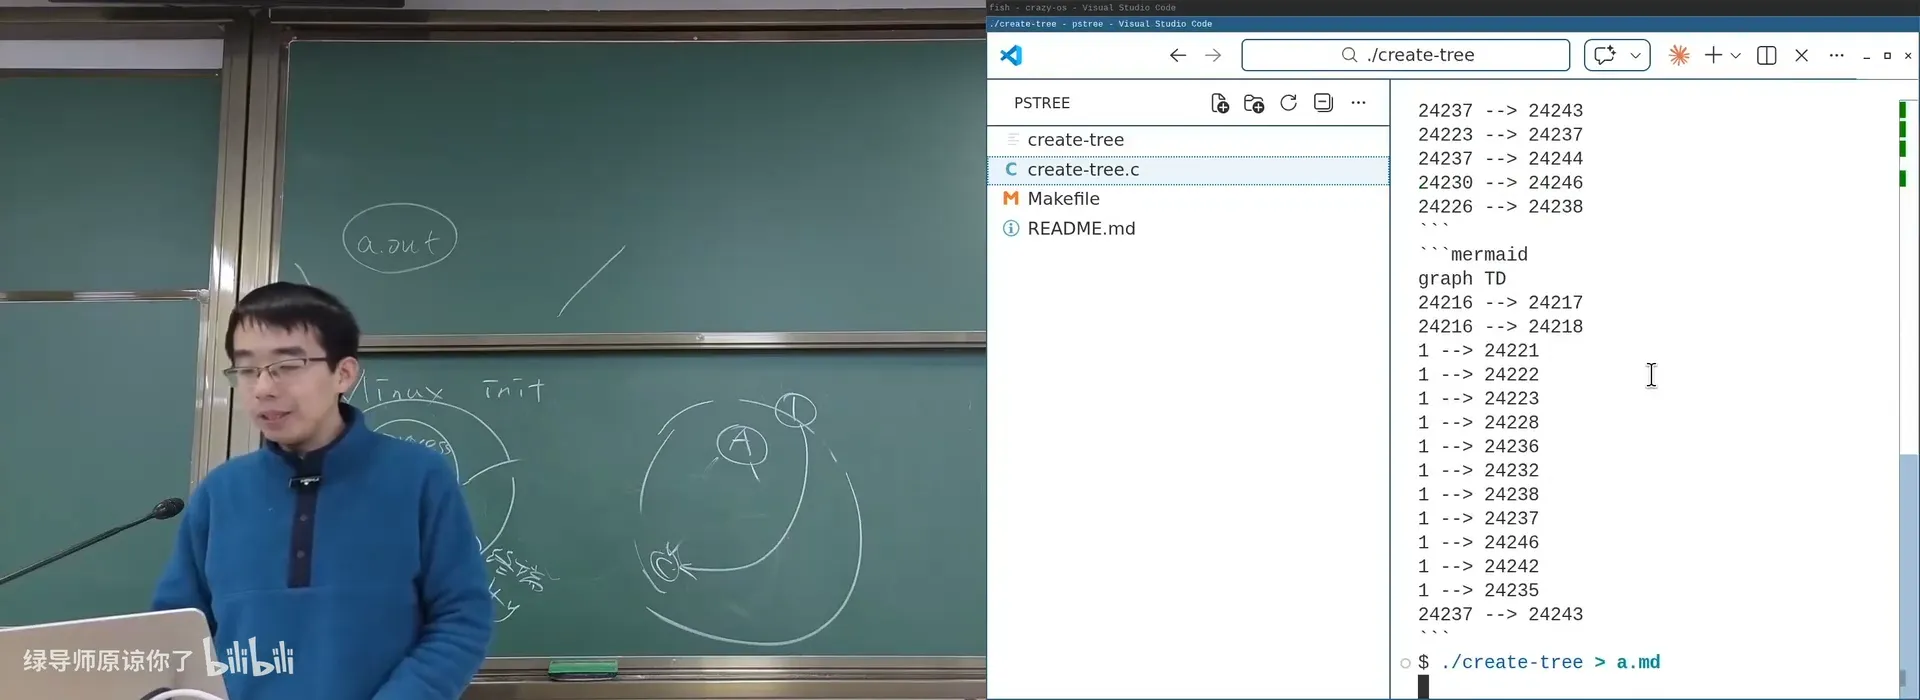
📷 5 层进程树(Mermaid 渲染):进程退出后孤儿被过继给 PID 1
回到原视频 (00:48:30)
3.4 fork 的用途:它到底能干什么花活?
(参考时间: 00:53)
既然 fork 只是「复制自己」,为什么 UNIX 要这么设计,而不是直接 spawn?因为完整的全量快照能玩出很多花活:
① 共享信息的预处理。 你要用多核并行算一个大任务,但每个分片都需要一份公共的预处理结果(比如先算出一张巨大的素数表)。做法是:先在一个进程里把素数表算出来,然后 fork——因为 fork 是状态的完整复制,所有子进程都能直接访问这份只读的共享数据,而物理内存里只有一份。
② Android Zygote:把「冷启动」变快。 安卓应用用 Java/ART 编写,main 开始前可能要加载、校验成百上千个类。在早期只有几百 MHz 主频的手机上,这段初始化会让 App 卡顿得难以忍受。Android 的解法是 Zygote Process:把公共的类加载、运行时初始化都做在一个「母体」进程里,等你点开一个 App 时,Linux 层面只是执行一次 fork,复制出来的子进程再「分化」成具体的应用。
graph TD
    Z["Zygote<br>(受精卵:预加载公共库与运行时)"] -->|fork| A["原神"]
    Z -->|fork| B["计算器"]
    Z -->|fork| C["…"]
    Z -.->|"自身保持不变"| Z
讲师用「受精卵」来比喻 Zygote:母细胞分裂时始终保持基因不变,分化出的细胞才变成心脏、骨骼——就像 fork 出的子进程变成不同的应用,而 Zygote 本身始终在那里。
编者拓展|Zygote 与「冷启动」:Android 的做法本质上是 fork 的写时复制 + 预加载:Zygote 在启动时预加载了 Android Framework 的公共类和资源,App 进程通过
fork继承这份已就绪的运行时,于是跳过了最昂贵的初始化。代价是:Zygote 里不能有非线程安全的状态被意外继承(比如已打开的锁、已连的 socket),否则子进程会「带病出生」——这也是 Android 后来引入Zygote.forkAndSpecialize等机制的原因。
③ 并行搜索(fork-based DFS)。 走迷宫的递归 DFS,通常靠「把状态当参数传」来维护搜索状态。借助 fork,你可以在每个搜索分支创建一个进程——因为 fork 会快照当前搜索状态,每个子进程沿着自己的分支继续 DFS,互不干扰,于是几乎不做任何修改就实现了并行搜索。
编者拓展|从 fork-based DFS 到 checkpoint / restore:顺着这个思路可以走得更远——既然
fork就是「进程状态的快照」,那么定期给程序做快照、出事时从快照恢复,就是可行的。这正是 CRIU(Checkpoint/Restore In Userspace)这类工具在做的事;在「程序有 bug 会崩」的场景里,它甚至可以让服务从快照里『复活』。讲师提到的「每隔几秒做一次快照,崩了就把快照拿回来继续服务」,说的就是这个思想。
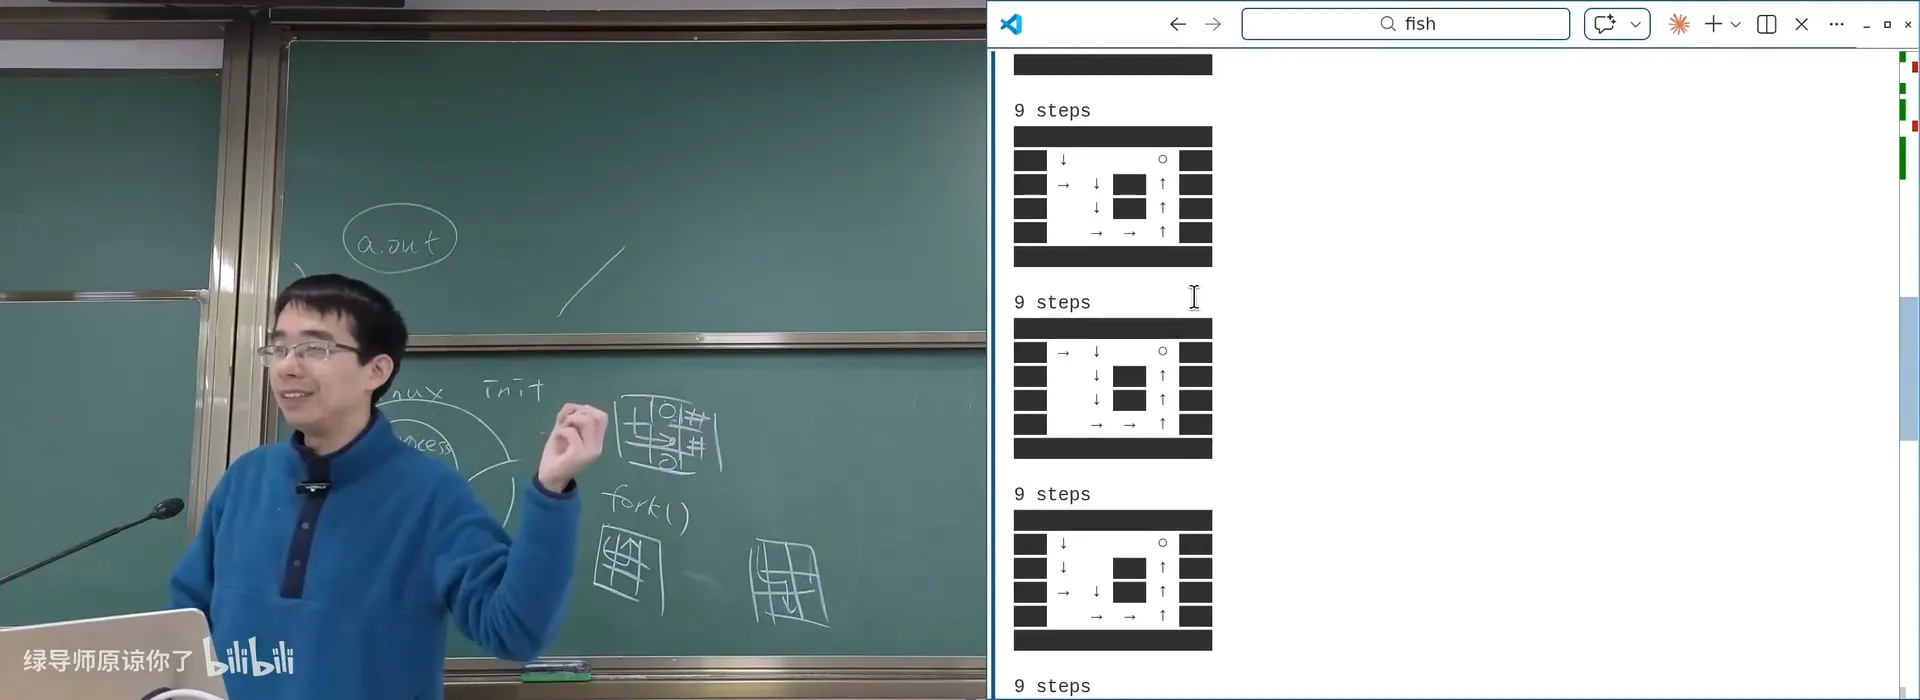
📷 fork-based DFS:九步的路径被并行地同时打印出来
回到原视频 (01:00:30)
3.5 Fork Bomb:状态复制的「核裂变」
(参考时间: 00:50)
fork 复制自己,那么「不停地 fork」会怎样?
while (1) fork();
这会发生指数级增长:1 变 2、2 变 4、4 变 8……和核弹的链式反应一模一样。系统里所有资源会在瞬间被耗尽——因为像 CrazyOS 那样的进程表是个固定大小的数组,用光了就再也创建不出进程,系统直接卡死。
- 在老式 UNIX 系统上,甚至一行 bash 就能炸掉系统:
:(){ :|:& };: - 今天的 Linux 有 OOM(Out-of-Memory)保护:资源耗尽时会杀掉一部分进程,能识别出是哪个进程组在捣乱,从而清掉 fork bomb。
编者拓展|fork bomb 那一行怎么读:
:(){ :|:& };:在 bash 里可以拆成: -:()定义一个名叫:的函数; -{ :|:& }函数体是运行自身两次(:|:用管道把两个副本连起来,&让它们后台运行); -;:立刻调用这个函数。于是每次调用都产生两个新调用,进程数指数爆炸。它的名字(fork bomb)形象地说明了
fork的本质——复制自己;而「在受控情况下根据返回值区分父子」,也是fork可以被正常使用的关键。
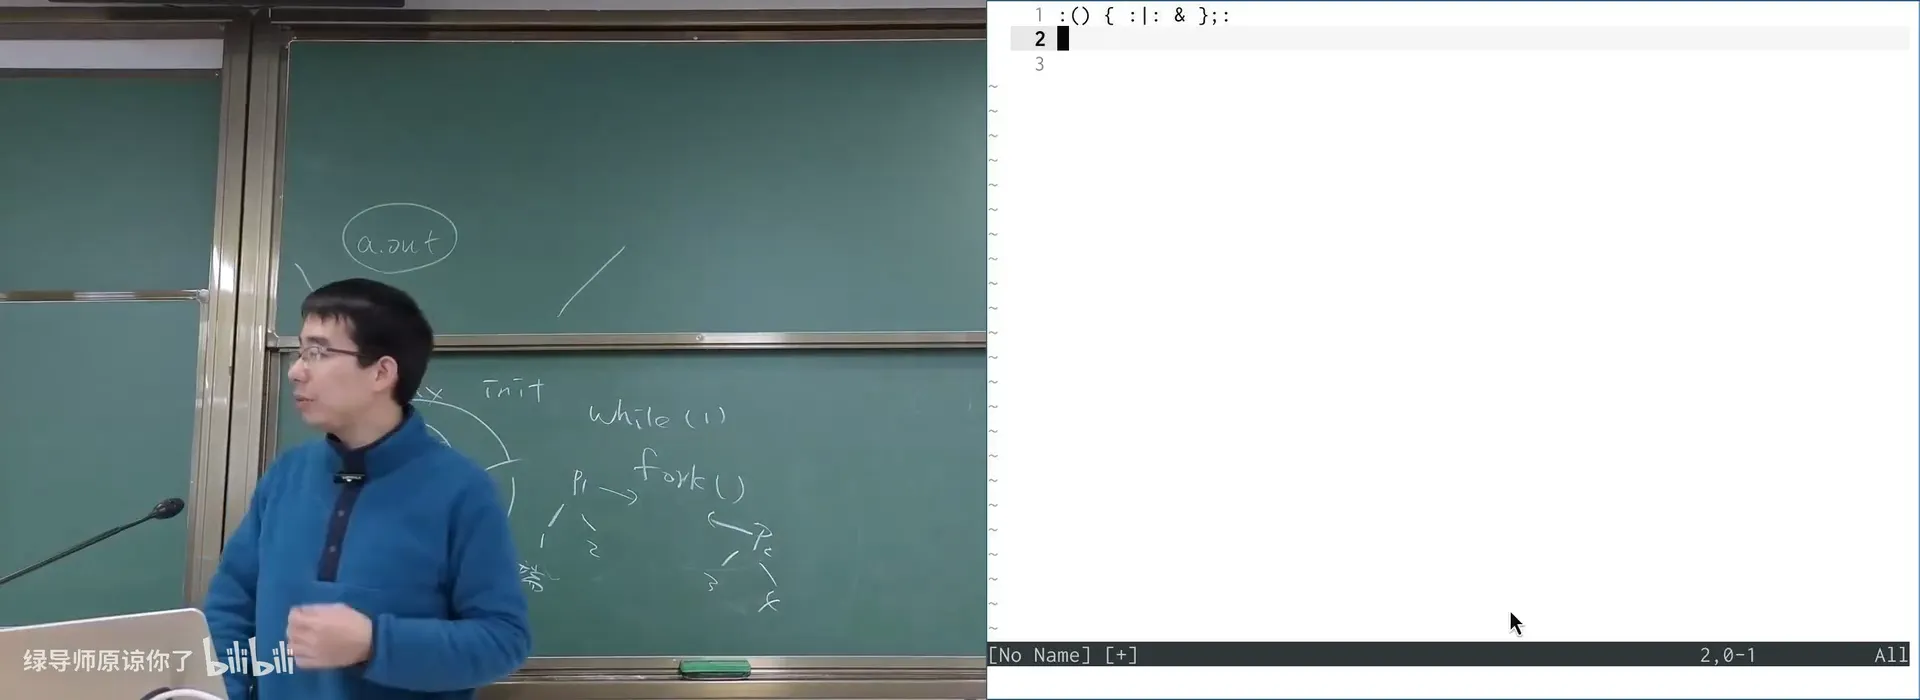
📷 bash 版 fork bomb 的一行代码
回到原视频 (00:52:30)
3.6 fork 的麻烦:一个「幽灵缓冲区」
(参考时间: 01:02)
fork 让写程序变得方便,也让理解程序行为变得困难。一道经典的期中题:
for (int i = 0; i < 2; i++) {
    fork();
    printf("Hello\n");
}
- 直觉推导:
fork后父子各打印一次,printf执行次数是 $2^0 + 2^1 + 2^2 = 7$?——不对,正确答案是 6 次(把循环展开、逐步单步,会得到 6 个Hello)。 - 但真正的坑在下一层:运行
./a.out打印 6 行;运行./a.out | cat却打印 8 行!
为什么?因为 printf 并不直接调用 write:libc 在 printf 和 write 之间插了一层用户态缓冲区。
- 当标准输出是终端时,默认是行缓冲——遇到换行就
write一次; - 当标准输出是文件/管道时,默认是全缓冲——攒够一个块(如 4 KB / 8 KB)才
write。
关键在于:这个缓冲区也是进程状态的一部分。所以当 fork 发生时,缓冲区的内容被原样复制了一份——Hello\n 还没被 write 出去,就被复制到了子进程里,最终重复输出。
编者拓展|行缓冲、全缓冲与
setbuf/stdbuf:C 标准库的 stdio 有三种缓冲模式: -_IONBF:无缓冲; -_IOLBF:行缓冲(终端默认); -_IOFBF:全缓冲(重定向到文件/管道时默认)。你可以用
setvbuf(3)/setbuf(3)在程序内改变它,或用stdbuf(1)在不修改程序的情况下强制缓冲模式(stdbuf -o0关闭缓冲、-oL行缓冲)。理解这一点,能解释一大类「我明明打印了,为什么看不到 / 为什么会重复」的诡异现象。教训:想搞清楚这类行为,就动用那句口号——「机器永远是对的」。提出假设(是缓冲区?),去求证(对比
strace的系统调用序列),然后你就真的弄懂了。strace ./a.out会显示:你肉眼看到的输出,都来自write系统调用;printf与write之间,隔着 libc 的缓冲.编者拓展|为什么缓冲区会被 fork 复制:因为
fork复制的是整个进程的用户态内存,而 stdio 缓冲区就是一段普通的堆内存。它不像「打开的文件描述符」那样有专门的内核语义——它只是内存字节。fork 忠实复制一切,包括那些「你没想到会被复制」的东西。这正是讲师反复强调的:在系统编程里,你必须知道系统里每一个部件的精确行为,才能做出正确判断。
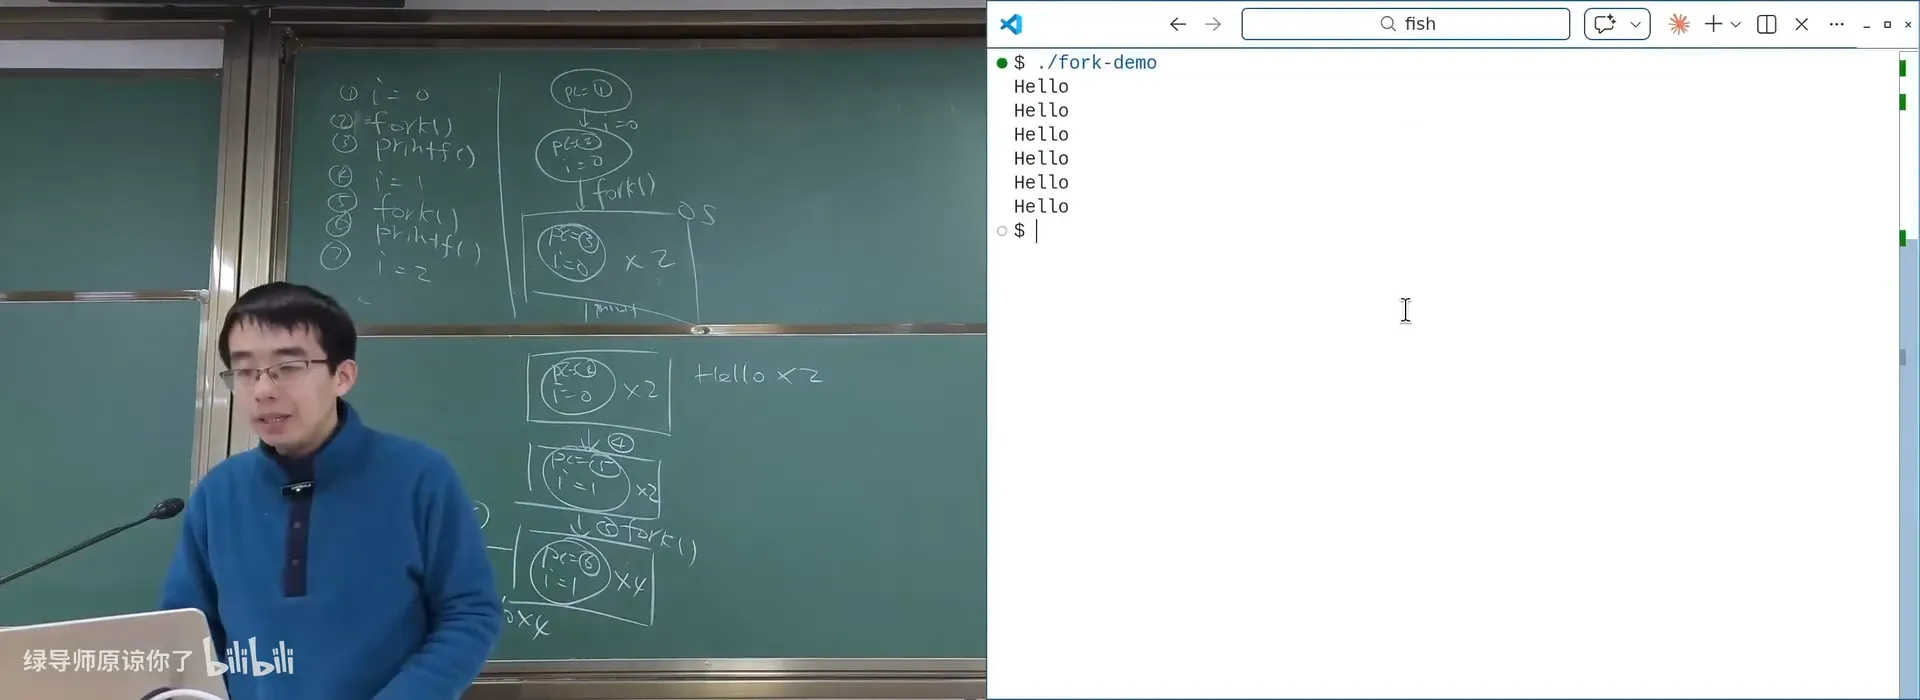
📷 同一个程序:./a.out 打印 6 行,./a.out | cat 打印 8 行
回到原视频 (01:06:55)
3.7 execve():让进程「复位」成另一个程序
(参考时间: 01:12)
fork 解决了「复制当前进程」,但没能解决「原生启动另一个程序」。如果系统里只有 fork,那么无论 fork 多少次,世界里永远只有「自己」的副本——你根本实现不了 spawn(比如启动 ls、wc、原神.exe)。
UNIX 的答案是再给一个系统调用:execve()。
int execve(const char *filename,
           char *const argv[],
           char *const envp[]);
它的行为是——把当前进程「就地复位」成另一个可执行文件描述的初始状态。
graph LR
    A["进程 A<br>(当前状态)"] -->|"fork()"| B["进程 B = A 的副本"]
    B -->|"execve()"| C["进程 B<br>= 新程序的初始状态<br>(程序 A 的状态就地销毁)"]
- 进程原有的状态被全部销毁——它变成另一个程序的初始状态(「状态机的复位」);
- 操作系统维护的状态基本不变:进程号、当前目录、打开的文件……都保留下来(所以后面才会有
O_CLOEXEC这样的机制来处理「打开的文件要不要跨execve保留」)。
编者拓展|
execve的三个参数与exec*家族:execve是唯一真正「执行程序」的系统调用,它的三个参数分别决定新程序的: -filename:可执行文件的路径; -argv:传给main的参数向量(argv[0]通常是程序名,后面是命令行参数); -envp:环境变量数组。POSIX 还提供了
execl/execlp/execvp等一堆库函数——它们只是execve的便利封装(比如execvp会自动去PATH里找可执行文件、exec...l用可变参数逐个传参而不是数组)。无论用哪一个,最终都落到execve。这也是为什么:strace任何程序,第一条系统调用几乎总是execve。
fork + execve 的配合,才是 UNIX 里「启动一个新程序」的标准姿势:
int pid = fork();
if (pid == -1) {            // 错误处理
    perror("fork");
} else if (pid == 0) {      // 子进程:复位成新程序
    execve(...);
    perror("execve");       // 只有 execve 失败才会走到这
    exit(EXIT_FAILURE);
} else {                    // 父进程:等子进程结束
    int status;
    waitpid(pid, &status, 0);
}
编者拓展|为什么先
fork再execve:如果直接execve,当前进程自己就被替换掉了,跑完新程序它不会回来。所以要「启动一个程序并继续做别的事」,必须先fork出一个子进程,让子进程去execve,父进程则可以wait或继续工作。这套「fork + exec」还有一个额外好处:在execve之前,子进程可以自由地修改自己的环境(改PATH、重定向0/1/2、设置O_CLOEXEC),这正是 shell 实现管道、重定向、环境变量注入的基础。
3.8 环境变量与 PATH
(参考时间: 01:17)
execve 的第三个参数 envp,是一组环境变量。它解决了困扰大家多年的一个疑问:main 的参数是 execve 给的!
int main(int argc, char *argv[], char *envp[])
argc/argv:命令行参数(也就是/proc/<pid>/cmdline里能看到的东西);envp:环境变量;也可以在程序里通过environ全局变量访问;- 程序被正确加载到内存:代码、数据、PC 都在程序入口。
环境变量是 UNIX 里一套非常重要的「进程启动配置」机制。常见的有:
PATH:可执行文件的搜索路径,以:分隔;PWD:当前工作目录;TERM:终端类型(讲师现场演示它是foot,但伪装成xterm-256color);- 还有
HOME、PS1、DISPLAY……
PATH 的 demo 极其精彩:还记得 gcc 的 strace 吗?
execve("/usr/local/sbin/as", ["as", "--64", ...])  -> -1 ENOENT
execve("/usr/local/bin/as",  ["as", "--64", ...])  -> -1 ENOENT
execve("/usr/sbin/as",       ["as", "--64", ...])  -> -1 ENOENT
execve("/usr/bin/as",        ["as", "--64", ...])  -> OK
这个搜索顺序恰好就是 PATH 里指定的顺序。把 PATH 清空:
$ PATH="" gcc a.c
gcc: error trying to exec 'as': execvp: No such file or directory
程序就找不到汇编器了;把 PATH 设成正确的值,它又能工作。计算机世界里没有任何魔法,机器永远是对的。
编者拓展|环境变量与 API Key 的安全隐患:环境变量会被子进程默认继承(
fork复制、execve默认透传;很多exec*库函数也默认继承environ)。这意味着:如果你把 API Key 放进环境变量,任何你启动的子进程都能读到它。讲师提醒——「幸好我没有把 OpenAI 的 API Key 放在环境变量里。」更安全的做法包括:用专门的密钥管理服务、按需注入最小权限的凭据、或用execve显式传入一个经过裁剪的环境。这也是「把秘密放在环境变量里」(十二要素应用的一条早期建议)在安全上被诟病的原因。
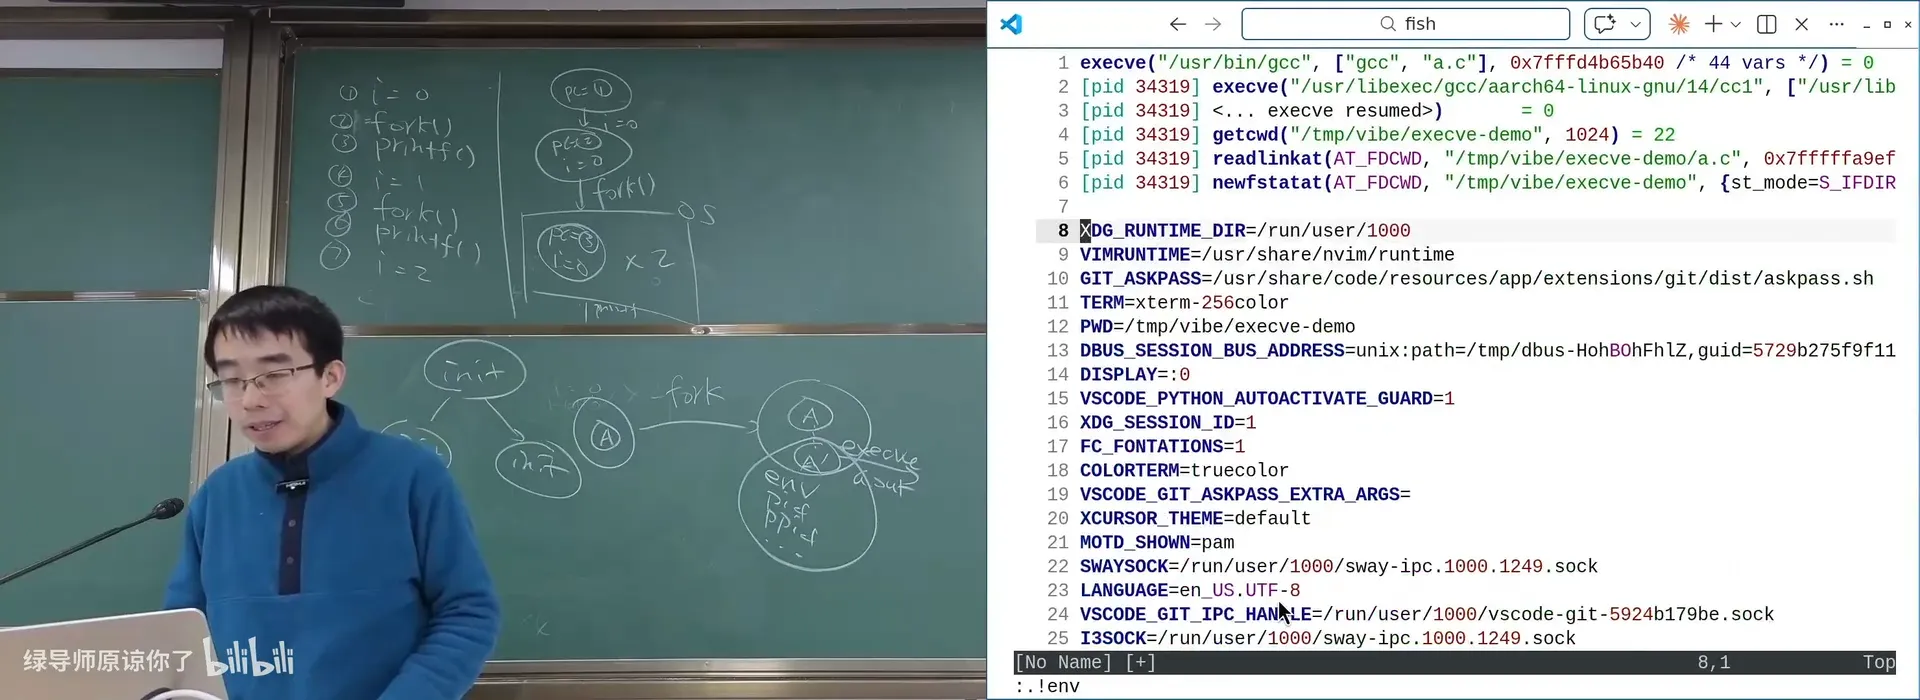
📷 gcc 的 strace:按 PATH 顺序依次 execve,直到找到 /usr/bin/as
回到原视频 (01:22:30)
3.9 销毁进程:exit / _exit
(参考时间: 01:20)
最后一个 API 是状态机的销毁:
void _exit(int status);
- 它立即摧毁状态机,并把一个返回值(退出状态)交给父进程;
- 这是「没有争议」的设计(因为方向明确)。
编者拓展|
_exit与exit的区别,以及exit_group:这一点非常容易踩坑: -_exit(2):系统调用,立即终止进程,不刷新 stdio 缓冲区、不执行atexit注册的钩子; -exit(3):C 库函数,先刷新 stdio、调用atexit/on_exit钩子,最后才调用_exit。所以如果你在
printf后直接调用_exit,缓冲区里的内容可能永远丢失(这与 §3.6 的缓冲区问题同源)。 有了线程之后,Linux 还提供了两个系统调用:exit(只结束当前线程)与exit_group(结束整个进程的所有线程)。strace一下就能看到程序实际用的是哪个。这些都是「历史包袱」与「线程时代」叠加出来的细节。
3.10 生命周期小结:spawn = fork + execve(+ wait)
(参考时间: 01:24)
至此,UNIX 用三个系统调用就把「进程管理」讲完了:
graph LR
    F["fork()<br>复制状态机"] --> E["execve()<br>复位状态机"]
    E --> X["_exit()<br>销毁状态机"]
fork复制、execve重置、_exit退出——再加上父进程的waitpid收尸,就能构造出任意进程世界,实现「原生启动」;
编者拓展|
waitpid与「收尸」:子进程退出后,内核会保留它的一小份信息(退出状态),等父进程来取——这就是「僵尸进程(zombie)」的由来。父进程调用waitpid(pid, &status, 0)取出这个状态(进程才真正「消失」),这个动作俗称「收尸」。status里既包含退出码,也包含「是被哪个信号杀死的」等信息(可用WIFEXITED/WEXITSTATUS等宏解析)。如果父进程一直不收,僵尸就会一直占用内核里的一格进程表项。 - 你用ps看到的那棵进程树,就是这么长出来的。
讲师说:「有这三个系统调用,就构建出了整个 UNIX 世界上所有的进程。」后面的课程会不断用到它们,并介绍它们更灵活的应用。
总结
- CrazyOS 是理解虚拟化的最佳模型:一个死循环,每次「取一条指令、执行一条」;真实操作系统只是把「逐条执行」换成了「把进程状态装进 CPU 运行一会儿」(上下文切换)。
- 程序 vs 进程:程序是状态机的静态描述(一份配方),进程是进行中的状态机实例;同一份程序可以跑出多个进程。
- 操作系统维护了远超内存+寄存器的进程状态:
pid/ppid/pgid/uid…、命令行、调度信息、打开的文件、内存……想了解它们,要么走 syscall,要么走 procfs(/proc/[pid]/、/proc/self/)。 - 创建进程的设计之争:Windows 走 spawn / CreateProcess(直观);UNIX 走 fork + execve(复制 + 复位),并用
_exit销毁。 - fork 复制的是完整状态:内存、寄存器、OS 内部状态(乃至 libc 缓冲区)都会被复制;因此能玩出「共享预处理」「Android Zygote」「fork-based DFS」「checkpoint/restore」「fork bomb」这些花活,也会带来「6 行 vs 8 行」这种缓冲区陷阱。Linux 用写时复制让 fork 变得高效。
- 孤儿进程会被过继给 PID 1,从而保证
ppid永远合法;PID 会被复用,因此有专门的机制维护「唯一标识」。 execve是唯一能「执行程序」的系统调用:它复位状态机,并把argv(命令行参数)和envp(环境变量)交给新程序的main;PATH只是exec*家族对它的封装。- 贯穿全场的一句话:计算机世界里没有魔法,机器永远是对的。遇到任何无法解释的行为(比如那个「幽灵缓冲区」),提出假设、用
strace求证,就一定能弄明白。
附:官方参考与延伸阅读
本讲的讲义见课程主页,以下链接按书中出现顺序整理:
阅读材料:课程网站(课程概述、参考书与参考资料、生存指南);教科书 Operating Systems: Three Easy Pieces 的第 3 章(Dialogue)、第 4 章(Processes)、第 5 章(Process API)。
版权说明:本讲讲义与幻灯片作者为蒋炎岩,采用 Creative Commons BY-NC 4.0 许可,来源于 https://jyywiki.cn/OS/2026/。视频画面与字幕版权归原作者所有。本书为课堂内容的学习性重构。