第6讲 · 进程的地址空间:从指针到 mmap,再到「入侵」
2026 南京大学《操作系统原理》第六讲 · 课堂实录重构
| 主讲 | 蒋炎岩(Yanyan Jiang) |
| 视频 | https://www.bilibili.com/video/BV18nAjz9EcW/ |
| 课程主页 | https://jyywiki.cn/OS/2026/ |
| 本讲讲义 | https://jyywiki.cn/OS/2026/lect6.md |
| 讲义 / 幻灯片作者 | 蒋炎岩,https://jyywiki.cn/ |
| 讲义 / 幻灯片许可 | CC BY-NC 4.0 |
| 图片来源 | 书中插图为课堂演示与讲义渲染图;演示类截图为视频画面 |
对应讲次:第6讲(南京大学 操作系统原理)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者说明:本书由课堂录像的语音字幕重构而成,术语、章节骨架与参考链接已按课程官方讲义(
lect6.md)校准。讲师的口语风格、类比与案例被尽量保留;编辑性的补充一律以「编者说明」或「编者拓展」标出。
引子:进程是有「内存」的
(参考时间: 00:00)
上一讲讲了三个进程相关的系统调用——fork、execve、exit(以及 Windows 式的 spawn),也讲了一些有趣的用法(Zygote、用 fork 做并行 DFS)。本讲回到 CrazyOS 这个极简模型,去观察一件之前「一闪而过」的事:
#define MEM_SIZE   (1 << 20)
#define MEM_OFFSET 0x80000000u
#define STACK_TOP  (MEM_OFFSET + MEM_SIZE)

struct proc {
    struct CPUState cpu;   // 指向 mem[MEM_SIZE]
    uint8_t mem[MEM_SIZE]; // 进程的「内存」
    // OS-internal state (pid, buf, buf_len, ...)
};
进程是有内存的:代码(指令序列)、数据、堆、栈……全都在同一份内存里。但真实的程序,其内存比 CrazyOS 复杂得多——于是有了今天的主题:进程的地址空间(address space)。
编者说明:本讲有个贯穿始终的学习方法论——「知识正向构建」比「反向总结」更重要。教科书(和 AI 给的定义)是「已经理解的人总结好的」,而你更需要的是从无到有地把一个现代系统构建/理解出来。
一、进程的地址空间是什么
1.1 从「指针」理解地址空间
(参考时间: 00:03)
AI 给的「标准答案」是:
进程地址空间是操作系统为每个进程提供的一套独立的、连续的虚拟内存地址范围,因此也叫「虚拟地址空间」。
它的核心作用是隔离与保护、便于管理与扩展(程序以为自己占有一大片连续内存,实际按需分配)、在隔离前提下支持有限的共享。这些都对,但不蕴含「每一个字节到底是怎么来、怎么定义的」。
讲师换了个更直观的角度:地址空间就是「进程所有你能访问的那个字节序列」,而你在编程语言里访问它的方式就是——指针。
volatile char *ptr = input();   // 从键盘输入一个 64 位整数
*ptr;        // load
*ptr = 1;    // store
任何一个 64 位整数「都是一个合法指针」,但操作系统未必允许你访问——如果是非法地址,程序就会 segmentation fault。
编者拓展|这里的
volatile为什么要加? 它和const一样,用来修饰「有内存地址的东西」:const说「只能读不能写」;volatile说「所有对这个内存的访问都不能被优化掉」。因为*ptr;这行 load 的结果没有被用到,编译器完全可以把它删掉——加上volatile才能保住这次访存。你甚至可以让指针本身也是 volatile:char * volatile p。这些细节以前是编程课的重点,现在「不太需要把这些事搞清楚」了。
📷 指针遍历代码/数据/栈:打印各自的地址
回到原视频 (00:10:00)
一个很好玩的发现:任何一个符号(函数名 main 也是)都是一个合法指针。把 main 赋给函数指针、用 %p 打印出它的地址,再读出它开头的若干字节,验证它确实就是 main 的二进制代码。
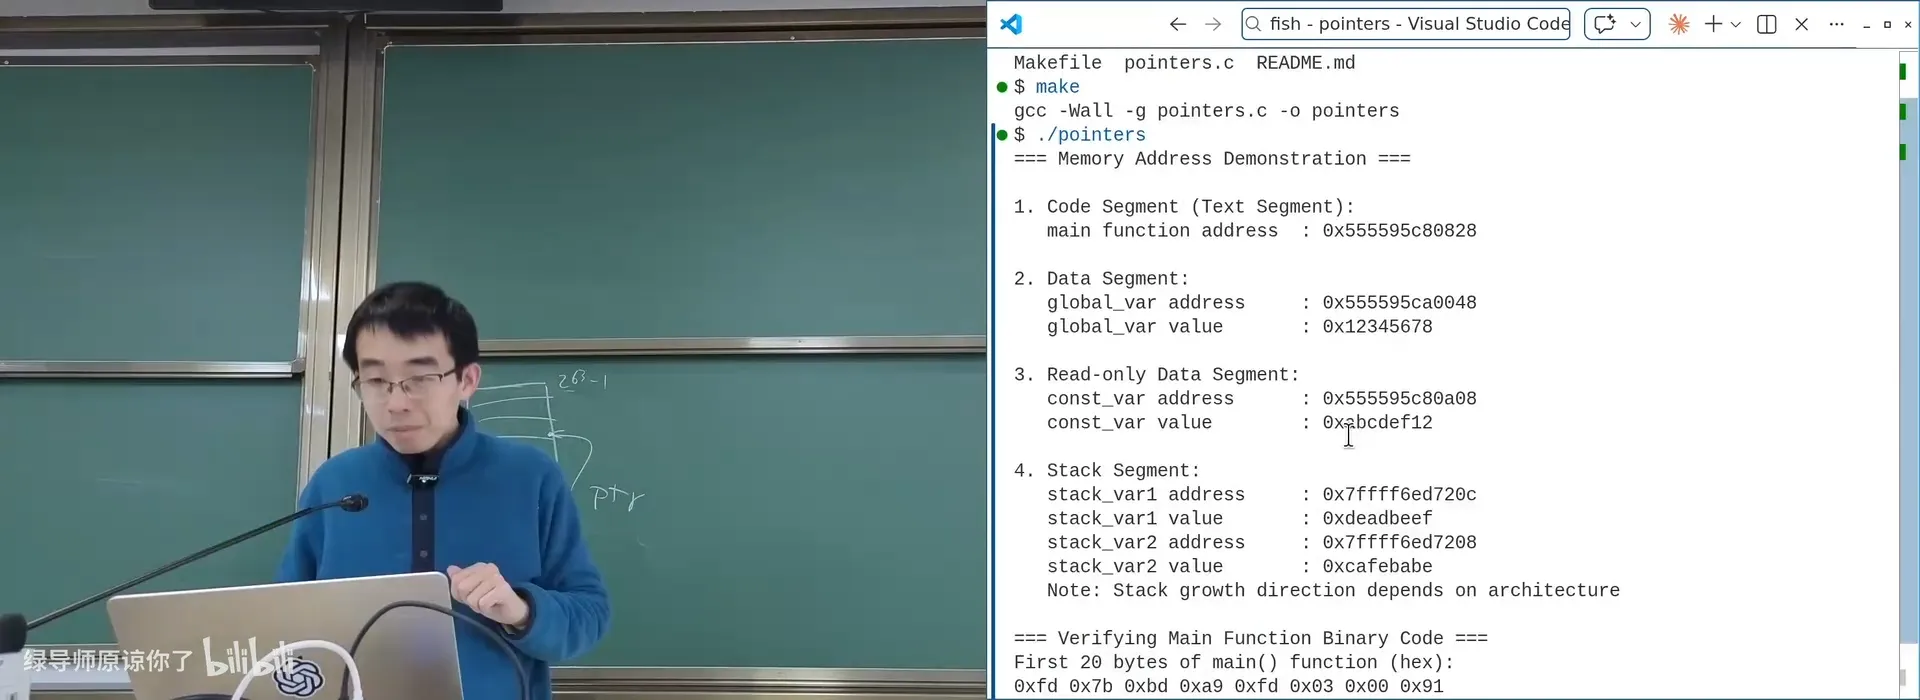
📷 读出 `main` 指向的字节,与反汇编/ELF 内容交叉验证
回到原视频 (00:12:00)
1.2 今天这节课的「关键问题」
(参考时间: 00:13)
由「机器永远是对的」和「你没有写过的代码都是错的」两条公理,可以推出:
进程地址空间里的每一个字节,都应该是规定好的、可以解释的。
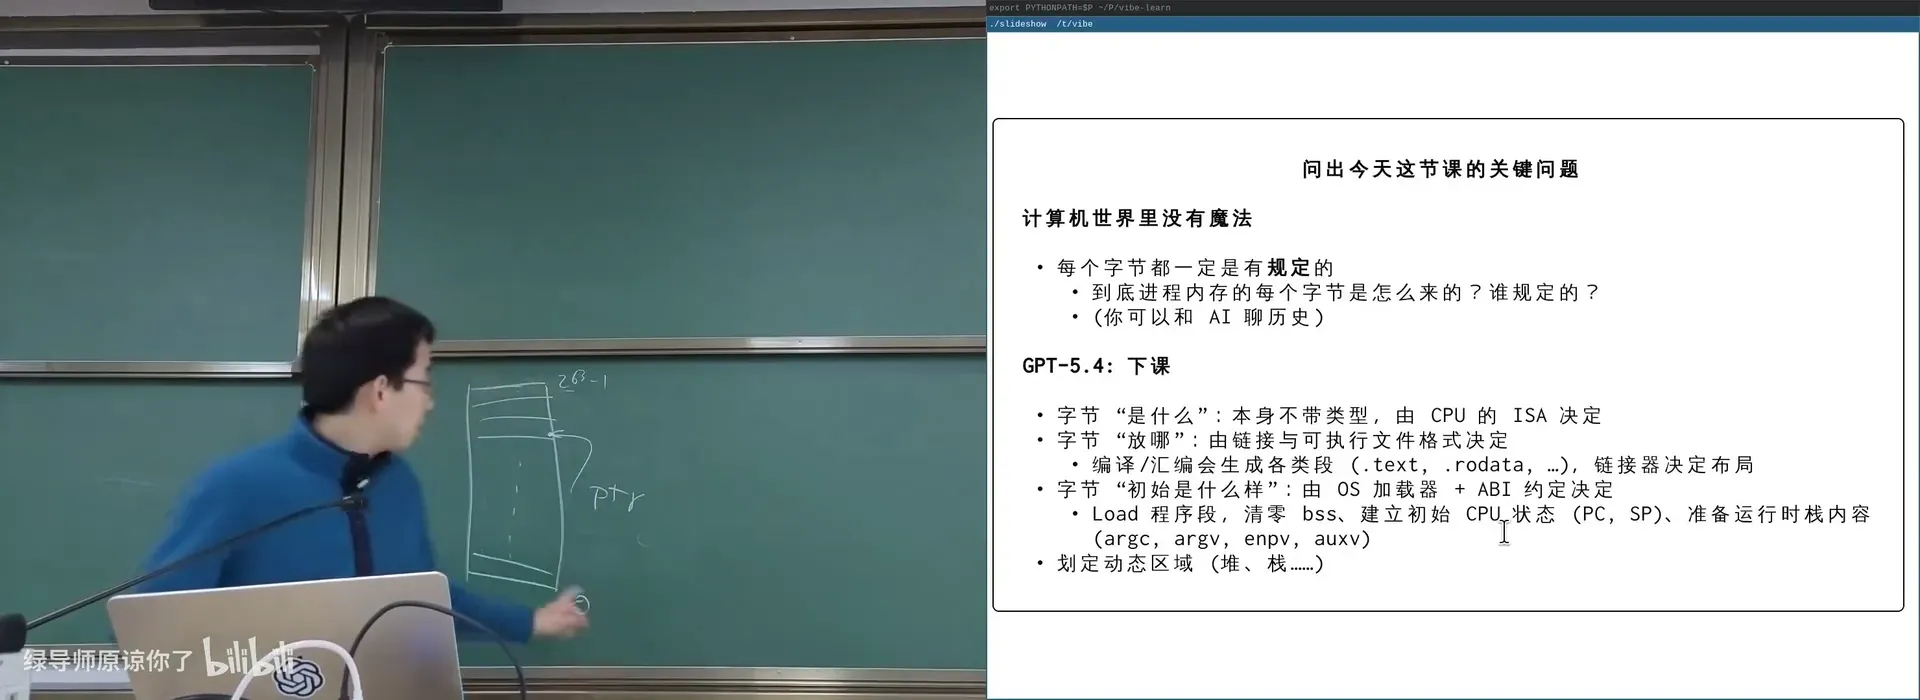
「每个字节是怎么来的?谁规定的?」——GPT-5.4 给了一个很好的回答:
| 问题 | 由谁决定 |
|---|---|
| 字节是什么 | 字节本身不带类型,由 CPU 的 ISA 决定(PC 指向它就被当指令执行) |
| 字节放哪 | 由链接与可执行文件格式决定(编译生成 .text/.rodata…,链接器决定布局) |
| 字节初始什么样 | 由 OS 加载器 + ABI 约定决定(加载 PT_LOAD 段、清零 bss、建立初始 CPU 状态、准备初始栈) |
| 动态区域 | 堆、栈等由运行时划定 |
编者拓展|ASLR:为什么地址每次都不一样? 你会发现同一个程序每次运行,
main的地址都略有不同——这就是 Address Space Layout Randomization(ASLR,地址空间布局随机化):让攻击者更难得手(比如缓冲区溢出攻击)。而可执行文件本身的布局,由 ELF 的PT_LOAD段决定:静态链接的 binary 会被加载到固定地址;PIE(Position-Independent Executable,位置无关代码)则可以加载到地址空间的任何地方,由操作系统决定。
📷 反复运行同一程序:地址每次不同,正是 ASLR
回到原视频 (00:15:00)
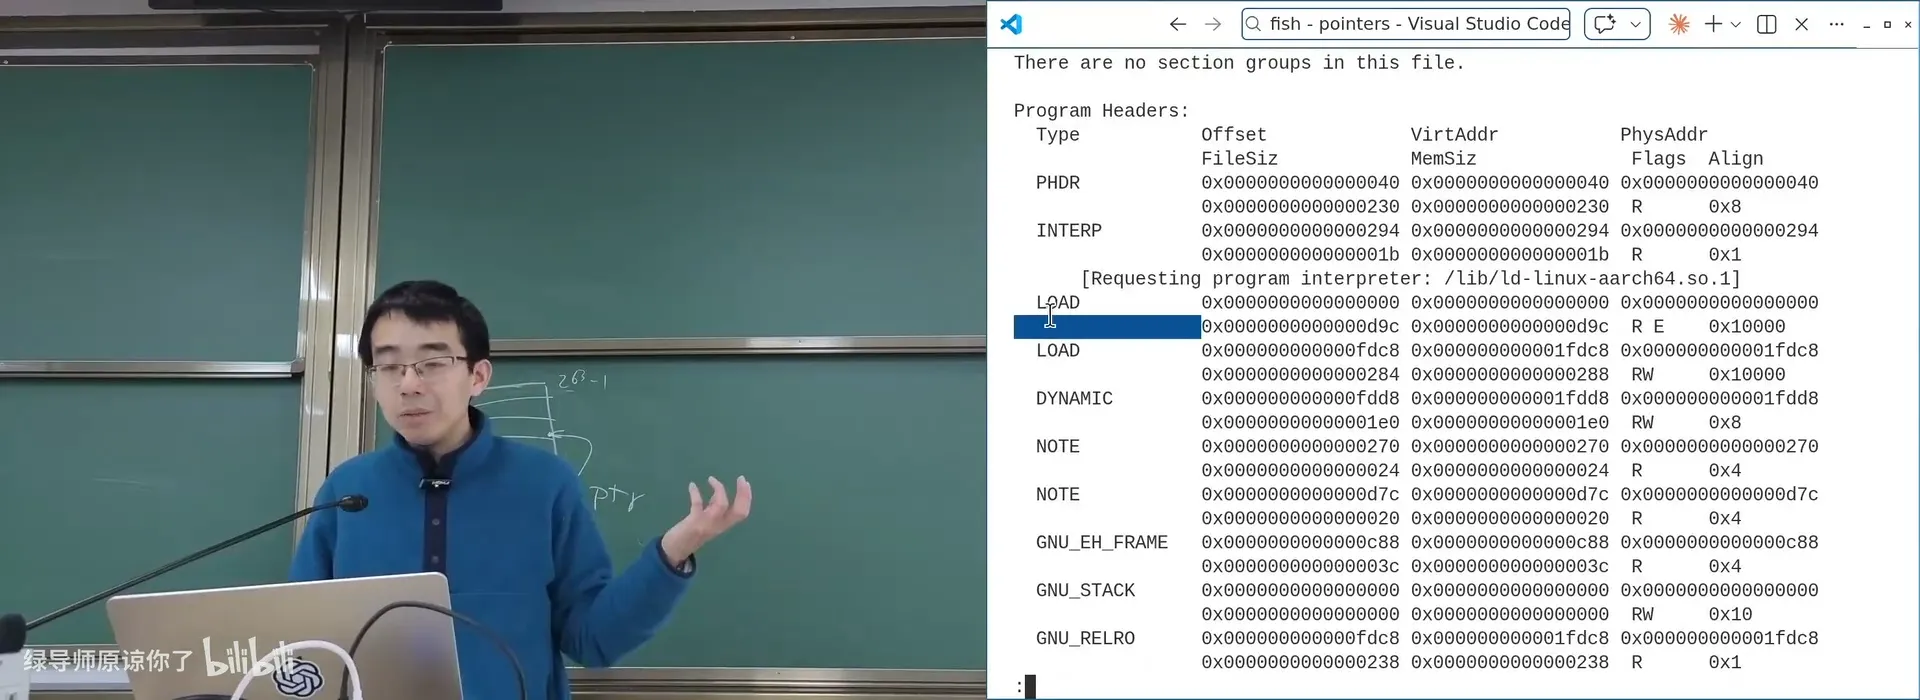
📷 readelf -a:ELF 里的 `PT_LOAD` 段决定「字节放哪」
回到原视频 (00:16:50)
编者拓展|「概念是概念,实现是实现」:GPT 告诉了你正确的概念,但概念不等于实现。计算机(像
Compute Science这门人造科学一样)有一条「公理」:凡是人类觉得有意义的事,就一定能做到。所以「地址空间里有什么」一定有办法看到——讲师现场就用 AI 写了个工具把它打印出来。
二、看见地址空间
2.1 Process Address Space Explorer
(参考时间: 00:19)
讲师的 prompt 大意是:
我在课堂上学习了 Linux 进程的地址空间。请你帮我做一个命令行工具,从命令行接收一个 pid,解析它的地址空间,输出每个部分是什么;如果是可执行的区域,把第一个 KB 的内容反汇编(要兼容 x86-64 和 arm64)。
工具的实现思路是:解析 /proc/<pid>/maps,识别每个内存区域,对可执行区域用 Capstone 反汇编。运行效果让我们看到:
- 一个静态链接的最小程序,在
0x400000附近有一段可读可执行的区域,它映射到a.out(File Mapping)——「这次就是来真的」; - 在高地址(栈附近)还有
vvar和vdso,然后才是栈。
关键点:讲师的 prompt 里没有说该怎么做。他只是坚信「应该有办法」——「你有一个强烈的信念,应该有办法。你是不需要知道它怎么解析的。」
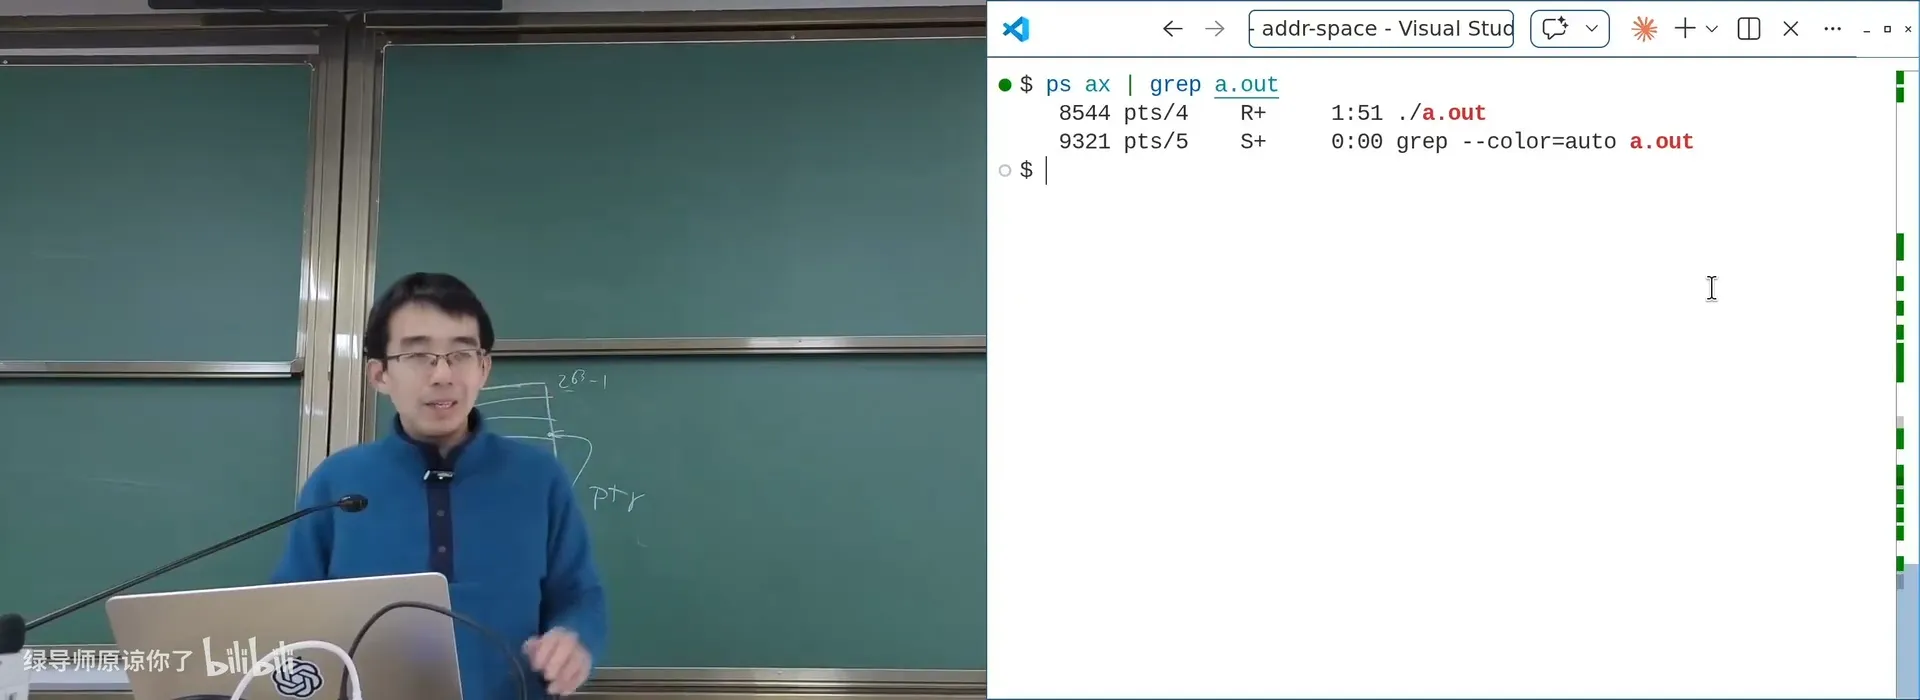
📷 先用 `ps ax | grep a.out` 找到目标进程号(实操)
回到原视频 (00:21:30)
2.2 /proc/<pid>/maps 与 vDSO/vvar
(参考时间: 00:27)
顺着工具的实现,就发现了 procfs 里那个关键文件:
/proc/<pid>/maps # 进程完整的地址空间镜像:从哪到哪、权限是什么、映射到什么文件
它能看到 libc/libm/libgcc 的哪些部分被放进了地址空间,也能看到 vvar 和 vdso:「以前要读 proc 手册才知道每个域是什么,现在直接问 AI 就行。」
编者拓展|vDSO / vvar 是什么:
vdso(virtual dynamic shared object)是内核映射进每个进程地址空间的一段代码;vvar是一块只读数据(秒级时钟、CPU 编号等)。它们让gettimeofday/getpid这类高频、只读的「系统调用」不必陷入内核(下一讲会实测)。所以即使是最小的程序,地址空间里也不止「代码 + 栈」。
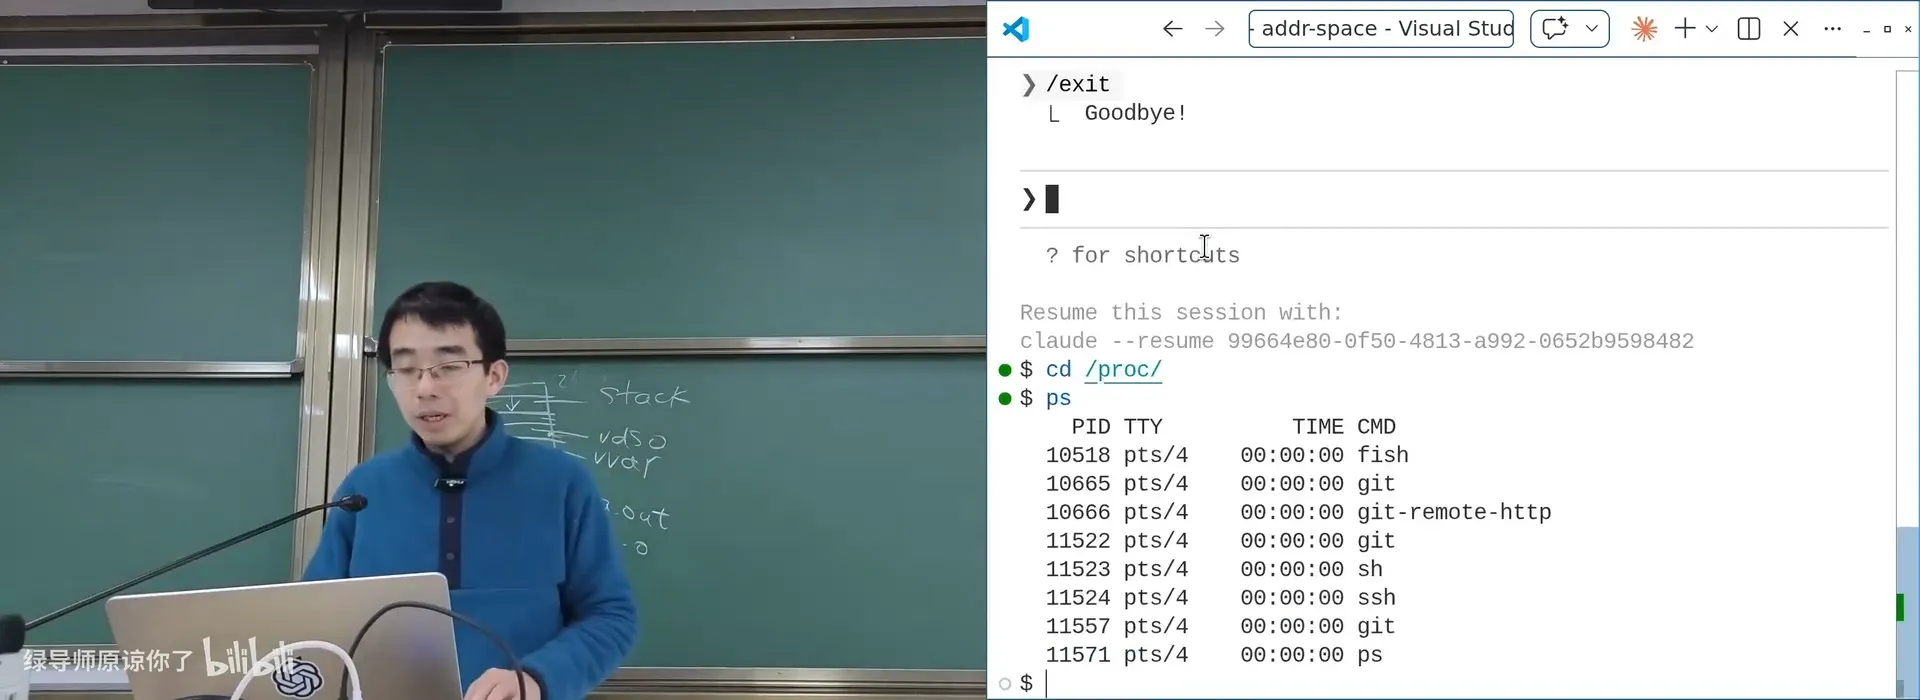
📷 cat /proc/
回到原视频 (00:27:45)
编者说明:讲师的告诫值得记下——「你更重要的是知道操作系统能提供什么样的能力」,而不是实现细节。prompt 里只要表达「我学习了概念、所以应该有办法」,就足够了。
三、地址空间管理 API
3.1 MMU:操作系统给进程戴上的「VR 眼镜」
(参考时间: 00:29)
如果从 minimal.S 开始,地址空间里「什么也没有」(除了代码和栈)。那么 malloc 的内存从哪里来?
进程自己做不到的事,必须请求操作系统。而操作系统之所以能「凭空变出内存」,靠的是 MMU(Memory Management Unit)——讲师把它比作操作系统强制给用户态进程套上的、摘不下来的 VR 眼镜:
- 进程能用的指令很少(只有 load/store 和计算),它不能配置 MMU;
- 于是它「看到的」物理世界,其实是操作系统给它编出来的;
- 操作系统想让它能访问哪一页,它就能访问哪一页——因为所有访存都会经过 MMU,操作系统可以在那里把访问路由到任意物理页,或者让它触发异常。
编者拓展|「水缸里的脑」与虚拟内存:进程「根本不知道世界之外是不是还有世界」。这正是虚拟内存的威力:每个进程都以为自己独占整台机器,而在 MMU 背后,物理内存是被操作系统统一调度的。
3.2 第一个答案:brk / sbrk
(参考时间: 00:33)
要让你来设计「修改地址空间」的系统调用,你会怎么设计?UNIX 最早的答案是 brk / sbrk(change data segment size):
   ┌──────┬──────┬──────┐
   │ code │ data │ bss  │ ← break(.bss 之后的边界)
   └──────┴──────┴──────┘
brk 是 .bss 之后的一个边界;要更多内存就把 break 往上移,不要就往下移。这是最古老、也最「历史遗留」的方式——今天 brk 显得不够用了。
3.3 mmap / munmap / mprotect
(参考时间: 00:35)
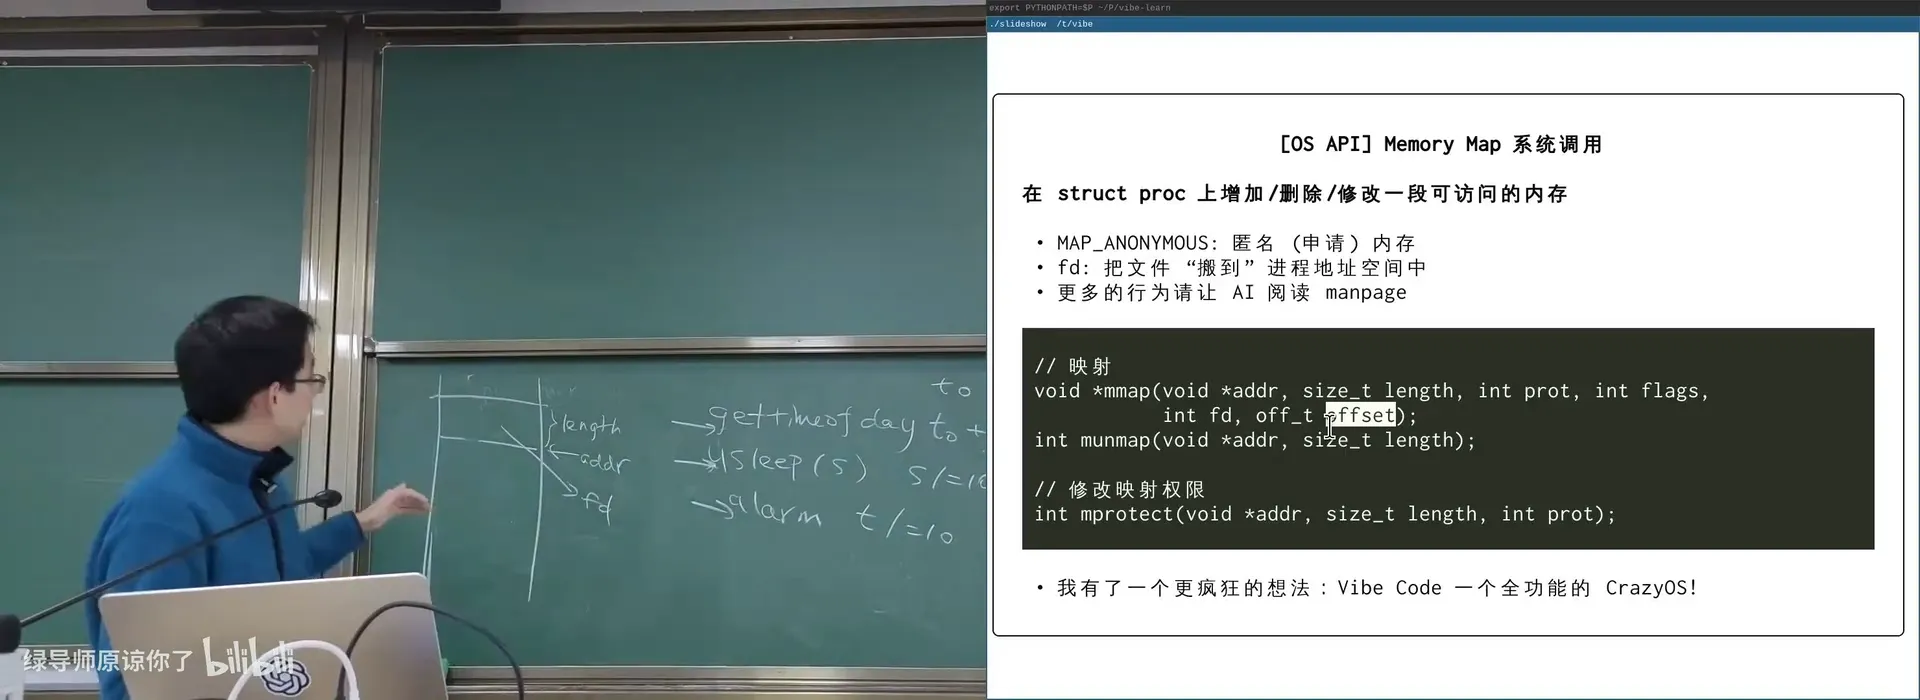
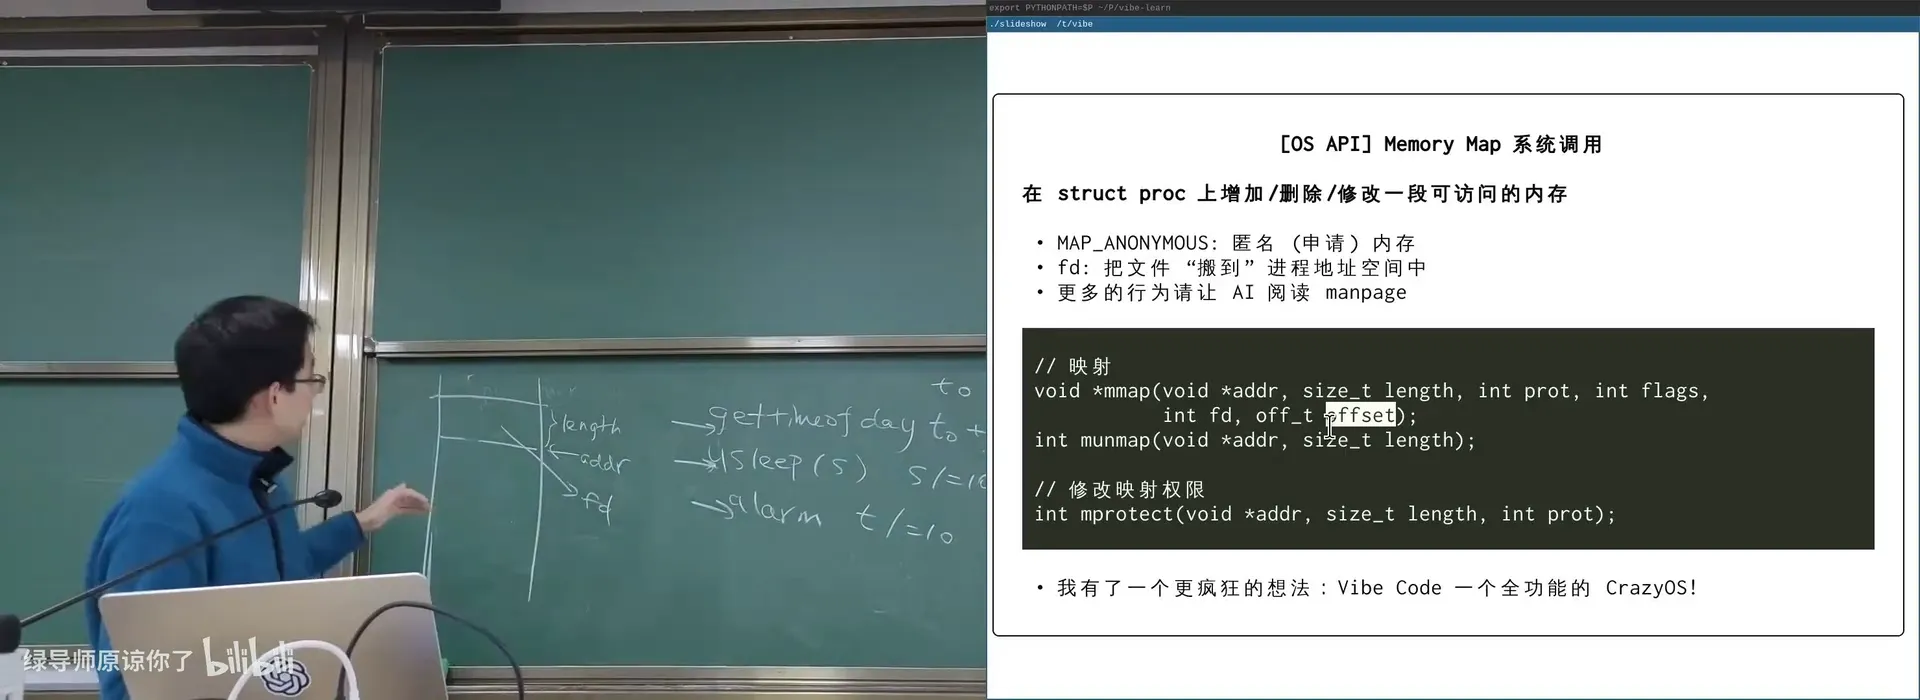
现代的方式是 mmap 系列。既然地址空间就是「一块一块可访问的内存」,那 mmap 要做的就是在地址空间上添一段可访问的区域,并配置它的:
// 映射一段内存
void *mmap(void *addr, size_t length, int prot, int flags,
           int fd, off_t offset);
int munmap(void *addr, size_t length);        // 回收

// 修改一段映射的权限
int mprotect(void *addr, size_t length, int prot);
MAP_ANONYMOUS:匿名映射——分配一段内存,初始值为 0;fd+offset:把一个文件的一部分直接「搬进」地址空间;prot:PROT_READ/PROT_WRITE/PROT_EXEC。
编者拓展|
mmap(8GB)为什么是「一瞬间」完成的? 讲师现场mmap了 8 GB(和他的物理内存一样大!),然后在 2GB/4GB/7GB 处分别写入,程序 1.62 毫秒就执行完了。原因是:mmap只是修改了「VR 眼镜的配置」——它做了一个标记「这块内存属于你了」,但真正只有在你访问(load/store)到某一页时,才通过缺页异常把物理内存分配给你(demand paging,按需分页)。这也是为什么地址空间可以「许愿」比物理内存更大的空间。
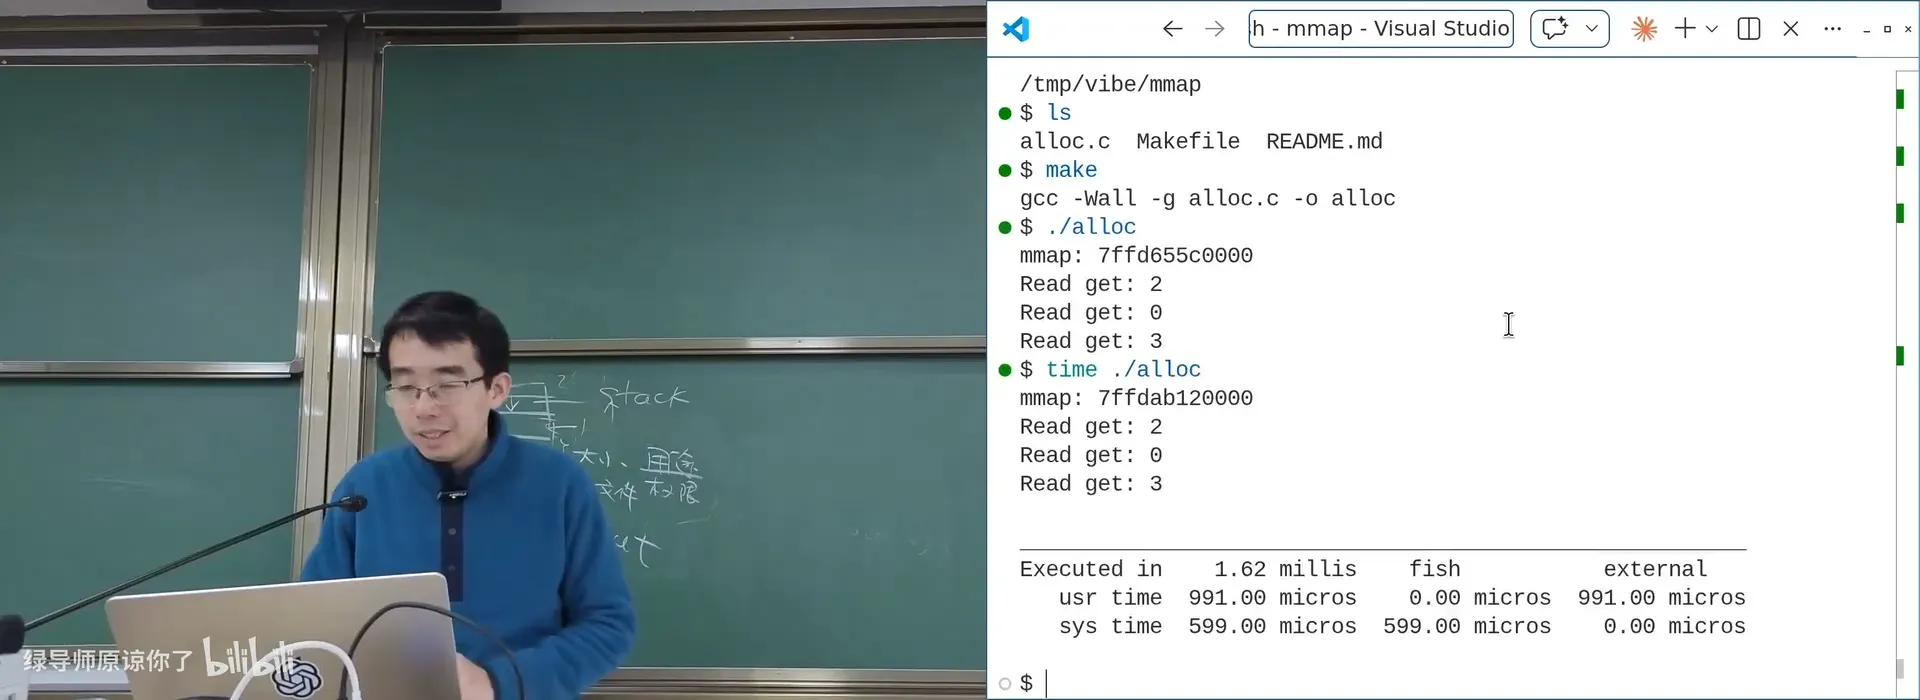
📷 mmap 分配 8GB:一瞬间返回,访问时才真正分配
回到原视频 (00:39:50)
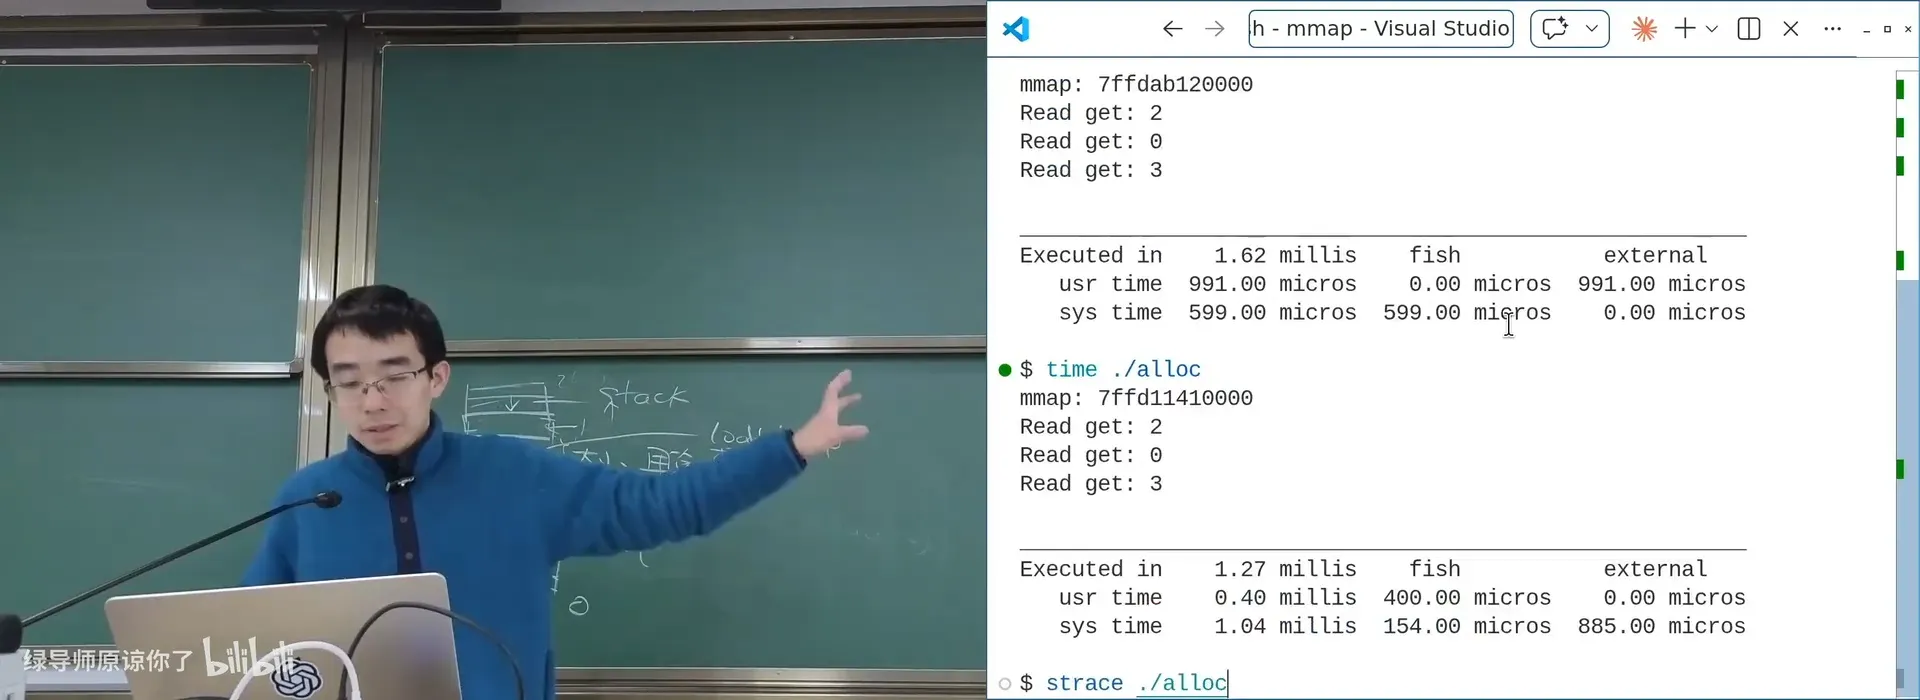
📷 strace 看 mmap:参数是 `PROT_READ|PROT_WRITE`、`MAP_PRIVATE|MAP_ANONYMOUS`、8GB
回到原视频 (00:41:20)
everything is a file 让 mmap 更强大:只要 open 一个文件(设备也是文件),就能把它的内容映射进地址空间。讲师演示了把整块磁盘(/dev/sda)映射进来(128 << 30 = 128 GB)——「64 位地址空间的好处:可以把一个 1 TB 的设备直接映射进内存,然后一个指针就能读写它」。他还真的(不小心)抹掉过一次讲台电脑的磁盘,导致下一节课直接教学事故——所以「这些机器都有还原卡,但我从物理设备访问就绕过了它」。
编者拓展|
mmap是「所有内存功能」的底层: - 内存分配:进程内的分配器(malloc)先向操作系统要一大块(sbrk或mmap),再切小; - Memory-mapped I/O:/dev/gpiomem、显卡; - 进程间共享内存:shm_open()返回一个文件,用mmap在两个进程间共享; - JIT(Just-in-Time):用mmap分配内存、写入生成的代码,再用mprotect把它改成可执行——浏览器/Java/JS 的 JIT 引擎就是这么做的。注意
mprotect把「可写」变成「可执行」这一步:字节本身不带类型,只要 PC 跳过去、那段内存可读可执行,它就会被当代码执行。为了安全,普通数据默认不可执行(否则控制流一旦跳错就可能执行恶意代码)——所以生成的代码必须显式mprotect成可执行。
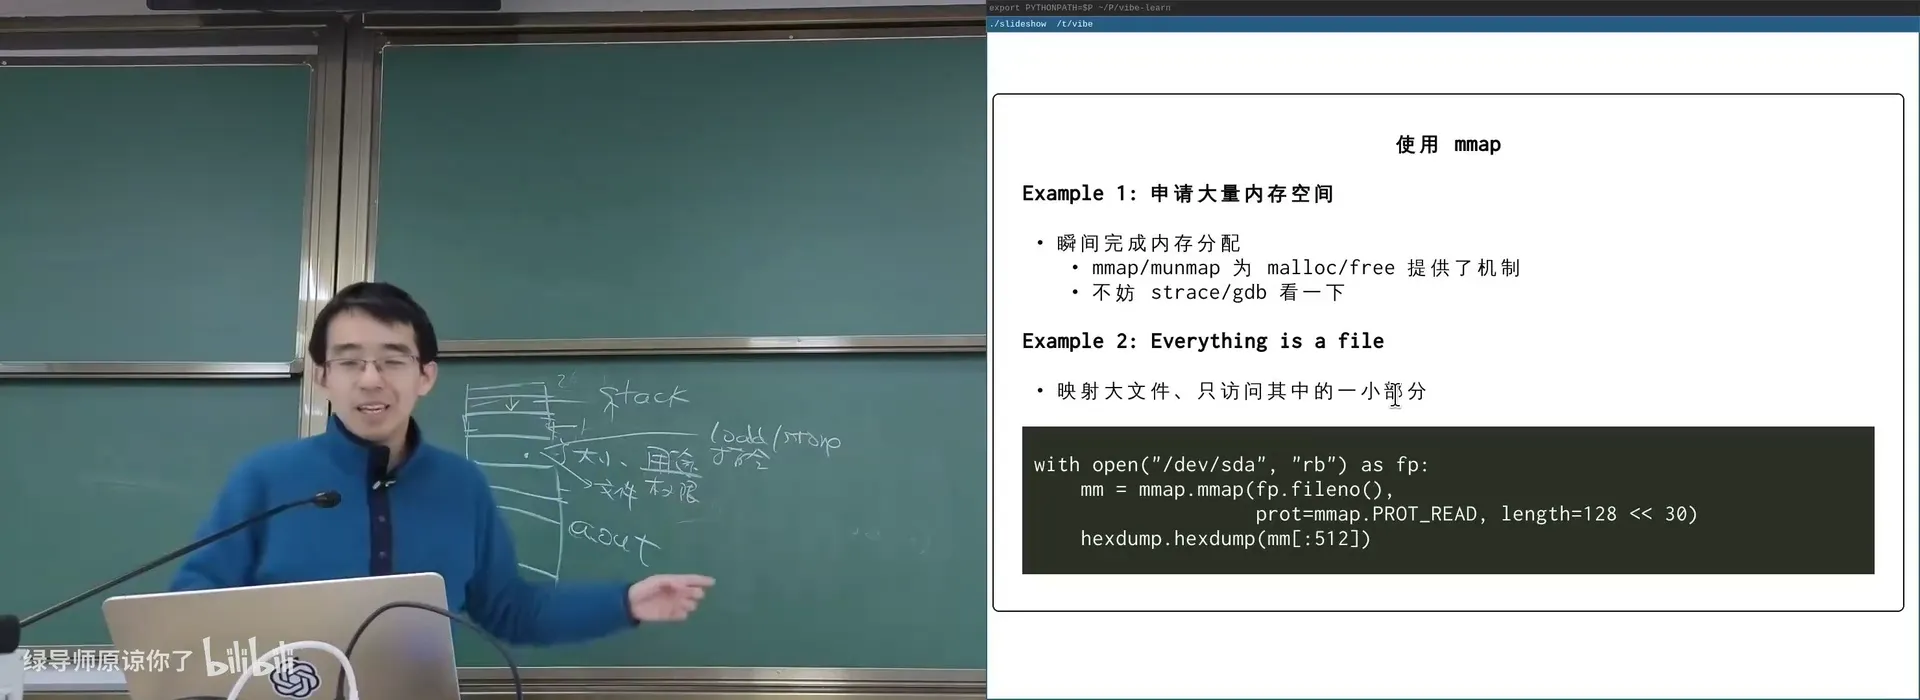
📷 mmap 一个磁盘/设备:一个指针就能读写它
回到原视频 (00:43:30)
四、入侵进程地址空间
(参考时间: 00:47)
前面「探索进程地址空间」的工具,其实已经悄无声息地做了件「很可怕」的事:在命令行里读另一个进程的内存。谁以前干过这件事?——调试器。
4.1 gdb 的原理:mprotect + ptrace + int3
(参考时间: 00:47)
在只读可执行的一段代码上打断点,gdb 是怎么做到的?
graph LR
    A["目标代码(只读可执行)"] -->|"1. mprotect 改成可读可写可执行"| B["写入一条 int3(x86,一字节)"]
    B -->|"2. 放程序继续执行"| C["程序撞上 int3 → 陷入内核"]
    C -->|"3. ptrace 拦截"| D["gdb 被激活"]
    D -->|"4. patch 回原指令"| A
- 用
mprotect(Map 系列系统调用)把目标代码改成可写; - 写入一条
int3(x86 上一字节的断点指令); - 程序执行到那里就会陷入内核,由
ptrace系统调用拦截,控制权转到gdb; gdb把原指令 patch 回去,继续执行。
编者拓展|一个「最小 gdb」在今天分分钟能做:讲师说,以前讲 gdb 原理要花一节课,现在让 AI vibe code 一个「能在某处打断点」的最小 gdb,它就能把完整流程给你。
mmap系列 +ptrace这两个系统调用,就是「调试器」的全部。编者说明:讲师由此感慨「Code is cheap」的今天,我们像回到了 1970 年代个人电脑兴起的时候——一个想法 + 好的工程实践,就可能做出一个真正的产品。
4.2 更早的「物理入侵」:Game Genie
(参考时间: 00:51)
在个人电脑还没有 MMU 的年代,就有一件天才的硬件产品——Game Genie(金手指)。
游戏卡带插进机器,本质上是把 ROM 映射到游戏机地址空间(插卡 ≈ mmap(NULL, rom_size, PROT_READ|PROT_EXEC, MAP_PRIVATE, rom_fd, 0))。而卡带和接口之间、导线是裸露的——于是可以在卡带前面加一个外挂:
- 它是一个非常简单的可编程逻辑,劫持 Firmware(启动时跳到 Game Genie 的界面);
- 你在界面上输入作弊码(如 8 个字符),它就被写进一张 look-up table(LUT);
- 基本工作原理:
if (address == x && data == y) data = z——当 CPU 读地址 a 得到 x 时,替换成 y。
比如马里奥初始有 3 条命,那个 3 是指令里的一个立即数;只要在 LUT 里匹配到那条指令的地址和数据,把数字换掉,你就有了 99 条命。
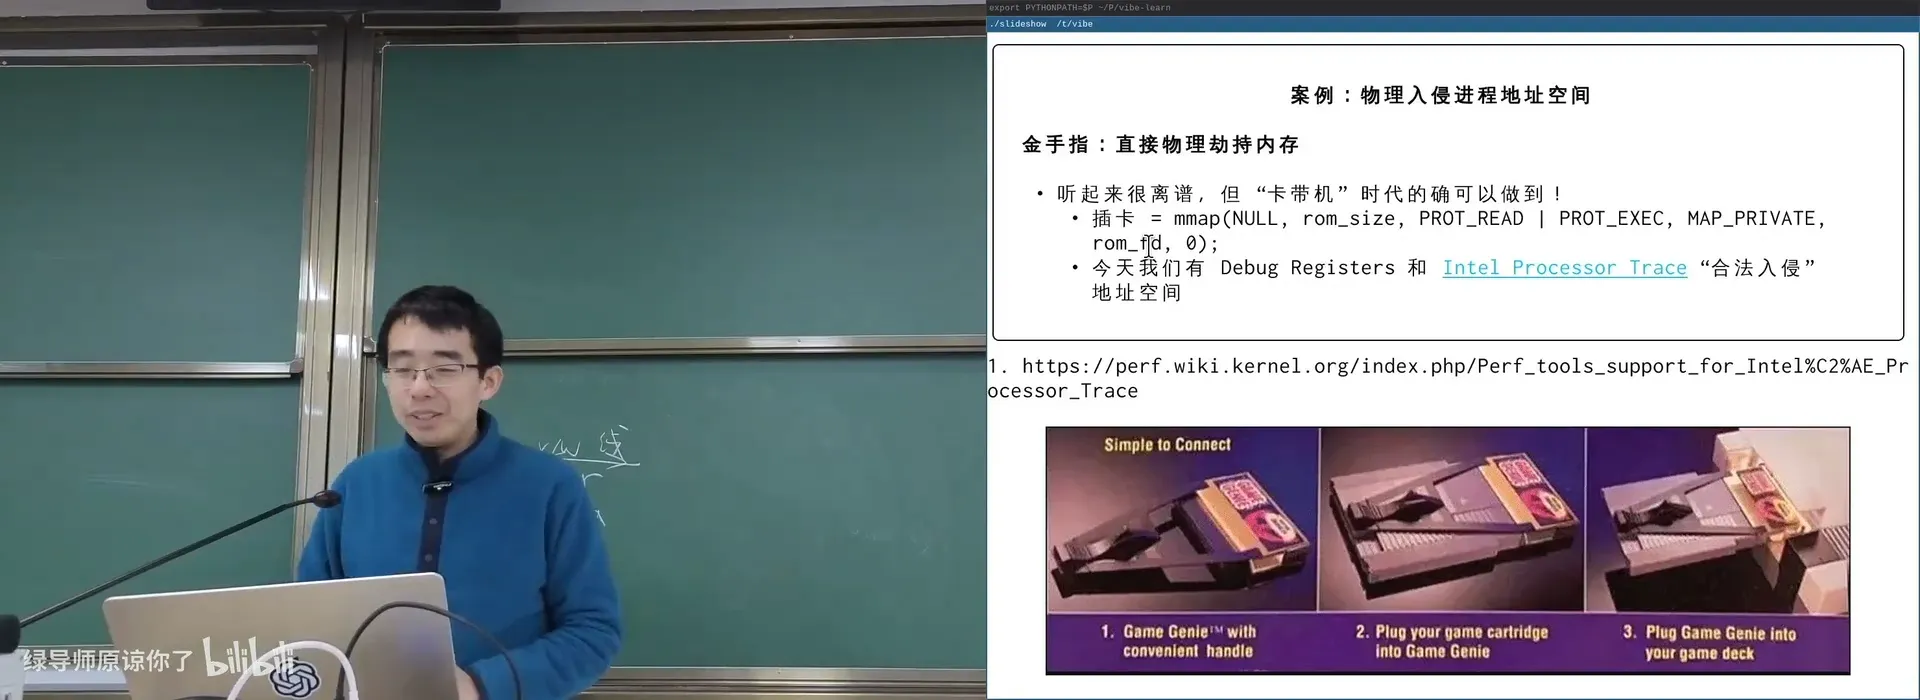
📷 Game Genie 的 look-up table:地址/数据匹配就替换
回到原视频 (00:54:00)
4.3 扫描内存的游戏修改器
(参考时间: 00:56)
对任何游戏都生效的「金手指」需要知道程序的语义(哪个地址是金钱、哪个是经验)。但你不必「读懂」,只要观察它们的变化:
- 进入游戏时 EXP = 4950 → 扫描内存里所有等于 4950 的位置(可能上百个候选);
- 打一个怪,EXP = 5100 → 只保留那些也变成 5100 的地址(指针等不会跟着变,就被排除了);
- 剩下唯一符合条件的
int *p,改成 1,000,000,出门就满级。
这正是 Game Wizard 32 / Cheat Engine / 金山游侠 的原理。讲师现场演示了在 DOSBox 里改「红色警戒」的金钱:
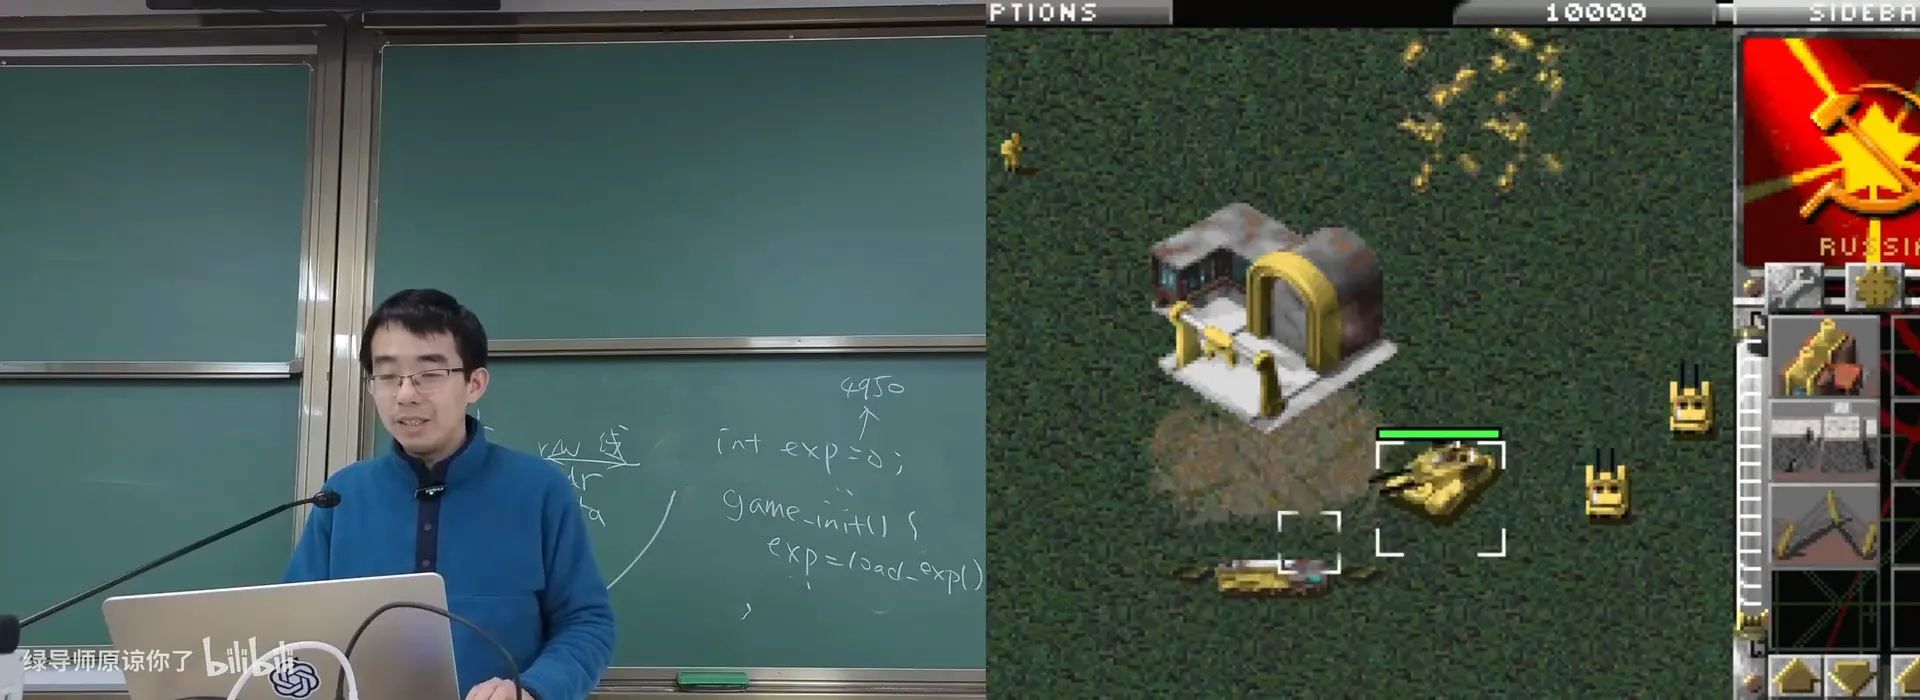
📷 游戏修改实战:红色警戒里把金钱改成 10000
回到原视频 (00:59:50)
编者拓展|为什么对有些游戏不生效:如果游戏每次更新都是
state_new = new State(state); state = state_new;,那么地址每次都变,简单的「扫描内存」就失效了——你需要更深入地理解程序语义(本质上就是给这个游戏写一个定制的 gdb 脚本)。汉诺塔本身也可以看作一个「外挂」:用调试器打印/劫持它的状态。
4.4 变速齿轮:patch 所有和时间相关的系统调用
(参考时间: 01:06)
「变速齿轮」为什么能改变一个程序对时间的感知?因为进程自己感知不到时间——它只有寄存器和内存,要知道时间就必须通过系统调用(gettimeofday、sleep/usleep、alarm)。于是:
- 在时间相关函数的入口打断点(gdb 断点),或干脆替换成自己的实现;
sleep/alarm的时间参数除以 10(让等待变短);gettimeofday稍麻烦一点:记录启动时刻T0,返回T0 + (T - T0) * 10(让时间轴走快 10 倍)。
于是「每动一下都 sleep 0.1 秒」的游戏就加速了。「曾经帮我们省下了很多时间。」
编者拓展|这是一种怎样的能力? 它说明:一个进程对外部世界的全部认知,都要经过系统调用。只要你能拦截/替换系统调用(通过调试器或库注入),你就能重定义它的世界——时间、随机数、文件内容……这与「MMU 是 VR 眼镜」是同一个道理,只是发生在 API 层。
4.5 终极外挂:DMA 与 CXL double-write
(参考时间: 01:11)
如果连操作系统都不信任,还有「硬件级」的办法:DMA 外挂。内存(DRAM)是通过总线连到 CPU 的;你可以在总线上再挂一个设备,让它不断把游戏内存 copy 到另一台机器/FPGA——几乎无法预防。
更进一步,CXL(高速内存互联)可以实现 double-write / memory mirror:数据中心用它做多副本容错,但它也可以是一个完美的游戏外挂机制——甚至「你卖给别人的就是一根内存条,上面多一个接口」。讲师畅想:未来你的电脑所有东西都接一个旁路,你的 copilot 就能知道你的电脑发生了什么。
📷 DMA / CXL double-write:硬件级「内存镜子」
回到原视频 (01:16:00)
4.6 AI 时代的畅想
(参考时间: 01:14)
既然能入侵进程地址空间、能逆向程序语义,能做的事情就很多:
- 重置任何老游戏:用 AI 逆向老游戏逻辑,在 DOSBox 里加上自己的一段渲染(像 DLSS 那样的神经网络增强),游戏逻辑是老的,画面是现代版的——「这可能就是一个产品级的东西」;
- AI 游戏辅助 / copilot:采集游戏画面做图像分割,在另一个屏幕给出「应该怎么玩」的建议;甚至学习时旁边有个 AI 不停提醒你哪里不对,效率提高 10 倍;
- 软、硬、物理融合的应用:可能是未来课程的 Project。
编者说明:讲师也坦率承认对「实验」的怀疑——「OS Lab 现在豆包一句话就做完了,那我们为什么还要做这样的实验呢?」这正是 AI 时代教学要面对的真问题。
4.7 最后一步:/proc/<pid>/mem
(参考时间: 01:17)
实现游戏修改器的最后一块拼图,是 procfs 里另一个特别的文件:
/proc/<pid>/mem # 大小与整个地址空间一样大;读它 = 读进程内存,写它 = 改进程内存
打开它拿到 fd,用 lseek 移动游标(和 C 里 fseek 一样),就能在任意地址 read/write。「这就是我刚才探索地址空间的程序」——逻辑完全一样。
📷 读 /proc/
回到原视频 (01:22:00)
编者说明:讲师再次强调——不需要看实现细节。「我们要的是先建立正确的概念,然后再去了解细节。关键是:你能提出正确的问题,并且有一个 mindset——所有合理的事情都是能办得到的。」
总结
- 地址空间 = 进程能访问的那片字节序列;访问它的方式是指针;每个字节是什么由 ISA 决定,放哪由链接/可执行文件格式决定,初始值由加载器 + ABI 决定,动态区域由运行时划定。
- ASLR 让地址每次不同(安全);PIE 让程序可加载到任意位置;静态链接则加载到固定地址。
- 看见地址空间:
/proc/<pid>/maps是完整的地址空间地图;即使是极小程序,也有vdso/vvar。 - 管理地址空间:最早的
brk/sbrk(移动.bss边界);现代的mmap/munmap/mprotect——MAP_ANONYMOUS分配内存(按需分页,所以 8GB 一瞬间)、fd+offset把文件/设备搬进地址空间、mprotect改权限(JIT 的关键)。 - MMU 是操作系统给进程戴上的 VR 眼镜:所有访存经过它,操作系统可路由到任意物理页或触发异常。
- 入侵地址空间:
gdb用mprotect+int3+ptrace;/proc/<pid>/mem让你直接读写别的进程内存;Game Genie 是硬件金手指(LUT),Cheat Engine / 金山游侠靠内存扫描,变速齿轮靠 patch 系统调用,DMA/CXL 则是硬件级终极手段。 - 两条公理:机器永远是对的、你没有写过的代码都是错的——加上「有意义的事一定做得到」,计算机世界里就没有魔法。
附:官方参考与延伸阅读
本讲的讲义见课程主页,以下链接按书中出现顺序整理:
阅读材料:教科书 Operating Systems: Three Easy Pieces 第 12 章(Dialogue)、第 13 章(Address Spaces)、第 14 章(Memory API)。
版权说明:本讲讲义与幻灯片作者为蒋炎岩,采用 Creative Commons BY-NC 4.0 许可,来源于 https://jyywiki.cn/OS/2026/。视频画面与字幕版权归原作者所有。本书为课堂内容的学习性重构。