第7讲 · 访问操作系统对象:Everything is a File 与文件描述符
2026 南京大学《操作系统原理》第七讲 · 课堂实录重构
| 主讲 | 蒋炎岩(Yanyan Jiang) |
| 视频 | https://www.bilibili.com/video/BV1QFQmB7EQD/ |
| 课程主页 | https://jyywiki.cn/OS/2026/ |
| 本讲讲义 | https://jyywiki.cn/OS/2026/lect7.md |
| 讲义 / 幻灯片作者 | 蒋炎岩,https://jyywiki.cn/ |
| 讲义 / 幻灯片许可 | CC BY-NC 4.0 |
| 图片来源 | 书中插图为课堂演示与讲义渲染图;演示类截图为视频画面 |
对应讲次:第7讲(南京大学 操作系统原理)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者说明:本书由课堂录像的语音字幕重构而成,术语、章节骨架与参考链接已按课程官方讲义(
lect7.md)校准。讲师的口语风格、类比与案例被尽量保留;编辑性的补充一律以「编者说明」或「编者拓展」标出。
引子:关于实验的一次「小白演示」
(参考时间: 00:00)
本讲从一次「事故」讲起。上周发布了本学期的第一个实验;但讲师在 3 月 22 日中午更新 main 分支时拷错了目录——用了新版本的框架,却把旧版本的 testkit 复制了进去,于是无论怎么做都通不过 System Test。所幸有同学发现了并写邮件反馈,讲师「本来已经准备离开办公室,吓得赶快把 bug 修了」。
比 bug 本身更有意思的,是讲师演示的处理方式:他把自己假装成一个完全的新手小白,打开一个 coding agent,把实验要求粘贴进去,看 AI 会怎么做。
AI 的表现相当到位:它知道要在命令行里执行正确的命令,会把框架代码 clone 到 OS2026 目录,会真的去检查目录结构是否和实验手册一致,然后给出肯定的答复;你还可以不断追问,让它一步步把整个作业做完。
接着是最精彩的一段:讲师想做一件「不太常规」的事——把 main 分支往前回退一个 commit:
- 他只需要知道「这件事可以做」;
- AI 就先
git log查看历史,确认哪个分支需要回退,然后给出正确的命令git reset --hard; - 执行完还提醒他:如果想恢复,可以用
git reflog找到那个 commit,再用git cherry-pick或git reset找回来。
编者拓展|
git reset --hard与「平行世界」:git reset --hard <commit>会把「当前分支的指针」移动到指定提交,并同时把工作区和暂存区也强制改回那个提交的状态——所以未提交的改动会丢失。之所以在演示里很安全,是因为那是新 clone 下来的仓库,自己的代码不在里面。而git reflog记录了 HEAD 的每一次移动(哪怕已经「看不见」的提交),所以退回的提交通常还能靠它找回——这正是我们在第 04 讲说的「Git 给了你无数个平行宇宙」。
短短几分钟里,讲师就「学会」了 git reset、git log、git fetch、git merge 好几个命令。他的结论是:
拥抱世界的变化,让 AI 放大你的自主性(self-motivation)。 你愿意往前走一小步,就能做很多事情。
编者说明:这句话是本讲(乃至整门课)的方法论:你负责知道「能做什么」和「下一步该做什么」,把「具体怎么做」交给 AI。 以前学一门课要被迫啃很多文档、翻很厚的书;现在你随时可以让 AI 把「你需要的那一点知识」从海量信息里精准隔离出来。
回到主线:进程是一个「封闭的世界」
(参考时间: 00:06)
上周我们讲了一组系统调用——fork、execve、exit:一个程序运行起来后就是一个状态机(内存 + 寄存器);想创建进程就 fork(完整复制状态)、想执行别的程序就 execve(复位状态)、想结束就 exit。
由此得到一个很重要的观念:
进程是一个「封闭的世界」——除了寄存器和内存是程序「自己」的,其他一切都要通过系统调用去访问。
- 进程管理 API:
fork/execve/exit(+wait); - 内存管理 API:
mmap/munmap/mprotect(还有msync,能把一段内存里写的数据同步回映射的文件); - 那么,操作系统里肯定还有别的对象——文件、管道、网络连接、锁……它们也需要一套 API 来管理。
这就是本讲的主题:操作系统中的对象,以及管理它们的 API。
一个很自然的例子会逼出「新对象」的需求:你用 fork 创建了 128 个进程并行算科学计算,每个进程算出一个数字,你想把这些数字加起来——光靠 fork/execve/exit 是做不到的。你需要在操作系统里创建一个新对象,让父子进程都能访问它,从而交换数据。
一、程序员想什么,操作系统设计者想什么
1.1 程序员的脑袋:请求操作系统「做一件事」
(参考时间: 00:10)
写程序时,除了「把一个数据结构变成另一个数据结构」的计算型任务,你还会不断调用库函数去完成「非计算型任务」:发一个网络请求、写一个文件、和别的进程通信……这些事情的本质,都是去访问操作系统里的对象。
- 你想读取
/proc/1234/maps?最舒服的写法是Path("/proc/1234/maps").read_text(); - 你想要一份进程的内存映射?你想要的是
GetMemoryMap(pid)这种「返回一个数据结构」的接口; - 你想读另一个进程的内存?你想要的是
ReadProcessMemory(pid, addr, buf, size)。
程序员脑袋里想的,是面向对象、抽象、舒服的接口。
1.2 操作系统设计者的脑袋:提供一套简单、稳定的通用 API
(参考时间: 00:12)
而操作系统设计者脑子里想的,是一套简单、稳定、通用的抽象层,让应用生态能繁荣发展——「开发者要什么就给什么」是一种设计(Windows),「提供一个通用机制让你自己组合」是另一种设计(UNIX)。
Windows 走的是「迎合」路线:你想要创建文件,就给你 CreateFileW、WriteFile、SetFilePointerEx;你想访问别的进程,就给你 OpenProcess、ReadProcessMemory、VirtualQueryEx、K32EnumProcessModulesEx……这些 API 的参数直接传到内核,所以效率很高,也「非常符合软件工程规范」。
UNIX 走的是另一条路:Everything is a File。
编者拓展|两种路线可以互译,代价不同:同样是「读进程内存映射」,UNIX 的做法是把内核里的数据结构序列化成文本、写到
/proc/<pid>/maps,用户再用文本解析读回来;Windows 则是直接把内核数据结构/查询结果返回。前者多了一次序列化和一次解析(性能更差),却换来一个巨大的好处——这个接口既是机器可读的,也是人类可读的,而且能复用已有的文件工具。讲师说:「今天谁好谁坏,其实又不好说了。」
📷 /proc/
回到原视频 (00:14:30)
二、Everything is a File
2.1 什么是「文件」?
(参考时间: 00:17)
「文件」是大家上小学电脑课就学过的概念——一个有名字的数据对象,一个可以按位置读写的字节序列。而字节序列在计算机世界里是一个极其朴实的抽象(冯·诺依曼结构里,最重要的就是代码和数据):
- 你在键盘上每按一个键,就产生一个新的字节 → 像一个「只增不减的列表」;
- 一张图片、一个 JSON,都可以看成字节数组;
- 浏览器下载网页时,服务器就是一个字节一个字节地把 HTML 发给你(前面还有你看不见的头部信息,告诉你类型和长度)——这就是万维网工作的原理。
而这个抽象可以覆盖的东西远超你的想象:
graph LR
    F["文件(字节序列)"] --> S["数据流 / 数组"]
    F --> N["网络连接(正在向你发数据的服务器)"]
    F --> D["设备:打印机 / 终端 / 显卡"]
    F --> L["一把锁"]
    F --> P["一个管道"]
连打印机、终端、显卡都可以「假装」自己是文件(为什么?讲到设备驱动时会回答)。甚至一把锁、一个管道,也可以。
于是 UNIX 的基本想法就是:如果所有东西都是文件,那我只要有一套工具(cat、wc、grep……),就能处理操作系统里的任何对象。再进一步,用目录来管理这些名字——一个操作系统对象对应一个路径名。真要自己实现文件系统,甚至可以简单到「一个从 Path 到 bytes 的 dict」。
编者拓展|「一切皆文件」的历史与边界:这并非空想。Linux 把大量内核对象都做成了文件:
/proc(进程与内核信息)、/sys(设备与驱动模型)、/dev(设备节点)。但这套抽象也有代价:文本序列化有性能开销、格式随内核演进、/proc里很多文件其实是「一次性的伪文件」(读一次内容就变)。所以现代系统里也有大量非文件对象(例如 epoll、io_uring、seccomp)——「一切皆文件」是一种强大的默认,而不是绝对教条。
2.2 文件系统足以构建任何信息系统
(参考时间: 00:22)
讲师用课程网站举例:他选了提交系统里直接看后台目录——files_receive/OS2025/...,每个同学的提交就是一个文件;后端收到提交就往某个目录写一个文件;online judge 不断 watch 这个目录,评测完就生成一个 .result 文件;你刷新页面时,后端就是遍历目录树。
为什么不用数据库? 讲师的理由很有意思:
- 用了数据库之后,想 hack 它就变得前所未有地困难——你必须为它写一个管理端(就像你们的教务系统,数据被强行封装,只能用它给的接口);
- 而用文件系统:想删除一份提交,就把它删掉;想 rejudge 所有 M1,就用
find把结果文件删掉,judge 扫描到没有.result的提交就会重新评。用 UNIX 的一切工具都行。 - 想给每份结果加一条「AI 点评」,只要在每个结果文件里加一段文字就行。
编者拓展|文件系统 vs 数据库:一致性的代价:文件系统没有强一致性保证——如果你要写三个文件,写到第二个时程序崩了,系统就进入了不一致状态。讲师用「人力 + 概率」来换方便:赌服务器运行时几乎不出这种事,出了就用一两个命令删掉。如果你的场景对一致性要求高(金融、库存……),数据库的事务(ACID)就是必需的。讲师也给出了 AI 时代的新思路:先用文件系统写一个低性能但正确的参考实现,再让大模型把它翻译成数据库 / serverless 的实现,甚至自动证明幂等性与语义等价。
2.3 文件系统里到底有什么:FHS
(参考时间: 00:30)
Linux 的文件树不是随便长的,背后有一个标准——FHS(Filesystem Hierarchy Standard)。它让软件和用户可以预测文件应该装在哪里:/home、/dev、/boot、/usr、/etc、/srv……(Mac OS 就不完全遵循 FHS,所以你换系统时得重新熟悉)。
编者拓展|FHS 里的几个常见目录: -
/etc:系统的配置文件; -/usr:用户程序与数据(/usr/bin放可执行文件、/usr/lib放库); -/var:会变化的数据(日志、缓存、邮件……); -/proc:虚拟文件系统,暴露进程与内核信息; -/sys:另一个虚拟文件系统,暴露设备与驱动; -/srv:服务数据;/dev:设备文件。以前学这些要靠「翻厚厚的书、搜零散博客」;现在你对哪个感兴趣就问 AI,它会精准地把你需要的那一点知识隔离出来。
讲师现场演示了
ls /:/home、/dev、/boot、/usr、/etc……你会看到几乎每一个 Linux 都遵循这套结构。
2.4 UNIX Philosophy:KISS
(参考时间: 00:33)
在这样一个「一切皆文件」的世界里,UNIX Philosophy 的力量就体现出来了。它又叫 KISS(Keep It Simple, Stupid),有三个要点:
- 每个工具只做一件事,并把它做好(
grep、sed、awk……); - 让工具能协同工作(work together);
- 用文本流(text stream)作为通用接口。
为什么「文本接口」是个了不起的设计? 因为文本既人类可读,也机器可读。看 /proc/<pid>/maps 的文本输出,power user 一眼就懂;而 Windows 返回的是一个二进制数据结构(里面混着字符串、指针、十六进制数),你还得再写一个工具去解析它。
编者拓展|这是一次勇敢的取舍,而且对 AI 特别友好:在 1970 年代,每一个时钟周期都很贵,选择「牺牲性能换取通用、可读的文本接口」需要很大勇气。今天这个决定意外地非常适合大语言模型——大模型正是在自然语言上预训练出来的,读命令行工具的文本输出、写命令行工具,它都很擅长。讲师现场演示了这条「像自然语言的命令」:
bash
grep -s VmRSS /proc/*[0-9]/status | awk '{sum += $2} END {print sum " kB"}'
它用通配符找出
/proc下所有进程的status,再累加VmRSS(物理内存占用),一行就求出了系统所有进程的物理内存总和。这就是「quick & dirty」的 hacker 风格。当然,这套设计也被《UNIX 痛恨者手册》(The Unix Haters Handbook)骂得很惨——比如文件名里带空格会让一堆工具出错,连 GNU make 至今都不能很好地处理带空格的文件名。讲师的判断是:这些「诡异行为」的代价,换来了自然语言与编程语言之间的一个平衡点;而它今天也已经完成了历史使命——成了大模型的语料。
三、访问操作系统对象:文件描述符
(参考时间: 00:42)
现在回到最开始的问题:操作系统到底提供了什么样的 API 来访问它的对象?
3.1 从 CrazyOS 的 struct FILE 说起
(参考时间: 00:43)
还记得 CrazyOS 里那个 putchar 系统调用吗?它在操作系统内部,就是把字符写进每个进程的一个缓冲区:
struct FILE {          // CrazyOS 里的「文件」
    char *data;        // 指向缓冲区
    size_t offset;     // 写到哪了
};

// open:  f = malloc(sizeof(struct FILE));
// close: free(f);
// read/write: *(f->data++);       // 写一个字节,offset 后移
// lseek: f->offset = ...;         // 移动读写位置
// dup:   f_new = f;               // 指向同一个文件
这不就是「文件」吗! 文件在操作系统内部,无非就是一个 buffer、一个长度、一个指向「现在写到哪」的 offset。我们甚至可以想象把它塞进进程的 struct proc 里——根据 Everything is a File,你从用户的角度看到的是 /home/.../a.md 这样的路径,而它映射到内部的一个可访问的字节序列。
进一步的类比:C 标准库里的 struct FILE(fopen/fread/fwrite)其实就是对 UNIX 最早那套系统调用的一层封装。所以是「先有系统调用,才有 C 的 API」——只是你们先学了 C 的 API,我们反过来讲。
3.2 文件描述符:指向操作系统对象的「指针」
(参考时间: 00:47)
问题来了:操作系统内部有 struct FILE,但应用程序拿不到这个指针——程序只有内存和寄存器(也就是你在 main 里能碰的东西)。
UNIX 的答案,是给每个进程另一个「地址空间」:
0 → stdin(标准输入)
1 → stdout(标准输出)
2 → stderr(标准错误)
3, 4, 5, …  → 你 open 出来的文件
- 这个地址空间不能用普通指针(load/store)访问,必须通过系统调用访问;
- 你最早见过它:第一讲那个最小的二进制程序用
write(1, buf, size)往终端输出,那个1就是「编号为 1 的文件」。它有点像 x86 里的 I/O 端口——你不能直接解引用,只能通过指令指定端口号。
所以,文件描述符(file descriptor, fd)就是一个「指向操作系统对象的指针」,只不过它的编号从 0、1、2 开始。用 open 打开文件时,会在进程的 fd 空间里分配一个最小的未使用编号(所以新文件通常从 3 开始;文件关闭后编号可以被复用)。
编者拓展|它其实是「能力指针(capability)」:文件描述符不只是「第几号文件」这么简单,它是内核给你的一张受限的、可传递的凭据:你持有 fd,就代表你有权对这个对象做「该 fd 允许的」操作(读/写/追加……)。这解释了两件事:① 为什么
dup能让你「多拿到一个指向同一对象的引用」;② 为什么把 fd 泄露给子进程是危险的——你等于把访问权限也交了出去(见 §3.4 的O_CLOEXEC)。Windows 的 handle 把这个「带权限的指针」做得更显式,名字也更形象。
3.3 Windows Handle 与「句柄」的乌龙
(参考时间: 00:53)
Windows 里对应文件描述符的东西叫 Handle。讲师觉得这名字更形象:
- handle 是门上的把手——你抓住把手,就获得了控制那扇门的权限;
- 也是一个锅的把手、特斯拉车门的把手;抓上它,你就能控制它。
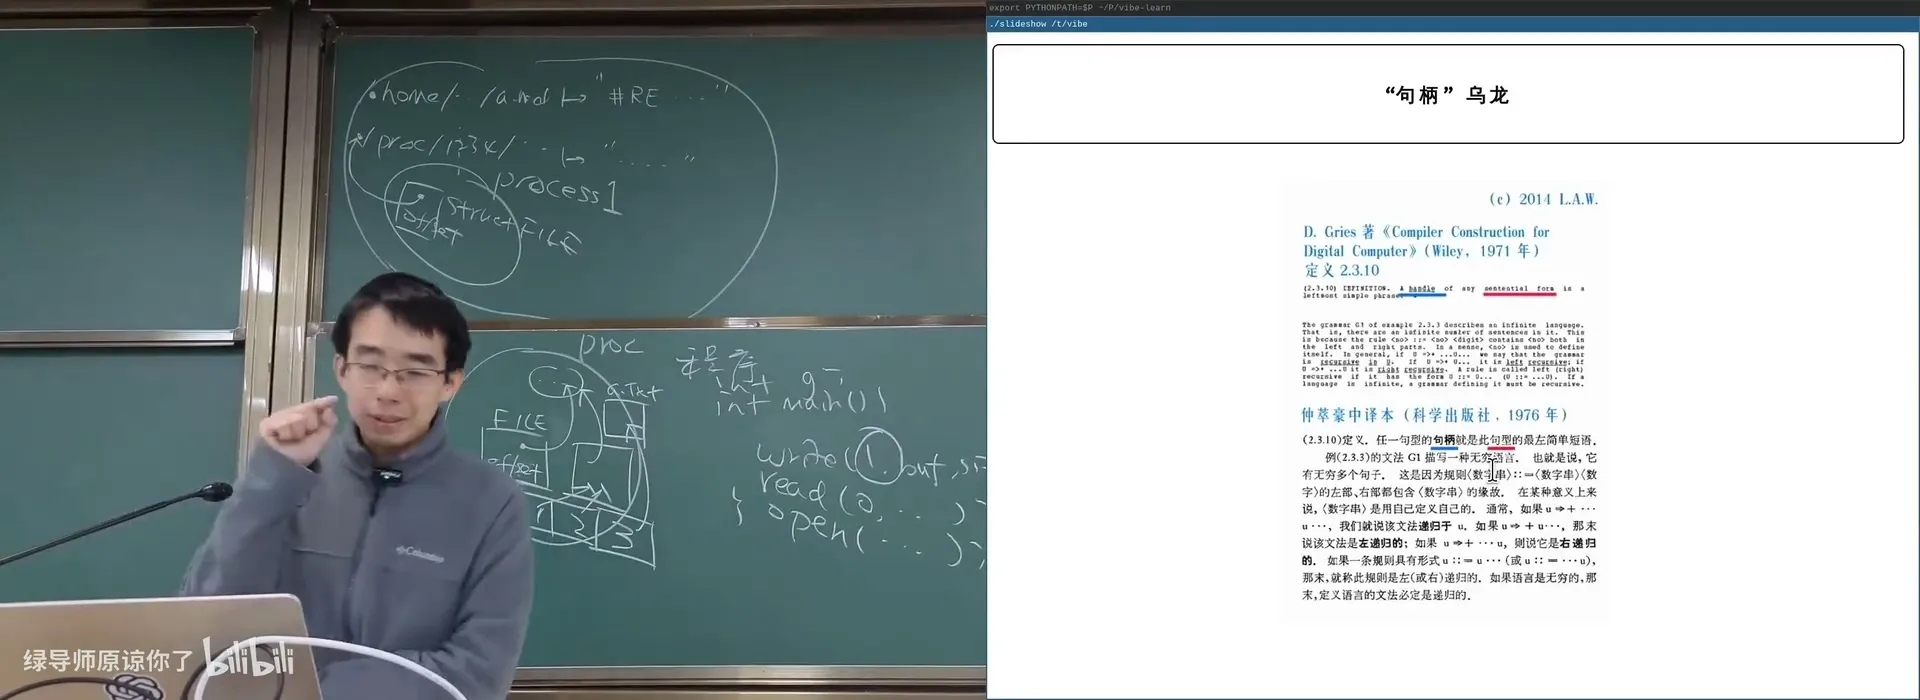
所以「handle 指向操作系统对象、并赋予你操作权限」的直觉非常清楚。而中文把它翻译成「句柄」,纯属历史乌龙:早期一本讲编译的书把 "a handle of a sentence"(句子的「柄」)直译成「句柄」,于是这个奇怪的词就被一直沿用、最后被 Windows 官方翻译采用。你在任务管理器里看到的「句柄数」就是它。
📷 Windows 任务管理器里的「句柄」(handle)
回到原视频 (00:57:30)
3.4 真正的复杂性:API 之间会互相影响
(参考时间: 00:59)
「打开一个文件、往里写一个字节」看起来极简单:
int fd = open("log.txt", O_WRONLY);
write(fd, "1", 1);
write(fd, "2", 1);   // 文件里会依次出现 1、2
但如果中间发生 fork 呢?
write(fd, "1", 1);   // 先写 1
fork();              // 复制出一个子进程
write(fd, "2", 1);   // 父进程和子进程都会执行这句!
现在世界上有两个进程都要「往同一个文件的当前位置写一个 2」。文件里最后是一个 2,还是两个 2? 这取决于操作系统设计者的选择:
graph TD
    A["打开 log.txt(内核中的一个 struct FILE<br>= 缓冲区 + offset)"] -->|"fork 时深拷贝"| B["父、子各有一份 offset<br>→ 结果是一个 2"]
    A -->|"fork 时浅拷贝(UNIX 的选择)"| C["父、子共享同一个 offset<br>→ 结果是两个 2,不互相覆盖"]
- 深拷贝:fork 时连
struct FILE和 offset 都复制一份 → 会互相覆盖,最后只剩一个2; - 浅拷贝:父子共享同一个 offset(像两个指针指向同一个对象)→ 各自写、追加,最后是两个
2。
UNIX 选了浅拷贝。 理由是:当父子进程共享一个文件、并以追加方式写入时,不应该互相覆盖对方的数据(覆盖通常不是程序员想要的)。
编者拓展|
fork的「原罪」与O_CLOEXEC:fork复制的是整个进程持有的所有资源,于是它必须和几乎每一个系统调用、每一种对象都定义清楚「复制后的语义」——这正是「fork 看起来优雅、实现起来极其复杂」的原因。有一篇很有名的论文 A fork() in the road(微软研究院的 Andrew Baumann 等)就主张「不要再教 fork 了」。更危险的场景是权限泄露:父进程持有一个敏感文件的 fd,如果不小心忘记关闭就去
execve执行了另一个程序,那个子进程就继承了这份访问权限。所以 Windows 的 handle 默认不继承(可显式bInheritHandles),遵循最小权限原则;Linux 则补了O_CLOEXEC/close-on-exec:让 fd 在execve时自动关闭。软件系统的每一处设计,都要小心考虑它和其他部分的交互。
四、特殊的文件:看看系统里到底有什么
(参考时间: 01:06)
既然「一切皆文件」,那就可以直接把系统里的对象都列出来看。讲师用一条命令打开「所有进程打开的所有文件」:
ls -l /proc/*/fd/* 2>/dev/null \
  | awk '{print $(NF-2), $(NF-1), $NF}' \
  | claude explain it
你会看到:每个进程都打开了一些文件——有的打开 /dev/pts/5(伪终端)、有的打开 pipe、有的打开 /dev/tty7(真正的控制台)、/dev/null(空设备)、GPU 渲染设备、输入设备、/dev/urandom(随机数)、套接字、管道……
更神奇的是:你甚至能看到别的进程打开了什么文件(在文件系统里就能看到);只要你有权限,你甚至可以打开别人的终端往里写数据——比如往 /dev/pts/5 写一个 hello,别人的终端上就会出现这个 hello。
编者拓展|常见特殊文件的含义: -
/dev/pts/N:伪终端(pseudo terminal slave),你的终端模拟器给 shell 分配的「一端」; -/dev/tty7:真正的虚拟控制台(Ctrl+Alt+F7 那种); -/dev/null:黑洞,写入的数据被丢弃,读永远是 EOF; -/dev/zero:读出来是无限的零字节; -/dev/urandom:随机字节流; -/dev/sda、/dev/nvme0n1:块设备(磁盘 / SSD);讲师在树莓派上则是/dev/mmcblk0(SD 卡)。讲师的原话是:「在 everything is a file 的加持下,你理解操作系统里任何一部分都变得前所未有的简单——你需要的只是想象力。」
五、匿名管道:让两个进程交换数据
5.1 管道是一种「会互相等待的文件」
(参考时间: 01:11)
「进程是一个封闭的世界」,所以父子进程之间要交换数据,就得靠一个新的操作系统对象。最经典的就是管道(pipe):
int pipe(int pipefd[2]); // pipefd[0] = 读口,pipefd[1] = 写口
管道可以理解成一个特殊的文件,有一个读口、一个写口:
- 用
write往写口写、用read从读口读; - 如果管道是空的,
read会阻塞,直到有数据; - 如果管道满了,
write会阻塞,直到有空位。
正是这个「阻塞」机制,让管道成了进程间同步与通信的好工具:128 个进程各自算出结果、从写口写进去,主进程从读口把 128 个数字读出来求和;每个进程写完再写一个「OK」,主进程读到足够的 OK 就知道大家都完成了。用管道,你就能实现「等进程做完再进入下一步」。
编者拓展|管道的容量与「死锁」:管道不是无限的。Linux 的管道缓冲区通常是 64 KiB,且对一个原子写入有
PIPE_BUF(至少 512 字节,Linux 上是 4096)的保证:小于PIPE_BUF的写是原子的,大于它的写可能被拆开、与其他写交错。如果写端持续写、读端却一直不读,缓冲区满后write就会一直阻塞;而如果两个进程互相等待对方(A 等 B 读、B 等 A 读),就会死锁。这些都是并发编程里最经典的问题。
5.2 命名管道 vs 匿名管道
(参考时间: 01:13)
- 命名管道(FIFO):用
mkfifo创建一个有名字的管道(你在ls -l里会看到一个p)。任何人都可以open它来读或写。演示里:./pipe read会等在那里,直到你write hello;反过来,没人读时write也会一直等——「互相等待」的效果非常直观。 - 匿名管道:shell 里的
|用的就是它。它没有名字,靠pipe()返回的两个 fd 来访问,通常配合fork:父子各持一端,一个写、一个读。
编者拓展|为什么 shell 的
|好用,而pipe()的 API 却很丑:C 里的用法是「先定义一个长度为 2 的数组,再调pipe,然后pipefd[0]是读口、pipefd[1]是写口」——参数是输出参数(out-params),语义要记。讲师吐槽:现代语言本可以写成let (r, w) = pipe()这样清晰的形式。而要实现ls | wc,你还需要用dup2把子进程的标准输出指向管道的写口、把另一个子进程的标准输入指向管道的读口,并关掉多余的一端(「文件描述的腾挪」,下一讲细讲)。
5.3 用 AI 把「文件描述符的复制」画出来
(参考时间: 01:19)
管道 + fork 之后的 fd 关系图,是传统课堂上最容易「画得一塌糊涂」的地方。讲师的处理方式很有代表性:
他让 AI web code 了一个调试任意管道程序的脚本:它
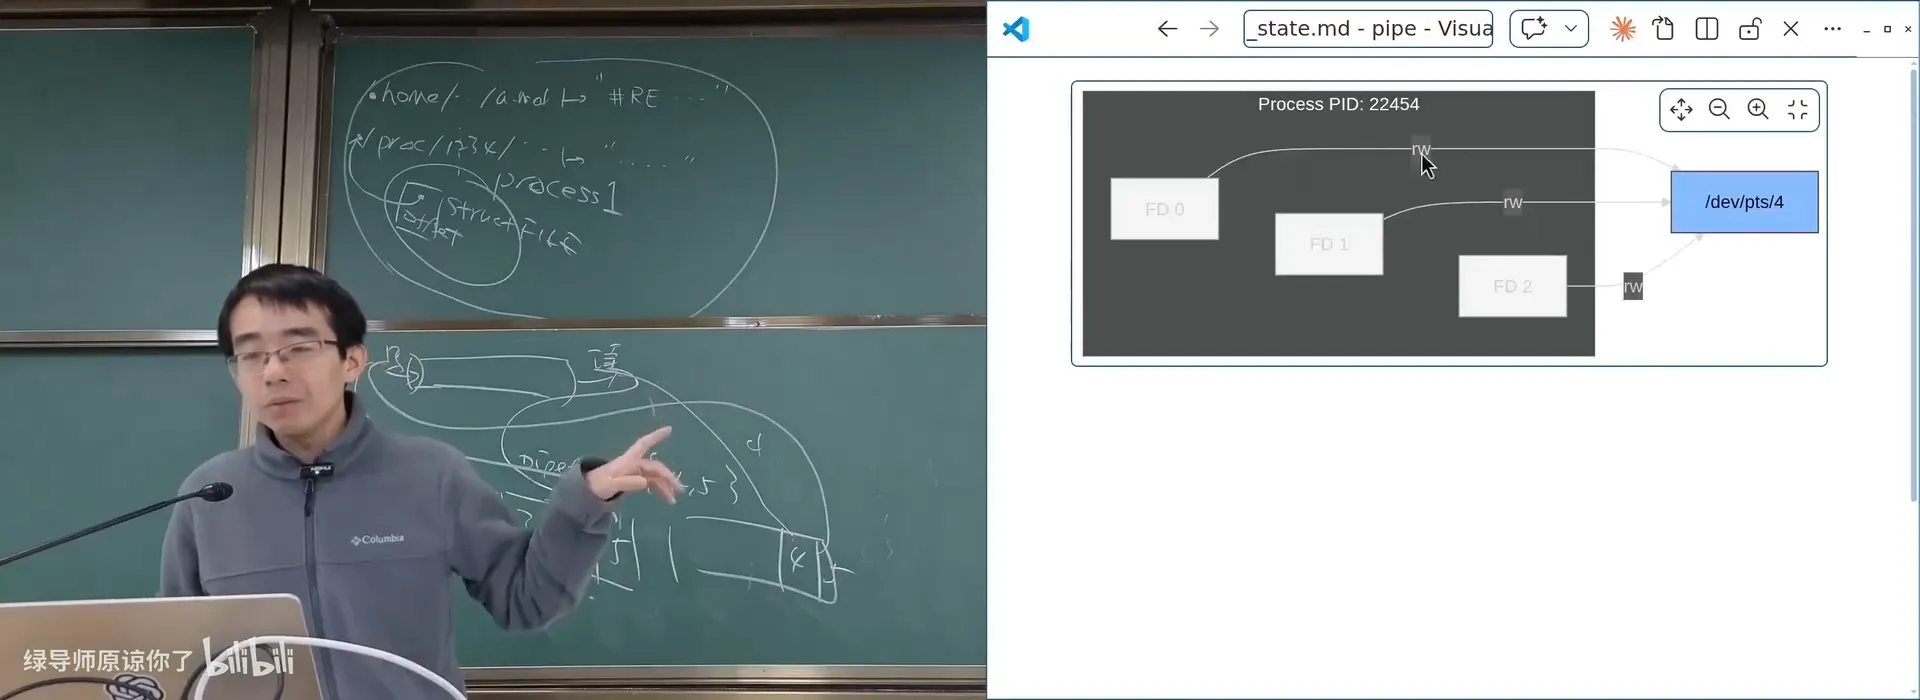
fork、执行pipe、在每一步读/proc/<pid>/fd,然后把父子进程的 fd 指向关系渲染成一张 Mermaid 图,存进 Markdown 里预览。
于是你能亲眼看到:
- 进程 22454 的 fd 0/1/2 原本指向
/dev/pts/4(终端); - 执行
pipe后,多了 fd 3(读口)和 fd 4(写口); fork之后,父子进程的 0/1/2 都还指向/dev/pts/4,3/4 也都还指向管道的两端;- 父进程关掉读口后,它的 fd 4(写口)还在;子进程关掉写口后,它的 fd 3(读口)指向管道——一个写、一个读,正好。
讲师说:以前他要在黑板上画这张图;现在一行 prompt + AI 生成的调试脚本就能得到一张精确、可交互的图。「你再也不需要读文档去理解管道——直接调试示例代码,看程序的状态。」
📷 AI 生成的 Mermaid 图:父子进程的文件描述符与管道指向关系
回到原视频 (01:22:00)
六、综合例子:TestKit 测试框架
(参考时间: 01:26)
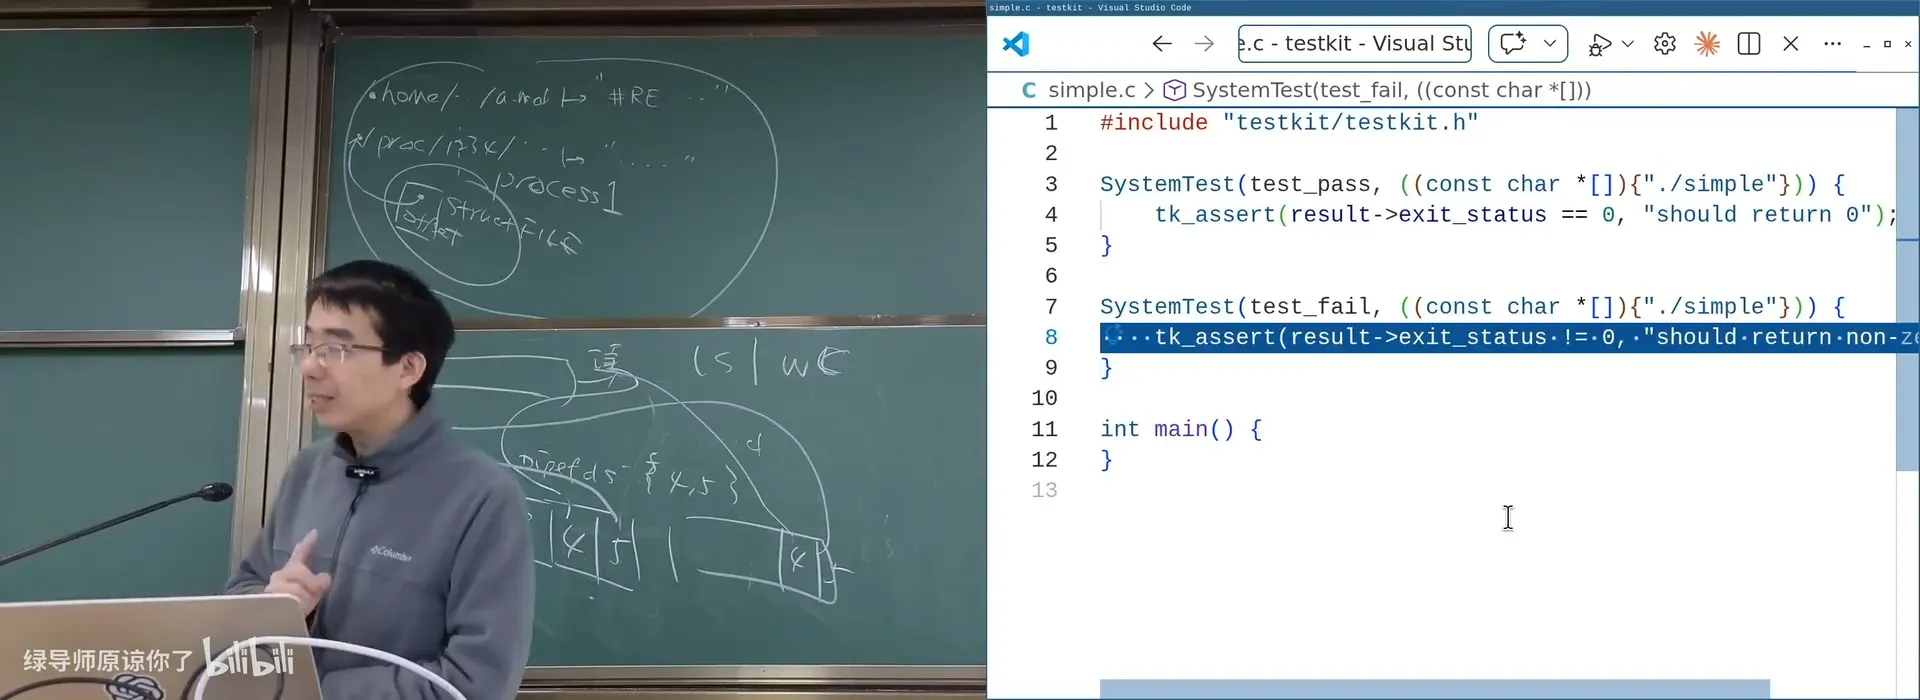
最后一个例子把本讲的多个概念串了起来——同学们的第一个测试框架 TestKit:
- 你只需要
#include "testkit.h"并链接testkit.c,就能直接在代码里写单元测试和系统测试,随时随地调用内部函数; - 它的关键实现,恰恰是进程管理 + 内存映射的综合应用:
graph TD
    M["父进程:为每个测试用例<br>用 mmap 创建一段共享缓冲区"] --> F["fork 出子进程运行该用例"]
    F --> T["给子进程设置一个闹钟(alarm / timeout)"]
    T --> R["子进程把结果写入共享缓冲区"]
    R --> C["父进程等待它结束,检查输出"]
    T -.->|"超时则杀掉"| C
- 为什么
assert会把程序 crash 掉(abort),但 TestKit 还能继续跑剩下的用例? 因为每个用例都跑在子进程里——子进程崩溃不影响父进程; - 死循环怎么办? 给子进程设一个闹钟(timeout),超时就把它杀掉;
- 怎么收集结果? 父进程先用
mmap建立共享内存,子进程把测试输出写进去,父进程读出来检查。
讲师也照例提醒:「今天再也不要用古法去读代码了。」 你完全可以让 AI 去解释、去写测试用例——「用魔法打败魔法」,他自己甚至有个作业的测试用例是 AIGC 的、看都没看一眼。
📷 TestKit:在子进程中运行测试用例,超时则杀掉
回到原视频 (01:27:30)
总结
- 操作系统是一个「对象管理系统」:进程是封闭世界(内存 + 寄存器),其他一切都要通过系统调用访问;除了进程、内存,还有文件、管道、网络连接、锁等大量对象。
- 两种设计哲学:Windows 走「开发者要什么就给什么」(高效、结构化,但难以被用户直接 hack);UNIX 走 Everything is a File(把对象暴露成文件 + 一套通用工具)。
- 文件的本质是「有名字的字节序列」,而字节序列可以表示数据流、网络连接、设备、锁、管道……于是 UNIX 用一套统一的工具处理所有对象;用目录管理名字;文件系统足以构建任何信息系统(代价是没有强一致性保证)。
- UNIX Philosophy(KISS):做一件事并做好、协同工作、用文本流作通用接口——文本「人类可读、机器可读」,在 AI 时代对大模型尤其友好。
- 文件描述符:内核里每个打开的文件是一个
struct FILE(buffer + offset);应用程序通过 0/1/2/… 这一「fd 地址空间」来访问它们,fd 就是指向操作系统对象的、带权限的指针(Windows 叫 handle)。 - API 之间会互相影响:
fork之后,文件的 offset 是共享的(浅拷贝)——这是 UNIX 故意选的语义,避免父子互相覆盖;而「复制一切」也让 fd 泄露成为安全隐患,于是有了O_CLOEXEC。 - 管道:一种「会互相等待的文件」(空则读阻塞、满则写阻塞),既能通信又能同步;命名管道有名字、匿名管道配合
fork使用(shell 的|)。 - 贯穿全场:计算机世界里没有魔法。想知道任何事,就提出正确的问题,让 AI 帮你把它解释清楚——你需要的只是想象力。
附:官方参考与延伸阅读
本讲的讲义见课程主页,以下链接按书中出现顺序整理:
| 主题 | 链接 |
|---|---|
| Crazy OS(内部文件与系统调用的最小模型) | https://jyywiki.cn/OS/demos/virtualization/crazy-os |
| 文件描述符 Demo | https://jyywiki.cn/OS/demos/virtualization/filedesc |
| UNIX 管道 Demo | https://jyywiki.cn/OS/demos/virtualization/pipe |
| TestKit 测试框架 | https://jyywiki.cn/OS/demos/virtualization/testkit |
| Filesystem Hierarchy Standard (FHS) | https://refspecs.linuxfoundation.org/FHS_3.0/fhs/index.html |
| The Unix Haters Handbook | https://web.mit.edu/%7Esimsong/www/ugh.pdf |
| A fork() in the road(微软研究院) | https://www.microsoft.com/en-us/research/publication/a-fork-in-the-road/ |
| OSTEP:Operating Systems: Three Easy Pieces | https://pages.cs.wisc.edu/~remzi/OSTEP/ |
open(2) 手册(含 O_CLOEXEC) |
https://man7.org/linux/man-pages/man2/open.2.html |
pipe(2) / pipe(7) 手册 |
https://man7.org/linux/man-pages/man7/pipe.7.html |
dup(2) / dup2(2) 手册 |
https://man7.org/linux/man-pages/man2/dup.2.html |
mkfifo(3) / mkfifo(1) 手册 |
https://man7.org/linux/man-pages/man3/mkfifo.3.html |
proc(5):/proc 文件系统 |
https://man7.org/linux/man-pages/man5/proc.5.html |
阅读材料:教科书 Operating Systems: Three Easy Pieces 第 39 章(Files and Directories)。
版权说明:本讲讲义与幻灯片作者为蒋炎岩,采用 Creative Commons BY-NC 4.0 许可,来源于 https://jyywiki.cn/OS/2026/。视频画面与字幕版权归原作者所有。本书为课堂内容的学习性重构。