第9讲 · C 标准库的原理与实现:从 _start 到应用生态的第一级抽象
2026 南京大学《操作系统原理》第九讲 · 课堂实录重构
| 主讲 | 蒋炎岩(Yanyan Jiang) |
| 视频 | https://www.bilibili.com/video/BV1GHXCBkEZf/ |
| 课程主页 | https://jyywiki.cn/OS/2026/ |
| 本讲讲义 | https://jyywiki.cn/OS/2026/lect9.md |
| 讲义 / 幻灯片作者 | 蒋炎岩,https://jyywiki.cn/ |
| 讲义 / 幻灯片许可 | CC BY-NC 4.0 |
| 图片来源 | 书中插图为课堂演示与讲义渲染图;演示类截图为视频画面 |
对应讲次:第9讲(南京大学 操作系统原理)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者说明:本书由课堂录像的语音字幕重构而成,术语、章节骨架与参考链接已按课程官方讲义(
lect9.md)校准。讲师的口语风格、类比与案例被尽量保留;编辑性的补充一律以「编者说明」或「编者拓展」标出。
引子:一层一层垒出来的应用生态
(参考时间: 00:00)
本讲从实验 M2 的更新说起(需要正确配置 MODULE、课程 token 等环境变量才能提交),然后回顾了这几周的主线:
- 从一个最小的、连退出都做不到的程序(只有一个
_start、一段死循环)出发,用LD/as把它变成a.out,它就能真的在操作系统上跑起来; - 程序的寄存器与内存可以直接访问,其余一切都要通过系统调用:
- 进程管理:
fork/execve/exit; - 内存管理:
mmap/munmap/mprotect; - 访问对象:
open/read/write/lseek; - UNIX 还给了我们一整个世界:
/proc/[pid]/maps(把进程内存变成可读写的文件)、PTY、pipe……
用这些 API,原则上就能构建任何应用——甚至一个浏览器(open 一个远端 socket、拿回 HTML、解析、渲染),或者一个终端里的浏览器。
但真实的软件生态并不直接构建在这么底层的 API 上。这一讲要讲的,就是:我们怎样在 C 和一小撮系统调用这个极小的核心之上,一层一层垒出舒适的开发世界。而第一层就是 libc。
编者说明:讲师给了一个很实用的「AI 时代读手册」范式:
bash
man -P cat pty | claude   # 把手册全文交给 AI,先要 summary,再任意追问
你也可以让 AI 写一个「遍历所有手册并以树状展示」的工具(一行 shell script 即可),做全局搜索。「在 AI 之前,你必须自己花时间读所有东西;现在你只需要知道世界上有什么、并快速提取你想要的那一点。」
一、C 与 libc:跨语言的能力,是从哪来的?
1.1 SimpleC 不是 C 的「完全体」
(参考时间: 00:09)
回顾:我们可以把任意 C 程序改写成 SimpleC 的形式(赋值只有「变量 = 单操作」、分支/循环也都规约到极简形式),于是它可以几乎直译成汇编(x86 / ARM / RISC-V 都行)——只要有跳转、寄存器腾挪、load/store。指针、数组、结构体、函数调用,都是内存和寄存器的直接操作。
但这只是 C 里「与计算相关」的那部分。C 的完全体,还有一项所有语言都有的能力:跨语言调用(Foreign Function Interface, FFI)。
编者拓展|FFI 无处不在:Python 的
mmap模块背后,一定有一个真正的mmap系统调用;而 Python 本身没有「系统调用」这个概念——它靠ctypes、C 扩展等 FFI 去调用 C/汇编写的东西。C 与汇编之间靠 ABI(Application Binary Interface)规约:参数放在哪些寄存器(x86-64 下第一个参数在rdi、第二个在rsi……)、栈上是什么样子、返回值在哪。一旦 C 能调用汇编函数,它就能用syscall指令做系统调用——这就是fork、pipe这些函数最终「落到汇编」的方式。
1.2 内联汇编:一个设计得很糟的嵌入式 DSL
(参考时间: 00:13)
C 与汇编交互的另一种方式是内联汇编(inline assembly)。它可以做系统调用:
void _start() {
    __asm__("mov $60, %eax\n"   // syscall: exit
            "xor %edi, %edi\n"  // status: 0
            "syscall");
}
也可以与 C 变量交互(GCC 扩展语法):
int a = 7, result;
__asm__ ("leal (%1,%1,4), %0"  // result = a * 5
    : "=r" (result)            // output operand
    : "r"  (a));               // input operand
它的语法长这样:
Instructions : Outputs : Inputs : Clobbers : GotoLabels
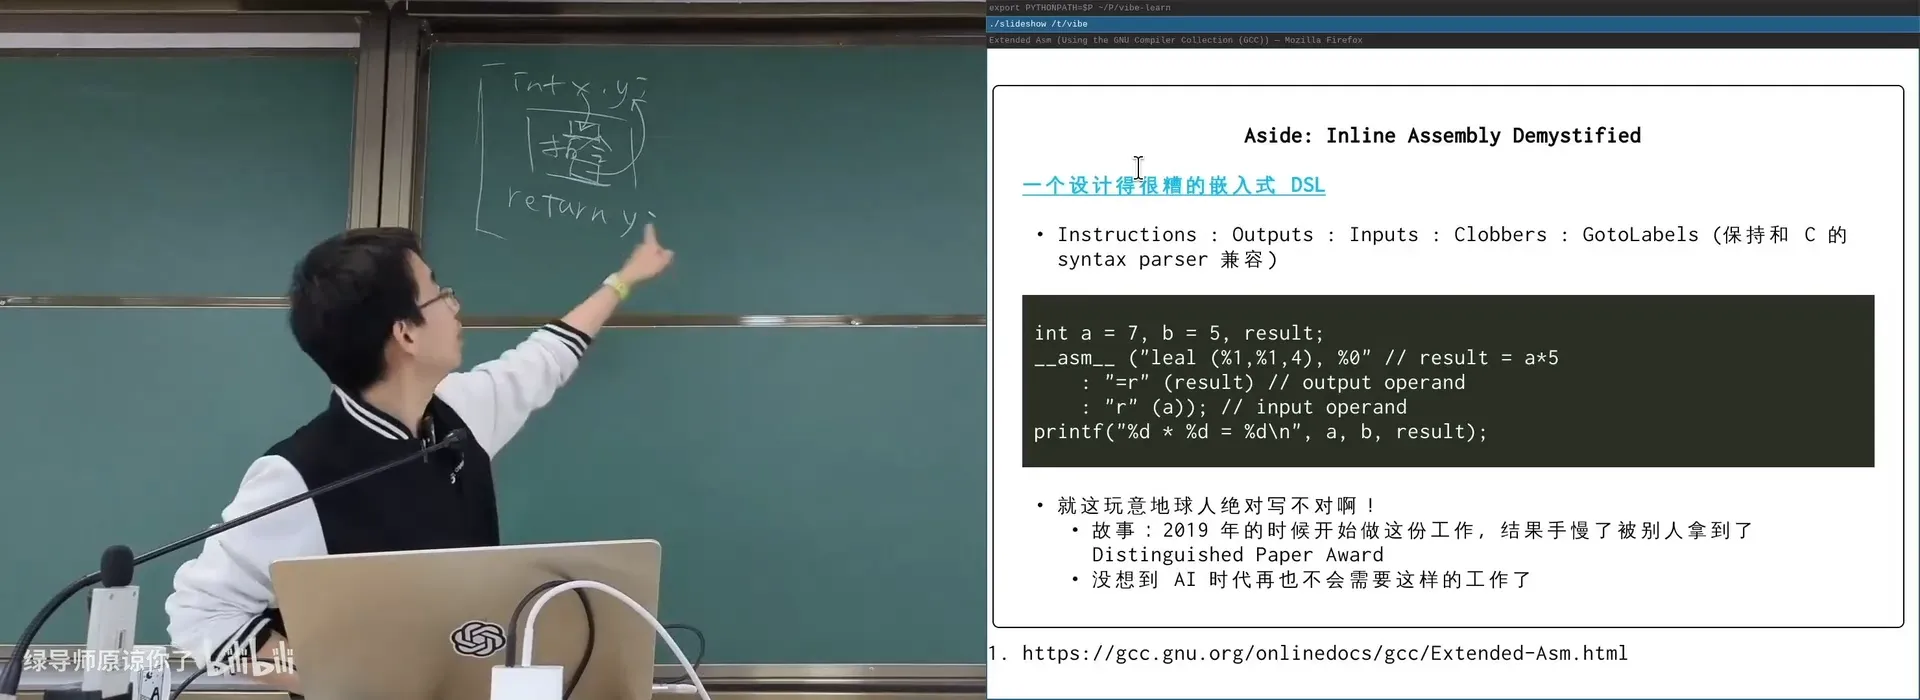
📷 GCC 扩展内联汇编:Instructions : Outputs : Inputs : Clobbers
回到原视频 (00:16:30)
讲师对它评价很直接——「就这玩意地球人绝对写不对啊!」 为什么设计得这么怪?
编者拓展|内联汇编为什么这么「丑」: - 要兼容 C 的语法解析器:所以指令写成字符串、括号必须配对、用百分号占位(
%0、%1)来引用外部变量——就像printf的格式串; - 约束(constraints):"=r"表示「输出、放进任意寄存器」,"r"表示「输入、放进寄存器」;如果同一个变量既读又写,要把=改成+; - Clobber(破坏列表):你写的汇编可能改了编译器要用的寄存器(比如系统调用要用rax、rdi…),必须显式声明「我破坏了这些」,否则编译器优化时就会踩坑; - 编译器对字符串里的指令完全不负责任:它不解析指令语义(甚至可以是自定义指令,只要汇编器认识)。最可怕的是「漏声明副作用」:你今天写的汇编恰好没和编译器撞寄存器,程序就是对的;等编译器升级、变得更激进,那个寄存器被用上,程序就莫名其妙地坏了——而且怎么测都测不出来。
讲师讲了段往事:2019 年他做「内联汇编误用」的研究,本想写一篇 Inline Assembly Demystified,结果手慢了,被别人抢发了 Distinguished Paper Award。而今天,这门课再也不需要教内联汇编的细节了——你只需要建立「C 有一个 FFI 机制」这个概念,剩下交给 AI。他甚至说:「只要给它足够的算力,AI 能学会,甚至靠 self-play 自己学会。」
1.3 抽象层上的抽象层
(参考时间: 00:23)
这其实是计算机系统发展的一个缩影——在抽象之上再垒抽象:
graph TD
    A["1950s:只有汇编语言"] --> B["1970s:用汇编编程 = 行为艺术<br>(C / Pascal 与结构化程序设计普及)"]
    B --> C["2010s:C = 「古法编程」<br>(C++ / Java / JS / Python 兴起)"]
    C --> D["2026:用高级语言编程 = 行为艺术<br>(自然语言就是编程语言)"]
有意思的是,「结构化程序设计」在今天「复活」了:先把问题分成几个抽象的部分,再逐步 refine——这套思路特别适合 vibe coding。
1.4 标准化的力量:ISO C 与 POSIX
(参考时间: 00:25)
为什么 C 能成为「世界的底座」?因为它有标准:
- ISO C:规定语法与语义,稳定、可靠(不用担心升级版本破坏实现),有世界上最好的可移植性;
- POSIX(Portable Operating System Interface):是 C 的子集扩展(
unistd.h、fork、pipe……),几乎所有「能用」的操作系统都提供一定的 POSIX 兼容性。
graph TD
    HW["硬件"] --> ASM["汇编 / ABI"]
    ASM --> C["C(ISO C)"]
    C --> POSIX["POSIX(unistd.h, fork, pipe…)"]
    POSIX --> APP["应用生态(Python / JS / Java / Android…)"]
编者拓展|「一致性」的代价与价值:讲师把 C 与 JavaScript/Python 对比得很到位——用 JS/Python 今天开发很爽,但明天依赖一 break,程序就跑不起来,你得让 AI 去修,修成什么样自己也不知道,软件进入一种「能用但失控」的状态。而 C 代表的是经典、稳、一层一层的世界:只用最小子集、以可移植方式写(比如不假设
int是几字节),同一份代码能从超级计算机跑到手表、手环、只有 1 KB 内存的设备。事实上,从 Linux、macOS,到 Android、HarmonyOS,都至少有一个 C 编译器 + 一层 POSIX——因为只有这样,别人写的东西才能「几乎不改地」跑起来。
busybox、Android 的toybox都是在 C + POSIX 接口上实现的小工具集。
二、探索 libc:用 musl 代替 glibc 来「读懂原理」
(参考时间: 00:29)
系统里默认的 libc 通常是 glibc。你当然可以下载它的调试符号去逐行调试,但讲师不建议:
- glibc 有非常沉重的历史包袱——每来一个新需求就打个补丁,每来一个新指令集特性就想用进来提升性能;
- 结果是代码库膨胀、维护困难、新手阅读体验极差。
「基本原则:总有办法的,你只要问就行了。」 一个更好的学习对象是 musl libc——现代、工整、基于 Linux API 实现(而不是古老的 POSIX API),把历史包袱丢掉了。讲师直接让 AI(豆包)把 musl 1.2.6 编译成一份带调试信息的 musl-gcc,一次搞定。
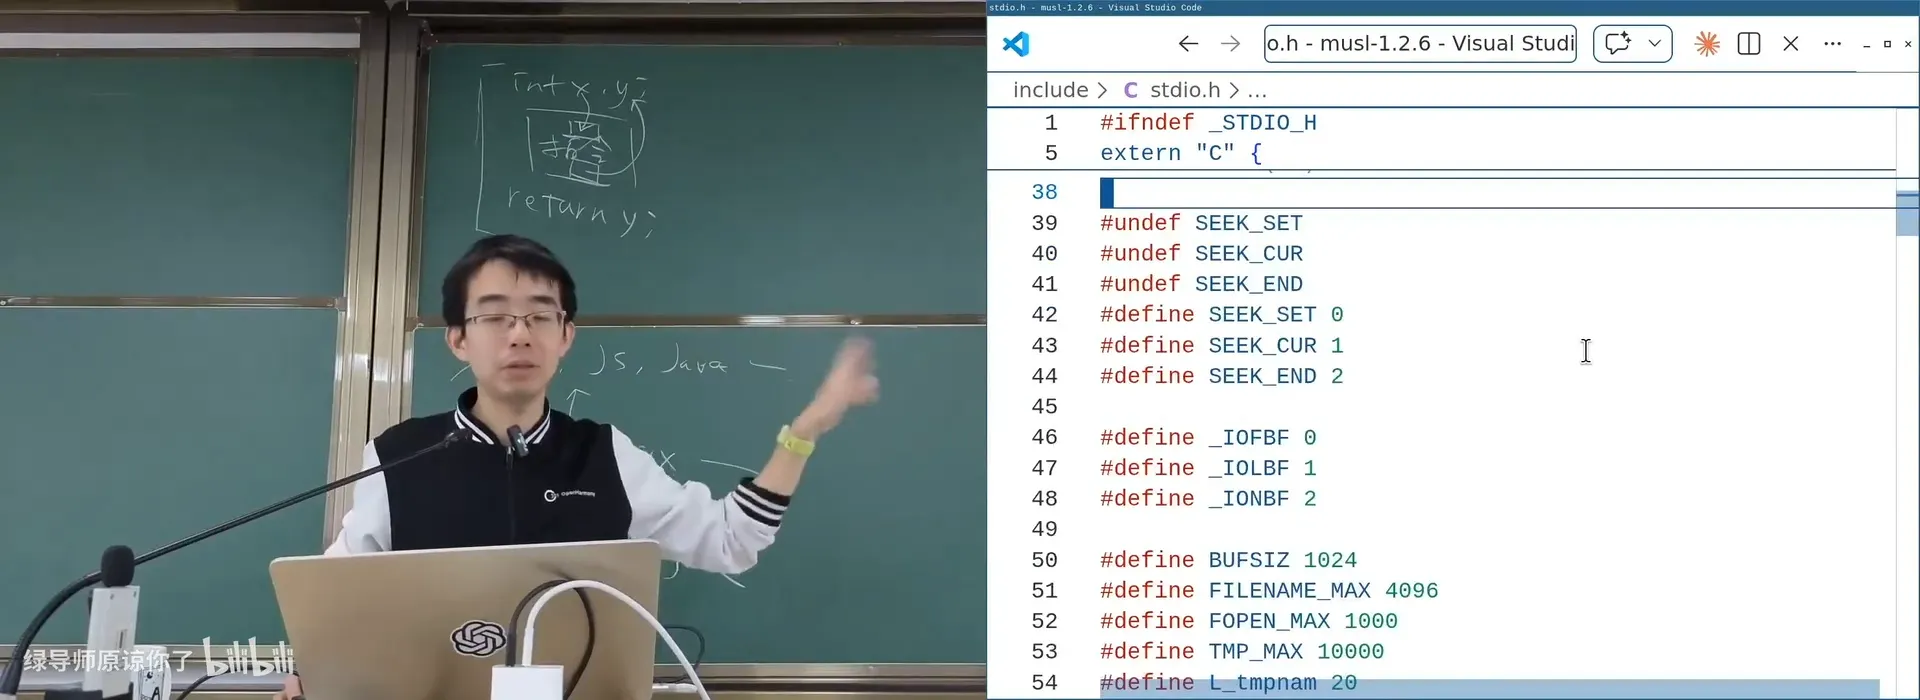
📷 musl libc 源码:现代、工整、无历史包袱
回到原视频 (00:34:30)
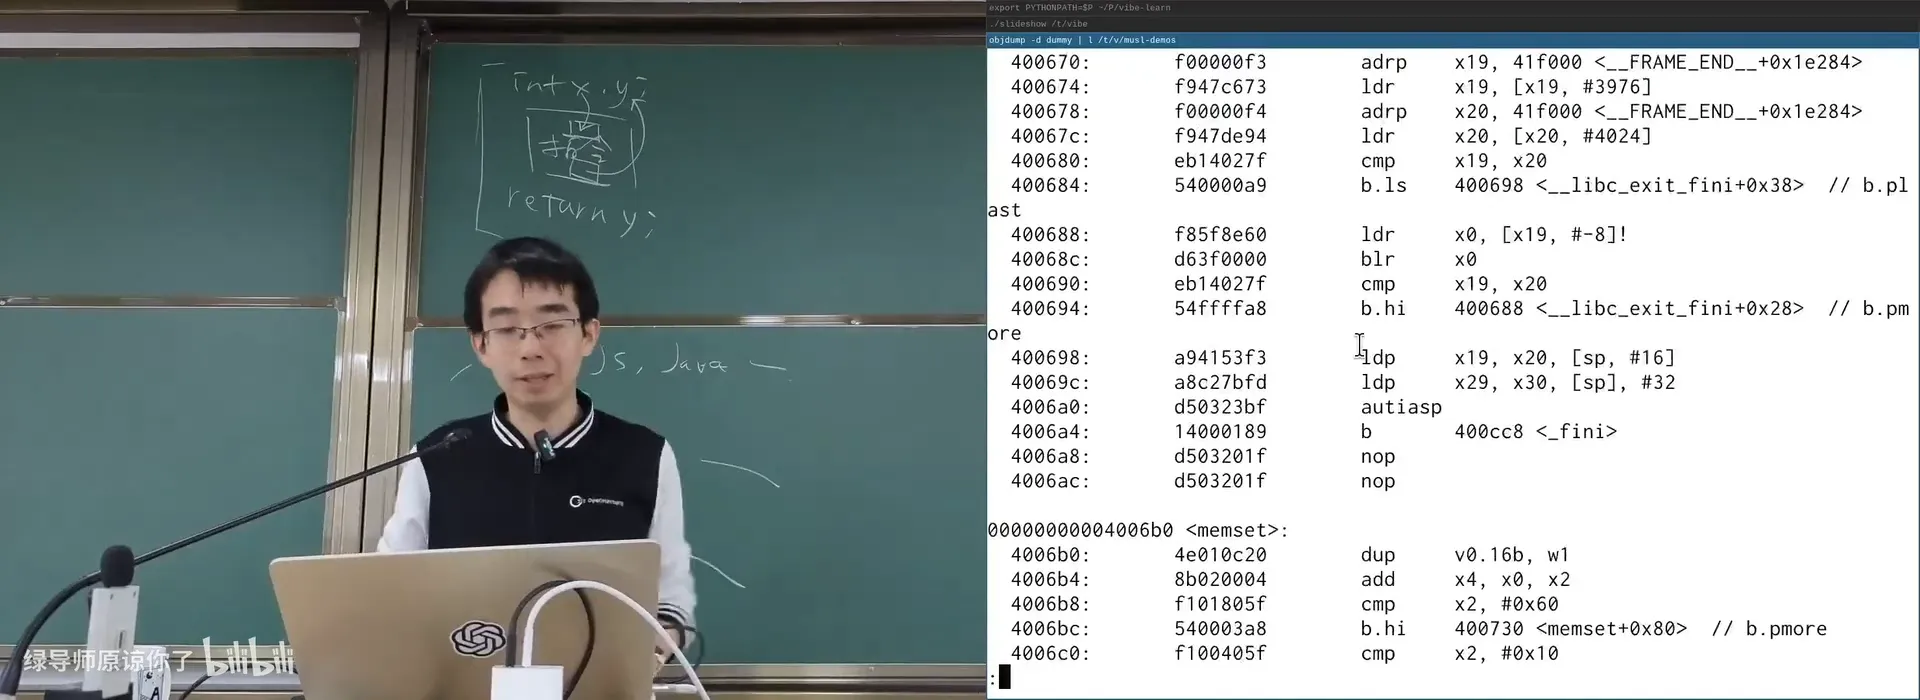
📷 objdump 查看 musl-gcc 产物:_start / memset 等(实操)
回到原视频 (00:36:35)
编者拓展|从一个「解压」笑话说起:讲师提到
tar的参数「太古老」,不完全符合后来的 POSIX 参数风格。有个著名笑话:「你有一颗核弹 10 秒后爆炸,请写出一条合法的 tar 命令解压文件」——因为几乎没人能一次写对。今天这也不是问题了:让 AI 帮你写/读懂它。
动手调试一份 musl libc,是这一讲的核心方法论:从一个「最简单」的 C 例子出发,深入它的每一条汇编指令、每一个系统调用,看程序和处理器、操作系统所有的交互。
三、Freestanding 环境:不依赖操作系统的那些库
(参考时间: 00:36)
libc 的功能可以分成两类:
- 不依赖 Host OS 的(不需要系统调用)——这叫 freestanding 环境。C 编译器本身就要在「没有操作系统」的环境里能用(比如用来写内核);
- 依赖 OS 的(如
putchar、exit、fopen)——这叫 hosted 环境。
3.1 机器相关的常数与定义
(参考时间: 00:37)
你所有「不知道」的定义都在这里:
stddef.h:size_t、NULL、offsetof……float.h:浮点数的实现相关参数;limits.h:各种整数的范围;stdint.h/inttypes.h:定长整数与打印它们的格式宏。
编者拓展|
int到底几字节?以及PRId64的由来:int的长度和机器相关:32 位机上long是 4 字节,64 位机上是 8 字节。所以「我想打印一个int64_t,该用%d还是%ld」这类问题,就靠inttypes.h里的宏解决:PRId32、PRId64、PRIuPTR……一个有意思的观察:这些宏其实是字符串字面量的拼接。用
gcc -E(只做预处理)展开inttypes.h就能看到:相邻的两个字符串字面量("abc" "def")会被编译器自动拼接成"abcdef"——「编程语言里的各种机制是环环相扣的」。还有一个好玩的宏是
offsetof(T, m):它告诉你结构体某成员相对头部的偏移。它的实现是「假装在地址 0 处有一个对象,取成员的地址」(不对该指针解引用)——在 C 里是完全合法的操作。
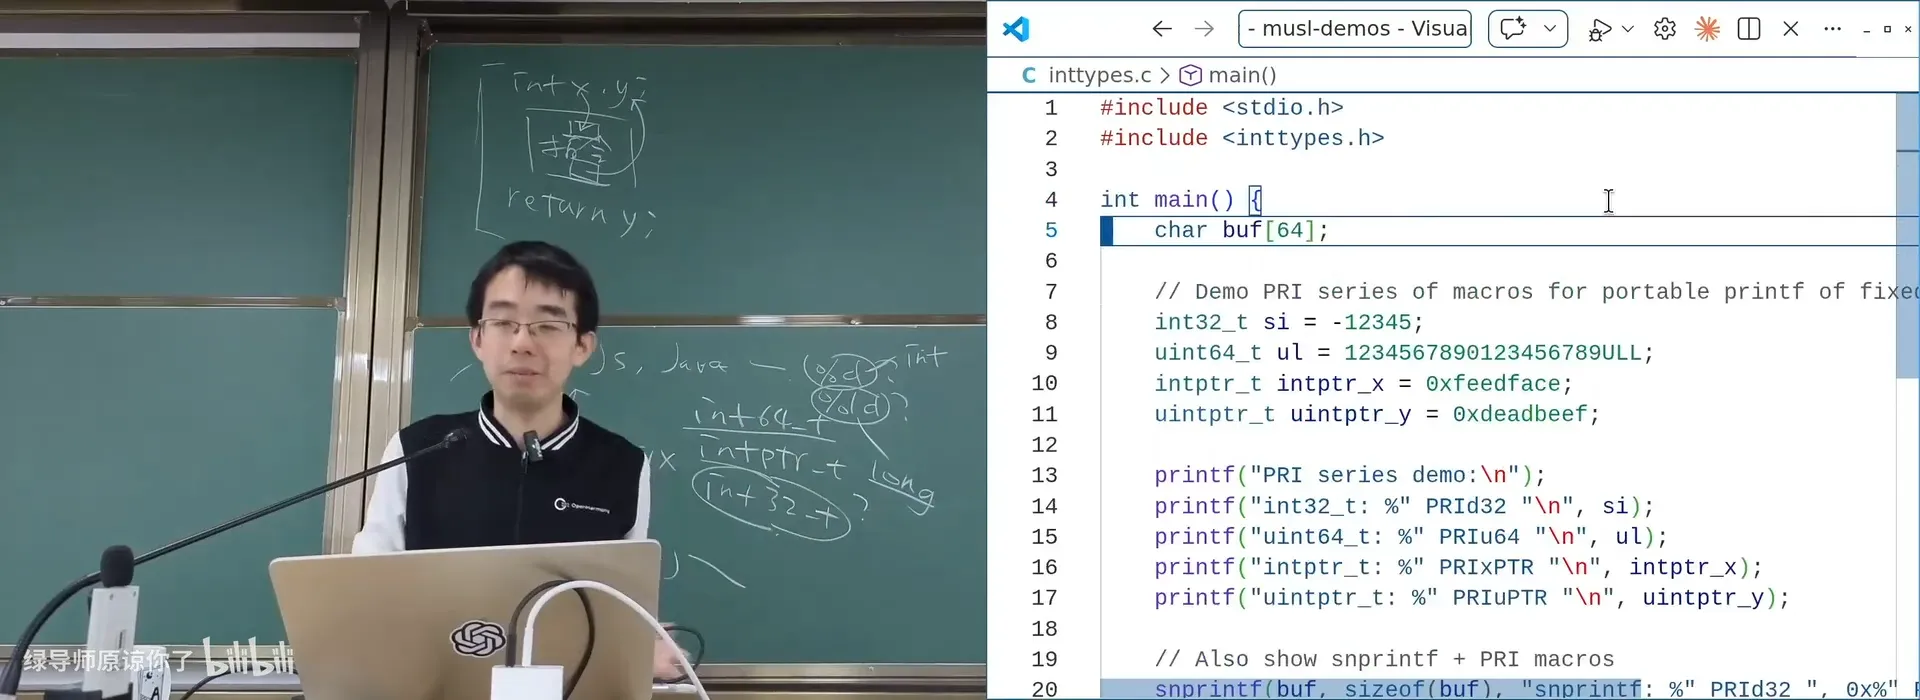
📷 inttypes.c:用 PRId32 / PRIu64 等宏可移植地打印定长整数
回到原视频 (00:40:00)
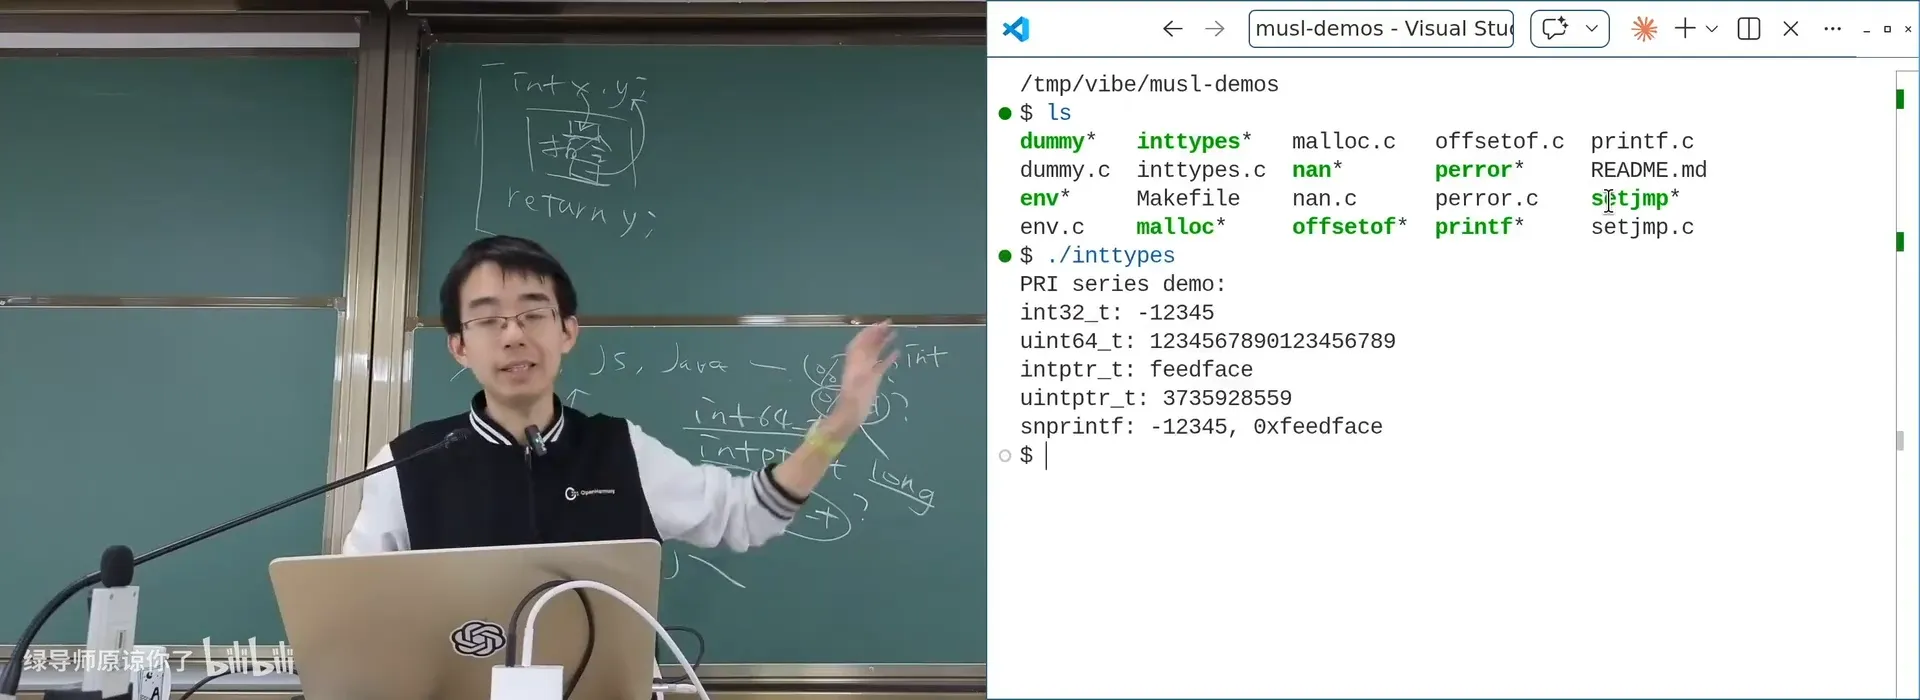
📷 gcc -E 展开 inttypes.h:字符串字面量拼接(实操)
回到原视频 (00:40:25)
3.2 stdarg.h:变参数是怎么实现的
(参考时间: 00:43)
printf 可以接收任意多个参数,靠的是 stdarg.h(va_list、va_start、va_arg……)。它的实现和指令集 / ABI 强相关:
- 在32 位机器上,调用约定是把参数全压到栈上,于是「第一个参数的地址 + 1」就拿到了参数数组,实现相对简单;
- 在现代 64 位机器上,参数大多通过寄存器传递(
rdi、rsi……),标准库必须和编译器协作,把需要的寄存器存到内存里,va_list才能正确地逐个访问参数。
编者说明:这也是为什么
stdarg的实现在不同架构上差别巨大、看起来相当复杂。
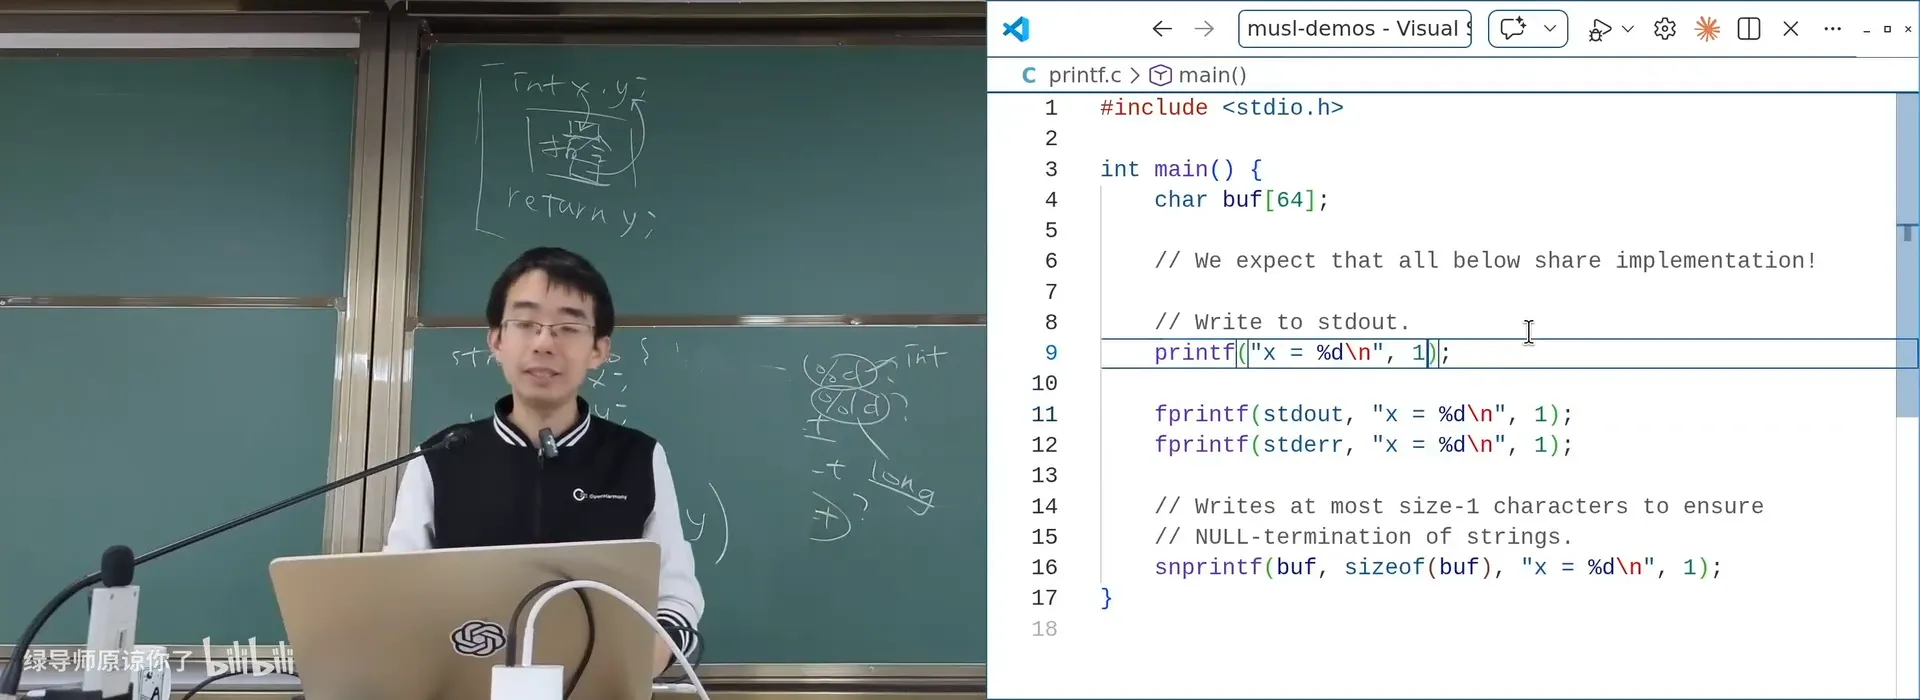
📷 print.c:printf / fprintf / snprintf 共享同一实现(实操)
回到原视频 (00:43:45)
3.3 一些「随手可以实现」的函数
(参考时间: 00:45)
讲师把它们称为「课后习题」——因为C 实际上是「高级汇编语言」,标准库是真的很难做。
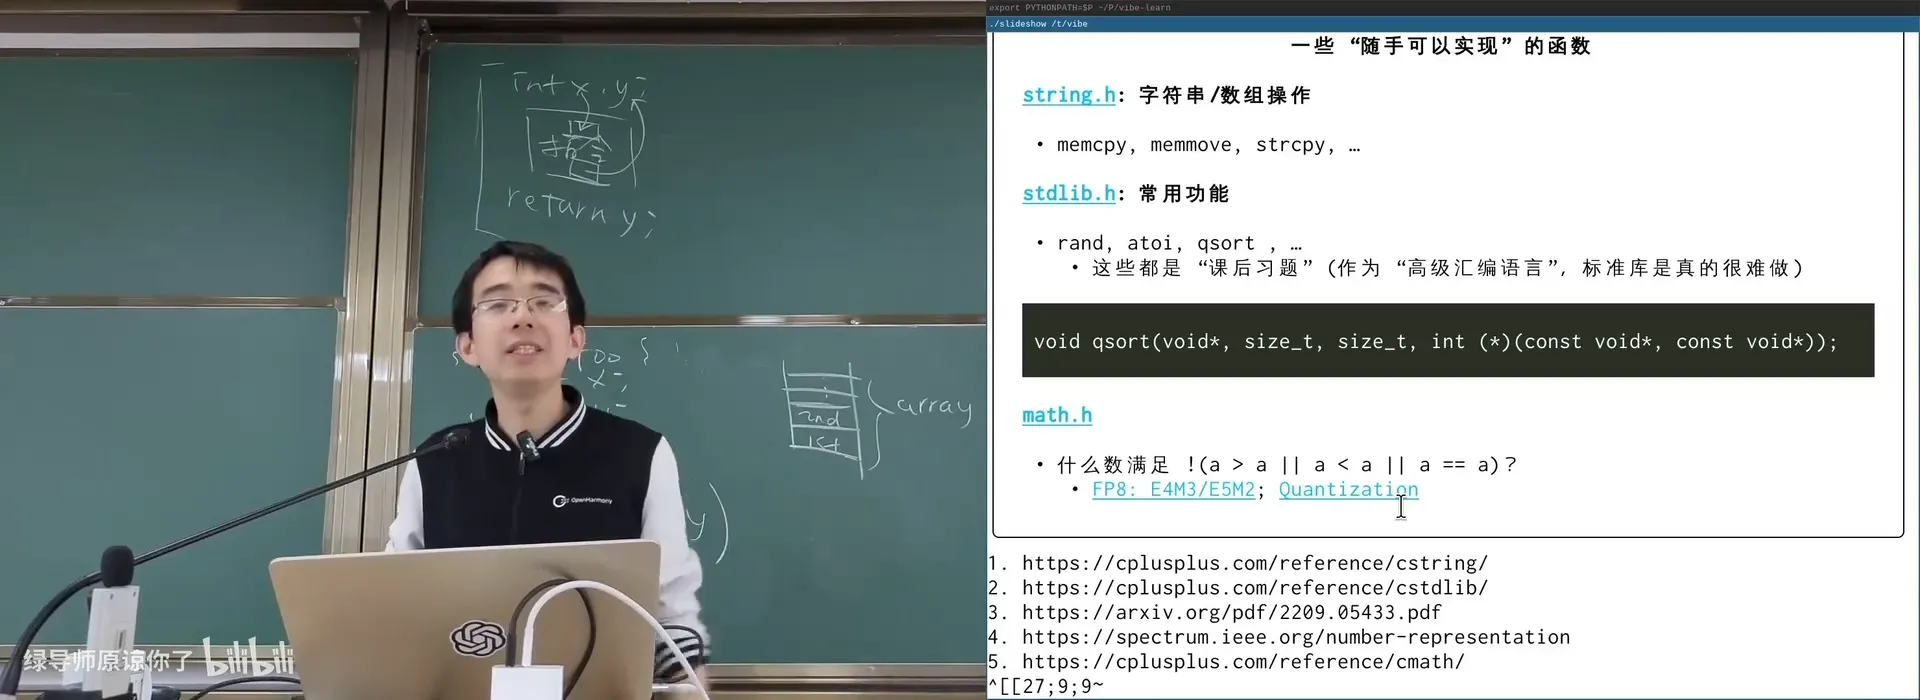
📷 一些「随手可以实现」的函数:string.h / stdlib.h(qsort)/ math.h
回到原视频 (00:47:30)
编者拓展|
rand并不随机,qsort并不好用,math.h水很深: -rand是一个确定性的伪随机数生成器:给了相同的seed,每次运行生成的序列完全相同——它只是一个数学函数。 -qsort难用的根源在于 C 的语法机制太弱:它的签名是void qsort(void*, size_t, size_t, int (*)(const void*, const void*))——不能像 C++/Python 那样把「比较逻辑」优雅地带上。你在实际项目里更愿意自己写结构体 + 比较函数。 -math.h里有个惊人的事实:存在一个数a,满足!(a > a) && !(a < a) && !(a == a)——它就是 NaN(Not a Number)。浮点数(IEEE 754 / 甚至 FP8)的水非常深。
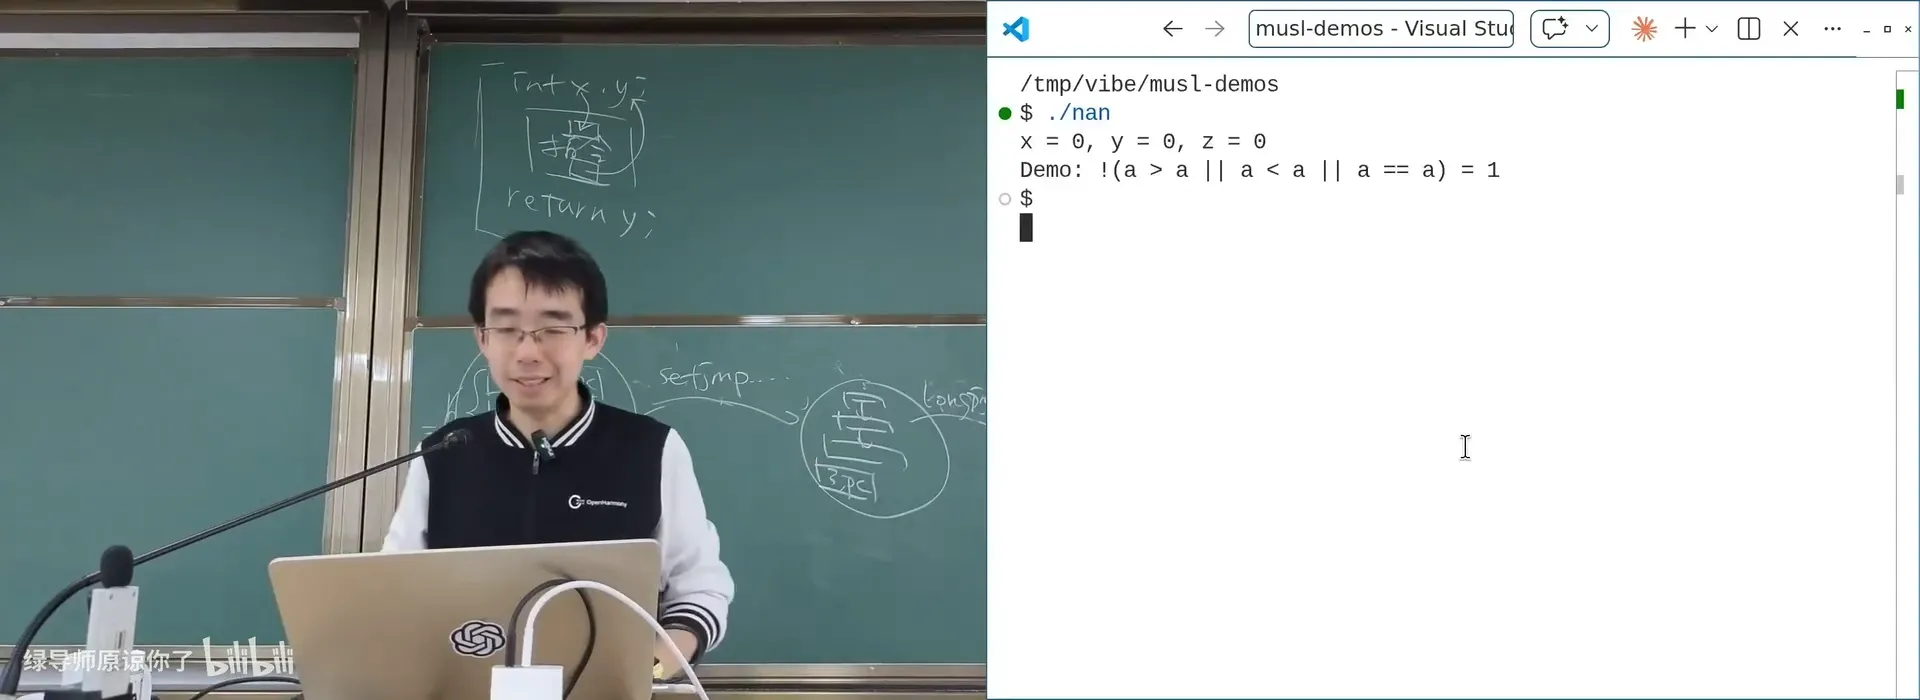
📷 NaN:一个自己不等于自己的数(Demo 输出 `!(a > a || a < a || a == a) = 1`)
回到原视频 (00:53:00)
3.4 setjmp / longjmp:一次「栈上的长跳转」
(参考时间: 00:48)
这是 freestanding 里最特别的一组函数。回忆 SimpleC 的执行模型:程序有一个调用栈,每次函数调用 push 一个 frame,返回就 pop;每次执行的都是栈顶 frame 的 PC 处的那条语句。
setjmp / longjmp 就是在这个模型上做的一个「hack」:
case "call setjmp":
    buf.depth = len(stack)        # 记住栈的高度
    buf.pc    = stack[-1].PC      # 记住当前 PC
    stack[-1].retval = 0
case "call longjmp":
    stack = stack[:buf.depth]     # 把中间的调用帧全部弹掉
    stack[-1].PC = buf.pc         # 跳回去
    stack[-1].retval = (x if x != 0 else 1)
graph LR
    M["main:setjmp(buf) 返回 0"] --> F["first()"] --> S["second()"]
    S -->|"longjmp(buf, 1)"| M2["直接跳回 setjmp 处<br>(中间所有栈帧被丢弃)"]
setjmp(buf)在buf里记住「当前栈深度 + PC」,然后正常返回 0;- 之后你可以调用任意多层函数;
- 只要调用
longjmp(buf, val),就会一下子把几百层、几千层栈帧全部弹掉,回到setjmp的位置,并把返回值变成val(0 会被改成 1)。
讲师把它比作「一个大号的 goto」:
你今天要去上课,先在自己的宿舍里
setjmp做一个标记;然后去教学楼、逸夫楼、食堂……不管你中间干了什么,最后longjmp一下,直接清掉历史、回到宿舍。编者拓展|
longjmp的两种经典用途: 1. 集中式的错误处理 / 资源清理:C 里在for循环中提前return很容易忘记释放资源。经典写法是用goto out(函数内的“清理标签”)把所有释放集中到一处;而setjmp/longjmp就是跨函数版本的长跳转——「label 写在 buffer 里,还包括了当前栈的深度」。 2. 实现协程 / 上下文切换:本课程有实验会让你用它来实现协程。它甚至不需要任何系统调用,只要编译器配合生成正确的指令序列即可。实际实现里,
buf除了栈深度和 PC,还会保存一些寄存器——这些细节不用记,你只需要知道「通过一个 long jump 可以跳回来」。
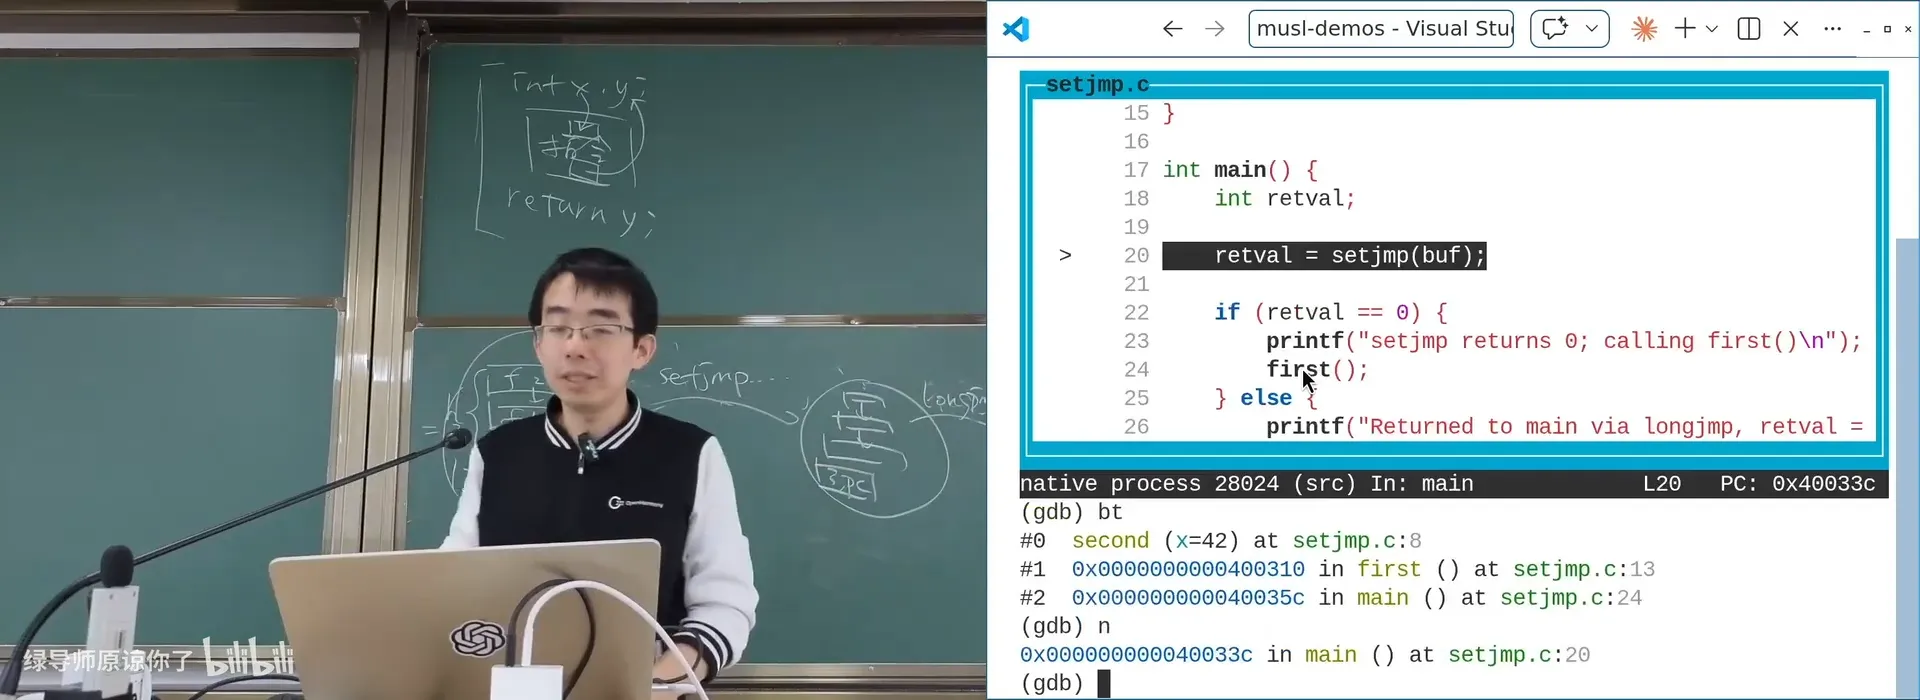
📷 gdb 调试 setjmp/longjmp:三层调用栈被一次 longjmp 弹掉
回到原视频 (00:54:30)
四、系统调用的封装
4.1 stdio.h:FILE * 的背后是一个文件描述符
(参考时间: 00:55)
C 标准库的 stdio.h 和 UNIX 的文件操作 API 几乎一一对应:
| C 标准库 | UNIX 系统调用 |
|---|---|
fopen → FILE * |
open → 文件描述符 |
fread / fwrite |
read / write |
fseek / ftell / feof |
lseek |
FILE * 背后其实就是一个文件描述符——「C 和 UNIX 的设计就是这样密不可分」。讲师用 gdb 直接查看了 stdout 的具体结构;而 musl 里 struct FILE 比 glibc 干净得多,一看就懂:
struct _IO_FILE {
    int fd;              // 文件描述符(操作系统对象)
    int pipe_fd;         // 管道相关
    int pid;             // 进程相关
    unsigned char *buf;  // stdio 的缓冲区
    // 用「函数指针」实现面向对象:
    //   read / write / seek / close
};
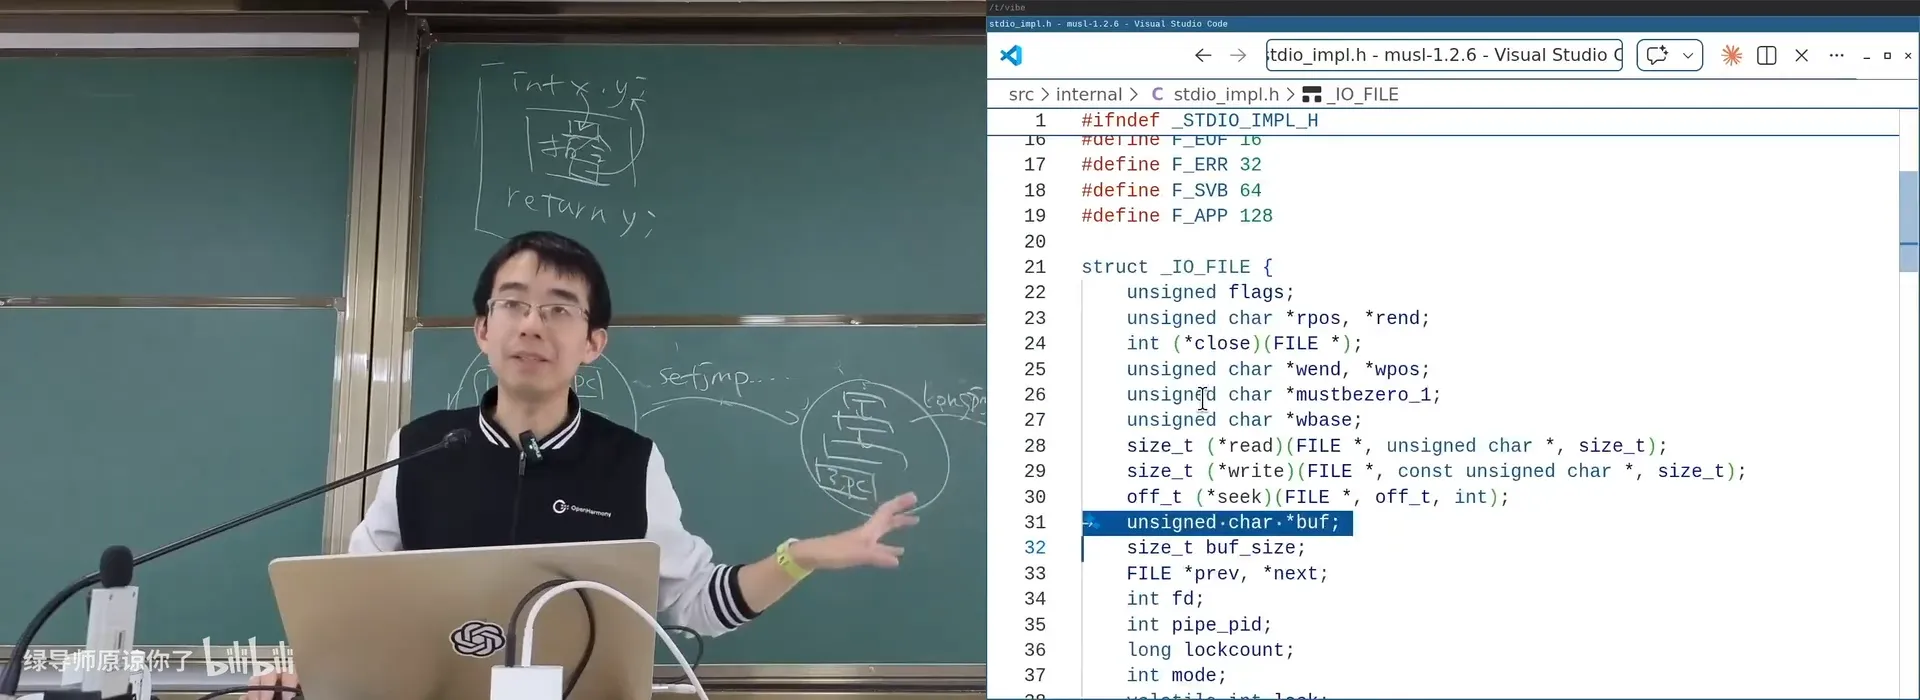
📷 musl 的 struct FILE:一个 fd、一个 buffer、一组函数指针
回到原视频 (00:57:30)
编者拓展|
FILE就是一个「用 C 实现的面向对象对象」:它把函数指针(read/write/seek/close)挂在结构体上,于是同一个FILE类型可以有多个不同后端的实现——普通文件、内存 buffer(sprintf)、管道……「这就是你在自己项目里想支持自定义排序/比较时一定会用的手法」。而 stdio 的缓冲区(buf)也解释了上一讲那个「6 行 vs 8 行」的 fork 陷阱——缓冲区是FILE的一部分,会被fork复制。
printf family 没有「代码克隆」:printf、fprintf、sprintf……最终都汇聚到一个 vfprintf:
int vfprintf(FILE *, const char *, va_list);
真正的「打印核心」只有一份:从左到右扫描 format string,遇到 %d/%s 就路由到对应的处理,再把结果写进 FILE。讲师带你用 gdb 逐级跟进——printf 最终会调用到 fprintf(stdout, ...),再用 stdarg 把参数列表一个个取出来。
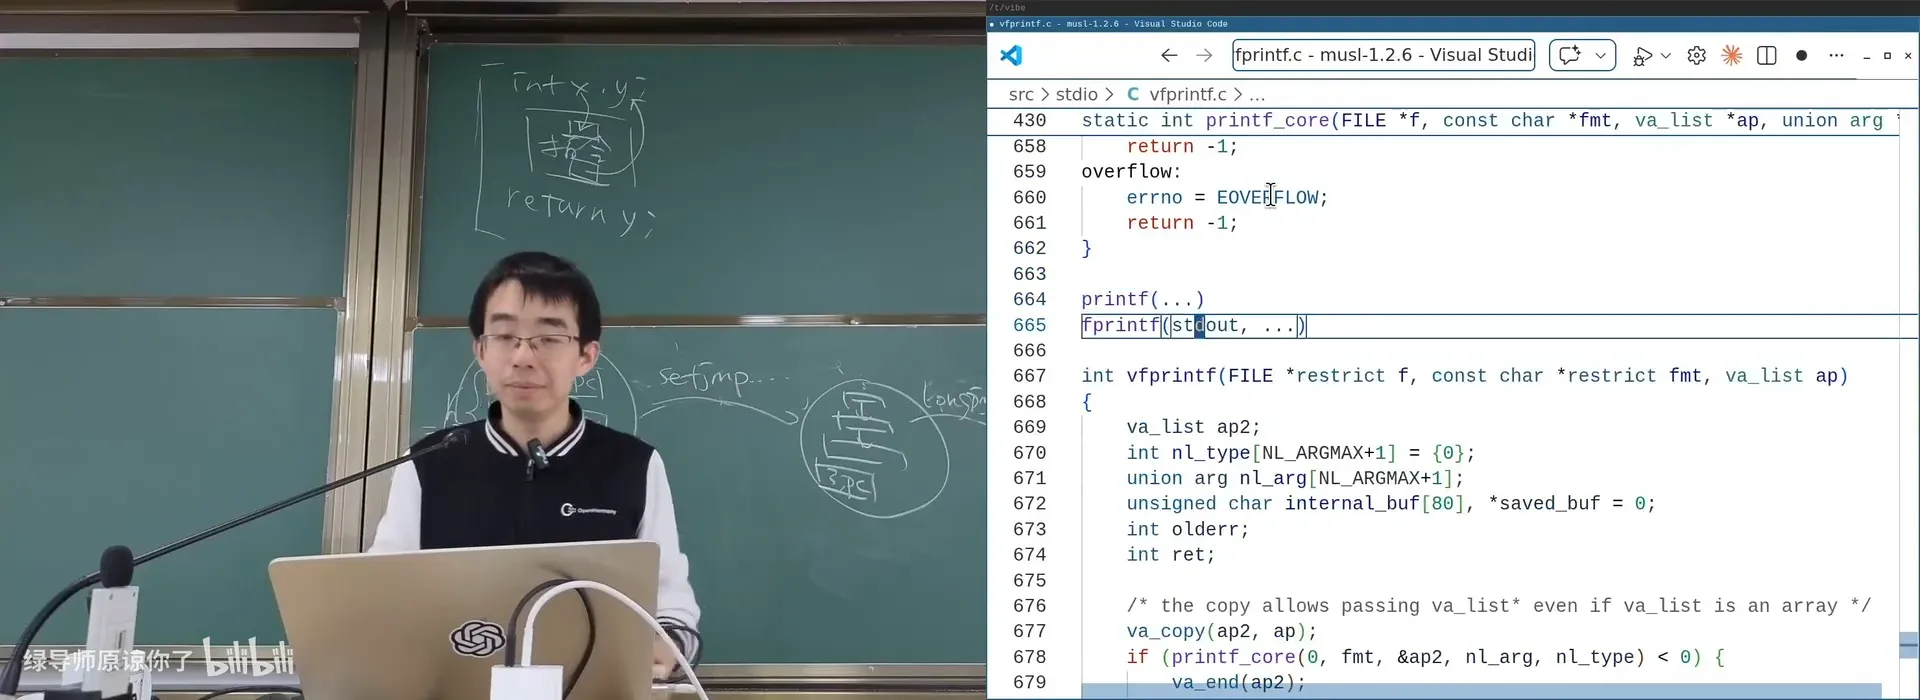
📷 vfprintf.c:printf 最终就是 fprintf(stdout, ...)(源码)
回到原视频 (00:59:52)
4.2 进程管理:abort / exit / atexit / system / popen
(参考时间: 01:00)
abort:给自己发送SIGABRT(像SIGINT一样是个信号),触发 core dump。assert失败调用的就是它——所以你看到assert之后程序的退出状态码是负数(补码意义上)。如果配置了 core dump 大小,就会生成核心转储文件,你可以用调试器事后分析。
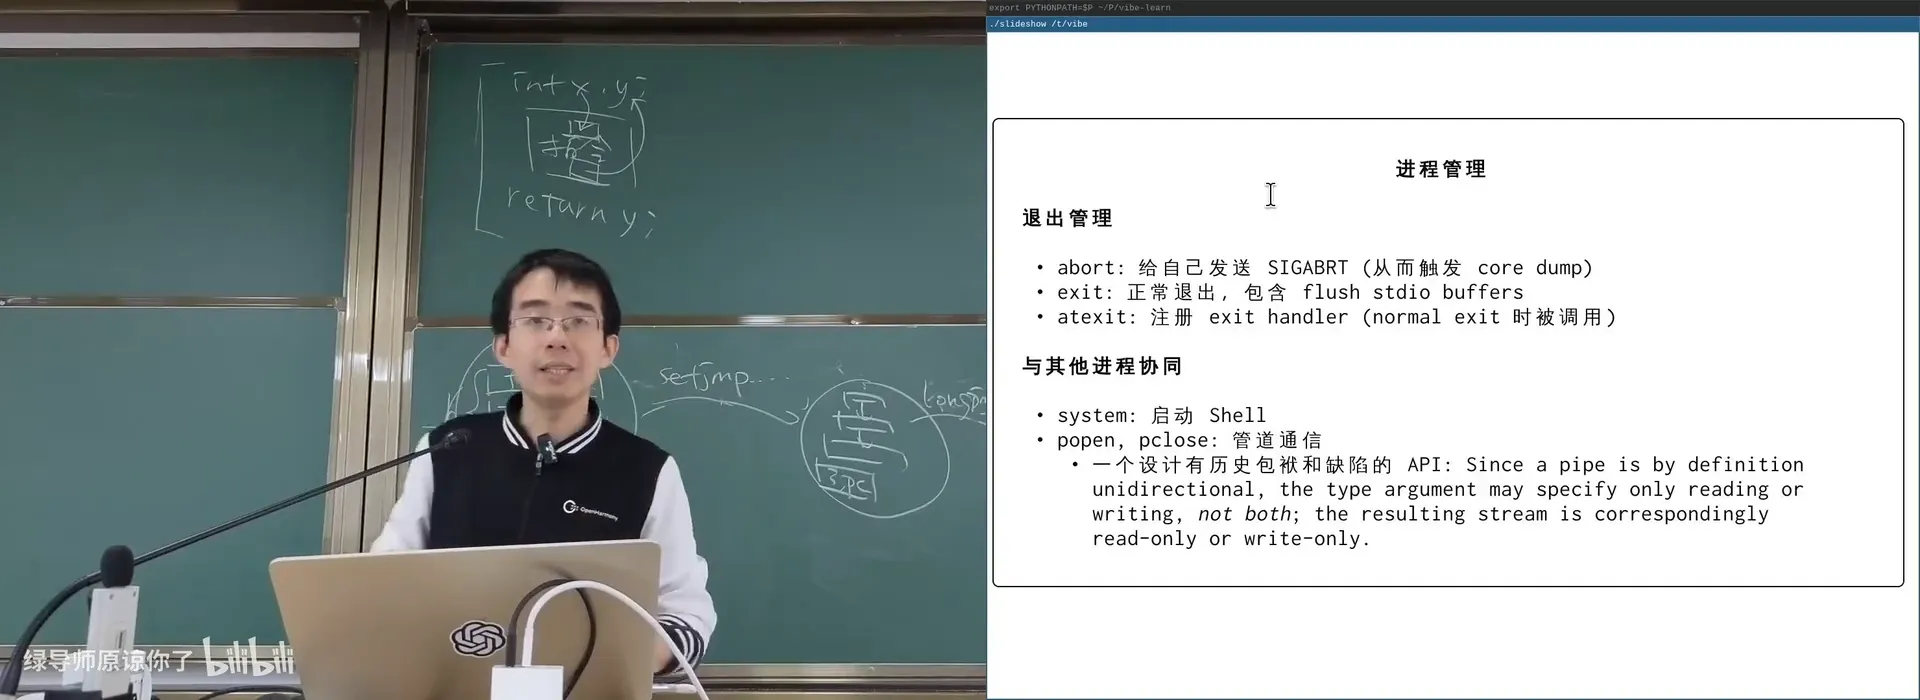
📷 abort / assert 失败触发信号与 core dump(实操)
回到原视频 (01:03:00)
exit:正常退出,包含 flush stdio buffers,并调用atexit注册的 handler;而_exit是系统调用,不 flush、不调用 handler(见第 05 讲)。atexit:注册「正常退出时被调用」的清理函数——典型用途是删除临时文件(/tmp空间有限,长期不清理会占满管理员的空间)。system:启动一个 Shell 来执行命令(所以比较重,但很好用,比如system("clear"))。popen/pclose:管道通信,返回一个FILE *。
编者拓展|
core dump的「core」是磁芯内存:这个词来自早期的磁芯内存(core memory)——用磁环的磁化方向表示 0/1。当年需要把磁芯内存的状态转储到更永久的存储上,所以叫「core dump」;今天它泛指把进程内存 dump 到文件里的过程。另外,
popen有一个历史包袱式的妥协:管道是单向的——你只能读或只能写,不能同时。原因是pipe虽然返回两个 fd,但FILE *里只装得下一个 fd;若要两边都能读写,这个 API 会难看到不成样子。它还因此比 Python 的subprocess.Popen(可以双向)逊色。但单向管道在「调用程序并拿结果」时已经很好用了,而且比system更好——因为system没法控制输出。
4.3 errno / perror / 本地化
(参考时间: 01:06)
所有 API 都可能失败。每个系统调用的手册里都有 ERRORS 一节,列出明确的错误码(EAGAIN、ENOMEM、EACCES、EEXIST……)。这些错误在 libc 里都必须被妥善处理——不像 OJ 环境(OJ 常假设「用户输入永远是对的」,错误由 OJ 负责)。
errno 是一个全局变量,记录上一次失败的原因;perror 会打印「你给的字符串 + 该错误的描述」。而那个反复出现的 No such file or directory不是巧合——它由 libc 根据当前语言环境输出:
$ gcc nonexist.c
gcc: error: nonexist.c: No such file or directory
$ LANGUAGE=zh_CN ls nonexist
ls: 无法访问 'nonexist': 没有那个文件或目录
同一个 ls 程序、访问同一个系统调用,为什么能区分语言?答案就是 libc——perror 会根据 LANGUAGE 环境变量输出对应语言的错误信息。
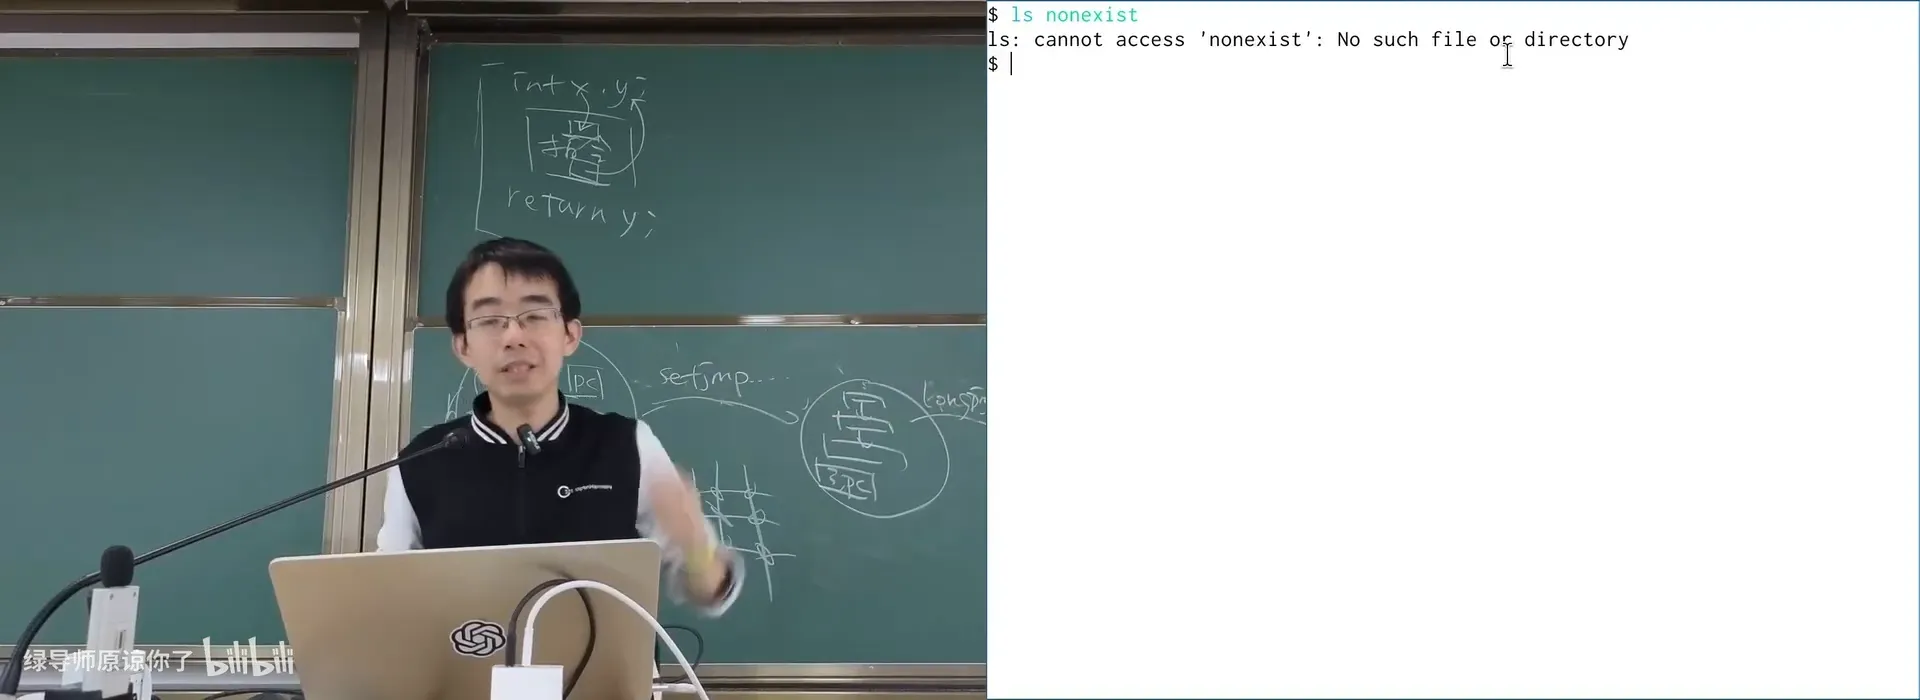
📷 LANGUAGE=zh_CN:同一个 ls,错误信息变成中文
回到原视频 (01:09:00)
编者拓展|
perror(3)与strerror(3)、errno的正确用法:errno是线程局部的(现代实现里),而且任何函数调用都可能覆盖它——所以正确做法是:调用失败后立刻保存errno,再处理;打印错误用perror(会自动加上「函数名: 错误描述」)或strerror(errno)。把errno当普通返回值跨函数传递、或在失败后隔了几步才读,都是常见 bug。
4.4 进程运行环境的封装:environ 到底是谁赋的值?
(参考时间: 01:11)
C 程序的 main 有第三个参数 envp:
int main(int argc, char *argv[], char *envp[]);
libc 还提供了一个全局变量 environ(man 7 environ),让你不必通过 main 参数就能访问环境变量。UNIX 的设计是:默认情况下,子进程继承父进程的环境变量(exec* 家族里带 e 的版本可以显式传 envp)。于是 LANGUAGE 这样的变量会沿着整棵进程树一路继承下去——「一个意想不到、但又无处不在的机制」。
但这里有个非常好的问题:
environ是一个指针变量,它在进程地址空间里一定有地址。可它是谁赋值的?
environ是一个符号(变量),在数据区/BSS;- 而进程初始化时,
argv/envp是放在栈上的(见 System V ABI 的「Initial Process Stack」); - 更麻烦的是 ASLR(地址空间随机化):栈的位置每次运行都不同,
envp的地址每次都变。
那谁能在进程刚启动时,把 environ 指向正确的栈位置?——一定是 libc! 讲师用 watch point 一探便知:libc 里有个 __init_libc,其中一行 __environ = envp; 就是答案。
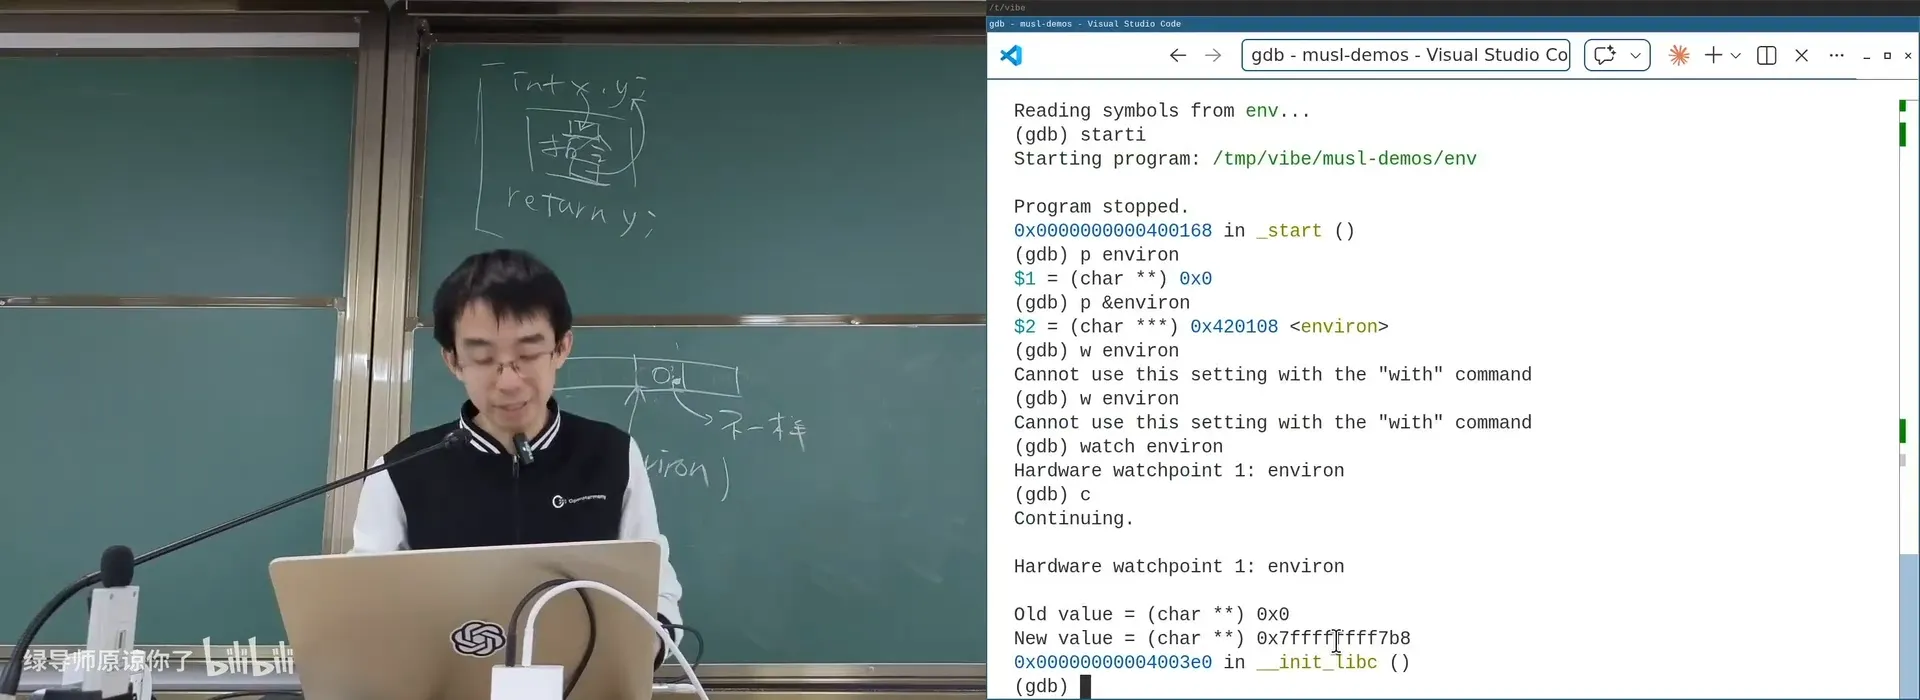
📷 watch point 命中 __init_libc:__environ = envp
回到原视频 (01:19:30)
graph LR
    A["内核按 System V ABI<br>把 argc/argv/envp 放到栈上"] --> B["_start(libc 的一段汇编)<br>从栈指针取出参数"]
    B --> C["__libc_start_main → __init_libc<br>__environ = envp"]
    C --> D["调用 main(argc, argv, envp)"]
    D --> E["exit → atexit handlers → flush → _exit"]
编者拓展|ASLR 与「初始进程栈」:
System V ABI明确规定了进程启动时栈的布局(argc、argv[]、NULL、envp[]、auxv……)。libc 里那段叫_start的最小汇编,只做几件事:从%rsp(栈指针)取出参数的个数与位置,算出envp = argv + argc + 1,然后跳进__libc_start_main。「计算机系统里面没有任何的魔法」——你对照 ABI 手册看,会发现代码和图描述完全一模一样。
4.5 C Runtime:程序终究从 _start 开始
(参考时间: 01:20)
到此我们补上了一块拼图:程序的入口不是 main,而是 _start——它也是 libc 的一部分。
- 打开编译过程,你会看到二进制链接了
crt1.o(C runtime)、crtbegin.o、crtend.o、crtn.o等; _start做最少的初始化,然后把控制权交给__libc_start_main;__libc_start_main会调用__init_libc(设置environ等),再调用main;main返回后,最终进入exit:调用atexithandlers、flush stdio buffers,最后用exit(或_exit)系统调用结束进程。
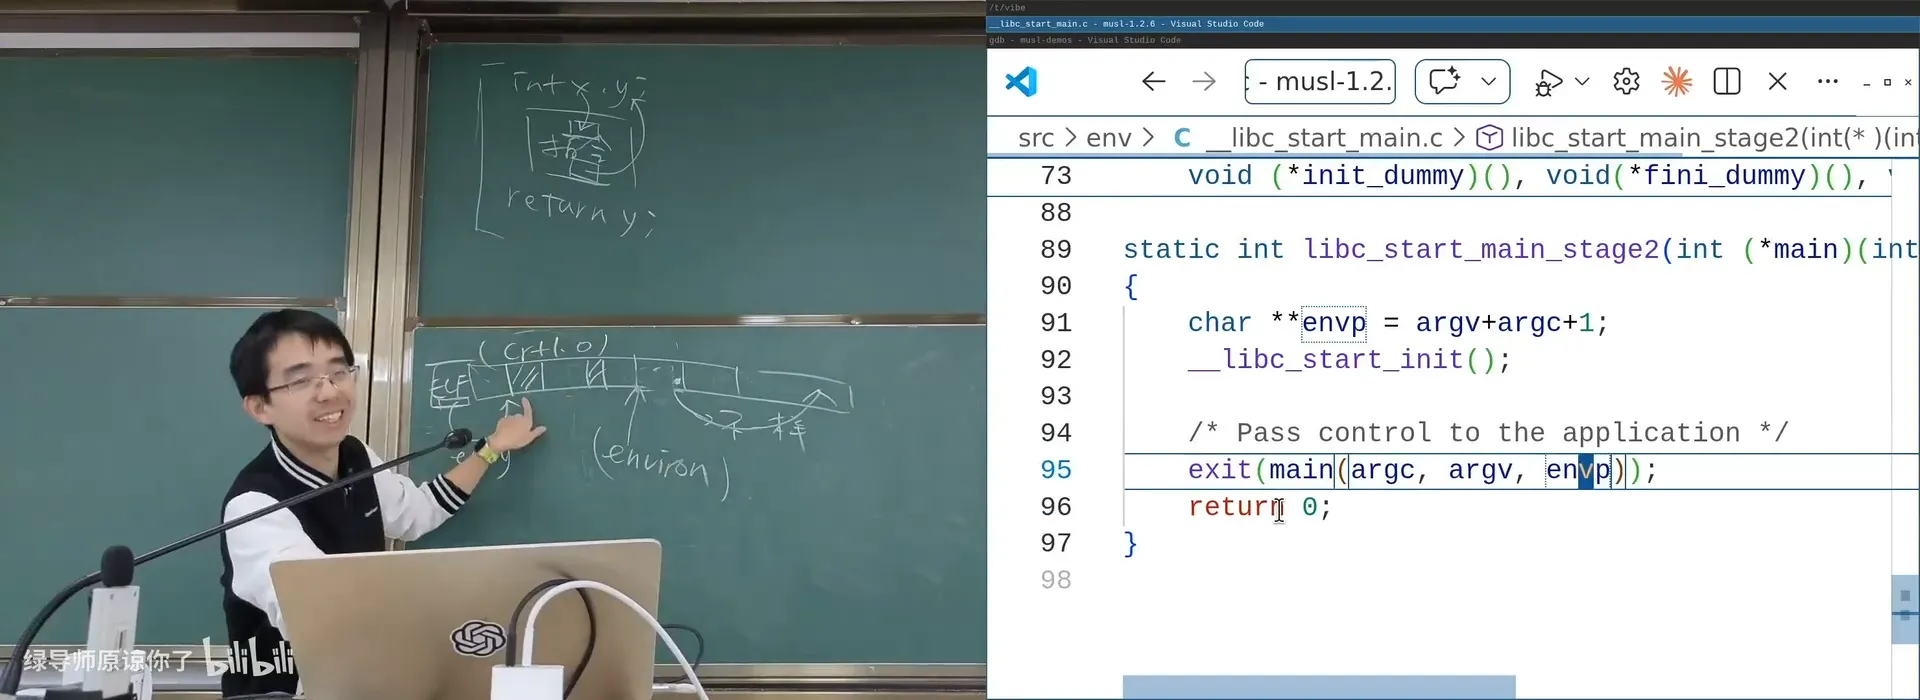
📷 __libc_start_main 与 exit:C 程序真正的入口与出口(实操)
回到原视频 (01:24:45)
graph TD
    E["ELF 入口点(链接器把 _start 的地址填进 ELF header)"] --> S["_start(crt1.o 里的汇编)"]
    S --> L["__libc_start_main"]
    L --> I["__init_libc(__environ = envp)"]
    I --> M["main(argc, argv, envp)"]
    M --> X["exit:atexit handlers → flush → _exit"]
讲师用 readelf -h 查看了 ELF 的 entry point address:「这就是链接器最后填进去的——它会找到 _start 符号,把地址写进 ELF 头。」
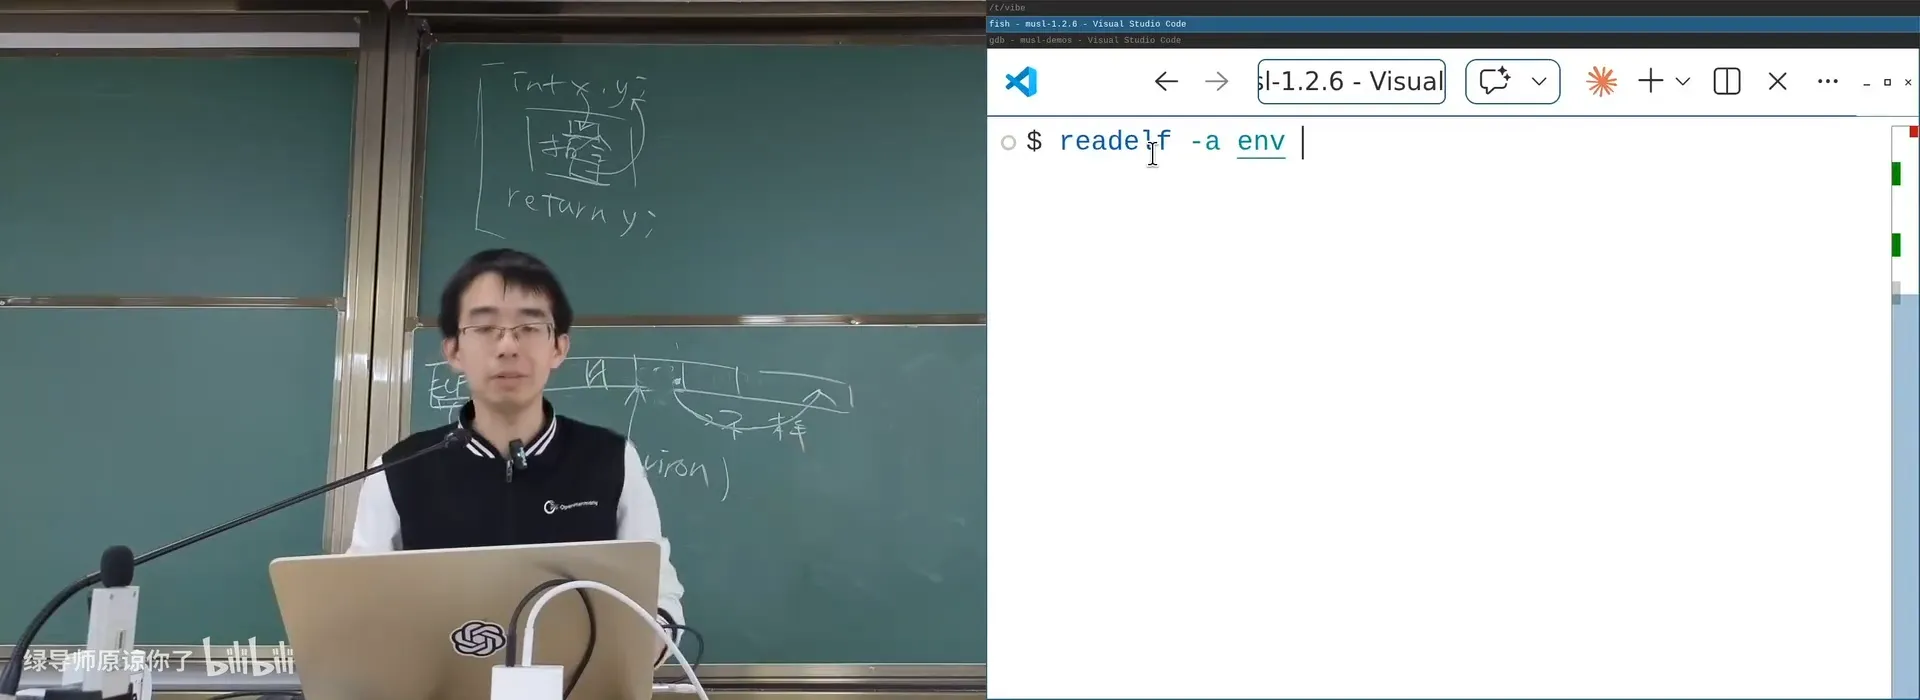
📷 readelf:ELF 入口点就是 _start 的地址
回到原视频 (01:23:30)
编者拓展|「C 不是低级语言」:讲义在结尾引了两篇有意思的文章——C is not a low-level language 与 C isn't a programming language any more:C 的许多语义(越界是 UB、指针别名规则等)其实离真实机器很远,它更像一个「可移植的汇编 + 强加给硬件的抽象机器」模型。这也呼应了本讲的主线:C/libc 是第一级抽象,在它之上才长出了 C++、Java、浏览器世界、乃至今天的人工智能世界。
总结
- C 的完全体 = SimpleC + FFI:SimpleC 覆盖计算(内存+寄存器),而 FFI(跨语言调用,靠 ABI 规约)让你能调用汇编、进而调用系统调用。一旦能调用系统调用,就能在应用世界里实现任何东西。
- 内联汇编是一个设计得很糟的嵌入式 DSL(
Instructions : Outputs : Inputs : Clobbers : GotoLabels),极易写错、且副作用漏声明会「今天对、明天错」;AI 时代你只需要建立概念。 - 标准化是底座:ISO C 保证稳定、可靠、最佳可移植性;POSIX 在其上提供
fork/pipe等。C 的「一层层抽象」支撑起了 Python/JS/Java/Android 等整个生态。 - 学 libc 用 musl 而不是 glibc:musl 现代、工整、无历史包袱;配
-g3编译出可调试的musl-gcc,就能从第一条指令开始调试。 - freestanding 环境(
stddef/limits/stdint/inttypes/stdarg/string/stdlib/math/setjmp)不依赖操作系统;你所有「不知道的定义」都在里面(offsetof、PRId64、NaN……)。 setjmp/longjmp是「栈上的长跳转」:在buf里记下栈深度与 PC,longjmp时把中间的栈帧全部弹掉——可用作跨函数的错误处理/资源清理,也是实现协程的基础。- 系统调用的封装:
stdio的FILE *背后是文件描述符(用函数指针实现面向对象);printffamily 汇聚到vfprintf(无代码克隆);abort/exit/atexit/system/popen封装了进程管理;errno/perror封装了错误与本地化。 - 运行环境的封装:
environ由 libc 在__init_libc里赋值(因为 ASLR 让栈地址每次不同);环境变量沿进程树继承,LANGUAGE就是这样影响全局的。 - C Runtime:程序从
_start开始,crt1.o→__libc_start_main→__init_libc→main→exit。「计算机系统里面没有任何的魔法」——对照 System V ABI 手册,一切严丝合缝。
附:官方参考与延伸阅读
本讲的讲义见课程主页,以下链接按书中出现顺序整理:
| 主题 | 链接 |
|---|---|
| musl libc | https://musl.libc.org |
| 调试「小程序」(musl-demos) | https://jyywiki.cn/OS/demos/virtualization/musl-demos |
| GCC Extended Asm(内联汇编手册) | https://gcc.gnu.org/onlinedocs/gcc/Extended-Asm.html |
| Freestanding 环境(cppreference) | https://en.cppreference.com/w/cpp/freestanding |
stddef.h / stdint.h / inttypes.h / stdarg.h |
https://cplusplus.com/reference/cstdint/ |
| FP8(E4M3/E5M2) | https://arxiv.org/pdf/2209.05433.pdf |
| C is not a low-level language(ACM Queue) | https://dl.acm.org/doi/pdf/10.1145/3209212 |
| C isn't a programming language any more | https://gankra.github.io/blah/c-isnt-a-language/ |
| OSTEP:Operating Systems: Three Easy Pieces | https://pages.cs.wisc.edu/~remzi/OSTEP/ |
setjmp(3) / longjmp(3) 手册 |
https://man7.org/linux/man-pages/man3/setjmp.3.html |
environ(7) 手册 |
https://man7.org/linux/man-pages/man7/environ.7.html |
perror(3) / strerror(3) 手册 |
https://man7.org/linux/man-pages/man3/perror.3.html |
popen(3) / pclose(3) 手册 |
https://man7.org/linux/man-pages/man3/popen.3.html |
阅读材料:在 AI 的帮助下调试 musl libc 中你感兴趣的函数。
版权说明:本讲讲义与幻灯片作者为蒋炎岩,采用 Creative Commons BY-NC 4.0 许可,来源于 https://jyywiki.cn/OS/2026/。视频画面与字幕版权归原作者所有。本书为课堂内容的学习性重构。