第10讲 · 调试 C 标准库:Debug Info、crt1.o、setjmp 与 malloc
2026 南京大学《操作系统原理》第十讲 · 课堂实录重构
| 主讲 | 蒋炎岩(Yanyan Jiang) |
| 视频 | https://www.bilibili.com/video/BV1yu9cBCEAb/ |
| 课程主页 | https://jyywiki.cn/OS/2026/ |
| 本讲讲义 | https://jyywiki.cn/OS/2026/lect10.md |
| 讲义 / 幻灯片作者 | 蒋炎岩,https://jyywiki.cn/ |
| 讲义 / 幻灯片许可 | CC BY-NC 4.0 |
| 图片来源 | 书中插图为课堂演示与讲义渲染图;演示类截图为视频画面 |
对应讲次:第10讲(南京大学 操作系统原理)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者说明:本书由课堂录像的语音字幕重构而成,术语、章节骨架与参考链接已按课程官方讲义(
lect10.md)校准。讲师的口语风格、类比与案例被尽量保留;编辑性的补充一律以「编者说明」或「编者拓展」标出。
引子:一次「翻车」的复现与修复
(参考时间: 00:00)
本讲开头,讲师复盘了上一讲的翻车现场:他当时直接让豆包「帮我把 musl libc 编译并安装好」,豆包跑了一段很长的脚本、说「搞定了」,讲师也没有细看输出、只做了不严谨的测试——结果发现能调进一部分 crt1 的源码,就以为成功了。
真相是:他根本没有把自己的 libc 装进系统,musl-gcc 还是用 apt 装的那个,调试信息也用不起来。这一讲他学乖了:在豆包的每一条命令之后都看一眼它做了什么,最后确认这次是真的编译、安装、调试通过了。
编者说明:这是一次很生动的「AI 编程要盯住结果」的示范——豆包会幻觉般地告诉你「成功了」。这也呼应了本讲的主线:
-g到底做了什么、调试信息为什么能让你「看见真相」。编者拓展|libc 的原理,其实你已经会了:在 freestanding 环境里,除了「我的代码」什么都没有——你控制了
_start,就控制了一切;再用 FFI / 内联汇编就能执行系统调用。所以「自己实现一个 libc」在原理上并不困难:入口 (_start) → 取argc/argv/envp→ 调main→exit。
一、Debug Info:二进制里那些「额外的东西」
(参考时间: 00:08)
上一讲翻车的直接表现是:gdb 时告诉你「no source code available」——因为动态链接的 glibc 没有调试信息。你只要 gcc -g 编译自己的代码,就能看到源码;但一旦 step 进 libc,又看不到了。
编者拓展|
-g到底做了什么:gcc -g会在 ELF 里塞进额外的 section:.debug_info、.debug_line、.debug_str、.debug_frame、.debug_ranges、.debug_loclists……用readelf -a就能看到。把这些东西丢给大模型,它会告诉你这就是 DWARF 调试标准。还有一个有趣的命名梗:DWARF 是「矮人」,ELF 是「精灵」——「里面有很多命名梗」。
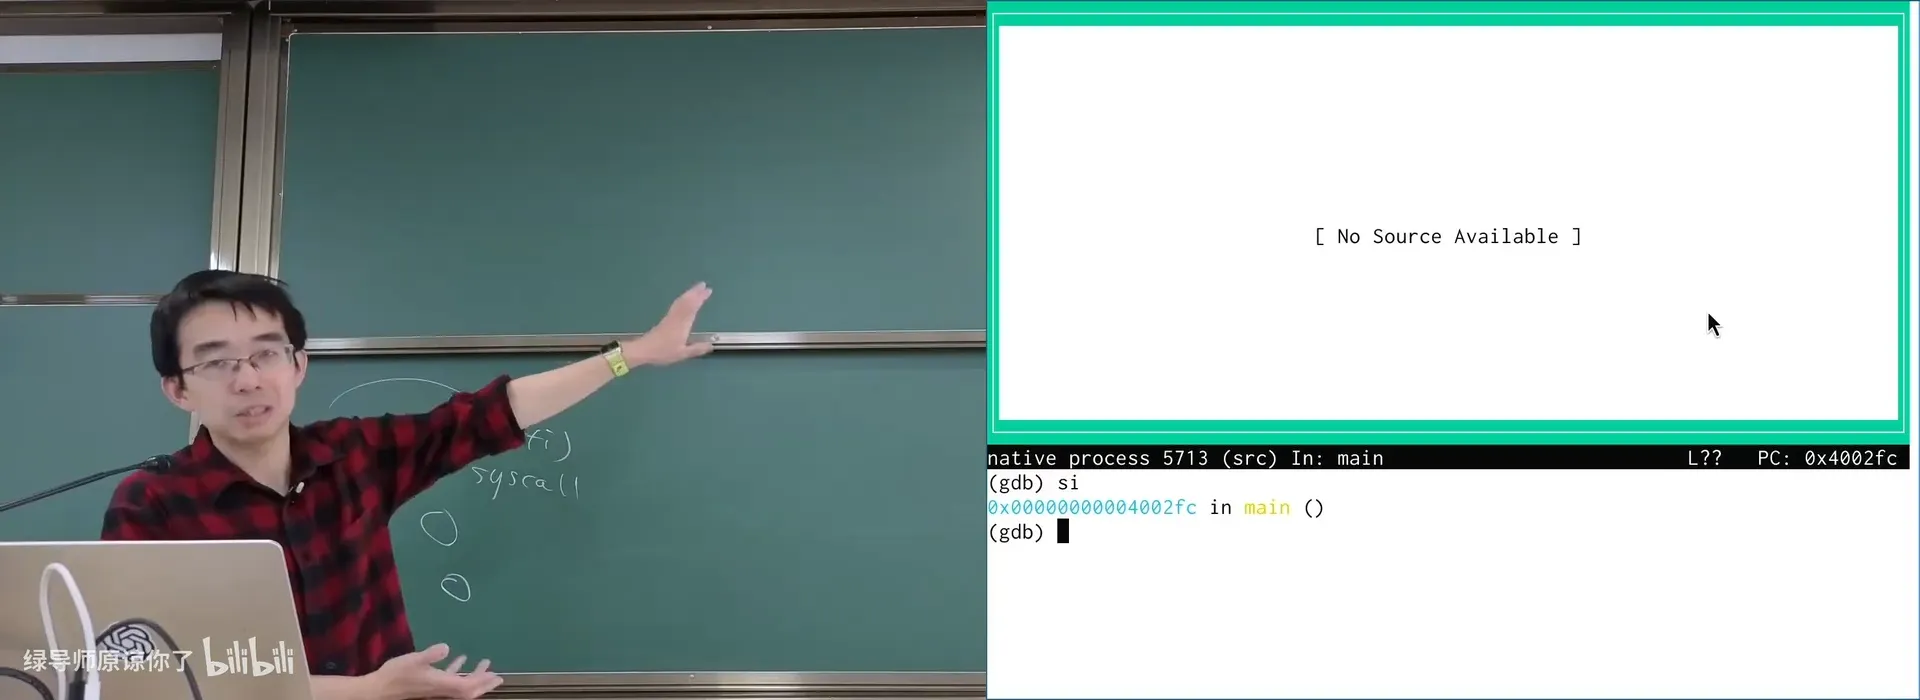
📷 翻车现场:gdb 提示没有可用的源代码
回到原视频 (00:08:30)
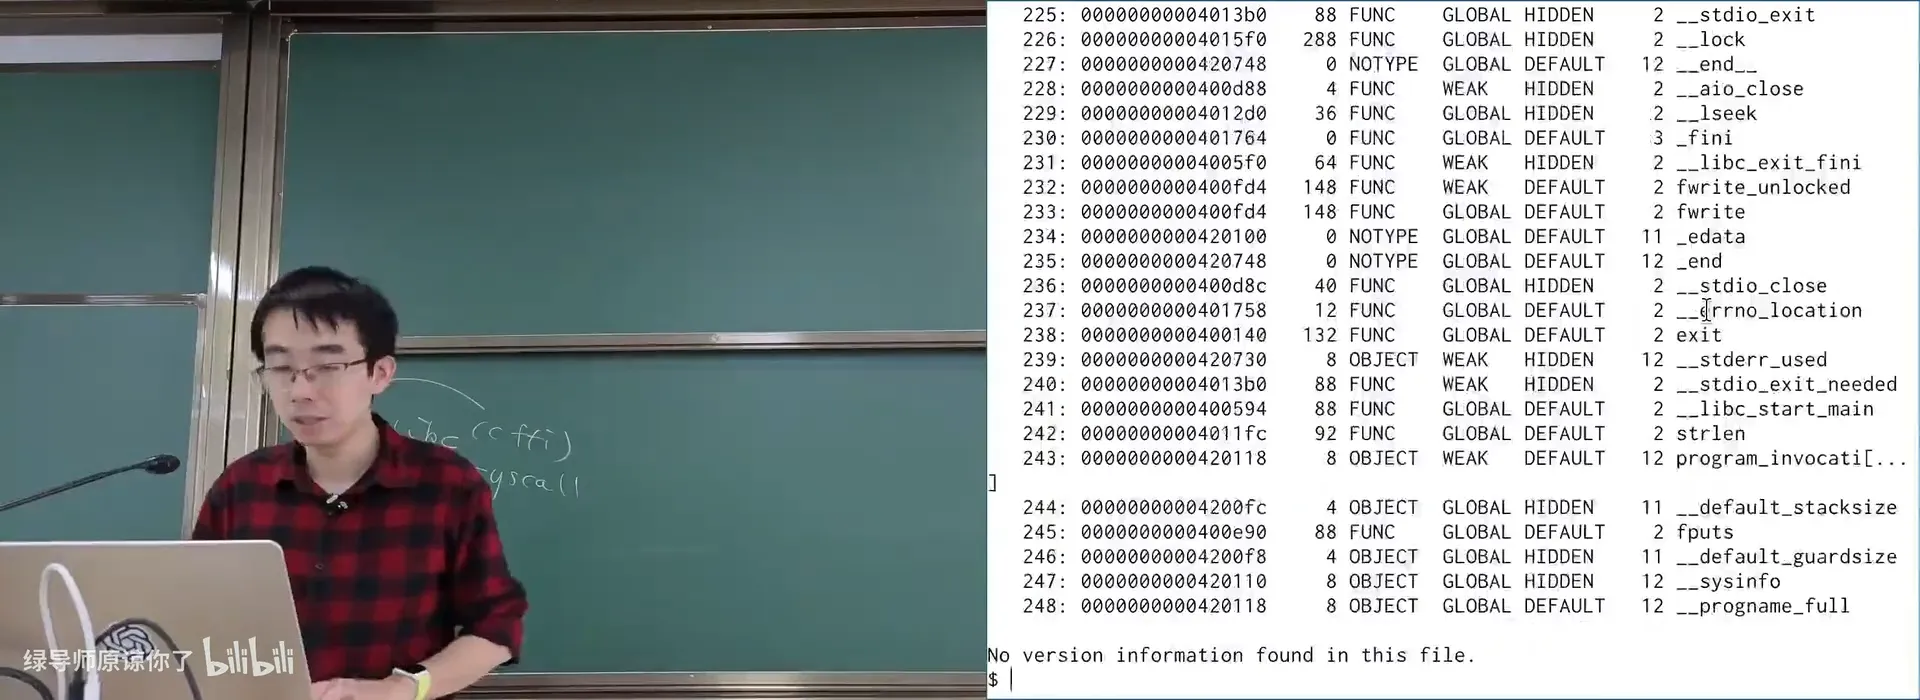
📷 readelf -a:看看 -g 塞进了哪些 .debug_* section
回到原视频 (00:11:00)
-g 的意义,可以这样理解:
- 汇编层面,程序状态只有 PC 和寄存器、内存;
- Debug info 把这些低级状态映射回高级状态(栈帧、变量、源代码行):某条指令对应哪一行、在某个 PC 范围内某个变量的值在哪里、怎么算出来。
即使只有符号表(不用 -g),你也能在 gdb 里大致知道「现在在哪个函数里」:nm a.out 能看到 main 在 .text 的某个地址;PC 走到那个地址,就知道 main 开始执行了。再加上 addr2line(把地址转成源码行),你甚至可以自己实现一个调试器。
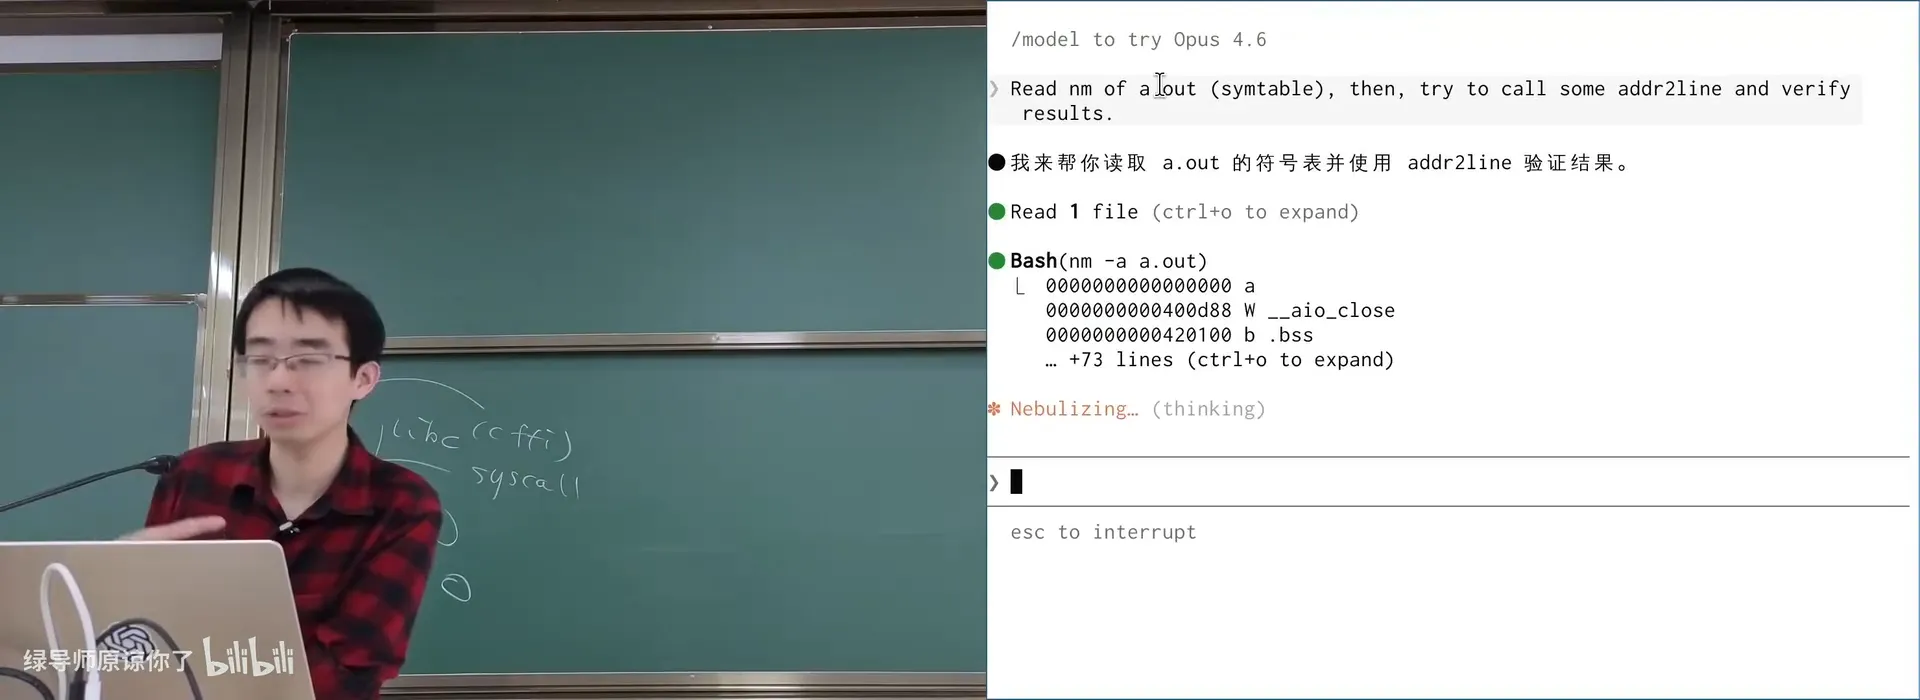
📷 addr2line -e a.out -f 0x400218:地址反查源码行(实操)
回到原视频 (00:16:50)
📷 gdb 调试带 -g 的 crt1.c:终于能看到源码
回到原视频 (00:10:00)
编者拓展|DWARF 里有一个「图灵完备的小虚拟机」:它不只是「行号 → 地址」的映射——它包含一个bytecode 指令集,能访问寄存器、做算术、分支,用来描述「在某个 PC 范围内,变量的值在什么地方、如何算出来」。为什么需要它?因为
int x在优化后可能在寄存器里、在内存里、甚至被优化掉了(你调试时看到的optimized out就是它)。它也能用来实现 C++ 异常的 stack unwinding。
1.1 JavaScript 的 Debug Info:Source Map 与 Claude Code 泄漏
(参考时间: 00:20)
不同语言的 debug info 形态不同。以 JavaScript 为例:TypeScript 经过一层层 transpiler 转译成旧版 JS,最后在浏览器里运行——出错时你希望映射回源代码。但浏览器是沙盒,没有你的项目目录,于是 JS 用 Source Map(.map,一个 JSON),把调试信息连同源代码一起打包:
{
  "version": 3,
  "file": "bundle.js",
  "sources": ["src/index.js"],
  "names": ["map", "callbackFn"],
  "mappings": "AAAA, ...",
  "sourcesContent": ["const x = 1; ..."]   // 就是这个!
}
讲师顺势点评了最近的 Claude Code 源代码泄漏事件:cli.js.map 泄漏后「光速就有了能运行的版本」。他翻了一遍,觉得「挺屎山的」,但也发现了好玩的东西(比如一行 checks if input matches negative keyword patterns、一段没有调用链的死代码),还强调安全风险:来路不明的「能运行版本」如果 build 会执行脚本,可能投毒、泄露你的 token,要在干净沙盒里处理。他调侃:「他们的 CI 竟然没有用 Claude 检查一下『是否存在潜在内部信息泄漏』。」
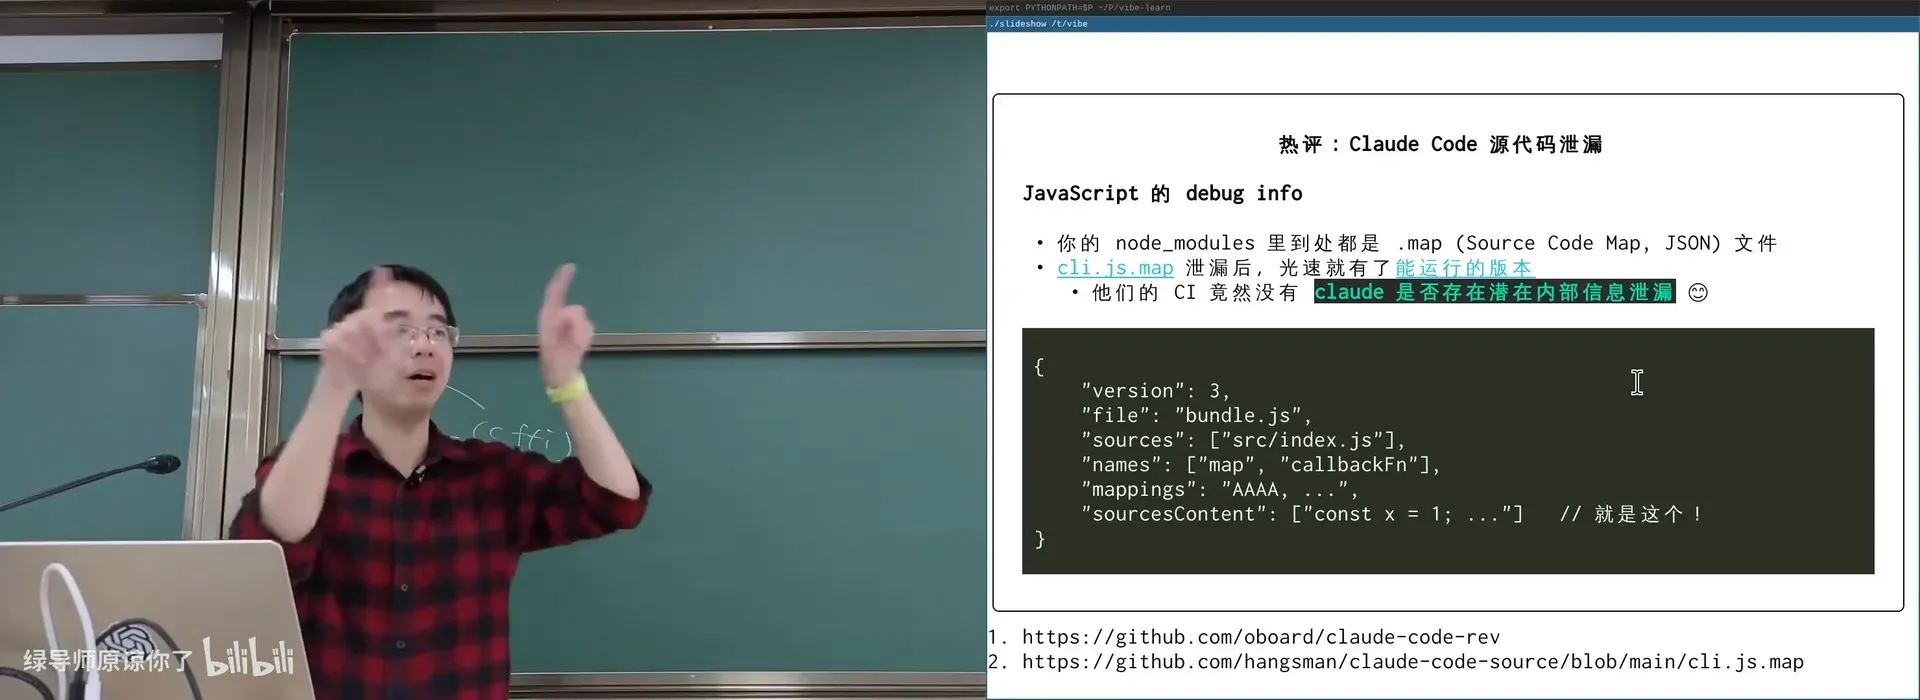
📷 cli.js.map:Source Map 里直接打包了完整源代码
回到原视频 (00:23:00)
1.2 Debug Info 能做什么
(参考时间: 00:29)
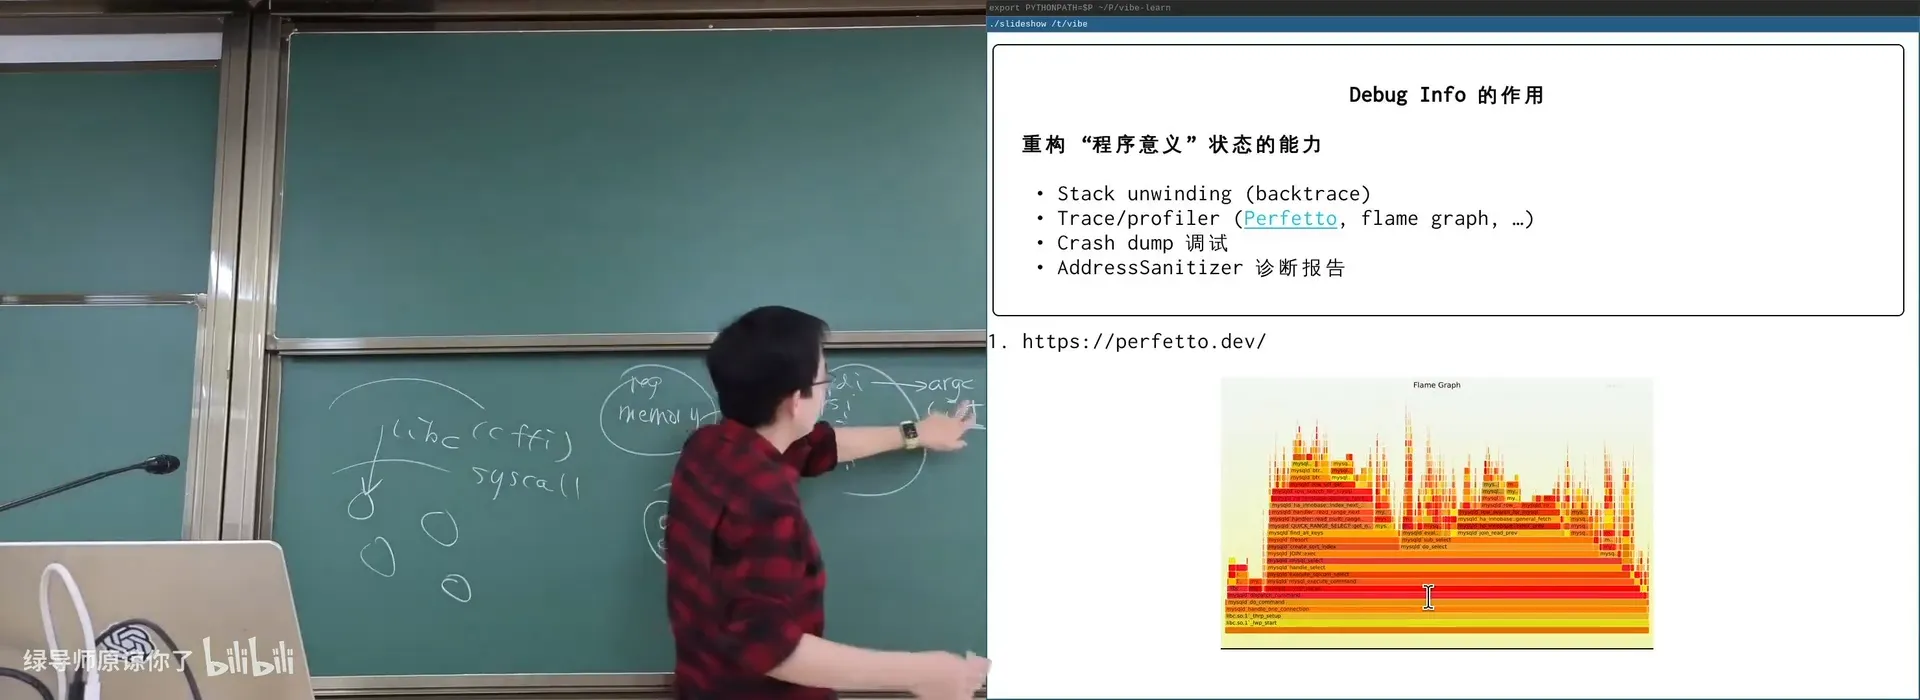
有了「从二进制状态重构源代码状态」的能力,就能做很多事:
- Backtrace(栈回溯):
bt一瞬间恢复出「谁调用了谁」的完整调用栈; - Trace / profiler:从
strace到采样式 profiler; - Flame graph(火焰图):每隔一小段时间暂停程序采样,再用 debug info 恢复调用栈。横轴是时间,纵轴是调用栈;大部分时间花在少数函数上,就能找到性能瓶颈;
- Crash dump 调试:程序崩了,你可以对「汇编意义上的快照」调试,甚至改一个 PC 让它继续跑;
- AddressSanitizer:
-fsanitize=address能抓到 heap-use-after-free 之类的 UB,并借助调试信息给出源码级报告。
graph LR
    A["二进制状态<br>(PC / 寄存器 / 内存)"] -->|Debug Info| B["高级程序状态<br>(栈帧 / 变量 / 源码行)"]
    B --> C["backtrace / 火焰图 / crash dump / ASan"]
编者拓展|
strace里 musl 的「极简」:讲师对比了用 musl 和用(静态)gcc 编译的同一个最小程序——musl 的strace在execve之后只有一两个系统调用就进入程序;而 gcc 的版本还有readlinkat、getrandom等一堆。system calls 是操作系统提供的功能,而调试信息让你能「隔一段时间采样」它——这正是火焰图的基础。
📷 strace 对比:musl 编译的程序系统调用极简,gcc 的多得多(实操)
回到原视频 (00:30:00)
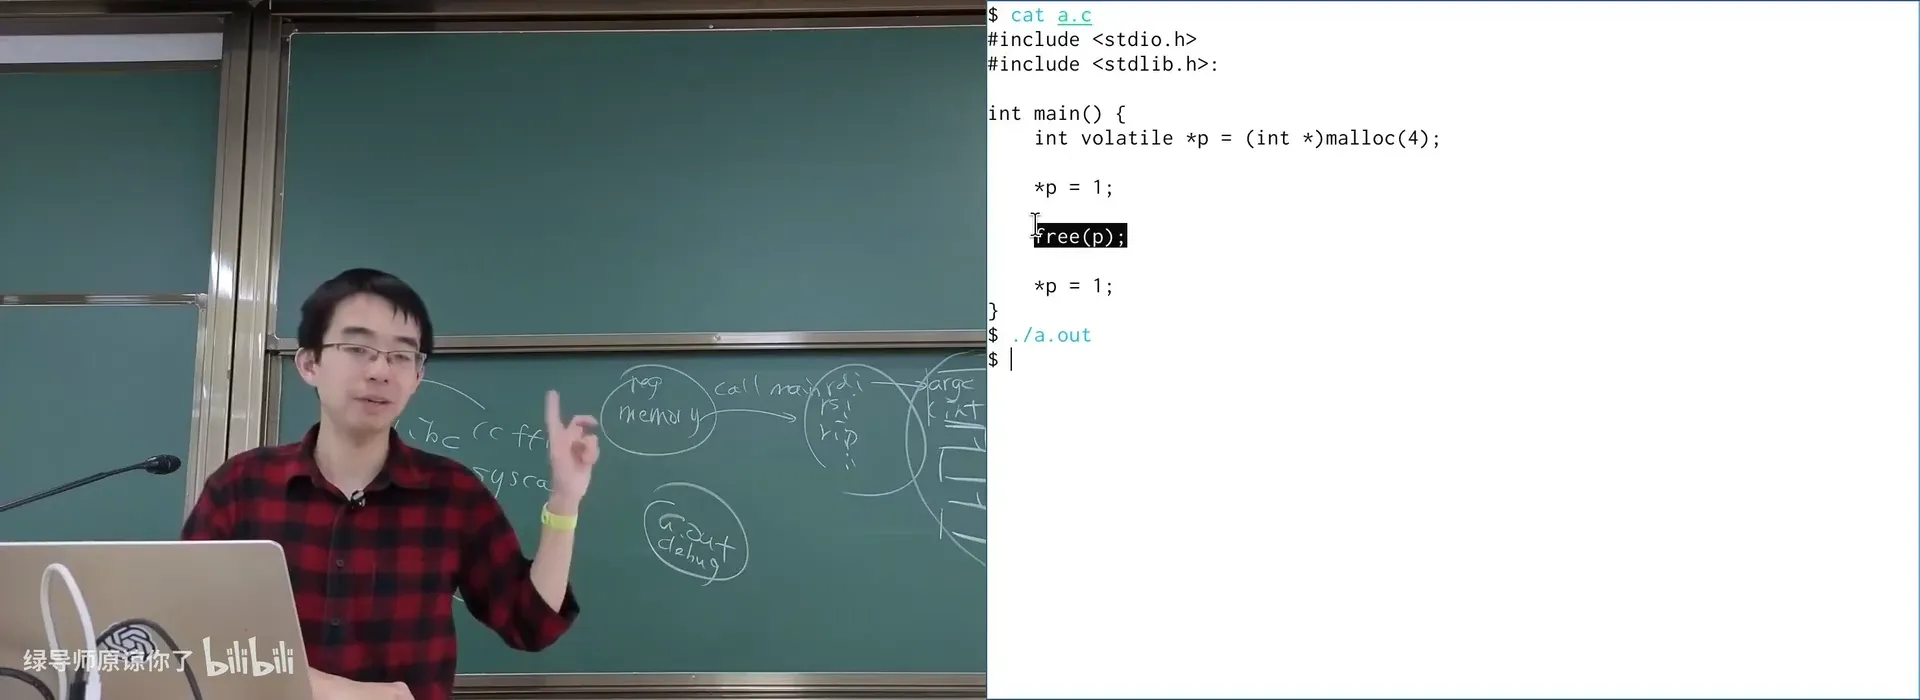
📷 用 ASan 抓到 heap-use-after-free(源码级诊断)
回到原视频 (00:34:30)
二、调试 libc 的「隐秘角落」
(参考时间: 00:35)
从现在起,我们就把上一讲编译好的、带调试信息的 musl 拿出来真刀真枪地调。
2.1 crt1.o 与「初始进程栈」
(参考时间: 00:35)
从最小的 dummy.c(return 1)开始。strace 显示它 execve 之后只做了很少几件事就 exit 了。用 gdb 从第一条指令开始调:
- 第一条是
_start——一小段汇编,layout source时看不到源码(正常); - 一旦进入
_start_c(第一个 C 函数),就能顺着参数long *sp逆向出「初始进程栈」: argc = p[0];argv = p + 1;envp = argv + argc + 1;- 打印
envp[0]真的就是一个环境变量;再往后还能看到辅助向量(auxv)。
我们可以在程序里完整地看到这一点——这也再次验证了 System V ABI 规定的初始栈布局。「至少我确实确定了:初始的栈是这样的。」
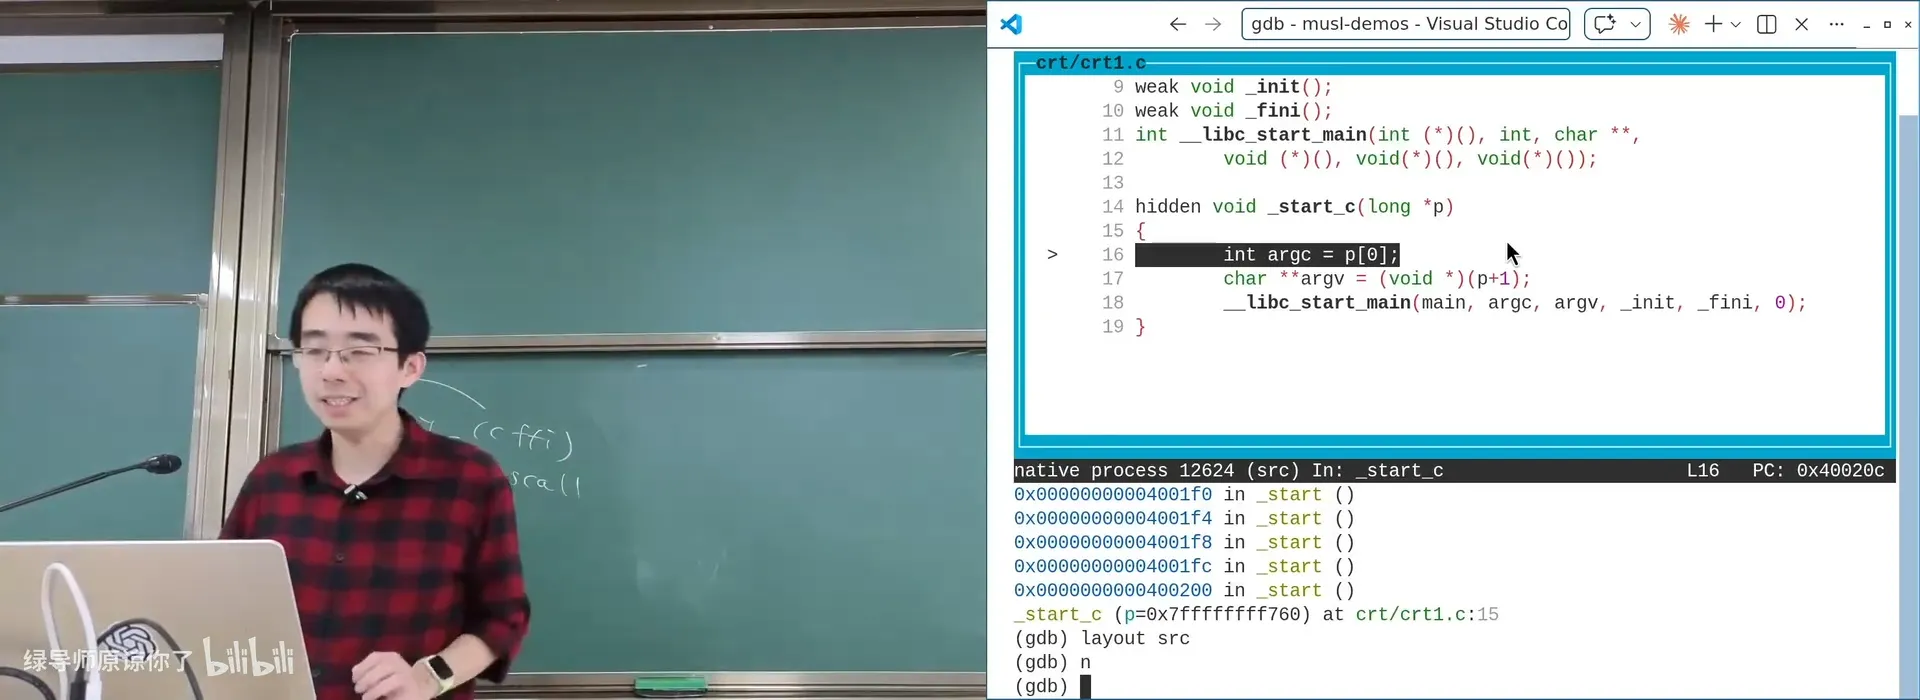
📷 gdb 从 `_start` 逆向出 initial process stack:argc / argv / envp
回到原视频 (00:36:30)
接着往下调 __init_libc:environ = envp 就在这一行(上一讲用 watch point 看过的那个);然后它跳过所有环境变量、逐个处理辅助向量,再调用 libc_start_main_stage2。最后就是 libc 的「经典一句」:
exit(main(argc, argv, envp));
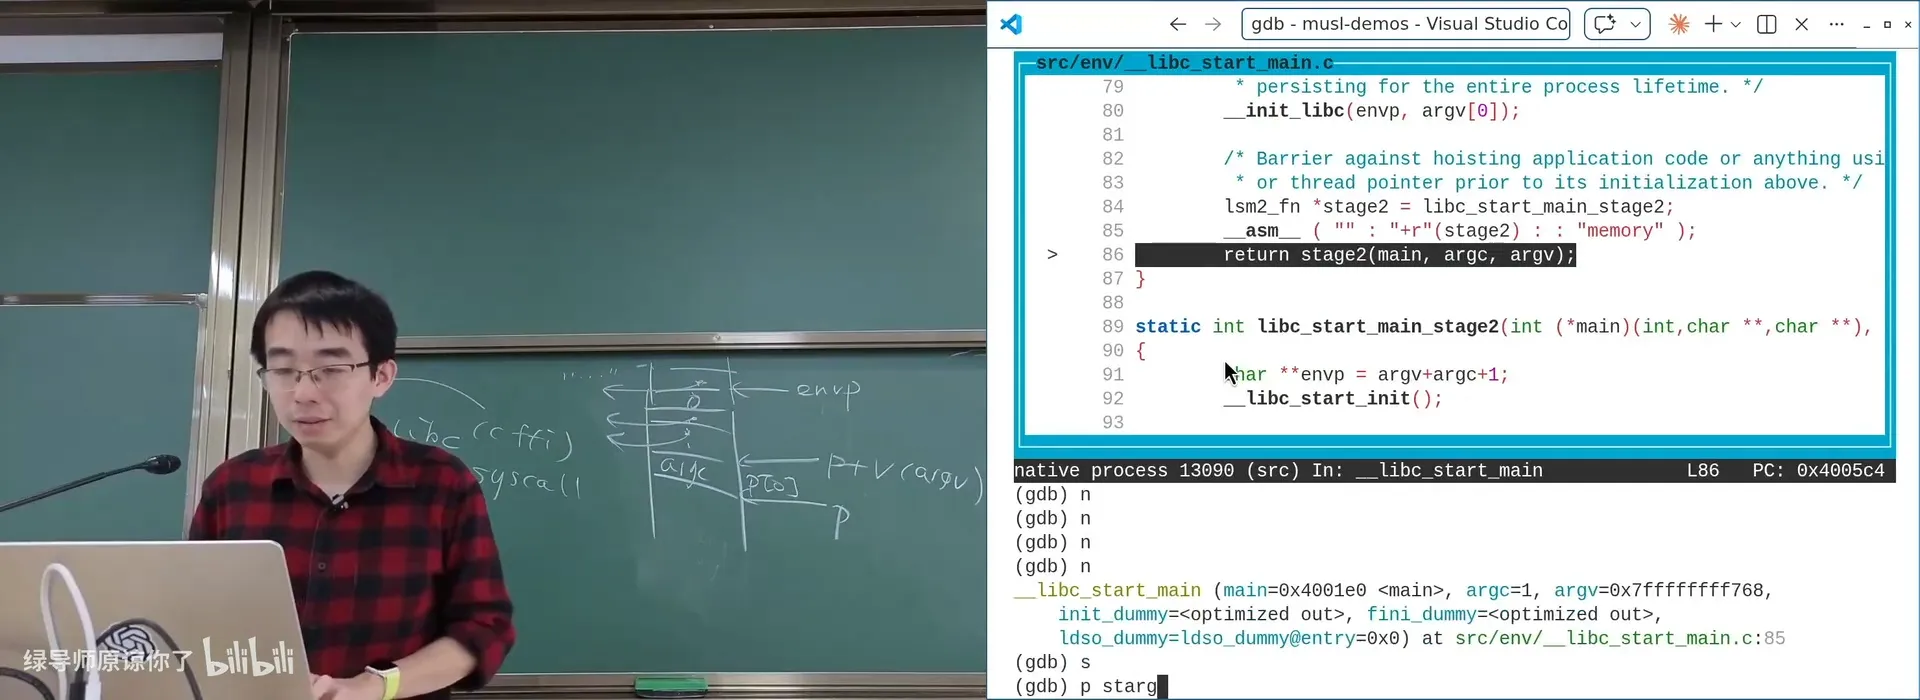
📷 gdb 跟进 `libc_start_main_stage2`:`exit(main(argc, argv, envp))`
回到原视频 (00:39:30)
编者说明:讲师建议调大一点的代码时别用命令行 gdb,用编辑器的可视化调试(配好 LSP 后可以自由跳转,看结构体、看变量都舒服得多)。
2.2 调试 printf 与「变参数」
(参考时间: 00:41)
在 printf 上打断点、step into,就进入了 musl 的 stdio.h/printf。可以看到:
printf很短,基本就是把参数取出来,转调vfprintf(stdout, fmt, ap);stdout的struct FILE里:fd = 1、buf(此刻是空的)、buf_size = 1024……一下子就能看懂FILE的内部;- 继续
step into到printf_core:它先试探性地做一次,再真正打印;最后落到writev系统调用(和strace里看到的一次write对应)。
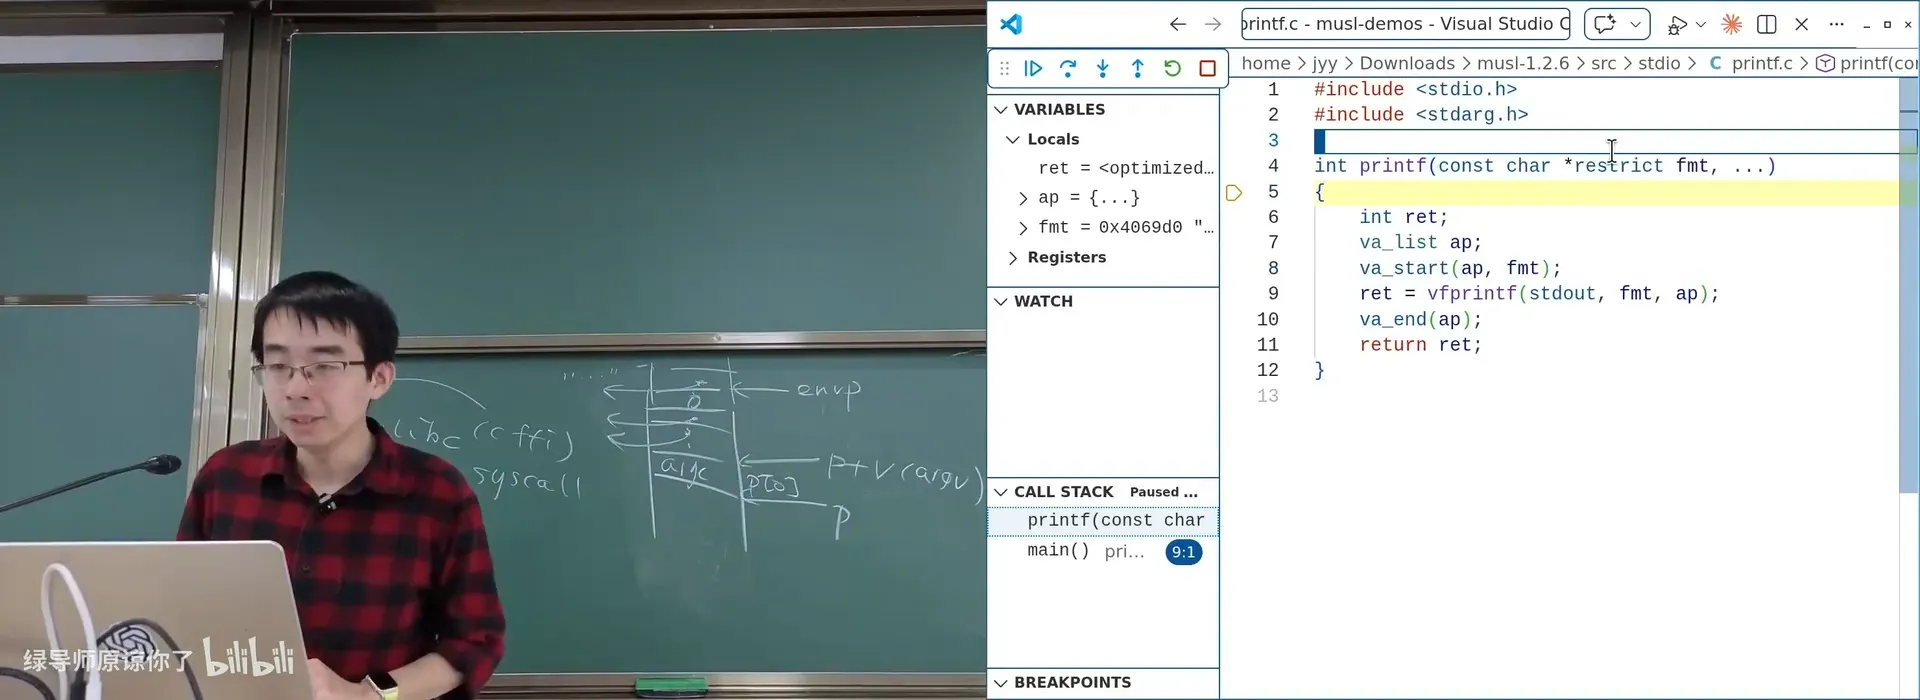
📷 gdb 进入 musl 的 printf:`stdout` 的 `fd=1`、buffer 等内部结构
回到原视频 (00:42:00)
变参数(void foo(int n, ...)) 是另一个「机器级」的角落:
void foo(int n, ...) {
    intptr_t *vargs = (intptr_t *)&n;
    // vargs[0], vargs[1], ...
}
- 这个「取第一个参数地址、当成数组」的 hack,只在 x86-32 的 cdecl 约定下成立(参数全在栈上);
- 在 x86-64 / aarch64 / RISC-V 上,参数大多通过寄存器传递,这个 hack 就失效了;
- 所以 libc 会和编译器协作:在进入变参数函数时,把寄存器里的参数 store 到栈上,
va_list才能正确地逐个访问。
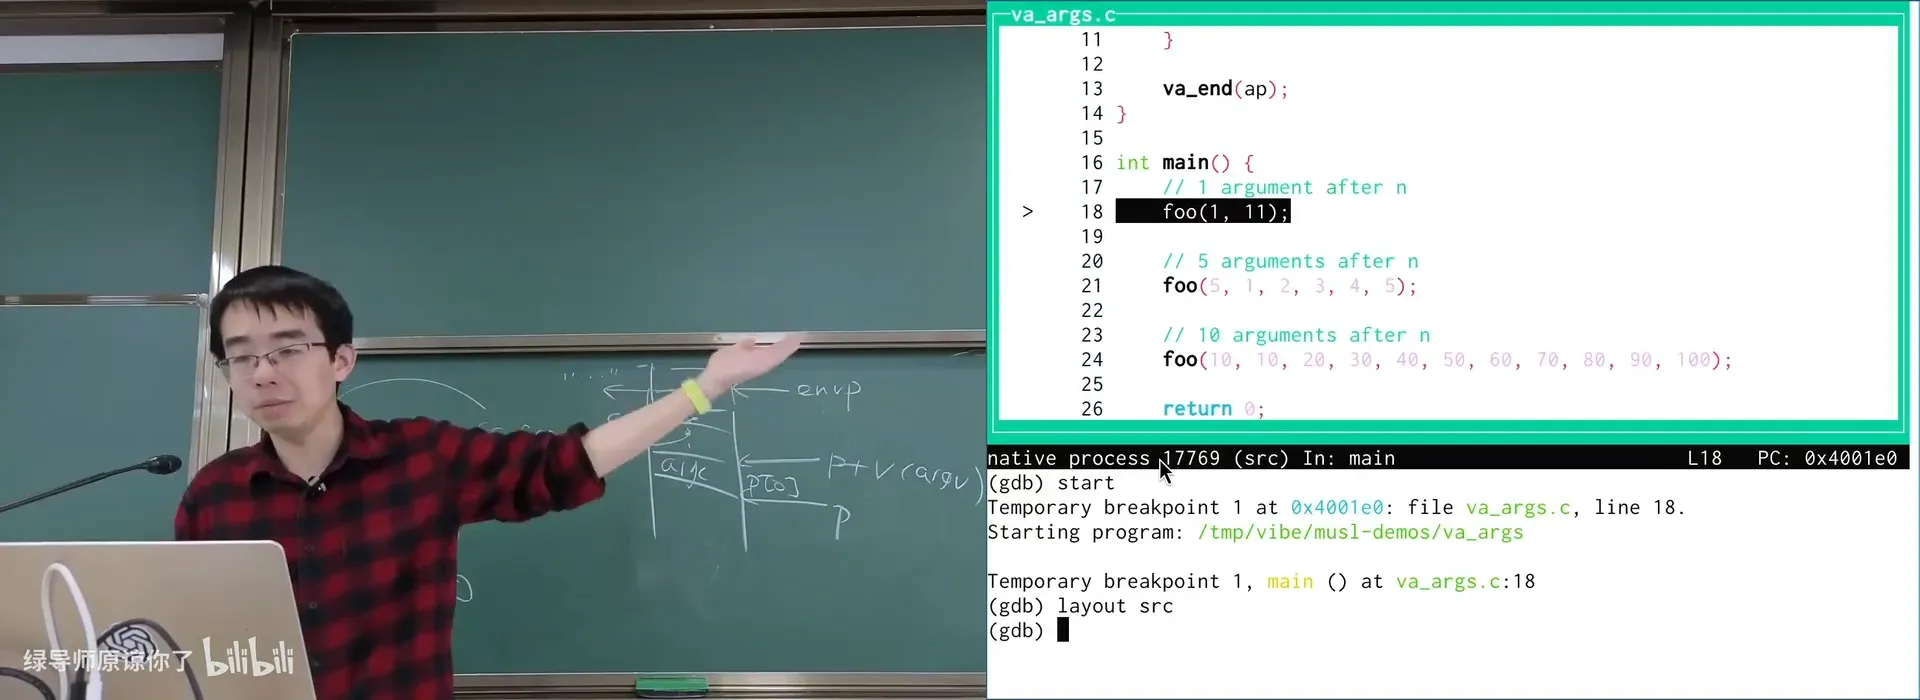
📷 变参数:编译器与 libc 协作,把寄存器参数存到栈上
回到原视频 (00:46:00)
编者拓展|你自己就能「逆向出调用约定」:讲师用一个小实验证明了这一点——在汇编层面可以看到:
foo(1, 11)时,1写进w0、11写进w1;而 libc 生成的「序言」代码把x1/x2、x3/x4一对一对 store 到sp+56、sp+72……「这些值你不知道是什么,但你能明确看到:寄存器里的参数被存到了栈上,形成一个小数组,变参数才能实现。」
2.3 调试 setjmp / longjmp:给寄存器「刷漆」
(参考时间: 00:48)
为了搞清楚 setjmp/longjmp 到底保存/恢复了哪些寄存器,讲师让 AI 写了一段很巧妙的「刷漆实验」:
- 先把所有寄存器刷成一个值(红色);
- 执行
setjmp;再把所有寄存器刷成另一个值(蓝色); - 执行
longjmp,看哪些寄存器变回了红色。
结果非常清楚:
longjmp之后,x19到x28被恢复(变回红色);而x0到x18还是蓝色(即被编译器改过的值);- 这就直接逆向出了 aarch64 的调用约定:
x19–x28是 callee-saved(被调用者保存),x0–x18是 caller-saved(调用者保存,讲师更喜欢叫 call-clobbered)。
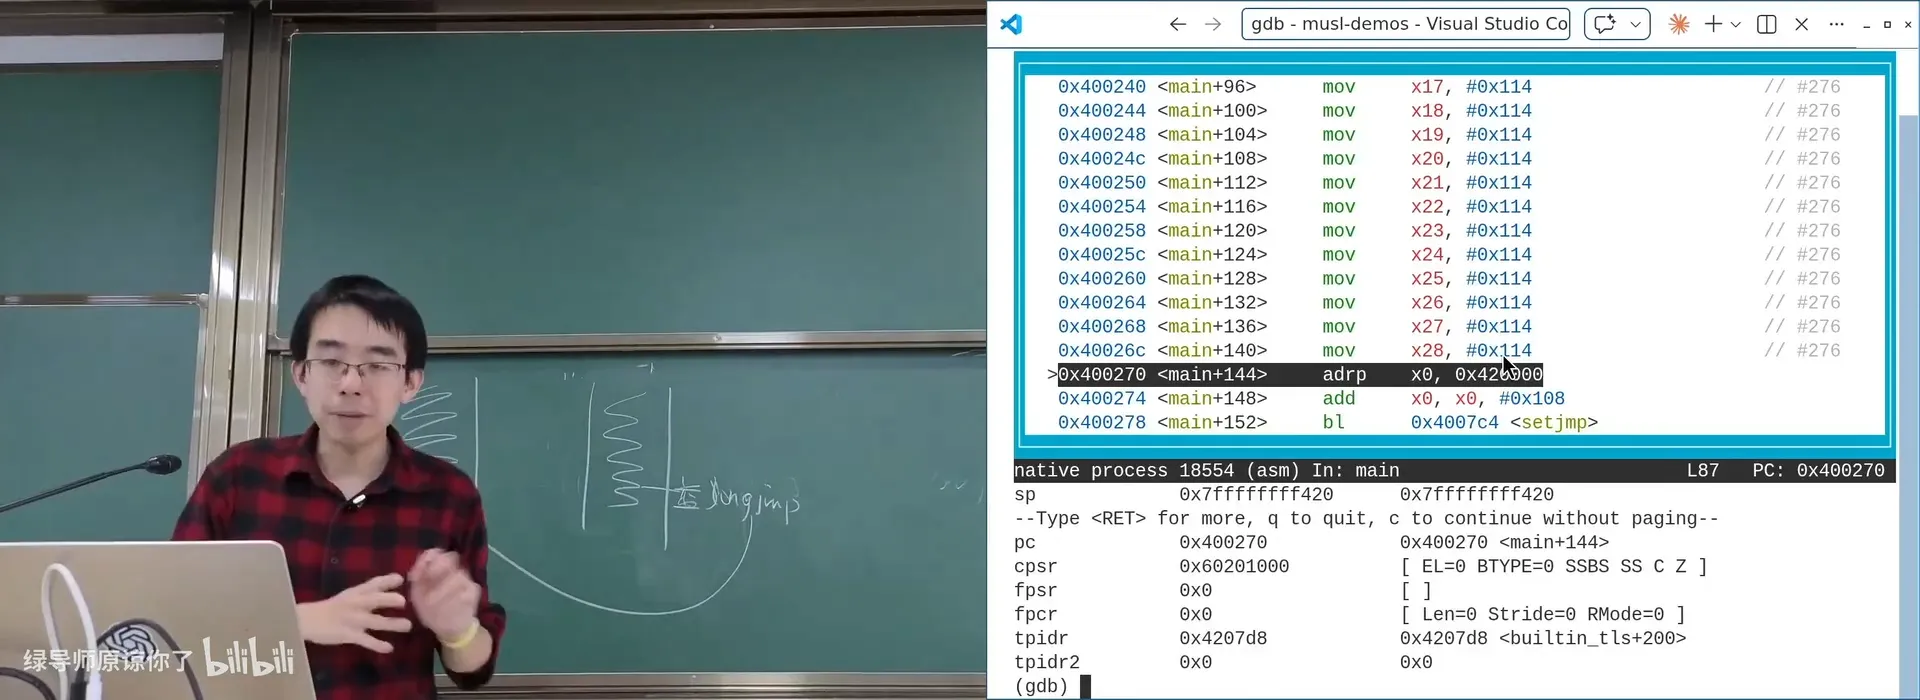
📷 setjmp 前给所有寄存器「刷漆」,观察哪些被保存
回到原视频 (00:51:00)
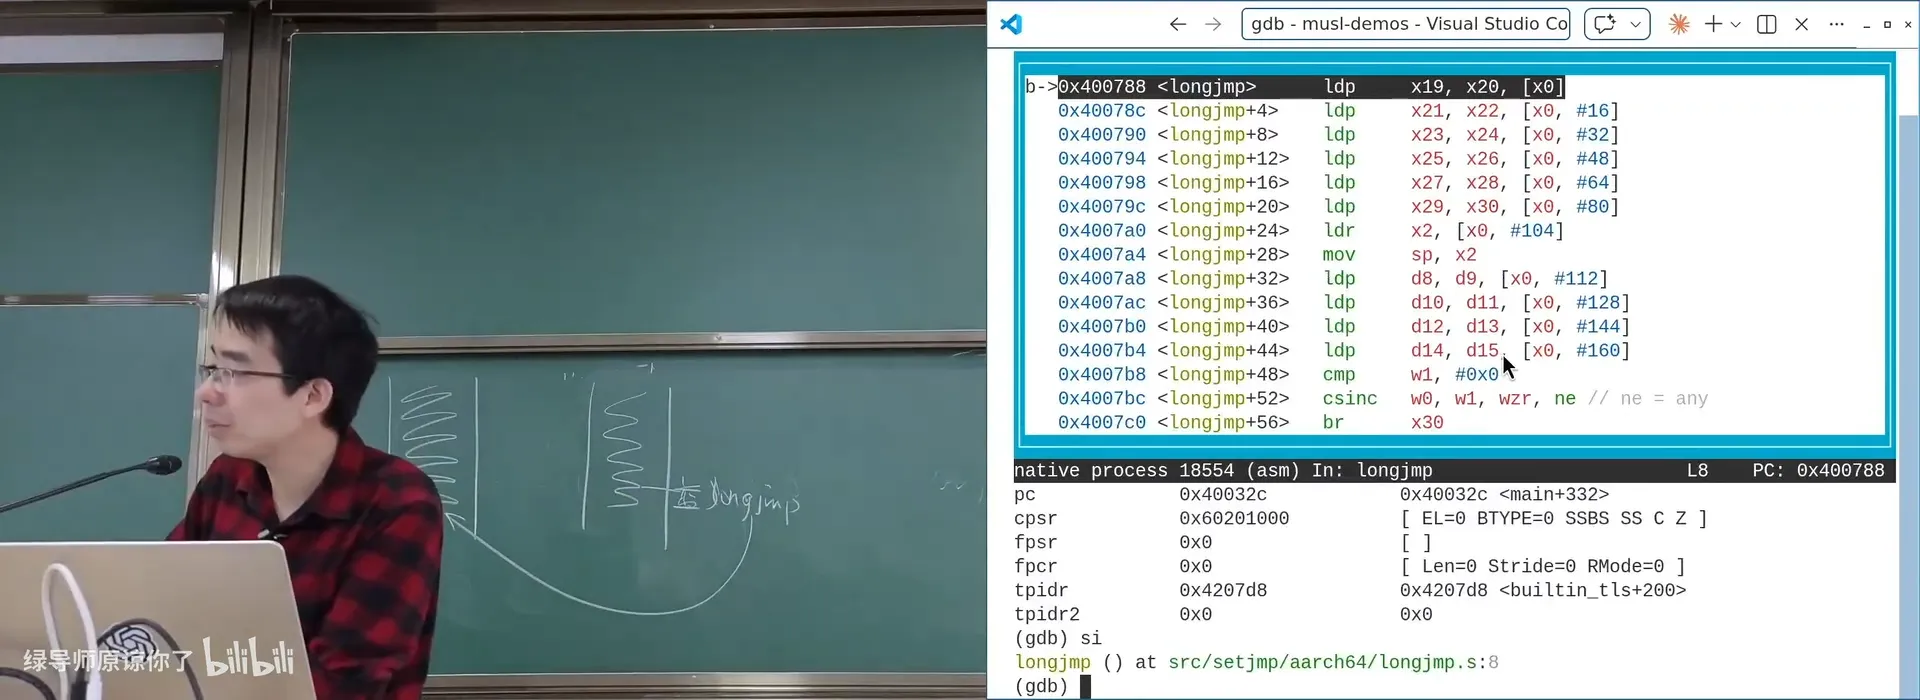
📷 longjmp 之后:`x19`–`x28` 被恢复,`x0`–`x18` 仍是新值
回到原视频 (00:52:40)
编者拓展|为什么不用保存
x0–x18:因为调用约定保证——一旦你调用任何函数,x0–x18里的值就不再需要了(编译器可以随便用它们)。所以setjmp只保存「被调用者必须负责保留」的那批寄存器就够。讲师还吐槽了那对很难记的术语:caller-saved/callee-saved——「中文翻译成『调用者保存/被调用者保存』之后更难反应过来了」,不如通过一个小实验去观察它的行为。
2.4 调试 gettimeofday:原来它不进入内核
(参考时间: 00:56)
用一个 gettimeofday 前后夹着 usleep(200ms) 的小程序测时间差。奇怪的是:strace 里只有 nanosleep,没有任何 gettimeofday——但打印出来的时间却是对的!
顺着 musl 的 gettimeofday 一路调下去,真相揭晓:它走的是 vDSO。
graph TD
    G["gettimeofday()"] --> C["__clock_gettime()"]
    C -->|"首次:lazy load"| A["解析 AUXV 里的<br>AT_SYSINFO_EHDR(vDSO 位置)"]
    A --> P["像加载器一样<br>遍历 vDSO 的 ELF program header / 符号表"]
    P --> F["找到 __kernel_clock_gettime 的地址"]
    F -->|"直接调用"| R["读 vDSO 里的 clock + CPU cycle count"]
    R --> S["seqcount 循环:读两次 seq,相等则成功"]
vDSO是内核映射进每个进程地址空间的一小段代码(vvar是一块共享数据,里面有 clock、CPU id 等);- 每次时钟中断,内核把 clock tick 加一;需要「不太精确」的时间时,直接从 vDSO/vvar 读,配合 CPU 的 cycle count 就能算出较精确的时间;
- 关键的
seqcount循环:先读一次序号、再读第二次,两次相等才认为读到了稳定值(否则重试)。讲师单步调试时这个循环一直出不来,正是因为单步让每条指令之间延迟巨大,几乎必然跨过一次 tick。
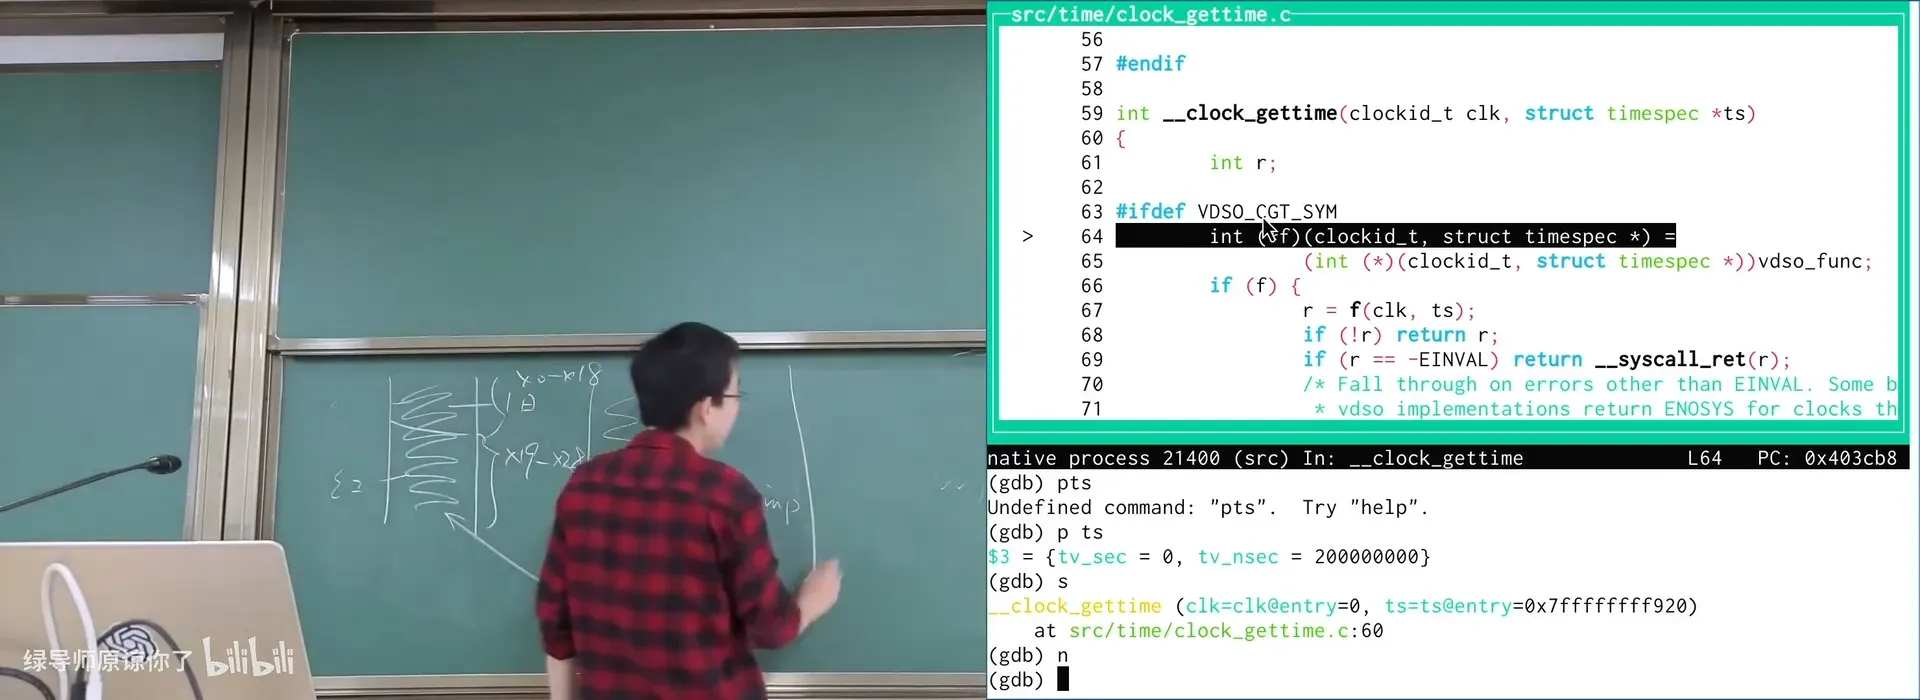
📷 vDSO:`gettimeofday` 直接跳进进程地址空间里的 `__kernel_clock_gettime`
回到原视频 (01:02:00)
编者拓展|「不陷入内核的系统调用」= vDSO:像
gettimeofday、clock_gettime、time这类高频、只读的调用,内核把实现放进了用户态可执行的一段代码(vDSO),于是它们不需要syscall指令陷入内核,性能大幅提升。AUXV 里的AT_SYSINFO_EHDR指向 vDSO 的 ELF 头,libc 在首次调用时「像加载器一样」解析它、缓存函数地址。讲师甚至让 AI 生成了一段指令级 trace:从进入__kernel_clock_gettime到出来,没有一次陷入内核。
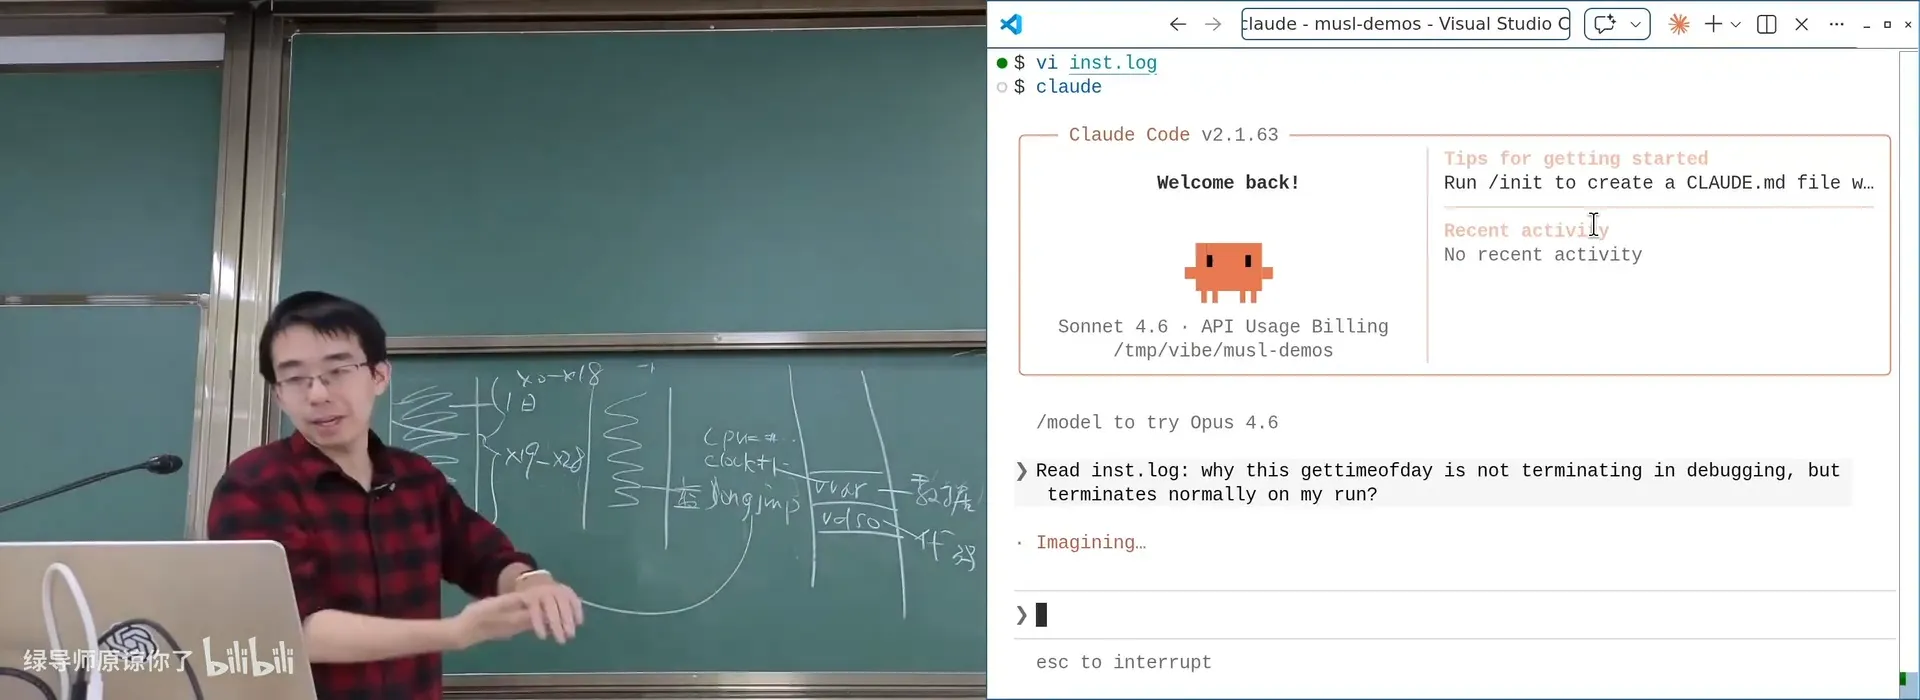
📷 AI 生成的指令序列日志:`gettimeofday` 的 seqcount 循环
回到原视频 (01:09:00)
三、动态内存分配:malloc / free
(参考时间: 01:11)
malloc/free 的 API 非常直观:ptr = malloc(n); free(ptr);。但问题是:
内存从哪里来?
操作系统不支持分配「一小段」内存:mmap 以页(4 KiB)为单位,sbrk 也是移动整个数据段的边界。所以 libc 的做法是:一次性向操作系统要一大块(用 mmap + MAP_ANONYMOUS,或早期的 sbrk),自己在这块内存上实现一个数据结构,再切出小段给 malloc。
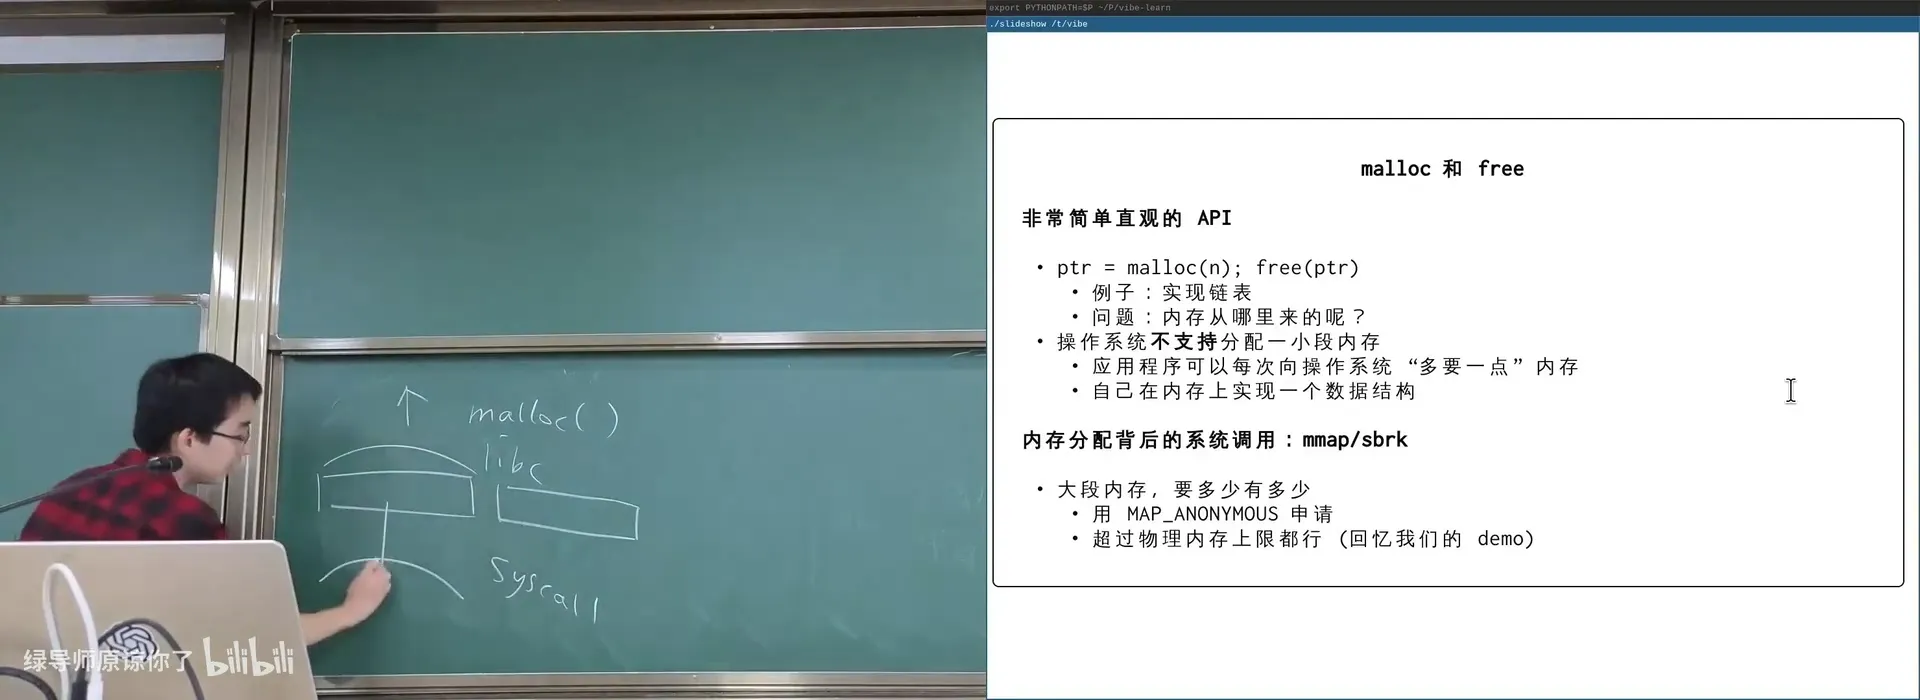
📷 strace 一次 malloc:背后就是 mmap / sbrk
回到原视频 (01:14:00)
3.1 「十亿美元错误」与最小完备性
(参考时间: 01:14)
讲师把 malloc/free 称为「一个设计得很有问题的 API」,并引用了 Tony Hoare 的名言:
I call it my billion-dollar mistake. It was the invention of the null reference in 1965.
对比 open/write 这类系统调用——它们提供了最小完备性、把机制与策略分离(操作系统只管字节序列,语义由应用负责),设计得「没有太大问题」。但 malloc/free 引入了一个额外要求:
- 在任何可能路径上,
malloc都必须配一次free; free之后,那个指针立刻变成非法,不能再使用。
「就为了证明这个,人类不知道走了多少弯路」:managed runtime、RAII、Rust 的 ownership/borrowing……以及无穷无尽的 CVE(use-after-free、concurrent use-after-free、memory leak……)。
编者拓展|RAII 与所有权:C++ 用 RAII(Resource Acquisition Is Initialization)——把资源的获取放在构造函数、释放在析构函数,这样即使中途
return也不会泄漏;Rust 则用所有权/借用在编译期拒绝这类代码。讲师的观点很尖锐:理想情况下,像 Rust 那样「指针一旦被拿走就再也访问不到」,才是对的。
3.2 实现高效的 malloc:先看 workload
(参考时间: 01:17)
如果要自己实现 malloc,基本思路是:
- n 足够大 → 直接
mmap向操作系统要(头尾浪费一点无所谓); - n 不大 → 维护一个不相交小区间集合的数据结构,每次
find-first找一块够大的空间割出来。
「如果你向这个方向思考,就会想到平衡二叉搜索树」——但这不是真实分配器的做法。讲师引出 1995 年的那篇 malloc 综述:「这才叫 research」——Segregated free lists 早在 1964 年就提出了;「停止无意义的『科研实践』,去做真正有价值的事情」。他引了那篇文章里的一段:
Understanding real program behavior still remains the most important first step in formulating a theory of memory management. ... We must try to discern what is relevant and characterize it; this is necessary before formal techniques can be applied usefully.
由此得出两条铁律:
- 「脱离 workload 做优化就是耍流氓」——在考虑性能之前,先理解你需要考虑什么样的性能;而 workload 去哪里找?当然是 paper(顺便白得一个方案);
- 现实系统中通常不考虑 adversarial worst case(现实应用是「正常」的)——但这给了很多 DoS 机会。
对 malloc 的观察:小对象(字符串、临时对象)创建/分配最频繁,所以「我们几乎只要管好小对象就好了」。又因为所有分配会在所有处理器上发生,小对象分配的 scalability 是主要瓶颈——用链表/区间树做 first-fit 可不是好主意。
3.3 Fast & Slow:Segregated Lists(Slab)
(参考时间: 01:19)
讲师借 Kahneman 的《思考,快与慢》类比:好的系统要两套路径——
- Fast path(系统 I):性能极好、覆盖大部分情况,但有小概率失败,失败就 fall back;
- Slow path(系统 II):不在乎快,但把困难的事做好。
空间换简洁的具体做法是 Segregated Lists(Slab):
- 每个 slab 里的每个对象一样大;
- 每个线程拥有「每个对象大小」的 slab;
- fast path → 立即在线程本地分配完成;slow path →
mmap(); - 回收是 O(1)。
graph TD
    M["malloc(n)"] --> F{"线程本地 slab<br>里有空闲块?"}
    F -->|"有(fast path)"| R["直接返回,O(1)"]
    F -->|"没有(slow path)"| S["向操作系统 mmap 一大块<br>切成该大小的 slab"]
    S --> R
编者拓展|「为 AI 搭舞台」:讲师再次回到那句 Heuristics is dead, Policy is Heuristics, LLM is Policy, Mechanism is King——为 AI 搭好舞台,让它在 design space 里探索,甚至允许扩充 design space。他说,让 PhD 学生做综述的意义,正是学会提取 design space 的能力:malloc/free 的 design space 是什么?(对象大小分类?线程本地?fast/slow 路径?分配/回收的复杂度?)
总结
- AI 会幻觉「成功」:豆包报告 musl 编译成功是假的——在每一条 AI 命令后看一眼结果,是本讲最实际的教训。
- libc 原理你已经会:控制
_start就控制一切;FFI/内联汇编访问系统调用;libc 是平台无关的抽象层(fopen/fseek/ftell在任何「给人用」的操作系统上都存在),从超级计算机到手表手环都有它。 - Debug Info(
-g/ DWARF):-g往 ELF 里加.debug_*section,把「汇编状态」映射回「源代码状态」;DWARF 本身包含一个图灵完备的 bytecode。JavaScript 用 Source Map(.map,含sourcesContent)——Claude Code 泄漏就源于此,也带来投毒/泄密风险。 - Debug Info 的用途:backtrace、火焰图 profiler、crash dump、AddressSanitizer(抓 use-after-free 等 UB)。
- 调试 libc 的隐秘角落:
- crt1.o /
_start:从第一条指令逆向出初始进程栈(argc/argv/envp/auxv),直到exit(main(argc, argv, envp)); printf/ 变参数:FILE内部一目了然(fd=1、buffer);变参数靠编译器 + libc 协作把寄存器参数存到栈上;setjmp/longjmp:「刷漆实验」逆向出 aarch64 调用约定(x19–x28callee-saved);gettimeofday/ vDSO:不陷入内核的「系统调用」,通过 AUXV 找到 vDSO 里的__kernel_clock_gettime,用 seqcount 循环读时钟。malloc/free:内存来自mmap/sbrk(按页),libc 自己管理小对象;它引入了「配对释放、释放后不可再用」的心智负担(billion-dollar mistake 的同类),催生了 RAII / 所有权;性能优化必须先看 workload,真实实现是 fast/slow 路径 + Segregated Lists(Slab)。
附:官方参考与延伸阅读
本讲的讲义见课程主页,以下链接按书中出现顺序整理:
阅读材料:在 AI 的帮助下调试 musl libc 中你感兴趣的函数;并阅读 1995 年那篇 malloc 综述,「体会一下什么叫真正严肃的科研」。
版权说明:本讲讲义与幻灯片作者为蒋炎岩,采用 Creative Commons BY-NC 4.0 许可,来源于 https://jyywiki.cn/OS/2026/。视频画面与字幕版权归原作者所有。本书为课堂内容的学习性重构。