第14讲 · 并发控制:互斥——从「make it work」到 futex
2026 南京大学《操作系统原理》第十四讲 · 课堂实录重构
| 主讲 | 蒋炎岩(Yanyan Jiang) |
| 视频 | https://www.bilibili.com/video/BV1hNdhB1Efe/ |
| 课程主页 | https://jyywiki.cn/OS/2026/ |
| 本讲讲义 | https://jyywiki.cn/OS/2026/lect14.md |
| 讲义 / 幻灯片作者 | 蒋炎岩,https://jyywiki.cn/ |
| 讲义 / 幻灯片许可 | CC BY-NC 4.0 |
| 图片来源 | 书中插图为课堂演示与讲义渲染图;演示类截图为视频画面 |
对应讲次:第14讲(南京大学 操作系统原理)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者说明:本书由课堂录像的语音字幕重构而成,术语、章节骨架与参考链接已按课程官方讲义(
lect14.md)校准。讲师的口语风格、类比与案例被尽量保留;编辑性的补充一律以「编者说明」或「编者拓展」标出。
引子:为什么在《操作系统》课讲并发?
(参考时间: 00:00)
上一讲「从入门到放弃」:有了 spawn/join,你能写多线程程序,但连 1+1 都算不对、1,2,3 都数不清。
为什么操作系统课要讲并发?因为——UNIX 里 fork 出来的进程不共享内存,但系统调用的执行是共享内存的:
syscall指令本质上是一次带权限切换的跳转,从不可信的应用程序进入操作系统内核;- 于是每个进程在操作系统内执行的部分,就成了一个线程;
- 两个进程同时执行
read(fd, buf, size)/write(fd, buf, size),访问同一个文件——内核里的这部分就会并发/并行,出现上节课的1+1、123问题。
编者说明:「操作系统是第一个真正严肃的、大型的、让人类头疼的并发程序。」很多早期的并发结果都来自操作系统研究。所以在这里讲并发顺理成章。
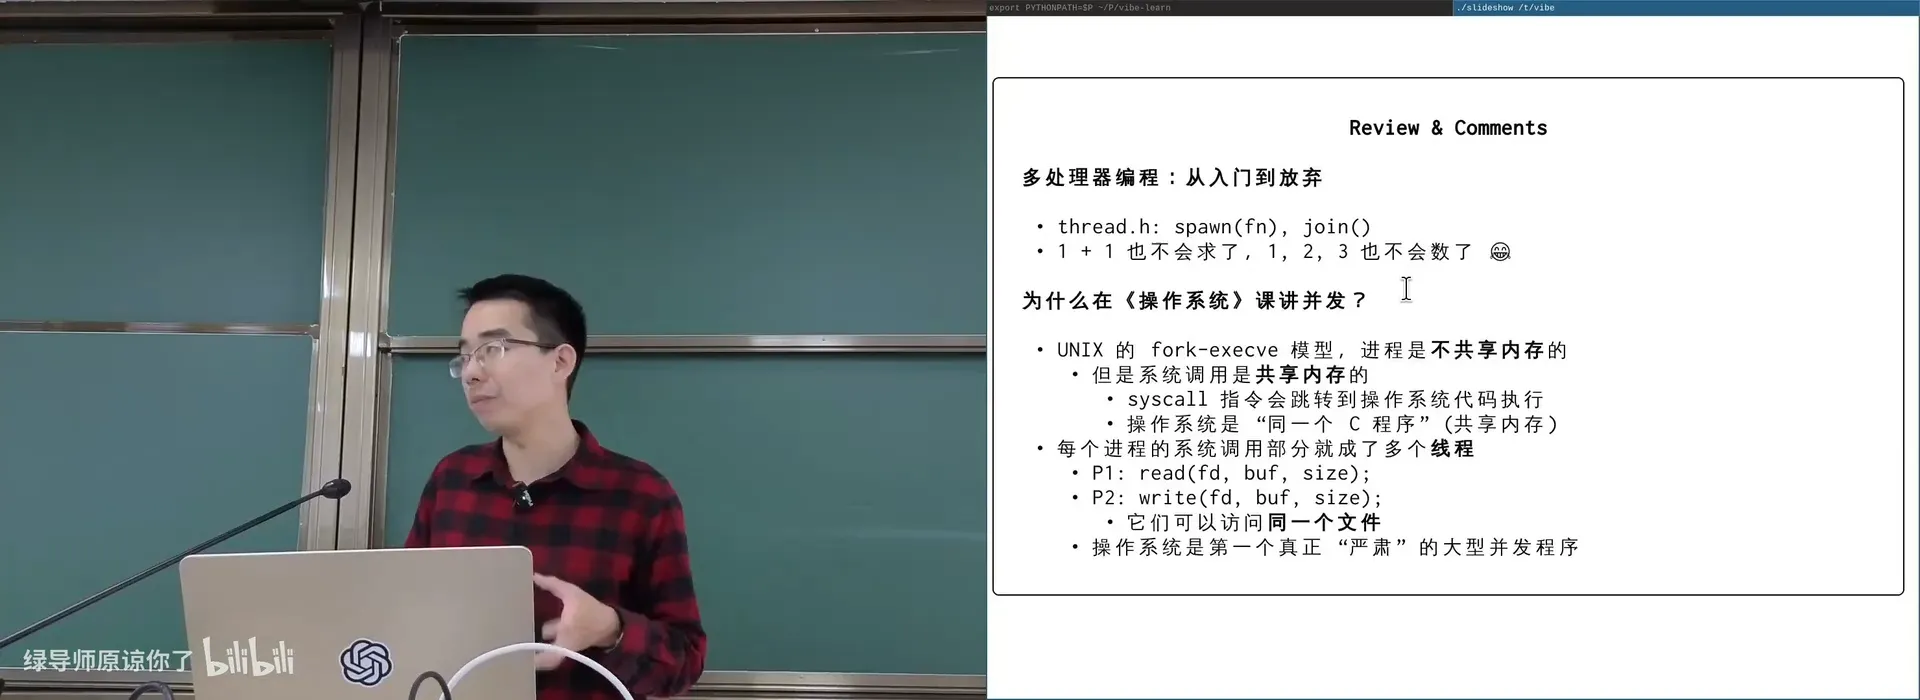
📷 系统调用是「共享内存」的:每个进程的内核部分就是一个线程
回到原视频 (00:02:00)
一、互斥:概念与 API
1.1 我们想要一个「make it work」
(参考时间: 00:03)
我们希望引入一个机制,让 sum++「无论怎么执行结果都对」——把一段代码变成不能并发/并行执行:
long sum = 0;
void T_sum() {
    make_it_work {
        sum++;
    }
}
这其实就是 Transactional Memory(事务内存):把一段代码(可以很长)用 atomic 包起来,里面的读写要么全部执行、要么什么都不做。Intel 甚至把它做进了指令集(TSX:xbegin / xend,2010 年代)——但它引发了很多安全漏洞,消费级 CPU 上已经看不到了(服务器上还留有),ARM 也一度加入又放弃。「这是一条可以和所有指令产生关联的指令」,像 fork 一样给实现带来大麻烦。
1.2 单处理器内核里:关中断
(参考时间: 00:06)
如果是单处理器、且你在操作系统内核里,有一个简单粗暴的办法——关中断:
disable_interrupt();
sum++;     // 现在没人能打扰我了
enable_interrupt();
为什么有效? 我们的状态机模型隐含假设「每条指令执行时中断是开着的」——所以系统其实是非确定的,这是内核并发的来源(中断式并发)。把中断关掉,「stop the world」,指令流就完全确定了。代价是:如果你在内核里关中断死循环,计算机就死掉了——这正是为什么要有 CPU Reset(Windows 蓝屏的常见原因)。
编者拓展|用户态能关中断吗? 讲师让 AI 写了一个「关中断死循环」的程序——在用户态跑不了:arm 上执行 MSR 指令会得到
illegal instruction(不存在的指令/没权限),x86 上会得到protection error/segmentation fault。只有内核才能关中断。
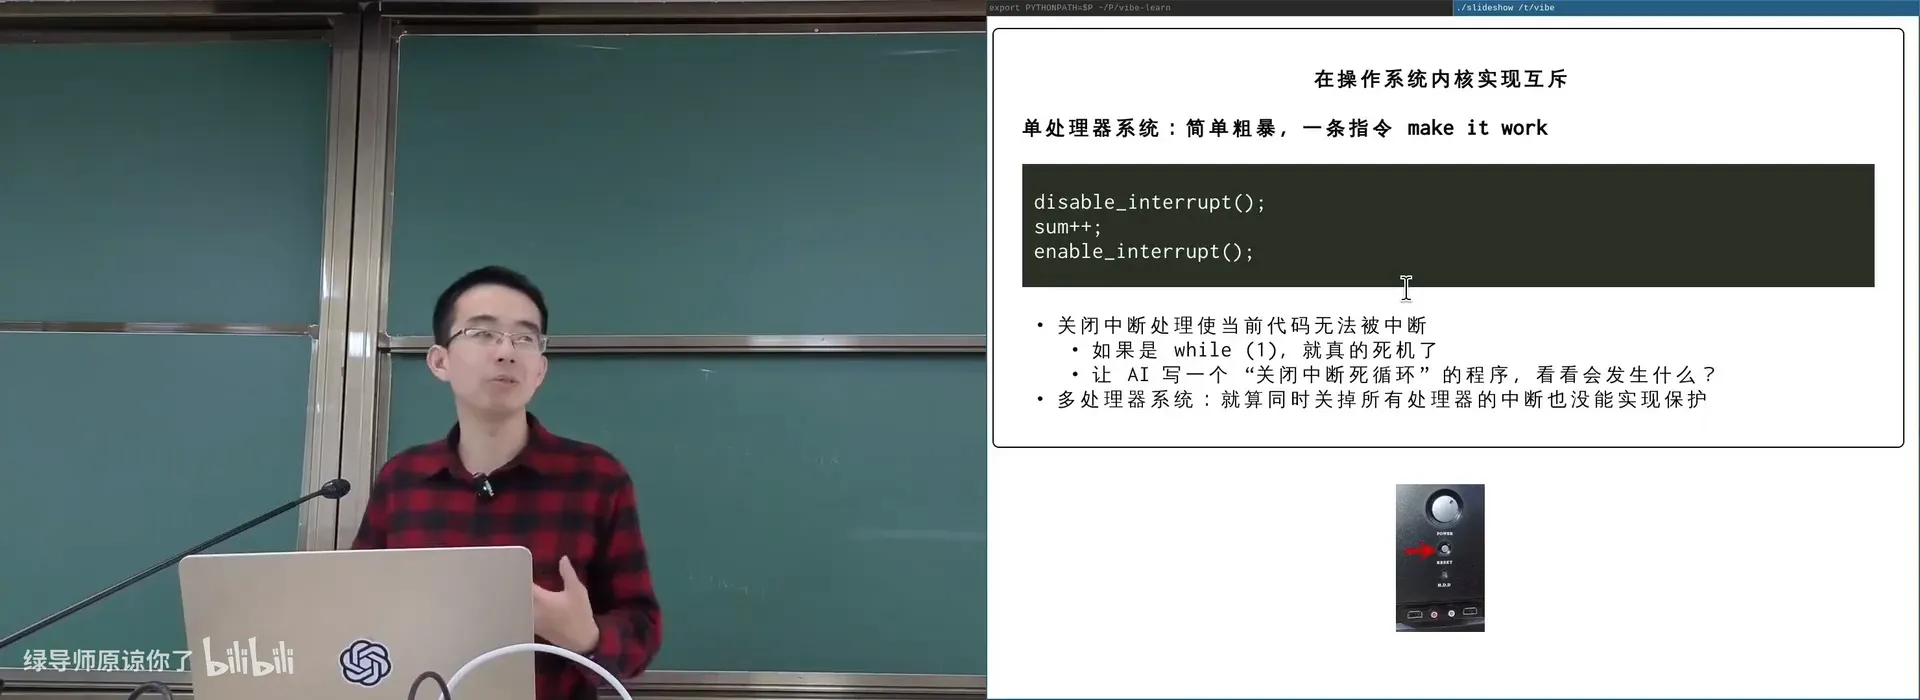
📷 用户态尝试关中断:illegal instruction / segmentation fault
回到原视频 (00:07:00)
1.3 互斥的 API
(参考时间: 00:10)
把「关中断/开中断」扩展成一对 API,就得到互斥(mutually exclusive):
lock();
// 任意代码,例如 sum++;
unlock();
被 lock/unlock 包住的代码叫临界区(critical section)。lock 返回后,这段代码就不会再和其他加锁代码并发——并发被消除了。
讲师给了两个「拟人视角」:
- 宿舍厕所的包厢:
lock进去锁门(别人进不来),unlock出来解锁; - 桌上有一把钥匙 🔑:
lock(acquire)拿到钥匙才能继续,unlock(release)把钥匙放回去。
编者说明:
unlock还有一个额外语义——可见性:它保证临界区内写的数据全部进入内存,后续线程能读到。这就是 C++ 内存模型里的 acquire/release semantics。
可以有很多把锁(很多张桌子):
mutex_t lock_a = MUTEX_INIT(), lock_b = MUTEX_INIT();
mutex_lock(&lock_a);  x++;  mutex_unlock(&lock_a);
mutex_lock(&lock_b);  y++;  mutex_unlock(&lock_b);
这里 x 和 y 是不同内存地址,用不同的锁保护它们就互不干扰。终于可以实现 1+1 了!
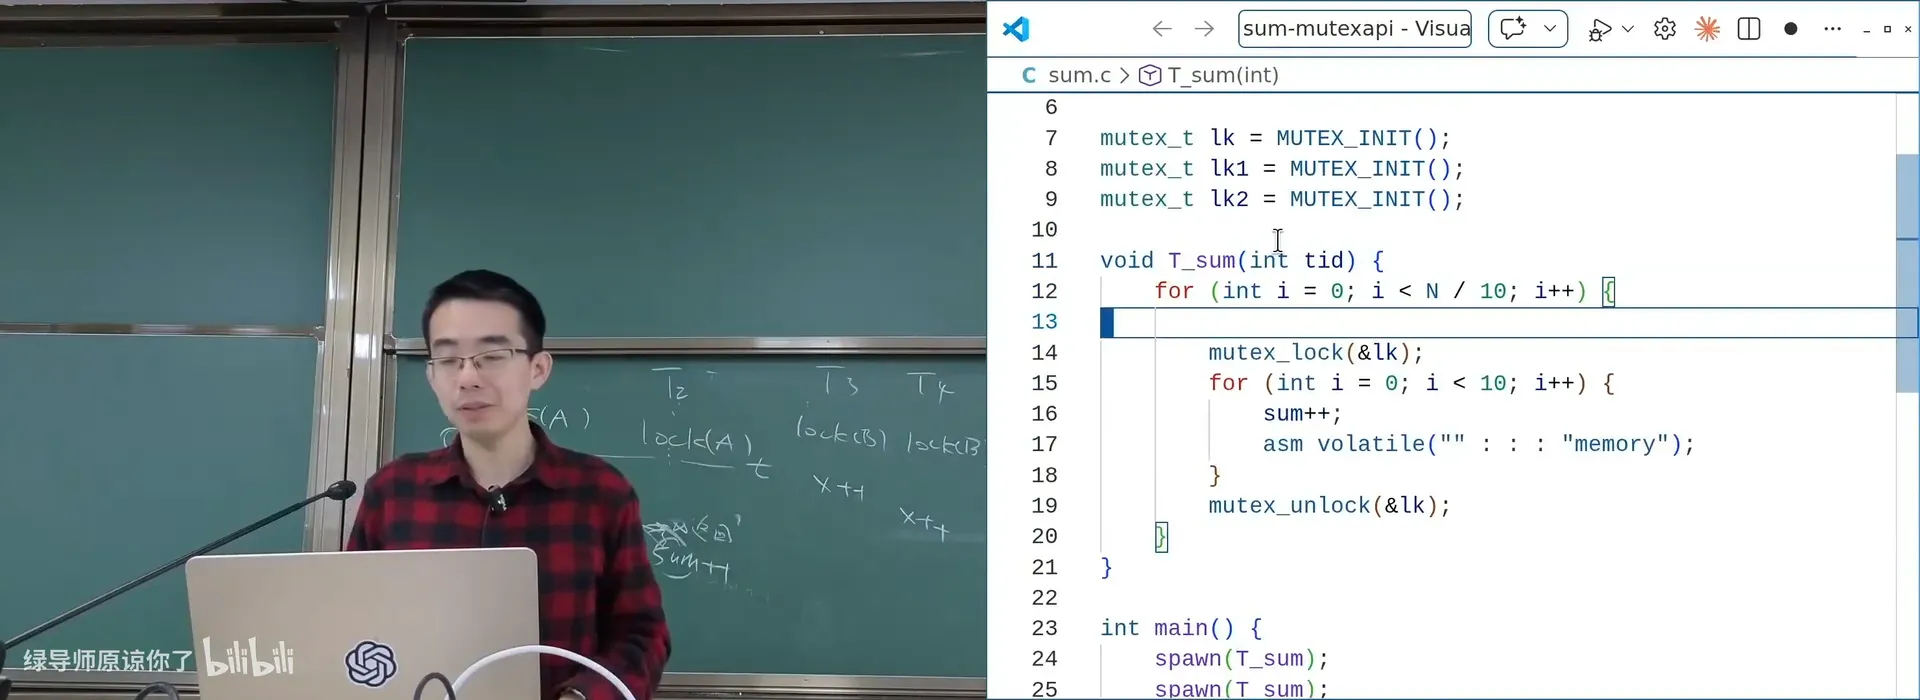
📷 mutex_lock / mutex_unlock:用同一把锁保护 sum++,结果正确
回到原视频 (00:18:00)
二、使用互斥锁:把并发「退回」到顺序
2.1 正确使用锁 ≈ stop the world
(参考时间: 00:19)
假设你正确使用锁(别的线程不会和临界区内的读写干扰),那么程序行为就和 lock(); unlock(); 等价——甚至和 stop_the_world() 等价。讲师用《JOJO》里的 「The World」 打比方:你lock的瞬间,世界仿佛停下来了,只有你能动;unlock的一瞬间,你对世界施加的作用全部成立**。
于是——上一讲的那些复杂东西都消失了:「人类本质上是 sequential creature」,把一个多线程程序通过互斥「退回」成顺序程序,你对程序的理解方式又回来了。
2.2 你高兴得太早了:锁是程序员负责的
(参考时间: 00:23)
「自从 acquire/release 这个 API 被设计出来,人类就走上了万劫不复的错误道路。」因为 lock 和 unlock 都是程序员负责的:
- 你得在写代码时清楚知道什么时间和谁共享数据;
malloc/free的教训(配对释放)在锁这里重现:函数第一行lock、最后一行unlock,中间一个return——就错了;- 常见的低级错误:
T_1: lock(&l); sum++; unlock(&l);
T_2: lock(&I); sum++; unlock(&I);   // 用错变量名 → 形同虚设
「不要笑,小丑就是我自己」——现实里你有几十把锁、几十个文件,函数互相调用,「没有人能确信自己记得」。
并发数据结构更麻烦:以双向链表为例,如果每个节点一把锁,遍历时要「先锁 next、再解锁 current」,插入/删除要同时持有 prev/current/next 三把锁,删除后的内存回收还必须由「最后一个引用的线程」来做。
编者拓展|《操作系统》课的建议:一把大锁保平安——「但凡可能共享的东西都上同一把锁」。这看起来很蠢,但 Linux 内核从单处理器迁移到多处理器时,干的第一件事就是引入
BKL(Big Kernel Lock):先用一把大锁保证正确,再慢慢把关键路径上的大锁拆成小锁,并做充足的压力测试。另一句来自 Knuth 的告诫:«Premature optimization is the root of all evil.»——你脑子一热做的「优化」(比如把
*2改成左移)往往不在关键瓶颈上,反而让代码更难懂。先把你想做什么准确表达出来,再慢慢优化瓶颈路径。
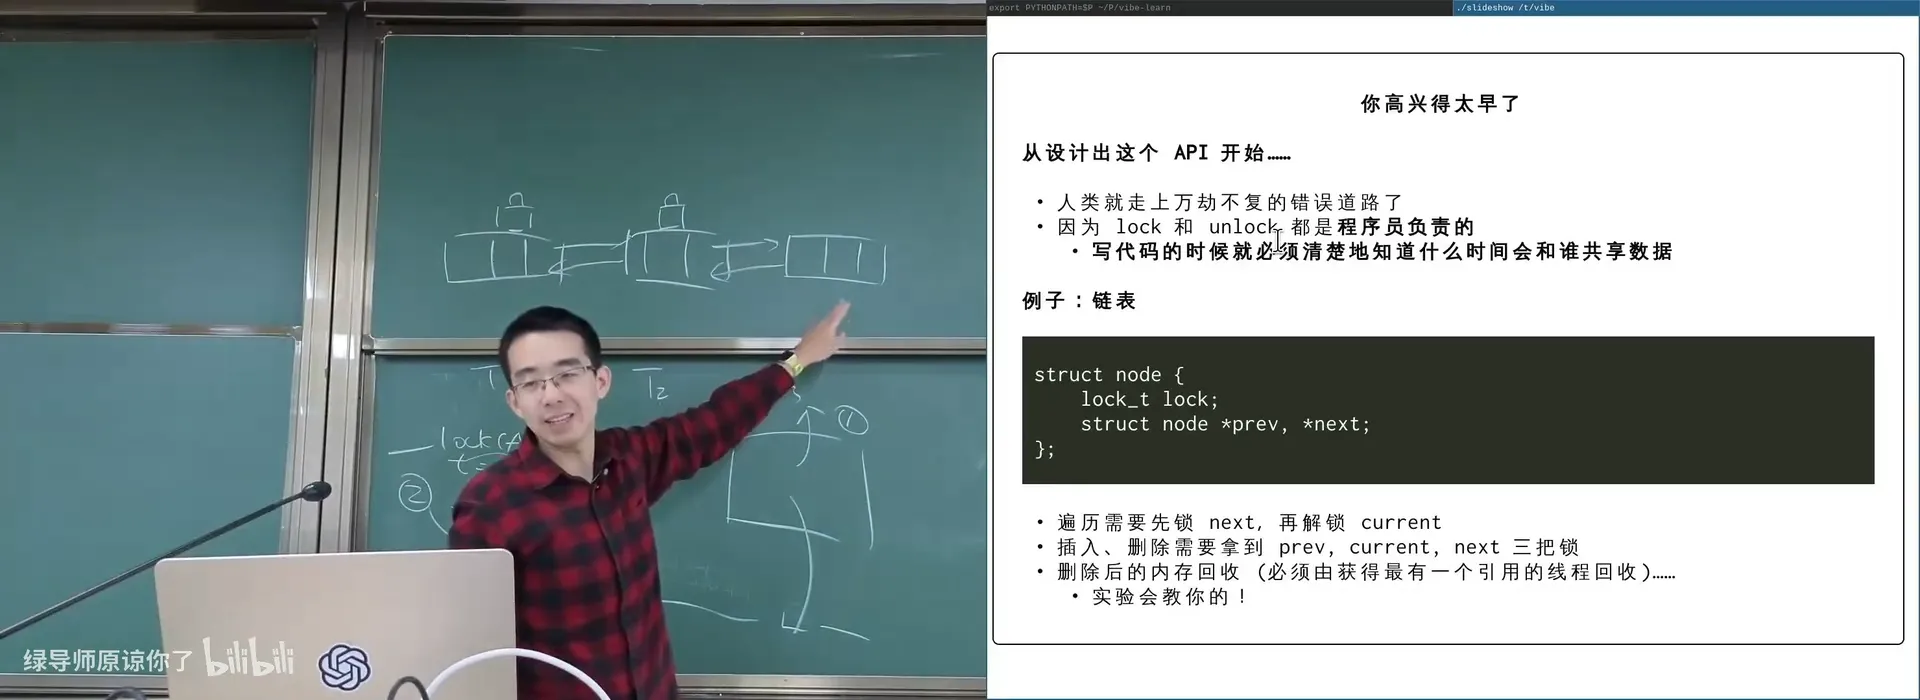
📷 每个链表节点一把锁:遍历/插入/删除/回收都变得极其复杂
回到原视频 (00:26:30)
2.3 FAQ:都不并发了,还要线程吗?
(参考时间: 00:33)
- 悲观的 Amdahl's Law:如果有 $1/k$ 的代码不能并行,那么 $T_\infty > T_1/k$——再多的处理器也只能加速有限;
- 乐观的 Gustafson's Law(更细致的版本):能并行的部分总是能并行的,$T_p < T_\infty + T_1/p$;
- 经典物理的局部性原理:「物体对相邻物体的影响需要时间」,任何物理世界模拟都可以大规模并行;
- Embarrassingly parallel 的例子:图书馆 vs 分布式数据存储;大脑 vs 深度神经网络;NP-Hard 问题的搜索(还记得 fork-based DFS 吗)。
结论:并发控制控制的是关键数据结构;程序里真正需要串行的部分非常少,所以高并行度依然可以实现。
三、在操作系统上实现互斥
3.1 错误的尝试:Dekker 与 Peterson
(参考时间: 00:39)
- Dekker's Algorithm(1965):第一个公开正确的算法——「A 进程可以在对方不想进入时进入临界区,否则只有在轮到它时才能进入」(一句绕口令);
- Peterson's Algorithm(1981):更简洁,依然是绕口令——「A 可以在对方不想进、或自己表达了意愿并把机会让给对方时进入」。
难点:你很难从字面上判断它对不对——「n 个线程循环 m 次,sum 的最小值是多少?」是 NP 完全(甚至更难)的问题。
讲师用一个拟人协议讲 Peterson:Alice 拿 Bob 的名字、Bob 拿 Alice 的名字,桌上三个变量(你的手、他的手、厕所门):
- 举起自己的旗子(store 手);
- 把写有对方名字的字条贴到门上(store 门);
- 观察:对方不举旗,或门上名字是自己 → 进;否则继续观察;
- 出厕所后放下自己的旗子(门上的字条不用管)。
「看似谦让,实则手快有(被另一个人的标签覆盖)、手慢无」。
编者拓展|用模型检查器「暴力证明」:与其在黑板上一遍遍推演,不如写一个 model checker——proof by brute force:把「举手状态 + 门上名字 + PC」写成状态 $(x, y, turn, PC_1, PC_2)$,穷举所有状态,检查「有没有两个人同时在临界区」。讲师甚至把状态迁移图画出来。这项技术在 2007 年得了图灵奖。他还现场用「改协议」来提问:先贴标签再举旗还对吗?放下旗子后撕掉字条还对吗?交换观察顺序还对吗?——「我是一个很叛逆的人」。
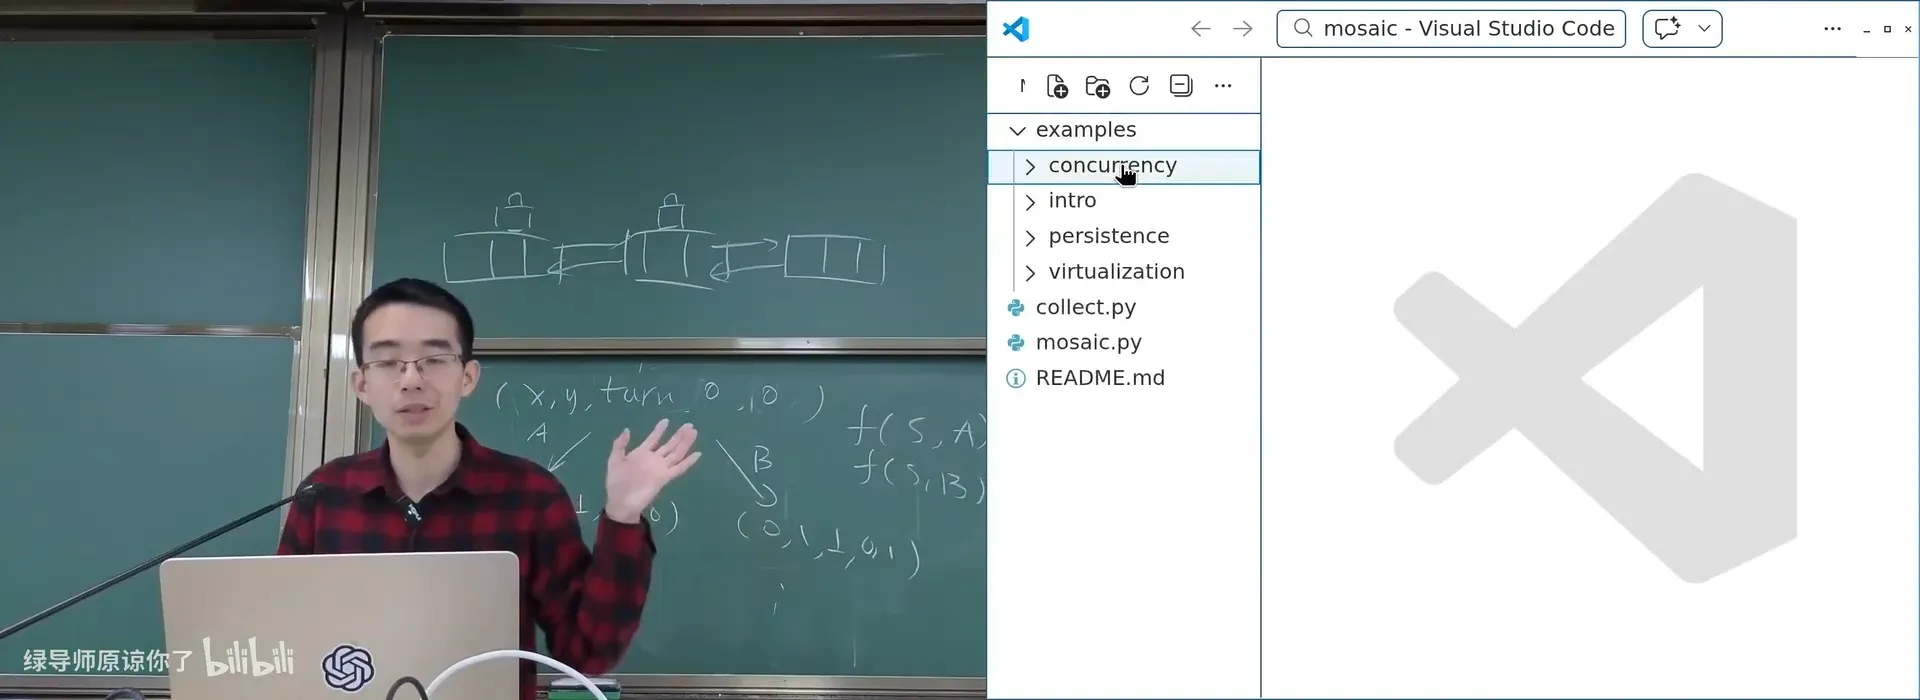
📷 用 Python 模型检查器穷举 Peterson 协议的所有状态
回到原视频 (00:47:30)
3.2 但 Peterson 的假设在现代机器上不成立
(参考时间: 00:53)
Peterson 的证明依赖两个假设:load/store 瞬间完成且生效、指令按程序顺序执行。上一讲已经证明这两个假设都是错的。(在 1965 年这还算合理——没有高性能编译器,也没有多核。)
所以直接写 load/store 实现互斥是「路线错误」。要让它工作,需要两类屏障:
- Compiler barrier:
asm volatile("" ::: "memory")或volatile变量; - Memory barrier:
__sync_synchronize()(编译器屏障 + 硬件屏障)——x86 是mfence、ARM 是dmb ish、RISC-V 是fence rw, rw。
而且Peterson 只适用于两个线程——用 spawn 可以释放出 100 个动态生灭的线程,你根本不知道任何时刻系统里有多少线程。
编者说明:讲师说,他实现了一个错误的 Peterson 算法,在他自己的机器上竟然无法复现——「这就是并发最可怕的地方:一个真的错的程序,可能因为各种机缘巧合看起来是对的」。这正对应你们马上要做的实验:跑了很多轮测试觉得没问题,交到 OJ 上就是过不了。
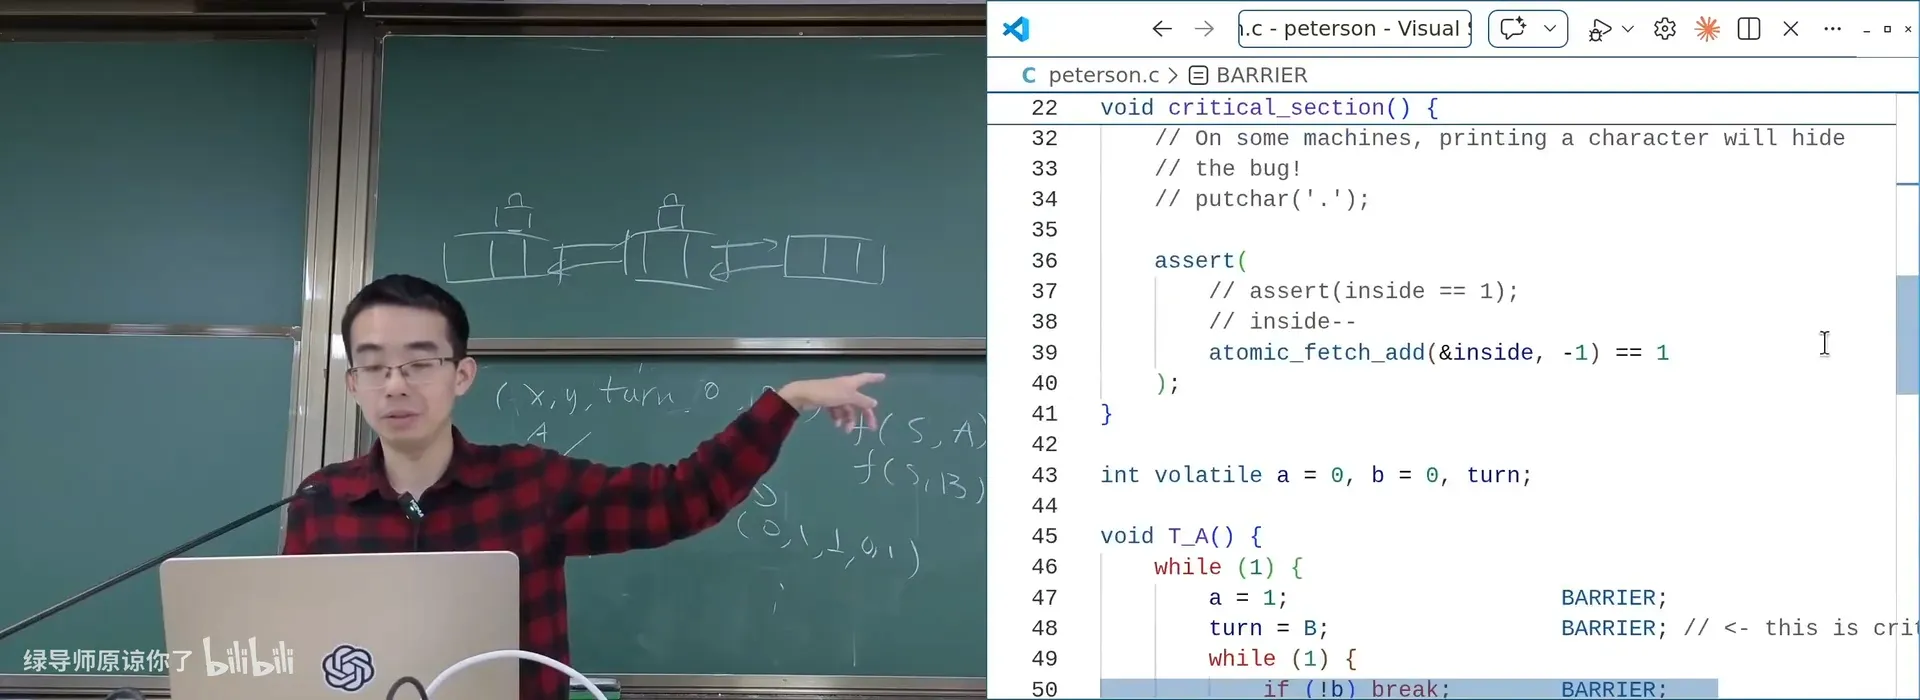
📷 加上 memory barrier 的 Peterson:既低效又难实现
回到原视频 (00:55:00)
3.3 硬件来帮忙:原子指令
(参考时间: 00:58)
计算机系统是我们自己造的——「这是 Computer Science 和自然科学一个很大的不同:相当多的游戏规则是我们定的」。软件不好解决,就让硬件帮忙:加一些不过于复杂的指令。
分析 lock() 的错误实现(和「山寨支付宝」一样):
void lock() {
retry:
    if (can_go == ✅) { can_go = ❌; }  // 检查与写入之间被抢占 → 出错
    else goto retry;
}
void unlock() { can_go = ✅; }
只要提供一小段时间的 stop-the-world,把「load + 计算 + store」变成一条不可被打断的原子指令——希腊语 ἄτομος(atomos),不可分割:
- x86:
lock前缀(Bus Lock,80486 起真有一条总线锁); - RISC-V:LR/SC(Load-Linked/Store-Conditional,来自 MIPS)与 A 扩展;
- ARM:
ldxr/stxr、stadd(store add)……
movl $✅, %eax
movl $❌, %edx
lock cmpxchgl %edx, (can_go)   # 原子比较并交换
甚至一条 lock addq $1, (sum) 就能实现 +1。「终于可以实现 1+1 了。」
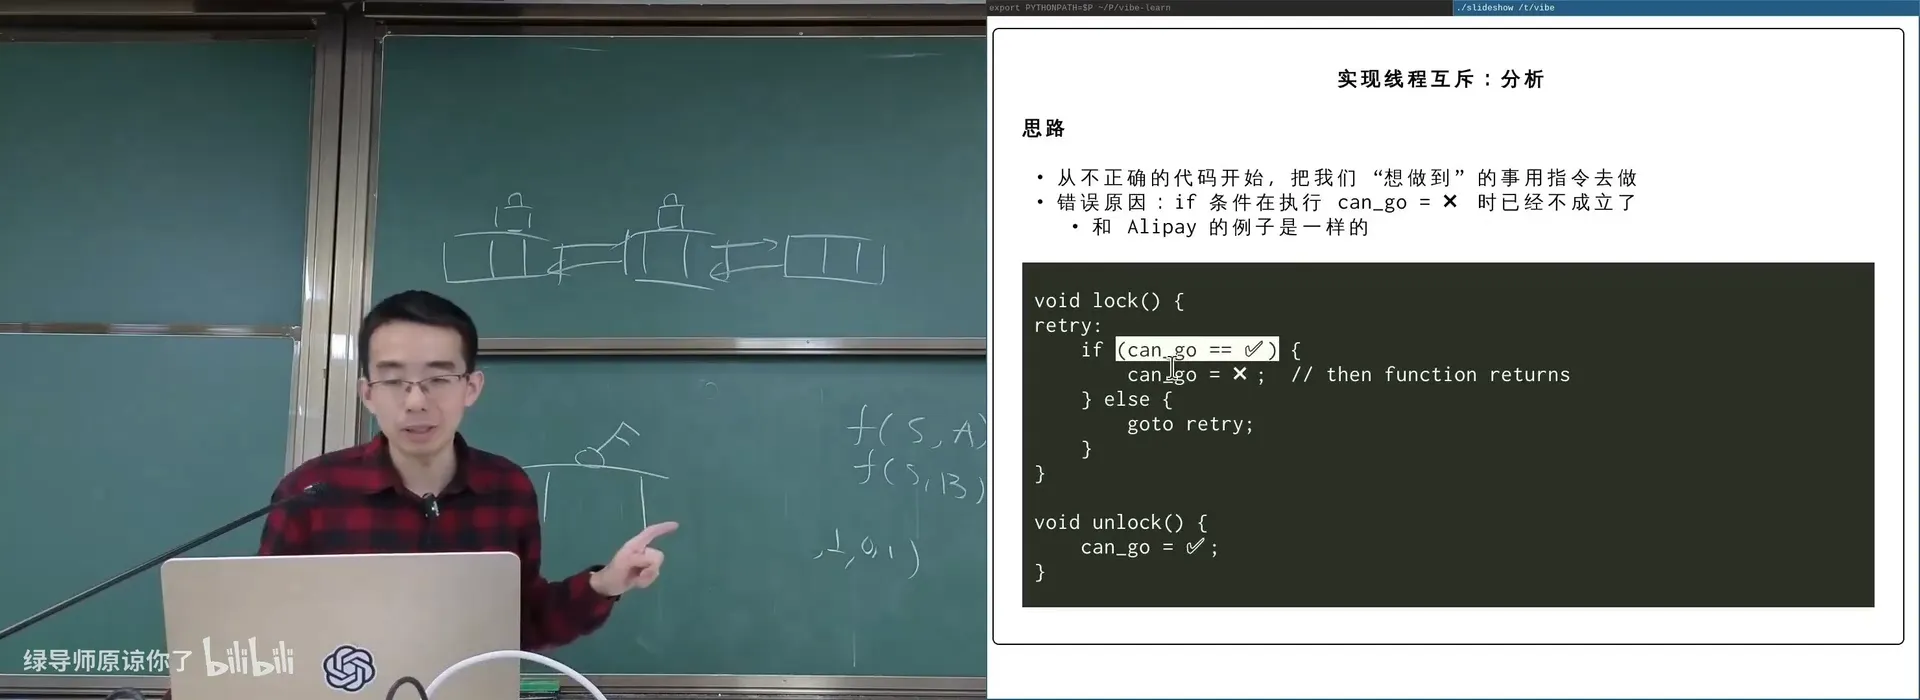
📷 80486:lock 前缀 + 总线锁,实现原子指令
回到原视频 (01:03:00)
3.4 自旋锁:严重的性能问题
(参考时间: 01:05)
用「原子的 exchange(把自己手里的白纸和桌上的钥匙交换)」就能实现 自旋锁(spinlock):
graph TD
    L["lock:原子 exchange 试图拿走钥匙"] -->|"拿到 ✅"| C["进入临界区"]
    L -->|"拿到 ❌(别人拿着)"| L
    C --> U["unlock:把钥匙放回桌上"]
- 性能问题 1:除了拿到锁的线程,其他处理器上的线程都在空转——「一核有难,八核围观」。如果代码执行很久,不如把处理器让给别的线程;
- 性能问题 2(更严重):应用程序不能关中断——持有自旋锁的线程可能被操作系统切换出去,于是系统里 100% 的资源都被浪费(尤其在「可运行线程数 > CPU 数」时)。
3.5 让操作系统来帮忙:futex
(参考时间: 01:11)
线程自己解决不了,就通过系统调用告诉操作系统:
syscall(SYSCALL_acquire, &lk);   // 拿不到锁 → 把线程设为「不可执行」并切换
syscall(SYSCALL_release, &lk);   // 释放锁 → 唤醒等待的线程
内核里剩下的工作用「关中断 + 自旋」完成(自旋锁只用来保护内核里非常短的代码块)。
Linux 实际用一个系统调用实现:futex(Fast user-space mutex)——man 7 futex。它精妙在于Fast path(纯用户态) 与 Slow path(内核):没人争抢锁时根本不需要进入内核。难点在于release 时也想不进入内核(所以要处理「等待者的唤醒」与「状态一致性」)。推荐阅读 LWN: A futex overview and update 和 Ulrich Drepper 的 Futexes are tricky。
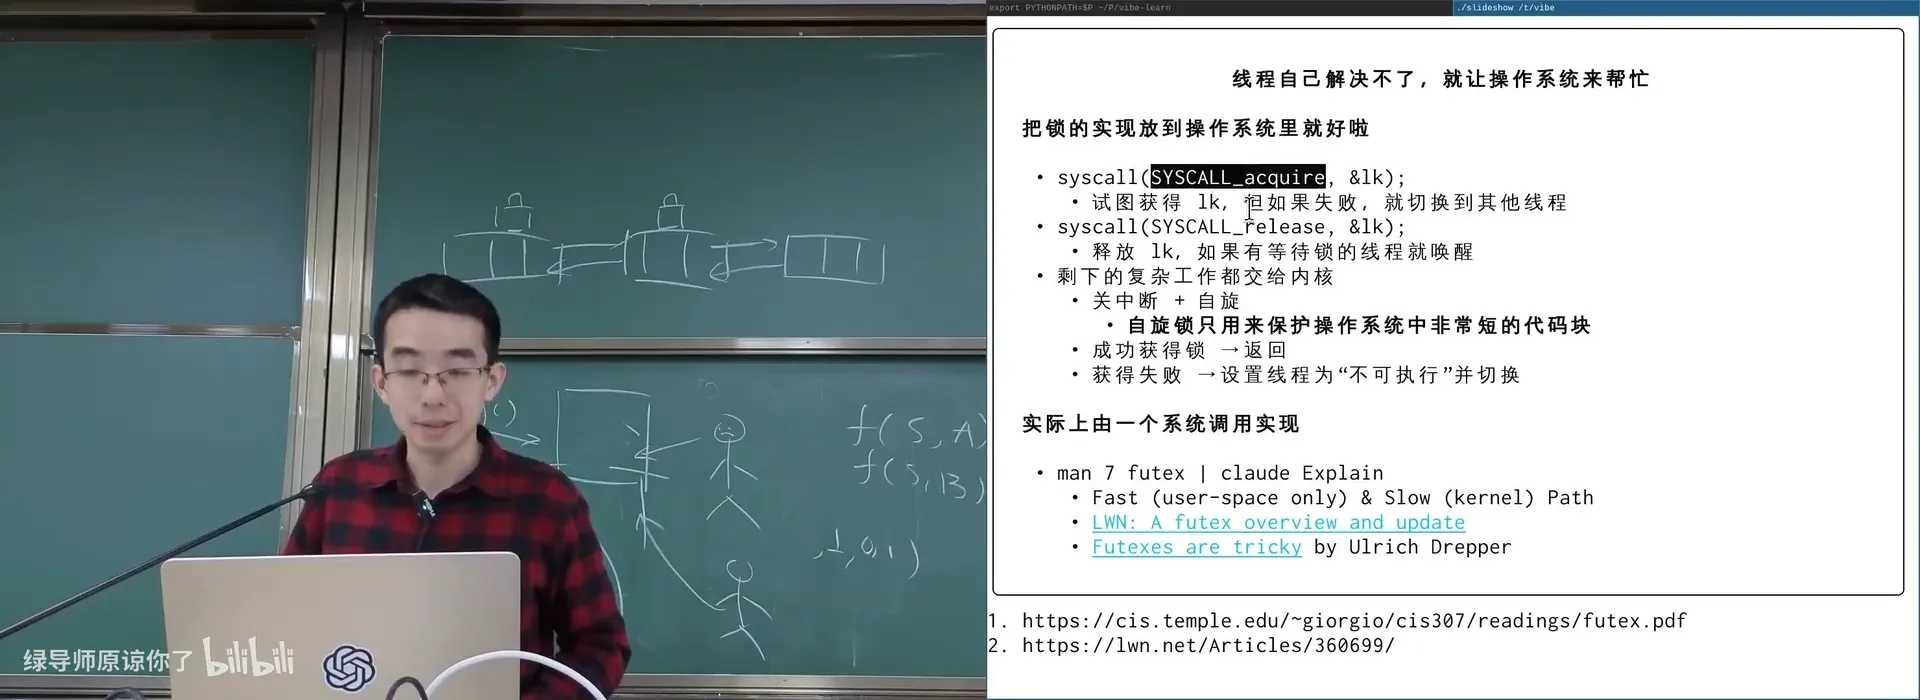
📷 futex:fast path 在用户态完成,slow path 才进内核
回到原视频 (01:12:00)
3.6 定量实验:到底谁快?
(参考时间: 01:15)
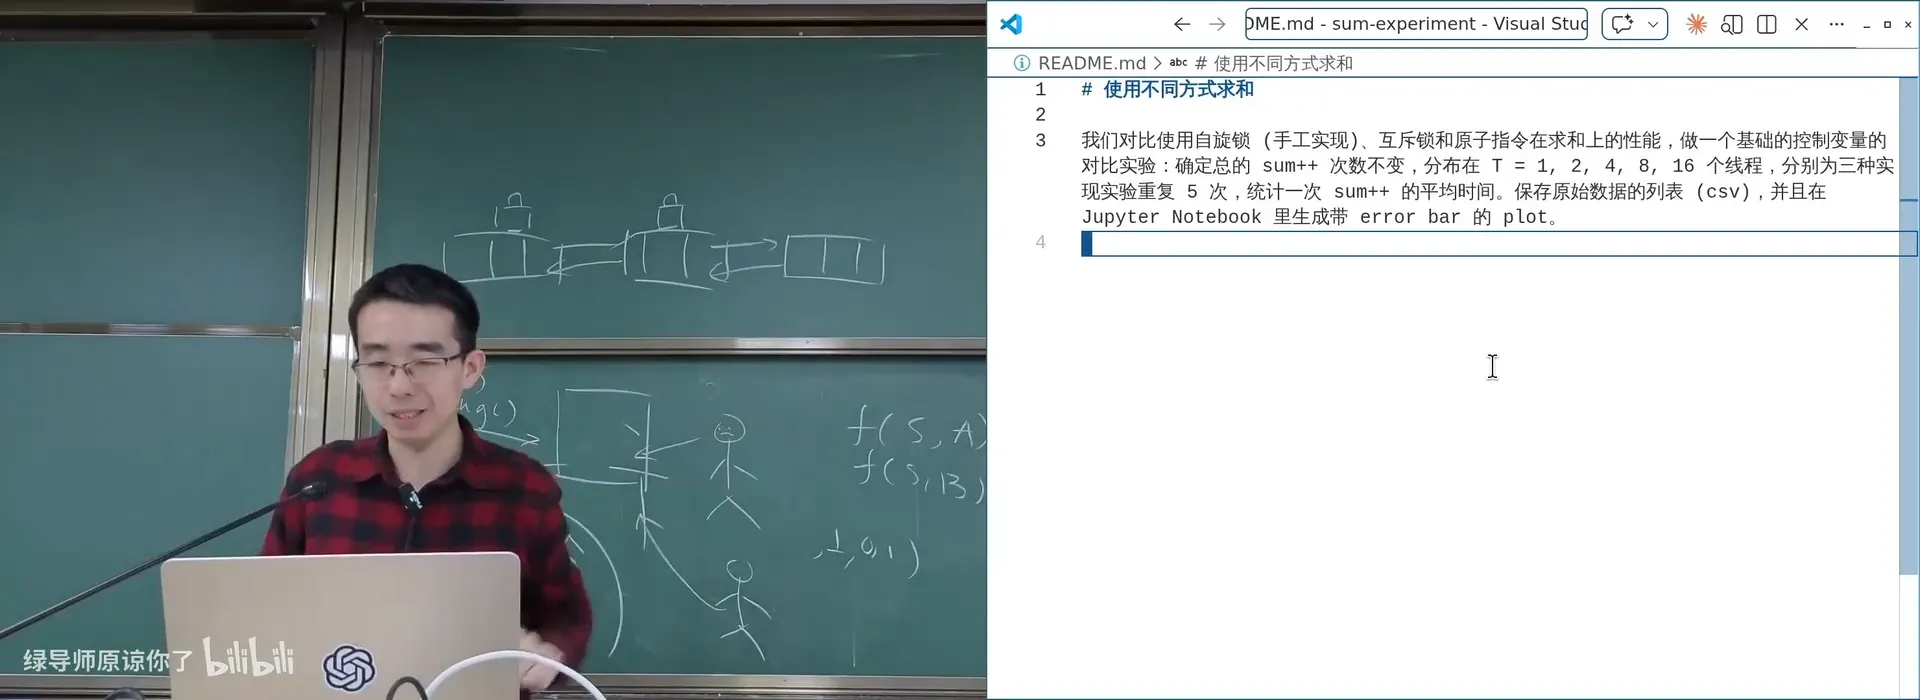
讲师强调「量化的研究方法」:你根据线索(「一核有难八核围观」)假设它们的性能不同,就应该准确地度量差异。他用一个 prompt让 AI 生成实验脚本:
- 控制变量:总
sum++次数不变,分布在 T = 1, 2, 4, 8, 16 个线程; - 对比四种实现:atomic、mutex、spinlock、futex(每次强制进入内核);
- 每种重复 5 次,统计一次
sum++的平均时间; - 保存原始数据(CSV),在 Jupyter 里画带 error bar 的图。
📷 一个 prompt 生成的控制变量实验脚本
回到原视频 (01:18:30)
结果:
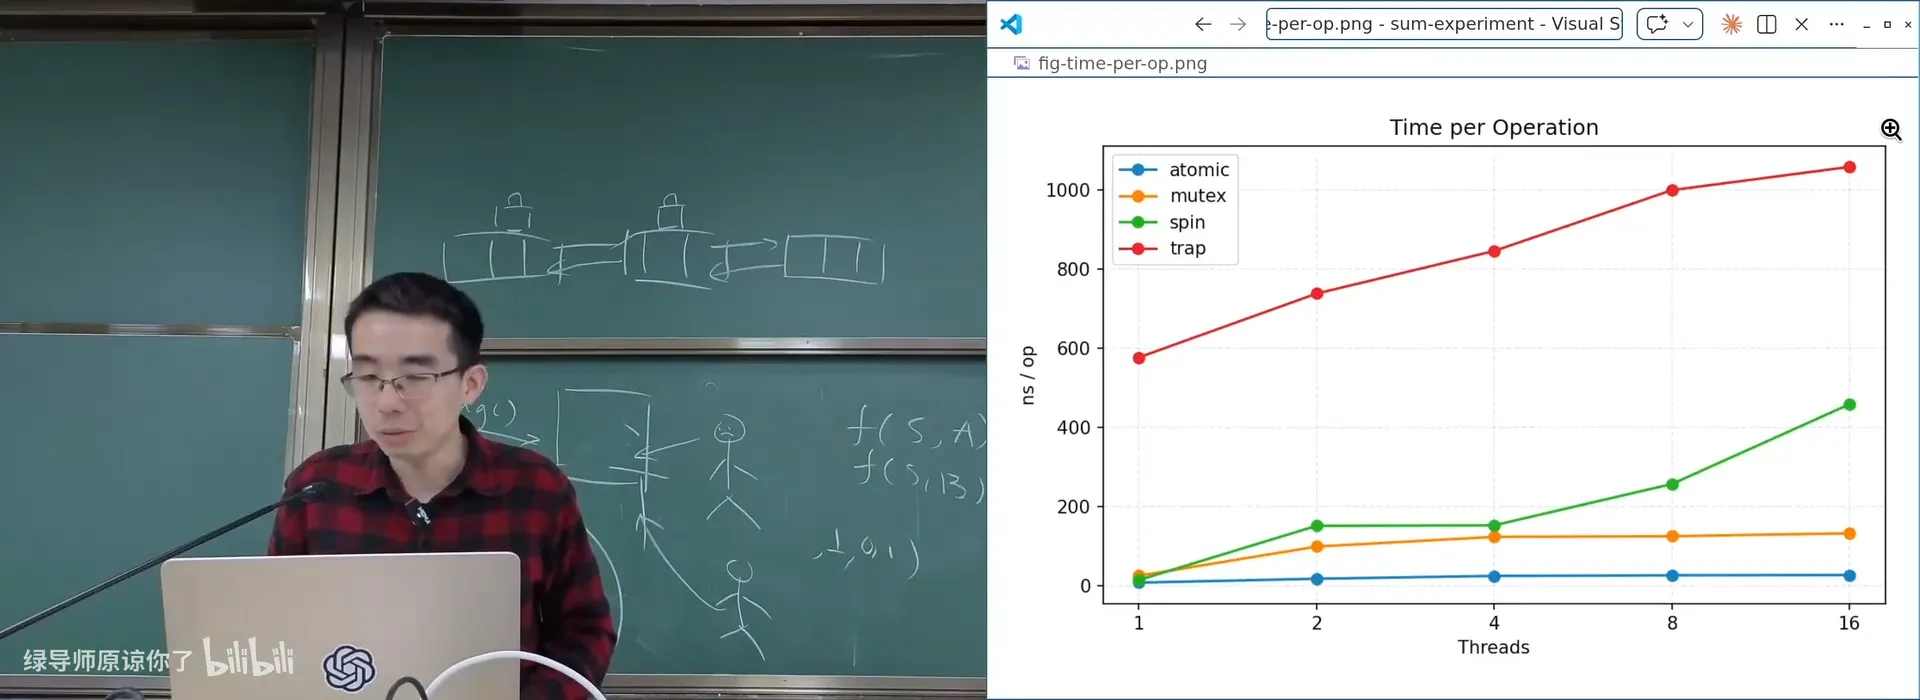
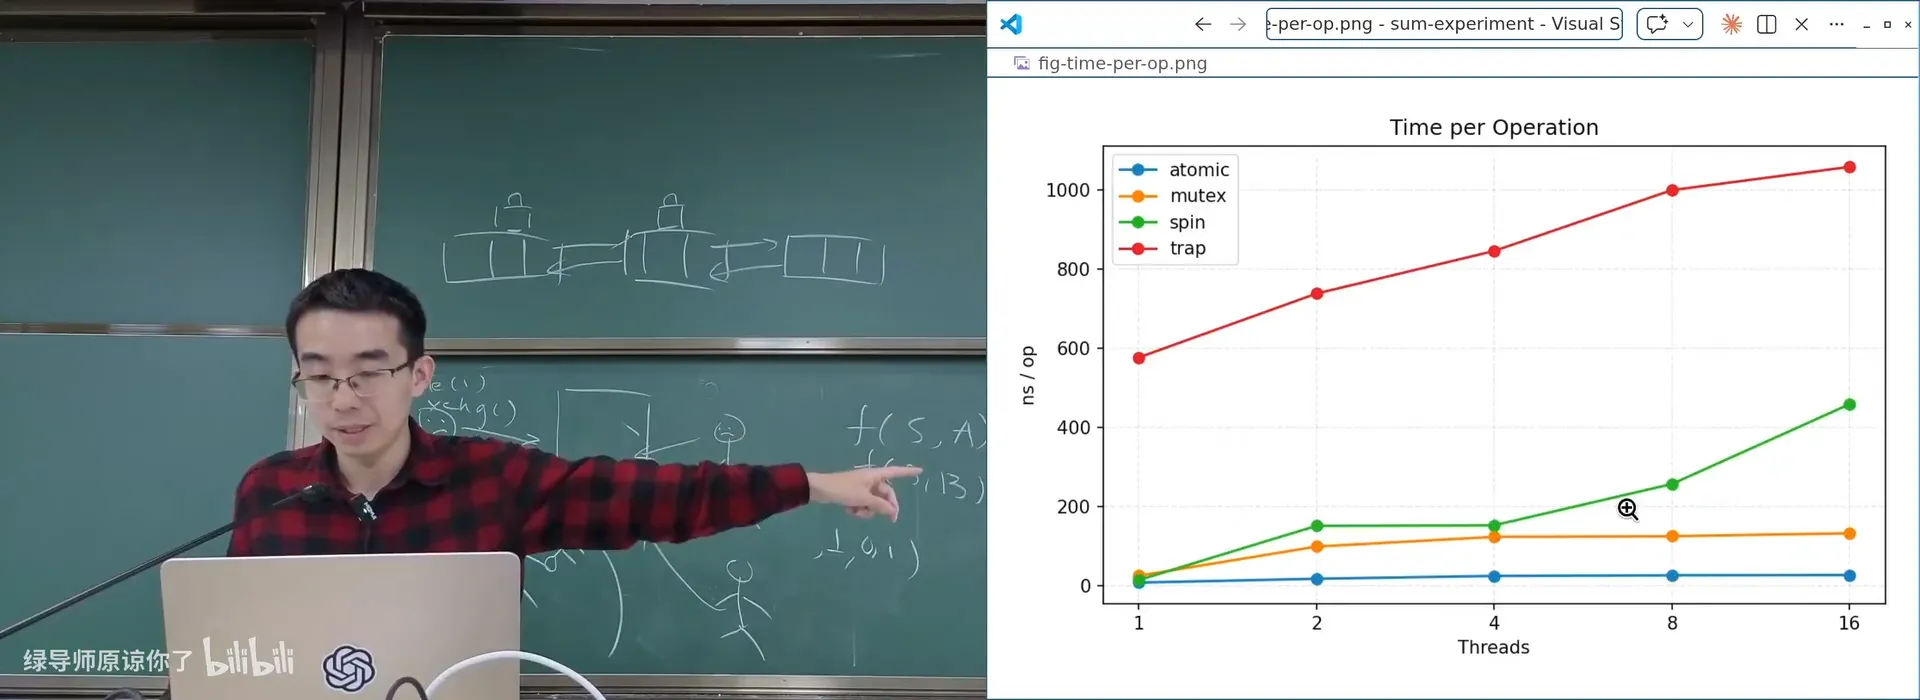
- 单线程最快(无论哪种实现);futex(每次进内核)慢很多(几百纳秒),atomic/mutex/spin 只要几纳秒;
- 线程数超过处理器数量(树莓派 4 核)后,mutex 和 atomic 几乎没有显著下降,而 spinlock 性能急剧下降——正因为「持有自旋锁时被切走」。
📷 每次 sum++ 的平均时间(ns):futex 的陷阱代价、spinlock 的扩展性问题
回到原视频 (01:19:30)
📷 每秒可执行的 sum++ 次数:mutex 的 scalability 明显更好
回到原视频 (01:21:30)
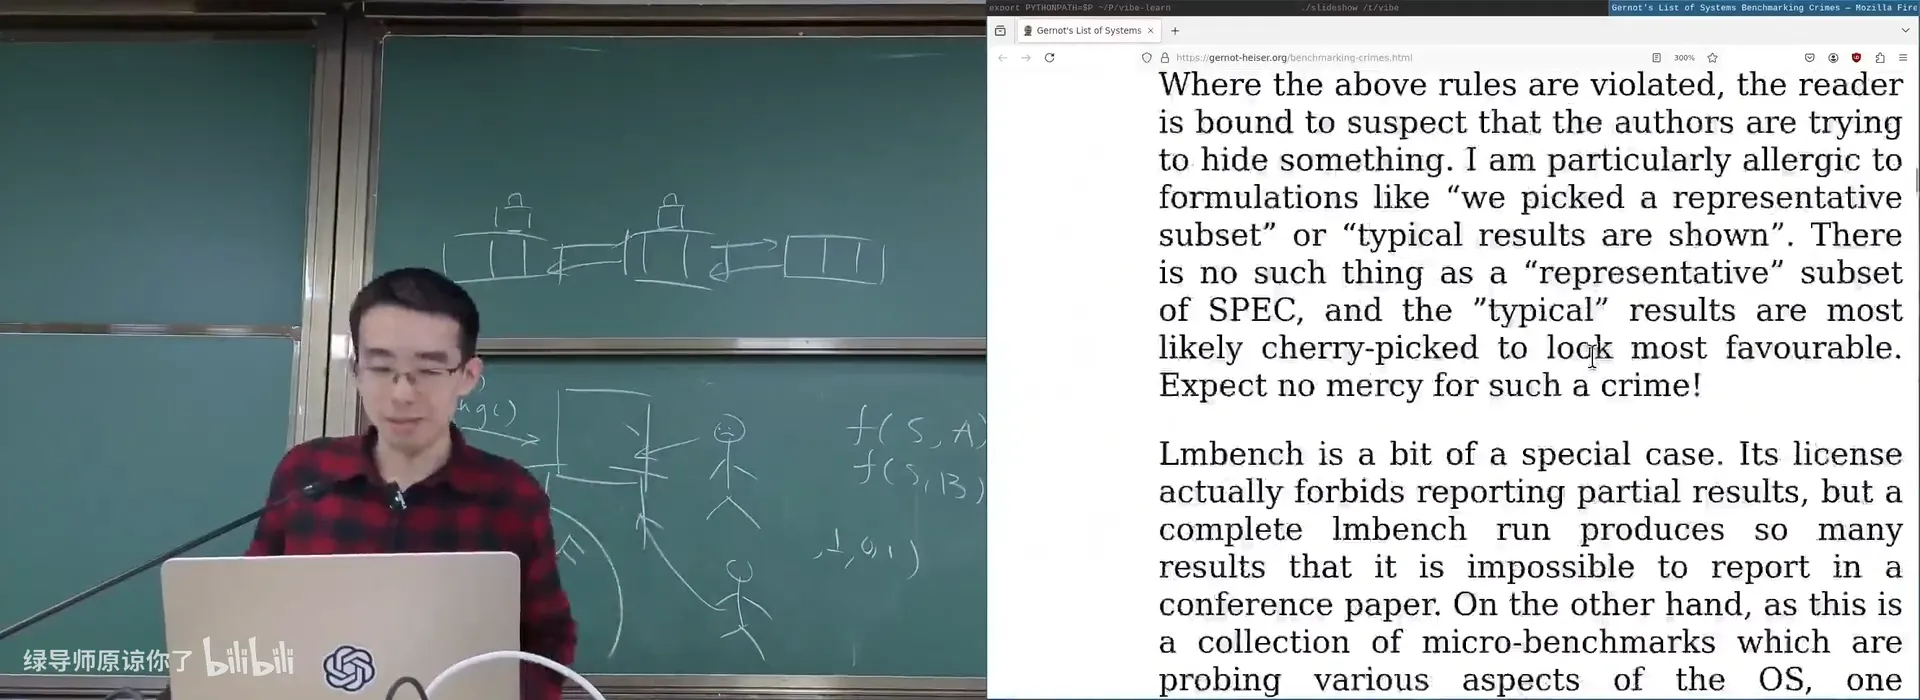
编者拓展|Systems Benchmarking Crimes:讲师郑重要求:做实验前先读一遍 Systems Benchmarking Crimes。常见「罪行」包括 selective data set hiding deficiencies(挑对自己有利的数据)——「你可以做 1 万次实验,把最好的那次拿出来,就没人比得过你了」。绝不要 cherry-picking。
📷 Systems Benchmarking Crimes:做定量研究前的必读
回到原视频 (01:23:00)
总结
- 为什么在 OS 课讲并发:
fn fork的进程不共享内存,但系统调用是共享内存的(每个进程的内核部分就是一个线程)——操作系统是第一个严肃的大型并发程序。 - 互斥(mutex):把并发「退回」到顺序。拟人视角(厕所包厢 / 桌上一把钥匙);可以有很多把锁。
- 使用锁的原则:正确使用锁 ≈ stop the world;但锁由程序员负责,极易犯错(配对、同名变量、并发数据结构、内存回收)。建议:从一把大锁保平安开始 + 压力测试;Premature optimization is the root of all evil。
- 还需要线程吗:Amdahl's Law(悲观)/ Gustafson's Law(乐观);物理世界的局部性意味着大量 embarrassingly parallel 的工作。
- 实现互斥的路线:Dekker/Peterson 试图在 load/store 上实现互斥——路线错误(假设在现代机器上不成立,只适合两个线程)。正确做法是让硬件提供原子指令(
lock cmpxchg、LR/SC、ldxr/stxr)。 - 自旋锁的问题:「一核有难八核围观」;持有者被切走 → 资源浪费。让操作系统帮忙 → futex(fast user-space / slow kernel path)。
- 量化研究:用控制变量实验对比 atomic/mutex/spin/futex 的 scalability;不要 benchmarking crime。
附:官方参考与延伸阅读
本讲的讲义见课程主页,以下链接按书中出现顺序整理:
阅读材料:教科书 Operating Systems: Three Easy Pieces 第 29 章(Locked Data Structures)。
版权说明:本讲讲义与幻灯片作者为蒋炎岩,采用 Creative Commons BY-NC 4.0 许可,来源于 https://jyywiki.cn/OS/2026/。视频画面与字幕版权归原作者所有。本书为课堂内容的学习性重构。