第18讲 · 并行算法与数据结构
2026 南京大学《操作系统原理》第十八讲 · 课堂实录重构
| 主讲 | 蒋炎岩(Yanyan Jiang) |
| 视频 | https://www.bilibili.com/video/BV1WqdTBiEkN/ |
| 课程主页 | https://jyywiki.cn/OS/2026/ |
| 本讲讲义 | https://jyywiki.cn/OS/2026/lect18.md |
| 讲义 / 幻灯片作者 | 蒋炎岩,https://jyywiki.cn/ |
| 讲义 / 幻灯片许可 | CC BY-NC 4.0 |
| 图片来源 | 书中插图为课堂演示与讲义渲染图;演示类截图为视频画面 |
对应讲次:第18讲(南京大学 操作系统原理)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者说明:本书由课堂录像的语音字幕重构而成,术语、章节骨架与参考链接已按课程官方讲义(
lect18.md)校准。讲师的口语风格、类比与案例被尽量保留;编辑性的补充一律以「编者说明」或「编者拓展」标出。
引子:期中测验选讲
(参考时间: 00:00)
统计数据:一共收到 49 份有名字的试卷(交卷率约 50%)。「我会 normalize 成绩,所以放弃交卷的同学理论上会稍微吃一点亏,但吃亏也不大,期末考试还可以挣回来。」
编者拓展|「我们怎么考试,才能培养出能驾驭 AI 的超级个体?」:讲师把期中题目丢给 AI 生成讲评幻灯片(「我一个字也没改,也没看」),结果发现 AI 的答案实在太完美了——「AI 在训练阶段,它每一个 batch 的训练数据都是一场考试,每经过一次考试 AI 就变强一点。」
「我是第一次不用标准化考试的方式,而是所有题目都是某种程度的编程题,看大家对编程里概念掌握到什么程度……我们不希望你们记住所有细节,但能看出你对问题的理解。」这引出一个至今没有答案的问题:「AI 因为专门为写代码训练过,对世界上所有和代码相关的工具都了如指掌,它完全知道每一个 API 的设计为什么、如果那样设计会带来什么后果。我们写代码永远写不过 AI 了……那我们又应该怎么办?」
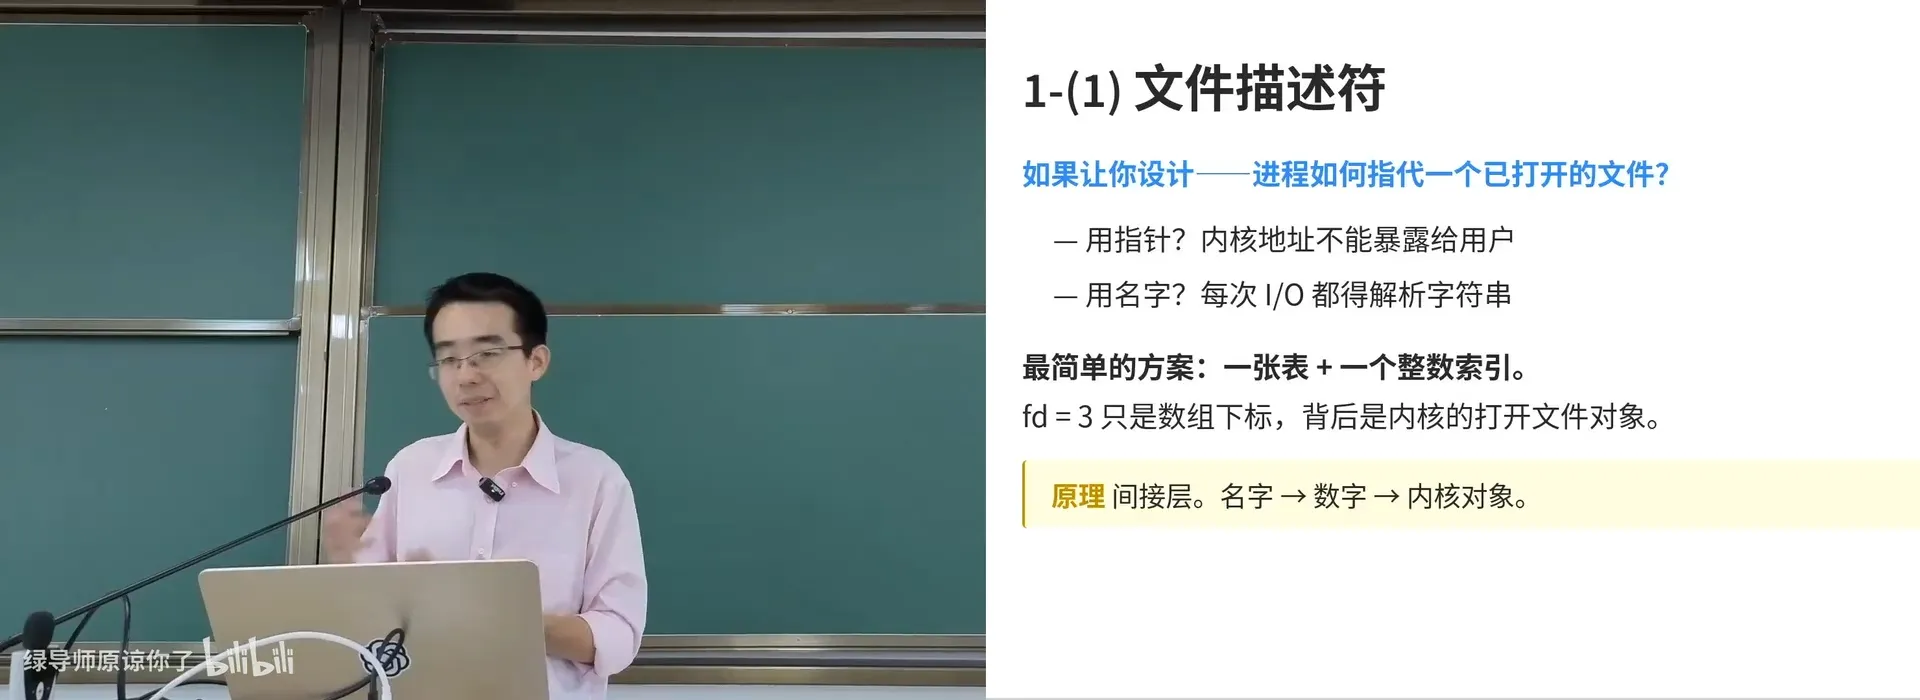
📷 把期中题目丢给 AI 生成讲评:AI 的答案「实在是太完美了」
回到原视频 (00:02:00)
几道题回顾(讲师一边讲、一边用 AI 逐题分析):
- 文件描述符:进程地址空间隔离,不能直接访问对象;不能用指针、不能用名字——UNIX 的选择是一张表和一个整数(
fd是下标,背后是对象); fork后如何处理文件描述符:两个设计选择(各自独立 offset v.s. 共享 offset)——UNIX 选择共享,「因为fork/execve是用来实现管道、重定向的,只有共享才能把两个进程的输出串起来而不是交错」——「共享状态是协作的前提」;execve:换掉代码/数据段、保持 fd 和 pid;- 终端 UI:需要画界面(Unicode 只是一部分),主要靠 Escape Code(控制光标、擦除屏幕)+ PTY + 信号(Ctrl+C);
gdb的机制:watchpoint(地址被修改时停下来)、reverse execution(记录每条指令)——「AI 的直觉真的非常好,你说出一个需求,它就知道该用什么工具」;struct file找不到定义? 它是typedef的(实际是-io-file);可以用gcc -E看预编译展开的结果——「编译器看到的和你看到的不一样」;fork对 buffer 和 lock 的影响:锁的用户态实现一定有一个int lock在进程地址空间里,它会被复制——所以「fork 时如果别的线程持有自旋锁,就会死锁」;多线程 fork 更麻烦,POSIX 的选择是只有调用 fork 的线程存活,「推荐唯一安全的选择是 fork 后立刻 exec」。
编者说明:AI 还给出了一句让讲师「陷入迷茫」的话——「你不需要记住所有答案,你只需要问自己:如果是我来设计,我会怎么做?答案往往比你以为的更自然。」
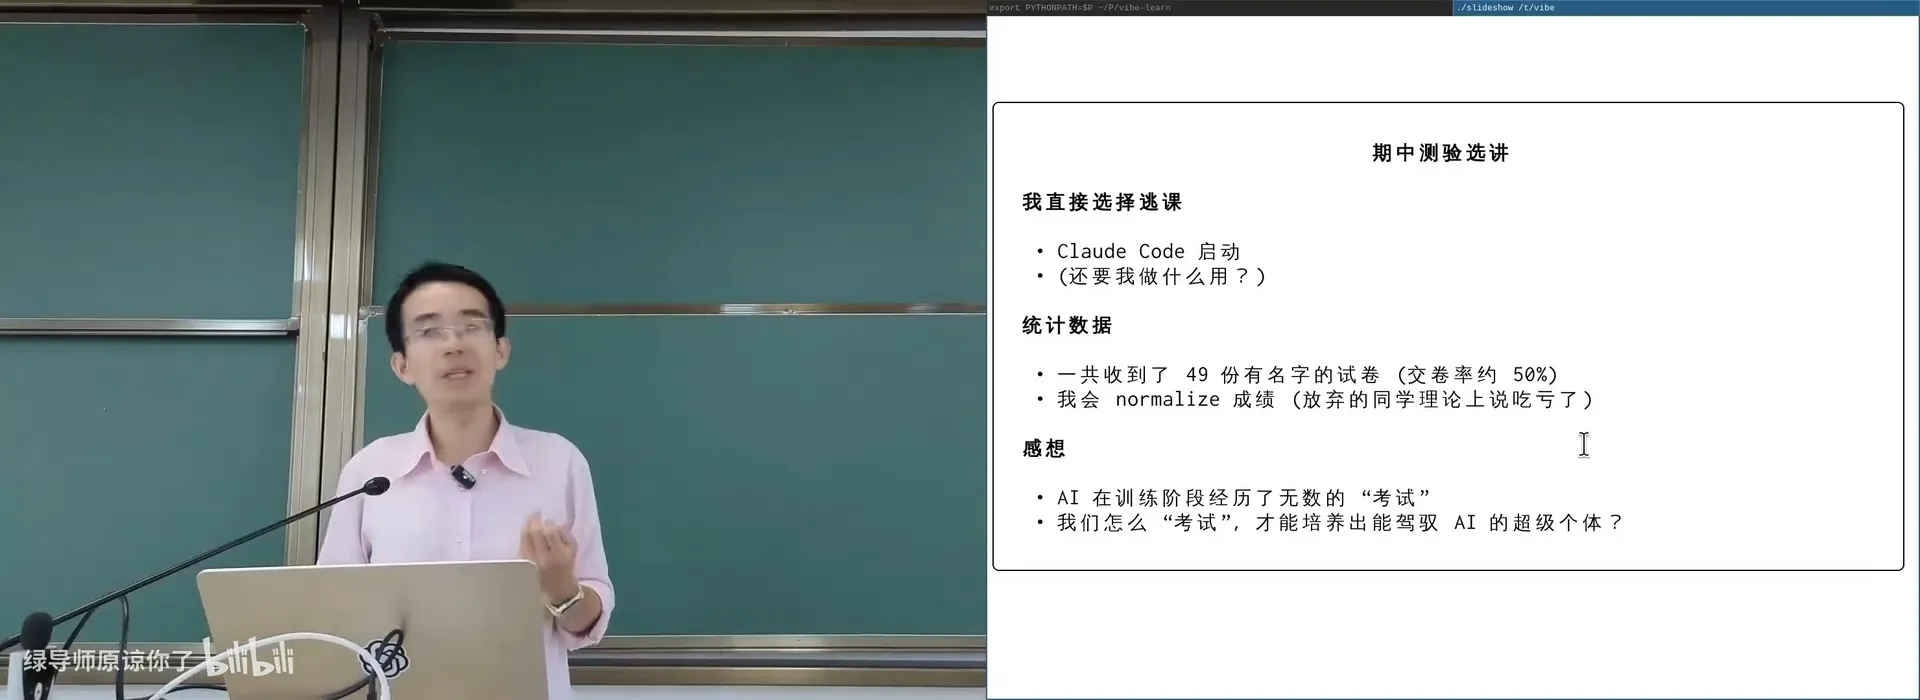
📷 AI 的表现与「失控感」:我们到底该教什么、考什么?
回到原视频 (00:12:30)
一、并发编程:回到 sum++
(参考时间: 00:14)
void T_sum() {
    mutex_lock(&lk);
    sum++;
    mutex_unlock(&lk);
}
这在并发编程里是非常常见的 pattern(buf[len++] = elem;、mapping[key] = value;……)——加锁保证了正确性,但...
性能实验(sum-experiment):对比自旋锁(手工实现)、互斥锁、原子指令,固定的 sum++ 总次数分布在 T = 1, 2, 4, 8, 16 个线程,各重复 5 次,画带 error bar 的图:
- 线程越多,每一次
sum++的时间都在增长(进入内核 / 自旋都越来越慢); - Mutex 和 Atomic 到 4/8/16 线程时基本上性能保持不变(饱和);
- 「但不下降也是很糟糕的事——理论上 1 个 CPU 花 1 秒,2 个 CPU 就该花 0.5 秒,4 个就该花 0.25 秒。你给更多的算力,就应该能完成更多操作。」
结论:锁给了我们完整的 serializability(能排出每一次 lock/unlock 的顺序),并保证了 release→acquire 的数据可见性(「sum = 101 必须让别人也看到,不能看到更旧的值」)——但代价是 scalability:性能无法随 CPU/线程/机器增加而增长。
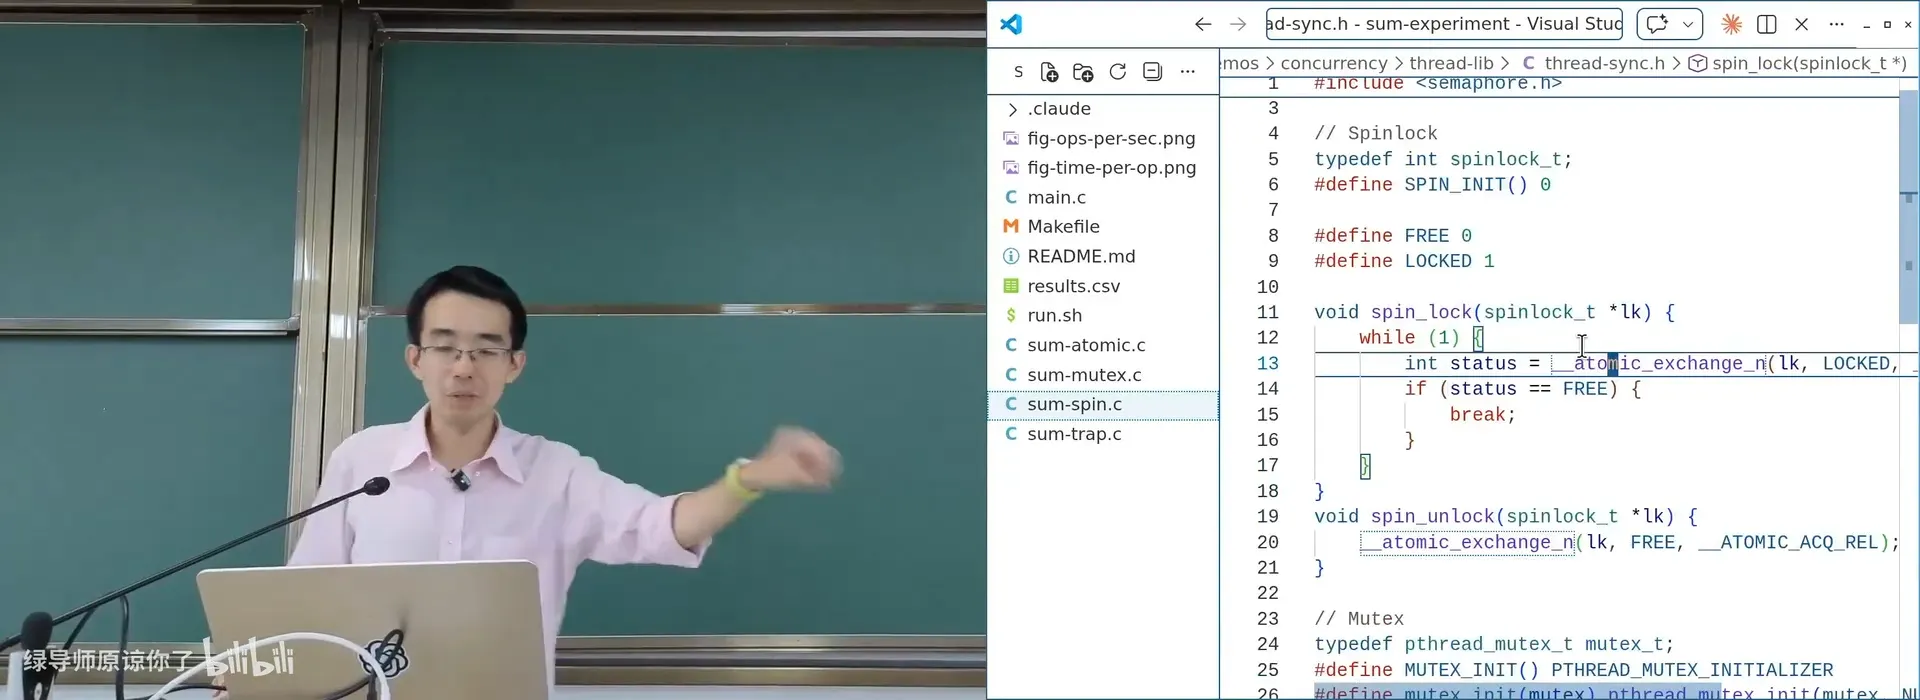
📷 sum-experiment:互斥锁保证了正确性,但性能无法随线程数增长
回到原视频 (00:16:30)
二、并行算法(Scale Up & Scale Out)
(参考时间: 00:20)
任何一个并行计算问题的本质都是一个计算图(DAG):每个节点是一次计算,每条边是一个依赖关系。
- Scale up:一台计算机内,线程数增长,性能不断增长;
- Scale out:再来一台计算机、再来一台……计算机数量增加,性能依然增长。
「这两个是这几年大数据和 AI 时代最核心的引擎——你才有全国人民都在刷抖音、都在调大模型 API。」
关键:让被串行化的区域变得很小:
// 把 job->run() 做成"大部分是线程本地计算"
mutex_lock(&lk);  job = get();      mutex_unlock(&lk);
job->run();       // mostly thread-local computation
job->done();      // enable other jobs
「只要 job->run() 的时间 >> 互斥的时间,就可以 scale。」——计算图的深度 v.s. 宽度:许多问题天生适合这个结构(例子:LCS/动态规划——把计算图沿对角线切分,块和块之间有依赖,块内部独立)。
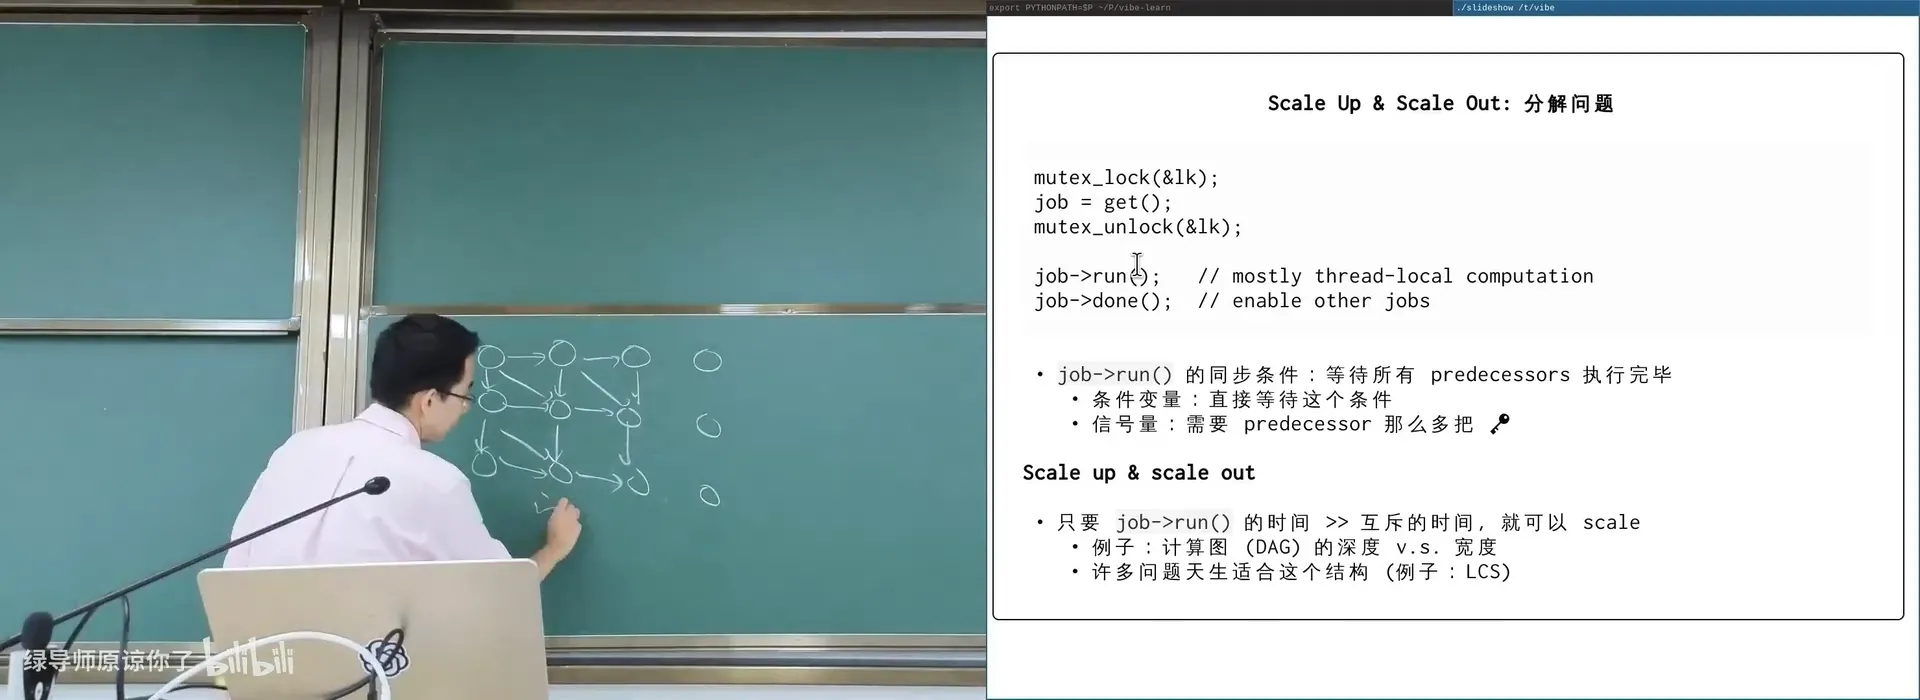
📷 计算图(DAG)分解:让同步/上锁时间变得很小,绝大部分是本地计算
回到原视频 (00:21:00)
2.1 高性能计算(HPC)
编者说明:HPC 的定义(IBM):A technology that harnesses the power of supercomputers or computer clusters to solve complex problems requiring massive computation. 源自数值密集型科学计算——「大到宇宙小到量子,有模型就能模拟」:核爆炸、有限元、天气预报、航天、制造、能源、制药……历史上一直是 HPC 最大的客户;近几十年新增两个新力量:矿场(proof-of-work) 和 AI 推理。
CRAY-1(1976):The world's most expensive love-seat——138 MFLOPS @ 115kW(因为底座设计成可以坐人)。对比:
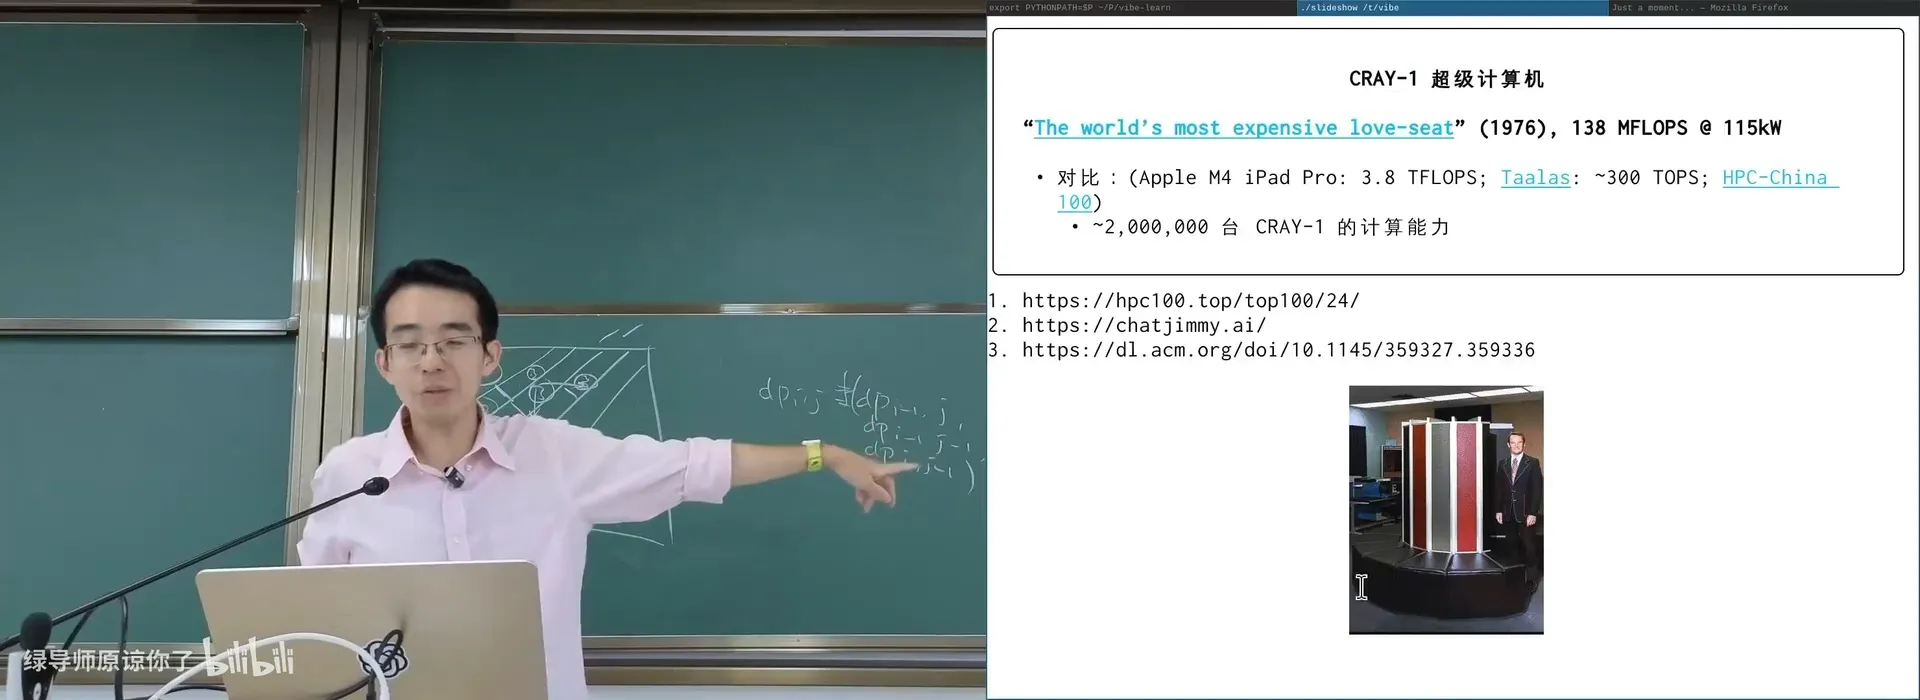
📷 CRAY-1(1976):世界上最贵的沙发——138 MFLOPS @ 115kW
回到原视频 (00:28:20)
- Apple M4 iPad Pro:3.8 TFLOPS(「M → G → T,没有一百万倍,但数量级已经来到了百万的差距」);
- Taalas / ChatJimmy:~300 TOPS——「把 8B 模型烧到电路上」,15000 token/s,「按一下回车 token 就出来」,「约等于 200 万台 CRAY-1 的计算能力,而芯片只有 20 几瓦」;
- HPC-China 100(2025):用 PFLOPS 衡量,榜首是神威·太湖之光(江南计算所)。
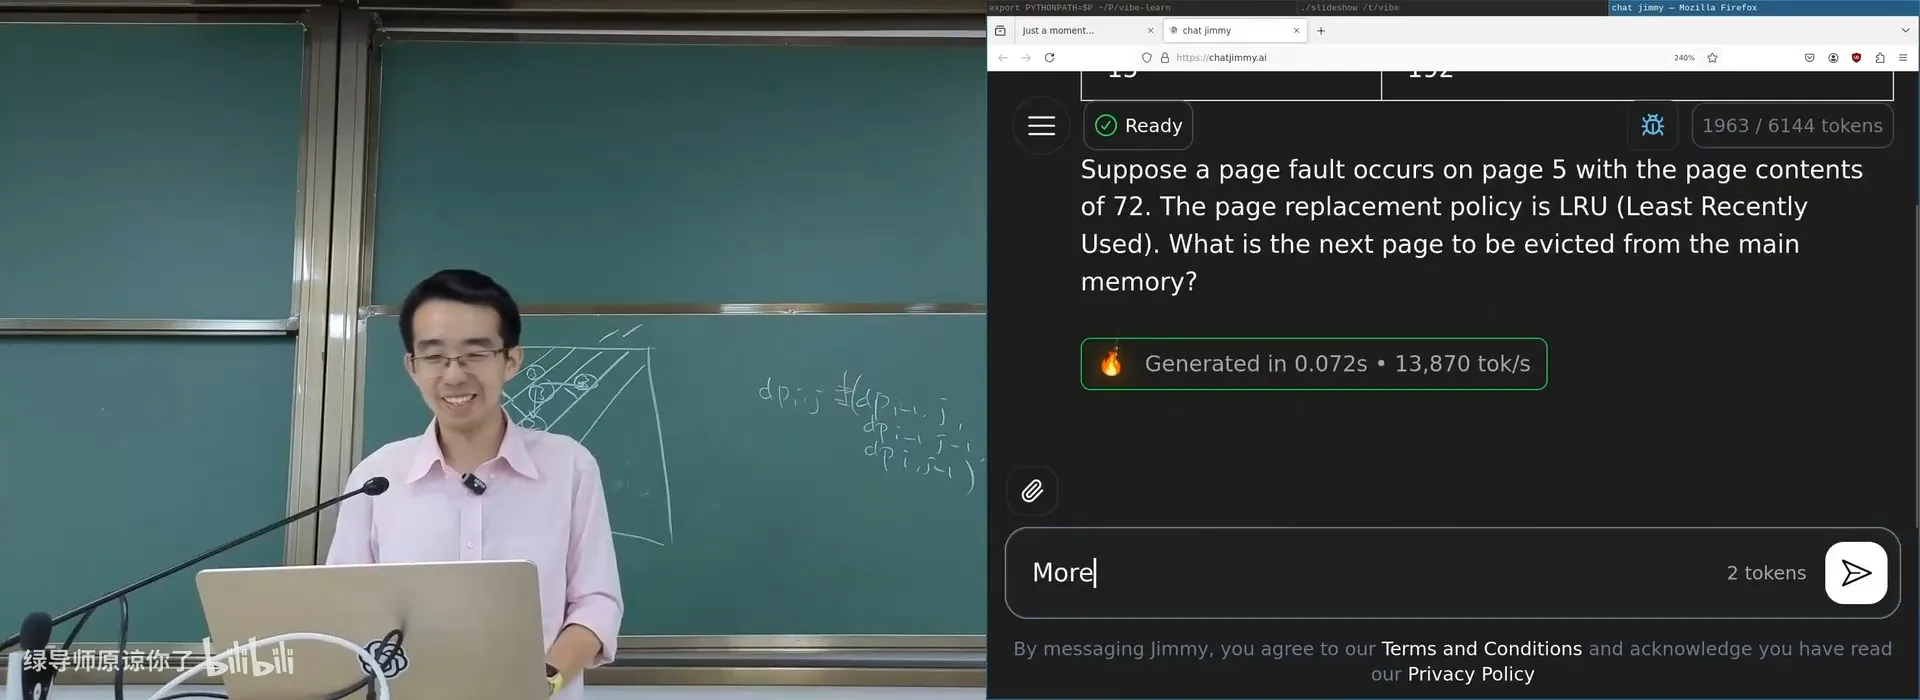
📷 ChatJimmy / Taalas:把 8B 模型烧进电路,13,870 tok/s(约等于 200 万台 CRAY-1,而芯片只有 20 几瓦)
回到原视频 (00:30:00)
编者拓展|Linpack 与牛顿法:HPC-China 100 的测试基准是 Linpack——求解稠密矩阵的线性方程组 $Ax=b$,可以分块计算。「为什么线性方程组这么重要?因为所有的非线性系统,你都可以用牛顿法变成线性的(有限元……)。哪怕再复杂的问题,局部最后也会分解成稠密的线性方程组。」
Embarrassingly Parallel(令人尴尬的并行):整个计算图几乎不需要同步和通信:
- Tree search(fork-based DFS)——「你先搜十层,得到几百万几千万个搜索节点,再把它们分配到机器上」;
- Monte Carlo 模拟——「每一次采样都是独立的」;
- 视频逐帧处理——「关键帧切好后,段与段之间完全独立」。
编者拓展|「哪怕十几倍加速也是非常值得的」:「如果 20 个核你能快 10 倍,本来一分钟的任务只要 6 秒——一分钟到六秒。等五六秒没出来时你肯定去摸鱼了,但 6 秒你就可以在 6 秒内继续做下一件事。」讲师分享了自己的小技巧:给 Claude Code 加一个 hook,当它 trap 到用户输入时叮一声,「这样我就可以完全放到后面」。
2.2 Mandelbrot Set:一个可爱的例子
(参考时间: 00:40)
讲师花了不少时间介绍 Julia Set / Mandelbrot Set:
- 以递推公式 $x_n = x_{n-1}^2$ 为例:$x_0 > 1$ 序列发散,$-1 \le x_0 \le 1$ 收敛(「不停地往左跳,越跳越小」);
- 放到复平面上(复数乘法一部分是标量、一部分是旋转):$|x_0| \le 1$(单位圆内)时收敛;
- 加一个常数 $c$($z_n = z_{n-1}^2 + c$),收敛区域就变成了千变万化的 Julia Set;反过来固定 $x_0 = 0$、改变 $c$,就得到 Mandelbrot Set——「边界上有非常精细的图案」。
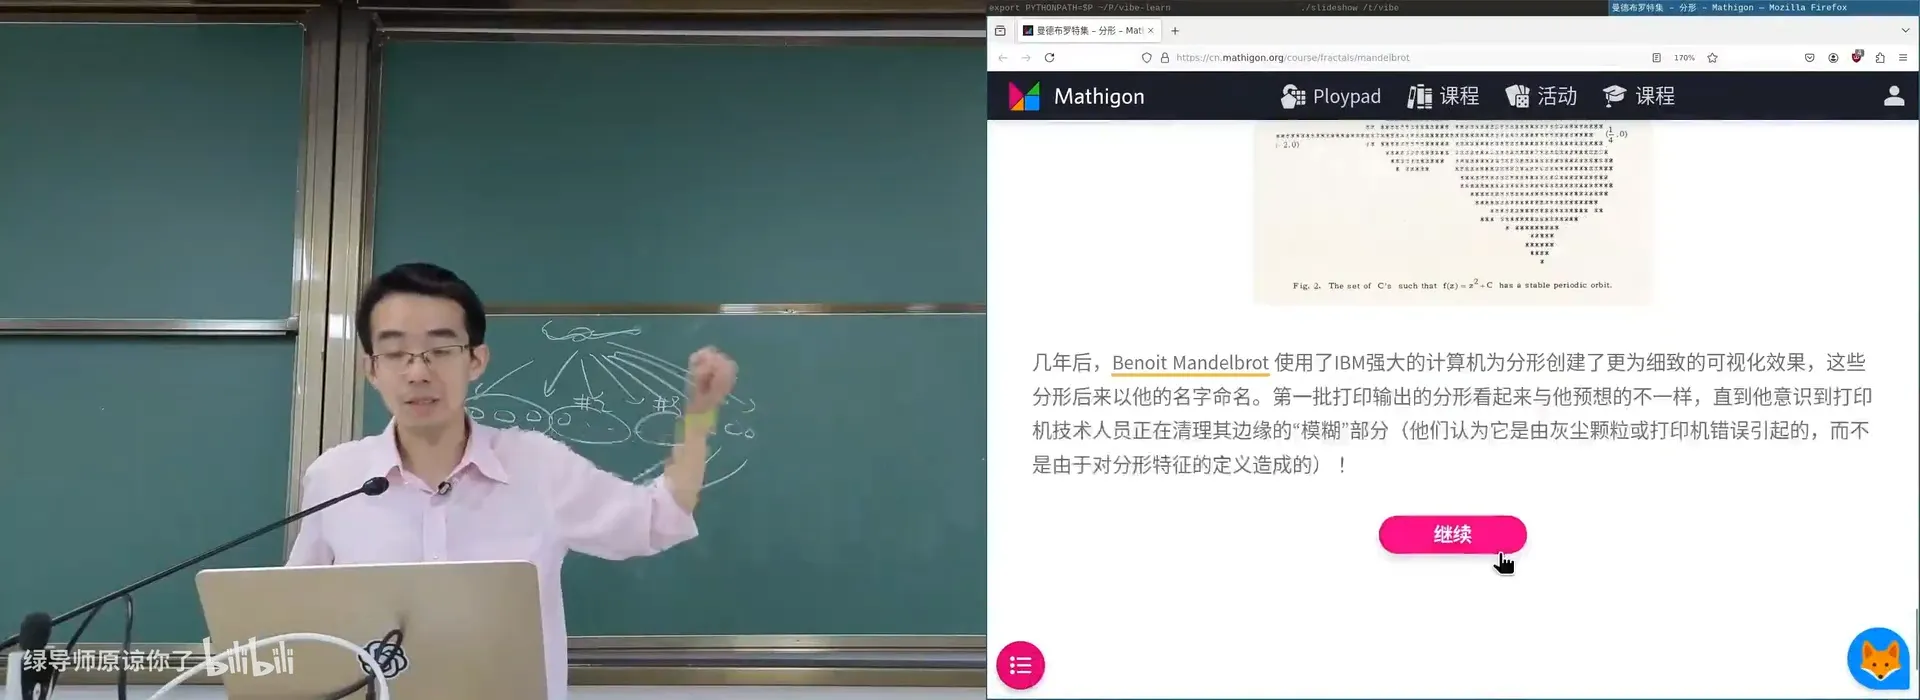
📷 Julia Set / Mandelbrot Set:$z_n = z_{n-1}^2 + c$ 的收敛区域
回到原视频 (00:44:30)
编者拓展|「我觉得大学要完蛋了」:讲师看了一个数学教学的 walkthrough 后感叹——「我不该在操作系统课上讲的内容,讲得比我在操作系统课上讲的还要好。」它可以让你重走每一个数学家发现每一个数学概念的心路历程,同时用可视化的方式随时随地生成,还有 GPT-5.5 Extra High 为你生成适合的代码。「它那个教学辅助做得如此之好,使得你学数学的时候完全可以不用那么困难。」
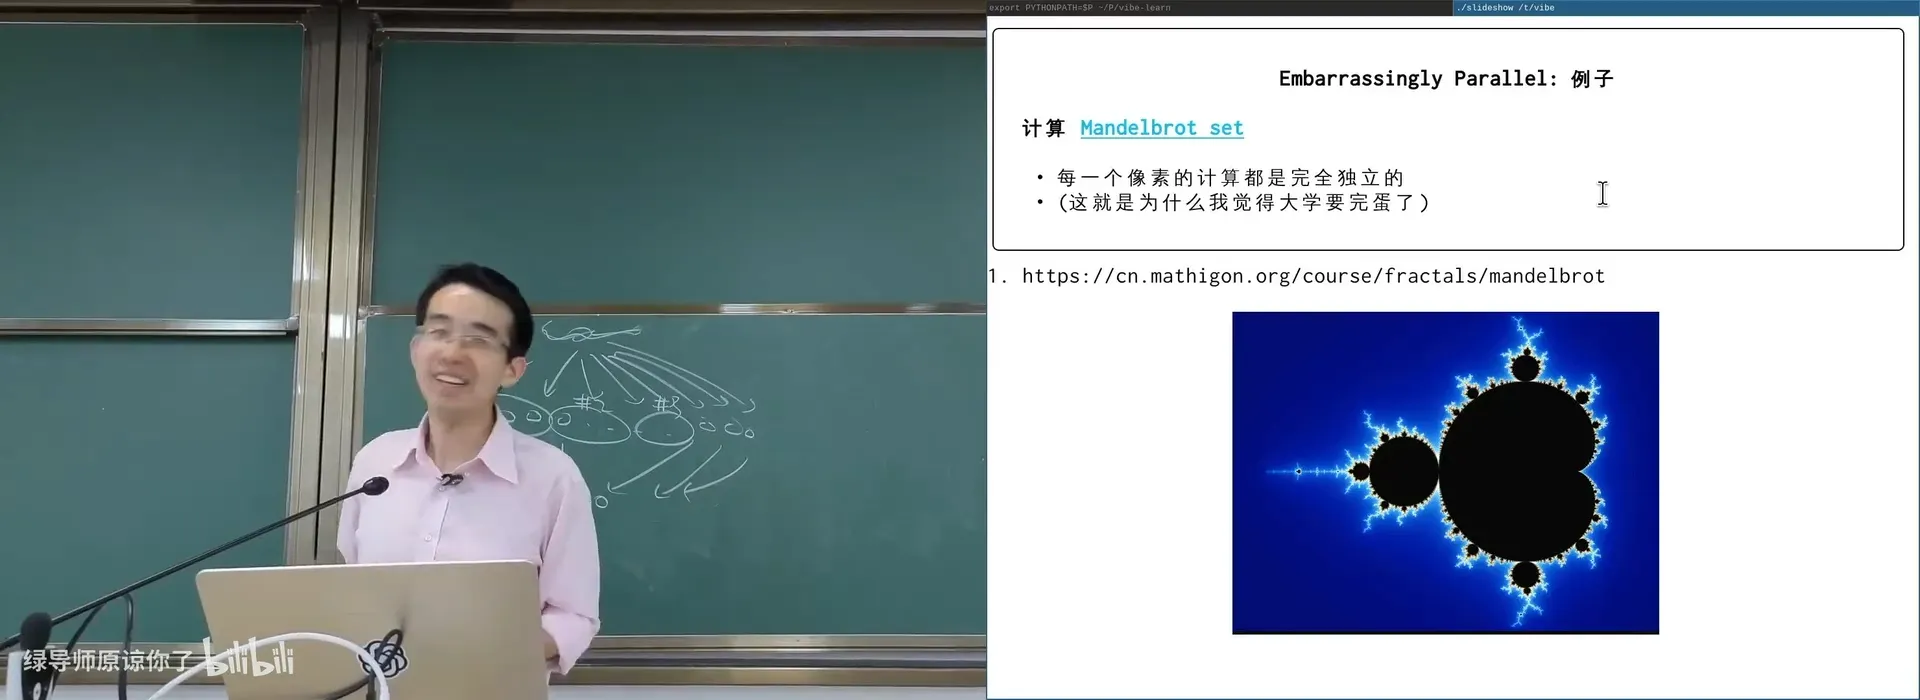
📷 「我觉得大学要完蛋了」:AI 的数学教学辅助比课上讲得还好
回到原视频 (00:46:00)
Mandelbrot 的计算完全 embarrassingly parallel——每个像素的计算完全独立:
// 计算 6400×6400 的 Mandelbrot Set
#pragma omp parallel num_threads(128)
for (int i = 0; i < 1024; i++) { /* 各自填一部分像素 */ }
讲师用混用 OpenMP 和线程库:mandelbrot——「1 个线程大概花了 18 秒,创建 16 个线程后明显感觉到速度变快了——3 秒」。(另一个 monitor 线程实时追踪渲染进度。)
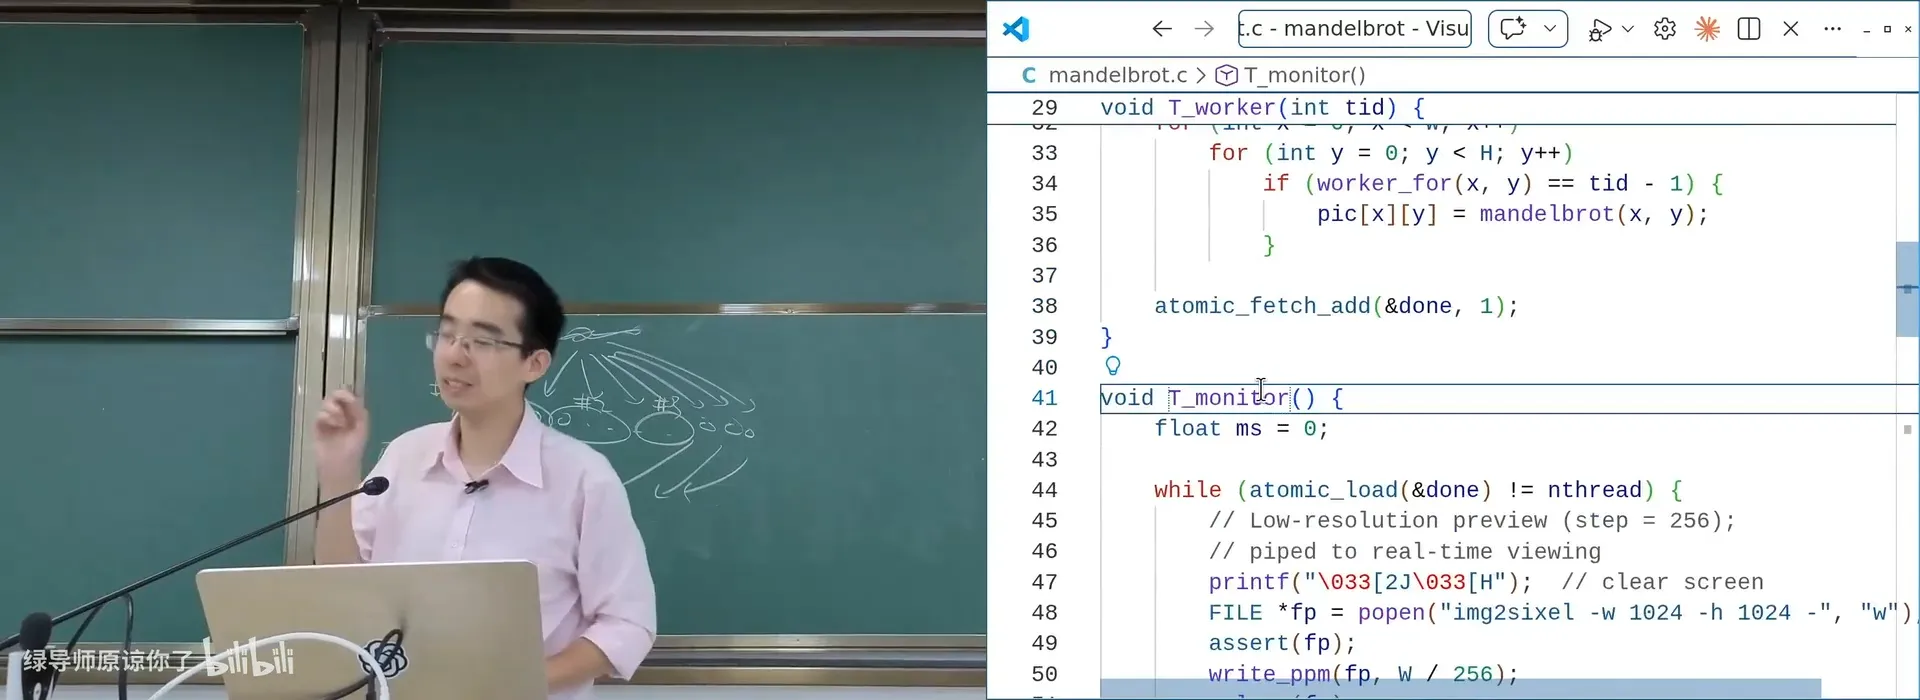
📷 Mandelbrot 演示:1 线程 ~18s → 16 线程 ~3s
回到原视频 (00:50:00)
编者拓展|OpenMP/MPI:为「不想懂线程」的人设计:对于非计算机专业(物理、化学)的同学,「如果我第一节课就讲线程同步的细节,他们一定会错到怀疑人生,而且没有工具去 debug」。所以我们不把太多自由交给开发者,而是提供尽可能简单的编程机制:MPI(message passing)、OpenMP(
#pragma omp parallel for)。「一个从未接触过、只学过 C 语言的物理系同学,不需要知道任何线程概念,只需要记得师兄告诉他的一句『魔法』——加上
#pragma omp parallel for,如同魔法一般,程序就自动并行了。」
2.3 实验 gpt.c 的通关密码
(参考时间: 00:55)
编者说明:实验
gpt.c裁剪自 Karpathy 的 llm.c。「大家不要偷看 llm.c——如果你们偷看了加在哪,你马上就知道你的gpt.c应该怎么优化了。」——整个代码和并行计算相关的只有 5 行:
#ifdef OMP
#include <omp.h>
#endif

#pragma omp parallel for
#pragma omp parallel for collapse(2)
「如果没有 -fopenmp 编译选项,#pragma 会被直接忽略,gpt.c 完全就是一个单线程程序。」——你们需要自己找到 GPT-2 推理里哪一个循环最可以并行化,然后用线程库实现同步。
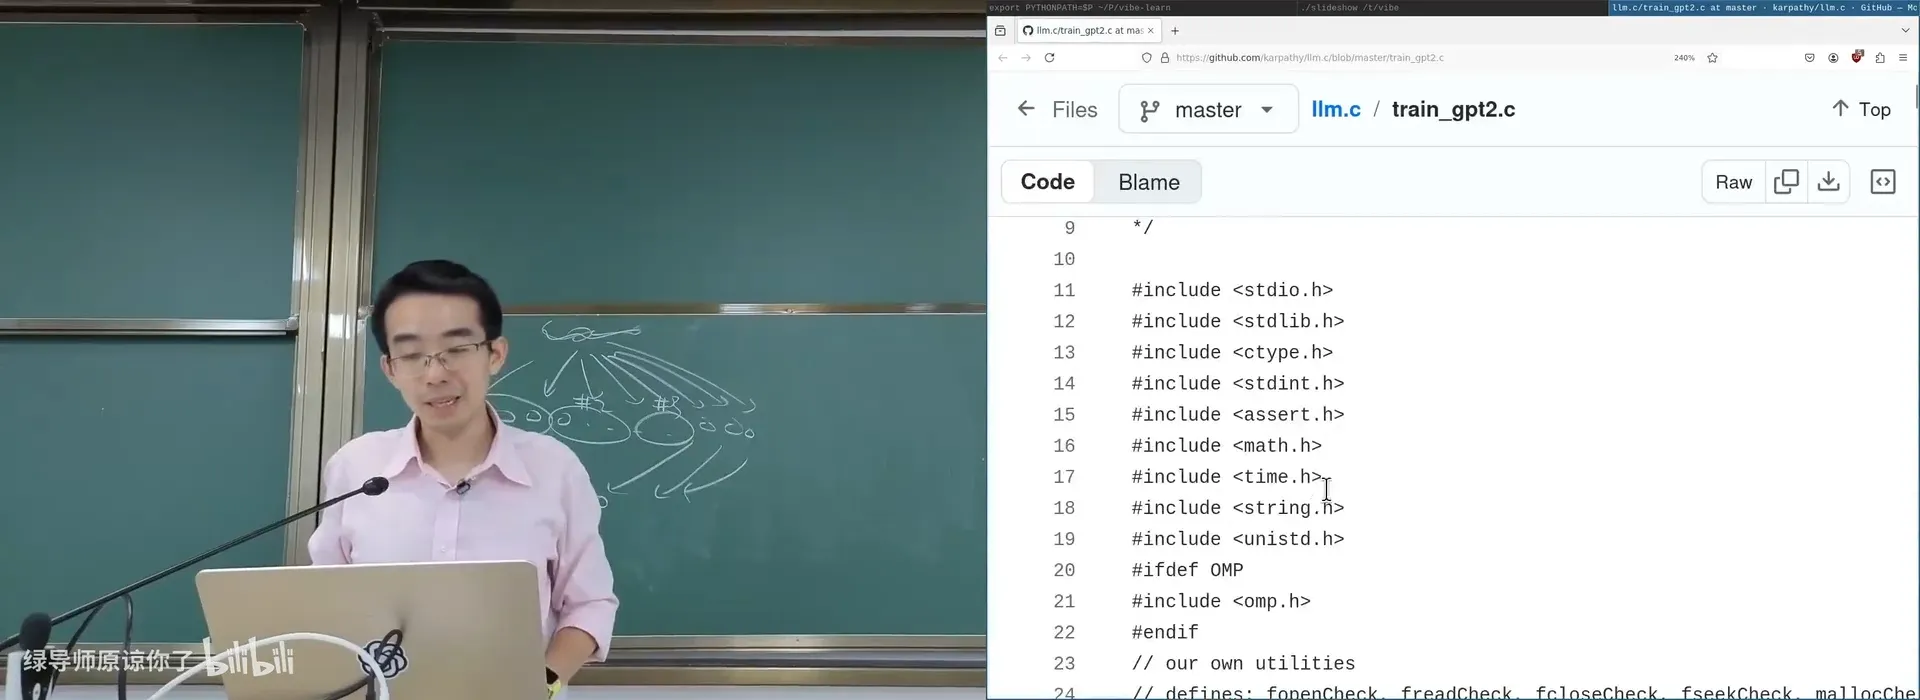
📷 gpt.c / llm.c:并行化只用了 5 行 OpenMP pragma
回到原视频 (00:56:00)
编者拓展|「现在又变了」:「曾经 OpenMP 这样的机制对非专业人士非常友好……但现在又变了——你已经不需要人类友好的编程机制了,因为反正没有人会去读代码了。我们都是做 harness engineering,只要你给我那个东西最终是对的,我根本不 care 你怎么实现。所以你们可以直接交给 AI agent——但你要把验收做好,确保 AI 交给你的东西是你想要的,而不是它幻觉出来的。」
三、并行数据结构
3.1 Sloppy Counter:牺牲可见性换性能
(参考时间: 00:59)
「如果就是有很多并行数据结构操作呢?」——例子:操作系统内核(无穷的 data race)、数据库(点赞 = 对一个点赞数 sum++)、网络游戏服务器、量化交易……
关键洞察:对 sum++,我们可以不需要完全严格的顺序执行——允许 load 看到「不太离谱」的旧值,但仍保持「最终一致性」:
int sum_local[MAX_TID];
void T_sum(int tid) {
    if (++sum_local[tid] == 100) {
        mutex_lock(&lk);
        sum += sum_local[tid];   // "Sloppy" counter
        mutex_unlock(&lk);
        sum_local[tid] = 0;
    }
}
- 为什么锁的可见性这么贵?因为每个 CPU 都有独立的 L1 cache,「
sum = 101要让你看见,至少在总线上绕一圈,传播到每一个 CPU」; - Sloppy counter:绝大部分计算留在本地,只有少部分上锁。「实际上你们现在的点赞都是这样实现的——点赞是比较松散的,可能有延迟,不代表真实精确的点赞数。」
- 也可以加 timeout(每毫秒把本地的加回去),保证「任何人读到的
sum都是一毫秒之内的」。
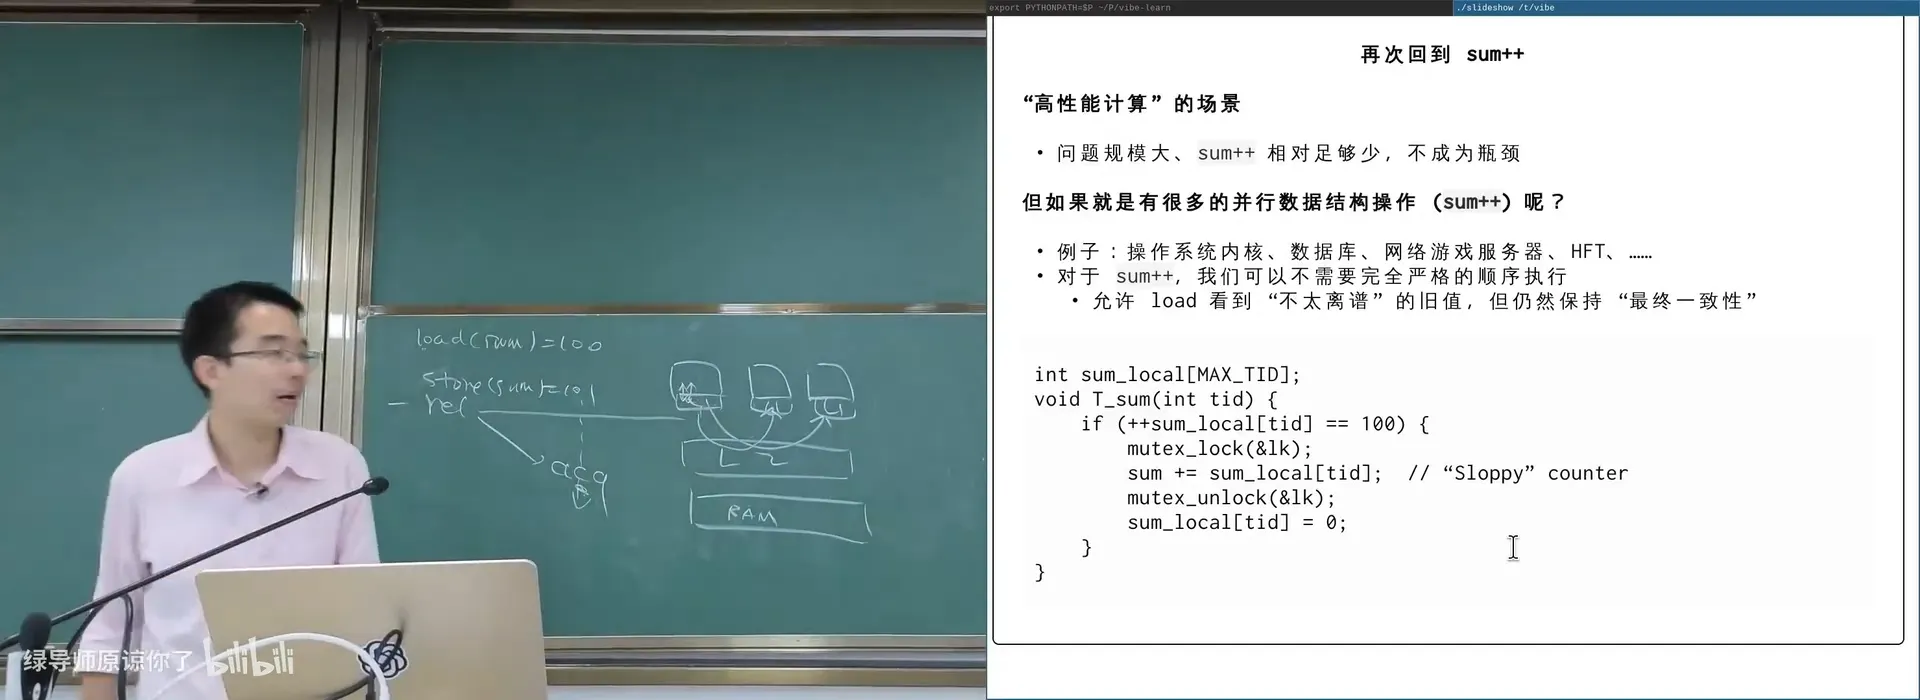
📷 Sloppy counter:允许看到旧值(最终一致性),把绝大部分计算留在本地
回到原视频 (01:04:00)
3.2 Thread-local Storage
(参考时间: 01:06)
int sum_local[] 很难看——「我不喜欢它,你不喜欢它,操作系统设计者不喜欢它,语言设计者也不喜欢它」。于是有了 thread_local(C++11 / C23):
thread_local int sum_local;   // 每个线程各自一份拷贝

void T_sum() {
    // thread_local int t;    // Compile error!局部变量不能 thread_local
    sum_local++;
}
编者说明:
thread_local可以是任何类型(包括 struct、指针)、可以赋初值。「如果你在非全局作用域里定义thread_local,编译器会直接报错——因为『每个线程一份』和『每次函数调用栈上一份』的含义是冲突的。」演示中,四个线程取&x得到不同的地址,各自的值加一后都是 101——「它确实在起作用。」
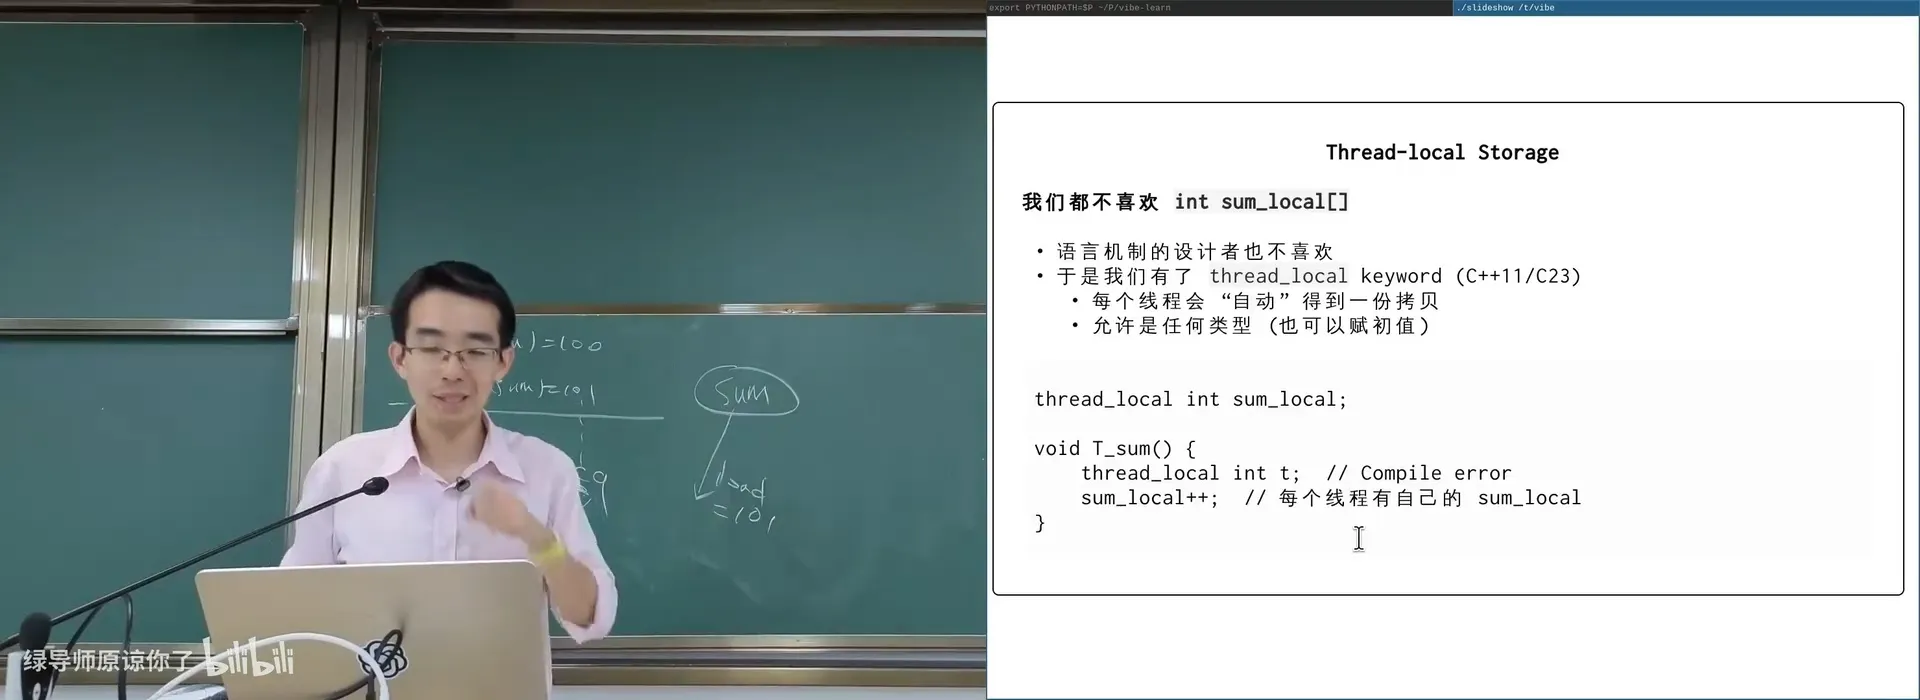
📷 thread_local:每个线程自动得到一份拷贝
回到原视频 (01:07:00)
实现——编译器知道每个变量的修饰符,用不同的寻址方式:
int x;                 // 全局:x(%rip),PC 相对寻址
void foo() { int y; }  // 栈上:y(%rsp)
thread_local int z;    // 线程局部:z(%fs) —— 偷用 fs 段寄存器做 TLS base
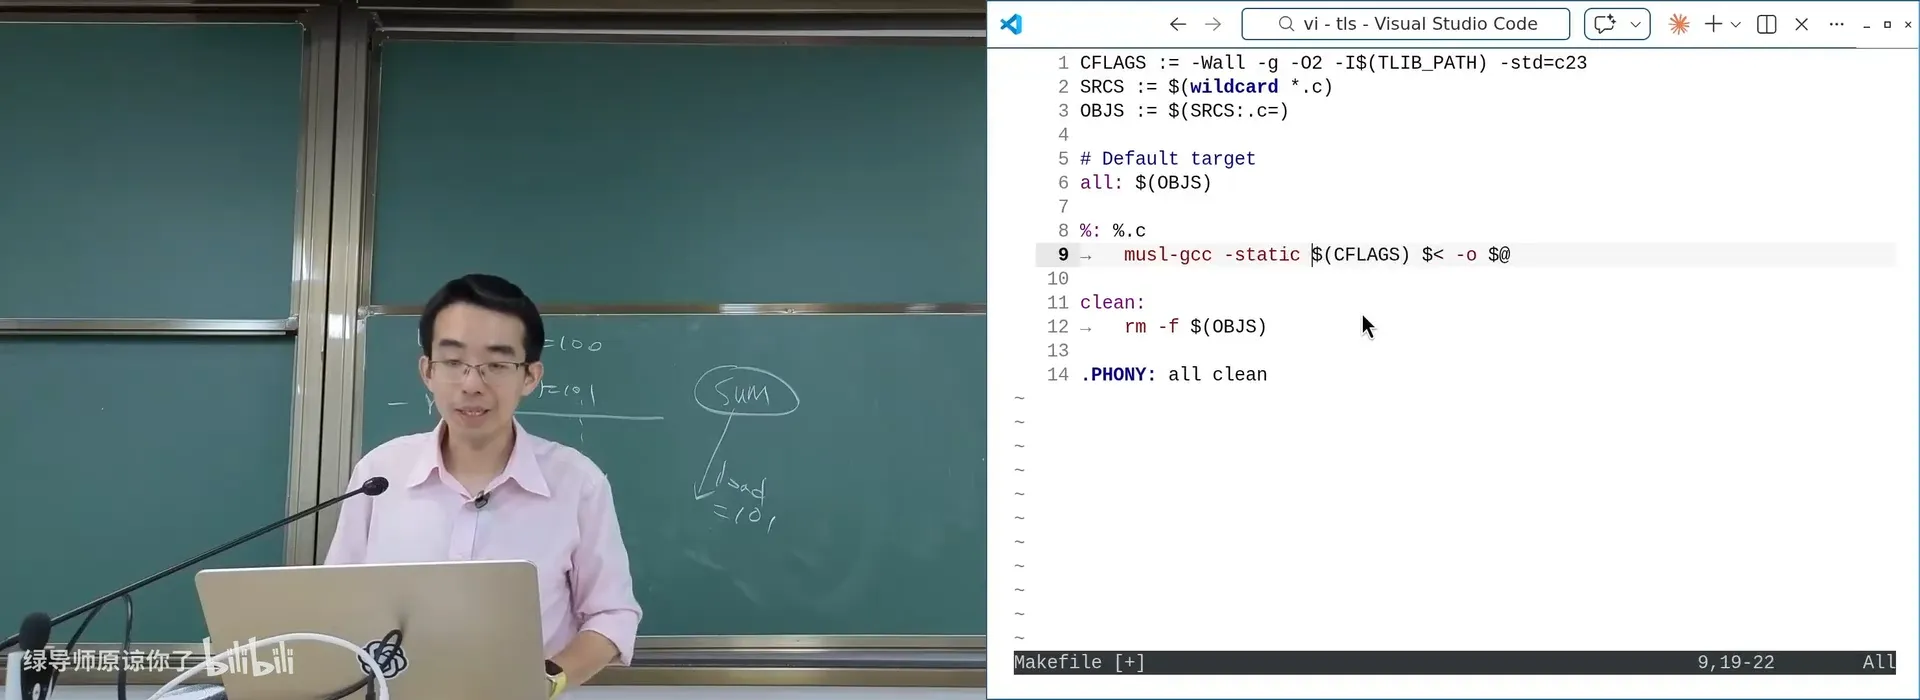
📷 TLS 的寻址:x86-64 用 `fs` 段寄存器作为 TLS base(`z(%fs)`)
回到原视频 (01:10:00)
.tdata, .tbss段(thread-local 的大小是编译时确定的);- 初始化更复杂:
thread_local int x = 42必须在每次线程创建时赋值——「和全局的.data x = 42(由 ELF loader 搬一次)不一样,这个 42 每创建一个新线程就要写一次。」
编者拓展|TLS 的初始化由
spawn完成:讲师让 AI(DeepSeek)读 ELF、线程栈和pthread_create的返回代码,解释整个过程——每个线程有一个struct pthread,里面有一个指向 TLS 数据的指针;pthread_create会mmap一个线程栈、同时分配 TLS 区域,然后调用一段copyTLS的代码,把.tdata复制到线程的 TLS 区域。「而且它是在主线程里、而不是在创建子线程里去处理这个 TLS 的。」「实际上操作系统的实现比你们想象的要复杂一点——我讲线程时忽略了这一点,因为第一节课讲这些细节你们马上就不知道我在说什么了。」
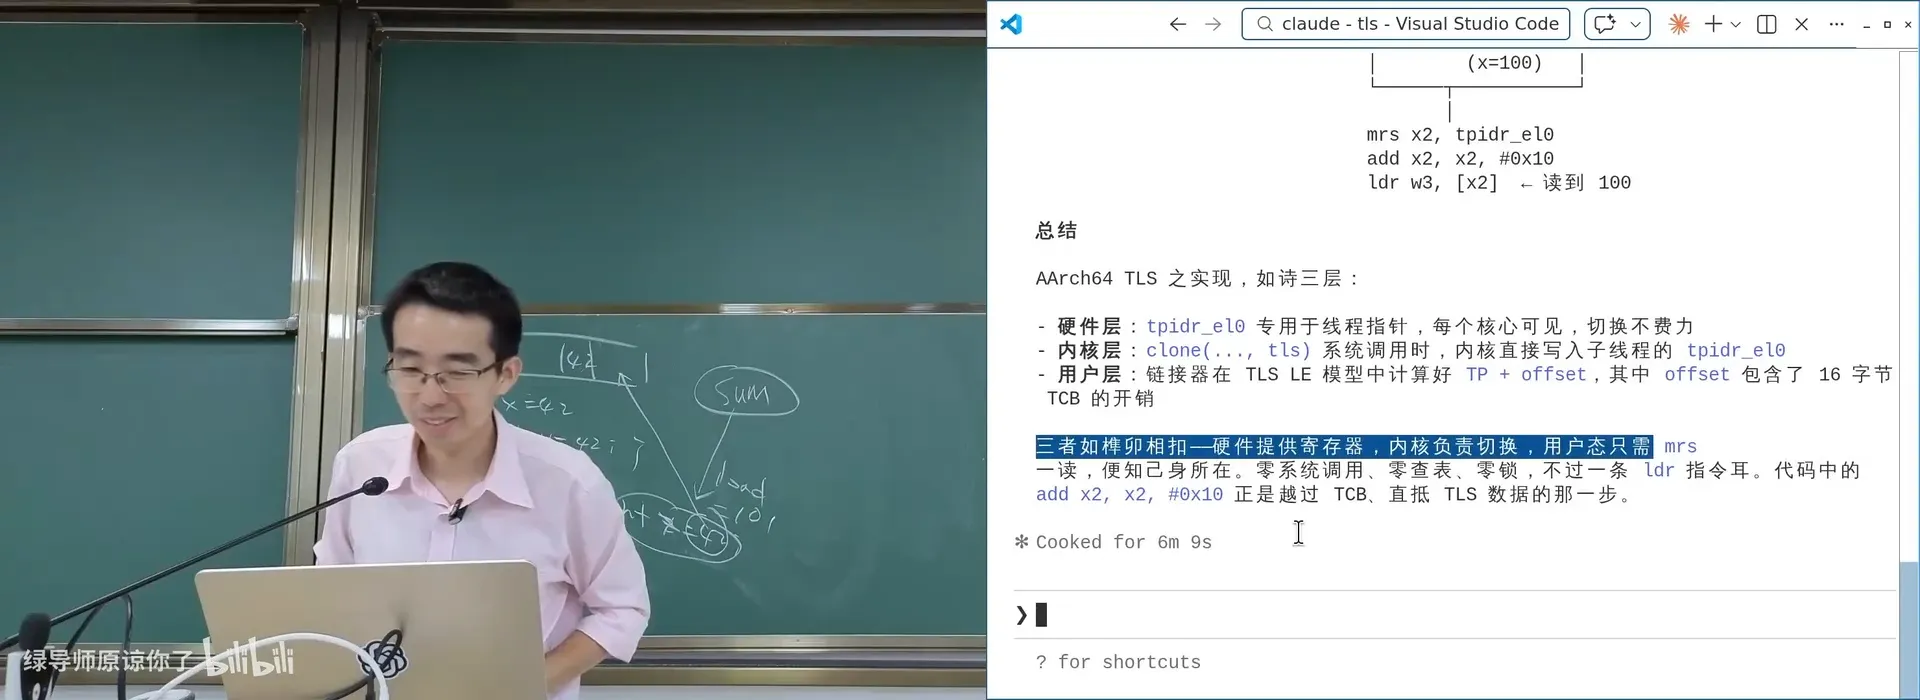
📷 TLS 的初始化:`thread_local int x = 42` 必须在每次线程创建时由 `spawn` 复制 `.tdata`
回到原视频 (01:16:00)
3.3 锁的拆分
(参考时间: 01:19)
抽象数据类型(ADT)天生是「分散」存储的,于是又有访问的局部性:「读写数据结构的一部分,未必需要锁住整个数据结构」。
| 技术 | 说明 |
|---|---|
| 原子指令 | 能用原子就不用锁(sum++ → atomic_inc)。「mymalloc 的 Online Judge 就是这么逃课的」——分配大内存、用原子计数器 n 分配 slot,一边往前跑一边回收 |
| Reader/Writer lock | 读可以多个线程同时做,写只有一个且排斥读(pthread_rwlock_t) |
| Segment/element-wise lock | 把数据结构切段,各段各一把锁 |
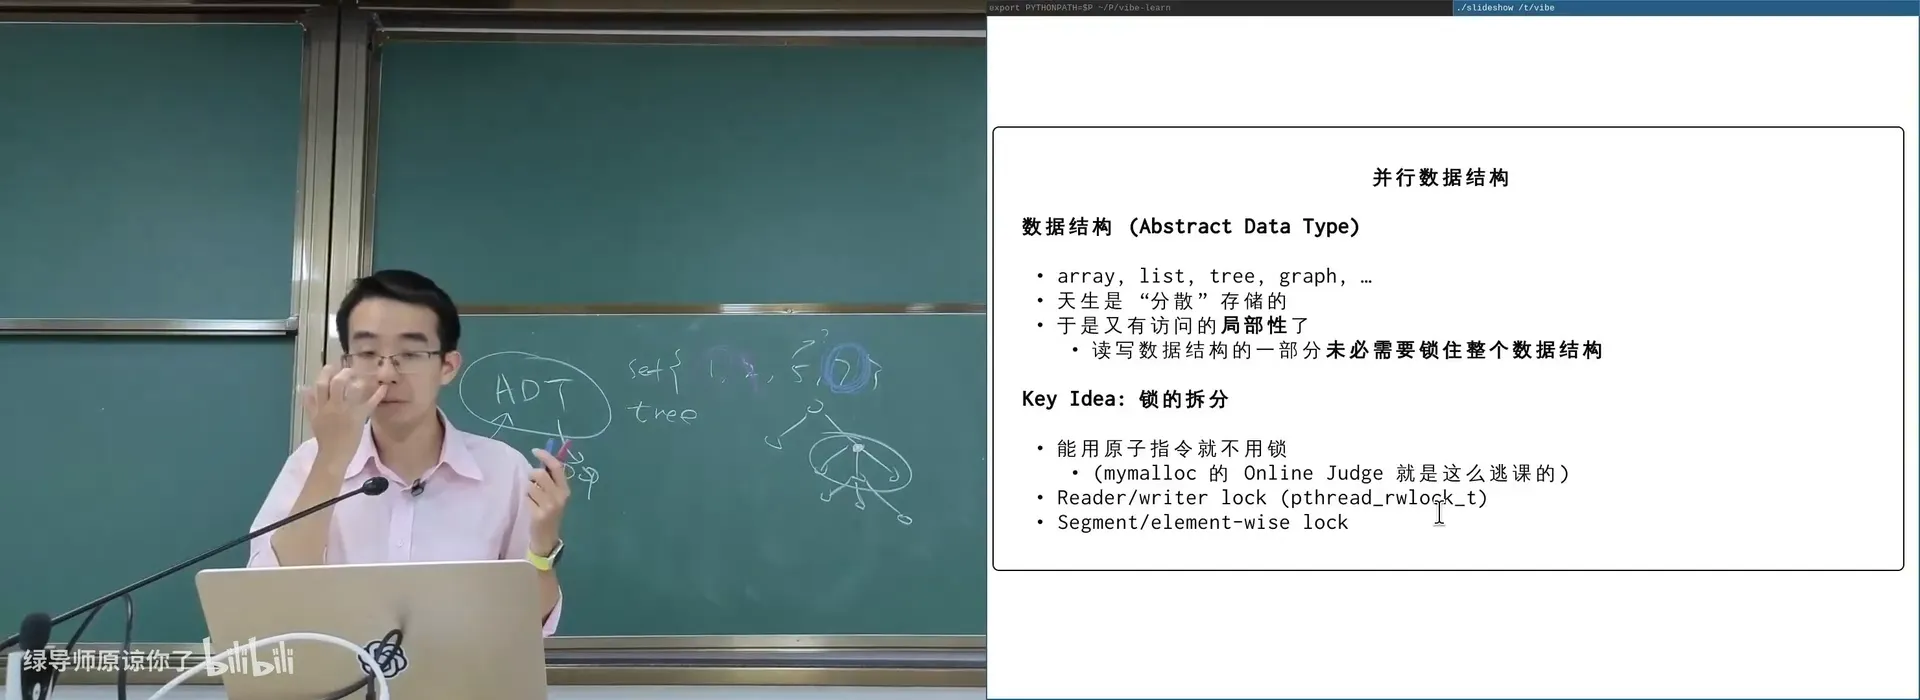
📷 锁的拆分:原子指令 / 读写锁 / 分段锁——把数据结构的不同部分分开上锁
回到原视频 (01:19:00)
编者拓展|
sloppy counter也可以用「数据结构」来解释:你可以把sum++想象成往一个 list 上 append 一个节点,sum就是 list 的 size;本地积累 100 个,再一次性拼到全局 list 上。「把尽可能多的计算留在本地」,这是并发数据结构优化非常关键的一点,也是你们实现 Malloc 里非常关键的一点。
例子:Hash Table——hash(key) 转成数组下标,O(1) 插入/删除/查找,而且可以 per-bucket lock(甚至读写锁)。
编者说明:Open Addressing 带来的麻烦: - 并发的查找、删除、遍历——删除时需要 tombstone(因为
X, Z, W同一 hash,删掉Z会让X的探测链断裂,找不到W); - Resize 会「摧毁」已有数组:「简单方法是阻止 resize 和任何并发访问(相当于持有 write lock)——每个操作都需要获得 bucket lock 和 resize lock(知道为什么会死锁了吧)」;「复杂方法就是!(@#^@&%^!(#&(!@&#」。「所以请大家对库函数保持敬畏之心。」(下节课专门讲 Malloc。)
📷 Hash Table:per-bucket lock;open addressing 的 tombstone 与 resize 是两大难题
回到原视频 (01:23:00)
总结
- 并发编程不仅要正确,更要高效:互斥锁保证了正确性(serializability + 可见性),但完全的 serializability 限制了 scalability;
- 并行算法:计算图(DAG) 分解 → 让同步区域变小;Scale up & Scale out;HPC(CRAY-1、Linpack、牛顿法)与 embarrassingly parallel(tree search、Monte Carlo、视频逐帧、Mandelbrot);OpenMP/MPI 的「魔法」;
- 并行数据结构:
- Sloppy counter:牺牲可见性(最终一致性)把计算留在本地;
thread_local:语言级消除共享(.tdata/.tbss,x86-64 用fs段寄存器);- 锁的拆分:原子指令、读写锁、segment/element-wise lock;
- 关键:脱离 workload 做优化就是耍流氓——理解真实负载的特征才是性能优化的第一步。
编者拓展|在 AI 时代「驾驭 AI」:讲师说,如果我们不教这些概念,「你们就会对 AI 越来越失控——给 AI 提一个需求,它第一遍做错,第二遍开始用 gdb 调试、改、用各种奇怪的工具看输出,最后一把头说『我给你搞对了』」,而你们不知道怎么应对这种失控感。「至少到今天,我们还没有一个很好的办法,让 AI 在系统设计、架构设计、工具设计上形成它自己的品位。」「所以概念还是要讲的——只有了解了这些概念,你们才知道用什么 prompt 让 AI 往哪个方向努力。」
附:官方参考与延伸阅读
本讲的讲义见课程主页,以下链接按书中出现顺序整理:
| 主题 | 链接 |
|---|---|
| 使用不同方式求和(sum-experiment) | https://jyywiki.cn/OS/demos/concurrency/sum-experiment |
| 绘制 Mandelbrot Set(mandelbrot) | https://jyywiki.cn/OS/demos/concurrency/mandelbrot |
| Thread-local Storage(tls 演示) | https://jyywiki.cn/OS/demos/concurrency/tls |
| Karpathy, llm.c | https://github.com/karpathy/llm.c/blob/master/train_gpt2.c |
| CRAY-1: The World's Most Expensive Love-seat | https://dl.acm.org/doi/10.1145/359327.359336 |
| Mandelbrot Set(Mathigon) | https://cn.mathigon.org/course/fractals/mandelbrot |
| Taalas / ChatJimmy | https://chatjimmy.ai/ |
| HPC-China 100 | https://hpc100.top/top100/24/ |
| MPI Tutorials(LLNL) | https://hpc-tutorials.llnl.gov/mpi/ |
| OpenMP | https://www.openmp.org/ |
| OSTEP(第 29–31 章:Concurrency;第 32 章:Concurrency Bugs) | https://pages.cs.wisc.edu/~remzi/OSTEP/ |
阅读材料:读 OSTEP 并发部分;读 CRAY-1 论文;动手把 gpt.c 并行化并用 perf 观察。
版权说明:本讲讲义与幻灯片作者为蒋炎岩,采用 Creative Commons BY-NC 4.0 许可,来源于 https://jyywiki.cn/OS/2026/。视频画面与字幕版权归原作者所有。本书为课堂内容的学习性重构。