第20讲 · CPU、GPU 和 SIMT 编程模型
2026 南京大学《操作系统原理》第二十讲 · 课堂实录重构
| 主讲 | 蒋炎岩(Yanyan Jiang) |
| 视频 | https://www.bilibili.com/video/BV1df536aEMk/ |
| 课程主页 | https://jyywiki.cn/OS/2026/ |
| 本讲讲义 | https://jyywiki.cn/OS/2026/lect20.md |
| 讲义 / 幻灯片作者 | 蒋炎岩,https://jyywiki.cn/ |
| 讲义 / 幻灯片许可 | CC BY-NC 4.0 |
| 图片来源 | 书中插图为课堂演示与讲义渲染图;演示类截图为视频画面 |
对应讲次:第20讲(南京大学 操作系统原理)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者说明:本书由课堂录像的语音字幕重构而成,术语、章节骨架与参考链接已按课程官方讲义(
lect20.md)校准。讲师的口语风格、类比与案例被尽量保留;编辑性的补充一律以「编者说明」或「编者拓展」标出。
引子:是时候推翻 CPU 的统治了
(参考时间: 00:00)
回顾前面学的:计算图(理解并行计算的关键)、轻量化线程(generator/coroutine、非阻塞 I/O、goroutine)、异步编程(事件驱动、Promise、async/await)——这些都是 CPU 上的并行/并发模型。
「是时候推翻 CPU 在计算这件事上的统治了。」
一、CPU 内部的并行
1.1 「顺序执行」只是一个精心维护的假象
(参考时间: 00:01)
CPU 就是那个「无情地执行指令的机器」(rv32ima_step)。但——顺序执行只是一个精心维护的假象,每个程序其实都是并行程序。
为什么?因为逻辑门天生是并行的(信号从左到右流过电路时,所有门同时工作):
- 我可以一次从内存取出 64 bit、128 bit;
- 我可以同时译码两条指令,再放一个电路判断它们有没有数据依赖,没有就同时执行(双端口寄存器堆);
- 现代 CPU 里有一条很长的指令队列,每个周期塞进 3–4 条指令,配上动态数据流分析器,实现乱序发射、按序提交——「CPU 本身就是一个编译器」。
怎么证明你的 CPU 一个周期能执行超过一条指令? 讲师给了个「开放题」思路:从 /proc/cpuinfo 知道 CPU 型号与频率 → 写汇编构造不同依赖关系的指令序列 → 用 perf stat 统计 IPC(Instructions Per Cycle)。
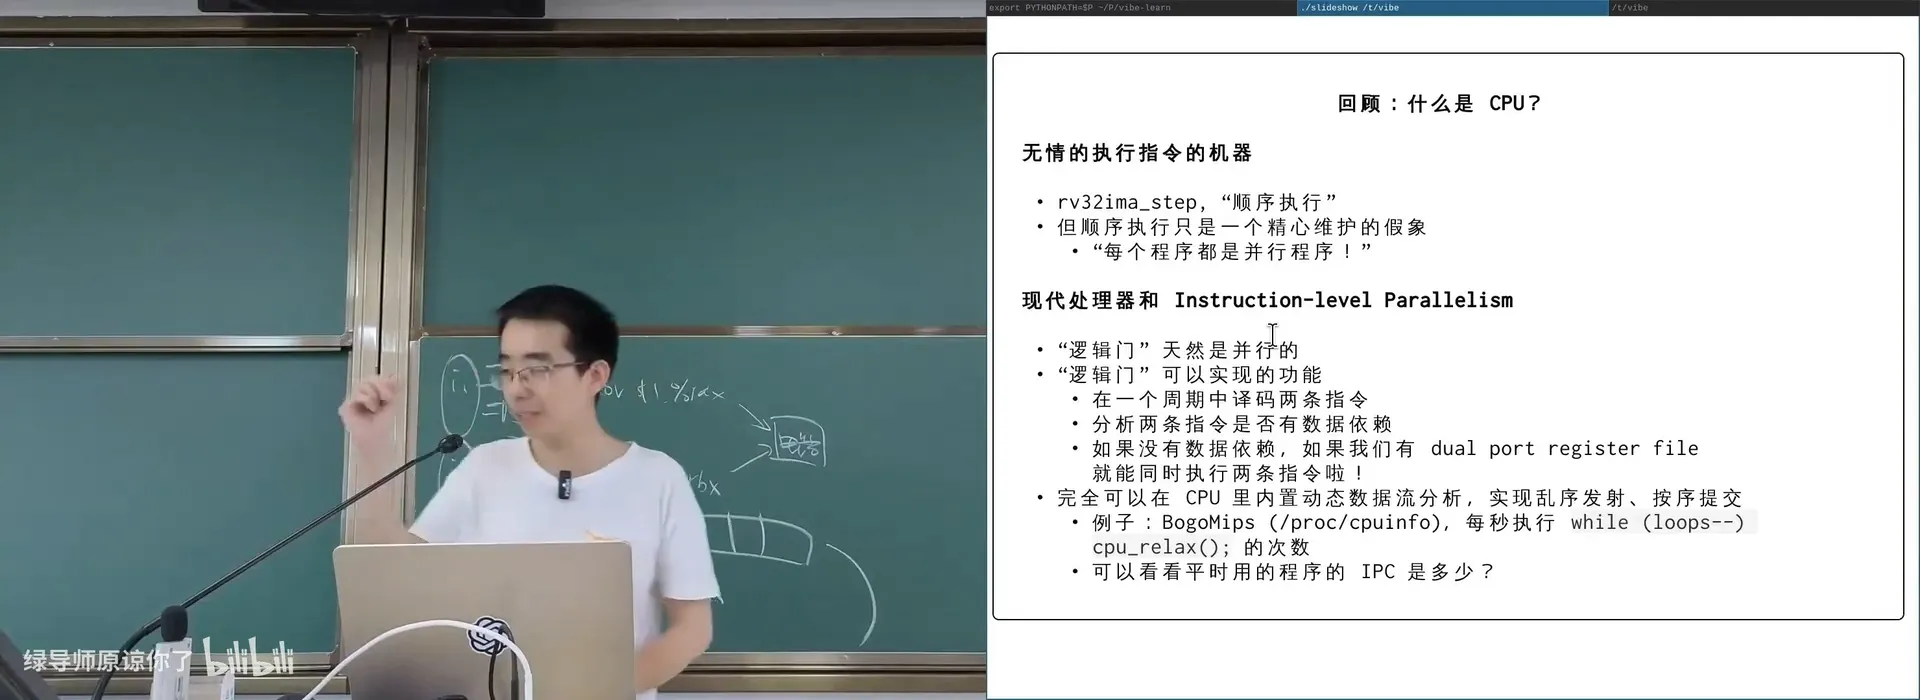
📷 BogoMIPS:`/proc/cpuinfo` 里那个「每秒钟几百万次空循环」的估算值
回到原视频 (00:08:00)
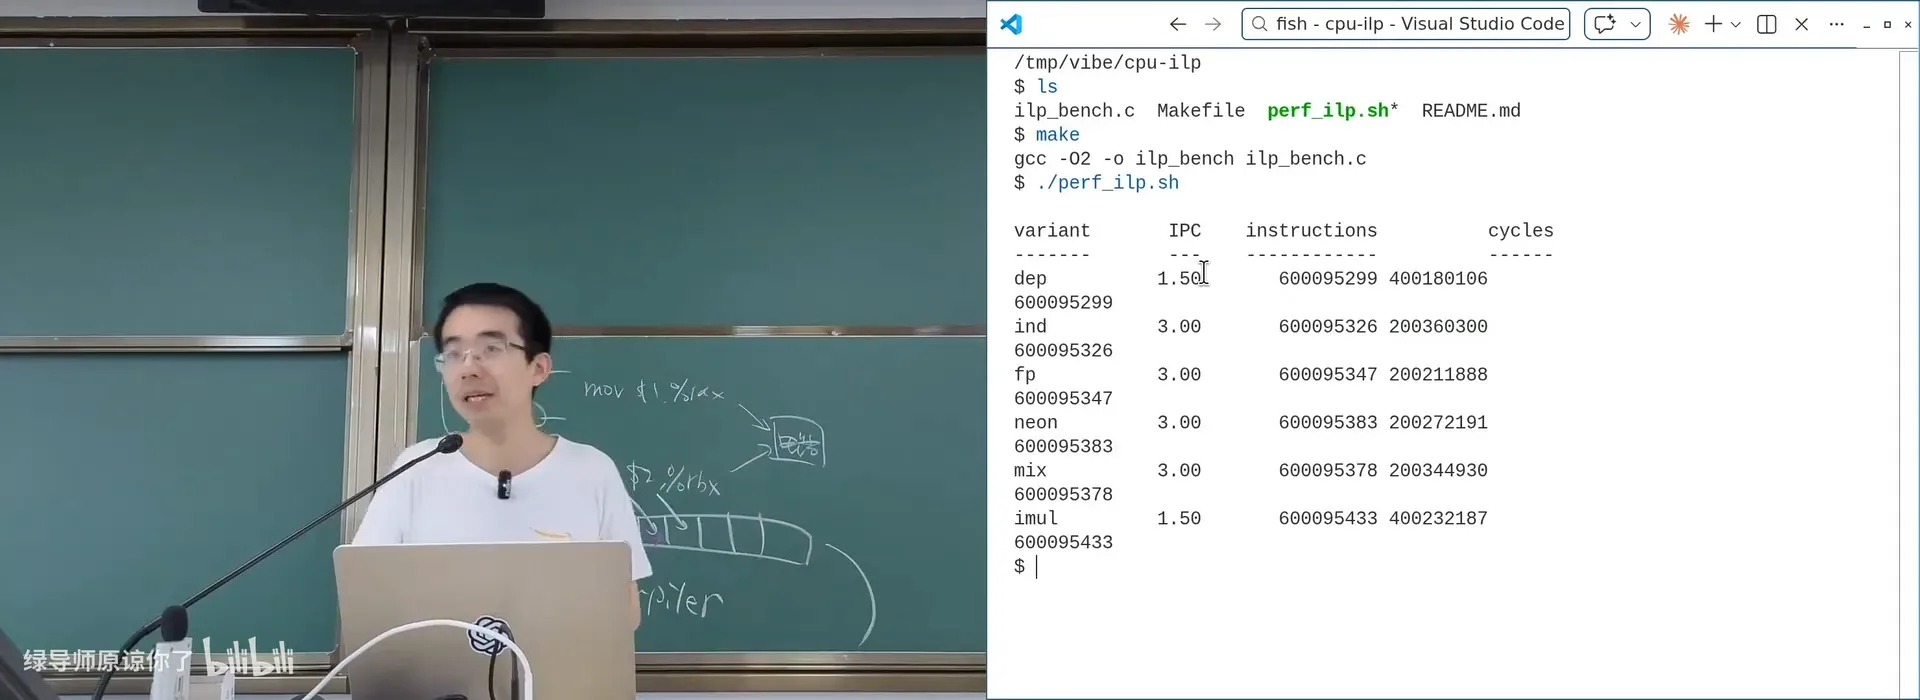
📷 cpu-ilp:用 `perf stat` 测量不同指令序列的 IPC
回到原视频 (00:12:30)
编者拓展|BogoMIPS 与
delay:早期(或固件/内核刚启动、精确计时器还不可用时)需要实现delay(20ms)。答案:假设 CPU 频率固定,就用while (loops--) cpu_relax();计数。由此得出 BogoMIPS(Bogus MIPS)——一个估算值。有意思的是,它常常大于 CPU 的主频(比如 2GHz 的 CPU 得到 5000),这本身就说明一个时钟周期能执行多条指令。
1.2 功耗墙:跑得越快,浪费得越多
(参考时间: 00:15)
为了让指令「一二三」能同时执行,CPU 付出了巨大的功耗:那个队列、数据流分析器、重命名……电路的每一次翻转都要发热,而这些能量没有参与实际计算——「你收 100 块,99 块都交税了」。
热功耗公式:
$$\text{Power} = C V^2 f$$
- 1995–2005:先进制程不断突破功耗墙,单核性能持续增长(Intel 的 Tick-Tock,每一年半交替升级制程/微架构,其实就是「把队列从 1024 项变成 2048 项」这么粗暴);
- 暗硅时代(Dark Silicon):制程不能无限变好,$C$ 和 $V^2$ 定了下来——你就算能塞更大的电路,散热也跟不上了(一个封装约 100 多瓦)。于是有了墙(功耗墙、频率墙、内存墙、I/O 墙)和税(存储税、网络税、计算税……)。
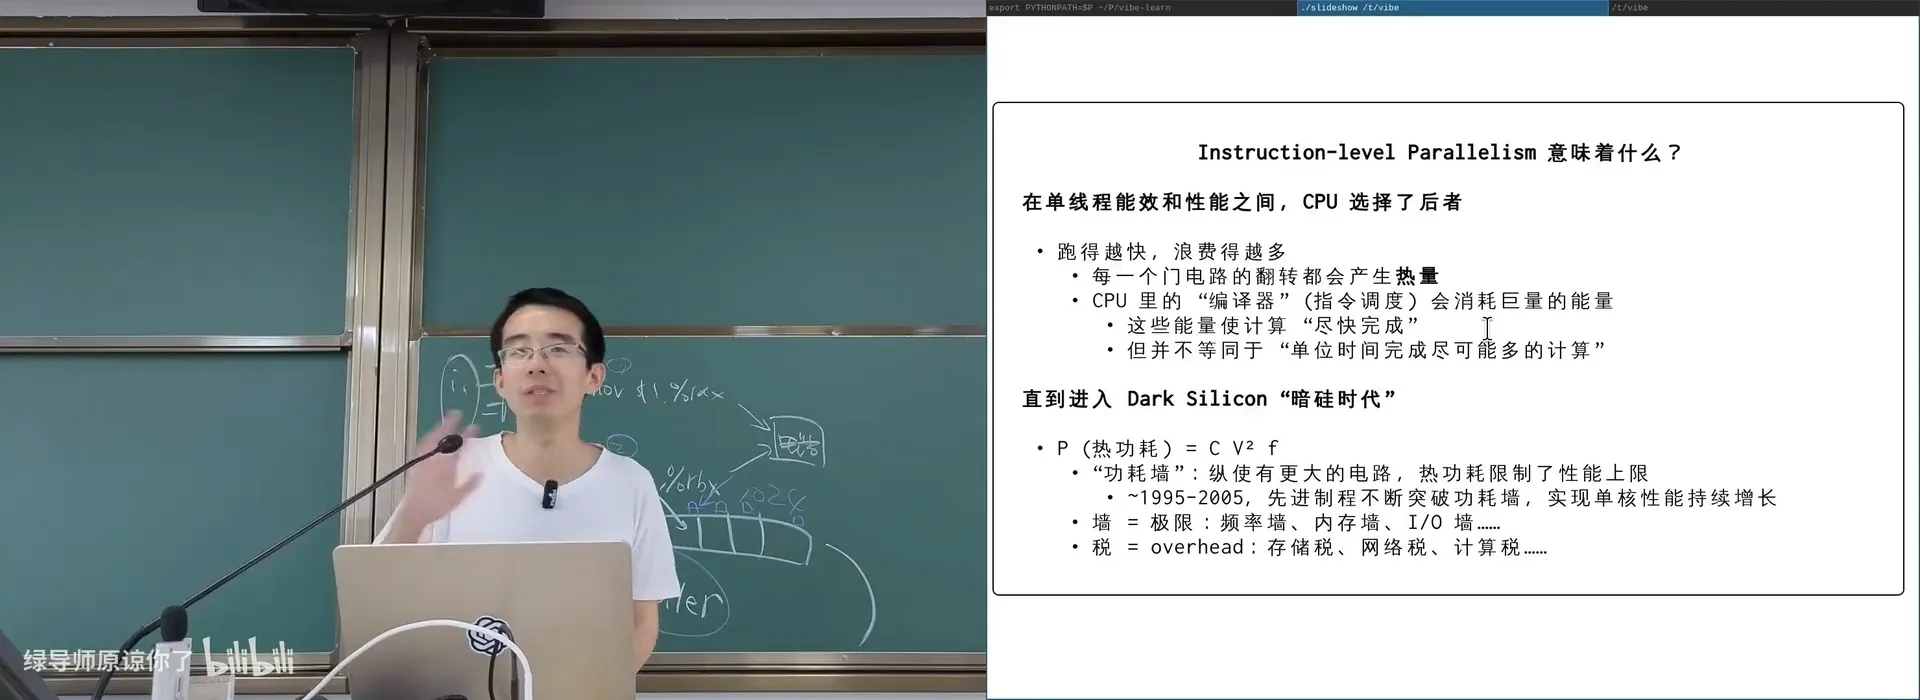
📷 功耗墙:P = C V² f——纵有更大的电路,热功耗限制了性能上限
回到原视频 (00:16:00)
面对功耗墙,两条路:
- 让一条指令处理更多数据 → SIMD(调度一条指令的能量大致是定数,如果一条指令能做更多事,调度的代价就被分摊了);
- 用更多更简单的处理器 → 多处理器、异构多处理器(ARM big.LITTLE,Intel P-cores/E-cores)。
1.3 SIMD:分摊指令调度的开销
(参考时间: 00:24)
SIMD(Single Instruction, Multiple Data):把一个大操作数分成几个小操作数。1997 年的 Intel MMX(MultiMedia eXtension)——一个很有年代感的名字:
- 为 32 位机增加一组 64 位寄存器,可以当成 4 个 16-bit 整数用;
- 增加一组「packed」操作指令(57 条),做加法时四个数字同时相加,且每个 16 位内部溢出不会串到相邻位;
- Intel 甚至随处理器附赠一张光盘,里面有个展示 MMX 的 3D 游戏(在当时画面非常惊艳)。
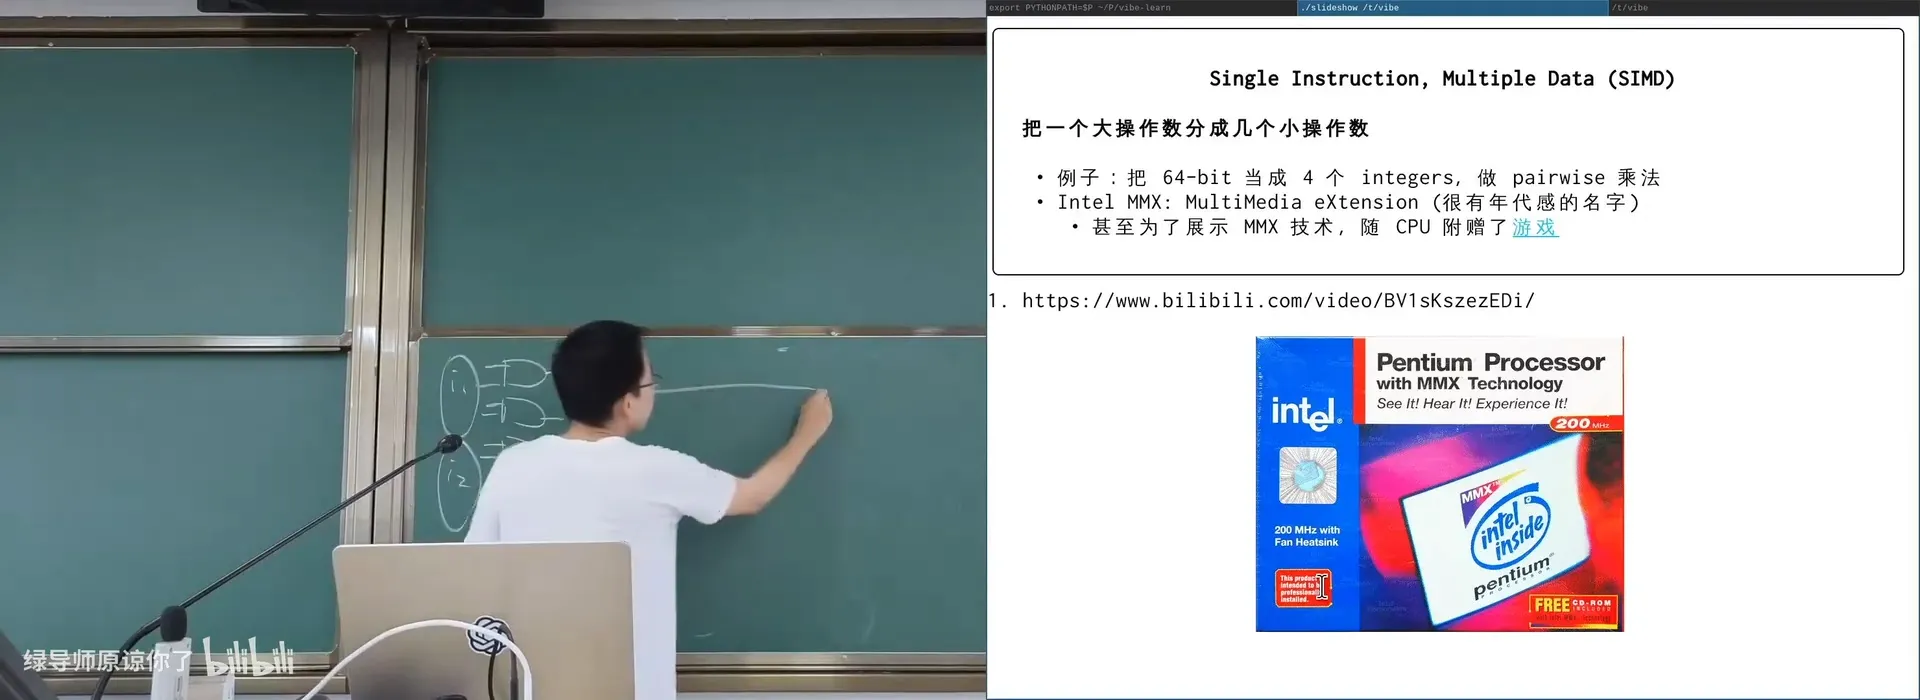
📷 MMX:64 位寄存器当成 4×int16,一条指令操作多个数据
回到原视频 (00:26:00)
编者拓展|你其实一直在用「SIMD 思想」: - Bitset:
(arr[x / 8] >> (x % 8)) & 1——把一个 32 位整数当成 32 个 bit 用; -lowbit:x & -x == x & (~x + 1); -popcount():用「掩码 + 移位 + 加法」把 32 个 bit 当成 32 个 1-bit 数并行统计。讲师现场讲了经典的 popcount 位运算技巧(
x & 0x55555555取奇数位、x & 0xaaaaaaaa取偶数位、对齐相加、递归汇聚)。不过他也提醒:这种「聪明」写法在现代处理器上性能反而差(对动态流水线不友好)——查表(把 32 位拆成 4 个字节,查预先算好的表)反而更快。
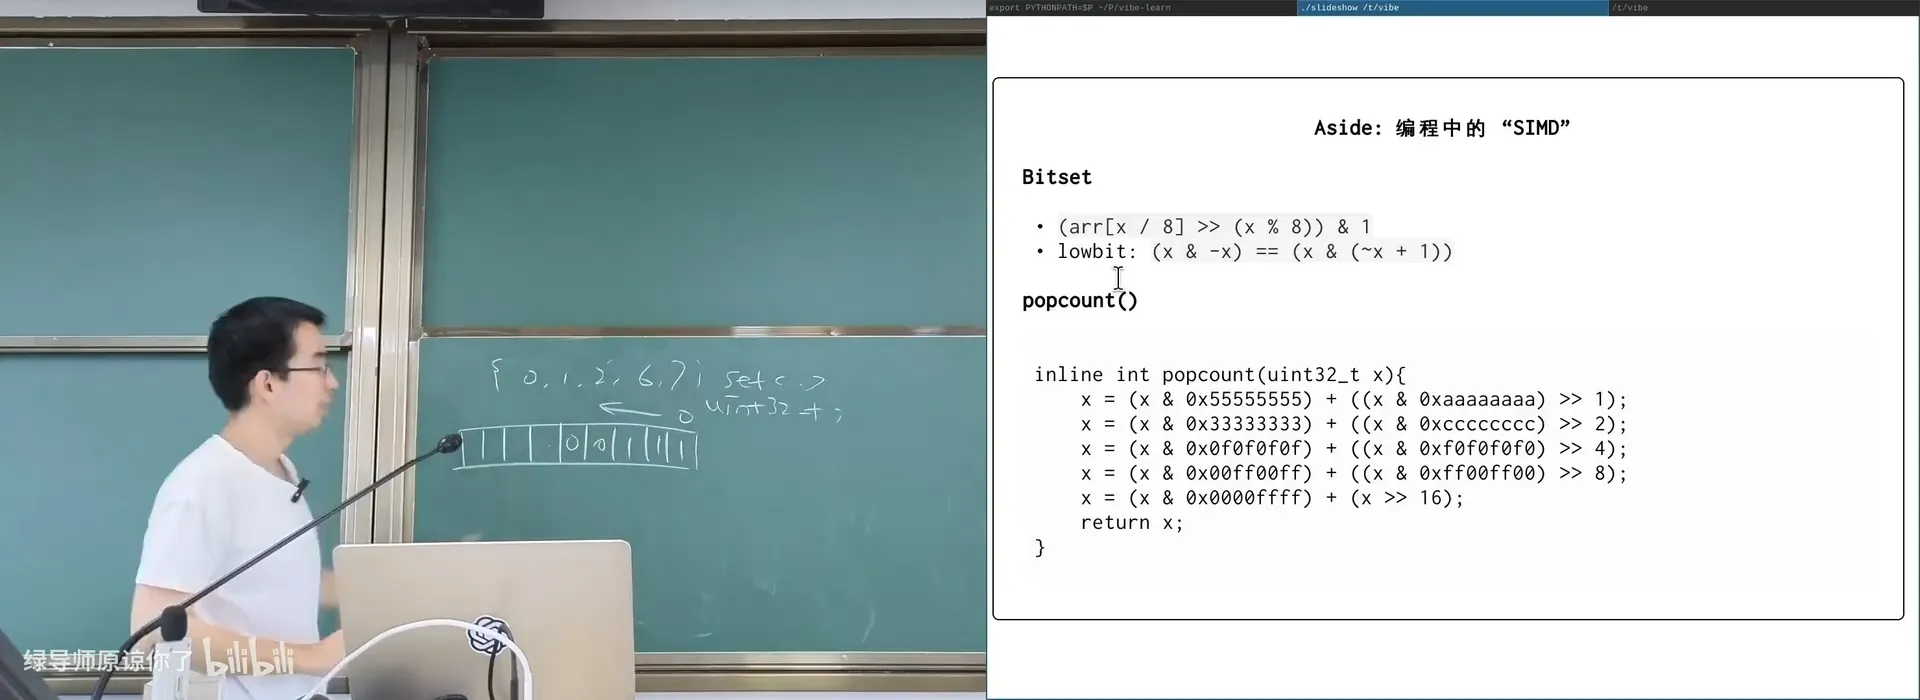
📷 popcount:用位运算把「32 个数」当成 SIMD 并行统计
回到原视频 (00:29:00)
寄存器越长,调度代价被摊薄得越多:%mm(64) → %xmm(128) → %ymm(256) → %zmm(512, AVX-512)。(mm 的「多媒体」含义已过时,但名字被永远保留下来;AVX-512 已经撞上热密度极限,一开就可能降频。)它还支持更多数据类型(int8/16/32、float32/64)、更多运算(Shuffle:c[i]=a[b[i]];FMA:a*b+c 一条指令完成)。
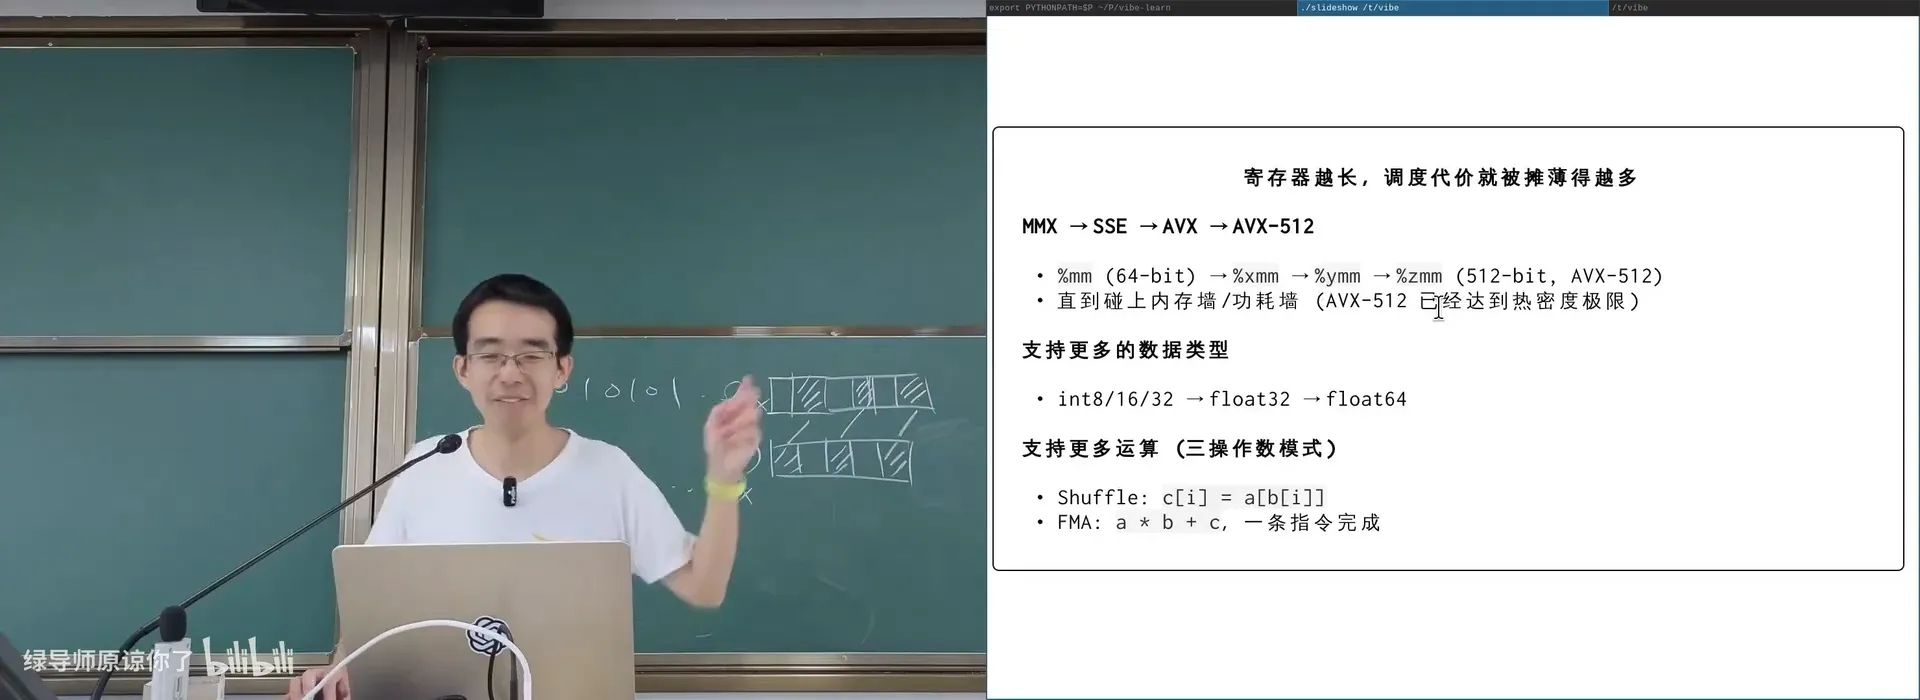
📷 MMX → SSE → AVX → AVX-512:寄存器越来越宽,直到撞上热密度极限
回到原视频 (00:34:30)
但 SIMD 没完全解决问题:它依然在 CPU 里被调度,要参与缓存和动态流水线,会和其他指令抢缓存、抢功耗。
编者拓展|VLIW(Very Long Instruction Word):一个激进但失败的尝试——完全消灭动态流水线,把「打包指令 + 静态调度」全交给编译器。Intel 的 IA64 就是 VLIW,失败了(当年指令级并行和先进制程的收益很大、又没有迁移成本)。「但在大模型时代,它可能又要复活了——因为它是真正能让指令调度代价接近零的方案,只是当年编译器技术还跟不上。」
二、改变人类命运的另一条时间线:GPU
2.1 游戏机的「性能危机」
(参考时间: 00:39)
1972 年的 Magnavox Odyssey——世界上第一台发售的游戏主机:没有声音,画面只是光点(只能玩 Pong)。
1983 年的 NES(任天堂红白机)面临一个计算危机:
- CPU:MOS 6502 @ 1.79 MHz,IPC ≈ 0.43(没有动态流水线,甚至没有多处理器概念);
- 屏幕:256×240 = 61K 像素,60 FPS;
- 也就是说:每帧只有约 10K 条指令,要渲染 61K 像素——怎么办到的?
核心想法:把「要算什么」和「怎么画」分开——CPU 只做「场景描述」这个数据结构,由专用硬件把数据结构变成图形。
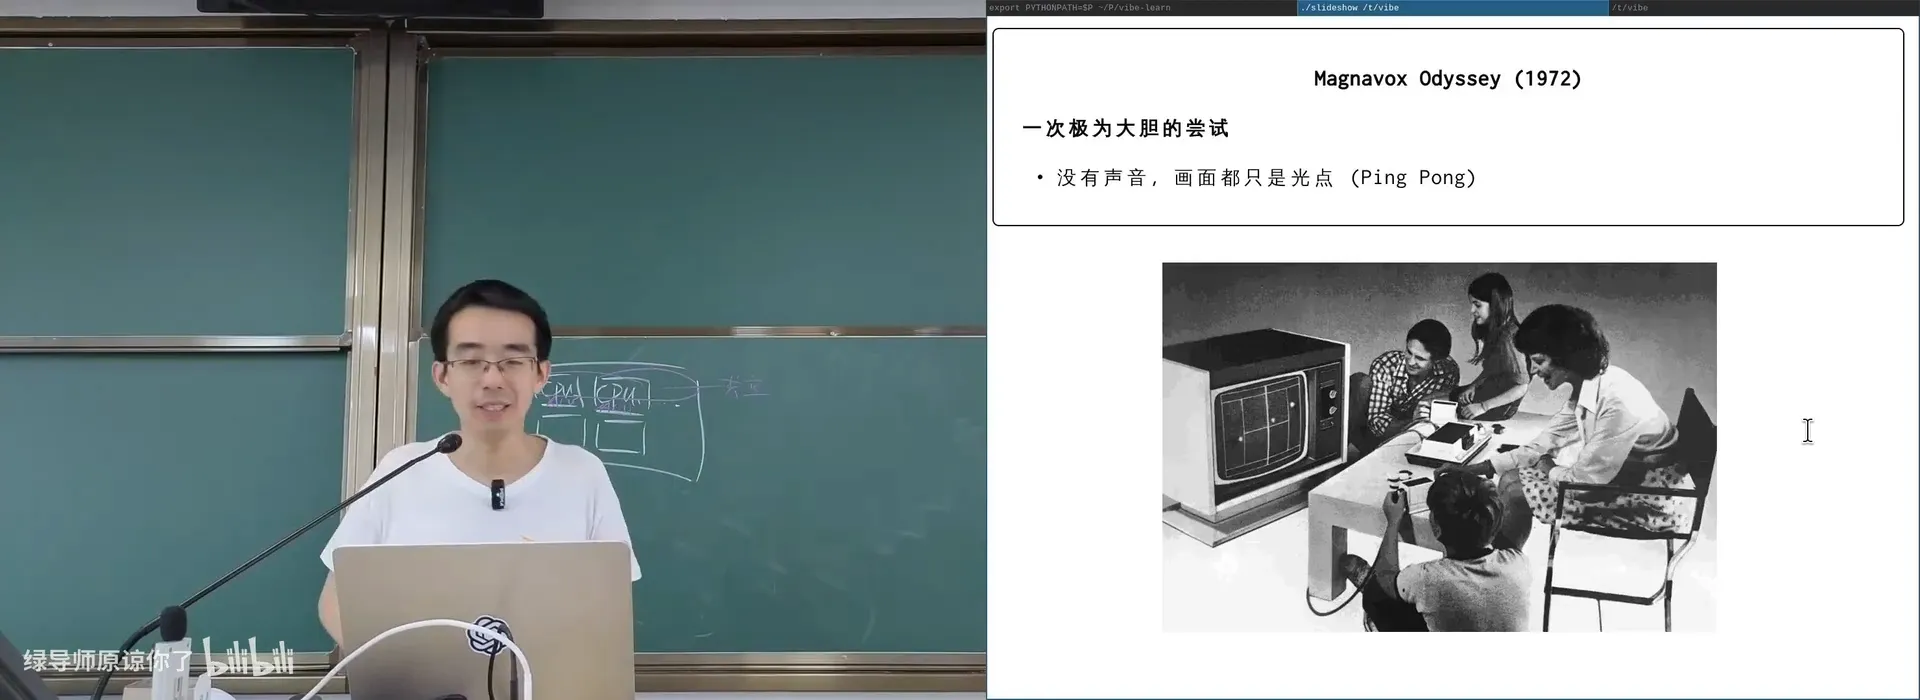
📷 Magnavox Odyssey 与 NES:娱乐需求驱动了图形硬件的发展
回到原视频 (00:42:00)
2.2 NES 的「场景描述」与 PPU
(参考时间: 00:45)
- 绘制基本单位是 8×8 的「贴块」(tile),每个贴块只有 4 种颜色(其中 1 个透明色);
- Tile ROM + Tile Map(Name Tables)+ Attribute Tables:背景是一个比屏幕更大的规则块阵列,从而能实现卷轴(scrolling);
- Sprites(动态前景):
(x, y, tile, attr),共 64 个,放在 256 字节的 Sprite RAM 里;8-bit 属性里有调色板、优先级(z 轴)、水平/垂直翻转(Super Mario 的蘑菇「走路」动画就是交换左右脚 + 镜像翻转做的)。
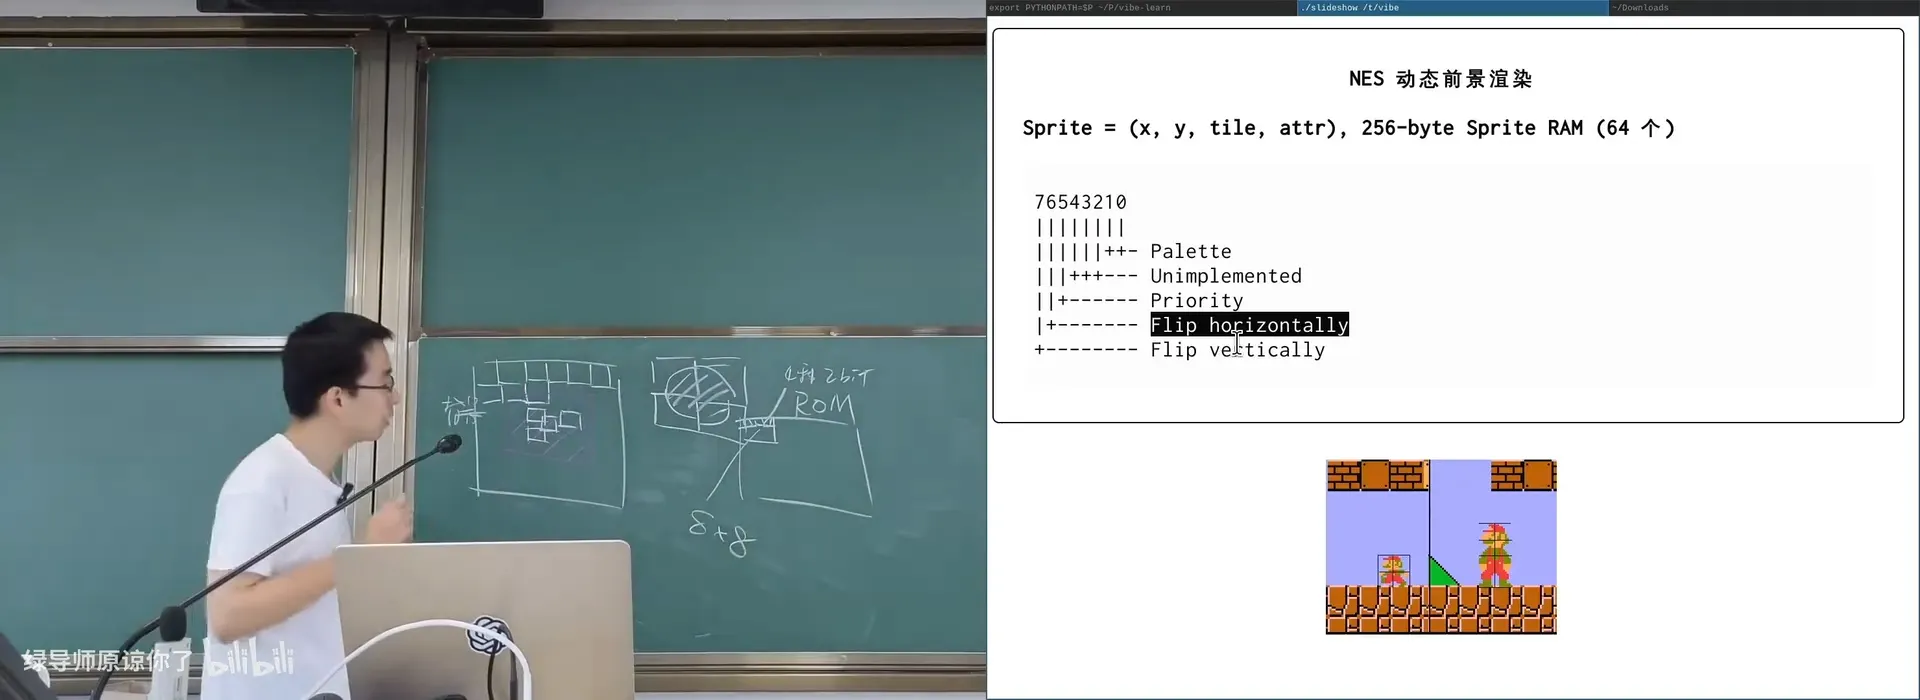
📷 NES Sprite 属性:调色板 / 优先级 / 水平垂直翻转
回到原视频 (00:50:00)
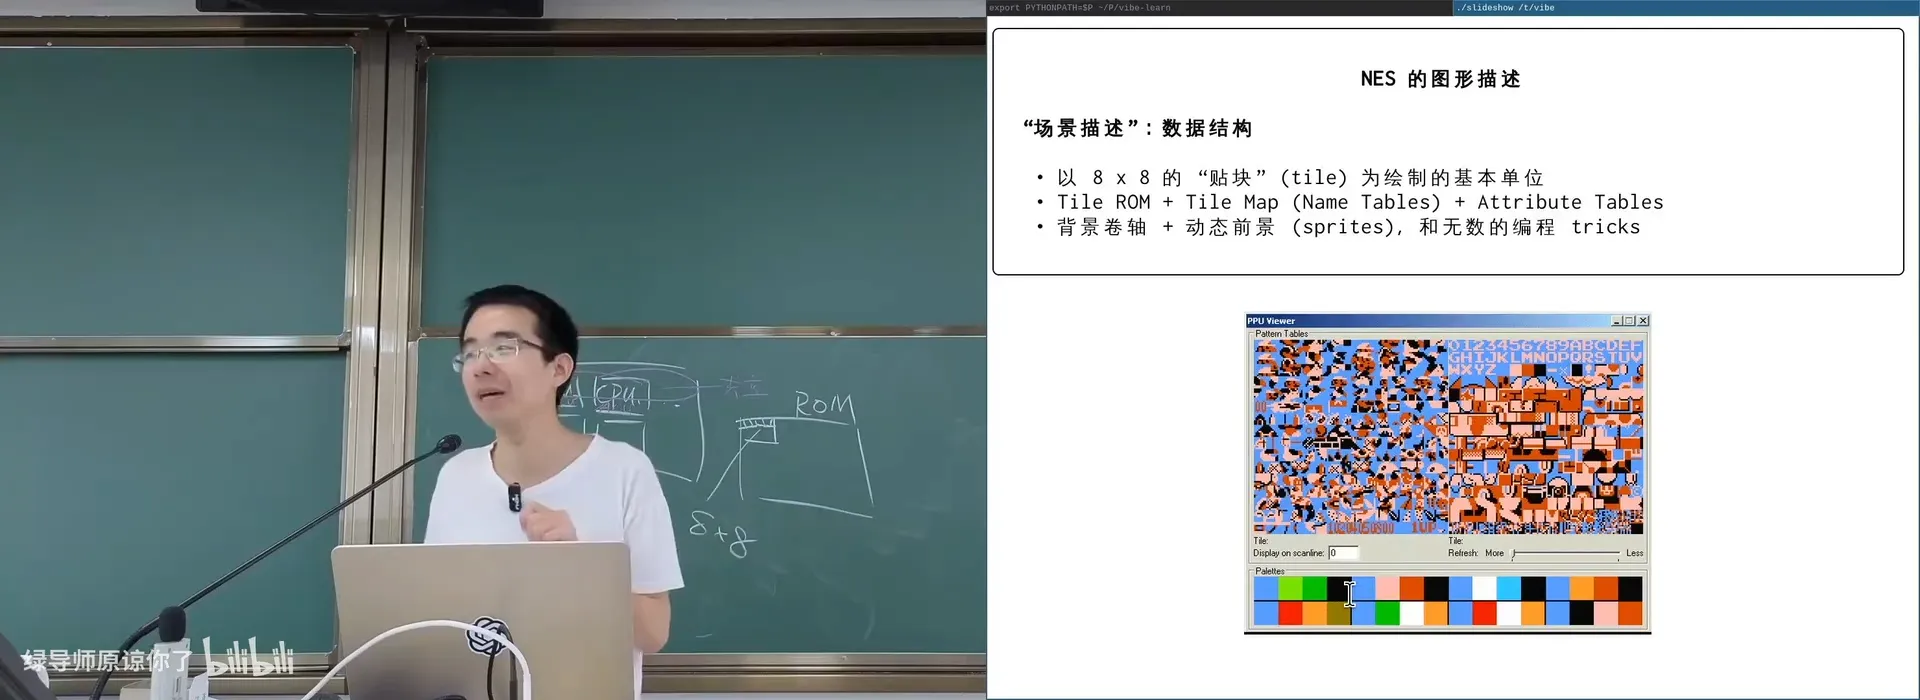
📷 NES 的 PPU:Tile ROM + Tile Map + Attribute Table + Sprite
回到原视频 (00:46:30)
PPU 中的「静态渲染管线」:对每一个像素做的事情都是一样的——依次算出背景像素、Sprite 像素的颜色,再合成(这些概念一直用到今天的 z-buffer)。这就是早期的 fixed-function pipeline GPU:每个 GPU「线程」都在做完全相同的动作。
// 逐行扫描
for (int row = 0; row < lines; row++) {
    #pragma omp parallel for
    for (int i = 0; i < 64; i++) {
        struct sprite *s = &SPRAM[i];
        if (s->y <= row && row < s->y + 8) { /* 绘制 sprite */ }
    }
    display_row(row);
}
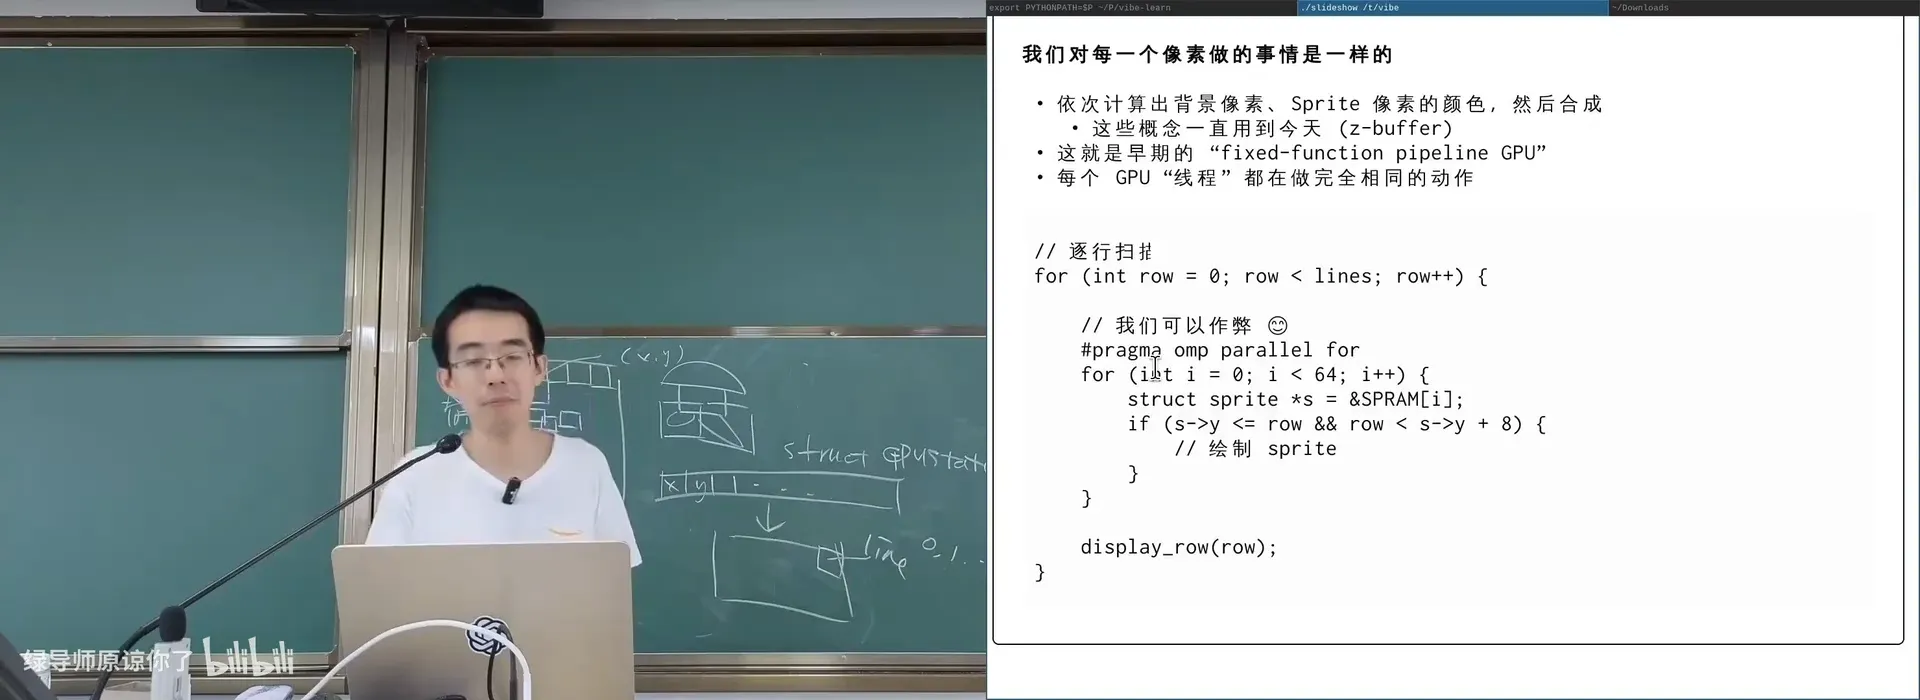
📷 PPU 逐行扫描 + Sprite 匹配:本质上就是 z-buffer 的前身
回到原视频 (00:52:30)
编者说明:讲师指出,这个「把计算固化进电路」的想法在历史上反复出现——「矿卡」就是同一个思路(把哈希计算固化进电路)。「如果你在 1983 年意识到这一点,到比特币热潮时你就会发大财。」
2.3 从 2D 到 3D,再到「可编程着色器」
(参考时间: 00:55)
- 2D 图形:动态拼凑贴图(texture)实现场景绘制——依然是「固定循环、执行相同逻辑」;
- 2D 模拟 3D:Game Boy Advance 上的 V-Rally 3 用二维贴图硬生生贴出 3D;但因为缺少深度信息,affine 贴图会产生视觉错误(贴图扭曲);
📷 2D 贴图硬贴出 3D:缺少深度信息导致 affine 贴图失真
回到原视频 (00:58:00)
- 3D 场景描述:Vertex、Face、Texture、Material、Light、Camera。三角剖分定理保证你看到的一切都是三角形;3D 空间的变换(平移、摄像机投影)在 4 维齐次坐标下都是线性的(一个 4×4 矩阵搞定一切)。
编者拓展|齐次坐标为何巧妙:二维里你无法用一个 2×2 矩阵表示平移(只能旋转/缩放),但把点写成 $(x,y,1)$、放进三维空间,就能用一个 3×3 矩阵把平移也写成线性变换——「你就可以用乘一个矩阵的方式实现三维世界里的一切变化」。
从「数据结构」到「编程语言」:可编程着色器(Shader)
- Vertex Shader:可以编程修改几何形状。Killer application:水面的波纹、毛发的摆动——「本质和 Mandelbrot 一样,给每个顶点跑同样的程序改坐标,不占任何 CPU」;
- Fragment (Pixel) Shader:可以编程修改颜色。典型应用:法线贴图(normal mapping)——在不增加任何多边形的情况下,用「假法线 + 光照夹角」骗过光照计算,让墙面看起来真实立体(远看不穿帮,近看还是会露馅)。
// Fragment shader 干的事:为每一个像素去修改它的颜色值
// 你可以调亮/调暗、做 mask、做法线贴图……
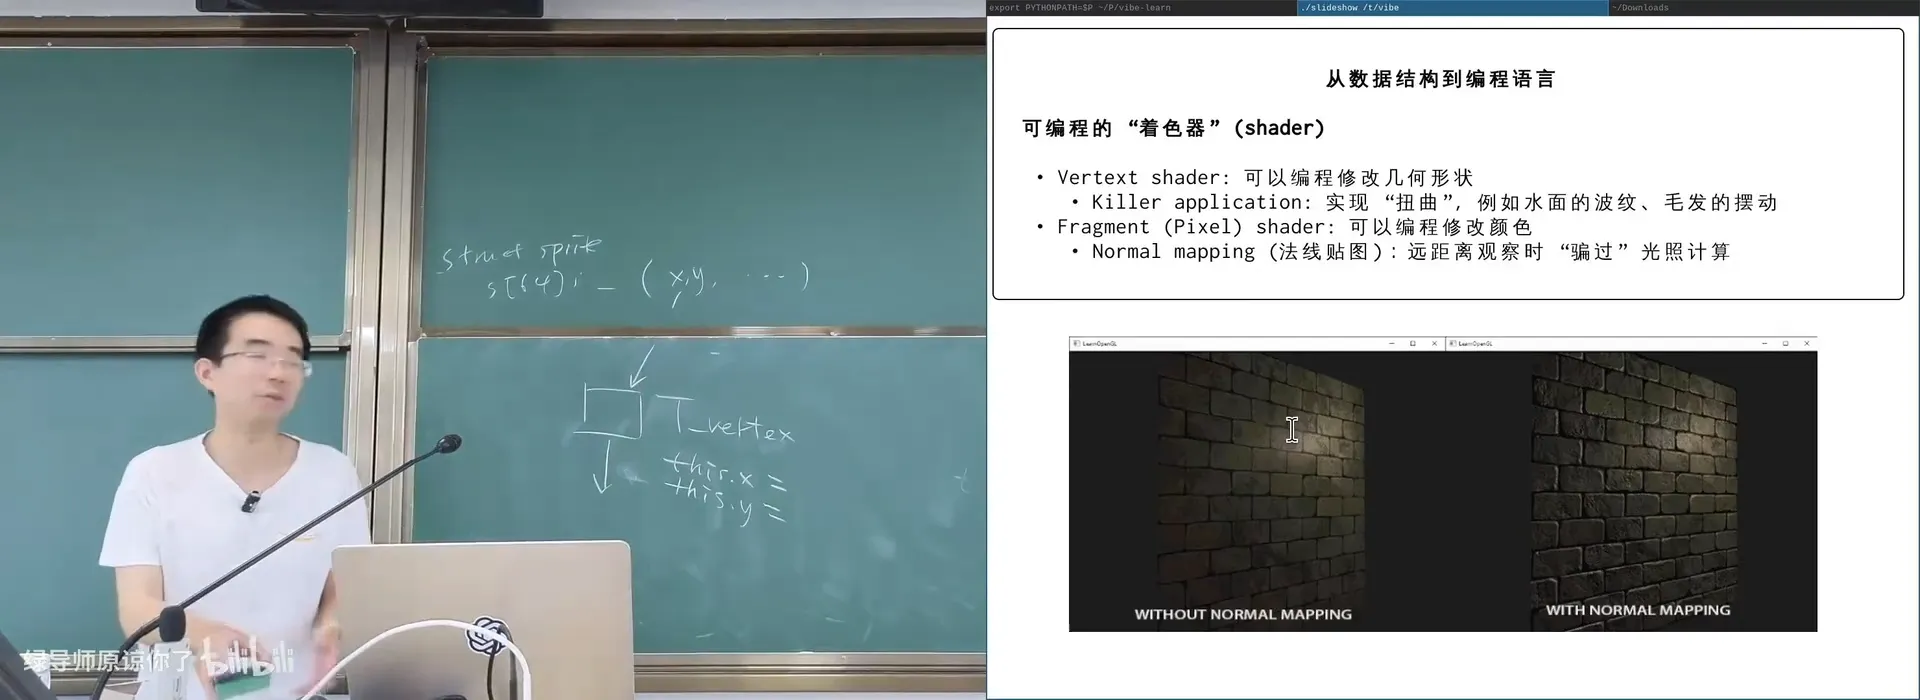
📷 Shader:用「套娃」方式在程序里嵌入 GLSL,跳过完整编译流程作用于像素
回到原视频 (01:05:00)
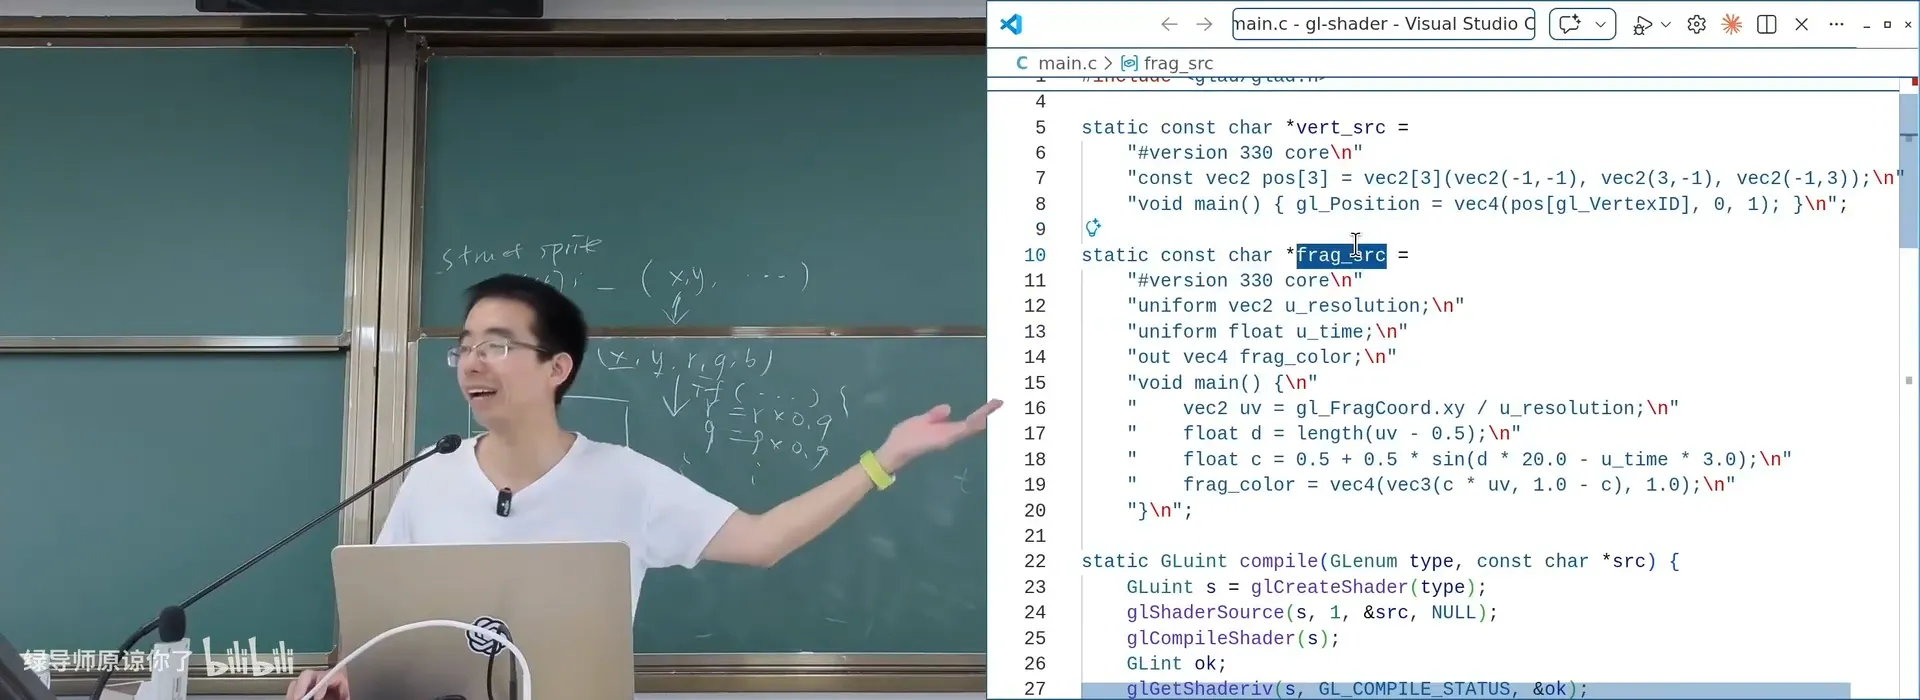
📷 OpenGL Shader:一个字符串形式的程序,被编译后作用到每一个像素
回到原视频 (01:11:00)
2.4 GPGPU:用图形硬件做通用计算
(参考时间: 01:11)
「Shader Program 就是:为一大堆东西执行同一段代码。」——「绕了一圈,又回到《操作系统》讲并发的第一课了!」
2001 年的论文 Fast matrix multiplies using graphics hardware:把科学计算问题变成图片处理问题——用外积分解 $AB = \sum_k A_{,k} B_{k,}$,把矩阵变成「图片」,送到显卡上运算,再用 pixel shader 做「图片叠加」。
2006 年 GeForce 8800(首个 CUDA GPU, G80):128 cores(对比当时 Intel 桌面 CPU 2C4T),首个支持 C 的 GPU,首个使用标量线程处理器的 GPU(程序员不必再手动管理向量寄存器)。RTX 5080 已经有 10,752 个 CUDA Cores——「这是怎么做到的?它们也(可以)是 shared memory 啊!」
三、SIMT:CUDA 的编程模型
3.1 你早就学过 CUDA 了
(参考时间: 01:15)
CUDA 的编程模型,本质上就是在 GPU 上启动海量轻量级线程:
__device__ int *screen;

void T_kernel(int row, int col) {
    int color = f(row, col);        // 任意 C/C++ 代码
    screen[row * 1920 + col] = color;
}

for (int row = 0; row < 1080; ++row)
    for (int col = 0; col < 1920; ++col)
        spawn(T_kernel, row, col);   // 在 GPU 上启动 2,073,600 个线程
「恭喜!你发明了 CUDA(的 programming model)。」——你第一次看到 CUDA 代码里那些 __device__、三个尖括号 <<<...>>> 会觉得害怕,其实一点也不可怕:你只是想创建一大堆线程,它们运行同样的代码。(这也是为什么图形/游戏里每个像素都运行同样的代码。)
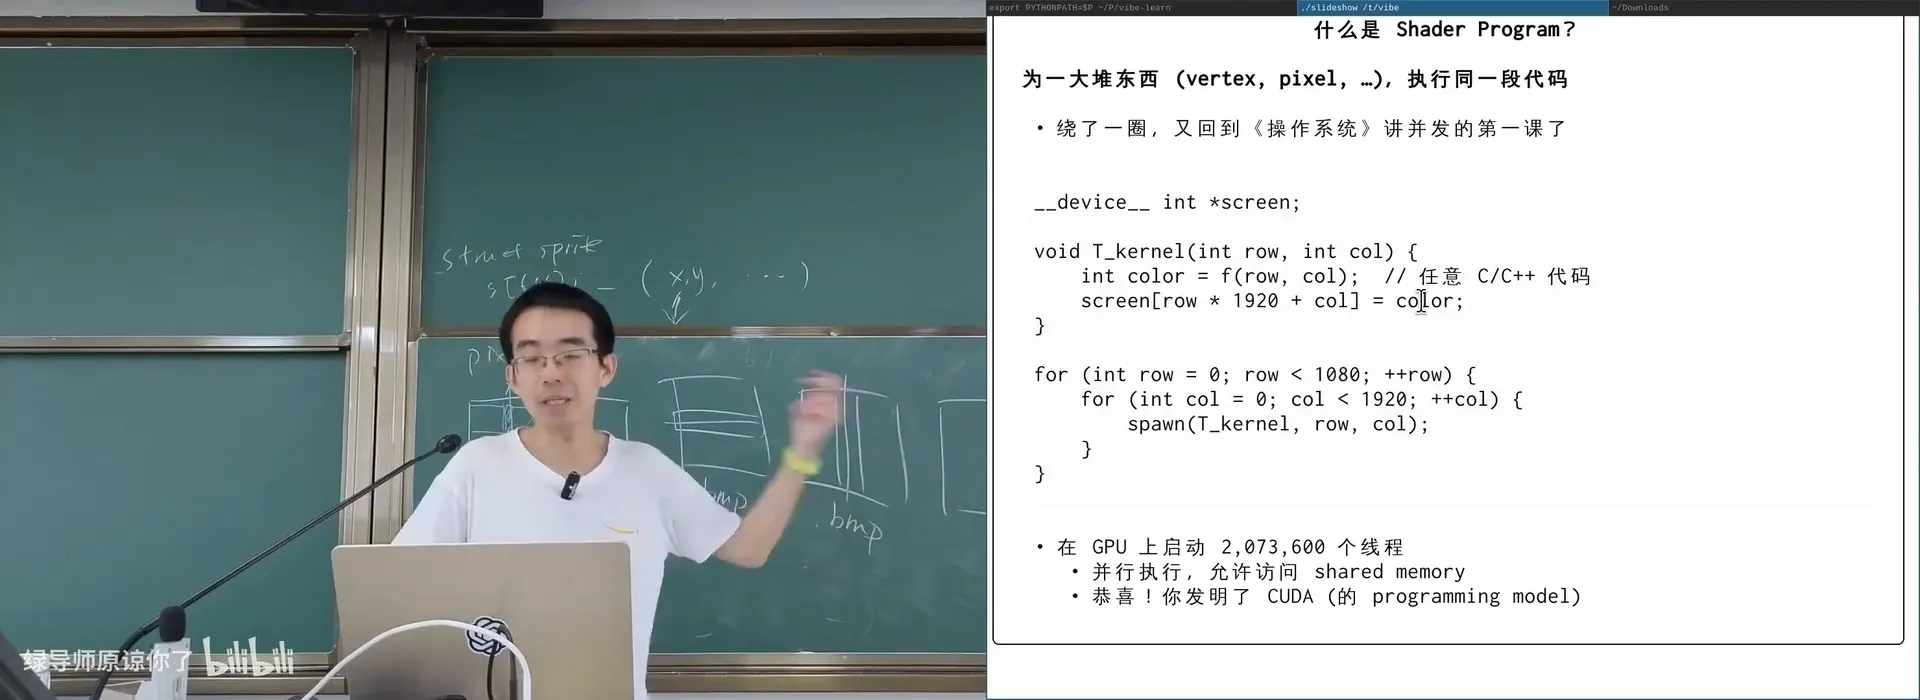
📷 CUDA kernel:为每一个像素 spawn 一个线程,写回显存
回到原视频 (01:16:00)
3.2 SIMT:一个 PC 管一束线程
(参考时间: 01:18)
「为什么会有 GPU?」 回到那个「疯狂想法」:如果每个 CPU 只保留绝对必要的部件(ALU、寄存器),把能被共享的(译码器、取指、PC)只放一份,那交的税就变少了。
SIMT(Single Instruction, Multiple Threads):
- 假设 $(3,0), (3,1), \dots, (3,31)$ 被分配到同一个 core 上,构成一个 Thread Warp(线程束,32 个线程);
- 这一束线程共享同一个 Program Counter——因为取指令/译码要占电路(32 位的指令译码逻辑一大堆
if-else),而寄存器、ALU 省不了,能省的 PC/译码器只放一份; - 于是编译出的 code 里,行/列/颜色都在独立的寄存器里,一条 store 指令执行时:
一条 store 指令 → 生成「非常长」的连续 store
screen[3*1920 + 0] = color_0;
screen[3*1920 + 1] = color_1;
...
Memory coalescing(内存合并)就神奇地发生了——「这一个 thread warp 好像做了一个 128-byte 的 store」。而一个 NVIDIA Stream Multiprocessor 可以保存多个(32 个)warps,当一组线程 load/store stall(比如 cache miss)时,就切换到另一组——以隐藏延迟。
graph TD
    SM["Stream Multiprocessor"] --> W["Thread Warp 0(32 线程,共享 PC)"]
    SM --> W2["Thread Warp 1"]
    SM --> W3["…(共 32 个 warp)"]
    W -->|"load/store stall"| SW["切换到另一个 warp"]
    SW --> W2
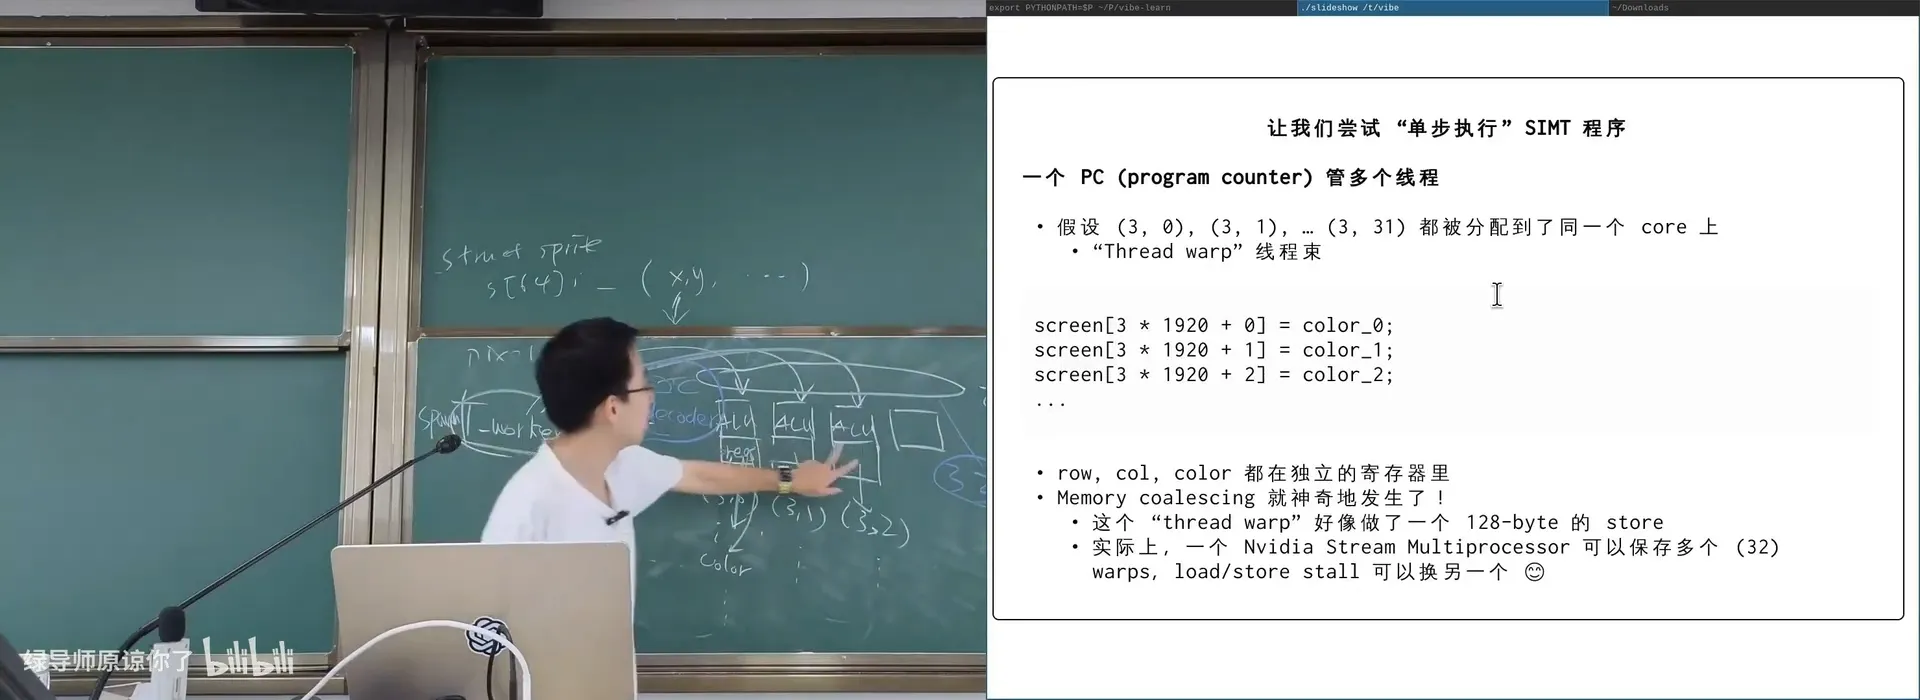
📷 SIMT:一束线程共享一个 PC,一条 store 变成一段连续的 128-byte store
回到原视频 (01:22:00)
3.3 SIMT 的代价:分支与内存合并
(参考时间: 01:26)
这也意味着 CUDA 程序很难写:
- 内存访问的连续性极其重要:
map[row*1920+col]是连续的(最佳性能),改成等价的map[row+col*1080]就性能爆差(内存全不连续,内存控制器只能一个 word 一个 word 地写); - 分支(branch)非常讨厌:一个 PC 无法「二选一」。CUDA 编译出的所有内容没有真正的 if/else——它把
if A else B变成「算一个条件放进寄存器 → 根据寄存器值 disable 掉不满足条件的线程 → 线性地先执行 A 再执行 B」。SIMT 不是没有代价的。
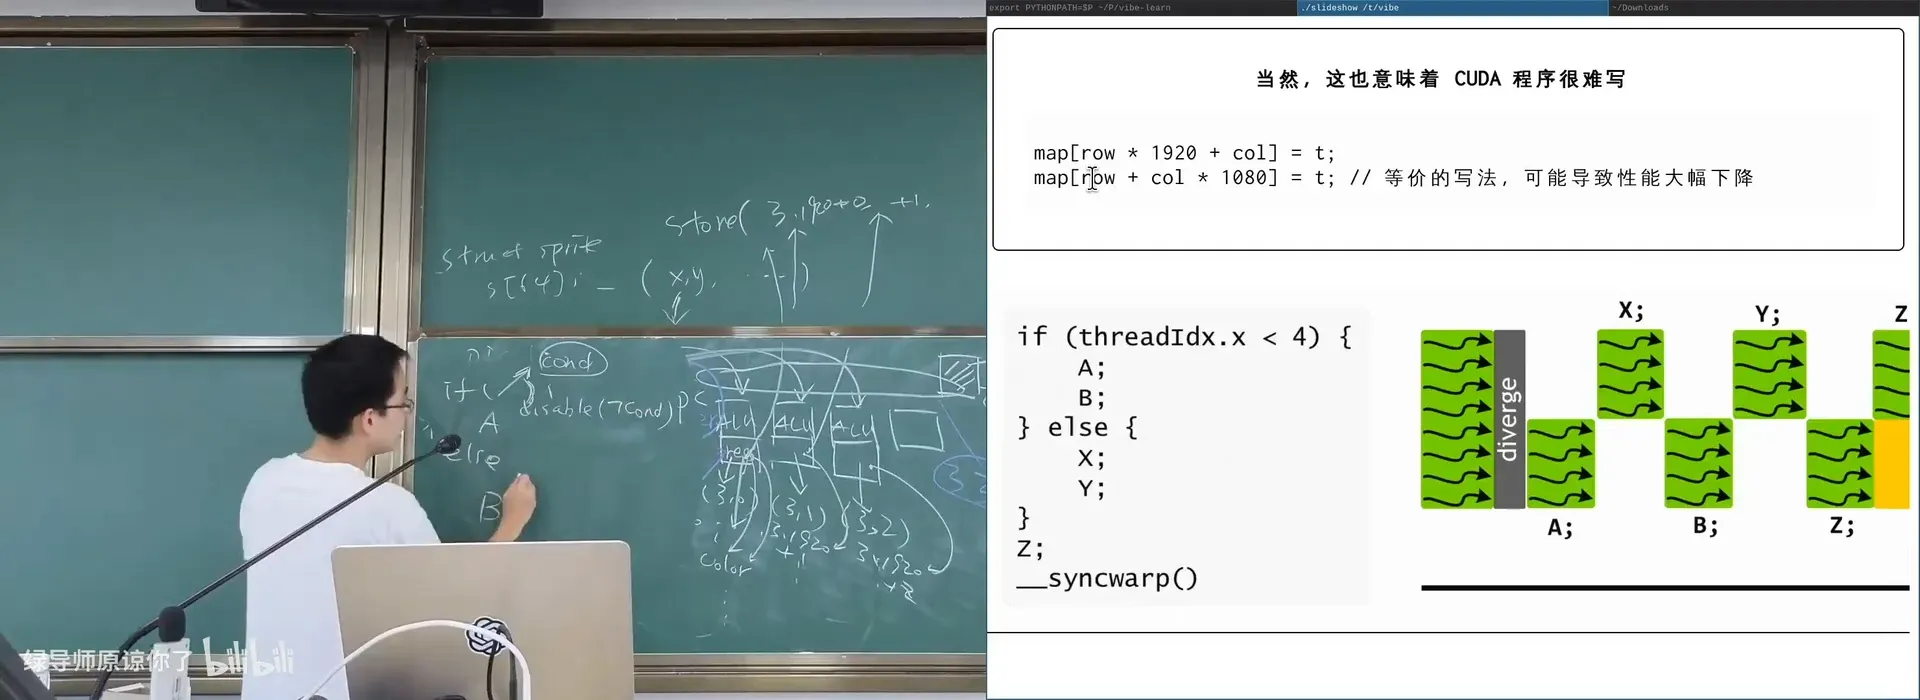
📷 SIMT 的分支:没有真正的 if/else,而是「disable 不满足条件的线程」线性执行
回到原视频 (01:29:00)
编者拓展|CUDA 的收益:渲染 25600×25600 的 Mandelbrot Set——Ryzen 5 9600X:25.1s @ 65W;RTX 4060Ti:6.1s @ 42W(而且这已经是对 CUDA「不太友好」的程序:不确定的 while 循环,最慢的那个线程会拖慢整个 thread warp)。「经过编译器优化,GPU 上的汇编比你想象的短,你可以直接阅读它——但 GPU 并不擅长执行数据中心里的业务逻辑。」
总结
- CPU 内部的并行:逻辑门天生并行;现代 CPU 是「编译器」(乱序发射、按序提交)。可以用
perf stat测 IPC、用 BogoMIPS 感受「一个周期多条指令」。 - 功耗墙($P=CV^2f$)与暗硅时代:为了「跑得快」浪费了大量能量;于是有两条路——SIMD(一条指令处理更多数据,摊薄调度代价)和更多更简单的处理器(big.LITTLE)。
- SIMD:MMX(64-bit,4×int16)→ SSE → AVX → AVX-512;支持更多类型与运算(Shuffle、FMA)。但它仍参与动态流水线,没解决根本问题;VLIW 是激进的失败尝试(大模型时代可能复活)。
- GPU 的时间线:Magnavox Odyssey(1972)→ NES 的性能危机(把「算什么」和「怎么画」分开,用「场景描述」数据结构 + 专用硬件)→ 2D→3D → 可编程着色器(vertex/fragment shader) → 用图形硬件做通用计算(GPGPU)。
- SIMT / CUDA:为海量数据执行同一段代码;一束线程(warp)共享一个 PC(省译码电路),一条指令生成连续的内存访问(memory coalescing),用多 warp 切换隐藏延迟。
- 代价:CUDA 程序难写——内存访问必须连续、分支会「divergence」。但收益巨大(Mandelbrot:6.1s vs 25.1s)。
- 历史回望:从 CPU 到领域加速器,再变「通用」一点,就是 GPGPU。出乎 Nvidia 意料的是,CUDA 没有在科学计算掀起革命,却引领了人工智能的时代。
附:官方参考与延伸阅读
本讲的讲义见课程主页,以下链接按书中出现顺序整理:
| 主题 | 链接 |
|---|---|
| RISC-V 处理器模拟器(mini-rv32ima) | https://jyywiki.cn/OS/demos/intro/mini-rv32ima |
| 指令级并行(cpu-ilp) | https://jyywiki.cn/OS/demos/concurrency/cpu-ilp |
| OpenGL Shader(gl-shader) | https://jyywiki.cn/OS/demos/concurrency/gl-shader |
| CUDA 实现的 Mandelbrot Set(mandelbrot-cu) | https://jyywiki.cn/OS/demos/concurrency/mandelbrot-cu |
| MMX 手册 | https://jyywiki.cn/OS/manuals/mmx.pdf |
| Larson & McAllister, Fast Matrix Multiplies Using Graphics Hardware(SC'01) | https://dl.acm.org/doi/pdf/10.1145/582034.582089 |
| NVIDIA Fermi 白皮书 | https://www.nvidia.com/content/PDF/fermi_white_papers/NVIDIA_Fermi_Compute_Architecture_Whitepaper.pdf |
| Game Boy Advance: V-Rally 3 | https://www.bilibili.com/video/BV1bT4y1g75x/ |
| OSTEP:Operating Systems: Three Easy Pieces | https://pages.cs.wisc.edu/~remzi/OSTEP/ |
perf-stat(1) 手册 |
https://man7.org/linux/man-pages/man1/perf-stat.1.html |
| CUDA C++ Programming Guide | https://docs.nvidia.com/cuda/cuda-c-programming-guide/ |
阅读材料:如有 GPU 设备,可动手跑一跑 mandelbrot-cu,对比 CPU 版本;并让 AI 帮你解释 SIMT 模型生成的 GPU 汇编。
版权说明:本讲讲义与幻灯片作者为蒋炎岩,采用 Creative Commons BY-NC 4.0 许可,来源于 https://jyywiki.cn/OS/2026/。视频画面与字幕版权归原作者所有。本书为课堂内容的学习性重构。