第21讲 · 一个 Token 的旅程
2026 南京大学《操作系统原理》第二十一讲 · 课堂实录重构
| 主讲 | 蒋炎岩(Yanyan Jiang) |
| 视频 | https://www.bilibili.com/video/BV1zS5R6tEWZ/ |
| 课程主页 | https://jyywiki.cn/OS/2026/ |
| 本讲讲义 | https://jyywiki.cn/OS/2026/lect21.md |
| 讲义 / 幻灯片作者 | 蒋炎岩,https://jyywiki.cn/ |
| 讲义 / 幻灯片许可 | CC BY-NC 4.0 |
| 图片来源 | 书中插图为课堂演示与讲义渲染图;演示类截图为视频画面 |
对应讲次:第21讲(南京大学 操作系统原理)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者说明:本书由课堂录像的语音字幕重构而成,术语、章节骨架与参考链接已按课程官方讲义(
lect21.md)校准。讲师的口语风格、类比与案例被尽量保留;编辑性的补充一律以「编者说明」或「编者拓展」标出。
引子:并发部分的最后一课
(参考时间: 00:00)
课程进行到后半程,大家应该已经感受到 malloc lab 的「恶意」了:写一个并发程序、哪怕是 lock-free 的一小块底层,一点点小错误都极其致命。所以要对系统设计者心存敬畏——你需要一整套方法与工具(如 sanitizer、deadlock detector),人类本身很难做好。
前几周讲的并发内容串起来:
- 入门:
spawn/join——打开魔鬼的盒子,一切计算图的并行基础;再加互斥锁、条件变量、信号量去同步; - 面向异构复杂线程:更轻量的线程(coroutine、non-blocking I/O、goroutine)、异步编程(Promise、async/await)——本质都是某种
spawn/join,只不过并行交给运行框架; - 面向同构小而短的线程:最大化计算密度与能效比——SIMD 与 SIMT/CUDA。
今天,我们看真实的系统。 用一个「Token 的旅程」把学过的知识全串起来:当我与大模型对话,然后收到 token,这中间大概发生了什么。
一、用户的视角
1.1 让 DeepSeek 和我聊聊天
(参考时间: 00:06)
DeepSeek 官方 API 文档给出的用法:
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -d '{
        "model": "deepseek-v4-flash",
        "messages": [ {"role": "user", "content": "Hooo."} ],
        "stream": true
      }'
- 环境变量
DEEPSEEK_API_KEY是操作系统课的内容(还记得期中考的execve的envp吗?它会加载到栈上、并在子进程间继承); - jyywiki.cn/submit.sh 也是同样的套路(
curl);我们准备了一个「有功能」的 Python 版本——用strace把它拆开:建立连接、发送 HTTP request、等待数据。
📷 DeepSeek API 文档:一个 curl 请求就是一个 HTTP 请求
回到原视频 (00:06:00)
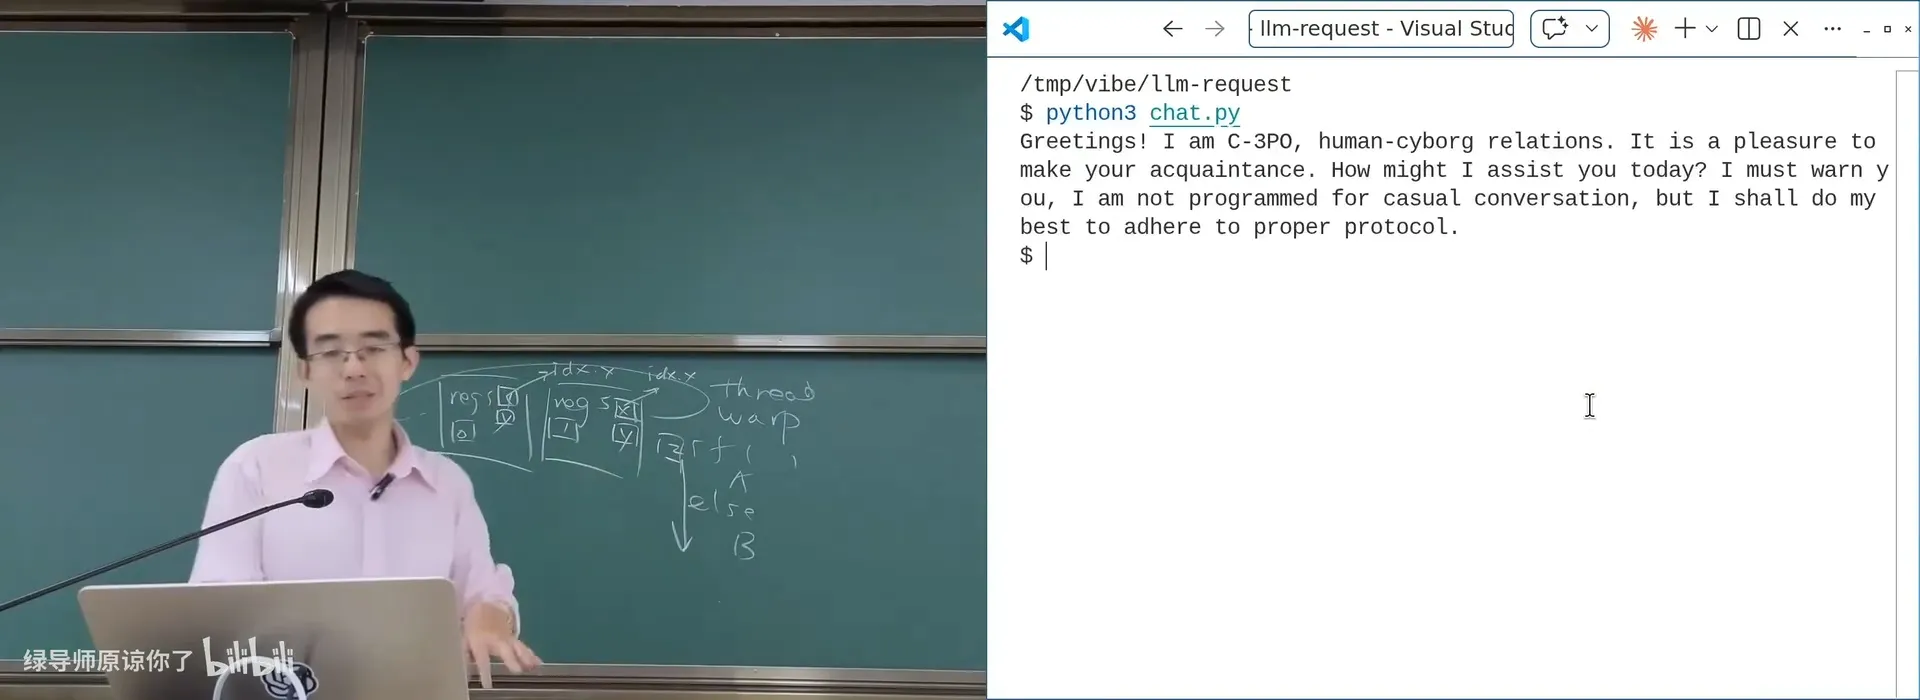
📷 我们用 requests 库写的命令行聊天程序:可以管道式地喂输入
回到原视频 (00:09:00)
1.2 用 strace 看系统调用
(参考时间: 00:10)
在操作系统课上我们选择「逃课」网络部分,但给了大家一个工具——strace:让 AI 去 trace 网络相关的系统调用,看一个 HTTP 请求在系统调用层面到底发生了什么:
- DNS 解析、TCP 三次握手(
connect到 443 端口); read/write/send/recv—— 你看到的文本形式的 HTTP 数据;- 每一层协议都在包头加东西——这就是「网络税」。
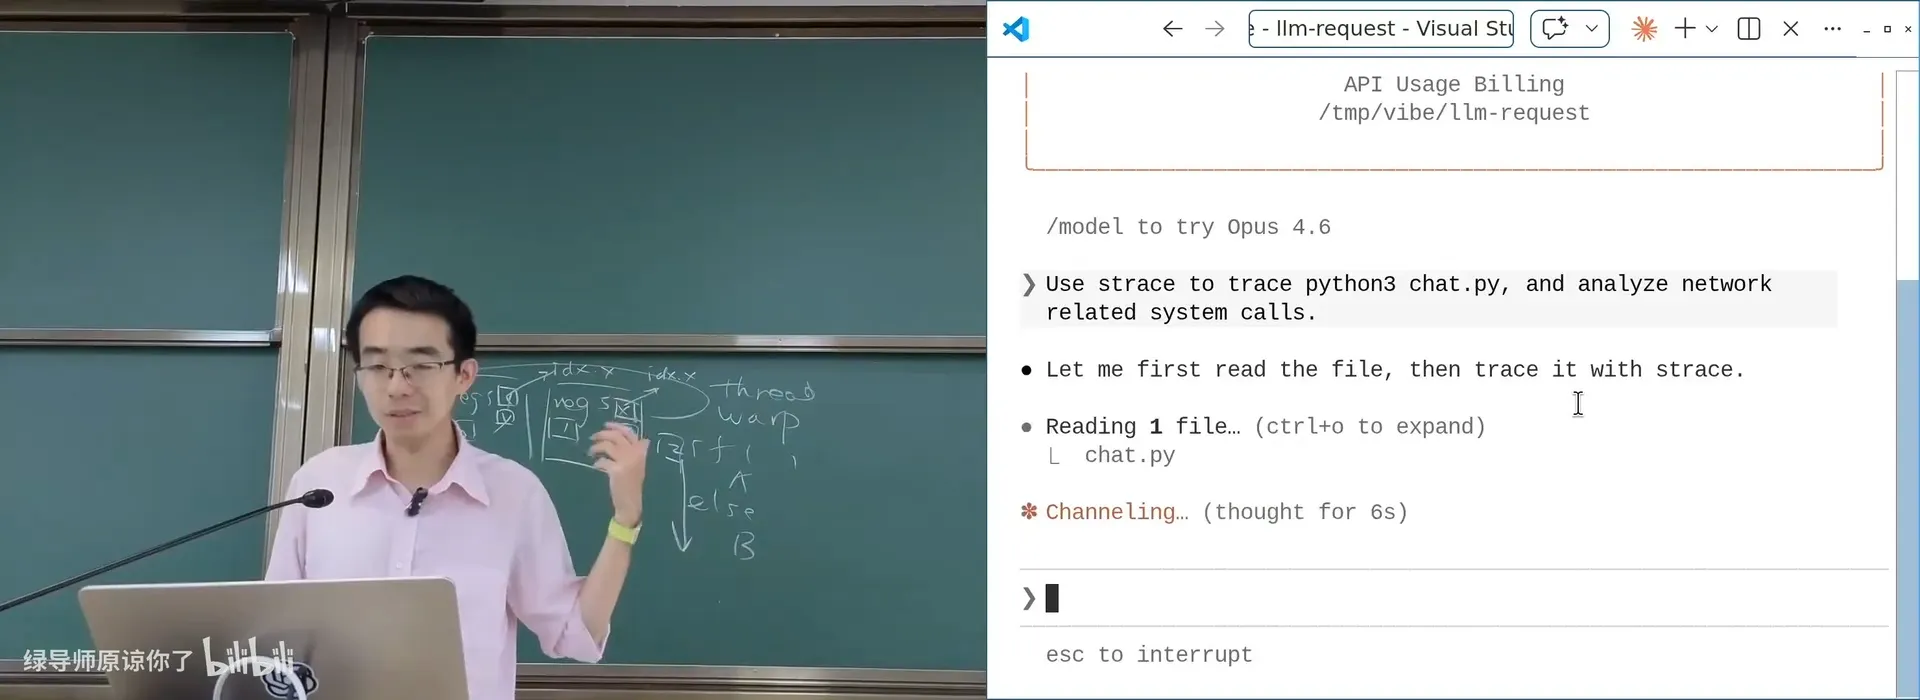
📷 用 strace 拆开程序:DNS、connect、收发数据一览无余
回到原视频 (00:10:30)
编者拓展|DNS 端口是 53:讲师特意提了一句——「你们网络课会不会考 DNS 是哪一个端口?53。你反复观察程序的执行,就会对这些事情留下印象,考试的选择题里你一眼就能想到。」这类「见过就记住」的经验,正是动手的价值。
1.3 数据如何到达另一台机器
(参考时间: 00:13)
第一步:DNS 解析——域名 → IP:
dig api.deepseek.com +short
你会发现 DeepSeek 不止一个 IP(DNS 本身就在做负载均衡);而且在地球不同地方执行会得到不同的 IP——真实面向全球的服务比想象的复杂,请求很可能走到的是腾讯云 CDN 的节点。
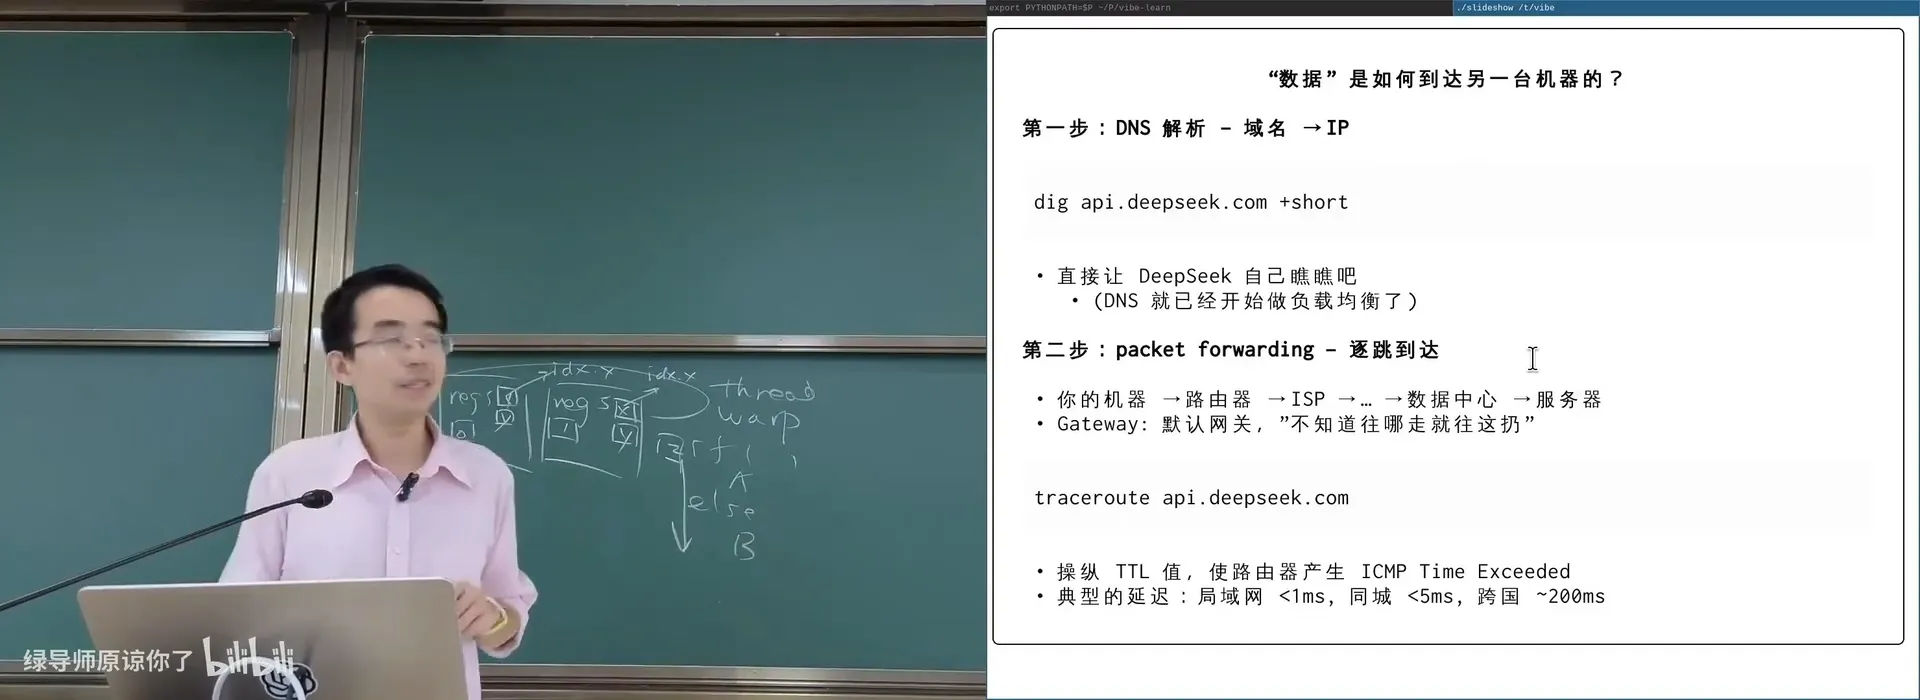
📷 dig api.deepseek.com:DNS 返回多个 IP,开始做负载均衡
回到原视频 (00:13:00)
第二步:packet forwarding——逐跳到达:
traceroute api.deepseek.com
它操纵 TTL 值,让路由器产生 ICMP Time Exceeded,从而逐跳探查链路。典型延迟:局域网 <1ms,同城 <5ms,跨国 ~200ms。默认网关(Gateway)就是「不知道往哪走就往这扔」。
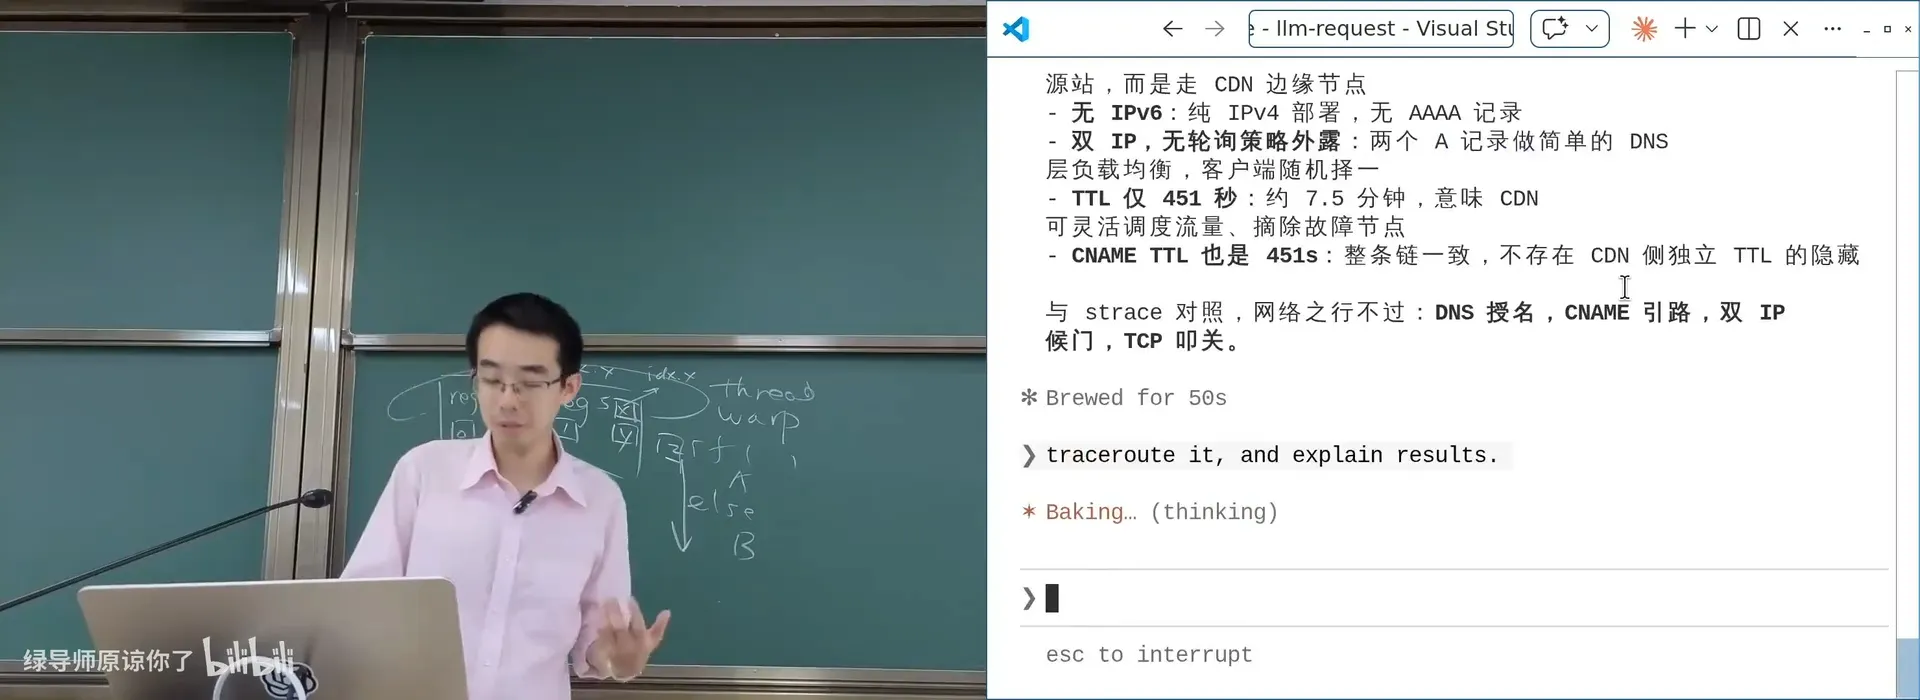
📷 traceroute:操纵 TTL 逐跳探查网络链路
回到原视频 (00:15:00)
1.4 到达数据中心:Load Balancer
(参考时间: 00:16)
你可以亲眼看到 response(curl -i):
HTTP/2 200
server: openresty
content-type: text/event-stream
cache-control: no-cache
connection: keep-alive
「server: openresty」说明这里很可能只是一个 API 网关/负载均衡——它会把请求转发给真正的业务服务器。而且 https://api.deepseek.com/ 和 https://www.deepseek.com/ 是不同的服务(前者 openresty,后者 tencent-cos)。
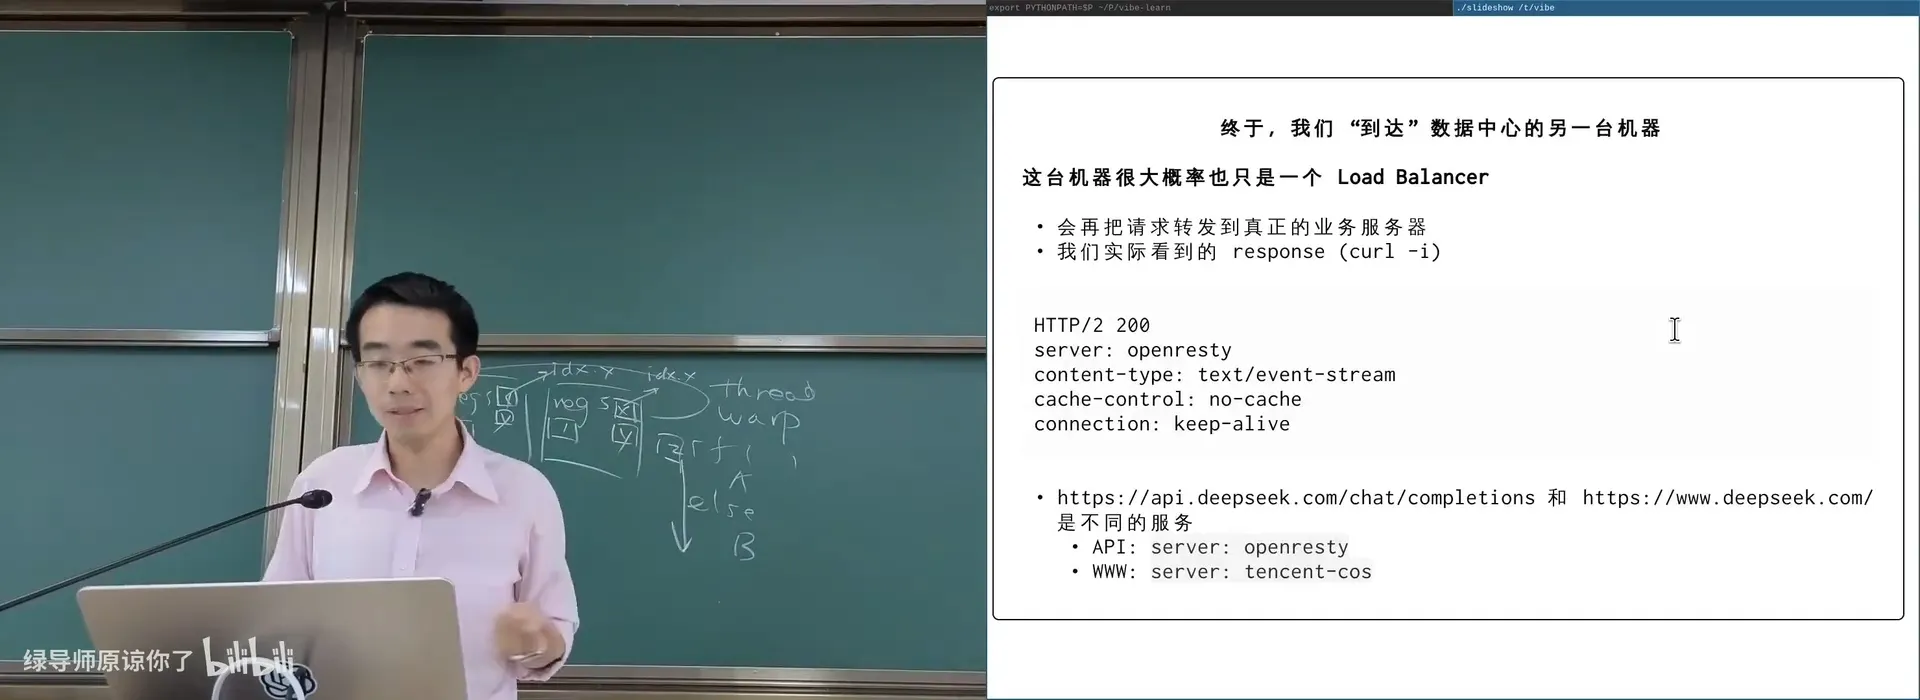
📷 curl -i:`server: openresty` 暴露了 API 网关/负载均衡
回到原视频 (00:16:30)
最终到达业务节点:它收到 Header 里的 DEEPSEEK_API_KEY、Body 里的 JSON(model、messages、stream……)。真正的麻烦才刚开始——服务端要鉴权、计费、审计……后面还连着数据库、缓存、消息队列……我们学的操作系统 API、并发编程,默默支撑了这一切。
二、进入数据中心
2.1 数据中心:互联网 & AI 时代的幕后英雄
(参考时间: 00:21)
Datacenter:“A network of computing and storage resources that enable the delivery of shared applications and data.” —— CISCO
- 上半场:应用后端(199X – 至今):从静态 http 页面(Yahoo!)→ Web 2.0(Facebook)→ 移动互联网(iOS/Android)。「云端有你的完整 personality——同时也意味着我们其实没有任何隐私 😂」;
- 下半场:AI 推理(2022 – 至今):DeepSeekV4 Flash 是 284B-A13B(总参数 284B,激活 13B)、Pro 是 1.6T-A49B——「这还只是 per token 的计算量,不包括 attention 的成本。」
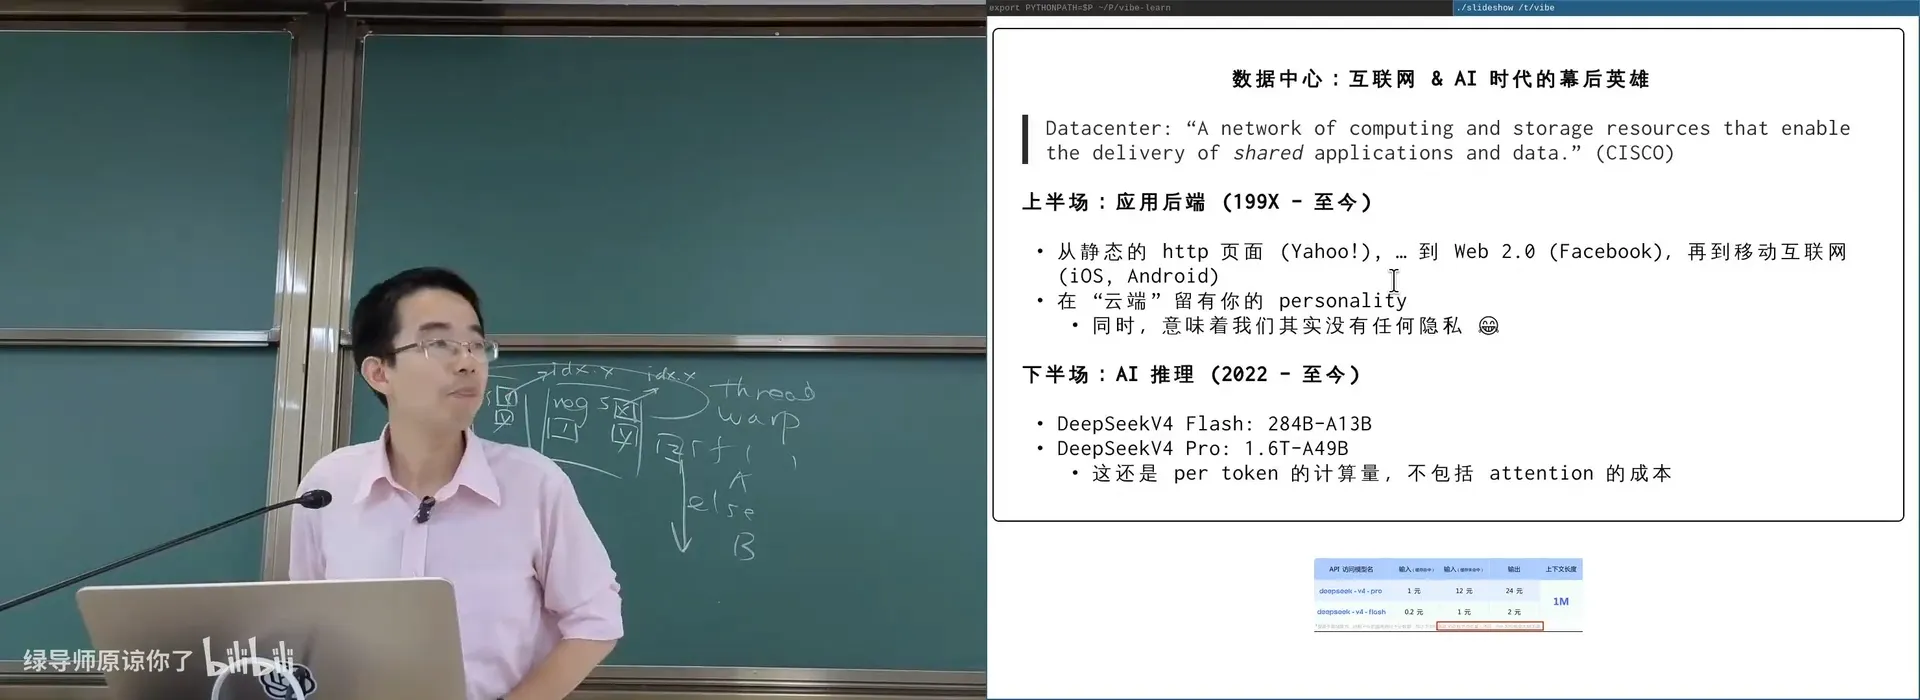
📷 数据中心的下半场:DeepSeekV4 的参数规模
回到原视频 (00:22:30)
编者拓展|数据中心的产业链与「世界模型」:讲师说,学校教「做题」,很少教「题目是怎么来的」。但市场的供需关系永远存在——朝阳产业需要更多人,夕阳产业会陷入内卷。技术总有一天过时,你要获得「推导出这些技术」的能力,才能获得 vision。他还提到学校不太教的「世界模型」:产业结构、市场环境、企业的本质、供应链、股权、激励机制……「做题家们进入社会,还会经历一次重新学习。」
2.2 数据中心里的海量分布式数据处理
(参考时间: 00:27)
- 实时的「小数据处理」(CRUD):订单事务、内容分发、用户鉴权、弹幕、计费、视频串流……(DeepSeek Chat 会保存完整的聊天记录,允许继续追问);
- 半离线的「中数据处理」:周期记账、备份、数据看板……
- 离线的「大数据处理」:内容索引、数据挖掘、流量分析……
- 所有应用,无一例外:豆包、千问、搜索、社交、支付、游戏……
编者说明:讲师指出 CRUD 是「传统数据中心」的核心。以 DeepSeek 为例,API 与网页后端不同:网页会保存你完整的聊天记录,所以你明天可以回到网页继续追问。
2.3 The C10K Problem
(参考时间: 00:30)
Dan Kegel, 1999:It's time for web servers to handle ten thousand clients simultaneously, don't you think? After all, the web is a big place now.
while (true) {
    Request *rq = get_request();
    pthread_create(&tid, NULL, handle_request, rq);
    // 如果软件写得不好,就无法支撑 C10K
}
C10K 催生了 epoll、Nginx、事件驱动架构,以及之前的并发模型(goroutine 等)。再等到 C10M 的时代(一千万并发),就必须走向分布式系统了(Google, 2003)。
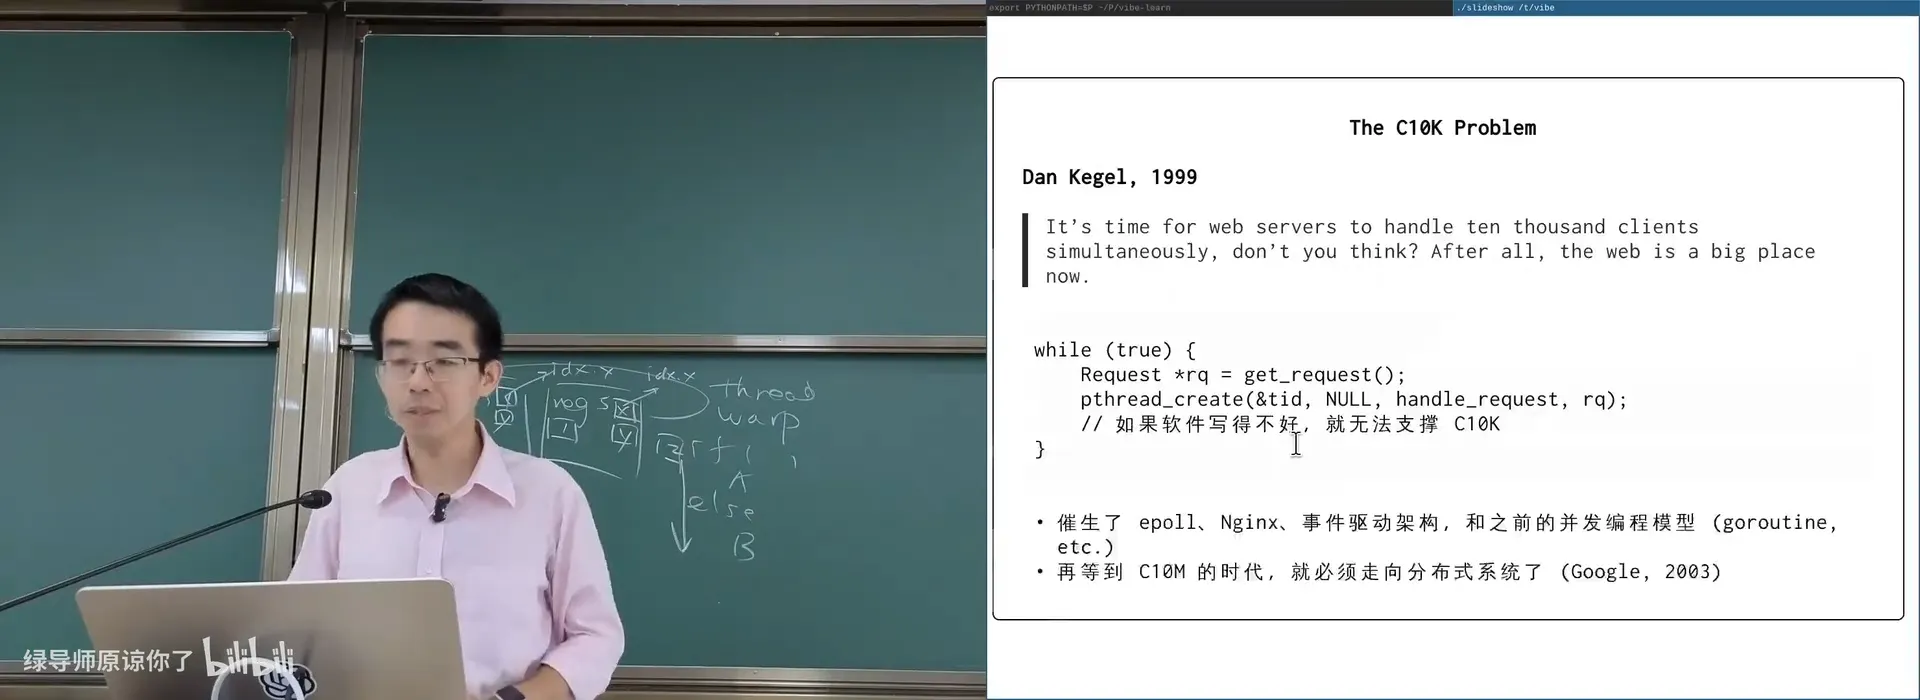
📷 The C10K Problem:一万个并发客户端催生了 epoll / 事件驱动
回到原视频 (00:30:30)
2.4 数据中心里的并发编程为何难
(参考时间: 00:33)
- 高吞吐(QPS)& 低延迟的事件处理:处理一个事件可能关联 1000 多个模块(这是一个计算图);
- P99/P999 Latency 关键:一次 fully locked hash table resize 就能造成性能事故——几十 MB 的 memory copy + 迁移,延迟可达 100ms,而此时几万个并发客户端全都要等,对 P99 是毁灭性伤害;
- DoS(Denial of Service):全国的小爱音箱在小米汽车发布会上同步瘫痪;
- 超高可靠性:99.9999% 的可用性和绝对的数据正确性。
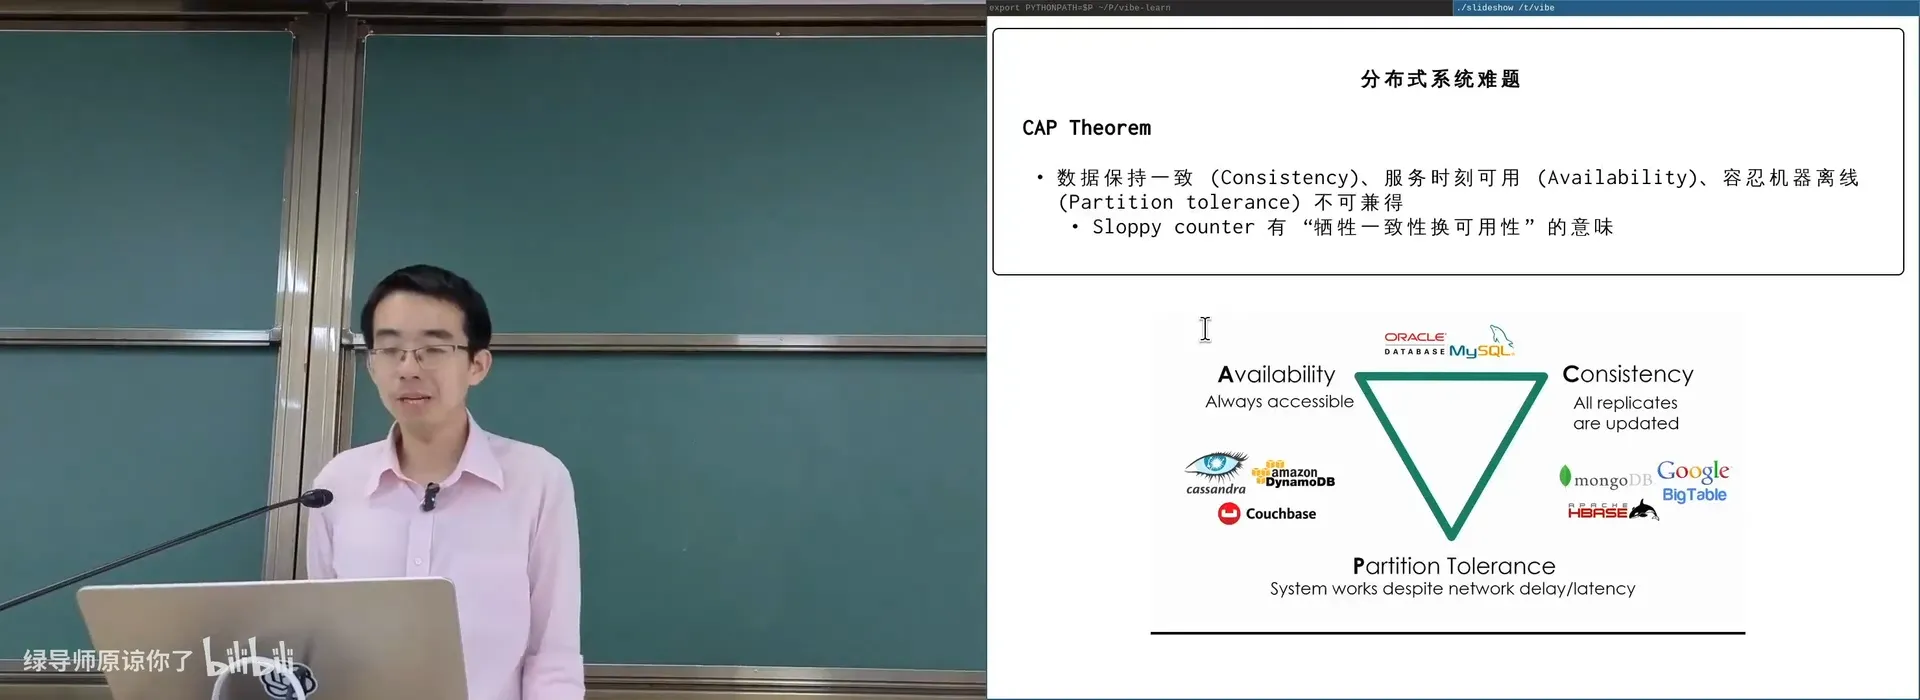
编者拓展|CAP 定理(不可能三角):数据保持一致(Consistency)、服务时刻可用(Availability)、容忍机器离线(Partition tolerance)——三者不可兼得。讲师用发朋友圈的例子讲得很传神:你先拉黑你妈(一个 CRUD 请求),然后发朋友圈;如果你的手机从校园网切到 5G,两个请求可能落到不同的数据中心——网络分区时,要么看到朋友圈(牺牲一致性),要么等同步完成(牺牲可用性)。实际系统花了约 10 年(从 Google 那几个分布式系统开始)让用户完全感受不到 CAP 的存在。
2.5 解决方法:重新设计系统接口
(参考时间: 00:44)
以 LLM Request 为例:
DEEPSEEK_API_KEY需要从 key 反查到账号做鉴权、billing,还要做日志记录(审计、429 频率控制);而同一个 key 可以被多个机器使用(真正的并行),用户还可以随时 disable API key——这就立即撞到了 CAP 定理的墙(分布式的锁开销从 ns 级到 ms 级,还有随时可能发生的 non-deterministic delay/crash)。UNIX 的设计(open/read/write)对单机应用很好,对分布式应用不行:
- 数据 v.s. 计算:UNIX 是把数据带到计算(管道流式);分布式系统必须把计算分发到机器/线程(把计算带到数据);
- 容错和可靠性:UNIX 假设机器和程序都是可靠的;分布式系统必须支持透明的网络延迟/容错(重算)。
扩展 UNIX 的设计(「Everything is a file 在 UNIX 时代成功了,在分布式计算时代依然可以」):
系统 作用 Google File System 数据依然是文件(byte array),分片存储在成百上千台机器上 BigTable 在文件基础上构建 key-value 数据库,解决 CRUD(OLTP, Transactional) MapReduce 限制计算必须是「能 scale out」的形式,解决后台索引(OLAP, Analytical) 2.6 如何为大规模分布式系统编程?
(参考时间: 00:51)
「其实只要抄之前 Promise 的答案就行了」:
足够好的存储系统 + 描述数据上的计算图 = Serverless Computing
Function as a Service: Write Once, Planet Scale —— 用函数的写法表达分布式流程,C10M 就让厂商去头疼吧。
const dynamo = new AWS.DynamoDB.DocumentClient();
exports.handler = async (event) => {
    const apiKey = event.headers['Authorization']?.replace('Bearer ', '');
    const user = await dynamo.send(new GetCommand({
        TableName: 'APIKeys', Key: { apiKey }
    })).Item;
    if (!user || user.disabled) {
        return { statusCode: 401, body: ... };
    }
    return {
        statusCode: 200,
        body: do_llm_inference(...),  // 就剩下它了
    };
};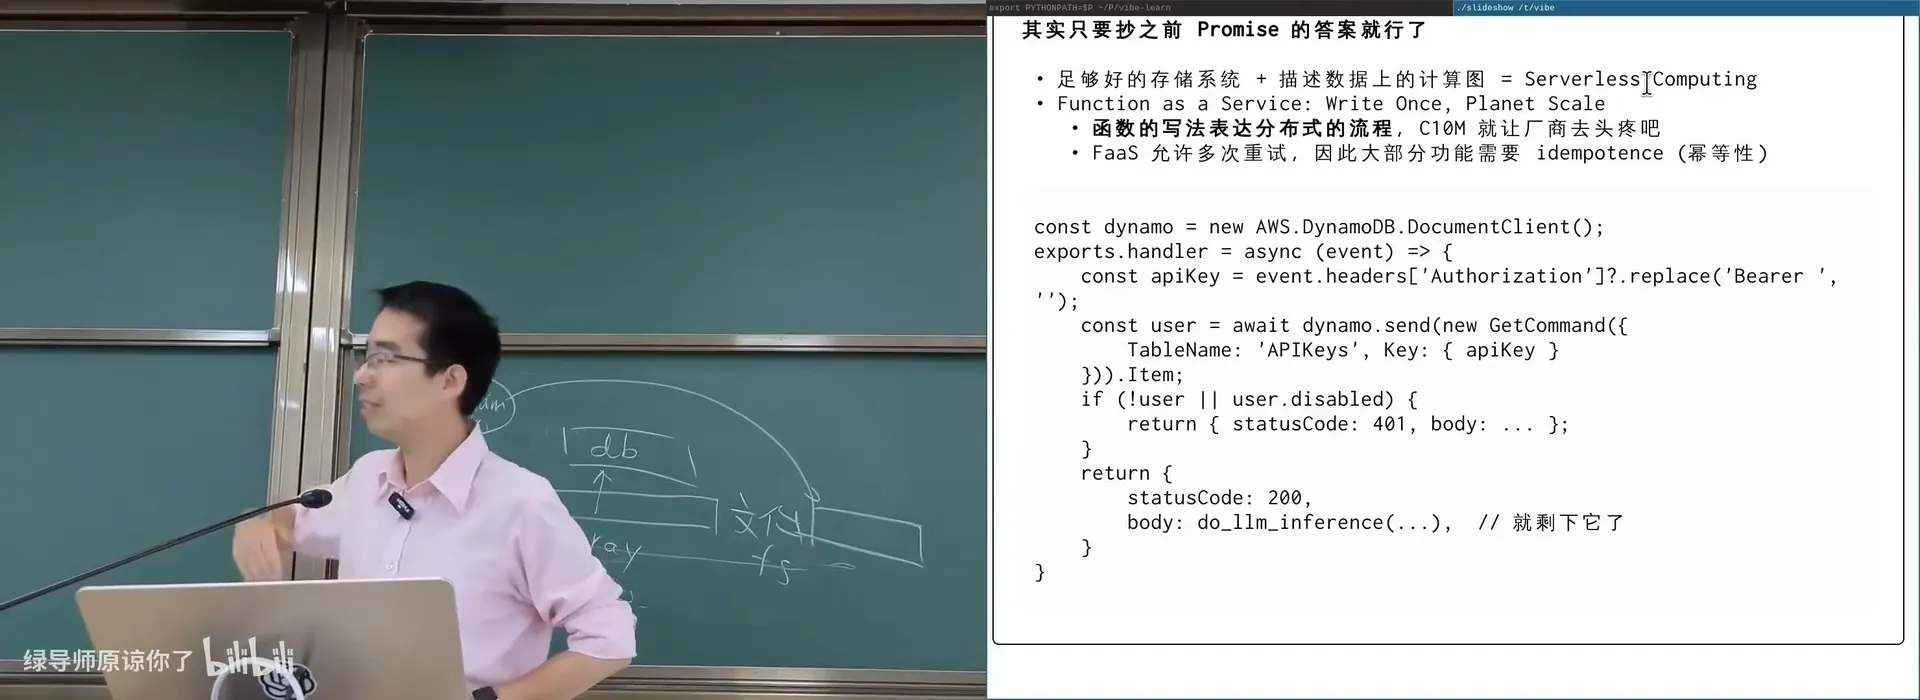
📷 Serverless / FaaS:一个 event handler 描述计算图,infrastructure 交给厂商
回到原视频 (00:53:00)编者拓展|幂等性(idempotence):FaaS 允许多次重试,因此大部分功能需要幂等。讲师举了记账的例子:如果是
sum = load(); sum++; store();,一旦中途 crash 重跑,账会被记两次;正确做法是产生一个 random key、往一个 set 里加、然后取 set 的大小——这样无论跑几次结果都一样(幂等)。「random key 在函数进入系统时就申请好。」
三、从 Token 到 Tensor
3.1 进入 SIMT 的世界
(参考时间: 01:00)
do_llm_inference()的本质:next-token prediction——从一个「学到的」函数里采样。这是一个非常大的计算图,但存在一个「很短的 generator」(gpt.c)。编者拓展|The Bitter Lesson(苦涩的教训):Richard Sutton 的著名文章——凡是依赖「人类手工知识」的方法,长期看都会被「能随算力规模化」的通用方法打败。 Transformer 战胜 LSTM 正是这一规律的又一次应验。
为什么需要 tensor?——一个数字叫 scalar,一维数组叫 vector,二维数组叫 matrix,更高维就叫 tensor。图像是矩阵,但深度学习里图像有 RGB 3 个 channel,经过卷积后维数越来越多,再加上 batch 又有好多份……「这个高维数组就是 tensor,没有什么神秘的,是实现系统时很自然会用到的概念。」
📷 从标量、向量、矩阵到 Tensor:图像有 RGB 通道,维度越堆越高
回到原视频 (01:03:00)3.2 Attention is All You Need
(参考时间: 01:06)
每一层 Transformer(head)都是「一本书」,输出一个「改写后的版本」(去掉噪声,越来越接近天书):
- Q(Query):需要补全的句子——「我在找什么」;
- K(Key):书的目录——「我有什么」;
- V(Value):书的内容——「具体内容是什么」,甚至这也是学出来的。
「看书」以后生成短时记忆,不需要再看 context,直接经过全连接层「重写」记忆,传给下一层。每往上一层,信息密度就越接近最后要输出的 next token——「有意思的地方是:越后面的层,你越不知道你看到的是什么,因为书里每个东西都是学出来的。」
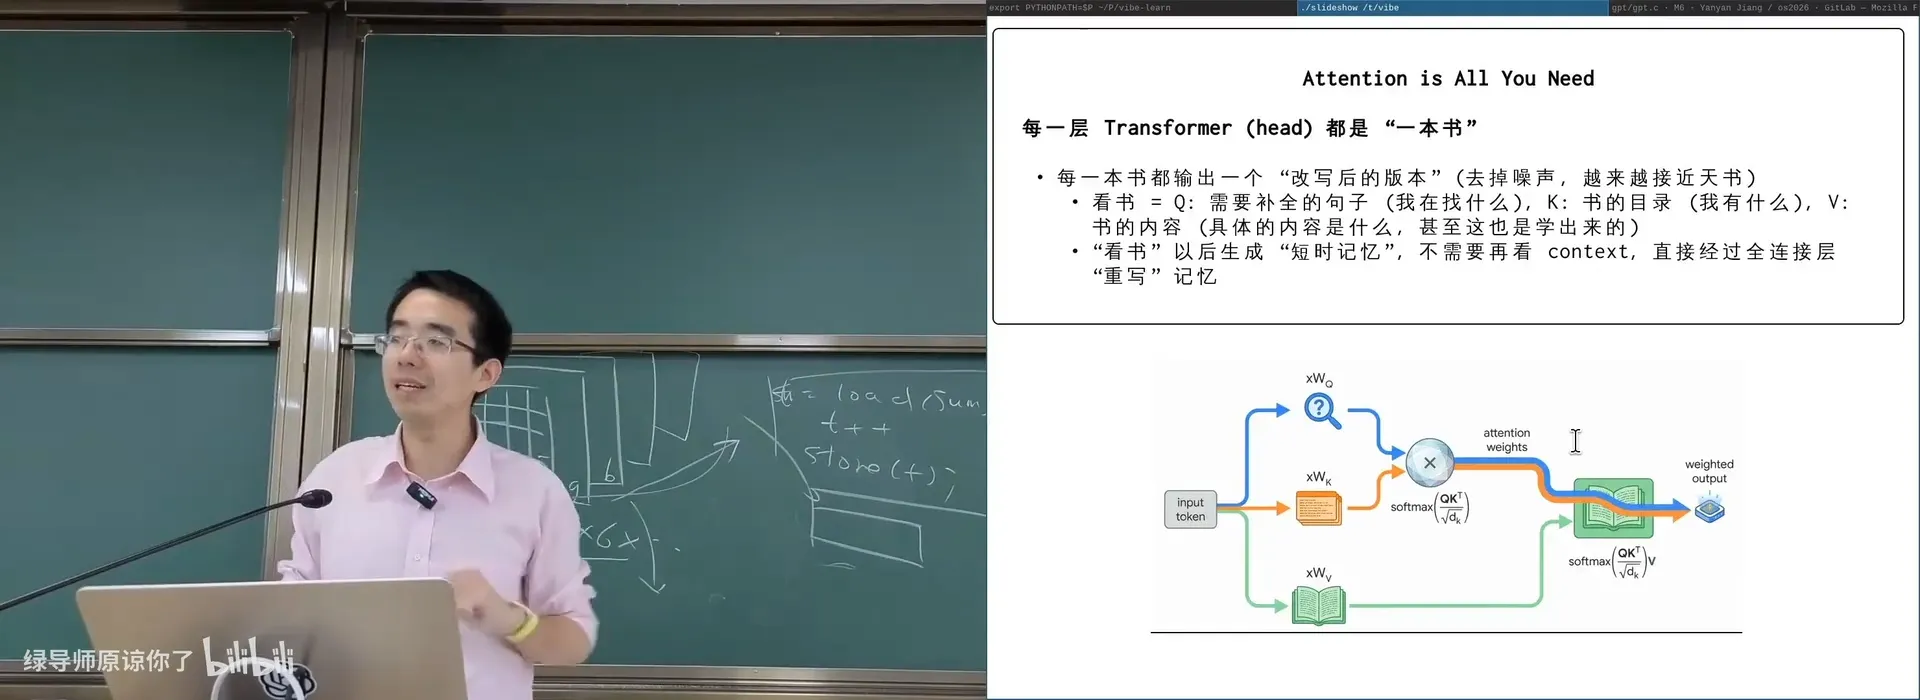
📷 Q/K/V 类比「看书」:Q 要找什么、K 是目录、V 是内容,输出短时记忆
回到原视频 (01:07:00)3.3 实现:
llm.c里的矩阵乘法(参考时间: 01:10)
看一眼
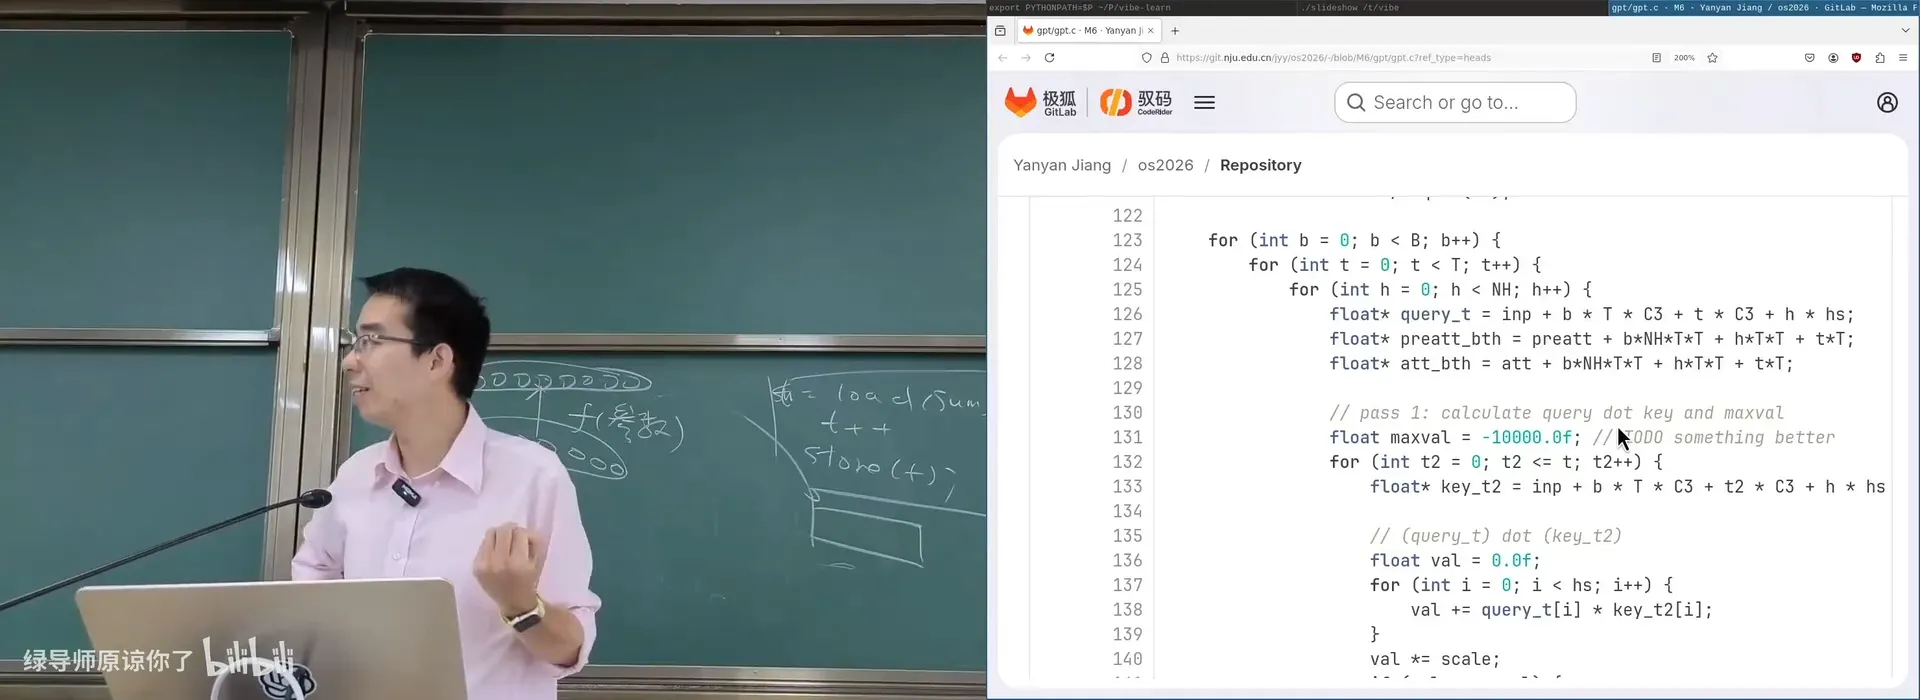
llm.c/train_gpt2_fp32.cu的attention_forward、matmul_forward——是不是和mandelbrot()很像?void matmul_forward(float* out, ..., int B, int T, int C, int OC) { int sqrt_block_size = 16; dim3 gridDim(CEIL_DIV(B * T, 8*sqrt_block_size), CEIL_DIV(OC, 8*sqrt_block_size)); dim3 blockDim(sqrt_block_size, sqrt_block_size); matmul_forward_kernel4<<<gridDim, blockDim>>>(out, inp, weight, bias, C, OC); cudaCheck(cudaGetLastError()); }
<<< >>>:发送参数到 GPU,GPU 开始执行,CPU 立即返回;GPU 内部会按顺序执行所有的 kernels;- 最内层是一个 inner product——完全可以用 SIMD 的 FMA 指令实现;
- 所以「你可以非常容易地用 spawn、SIMD、SIMT 任何一种方式并行化它——当然要获得极致的性能,这并不容易」。
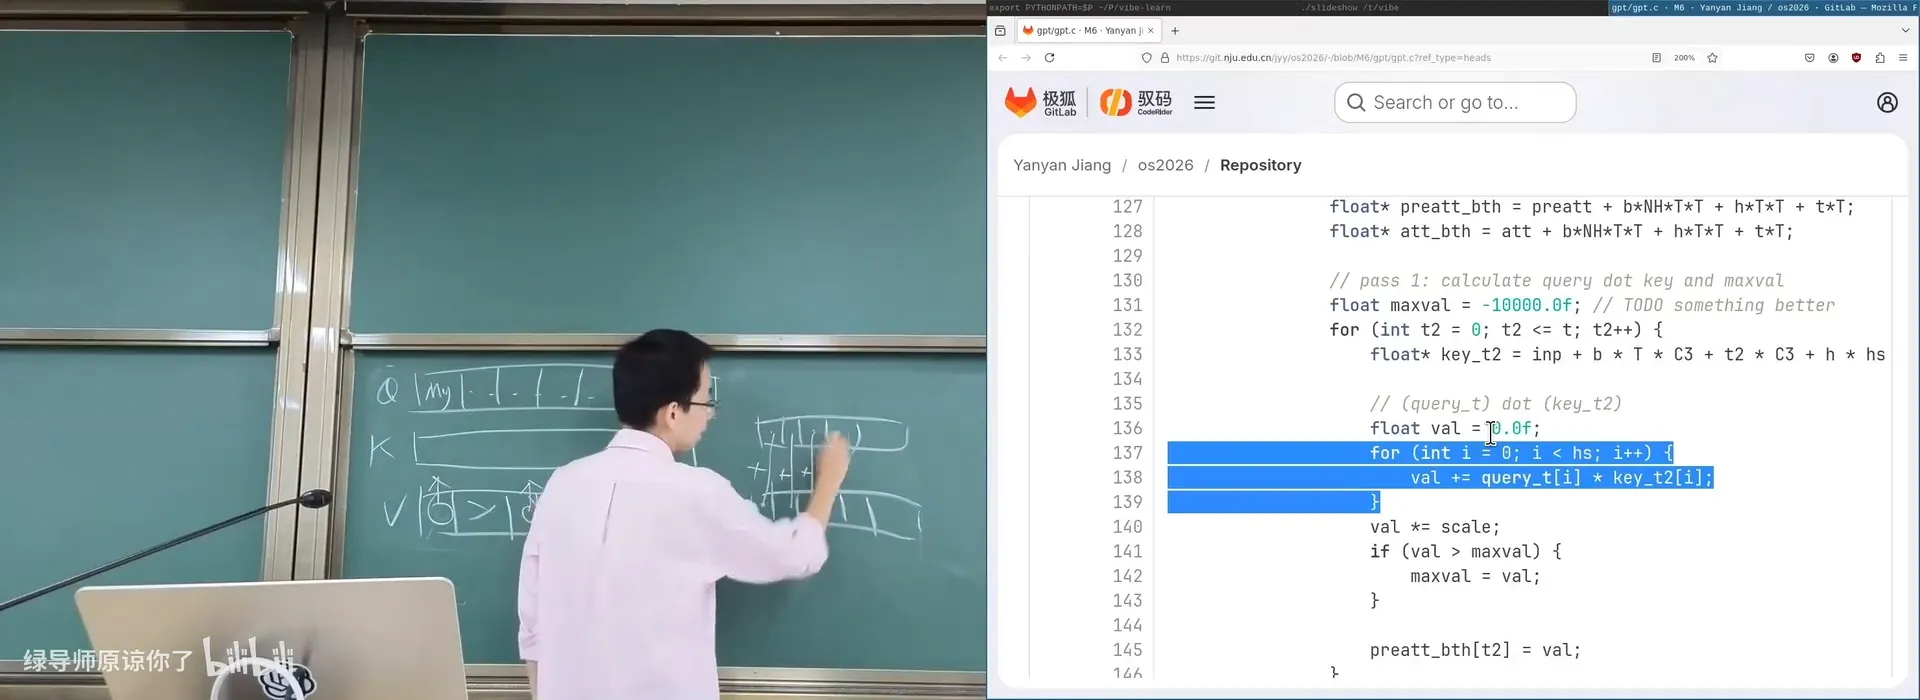
📷 gpt.c 源码:attention 最内层的 inner product(`val += query_ti * key_t2i`)
回到原视频 (01:11:00)3.4 压榨极致性能:Tensor Cores
(参考时间: 01:13)
能不能把 SIMD 引入到 PTX 指令集里? SIMT + SIMD,指令译码的开销就真的接近零了——「恭喜你,你发明了 Tensor Cores(混合精度 FMA:$D_{m\times n} \mathrel{+}= A_{m\times k} \times B_{k\times n}$)」。
「不,你没有。」——SIMD 只是省去了
base + row*stride + col的指令,真正的难题是内存移动与布局优化:
- 多维寻址、稀疏数据搬运、跨步访问、异步同步、布局转换和内存管理;
cp.async.bulk.tensor:支持稀疏数据拷贝(解压缩)、支持 zero-overhead 转置……这也就是为什么矩阵要分块(tile)——内存是线性编址的,两个大矩阵相乘,无论行优先还是列优先,总有一个矩阵的访问不连续。
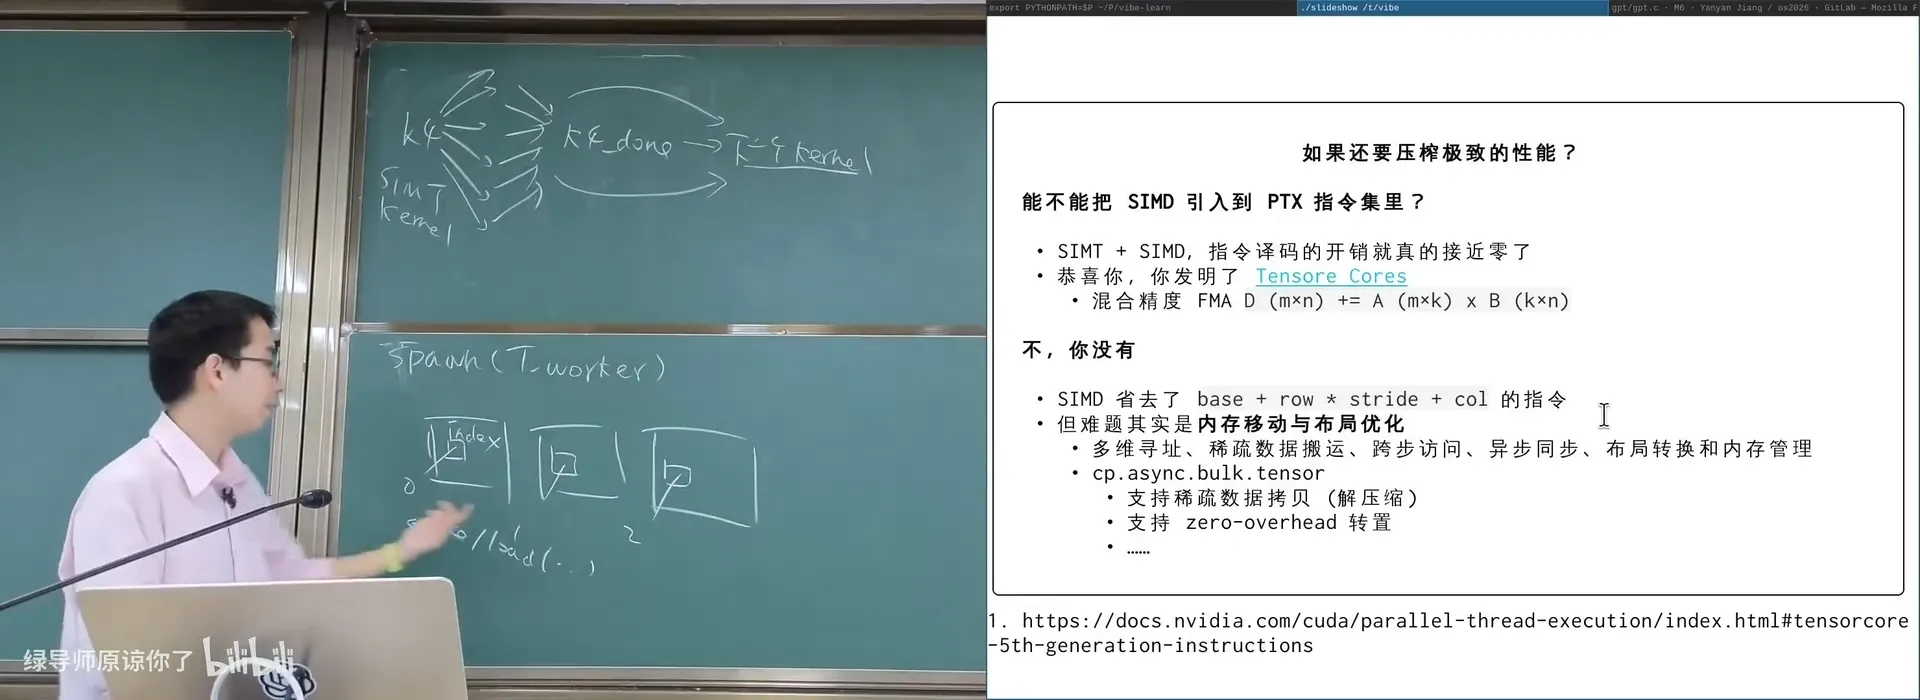
📷 Tensor Cores:把 SIMD 引入 SIMT,但真正的难题是内存移动与布局优化
回到原视频 (01:15:30)3.5 十万亿美元产业生态的起点
(参考时间: 01:20)
底层:加速器(GPU)、底层编程模型(CUDA)、库函数(cuBLAS、DeepGEMM、NCCL) 中层:编译器(FlashAttention、Triton)、训练(Megatron)、推理(vLLM)框架 开发者生态:训练(PyTorch、TensorFlow)、模型分发(HuggingFace)…… 用户接口:ollama、OpenWebUI…… 应用:Claude Code、OpenClaw、Manvus、NotebookLM……「你能想到的一切,都有人做。」
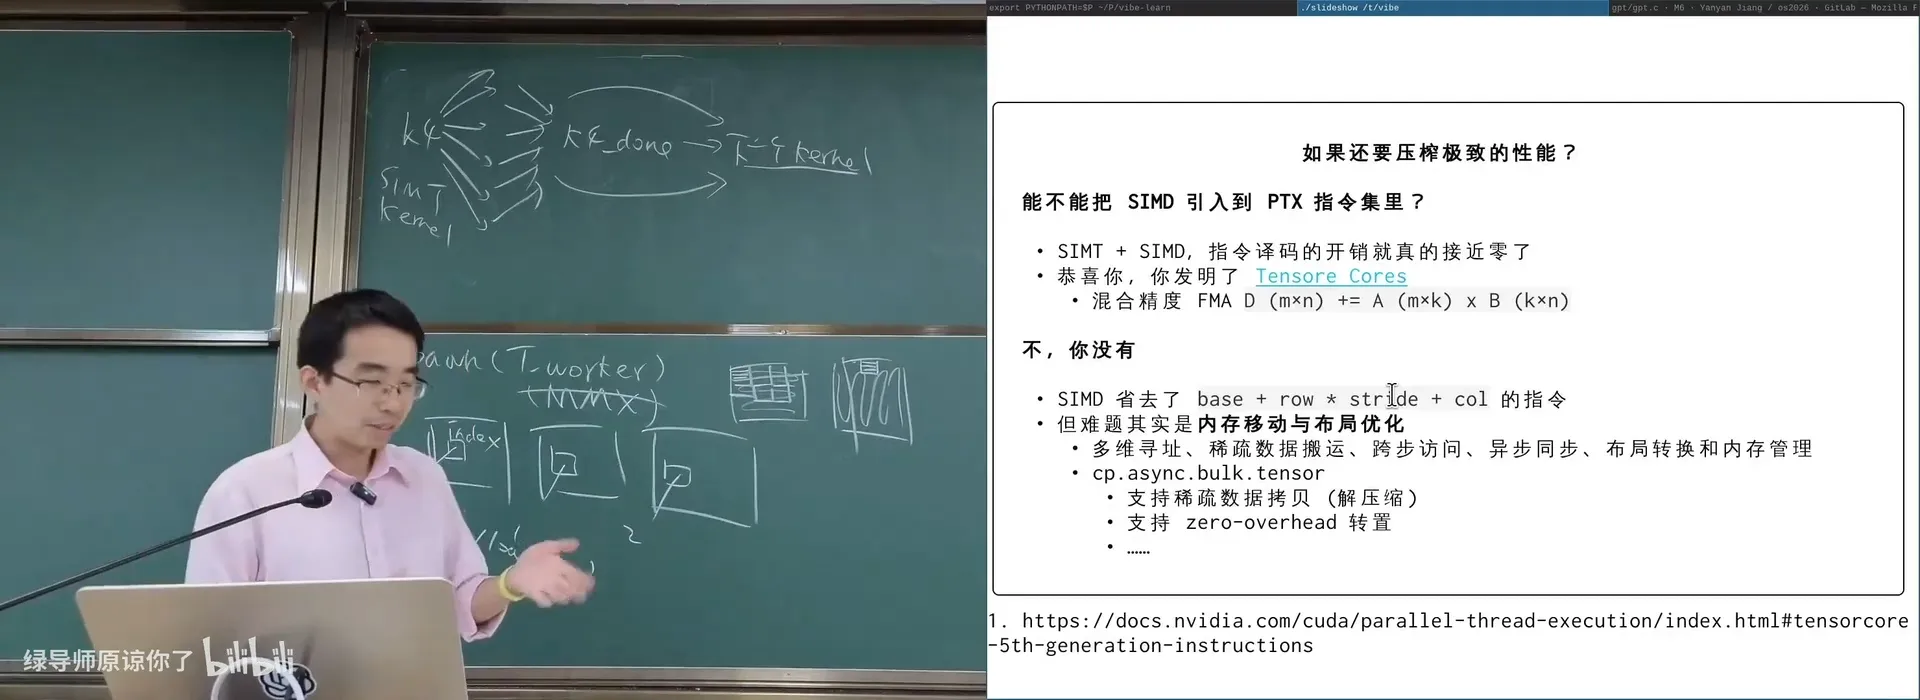
📷 历史总是惊人地相似:ASIC/MMX → GPU/CUDA → 库/框架/应用,与 UNIX 生态如出一辙
回到原视频 (01:20:00)编者拓展|「历史总是惊人地相似」:就像 1997 年 Intel 做 MMX 一样,处理器发布了,必须有人为它的扩展指令集写汇编,否则性能用不起来。于是有了 cuBLAS(Basic Linear Algebra)、DeepGEMM(General Matrix Multiply)、NCCL(通信库),再往上才是框架与应用——「这和我们学过的 UNIX 世界非常像:libc 之上长出整个生态。」
3.6 生成一个 Token:Prefill 与 Decode
(参考时间: 01:24)
如果推理集群运行的都是 GPT2-XL(1.5B)、1k context,问题几乎解决了(类似 http 请求到达业务节点,直接创建一个 goroutine)。但对于 1.6T、1M context 的模型,绝对是极为困难的:
- $O(n^2)$ 的 full attention → sparsify、low-rank……
- 「ChatGPT 爆火以后,NVDA 的起飞绝对是可以预见的。」
生成一个 token 要做两件事:
- Prefill:算出每一层所有的 attention「书库」(K 和 V),保存到 KV Cache;
- Decode:生成输出 token——读取完整 KV Cache,取出 K/V → 根据当前 Q 计算「短时记忆」→ 生成下一个 token → 更新 KV Cache。
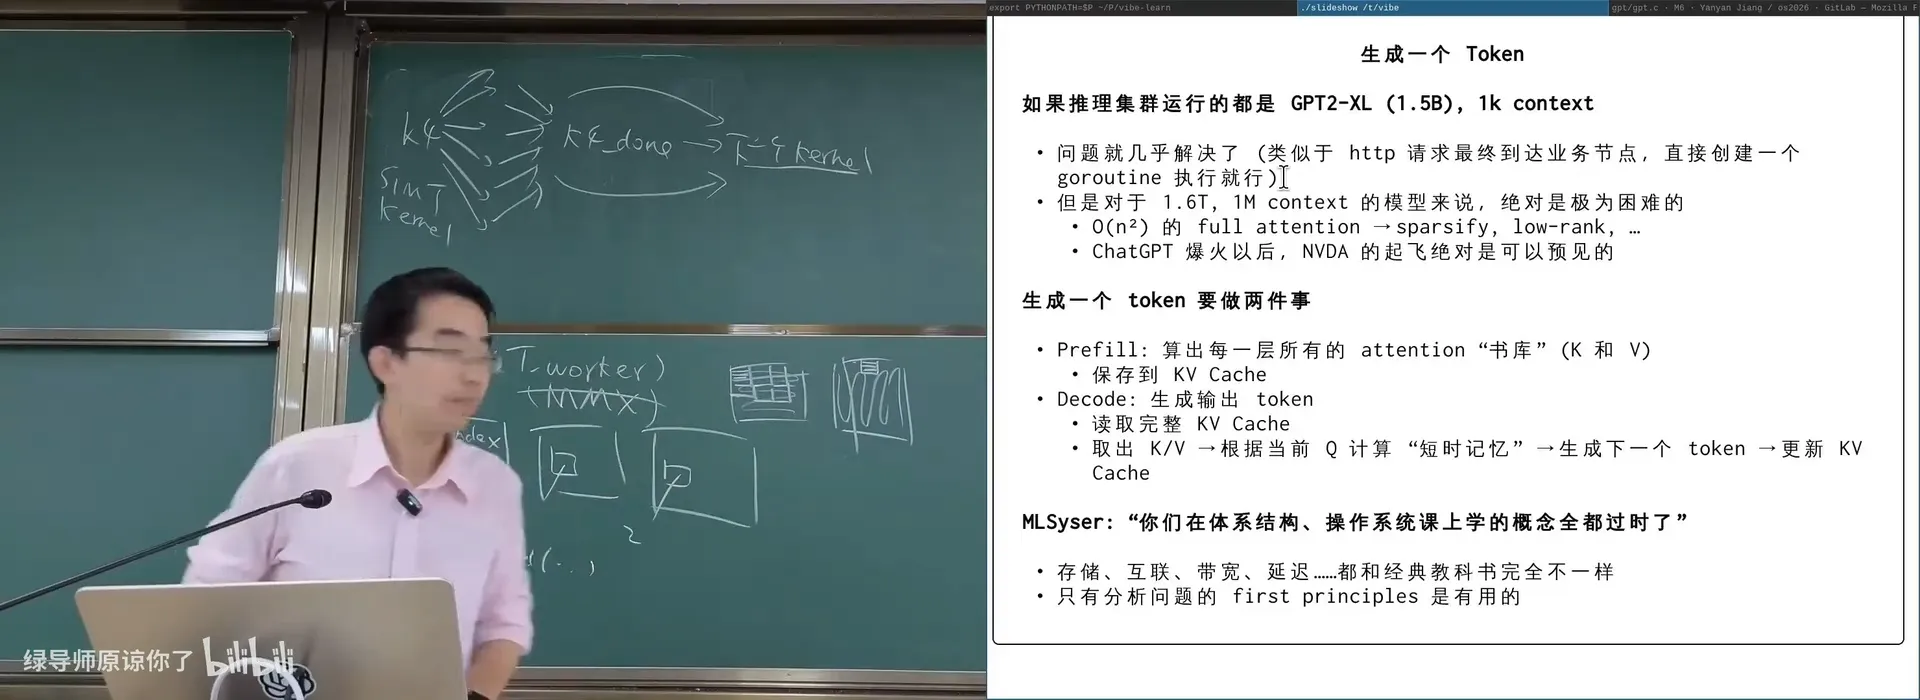
📷 Prefill / Decode 分离:KV Cache 是「书本」的复用,cache hit/miss 直接反映在价格里
回到原视频 (01:26:00)编者拓展|PD 分离与 KV Cache 定价:今天的推理服务普遍做了 PD 分离(Prefill/Decode 分离)。这也解释了为什么 DeepSeek API 会有 cache hit 和 cache miss 两个价格——如果你的 KV Cache 还是「热的」,就不用重新 prefill(省下大笔开销);太久被挤掉,就是 cache miss。
讲师还转述了 DeepSeek 前推理工程师在 ChinaSys 上的开场白:「你们在体系结构课、操作系统课上学过的所有概念——memory hierarchy、通信延迟、速度——在这里都不一样。但你们学到的分析问题的方法(用 profiler 看系统每个部分的行为)最后在生产中非常有用。」
3.7 旅程的终点:回程
(参考时间: 01:28)
生成出来的 token,在推理集群内经历了 TP(Tensor Parallelism)、PP(Pipeline Parallelism)、EP(Expert Parallelism)……最终返回一个整数。后端代码再次开始执行:审计(模型经常生成到一半闭嘴)、记账(通常是 append 到一个 log,再延迟更新到 dashboard)……最终生成一个 http event-stream response(jsonl),原路返回:
HTTP/1.1 200 Connection established
HTTP/2 200
content-type: text/event-stream; charset=utf-8 ...

data: {"id":"8fd70919-...","object":"chat.completion.chunk","created":1778726742,
       "model":"deepseek-v4-flash","system_fingerprint":"fp_8b330d02d0_prod0820_fp8_kvcache_20260402",
       "choices":[{"index":0,"delta":{"role":"assistant","content":null,...},"finish_reason":null}]}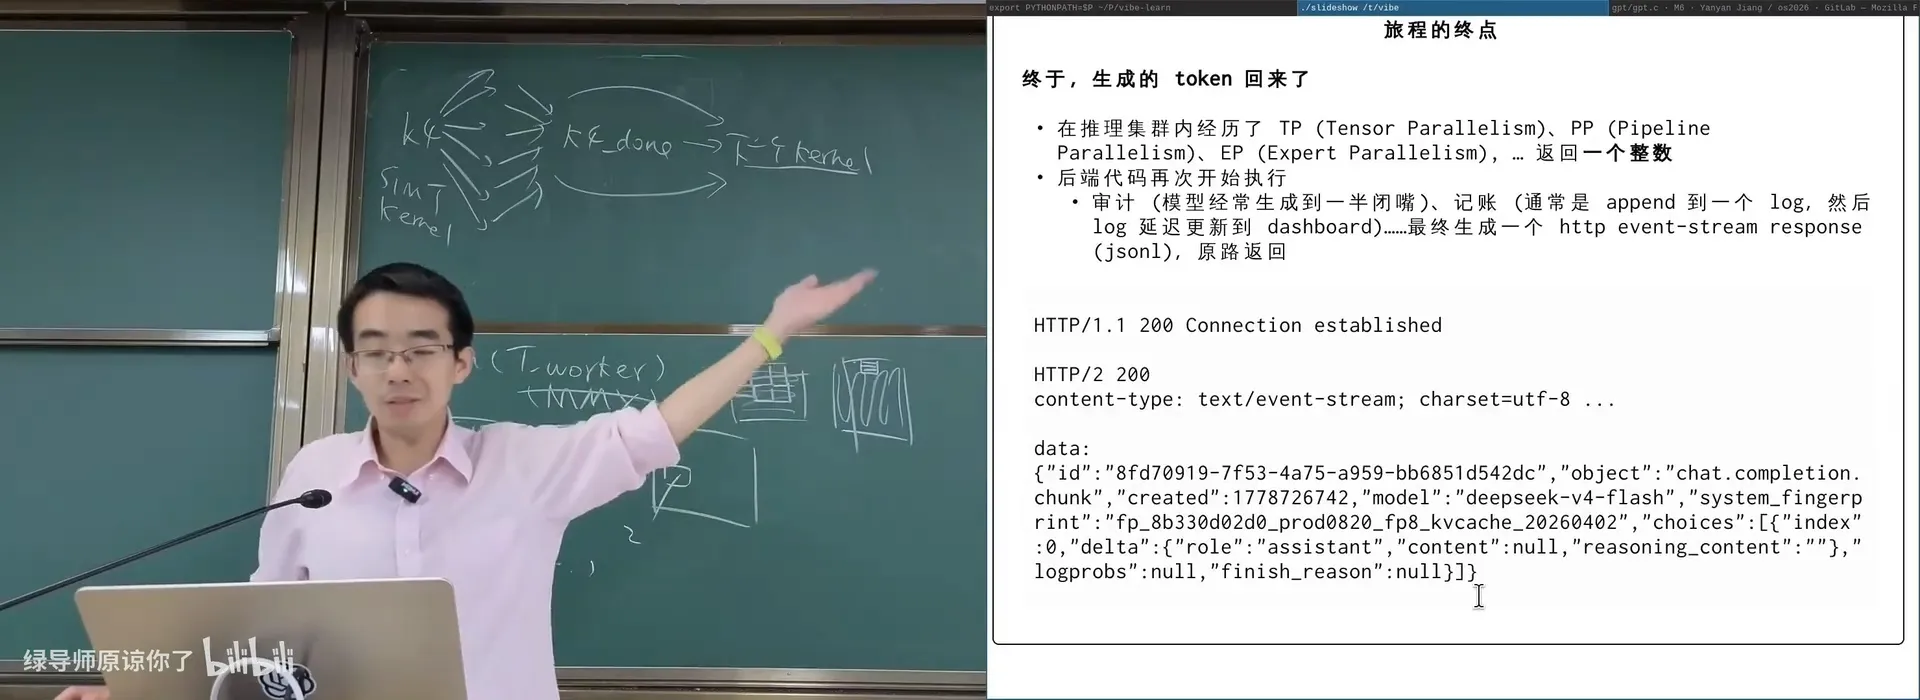
📷 回程:token 经历 TP/PP/EP,最终以 event-stream 原路返回
回到原视频 (01:28:30)
总结 · 旅程没有终点
- 一个 Token 的旅程,穿越了整个计算机系统栈:从浏览器的 HTTP 请求 → 数据中心的负载均衡、API 网关 → 分布式存储 → 最终到达 GPU 上的矩阵乘法;
- 我们学过的知识默默支撑了这一切:UNIX 系统调用、并发编程、SIMD/SIMT——「把做过的实验拼起来,就是一个非常完整的 Computer Systems 的图景」;
- 分布式系统的核心 mindset change:把计算带到数据(GFS / BigTable / MapReduce);Serverless / FaaS:「足够好的存储 + 描述计算图 = Write Once, Planet Scale」;
- 从 Token 到 Tensor:next-token prediction → Q/K/V 类比「看书」→
llm.c的矩阵乘法 → Tensor Cores → Prefill/Decode 与 KV Cache;- 「也许全世界都做错了呢?」:Scaling Law 只证明了 Transformer 在长上下文下比 LSTM 好,但「最好」的那个在哪里,人类也许还不知道;
- Takeaway:课堂的意义从来不是教会具体技术,而是在理解这些技术的过程中领悟属于自己的「还原方法论」,从而去面对未知的新挑战。「不要被服从性测试疯狂折磨,从 first principles 出发,在这个生态位里大胆去做点什么。」
编者拓展|「不要错上加错」:讲师对学术界有一段诚恳的批评——「无意义的学术裁缝是有害的。每年 AI 会议投稿几万篇,绝大部分对学术界是有害的。完全可以回头想一想:从 first principles 出发,这个十万亿美元生态位里,到底还有什么事情做错了,然后大胆地去做点什么。」
附:官方参考与延伸阅读
本讲的讲义见课程主页,以下链接按书中出现顺序整理:
主题 链接 一个 LLM Request(llm-request) https://jyywiki.cn/OS/demos/concurrency/llm-request /submit.sh(curl 提交)https://jyywiki.cn/submit.sh gpt.c(很短的 generator) https://git.nju.edu.cn/jyy/os2026/-/blob/M6/gpt/gpt.c?ref_type=heads Richard Sutton, The Bitter Lesson https://www.cs.utexas.edu/~eunsol/courses/data/bitter_lesson.pdf Tensor Core 5th-gen PTX 指令 https://docs.nvidia.com/cuda/parallel-thread-execution/index.html#tensorcore-5th-generation-instructions NVIDIA PTX ISA( cp.async.bulk.tensor)https://docs.nvidia.com/cuda/parallel-thread-execution/ Dan Kegel, The C10K Problem http://www.kegel.com/c10k.html CAP Theorem(Wikipedia) https://en.wikipedia.org/wiki/CAP_theorem Google File System / BigTable / MapReduce 论文 https://research.google/pubs/ OSTEP:Operating Systems: Three Easy Pieces https://pages.cs.wisc.edu/~remzi/OSTEP/ strace(1)手册https://man7.org/linux/man-pages/man1/strace.1.html 阅读材料:建议动手用
strace/dig/traceroute观察一个真实 HTTP 请求的全过程;并读一读 The Bitter Lesson 与 GFS/BigTable/MapReduce 三篇论文。版权说明:本讲讲义与幻灯片作者为蒋炎岩,采用 Creative Commons BY-NC 4.0 许可,来源于 https://jyywiki.cn/OS/2026/。视频画面与字幕版权归原作者所有。本书为课堂内容的学习性重构。