第26讲 · 文件系统实现
2026 南京大学《操作系统原理》第二十六讲 · 课堂实录重构
| 主讲 | 蒋炎岩(Yanyan Jiang) |
| 视频 | https://www.bilibili.com/video/BV12EV66bErd/ |
| 课程主页 | https://jyywiki.cn/OS/2026/ |
| 本讲讲义 | https://jyywiki.cn/OS/2026/lect26.md |
| 讲义 / 幻灯片作者 | 蒋炎岩,https://jyywiki.cn/ |
| 讲义 / 幻灯片许可 | CC BY-NC 4.0 |
| 图片来源 | 书中插图为课堂演示与讲义渲染图;演示类截图为视频画面 |
对应讲次:第26讲(南京大学 操作系统原理)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者说明:本书由课堂录像的语音字幕重构而成,术语、章节骨架与参考链接已按课程官方讲义(
lect26.md)校准。讲师的口语风格、类比与案例被尽量保留;编辑性的补充一律以「编者说明」或「编者拓展」标出。
引子
(参考时间: 00:00)
文件系统就是给你提供目录树状结构的东西——无论 procfs、sysfs,还是上节课那个 Galgame FS:「只要它符合我们反复使用的 UNIX 目录树结构,它就是文件系统。」
今天讲文件系统的实现:在 block device 上实现一个文件系统这样的数据结构,并实现 persistence。
block device 的模型:read_block / write_block / flush(等待落盘)——「你可以类比并发程序里的共享内存」:
- 内存是按字节寻址的字节序列(load/store);
- block device 是按块的字节数组(4KB 或软盘的 512B);
- data race 很危险——所以要用互斥锁;而 block device 也有一个类似 barrier 的指令(
flush),「等待所有在途的写落盘后再返回」。
编者拓展|「又打开了一次魔鬼的盒子」:讲师说,用这三个操作可以实现任何数据结构。但「当我打了并发这个比方,你们马上就有感觉了——我又一次打开了魔鬼的盒子」。课程的后半部分会讲:实现一个 crash-safe 的文件系统,会遇到和并发编程一样的问题。
一、实际设备与虚拟化
1.1 分区表:GPT
(参考时间: 00:03)
实际的 block device(SSD/HDD)本身也是一个数据结构,也有 specification。我们今天主要用 GPT(GUID Partition Table)——它是 UEFI specification 的一部分:
编者说明:为什么由固件厂商制定分区表标准?因为系统一启动,firmware 就要看到磁盘的分区布局——否则它不知道操作系统装在哪、数据盘在哪、该怎么挂载。所以可启动磁盘都遵循这个标准。
$ lsblk # /dev/mmcblk0(整卡)、p1、p2(两个分区)
数据结构都有入口:磁盘开头的第一个 block 一般是兼容的 MBR,后面才是 GPT;GPT 在磁盘尾部还备份了一份(分区信息丢了还能找回来)。「如果我用 dd 把整块设备写成全零,这台机器马上就成砖了——识别不出 p1、p2。」
「但这也可以是一个虚拟设备,甚至可以一层层叠很多层虚拟设备。」——Linux 有 LVM(Logical Volume Manager):image 文件 → loopback device → physical volume → volume group → logical volume → 分区。原则上还可以用多块磁盘虚拟出一块更大/更快/更可靠的磁盘(RAID)。
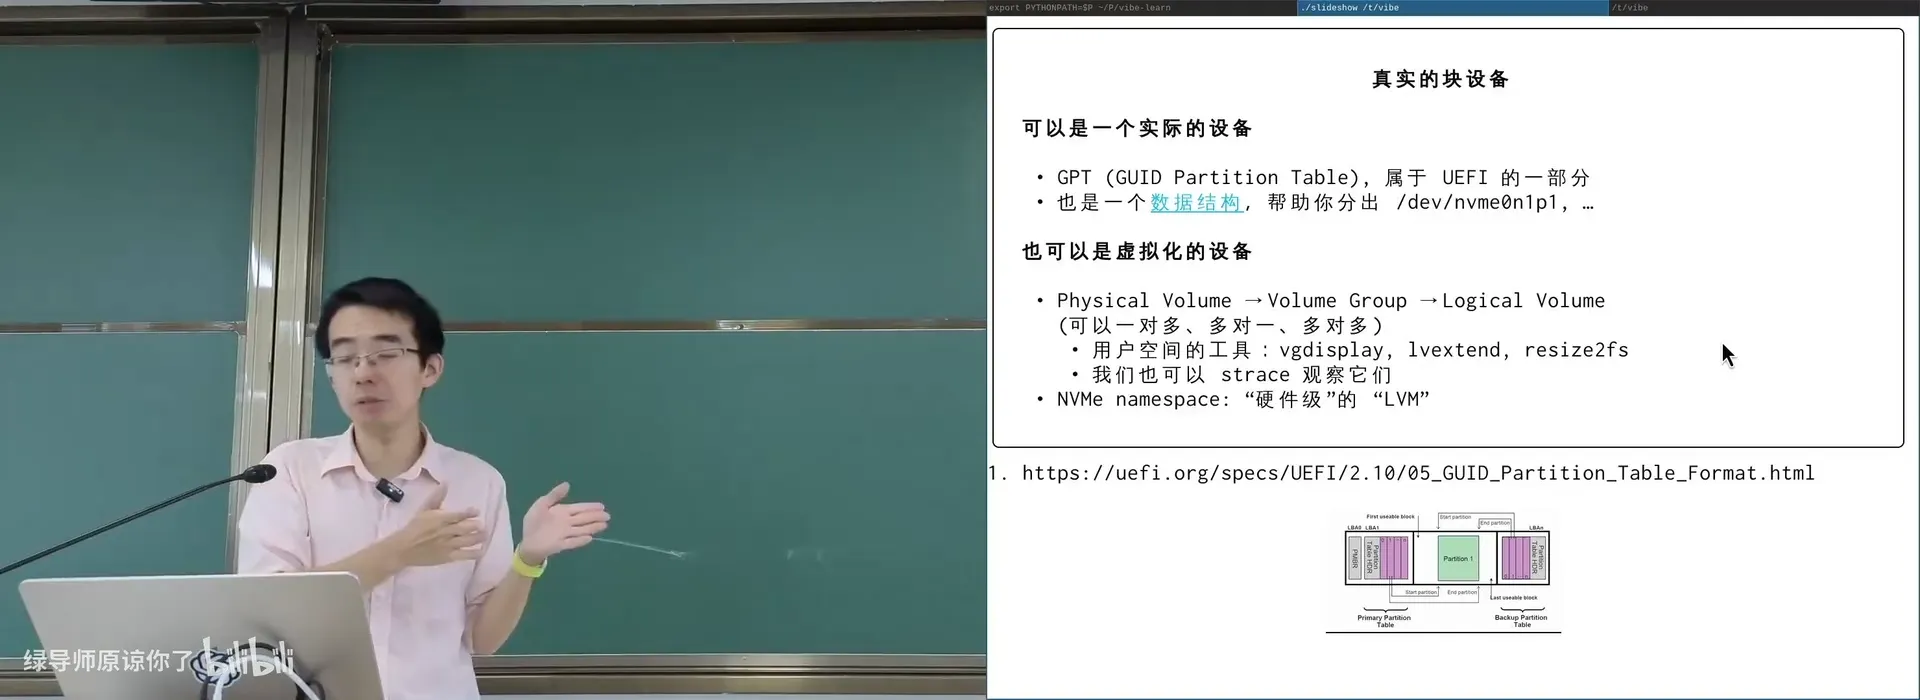
📷 GPT 分区表:磁盘头部的数据结构,firmware 启动时依赖它
回到原视频 (00:05:00)
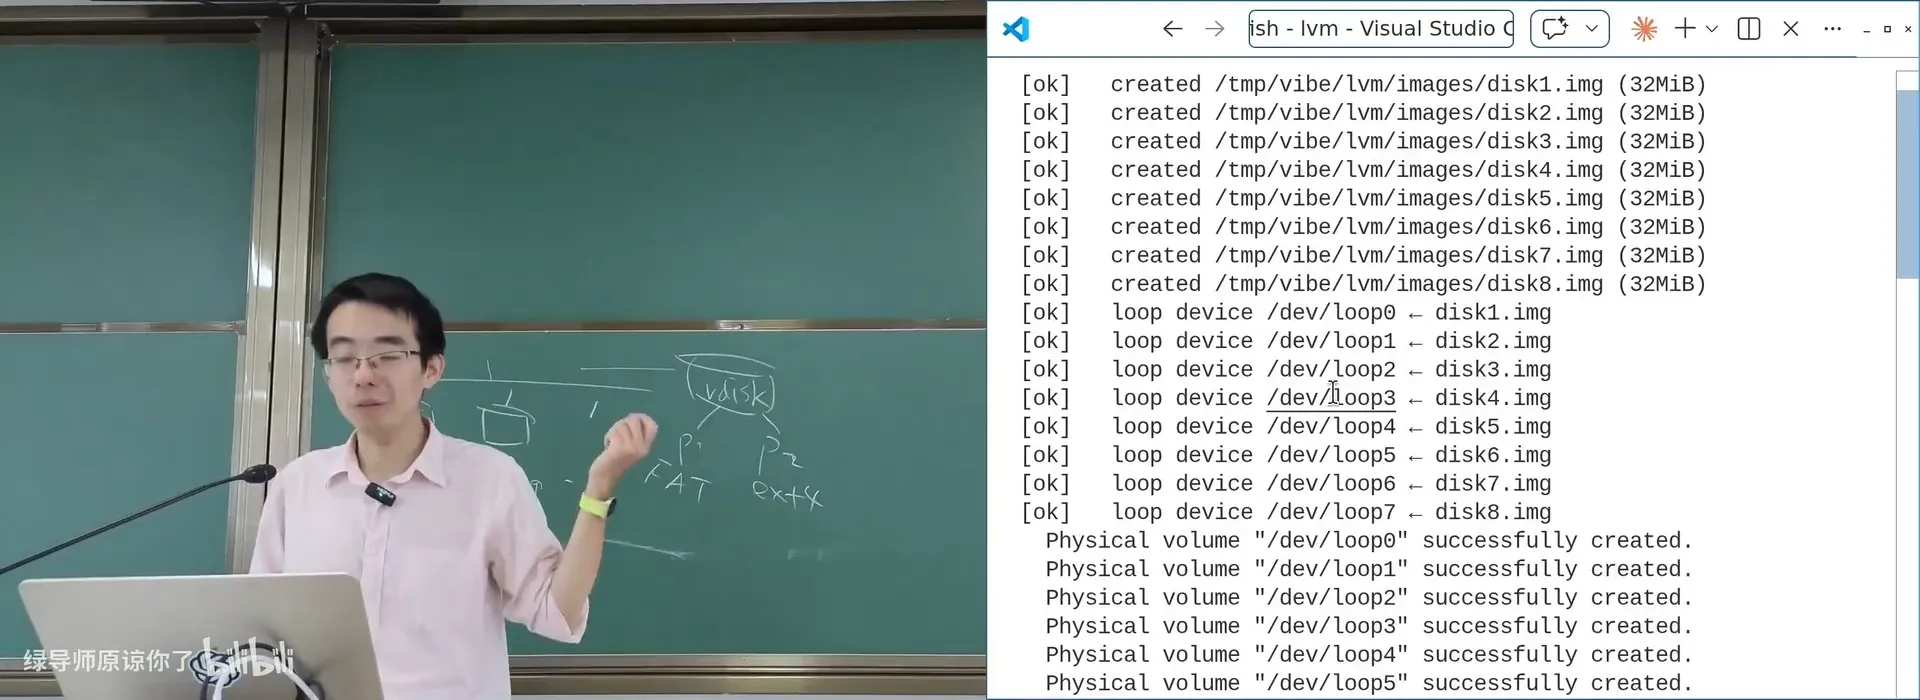
📷 LVM 演示日志:8 块 32MB 的虚拟磁盘 → loop device → volume group → GPT → p1(fat)/p2(ext4)
回到原视频 (00:08:00)
# lvm_demo 脚本(y web coding 出来的)
# 创建 8 个磁盘 → loop device → pvcreate → vgcreate vg_demo → 格式化 GPT → p1/p2
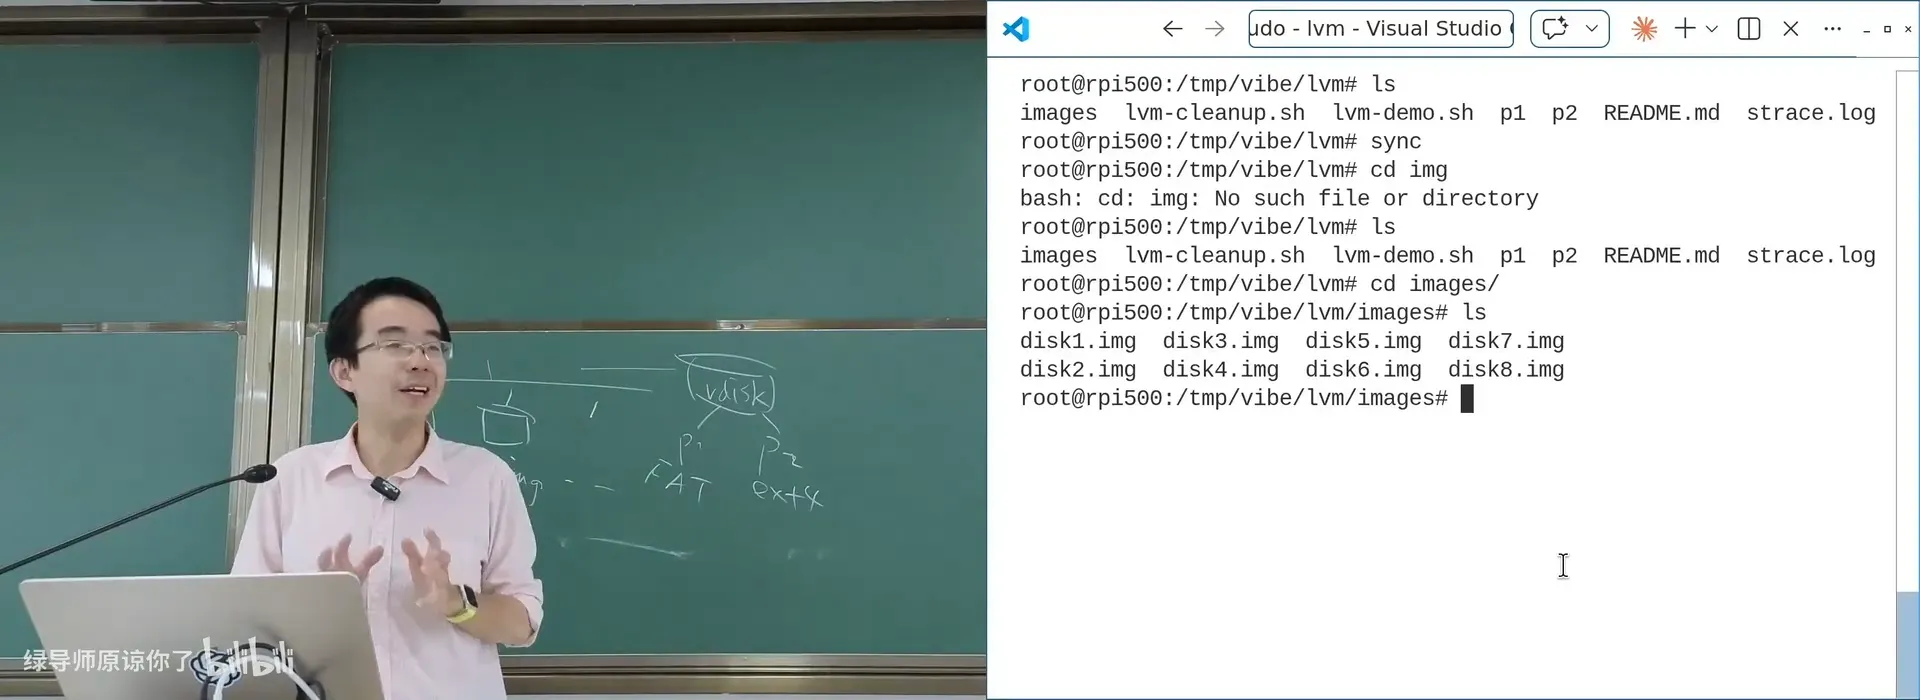
📷 写入的数据最终落在 loopback 设备对应的 image 文件里
回到原视频 (00:09:30)
编者拓展|「把整个系统打开看」:讲师让 AI 把 LVM 每条命令的所有系统调用扒出来——
loop-control(LOOP_CTL_GET_FREE)、/dev/mapper/control(DM_DEV_CREATE)……「全都是ioctl。」「这就是为什么复制一份 Linux 非常困难:内核里几乎每一个子系统的 API 都是通过ioctl暴露的(有些通过sysfs)。」
1.2 在 block device 上实现文件系统
(参考时间: 00:12)
实现文件系统就是一个数据结构的问题,但要高效非常有挑战——因为读写放大:
- 你只想要一个字节(比如文件的 size 或 mtime),却要把一整块读进来;
- 你更新一个字节,不仅要更新数据,还要更新 mtime 等 metadata,涉及多个块的写入;
- 就算写一个块,SSD 内部 FTL 的映射表又是 copy-on-write 的,又会产生写放大。 「理论上,写一个字节可能会有几万倍甚至几十万倍的写放大(极端情况);写一块依然会有若干倍(甚至十倍)。」
所以文件系统这一层要做缓存(就像 memory hierarchy):Linux 里有 buffer cache(「一个很糟糕的名字」),bread/bwrite 类比共享内存的 load/store——cache hit 就直接从内存走。
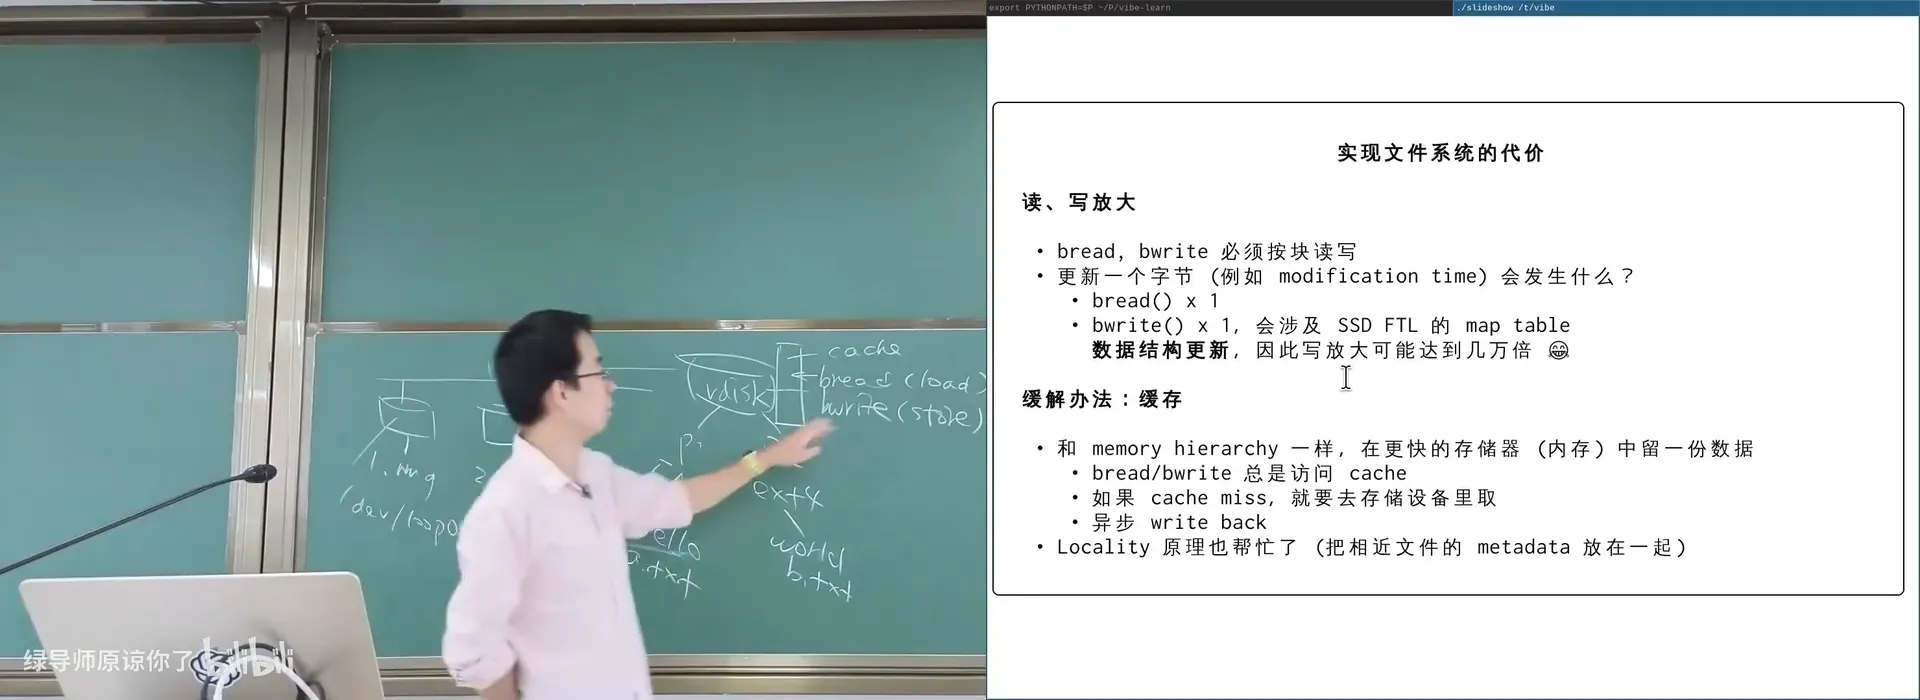
📷 buffer cache:文件系统级的缓存,用 locality 减少读写放大
回到原视频 (00:16:00)
编者拓展|先做「研究」再设计:要设计高效的文件系统,得先观察现有文件系统的统计——「厚着脸皮去找各种人,说你的文件系统能不能借我遍历一下……」。结论(稍过时但基本符合个人电脑):
- 绝大部分文件都很小(源代码、文档);
- 少数大文件占用绝大部分空间(数据库、电影);
- 一个目录里的 entry 不会太多;
- 文件系统大致是「半满」的。
「这些 findings 就可以指导你设计。」讲师还给了一个「版本答案」:写一个爬虫把所有数据结构相关的论文爬下来,给大模型一个 prompt,说『对磁盘的这种特性,我要实现一个优化某 workload 的文件系统,这是不是一个好 idea』——把所有不好的 idea 删掉,你就能得到一个新的实现。
二、经典文件系统的数据结构
2.1 入口:super block
(参考时间: 00:21)
所有数据结构都有入口(链表有 head、二叉树有 root、ELF 有 header + magic number……)。文件系统里,这个入口在分区头部,叫 super block——「如果只允许你损坏一个 block,那抹掉 super block 对用户造成的麻烦最大」:
magic number(识别文件系统类型);- block size(磁盘是 512B,但文件系统可以按 4KB 逻辑块编号,这样文件能更大);
- 剩余空间、还能分配多少文件、数据结构的起始位置与大小……
「mkfs 就是往前面写这些数据结构;mount 也是根据 super block 确定文件系统类型。」
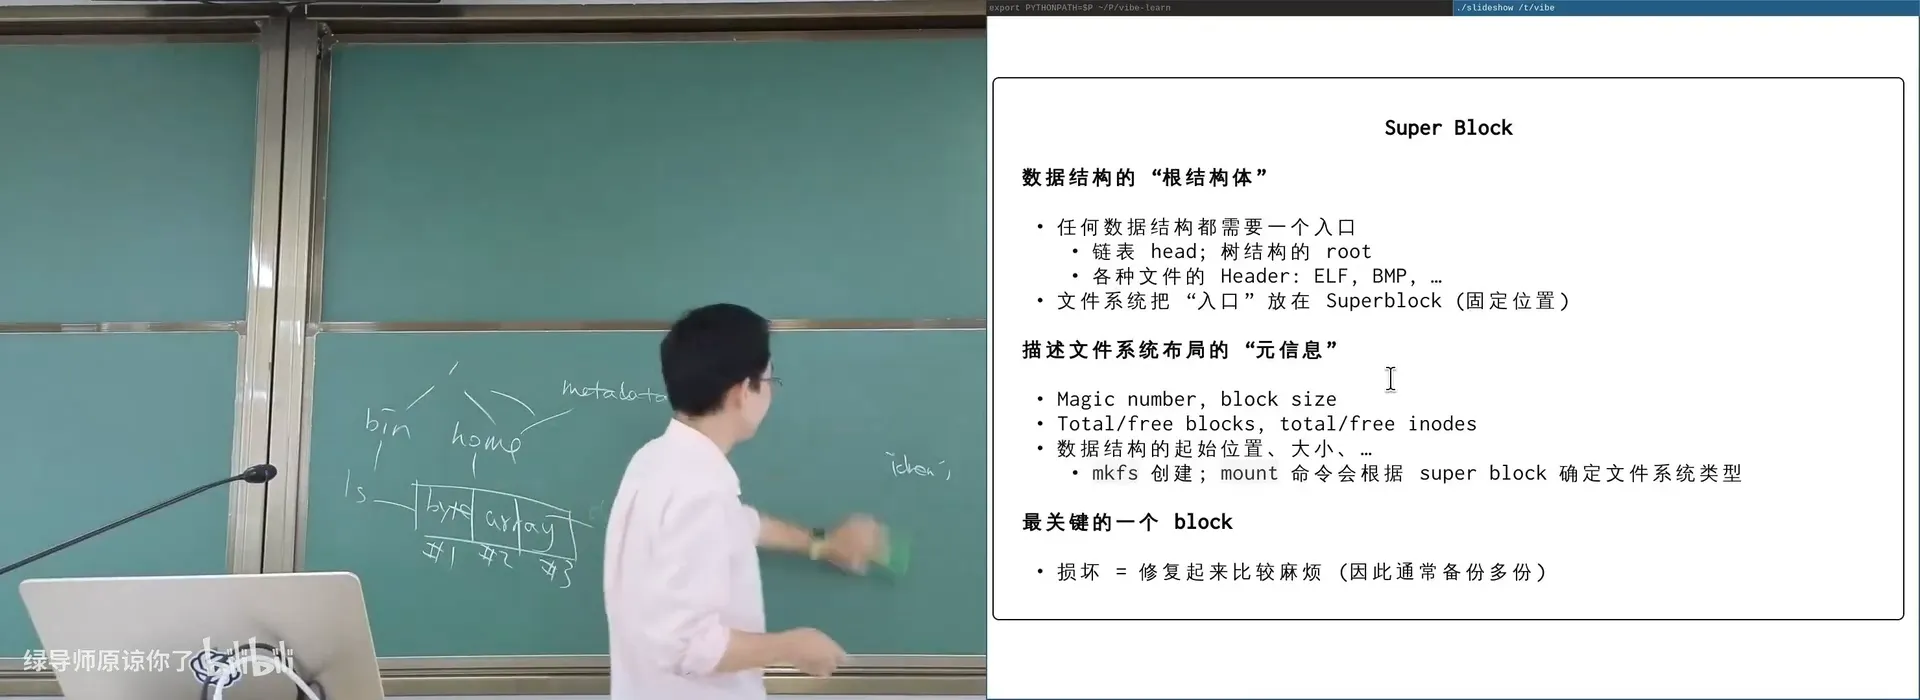
📷 super block:文件系统的入口,`mkfs` 写入、`mount` 读取
回到原视频 (00:22:00)
2.2 FAT:为极小磁盘而生
(参考时间: 00:26)
- 25″ 软盘单面只有 160KB(320 个 512B 的 sector)——设计思想不是花哨的数据结构,而是极致的空间节约
FAT(File Allocation Table) 的核心就是一个 next 数组:
- cluster:把若干($2^k$)个 512B 扇区绑成一个逻辑块;
next[i] = j:cluster i 的下一个 cluster 是 j(链表);next[i] = 0:free(可分配);next[i] = -1:文件结束;- FAT12 的指针只有 12 bit,两个 12-bit 打包成 3 字节,按 bit 紧压存储(「非常省空间」)。
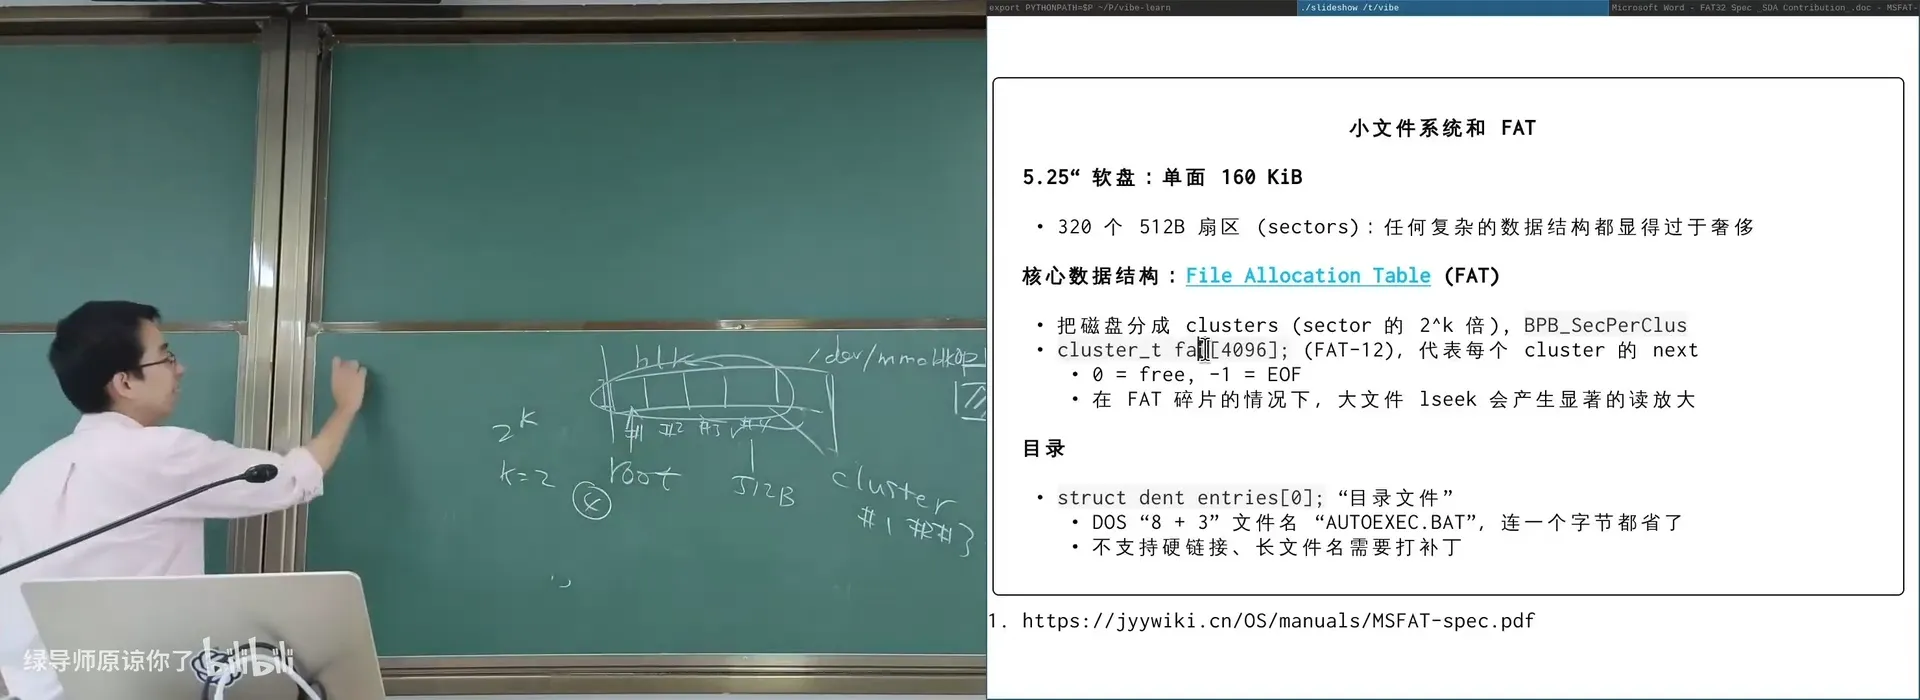
📷 FAT:一个 next 数组实现的链表;FAT12 的 12-bit 指针紧压存储
回到原视频 (00:30:00)
编者说明:小文件(FAT12 的 4096 个 cluster)性能完全没问题——「你可以把整个 FAT 一次读进内存,等于在内存里遍历这个数据结构」。但大文件 + 碎片就会导致严重的读写放大(next 跳来跳去)。
目录也是文件:目录项(dentry)是一个 struct,包含 11 字节的 8.3 短文件名(8 字符名 + 3 字符扩展名)、attribute(read-only / hidden / system / directory……)、文件大小、first cluster(指向文件第一块)。
编者拓展|有历史感的 8.3 文件名:
AUTOEXEC.BAT会在 DOS 启动时自动执行。「今天你随便就可以起很长的文件名——为什么在 FAT 里还能看到~1、~2的波浪线? 因为为了向前兼容,长文件名会被截断、用波浪线加编号区分。」
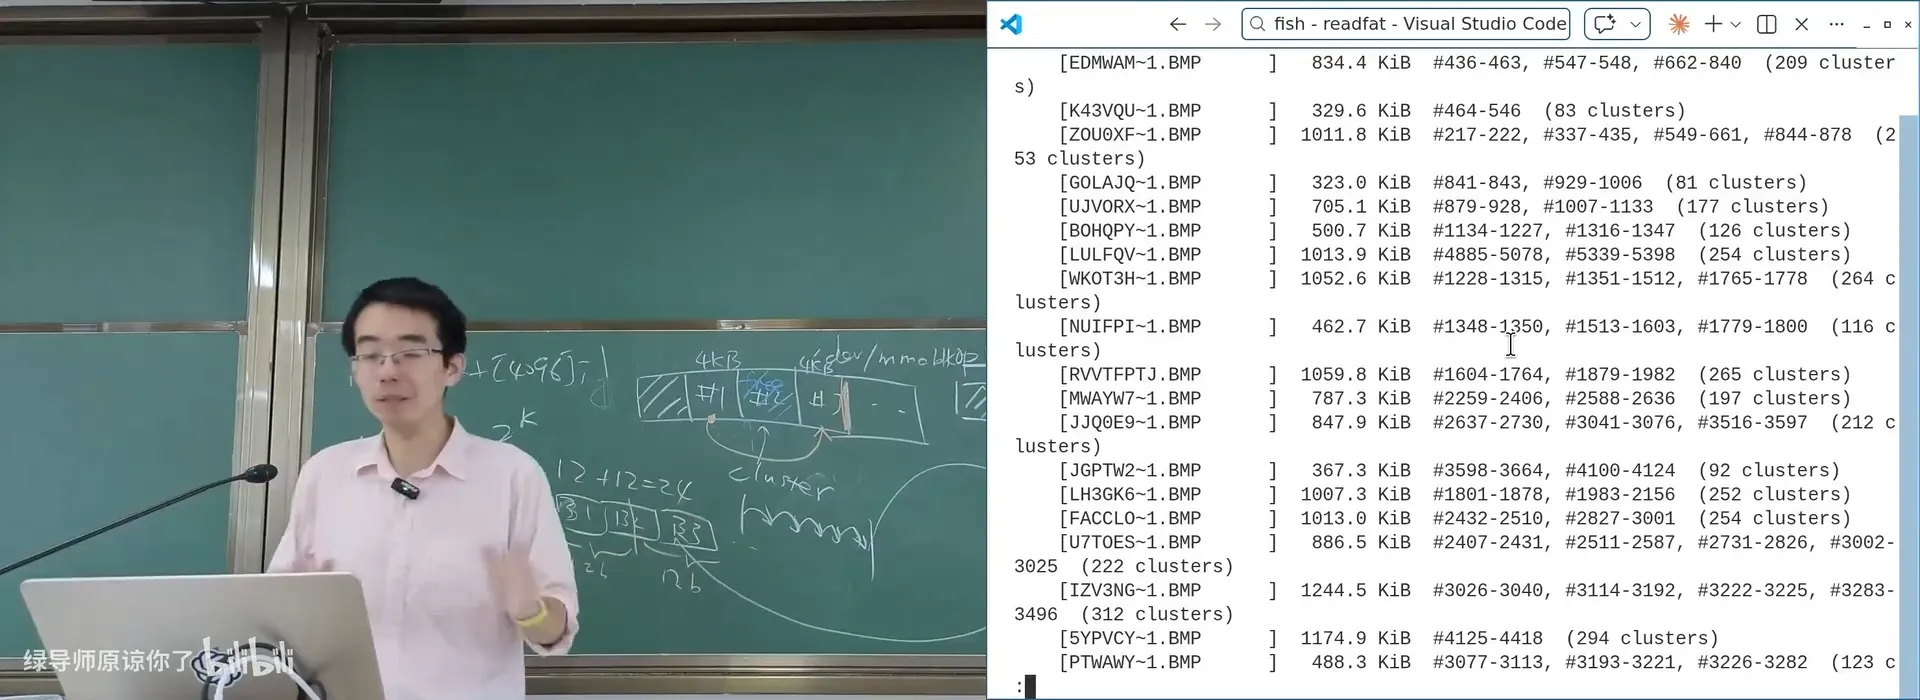
📷 FAT 的目录项:11 字节 8.3 短文件名 + attribute + first cluster
回到原视频 (00:37:00)
用程序解析 FAT:讲师给了一个 fat.c 工具——用 mmap 把整个磁盘镜像映射到进程地址空间,super block 就变成了一个指针(「它就是一个数据结构」),再用 DFS 扫描整个目录树。
// fat.c 的思路
// mmap 整个磁盘镜像 → fat32_header(super block)就是一个指针
// DFS scan 遍历目录树,输出每个文件的 cluster 链表(连续 or 碎片)
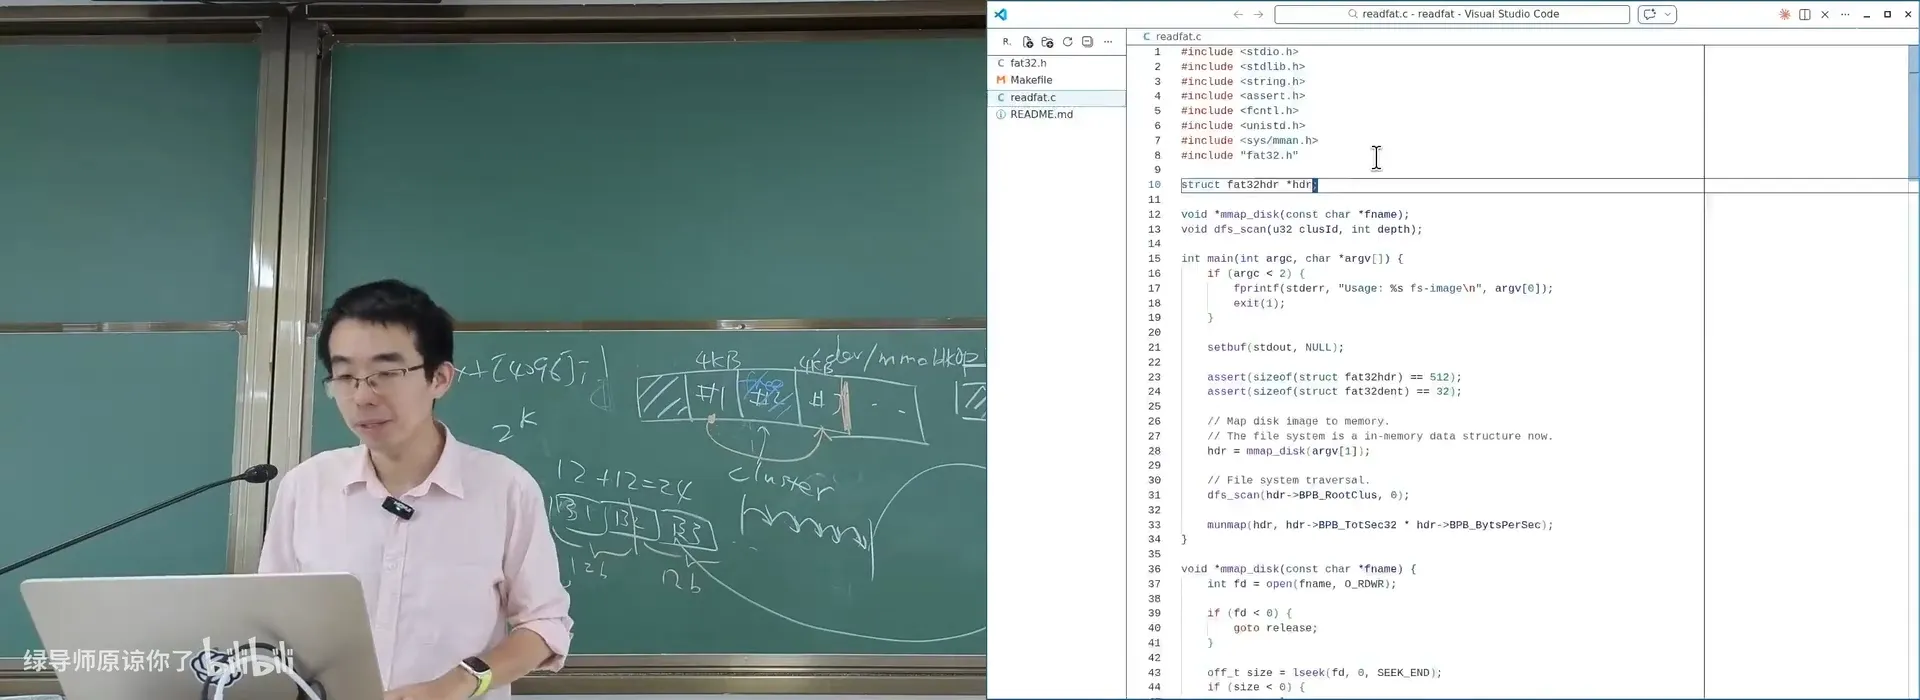
📷 fat.c:把文件系统真的当成数据结构,DFS 扫描目录树、检查 cluster 连续性
回到原视频 (00:35:00)
2.3 UNIX:inode 与多级索引
(参考时间: 00:41)
UNIX 的设计者「长得比 FAT 远一些」——他想到了大文件、大文件系统、以及支持链接:UNIX 文件系统是一个图,不是目录树(. 指向自己、.. 指向上级)。
核心:struct inode(节点)+ 目录里的边:
- inode 存一个文件的全部 metadata(
st_mode、st_size、时间戳、inode 编号……); - 目录文件里存一个从文件名 → inode 编号的映射(顺序存储即可);
index:文件的块索引——UNIX 用了一个联合的数据结构:为了「大部分文件是小文件、大部分时候只读文件头」,它把文件的前若干块直接写在 inode 里(直接指针);文件超大时再用一级/二级/三级间接索引(4KB 页表 × 1024→1024³)。
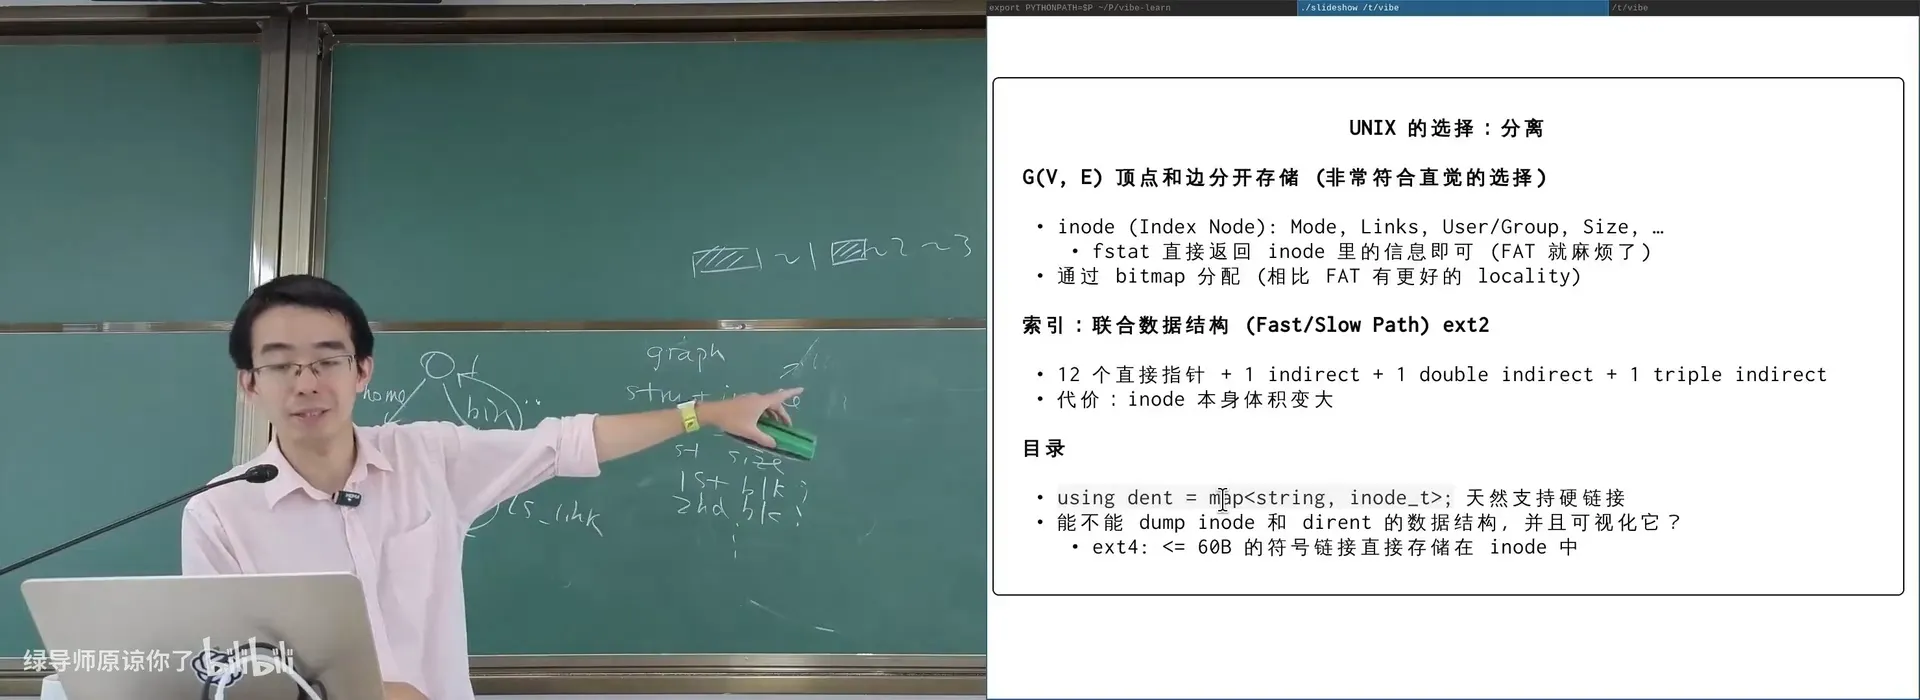
📷 UNIX inode:直接块 + 一级/二级/三级间接索引,兼顾小文件的快与大文件的大
回到原视频 (00:45:30)
编者拓展|inode 的两个精妙设计: 1. 把所有 inode 放在一起——「你在一个目录里写十个文件,大概率连续分配,于是读一个 inode 就把相邻相关的 inode 一起载入内存」(利用 locality)。 2. 短符号链接「偷」索引块的内存——≤60 字节的符号链接不分配数据块,直接把目标路径当作字符串存在 inode 的索引区里。「比如
ln -s ./a只有几个字节,我直接偷这块内存。」
用 debugfs 解剖 ext4:讲师让 AI 做了个 ext4.py 工具,可视化 inode 与链接:
$ debugfs ...   # 底层查看文件系统元数据
# 输出:link count、每个文件的 block id、是否连续、inline symlink……
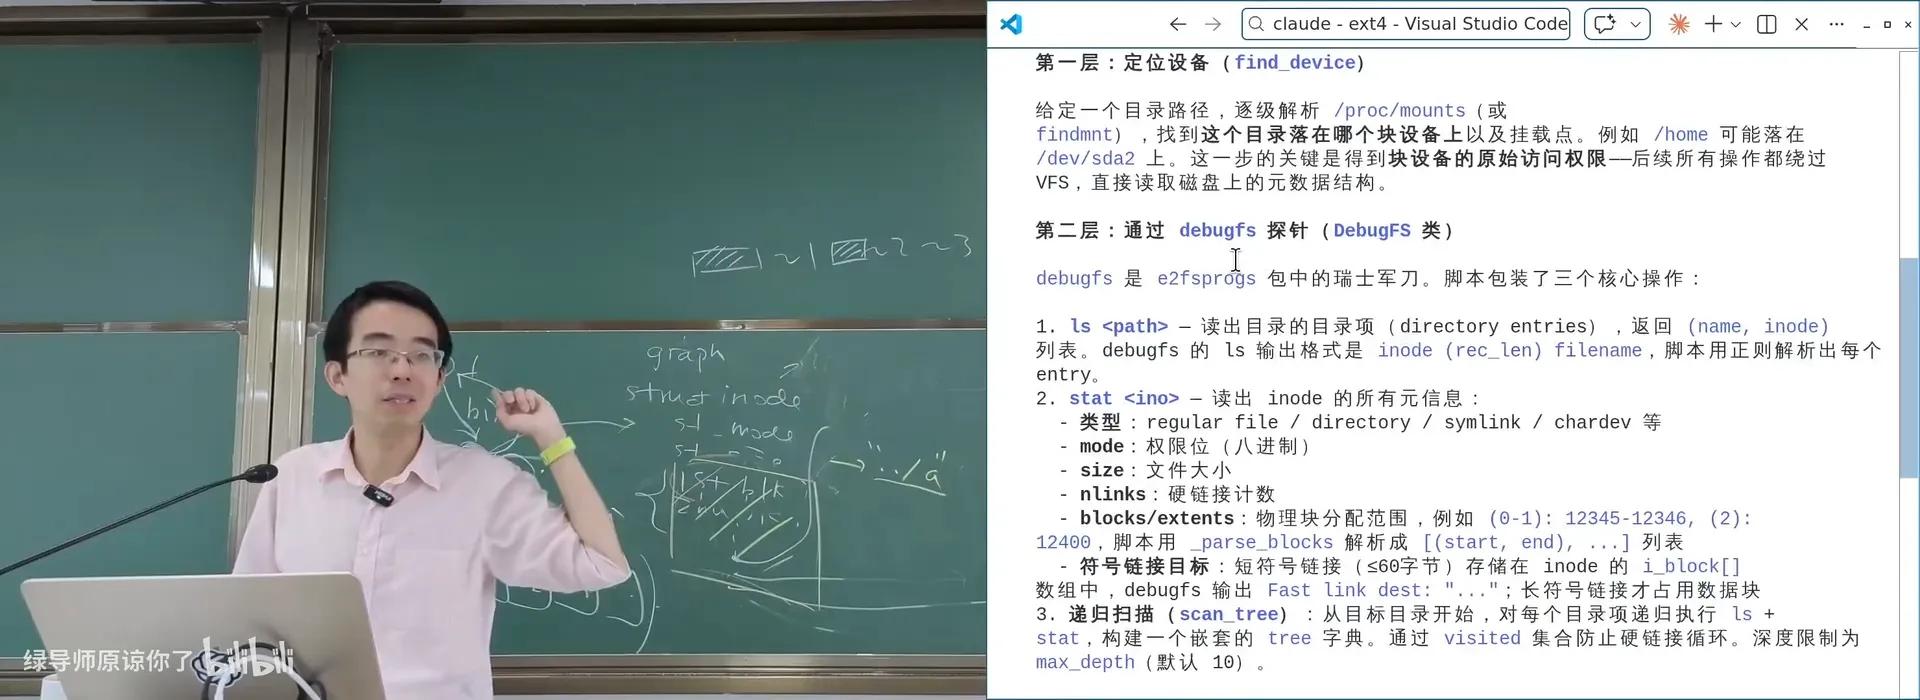
📷 debugfs 解剖:inode、block id、link count、inline symlink 一览无余
回到原视频 (00:48:30)
三、Crash Consistency:又一个魔鬼盒子
3.1 崩溃为何会破坏数据结构
(参考时间: 00:50)
操作系统的文件系统还有一个数据结构课没有的职责:应对崩溃(crash consistency)。
编者说明:写一个链表插入(
X.next = Y; Y.prev = X; Y.next = N; N.prev = Y),并发时你会加锁;但你从没想过线程突然被杀掉会怎样——如果写到一半 crash,Y.next还是空的,这个数据结构就 inconsistent 了,遍历它就 crash。
Append 一个 block 需要三个写:分配 block(改 bit map)、写 data、更新 inode。但这三个 bwrite 进了设备的队列——设备可能以任意顺序处理(谁离我近先处理谁)。所以:
$$\text{3 个写} \Rightarrow 2^3 = 8 \text{ 种落盘顺序,任何 subset 都可能发生}$$
危险的情况:inode 更新了、data 也写进去了,但 bit map 忘记更新——于是这个 block 在文件系统看来仍是 free 的。将来分配给别人、覆盖掉——你第二天回来发现文件内容变了。
编者拓展|「系统的人都是先挣钱后还债」:文件系统实现者知道这个问题,但在 1970 年代实现 crash-safe 数据结构太复杂了,「干脆先不管」。后果是 crash 后目录损坏、甚至得到 corrupted file system。讲师讲了在 UCLA/美国 lab 做的 小板子——从 VGA 给一个信号物理切断 SSD 电源,结果很多 SSD 的固件在 crash 后整块盘就死了(后来促成了厂商一大批固件修复)。
解决方案曾是事后
fsck(「小时候机房开机扫描文件系统」)——扫描所有 inode 与 bit map,修复不一致;无法归属的文件丢进lost+found目录。「这也就是那个『摄影师事件』的由来(修电脑被判八个月)。」
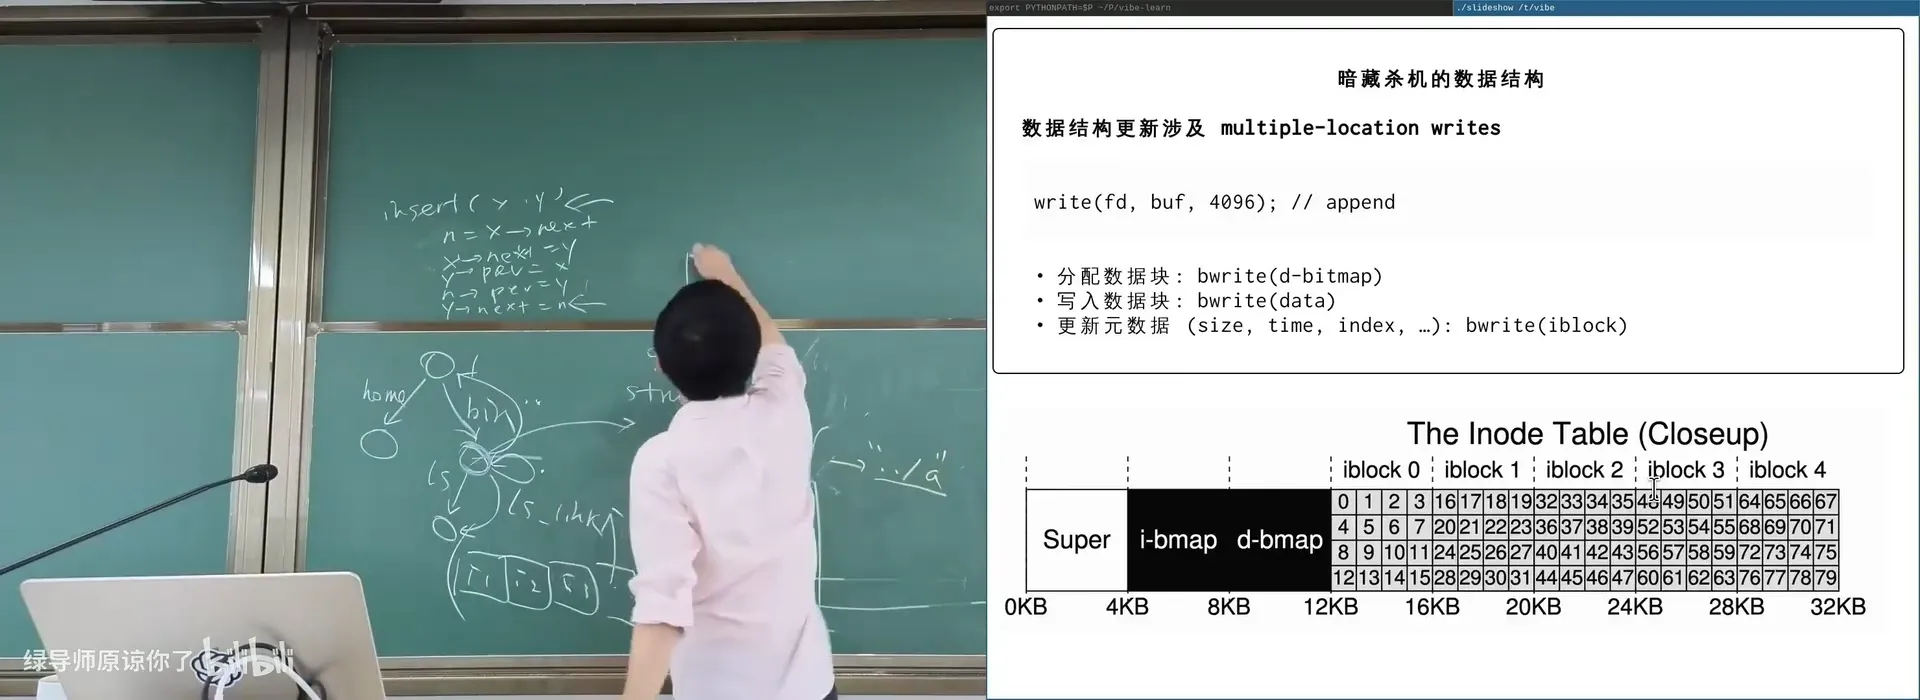
📷 crash 后的不一致:inode 指向了第 40 块,但 bit map 里第 40 块还是 free
回到原视频 (00:52:30)
3.2 Journaling:redo log
(参考时间: 01:02)
我们真正想要的,是实现一个 crash-safe 的文件系统——回到数据结构:
- 对数据结构的「就地写」是 crash-unsafe(多个指针要多步更新);
- append-only 是容易做到 crash-consistent 的。
关键洞察:数据结构有两种视角——一种是实际的数据结构(树、节点、指针);另一种是记录它的所有操作。「如果你能记住所有操作,就算数据结构不一致了——甚至整个丢了——你只要 replay 这个操作序列,就能把它恢复回来。」Memory trace:记录所有对共享内存的写,replay 这些写,就能还原任何数据结构。
于是有了 journaling(日志):
graph TD
    A["要执行一组 bwrite:更新 inode / bit map / data"] --> B["先以 append-only 方式写入 journal 区域"]
    B --> C["flush:确保 journal 落盘"]
    C --> D["写入 transaction end 标记 + flush"]
    D --> E["checkpoint:把 journal 的操作 replay 到实际数据结构"]
    E --> F["完成后可丢弃 journal"]
- Write-ahead log(也叫 redo log):先写日志、再改数据结构;
transaction begin→ 写数据 → flush →transaction end:只要看到transaction end,就说明它之前的所有数据一定已经落盘(happens-before 关系),于是可以安全 replay;- 「如果
flush之前崩溃,就好像这件事没做过。」
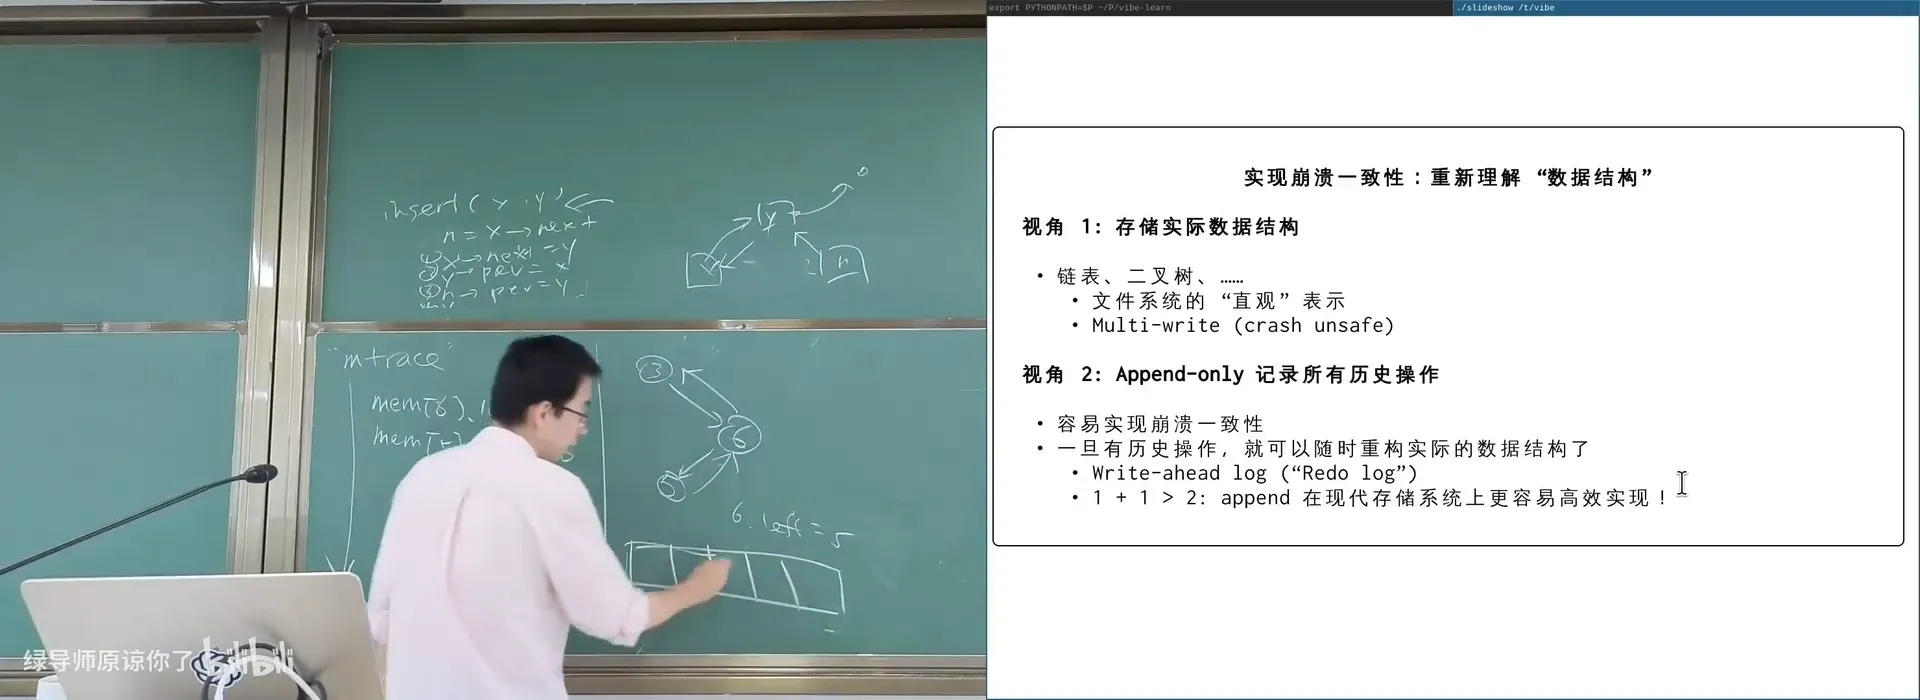
📷 journal 的原理:先写 redo log + flush,看到 transaction end 才 checkpoint 到数据结构
回到原视频 (01:05:00)
编者拓展|LSM Tree:日志思想催生了 Log-Structured Merge Tree(LSM-Tree)——现代 key-value 存储乃至数据库的根基:内存里的热点数据结构(如 skip list)+ write-ahead log → 写满后 flush 到磁盘,形成层层不可变、一层比一层大的树,靠均摊分析得到接近 $O(\log)$ 的复杂度。
3.3 ext4 的工程优化
(参考时间: 01:11)
- 合并事务(哪怕 xv6 这样的小内核也会把多次系统调用合并成一个 transaction,减少 flush 次数);
- Linux 的 JBD2(Journaling Block Device 2):每个设备有一个 journaling daemon,每隔一段时间(如 30 秒)做一次 snapshot;
- ext4 的 checksum 技巧:不需要真的等 flush,而是在日志头部写一个 checksum + 长度——crash 后读一下,checksum 对就 replay,不对就把后面的全扔掉;
- metadata journal(ext4 默认):只把 metadata(inode、bit map)的更新写进日志,文件内容的修改不进日志——因为数据丢了是应用程序的责任。「crash consistency 意味着 crash 后会丢一小段时间的内容,它更要保证目录树的完整性(不能因为目录节点出问题把整个目录丢进
lost+found)。」
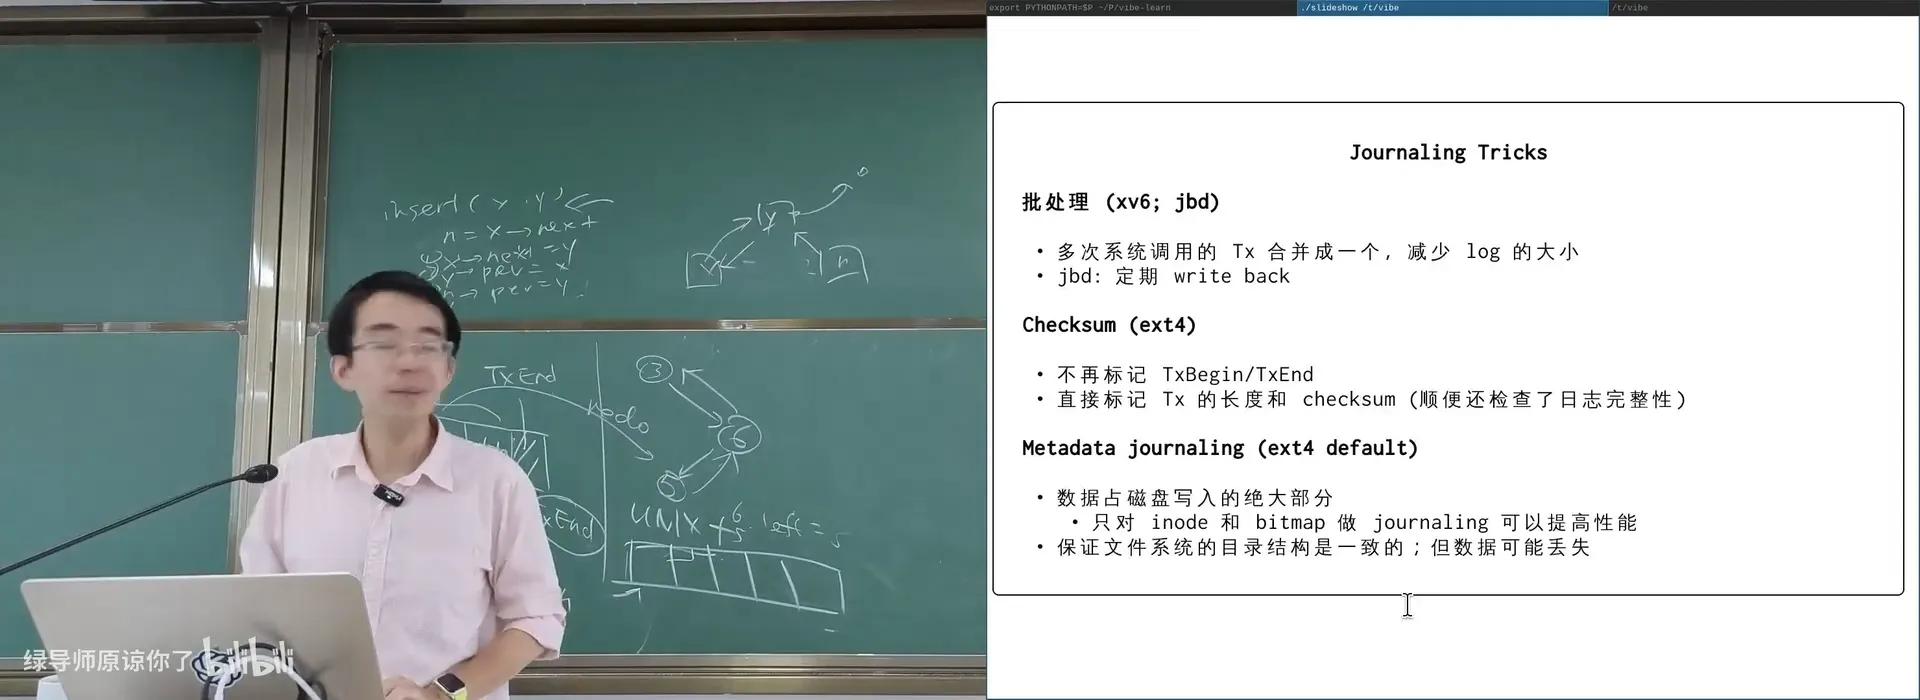
📷 ext4:用 checksum + 长度替代昂贵的 flush;默认 metadata journal 兼顾性能与目录一致性
回到原视频 (01:12:30)
3.4 「怎么保存一个文件?」
(参考时间: 01:14)
你真的会保存文件吗? 假设你在写文本编辑器:
- 绝对不能
open(O_TRUNC)直接写——「打开的一瞬间,文件内容就没了」,此时程序被杀掉,文件就没了; - 常见做法:写
A.txt.tmp→close→unlink A.txt→rename A.txt.tmp A.txt。
但 metadata journal 下这个做法仍然不安全!因为 unlink A.txt 本身是 metadata 操作,会被 journal。crash 后 redo log 里看到的是「创建一个空文件 + 删除 A.txt」——你保存的文件还是没了。(「git 不管文件系统一致性,因为它是 persistent data structure——所有 object 都在,扫描一遍总能恢复。」)
正确的方式:
- 加
fsync(fsync/fdatasync,甚至syncfs)——「告诉操作系统把所有东西落盘」; fdatasync的性能最好——它同步文件 data,只有当 metadata(size、索引)真的变了才同步 metadata;对于一个固定大小的数据库文件,fdatasync没有额外的 inode 落盘开销。- 其实只需要一个
rename——rename系统调用保证原子性(要么换过去,要么完全没换)。
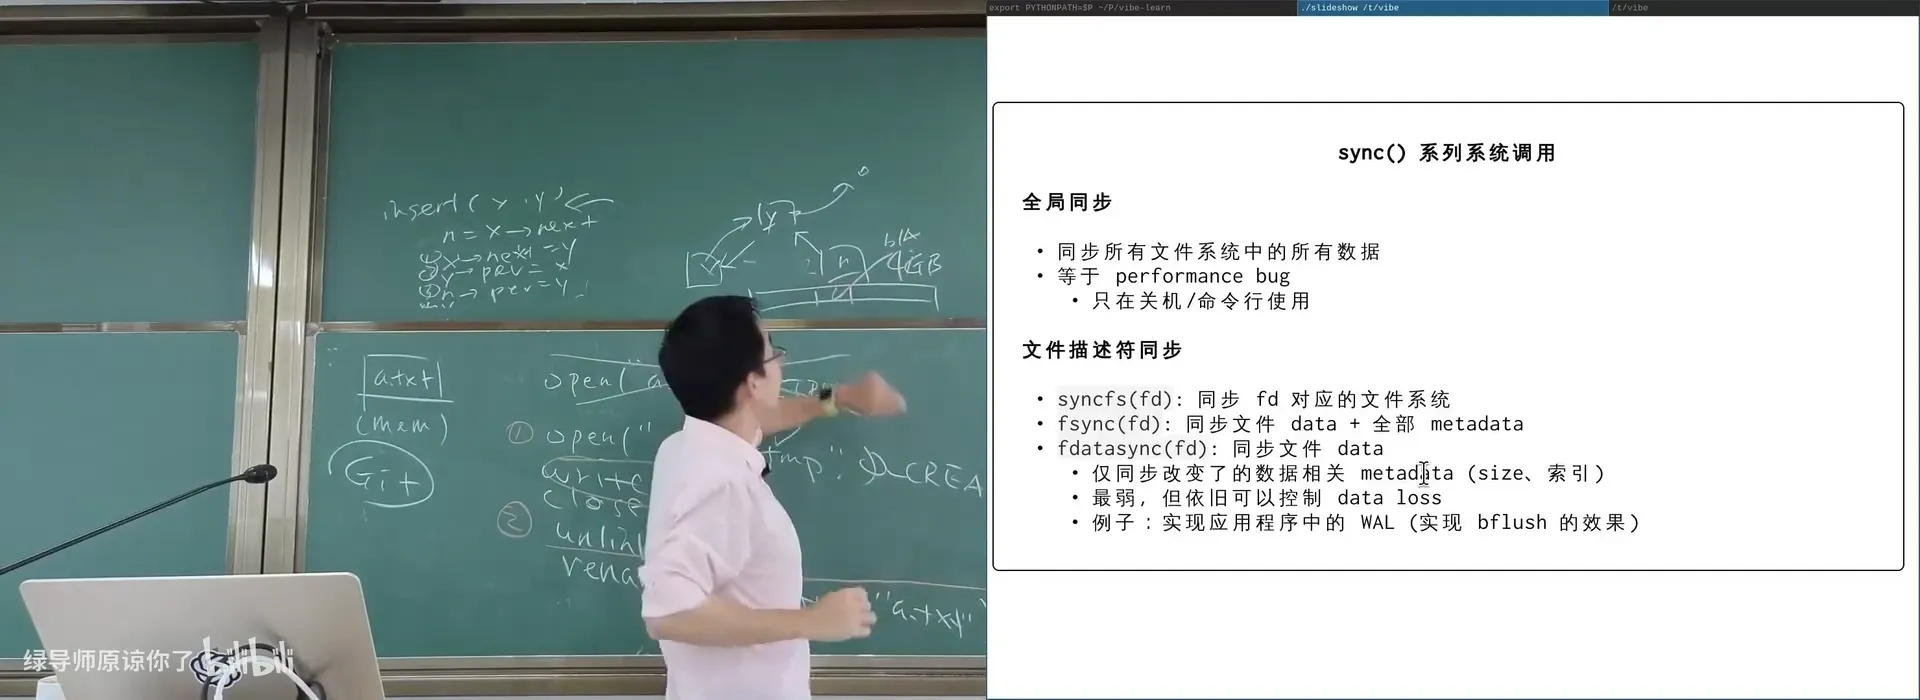
📷 正确保存文件:`fsync` + 原子 `rename`(`O_TRUNC` 直接写是灾难)
回到原视频 (01:21:00)
编者拓展|「所有业余程序员写的软件都有 crash consistency 问题」:讲师读 PhD 时做过一个研究,发现 make(可能留下错误的 build)、sort(in-place 可能丢文件)、perl -i(in-place 替换可能丢文件)……甚至 2016 年的 Node.js 世界里根本不存在一个能安全保存文件的 API(Github issue 里有人抱怨「保存大文件时磁盘满了,文件就消失了」)。
而今天:「我把 10 年前的论文丢给大模型,让它帮我实现一个 crash-consistent checker」(简化版,近 1000 行代码)。用它观测
sed保存文件的过程、生成大量模拟 crash 现场,再让大模型解读结果——「相当于让大模型直接复现了我当年论文里的研究结果。」「你甚至会发现一个洗论文的流量密码:找一个还不错的 paper,用 token 和算力把实验规模扩大 100 倍,用 LM 替代所有 heuristics。但大家不要这样做——你们学了操作系统,要去做地球上没有人做过的事情。」
总结
- block device 模型:
read_block/write_block/flush——类比共享内存 + barrier;实际设备有 GPT 分区表、可层层虚拟化(loopback、LVM、RAID); - 文件系统 = 数据结构:super block(入口)→ FAT(next 数组,为极小磁盘而生,8.3 短名)→ UNIX inode(直接 + 多级间接索引,短符号链接 inline);
- 读写放大 → buffer cache;设计要参考真实文件的大小分布;
- Crash Consistency:就地写 crash-unsafe(多步指针更新 + 任意落盘顺序 = $2^n$ 种情况)→ journaling(redo log / write-ahead log) + happens-before;
- 工程优化:事务合并、JBD2、ext4 checksum + metadata journal;
- 保存文件的正确方式:
fsync(最好fdatasync)+ 原子rename; - Takeaway:文件系统本质上是一个数据结构——「你完全是应该在数据结构课里把所有的内容都讲好」——但操作系统还多了一个职责:应对崩溃。
编者拓展|「你们真正应该相信的是:所有东西都是可以做的」:讲师最后说——「操作系统课到底教会了我们什么?日志、crash consistency、一组
fsyncAPI……但我真正教你们的,是我反复做的:开一个 trace、web code 一个东西。你们真正应该相信的是:所有东西都是可以做的。」
附:官方参考与延伸阅读
本讲的讲义见课程主页,以下链接按书中出现顺序整理:
| 主题 | 链接 |
|---|---|
| FAT 文件系统规范 | https://wiki.osdev.org/FAT |
| UEFI 规范(含 GPT) | https://uefi.org/specifications |
| LVM | https://sourceware.org/lvm2/ |
| ext4 / debugfs | https://docs.kernel.org/filesystems/ext4/index.html |
| JBD2(Journaling Block Device 2) | https://docs.kernel.org/filesystems/ext4/journal.html |
fsync(2) / fdatasync(2) / sync(2) |
https://man7.org/linux/man-pages/man2/fsync.2.html |
| LSM-Tree 论文(O'Neil et al., 1996) | https://www.cs.umb.edu/~poneil/lsmtree.pdf |
| Crash consistency 研究(Pillai et al., OSDI'14) | https://www.usenix.org/conference/osdi14/technical-sessions/presentation/pillai |
| OSTEP(第 39–43 章:Filesystem Implementation, Crash Consistency) | https://pages.cs.wisc.edu/~remzi/OSTEP/ |
阅读材料:读 OSTEP 的文件系统实现与 crash consistency 章节(第 39–43 章,含 RAID);用 debugfs 剖一剖自己的 ext4。
版权说明:本讲讲义与幻灯片作者为蒋炎岩,采用 Creative Commons BY-NC 4.0 许可,来源于 https://jyywiki.cn/OS/2026/。视频画面与字幕版权归原作者所有。本书为课堂内容的学习性重构。