第27讲 · 数据库系统
2026 南京大学《操作系统原理》第二十七讲(Hacking Day)· 课堂实录重构
| 主讲 | 蒋炎岩(Yanyan Jiang) |
| 视频 | https://www.bilibili.com/video/BV1eqEA6JEZA/ |
| 课程主页 | https://jyywiki.cn/OS/2026/ |
| 本讲讲义 | 本讲为 Hacking Day 补充选讲,讲义见课程主页 https://jyywiki.cn/OS/2026/ |
| 讲义 / 幻灯片作者 | 蒋炎岩,https://jyywiki.cn/ |
| 讲义 / 幻灯片许可 | CC BY-NC 4.0 |
| 图片来源 | 书中插图为课堂演示与讲义渲染图;演示类截图为视频画面 |
对应讲次:第27讲(南京大学 操作系统原理)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者说明:本书由课堂录像的语音字幕重构而成。本讲是 Hacking Day 补充选讲(数据库系统专题),课堂内容作为主线保留;编辑性的补充一律以「编者说明」或「编者拓展」标出。
引子:从文件系统再往前一步
(参考时间: 00:00)
上一讲讲了文件系统的实现:文件系统是磁盘上的一个数据结构——如果你的数据结构课学得好,就很容易理解它「其实就是在做一棵目录树(图)」,只不过访问方式从「按字节」换成了「按块」。
上一讲还讲了两个额外话题:文件系统的 crash consistency 与应用程序的 crash consistency——你要保证数据结构在「随时可能断电、线程随时可能消失」的情况下,重启后仍能恢复到一个正确的状态(可能丢掉最近几次操作,但整体不能 corrupt)。
今天顺着文件系统继续往前:有了一个好的文件系统,我们能用它来做什么?
编者拓展|一个容易被忽略的观点:真正访问文件的不是人,而是应用程序。你与计算机的交互只有键盘、鼠标和屏幕,屏幕上的内容都是应用程序在读写文件。哪怕你只是
cat一个文件,那也是「一个最简单的应用程序」在调用open、read。正因如此,讲师上一讲强调——应用程序的 crash consistency 同样重要:文件系统一致、但应用丢了数据,对用户来说照样不可接受。
一、一切应用数据,都是数据结构的增删改查
(参考时间: 00:02)
软件是物理世界的过程在信息世界里的投影(而且通常是有损的)。任何应用都有把数据持久化的需求:个人信息、订单、支付记录……而这些数据,本质上都是数据结构的增删改查(CRUD)。
例子 1:教务系统。 打开教务系统你会发现,看到的界面全是「数据结构的操作」:编辑教学班、编辑周历、查看选课列表……「就好像文件系统一样,增删改查」。
例子 2:PowerPoint / Word 文档。 一个「看起来不像数据结构」的东西,其实也是数据结构——把 .pptx 当 ZIP 解开:
$ unzip 离散数学-slides.pptx        # 一个 pptx 同时也是一个合法的 zip
$ ls ppt/media/                     # 里面的图片都是独立文件
于是你可以把文档里所有原始图片一次性导出来。pptx 本质上是一套 XML(Office Open XML,遵循 ISO/IEC 29500)——「页、每页里每个东西在哪里、怎么保存」,全都是一棵可读、可改的树。讲师甚至现场让 coding agent 把一个中文离散数学 slides 翻译成英文(标题、每页标题都变成英文),「完全是文本的修改」。
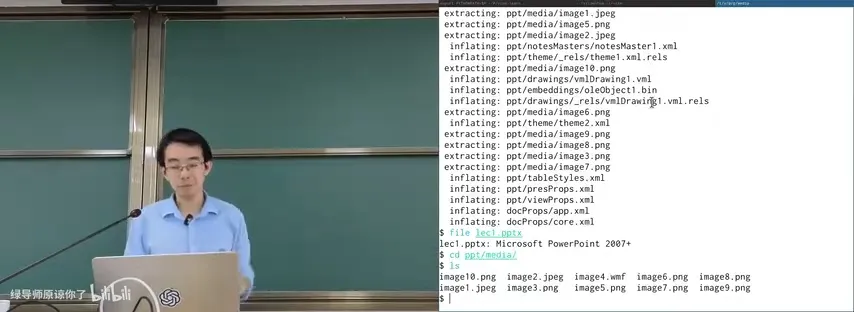
📷 把 .pptx 当 ZIP 解开:里面是 XML 与独立的图片文件
回到原视频 (00:07:05)
编者拓展|为什么会有 OpenXML:早期
.doc是不开放的二进制格式,欧盟等对微软施加压力(「标准不公开,就在政府层面禁用你」),最终促成了微软自己做一个开放标准、让大家来遵循它——这就是 Office Open XML。它带来的一个重要后果是:文档从此是「可编程的」——能用代码解析、批量修改、做自动化(也正因如此,今天 AI agent 能直接操作docx/pptx)。编者说明:讲师指出 Anthropic 官方的
docx/pptxskill 就是去解析这个文件。但他并不认为这是最好的做法——「格式并不规整,也许我们需要一个更好的查询语言」。
结论:实现一切应用数据持久化的本质,就是实现数据结构的持久化。 实现它有两种典型方法:
- 使用文件和目录(借力 UNIX 的
Everything is a file); - 在文件之上构建一个数据结构(自己设计布局)。
二、方法一:用文件和目录
(参考时间: 00:09)
如果让你用文件系统实现一个教务系统,一个很自然的做法是:用目录树来组织。
教务app/
└── 操作系统课-2026/
    ├── metadata.json          # 开课信息
    ├── syllabus.md            # 教学大纲
    └── enrollment/
        ├── 2312001.md         # 每个选课同学一个文件
        ├── 2312002.md
        └── ...
好处:所有的东西都是平的——UNIX 世界的所有工具(find、grep、sed……)都能用,agent 也能用。「目录结构是非常 agent-friendly 的方式。」
用符号链接做「引用」:你不必复制学生的个人信息,只要在选课列表里放一个符号链接指向那个学生的目录——学生更新了 email 或手机号,你这里自动同步。「完全可以用目录来存储任何数据结构,就像 docx/pptx 一样。」
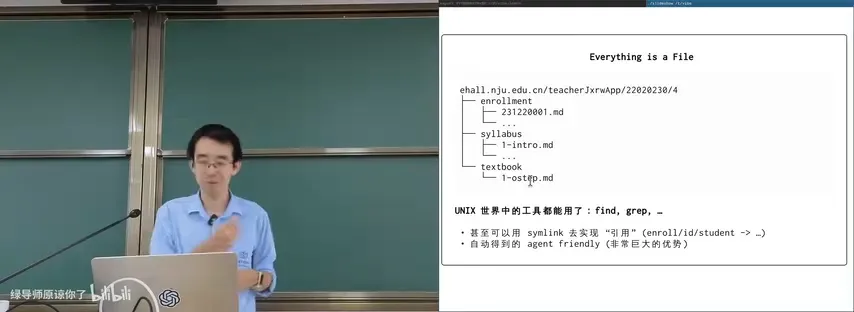
📷 用目录树实现教务系统:每个实体一个文件,用符号链接做引用
回到原视频 (00:12:00)
2.1 真实案例:课程网站与 Online Judge
(参考时间: 00:14)
这门课自己的网站就是这个风格:所有提交都在一个目录树底下。
(提交根目录)/COURSE/MODULE/学号/xxxx.result
make submit时会设置环境变量COURSE、MODULE——代码正是拿它们去打开对应的目录(改错了就报「找不到」);- 每次提交留下一个压缩包;一个独立的监听程序发现「有压缩包但没有
.result」,就送去 Online Judge(办公室里的一台机器)跑,跑完把.result写回来; - 想统计「M5 有多少份 accepted」,直接
grep一下.result、数一数行数就行;想 rejudge,删掉.result即可。
「这一切我都不需要知道任何(数据库)系统,而且可以让 agent 来帮我做。」——这是文件系统的好处:它是一个公共接口,agent 用得很溜。
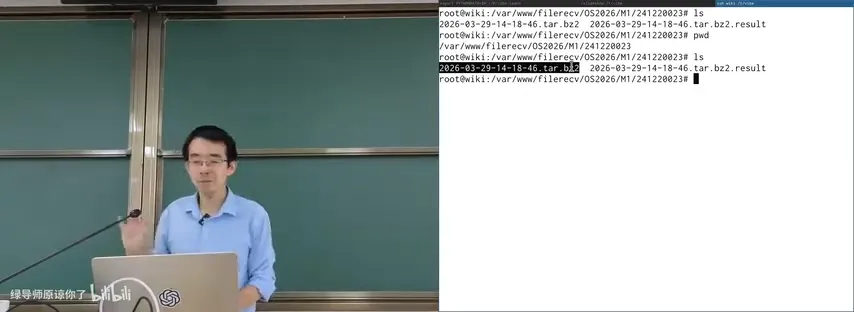
📷 课程网站:提交目录 + 监听程序 + OJ,全部建立在文件系统上
回到原视频 (00:15:00)
编者说明:这个架构的可靠性是「够用」的——阿里云的机器还算可靠,偶尔丢一两个
.result,同学刷新五分钟发现没进 pending 状态会自己再交一次,影响也不大。「所以这是一个完全可以接受的方案。」
2.2 代价:多文件写的原子性
(参考时间: 00:17)
用文件/目录实现数据库不是没有代价:
- 多文件写没有原子性:把「一个同学的选课名单」批量导入,要写 100 个文件——写到第 50 个时 crash,数据结构就进入不一致状态。你要么自己写一个
fsck,要么像 git 一样搞一个 append-only 机制。「在文件系统上实现一个 crash-consistent 的 application,是很有挑战性的问题。」 (当然也有办法:利用rename的原子性——创建一个临时目录,再原子地rename过去。) - 性能开销:每次读写都要过文件系统的系统调用(路径检查、metadata fetch);而且维护了很多你并不需要的信息(比如每个文件的
mtime——「我的 OJ 把时间写在文件名里,根本不需要操作系统的mtime」),造成隐藏的读写放大。
「对我这种小规模系统、或者一次 OJ 评测的开销远大于文件系统开销时,这个代价完全可以接受」——尤其是在要hot fix 的时候,这种架构非常顺手。
三、方法二:在文件之上构建数据结构
(参考时间: 00:19)
如果你一点额外开销都不想付,那就自己在文件上实现一个数据结构。因为——文件就是一个 byte array,而磁盘也是 byte array:
- 你已经做过一次「虚拟化」:在磁盘(byte array)上放一个数据结构(FAT 或 UNIX inode 图),把它变成一堆「文件」;
- 那当然可以再在文件(byte array)上做一次抽象,把它变成任何数据结构。「ELF 文件不就是一个数据结构吗?——有一堆 header、program header、PT_LOAD 段、符号表,指针指来指去……」
于是实现一个教务数据库,就是在文件头上放一个 superblock:
struct superblock {
    uint32_t magic;              // "教务DB"
    struct student *head;        // 学生链表
    struct student *free_list;   // 空闲链表(allocator)
    uint32_t count;
    char     wal[...];           // write-ahead log
};
关键的 hack:把文件 mmap 到固定地址。只要每次都映射到同一个虚拟地址,文件里的「指针」就直接有效——head 的值就是 0x10020,指向的正是文件里那个 student 的位置。于是:
// add:完全是数据结构课上学的链表插入
struct student *s = allocate(sizeof(struct student));
s->next = sb->head;
sb->head = s;
sb->count++;
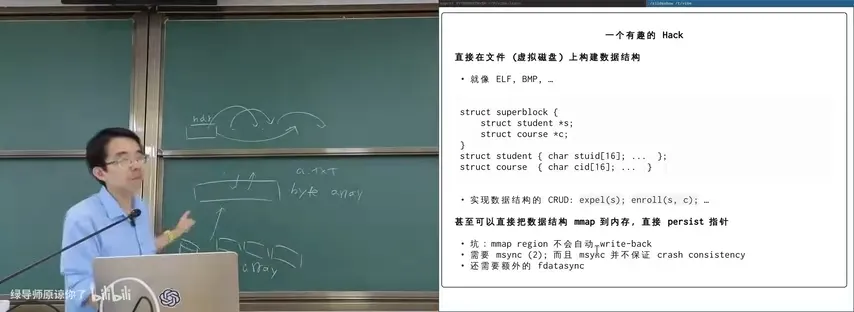
📷 把文件 mmap 到固定地址,直接在文件里存「指针」
回到原视频 (00:22:00)
编者说明:这套东西「理论上可以」,但生产环境里坑非常多。第一个坑:
mmap一个文件后,你对内存的修改不会立刻反映到磁盘(先写到 cache,甚至 L1 cache 里)。如果你频繁按数据结构的方式读写,而操作系统又要保持内存与磁盘同步,就会造成无限大的写放大。默认情况下,mmap的读写不做 writeback——「数据丢了就丢了」。
要让写入真正落盘,需要一串系统调用:
msync(addr, len, flags):synchronize a file with a memory map——告诉操作系统「这段内存写了,请写回磁盘」;- 但它不等落盘(不同于
fdatasync);要 crash consistency,还要再fdatasync; madvise(addr, len, advice):给「这段内存该怎么管」提建议(normal / random / sequential……)——它不是 POSIX,各系统行为不一。
「操作系统既想提供透明的抽象(memory-mapped file,随便读写),又要在写回时让你控制策略——这时就引入了很多复杂性。所以 mmap 可能并不是实现数据库的好 API。」
3.1 Write-Ahead Log(按需引入)
(参考时间: 00:29)
既然要 crash consistency,就按上一讲的思路,在 superblock 里塞一个 write-ahead log(这里只放一个 slot,是偷懒的简化版):
graph LR
    A["执行 add/delete"] --> B["把命令字符串写入 WAL"]
    B --> C["msync + fdatasync(确保日志落盘)"]
    C --> D["更新真正的数据结构"]
    D --> E["再次落盘后清空 WAL"]
    E --> F["事务提交完成"]
- crash 后重启时,先 replay WAL,再进入正常流程;
- 「你可以在磁盘上实现任何数据结构——因为它的实现和数据结构课上的一模一样,只是
malloc变成了在这个文件里分配。」
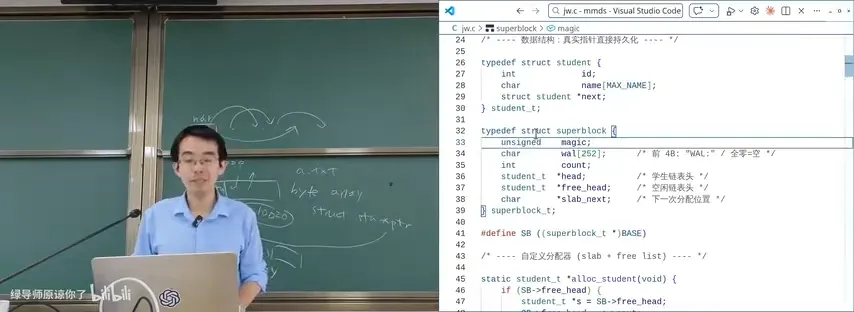
📷 Write-Ahead Log:命令先落盘,再更新数据结构,最后清空日志
回到原视频 (00:30:00)
讲师现场演示:直接 hack 数据库文件、在 WAL: 后面手写一条 add 99 XX 命令,再打开系统——replay 后 99 号同学就出现了,日志随即被清空。
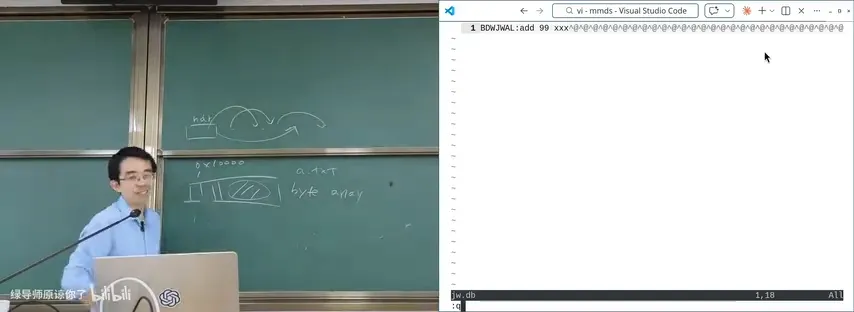
📷 手工写入 WAL,重启后被 replay:99 号同学出现
回到原视频 (00:32:00)
编者拓展|Single-Level Store(单级存储):顺着这个思路想到极致——既然「数据结构可以直接映射到磁盘」,那整个进程的内存能不能都
mmap到持久内存上?这样「拔电重启后程序状态还在」,就得到了一个 single-level store 的操作系统(内存与持久存储不再分层)。这在「有非易失内存(persistent memory)」时理论上是可做的(讲师提到有一篇相关研究论文)。「你有这种疯狂的小 idea,不断往实际里做,就可以做出真正有用的东西。」
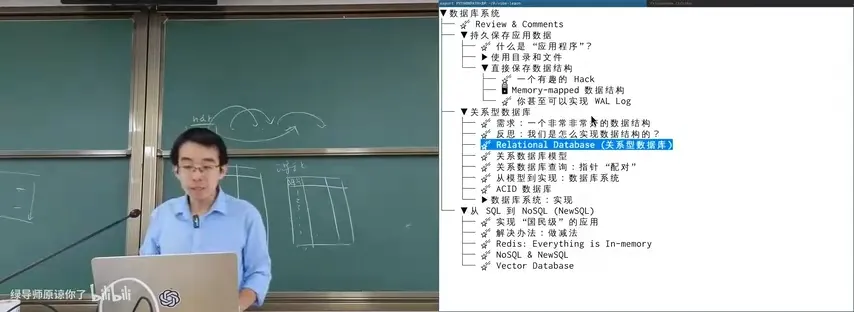
四、关系数据库:把「关系」做成表格
(参考时间: 00:35)
前面是在解决「把应用数据存下来」。现在野心更大:做一个能处理任意类型数据、又好用、性能又极致、还永不丢数据的「通用数据结构」——这就是关系数据库。
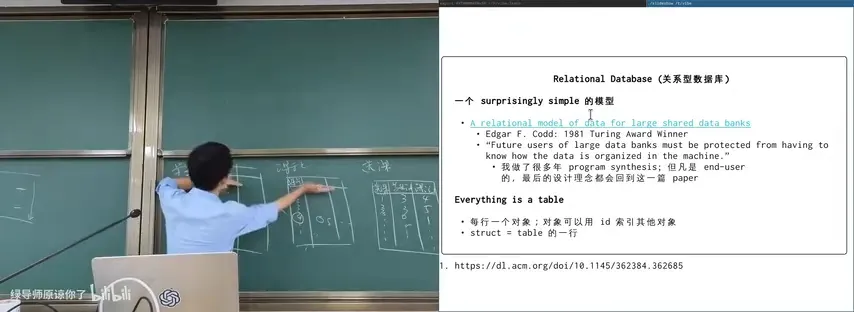
编者拓展|图灵奖与 Codd 的关系模型:关系数据库的理论基础是 E.F. Codd 1970 年的论文 A Relational Model of Data for Large Shared Data Banks,他因此获得图灵奖。论文的核心主张恰是本讲的出发点:
Future users of large data banks must be protected from having to know how the data is organized in the machine.
——用户只需在「概念层」描述数据与查询,不必关心数据在机器里怎么组织。这是数据库最重要的抽象。
4.1 关系模型:一切皆「二维表」
(参考时间: 00:39)
在内存里实现数据结构,我们的本能是指针(struct node { node *left, *right; })。但指针不是一个好的数据库抽象——因为你想表达的是「实体与实体之间的关系」,而世界上无非就是「一堆实体 + 一堆关系」。
答案简单得不能再简单:二维表(就像 Excel 的一张张表):
| 表 | 列 |
|---|---|
| students | 学号(主键)、姓名…… |
| courses | 课号(主键)、课名…… |
| enrollment | 学号、课号 |
「选课」这件多对多的事,就变成第三张表——用学号、课号把两个实体关联起来。「世界上只有三种最小的事实:学生、课程、选课。理论上你应该能用这三种最小的事实,推出任何其他导出的事实。」
📷 关系模型:一切皆二维表;多对多关系用「关联表」表达
回到原视频 (00:40:30)
4.2 Join:笛卡尔积 + 过滤
(参考时间: 00:42)
那么「一门课的选课列表」怎么算?数学上非常有趣的答案:对三张表做笛卡尔积(所有组合),再按条件过滤——这就是 join:
for s in students:
    for c in courses:
        for e in enrollment:
            if e.student_id == s.student_id and e.course_id == c.course_id:
                输出 (s, c, e)
「看起来非常低效,但如果你把它做得非常高效,无论你写多少层循环嵌套,它都能给你算出来——这就是能得图灵奖的想法。」用"学号/课号"这两个 primary key(主键),就能把「遍历整表」优化成「查索引」。
📷 join = 笛卡尔积 + 过滤:用三重循环描述,用索引高效执行
回到原视频 (00:43:00)
于是就有了 SQL(Structured Query Language,结构化查询语言)——一个专门管理数据的领域特定语言:
SELECT course.title
FROM   students
JOIN   enrollment ON students.id = enrollment.student_id
JOIN   courses    ON enrollment.course_id = courses.id
WHERE  students.name LIKE '张%';
「update 也是一个查询;INSERT INTO 就是往表里插数据。你可以随便写查询——想要什么就要什么。」
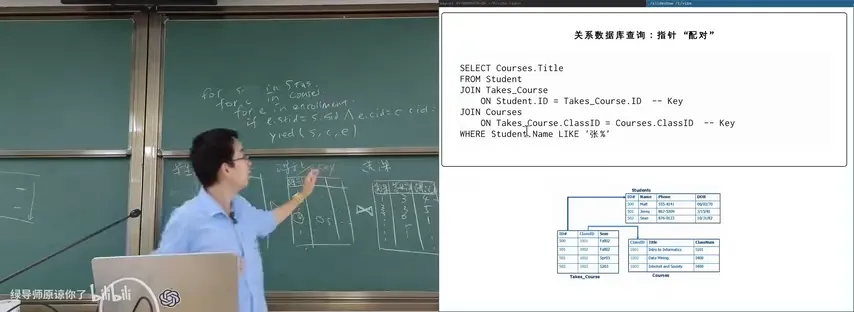
📷 SQL:把「事实」拆到最小的表,用查询导出任何想要的东西
回到原视频 (00:47:00)
4.3 ACID 与「事务」
(参考时间: 00:48)
数据库系统给出的保证是 ACID:
| 全称 | 含义 | |
|---|---|---|
| A | Atomicity | 原子性:要么全做,要么全不做 |
| C | Consistency | 一致性 |
| I | Isolation | 隔离性 |
| D | Durability | 持久性 |
编者说明:讲师从操作系统视角把它归纳为两点:Serializability(可串行化)——无论多少并发的事务(读的、写的),最终都能排成一个全局顺序,像是「1 执行完再执行 2……」,而不是 weak memory model 那种乱序;以及 strong crash consistency——系统随时 crash 都不会造成数据丢失,还支持任意的多写(multi-write)。
核心抽象:transaction(事务):
BEGIN TRANSACTION;
  UPDATE accounts SET balance = balance - 100 WHERE id = 'A';
  UPDATE accounts SET balance = balance + 100 WHERE id = 'B';
  -- ……可以在这里做任意图灵完备的计算、甚至 sleep
  -- 若余额不足 / 发现异常:ROLLBACK
COMMIT;
「在一个 transaction 里,你可以写任何代码。只要 abort,前面执行的操作全部都没有了;只有 commit,所有操作才立即生效,而且是 all-or-nothing。」
这解决了「转账」这类多写问题:它既要抵抗并发(两个线程同时判断余额),又要抵抗崩溃(扣了 100 但还没加 100 时断电)。
编者拓展|为什么这比「一把大锁」更难:如果只是并发,你上一把锁就行;但数据库还要保证「线程随时可能消失」——即 transaction 中途 crash,已执行的部分必须整体回滚。这需要 WAL + 恢复(rollback/replay) 的配合,是数据库最核心的工程之一。
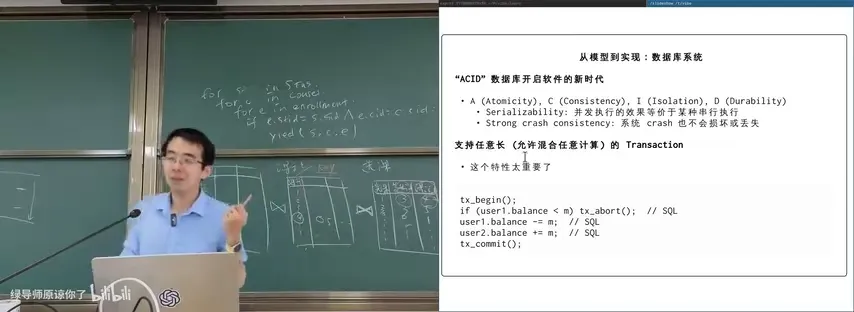
📷 ACID 与事务:begin / commit / abort 之间可以写任意代码,all-or-nothing
回到原视频 (00:50:00)
4.4 并发控制:2PL、死锁与 MVCC
(参考时间: 00:56)
数据库里每个请求都会读写不同的部分(可能几百张表),并发控制非常复杂。两种经典方法:
① Two-Phase Locking(2PL,两阶段锁):
- 想读某行/某表就上读锁,想写就上写锁;可以分块、分列(column)上锁,于是不相干的请求可以并行提交;
- 问题:会死锁。业务逻辑可能「先写 X 再写 Y」,也可能「先写 Y 再写 X」——典型的 A→B、B→A 死锁。
- 在操作系统内核里,你可以用 lock ordering 禁止这种代码(直接报错);但数据库不行——查询是别人写的,业务逻辑就是这样,你没法要求它改。
所以数据库有死锁检测(deadlock detector):像维护一张「谁等谁」的图,一旦成环就「破圈」——选一个 transaction abort,让它回滚、从头再来,另一个继续 commit。「回滚到什么程度、怎么回滚,都是无穷的复杂性。」
② MVCC(Multi-Version Concurrency Control,多版本并发控制):用一个很好的类比——
每个 transaction
BEGIN时,都git checkout出一个新分支:读永远读自己这个分支(别人怎么改都与我无关),写也只写进自己的分支;做完时,尝试向 main 分支merge。 - 两个事务改了不同的行 → 不冲突,都能 commit(本质是 replay 各自的 write-ahead log); - 两个事务改了同一行 → 冲突,其中一个分支被丢弃(abort)。
「和 git 不同的是,git 允许你 resolve merge conflict;数据库不能——因为 transaction 里可以有任意计算,值是程序算出来的。」
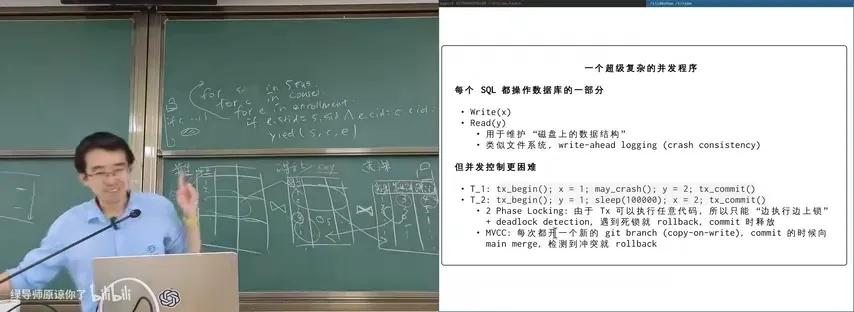
📷 MVCC:像 git 分支一样,每个事务在自己分支上读写,提交时 merge
回到原视频 (01:00:00)
编者说明:「这是一个超级复杂的并发程序,但也是一个了不起的工程奇迹。」上节课讲过的
serializability与crash consistency,在这里被实现成了「你只管写一把大锁,性能却优于你自己加细粒度锁,而且完全自动的崩溃恢复」——后台用的是 append-only + LSM-tree 之类的高性能并发结构。
4.5 查询优化:数据库里的「编译器」
(参考时间: 00:53)
一段 SQL 就是一段程序,所以可以等价改写(rewriting):
- 「把循环往外提」——把无关的循环消灭掉,剩下两个表直接查 key;
- 配套的是磁盘上的高性能索引结构(如 B+ 树)、缓存、分库分表、读写分离……
「你们的编译器 gcc -O0/-O1/-O2,本质上也是一大堆 rewriting rules;数据库里的查询优化器是同一件事——只是这两批人走了完全不同的路线。」
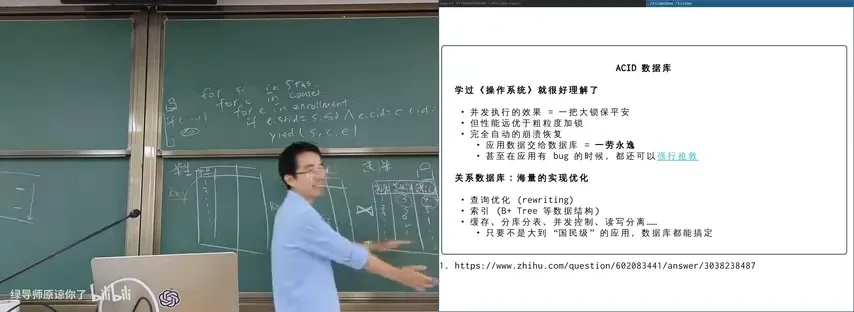
📷 查询优化器 = 一大堆 rewriting rules:把「三重循环」改写成查 index
回到原视频 (00:53:00)
4.6 SQLite:无处不在的小数据库
(参考时间: 01:02)
数据库不只服务互联网大厂,它也服务我们每个人。看看手机设置里那些小拨片(settings)——它们是持久化的。你会想「是不是每个 preference 一个文件、写个 0/1、再 fsync」?实际上是一个很小的 SQLite 数据库在管理:
SQLite: a C library that implements a small, fast, self-contained, high-reliability, full-featured SQL database engine. ——the most used database engine in the world
- 整个数据库就是一个文件,整个库也是一个文件(
libsqlite3.so); - 是 zero configuration:你只要有这个
.so,就能享受数据库的全部好处; - 每一个 Android / iOS app 都带一个 SQLite 引擎。
「系统里所有涉及 persistence 的地方,第一反应就是求助于 SQLite。」——想做一个动态构建的设置列表?一个 SQL 查询查出来就行;想改?一个 SQL 查询搞定,而且数据安稳地存到磁盘上,不用你操心 fsync。
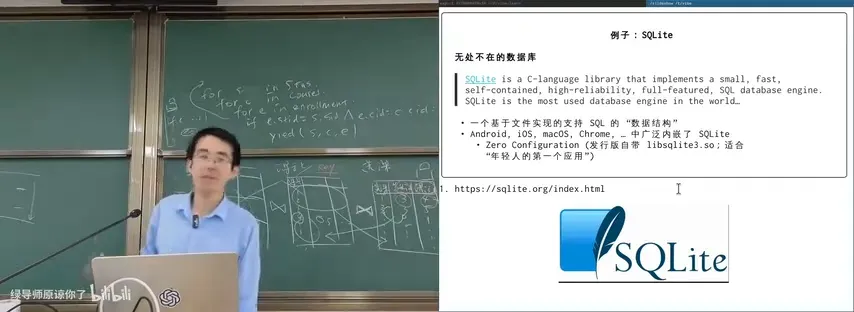
📷 SQLite:一个文件 + 一个库,世界上最广泛使用的数据库引擎
回到原视频 (01:04:00)
五、NoSQL 与 Key-Value:为了「更大」
(参考时间: 01:07)
微信的聊天记录,本质上一张表就能装下(一个气泡就是一条记录,内容是一段 XML)。「最近十条聊天」就是一句 SQL:
SELECT * FROM chat_records
WHERE sender_id = :me AND receiver_id = :peer
ORDER BY time DESC LIMIT 10;
「到百万、千万用户时,一台机器的 Postgres 都能扛。但到了微信的量级,压力就给到数据库引擎:分库分表、读写分离、索引、缓存……」而且——
你永远无法预知程序员会写出多么糟糕的 query。
「企业级系统里,下个单背后可能是 50 张表 join 在一起。SQL 给了太多能力,很难避免被滥用;而滥用就意味着 performance bug。用户量小的时候不致命,但数据一增长,它就会越来越慢。」
于是有了另一种思路:「SQL 给得太多了,也许在某些应用里,我可以给得少一点。」 给得少 → 系统实现更容易、性能更高、更容易分布式。
5.1 Key-Value:最简单又够用
(参考时间: 01:10)
最常用的数据结构是什么?——key-value(一个 map / dict):
user:2312001        -> '{"name":"张三","phone":"..."}'    # 用户信息(JSON)
enrollment:2312001  -> ["OS2026", ...]                    # 选课记录(append-only list)
- 查/改用户信息,就是读写一个 key 下的 JSON;
- 选课/退选可以做成 append-only list(「你不会选一万门课退一万门课」)——读的时候 replay 一遍就能得到当前状态;点赞就是往 list 里 append;
- Why append-only:它更容易实现、consistency 更容易保证,还能分布式并行(好多个线程各自 append,最后串起来);
- 分布式与负载均衡:对 key 做 hash,就能把请求均匀送到多台机器上——「自动 load balance,自动 scale」。
编者拓展|LSM-Tree 与 Redis:像这样的「只追加写 + 随机读」的键值存储,通常用 LSM-Tree(Log-Structured Merge Tree)实现——写入先进内存表 + 日志,写满后合并到磁盘上层层不可变的树,靠均摊分析得到好性能。而在它前面,还常放一层 Redis(in-memory key-value,支持 string/list/set/hash)——把「全世界几百万人同时点赞」先缓冲在内存里(比如一个 counter 或一个 list append),每隔一段时间再合并写回底层数据库,从而大幅减轻数据库压力。「这就已经很接近今天的高性能架构了。」
5.2 从 KV 到 NewSQL
(参考时间: 01:17)
但「key-value 用起来终究不如 SQL 好用」——因为 SQL 可以「随便写 50 层循环,你自动帮我搞定」。于是人们开始在简单模型上扩展:
| 类型 | 例子 | 特点 |
|---|---|---|
| Document DB | MongoDB | 以「类 JSON 文档」为单位(结构化存储,比纯 list 更好用) |
| Column DB | Cassandra(查询语言 CQL) | 按列组织;有表模型,但不提供 Full SQL |
| NewSQL | TiDB(国产)、Google Spanner、CockroachDB | 几乎完整的 SQL + 分布式 scale out |
「今天也不是版本答案,这是一个巨大的 industry。」
六、向量数据库:为 AI 时代准备的数据结构
(参考时间: 01:19)
前面所有数据库,本质上都是「某个数据结构的增删改查」。还有一种新的、和它们都不一样的向量数据库:
- 把一段文本/文档交给模型,变成一个高维向量(如 4096 维);向量可以存进数据库(甚至存进文件的 extended attributes);
- 向量数据库做的是 Nearest Neighbor Search(最近邻搜索):给定一个向量,找出库里和它最接近的向量;
- 距离可以用 dot product、cosine distance(余弦距离)等度量——向量越近,说明两份文档的内容越接近。
讲师现场做了个漂亮的演示:把他每一讲的幻灯片 embedding 成向量,算出两两距离,然后可视化——
- 第 13–21 讲(并发部分)聚成一团;
- 第 27 讲(今天,数据库)与第 24–26 讲(文件系统)关联很强,与第 26 讲(文件系统实现)关联稍弱;
- 第 4 讲(Agentic AI)是一个「孤岛」——「它已经识别出来了,我这一节课是 off topic 的,但我觉得在操作系统课里必须讲一讲。」
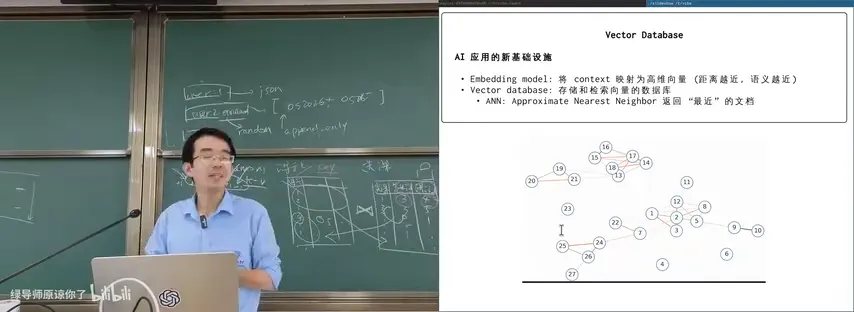
📷 把 27 讲 embedding 成向量再可视化:并发部分聚成一团,第 4 讲是孤岛
回到原视频 (01:20:00)
编者拓展|向量检索与 RAG:把文档 embedding 后存进向量库、用「最近邻」把相关片段找出来塞进大模型上下文,这就是 RAG(Retrieval-Augmented Generation,检索增强生成) 的检索部分。传统数据库靠精确匹配(等于、范围),向量库靠语义相似——所以它天然适合「找相关论文」「找出可能给我启发的东西」这类模糊需求。「构建一个论文数据库,把和我在讨论的东西相关的、甚至只是弱相关但能启发我的论文找出来」——「我不知道未来会变成什么样,但我相信世界会变成这样。」
总结:无论是 SQL、NoSQL 还是向量数据库,「本质上它们都是某一个数据结构的增删改查」——回到教务系统,它的功能就是增删改查;一个 PowerPoint 也是增删改查。「任何一个产品在设计的时候,背后都是那些数据管理的道理。」
总结
- 一切应用数据都是数据结构:教务系统、
pptx/docx(ZIP + XML)……「实现应用数据持久化的本质,就是实现数据结构的持久化」; - 方法一:用文件和目录——Tool-friendly、Agent-friendly(课程网站/OJ 就是范例),但多文件写没有原子性(要自己搞 crash consistency)、有性能开销;
- 方法二:在文件上构建数据结构——把文件
mmap到固定地址就能直接存「指针」,用 superblock + allocator + write-ahead log 实现任意数据结构与 crash consistency(启发了 single-level store);坑:msync/fdatasync/madvise的语义与写放大; - 关系数据库:关系模型(Codd,图灵奖)把一切变成二维表;join = 笛卡尔积 + 过滤;SQL 让用户只描述「要什么」;ACID/事务保证 serializability 与 crash consistency(这是数据库最有用的特性);
- 并发控制:2PL(会死锁 → 死锁检测 + 破圈)与 MVCC(像 git 分支 checkout/merge);
- 查询优化:数据库里的「编译器」(等价改写 + B+ 树索引);
- SQLite:一个文件 + 一个库,世界上最广泛使用的数据库引擎;
- NoSQL / Key-Value:为「更大」而生——KV + hash 负载均衡 + append-only + LSM-tree + Redis 缓存;再到 Document/Column/NewSQL;
- 向量数据库:为 AI 时代准备的「语义最近邻」数据结构;
- Takeaway:一切应用都是数据结构的增删改查——回到这个视角,你就能理解任何一个产品背后的数据管理之道。
附:官方参考与延伸阅读
本讲为 Hacking Day 补充选讲,以下链接按书中出现顺序整理:
| 主题 | 链接 |
|---|---|
| 课程主页 | https://jyywiki.cn/OS/2026/ |
| Codd, A Relational Model of Data for Large Shared Data Banks(1970) | https://dl.acm.org/doi/10.1145/362384.362685 |
| Office Open XML(ISO/IEC 29500) | https://en.wikipedia.org/wiki/Office_Open_XML |
| SQLite | https://www.sqlite.org/ |
| LSM-Tree(O'Neil et al., 1996) | https://www.cs.umb.edu/~poneil/lsmtree.pdf |
| Redis | https://redis.io/ |
| MongoDB | https://www.mongodb.com/ |
| Apache Cassandra | https://cassandra.apache.org/ |
| TiDB | https://www.pingcap.com/tidb/ |
| Google Spanner 论文 | https://research.google/pubs/pub39966/ |
| CockroachDB | https://www.cockroachlabs.com/ |
| Andy Pavlo, CMU 15-445 Database Systems | https://15445.courses.cs.cmu.edu/ |
| OSTEP(第 43 章:Log-structured File Systems;第 44 章:Flash-based SSDs) | https://pages.cs.wisc.edu/~remzi/OSTEP/ |
msync(2) / fdatasync(2) / madvise(2) 手册 |
https://man7.org/linux/man-pages/man2/msync.2.html |
阅读材料:读 OSTEP 相关章节;有兴趣的同学可以看 Andy Pavlo 的 CMU 15-445《Database Systems》公开课,理解「数据库里的编译器」;动手体验 SQLite(一个文件、一个库)。
版权说明:本讲讲义与幻灯片作者为蒋炎岩,采用 Creative Commons BY-NC 4.0 许可,来源于 https://jyywiki.cn/OS/2026/。视频画面与字幕版权归原作者所有。本书为课堂内容的学习性重构。