第1讲 · 从零构建语言模型:CS336 ——概览与分词
本电子书由教学视频重构而成。 书中代码、讲义与图片版权归斯坦福大学 CS336 课程团队所有,本电子书为课堂讲解的中文书面重构,仅供学习交流。
| 视频原标题 | *Stanford CS336 Language Modeling from Scratch |
| 授课 | Percy Liang、Tatsu Hashimoto(斯坦福大学 CS336 课程);本讲由 Percy Liang 主讲 |
| 视频地址 | https://www.youtube.com/watch?v=JuoVZkPBiKk |
| 课程主页 | https://stanford-cs336.github.io/(亦见 https://cs336.stanford.edu/) |
| 本讲官方讲义源码("可执行讲义") | https://github.com/stanford-cs336/lectures/blob/main/lecture_01.py |
| 课程作业仓库 | Assignment 1: Basics 等 |
对应讲次:第1讲(Stanford CS336 语言建模)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
导览
- 这一讲老师想回答的核心问题(按他的提问顺序)
老师开场先问:为什么在“AI 已经能替你写代码”的时候,还要教、还要学“从零构建语言模型”?接着他的问题链是:研究者为什么会和底层技术栈脱节?语言模型工业化、前沿模型够不到之后,这门课还能教什么?他进一步追问:苦涩的教训常被误读成什么?如果正确理解,效率为什么是贯穿整门课的主线?然后转向版图:过去十年“语言模型”这个词指的东西变了什么,哪些基本面没变?课程为什么分成五单元、五次作业?进入技术部分后,他的问题变成:文本怎样变成模型能操作的 token?为什么需要 tokenizer?字符级、字节级、词级这三种朴素方案各自卡在哪里?BPE 怎样训练、怎样编码?如果未来不要 tokenizer,替代方案必须满足什么条件?
- 难点在哪、为什么容易卡住
这一讲前半段信息密度高,动机、历史、开放模型生态、课程行政和作业政策交织,容易听成“综述+课程说明”,但真正的主线是老师反复用问题把技术栈串起来。后半段进入分词深潜,看似简单,实际概念翻转多:字符串、UTF-8 字节、token 索引、往返、压缩比、词表大小与序列长度之间的权衡,任何一个没对齐都会让后面代码读不下去。BPE 的算法概念很短,但工程实现和加速(merge 顺序、预分词、特殊 token、性能)很容易从“看懂”掉到“写不出、跑不快”。此外,效率主线在动机、系统、数据、缩放、分词之间来回出现,若只记零散结论,会丢失它的问题地图。
- 读者可能带着的疑问
① 老师真正提出的问题 - 为什么现在还要开一门“从零构建语言模型”的课? - 研究者与技术栈脱节到什么程度?模型工业化后,小模型实验还能教什么? - 苦涩的教训到底该怎样理解?效率为什么在大规模上更重要? - “语言模型”这个词过去十年变了什么?哪些基本面没变? - 五单元和五次作业为什么这样排?它们与效率主线是什么关系? - tokenizer 为什么存在?三种朴素方案各自为什么不够? - BPE 为什么成为默认选择?它的训练和编码到底在做什么? - 无 tokenizer 的未来需要满足什么条件?
② 编者预判的读者疑问
- 第一讲为什么有大量课程行政、作业政策和 AI 使用政策?这些需要认真对待吗?(编者预判)
- 前半段几乎没有公式推导,如何判断自己是否抓住了重点?(编者预判)
- 分词在整门课里占多大分量?作业 1 要把 BPE 优化到什么程度?(编者预判)
- GPT-5 分词器、tiktoken、o200k_base、压缩比这些术语如何对应?(编者预判)
- 为什么示例里的 encode 被说成“正确但极慢”?慢在哪里?(编者预判)
- 特殊 token、预分词、正则、Rust/C 重写,哪些是考试/作业重点?(编者预判)
- 效率主线怎样落到每个单元?分词也算效率问题吗?(编者预判)
- 本讲路线
老师先讲课程动机、领域史与五单元大纲,再进入分词技术深潜:从 Tokenizer 接口与真实分词器体验,到字符/字节/词级方案的比较,再到 BPE 的训练、编码与作业加速要求,最后收束到“无分词器未来”的条件和下一讲预告。
一、欢迎与课程定位
(参考时间: 00:04)
欢迎来到 CS336:Language Models from Scratch(从零构建语言模型)。这是这门课的第三次开课。教学团队包括 Percy、Tatsu、Marcel、Herman、Steven 等人。
📷 课程开场:教学团队与第三版课程
回到原视频 (00:00:04)
主讲 Percy 说,自己做语言模型已经二十年了,但其中大部分时间都是在做"小语言模型"——他自嘲,放在整个领域的大局里,现在讲的这些模型其实也仍然算小。两年前他和 Tatsu 第一次开这门课时,并不确定会有多少人愿意来学"从零构建语言模型",尤其是在连编码智能体(coding agent)都可能"零样本"写出一个语言模型的今天。结果报名的人非常多,这让他们很受触动:在 AI 能替你写代码的时代,仍有这么多人真心想弄明白这些东西到底是怎么工作的。
这门课有一个鲜明的主张,可以用一句话概括:
通过亲手构建来真正理解。(understanding via building)
第三次开课,有什么新东西?
(参考时间: 02:23)
📷 第三次开课的新变化:更多 MoE、长上下文与智能体
回到原视频 (00:02:23)
不变的是"从零开始"的理念:课程坚信,只有把一切都从底层搭起来,你才能真正理解它是如何工作的。当然,一个学期不可能真的把一切都从零搭完,所以教学团队花了两年时间反复打磨"配方",精挑细选出单位时间价值最高的那些内容。
变了的是——即使在一年之内,领域也变了很多。这一版课程会:
- 花更多时间讲混合专家模型(Mixture of Experts, MoE);
- 关注当下很热门的智能体(agents),也就是要理解长上下文(long-context)以及它所需的一切。
二、为什么要开这门课:研究者与技术栈的脱节
(参考时间: 03:23)
📷 为什么要开这门课:研究者与底层技术脱节
回到原视频 (00:03:23)
两年前促使他们开这门课的核心问题是:研究者正在与底层技术脱节。
- 大约十年前(2016 年前后):所有 AI 研究者都会自己实现并训练模型。
- 八年前(2018 年前后):研究者会下载预训练模型(比如 BERT),然后在下游任务上微调。
- 今天:很多人只要"提示"(prompt)一个模型就能做出成果。
提示模型当然没问题,用它可以做出很棒的东西;往更高的抽象层次走,总体上是好事。但问题在于——抽象是有漏洞的(leaky)。任何提示过模型的人都遇到过这种情况:你想让它做某件事,它就是做不到,而你毫无办法。
更进一步:如果你真的对基础研究感兴趣,那么只靠提示模型,会把自己的设计空间极大地限制住。做基础研究,往往需要把整个技术栈掀开(tear up the stack)。所以主讲的观点是:
要真正从事基础研究,就必须完整理解语言模型是如何工作的。
语言模型的"工业化"
(参考时间: 04:54)
但这里有个不小的麻烦:语言模型已经工业化了,前沿模型极其昂贵。
- 三年前,GPT-4 据称训练成本约 1 亿美元;如今成本可能在 10 亿美元量级(这一数字带有推测性)。
- 各大实验室正在建造的 GPU 集群规模大得惊人。
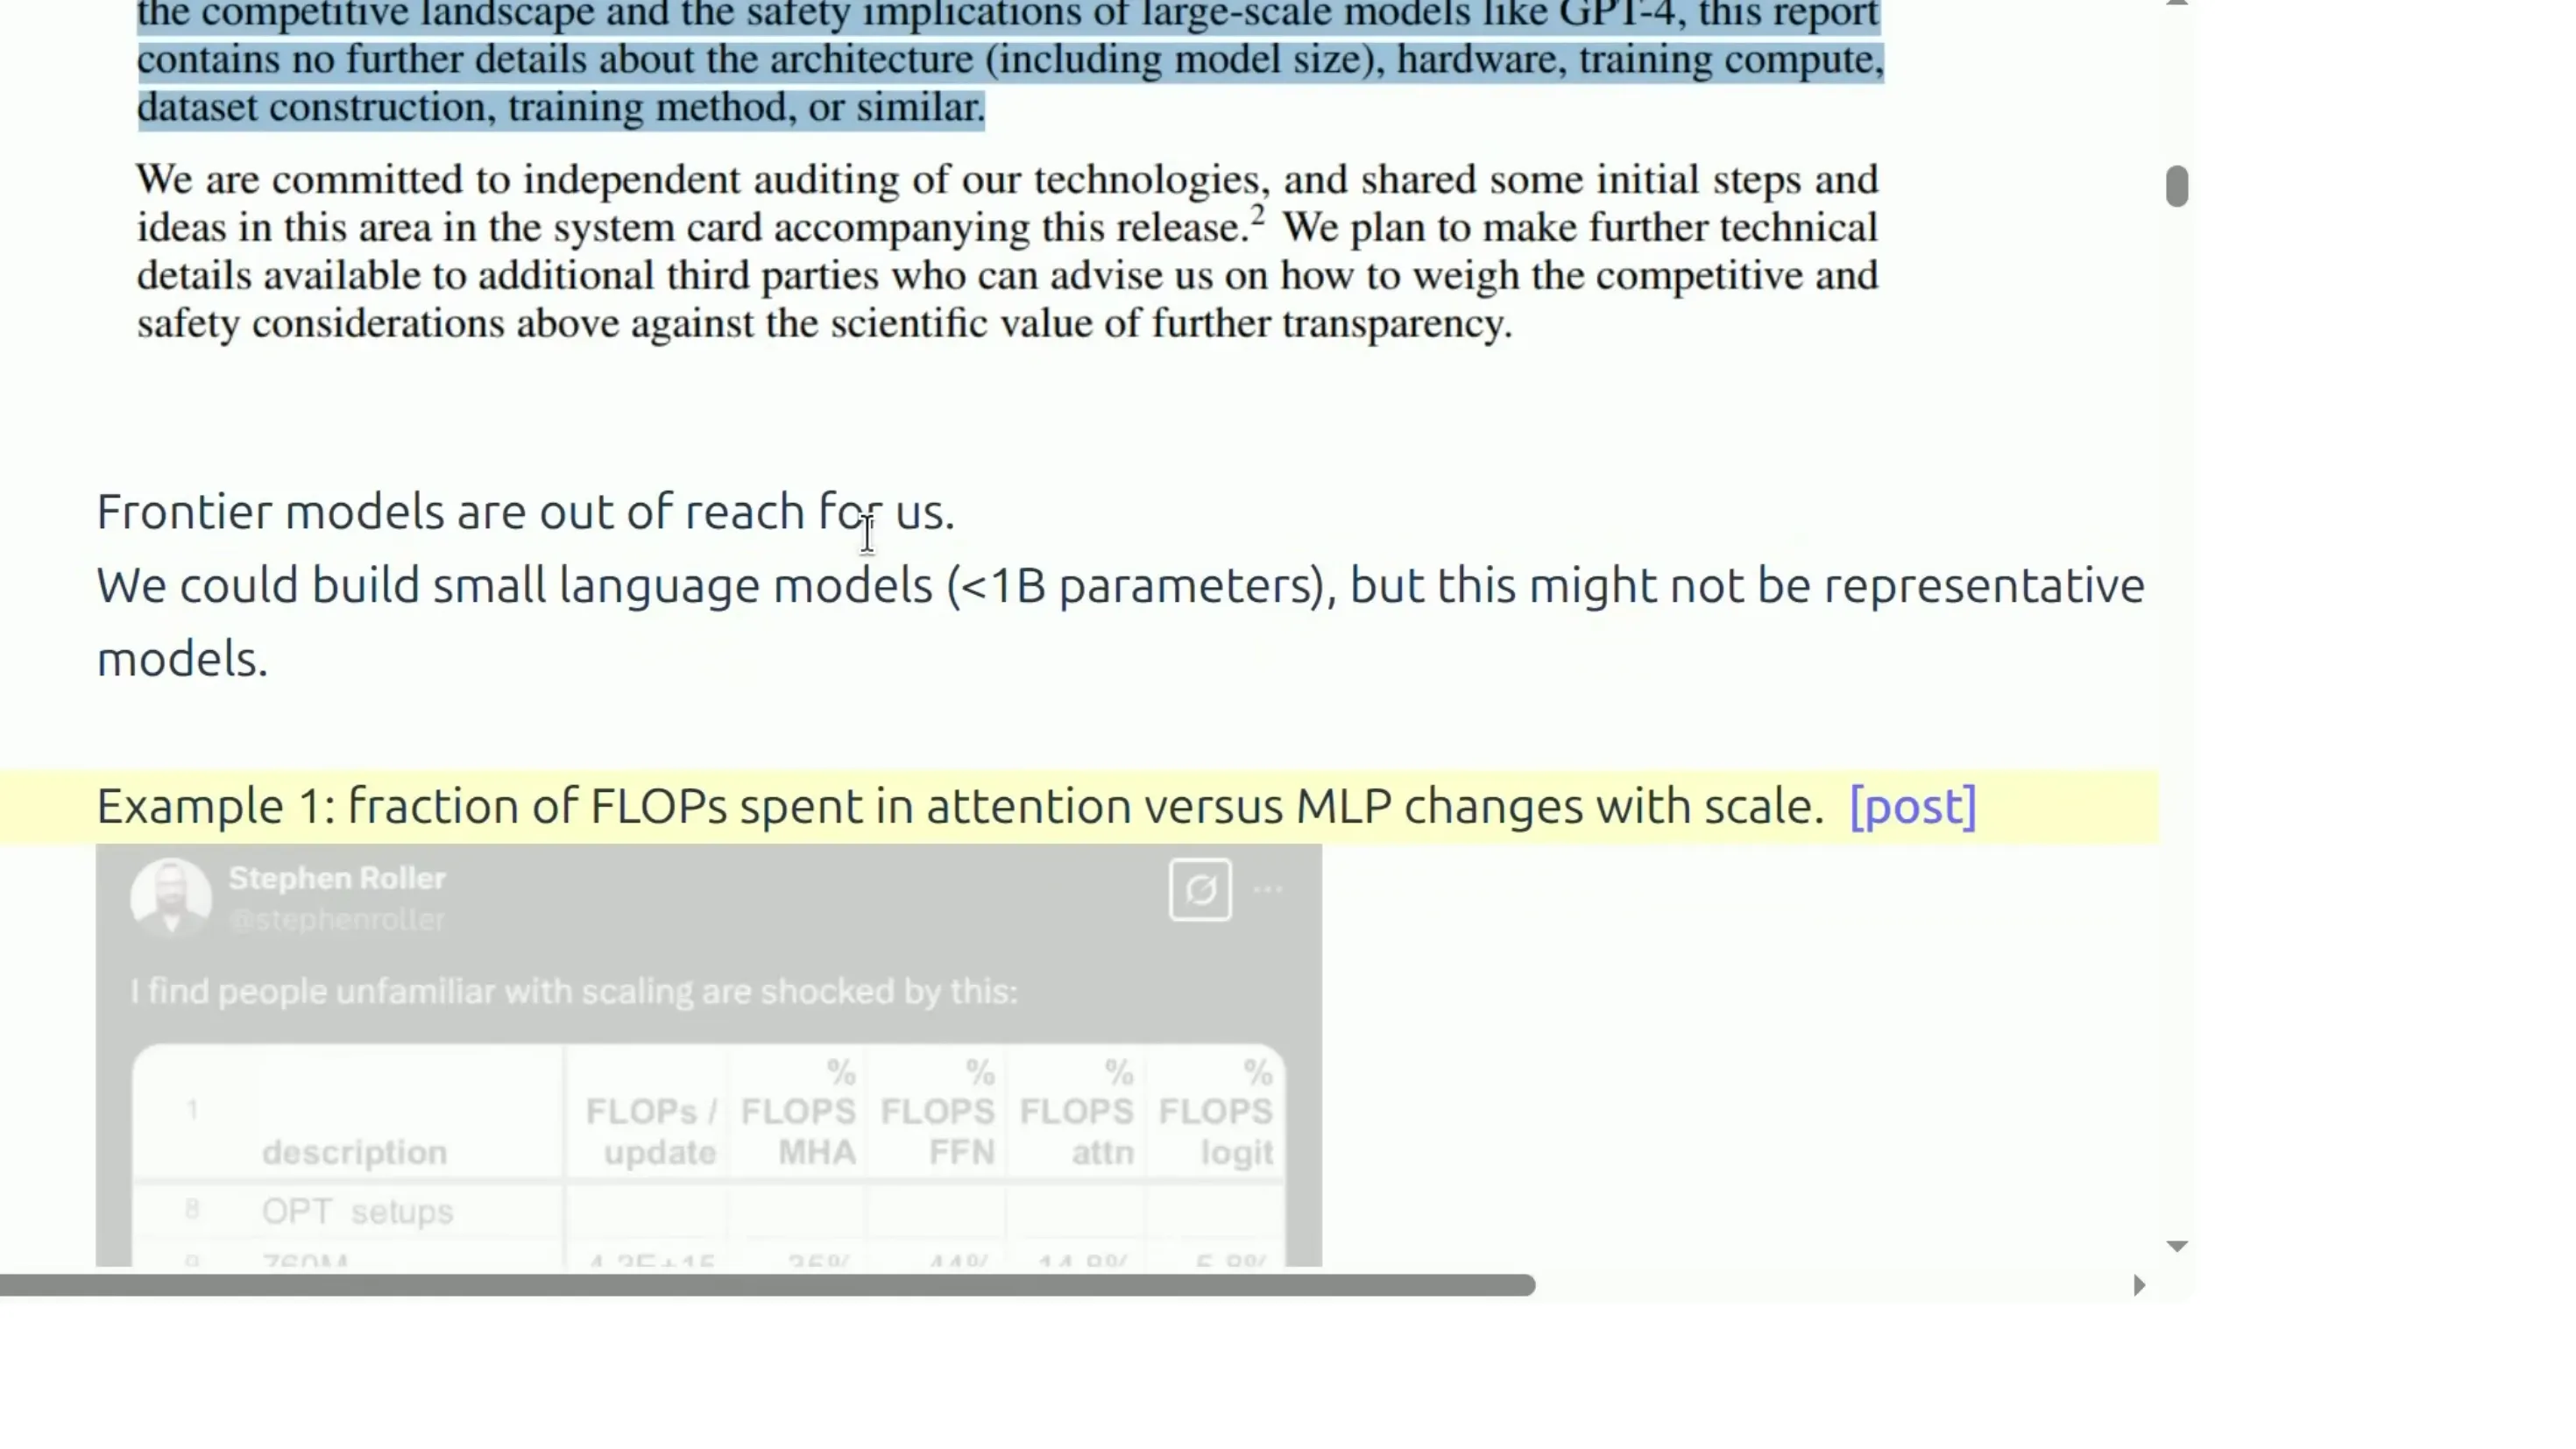
- 而且没有任何关于这些模型如何构建的公开细节。GPT-4 技术报告在 2023 年就明确写道:出于竞争格局与安全方面的考虑,他们不会公开任何关于模型如何构建的信息。
所以,前沿模型在某种意义上是我们够不到的。
我们可以训练小语言模型,课程也会带大家训练模型;但必须清醒地记住:小模型未必能代表真正的前沿模型。主讲给了两个例子:
- 例一:在小规模时,花在 MLP 层上的 FLOPs 比例约为 44%;而放大到 175B 参数时,这个比例上升到 80%。也就是说,"什么在起关键作用"会随规模改变——你在小规模上针对 attention 做的优化,到了大模型上未必有同样的收益。
- 例二:随规模涌现的能力(emergence)。小模型上很多任务怎么做都不 work,只有跨过某个临界规模,性能才会突然大幅提升。
📷 小模型与大规模模型的差异:MLP FLOPs 占比随规模上升
回到原视频 (00:05:56)
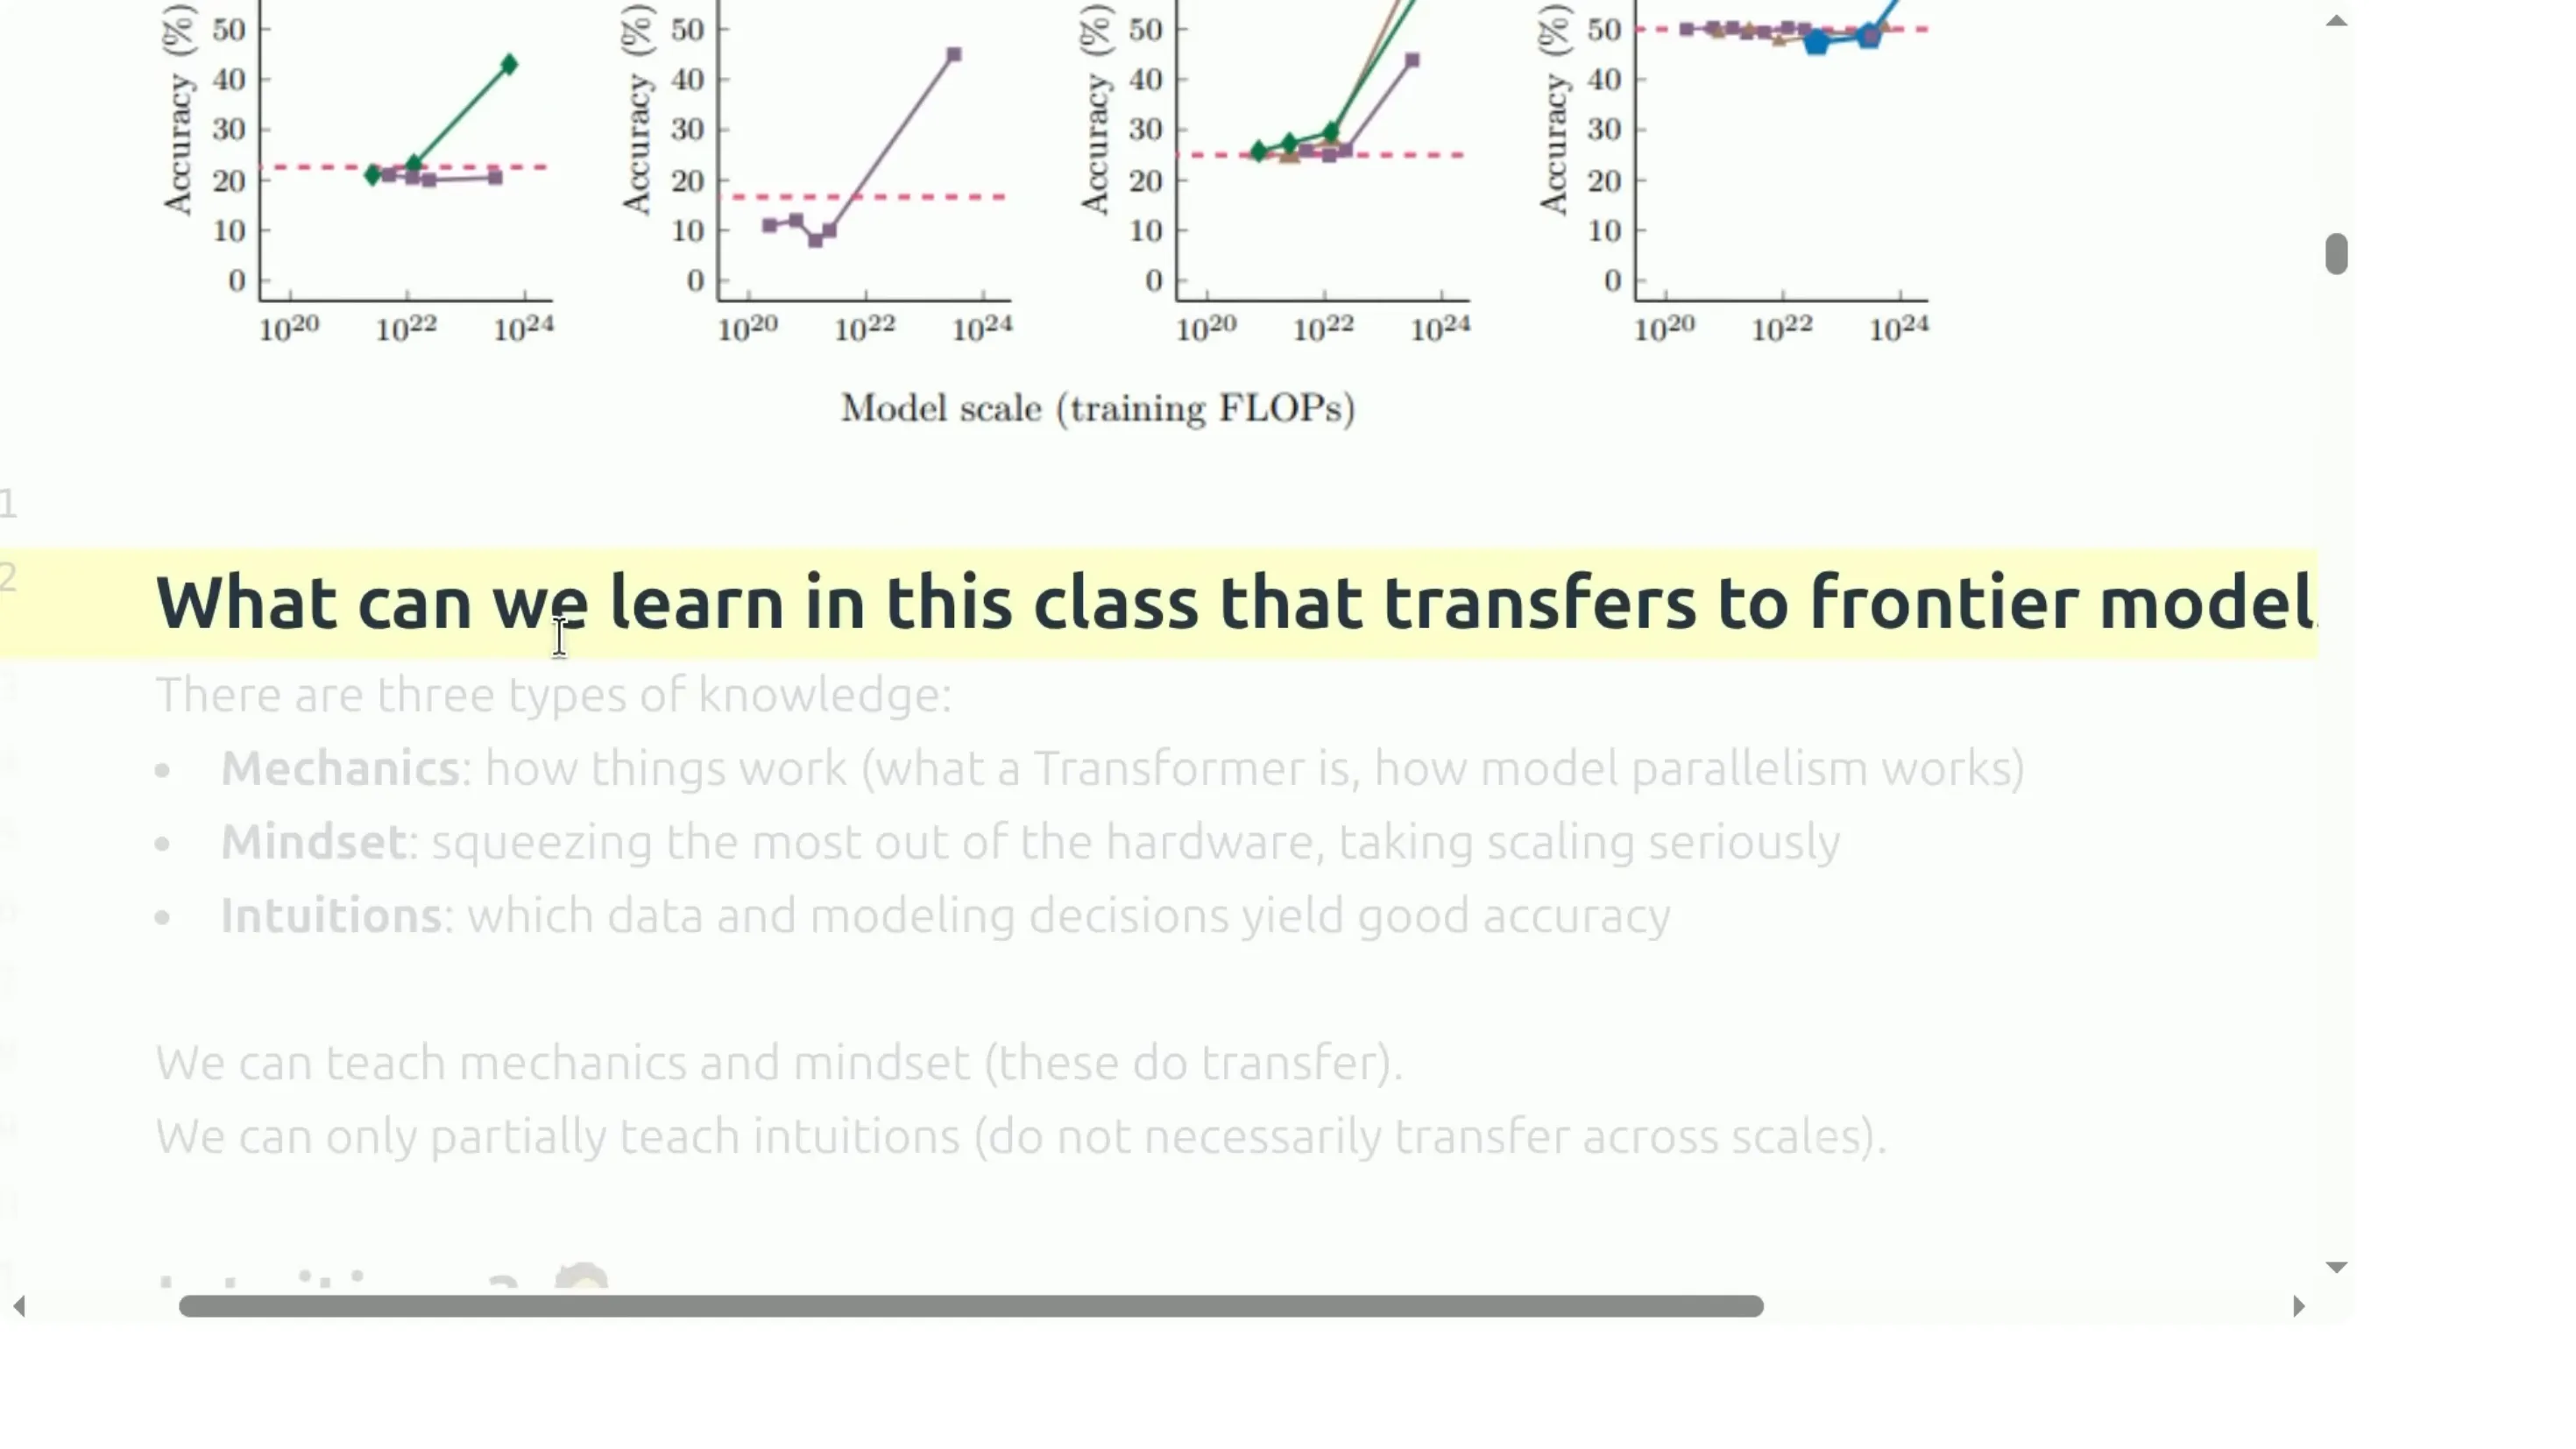
那这门课还能教会我们什么?三类知识
(参考时间: 07:20)
被上面这些"劝退"的信息一吓,你可能会泄气。但这门课仍然能教给你真正能迁移的东西。主讲把知识分成了三类:
- 机制(Mechanics):东西是怎么工作的——什么是 Transformer、模型并行如何运作。可以教、能迁移。
- 心态(Mindset):如何着手构建语言模型——如何榨干硬件的性能、严肃地对待规模化。可以教、能迁移。
- 直觉(Intuitions):哪些数据与建模决策会带来好效果。只能部分传授,且未必能跨规模迁移。
课程会把重点放在机制和心态上,尤其是反复强调:一切都要去 profile、去 benchmark,并努力优化效率。
📷 三类知识:机制、心态、直觉,其中直觉未必跨规模迁移
回到原视频 (00:07:20)
直觉为什么特殊:有些设计只是"实验碰出来的"
(参考时间: 08:21)
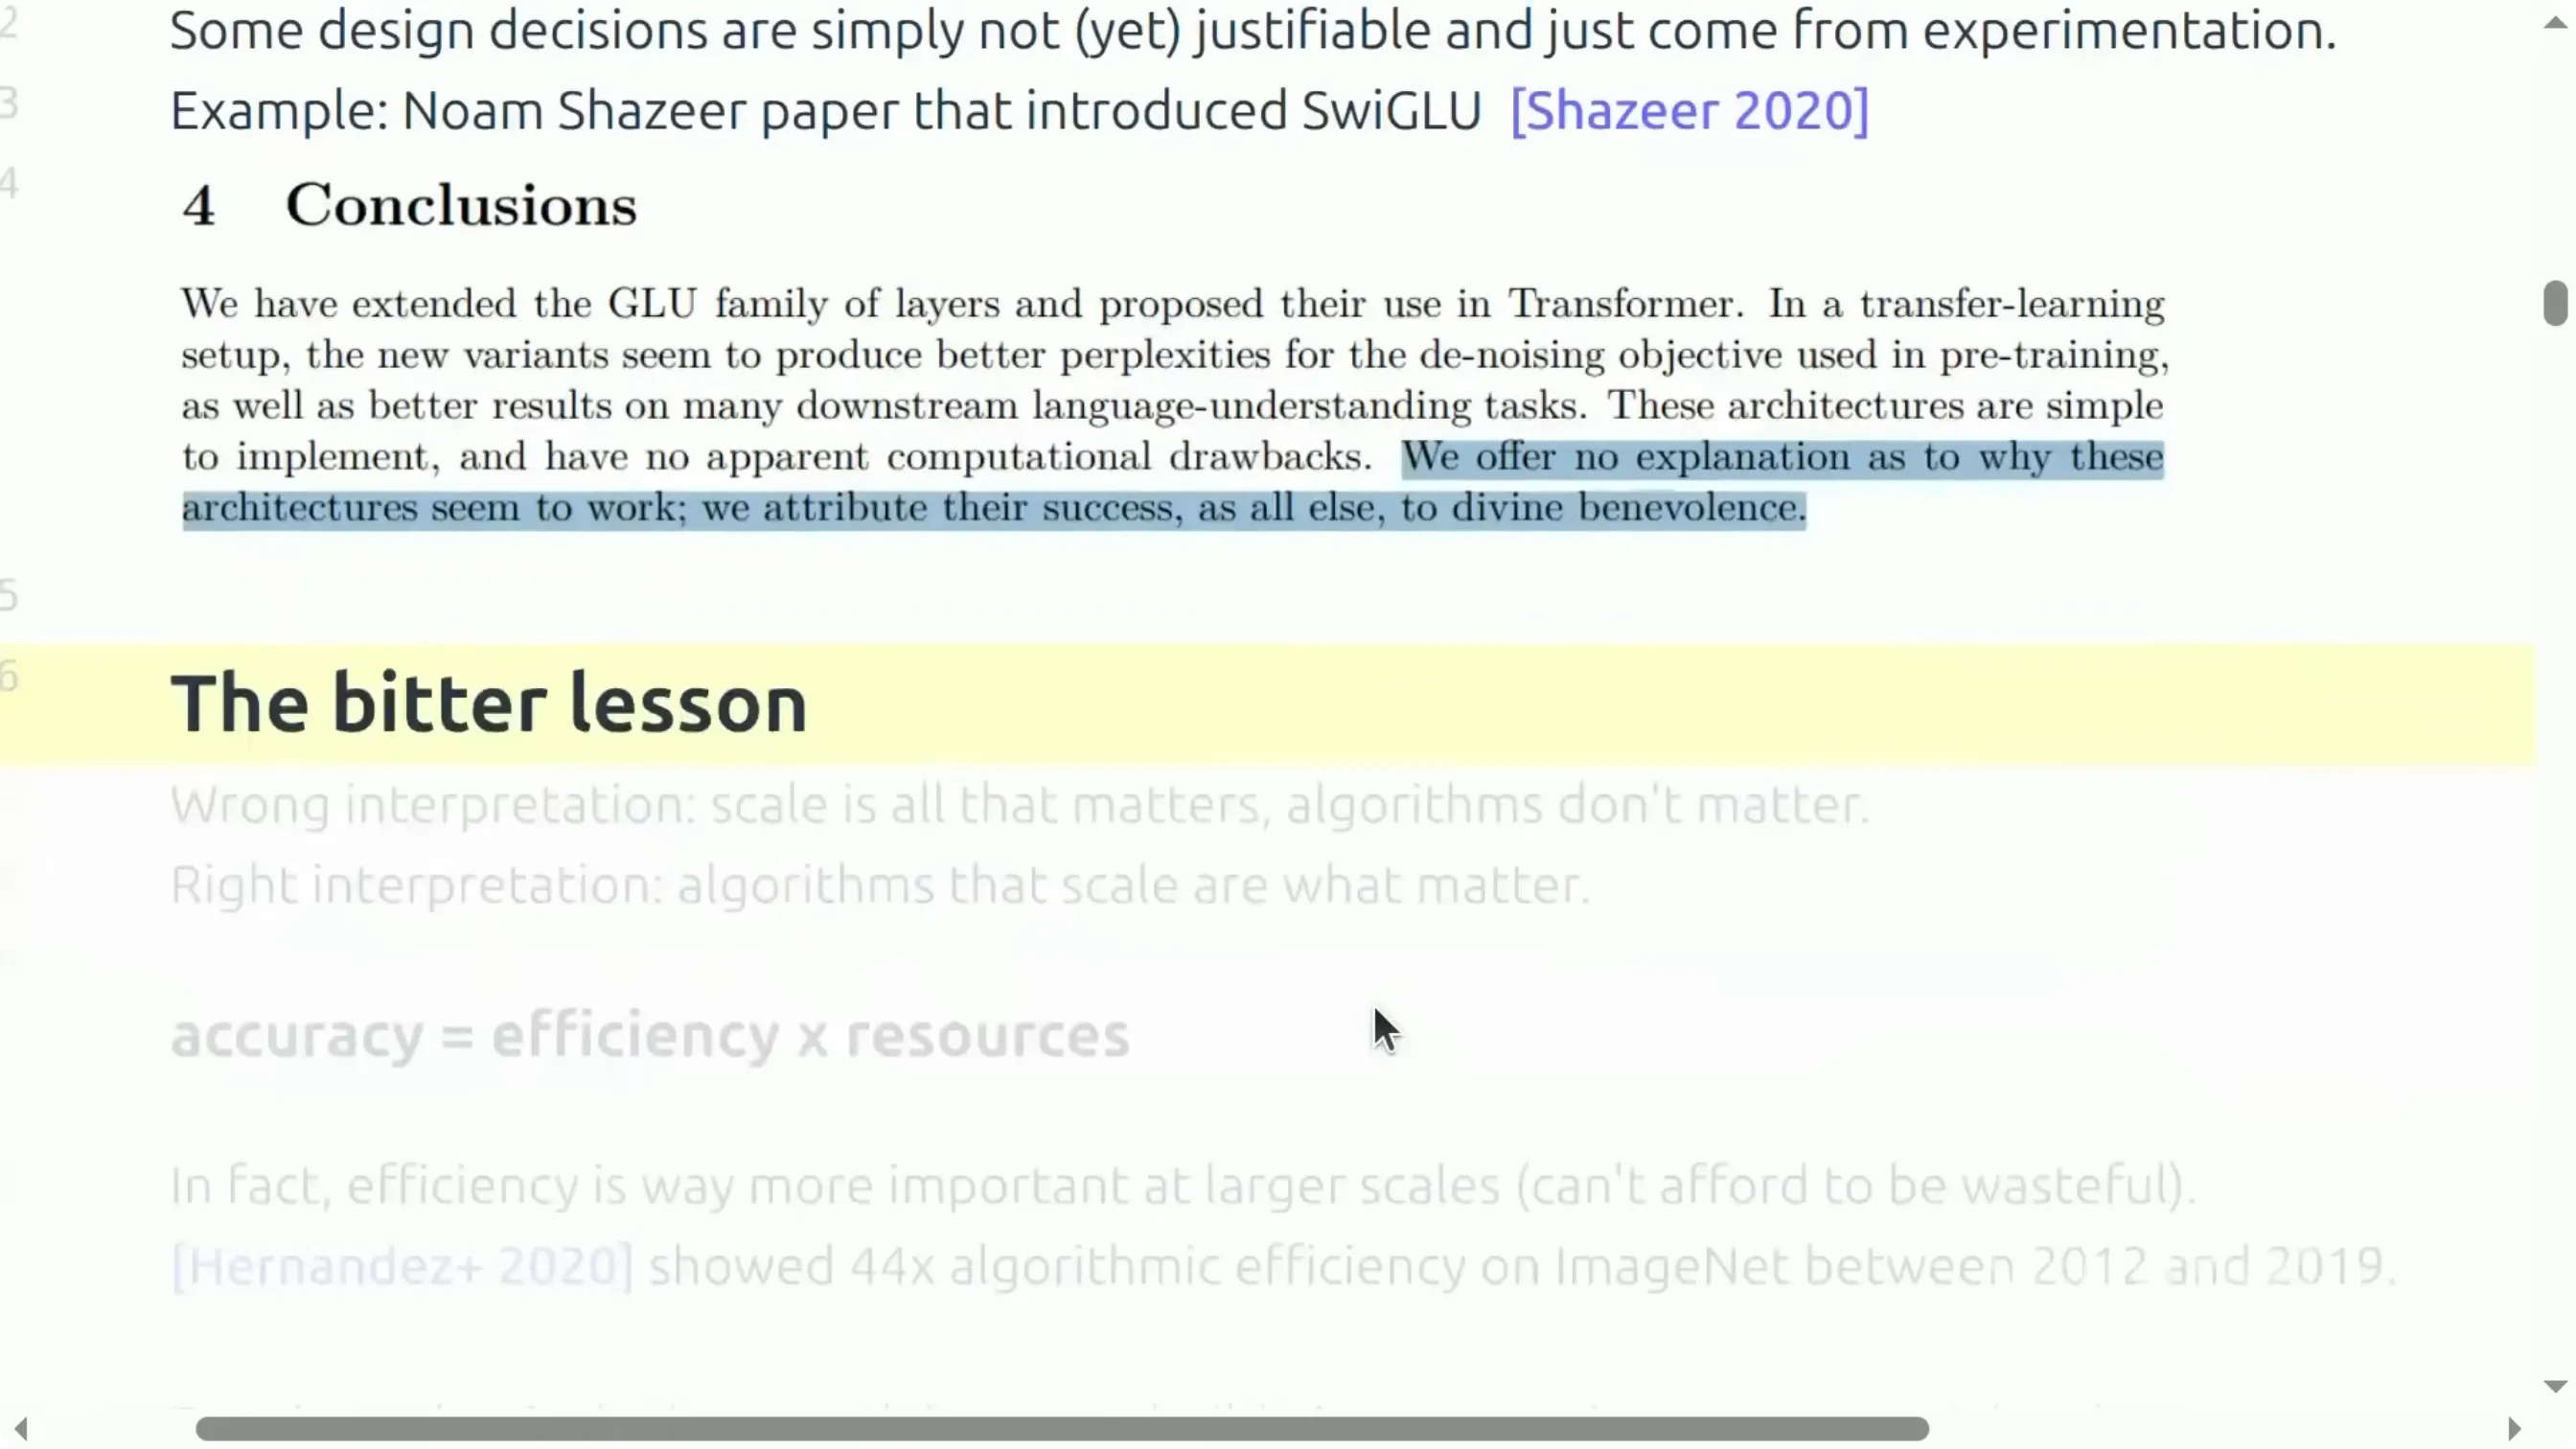
值得指出的是,有些设计决策根本讲不出道理,纯粹来自实验。机制是可以"由构造看出"的(你能看到并行和内核为何加速);而关于"哪种建模改动有效"的直觉,很多时候你只能跑实验。
主讲举了一个很著名的例子:Noam Shazeer 提出 SwiGLU 激活函数的那篇论文,在结论里非常诚实地写了最后一句——"我们不提供任何解释,只能把它们的成功归于神的恩典(divine benevolence)。"
苦涩的教训:不是"规模至上",而是"可扩展的算法至上"
(参考时间: 09:16)
📷 苦涩的教训:准确率 = 效率 × 资源
回到原视频 (00:09:16)
接下来主讲谈到了广为流传的"苦涩的教训"(The Bitter Lesson),并点出一个常见误解:
- 错误解读:只有规模重要,算法不重要。
- 正确解读:重要的是"能随规模扩展的算法"。
可以用一个很简洁的框架来理解:
准确率 = 效率 × 资源
其中"效率"是输出/输入,"资源"是输入。关键在于——效率在更大规模上反而更加重要:
- 做小规模实验时,如果一次跑得慢了一倍,大不了多等一会儿;
- 但在大模型规模上,一次训练可能耗费数亿美元,你绝不想浪费。哪怕只是 5% 的提升,也可能是件大事。
而且这是有实证的:OpenAI 在 2020 年的一篇论文指出,2012 到 2019 年间,ImageNet 上存在约 44 倍的"算法效率"提升。硬件固然变强了很多,但算法改进同样巨大——两者相乘,才带来效率与准确率的跃升。
课程的核心命题:在给定的算力与数据预算下,能造出的最好的模型是什么? 换言之——最大化效率!
主讲补充:当下的预训练基本是算力受限的(假设数据远多于算力);但如果哪天你手里攒下海量 B200 而数据有限,那就变成数据受限了。这条"效率"主线会贯穿整门课。
三、语言模型简史与研究版图
(参考时间: 11:38)
在进入技术细节之前,先花点时间把语言模型的历史脉络串起来。
前神经网络时代(2010 年代之前)
- 1950 年代:Shannon 用语言模型来测量英语的熵。
- 此后很长时间里,N-gram 语言模型被用于机器翻译和语音识别系统。它们不是整个系统,但却是保证"生成流畅文本"的重要一环。
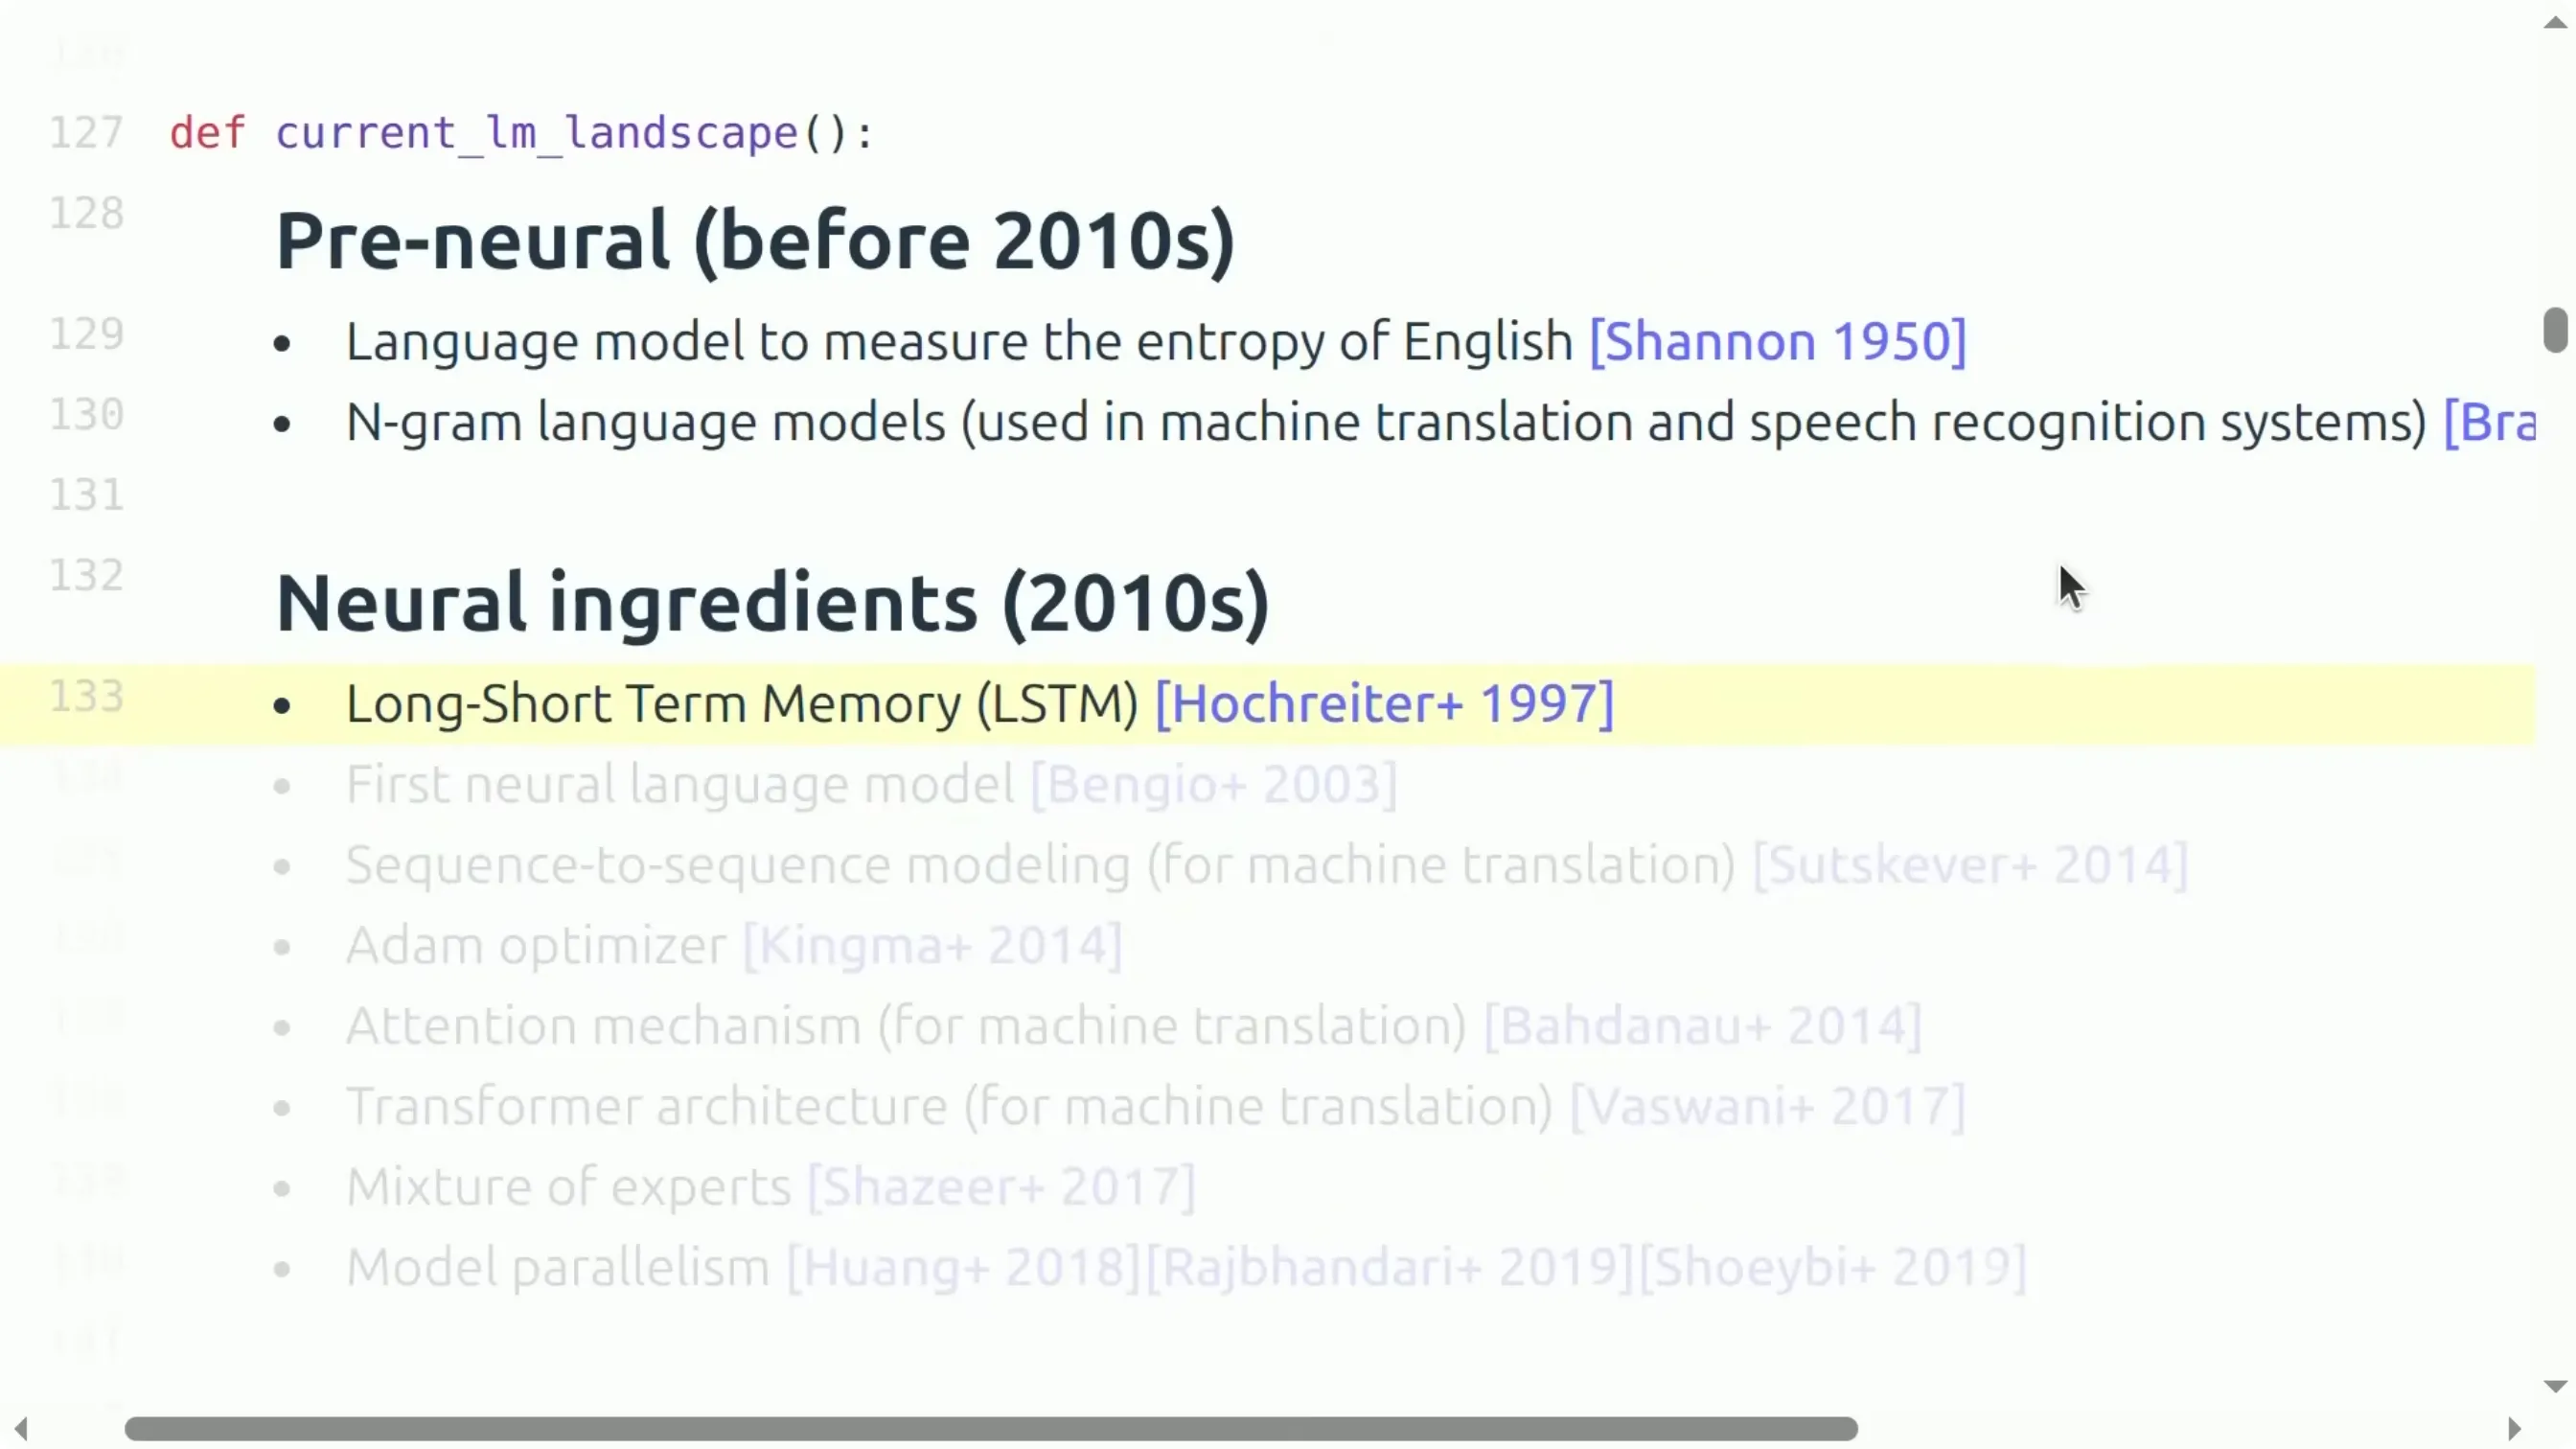
神经组件(2010 年代)
现代语言模型的血统来自神经架构。一批重要的思想在这个阶段出现:
- 1990 年代:LSTM(长短期记忆网络)。
- 2003 年:Yoshua Bengio 写下第一个神经语言模型。注意它并不是 LSTM,而是一个只看很小上下文的前馈网络。
- 2014 年:Seq2Seq 建模——大胆地宣称"可以把一整句话压缩成一个向量"。
- Adam 优化器。
- 注意力机制(为机器翻译而提出)。
- Transformer 架构(建立在注意力之上,同样为机器翻译而生)。
- 混合专家(MoE) 与 模型并行(GPipe、ZeRO、Megatron-LM 等)。
📷 2010 年代的神经组件:LSTM、Seq2Seq、注意力、Transformer、MoE、模型并行
回到原视频 (00:12:28)
早期基础模型(2010 年代后期)
- ELMo、BERT:在大规模文本上预训练,再在下游任务(如问答)上微调,就能带来巨大提升。这一时期的范式是:拿一个预训练模型,然后微调。
- Google 的 T5(11B):把一切任务都建模成 text-to-text(文本到文本)。
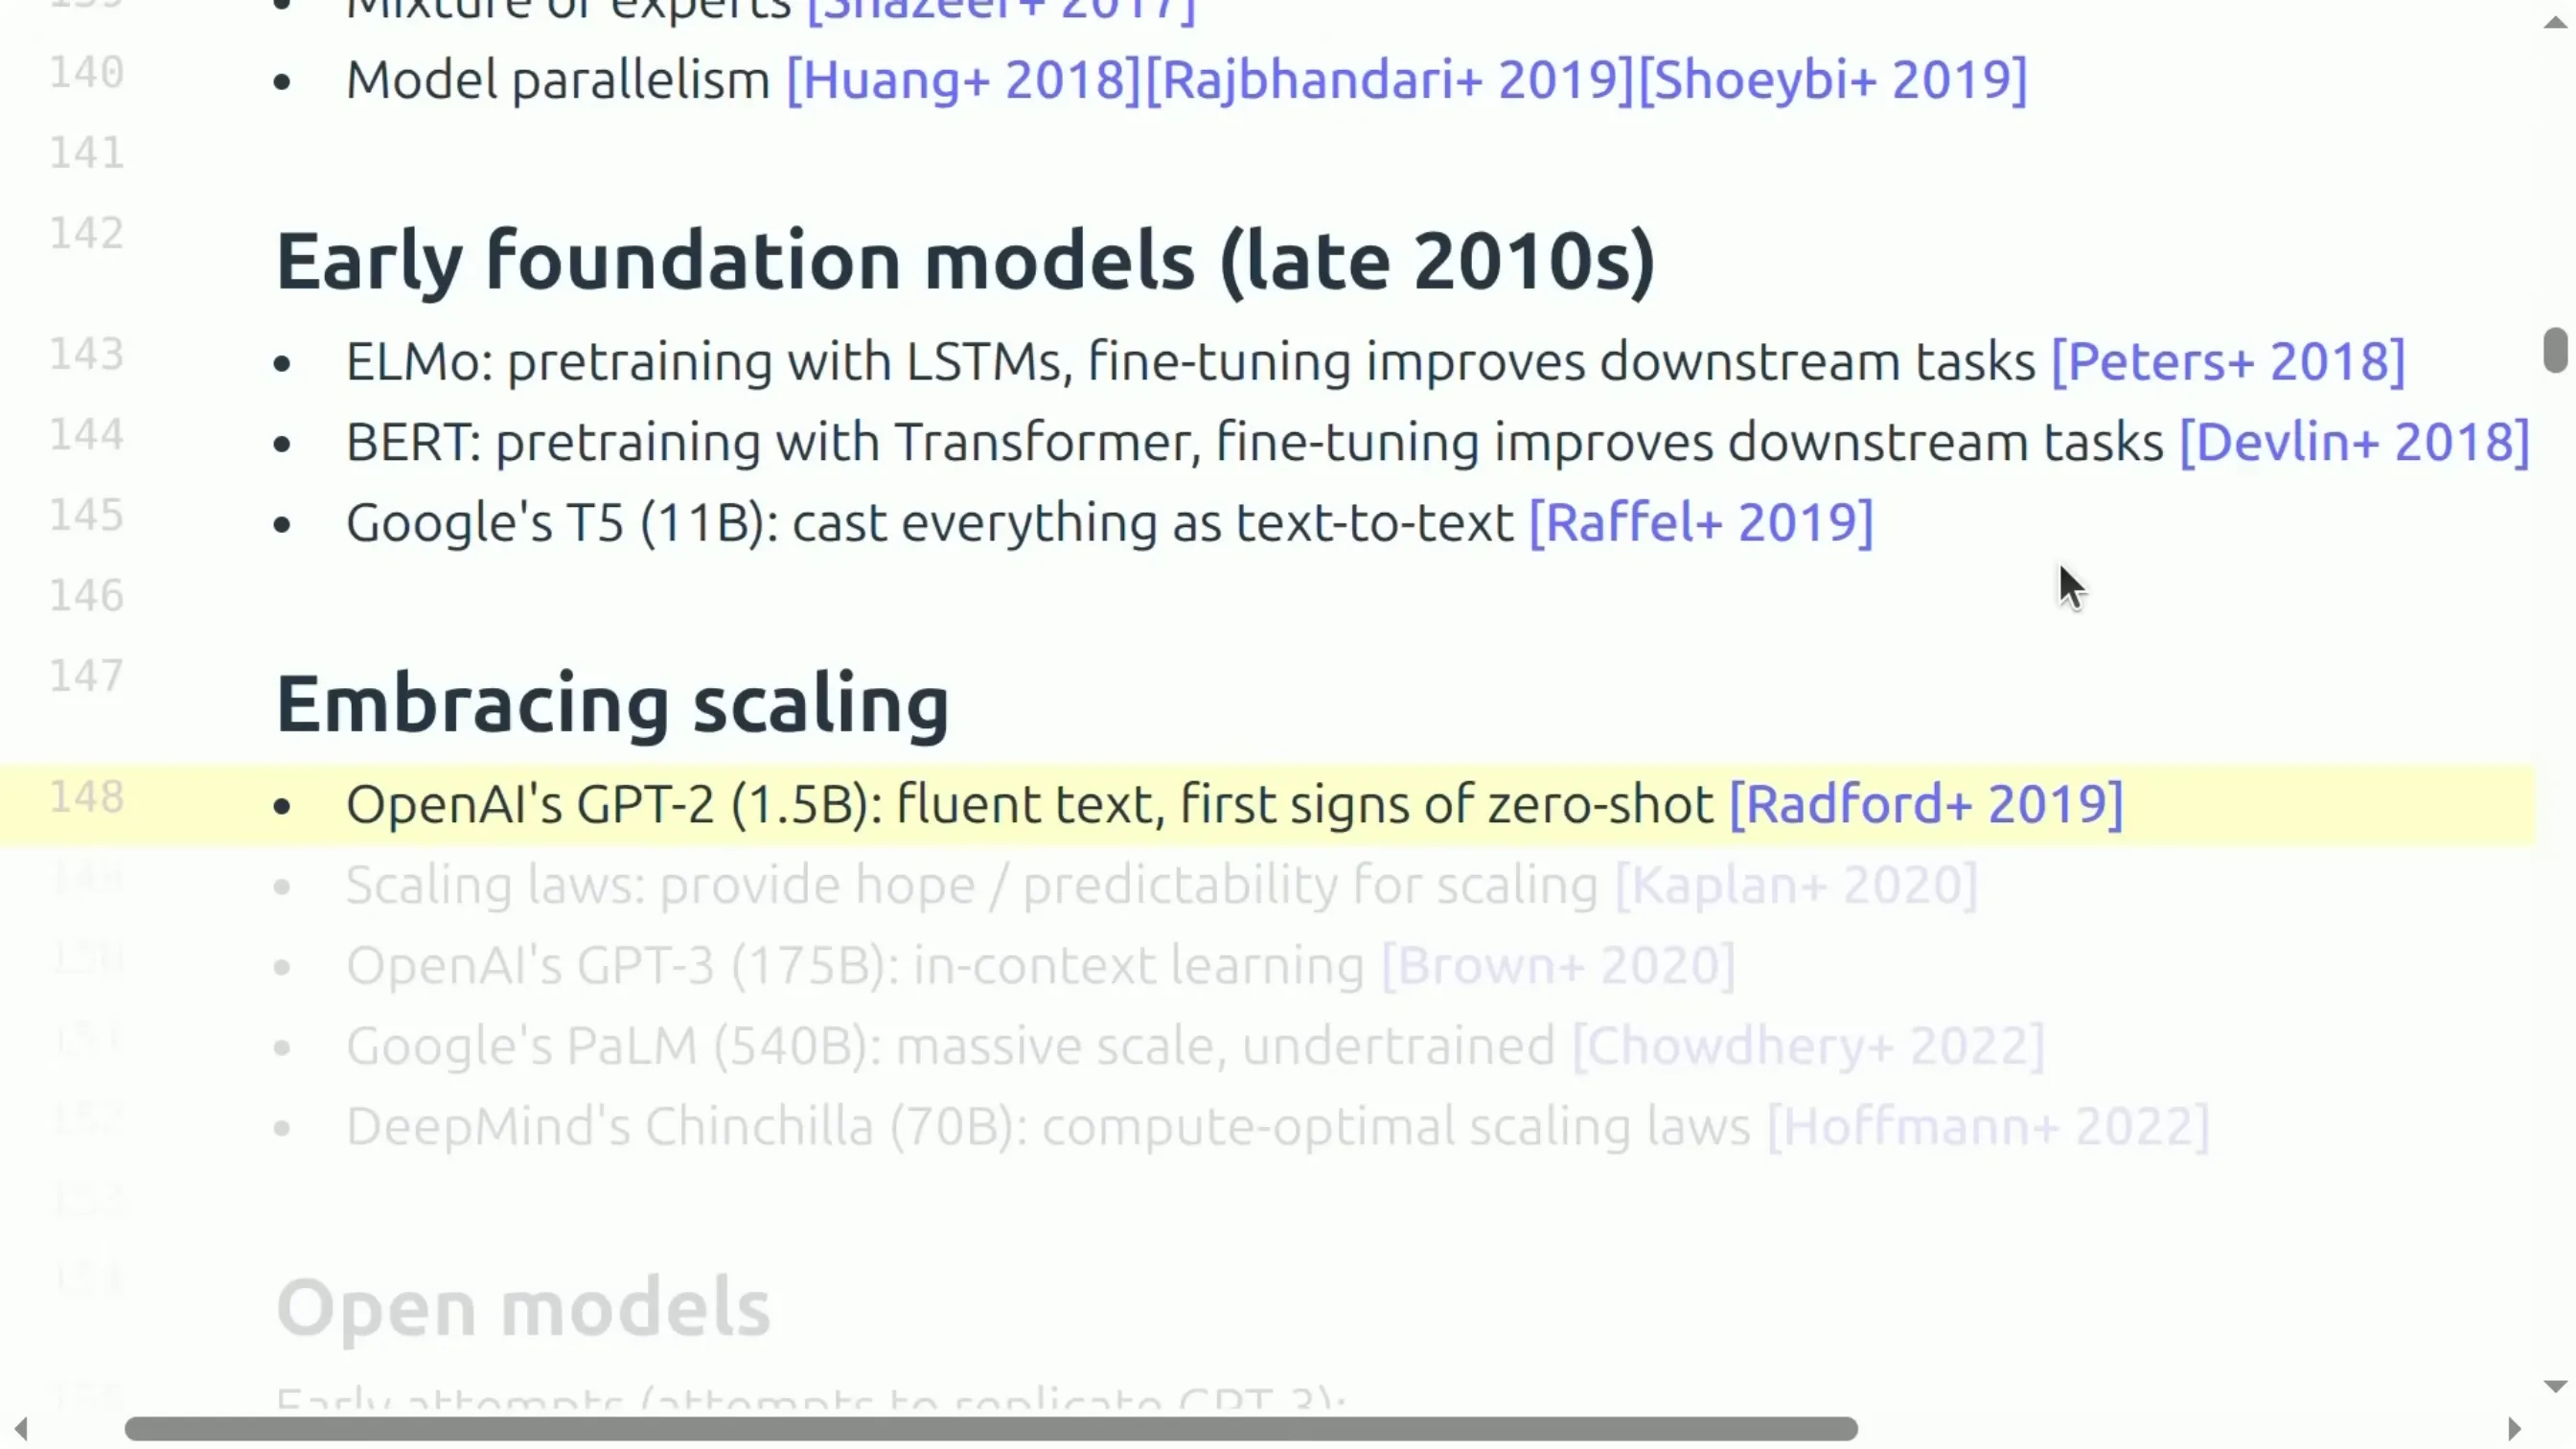
拥抱规模化
- OpenAI 的 GPT-2(1.5B):流畅的文本,首次出现零样本(zero-shot)的苗头。
- Scaling Laws(缩放定律):为放大规模提供了希望与可预测性——这是很关键的一步。
- OpenAI 的 GPT-3(175B):展现出上下文学习(in-context learning)等涌现能力。
- Google 的 PaLM(540B):规模巨大,但训练不足(undertrained)。
- DeepMind 的 Chinchilla(70B):提出算力最优(compute-optimal)的缩放定律。
📷 拥抱规模化:GPT-2、缩放定律、GPT-3、PaLM、Chinchilla
回到原视频 (00:14:04)
开放模型生态
GPT-3 出现后,很多人意识到这是"警钟",于是有了大量复现尝试:
- Eleuther(草根组织):开放了数据集(The Pile)与模型(GPT-J),但算力有限、规模不大。
- Meta 的 OPT(175B):从参数量看是在复现 GPT-3,但模型并不好,遇到了大量硬件问题。
- Hugging Face / BigScience 的 BLOOM(176B):侧重数据来源。
而最近三年,开放模型生态发生了很大变化:
- 可信的开放权重模型(权重 + 论文):Meta 的 Llama 系列(Llama / Llama 2 / Llama 3)、Mistral、DeepSeek、阿里 Qwen、月之暗面 Kimi、智谱 GLM、MiniMax、小米 MIMO 等。这些模型正在逼近闭源模型,并且在工业界被广泛使用。
- 完全开源模型(权重 + 论文 + 代码 + 数据):AI2 的 Olmo 系列、NVIDIA 的 Nemotron 系列,以及主讲自己参与的 Marin 项目。
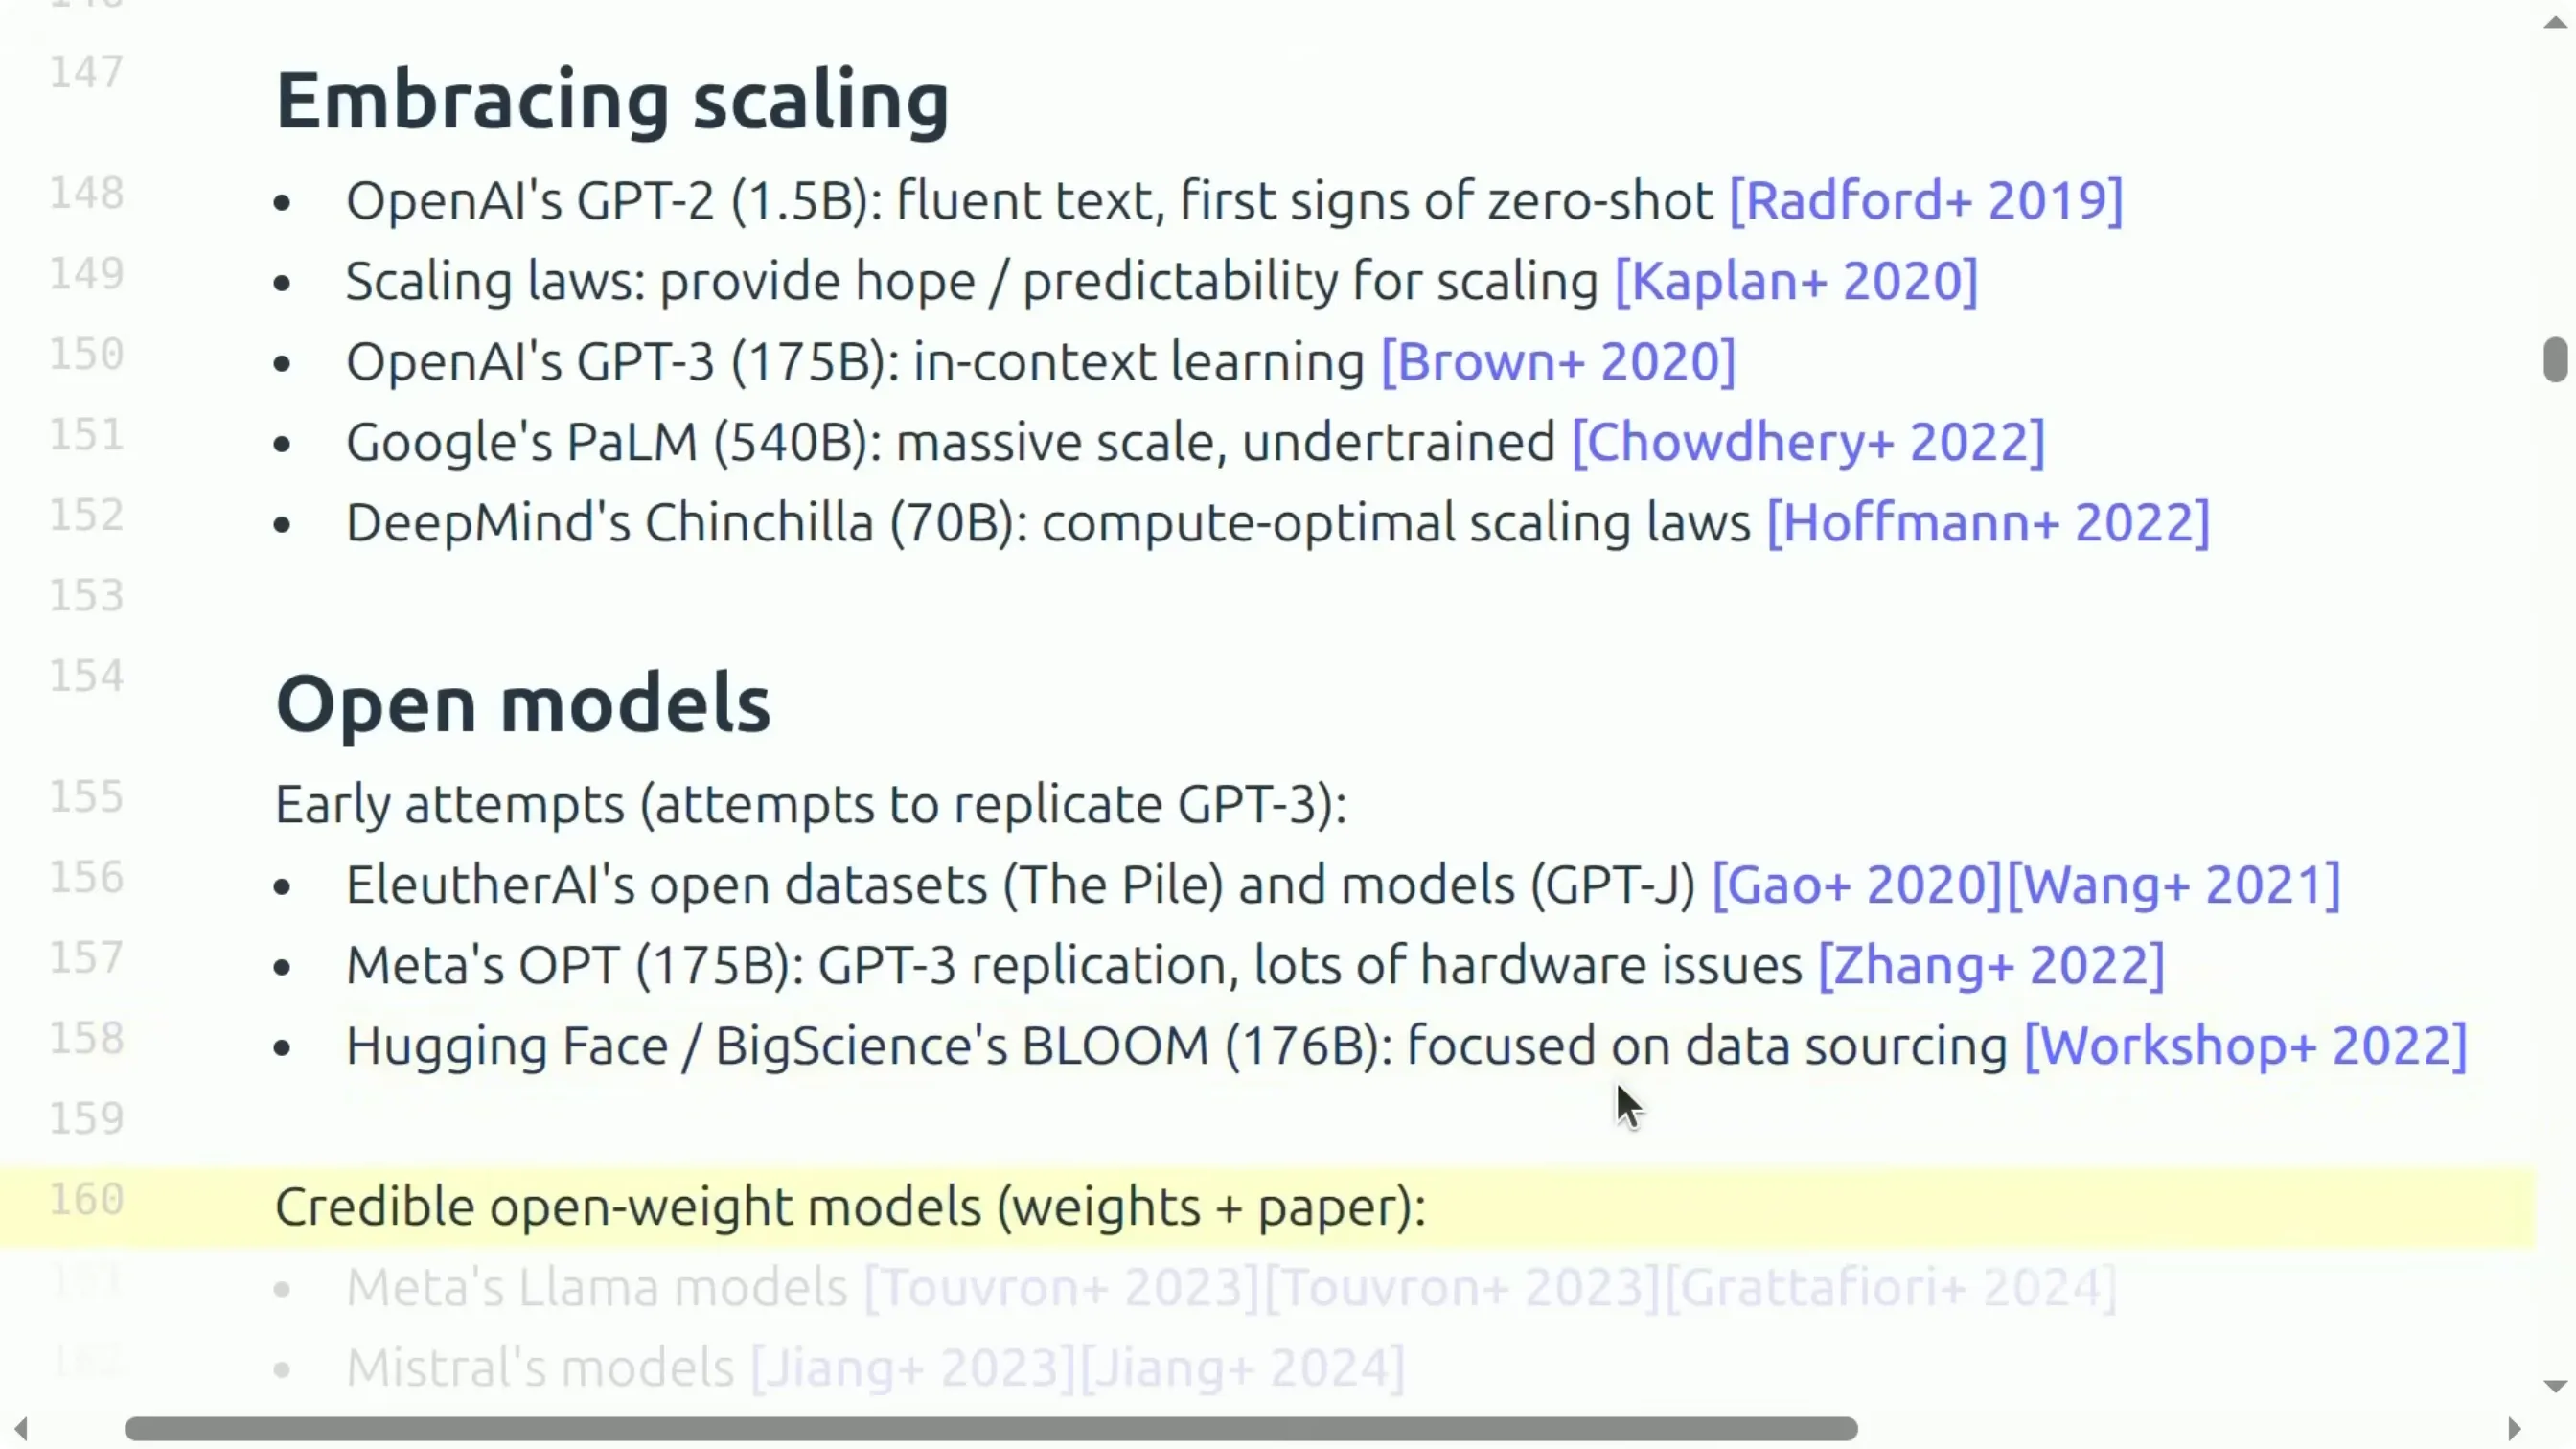
📷 开放模型生态:Llama、Mistral、DeepSeek、Qwen、Olmo、Nemotron、Marin 等
回到原视频 (00:15:36)
主讲特别强调开放生态对本课程的意义:如果没有这些开放模型与不断公开的论文,这门课根本无法开出来。 即使像 Qwen 的论文也会漏掉很多细节(比如数据混合比例),我们仍然无法完全复现前沿模型;但有总比没有好得多——这些论文让我们至少能窥见前沿模型是如何被构建的,并把碎片拼凑起来。
"语言模型"这个词的含义一直在变
(参考时间: 17:36)
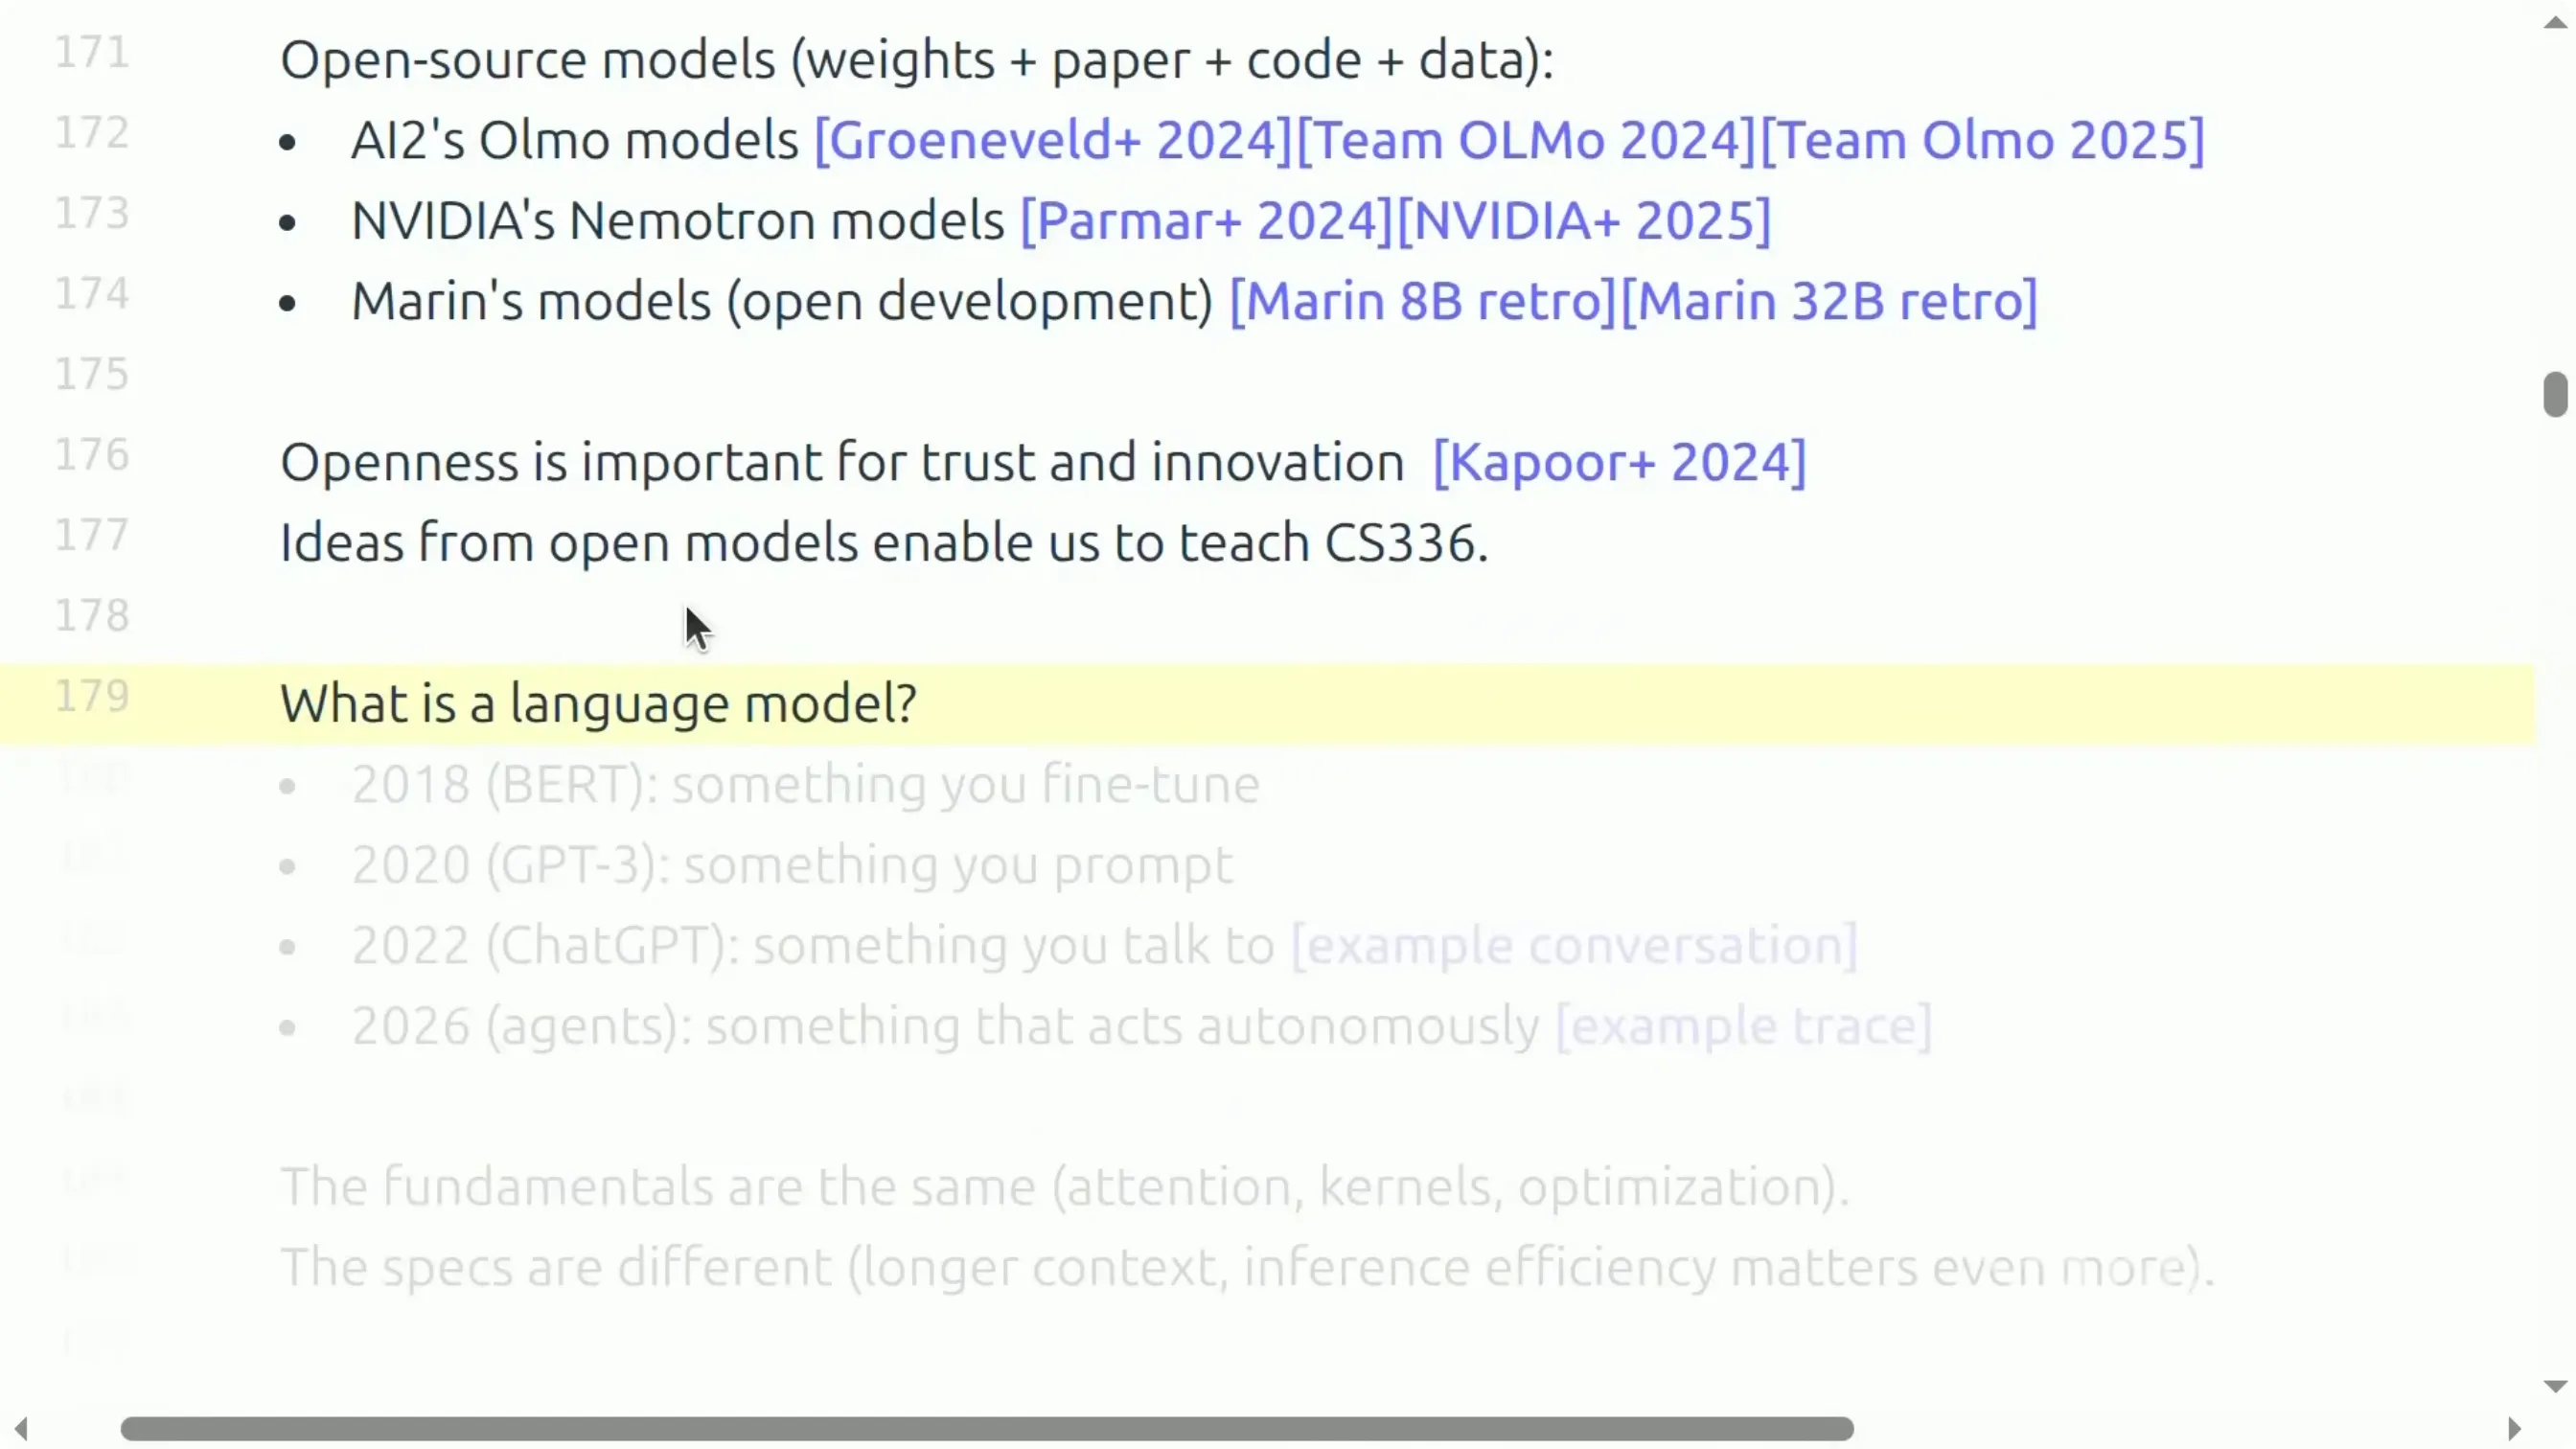
📷 "语言模型"含义的变迁:微调→提示→对话→智能体
回到原视频 (00:17:36)
过去十年里,"语言模型"指的是什么,一直在变:
| 年代 | 语言模型是…… |
|---|---|
| 2018(BERT) | 一个你拿去微调的东西 |
| 2020(GPT-3) | 一个你用来提示的东西 |
| 2022(ChatGPT) | 一个你和它对话的东西 |
| 2026(agents) | 一个能自主行动的东西 |
今天我们对语言模型的要求,可能超出了十年前任何人的想象。不过主讲认为:
- 基本面没有太大改变:我们仍然构建在 GPU 与内核之上;仍然用梯度(或类随机梯度)方法优化;核心仍然是 Transformer + 注意力。
- 变的是"规格":现在要求更长的上下文,这使推理效率变得比以前更加重要。
也正因为基本面变化不大,这门课不需要推倒重来——"只需要重讲 Tatsu 那部分关于最新架构的内容",主讲开玩笑说。
四、"可执行讲义":一种新的讲课形式
(参考时间: 19:30)
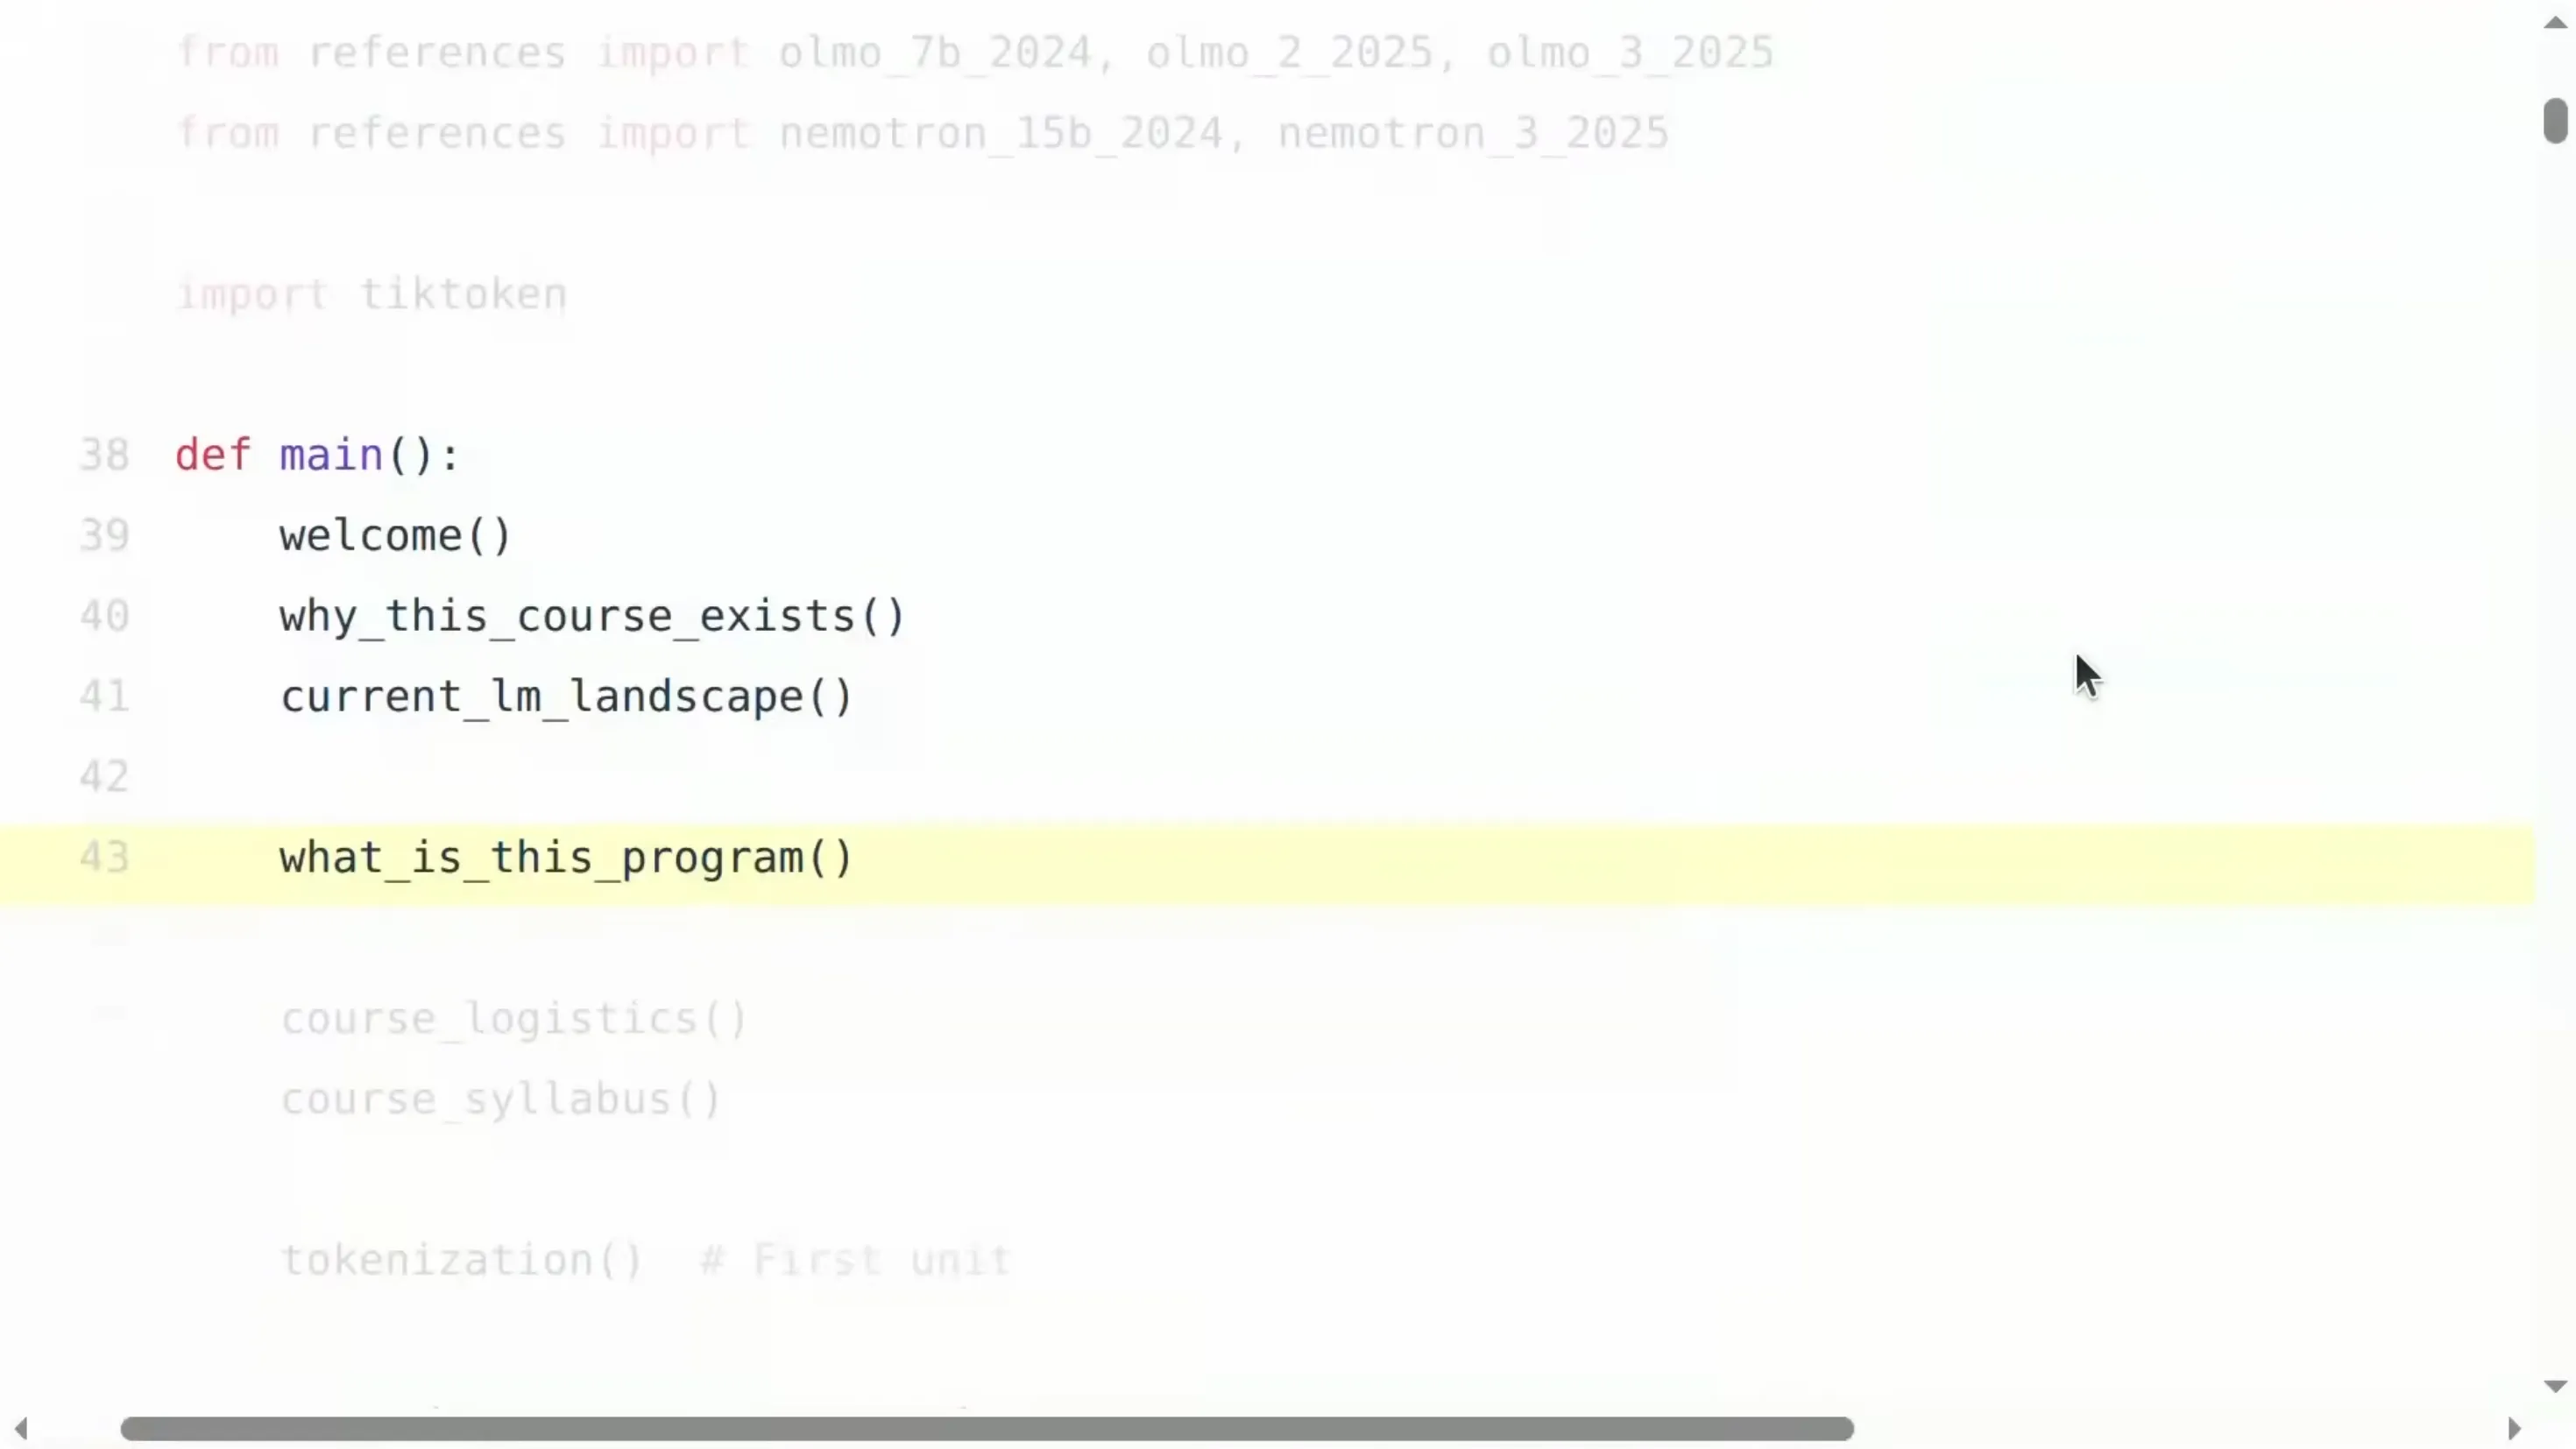
📷 可执行讲义:讲义本身就是一段 Python 程序
回到原视频 (00:19:30)
课程有一个有趣的设定:它是一份可执行讲义(executable lecture)。
如果你觉得它看起来像一段 Python 程序——没错,它真的就是一段 Python 程序,只是被渲染成了便于观看的样子。主讲在讲课时,实际上是在一步步"执行"这份讲义。这样做带来两个好处:
- 代码可以被查看和运行(因为一切都是代码);
- 讲义具有层级结构,你可以看到自己正处在哪个函数、哪个环节。
编者说明:本讲对应的官方源码是
lecture_01.py。书中引用的代码均取自该文件。
五、课程信息与作业安排
(参考时间: 20:14)
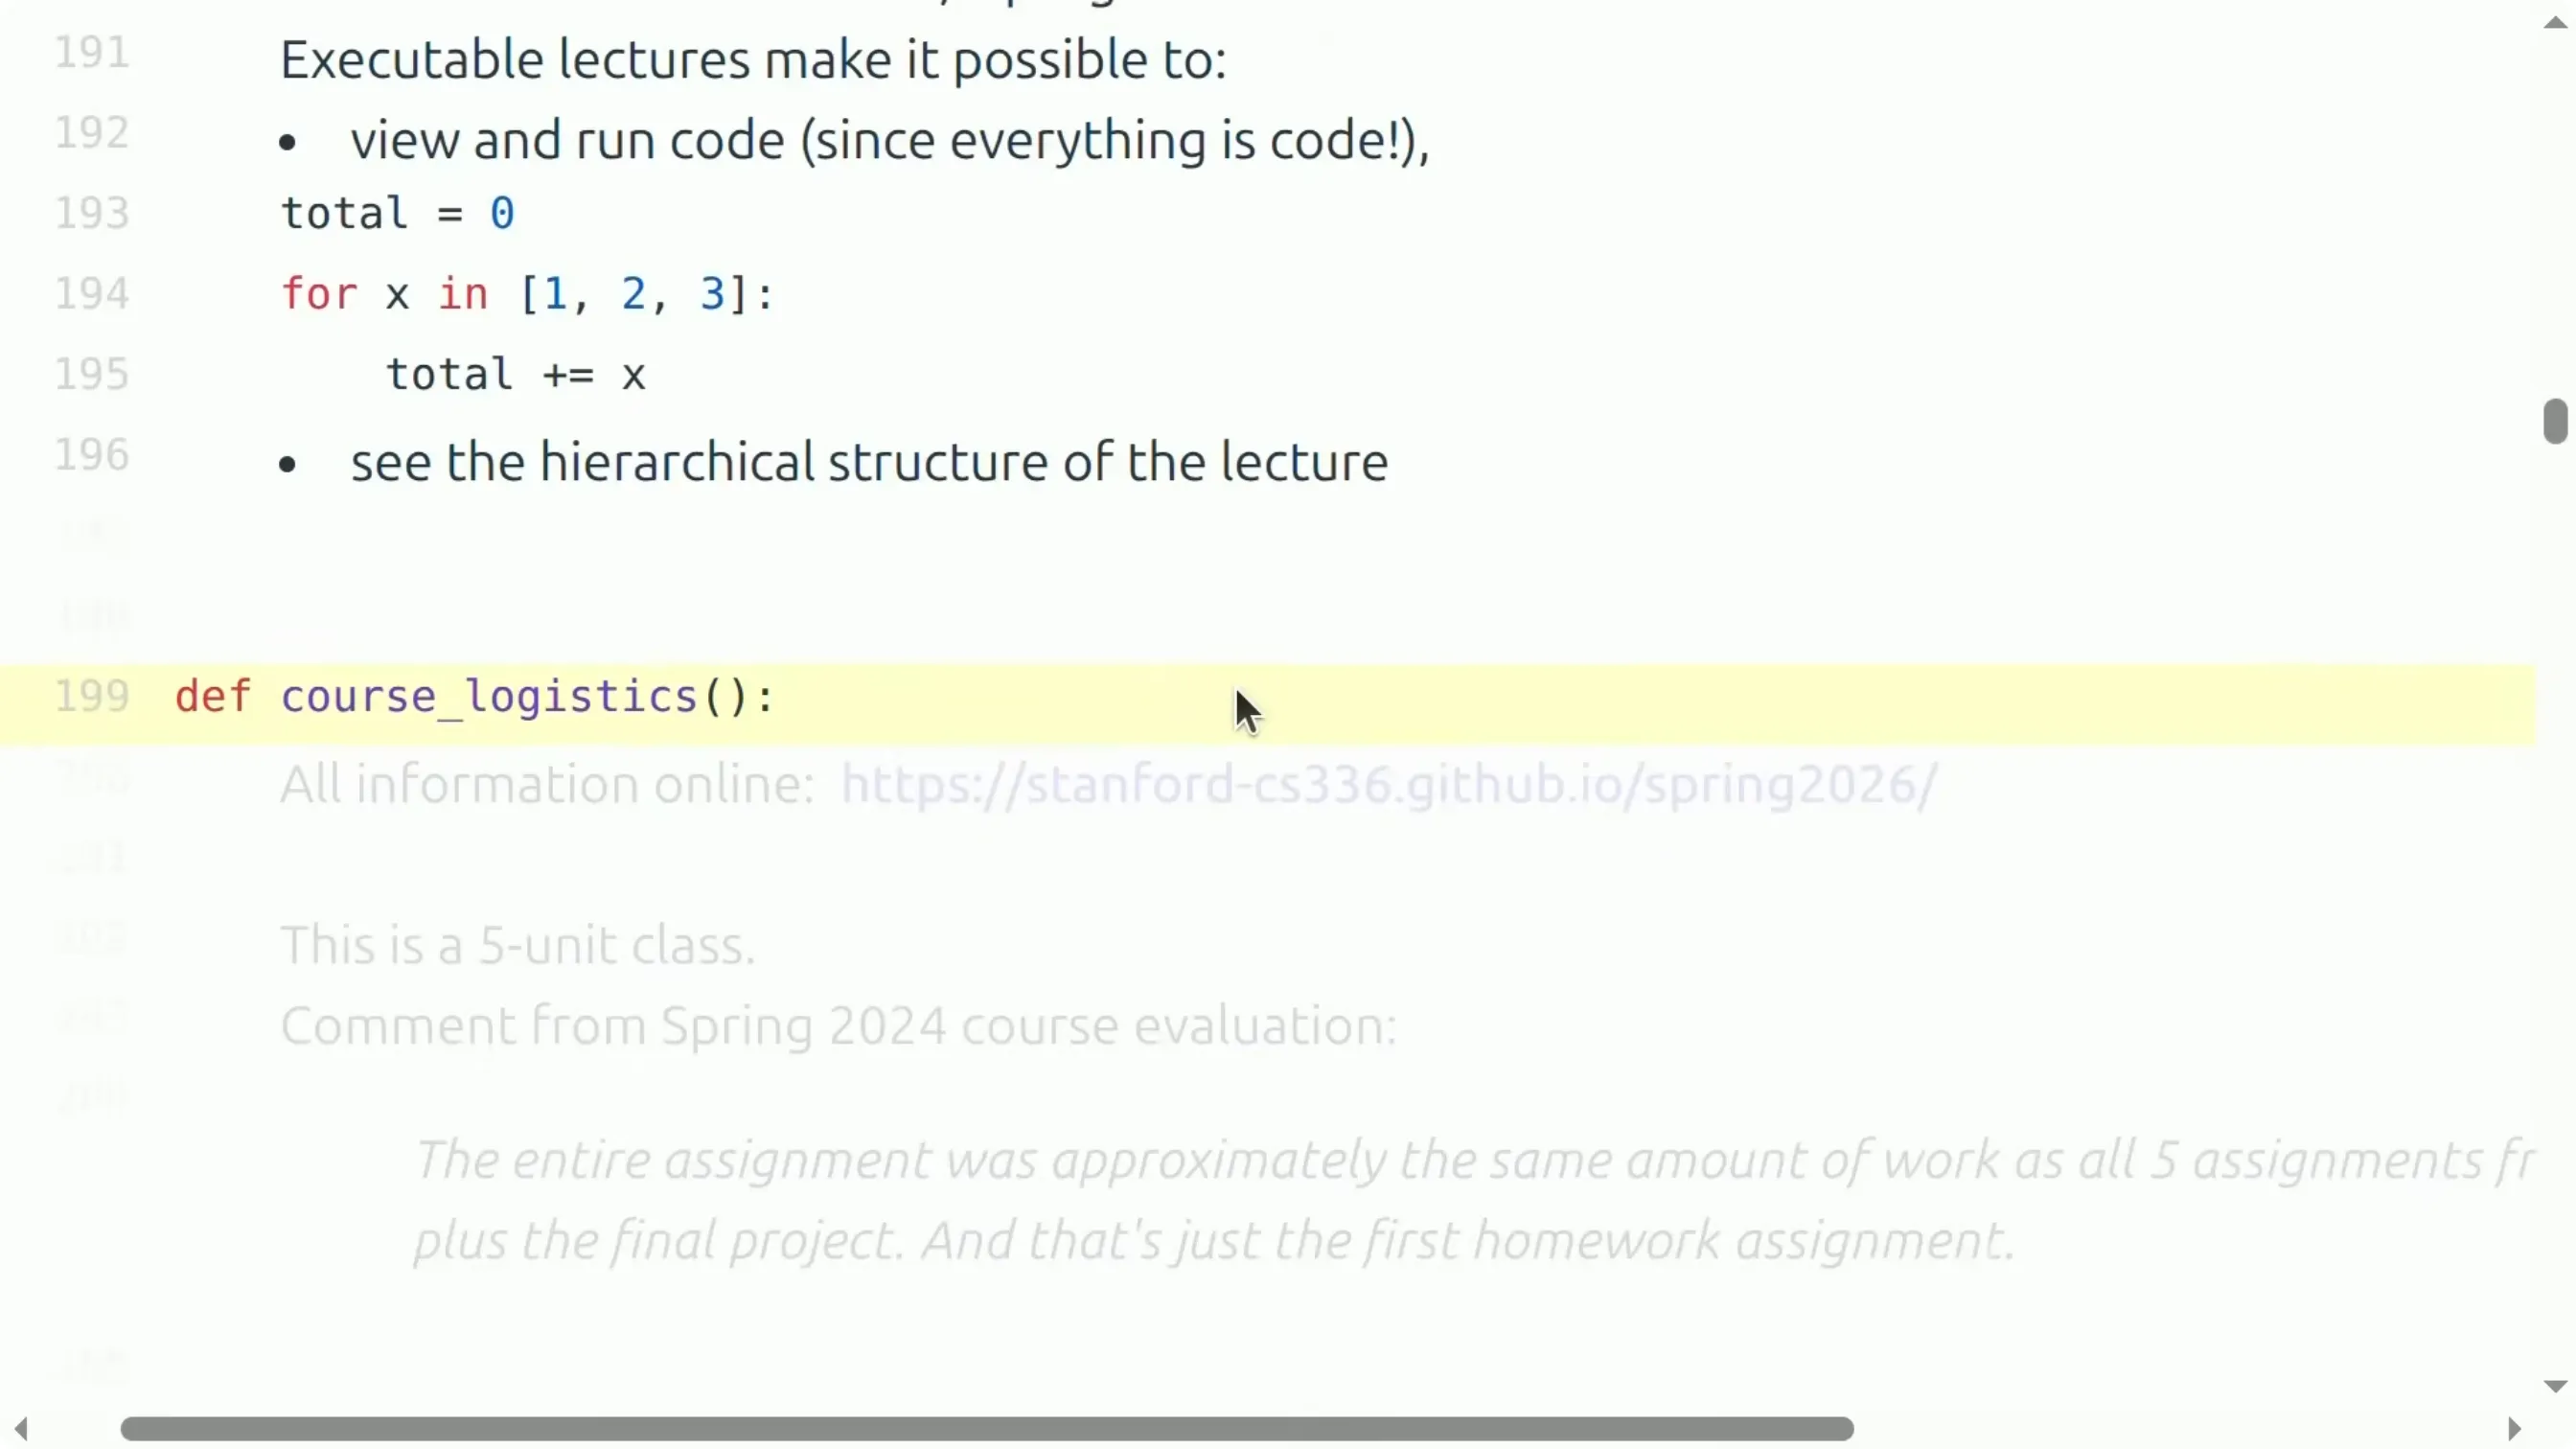
📷 课程信息:5 学分、5 次作业与课程主页
回到原视频 (00:20:14)
所有信息都在课程网站上:stanford-cs336.github.io(也可访问 cs336.stanford.edu)。
这是一门"硬课"
这是一门 5 学分的课,有 5 次作业,强度很大。主讲引用了一条往年的课程评价作为提醒:
"单单第一次作业的工作量,就大约等于 CS 224n 全部五次作业加上期末项目之和。"
主讲也说这条评价可能有些夸张,但"宁可把预期估保守一点"。
为什么你应该选这门课
- 你对"东西到底是怎么工作的"有一种近乎强迫的好奇心(这应当是首要动机)。
- 你想锻炼研究工程(research engineering)的肌肉,从而具备进入任何新环境、应对各种问题的能力与信心。
主讲打了个比方:他早年在斯坦福开过一门 Statistical Learning Theory(统计学习理论),教的是机器学习的理论面——学完后你读论文时能看懂所有数学。如今领域重心转向了系统与实证,这门 CS336 就是与之对应的那一门课:它给你足够的深度,让你觉得其他东西看起来都变简单了。
为什么你不该选这门课
- 你这个学期真的想做出研究。(去和导师聊聊,导师应该知道你在选这门课,否则可能会有"惊喜"。)
- 你想学AI 最热门的新技术。这门课不讲多模态,也不深入讲智能体——那些更适合去上研讨课(seminar)。
- 你带着自己的应用领域、想快速拿到好结果。那应该先提示模型、微调模型,把"自己预训练"作为最后手段——因为它又痛苦又昂贵。
如何在家跟学
所有讲义材料都会发布在网站上,课程通过 CGOE 录制,之后会发布到 YouTube。但主讲提醒:看视频固然好,你真正学到东西是靠做作业,所以要自己想办法给自己动力。
作业的设计哲学
- 5 次作业:basics、systems、scaling laws、data、alignment。
- 不提供脚手架代码,但提供大量单元测试,确保你造出来的东西是正确的——避免陷入"提交后只有对/错"的稀疏奖励困境。
- 作业结构上允许大部分在本地笔记本上完成:先本地实现、验证正确性;再在提供的集群上做真正的训练或内核性能测试。
- 部分作业有排行榜(leaderboard),比如"在给定预算下最小化困惑度(perplexity)"。
📷 作业设计:不提供脚手架,提供单测与排行榜
回到原视频 (00:23:30)
AI 使用政策
主讲坦言:如今编码智能体已经能解出全部作业。但显然——把 Assignment 1 的 PDF 丢给 Claude Code,你什么也学不到。同时,AI 在答疑和辅导上又非常有用。课程的做法是:
- 提供一个
AGENTS.md文件(等价于一段提示词),要求 AI 以教学为导向(pedagogically-minded); - 如果你要用 AI,必须配合这个提示词使用;
- 这样它会计论代码、澄清概念,但不会在你本该自己实现 Transformer 时替你把它生成出来。
主讲说这是第一年尝试,欢迎反馈。
算力
今年的算力由 Modal 赞助提供额度。往年是 SSH 进一个集群;今年改用更偏 API 的方式。主讲起初有些怀疑,但实际用下来体验相当不错。
六、课程大纲:五个单元,对应五次作业
(参考时间: 27:40)
课程分成五个部分,与五次作业一一对应。可以先用一张图看清整体结构:
graph TD
    C["CS336:从零构建语言模型<br/>贯穿主线 = 最大化效率"] --> B["1. Basics 基础<br/>分词 · 架构 · 训练"]
    C --> S["2. Systems 系统<br/>内核 · 并行 · 推理"]
    C --> SL["3. Scaling Laws 缩放定律<br/>给定算力如何配置"]
    C --> D["4. Data 数据<br/>评估 · 采集 · 处理"]
    C --> A["5. Alignment 对齐<br/>弱监督 · RLHF/DPO/GRPO"]
    B --> A1["作业 1:实现 BPE、Transformer、AdamW、训练循环"]
    S --> A2["作业 2:Triton 内核、分布式训练、优化器状态分片"]
    SL --> A3["作业 3:定义 training API,拟合缩放定律并外推"]
    D --> A4["作业 4:Common Crawl → 过滤、去重、混合"]
    A --> A5["作业 5:实现 DPO、GRPO"]
单元一:Basics(基础)
(参考时间: 27:45)
📷 课程大纲五单元与五次作业的对应关系
回到原视频 (00:27:45)
这部分基本是前两周的内容,目标是能够从零训练一个语言模型。三个组件是:分词(tokenization)→ 架构(architecture)→ 训练(training)。
分词:模型操作的"原子"是什么?
- 形式上,分词器在原始输入(字节)与整数序列(token)之间来回转换。
- 概念上,它是对文本的一种切分(segmentation)。
- 核心算法是 字节对编码(Byte-Pair Encoding, BPE):直观地说,就是把输入切成频繁出现的片段。
📷 分词:模型操作的"原子",BPE 与效率视角
回到原视频 (00:28:08)
从效率视角看,分词之所以好,有两个原因:
- 缩短序列长度:把很长的原始字节流压缩成数量更少的 token(例如 1000 字节 → 约 250 个 token);
- 自适应计算(adaptive computation):有些位置虽然字节多,但应该被压缩成一个 token;而另一些更罕见、更有信息量的片段则应保留为多个 token——也就是把更多建模容量花在"有意思"的部分。
主讲每年都希望不必再讲分词,因为终极梦想是有一个端到端、直接操作字节的方案。近年确实出现了一些有前景的网络(如 ByT5、MegaByte、BLT、T-FREE、H-Net 等),但至今还没有被放大到前沿规模。既然前沿模型仍在使用分词器,课程认为仍然值得教。
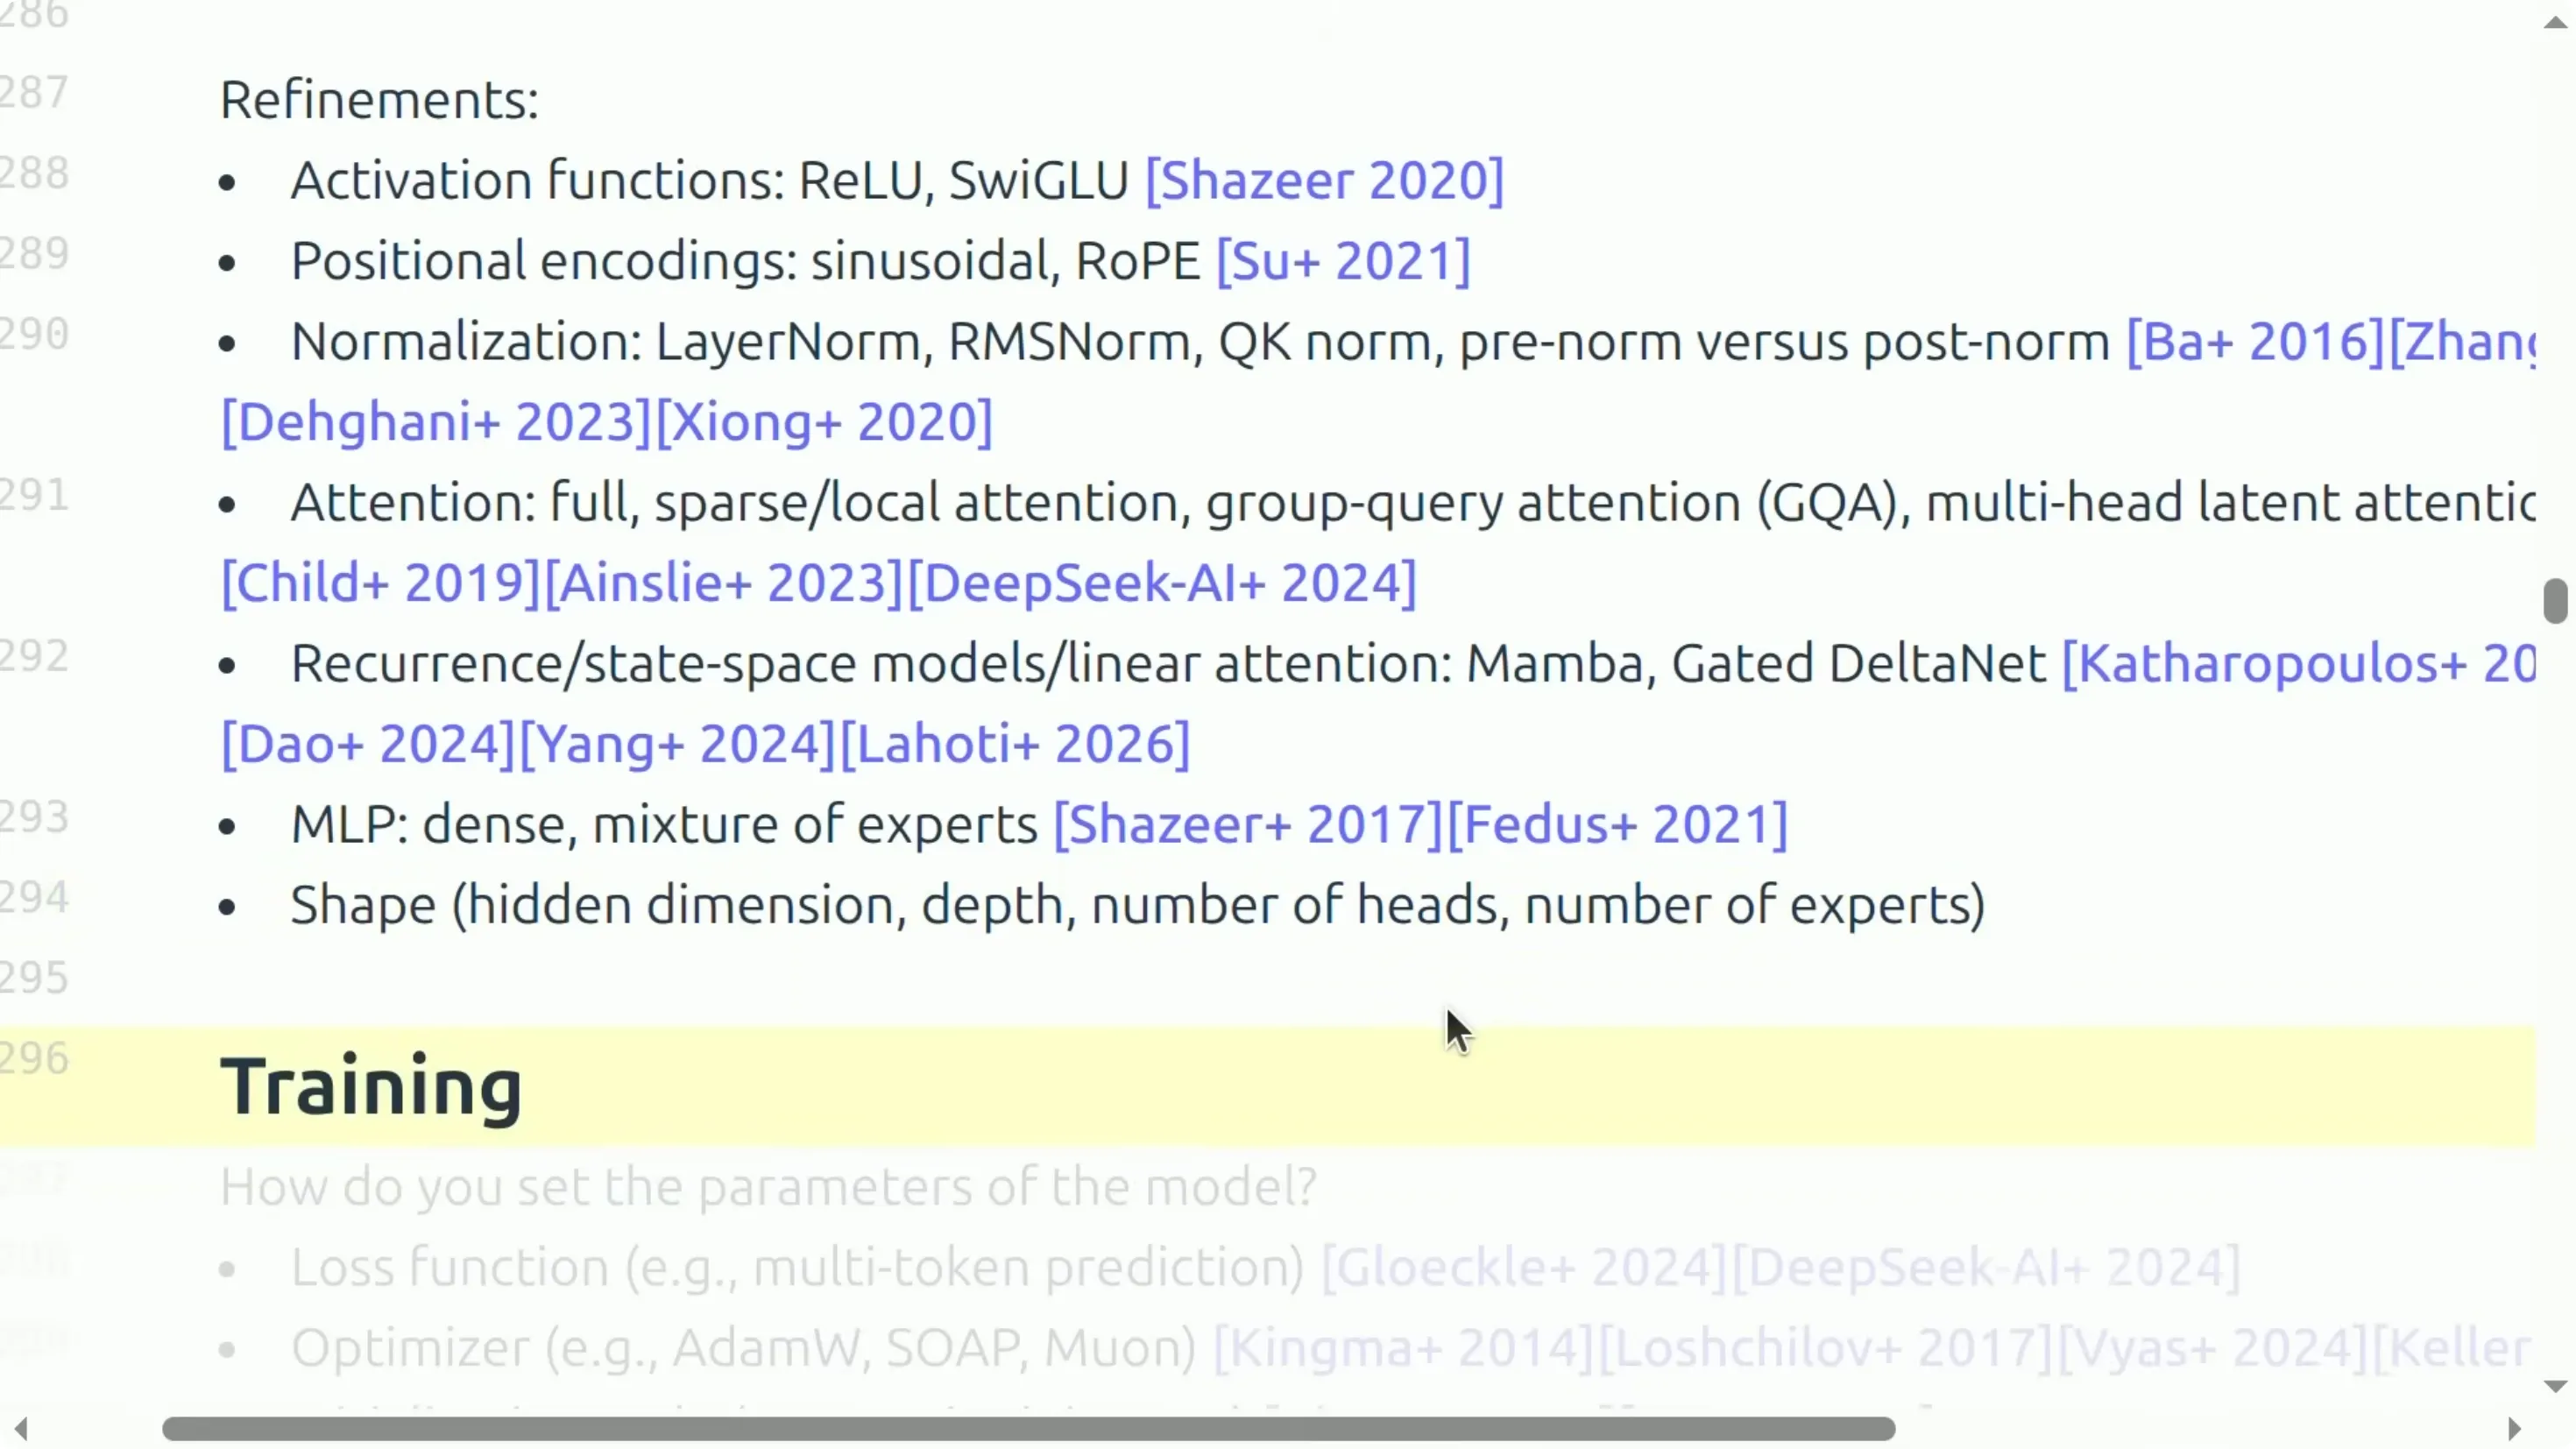
架构:Transformer 及其一系列改进
大家应该都熟悉 Transformer。自它诞生以来,出现了许多重要的改进:
- 激活函数:ReLU → SwiGLU 等;
- 位置编码:正弦位置编码 → RoPE 等;
- 归一化:LayerNorm、RMSNorm、QK-norm,还有 pre-norm 与 post-norm 的取舍;
- 注意力:从"全注意力"到 稀疏/局部注意力、分组查询注意力(GQA)、多头潜在注意力(MLA)等——因为注意力的计算量随序列长度 n 呈 n² 增长,非常昂贵;
- 循环/状态空间模型/线性注意力:如 Mamba、Gated DeltaNet。这类模型近几年更流行,通常与注意力做某种混合效果不错;
- MLP 层:原始的 Transformer 用稠密 MLP,而如今 混合专家(MoE) 已成为构建算力高效 Transformer 的主流范式——随之也带来新的训练技术;
- 模型形状:多少层、多少头、隐藏维度多大、多少专家。听起来只是超参数,但在语言模型与规模的语境下,影响极其巨大。
📷 Transformer 架构的各处改进:激活、位置编码、归一化、注意力、MLP、模型形状
回到原视频 (00:29:58)
训练:如何设定参数?
围绕训练有一堆设计决策:
- 损失函数:默认是下一个 token 预测;也有人发现一次预测多个 token(multi-token prediction) 有助于提升模型。
- 优化器:过去用 AdamW,如今越来越多使用 Muon(例如一些最新的开放模型,如 Kimi K2)。
- 初始化:看起来很无聊,却对大规模训练的稳定性有巨大影响(Xavier 初始化、muP 等)。
- 学习率调度:余弦(cosine)、WSD 等。
- 正则化、批大小(batch size)。
- MoE 特有的问题:负载均衡(如 aux-free 方案)。
主讲提醒:你可能会觉得"这些不就是超参数嘛,多试几组就行了"。但实际上——能否有原则地把这些超参数设对,往往决定了你的训练是会直接爆炸、毫无用处,还是会达到当前最优(state of the art)。 关于这一点,后面讲缩放定律时还会回来。
📷 训练阶段的设计决策:损失、优化器、初始化、学习率、正则、批大小、MoE
回到原视频 (00:32:20)
作业 1
在作业 1 中,你将从零实现:BPE 分词器、Transformer、交叉熵损失、AdamW 优化器、完整训练循环;还要做大量资源核算(resource accounting),从而理解算力都花在了哪里。你会在 TinyStories 和 OpenWebText 等数据集上训练模型,并在排行榜上尽可能快地压低困惑度——它和 NanoGPT speedrun 有点类似。
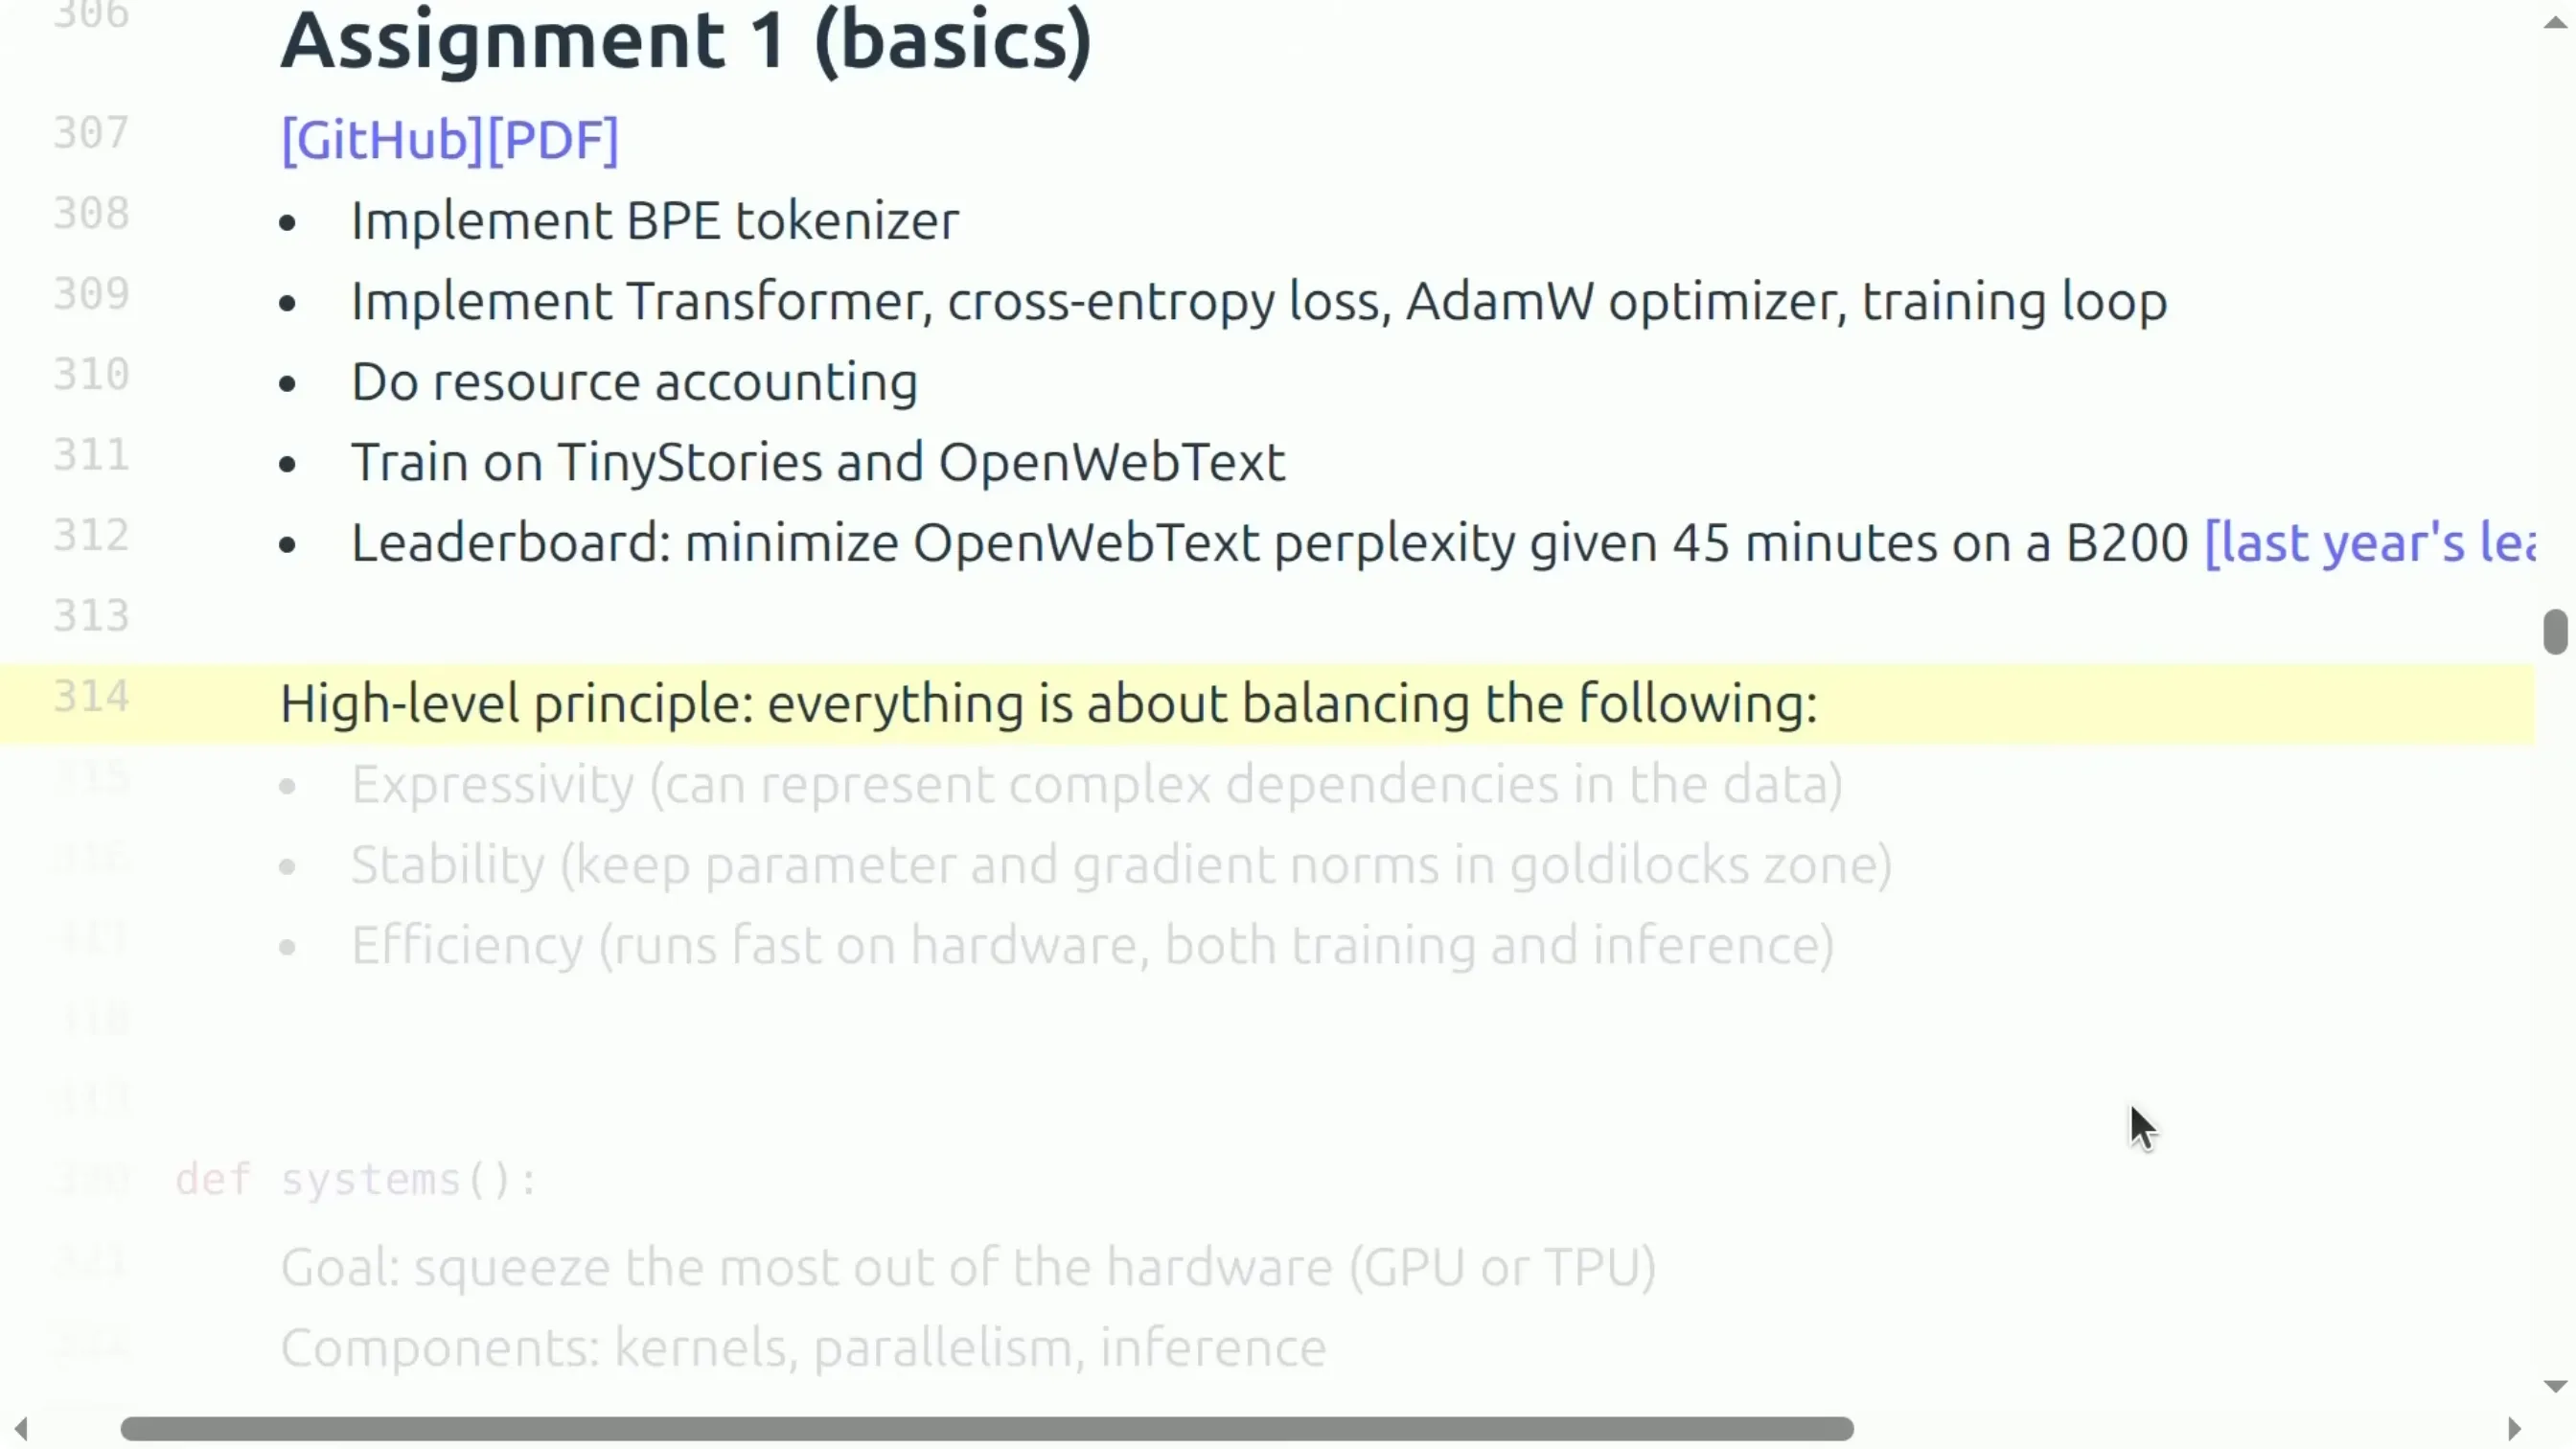
一个高层次的总结:三者的平衡
虽然分词、建模、训练被并列成三个部分,但一切都归结为下面三者的平衡:
| 维度 | 含义 | 代价 |
|---|---|---|
| 表达力(Expressivity) | 能表示数据中复杂的依赖关系 | 太弱则学不动 |
| 稳定性(Stability) | 把参数范数与梯度范数保持在"刚刚好"的区间 | 太大则爆炸,太小则消失 |
| 效率(Efficiency) | 在硬件上跑得快(训练与推理) | 直接决定成本 |
主讲强调:训练语言模型的很大一部分工作,其实就是在处理稳定性。 而效率则相对直接——就是让它跑得快。但这里有个关键的权衡:比如为了更快而把投影压到低维,那么"它还能不能一样好?"——做好这类取舍,正是这门课的重头戏。
📷 表达力、稳定性、效率三者的平衡
回到原视频 (00:34:40)
单元二:Systems(系统)
(参考时间: 35:55)
📷 系统单元:内核、并行与推理
回到原视频 (00:35:55)
目标是榨干硬件性能。三个主题:内核、并行、推理。
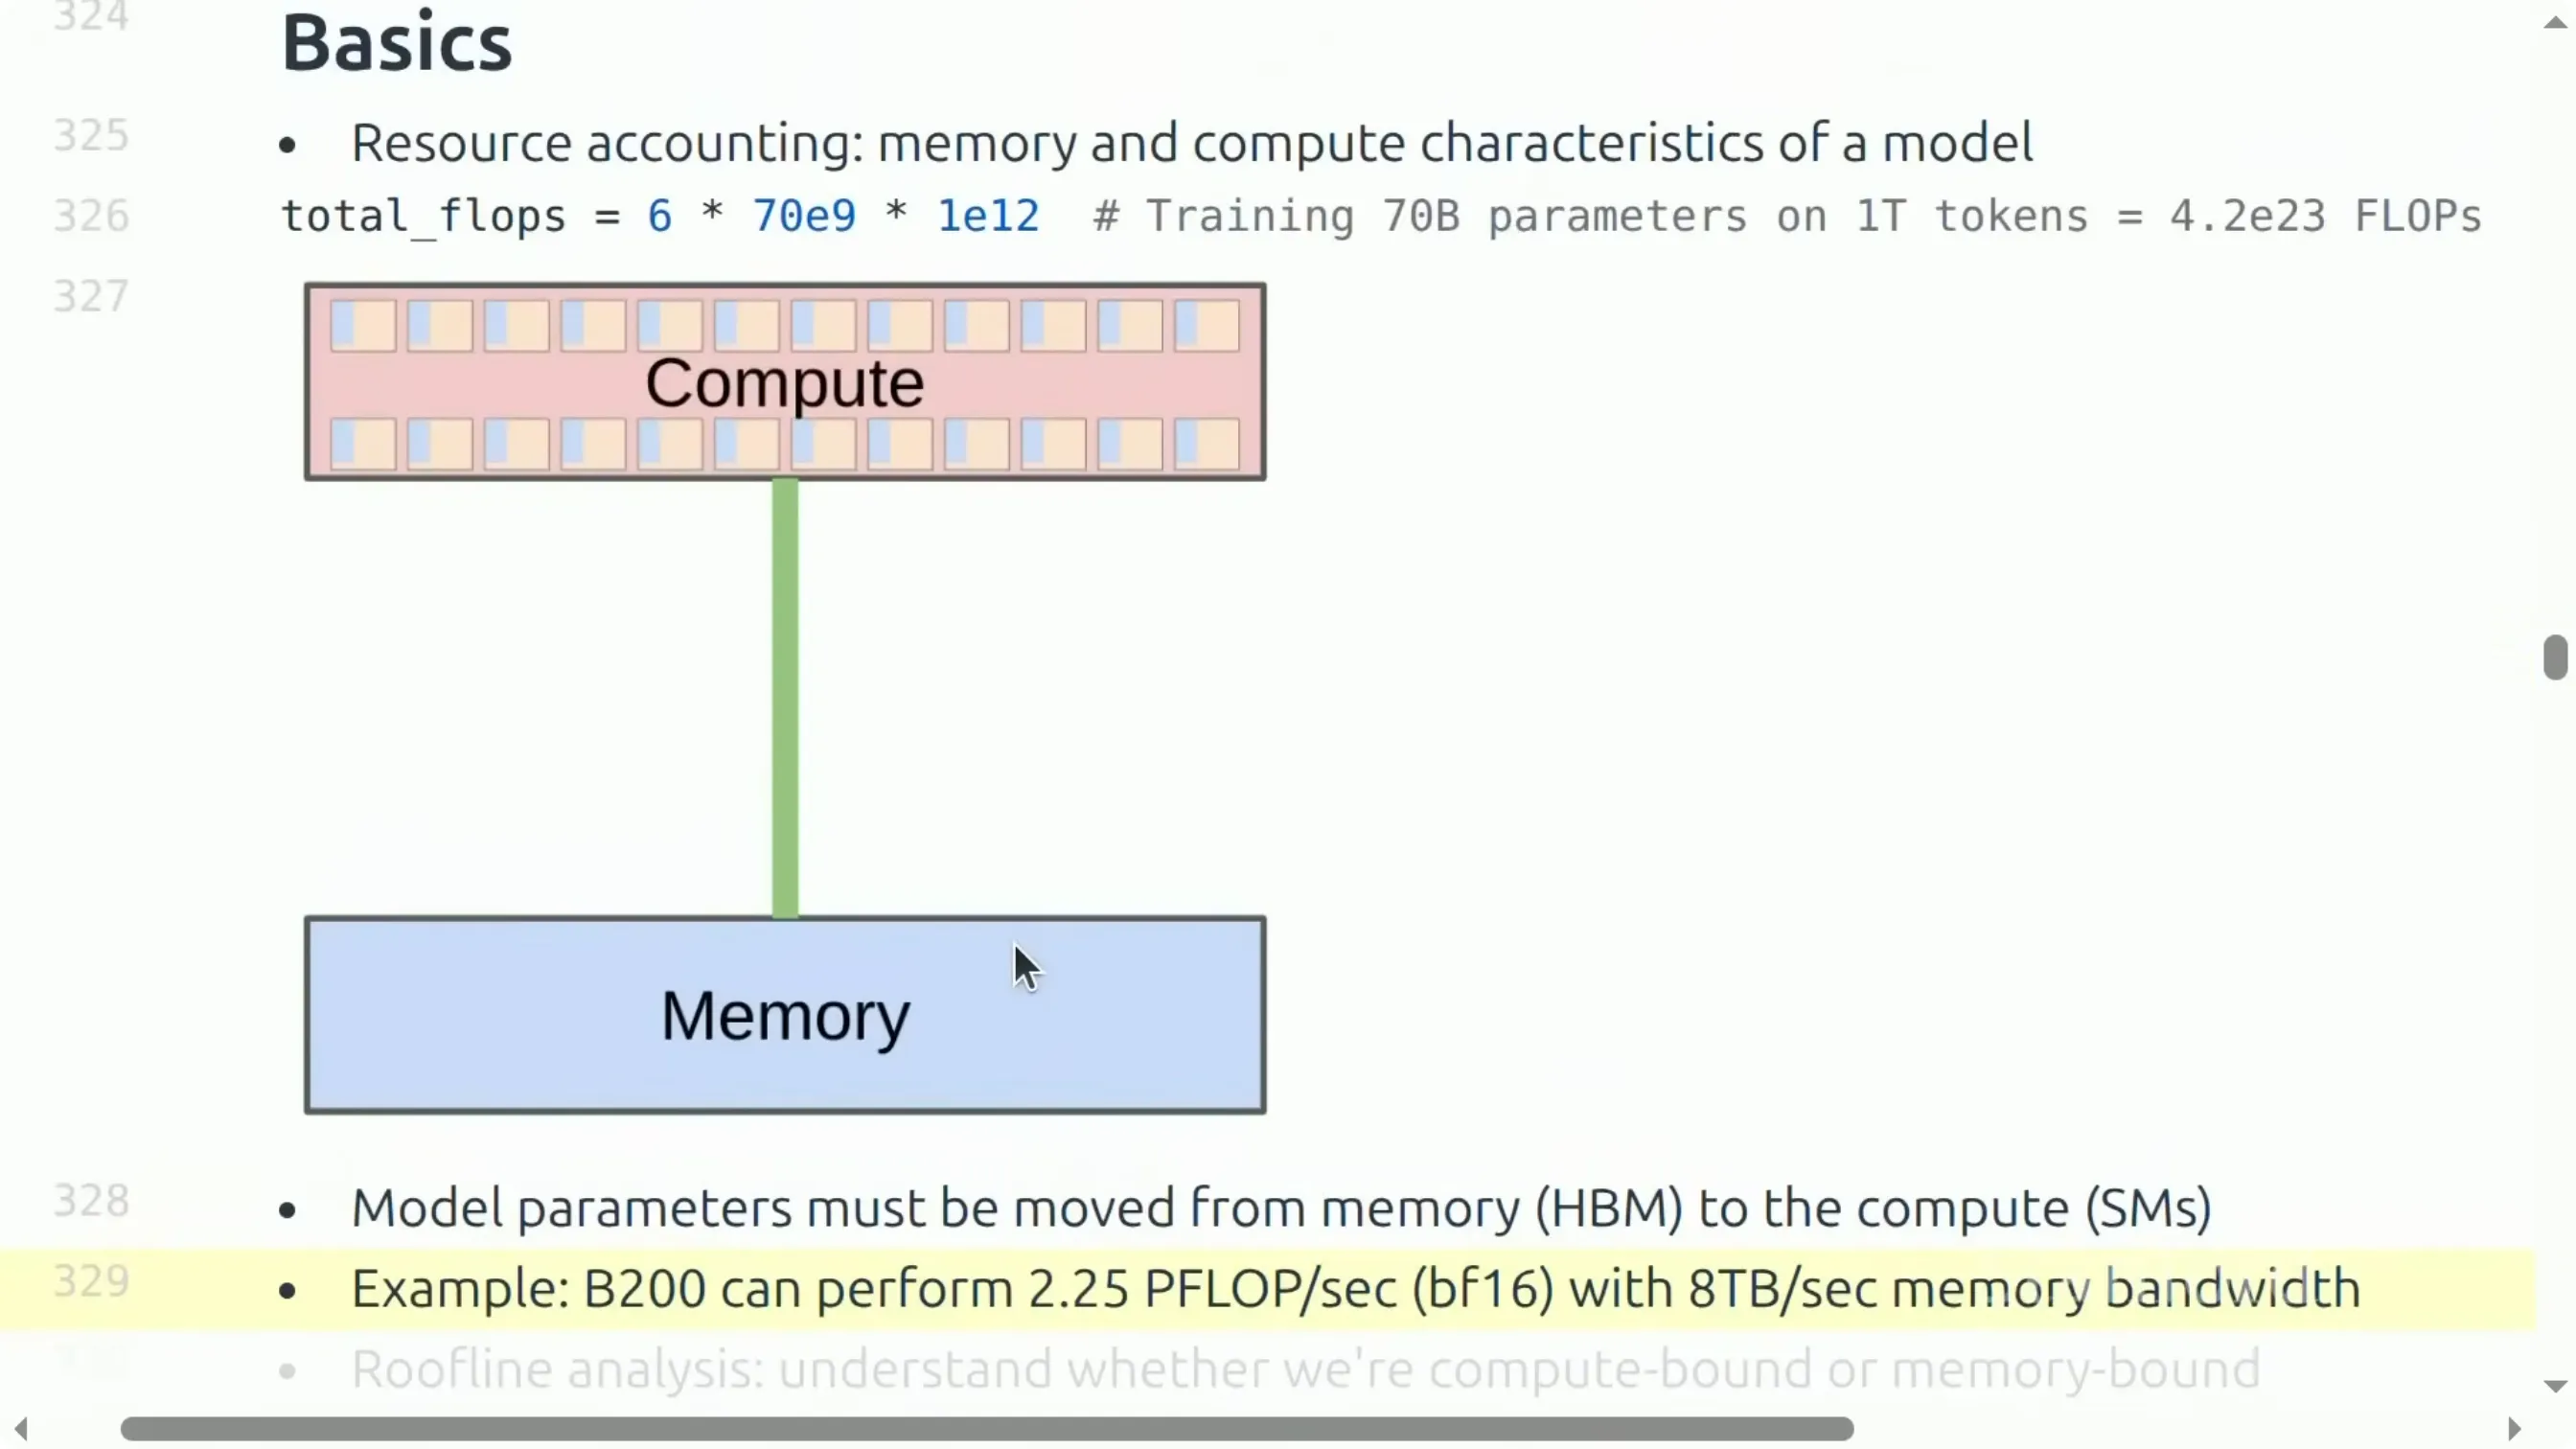
基础:资源核算
首先要搞清楚 FLOPs 和内存都花在哪里。课程会推导那个反复出现的公式:训练一个模型在 1 万亿 token 上,需要的 FLOPs 约为 6ND(N 为参数量,D 为 token 数),并解释它从何而来。
然后是硬件。有一个很关键的"漫画式"认识:
内存和算力不在同一个地方。 你必须把参数或激活值从内存搬到计算单元,算完再搬回去——而这通常就是瓶颈所在。
以 B200 为例:bf16 下每秒约 2.25 PFLOPs 算力,内存带宽每秒约 8 TB。课程会用这些数字做计算,估算不同类型算法需要多长时间,并引入 Roofline 分析来判断一个计算到底是算力受限还是内存受限——一般来说是内存受限。
📷 系统基础:资源核算、内存墙、Roofline 分析与 DGX B200
回到原视频 (00:37:22)
内核(Kernels)
内核就是跑在 GPU 上的一个函数。当你使用朴素 PyTorch 时,每个基本操作其实都在启动一个内置内核——你早就在用内核了。关键在于:对某些计算,你可以自己写内核让 GPU 跑得更快。
核心原则是:组织计算以最小化数据搬运。
简单例子:要计算 A 和 B 两个结果
- 朴素做法:从 HBM 读 → 算 A → 写回 → 再读 → 算 B → 写回(数据来回搬运两次);
- 融合(fusion):读一次 → 同时算 A 和 B → 写回一次。
Tiling(分块) 是同一思想的更精妙变体(FlashAttention 即属此类)。课程还会涉及 warp divergence、内存合并(coalescing)、bank conflicts、占用率(occupancy)、异步大块内存传输等 GPU"怪癖",并带大家用 Triton 写内核。
graph LR
    subgraph 朴素["朴素:两次往返"]
      M1["HBM 内存"] -->|读| A1["计算 A"]
      A1 -->|写| M1
      M1 -->|读| B1["计算 B"]
      B1 -->|写| M1
    end
    subgraph 融合["算子融合:一次往返"]
      M2["HBM 内存"] -->|读一次| AB["计算 A 与 B"]
      AB -->|写一次| M2
    end
并行(Parallelism)
如果有上千张 GPU 呢?"最小化数据搬运"的原则不变,只是跨 GPU 搬运数据更加昂贵。课程会讲经典的集合通信(collective)操作——gather、reduce、all-reduce——作为分布式训练的思考方式。
核心问题是:模型参数、激活、梯度、优化器状态都需要被切分(shard)到多张 GPU 上,然后把正确的数据送到正确的节点。切分方式有多种:数据并行、张量并行、流水线并行、序列并行、专家并行,各自有不同取舍。
📷 上千张 GPU 的并行:切分参数、激活、梯度、优化器状态,以及集合通信
回到原视频 (00:40:32)
推理(Inference)
推理越来越重要:不仅要用来和模型对话,还用于强化学习的 rollout、测试时计算(test-time compute)、生成合成数据、评估。
推理分为两个阶段:
- Prefill(预填充):把提示词的所有 token 前向计算、建立 key-value 缓存。很像训练,可以并行处理,通常是算力受限。
- Decode(解码):一次生成一个 token。很快变成内存受限——这正是推理难做的地方。
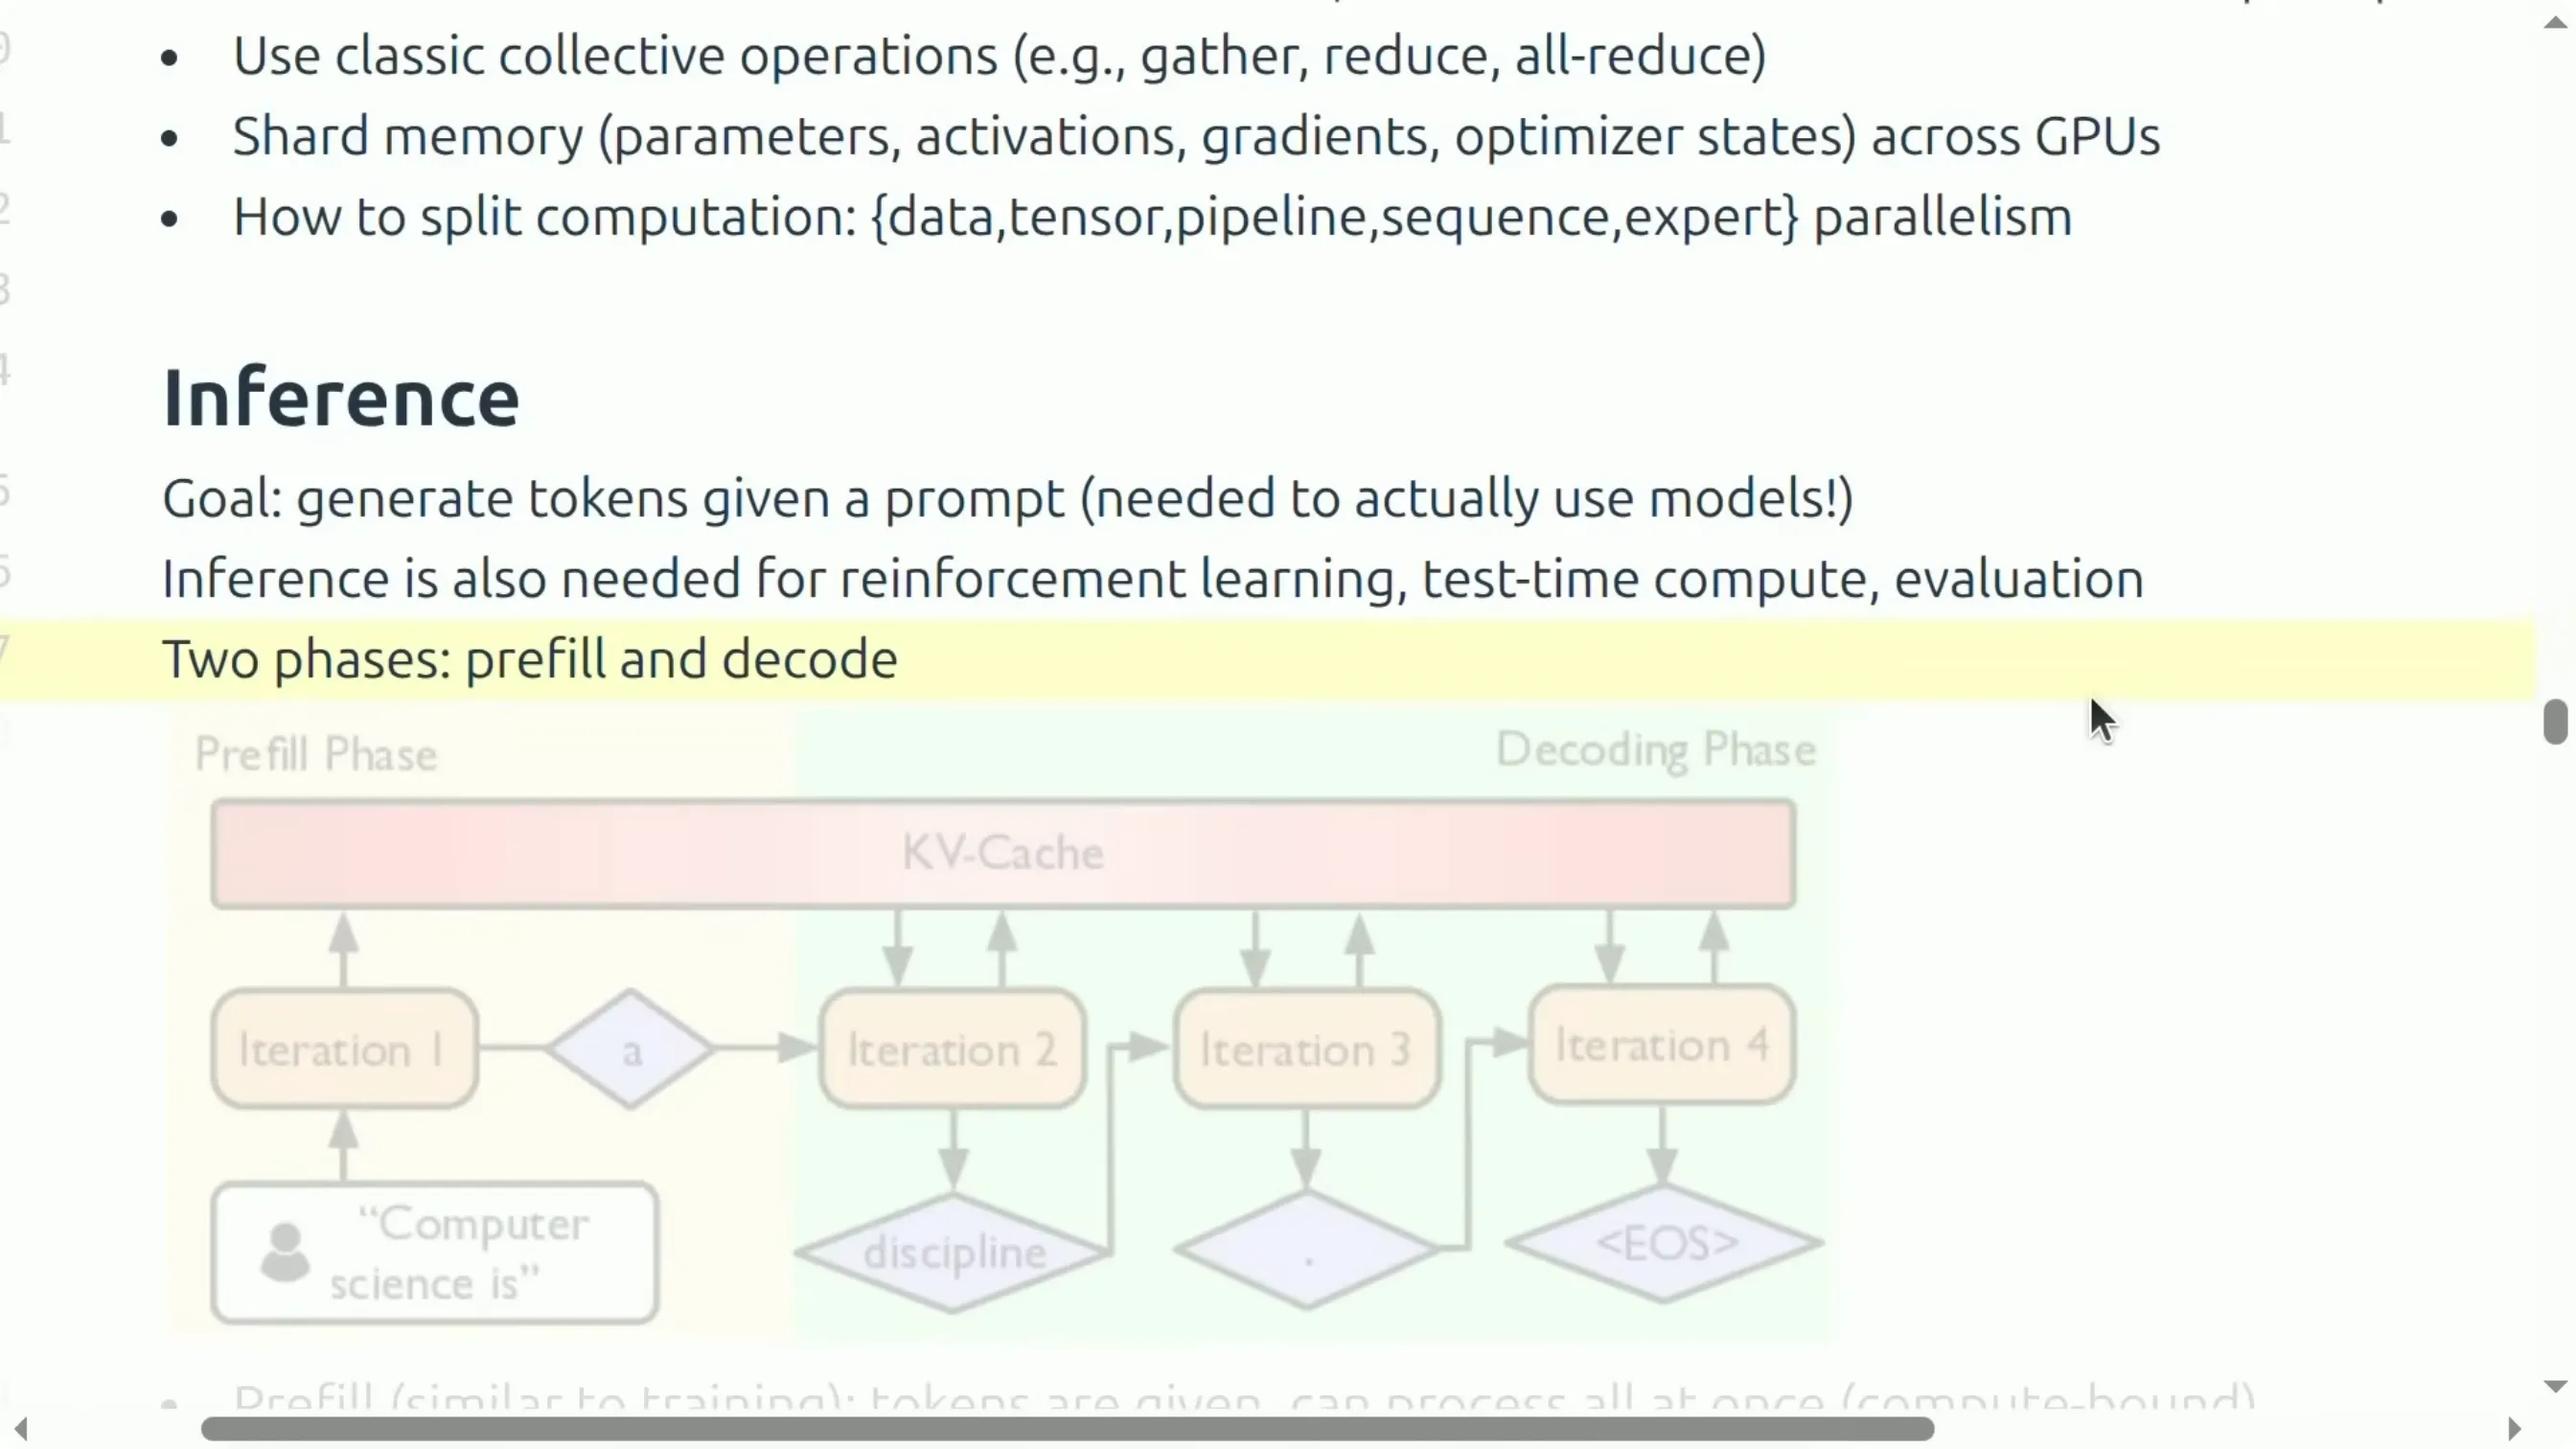
📷 推理的两个阶段:Prefill(算力受限)与 Decode(内存受限)
回到原视频 (00:42:37)
加速推理的手段:
- 换更便宜的模型:剪枝、量化、蒸馏;
- 投机解码(speculative decoding):用更便宜的"草稿"模型先跑出一串 token,再用完整模型并行给这些 token 打分,如果运气好就一次性接受——而且这是精确解码,不损失正确性;
- 系统优化:专门为推理设计的内核、连续批处理(continuous batching)等。
主讲还点出推理与训练的一个关键区别:在服务场景里,查询会在任意时刻到达,你必须想办法把它们攒成批;而训练里批是事先定义好的,可预测得多。
作业 2 与推荐读物
作业 2 会让你用 Triton 实现融合的 RMSNorm 内核、实现分布式数据并行训练、实现优化器状态分片,并对这些实现做 benchmark 与 profiling。
主讲推荐了一本很好的书:How to Scale Your Model(来自 Google)。它很好地提供了关于 Roofline 分析、Transformer 数学、如何在概念上处理 LLM 系统的理解。唯一要注意的是它侧重 TPU,但高层概念是相通的,而且新加了关于 GPU 的章节。
单元三:Scaling Laws(缩放定律)
(参考时间: 45:15)
📷 缩放定律:给定 1e25 FLOPs 该训练什么模型
回到原视频 (00:45:15)
到这里你已经能训练模型、能把它跑快,接下来要放大规模。设想一个场景:
如果你有 1e25 FLOPs 的算力(价值数千万美元),你会训练一个什么样的模型?
这很吓人——因为一旦搞砸,就是一大笔钱打水漂,而且你只有一次训练机会,不可能在这个规模上做常规的超参搜索。
关键的概念转变:不要把注意力放在"某一个要训练的模型"上,而要思考一个缩放配方(scaling recipe)——一个从 FLOP 预算映射到一组超参数的映射(本质就是一份 config 文件)。
对于给定的缩放配方,你会:
- 在较小规模上跑一批实验,得到各自的 loss;
- 把这些点拟合出缩放定律,用它预测目标规模上的 loss。
这样一来,你就能:
- 用小规模实验来优化面向大规模规模的配方;
- 在真正开跑之前,就预测出能达到的 loss——甚至可以用来融资("我在小规模上验证过,能训出 GPT-5 级别的模型,请给我钱")。
graph TD
    R["缩放配方<br/>FLOPs → 超参数"] --> S1["在小规模上跑实验<br/>(如 1e18 ~ 1e21 FLOPs)"]
    S1 --> F["拟合缩放定律"]
    F --> P["预测目标规模的 loss<br/>(如 1e25 FLOPs)"]
    P --> O["优化配方 / 提前决策"]
缩放定律不是自然规律
主讲强调一个常见误解:缩放定律不是自然定律,不会自动发生——你得"把它召唤出来"。它来自对缩放配方的精心构造,而且这个配方必须能外推。这意味着学习率、批大小等超参数随规模该如何变化,都得想清楚。
为此,你需要通过参数化模型来实现超参数迁移(hyperparameter transfer):让小规模上用的超参数,要么能直接用于大规模,要么是规模的可预测函数。否则——如果学习率时而 1e-5、时而 1e-4,你根本不可能"猜"出大模型该用哪个。
由此得到一个重要的心态转变:
可预测性(predictability)至少和最优性(optimality)一样重要。
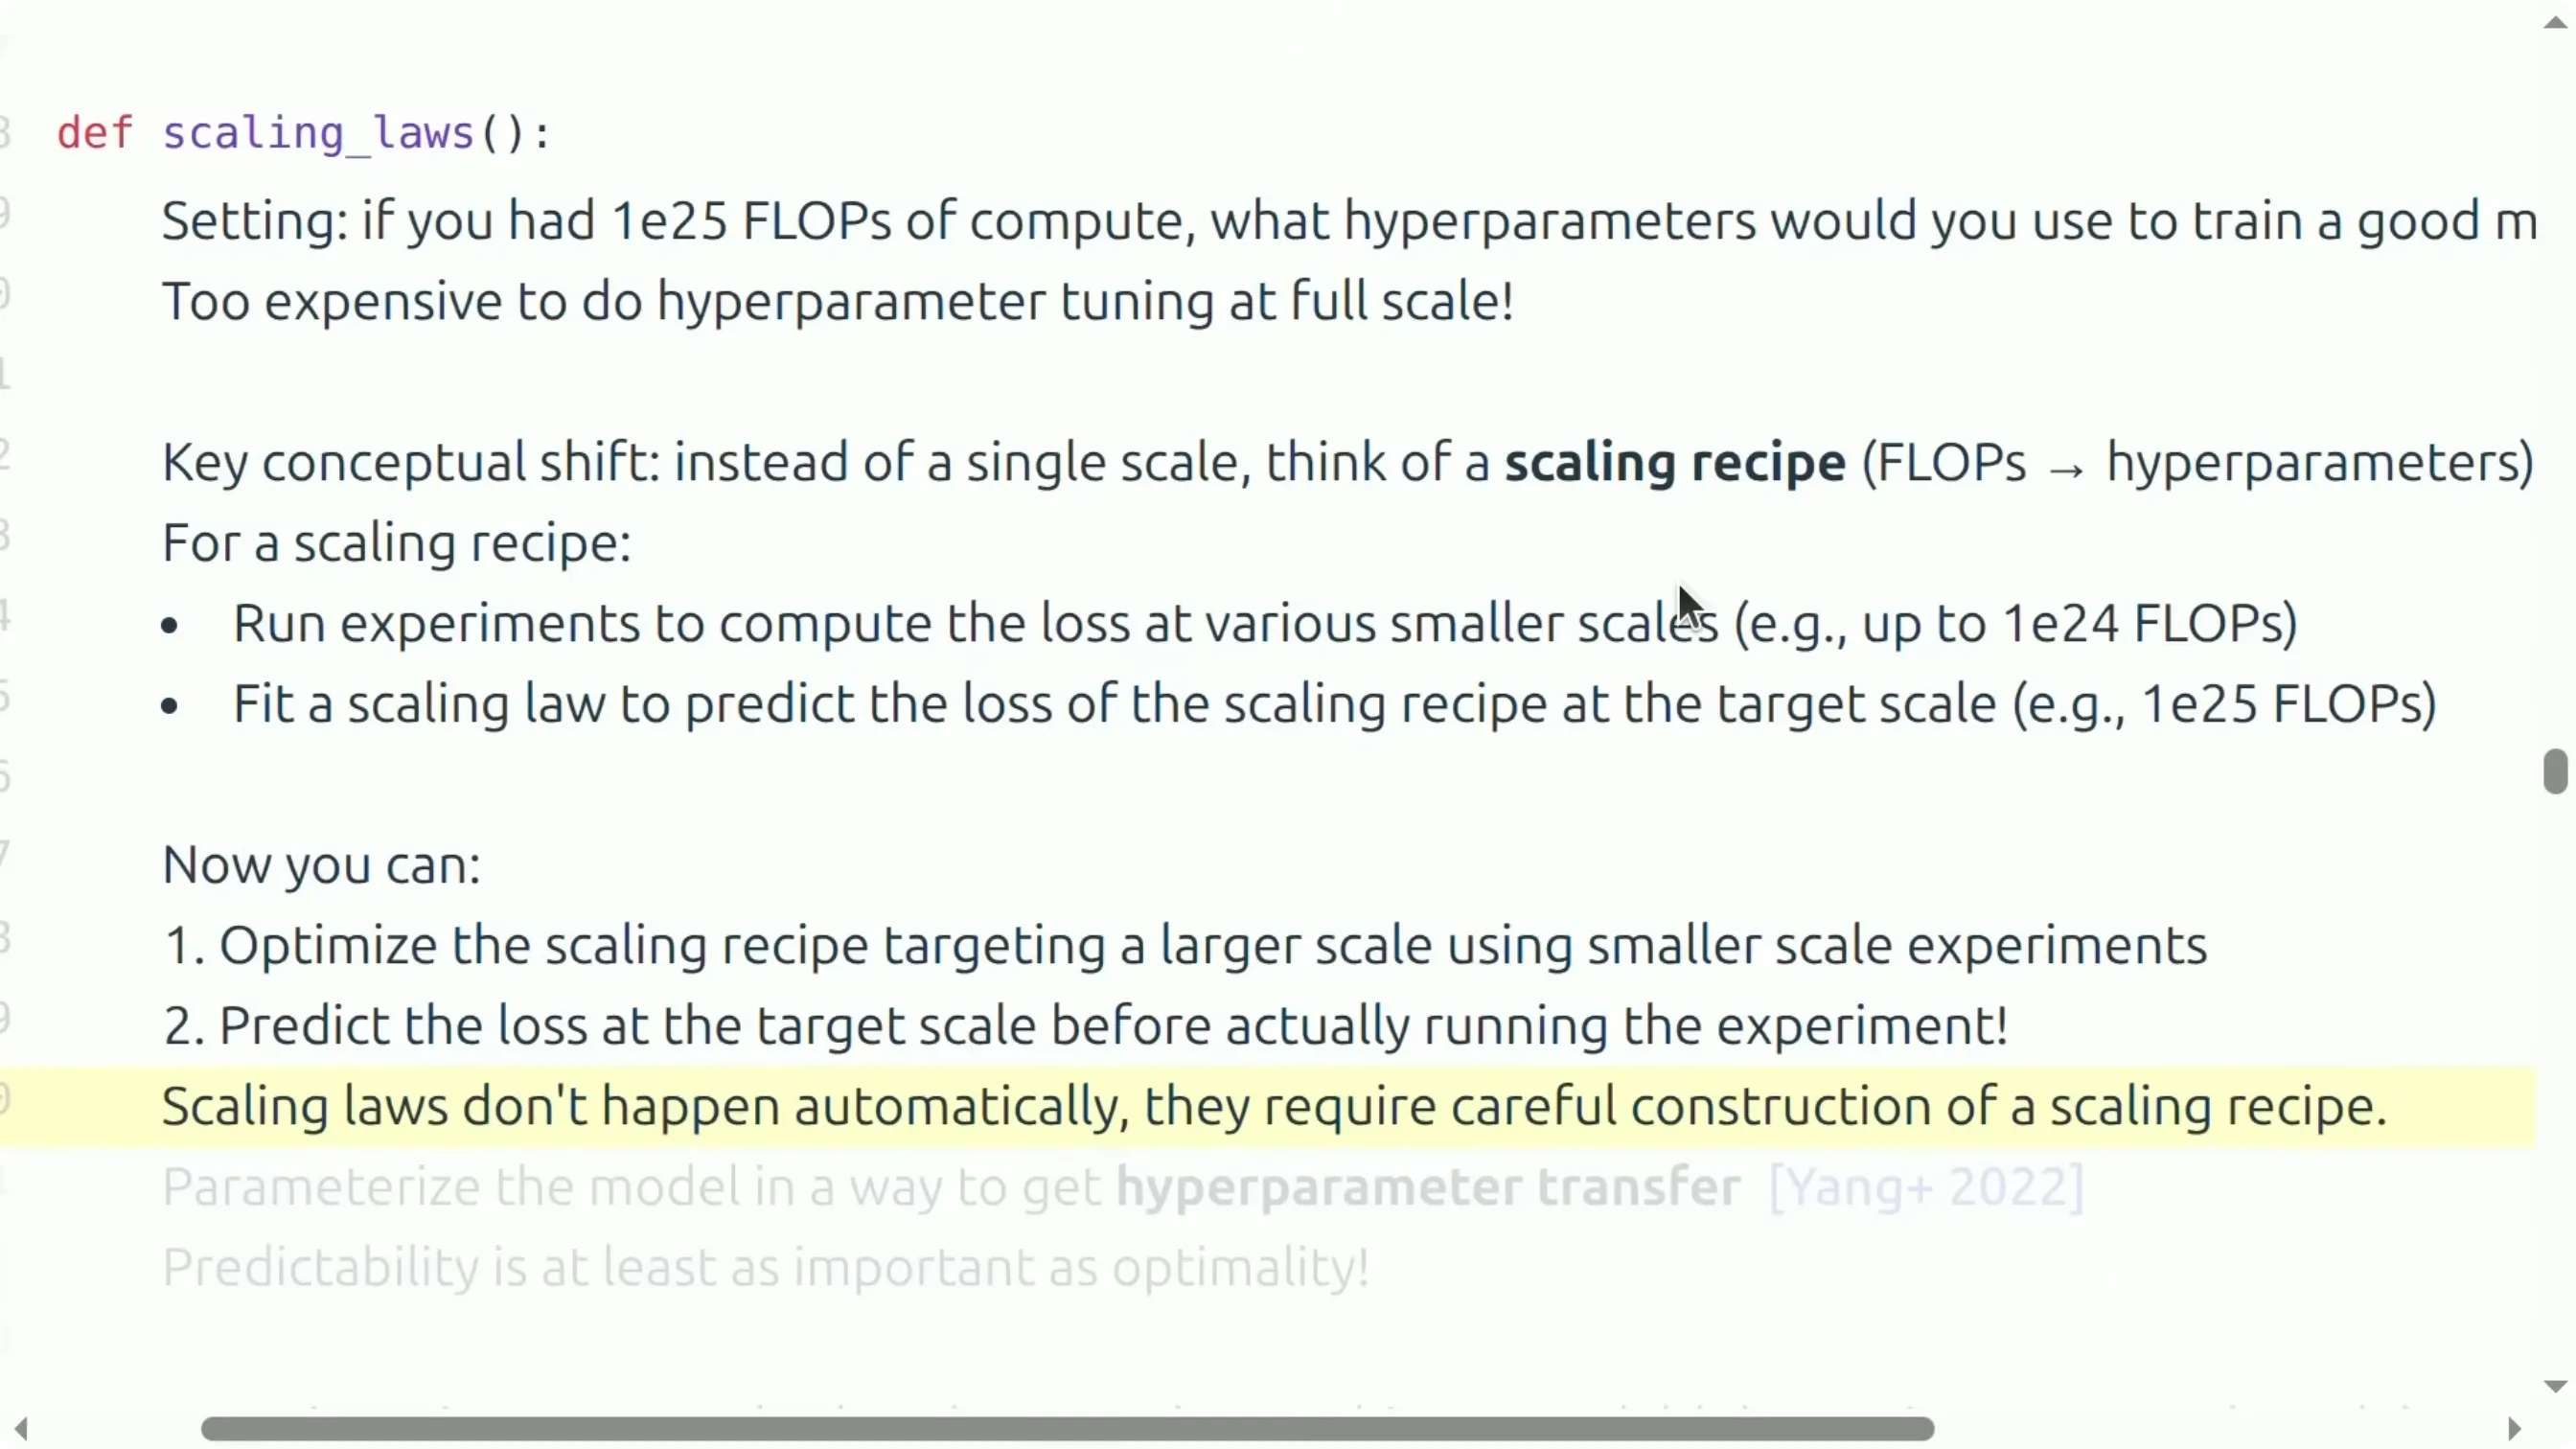
📷 超参数迁移与可预测性:可预测性至少与最优性同样重要
回到原视频 (00:48:00)
经典的算力最优缩放定律
实际要看的缩放定律相当经典:给定一个 FLOPs 预算,应该训更大的模型还是更多 token?
- 对每个 FLOPs 预算(比如从 6e18 一直扫到 3e21),遍历不同模型规模,挑出最好的那个;
- 然后拟合一条曲线,用来从 FLOPs 预算预测参数量。
如果运气好,这些点大致落在一条直线上;如果运气不好、点散得到处都是,那说明你对能否可靠外推毫无信心。
一个粗略的经验法则是:
数据量 ≈ 20 × 参数量。 例如一个 70B 参数的模型,应该训练大约 1.4 万亿 token。
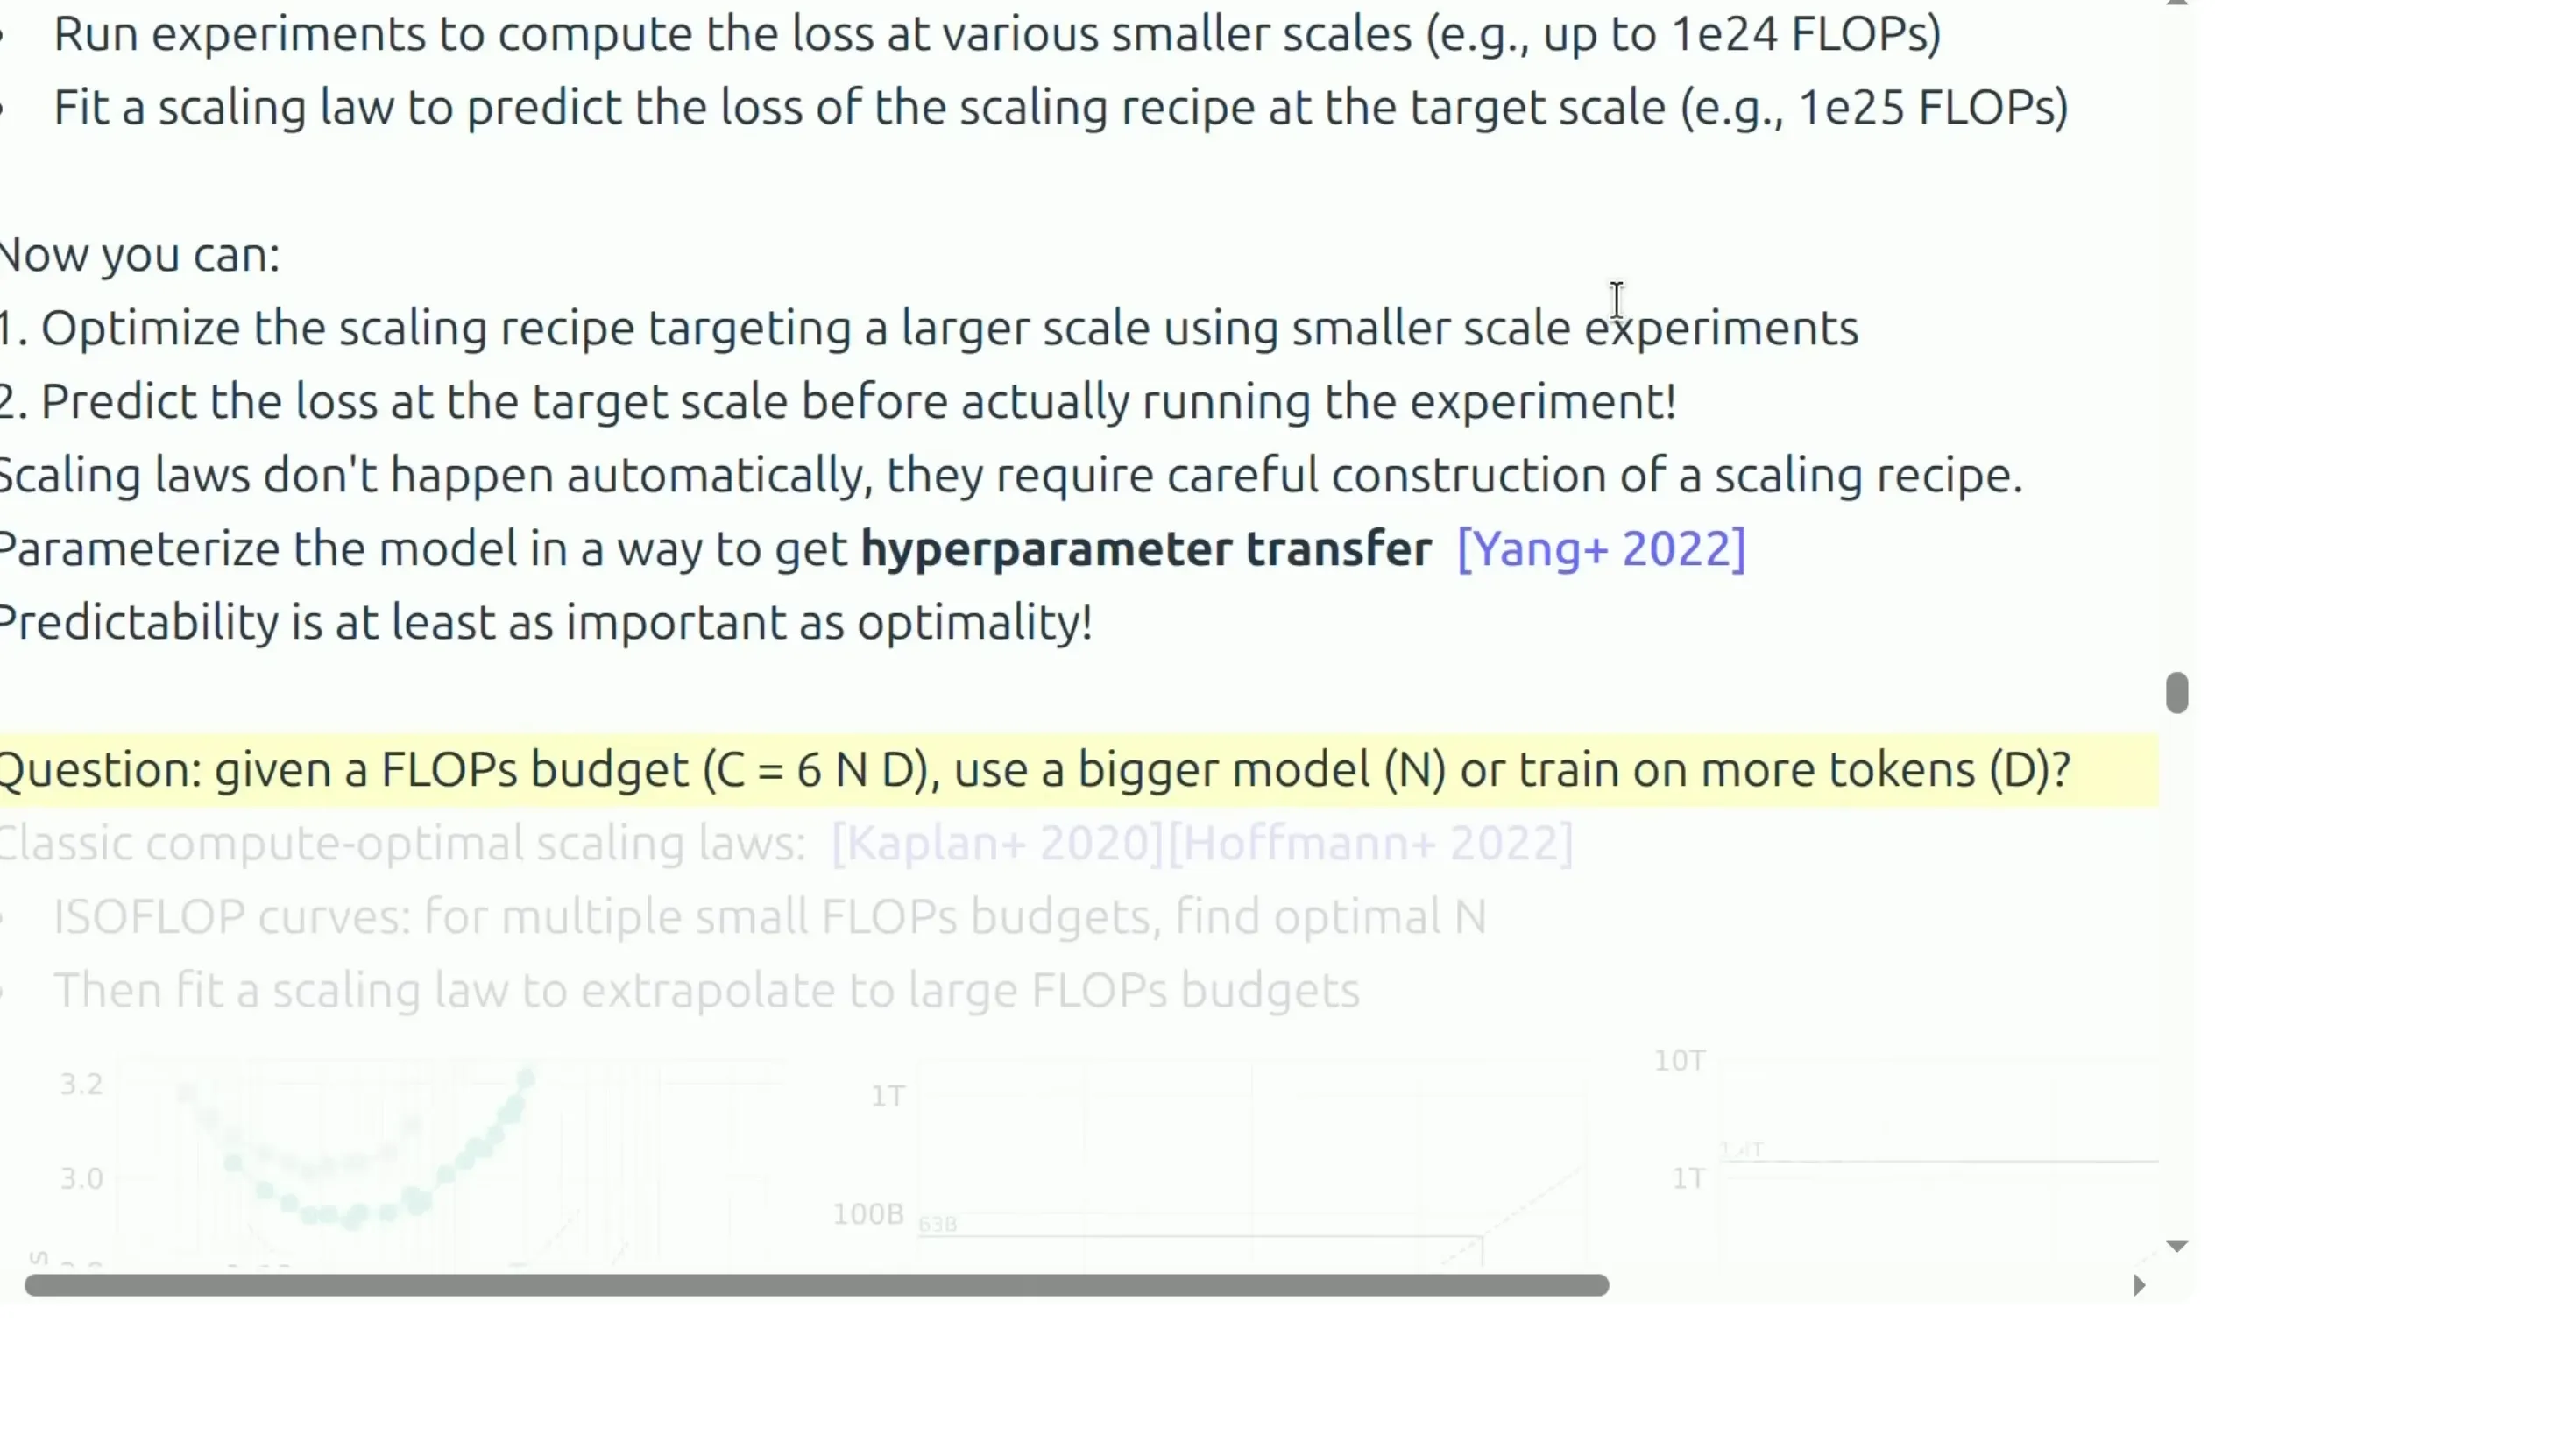
📷 Chinchilla 算力最优缩放定律:ISOFLOP 曲线与 D ≈ 20N
回到原视频 (00:49:20)
当然,具体数字会随数据集与架构变化。而且这个规则没有考虑推理成本——如今很多模型故意做得更小、却在远超"算力最优"的数据量上训练,就是因为推理时想要更小的模型。
主讲还分享了 Marin 项目的一个有趣实践:预注册(preregister)结果。他们在不同算力预算上拟合缩放定律,把预测外推到 1e22 FLOPs,然后等真正训练完成后,再回头比对预注册的 loss 是否命中。核心思想是:
我们预测了一个从未训练过的大模型的表现;如果能预测准,那就非常有价值。
作业 3
作业 3 会定义一个 training API:你给一组超参数,它还你一个 loss。这模拟了"如果我能做很多次训练会怎样"的场景——课程离线训练了模型并做成缓存,所以你看起来像是在真地训练。你要做的就是提交训练任务、收集数据点、拟合缩放定律、外推到目标规模,最后在给定预算下最小化 loss。它意在复现"手握 1 亿美元预算时必须精打细算"的那种高压感(当然,现实里这是低风险的)。
单元四:Data(数据)
(参考时间: 53:42)
📷 数据单元:评估、采集与处理
回到原视频 (00:53:42)
模型训好了、跑快了、也知道怎么放大了,那训练数据从哪来?这正是数据单元的主题,可能是最重要的部分之一——因为数据质量基本决定了模型有多好。
换个角度看:你想要模型具备什么能力? 数据就反映了这些诉求——要多语言?要会对话?要能做长程的智能体编码任务?
评估(Evaluation)
评估是个很深的主题,不只是"跑几个 benchmark",它服务于两个不同目的:
- 内部评估:指导模型开发。这里重要的是跨规模的平滑性(我们要的是可预测)与相对表现——因为你未必在意某个困惑度数字的绝对值。
- 外部评估:向客户、审稿人汇报绝对质量。这里重要的是生态效度(ecological validity)。
常见评估:
- 困惑度(Perplexity):最好在互联网上没有的私有文档上跑,以避免数据污染(contamination)。至今为止,困惑度仍是捕捉模型内在质量的极好方式。
- 进阶用例:GPQA、HLE、SWE-Bench、Terminal-Bench 等。
主讲提醒:语言模型号称通用(general purpose),所以需要非常多样的评估。而且不要把一个平均值当成全部——平均值往往把很多不同性质的东西混在一起了。
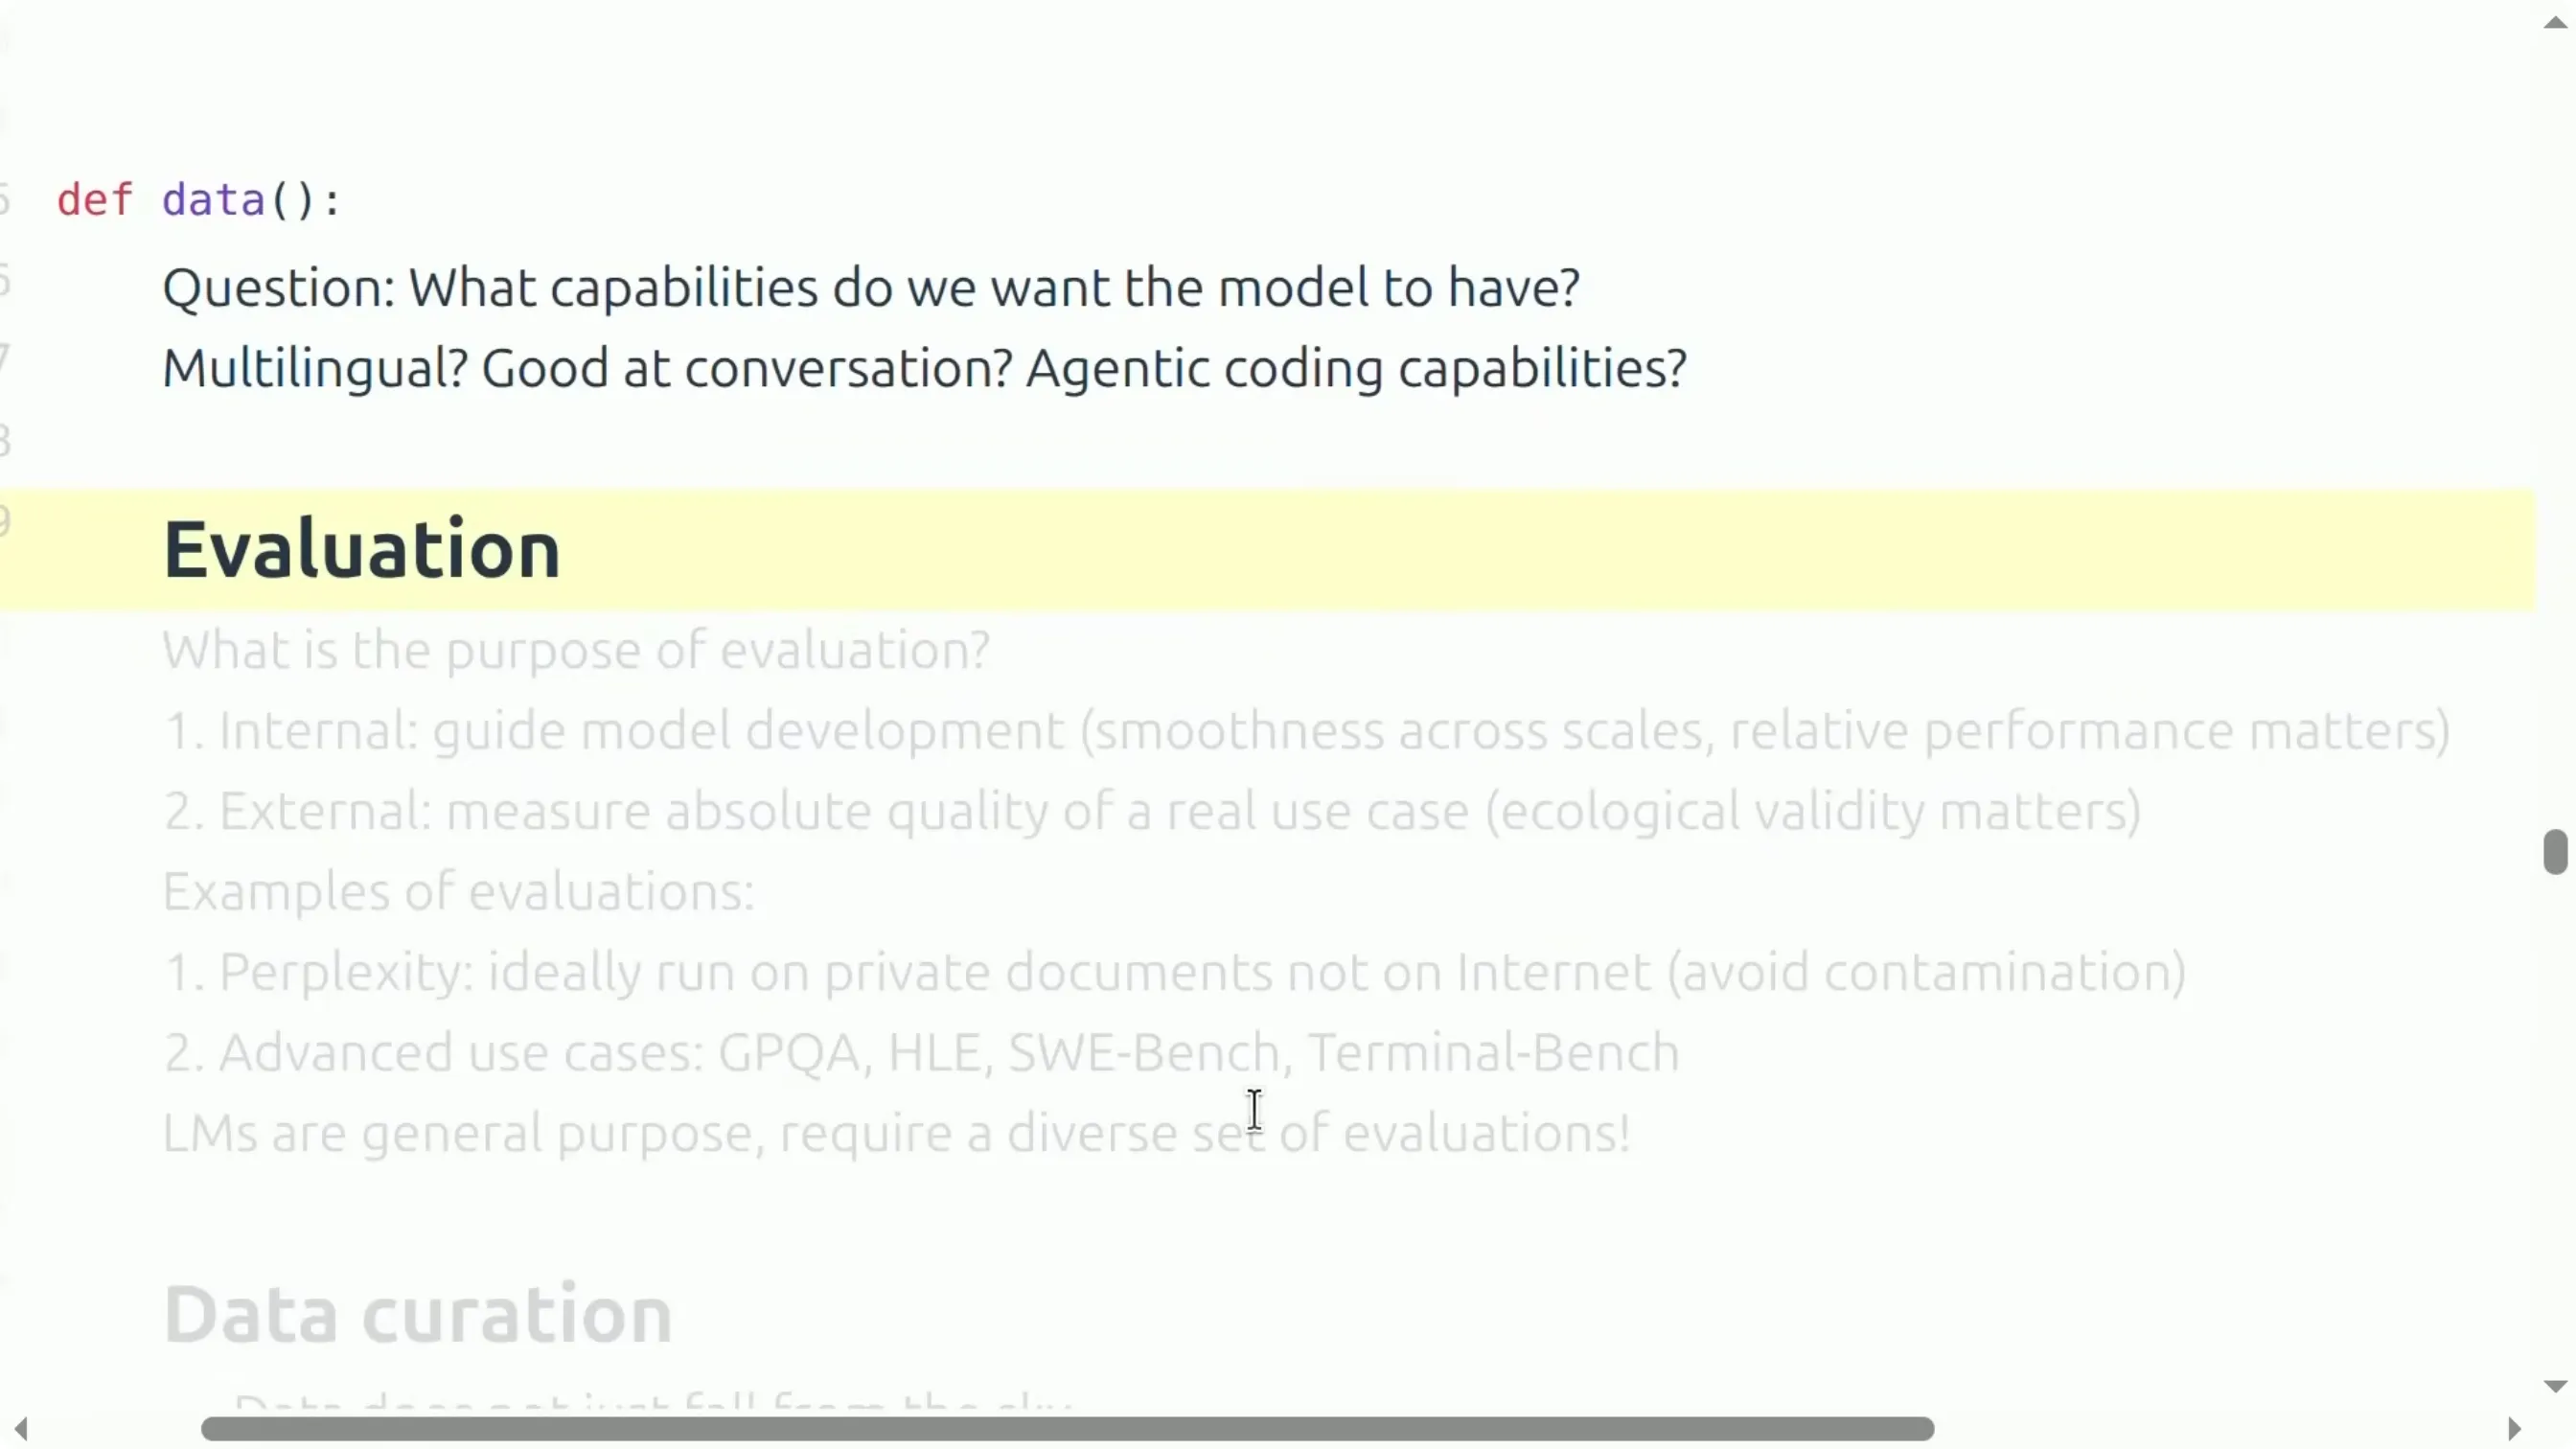
📷 评估的两个目的:内部开发(困惑度、平滑性)与外部汇报(生态效度)
回到原视频 (00:54:20)
数据采集与处理
数据不会从天上掉下来,必须主动策划。来源包括:从互联网爬取的网页、书籍、arXiv 论文、GitHub 代码等。数据集的构成相当多样(主讲引用了 The Pile 那张经典的构成图)。
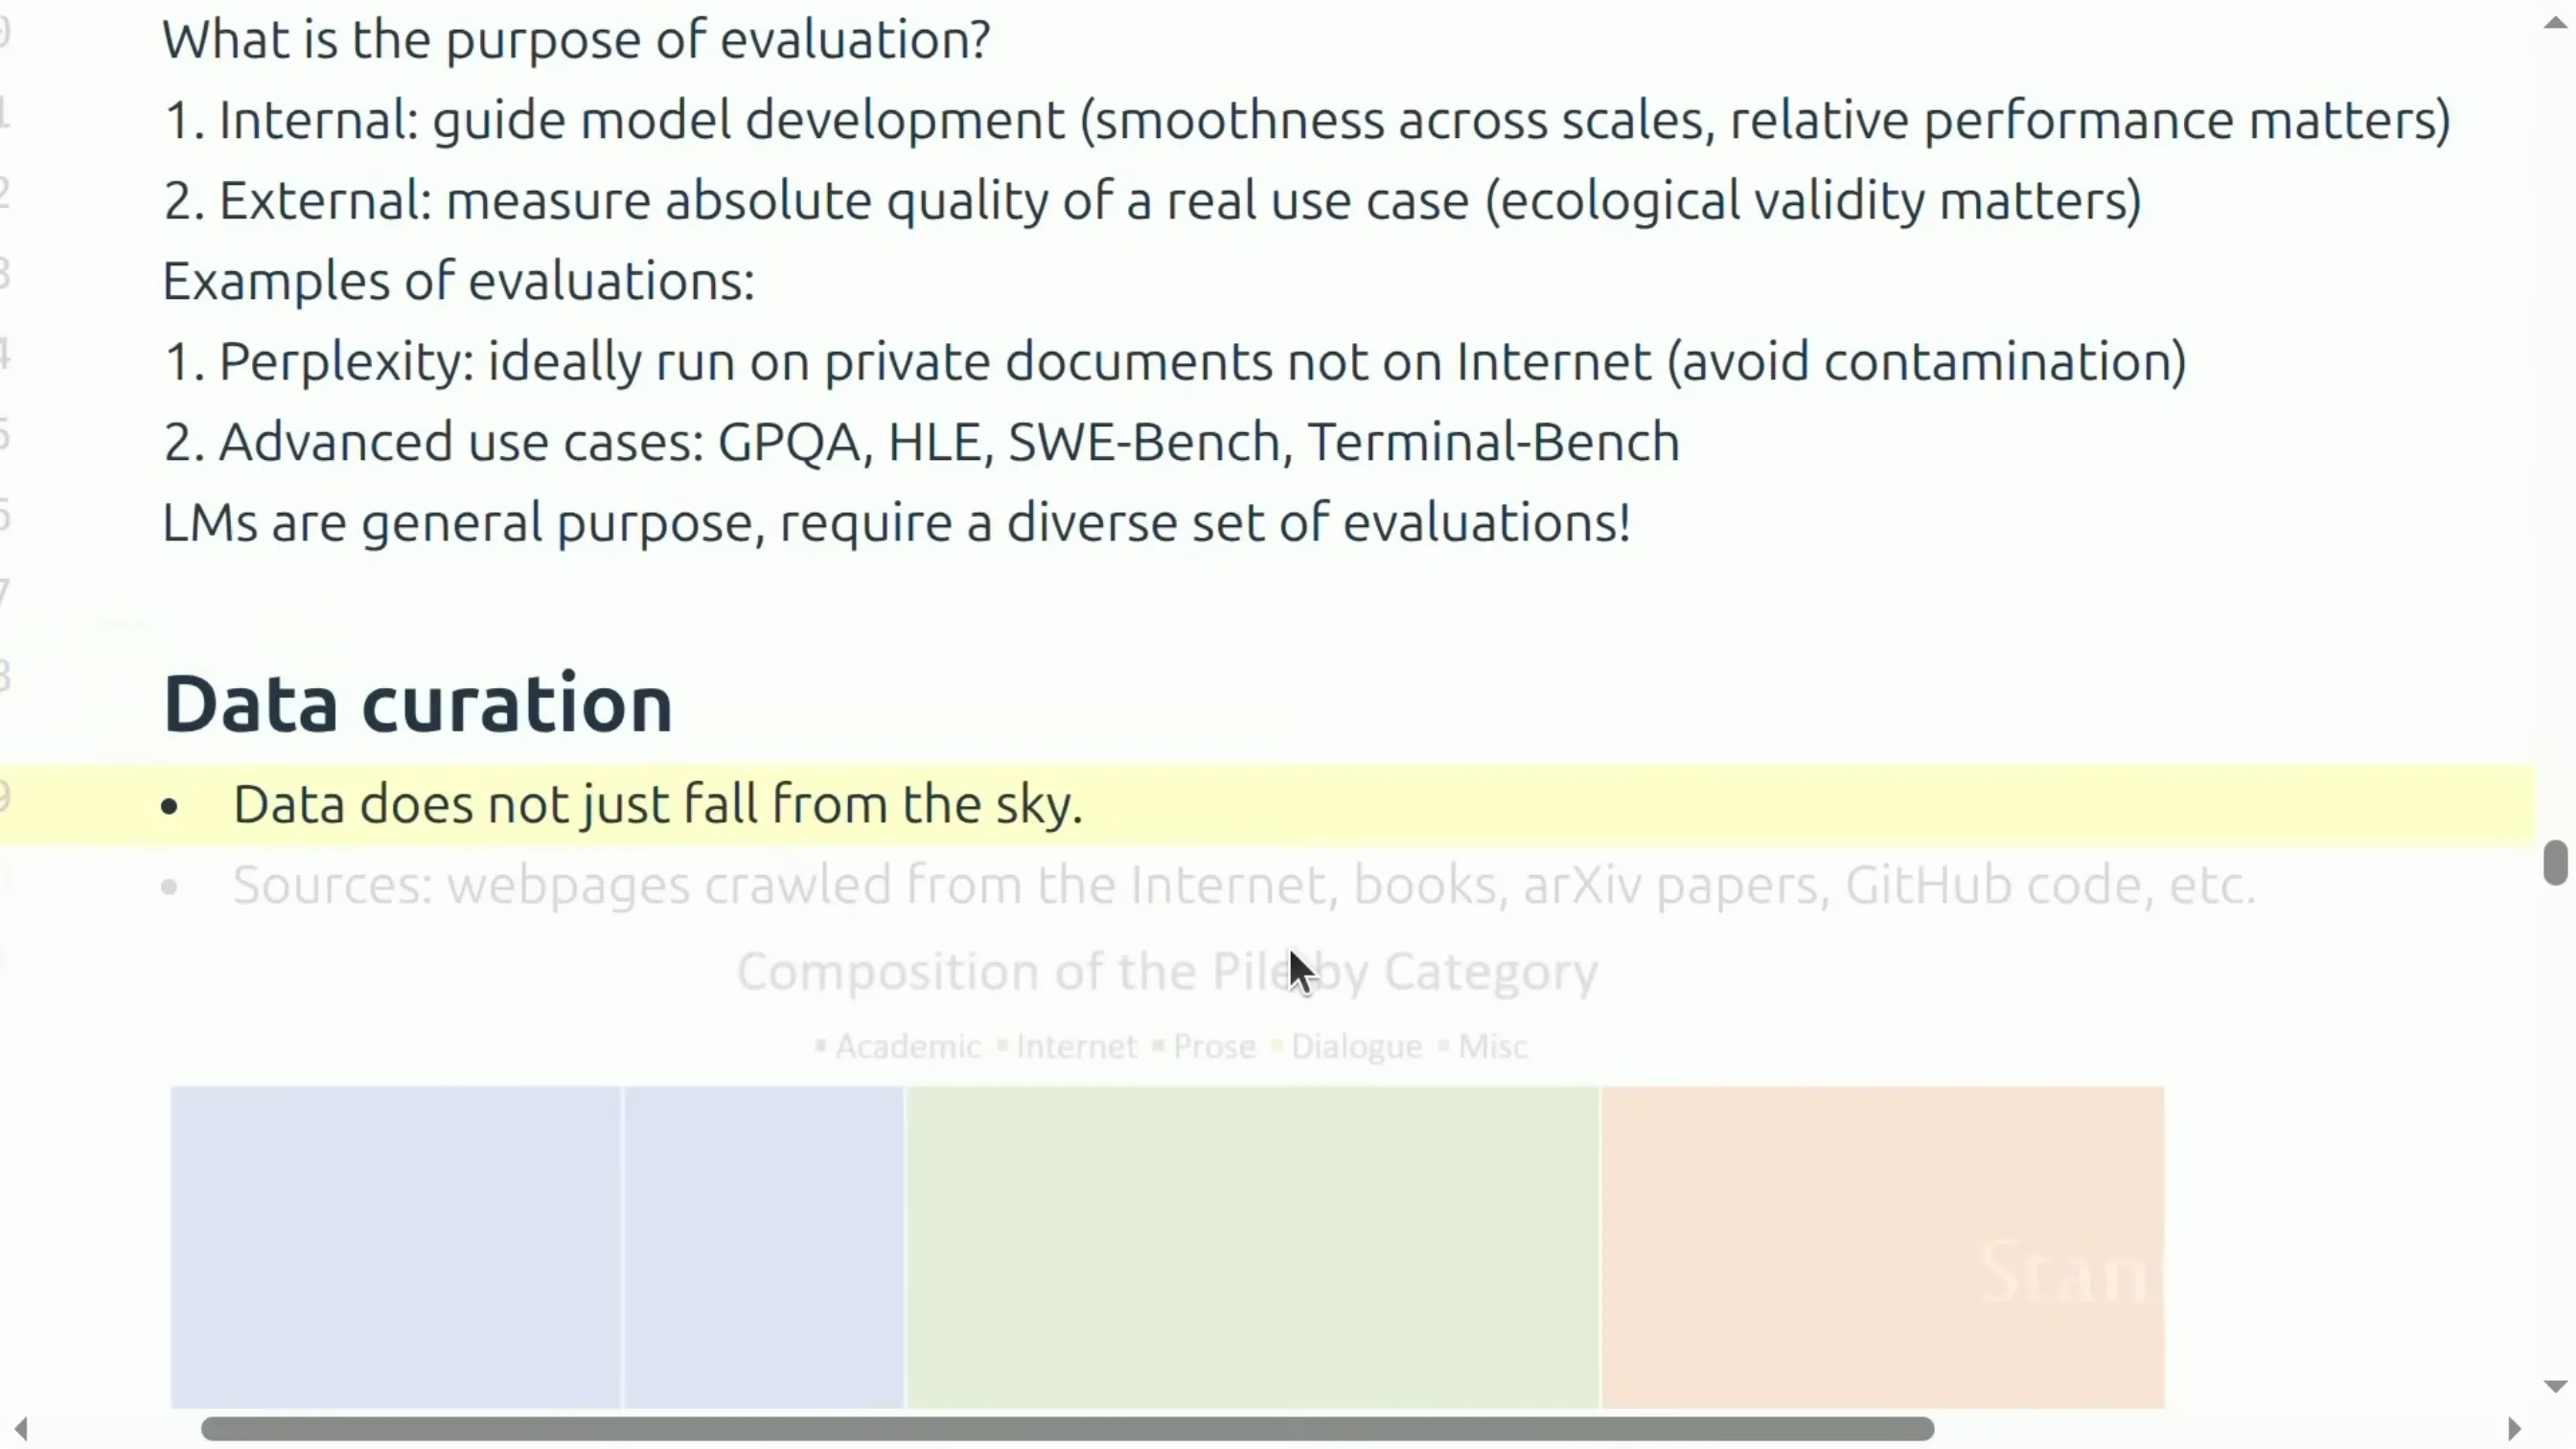
📷 数据必须主动策划:网页、书籍、论文、代码等来源
回到原视频 (00:56:52)
这里还有法律问题:用受版权保护的数据训练是否属于"合理使用(fair use)"?有时必须授权数据(比如 Google 与 Reddit 的交易)。例如大量 GitHub 代码没有许可证(license),你怎么解读——是默认可自由使用,还是保守地假设不行?
而且,数据本身甚至不是文本:它是 HTML、PDF,代码则是目录结构。必须经过处理才能变成可用于训练的文本。处理包括几个步骤:
- 转换(Transformation):把 HTML/PDF 转成文本(抽取正文);
- 过滤(Filtering):只保留高质量内容,剔除有害内容(用分类器);
- 去重(Deduplication):节省算力、避免记忆化,可用 Bloom filter 或 MinHash;
- 数据混合(Mixing):各来源该上调/下调多少权重;
- 改写 / 合成数据:用语言模型增强真实数据,使其更贴近下游任务。
按使用阶段,数据还可分为:
- 预训练数据:大规模、多样;
- 中期训练(mid-training)数据:高质量,包含长上下文数据;
- 后训练数据:监督微调(对话、带工具调用的智能体轨迹)。
作业 4
作业 4 会让你从一份很原始的语料(比如 Raw Web Crawl)出发,做全套的过滤、去重、清洗。主讲直言:这可以说是"脏活",但它是"从零构建语言模型"的重要一环,你得体验完整流程。
单元五:Alignment(对齐)
(参考时间: 01:00:26)
📷 对齐:用弱监督让模型偏好更好的回复
回到原视频 (01:00:26)
前面都是在完整监督(full supervision)下训练——预测下一个(或接下来几个)token。此时模型应该已经不错了,但还可以用弱监督(weak supervision)继续改进。
为什么用弱监督?因为"批评"有时比"生成"更容易。 你未必总有"这个提示的正确答案是什么"的数据,但你可能有一种判断什么是"好"的方式。
基本模板是:
- 让模型生成若干回复;
- 用人类 / 验证器 / 语言模型裁判给这些回复打分;
- 更新模型,使其偏好更好的回复。
具体算法:
- PPO(强化学习中的近端策略优化);
- DPO(直接偏好优化):针对偏好数据,更简单;
- GRPO(组相对偏好优化):去掉了价值函数。
挑战在于:
- RL 算法不稳定、难调;
- 在大规模下,需要大量新基础设施(带异步 rollout 的推理);
- 你要不断在系统效率与on-policyness(策略新鲜度)之间权衡。
主讲坦白自己"能监督就尽量监督,实在没办法才上 RL",但也承认有些同学就是喜欢做 RL。他还提到在规模上做 RL 的系统难题:需要推理服务器 + 训练服务器,推理服务器要生成 rollout(尤其是涉及代码执行的环境时),整个是一套编排游戏;一旦某些 worker 落后,就会变成 off-policy 问题。
作业 5
作业 5 的具体内容还在敲定。去年是实现 DPO 与 GRPO 并在某个数学 benchmark 上跑通;今年可能朝着更"真实"的方向再推进一步。
回到主线:一切都是效率
(参考时间: 01:02:55)
📷 效率主线复盘:各单元如何服务于效率
回到原视频 (01:02:55)
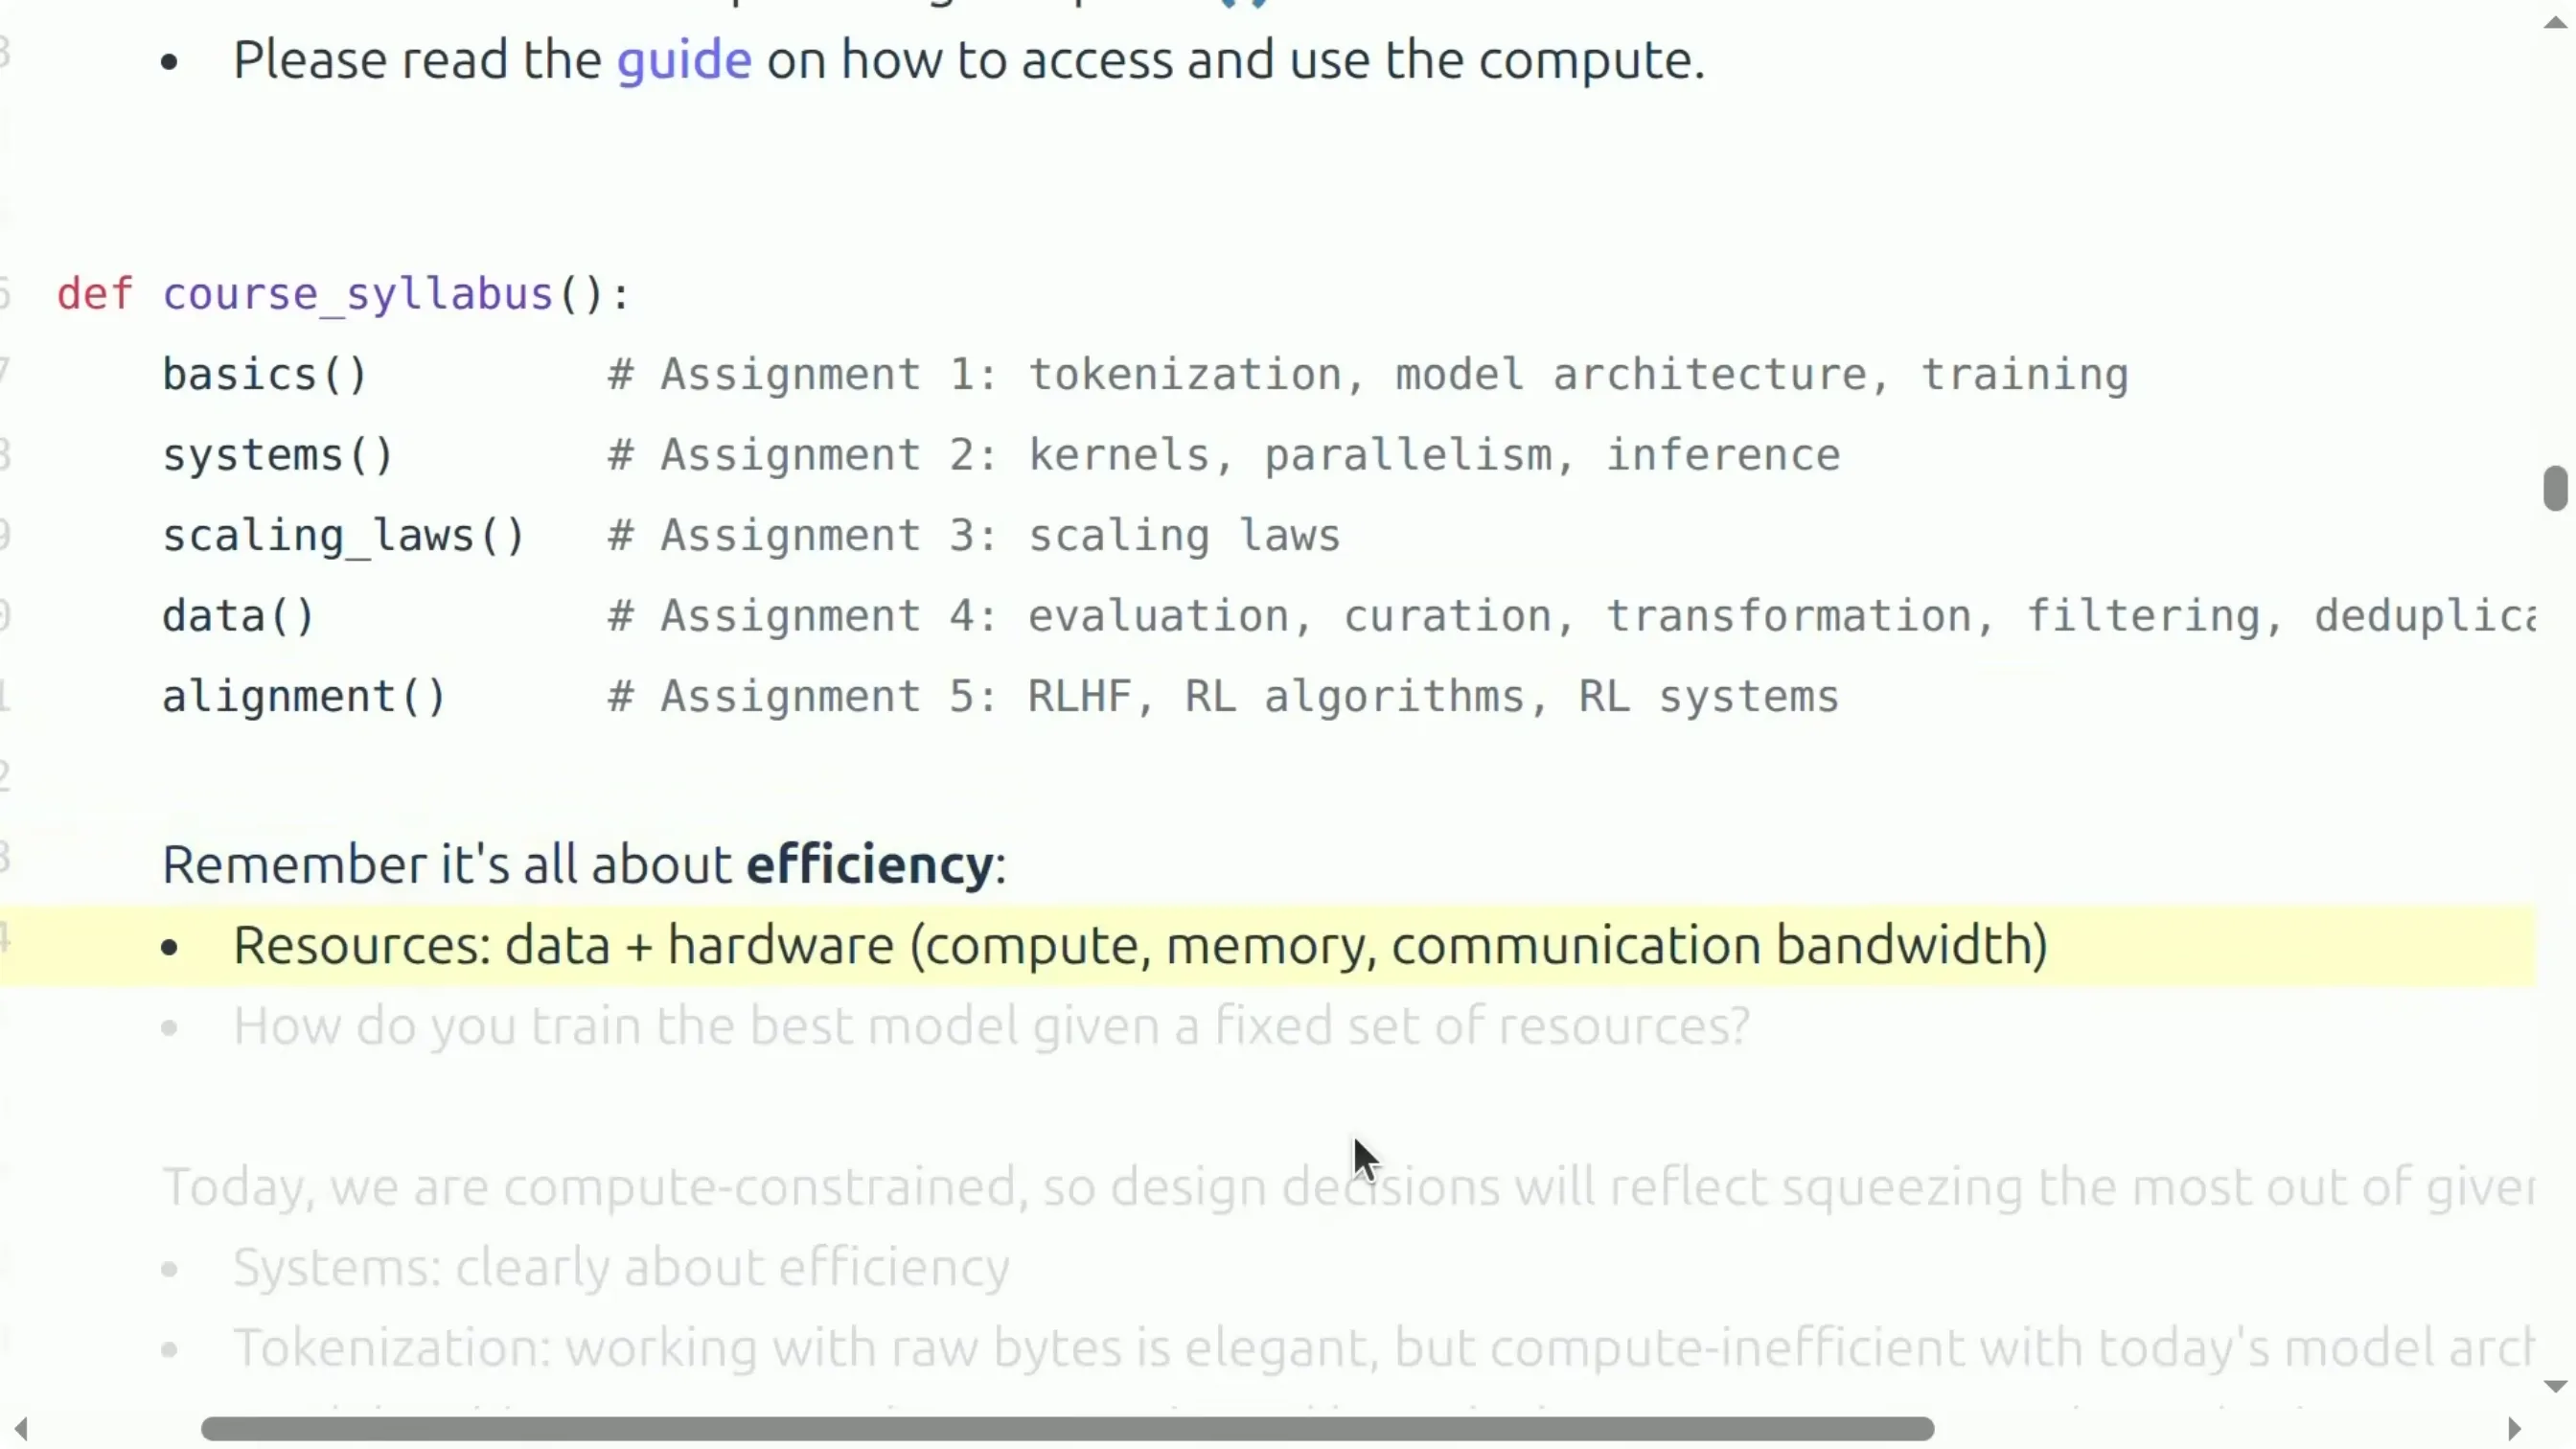
最后,主讲把整门课用效率这条线串了起来。你有各种资源:数据;以及硬件(算力核心、内存、通信带宽)。你要做的,就是在固定资源下,按照某种评估标准造出最好的模型。用这个视角看:
| 单元 | 与效率的关系 |
|---|---|
| Systems | 显然就是算力效率 |
| Tokenization | 直接操作字节虽然优雅,但在当今架构下算力效率低;分词就是在提升算力效率 |
| Model Architecture | 许多改动都为了减少内存或 FLOPs,很多受"更快推理"驱动 |
| Data Filtering | 不想把算力浪费在更新冗余、劣质数据上——固定预算下,坏数据多一分,好数据就少一分 |
| Scaling Laws | 本质上是在更小的模型上做有效的超参数调优 |
主讲收尾说:也许有一天我们会变成数据受限,那时各种设计决策的取舍会变;但这门课想教给你的整体心态是——始终思考你所用方法的效率。
七、分词深潜:模型操作的"原子"
(参考时间: 01:05:10)
📷 分词深潜开场:从 Unicode 字符串到 token
回到原视频 (01:05:10)
接下来进入本讲的第一个技术单元:分词(tokenization)。主讲先推荐了 Andrej Karpathy 那期讲得非常清楚的分词视频,建议去看。
从字符串到 token:一个来回转换的问题
(参考时间: 01:05:25)
起点:文本是 Unicode 字符串。而语言模型给出的是token 序列上的概率分布,token 通常用整数索引表示。所以我们需要两套程序:
- encode:把字符串变成 token 序列(整数);
- decode:把 token 序列变回字符串。
一个 Tokenizer 就是同时实现这两个方法的类——而且必须能往返(round trip):
class Tokenizer(ABC):
    """Abstract interface for a tokenizer."""
    def encode(self, string: str) -> list[int]:
        raise NotImplementedError

    def decode(self, indices: list[int]) -> str:
        raise NotImplementedError
编者说明:下面所有代码都取自本讲的官方"可执行讲义"
lecture_01.py,可直接阅读、运行。
某个字符串对应的 token 索引,看起来就像这样:
string = "Hello, 🌍! 你好!"
indices = [15496, 11, 995, 0]   # 示意
先动手玩一玩:真实分词器的直观感受
(参考时间: 01:05:50)
要建立手感,可以先去交互网站 tiktokenizer 上试不同的分词器。你会立刻注意到几件让人觉得"分词器很烦"、也正是人们想摆脱它的原因:
- 单词和它前面的空格属于同一个 token(比如
" world")。因此你会看到大量"空格 + 单词"构成的 token——这本身没问题,但确实很怪。 - 句首的
hello与句中的hello是两个完全不同的 token,索引之间毫无关系。比如"hello hello"里两个词被编码成不同的整数。 - 数字被切成每几位一个 token。不同分词器规则不一:有些让每个数字单独成 token(可预测,但词表爆炸),有些则不可预测——这里同样有权衡。
📷 真实分词器的几个反直觉现象:空格、句首与句中、数字切分
回到原视频 (01:06:03)
GPT-5 分词器、往返与压缩比
(参考时间: 01:07:00)
课程用 OpenAI 的 tiktoken 里的 GPT-5 分词器做演示:
def get_gpt5_tokenizer():
    # Code: https://github.com/openai/tiktoken
    return tiktoken.get_encoding("o200k_base")
先验证往返是否成立:
tokenizer = get_gpt5_tokenizer()
string = "Hello, 🌍! 你好!"
indices = tokenizer.encode(string)
reconstructed_string = tokenizer.decode(indices)
assert string == reconstructed_string
分词器必须能往返。 主讲强调:如果你实现的分词器不能往返,那就有问题了。
接着定义压缩比(compression ratio)——每个 token 平均对应多少字节:
def get_compression_ratio(string: str, indices: list[int]) -> float:
    """Given `string` that has been tokenized into `indices`, return the number of UTF-8 bytes per token."""
    num_bytes = len(bytes(string, encoding="utf-8"))
    num_tokens = len(indices)
    return num_bytes / num_tokens
对上面那个字符串:20 字节 / 8 个 token = 2.5,也就是压缩比 2.5 字节/token。
- 压缩比越大,序列越短——这很关键,因为注意力是平方复杂度的,你希望序列尽量短。
- 想提高压缩比,最直接的办法是增大词表(vocabulary size);但词表一大,就会稀疏——因为词表里每个元素都被当作一个独立的东西。如今(尤其是多语言)分词器的词表常常有 10 万到 20 万个 token。
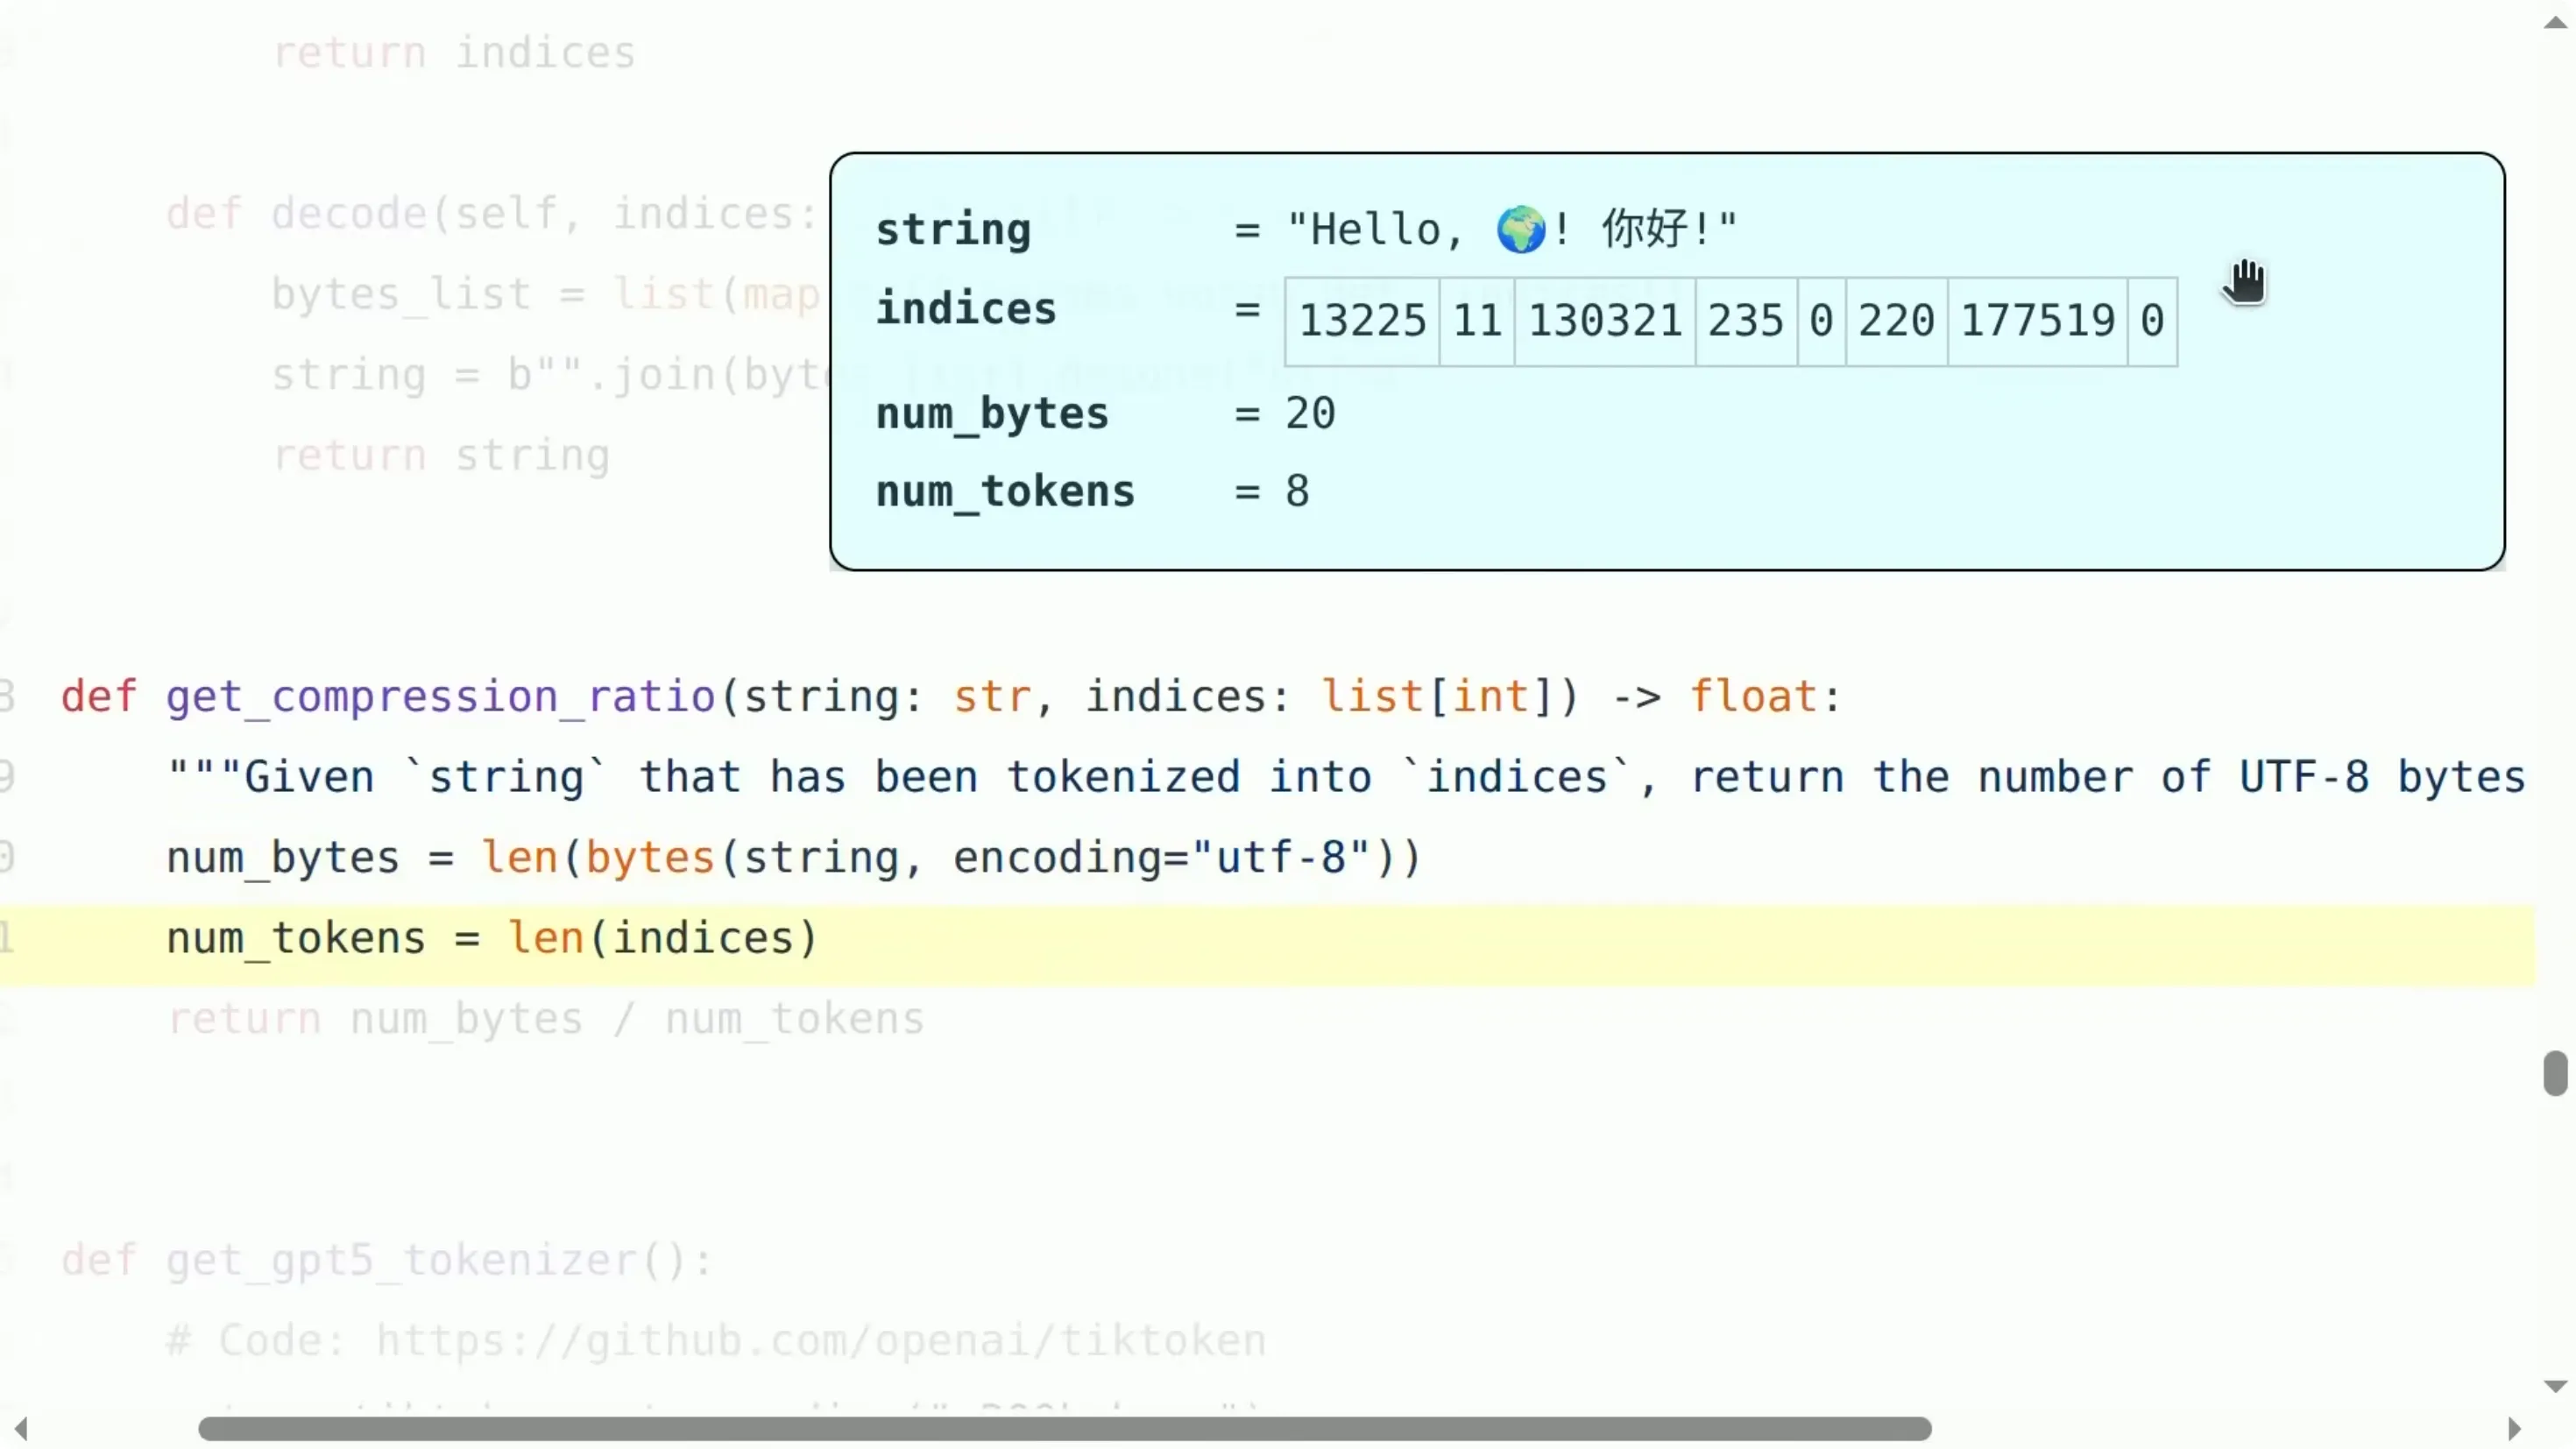
📷 GPT-5 分词器、编码/解码往返与压缩比 2.5
回到原视频 (01:07:40)
三种"朴素"分词方案
字符级分词器
(参考时间: 01:08:34)
最自然的想法是:Unicode 字符串就是一串 Unicode 字符,每个字符都可以用 ord 转成整数,再用 chr 转回来。
class CharacterTokenizer(Tokenizer):
    """Represent a string as a sequence of Unicode code points."""
    def encode(self, string: str) -> list[int]:
        return list(map(ord, string))

    def decode(self, indices: list[int]) -> str:
        return "".join(map(chr, indices))
它确实能往返,但有两个致命问题:
- 词表非常大:Unicode 有大约 15 万个字符;
- 很多字符极其罕见(比如 🌍),用它们占满词表是极其低效的。
此外,压缩比也很差——你会用很多 token 来表示一个序列,而很多索引几乎用不到。主讲总结:
它是"两头不讨好"的分词器:词表又大、压缩比又低。
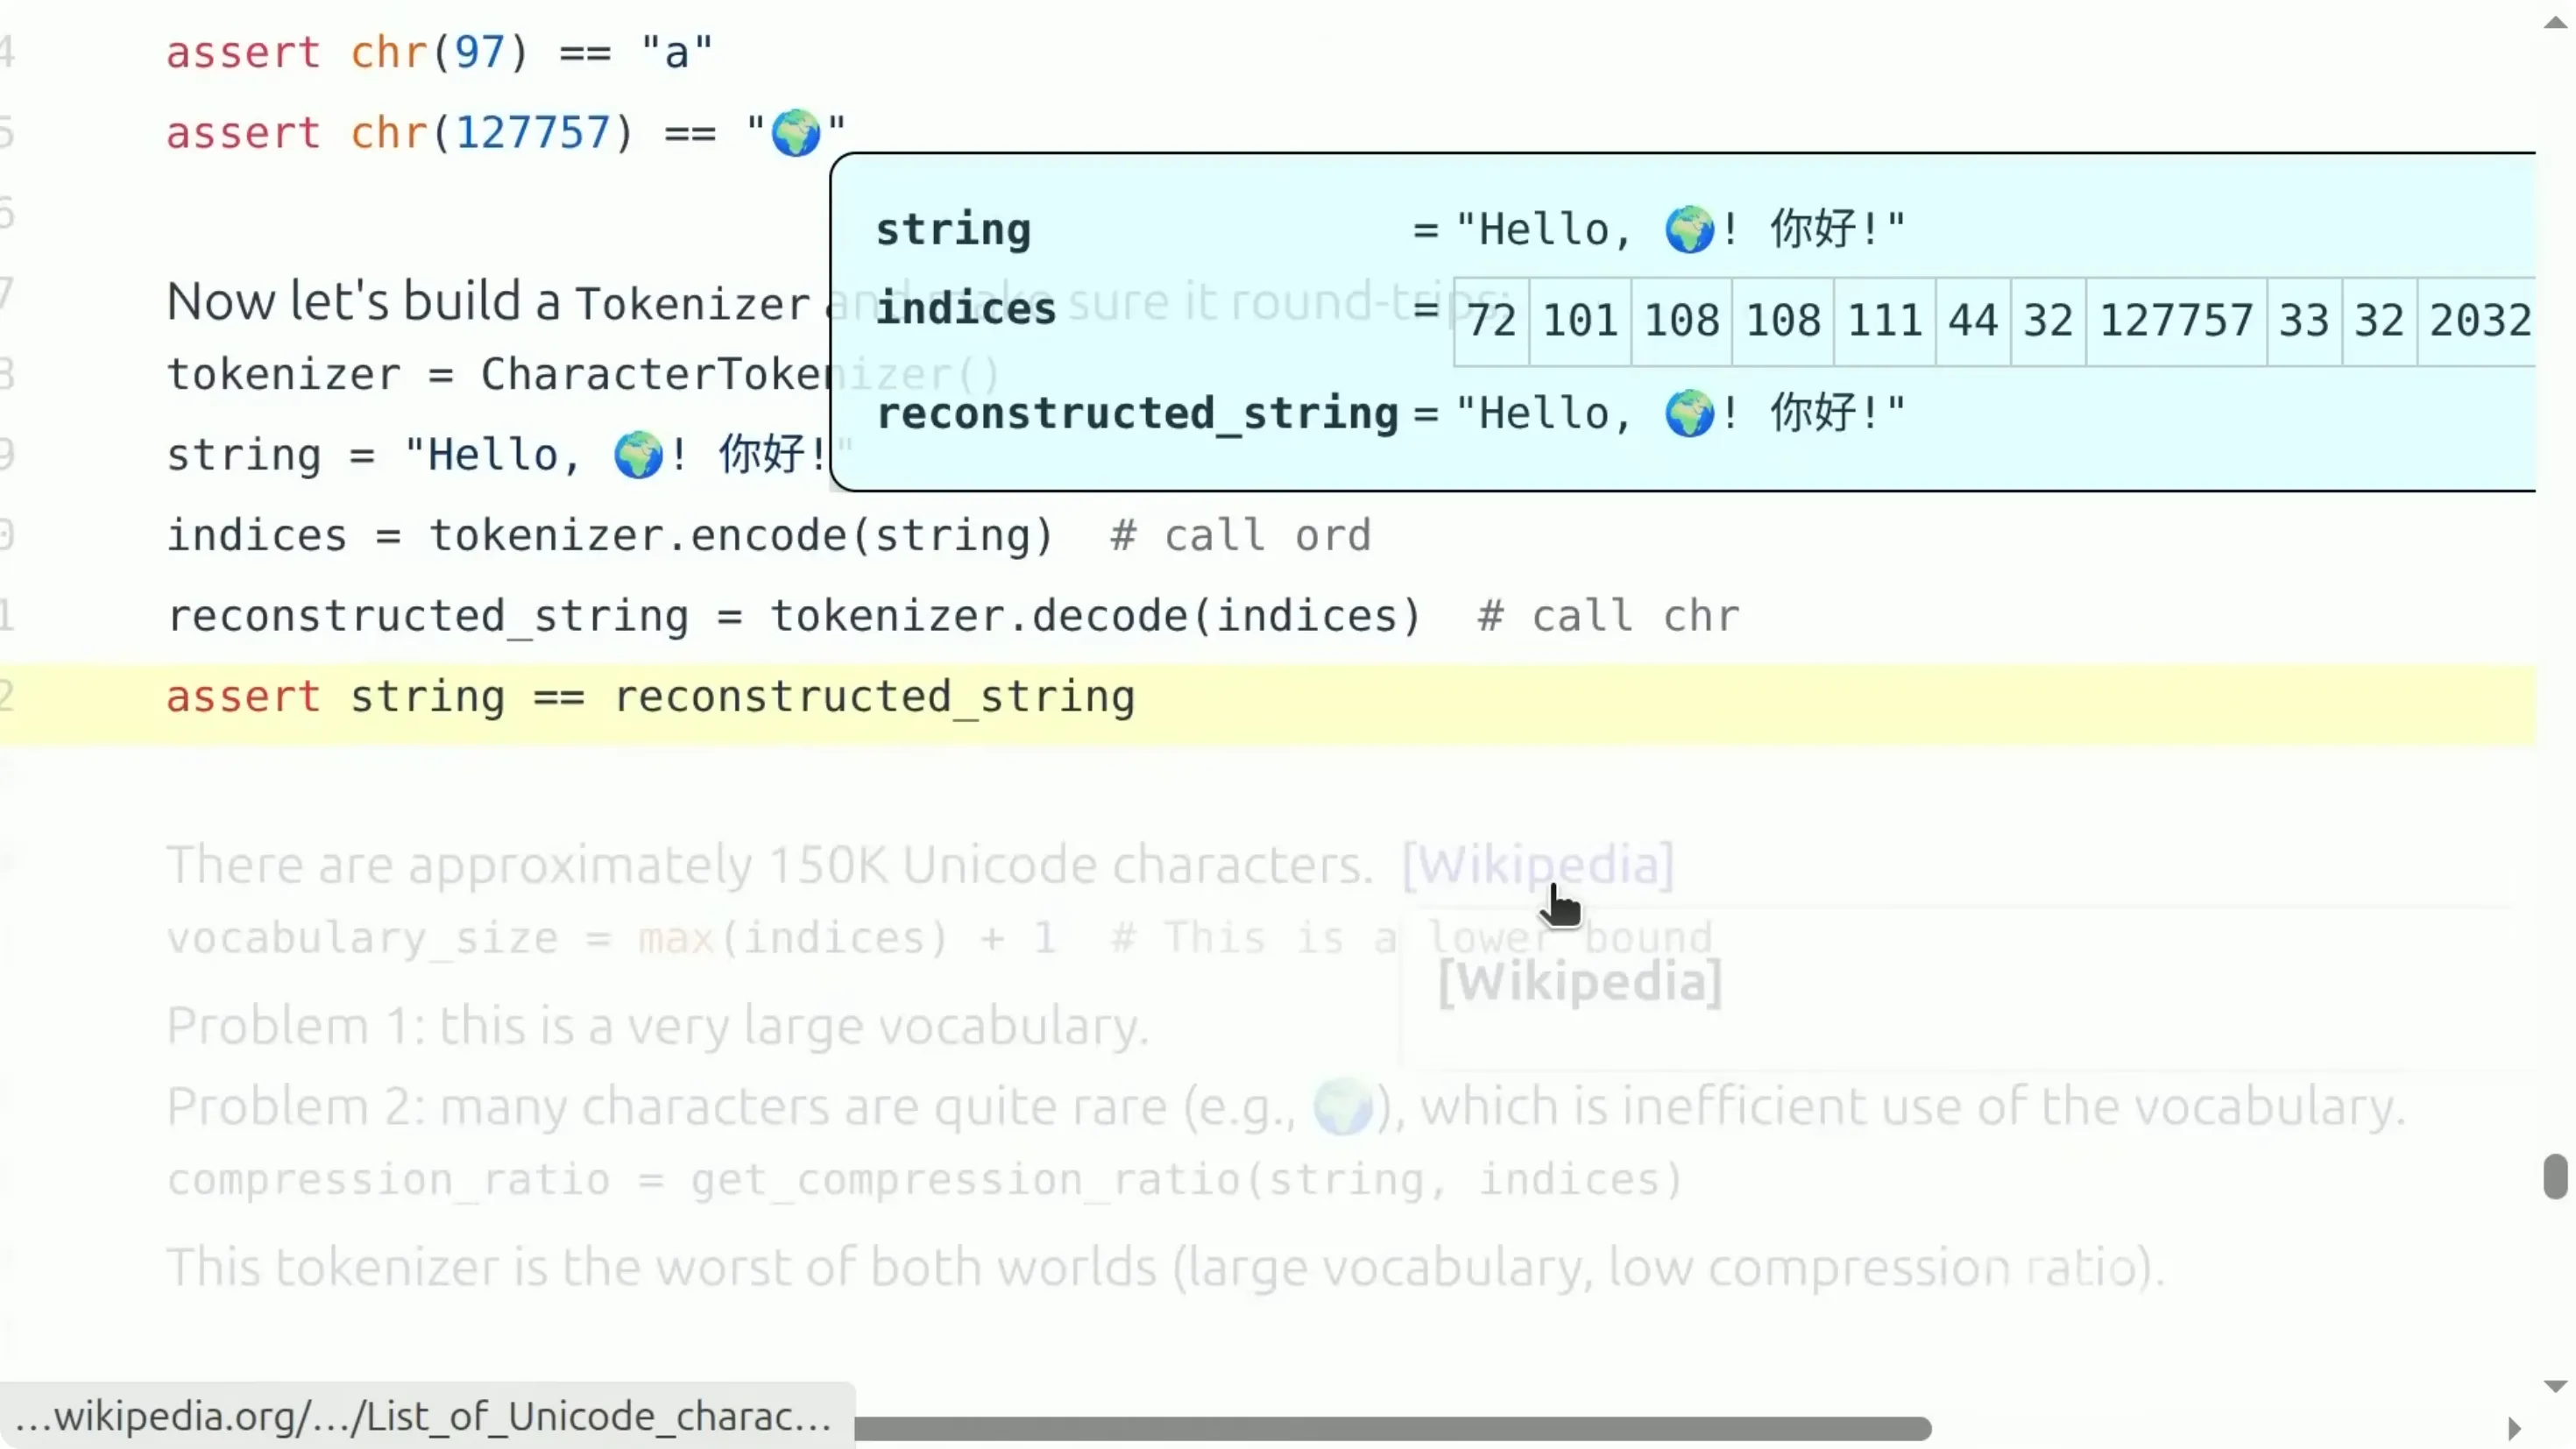
📷 字符级分词器:约 15 万 Unicode 字符,词表大而压缩比差
回到原视频 (01:09:01)
字节级分词器
(参考时间: 01:09:47)
换个思路:Unicode 字符串可以表示为字节序列,每个字节是 0~255 的整数。最常用的编码是 UTF-8。有的字符只占 1 个字节(如 a),有的占多个字节(如 🌍 占 4 个字节)。
class ByteTokenizer(Tokenizer):
    """Represent a string as a sequence of bytes."""
    def encode(self, string: str) -> list[int]:
        string_bytes = string.encode("utf-8")
        indices = list(map(int, string_bytes))
        return indices

    def decode(self, indices: list[int]) -> str:
        string_bytes = bytes(indices)
        string = string_bytes.decode("utf-8")
        return string
好处是词表很小、很规整:一个字节只能是 256 种取值。但代价是:
压缩比只有 1——序列会变得非常长。
考虑到 Transformer 的上下文长度有限(因为注意力是平方复杂度),这显然也不理想。主讲总结:字符级和字节级都很糟。
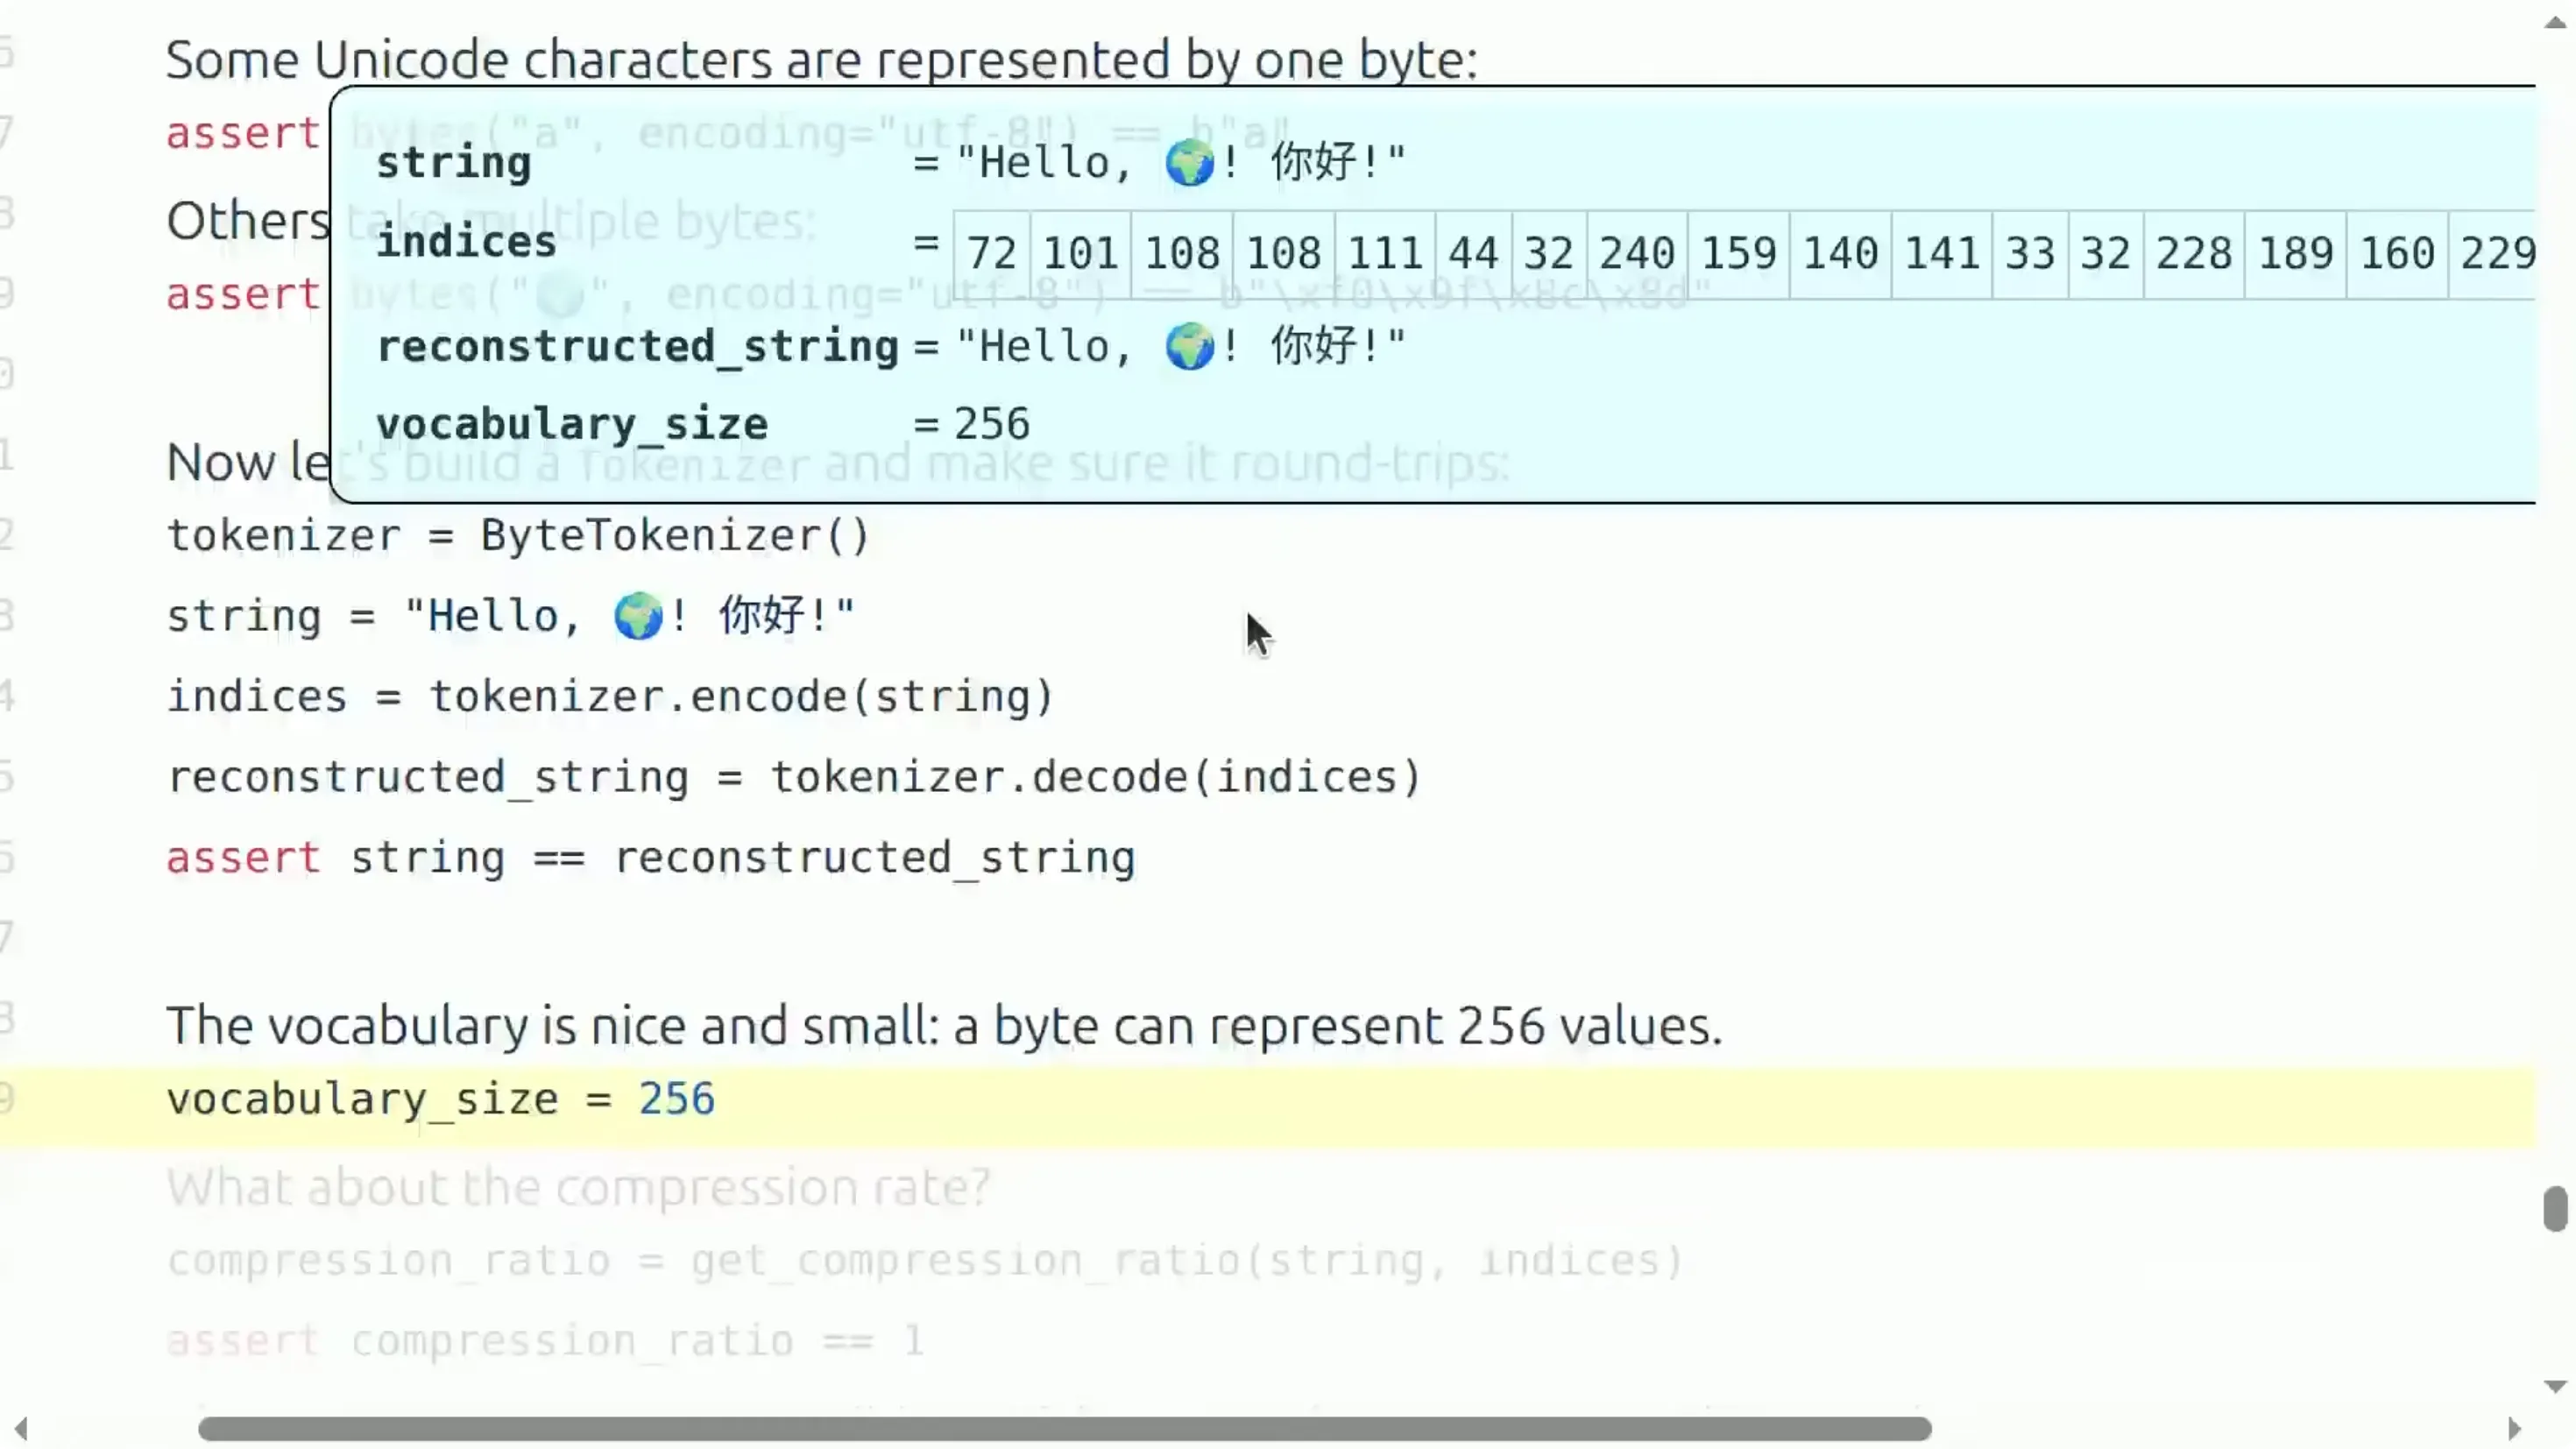
📷 字节级分词器:词表 256,但压缩比为 1,序列过长
回到原视频 (01:10:26)
词级分词器
(参考时间: 01:10:50)
另一种更接近经典 NLP 的做法是按词切分:
string = "I'll say supercalifragilisticexpialidocious!"

chunks = regex.findall(r"\w+|.", string)
这个正则把所有连续的字母数字字符聚成一个词(chunk),其余字符单独成块。然后把每个 chunk 映射成一个整数。
- 好处:每个 token 都是有意义的(因为词是人发明的,通常有稳定的语义)。
- 坏处:词表大小 = 训练数据中不同 chunk 的数量,可能极大——而且实际上是无界的。因为测试时会遇到没见过的词,过去会分配一个特殊的 UNK token,但那非常丑,还会搞乱困惑度的计算。
主讲结论:这个方案也不够好。
BPE:字节对编码
(参考时间: 01:12:00)
📷 BPE:常见序列用单 token,罕见序列拆成多 token
回到原视频 (01:12:00)
真正被采用的是 Byte Pair Encoding(BPE,字节对编码)。
- 它最初由 Philip Gage 在 1994 年提出,用于数据压缩,远早于语言模型的舞台;
- 后来被引入 NLP,用于神经机器翻译(Sennrich 等,2016);
- 第一个把 BPE 用于 LLM 的是 GPT-2。
基本思想:直接在原始文本上训练分词器,构造一套为数据量身定制的词表。它有一个很好的性质——一切都可被分词:
常见的序列用单个 token 表示;罕见的序列则被拆成多个更小的 token,而不是退化成 UNK。
算法:从字节出发,不断合并最高频的相邻对
(参考时间: 01:12:55)
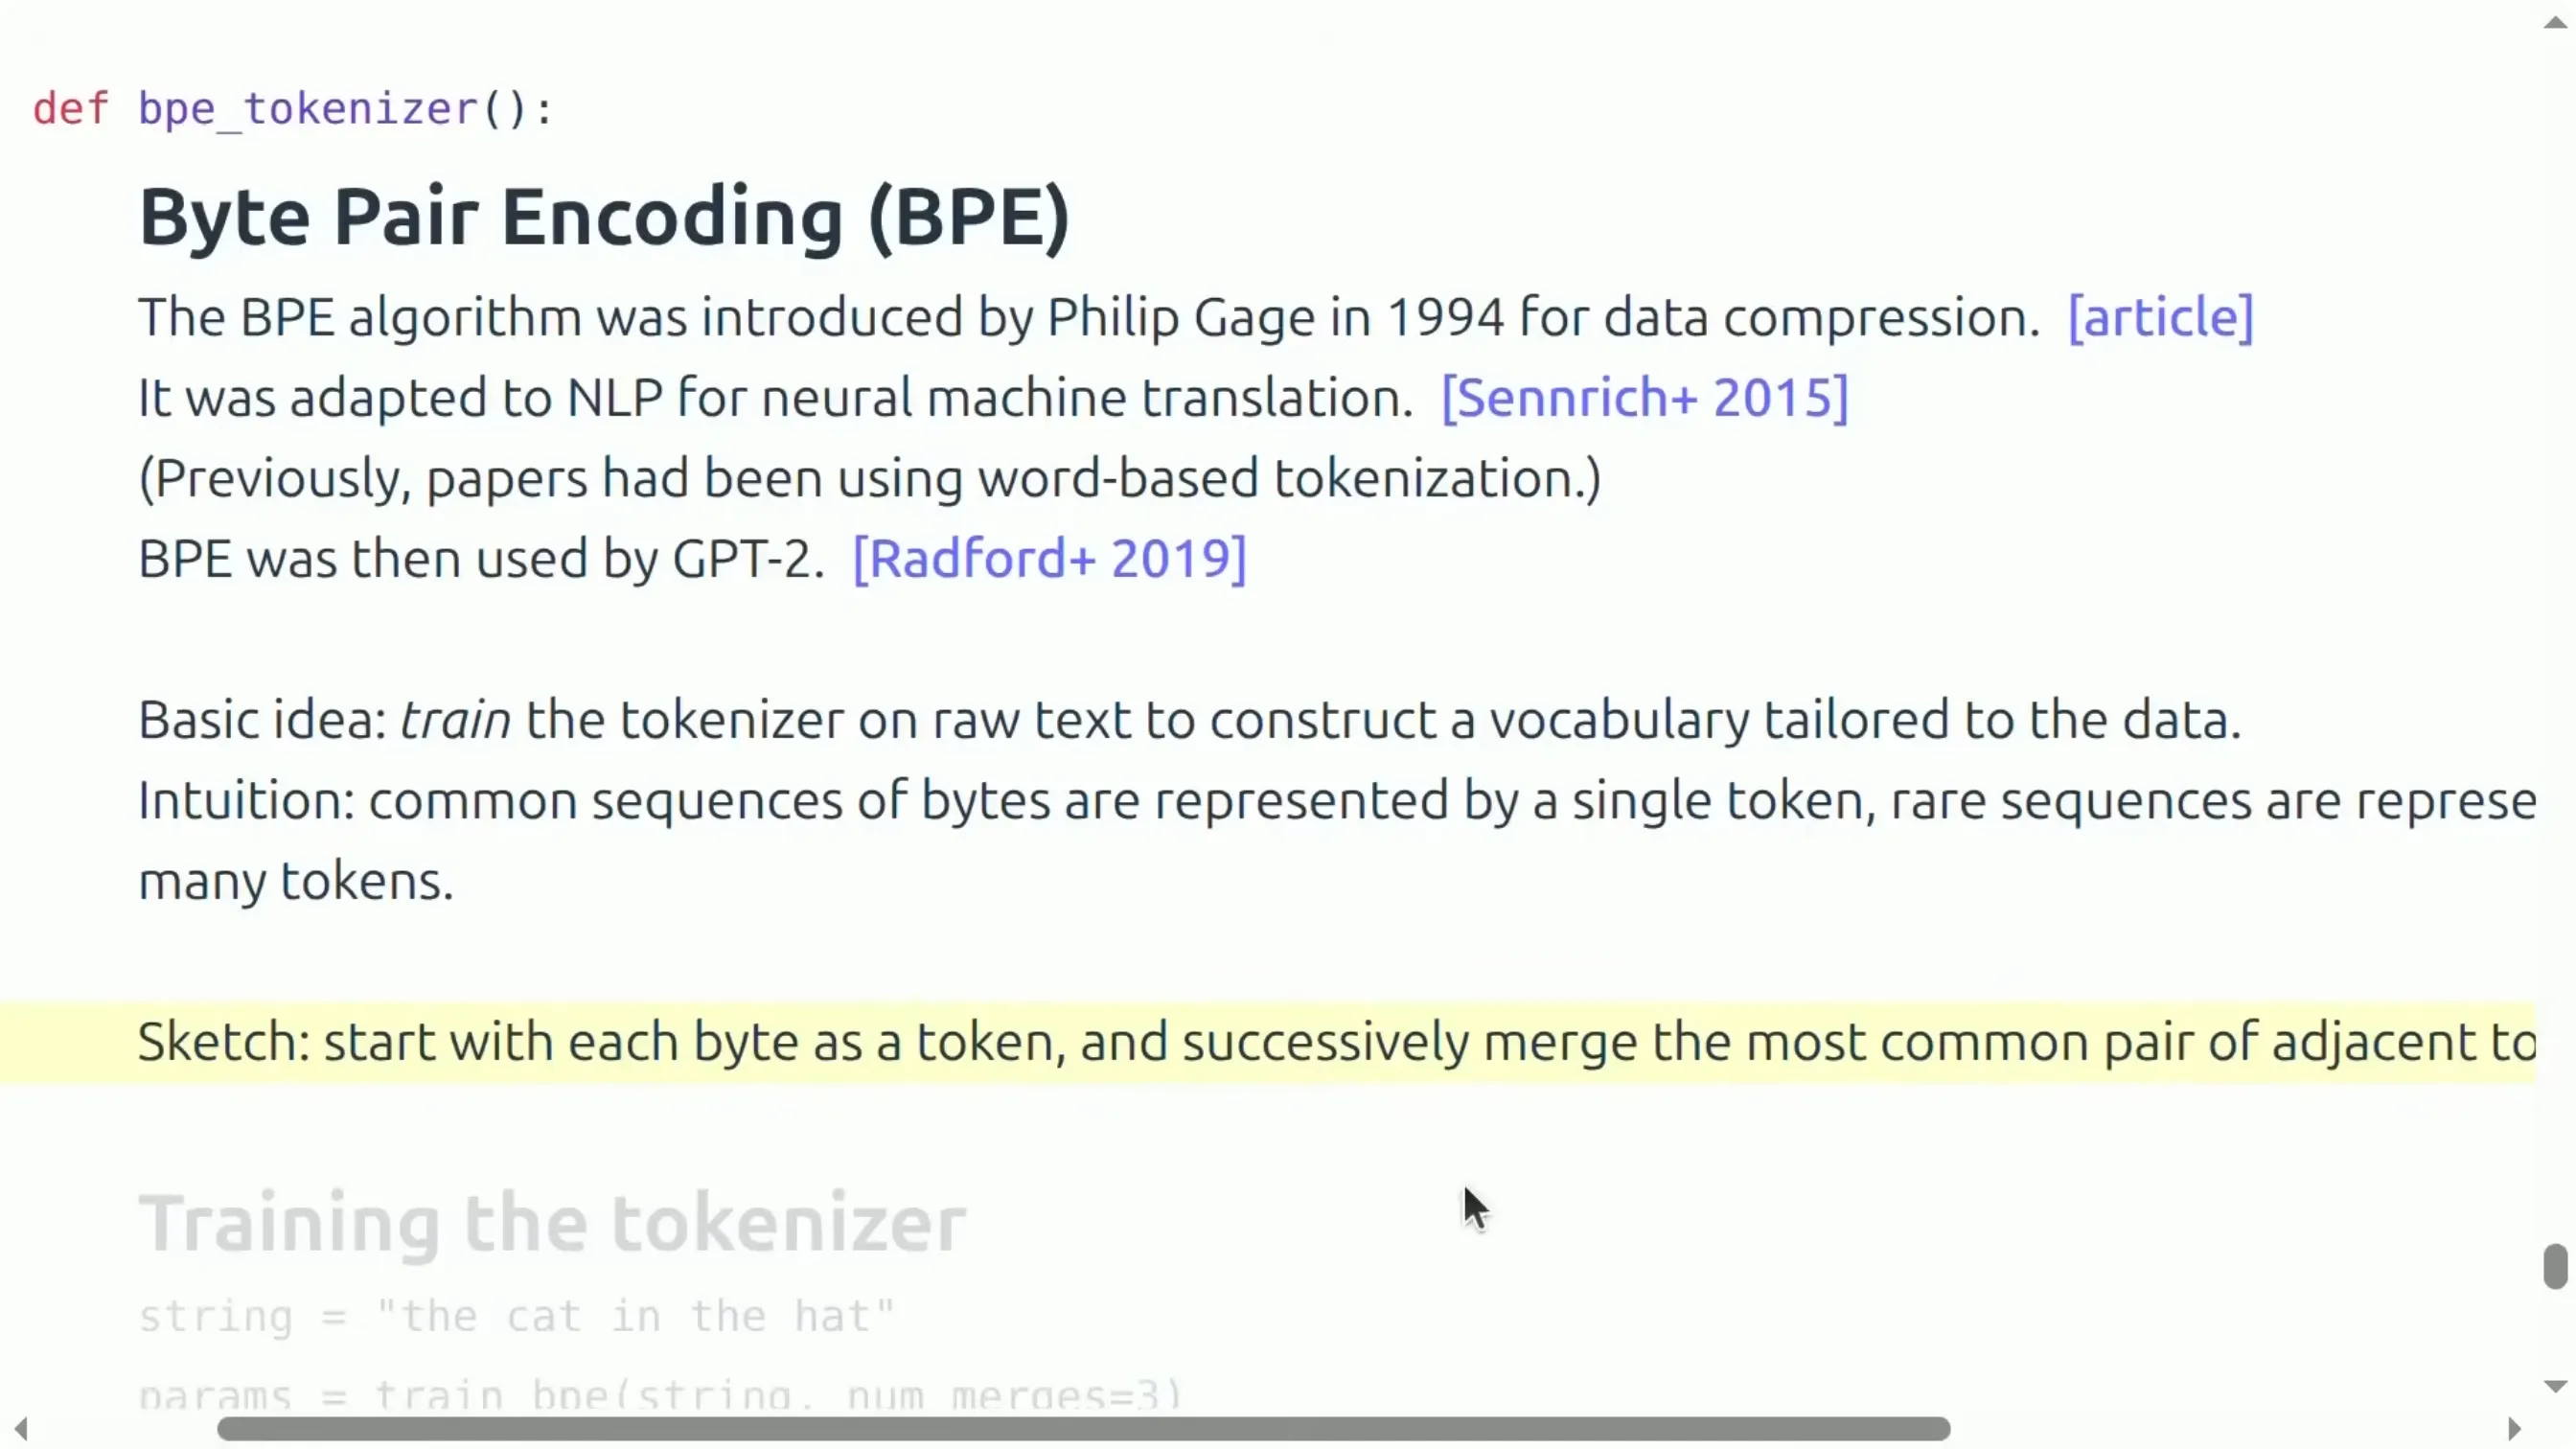
📷 BPE 训练算法:统计相邻对 → 合并最高频 pair
回到原视频 (01:12:55)
算法的概念非常简单:
- 把语料看成一条很长的序列,每个字节从最开始就是一个 token;
- 反复合并出现频率最高的相邻 token 对。
用一段代码把它讲清楚。这是 BPE 的核心“合并”原语——把序列里所有出现某个 pair 的地方替换成一个新索引:
def merge(indices: list[int], pair: tuple[int, int], new_index: int) -> list[int]:
    """Return `indices`, but with all instances of `pair` replaced with `new_index`."""
    new_indices = []
    i = 0
    while i < len(indices):
        if i + 1 < len(indices) and indices[i] == pair[0] and indices[i + 1] == pair[1]:
            new_indices.append(new_index)
            i += 2
        else:
            new_indices.append(indices[i])
            i += 1
    return new_indices
而"训练分词器"就是反复:统计相邻对 → 找最高频 → 合并:
def train_bpe(string: str, num_merges: int) -> BPETokenizerParams:
    indices = list(map(int, string.encode("utf-8")))
    merges: dict[tuple[int, int], int] = {}          # index1, index2 -> merged index
    vocab: dict[int, bytes] = {x: bytes([x]) for x in range(256)}  # index -> bytes

    for i in range(num_merges):
        # 统计每种相邻 token 对出现的次数
        counts = count_adjacent_pairs(indices)
        # 找出最高频的 pair
        pair = max(counts, key=counts.get)
        # 合并该 pair
        new_index = 256 + i
        merges[pair] = new_index
        vocab[new_index] = vocab[pair[0]] + vocab[pair[1]]
        indices = merge(indices, pair, new_index)

    compression_ratio = get_compression_ratio(string, indices)
    return BPETokenizerParams(vocab=vocab, merges=merges)

def count_adjacent_pairs(indices: list[int]) -> dict[tuple[int, int], int]:
    """Return a dictionary mapping each adjacent pair of tokens in `indices` to the number of times it occurs."""
    counts = defaultdict(int)
    for index1, index2 in zip(indices, indices[1:]):
        counts[(index1, index2)] += 1
    return counts
走一遍具体例子:"the cat in the hat"
(参考时间: 01:13:20)
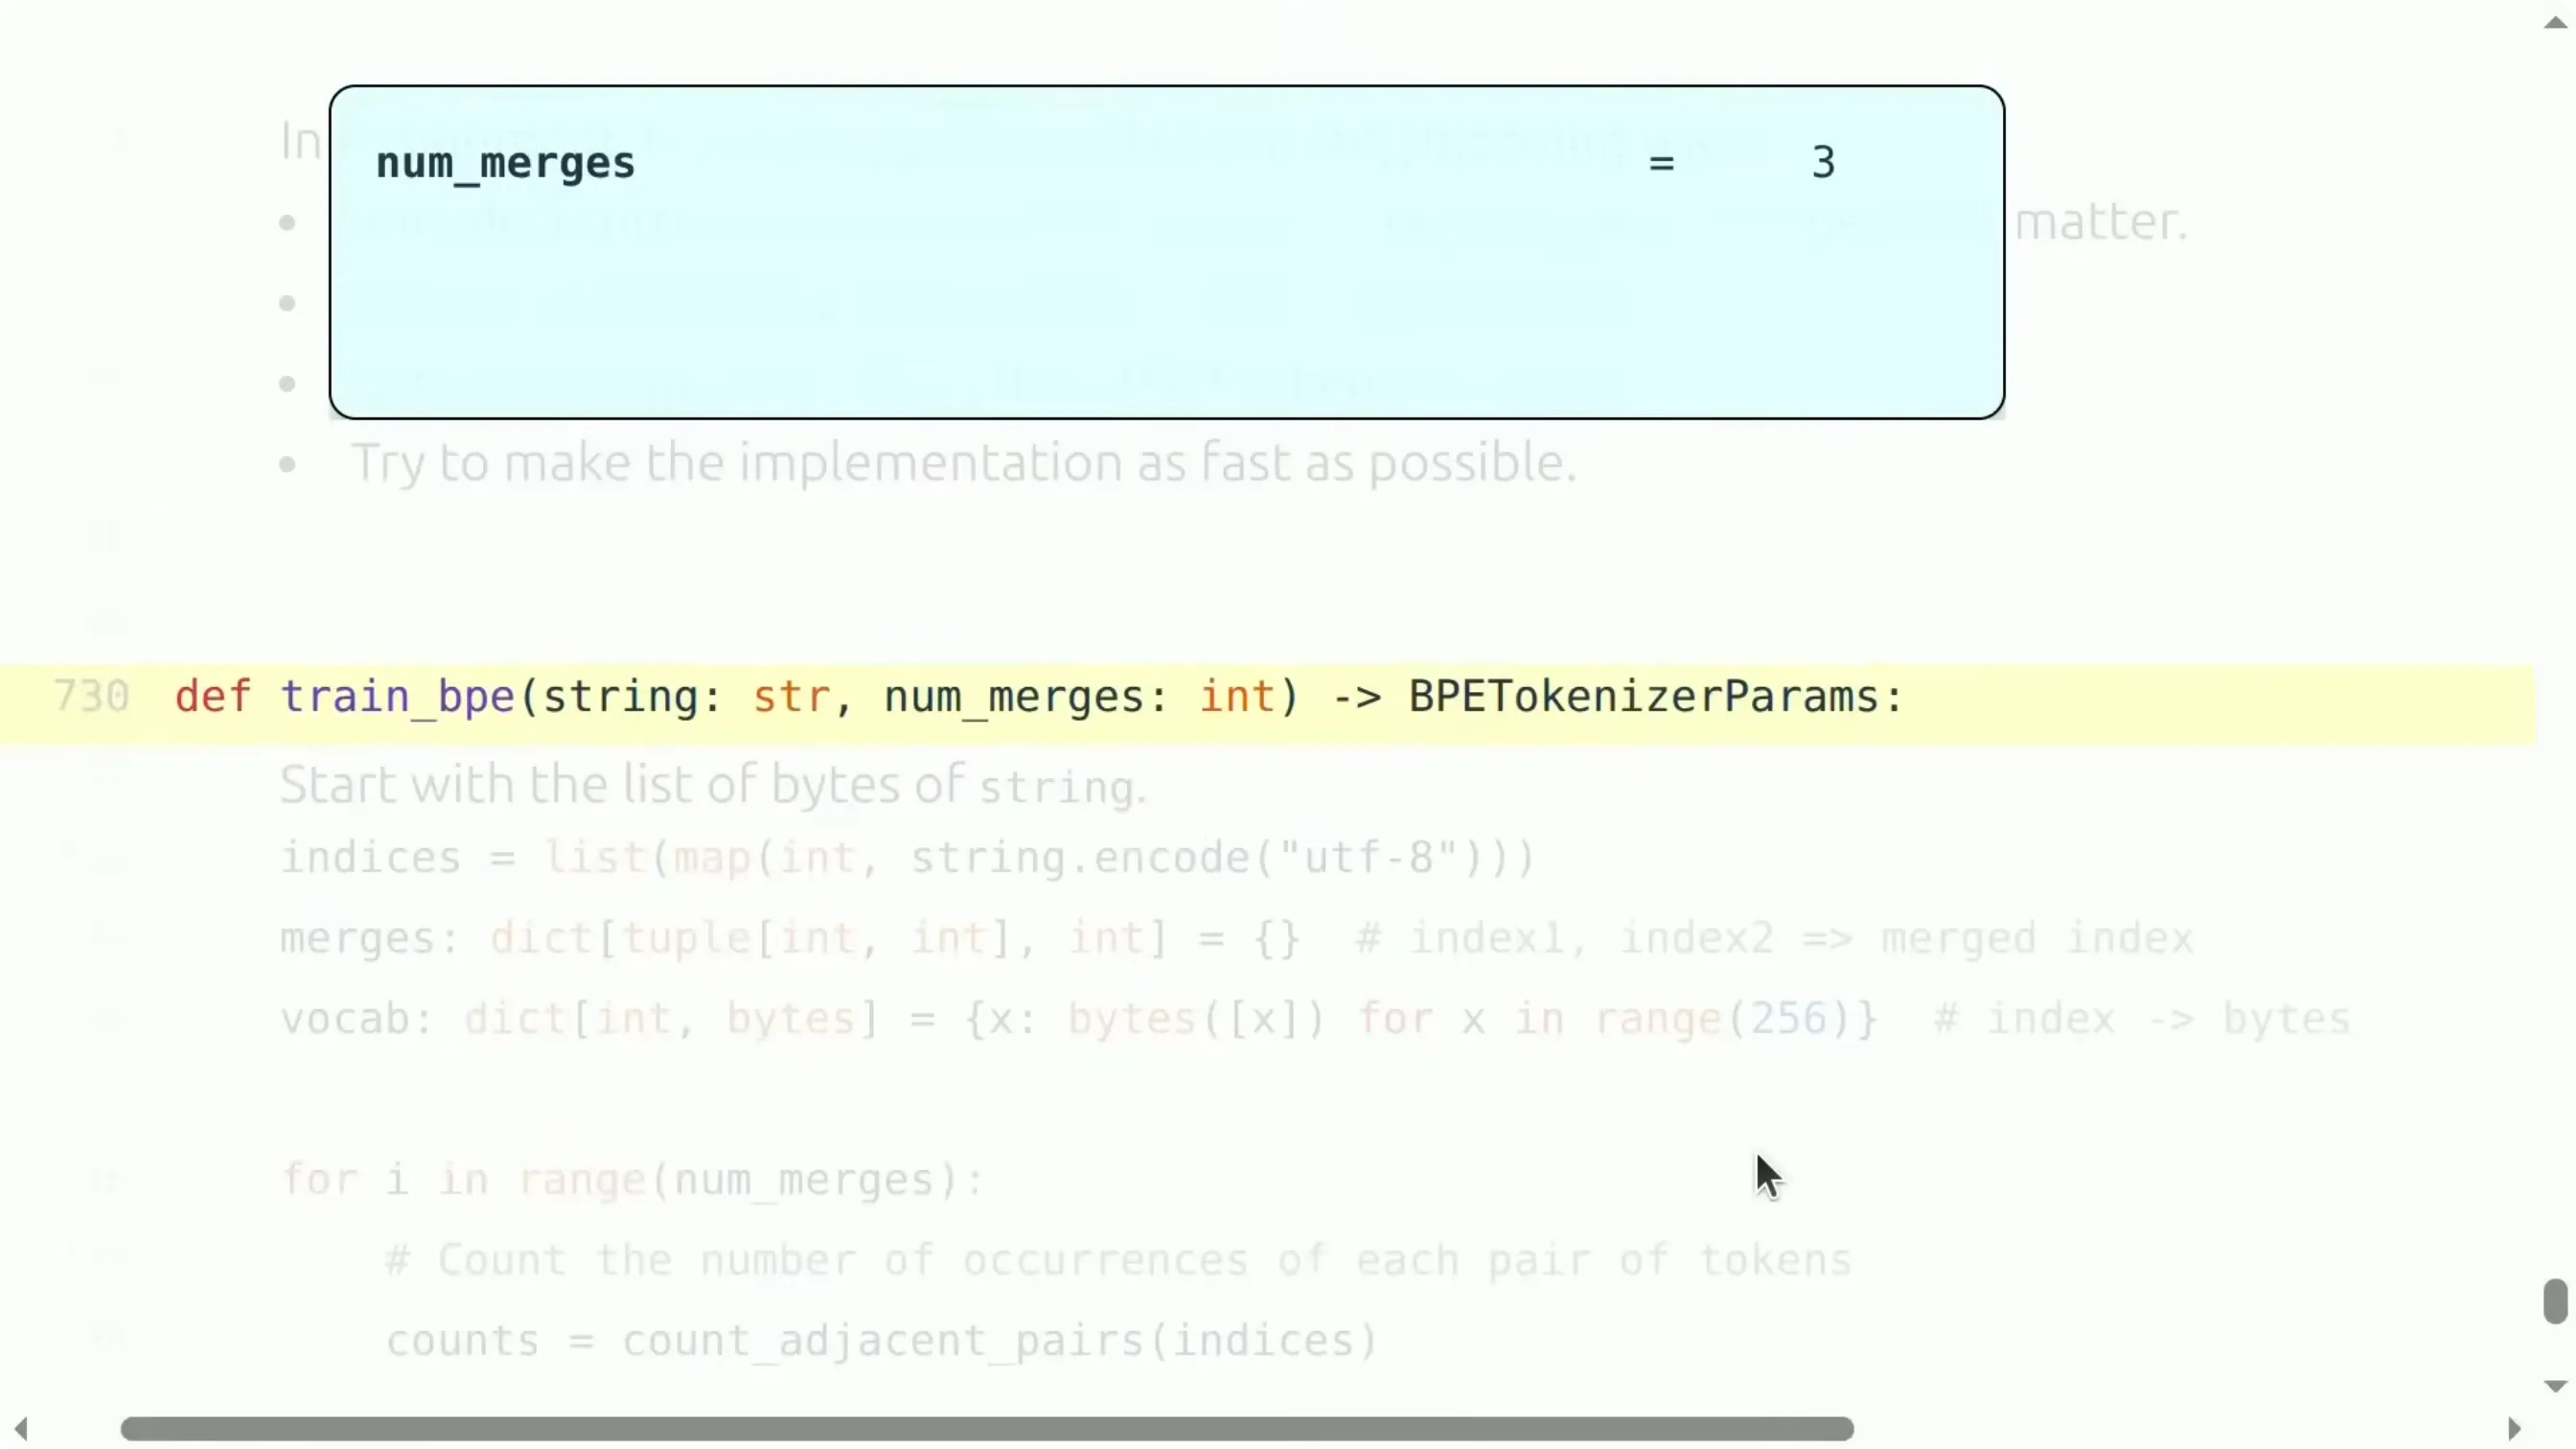
📷 BPE 代码走查:"the cat in the hat" 的合并过程
回到原视频 (01:13:20)
把字符串 "the cat in the hat" 喂给上面的 train_bpe,取 num_merges=3:
- 先转成字节序列。统计相邻对,发现
(116, 104)(即t、h)出现 两次,是最高频的(虽有并列,取第一个)。 - 合并它:创建一个新 token,记为 256,代表
th,加入词表。然后把序列里每一处116, 104替换成256。 - 迭代:下一次发现
(256, 101)(即th、e)最高频,合并成 257(代表the)。 - 再迭代一次,得到 258。
可以看到,随着合并进行,序列在变短、词表在变大。这个玩具例子上,最终的压缩比约为 1.5。
graph LR
    S0["字节序列<br/>(116,104) 出现两次"] --> M1["合并 → 新 token 256 = 'th'"]
    M1 --> M2["合并 → 新 token 257 = 'the'"]
    M2 --> M3["合并 → 新 token 258"]
    M3 --> R["序列越来越短<br/>词表越来越大"]
用训练好的分词器编码新文本
(参考时间: 01:15:25)
有了 merges 与词表,就能定义一个 BPE 分词器。它的结构与"要指定的全部参数"如下:
@dataclass(frozen=True)
class BPETokenizerParams:
    """All you need to specify a BPETokenizer."""
    vocab: dict[int, bytes]              # index -> bytes
    merges: dict[tuple[int, int], int]   # index1, index2 -> new_index

class BPETokenizer(Tokenizer):
    """BPE tokenizer given a set of merges and a vocabulary."""
    def __init__(self, params: BPETokenizerParams):
        self.params = params

    def encode(self, string: str) -> list[int]:
        indices = list(map(int, string.encode("utf-8")))
        # Note: this is a very slow implementation
        for pair, new_index in self.params.merges.items():
            indices = merge(indices, pair, new_index)
        return indices

    def decode(self, indices: list[int]) -> str:
        bytes_list = list(map(self.params.vocab.get, indices))
        string = b"".join(bytes_list).decode("utf-8")
        return string
编码新文本的过程,本质就是:把训练时得到的那些 merge,按顺序应用到新文本上。比如把 "the quick brown fox" 编码成一段索引序列,再解码回来,能还原原串。
现在训练和使用连起来:
string = "the cat in the hat"
params = train_bpe(string, num_merges=3)

tokenizer = BPETokenizer(params)
string = "the quick brown fox"
indices = tokenizer.encode(string)
reconstructed_string = tokenizer.decode(indices)
assert string == reconstructed_string
这份实现是对的,但极慢——这正是作业 1 的起点
(参考时间: 01:16:06)
主讲坦承:这份实现是完整的、能跑通的,但极其慢。 慢在哪?encode() 里,它对 每一个 merge 都从头扫一遍序列——而 merge 的数量约等于 词表大小 - 256,非常大。
作业 1 要求你在以下几个方面把它做得更好:
- 编码加速:只遍历真正相关的 merge,为此需要建立索引结构;
- 特殊 token:检测并保留特殊 token(如
<|endoftext|>)——概念不深,但对现代分词器很重要; - 预分词(pre-tokenization):先用正则(如 GPT-2 分词器的正则)把文本切成块,再对每块分别做分词——这样会快得多;
- 尽可能快:到某个点你会发现 Python 太慢,那就用你喜欢的语言(Rust、C 等)重写。
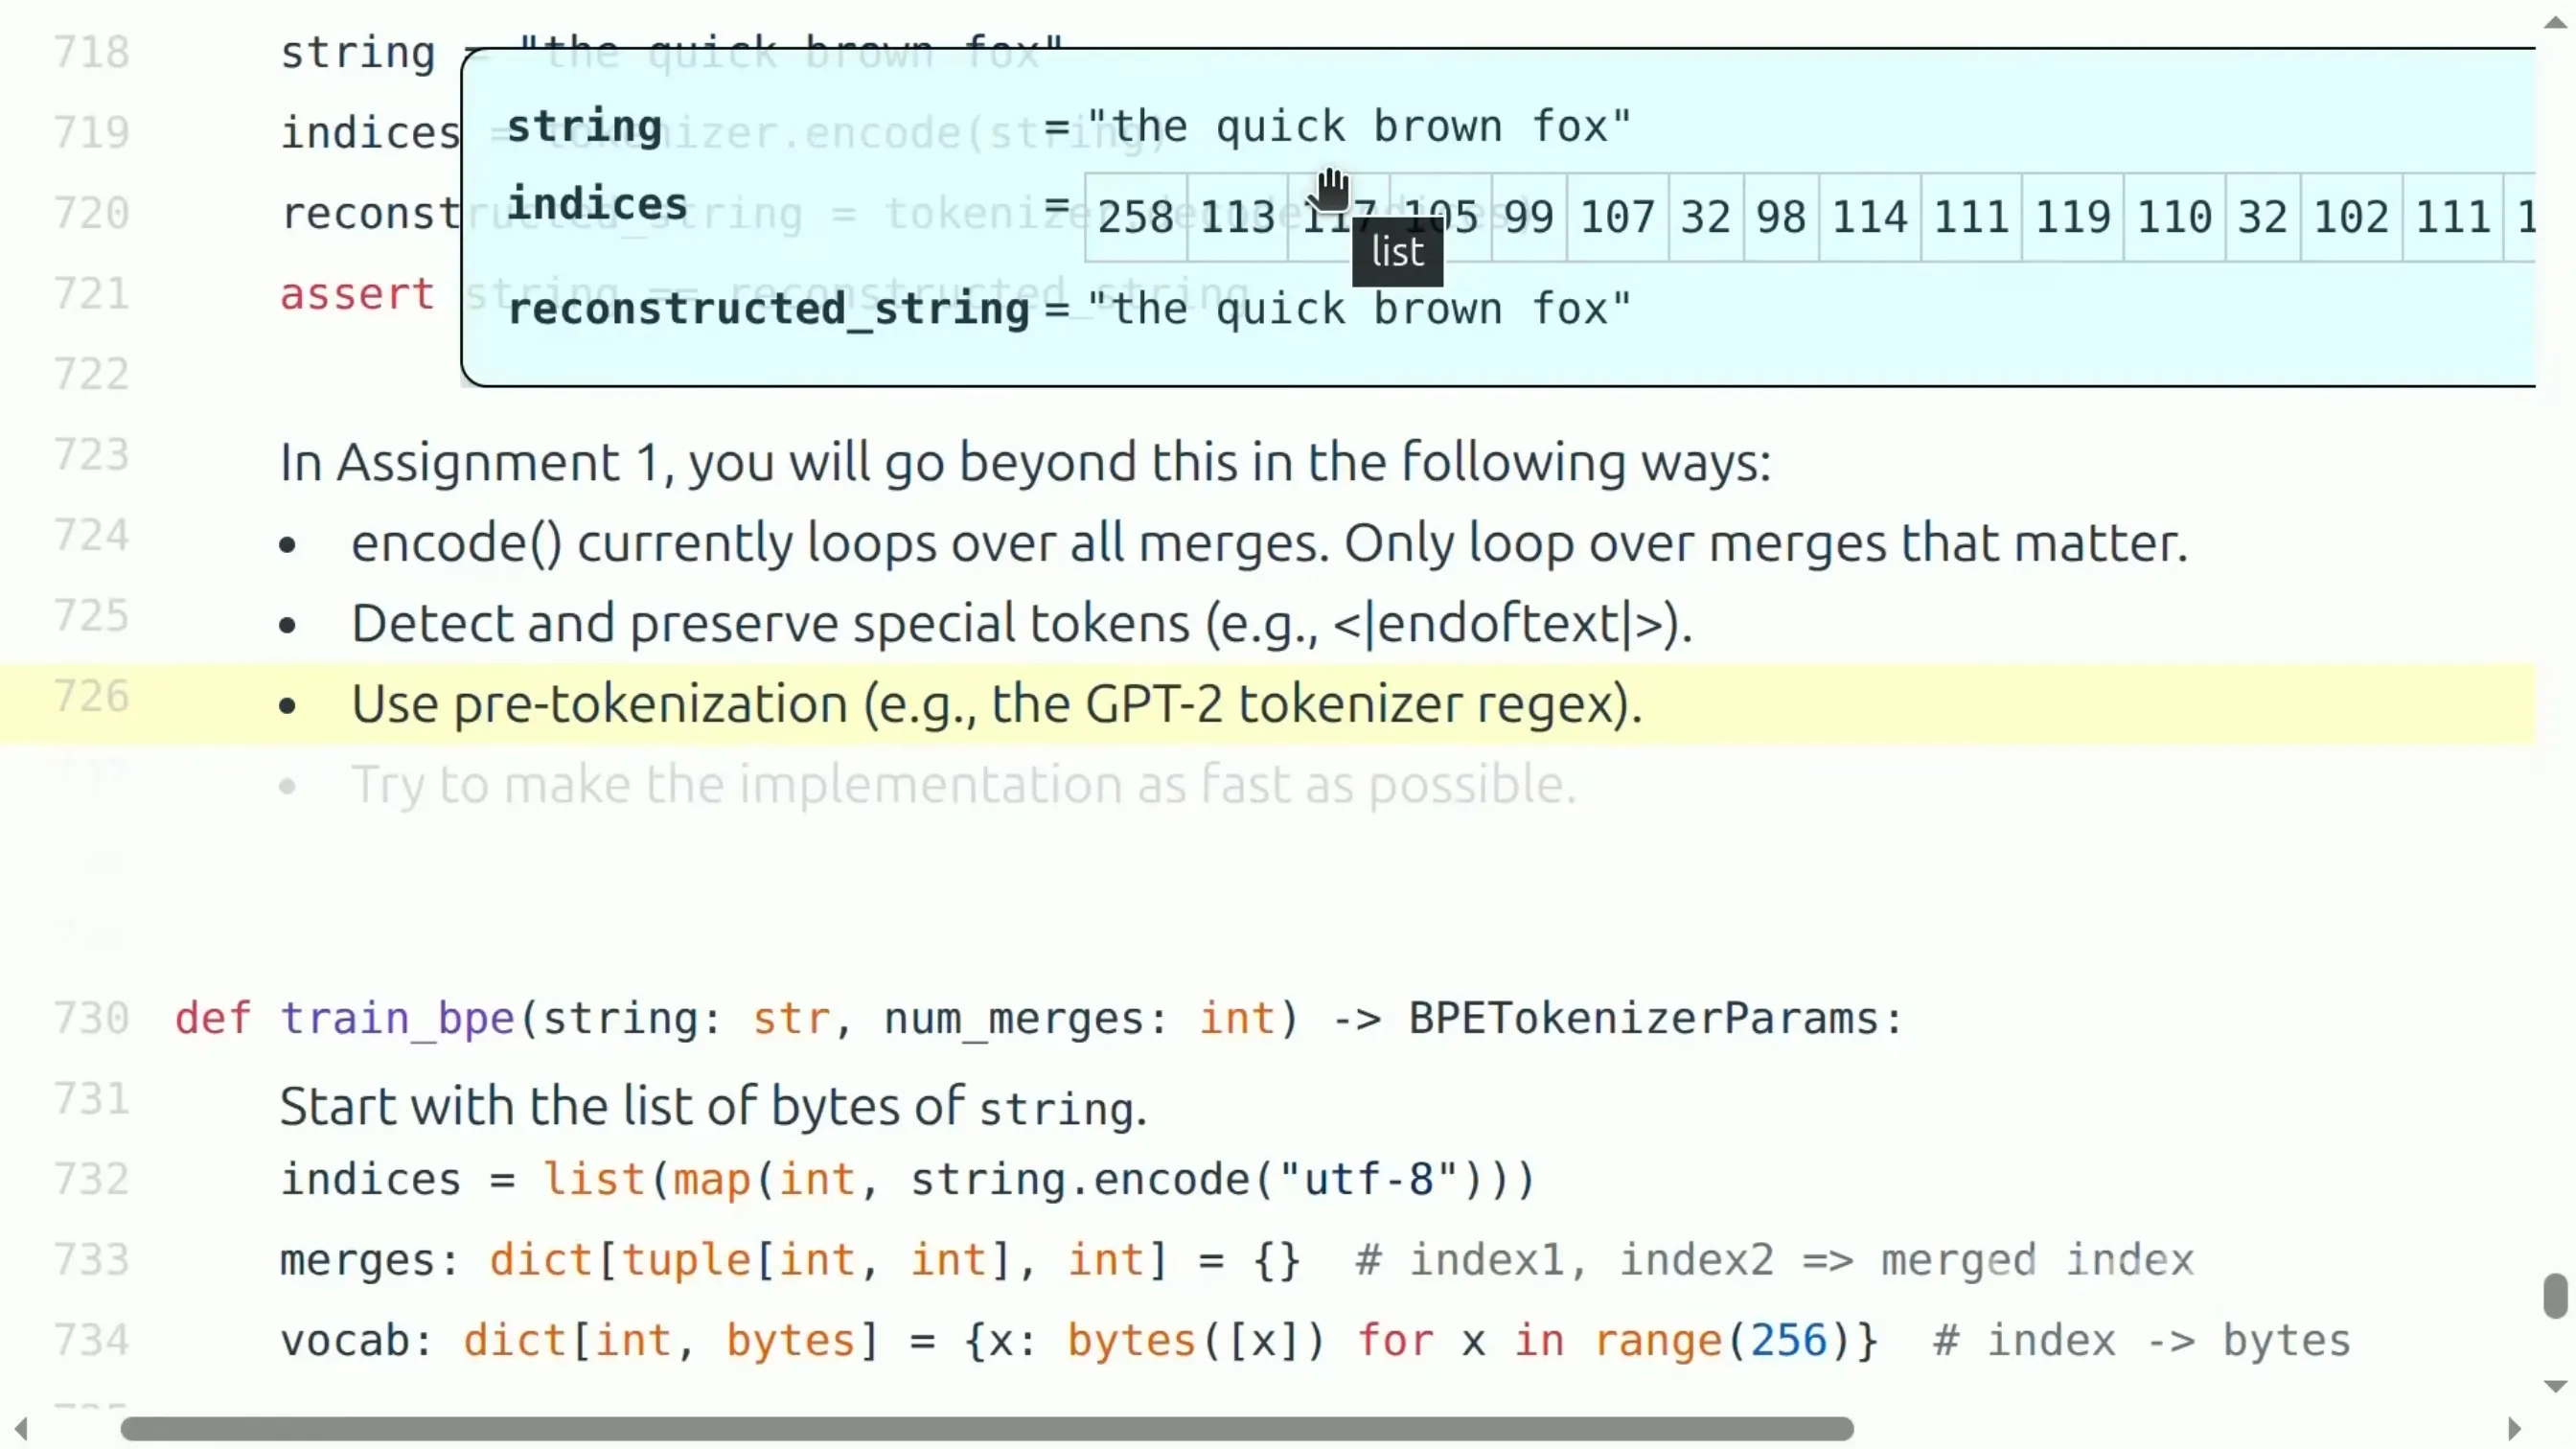
📷 作业 1 的分词器加速要求:只遍历相关 merge、特殊 token、预分词、极致性能
回到原视频 (01:17:00)
小结,以及"无分词器"未来的两个必要条件
(参考时间: 01:17:29)
📷 分词小结与无分词器未来的两个必要条件
回到原视频 (01:17:29)
- Tokenizer 在字符串(bytes)与 token(indices)之间转换。
- 字符级、字节级、词级分词都各有严重缺陷(词表过大 / 序列过长 / 词表无界 + UNK 问题)。
- BPE 是一个有效的、数据驱动的启发式方法。
主讲再次表示,希望有一天不必再教分词;但即便如此,任何用来取代分词器的方案,都应当满足两个性质:
- 模型(如 Transformer)需要在序列的某种"抽象块"上操作——这一点在文本之外的模态(视频、DNA)上尤其明显:个别字节的信噪比太低,必须先"抬升"到某个可建模的抽象层次;
- 这些块应该是可变长的(variable),从而支持自适应计算——不是所有字节都同等重要。
结语与下一讲
(参考时间: 01:18:59)
这一讲到此结束。下一讲(周三)将开始 Resource Accounting(资源核算) 单元——主讲说这是"系统部分的婴儿步"。之后再回到架构,并一路讲下去。
本讲我们走过了一条完整的脉络:
- 为什么要开这门课(研究者与技术栈的脱节、语言模型的工业化、机制/心态/直觉三类知识、苦涩的教训与"效率"主线);
- 语言模型的历史与研究版图(从 Shannon、n-gram 到 Transformer、GPT-3、开放模型生态,以及"语言模型"定义的变迁);
- 五单元大纲及其与作业、与"效率"的对应关系;
- 最后深入分词:为什么需要它、三种朴素方案的失败、BPE 的算法与实现,以及它未尽的作业与未来。
下一讲预告:资源核算(Resource Accounting)——算力、内存、通信带宽都花在了哪里。
附:官方参考与延伸阅读
本讲涉及的官方材料
- 课程主页:https://stanford-cs336.github.io/(亦见 https://cs336.stanford.edu/)
- 本讲"可执行讲义"源码:https://github.com/stanford-cs336/lectures/blob/main/lecture_01.py
- 课程讲义仓库:https://github.com/stanford-cs336/lectures(含
lecture_01.py、references.py等) - Assignment 1: Basics:https://github.com/stanford-cs336/assignment1-basics(PDF:cs336_spring2026_assignment1_basics.pdf)
- 往年(Spring 2025)作业与讲座录像:CS336 Spring 2025 讲座播放列表
- AI 使用政策指南:https://docs.google.com/document/d/1SZAlExB1qAc9izHt54gwunNpjKE6wXb8Y7yA_e-baK8
分词与语言模型
- Andrej Karpathy 的分词视频:https://www.youtube.com/watch?v=zduSFxRajkE(本讲明确推荐)
- tiktoken(OpenAI 分词器):https://github.com/openai/tiktoken
- tiktokenizer 交互网站:https://tiktokenizer.vercel.app/?encoder=gpt2
- BPE 的起源(Philip Gage, 1994):http://www.pennelynn.com/Documents/CUJ/HTML/94HTML/19940045.HTM
- BPE 引入 NMT(Sennrich et al., 2016)、WordPiece(Schuster & Nakajima, 2012)、Unigram(Kudo, 2018)
- GPT-2 论文(首次在 LLM 中使用 BPE):Language Models are Unsupervised Multitask Learners
- 无分词器方向:ByT5、MegaByte、BLT、T-FREE、H-Net 等(讲义中均给出链接)
历史与缩放定律
- Shannon 1950:Prediction and Entropy of Printed English;n-gram 语言模型:Brants et al., 2007
- LSTM(1997)、Bengio et al. 2003(第一个神经语言模型)、Seq2Seq(2014)、Adam(2014)、Bahdanau et al. 2015(注意力)
- Transformer(Vaswani et al., 2017):Attention Is All You Need
- MoE(2017)、GPipe(2018)、ZeRO(2019)、Megatron-LM(2019)
- ELMo(2018)、BERT(2018)、T5(2019)、GPT-2(2019)
- Kaplan et al. 2020(缩放定律)、GPT-3(2020)、PaLM(2022)、Chinchilla(2022)
- SwiGLU(Shazeer, 2020)——主讲引用其"归于神的恩典"作为"有些设计只是实验碰出来的"的例子
- 算法效率的 44 倍(OpenAI, 2020):https://arxiv.org/abs/2005.04305
系统与推理
- How to Scale Your Model(推荐书):https://jax-ml.github.io/scaling-book/
- FlashAttention(Tiling 的代表)、GQA(2023)、MLA(2024)、Mamba 系列、Gated DeltaNet(2024) 等
- Muon(2024)、AdamW(2017)、SOAP(2024)、muP(2022)、多 token 预测(2024)
版权说明:本书内容依据斯坦福大学 CS336(Spring 2026)第一讲的公开教学视频与官方讲义源码(
lecture_01.py)重构,代码与讲义版权归课程团队所有。本电子书仅用于学习交流,不用于商业用途。
已知疑点
- “CGOE 录制”疑为听错或缩写缺失。 正文“如何在家跟学”写课程通过 CGOE 录制;斯坦福课程录制常见为 SCPD(Stanford Center for Professional Development)或 Stanford Online,未见“CGOE”这一常见机构名。依据:正文 00:20:14 附近。
- “GPT-5 分词器”与代码中的
o200k_base可能不是同一命名层级。 讲义示例用tiktoken.get_encoding("o200k_base"),该编码通常关联 GPT-4o/OpenAI o200k 系列;讲者称其为 GPT-5 分词器,是否 2026 年 GPT-5 仍沿用该编码、还是课堂简称/口误,无法当场判定。依据:01:07:00 附近。 - 压缩比示例的字节数可能写错。 正文称
"Hello, 🌍! 你好!"为 20 字节 / 8 token = 2.5。按 UTF-8 计算,该串为 19 字节(Hello,7 + 🌍 4 +!1 + 空格 1 + 你 3 + 好 3),若 token 数为 8,压缩比约 2.375。依据:01:07:40 附近及代码示例。 - GRPO 的中文全称不标准。 正文写“组相对偏好优化”。常见全称为 Group Relative Policy Optimization(组相对策略优化),不是“偏好优化”。依据:01:00:26 对齐单元。
- “aux-free”可能漏词。 正文“MoE 特有的问题:负载均衡(如 aux-free 方案)”。业界常见说法是 auxiliary-loss-free / aux-loss-free load balancing;若讲者原话如此,也宜在中文里保留“无辅助损失”的限定。依据:00:32:20 附近。
- “第一个把 BPE 用于 LLM 的是 GPT-2”表述可能过宽。 GPT-1 原始工作已使用 BPE;若讲者原意为“GPT-2 首次在 LLM 中使用字节级 BPE”,正文缩写后容易与 GPT-1 的事实冲突。依据:01:12:00 附近。
- “小米 MIMO”大小写疑误。 小米公开模型通常写作 MiMo,而非全大写 MIMO。依据:00:15:36 开放模型生态。
- “MLP FLOPs 占比 44% → 80%”的数字来源与口径未交代。 正文称小规模约 44%、175B 时约 80%;未说明是否指训练 FLOPs、是否含 embedding、对应哪个模型族。该数字与常见 Transformer FLOPs 分布未必能直接对应,需核对官方讲义或原论文。依据:00:05:56。
- 教学团队人名拼写无法核对。 正文列出 Percy、Tatsu、Marcel、Herman、Steven;其中 Herman、Steven 等仅有名无姓,可能是听写或拼写误差。依据:00:04 开场。
- SwiGLU 论文结论的中文转述可能增添语气。 正文引作“我们不提供任何解释,只能把它们的成功归于神的恩典”。英文原句大意是“We offer no explanation ... we attribute their success, as all else, to divine benevolence”;“只能”是中文添补,不影响大意,但属于编者拿不准的语气判断。依据:08:21。