第2讲 · 从零构建语言模型:CS336 ——PyTorch 与资源核算
本电子书由教学视频重构而成。 书中代码、讲义与图片版权归斯坦福大学 CS336 课程团队所有,本电子书为课堂讲解的中文书面重构,仅供学习交流。
| 视频原标题 | *Stanford CS336 Language Modeling from Scratch |
| 授课 | Percy Liang、Tatsu Hashimoto(斯坦福大学 CS336 课程);本讲由 Percy Liang 主讲 |
| 视频地址 | https://www.youtube.com/watch?v=kuYAsz7zspQ |
| 课程主页 | https://stanford-cs336.github.io/ |
| 本讲官方讲义源码("可执行讲义") | https://github.com/stanford-cs336/lectures/blob/main/lecture_02.py |
| 课程作业仓库 | Assignment 1: Basics 等 |
对应讲次:第2讲(Stanford CS336 语言建模)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
导览
1. 老师想回答的核心问题
开课新闻之后,Percy 没有直接进入"PyTorch 教程",而是先抛两个信封背面的问题,把整讲锚在同一个追问上——一段训练究竟消耗多少资源:
- 在 1024 张 H100 上、用 15T token 训练一个 70B 模型,要多少天?(算力一路)
- 用 8 张 H100、配 AdamW,最大能训练多大的模型?(显存一路)
紧接着他由估算与实测的对照引出第二个问题:为什么实际跑出来的 MFU 只有大约 0.5?前一个问题要一套"数 FLOPs"的办法,后一个问题要一套"判断瓶颈在算还是在搬"的办法,这两条线撑起了本讲的全部骨架,也解释了他为什么先讲张量与精度、再讲 einops、再数 FLOPs、最后才引入算术强度。
2. 难点在哪,为什么容易卡住
- FLOPs 与 FLOP/s 同形近音、量纲完全不同。一个是"做了多少计算",一个是"每秒能做多少计算"。一旦在脑中滑码,后面所有估算都会错,且错得很隐蔽。
- 两套"强度"的对照方向。加速器强度是硬件属性,算术强度是算法属性,判据是两者比大小——方向极易记反。
- 反向传播的账要按"梯度对象"分。一层里对输入的梯度与对参数的梯度是两笔独立开销,不是一笔,直觉上容易少算。
- 一个广泛流传的公式的来历与边界。本讲给出一条常用 FLOPs 公式,它从最简单的逐层结构推出,向真实 Transformer 迁移时需要知道什么条件下仍成立。
- Einops 是思维方式的一次替换。习惯用位置下标想张量(
transpose(-2,-1)、dim=-1)的读者,要改成按名字对齐,起初会不自在。 - 多种精度格式的位账。符号/指数/尾数各占几位的布局,以及"动态范围 vs 分辨率"这对取舍,不逐个记住就读不懂后面章节的取舍。
3. 疑问分组
① 老师真正提出的问题
- 1024 张 H100、15T token、70B 参数,训完要多少天?
- 8 张 H100 加 AdamW,最多能训多大模型?
- H100 规格书上那个漂亮数字,为什么代码里到处要除以 2?
- 反向传播的算力为什么恰好是前向的两倍?
- 为什么实测 MFU 只有约 0.5——加速器大量时间究竟在等什么?
- 显存装不下模型时,可以做什么?
② 编者预判的读者疑问(编者预判)
- AdamW 下每个参数为什么记为 12 字节,这 12 字节怎么拆?
- 优化器状态为什么必须用 fp32,而不像参数那样用 bf16?
- bf16 为什么不砍总位数,而是从尾数挪位给指数?
- 为什么说 GELU 和 ReLU"一样快"?
- 为什么说矩阵-向量乘内存受限,就等于说推理难做?
- 激活检查点为什么偏偏选"每隔 √L 层存一个"?
- einops 只是语法糖吗,会不会有性能代价?
- 逐元素运算、点积、矩阵乘法里,哪些计算受限、哪些不是?
- 更低比特(fp4、甚至 1 位)能不能用来训练,而不是只用于推理?
4. 本讲路线
先以开课新闻和课程定位开场,说明为什么这一讲转向"资源核算";然后用两个估算题给出算力与显存两种核算的粗样。接着自底向上:先看张量与一串浮点精度(从 fp32 降到 fp4,夹着混合精度),再说张量如何搬到 GPU 上。之后插入一段 einops——用命名维度重写矩阵乘、归约与维度拆分/合并,它同时也是后面把导数写清楚的语言。再进入"数 FLOPs":区分 FLOPs 与 FLOP/s,从线性层建立基本计数单位,讲基准测试的同步坑与 MFU;随后引入算术强度、内存墙与 Roofline,用一串从逐元素到矩阵乘的算子练判据。到这一步零件凑齐,老师把它们拼成一次完整训练步的核算:参数、梯度、优化器状态、激活各占多少,以及一步的总 FLOPs。最后讲两个降显存的技巧(梯度累积、激活检查点)并总结。
一、开课新闻与本节课定位
(参考时间: 00:00)
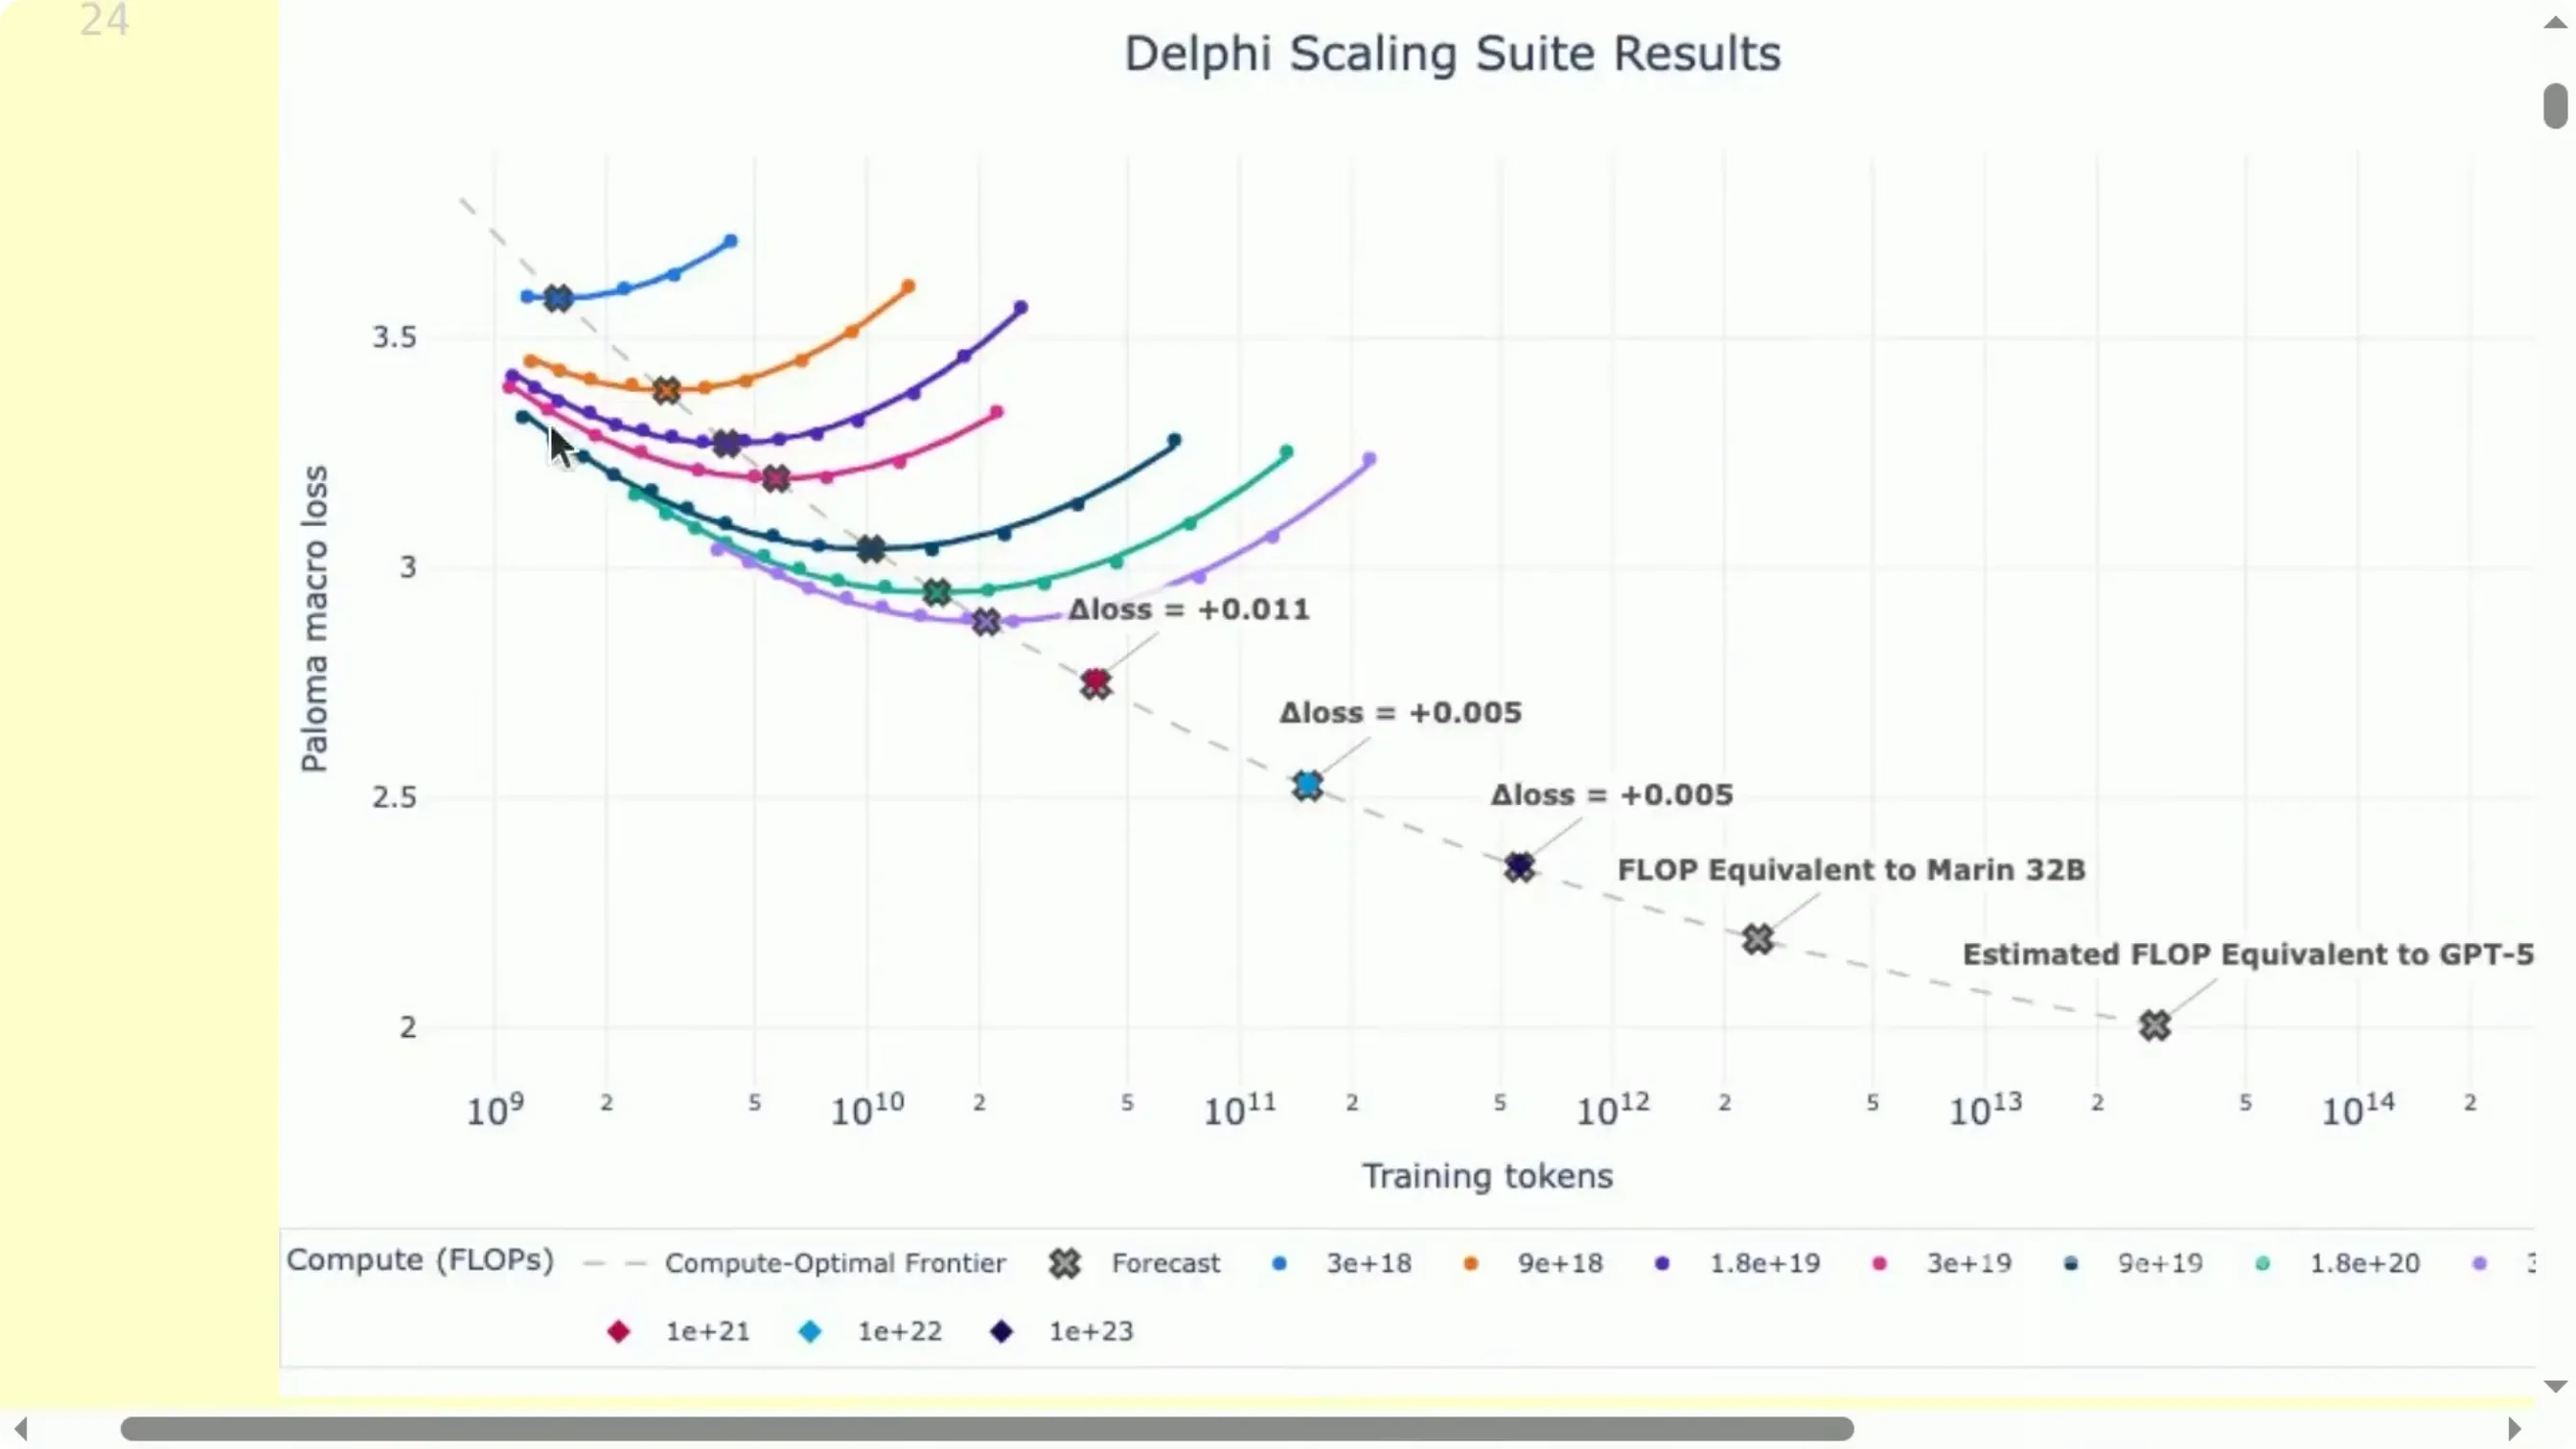
课前一则好消息:上一讲预告过的 Marin 项目训练已经跑完,而且实测 loss 与预测完全吻合——预测误差在 0.05 以内。按照这套缩放定律外推,可以估算出 GPT-5 级别的 loss 会是多少(当然,具体结果会因缩放定律的形态而有所浮动)。
📷 Marin 项目的 isoFLOP 曲线与预注册预测:实测 loss 命中预测
回到原视频 (00:00:21)
今天讲"资源核算"
(参考时间: 01:00)
📷 本节课主题:资源核算(systems 方向)
回到原视频 (00:01:00)
上一讲给出了整门课的概览,并讲了分词(会成为第一次作业的一部分)。这一讲转向系统(systems)方向,主题是资源核算(resource accounting)。
回到贯穿全课的那句话:我们要在有限的资源(算力、显存;数据在这门课里一般不是瓶颈)下,训练出最好的模型。核心目标就是最大化训练的计算效率。而要想优化效率,首先必须理解一段计算究竟消耗多少算力与显存——这正是本讲要给的工具。
主讲强调,今天要传授的三类知识分别是:
- 机制(Mechanics):非常直接——就是 PyTorch 与张量如何工作,没有任何魔法;
- 心态(Mindset):资源核算要成为习惯。写任何一行代码时,都要下意识想一下它的性能特征。
- 直觉(Intuitions):对资源如何被消耗建立感觉。今天没有机器学习层面的"魔法",那部分留给下一讲(架构)。
二、为什么值得做"信封背面的估算":两个问题
(参考时间: 02:04)
为了让你体会这门课结束时能回答什么问题,主讲先抛出两个"信封背面(back-of-envelope)"的估算题。
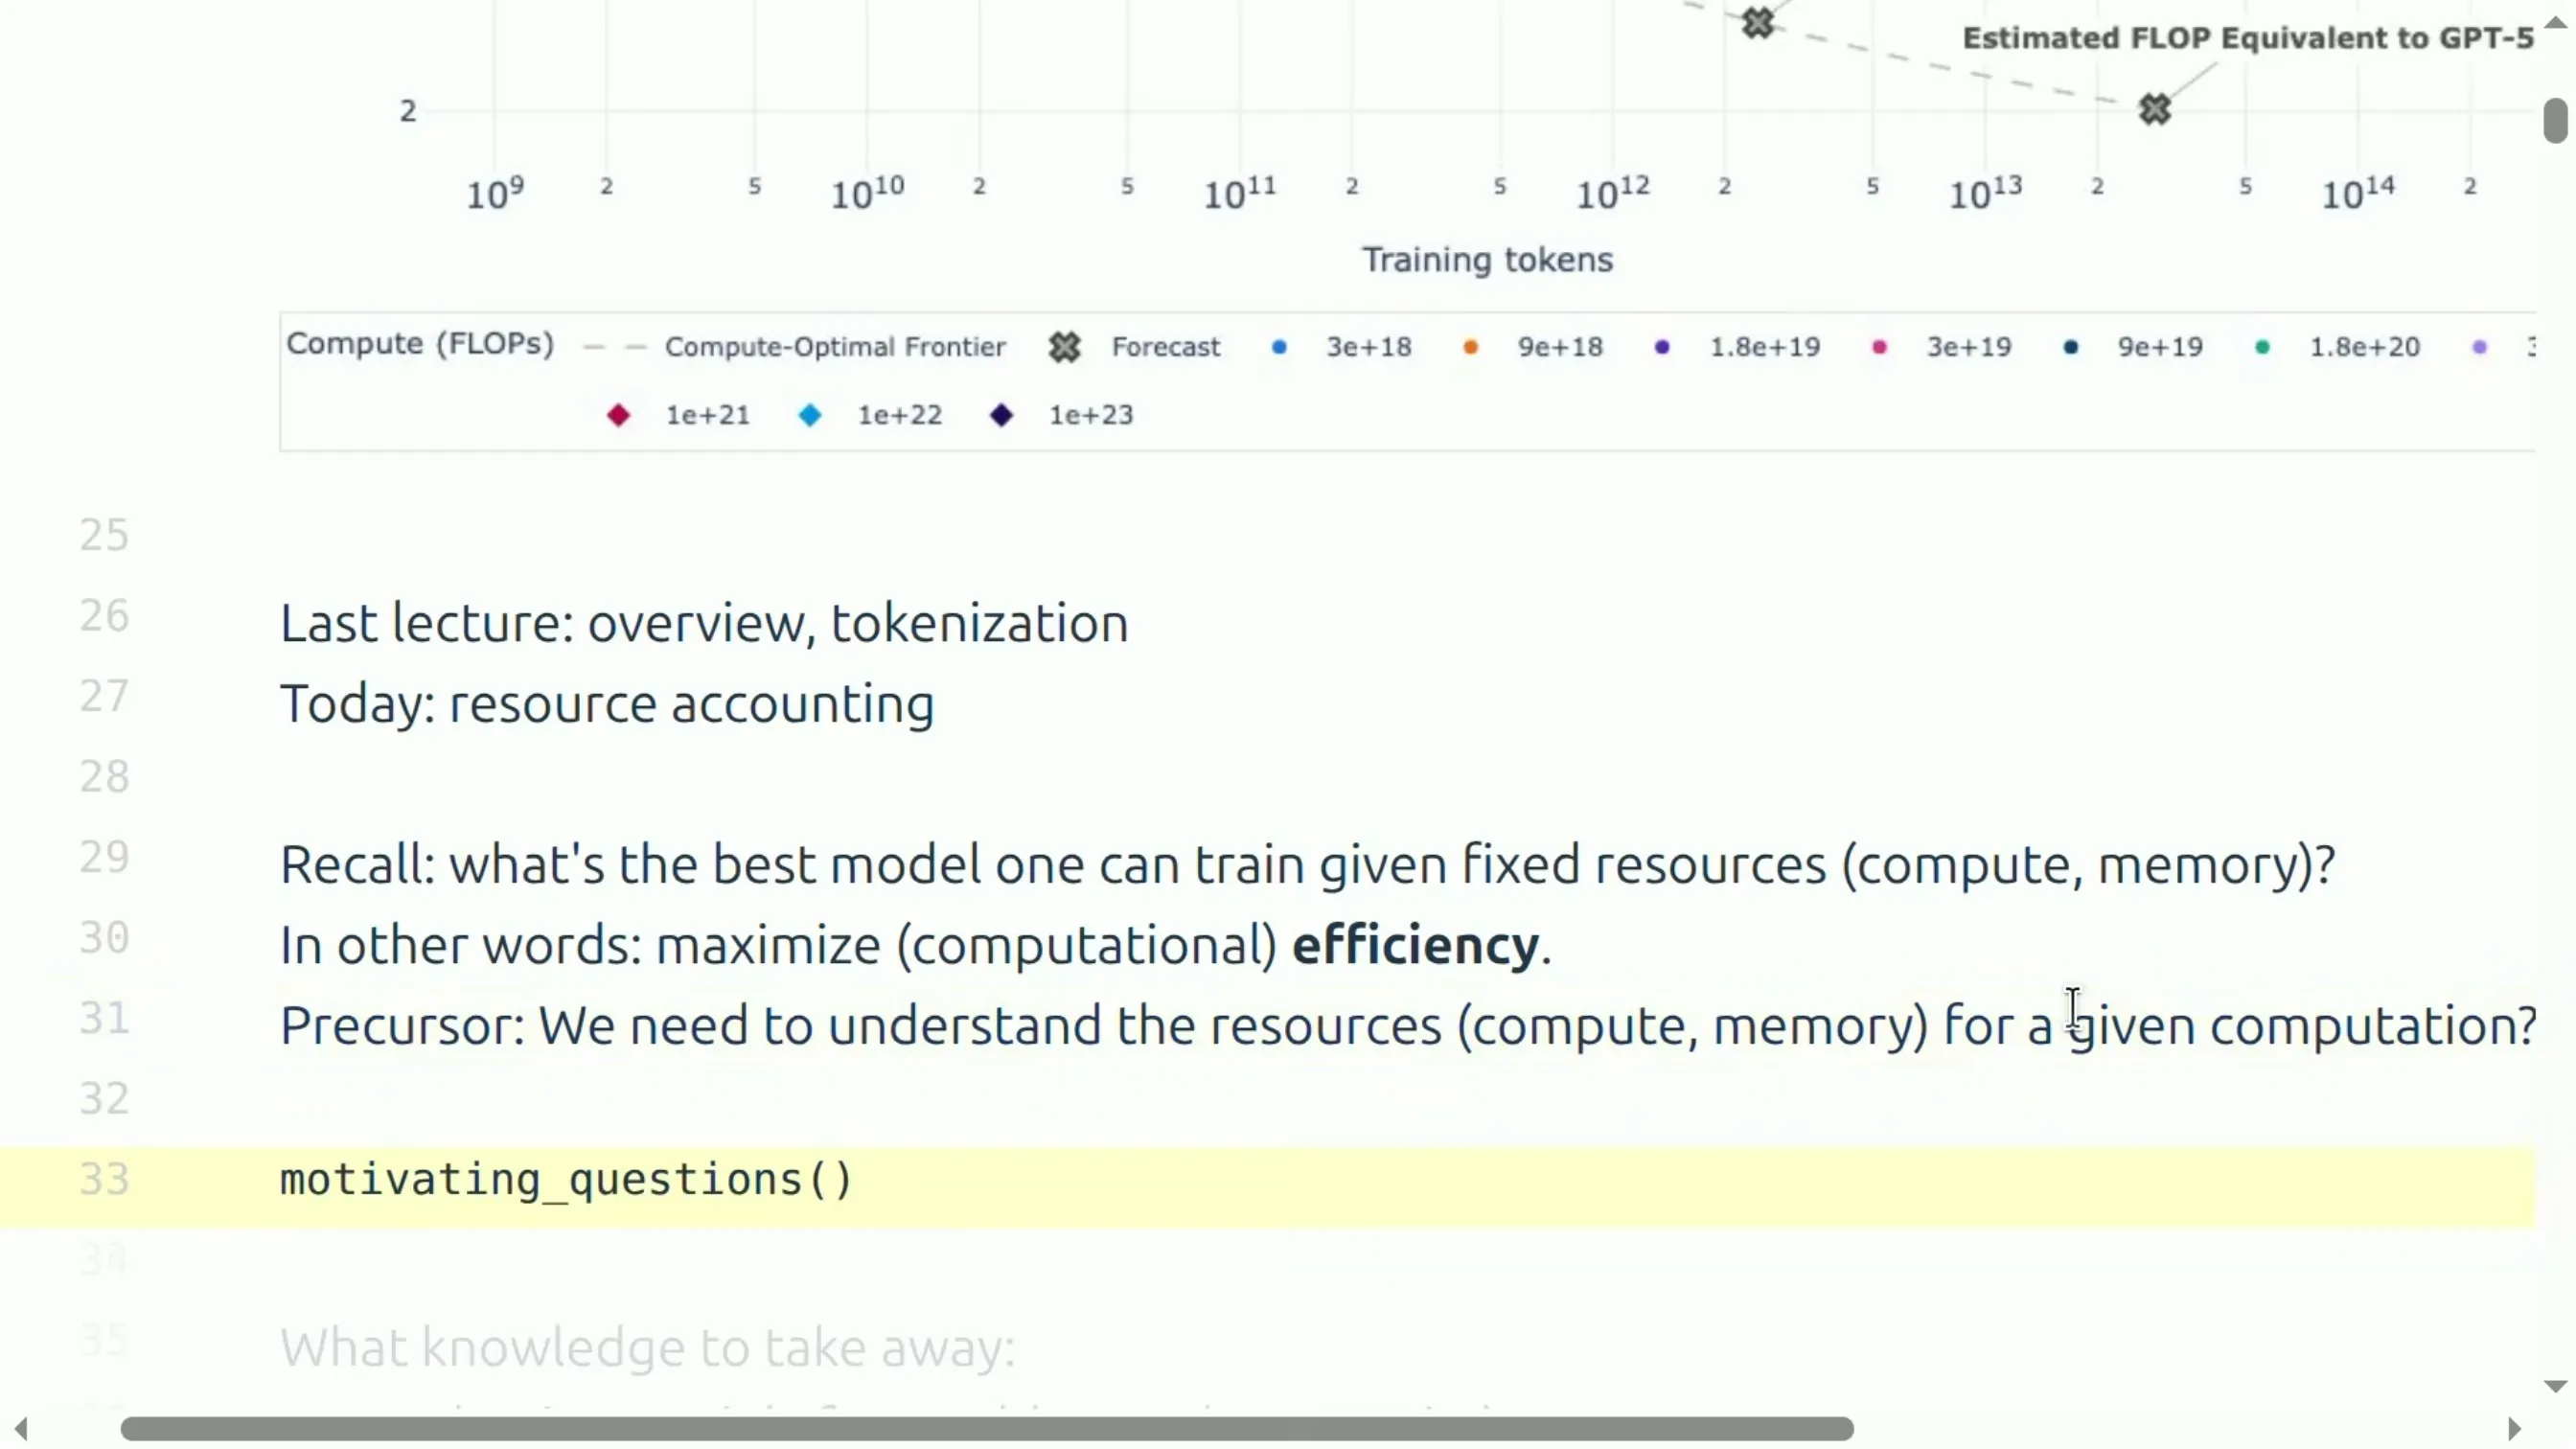
问题一:在 1024 张 H100 上,用 15T token 训练一个 70B 参数模型要多久?
(参考时间: 02:04)
用到三个事实:
- 训练所需 FLOPs ≈ 6 × 参数量 × token 数(今天稍后会推导它);
- H100 的算力可以从规格书查到;
- 实际利用率用 MFU(模型 FLOPs 利用率) 来刻画,这里假设 0.5。
于是:
total_flops = 6 * 70e9 * 15e12          # ≈ 6.3e24 FLOPs
h100_flop_per_sec = 1979e12 / 2          # 989.5e12 FLOP/s(后面解释为什么要除以 2)
mfu = 0.5
flops_per_day = h100_flop_per_sec * mfu * 1024 * 60 * 60 * 24
days = total_flops / flops_per_day       # ≈ 143 天
答案是大约 143 天。
📷 问题一:1024 张 H100 训练 70B/15T 模型需要多久
回到原视频 (00:02:04)
问题二:用 8 张 H100、配 AdamW,最大能训练多大的模型?
(参考时间: 02:50)
关键是一个参数在显存里要占用多少字节。用 AdamW 时,每个参数大致需要:
2(参数,bf16) + 2(梯度,bf16) + 4(优化器一阶矩,fp32) + 4(优化器二阶矩,fp32) = 12 字节
于是:
h100_bytes = 80e9                        # 每张 H100 有 80 GB HBM
bytes_per_parameter = 2 + 2 + (4 + 4)    # = 12
num_parameters = (h100_bytes * 8) / bytes_per_parameter   # ≈ 53e9
答案约为 530 亿参数。
注意:这个估算没有计入激活值(activations),而激活值取决于批大小与序列长度,所以 53B 是一个上界。
📷 问题二:8 张 H100 配 AdamW 能训练的最大模型约 53B
回到原视频 (00:02:50)
主讲提醒:这些都是很粗糙的估算,重点不是精确到每一位,而是建立起对资源量级的直觉——这种"心算(napkin math)"在以后会非常有用。
三、张量与存储:从 fp32 一路到 fp4
(参考时间: 04:46)
📷 张量:参数、梯度、优化器状态、激活、数据的统一表示
回到原视频 (00:04:46)
张量是万物的基石
自底向上看,最底层的东西是张量(tensor)。语言模型里的一切——数据、参数、梯度、优化器状态、激活值——本质上都是张量。
例如打开 Hugging Face 上的 DeepSeek v3.2 模型,你会看到它就是一大堆张量:每个张量都有各自的形状(shape)和精度(precision)。
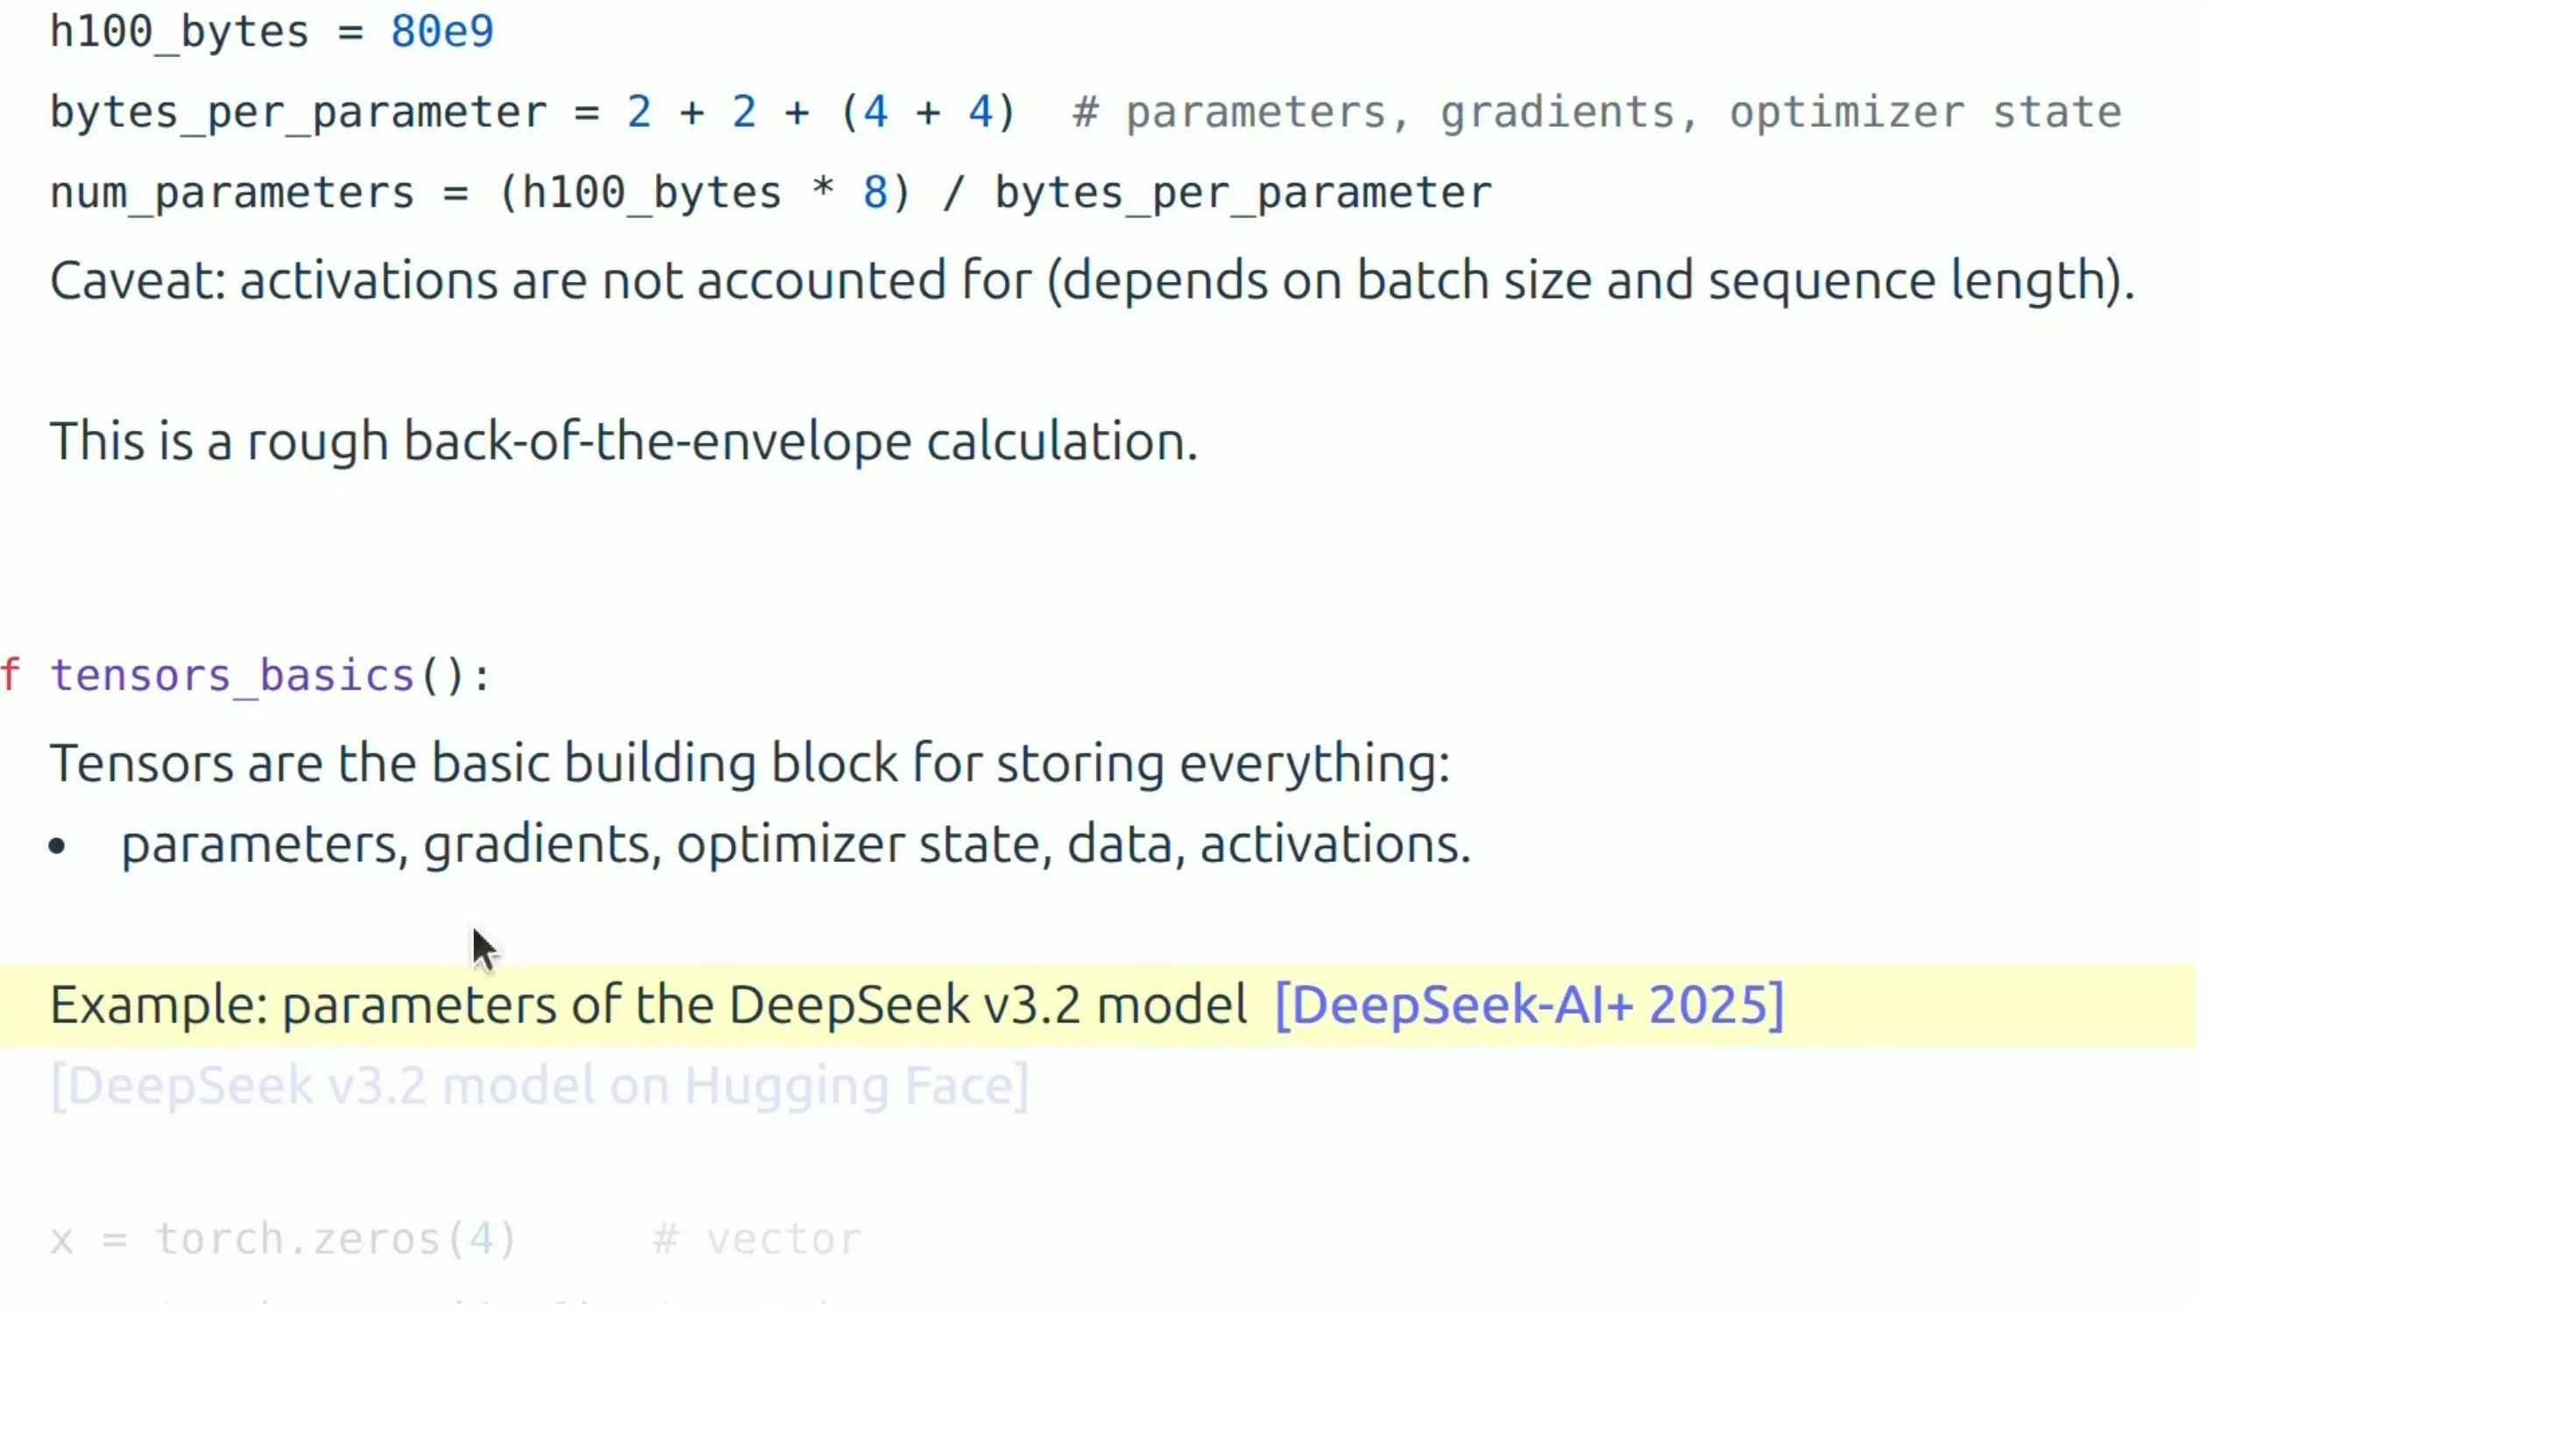
📷 张量是存储万物的基本单元:以 DeepSeek v3.2 模型为例
回到原视频 (00:05:06)
张量的秩(rank)是它的维度个数:
x = torch.zeros(4)        # rank 1(向量)
x = torch.zeros(4, 8)     # rank 2(矩阵)
x = torch.zeros(4, 8, 2)  # rank 3

# Transformer 里会出现 rank 4 的张量:
B, S, H, D = 32, 16, 16, 64   # 批大小 / 序列长度 / 头数 / 每头隐藏维度
x = torch.zeros(B, S, H, D)
显存占用 = 元素个数 × 每个元素的字节数
这才是"内存核算"的全部内容——非常直接:
x = torch.zeros(4, 8)
assert x.dtype == torch.float32   # 默认类型
assert x.numel() == 4 * 8
assert x.element_size() == 4      # float 占 4 字节
assert get_memory_usage(x) == 4 * 8 * 4   # 128 字节
一个令人有概念的对比:GPT-3 前馈层里的一个矩阵(12288*4 × 12288,fp32)就要占大约 2.3 GB。
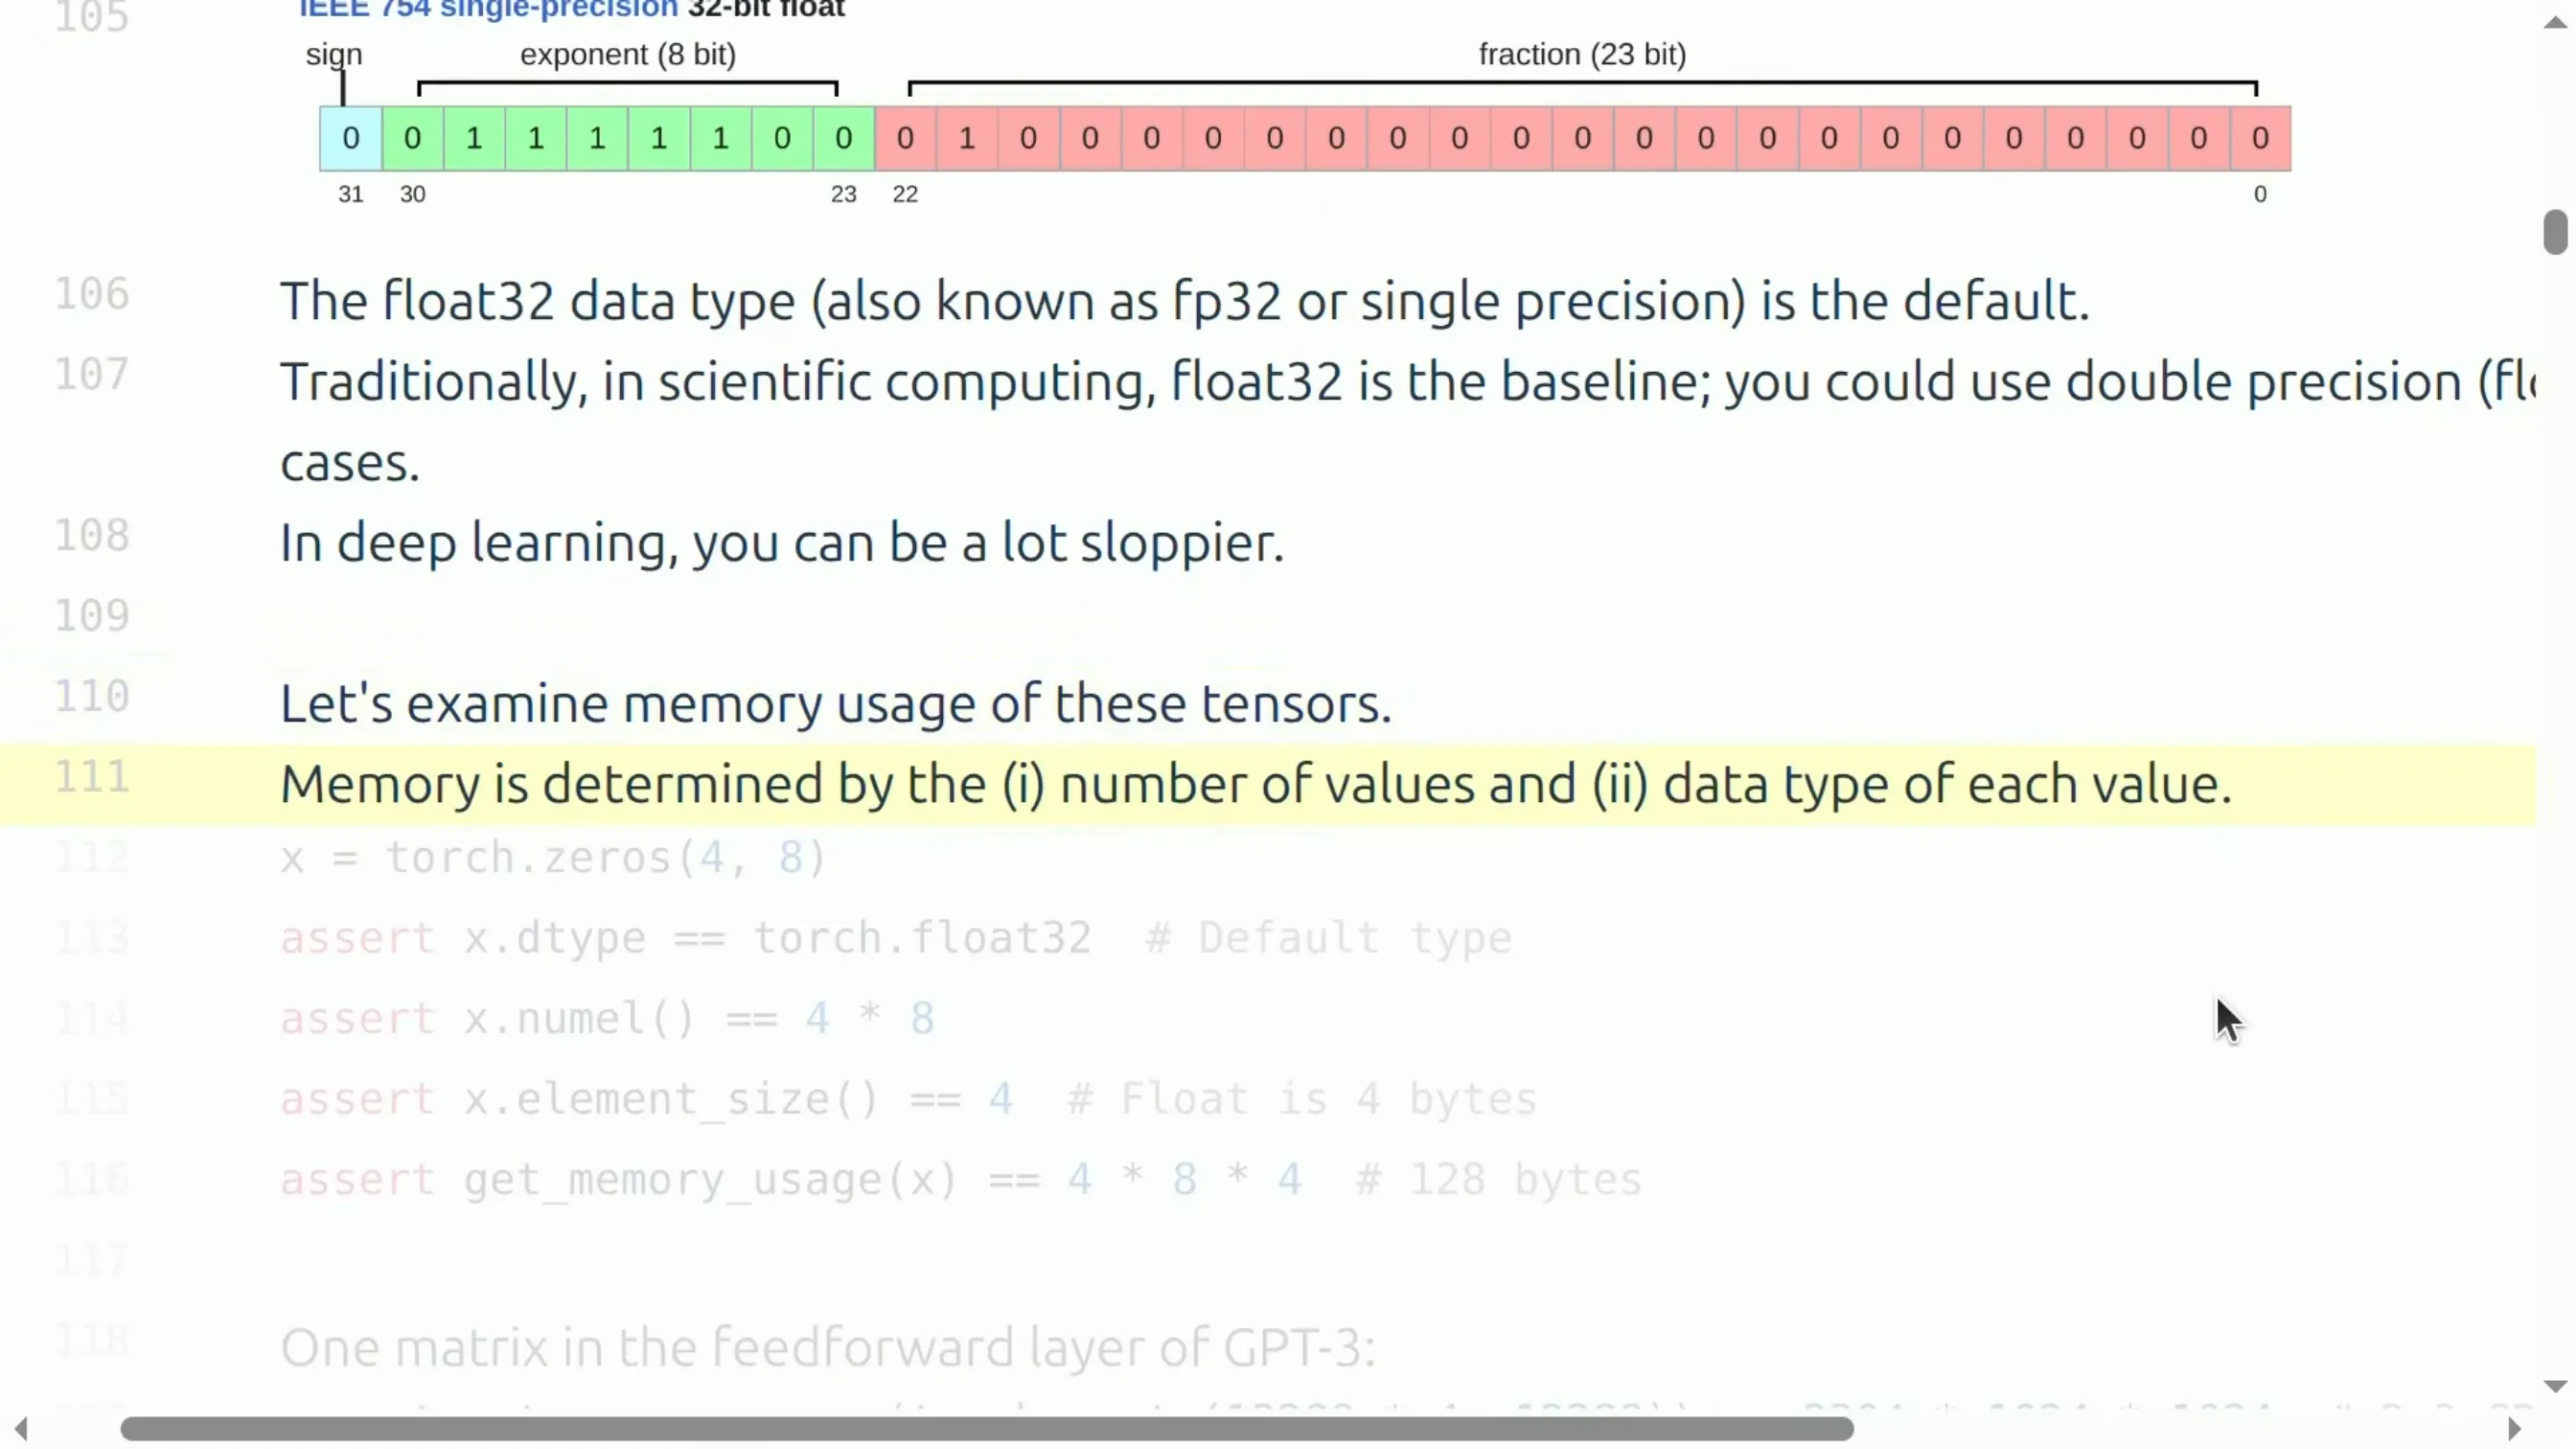
📷 用 4×8 矩阵理解显存计算,并对比 GPT-3 单个 2.3GB 的矩阵
回到原视频 (00:07:15)
fp32:基准,但太占地方
(参考时间: 06:02)
通常说 "float",默认指 fp32(单精度)。它用 32 个 bit:
- 1 位符号(sign);
- 8 位指数(exponent),决定动态范围(dynamic range);
- 其余 23 位是尾数/小数(mantissa/fraction),决定分辨率。
"单精度"这个说法来自科学计算:那时 fp32 是基线,要更精确就用 fp64(双精度)。但深度学习反其道而行——因为对我们要做的计算来说,fp32 都嫌太多、精度要求没那么高。
📷 fp32 的位布局:1 位符号、8 位指数、23 位尾数
回到原视频 (00:06:02)
fp16:省一半,但动态范围太差
(参考时间: 08:51)
既然要省,最直接的想法是把位数砍半,得到 fp16:符号 1 位、指数只有 5 位、其余是尾数。
问题在于动态范围很差:既表示不了很大的数,也表示不了很小的数。
x = torch.tensor([1e-8], dtype=torch.float16)
assert x == 0     # 下溢(underflow)!
早期用 fp16 训练,会遭遇下溢、上溢、NaN,很不稳定。根源正是指数只有 5 位(对比 fp32 的 8 位)。
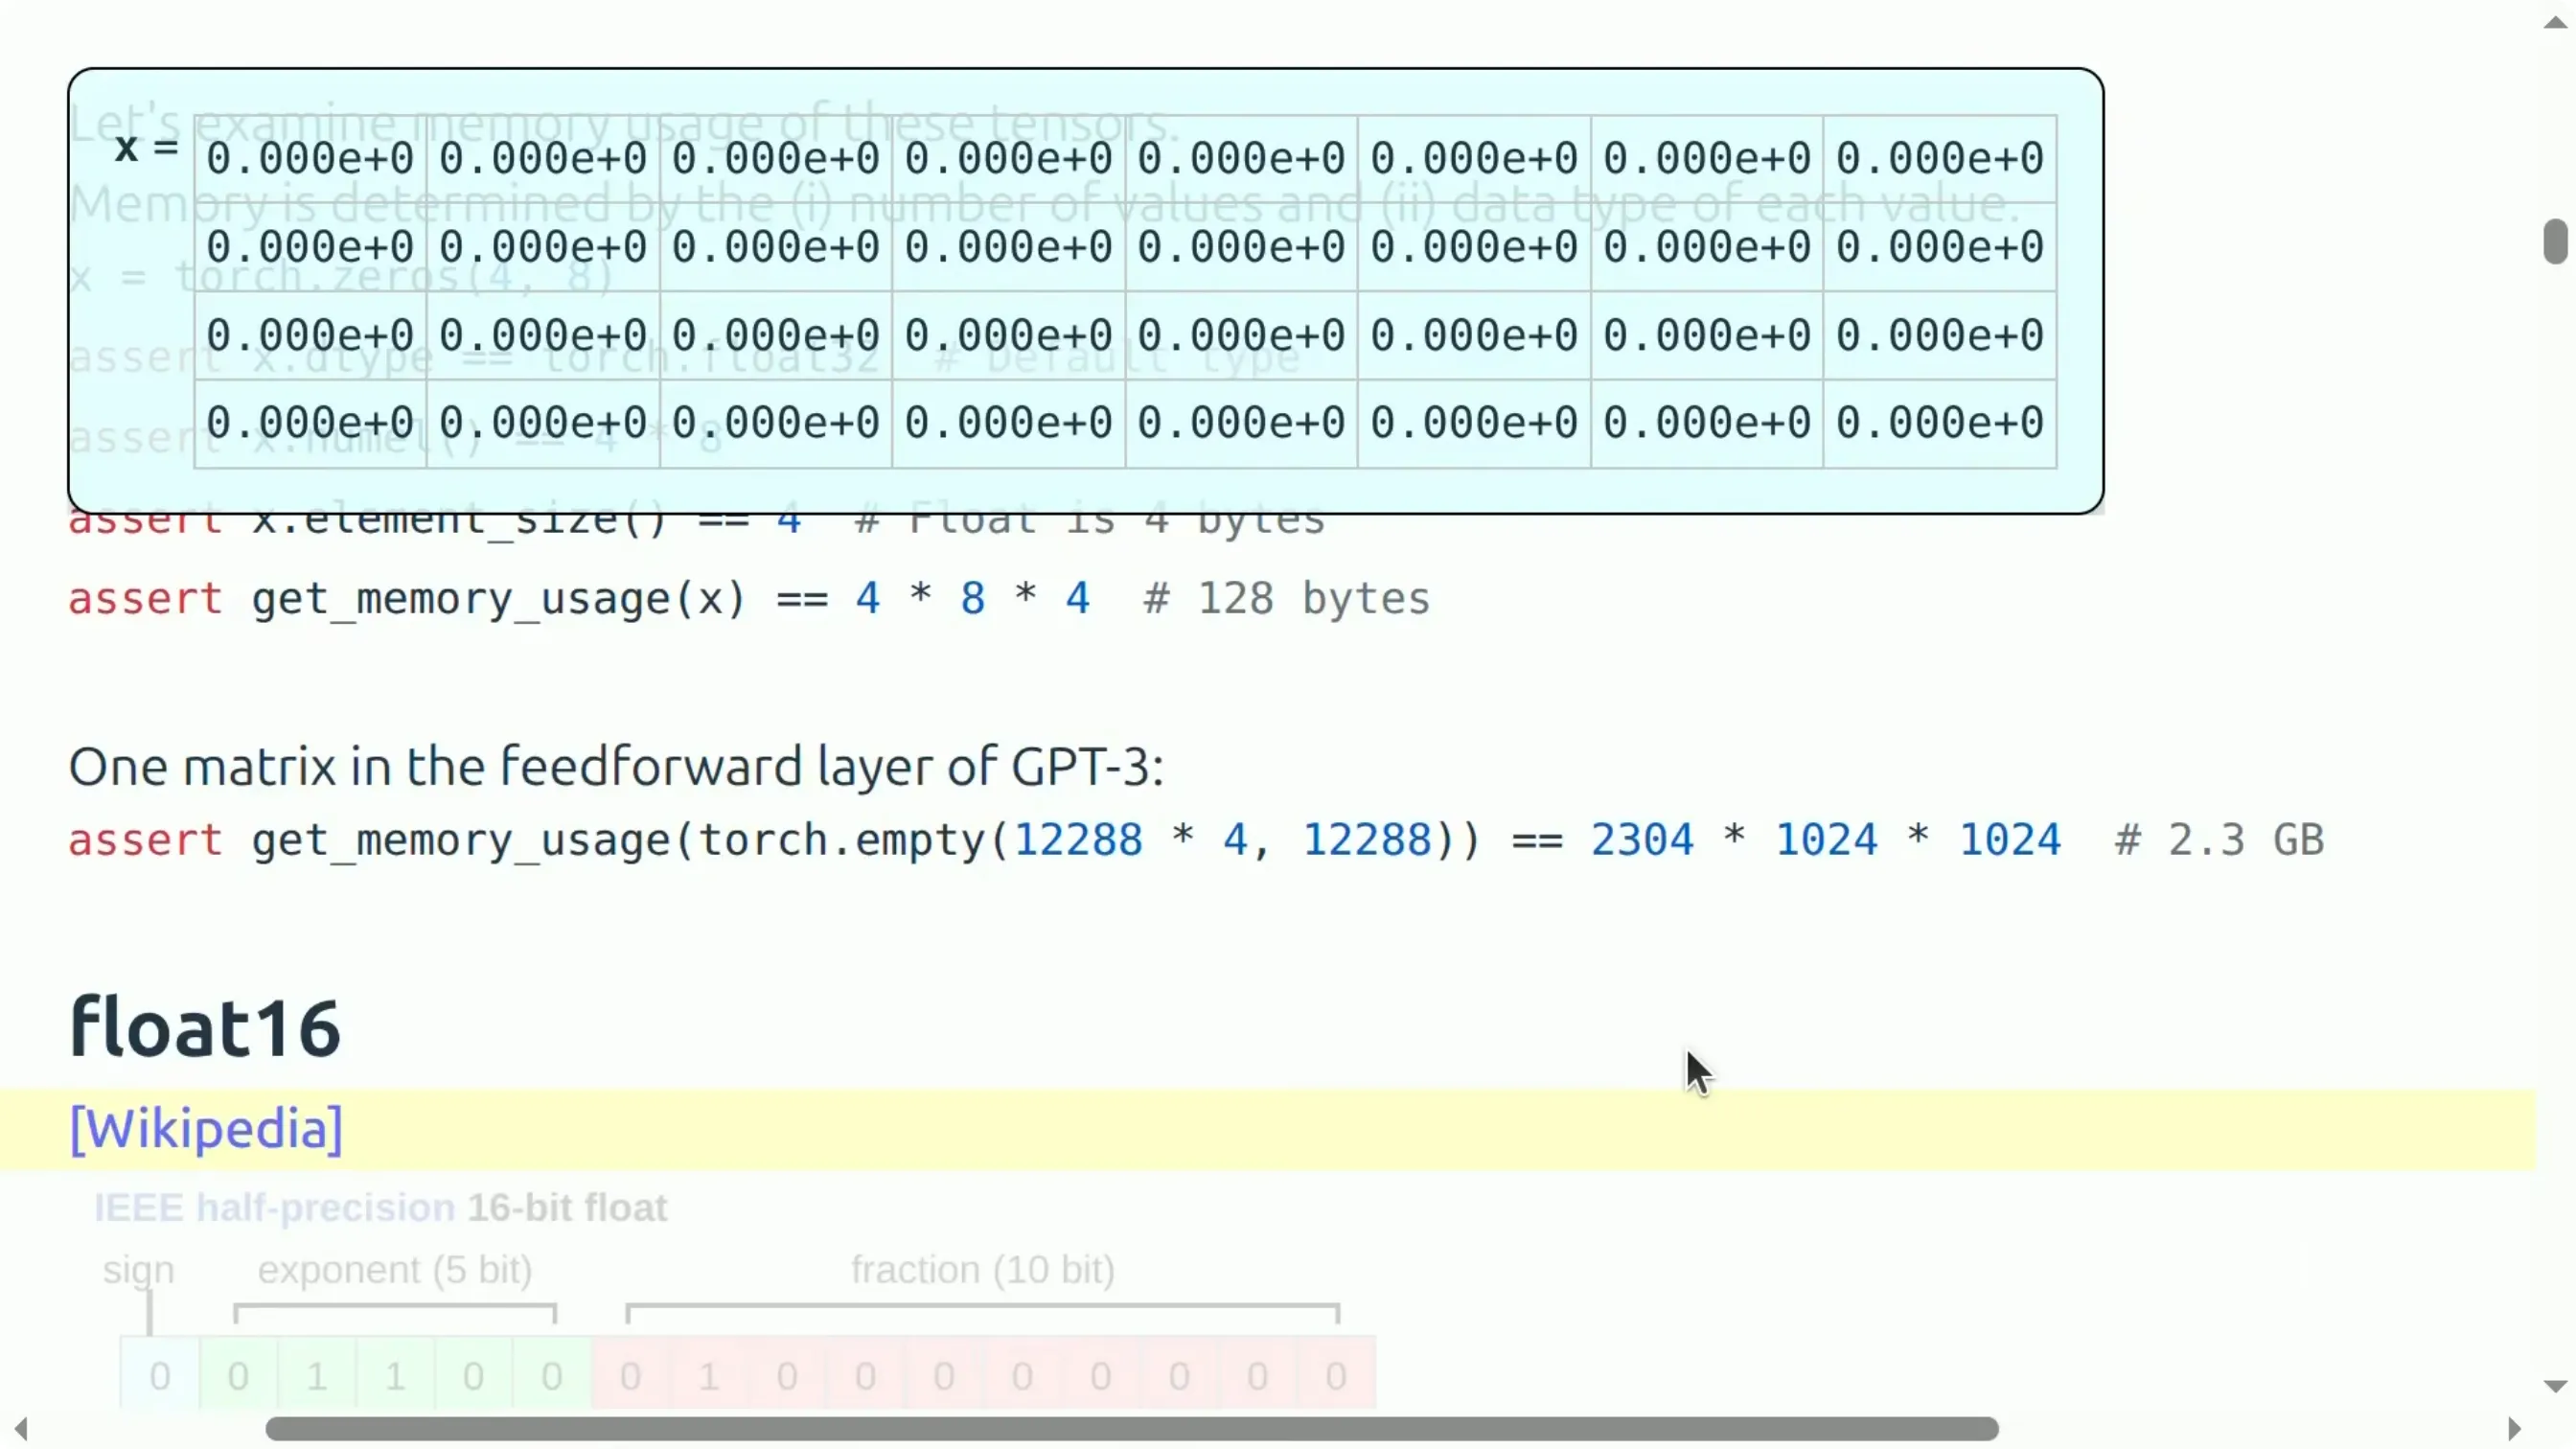
📷 fp16:位数砍半但动态范围差,1e-8 直接下溢为 0
回到原视频 (00:08:51)
bf16:深度学习的好折中
(参考时间: 09:55)
Brain Floating Point(bf16) 由 Google Brain 在 2018 年提出。它的洞察是:不减少总位数(仍是 16 位),而是从尾数里挪一些位给指数。
结果:bf16 与 fp16 占同样的显存,却拥有与 fp32 相同的动态范围,代价是分辨率更差。这之所以值得,是因为深度学习的计算本来就"糙"且随机——你更在意别上溢/下溢,而不需要那么高的分辨率。
x = torch.tensor([1e-8], dtype=torch.bfloat16)
assert x != 0     # 不再下溢!
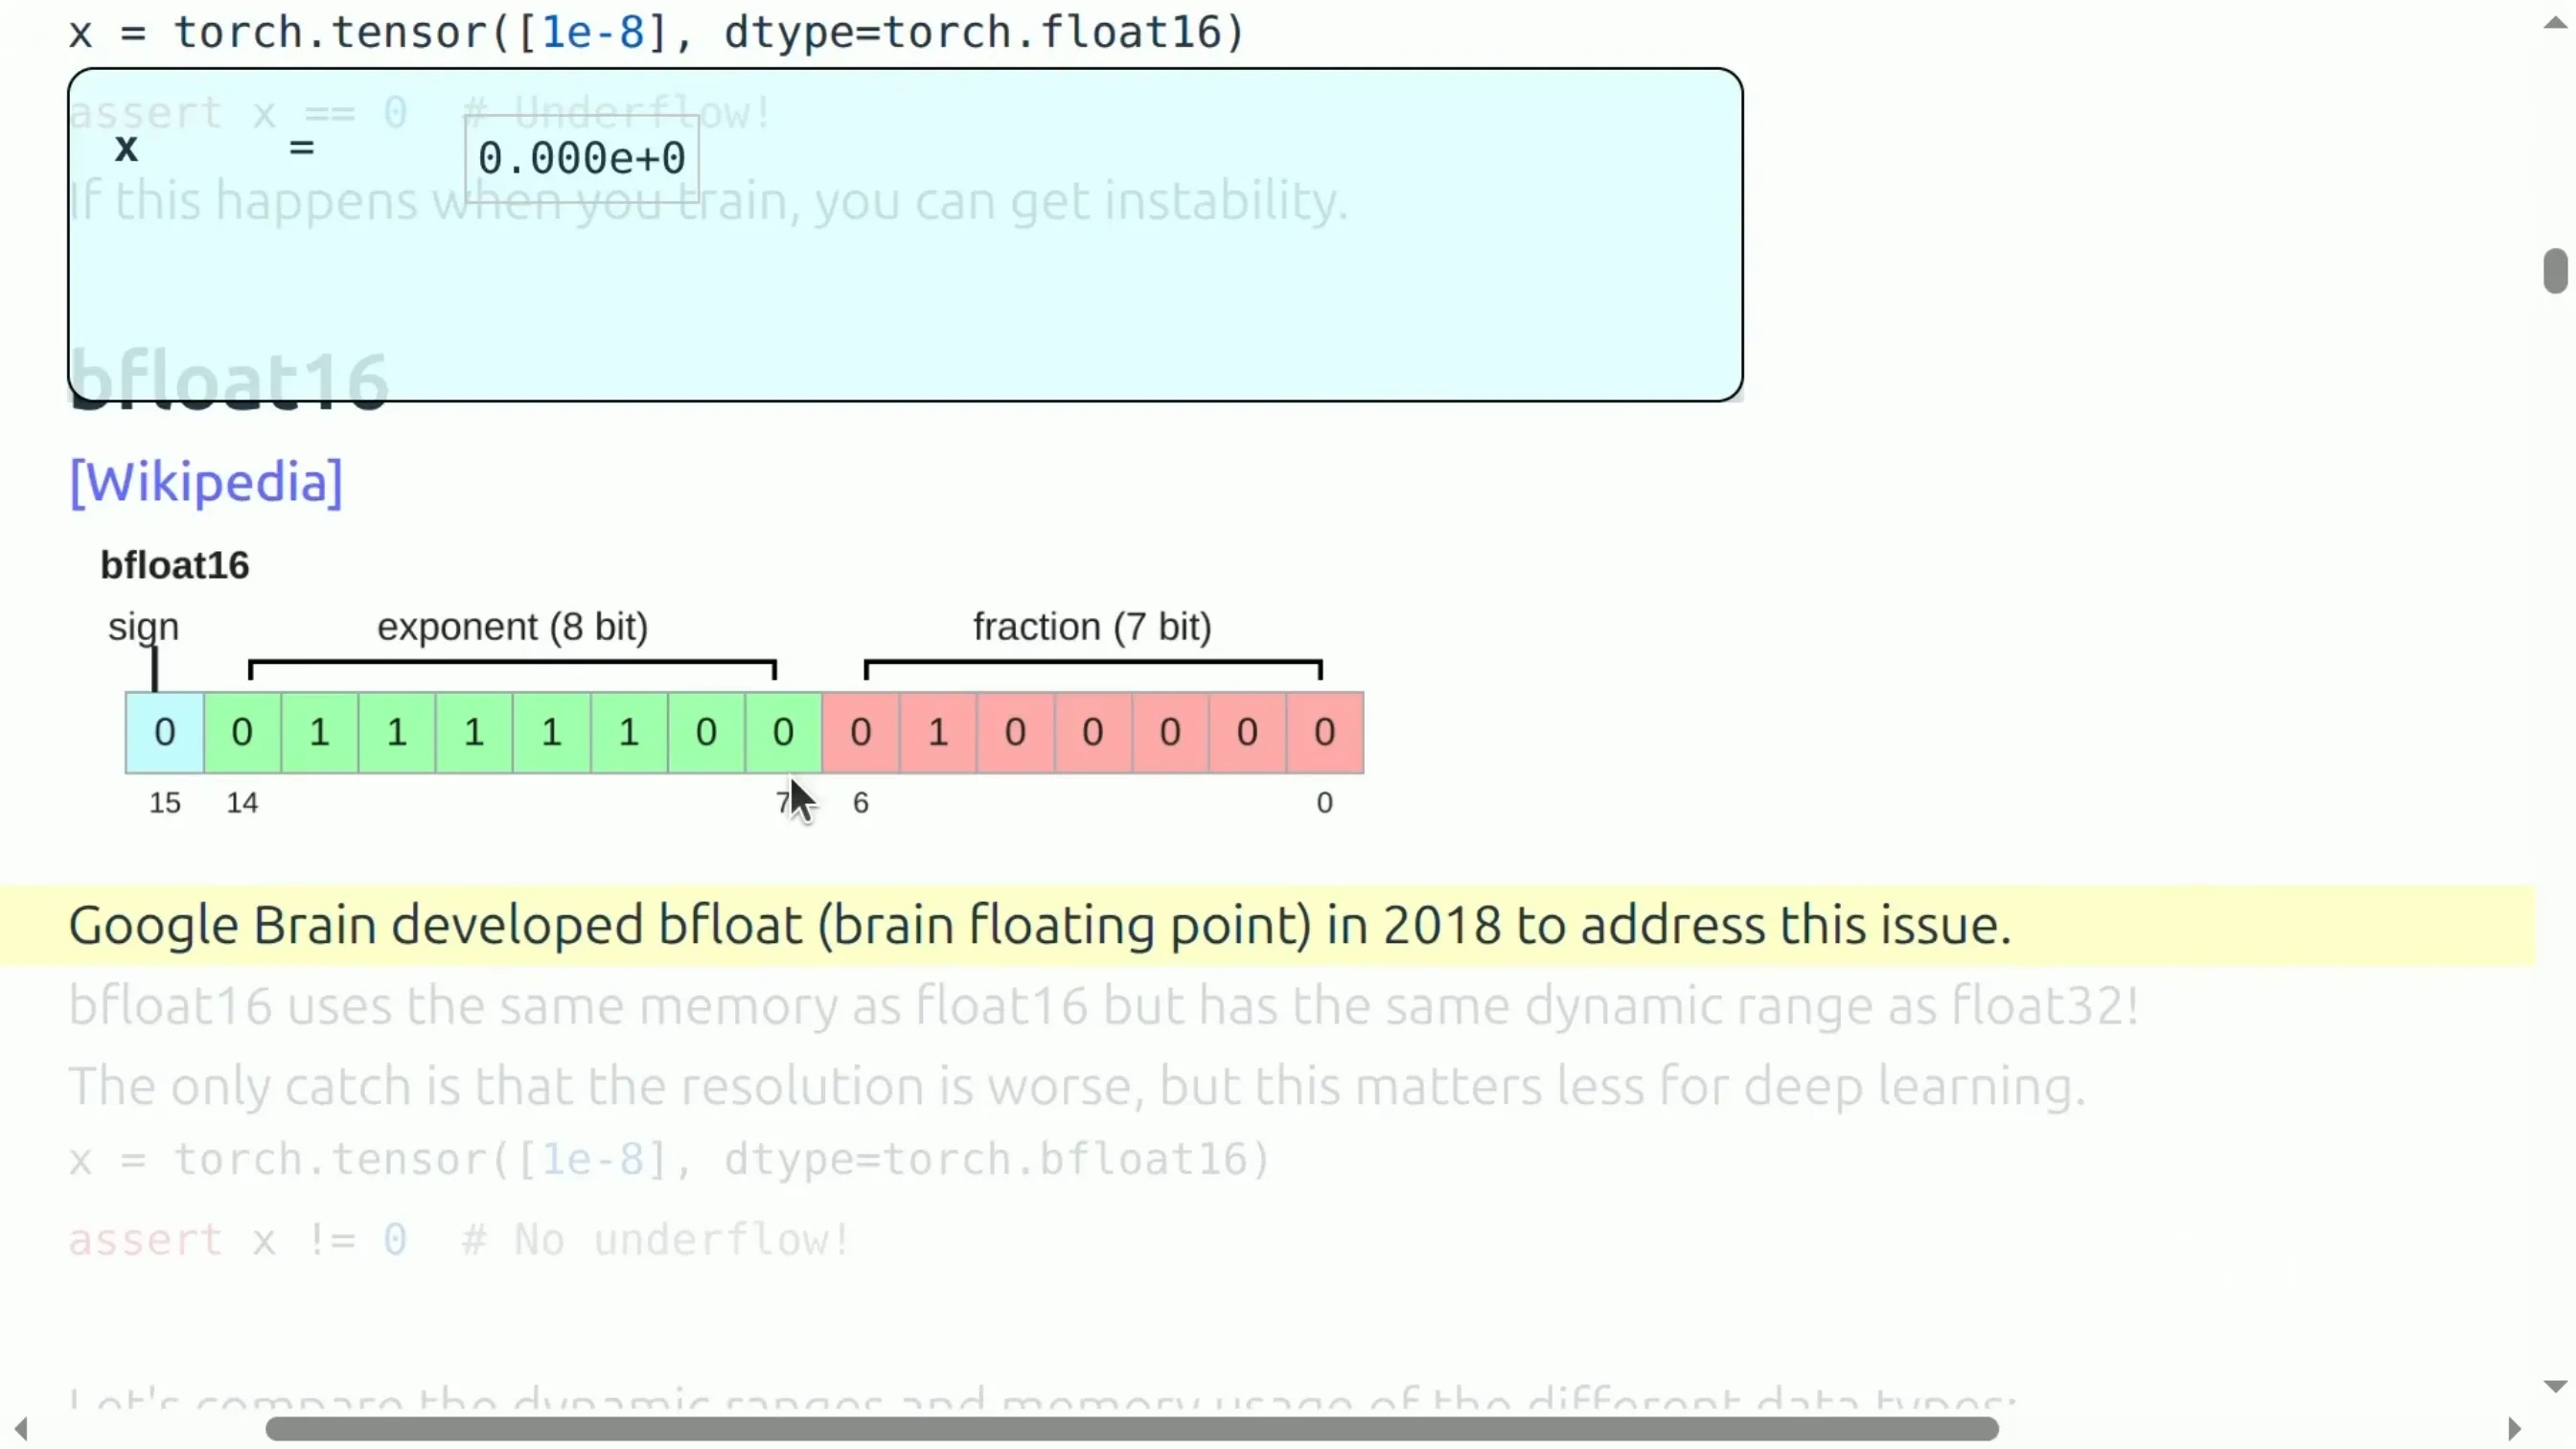
📷 bf16:与 fp32 相同的动态范围,代价是分辨率更低
回到原视频 (00:09:55)
混合精度训练
(参考时间: 11:52)
那么训练到底该用什么精度?
- 全 fp32:能训,但显存开销很大;
- fp16 / bf16:省显存,但有过不稳定风险(bf16 也可能有风险)。
目前的主流做法是混合精度训练(mixed precision):
- 参数、激活、梯度用 bf16;
- 优化器状态用 fp32(后面会解释为什么)。
PyTorch 提供了自动混合精度库 AMP:把代码包起来后,它会尽量把安全的操作转成 bf16(比如矩阵乘法),而对不安全的操作(比如指数运算)保持 fp32。
with torch.amp.autocast("cuda", dtype=torch.bfloat16):
    x = torch.zeros(4, 8)
📷 混合精度训练:计算用 bf16、优化器状态用 fp32,由 AMP 自动处理
回到原视频 (00:11:52)
再往下:fp8 与 fp4
(参考时间: 13:11)
如果用 bf16 还觉得不过瘾,可以更激进:
- fp8(2022 年标准化):H100 支持两种变体——E4M3(范围约 ±448)与 E5M2(范围约 ±57344)。取舍在于"要动态范围还是要分辨率"。
- fp4(NVIDIA 的 NVFP4,2025):每个值只有 4 位!可表示的值非常少,比如
-6, -4, -3, -2, -1.5, -1.0, -0.5, 0, 0.5, …, 6。这里有一个"小作弊":每块(block)共用一个缩放因子,所以单个值能获得超过 4 位的动态范围,但代价是相邻值的跨度不能太大。已经有模型(Nemotron 3 Super)用 NVFP4 训练。
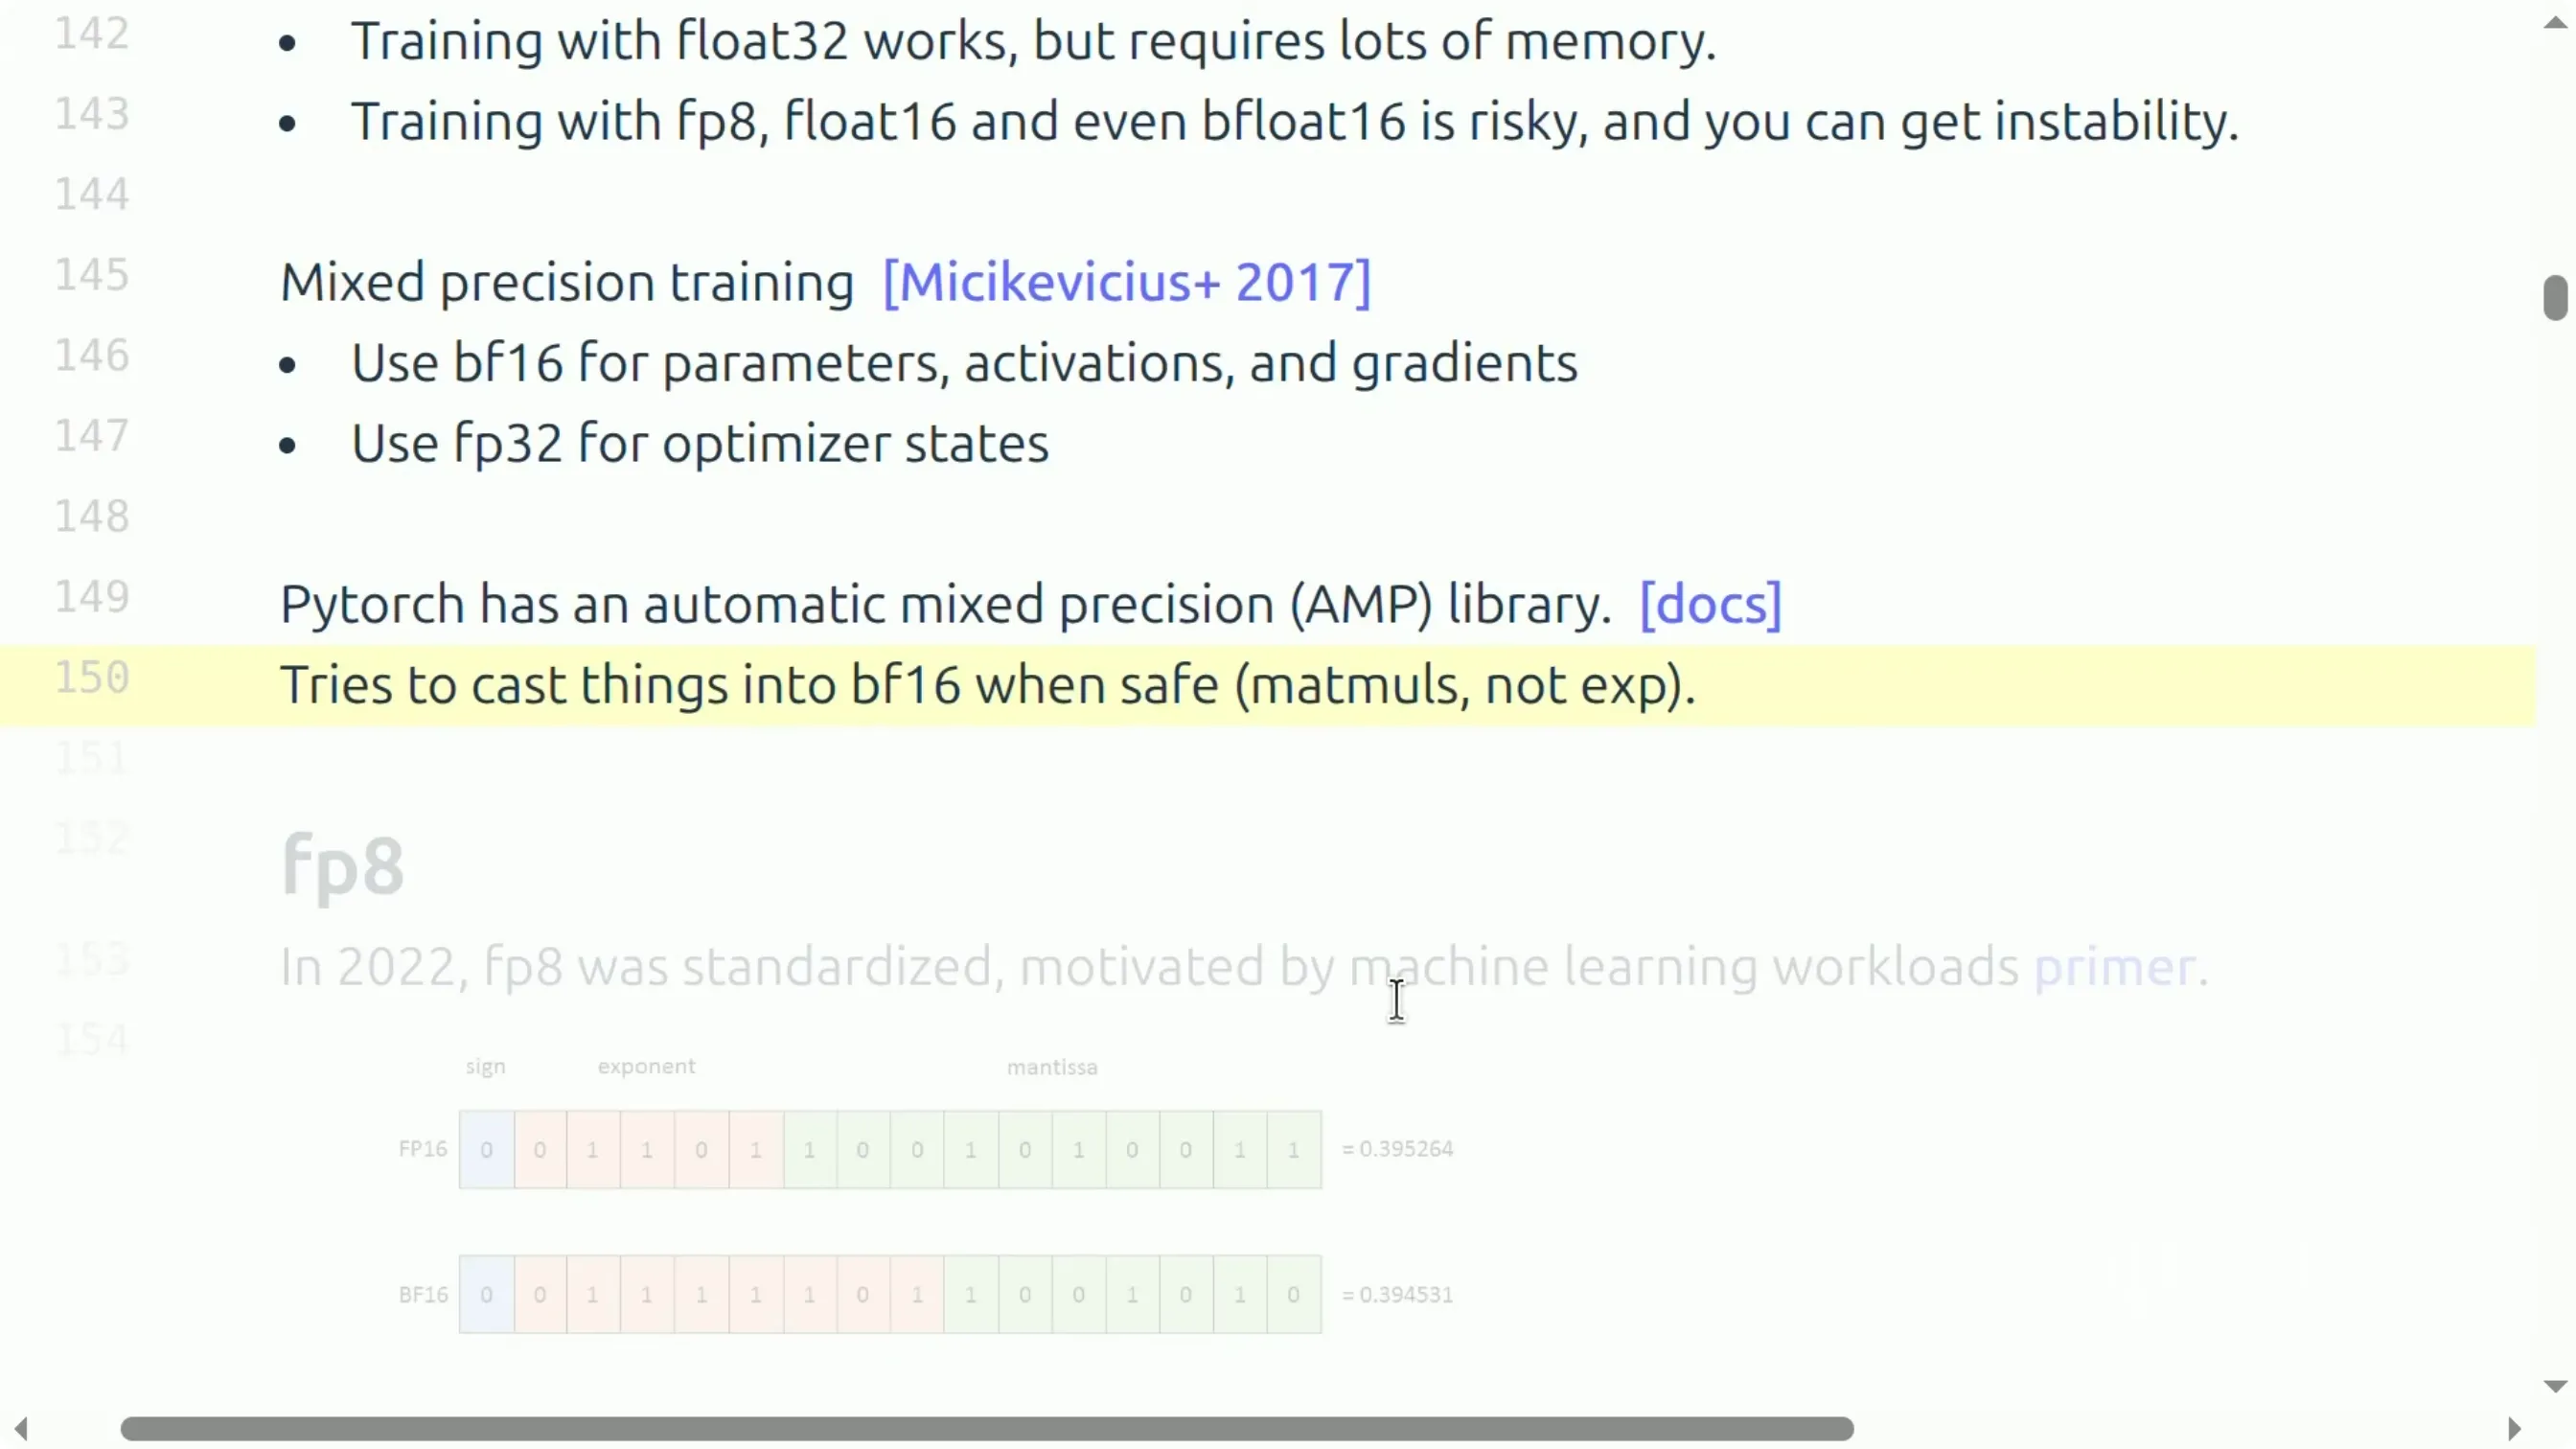
📷 fp8 的两种格式:E4M3 偏分辨率,E5M2 偏动态范围
回到原视频 (00:13:11)
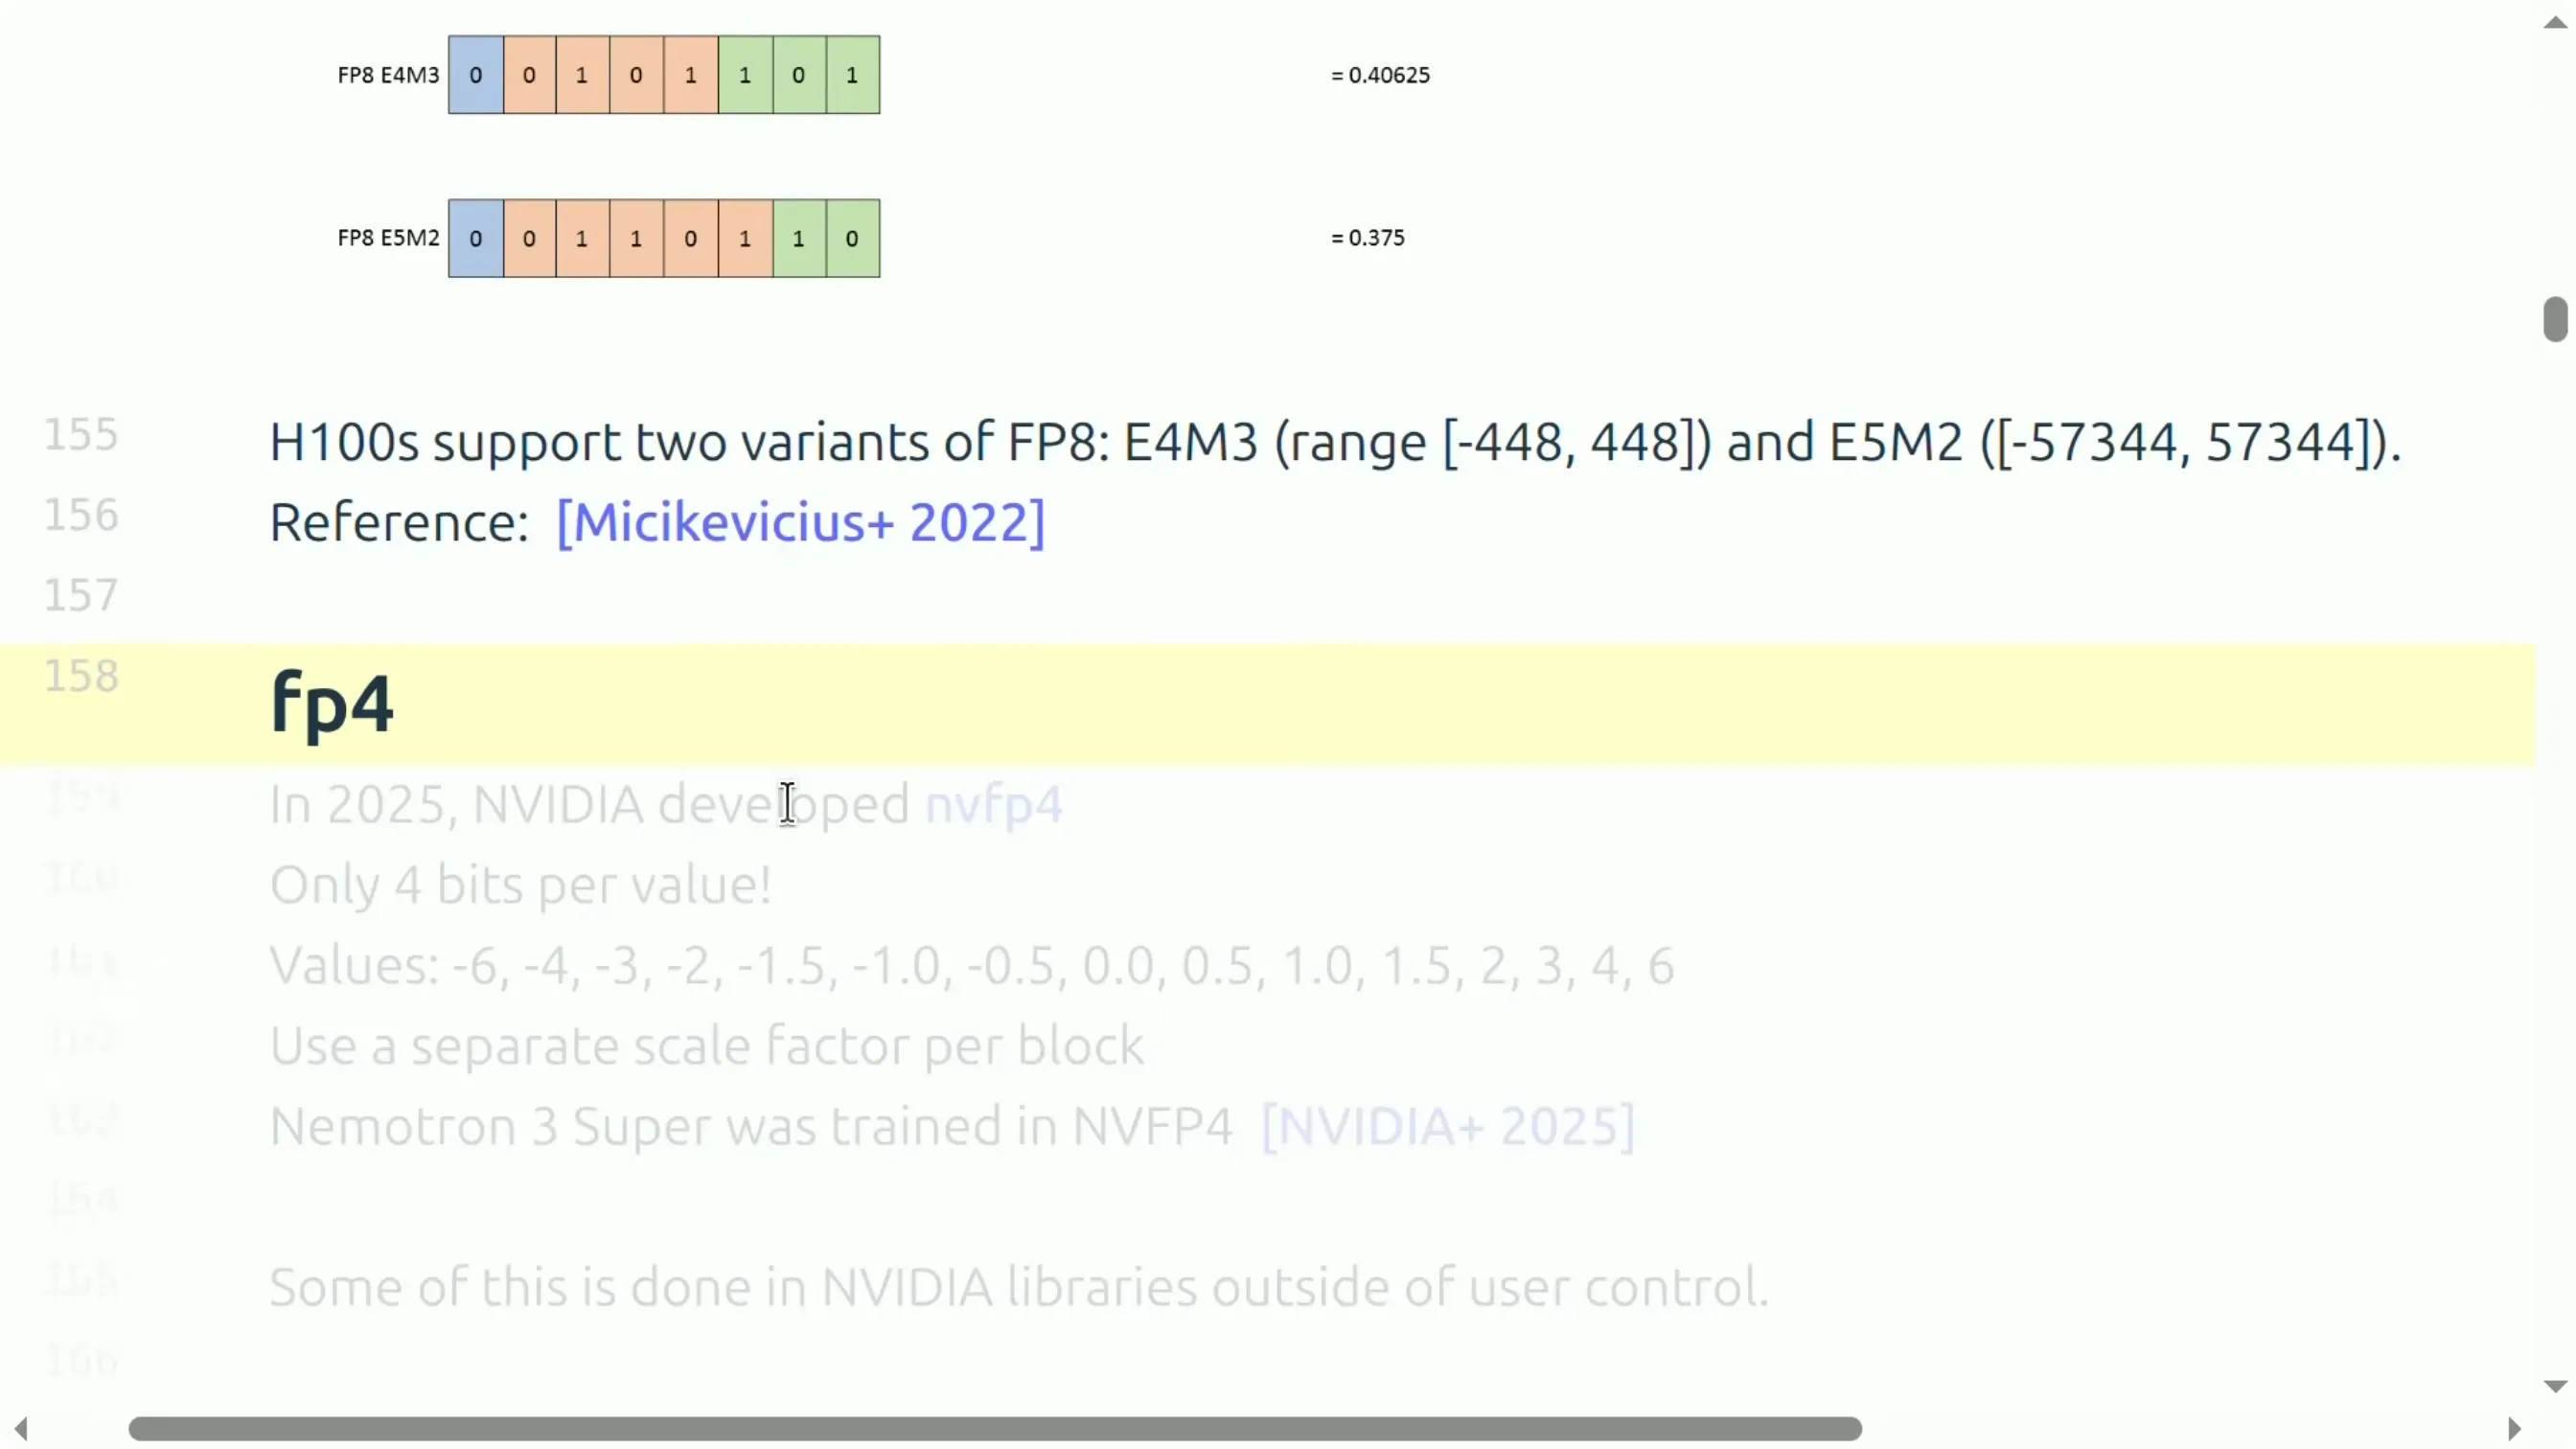
📷 fp4 / NVFP4:每值 4 位,靠块级缩放因子扩展动态范围
回到原视频 (00:13:45)
课堂问答:
- 块缩放是怎么回事? 在一个块内,各值仍受 4 位约束;但整块可以整体放大/缩小。于是一个单独的值能获得更大的动态范围,只是不能"这个值特别大、紧邻的值特别小"。
- 能不能降到 1 位? 要区分训练与推理:低比特推理通常是把一个已经在 bf16 上训好的模型量化到 1~2 位,这比从头训练一个 1 位模型容易得多——后者目前没有可信的成功案例。
- 主讲提醒:这些低精度有一部分由 NVIDIA 的软件栈在底层完成,并不是你自己建个张量调一下参数就能用上。
四、张量在 GPU 上
(参考时间: 17:00)
📷 把张量搬到 GPU:默认在 CPU,需显式 .to(device)
回到原视频 (00:17:00)
默认情况下,PyTorch 创建的张量在 CPU 内存里:
x = torch.zeros(32, 32)
assert x.device == torch.device("cpu")
要想利用 GPU 的大规模并行,必须把张量搬到 GPU 显存:
x = x.to(device)
# 或者直接建在 GPU 上:
with torch.device(device):
    x = torch.zeros(32, 32)
主讲提醒:这虽然简单,但一定要记得做,否则你根本拿不到任何加速。他还坦白,本讲的部分代码是在他自己的笔记本上(没有 GPU)执行的,所以有些代码只是"展示"而不会真正运行出结果。
五、Einops:给张量的维度起名字
(参考时间: 17:58)
接下来讲"用张量做计算"。在正式数 FLOPs 之前,先花点时间讲 Einops(Einstein Operations)。
动机:transpose(-2, -1) 到底转的是啥?
(参考时间: 18:24)
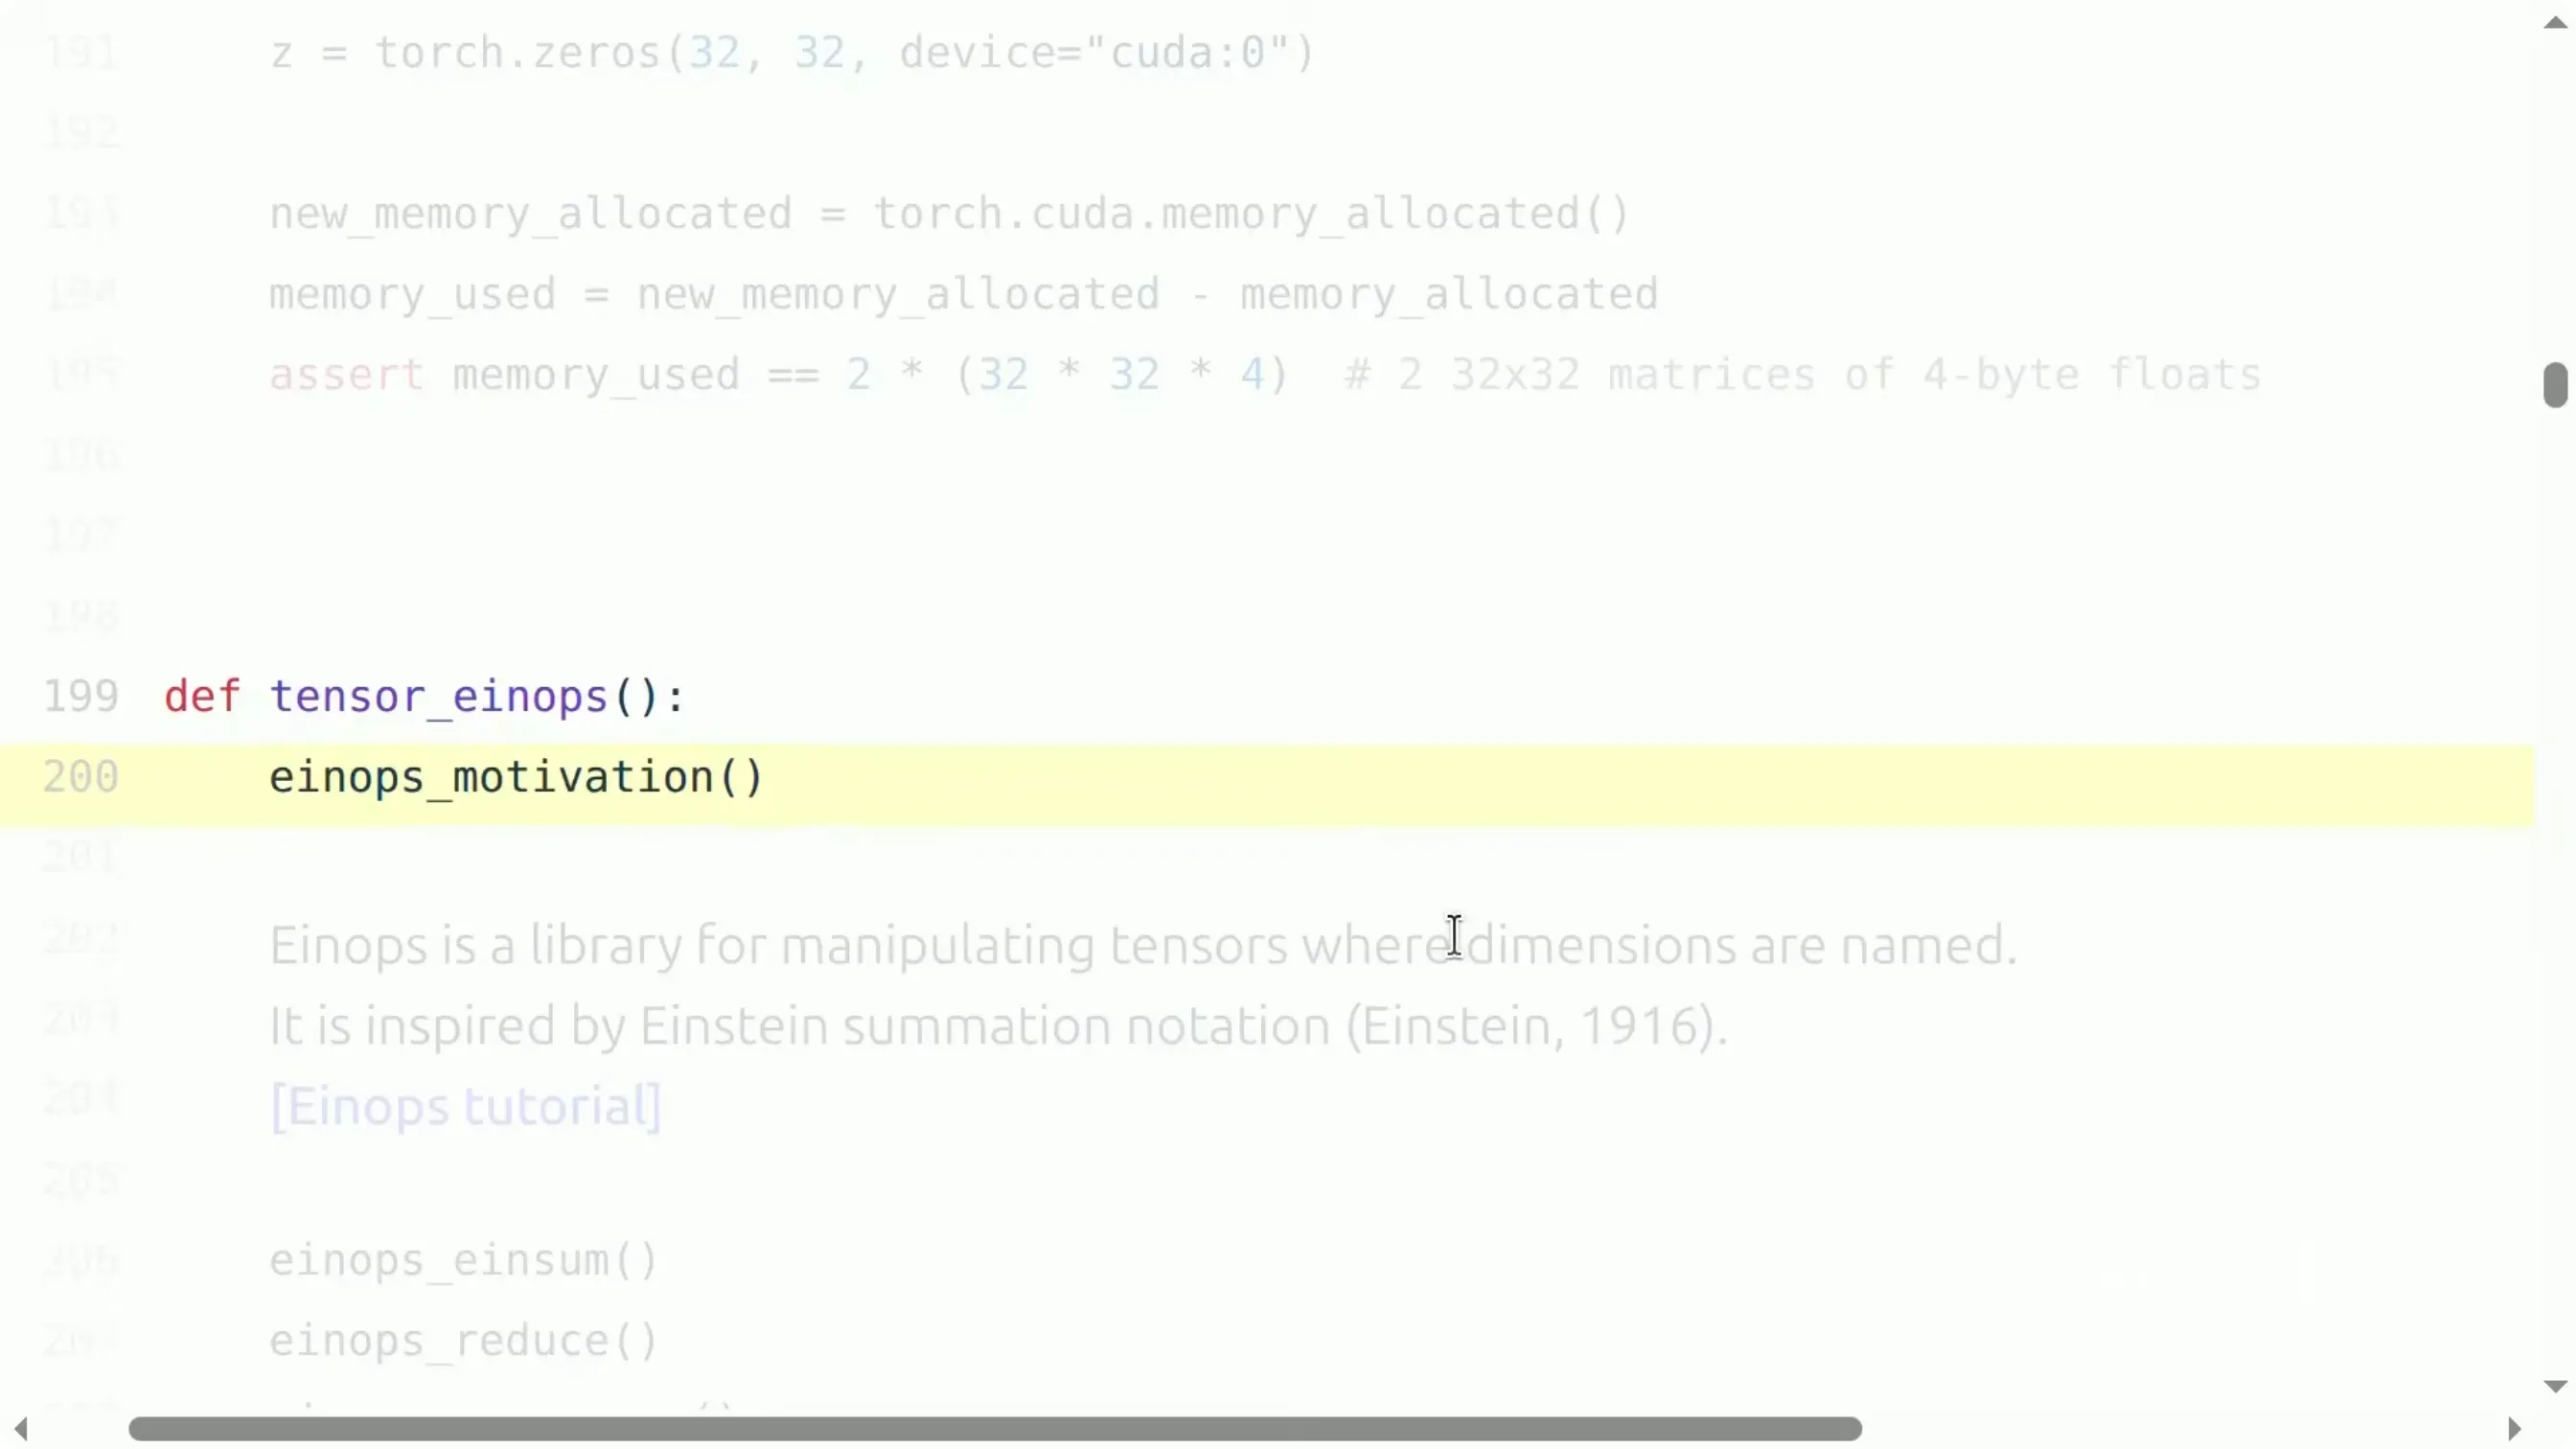
📷 Einops 的动机:x @ y.transpose(-2, -1) 里 -2、-1 是什么
回到原视频 (00:18:24)
传统 PyTorch 写法里,这样的代码非常容易出错、也极难读懂:
x = torch.ones(2, 2, 3)       # batch seq hidden
y = torch.ones(2, 2, 3)       # batch seq hidden
z = x @ y.transpose(-2, -1)   # batch seq seq
问题就在于 -2, -1 到底指哪两个维度?主讲说自己也经常搞混转置。Einops 的核心思想是:用"名字"而不是"位置下标"来描述维度。
graph LR
    A["传统写法<br/>x @ y.transpose(-2, -1)<br/>(-2、-1 是哪两维?)"] --> B["Einops 写法<br/>einsum(x, y, 'batch seq1 hidden, batch seq2 hidden -> batch seq1 seq2')<br/>(维度有名字)"]
einsum:带"好账本"的广义矩阵乘法
(参考时间: 19:17)
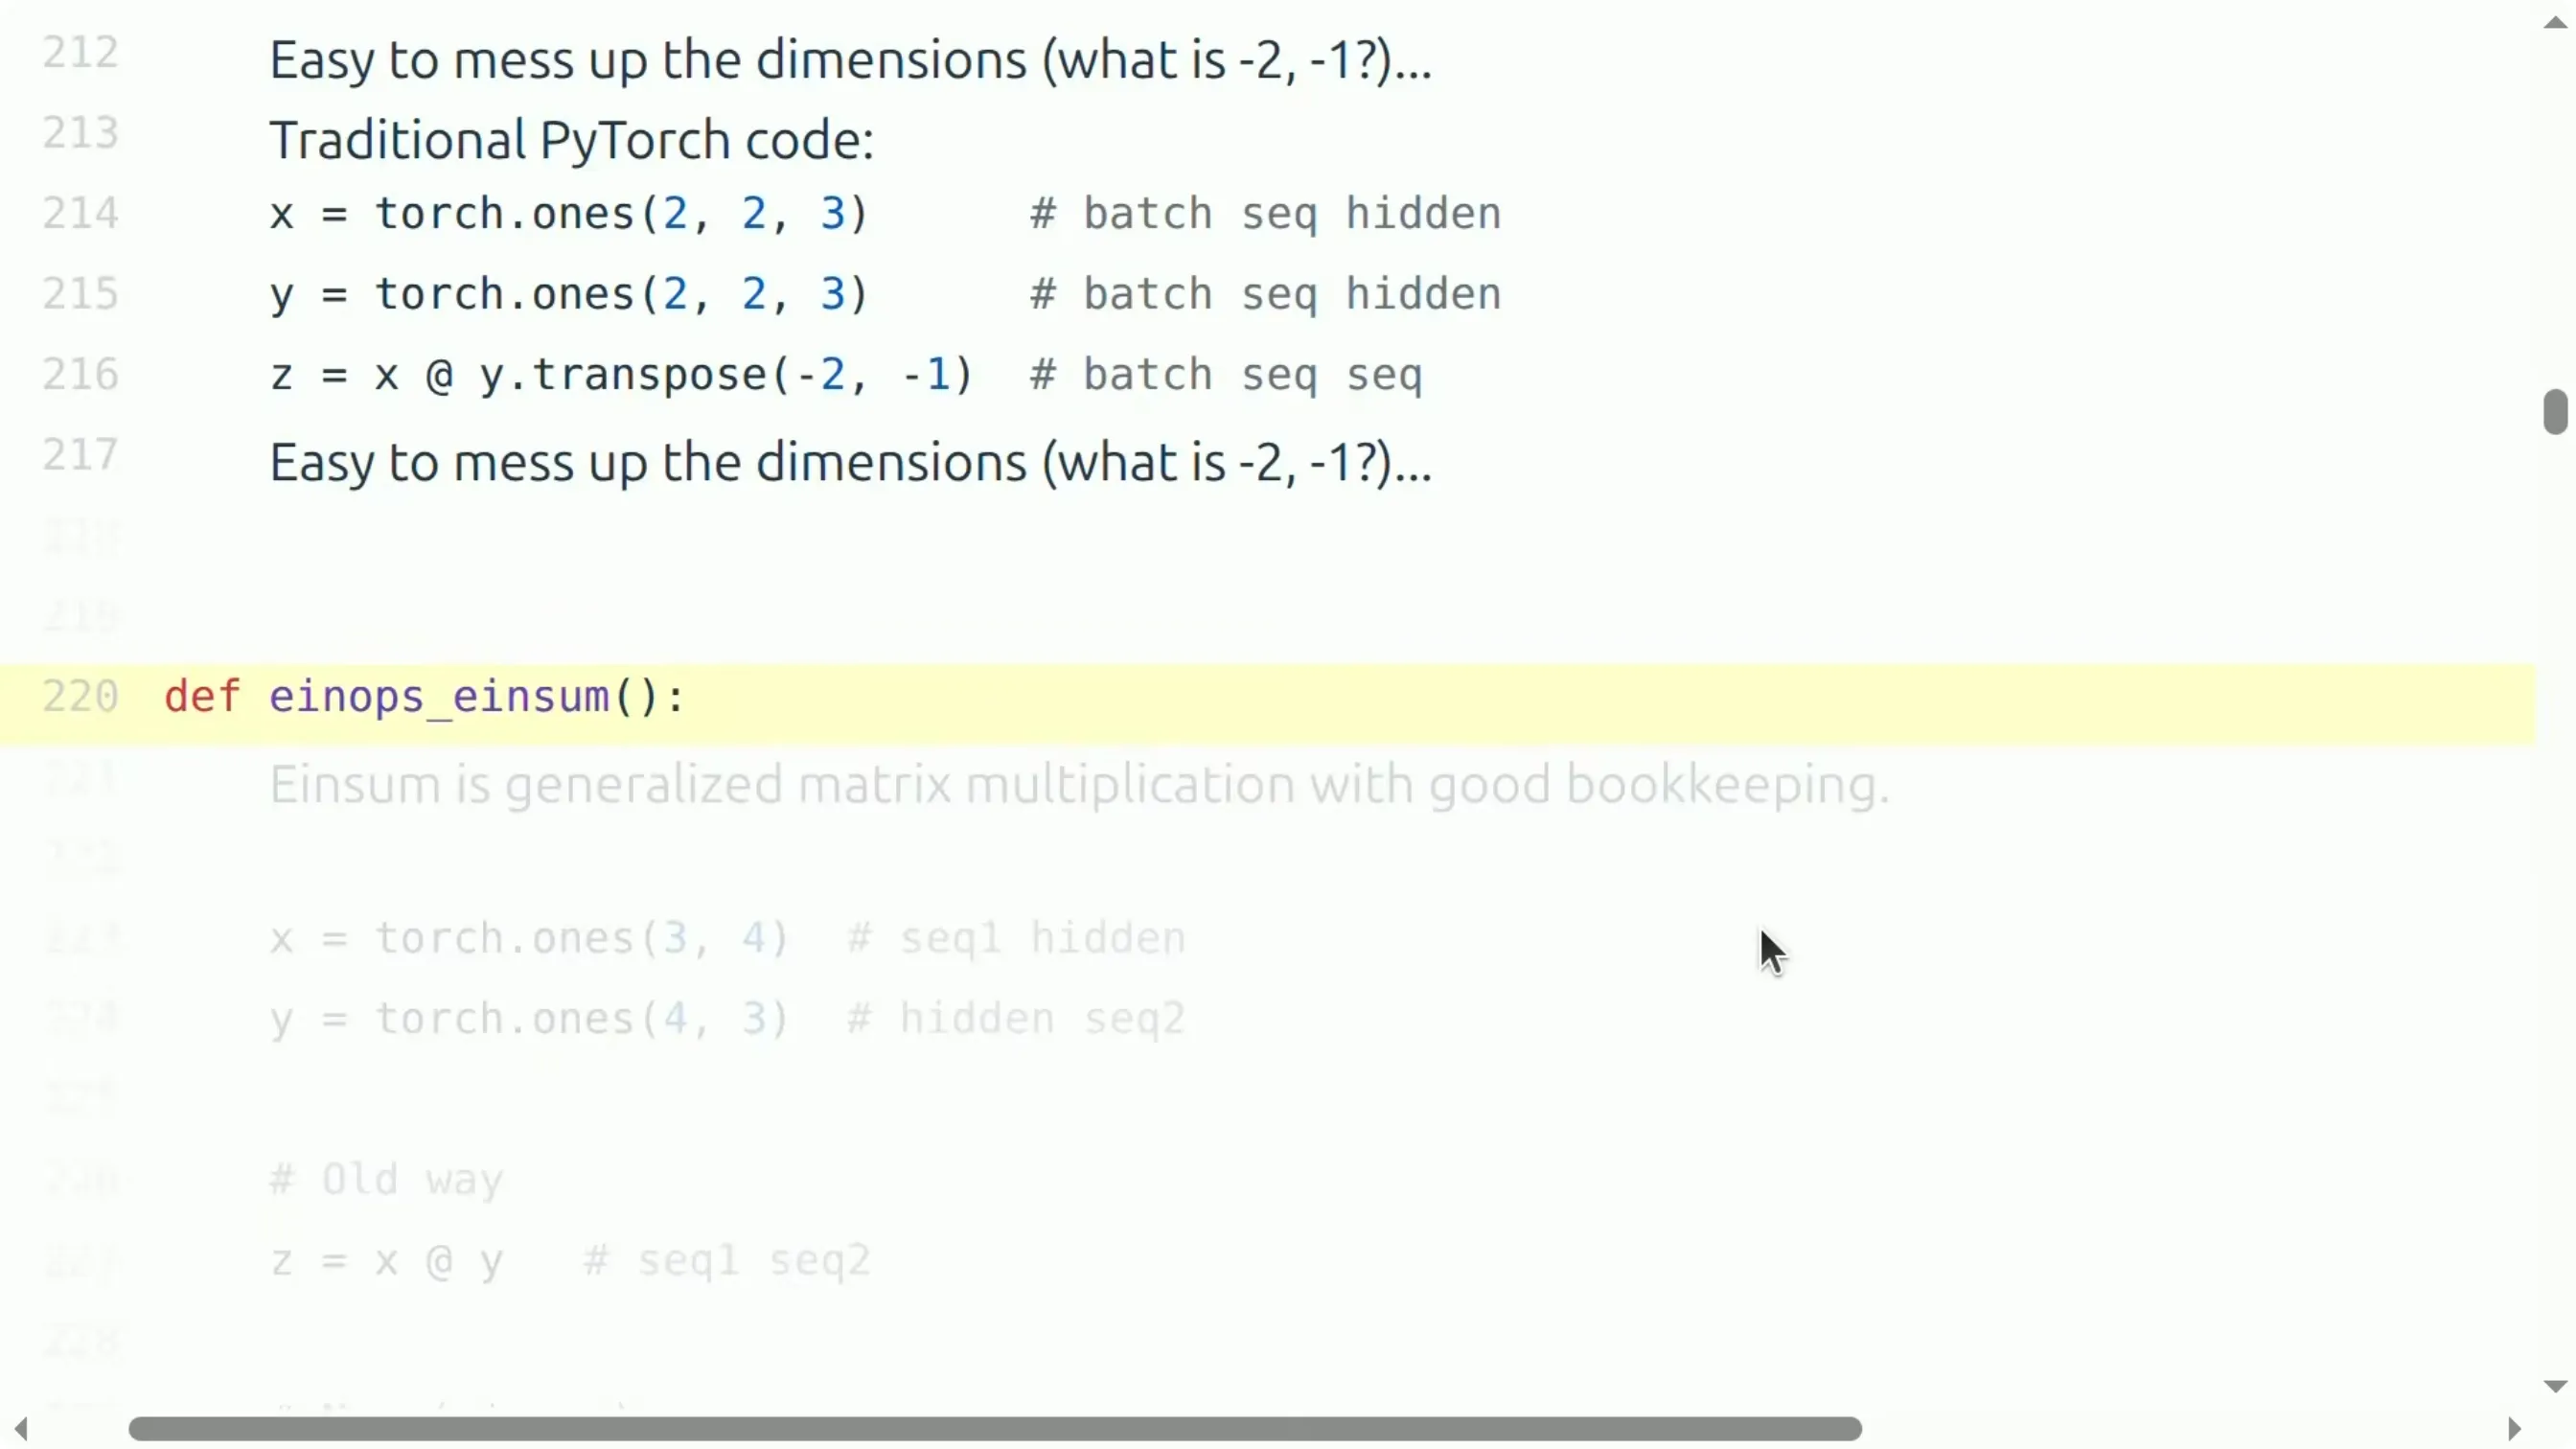
📷 einsum:用命名维度做广义矩阵乘法,未命名的维度被求和
回到原视频 (00:19:17)
einsum 是"广义的矩阵乘法 + 清晰的记账"。基本形式如下:
x = torch.ones(3, 4)  # seq1 hidden
y = torch.ones(4, 3)  # hidden seq2

# 传统写法
z = x @ y

# Einops 写法
z = einsum(x, y, "seq1 hidden, hidden seq2 -> seq1 seq2")
规则很简单:输出里没有出现的维度,会被求和掉。在上面这个例子里,hidden 不在输出中,所以沿它求和——这正是矩阵乘法的定义。
对更复杂的批处理情形,Einops 同样清晰:
x = torch.ones(2, 3, 4)  # batch seq1 hidden
y = torch.ones(2, 3, 4)  # batch seq2 hidden

# 传统写法(需要自己想清楚转置与广播)
z = x @ y.transpose(-2, -1)     # batch seq1 seq2

# Einops 写法
z = einsum(x, y, "batch seq1 hidden, batch seq2 hidden -> batch seq1 seq2")
主讲特别高兴的一点是:这里根本不需要写 transpose——因为你通过命名已经"隐式地"完成了转置。如果写成 hidden seq2,那就是不转置。
还可以用 ... 表示"广播任意多个维度",这样在处理 rank 很高的张量(比如 8 个批维度)时就不必一一枚举:
z = einsum(x, y, "... seq1 hidden, ... seq2 hidden -> ... seq1 seq2")
这在语言建模里很常用:你可能同时有 batch 维度、sequence 维度、head 维度,而你只关心其中的一次矩阵运算。写好 ... 后,甚至不用关心传进来的张量到底是多少维,代码更模块化。
reduce:sum / mean / max / min 的泛化
(参考时间: 22:55)
📷 reduce:sum / mean / max / min 的泛化
回到原视频 (00:22:55)
x = torch.ones(2, 3, 4)  # batch seq hidden

# 传统写法
y = x.sum(dim=-1)

# Einops 写法
y = reduce(x, "... hidden -> ...", "sum")
左边没出现在右边的 hidden 会被归约掉,最后的字符串指定归约方式(sum / mean / max / min)。课堂问答:这有没有加速?主讲说它基本就是同一套底层原语,可以理解为语法糖,性能相同。
rearrange:拆分 / 合并维度
(参考时间: 24:05)
📷 rearrange:拆分与合并维度(如 total_hidden → heads × hidden1)
回到原视频 (00:24:05)
有时一个维度实际上代表了两个维度(比如某个矩阵被 flatten 过),而你只想对其中一个做运算:
x = torch.ones(3, 8)  # seq total_hidden,其中 total_hidden = heads * hidden1
w = torch.ones(4, 4)  # hidden1 hidden2

# 把 total_hidden 拆成 heads 和 hidden1(heads=2,隐含 hidden1=4)
x = rearrange(x, "... (heads hidden1) -> ... heads hidden1", heads=2)

# 用 w 做变换
x = einsum(x, w, "... hidden1, hidden1 hidden2 -> ... hidden2")

# 再把 heads 和 hidden2 合回一维
x = rearrange(x, "... heads hidden2 -> ... (heads hidden2)")
括号 (...) 是"拆分/合并"的标记。课堂问答:把二维展平成一维时,是行优先还是列优先?主讲说,顺序由你在表达式里写的顺序决定(左边 (heads hidden1) 与右边 heads hidden1 的对应关系就规定了怎么排)。
主讲提醒:Einops 需要一点时间适应,但非常值得——一旦习惯了,转置、归约这些操作都会变得顺手而自然。
六、FLOPs 与性能
(参考时间: 27:21)
📷 FLOP 的定义:一次加法或乘法
回到原视频 (00:27:21)
现在回到资源核算的核心问题:张量运算到底消耗多少算力?
两个读音相同、极易混淆的缩写
(参考时间: 28:03)
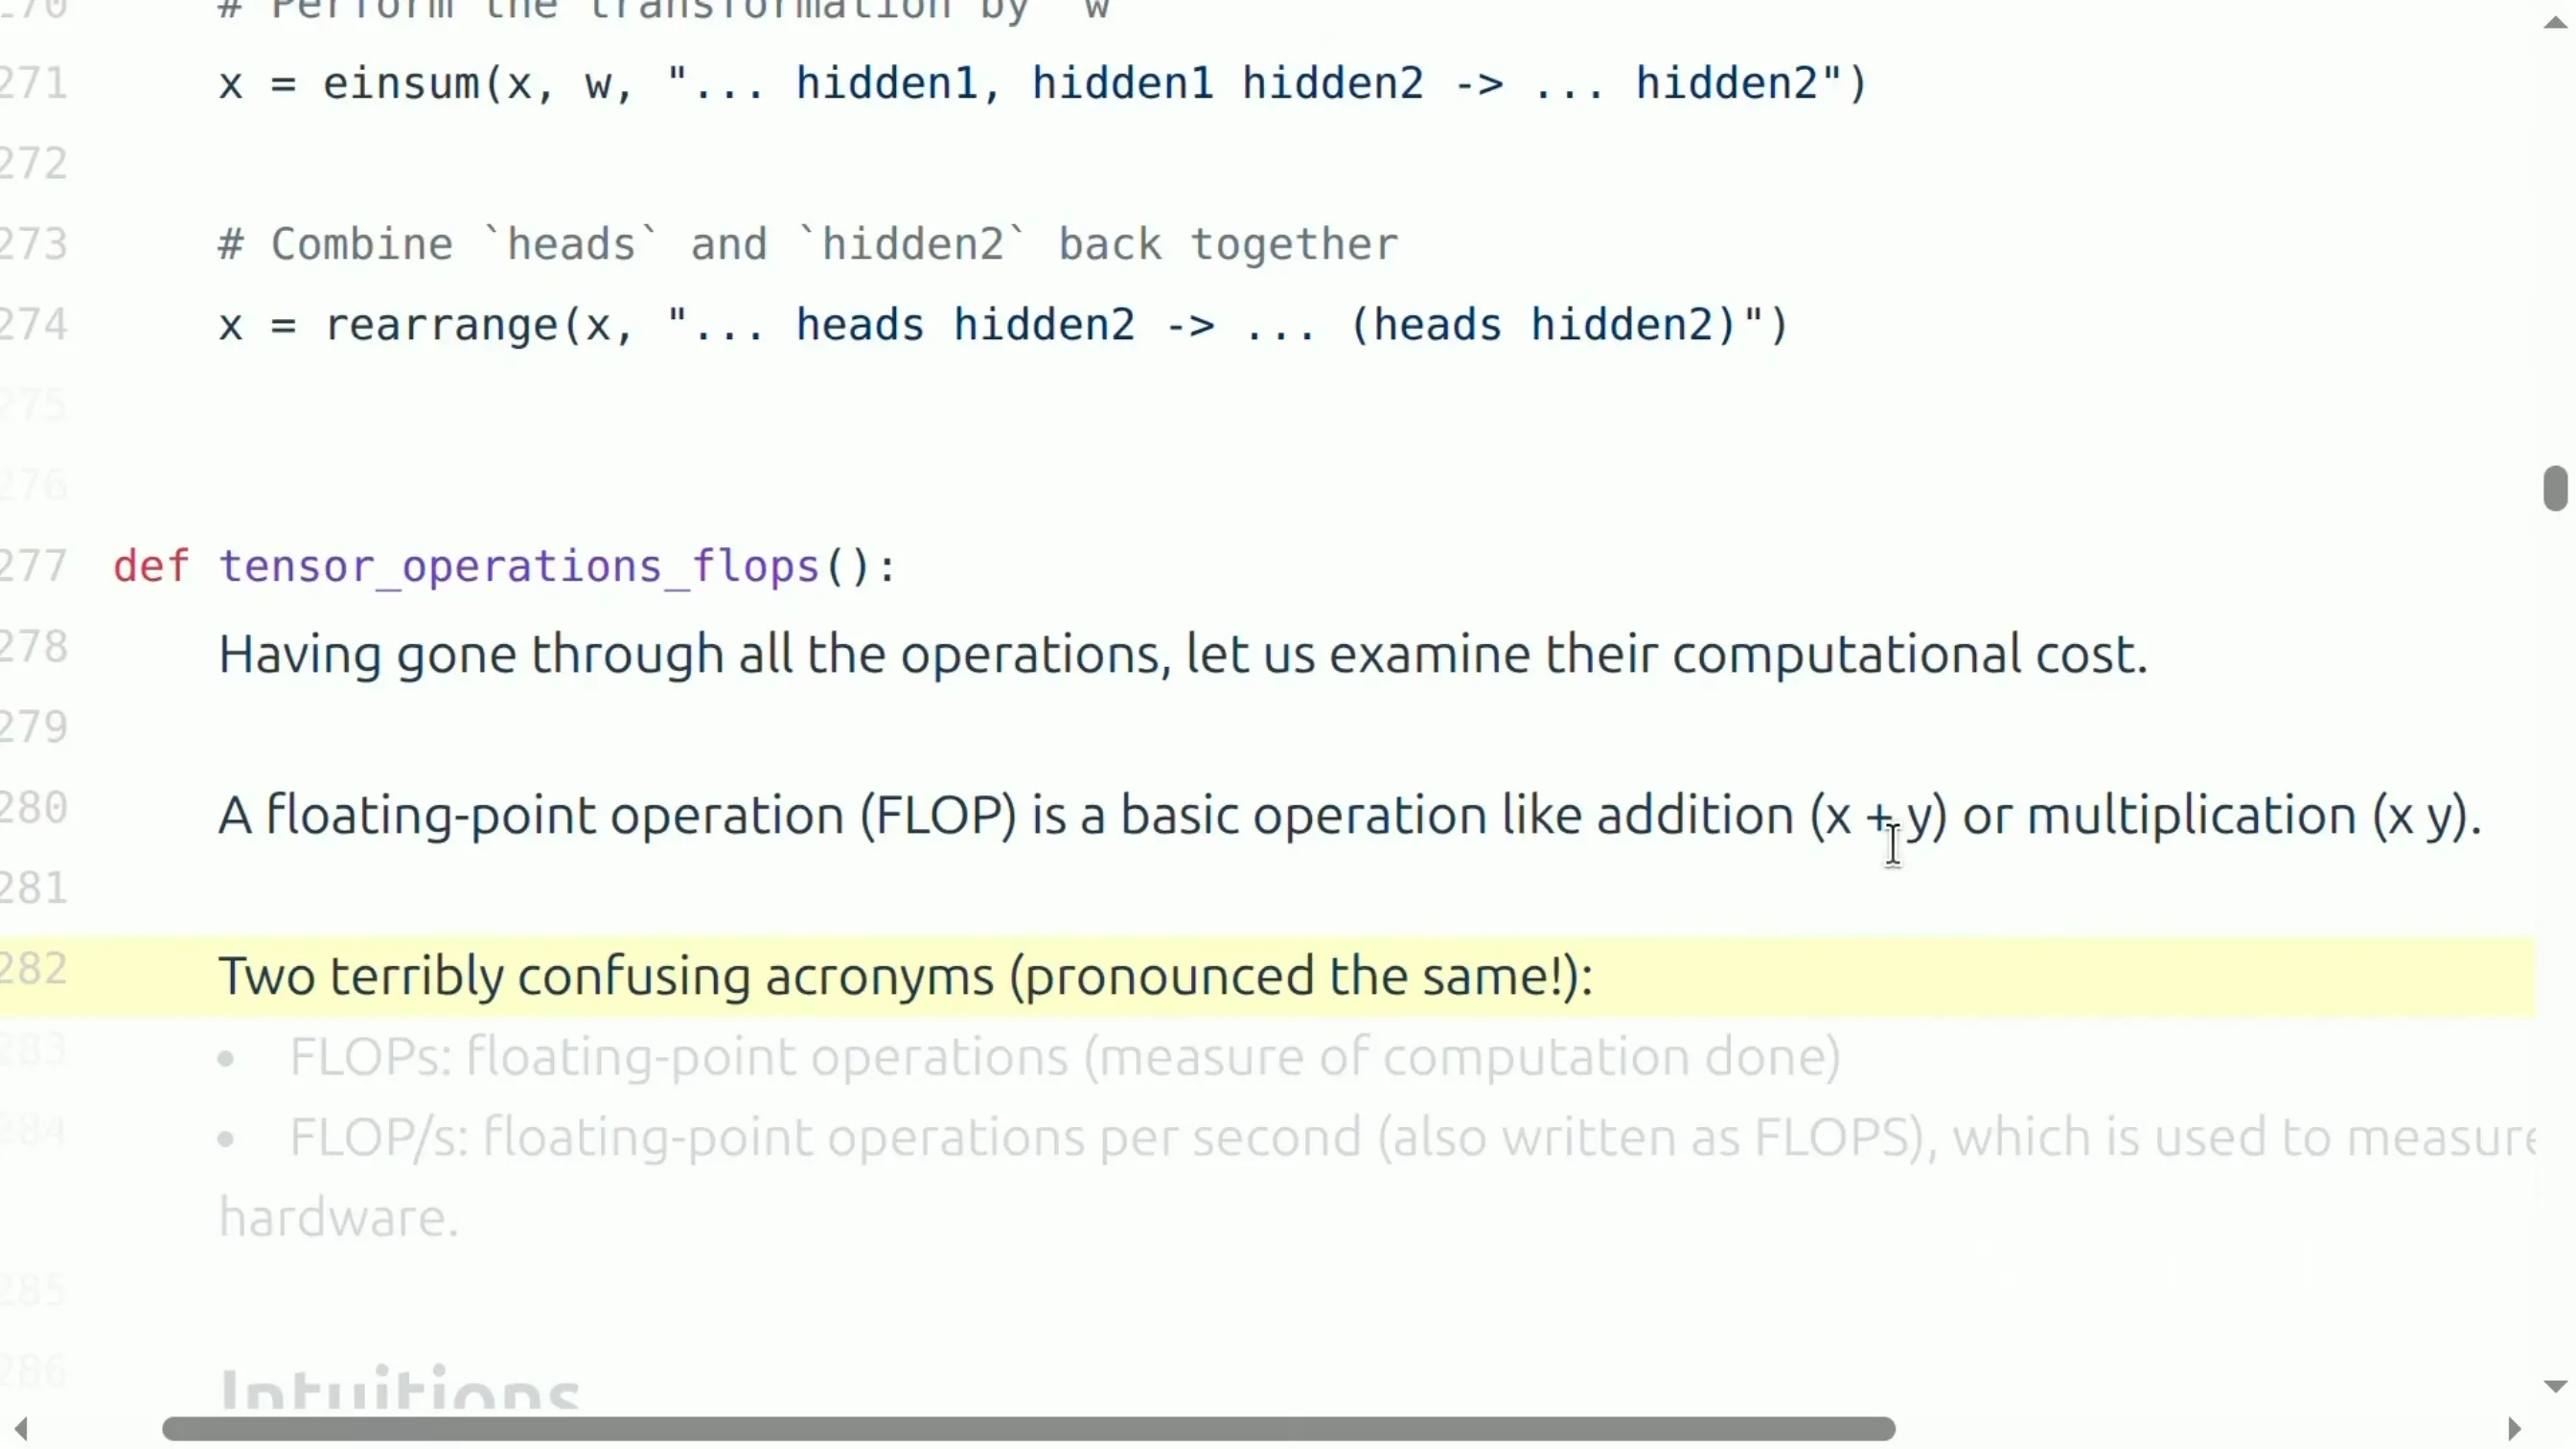
📷 FLOPs(计算量) vs FLOP/s(硬件速度)
回到原视频 (00:28:03)
- FLOPs:floating-point operations,浮点运算的次数——衡量"做了多少计算";
- FLOP/s(也写作 FLOPS):floating-point operations per second,每秒浮点运算次数——衡量"硬件有多快"。
主讲特意强调:他今后会一直写成 FLOP/s 以区分清楚。当你看到 H100 有"989 TFLOP/s"时,说的是后者;当你说"GPT-3 花了 3e23 FLOPs"时,说的是前者。
基本约定:一个 FLOP 就是一个基本运算,比如一次加法或一次乘法。GPU 还能做别的运算,但那些占比很小,我们主要关注加乘。
一些量级感:
- 训练 GPT-3(2020)约 3.14e23 FLOPs;
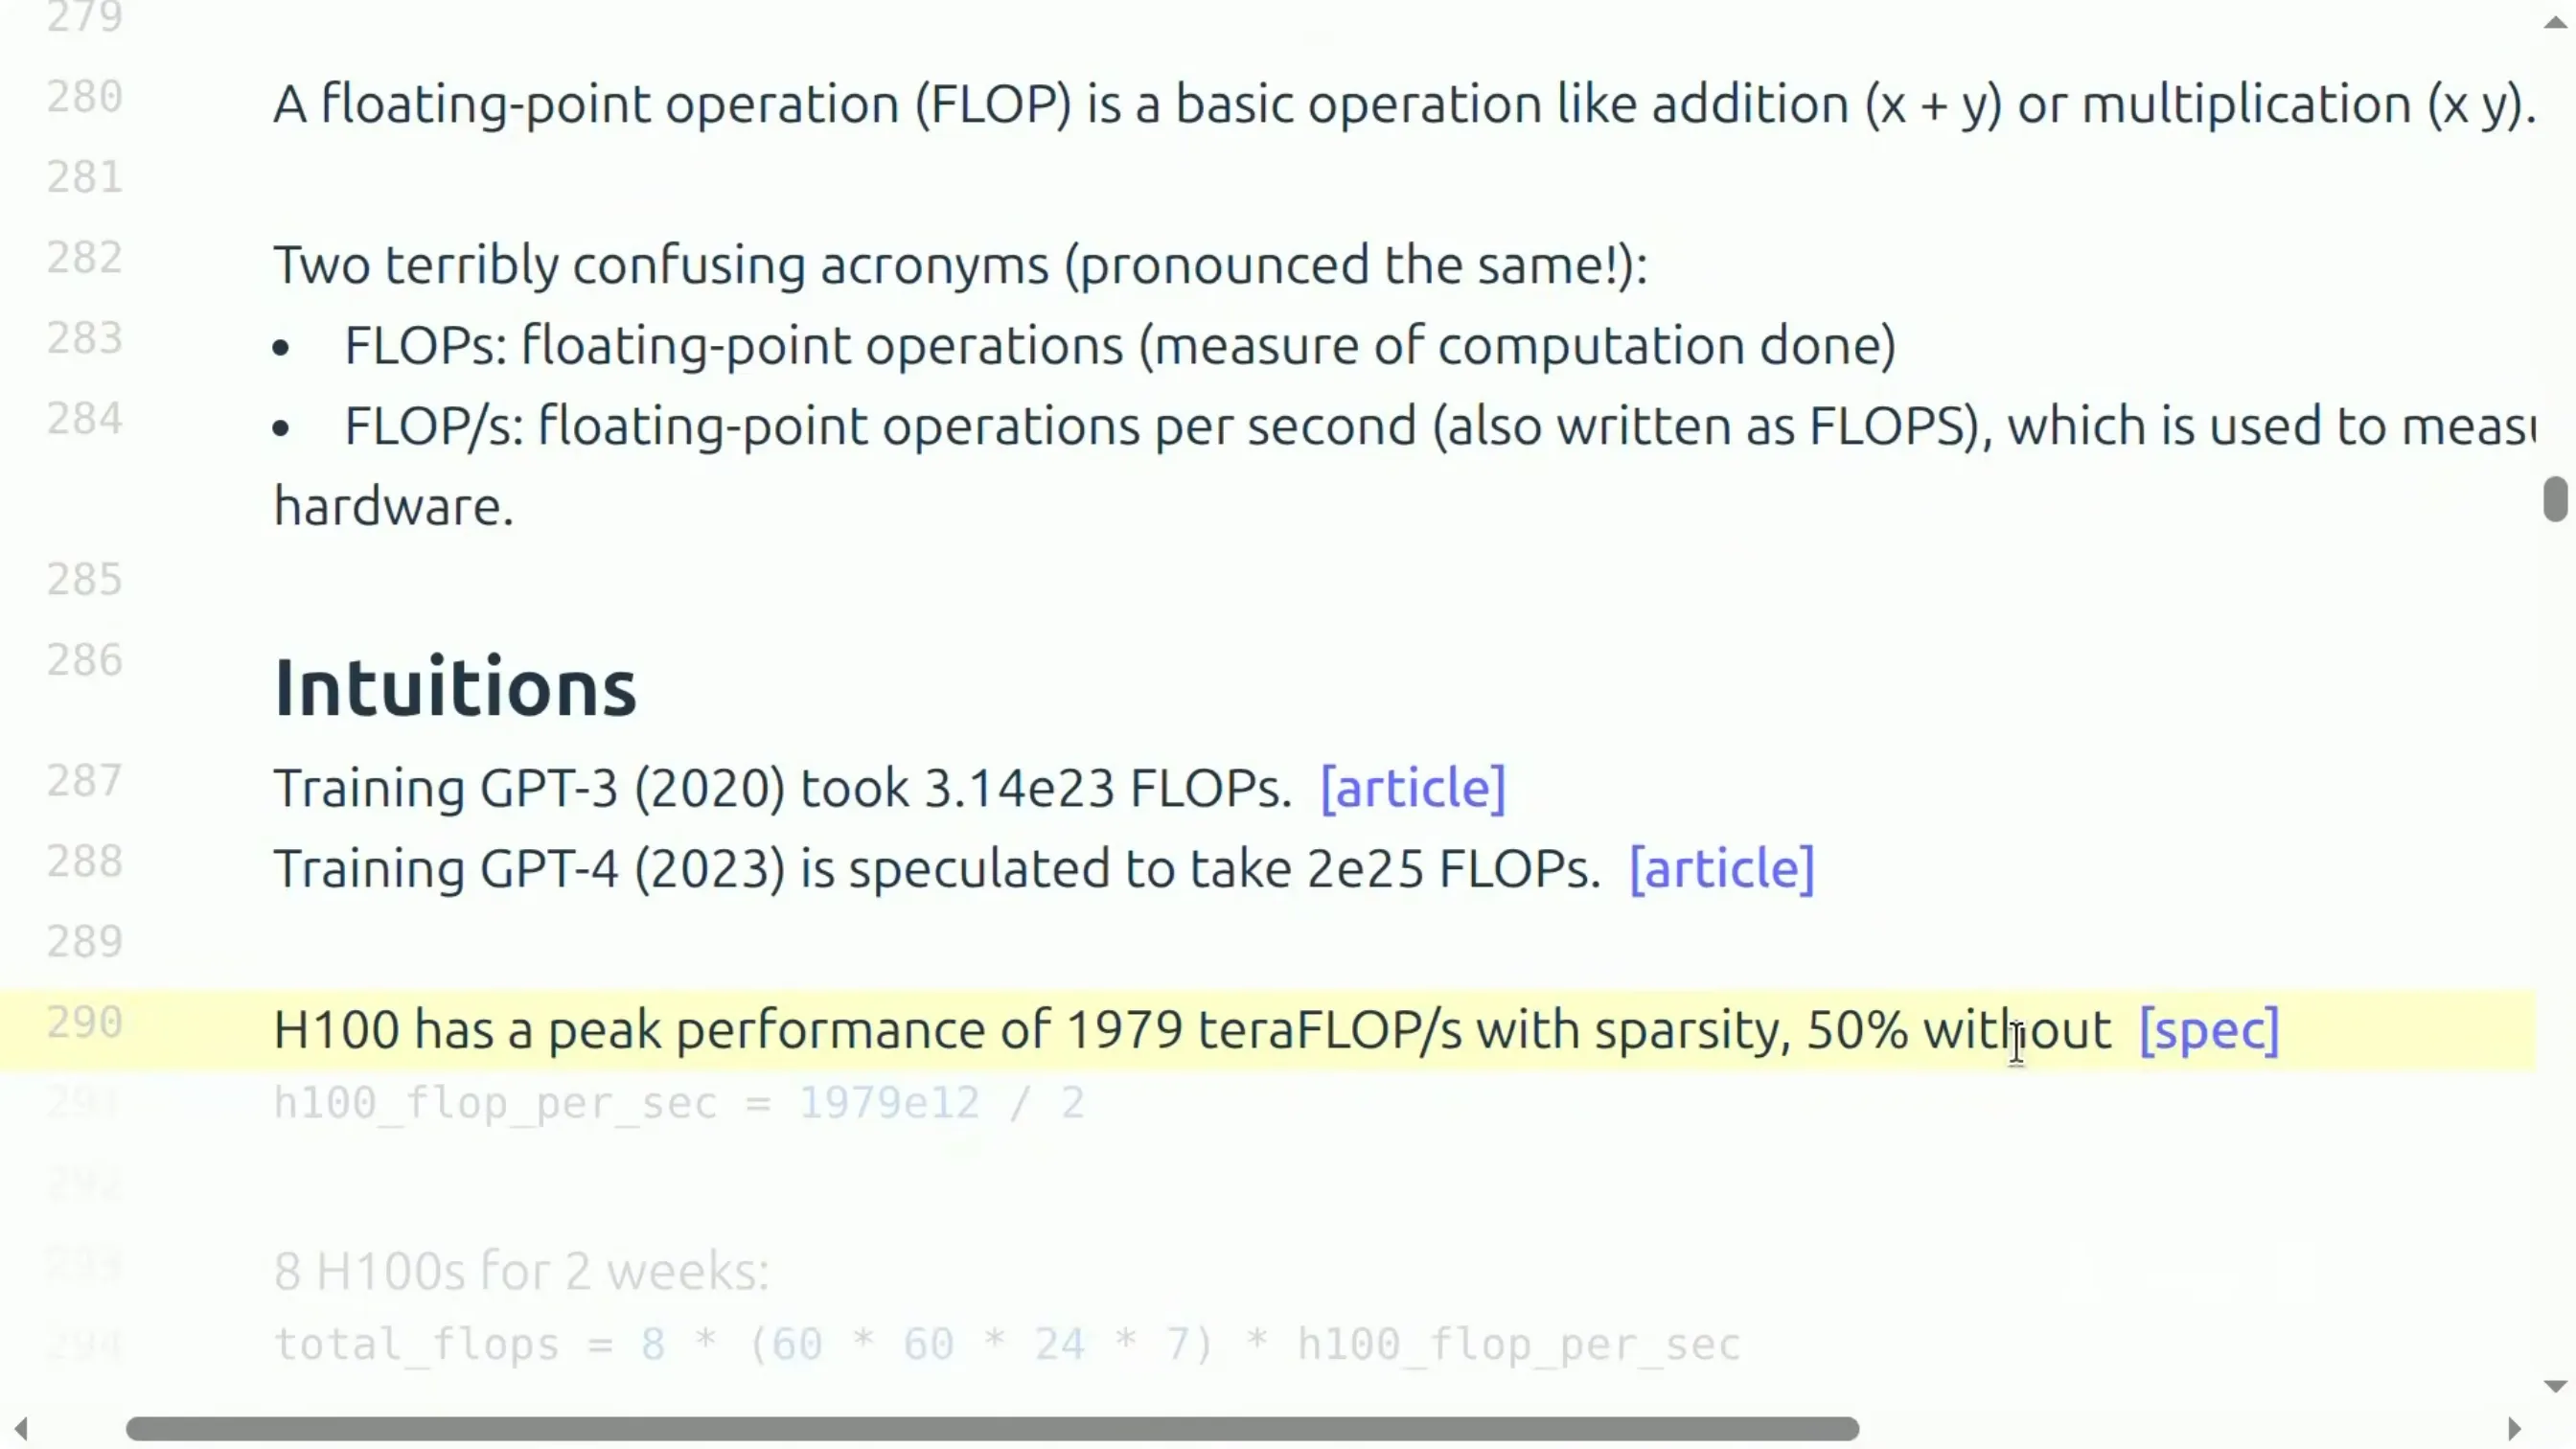
- 训练 GPT-4(2023)据推测约 2e25 FLOPs;
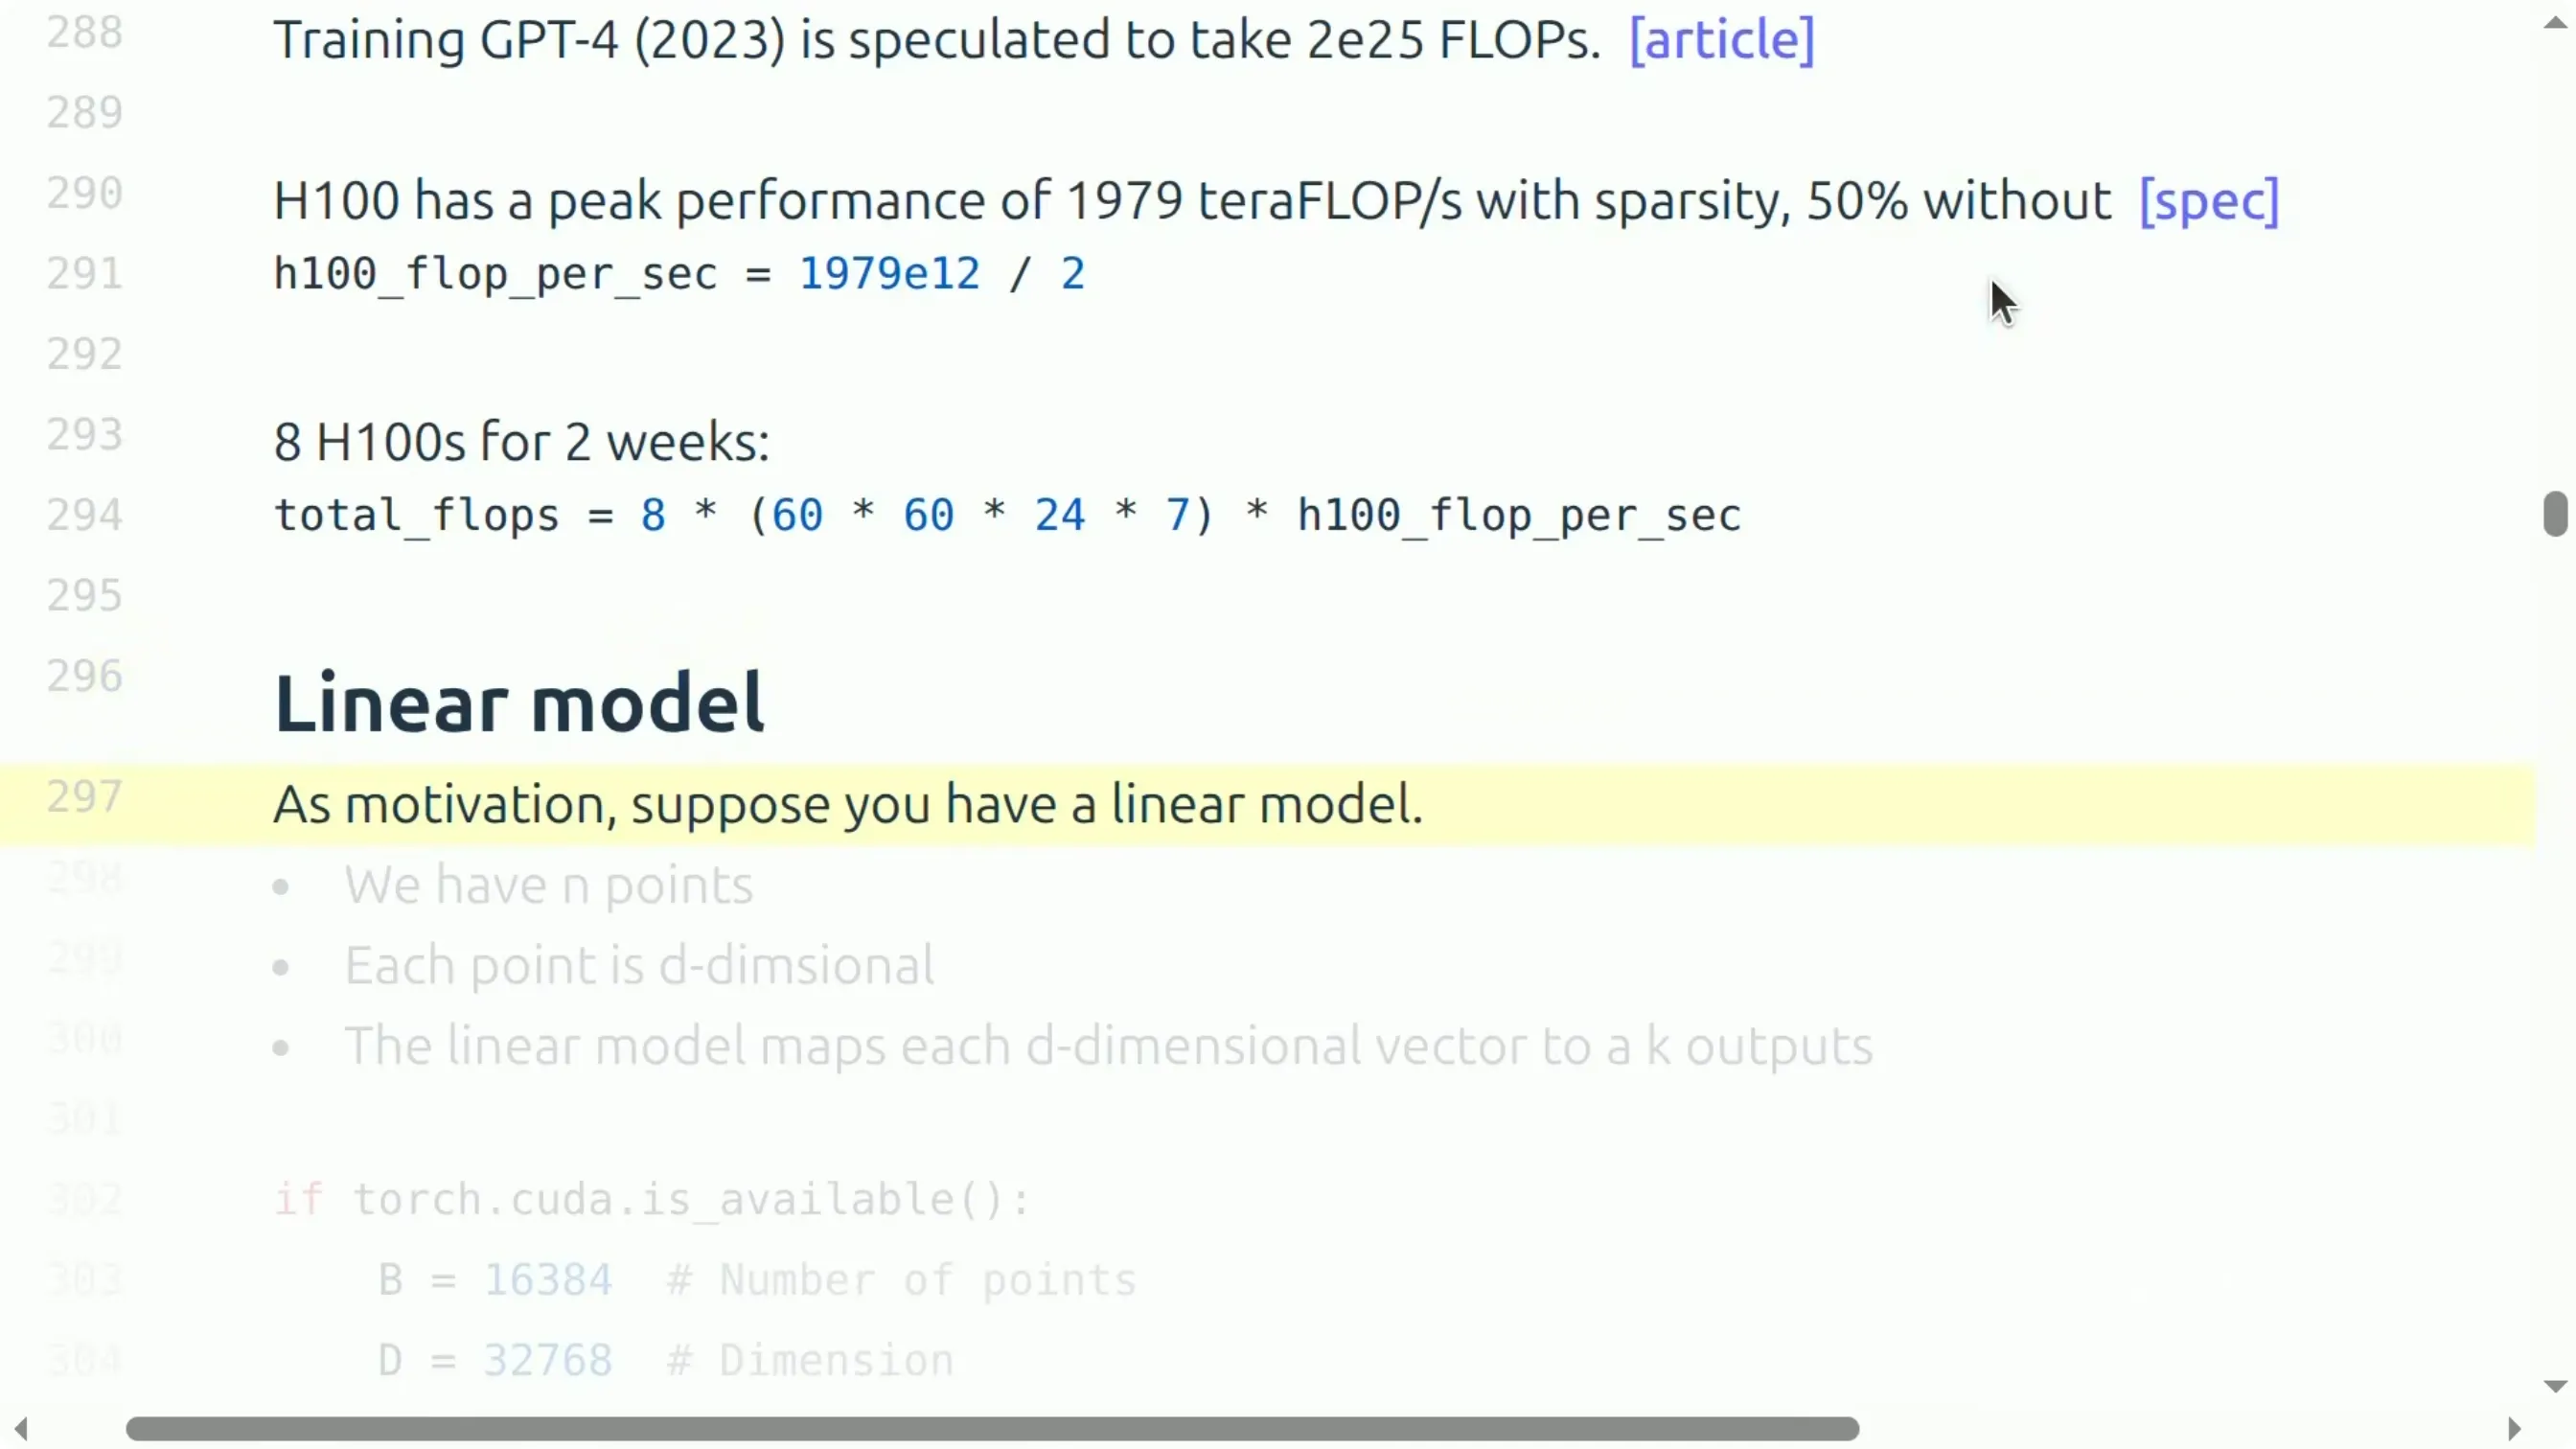
- H100 规格书标称 1979 TFLOP/s——但这是带稀疏性(sparsity)的数字,稠密(dense)要除以 2,即约 989.5 TFLOP/s。
实战提示:看到规格书上的漂亮数字,先去找脚注——很可能写着"with sparsity",那么实际稠密算力要砍半。所以代码里到处是
… / 2。
📷 H100 规格书标称 1979 TFLOP/s 是带稀疏性的,稠密需除以 2
回到原视频 (00:29:27)
从一个线性层数起:FLOPs = 2·B·D·K
(参考时间: 30:52)
📷 线性层 matmul 的 FLOPs = 2 × B × D × K
回到原视频 (00:30:52)
考虑一个线性模型:B 个数据点,每个是 D 维,映射到 K 维输出。
x = torch.ones(B, D)     # 数据矩阵
w = torch.randn(D, K)    # 权重矩阵
y = x @ w

actual_num_flops = 2 * B * D * K
为什么是 2·B·D·K?因为对每一个 (i, j, k) 三元组,都要做一次乘法(x[i][j] * w[j][k])和一次加法,所以是 2 倍。
换个角度看更直观:
FLOPs = 2 ×(数据点个数)×(参数个数)
因为 X 是
B×D、W 是D×K,而B × (D×K) = B × 参数量。
这正是后面 6ND 公式的雏形。
关于其他运算:逐元素(element-wise)运算的 FLOPs 就等于张量的元素个数(比如 x + y 也要 NM 次)。一个重要的经验是:
对足够大的矩阵来说,除了矩阵乘法,其他运算都便宜得多。所以数 FLOPs 时,我们主要盯住 matmul——但涉及显存时例外。
课堂问答:有没有更快的(次三次)矩阵乘法算法?主讲说,实际中人们更多关心的不是渐进复杂度,而是如何与系统协同设计(co-design)。另外,硬件层面加法与乘法的代价基本相同——虽然直觉上加法该更快。
基准测试:先 synchronize,再计时
(参考时间: 35:12)
📷 GPU 计时:测量前后都要 CUDA synchronize
回到原视频 (00:35:12)
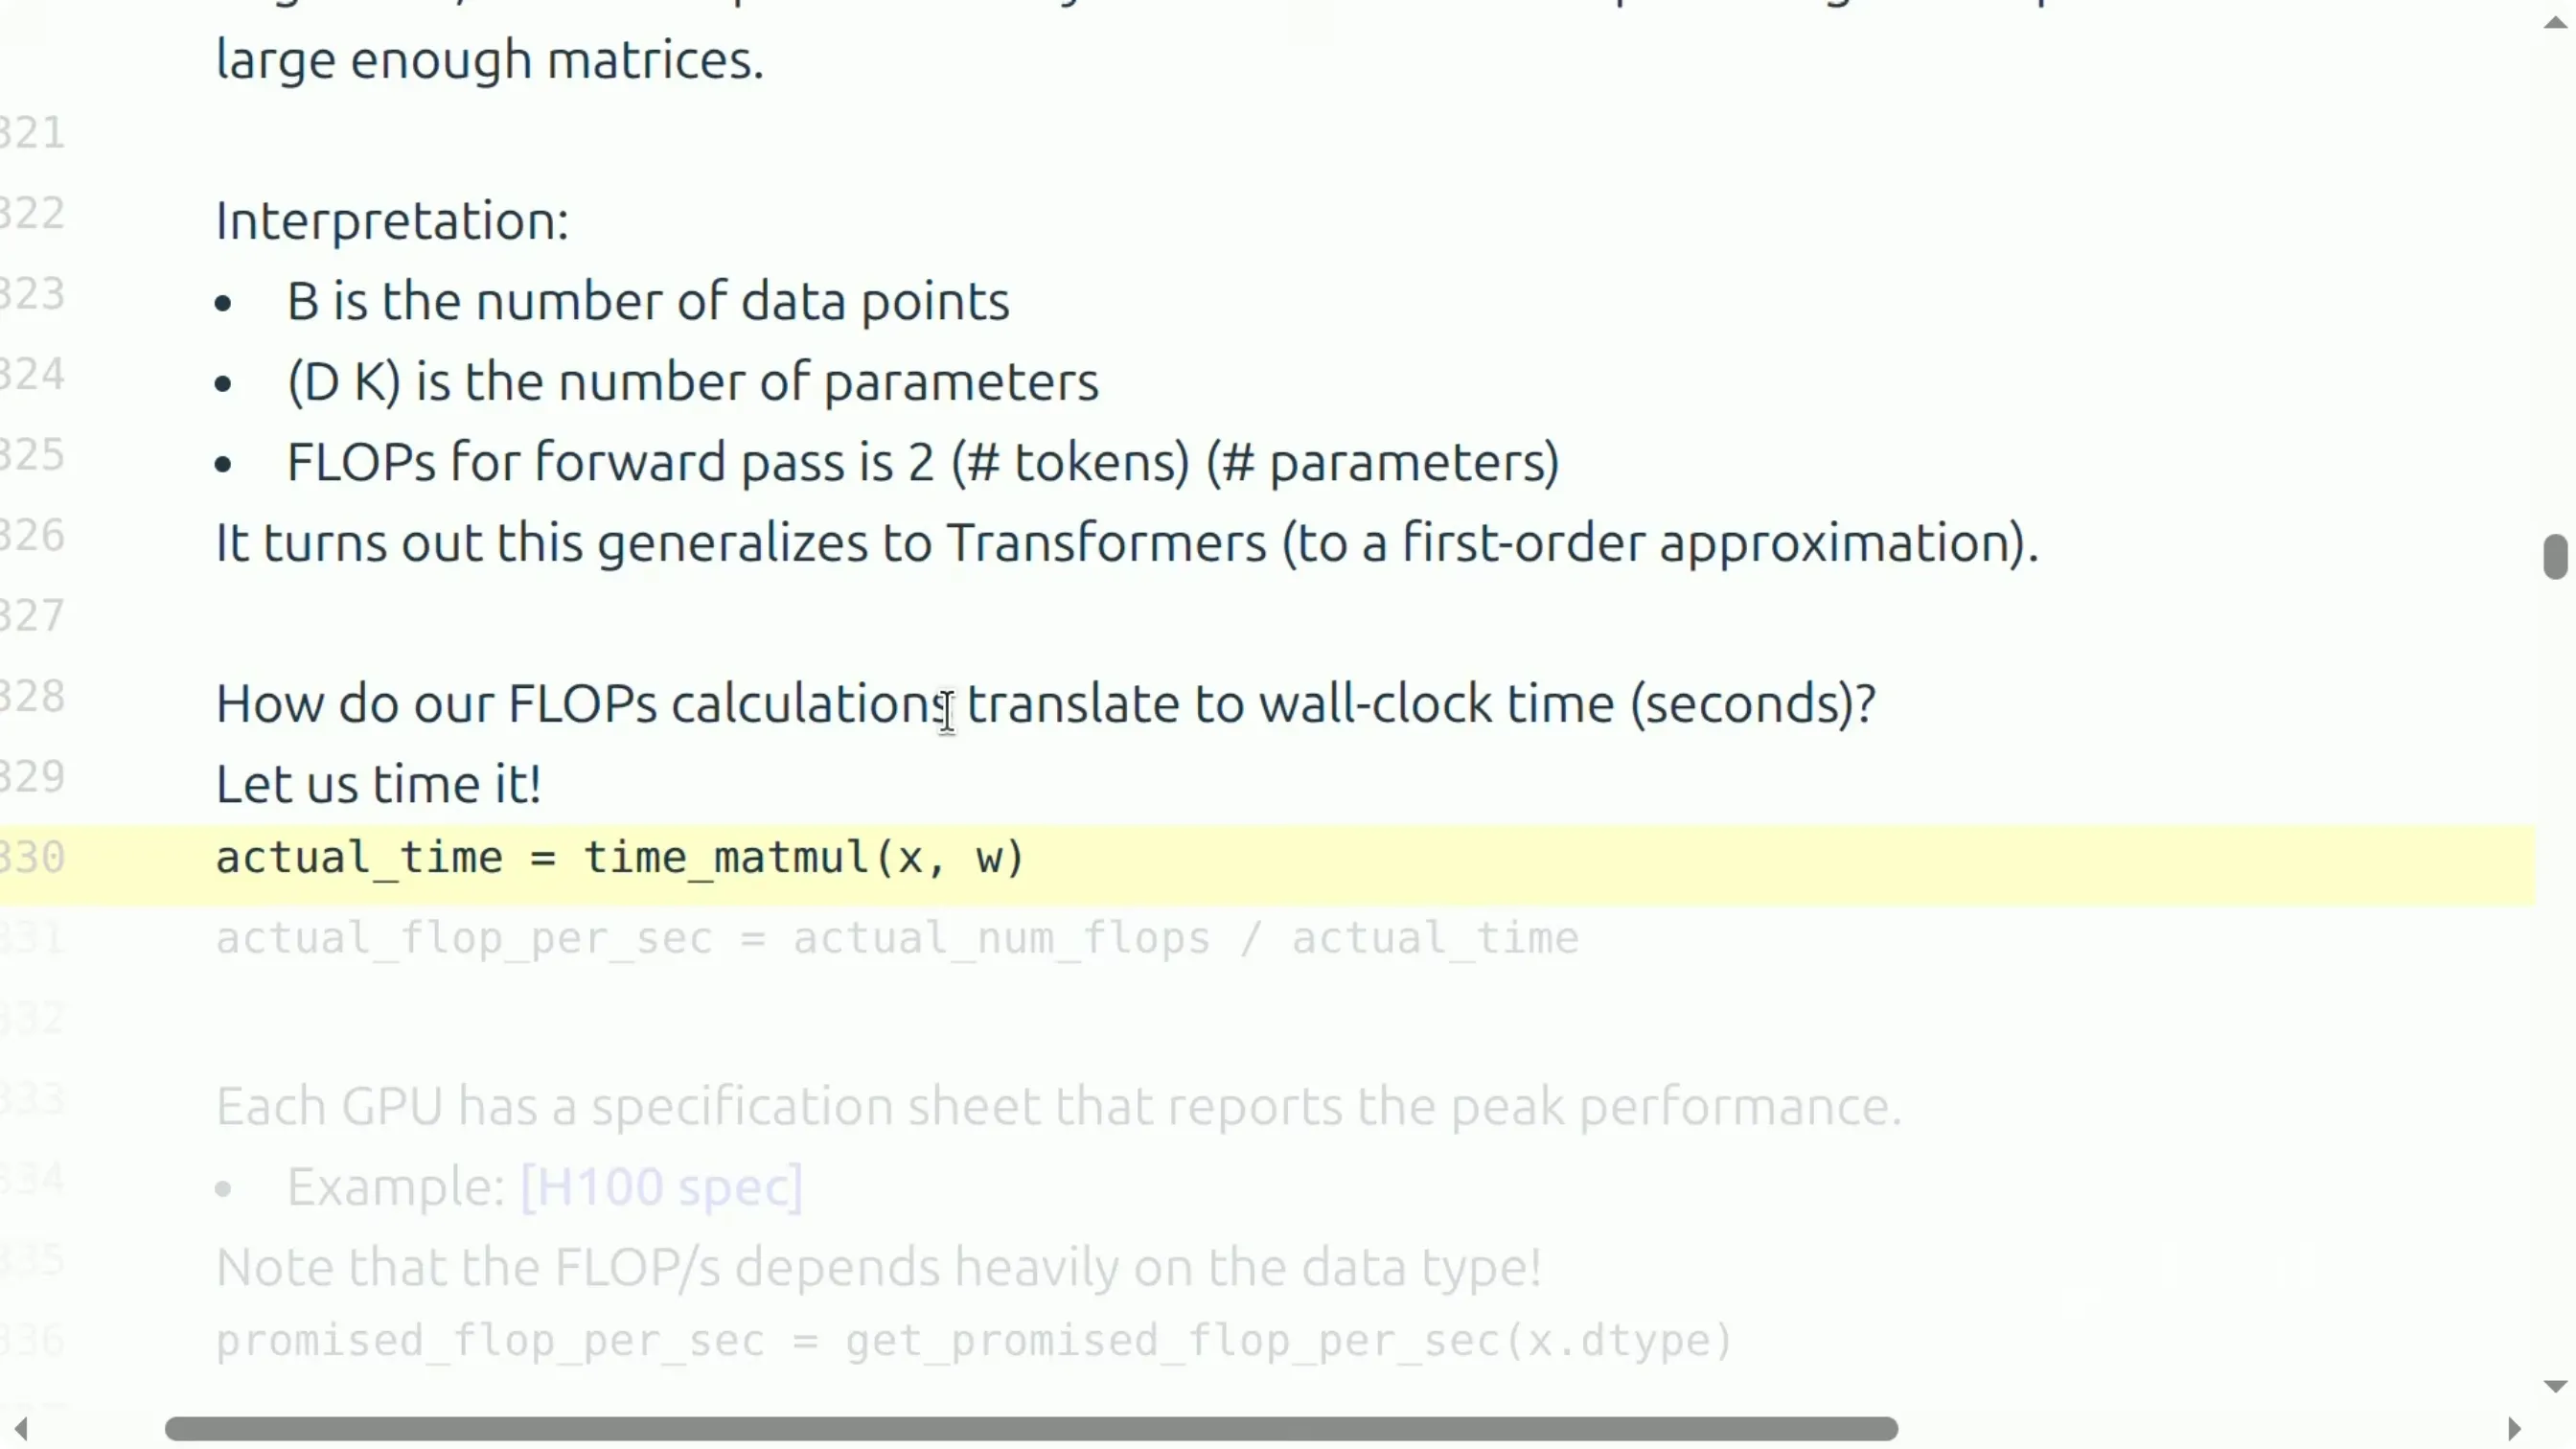
算出了"逻辑上的 FLOPs",接下来要问"在硬件上实际要多久"。计时本身有讲究,尤其在 GPU 上:
if torch.cuda.is_available():
    torch.cuda.synchronize()   # 等前面的 CUDA 线程做完
# 执行操作
func()
if torch.cuda.is_available():
    torch.cuda.synchronize()   # 再做一次同步
如果不做同步,你会测出"快得离谱"的时间——因为 CUDA 调用是异步、非阻塞的,函数立刻就返回了。此外,通常要多次运行取平均。
MFU:模型 FLOPs 利用率
(参考时间: 37:07)
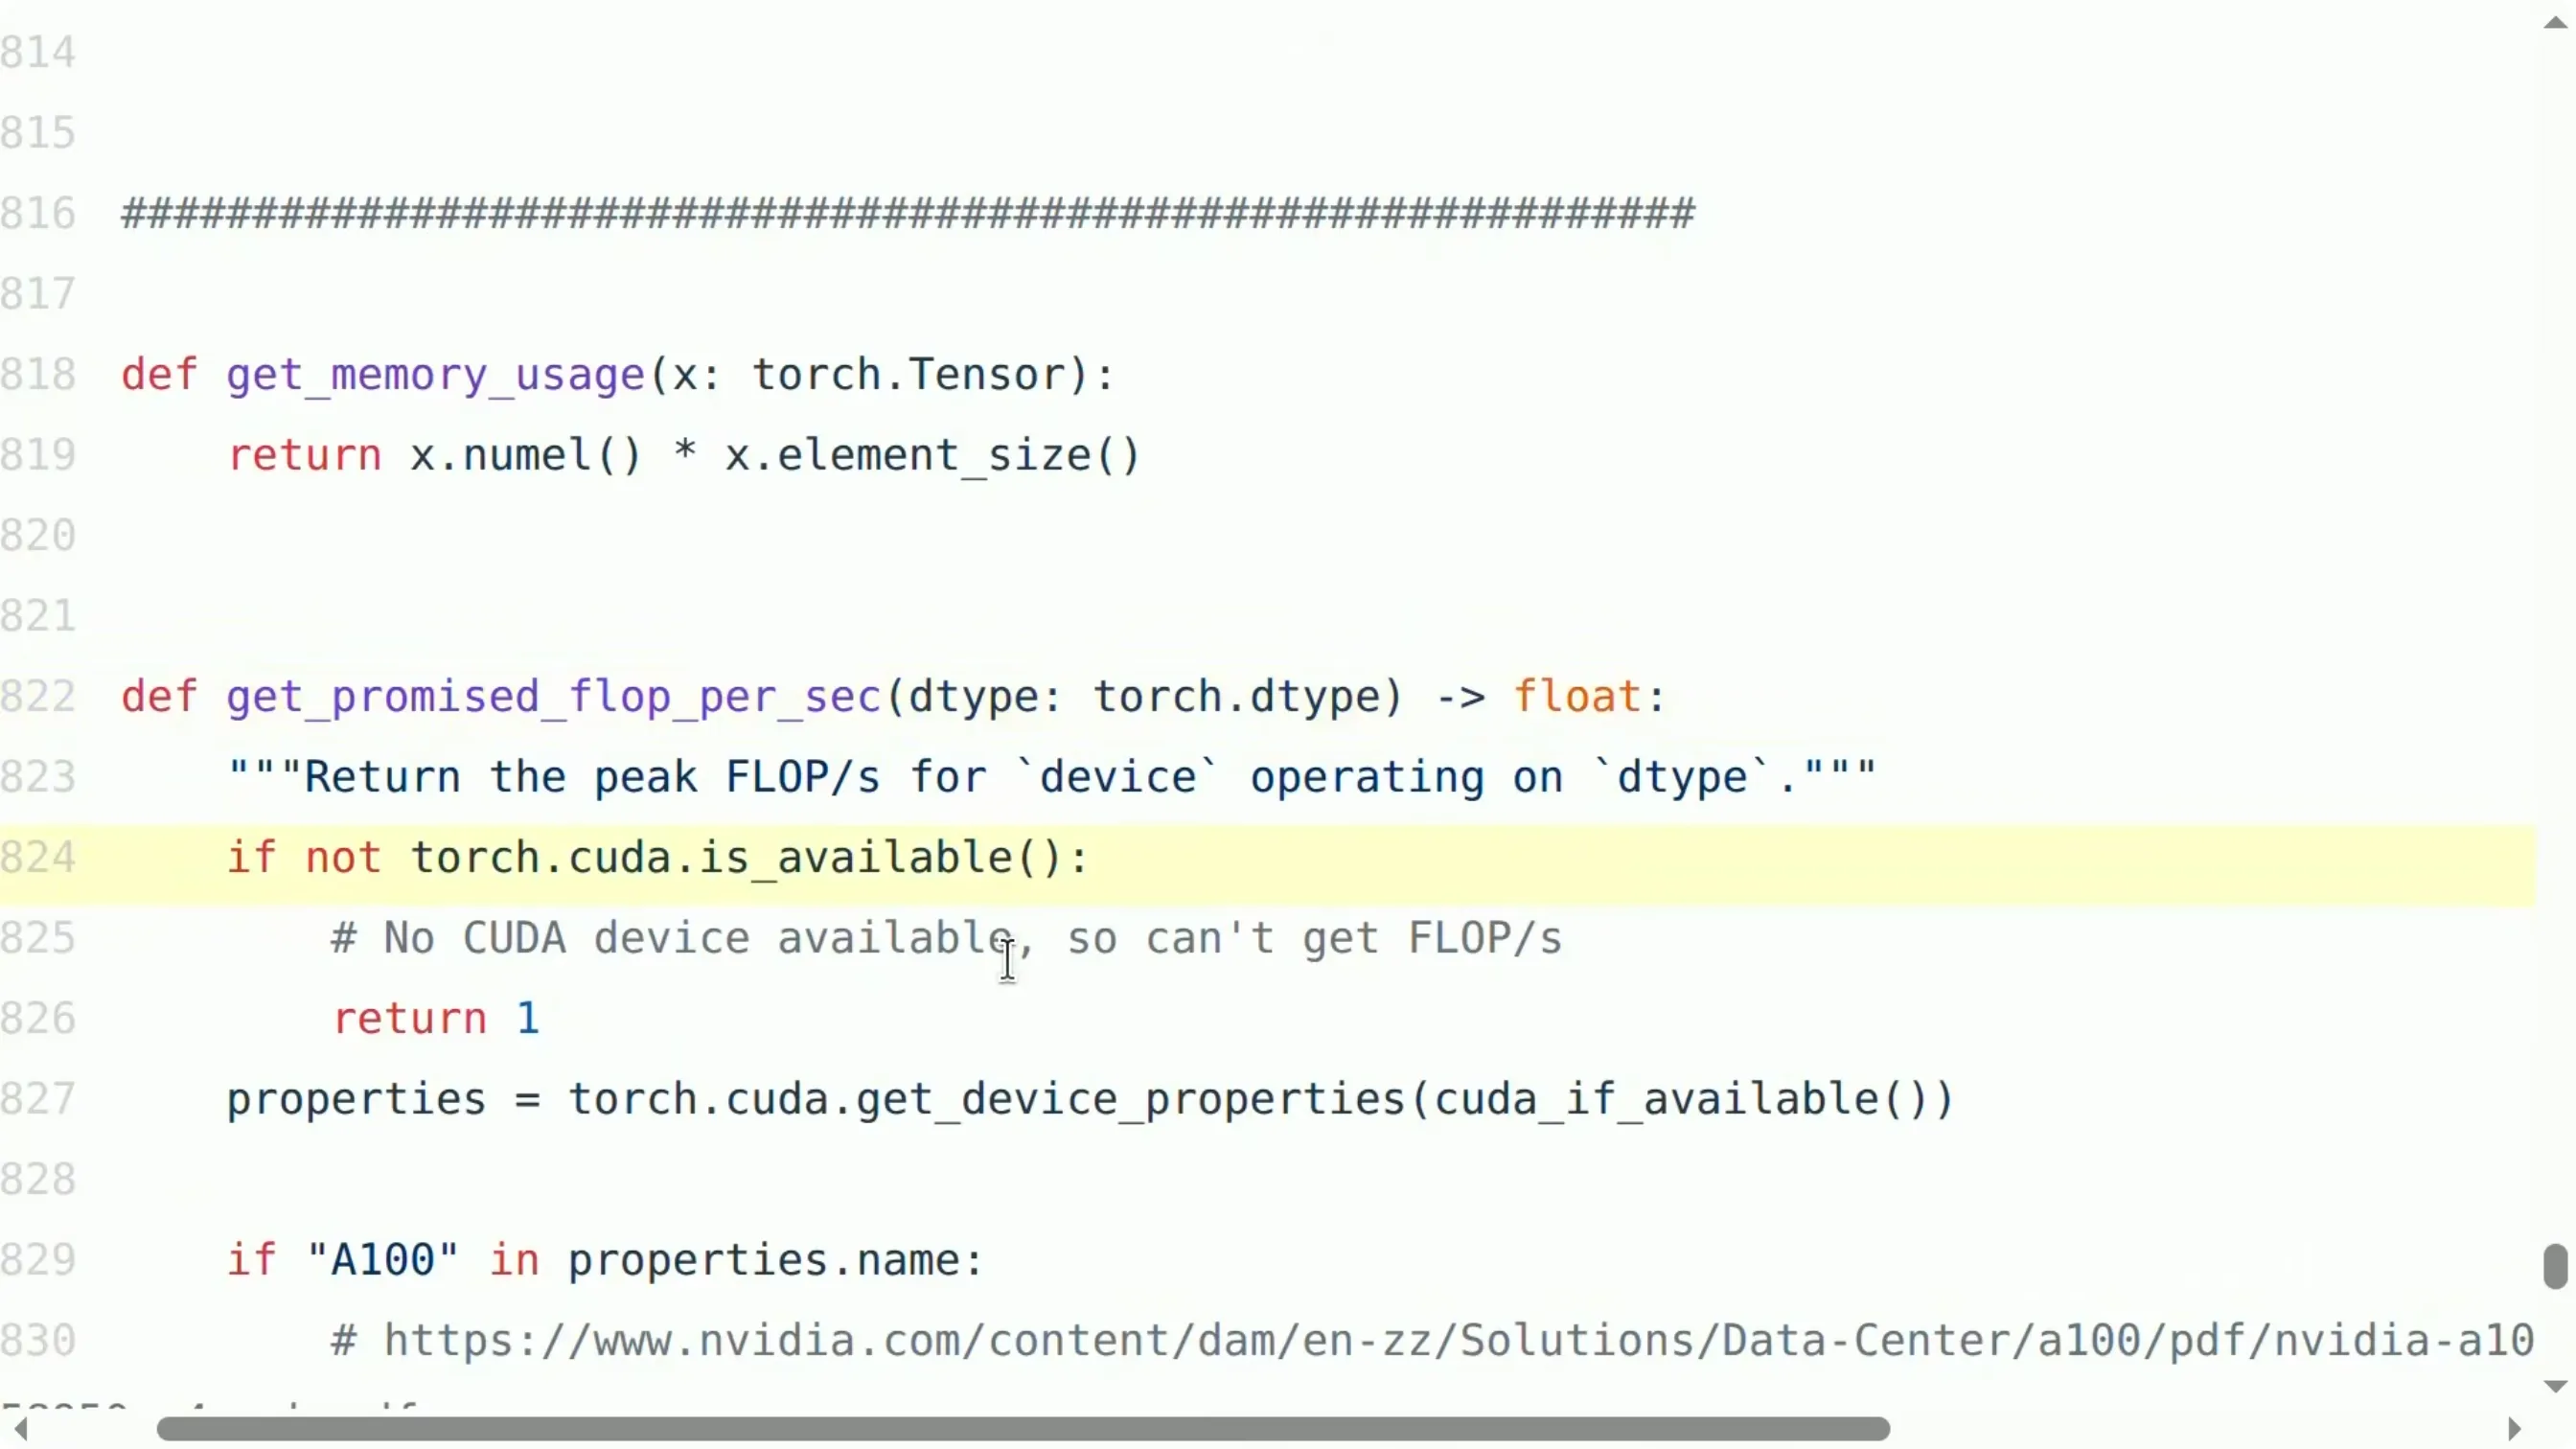
于是我们能把"实际速度"和"标称速度"对比,得到 MFU(Model FLOPs Utilization,模型 FLOPs 利用率):
MFU = 实际 FLOP/s ÷ 标称 FLOP/s (忽略通信与其他开销)
经验值:
| MFU | 含义 |
|---|---|
| ≥ 0.5 | 对现代模型来说已经相当不错,值得满意 |
| ~0.8 | 单纯的 matmul 也许能达到 |
| ~0.1 | 说明有问题,该去查一查 |
主讲提醒:MFU 永远不会超过 1。你会经常看到比标称低不少的数字,而"为什么只有 0.5"正是下一节要解释的——显存瓶颈。
📷 MFU = 实际 FLOP/s ÷ 标称 FLOP/s,≥0.5 就相当不错
回到原视频 (00:37:07)
小结:
- 矩阵乘法主导了计算,这是有意设计的结果;
- FLOP/s 取决于硬件(越好的硬件越快)与数据类型(fp32 如今很慢,bf16/fp8 快得多);
- MFU = 实际 / 标称。
七、算术强度与 Roofline 分析
(参考时间: 40:27)
📷 算术强度:内存→加速器→内存 的数据搬运路径
回到原视频 (00:40:27)
要回答"为什么 MFU 只有 0.5",就需要引入算术强度(arithmetic intensity)。
内存墙:计算要先把数据搬过来
(参考时间: 41:00)
主讲画了一张"卡通版"的硬件图:
- 一边是高带宽内存(HBM);
- 另一边是计算核心 / 加速器。
一次计算是这样发生的:
- 把输入(张量)从内存搬到加速器;
- 在加速器上做计算;
- 把输出搬回内存。
所以耗时取决于两件事:
- 加速器速度——就是上一节的 FLOP/s;
- 内存带宽——每秒能搬多少字节。
H100 的两个数字:989.5e12 FLOP/s,以及 3.35e12 字节/s(约 3.35 TB/s)。
主讲强调:内存不只是"放得下放不下"的问题,它还会拖慢速度——因为搬运本身要花时间。
graph LR
    HBM["HBM 高带宽内存<br/>(存放张量)"] -->|搬入输入| ACC["加速器 / 计算核心<br/>(做运算)"]
    ACC -->|搬回输出| HBM
    HBM -.->|"受限于内存带宽<br/>3.35 TB/s"| ACC
    ACC -.->|"受限于算力<br/>989.5 TFLOP/s"| HBM
案例一:ReLU——典型的内存受限
(参考时间: 42:38)
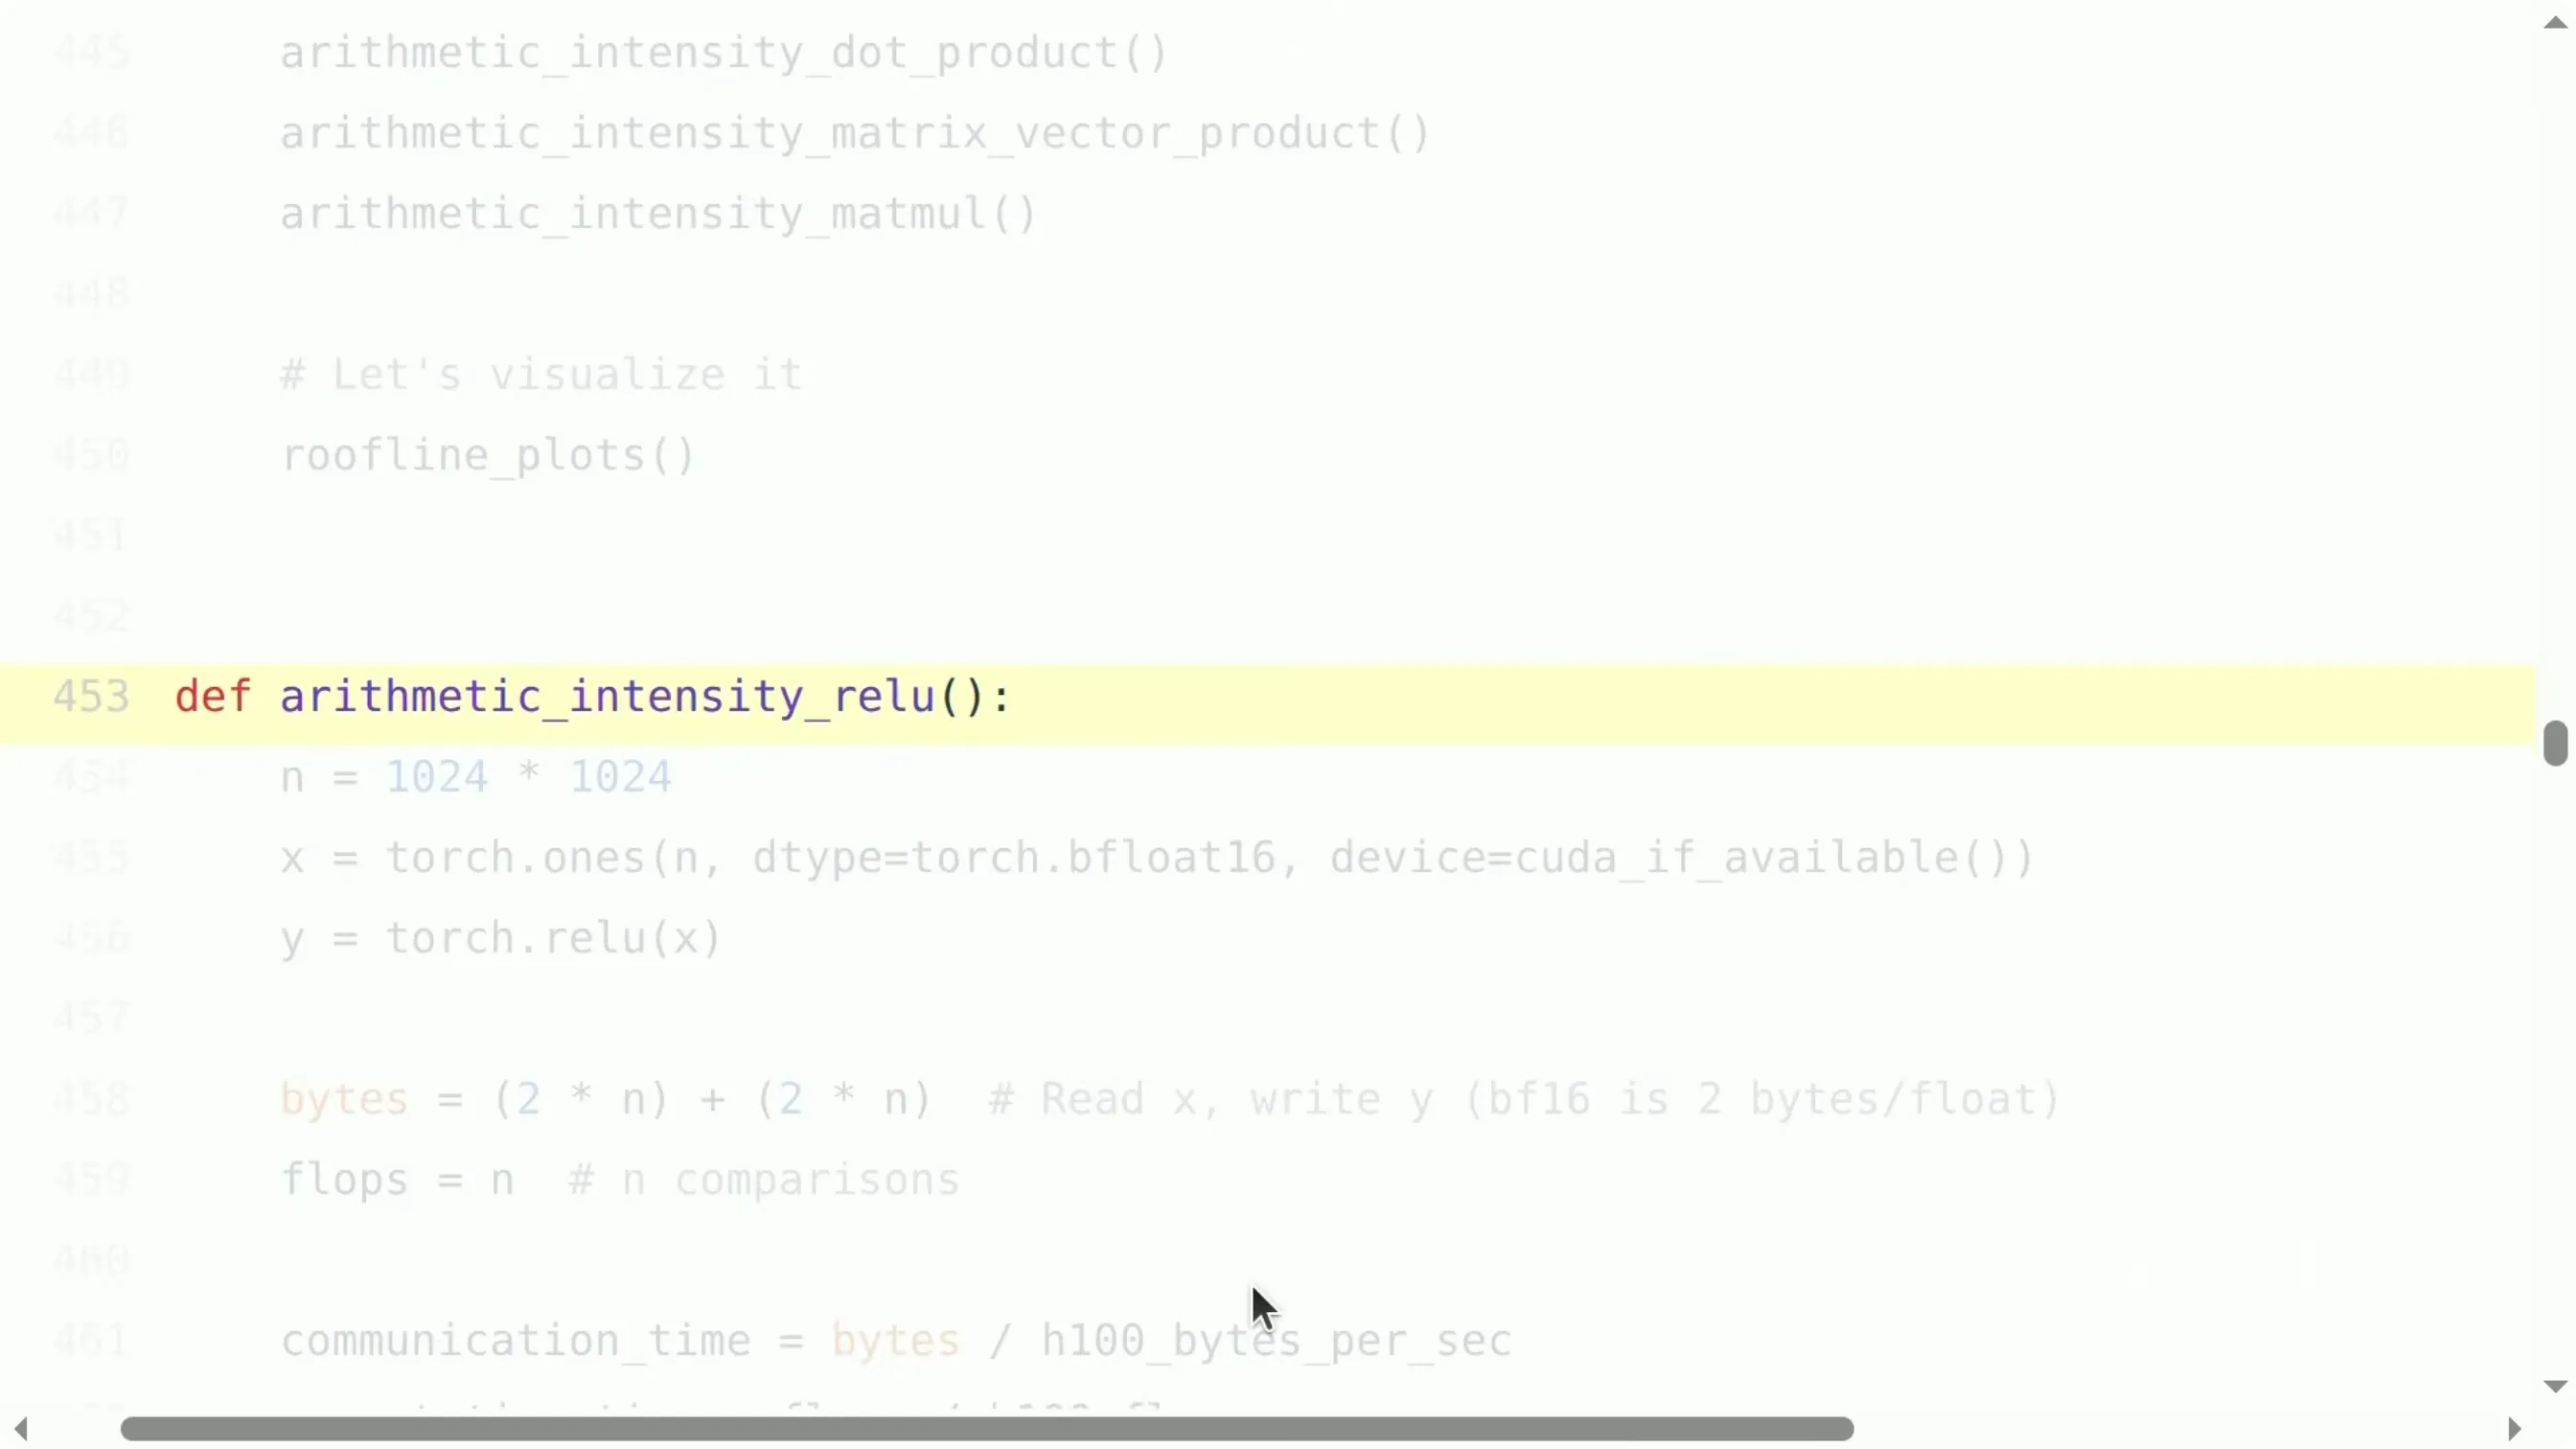
📷 ReLU:通信时间 ≫ 计算时间,内存受限
回到原视频 (00:42:38)
取一个 100 万维的 bf16 向量,做逐元素的 max(x, 0):
n = 1024 * 1024
x = torch.ones(n, dtype=torch.bfloat16)
y = torch.relu(x)

bytes = (2 * n) + (2 * n)   # 读 x(bf16,2 字节/元素)+ 写 y
flops = n                    # n 次比较
- 搬运量:4n 字节;
- 计算量:n 次 FLOP。
于是:
通信时间 = 4n / 3.35e12 ≈ 1e-6 秒
计算时间 = n / 989.5e12 ≈ 1e-9 秒
这里有个重要假设:通信与计算可以完美重叠(overlap)——数据一到就开始算,一边算一边搬。因此,总时间 ≈ max(通信时间, 计算时间) = 1e-6 秒。
结论:通信时间远大于计算时间,ReLU 是内存受限(memory-bound)的。也就是说,大部分时间都在等比特搬过来。
用"强度"统一描述
(参考时间: 46:01)
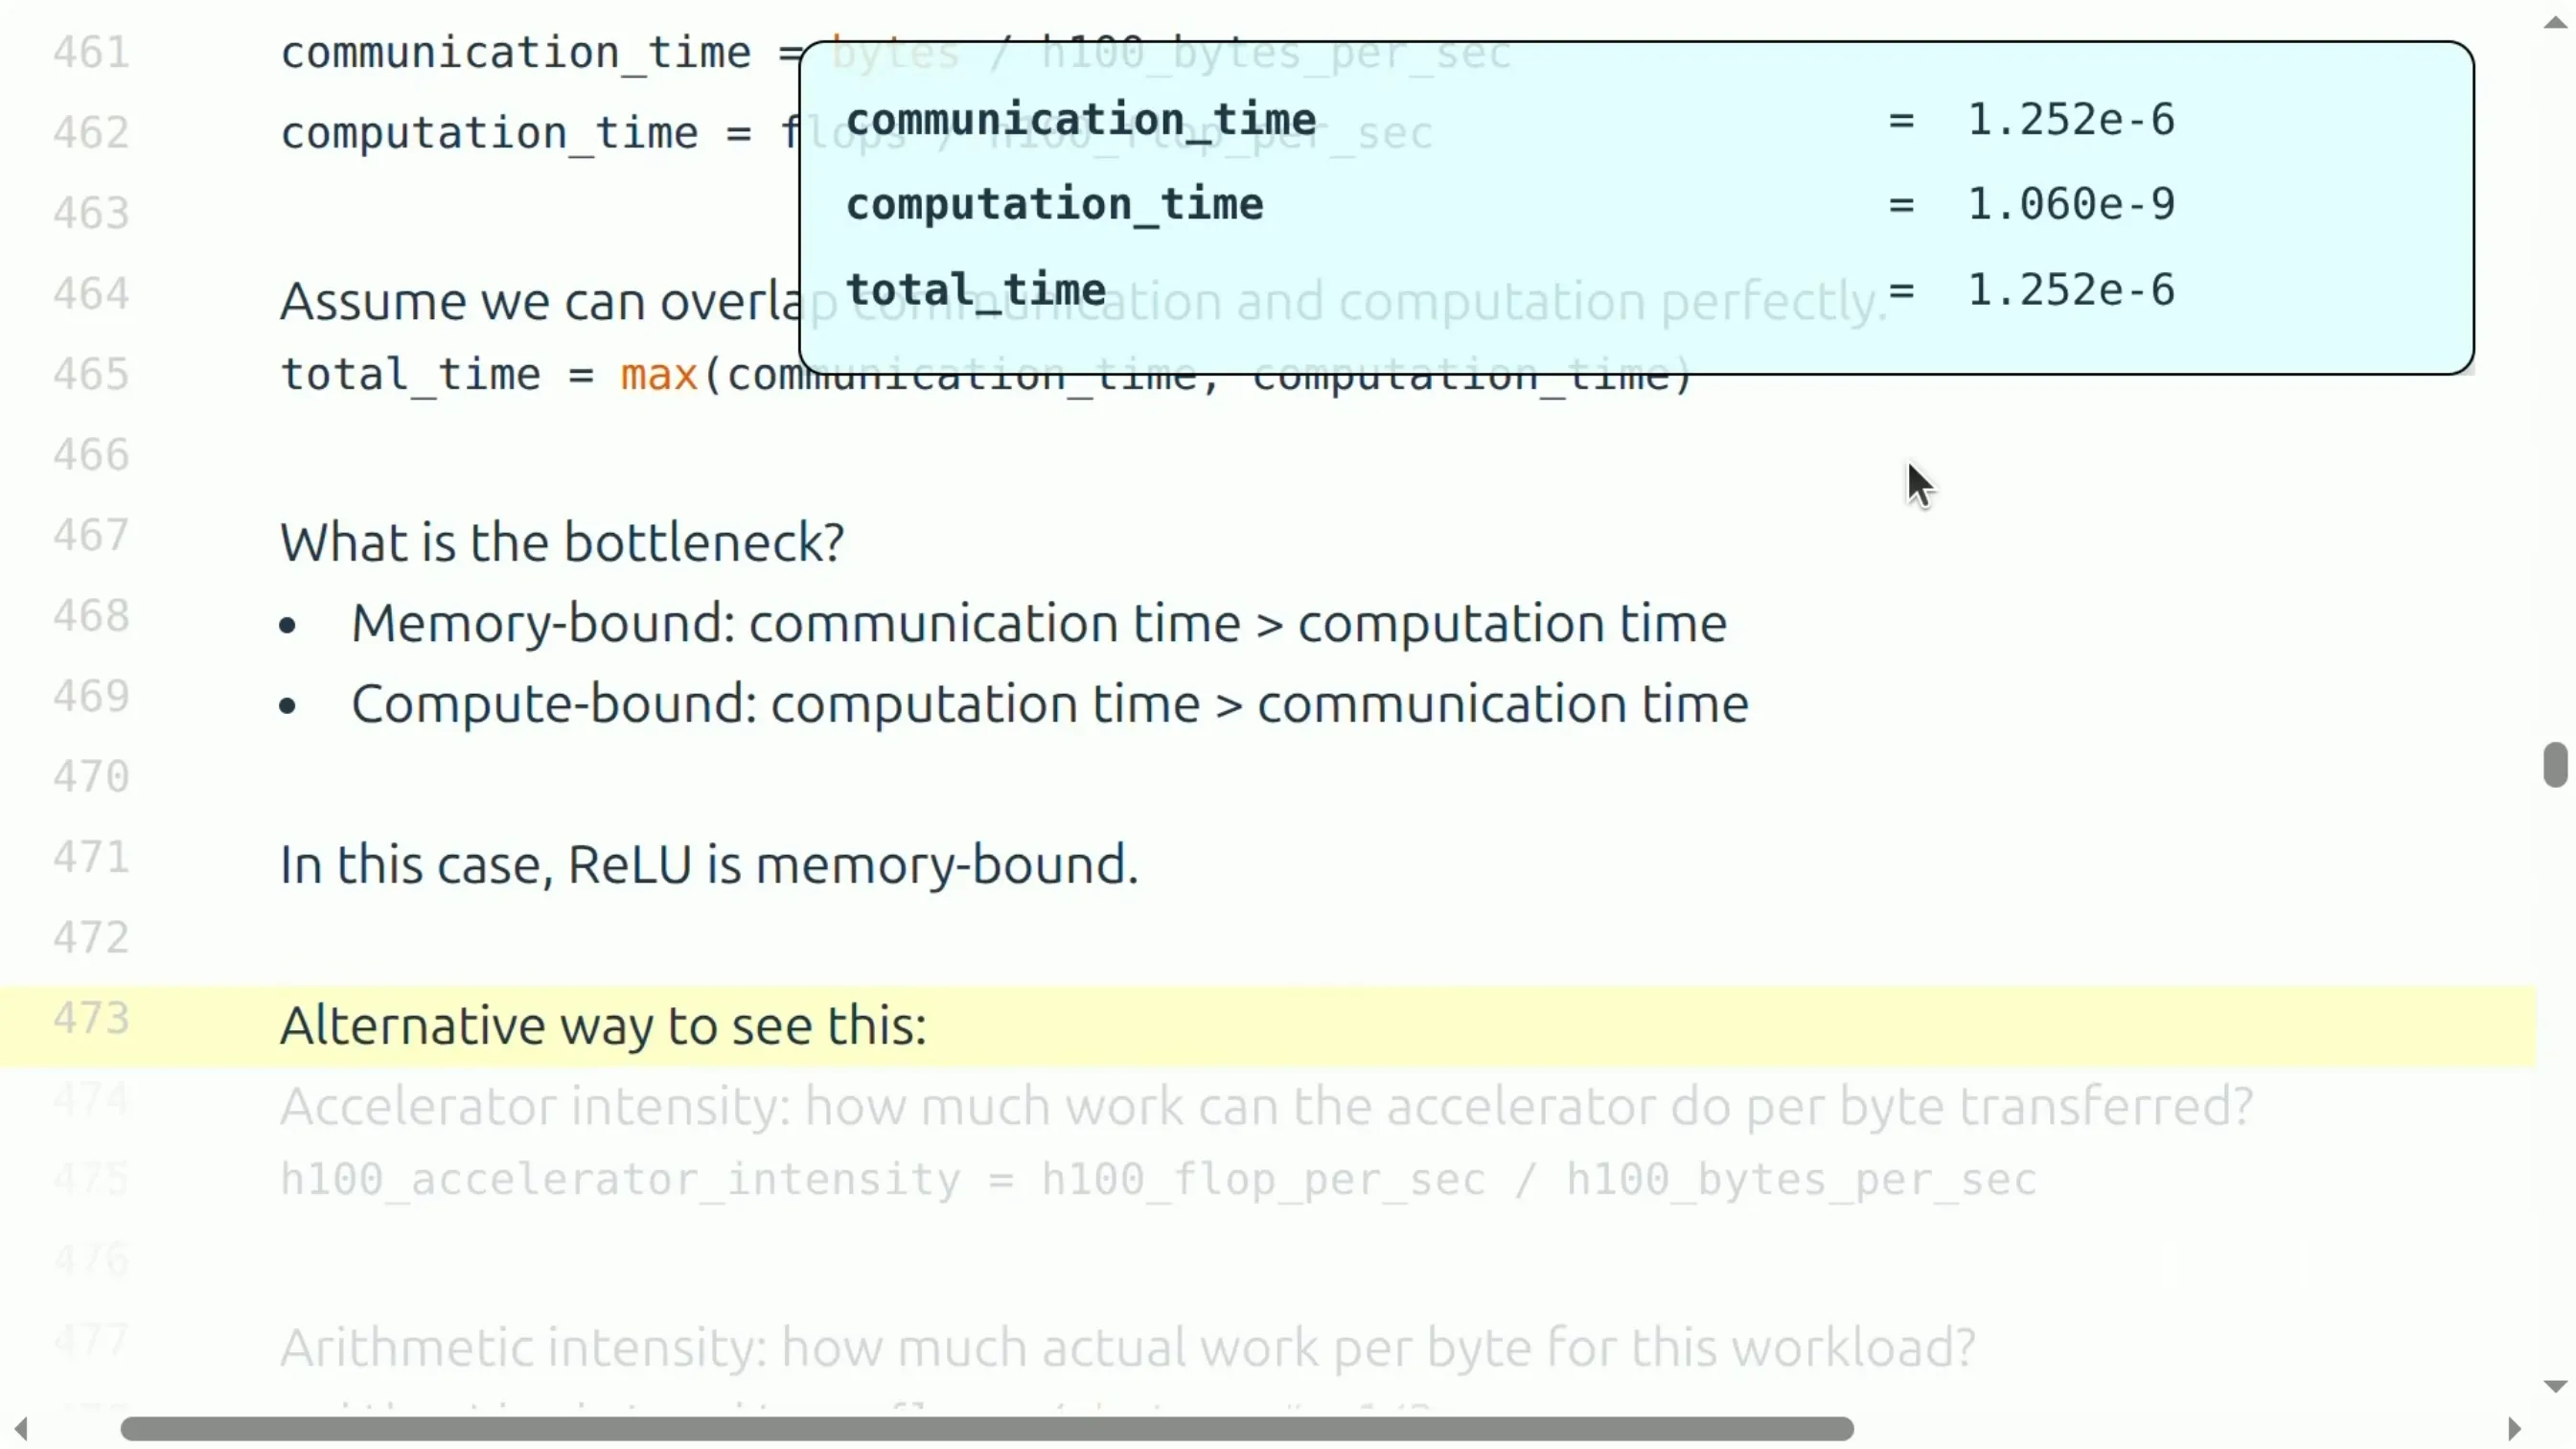
📷 加速器强度:H100 每字节约可做 295 次浮点运算
回到原视频 (00:46:01)
换一种更优雅的说法:
-
加速器强度(accelerator intensity):硬件每搬运一个字节,最多能做多少计算?
加速器强度 = FLOP/s ÷ 字节/s = 989.5e12 / 3.35e12 ≈ 295(约 300)也就是说,H100 每搬 1 字节,最多能做约 300 次浮点运算。 -
算术强度(arithmetic intensity):这份任务每搬运一个字节,实际做了多少计算?
算术强度 = FLOPs ÷ 搬运字节数
判据:
- 算术强度 < 加速器强度 → 内存受限;
- 算术强度 > 加速器强度 → 计算受限。
对 ReLU:算术强度 = n / 4n = 0.25,远小于 295 → 内存受限。(主讲说:以后听到有人说算术强度是 0.25,你就该说"这很糟糕"。)
案例二:GELU——更复杂,但仍然内存受限
(参考时间: 48:23)
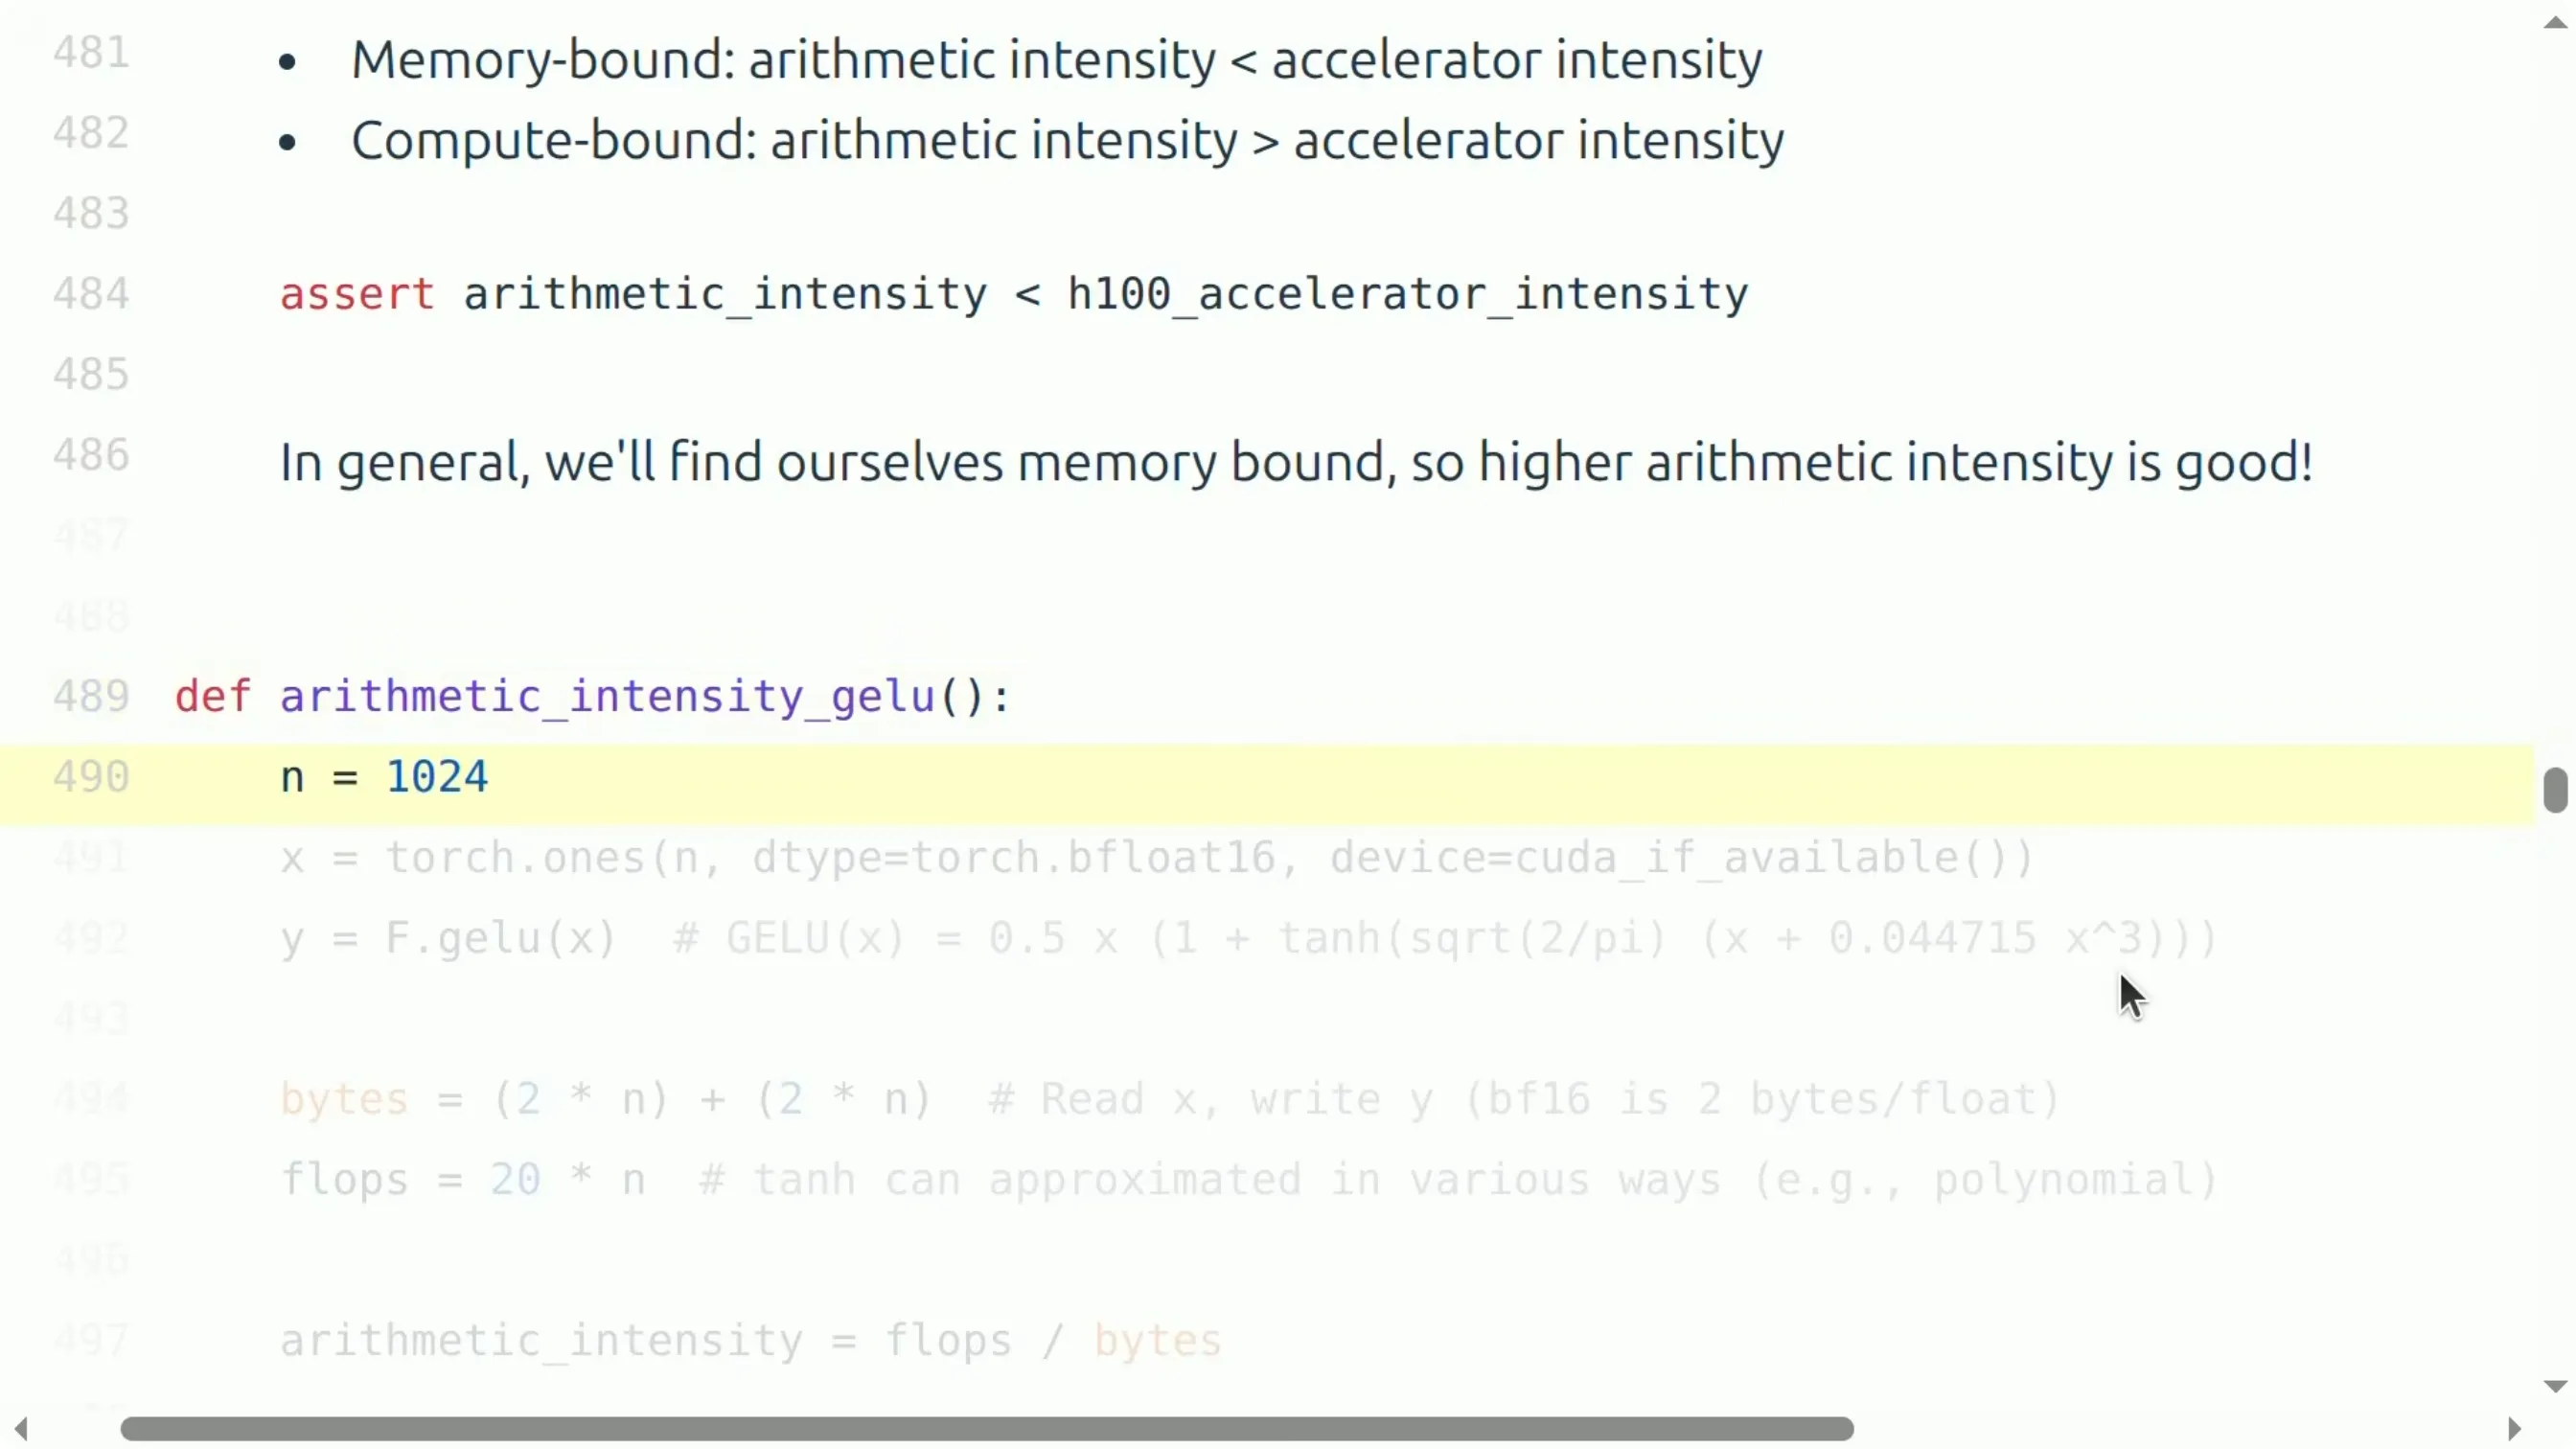
📷 GELU 算术强度约 5,仍远低于加速器强度:内存受限
回到原视频 (00:48:23)
GELU 的逐元素公式里含 tanh,计算量比 ReLU 大得多:
y = F.gelu(x)   # GELU(x) = 0.5 x (1 + tanh(sqrt(2/pi) (x + 0.044715 x^3)))

bytes = (2 * n) + (2 * n)   # 仍然只是读 x、写 y
flops = 20 * n              # 约 20 FLOPs/元素
- 搬运量仍是 4n;
- 计算量约 20n → 算术强度 ≈ 5。
5 仍然远小于 295,所以 GELU 同样是内存受限。
这个结论很反直觉,但很重要:
如果你孤立地比较 ReLU 与 GELU,会觉得 GELU 复杂得多、肯定慢;但实际上它们一样快——因为瓶颈根本不在计算上,而在于搬数据。
案例三:点积(dot product)
(参考时间: 49:48)
y = x @ w     # 两个长度 n 的向量

bytes = (2 * n) + (2 * n) + 2   # 读 x、读 w、写一个标量 y
flops = 2 * n - 1               # n 次乘法 + (n-1) 次加法
算术强度 ≈ (2n-1) / (4n+2) ≈ 0.5 → 内存受限。
案例四:矩阵-向量乘(matrix-vector product)
(参考时间: 50:33)
x = torch.ones(n)
w = torch.ones(n, n)
y = x @ w

bytes = (2 * n) + (2 * n * n) + (2 * n)   # 读 x、读 W(n²)、写 y
flops = n * (2 * n - 1)                    # n 个点积
算术强度 ≈ 1 → 仍然内存受限。
主讲说:这也正是推理为什么难做的原因——推理时你一次只生成一个 token,本质上就是矩阵-向量乘,而它是内存受限的。
案例五:矩阵乘法——终于计算受限
(参考时间: 51:22)
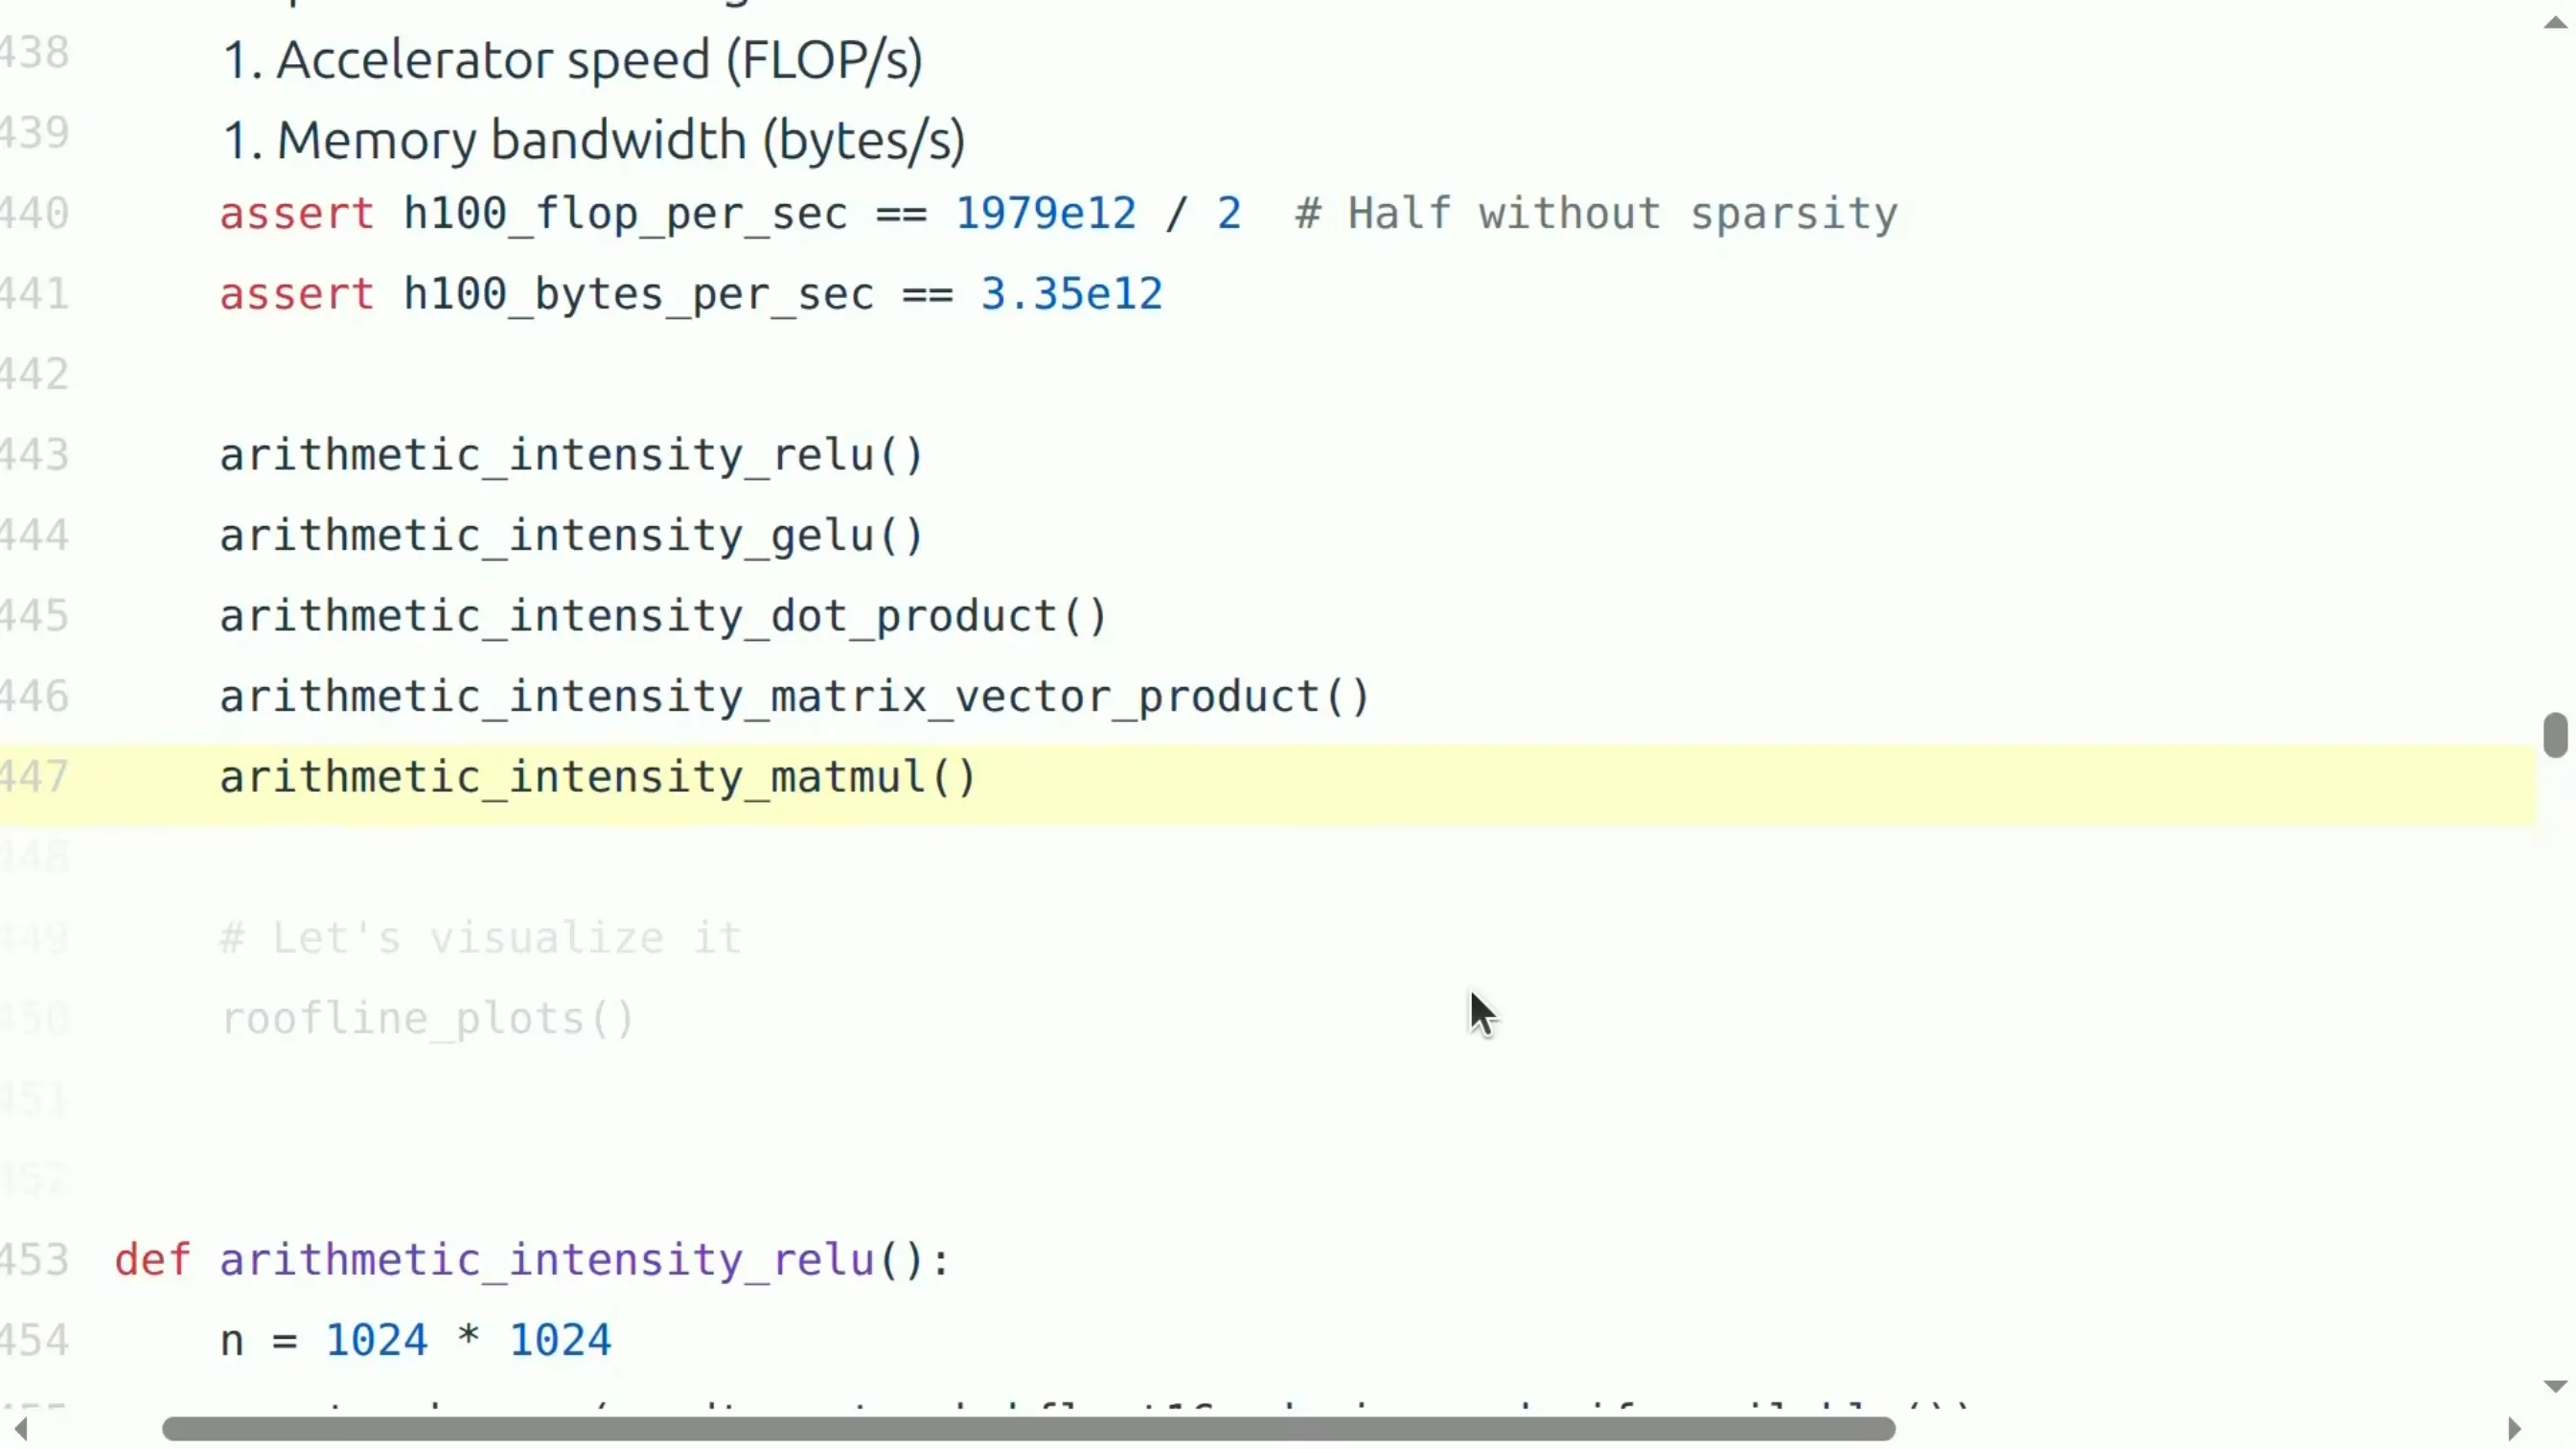
📷 矩阵乘法算术强度约 n/3,n 较大时变为计算受限
回到原视频 (00:51:22)
x = torch.ones(n, n)
w = torch.ones(n, n)
y = x @ w

bytes = (2 * n * n) + (2 * n * n) + (2 * n * n)   # 读 x、读 W、写 y
flops = n * n * (2 * n - 1)                        # n² 个点积
算术强度 ≈ n / 3。当 n = 1024 时约为 340,大于 295 → 计算受限!
直觉上很好理解:
你搬运的是 n² 量级的数据,但计算的是 n³ 量级的结果——两者的比值是 n 量级。矩阵越大,算术强度越高。
这也解释了为什么大家总说"要用大 batch size、要用大矩阵":
- 如果还在加速器强度以下,把矩阵改小并不会更快(反正都是内存受限);
- 只有当超过这个门槛,你才真正压满(saturate)加速器。
而 Transformer 恰好就是"一大堆大矩阵乘法,中间夹一些零碎操作",是有意设计成高算术强度的。反过来,推理是矩阵-向量乘,内存受限。
注意:算术强度也取决于精度。同样的操作,用 bf16 和 fp32,搬运的字节数不同,强度就不同。
Roofline 图,以及 MFU 的另一种写法
(参考时间: 54:53)
把上面的关系画出来,就是 Roofline 图:
- 横轴:算术强度(每一个竖切片对应一种算法);
- 纵轴:实际达到的 FLOP/s;
- 每条折线:一种硬件(比如 H100、B200);
- 折点(kink):正是该硬件的加速器强度,也就是"内存受限 ↔ 计算受限"的分界。
于是 MFU 有了一个漂亮的表达式:
MFU = min(1, 算术强度 / 加速器强度)
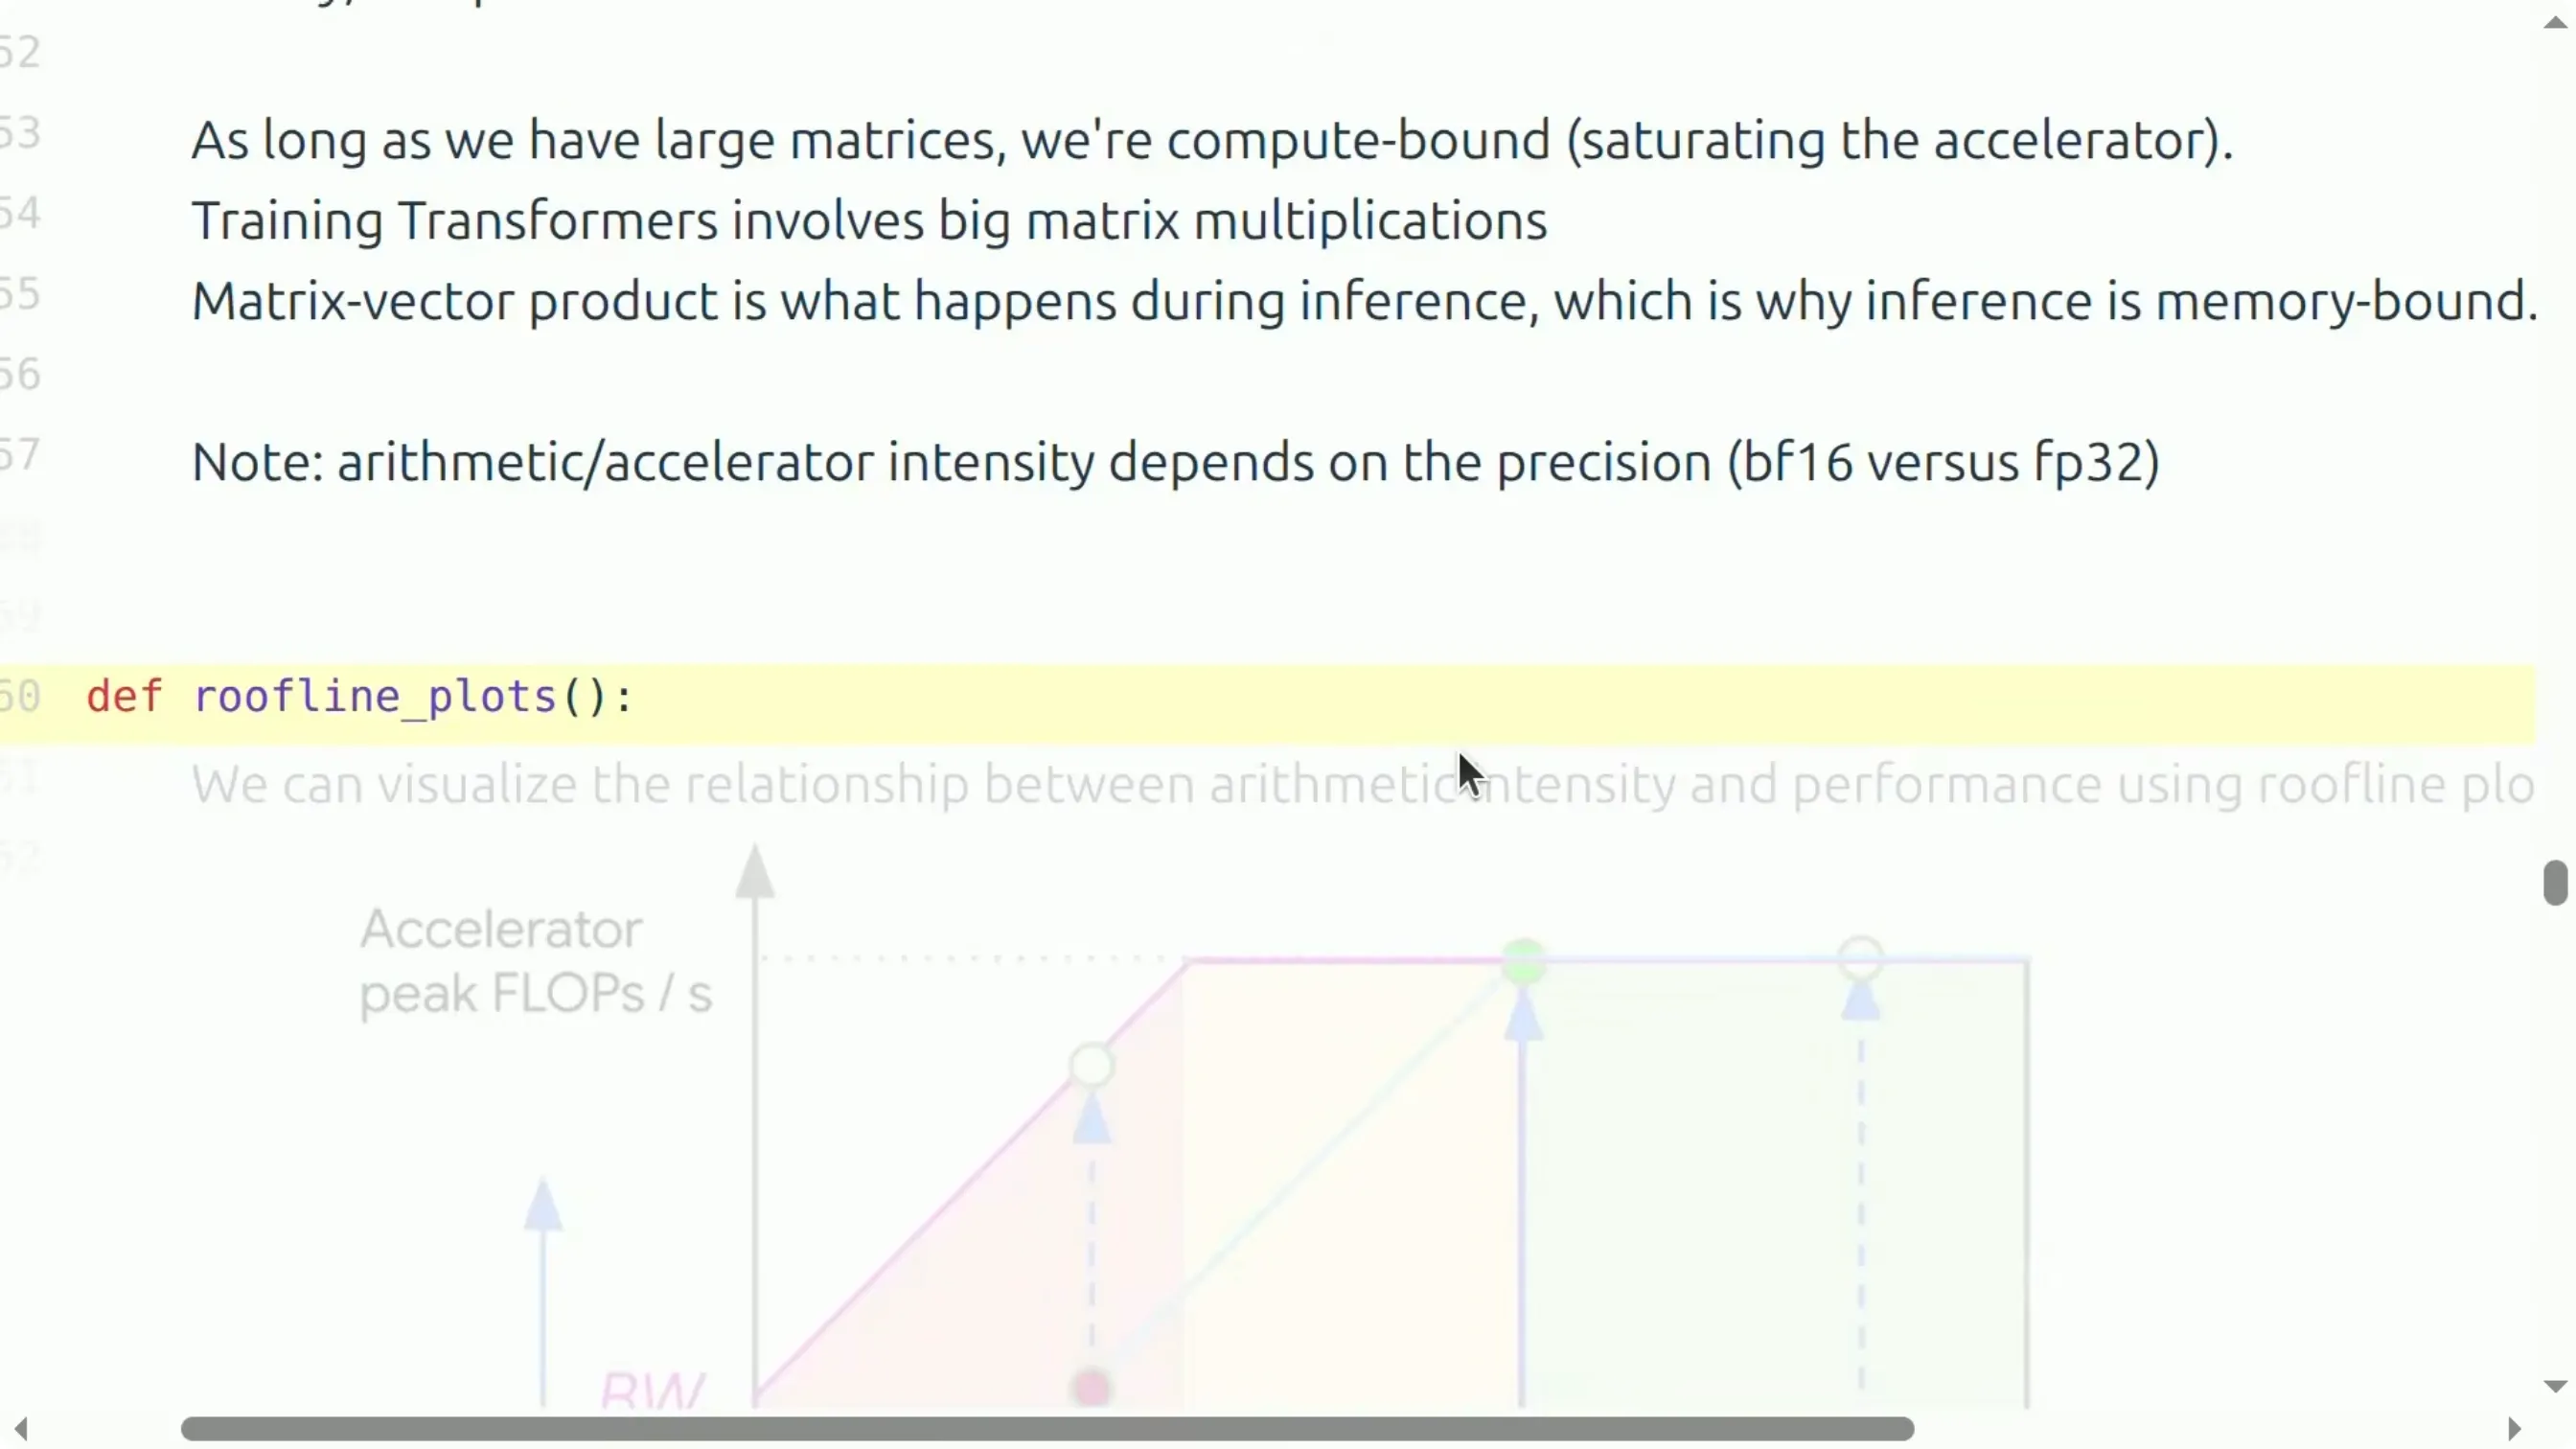
📷 Roofline 图:横轴算术强度、纵轴实际 FLOP/s,折点为加速器强度
回到原视频 (00:54:53)
课堂问答:既然模型大多是内存受限、加速器大量时间在"空转等内存",为什么不把加速器设计得更均衡?主讲笑说:如果你有答案,应该去告诉 Jensen(黄仁勋)。等后面讲 GPU 原理时会再深入一些。
本节小结:
- 现实中我们经常处于内存受限状态(数据搬运很贵);
- 提高算术强度是好事;
- 矩阵乘法是计算受限的,而其他操作基本都是内存受限的;
- 训练是大矩阵乘法,计算受限;推理是矩阵-向量乘,内存受限。
八、训练的显存与算力核算
(参考时间: 55:50)
前面算的都是单个张量运算。现在把它们组合起来,算一次训练要多少资源。
示例网络:一个"深网络"
(参考时间: 57:32)
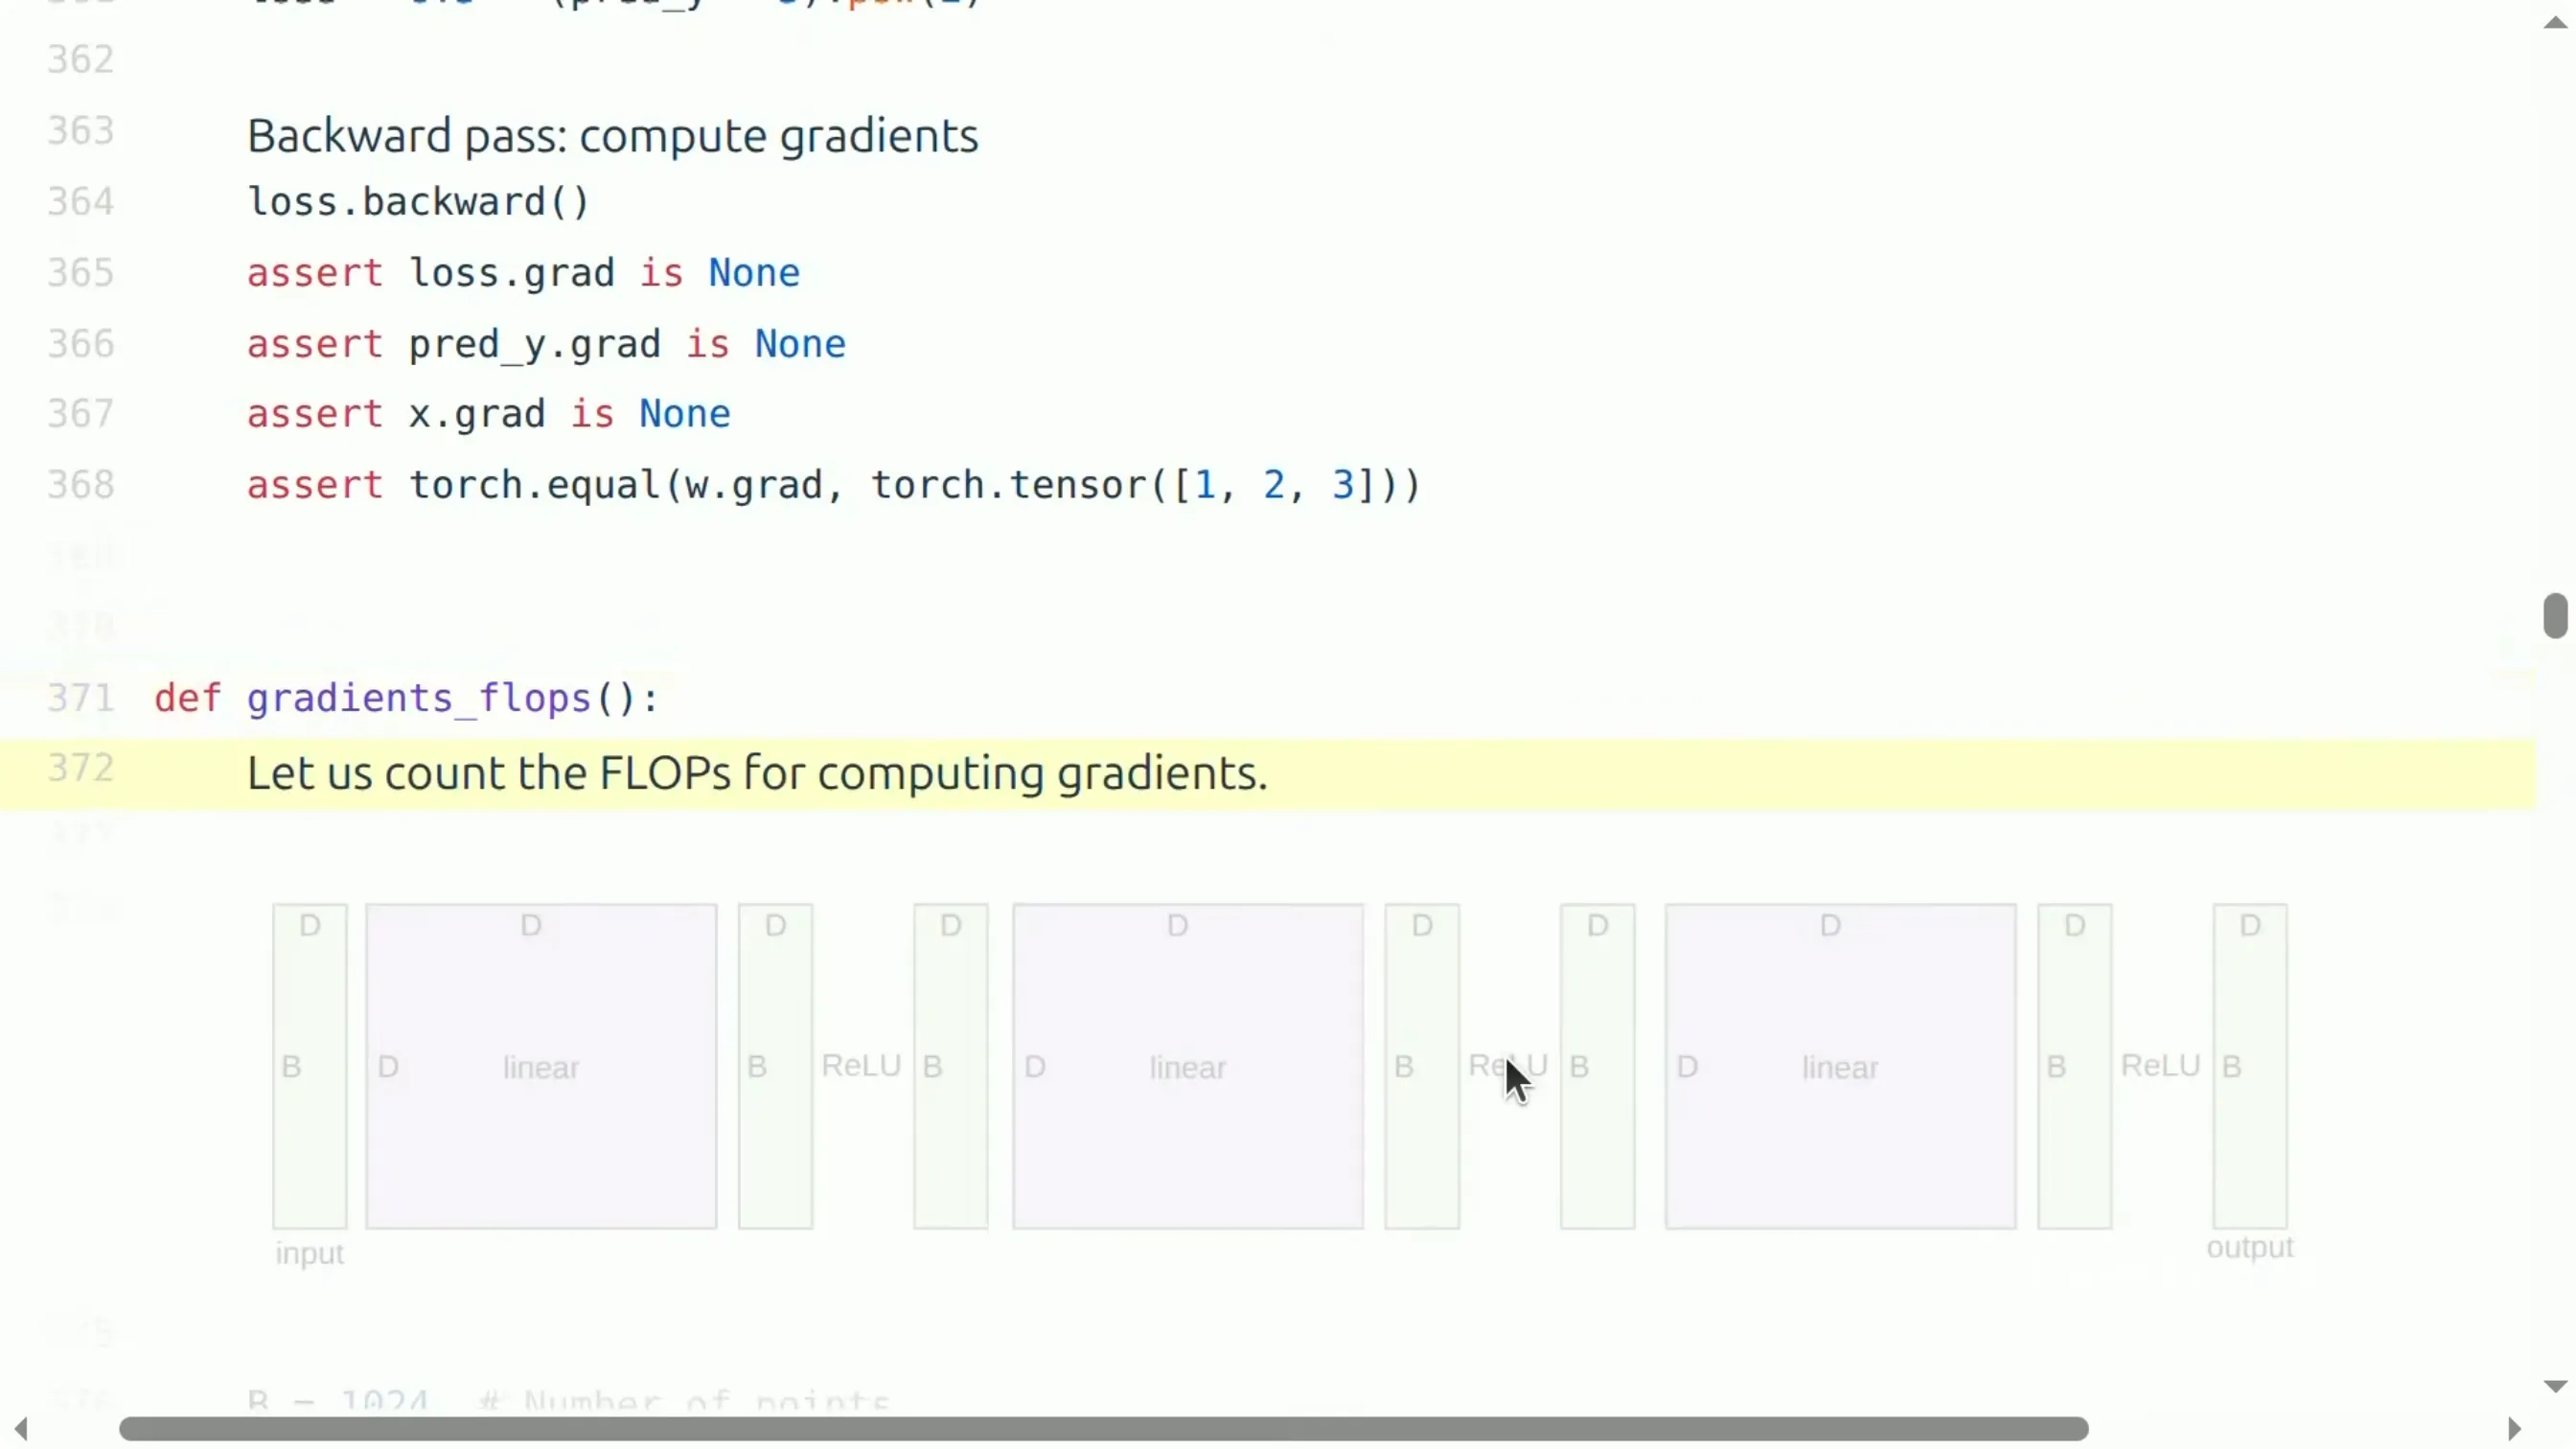
📷 深层网络示例:L 层、每层 D×D 线性变换加逐元素激活
回到原视频 (00:57:32)
用一个简单的深度网络作为贯穿的例子:输入是 B×D,经过 L 层,每层是一个 D×D 的线性变换加逐元素激活,输出仍是 B×D。
class Block(nn.Module):
    """简单块:线性变换 + ReLU 非线性。"""
    def __init__(self, dim: int):
        super().__init__()
        self.weight = nn.Parameter(torch.randn(dim, dim) / math.sqrt(dim))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = x @ self.weight   # 线性
        x = F.relu(x)         # 激活
        return x

class DeepNetwork(nn.Module):
    """把 dim 维向量映射到 dim 维向量。"""
    def __init__(self, dim: int, num_layers: int):
        super().__init__()
        self.layers = nn.ModuleList([Block(dim) for i in range(num_layers)])

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        for layer in self.layers:
            x = layer(x)
        return x
参数量是 D² × L。
梯度:PyTorch 的基本机制
(参考时间: 59:07)
先看一个最小的例子,回归 y = 0.5 (x·w − 5)²:
x = torch.tensor([1., 2, 3])
w = torch.tensor([1., 1, 1], requires_grad=True)   # 要算梯度
pred_y = x @ w
loss = 0.5 * (pred_y - 5).pow(2)

loss.backward()
assert torch.equal(w.grad, torch.tensor([1, 2, 3]))
前向算 loss,loss.backward() 之后 w.grad 就被填上了。这就是 PyTorch 的基本机制——今天不展开,重点看它消耗多少算力。
反向传播的 FLOPs:为什么是前向的 2 倍
(参考时间: 01:00:16)
📷 反向传播 FLOPs:对输入与对参数各一个 matmul
回到原视频 (01:00:16)
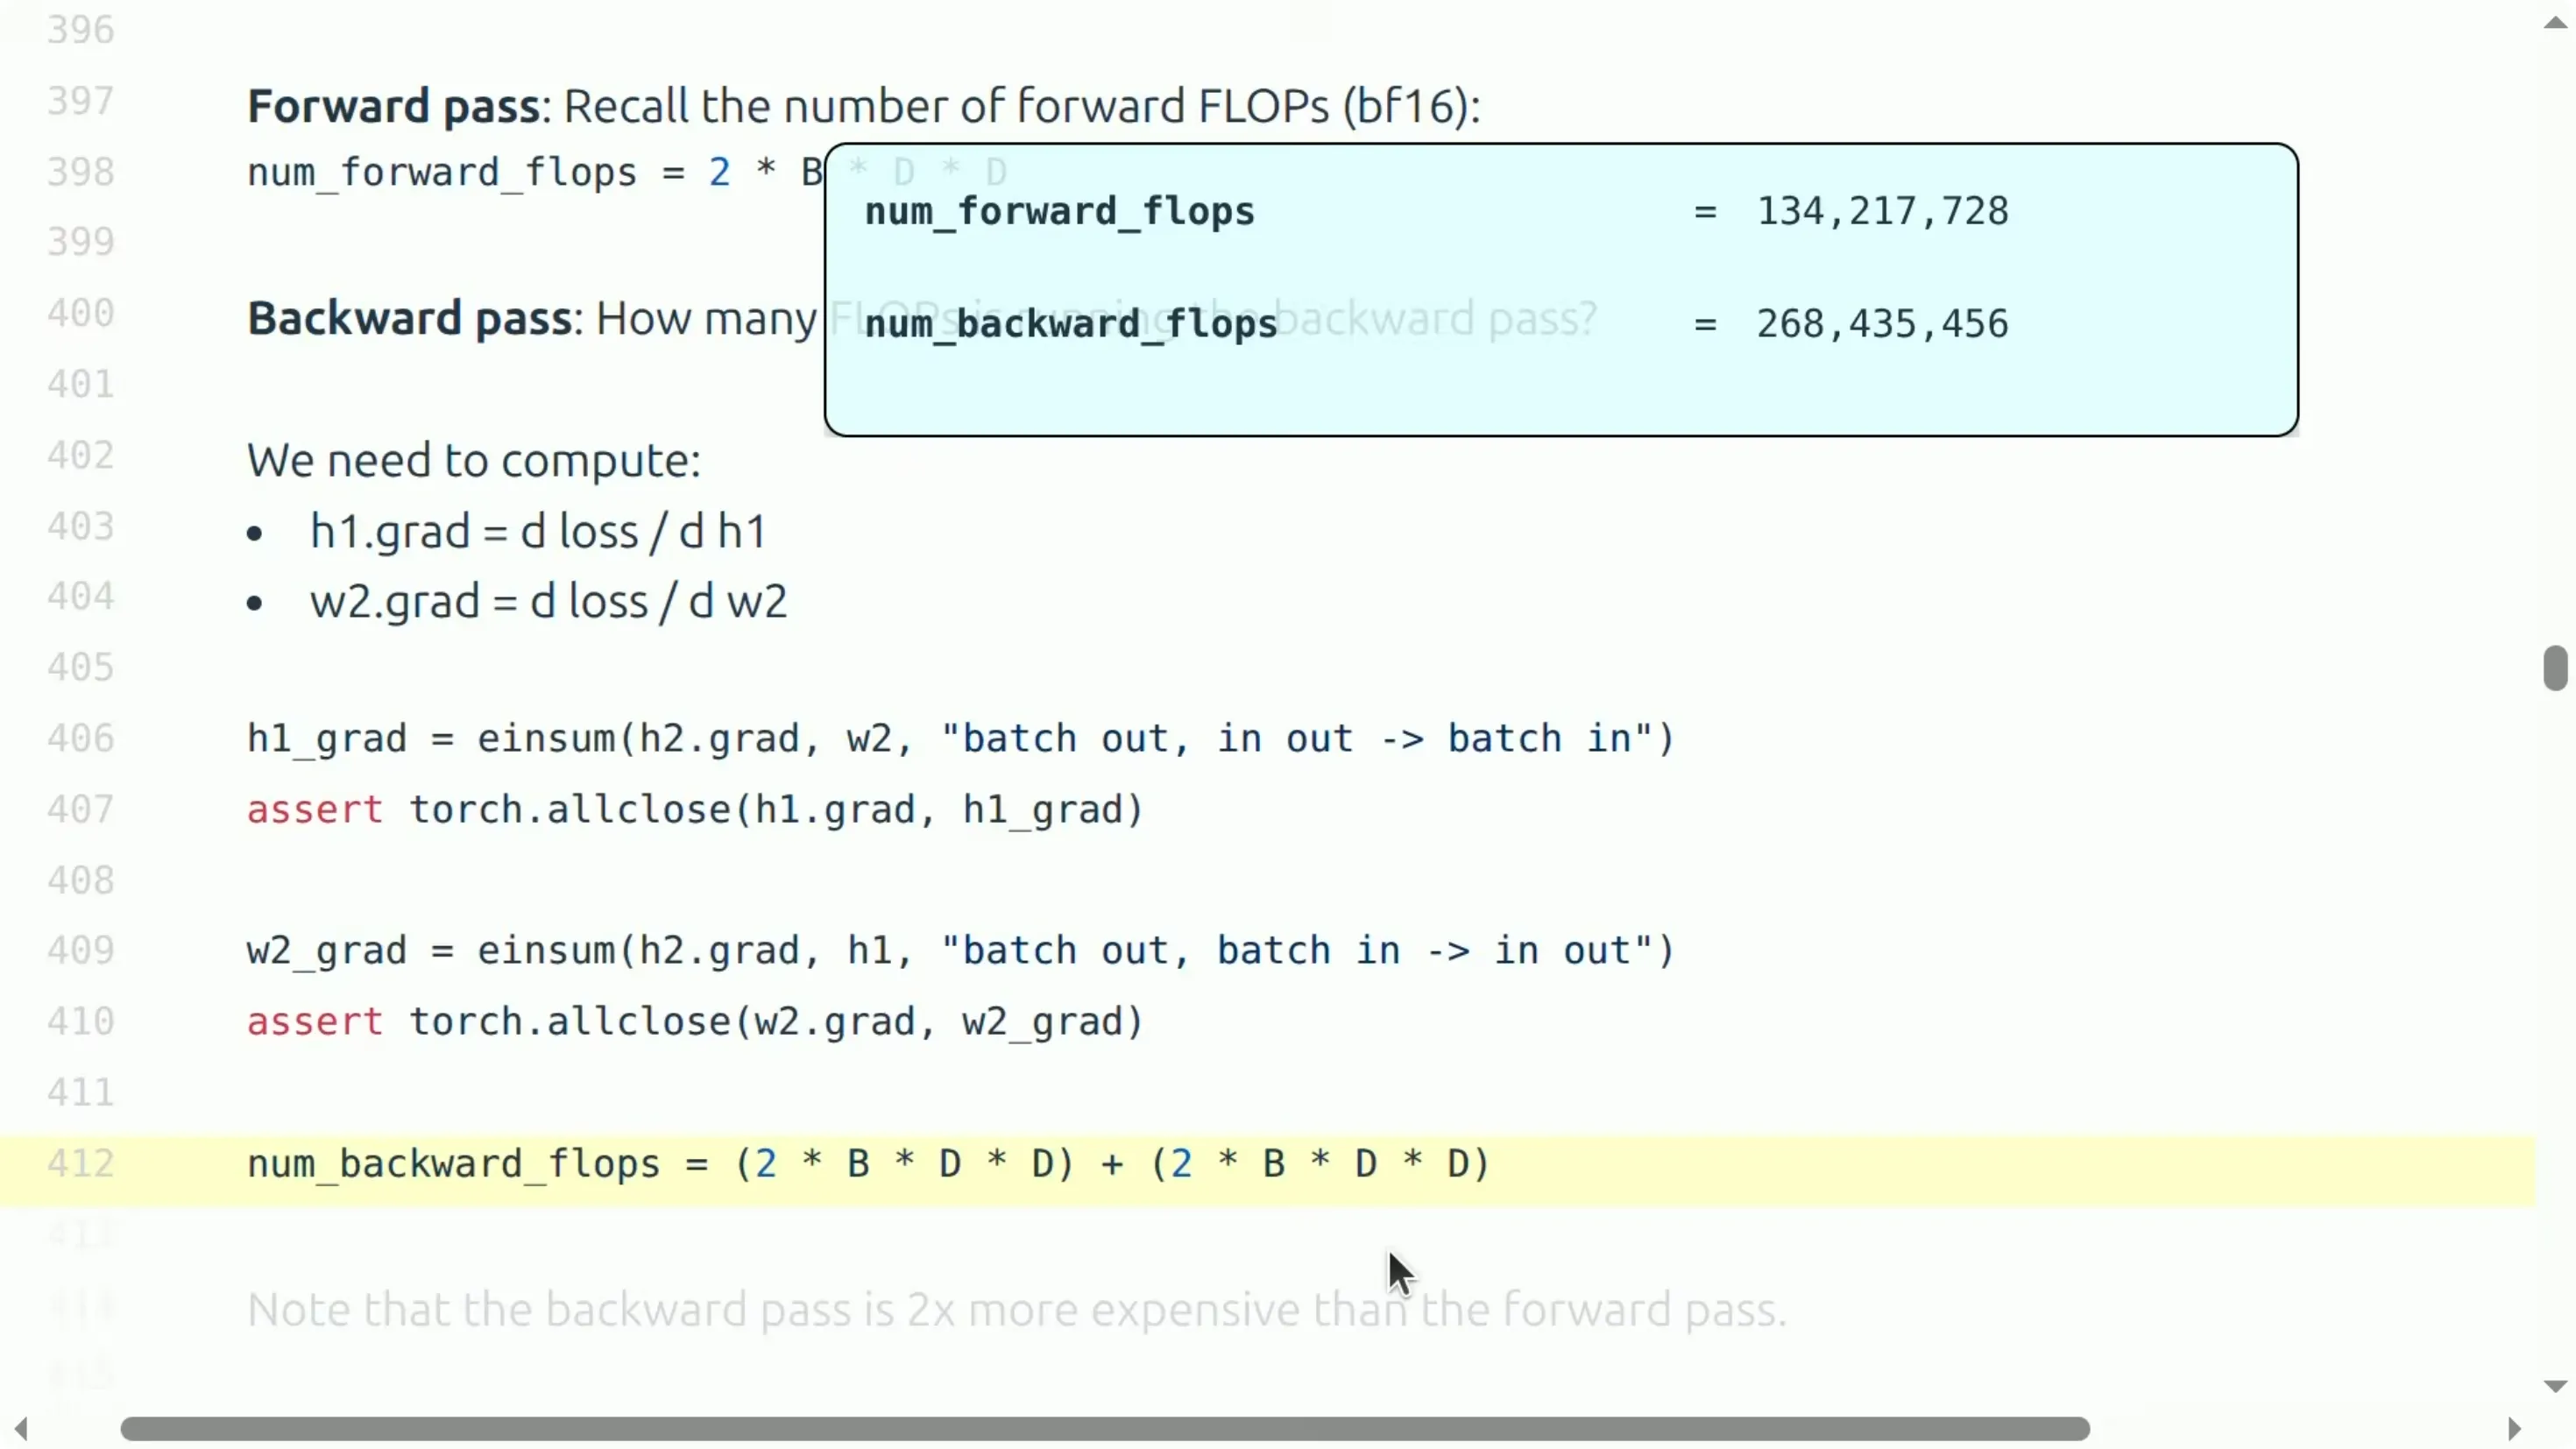
考虑一个两层线性网络 h1 = x @ w1、h2 = h1 @ w2,然后算 loss 并 loss.backward()。我们聚焦第 2 层 h2 = h1 @ w2。
前向就是一个矩阵乘法:
num_forward_flops = 2 * B * D * D
反向要算两个梯度(就是链式法则,用 einsum 写出来非常清楚):
# 对输入的梯度:h1.grad = d loss / d h1
h1_grad = einsum(h2.grad, w2, "batch out, in out -> batch in")

# 对参数的梯度:w2.grad = d loss / d w2
w2_grad = einsum(h2.grad, h1, "batch out, batch in -> in out")

num_backward_flops = (2 * B * D * D) + (2 * B * D * D)   # 两个 matmul
用 einsum 写反传有个好处:不用纠结转置该放哪。你只要记得标量情况下"h1.grad 应该是 h2.grad 乘 w2",剩下的就是按命名对齐维度——这里沿 out 维求和(即矩阵乘法)。
于是:
- 前向:
2BDD; - 反向:两个
2BDD,即4BDD——恰好是前向的 2 倍。
直觉:反向要为每一层算两个梯度(对输入的、对参数的),所以是前向的两倍。
把 6ND 拼出来
(参考时间: 01:05:06)
📷 反向传播是前向的 2 倍,前向 2 + 反向 4 = 6ND
回到原视频 (01:05:06)
上面只是第 2 层,对所有层求和即可:
| 阶段 | FLOPs |
|---|---|
| 前向 | 2 ×(数据点个数)×(参数量) |
| 反向 | 4 ×(数据点个数)×(参数量) |
| 合计 | 6 ×(数据点个数)×(参数量) |
这就是那个流传很广的 6ND 公式的来源(N = 参数量,D = 数据点/token 数),它只是把前向和反向数了一遍。
graph LR
    F["前向传播<br/>2 · (#data) · (#params)"] --> B["反向传播<br/>4 · (#data) · (#params)"]
    F --> T["训练一步总计<br/>6 · (#data) · (#params)"]
    B --> T
适用范围:这是针对 MLP 推出来的,但只要上下文长度不太大,它也是 Transformer 的很好近似。如果上下文很长,就还会多出与序列长度平方成正比的注意力部分,那就不在这个账里了。
优化器与"优化器状态"
(参考时间: 01:06:47)
📷 优化器与优化器状态:AdaGrad 存梯度平方和
回到原视频 (01:06:47)
训练的另一半是优化。为了不直接给作业答案,主讲用 AdaGrad(2011 年,早于 Adam)作演示。先回顾一族优化器的关系:
- momentum = SGD + 梯度的指数平均(一阶矩);
- AdaGrad = SGD + 用梯度平方做平均(二阶矩);
- RMSProp = AdaGrad,但用梯度平方的指数平均;
- Adam = RMSProp + momentum。
AdaGrad 的关键是维护一份优化器状态(optimizer state)——梯度的平方和:
class AdaGrad(torch.optim.Optimizer):
    def step(self):
        for group in self.param_groups:
            lr = group["lr"]
            for p in group["params"]:
                state = self.state[p]
                grad = p.grad.data
                g2 = state.get("g2", torch.zeros_like(grad))   # 历史梯度平方和
                g2 += torch.square(grad)                       # 更新状态
                state["g2"] = g2
                p.data -= lr * grad / torch.sqrt(g2 + 1e-5)    # 更新参数
一次训练步的完整账本
(参考时间: 01:09:15)
📷 一次训练步的显存账本:参数、梯度、优化器状态、激活
回到原视频 (01:09:15)
显存(参数量记为 P = D²·L):
| 项 | 大小 | 说明 |
|---|---|---|
| 参数 | 2 × P | bf16,2 字节/参数 |
| 梯度 | 2 × P | bf16,2 字节/参数 |
| 优化器状态 | 4 × P(AdaGrad)/ 8 × P(Adam) | fp32,出于稳定性 |
| 激活值 | 2 × (B · D · L) | bf16,随批大小与层数增长 |
关于优化器状态为什么要用 fp32:因为要反复做平方、再长期累积平均,用 bf16 会很不稳定。这也意味着优化器状态其实是显存的大头——Adam 要存一阶矩和二阶矩,共 8 字节/参数。
一个重要的区分:优化器状态不是计算速度的瓶颈(它不太参与搬运/计算的热点),但它决定了你能不能在显存里装下这个模型。
算力(一步):
flops = 6 * B * num_parameters
对于 Transformer,账会复杂一些,但思路完全一样——这正是作业 1 要你亲手做的事。
延伸阅读:Transformer 训练的显存账见 https://erees.dev/transformer-memory/;FLOPs 账见 https://www.adamcasson.com/posts/transformer-flops。
九、省显存的两大技巧
(参考时间: 01:06:50)
既然显存如此关键(既决定"装不装得下",有时也影响速度),就有必要主动降低显存占用。两个最常用的手段如下。
技巧一:梯度累积(gradient accumulation)
(参考时间: 01:12:27)
📷 梯度累积:micro-batch 累积梯度,定期更新参数
回到原视频 (01:12:27)
动机:我们希望用大 batch(有助于稳定性,后面 Tatsu 会讲"临界批大小"),但激活显存随批大小增长,批太大就会爆显存。
做法:
- 把一个大 batch 切成若干 micro-batch(微批);
- 在每个微批上算梯度;
- 把梯度累加起来(不要清零);
- 每
batch_size / micro_batch_size步,才真正更新一次参数并清零梯度。
# 大 batch 的激活显存
activation_memory = 2 * B * D * L
# 用 micro-batch 后
micro_batch_size = B / 4
activation_memory = 2 * micro_batch_size * D * L   # 降到 1/4
这是一个非常简单的代码改动,却能显著省显存,从而用上等效的大 batch。
技巧二:激活检查点(activation checkpointing)
(参考时间: 01:13:21)
📷 激活检查点:只存部分激活,反向时重算
回到原视频 (01:13:21)
先看一个对比:训练需要保存所有层的激活(因为反向要用到);而推理不需要算梯度,所以只需保存当前层的激活。
激活检查点(又叫梯度检查点 gradient checkpointing 或重计算 rematerialization)的思路是:
- 前向:只保存一部分层的激活(检查点);
- 反向:从最近的检查点重新计算缺失的激活。
这就是典型的用计算换显存。
在 PyTorch 里实现非常简单:
class DeepNetworkCheckpointed(nn.Module):
    """与 DeepNetwork 相同,但启用激活检查点。"""
    def __init__(self, dim: int, num_layers: int):
        super().__init__()
        self.layers = nn.ModuleList([Block(dim) for i in range(num_layers)])

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        for layer in self.layers:
            # 关键:只在检查点存激活,其余在反向时重算
            x = torch.utils.checkpoint.checkpoint(layer, x)
        return x
以"线性 + ReLU"的 Block 为例:不做检查点时,ReLU 前后的激活都要存;做了检查点后,只存 ReLU 之后的值,显存大约减半(反向时用 H2 就能重算出 G3)。
检查点的频率如何取舍? 设层数为 L:
| 策略 | 激活显存 | 重计算开销 |
|---|---|---|
| 每层都存 | O(L) | 无 |
| 完全不存 | O(1) | O(L²)(每层都从头重算) |
| 每隔 √L 层存一个 | O(√L) | O(L) |
每隔 √L 层存一个是一个不错的平衡点。
十、总结与下一讲
(参考时间: 01:16:15)
📷 本讲总结:张量、einops、6ND、算术强度、省显存技巧
回到原视频 (01:16:15)
本讲的内容可以浓缩为几条:
- 一切都是在张量上做运算——参数、梯度、激活、优化器状态、数据,全都是张量。
- Einops 提供了一种更好的思考张量运算的方式(用名字而非下标)。
6 × (#data) × (#params)是训练一步的 FLOPs——本讲已经把它"去神秘化"了(前向 2、反向 4)。- 算术强度 / Roofline 分析让我们能诊断一段计算是计算受限还是内存受限。
- 矩阵乘法是计算受限的;其余基本都是内存受限。
- 梯度累积与激活检查点可以降低显存,从而用上更大的批大小。
下一讲预告:由 Tatsu 主讲架构(architectures)。
附:官方参考与延伸阅读
本讲涉及的官方材料
- 课程主页:https://stanford-cs336.github.io/(亦见 https://cs336.stanford.edu/)
- 本讲"可执行讲义"源码:https://github.com/stanford-cs336/lectures/blob/main/lecture_02.py
- 课程讲义仓库:https://github.com/stanford-cs336/lectures
- Assignment 1: Basics:https://github.com/stanford-cs336/assignment1-basics
- AI 使用政策指南:https://docs.google.com/document/d/1SZAlExB1qAc9izHt54gwunNpjKE6wXb8Y7yA_e-baK8
- 集群使用指南:https://docs.google.com/document/d/1cHE0iKVyXLJ3XpIs2XuXTmZ-HMmPk2hIPeCvy-AydMg
精度与数值
- fp32(单精度):https://en.wikipedia.org/wiki/Single-precision_floating-point_format
- fp16(半精度):https://en.wikipedia.org/wiki/Half-precision_floating-point_format
- bf16(Brain Floating Point):https://en.wikipedia.org/wiki/Bfloat16_floating-point_format
- 混合精度训练(Micikevicius et al.):https://arxiv.org/pdf/1710.03740.pdf
- PyTorch AMP 文档:https://pytorch.org/docs/stable/amp.html
- fp8 入门(NVIDIA):https://docs.nvidia.com/deeplearning/transformer-engine/user-guide/examples/fp8_primer.html、fp8 论文:https://arxiv.org/pdf/2209.05433.pdf
- NVFP4:https://developer.nvidia.com/blog/introducing-nvfp4-for-efficient-and-accurate-low-precision-inference/
Einops
- Einops 教程:https://einops.rocks/1-einops-basics/
- Einstein 求和约定(Einstein, 1916)
FLOPs、算术强度与 Roofline
- GPT-3 训练 FLOPs:https://lambdalabs.com/blog/demystifying-gpt-3
- H100 规格:https://resources.nvidia.com/en-us-tensor-core/nvidia-tensor-core-gpu-datasheet
- How to Scale Your Model(Roofline 章节):https://jax-ml.github.io/scaling-book/roofline/
- Transformer 训练的显存:https://erees.dev/transformer-memory/
- Transformer 的 FLOPs:https://www.adamcasson.com/posts/transformer-flops
优化器
- AdaGrad(Duchi et al., 2011)、Adam(Kingma & Ba, 2014)、AdamW(Loshchilov & Hutter, 2017)
- 本讲涉及的模型:DeepSeek v3.2、Nemotron 3 Super(用 NVFP4 训练)
版权说明:本书内容依据斯坦福大学 CS336(Spring 2026)第二讲的公开教学视频与官方讲义源码(
lecture_02.py)重构,代码与讲义版权归课程团队所有。本电子书仅用于学习交流,不用于商业用途。
已知疑点
-
时间戳格式(已统一)。 原稿有四处写成非法的
mm:ss(60:16、65:06、66:47、69:15),本次已统一为hh:mm:ss(01:00:16、01:05:06、01:06:47、01:09:15)。其余(参考时间: ...)均取自字幕时间轴,可能存在数秒偏差。 -
"fp8 于 2022 年标准化"措辞。 IEEE 并未发布过名为 fp8 的正式标准;NVIDIA、Arm、Intel 等在 2022 年前后于 OCP 框架下发布 FD8 规范(E4M3 / E5M2)。文中给的两个范围(E4M3 约 ±448、E5M2 约 ±57344)与 OCP 规范一致,但"标准化"一词的来源无法当场判定,可能是口播的简化说法。
-
"Nemotron 3 Super 用 NVFP4 训练"。 NVFP4 是 NVIDIA 2025 年发布的 4 位格式,这点无争议;但"Nemotron 3 Super"这一具体型号名无法在公开资料中核对(NVIDIA 的 Nemotron 系列有多个命名变体),存在字幕听写误差的可能。
-
NVFP4 的可表示值列表是示意而非精确格点。 文中列
-6, -4, -3, -2, -1.5, -1.0, -0.5, 0, 0.5, …, 6,正负两侧不对称,而真实 NVFP4 的格点由"每块共享一个 E4M3 缩放因子 × 每个值 4 位"共同决定,并非一个固定集合。这段更像课堂口头的直观示意,照实记录容易被误读为固定格点。 -
H100 的 989.5 TFLOP/s 未逐处标精度。 该数字对应 BF16 稠密算力(标称值因带稀疏性而需除以 2)。但正文在问题一与 ReLU / GELU 等算例中反复使用它,没有逐处注明"这是 bf16 峰值"。若读者把它当作与精度无关的"H100 算力",或把它与 fp32 任务混用,结论会出现数倍偏差。这是编者重构时未加限定的一处含糊。
-
6·N·D 与硬件峰值并置时未说明精度前提。 FLOPs 的计数方式(一次乘、一次加各算 1 FLOP)与数据类型无关,但用它除以硬件峰值时必须选定精度。正文只解释了"为什么除以 2"(稀疏性),未解释"为什么取 bf16 峰值而非 fp32"。这是问题一估算里一处隐含前提。
-
反向传播的 einsum 说明存在歧义。 正文把"这里沿
out维求和"紧接在h1_grad = einsum(h2.grad, w2, "batch out, in out -> batch in")之后,但紧随其后的w2_grad = einsum(h2.grad, h1, "batch out, batch in -> in out")实际是沿batch维求和。原话很可能只指第一个式子,但两句并排阅读时容易被理解为两处梯度都沿out求和。 -
AdaGrad / Adam / AdamW 与 bf16 的年份、归属口径不一致。 正文写"AdaGrad(2011 年)"(与 Duchi et al. 2011 一致),而附录列 Adam(2014)、AdamW(2017);但 Adam 正式发表于 ICLR 2015、AdamW 正式发表于 ICLR 2019,这里统一采用了 arXiv 首发年。同理,bf16"由 Google Brain 在 2018 年提出"是业界通行说法(Cloud TPU / bfloat16),却没有一篇可引的 2018 年原始论文。建议在措辞上加"约"或补上具体出处。
-
GPT-3 矩阵例子的维度顺序未说明。 "12288*4 × 12288,fp32,约 2.3 GB"中,按 1 GB = 10⁹ 字节算约 2.42 GB、按 GiB 算约 2.25 GiB,"约 2.3 GB"两者都勉强对得上;但 GPT-3 前馈层的标准写法通常是 12288 → 49152,本讲给的行列顺序相当于其转置,取决于采用 W 还是 Wᵀ 的约定。这点未交代。
-
激活检查点的 O(√L) 表未列假设。 表中"每隔 √L 层存一个 → 激活显存 O(√L)、重计算开销 O(L)"来自 Chen et al. 2016 的经典分析,但严格结论依赖"每层激活等大、每层重算代价相同"这两个前提,原文对一般情形给出的界更细。作为课堂结论无碍,照搬到层大小不齐的网络会失准。
-
同一符号 D 在本讲有两个含义。 前面 D 指隐藏维度(
B, S, H, D、D×D线性层),后面又用来指数据点 / token 数。同讲内同符号两义、靠上下文区分;在"6 × B × num_parameters"与"6ND"并置处最容易混淆。这是沿用原讲记号带来的取舍。 -
训练步激活显存的系数口径未说明。 正文把一步的激活显存记为
2 × (B · D · L),相当于每层只保留一份层输出;但示例 Block 是"线性 + ReLU",不做激活检查点时中间张量不止一份,若计入全部中间量系数会更大。这笔账的口径没有明确写出。 -
若干跨讲次引用与经验值缺出处。 "后面 Tatsu 会讲'临界批大小'"只在本讲作为预告出现,未定义亦未给出处,只读本讲的读者可能误以为它是已讲术语;开课新闻中"实测 loss 与预测完全吻合——预测误差在 0.05 以内"未说明是 loss 的绝对差、相对差还是 isoFLOP 曲线上的其他度量,截图文字也无法逐字核对;MFU 的经验阈值表(≥0.5、~0.8、~0.1)是主讲的经验判断,随硬件、模型规模与实现浮动,正文以表格形式给出但未标来源。