第3讲 · Stanford CS336:从零开始的语言建模:架构
本书为课堂口语记录的中文书面化重构,观点归讲师,编者补充均已明确标注。
| 视频来源 | [Stanford CS336 Language Modeling from Scratch |
| 课程主页与讲义(若有) | 见文末「附:官方参考与延伸阅读」 |
| 本讲时长 | 约 89 分钟 |
| 讲述者 | 课程讲师(Percy Liang 的合讲者) |
对应讲次:第3讲(Stanford CS336 语言建模)
制作模型:deepseek-flash(vb compose,据 run.log)
导览
一、这一讲老师想回答的核心问题
老师开篇就把这节课的标题定为 「一些你并不想知道的架构与超参数的一切」(Everything you didn't want to know about architectures and hyperparameters)。他用他自己提出的问题顺序来组织全讲:
- 现代语言模型的架构长什么样? 从一个"朴素 Transformer"(Attention Is All You Need,即 Vaswani 等人 2017 年的论文)出发,到今天各家模型实际采用的结构,中间到底变了什么?
- 哪些改动是所有人都会做的? 也就是说,哪些选择几乎是"铁律"(比如把 LayerNorm 移出残差流、用 RMSNorm、用门控激活)。
- 哪些改动是可以自由变动的? 哪些"看起来很明显很重要"的超参数,其实可以随便选而几乎不影响性能(老师反复强调的一句是:这些超参数"很宽容")。
- 为什么这些选择是这样子的? 它们背后是性能考虑、系统(GPU 吞吐)考虑,还是训练稳定性考虑?
二、难点在哪
老师自己说,这是他一向觉得最"玄"(inscrutable)的一块。难点不在单个部件的数学,而在:
- 没有理论可以事先推断。他明确说:"我们没法事先就知道丢掉 bias 项是 OK 的"——很多结论只能靠"看别人做了什么 + 自己动手试"反推。
- 各种因素互相纠缠。比如权重衰减(weight decay)有时根本不是正则化,而是对优化器行为的一种干预;层归一化的位置又牵动梯度尺度、训练稳定性和网络深度。
- 系统与架构的互锁。一个操作可能只占 0.17% 的浮点运算量,却占 25% 的运行时——所以"哪个部件该删"不是看算术量,而是看内存搬运。
三、读者可能带着什么疑问进来
① 老师真正提出的问题(本讲的问题): - 该怎么给一个语言模型"选配"各个组件? - 这些组件里哪些是关键、哪些是无所谓的?
② 编者预判的读者疑问(编者预判,非老师原话): - (a) "Pre-Norm 和 Post-Norm 到底差在哪,为什么几乎所有人都用 Pre-Norm?" - (b) "SwiGLU、GeGLU、ReGLU……这些名字到底是什么意思?"(老师表示自己年轻时"引以为豪地拒绝去搞懂 SwiGLU",后来发现不得不懂。) - (c) "RoPE 为什么这么流行?它和正弦位置编码有什么本质区别?" - (d) "为什么大家还在用权重衰减,明明不担心过拟合?"
四、本讲路线
老师给出的大致路线是:先讲"共识性的架构部件"(层归一化的位置、归一化方式、激活函数门控、并行/串行、位置编码)→ 再降到"超参数"层面(FF 维度比例、头维度、宽高比、词表大小)→ 最后讲"稳定性技巧"(因为它和架构选择深度绑定:输出 softmax 的处理、QK-Norm、logit 软上限)→ 以注意力层面的干预(GQA/MQA、滑动窗口注意力)收尾。下一讲会补上状态空间模型(SSM)与 MoE 等内容。
编者说明:本讲全部围绕"稠密注意力"(dense attention)这一范畴。老师明确表示,改变注意力本身的替代方案(线性注意力、状态空间模型)留到下一讲。
一、总览:现代 Transformer 到底改了什么
(参考时间: 00:00:05)
老师给这节课定了一个"生态位":训练自己的模型、试不同的架构,是学习架构最好的方式(这也是本课程的哲学);但没那么多算力去穷举整个设计空间,所以次优的事情是学习别人的经验——把这一年里所有新出的模型摊开来看,找出哪些参数在"有效架构"里是固定的,哪些是可以自由变动的。
📷 课程开场,讲师在讲述本讲的目标与"从零开始的语言建模"的路线
回到原视频 (00:00:12)
1.1 一段关于"追模型"的切身经历
(参考时间: 00:03:19)
老师讲了一段非常具体的过程,正是这套"综述式方法"的由来:
- 去年备课时他以为"只有几篇论文,没问题"。结果一翻,冒出来 Qwen 2、Gemma 3、InternLM2、NeMo Tron 4……一年出了 19 个新的稠密(dense)模型,他"工作量爆了"。
- 今年他想:"不可能再这么多吧?训练 20 个稠密 LM 一年不合常理。"结果一开始以为只有 Qwen 3、Gemma 4(他说"Gemma 4 上周四刚出")、几乎还有 3 等等几个。他还特地点名了 Percy 自己用"Marine"训练的 8B 模型。
- 但真正去找以后,模型数量依然很多——而且大多数其实是 MoE(混合专家),那部分留到下一讲。正因为模型如此多样,我们才能得到一张足够好的"选择地图"。
他把这些整理成一张小表(结尾会再回到它),表里按模型列出词表大小、用的层归一化类型、位置编码类型等等,趋势一眼可见。
编者说明:上面出现的具体模型清单(Qwen 2/3、Gemma 3/4、InternLM2、NeMo Tron 4、Percy 的 8B 模型等)是本讲的核心材料,也是老师"综述有据"的直接体现,故予保留。其中"Marine"疑为某个训练框架名,见文末「已知疑点」。
1.2 架构演化的三段论
(参考时间: 00:06:22)
老师把架构史概括为三段:
graph LR
    A["早期实验期<br/>从 Transformer 到 GPT-3<br/>各试各的,无统一标准"] --> B["LLaMA 2 时代<br/>大家都去模仿 LLaMA 2<br/>只做微小改动"]
    B --> C["去年<br/>转向提升训练稳定性<br/>的架构修改"]
    C --> D["今年<br/>转向支持更长上下文<br/>的架构修改"]
这条时间线是理解后续所有"共识"的关键背景。
1.3 一句话概括"架构的本质"
老师说,架构其实是一组复杂权衡,因为它同时要满足三个目标:
- 泛化:要从数据里学到东西;
- 高效训练:要在 GPU 上跑得快;
- 不崩:训练到一半 loss 不能突然炸掉。
正因如此,很多架构选择才显得"不那么优雅"——它们是这三种需求妥协的产物。
二、层归一化:位置、类型与残差流的干净原则
(参考时间: 00:07:30)
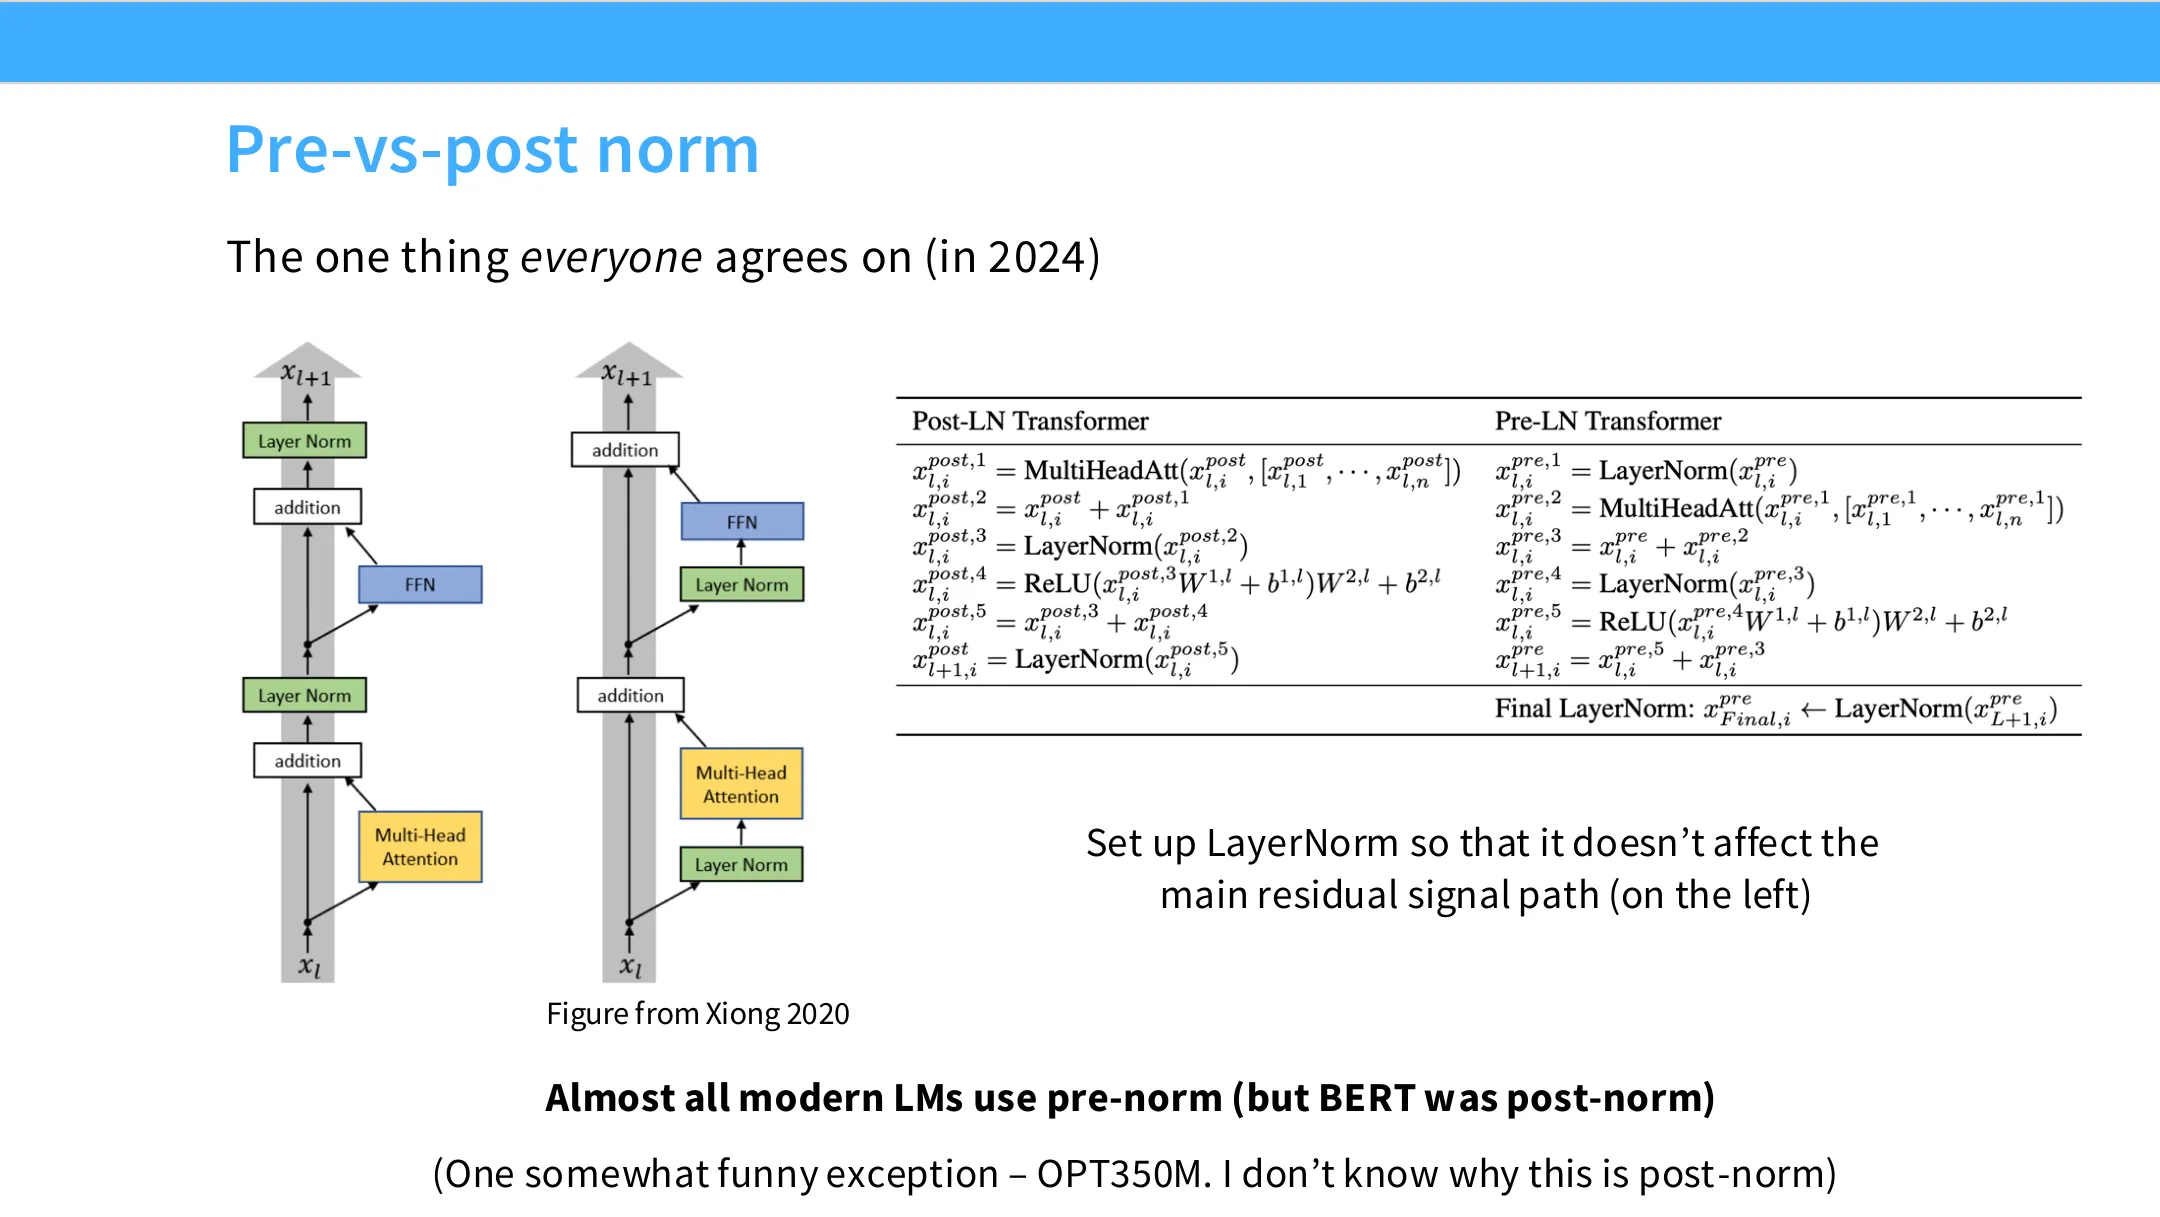
📷 画面回看(00:07:35)
回到原视频 (00:07:35)
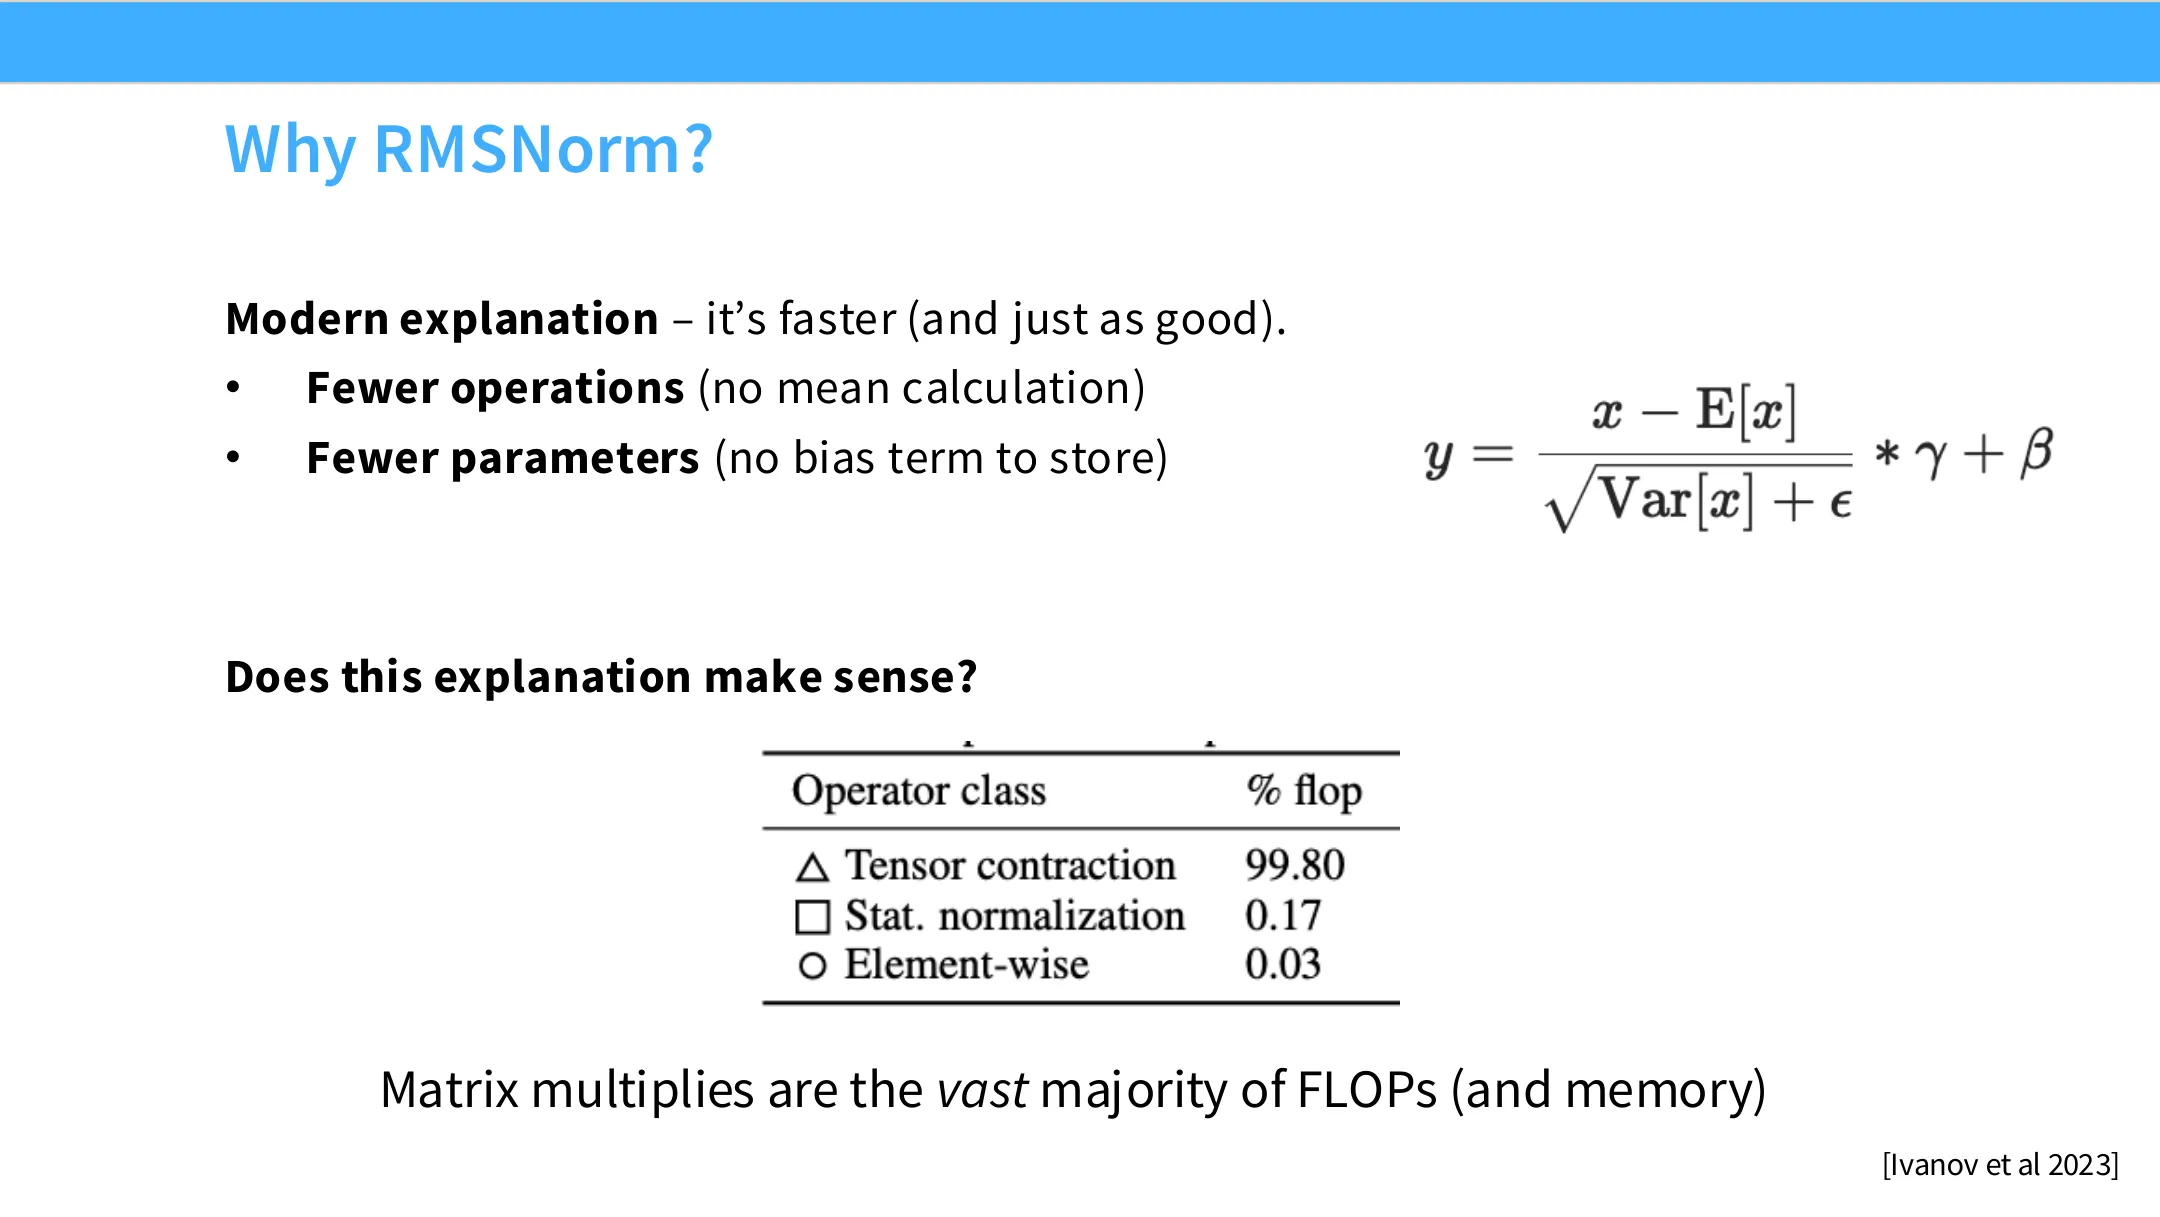
📷 画面回看(00:14:45)
回到原视频 (00:14:45)
老师说,架构上大家分歧很多,但有一件事几乎人人同意:Transformer 论文在"层归一化放在哪"这件事上做错了。
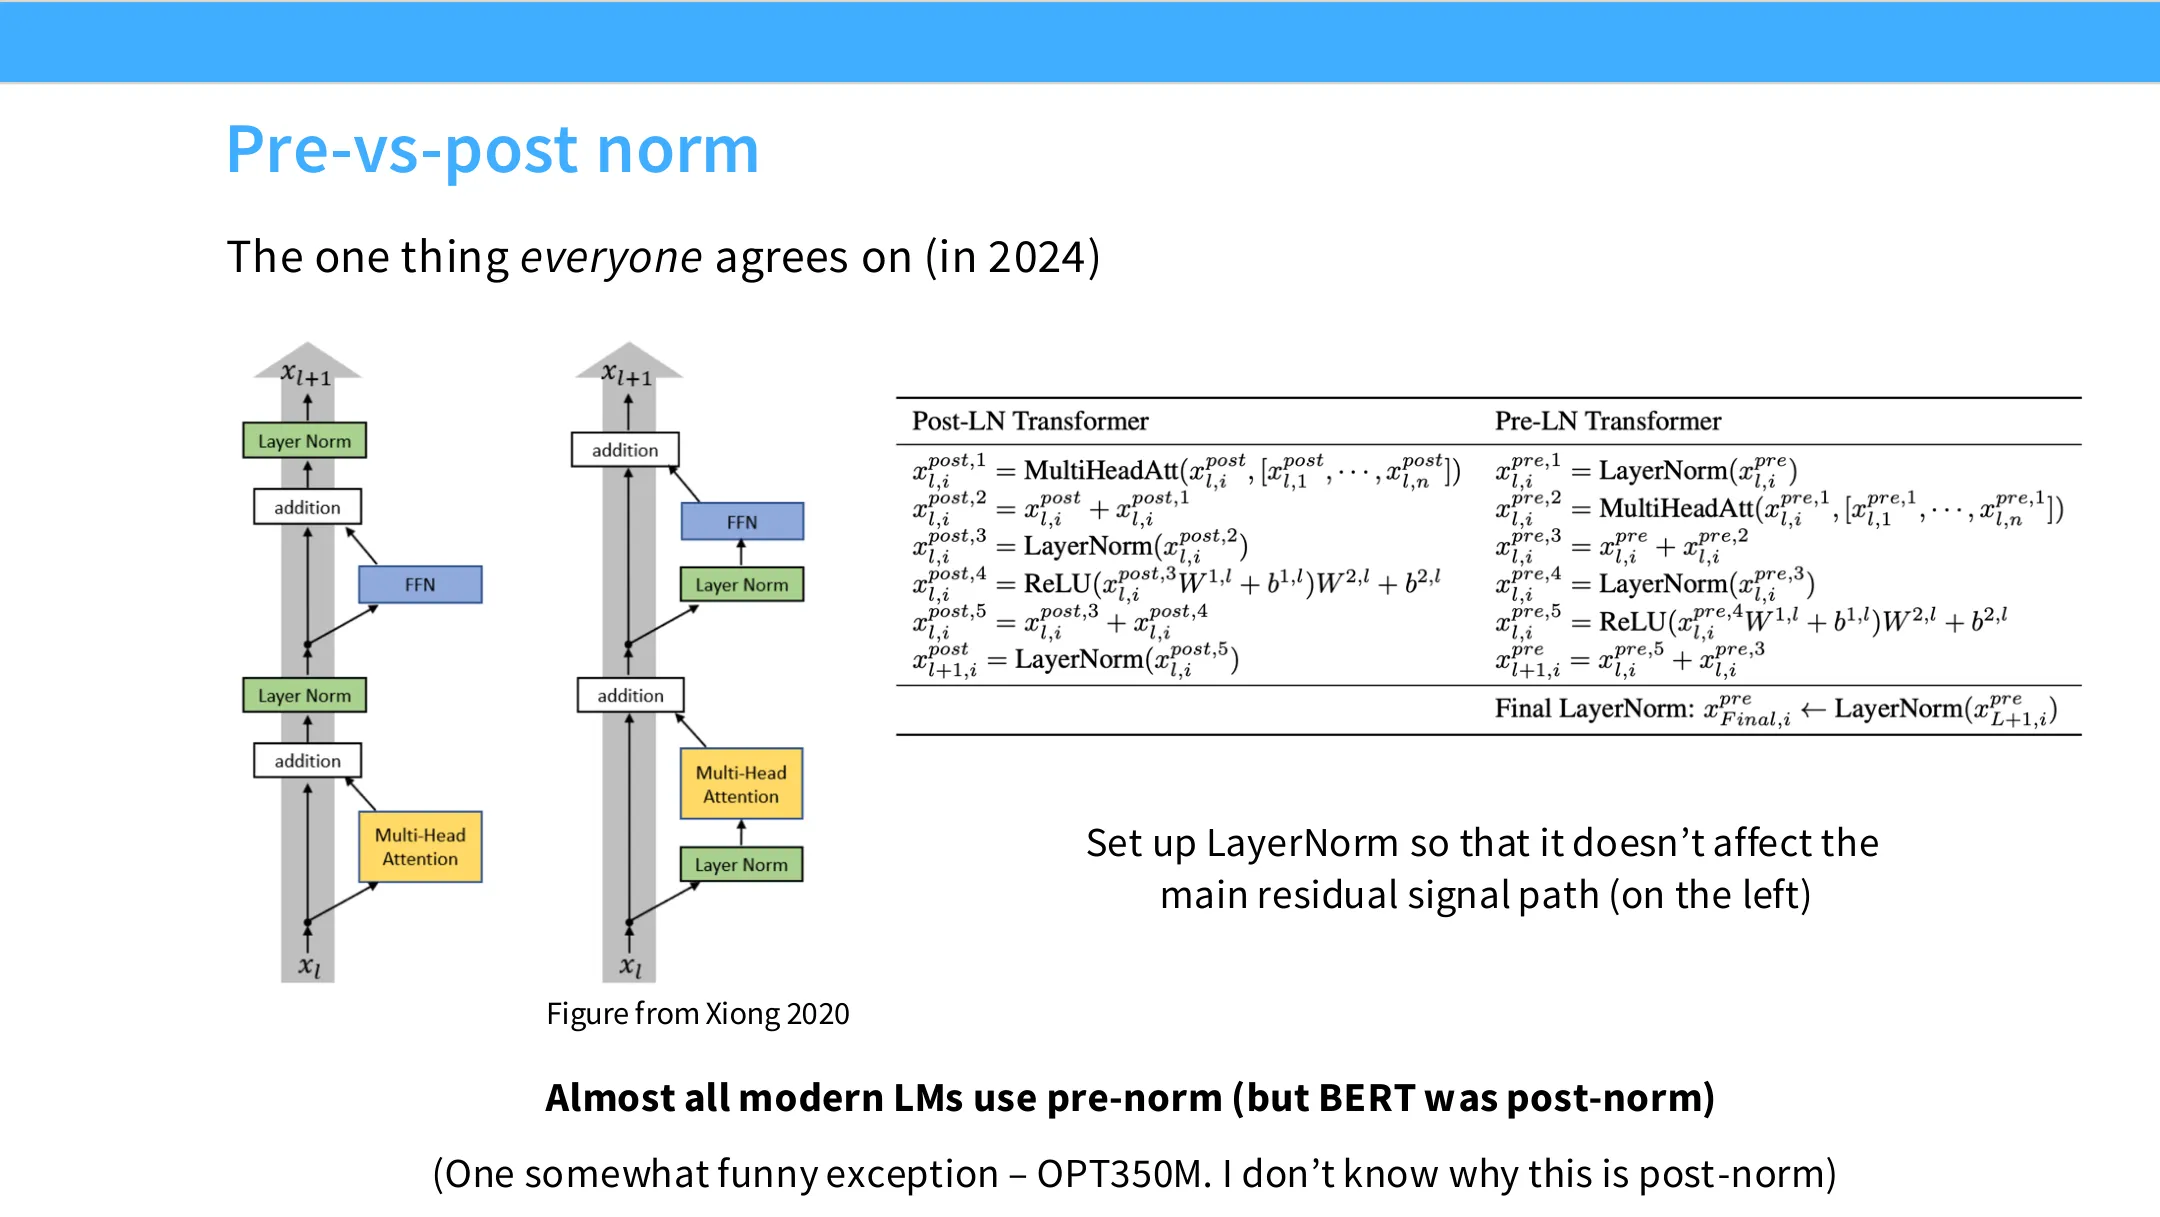
📷 原始 Transformer 的 Post-Norm 结构与残差流示意
回到原视频 (00:07:55)
2.1 Pre-Norm vs Post-Norm
在原始 Transformer 里,层归一化被放在残差路径(residual path)内部,也就是每次把某个部件的输出加回残差流之后再做一次归一化——老师称这种为 residual norm / post-norm。
替代方案是 Pre-Norm:把归一化放到残差流外面,在每个计算之前(多头注意力之前、FFN 之前)做归一化。
graph TD
    subgraph PostNorm["Post-Norm(原始做法)"]
        X1["x"] --> Attn1["注意力"] --> Add1["加回残差流"] --> LN1["LayerNorm 在残差流内"]
        LN1 --> Mlp1["FFN"] --> Add2["加回残差流"] --> LN2["LayerNorm 在残差流内"]
    end
    subgraph PreNorm["Pre-Norm(现代做法)"]
        X2["x"] --> LN1b["LayerNorm"] --> Attn2["注意力"]
        X2 --> Add1b
        Attn2 --> Add1b["加回残差流<br/>(残差流保持'干净')"]
        Add1b --> LN2b["LayerNorm"] --> Mlp2["FFN"]
        Add1b --> Add2b
        Mlp2 --> Add2b
    end
2.2 为什么大家一致地选 Pre-Norm
老师给出两条理由:
理由一(最初的动机):能否去掉 warm-up。 早期研究想解决"训练必须 warm-up"的问题,但很快发现去掉 warm-up 会严重影响稳定性与收敛。实验显示,Post-Norm 的收敛曲线(图中紫色虚线)明显不如 Pre-Norm;Pre-Norm 即便不做 warm-up 也能收敛得更好。
理由二(真正让它留下来):梯度衰减与保持残差流干净。 做架构的人常说的一句话是 "keep your residual stream clean"(保持残差流干净):
- 在 Pre-Norm 下,输入 $x$ 一路从底部直达顶部输出,反向传播时梯度可以沿这条直线直接回传,未经任何变换,因此梯度尺度稳定、信号传播良好。
- 在 Post-Norm 下,每穿过一个 Transformer block 就要做一次层归一化,会不断改变梯度的范数,导致复杂效应。
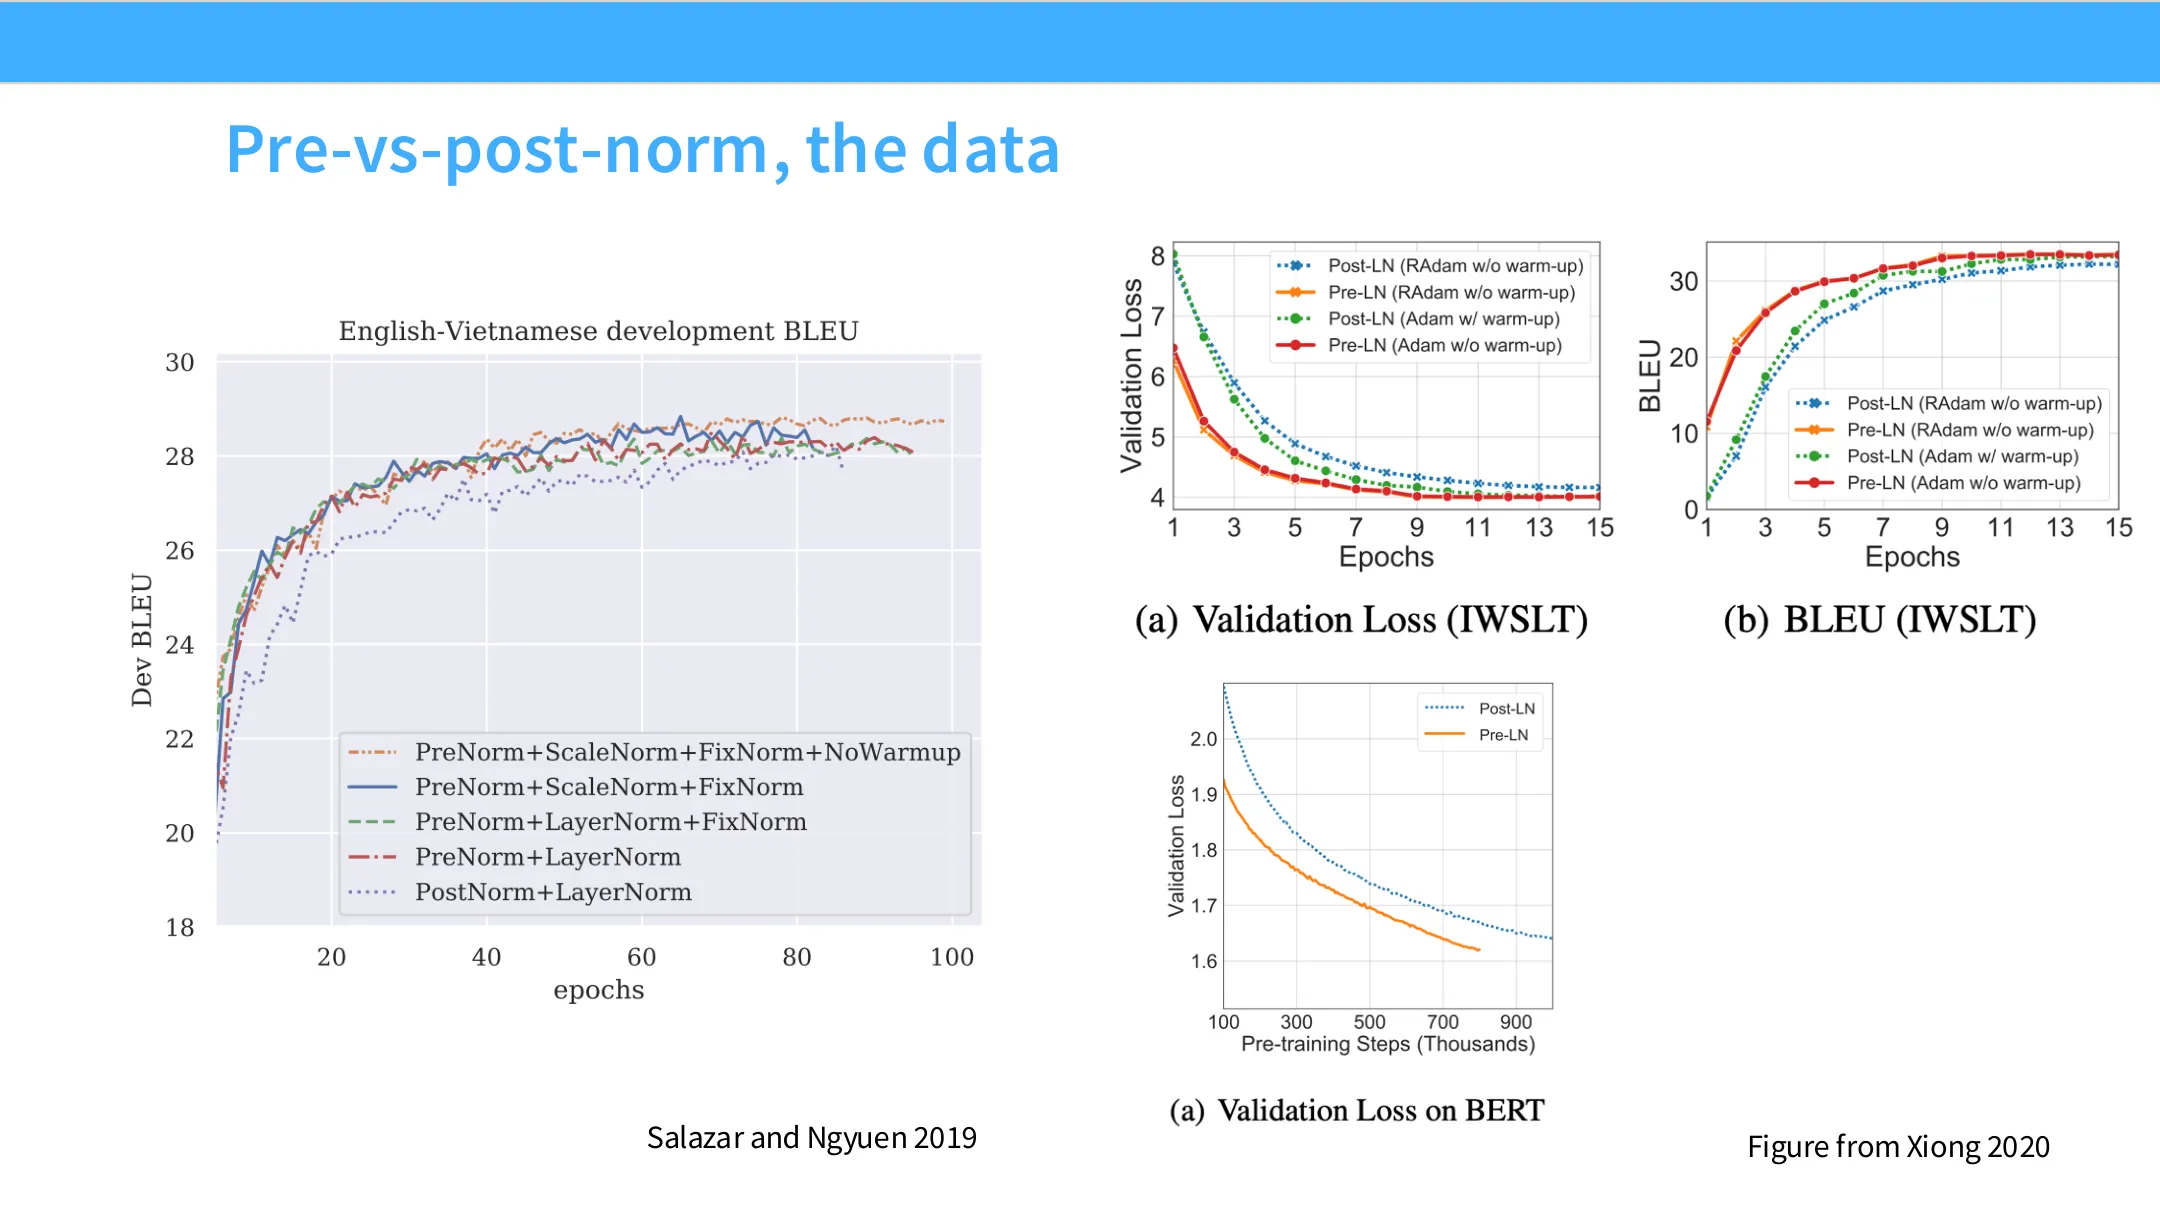
📷 Pre-Norm 相对 Post-Norm 更平滑的收敛与梯度曲线
回到原视频 (00:10:25)
这张对比图出自 Salazar 与 UN 的工作——据老师说是最早认真研究这一现象的人之一。老师认为,"稳定性 + 能训深"正是 Pre-Norm 能留存下来的根本原因。
编者说明:老师此处想强调的核心是——Pre-Norm 让梯度传播构成一条"恒等捷径",从而使深层网络既稳定又能训起来。这与残差连接本身的设计动机一脉相承。
2.3 归一化也可以放在计算之后
(参考时间: 00:12:45)
既然"把归一化移出残差流"才是关键,那它放在计算之前还是之后应该都行。事实也确实如此:
- Grok、Gemma 2、Olmo 2 等把归一化放到计算之后(但在残差流外);
- 还有一些模型到处撒归一化(前后都放,即 double norm)。
老师说了一句近乎"荒谬"却又被反复验证的结论:只要遇到稳定性问题,就往里加一个层归一化,往往就有用——"这听起来很怪,但每次都灵"。
2.4 LayerNorm 与 RMSNorm
(参考时间: 00:13:58)
原始 LayerNorm 的做法是:对激活 $x$ 做减均值、除方差,再缩放回去。
$$ \text{LN}(x) = \frac{x - \mu}{\sqrt{\sigma^2 + \epsilon}} \cdot \gamma + \beta, \quad \mu = \frac{1}{d}\sum_{i=1}^{d} x_i, \quad \sigma^2 = \frac{1}{d}\sum_{i=1}^{d} (x_i - \mu)^2 $$
而现代模型几乎都用 RMSNorm:不减均值、不加偏置,只做缩放:
$$ \text{RMSNorm}(x) = \frac{x}{\sqrt{\frac{1}{d}\sum_{i=1}^{d} x_i^2 + \epsilon}} \cdot \gamma $$
老师说:从表达能力看,LayerNorm 其实比 RMSNorm 更强,所以并非"必须"用 RMSNorm。但实践中:
- RMSNorm 与 LayerNorm 的效果几乎一样;
- RMSNorm 更快。
2.5 为什么"更快"很重要:算术强度视角
(参考时间: 00:14:56)
这里老师把话题拉到系统层面,引入 Percy 在上一讲提过的算术强度(arithmetic intensity)概念,并给了一个非常具体的数字对比:
- 归一化操作大约只占总浮点运算量的 0.17%;
- 但在某些设置下,可能占到运行时长的 25%。
为什么?因为浮点运算量 ≠ 运行时。运行时取决于内存搬运。矩阵乘法(张量收缩)大部分工作是"乘",而统计归一化(层归一化)大部分工作是"内存搬运"——激活值可能很大,搬来搬去很慢。所以只要能删掉一个"算术强度很低、表达力也不多"的小操作,就是免费的优化。
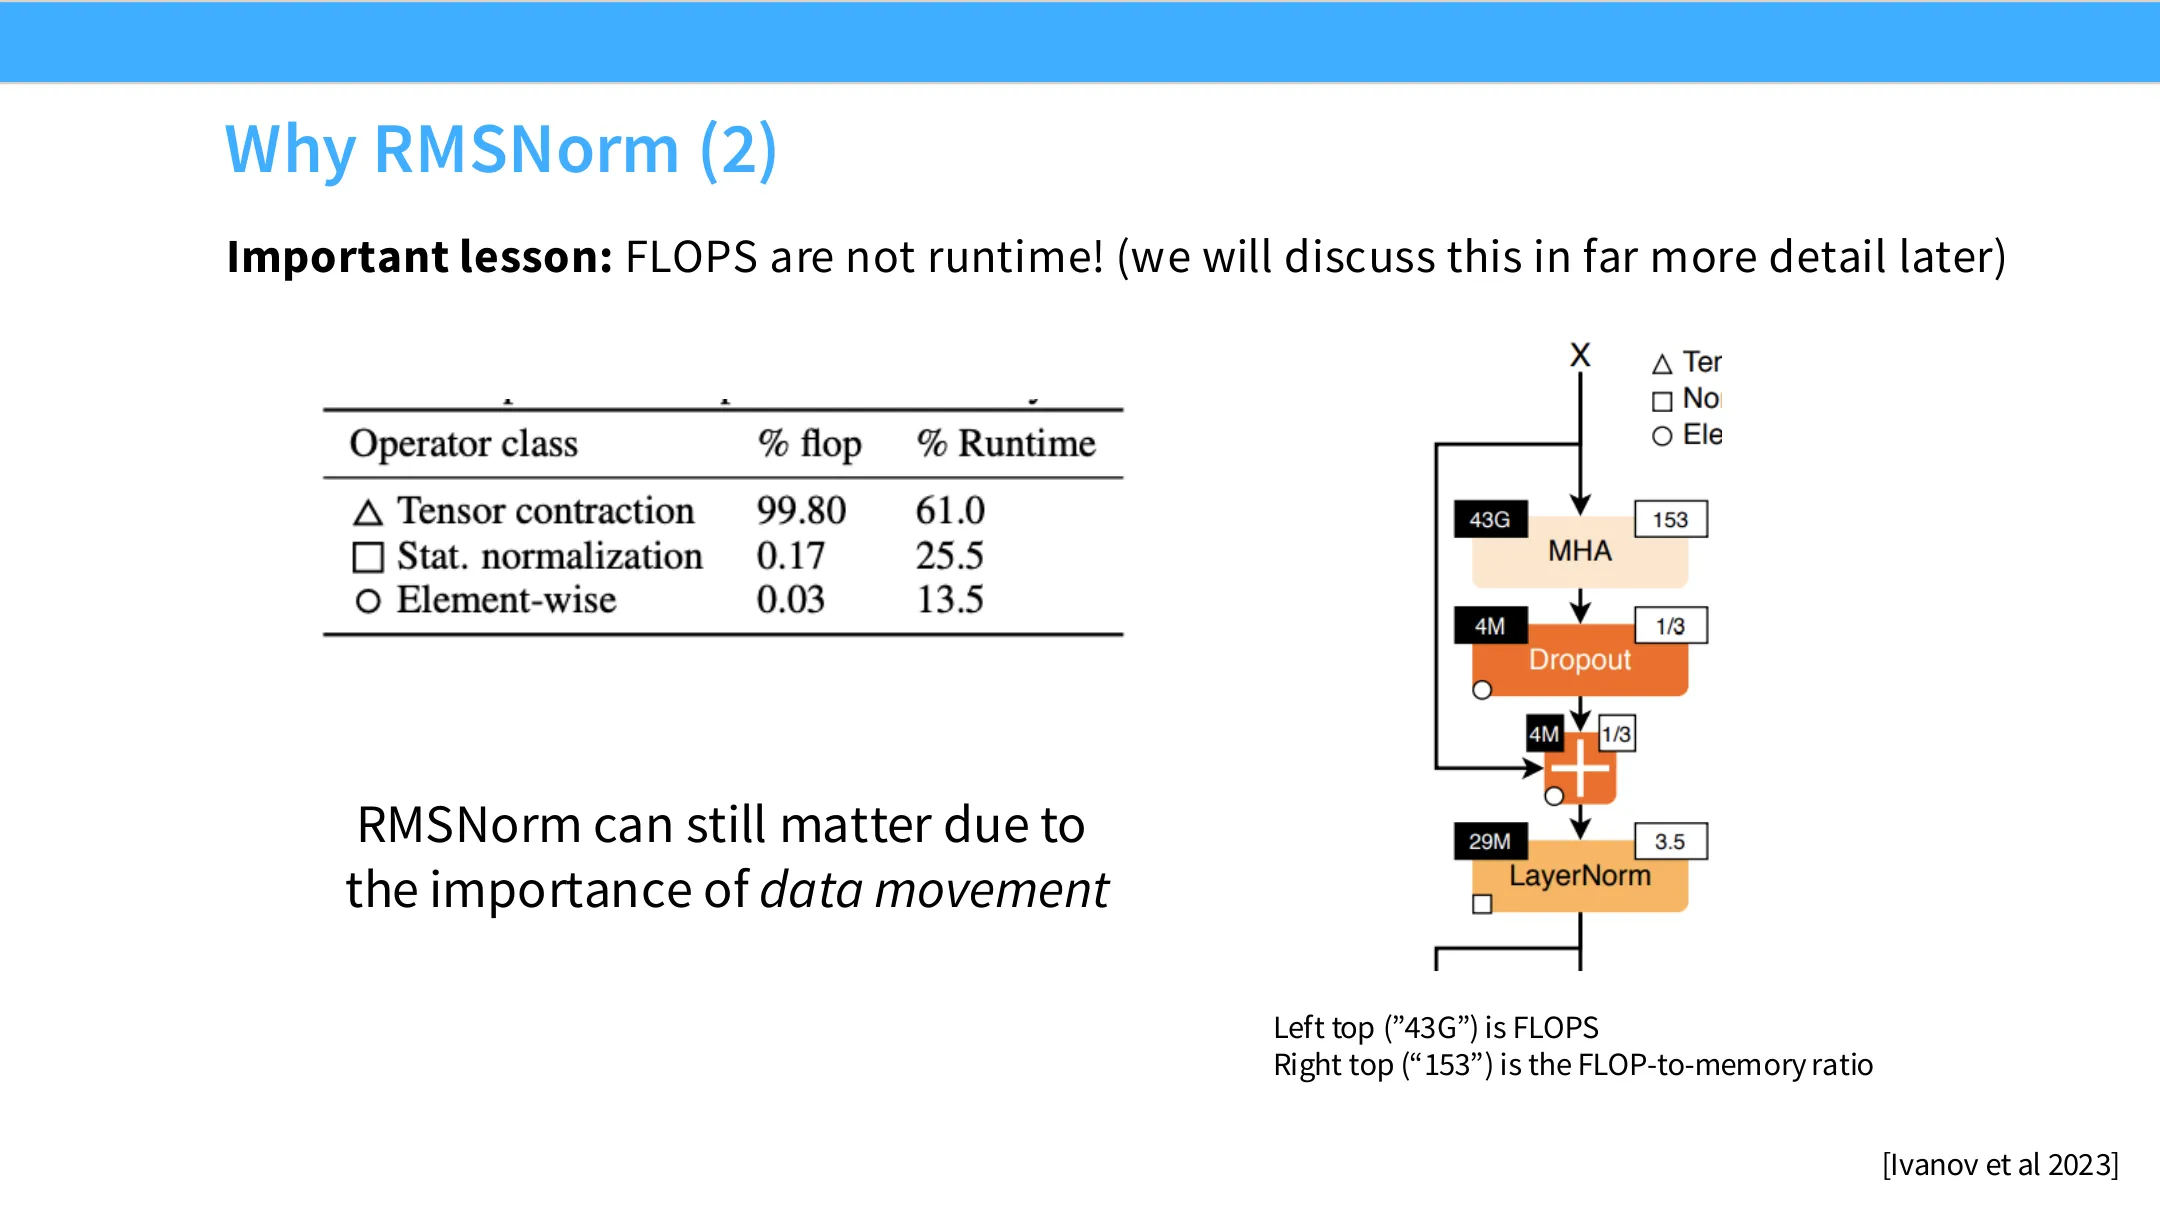
📷 算术强度对比图,LayerNorm 的算术强度极低,属于应尽量消除的操作
回到原视频 (00:16:37)
有学生问:"归一化的内存搬运为何相对算术如此不成比例?" 老师答:对张量收缩而言,大部分是乘法;对统计归一化而言,大部分是搬运,而搬运很慢——当"搬运"几乎占了全部开销时,代价就不小了。
有一篇 Google 2020 年的论文做了实证:把一个 2 亿参数的小 Transformer 换成 RMSNorm 后,"每秒步数"(第三种指标)提高了,而且性能甚至更好。老师强调:性能更好不是保证,但至少是免费的、白得的系统收益。
2.6 顺带删掉 bias 项
(参考时间: 00:18:02)
更一般地,Transformer 和神经网络里的偏置项(bias)通常没什么用。原版 Transformer 的线性层都有 bias,但大多数实现直接删掉了。
- 这同样是"算术强度低、相对更吃内存"的操作,删掉能白得系统收益;
- 有时 bias 还会引发稳定性问题;
- 但删除 bias 的主要理由还是简化系统。
老师说,这一类结论("LayerNorm 放外面 + 删 bias + 用 RMSNorm")无法先验推理,只能靠大量实验和集体经验得到。他还特别点名一个"好笑的例外":OPT-350M —— 为什么只有这一个模型在残差流里放了 post layer norm?他也不知道,"OPT 这一系列本来就是一锅粥"。
三、激活函数:从 ReLU 到门控线性单元(GLU)
(参考时间: 00:20:16)
📷 画面回看(00:21:00)
回到原视频 (00:21:00)
📷 画面回看(00:25:00)
回到原视频 (00:25:00)
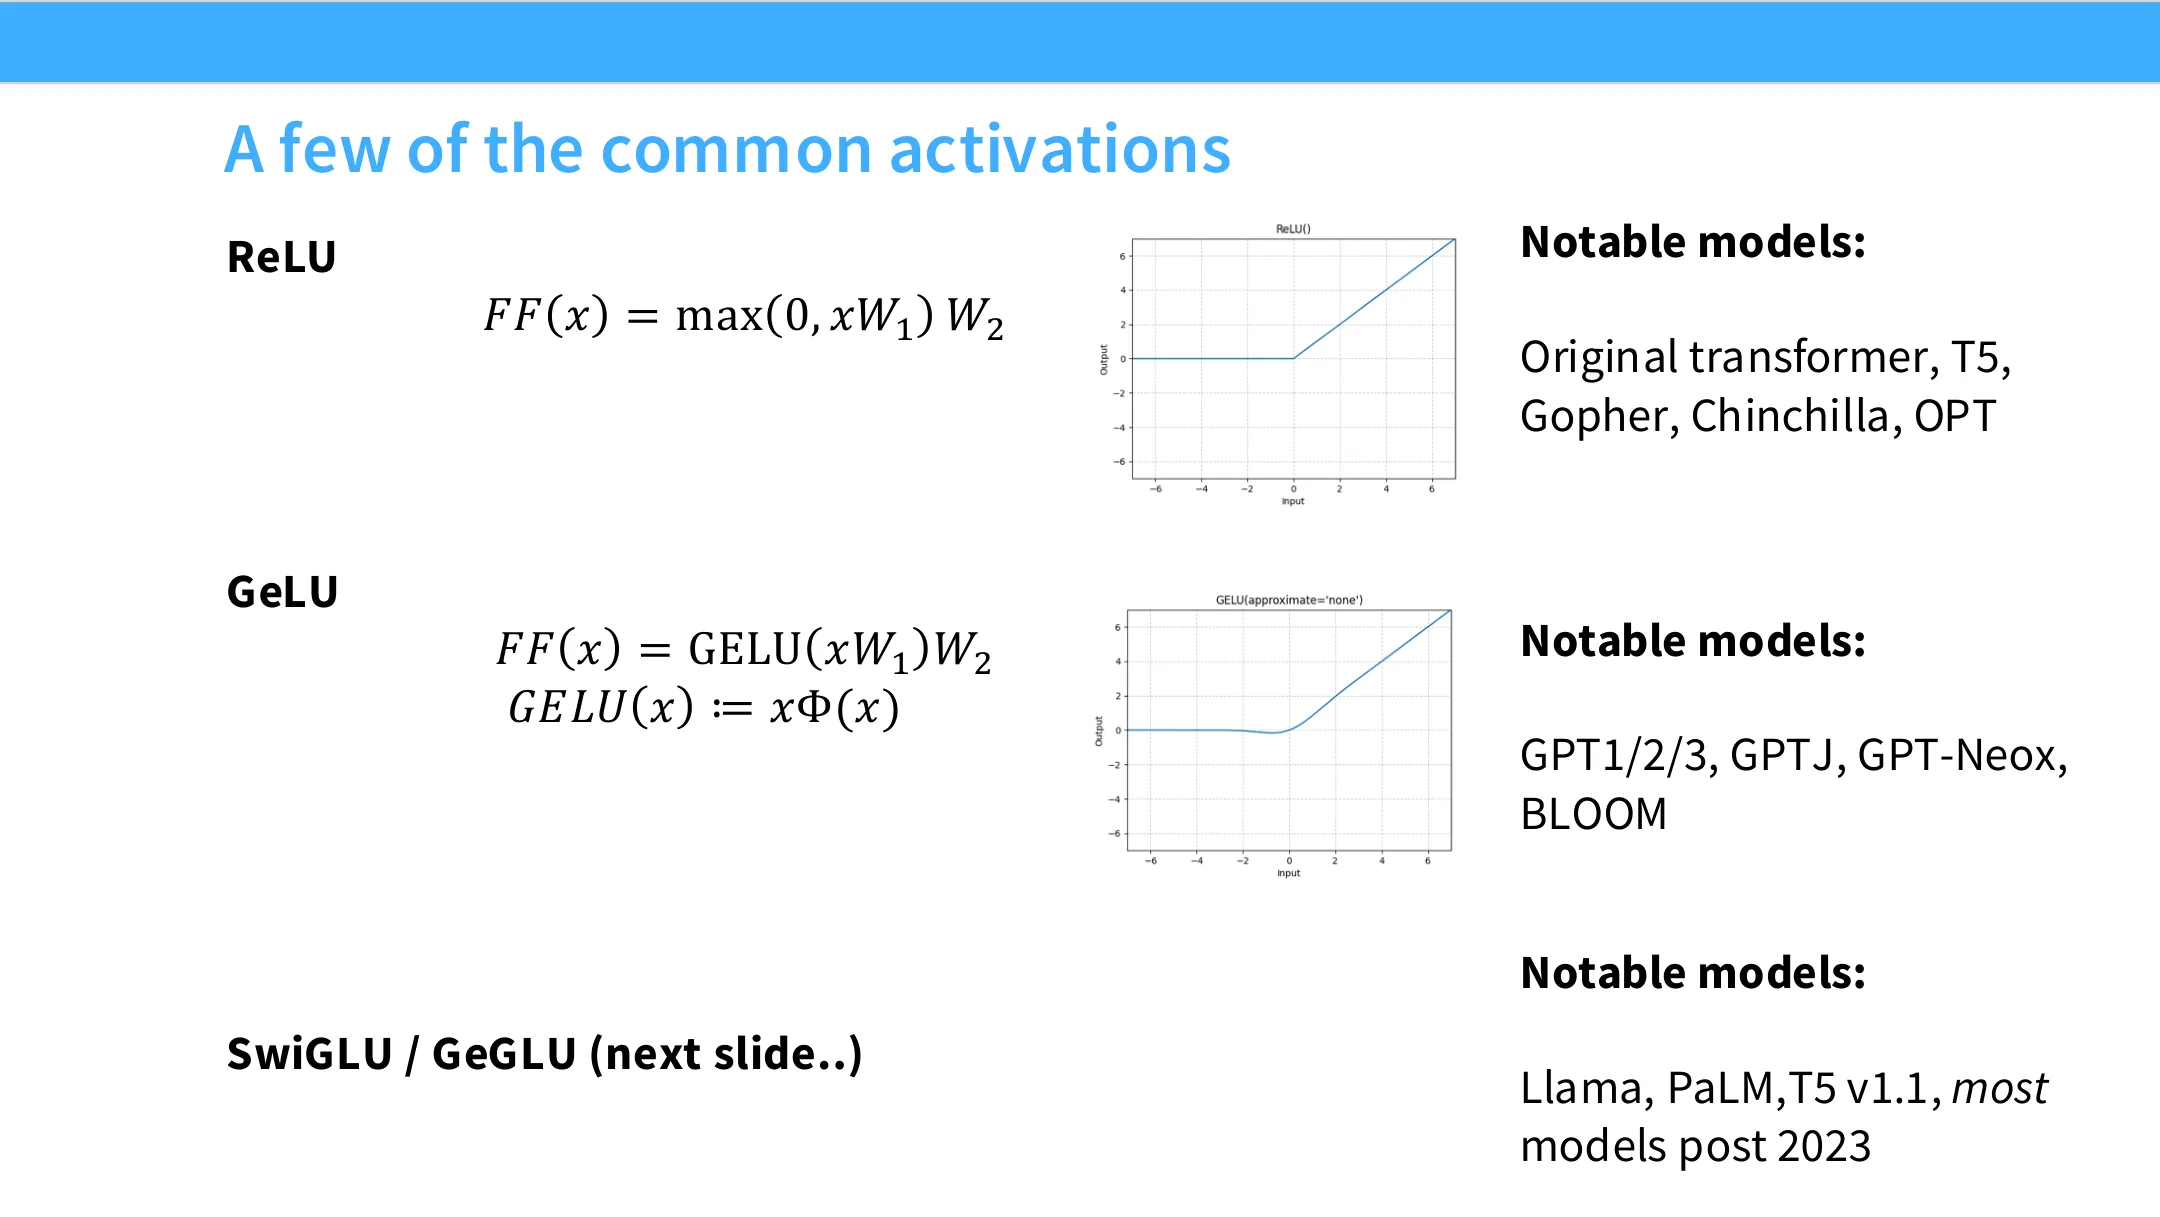
老师说,激活函数是一个"动物园":ReLU、GELU、Swish、ELU、GeGLU、SeLU、SwiGLU、LiGLU……他年轻时"以从未搞懂 SwiGLU 为荣",如今不得不好好理解——关键是搞清这些名字里哪一部分真正影响性能。
3.1 演进脉络
- ReLU:可以训出能用的模型(老师举例:Chinchilla 大概是这一组里最好的之一)。没有任何问题。
- GELU(高斯误差线性单元):与 ReLU 唯一的区别是底部那个"小凹坑",主体几乎不变,只改变零点附近的梯度。GPT-3 就是用它。
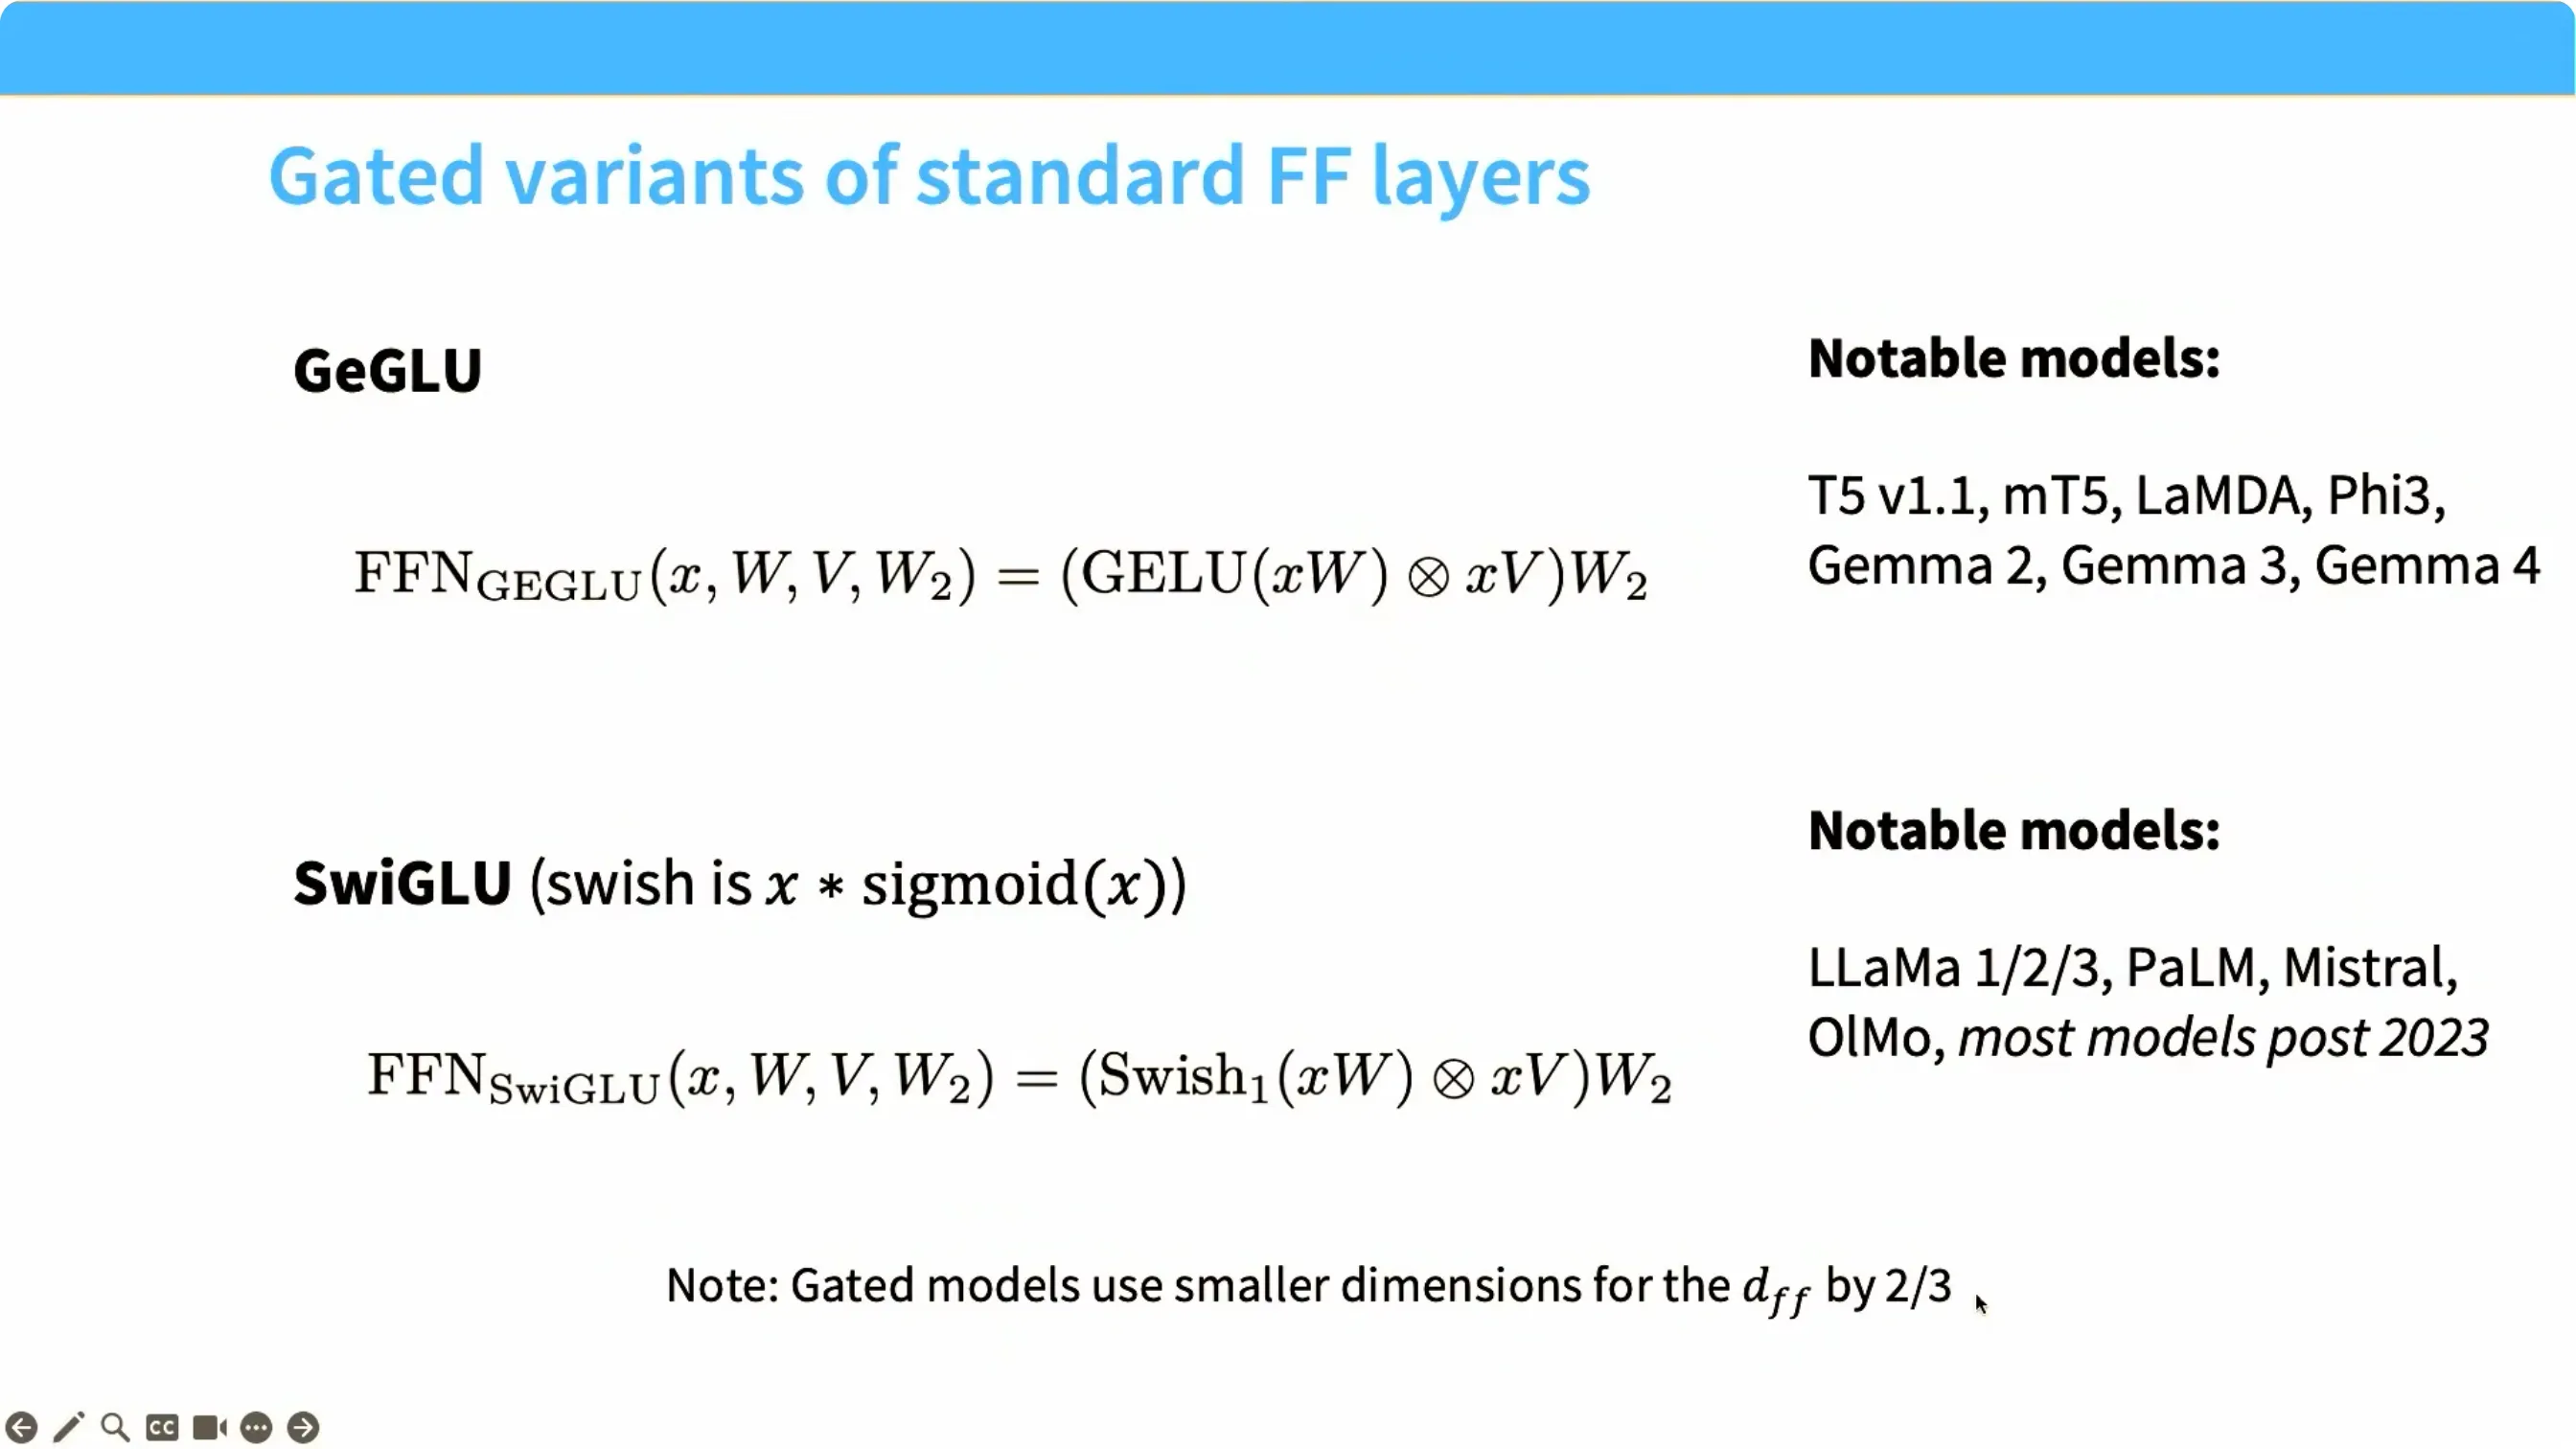
- 门控线性单元(GLU):如 SwiGLU、GeGLU,这才是如今的主战场。老师说,几乎所有可靠的现代模型都使用某种门控线性单元。
3.2 什么是门控线性单元(GLU)
普通 ReLU 前馈层:
$$ \text{FFN}(x) = W_2 \cdot \text{ReLU}(W_1 x) $$
"门控"的想法是:再拿一个向量去逐元素调节(modulate)ReLU 的输出。具体是在 ReLU 之外再引入一个门:
$$ \text{GLU}(x) = W_2 \Big( \text{ReLU}(W_1 x) \odot \sigma(V x) \Big) $$
其命名规则是"把第一个激活的名字 + GLU":
- 用 ReLU 门控 → ReGLU
- 用 GELU 门控 → GeGLU
- 用 Swish($x \cdot \sigma(x)$)门控 → SwiGLU
编者拓展|为什么"门控"有效:门控的思想来自 LSTM 等门控循环结构——用一个信号去调节另一个信号的通过程度。它相当于在前馈层里加入一个乘性交互路径,让网络有能力表达"根据上下文按需开启/关闭某个特征"的行为。这种乘性结构比单纯的逐元素非线性具有更强的表达力,因此在同样的参数预算下往往表现更好。
3.3 门控带来的参数问题与 2/3 规则
(参考时间: 00:24:10)
门控让前馈层多了一个矩阵 $V$(3 个矩阵而非 2 个),参数变多了。为保持参数量与原 MLP 相同,通常把前馈维度缩小到原来的约 2/3。
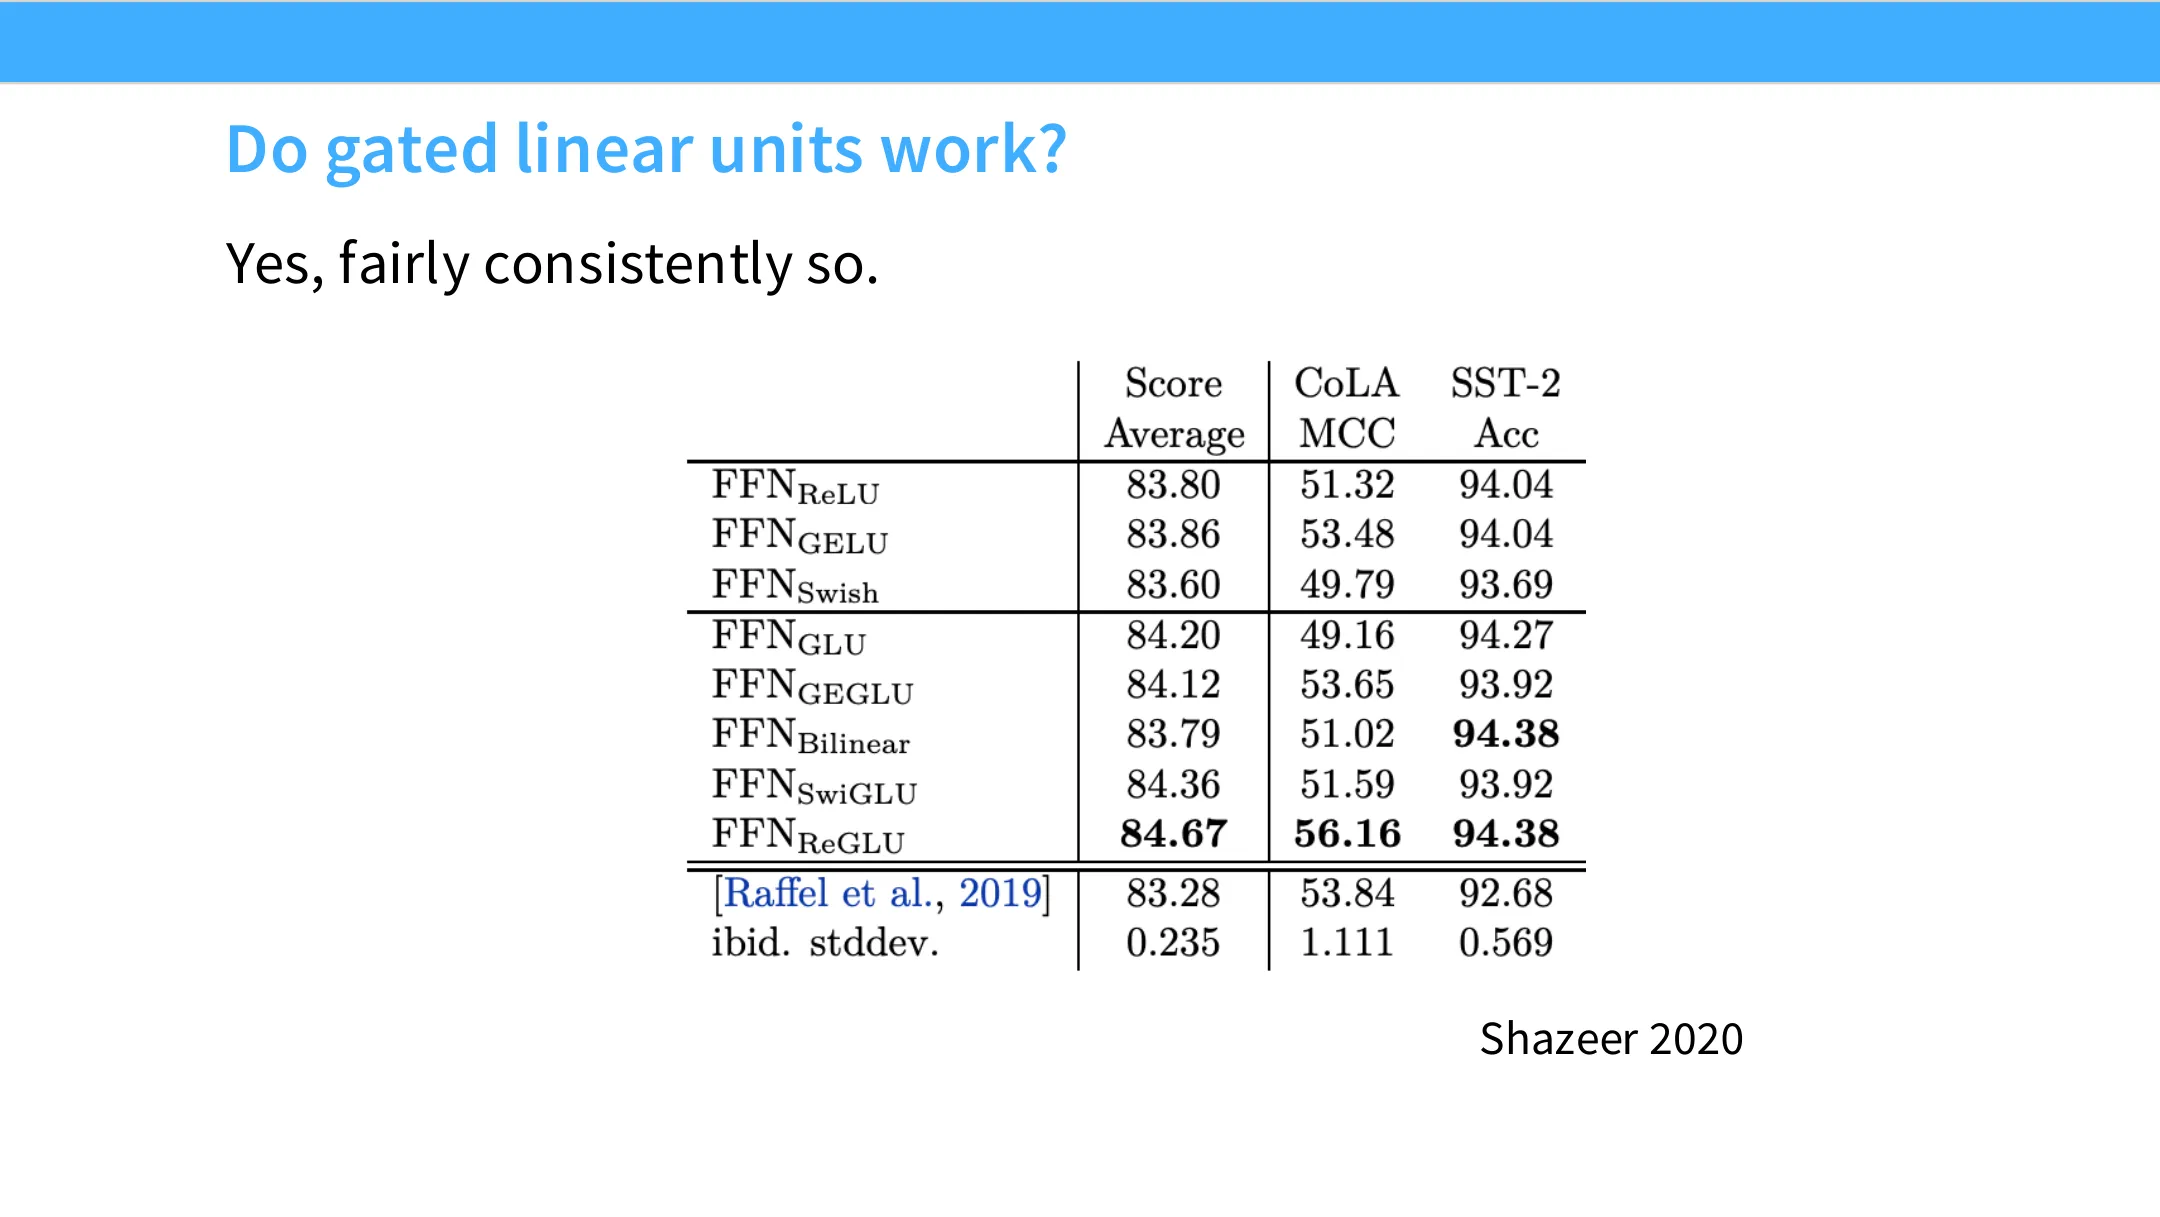
- 提出这一想法的经典论文来自 Noam Shazeer(老师提到,他的论文往往带误差棒、做多次重复实验,非常严谨);
- 在这些参数匹配的比较中,GLU 变体几乎总是持续优于非 GLU 变体。
📷 门控线性单元相对非门控变体的性能对比(带误差棒)
回到原视频 (00:25:35)
3.4 谁用哪个?
- Google 系(Gemma、T5)多用 GeGLU;
- LLaMA 系(含 PaLM)多用 SwiGLU——它是更主流的一个。
老师说,在门控变体之间选哪个其实关系不大,真正重要的单一维度是:对这些非线性做门控,它能以很低的计算开销带来不错的增益。
当然,门控并非必须:GPT-3 就没用门控;NeMo Tron 340B 甚至用了"平方 ReLU"(一个有点疯狂的选择)也照样能训。但如今见不到几个不用门控的模型了。
四、并行层 vs 串行层
(参考时间: 00:27:26)
📷 画面回看(00:28:00)
回到原视频 (00:28:00)
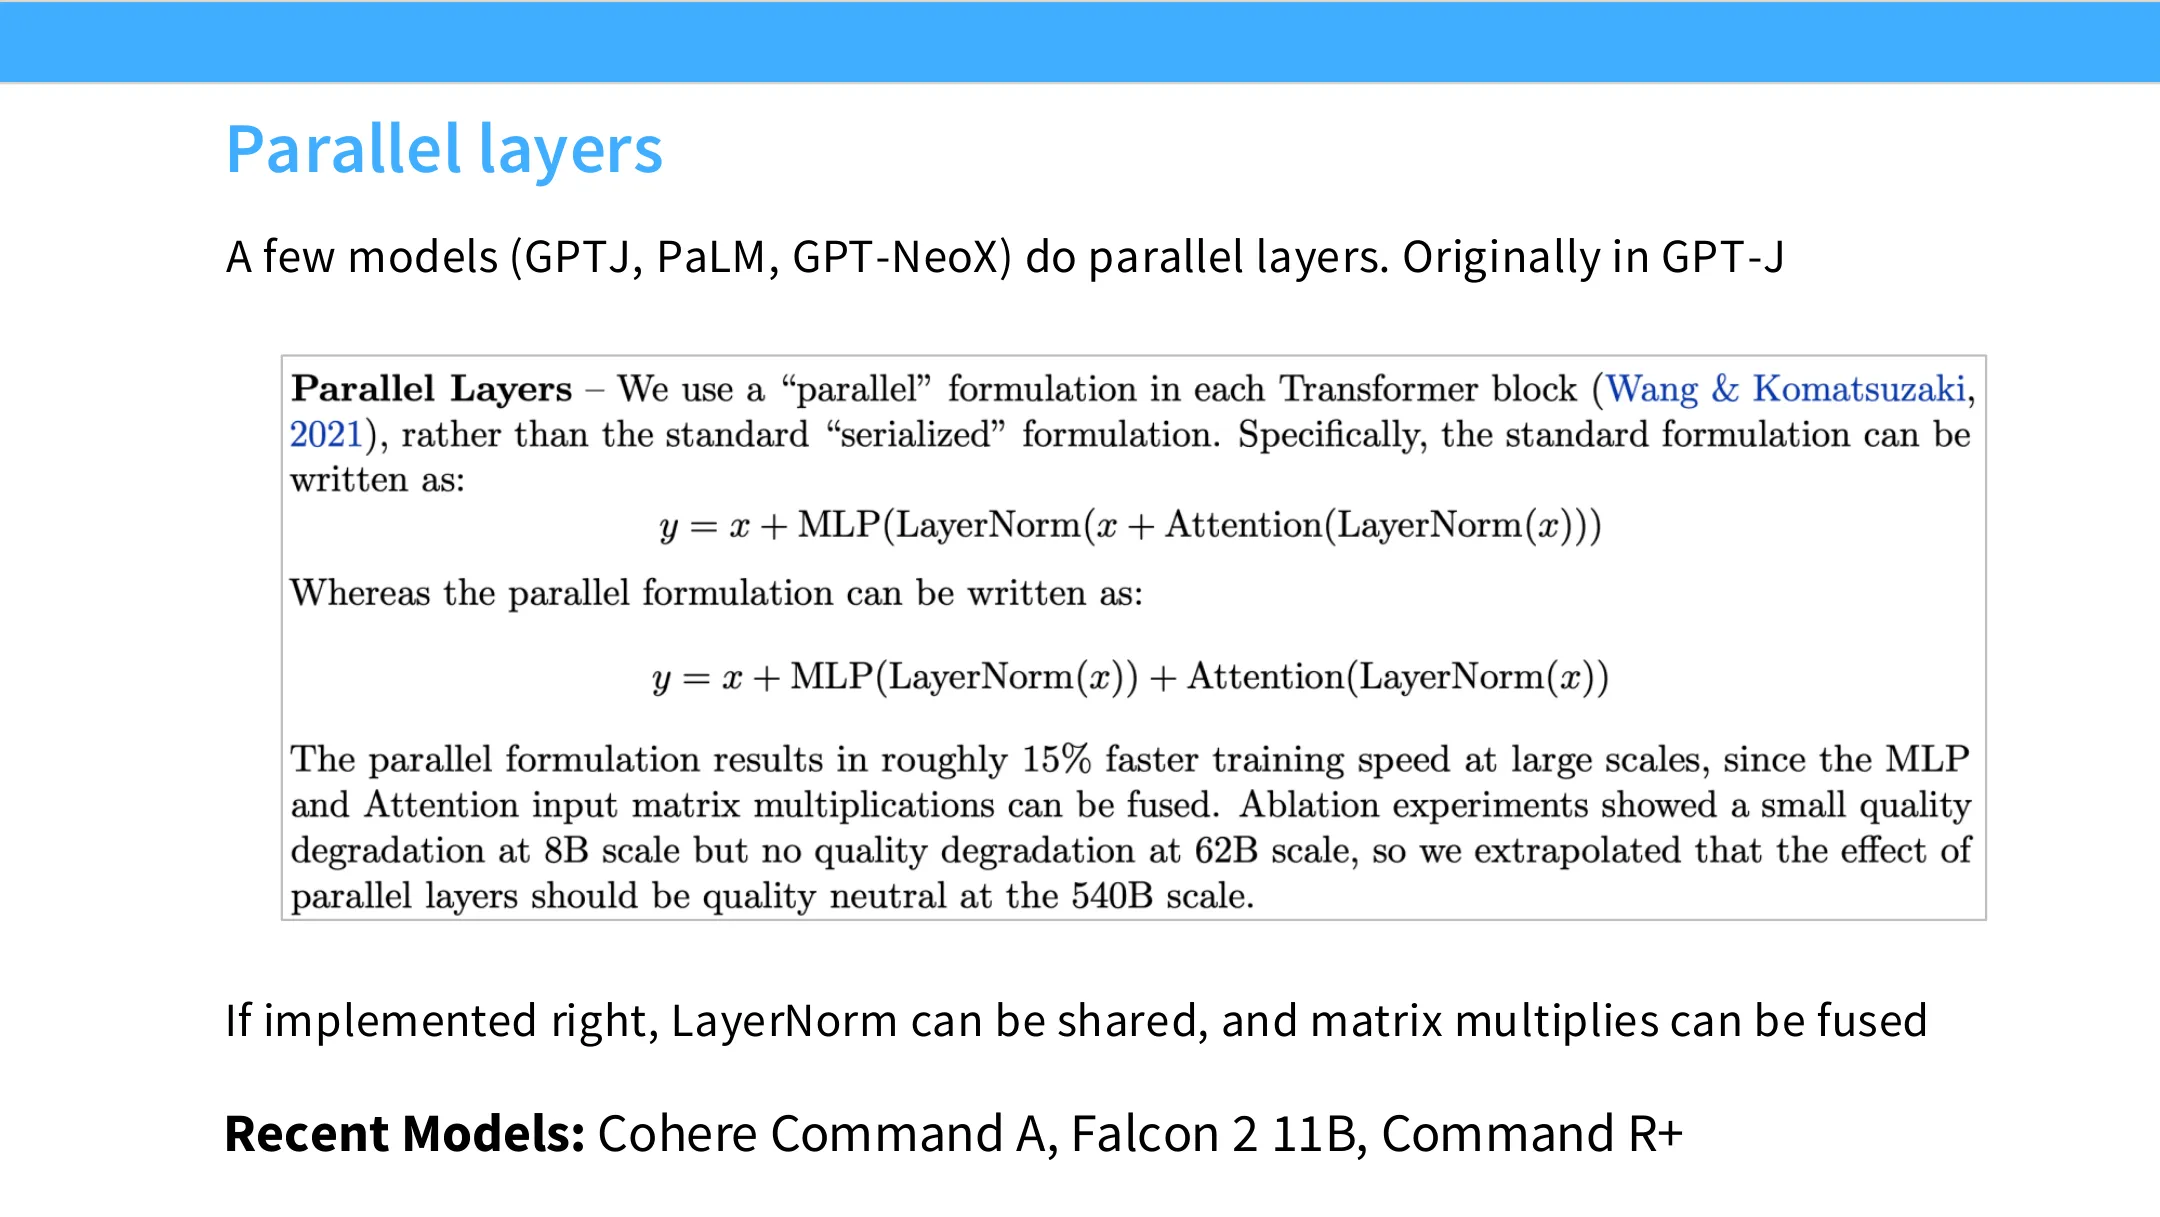
标准 Transformer block 是串行的:先算注意力,再算 MLP,一个接一个。"系统思维强"的人会说这是个瓶颈——必须等一个算完才能算另一个。于是有人提出:能不能把 Transformer block 并行化? 让 MLP 和注意力的输出相加后一起加回残差流。
这个想法最早出现在 GPT-J(GPT-3 的开源复现尝试),PaLM 报告里也有清晰描述。如果实现得当,还能共享层归一化、融合矩阵乘法,从而获得额外系统优化。
graph TD
    subgraph Serial["串行(主流)"]
        Xs["x"] --> Attns["注意力"] --> Adds["加"] --> Mlps["MLP"] --> Adds2["加"]
    end
    subgraph Parallel["并行(PaLM/GPT-J 系)"]
        Xp["x"] --> Attnp["注意力"]
        Xp --> Mlp2["MLP"]
        Attnp --> Addp["相加加回残差流"]
        Mlp2 --> Addp
    end
- 受 Google 影响的 Cohere 采用了这种结构(Cohere 的创始人是 Transformer 作者之一);
- 但其他采用者不多,过去两年这一做法明显退潮;
- 原因:串行形式的优化已经足够好,而并行带来的系统收益抵不过它对表达力的轻微损害——可以说,并行"损失了一半的深度"。
编者说明:老师把并行层描述为"用一半的深度换取系统效率",这是判断是否采用它的核心权衡。
学生在提问环节问:"并行的精度损失到底有多大?"老师回答:"这其实很混乱——PaLM 原文很自信地说'无性能损失、系统利用率提升 15%',但后来许多 Google 自己的模型不再用并行,这可以看作一个隐含信号:可能确有损失。只是据他所知,没有做过受控的、干净的并行 vs 串行对照实验。"
五、位置编码:从正弦到 RoPE
(参考时间: 00:31:04)
📷 画面回看(00:34:00)
回到原视频 (00:34:00)
📷 画面回看(00:39:40)
回到原视频 (00:39:40)
老师指出,位置编码是各实现差异最大、最不统一的地方,也是"信息如何跨位置传播"的核心。
首先复习一个前提:注意力本身与位置无关——如果没有位置编码,注意力只是一堆内积,你把词打乱,结果一样。
5.1 早期的几种方案
- 正弦/余弦位置编码:原版 Transformer 的做法,带有傅里叶变换的直觉——只要用正弦、余弦,无论怎么都能从它们里恢复出位置。
- 绝对位置编码:之后不少大模型给每个位置一个独立嵌入。
- 相对位置编码:若干 Google 模型(如 T5、Chinchilla)不把位置嵌入加进词向量,而是加进注意力计算本身——若两个位置相差 3,就往注意力矩阵里加一个对应偏移。
5.2 RoPE:真正成为主流的方案
(参考时间: 00:32:34)
RoPE(旋转位置编码) 是如今的主流——2024 年之后的大多数模型都用它。老师说它"某种程度上是从天而降",最初也来自 GPT-J(据一篇不太知名的博文 + 论文,作者来自中国)。
5.2.1 动机:我们只关心相对位置
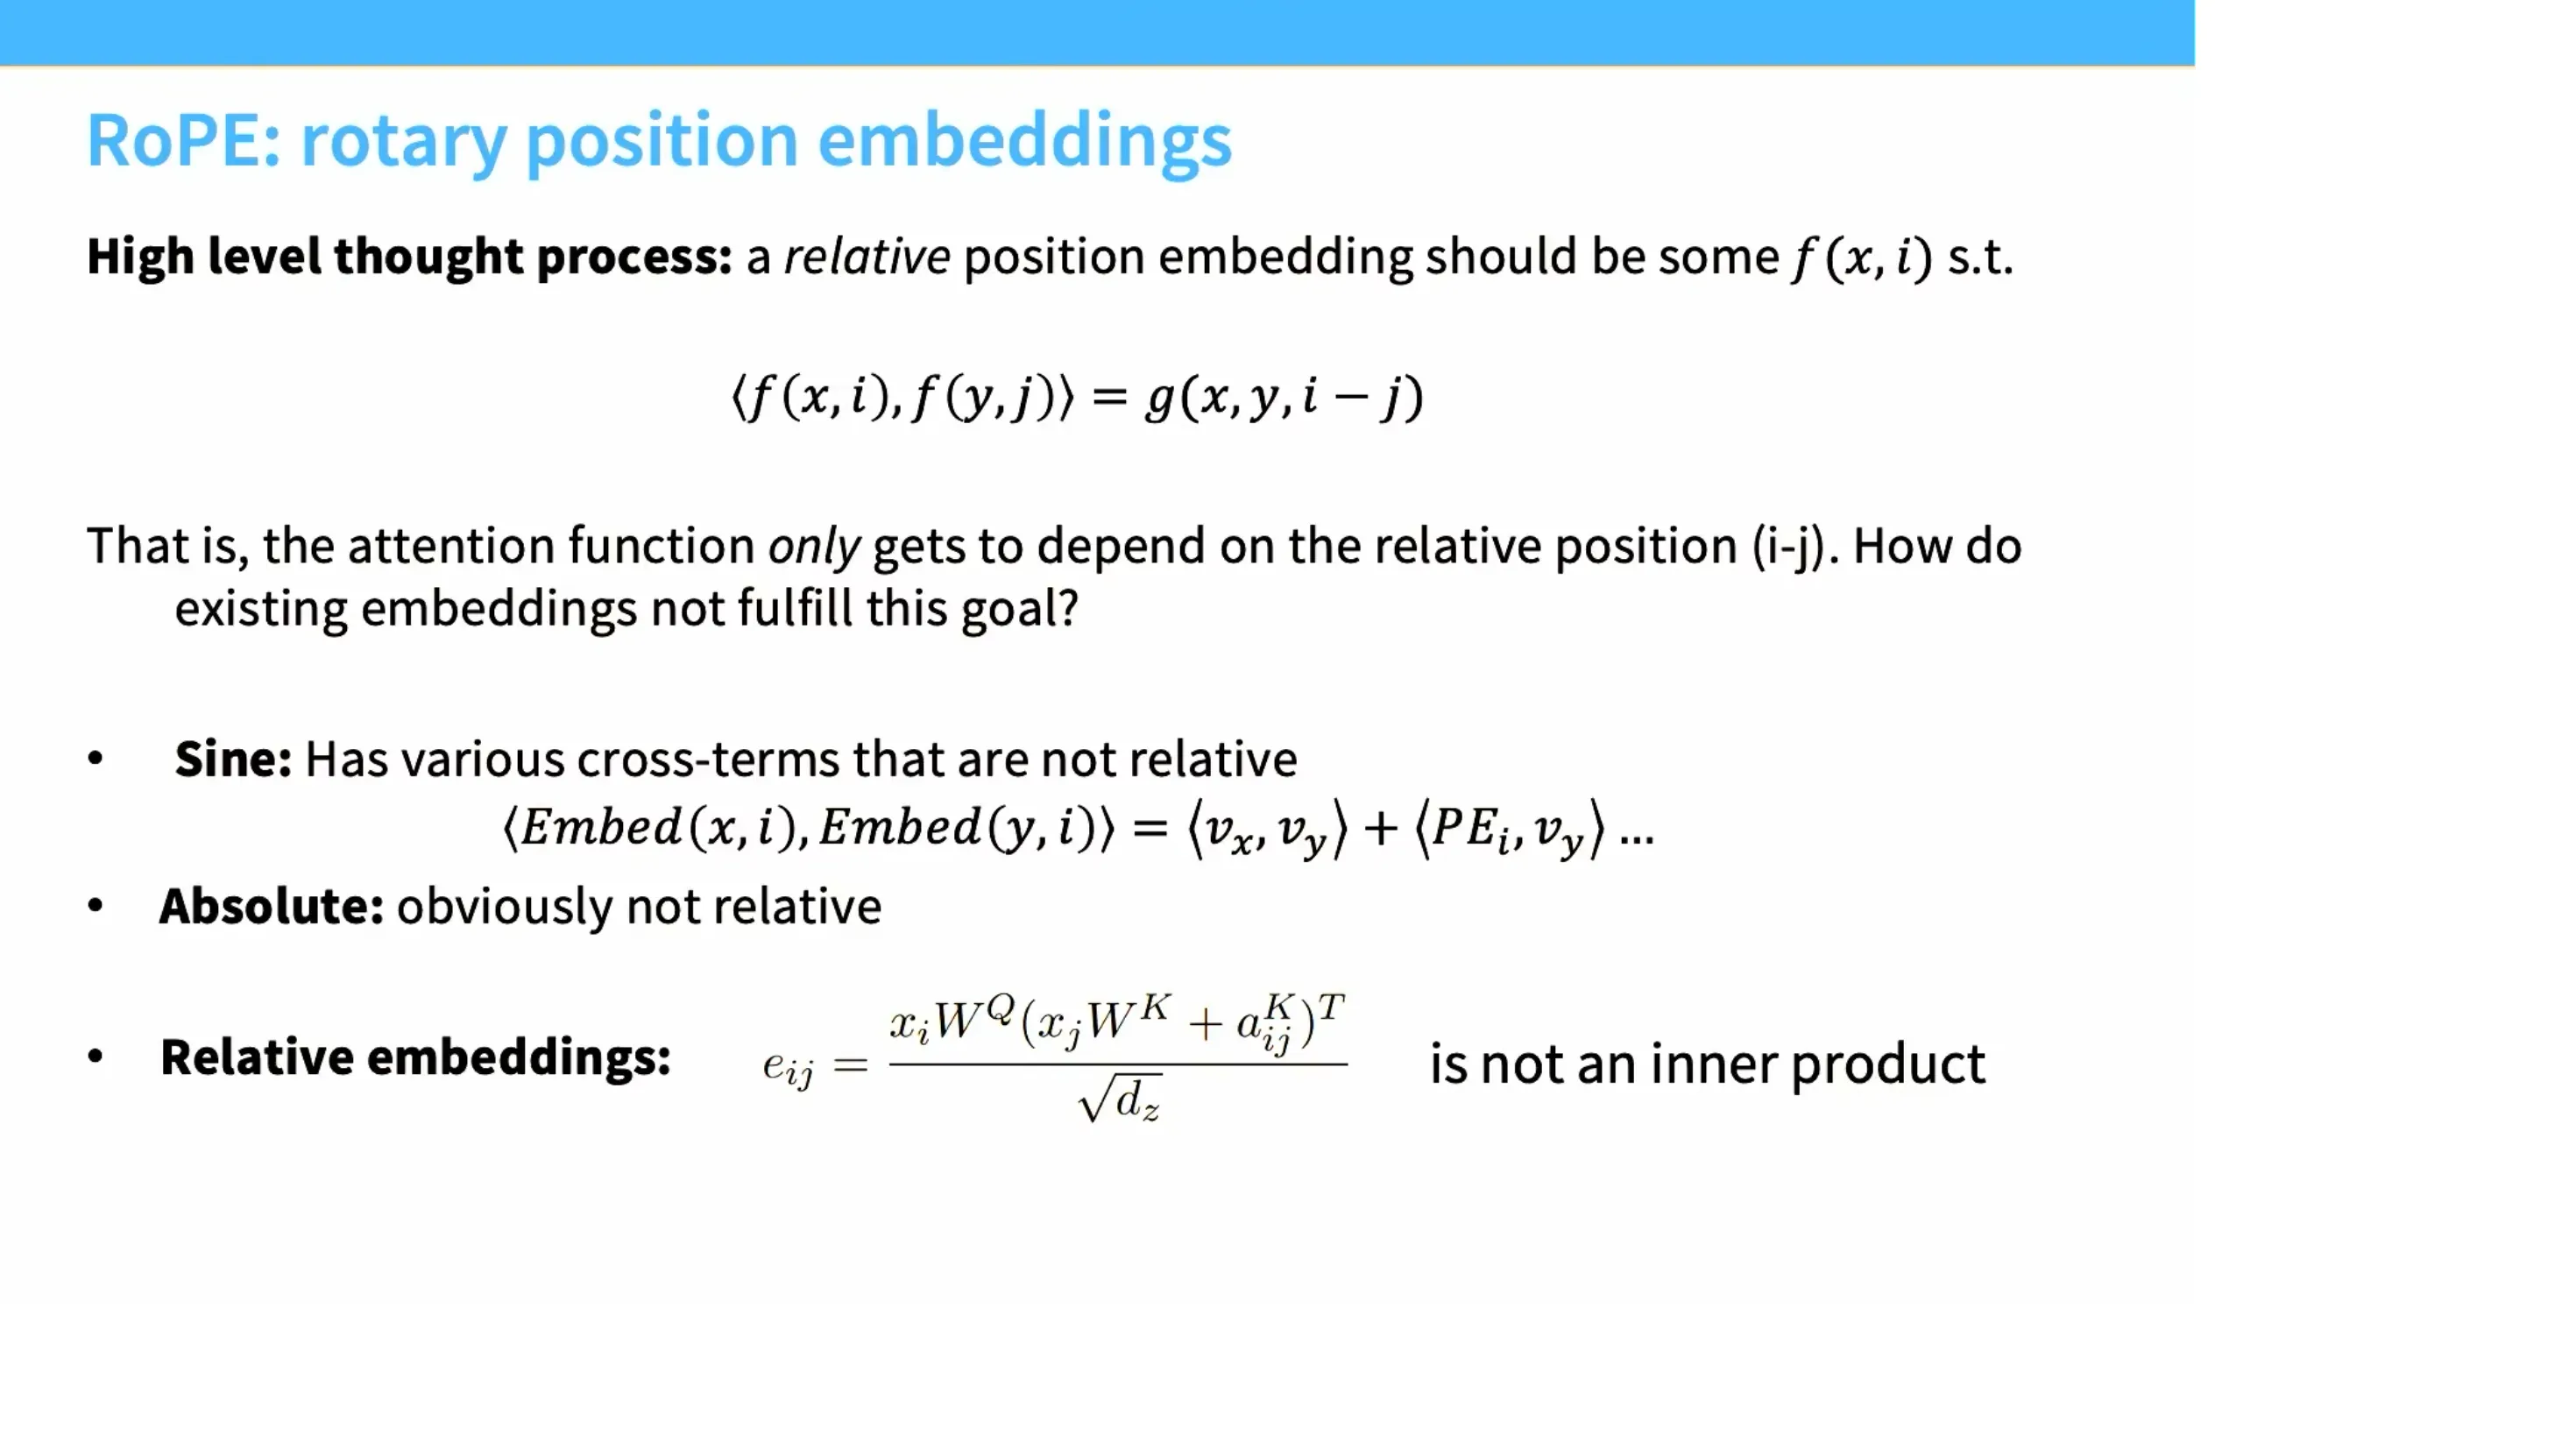
老师主张一个立场鲜明的观点:"不应该关心任何词在句中的绝对位置。如果两个词一起出现,无论出现在句首还是句尾,都应该得到相同的结果。"
形式化地:记 $\langle f(x_i, i), f(y_j, j) \rangle$ 为两个位置嵌入的内积($x, y$ 为词的语义向量,$i, j$ 为绝对位置),我们希望它只依赖相对差值 $i - j$:
$$ \langle f(x_i, i),\, f(y_j, j) \rangle = g(x, y,\, i - j) $$
老师逐一检查旧方案为什么满足不了这个等式:
- 正弦编码:因为含有绝对位置的交叉项,不是纯相对的;
- 绝对位置嵌入:顾名思义,不是相对的;
- 相对嵌入:算相对,但它不是"嵌入"——它只是往注意力矩阵加了个偏移,没有可提取的内积结构。
5.2.2 RoPE 的几何直觉:旋转
那么,怎样才能真正得到一个相对嵌入呢?答案很漂亮:利用内积对旋转的不变性。
- 内积对任意旋转都不变——旋转两个向量,它们的内积不变;
- 取词的语义向量(与位置无关)作为起点;
- 根据词出现的位置,对每个向量做一次旋转。
举一个二维例子:
- 句子
we know:we在位置 0,不旋转;know在位置 1,旋转一个角度; - 句子
of course we know:we在位置 2,旋转两倍角度;know在位置 3,旋转三倍角度; - 二者之间的相对夹角仍然是 1 —— 于是内积对绝对位置不变,只依赖相对距离。
graph LR
    A["词的语义向量<br/>(与位置无关)"] --> B["按位置 i 旋转角度 i·θ"]
    B --> C["得到位置编码后的向量"]
    C --> D["两两内积<br/>只依赖相对距离 (i−j)"]
5.2.3 从二维到高维
在二维上只有顺/逆时针两个选择;但高维里有无限多种旋转方式。RoPE 用最简单的办法:把 $D$ 维向量切成两两一组,对每一对做二维旋转,且各组旋转的 $\theta$ 频率不同:
- 低频的旋转很慢,能捕捉长距离依赖;
- 高频的旋转很快,能捕捉"它们是不是邻居"这类近距离依赖。
本质上,它把高维旋转反复归约为二维情形。(论文里对复数有一段很复杂的动机说明,但老师说,用"归约到二维 + 逐对旋转"这个几何直觉来理解最省力。)
编者说明:老师此处提到 Gemma 4 采用了一种叫 比例 RoPE / P-RoPE 的做法——它其实只旋转前两个坐标。"这是个奇怪的说法,但也是一种可行做法。"这说明 RoPE 空间里还有很多变体在起作用。
5.2.4 实现方式与"无交叉项"的关键
实现上,用正弦和余弦做一次稀疏乘法即可:
$$ \text{embedding} = (X W) \cdot R, $$
其中 $R$ 是由正弦/余弦构成的旋转矩阵。RoPE 在注意力层面施加(而非最底层),对 Queries 和 Keys 都施加正弦/余弦旋转。
老师说,这里有个关键:RoPE 看起来像正弦编码,但本质不同——它是乘上去的(而非当作嵌入加进去),因此不产生交叉项,内积纯粹是相对的,不会泄露绝对位置。
5.3 课堂问答
- Q:有没有更高维旋转的论文? 老师说没见过。任何"二维旋转"的做法其实都是这套的变体;但"任何闭合流形上的旋转"他没看到有人做。
- Q:如何系统掌握这些知识? 老师建议两条路:① 看得足够广,从而看出模式(这正是本讲的方法);② 自己动手试(哪怕很小规模),形成直觉和理论。"孤立地读单篇论文非常难,尤其现在——几乎没有哪篇论文给出完整细节。"
- Q:Eagle 和 RoPE 的区别? 区别只在于旋转了哪些坐标——Eagle 不旋转大多数坐标。原本理由是:低频部分旋转不多,所以可以省略,是一种为极小的模型做的优化(隐藏维度不够分给激活)。
- Q:相对嵌入没有内积结构,是因为它只作用于 key 吗? 它同时作用于 key 和 value,正是它产生相对效果的原因。而正弦编码的问题在于:它不仅有原向量,还混入词嵌入与位置嵌入的交叉项,可以从中"反解"出绝对位置——所以连正弦编码都不是纯相对的。只要你接受"要纯相对"这个前提,就几乎自然走到 RoPE。
- Q:相对嵌入(注入注意力矩阵)的那种做法问题在哪? 它在数学上"不能分解为内积形式"——这其实更多是美学问题。有人做(如 ALiBi),效果也不错,只是没成为主流。
六、超参数:比例、头维度、宽高比、词表
(参考时间: 00:41:00)
📷 画面回看(00:48:00)
回到原视频 (00:48:00)
📷 画面回看(00:54:30)
回到原视频 (00:54:30)
老师转入超参数,并说这是个"一旦真要训模型就会碰到"的问题。没有知识时会觉得"要搜一个非常大的高维空间,很可怕",但人们实际尝试的空间其实很小。
6.1 前馈层比例(FF ratio)
共识超参数:前馈维度 / 模型维度。
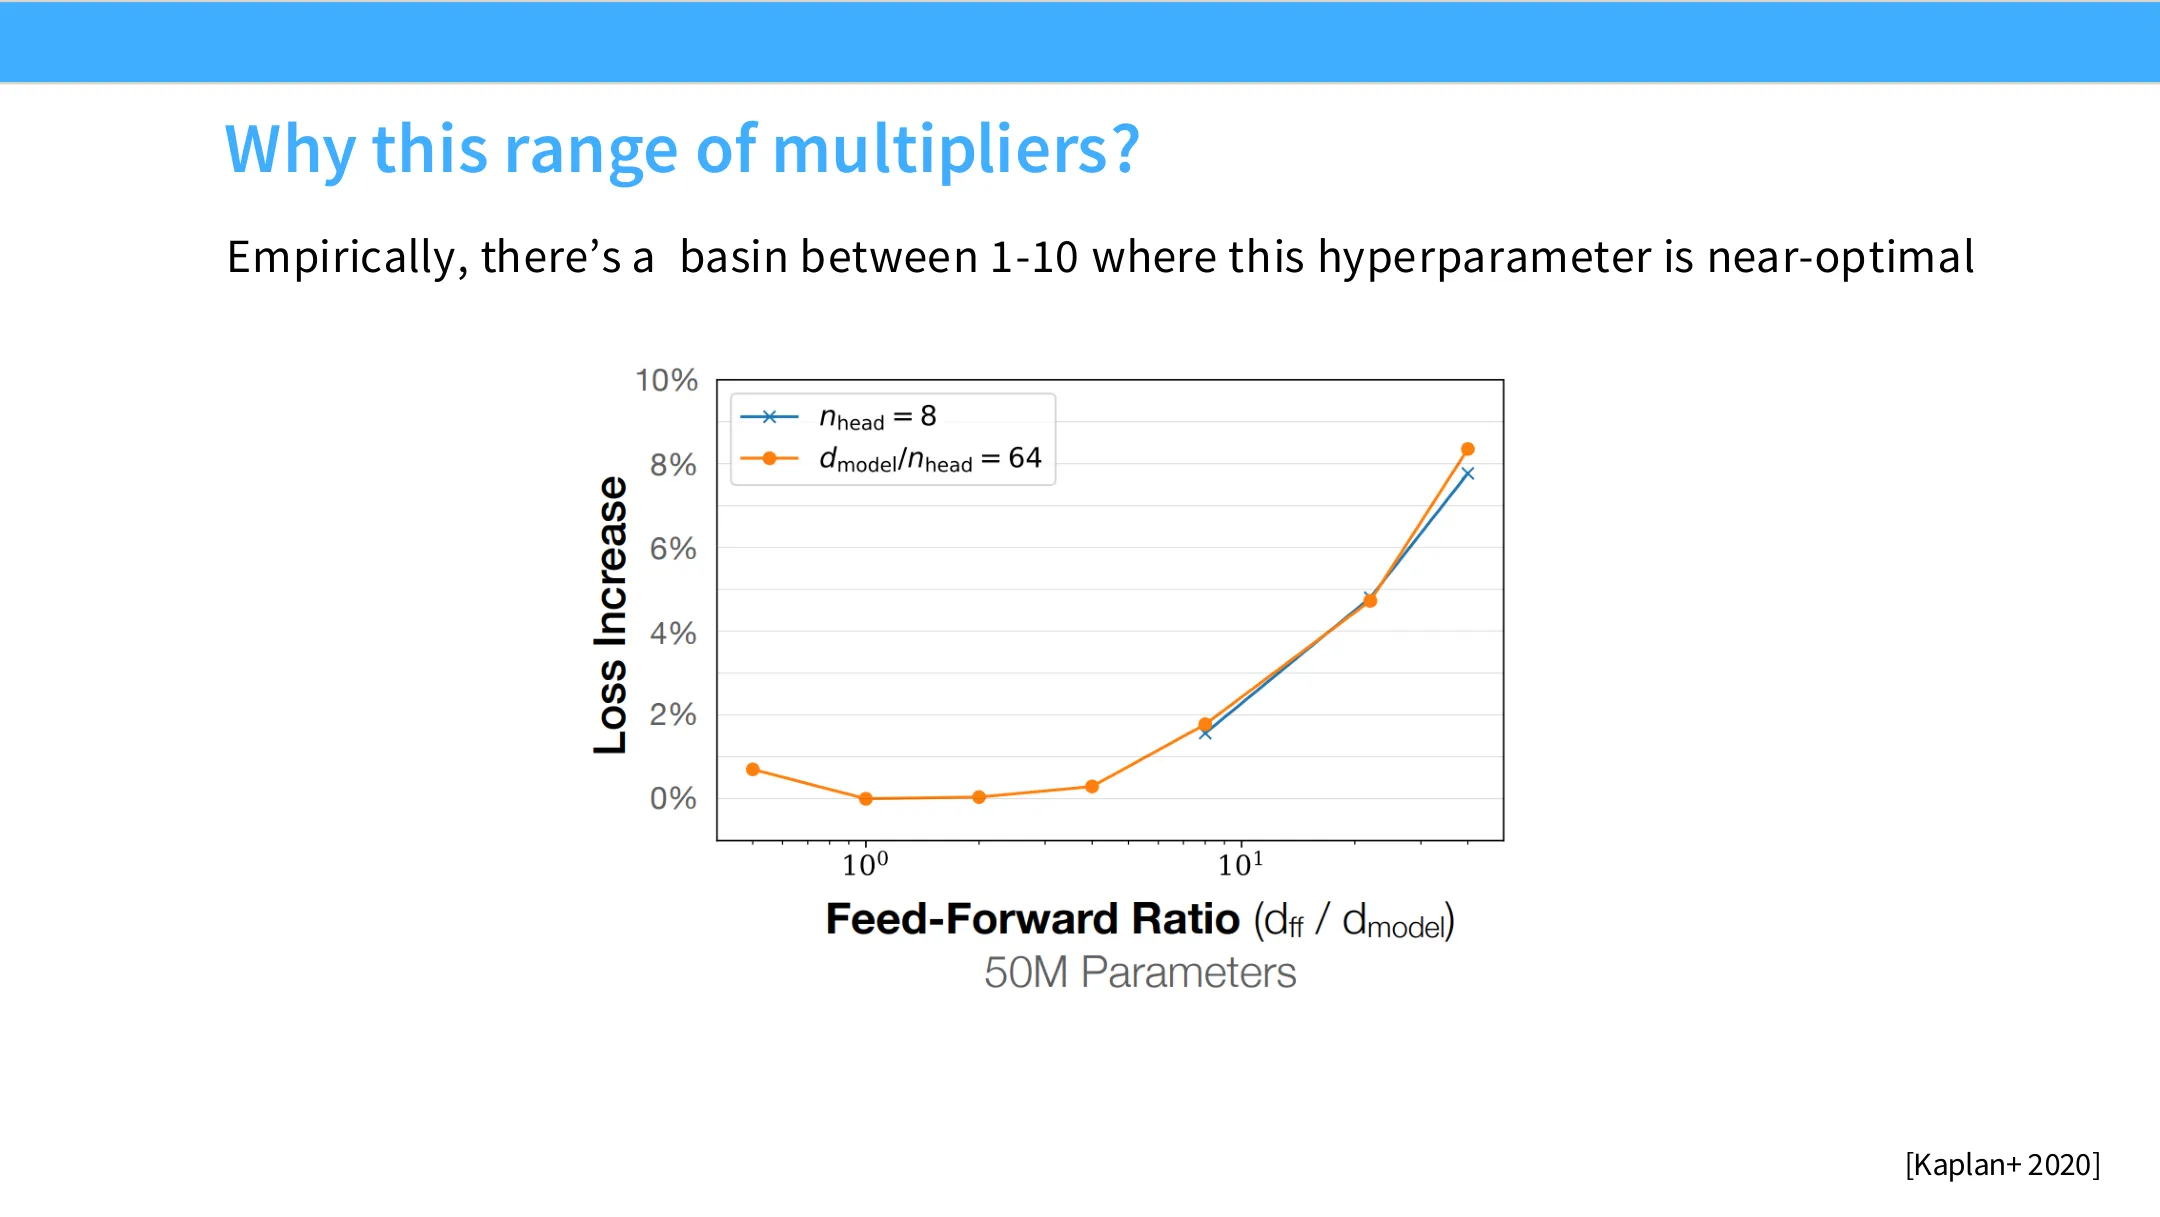
- 默认经验值:4×。这条规则"好得出奇"。例外很少,而"最极端的例外最后又绕回来了"。
例外一:门控线性单元。 GLU 多了矩阵 $V$,保持参数量不变就要缩到 2/3,于是比例落到 约 2.67(图中 2.67~2.5 这一段)。
例外二:LLaMA 的"任意选择"。 LLaMA 2 有一批高效的注意力头(用了 MQA,"后面会讲"),于是他们把比例再乘一个任意的 1.33,得到 约 3.5,本质上稍微加重了 MLP 的权重。
所以文献里常见:非 GLU 用 4,GLU 用 2.6 左右或 3.5。
例外三:T5 的 64×。 老师说他很喜欢这个例子——Google 有时非常大胆。T5 把这个倍数设成 64×,理由是系统性的:矩阵乘法越大,硬件利用率越高。Gemma 2 也试着往上推,但 64 仍属"惊人"。有意思的是 T5 的改进版 T5 v1.1 又回到了标准的 2.5 倍——虽未明说,但显然是"试着改回去"。
Kaplan 2020 的实证。 经典神经缩放定律论文里有一次对 FF 比例的扫描(针对很小的模型),发现存在一个"盆地":从约 1 到约 10 的一段,性能都很平(相对最优损失只差一点);超过 10 到 100 会二次地急剧变差。所以 2.6~4 之间都安全。
6.2 头维度(head dim)
(参考时间: 00:49:53)
多头注意力里,通常让头维度 × 头数 = 模型维度,即头维度 $d_{head} = D / H$,使得整体"相当于一个单头 Transformer 的规模"。并非必须如此,可以任意调整,但大多数模型都遵循,且效果不错。T5、以及另一个 Google 模型 Lambda 是显著例外,但大家都围绕在 1 附近。这又是一个很宽容的超参数,围绕 1 有很宽的盆地。
6.3 宽高比(aspect ratio)——概念上最有趣的超参数
(参考时间: 00:51:31)
放大或缩小模型时,通常固定一个宽高比(模型宽度 vs 深度),再整体变大。因此宽高比控制着整个深度-宽度权衡。人们会问:模型该多深?有没有最优?
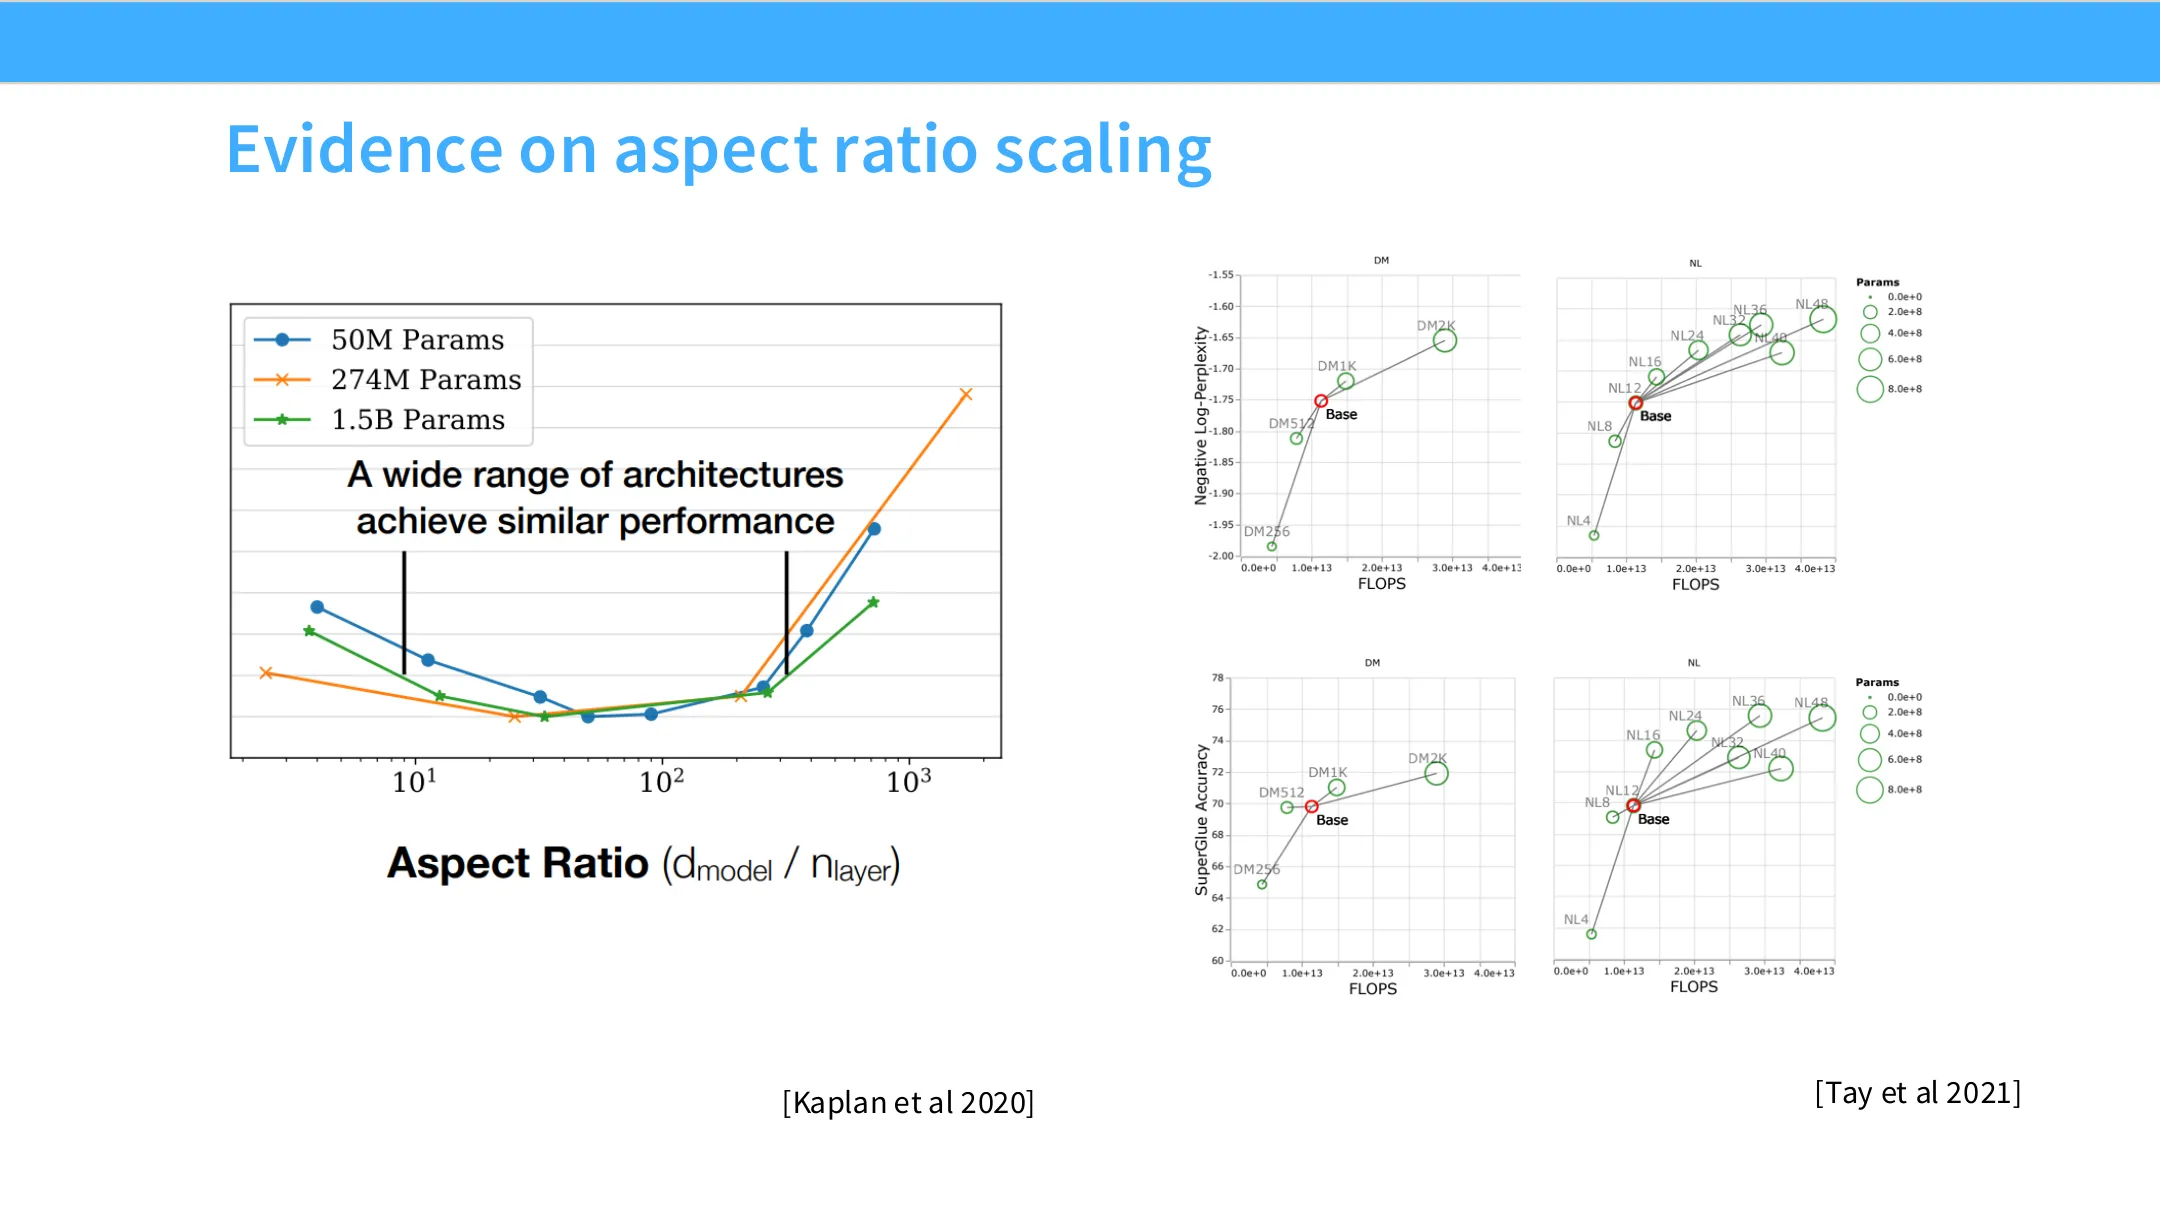
答案:变化确实比别的超参数大,但存在相当清晰的甜点区——大多数现代模型落在 $D\_model / N\_layers \approx 100$,即每层约 100 的宽度。GPT-3、LLaMA 等都符合。
这背后的权衡是表达力 vs 硬件:
- 太深:系统工程上很烦。并行方式得按层切分(流水线并行,pipeline parallel),"大多数人真的很不想碰";
- 太宽:很容易切分到多张 GPU(张量并行,tensor parallel),简单得多。
graph TD
    A["选择宽高比 D_model / N_layers"] --> B{太深?}
    B -->|是| C["需按层切分<br/>流水线并行<br/>工程复杂"]
    B -->|否| D{太宽?}
    D -->|是| E["切分容易<br/>张量并行<br/>但表达力存疑"]
    D -->|否| F["D/N ≈ 100<br/>甜点区"]
    C --> F
    E --> F
于是"系统上倾向宽,表达力上倾向深",最终落到约 100。Kaplan 等人还做了不同尺寸模型下的扫描:不论模型多大,最优宽高比都差不多,都在 100 附近。
另一个重要结论(来自老师称为"ETA 等"的工作):做各种架构变体实验后,发现真正起主要作用的其实是 FLOPs——FLOPs 越大模型越好,宽高比本身反而次要。
于是老师总结出一个贯穿全讲的洞见:存在一个宽容的超参数带,人们基本都在这个带里选;真正该操心的是"系统利用率",而非难以推理的"表达力"。
6.4 词表大小(vocab size)
(参考时间: 00:55:14)
清晰的二分格局:
- 早期单语模型(目标只是英文好):词表较小,约 3 万;
- LLaMA 之后(多语言、生产系统,含 GPT-4 等闭源模型):词表大得多,约 10 万到 20 万。
Google 系词表普遍更大;LLaMA 系约 10 万;单语模型约 3 万。
原因:多语言模型确实需要大得多的词表;右边这些模型整体也更大,而缩放定律显示"模型越大,能应付的词表越大"——现在也没人再训大型单语模型了。
课堂问答(关于 bits-per-byte):
一位学生问:用不同的分词器比较 bits-per-byte 是否有效?
老师先给正确的思维框架:语言建模是生成建模任务,建模序列的概率。只要序列固定、并且对所有可能字符串都给出了概率,那么在任何层面比较都是合法的。具体到 bits-per-byte:
- 要担心的是"你是否动了序列"。早期分词器会丢词/丢 token,那样比较就失效;但现代分词器是完整的——能编码任意序列,所以没问题。
- 要担心的是"是否做了长度归一化"。bits-per-byte 用的归一化因子始终是字节数,所以始终是合法比较。
老师说 perplexity 与 BPD 互为对偶。后面还有一个关于"改变切分方式后比较 perplexity"的追问,老师表示当面没完全听清,留待日后讨论——但认可这是个有意思的问题。
编者说明:这里的要点是——比较的合法性取决于①序列是否被无损保留、②归一化因子是否一致。这两条都满足时,跨分词器的比较就是公平的。
七、正则化:一个反直觉的世界
(参考时间: 00:59:20)
📷 画面回看(01:02:00)
回到原视频 (01:02:00)
这是老师认为"很反直觉、比 ML 101 直觉更有意思"的一节。
7.1 标准论证:我们几乎不会过拟合
- 语言建模有大量数据——通常"数据比我能处理的多",甚至有"互联网数据比 FLOPs 还多";
- 所以大概率一遍都见不到同一批数据(只跑单遍 pass);
- 单遍 SGD(或其他优化器)几乎不会记住数据;
- 因此,在算力受限的语言建模里,过拟合几乎从来不是问题。
老师们甚至有人只看训练损失,就因为坚信单遍 SGD 不会过拟合。
7.2 那为什么大家还用过 dropout / 权重衰减?
老师说,很多近期模型根本不提这些——它比技术报告愿意披露的层级还要底层。但真正翻看会发现:很多模型两个都用,尤其权重衰减在现代高性能语言模型里依然相当普遍。这非常令人费解。
7.3 权重衰减可能不是正则化,而是优化干预
(参考时间: 01:01:40)
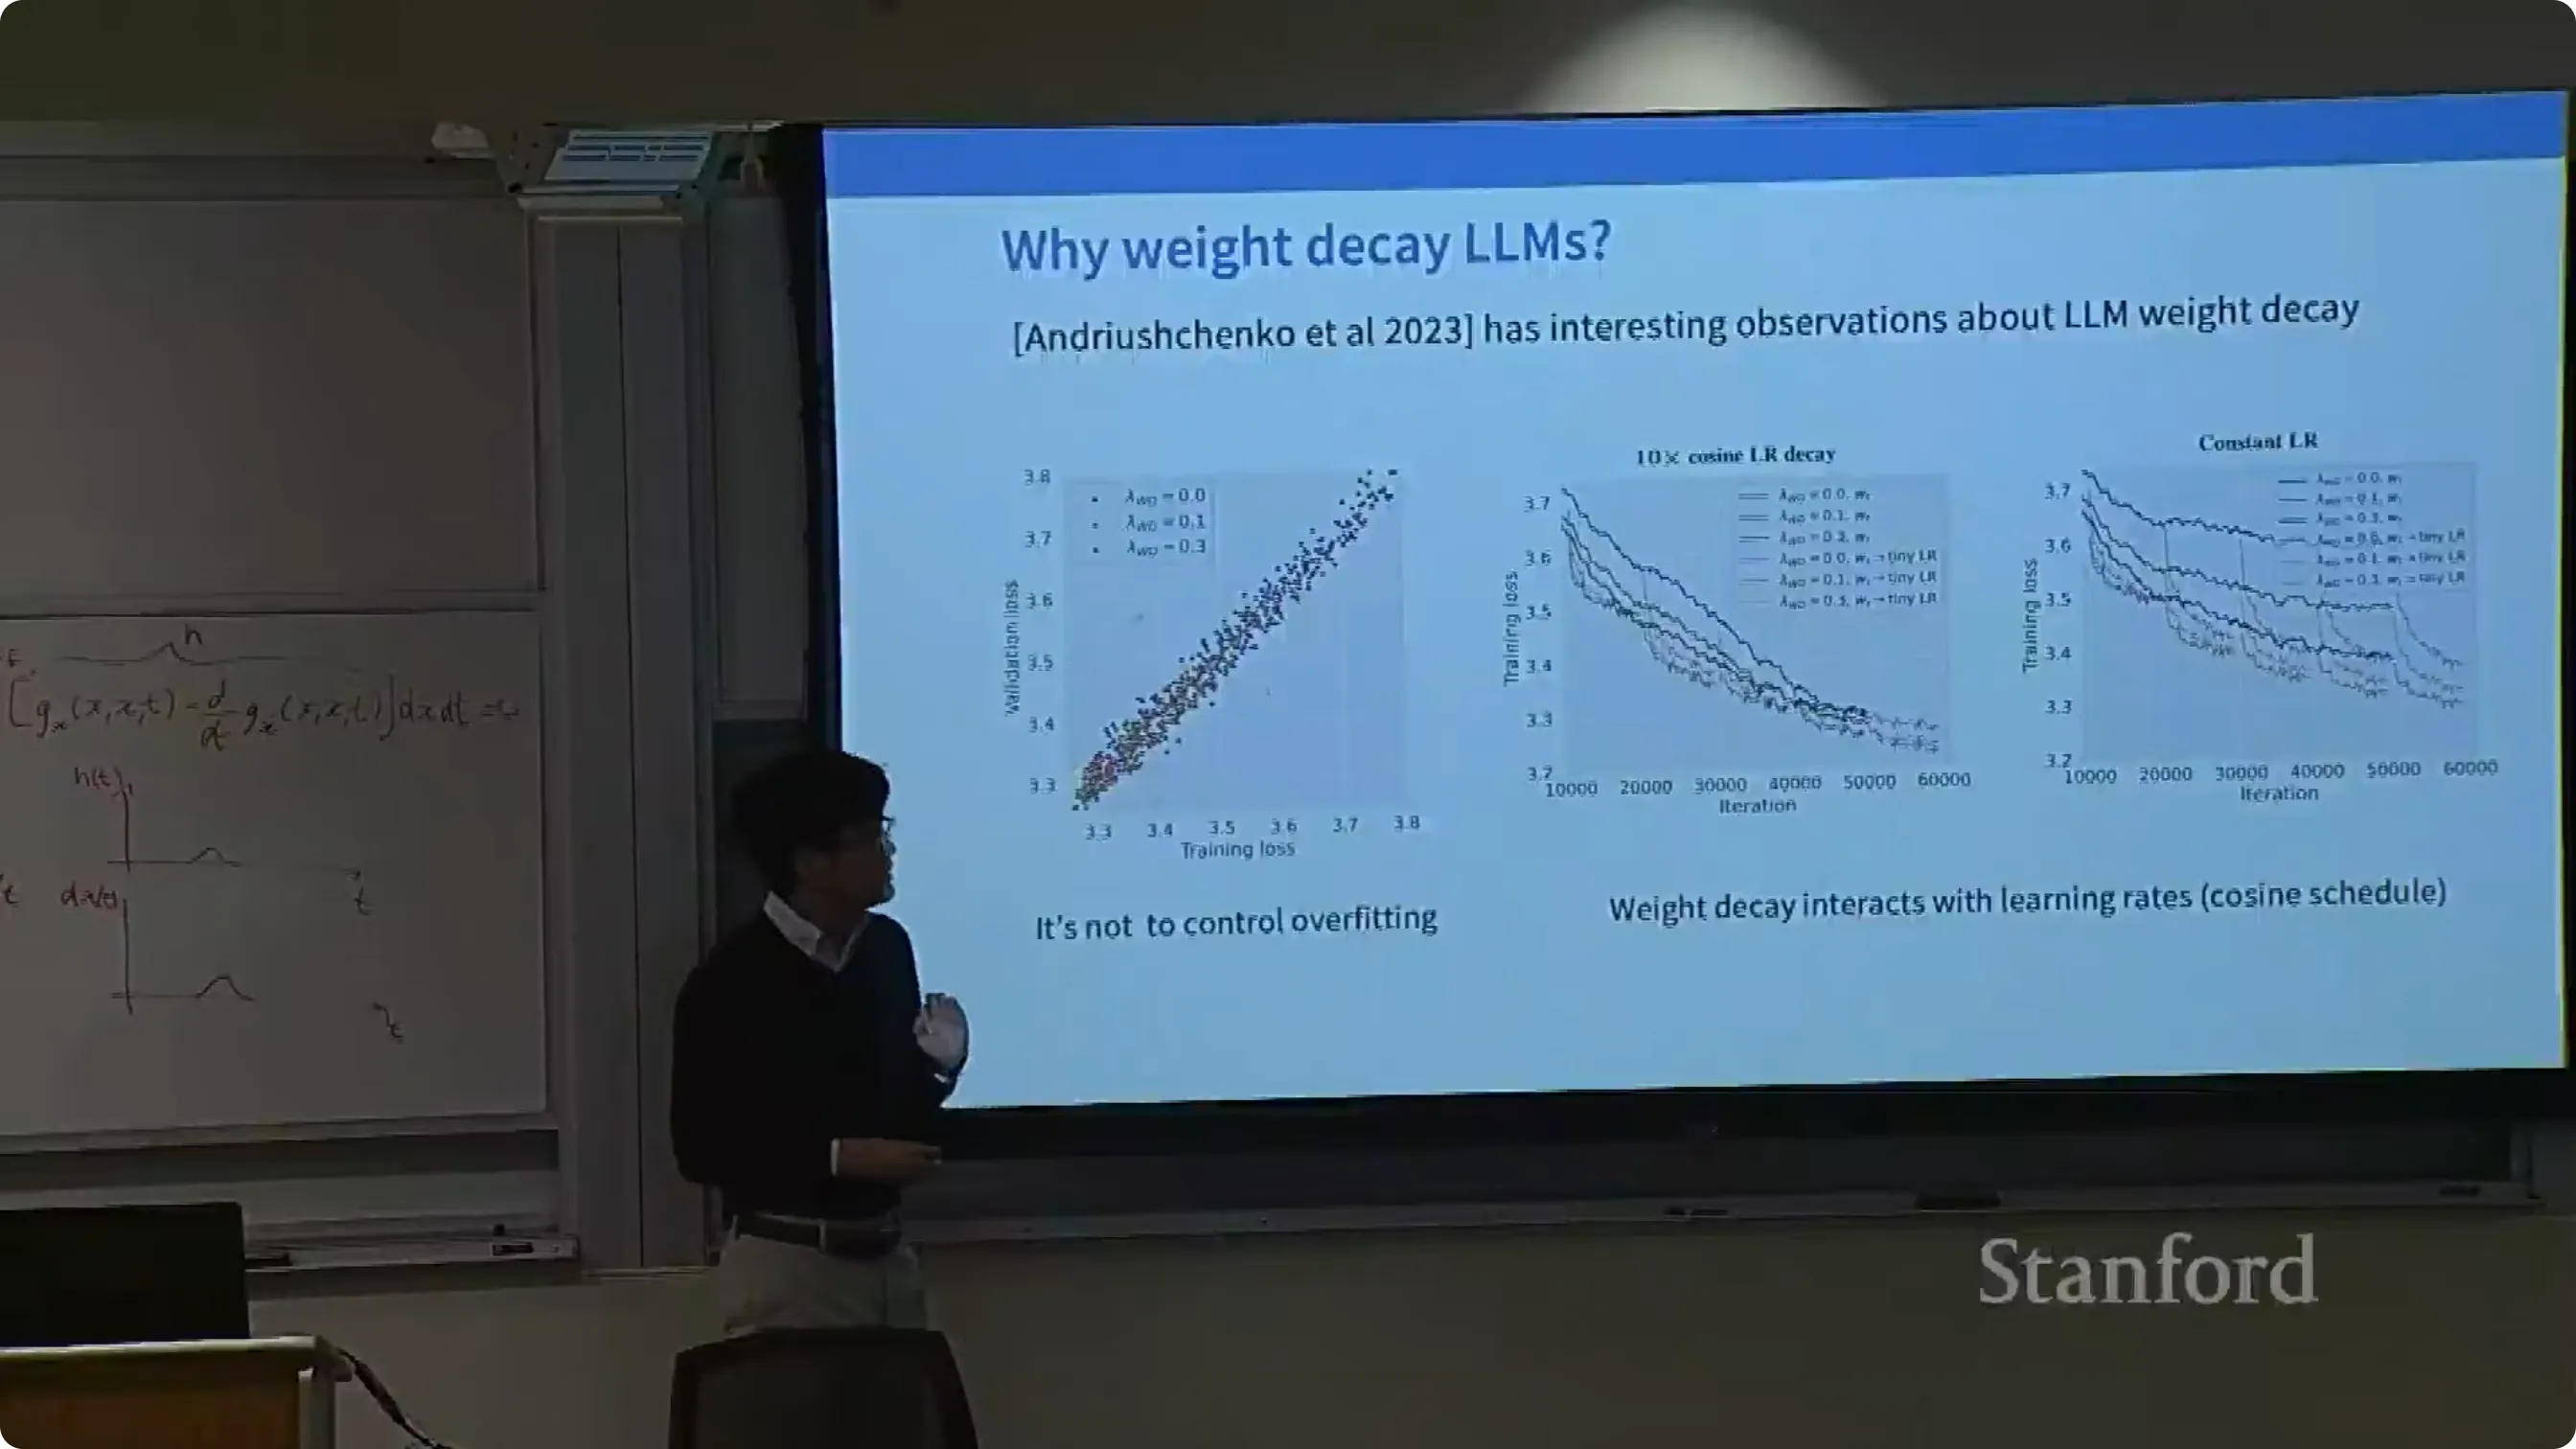
有论文论证并给出证据:权重衰减有时根本不是正则化器,而是与优化器交互、让优化变好。
- 单遍 SGD 下观察训练 vs 验证损失:不同权重衰减设置几乎没有区别,因为本来就没有过拟合(点落在 $x = y$ 直线上)。
- 但一旦把权重衰减与学习率衰减结合起来看:强权重衰减的蓝色虚线表现明显更好——它们起步慢,但最终收敛到更好的极小值(这在有学习率衰减时普遍成立,常数学习率时未必)。这可能正是与你直觉冲突的地方。
所以老师再次强调:架构/训练的超参数在很多情况下很难先验推理,必须动手实验——你可能会发现"权重衰减其实是一个优化干预,而非正则化干预"。
编者拓展|权重衰减为什么可能"帮助优化":在自适应优化器(如 AdamW)中,权重衰减相当于每步对参数做轻微"收缩到零"(shrinkage to zero),这可以限制有效步长、抑制参数无限增长。当它与学习率衰减配合时,往往能让模型在后期进入更平坦、更优的极小值区域。这也解释了为什么它在"没有过拟合"的语言建模里仍然有用。
7.4 课堂问答
- Q:扩散模型是否类似? 老师坦诚"没研究够"——训大扩散模型的人不多,而且很多模型是改造而来,架构其实和 LLaMA 类模型一样。至于"从零训扩散模型的最优架构是什么",他说不知道。
- Q:为什么正则化有时有效? 老师指出:不是所有正则化都能改善优化(dropout 现在没人用了,因为它与优化交互不好);但像权重衰减这种"收缩到零",可能允许你用更大的学习率或更快地衰减。这些项相互关联的方式很多。
7.5 超参数总纲
(参考时间: 01:03:26)
老师把超参数部分收成一句话:
- FF 因子 4× 规则;
- 头维度 × 头数 = 模型维度;
- 宽高比约 100;
- 正则化:可能要多试几种,因为它和优化器的互动很反直觉;一些人在"其实不需要正则化"的情况下仍在用。
八、训练稳定性:三个关键干预
(参考时间: 01:05:01)
📷 画面回看(01:08:00)
回到原视频 (01:08:00)
📷 画面回看(01:13:20)
回到原视频 (01:13:20)
老师说,近几年重点不在性能,而在稳定性。模型越贵,稳定性越关键。
- 前面说过,很多架构选择是"宽容的"——随便动也不会有大性能差异,没关系;
- 但只要训练中途炸一次——出现一大堆梯度尖峰——就可能得到质量很差、甚至不可恢复的模型。你可能已经烧掉了几百万美元,却训不下去。这是灾难。
- 所以不要训成那种"蓝色曲线到处是尖峰、梯度范数乱跳"的模型。
graph TD
    A["训练中不稳定:梯度尖峰"] --> B["定位嫌疑点"]
    B --> C["softmax 的两个危险点"]
    C --> C1["输出端 softmax<br/>→ 归一化因子 Z 可能爆炸"]
    C --> C2["注意力 softmax<br/>→ 输入 logits 尺度失控"]
    C1 --> D["干预一:Z loss(正则 log Z)"]
    C2 --> E["干预二:QK-Norm"]
    C2 --> F["干预三:Logit 软上限(soft cap)"]
不稳定的"惯犯"是 softmax,它有两个危险因素:指数(很容易爆炸)和除法(两个数相除也很危险)。语言模型里有两处 softmax:输出端和注意力。
8.1 输出端 softmax 与 Z loss
(参考时间: 01:07:05)
我们要计算 log 概率以算损失。log 概率为:
$$ \log P = u - \log Z, \quad Z = \sum_i \exp(u_i) $$
- $u$ 是模型输出(残差流加上所有东西的产物),若模型表现正常,$u$ 是"well-behaved"的;
- 但 $\log Z$ 未必。$Z$ 是指数,可能很大或很小,任一方向都会爆炸。
理想情况下希望 $Z$ 接近 1,即 $\log Z$ 接近 0。
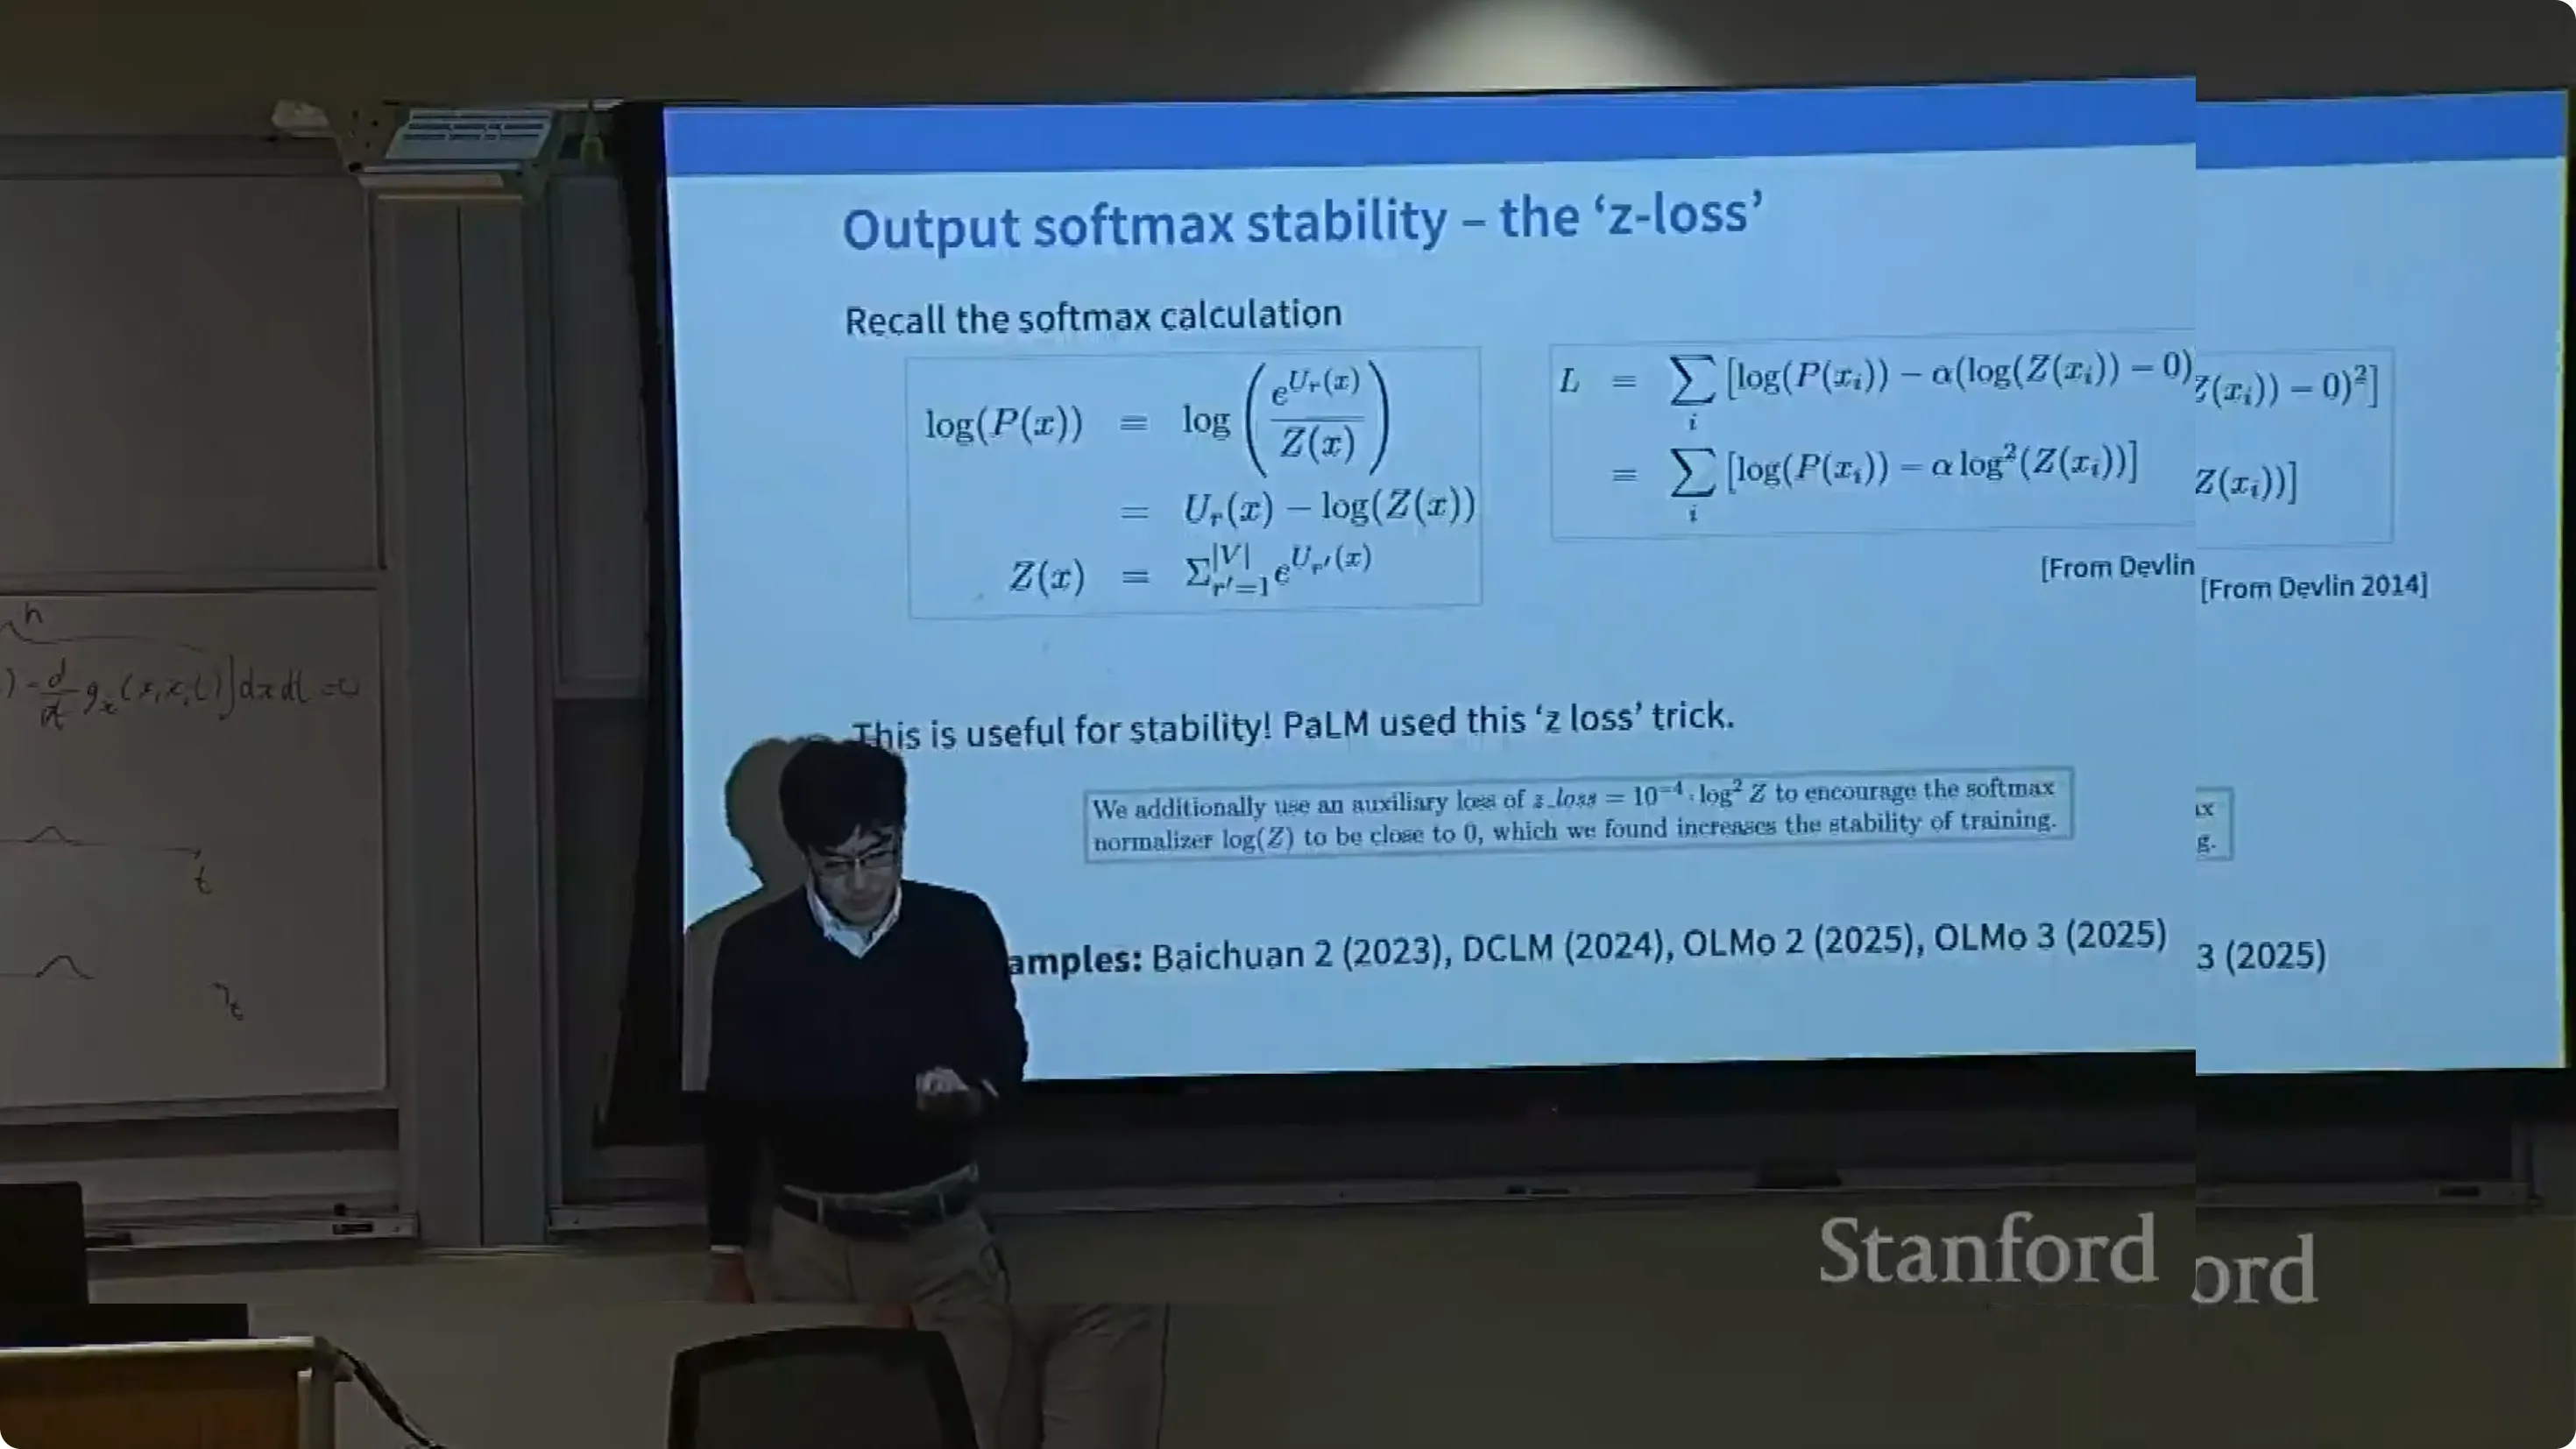
洞察:softmax 是过参数化的——给 $u$ 加一个常数,可在不影响输出的情况下改变 $Z$。因此可以加一个正则项惩罚 $\log Z$ 偏离 0:
$$ \mathcal{L}_{Z} = \alpha \cdot (\log Z)^2 $$
当 $\log Z$ 接近 0 时,整个表达式数值上很稳定。这就是 Z loss(Z 损失技巧),源自 Jacob Devlin 2014 年的论文,后来经若干开源模型(Baichuan 是第一个用的开源模型,之后 DCLM、OLMo 等也用了)重新流行。老师说,"这是个相当有效的做法"。
8.2 注意力 stabilit:QK-Norm
(参考时间: 01:09:35)
注意力是"退化(degeneracy)大量发生"的地方。老师给出一个总的 设计哲学:遇到不稳定,就想办法往里塞一个层归一化。
标准注意力流程:对输入做 pre-norm → 乘 QKV → 得到 $Q, K$ → 矩阵相乘 → softmax → 与 $V$ 相乘得到加权平均 → 输出。
QK-Norm 的做法:在 $Q$ 与 $K$ 相乘之前再加一个(RMS)层归一化。这样 $Q$、$K$ 的尺度都被归一化到大约 1,于是 softmax 的输入尺度受控,注意力 softmax 变得稳定。
graph LR
    X["x"] --> LN["Pre-Norm"] --> QKV["× W_qkv"]
    QKV --> Q["Q"]
    QKV --> K["K"]
    QKV --> V["V"]
    Q["Q"] --> QKN["RMSNorm"]
    K["K"] --> QKN["RMSNorm"]
    QKN --> MM["Q·Kᵀ"] --> SM["softmax"] --> WV["× V"] --> Out["输出"]
- 这个技巧最初来自多模态世界:做多模态的人(在 Emu3、Chameleon 等工作中)先发现并验证了 QK-Norm;
- 之后很多开源语言模型意识到同样的技巧完全适用于稳定语言模型的注意力;
- 现在 QK-Norm 已非常标准,大多数大模型都在用。它似乎不影响性能,却能有效防止注意力退化。
老师还感慨地描述了这一"层层递进"的过程:一开始层归一化只在 pre-norm;后来加到了每个 block 的非线性之后;现在又塞进了 Q 和 K。 这是这一领域稳定化技巧的演进方式。
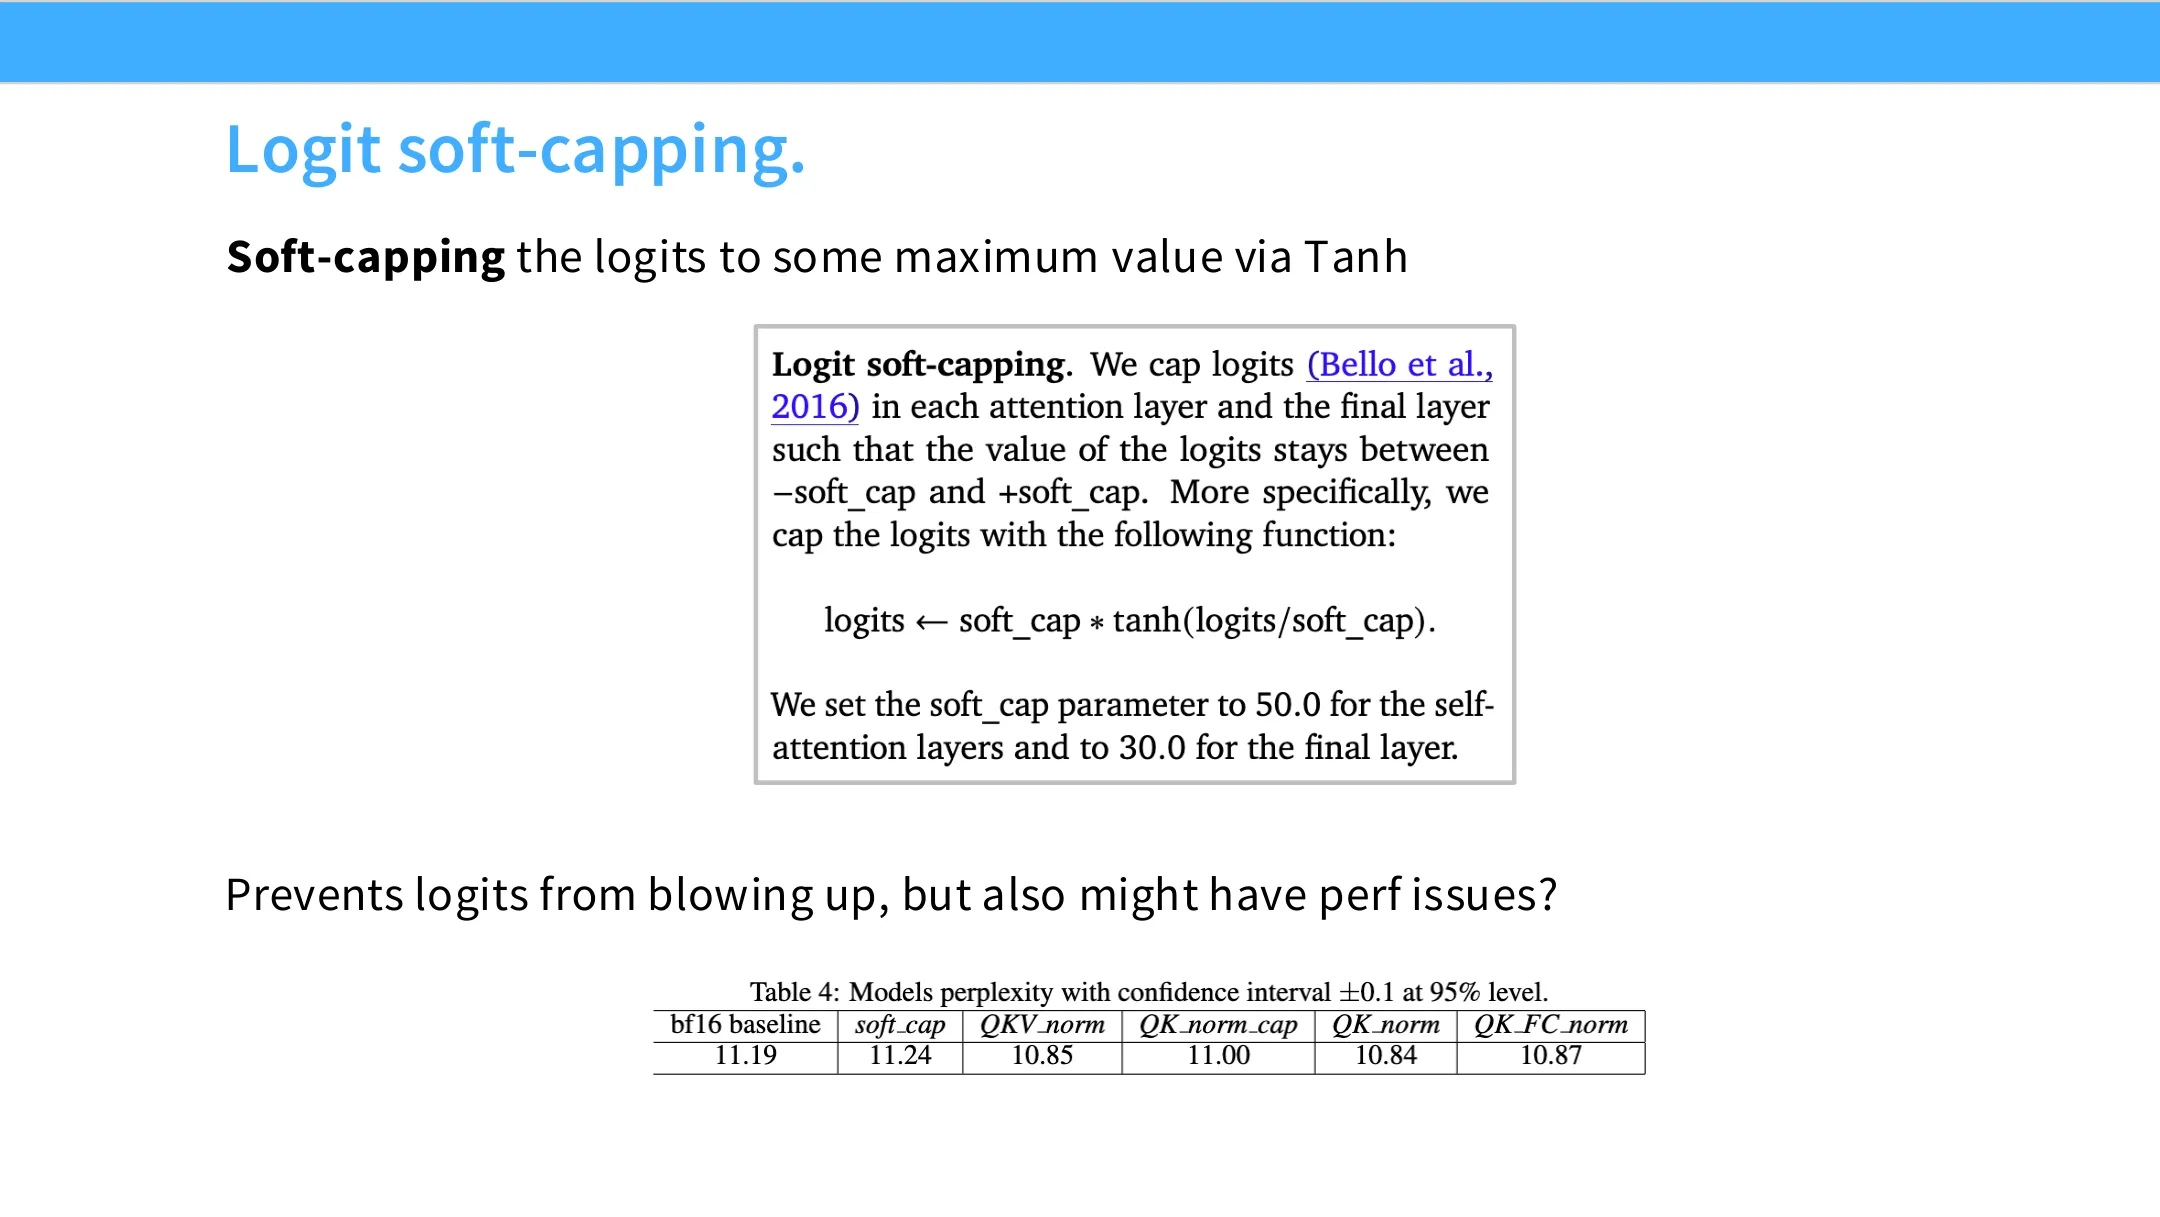
8.3 Logit 软上限(logit soft cap)
(参考时间: 01:12:20)
这是较不流行、更偏 Google 特有的做法。
- QK-Norm 是控制 softmax 的输入,然后"寄希望于输出良好";
- Logit soft cap 则更强硬:直接把进入 softmax 的logits 截断在某个范围内,使其既不过大也不过小,近似一个硬约束。用的是 tanh(有界)。
Gemma 系列(Gemma 2、3、4)都用了这一技巧:把注意力层所有 logits 都做软上限。
代价:Nvidia 有人做过系统的稳定性干预对比,发现:
- 用 QK-Norm 略好,因为你可以把学习率调高一点;
- 但单用软上限反而会损失性能——这是很强的干预,模型永远无法表达"非常自信"的信号(超过某个界限就被削平),存在质量退化。
所以它是一把双刃剑:非常安全,但有负面后果。
九、注意力层面的干预:GQA/MQA 与滑动窗口注意力
(参考时间: 01:14:08)
📷 画面回看(01:21:30)
回到原视频 (01:21:30)
老师只说"今天只讲稠密注意力下的干预",关于状态空间模型和线性时间注意力留到下一讲。今天要讲的三个高频干预是:GQA/MQA、滑动窗口注意力,以及对位置嵌入的形式的改动。
9.1 从"训练/预填充"到"部署/解码"
(参考时间: 01:15:55)
老师先设定动机:训练好模型后要服务大量用户,这要花两种资源的钱:
- FLOPs(计算);
- 内存访问(也影响延迟与利用率)。
训练 / 预填充阶段(给定 prompt 时):
- 总算术量 ≈ 批量 × 序列长度 × 隐藏维平方(再加上注意力的 $D^2$ 项);
- 内存访问 ≈ 批量 × 序列长度 × 隐藏维 + softmax 的 $N^2$ 项 + 投影的 $D^2$ 项。
算术强度较好,约 $\frac{1}{K}$($K$ 为头维度)和 $\frac{1}{BN}$——只要头维够大、序列或批量够长,GPU 就能被充分利用。
生成 / 解码阶段:不能并行——一次生成一个 token,再条件于它生成下一个(自回归的"诅咒")。高效做法是维护 KV cache:缓存过去所有 keys 和 queries,只计算必须的新 query-key 交互,所以能省很多计算。
但代价是算术强度变差:读取和写出的参数始终在读写。总算术量不变(还是同样的矩阵乘法,只是增量做),但内存访问模式中出现了 序列长度 × 隐藏维平方 这一项,不再是单纯的 $D^2$。算术强度变成:
$$ \frac{N}{D} + \frac{1}{B} $$
结论:要高效推理小模型,需要大批量 + 短序列,或很大的模型维度。而 $\frac{N}{D}$(序列长度 / 隐藏维)这一项在增量计算下极难降低。
9.2 MQA → GQA 的演进
(参考时间: 01:19:32)
问题:KV cache 让内存访问随序列长度增长,效率变差。
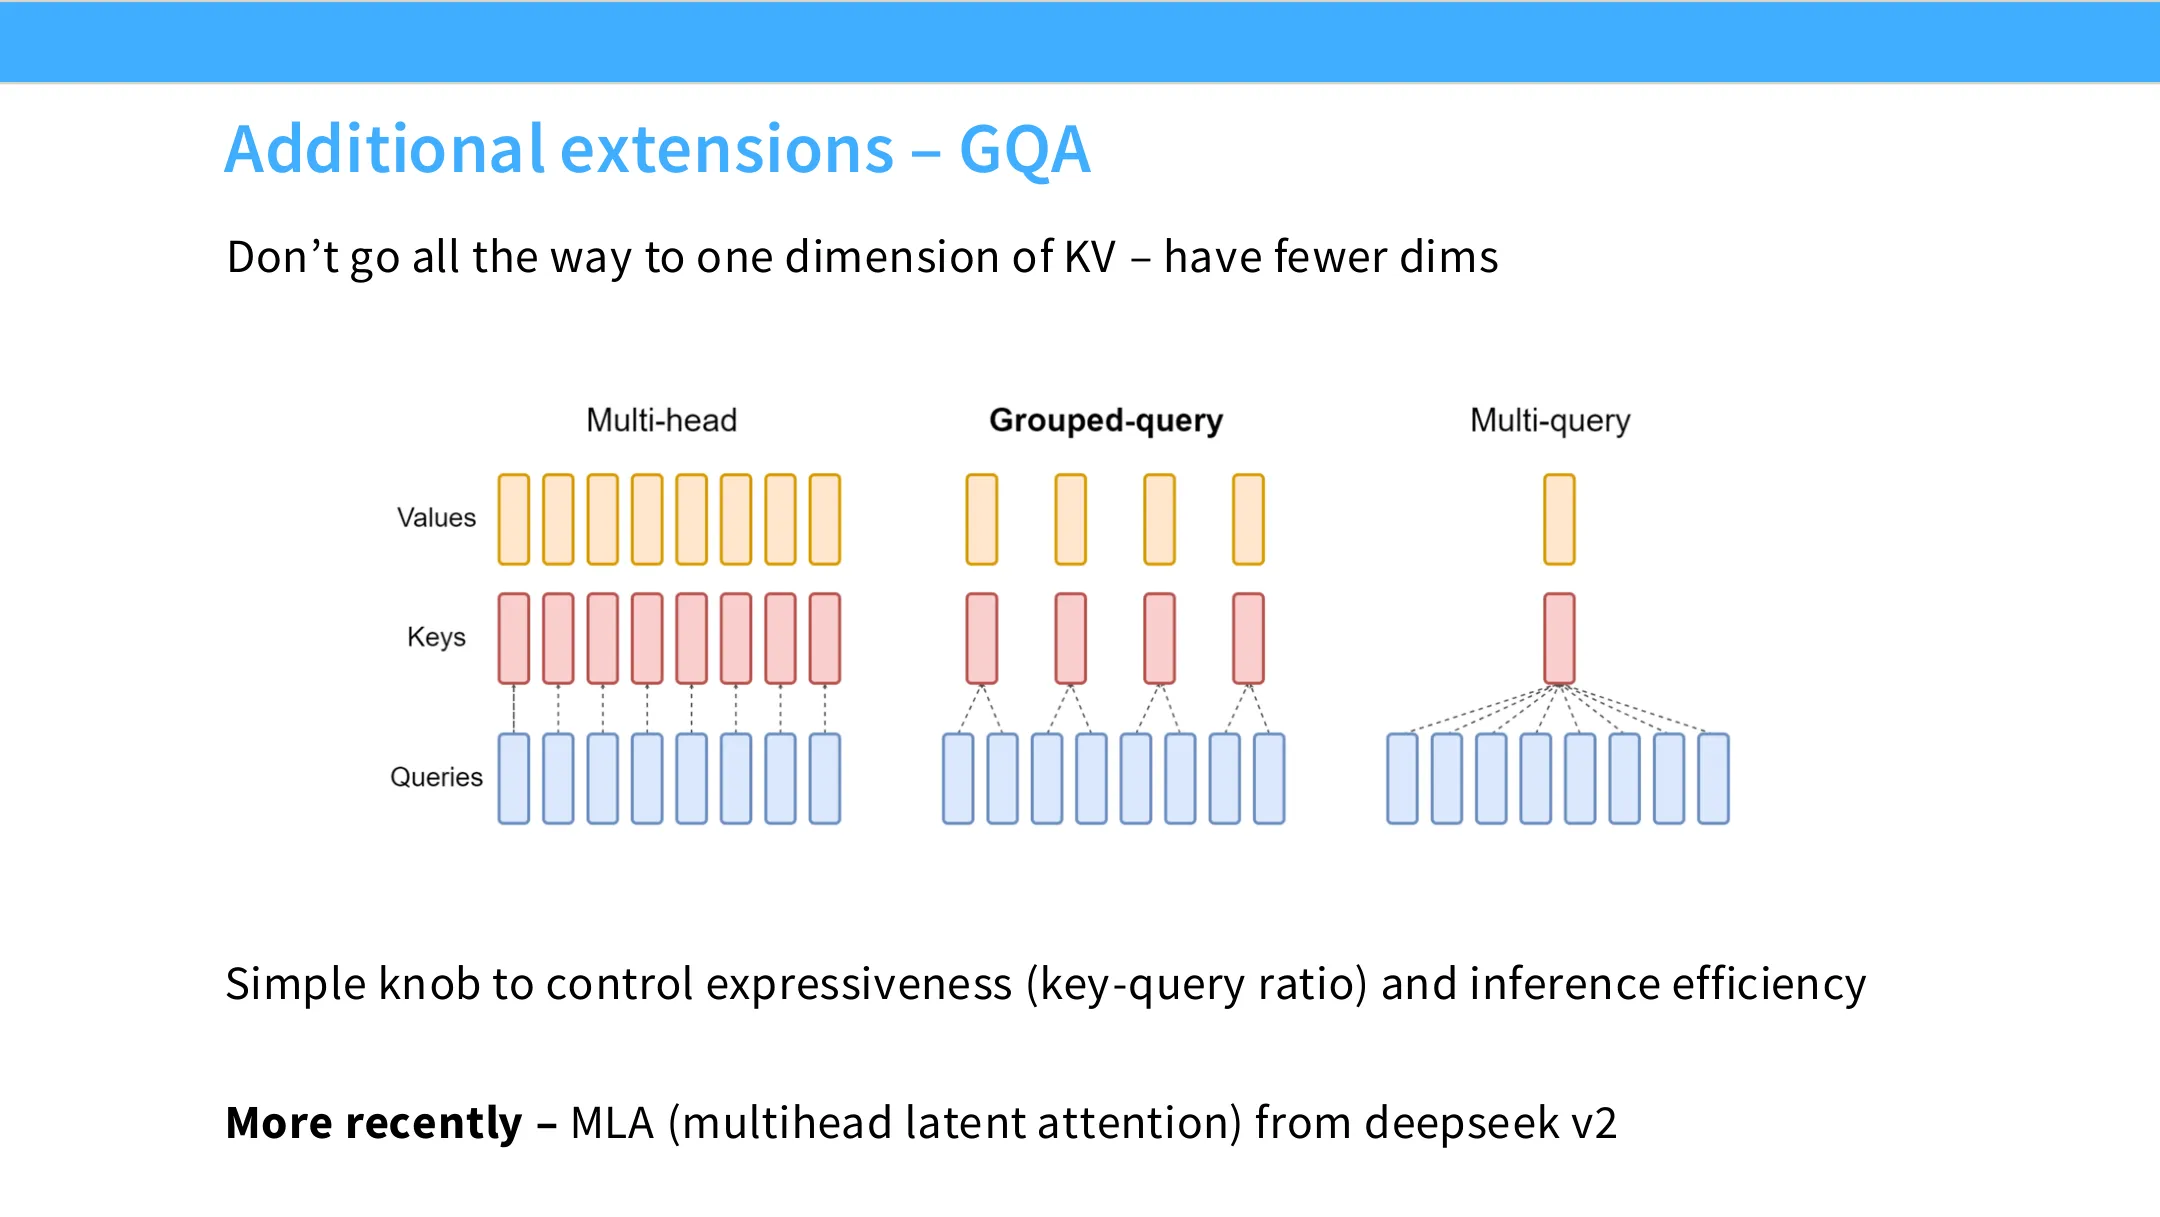
MQA(Multi-Query Attention,多查询注意力):让所有头共享同一组 keys 和 values,只有 queries 因头不同而不同。这样 KV cache 显著变小(所有头共享),总内存访问显著降低,算术强度中多了个 $H$(头数)的因子,大幅提升。
graph TD
    subgraph MHA["MHA 多头注意力"]
        Qh["每个头各自有 Q、K、V"]
    end
    subgraph MQA["MQA 多查询注意力"]
        Qm["每个头有独立 Q"] --> Kv["所有头共享 1 组 K、V"]
    end
    subgraph GQA["GQA 分组查询注意力"]
        Qg["每个头有独立 Q"] --> Kg["按组共享 K、V<br/>组数可调"]
    end
    MHA -->|"效率低、表达力高"| MQA
    MQA -->|"效率极高、表达力低"| GQA
    GQA -->|"效率与表达力折中"| Sweet["甜点区"]
MQA 的代价:所有 queries 共享一对 K、V,损失了不少表达力。
GQA(Grouped-Query Attention,分组查询注意力):折中方案——减少 K/V 的数量,但保留更多的 queries。引入一个"KV 头数 / query 头数"的比例来调节:
- 原版 Transformer = 多头(MHA):每个头各自的 Q、K、V;
- MQA:所有头共享一组 K、V;
- GQA:把 key/value 头分组,queries 仍保持很多,从而在表达力与推理效率之间连续可控。
GQA 的实测效果:在"下游性能 vs 每样本耗时"的图上:
- MHA:性能好,但成本高;
- MQA:成本低,但性能掉很多;
- GQA:几乎兼得两者——推理成本很低,性能接近完整的 MHA。
而且只要稍稍减少 KV 头数,就能拿到大部分效率收益,同时保留大部分表达力。
老师说,DeepSeek-V2 的"多 Head 潜在注意力(MLA)"是另一类不同分解、不同权衡的方案,下一讲会略提。但 GQA 的优势在于实践中的权衡非常有利——因此今天的模型几乎都采用 GQA 结构,用很小的表达力代价换来关键的推理成本降低。
课堂问答:
- Q:既然有这么多超参数经验,还有多少人真的去搜搜索? 老师说二者兼有:"每次训练都带有一些关于'什么可以变'的论点。"报告里往往一次只改一个架构改动,很少全都改。Google 是少数敢大幅度'加料'的组织——比如最近的 Gemma 4,每一层都有独立的嵌入,用来控制内存与 FLOPs 的权衡。
- Q:训练中会实验这些参数吗? 老师答:权重衰减会——人们常让它与学习率协同调整,效果很好。架构类的参数无法中途改,因为会让训练不兼容,所以基本固定。
- Q:MQA 是否只在推理时固定? 老师说不是——训练时就确定 key 的数量。
9.3 滑动窗口注意力与混合结构
(参考时间: 01:25:11)
滑动窗口注意力(sliding window attention) 是很老的想法:GPT-3 就已经用——交替使用全注意力(每个位置可以看到过去所有位置) 和 带状矩阵式注意力(只能看到固定窗口内的位置)。OpenAI 早期也有关于不同注意力模式的工作。
但这一做法在过去一年里变得非常流行:交替"全局 + 局部"注意力,是在"管理长上下文性能"和"不付太多推理成本"之间的甜点区。
graph TD
    A["层结构(每 4 层)"] --> B["第 1 层:全注意力<br/>可看所有历史"]
    B --> C["第 2、3、4 层:滑动窗口注意力<br/>只看局部"]
    C --> D["下一次全注意力<br/>聚合前面所有局部信息"]
    D --> E["以此类推<br/>局部信息逐层汇聚为全局"]
具体例子:
- Cohere Command A 据老师说是第一个他看到的采用者:每 4 层里有一层全注意力,其余 3 层是滑动窗口;
- 逐层向下(图中方向)时,局部注意力会把局部信息汇聚成全局信息——底层的局部注意力最终也能访问更多全局信息;
- 这样能在不诉诸状态空间模型等更激进方案的前提下,管理长上下文成本。
还有一些创新是对长距离信息的嵌入形式动手——比如去掉 RoPE,让长距离部分根本没有位置嵌入(近乎"词袋"),而短距离部分仍保留位置信息。这类改动涉及嵌入 + 局部/全局交替结构两方面。
老师说,这仍是活跃的研究领域,也是架构工作最多、变化最大的地方。
采用者:
- LLaMA 4、Gemma 4、Olmo 3 都用了滑动窗口 + 全注意力的组合(他们用的是完整 RoPE 而不是 no-position),
- Qwen 3.5 稍有不同:它交替的"便宜层"是状态空间模型——门控 DeltaNet(gated DeltaNet),每 4 层来一次全注意力。这和滑动窗口是同样的交替结构,只是把"便宜的层"换成了 SSM。
老师说,这就是过去一年出现的新主题:开放模型在认真解决长上下文性能,而目前的做法是"混合模型"——既不是纯全局注意力,也不是纯廉价注意力,而是两者的混合,目前看效果很好。
十、收束
(参考时间: 01:28:37)
老师总结:把这些模型横着看,就能看出很多模式和共识,从而形成一种"什么可以做、什么对大家是好的"的一般认识。同时也会看到不少差异——如何处理上下文、如何处理位置嵌入,乃至分词都各不相同。
但共性是存在的。希望这些共性,能在同学们做作业、刷排行榜(leaderboard)时,提供一些直觉。
已知疑点
本节罗列本讲中不确定、可能听错、或与常识/官方资料冲突的地方,并注明依据或时间点。凡拿不准处,我们宁可标注,不替讲师做决定。
- 模型名称拼写(多处):
- (00:03:27) "InternLM2" 与 "Gemma 3"、"Qwen 2" 并列,判断为公开的 InternLM 系列,但字幕未给出确切版本号。
- (00:03:39) "NeMo Tron 4" 疑为 Nemotron 4(NVIDIA 系列),字幕可能的听写误差,正文按"NeMo Tron 340B"保留讲师口述。
- (00:03:59) "Percy's own 8B model trained with Marine" —— "Marine" 疑为某个训练框架/项目的名(可能是 Marin),字幕不确定,正文已标注。
- 人名/论文名 (00:10:25):"Salazar 与 UN" —— 字幕中第二个人名被截断,可能是 Salazar and ... 的某位合著者。正文按字幕保留,标注不确定。
- "Gemma 4"/"Qwen 3.5" 等未来时间点:本讲属于 Spring 2026 课程,讲师多次提到"上周四刚出的 Gemma 4",以及"Qwen 3.5"。这些在一般公开资料中属于较新的发布,编者未逐一核实版本号,正文按讲师原述保留。
- "Eagle" 位置编码 (00:41:27):学生提问中出现的 "Eagle",与正文讨论的 RoPE 变体相关;讲师回答说"区别只在于旋转了哪些坐标"。编者未在该范畴中确认一个公认名为 "Eagle" 的位置编码,可能是 ASR 误差或某个非主流做法,正文照讲师口述处理。
- Z loss 年份 (01:08:35):讲师先说 "Jacob Devlin's paper 2024",随即自我更正为 2014。正文采用 2014。
- 正则化与优化器交互的表述 (01:04:45):讲师关于"权重衰减与 AdamW 类优化器交互"的说明较口语化,编者按"它可能允许用更大学习率或更快衰减"复述;具体的耦合机制、以及"是否所有自适应优化器都如此"在讲中并未展开。
- 并行层的精度损失 (00:41:00 附近问答):PaLM 原文声称"无性能损失",但讲师指出后续 Google 模型多不再采用,这可能暗示存在损失;但据讲师说没有受控实验,故正文明确标注"此为隐含信号,而非定论"。
- bits-per-byte 问答的完整结论 (00:57:11 起):学生对"改变切分方式后比较 perplexity"的追问,讲师表示"没完全听懂,留待日后讨论",故本节对该问题不作定论。
若本讲中还有你注意到、但此处未列出的疑点,欢迎在课程论坛补充。本节的目的是让读者清楚"哪些是已定论,哪些是待定"。