第4讲 · Stanford CS336:从零开始的语言建模|:注意力的替代方案
课程信息
| 课程 | Stanford CS336 Language Modeling from Scratch(2026 春季) |
| 本讲 | Lecture 4 — Attention Alternatives(注意力的替代方案:线性时间注意力与混合专家) |
| 视频 | https://www.youtube.com/watch?v=cKSwj_qZ8Jg |
| 时长 | 约 86 分钟(5180 秒) |
| 本书定位 | 面向 CS 初学者的课堂重构稿。本书是课堂口语记录的重构,保留讲师的推理链、类比与案例;凡编者补充的内容一律以「编者说明 / 编者拓展」明确标注,不冒充讲师原话。 |
对应讲次:第4讲(Stanford CS336 语言建模)
制作模型:deepseek-flash(vb compose,据 run.log)
导览
这是一张帮助你在 3–5 分钟内建立全局理解的问题地图。导览只给地图,不复述结论、不剧透推导。
① 讲师真正想回答的核心问题
- 问题一:既然现实世界(更长上下文、更复杂 workload、agent 场景)需要越来越长的上下文窗口,那我们能用什么样的架构改造,把注意力对序列长度的依赖从二次(quadratic)降到线性(linear)?这条路线要绕开哪一道门口,才能既省算力又不掉性能?(见
[00:00:51]、[00:01:04]、[00:04:54]) - 问题二:Transformer 的 MLP 部分能不能也用稀疏化来「白嫖」参数——也就是混合专家(Mixture of Experts, MoE):在不增加前向/后向 FLOPs 的前提下拿到更多参数。(见
[00:01:08]、[00:34:25]、[00:36:19]) - 贯穿两问的元问题:当「大 O 复杂度」与「常数因子」打架时,该信谁? 讲师反复强调「说实话,常数因子极其重要」(见
[00:03:20]、[00:27:31])。
② 难点在哪——最容易卡住的地方
- 线性注意力的「丢 softmax」这一步:把 $\mathrm{softmax}(QK^\top)V$ 改写成 $Q(K^\top V)$,是有损的(丢掉了 softmax 的行归一化);而紧接着的「线性形式 ⇄ RNN 形式」却是精确等价的。学生容易把这两步混为一谈,误以为整个改造无损。(讲师在
[00:20:56]–[00:21:36]专门澄清了这一点) - 门控与状态依赖的边界:在把线性注意力「续命」成 Mamba 2、Gated DeltaNet 时,什么可以门控、什么不可以(只能用「依赖输入」的门,不能用「依赖状态」的门),决定了你还能不能保留「训练可并行、推理可串行」的双重性。(见
[00:14:31]) - MoE 的稀疏性与可微性冲突:训练时若只激活 top-K 专家,被选中的专家吃梯度、没被选中的永远不被观测,路由就变成了一个统计意义上的 bandit 问题,而 top-K 本身又不可微。(见
[00:42:44]、[00:59:09]) - 专家坍缩(expert collapse):若只做普通梯度下降,会出现「强者愈强」的正反馈,最终少数专家吃掉几乎所有 token。(见
[01:03:31])
③ 读者可能带着什么疑问进来
(A)讲师在课上实际提出的问题(来自字幕,按他抛出的顺序):
- 线性时间注意力长什么样?我们能怎么做?(
[00:05:01]) - 为什么这些方法直到最近两年才真正可用?(
[00:05:24]) - MoE 为什么这么流行、又为什么流行得这么慢?(
[00:45:33]) - MoE 到底该怎么设计?该从哪几个轴去变化?(
[00:47:36]) - 明明可以训练时激活全部专家、顺便学路由,为什么偏要稀疏?(
[00:41:50])
(B)编者预判的读者疑问(标注为「编者预判」,与上一组区分):
- 编者预判:丢掉 softmax 之后,线性注意力损失了多少表达能力?为什么还能工作?(讲师在
[00:32:44]借「状态空间模型的下行代价」部分回答了核心) - 编者预判:既然有 Mamba 2、Gated DeltaNet 这么多花样,它们和最早那个「朴素线性注意力」到底差在哪?
- 编者预判:MoE 的负载均衡损失为什么长那样?它的梯度到底在压什么?(讲师在
[01:05:12]用「求导看梯度」的方法拆解,这是本讲最漂亮的一段推导) - 编者预判:MoE 的系统开销(通信、并行、稳定性)会不会抵消掉它「白嫖参数」的收益?
④ 本讲路线
讲师先谈注意力侧:从「乘法结合律」这一个核心想法出发([00:05:58]),逐步搭出线性注意力 → 加门控的 Mamba 2 → 加第二个门与「投影式更新」的 Gated DeltaNet,并强调它们几乎全部是混合(hybrid)架构([00:11:03])。随后给出正交的另一条降本思路——DeepSeek 稀疏注意力(DSA),用「轻量索引器 + top-K + 全注意力」的分层结构省算力([00:23:13])。然后,在同一个「top-K 选择」的想法上,自然过渡到MoE:先讲动机与产业现状,再讲路由器设计空间、共享专家与细粒度专家、负载均衡损失的来历,最后落到系统侧(专家并行、通信投影、稳定性)与 DeepSeek V1→V2→V3 的演化脉络。
1. 引言:两条改造 Transformer 的路线
(参考时间: 00:00:25)
上一讲讨论的是基础 Transformer,以及如何微调它的各个部件,拼装出一个现代语言模型。本讲要更进一步,谈两个我认为「更高级、更复杂」的架构发展——它们都建立在常规 Transformer 之上。
今天的两个主题:
- 注意力的替代方案(attention alternatives):通过架构改动,让我们能够支撑更长的上下文。这些方法大体上都把对序列长度的依赖,从二次(quadratic)降到线性(linear)。这是对 Transformer 中注意力块的改造。
- 混合专家(Mixture of Experts, MoE):这是对 Transformer 中 MLP 部分的改造。MoE 让我们在硬件利用上获得显著更好的效率——用更少的计算量换取更多的参数。
编者说明:本讲把「省算力」拆成两条正交的路线。一条动注意力(改变 token 之间如何互相看),一条动FFN/MLP(改变每个 token 内部如何处理信息)。这两条线都可以叠加使用,很多前沿模型(如 DeepSeek V3、Qwen 系列)同时采用了二者。
graph TD
    A[Transformer Block] --> B[注意力块 Attention]
    A --> C[MLP / FFN 块]
    B --> D["路线一:注意力替代方案<br/>线性时间 / 稀疏注意力<br/>→ 更长上下文"]
    C --> E["路线二:混合专家 MoE<br/>参数↑ 但 FLOPs 不变<br/>→ 更高效投入参数"]
    D --> F[混合架构 Hybrid]
    E --> G[专家并行 Expert Parallel]
    style D fill:#dbeafe
    style E fill:#fef3c7
2. 长上下文的动机与成本结构
(参考时间: 00:01:32)
现在的趋势很明确:人们想要更长的上下文长度。你需要把大量信息塞进上下文,让模型拥有更多知识;也许它是一个要操作许多事情的 agent。
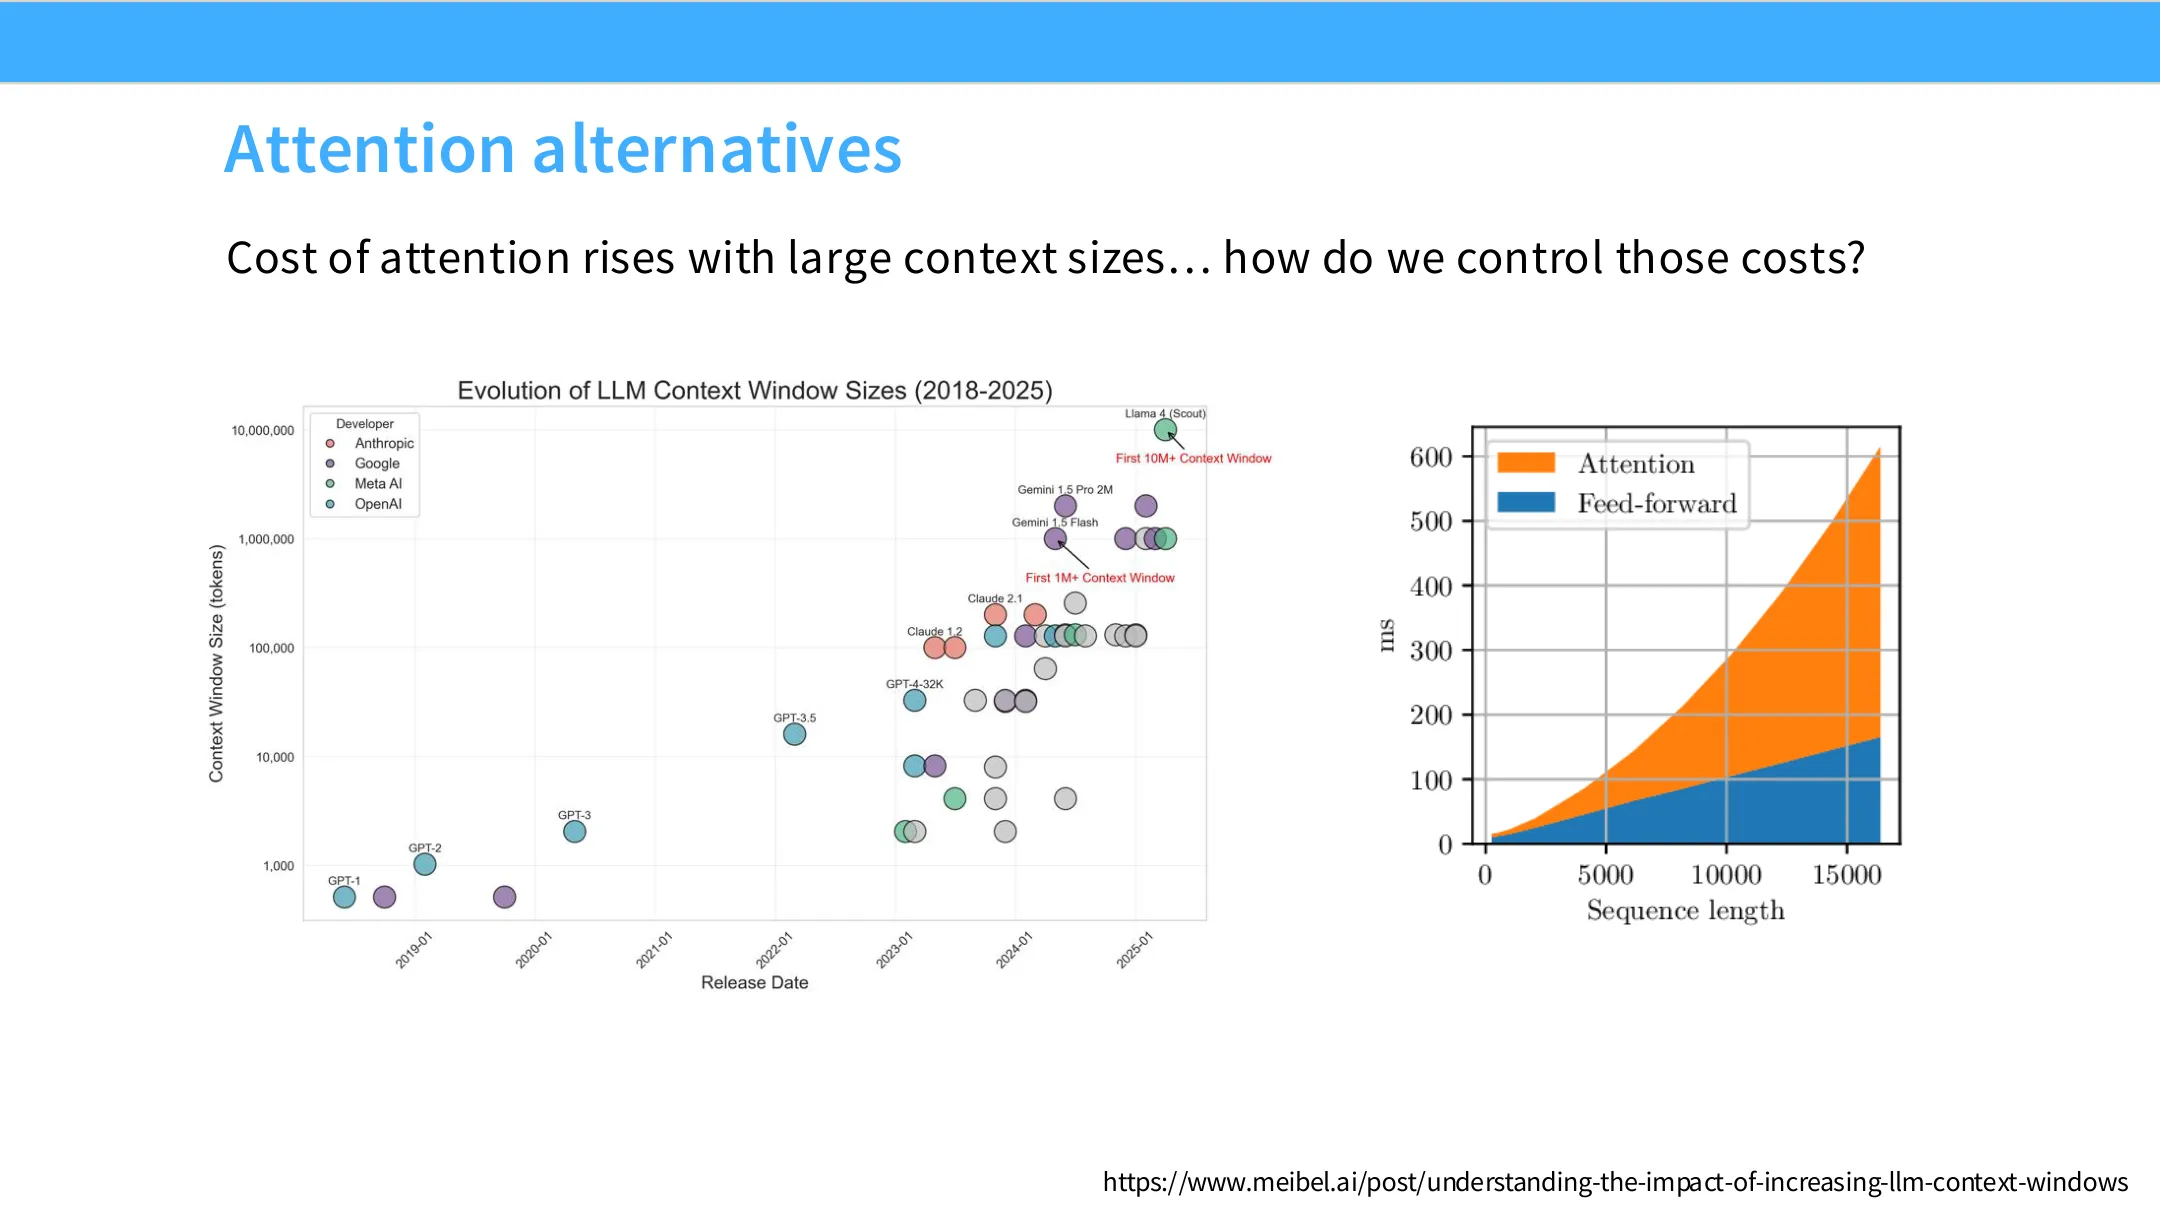
讲师展示了一张图:横轴是时间(不同模型随时间的演化),纵轴是上下文窗口大小(对数刻度)。可以看到几乎所有顶级语言模型厂商都在竞赛式地提供越来越大的上下文窗口,以支撑更复杂的 workload。
2.1 谁在吃掉算力:FFN 还是注意力?
同一张图的右侧还画了一条计算成本比例曲线:它展示了随序列长度增加,前馈网络(feed-forward)部分与注意力(attention)部分的计算成本之比。
- FFN:一开始占比较大,但随序列长度线性增长。
- 注意力:由于所有位置两两相连(all-to-all),是二次增长(quadratic)的,因此随着序列变长,它很快反超 FFN。
📷 上下文窗口增长与注意力成本占比
回到原视频 (00:01:32)
换句话说:过去在大模型 + 较短序列的场景下,FFN 是主要成本;而当序列变得很长时,注意力越来越成为瓶颈。
2.2 控制成本的基本工具箱
(参考时间: 00:02:49)
对付注意力成本,有两类手段:
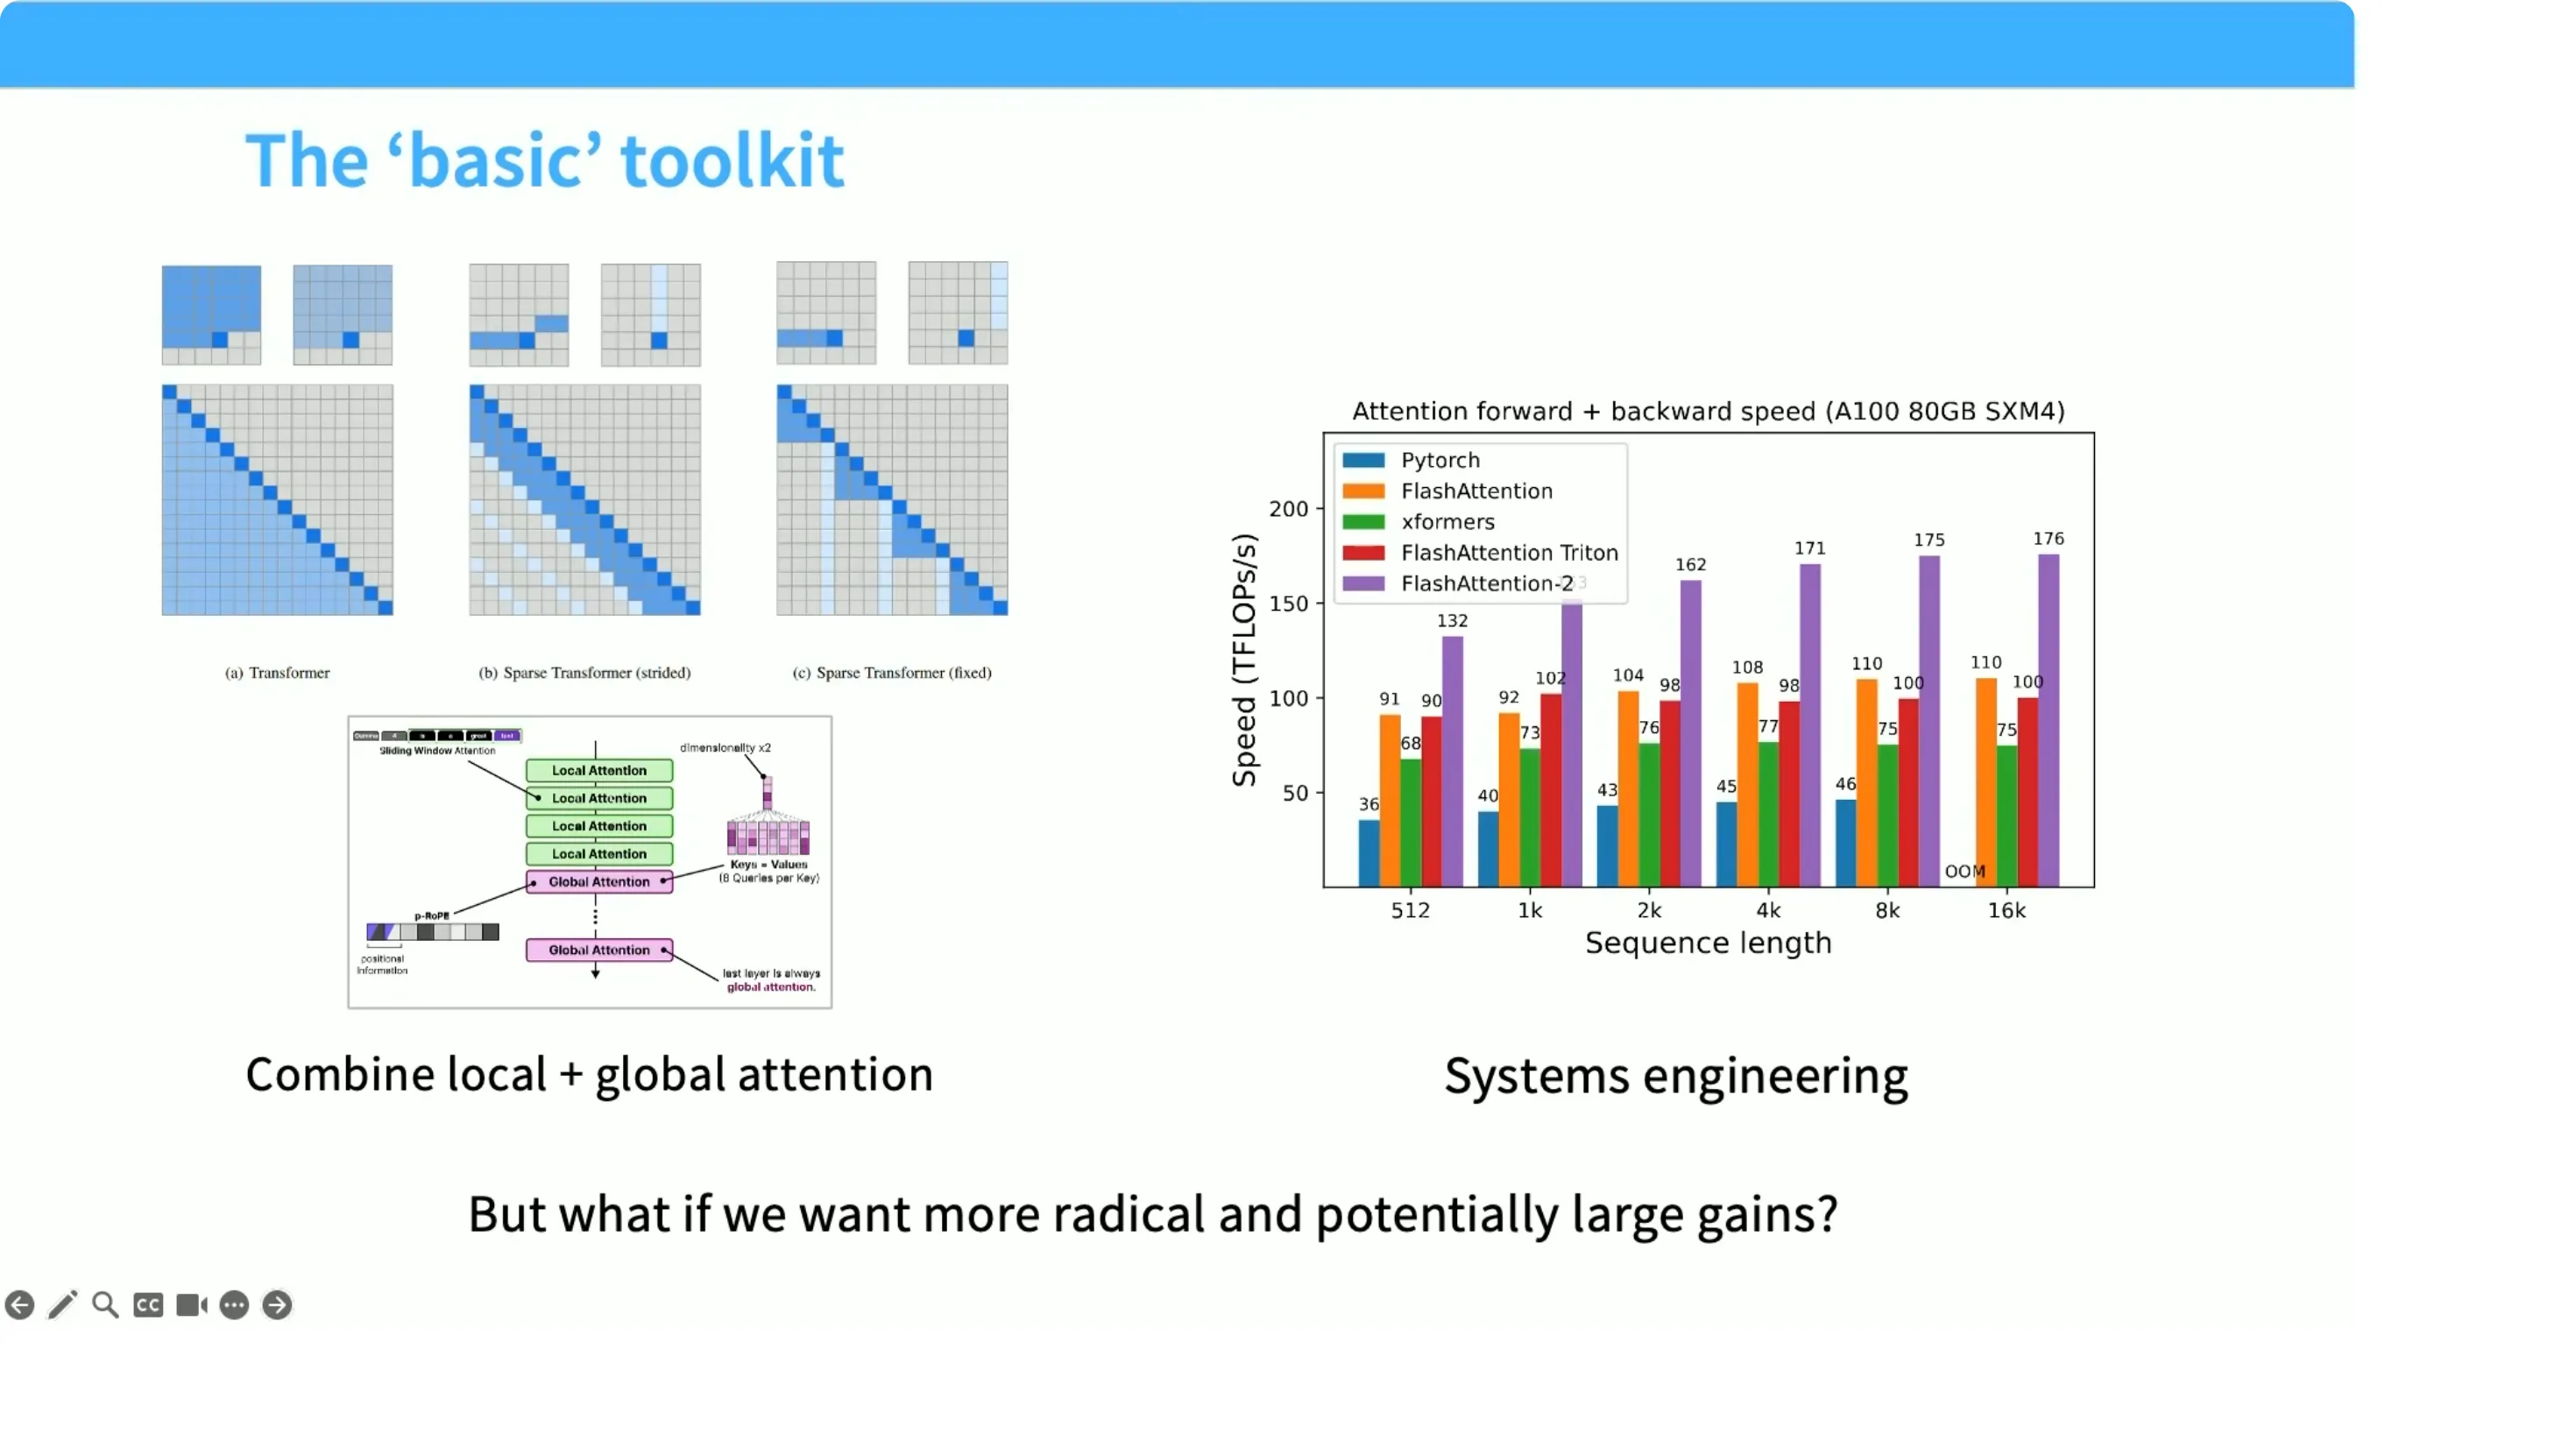
- 局部注意力 + 混合(hybrid)拼接:如果你只在每八层里做一次全局注意力、其余层都做很局部的注意力,你就能极大地控制成本。
- 系统工程(systems engineering):常数因子极其重要。讲师强调,这是一个很容易被「理论导向的计算机科学传统」忽视的点——大家容易只盯着大 O(线性还是二次),而忘记常数因子。
编者拓展|Flash Attention 为什么重要 讲师在这里点名了 Flash Attention(
[00:03:43])。它的核心思想是:不把巨大的 $N \times N$ 注意力矩阵真正写进显存,而是把注意力运算重排成对内存层级(SRAM / HBM)更友好的分块(tiling)计算,最大限度减少显存带宽上的搬运开销。 - 它没有解决二次复杂度问题; - 但它是一个纯粹的常数因子优化,却带来了「货真价实的戏剧性提升」。讲师展示的对照中(
[00:04:07]):基础 PyTorch 实现在较短序列上大约每秒 30–40 万亿次浮点运算(TFLOPs),而 Flash Attention 常常能带来两倍以上的提升;在某些规模下,朴素实现甚至已经放不进显存,而 Flash Attention 因为不物化(materialize)大矩阵,还能继续跑——哪怕慢一点。这一讲会在后续的系统课(约三讲之后)和系统作业中更详细地展开。
📷 Flash Attention 相较基础 PyTorch 的性能提升
回到原视频 (00:04:07)
但讲师也提醒:如果上下文要到 500 万、1000 万 token,这些技巧就不够用了。我们想要的是更激进、更大的能力提升——这就引出了核心问题:有没有办法让复杂度对序列长度线性?
3. 线性注意力:乘法结合律的魔法
(参考时间: 00:05:08)
多年来很多人尝试过各种方案,也有一些「错误的开局」。但最近大概两年,出现了一批相当有效、并已在规模上被反复验证(battle-tested)的线性时间注意力配方——这也是为什么这是第一年讲师愿意在课上讲线性时间注意力:因为它现在明确地在生产规模上work。([00:05:24])
讲师强调:要理解所有有效方法,你只需要先理解一个核心想法,然后在其上不断扩展。这个想法就是:
乘法的结合律(associativity of multiplication)。
3.1 从 QK^T V 到 Q(K^T V)
(参考时间: 00:06:01)
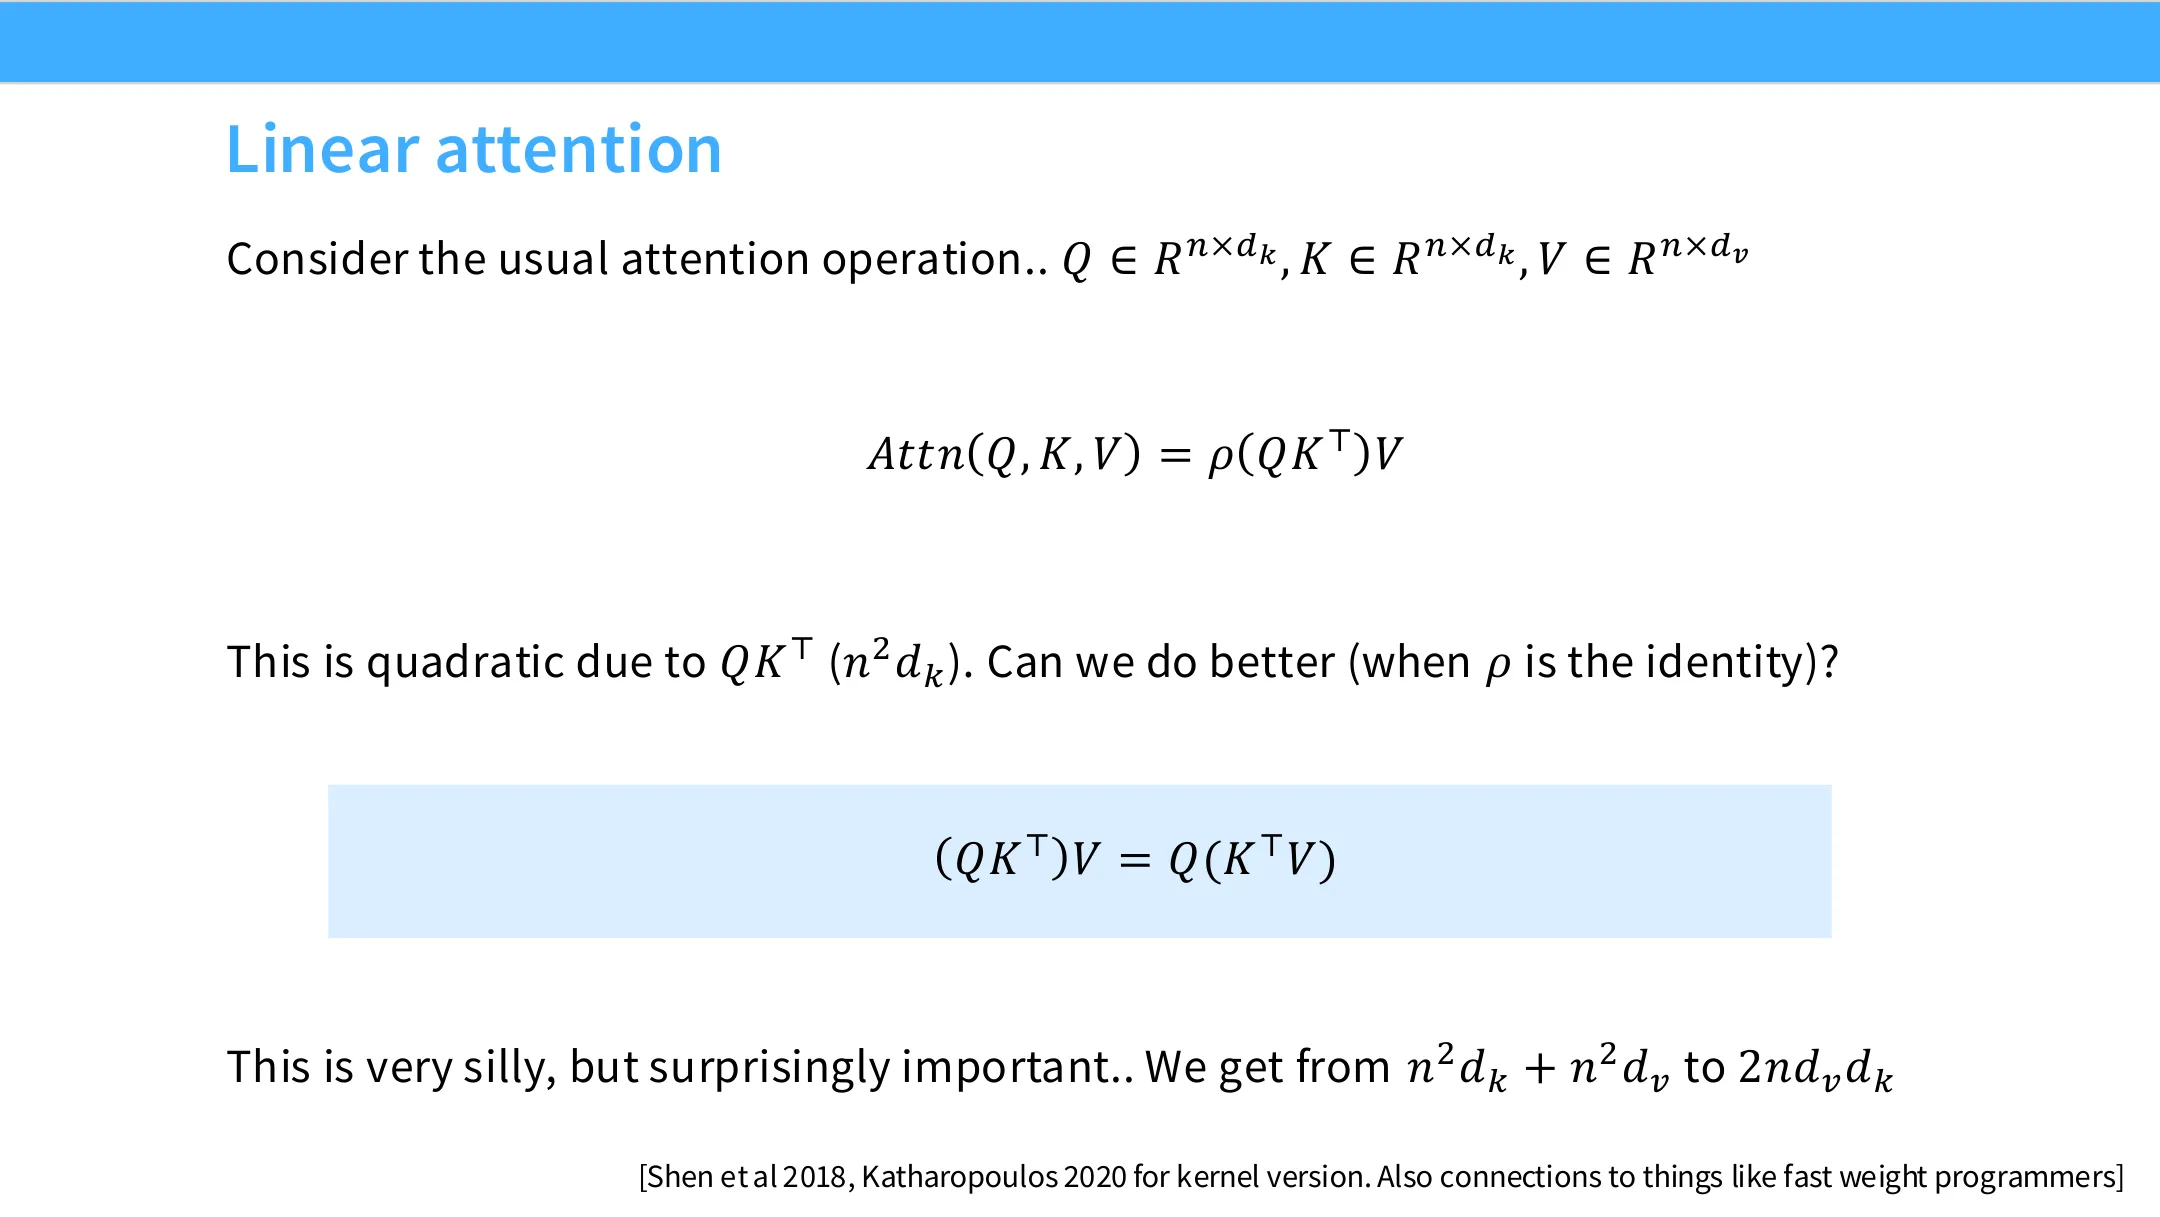
标准注意力可以写成紧凑形式。设 $Q \in \mathbb{R}^{N \times d_k}$、$K \in \mathbb{R}^{N \times d_k}$、$V \in \mathbb{R}^{N \times d_v}$,其中 $N$ 是序列长度:
$$ \text{Attn}(Q, K, V) = \mathrm{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}}\right)V $$
其中 $QK^\top$ 产生一个 $N \times N$ 的全对全(all-to-all)交互矩阵,这就是二次复杂度的来源($O(N^2 d_k)$)。
📷 标准注意力的矩阵记号
回到原视频 (00:06:06)
现在,暂时忘掉 softmax,把那一行丢开。如果没有 softmax,我们就能重排括号:
$$ (QK^\top)V \;\longrightarrow\; Q\,(K^\top V) $$
这一步改变了「哪一部分是二次的」([00:07:04]):
- 原式:$O(N^2 d_k)$,依赖 $N^2$。而 $N$(上下文长度)可以到百万级,非常糟糕。
- 新式:先算 $K^\top V$(一个 $d_k \times d_v$ 的矩阵),代价是 $O(N d_k d_v)$。这里 $d_k, d_v$ 通常是几千到几万,没有人会有百万维的隐藏维度。
因此,依赖 $N$ 的那一项从 $N^2$ 变成了 $N$,且系数是良性的 $d_k d_v$。这就是第一件必须知道的事:乘法结合律让我们能改变复杂度对序列长度的依赖。
编者说明:注意这一步的「代价」是丢掉了 softmax 的行归一化。讲师在后面的问答里(
[00:20:56])反复强调:这一步是有损的(lossy),softmax 一旦丢掉,就意味着模型少了「选择性关注」的能力。而下一步的 RNN 等价则是精确的。这是本讲最容易被混淆的两个「等价/不等价」,务必记牢。
3.2 线性注意力与 RNN 的对偶性
(参考时间: 00:07:56)
线性注意力一个非常好的性质:右侧的矩阵乘法在自注意力场景下和 RNN 长得一模一样。
不用稠密形式,我们可以从左向右增量地扫描上下文。定义状态 $S$:
$$ S_t = S_{t-1} + k_t^\top v_t, \qquad o_t = q_t\, S_t $$
也就是说,我们增量地累加 K 与 V 的外积,得到状态 $S$,再用当前的 $Q$ 去乘它得到输出 $o_t$。
编者说明:这里用外积 $k_t^\top v_t$($d_k \times d_v$ 的矩阵)不断累加,正是「把所有历史 KV 汇总到一个固定大小的状态里」的过程。稠密形式($Q(K^\top V)$)与递归形式(上式)是数学上精确等价的。
这就是「双重性(duality)」的精髓([00:09:05]):
- 稠密形式:并行、可在 GPU 上高效训练。
- 递归形式(RNN):推理时状态 $S$ 大小固定,只需一路向前携带。RNN 很适合推理。
- 线性注意力同时具备两种形态——训练用并行、推理用串行,兼得两全。
graph LR
    A["逐步累加外积<br/>Sₜ = Sₜ₋₁ + kₜᵀvₜ"] --> B["得到固定大小状态 S"]
    B --> C["乘以当前 query<br/>oₜ = qₜ · Sₜ"]
    D["稠密形式<br/>Q(KᵀV)"] -.->|精确等价| A
    D --> E["训练:并行 ✅"]
    A --> F["推理:串行 RNN ✅"]
    style D fill:#dbeafe
    style E fill:#dcfce7
    style F fill:#dcfce7
讲师特别指出:到目前为止,还没有人真正在规模上验证过「纯线性」的注意力机制。他后面要讲的一切,几乎都是混合(hybrid)——即若干线性层配一个全 softmax 层。([00:11:03])
3.3 一个真实案例:MiniMax M1 的 7:1 混合
(参考时间: 00:09:55)
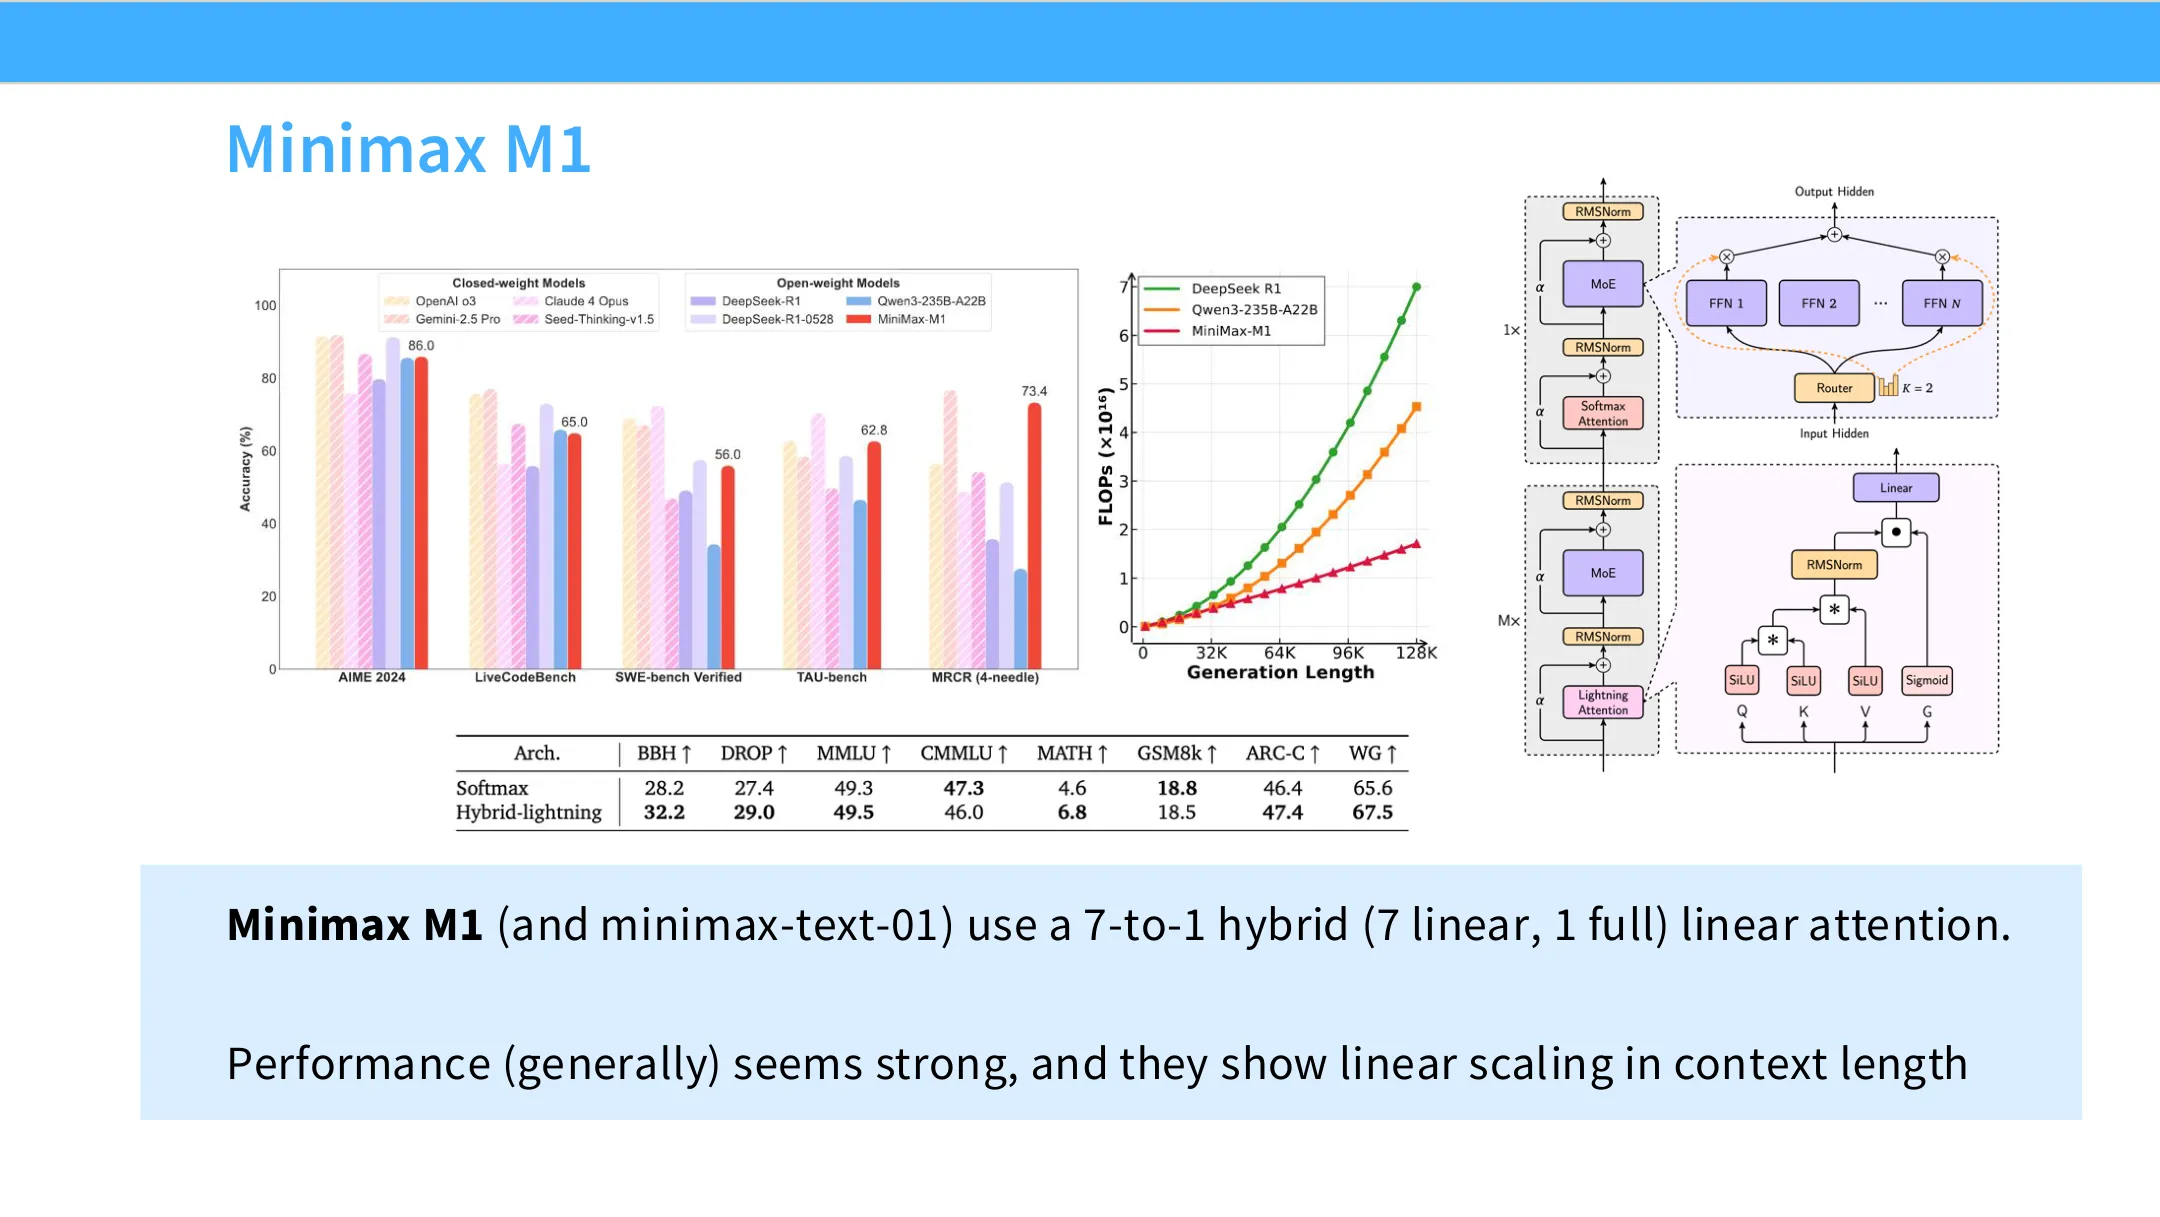
讲师给了一个已经在规模上跑通的例子:MiniMax M1——一个规模较大、性能较高的中文开源模型。它采用了 7:1 的混合:7 层线性注意力 + 1 层完整 softmax 注意力。
结果显示:性能相当强,能与 OpenAI o3 或 DeepSeek R1 等强模型相比,相当有竞争力;而且由于大部分层是线性注意力,对上下文长度的依赖远远更温和(不是完全线性,因为有那几层 softmax,但曲线明显更平缓)。
📷 MiniMax M1 的 7:1 混合架构性能
回到原视频 (00:10:07)
编者拓展|为什么「几乎全线性 + 偶尔全注意力」能行? 全 softmax 注意力提供「全对全」的精确信息检索能力;线性注意力则提供廉价的、固定状态容量的信息压缩。混合架构的本质是:让少数层负责昂贵的精确检索,让多数层负责廉价的压缩与累积。这也是讲师后面解释「为什么纯 RNN 会掉点、混合则几乎不掉」的核心直觉(
[00:32:44])。
4. Mamba 2:给状态更新加上门控
(参考时间: 00:11:11)
有人可能会说:「线性注意力太朴素太简单了,我想要更『认真』的神经网络结构。」那么就在线性注意力的 RNN 形式上做小扩展,于是得到 —— Mamba 2。
编者说明:Mamba、Mamba 2、Mamba 3 是由 Albert Gu 与 Tri Dao 等人提出的状态空间模型(State Space Model, SSM)家族(
[00:11:51])。它们最初从状态空间理论推导而来,但讲师指出:看它的实际机制,Mamba 2 完全可以被看成一个对线性注意力机制的、非常简单的扩展。
4.1 为什么要加门控:灵感来自 LSTM
我们回顾一下线性注意力的状态更新:我们总是在把状态 S 一路向前传。但从古老的 LSTM 时代我们就知道:知道什么时候该传递信息、什么时候不该传递,是非常重要的——要会「遗忘」,把信息清零。
于是 Mamba 2 引入一个门 $\gamma_t$:
$$ S_t = \gamma_t \odot S_{t-1} + K_t V_t^\top $$
关键性质([00:12:53]):
- 所有的状态依赖项都是那些 $S$。
- 而 $\gamma_t$ 完全不是状态依赖的,它只依赖于当前输入 $X_t$。
正因为 $\gamma_t$ 不依赖状态,这个更新计算非常简单,而且对偶性得以保留:你既可以把 Mamba 2 写成大矩阵乘法(用于训练),也可以在推理时用递归形式(用于推理)。
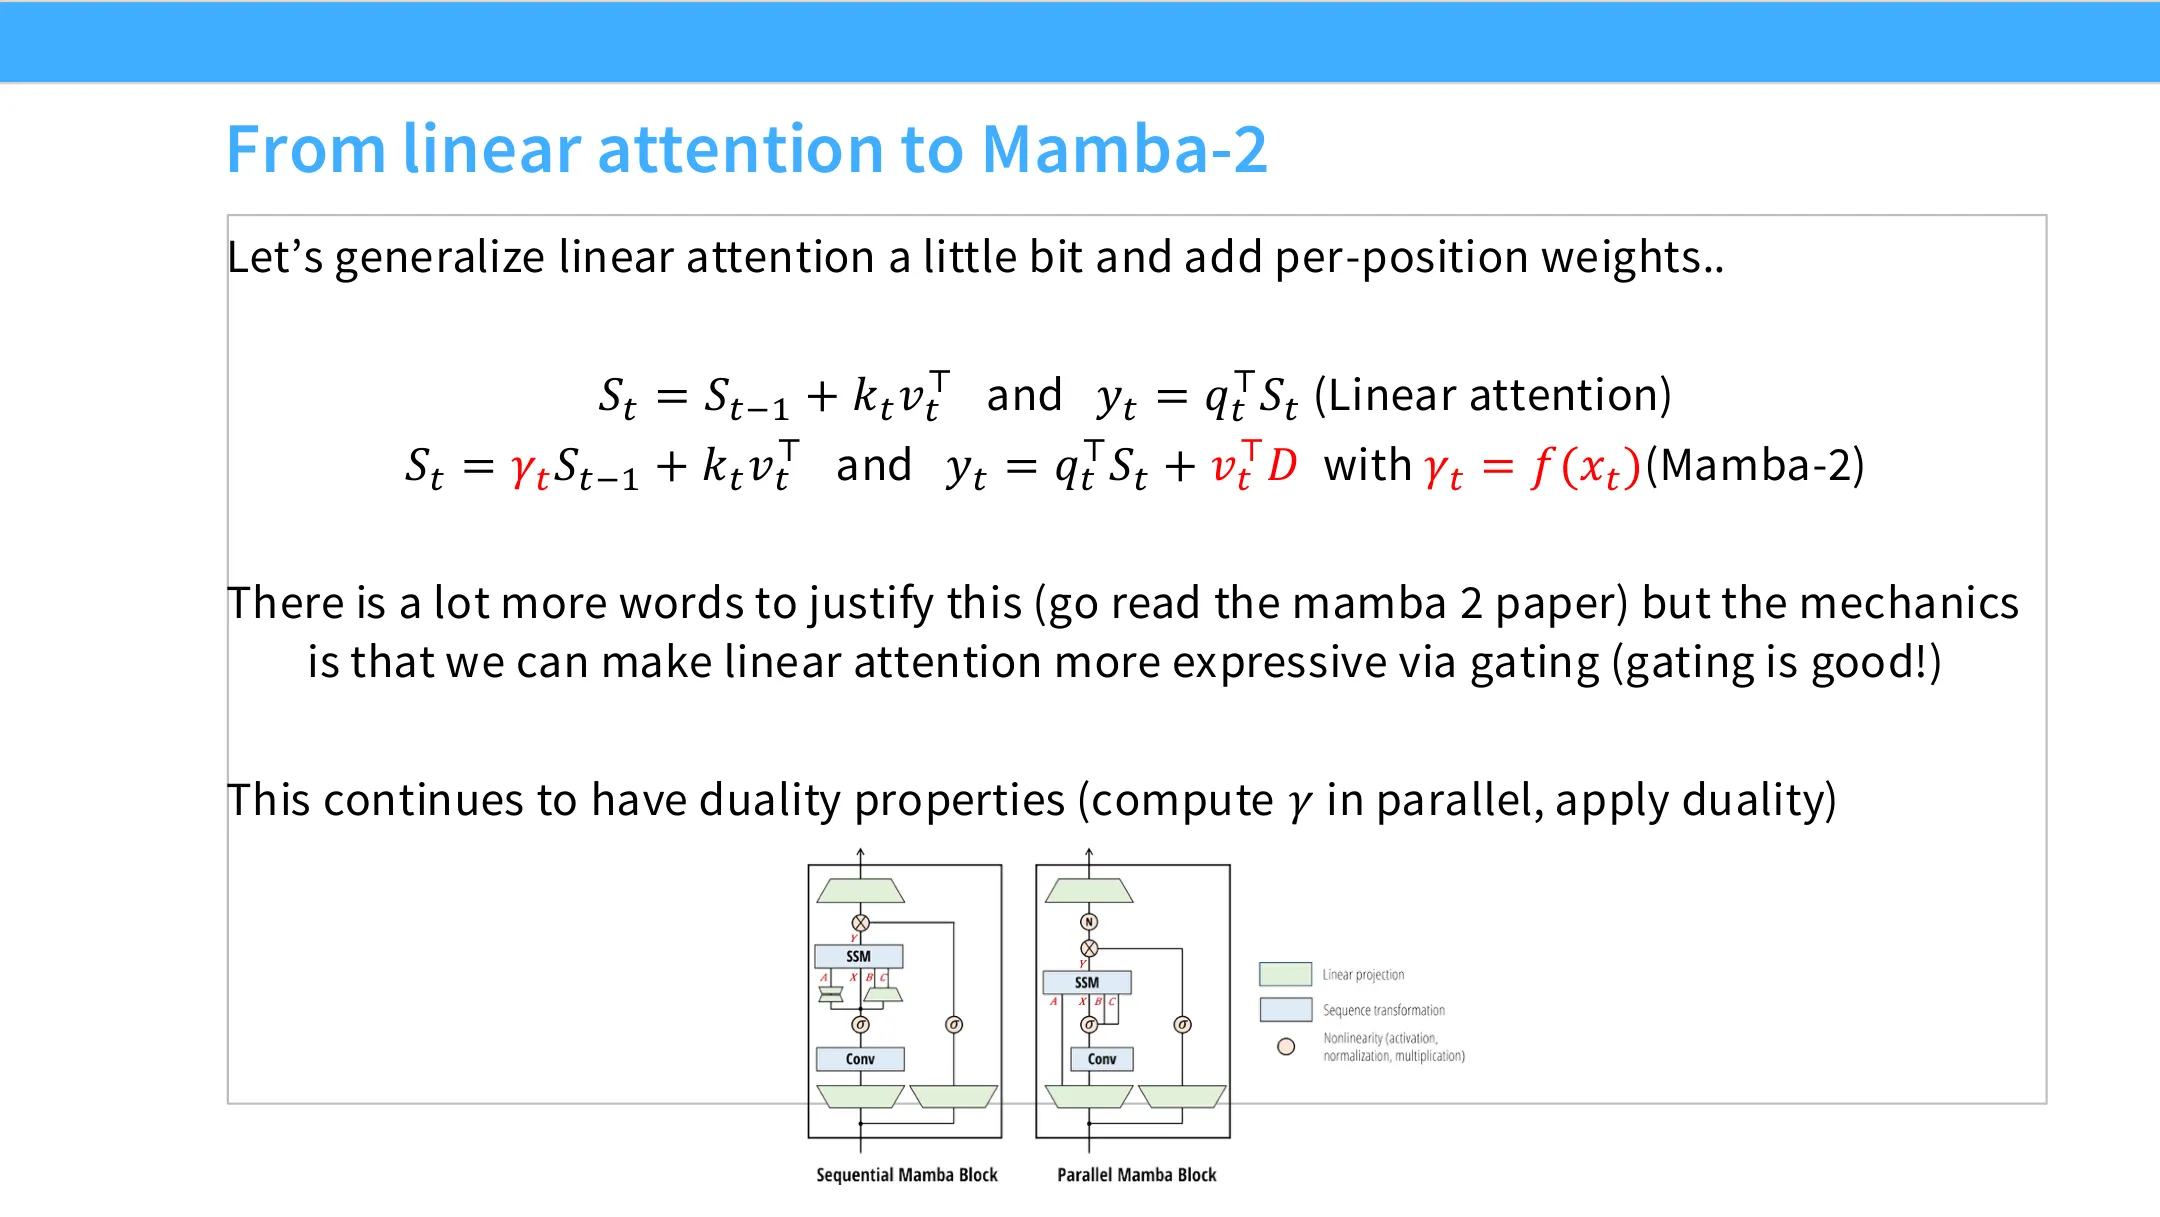
📷 Mamba 2 的门控状态更新
回到原视频 (00:11:47)
4.2 门控的「铁律」
(参考时间: 00:14:31)
讲师给出一条经验法则:只要你用纯输入依赖(input-dependent)的项去门控 RNN 里的各项——不引入状态依赖——那么「并行(训练)/串行(推理)」的双重性就依然成立。这几乎是你能对操作做的「边界」:一旦门控开始依赖状态,双重性就可能被破坏。
graph TD
    A["线性注意力状态更新<br/>Sₜ = Sₜ₋₁ + KₜVₜᵀ"] --> B{"门控依赖什么?"}
    B -->|"只依赖输入 Xₜ"| C["保留对偶性 ✅<br/>训练并行 + 推理串行"]
    B -->|"依赖状态 S"| D["对偶性可能被破坏 ⚠️"]
    style C fill:#dcfce7
    style D fill:#fee2e2
编者说明:Mamba 2 在状态更新之外,还对输出 $y_t$ 加了一个残差式的 $D \cdot v_t$ 项(讲师在
[00:15:33]补充说这是为了呈现「真正的 Mamba 2 更新」而非简版)。讲师说这一项「不是状态更新的核心,可以暂时忽略」。
4.3 规模验证:NeMo Tron 3
(参考时间: 00:13:27)
NeMo Tron 3 采用了「把 Mamba 2 作为轻量层、再周期性插入大 softmax 注意力」的混合设计,在推理成本与表达力之间做权衡。它取得了不错的性能(与 Qwen 3、GPT-OSS 等对比),并且因为有了这些 Mamba 2 层,在较大上下文长度下有很好的吞吐(throughput)。
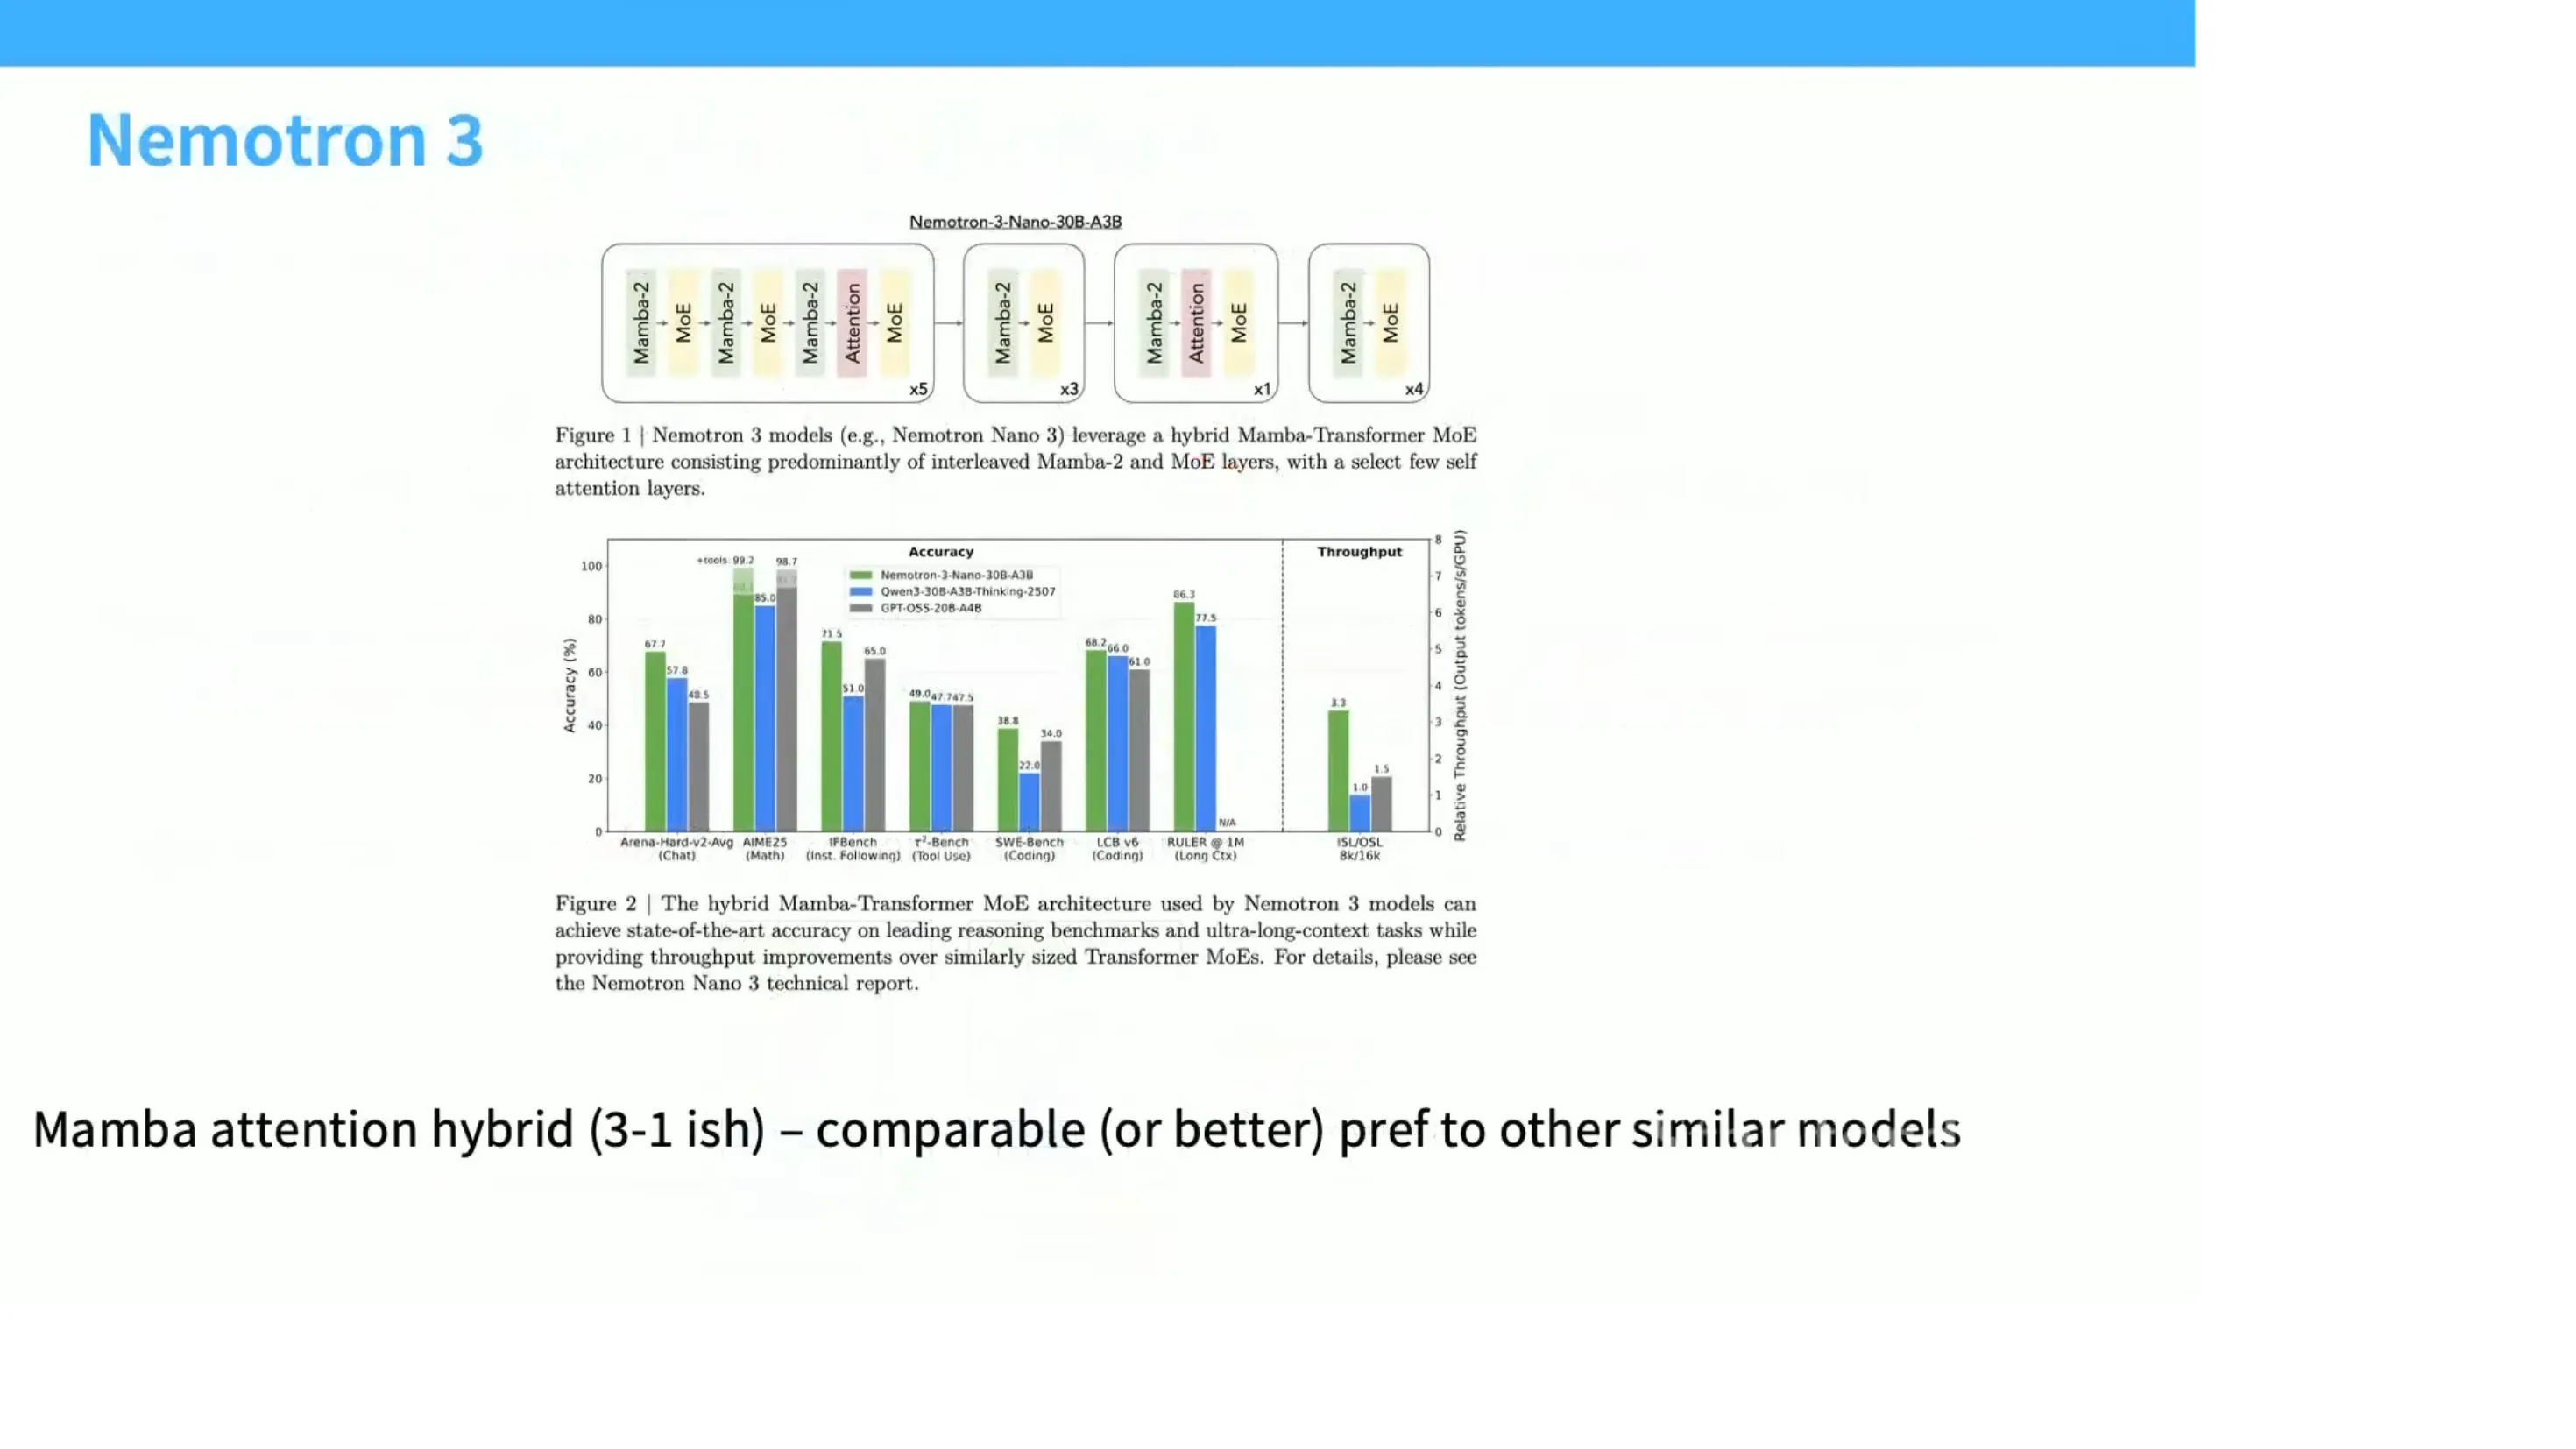
📷 NeMo Tron 3 结合 Mamba 2 与 softmax 注意力的混合设计
回到原视频 (00:13:27)
讲师指出:这些还是小型的前沿模型(不是真正超大规模的前沿模型),但它们是开源的,足以证明这条路走得通。
5. Gated DeltaNet:第二个门与投影式更新
(参考时间: 00:15:01)
我们继续「把递归做得越来越复杂」。在 Gated DeltaNet 中,除了 Mamba 2 那样的 $\gamma_t$ 之外,还加入了第二个门 $\beta_t$,并且把更新方向本身也改了。
5.1 第二个门 βₜ:一个「是否写入」的门
讲师把 $\beta_t$ 理解为「是否输入」的门(no-input operation gate)([00:16:14]):
- 如果 $\beta_t = 0$,就意味着不取当前信息、不把它写进状态。
- 这和 LSTM 如出一辙:一个门控制「遗忘」,一个门控制「是否写入当前时间步的信息」。虽然推导来源不同,但原理非常相似。
5.2 投影式更新:不只是写,还要擦
(参考时间: 00:16:55)
Gated DeltaNet 真正有意思的地方(来自 DeltaNet 而非「Gated」部分)是更新方向。
在经典做法里,你可能会写成 $1 - \beta_t$。而 Gated DeltaNet 做的是:当你用 $\beta_t$ 写入新信息时,同时要把当前的 key 方向投影出去——也就是既「写入」,又「擦除」曾经写入的旧 key。
数学上,这体现为一个投影算子:
$$ \bigl(I - \beta_t\, k_t k_t^\top\bigr) $$
这个蓝色项 $\bigl(I - \beta_t k_t k_t^\top\bigr)$ 大致上扮演了一个投影器,把 $k_t$ 方向上的分量投影出去。
编者说明:讲师在这里非常谨慎地加了一句「这不完全准确,因为这里并没有做单位归一化(unit normalization),但你能大致 get 到这个直觉」(
[00:17:38])。真正的 DeltaNet 更新来自求解一个「元学习式最小二乘问题」,其形式在细节上和这个直觉版本略有出入。
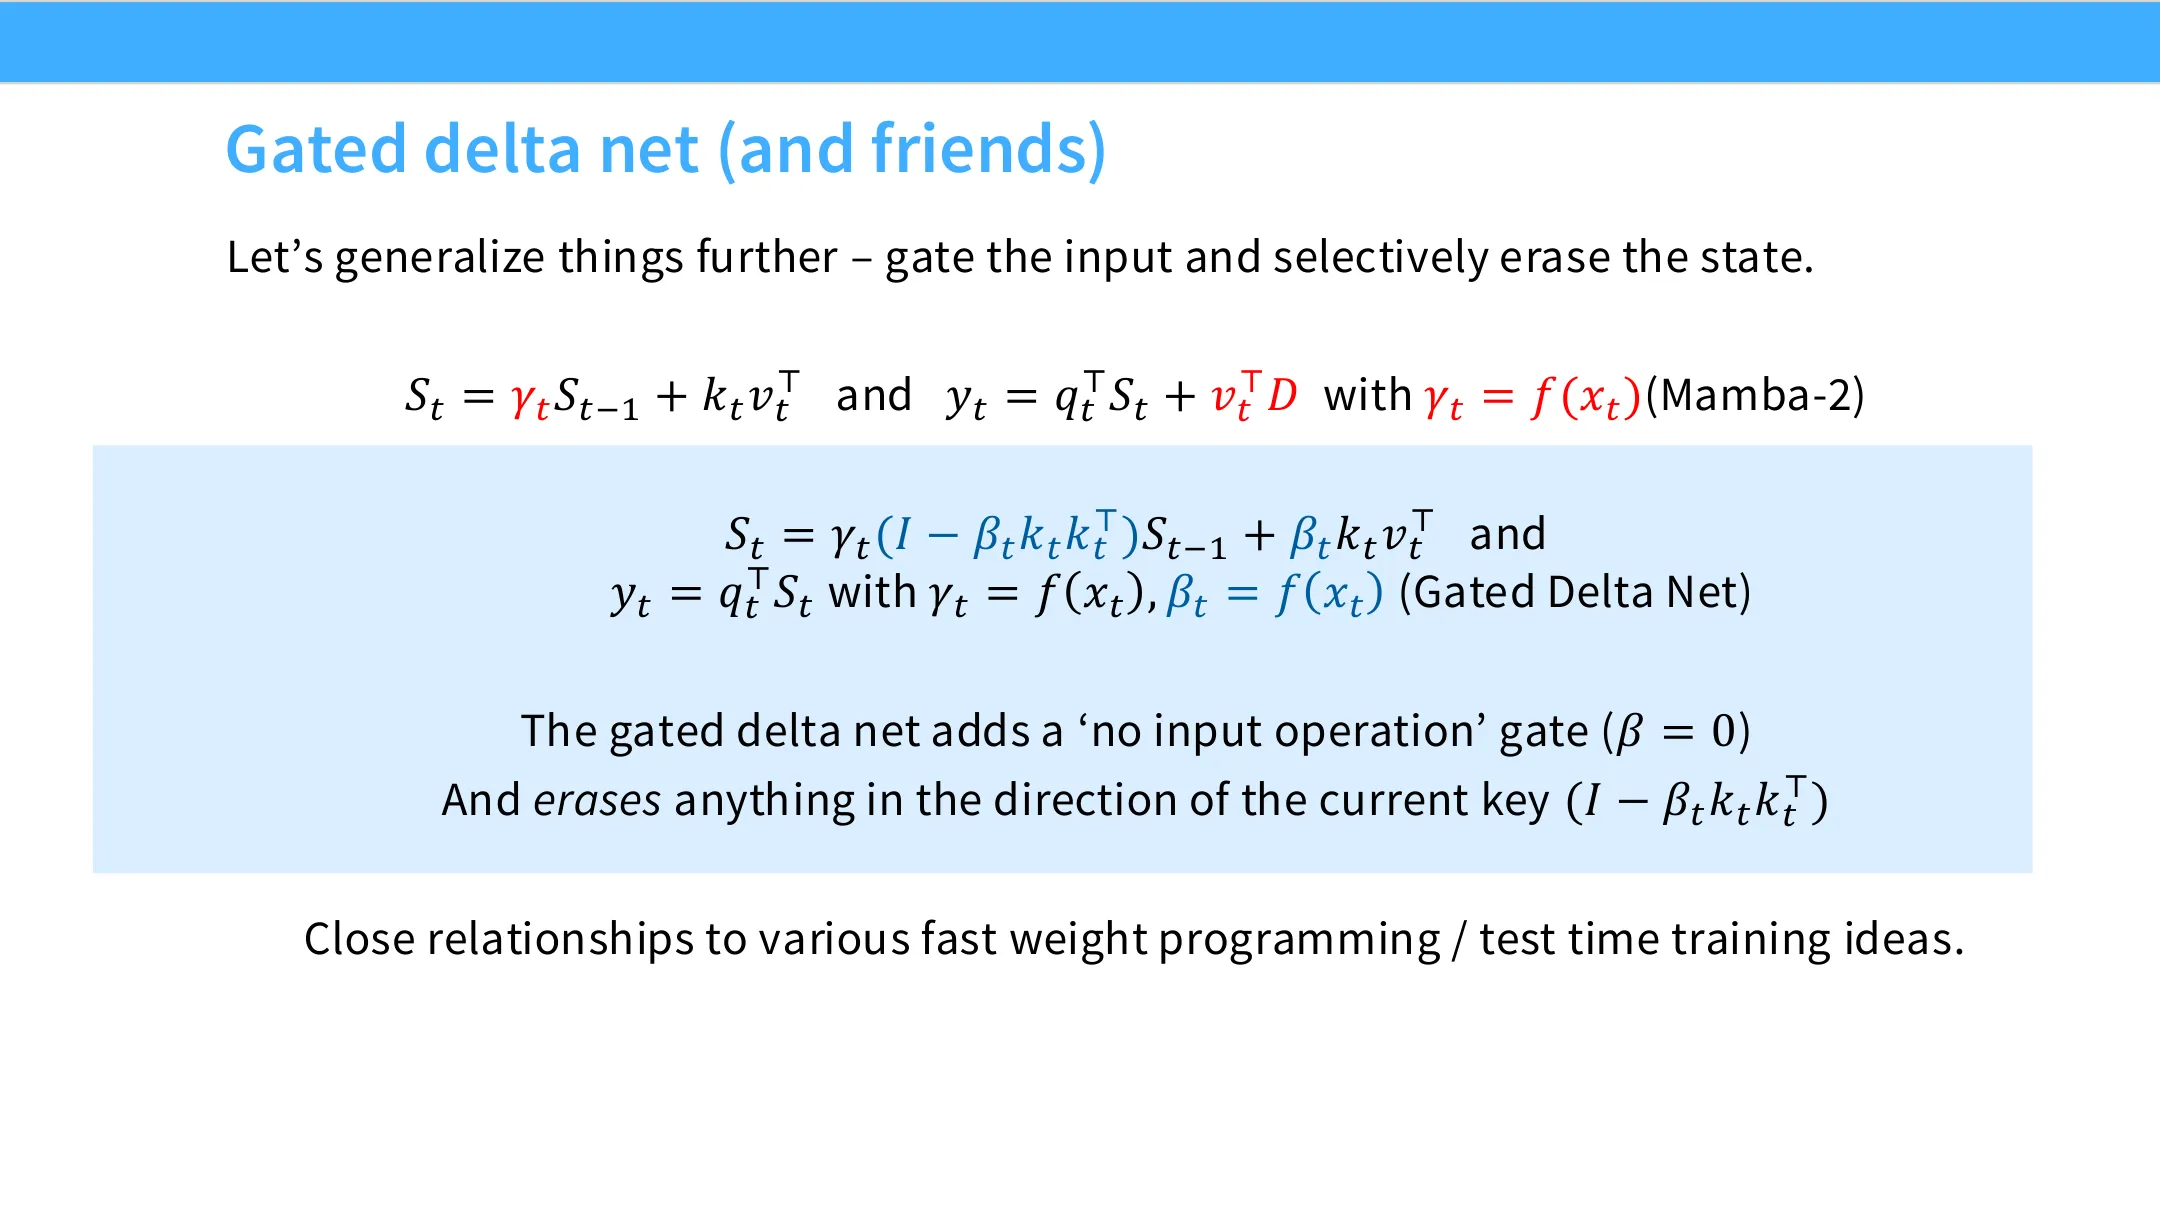
📷 Gated DeltaNet 的投影式更新
回到原视频 (00:15:01)
5.3 「同一个解」在多处被重新发明
(参考时间: 00:17:53)
讲师指出一个耐人寻味的现象:这个投影式更新在不同领域被反复「重新发明」:
- 当你尝试求解某种元学习最小二乘(meta-learning least squares)问题时,这个投影算子会自然出现;
- 在快速权重编程(fast weight programming)和测试时训练(test-time training)领域,研究者们从完全不同的设计原则出发,最终却得到了一模一样的解。
5.4 规模验证:Qwen 3.5 / Qwen Next
(参考时间: 00:18:21)
目前最好的开源模型之一 —— Qwen 3.5 及其前身 Qwen Next —— 就采用了恰好这套架构:3:1 的 Gated DeltaNet / 注意力混合。表现:
- 性能合理:与同代前沿模型相比,混合架构似乎几乎不损害性能;
- 推理特性强:随着上下文长度增加,Qwen Next 的解码吞吐显著高于 Qwen 3。
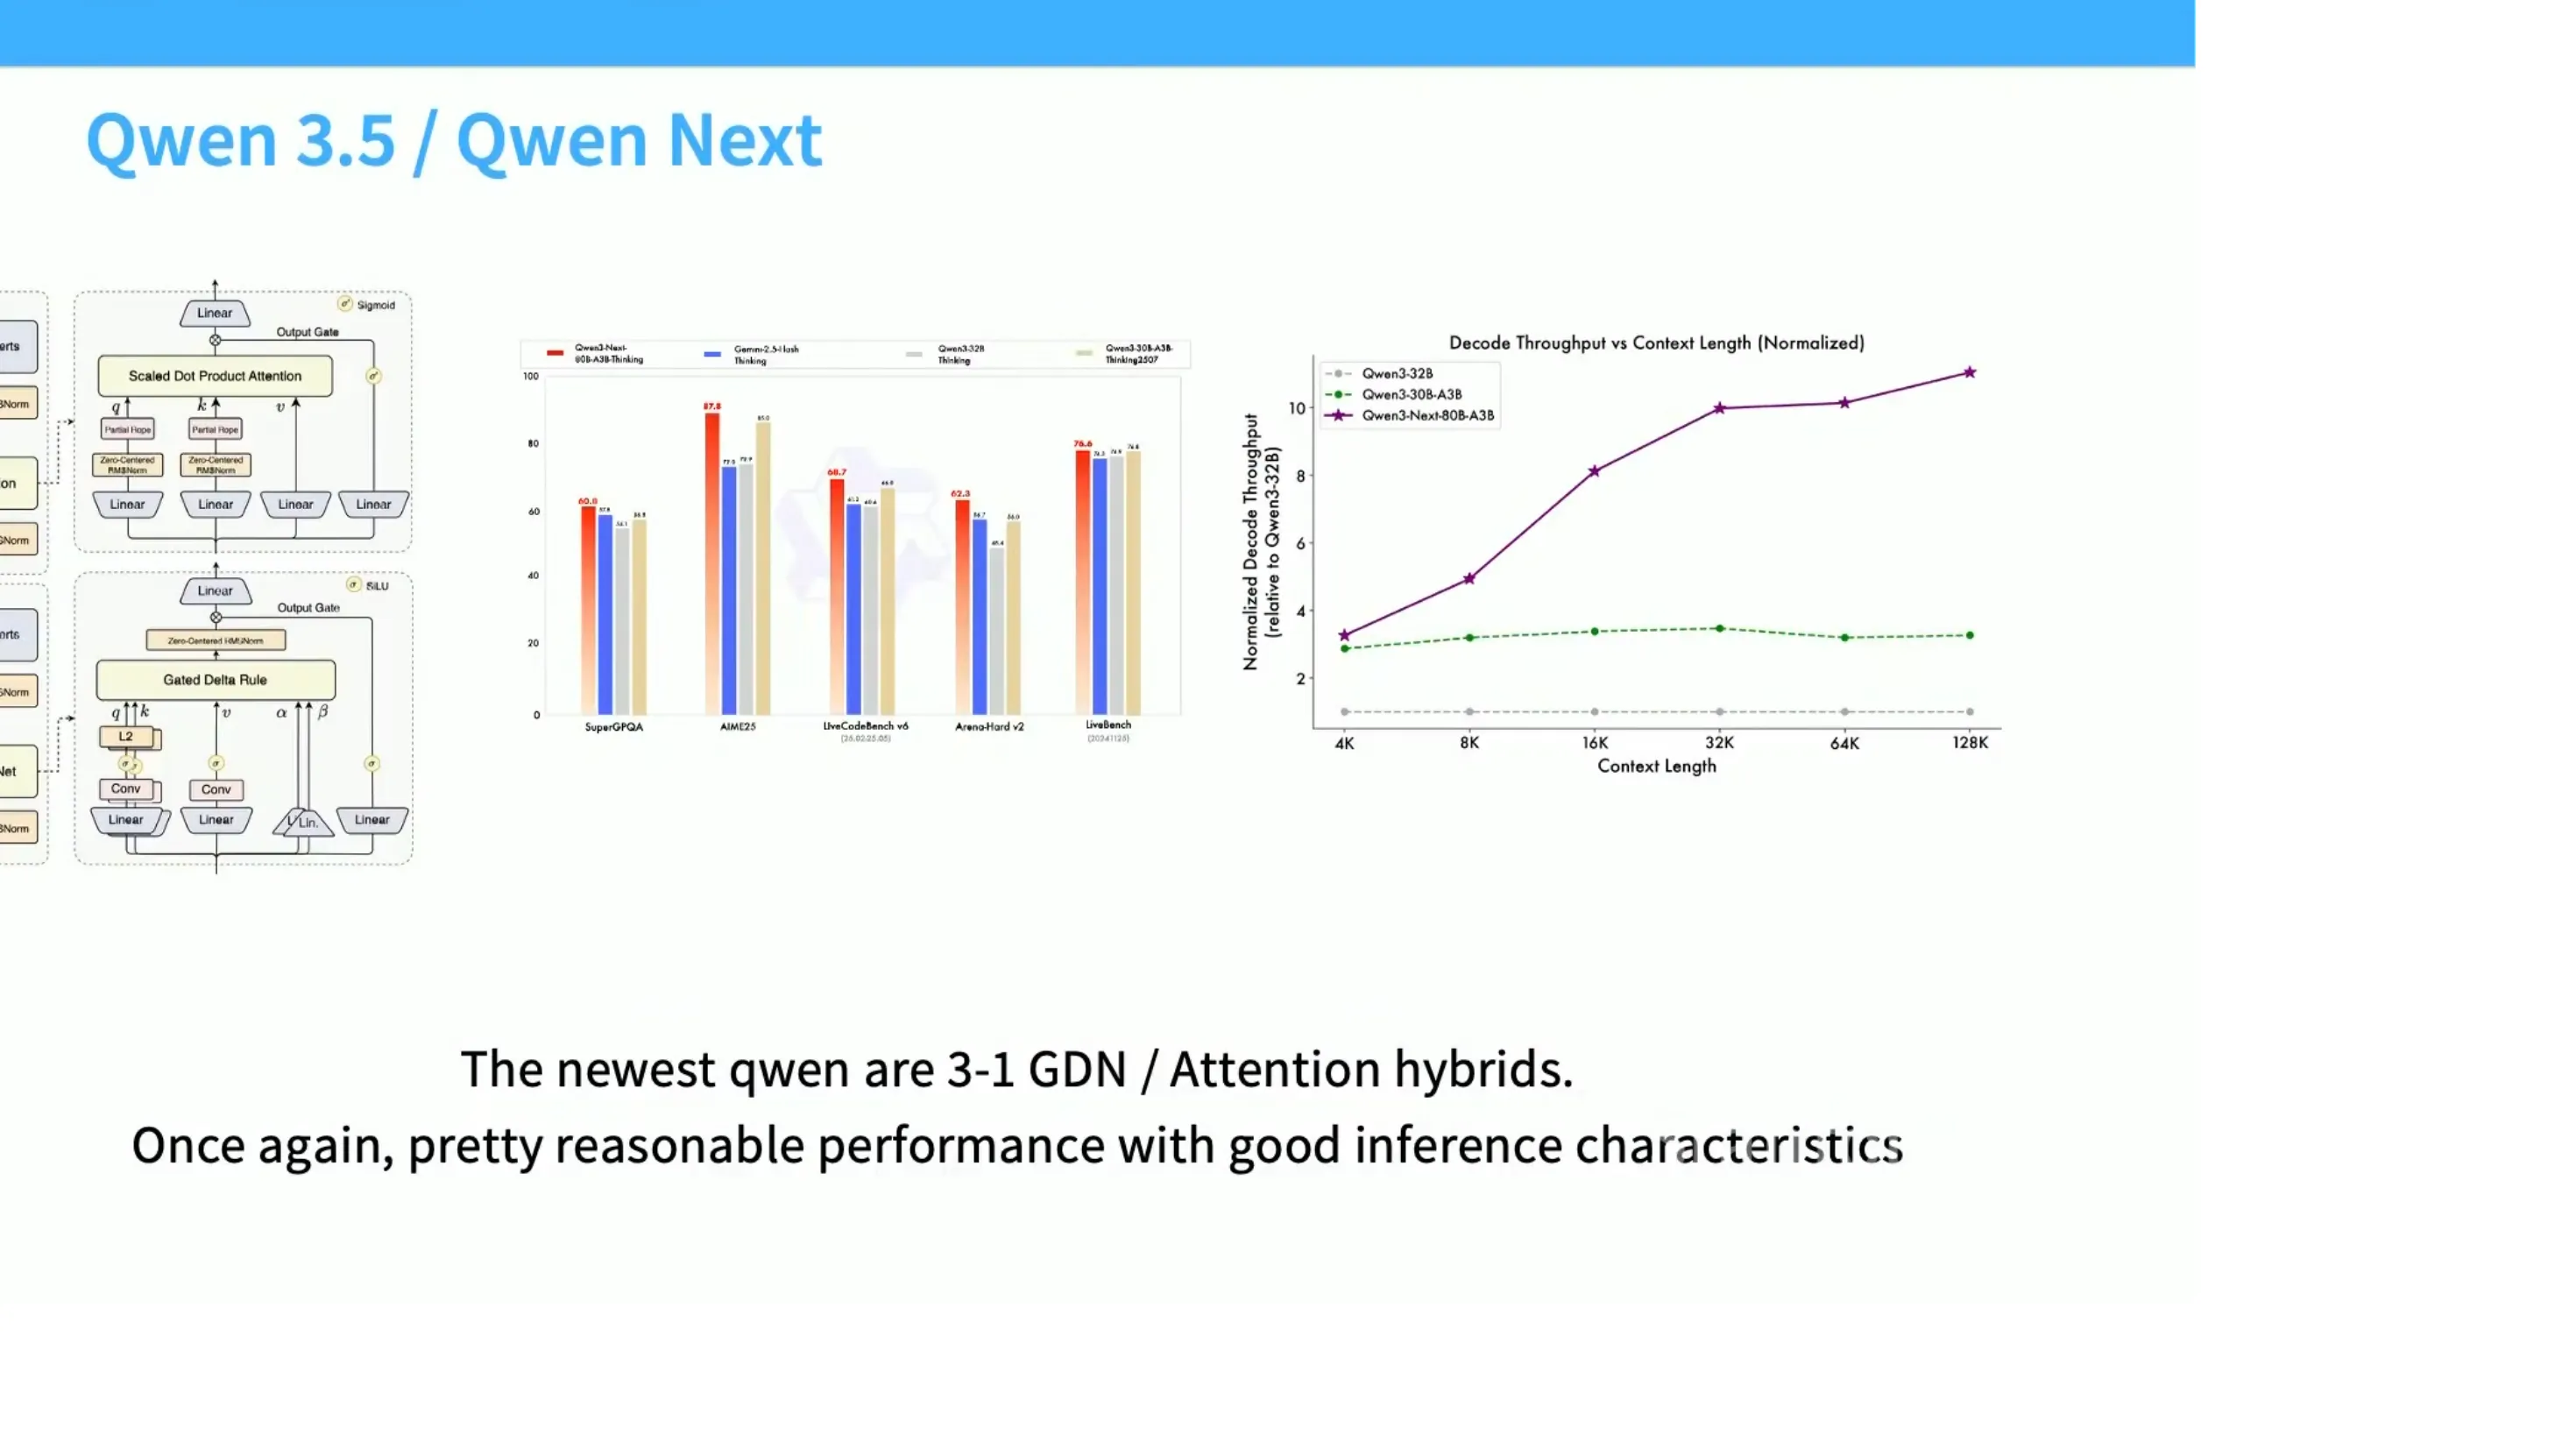
📷 Qwen Next 的 3:1 Gated DeltaNet 混合与解码吞吐
回到原视频 (00:18:21)
6. 混合架构的性能研究
(参考时间: 00:19:04)
讲师提醒:关于混合架构的受控研究并不多。有一个由 ByteDance Seed 与 UC Santa Cruz 合作的研究([00:19:13]),系统比较了 Mamba 2、Gated DeltaNet 等架构作为「非全注意力层比例」的函数。
结果如下:
- 右侧面板中,虚线是全注意力的基线性能。
- 横轴从左到右,非全注意力层(也就是 RNN 层)的比例不断增加。
- 你会看到性能退化:
- 对于表现最好的架构(黄色、橙色、蓝色,即各种 Gated DeltaNet 变体),在低比例区间基本没有性能损失;
- 一旦越过某个点,长上下文的性能开始显著退化;
- 到完全 RNN 时,所有架构都出现明显退化。
同样的故事在其他评测中也出现:
- 单 key 检索(single key retrieval):这是所有长上下文架构专门优化过的任务,所以退化不那么明显;
- QA 性能:随着混合比例提高,性能稳步下降,最终到达纯 RNN 那个最低点。
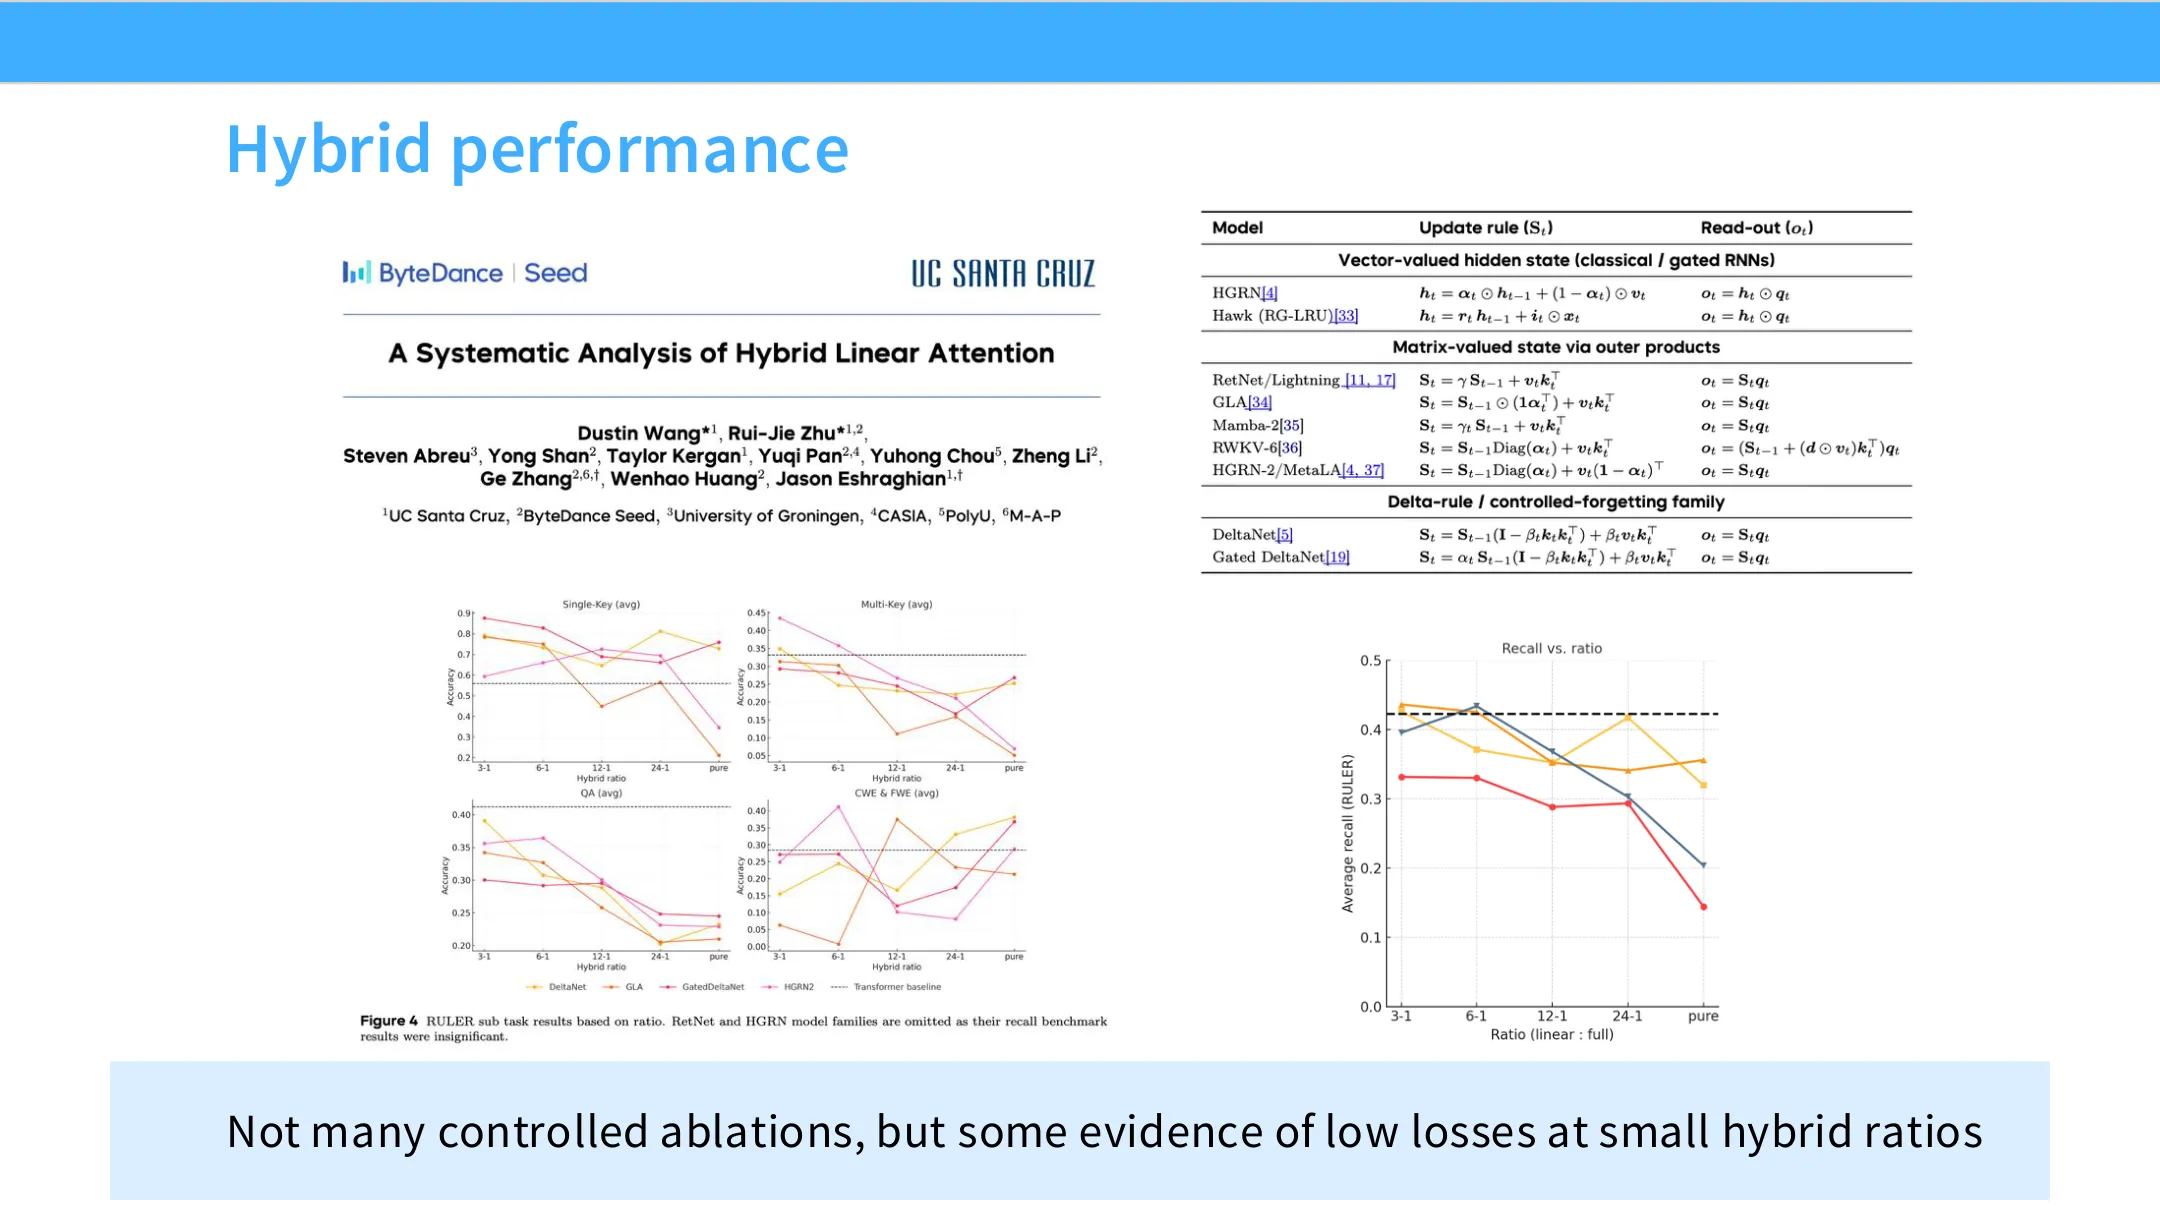
📷 混合比例与长上下文性能退化
回到原视频 (00:19:13)
graph LR
    A["全注意力基线<br/>虚线"] --> B["低混合比例<br/>性能几乎不损失 ✅"]
    B --> C["越过某点<br/>长上下文显著退化 ⚠️"]
    C --> D["纯 RNN<br/>所有架构均明显退化 ❌"]
    style A fill:#dcfce7
    style D fill:#fee2e2
6.1 课堂问答:精确定义与边界
这一段问答澄清了几个容易被混淆的点([00:20:49]):
- 「并行形式 vs 递归形式等价吗?」 讲师澄清:他说的「递归(recurrent)」指的是一般意义上的 RNN 形式。Gated DeltaNet 是一种递归,但它不等价于最开头那个全 softmax 注意力。等价链条是分两步的:
- 第一步(有损):丢掉 softmax,$QK^\top V \to Q(K^\top V)$;
-
第二步(精确):线性形式 $\leftrightarrow$ 递归形式,完全等价。
-
「公式里那个 $D \cdot v_t$ 是干什么的?」(
[00:21:36]) 这是对当前时间步 value 的直通项,作用类似残差连接:让当前 token 的 value 直接流向注意力的输出。$D$ 是一个可调的门,控制直通量的多少。 -
「去掉 softmax 会影响训练稳定性吗?」(
[00:30:03]) 讲师:没有遇到过「线性化 softmax 导致的注意力问题」的记录。恰恰相反,softmax 往往才是稳定性的麻烦来源,所以这一步可能反而改善架构的稳定性。 -
「FP4 精度的注意力可能吗?」(
[00:31:47]) 讲师认为 indexer 的部分动机正来自于此——低精度做选择、全精度做计算。但想用 FP4 甚至更低精度做完整注意力,讲师不太确定有很好的方法,因为 softmax 相关的下溢/上溢在低精度下会变得很麻烦。 -
「状态空间模型对比 Transformer 到底劣在哪?」(
[00:32:44]) 这是本段最重要的一问。讲师答:劣势在于表达能力(expressive power)。softmax 注意力的全对全连接极其强大、又极其好训练。过去相比 LSTM,注意力有一个极强的优势:硬件效率(可以并行训练)。 状态空间模型之所以在承认「和 LSTM 类似、表达力有短板」的情况下还能流行,正是因为它借着线性注意力带来的对偶性,把「矩阵乘法式的训练效率」补了回来。但根本的权衡仍在:有限状态意味着你必须把所有信息压缩进那个固定大小的状态里,这相对于「把所有东西都原样带着走」是一种损失。 -
「状态大小和上下文长度怎么权衡?」(
[00:33:50]) 如果你让状态大小 = 上下文长度,那就「没问题了」——但你会在成本上付出巨大代价。真正的「免费午餐」问题是:你想要一个很小的状态,却要把一个很大上下文里的所有信息都压进去,这非常难。也许有一天能做到毫无权衡,但目前的权衡就出现在这里。
7. DeepSeek 稀疏注意力(DSA)
(参考时间: 00:22:52)
讲完「复杂度理论味道很浓」的线性注意力,讲师转到另一条正交的降本路线:DSA(DeepSeek Sparse Attention,DeepSeek 稀疏注意力),出自 DeepSeek 3.2。
编者说明:讲师顺带开了个玩笑——DSA 里的「Sparse」并不是在玩「稀疏注意力」的谐音梗(
[00:23:28])。这是个不经意的双关。
7.1 核心思想:轻量索引器先筛选
(参考时间: 00:23:25)
不再对所有 token 计算注意力,而是:
- 先跑一个轻量索引器(lightweight indexer);
- 索引器从很长的上下文中挑出一个子集(远小于完整序列);
- 只在这个较小的子集上做全 softmax 注意力。
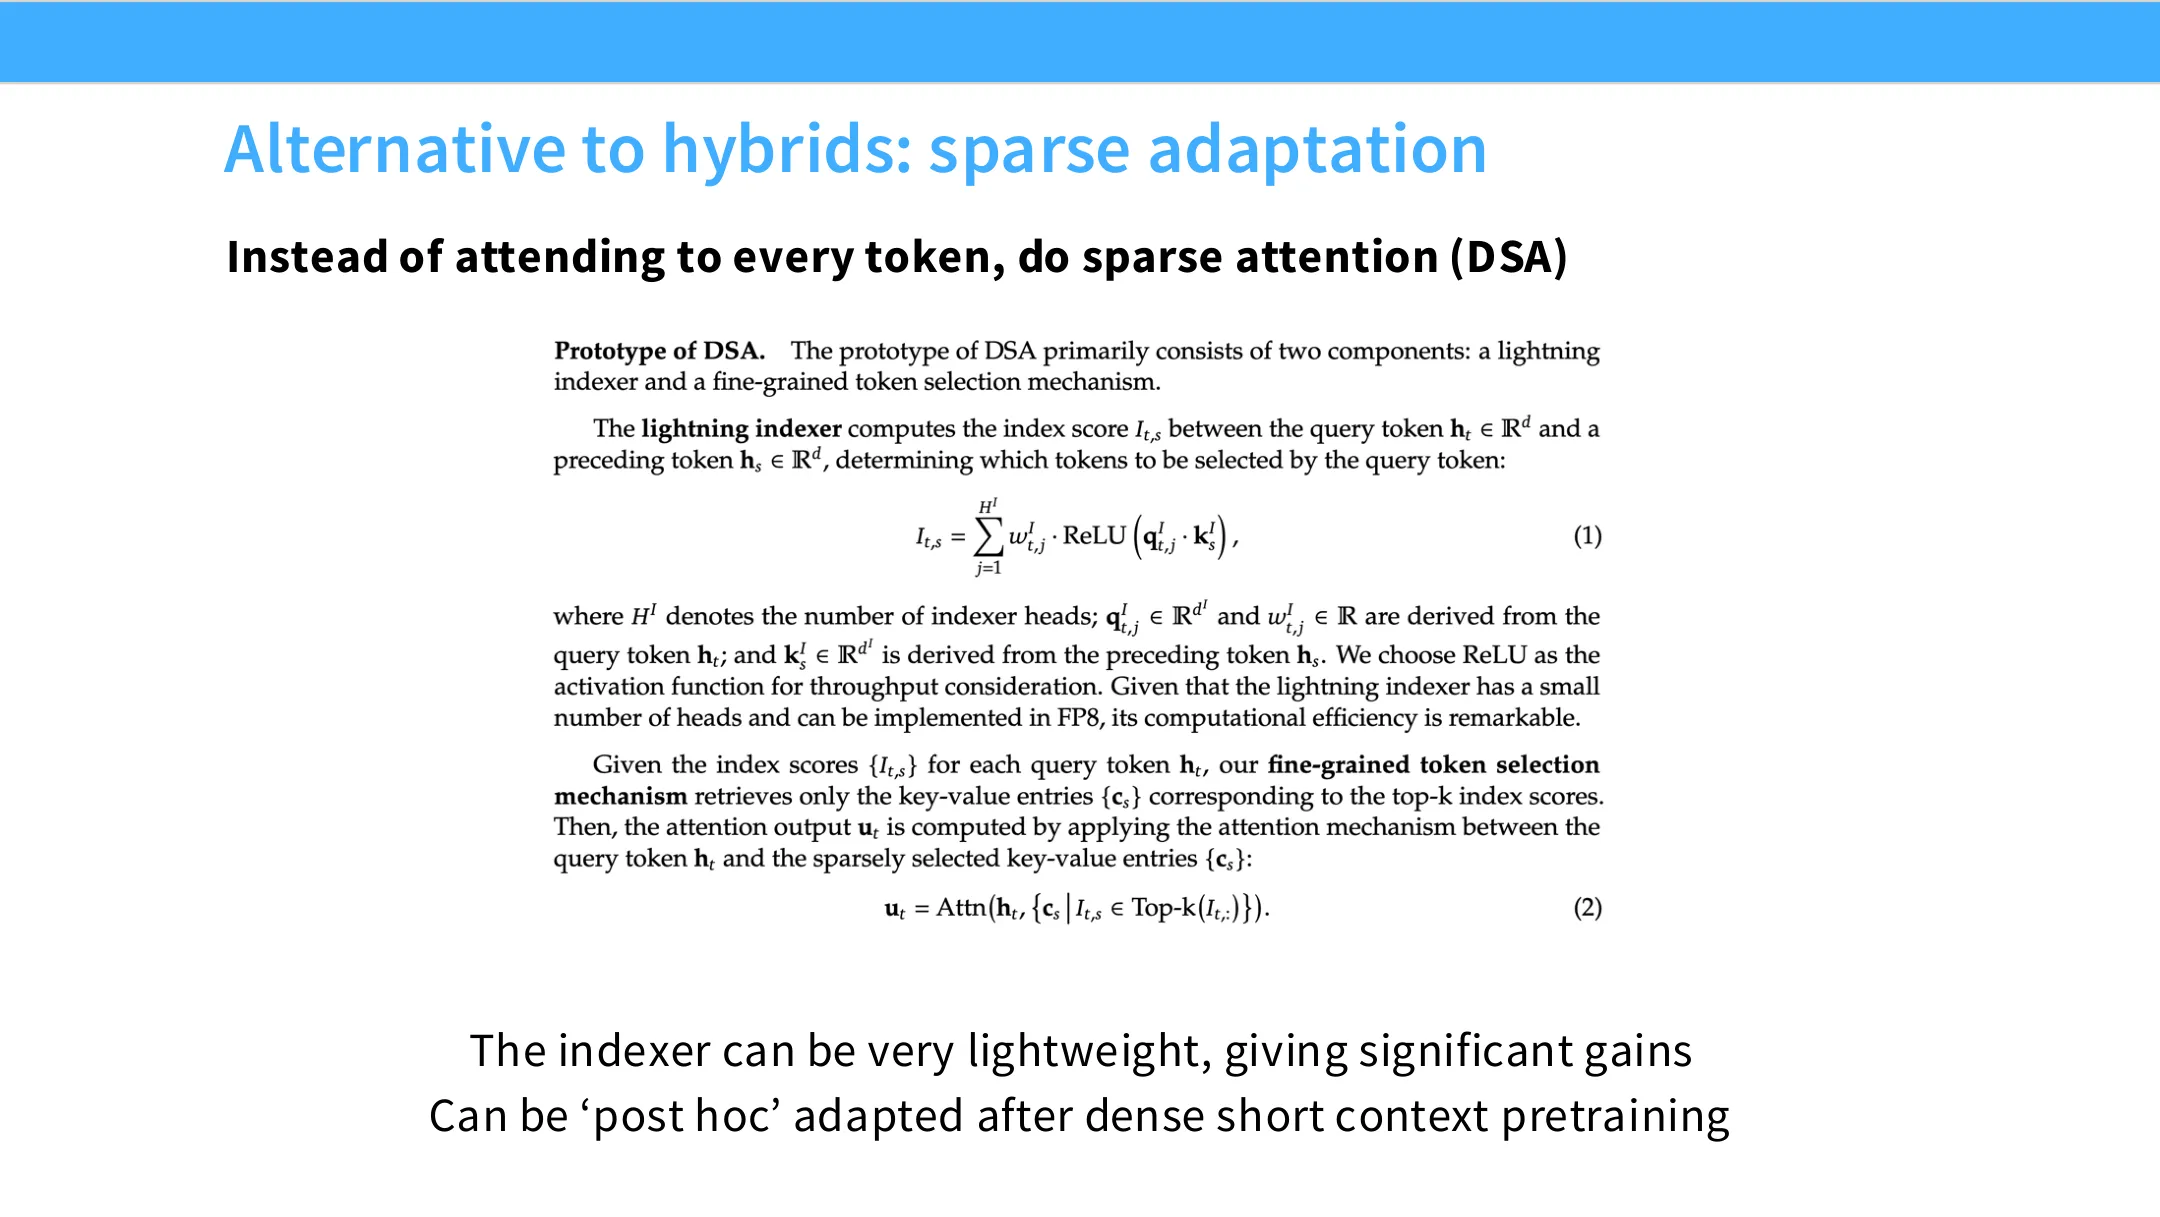
📷 DSA:轻量索引器 + top-K + 全注意力
回到原视频 (00:23:17)
7.2 前向流程
(参考时间: 00:23:52)
前向过程(至少前向)机制上相当简单:
- 先有常规的 $Q$ 和 $K$;
- 把它们送进索引器:索引器计算 $QK^\top$ 内积,过一个 ReLU,再乘上从前序 token 派生出的权重,得到每个位置的激活;
- 然后过一个 top-K:只有得分最高的若干个位置被纳入注意力计算;
- 最后在这入选的子集上做常规注意力,输出 key-value。
graph TD
    A["长上下文输入<br/>N 个 token"] --> B["计算 Q、K"]
    B --> C["轻量索引器<br/>内积 → ReLU → 权重"]
    C --> D["每个位置得到激活分数"]
    D --> E["Top-K 选择<br/>保留得分最高的 K 个位置"]
    E --> F["仅在这 K 个位置<br/>做全 softmax 注意力"]
    F --> G["输出 key-value"]
    style C fill:#dbeafe
    style E fill:#fef3c7
7.3 关键工程技巧:不动主预训练
(参考时间: 00:24:43)
DSA 和 GLM 都展示了一个重要的工程实践:你不需要在预训练阶段就引入索引器。
- 训练索引器很麻烦、很复杂;
- 所以做法是:先训练一个普通 Transformer;
- 在做长上下文扩展(long context extension)时,再插入这个轻量索引器,并在一个独立于预训练的扩展阶段训练模型适应它。
好处:这个阶段本身的计算开销相当轻。
讲师还引用 GLM 5 的说法([00:26:02]):即使在全 DSA 训练下,相对于全注意力,性能损失也很小——包括在长上下文检索这类对 RNN 式架构较难的任务上。
7.4 关键:它不是线性的
(参考时间: 00:26:43)
讲师特意回到上一张 slide 强调:DSA 不是线性时间。
- 索引器仍要对全对全做运算(那些 $QK^\top$ 内积),成本仍是非线性的;
- 但索引器可以做得非常便宜——比如降低维度、让权重矩阵很小、用更低精度。
课堂上有一位同学追问([00:27:31]):「既然索引器是二次的、索引器之后的注意力也是二次的,那为什么能省钱?」讲师答:这其实是一个偏系统的技巧:
- 索引器虽然仍是二次,但常数因子极好(可以低精度、可以低维度);
- 后面做全注意力的那部分虽然也是二次,但作用在更短的上下文上(因为是 top-K,K 可控制)。
这正是全讲的母题:「有时候不要过于纠结二次还是非二次,常数因子真的非常重要。」([00:28:21])
7.5 效果与流程位置
DSA 让 DeepSeek V3.2 在 prefill(处理输入)与 decode(生成)两侧都获得了比上一代(非稀疏注意力)更友好的扩展曲线,同时性能与同期前沿模型(Claude 4.5 Sonnet、Gemini 3 等)相当。([00:25:14])
关于它插在流程的哪一步([00:29:24]),标准配方是:
graph LR
    A["短上下文预训练"] --> B["长上下文扩展<br/>(插入索引器 / DSA)"] --> C["后训练 Post-training"]
    style B fill:#fef3c7
- top-K 中的 K 通常选取接近短上下文长度的量级,并且会设上限(无论输入多大都受此约束)(
[00:29:43])。 - 讲师自己也感叹:把一个看起来吓人的、不可微的 top-K 对象「bolted on」上去居然能 work,是有点反直觉的——「但你接下来会看到,也许你不该那么害怕 top-K selection」(
[00:29:08])。
8. 混合专家(MoE):概览与动机
(参考时间: 00:34:25)
接下来进入今天的第二部分:混合专家(Mixture of Experts, MoE)。
8.1 一句话直觉:MoE 就是一个「更高效的 MLP」
"One way of thinking about mixture of experts is they are just a more efficient MLP."
概念上 MoE 并没有改变游戏规则。你可以把它想成:你的 MLP 还是那个 MLP,只是有人给了你一个更高效的版本。
那么为什么还要专门讲它?讲师给了两个理由([00:34:45]):
- 产业现实:如今很多模型都在用 MoE、都在发 MoE。想真正深入理解语言模型,就必须理解它。
- MoE 有一些非常有趣的机械部件(mechanical primitives)。当你看到 MoE 是怎么搭起来的时候,你会发现 MoE 式的原语在很多地方都能用上——「哦,我可以用神经网络做更有意思的事」。
8.2 MoE 到底改了什么
(参考时间: 00:35:26)
左边是常规 Transformer 的 MLP:注意力 → 归一化 → 前馈(FFN),「大量稠密的信息处理」发生在这里。
右边改成 MoE:把一个大的 FFN 切成若干个 FFN(这里示意为 4 个)。假设这些 FFN 大小和原来的 FFN 一样(注意:是复制,不是切碎)。然后,如果有某种魔法,能对每个输入告诉我该选哪个 FFN:
- 我拥有了 4 倍参数(就 FFN 而言);
- 但在任何前向/后向中,我只付出 1 个 FFN 的成本。
这就是 MoE 的心智模型([00:36:45]):增加参数,但不增加 FLOPs。
编者说明:原始 MoE 论文的动机是「参数中心主义」的——如果你相信参数越多越好,但又不想付更多参数的算力成本,就需要右边的这种结构。这是理解 MoE 一切的起点。
graph TD
    subgraph Dense["稠密 Transformer Block"]
        A1[注意力] --> A2[归一化] --> A3["单个大 FFN<br/>参数量 P,FLOPs ∝ P"]
    end
    subgraph MoE["MoE Transformer Block"]
        B1[注意力] --> B2[归一化] --> B3["路由器 Router"]
        B3 --> B4[专家 1]
        B3 --> B5[专家 2]
        B3 --> B6[专家 3]
        B3 --> B7[专家 N]
        B4 --> B8["只选 top-K 个专家<br/>参数 4P,FLOPs ∝ K"]
        B5 --> B8
        B6 --> B8
        B7 --> B8
    end
    style B3 fill:#dbeafe
    style B8 fill:#fef3c7
8.3 为什么这么流行:参数越多,通常越好
(参考时间: 00:36:59)
现在 Hugging Face 上超过一定规模的模型,几乎清一色是 MoE。原因似乎是:在总计算量保持不变的前提下,只增加稀疏参数的数量,模型总会变得更好。这或许是「更多参数确实普遍有益(即便只有一部分被激活)」的证据。
讲师引用了 Fedus 等人 2022 年的 Switch Transformer 论文([00:37:39]):
- 横轴是专家数量,激活参数保持不变;
- 纵轴是语言建模测试损失;
- 随着专家数增加,测试损失持续下降。如果你只关心前向 FLOPs,那这简直「可爱」。
- 右侧同图还显示:在相同训练计算量下,专家越多,性能越好。
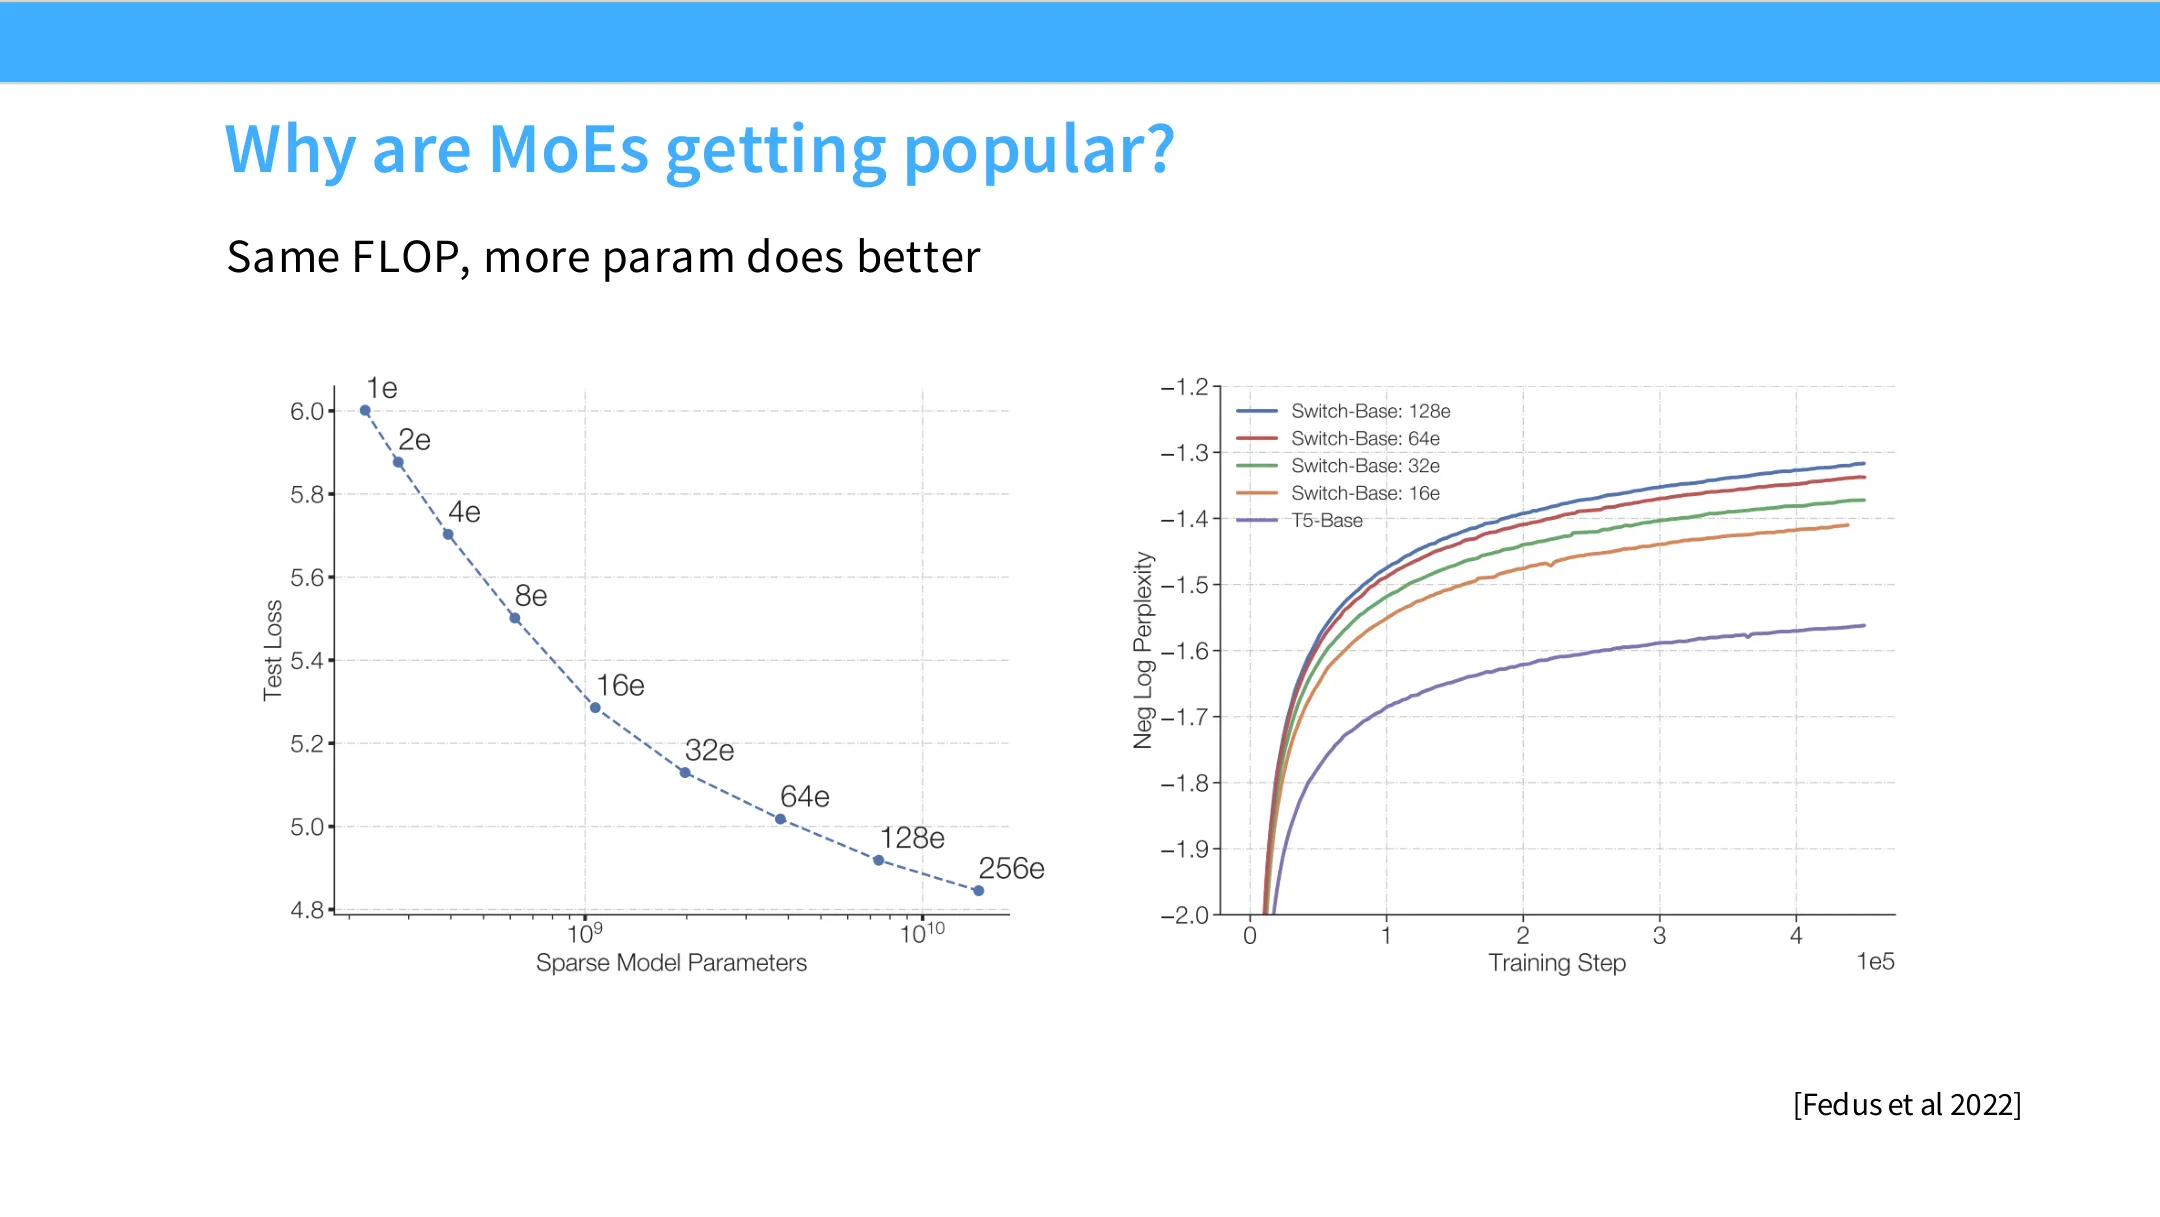
📷 Switch Transformer:专家数增加、测试损失持续下降
回到原视频 (00:37:39)
训练和推理都是「白赚」——讲师原话是「pretty wonderful, pretty great」。
8.4 独立验证:AI2 的 OLMo 研究
(参考时间: 00:38:28)
AI2(Allen Institute for AI) 的 OLMo 论文(开源的 MoE 分析)看到了同样的现象:看训练损失、验证损失、下游基准,MoE 相对于稠密对照,大约有 2 倍左右的训练加速。
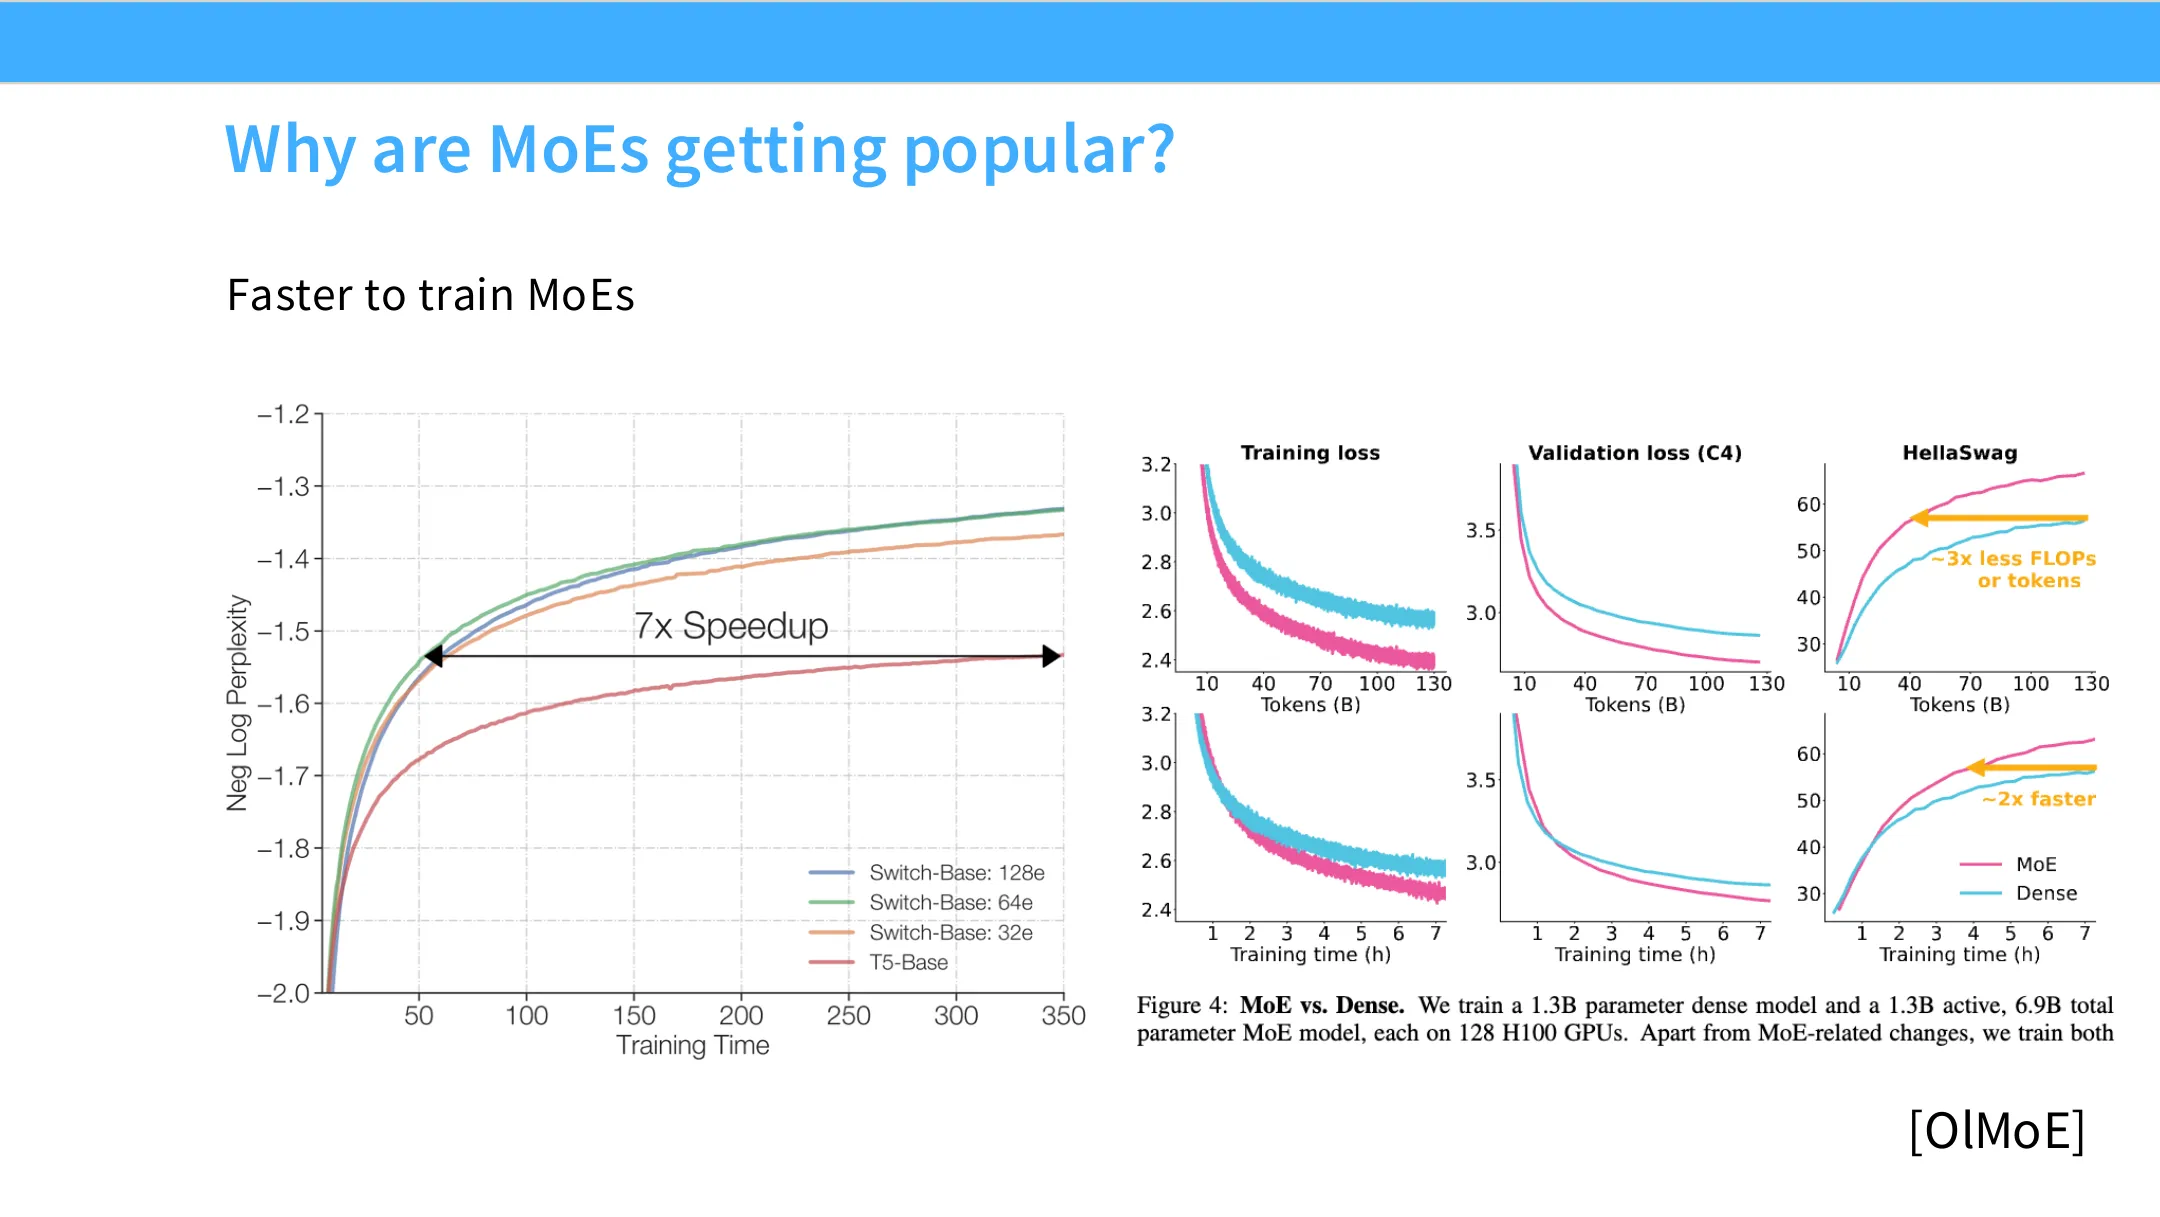
📷 OLMo:MoE 相对稠密模型约 2 倍训练加速
回到原视频 (00:38:39)
8.5 真实世界证据
(参考时间: 00:39:00)
从已发布的 MoE 模型看,它们在激活参数量上都明显强于稠密模型(如果你关心推理 FLOPs,激活参数量才是关键),甚至从训练与服务的总成本看也是如此。
- DeepSeek V2 及更早的 DeepSeek MoE 发布时,是一个重大转折点:更少的激活参数,MMLU 性能却不逊于甚至超过同期所有稠密模型。
- 西方开源侧:Llama 4 和 GPT-OSS 是较大的强 MoE,但讲师认为西方开源发布总体上「停滞」了(
[00:40:54])。 - 讲师认为 MoE 的研究和训练主力在中国:Qwen、DeepSeek,以及 MiniCPM 等。(
[00:41:07]) - 早期 Qwen 1.5 MoE(
[00:41:32]):一个 27 亿激活参数的小模型,表现好于当时很多 7B 模型。 - 这些早期的 proof of work 说服了整个开源社区:这是正确的方向。
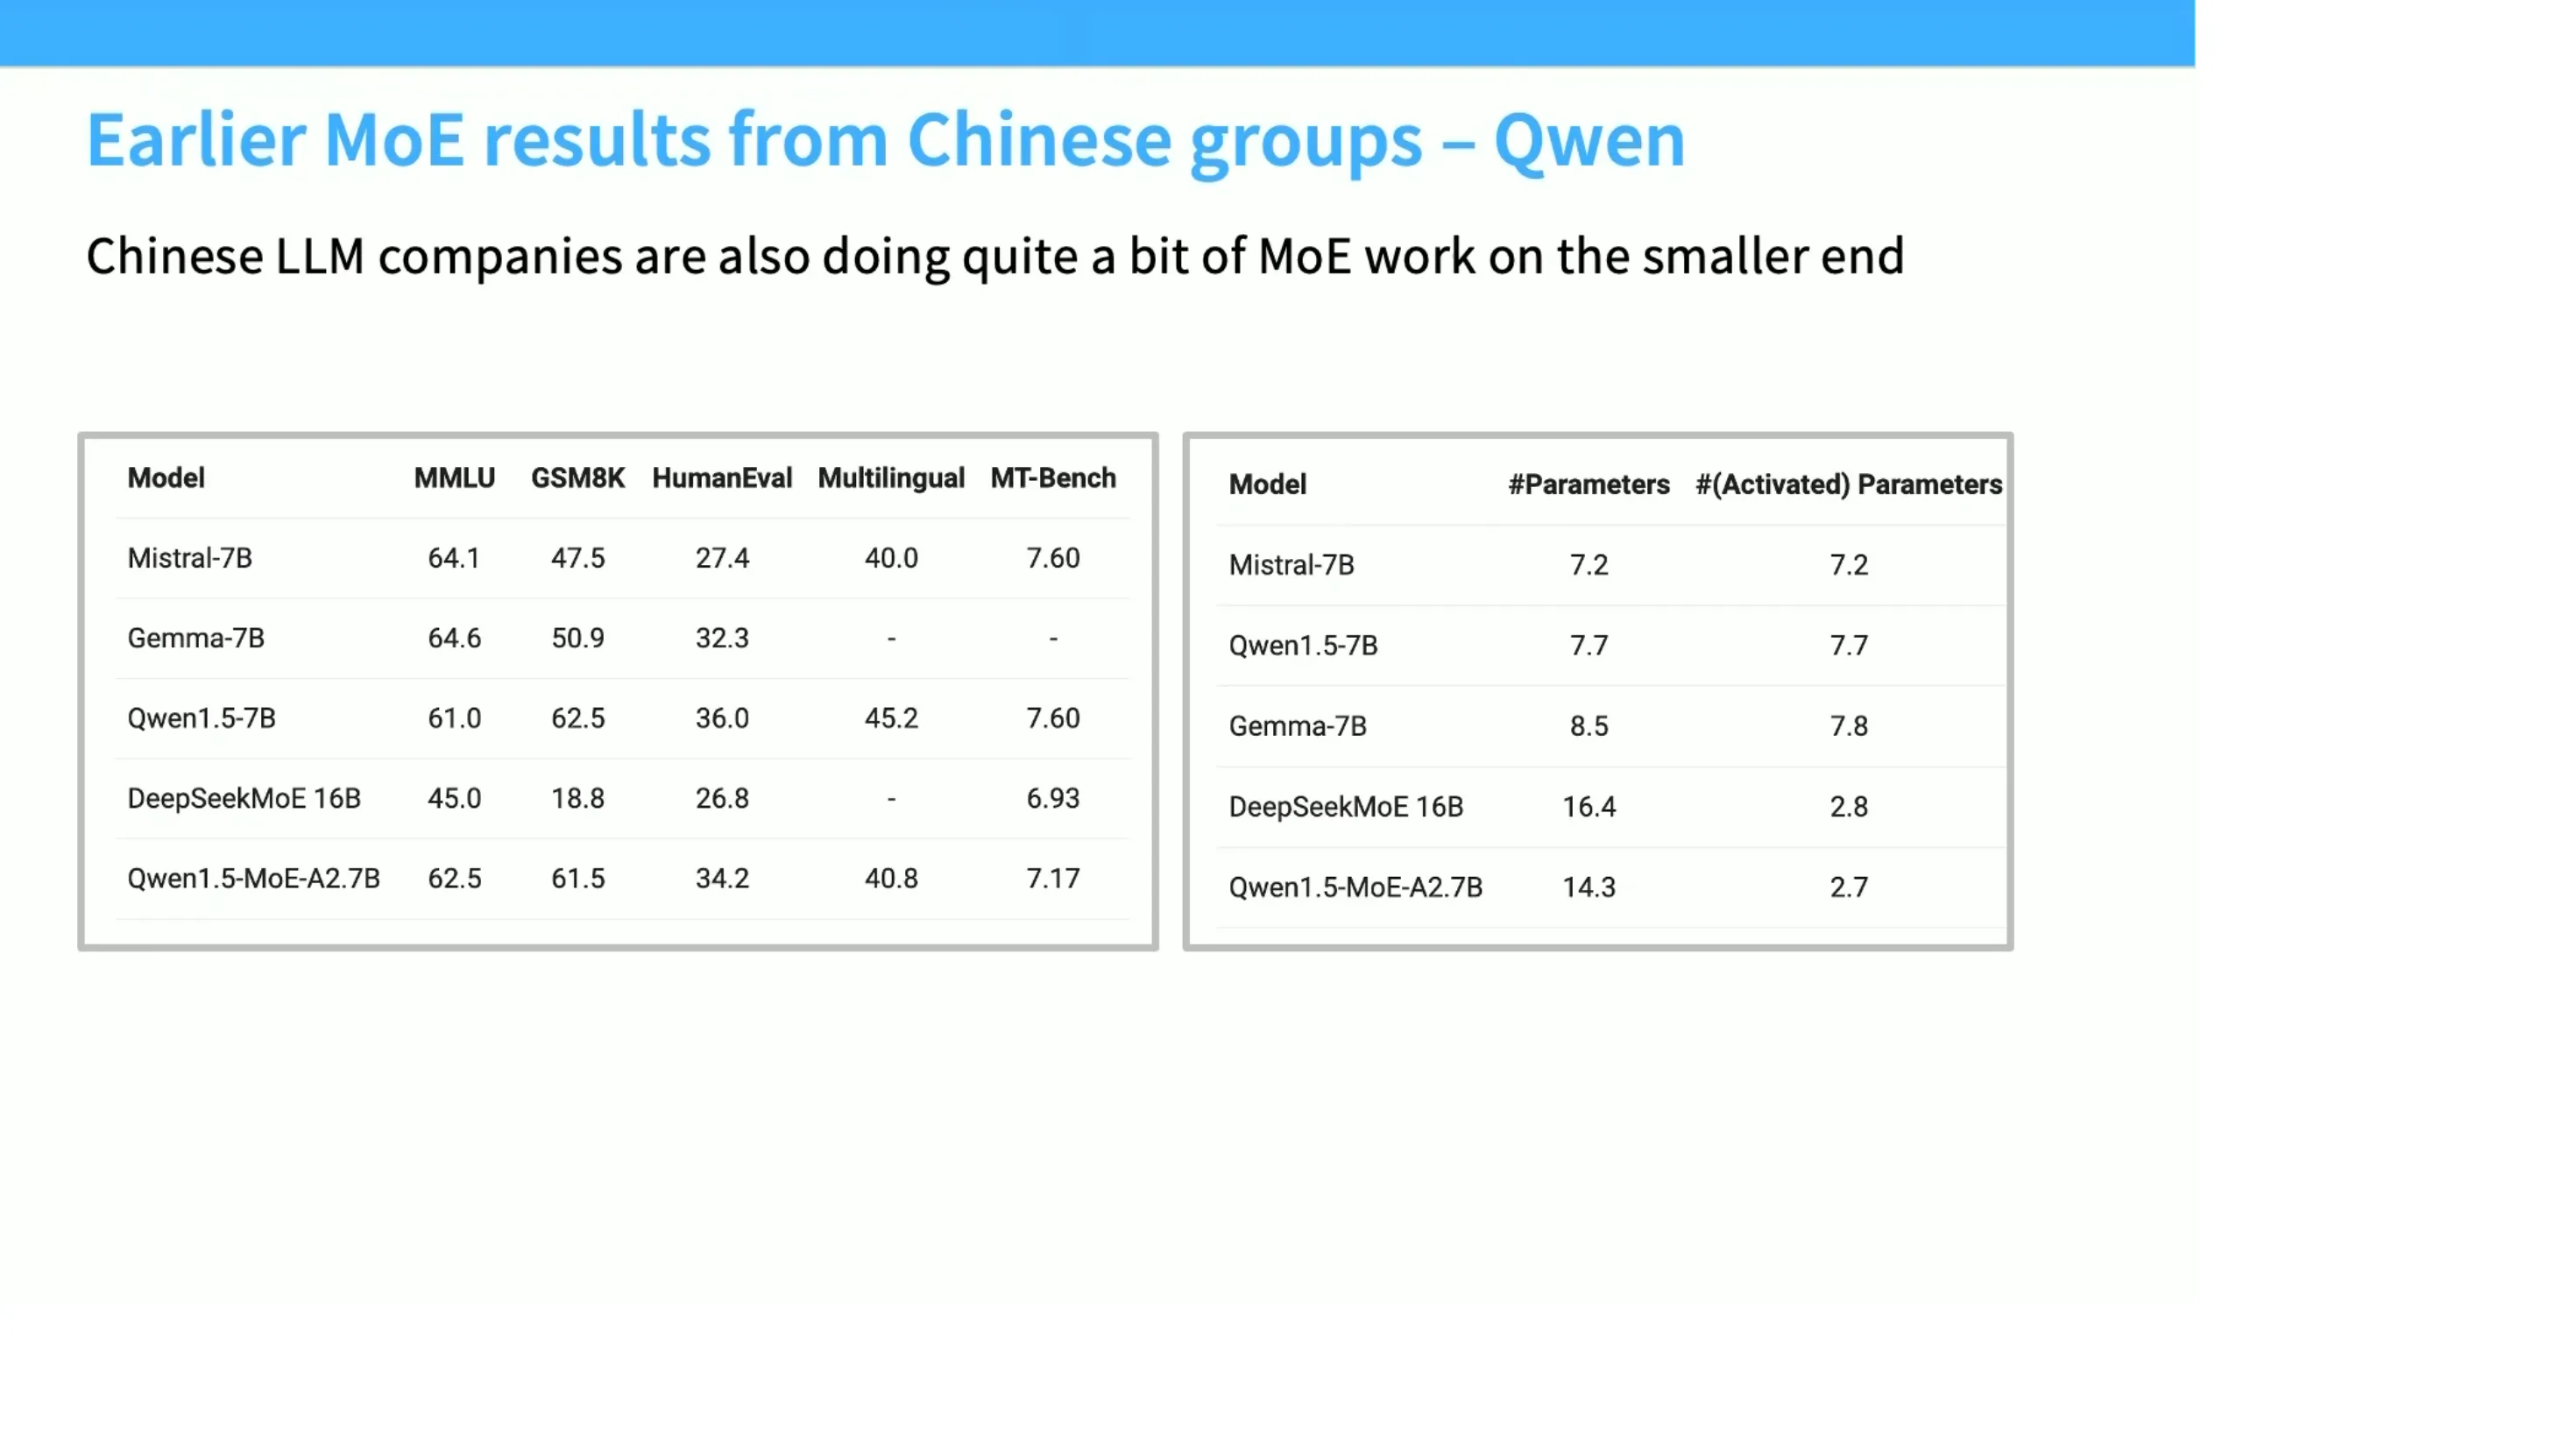
📷 Qwen 1.5 MoE:小激活参数超越同期 7B 稠密模型
回到原视频 (00:41:32)
8.6 MoE 是又一条并行轴
(参考时间: 00:39:49)
MoE 还给你另一条并行化轴(讲师说,并行化会在三讲之后的系统课上详述):
- 数据并行、模型并行各有其上限(batch size 满了就不能再数据并行;模型切点用完了就不能再切)。
- MoE 给你额外的一条轴:每个 FFN 里的专家天然就是一块块(chunk),可以放到不同设备上,然后把激活路由到不同设备——这就是专家并行(expert parallel)。
8.7 课堂问答:通信瓶颈与训练稀疏性
-
「专家并行会不会有通信瓶颈?」(
[00:42:12]) 会。你要付出把激活发送出去的通信成本。总体上你是在做权衡:换来更高聚合 FLOPs、更低内存占用,代价是通信。这是否净赚,高度依赖你的网络拓扑。(讲师预告会有「减少通信」的一个技巧) -
「训练时呢?」(
[00:42:35]) 这是关键:训练时专家也是稀疏的。这恰恰是 MoE 难做的地方。如果训练时激活所有专家,你就会看到每个专家对当前输入的表现,学路由会很简单。但真实情况是只激活 1 个或 K 个专家,你不知道其余专家的表现——你只知道被激活的那几个。尽管这样,你还是必须学会路由。所以问题带上了一点RL bandit 的味道([00:43:14])。 讲师的吐槽:「我们不用 RL,也不用 bandit,我们用启发式和深度学习魔法。」 -
「切换专家的粒度是什么?」(
[00:43:20]) token 级别。每个 token 都会得到一个专家。而且路由器非常朴素——基本就是输入和一个权重矩阵的一次矩阵乘法,不会去理解「这是不是一个医学问题」,只会说「这个 token 看起来像日语,送它去 7 号专家」。
9. 路由器设计空间
(参考时间: 00:47:36)
讲完产业概览,讲师转入如何设计一个 MoE。他给出三个变化轴:
- 路由函数(routing function):路由器如何把 token 分派给专家;
- 专家大小(expert size):在给定预算下,是「多专家、小参数」还是「少专家、大参数」;
- 训练(training):训练一个「路由 token 到不同位置」的模型非常困难。
在所有方案里,我们都不想激活全部专家——我们永远只选 top-K。
9.1 Token 选择专家 vs 专家选择 token
(参考时间: 00:48:56)
有几种选择方式:
- token 选专家:每个 token 挑自己最喜欢的专家;
- 专家选 token:每个专家挑自己最喜欢的 token;
- 全局路由:一个很复杂、全局决定分配的 router。
实践中,几乎所有 MoE 都用 token-choice top-K。OLMo 论文的对照([00:49:13])显示:
- token-choice 得到更低的验证损失、更高的下游基准分数;
- 专家选择也能训(有过成功的模型,例如某个 Llama 4 模型,但讲师调侃「在我看,那是未发布的 Llama 4 之一,我不认为这是强烈的信心背书」(
[00:49:40]))。
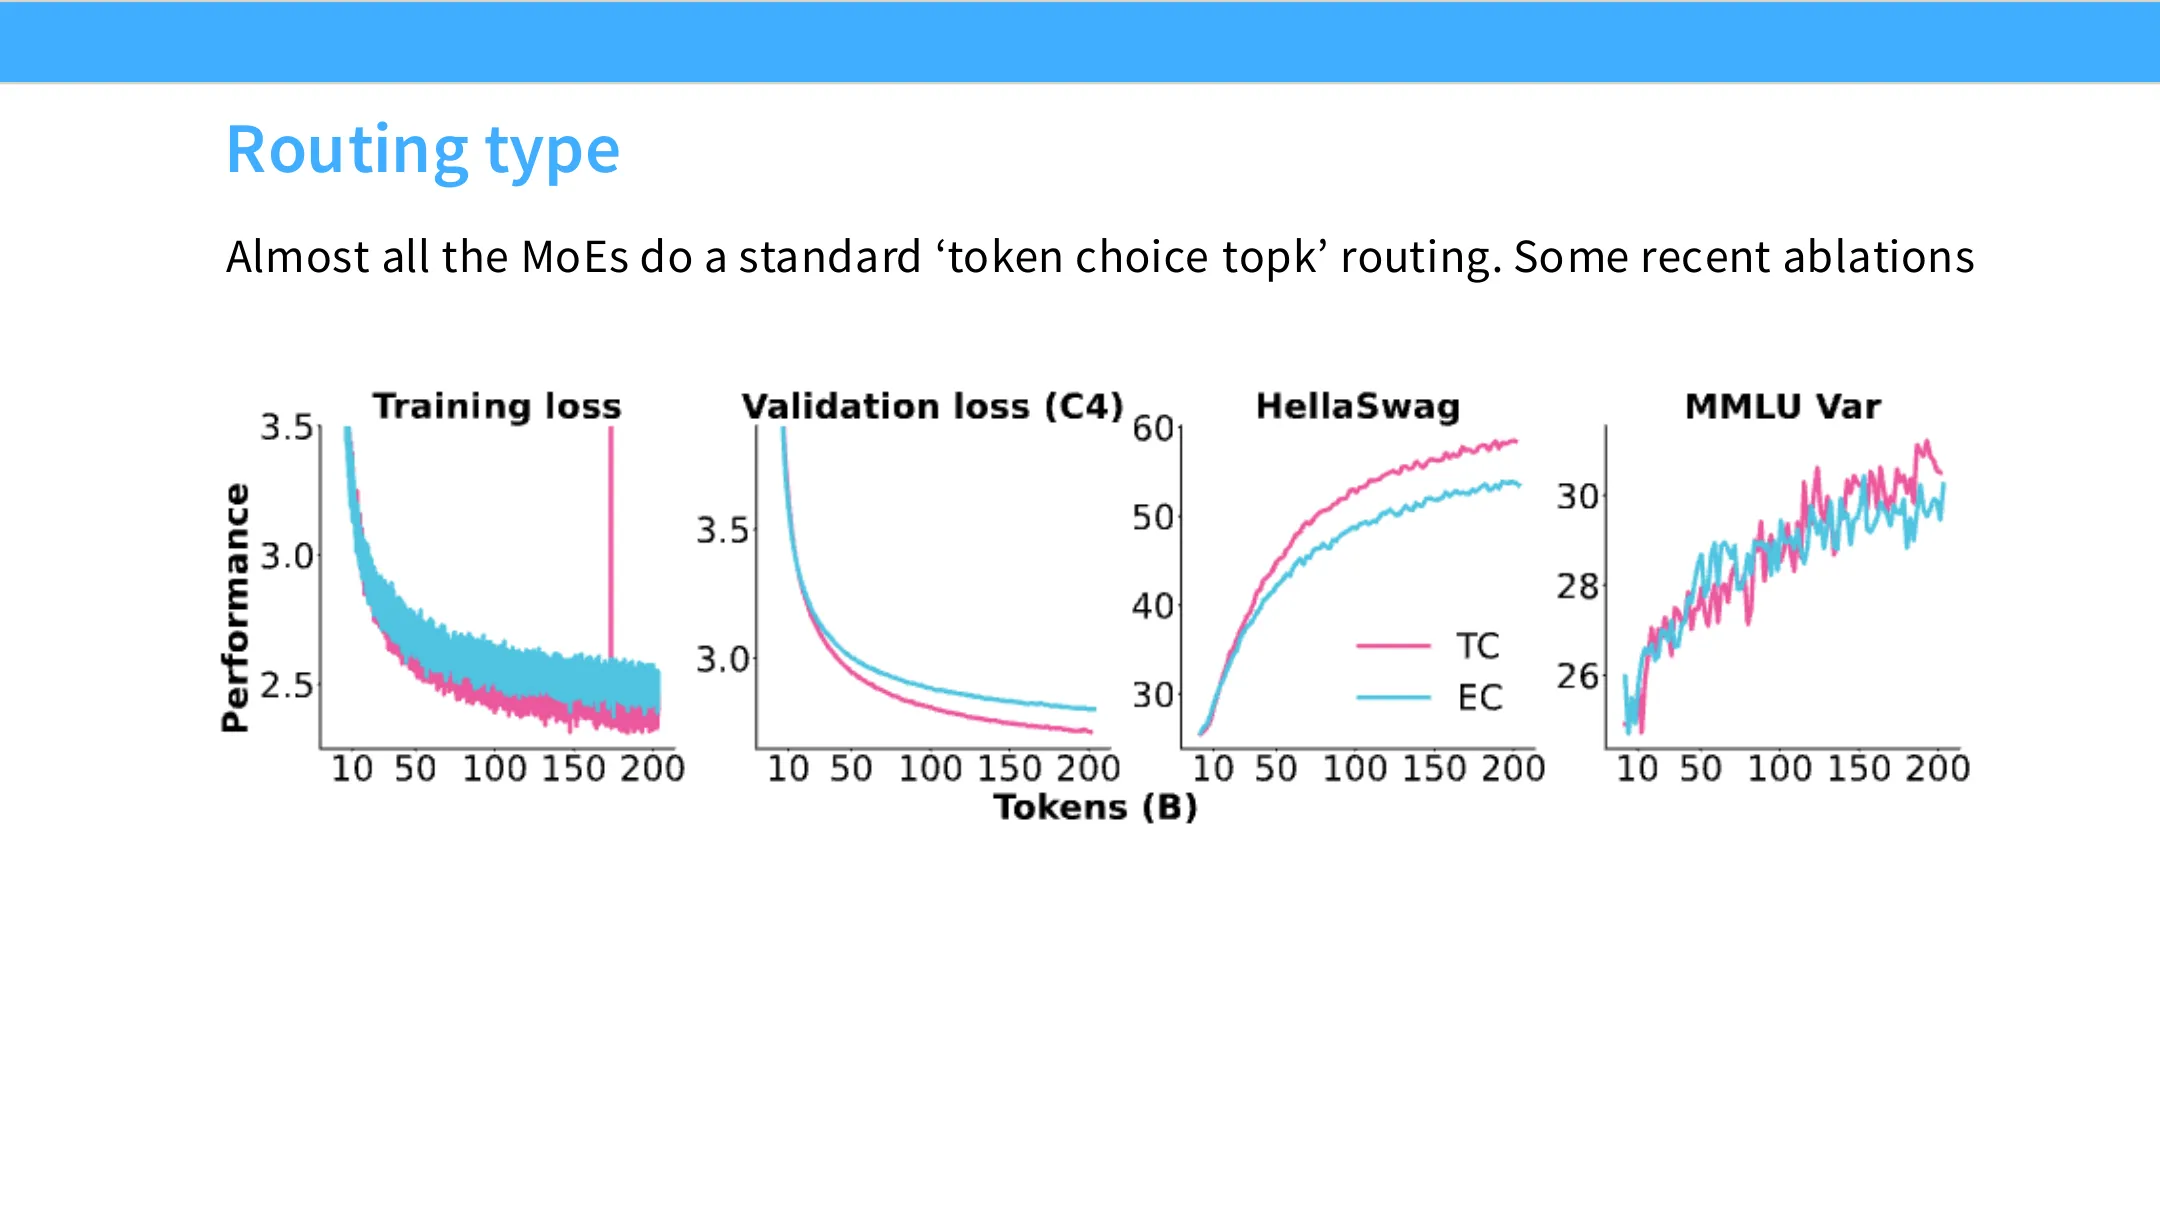
📷 OLMo:Token-Choice vs Expert-Choice 的验证损失对比
回到原视频 (00:49:13)
9.2 路由函数的几种选择
(参考时间: 00:49:55)
方案 A:内积路由器(The inner-product router)——最经典、最主流
- 用一个小的线性投影:把输入打进去,每个专家有一个向量方向,内积最近者被选中。
- 用在:Switch Transformer、GShard(两篇早期 Google 论文),以及 Grok、Mistral、DBRX、DeepSeek 等。
- K 的选择因论文而异。
方案 B:哈希路由(Hashing-based routing)
- 完全不学路由:把输入的 $X$ 直接哈希,分送到不同的 FFN。
- 这也 work,能带来收益,但不如 top-K 那么多。
- 论文里常见 baseline,实际部署中很少用。
方案 C:用 RL 学路由
- 因为路由天然是个bandit 问题(K 选 N,看不到未选中的表现),从「经典学习理论」视角看,这是最自然的想法。
- 最早由 Bengio 等人 2013 年 尝试。
- 但不常见,原因:RL 算法本身的开销和随机性。而后来人们发现,用一批简单的启发式配方,就能让经典 top-K 路由很好地 work——所以没理由去用更复杂的东西。
方案 D:线性分配问题(Linear Assignment Problem)
- 全局计算每对(token, 专家)的得分,然后用线性分配精确求解最优分配。
- 讲师说这是「我很喜欢、觉得很酷」的想法——因为他喜欢讲道理的东西。
- 但从未在大规模上被验证,因为它相对于其他方案极其昂贵。
9.3 Top-K 路由的具体形式
(参考时间: 00:53:01)
Top-K 路由现在是共识路由机制。它和之前的 DSA、以及 H-Nets 等其他论文里的模式高度相似——所以这是一个值得学会识别(recognize)的模式。
它长这样:取输入,过一遍前馈,计算得分,用 softmax 在专家之间归一化,选出 top-K 作为门(gate),控制各专家:
$$ \text{Output} = \sum_{i \in \text{TopK}(S)} g_i \, \mathrm{FFN}_i(U) \;+\; U $$
其中 $S$ 是路由得分,$g_i$ 是对应门控。门的学法是:每个专家一个权重向量,与输入做内积——非常轻量,没有任何花哨的地方。
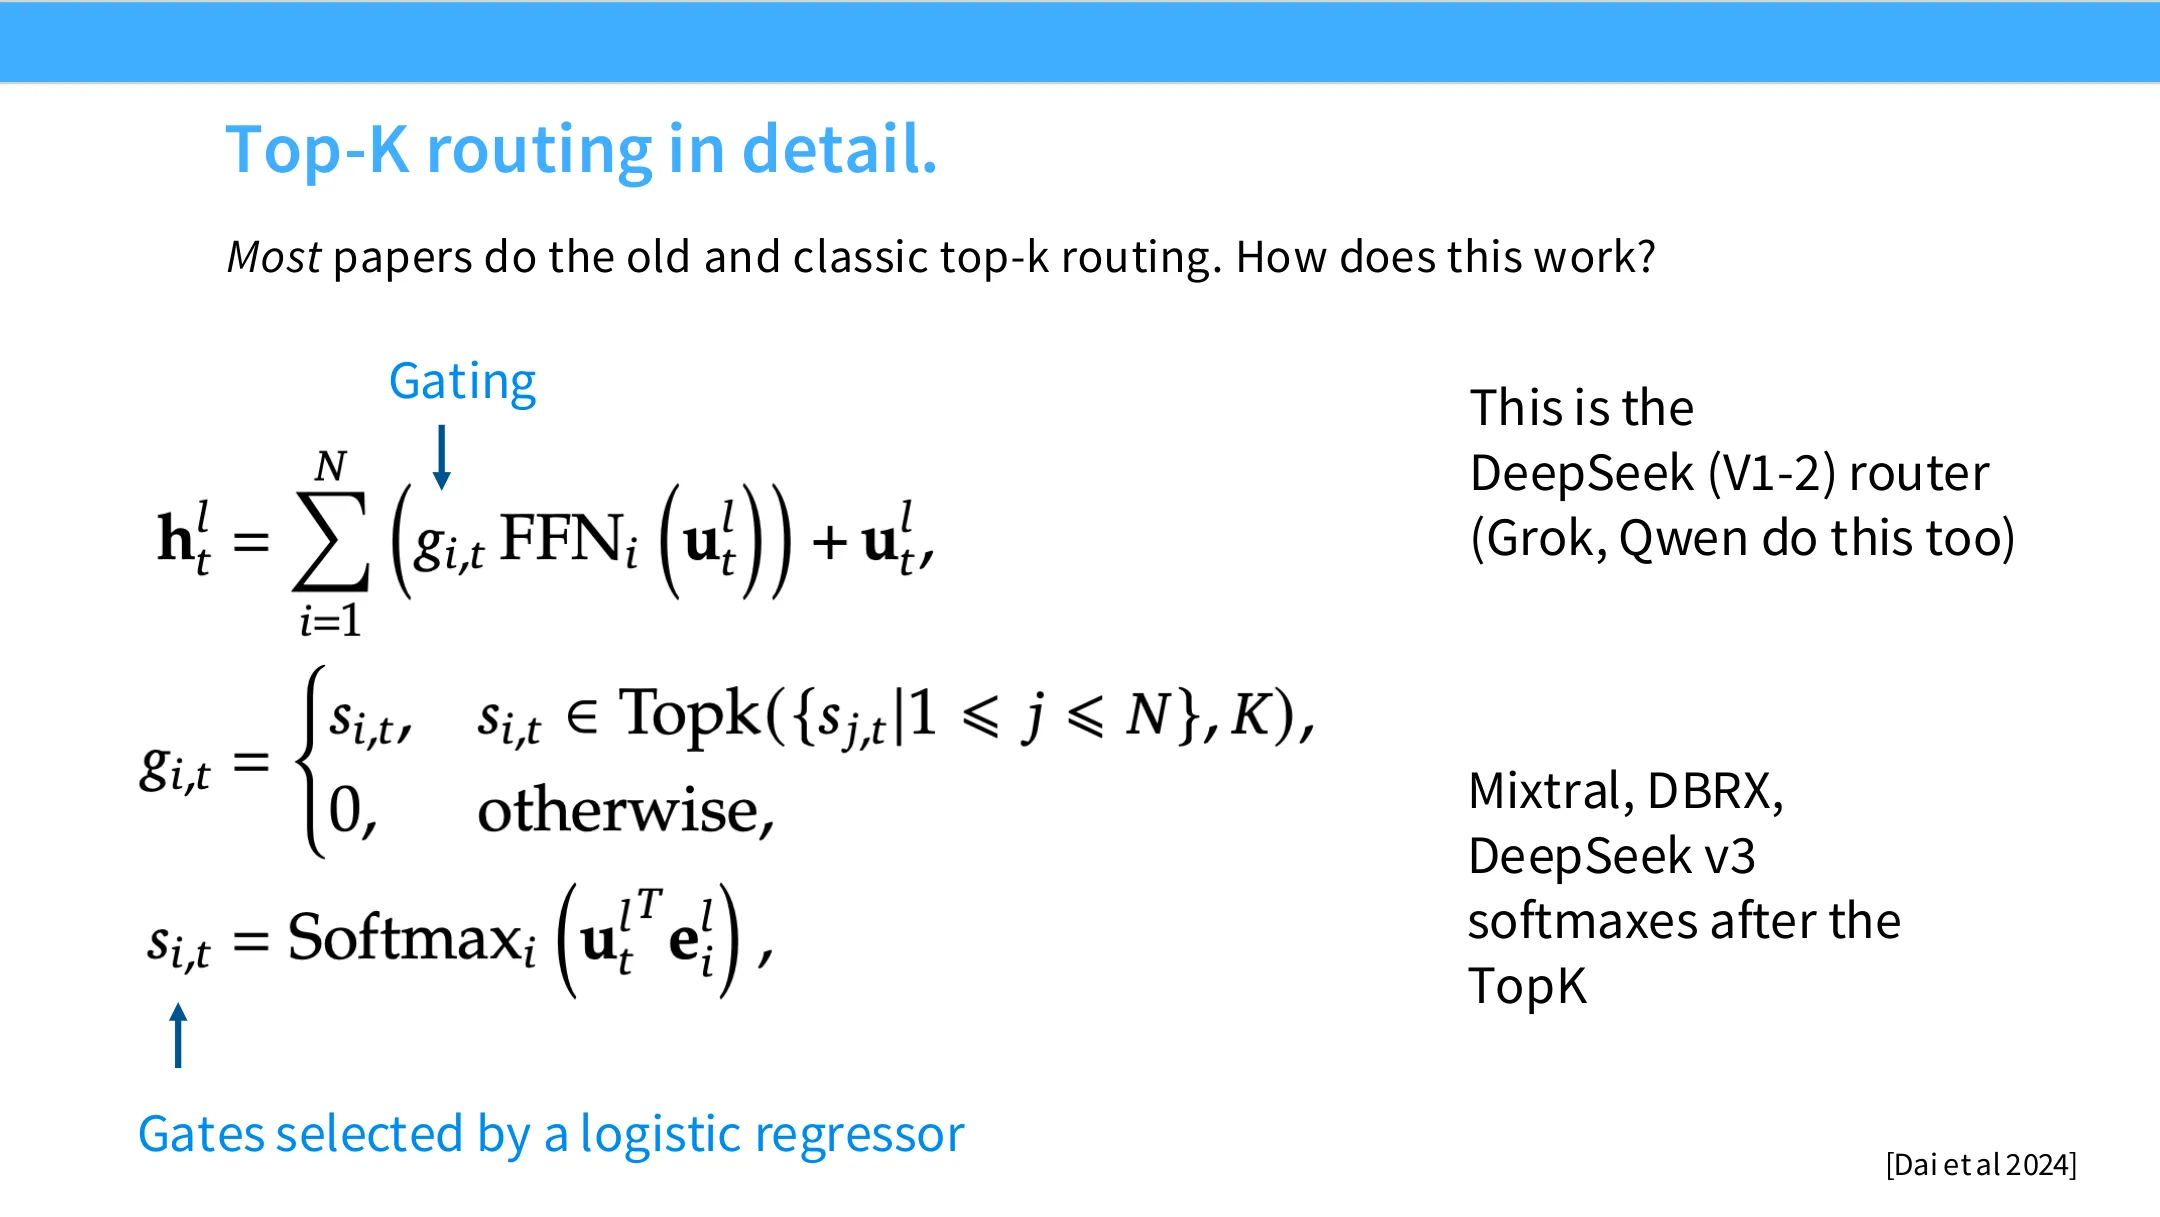
📷 Top-K 路由:内积得分 → top-K → 门控专家
回到原视频 (00:53:58)
编者拓展|一个可用于识别的模式 「内积打分 → 取 top-K → 用归一化后的权重加权」这个模式,在 DSA 的轻量索引器、MoE 的 top-K 路由器、RetNet / H-Nets 等很多地方都出现过。讲师特意指出这是一个值得培养的模式识别能力。一旦你识别出它,你就能快速看懂很多看似不同的架构论文其实在讲同一件事。
9.4 共享专家与细粒度专家:DeepSeek 的贡献
(参考时间: 00:54:24)
在这个简单框架里,DeepSeek MoE 及其同伴做了重要的创新。
共享专家(Shared Experts)——现在是极其广泛使用的设计([00:54:37]):
- 直觉:有些处理对所有 token 都是通用的。你不希望每次都是不同的专家,你希望某些专家永远被应用,而另一些有条件地应用。
- 具体做法:把专家切成更细粒度的块(fine-grained chunks),其中一部分小块被设为共享专家——它们绕过路由器、永远在线,处理完输入后加回输出。
- 好处:在经典专家设计里,很多权重其实是在做通用建模。把这些「通用活儿」卸载到一个共享专家上,可以让其余专家更专注于专业化。
DeepSeek 的消融实验([00:55:50]):
- 对照组:无共享专家 + 16 个(大块)路由专家,这是老 Google GShard 的设计;
- 实验组:非常细粒度的专家切分 + 1 个共享专家。
- 结论:把专家切小 + 加一个共享专家,两项干预都能带来显著收益。在某些任务上(TriviaQA、Natural Questions),共享专家带来的提升(蓝→黄)非常显著。
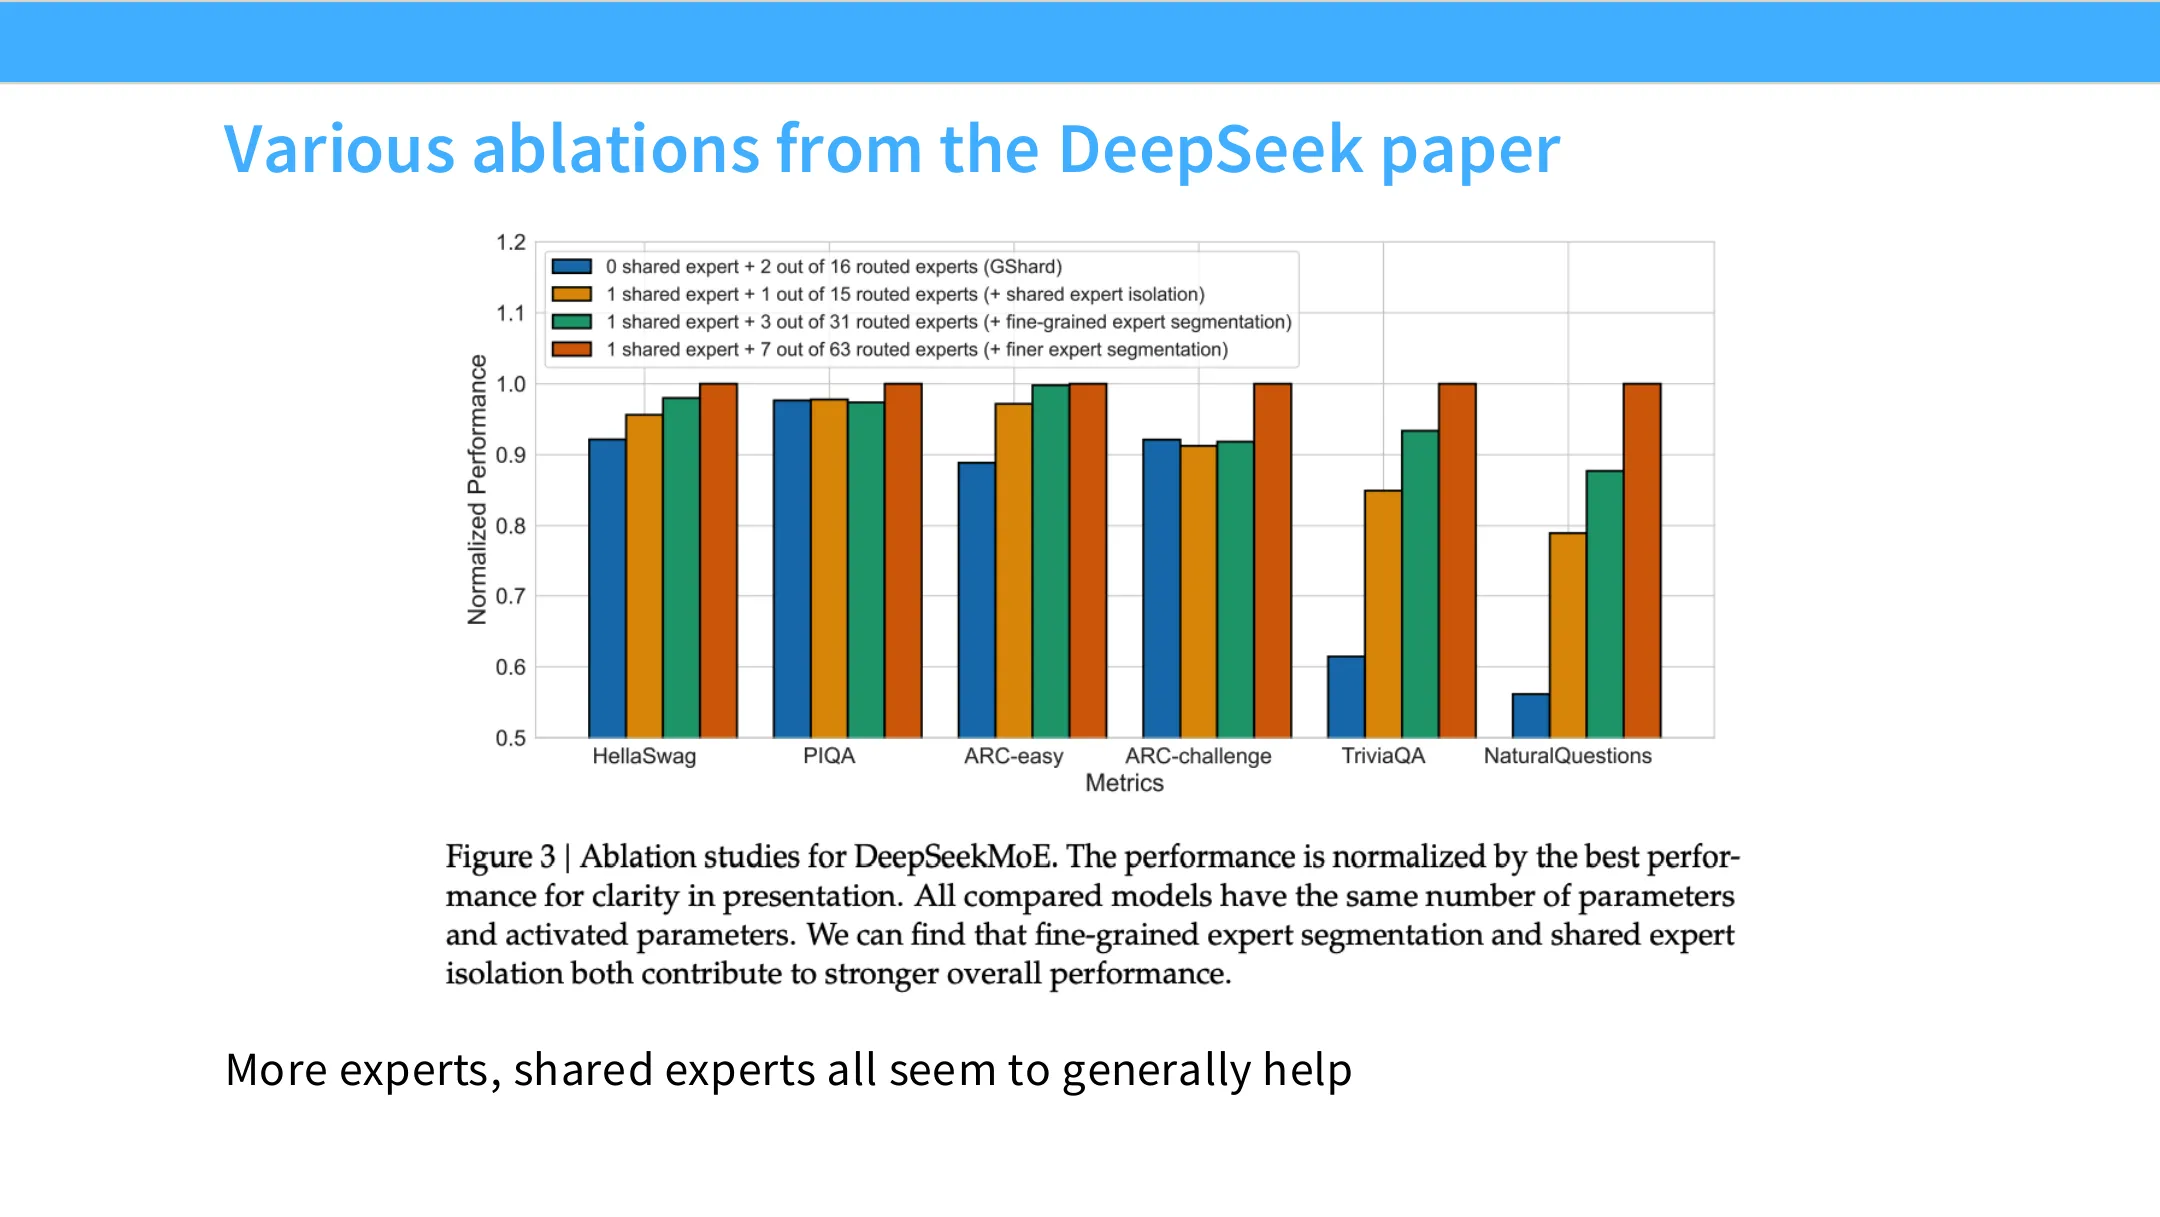
📷 DeepSeek MoE 的共享专家消融实验
回到原视频 (00:55:50)
独立验证与分歧:AI2 的 OLMo([00:56:41])认为「共享专家帮助不大」,但在「多而细的专家有益」这一点上与 DeepSeek 一致。所以两边在共享专家这个点上略有分歧。
总结:现在许多近期 MoE 基本遵循 DeepSeek 的设计([00:57:03]):
- 早期一些 MoE:Google(前三篇)、Mistral、DBRX、Grok 等;
- DeepSeek V1 提出细粒度 + 共享专家的设计;
- 之后大家纷纷效仿 DeepSeek。这在某种意义上类似于 Llama 之于稠密 Transformer 的标准地位——DeepSeek MoE / DeepSeek V3 就是 MoE 侧被大家抄的标准设计。
- 看 Qwen 3.5、GLM 等现代模型,共享专家 + 细粒度专家依然随处可见,是一个非常经过实战检验的设计。
课堂追问([00:58:02]):「有共享专家时,并行化怎么办?」——答:共享专家得不到并行收益,每个激活都得过它。你可以复制共享专家,用内存开销换取通信开销的降低。
10. 训练 MoE:负载均衡的艺术
(参考时间: 00:58:31)
这是本讲「非常意外、非常深刻的深度学习内容」。
讲师坦白:初学 MoE 时,我以为这些东西根本训不好。但事实是:有一堆技巧,组合起来就能相当稳健地 work。
10.1 核心矛盾:稀疏 vs 可微
(参考时间: 00:58:57)
- 训练时不激活所有专家(否则要付全部 FLOPs,而我们专家很多),稀疏是训练效率的必需;
- 但稀疏之后,门控决策不再可微;
- 而且看不到其他反事实(counterfactual)专家——我们本可以选的专家,看不到它们表现如何。
这两个都是大问题。解决方案有三类:
- 用 RL 优化门控策略——不太流行;
- 随机扰动(stochastic perturbations)——explore-exploit bandit 风格;
- 一整堆奇怪的启发式,处理稀疏门控的分配平衡。
实践中用的是第三类——一组最终会 work 的有趣启发式。
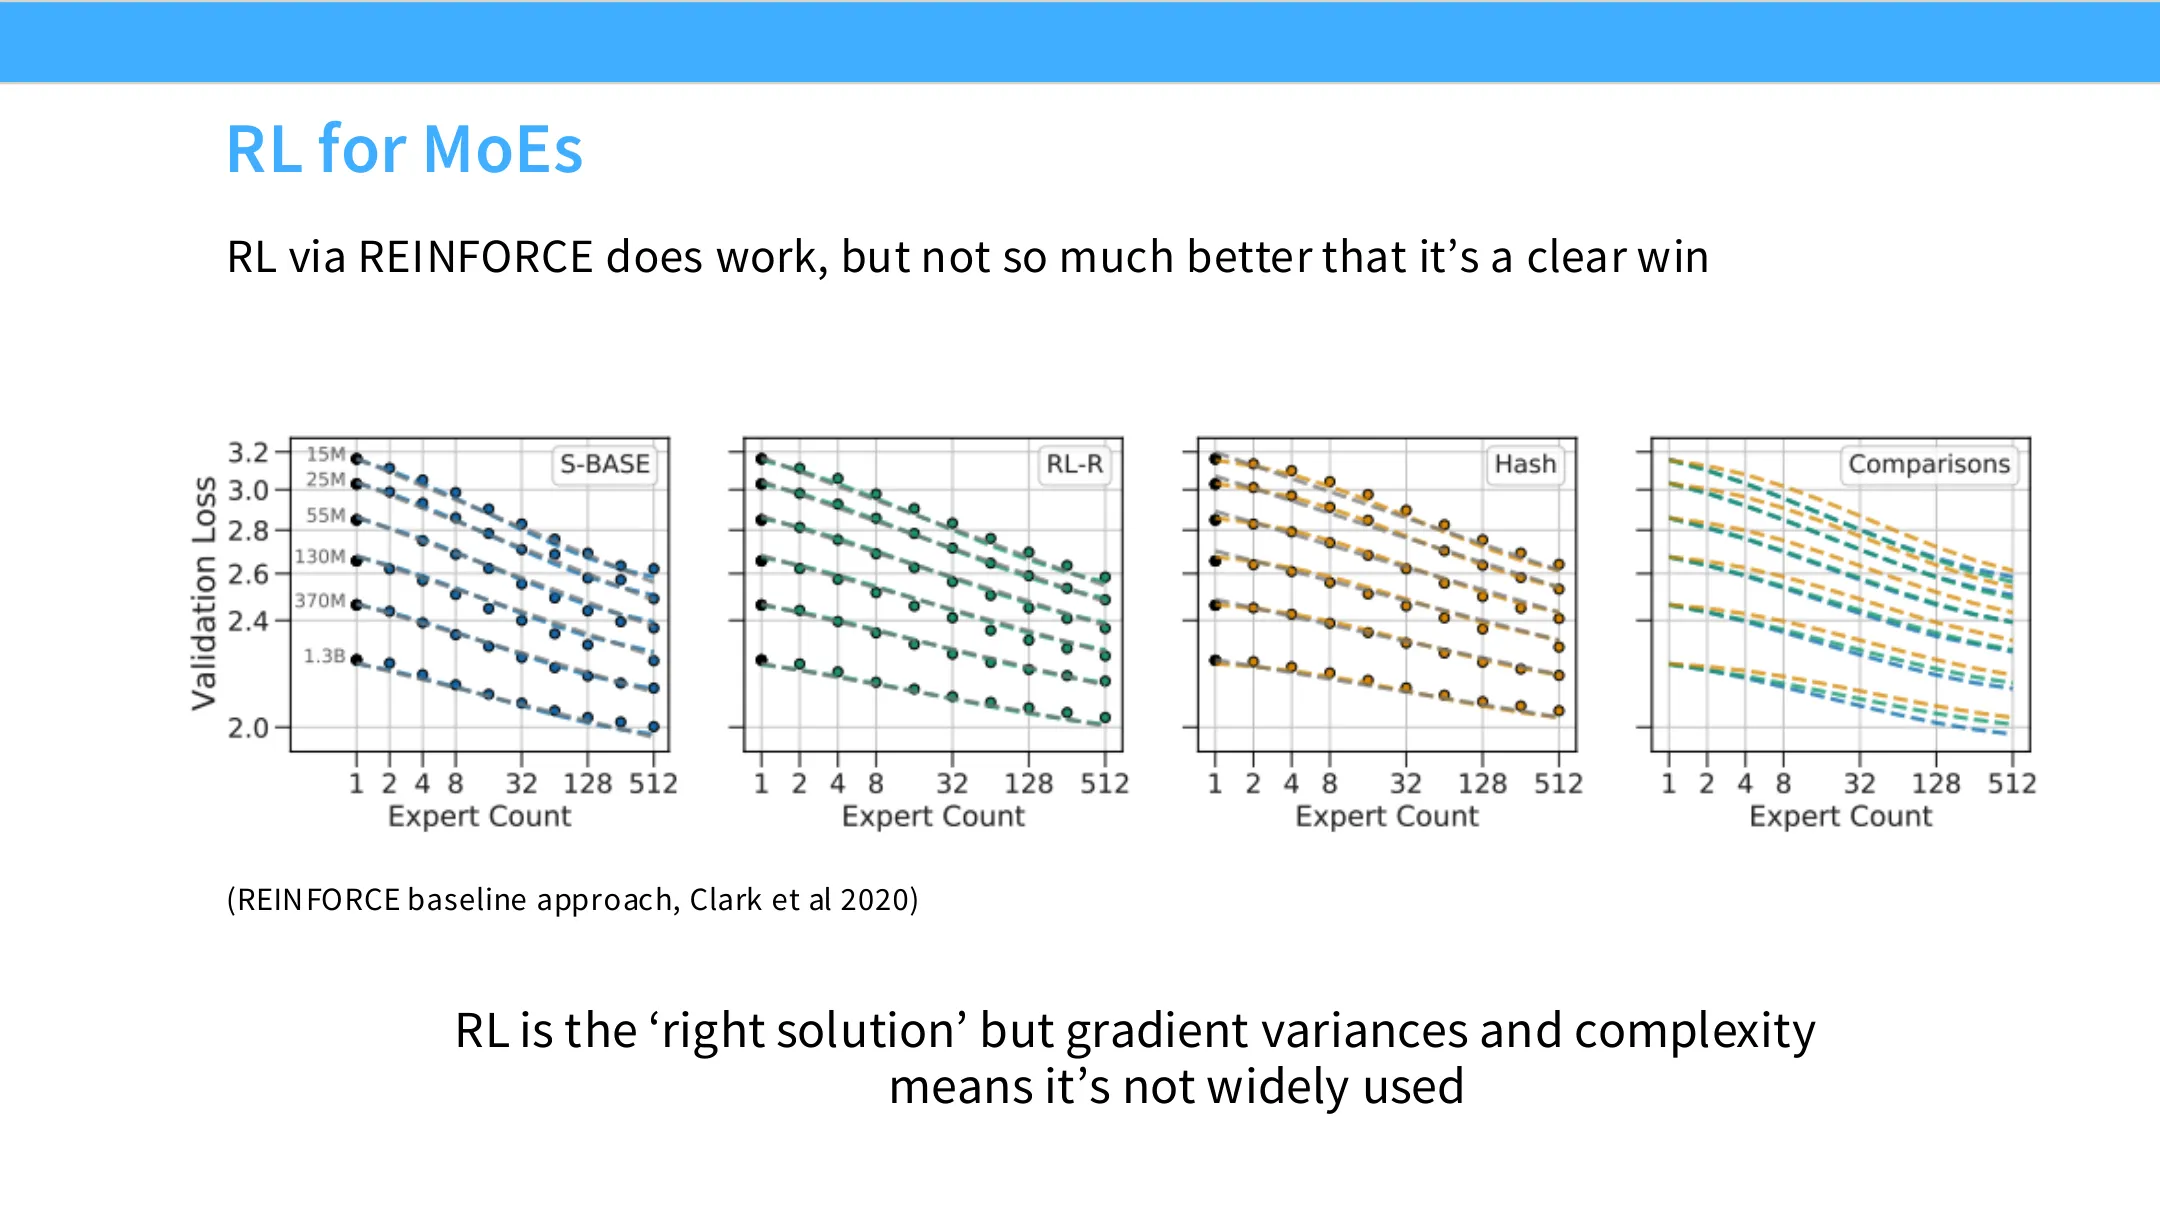
10.2 路线一与二(不流行,但值得知道)
用 RL 学路由(Clark 2020,[01:00:06]):
- 可以 work(图中的绿线是一个 baseline);
- 但由于梯度方差和复杂性,并不是最优解;
- 论文里提出的一些方法轻松超过用 REINFORCE 梯度做路由。
📷 Clark 2020:用 RL 学路由 vs 启发式方法
回到原视频 (00:59:55)
随机近似(Stochastic Approximation)(Shazeer 等人的早期 MoE 论文,[01:00:52]):
- 训练时不做硬决策,而做随机决策;
- 在路由内积 $H$ 上注入与输入尺度相关的噪声;
- 然后照常取 top-K、softmax。
- 效果:两个接近的专家会随机地二中选一,从而打破平局、增加探索;
- 反向传播会让有用的专家获得更高权重,逐渐被更多选中;
- 产生更鲁棒的专家。
graph TD
    A["输入 X → 路由内积 H"] --> B["注入输入尺度相关的噪声"]
    B --> C["H' = H + noise"]
    C --> D["Top-K + Softmax"]
    D --> E["被选中的专家"]
    E --> F["反向传播"]
    F -->|"有用专家 → 更高权重"| G["更鲁棒的专家<br/>(略微探索)"]
后续发现:Fit Fedus 2022 做了一种均匀乘性扰动,用于「让专家更鲁棒」,但后来被后续 Google 论文移除了。其后的消融表明:不做这些随机鲁棒性技巧,反而能改善稳定性和最终 MoE 质量。所以这些探索性项并非必须。
10.3 路线三:启发式 —— 负载均衡损失
(参考时间: 01:03:05)
现在进入真正在做的事情:一系列启发式,核心是平衡(balancing)。
问题:如果只做普通梯度下降、忽略探索/利用,会发生什么?
- 先选 top-K 专家;
- 其中最强的专家获得更多信号;
- 反向传播说「那个专家好,把它的权重提高」;
- 于是形成 rich gets richer(强者愈强);
- 被选中的专家权重越来越高 → 被选中越多 → 吃掉一切;
- 最终形成 专家坍缩(expert collapse)/ 专家饥饿(expert starvation)。
这是必须解决的核心问题。解决方案:往总损失里加一个启发式损失,用来平衡不同专家收到的 token。
10.4 Switch Transformer 的负载均衡损失
(参考时间: 01:04:20)
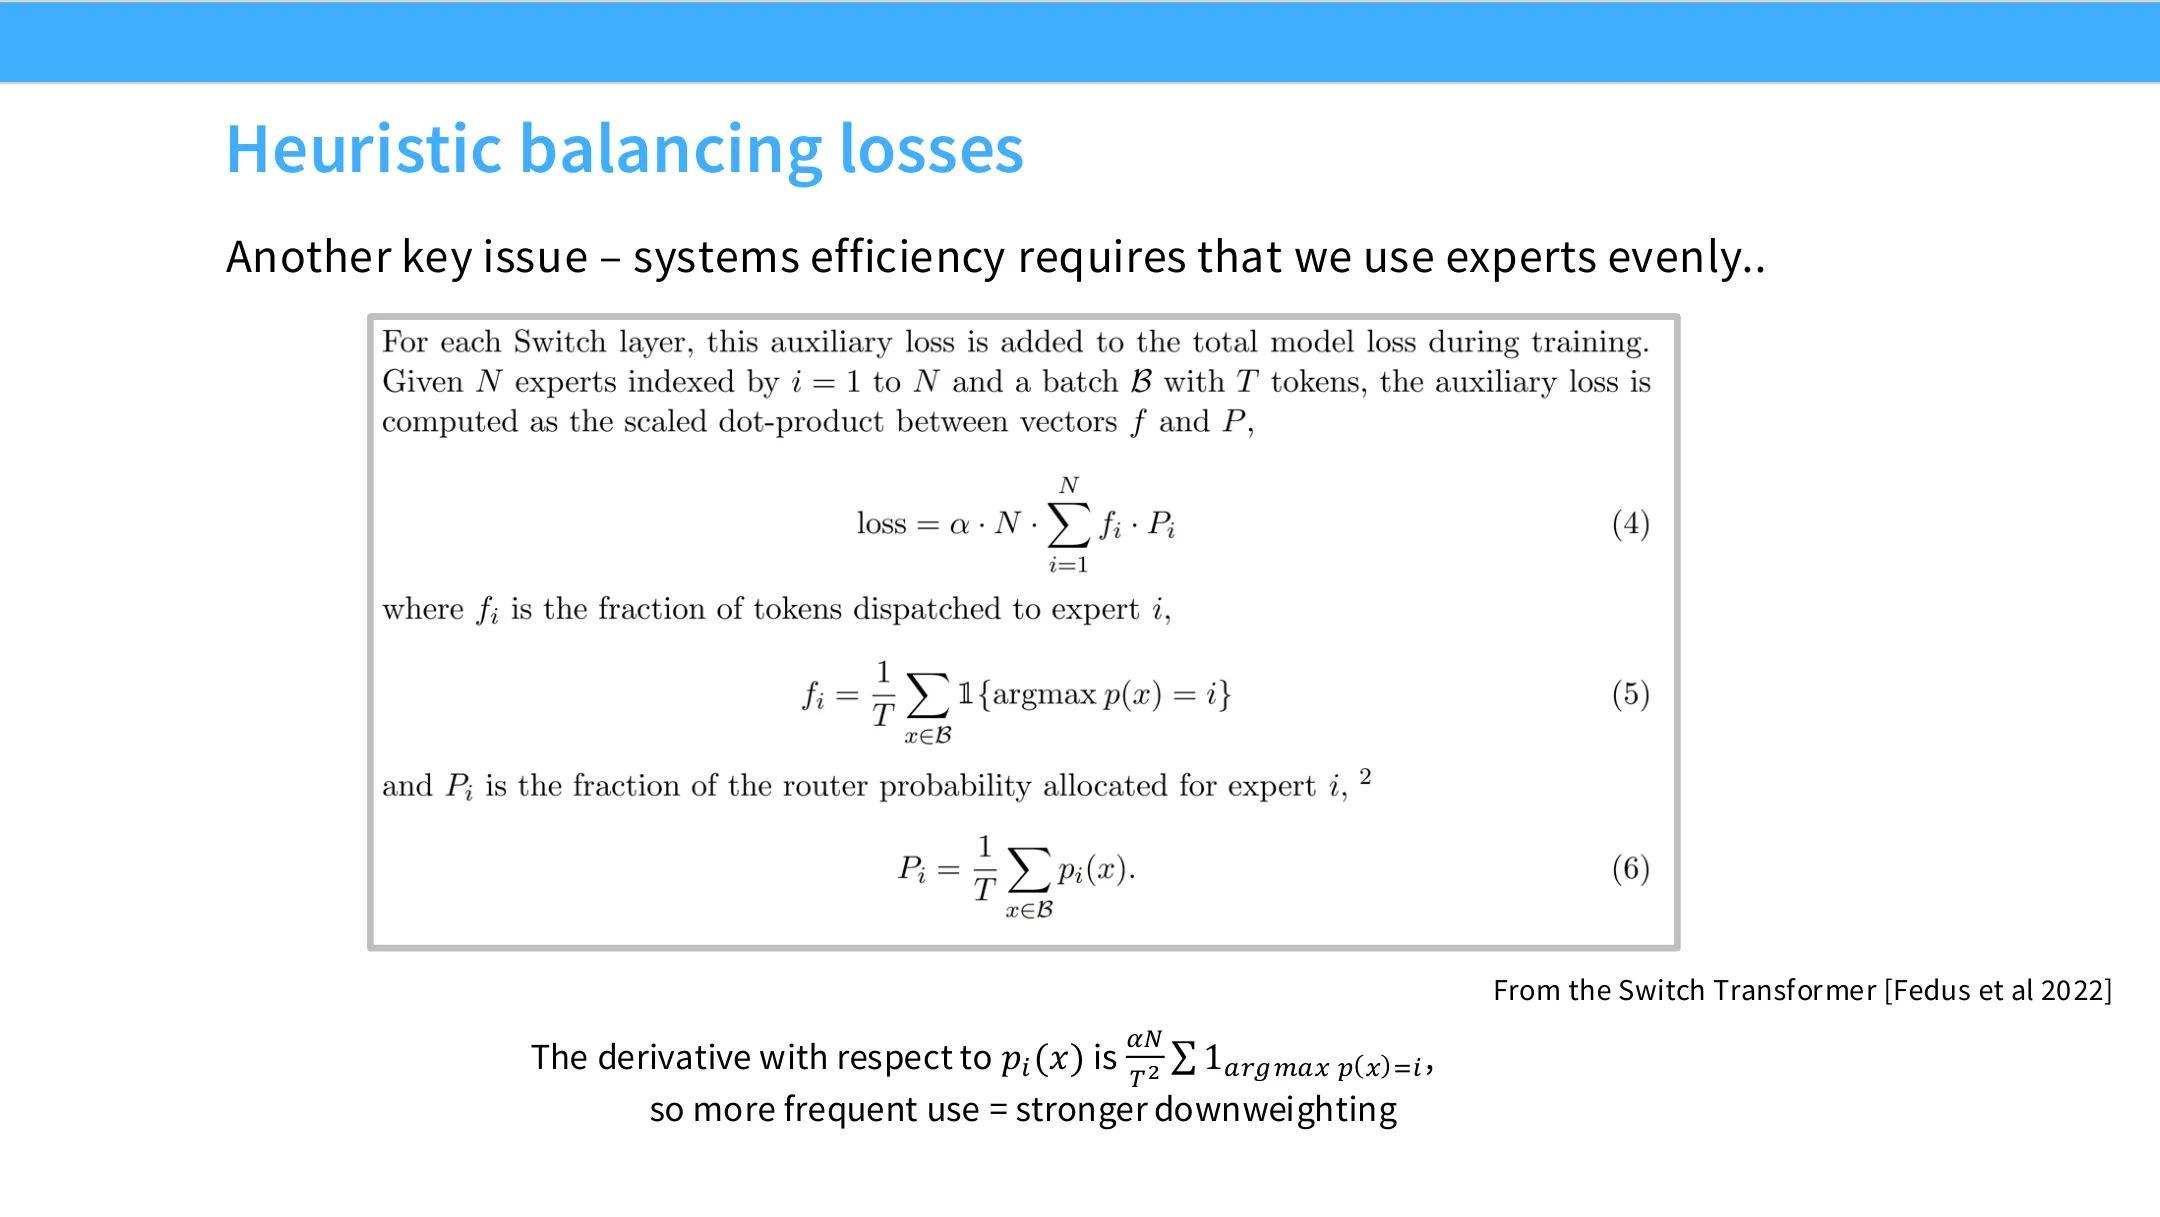
以 Switch Transformer 为例。设有 $N$ 个专家,一批 token。我们想让这两个量的内积尽量小:
$$ \text{aux loss} = N \sum_{i=1}^{N} f_i \, P_i $$
其中:
- $f_i$ = 派发给专家 $i$ 的 token 占比(硬分配);
- $P_i$ = 路由器分配给专家 $i$ 的概率质量(软版本,不是硬分配,而是总概率);
讲师说:这个损失不是能凭第一原理推出来的。看懂它最简单的办法是求导([01:05:12]):
对 $P_i$ 求导,得到的正是 $f_i$(派发给该专家的 token 占比)。
解释:你可以把它看成一个梯度空间里的惩罚——你收到的 token 越多,你得到的负梯度越强。也就是说,这个损失按 token 占比,去压低那些非常热门的专家的概率质量。
这就是它的作用:专门把热门专家往下压。
📷 Switch Transformer 的负载均衡损失(公式 4)
回到原视频 (01:03:58)
10.5 用这些部件重建 DeepSeek V1 / V2
(参考时间: 01:06:00)
有了这些技术,就能重构出 DeepSeek V1、V2 的 MoE 系统:
- 跑正常的损失;
- 直接对专家反向传播——忽略所有不可微性和探索性顾虑;
- 加上逐专家(per-expert)的平衡损失——和 Switch Transformer 完全一样($f_i \times P_i$)。
DeepSeek 的系统工程师还加了第二层([01:06:38]):按设备(per-device)平衡。
- 假设每台机器放 4 个专家;两台机器都有 4 个专家;
- 你希望两台机器负载均衡,都能满载运转;
- 这不是让专家更均匀,而是确保设备更均匀。
- 做法一样:同样的函数,只是把「专家」换成「每台设备的占比」。
DeepSeek V3 的进一步改进([01:07:11]):
- 引入逐专家偏置项(per-expert bias),用在线学习技巧来平衡专家,减少一些辅助损失;
- 但仍然必须保留一些辅助损失,以防极端失衡发生。
讲师点评:DeepSeek V3 及后续逐步去掉了一些「更丑」的辅助损失——但到目前为止,还没有完全去掉它们的方案。
10.6 去掉负载均衡损失的后果:非常惨烈
(参考时间: 01:07:52)
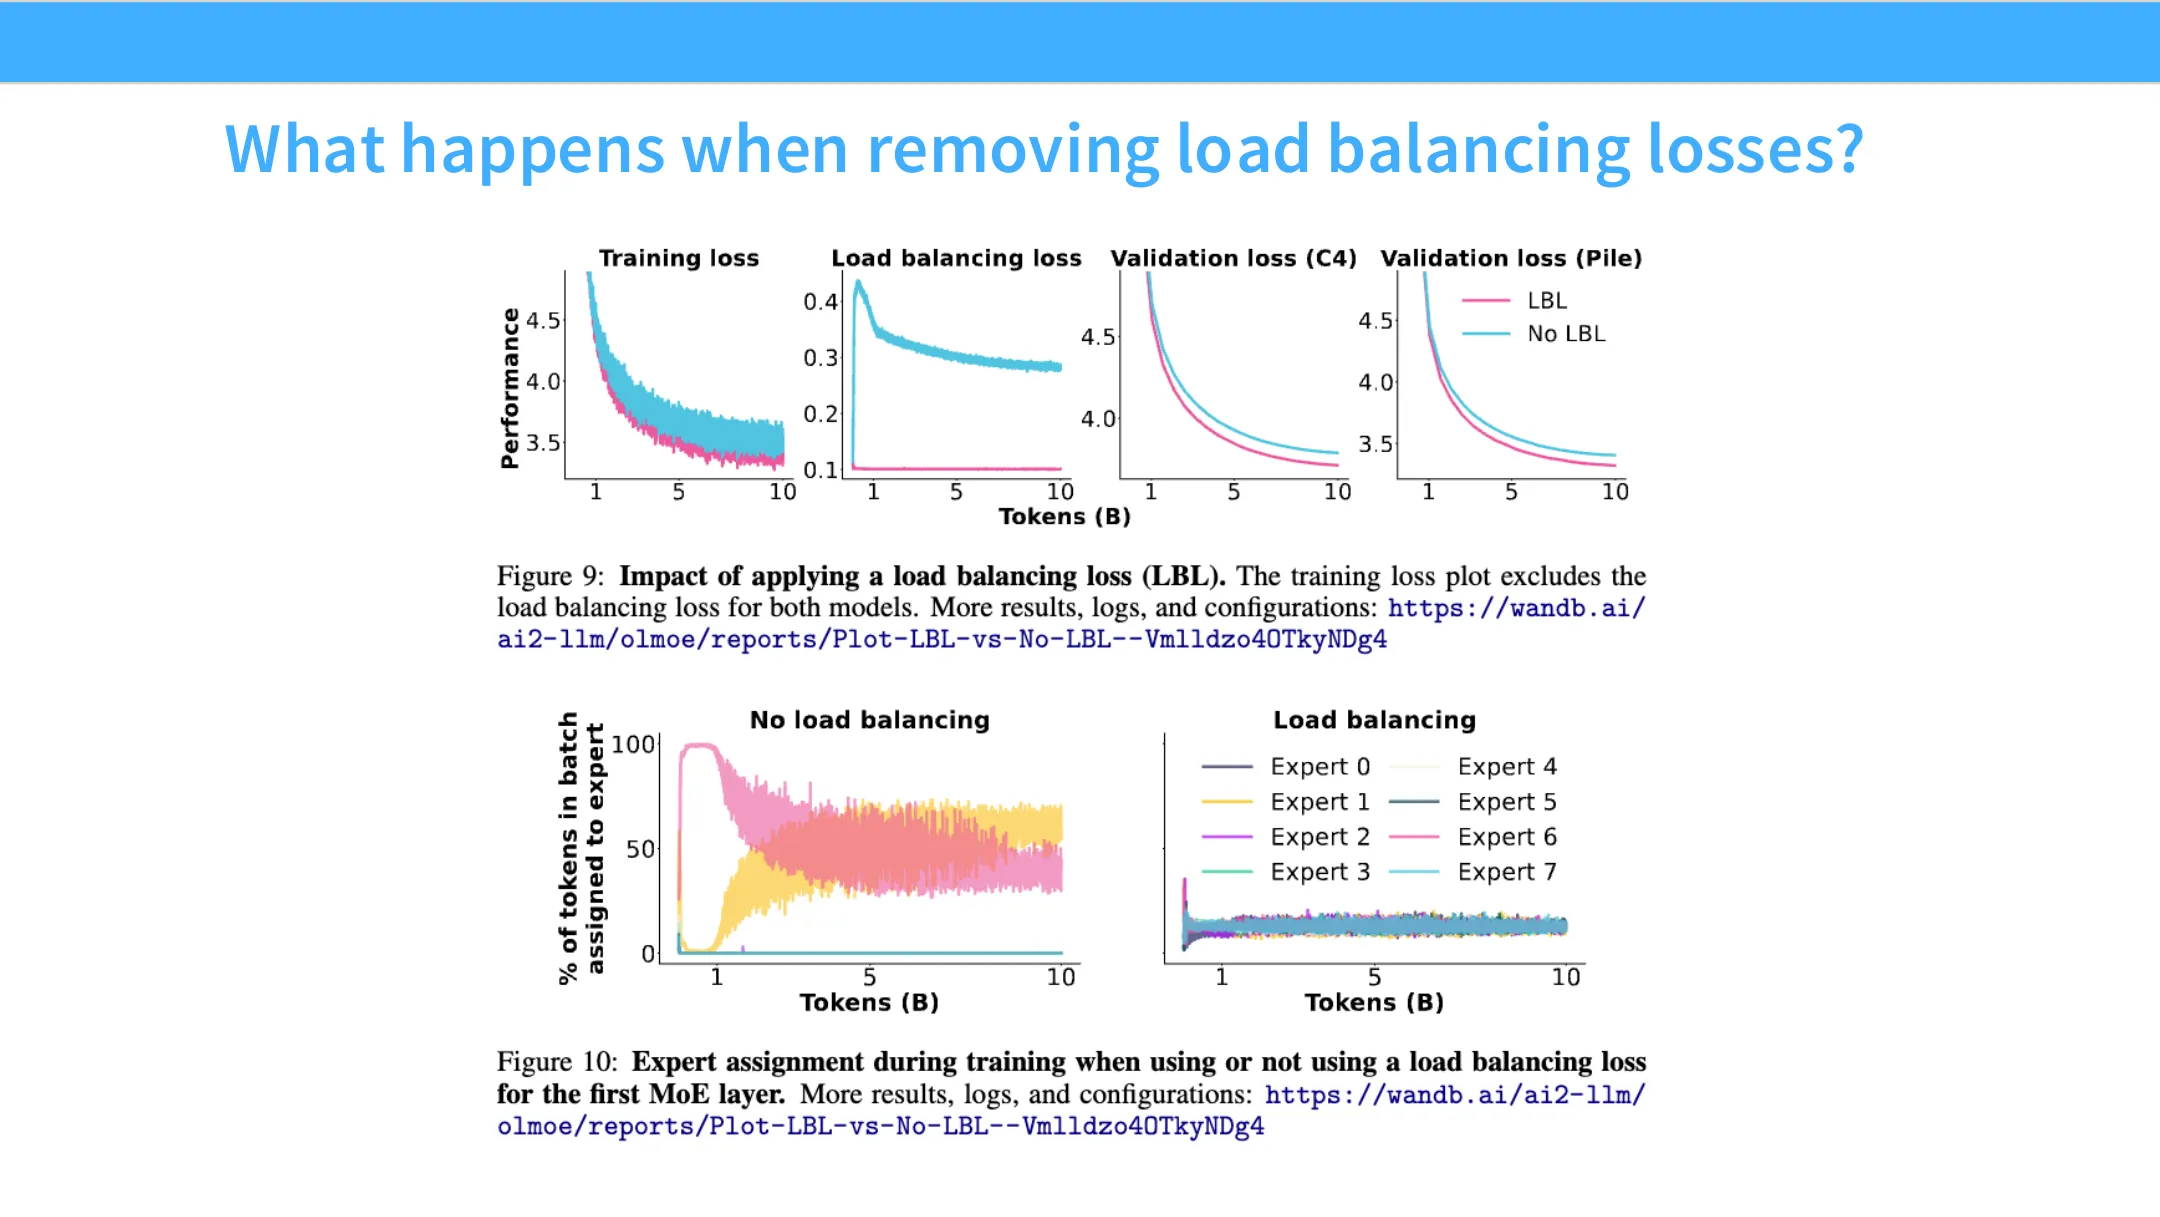
讲师真心话:"I wish I could just get rid of the load balancing loss"——但去掉它后果是灾难性的。
来自 OLMo 论文的消融:
- 保留负载均衡损失:粉色曲线,非常正常的训练曲线;验证损失显著更低、更健康;
- 去掉负载均衡损失:损失显著升高,训练损失也表现不佳。
更说明问题的是底部的两个面板(专家使用分布):
- 无负载均衡:几乎所有 token 都涌向两个专家(黄色的、粉色的)——其余专家完全不工作,白白浪费参数;
- 有负载均衡:即使只是启发式地,所有专家都被均匀使用。
📷 OLMo:去掉负载均衡损失后的专家坍缩
回到原视频 (01:08:11)
graph TD
    A["训练 MoE:仅做普通梯度下降"] --> B["top-K 专家获得更多梯度"]
    B --> C["热门专家权重↑"]
    C --> D["被选中频率↑"]
    D -->|"正反馈循环"| B
    D --> E["专家坍缩:少数专家吃掉所有 token ❌"]
    F["加负载均衡损失<br/>aux = N Σ fᵢPᵢ"] -.->|"抑制正反馈"| G["专家均匀使用 ✅"]
    style E fill:#fee2e2
    style G fill:#dcfce7
10.7 总结:为什么这么「朴素」的方法能 work
(参考时间: 01:09:24)
讲师认为这仍然很反直觉:
- 有一个不可微的 top-K 选择,是个相当复杂的对象;
- 但你真正需要做的,只是加一个平衡损失让专家均匀;
- 其余的,就当成普通可微系统,把梯度灌进去;
- 结果模型训练得非常漂亮。
关键动态:「有用专家会得到强化」的正反馈,被「强制均匀」的力抵消——两股力互相平衡。
10.8 这个模式的未来
(参考时间: 01:09:50)
同样的技巧也用在 DSA 上(我们已经看到那个 top-K)。也用于 H-Nets(一个尝试去掉 tokenizer 的工作)。讲师预测:「top-K 选择 + 用负载均衡或其他辅助损失来使不可微部分可训练」,将成为未来架构设计的常用手法。
课堂追问([01:10:19]):「MoE 的专家真的有语义吗?」
- 有论文可视化「哪些 token 被哪些专家激活」。
- 由于路由器太简单,并非「医学专家」「法律专家」这种语义专家;
- 但确实能看到某些 token 被分到特定专家:标点可能分到一个专家、非英语字符集可能分到另一个专家;
- 但你是不会看到「华尔街日报专家」这种东西的——没有语义。
追问([01:11:04]):「为什么既有逐专家损失、又有逐设备损失?」
- 逐专家损失若完美执行,在专家均匀分配时会自动带来逐设备平衡;
- 但你不想把逐专家损失调到会导致完全均匀的程度——因为那会损害训练动态;
- 而逐设备平衡足够重要,值得加一点额外损失去鼓励它。
11. MoE 的系统侧:专家并行
(参考时间: 01:11:37)
在收尾前,讲师谈 MoE 的系统侧。
训练 MoE 引入了额外的、有趣的系统动态。
11.1 标准并行回顾及其上限
- 数据并行:把数据分到很多机器上;
- 模型并行:把模型分到不同机器上;
- 二者可以各种组合。
问题是:每种并行都有自己的上限。
- 数据并行:batch size 到顶就不能再并行;
- 模型并行:有天然的切点,切点用完了就不能再切。
11.2 MoE 给的新轴
(参考时间: 01:12:36)
专家并行(expert parallelism) 给出额外的并行轴。而且:
- 底层实现可以利用 GPU 上已经内置的稀疏矩阵乘法;
- 单个 GPU 上有多个专家时,可以拆成多个小矩阵乘法,但不理想(你想让矩阵乘法更大、缓存复用更好);
- 更好的做法是利用结构化稀疏(block diagonal 是最基本的一种,但也可以用更复杂的形式),硬件原生支持;
- 这创造了硬件-架构协同设计(hardware-architecture co-design)的机会。
11.3 通信投影技巧(NeMo Tron 3)
(参考时间: 01:13:59)
专家并行时,要把激活从设备发到设备(「你属于那个专家,我把你送过去」)。这可能是显著的通信开销。
技巧:
- 共享专家不需要通信,这部分可以保留大维度;
- 需要通信的(路由)专家,让它们的激活维度更低。
具体做法:先把残差流(residual stream)下投影(down-project),再做那个把激活发送出去的集合通信调用。这样能显著节省通信,同时不必承受整个隐藏维度都变小的所有缺点。
这是一种投影技巧,用来精巧控制通信 vs 并行的权衡。
graph TD
    A["残差流<br/>高维"] --> B{"是否经共享专家?"}
    B -->|"是"| C["共享专家<br/>本地处理,无需通信"]
    B -->|"否"| D["先做下投影<br/>→ 低维激活"]
    D --> E["路由到远端专家<br/>集合通信代价 ↓"]
    E --> F["远端专家处理"]
    C --> G["汇总输出"]
    F --> G
    style C fill:#dcfce7
    style D fill:#fef3c7
12. MoE 的稳定性与微调问题
12.1 随机性:早期的一个「有趣缺点」
(参考时间: 01:15:07)
早期 MoE 推理基础设施的一个有趣但已被解决的细节:随机性(stochasticity)。
- 如果朴素地做 MoE 基础设施,若专家在输入分布上不是完美均衡,某些专家会比其他更热门;
- 假设 0 号专家是超级热门专家,那么它的队列会不断积累;
- 队列太长时,你不得不开始丢弃 token;
- 早期 MoE 推理代码会静默地丢弃这些 token,返回一个零,然后当作什么事都没发生地继续;
- 后果:奇怪的随机性——如果其他用户发出的 query 命中了你在用的专家,他们会把你从专家队列里挤出去,于是你的结果可能变差。
现在:dropless(不丢弃)架构已经解决了大部分这类问题。所以这已不再是真正的 issue。MegaBlocks 等常见的开源 MoE 框架已经没有这个问题了。
编者说明:MegaBlocks 是一个面向 MoE 的高效开源训练库,其核心之一是不丢弃 token(dropless)的稀疏计算与负载不均衡处理,正是讲师所说的那类基础设施。
12.2 路由 softmax 的稳定性
(参考时间: 01:16:35)
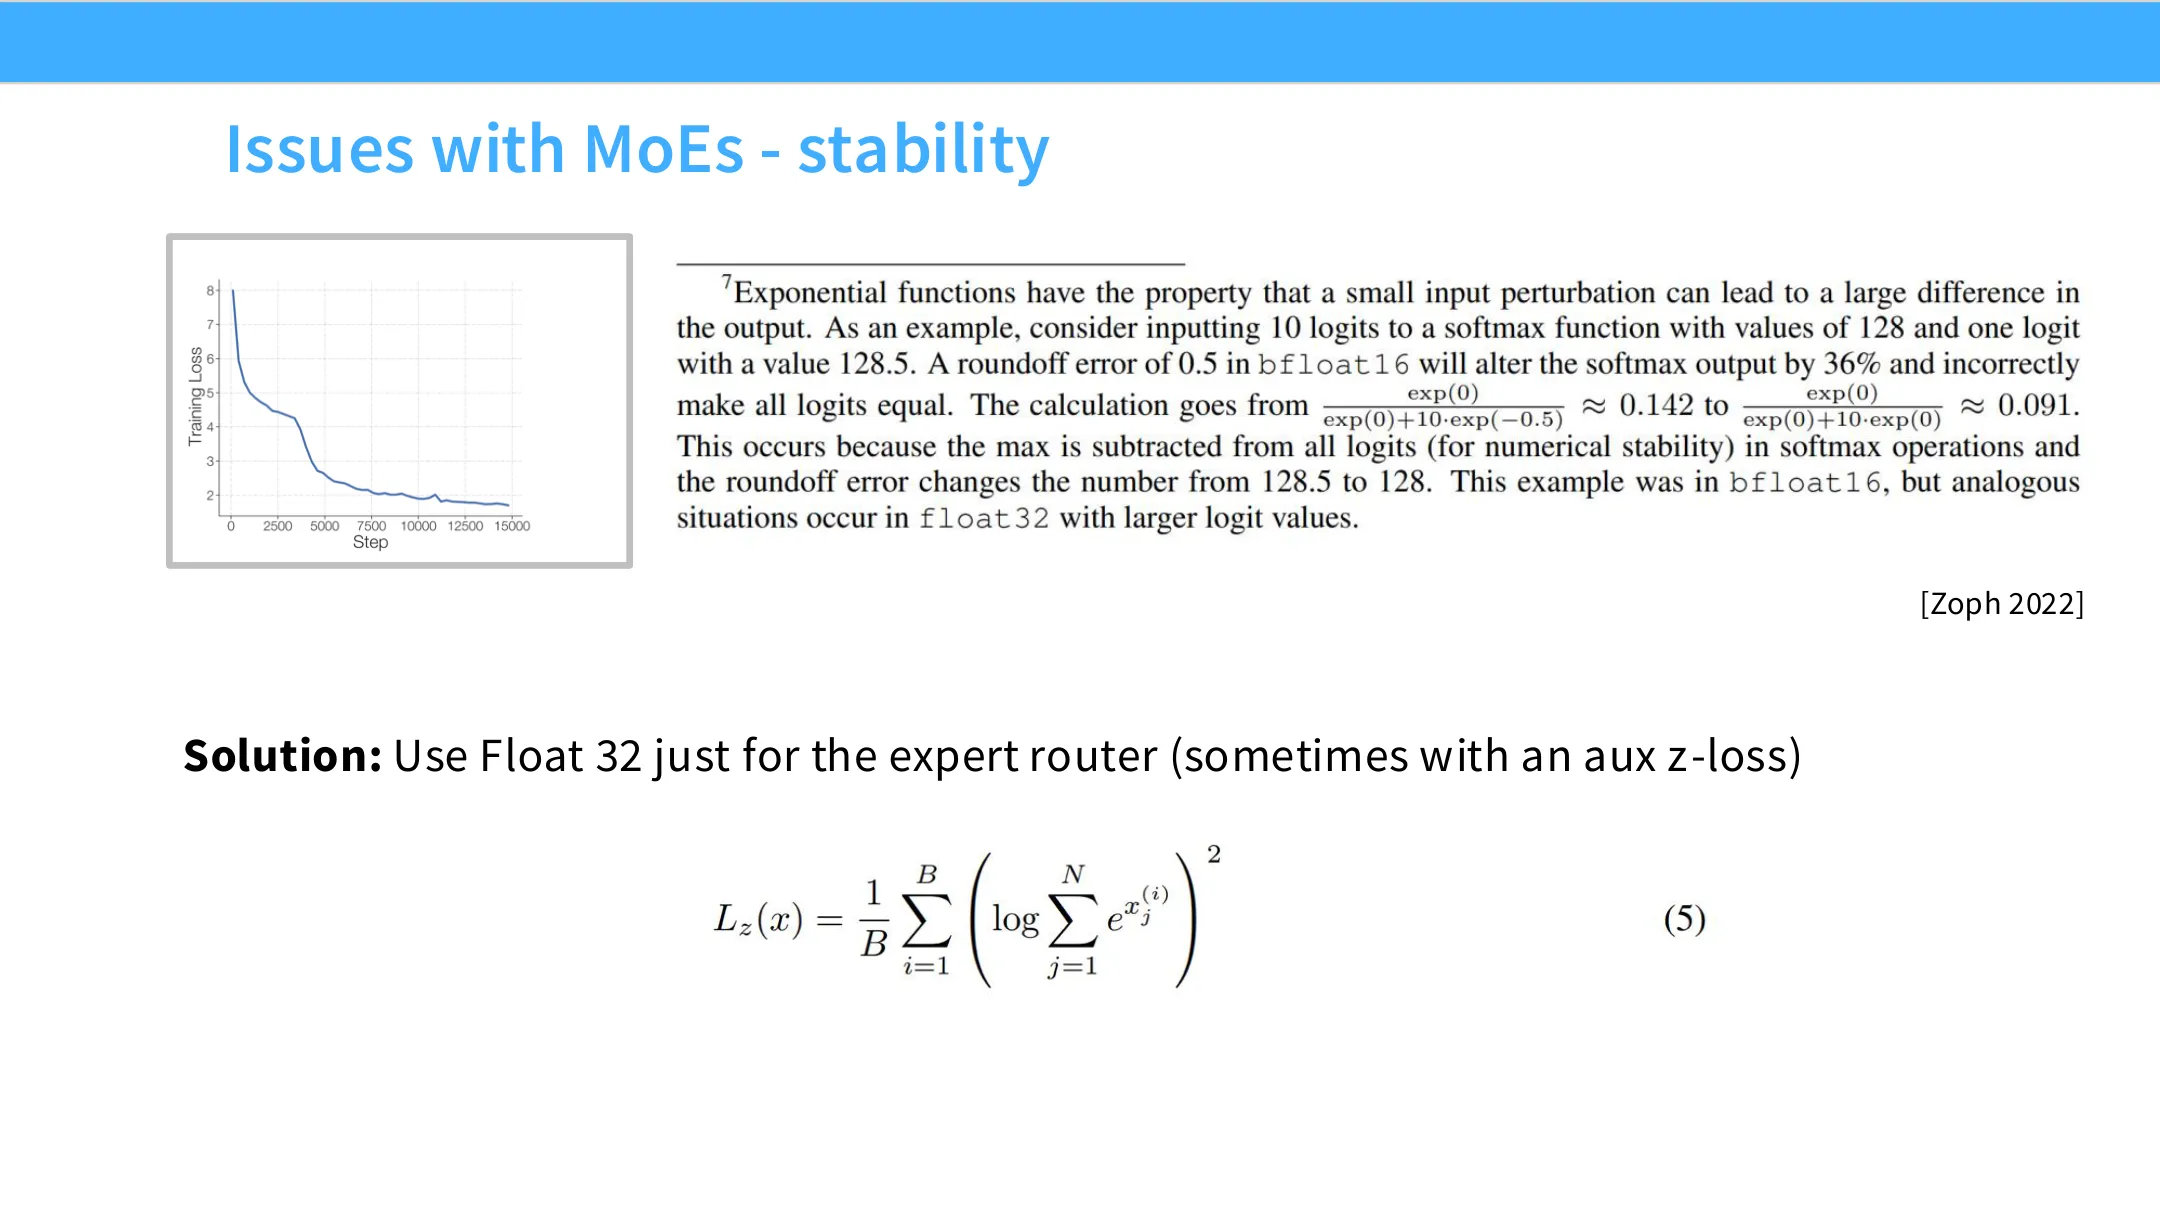
讲师回顾上一讲的观点:指数运算是危险的、除法是危险的,所以 softmax 是「危险区」。
而 MoE 引入了又一个 softmax(路由器里的那个)。人们很早就注意到 MoE 里的 softmax 可能非常危险:
- Barrett Zoph 等人在早期 Google 时代专门写了一篇关于 MoE 稳定性的论文(
[01:17:15]); - 常见解法:
- 路由器单独用 float32;
- 加 Z loss(上一讲也讲过,用来控制 softmax 稳定性问题);
- Z loss 在早期 MoE 路由稳定性里相当流行;
- OLMo 也做了加/不加 Z loss 的消融:从那些非常尖锐的训练损失曲线能看出,在 router 上加 Z loss 可以相当有帮助。
📷 OLMo:router 加 Z loss 可以缓解训练损失尖峰
回到原视频 (01:17:36)
12.3 微调时的过拟合
(参考时间: 01:18:11)
MoE 微调起来很烦:
- 参数太多——如果你试图微调专家,会遭遇严重的过拟合;
- 在图上可以看到:
- 稠密模型:train / val 差距不大,不过分过拟合;
- 稀疏模型:微调某个下游任务时,train / val gap 极其大(当时是 GLUE 的一个任务)。
可以做的补救:
- 微调非 MoE 的 FFN;
- 只微调注意力(这在近期的 MoE 工作里很常见);
- 若模型有非 MoE 层,也可以只微调它们(Barrett Zoph 等人主张过);
- 「苦涩的教训(bitter lesson)」版:直接用 140 万个样本——数据多,你几乎可以在微调阶段完全重训整个 MoE,就不会有这么大的泛化 gap。
编者拓展|什么是「苦涩的教训」 这是 Rich Sutton 的著名论断:凡是依赖人类知识注入的方法,长期看总会被「简单方法 + 大规模算力 + 海量数据」击败。讲师把这条原理用在 MoE 微调上——与其费劲设计精细的微调干预,不如直接把数据堆够。
13. 模型升级(Upcycling)
(参考时间: 01:19:12)
最后一个 MoE 相关技巧:Upcycling(升级再利用)。
讲师提醒:这个技巧在过去一年已明显不再流行——他说今年没见过一个 upcycled 模型。但它是个很酷的想法,早期也有非常好的模型用它,所以要讲。
13.1 想法
(参考时间: 01:20:00)
- 你想要一个 MoE,那就拿一个已经训好的稠密模型;
- 基于它实例化一个 MoE:把所有东西(包括 MLP)复制一大堆副本;
- 路由器随机初始化;
- 然后训练。
为什么能 work?
- 由于哪些输入进哪个 MLP 的随机性,这些专家会开始专业化;
- 最终你会得到一个 MoE。
早期论文([01:20:35])展示:upcycled 的方法,比起继续训练同一个稠密模型,能获得明显更好的语言建模(当时是准确率)性能。
13.2 规模验证
- MiniCPM(讲师喜欢,因为做很多受控消融,
[01:21:01]):把 MiniCPM 2.4B upcycle 到 13.4B,得到一堆近乎免费的收益。 - Qwen(
[01:21:24]):QwenMoE 从 1.8B Qwen upcycle 到 Qwen 1.5A 2.7B,成为一个早期大规模 upcycling 的成功案例。
为什么不流行了?([01:21:49])现在你不会再训稠密模型再转换——你会一开始就训练大 MoE 英雄跑(hero run)。但这个想法本身在 MoE 的行动空间(action space)里仍值得知道。
graph TD
    A["已训练的稠密模型<br/>(含 MLP)"] --> B["复制多个 MLP 副本<br/>作为专家"]
    A --> C["路由器随机初始化"]
    B --> D["训练"]
    C --> D
    D --> E["不同输入随机进入不同专家"]
    E --> F["专家逐渐专业化"]
    F --> G["得到一个 MoE ✅<br/>近乎免费的性能提升"]
    style D fill:#dbeafe
    style G fill:#dcfce7
14. DeepSeek MoE 的演进:V1、V2、V3
(参考时间: 01:22:11)
讲师最后串起 DeepSeek 的 V1、V2、V3——从这三代模型的演化里可以学到很多。
14.1 DeepSeek MoE V1:现代 MoE 的原型
(参考时间: 01:22:32)
V1 已经是很多现代 MoE 的原型:
- 共享 + 细粒度专家结构;
- 标准 top-K 路由 + 辅助损失平衡。
讲师评价:这是 MoE 模型的「柏拉图式理想型」。
14.2 DeepSeek V2:把系统意识加入架构
(参考时间: 01:22:56)
V2 就是把 V1 放大:
- 两个共享专家;
- 更多细粒度专家;
- 设备路由(device routing);
- 通信平衡(communication balancing)。
后面两个其实都是给系统加辅助损失。
讲师金句:成功的语言模型训练不仅仅关乎深度学习,也关乎真正尊重你的系统(respecting your system)。 DeepSeek V2 是这一哲学的体现。
14.3 DeepSeek V3:延续 + 系统创新
(参考时间: 01:23:24)
V3 仍然有共享 + 细粒度专家设计,但平衡方式不同:
- 有 aux-loss-free(无辅助损失) 的专家平衡方式;
- 权重改用 sigmoid + softmax;
- 整体大体相似。
V3 的其他系统创新(讲师「是他们的系统的忠实粉丝」):
a) 多头潜在注意力(Multi-head Latent Attention, MLA)([01:23:59])
- 不再直接产生 $Q, K, V$,而是先产生一个低维的潜在量 $C$;
- 再从 $C$ 产生 $Q, K, V$;
- 好处:之前需要给所有 $K, V$ 存 KV cache,而现在只需存这些 $C$——$C$ 维度更低,大大节省 KV cache;
- 「Latent」这个名字正来自这些$C$是潜在的、是需要被保存的 KV cache 量;
- 要注意的复杂性:这与 RoPE 在做 KV cache 时会冲突,得小心处理维度旋转方式——技巧是用非潜在维度编码位置。
b) 多 token 预测(Multi-Token Prediction, MTP)([01:24:12])
- 不再只预测一个未来 token,而是一次预测多个;
- 有统计上的理由说明它可能让你更好地预测未来;
- 也有一个系统上的理由:你现在内建了一个投机解码器(speculative decoder);
- Percy 会在之后的推理课上讲这个;
- 讲师说这是他觉得作为 MoE 思路很酷的东西——但并没有广泛流行。
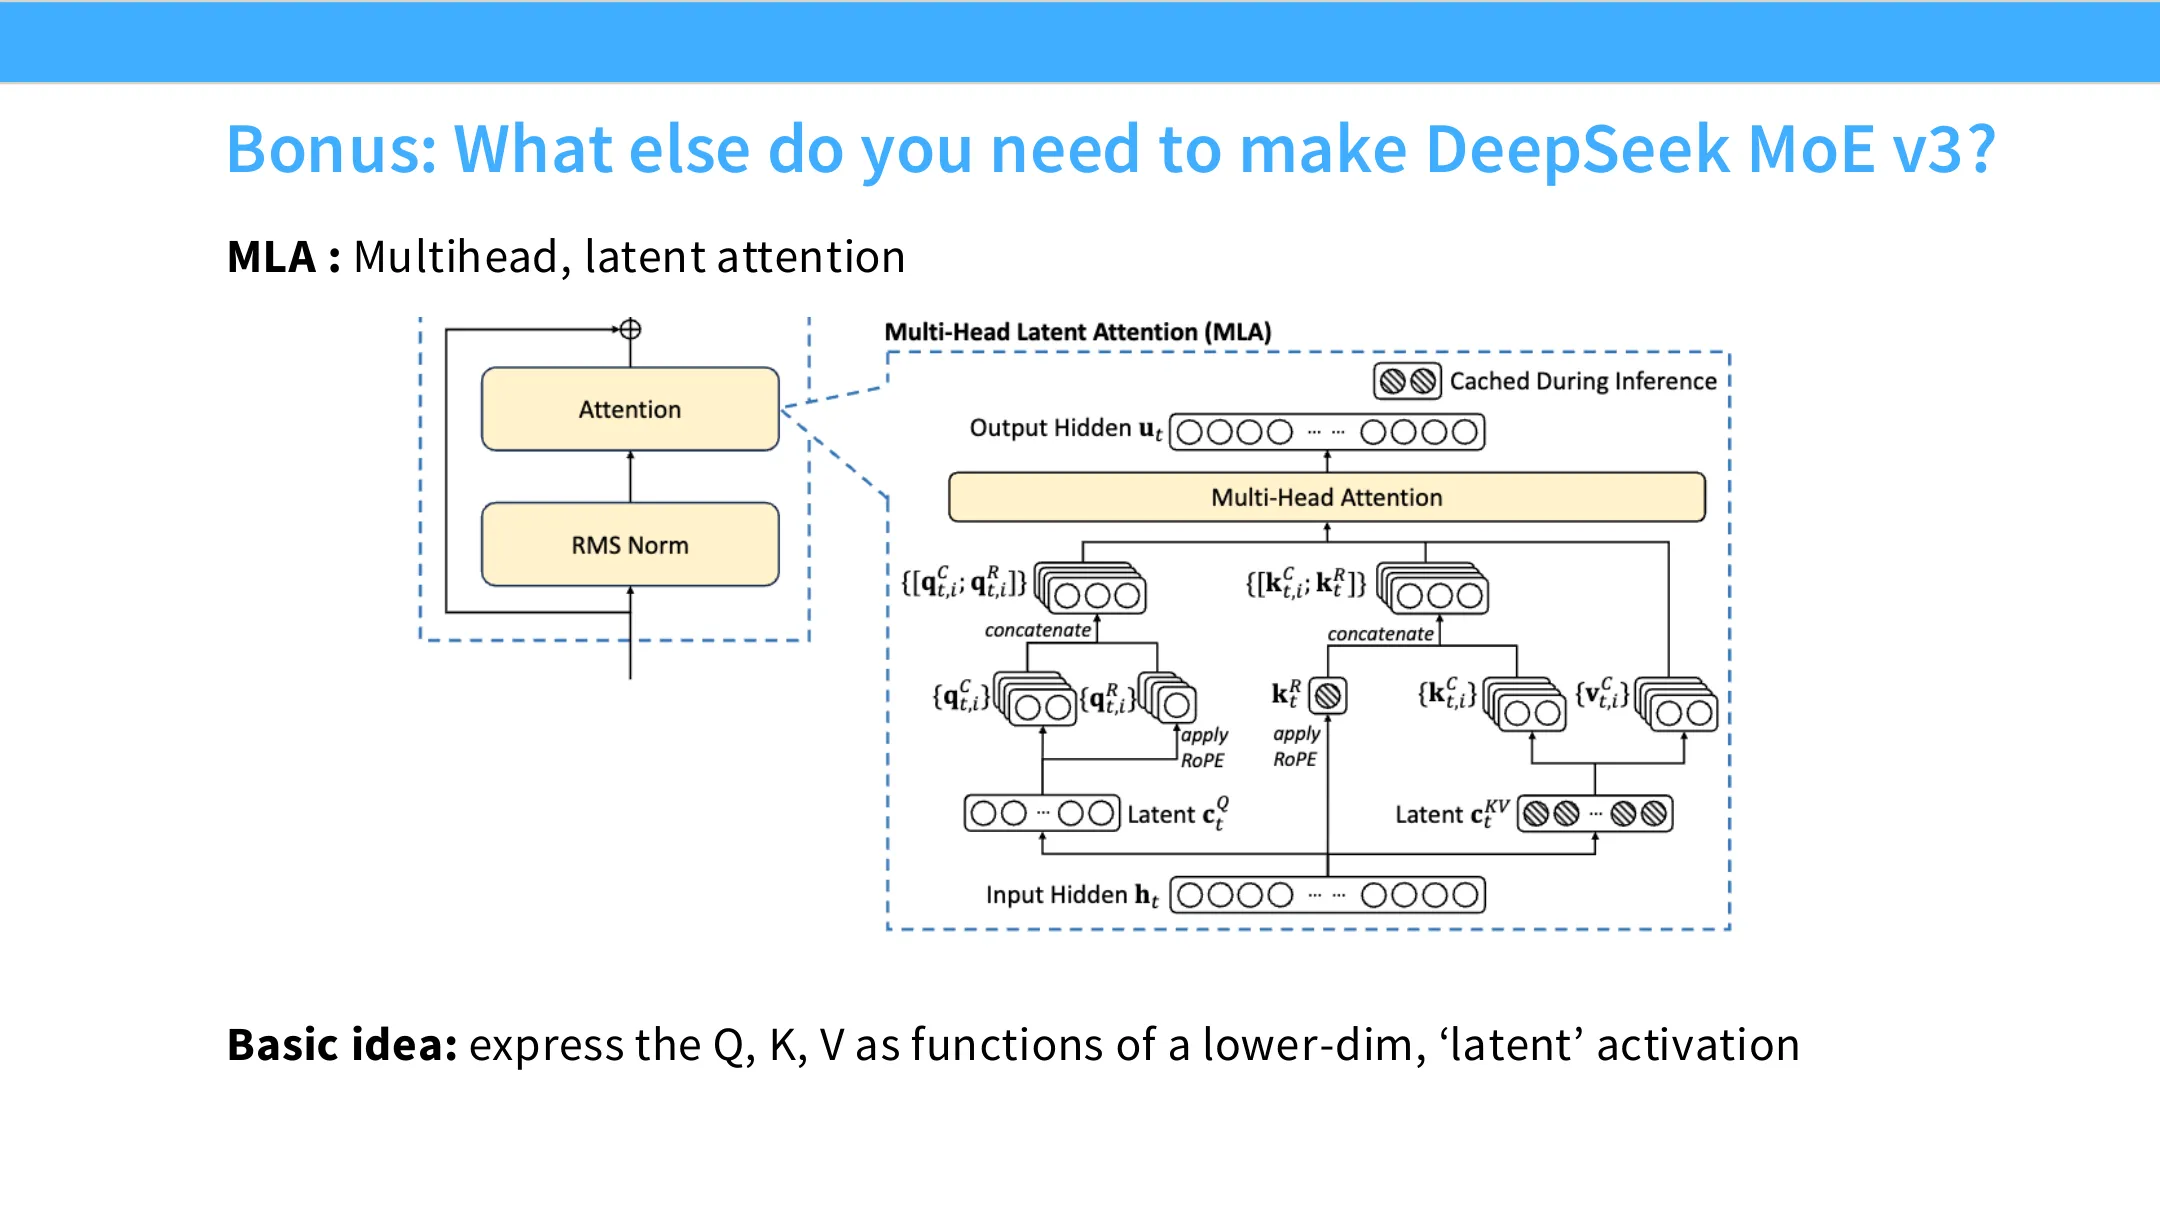
📷 DeepSeek V3 的多头潜在注意力与多 token 预测
回到原视频 (01:24:12)
15. 总结
(参考时间: 01:25:41)
把一切串起来:
- MoE 是一个极其聪明的想法——利用稀疏性,让你拥有比你所付出的计算成本更多的参数。你不为所有参数付 FLOPs,但你拿到了参数的好处;
- 你可能一开始觉得这个路由问题很难,但事实证明,非常简单的方案在规模上也能 work;
- 到这一步,MoE 已经明确是「留下来」的技术。所以你应该理解它是什么、它怎么工作。
附:参考与延伸阅读
编者补充
已知疑点
- 本讲字幕取自 YouTube 自动字幕轨(
en),专有名词、人名与模型名可能存在同音识别错误;文中出现的论文标题、模型版本号(如 DeepSeek V1/V2/V3、Qwen 系列)请以官方 PDF 幻灯片(course/lecture_04.pdf)为准。 - 讲者现场提到的部分数字(参数量、专家数、激活比例)在字幕中偶有含糊,编者已尽量结合幻灯片校准,仍有个别处未能逐一核实(正文已用「编者说明」标出)。
- 字幕本身没有丢失或明显截断;除上述术语类风险外,未发现影响理解的其他疑点。