第5讲 · Stanford CS336 从零开始的语言建模:GPU 与 TPU
| 课程 | Stanford CS336 Language Modeling from Scratch(Spring 2026) |
| 本讲 | Lecture 5 — GPUs, TPUs |
| 视频 | https://www.youtube.com/watch?v=izZba4UA7iY |
| 视频 ID | izZba4UA7iY 时长:约 79 分钟 |
| 主讲 | Tatsunori Hashimoto(Tatsu),斯坦福 |
对应讲次:第5讲(Stanford CS336 语言建模)
制作模型:deepseek-flash(vb compose,据 run.log)
整理说明:本书由课堂英文口语字幕重构、翻译为中文书面语,并补充必要背景。所有「编者说明 / 编者拓展」均为整理者所加,不代表讲师原话。
导览
① 老师真正提出的问题
这一讲,Tatsu 是按他自己在本堂课里抛出的顺序来推进的,核心问题依次是:
- 为什么现在要让模型继续变大,只能靠 GPU 这类"大规模并行"硬件?(旧时代靠时钟频率越来越快,为什么这条路走不通了?)
- 一块 GPU 到底长什么样? 它和 CPU 的"设计哲学"差在哪里,为什么这个差异决定了我们怎么写代码?
- 那么怎样才能让一段代码在 GPU 上真正跑得快? 他会给出六个可以拼装使用的技巧。
- 把这六个技巧合起来,我们能不能自己"重新发明"Flash Attention? ——这是他留给整讲的"胜利的一圈"。
一句话:他把这一讲组织成「硬件心智模型 → 六个技巧积木 → 拼出 Flash Attention」三段。
② 难点在哪
- 第一次接触 GPU 的人会觉得它"又像魔法、又是台奇怪的设备"(老师原话)。难点不在背概念,而在建立一套能推理的心智模型:Compute 涨得飞快,Memory 涨得要慢得多,于是几乎所有优化最后都变成"让数据少跑几趟"。
- 最容易卡住的一步是 Tiling(分块):为什么把矩阵切块塞进 shared memory 就能变快?为什么矩阵尺寸只差 1、吞吐却断崖下跌?这里需要同时抓住"内存层次 + 合并访问 + SM 数量"三件事,任何一件没抓住就会觉得这是"GPU 玄学"。
③ 读者可能带着的疑问
① 老师真正提出的问题(承上):承接上面 ①②③④。
② 编者预判的读者疑问(编者预判,非讲师原话):
- GPU 和 CPU 到底差在哪?为什么 CPU 那套"串行跑得更快"的老经验失效了?
- SM、warp、block、thread 这些词到底谁包含谁?
- 我平时写 PyTorch,这些底层东西跟我有关系吗?(有——老师会反复强调"哪怕你不写 kernel,也要能推理硬件,否则你永远做不好 scaling"。)
- 低精度(FP8/FP4)听起来很可怕,它到底怎么做到的?会不会训崩?
- 为什么矩阵尺寸"凑成 16 或 32 的倍数"就更快?为什么把词表从 5257 改成 5304 反而加速 25%?
- Flash Attention 到底"发明"了什么?(老师答案很朴素:它就是把 分块 和 重计算 套到 attention 上。)
④ 本讲路线
- 第一段(约 0–30 分钟):GPU/TPU 的硬件模型——SM、内存层次、编程模型、TPU 的"趋同演化"。
- 第二段(约 30–72 分钟):让 GPU 变快的六个技巧——控制分歧、低精度、算子融合、重计算、合并访问、分块;最后用它们破解那张"神秘吞吐曲线"。
- 第三段(约 72 分钟往后):把六个技巧组装起来,亲手推导出 Flash Attention。
导览只给地图,不剧透推导,也不提前给结论。
0. 开场:进入"系统"部分
(参考时间: 00:05)
编者说明:视频开始于 00:00:05,老师开场即宣布:前面两讲做的是神经网络的部分,从这一讲起进入课程的系统(systems)部分,内容依次是 GPU、并行化与推理。
老师给了一个总纲式的判断:系统是整条技术栈里"最能讲道理"的一块——你可以一步步逻辑推演,得到明确的结论,这让人非常满足。但他也提醒:第一次和 GPU 打交道,它既像魔法,又像一台非常古怪的设备。
他现场做了一次小调查:多少人上过 GPU 编程课?大约四分之一或更少。他说这很正常——第一次接触这些东西确实有魔法感,就像深度神经网络一样。
编者说明(本讲的承诺):老师在一开始就许下一个具体的承诺——听完这一讲,你会看懂下面这张"神秘吞吐曲线",并理解它为什么会是那个样子。这条曲线会贯穿全讲:横轴是矩阵乘法的维度,纵轴是吞吐量(每秒处理的元素数)。你会看到各种诡异的花纹——某些尺寸下矩阵乘法明显慢一大截。为什么?这正是本讲要回答的。
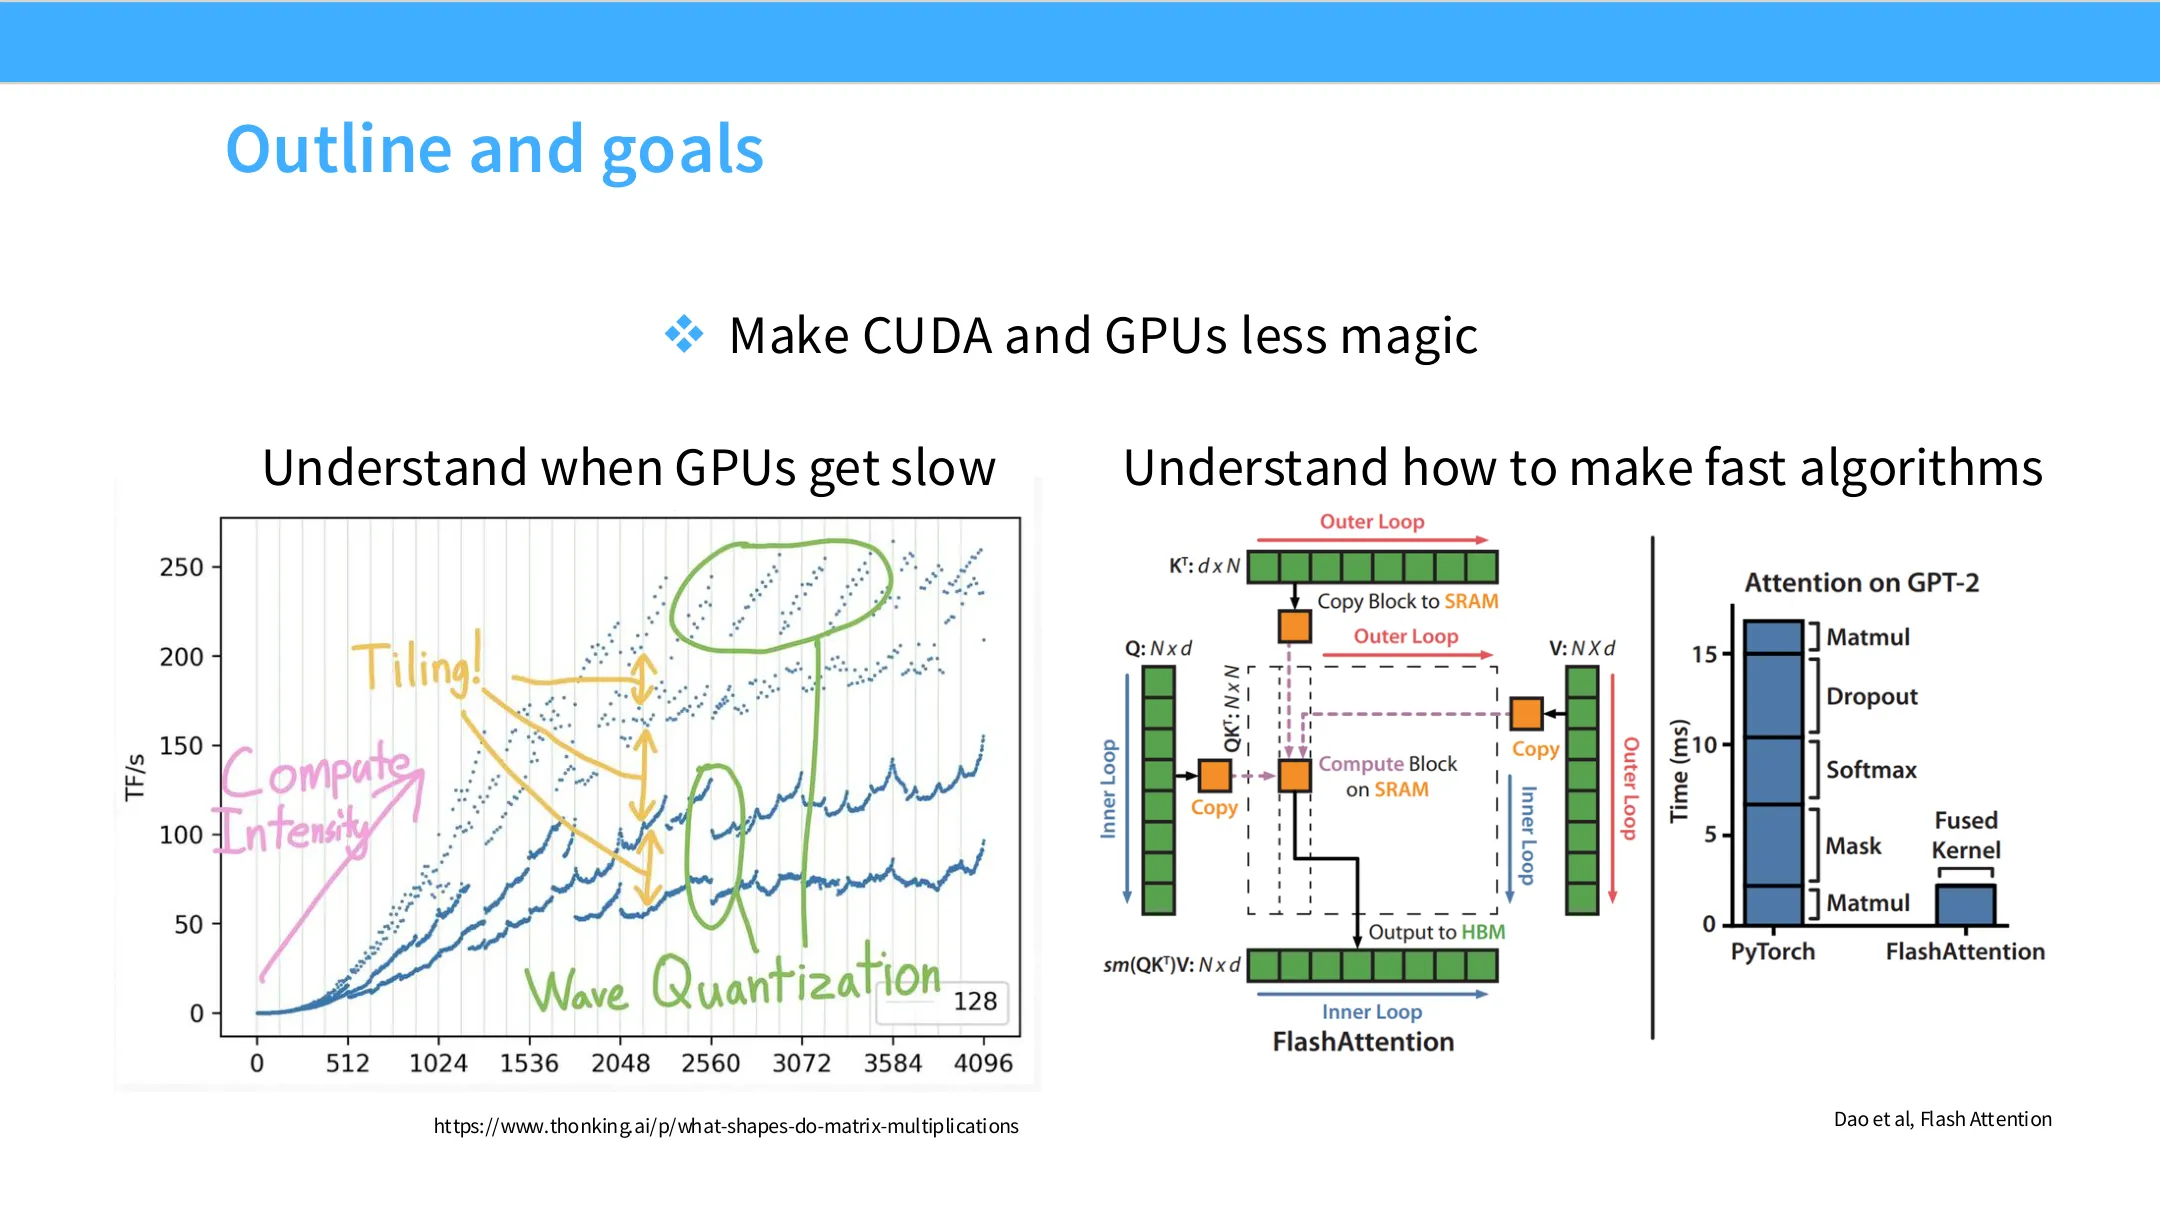
📷 矩阵乘法吞吐随维度变化的曲线(纵轴吞吐、横轴维度,带各种怪异花纹)
回到原视频 (00:01:14)
为什么要先理解硬件
老师强调:哪怕你不是系统方向的人,只要你在做架构设计或推理,就必须理解"你的模型在硬件上是怎么执行的"心智模型。
他回溯到 Percy(Percy Liang)在课程开头的 scale 讲:
Big part of scaling 就是确保你高效地使用你的资源;不理解系统,你永远无法高效利用资源。
他也顺带自嘲:"我不是系统方向的人(surprise)。"因此他强烈推荐了两类外部资源(本讲大量参考了它们):
- Horace He 的博客:把 GPU 原理讲得极好的 explainer。
- GPU mode(原来叫 CUDA mode)社区:一群热爱聊 GPU、CUDA kernel 的人。
- Google 出品的书(他称之为"TPU 书 / 现在的 GPU 书"):老师称它是"极好的资源",并提示课后作业会包含和这本书习题相似的内容。
编者补充|延伸阅读:老师提到的那本 Google 书,一般指 Google/JAX 团队维护的 How To Scale Your Model(JAX scaling book):https://jax-ml.github.io/scaling-book/。Horace He 的博客见 https://horace.io/。GPU MODE 社区见 https://github.com/gpu-mode。
本讲三段结构
(参考时间: 00:03:19)
graph TD
    A["第一段:GPU 硬件导论<br/>硬件模型 + 编程模型"] --> B["第二段:让 GPU 变快的六个技巧<br/>(building blocks)"]
    B --> C["第三段:把所有技巧拼起来<br/>重新推导 Flash Attention = 胜利的一圈"]
- 第一段:GPU 的硬件模型,以及 GPU 编程是怎么工作的。核心目的是让你从哲学层面理解 GPU 与 CPU 的不同。
- 第二段:六个重要技巧,让你能把代码改造得在 GPU 上高效运行。
- 第三段:Flash Attention——"胜利的一圈",此时你已经具备"自己重新发明 Flash Attention"的全部工具。
第一部分:GPU 的硬件模型
1.1 从"时钟越来越快"到"大规模并行"
(参考时间: 00:04:14)
老师先引出一个前提:如果有更多算力,就能训出更好的语言模型——这是整个领域的"硬通货"。算力增长的三个来源是:
- 更快的硬件;
- 更高的利用率;
- 更多的芯片 + 更好的并行化。
如果我们是在 1990 年代讨论这件事,答案会是时钟频率:
- CPU 串行执行指令,我们把指令执行得越来越快;
- 晶体管变小、时钟变快,这就是 Dennard scaling,它稳定工作了相当长时间;
- 大约到 2000 年代,这种 scaling 触到天花板。
(参考时间: 00:05:24) 一个有趣的旁注:晶体管数量确实还在继续增长,但把晶体管做小并不等于让它跑得更快——它不会以更高的时钟频率工作。这里有根本的物理原因,到某个点后你不再能从"更小的晶体管"里持续获益。
于是问题变成一个根本性的追问:
在"不能单纯提高频率"的世界里,我们如何让 LLM 继续 scale?
答案就是并行(parallel scaling),而 GPU 是其中的核心。老师说 Percy 下一讲会讲更进阶的主题(并行),而"并行"与"GPU"本质上属于同一种范式:与其让单个时钟越来越快(串行加速),不如横向铺开,让更多东西同时执行指令。
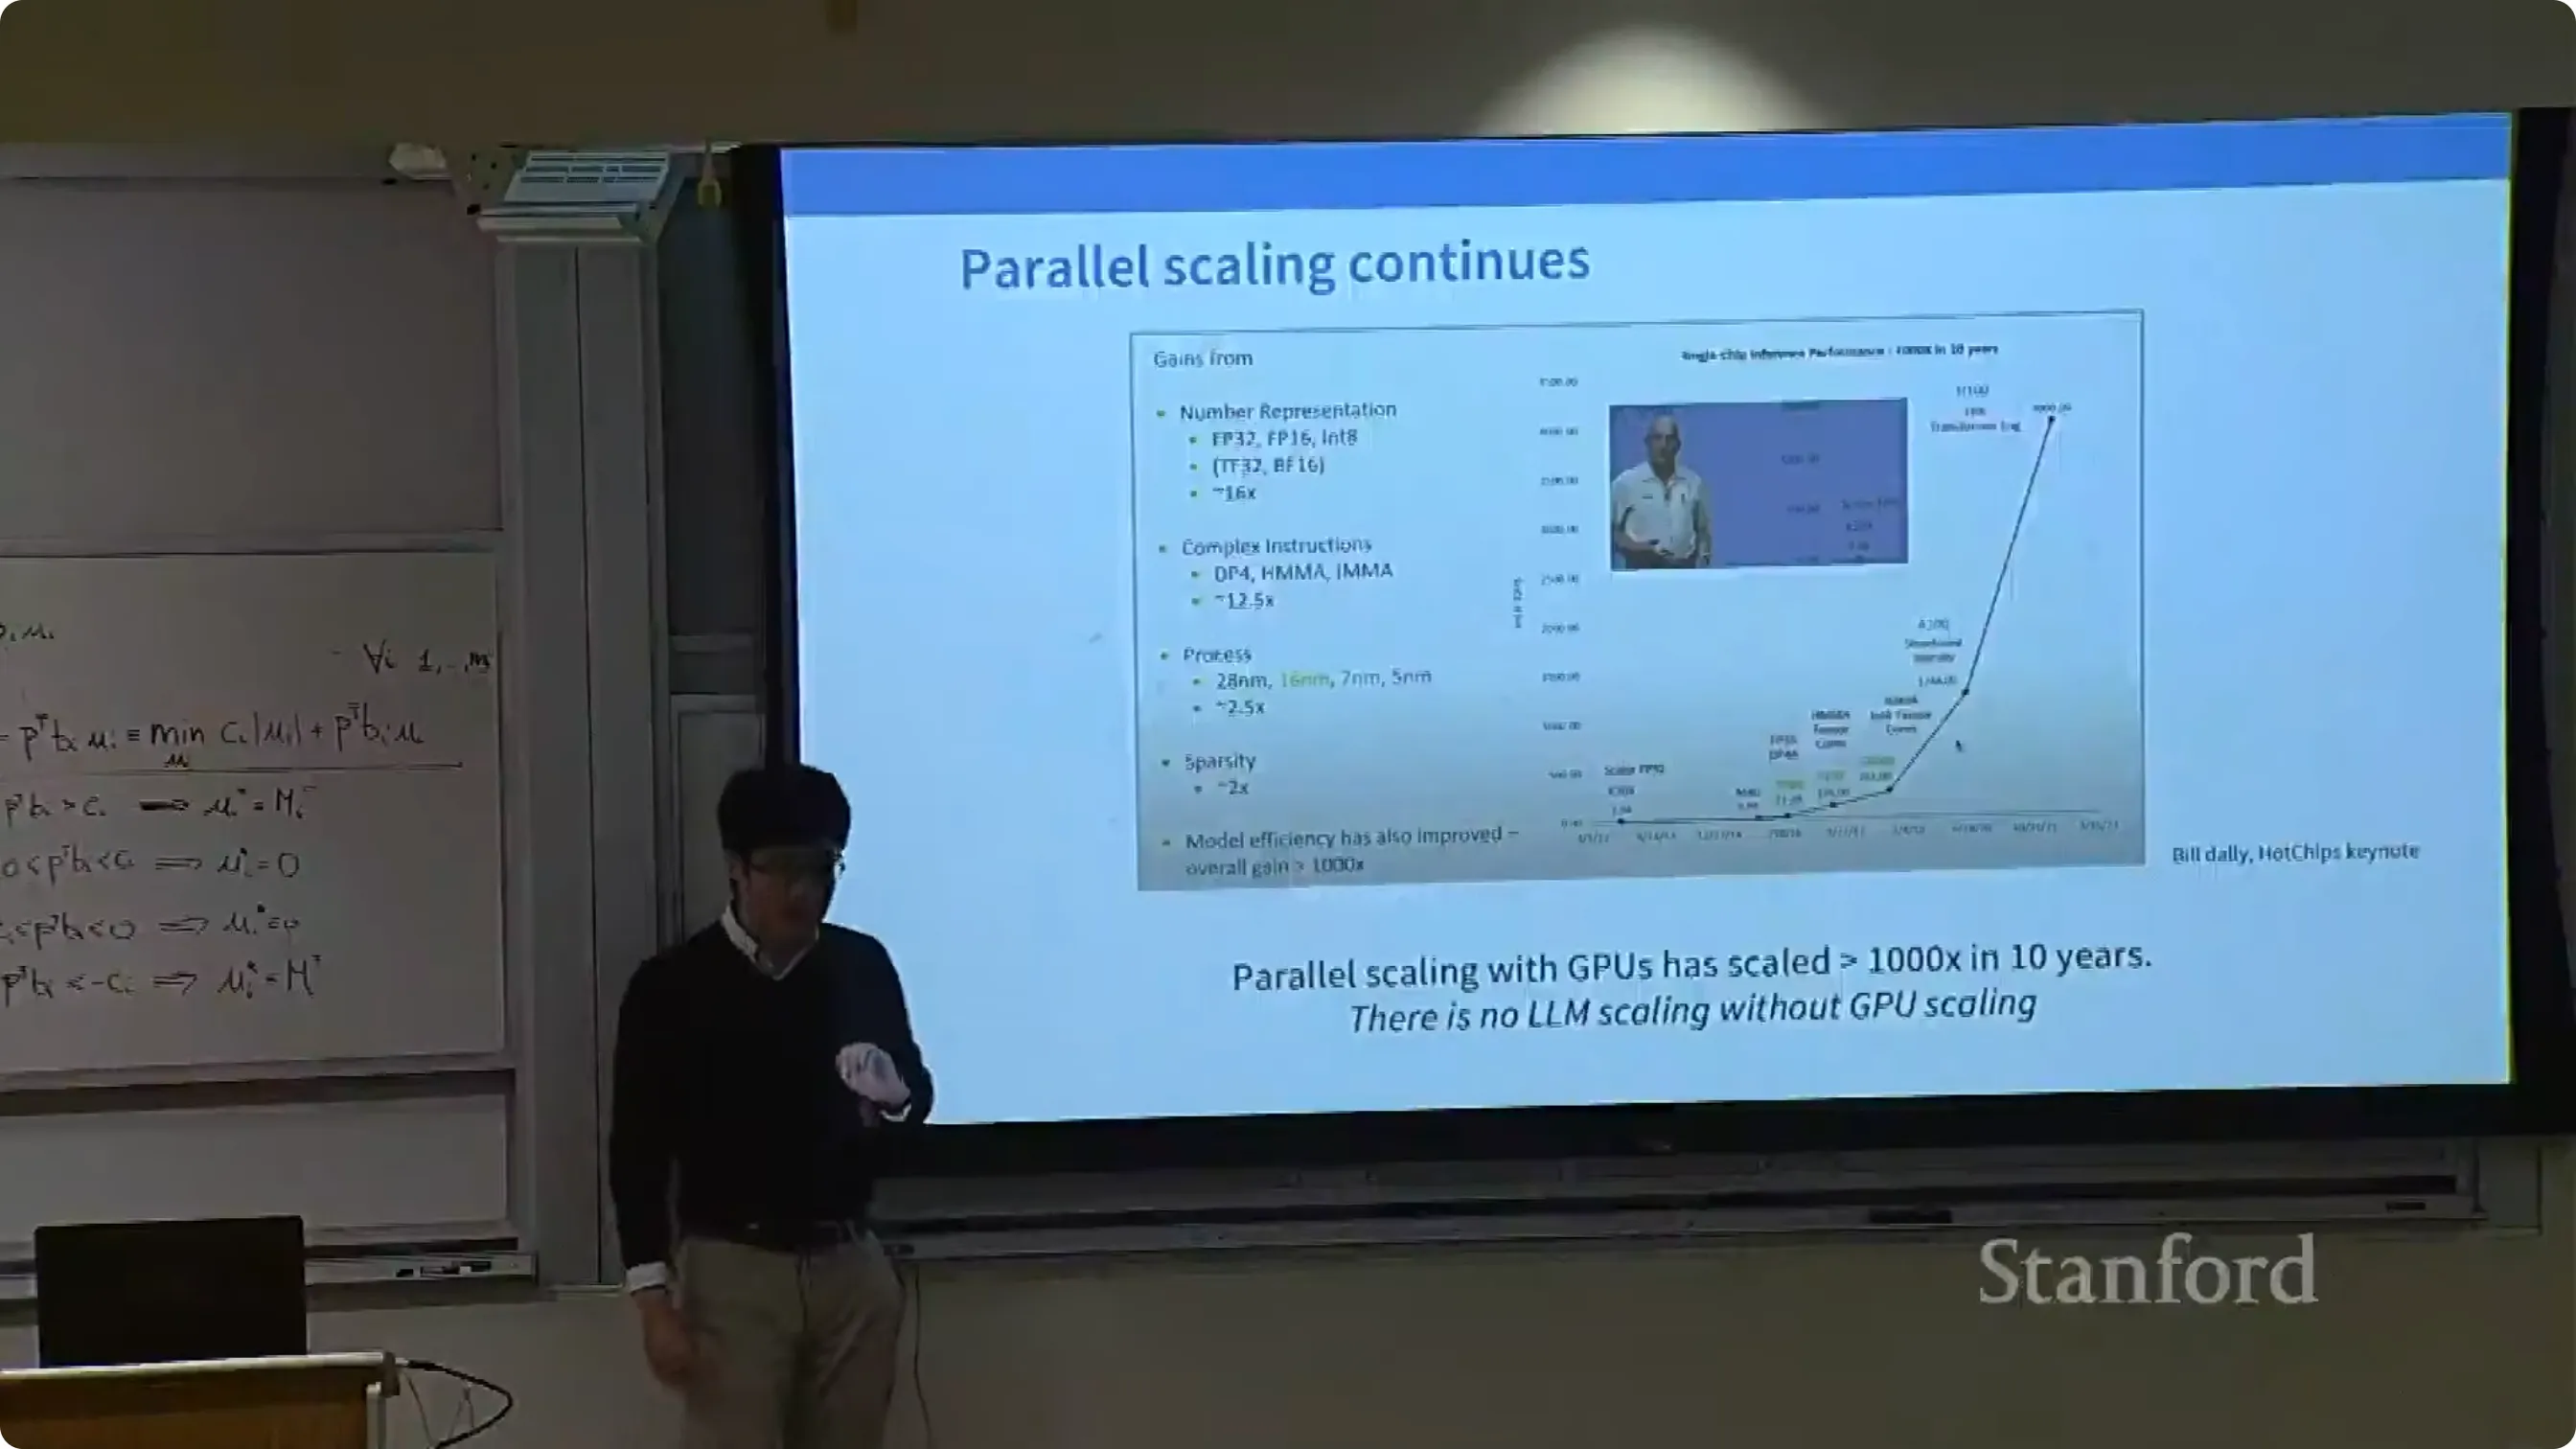
📷 GPU 算力随年份的增长曲线(从 K20/M40 到 P100/V100 之后起飞)
回到原视频 (00:06:26)
(参考时间: 00:06:44) 有一张堪称"一图胜千言"的曲线图:早期 K20、M40 时代 flops 尚可但按今天标准很可怜;到 P100 / V100 附近曲线陡然起飞,逐年获得超指数级的浮点算力增长。老师说:GPU 的 scaling 几乎驱动了我们所见到的全部算力增长。
他把后续硬件创新点先点出来放进你脑子里:
- 2017 年 V100 时代,开始出现 Tensor Core(张量核心)——一大硬件创新;
- 随后几年,结构化稀疏(structured sparsity)、FP8 以及各种更低比特的格式,进一步推高 flops。
1.2 GPU 与 CPU 的设计哲学之别
(参考时间: 00:07:31)
老师说:已经熟悉 GPU 的人可以跳过,但对其他人,理解这背后的"哲学"极其重要。
CPU:
- 为快速串行执行而生;
- 要处理复杂的分支逻辑、条件判断、控制流;
- 因此 CPU 有很大的控制单元,但只有很少几个 ALU(算术逻辑单元);
- 追求低延迟:从拿到指令到完成指令的时间要非常短。
GPU:
- 为吞吐量(throughput)而生;
- 一个任务可能要很久才完成,你可能处理完一个任务、停下、去做另一个、再回来;
- 但即便单个任务不快,你在所有任务上获得巨大的聚合吞吐;
- 实现方式是成百上千个轻量核心塞进一块芯片,全部并行执行。
用一句话总结:CPU 是"快而少",GPU 是"慢而多"。 这是两种完全不同的编程与思维方式。
老师的比喻(编者复述):右侧那张图很形象——CPU 像一个会一口气快速做完一件事的专家;GPU 则像一条长长的流水线,单个环节慢,但整条线每秒吐出大量成品。
1.3 GPU 的硬件结构:SM 与内存层次
(参考时间: 00:09:02)
老师的目标是给 GPU 去魅:不要把它想成一堆英伟达写的规格文字,而要能在脑子里"看见"硬件。
graph TD
    subgraph Chip["GPU 芯片(die)"]
        SM1["SM(Streaming Multiprocessor)<br/>内含 L1/SRAM + 多个流处理器"]
        SM2["SM"]
        SMD["…… 共 100+ 个 SM"]
        L2["L2 缓存(在片上,但离 SM 较远)"]
    end
    HBM["Global Memory / HBM<br/>(芯片外的 DRAM,容量最大、最慢)"]
    SM1 <--> L2
    SM2 <--> L2
    SMD <--> L2
    L2 <--> HBM
- SM(Streaming Multiprocessor,流式多处理器)是 GPU 的基本计算单元,可近似看成"一个核心"。它自带子组件来加速计算,并能访问特定类型的存储器。
- 每个 SM 内部不是一个计算单元,而是若干流处理器,可以并行执行不同的线程(thread)。
- GPU 有海量 SM:例如 A100 有 128 个 SM,每个都能独立编程、独立跑不同的任务,也都可访问外面的 global memory。
编者拓展|为什么是 128 个 SM? SM 的数量决定了一块 GPU"能同时铺开多少独立工作"。这会在后面"波量化(wave quantization)"那一节里变成一个关键数字——当你的任务不能被 SM 数量整除时,一部分 SM 会空闲,吞吐断崖式下跌。
内存层次(memory hierarchy)
(参考时间: 00:10:20)
老师特别强调:现代硬件的 LLM 优化,本质上是被"内存"定义的。所以我们先要弄清内存有哪些层、住哪里。
| 层级 | 大致延迟(A100 基准测试) | 位置 | 是否可编程 |
|---|---|---|---|
| 寄存器 registers | 最快 | SM 内 | 是 |
| L1 / shared memory | 约 20–30 周期 | SM 内 | shared 可编程;L1 由硬件自管 |
| L2 cache | 慢得多 | 片上,离 SM 较远 | 由硬件自管 |
| Global memory (HBM) | 约比 L1 慢 10 倍 | 芯片外(DRAM) | 是 |
几处关键点:
- L1 与共享内存非常快:约 20–30 周期就能读写。
- L2 慢得多;global memory 又是 L2 的约 10 倍慢——这是巨大的速度差。
- 平时我们说"一块 H200 有 144 GB 显存",指的是 global memory,不是 shared 或 L1。
为什么不做一整块"共享内存芯片"?
(参考时间: 00:12:20) 有同学问:"既然共享内存这么好,为什么不整块芯片都做成共享内存?"老师答:
- 贵得多——几百倍;
- 而且非常耗电,这跟这些内存的构造方式有关。
因此,实际加速器必须是内存层次化的,关键是"用得得当"。
他提到 Groq(老师说它"最近被英伟达收购")的设计就是堆一大块 SRAM,对推理这类负载很友好;但对绝大多数加速器而言,你还是得尊重这个层次结构,才能把任何东西跑快。
编者说明(存疑,见文末"已知疑点"):老师此处提到某家"最近被英伟达收购"的公司,字幕写作 Grok/Rock(见 00:01:39 与 01:01:13 两处),名称与归属表述在整理时无法核实,读者不必据此记忆具体公司,只需记住"全 SRAM 架构昂贵且耗电"这一结论。
shared memory 与 L1 的区别
(参考时间: 00:12:54) 同学提问两者区别,老师回答:
- L1 cache 只是一个"缓存"——自动存放最近访问过的数据,你不控制它;
- shared memory 是一个可编程的部件——你可以主动把东西放进去、取出来。
L2 为什么比 L1 慢?
(参考时间: 00:28:11) 同学的追问,老师答:
- 物理距离是主因;L1、L2 都是 SRAM(这正是 global memory 慢很多的原因之一——它是 DRAM);
- 物理距离 + 所用的互联(interconnect)决定了延迟;
- 补充:TPU 中相当于 L2 的层快得多,因为它在硅片上做了不同的取舍——这是它的卖点之一。
编者拓展|SRAM vs DRAM:SRAM 用多晶体管存一位,速度快、不需刷新,但每比特占面积大、耗电高;DRAM 用"电容 + 少量晶体管"存一位,密度高、便宜,但访问需要等待电荷感测(这正是后面"突发/burst"的来源),且需要周期性刷新。所以片上缓存用 SRAM、主存用 DRAM,是成本与速度权衡的必然结果。
1.4 编程与执行模型:thread、block、warp
(参考时间: 00:13:26)
老师介绍了执行模型里的三个核心角色:
- Thread(线程):并行执行工作的轻量单位。关键特性是 SIMT(Single Instruction, Multiple Thread)——所有线程执行完全相同的指令,只是输入不同,因此能做各自有用的工作。这对效率和编程模型都有深远影响:如果线程能各干各的,编程会变得极难,所以 GPU 是在可编程性与效率之间做取舍。
- Block(块):一组线程。之所以重要,是因为一个 block 保证运行在同一个 SM 上。而 SM 有共享内存,所以 block 能访问一块共享的内存池。这会在后面 Tiling 时变得至关重要——不同 block 复用同一块内存。
- Warp(线程束):本质是 GPU 内部的调度单位。线程以连续编号的 32 个为一组执行,这就是一个 warp。这样做降低了调度器的开销。
老师本人的措辞习惯:"当我说'不同的 warp 在执行',指的就是 32 个线程一起执行的那个基本单位。"
同学的两处澄清:
- "所有线程执行相同指令"——是同一个 warp 内的所有线程。(参考时间: 00:14:51)
- 调度器决定下一个执行哪个 warp。
1.5 GPU 的内存模型
(参考时间: 00:15:49)
设备代码可以访问如下内存(从近到远):
- 寄存器(registers):最快、最局部,存一些很小的东西(比如数组的起止地址)。
- 本地内存(local memory):在单个 SM 内。
- 共享内存(shared memory):在 block 内共享。如果你要跨线程传递信息或让信息被多个线程复用,就应该放在这里。
- 全局内存(global memory):就是那块"很远的 DRAM",只要愿意付延迟就能读。
- 常量内存(constant memory):较少在实际编程中使用。
- 主机内存(host memory):CPU 侧内存,必要时可以把数据 offload 到 GPU 之外。
最核心的一句:一旦你走出 shared memory,一切都会变慢。 因此"把 block 分组,以减少 global memory 读取的次数"就是整堂课的主旋律。
1.6 旁白一:内存与算力的剪刀差
(参考时间: 00:25:33)
老师用最后一张硬件幻灯片说明:GPU 的不同部件在以不同速率增长。
- 灰线:总算力(flops)——涨得飞快;
- 绿线:内存带宽(memory bandwidth)——增长相对缓慢;
- 蓝线:并行互联(device 间连接)——也涨得很慢。
含义非常明确:
在早期 GPU 编程时代,你可能不必太在意内存,因为算力还没比内存快多少。但越往右走,算力与内存的鸿沟越大,所以今天讲的很多优化都是内存优化。要充分利用硬件,代价会越来越高。
(参考时间: 00:28:31) 同学追问这个剪刀差会不会改变未来芯片布局(预算怎么分配)。老师借题发挥了一个很现场的观察:
- 推理的硬件格局更"疯狂":去年开始流行 prefill-decode 分离——prefill 是重矩阵乘法(算力重),decode 是内存带宽受限,于是用两块不同芯片分别处理;
- 有些模型(老师举例提到一个中国开源模型,字幕记为 "step one three",见文末疑点)甚至把不同层拆到不同加速器:attention 去一块芯片、MLP 去另一块;
- 结论:如果这个 gap 继续扩大,任何"善用宝贵快速内存"的巧思都会变得极有价值。
编者说明:这里的 "step one three" 可能是某个 Step 系列开源模型名称的听写误差,见"已知疑点"。此处不必记具体模型名,抓住要点即可:推理比训练更受内存带宽约束。
1.7 旁白二:TPU——一次"趋同演化"
(参考时间: 00:17:17)
老师花两张幻灯片讲 TPU,理由有二:一是 TPU 越来越流行;二是它是GPU 的"另一条演化路线",对比一下能看清"什么相同、什么不同"。
一个反直觉的观察:在高层次上,TPU 和 GPU 极其相似——这就是趋同演化。如果你要造一台"能高效做机器学习的省电加速器",你最后大概率会走到同一个地方。
TPU 与 GPU 的核心心智差异:
- TPU 在某种意义上更简单,更为机器学习负载优化;
- 控制单元更轻;
- 矩阵乘法单元更大。
但它的基本结构是一样的:
- 有专门做矩阵乘法的电路;
- 有做并行向量运算的部件;
- 有控制单元;
- 内存结构也一样:慢的层叫 HBM,更快的局部内存叫 S-mem / shared memory。
真正最大的差别——老师今天不讲——在网络/互联,而不在单颗芯片。
GPU 概念 ↔ TPU 概念 一一对应
(参考时间: 00:19:24) 老师引用 "JAX 书" 里的一张对照表,说这个映射相当精确:
| GPU | TPU |
|---|---|
| Tensor Core(矩阵乘法单元) | MXU(矩阵乘法单元) |
| Streaming Multiprocessor(SM,处理器) | Tensor Core(注意!TPU 把处理器叫 tensor core) |
| 更小的矩阵乘法单元(数百个) | 更大的矩阵乘法单元(8 个) |
| Shared memory / L1 | S-mem |
⚠️ 一个极其容易混淆的命名陷阱(老师说这"非常非常令人困惑"): TPU 把它的"流式多处理器"叫做 tensor core;GPU 把它的"矩阵乘法单元"叫做 tensor core。两个东西名字一模一样,必须靠上下文区分: - 说 TPU 的 tensor core → 指处理器; - 说 GPU 的 tensor core → 指矩阵乘法单元。
规模对比:少而大 vs 多而小
(参考时间: 00:20:52)
- 一块常见 GPU(如 H100)可能有约 132 个 SM(很多处理器);TPU 只有 2 个单元。
- 只看矩阵乘法单元:GPU 约 528 个;TPU 只有 8 个。
- 二者是相近量级的对象,但策略截然不同:
- TPU:更少、更大的矩阵乘法单元;
- GPU:更多、更小的矩阵乘法单元。
- 后果:GPU 更灵活(想怎么编就怎么编),而 TPU 把你锁死在"大矩阵乘法"上。
老师讲了一个他亲身经历的例子(这是"思想的起源",务必保留):
在我写的一篇论文里做过 batch size sweep:一路往下扫,到 64 就停了。为什么?因为 TPU 的 tensor core 拒绝接受任何小于 64 维的输入——它必须是"大矩阵乘法"。而 GPU 因为单元又小又多,就能灵活处理更小的尺寸。
结论:GPU 与 TPU 共享大量相似性——都依赖内存层次、都有矩阵乘法单元,所以今天教的核心理念在两者之间是可以迁移的。这就是趋同演化:"只有那么几种方式能经济地分配内存,也只有那么几种方式能把矩阵乘得足够快。"
1.8 为什么矩阵乘法是"特权操作"
(参考时间: 00:24:53)
老师说,即便在 Tensor Core 出现之前,人们就意识到:大规模并行的商品显卡,对科学计算会非常有效。
他提到一篇早期的经典论文——用图形硬件做快速矩阵乘法,是"非常酷的黑客工作":
人们发现:明明 GPU 是给 shader 用的,但可以编写特定的 shader 让它做矩阵乘法;甚至不同的渲染设置就能换来更快的矩阵乘法。
这是很妙的计算机科学。但今天你不必再这么做了:
- 从 V100 起,英伟达决定:"给你一块硬件,专门替你做矩阵乘法"(即张量核心);
- 一旦这块硬件存在,matmul 就成了机器学习里唯一的"特权操作";
- 于是可并行但不是矩阵乘法的操作,与矩阵乘法之间出现了巨大吞吐鸿沟;
- 因此,任何"随算力 scale"的未来 ML 架构,几乎一定会包含矩阵乘法——因为这是唯一能有效拿到大量算力的方式。
- 具体数字:矩阵乘法比 GPU 上任何其他浮点运算快 10 倍以上。
编者拓展|算术强度与 Roofline(为何矩阵乘法是"特权") 衡量一段计算"值不值得搬到算力上",看它的算术强度(arithmetic intensity):
$$I = \frac{\text{FLOPs}}{\text{Bytes moved}}$$
Roofline 模型给出的吞吐上限是:
$$\text{Throughput} = \min\Big(\underbrace{\text{Peak FLOPS}}_{\text{算力上限}},\; \underbrace{I \times \text{Memory BW}}_{\text{内存上限}}\Big)$$
矩阵乘法之所以"特权",是因为它对 $M\times N\times K$ 的运算只搬 $M\times N + N\times K + M\times K$ 个元素,$I$ 随维度线性增长,几乎总能落在"算力上限"那一侧;而逐元素运算(如 ReLU、softmax)的 $I$ 是常数,永远贴着"内存上限"。
1.9 第一段小结
(参考时间: 00:26:44) 老师给出这段的心智模型清单:
- GPU 是极度并行的:指令全部同时执行;
- 算力增长极快,且比内存更快,所以内存极其重要;
- 因为内存重要,一切都要尊重内存层次:尽量把东西放进 shared memory,而不是 global memory。
他说:你不可能靠 20 分钟彻底理解 GPU 硬件,但只要你带着这三句话,就能消化下一部分。(参考时间: 00:27:30) 随后停顿接受提问。
(参考时间: 00:27:38) 同学追问:"所以 V100 之前没有专门的矩阵乘法单元?"老师确认:张量核心是 V100 的新增。在那之前你只能手动编程——当然有那么多 SM 和 ALU,也能取得不错的吞吐,但专用电路真正地改变了游戏规则。
第二部分:让 GPU 跑得快的六个技巧
(参考时间: 00:30:10)
现在你已经对 GPU 有整体感觉了。接下来是一套基础积木,可以拼装出"让负载在 GPU 上跑得快"的方案。为保持动机,老师再次立下目标:
到本节结束,我要向你解释清楚那张神秘吞吐曲线。
再回顾一下那张图((参考时间: 00:30:28)):
- 横轴:方阵的维度(做两个方阵相乘);
- 纵轴:每秒处理的元素数(吞吐);
- 总体趋势:越往右吞吐越高(矩阵越大,工作量越大,硬件利用率越高);
- 但图上有各种奇怪的花纹:某些尺寸下明显慢一大截。
我们的目标变成两个问题:为什么会有这些花纹?怎么才能待在曲线的顶部而不是底部?
2.0 先看 Roofline 模型
(参考时间: 00:31:10) Percy 之前提过的 Roofline 模型在这里再次登场。它把吞吐画成一条"斜线 + 平台":
graph LR
    A["内存受限区<br/>(斜线)<br/>算力再多也没用"] --> B["算力受限区<br/>(平台)<br/>矩阵乘单元已饱和"]
- 斜线段 = 内存受限:不管给它多少算力,吞吐都上不去;
- 到某个点,每单位内存搬运对应的工作量足够多,算力单元被完全喂饱;
- 平台段 = 算力受限:再给更多工作也不会更快,因为矩阵乘法单元已经饱和。
因此,要让代码跑得高效,就是设法待在"平台段"——也就是提高算术强度(每次内存读取对应的计算量要足够高)。
编者拓展|算术强度的量化直觉 老师举了个"很蠢但很直观"的例子:一个长度为 $N$ 的向量,逐元素做一次运算。 - FP32:读 4 字节 + 写 4 字节 = 8 字节/元素,只做了 1 次 flop → $8\ \text{Bytes/flop}$; - BF16:字节数减半 → $4\ \text{Bytes/flop}$。
这就是"低精度"为什么能同时缓解内存瓶颈:每 flop 要搬的字节数直接减半。(注意这其实是算术强度的倒数。)
老师说接下来有六个技巧,第一个的"味道"和其余五个不同,其余五个都围绕尽量减少内存搬运这一主题。
技巧一:控制分歧(Control Divergence)
(参考时间: 00:33:02)
这个技巧是GPU 特有的,源自之前讲过的 SIMT 模型——"每个线程执行同样的东西"。
问题:如果在一段跑在 GPU 上的代码里写了 if 语句,会发生什么?
- 在 CPU 上:很直白——选一个分支执行,然后继续。
- 在 GPU 上:行为反直觉——因为所有线程必须执行同一条指令,所以每个线程实际上会"执行"if 和 else 两条分支,但不在该分支里的线程只是被掩码掉、空转等待。
graph TD
    A["所有线程到达 if"] --> B["部分线程走分支 A<br/>(分支 B 的线程空转)"]
    B --> C["部分线程走分支 B<br/>(分支 A 的线程空转)"]
    C --> D["继续"]
这叫做控制分歧(control divergence)。它的好处是简化编程;代价是产生巨大的计算空隙(GPU 在空转)。
这也是为什么在 GPU 代码里要尽量避免写 if:比如实现 ReLU 时,你经常会看到乘以 mask / 乘 0,而不是写一个 if 只更新一半——因为一次乘法能"一起完成",而 if 可能要花两个时钟周期/两次操作。
编者拓展|为什么 ReLU 常写成
x * (x > 0):在现代 GPU 上,比较与乘法的向量化开销很低,而分支会引入 warp 内分歧。用"掩码乘法"把控制流换成数据流,能让整个 warp 步调一致地前进,避免串行执行两条分支。
技巧二:低精度计算(Low Precision)
(参考时间: 00:34:53)
老师说:这个技巧你几乎不用做什么额外工作,但它可能是最重要的之一,也是英伟达投入最多的方向。
回到那张"超指数增长"的曲线——它从哪来?很大一部分来自数字表示(number representations):
$$\text{FP32} \rightarrow \text{BF16} \rightarrow \text{INT8} \rightarrow \dots$$
不断降低数字精度。比特数减半,要搬的比特就减半,于是内存搬运减半——至少暂时解决了内存瓶颈。
低精度的"黑魔法"
(参考时间: 00:36:33) 现实中低精度在 GPU 上并不简单。做矩阵乘法时,张量核心如何真正在低精度下工作?
- 你不会把所有东西都保持在低精度;
- 在做乘积之前先 downcast(降精度);
- 对矩阵乘法里的部分和(partial sums)用全精度累加;
- 结果可能以 FP32 输出。
老师强调:低精度的难,不在"降低精度"本身(谁都会),而在"该把哪些操作放在哪种数字格式里":
- 矩阵乘法:权重和激活也许都能低精度;
- 但 softmax,也许必须 FP32;
- 指数运算也许必须 FP32,也许能容忍 BF16。
这就是为什么低精度是一条缓慢、经验性、逐步推进的路——花了好几年才达到今天的状态。
从 BF16 到 FP8:格式开始分化
(参考时间: 00:38:11) 人们还在继续往前压——只要你算过高速内存有多贵,就会想"要是精度再砍一半就好了"。
到 FP8 时,不再有统一的标准格式:
- E4M3:4 位指数、3 位尾数;
- E5M2:指数更多、尾数更少。
一旦比特数少到这种程度,就没有万能格式了,不同场景用不同格式。
MXFP8:多缩放因子的花招
(参考时间: 00:38:51) 老师简要讲了 MXFP8,因为它"既酷,对训练的后果又很古怪"。
传统 FP8 训练:
- 激活用 8 位(FP8);
- 配一个 FP32 缩放因子(scale factor),用来上下调整范围。
为什么需要缩放因子?因为指数位只有 4 位左右——太少,很快就会上溢/下溢,需要缩放因子把你保持在合适的范围内。
问题:单个矩阵内部的量级可能差异极大——序列里某一段的激活可能远大于另一段。一个缩放因子不够。
MXFP8 的做法:用很多缩放因子。
- 每个缩放因子对应一块彩色子矩阵(比如每 4 个元素一组对应一个缩放因子……实际是每 32 个元素一个);
- 缩放因子本身也是低精度:8 位、E8M0(只有指数位、全是 2 的幂)。
老师在这里((参考时间: 00:40:35))故意停下来问全班:
不去读第三点。想一想,这个设计有什么大问题?
答案:转置(transpose)。这个矩阵的转置不会保留相同的缩放模式。
- 过去矩阵转置很简单——直接转,不用做别的;
- 现在转置变得非常复杂:必须重新量化整块矩阵,去适配那个"每 32 个元素一个缩放因子"的模式。
而现实中的做法(老师说"既疯狂又酷"):
内部会为每个量化矩阵保存两份副本——一份原矩阵、一份转置。这样一旦需要转置,转置版本已经在那里等着你。
老师的落点:重点不是 GPU 冷知识,而是一旦到了 FP8/FP4 这种格式,事情就变得极其 exotic——指数和尾数损失都很极端,必须非常聪明。
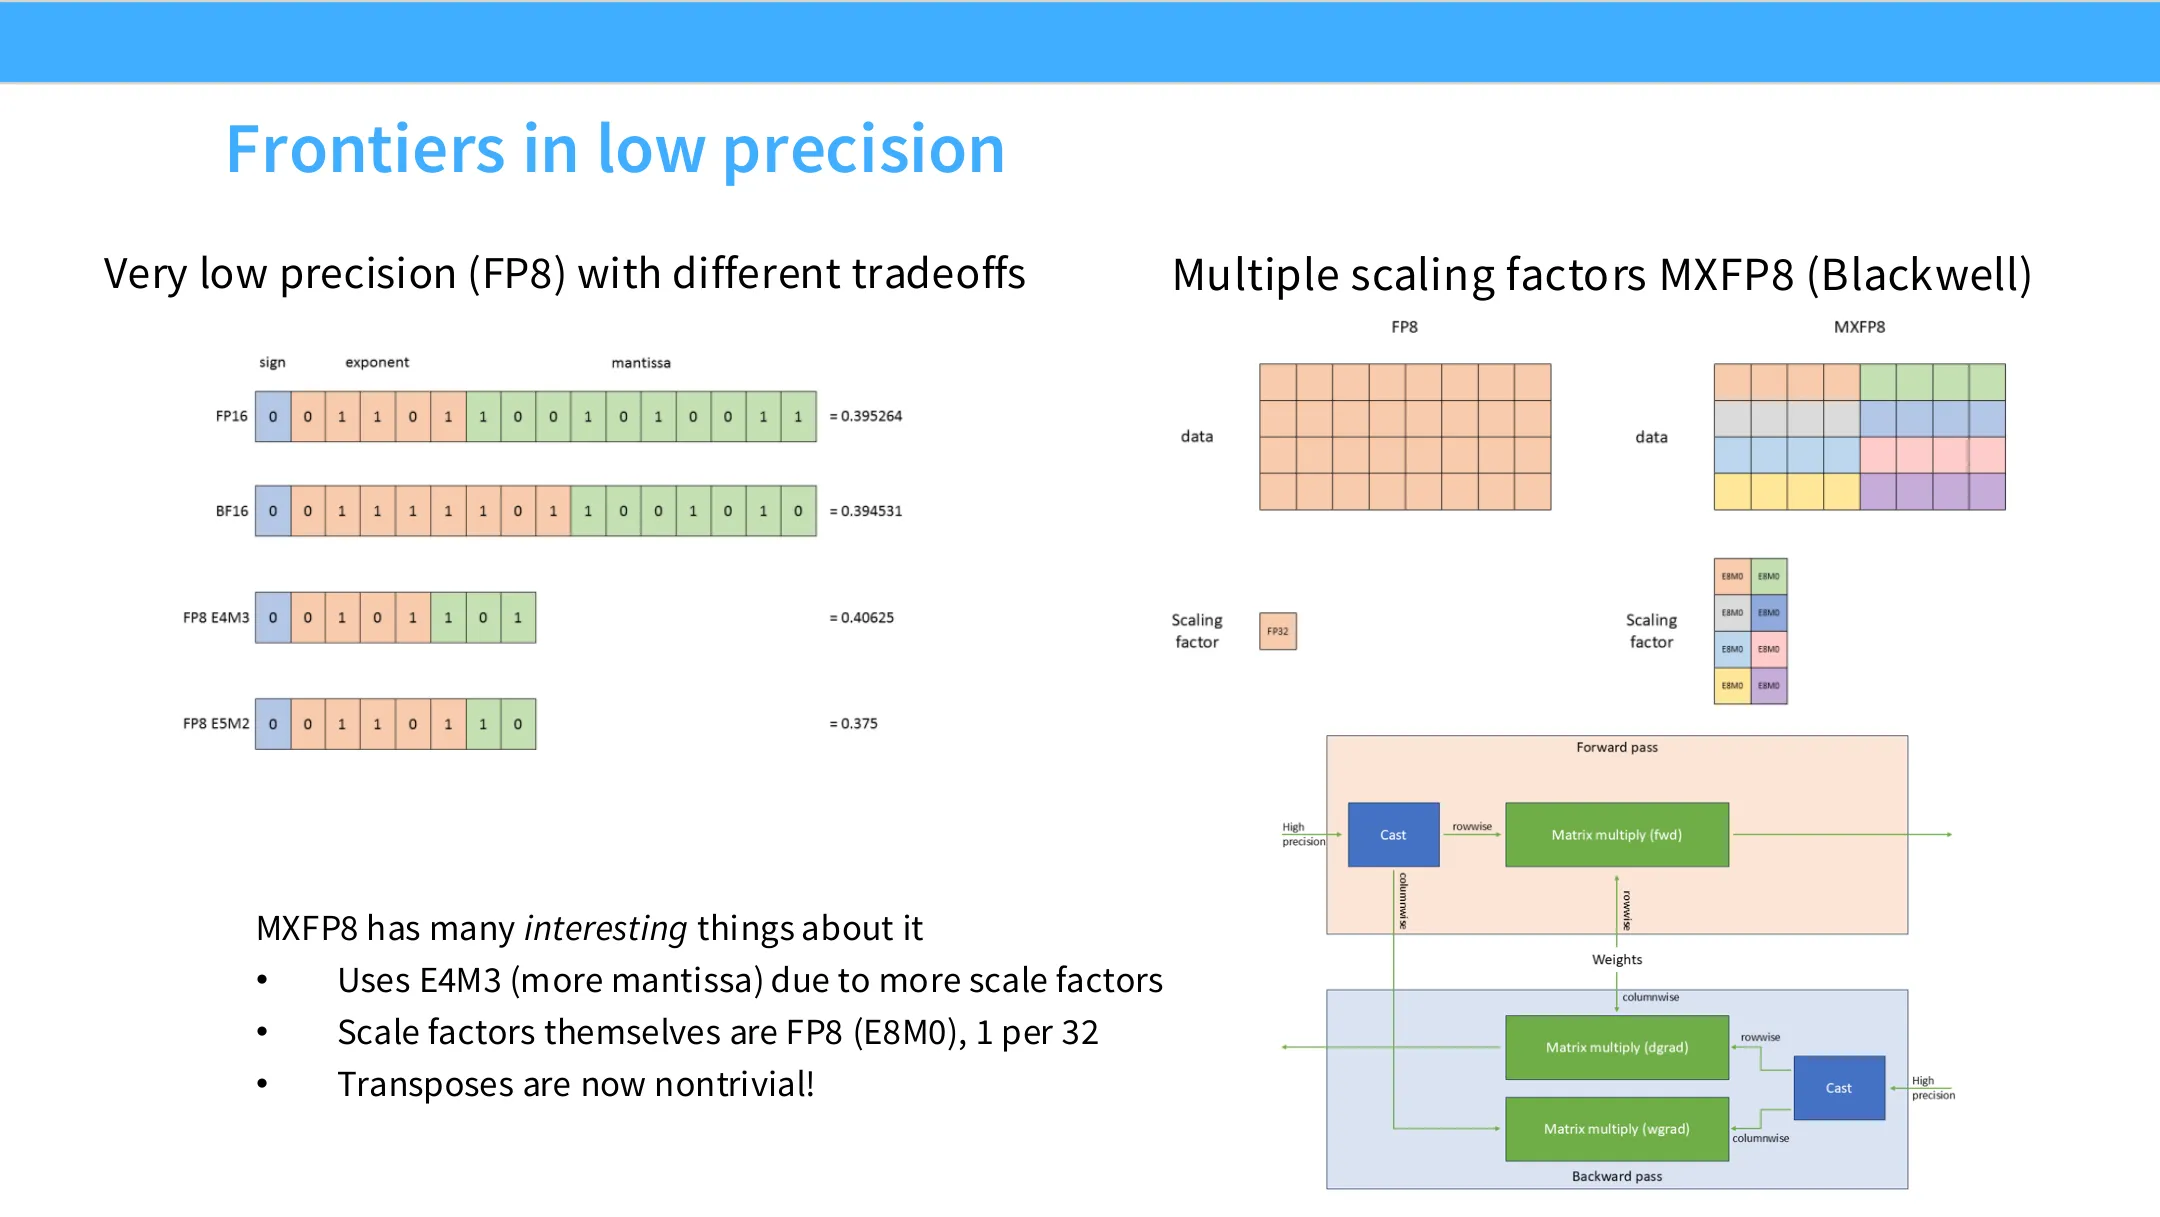
📷 MXFP8:多缩放因子的块状量化(每若干元素一个缩放因子,缩放因子本身为 8 位幂次)
回到原视频 (00:39:39)
FP8 的实际收益与代价
(参考时间: 00:42:31)
- 你会只量化那些"看起来安全"的层(这本身也是试错);
- 收益:做那些矩阵乘法时,大约节省 20%–30%,甚至更多(取决于矩阵大小);
- 但它不是 2 倍加速,因为要付出大量量化/反量化的开销;
- 所以它不是免费的。
同学提问:第一层和最后一层很难量化,有直觉吗?老师答:
- 第一层——他没有明确直觉;
- 最后一层难量化,是因为它是一阶因素,决定了大量 loss;量化最后一层会导致不稳定和大 loss 抬升。
FP4:MXFP4
(参考时间: 00:43:13) 老师坦言放到这一页"几乎因为它太离谱了":
- MXFP4 的全部内容能在一张幻灯片里列完:取值就是 −6 到 6 之间所有可能的数;
- 结构:结构化块,每 16 个数配 一个缩放因子,缩放因子本身是 FP4(E4M3);
- 有一篇论文做到了用 FP4 训练,但老师没听说有人在"野外"用 FP4 训练真正的大模型;
- 但他认为这是趋势——"下一代模型大概率会用 FP4"。
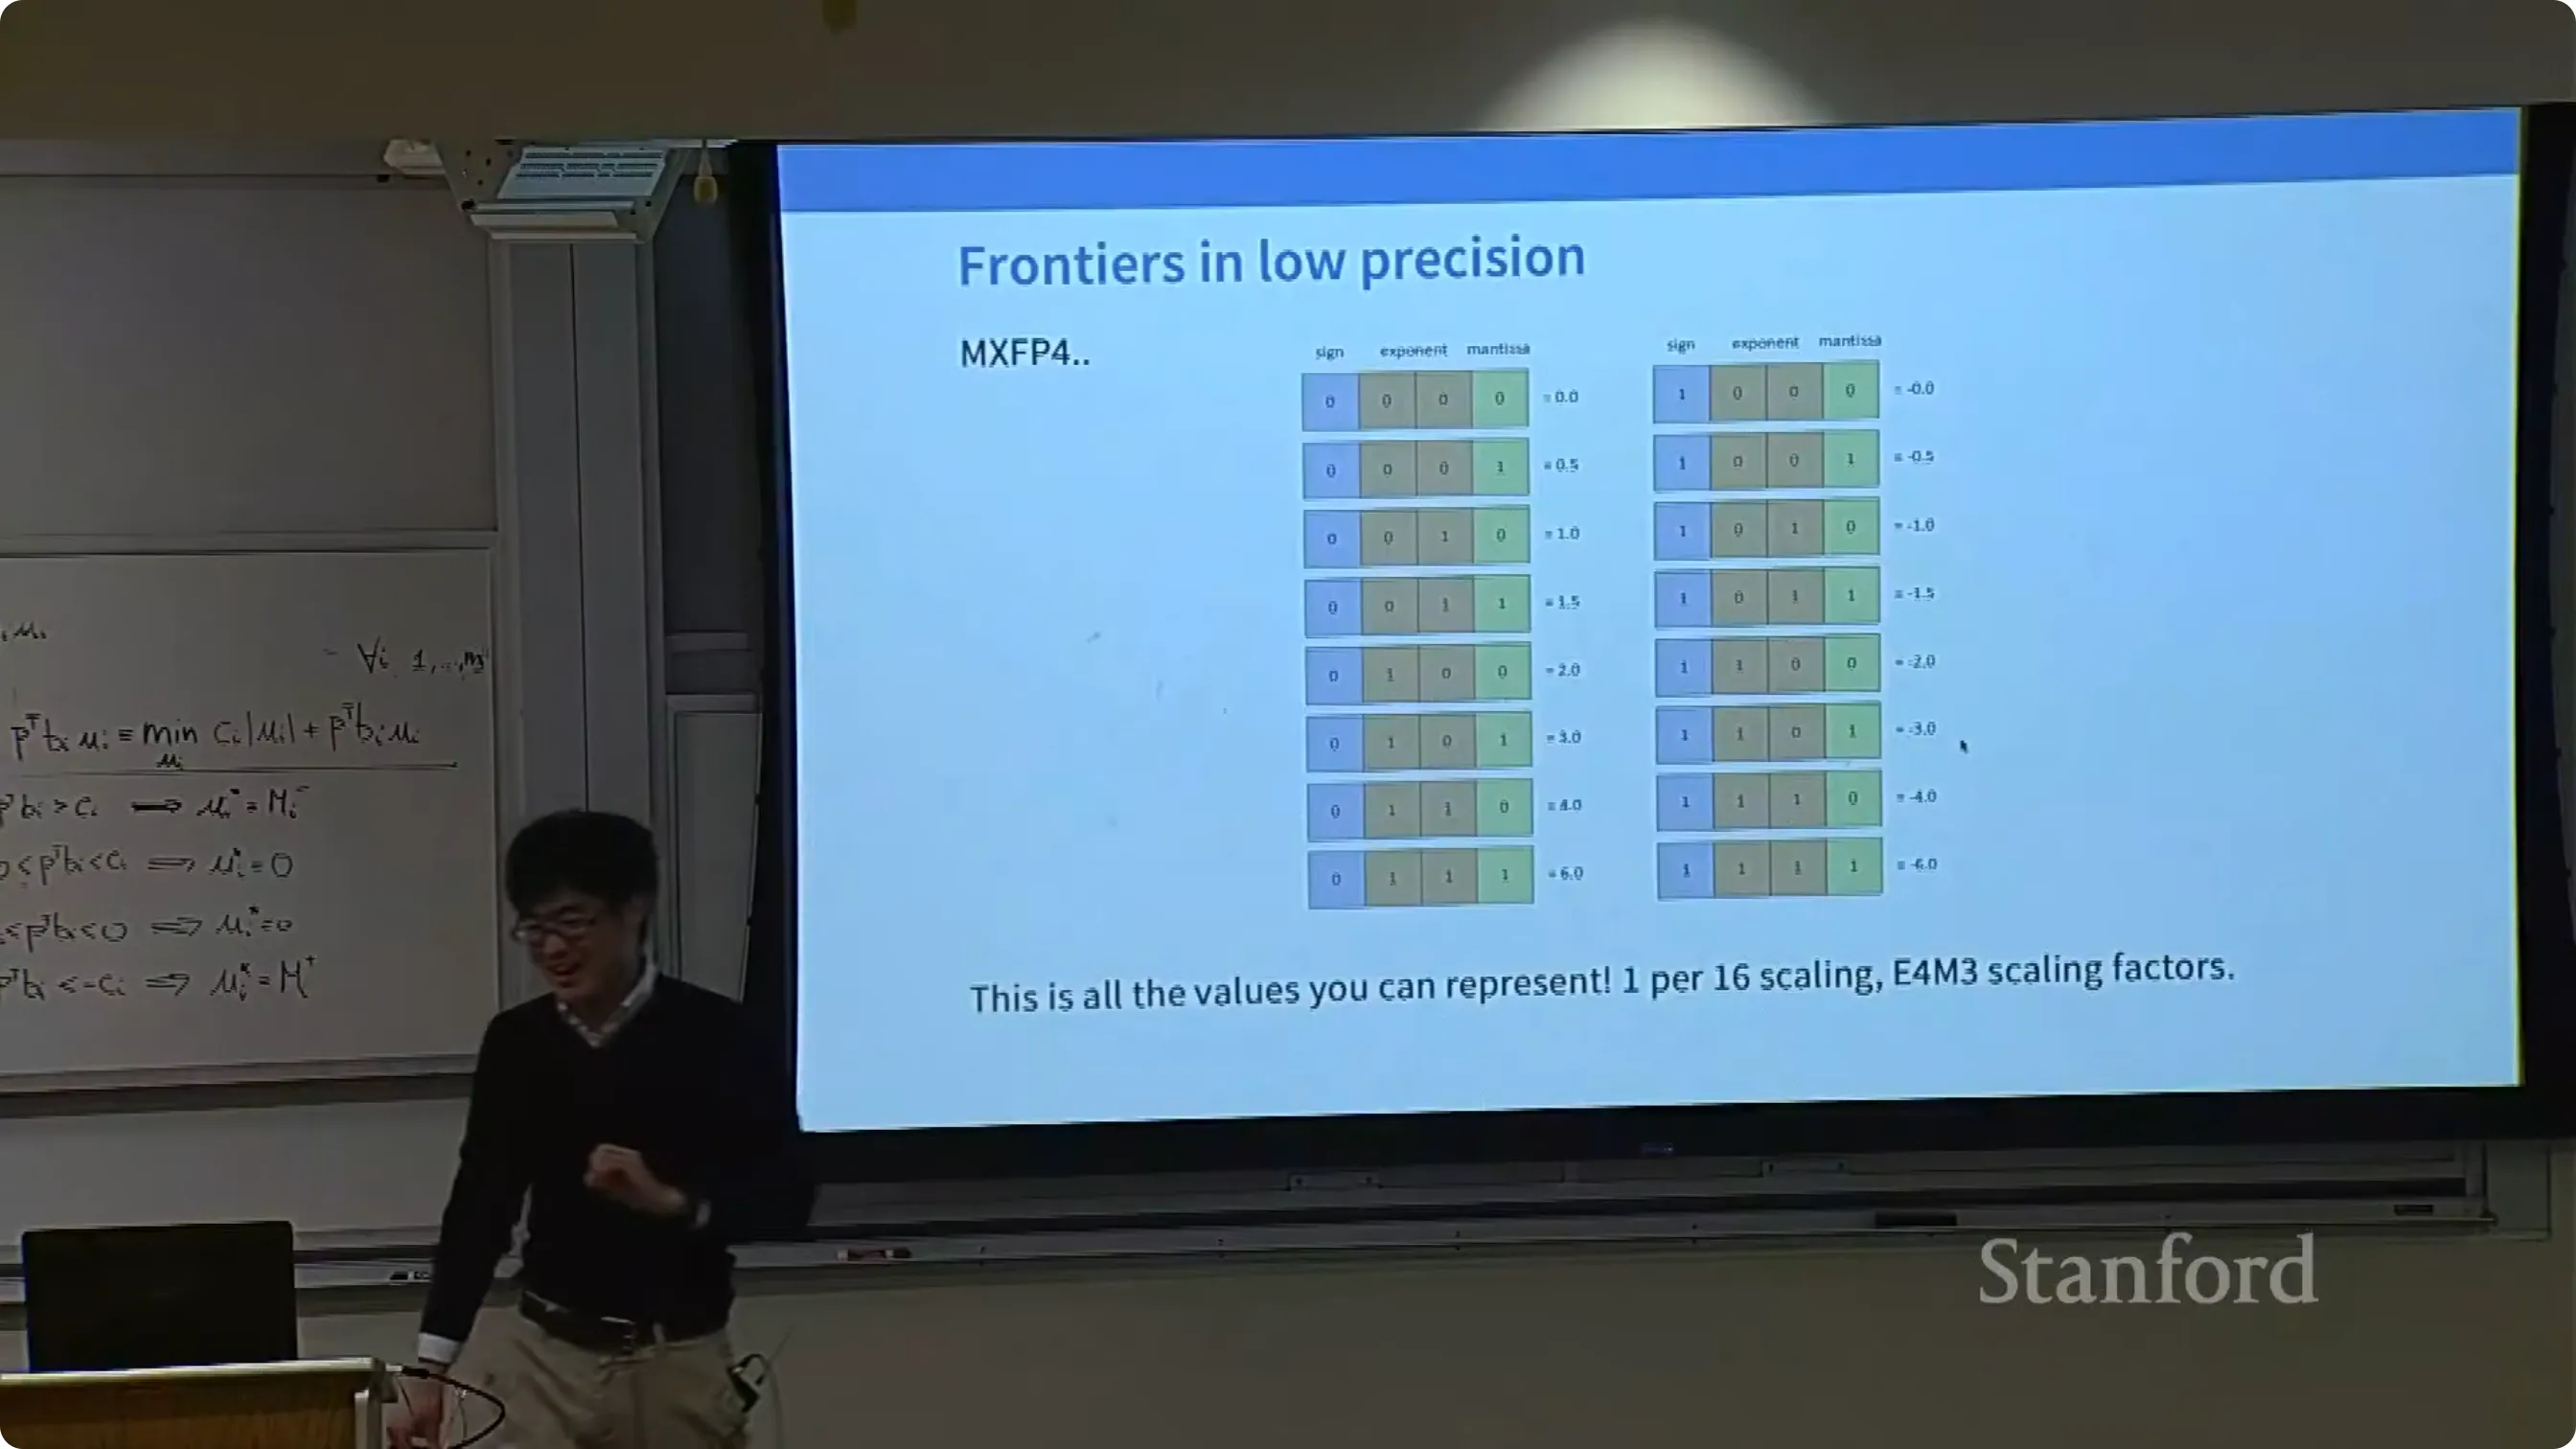
📷 MXFP4 的全部可表示取值(约 −6 到 +6)
回到原视频 (00:43:30)
问答
(参考时间: 00:44:02 起) 一连串提问,要点如下:
- 只能对矩阵量化,不能对标量量化吗? ——什么都能量化(比如 ReLU 之后的激活),只是没多大必要;矩阵乘法量化才能带来大的吞吐提升,这就是为什么 MXFP8 训练里都是 matmul 在被量化。
- 是硬件限制吗? ——不是限制,而是硬件内建了对这些格式的加速支持。
- 低精度的收益是省带宽还是也算力? ——两者都有:对乘量化后的数,算力几乎线性提升;但因为要量化/反量化,收益被稀释。
- 缩放因子需要"训练"吗? ——它是实现相关的选择:有的库扫一遍取 max/min,有的用历史运行统计。老师不把它叫"训练"。训练时没有梯度;推理时可能拟合它们。
- 结构化稀疏呢? ——做了很多。MoE 就是一个成功的结构化稀疏例子。老师也提到 Chris Ré 做过很多种结构化矩阵;但收益与表示损失相比,大体上"已经两清"——不是坏主意,但经验上没必然 pan out。
- 当前 SOTA 做法(如把大模型蒸馏/量化到能跑在 Mac 上)? ——先训大模型再量化下去;有一系列量化 scaling law 论文刻画取舍;SOTA 是量化感知训练 + 模型 scaling + 后训练量化的结合。这不完全理解,连业界都在谈"量化的科学"。
编者说明:关于"训练时缩放因子是否有梯度"一句,老师说到 inference 时可能拟合、training 时不会。此为讲师当场表述,读者如需精确实现细节,请以所用库(如 Transformer Engine、torchao)的文档为准。
技巧三:算子融合(Operator Fusion)
(参考时间: 00:47:42)
这是一个更偏编程概念的技巧,想法很简单,但你会惊讶于它其实并不总自动发生。
老师用了一个工厂比喻:
- GPU 像一座工厂,有仓库(memory)和计算车间(compute),中间靠一条传送带(内存带宽)来回运料;
- 如果算力扩了,你就会被那条传送带卡住;
- 如果你有很多个操作,就要把原料来回运很多趟——这消耗大量双向内存带宽。
改进方案:干脆搞一座大工厂,一次收料、一次交货。这样你只付两次内存带宽。这就是算子融合。
例子:$\sin^2 + \cos^2$
(参考时间: 00:48:44) 老师给出一个极简例子。PyTorch 的计算图是:
graph LR
    X["x"] --> S["sin"]
    X --> C["cos"]
    S --> S2["平方"]
    C --> C2["平方"]
    S2 --> Add["+"]
    C2 --> Add
    Add --> Out["输出"]
朴素执行:每个操作都是一个"工厂",每次调用都读写一次 global memory——内存代价相当高。
融合执行:写一段 GPU 代码,从 global memory 读一次,在 SM 内部把整件事做完,写回一次。这就是 fusion,一个 kernel 干完全部。
谁能自动做到:
- Torch Compile(PyTorch 的编译器);
- JAX Compile(与 JAX 深度集成)。
两者都能把这类基础运算融合成一次 CUDA 调用。老师说:简单版可以指望编译器解决,进阶版往往需要手动干预。
编者拓展|融合的边界:编译器能融合的多是"逐元素/小张量"级操作(element-wise、reduction)。一旦遇到需要在不同数据布局间搬运、或跨 block 通信的操作,就不一定能自动融合,此时需要手写 kernel(后面 Flash Attention 就是典型的手写融合)。
技巧四:重计算(Recomputation)
(参考时间: 00:50:12)
这是又一个"从系统视角看反传"的技巧。
复习背景:反向传播里,前向时沿着计算树向上走,保存激活值;反向时用保存的激活值来计算梯度。
但这里我们不从数学角度、而从系统角度看:如何把内存降到最低?
取一个简单例子:
$$x \rightarrow \text{sigmoid} \rightarrow \text{sigmoid} \rightarrow \text{sigmoid} \rightarrow \text{out}$$
每个 sigmoid 都会产生一个需要保存的激活(记为 $S_2, S_1$ 等)。反向时要用它们,把梯度往回推。
朴素做法的内存账((参考时间: 00:51:21)):
- 前向:读 $x$ 1 次,写 $S_2, S_1, \text{out}$ 3 次;
- 反向:对称地再来一遍;
- 合计 8 次内存读写,算术强度极低(只是一堆 sigmoid)。
重计算做法:把激活全部扔掉。听起来反常,但要想象这样一个世界——
计算超级便宜(你有富余的算力没用满),内存非常贵(每次读写都有大代价)。
在这个世界里,你更愿意:
- 反向时拿到 $d\text{out}$ 和 $x$,就地重新前向一遍,按需重算出激活;
- 内存账变成:读 $d\text{out}$、读 $x$、写 $dx$ = 5 次内存读写。
结果:内存访问从 8 次降到 5 次(即原来的 5/8),计算量略增,但用算力换了内存。
老师说:我们平时不会这么想,因为平时只关心"算出梯度";一旦有了系统思维,就会开始考虑重计算。
编者拓展|重计算的经典形态:这正是 gradient checkpointing(梯度检查点) 的思想来源。它也是 Flash Attention 的最后一块拼图(见第三部分)——attention 的 $n^2$ 激活矩阵太大,干脆不存、反向时逐 tile 重算。
技巧五:内存访问合并(Coalescing)
(参考时间: 00:52:52)
又一个"内存冷知识",但它出人意料地重要,也说明了为什么必须理解所交互硬件的模型。
事实:global memory(芯片外的 DRAM)以"突发(burst)"方式访问。
什么意思?你访问第一个位置时,并不只拿到那一个值——你可以几乎免费地拿到一整块(例如前 4 个值)。原因在于 DRAM 单元的排列方式:
- 存储单元排成网格;
- 选中一"行/列"后,放大器一次性读出整块;
- 所以当你触发某个位置,同一突发段内其他位置的数据也一并送达、不再额外收费。
一个 burst section 可能是 128 字节——一次读取最多返回 128 字节,只要它们在同一连续块里。
推论:如果读取连续排列,会快得多。这种访问叫做合并访问(coalesced)。
- 定义:一个 warp 内的所有线程落在同一个 burst 内,就是 coalesced(充分利用了 DRAM 的这个好性质);
- 多个 warp 会有多个 burst section,但把读取分组就能高效读内存。
行主序 vs 列主序
(参考时间: 00:56:11) 老师给出一条助记规则:
对有线程的行主序(row-major)矩阵,沿主轴的线程访问不合并(not coalesced)。
配一张 4×4 的例子理解:
- 行主序下内存地址顺序:黄 → 红 → ……(一行一行排);
- 若线程逐列读:第一次迭代会分别命中每个元素,而每个元素落在不同 burst window,于是你整块都读了,却只想要一列;
- 反过来若按行读,每个线程都能在一次内存读中拿到自己需要的东西。
结论:coalescing 能对"从大块连续结构(如矩阵)读取"带来显著提升。这就是为什么要考虑行序/列序排列。
技巧六:分块(Tiling)——最重要的一块
(参考时间: 00:57:52)
老师说:分块恐怕是影响性能最大的一个想法。它的核心是"把内存层次用到极限":
- 尽量把内存访问分组;
- 让共享内存访问成批进行,并且发生在共享内存上。
为什么叫"分块":把需要的数据切成小块(tile),每个 tile 载入 shared memory;tile 载入后反复读取、尽可能多地计算。
矩阵乘法的分块
(参考时间: 00:58:41)
考虑矩阵乘法(右下角是输出矩阵)。观察:
- 若不分组,每个输入元素会被读 $n$ 次($n \times n$ 矩阵乘法里);
- 但矩阵的天然结构允许很自然的分组——把它切成子矩阵。
graph TD
    A["加载 M00 tile 与 N00 tile 到 shared memory<br/>(付一次 global → shared 的慢成本)"] --> B["在 shared memory 内做子矩阵乘法<br/>累加部分和到输出 tile"]
    B --> C["对下一组 tile 重复"]
    C --> D["全部算完后写回 global memory"]
- 先载入 M 的 top-left tile 和 N 的 top-left tile 到 shared memory;
- 付一次从 global memory 慢慢搬的成本;
- 之后在 shared memory 内高速读写这些 tile,把两个子矩阵相乘,把部分和累加到输出子矩阵;
- 全部算完再写回去。
分块的数学效果
(参考时间: 01:00:21)
- 不分块:每个输入被读 $n$ 次;
- 分块(tile 大小 $T$):每个输入从 global memory 读 $\dfrac{n}{T}$ 次,然后在每个 tile 内被访问 $T$ 次;
- 极端情形 $T = n$:只从 global memory 读一次,其余全在 shared memory——减少 $T$ 倍的 global memory 访问。
分块尺寸越大,global memory 访问就减少得越多。这是矩阵乘法能大幅提速的关键。
分块的"坑":尺寸问题
(参考时间: 01:01:59) 分块很强大,但很复杂,会有一些极其微妙的现象:
坑一:tile 切割不整齐
- 设 tile 尺寸 128×128,矩阵 256×256——完美切成 4 个 tile;
- 但把维度加 1,就会产生两条几乎为空的细细的长条 tile。
于是你意识到:tile 尺寸其实是个要优化的东西,它要在内存带宽和"空转的大片空白"之间权衡。它受三件事影响:
- 合并内存访问;
- 加速器上 shared memory 的大小;
- 矩阵的尺寸。
PyTorch 里就有一个开关:torch.max_autotune(老师提到"max auto tune")。打开它,PyTorch 会在接下来十几分钟里跑无穷无尽的 benchmark——本质上就是试各种 tile 尺寸,找出哪个对你手上的矩阵最快。你会从中得到可观的收益。
坑二:coalescing 与对齐
(参考时间: 01:04:01)
如果你的矩阵尺寸"不对",读一个 tile 可能触发很多次内存读。
- 对齐时:若 burst section 的宽度正好等于 tile 宽度,逐块读就能通过四次读读完整块,非常高效;coalescing 良好;
- 错位一个:把矩阵尺寸动一格,第一个元素被挪走,这个蓝色 tile 就落在错位的位置——无法再用合并读一次读完整个 tile,因为所有东西都变得 ragged、misaligned;至少要读两个 tile 的量才能取出一个 tile。
解决办法:padding(填充)——把 burst section 的边界和 tile 尺寸对齐起来。
Karpathy 的 nanoGPT 之谜
(参考时间: 01:05:10) 老师讲了他最喜欢的一个例子:
Andrej Karpathy 在做 nanoGPT speedrun 时说:他把 词表大小从 5257 改到 5304,竟然获得了 25% 的加速。
这非常反直觉——padding 反而加速。但学到这里你就能理解了:
- padding 会移动行列,使读取变得高效合并;而在其他尺寸下则不会。
- 所以矩阵尺寸对齐(一般是 2 的幂,最好也能被 32 整除)就变得至关重要。
同学提问:"有推荐的 tile 尺寸吗?"老师答:
- 不要主动去想 tile 尺寸——除非你在手写 kernel,否则它通常是底层系统的事情;
- 但你确实要关心矩阵的尺寸——一般希望它是 2 的幂、且能被 32 整除。
编者说明:Karpathy 的这次"5257→5304 提速 25%"是著名的工程轶事,与词表大小的 embedding/输出层张量对齐有关,与本节讲的 coalescing 直接对应。参见 nanoGPT:https://github.com/karpathy/nanoGPT。
2.7 破解"矩阵乘法之谜"
(参考时间: 01:06:19)
现在万事俱备,可以逐个解释那张神秘曲线了。老师把现象逐个拆解:
现象一:对角线上的"向上爬升"
- 这部分由算术强度解释——Roofline 的对角线;
- 需要有足够工作量去喂满计算单元,这就是斜向上的趋势。
现象二:不同倍数的花纹
(参考时间: 01:06:41)
把曲线上的线按矩阵的可整除性染色:
- 蓝色:只被 1 整除(奇数);
- 橙色/黄:能被 2 整除;
- 绿色:能被 8 整除;
- 红色:能被 16 整除;
- 紫色:能被 32 整除。
观察:只被 1 或 2 整除的,吞吐非常差;一旦到更高的倍数(16、32),惩罚消失、表现相当。
原因不是"2 的幂有魔力",而是:16 和 32 足够大,使得:
- burst window 的性质对上了——整个 burst window 恰好落在 tile 内;
- 于是可以合并读取整个 tile;
- 对对齐有重大影响。
现象三:橙色线上的周期性骤跌
(参考时间: 01:07:44) 橙色线上有时会突然性能下降——只是多加了一个维度,吞吐为什么就崩了? 老师称这是"Percy 称作 GPU trivia、我却很喜欢"的一段。用上全部知识就能解释它。
具体:
- 发生在 1792 → 1793 之间((参考时间: 01:08:14));
- 用的是 256×128 的 tile 尺寸;
- 1792 时:tile 数是 98;
- 1793 时:两个方向各多一格 → 变成 120 个 tile。
98 → 120,变差了,但不至于差这么多——这个下跌是断裂式的。真正的原因:
A100 有 108 个 SM。 - 98 个 tile 能塞进 108 个 SM; - 120 个 tile 塞不进——108 个 SM 干完后,还剩 12 个 tile,大多数 GPU 只能空转等待。
于是你只把 tile 数加了一点点,就得多等一整个"波次(wave)"才能处理完剩下那批 tile。
这就是"波量化(wave quantization)"。
graph TD
    A["1792: 98 tiles <= 108 SMs<br/>一波跑完 → 快"] --> B["1793: 120 tiles > 108 SMs<br/>需要第二波 → 108 个 SM 大部分空转 → 慢"]
编者说明:这解释了为什么模型维度、batch、序列长度常被工程师"凑"成 108 的倍数或 2 的幂的组合——避免波量化。老师的例子是 1792(=108 附近能一波装下的 tile 数)与 1793 的对比。
一句话串起六个技巧
(参考时间: 01:09:24) 老师收束第二部分:让 ML 负载在 GPU 上跑得快,故事几乎全是"内存、内存、内存"。
- 合并(coalesce)内存读,让它们成批;
- 融合(fuse)算子,减少读取;
- 无论如何都要读的,就复用——搬到 shared memory 里反复用(即 tiling);
- 用别的资源换内存——量化(低精度) 和 重计算。
(参考时间: 01:10:09) 问答要点:
- 为什么把 SRAM 做大很贵? ——三个原因:造 SRAM 本身贵;物理上必须离得近(信号传播困难);SRAM 和 DRAM 是不同存储机制——SRAM 必须持续供电才能保持数值,非常耗电。考虑 TCO 和能耗,你不会想要一整块大 SRAM,而是只在需要的地方用。
- 把分块做到 32/64 以上会更好吗? ——不会,它是"被 burst 尺寸整除"的性质,是 divisor 问题,不是越大越好。
- 为什么是 108 个 SM? ——"这就是 SM 的数量,你得去问 Jensen(黄仁勋)。"
第三部分:把技巧拼起来——重新推导 Flash Attention
(参考时间: 01:11:50)
老师说:这是"某种意义上的压轴"。我们已经学了一堆 GPU 知识,现在把它们全部拧到一起,去复现/理解 Flash Attention。
Flash Attention 是近年来 attention 能力的一大进步,而它完全是系统层面的工作:
- 从 PyTorch 朴素实现的 attention → 一个巧妙融合的单一 kernel;
- 带来延迟的大幅改善(服务于推理),也是内存高效的 attention 计算方式(能支持越来越长的注意力);
- 收益的很大一部分来自减少从 HBM(即 global memory)搬运的内存量。
论文原话(如果你读了):他们只是做了两件事——
- 分块(tiling);
- 重计算(recomputation)。
然后以一种内存访问次数量级次于二次的方式来做。老师说:这些组件你现在全懂了。
3.1 复习 Attention 计算
(参考时间: 01:13:05)
Attention 由几个操作组成:
- K、Q、V;
- 先拿 K 和 Q 做矩阵乘法;
- 中间一个 softmax;
- 末尾再和 V 做一次矩阵乘法。
也就是:三次矩阵乘法 + 一次 softmax。
矩阵乘法我们知道怎么做——做分块矩阵乘法。论文的 Figure 1 literally 就是分块矩阵乘法:把 K、Q 切块,一块一块乘,算完写回。这里没有任何新鲜东西。
真正棘手的地方:softmax 是全局操作——它把所有 tile 绑在一起。所以直觉上很难把 attention tiling。
3.2 核心洞见:在线 Softmax(Online Softmax)
(参考时间: 01:14:02) 一旦你看到这个技巧,"剩下的都变得很简单"。
标准 softmax 做法:
- 对所有元素取指数;
- 为数值稳定性减去最大值;
- 归一化。
在线做法:边走边算归一化的 softmax——
- 每次遇到比之前见过的更大的数,就换掉最大值;
- 这给你一个在线的、推进中的 softmax;
- 唯一棘手的是最大值——办法是记录最大值,每次遇到新最大值就替换并做出相应修正;
- 否则它其实就是"对目前见过的一切做指数运算的在线累加和(running sum)";
- 最后,用在线累加出的累加器做一次除法即可。
形式化地(编者补写):
设处理到第 $j$ 块时,已知历史最大值 $m_{j-1}$ 与历史归一化累加和 $\ell_{j-1}$,当前块的块内最大值记为 $\tilde m_j$:更新最大值
$$m_j = \max(m_{j-1},\, \tilde m_j),$$
并以缩放因子 $e^{\,m_{j-1} - m_j}$ 修正历史累加和,把当前块的贡献并进来:
$$\ell_j = e^{\,m_{j-1}-m_j}\,\ell_{j-1} \;+\; \sum_{e \in \text{block } j} e^{\,e - m_j}.$$
编者拓展|为什么要有这个"修正":朴素 softmax 需要看到所有元素才能定出最大值;一旦改成"分段统计",最大值可能在中途被刷新,于是之前用旧最大值算出的指数和都偏大了一个因子,需要用 $e^{m_{\text{旧}}-m_{\text{新}}}$ 一次性缩放回来。这就是 Flash Attention 能让 softmax 变得"可分块"的关键。
关键性质:因为在线 softmax 是分块推进的,所以可以逐 tile 计算:
- 不需要看到后面的 tile,就能算出当前 tile 的 softmax;
- 可以把部分结果存起来(甚至写回 global memory);
- 然后继续。
3.3 分块 attention 的数据流
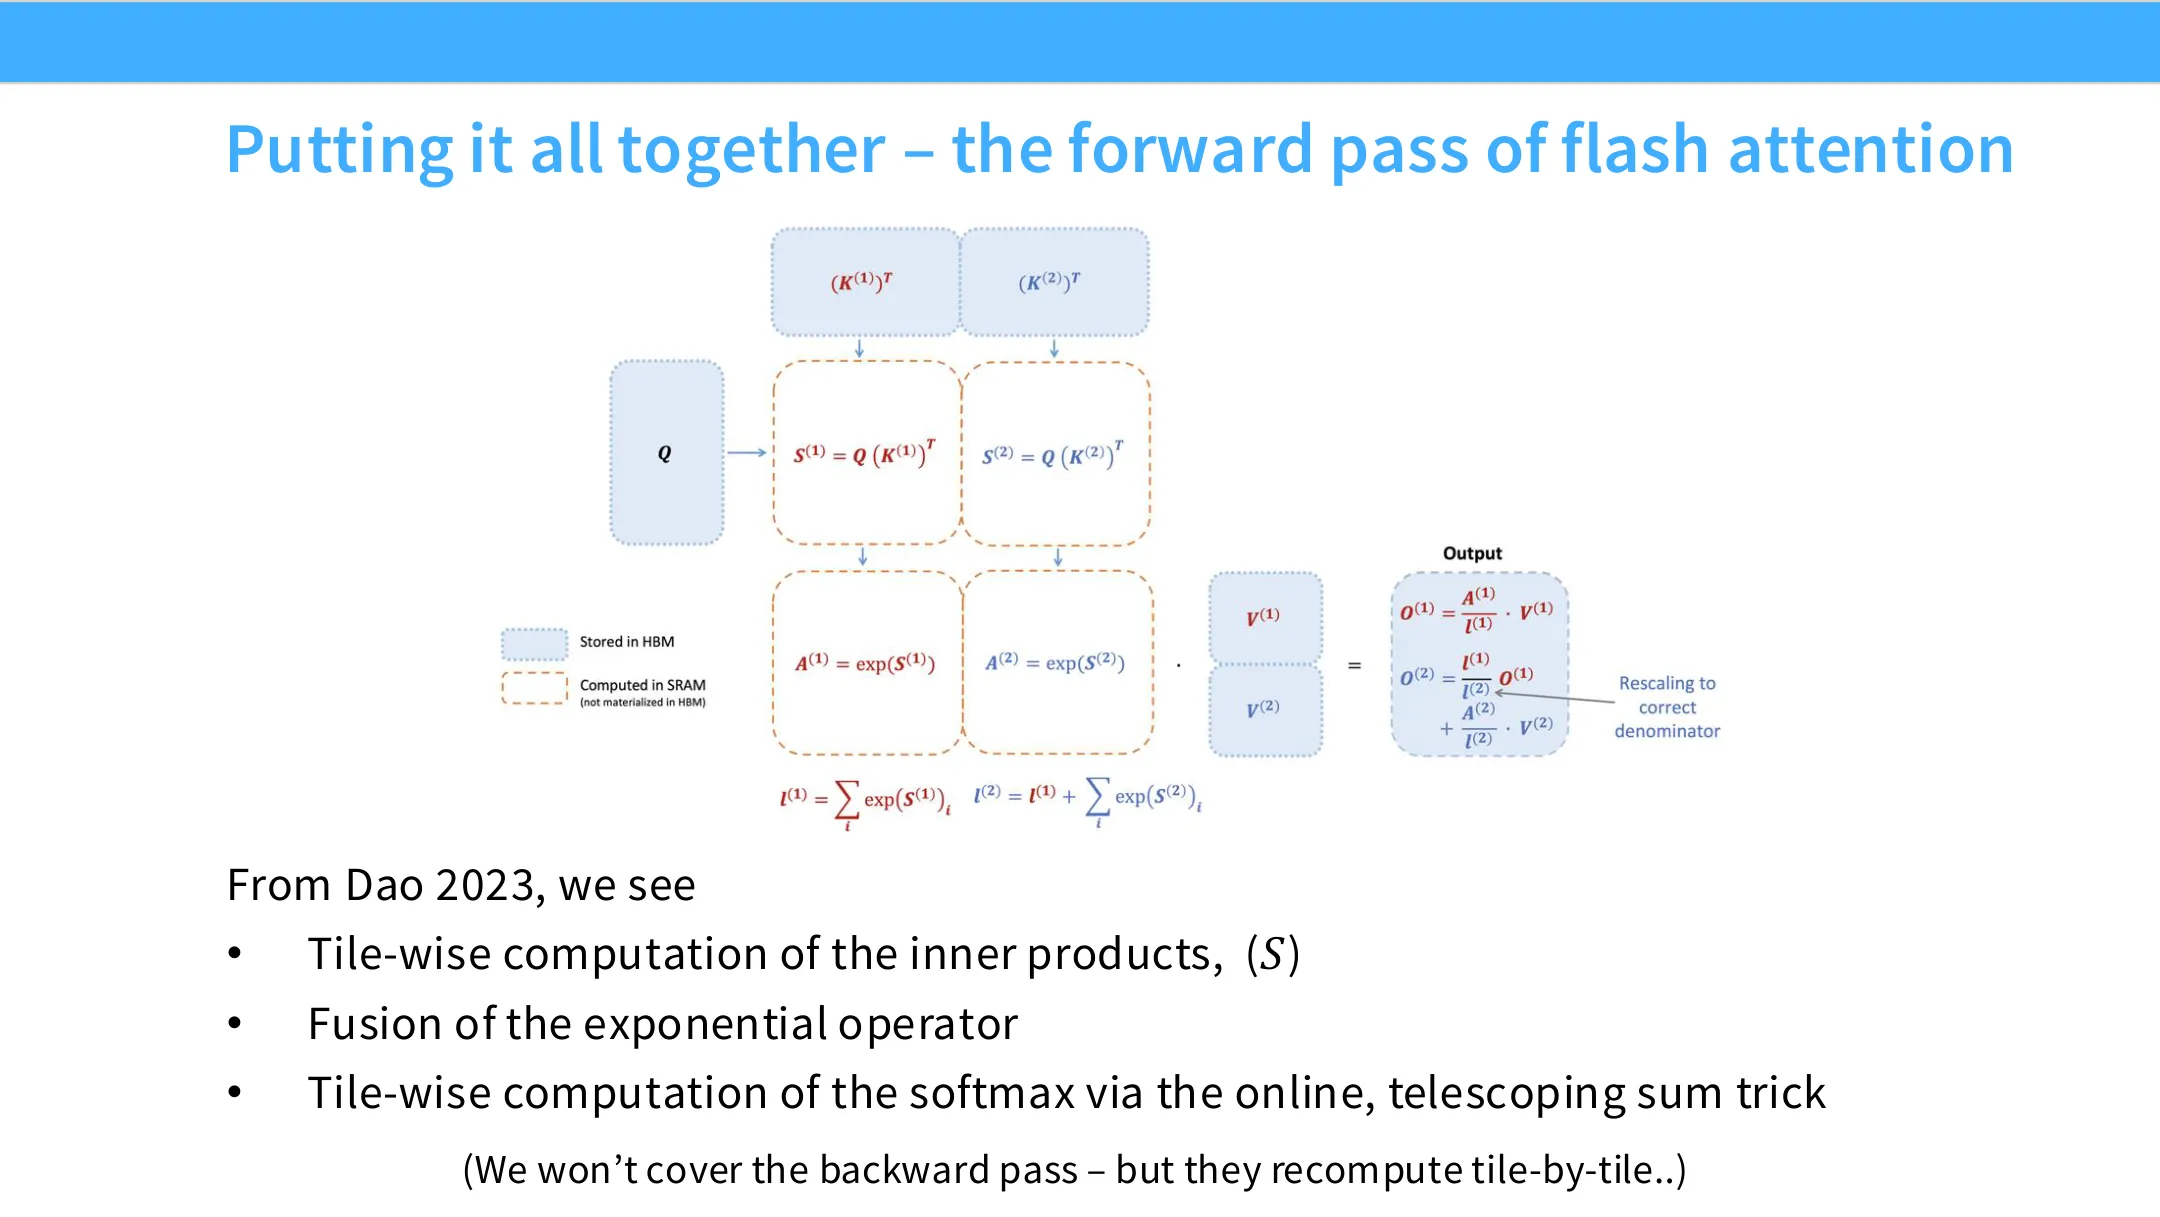
📷 Flash Attention 分块示意(虚线块为 SRAM 中分块计算,蓝框为 HBM 中的全局数据)
回到原视频 (01:15:51)
(参考时间: 01:15:35) 老师展示了一张(来自 Flash Attention 2)的可视化图,很清楚地标出了哪些部分被分块:
- 虚线块:在 SRAM 中以 tile 为单位进行计算;
- 蓝框:位于 HBM(global memory)中。
流程:
- 做 K·Q 内积 → 分块矩阵乘法 → 结果留在 SRAM;
- 在 SRAM 内计算指数;
- 在同一 tile 内计算运行中的 softmax;
- 移到下一个 tile,重复;
- 但一路保留软 max 的部分运行和(放在 shared memory / 寄存器 / 别处,数量很小);
- 全部 tile 处理完,得到所有指数化量和归一化量后,非常简单:以分块形式与 V 相乘,最后一次性相除。
这样就能把 attention 切成小的分块块,然后跑起来。
3.4 最后一块:重计算
(参考时间: 01:16:52)
老师说不展开细节,但要点是:
- 如果保存激活,attention 会有一个 $n^2$ 大小的激活要保存;
- 干脆全扔掉,在反向传播时逐 tile 重算。
于是 Flash Attention = 分块 + 重计算。
(参考时间: 01:17:19) 老师说:至此我们已经看过所有技巧的实战。而你看到的大多数高效实现、用好 GPU 的方法,本质上都归结为这些思想。
收束:整堂课的三条主线
(参考时间: 01:17:29) 老师把全讲收束成三点:
- 理解硬件至关重要。 硬件(GPU)驱动着 scale 与 compute。我们必须理解到最底层的细节,才能真正明白"为什么做某个决策"。他说:我不想你们成为那种给矩阵盲目乘 32 的"货物崇拜(cargo cult)"程序员——我希望你们真正理解为什么这么做,而这要一路下探到硬件层面。
- 算力增长的方式意味着我们要盯紧 matmul。 那是算术密集的核心操作;而由于算力与内存之间的鸿沟,我们必须非常小心地考虑数据搬运。
- 像 Flash Attention 这样的东西非常酷,而且它是"硬件感知的架构工作"。 在做架构设计时认真考虑硬件,对未来系统的良好性能至关重要。
他说完 "Thanks" 结束。
附:参考与延伸阅读
(本书材料里没有外部链接;正文中的链接均为撰写时补充。)
已知疑点
本讲整体清晰,但以下地方在字幕/听写或讲师当场表述上存在不确定,逐条列出供读者核查:
- "Groq / Grok / Rock"公司名称与归属(出现于 00:01:39、01:01:13)。
-
老师提到"一家最近被英伟达收购、设计上堆了一大块 SRAM 的公司"。字幕写作 "Grok"(另一处作 "Rock")。整理时无法核实该公司的确切名称与"被英伟达收购"这一归属,故正文以老师原意表述并加注存疑。不影响结论:全 SRAM 架构贵且耗电。
-
"step one three"中国开源模型(约 00:29:29)。
-
老师提到某中国开源模型把不同层拆分到不同加速器(attention 一块、MLP 一块)。字幕记为 "step one three",具体模型名不确定,可能是 Step 系列某型号的听写误差。正文已按"某中国开源模型"保守表述。
-
公司的 SRAM 推理架构(01:01:13 与 00:12:39 可能对应同一公司)。
-
与第 1 条相关,两处是否指同一家公司,无法从字幕确认。
-
A100 的 SM 数量。
-
老师多处说 A100 有 108 个 SM(如 01:08:54)。这一数字与波量化的计算(98 能装下、120 装不下)自洽,但不同来源对 A100 的 SM 数量给出的数值可能略有差异,读者如用于精确计算请自行核对官方规格。
-
MXFP8 的缩放因子粒度。
-
字幕中老师先说每 4 个元素配一个缩放因子("first four elements"),随后又说"每 32 个元素一个缩放因子"("one scale factor every 32 elements")。两处措辞不完全一致,可能是口误或板书切换。正文按"每 32 个元素"这一更常见说法呈现,并保留老师的原话线索。
-
Horace He 的博客、GPU mode、"Google 出品的书"的具体链接。
-
老师只口头提及,未给链接。正文"编者补充"中给出的链接(horace.io、github.com/gpu-mode、jax-ml.github.io/scaling-book)为整理者根据常识补全,可能并非老师所指的唯一或精确页面。
-
"max auto tune" 的具体开关名。
-
老师说 "max auto tune",PyTorch 中对应概念更可能是
torch.backends.cuda.matmul.allow_tf32之外的卷积/矩阵自动调优机制(如 cuDNN benchmark / Triton autotune)。正文保留老师原话 "max_autotune",具体 API 名以最新 PyTorch 文档为准。 -
"second part 有六个技巧"的完整计数。
- 老师明确说"六个技巧",但口述顺序中,"控制分歧"被描述为"味道不同、可算可不算",其余五个围绕内存。正文按"控制分歧 + 低精度 + 融合 + 重计算 + 合并 + 分块"呈现为六项;若严格按"内存技巧"口径,则只有五项。此为讲师当场表述的模糊处,非整理错误。