第6讲 · Stanford CS336:从零开始的语言模型
对应讲次:第6讲(Stanford CS336 语言建模)
制作模型:deepseek-flash(vb compose,据 run.log)
Kernels、Triton 与 XLA:亲手上 GPU 写核函数
课程信息 本讲是 Stanford CS336《Language Modeling from Scratch》(2026 春季) 第 6 讲。视频地址:YouTube,时长约 87 分钟。 讲者 本讲承接上一讲由 Tatsu 主讲的「GPU 高层概览」,同一位课程讲者带领大家下沉到代码,亲手编写 Triton 核函数并做基准测试与性能剖析。 许可与出处 本书是对课堂录音字幕的书面重构,非官方讲义;课程材料的版权归课程作者所有。若课程主页提供了官方讲义与幻灯片,请以其为准。
导览:3–5 分钟的问题地图
一、这一讲想回答的核心问题
上一讲把 GPU 当作一个黑箱讲了「它大概长什么样、有哪些怪脾气」。这一讲讲师换了一个问题:当我们真的要亲手写 GPU 代码时,到底怎么写、写出来为什么快或慢? 顺着他的提问顺序,本讲要回答:
- GPU 的编程模型是什么?(线程、线程块、网格)
- 为什么编程模型如此「干净」,而性能却对硬件高度敏感?
- 在开始写核函数之前,该怎么测量(benchmark) 和剖析(profile) 自己的代码?
- 如何用 Triton 从最简单到最复杂地写核函数:逐元素 → 行归约 → 矩阵乘法?
二、难点在哪里
- 心智模型的切换:在 PyTorch 里你是「函数式」的——写个表达式就有结果。在 Triton 里,你必须在线程块的粒度上显式地从 HBM 读数据、算、再写回 HBM。很多初学者卡在「为什么我要手动管这几个指针」。
- 看不见的硬件:warp、bank conflict、内存合并、占用率(occupancy)……这些概念在源代码里根本看不到,却直接决定快慢。最容易被卡住的一步,是把「代码正确」误当成「代码够快」。
- 数据装不下时怎么办:当一行/一个矩阵放不进一个线程块时,需要引入 tiling(分块)——这是本讲从 softmax 讲到 matmul 的主线,也是 flash attention 的必要前奏。
三、读者可能带着的疑问
① 讲者真正提出的问题(他自己列出的路线)
- 为什么要有「线程块」这种中间层?网格里直接放一堆线程不行吗?
- 同一个 GELU,不同写法为什么速度能差好几倍?
- Triton 到底比 CUDA 好在哪里?它和 PTX 是什么关系?
② 编者预判的读者疑问(这些是编者按读者角度补充的,不是讲者原话)
- 既然 PyTorch 已经很快,我为什么要自己写核函数?
- Triton 会取代 CUDA 吗?我该先学哪个?
- 「算术强度」「占用率」这些词听起来很唬人,对写代码真有帮助吗?
四、本讲路线
讲者打算这样走:先用几分钟把 GPU 内存层次和编程模型重新讲一遍 → 举五个「硬件为什么会让你慢下来」的例子(warp、寄存器占用、bank conflict、内存合并、块占用率)→ 讲基准测试与性能剖析的哲学 → 然后从最简单的 Triton 逐元素核开始,逐步过渡到 softmax(行内归约)、行求和(引出 tiling),最后落到矩阵乘法(tiling 的经典案例)。读完这一讲,你就具备了实现 flash attention 所需的全部「配料」。
一、先把 GPU 的内存层次与编程模型复习一遍
(参考时间: 00:00:05)
讲者开场先做了一次复习——不是简单重复,而是为后面「为什么性能敏感」埋下伏笔。
1.1 GPU 的简化结构
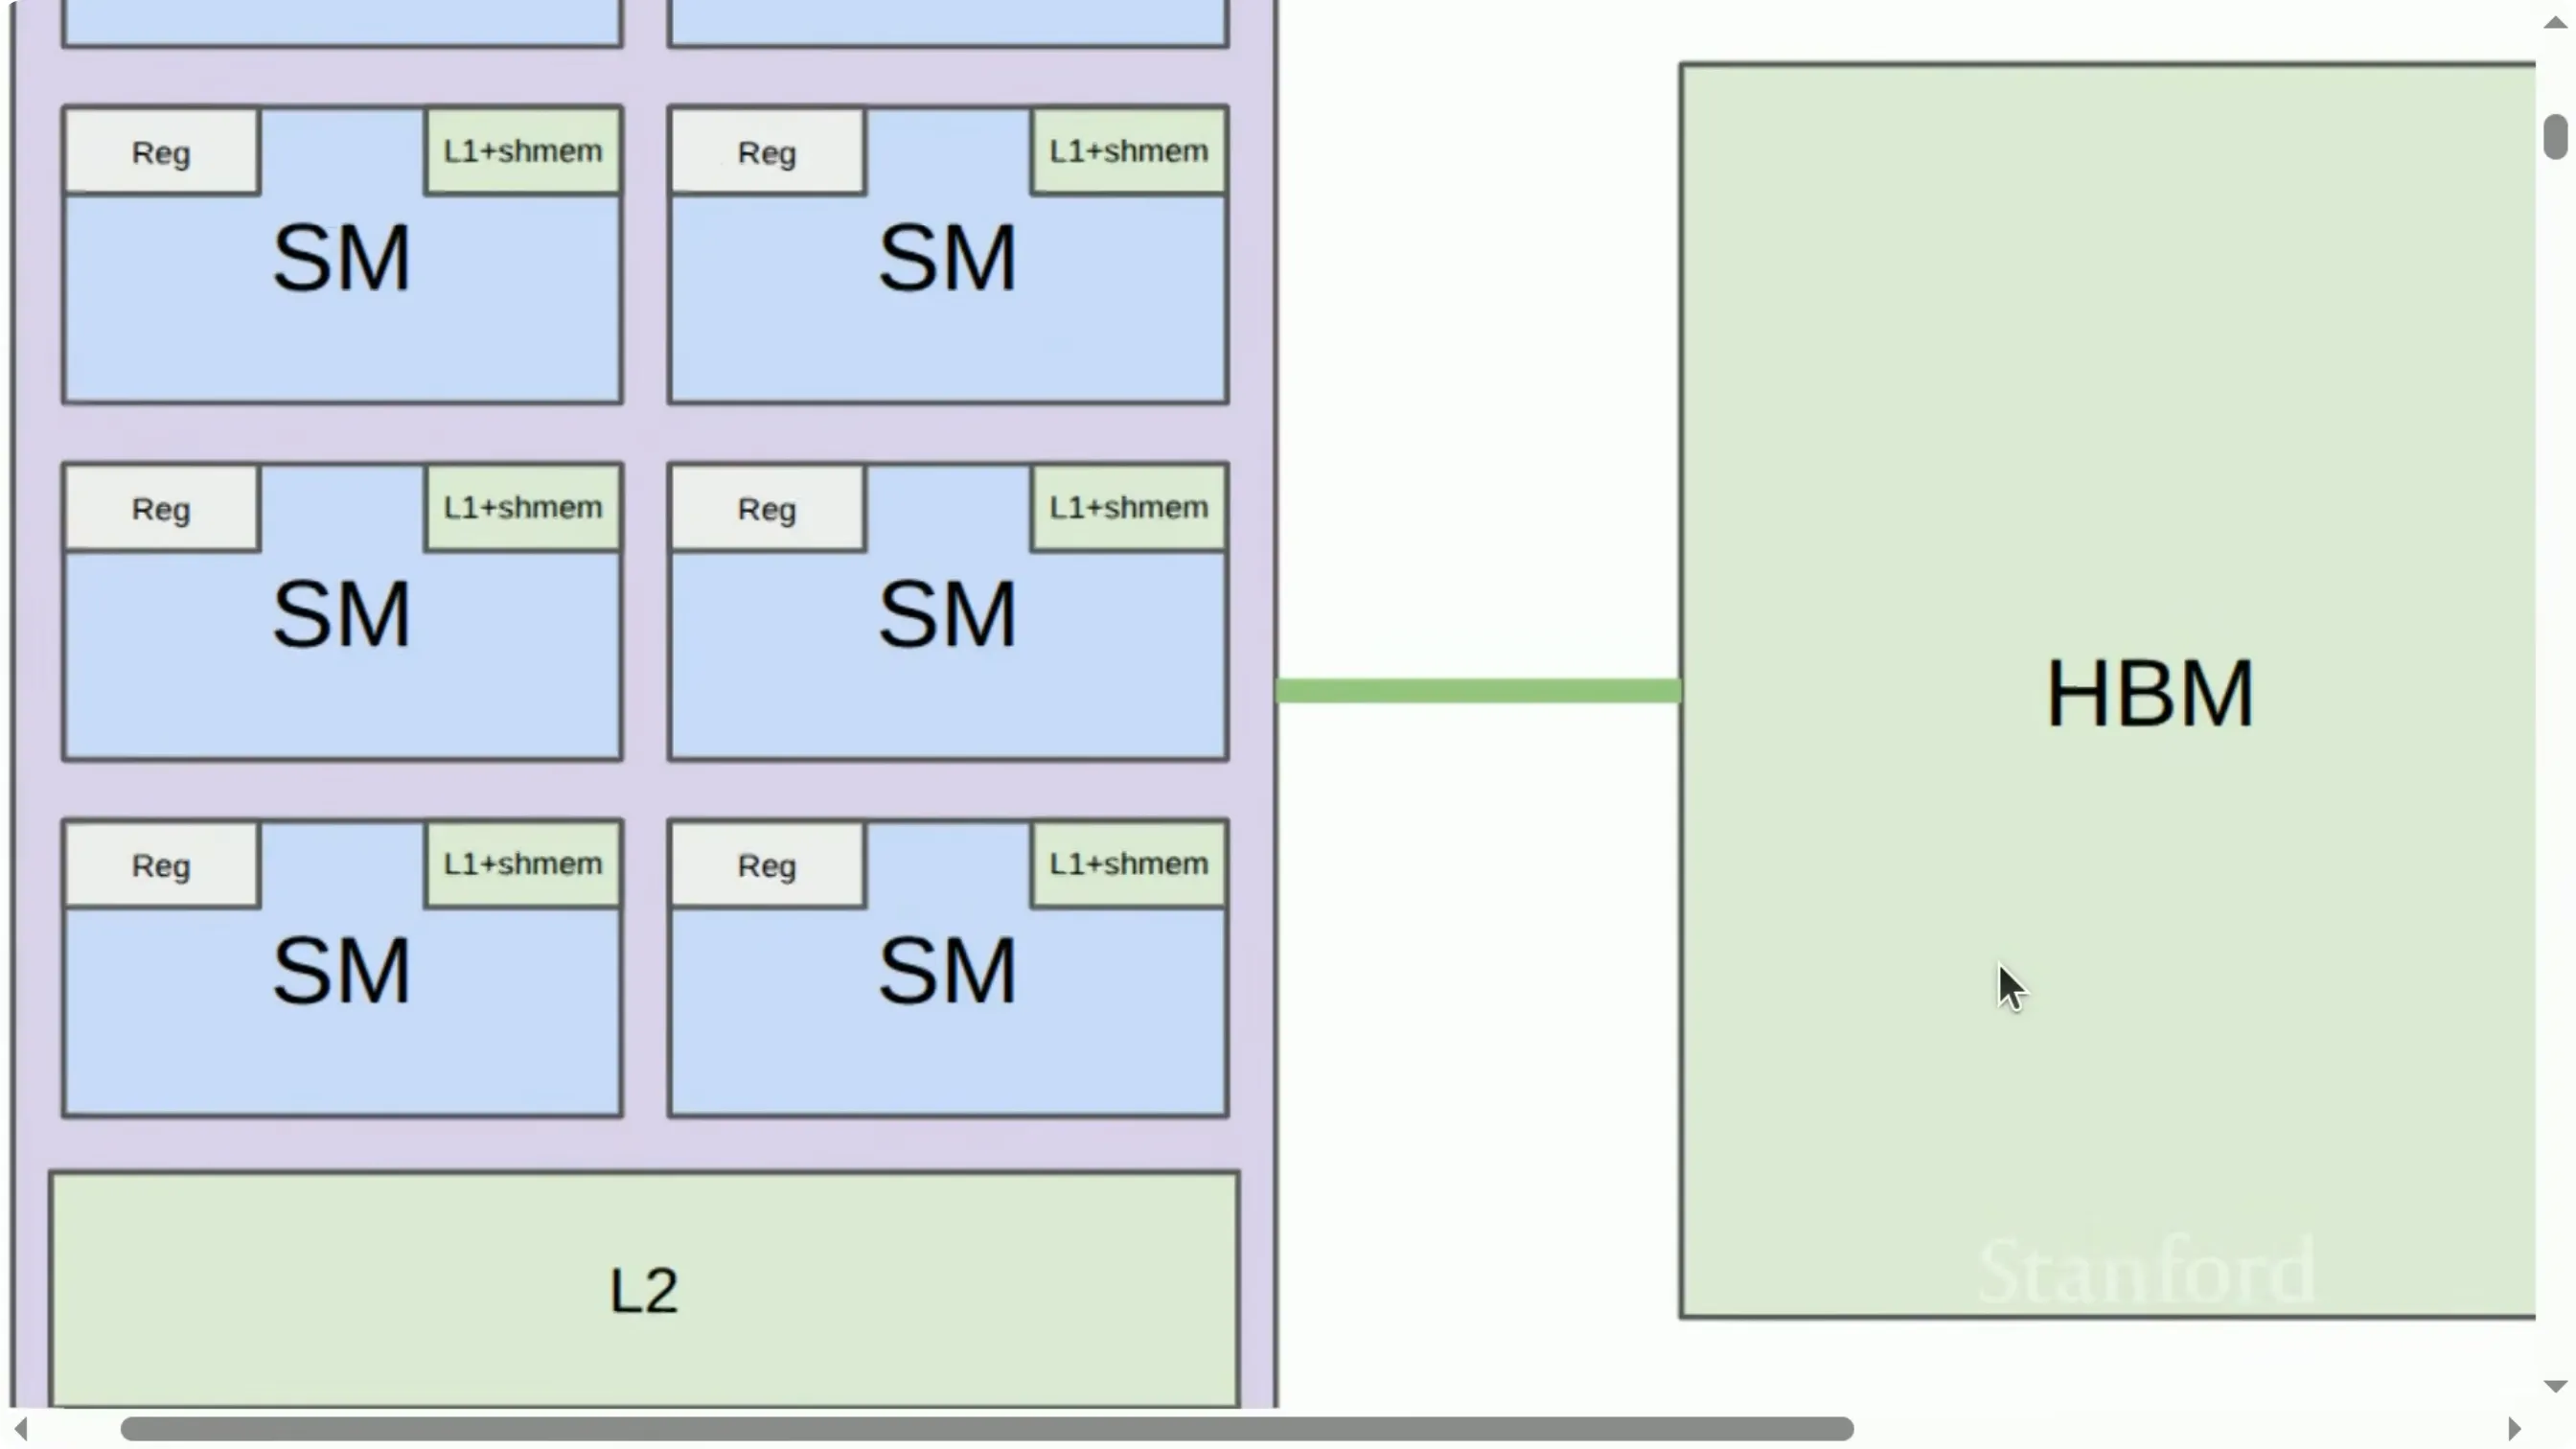
📷 一块典型 GPU 的简化结构:右侧是显存,左侧是 GPU 芯片
回到原视频 (00:00:40)
一块典型 GPU 由两部分构成:显存和实际的 GPU 芯片。以 NVIDIA GPU 为例,从 M100、H100 到 B200,每一代芯片里都有若干个流式多处理器 (Streaming Multiprocessor, SM)。
- SM 的数量大约是 100 到 200 之间,这个数量多年来变化不大。
- 每个 SM 内部有一组寄存器。B200 每个 SM 有 65,000 个寄存器,合计 256 KB。
- 寄存器之外还有 L1 缓存和共享内存 (shared memory)——注意这两者其实是同一块物理内存:共享内存你可以手动控制,L1 你不能。它们都是「每个 SM 私有」的。
- 再往外是 L2 缓存,它不是每个 SM 私有,而是整块芯片共享,容量更大。
- 最外层是 HBM 高带宽显存 (High Bandwidth Memory),容量最大,也是这十几年里增长最猛的一项。
1.2 容量与带宽的层次结构
讲者特别强调:除了容量,更要看带宽,而且带宽大致与容量反相关。
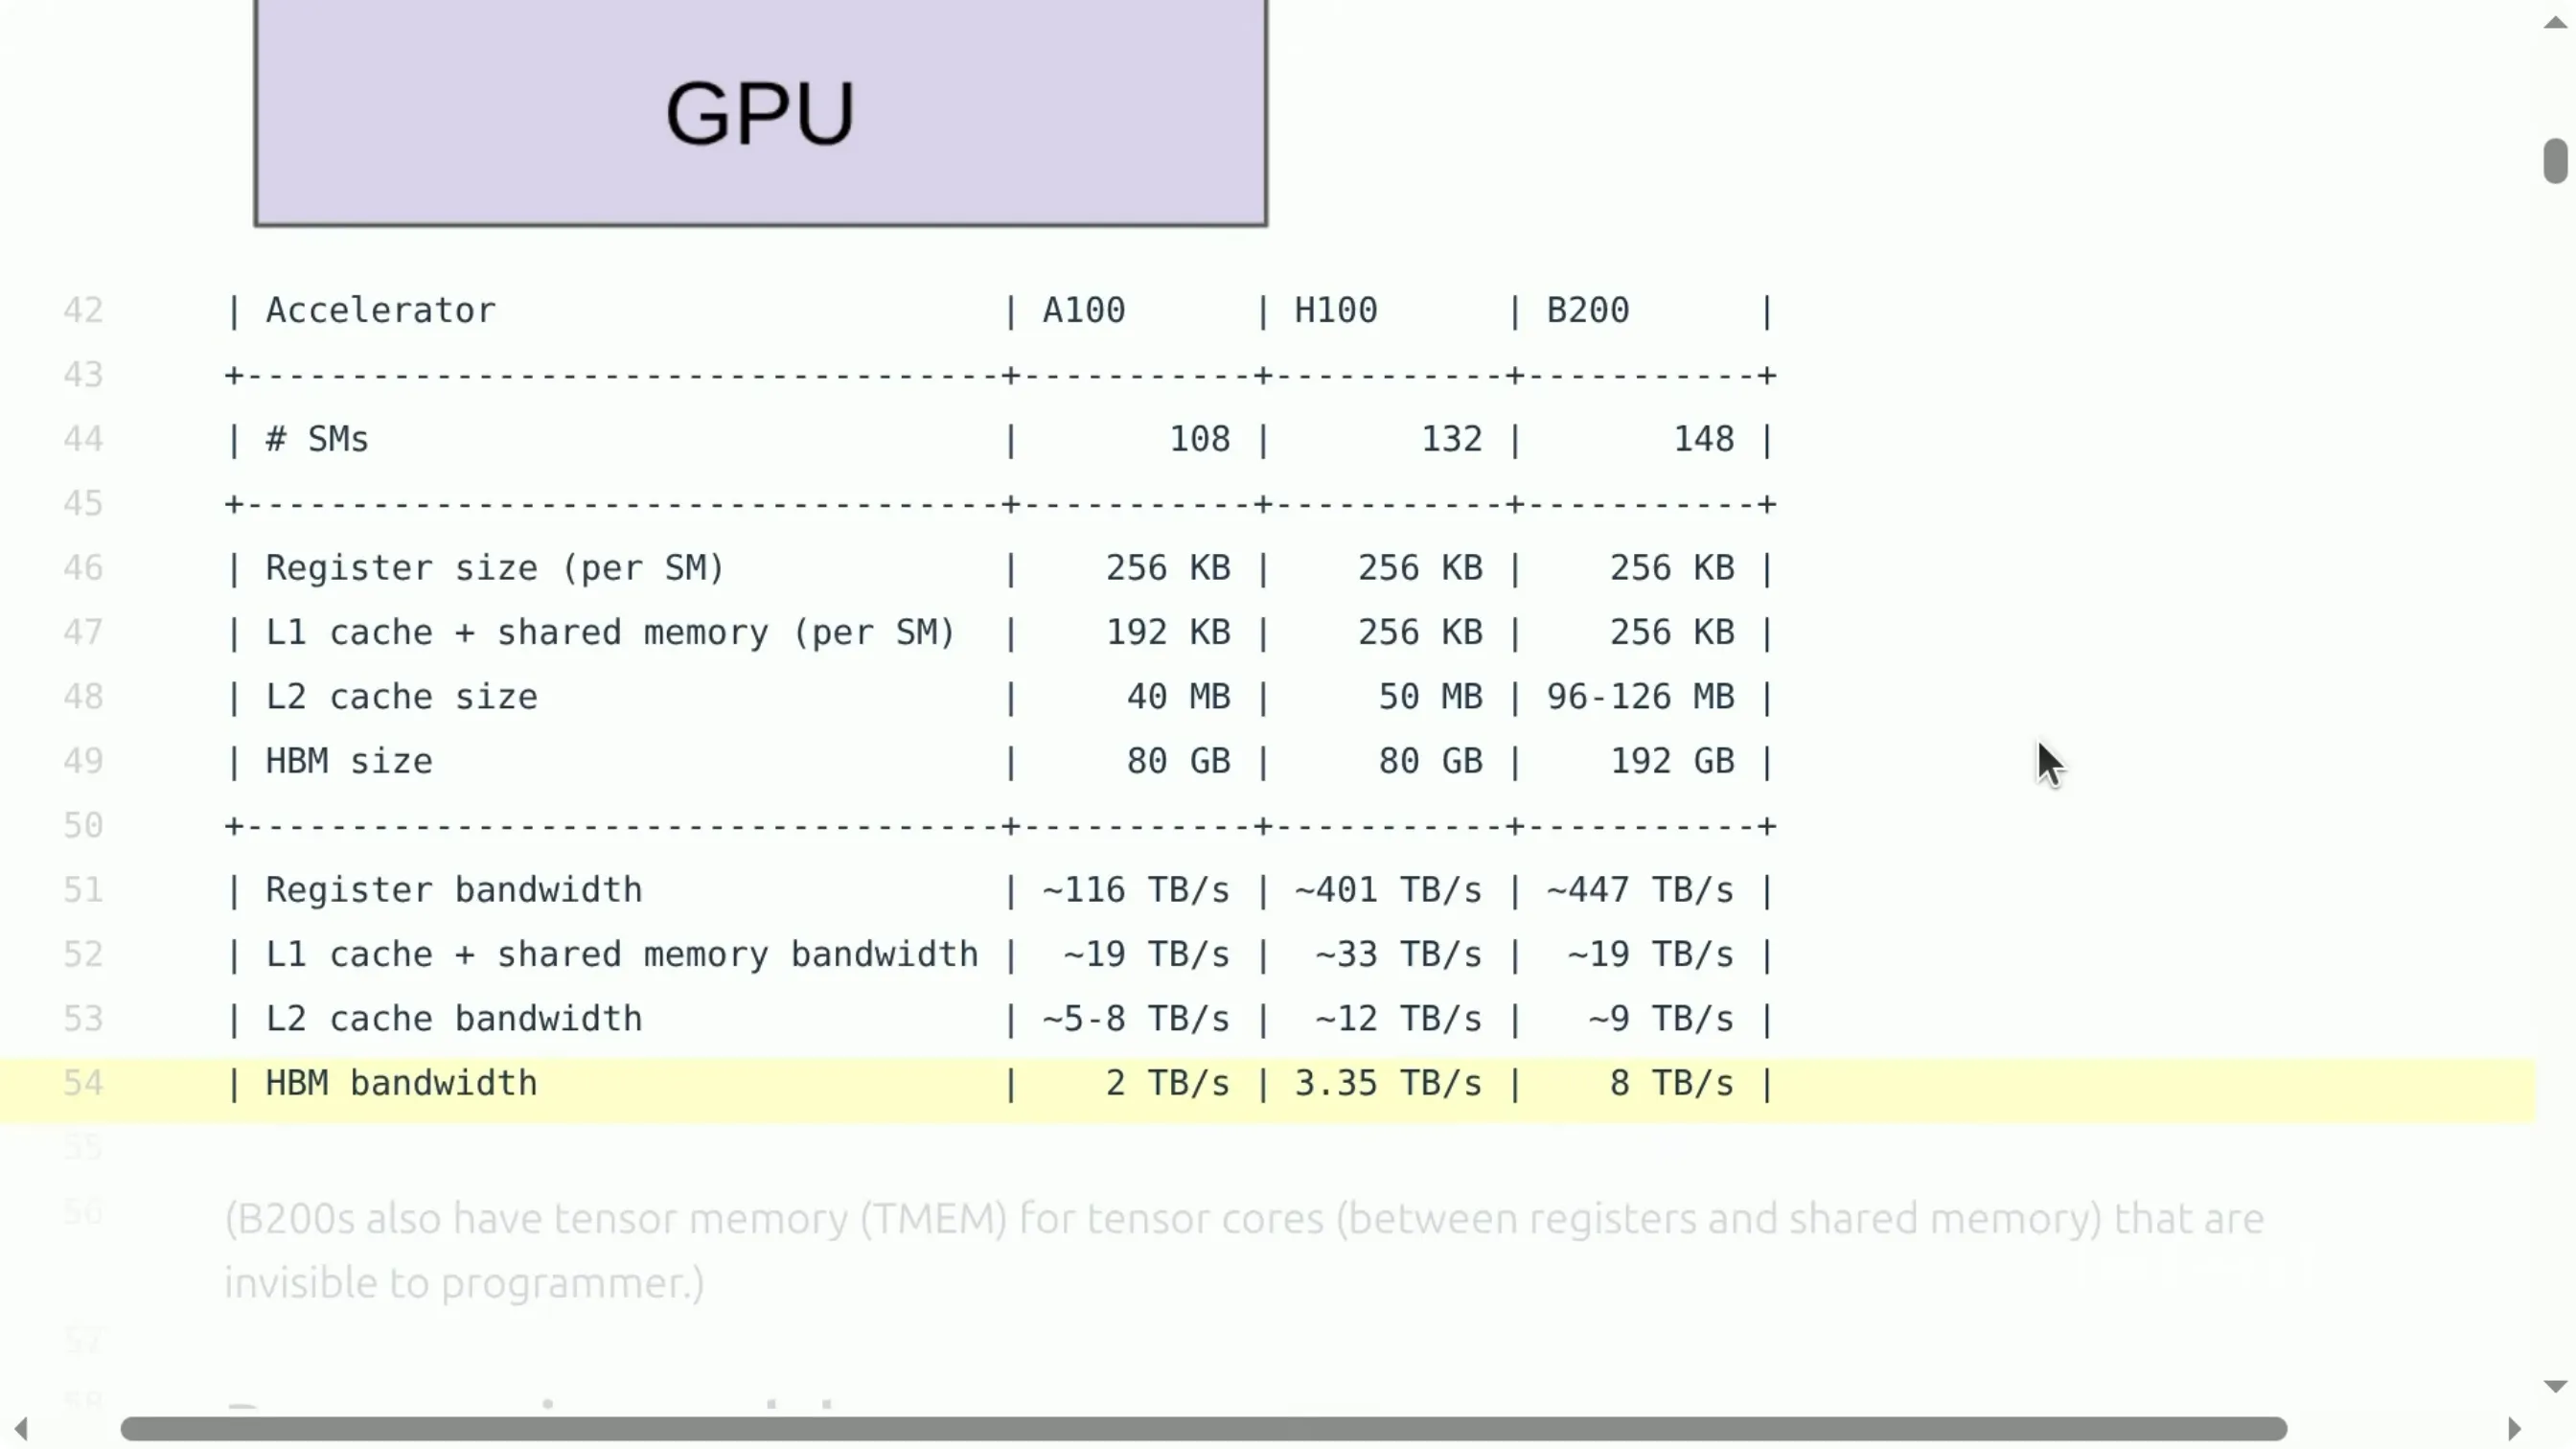
📷 GPU 内存层次:寄存器最快最小,HBM 最慢最大
回到原视频 (00:02:59)
graph TD
    subgraph SM["每个 SM 内部(快 · 小)"]
        R["寄存器 Register<br/>每线程私有"]
        L1["L1 / 共享内存<br/>每个 SM 私有"]
    end
    L2["L2 缓存<br/>整块芯片共享"]
    HBM["HBM 高带宽显存<br/>全局 · 最慢 · 最大"]
    HBM --> L2 --> L1 --> R
- 寄存器最快;
- L1略慢;
- L2更慢;
- HBM最慢——但即便如此,8 TB/s 的带宽放在大环境里也不算慢。
编者拓展|算术强度与 Roofline 模型
讲者反复提到的「为什么慢」,可以用算术强度 (arithmetic intensity) 这个量来量化:
$$\text{算术强度} = \frac{\text{浮点运算次数 (FLOPs)}}{\text{搬运字节数 (Bytes)}}$$
它衡量「每从内存搬 1 字节,能换回多少次计算」。如果算术强度很低(搬运多、计算少),程序就是内存瓶颈 (memory-bound);如果很高,就是计算瓶颈 (compute-bound)。GPU 的算力增长远快于带宽增长,所以现代深度学习优化的核心思路之一,就是尽量提高算术强度——这正是后面 tiling 的全部动机。想深入的同学可以查 NVIDIA 的 Roofline 模型白皮书。
一句话记住这层结构:大内存慢而远、但大;快内存(寄存器、L1)在 SM 上、近而快、但小。这就是我们要打交道的环境。
1.3 如何给 GPU 编程:线程、线程块、网格
(参考时间: 00:03:18)
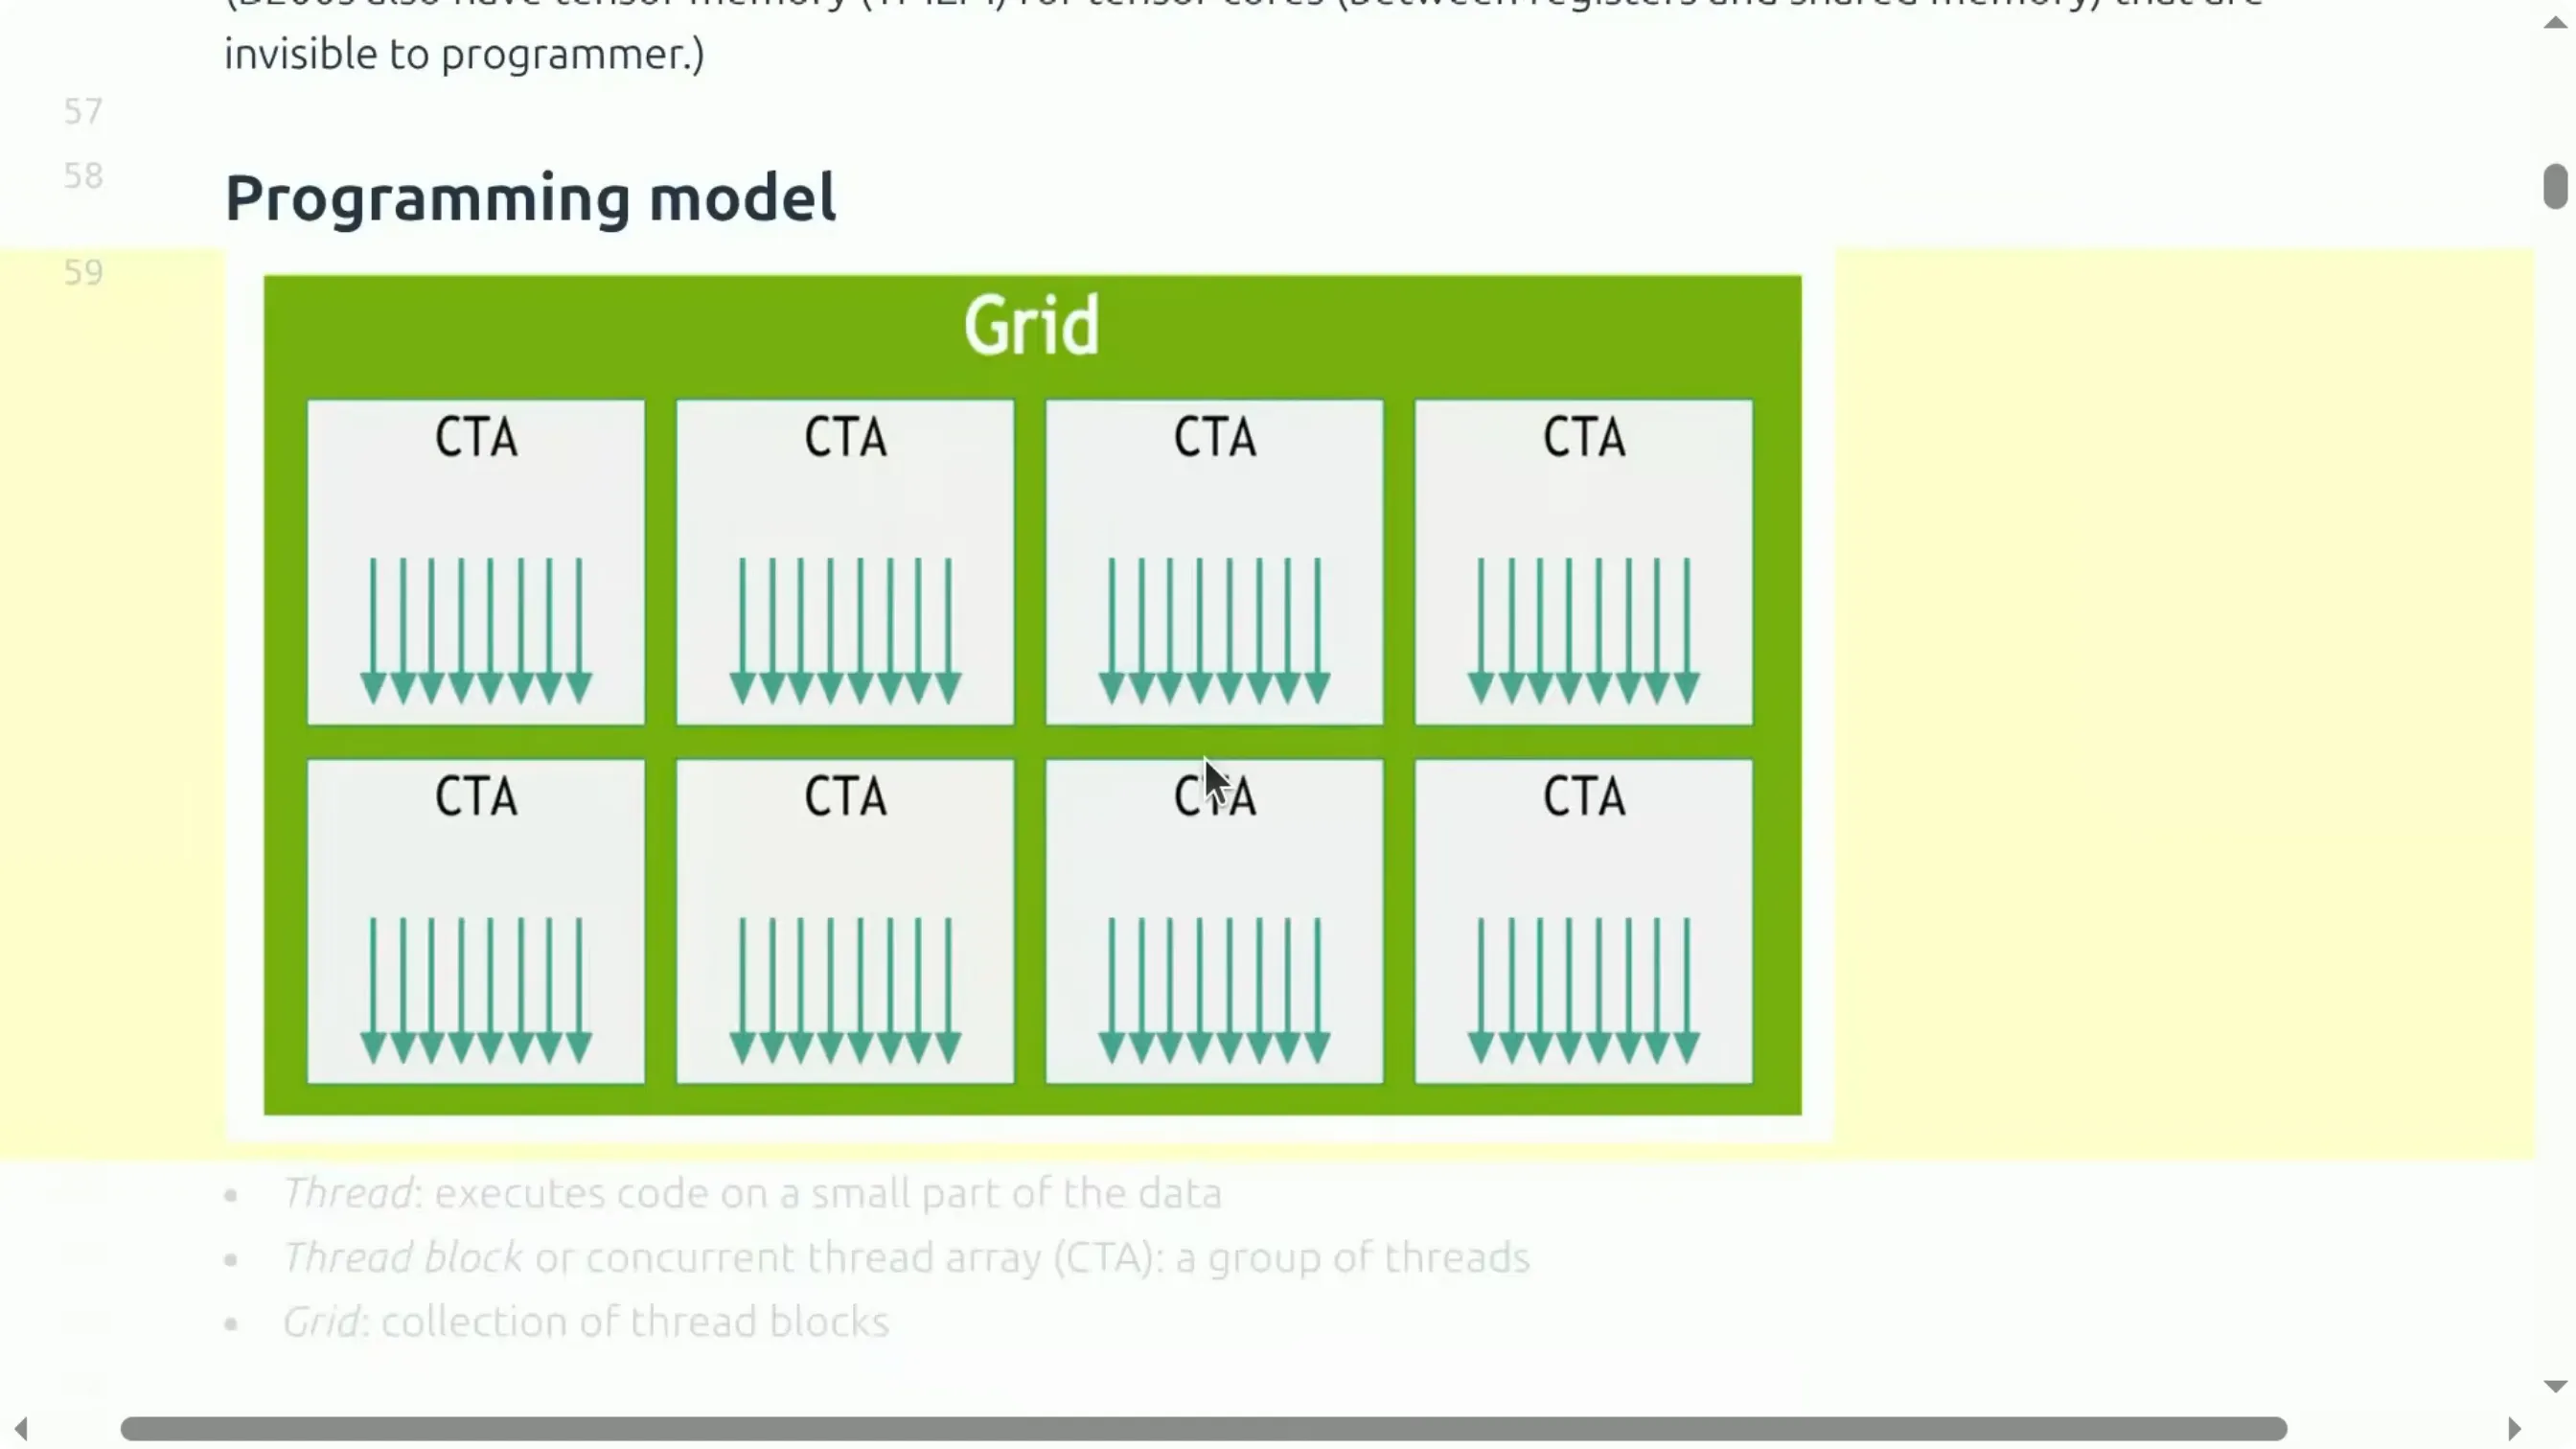
📷 编程模型:线程组成线程块,线程块组成网格
回到原视频 (00:03:22)
GPU 的编程模型有三级结构:
- 线程 (thread):每个线程在一小片数据上执行一段代码。图中每一个箭头就是一个线程。
- 线程块 (thread block):又叫并发线程阵列 (Concurrent Thread Array, CTA),是若干线程的集合。
- 网格 (grid):线程块的集合。启动一个核函数,本质上就是启动一个网格,让所有线程块并行地跑起来。
编者说明:H100、B200 还引入了更高层的 线程块簇 (thread block cluster),允许若干线程块之间共享一部分分布式内存;B200 还新增了用于张量核心的 张量内存 (tensor memory),位置介于寄存器和共享内存之间。这些对程序员基本是透明的,本讲暂不涉及。
1.4 为什么需要「线程块」这一层?
讲者提了一个很自然的问题:既然所有运算都是并行的,为什么不让网格里直接放一堆线程、每个线程算一小片数据就完事?
- 对于纯逐元素 (element-wise) 运算,比如 GELU,确实可以——每个线程处理一个元素,就像
for i in range(len(data)),线程非常自然。 - 但对于需要线程间通信的运算,比如 softmax 或矩阵乘法,这个视角就不够用了。
你可以只靠线程:让每个元素自己算,所有读写在 HBM 上来回。但前面刚说过,HBM 非常慢,这会是灾难性的策略。更好的做法是用共享内存,而共享内存是每个 SM 私有的——线程块正好让你表达「一组会共享同一块共享内存的线程」。
于是流程变成:一个线程块被调度到某个 SM 上,它从 HBM 读一批数据,处理过程中通过共享内存做线程间通信,最后把结果写回 HBM。
这正是之后的分块 (tiling) 的全部游戏规则。而在 Triton 里,我们原生地就以线程块为单位来思考——一旦习惯了这个视角,写核函数会轻松很多。
二、硬件的坑:为什么性能如此敏感
(参考时间: 00:07:15)
讲者指出本讲的关键张力:
- 编程模型很干净,它提供了对硬件的抽象。你只需定义线程块、定义每个线程要做什么,写起来就像写 Python。如果只关心正确性,知道这些就够了。
- 但性能完全依赖硬件。 想拿到高性能,你必须深入理解硬件。我们之所以要谈 GPU 和核函数,全部目的就是榨取性能。
于是就有了「理解计算」和「理解硬件」两个层面。接下来讲者用约五个例子来展示硬件细节如何影响性能。
2.1 Warp 与分支发散
(参考时间: 00:08:47)
warp 不在上面那套干净的编程模型里——你写代码时并不需要显式关心它,但它是硬件真实存在的结构。
📷 线程被进一步组织成 warp,每个 warp 有 32 个线程
回到原视频 (00:09:20)
- 一个 warp 有 32 个线程。 一个 64 线程的线程块包含 2 个 warp(前 32 个、后 32 个)。
- 同一个 warp 内的所有线程必须在同一个周期里锁步执行同一条指令。
- 控制发散 (control divergence) 指:warp 内不同线程需要执行不同的指令,典型场景就是条件分支
if A then A else B。此时硬件只能先执行一部分线程的 A、再执行另一部分线程的 B,串行化了本应并行的执行。这就是为什么一般应尽量避免分支。
不过 warp 也有一个很酷的性质:一个 SM 会同时运行多个 warp。SM 里有一个 warp 调度器和一批常驻 warp。当某个 warp 去读 HBM(可能要花约 100 个周期)时,SM 可以零开销地立刻切换到另一个可以被执行的 warp——这在 CPU 上通常做不到。
这套设计的目的就是隐藏延迟:不要让某个 warp 干等内存,而是趁它等待时切换到别的 warp 去做张量核心运算。
编者说明:这就是 GPU 与 CPU 的关键区别之一。CPU 靠大缓存 + 乱序执行 + 分支预测来隐藏延迟;GPU 则靠海量线程 + 快速上下文切换来隐藏延迟。GELU 这类逐元素运算天然没有分支发散问题,但当你的核函数里出现
if时,就必须警惕 warp 内的线程是否走了不同分支。
2.2 寄存器占用与占用率 (Occupancy)
(参考时间: 00:11:16)
每个线程最多能用 255 个寄存器。而 SM 的寄存器总数是固定的(B200 为 65,000 个)。这意味着:
每个线程用的寄存器越多,能同时跑的线程就越少。
这个「能同时跑的 warp 数 / 最大 warp 数」就是占用率 (occupancy)。但讲者特别提醒:占用率高不一定好。如果线程虽少、但每个线程干更多活,反而可能更快。
他给了一个想减少线程数的例子——线程粗化 (thread coarsening):对逐元素运算,你可以让一个线程只处理一个元素(线程很多),也可以让一个线程处理多个元素(比如 8 个)。后者线程更少、调度更简单,但每个线程做更多工作。「如果线程太轻,就把它们养胖一点。」
具体算一遍占用率:
假设一个线程块有 128 个线程,每个线程用 160 个寄存器:
$$ \text{寄存器数/线程} = 160 < 255 \quad \checkmark $$
$$ \text{寄存器数/块} = 128 \times 160 = 20{,}480 $$
SM 上有 65,000 个寄存器,所以最多同时跑:
$$ \left\lfloor \frac{65{,}000}{20{,}480} \right\rfloor = 3 \text{ 个块} $$
3 个块 × 128 线程 = 384 线程 = 12 个 warp。而硬件上限是每个 SM 64 个 warp,于是占用率为:
$$ \frac{12}{64} \approx 18.75\% $$
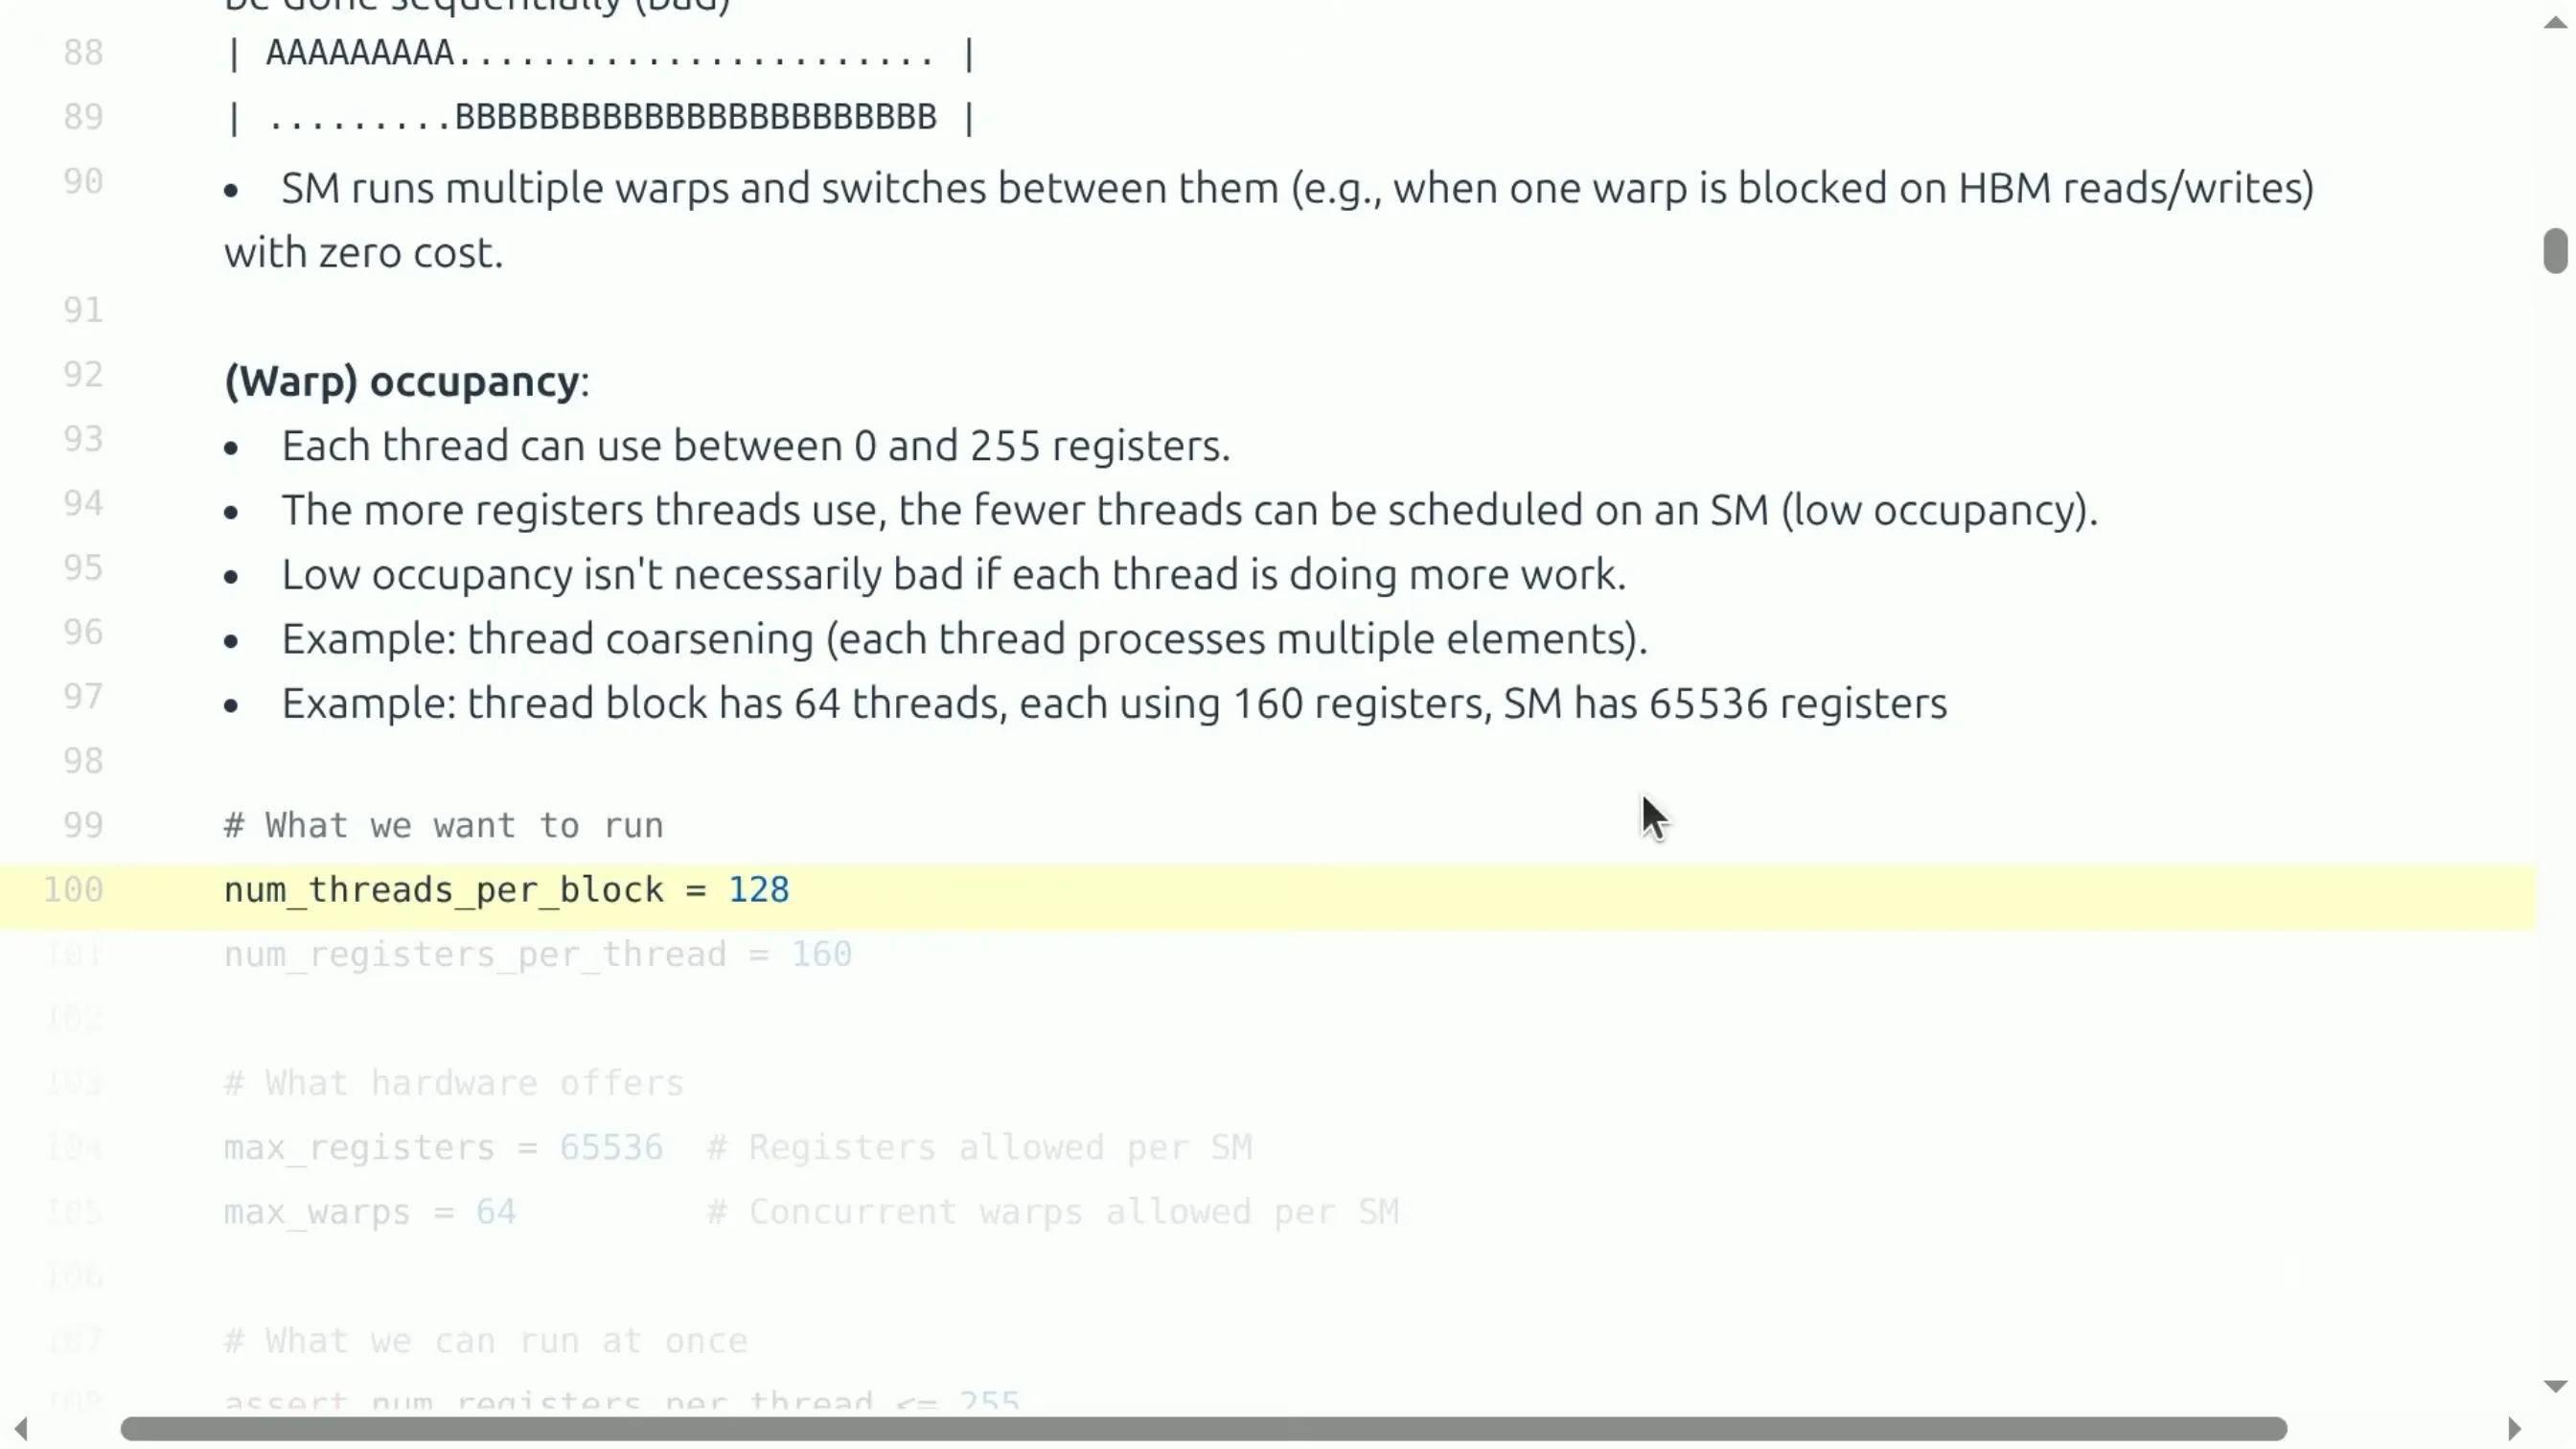
📷 占用率计算示例:寄存器用量过大导致只能跑 3 个块
回到原视频 (00:12:54)
也就是说,是内存(寄存器)在限制你能做多少计算。
2.3 共享内存的 Bank Conflict
(参考时间: 00:14:20)
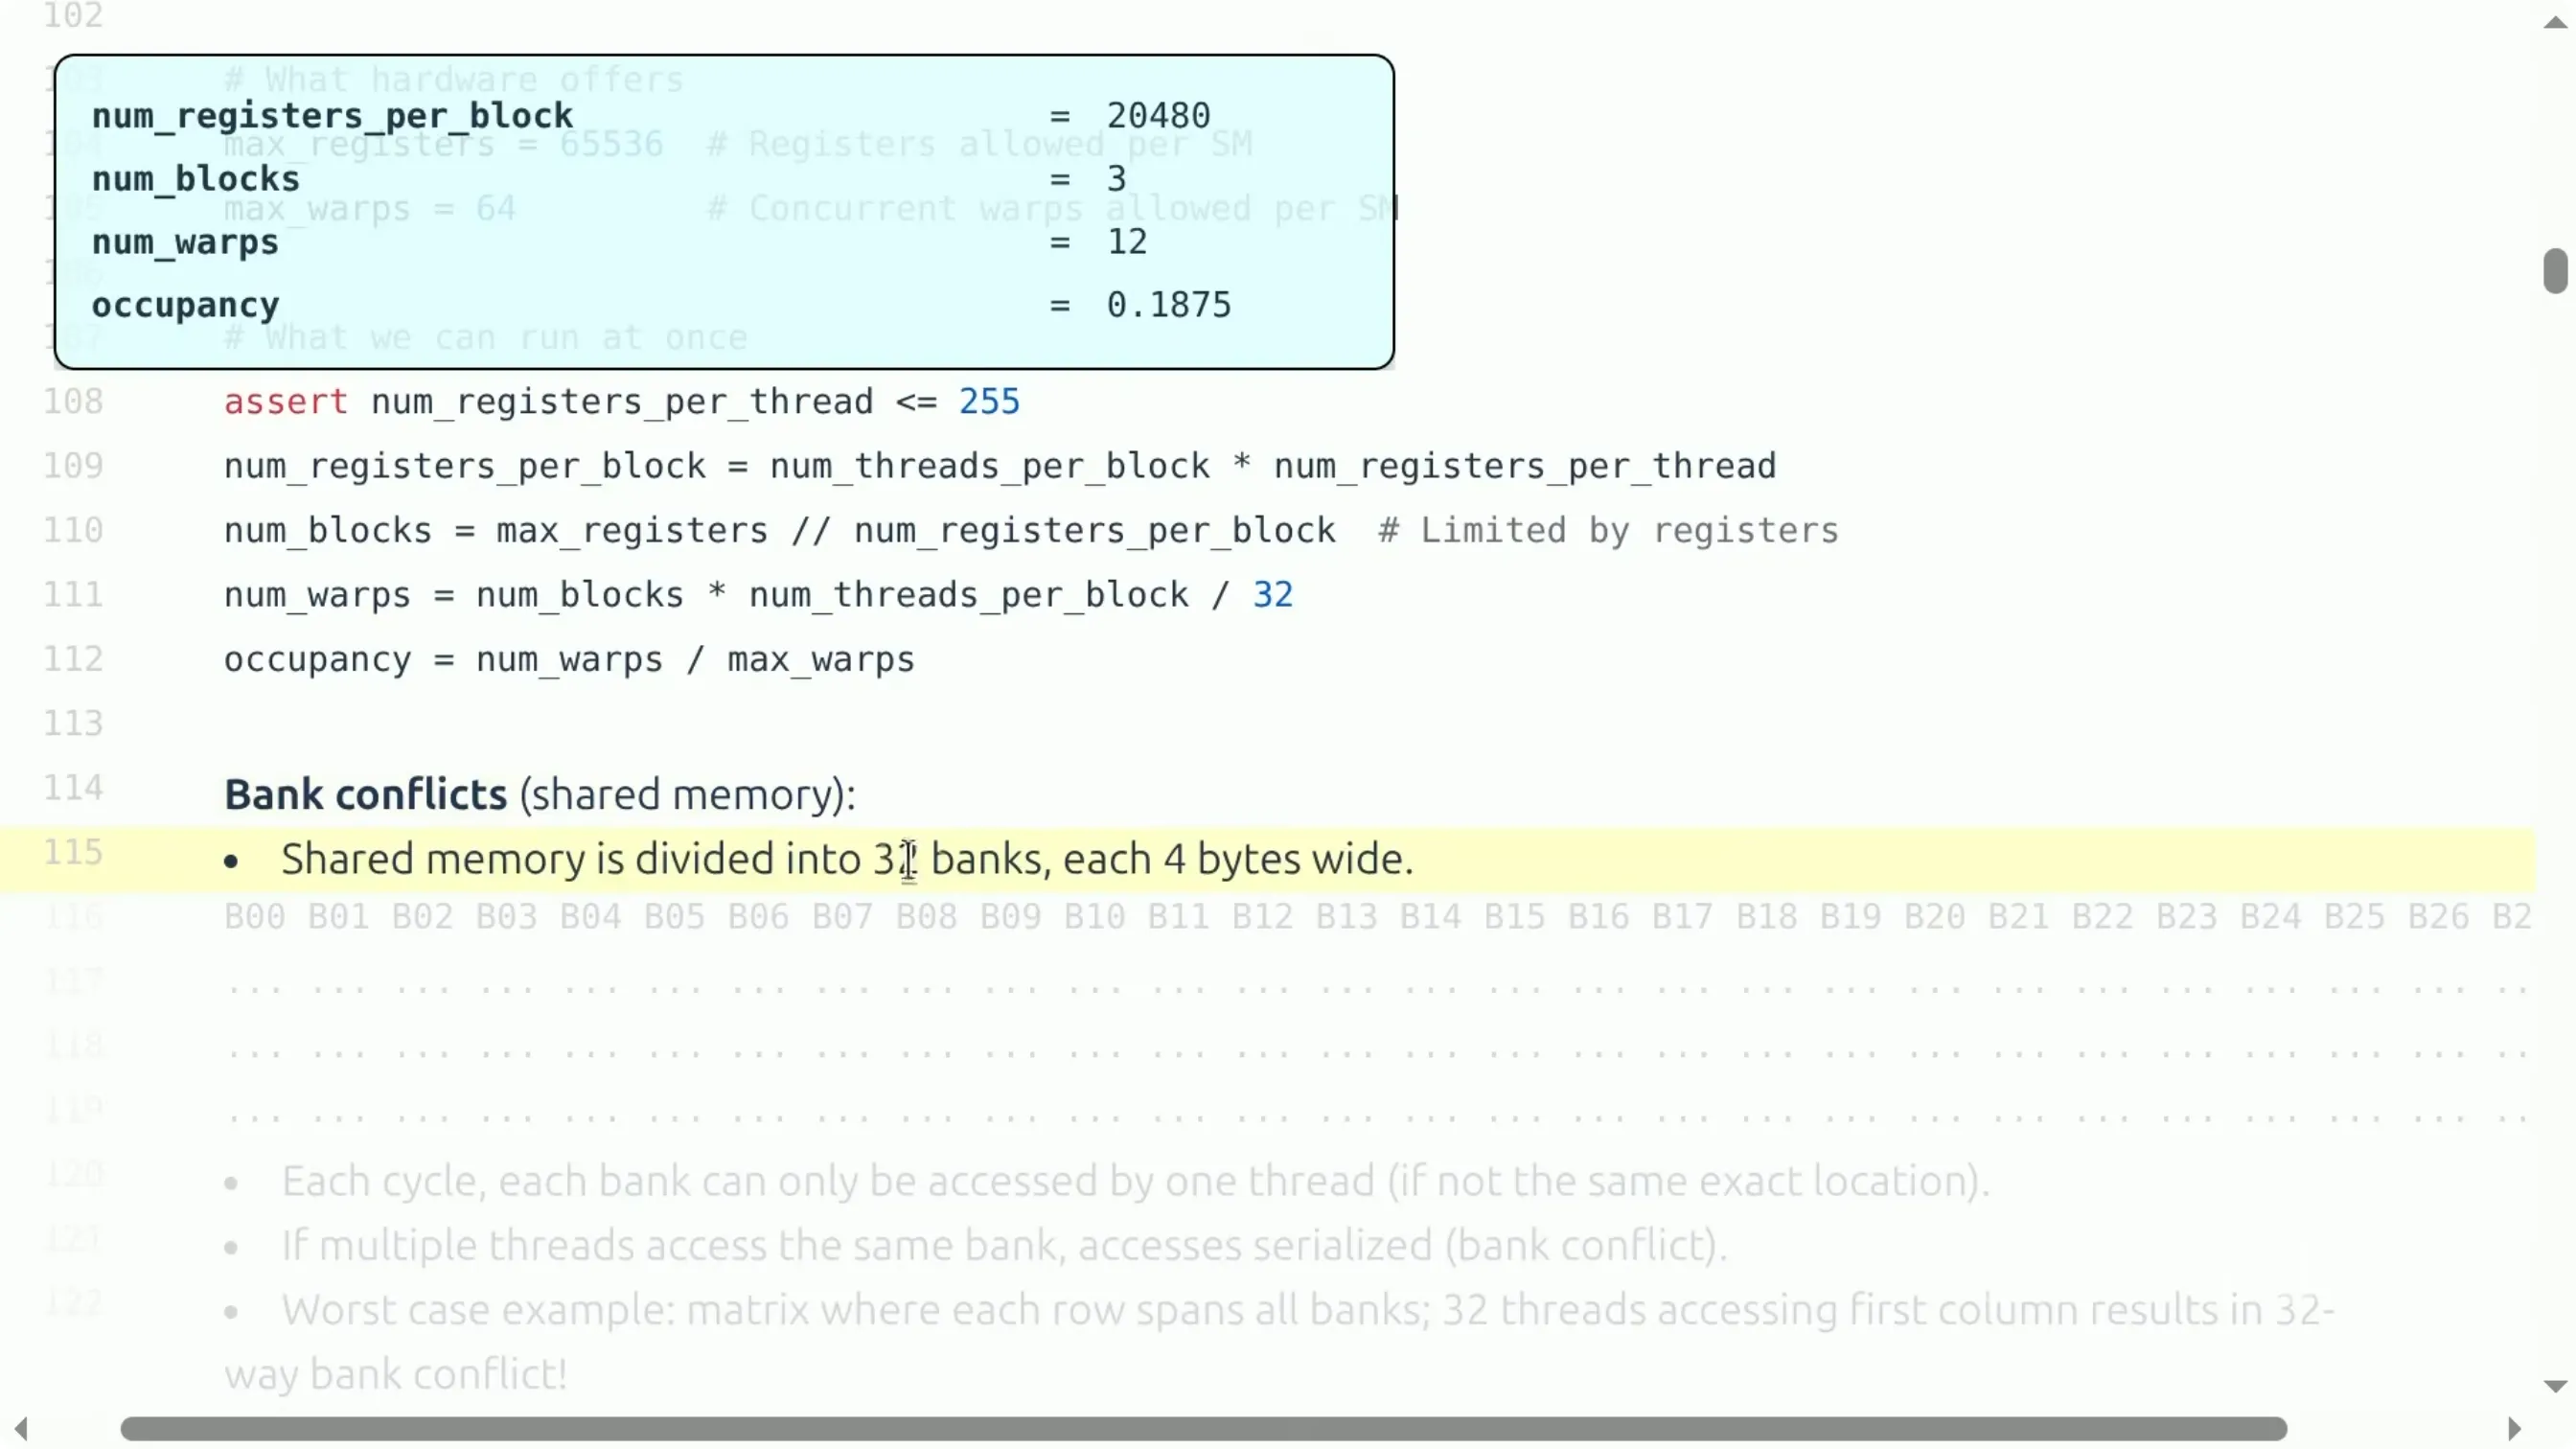
📷 共享内存被分成 32 个 bank,每个 4 字节宽
回到原视频 (00:14:36)
共享内存(本质上是 L1)被硬件划分为 32 个 bank,每个 4 字节宽。约束是:
每个时钟周期,每个 bank 最多只能被一个线程访问。
如果多个线程同时访问同一个 bank,访问就必须串行化——这叫 bank conflict。
最坏情形:一个矩阵按 M[i][j] 的布局存储,如果有 32 个线程试图同时访问第一列,它们会全部排队等待,形成 32 路 bank conflict——这是能遇到的最坏情况。
你可能会问:那为什么不总按行访问?因为矩阵乘法避不开。 matmul 必须同时访问一个矩阵的行和另一个矩阵的列,还经常转置,所以你无法永远自由选择访问顺序。针对这个问题有一个叫 swizzling(重排) 的技巧,会重新安排共享内存的布局以规避 bank conflict——本讲不深入。在剖析时,你可以直接查看 bank conflict 和占用率指标。
编者拓展|为什么是「32」这个数
32 不是巧合:它正好等于一个 warp 的线程数。硬件希望 warp 里 32 个线程能「一周期内各取一个 bank」,即所谓 conflict-free。判断方法:看这些线程访问的地址
addr对 32 取模后的bank = (addr / 4) % 32是否互不相同。如果 32 个线程访问连续地址(步长为 1 个元素),它们正好落在 32 个不同 bank 上,无冲突;如果步长恰为 32,则全部撞在同一个 bank 上——这正是「按列访问」最坏的原因。
2.4 内存合并访问 (Memory Coalescing)
(参考时间: 00:16:55)
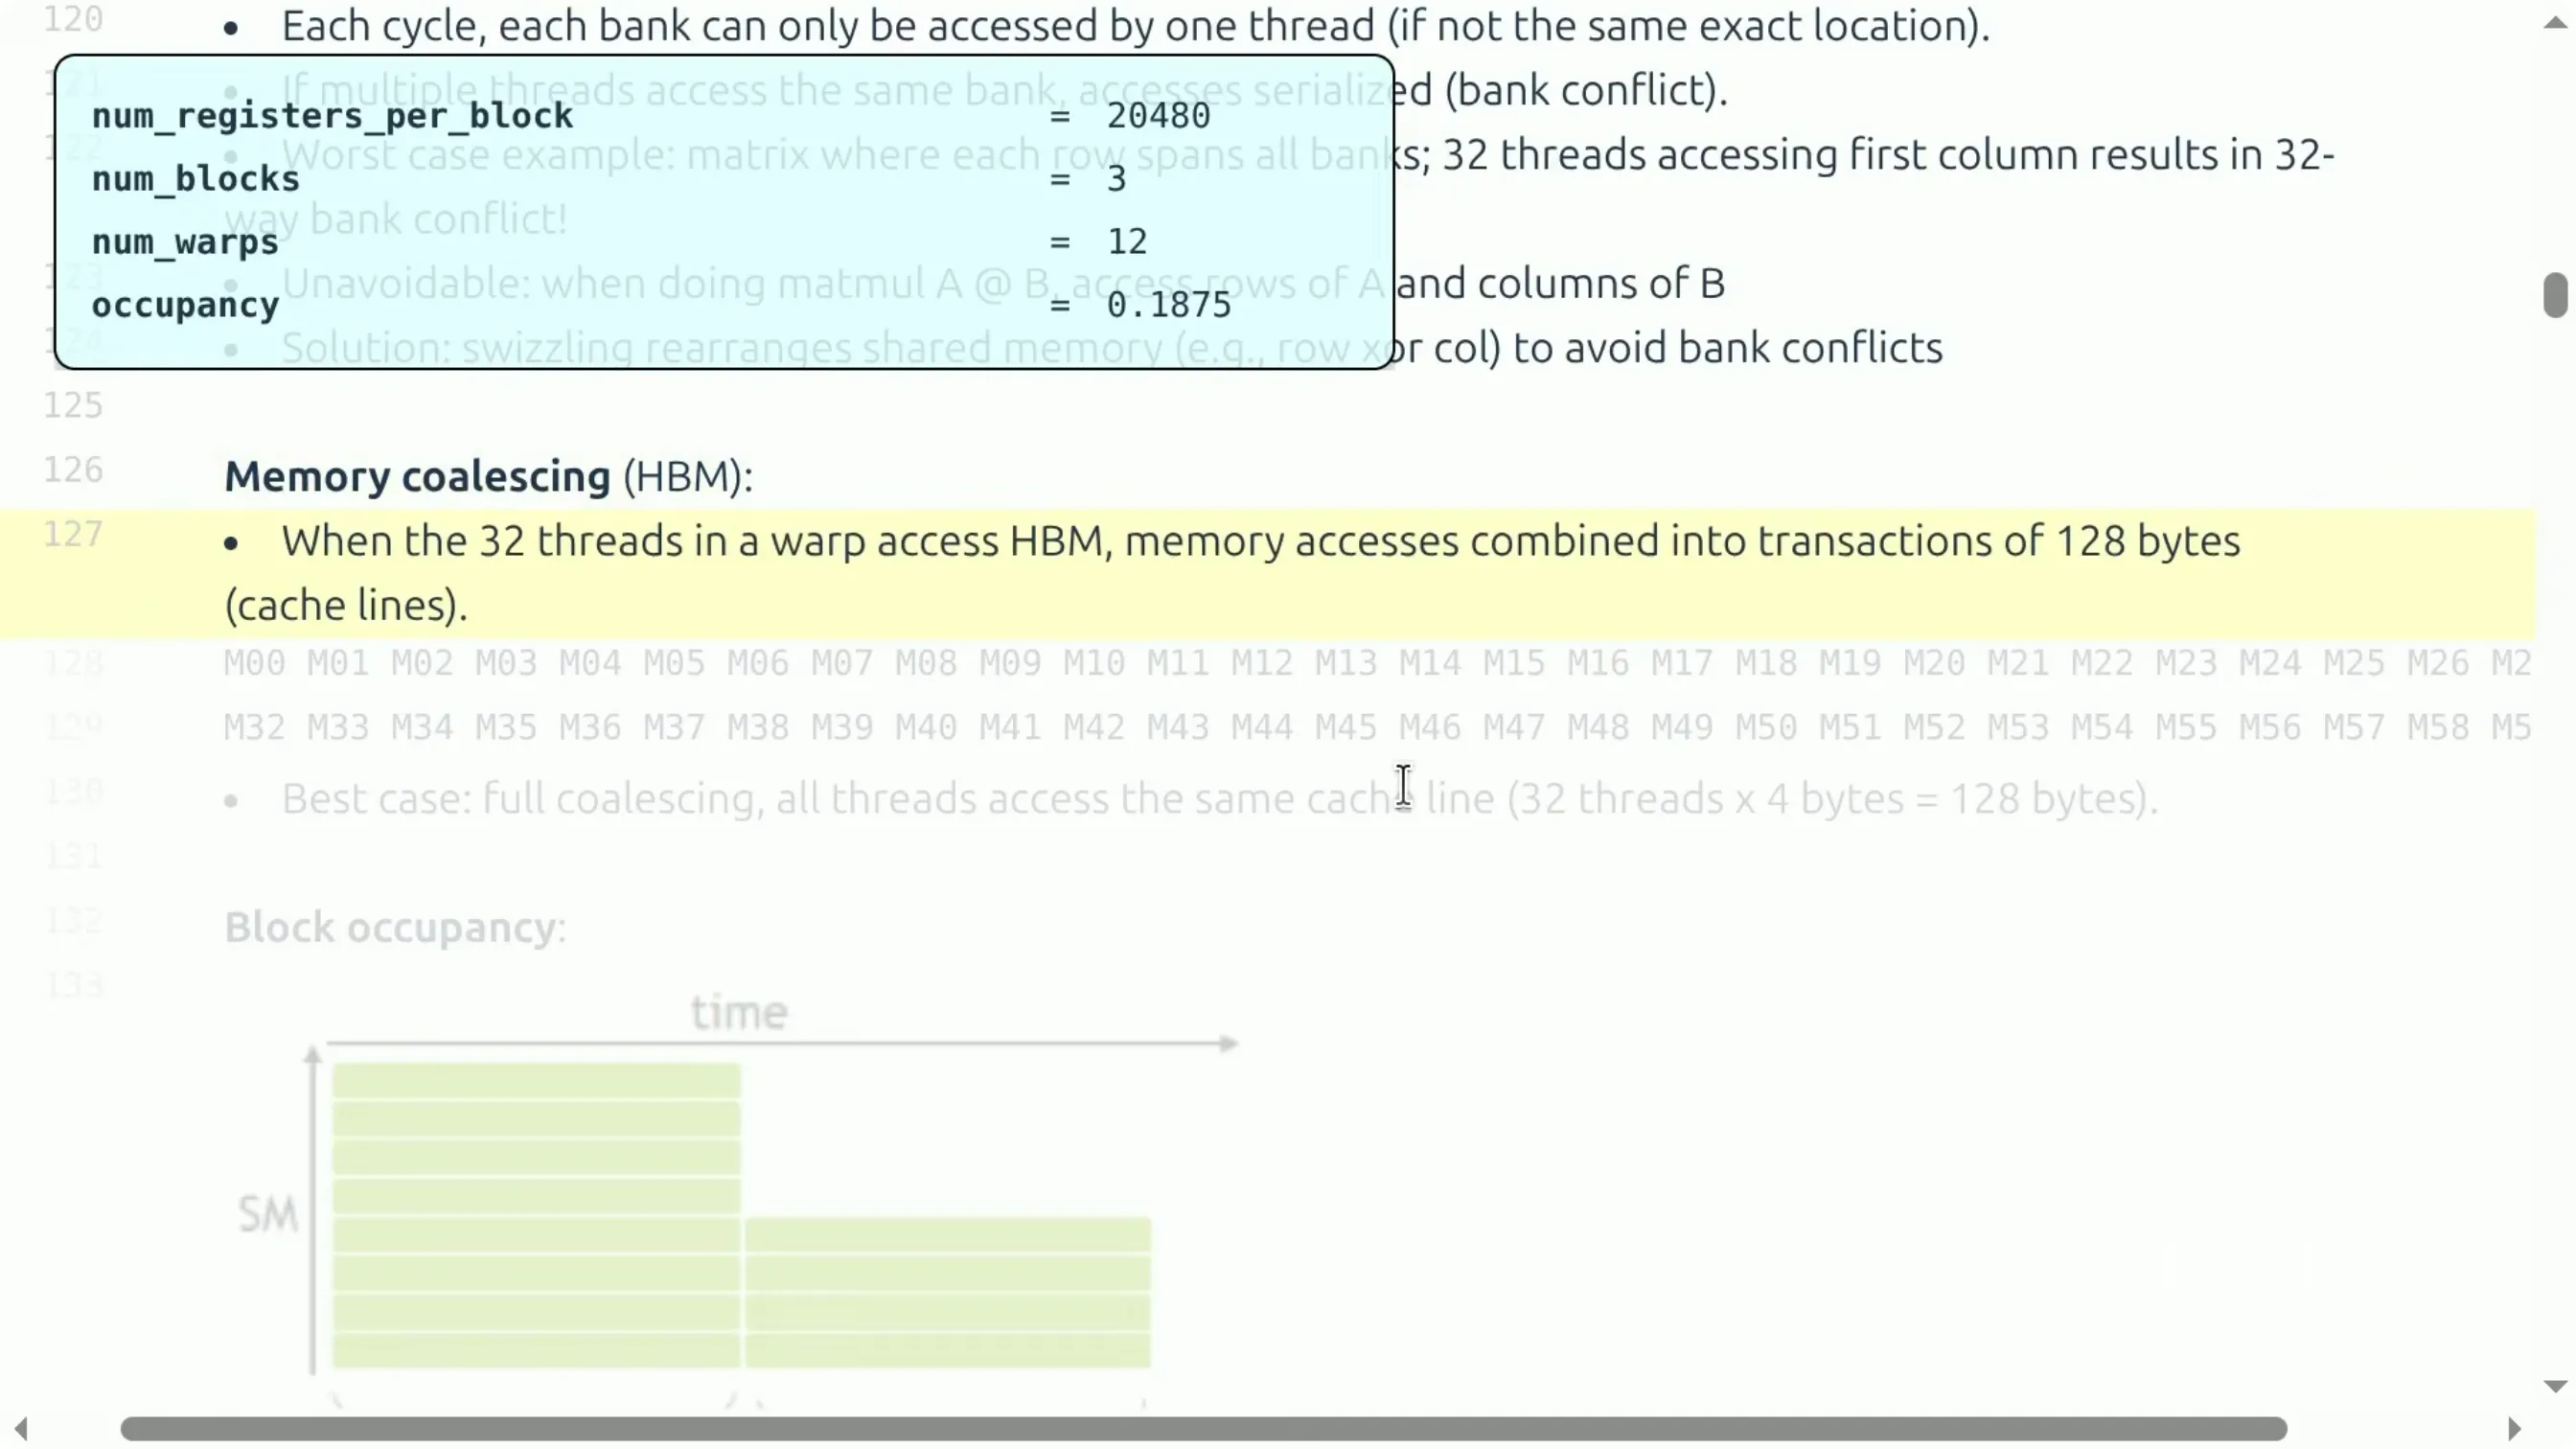
📷 内存合并:warp 内 32 个线程访问连续地址时,硬件合并成一次 cache line 取回
回到原视频 (00:17:00)
当一个 warp 里的 32 个线程访问 HBM 时,硬件会把这些访问合并成一次事务,大小约 32–128 字节,也就是一条 cache line,一次性取回。
- 完全合并 (full coalescing) ——最优情况:线程 1 访问
M[0][0]、线程 2 访问M[0][1]……它们落在同一条 cache line 上,硬件一把抓回来,全部用得上。 - 按列访问 ——最差情况:每个线程落在线程不连续的地址上,硬件取回一整条 cache line,但大部分数据用不上,白白浪费带宽。
注意这其实和 bank conflict 很像,但约束完全不同:bank conflict 是关于共享内存的,coalescing 是关于 HBM 的。对逐元素运算无所谓(随便什么顺序都行),但对 matmul 就很关键。
2.5 块占用率与「尾波」
(参考时间: 00:18:15)
线程块会被调度到 SM 上。逻辑上你能定义任意多个线程块,但物理上芯片的 SM 数有限——比如 B200 有 148 个 SM。
如果你启动了 160 个线程块:
- 第一波只能调度 148 个;
- 剩下的 12 个必须等前一批跑完才轮得上;
- 而最后一波只有 12 个线程块在跑,却有 136 个 SM 闲着。
这叫低占用率(准确说是尾波浪费)。
编者说明:讲者提到的「让线程块数目整除 SM 数目」是一条经验法则,用来避免这种「尾波」。不过实际中很难做到完美,因为线程块运行时间往往不相等。有同学追问「能不能让线程块共享 SM」,讲者的回答是:如果某个块已经把 SM 的张量核心用满了,再塞一个块进去并不会更快;真正的解法是调整块的大小(block size)和块的数量,避免这种参差的尾巴。
2.6 小结:干净的模型 vs. 脏乱的硬件
把这一节收束一下:
- 模型层面:网格里有线程块,线程块里有线程;HBM 对所有人全局,共享内存对线程块本地,寄存器对线程本地。这套抽象非常优雅。
- 硬件层面:warp、bank conflict、内存合并、占用率……这些细节真正决定性能。
讲者强调,很多细节之所以难掌握,是因为你必须精确知道 SM 有多少个、各种尺寸是多少,而且调度器有时会做一些你无法控制的事——它比编程模型乱得多。所以,在动手写核函数之前,先测量。
三、基准测试与性能剖析:先测量,再优化
(参考时间: 00:21:45)
讲者把这一节定位为「方法论」,内容不多,但希望强调一种哲学:
成功的配方:基准测试你的代码 → 剖析你的代码 → 做修改 → 再基准测试、再剖析。
他强调,之所以在教你写核函数之前先讲这个,是因为你应该永远先测量、先找出瓶颈,再开始写核函数。
3.1 基准测试 (Benchmarking)
基准测试衡量的是「花了多长时间」,给你一个端到端时间。它不告诉你时间花在哪里,但非常有用——因为那正是你最关心的数字。而且因为它把结果压成一个数,你能直观看到随维度扩大,性能怎么变化。
本课既然是「from scratch」,讲者就从零手写基准测试,并借此指出几个坑。
要测的操作:矩阵乘法。下面这个包装函数会生成两个 dimension × dimension 的随机方阵,并返回一个执行该运算的函数:
def run_operation2(dimension):
    A = torch.randn(dimension, dimension, device='cuda')
    B = torch.randn(dimension, dimension, device='cuda')
    def op():
        return A @ B   # 两个矩阵已经生成好,这里只做乘法
    return op
最朴素的做法是「按表计时」:开始计时 → 跑 → 结束计时。但要注意几点:
- 一定要预热 (warm up)。 有些东西是惰性编译 (lazy compile) 的,你不希望编译时间混进测量结果。而且大多数情况下你关心的是反复运行时的速度,初始条件并不重要。
- 要多次计时取平均,因为有方差。严格的话可以看整个分布、P95 等,但这里先取平均。
- 正确的计时方式是用 CUDA event:记录
start事件 → 执行计算 → 记录end事件 → 同步以待 GPU 线程结束。
start_event = torch.cuda.Event(enable_timing=True)
end_event   = torch.cuda.Event(enable_timing=True)

# 预热
for _ in range(warmup):
    op()

start_event.record()
for _ in range(iters):
    op()
end_event.record()

torch.cuda.synchronize()          # 同步屏障
elapsed_ms = start_event.elapsed_time(end_event) / iters
编者说明:为什么必须
synchronize()?因为 GPU 上的操作是异步的——CPU 发起核函数调用后会立刻返回,真正在 GPU 上跑可能还没结束。不调用同步,你测到的只是「CPU 把任务丢出去花了多久」,而不是「GPU 算完花了多久」。
- 扫描规模,观察 scaling。 把矩阵从 2×2 一路放大,看时间如何变化。
讲者展示了一条曲线:矩阵乘法的耗时应随维度呈立方级增长,但你会发现一段平台期——在维度涨到接近 2000 之前,时间几乎是常数。
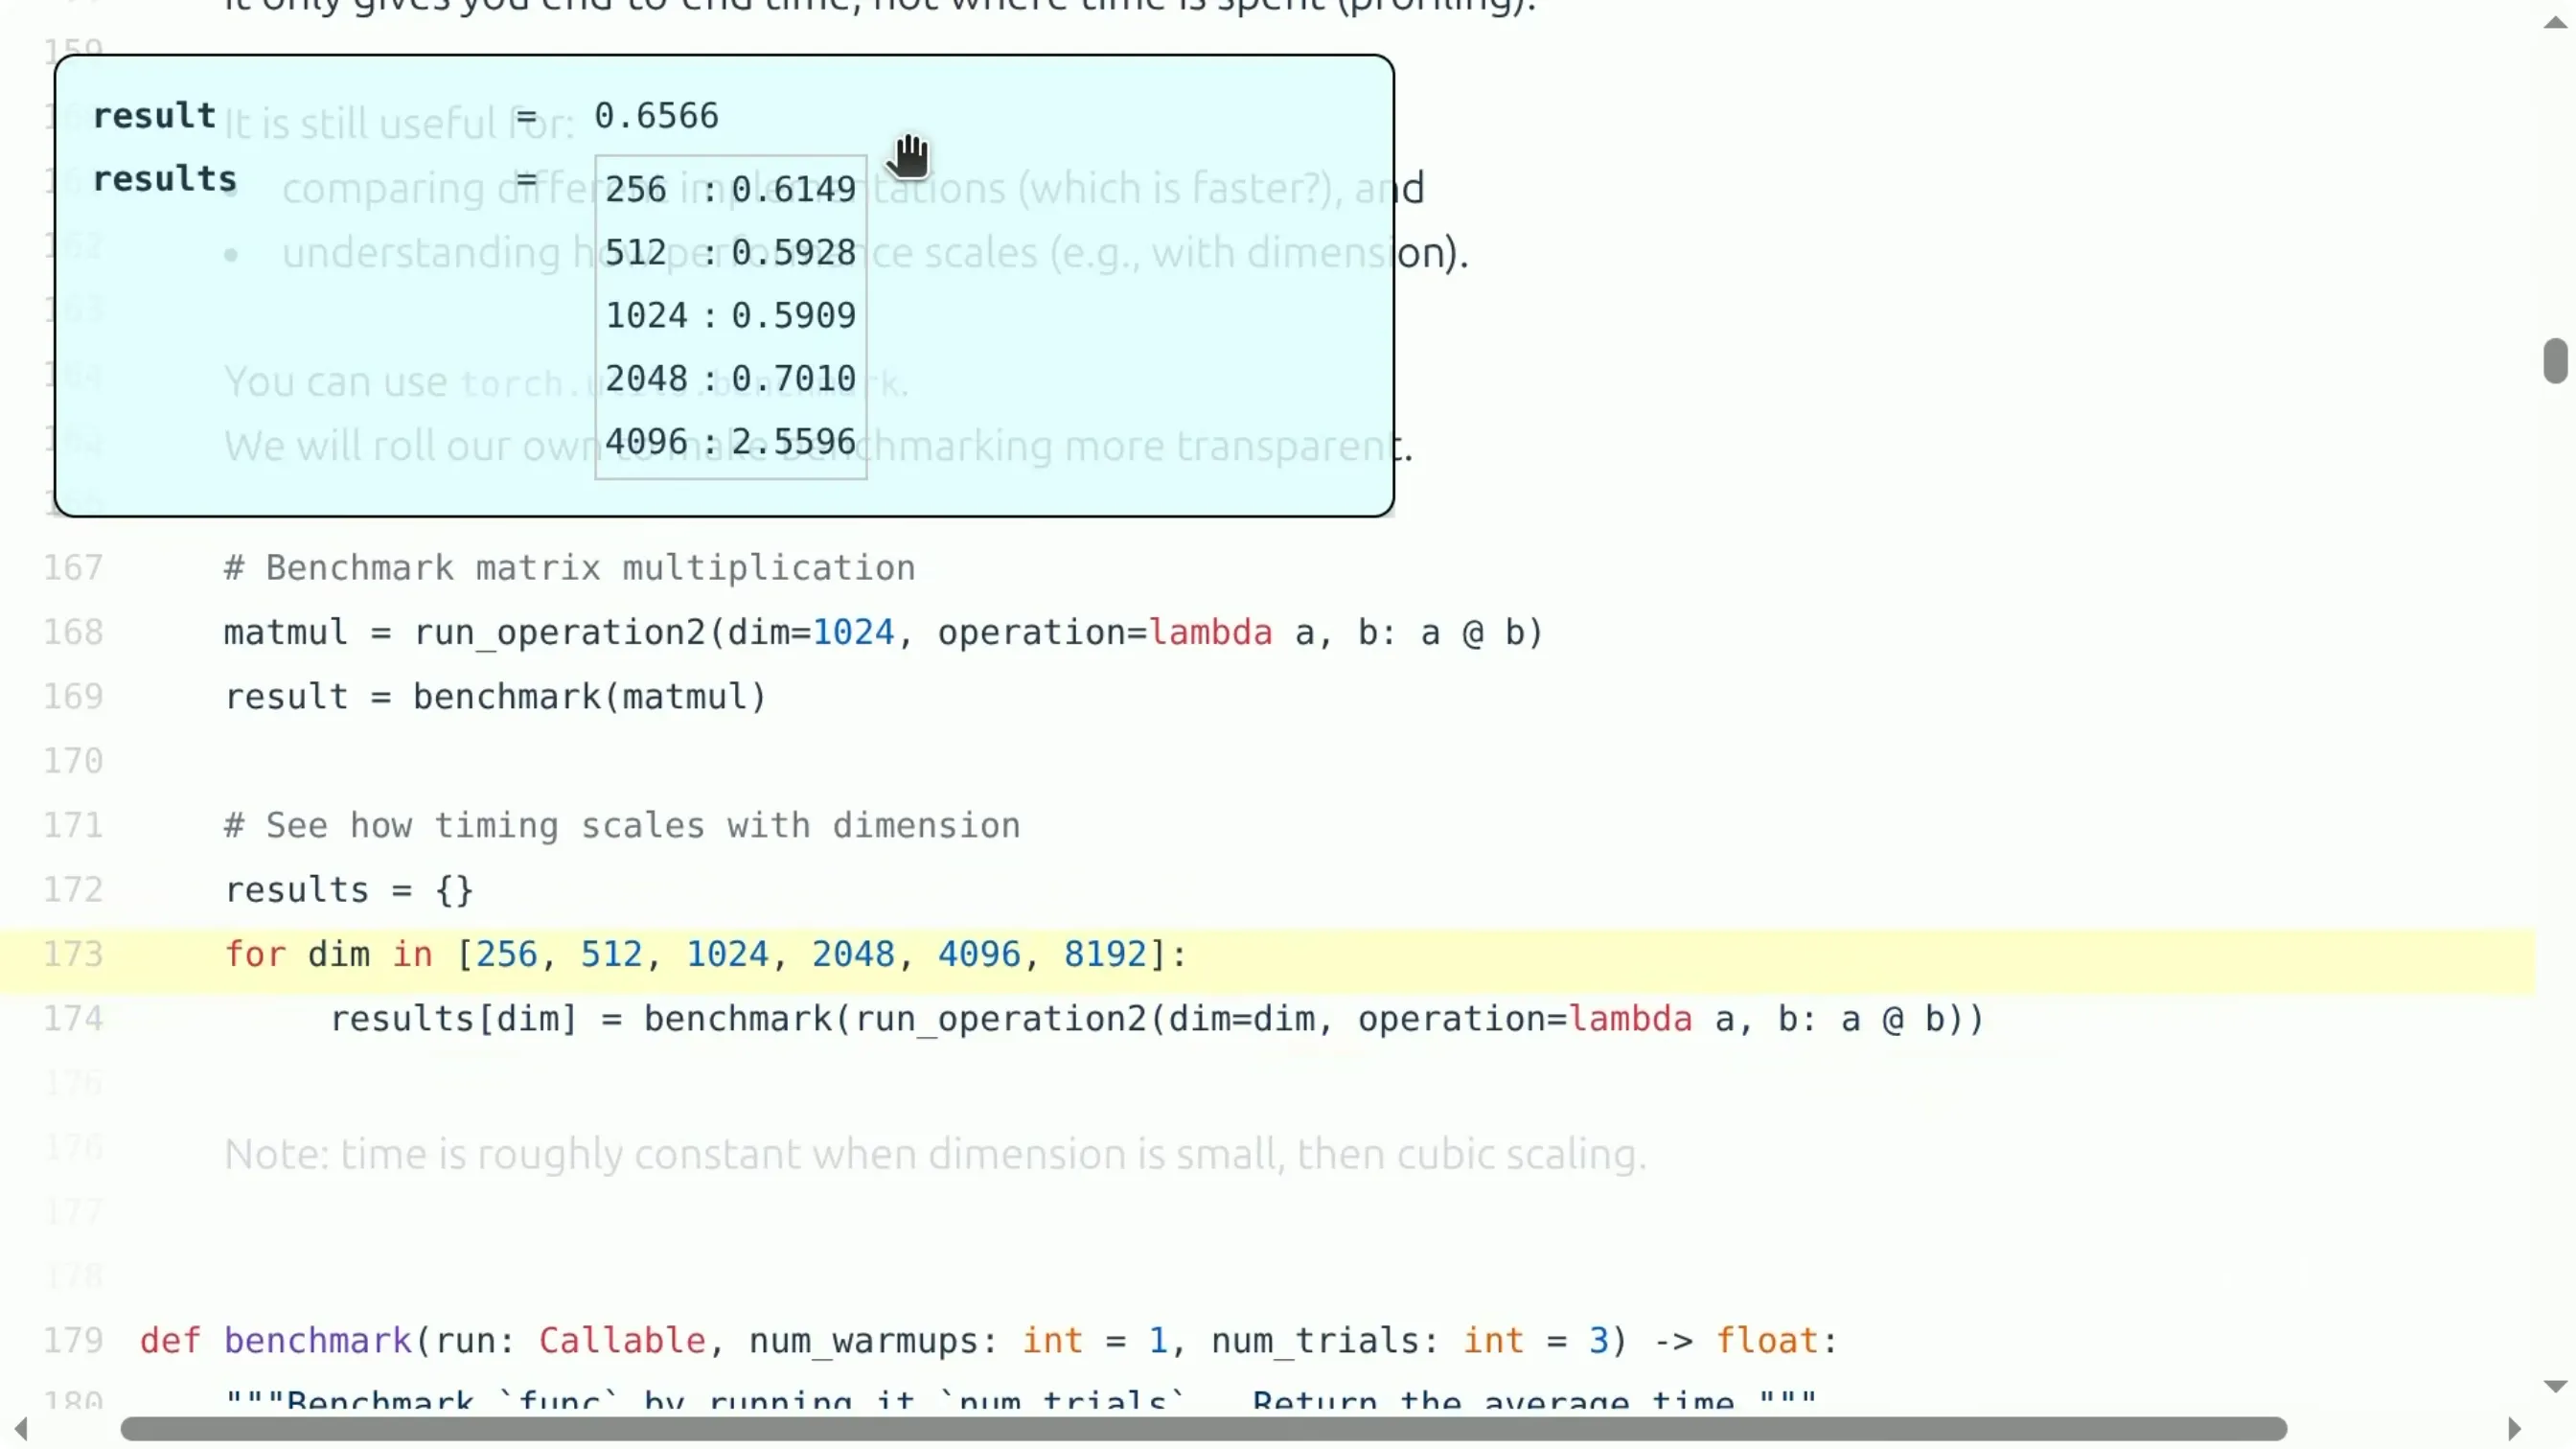
📷 矩阵乘法的规模-时间曲线:小矩阵处有一段平台,说明 GPU 未被喂饱
回到原视频 (00:25:46)
原因:GPU 是为大矩阵乘法设计的。给它一个 2×2 的小矩阵,它极其低效——不是变慢,而是根本没用起来,所以时间被卡在一个「地板」上。
3.2 性能剖析 (Profiling)
(参考时间: 00:26:20)
剖析告诉你「时间到底花在哪里」。讲者顺便指出一个容易被忽略的价值:即使你不关心时间,剖析也能帮你弄清底层到底发生了什么——尤其是当你用高层语言(比如 PyTorch)写了一行代码,却想理解它背后调用了什么的时候。
PyTorch 自带 profiler;作业里你还会用到一个能提供更多细节的工具(讲者提到「site」,编者推测可能是 NVIDIA Nsight 一类工具,见文末疑点)。
先看一个最简单的例子:两个张量相加。
你平时写 PyTorch 大概不会想「a + b 底下发生了什么」。剖析之后你会发现它调用了一个名字很长的 kernel,形如 vectorized_elementwise_kernel ... CUDAFunctor_add。顾名思义,这就是一个「把两个张量相加」的核函数。因为我们只做了一个加法,它当然占了 100% 的时间。
再看矩阵乘法。 在 PyTorch 里写 A @ B,剖析后同样是一个名字很长的核函数:
...cutlass...f32_f32_64_64_16...
讲者引导大家解读这个名字:
- CUTLASS 是 NVIDIA 用于线性代数的 CUDA 库;
- SM100 对应 Blackwell 架构,说明这是为 Blackwell 专门设计的核函数;
- f32 是数据类型(FP32);
- 64 64 16 是 tile 的形状——这正是后面讲 matmul tiling 时会再遇到的参数。
关键观察:如果你把维度改成 128×128,剖析出来的核函数名字会变(比如 32 32 16)。也就是说:
看起来你只是做了一次加法,但底层可能发生任何事。 不同的张量维度会触发不同的 CUDA 核函数,核函数的名字本身就透露了它的实现细节。
四、第一个 Triton 核函数
(参考时间: 00:35:35)
4.1 CUDA 还是 Triton?
在写代码之前,要先理解 Triton 的设计哲学。讲者先讲 CUDA(NVIDIA 开发、多年来的写核函数标准工具):
- 心智模型:关心「每个线程」做什么。 你写一段带线程 ID 的代码,这段代码就按线程执行。
- 优点:和底层贴得很近,粒度高、控制精细。
- 缺点:当运算开始涉及线程间通信时,你必须手动同步、手动管理共享内存、做一堆簿记。逐元素运算用 CUDA 没问题,但复杂运算就很麻烦。
Triton 的价值就在于此:
- 由 OpenAI 开发,如今已是相当标准的工具;
- 心智模型:关心「每个线程块」做什么;
- 一个线程块会:把数据读入共享内存 → 运算 → 写回全局内存;
- 它处在「逐元素」与「整个大运算」之间的中间抽象层——在 PyTorch 里你的原子操作是「把大矩阵乘起来」,在 Triton 里你思考的是这一块数据该怎么处理。
编者说明:讲者坦诚地指出 Triton 的局限——如果你想榨干最新硬件每一个新特性,Triton 可能给不了你全部灵活性。但对本课、对入门来说它足够强大。至于「Triton 会不会取代 CUDA」——讲者的态度是:每种语言都有自己的归纳偏置(inductive bias),Triton 由「训练 transformer 的人」打造,所以凡是与 transformer 相关的任务它都很顺手。
4.2 编写向量加法核函数:从准备到启动
(参考时间: 00:39:50)
讲者从一个最简单的例子开始:一个 8000 维的向量的逐元素运算。
先做准备工作(这段还是纯 PyTorch):
x = torch.randn(8000, device='cuda')
output = torch.empty_like(x)        # Triton 不返回函数值,你要预先分配输出张量
关键差别:在 Triton 里我们不再函数式思考,而是显式地读和写。所以我们要预先分配好输出张量 output,让核函数往里写。
这个 8000 维向量装不进一个 SM,所以要切块。把块大小设为 1024,就有 8 个块。
启动核函数用了一套略怪的语法——方括号里写的是网格的形状:
num_elements = x.numel()
BLOCK_SIZE = 1024
num_blocks = triton.cdiv(num_elements, BLOCK_SIZE)   # = 8

vector_add_kernel[(num_blocks,)](x, output, num_elements, BLOCK_SIZE=BLOCK_SIZE)
#                   ^^^^^^^^^^^^ 网格里有 num_blocks 个块
意思是:网格里有 num_blocks 个块,每个块都会调用一次 vector_add_kernel,并传入 x、output、元素总数和块大小。
4.3 核函数内部:唤醒 → 定位 → 读 → 算 → 写
(参考时间: 00:41:35)
@triton.jit
def vector_add_kernel(x_ptr, y_ptr, num_elements, BLOCK_SIZE: tl.constexpr):
    # 1) 我是谁?
    pid = tl.program_id(0)              # 块的编号

    # 2) 我负责哪一段数据?
    start = pid * BLOCK_SIZE
    offsets = start + tl.arange(0, BLOCK_SIZE)   # [start, start+1, ..., start+BLOCK_SIZE-1]

    # 3) 边界掩码(元素总数可能不是块大小的整数倍)
    mask = offsets < num_elements

    # 4) 从 HBM 读入
    x = tl.load(x_ptr + offsets, mask=mask)

    # 5) 计算
    y = x                              # 这里可以是任意逐元素运算

    # 6) 写回 HBM
    tl.store(y_ptr + offsets, y, mask=mask)
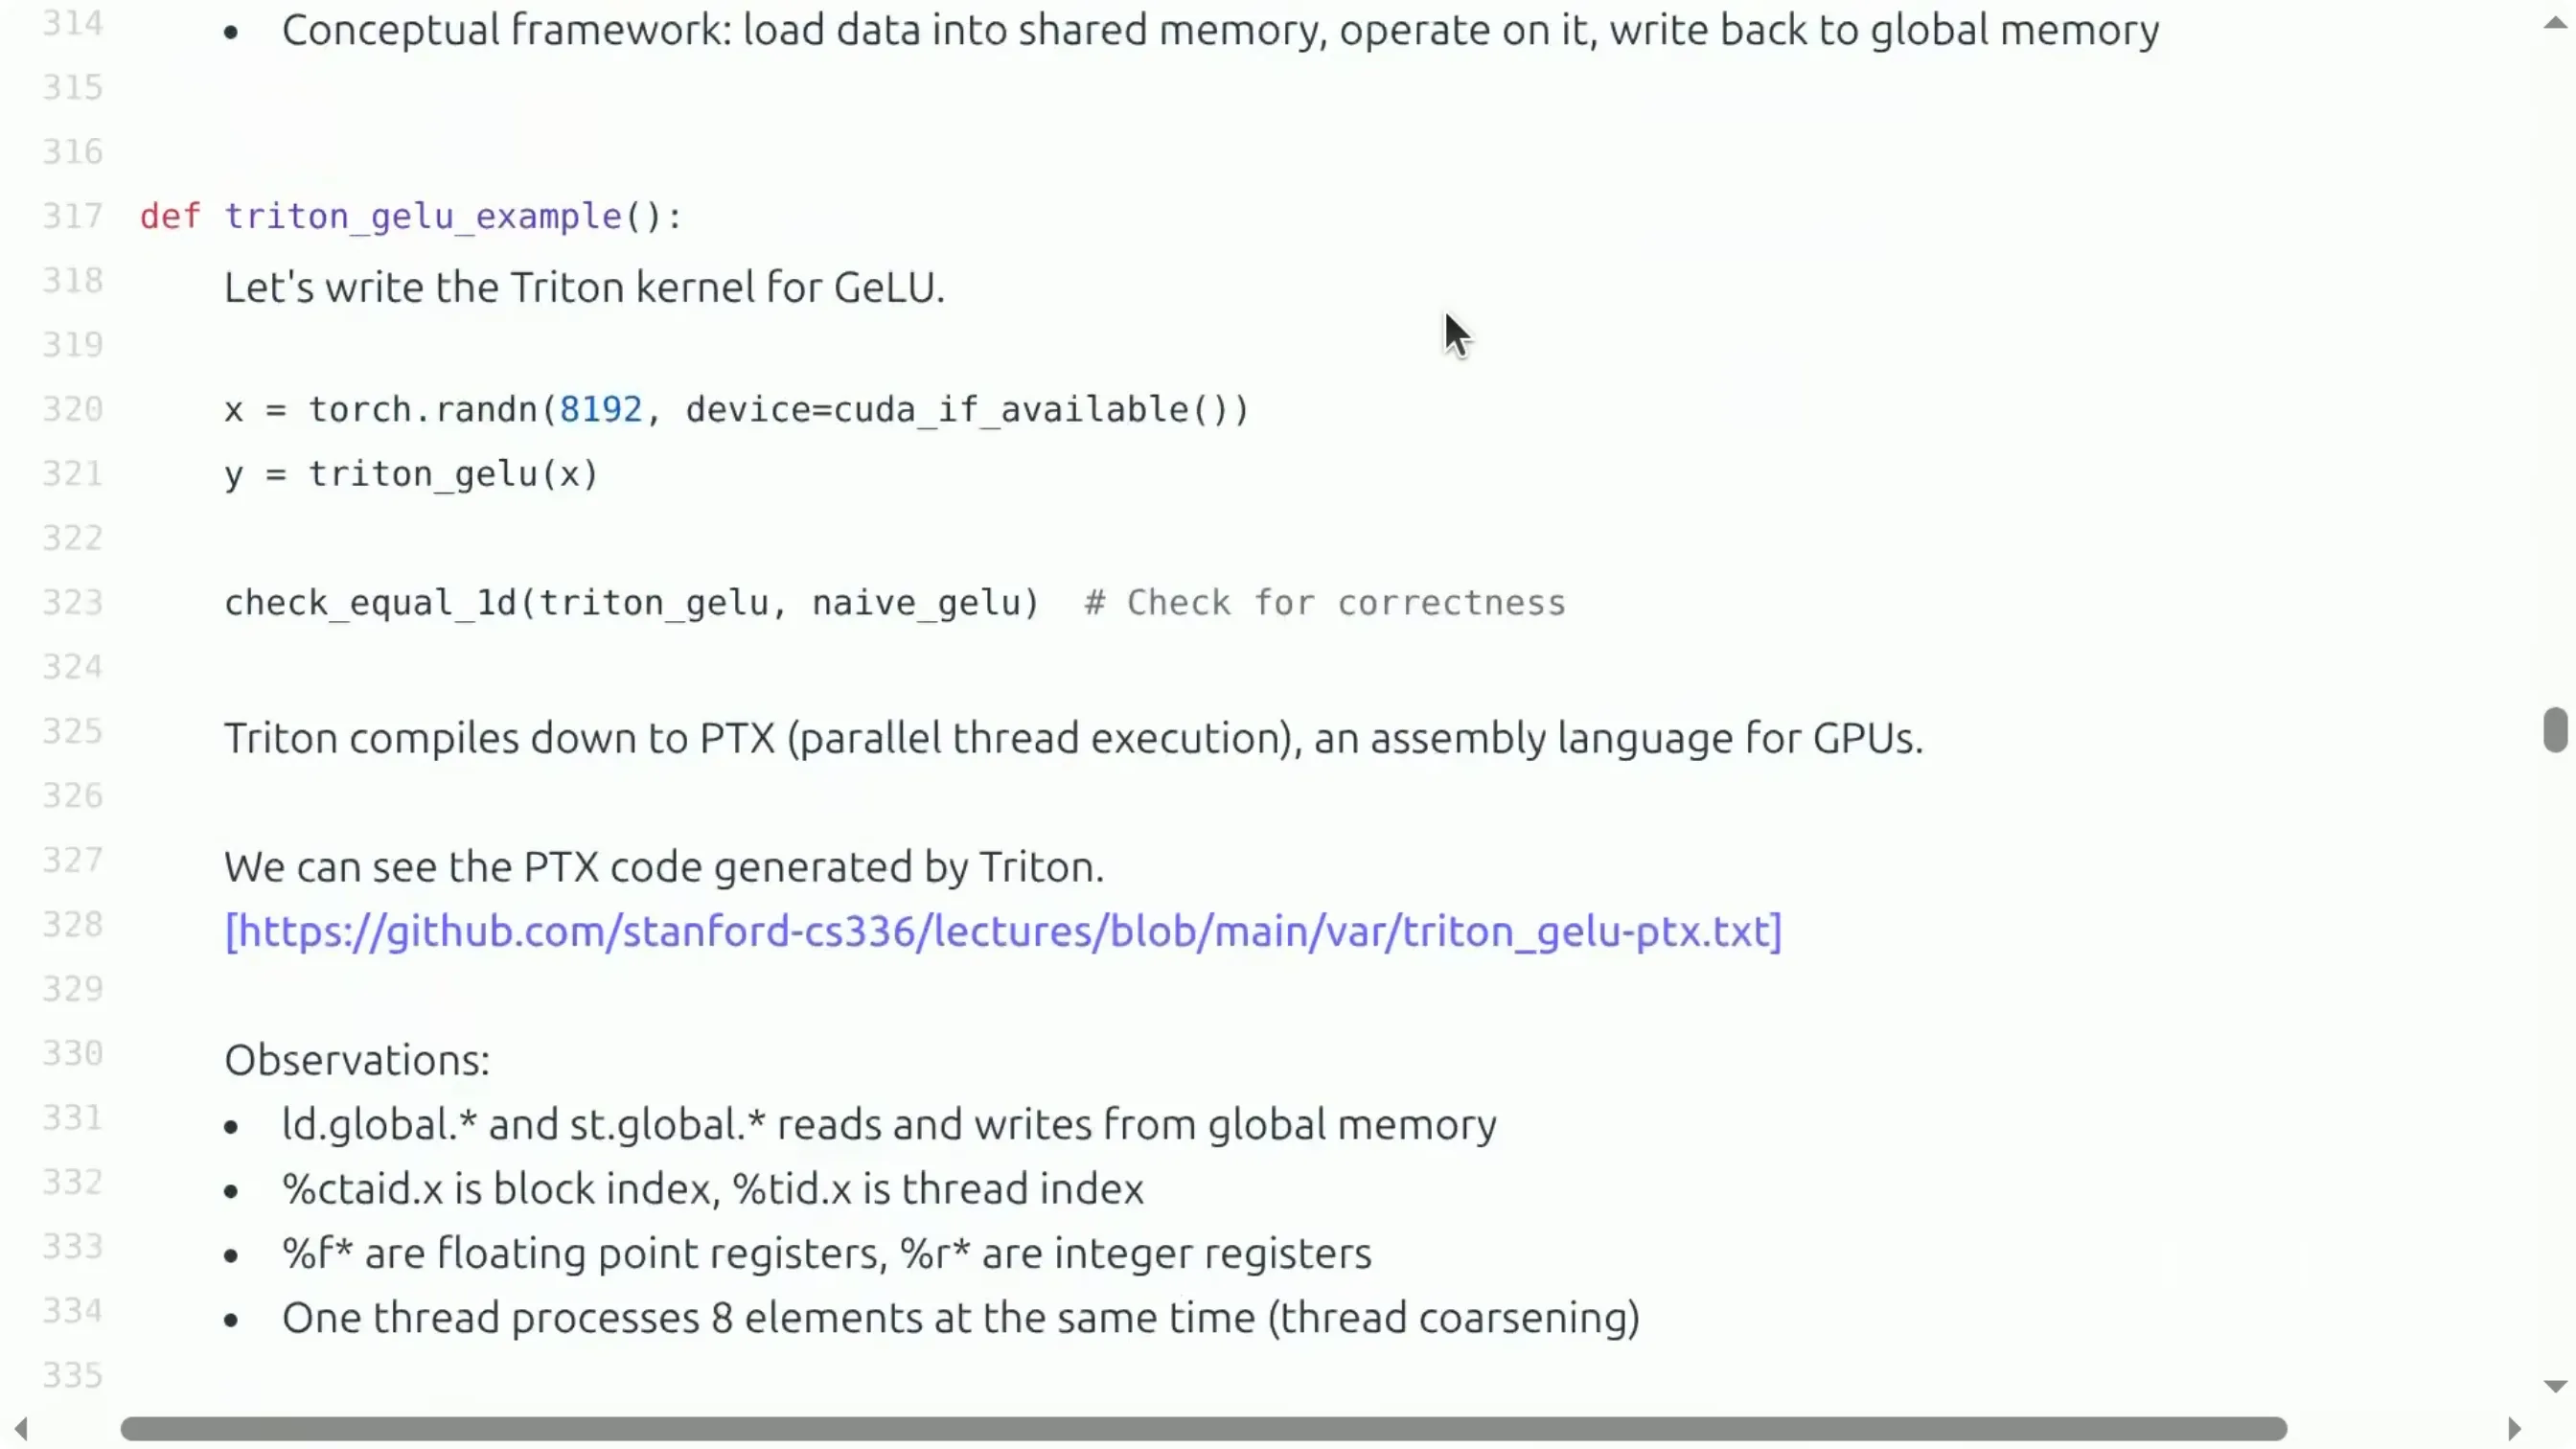
📷 最简单的 Triton 核函数:读出、计算、写回
回到原视频 (00:43:05)
逐步拆解这段「你能想象的最简单的核函数」:
- 参数是指针,不是张量。 传进来的
x_ptr、y_ptr本质上是整数地址,你得习惯这一点。 pid = tl.program_id(0):块「醒来」后先问「我是谁」。pid就是块的编号:0、1、2、3……start = pid * BLOCK_SIZE:算出本块负责数据的起始偏移。pid=0 时 start=0;pid=1 时 start=BLOCK_SIZE;以此类推。offsets = start + tl.arange(0, BLOCK_SIZE):tl.arange(0, BLOCK_SIZE)概念上给出0, 1, ..., BLOCK_SIZE-1,于是offsets就是本块覆盖的所有下标。mask:8000 恰好能被 1024 整除时会怎样?不会怎样。但一般情况下不会整除,所以需要掩码——数据没到的地方为False,不读也不写。tl.load(x_ptr + offsets, mask=mask):这是指针算术——把偏移加到基地址上,得到要访问的内存位置,按掩码读进来。- 运算:读进来以后它就是「一个向量」,你可以做普通的逐元素计算。
tl.store(y_ptr + offsets, y, mask=mask):把结果按偏移写回 HBM。
核函数的通用骨架:传入输入/输出 → 醒来 → 算出自己的下标 → 读 → 算 → 写回 HBM。后面所有核函数都长这个样子。
4.4 学生提问:它和 CUDA 有什么区别?
讲者借问答澄清了几个要点:
- 逐元素场景下,Triton 和 CUDA 看起来几乎一样,甚至 CUDA 更简单——它真是逐元素的:唤醒、识别自己的线程、处理那一个元素。这里的区别只在于 Triton 是向量化版本(一次处理一整块)。等到运算超出逐元素的范围,CUDA 就会变得麻烦得多,Triton 的抽象价值才显现出来。
- 谁来把数据放进寄存器还是共享内存? 你控制不了——由硬件/编译器决定。(后面才详细展开。)
tl.load到底做了什么? 讲者说:从概念上讲,x_ptr是一个 HBM 地址,tl.load把一串地址对应的数据取回,赋给局部变量x,实际可能落在寄存器或共享内存——由 Triton 决定。
4.5 一条「善意的谎言」与 PTX
(参考时间: 00:47:00)
有同学追问:tl.load 执行时,从 HBM 到共享内存再到寄存器,到底一步步发生了什么?
讲者的回答很关键:这段 Triton 代码某种意义上是个「善意的谎言」。GPU 并不会真的在运行时去调用 tl.load 这个库函数执行你写的代码——它主要是给你(程序员)用来「描述计算」的。真正的魔法在于:
Triton 编译器把你的代码编译成 PTX,然后由 PTX 去做真正的工作。
PTX 是一种面向 NVIDIA GPU 的中间汇编语言。
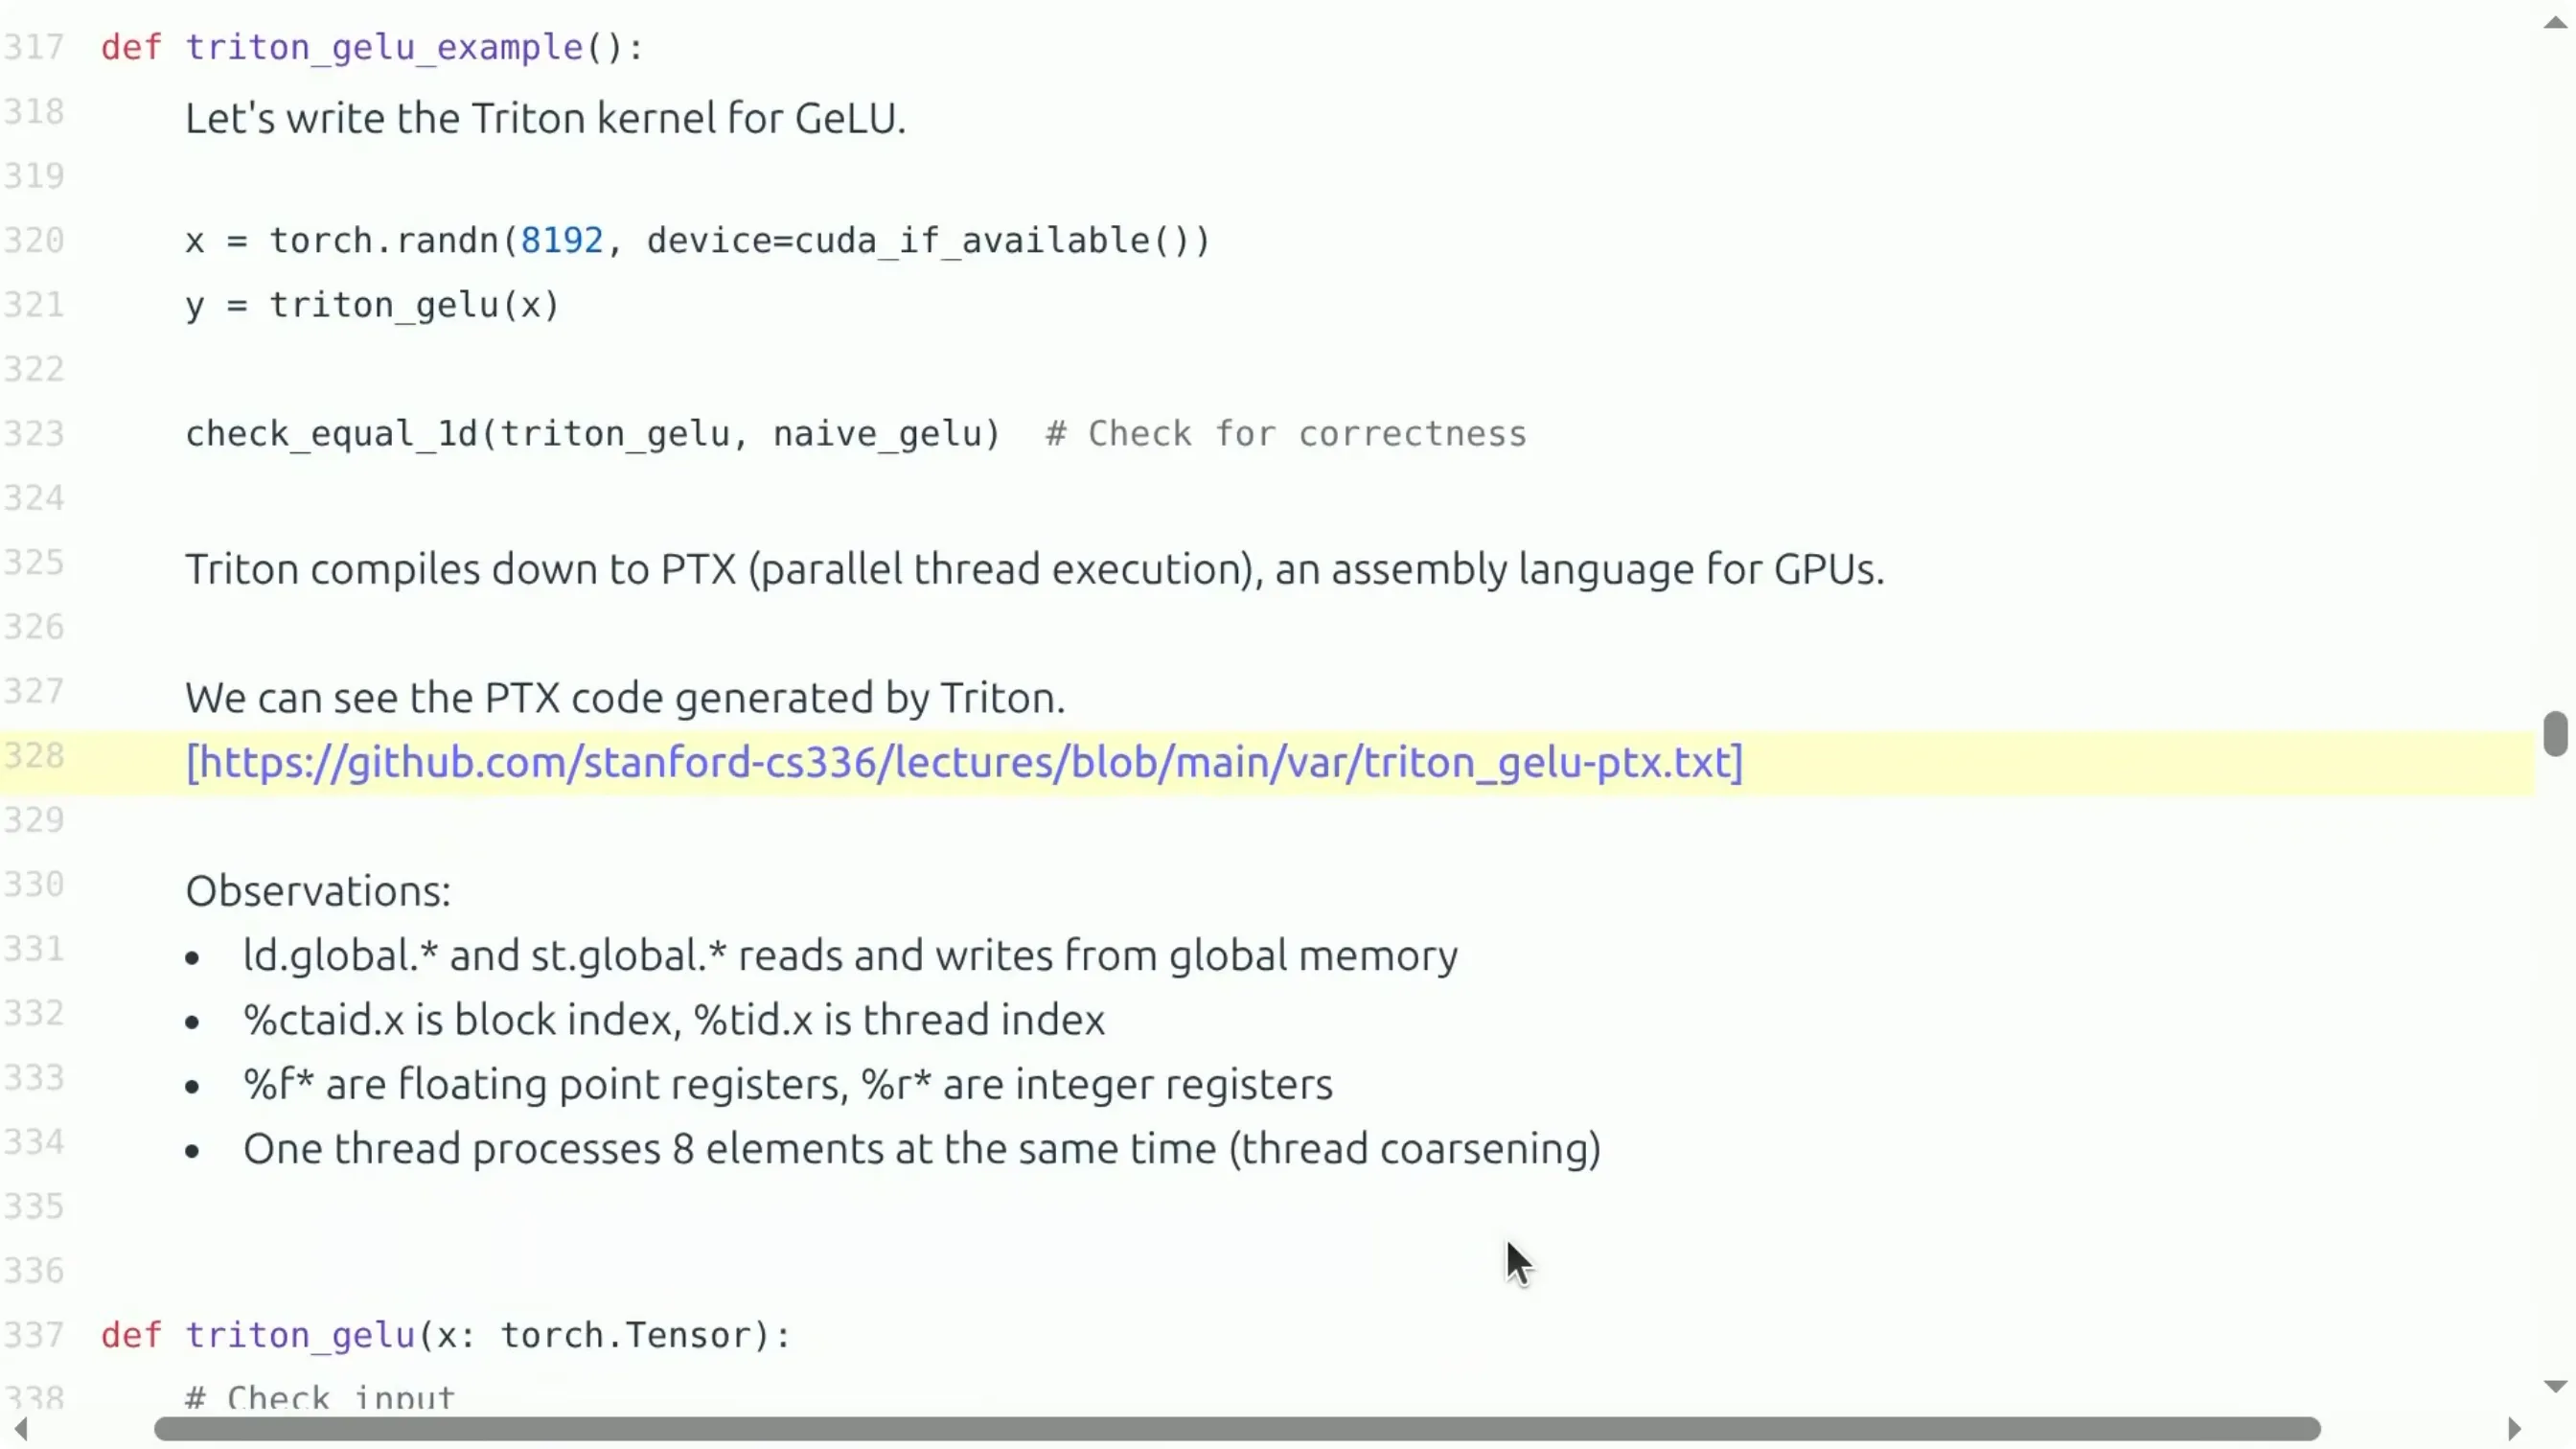
📷 Triton 编译器把核函数翻译成 PTX 中间汇编
回到原视频 (00:51:20)
讲者展示了一段 PTX,给出几点观察:
- 这已经是「单个线程」在做的事——线程块的层级已经被编译掉了。
ld.global表示从 HBM 加载到寄存器。寄存器用名字标识:R开头的通常是整数寄存器,fR开头的是浮点寄存器。- 里面还有
mov之类的指令(把 0 移到某个寄存器)、乘法(把某寄存器乘以某常数存入另一个寄存器)。 - 底部有
st.global,表示写回 HBM。
也就是说,这段才是真正在一个线程上执行的代码,而 Triton 是它上面的一层。
一个隐藏的细节——线程粗化。 讲者指出,PTX 里能看到「一堆成块的操作」:这是一个线程,却在处理 8 个元素,而不是单个元素。也就是说,编译器判断这个线程太轻了,主动把它「养胖」了一点。这个概念正好呼应前面讲的线程粗化。
- 谁来区分不同线程? 代码只编译一次,是同一段代码被所有线程执行。线程靠传入的身份信息来区分自己:
%ctaid.x是块索引;%tid.x是块内线程索引。
讲者补充:PTX 里仍有很多东西没有指定——比如到底哪些 SM 在跑、warp 怎么分配——这些大都是硬件控制的,你在 PTX 里看不到。
关于「要不要手写 PTX」:PTX 是编译器生成的,通常不需要人写。确实有人手写 PTX(如果你觉得自己比编译器强),但 NVIDIA 的编译器一般已经相当成熟。只有一些不够成熟的其他加速器,才需要你手动多干预一点。
4.6 一个关于「等待」的补充问答
(参考时间: 00:55:00)
有同学用类比提问:当某个 warp 被调度到 SM 上、碰到那个阻塞性的 tl.load 时,是不是像 CPU 的 trap 调用一样「傻等」,于是另一个 warp 被调度进来、等 load 完成后再切回来?
讲者的回答:正是如此。tl.load 会阻塞若干周期,而它所在的 SM 同时在跑多个 warp,于是硬件可以立刻切换到一个可以执行的 warp;等这个 warp 的 load 完成后,warp 调度器再切回来接管。
(讲者坦承,被问到「为什么有 4 个 warp 调度器」时,他也不知道确切原因。)
五、Softmax:行内归约
(参考时间: 00:57:20)
讲者预告了接下来的三个例子,难度递增,最终目标是让你具备实现 flash attention 的全部配料:
- GELU——逐元素,虽然没有分支,但计算本身有点「脏」,属于最简单的一类;
- Softmax——需要归约,先讲「一行放得进一个块」的情况,再讲「放不下」的情况;
- 矩阵乘法——tiling 的经典案例。
5.1 Softmax 是什么
Softmax 对矩阵的每一行做指数化并归一化:先求每行的最大值(为了数值稳定),减掉它,再做逐元素指数、求和、相除。
$$ \text{softmax}(x_i) = \frac{e^{\,x_i - \max_j x_j}}{\sum_{j} e^{\,x_j - \max_j x_j}} $$
它在 attention 里用、在生成概率输出时也用,是个好东西。
5.2 朴素实现 vs. Triton 实现
朴素 PyTorch 实现(也是作业里的第一题):
def naive_softmax(x):
    x_max = x.max(dim=1).values      # 每行最大值(数值稳定)
    z = x - x_max[:, None]           # 减掉最大值
    numerator = z.exp()
    denominator = numerator.sum(dim=1)
    out = numerator / denominator[:, None]
    return out
问题在于读写次数。 这是纯 PyTorch,每一步都是独立的核函数(除非你用 torch.compile)。每一步都要读写 HBM:
- 大约 5 次 MN 读、3 次 MN 写;
- 而理论上你其实只需要少得多的读写。
5.3 写 Triton 版 softmax
(参考时间: 01:00:23)
核心决策:让每一行对应一个块。 为什么?因为 softmax 要沿行归一化和求和——它不是逐元素的,但它是「按行」的,块与块之间不交互,也就不需要共享内存(注意:块与块之间本就没有共享内存)。
@triton.jit
def softmax_kernel(output_ptr, input_ptr, input_row_stride, output_row_stride,
                   n_cols, BLOCK_SIZE: tl.constexpr):
    row_idx = tl.program_id(0)                                  # 我是第几行
    row_start_ptr = input_ptr + row_idx * input_row_stride      # 行的起点
    col_offsets = tl.arange(0, BLOCK_SIZE)                      # 0 .. BLOCK_SIZE-1
    input_ptrs = row_start_ptr + col_offsets                    # 本行所有元素的地址

    # 掩码位置填 -inf(等价于 softmax 里的 0)
    row = tl.load(input_ptrs, mask=col_offsets < n_cols, other=float('-inf'))

    # 与朴素 softmax 完全相同的核心计算
    row_minus_max = row - tl.max(row, axis=0)
    numerator = tl.exp(row_minus_max)
    denominator = tl.sum(numerator, axis=0)
    softmax_out = numerator / denominator

    tl.store(output_ptr + row_idx * output_row_stride + col_offsets,
             softmax_out, mask=col_offsets < n_cols)
代码要点:
- 块大小取「列数向上取整到 2 的幂」——「图个吉利」,因为硬件喜欢 2 的幂。块的数量 = 行数 M(每行一个块)。
- 启动时传入输入指针、输出指针,以及步长 (strides),告诉它「往下走一行要跨多远」。
- 掩码用
-inf而非 0:因为后面要做指数,exp(-inf)=0,正好等价于「这些位置在 softmax 里贡献为 0」。 - 中间的计算部分和朴素实现几乎一模一样——一旦搭好脚手架,核心计算看起来就像普通 PyTorch。这正是 Triton 的便利之处:只要数据能装进一个块,你几乎就能像写 PyTorch 一样写核函数。
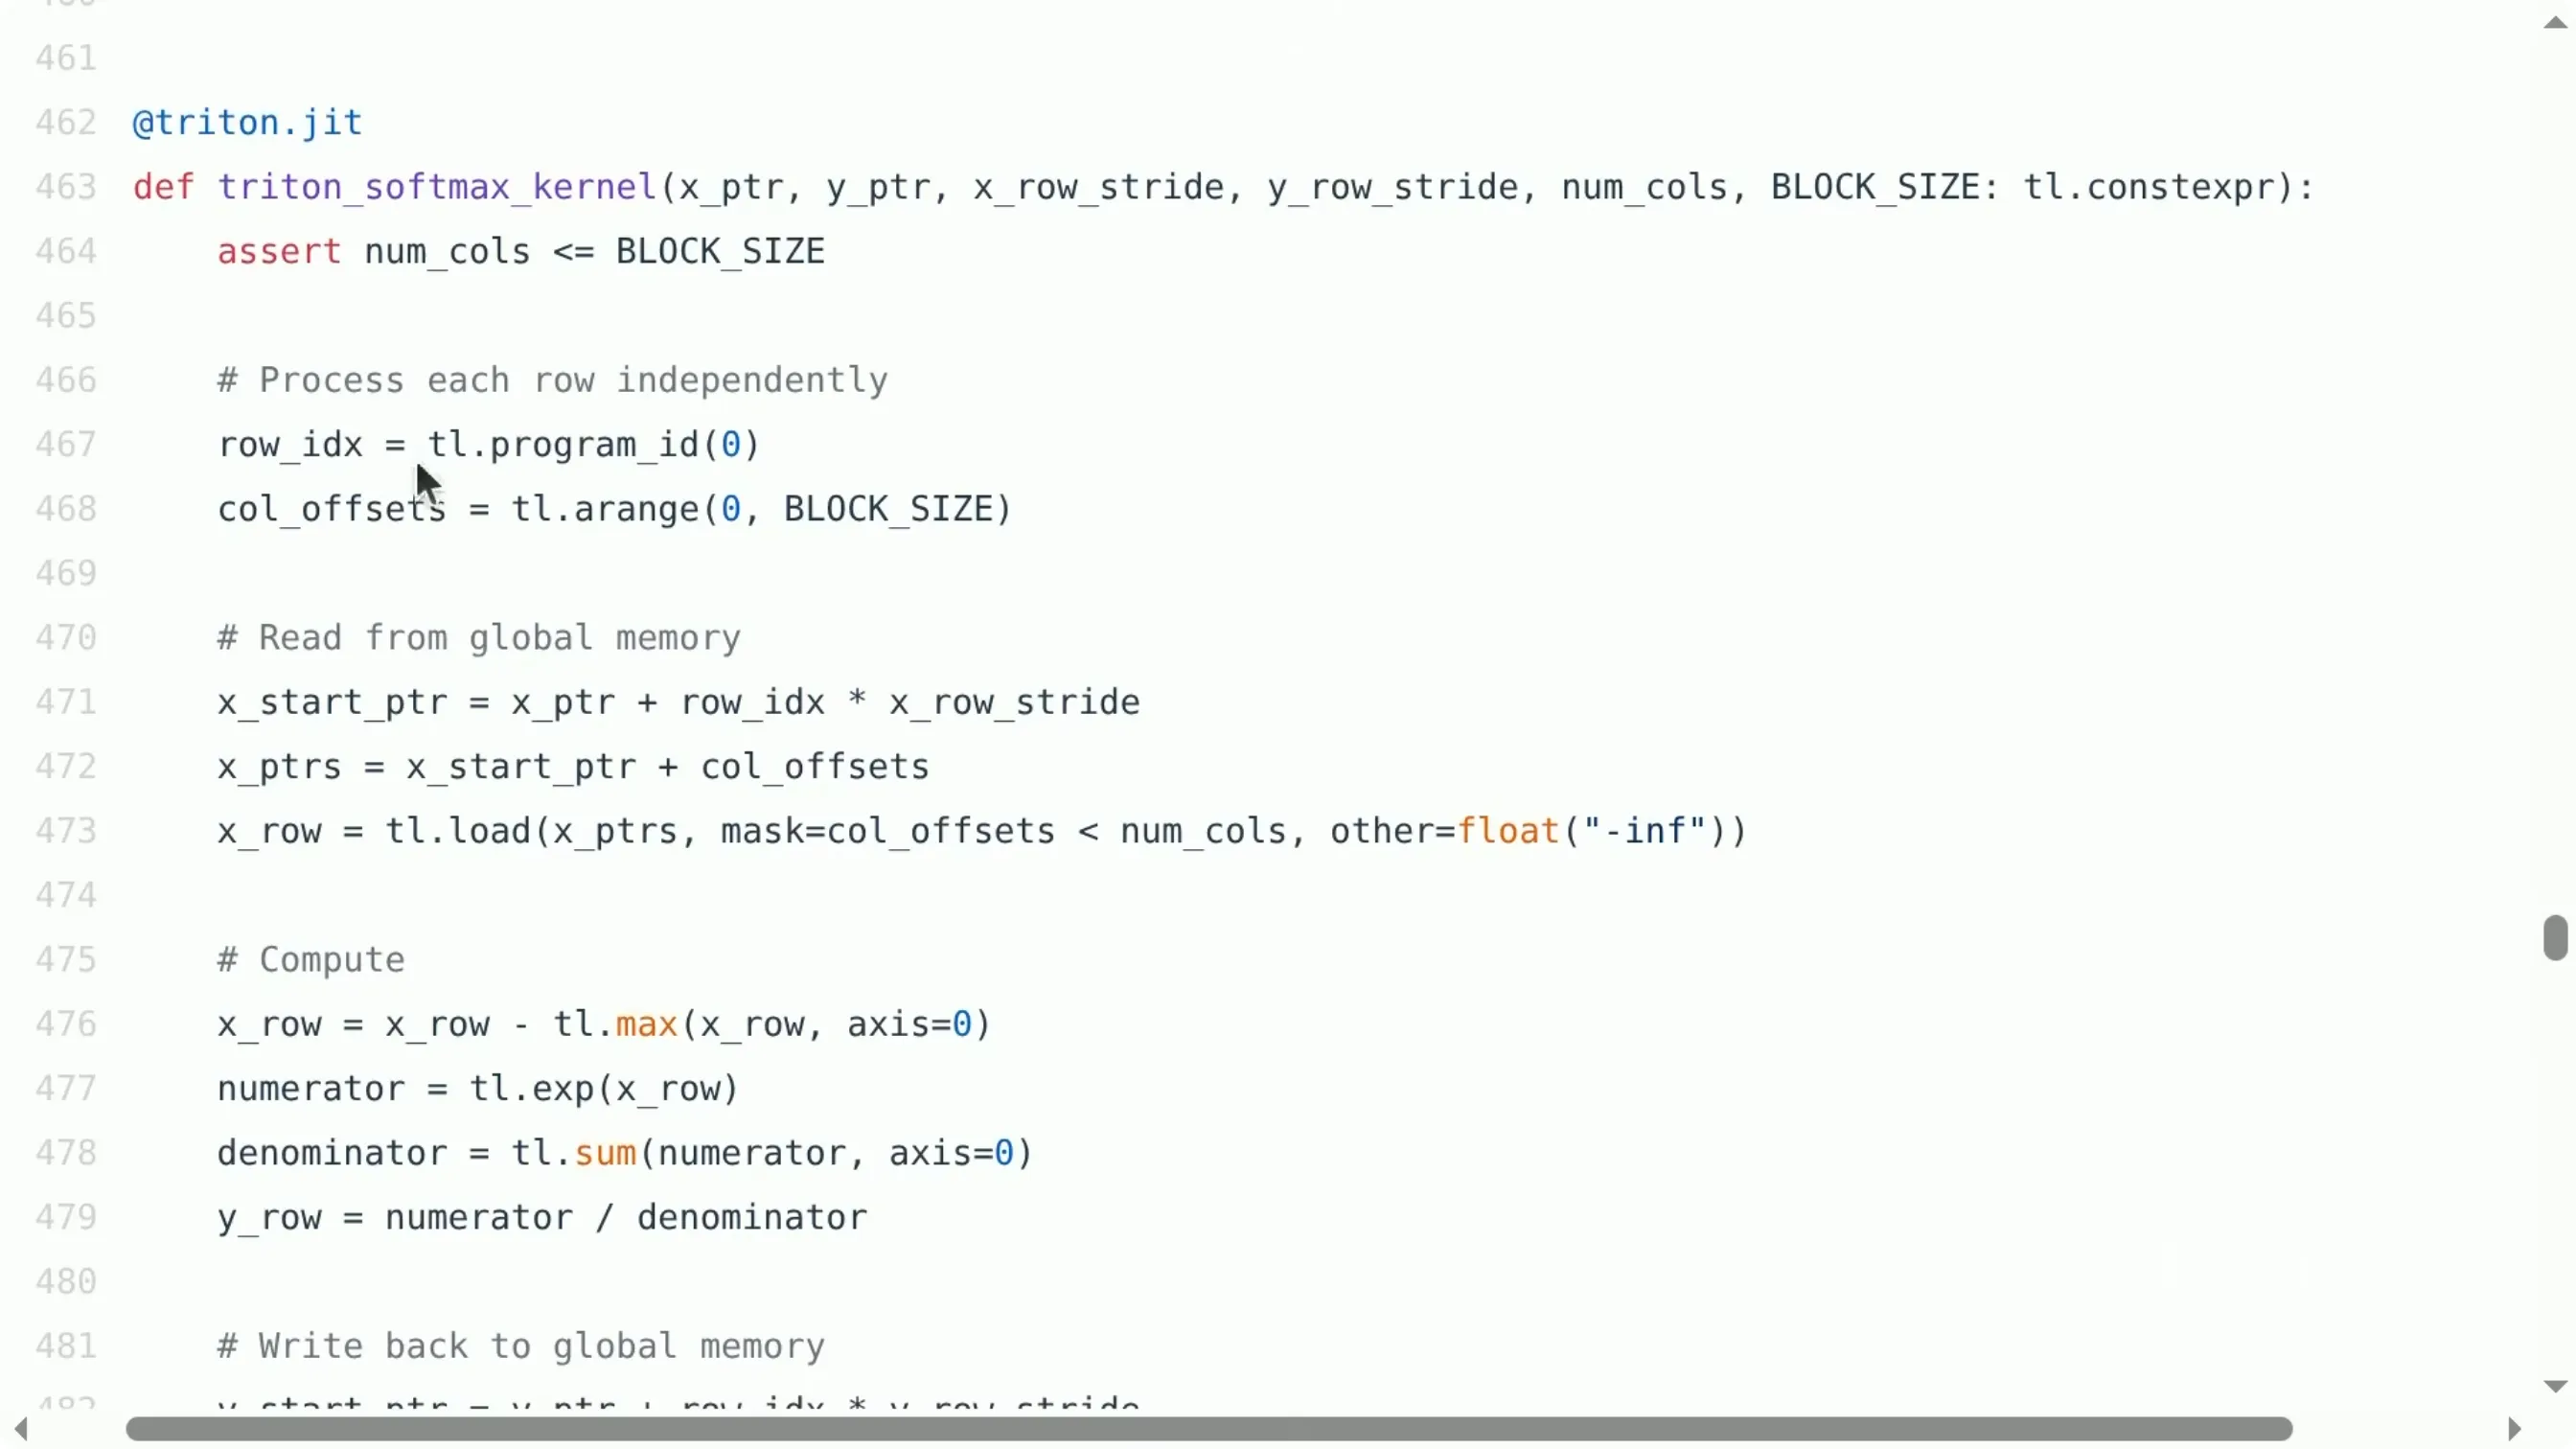
📷 每行一个块的 softmax 核函数:归约发生在块内,块之间互不干扰
回到原视频 (01:02:30)
5.4 学生提问:能按列做 softmax 吗?
可以。因为这里全程跟踪指针,指针可以指向任何地方。要做到按列,只需修改列的偏移/步长即可。
5.5 GELU 与 Profiler 的对照
(参考时间: 00:31:00)
讲者插入了一段对比实验来印证「核函数融合」的价值。GELU 的常见定义(含 tanh 近似):
$$ \text{GELU}(x) = x \cdot \Phi(x) \approx 0.5\,x\left(1 + \tanh\!\Big(\sqrt{2/\pi}\,\big(x + 0.044715\,x^3\big)\Big)\right) $$
这里的三条「马」是:
- 朴素 PyTorch 实现——把公式照抄成 PyTorch 表达式;
- 内置实现——
nn.functional.gelu; - 编译实现——对朴素函数调用
torch.compile。
用同一个随机输入可以验证三者结果一致。基准测试结果:朴素实现约 3.75 ms,内置实现快得多,编译实现也快得多但略逊于内置实现。
剖析之后就能看清原因:
朴素实现调用了一连串核函数——binary functor、unary、add、tanh……因为 PyTorch 会把计算图里每个基本运算法子变成一个核函数。每个核函数都得从 HBM 读、算完写回 HBM,再被下一个核函数读回来,无数趟往返。
内置实现就是一个单独的 GELU 核函数。 没什么魔法——因为大家都用 GELU,所以有人专门为它写了核函数放进了标准库。
编译实现则很有意思:它的底层是一个单一的 Triton 核函数。torch.compile 会分析计算图,把所有基本运算融合成一个 Triton 核函数:读一次 HBM,写一次 HBM。这就是算子融合 (kernel fusion)。
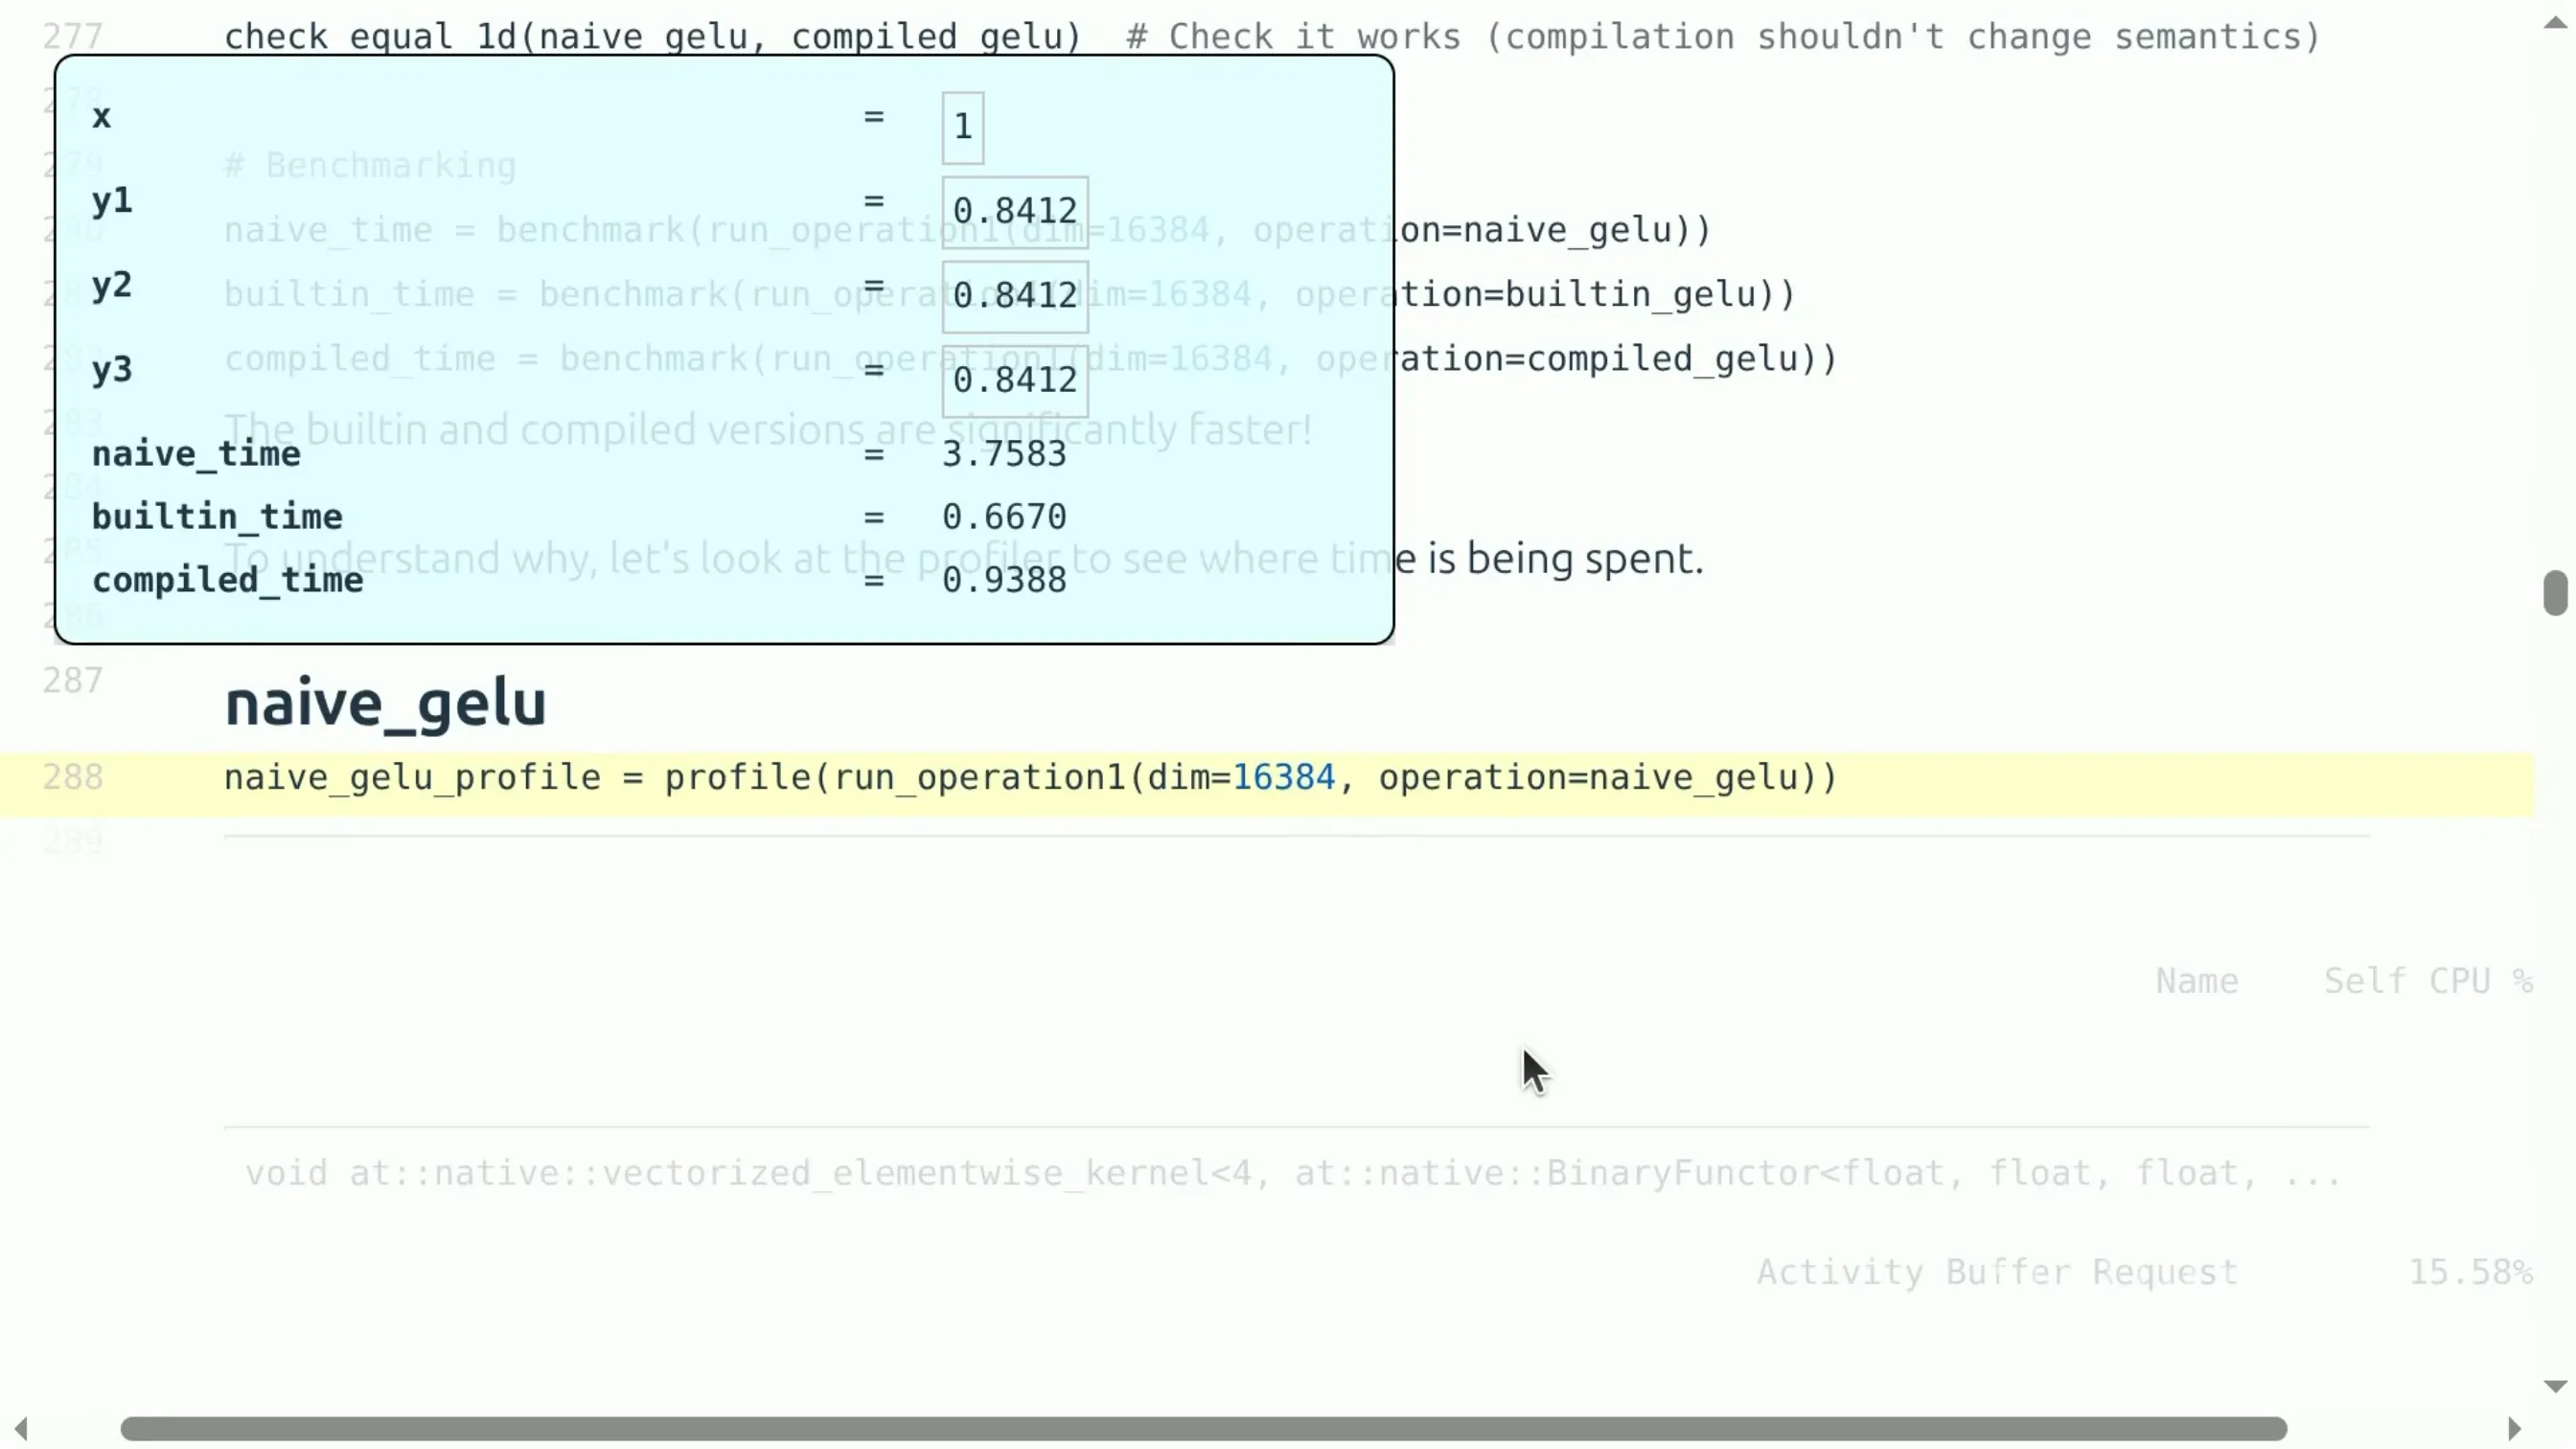
📷 Profiler 对比:朴素实现是一串核函数,编译实现是单个融合的 Triton 核函数
回到原视频 (00:32:45)
graph TD
    A["输入张量 x"] --> B{实现方式}
    B -->|朴素 PyTorch| C["多个 kernel<br/>反复读写 HBM"]
    B -->|nn.functional.gelu| D["单个 CUDA kernel<br/>手写并内置"]
    B -->|torch.compile| E["单个 Triton kernel<br/>由编译器融合生成"]
编者拓展|为什么「融合」能快这么多
单次核函数调用的开销,本质是数据在 HBM 与 SM 之间来回搬运。若一个运算被拆成 $k$ 个核函数,数据就要被读写约 $O(k)$ 次;而融合后只需读写 $O(1)$ 次。当运算是内存瓶颈(算术强度低,如逐元素激活)时,这种差距尤其显著——你可能把内存流量压到原来的几分之一,速度就跟着涨几倍。这也解释了为什么讲者说
torch.compile能「白嫖」一大截性能:它自动替你做融合,无需你手写核函数。
(顺便:讲者提到去年做这个实验时,编译实现和内置实现的速度更接近;这类数字与硬件、编译版本强相关,仅供参考。)
六、行归约:当一行装不进一个块
(参考时间: 01:04:00)
6.1 问题设定
前面 softmax 假设「一行能装进一个块」。现在把它推开:假设一行有 4000 列,而块大小只有 1024,装不下。
策略:把行切成 tile(小块)。 这一行切成 4 个 tile,每个线程迭代遍历所有 tile 并累加,最后做一次归约。
为了好讲,讲者把问题简化成 行求和 (row sum)(比 softmax 更纯粹)。
6.2 概念演示:线程各管各的累加器
假设一行是 [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5, ...],切分成若干 tile:
- 线程各管一列,各持一个累加器;
- 处理 tile 0:把
3, 1, 4, 1放进累加器; - 处理 tile 1:把
5加到 3 得 8、9加到 1 得 10、2加到 4 得 6、6加到 1 得 7…… - 处理 tile 2:继续累加;
- 循环结束后,得到一个累加器向量,再把它求和成一个标量,写出。
graph TD
    A["每个线程块负责一整行"] --> B["把行切成若干 tile"]
    B --> C["遍历每个 tile"]
    C --> D["从 HBM 加载该 tile"]
    D --> E["累加到累加器(寄存器/共享内存)"]
    E --> F{还有 tile?}
    F -->|是| C
    F -->|否| G["跨线程归约求和"]
    G --> H["把标量写回 HBM"]
6.3 代码形态
@triton.jit
def row_sum_kernel(x_ptr, out_ptr, n_cols, stride, BLOCK_SIZE: tl.constexpr):
    row = tl.program_id(0)                     # 我在哪一行

    # 沿这一行迭代遍历所有 tile
    acc = tl.zeros([BLOCK_SIZE], dtype=tl.float32)
    for start in range(0, n_cols, BLOCK_SIZE):
        cols = start + tl.arange(0, BLOCK_SIZE)
        x = tl.load(x_ptr + row * stride + cols, mask=cols < n_cols, other=0.0)
        acc += x                              # 各线程累加各自的份额

    total = tl.sum(acc, axis=0)               # 跨线程归约得到一个标量
    tl.store(out_ptr + row, total)
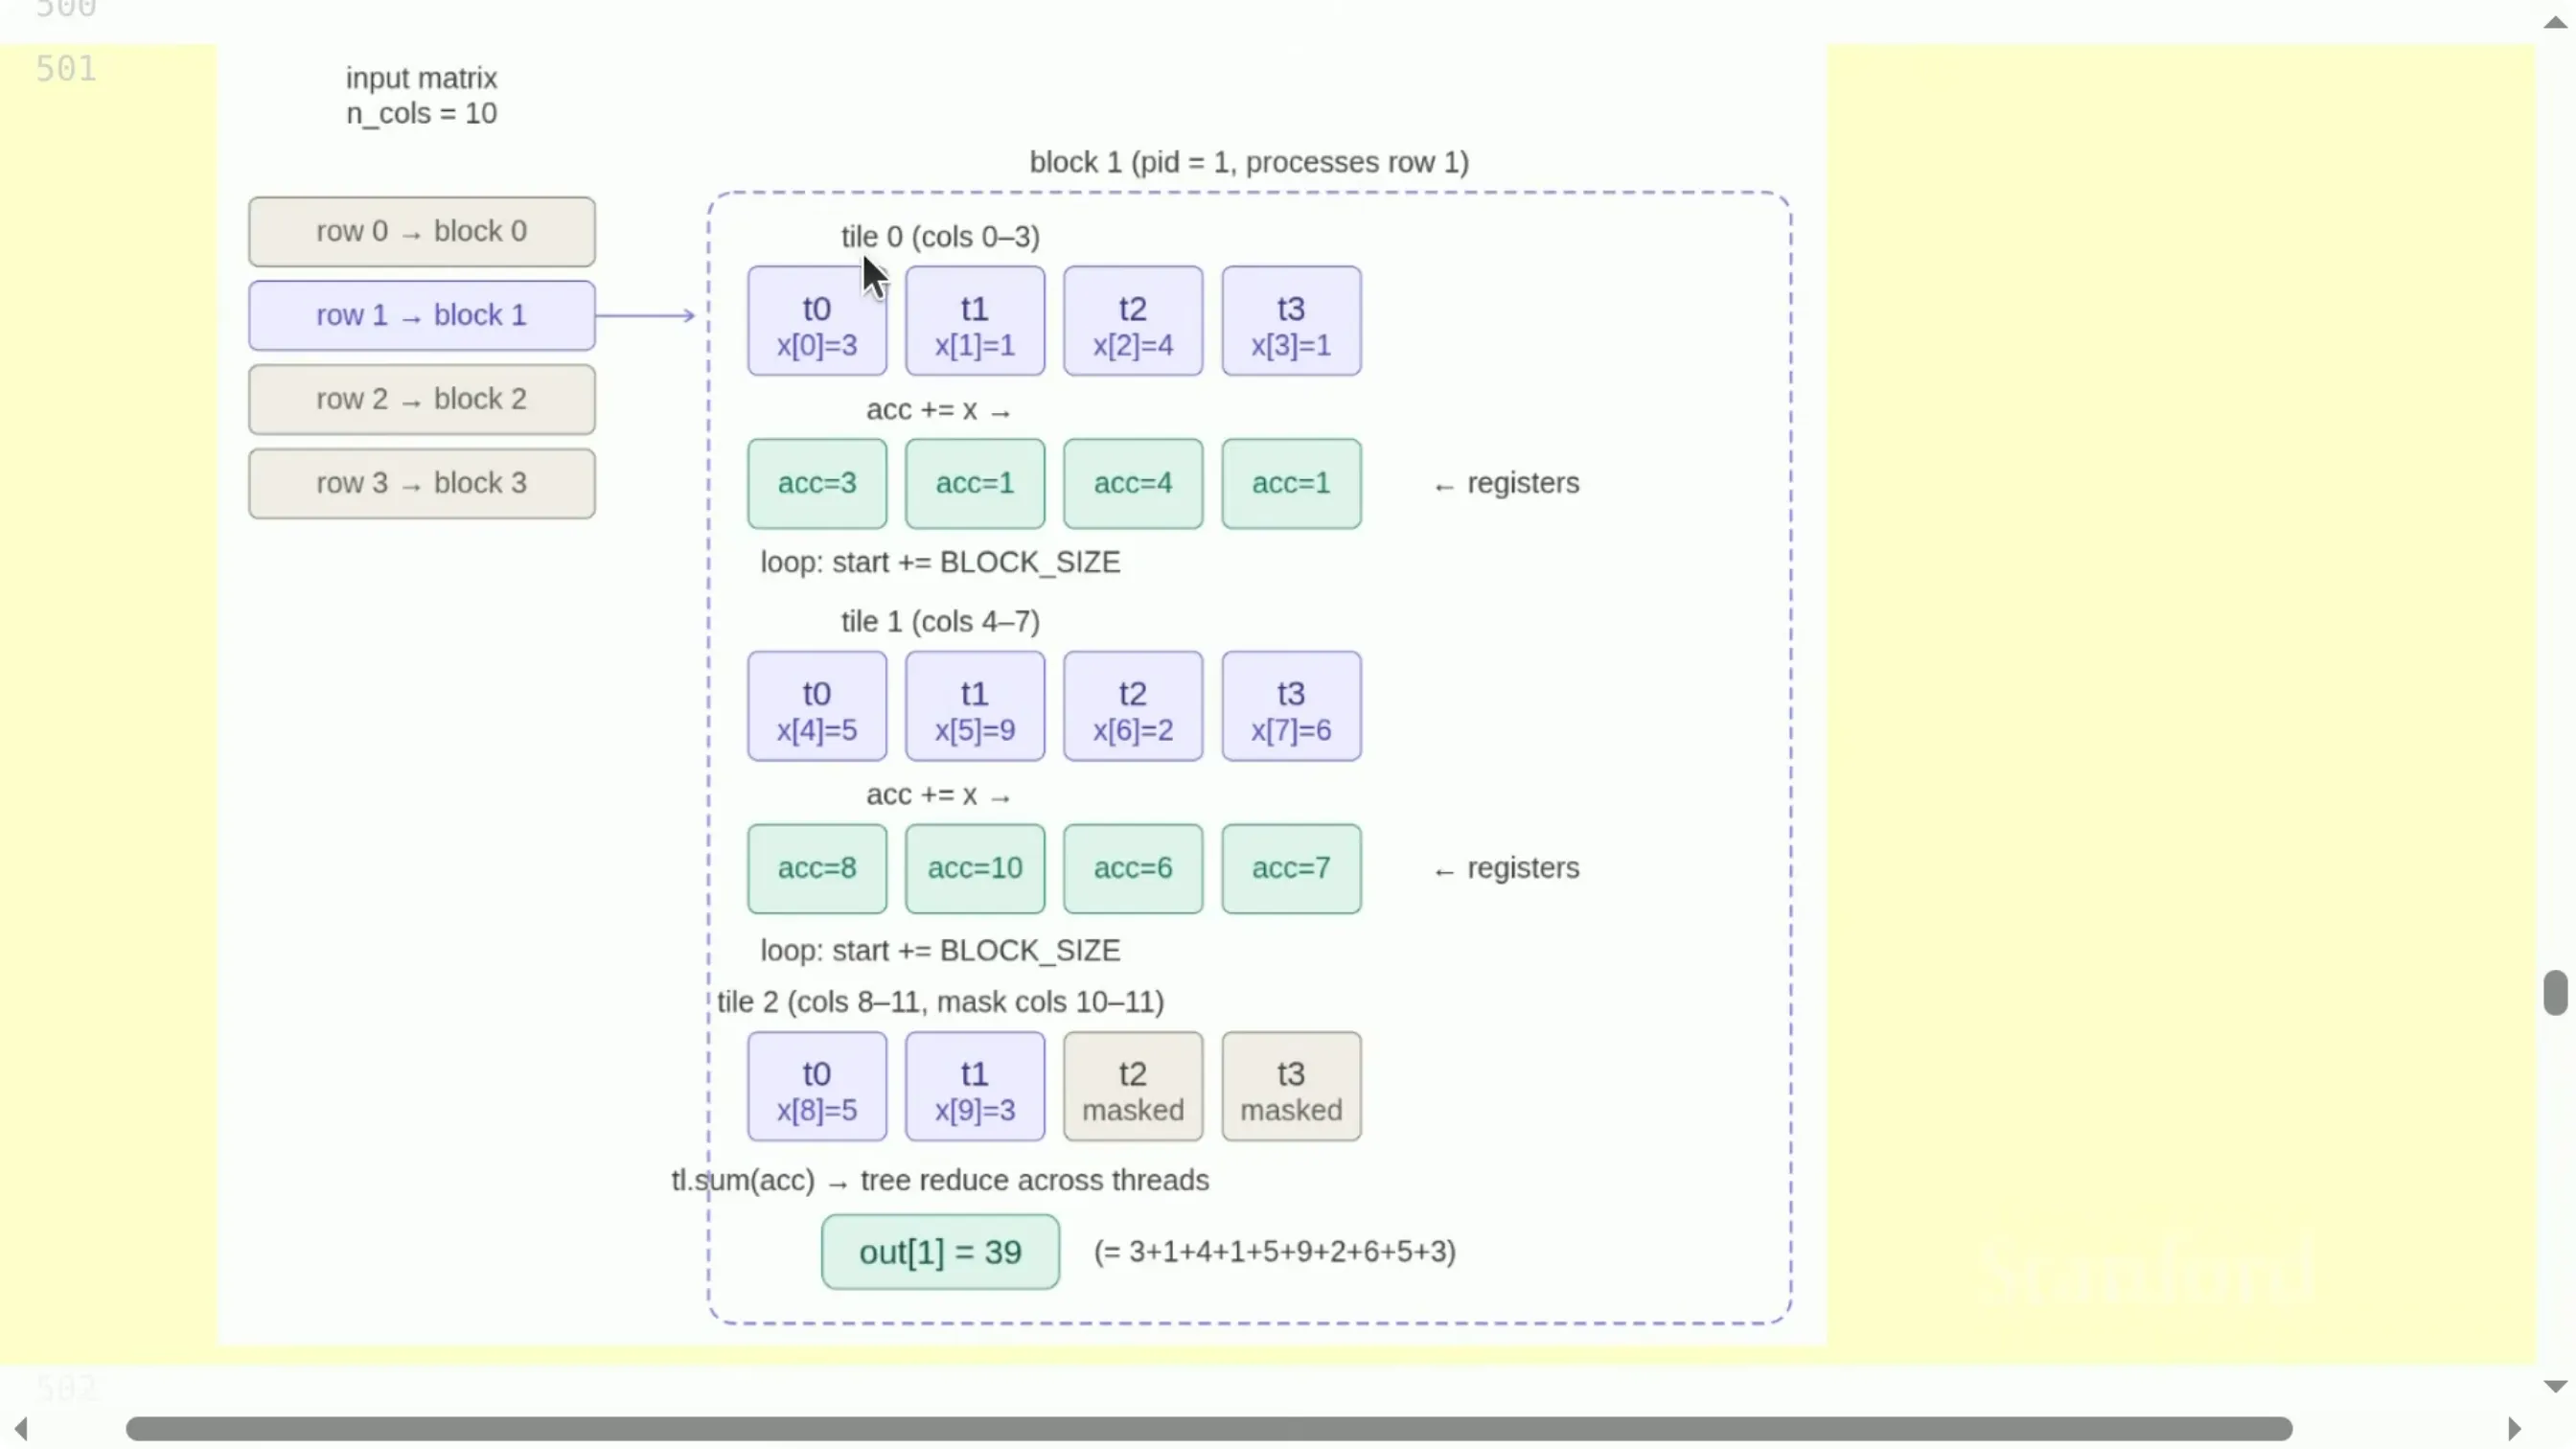
📷 行归约:线程块处理一整行,内部再切成 tile 迭代累加
回到原视频 (01:07:06)
要点:
- 块大小 = tile 大小 = 线程数。我们现在处理的数据比块大,所以必须迭代。
- 循环里
start从 0 走到BLOCK_SIZE、2*BLOCK_SIZE……每次跳一个 tile。 - 累加器
acc落在寄存器或共享内存(由 Triton 编译器决定)。块大小足够大时它必须放共享内存。 - 循环结束、处理完整行后,对累加器做一次
tl.sum得到一个标量,写出。
6.4 关键区分:块 vs. tile
讲者特别提醒,别把这里和之前 GELU 里对向量切块搞混:
- GELU 里,一个向量的每一片是一个独立的块,块与块之间彼此独立处理;
- 这里,一行被切成几个 tile,它们不是块——整行才对应一个块,块必须处理完所有 tile。
也正是从这一刻起,代码开始不太像 PyTorch 了——因为你无法把所有数据装进一次处理。
编者说明:这里引出的是分块思想 (tiling) 的雏形。当「一次装不下」时,标准做法就是「切成小块、逐块处理、累加中间结果」,最后再合并。这个模式在 matmul、flash attention 里会反复出现——flash attention 之所以能把超长序列放进有限的 SRAM/共享内存,靠的正是「分块 + 在线累加」。
七、矩阵乘法:Tiling 的经典案例
(参考时间: 01:12:00)
终于到「压轴」了。矩阵乘法是深度学习的主粮,被优化到了极致。讲者加了个小小的花样:做矩阵乘后再接一个 ReLU(Y = ReLU(A @ B))。这不是凭空而来——一个线性层就是「矩阵乘 + 激活」。
7.1 朴素做法及其致命缺陷
设 $A$ 是 $M \times K$,$B$ 是 $K \times N$,则 $C = AB$ 是 $M \times N$。逐元素计算:
$$ C_{ij} = \sum_{k=1}^{K} A_{ik} B_{kj} $$
朴素核函数:固定输出 $C$ 的其中一个元素(例如 $M=1, N=1$,即算 $C_{5,?}$),遍历 $K$:
@triton.jit
def naive_matmul_kernel(a_ptr, b_ptr, c_ptr, M, N, K, ...):
    # 每个 (m, n) 元素一个"线程"(这里是最朴素、也最慢的版本)
    m = tl.program_id(0)
    n = tl.program_id(1)
    acc = 0.0
    for k in range(K):
        a = tl.load(a_ptr + m * K + k)     # 读 A[m][k]
        b = tl.load(b_ptr + k * N + n)     # 读 B[k][n]
        acc += a * b                        # 累加
    tl.store(c_ptr + m * N + n, acc)        # 写出到 HBM
这是正确的,但读写次数极差。
7.2 为什么朴素做法是灾难:算术强度
对每一个 $(m, n, k)$ 组合,都要从 HBM 读一次。因此:
- 读次数约为 $O(MKN)$;
- 计算次数也是 $O(MKN)$;
- 于是算术强度:
$$ \text{AI}_{\text{naive}} = \frac{O(MKN)}{O(MKN)} = O(1) $$
算术强度是常数——这非常糟糕。 无法把计算「喂饱」内存带宽。
7.3 冗余读:问题的真正来源
关键观察:有大量重复的读。
算 $C_{4}$ 要读 $A_{4}, A_{5}, A_{6}$;算 $C_{5}$ 又要把这些再读一遍。如果能一次读进来复用,就能省下大量读取。
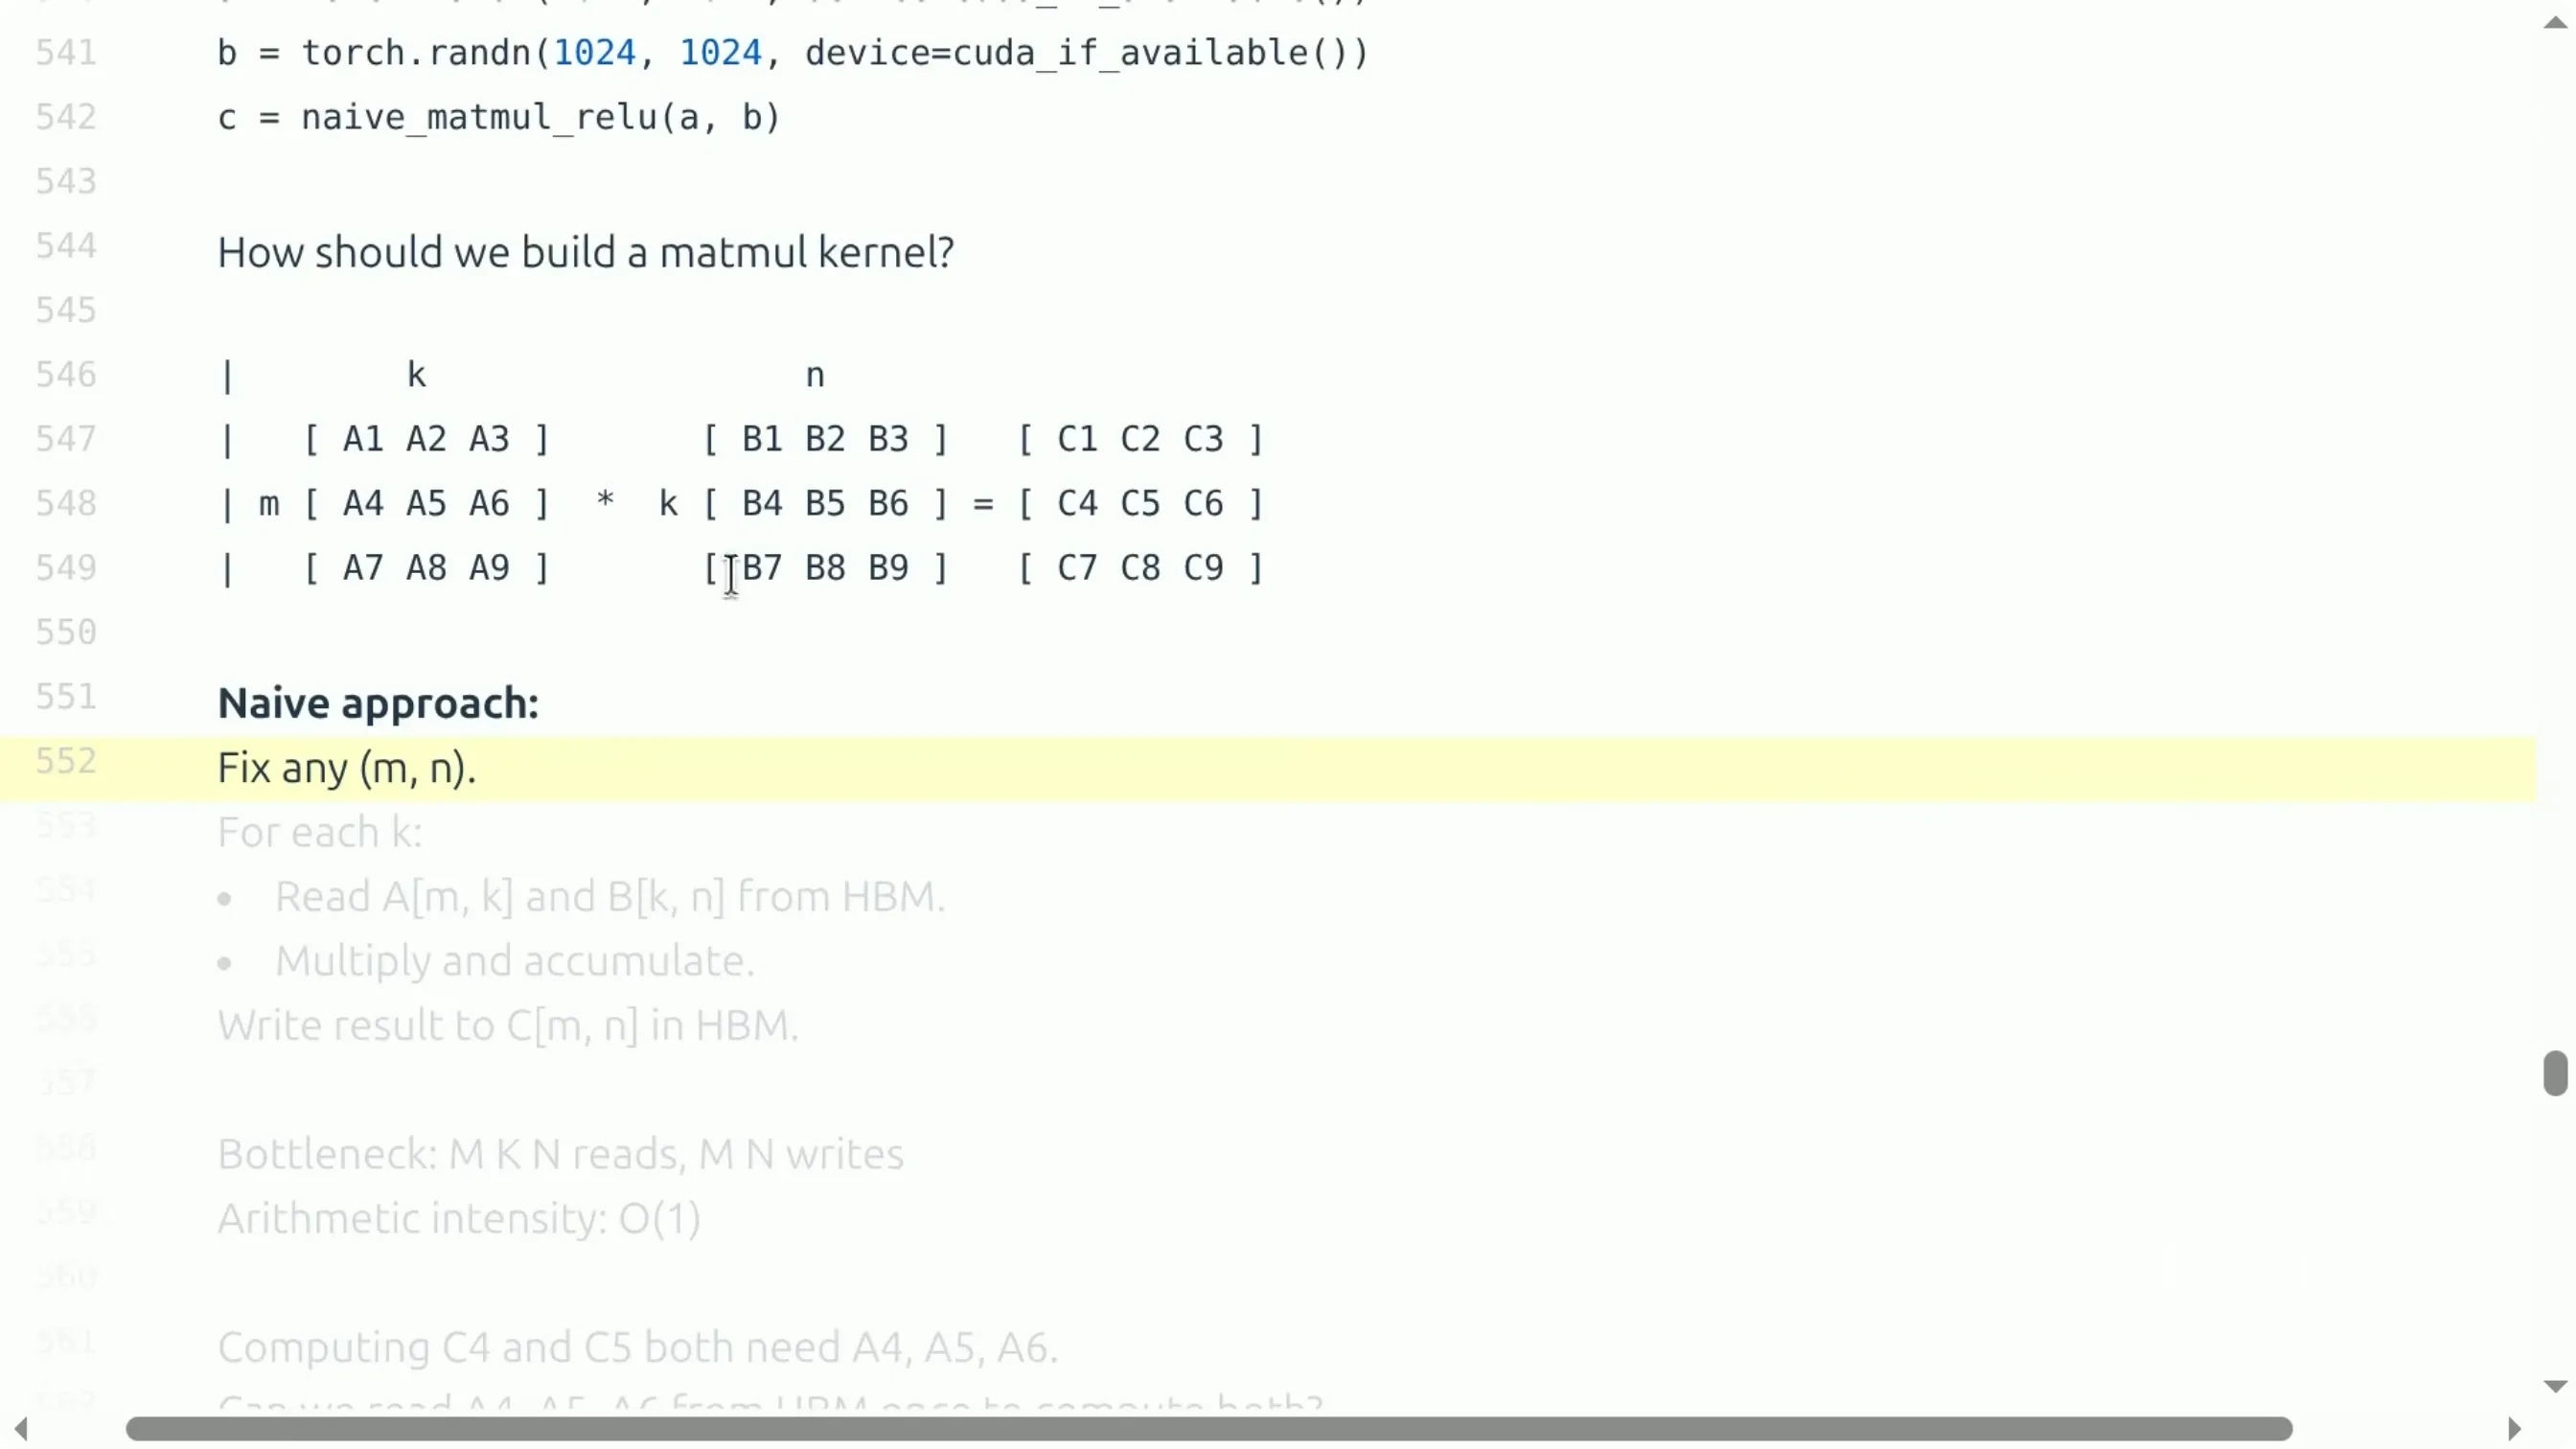
📷 朴素矩阵乘法:每个元素独立去 HBM 读一整行一列,重复读取严重
回到原视频 (01:13:00)
7.4 理想做法:全读入共享内存
理想化方案:把整个 $A$ 和 $B$ 读进共享内存,然后算 $C$。
- 读取量从 $O(MKN)$ 降到 $O(MK + KN)$(二次级);
- 算术强度升到 $O(N)$——这是「最理想」的量级,也是第二讲里说的目标;此时没有冗余读。
但问题在于:$A$ 和 $B$ 通常太大,装不进共享内存。
7.5 真正的正解:Tiling(分块)
于是引出分块 (tiling) 这个经典思想:能塞多少进共享内存就塞多少。
从整体看,它像朴素做法;但局部看,它像理想做法。
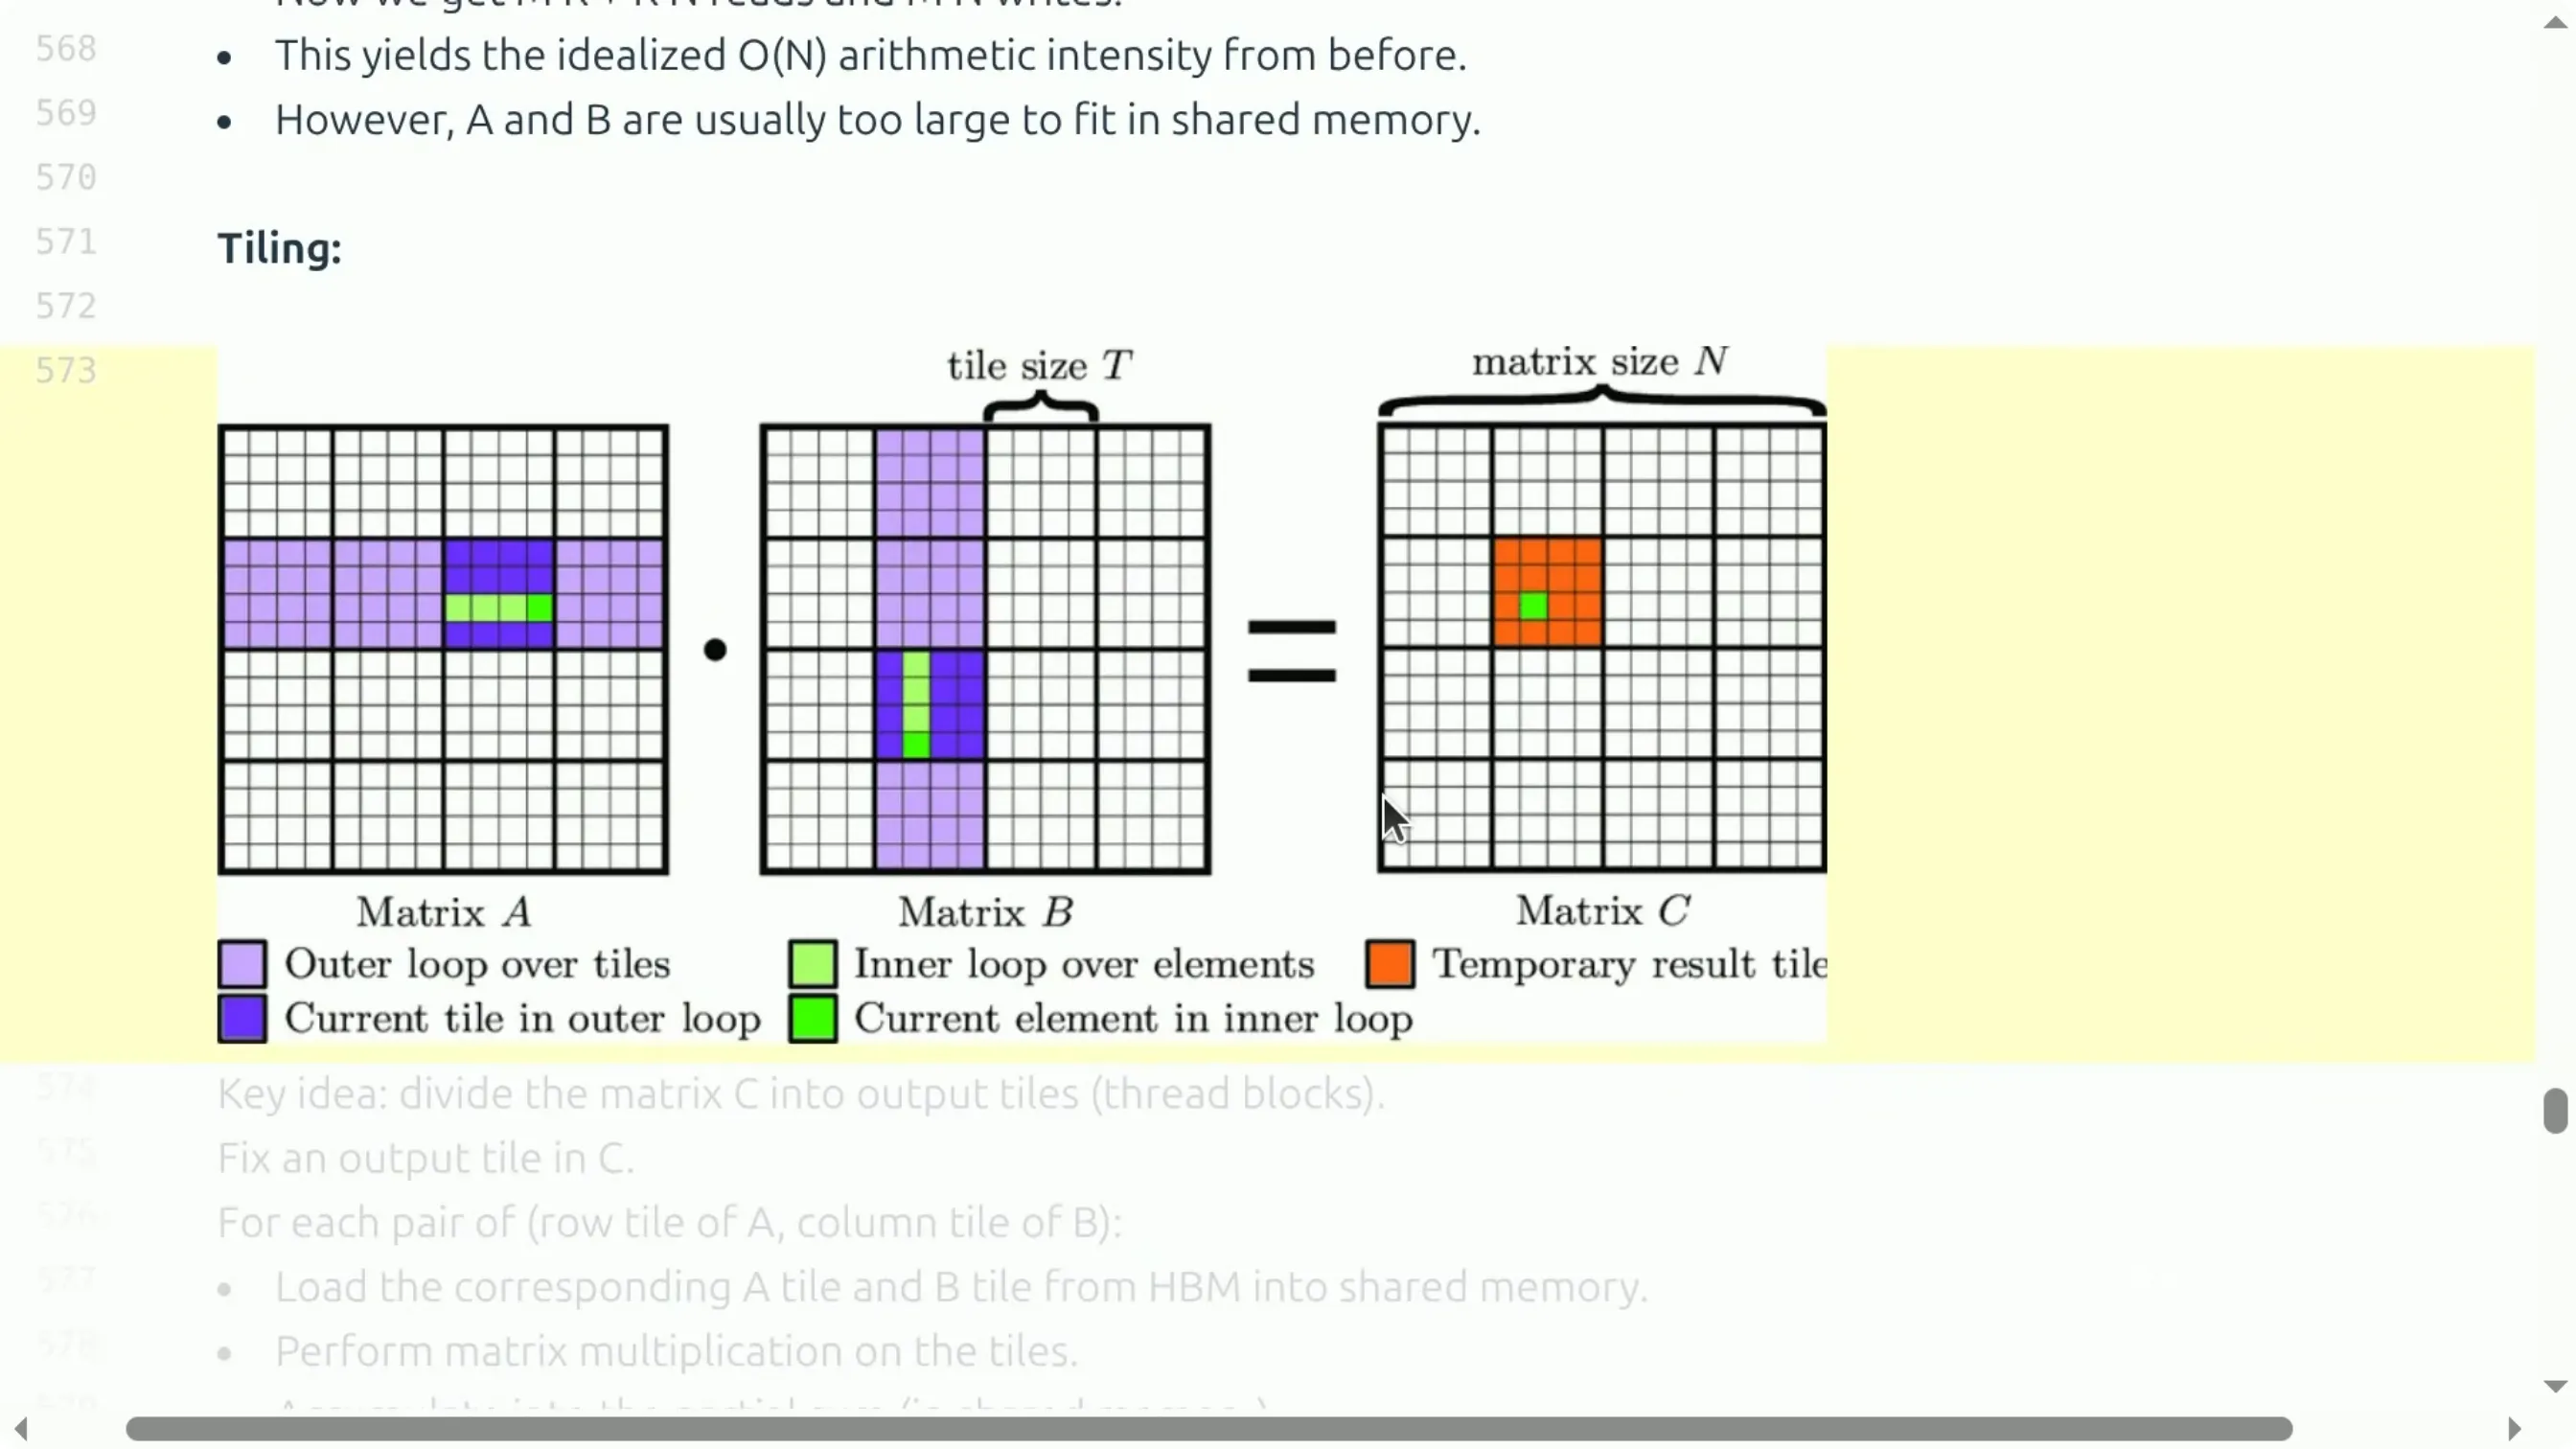
📷 Tiling:把输出矩阵 C 切成小块,每个小块交给一个线程块
回到原视频 (01:16:41)
具体机制:
- 把输出 $C$ 切成一块块 tile,每个 tile 交给一个线程块——不同 tile 由不同线程块完全独立计算。
- 线程块醒来后,沿着 $K$ 维迭代:对每一组「$A$ 的行 tile」和「$B$ 的列 tile」,把它们加载进共享内存。
- 在共享内存上把这两个小矩阵相乘,累加到部分和。
- 扫完 $K$ 维之后,才把这个输出 tile 写回 HBM。
graph TD
    A["给 C 的每个 tile 分配一个线程块"] --> B["沿 K 维迭代"]
    B --> C["把 A 的行 tile 与 B 的列 tile 载入共享内存"]
    C --> D["在共享内存上做小矩阵乘"]
    D --> E["累加到累加器"]
    E --> F{还有未处理的 K 维 tile?}
    F -->|是| B
    F -->|否| G["(可选)施加逐元素激活,如 ReLU"]
    G --> H["把 C 的这个 tile 写回 HBM"]
算术强度因此提升到与 tile 大小同阶。你无法达到理想的 $O(N)$(那要求把整块矩阵塞进共享内存),但只要 tile 够大,就已经「相当不错」。
7.6 附带收益:算子融合
讲者指出一个 bonus:既然你为了矩阵乘都得写核函数了,顺手把逐元素激活也加上去非常容易——这就是算子融合。正好用到了前面加 ReLU 的设定:在把 tile 写回 HBM 之前,先对它施加 ReLU 即可。
7.7 stride 小科普
代码里要用到 stride,讲者快速解释:
一个张量是多维数组,但内存里是线性的。stride 告诉你如何把多维下标映射成线性下标:
$$ \text{linear\_index} = \text{row} \times \text{stride}_\text{row} + \text{col} \times \text{stride}_\text{col} $$
例如行主序的矩阵:每往下走一行,内存里跳 4 个位置(stride_row = 4);每往右走一列,跳 1 个位置(stride_col = 1)。若是转置矩阵,则两者对调。
编者说明:stride 也叫步长。它是理解 Triton 里「指针算术」的关键——核函数里看到的其实是一串按 stride 计算出来的地址。正因为地址是程序员显式算出来的,才能支持各种布局(行主序、列主序、转置、非连续 slice),这也是 Triton 灵活性的来源之一。
7.8 矩阵乘核函数的骨架
@triton.jit
def matmul_relu_kernel(a_ptr, b_ptr, c_ptr,
                       M, N, K,
                       stride_am, stride_ak,
                       stride_bk, stride_bn,
                       stride_cm, stride_cn,
                       BLOCK_M: tl.constexpr, BLOCK_N: tl.constexpr, BLOCK_K: tl.constexpr):
    # 1) 我是 C 里的哪个 tile?
    pid_m = tl.program_id(0)
    pid_n = tl.program_id(1)

    # 2) 算出行/列下标,以及各自的地址偏移
    offs_m = pid_m * BLOCK_M + tl.arange(0, BLOCK_M)
    offs_n = pid_n * BLOCK_N + tl.arange(0, BLOCK_N)
    offs_k = tl.arange(0, BLOCK_K)

    a_ptrs = a_ptr + offs_m[:, None] * stride_am + offs_k[None, :] * stride_ak
    b_ptrs = b_ptr + offs_k[:, None] * stride_bk + offs_n[None, :] * stride_bn

    # 3) 累加器(在共享内存里),形状 BLOCK_M × BLOCK_N
    acc = tl.zeros((BLOCK_M, BLOCK_N), dtype=tl.float32)

    # 4) 沿 K 维迭代,边加载 tile 边累加
    for k in range(0, K, BLOCK_K):
        a = tl.load(a_ptrs)                 # 加载 A 的小块
        b = tl.load(b_ptrs)                 # 加载 B 的小块
        acc += tl.dot(a, b)                 # 在共享内存上做小矩阵乘
        a_ptrs += BLOCK_K * stride_ak        # 前进到下一个 K 维 tile
        b_ptrs += BLOCK_K * stride_bk

    # 5) 顺手融合 ReLU,然后写回
    acc = tl.maximum(acc, 0.0)
    tl.store(c_ptr + offs_m[:, None] * stride_cm + offs_n[None, :] * stride_cn, acc)
要点:
- 你醒来后属于 tile $(M, N)$,负责计算 C 的这一小块;
- 一堆下标操作看着琐碎,但都直截了当——就是算 A、B 的地址;
- 累加器
acc是BLOCK_M × BLOCK_N,住在共享内存; - 主循环很像之前的行归约,只是现在同时沿着行 tile 和 列 tile 移动;
- 一旦数据在共享内存里,「它又变得像 PyTorch 了」——你可以直接写
tl.dot(a, b),它会帮你算; - 循环结束后施加 ReLU,最后写出。
八、本讲总结
(参考时间: 01:22:12)
把这一讲从头到尾串起来:
- 有编程模型——你可以用 PyTorch、Triton 或 PTX 来表达计算,这是程序员能控制的部分。你甚至能写 PTX、做任意特化。
- 但这不是全貌——代码最终要跑在硬件上,SM 数量有限、bank 数量有限、内存和寄存器尺寸都有上限。你带着大矩阵和 transformer 来,它们必须被塞进这些硬约束里。这就是为什么基准测试与性能剖析如此重要——帮你看清硬件的「乱」是怎么转化为性能的。
- Triton 是一门以线程块为中心的漂亮语言。到这里你应该体会到:用线程块思考比用单个线程思考更容易——你不必手动同步线程、不必手动管共享内存。你只需:把计算拆成线程块,每个块「读共享内存 → 算 → 写回 HBM」。
- 例子难度递增:
- 逐元素(GELU)——最简单;
- 行内归约(softmax)——引入归约;
- 归约但装不进一行(行求和)——tiling 的雏形;
- 矩阵乘法——tiling 的经典范例。
讲者预告:下一讲将走向多 GPU 编程。
问答补充:
- 「除了 Triton 还有哪些选择?离最优性能有多远?」 语言都有各自的归纳偏置——让某些事容易、某些事难。Triton 由「训练 transformer 的人」打造,所以 transformer 相关的任务都很顺手。极端情况下你可以直接写 PTX(但不建议作为第一步)。此外还有 ThunderKittens、CUTE 等其他 DSL——它们并不一定在栈的上游或下游,只是给你不同的特性取舍。
- 「高维张量运算,是应该一次性加载整块,还是逐元素处理?」 很难抽象回答,取决于计算的本质。
附:参考与延伸阅读
编者补充
已知疑点
本节集中列出编者改写时无法完全确定的地方。凡有疑问处均给出依据或时间点,供读者自行核对原视频。
-
课程主页 / 官方讲义 / 幻灯片:本讲对应的官方讲义与幻灯片链接未能确认。若有
course/目录(如*.notes.md、slides_text.md),术语与章节应以讲义为准;本书未使用官方幻灯片渲染图,所有截图均以SCREENSHOT占位符标注,为编者依据字幕中「如图所示 / 看这张图 / 让我们看看」等明确画面提示选取,可能与真实幻灯片页不完全对应。 -
讲者姓名:字幕只提到「上一讲由 Tatsu 主讲」,未直接给出本讲讲者姓名,因此本书统一以「讲者」指代。CS336 通常由两人合授,具体署名请以课程主页为准。
-
作业中的剖析工具名:(参考时间: 00:26:55) 讲者说「in your assignment you're using site which gives you more details」。「site」很可能是语音识别错误,编者推测其指 NVIDIA Nsight,但无法确证。正文中已标注为推测。
-
PTX 中的线程粗化元素数:(参考时间: 00:52:57) 讲者说这个线程「processing eight elements」。数字 8 可能是对画面中具体代码的目测,可能并不精确,编者按原话保留了「8」。
-
GELU 基准测试的具体数字:(参考时间: 00:32:04) 讲者口述「naive takes... 3.75」,随后承认「去年做时两者更接近」,并强调结果与硬件、编译版本强相关。因此 3.75 ms 只应视为一次课堂演示的示意值,不是稳定基准。
-
矩阵乘法核函数名字的解读:(参考时间: 00:29:00) 讲者对剖析出来的核函数名做了拆解(CUTLASS / SM100 / f32 / 64 64 16)。由于字幕转录中名字被截断,具体字符串可能有误;编者在正文中给出的是一种合理的解释框架,而非逐字符转抄的原名。
-
「128 线程、160 寄存器」占用率示例的取整:(参考时间: 00:13:00) 讲者算得 3 个块、12 个 warp、约 18% 占用率。$12/64 = 18.75\%$,讲者口语说「18%」。另外真实硬件对寄存器分配有对齐/粒度约束,实际可容纳的块数可能与简单除法略有出入,这里的数字应理解为教学近似。
-
本讲标题中的「XLA」:官方标题为「Kernels, Triton, XLA」,但实际讲授内容集中在 Triton 核函数与性能剖析,未专门展开 XLA(XLA 更多体现在
torch.compile生成 Triton 代码这一层面)。此处如实指出,以免读者对覆盖范围产生误解。 -
若干口误/听写不确定处:字幕中存在明显口误或 ASR 噪声,如把
B200读作「M100s 到 H100s 到 B200s」中的一代、把「4 个 warp 调度器」的原因承认不知道((参考时间: 00:57:13))、把 softmax 的转置写法讨论得较为随意((参考时间: 01:04:45))。这些地方编者按上下文做了合理化的书面表达,可能与原话细节有出入。