第7讲 · Stanford CS336:从零开始训练语言模型:并行 (Parallelism)
| 课程 | Stanford CS336 Language Modeling from Scratch(Spring 2026) |
| 本讲 | Lecture 7 — Parallelism |
| 视频 | https://www.youtube.com/watch?v=SzpOcwdIL0Y(时长 4862 秒) |
| 视频 ID | SzpOcwdIL0Y |
对应讲次:第7讲(Stanford CS336 语言建模)
制作模型:deepseek-flash(vb compose,据 run.log)
整理说明:本书由课堂字幕重构为中文书面语,保留了讲师的类比、案例与推理链;编者补充内容均以「编者说明 / 编者拓展」标注,不代表讲师原话。
导览
这一讲要回答的核心问题只有一个:当一块 GPU 已经用满之后,怎样利用多块 GPU 让训练更快?
上一讲我们"钻进"了单块 GPU 内部——HBM、L2/L1 cache、寄存器、流多处理器 (SM)——研究如何写 kernel 把单卡榨干。这一讲把视野拉出来:从一块 GPU 扩展到四块、上千块,然后要解决的核心矛盾是——计算单元 (ALU、Tensor Core) 离数据很远。单卡时"很远"指的是隔着 HBM,多卡时"很远"指数据可能在另一块 GPU 上。整堂课的游戏规则始终没变:编排计算,避免数据传输成为瓶颈。用很多 GPU 很容易,用"好"很难。
难点在哪:一是集合通信原语 (collective operations) 名目繁多、术语混乱,reduce / scatter / gather / all-gather / reduce-scatter / all-reduce 极易记混;二是"选哪种并行"不是纯算法问题,而是与硬件互联带宽强绑定的工程决策——张量并行走 NVLink,流水线并行能忍受慢得多的链路;三是多进程 + CUDA 异步双重并发,时序很难推理。
读者可能带着的疑问——
- ① 老师真正提出的问题:为什么要有集合通信原语?多卡的带宽层级长什么样?三种并行(数据 / 张量 / 流水线)各自切的是什么?为什么 all-reduce 等于 reduce-scatter 加 all-gather?
- ② 编者预判的读者疑问(编者预判):术语到底怎么记?rank 和目标 GPU 是固定的吗?batch size 和 world size 有关系吗?这些原语在 PyTorch 里长什么样?TPU / JAX 路线有什么不同?
本讲路线:老师先花一半时间铺"积木"——集合通信原语 → 硬件互联 → PyTorch 代码 → 通信基准测试;然后用一个极简 MLP 依次演示三种并行:数据并行 (DDP)、张量并行 (TP)、流水线并行 (PP),并强调 MLP 的核心计算就是 Transformer 里真正的瓶颈,所以这个玩具足够代表真实情况。
一、从单 GPU 到多 GPU:为什么需要并行
(参考时间: 00:00:08)
上一周我们把注意力放在"一个盒子"内部——一块 GPU,里面有高带宽显存 (HBM)、L2 cache、L1 cache、寄存器,以及一堆流多处理器 (SM)。这一周盒子被扩展了:不再是 1 块 GPU,而是 4 块、乃至上千块,它们之间用某种方式互联,而你要想办法把这些算力用起来训练模型。
📷 单卡内部结构与多卡互联的整体图景
回到原视频 (00:00:32)
单卡与多卡看似两件事,但缩小看时它们的处境是同构的:计算单元(ALU、Tensor Core)离数据很远。单卡时"远"是远在 HBM 那头;多卡时,你需要的张量可能整块躺在另一块 GPU 上,得想办法把它"铲"过来。所以原理一脉相承——核心是编排计算,绕开数据搬运瓶颈。
我们可以把整个层级"泛化"地列出来,从近到远:
graph LR
    A["SM / 寄存器 / L1·共享内存<br/>(最快)"] --> B["HBM 高带宽显存<br/>(本讲视为'快')"]
    B --> C["单节点多卡<br/>NVLink + NVLink Switch"]
    C --> D["多节点<br/>InfiniBand / Ethernet<br/>(最慢)"]
这里有个有意思的视角转换:上一讲我们抱怨 HBM "太慢",而在本讲里 HBM 是被当作"快"的一方——因为它跟 NVLink、InfiniBand 相比反而很快。
为什么要用多块 GPU?
(参考时间: 00:03:17)
理由其实只有两条,老师把它讲得很直白:
- 装不下:参数、激活、梯度、优化器状态塞不进单卡的显存。比如 B200 有 192 GB 显存,而一个 1 万亿参数的模型根本放不下。
- 想更快:即使模型能塞进单卡,你也可以把计算拆开来,用更多 GPU 加速训练。
但天下没有免费的午餐:拆得越开,就越要付出通信带宽的代价。所以"到底怎么并行"是一个需要精算的决策——你可能有更少的核心,但不用付通信费;也可能用更多核心,但要付通信费。这两者需要权衡取舍。
编者说明:老师此处点出的是并行训练的根本权衡——显存墙 (memory wall) 与通信墙。前者迫使你分片(否则根本放不下),后者惩罚你分片(每次跨卡通信都有带宽与延迟成本)。后面三种并行的取舍,本质上就是在这两堵墙之间找平衡。
编者拓展|显存里到底存了什么:训练一个模型时,单卡的显存不是只装参数。以 Adam 优化器为例,通常需要:参数副本 $W$、梯度 $G$、一阶动量 $m$、二阶动量 $v$。若以 FP16 存参数与梯度、FP32 存优化器状态,则每个参数大约需要 $2+2+4+4=12$ 字节。一个 1 万亿参数的模型仅优化器状态就要约 12 TB —— 这正是"必须分片"的量化依据,也是下一讲 FSDP / ZeRO 要解决的问题。
二、集合通信原语:并行编程的积木
(参考时间: 00:05:52)
2.1 什么是集合通信
集合通信 (collective operations) 是分布式编程里的原语,可以追溯到 1980 年代——并行编程非常古老,它不是为语言模型训练发明的。但有意思的是,几十年后的今天,我们训练语言模型用的还是同一批原语。
所谓 "collective"(集合),就是你指定一个通用的通信模式 / 模板,作用于多台设备,而不是手动管理"这块 GPU 怎么点对点地跟那块 GPU 说话"。这样做更简单,系统能替你做的事也更多——是一套非常久经考验的并行编程接口。
标准术语:
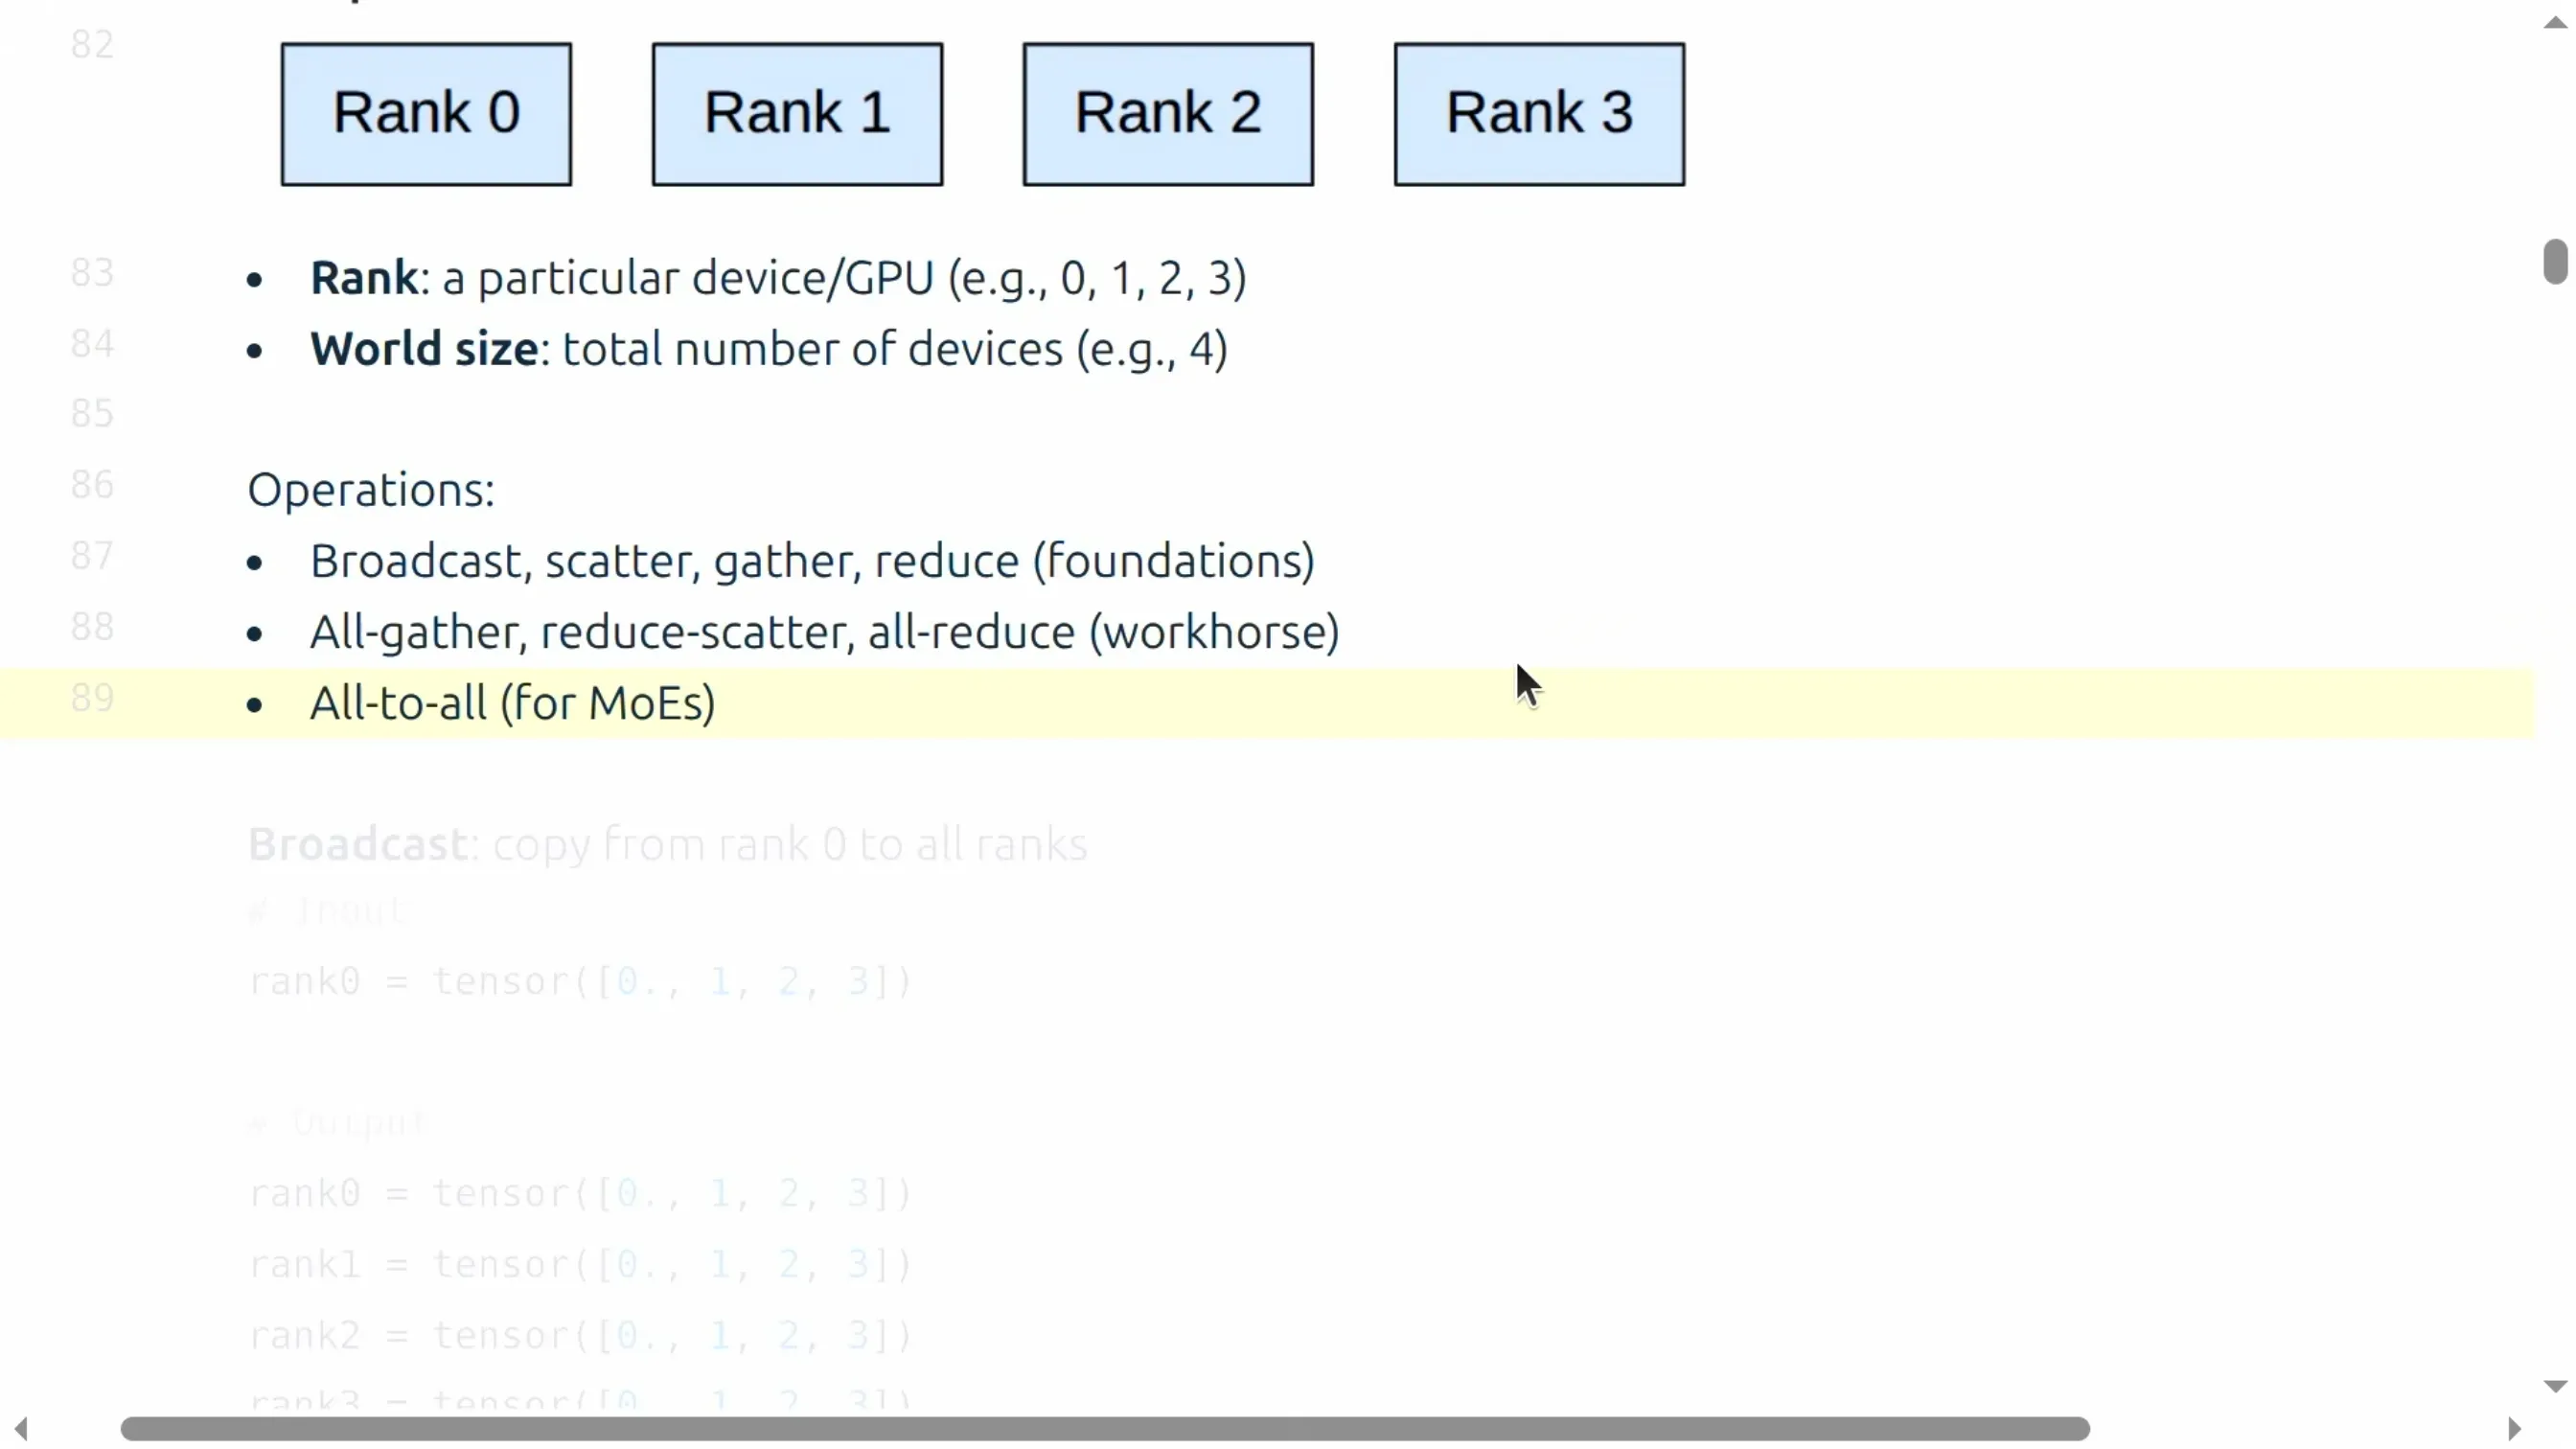
- rank(秩):对应一个具体设备,本课程中就是一块 GPU(也可能是一块 TPU)。
- world size(世界大小):设备总数。
例如有 4 个 rank,world size 就是 4。
老师把要讲的运算列成了一张清单:broadcast、scatter、gather、reduce、all-gather、reduce-scatter、all-reduce、all-to-all。它们各自规定了"一组设备如何把一定量的数据传/算到另一组设备"。
其中:
broadcast / scatter / gather / reduce是热身(warm-up),帮助你理解集合通信的运作方式,但并不是驱动训练的主力;all-gather / reduce-scatter / all-reduce才是在分布式训练里反复出现的原语;all-to-all对 MOE(混合专家)很重要,本讲不展开。
2.2 热身原语:broadcast / scatter / gather / reduce
Broadcast(广播) (参考时间: 00:08:24)
rank 0(也可以是任意一个 rank)持有一个张量,比如 [0 1 2 3],它把这个张量广播到所有 rank。操作结束后,每个 rank 上都有一份相同的张量。
📷 broadcast:rank 0 把张量复制给所有 rank
回到原视频 (00:07:25)
broadcast 一般不走在训练的核心路径上,典型用途是初始化——比如加载一个 checkpoint,然后广播给所有 rank,属于"只做一次"的操作。
编者说明:学生问"这跟 NumPy 的 broadcasting 是一回事吗?"老师回答:概念上一样,都是"一个东西变多个",但 NumPy 的广播是标量扩散到张量的形状规则,而这里的 broadcast 是集合通信的实例,用于跨进程通信,二者只是名字像。
Scatter(散射) (参考时间: 00:09:11)
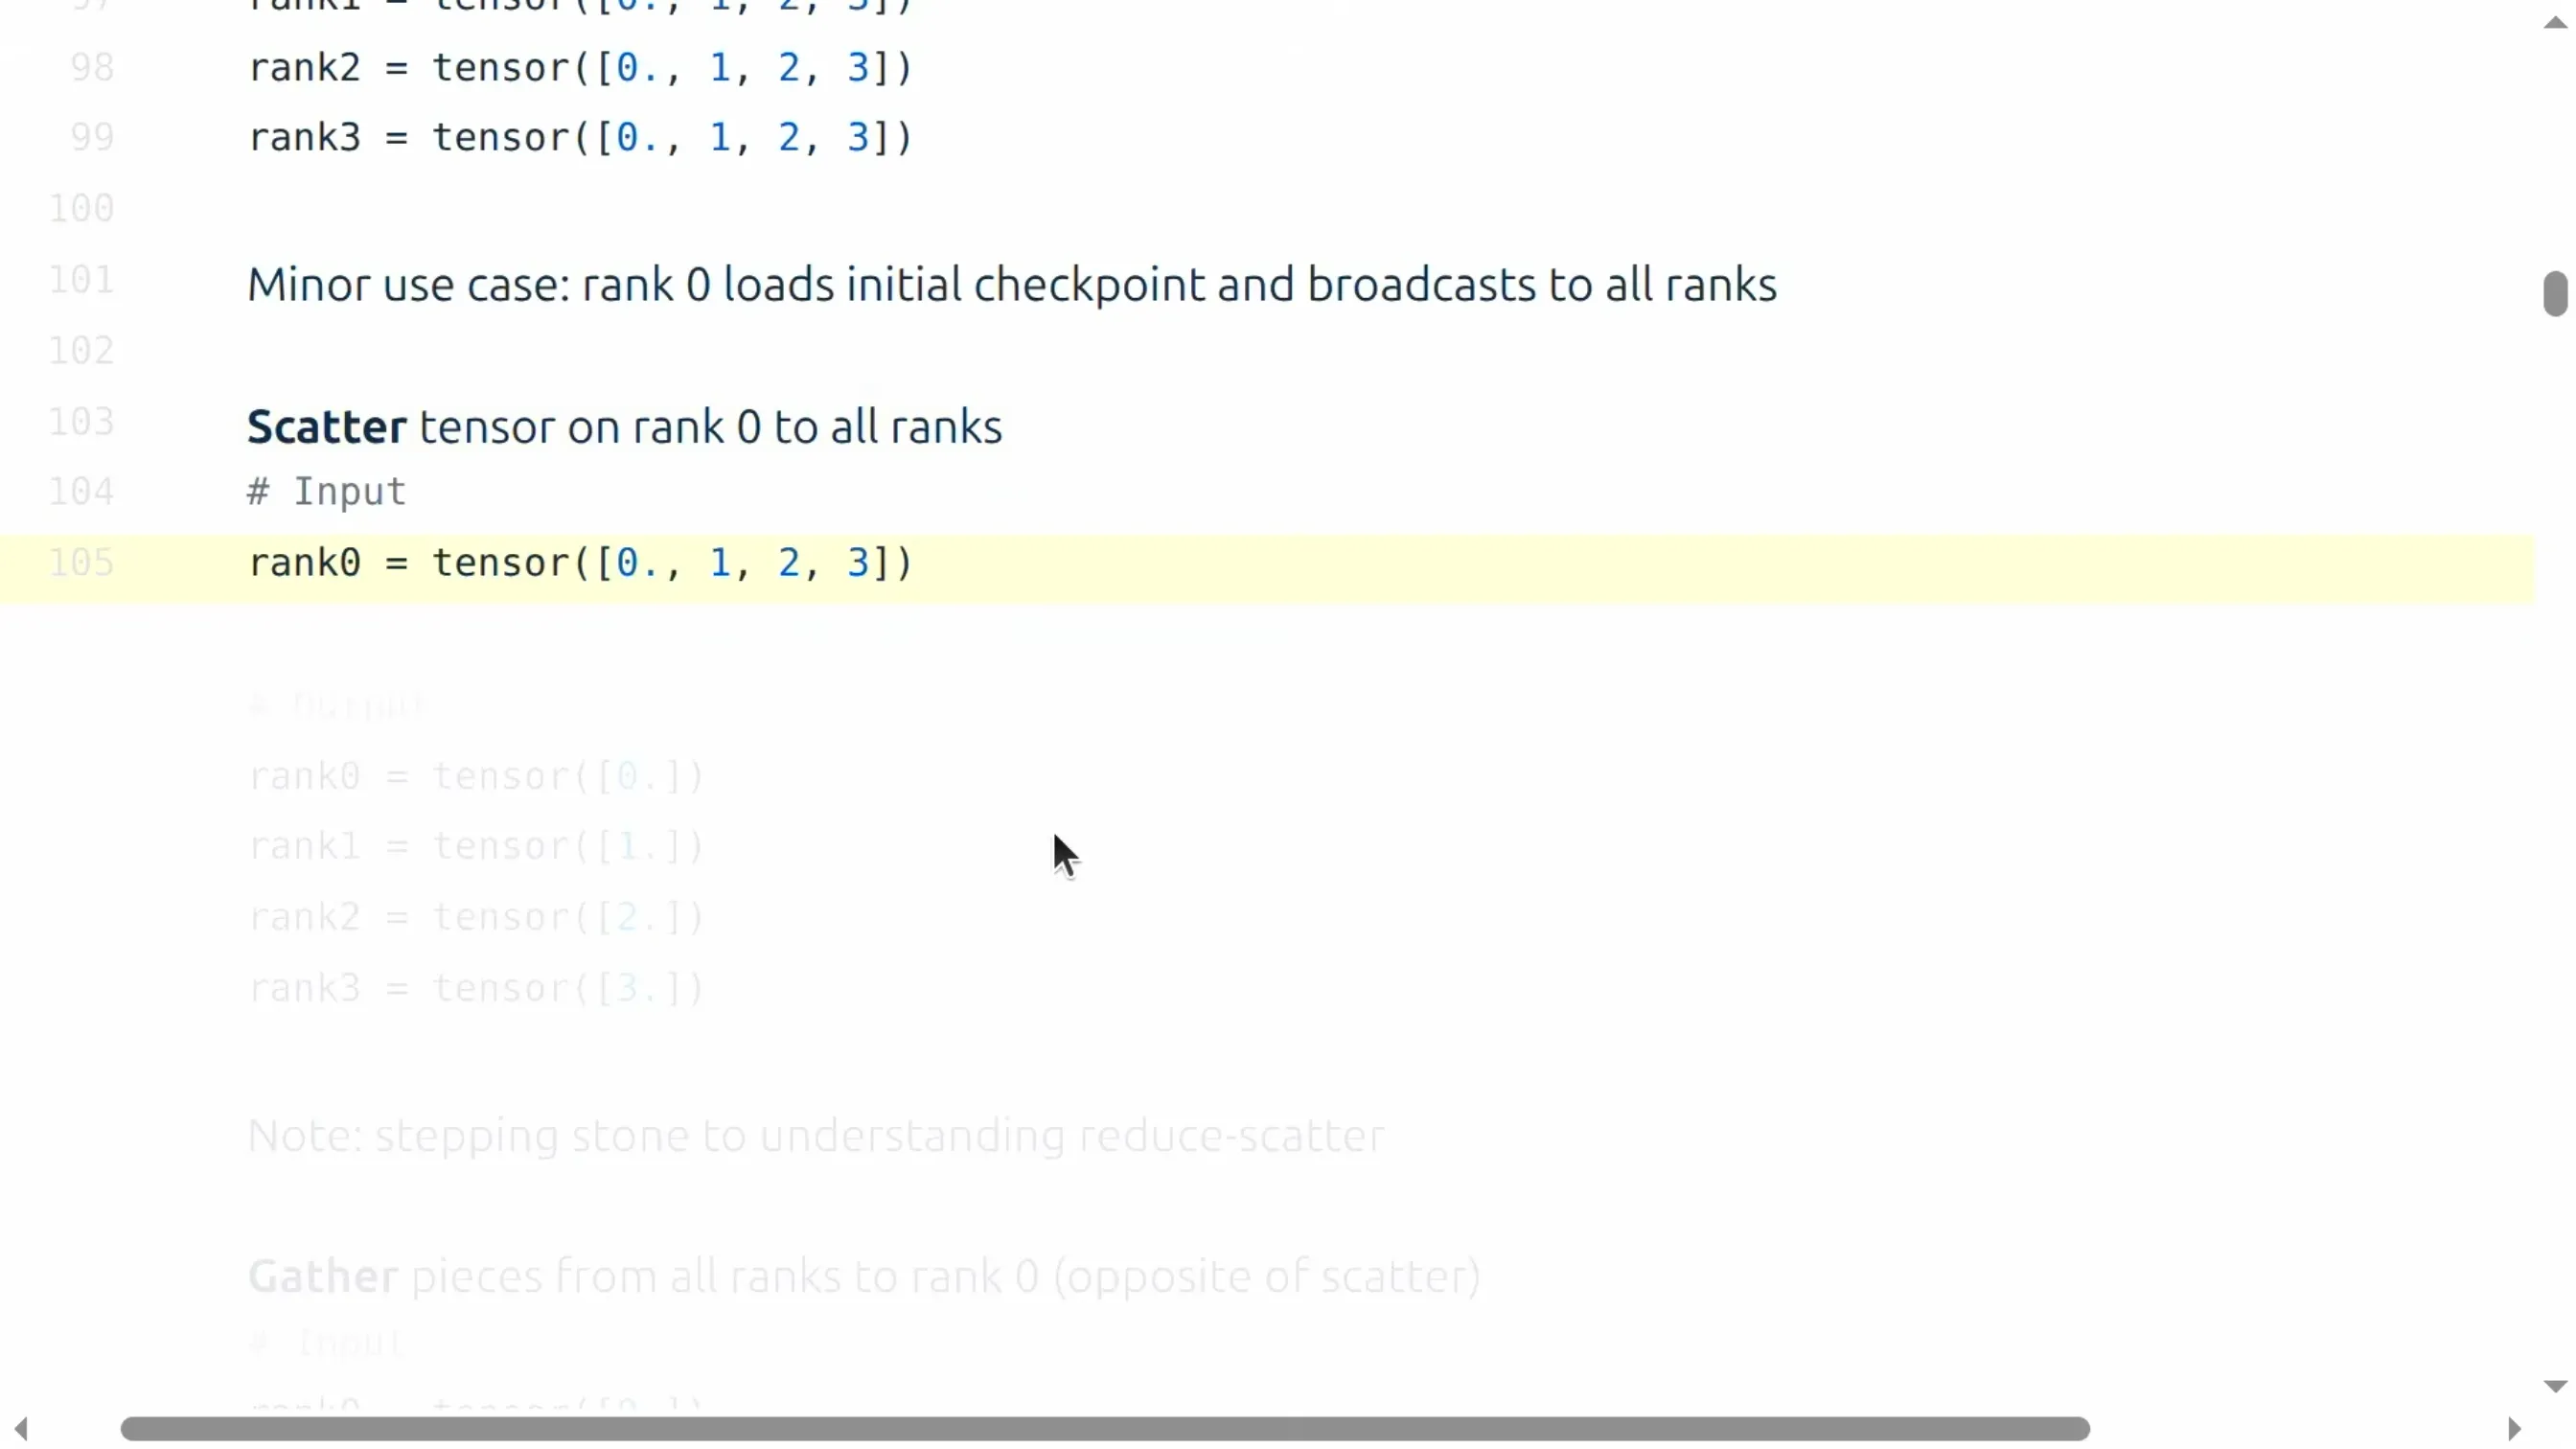
rank 0 有一个张量,把它按 world size 切分:rank 0 拿第 0 份,rank 1 拿第 1 份,rank 2 拿第 2 份……以此类推。
📷 scatter:把大张量切成 world size 份分发下去
回到原视频 (00:09:18)
scatter 本身不直接用,但它是理解 reduce-scatter 的踏脚石。它的直观意义是:你想让各个 GPU 各自在"不同部分"上做本地计算。
Gather(聚集) (参考时间: 00:10:13)
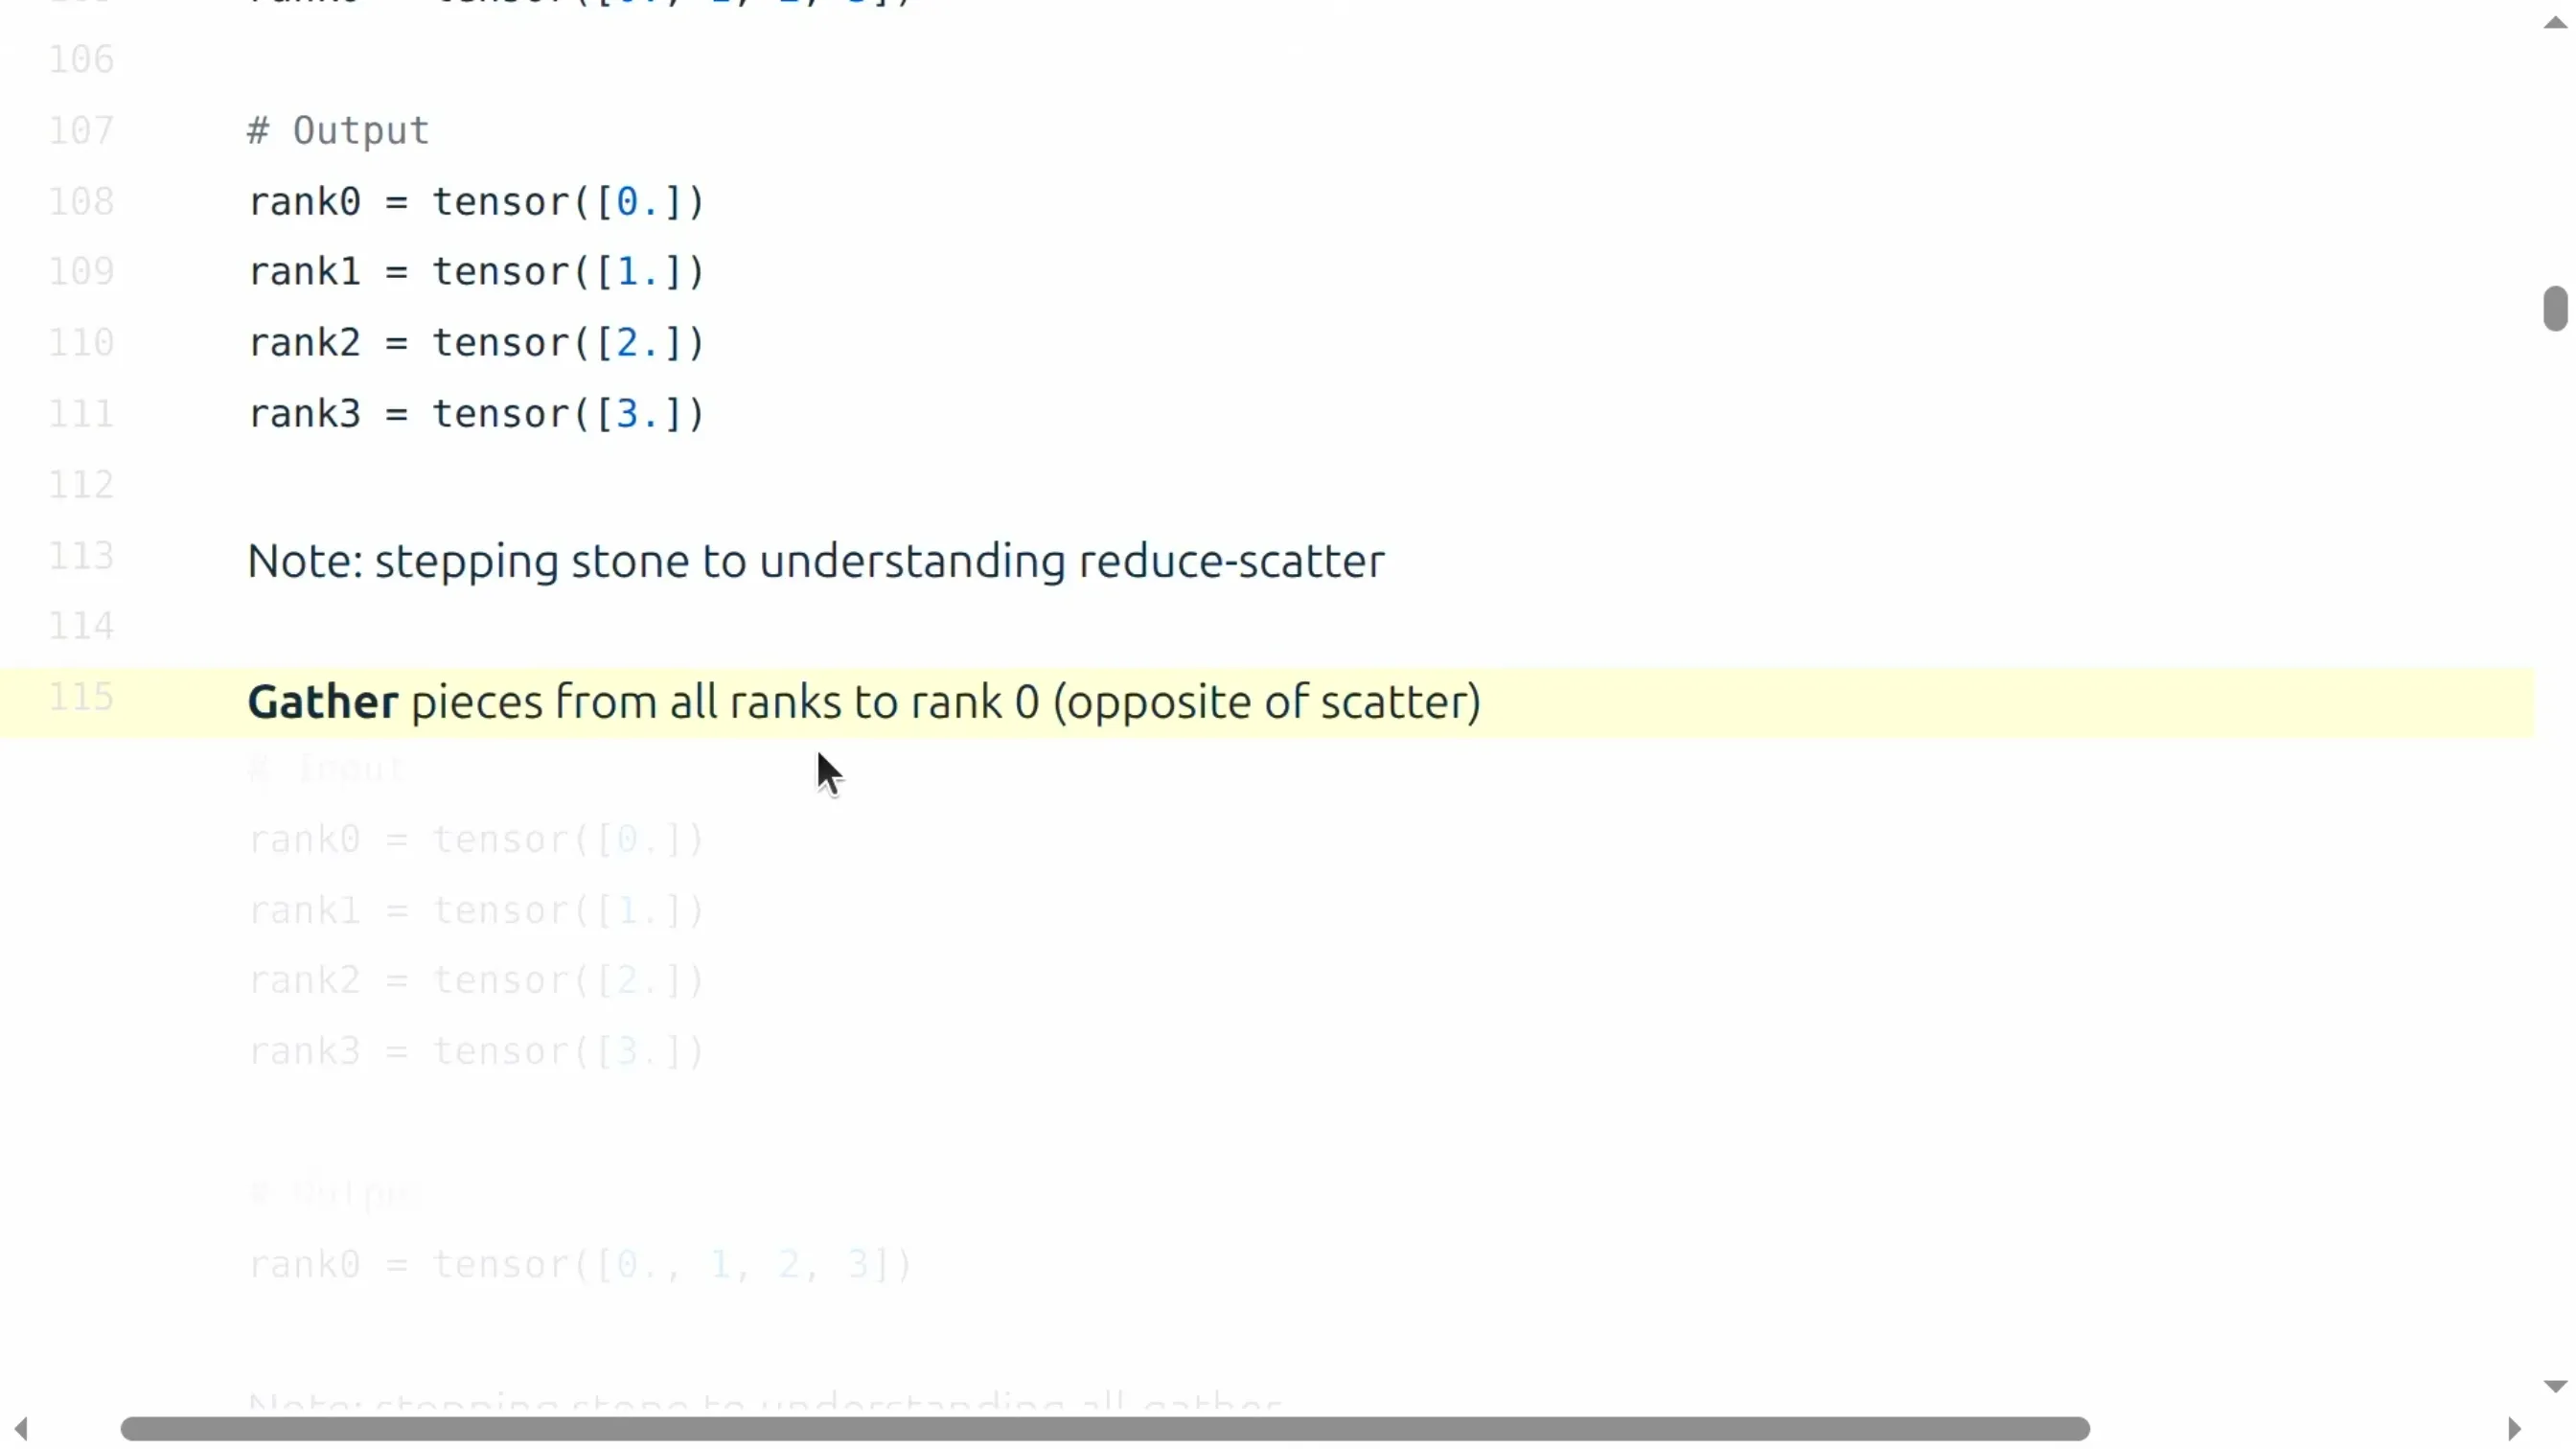
gather 是 scatter 的逆运算。输入是一堆分散在各自 rank 上的片段,gather 相对于某个目标 rank(比如 rank 0)把这些片段拼接在一起。
📷 gather:把分散的片段拼接到目标 rank
回到原视频 (00:10:18)
同样地,gather 不直接用,但它是理解 all-gather 的踏脚石。
Reduce(归约) (参考时间: 00:10:45)
熟悉函数式编程的人不会陌生——reduce 就是那个 reduce。输入分布和 gather 相同(每个 rank 有一份数据),但这次不是拼接,而是对它们施加一个归约操作,把结果放到 rank 0。例如用求和归约 [0,1,2,3] 得到 6。
可以这样理解:gather 相当于"以拼接为归约操作"的 reduce。
编者说明:reduce 要求归约操作满足结合律与交换律(associative & commutative)——可以是求和、取最大、取最小等。这一点是后面 all-reduce、reduce-scatter 能高效实现的前提。
2.3 训练主力原语:all-gather / reduce-scatter / all-reduce
All-Gather (参考时间: 00:12:38)
all-gather 就是"对所有 rank 做 gather",而不是只把结果给 rank 0。
all的含义是:输出到所有 rank;gather的含义是:做的动作是聚集。
老师特意强调了一句后来会反复出现的话(不必精确理解,先记住):每个 rank 持有部分参数,你需要 all-gather 这些参数,得到完整的参数,才能做完整的前向。
训练中会看到大量的"gather → 做点事 → scatter → gather → scatter……"循环。
Reduce-Scatter (参考时间: 00:13:42)
reduce-scatter 是"对每个维度做 reduce,然后把结果 scatter 出去"。
举例:4 个设备各有向量,对每一分量做归约,然后:
- 第 1 个分量加起来得
6,写到某个 rank; - 第 2 个分量加起来得
10,写到另一个 rank; - ……
结果是每个分量被归约后分发到不同的 rank,而不是像 reduce 那样全部堆到 rank 0。
它的用途先剧透一下:在反向传播之后,每块 GPU 处理的是不同数据,需要把所有梯度加起来,然后重新分配存储。
All-Reduce (参考时间: 00:15:18)
如果你理解了 reduce-scatter 和 all-gather,那么 all-reduce 就是"先做前者,再做后者"。
- 先 reduce-scatter:
6, 10, 14, 18分散在不同 rank; - 再 all-gather:把它们复制到所有节点。
换个说法,all-reduce 反而是最好理解的:一堆张量 → 归约(这里是求和)→ 复制到所有节点。
我们会最先在数据并行里遇到它——对梯度求和,再把完整参数复制给所有 rank。所以看这一讲时,可以把注意力先集中在 all-reduce 上;后面要做 ZeRO / FSDP 那种更花哨的东西时,才需要把 all-reduce 拆成 reduce-scatter + all-gather,因为拆开之后你才能插手、更好地管理中间过程。
All-to-All (参考时间: 00:16:48)
all-to-all 某种意义上最通用:你显式指定每个 rank 怎么把某条消息发给另一个 rank。
例:输入 [0 1 2 3]——
- rank 0 想把
0发给 rank 0(即留给自己)、1发给 rank 1、2发给 rank 2、3发给 rank 3; - rank 1 想把
4发给 rank 0、5发给 rank 1……
即位置决定目的 rank。输出时,每个 rank 会收到"所有以它为目的地"的元素。若流量完全均衡,all-to-all 就可以看成"把矩阵转置一下";但它也能处理不均衡的分发。
编者说明:老师把均衡的 all-to-all 类比为矩阵转置,很形象——如果每个 rank 发给其他每个 rank 的字节数相同,那么通信可以组织成一个可转置的矩阵。联系到之前讲 MOE 的负载均衡:理想目标是让 all-to-all 尽可能接近这种"整齐的转置"。
all-reduce = reduce-scatter + all-gather 的关系图:
graph TD
    IN["各 rank 上的不同张量<br/>(如 [0,1,2,3],[1,2,3,4],...)"] --> RS["Reduce-Scatter<br/>逐分量归约后分发"]
    RS --> RSout["各 rank 持有部分归约结果<br/>(如 6 / 10 / 14 / 18)"]
    RSout --> AG["All-Gather<br/>把片段汇聚到所有 rank"]
    AG --> OUT["所有 rank 持有完整归约结果"]
    IN -.->|等价于| OUT
2.4 记忆技巧小结
(参考时间: 00:19:43)
老师总结了一套帮助记忆的说法,非常实用:
- reduce:执行某种结合且可交换的运算(sum、max、min……)。
- scatter 是 gather 的逆运算:scatter 分发,gather 集中。
- all 表示目的地是"所有设备"——这解释了
all-reduce与all-gather。
编者说明:学生问 gather / reduce 里"目标 rank 0"是不是固定的一台 GPU?老师答复:不固定,具体目标(GPU ID / rank)在执行调用时指定,不必提前固定。另一位学生问这些是不是只是"概念积木"而非真代码?老师答:现在展示的是概念,很快会给出真实代码。
三、硬件互联:GPU 之间怎么通信
(参考时间: 00:21:56)
3.1 从家用 PCIe 到数据中心拓扑
先看一张非常经典、非常有年代感的图,它展示了计算机的传统工作方式:
- 一台服务器,一堆 CPU;
- PCIe 总线连接外设(历史上鼠标、键盘也走这里);
- 总线上挂着一堆 GPU,还有 RAM;
- 这台机器通过 Ethernet(以太网)连到另一台机器。
在这种"土法"配置里:同节点内的 GPU 用 PCIe 通信,跨节点的 GPU 必须绕一大圈走以太网。老师调侃说,这就像你把自己的游戏显卡跟朋友的显卡连起来说"我要训练一个大模型"——理论上能跑,但很惨。
真正严肃训练时,图景更接近这样(即开头那张图的细节):
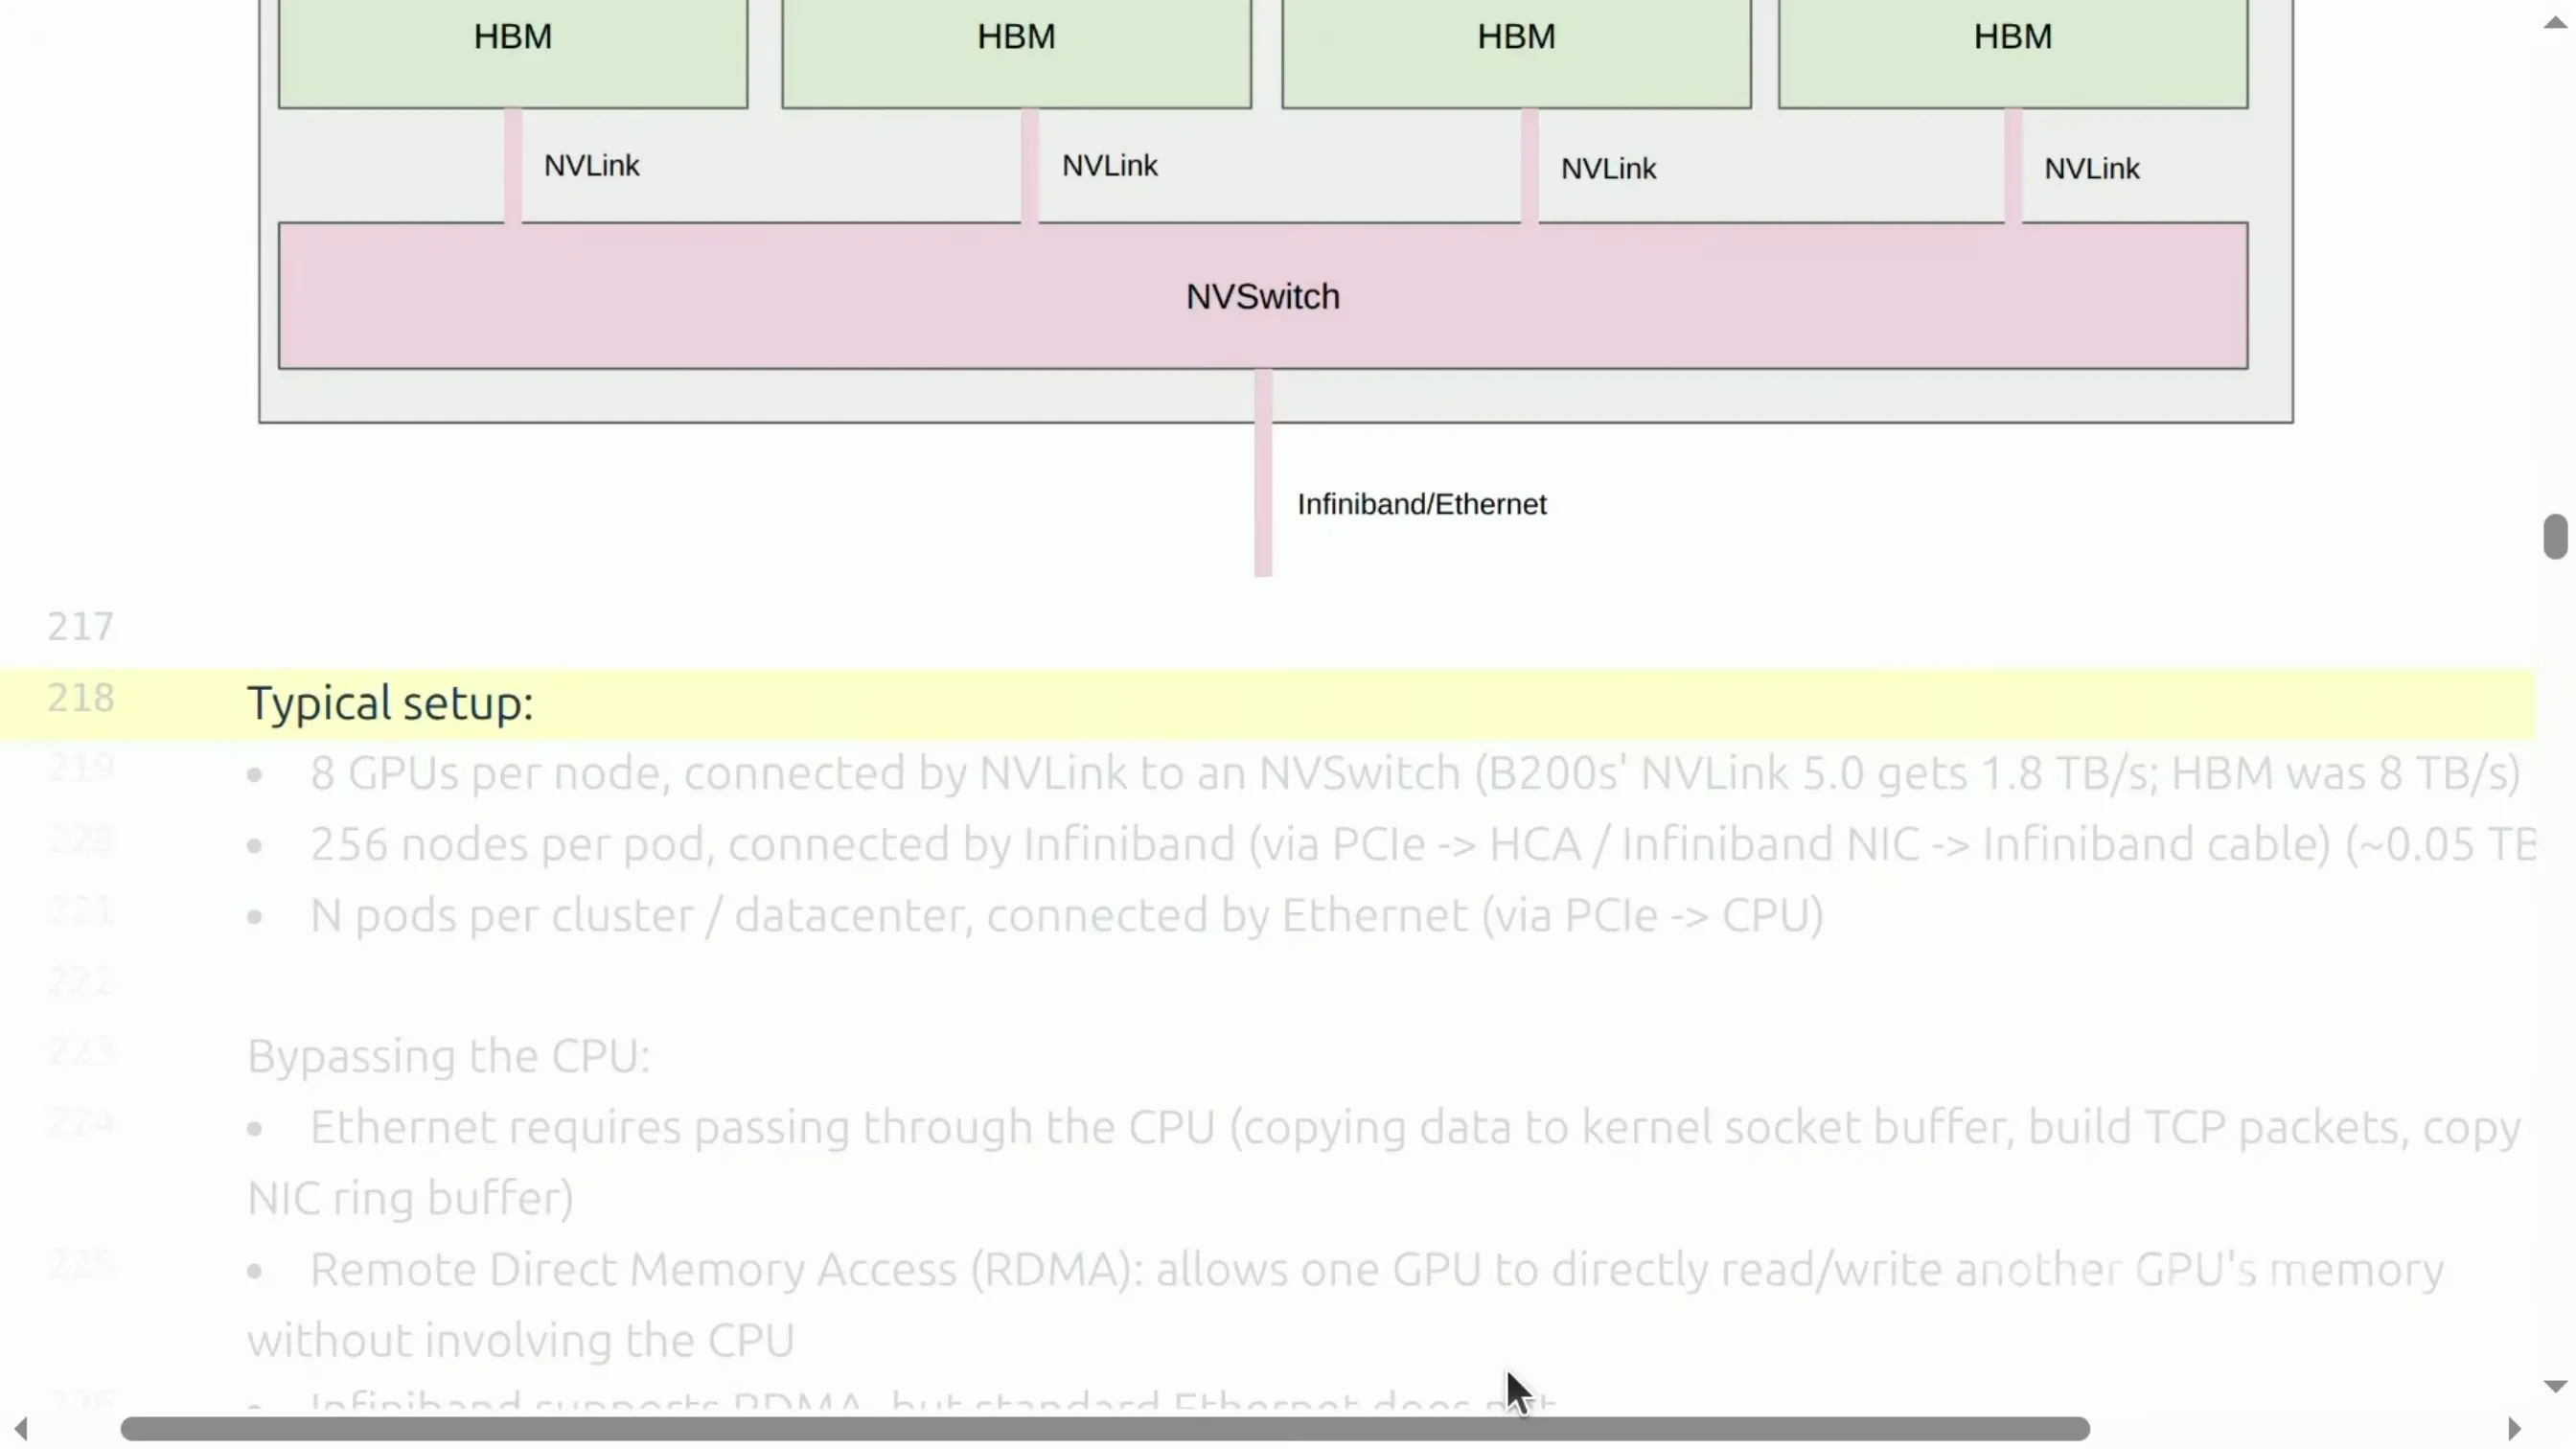
📷 数据中心 GPU 互联:NVLink / NVLink Switch / InfiniBand
回到原视频 (00:23:36)
典型配置:每节点通常 8 块 GPU("8"是典型值,图中那个"256"是随手写的示意),它们通过 NVLink 连到一个 NVLink Switch 上。
量级校准:
- 若用 NVLink 5,总带宽约 1.8 TB/s;
- 而 B200 的 HBM 带宽约 8 TB/s。
也就是说,NVLink 大致比 HBM 慢 4 倍。从"设备间"的角度看这已经很快,但显然不如 HBM;而 HBM 又远慢于共享内存 / L1。
关键结论:NVLink 连到 switch 后,从编程视角看,任意两块 GPU 之间都可以"直连通信"——你只管 GPU 到 GPU,硬件负责把它送到 switch、再由 switch 路由。
3.2 层级式拓扑:节点 → Pod → 集群
随着集群规模增长,你不可能让一个 NV switch 处理 10 万块 GPU。所以拓扑是分层的:
- 节点内:NVLink + NVSwitch。
- Pod:若干节点打包成 pod,pod 之间用 InfiniBand 连接。此时 GPU 不再直连 GPU,而要通过 PCIe + 特殊 InfiniBand 线缆,速度低得多。
- 更大规模:InfiniBand 也不够用时,pod 之间再走 Ethernet——而以太网要经过 CPU,更慢。
graph TD
    subgraph "节点 / Node"
        G1[GPU] --- S1[NVLink Switch]
        G2[GPU] --- S1
        G8[GPU] --- S1
    end
    S1 -->|InfiniBand| POD[Pod 内其他节点]
    POD -->|InfiniBand| IB[更大规模 Pod]
    IB -->|Ethernet 经 CPU| ETH[跨 Pod 集群]
这和访存层级是同构的:节点越多,越慢。你不可能用一个 NV switch 撑起 10 万块 GPU。
3.3 RDMA:绕过 CPU
(参考时间: 00:26:30)
前面提到"以太网要经过 CPU",为什么这是个问题?传统以太网的流程是:
- GPU 必须和 CPU 对话,把数据拷进 内核 socket buffer(这里的"内核"是 CPU 传统意义上的操作系统内核,不是 GPU kernel);
- CPU 组装网络包,拷到网络接口卡;
- 再发出去。
这一通操作引入大量延迟。解决办法是 RDMA(Remote Direct Memory Access,远程直接内存访问):允许一块 GPU 直接读 / 写另一块 GPU 的内存,完全不经过 CPU。
- NVLink / NVSwitch 天然支持 RDMA;
- InfiniBand 也支持 RDMA;
- 标准以太网不支持——但注意,有三个值得关注的新进展。
3.4 两个重要进展:NVL72 与 RoCE
进展一:NVL72。 NVIDIA 一直在推"更大 Pod"的极限。在 B200 / B300 上,他们把 8 卡一个 tray、9 个 tray 组合,做成 NVL72——72 块 GPU 全被 NV switch 到同一个 NVLink 域内。普通人会以为"只有 8 块 GPU 高速互连,出了这个域就很慢",但只要有钱买这套硬件,你就能得到一个高达 72 卡的高速域。
进展二:RoCE(RDMA over Converged Ethernet,融合以太网上的 RDMA)。 既然标准以太网不支持 RDMA,那就让以太网也能绕过 CPU——RoCE 是业界对 InfiniBand 的"平替"回应。原因是 InfiniBand 非常昂贵(跟许多 NVIDIA 产品一样)。Meta 曾发表论文表示在探索这条路——Llama 可能是、也可能不是通过融合以太网训练的(老师留有保留地说"可能")。
编者说明:RoCE 的意义在于成本。InfiniBand 在超大规模训练中带宽高、延迟低、支持 RDMA,但价格高昂且生态封闭;RoCE 试图用更便宜的以太网硬件达到接近的效果。这也是"训练集群选择哪种链路"这类工程决策背后的现实考量。
3.5 底层实现:NCCL
(参考时间: 00:30:03)
在最底层,有一个叫 NCCL(NVIDIA Collective Communications Library,读作 "nickel")的库,它把集合通信操作(all-reduce、reduce、broadcast……)翻译成 GPU 之间实际发送的底层数据包。
NCCL 的工作方式:
- 当你说"我要 all-reduce";
- NCCL 自己去探测硬件拓扑,找出不同 GPU 之间的路径;
- 然后启动 GPU kernel 来收发数据。
注意:归根结底,GPU 上跑的一切都是 kernel——所以也存在"通信 kernel",它们真正完成与其他 GPU 的通信。
编者说明:学生问"NCCL 是否为多节点集群做了优化?"老师说自己不清楚细节,但可以合理推断:NVIDIA 的大客户就是大模型训练/推理厂商,他们几乎肯定对整个技术栈做了优化。另有学生问"9 块 GPU 怎么分配"——老师答:取决于 9 块落在哪,如果第 9 块跨到了另一个节点又没有 NVLink,就会很惨(算力贡献小、通信还很贵)。
四、PyTorch 动手:用代码实现集合通信
(参考时间: 00:36:20)
PyTorch 提供了 torch.distributed 库,对集合通信给出了干净的接口,你不必显式地想 NCCL。这个库还支持不同后端:
- GPU 上用 NCCL 后端;
- CPU 上有 Gloo 后端(并行编程早于 GPU 很久,CPU 上也能做集合通信)。
- 它还支持更上层的模型与算法(如 FSDP),但本课程不用,因为我们要从零构建。
编者说明(重要):老师提醒,本讲代码默认使用
multiprocessing,但他在逐步讲解时会切到一种"单进程模式"方便展示 stdout。如果你自己按默认多进程方式跑,能看到正常的输出;跟随本讲的逐步走查时,并没有真正做多进程。
4.1 进程模型与 barrier
(参考时间: 00:37:14)
核心 API 是 spawn:它接收一个函数,并把它复制运行 world_size 次。
- world size 是进程数;
- rank 是
0, 1, 2, …, world_size − 1; - 这些函数在各自进程上同时运行。
初始化时要配置 master address 和 port——但注意:这不是 GPU 真正通信用的通道,只是元数据和协调用的。真正的数据走 NCCL,否则会非常慢。若 CUDA 可用就用 NCCL 后端;若在笔记本上跑,就用 Gloo。
关键概念:barrier(屏障)。它是一个同步点——当代码执行到这里,会等待所有进程都到达这个点。因为各进程是异步运行的,你无法保证某个进程不会完全先于其他进程跑完。若你希望"某些代码先于其他代码执行",就插入 barrier。
代价:插入越多 barrier,就越可能不必要地等待。
4.2 All-Reduce 代码示例
(参考时间: 00:40:01)
# 每个 rank 的初始张量不同
tensor = torch.tensor([rank, rank+1, rank+2, rank+3])

# 打印 all-reduce 前的状态(顺序随机,因为进程异步)
print(f"rank {rank} before all reduce: {tensor}")

# all-reduce:原地写回,sum 归约
dist.all_reduce(tensor, op=dist.ReduceOp.SUM, async_op=False)
运行结果(rank 0 打印 [0 1 2 3]、rank 1 打印 [1 2 3 4]……):注意打印顺序是硬件随机决定的,因为进程异步运行,但数据都在。all-reduce 后再打印,各 rank 得到的是逐分量求和并复制到所有 rank的结果。
编者说明:
async_op=False表示不做异步。如果设成async_op=True,代码会立刻返回,你可以去做别的事,之后再调用wait或 barrier 确保完成——这正是计算与通信重叠 (overlap) 的基础。本课程不细讲这个,但它在实践中非常重要。
4.3 Reduce-Scatter 与 All-Gather 代码示例
reduce-scatter (参考时间: 00:42:22):
# 输入:每个 rank 从 0 到 world_size 的向量
# 输出:预先分配
dist.reduce_scatter_tensor(output, input, op=dist.ReduceOp.SUM)
注意和 all-reduce 的差异:这里不是原地写回,而是有独立的 input 和 output。操作后,input 不变,output 得到逐分量归约后分发到各 rank的结果。
all-gather (参考时间: 00:45:03):
# 输入是 reduce-scatter 的输出;输出是预分配的张量
dist.all_gather_into_tensor(output, input)
到此为止,你就用代码事实证明了「all-reduce = reduce-scatter + all-gather」。最后记得清理(destroy process group),这是好习惯。
编者说明:学生问"如果 barrier 放在 CUDA synchronize 之前会怎样?"老师解释:如果先 barrier 再 synchronize,那么 CUDA 操作可能还没跑完就到 barrier,而 barrier 只保证进程到达同一点,各进程仍各自在同步自己的 CUDA kernel——结果并没有真正同步。所以先 synchronize CUDA,再 barrier 才安全。
五、通信基准测试与有效带宽
(参考时间: 00:46:31)
5.1 如何测量通信速度
进行 all-reduce 基准测试的流程:
- 创建含 1 亿个元素的张量;
- 先热身(warm up)——和之前做 benchmark 时一样;
- 调用 CUDA synchronize 与 barrier,确保两重异步(CUDA kernel 与不同进程)都已结束;
- 计时,执行 all-reduce;
- 再次同步,停止计时。
注意:每个 rank 都会报告一个时间,它们可能不同(毕竟是不同进程)。若要一个数,取平均即可。
5.2 有效带宽 (Effective Bandwidth)
(参考时间: 00:48:30)
光看"花了 1.6 毫秒"看不出好坏,所以要计算有效带宽。思路是:算出这次计算应该发送了多少字节,再除以总时长。
以 all-reduce 为例:
- 载荷大小:
size = 每元素字节数 × 元素个数。 - 应发送字节数:从 rank 0 + rank 1 + … 需要 world_size − 1 步加法,乘以 2(既要发送、又要归约),再乘以载荷:
$$ \text{sent\_bytes} = 2 \times \text{size} \times (\text{world\_size} - 1) $$
- 有效带宽:
$$ \text{effective\_bw} = \frac{2 \times \text{size} \times (\text{world\_size} - 1)}{\text{world\_size} \times \text{duration}} $$
当 world size 增大时,$\frac{\text{world\_size}-1}{\text{world\_size}} \to 1$,于是:
$$ \text{effective\_bw} \approx \frac{2 \times \text{size}}{\text{duration}} $$
这个结果有两个漂亮的特性:与 world size 无关(增加 GPU 不会改变带宽),且与拓扑无关(NCCL 是否走 ring 还是 tree 都由它自行决定)。在这个例子里,实测约为 400 GB/s 量级。
编者说明:这里的核心直觉是——讲者在用一个归一化指标衡量通信效率,就像性能优化里用 MFU 衡量"算力用了多少"。有效带宽用"应有字节数 / 实际耗时"来回答"这次通信划不划算"。学生对 $\frac{\text{world\_size}-1}{\text{world\_size}}$ 收敛到 1 的那步可能存疑,但结论很简单:world size 越大,每块 GPU 承担的"分摊"越少,带宽趋近常数。
5.3 Reduce-Scatter 基准与对比
(参考时间: 00:51:44)
reduce-scatter 的测试同理:创建输入输出、热身、执行、计时。有效带宽的公式里没有那个 2 倍因子,但结果仍然相近(400s GB/s 量级),只是会有一些随机波动。
为什么两种操作带宽差不多? 因为 all-reduce 是 reduce-scatter + all-gather,它天然搬运了两倍的数据(reduce-scatter 有成本,all-gather 也有成本);但 all-reduce 也花了两倍的时间。两两相消,带宽相同。
graph LR
    RS["Reduce-Scatter<br/>搬运 1× 数据"] --> TOTAL
    AG["All-Gather<br/>搬运 1× 数据"] --> TOTAL
    TOTAL["All-Reduce<br/>搬运 2× 数据,耗时 2×"] --> BW["带宽 = 搬运量 / 耗时<br/>≈ 不变"]
六、数据并行 (DDP)
(参考时间: 00:55:11)
现在进入本讲第二部分:真正开始训练模型。老师用一个极简的 MLP(多层感知机)实现来演示——之所以用 MLP,是因为MLP 是 Transformer 里真正的计算瓶颈,所以用 MLP 代表性是足够的。
先记住三种并行的切分示意图:
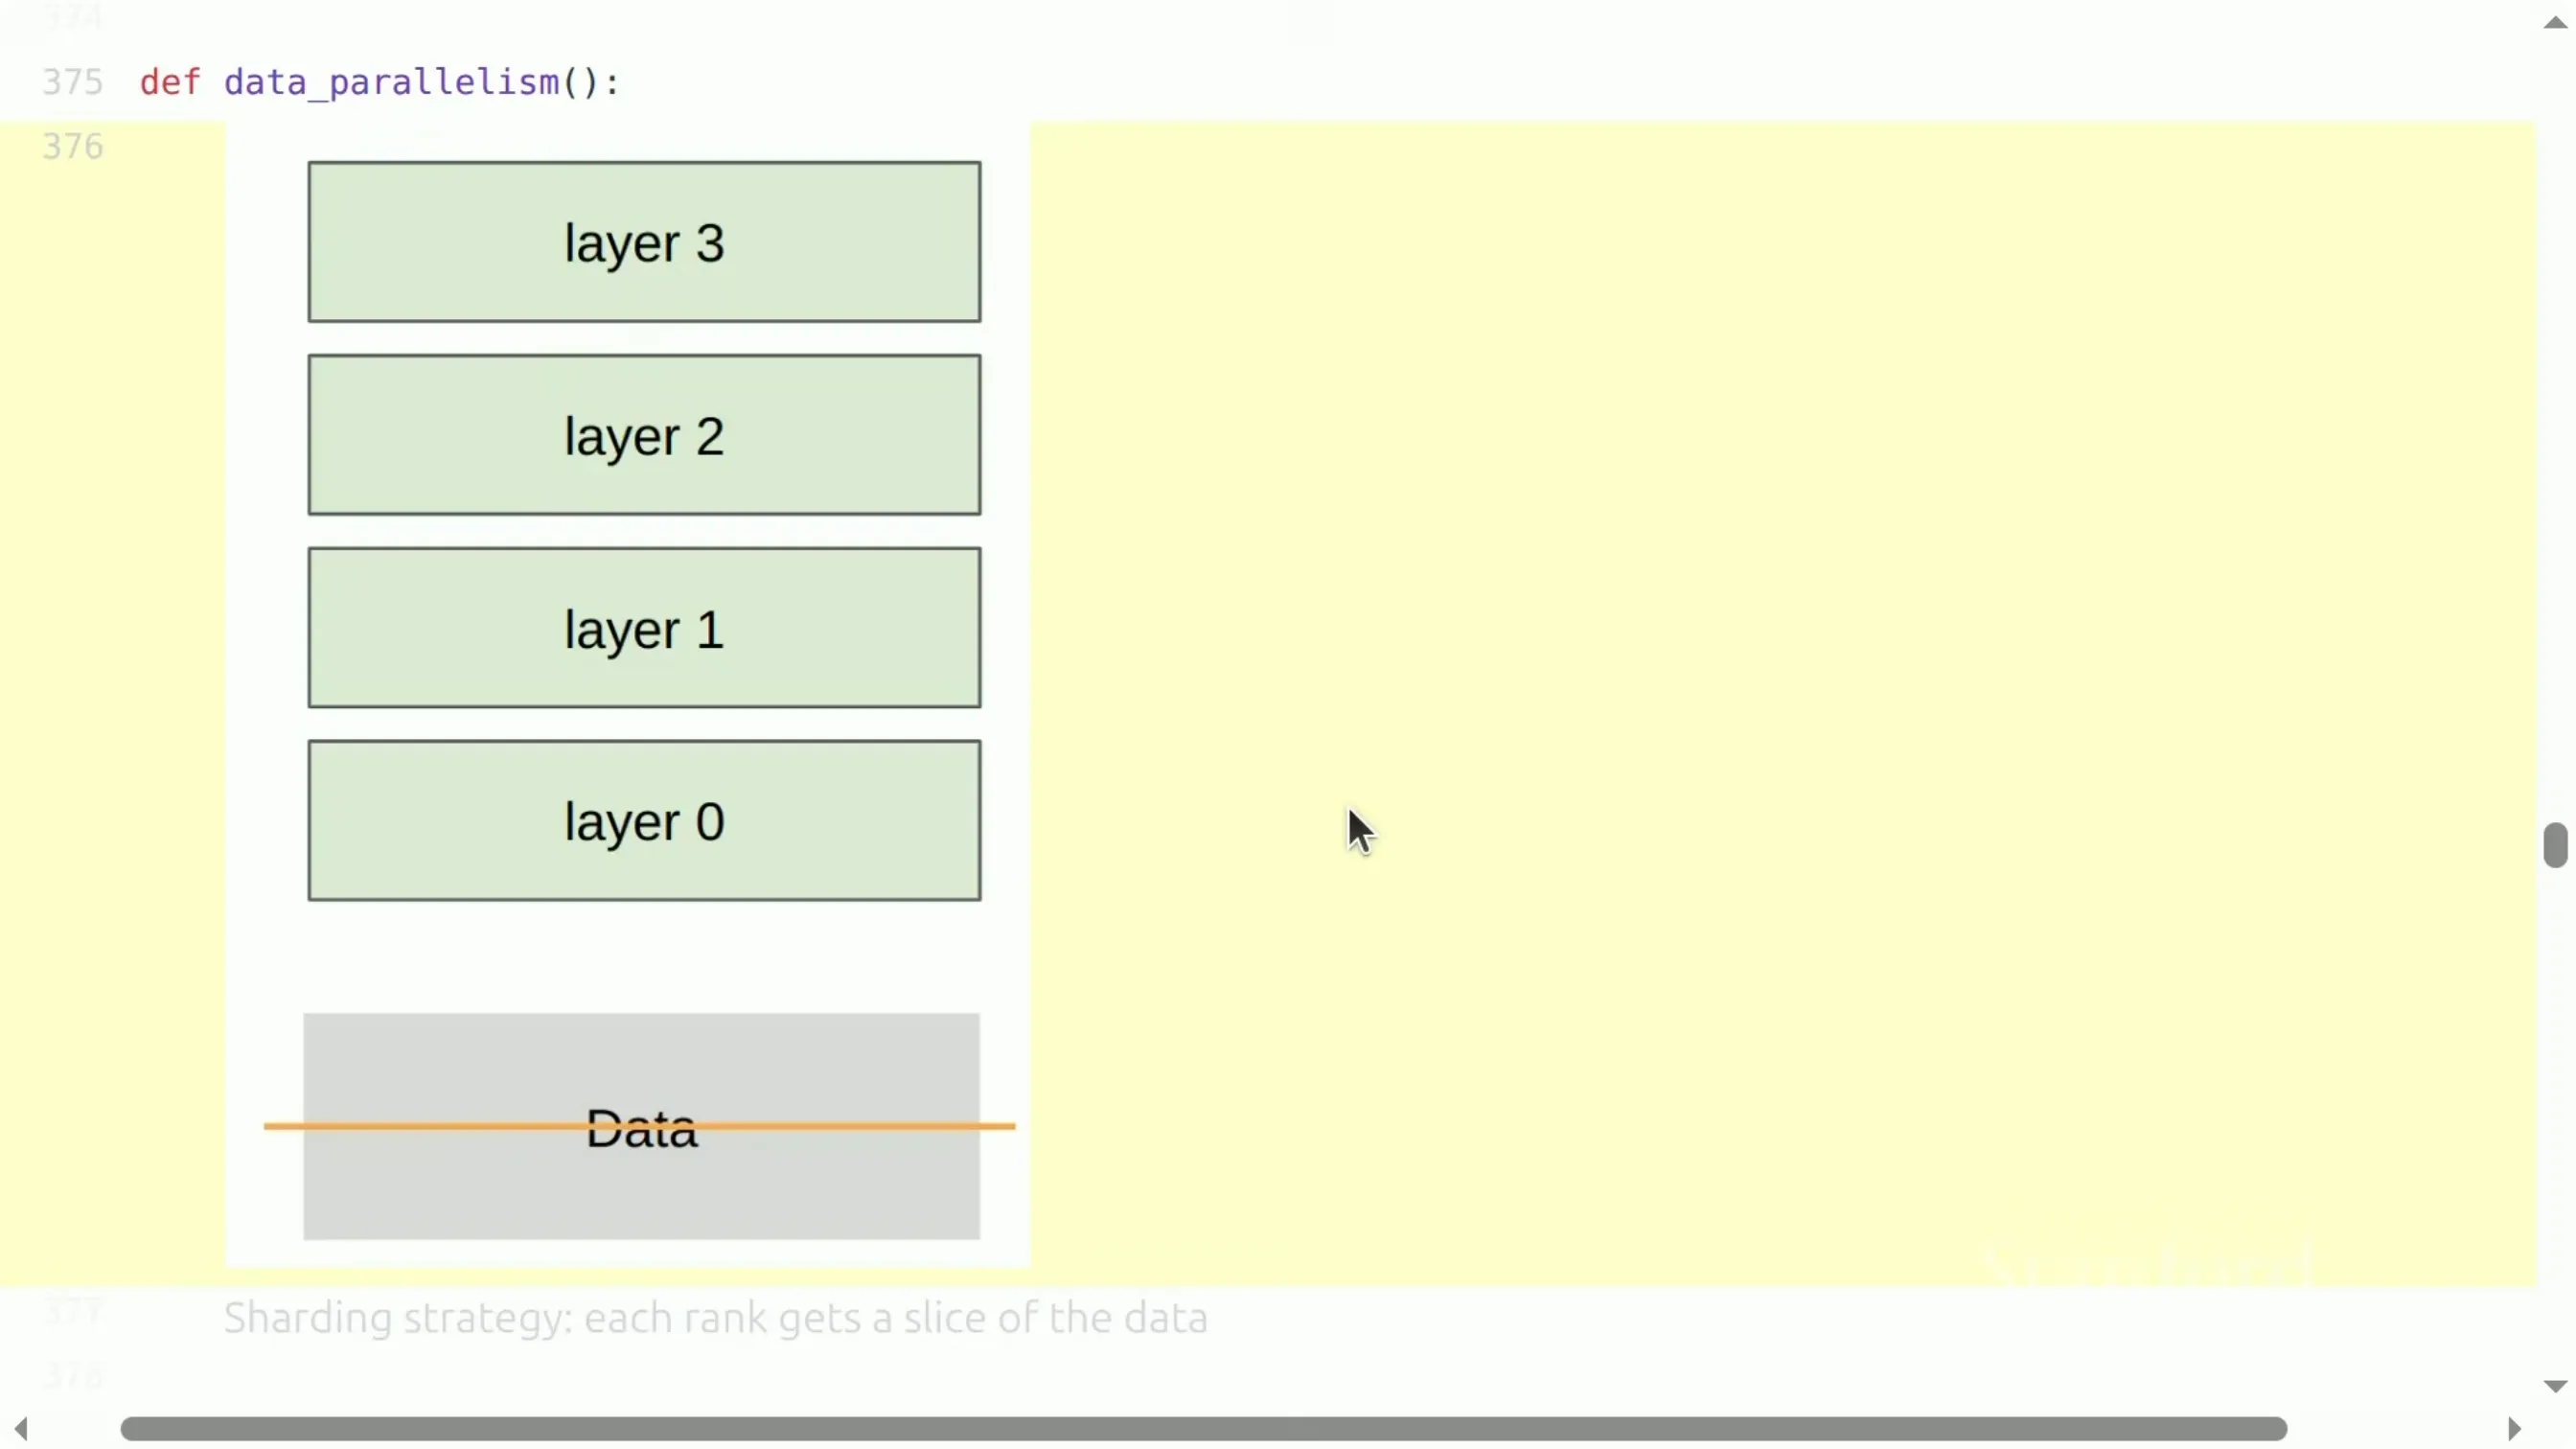
📷 数据并行 / 张量并行 / 流水线并行的切分方式
回到原视频 (00:55:42)
- 数据并行:按数据切,切"列"方向;
- 张量并行:按张量切,切"行"方向;
- 流水线并行:按层切,切"深度"。
6.1 数据并行的原理
(参考时间: 00:55:58)
数据并行的核心思想是:把数据切分,每块 GPU 负责一部分数据,各自保留全量参数、做正常的模型训练,然后同步。
示例设置:
- batch size = 128,num_dim = 1024 → 数据矩阵是
128 × 1024; - 把行(样本维)切成 world_size 份(本例是 4);
- 每个 rank 拿到一部分,local batch size = batch_size / world_size = 32。
graph TD
    DATA["完整数据<br/>128 × 1024"] --> S0["rank0: 32 × 1024"]
    DATA --> S1["rank1: 32 × 1024"]
    DATA --> S2["rank2: 32 × 1024"]
    DATA --> S3["rank3: 32 × 1024"]
编者说明:老师提醒——实际中每个 rank 应该各自加载自己的那份数据,而不是让 rank 0 加载完再分发(那会形成瓶颈)。上面的切分只是为讲解清晰。
6.2 DDP 训练循环
(参考时间: 00:58:37)
# 每个 rank 持有全量模型参数(num_dim × num_dim 的矩阵)
params = [torch.randn(num_dim, num_dim) for _ in range(num_layers)]
optimizer = torch.optim.SGD(params, lr=...)

for step in range(num_steps):
    # 1. 前向:用本 rank 那部分数据
    x = data                      # 只含本 rank 的 batch 切片
    for layer in range(num_layers):
        x = x @ params[layer]
        x = relu(x)

    # 2. 反向
    loss = ...
    loss.backward()

    # 3. 关键一步:对所有参数的梯度做 all-reduce 求平均
    for p in params:
        dist.all_reduce(p.grad)
        p.grad /= world_size      # 取平均

    # 4. 更新参数
    optimizer.step()
DDP 的关键在于第 3 步:因为每个 rank 数据不同,梯度也不同,所以要把所有 worker 的梯度同步。这是 DDP 与标准训练唯一的区别——就是在反向传播之后插一句 all-reduce 求平均,一行代码级别的改动。
同步完成后,每个 rank 拥有完全相同的梯度,于是参数更新后仍然保持一致。于是:每个 rank 仿佛是在全量数据上做参数更新,实际上只处理了部分数据。
老师反复赞叹:"我觉得它其实很优雅(elegant)"
graph TD
    F["各 rank 前向<br/>(各自的数据切片)"] --> B["各 rank 反向<br/>(梯度不同)"]
    B --> AR["All-Reduce 梯度并求平均<br/>(梯度变为相同)"]
    AR --> U["各 rank 更新参数<br/>(参数保持一致)"]
    U --> F
6.3 小结与问答
(参考时间: 01:02:12)
总结:各 rank 的 loss 不同、初始梯度也不同,但经过 all-reduce 后梯度相同,因此参数始终保持相同。
Q&A 要点:
- batch size 必须 > 1 吗? 是的,至少要为 world size 才能成立,且最好大得多。
- batch size 是否要是 world size 的倍数? 最好如此,否则可以补零,但大家都省事一点比较好。
- Transformer 上长什么样? 基本一样。DDP 很模块化——它在反向之后只负责平均梯度,根本不关心你的前向长什么样。
- 为什么用 all-reduce 而不是 reduce-scatter? 因为这里的 all-reduce 是"简单单块"操作,代价是必须把所有模型参数都留在显存里。如果参数装不下,就要更聪明——这正是下一讲 FSDP 与 ZeRO 的主题。
七、张量并行 (Tensor Parallelism)
(参考时间: 01:03:20)
7.1 张量并行的原理
这次不切数据,而是切每一个层。每个 rank 拿到每层的一部分。
代价:需要搬运的数据量大得多。
设置:假设数据完整(每个 rank 都有全量数据,为简化起见);数据形状 batch_size × num_dim。引入 local num_dim——本 rank 只负责一部分维度。
关键图景:
- 每个模型仍然有所有层;
- 但参数现在是
num_dim × local_num_dim(也就是按列切开,称为列并行 tensor parallel,也可以按行切,本讲不讲)。
也就是说,如果原来某一层的参数矩阵是 num_dim × num_dim,现在就沿列切成 num_dim × local_num_dim,每个 rank 拿一列块。
7.2 张量并行的前向
(参考时间: 01:04:34)
# 每个 rank 只持有参数矩阵的一部分列
params = [torch.randn(num_dim, local_num_dim) for _ in range(num_layers)]

for layer in range(num_layers):
    # 1. 用本 rank 的参数切片做矩阵乘
    x = data @ params[layer]

    # 2. 非线性激活(逐元素,可直接在切片上做)
    x = relu(x)

    # 3. 关键一步:all-gather 激活,把完整激活拼回来
    gathered = [torch.empty_like(x) for _ in range(world_size)]
    dist.all_gather(gathered, x)
    x = torch.cat(gathered, dim=-1)   # batch_size × num_dim
逐层循环:
- 用参数切片做矩阵乘(我只负责一部分列);
- 应用逐元素的非线性激活——可以直接在本 rank 的切片上做;
- 通信激活:各 rank 的激活是分散的,需要 all-gather 把完整激活拼回来(
batch_size × num_dim)。
验证:拼接后的形状是 batch_size × local_num_dim 的片段组合成 batch_size × num_dim——正确。
7.3 与数据并行的对比
| 维度 | 数据并行 (DDP) | 张量并行 (TP) |
|---|---|---|
| 切什么 | 数据(样本维) | 模型(特征维) |
| 模型处理 | 当成一个模块 | 要"折腾"模型内部 |
| 通信 | 只在反向之后 | 每层前向/反向都要 |
| 通信量 | 较小 | 很大(激活每次都要搬) |
| 嵌入方式 | 极优雅,一行改动 | 需显式改写模型 |
编者说明:老师强调了 DDP 的"优雅"——它根本不需要碰模型内部,把模型当黑箱,只在反向之后平均梯度。而张量并行必须改写模型每一层的前向,强依赖"矩阵乘可以切分成小块矩阵乘、在不同 rank 上分别做、再拼起来"这一事实。
7.4 前向 × 反向的对偶性
(参考时间: 01:08:08)
老师点出一个精彩的对偶关系:
前向 all-gather,反向就 reduce-scatter。
- 前向:all-gather 把分散的激活拼成完整的,供下一层使用;
- 反向:激活的梯度需要按原来的切分方式分回到各 rank(reduce-scatter)。
这条对偶性在其他并行方式里也会反复出现。
编者说明:学生问"这是 autograd 自动做的吗?"老师答:如果只调
.backward(),PyTorch 不会自动做,因为它不知道你并行切分了。PyTorch 确实有一些自动化工具,但本课为了让核心机制可见,是显式管理的——inverse 的 reduce-scatter 要你自己调。这与本课"从零构建"的精神一致(336 = 从零构建语言模型)。真实生产中你大概不必手写这些。
八、流水线并行 (Pipeline Parallelism)
(参考时间: 01:09:38)
8.1 流水线并行的原理
切法:按层切。每个 rank 拿到一部分层,但每层内拿到全部维度。
- 每个 rank 拥有
local_num_layers个num_dim × num_dim的矩阵; - 数据方面:每个 rank 最终都会见到全部数据(以某种形式)。
相对于数据并行按数据切、张量并行按维度切,流水线是按深度切。
graph LR
    D["输入数据"] --> R0["rank0<br/>层 0~k"]
    R0 -->|send| R1["rank1<br/>层 k+1~2k"]
    R1 -->|send| R2["rank2<br/>层 2k+1~3k"]
    R2 -->|send| R3["rank3<br/>层 3k+1~end"]
8.2 微批 (Micro-batch) 与流水线气泡
(参考时间: 01:10:52)
为什么需要微批? 先看朴素的流水线:一个 rank 拿到数据,处理若干层,发给下一个 GPU;下一个处理若干层,再发给下一个……这是分割深网的很自然方式。
问题:会产生 pipeline bubble(流水线气泡)——某些时刻,某个 rank 在干等其他张量,效率很低。
解法:把 batch 切成很多微批 (micro-batch),让它们快速流过流水线、一个接一个进入下一段,从而减少气泡数量。这正是老师把 batch 分块的原因。
微批版的前向:
# 只有 rank 0 有数据;把它切成 num_micro 份
micro_batches = data.chunk(num_micro_batches)

for mb in micro_batches:
    if rank > 0:
        dist.recv(x, src=rank - 1)         # 从上一个 rank 接收

    for layer in local_layers:
        x = x @ params[layer]
        x = relu(x)

    if rank < world_size - 1:
        dist.send(x, dst=rank + 1)         # 发给下一个 rank
这里用到了点对点 (point-to-point) 的 recv 与 send:
recv(x, src=rank-1):从 rank − 1 接收张量到x;send(x, dst=rank+1):把x发给 rank + 1。
顺便一提,正规流水线并行会用到 P2P 而不是集合通信——这也是它区别于前两种并行的特征。
8.3 通信与计算重叠
(参考时间: 01:13:32)
朴素版还没处理的一个关键点是通信与计算重叠 (overlap)——这在流水线并行里尤其重要。
思路:用异步的 isend / irecv,让"正在计算"与"正在收发数据"并行发生;等需要结果时再 wait。
老师指出:其实数据并行也能做这种重叠——不必等到整个反向跑完才开始 all-reduce;可以一旦某个梯度算完,立刻开始发送它。这正是 assignment 2 要探索的。这能进一步提高重叠程度。
九、总结与并行策略的选择
(参考时间: 01:15:11)
9.1 还有哪些并行方式
本讲没覆盖的:
- 序列并行 (sequence parallelism):把序列切成段,并行化 attention 计算。
- 专家并行 (expert parallelism):并行化 MOE 里的专家——这就是前面提到的 all-to-all 出场的地方。
- 各种并行方式的组合 (combinations):也会出现在作业里。
9.2 选哪种并行?取决于硬件
(参考时间: 01:16:08)
这是本讲非常重要的一个工程判断:
- 张量并行:通信量非常大(每一层都要发送激活,而且激活相当大),所以通常只在节点内做——即 NVLink / NVSwitch 域内的高带宽场景。你不会把张量并行放到 NVLink 域之外。
- 流水线并行:能容忍慢得多的互联。因此在一些去中心化训练工作里,节点物理上横跨半个地球时,用的是流水线并行——而绝不会用张量并行。
组合的常见形态:节点内做 tensor parallel,节点间做 data parallel / FSDP,需要时再叠加 pipeline parallelism。
还有一类效应:数据并行可以做得很开,但会撞上 critical batch size(临界批大小)——批大小增到一定程度后再增就没有收益了,此时纯属浪费算力,还不如改用张量并行。这些考量会在后续课程展开。
9.3 PyTorch vs JAX / TPU
(参考时间: 01:18:02)
课程刻意选择 PyTorch,并且是非常原始地使用集合通信操作——目的是让你能机械地看清发生了什么。
另一种路线(尤其是 JAX + TPU 世界):你只需定义模型和分片策略 (sharding strategy),编译器自动决定需要哪些通信操作。你只要声明"这块数据需要同时存在于这里、那里",编译器就"施展魔法"算出来。
这很诱人,但老师打了个趣:那样就把"从零构建"的乐趣拿掉了。
9.4 全课收束:分片、复制与"存储 vs 计算"的权衡
(参考时间: 01:19:08)
最终总结:并行方式有很多种——你可以按数据切、按张量切、按专家切、按流水线切、按序列切。
- 数据并行:本讲只讲了 DDP,下次讲 FSDP 与 ZeRO;
- 张量并行:要求极快的互连;
- 流水线并行:对互连要求低,但必须努力减少流水线气泡。
而贯穿始终的一大主题是"重算还是存储,或是存到别的地方":
- 之前讲 activation checkpointing 时,是"重算 vs 存在本地显存";
- 这里可以推广为:把东西存到另一块 GPU 上。
从这个角度看数据并行:它其实在做冗余工作——每个 rank 都在更新参数、都在保留全部参数。但之所以这么做,是为了免去搬运优化器状态的开销。
graph TD
    Q{"并行策略怎么选?"} -->|数据能切、模型能装下| DP["数据并行 (DDP)"]
    Q -->|模型装不下| FSDP["FSDP / ZeRO (下一讲)"]
    Q -->|高带宽域内、想加速单层| TP["张量并行<br/>仅限 NVLink 域内"]
    Q -->|跨节点 / 跨地域、容忍慢链路| PP["流水线并行<br/>需处理气泡 + 重叠"]
    DP --> COMBO["组合: TP(节点内) + DP/FSDP + PP"]
    TP --> COMBO
    PP --> COMBO
老师的收尾判断:硬件在变快,但我们永远想要更大的模型。所以这种层级式结构(hierarchical structure)将长期存在。
附:参考与延伸阅读
编者补充
已知疑点
(1) 专有名词 / 听写不确定性
NCCL:字幕中拼写多次出现为 "nickel",这是发音的写法,实际库名是 NCCL(NVIDIA Collective Communications Library)。本书统一写作 NCCL。Gloo:字幕写作 "glue",实际是 CPU 端的集合通信后端 Gloo(Facebook 开源)。已按实际名称订正。RoCE:字幕写作 "RDMA over a converged Ethernet",正式名称为 RDMA over Converged Ethernet,本书按正式名称处理。FSDP / SFDP:字幕中同时出现 "SFTP"、"SFDP"、"FSDP" 等写法。实际指的是 PyTorch 的 Fully Sharded Data Parallel (FSDP),本书统一订正为 FSDP。Tatsu / Toshi / Tatsuzou / Tatsu:讲师在提到"下周讲更深入的并行技术"的同事时,名字被字幕听写成了多个不同形式。本书统一处理为 Tatsu,可能与讲师真实姓名有出入。- "B300":讲座中提到 NVL72 时提到 "B200s and the B300s",B300 是否已有此代产品、名称是否准确,无法当场核实,请读者以 NVIDIA 官方资料为准。
(2) 数据与量级
- NVLink 5 的 1.8 " terabits / terabytes per second":讲师此处口中出现 "terabits" 与 "terabytes" 的口误并自我纠正,本书按语境采用 TB/s(每秒太字节)的量级解释;与 HBM 带宽(B200 约 8 TB/s)比较约慢 4 倍。请以官方规格核对精确数值。
- 有效带宽公式:讲师口述为 "size × 2 × world size − 1 / world size × duration",字面存在歧义(可能被理解为线性表达式)。本书按"应发送字节数 = 2 × size × (world_size − 1),再除以 world_size × duration"来还原,保证其"world size 增大时收敛到 2 × size / duration"的结论成立。若与讲义源码不符,请以讲义为准。
- 实测 400 GB/s 量级:这是在讲师笔记本(Gloo 后端 / 演示环境)上测得的数,仅作数量级参考,不代表真实 GPU 集群的性能。
(3) 表述含糊 / 与常识可能冲突,且当场无法判定
- NCCL 是否为多节点集群优化:学生直接问,讲师表示自己"不清楚细节",只能合理推断 NVIDIA 大概率做了整套栈级优化。这是一处讲师明确表示不确定的地方,本书保留其不确定态度,未作断言。
- "Llama 可能是、也可能不是通过融合以太网训练的":讲师原话用 "may or may not have been",属于不经意的表述。本书原样保留,读者不应据此认定 Meta 用了 RoCE。
- "Meta 的论文":讲师提到 Meta 有论文探索 RoCE,但未给出具体标题或时间点,无法在本讲范围内定位出处,故本书未添加链接。
- TPU 与 JAX 的部分:讲师对 TPU 各组件对应的命名明确表示"不太熟,可以课后聊"。本书未对 TPU 内部结构作展开,以免越界。
(4) 编者判断,可能有偏差
- 讲师举例时提到的"4 块 GPU"以及演示用的
num_dim = 1024、batch size = 128等,是为讲解清晰而构造的教学示例,并非某种硬性推荐配置。读者不应把它们当成"标准超参"。 - 关于代码示例,本书在保留讲师所述逻辑的前提下,为了可读性使用了
torch.optim.SGD、relu等统一写法;讲师原演示中可能使用了具体不同的 API 名称。核心机制(all-reduce 求平均梯度、all-gather 聚合激活、micro-batch + P2P)与原意一致。 - 讲师提到"
torch.distributed支持 FSDP 等高层算法,但本课不用"——本书保留了这一说明,但未展开 FSDP 细节,留待下一讲。