第9讲 · Stanford CS336:从零开始的语言建模
对应讲次:第9讲(Stanford CS336 语言建模)
制作模型:deepseek-flash(vb compose,据 run.log)
Scaling Laws(基础篇)
课程:Stanford CS336 — Language Modeling from Scratch(Spring 2026)
本讲:Lecture 9 — Scaling Laws: Basics
视频地址:https://www.youtube.com/watch?v=Q15rhEWZPQ4
课程主页:https://stanford-cs336.github.io/
官方讲义与幻灯片:
course/lecture.pdf(课程站点)版权说明:本讲义与幻灯片版权归 Stanford CS336 课程组所有;本书是课堂口语记录的中文重构,用于学习交流。术语、章节与事实以官方讲义为准。
导览
这是一张问题地图,供你在 3–5 分钟内把握整讲走向。若你时间有限,读这一节就够;若想深究,请沿正文顺序读下去。
1. 本讲老师真正提出的问题
老师用一个具体场景开场,整讲都在回答它:
你有一位很富有的朋友,给了你 10 000 张 B200、用一个月,让你训一个「很好的开源语言模型」。你该怎么做?
这个场景把问题拆成三个层次(也正是课程已经/即将讲的模块):
- 先搭好基础设施团队与分布式训练框架(A2);
- 再准备一份优秀的预训练数据集(A4);
- 然后去训一个大模型——可是,究竟该训哪一个?(就是本讲要回答的)。
于是本讲的核心问题不是「scaling law 是什么」,而是:在花掉几百万美元之前,我怎样用便宜的小实验,把大模型的架构、优化器、宽度深度、批大小、学习率、数据/参数配比都提前定下来?
2. 难点在哪
最容易卡住的,不是记住「误差是幂律」这个结论,而是三件事:
- 为什么偏偏是幂律? 老师花了两三个统计例子(均值估计、非参数回归)来演示「多项式收敛率」是幂律的来源,而不是机械地拟合曲线。
- Scaling law 是「工程化」出来的,不是自然现象。同一批数据、换一种参数计数方式、换一个 warm-up 策略,指数就能从 0.73 变成 0.5。细节极其敏感,一次实验设计的疏忽就能得出看似合理却错误的结论。
- 上游(困惑度)与下游(任务表现)会脱钩。Scaling law 在困惑度上极其干净,但到下游戏任务就未必——这是最容易被误用的地方。
3. 你可能带着什么疑问进来
① 老师明确提出的问题(按他讲述的顺序):
- 数据的多少,会怎样影响性能?有没有简单规律?
- 这些规律是怎么来的(理论根源)?
- 既然数据越多越好,那该多喂数据,还是该把模型做大?
- 大模型的超参数,在小模型上定好就能直接搬上去吗?
② 编者预判你(初学者)可能的疑问(编者预判,非老师原话):
- 幂律的「指数」到底是什么?它和维数、和「模型学会了什么」有关系吗?
- 为什么 Kaplan 和 Chinchilla 两篇论文都「认真做了」,结论却差这么多?
- 「20 tokens/参数」这条经验法则,今天还成立吗?
- 我该不该相信 scaling law?它什么时候会「失效」?
4. 本讲路线
老师先讲历史(这部分老到可以追到 1990 年代),建立「scaling law 不是深度学习的发明」这个认知;接着用统计例子解释幂律为何自然出现;然后用大量的实验图展示 scaling law 可以用于工程决策(选架构、选优化器、定批次、定学习率);最后进入联合 scaling law(数据 × 模型)与著名的 Chinchilla vs Kaplan 之争。全程他反复强调一句话:scaling law 是「工程化」出来的,细节决定成败。
一、为什么需要 scaling law:一个思想实验
(参考时间: 00:00:05)
本讲暂时离开「系统」的话题,回到更偏深度学习的内容。围绕 scaling law 及邻近现象共有两讲:今天讲最基础的,把经典工作讲清楚,并把它与机器学习入门课里的概念连起来;下一次会讲更进阶的版本——深入现代开源模型的技术报告、μP 等参数初始化方法,今年还会额外加入优化器的内容。由于排课原因,中间会插入一讲 inference(推理),所以节奏是:scaling law → inference → scaling law。
📷 Lecture 9 封面:Scaling Laws - Basics
回到原视频 (00:00:05)
1.1 一个让人焦虑的场景
(参考时间: 00:01:10)
想象这样一个情形:
你有一位非常富有的朋友,给了你 10 000 张 B200,用一个月,并请你训练一个很棒的开源语言模型。他希望这些 B200 物有所值。
你已经(或将要)完成前两步:
- 组建好基础设施团队、搭好分布式训练框架(对应 A2);
- 准备好一份优秀的预训练数据集(对应 A4)。
📷 把 scaling 当回事:三步走,最后一步是「训哪个模型」
回到原视频 (00:01:10)
现在你要去训一个大模型了。但「训一个大模型」背后有无数选择:用什么架构?超参数怎么设?而这些问题一旦押错,代价可能是数百万美元的一次训练。怎样才算「严肃地把 scaling 当回事」?怎样保证这次大训练一定成功?
1.2 为什么要自己优化超参数
(参考时间: 00:02:07)
其中一部分选择你可以直接抄文献——比如架构讲座里讲的「已采用的最佳实践」,你大致凭经验挑一挑就能用。但如果你身处前沿,想做出比当今最好模型还要好的东西,你就必须真正去优化这些选择,而不是照抄别人的配置。照抄只能做到「不差」,做不到「领先」。
这就迫使我们直面 scaling law 这件事。
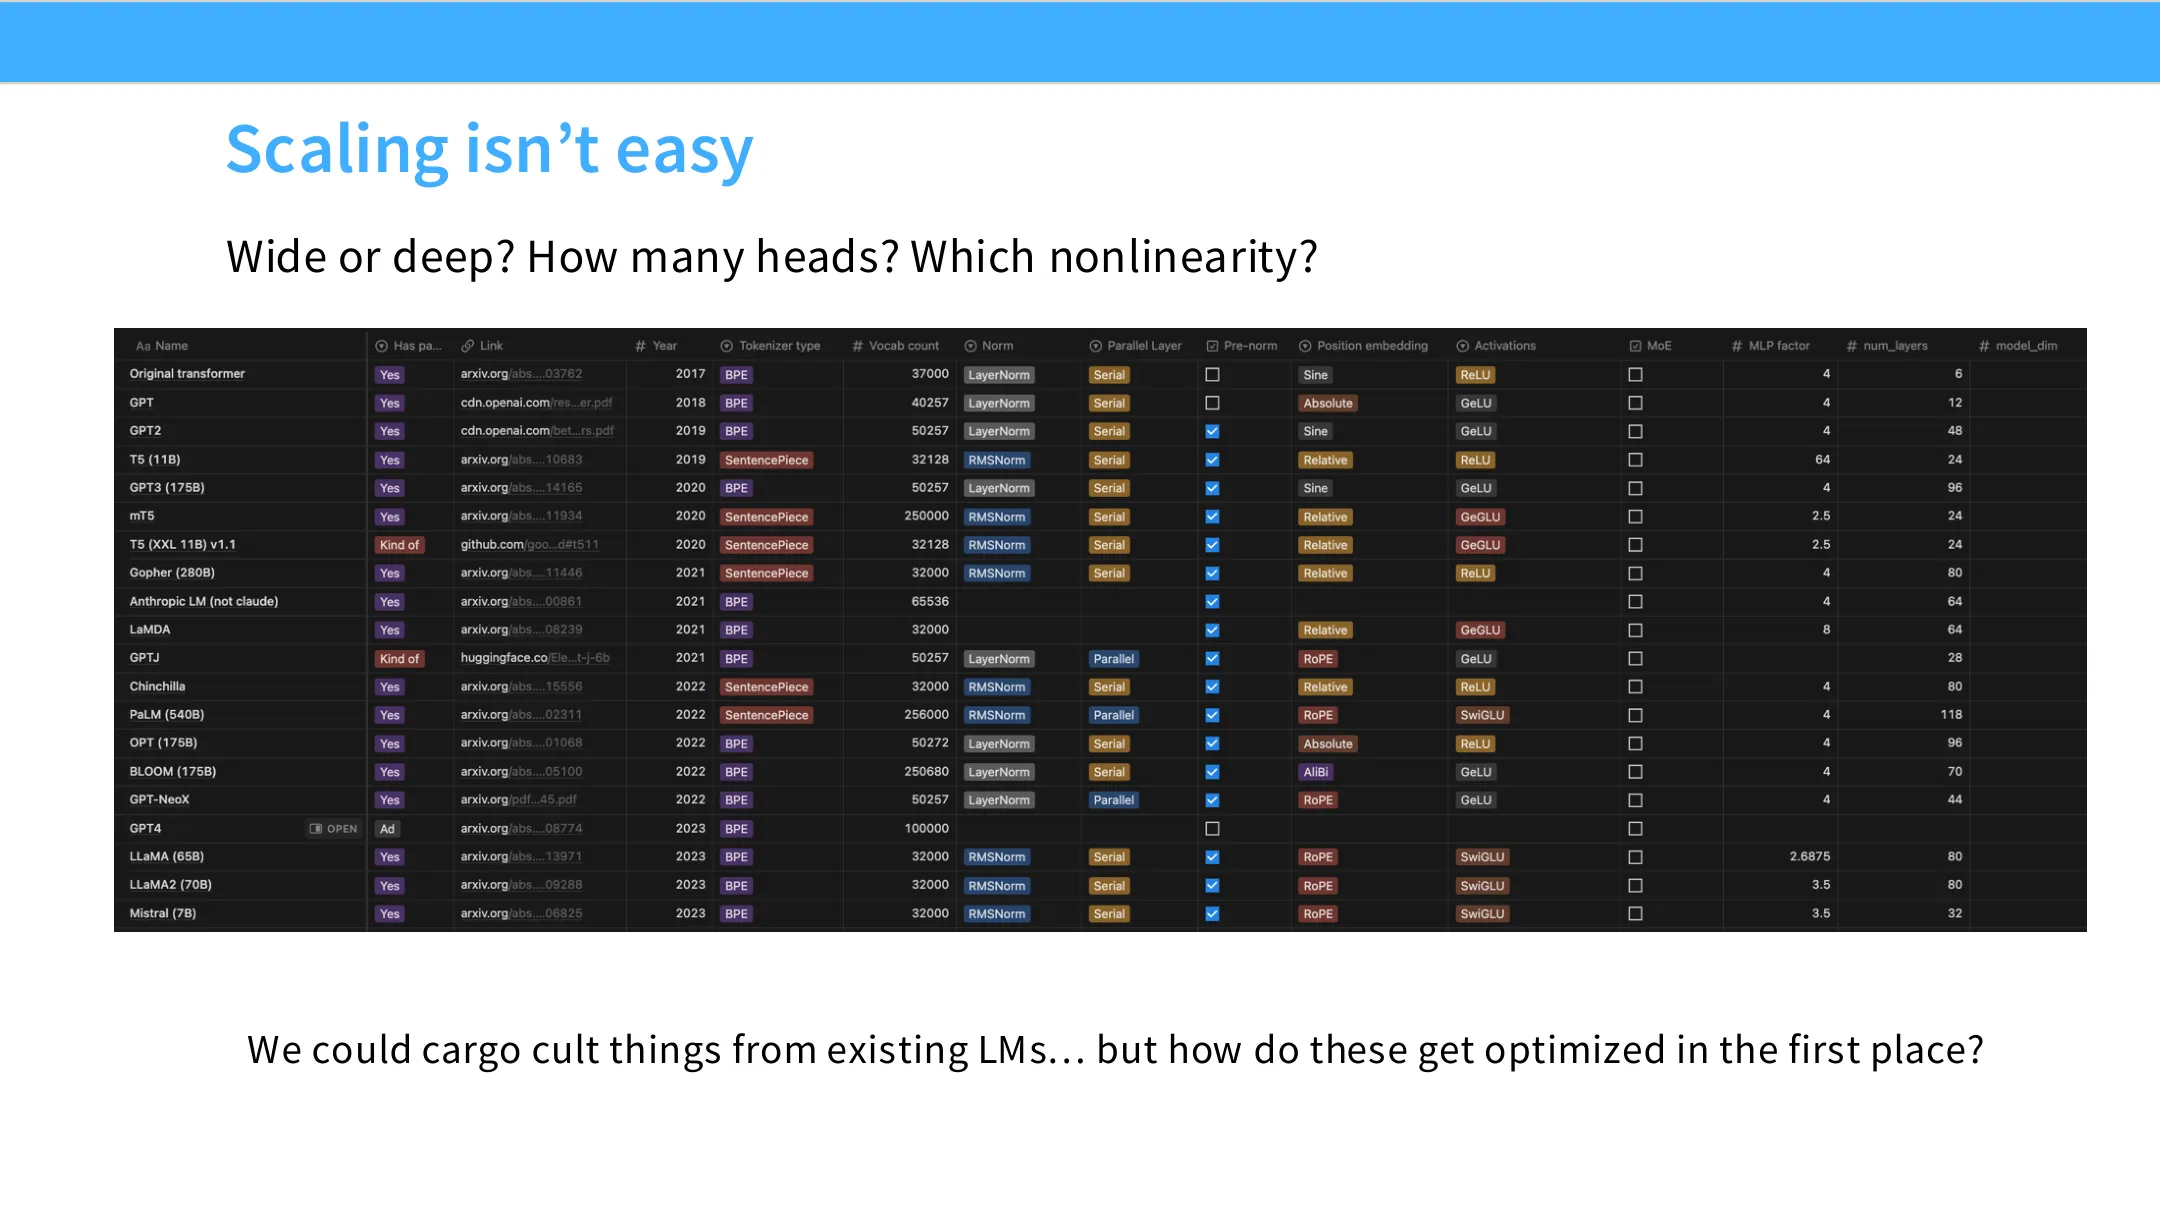
📷 Scaling isn't easy:宽还是深?多少个头?用哪种非线性?
回到原视频 (00:02:07)
1.3 Scaling law 是一种「对超参数的外推」
(参考时间: 00:02:48)
Scaling law 不只是一种工具,有人把它叫作一种范式。如果你跟大实验室里真正做 scaling 工作的人聊天,会发现它几乎是一种信仰——他们「真的相信」scaling law。(你也会看到,scaling law 有时是相当棘手的对象。)
用一句话概括:
Scaling law 是一些简单的、可预测的规律,用来把小规模模型的性能和行為,外推到大规模。
最「笨」的做法是:我有一个大预算,就在大模型上跑很多次训练,直接在大规模上调超参数。这非常浪费。更好的做法是:把所有优化都放在小规模做,再用一条简单规律把小规模行为外推到大规模行为。只要小规模与大规模之间存在某种简单、稳健的连系(某种规律性),你就能对这套新方法有信心。
这正是本讲的主题——scaling law 的工程视角。
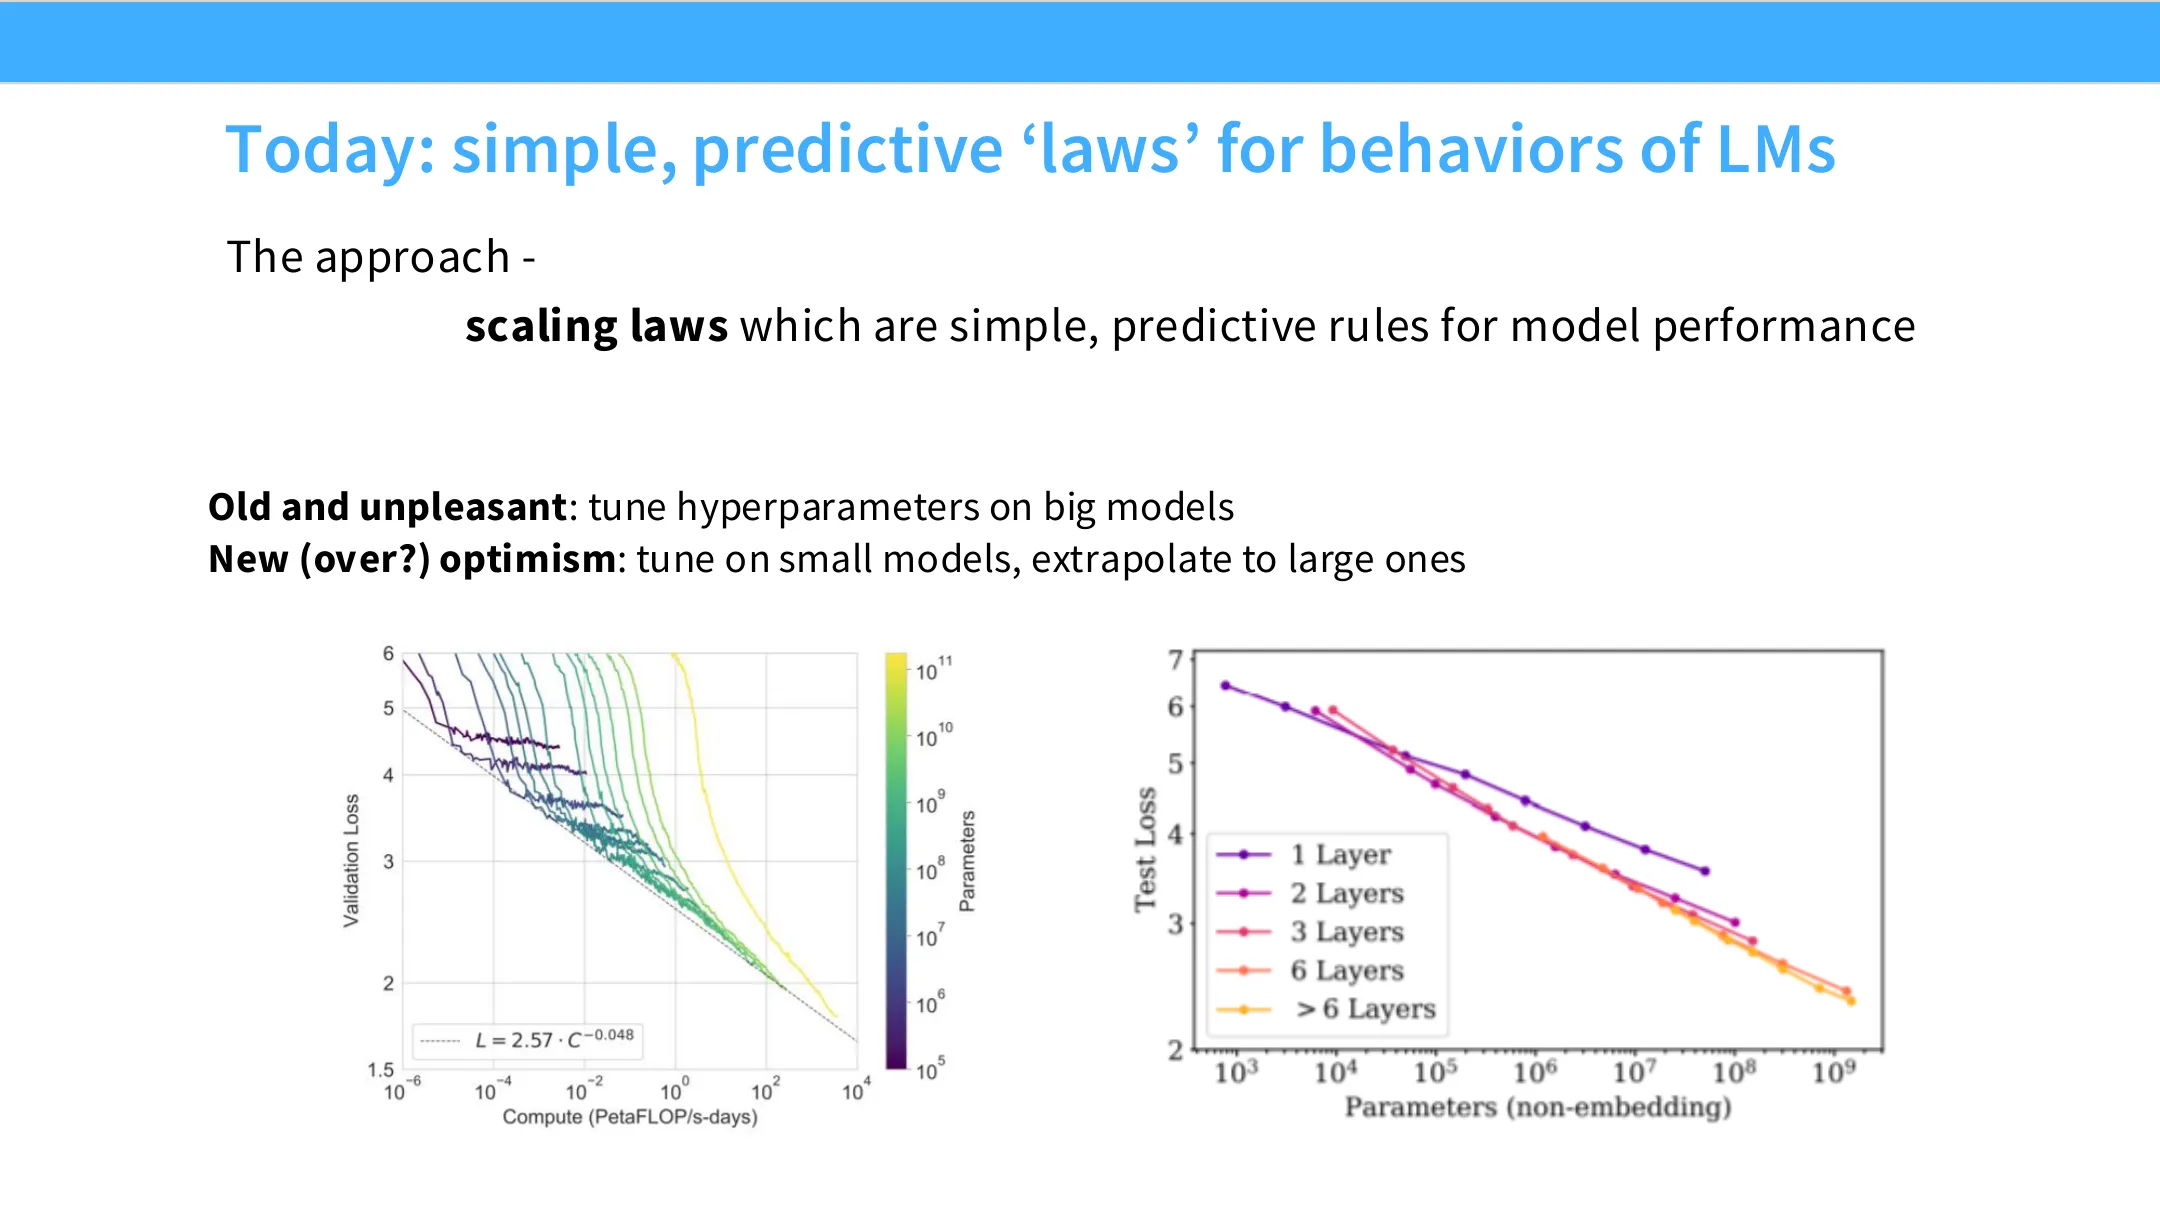
📷 今天的路线:简单、可预测的规律 + 小模型上调,外推到大模型
回到原视频 (00:02:48)
编者拓展|什么是「幂律 scaling law」
一条落在双对数坐标(log-log)上的直线,就是「幂律」关系:设误差为 $L$、资源为 $x$,则
$$L = a \cdot x^{-\alpha} \quad\Longleftrightarrow\quad \log L = \log a - \alpha \log x.$$
在 log-log 图上,$-\alpha$ 就是斜率,$\log a$ 是截距。这里 $\alpha>0$ 称为指数。我们在本讲后面会反复看到:改架构、换优化器、换数据分布,往往只改变截距 $a$(即整条线上下平移),而斜率 $-\alpha$ 几乎不变。这条经验,几乎是理解整讲的钥匙。
二、历史与背景:scaling law 从何而来
2.1 百年理论:样本复杂度与收敛率
(参考时间: 00:04:03)
Scaling law 之所以有趣,是因为它既是「最新范式」,又和非常古典的想法紧密相连。机器学习的理论家其实很早就在问同一个问题:给定一个模型类,它到底能有多好? 这个问题的理论答案就是泛化界(generalization bound):在有限假设类上,你的误差最多比训练集上的表现差多少;对更复杂的类(如光滑密度)也能写出类似的界。
关键在于:这些界往往依赖于样本量 $n$。 换句话说,泛化界给出的正是「损失如何随训练集增大而变化」的理论上界——这与「我数据变多会发生什么」非常接近。
如果把「最早的 scaling law 论文」追溯下去,可以一直追到贝尔实验室:Corinna Cortes、Vladimir Vapnik 等人做严肃的机器学习理论工作时就在问——在大数据集上训练分类器很贵,能不能改在较小样本上训练分类器、拟合一条误差衰减曲线,用它来估计性能?这几乎字面上就是一条数据 scaling law,早在 1993 年。
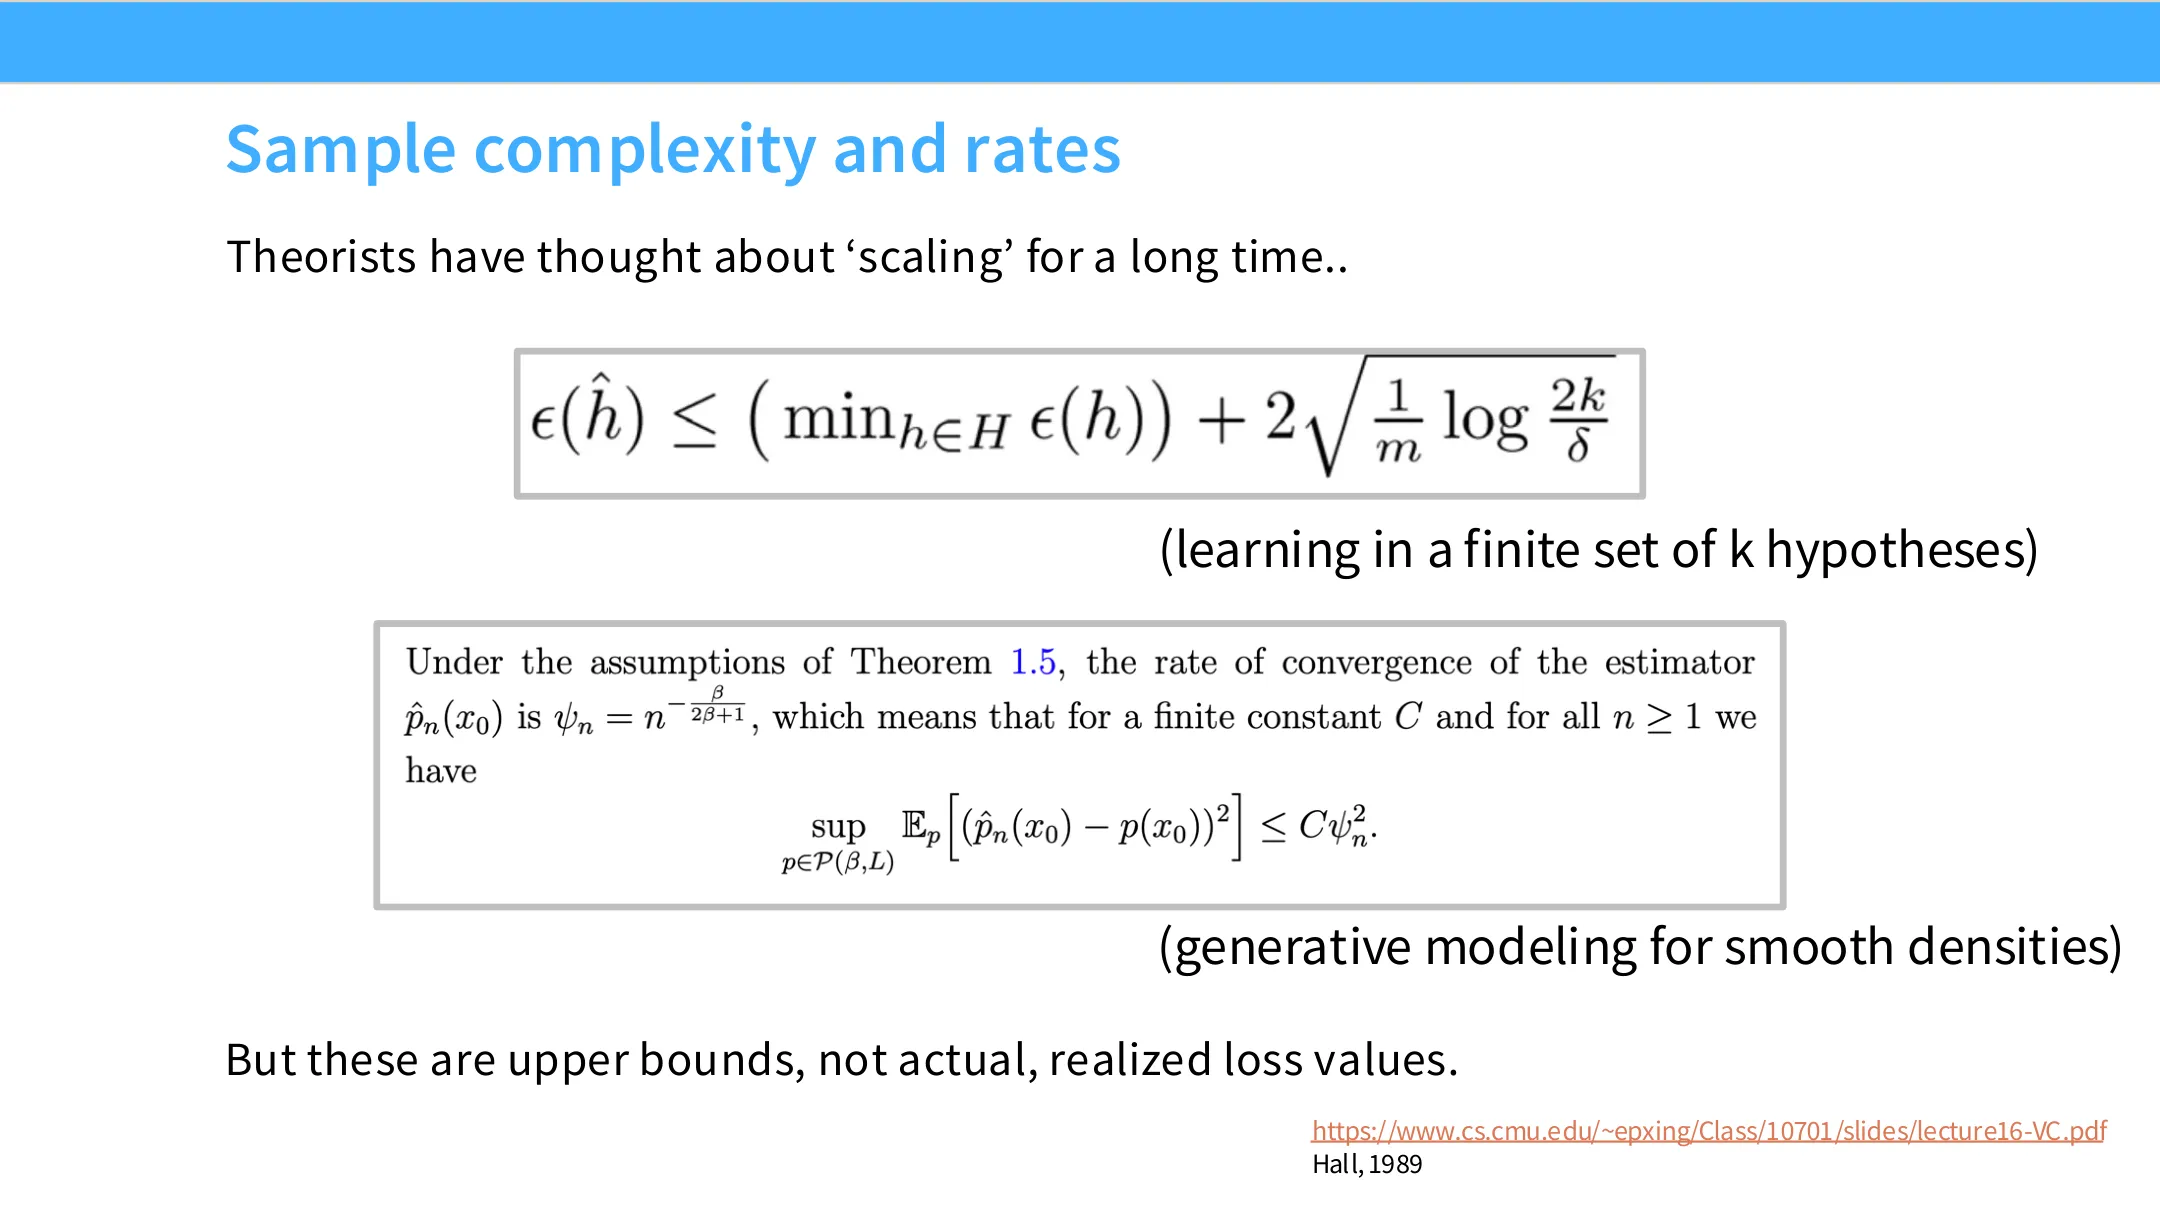
📷 样本复杂度与收敛率:理论家早就想过 scaling,但那是上界,不是实际损失值
回到原视频 (00:04:44)
编者说明:幻灯片上引用的两份经典文献——有限假设类上的学习、以及光滑密度的生成建模——是 VC 理论一脉工作。老师强调的要点是:理论给出的是上界(upper bound),而不是你会实际观察到的那种损失值;实际的 scaling law 是经验曲线,性质上更「紧」也更神秘。
2.2 早期数据 scaling:从 1993 到 2017
(参考时间: 00:05:55)
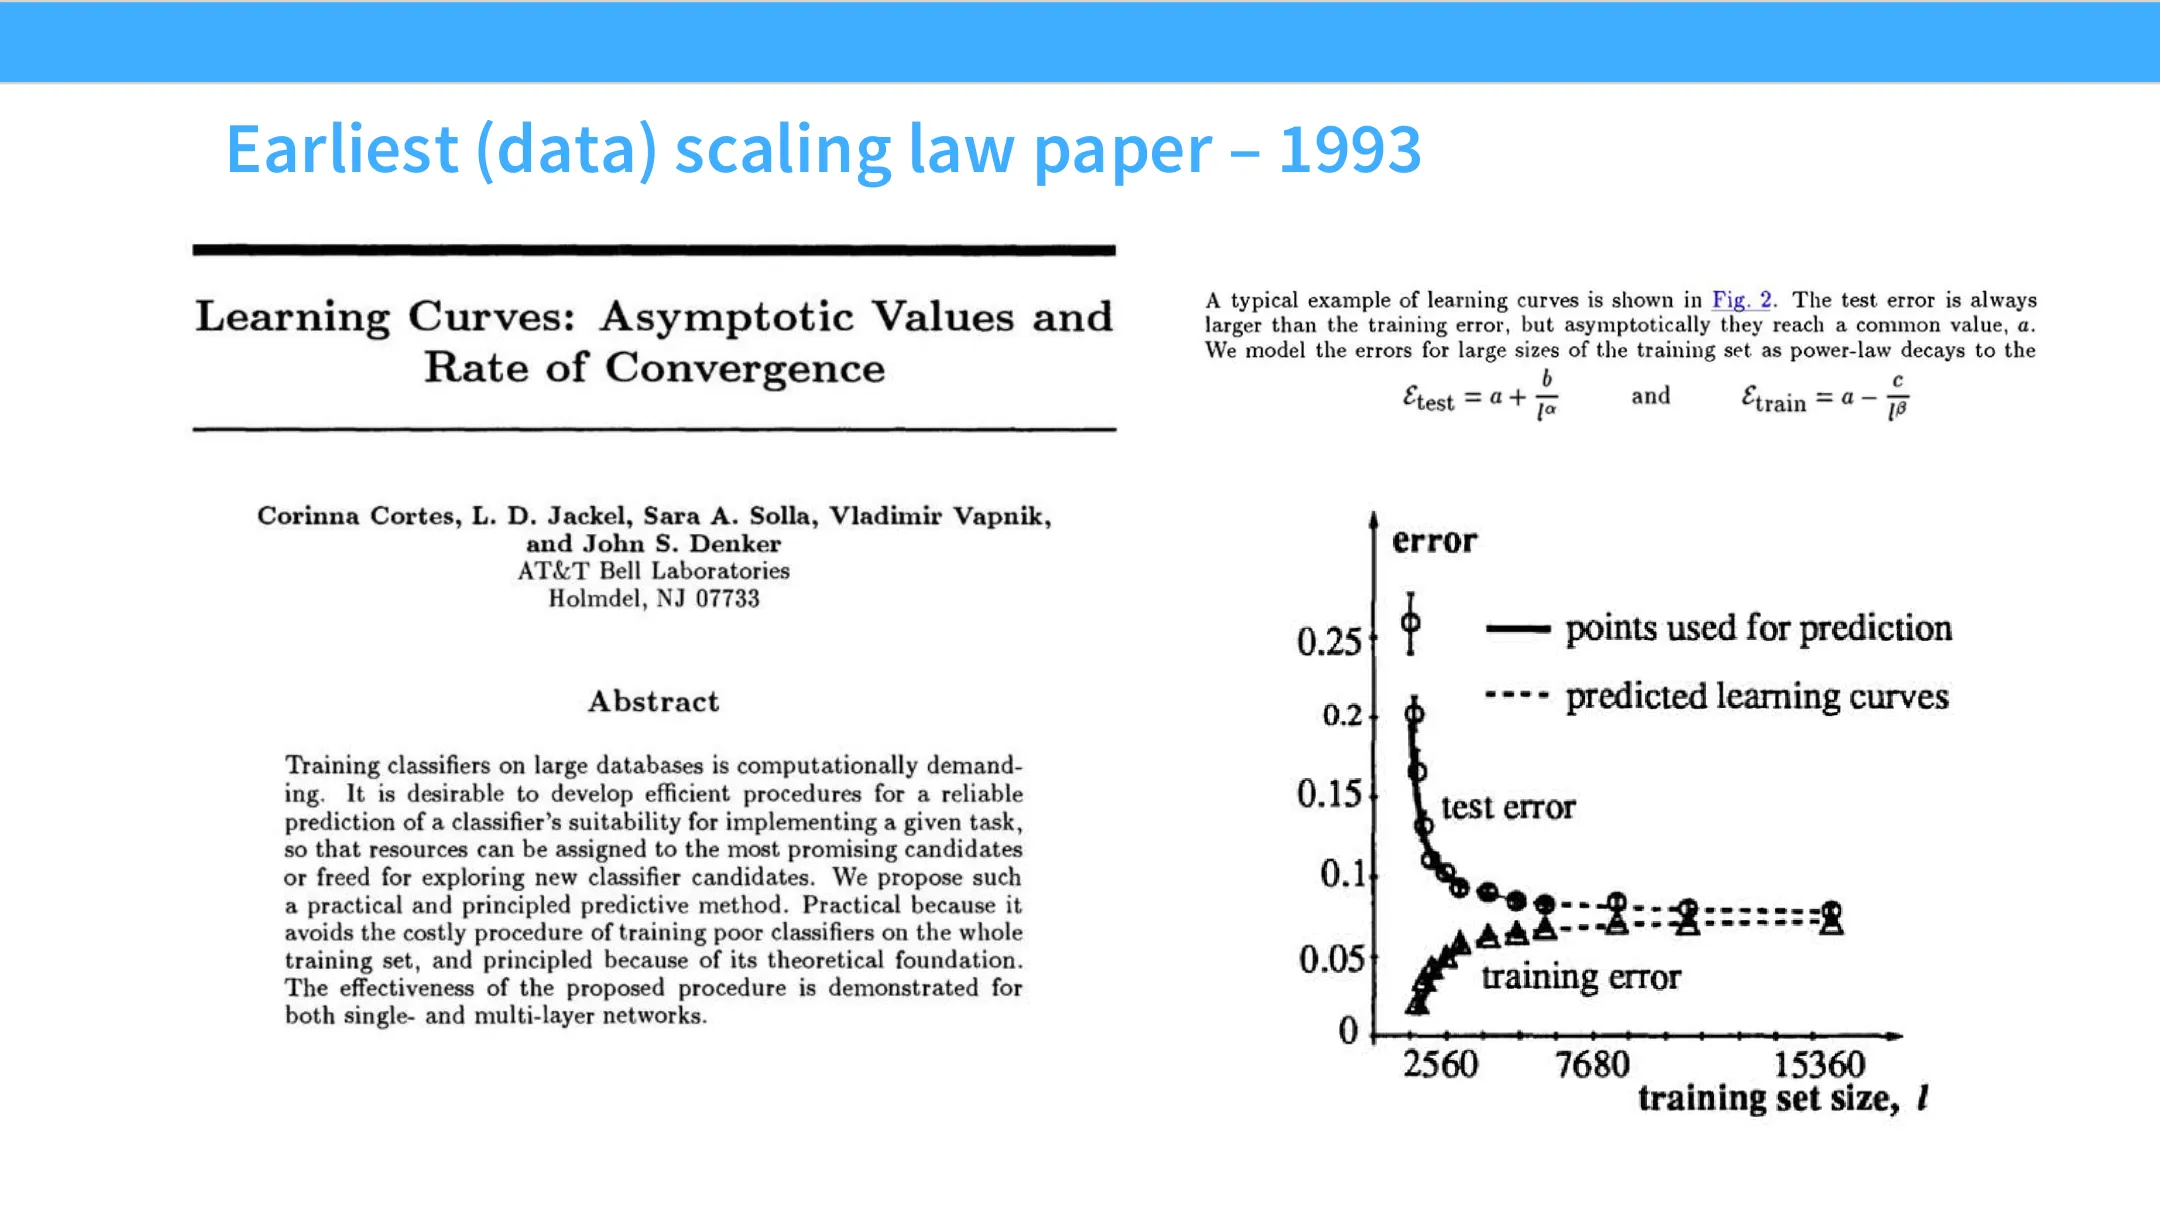
📷 最早的数据 scaling law 论文之一(1993)
回到原视频 (00:05:55)
顺着历史往下走,会看到一系列「用更多数据就能稳定提升」的工作:
- Banko & Brill(2001):经典的 NLP 参考点,指出「与其改进算法,不如收集更多数据」,因为性能随数据量呈对数线性上升。这是把 scaling 当作提升系统性能的正当途径的一个源头。
- Kolachina 等(2012):开始测试函数形式,发现数据量与下游性能之间是幂律关系。
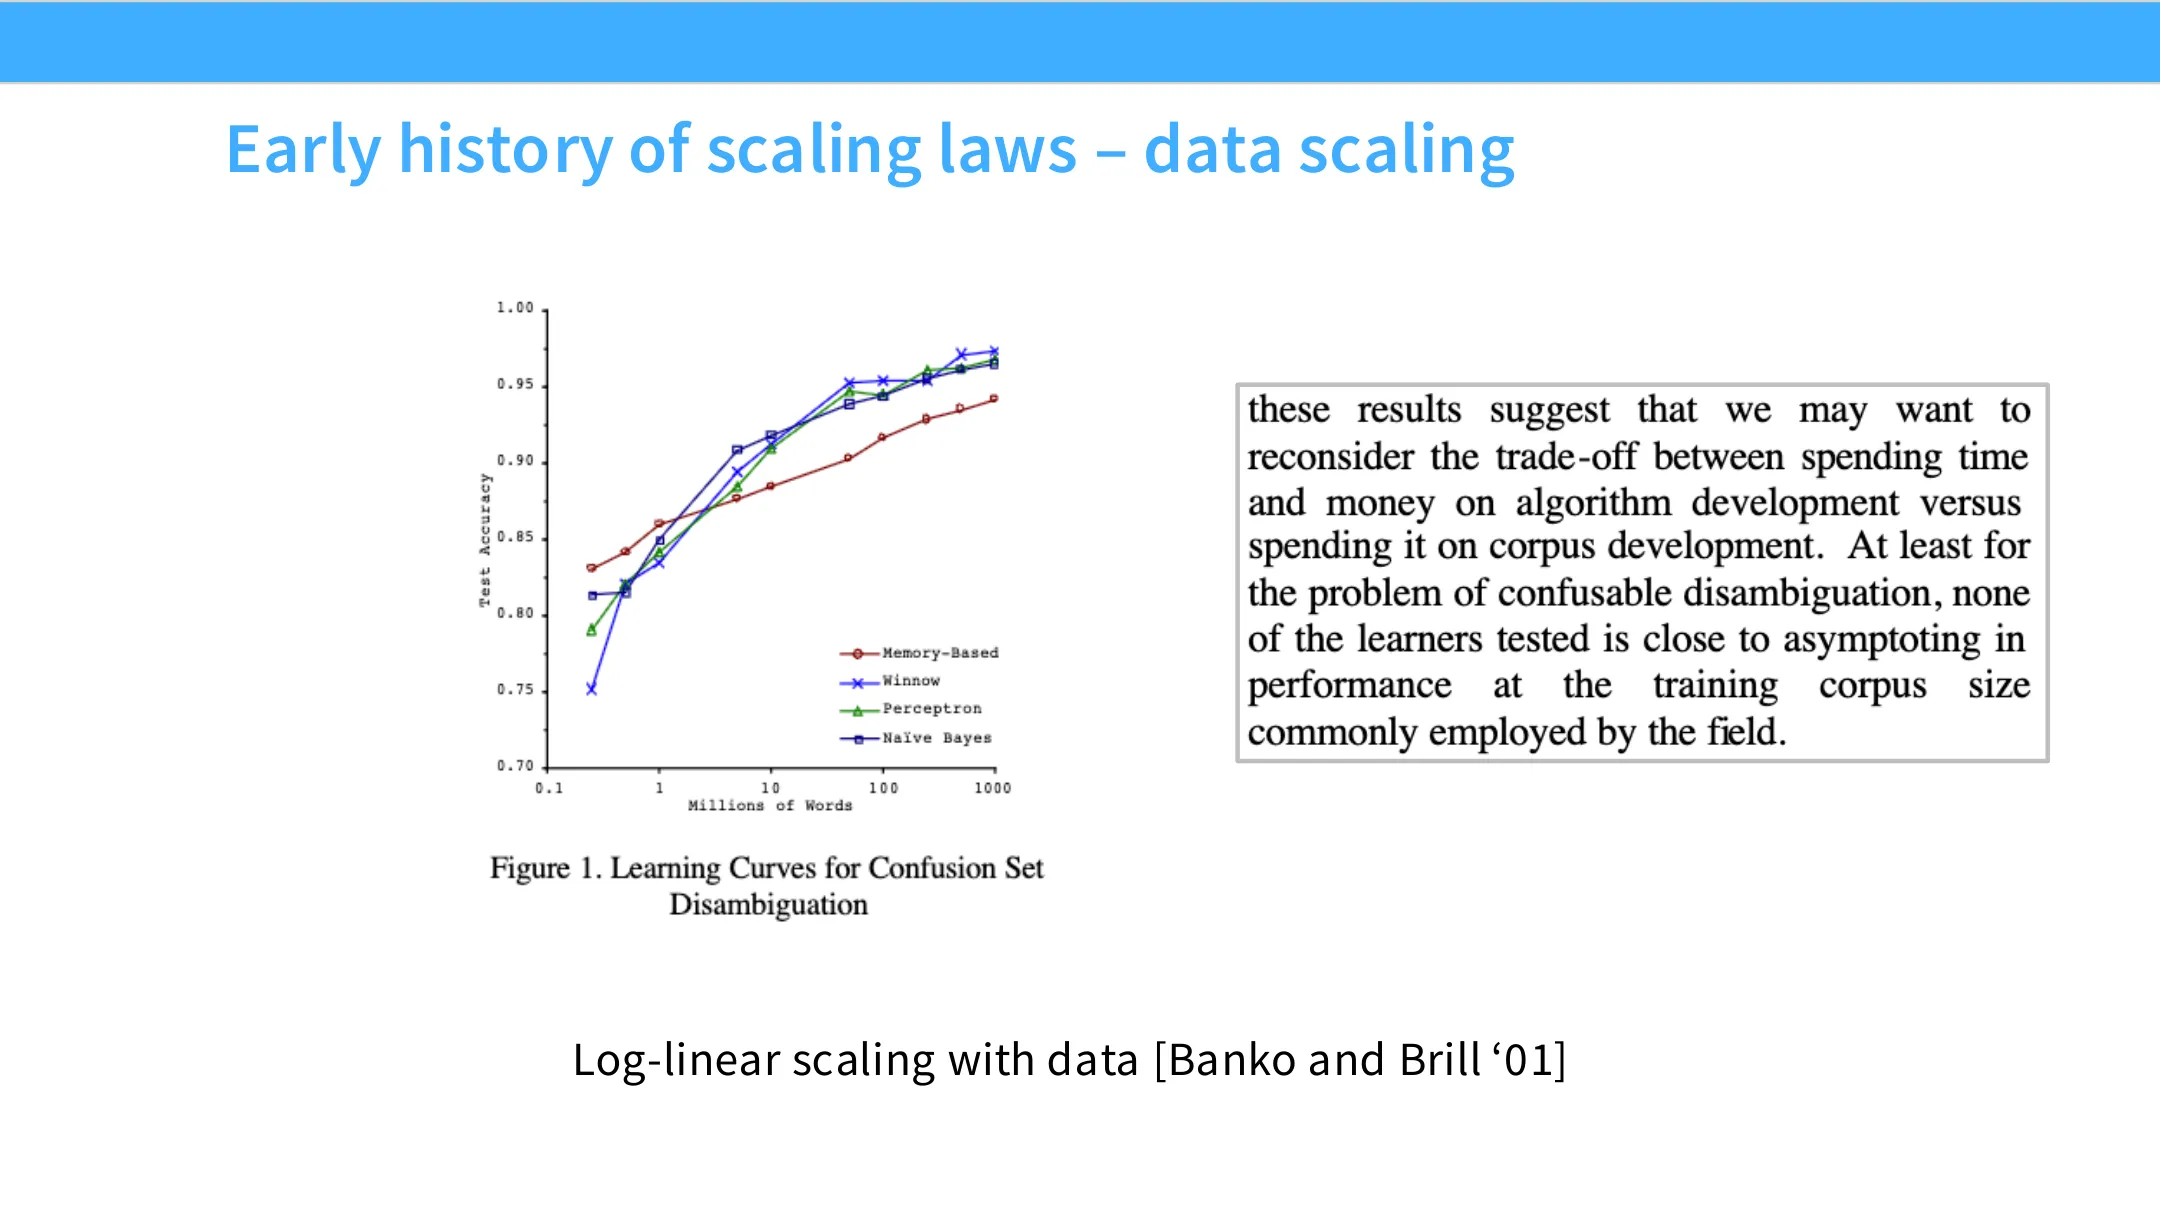
📷 Banko & Brill:性能随数据量对数线性增长
回到原视频 (00:07:00)
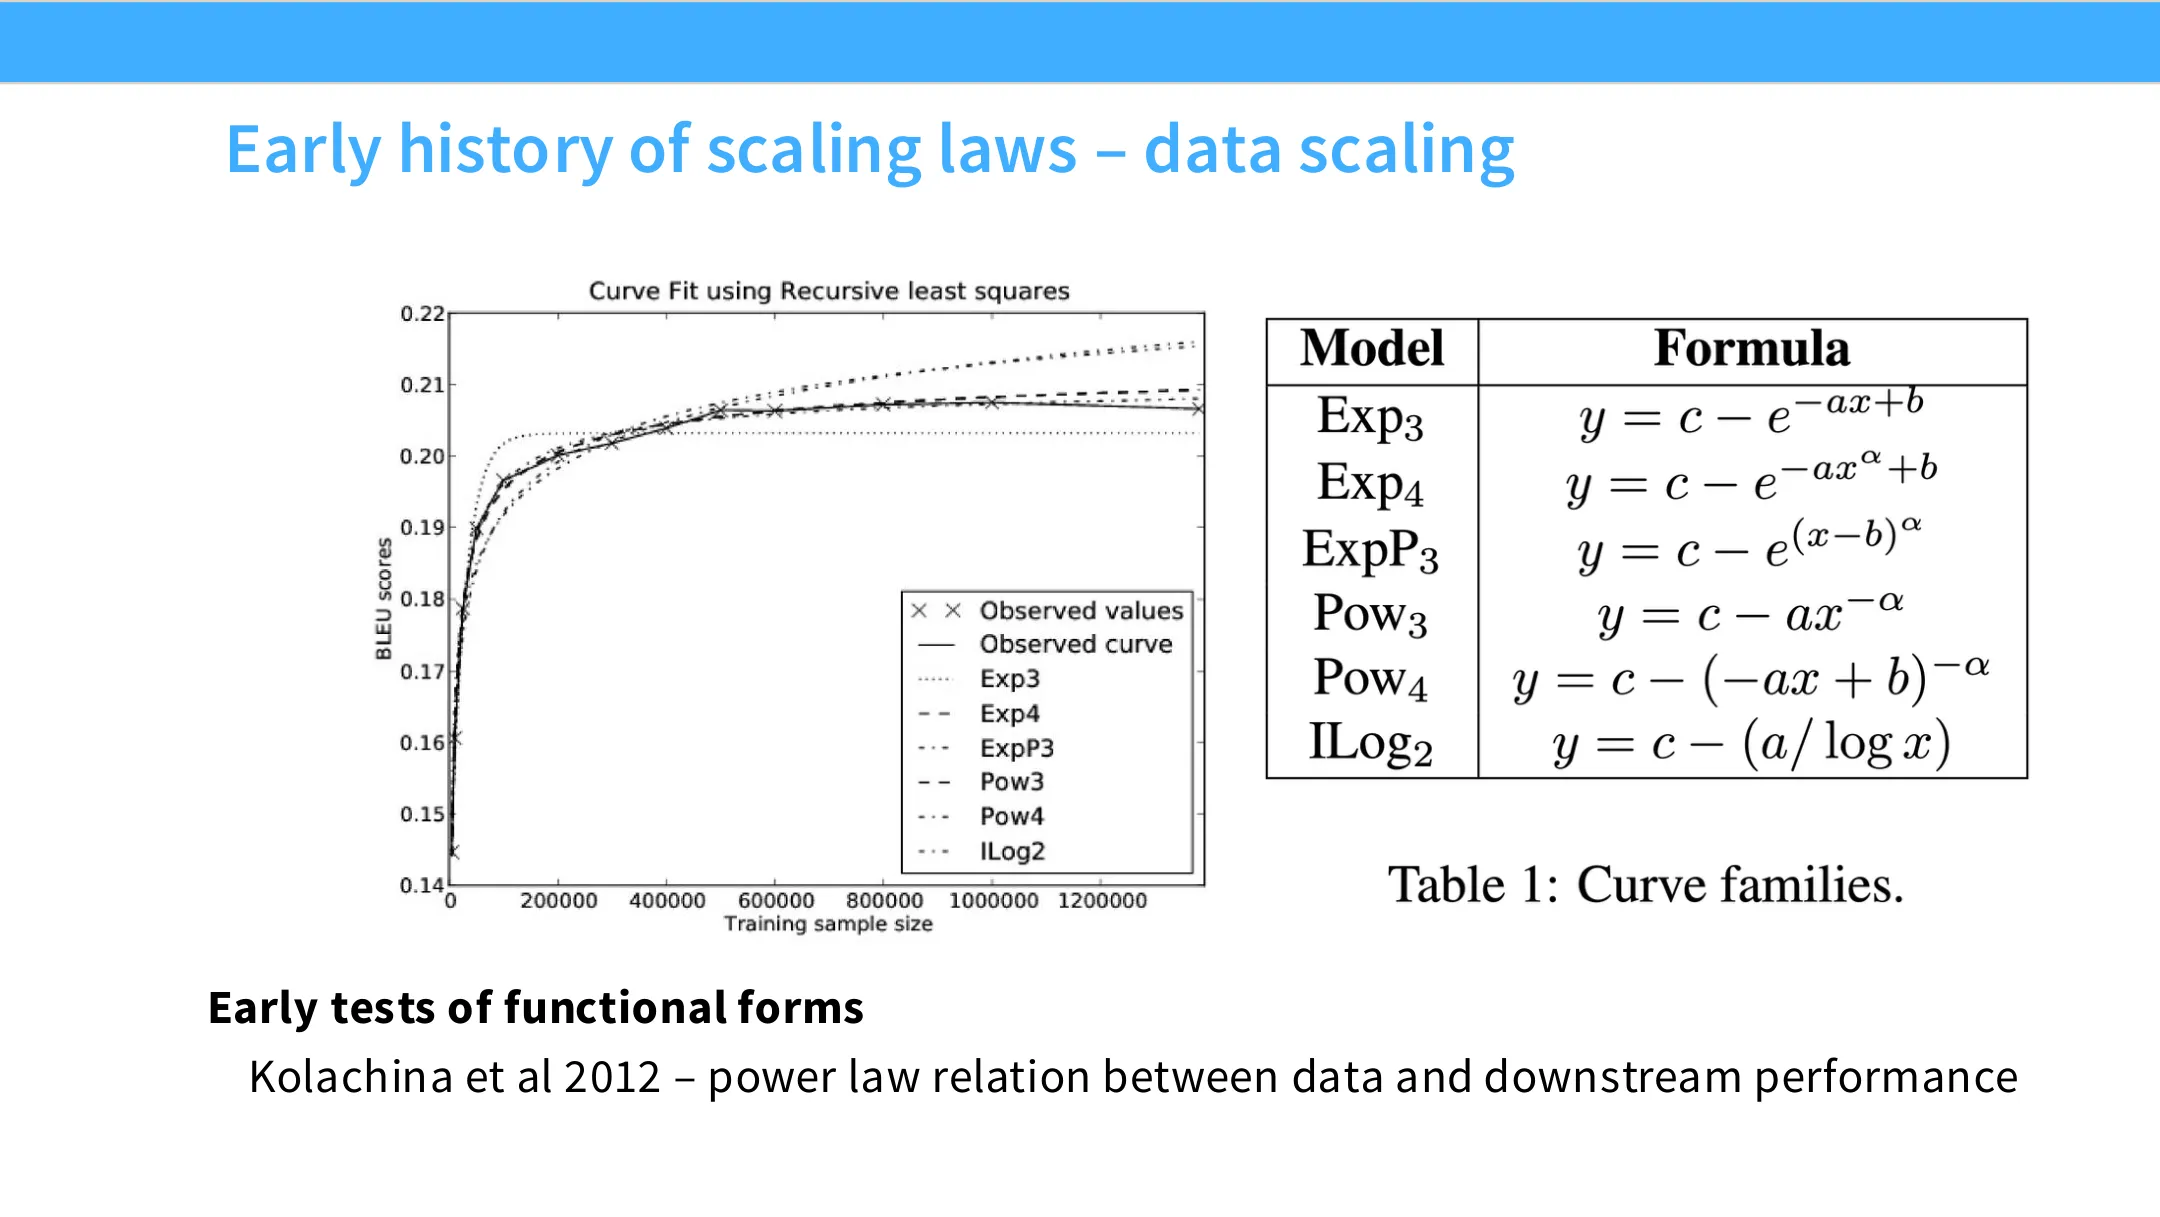
📷 Kolachina 等:数据与下游性能的幂律关系
回到原视频 (00:07:36)
老师在这里点明一条:这类工作最终得到的,正是我们今天仍在用的三、四次幂函数形式。后面的整讲里,你会反复看到这些多项式(power three、power four)出现——也就是说,2010 年代我们就知道这些函数形式对模型行为有很强的预测力。
2.3 Hestness(2017):最超前的一篇
(参考时间: 00:08:28)
老师特别想提这篇论文,因为它没有得到应有的引用。在他看来,神经 scaling 的源头可以追到 Hestness 2017。
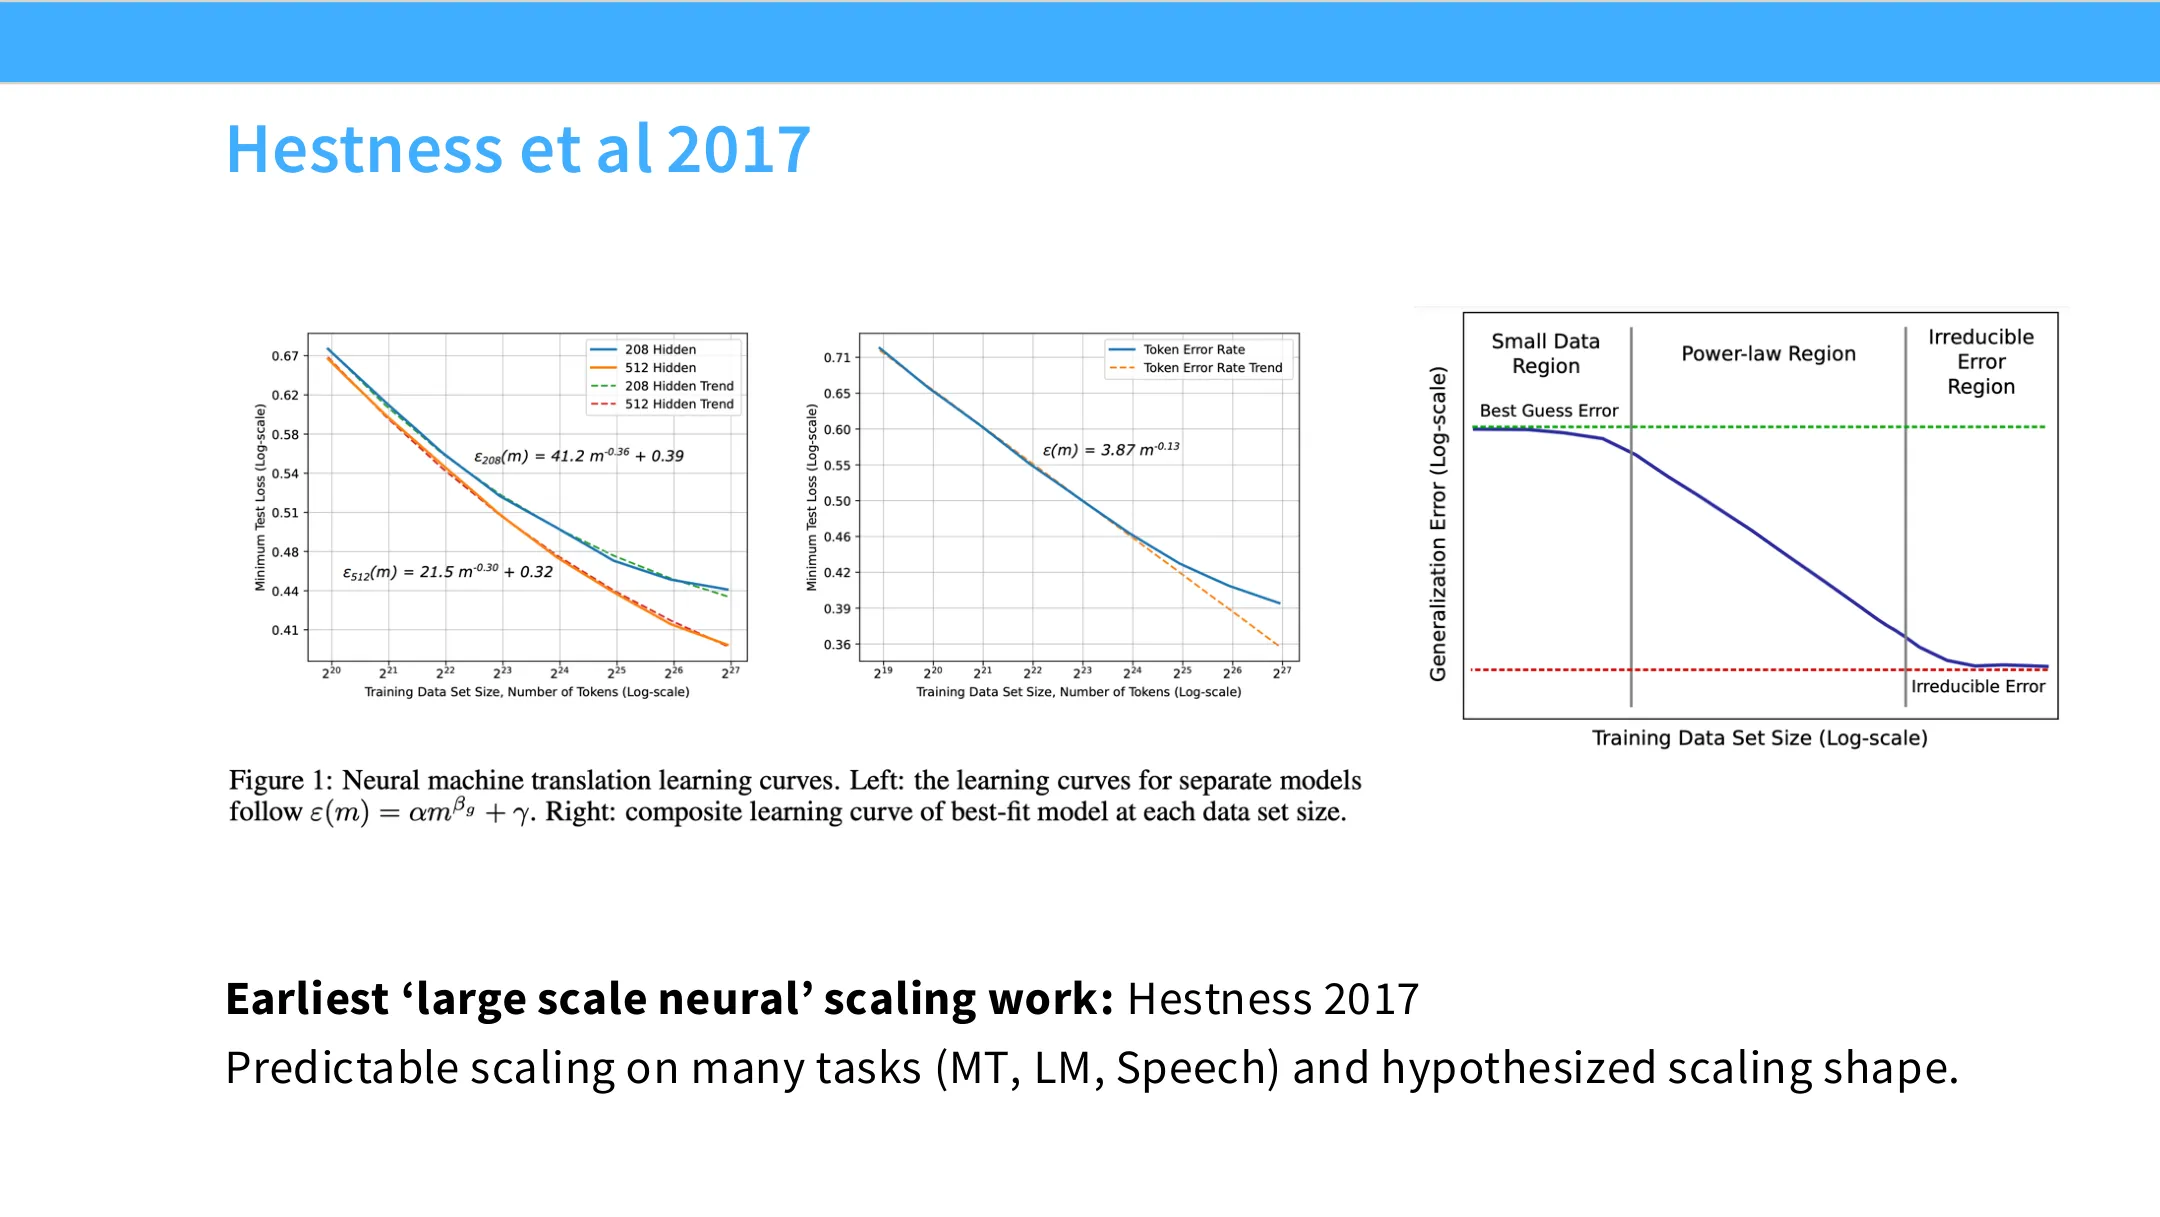
📷 Hestness 2017:最早的大规模神经 scaling 工作
回到原视频 (00:08:28)
这项工作:
- 在多种系统(不同语音识别、机器翻译、语言模型)上,建立了以数据集大小为自变量的 scaling law;
- 证明这些系统在大量领域上都遵循漂亮的多项式趋势。
它非常超前,因为 2017 年远早于 OpenAI 在 2020 年代的一系列 scaling law 工作。而它讨论的内容,恰恰就是我们今天也在讨论的:
- 涌现(emergence)——因为准确率是比损失更「不连续」的度量,模型可能突然表现出某种能力;
- 按算力 scaling——如果系统能随训练数据可预测地 scaling,那么算力就至关重要;
- 速度等于准确率——既然按算力 scaling,那么系统优化(更快)就等价于准确率提升。
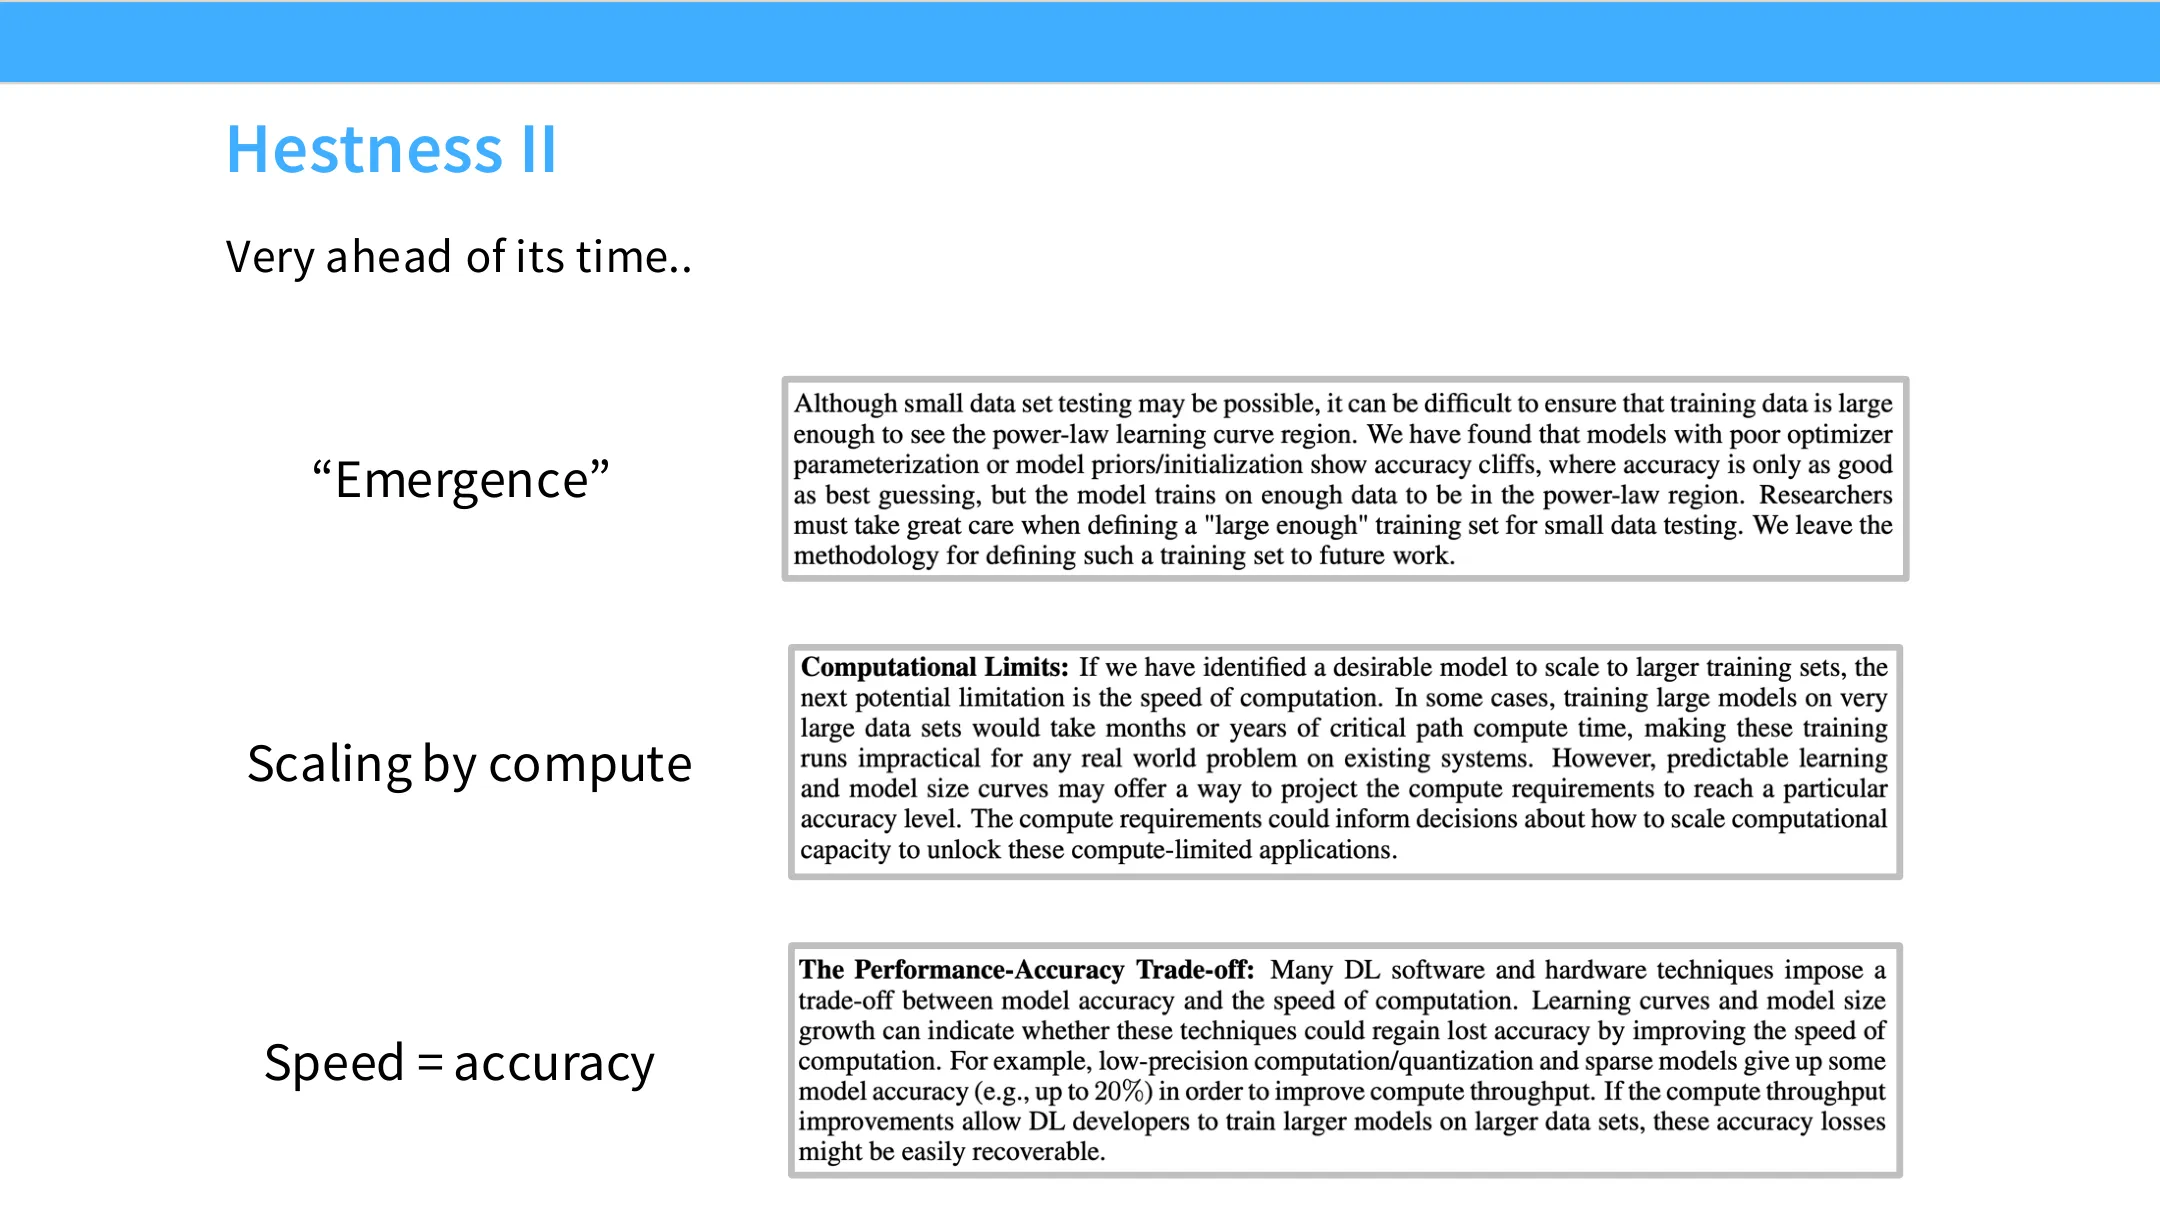
📷 Hestness II:非常超前——「涌现」、按算力 scaling、速度=准确率
回到原视频 (00:09:04)
老师的感慨很值得记下来:「如果我 2017 年就认真读了、认真想了这些 scaling law 论文,我本可以更早知道我们现在所处的这个 regime。」 也就是说,今天我们所处的「大语言模型时代」的很多现象,其实在看见这些大模型之前就能预知。他每次讲 scaling law 都会提这篇,就是想说:这些现象远早于现代语言建模时代就被认识了。
编者说明:老师此话的深意是——scaling law 的「预测力」不只用于事后解释,它本身就是事前判断一个方向值不值得投入的依据。这与本讲主线一致:用便宜实验预判大规模结果。
课堂问答(参考时间: 00:10:23):
- 问:这些规律是纯经验发现的,还是有什么办法能论证?
- 答:这些是纯粹的曲线拟合。后面会讲幂律从何而来、为什么多项式是自然的一类。没有「金科玉律」说它们只能长这样。不过,理论确实提供了很多候选的函数形式——理论总在思考「误差率如何随各种量衰减」;物理学家也擅长这个,他们爱研究极限行为,而极限常常给出不同的 scaling law 函数形式。
三、数据 scaling law:经验规律与理论基础
(参考时间: 00:11:22)
接下来进入更现代的神网络语言模型 scaling,从数据 scaling law 讲起——因为它最简单、最自然,而且能一步步演示「怎么猜出一个 scaling law 的函数形式」。
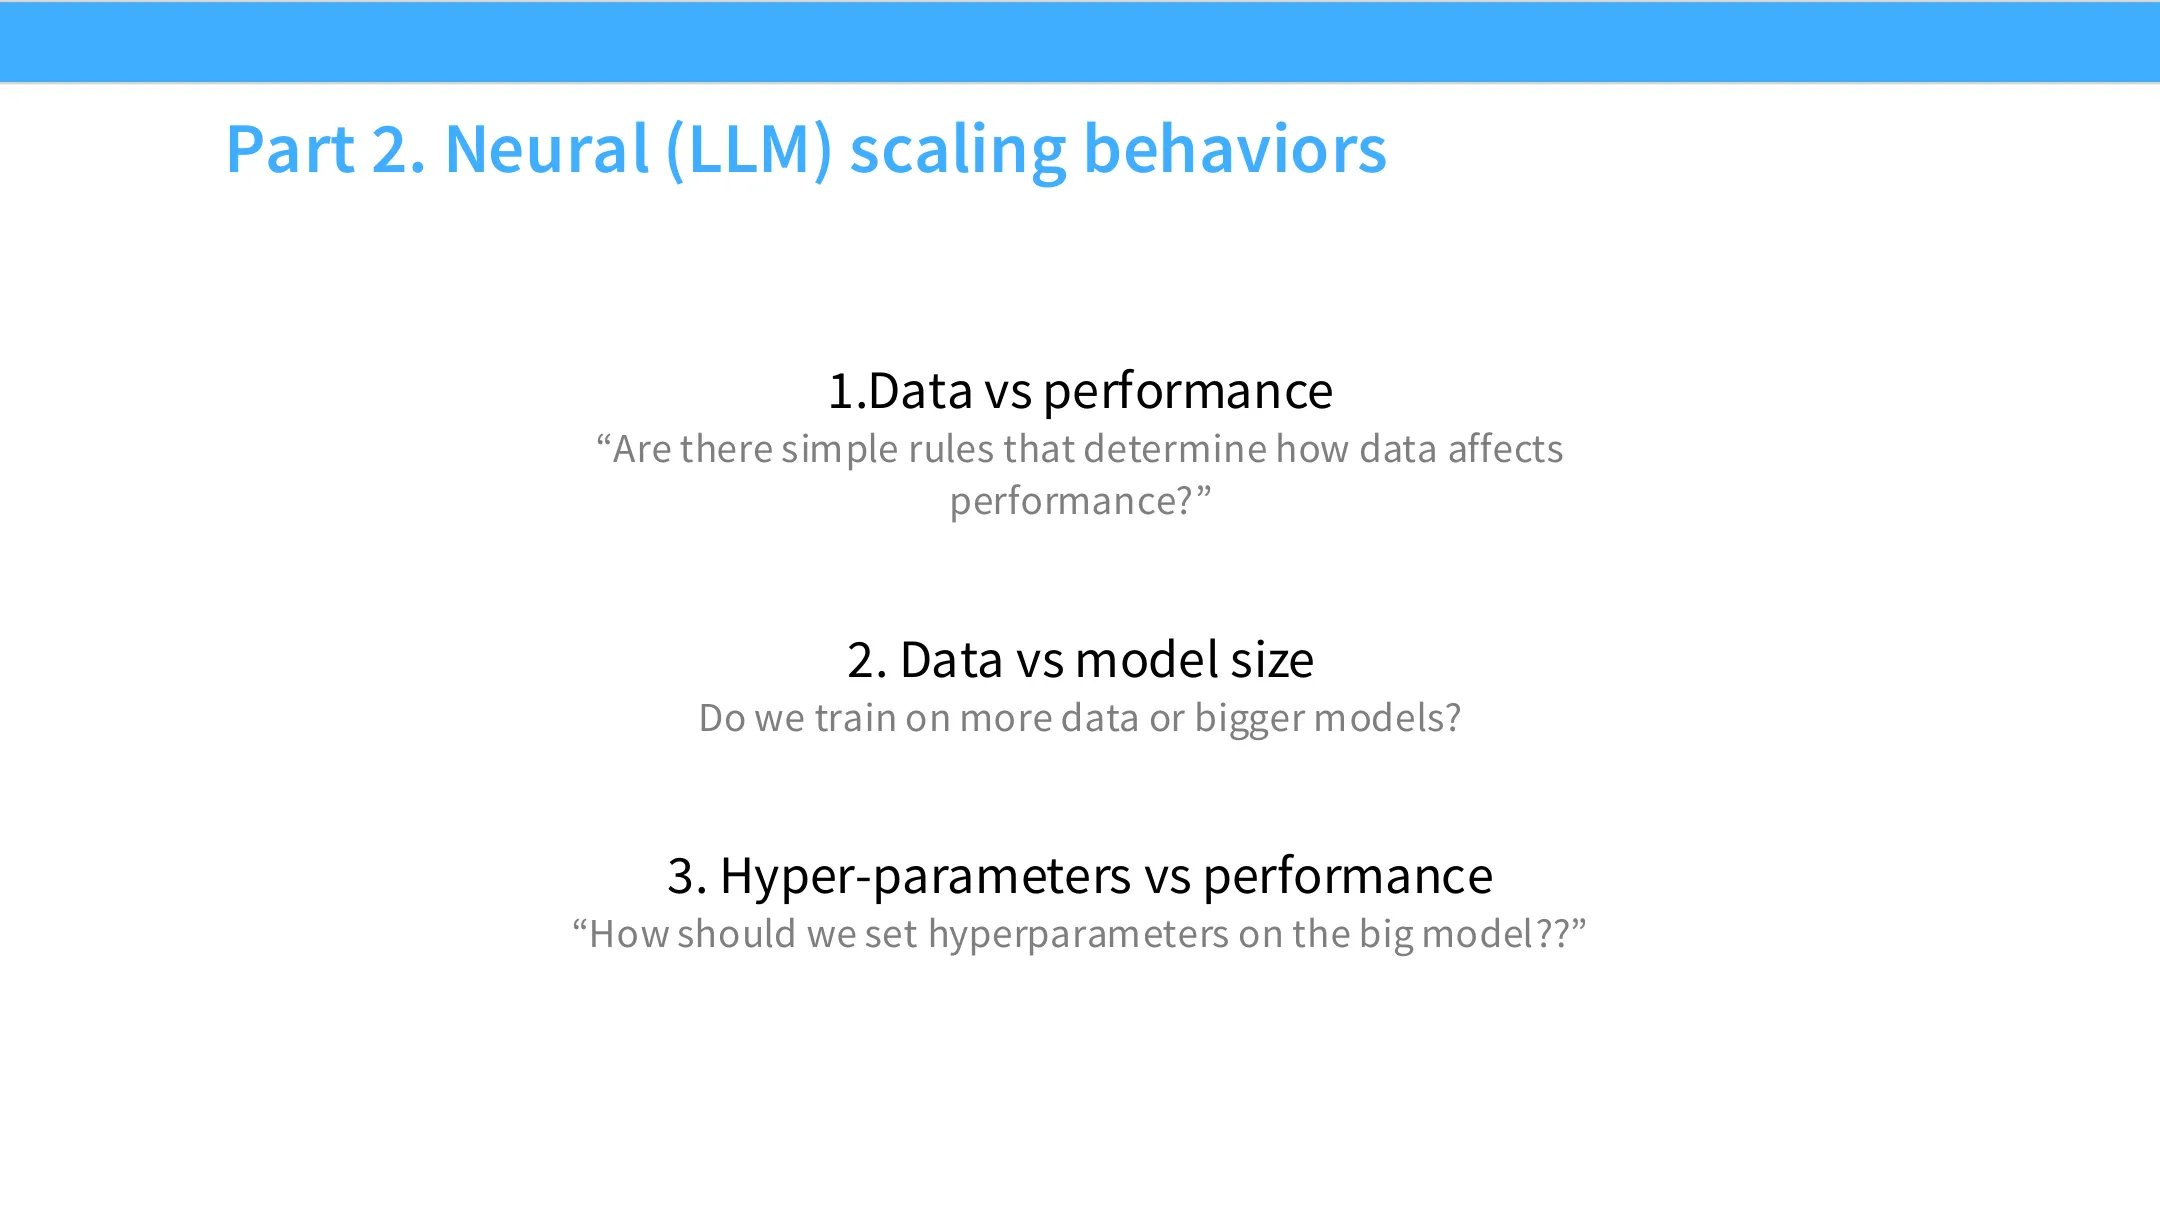
📷 Part 2 开篇:本讲要回答的三个问题——数据 vs 性能、数据 vs 模型大小、超参数 vs 性能
回到原视频 (00:11:22)
3.1 幂律关系能覆盖大量因素
(参考时间: 00:12:00)
先看一个宏观观察:这些幂律关系似乎对大量不同的因素都成立。预训练里最常见的几种横轴是:
- 把算力放在横轴,测试损失的对数放纵轴;
- 把数据集大小放横轴,损失的对数放纵轴;
- 把参数放横轴,损失的对数放纵轴。
这些「资源」在 log 轴上,都能让 log 测试损失线性化。
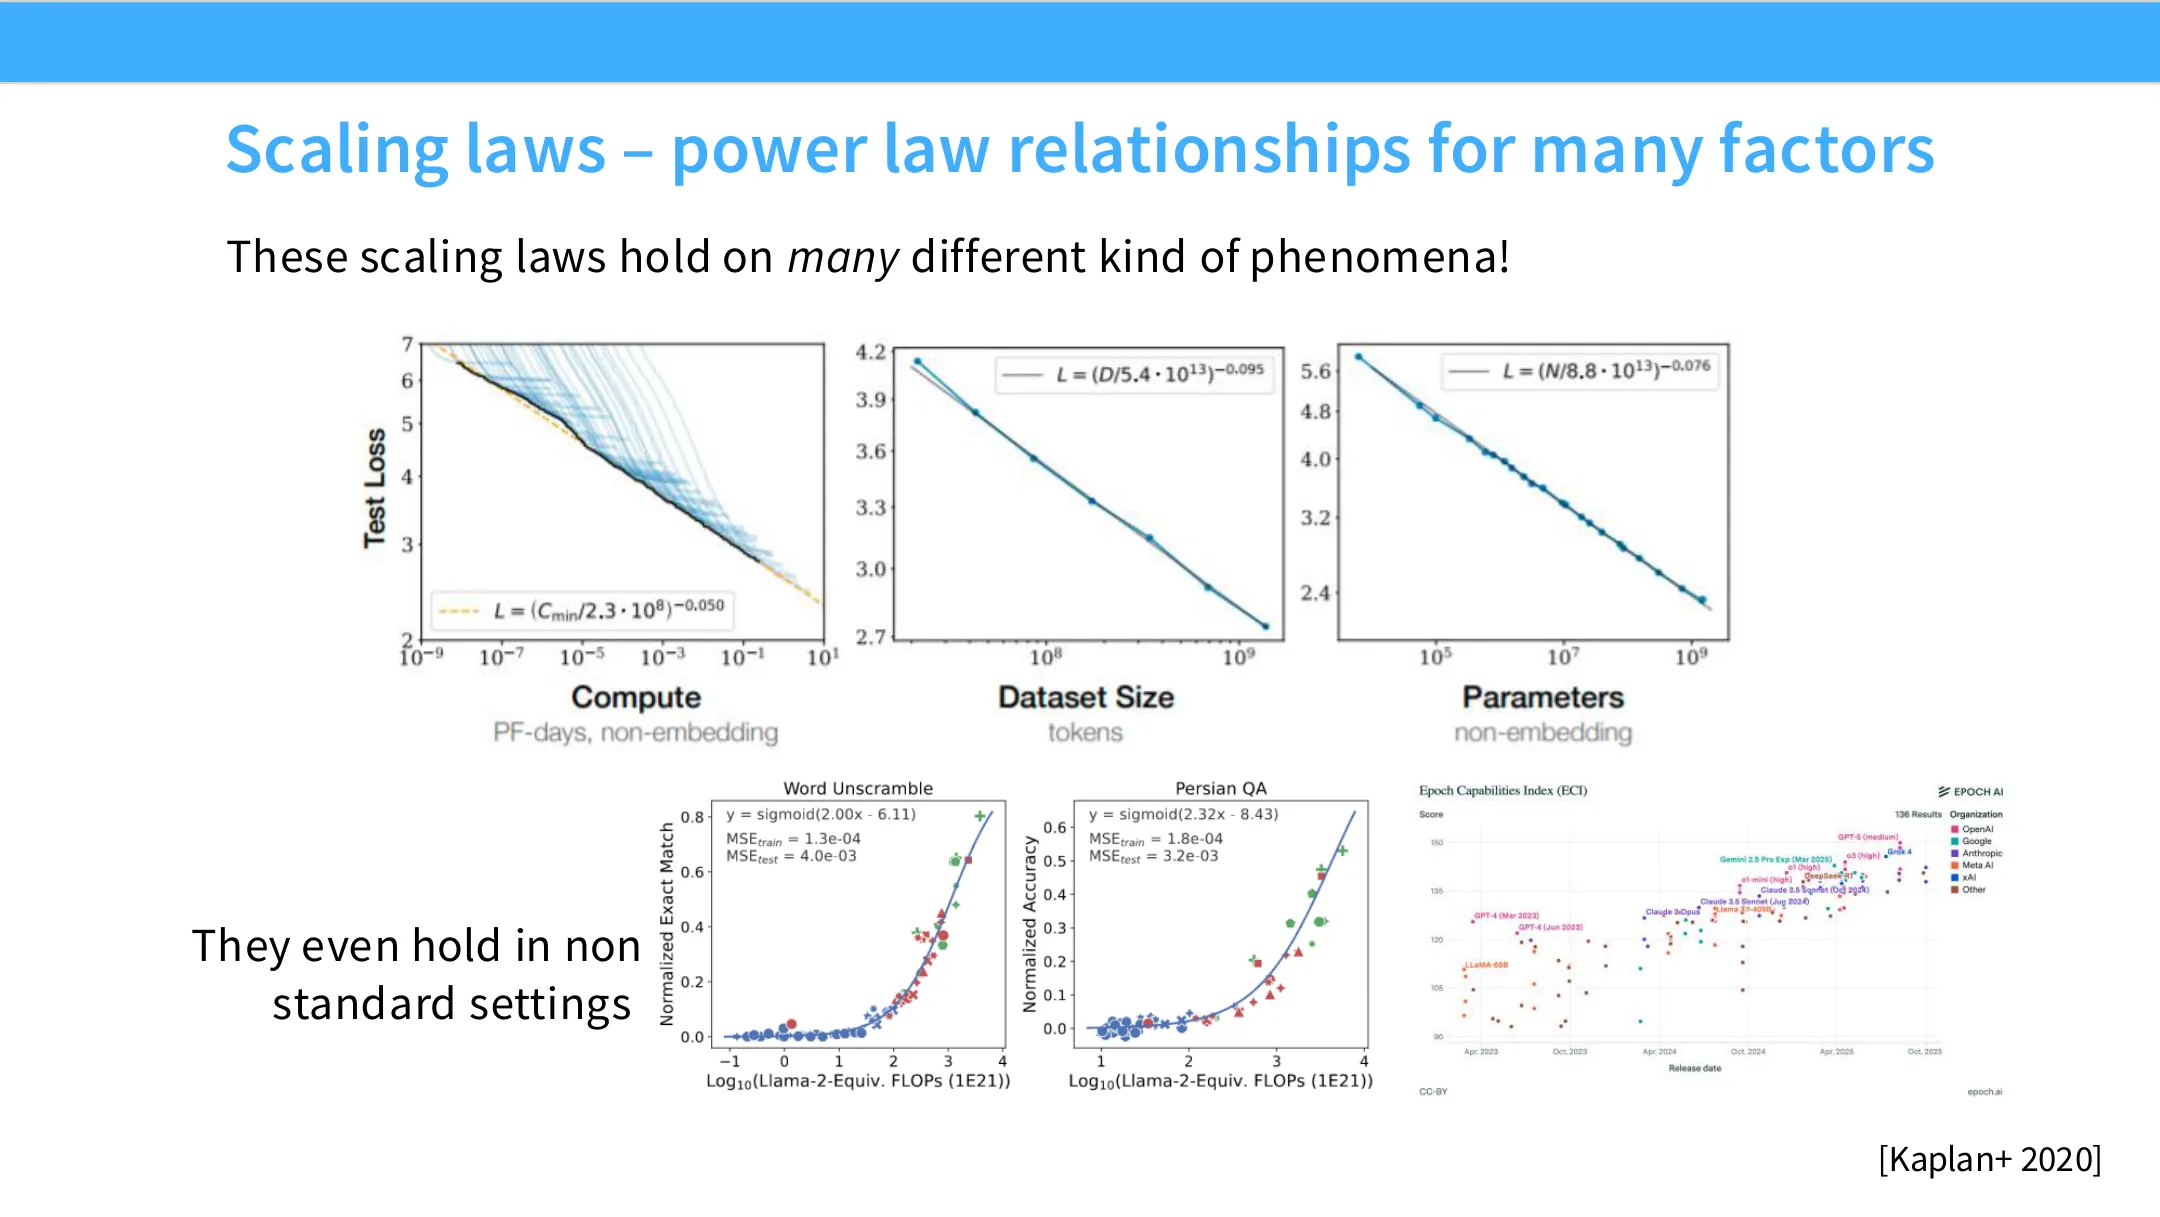
📷 Scaling law:对多种因素的幂律关系
回到原视频 (00:12:00)
还能看到更「异国情调」的 scaling law:
- 下游基准上的 scaling law,通常表现为 sigmoid 形状;
- 近期还有预测类工作,把日期放在横轴,奇怪的是这些曲线的上包络常常是线性的。
老师强调:底部那些更奇特的 scaling law 没有先验理由必然成立,但事实是——语言模型性能关于算力与资源的规律性,比它初看起来强得多。
3.2 数据 scaling law 的形状与含义
(参考时间: 00:13:35)
数据 scaling law 是一个非常简单的单变量关系。设定是:固定模型训练流程(除特别说明,模型通常比数据集大),然后规律地增大数据集,观察误差如何下降。
我们一般期望这个关系:
- 单调(超参调得好的话),因为更多的数据应该带来更好的性能;
- 最终从「随机猜测」下降到某个不可约误差(noise floor),即比任务本身的熵更低的损失是不可能的。
所以曲线整体呈 S 形(sigmoid-like)。
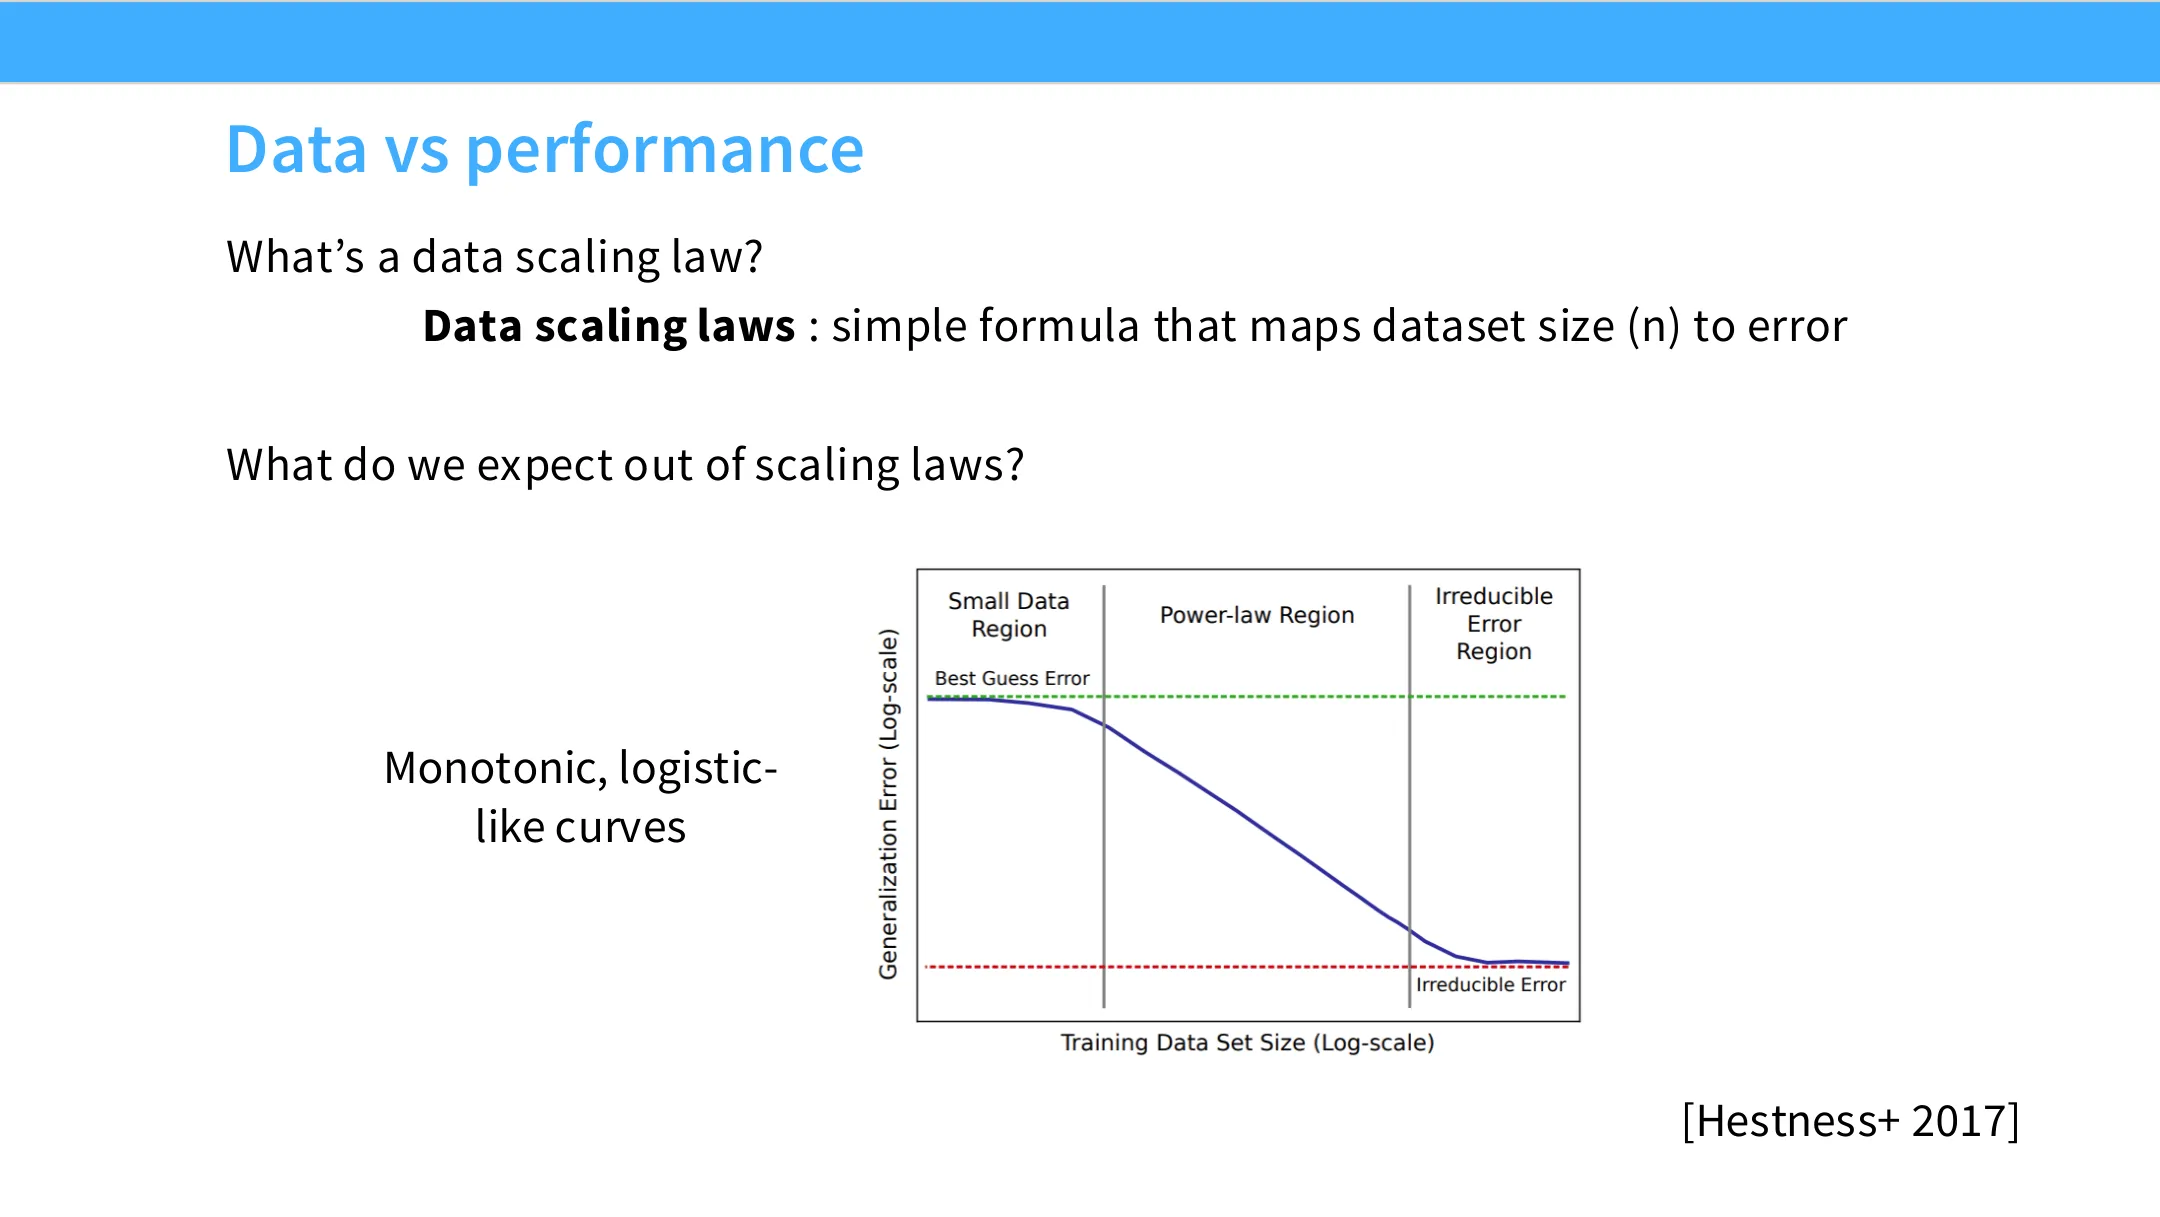
📷 Data vs performance:数据 scaling law 是把数据集大小 n 映射到误差的简单公式
回到原视频 (00:13:35)
3.3 关键的实证观察:log-log 上是直线
(参考时间: 00:14:33)
现在做一个经验观察(你自己在作业三里也会做出类似的图):取一个远大于数据集的模型,增大数据集,横轴取 log 数据量,纵轴取 log 测试损失,你会看到非常清晰的线性趋势。
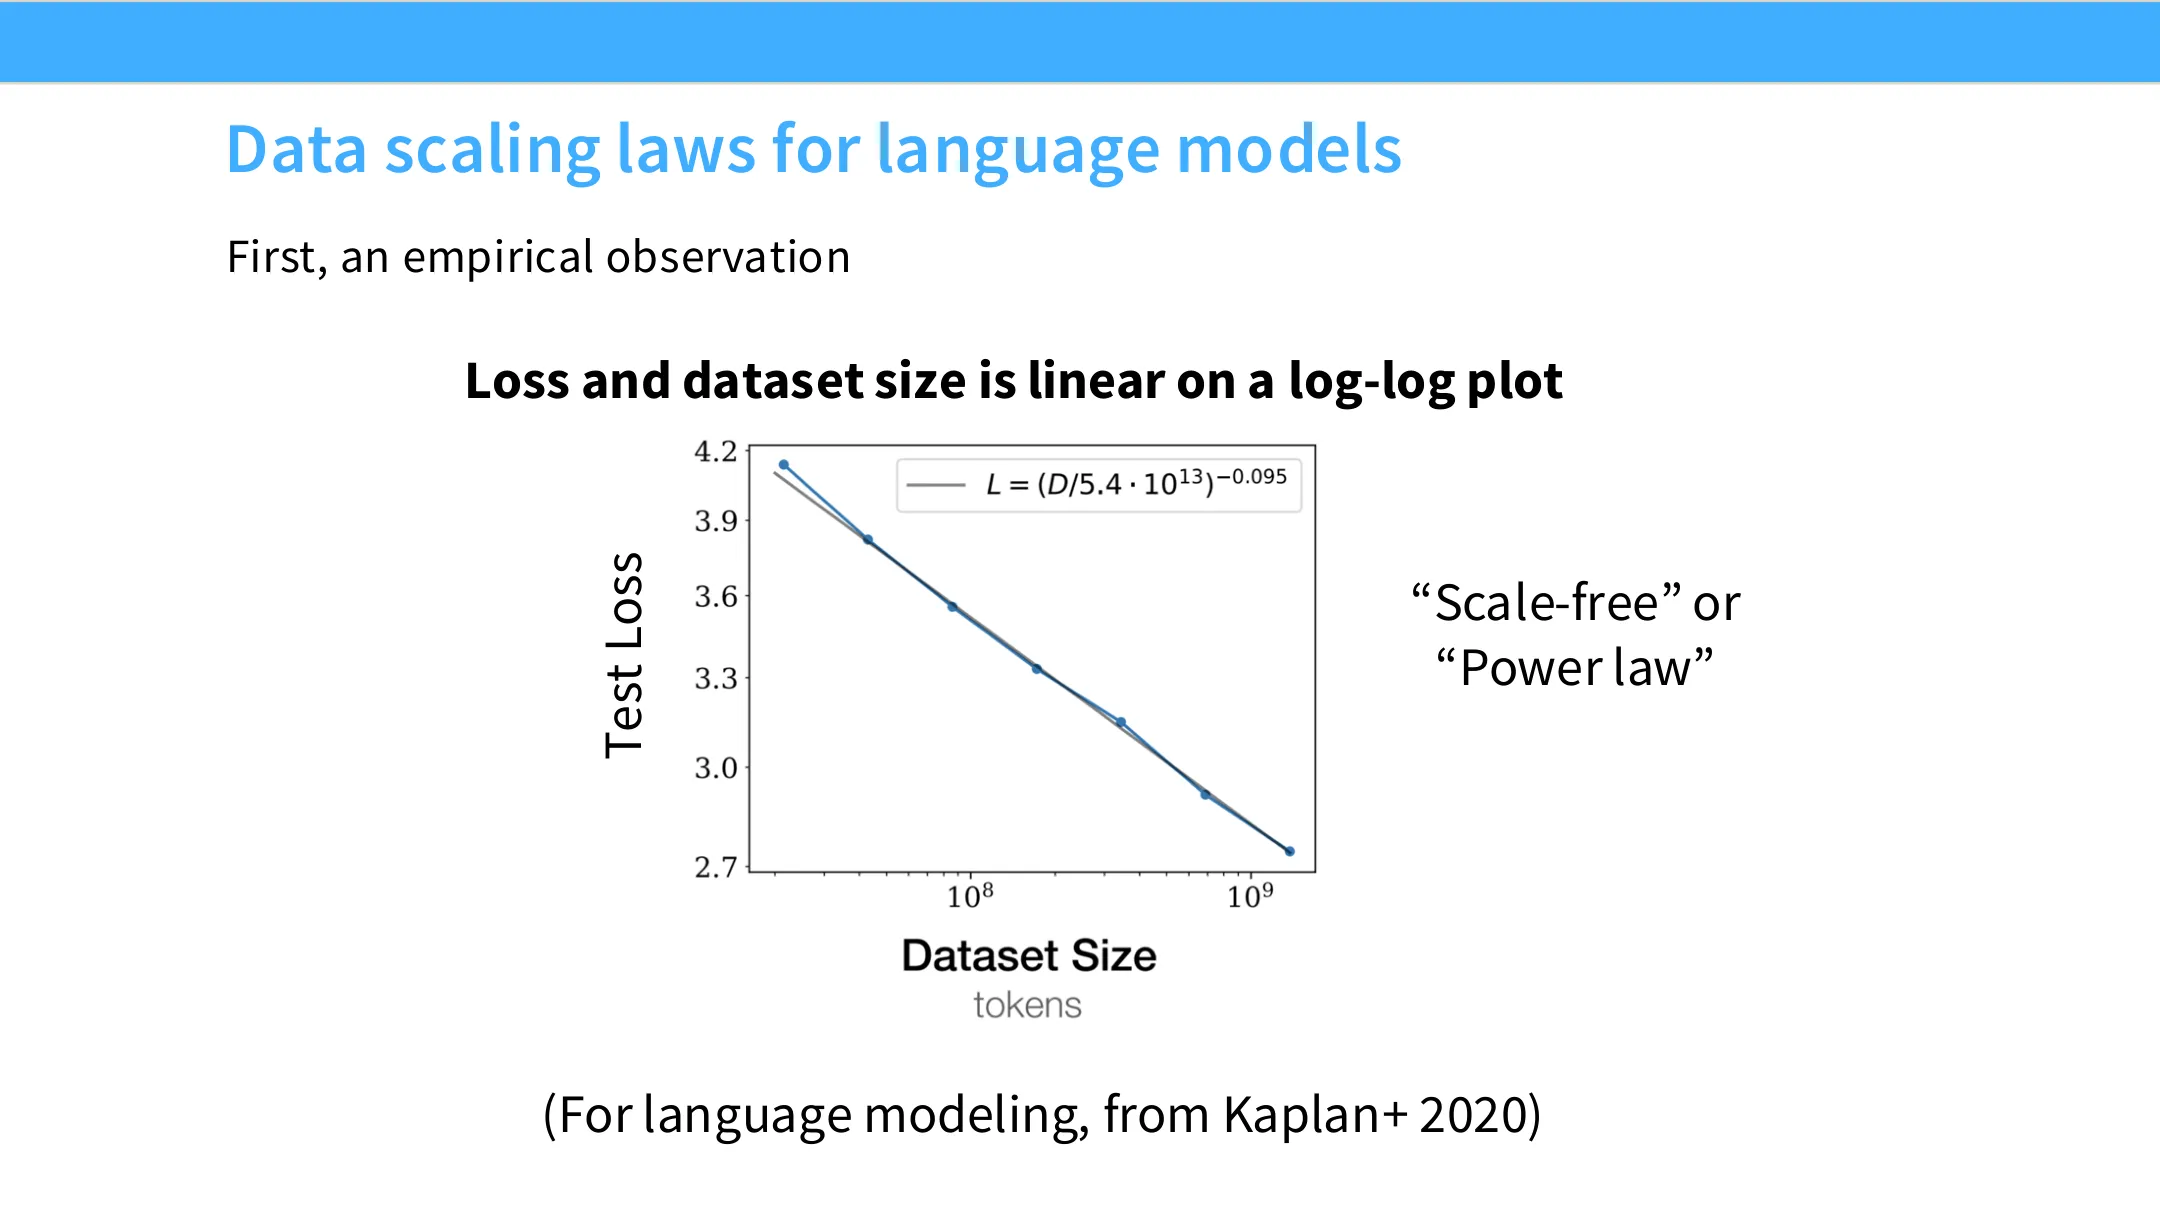
📷 数据 scaling law:log-log 上损失与数据量成直线(来自 Kaplan 2020)
回到原视频 (00:14:33)
这就是「scale-free」或「幂律(power law)」关系。它的含义是:
- 误差在多项式衰减;
- 而且通常意味着你离渐近线还很远——一旦接近渐近线,曲线会弯折而非保持直线。
编者拓展|为什么「离渐近线很远」意味着直线
若真实误差是 $L = C + a n^{-\alpha}$($C$ 是不可约误差),当 $n$ 很小、$a n^{-\alpha} \gg C$ 时,$L \approx a n^{-\alpha}$,在 log-log 上就是一条直线,斜率 $-\alpha$;当 $n$ 很大、$a n^{-\alpha} \ll C$ 时,$L \to C$,曲线弯折并压平。这就是为什么「S 形」在小样本端表现为直线,在大样本端才露出弯折。
3.4 理论基础一:均值估计的 scaling law
(参考时间: 00:15:44)
接下来几页暂时「不是语言建模课,而是统计课」。要回答:为什么 scaling law 会出现?误差为什么是幂律?
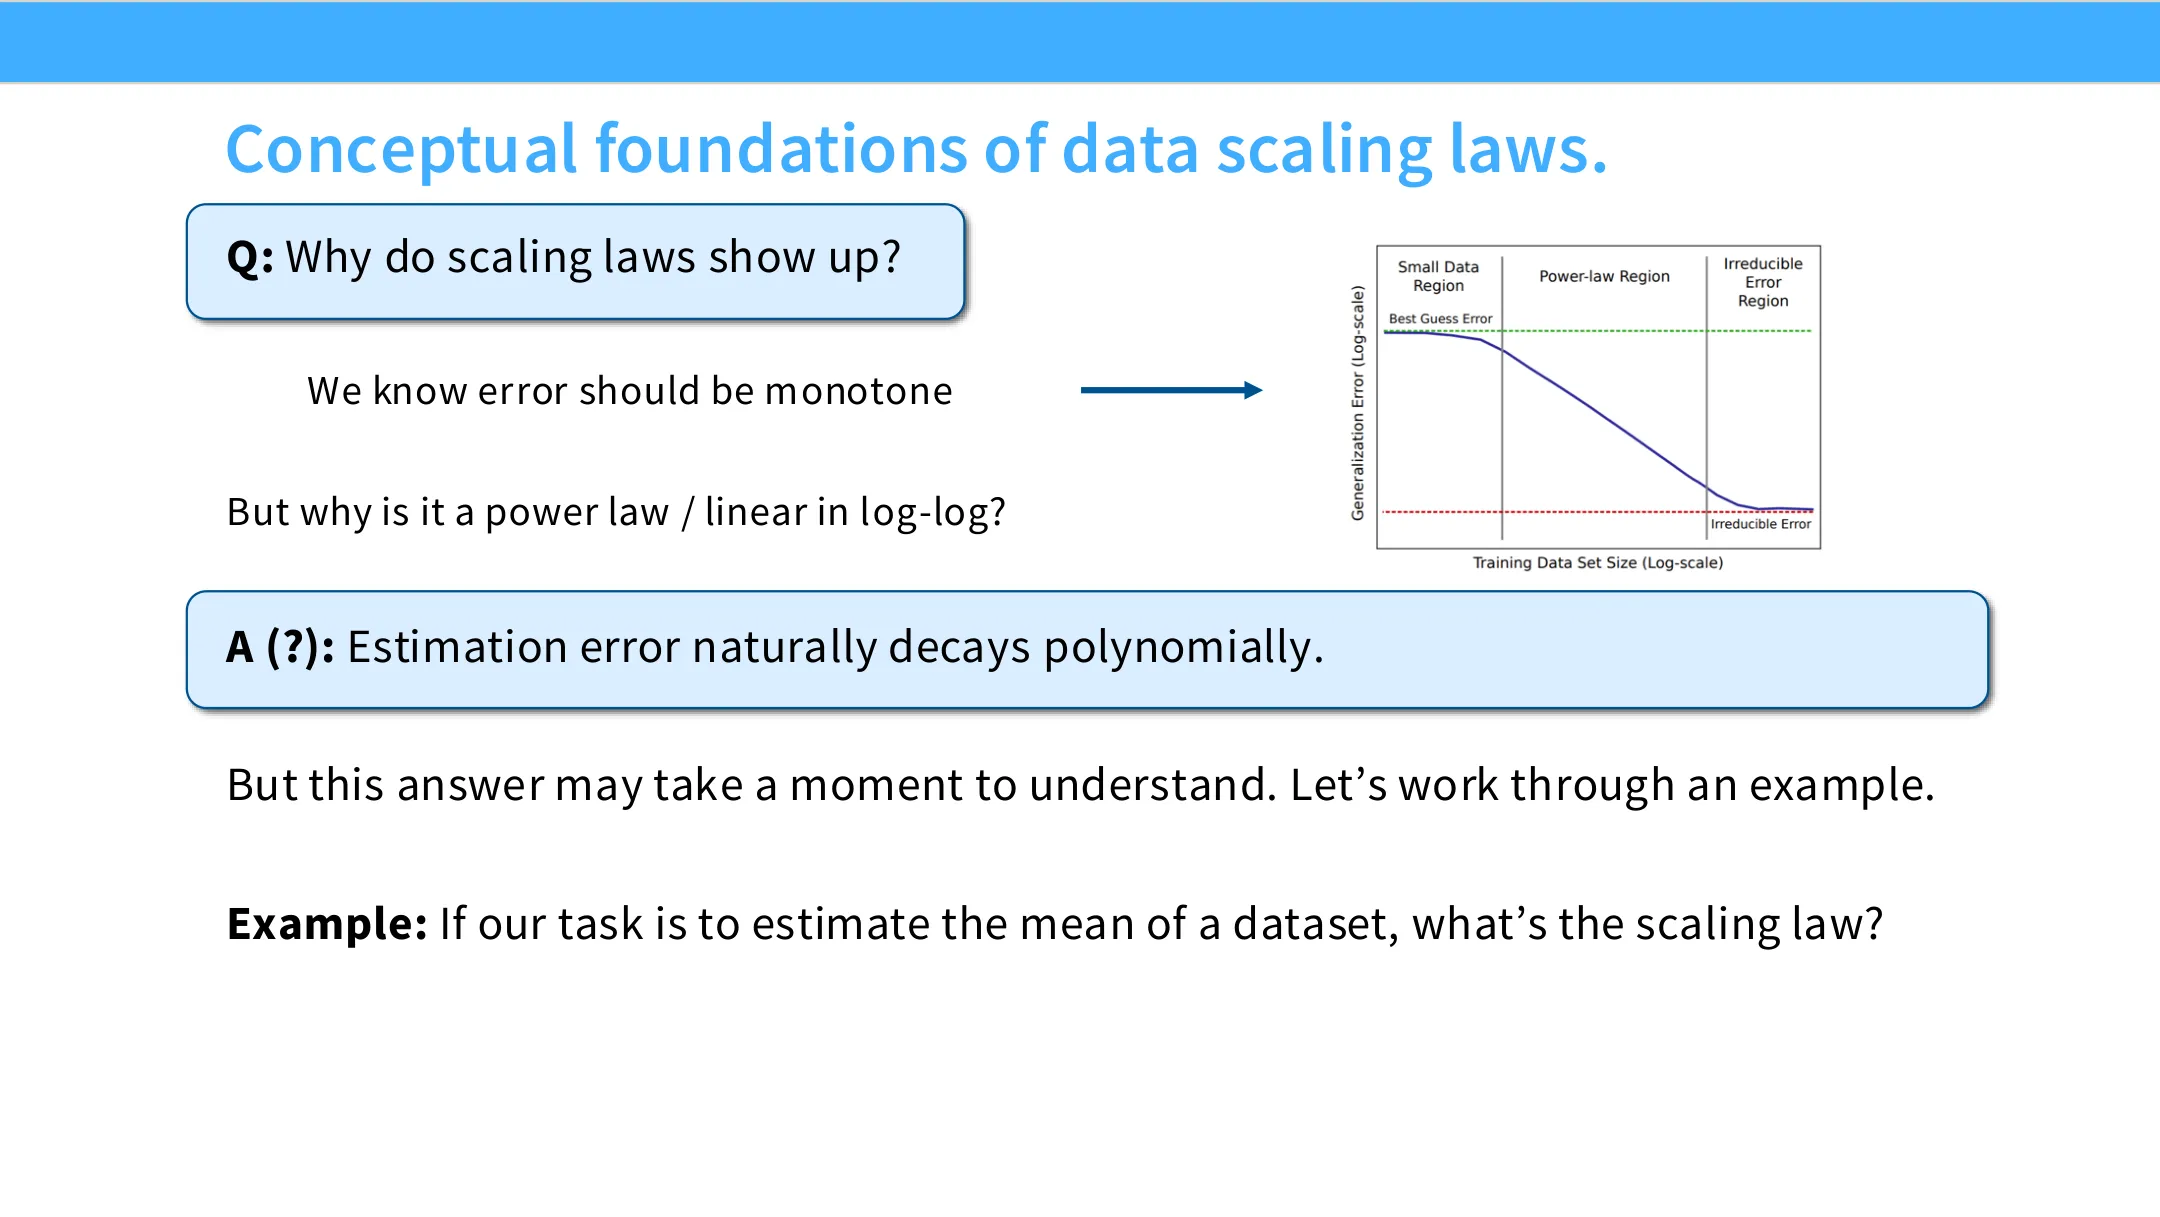
📷 概念基础:误差应当是单调的,但为什么是幂律 / log-log 上的直线?
回到原视频 (00:15:44)
一个初步回答是:估计误差天然按多项式衰减。让我们用一个例子走一遍。
玩具例子:估计均值。
设输入 $x_1, \dots, x_n \sim \mathcal{N}(\mu, \sigma^2)$,任务是估计均值:
$$\hat{\mu} = \frac{\sum_i x_i}{n}.$$
由标准结果,期望误差为:
$$\mathbb{E}\left[(\hat{\mu} - \mu)^2\right] = \frac{\sigma^2}{n}.$$
这本身就是一条 scaling law!取对数:
$$\log(\text{Error}) = -\log n + 2\log\sigma.$$
即 $y = -x + C$,斜率是 $-1$。更一般地,任何 $1/n^{\alpha}$ 形式的多项式率都是一条 scaling law。
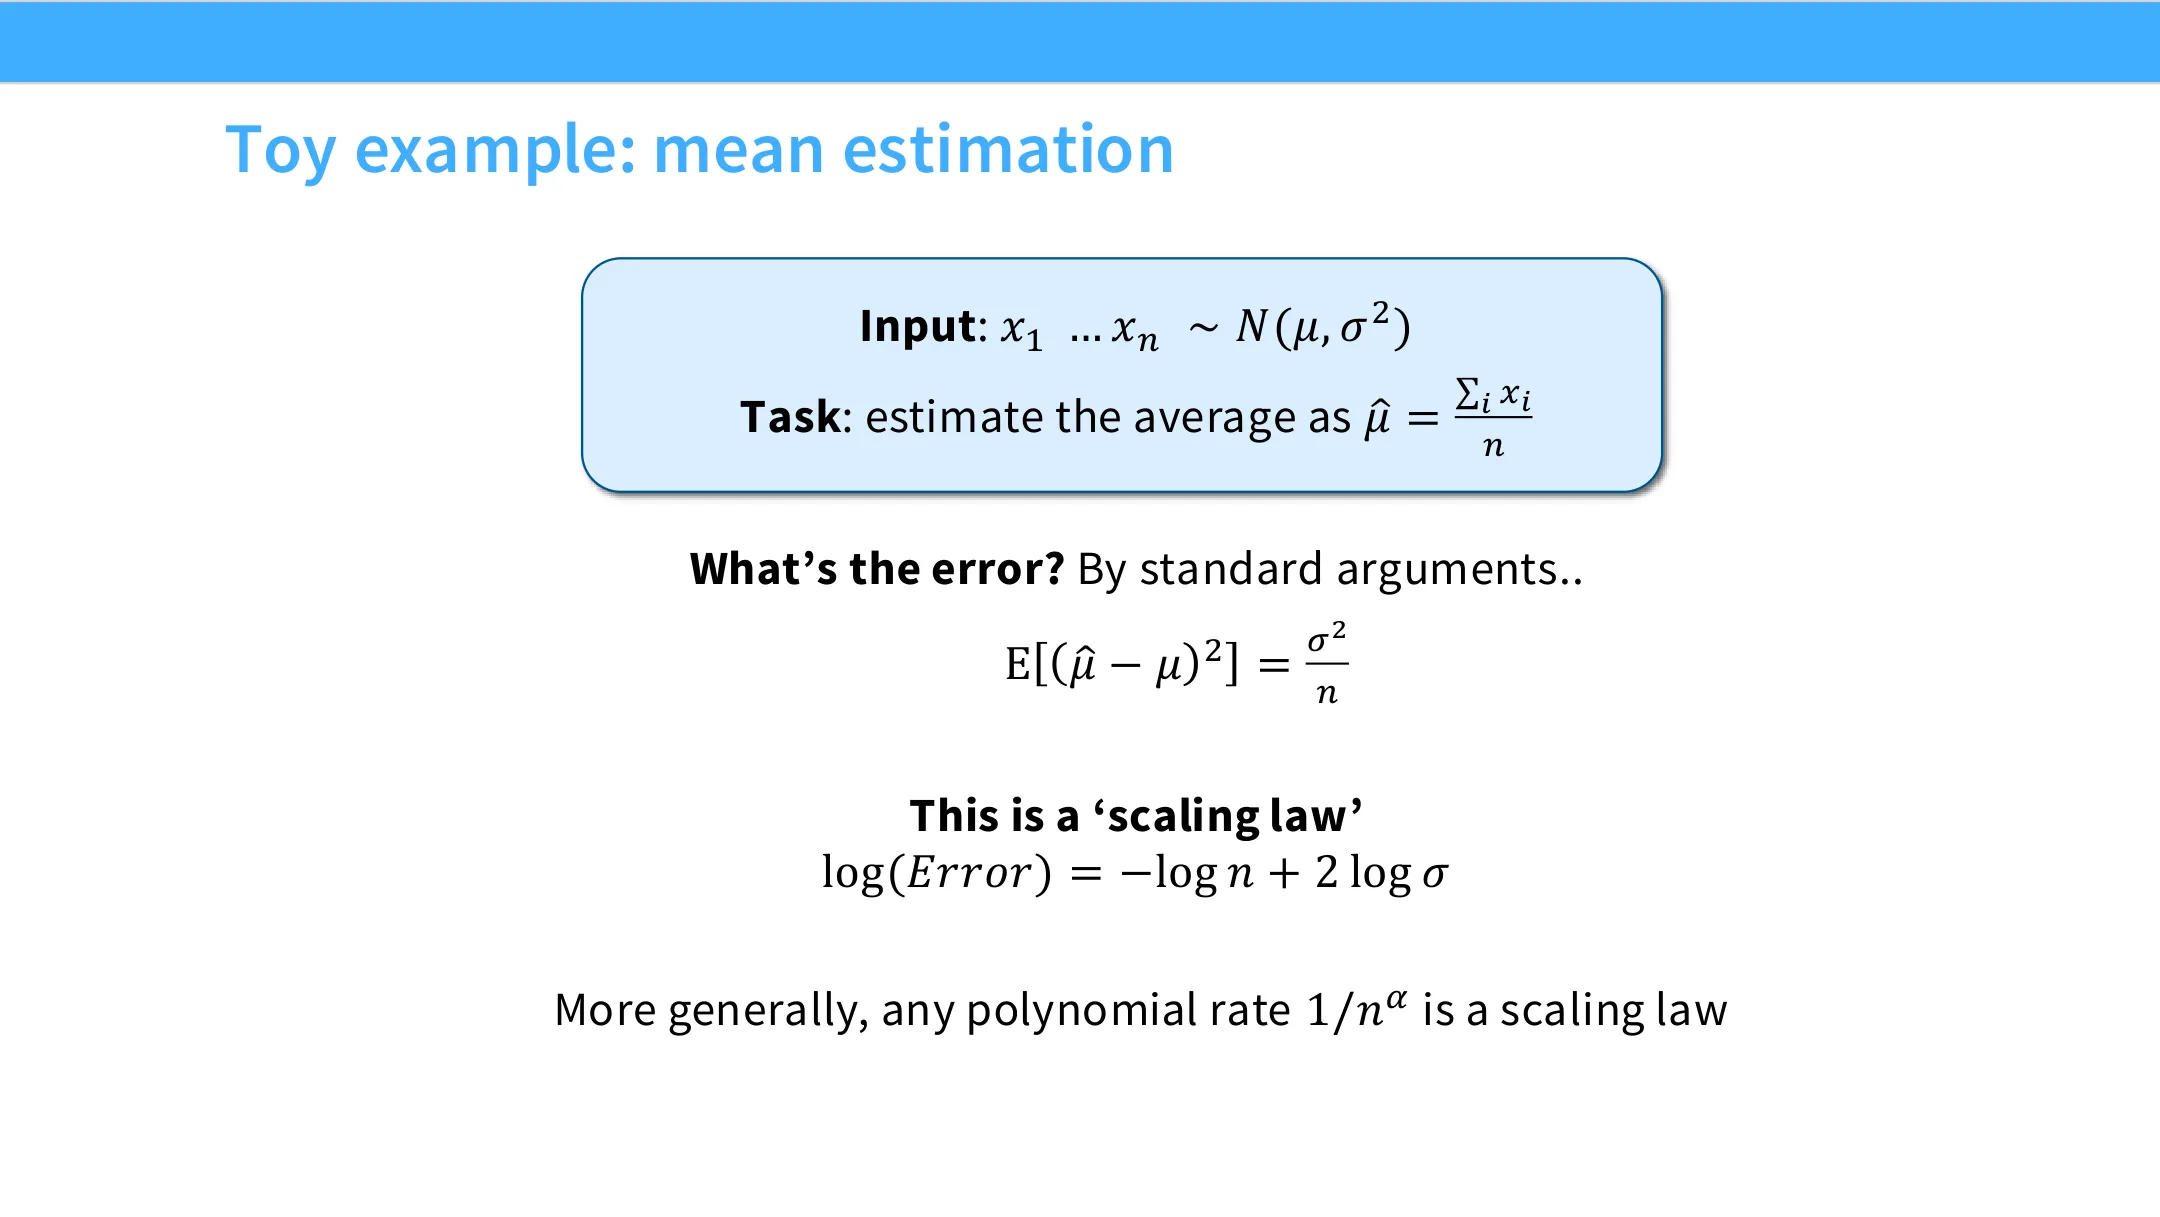
📷 玩具例子:均值估计——误差是 σ²/n,本身就是一个 scaling law
回到原视频 (00:15:55)
编者说明:这就是所谓「参数化估计」的典型速率——均值估计、线性回归等经典模型,收敛率都是 $1/n$ 量级(回归里可能写成 $d/n$)。于是如果理论是唯一的来源,我们在 log-log 图上应当看到斜率约为 $-1$ 的直线。
3.5 神经网络指数之谜:斜率不是 $-1$
(参考时间: 00:17:21)
但拟合神经 scaling law 时,指数差得远:Hestness 与 Kaplan 的结果大致是 -0.1、-0.3 一类,比估计均值或线性回归慢得多。依然是多项式,但收敛率慢很多。
这个指数从哪里来?
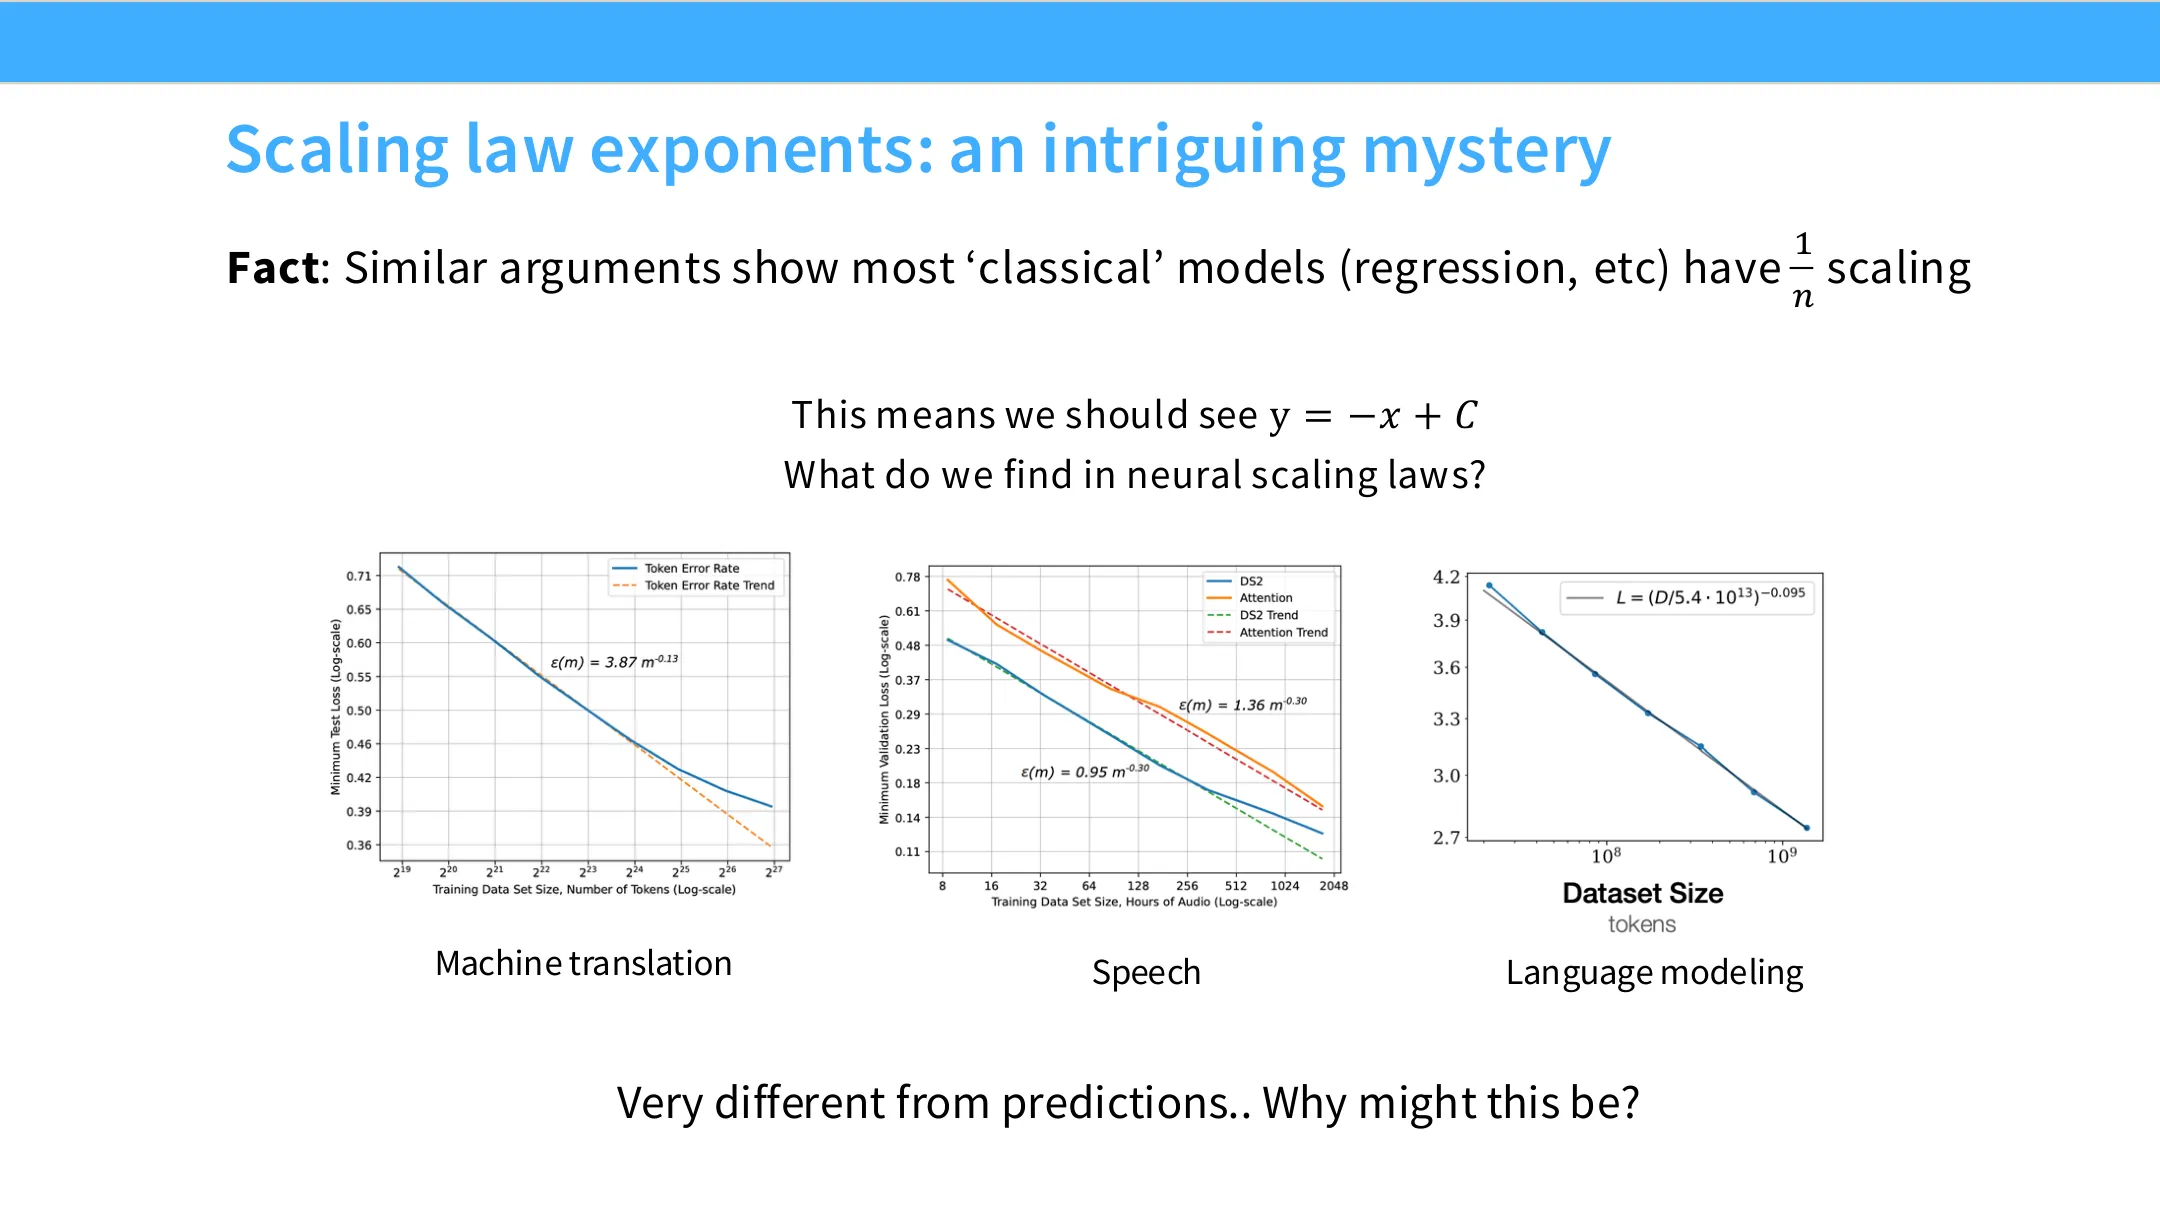
📷 Scaling law 的指数之谜:经典模型是 1/n 速率,但神经 scaling law 的指数完全不同
回到原视频 (00:17:21)
3.6 理论基础二:非参数学习的 scaling law
(参考时间: 00:18:17)
一个能产生这种较慢速率的来源,是非参数模型。看一个例子:
设输入 $x_1, \dots, x_n$ 在 2 维单位方框内均匀分布,$y_i = f(x_i) + \mathcal{N}(0,1)$,任务是估计未知函数 $f(x)$。
一个平凡估计器:把空间切成边长 $n^{-1/4}$ 的小方格。则大约有 $\sqrt{n}$ 个格子,每格分到约 $\sqrt{n}$ 个样本,估计误差约为 $1/\sqrt{n}$,即
$$\text{Error} \approx \frac{1}{\sqrt{n}} + \text{(其他光滑性项)}.$$
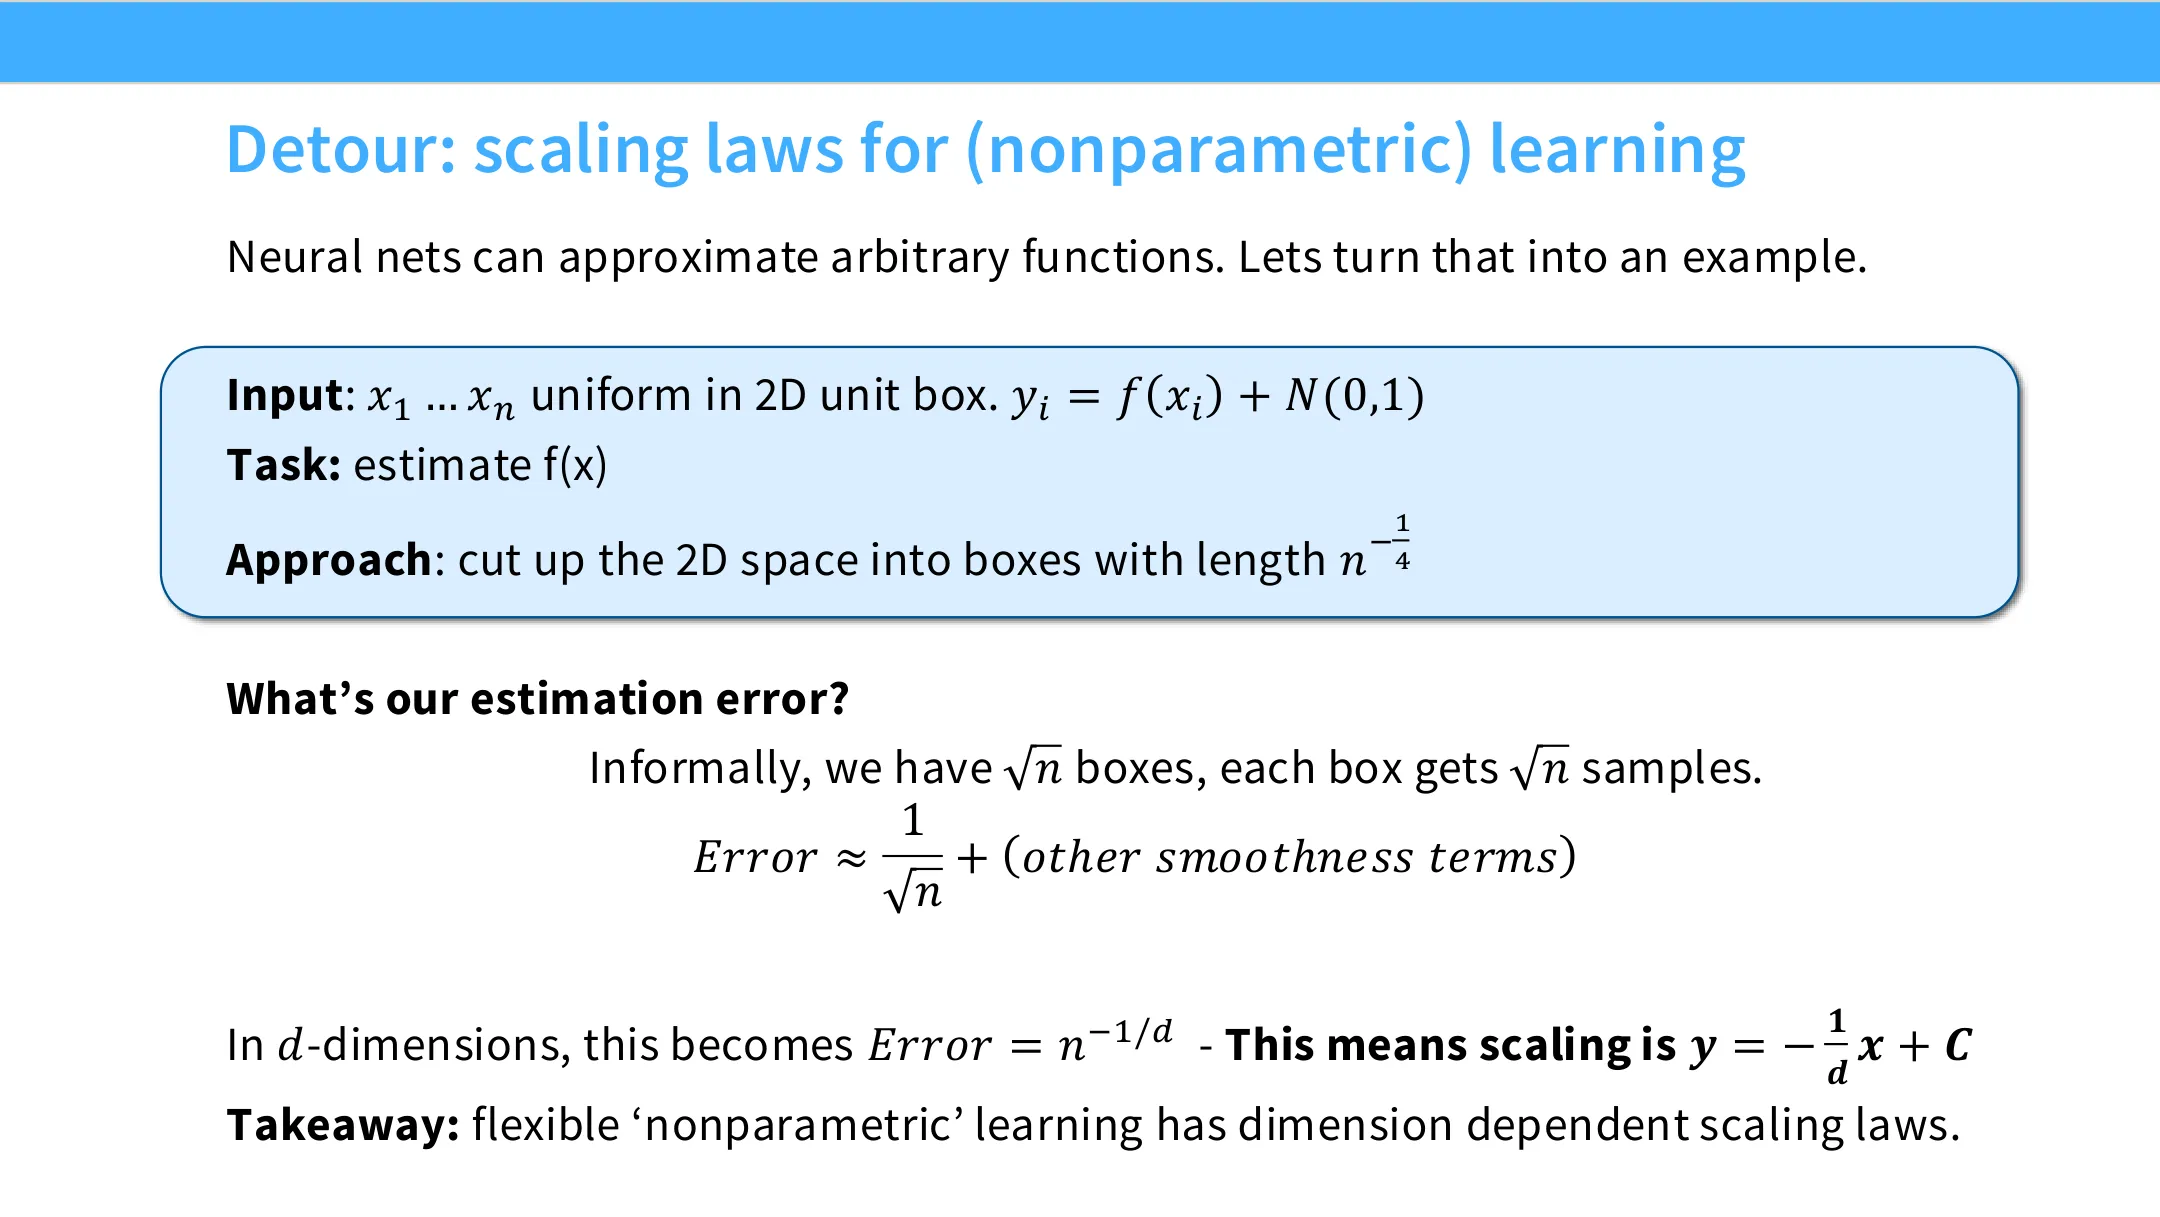
📷 非参数学习的 detour:在 2D 空间切格子估计 f(x)
回到原视频 (00:18:17)
推广到 $d$ 维:
$$\text{Error} \approx n^{-1/d}.$$
也就是说,scaling law 变成
$$y = -\frac{1}{d}x + C.$$
结论(老师原话意的转述):灵活的「非参数」学习,其 scaling law 的指数依赖维数 $d$。
编者拓展|「维数灾难」与 $1/d$ 速率
这个 $n^{-1/d}$ 是非参数回归的经典收敛率,被称为维数灾难的体现:$d$ 越大,为了把误差降一半,样本量要翻 $2^d$ 倍。所以神经网络的 $-0.1$ 级别指数,等价于「它在以大约 10 维的非参数估计器的速率学习数据」。这也是「本征维度(intrinsic dimension)」理论想表达的东西。
3.7 本征维度理论:买多大账?
(参考时间: 00:19:46)
有人(Bahri 2021 等)把它讲得更强:
- Scaling law 源于 $1/n^{\alpha}$ 的多项式学习率;
- 有人认为指数 $\alpha$ 与数据的本征维度紧密相关。
但老师谨慎提醒:本征维度的估计器本身很不可靠,这个论证不严密。 这个直觉你可以「按自己的程度去接受」。证据有些地方可能不太靠谱,它依赖于本征维度的估计。
不过这个想法很有意思:这些指数或许真的在告诉我们——神经网络到底学习得多快。
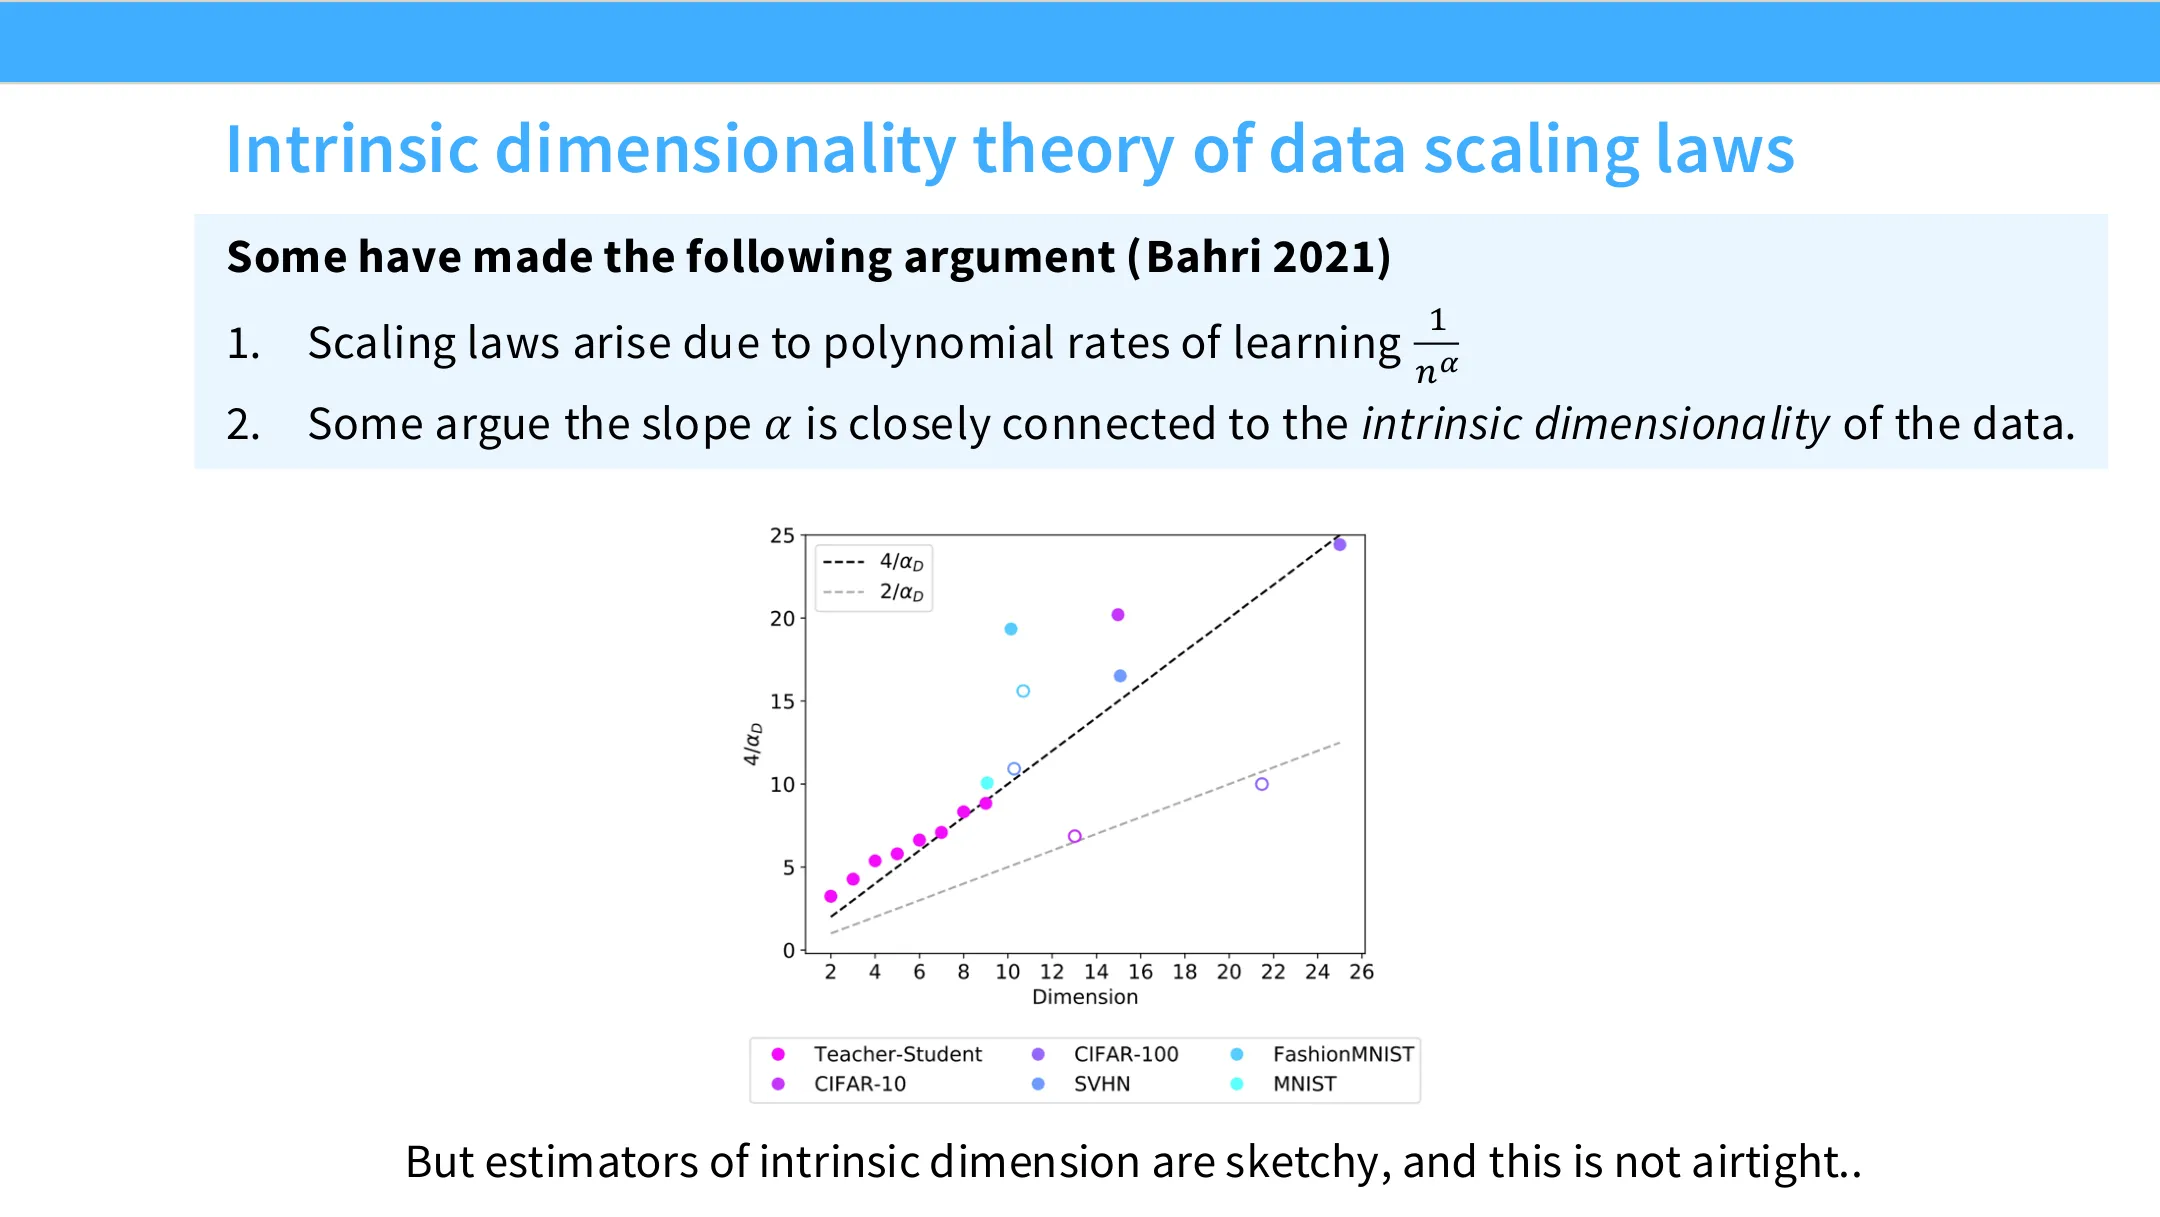
📷 本征维度理论:指数 α 可能与数据本征维度有关,但估计器不可靠
回到原视频 (00:19:46)
课堂问答(参考时间: 00:20:39):
- 问:你说「模型总是比数据集大」,是参数数 vs token 数一对一比较吗?
- 答:当模型相对数据变得很小(数据远多于模型容量)时,你就进入了不可约误差regime——数据再多也没用。所以在讲 scaling law 时我们通常只看 幂律 regime,要么就显式拟合渐近线再修正。说「模型比数据大」,只要处在幂律 regime 即可,通常大约 10 倍就够。
老师在这里收尾:数据 scaling law 最基础的一版——单一分布、采样、学习——就到这里。
四、数据工程中的 scaling:混合、重复与筛选
4.1 数据 scaling law 本身不够用
(参考时间: 00:21:41)
数据 scaling law 本身并没那么有用——它只告诉你「模型学得多快」,这利于预测,但不利于工程。工程上你更关心别的:
- 最优数据混合是什么?(怎样为模型挑选训练数据)
- 该不该重复数据?还是把算力省下来做别的?
- 或者:重复高质量数据、不重复低质量数据?
有很多工程决策可以做。Scaling law 怎样帮上忙?
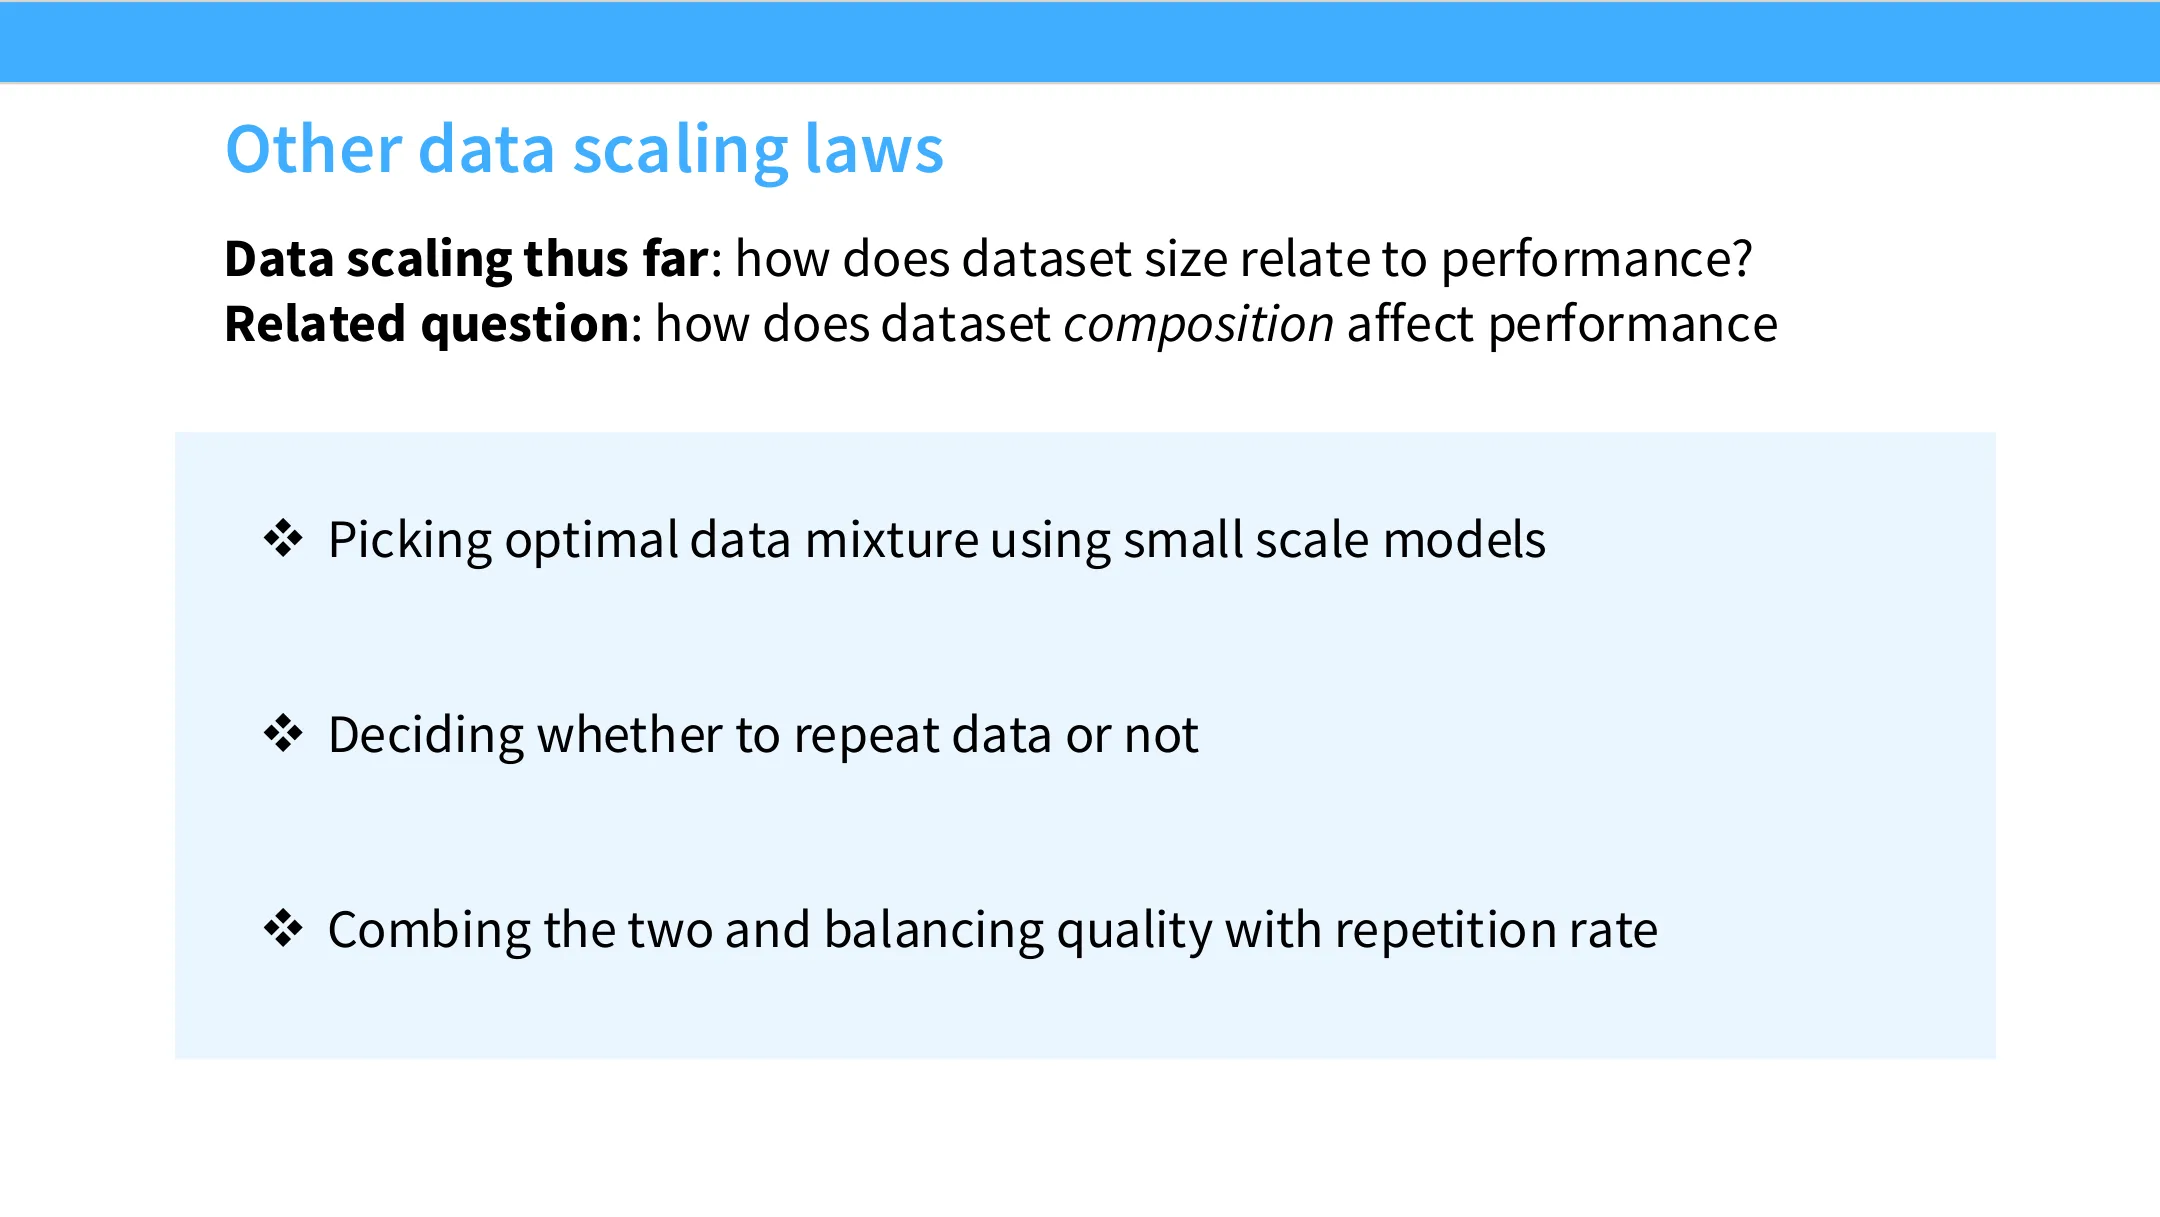
📷 其他数据 scaling law:数据组成如何影响性能
回到原视频 (00:21:41)
4.2 分布偏移:改截距,不改斜率
(参考时间: 00:22:28)
关键洞察来自一个类比:数据 scaling law 是泛化界的经验版本,它告诉我们——对很多模型,数据集的组成主要影响截距(offset),而斜率由模型类决定。也就是说,不同数据分布下斜率可能保持不变,只有截距改变,而这个截距的形状可以非常有意思。
幻灯片上给了一个玩具模型:线性回归、可以从两种数据源采样。如果只取一种数据,误差怎么都高;你需要两者的混合。把截距的表达式写出来,就会得到「数据多样性非常有价值」这样很漂亮的洞见。
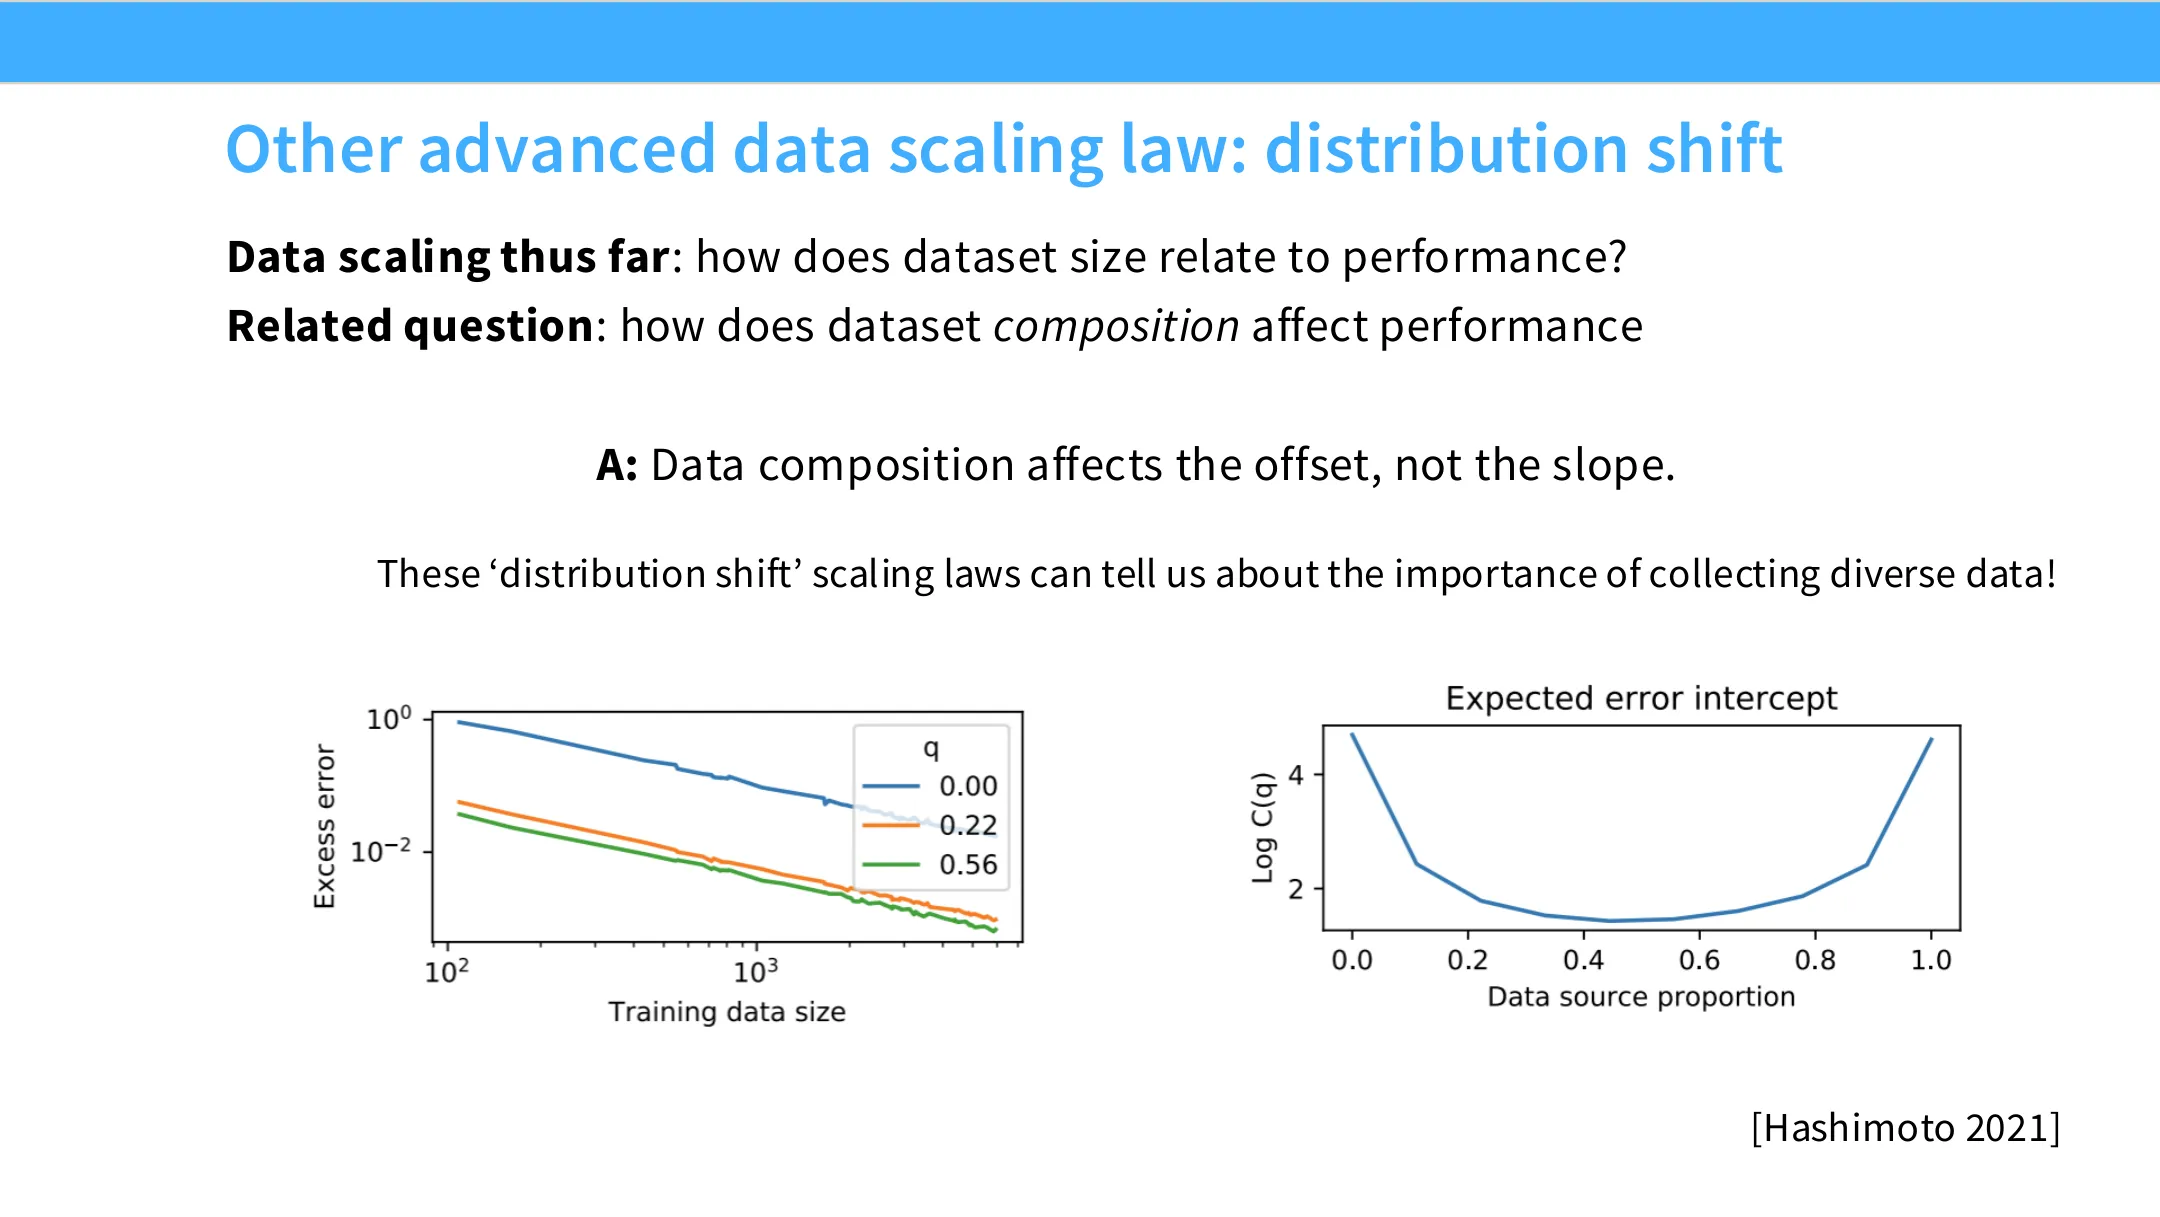
📷 分布偏移 scaling law:数据组成影响截距而非斜率(Hashimoto 2021)
回到原视频 (00:22:28)
4.3 用 scaling law 选数据混合(以及现实的教训)
(参考时间: 00:23:37)
实用含义:你可以在混合数据上拟合 data scaling law,用它做预训练数据优化。
比如你只有两个来源:新闻和维基百科,想知道该用多少新闻、多少维基。做法是:
- 在很小的模型和很小的数据上,训练一批、拟合「不同混合比例 → 性能」的函数;
- 一点一点把模型放大,观察趋势如何变化;
- 像外推数据 scaling law 一样外推,问:如果 scale 到我的完整训练规模,哪个混合比例最优?
这是一个很简单的思路:在小算力上拟合函数形式,找最小值,再外推到大规模。
但老师紧接着泼冷水(很重要):
现实中做过大量数据混合工作的人会告诉你,现实比这个理想世界吵闹得多。据我所知,很多情况下实际发生的是——训练一堆小模型,挑出最好的数据混合,直接把它 scale 上去。根本不用 scaling law。
He 提了一个大规模实证研究(data decide 类工作):如果不拟合 scaling law、只在小规模挑最好的数据混合,效果就很好。 这与「截距不同但斜率不变」的论证一致——因为斜率不变,小规模的最优混合也就是大规模的最优混合。
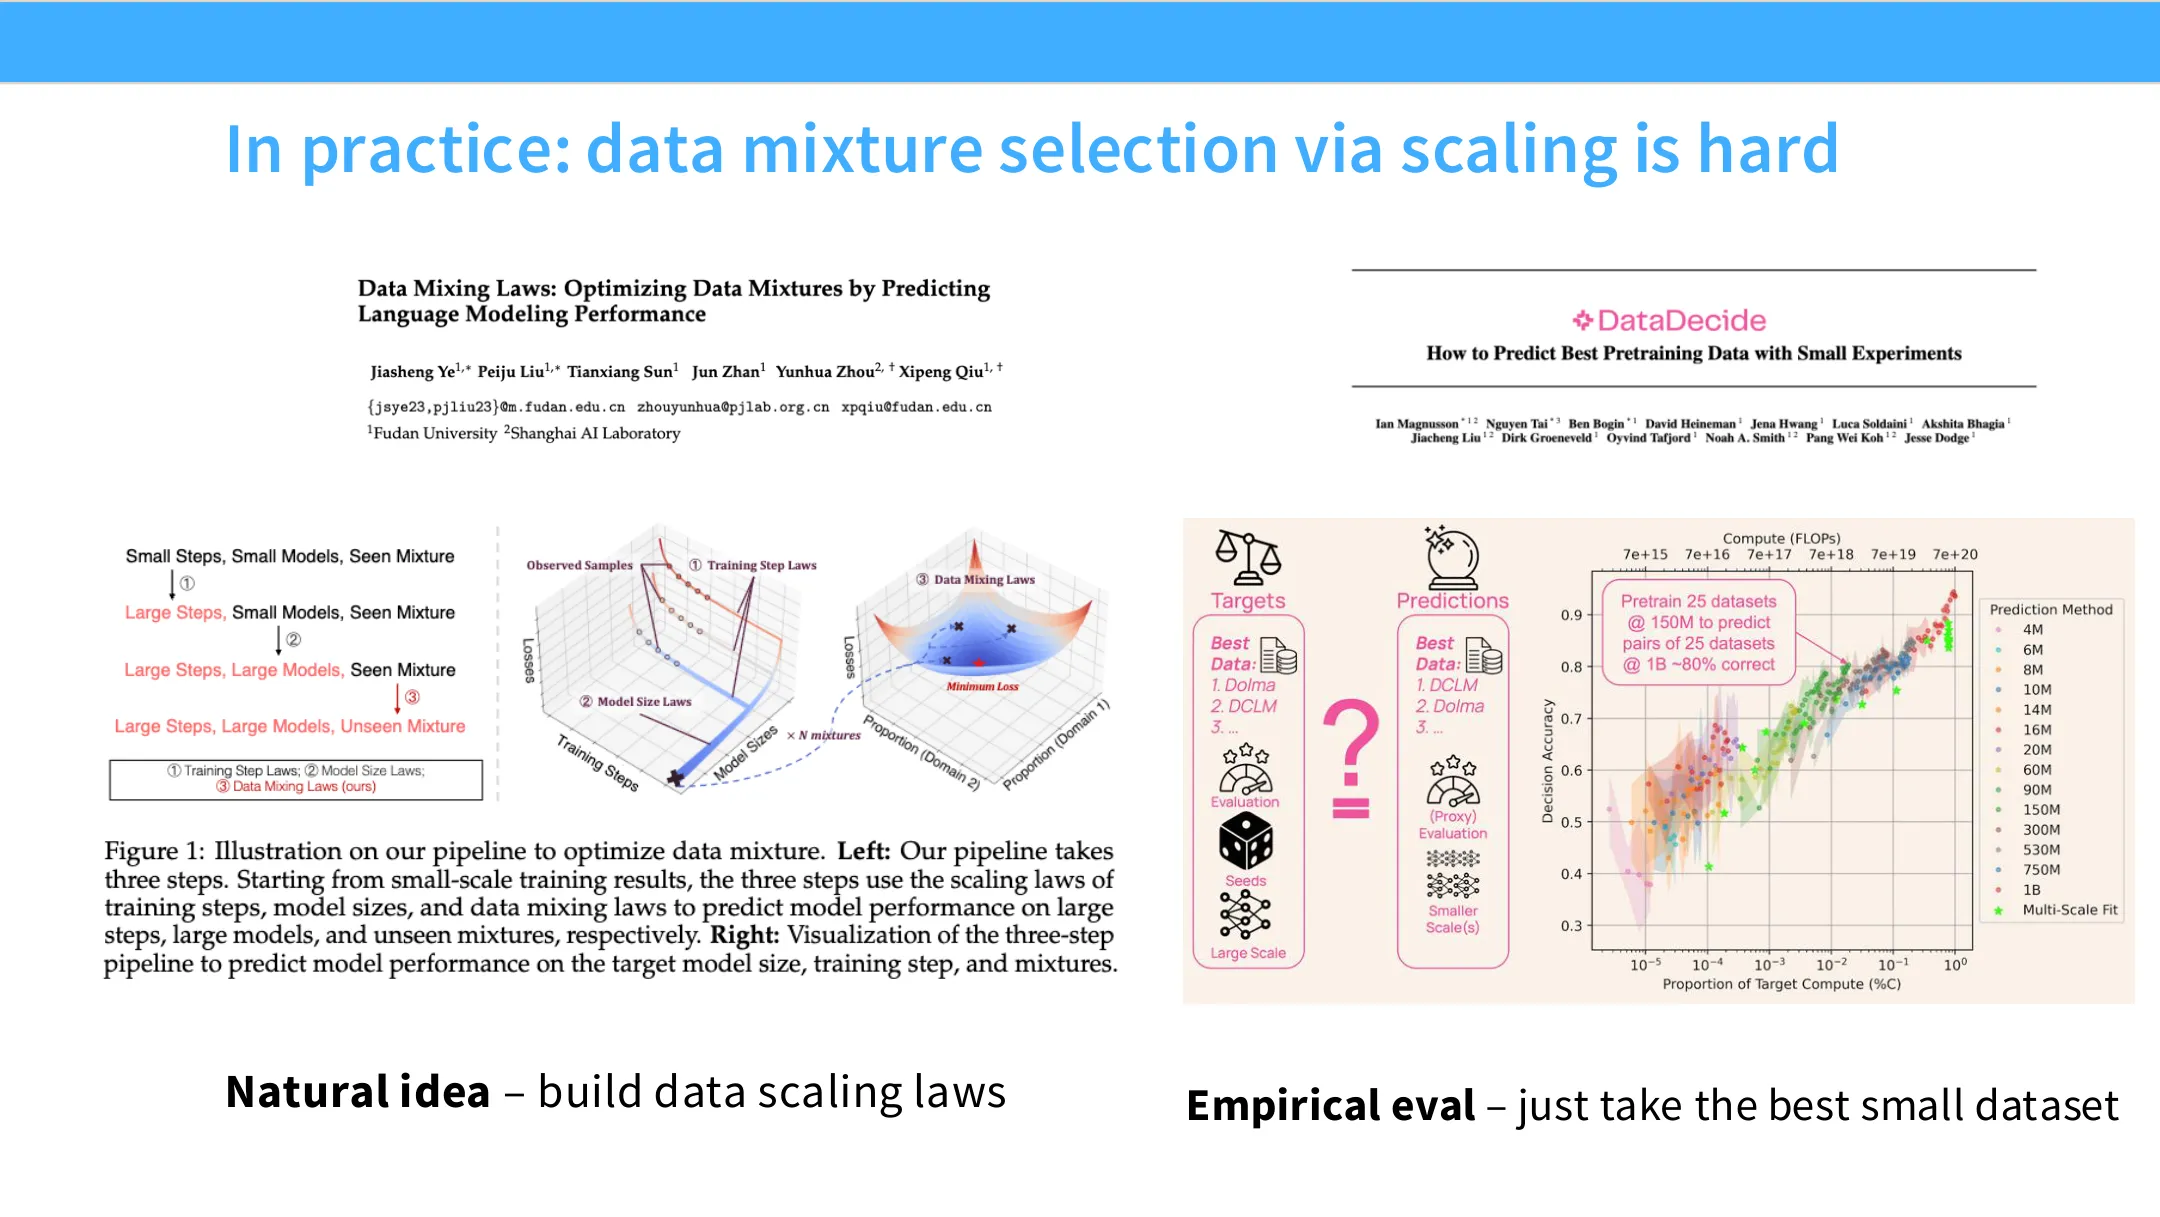
📷 实践中:数据混合的 scaling 很难,往往「直接取最好的小数据集混合」即可
回到原视频 (00:23:37)
4.4 数据重复的 scaling law
(参考时间: 00:25:22)
另一组有意思的问题:数据重复。算力在增长,数据量却不再增长,所以很多人关心「反复多次重复同一批数据」会发生什么。
有一项研究(scaling data-constrained language models)大致表明:
- 用标准训练配方,最多约 4 个 epoch,你完全不会受害;
- 但如果超过这个点,你的实际 scaling law(图上深色曲线)会比「有新鲜数据时的投影 scaling law」(虚线)差很多。
也可以写下一个修改过的函数形式,一般能预测重复下的行为。
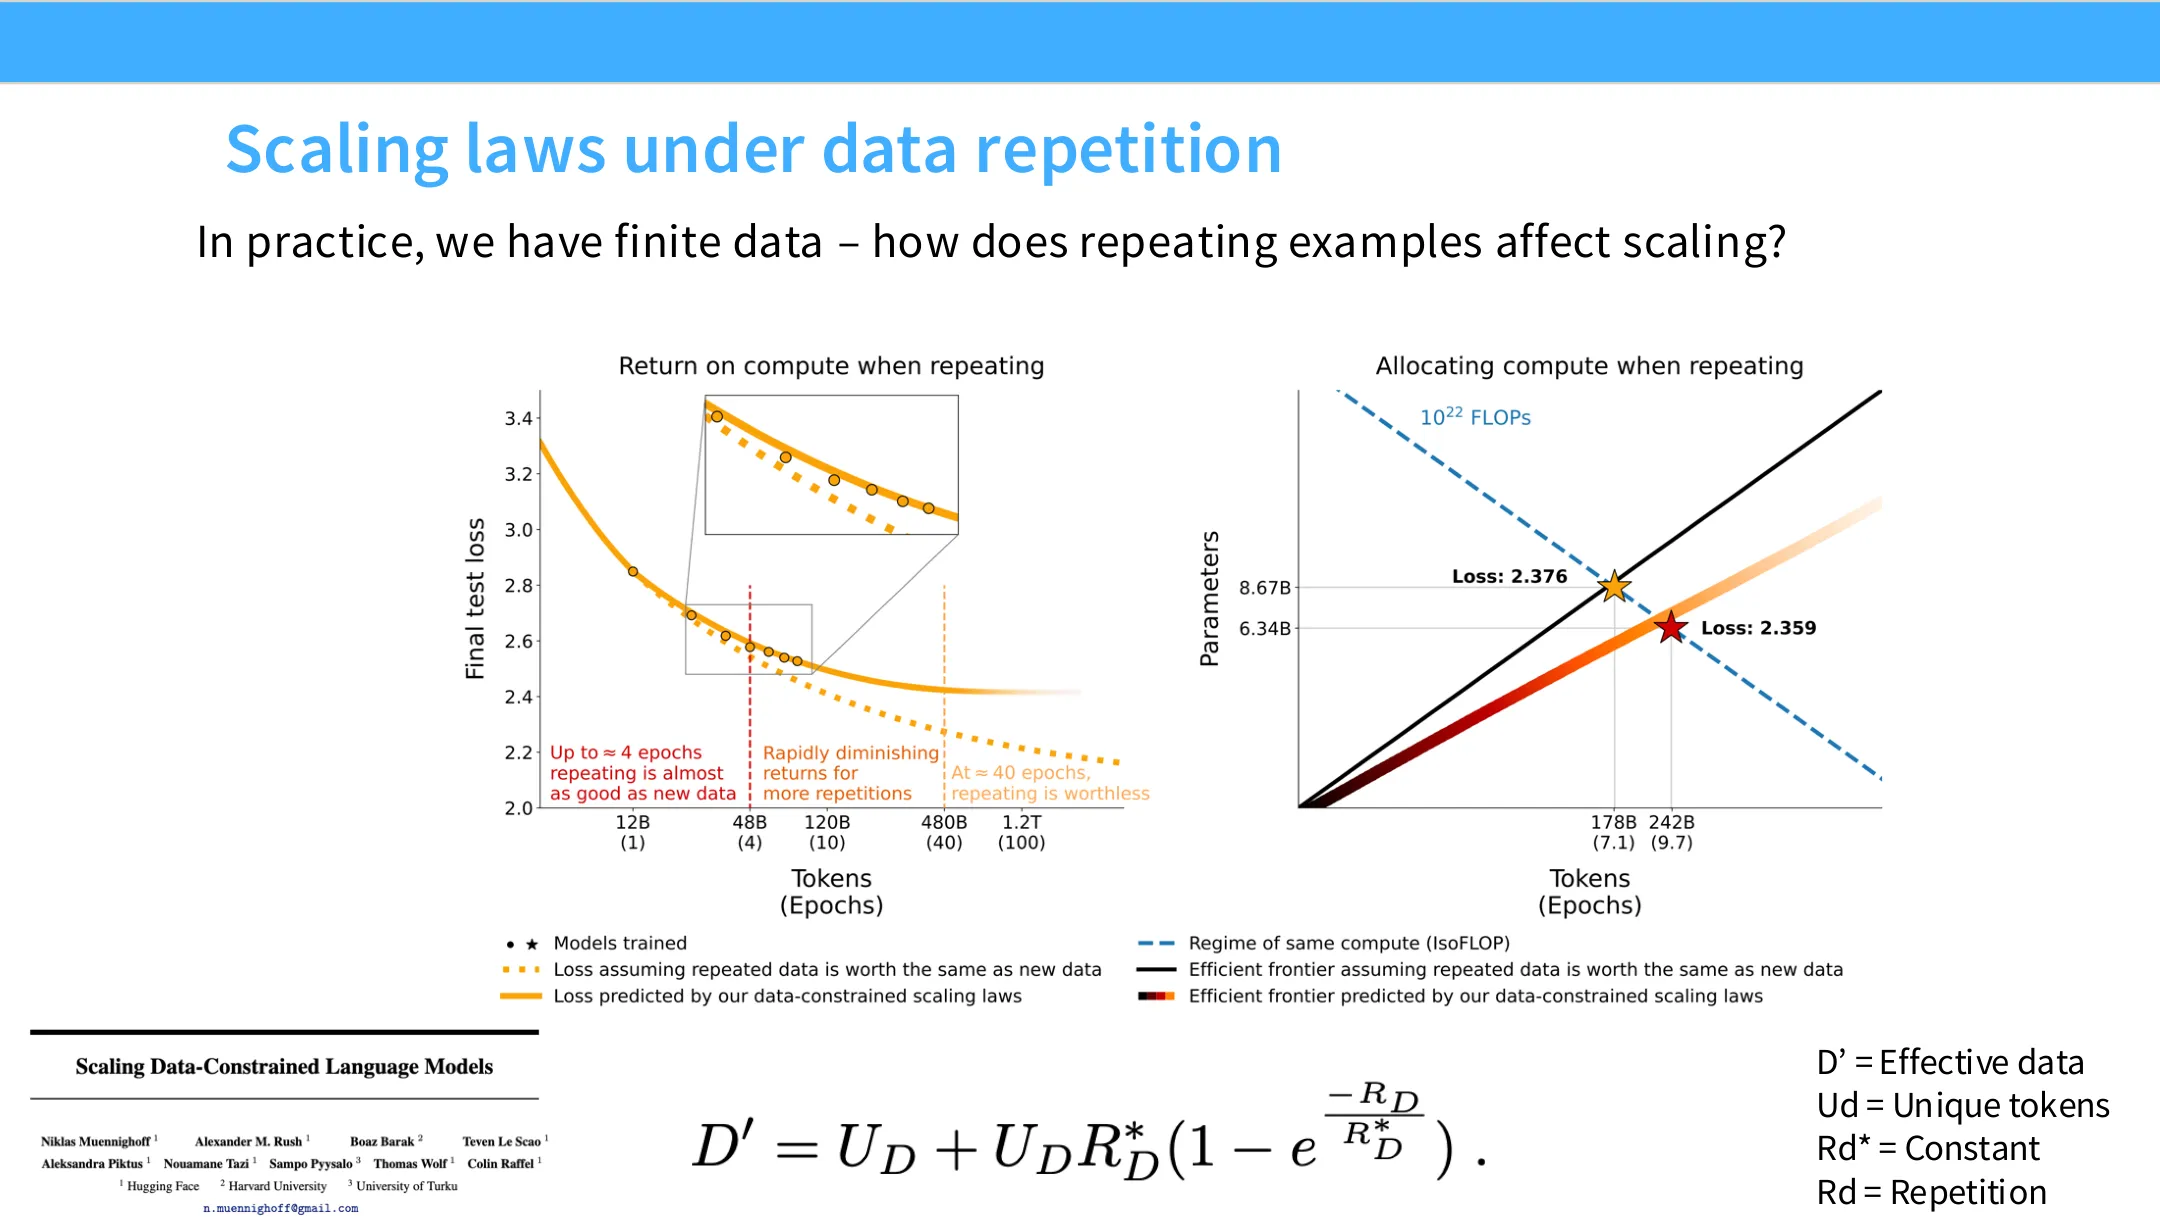
📷 数据重复下的 scaling law:约 4 个 epoch 内无损,之后实际曲线比投影差
回到原视频 (00:25:22)
4.5 无限算力下的 scaling
(参考时间: 00:26:16)
把这个思路推到极端:如果算力是无限的会怎样? 这是老师与共同指导的学生 Perseus 的近作所探讨的:允许任意多次 epoch,能拿到的最优是什么?
结论:
- 你不能无限重复数据,也不能无限放大模型——它们都有递减收益;
- 于是你会转向其他手段,比如模型集成(ensemble),从数据里榨出更多;
- 一个有意思的观察是:标准数据 scaling law(图中红色)是漂亮的、可预测的改进;而当你加入正则化、加集成等干预时,性能确实提升,但斜率看起来惊人地相似。
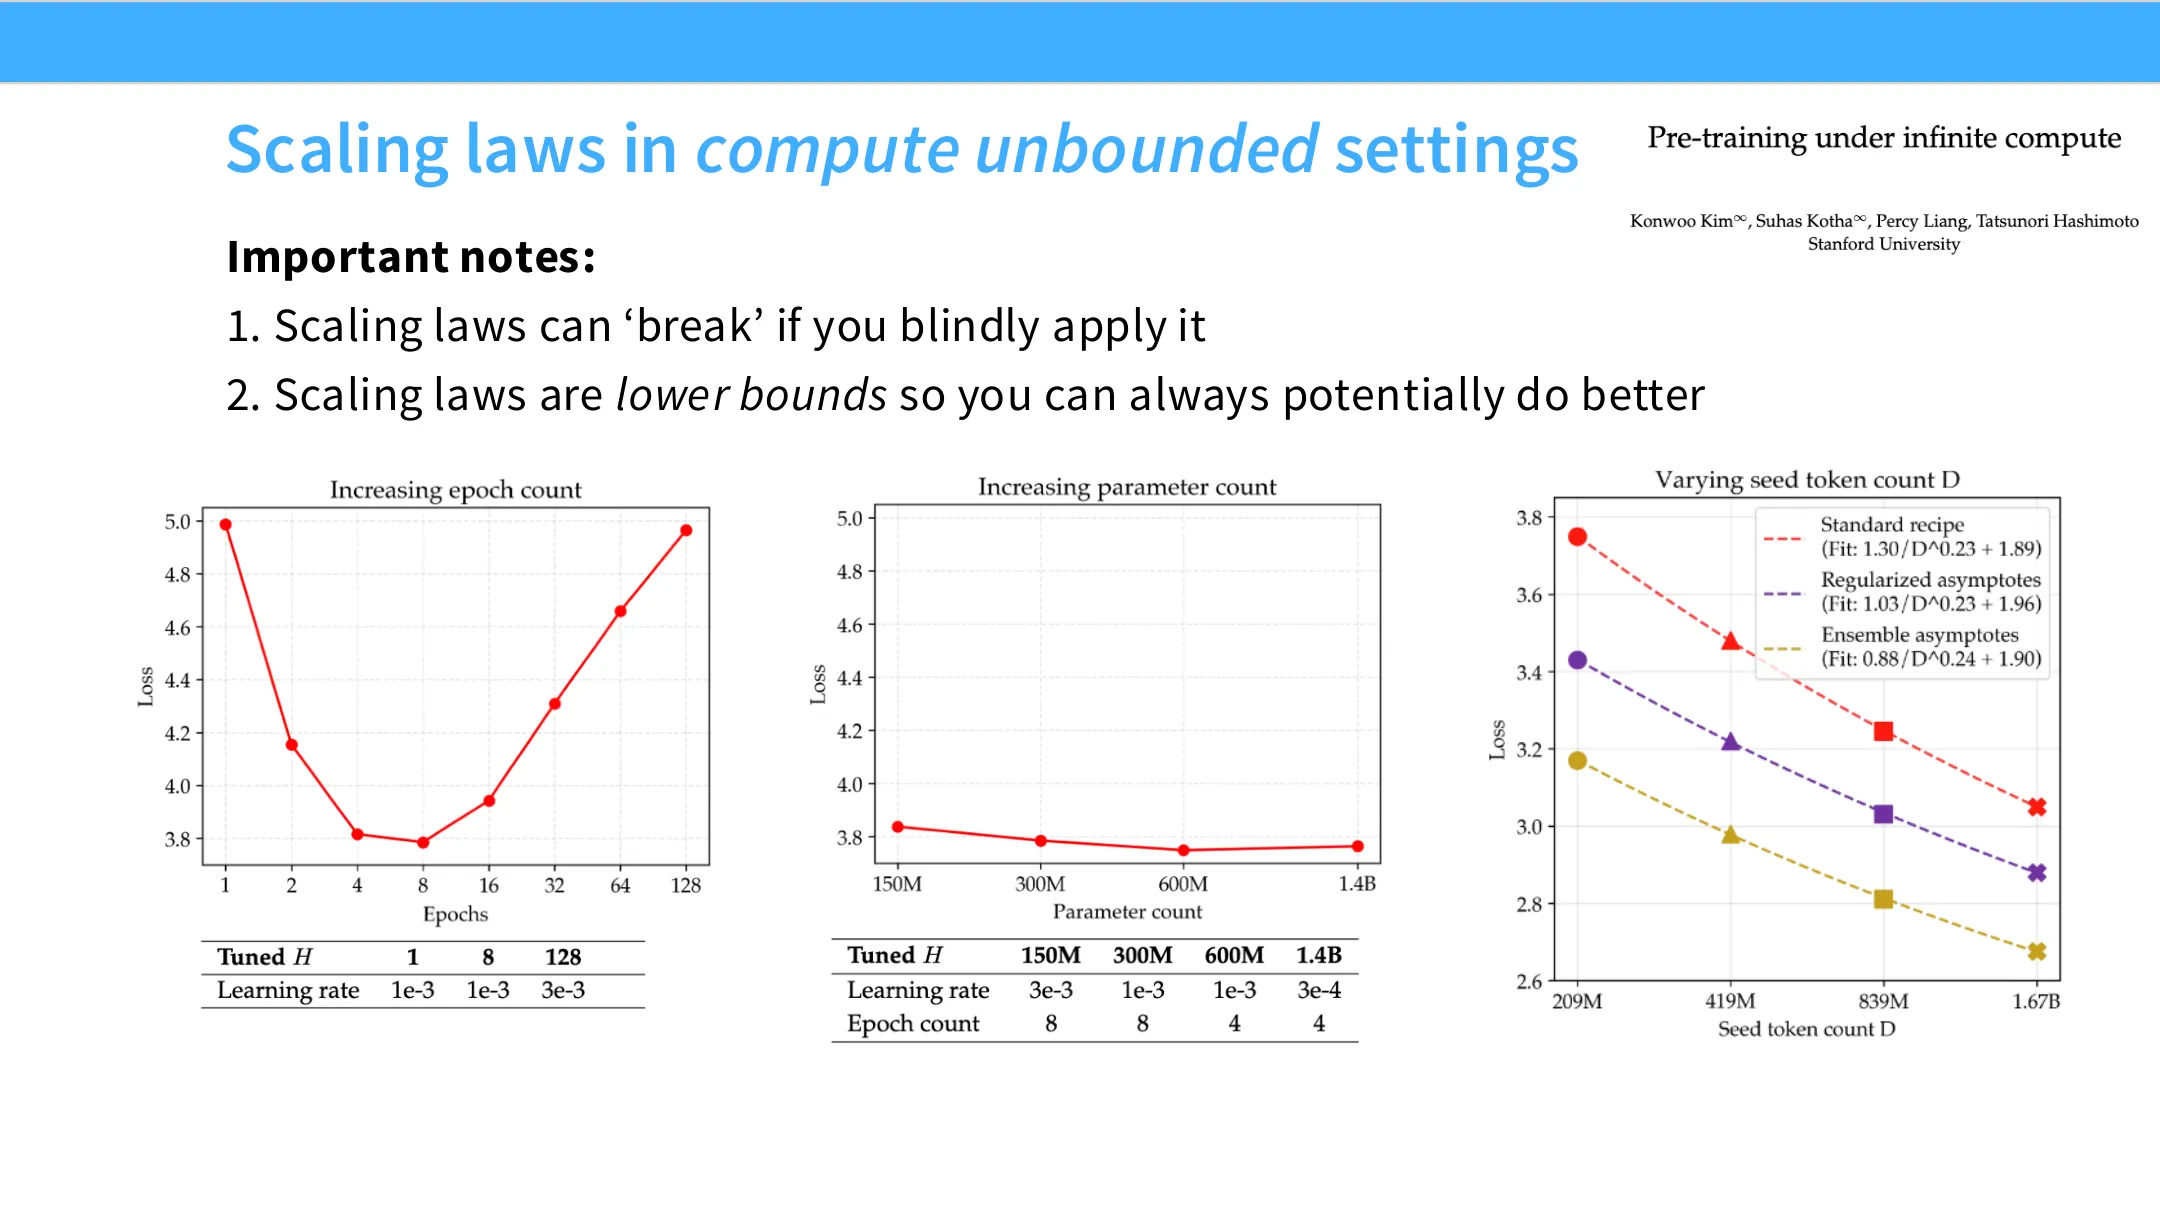
📷 无限算力下的 scaling law:各种干预提升性能,但斜率惊人地相似
回到原视频 (00:26:16)
老师由此引出 scaling law 的一个普遍教训:
当你开始拟合自己的 scaling law 时,会非常频繁地发现:你的斜率不变。 你做的干预,往往只改变截距。
4.6 数据筛选是「随规模变化」的
(参考时间: 00:27:19)
最后一点:很多我们关心的数据现象其实高度依赖规模。一个典型例子是数据过滤(data filtering):
- 如果你或我明天要过滤数据,我们多半会非常激进——只保留最高质量的部分。因为你我算力都不多,反正训不完整个互联网,那就干脆筛出最高质量的。
- 但如果你算力很多,你就想训更多东西,因为你不希望反复重复那批高质量数据。于是随着算力增加,你的过滤器会越来越松,甚至开始训练质量更低的数据。
所以,很多我们常常当成「静态」问题来想的东西(比如数据过滤、数据质量),其实是动态的。随着规模变大,你必须重新考虑「剩下的数据从哪来」——过滤器不能固定不变,最优过滤器随规模变化。
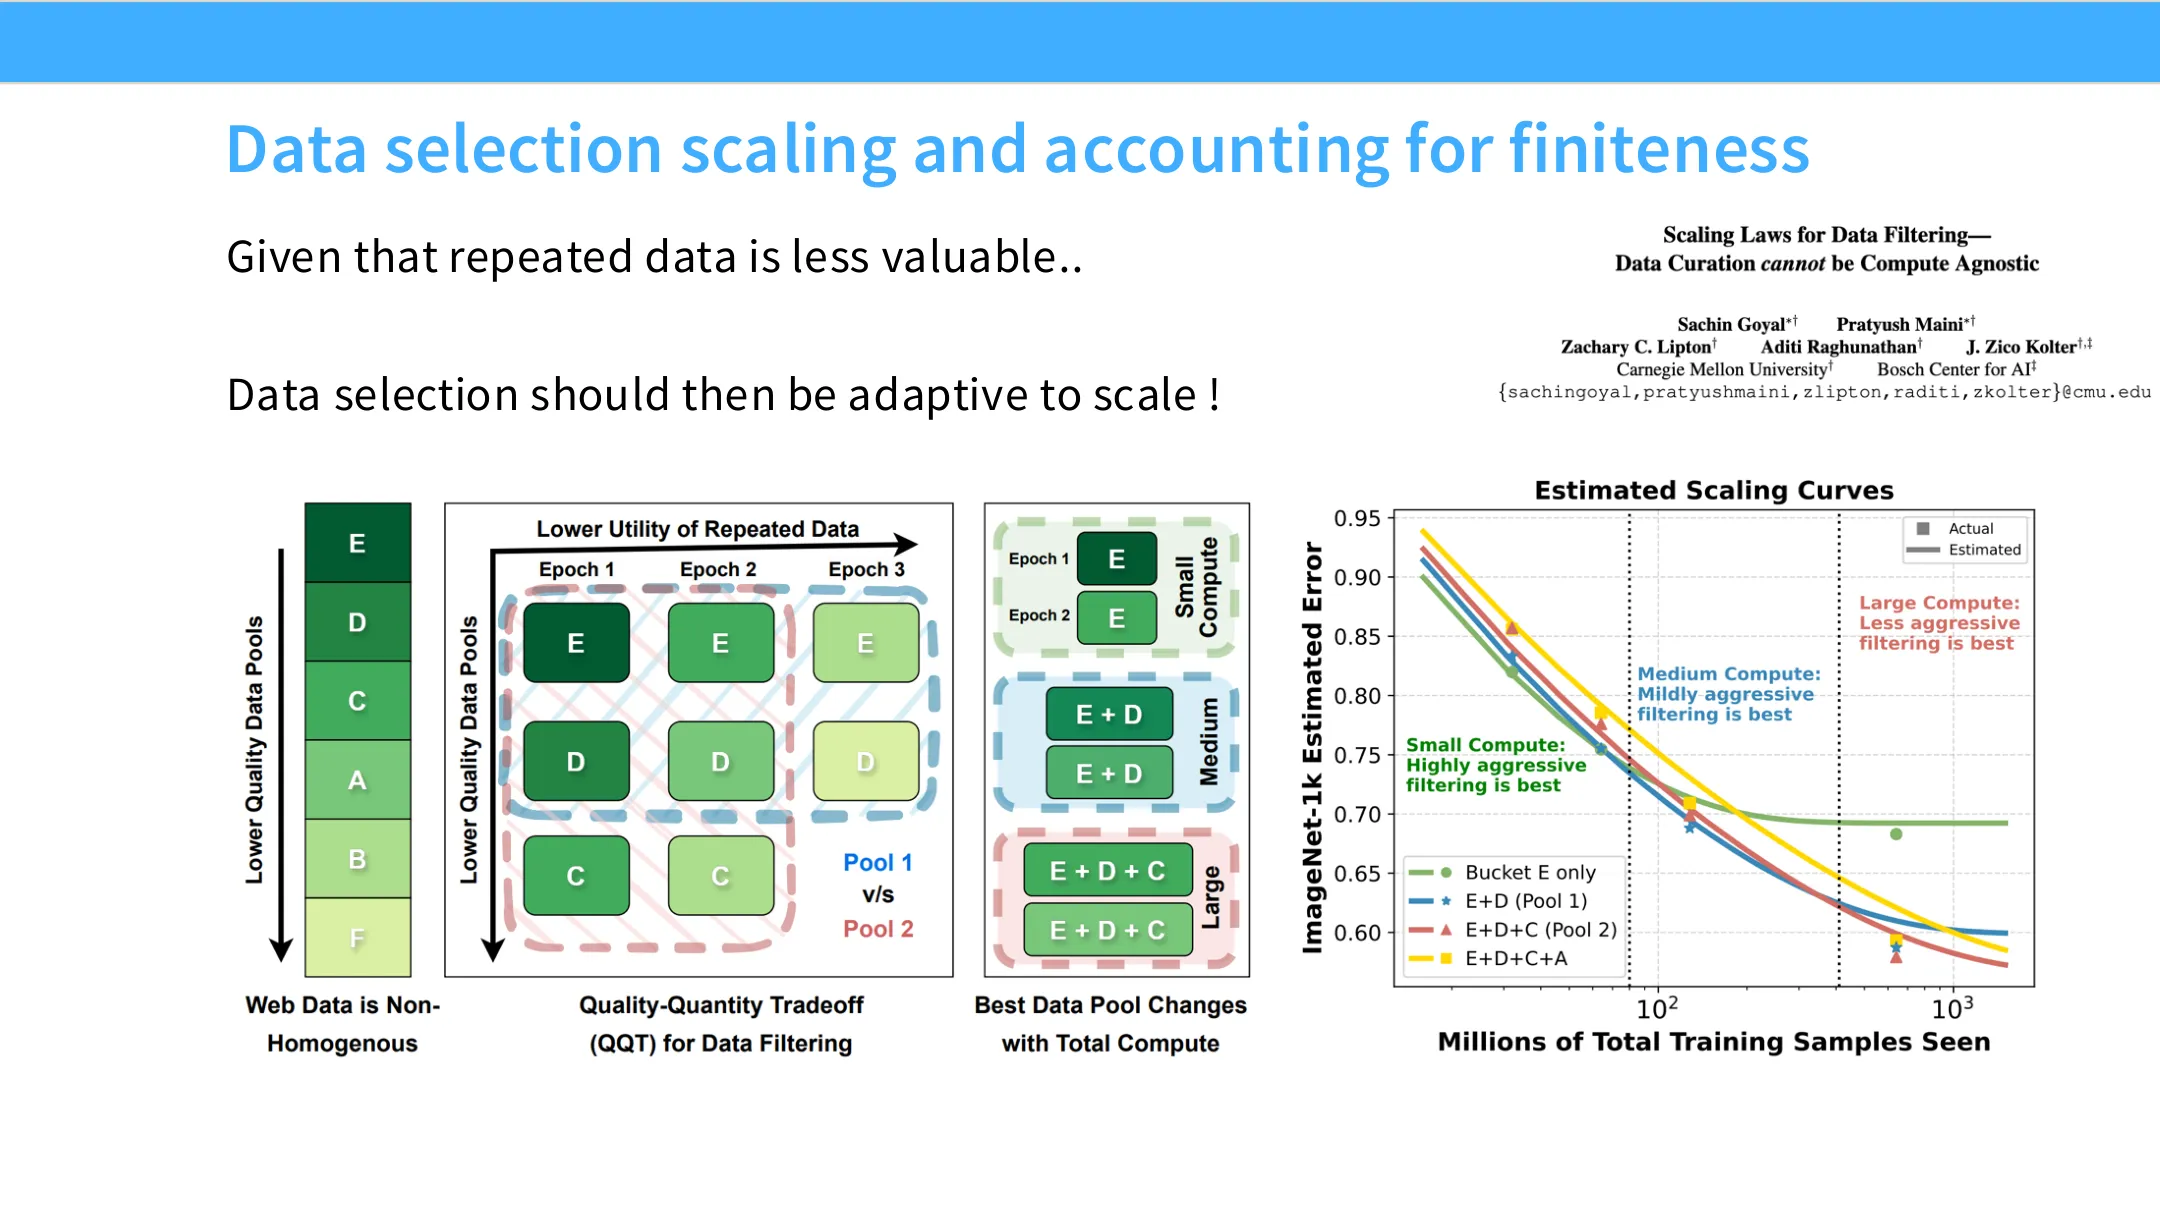
📷 数据选择随规模变化:小算力下激进过滤,大算力下放松过滤
回到原视频 (00:27:19)
4.7 数据 scaling law 小结
(参考时间: 00:29:00)
- log 数据量 vs log 误差之间,存在惊人的线性关系;
- 它跨领域、跨模型都成立;
- 理论理解上,它类似泛化界(均值估计那个例子);
- 应用上,用于数据收集 / 筛选(curation)。
老师评价:这部分(数据 scaling law)是整讲里最直白的——数据变多,性能可预测地变好。对一个有统计/机器学习头脑的人来说毫不意外;但「这么大的模型也服从多项式规律」本身仍然很酷。
📷 数据 scaling law recap
回到原视频 (00:29:00)
课堂问答(参考时间: 00:29:02,关于「无限算力」图上的坐标轴):
- 问:右边那张图看起来损失和数据集大小都是线性的,可前面例子是 log-log,为什么这里是线性?
- 答:这其实是一个糟糕的轴,它看起来线性,实际上 x 轴是倍增(log)的;y 轴虽然看起来不 log,但取值范围太小,线性与 log 基本一样。而拟合的函数形式仍是多项式。
- 重要提醒:如果你只有很小的一个算力区间,你很难分辨某东西是多项式 scaling 还是指数 scaling——因为泰勒展开是真实存在的,只要放得足够大,什么看起来都线性。所以对「这是不是多项式」这个问题,永远要保持一点警惕和怀疑。
五、模型工程的 scaling:用超参数 scaling law 做设计
5.1 从「调参」到「可预测」
(参考时间: 00:30:17)
接下来谈更「异国情调」的 scaling——用 scaling law 做模型工程。
动机:你可能是「激进分子」,觉得 LSTM 才是未来,为什么不能用 LSTM 替换 Transformer?也可能你想「在 SGD 上训练」。此外,算力有限时还有一堆权衡:该训更久,还是训更大?该收集更多数据,还是买更多 GPU?
Scaling law 为这些权衡提供了定量的方法。
📷 Scaling laws for model engineering:怎样高效设计超大模型
回到原视频 (00:30:17)
老师先讲一些简单的超参数问题:怎么选架构、优化器;然后给出第一性原理的答案(相比架构讲座里的「看别人怎么做」)。这里的前提是:你得相信 scaling law;只要你信,你就能自己做实验、自己找答案。
📷 超参数问题:架构、优化器、宽高比/深度、批大小
回到原视频 (00:31:38)
5.2 问题一:Transformer 真的比 LSTM 好吗?
(参考时间: 00:32:07)
LSTM 也能跑得还行,能拟合分布;随着 Mamba 出现,我们也知道 SSM 能行。那么——它们真的更好吗?
- 暴力做法:花几千万美元训一个 GPT-3 级别的 LSTM。
- Scaling law 做法:训一堆小模型——让 Transformer 在一系列算力区间上训练,让不同层数的 LSTM 也在一系列算力区间上训练。
结果展示:LSTM 有不同的截距,甚至可能不同的斜率;因此你不该选 LSTM——这张图会支持你「放大 Transformer 而非 LSTM」的决策。
今天很多架构论文(Mamba、Gated DeltaNet 等)都会放一张这样的图:基础 Transformer、我超酷的模型,而你的模型通常要么在上方、要么在下方(因为那才能证明你更好);你绝不想让自己的斜率更差,因为那意味着 scale 到更大时你的模型最终会更差。
这就是不训超大模型也能推理架构优劣的一种方式。
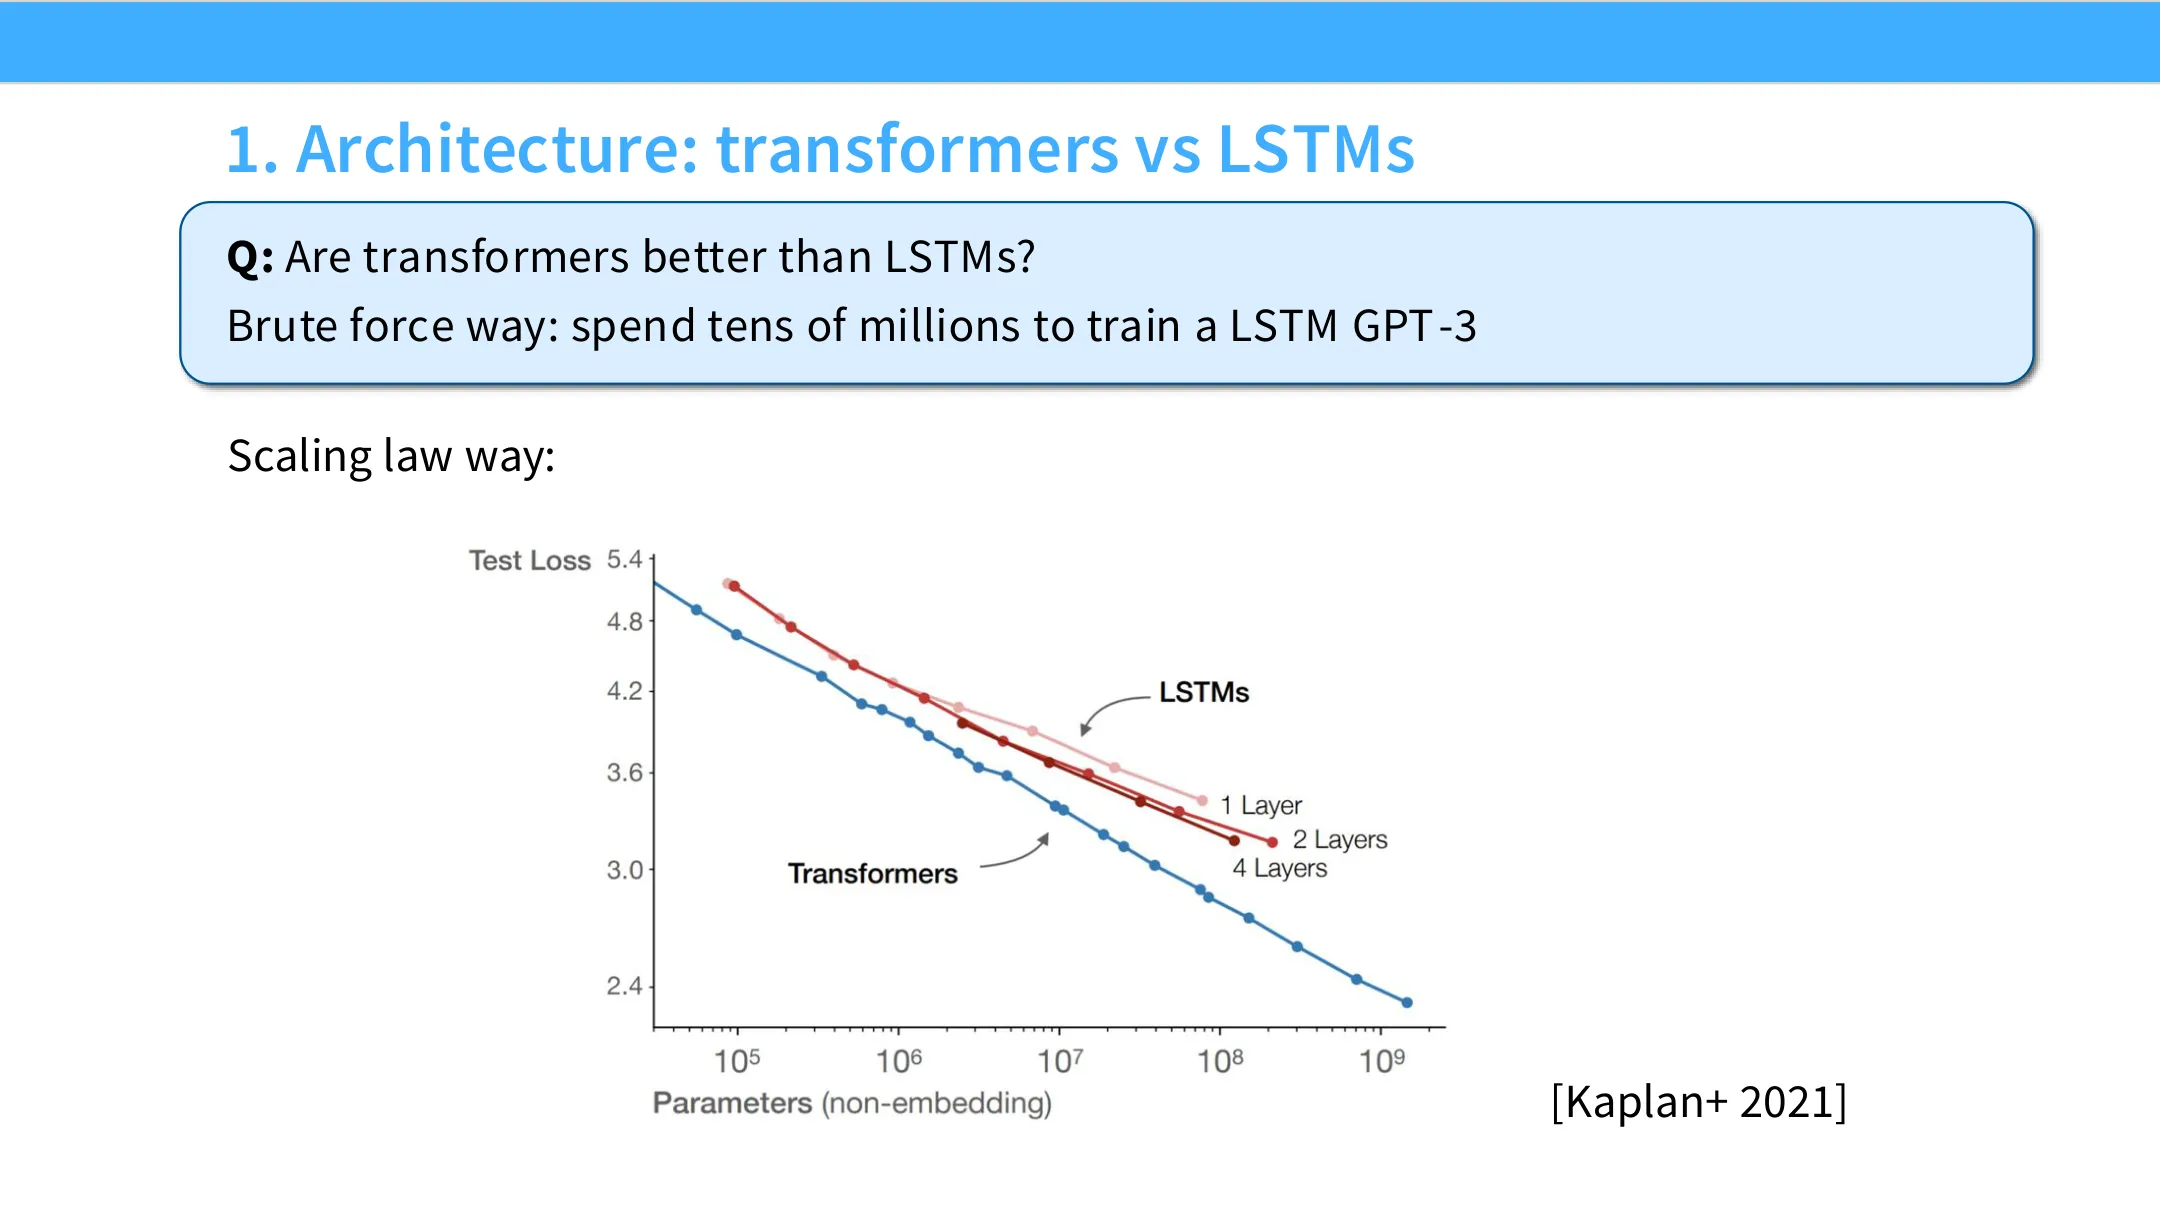
📷 Transformer vs LSTM:LSTM 有不同截距甚至斜率,因此不该选它 (Kaplan+ 2021)
回到原视频 (00:32:07)
5.3 跨架构的 scaling 研究
(参考时间: 00:33:11)
近期又好又新的架构 scaling 论文不算多。老师喜欢的一篇是 Google(Tay 等人 2022)做的:他们在 T5 风格模型上做了大量 scaling 研究,把越来越大的 T5 变体在多种架构上训练。
这篇论文很酷的一点:它恰好捕捉到了我们今天在前沿模型里实现的架构改动。比如:
- performer(一种高效注意力)——它 scaling 不好,我们今天不实现它;
- gated linear unit(GLU)——红线全程优于绿线,我们实现了它;
- switch transformer——虽然最大那次运行有点怪,但整体缩放趋势良好;
- mixture of softmax——今天其实不用了,但按趋势看它可能是个有效的干预。
你可以从这些 scaling 趋势看出:这些论文虽然算力量级远小于今天,却能看到驱动前沿模型发展的架构趋势。这正是为什么很多人把 scaling law 当作一种近乎范式的判断标准:「如果一个改动在 scaling law 上看不出来,它就不是个好改动。」 因为很多过往工作已经成功预测了今天所见。
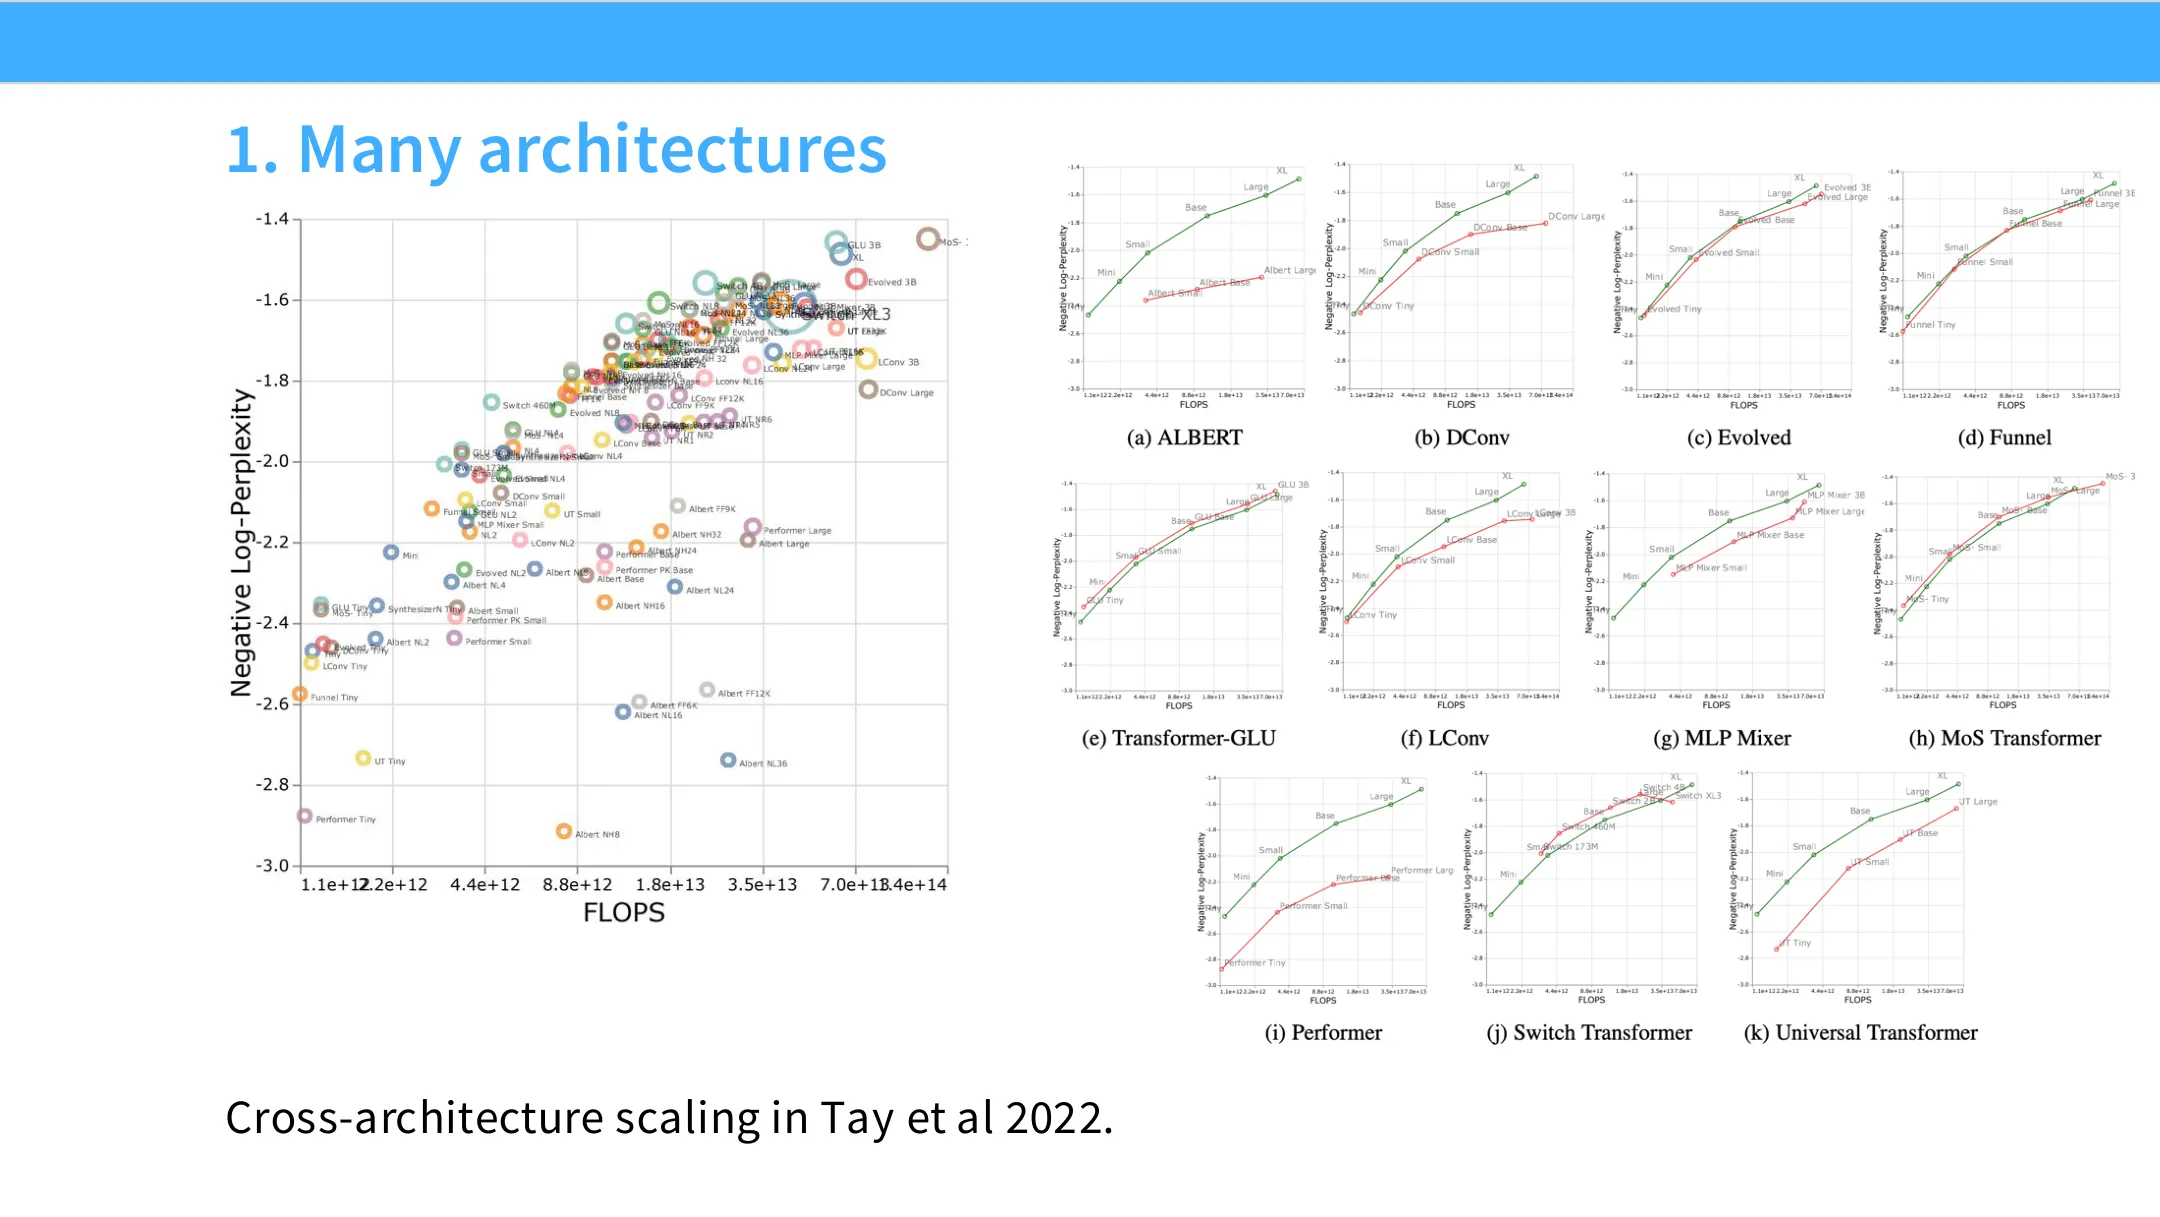
📷 跨架构 scaling:Tay 等人 2022 在 T5 上的研究
回到原视频 (00:33:11)
5.4 问题二:SGD 还是 Adam?
(参考时间: 00:34:49)
用 scaling law 分析优化器选择(Hestness 这套图)会看到非常清晰的趋势:截距不同,但斜率非常相似。
老师反复感叹这一点:即使干预大到「从 SGD 换到 Adam」这种程度,斜率往往还是几乎一样。 如果你亲身用过 SGD 或 Adam,你会觉得这是巨大的变化——但 scaling 趋势几乎不变。(这里其实是 2017 年的工作,是 pre-Transformer 时代的,用的是 recurrent highway nets——RHN。)
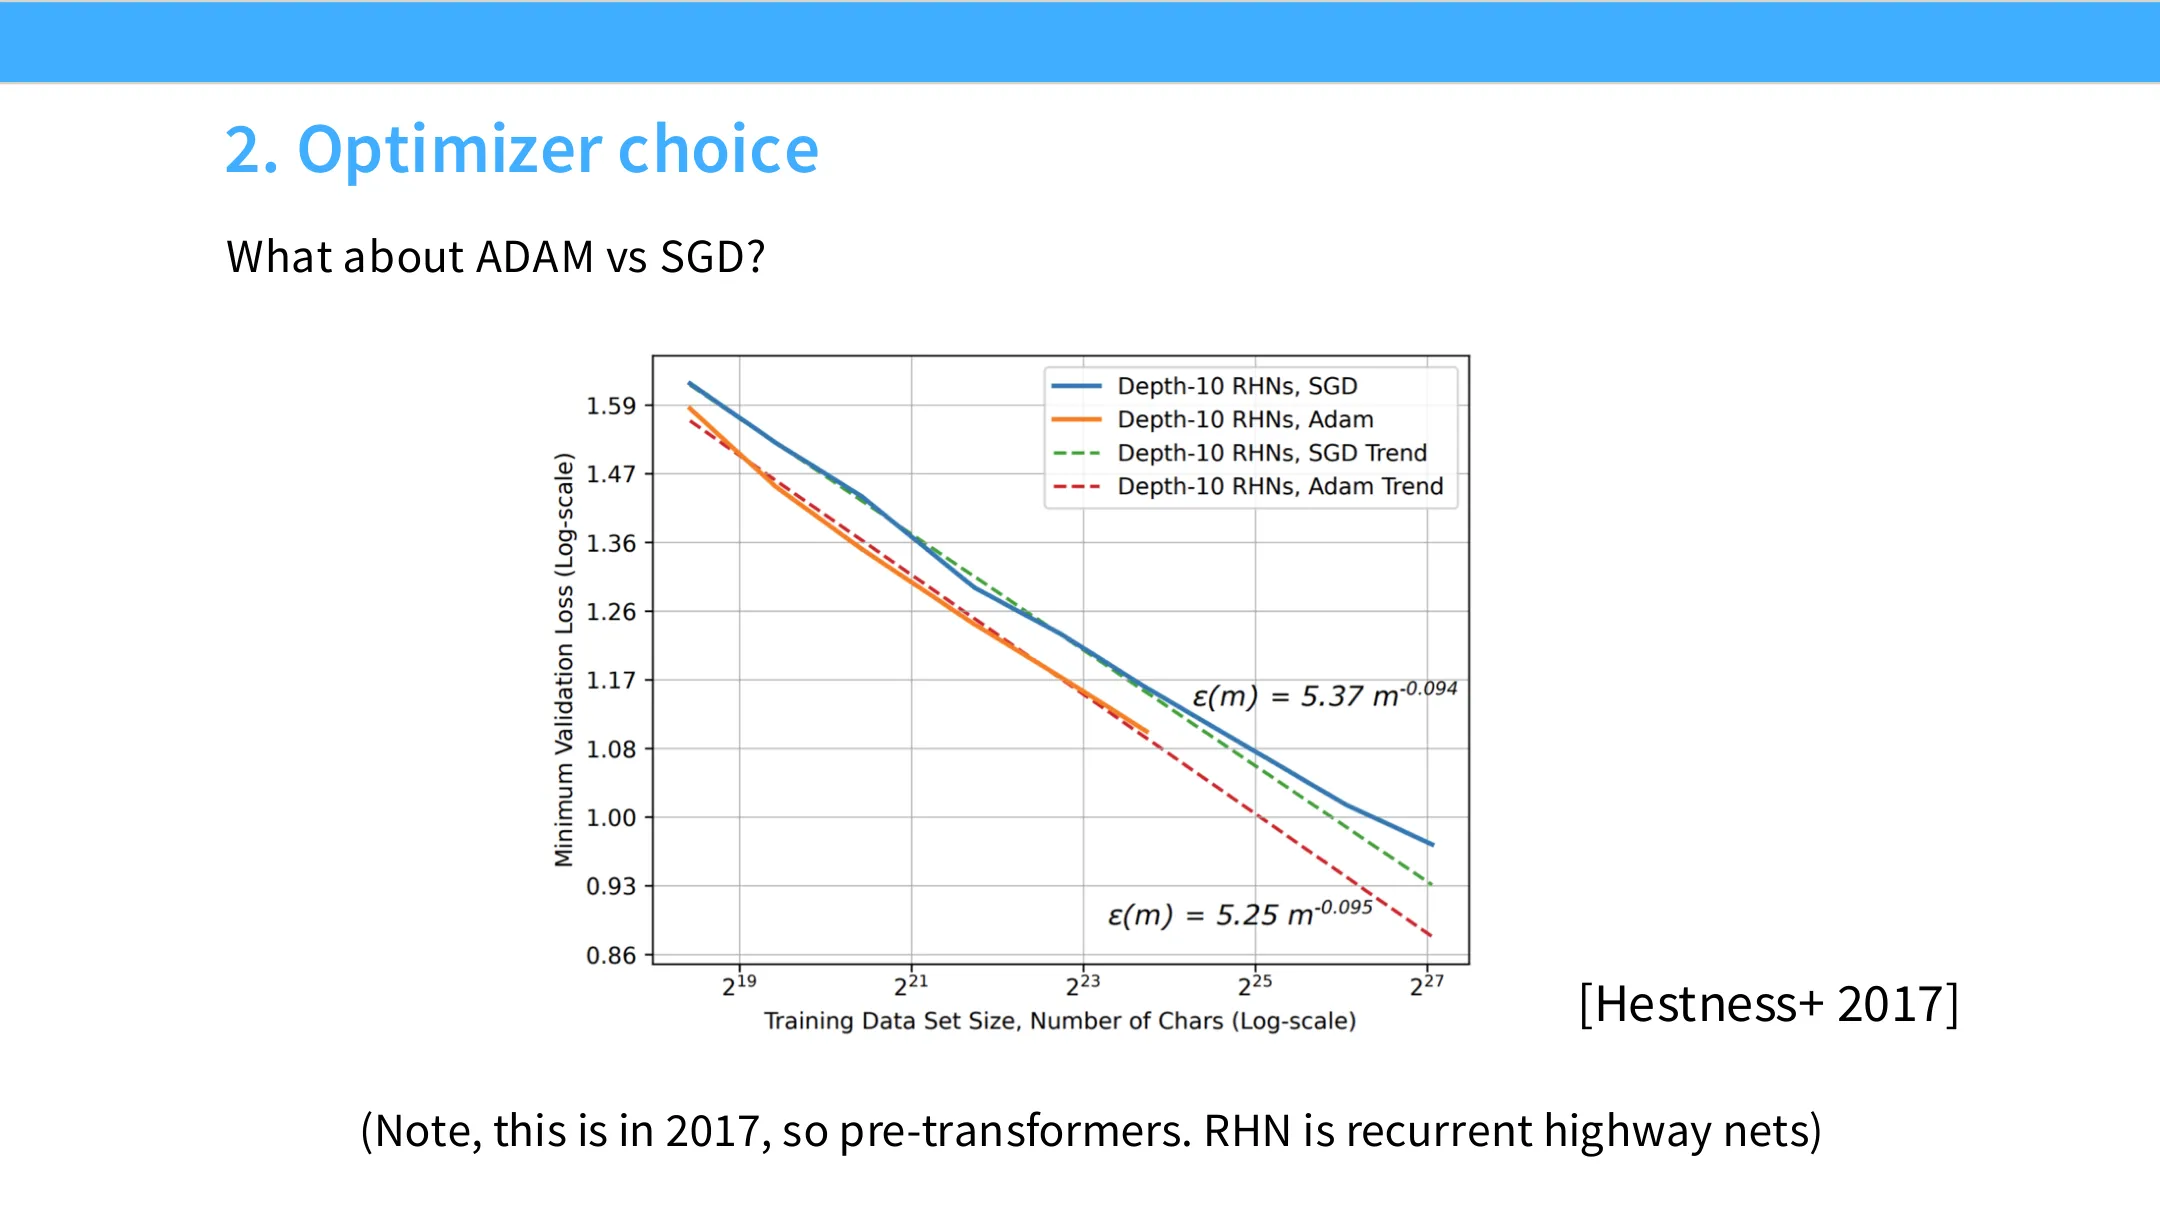
📷 优化器选择:SGD vs Adam,截距不同但斜率相似 (Hestness+ 2017)
回到原视频 (00:34:49)
5.5 问题三:深度 / 宽度
(参考时间: 00:35:37)
架构讲座里讲过宽高比(depth-to-width)。当时说「挑个大致合理的、比如 4 倍于合理乘子的数字」。但如果做 scaling 分析,你能更精确地知道发生了什么。
先看「层数」的 scaling 趋势:
- 层数极少(比如 1 层)对模型非常糟,是可怕、可怕的 scaling 趋势;
- 超过 1 层后其实就相当有竞争力;
- 但在每个算力量级上,更多层通常更好(至少在这个例子里)。
更精细的研究(Kaplan 里有)是去识别「尺度不变(scale-invariant)」的量,比如宽高比:层数不是尺度不变的量——模型越大,你确实想要更多层;但模型变大时,最优宽高比可能保持不变。
于是看宽高比在不同模型大小下的表现:基本上在每层约 100 维附近取得同样的极小值(可能略小一点),并且会有一点位移——更深的模型倾向于更小的宽高比,但极小值大体稳定。
你可以对注意力头维度等做类似分析。Kaplan 在这方面做得很好。这样你就对自己的 scaling 策略有信心:「我的策略是固定宽高比再放大——既然最优值不会随模型变大而漂移太多,那我们就大概是安全的。」
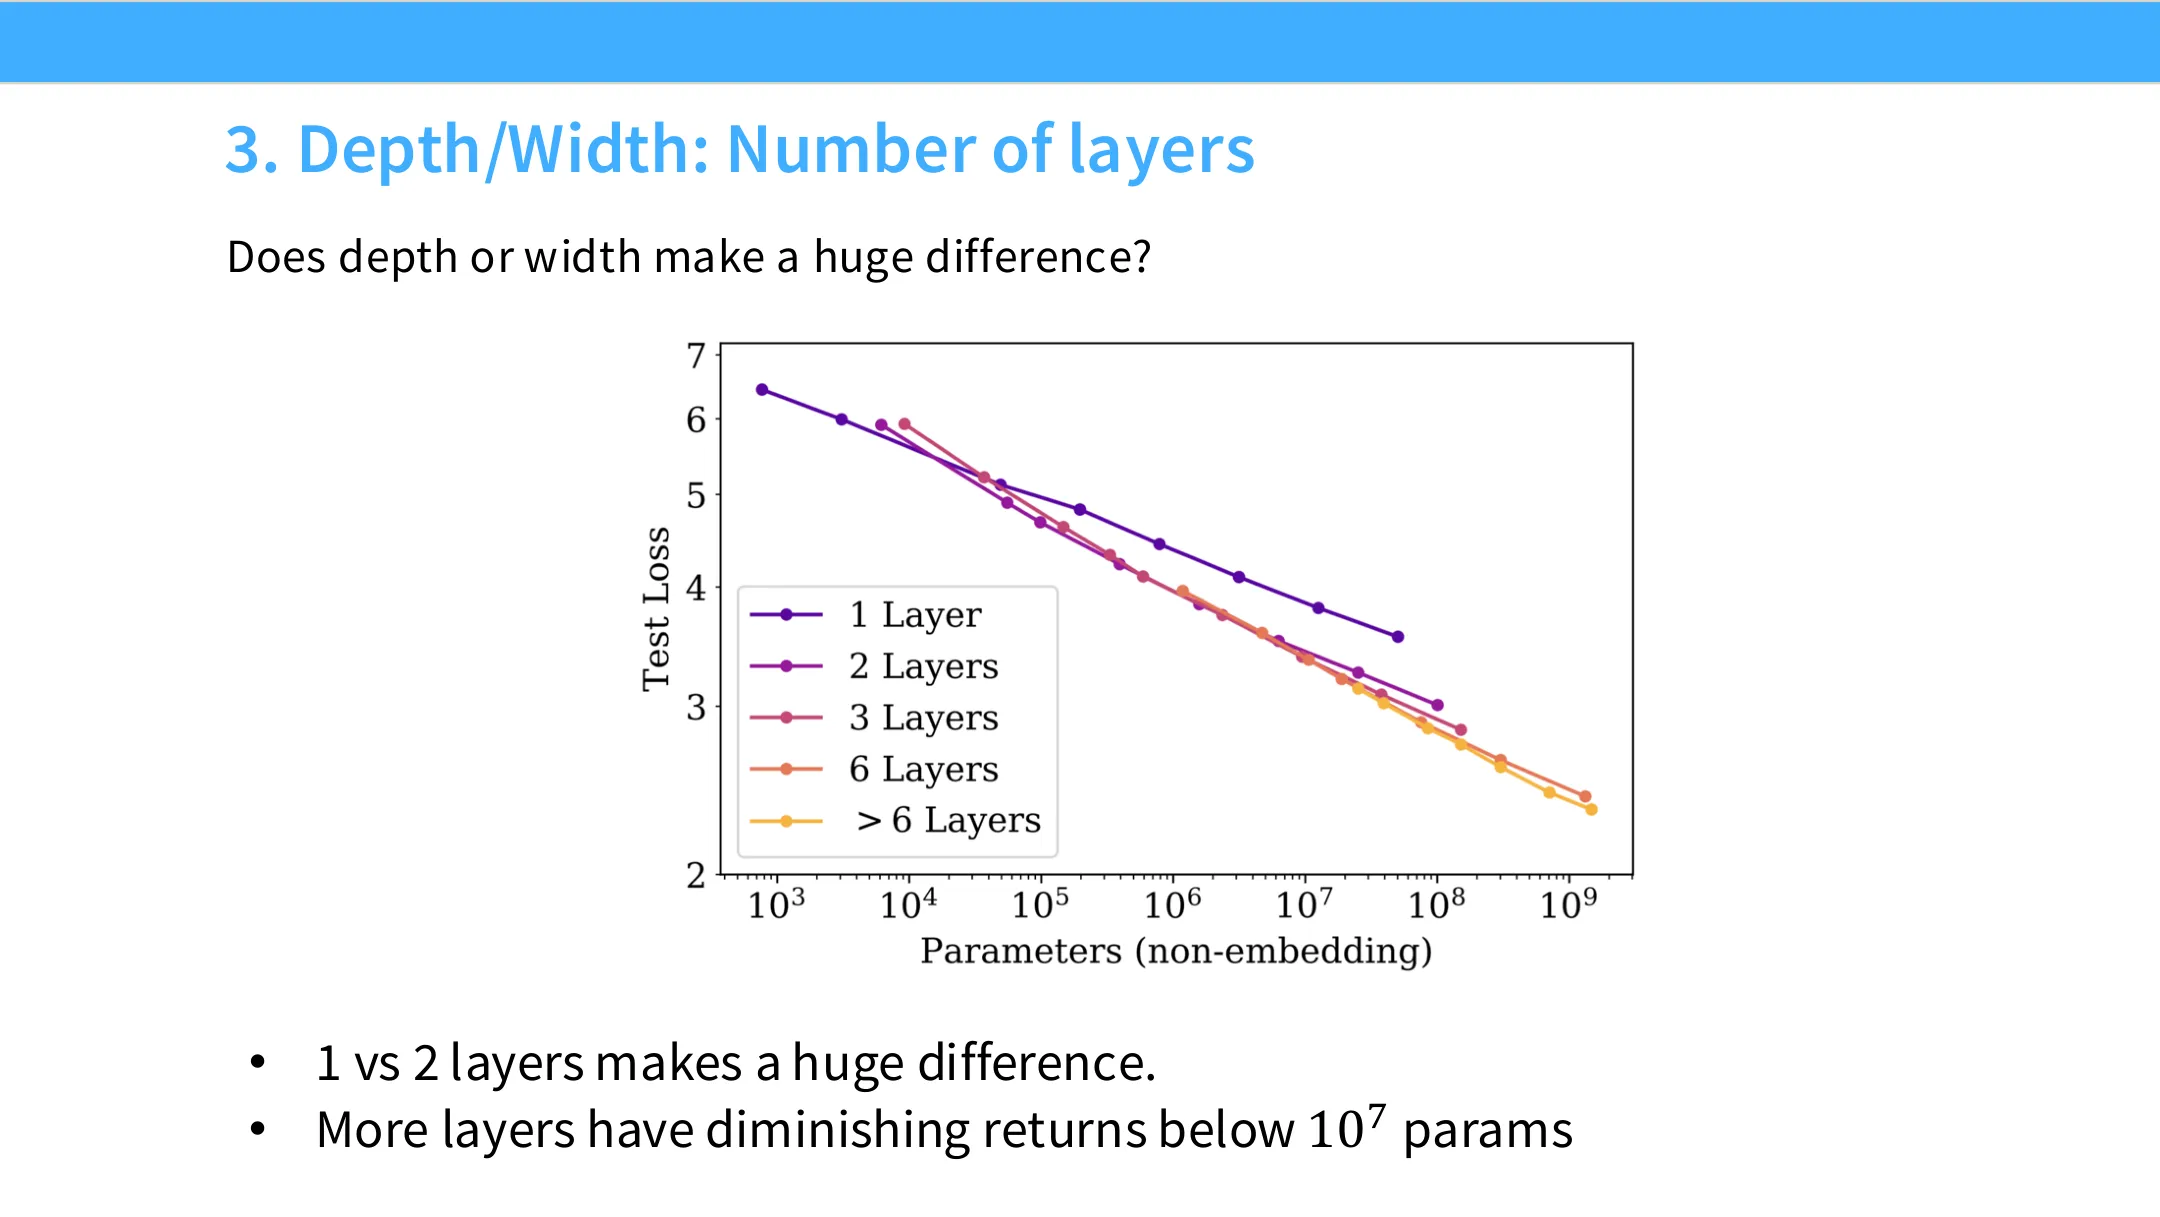
📷 深度/宽度:层数越多(超过 1 层后)通常越好,但收益递减
回到原视频 (00:35:37)
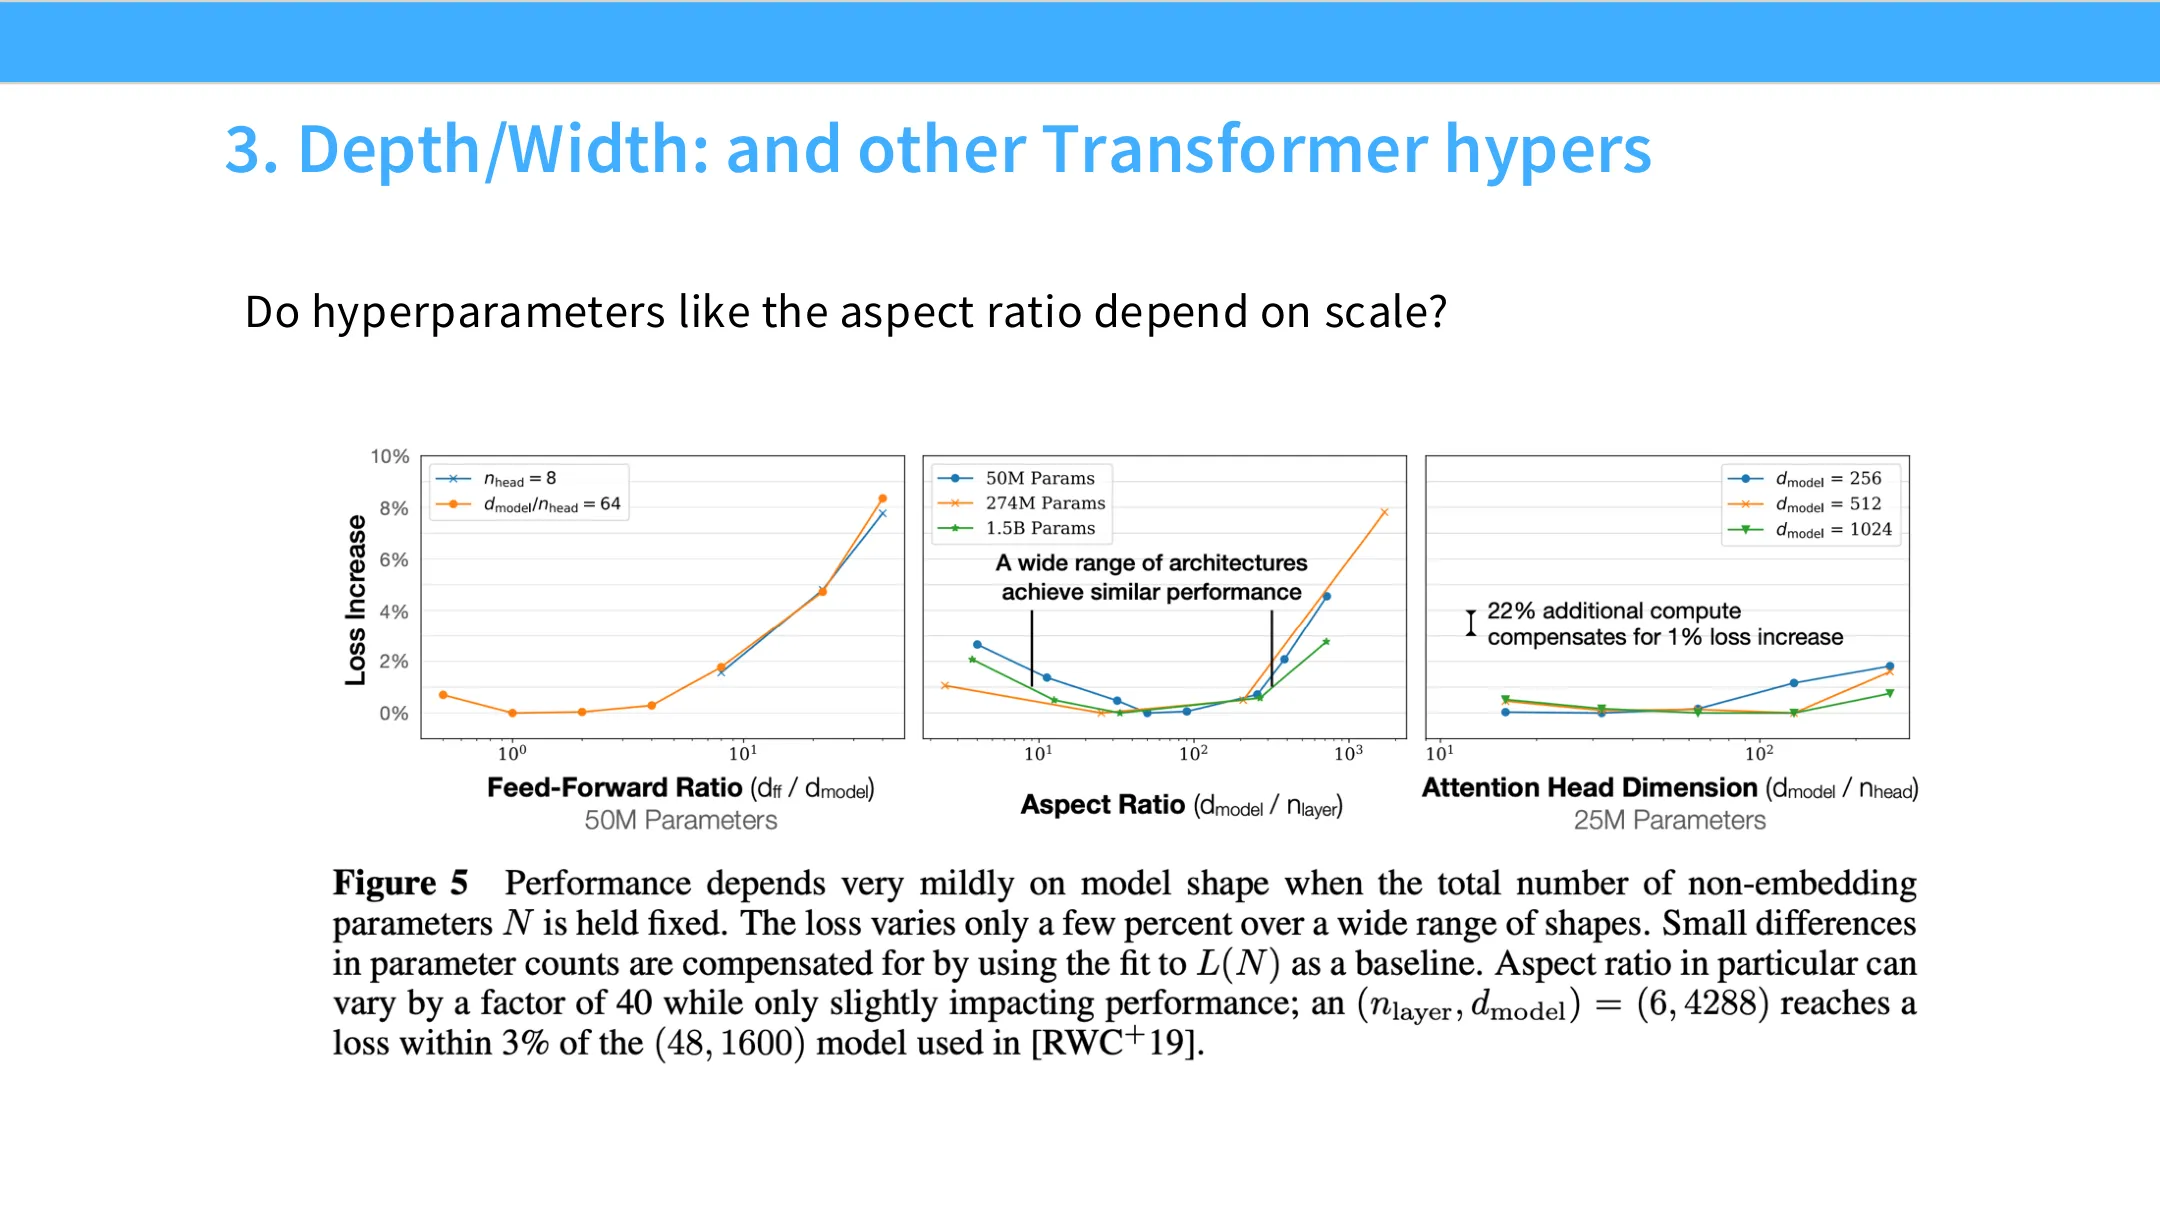
📷 宽高比是尺度不变量:极小值大约在每层 100 维,随规模基本稳定
回到原视频 (00:36:30)
5.6 但并非所有参数都生而平等
(参考时间: 00:37:34)
这是一个巨大的一罐虫,会反复出现:并非所有参数都是平等的。
缩放律长什么样,取决于你如何定义「参数」。 在 Kaplan 论文中,他们观察到一个现象:如果把嵌入参数也算进深度 scaling law,会得到非常奇怪的曲线。于是他们决定排除所有嵌入参数,只计非嵌入参数(可以自我辩解为「这些才是真正做计算的参数」)。这一点后来会对某些结果的有效性产生不小的影响。
老师的要点是:scaling law 不是魔法。 他引述同事 Percy 的观点:scaling law、跨尺度的这种可预测性,是「工程化」出来的,它不会自动发生。你需要:
- 挑对正确的横轴去看;
- 确保超参数设置正确;
只有满足这些条件,跨多个算力量级才可能出现可预测的 scaling。
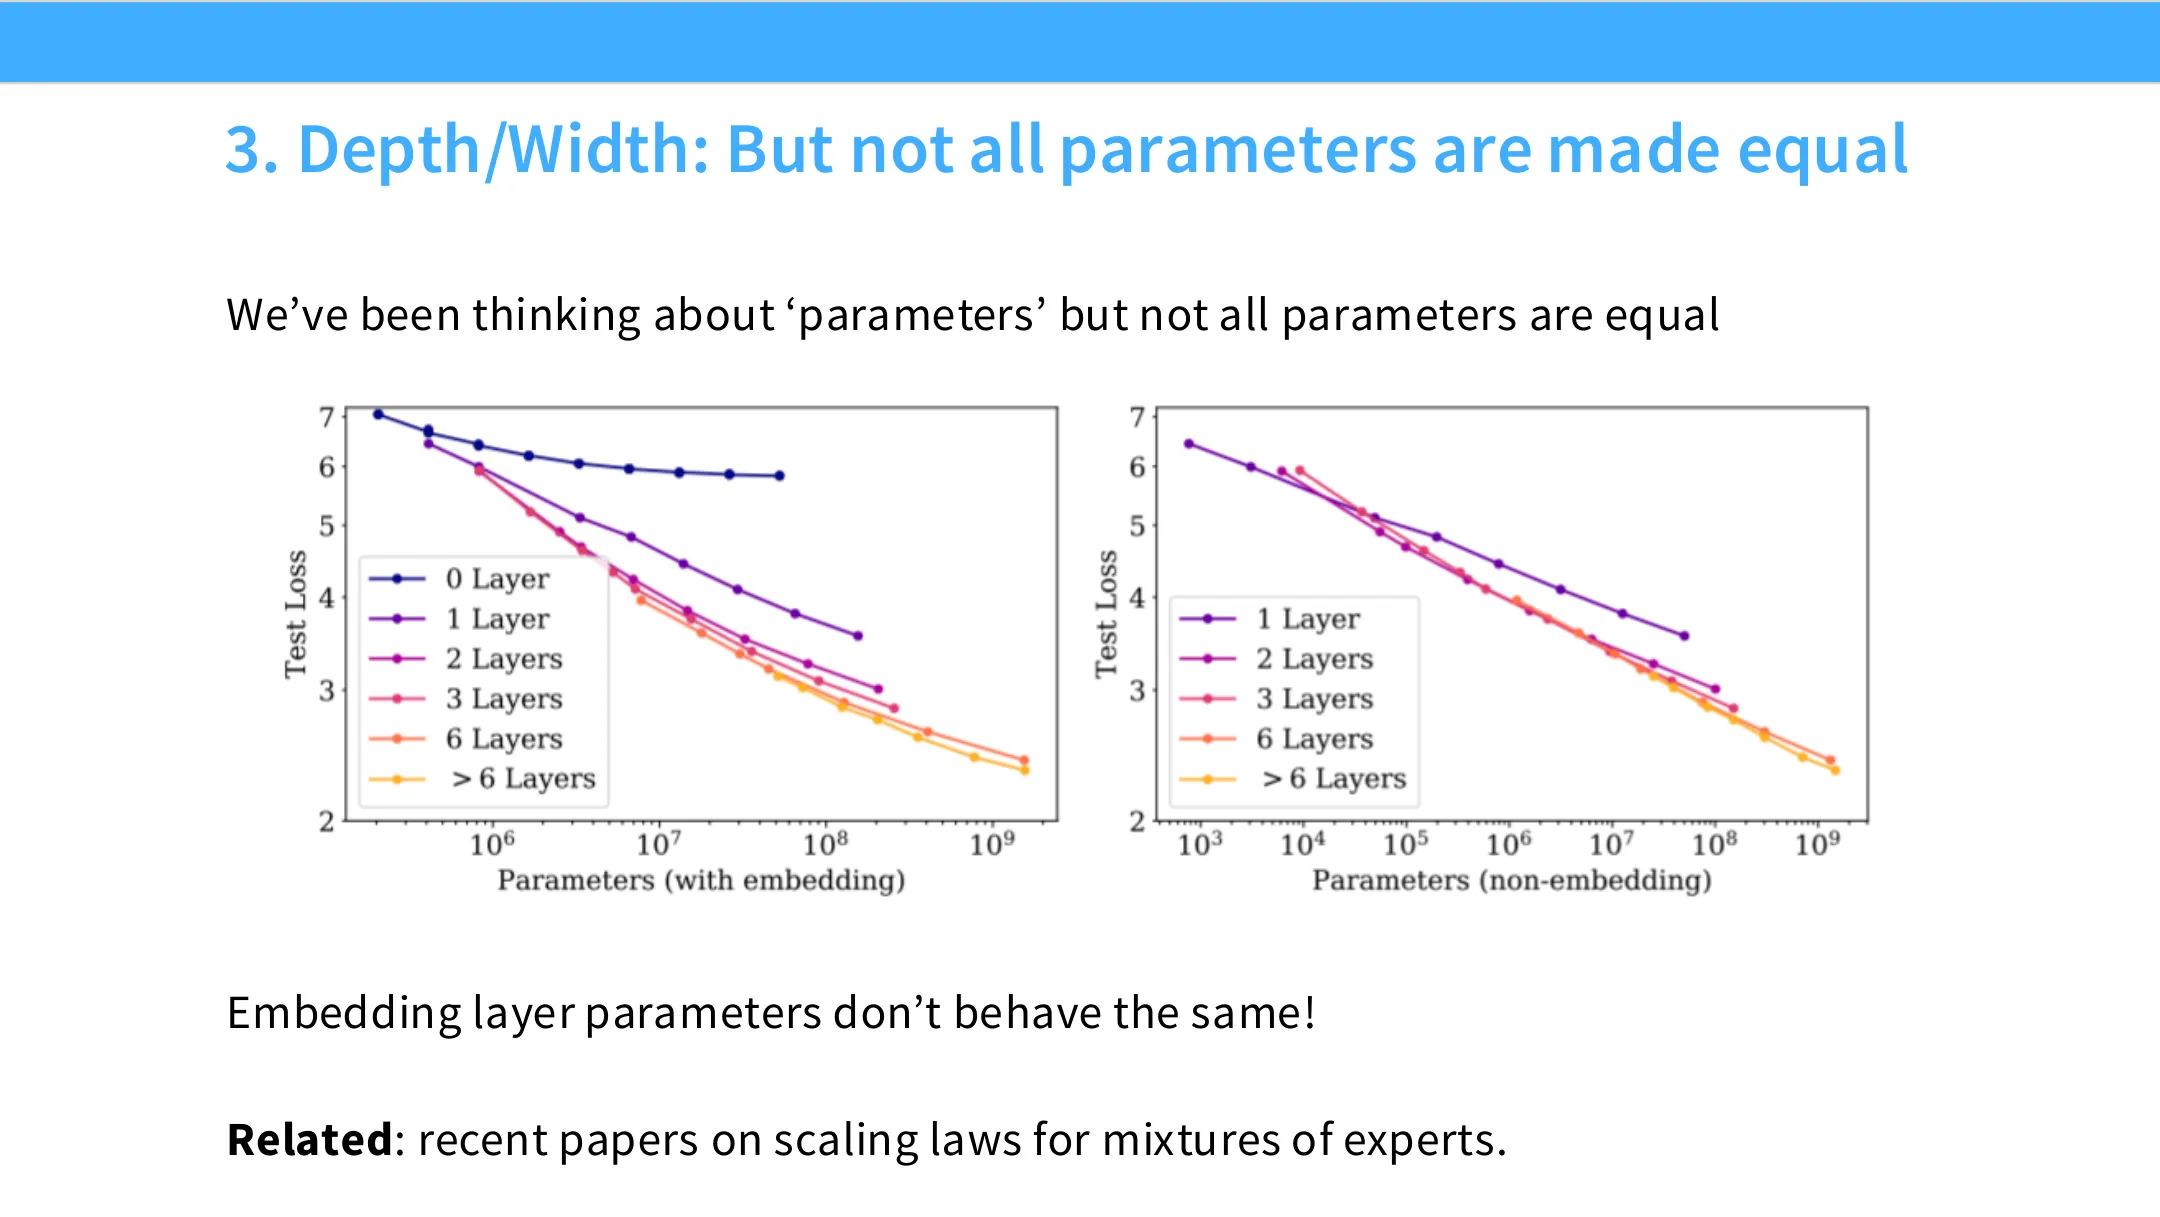
📷 并非所有参数都平等:嵌入层参数行为不同
回到原视频 (00:37:34)
相关前沿:MoE(专家混合)。既然 MoE 已成为训练大模型的主流方式,在「参数数」与「激活参数数」解耦的新世界里,到底什么算「一个参数」就变得很重要。Apple 和 MIT 的一些人有很干净的分析,展示了关于总参数和激活参数的 scaling 趋势。一个很酷的结果是:当你想最小化损失、把总参数往右推时,你会得到越来越稀疏的模型。
一个反直觉的结果是:从图上「后面」移到「前面」——保持激活参数不变,但增加总参数(更稀疏)——损失会改善。 也就是说,MoE 里未被激活的参数,仍然在帮你降低损失。这说明「优化 MoE 的所有量」都有可预测的 scaling 规律。
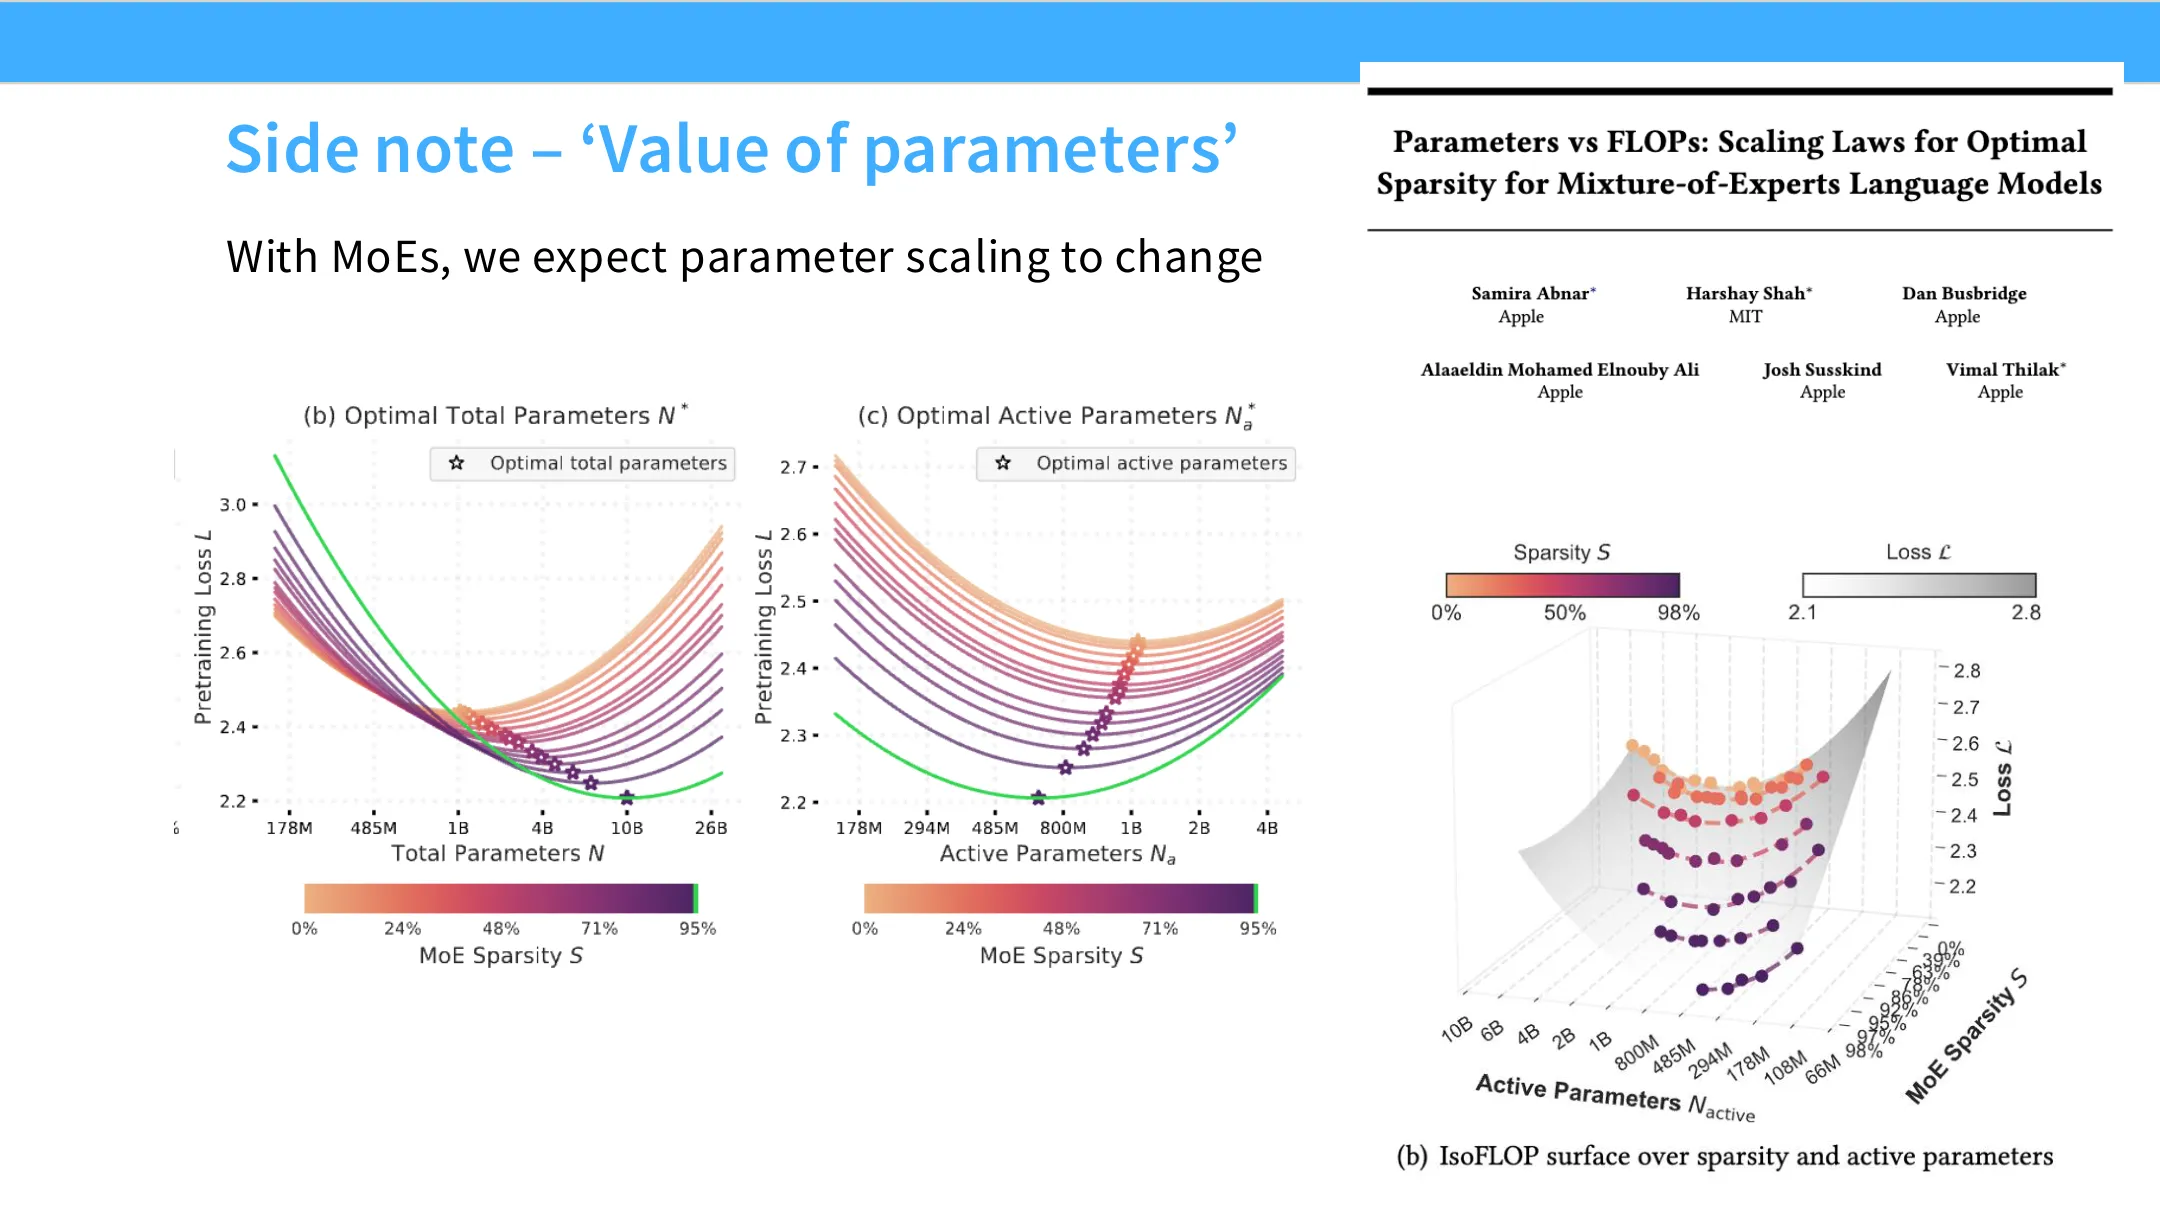
📷 旁注:参数的「价值」——MoE 里未激活参数也在帮忙降 loss
回到原视频 (00:39:06)
编者拓展|MoE 与「参数价值」
MoE 用门控(router)为每个 token 只激活一部分专家,从而在总参数量很大的同时让每个 token 的计算量(激活参数)保持较小。上面这个结论意味着:稀疏化(增加总参数/减少激活比例)在固定算力下仍能降低 loss。这也是为什么现代大模型普遍走 MoE 路线——训练与推理的算力经济学都更划算。
5.7 问题四:临界批大小(Critical Batch Size)
(参考时间: 00:41:15)
现在讲两个你真正必须重新调的东西:批大小和学习率——你无法照搬,因为二者相互耦合。
批大小还有一个额外的系统约束:我们希望批越大越好,因为大批量利于并行化(数据并行需要大批量)。所以真正的问题是:批大小最多能开多大而不开始受损? 以及这个临界点如何随模型大小变化?
于是引出临界批大小这个重要概念:
- 在达到某个点之前,增大批大小有完美的收益——称为噪声受限(noise-limited) regime。在这个 regime,每多丢进批里一个样本,都在降低 SGD 步的梯度噪声;因为你是方差受限,这种方差下降非常有益。这是「完美 scaling」的 regime——你几乎做到了给定样本量下能做的极限。
- 到了某个点,批大到已经把梯度噪声压到梯度的本底噪声,你不再方差受限,而变成偏差受限(bias-limited)。因为在梯度下降里,你只看目标的局部结构,没有全局视角。无论噪声多低,你总是朝「浅蓝方向」走,而局部下降方向与全局最优方向之间存在分歧。于是你开始收益递减——限制因素不再是方差,而是这个偏差项。
临界批大小就是「从完美 scaling regime 跨入低效 scaling regime」的那个便捷权衡点,是设定批大小的良好经验法则。
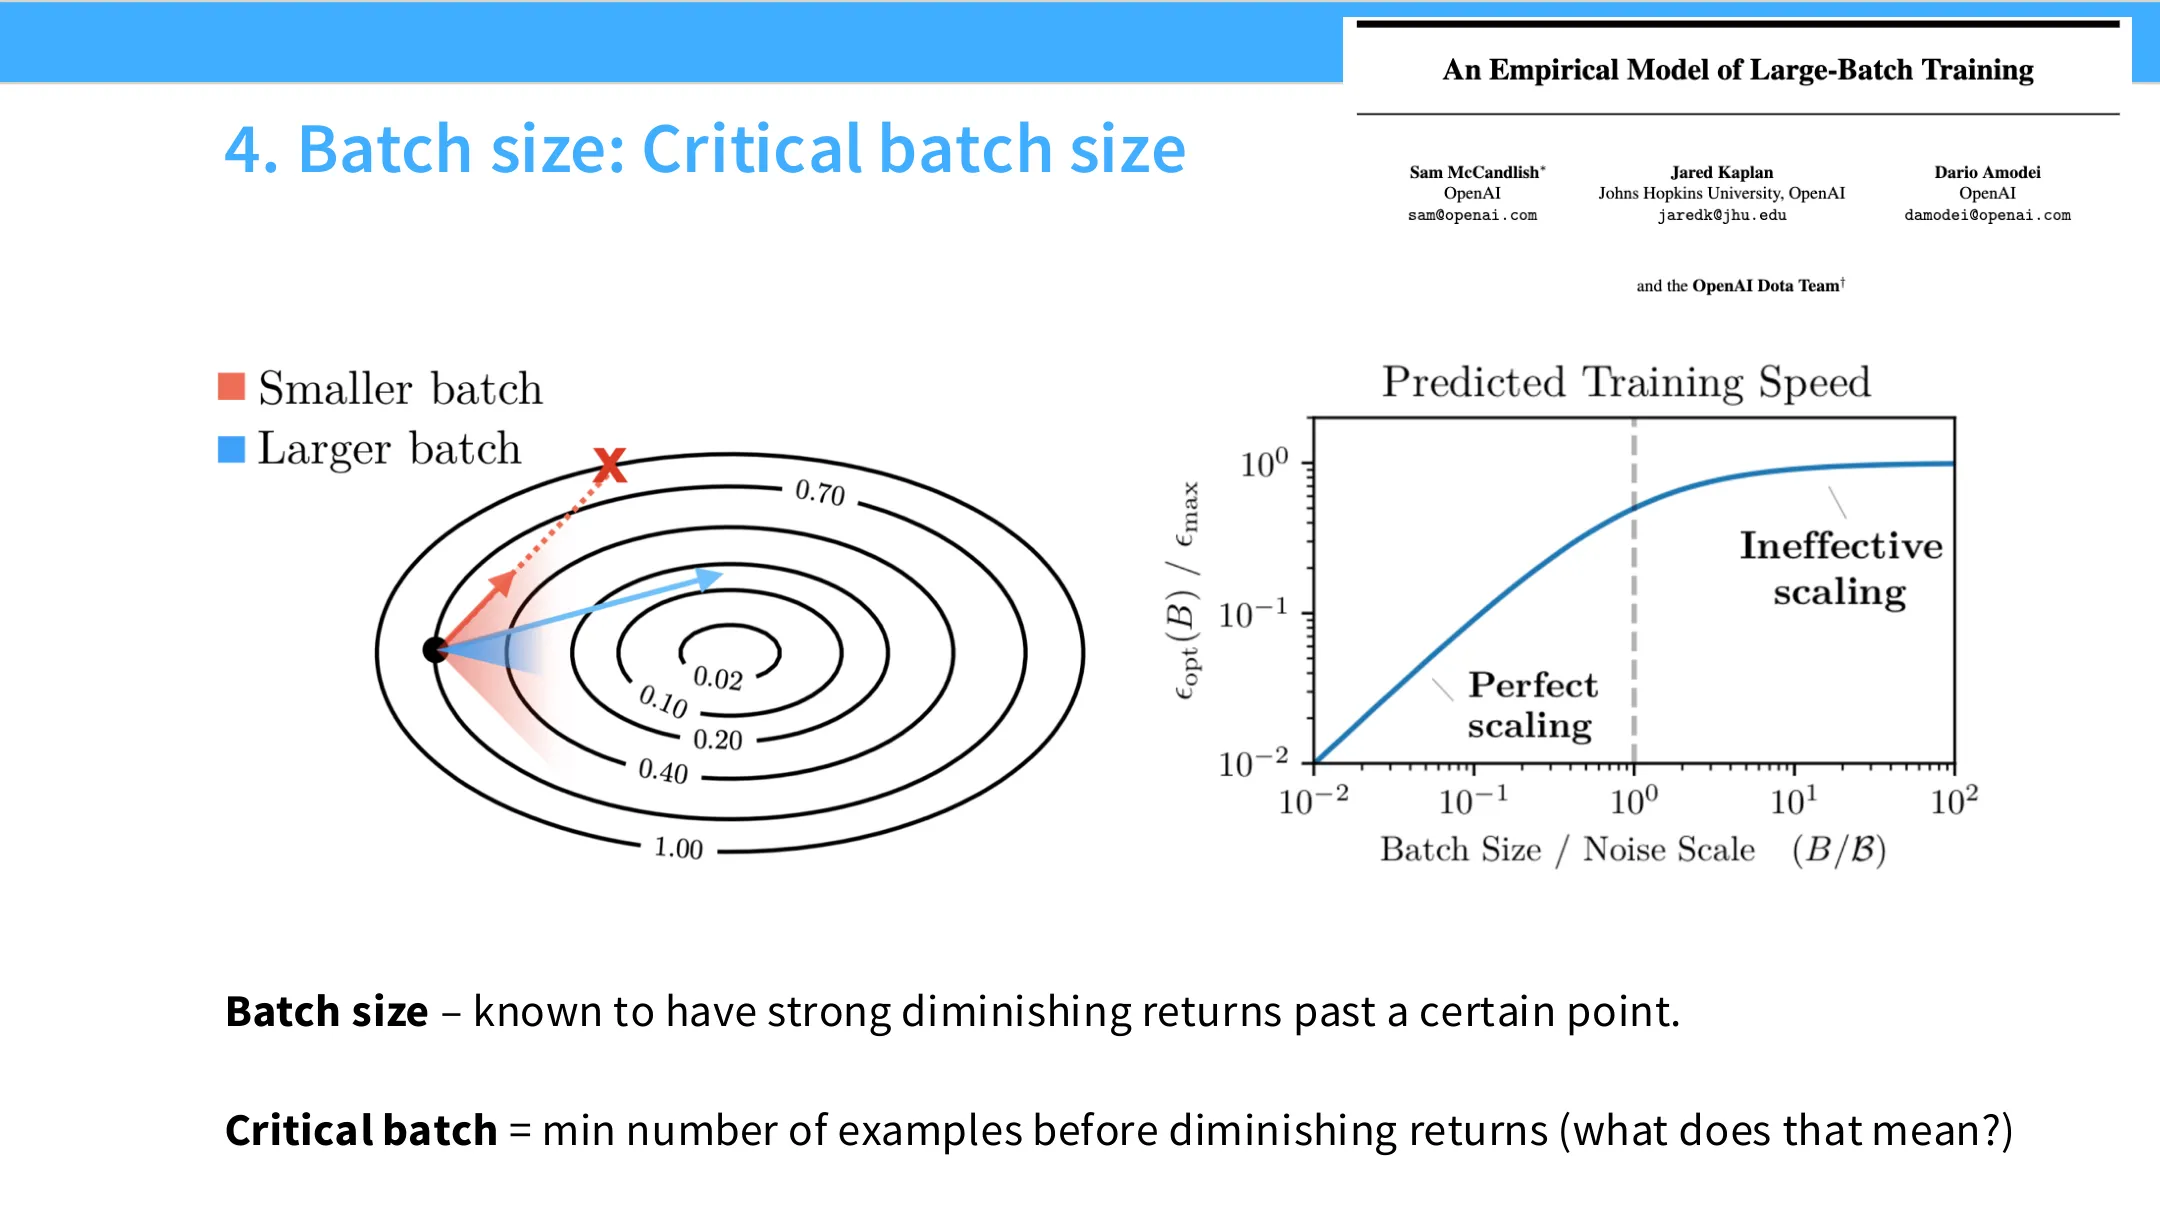
📷 临界批大小:noise-limited 与 bias-limited 的切换点
回到原视频 (00:41:15)
5.8 临界批大小的精确定义
(参考时间: 00:44:11)
具体怎么估计?
- 选一个目标损失(你想尽快达到的数);
- 在多个批大小上做 sweep,记录达到目标损失所需的 ① 步数 $S$、② 样本数 $E$(二者由批大小联系:步数 × 批大小 = 样本数)。
OpenAI 等人论证,所需步数与样本数大致成反比,可以用下式归一化:
$$S = S_{\min} + \frac{E_{\min}}{B}, \qquad E = E_{\min} + B \cdot S_{\min},\qquad B_{\text{crit}} = \frac{E_{\min}}{S_{\min}},$$
其中 $B$ 是批大小,$S_{\min}$ 是最小可能步数,$E_{\min}$ 是最小可能样本数。
这是一个非常自然的权衡:想最小化样本数就要很多步;想最小化步数就要很多样本。目标是把两边平衡。 求解后得到:
$$B_{\text{crit}} = \frac{E_{\min}}{S_{\min}}.$$
它会给你比最优稍多的步数、稍多的样本,但平衡了等式两边——可以理解为「在不炸掉步数的前提下,优化收敛率」。
还有一个附加点(老师不展开但推荐读 critical batch size 论文):这个量也可以近似为梯度协方差矩阵的迹与梯度平方范数之比:
$$B_{\text{crit}} \approx \frac{\operatorname{tr}\!\left(\Sigma_g\right)}{\lVert g\rVert^2}.$$
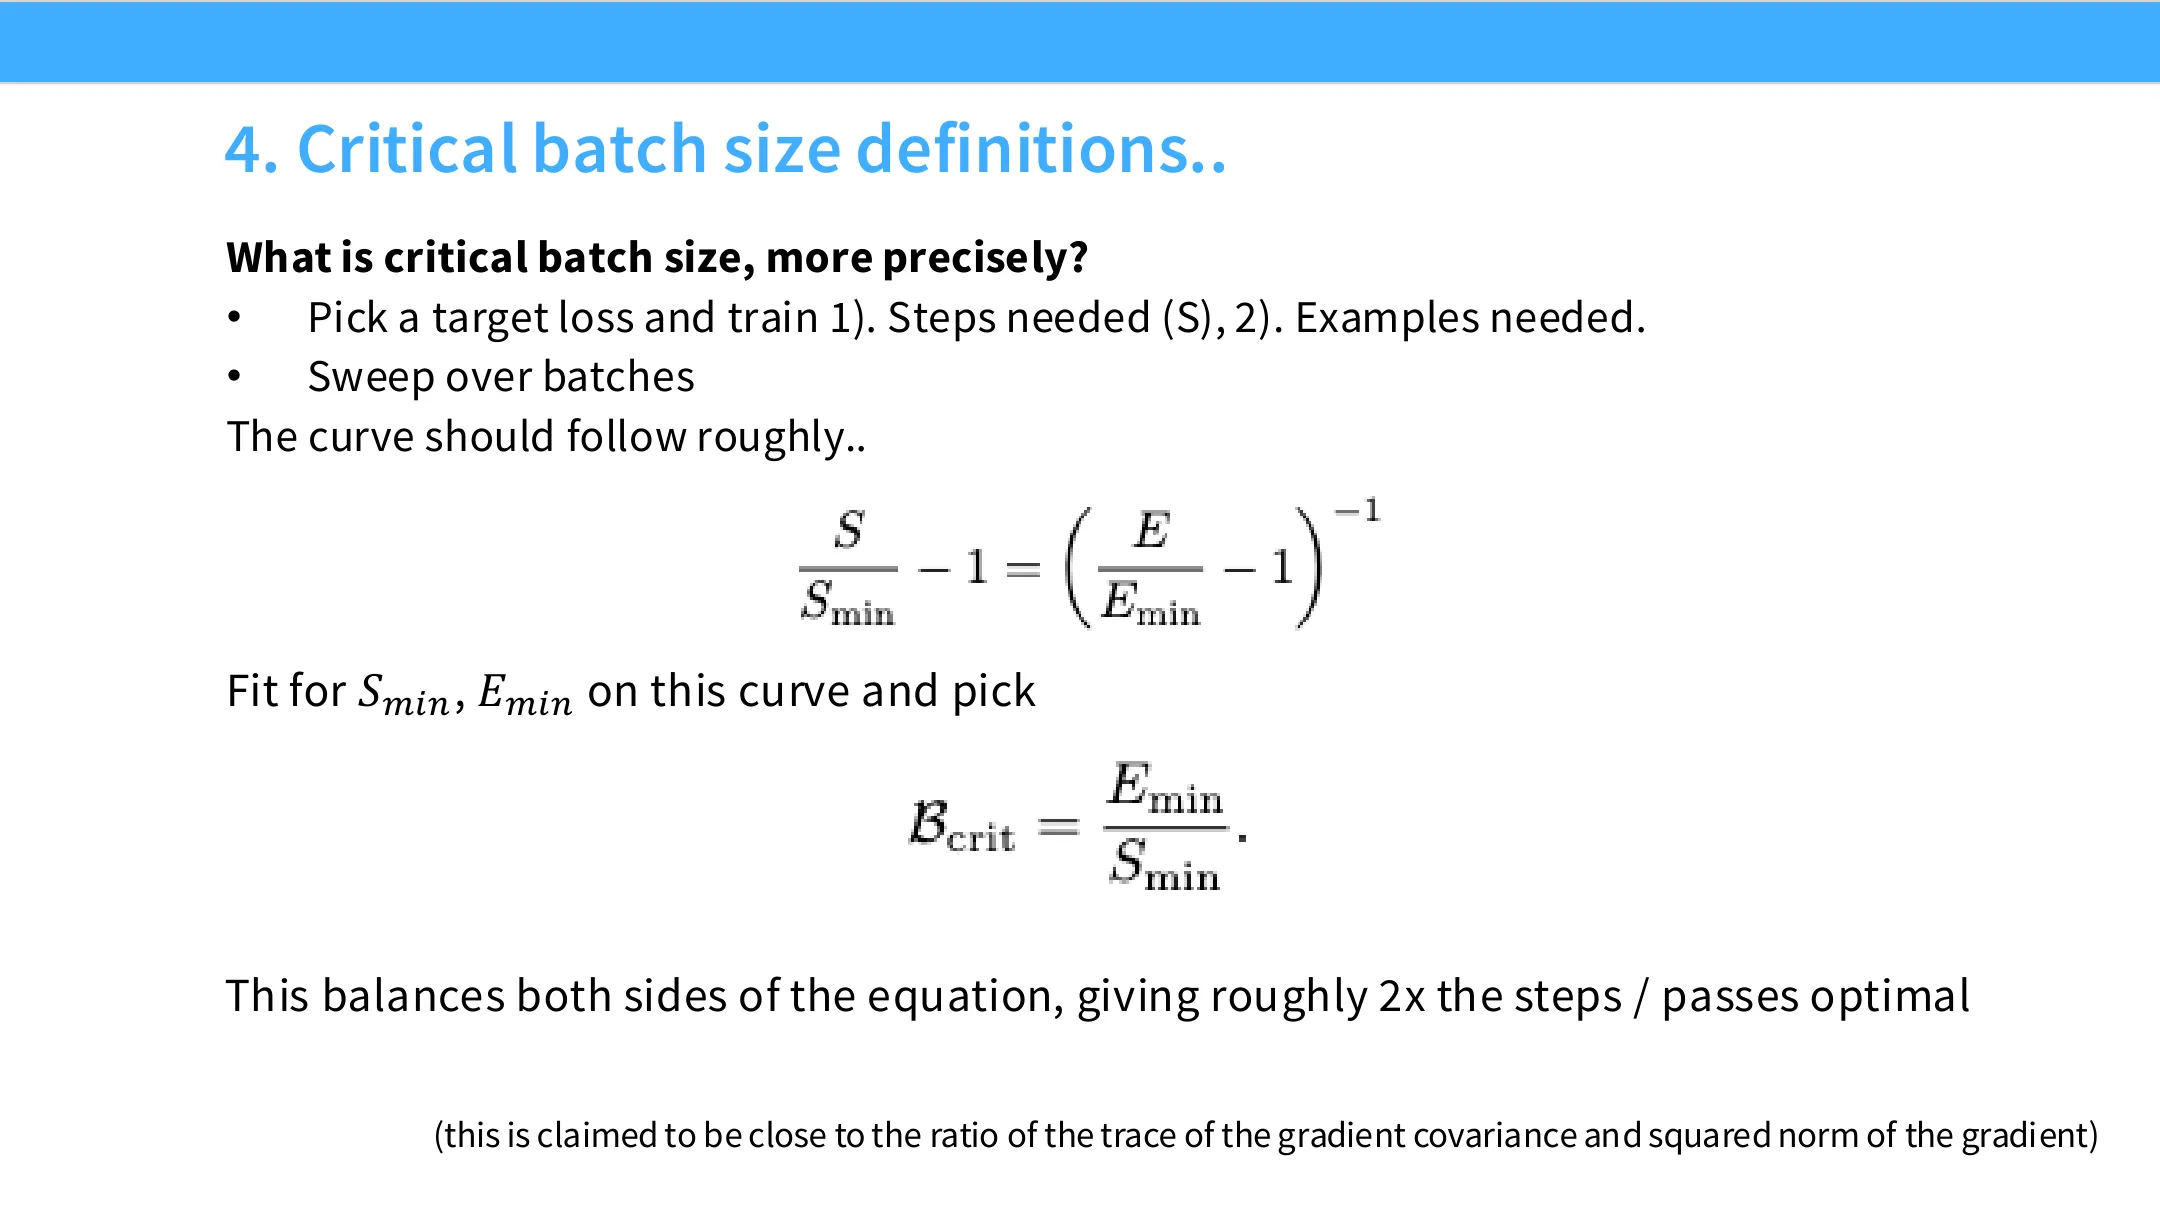
📷 临界批大小的定义:在 S 与 E 之间平衡,取 B_crit = E_min / S_min
回到原视频 (00:44:11)
5.9 临界批大小随损失如何变化
(参考时间: 00:47:56)
为什么这个话题会出现在 scaling law 讲座里?因为如果你选批大小 ≈ 临界批大小,就能问:这个量如何随目标损失(≈ 算力)变化?
结论是:当损失越来越低(算力越来越大),临界批大小会增大,而且呈非常可预测的幂律增长(大致是批大小的逆多项式关系)。
这很合理:越接近最小值,方差降低的价值越大——因为你在优化越来越精细的对象,噪声的代价大大增加。
所以大规模训练时你可以用相当大的批;这也解释了为什么「目标损失越低 → 批越大」。
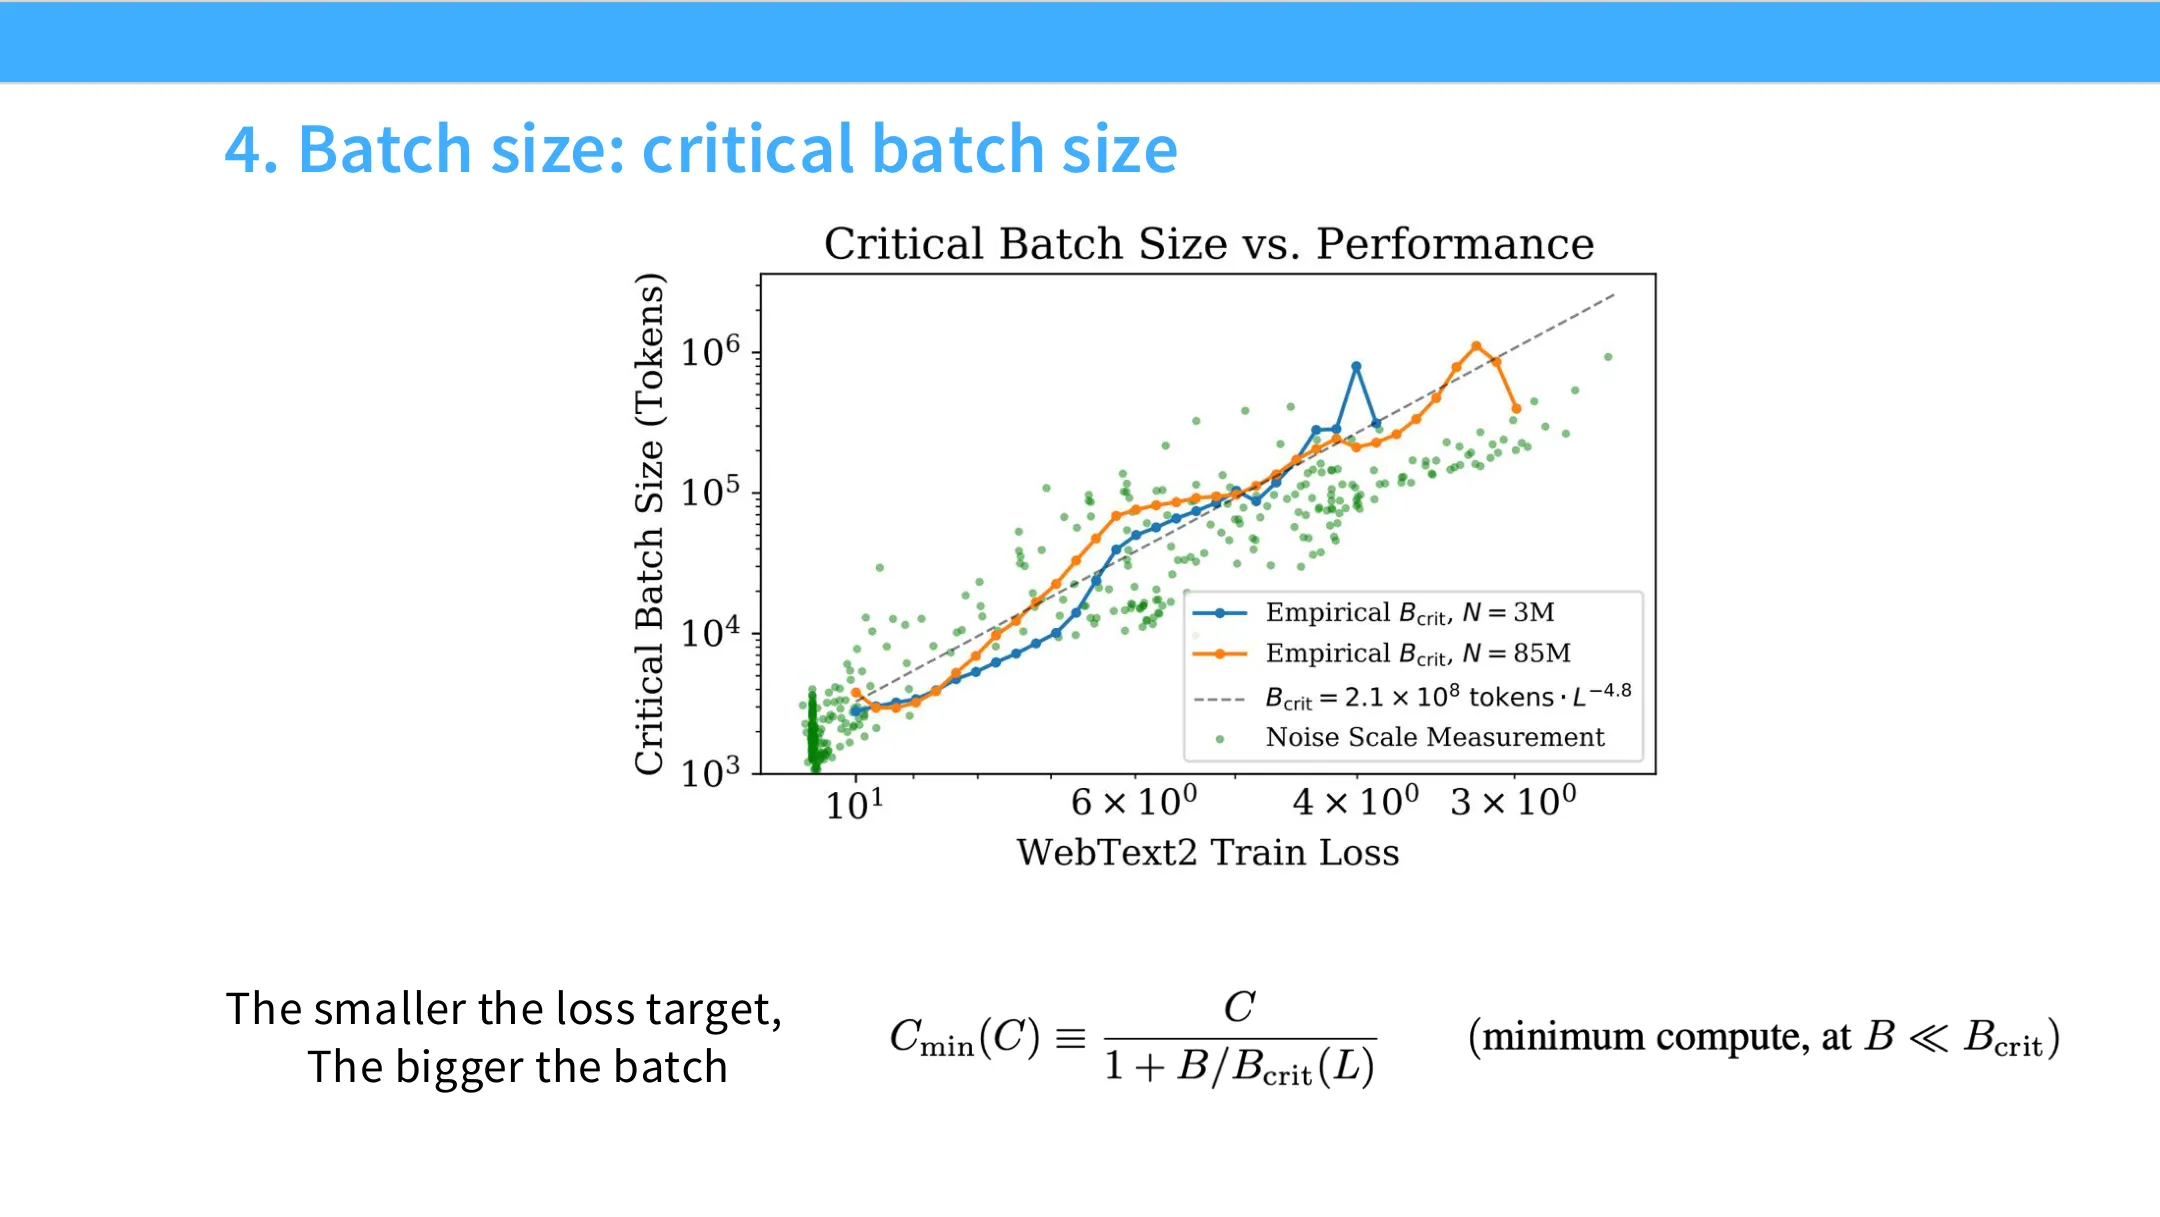
📷 临界批大小:目标损失越低,批越大(幂律)(Kaplan+ 2020 相关)
回到原视频 (00:47:56)
5.10 问题五:学习率、μP 与尺度感知的选择
(参考时间: 00:48:42)
学习率这块也更复杂,老师会在进阶 scaling 讲座里详讲。先给一个心智图像(标准世界,假设只是一个普通 MLP,只做宽度 scaling,不做深度 scaling):
- 模型越大 → 学习率应越小。直觉:参数更多、一次改动更多东西,那每一步就该迈小一点。一个常见的经验法则是按 $1/\text{width}$ 缩放学习率。
- 另一派做法是重新参数化网络:改初始化尺度、改优化器各部分的步长,强迫模型在不同尺度下具有相同的学习率极小值。这就是 μP 一类的思想。
设定大模型学习率的两条路线:
- 估计极小值的位置,并预测你的极小值在哪——因为极小值的变化很可预测,所以这不是个疯狂的想法;
- 重新参数化模型,让学习率极小值保持不变,然后挑一个最好的学习率直接用。
两种路线都在规模化训练里成功过。老师经验上觉得更多人偏爱 scaling law 路线,但两者都可行。
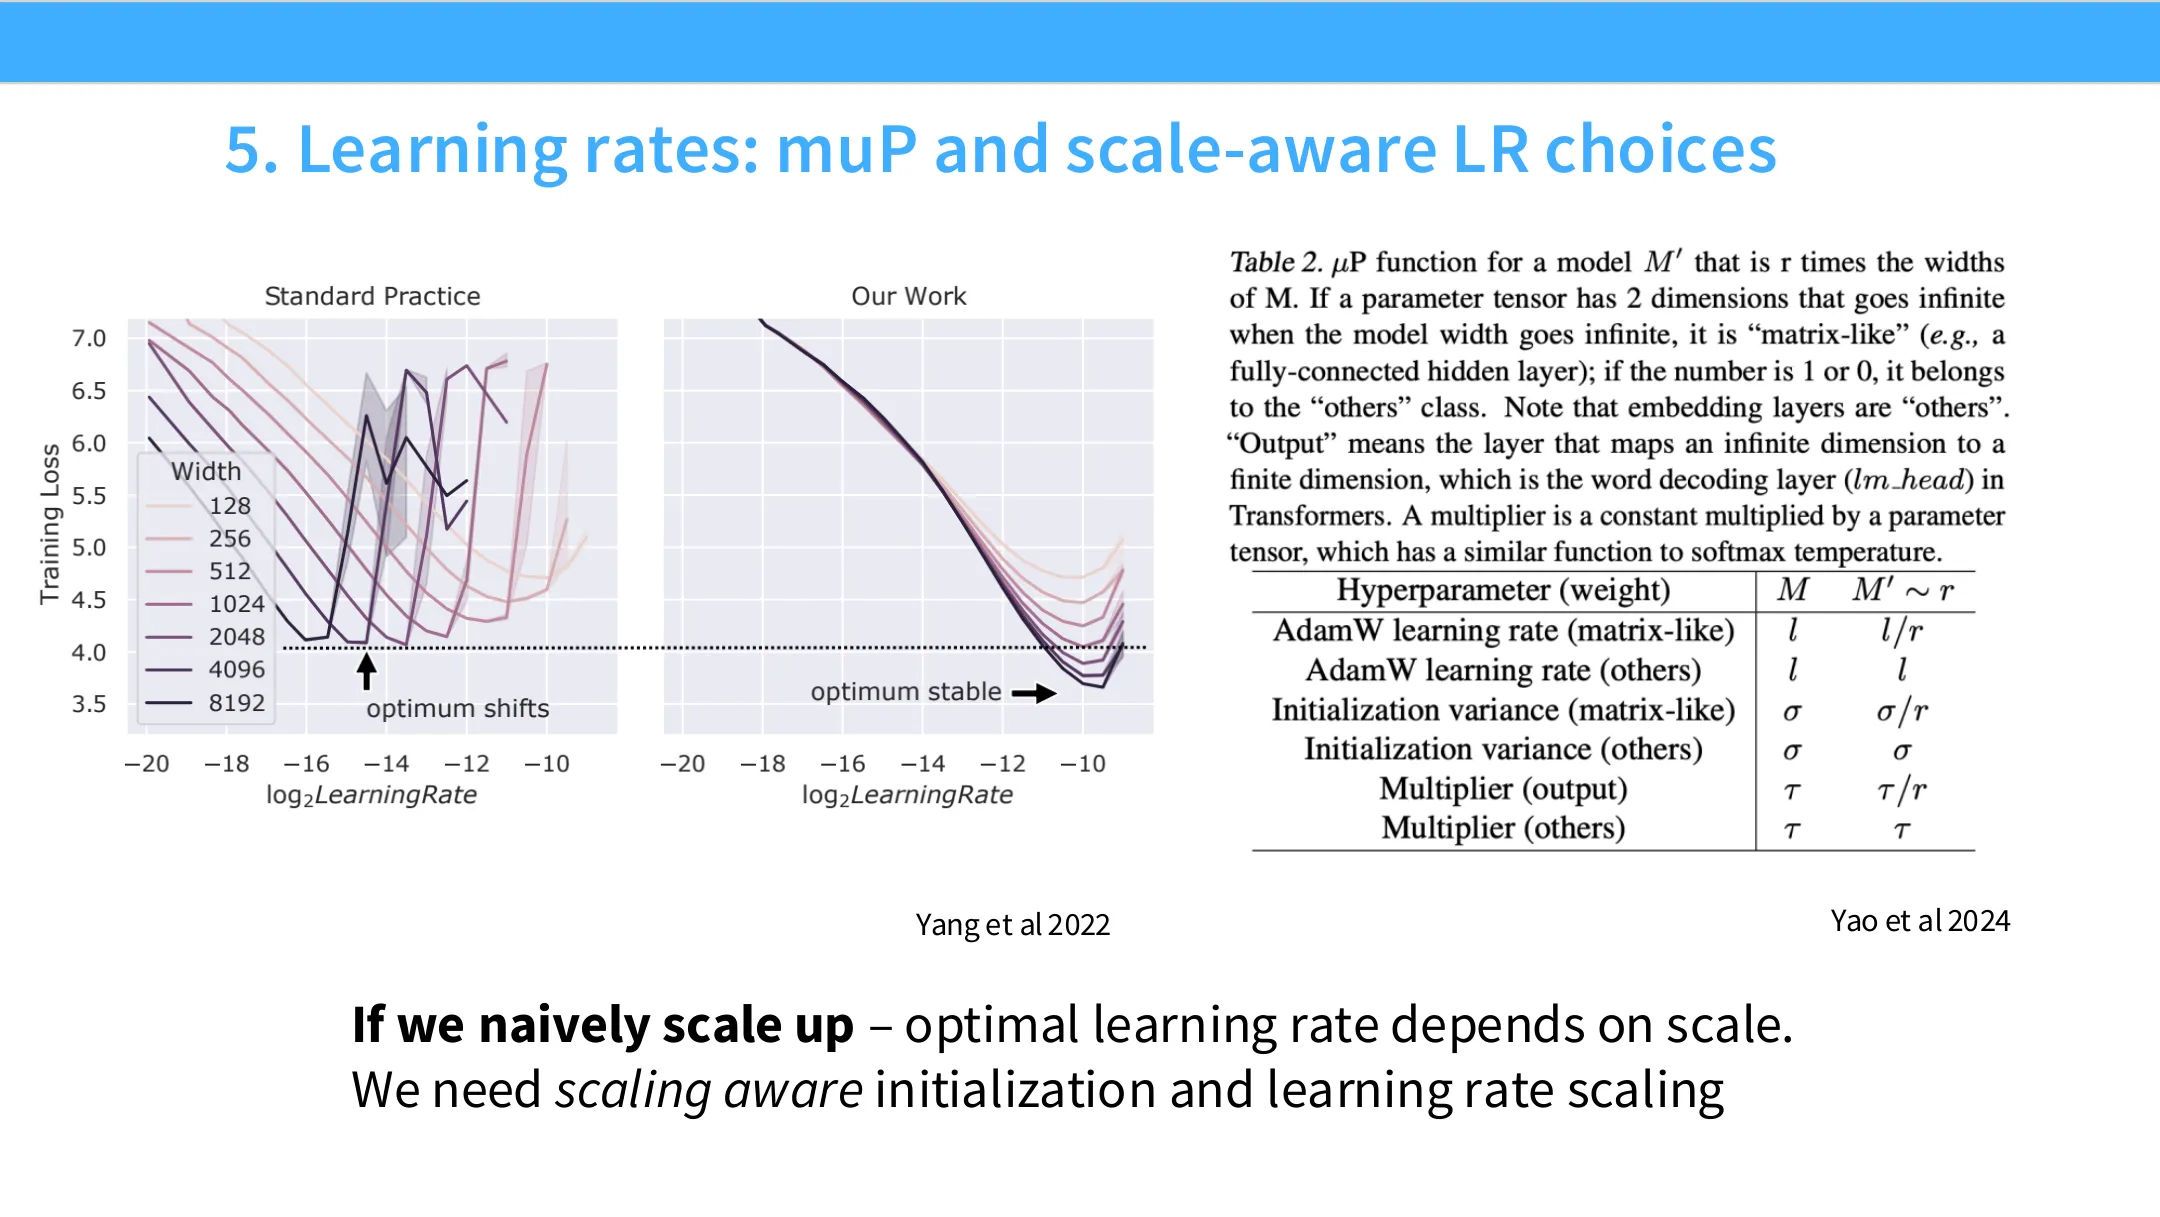
📷 学习率:μP 与尺度感知的学习率选择(Yang et al 2022;Yao et al 2024)
回到原视频 (00:48:42)
5.11 警告:上下游表现可能大不相同
(参考时间: 00:51:08)
在进入最后一节前,老师强调:上游(预训练)与下游(任务)表现可能很不相同。
看对数似然:参数越多,困惑度越可预测地变好,是非常漂亮的线性趋势。于是你以为「那就把我们最好的模型 NL-12 发出去吧」——结果 NL-12 并不是最好的,实际最好的是 NL-32 XL,而它在困惑度上更差。
这是老师见过的上下游相关性最差的例子之一。要点:scaling law 一般是你想用在困惑度这一侧的对象——因为它干净、规律、可预测;但从困惑度到下游任务的迁移,远比表面看上去不确定。这是你必须非常谨慎的地方。
一个轶事:老师的几位前学生在各处做 post-training,总是抱怨——「那些预训练的人,把模型丢给你,说『困惑度很好,剩下是你的问题了。』」 但问题往往起源于预训练那一侧。你不想成为那种人;你要真正考虑迁移,而不只是盯着困惑度。
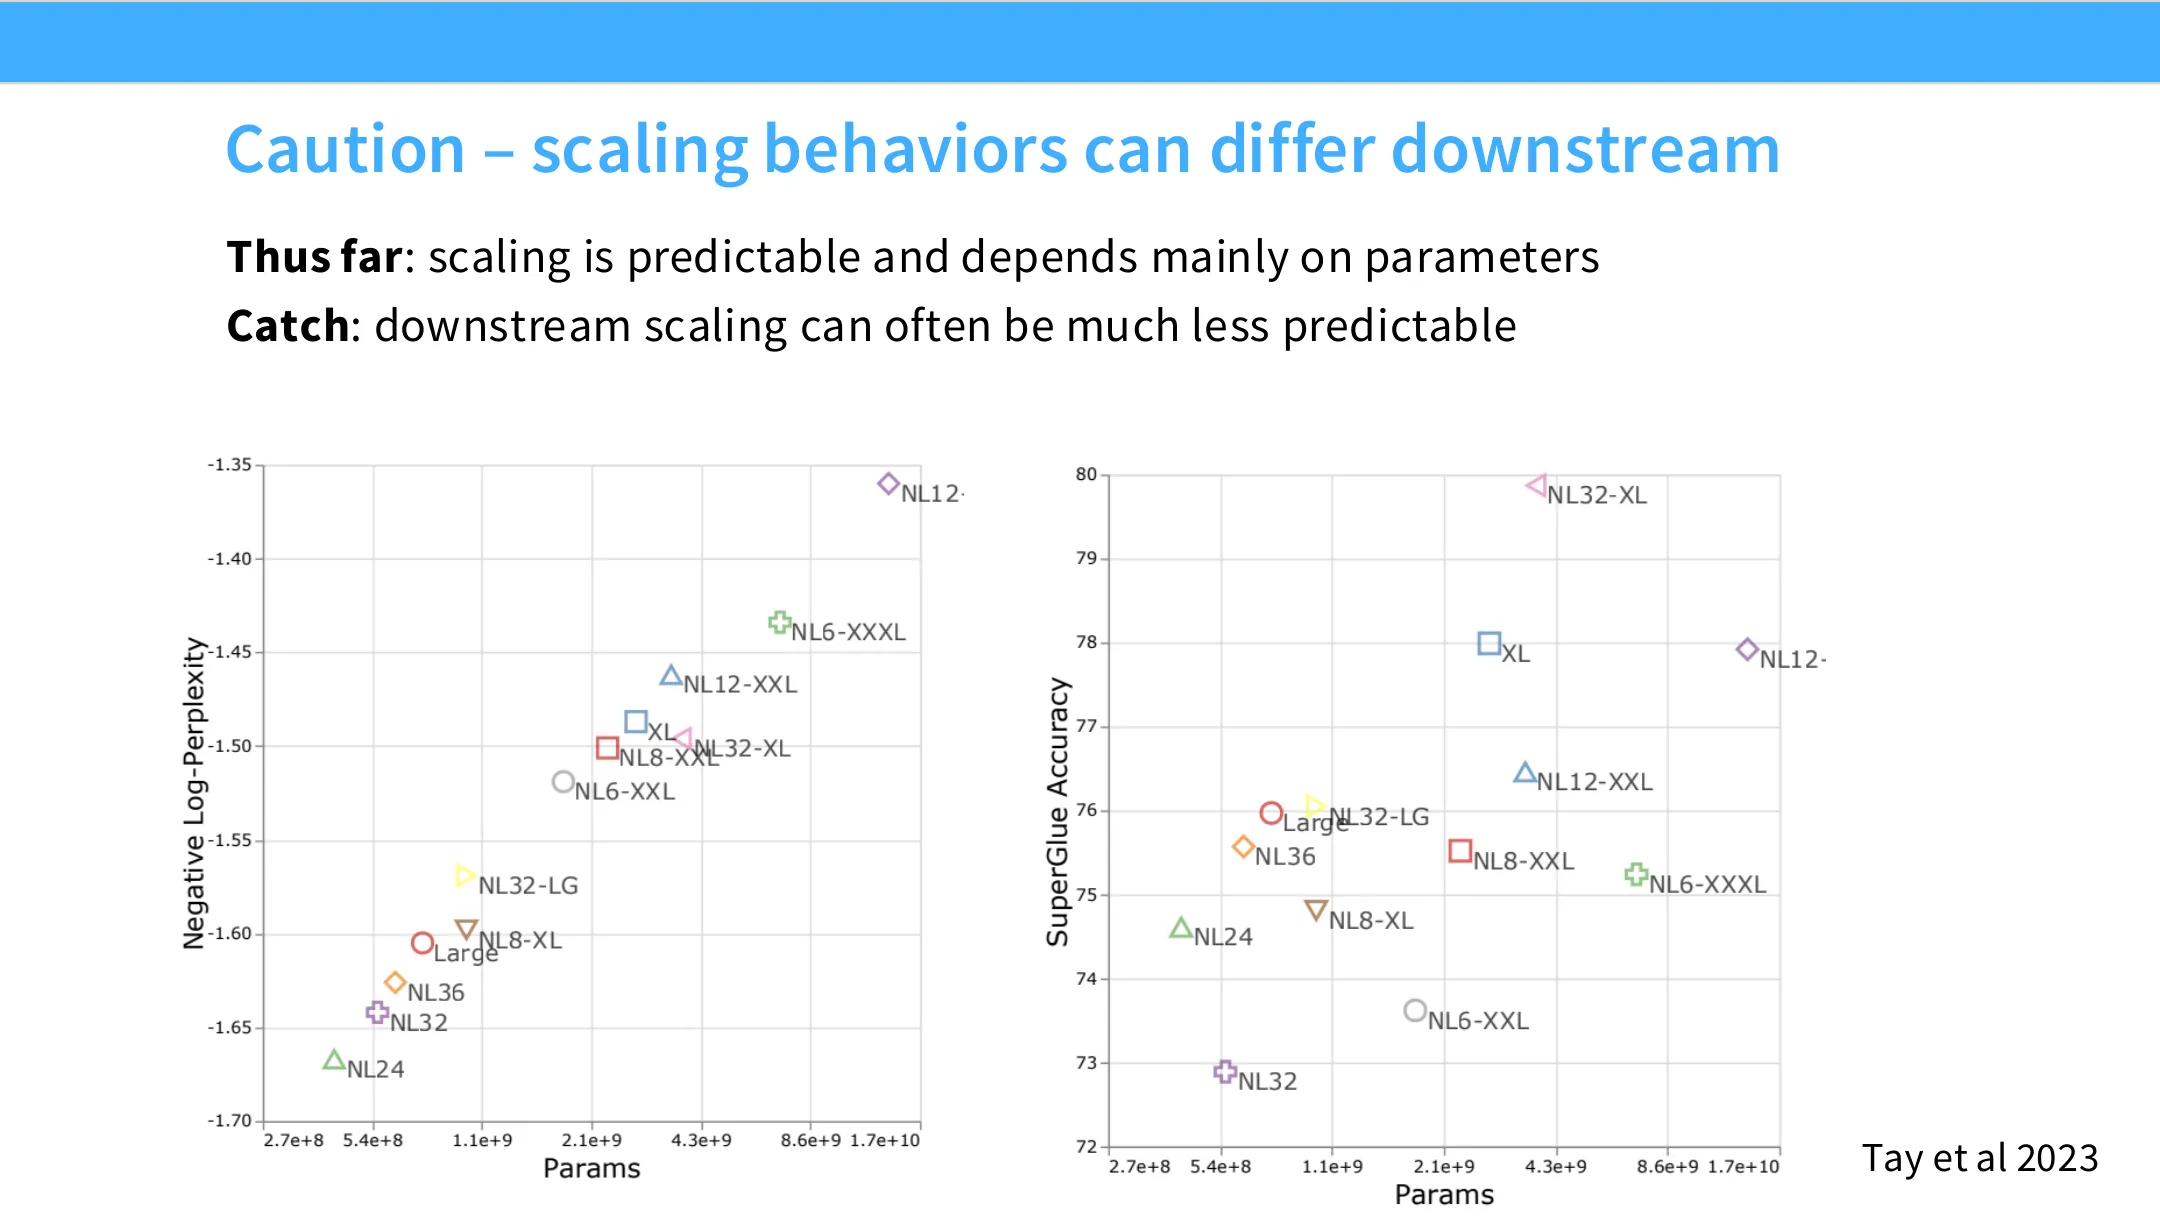
📷 警告:上下游 scaling 可能不同——困惑度最好 ≠ 下游最好 (Tay et al 2023)
回到原视频 (00:51:08)
5.12 令人惊讶的结论 + scaling-law 设计流程
(参考时间: 00:52:37)
令人惊讶的结论:大模型上超参数的影响,可以在训练前就被预测——优化器选择、模型深度、架构选择,皆可。
基于 scaling law 的设计流程:
- 训几个较小的模型;
- 建立一条 scaling law(比如 ADAM vs SGD 的 scaling law);
- 根据 scaling law 的预测,选择最优超参数。
老师强调:在你做大训练之前,你应该对将会看到什么有一个大致概念——不只是「它能不能训起来」。事实上,有了 scaling law,你应当能相当精确地预测数值,甚至几乎预测这次运行会有多好、换一个优化器增益有多少。
这就是 scaling-law 程序的朴素版本:训小模型 → 拟合 log-log 直线 → 如果拟合足够好,就对「差距会持续」有信心 → 部署到大训练。虽然朴素,但相当接近实践做法——总比「凭空丢一个大训练」强。
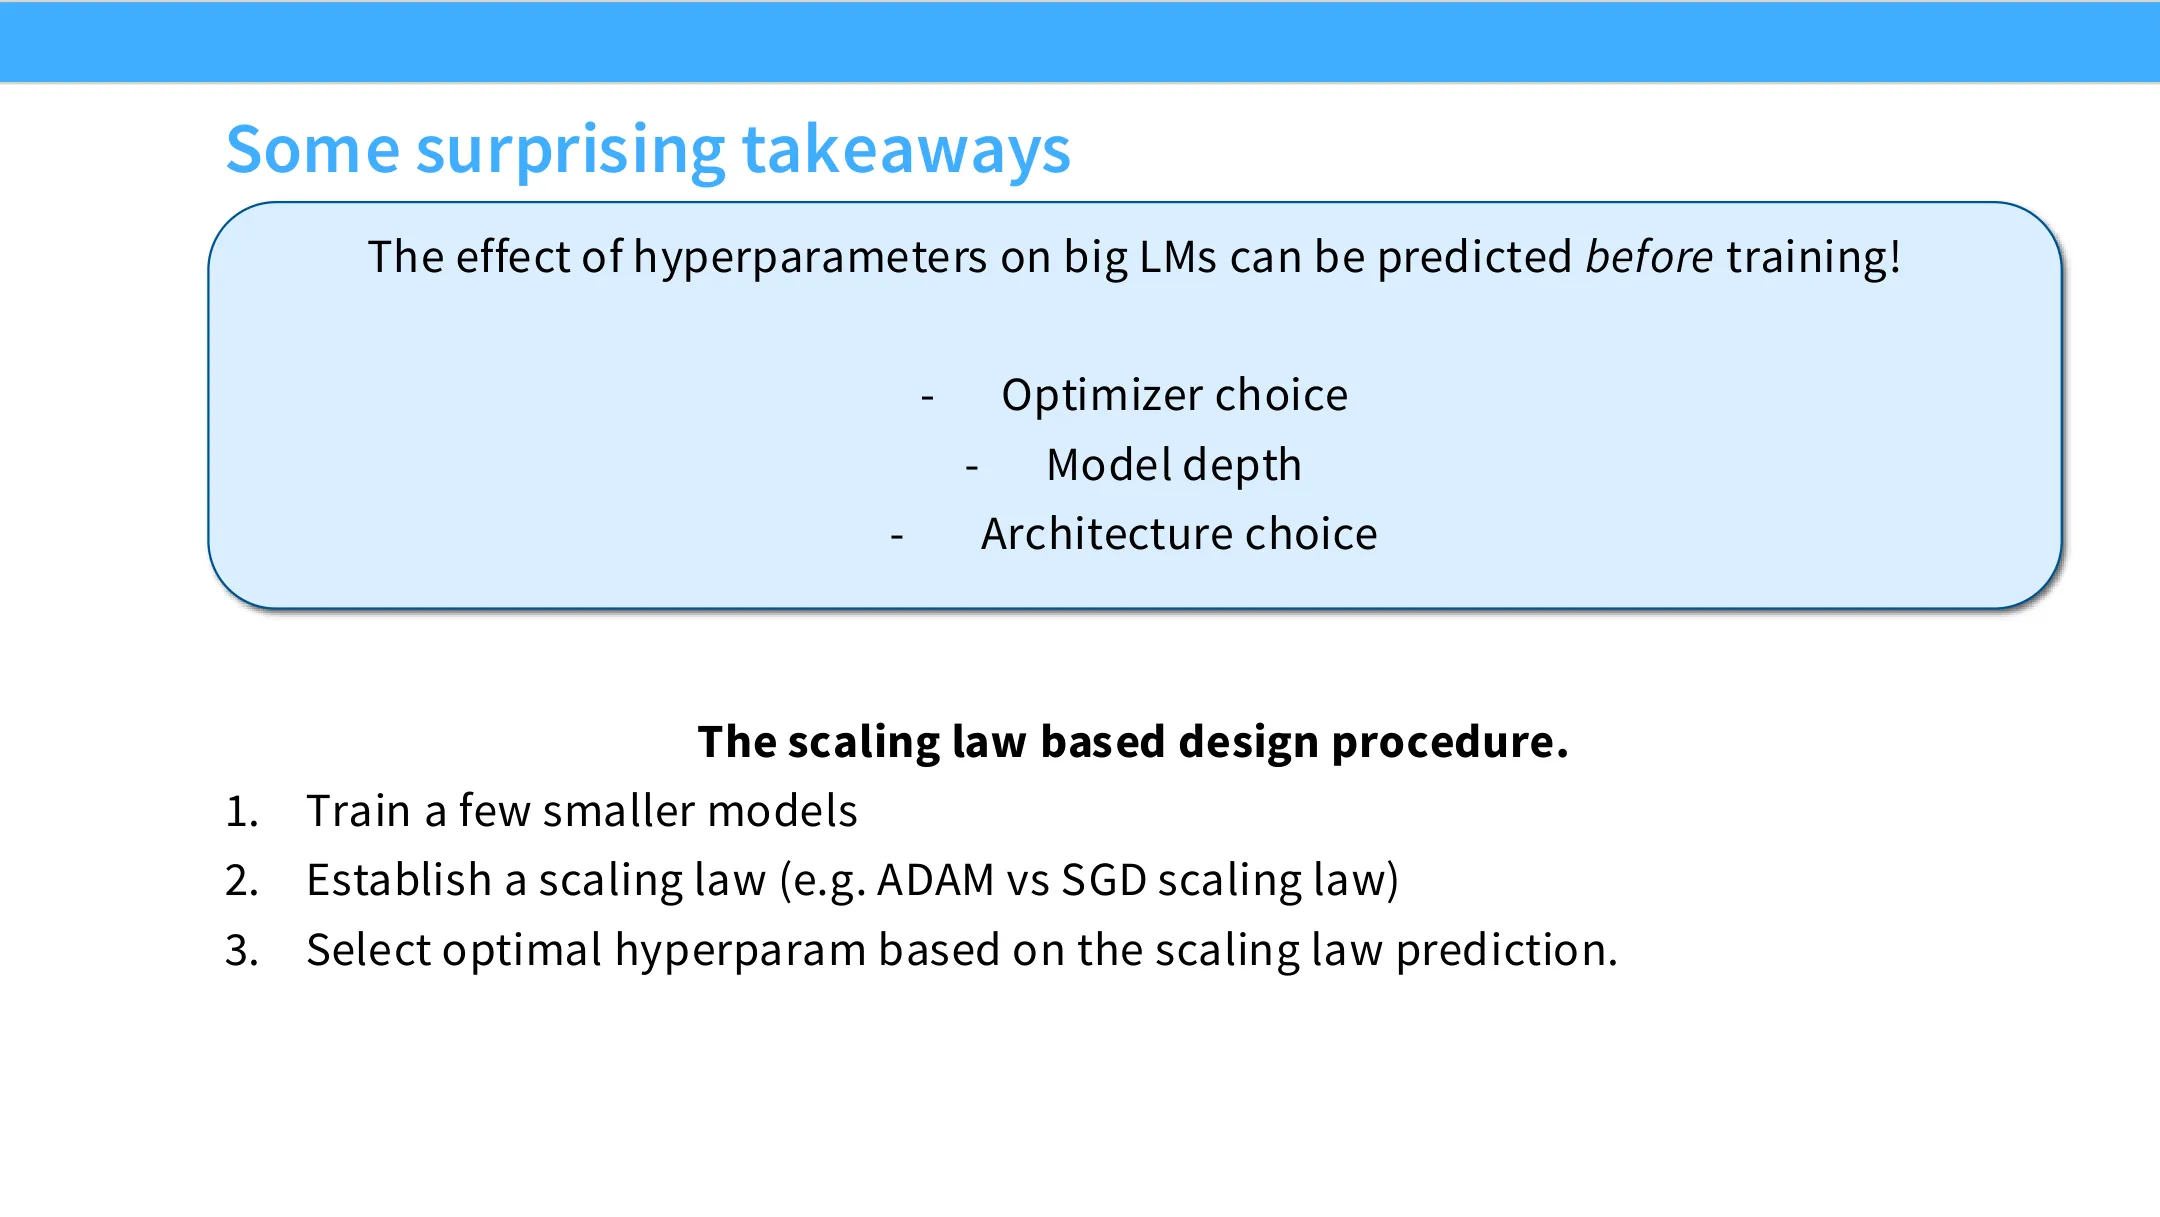
📷 令人惊讶的结论 + scaling law 设计流程三步
回到原视频 (00:52:37)
课堂问答(参考时间: 00:53:43):
- 问:scaling law 上的每个数据点,如何处理方差?跑几次?取平均还是取最小/最大?
- 答:我见过的几乎所有情况都是单次(singleton)。因为看困惑度时它非常干净——重跑的话方差大概在小数点后第二位。训练数据很同质、数据量大、评测集大,方差被压得很低。但如果你做的是学习率或临界批大小的 scaling law,会看到一些可怕的噪声。确实有人做方差缩减,但并不常见——也许不如它应该的那样常见。
- 问:多数人是不是直接在下游指标上做 scaling law,而不用困惑度?
- 答:有人直接在下游指标上做 scaling law,但那有同一个问题。正确的心态是:先可靠地确立一件事——先在一个低方差的测量(如困惑度)上建立 scaling 规律,再依赖某种关于迁移的信念或另行建立迁移,去表明它会迁移到下游。
- 问:有些图是测试损失、有些是训练损失,什么时候用哪个?
- 答:做正经科学实践(如 Kaplan 2021)时拟合测试损失;但现实中,除了极少数(无限算力、重复数据那类),你基本都是单遍 SGD,所以泛化差距很小,train 和 val 非常接近。有些预训练代码库甚至根本没有验证损失。这就是为什么很多图把二者互换——它们都在单遍 regime。
六、联合 scaling law:要数据还是要模型?
6.1 联合数据-模型 scaling law
(参考时间: 00:56:45)
现在讲 scaling law 最著名的用途之一——哪怕你从没亲自用过,你一定用过它的经验法则。
动机问题:我该要更多数据,还是更大的模型?你的资源是算力,有人会(比方说)给你一定量的 FLOPs。FLOPs ≈ 数据量 × 参数量(线性关系)。于是问题变成:这笔 FLOPs 该怎么分配?
显然:往一个小模型里灌海量数据是浪费——那条深紫色线会很早就压平。你本该用同样的 token 量去训那个大黄模型。
如果你能理解「数据量与模型大小如何共同决定性能」,就能精确优化这个分配。于是有更进阶的 scaling law,描述多个对象联合的行为。
几乎同时,Kaplan 和 Rosenfeld 各自提出(大致等价)的函数形式,描述模型大小与数据量如何共同影响误差:
$$\text{(Rosenfeld)} \quad \text{Error} = n^{-\alpha} + m^{-\beta} + C.$$
$$\text{(Kaplan)} \quad \text{Error} = m^{-\alpha} + \left(n^{-1}\right)^{\beta}.$$
Rosenfeld 的形式非常简单,就是两个逆项之和(两条 scaling law 相加);Kaplan 的稍复杂,但大意相同。
看极限就知道它很直觉:
- 若数据无限:$n^{-\alpha} \to 0$,你变成纯模型大小的 scaling law;
- 若模型无限:模型项被压下去,你变成纯数据的 scaling law。
老师顺便给了一个通用技巧:如果别人告诉你一条 scaling law,就去对每个变量取极限,以理解系统的行为。
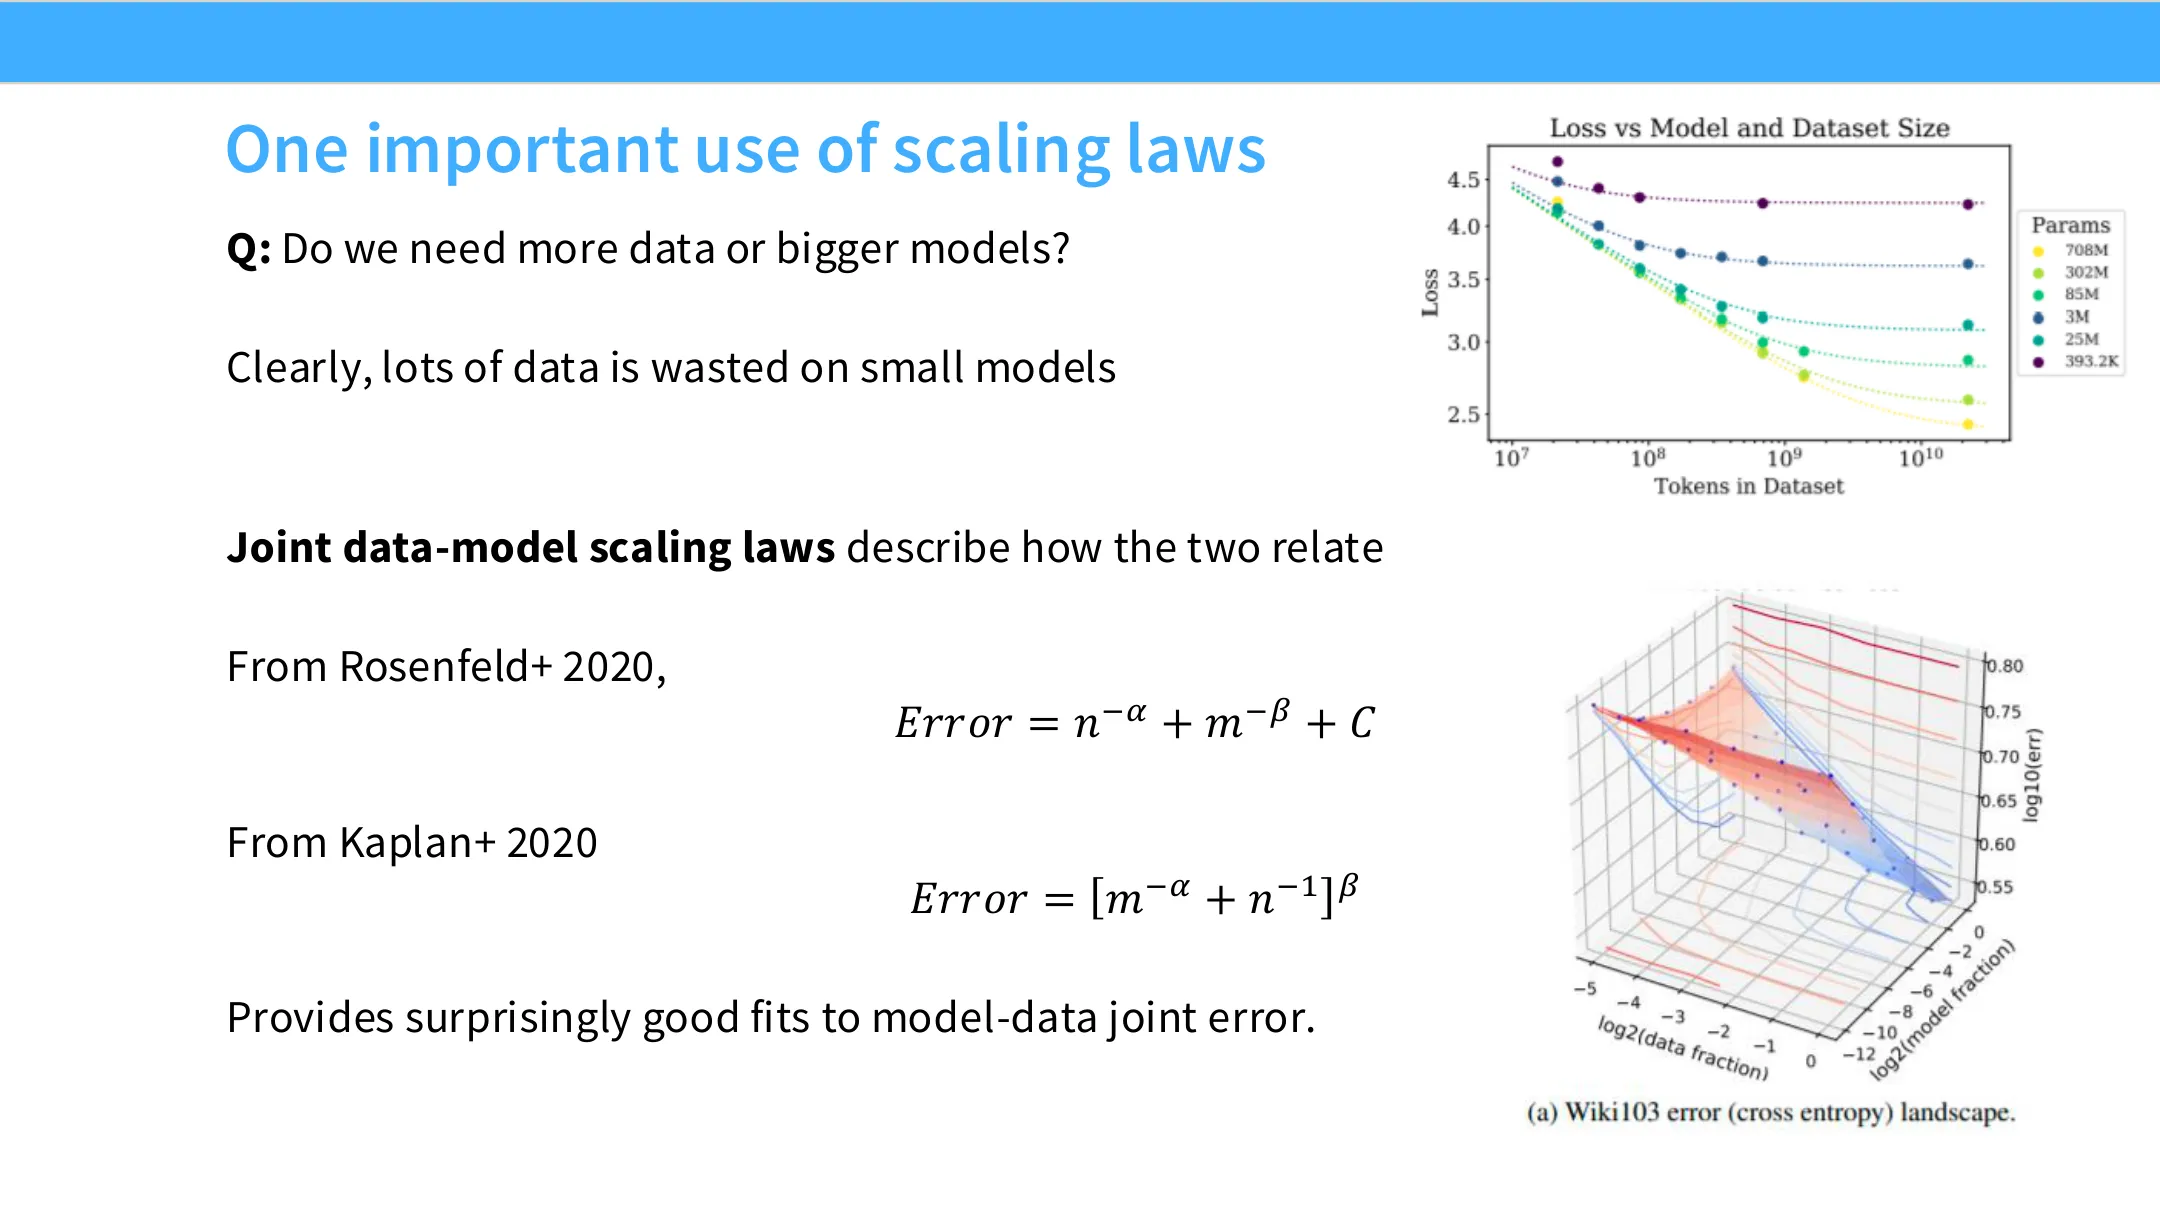
📷 联合 scaling law:Rosenfeld 与 Kaplan 的函数形式,取极限可退化回单变量律
回到原视频 (00:56:45)
6.2 联合 scaling 的外推能力
(参考时间: 00:59:24)
很酷的一点:Rosenfeld 等人表明,即使外推,这些函数形式也拟合得很好。做法是:
- 只在低算力 / 低数据的「绿色点」上拟合(你从没见过高数据或大模型的点);
- 然后从这块小角落外推到高算力、高数据、大模型的 regime;
- 误差预测得相当准确。
例如从 Kai 那个图可以观察到:很小的模型 + 巨量数据 = 算力浪费。
一旦有了这样的联合函数,就变成一个简单问题:在固定 FLOPs 约束下,最小化这个式子——一个简单的非线性优化。
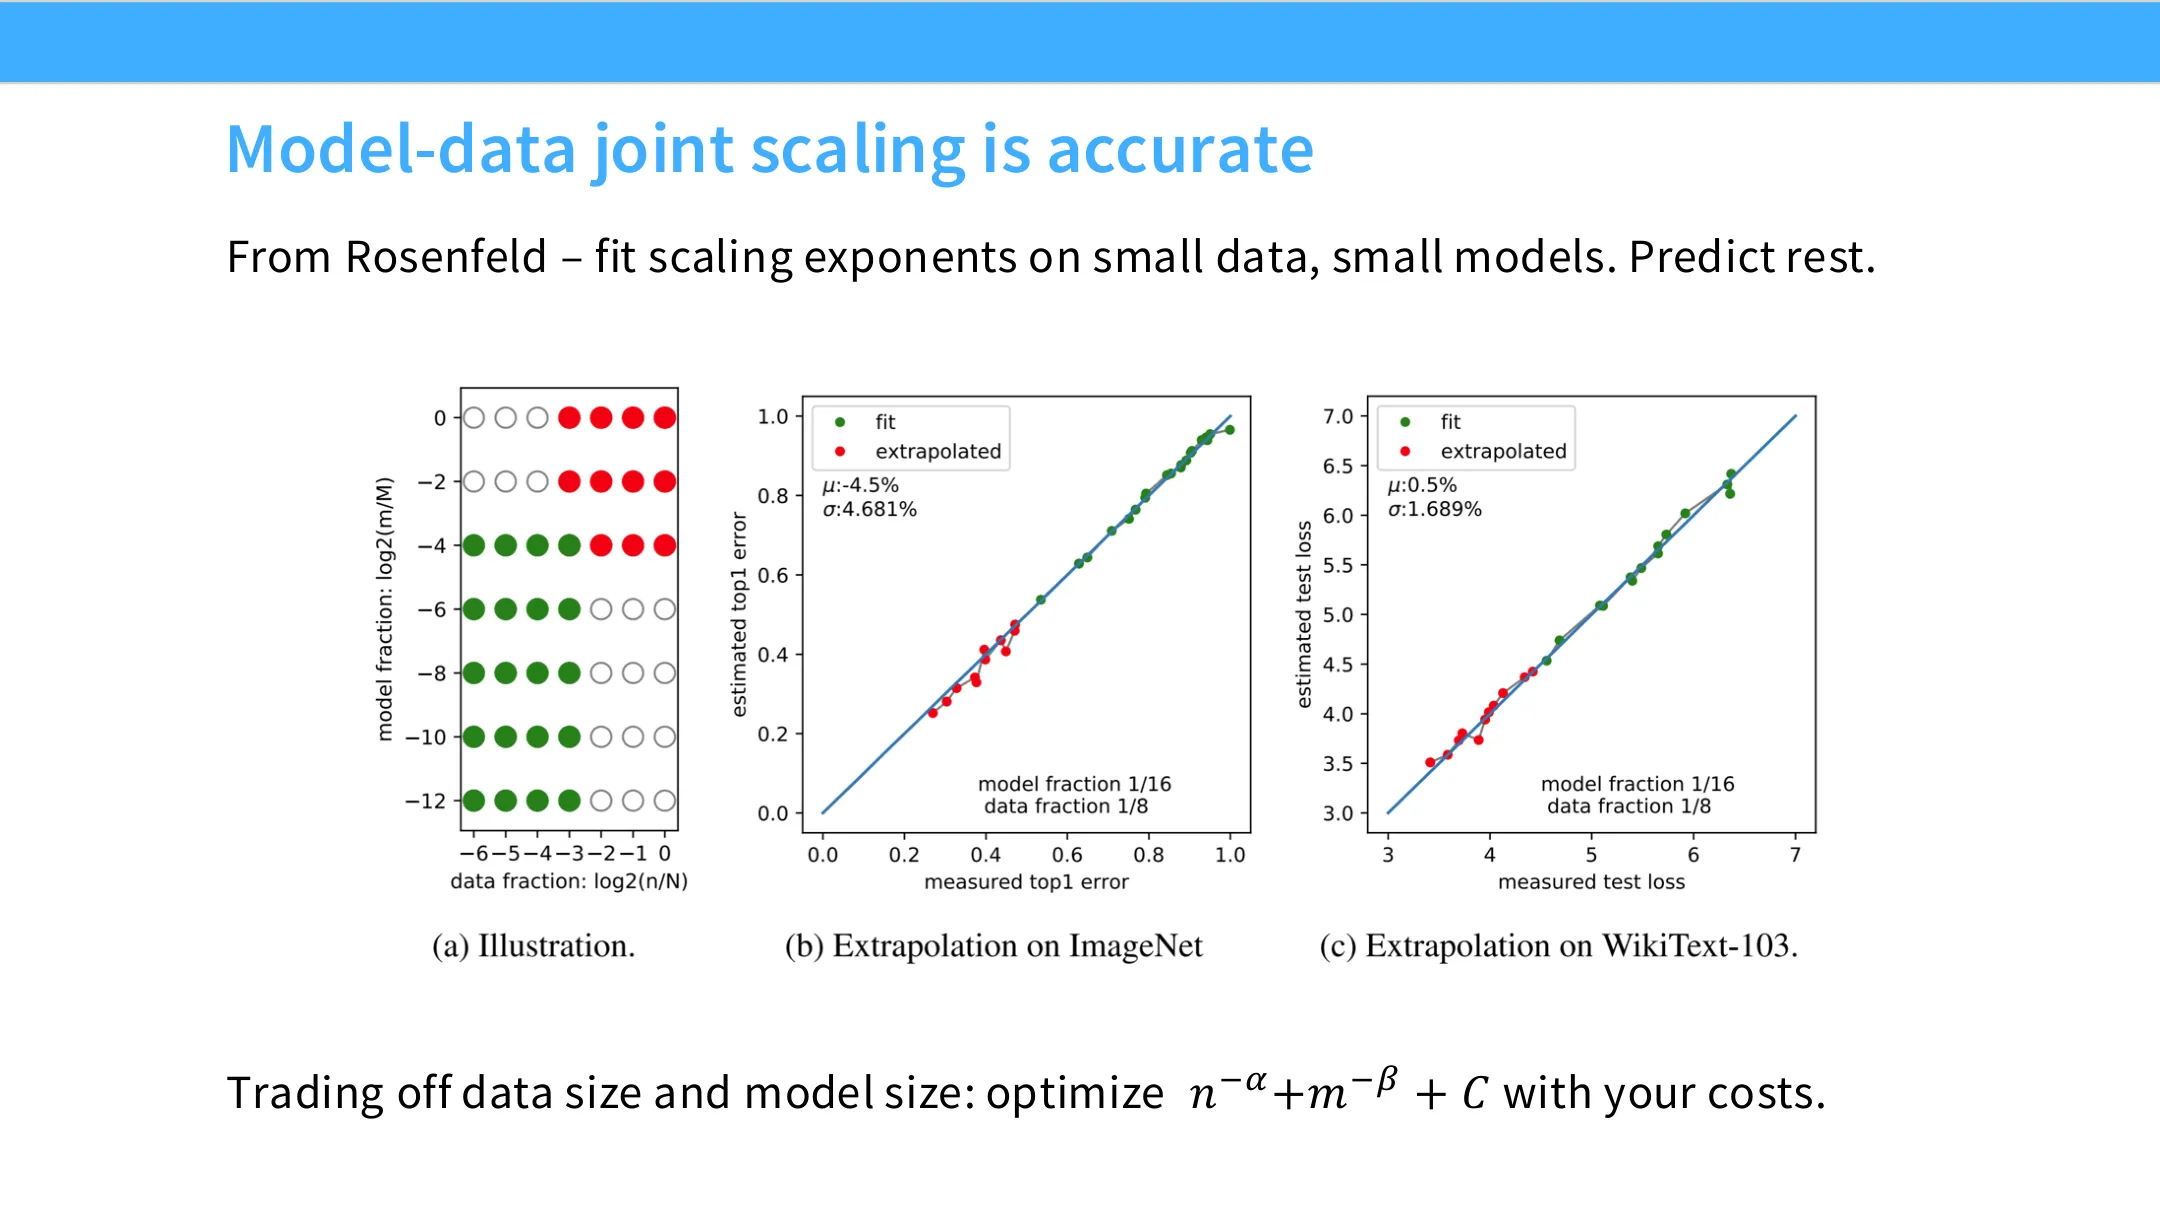
📷 联合 scaling 外推准确:在小数据、小模型上拟合,预测其余
回到原视频 (00:59:24)
6.3 最优算力/数据权衡:Chinchilla 的前奏
(参考时间: 01:00:11)
Kaplan 和 Rosenfeld 都对「数据、模型、性能」的关系做了预测。若解 Kaplan 的优化,会得到大致的结论:
$$N_{\text{opt}} = C^{0.73}, \qquad D_{\text{opt}} = C^{0.27},$$
其中 $N$ 是参数量、$D$ 是数据量(tokens per parameter 随算力 $C$ 增大而下降)。注意——幻灯上老师一度念反了,随即纠正:$N$ 应是参数量、$D$ 是数据量,于是每参数 token 数随算力增大而减少。
也就是说,Kaplan 的处方是:算力越大,就训越来越大、越来越大的模型。
这正是 GPT-3 时代的驱动力之一:那阵子大家都在训千亿参数、甚至万亿参数的稠密模型——人们看到 GPT-3、看到 Kaplan 的预测,就把大训练砸在这些超大模型上。
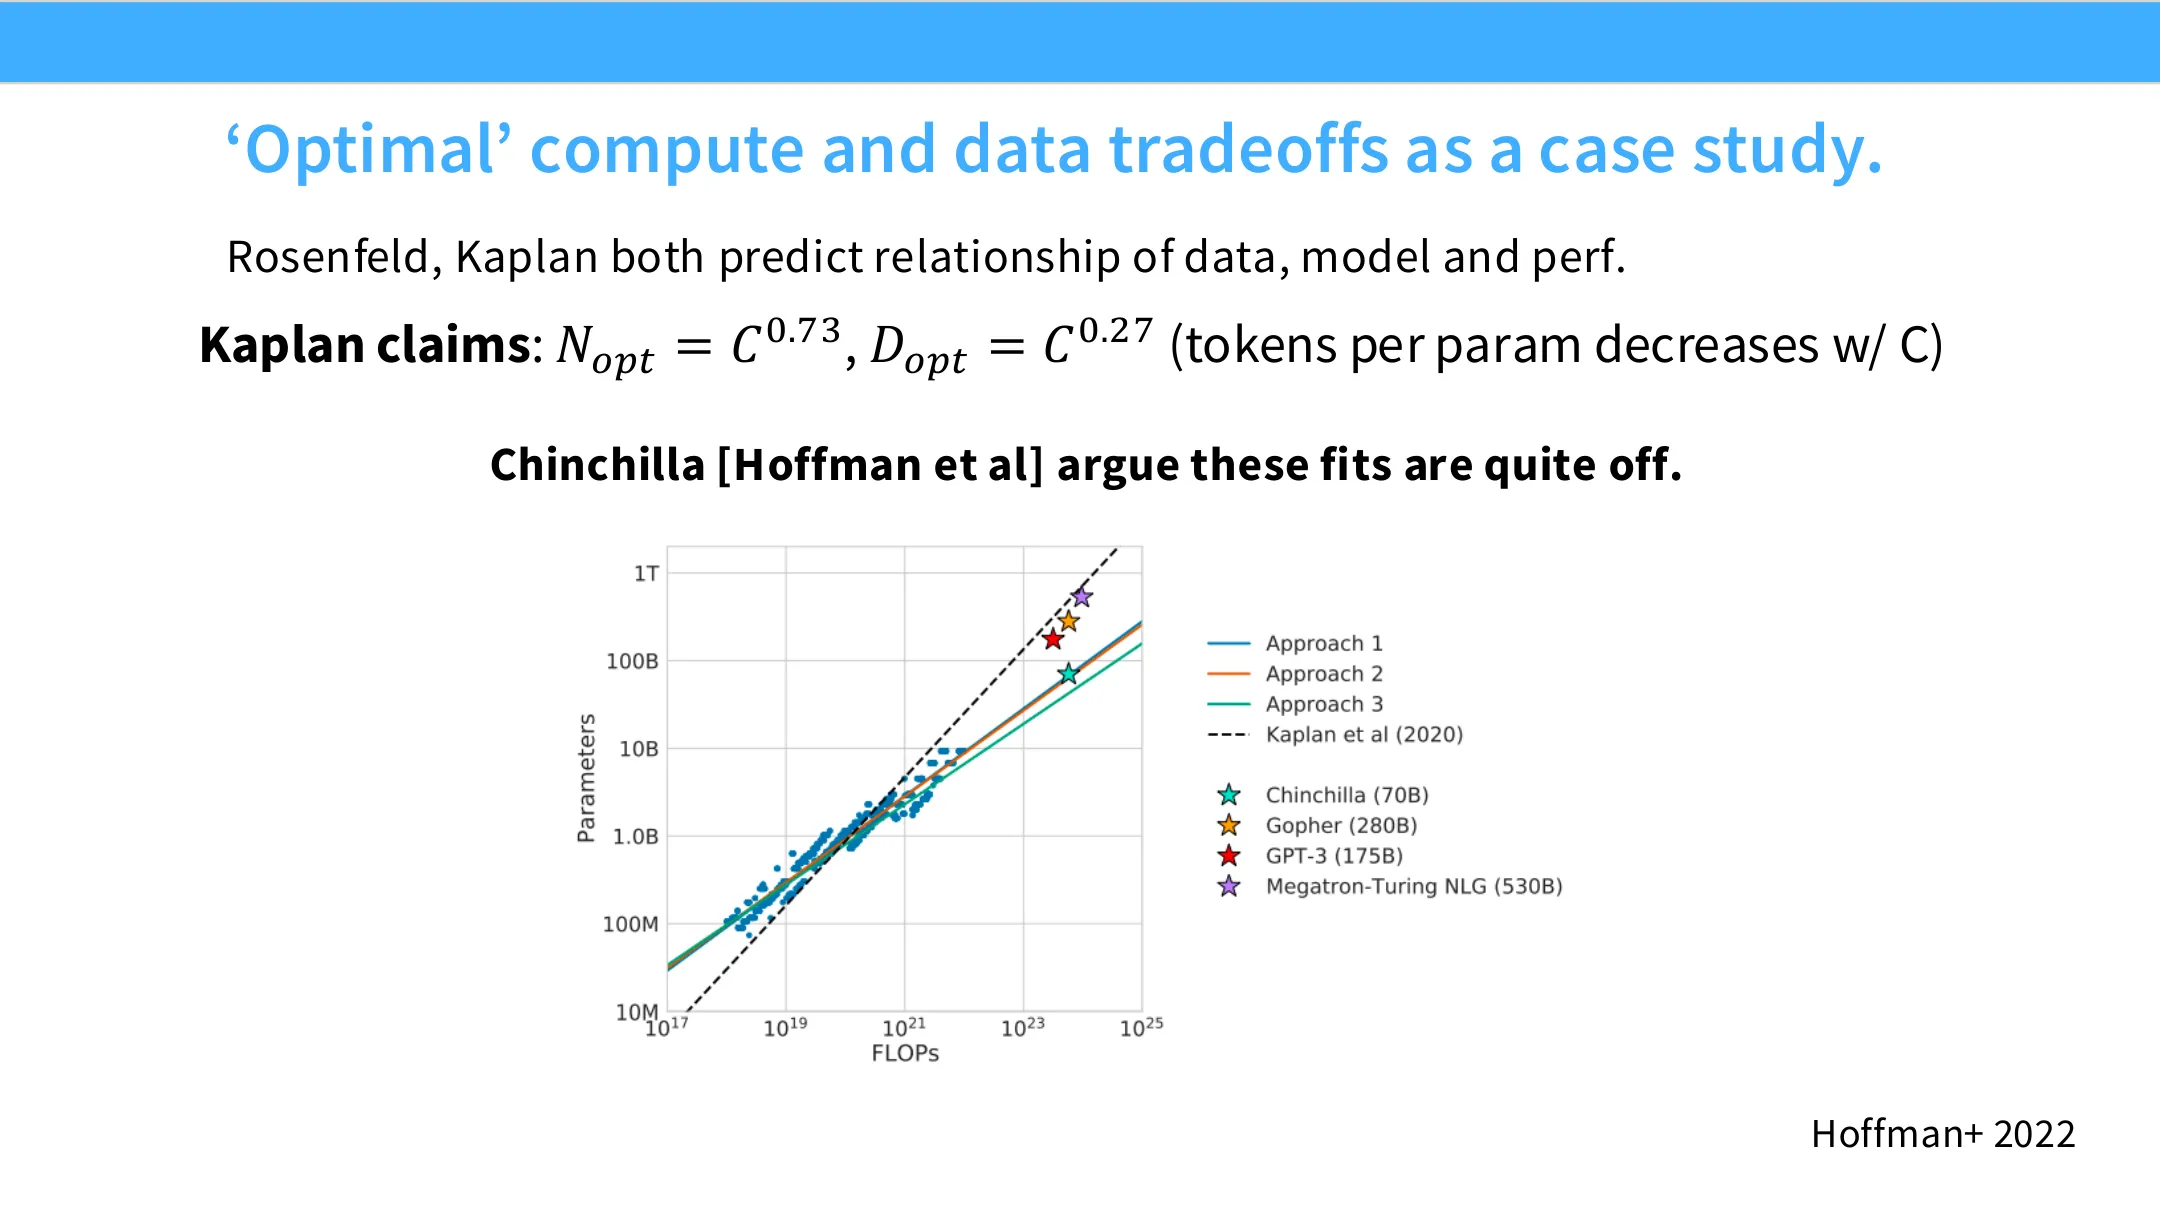
📷 最优算力/数据权衡:Kaplan 预测 N_opt=C^0.73, D_opt=C^0.27(每参数 token 随算力下降)
回到原视频 (01:00:11)
七、Chinchilla 与 Kaplan 之争
7.1 分歧:模型其实该更小
(参考时间: 01:02:30)
几年后(2022),DeepMind 的 Hoffmann 等人(Chinchilla)说:这些预测全错得厉害。 那些按 Kaplan 训出来的巨大模型(图上三个星星)太大了;真正该训的是另一条趋势——小得多的模型(青色星星)。
这就是著名的 Chinchilla 结论:20 tokens / 参数。但老师认为,更值得细看的是这场分歧本身——它告诉我们该怎样认真、敏感地对待 scaling law,而不是「转个曲柄就得到答案」。
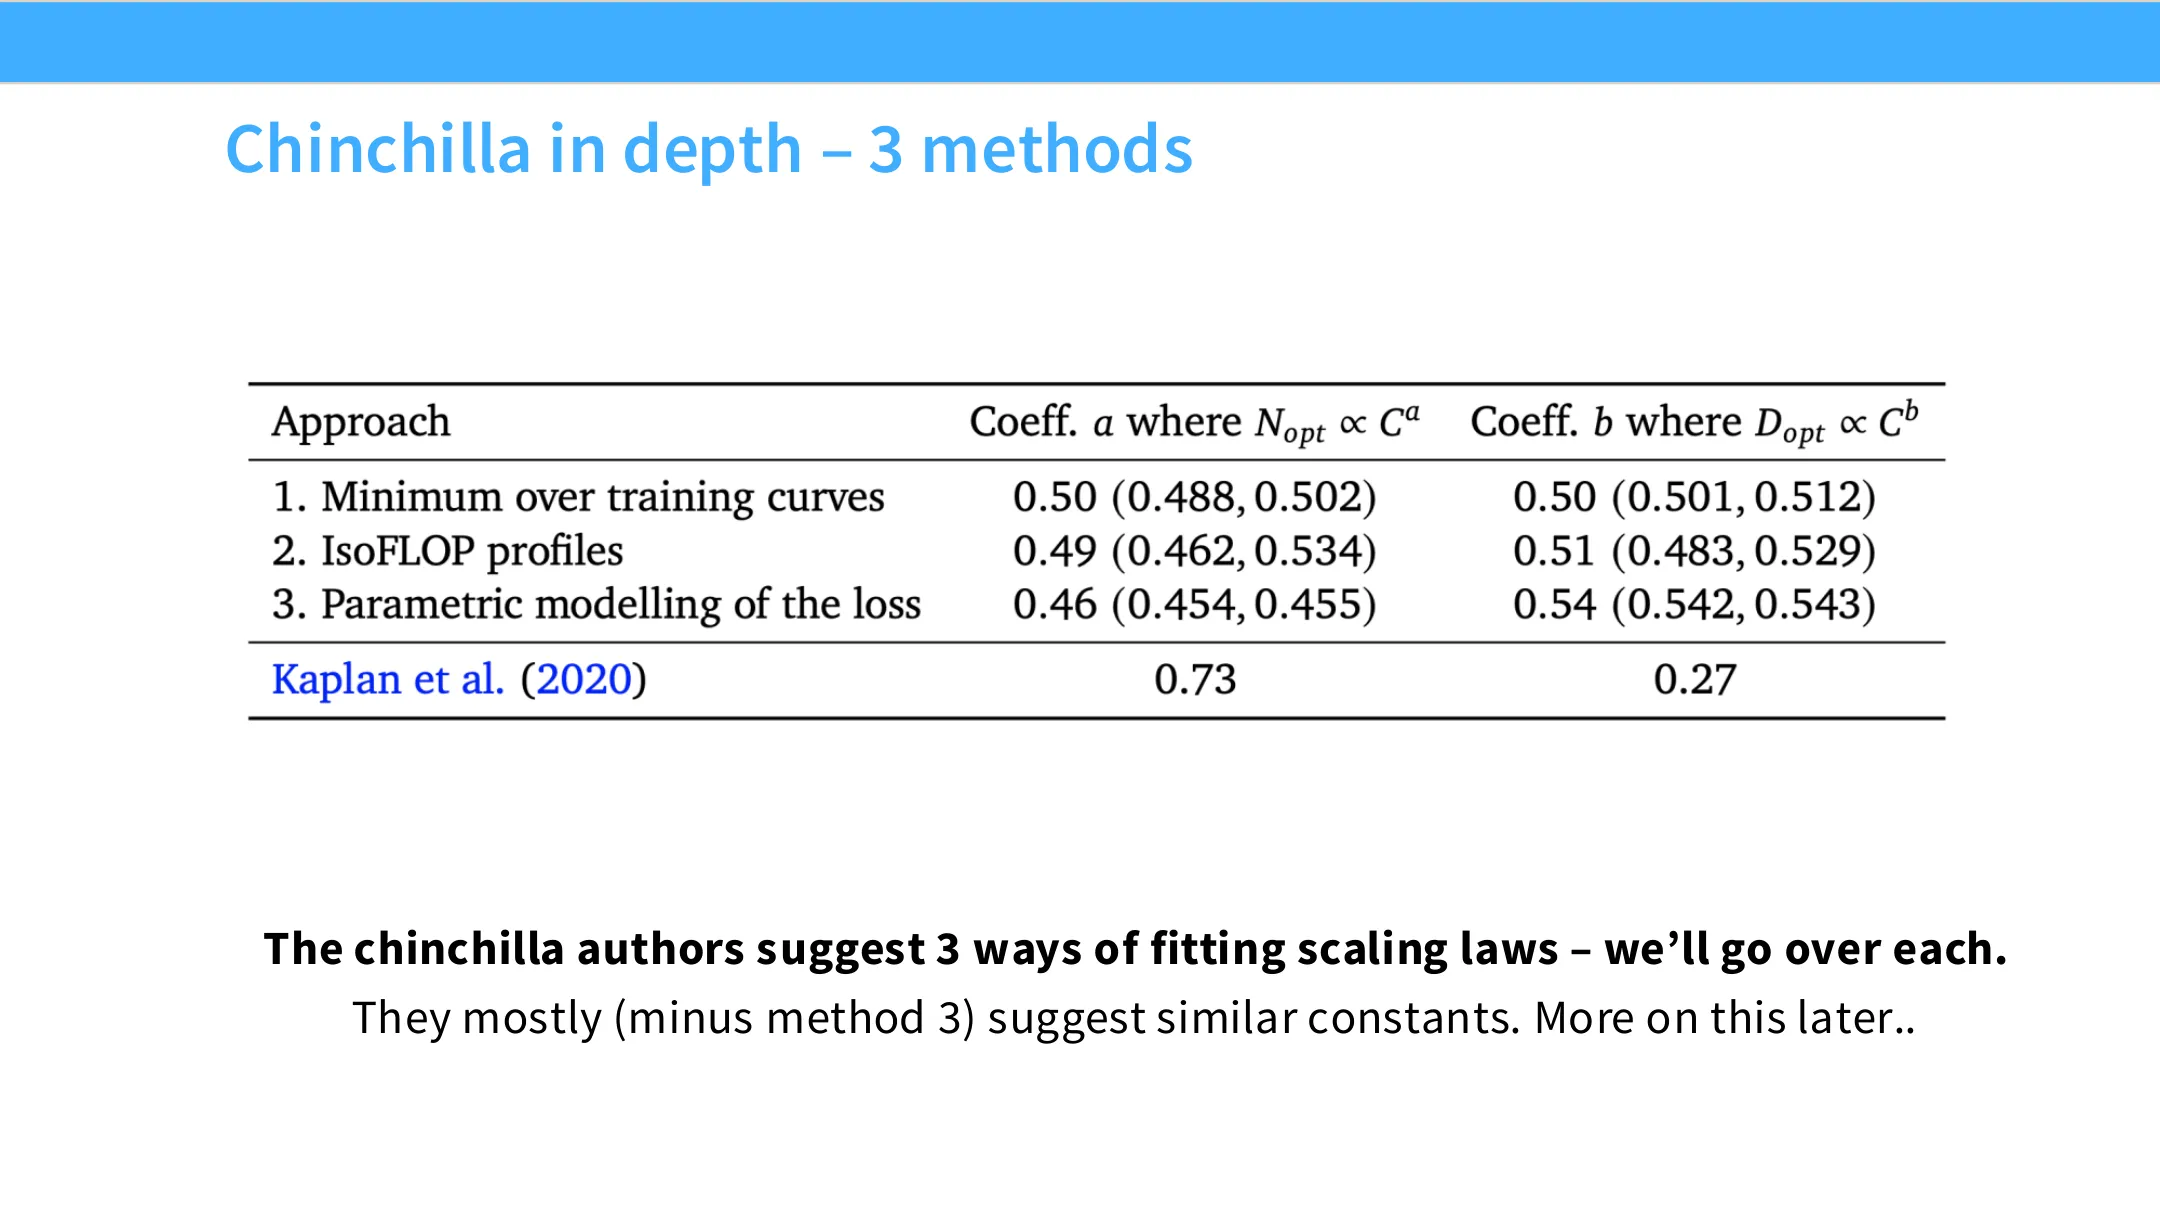
📷 Chinchilla in depth:三种拟合 scaling law 的方法
回到原视频 (01:02:30)
Chinchilla 作者提出三种拟合 scaling law 的方法,老师很喜欢这个做法——它是对建模假设的一种鲁棒化:
- 方法一、二给出的系数大致相同(0.5 / 0.5、0.49 / 0.51);
- 方法三稍有差异(0.46 / 0.54),但后面会解释原因;
- 与 Kaplan 的巨大差异就在于指数——这正是「训大模型 vs 训小模型」的分野。
编者拓展|Chinchilla scaling law 的三种拟合方法
方法一与二都给出「数据与模型应同比缩放」的结论(指数接近 0.5 / 0.5),也就是固定的「每参数 token 数」($D/N$ 恒定)——这是 20:1 法则的来源。方法三的指数不同(0.46 / 0.54),意味着随算力增大,token 会越来越多于参数——这是一个渐近意义完全不同的结论。因此方法三是否自洽,非常重要。
7.2 方法一:min-over-runs(下包络)
(参考时间: 01:03:17)
这是 Kaplan 也部分使用过的「下包络法」:
- 每一根彩色线是一条训练曲线;
- 取这些曲线的下包络(lower envelope)——对某个 FLOP,它是所有训练运行中达到过的最好损失;
- 在高算力段把下包络点取出,绘制「每个 FLOP 点对应的模型大小」的散点图;
- 会得到漂亮线性趋势,估计出「FLOPs 到参数」的最优权衡。
Chinchilla 的答案:67B 参数(对应它们的算力预算)。
这个方法简单,但判断下包络在哪之类的地方相当 tricky。
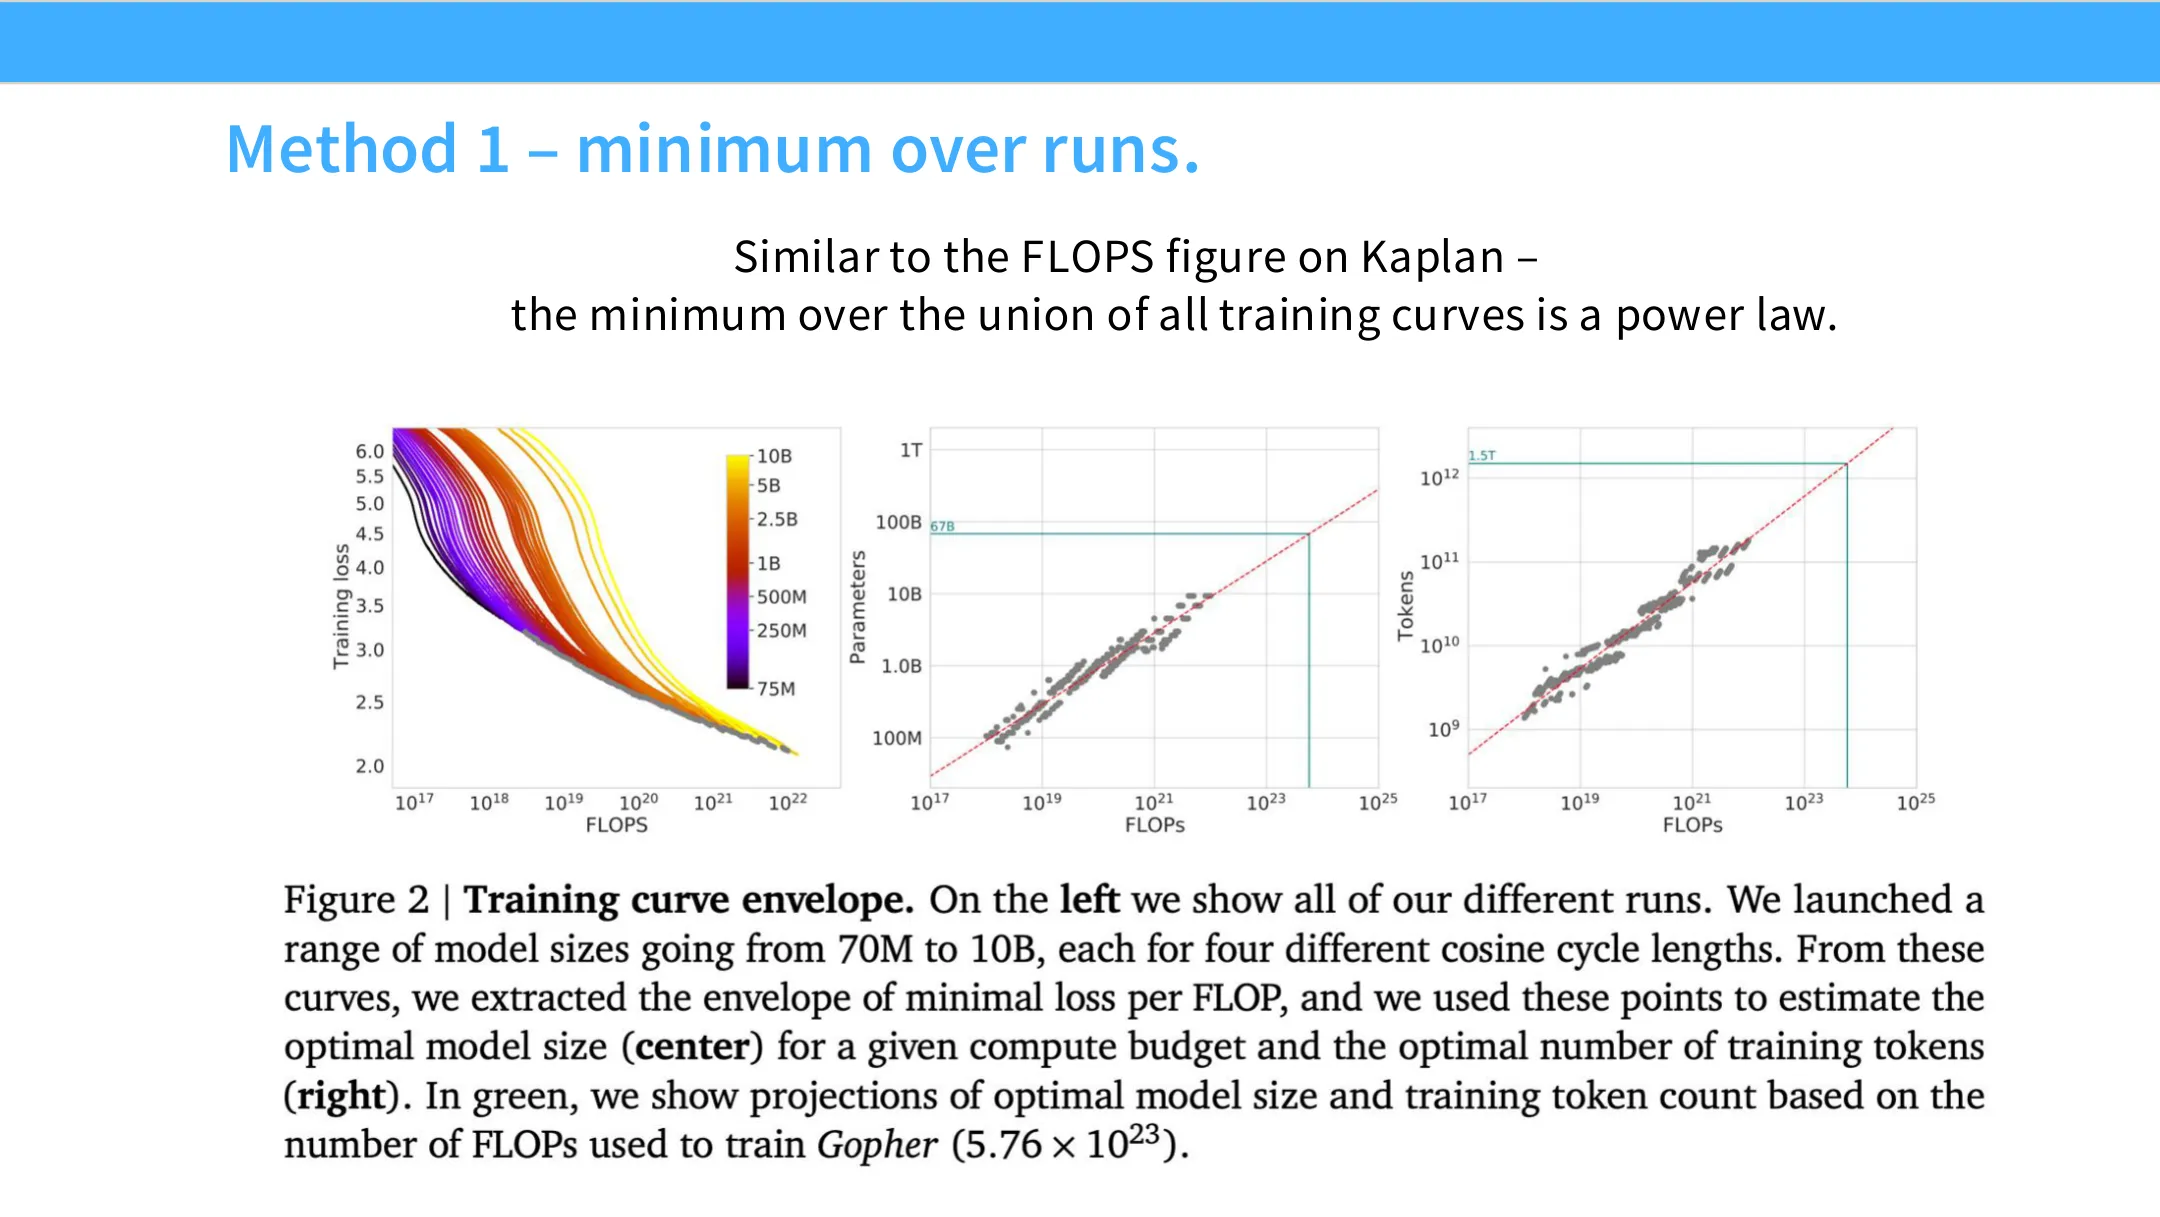
📷 方法一:min-over-runs,取所有训练曲线的下包络(Chinchilla 给出 67B 参数)
回到原视频 (01:03:17)
7.3 方法二:IsoFLOPS(等算力)
(参考时间: 01:04:28)
这是如今非常流行、也很容易、很稳健的方法——老师个人最喜欢的。
做法:
- 选一组不同的 FLOPs 预算(比如按 3 倍、6 倍递增);
- 对每个 FLOPs 预算,扫描「参数/数据权衡」——固定 FLOPs,双倍数据、减半模型,以此类推;
- 这会生成一串训练运行,其终点损失扫出一条曲线;
- 对每条曲线取最小值(或拟合二次曲线再取最小),勾出一条线;
- 把每条曲线的谷底画成「FLOPs → 参数」的函数。
Chinchilla 得到 63B 参数——与方法一非常接近。
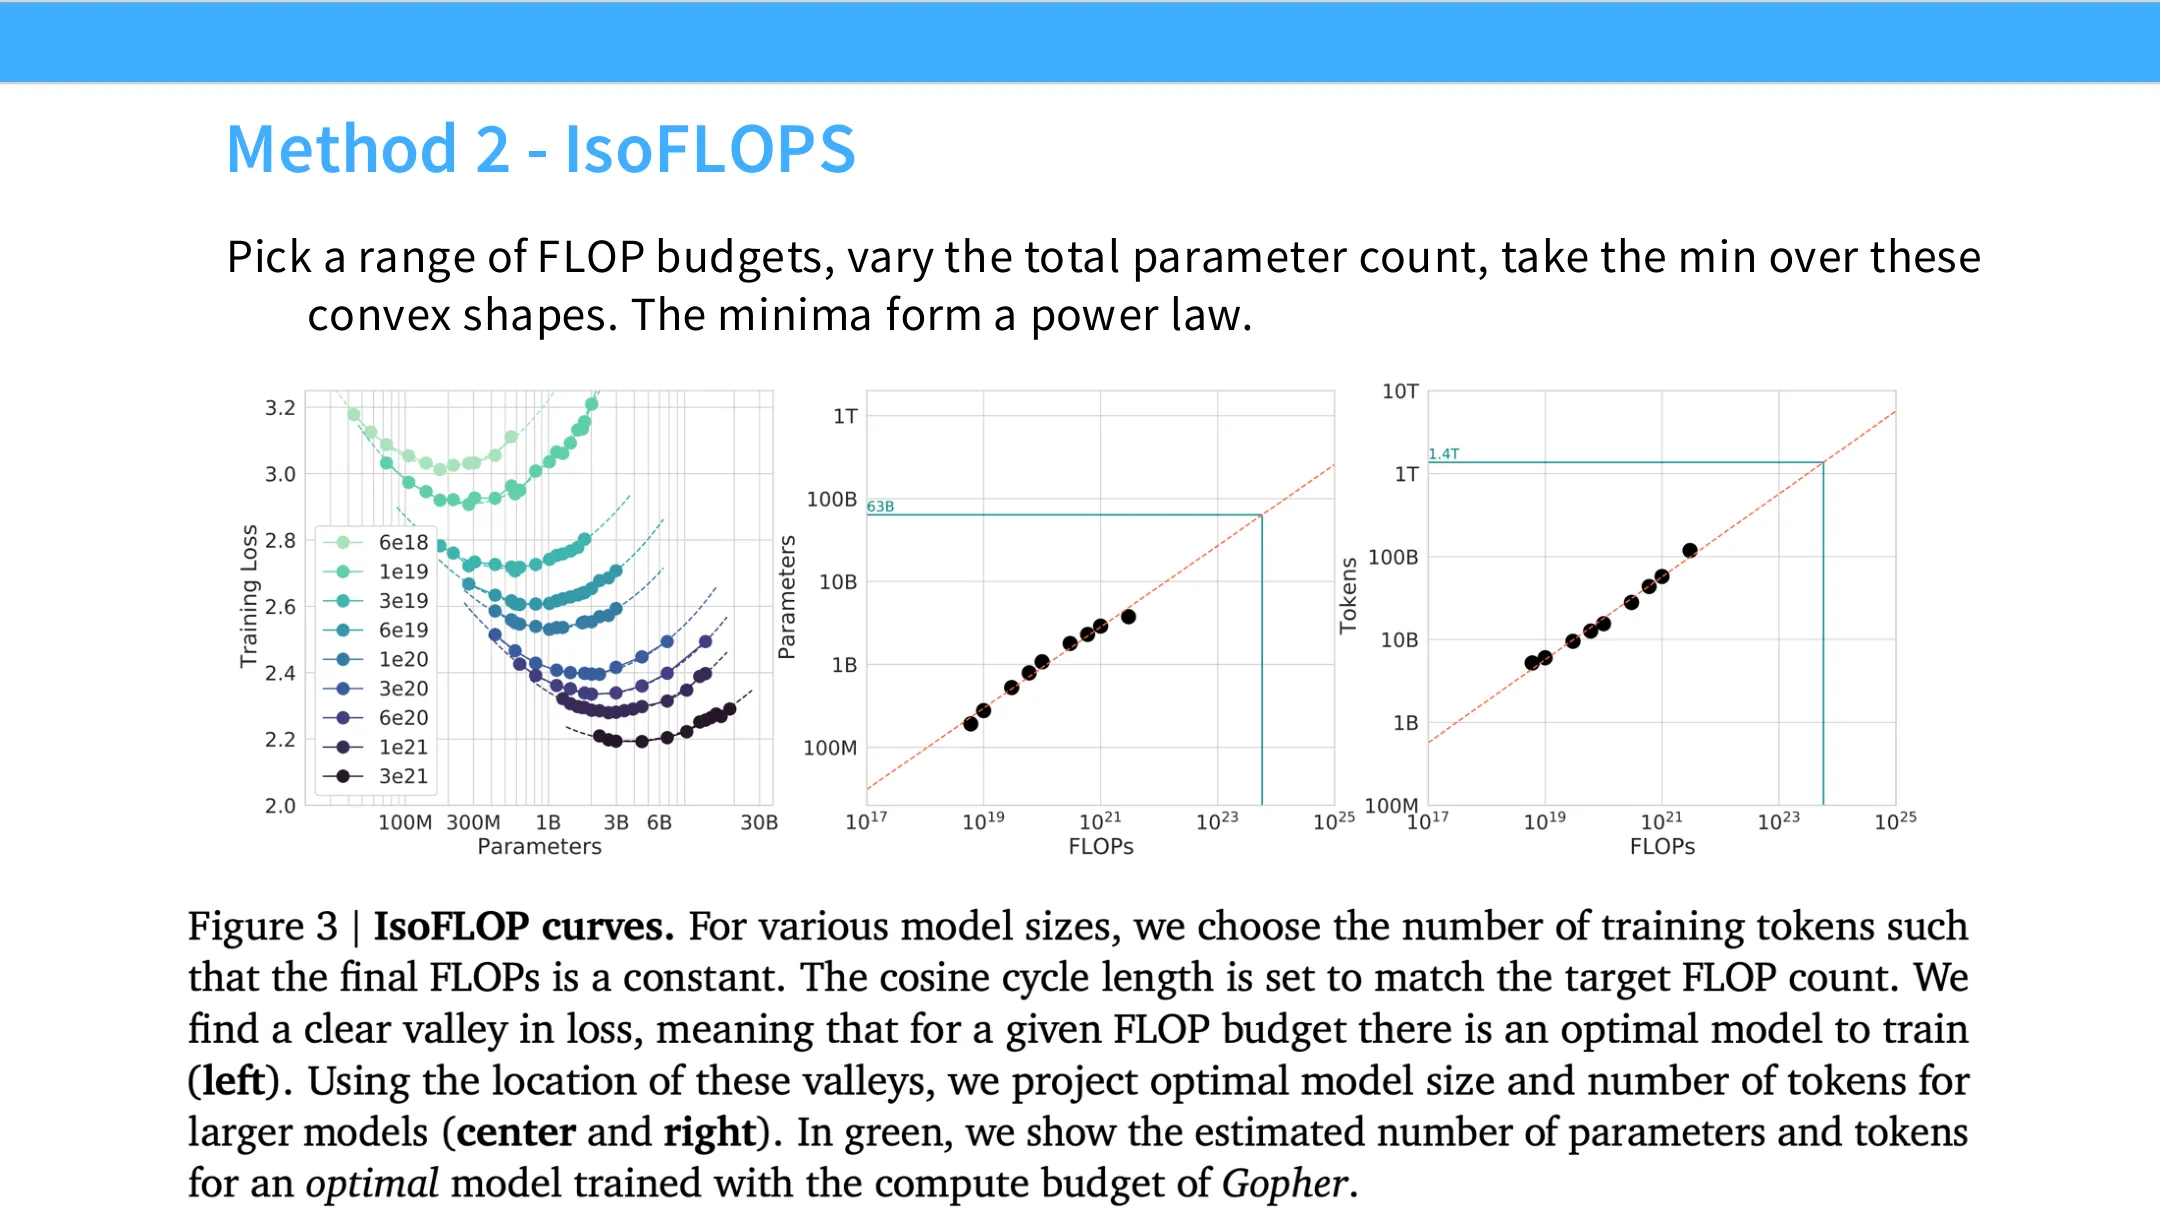
📷 方法二:IsoFLOPS,固定算力预算扫描参数/数据权衡,取曲线谷底
回到原视频 (01:04:28)
7.4 方法三:联合拟合(joint fits)
(参考时间: 01:05:47)
这是最自然的一种(Rosenfeld 和 Kaplan 也都提出过):既然二者都给出了「损失-数据-模型」的联合函数形式,那就:
- 跑一大把训练(在「大小-数据」网格上);
- 用最小二乘去拟合这个联合 scaling law,估出系数。
这是最暴力的一种。但它有个难点:你在拟合一个曲面,变量很多,如何做曲线拟合非常重要,也很 tricky——和方法一一样,不是一条平直的路,不如 IsoFLOPS 那么直接。
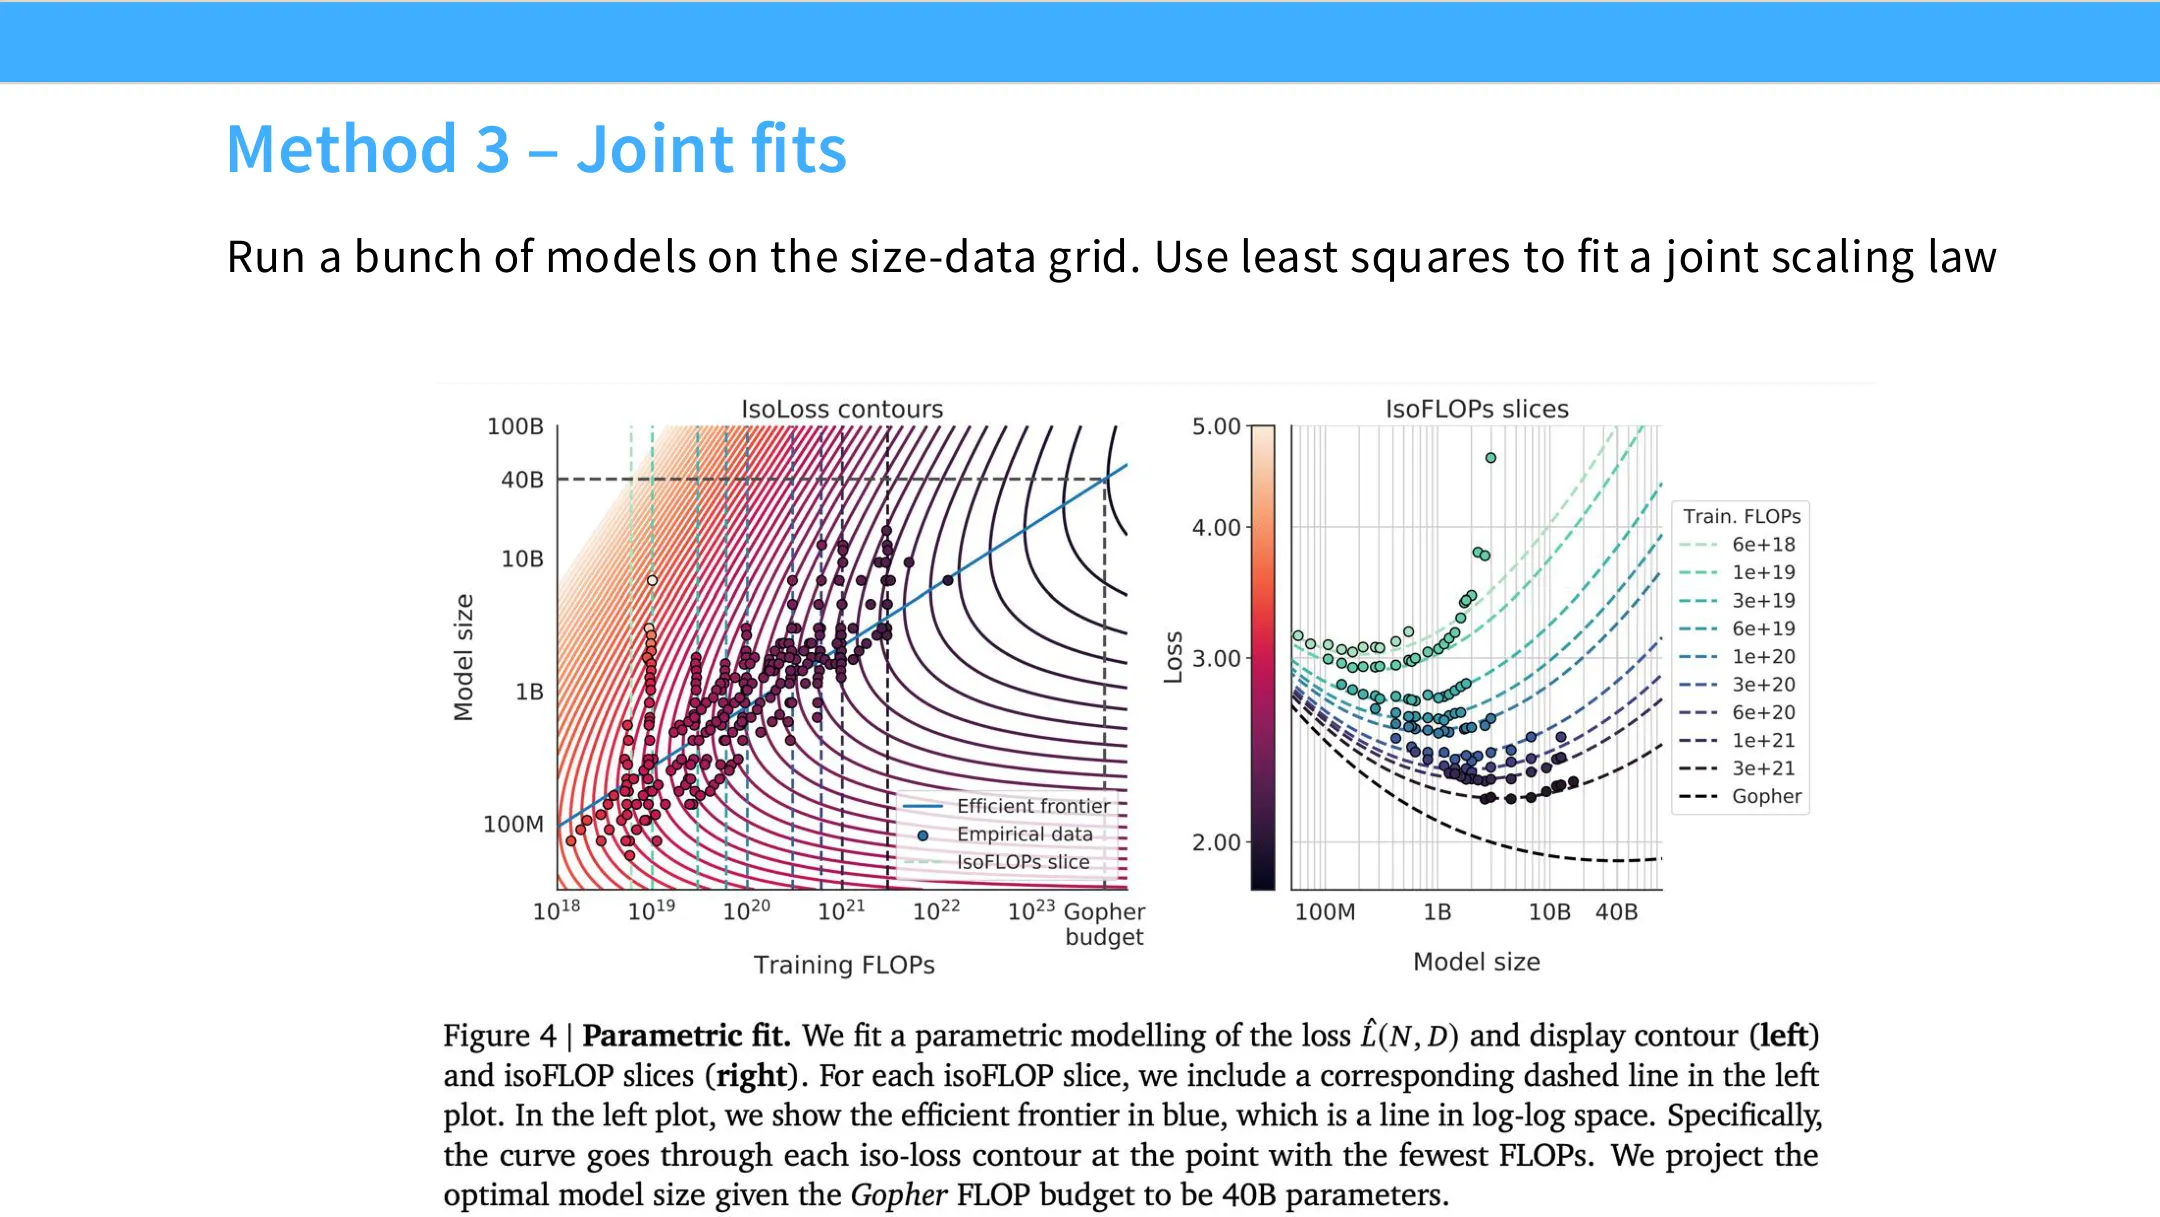
📷 方法三:联合拟合,用最小二乘拟合联合 scaling 曲面
回到原视频 (01:05:47)
7.5 为什么差异如此之大?
(参考时间: 01:07:34)
有趣的是:Chinchilla 做的事看起来和 Kaplan 没有本质不同——不是「Kaplan 做了一件疯事,Chinchilla 做了聪明事」。两边都做了相当合理的处理。但预测结果差异很大。事后看,我们普遍同意 Chinchilla 更接近正确的 scaling。
为什么两个都在拟合联合 scaling law,却差这么多?
这里进入 scaling law 的「泥泞现实」:scaling law 会随实现细节、超参数设置、甚至横轴选择而剧烈改变。
老师引了一篇论文(Resolving Discrepancies in Compute-Optimal Scaling of Language Models,Yi 是最后作者,曾是他的学生)。这项工作:
- 先复现 Kaplan 的结果(用大致 Kaplan 的设置);
- 然后改参数计数方式——曲线移动一点;
- 再改学习率 warm-up 的做法——曲线又移动一点;
- 再多调一点优化器——于是得到 Chinchilla 的结果。
结论:一串看似非常微小的决策,最终造成了 Kaplan scaling law 与 Chinchilla scaling law 之间的巨大差距。
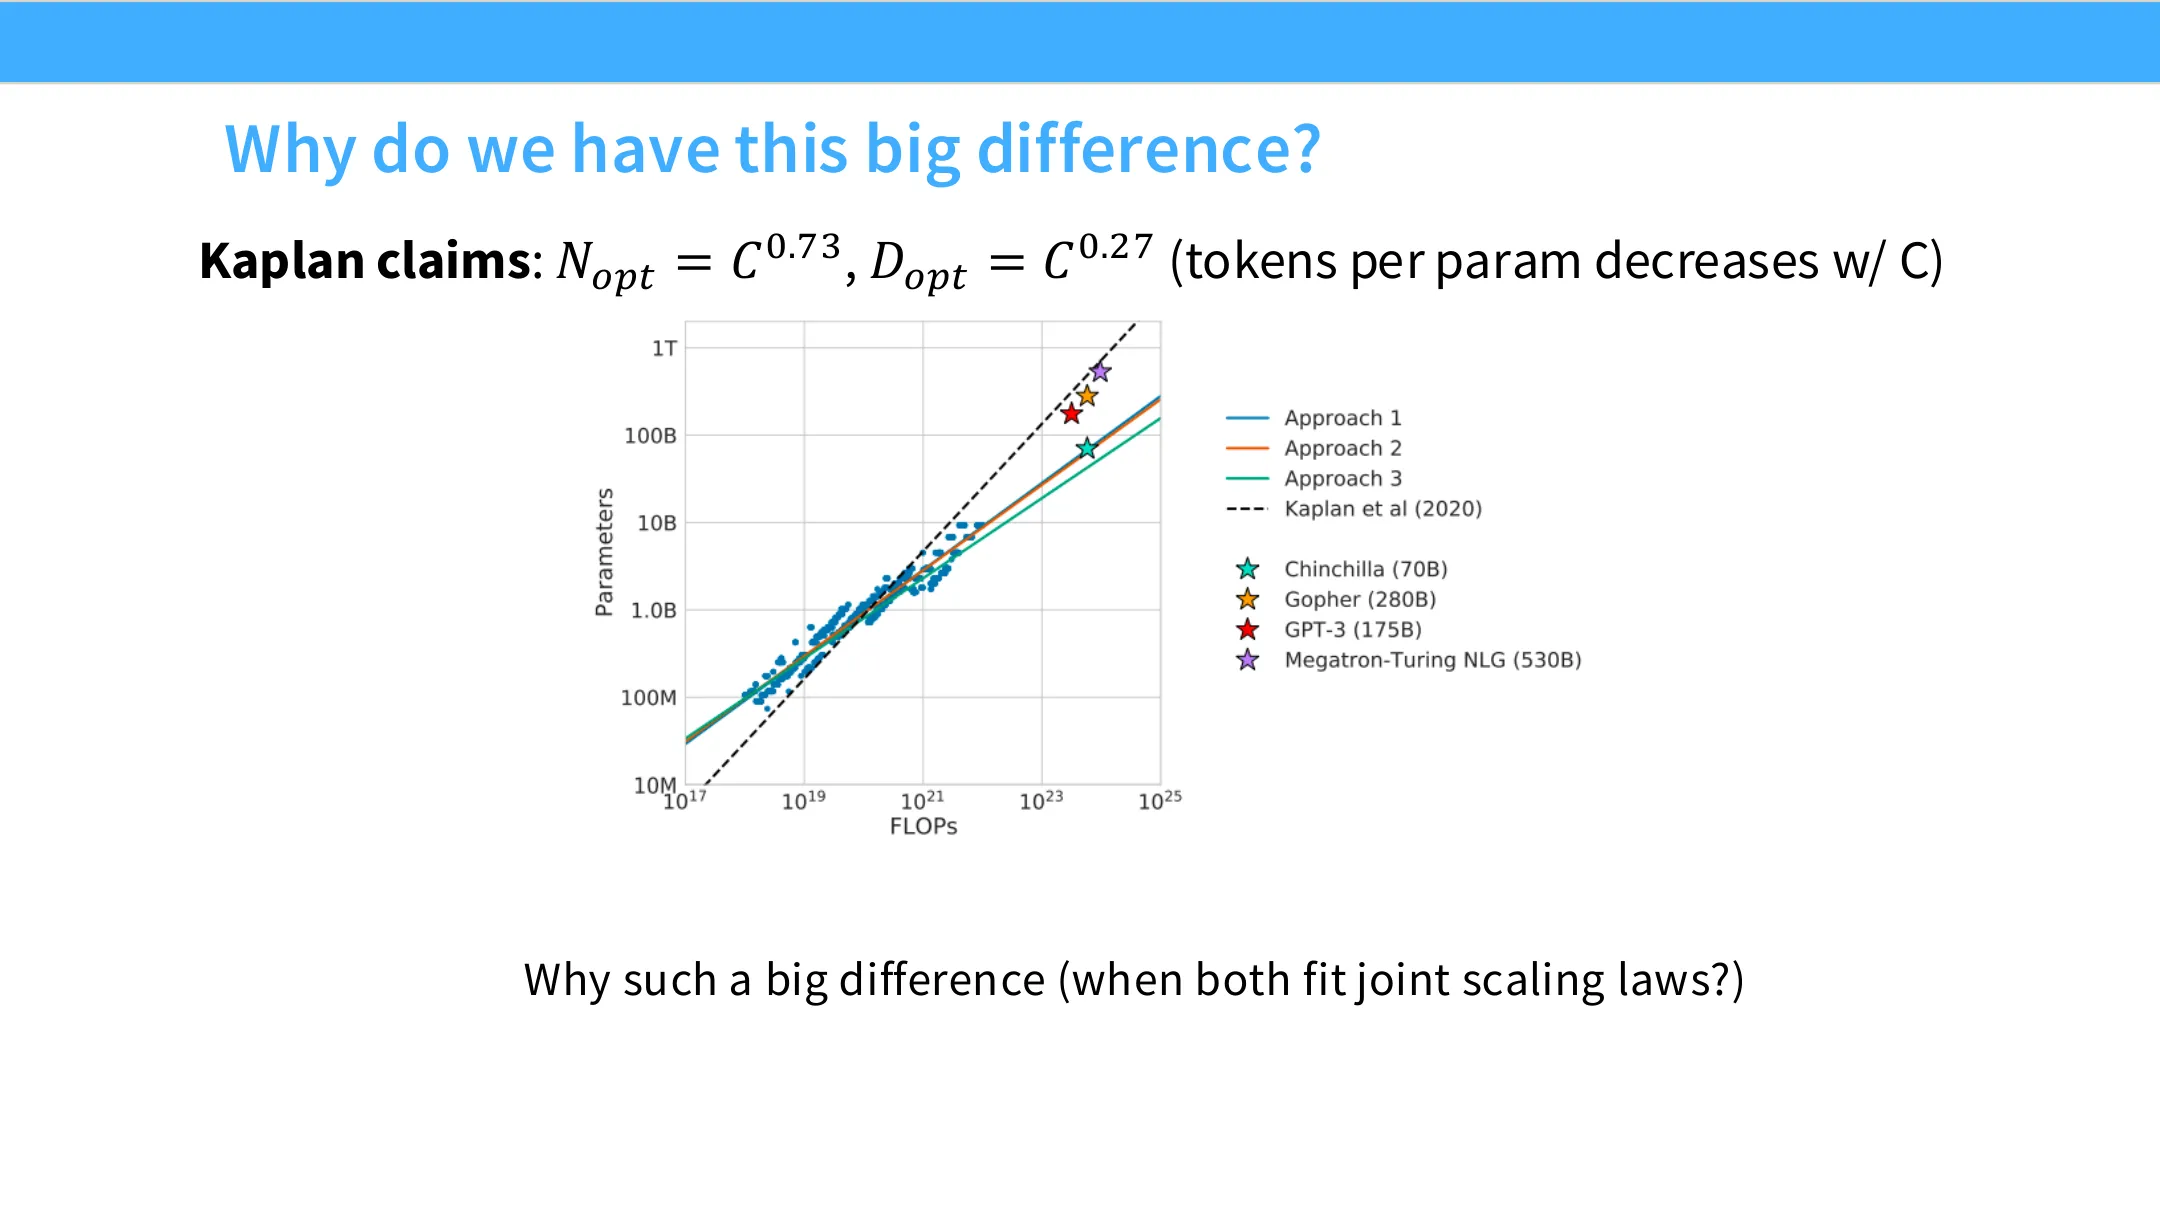
📷 为什么两种联合拟合差异如此之大?一串微小决策累积成大差距
回到原视频 (01:07:34)
7.6 解释一:参数计数与 warm-up
(参考时间: 01:08:51)
具体是哪些「微小决策」?
① 参数计数。 回到 Kaplan:他们因为看到包含嵌入参数时的奇怪曲线,排除了嵌入参数——这本身通常没问题。但他们还排除了最后一层(软最大层)的参数,因为很多模型里嵌入层与最后的线性层是对偶的——形状相同(嵌入是「词表 × 隐藏维」,输出矩阵是「隐藏维 × 词表」)。于是他们说「两个都排除吧」。结果发现:是否包含或排除这些,对 scaling law 的形状有实质性影响。
② 一个更像「疏忽」而非「观点分歧」的问题:Kaplan 训的很多模型非常小,小到在 warm-up 结束时还没收敛——学习率设得非常次优,因此模型没充分收敛。
③ 固定大 batch,对小模型次优。 Kaplan 等人固定了一个大 batch,而这对较小的模型是次优的。如果正确调节、使用变化的 batch size,就会得到与 Chinchilla 完全一致的结果。
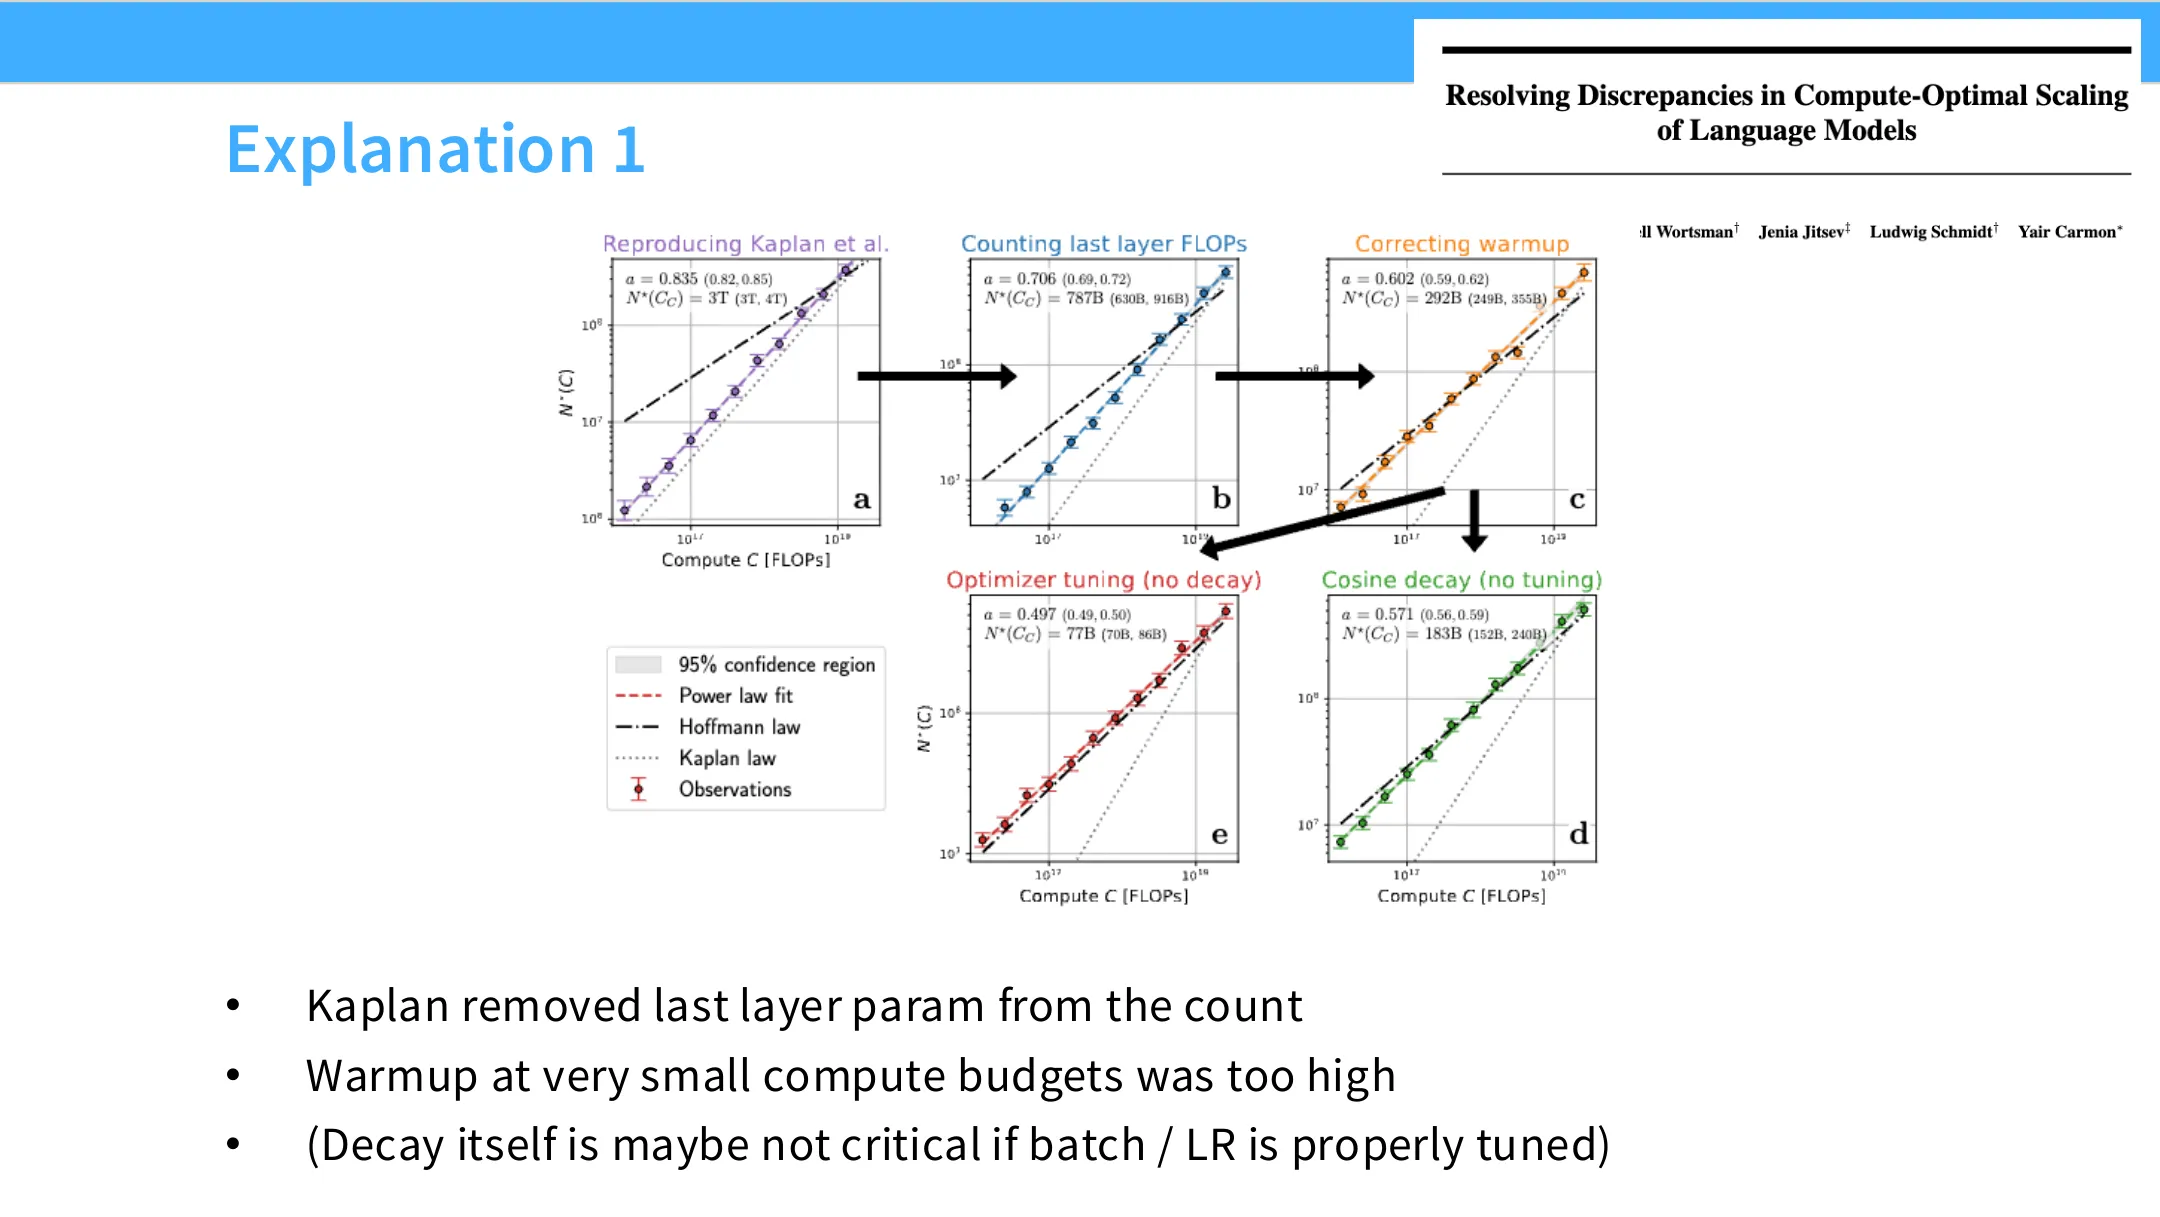
📷 解释一:Kaplan 去掉最后一层参数、小模型 warm-up 期未收敛、固定批大小对小模型次优
回到原视频 (01:08:51)
老师强调一个要点:scaling law 在某种意义上是「下界」——它在说:「如果我继续这个配方并放大,我就会得到这个。」但如果你把一个你不该放大的配方放大(比如 warm-up 很离谱、batch 很大得很离谱),你会得到糟糕的 scaling law。所以要尽可能贴近一次真正的完整运行。
7.7 解释二:非嵌入 vs 总参数 + 小非线性
(参考时间: 01:11:01)
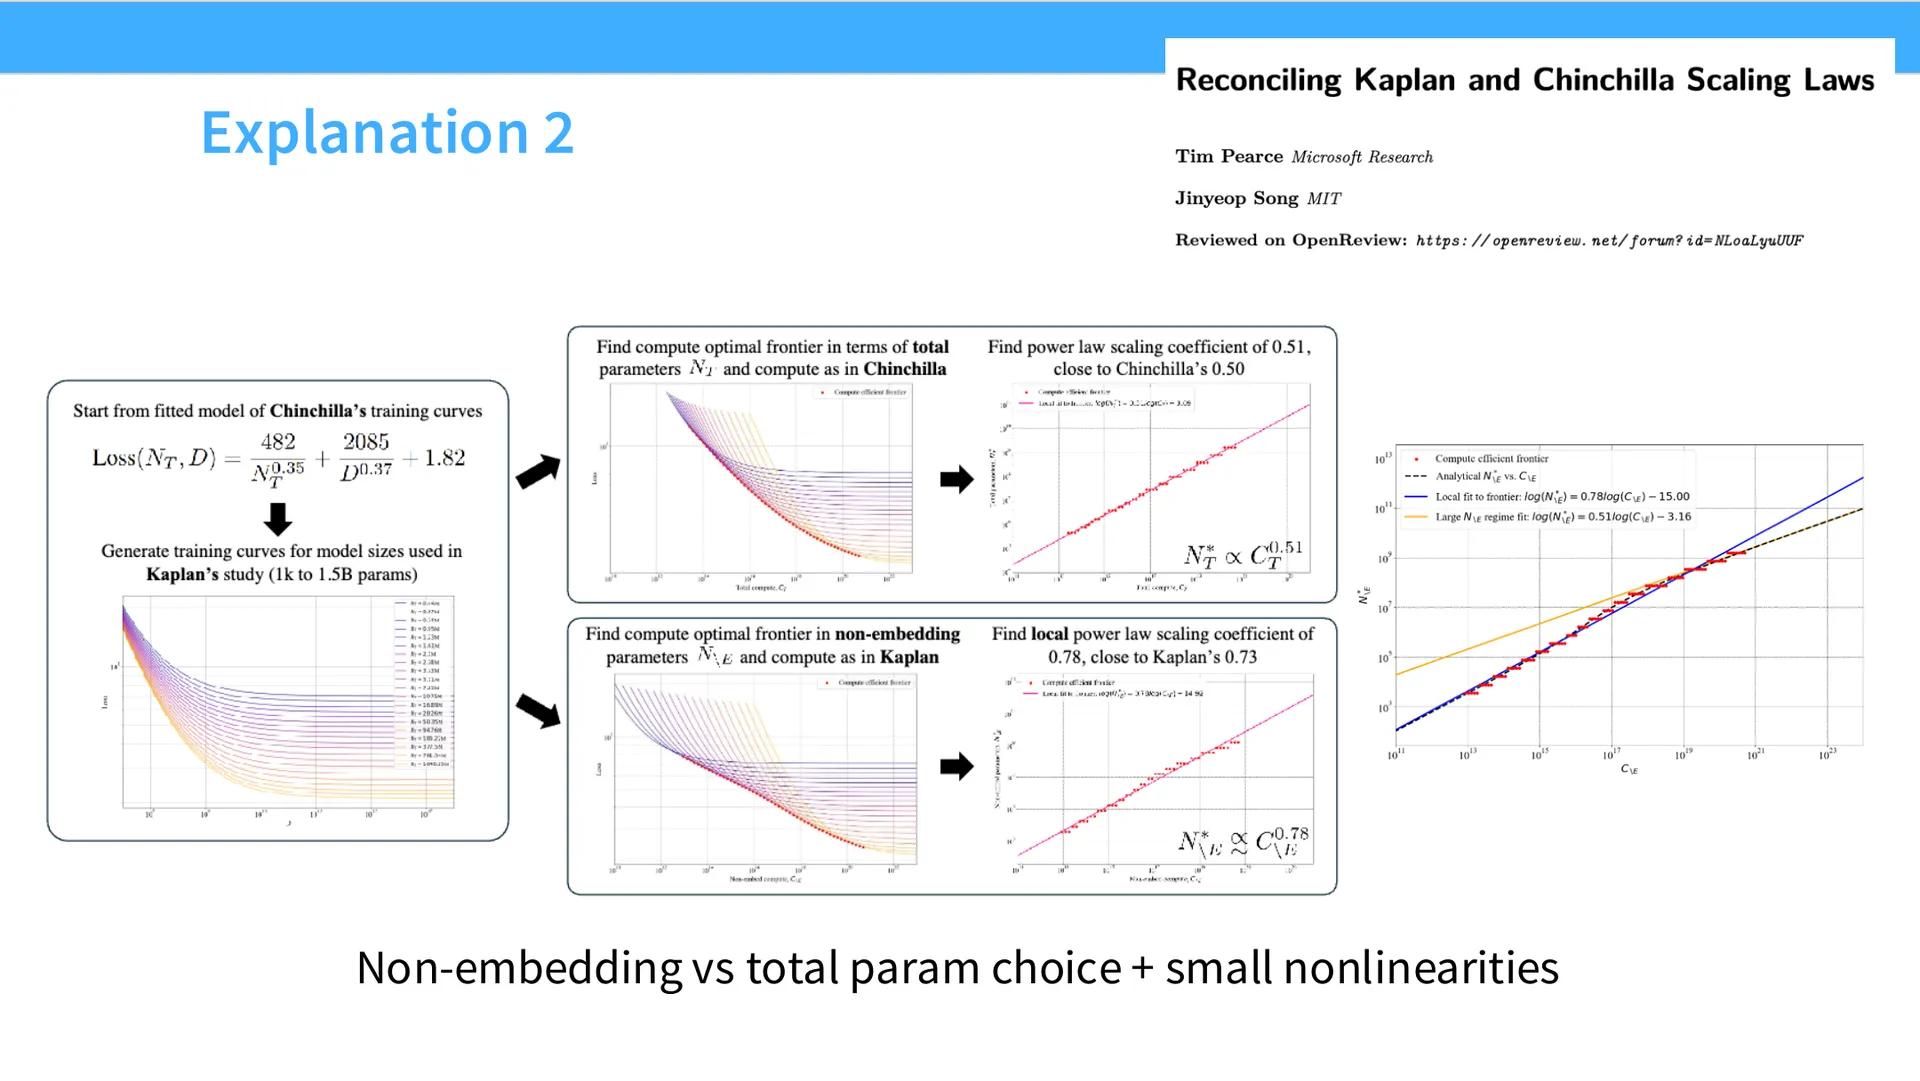
另一篇很有意思的论文(Pearson 与 Song)用了一种聪明的做法:不训练任何模型,只取 Chinchilla 训练曲线(或隐含的函数形式),模拟出「如果按 Kaplan 做(忽略嵌入参数、缩小规模)会得到什么训练曲线」「如果用总参数计数会怎样」,然后比较。
他们发现两个效应:
- Kaplan 处在低得多的算力尺度,因此对微小变化非常敏感;
- 忽略非嵌入参数这一改动,已经足够大到相对 Chinchilla 破坏结果。
他们的论证与 Yi 等人略有不同:这里是算力尺度 + 由非嵌入参数引入的轻微非线性共同导致了分歧。
老师借此再强调:注意细节非常重要。 大量建立可靠 scaling law 的工作,本质上就是在找出正确的 regime,以便跨算力尺度获得可靠 scaling。
7.8 有趣的尾声:Chinchilla 方法三的「数据取证」
(参考时间: 01:12:17)
Chinchilla 论文里还留了一个谜团:方法三从来不与方法一、二一致。数字看起来不大,作者也很不以为意,但含义并不平凡。
- 方法一、二说:参数与 token 应同比例 scaling(固定比例——这就是「20 倍」的来历);
- 方法三的指数不同,意味着如果放大算力,最终会token 远多于参数——渐近结论完全不同。
Epoch AI 的人对此很在意,但拿不到原始数据或代码,于是他们从论文图里把数据抠出来,重新拟合方法三的回归(那张 3D 曲面)。
结果发现:原论文很可能对原始数据欠拟合(underfitted)。 重做曲线拟合后,损失显著低于原论文所提的 scaling law;而且如果按重拟合的模型,几乎正好得到 Chinchilla 那句 「20 tokens / 参数」的经验法则。
这是一个有趣的结尾:作者虽然犯了错,但他们比自己所知道的更正确——方法三之所以与方法一、二不一致,唯一原因就是这个错误。所以这套方法终究是稳健的。
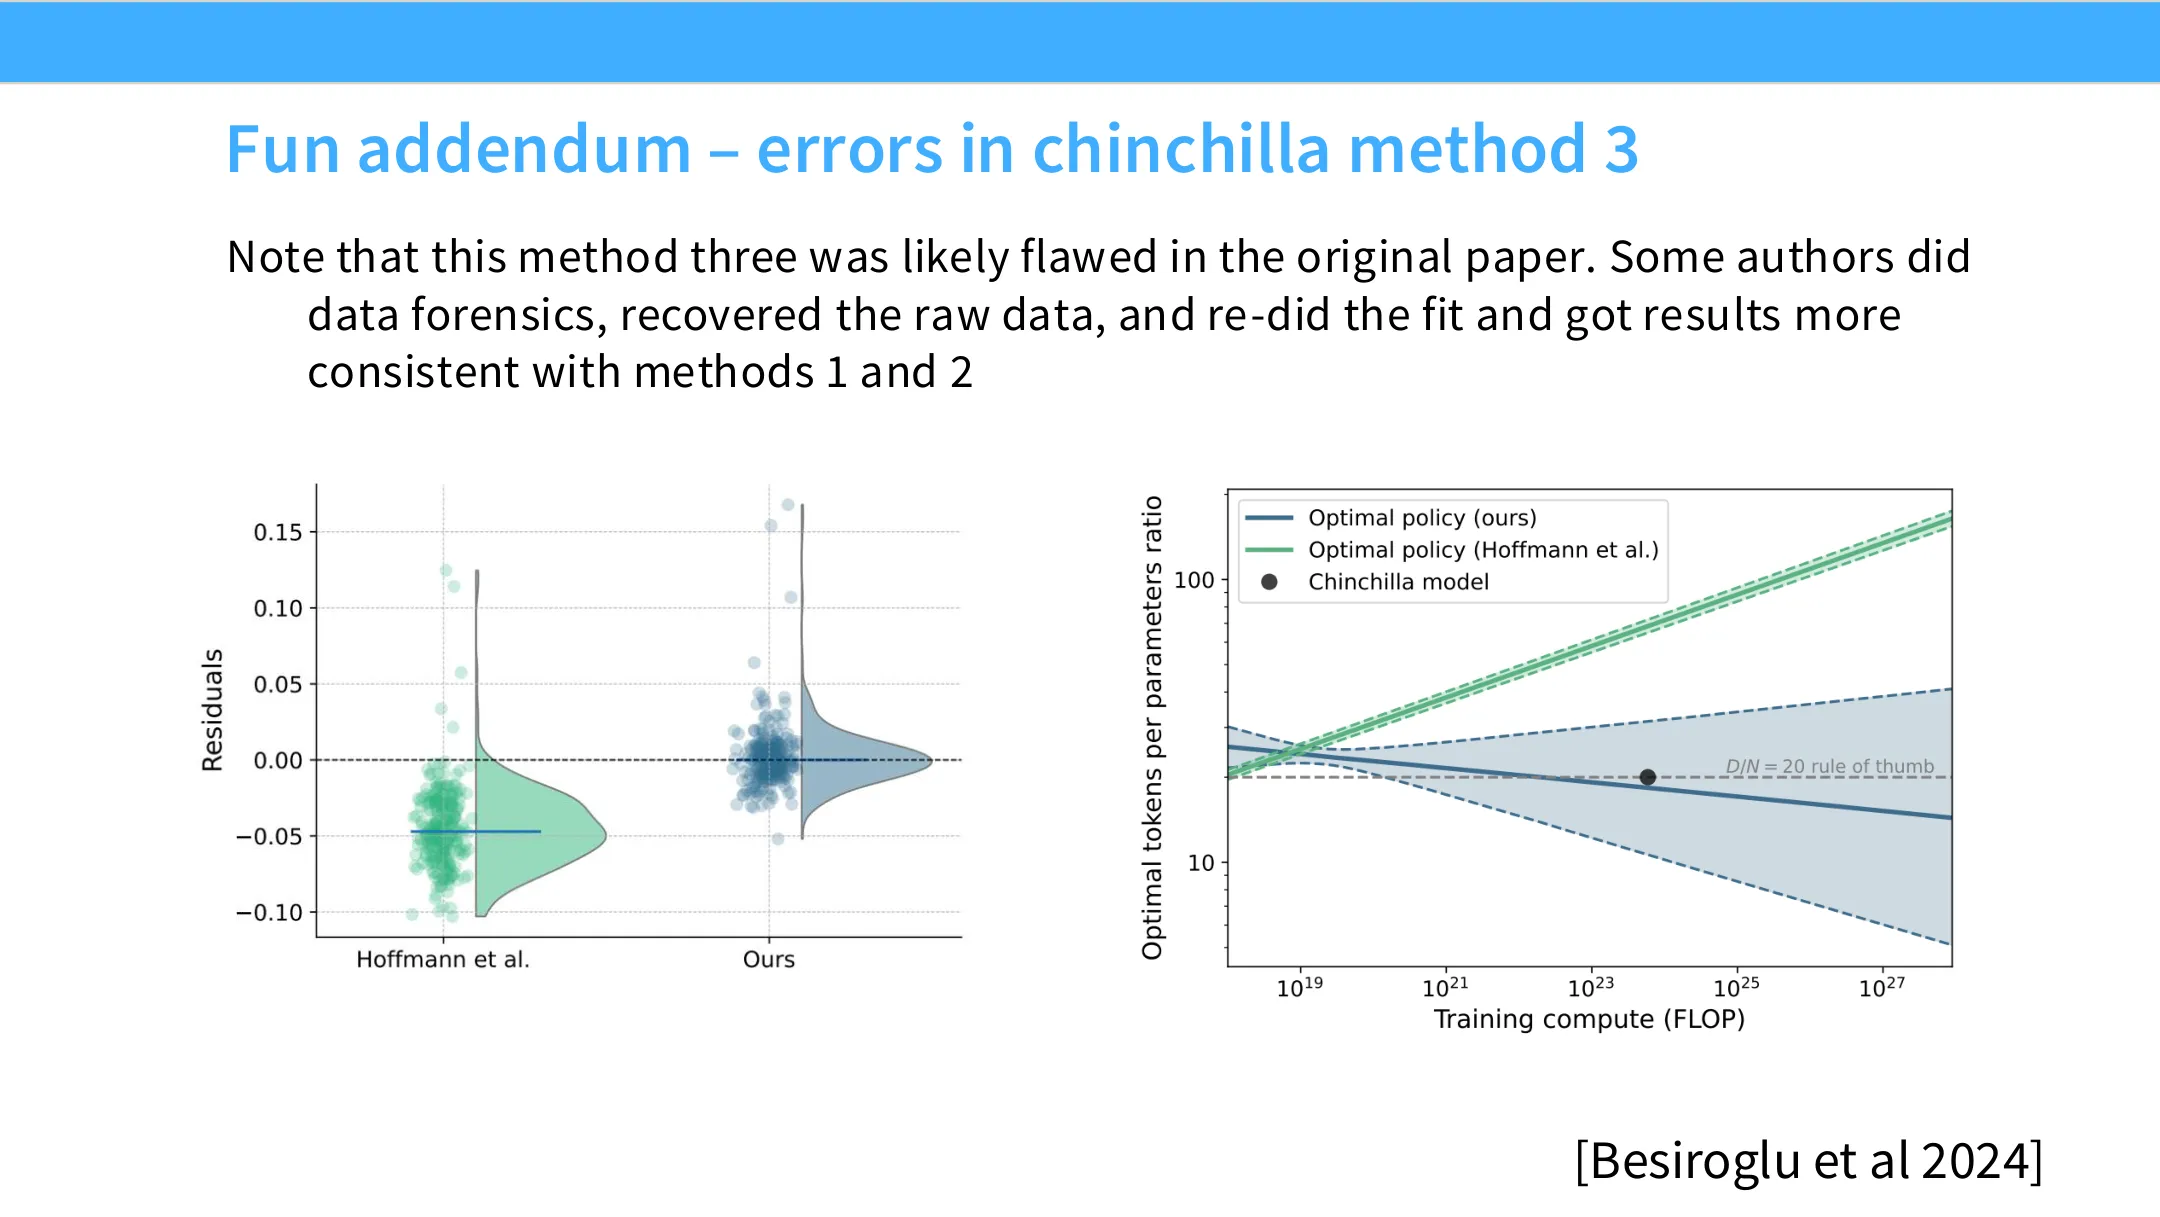
📷 有趣的尾声:Chinchilla 方法三很可能欠拟合,Epoch AI 数据取证后重拟合,得到 20:1 法则 (Besiroglu et al 2024)
回到原视频 (01:12:17)
7.9 重要提醒:训练最优 ≠ 你想要的
(参考时间: 01:14:22)
Chinchilla 告诉你的是:在固定训练算力下,什么模型最好。但在真实部署里,大部分算力花在推理。所以我们应当「过度训练」——用远多于 20 倍的数据去训一个更小的模型。看历史上各模型的 token/参数比:
| 模型 | 每参数 token 数 |
|---|---|
| GPT-3 | 2 |
| Chinchilla | 20 |
| LLaMA 65B | 22 |
| Llama 2 70B | 29 |
| Mistral 7B | 110 |
| Llama 3 70B | 215 |
你预期的使用量越大,就越值得付出这个前期成本。
历史脉络:GPT-3 那会儿是明显欠训练(3 tokens/参数),Chinchilla 给出 20/参数 的现代比例,之后一段时间大家在 20 左右——那是「模型很酷但还没被大规模服务」的时代。随着服务(serving)变成现实,你开始过度训练,并转向 MoE、做各种取舍来优化推理服务。
老师总结:Chinchilla 重要,不是因为 20:1 是唯一金律(做研究的话也许好用),而是因为它告诉我们该怎么拟合 scaling law、该怎么思考 scaling law。
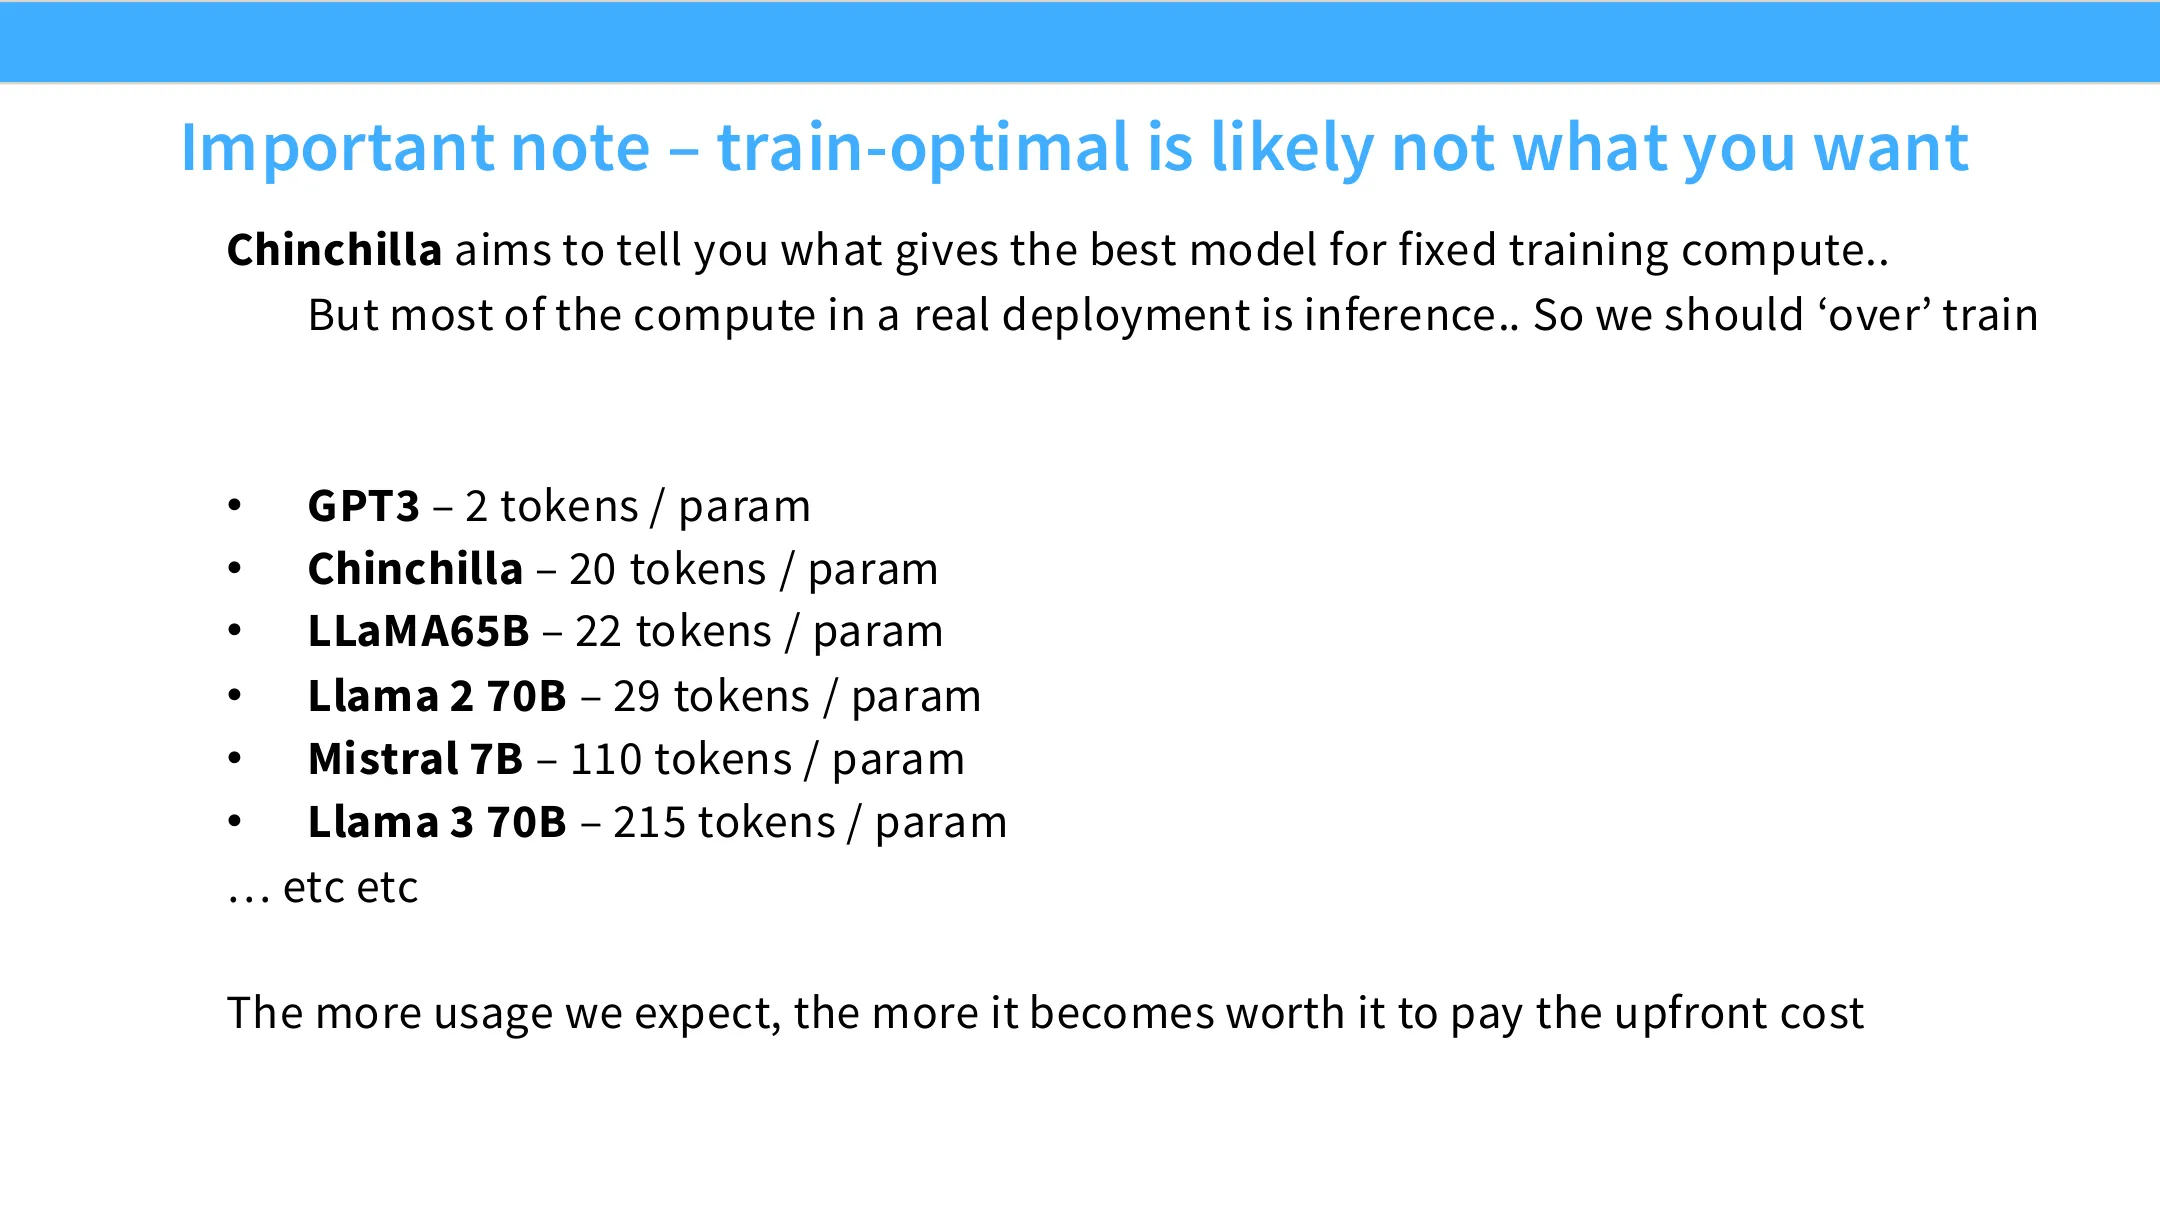
📷 重要提醒:训练最优 ≠ 生产最优——推理算力主导,所以要「过度训练」
回到原视频 (01:14:22)
编者说明:此处的单位「token/参数」应与正文上一段末尾「约 10 倍」的说法区分开——前者是「数据量相对模型容量」(以容量估计)的一种粗略说法,本表是精确的 token/参数比。两者是不同语境下的粗略量级。
八、IsoFLOPS 的普适性与研究范式
(参考时间: 01:16:03)
作为收尾,老师再次点赞 IsoFLOPS:它作为一种研究工具特别耐用。
- 做法:固定一个 FLOP 预算,然后扫描其余自由度,看曲面长什么样;
- 好处:它给出相当可靠的读数——不同参数如何随你的自由变量变化;
- 应用:扩散模型(他的一个学生做过)、以及前面讲的 MoE 研究,都是 IsoFLOPS 式设计。
建议:每当你纠结「如何决定这么多取舍」时,IsoFLOPS 总是个好的默认选择。
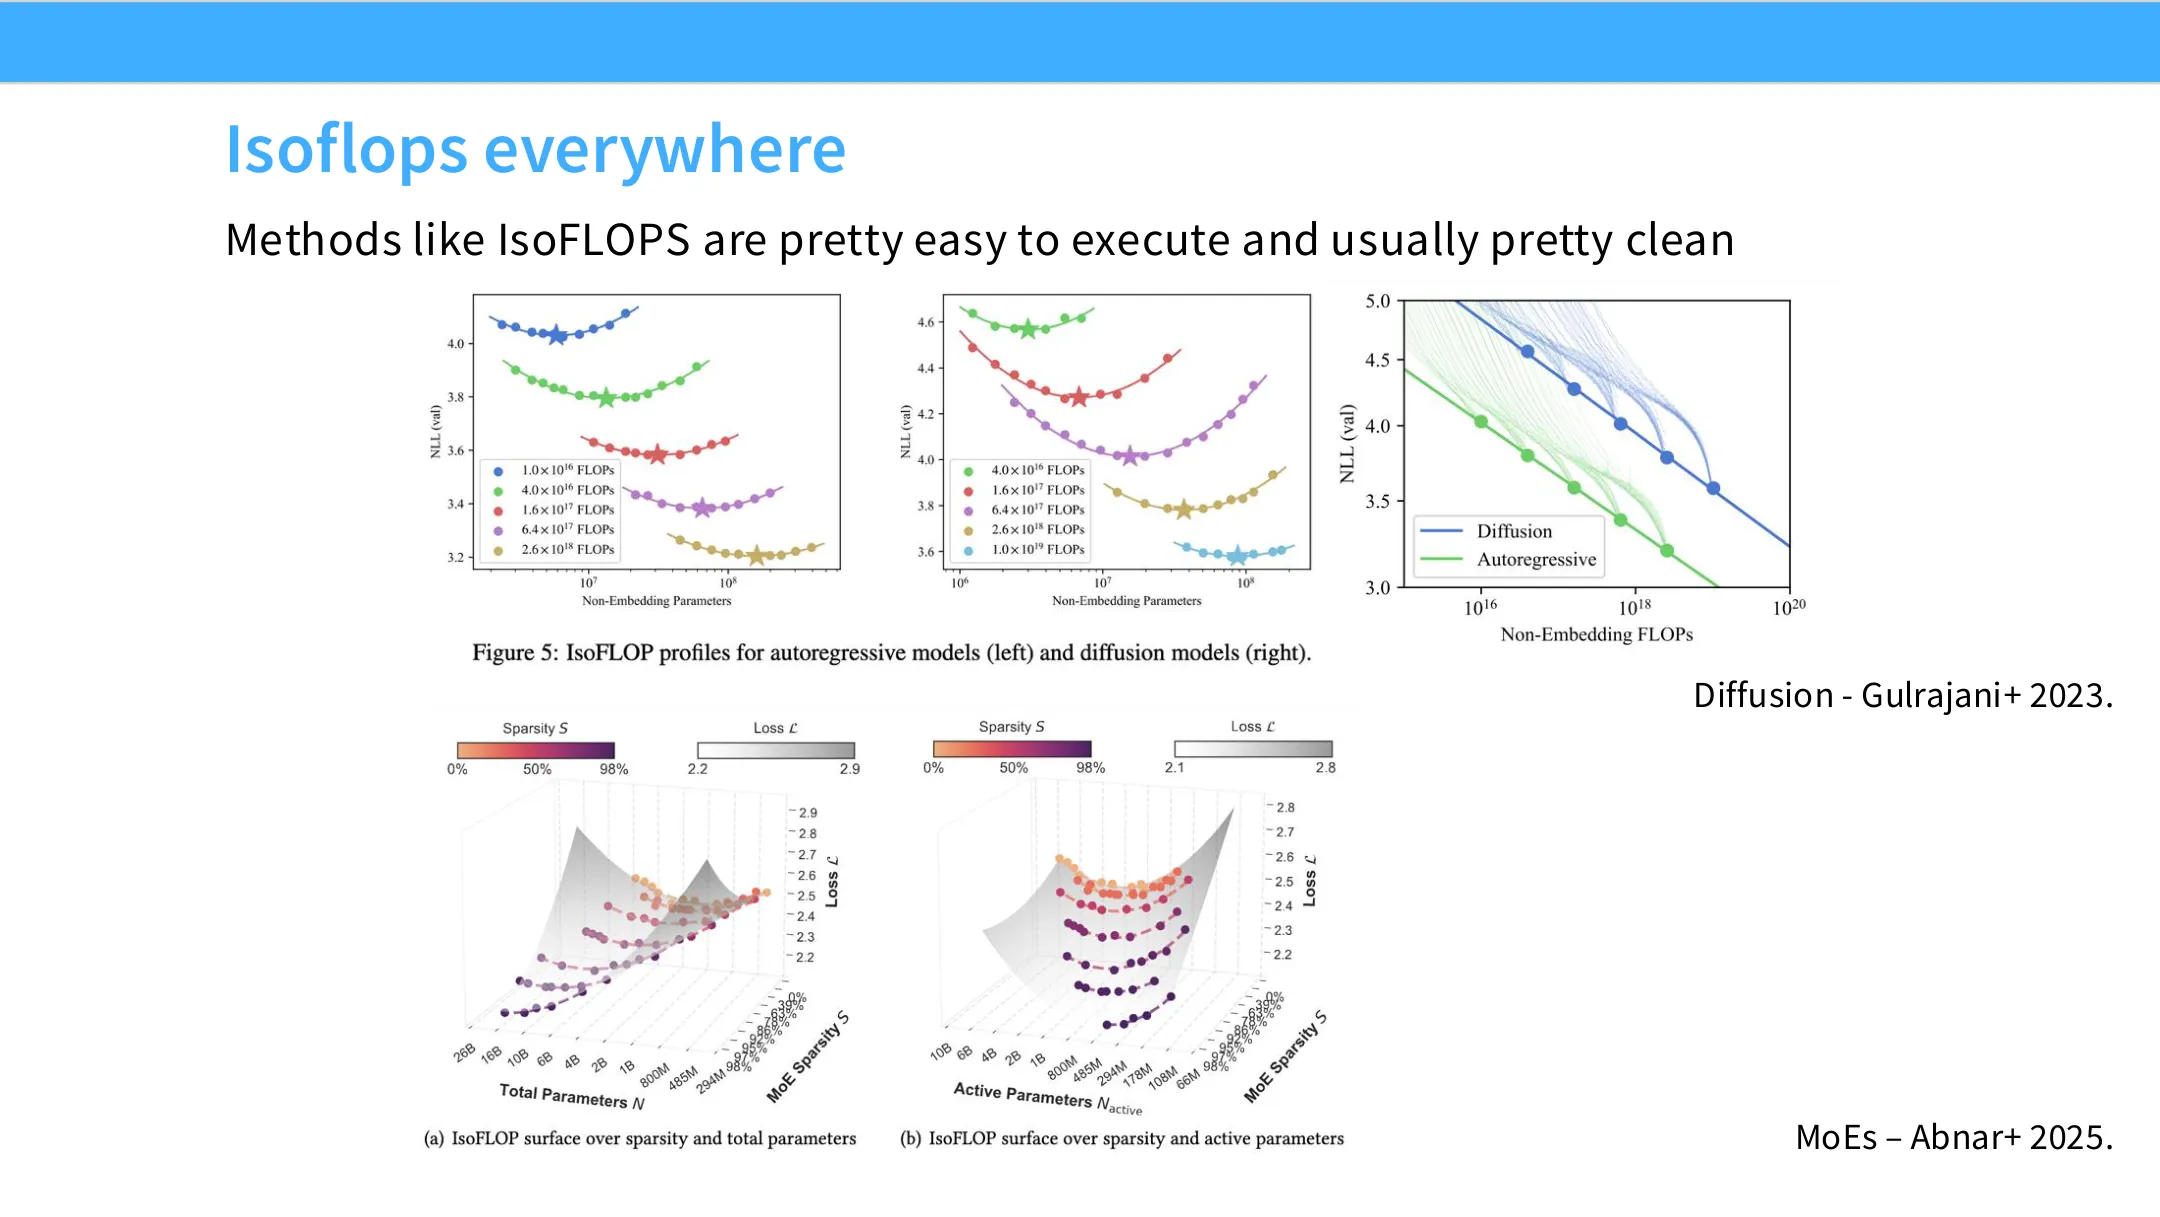
📷 Isoflops everywhere:扩散模型(Gulrajani+ 2023)与 MoE(Abnar+ 2025)都用 IsoFLOPS
回到原视频 (01:16:03)
📷 Scaling laws for models and compute:log-linearity 延伸到参数量与算力
回到原视频 (01:16:48)
九、本讲回顾
(参考时间: 01:17:39)
用一句话把整讲串起来:
资源投入与性能产出之间存在 log-线性规律,它延伸到很多维度——模型参数、算力、MoE 的稀疏度等。这让我们能把很多原本「凭感觉」的选择,做得更有证据支撑。
三个层面的收获:
- 数据 scaling:理解数据如何影响模型,理论干净;只是指数略奇怪。
- 模型 scaling:极大降低训练成本——用小模型预判大模型上的超参数选择。
- Scaling 作为预测:理解「哪些问题可以被暴力解决」。
并且:这允许我们在不对大模型做大训练的情况下,进行规模化的工程决策。
下讲(本系列顺序上)是 Percy 讲 inference,之后我们会回到更进阶、更 niche 的 scaling 话题。
📷 Recap:scaling laws 既令人惊讶又实用
回到原视频 (01:17:39)
附:参考与延伸阅读
编者补充
已知疑点
本节集中列出本讲重构中不确定或存疑之处,供你带着怀疑阅读。
- 参数计数与公式符号(多处)
- 幻灯片上联合 scaling law 的写法
Error = m^{-α} + n^{-1}^{β}存在排版残缺,无法确定 Kaplan 原始形式是 $m^{-\alpha} + (n^{-1})^{\beta}$ 还是 $((m^{-1})^{\alpha} + (n^{-1})^{\beta})$ 一类。正文按幻灯片给出的近似形式转写,并已改用 Rosenfeld 的清晰写法 $n^{-\alpha}+m^{-\beta}+C$ 作对照。依据:course/slides_text.mdSlide 43;时间点 00:56:45 附近。 -
Kaplan 的 $N_{\text{opt}} = C^{0.73}$、$D_{\text{opt}} = C^{0.27}$ 中,老师在现场一度把 $N$ 与 $D$ 念反,随后纠正为「$N$ 是参数量、$D$ 是数据量」。依据:01:00:11 附近的口播自我纠正。 请以「每参数 token 数随算力下降」这一语义为准。
-
课堂引用的若干论文作者 / 标题
- 「Resolving Discrepancies in Compute-Optimal Scaling of Language Models」老师现场说「我盖住了作者」,只说 Yi 是最后作者、曾是这里的学生。完整作者列表未在本讲确认。
- 「Pearson 与 Song」那篇论文的准确标题/会议未给出,仅据口播记录。依据:01:11:01 附近。
-
Hestness 那篇论文的口播副标题与幻灯片标题略有出入,正文按幻灯片内容转述。
-
数据混合实证研究的具体名称
-
老师提到「data decide」是「一份关于数据混合的大规模实证研究」,但口播名称含混(可能指 DataComp 或某数据集决策工作)。正文以「data decide 类工作」泛称,未坐实具体标题。依据:00:24:49 附近。
-
具体数值的口播误差
- 宽高比极小值「大约每层 100 维(可能略小)」为口播近似,未与 Kaplan 原论文逐字核对。依据:00:36:30 附近。
-
临界批大小公式中 $S_{\min}$、$E_{\min}$ 的拟合细节,幻灯片只给「大致反比」形式,正文按此转写并补出常见线性化写法,可能与 OpenAI 原式在常数项上略有差别。依据:00:44:11 附近。
-
图片/时间锚点的不确定性
- 文末附录中幻灯片的页码与视频时间的对应依据画面匹配推断,并非逐帧校准;如某页与你的观感不符,请以视频实际时间为准。
-
本讲绝大多数画面即官方幻灯片,已收录为文末「附录:官方幻灯片(全部)」;非幻灯片画面(如现场在屏幕上操作)在字幕中无明确画面提示,故未单独抽帧。
-
编辑补充的边界
- 本节所有
> **编者拓展**/> **编者说明**均为编者所加,用于补足讲者点到未展开之处(幂律数学、维数灾难、MoE、μP、Chinchilla 三方法比较等)。凡涉及外部事实/数字的补充均已尽量给出来源;拿不准处在文中已标注。它们不代表讲者原话。
附录:官方幻灯片(全部)
🖼️ 第 5 页幻灯片 · Part 1. Scaling laws, history and background.
🖼️ 第 52 页幻灯片 · Explanation 2