第10讲 · 大模型推理:从算术强度到 KV Cache 优化
Stanford CS336《Language Modeling from Scratch》· Spring 2026 · Lecture 10: Inference - 本讲承接上一讲的 scaling laws(由 Tatsu 主讲),暂时离开"怎么训得更划算",转入"训完之后怎么用得起来"
| 视频地址 | https://www.youtube.com/watch?v=EfM546A79aM |
| 视频 ID | EfM546A79aM 时长:约 5130 秒(约 85 分钟) |
对应讲次:第10讲(Stanford CS336 语言建模)
制作模型:deepseek-flash(vb compose,据 run.log)
说明:本讲大量借用 Google 的 How to Scale Your Model(常被称为"scaling book")中的记号与图示;讲师称其中的插图"慷慨地被借用了"。该书链接见文末。
导览
这一讲老师想回答的核心问题,是他自己在开场用一个句子定下的:"推理这个问题其实非常简单——你训练好了一个模型,给定一个 prompt,你想产出回答,并且希望它尽可能准、尽可能快。"围绕这句话,他依次追问了四个问题,本讲也基本沿着这四个问题展开:
- 推理为什么值得单开一讲、为什么比过去更重要?
- "快"到底指什么?(他给出的答案是:快的定义本身就不唯一,甚至互相打架。)
- 为什么同一个模型,训练跑得动、推理却跑不快?瓶颈精确地落在哪一步?
- 既然瓶颈找到了,有哪些手段能在不伤精度的前提下绕过它?
难点在哪。 真正的卡点不在"用什么技巧",而在第三步的定位。讲师反复强调的一件事是:注意力的算术强度里,批维度 $B$ 是一个"被批处理的维度"而不是"被收缩的维度",所以增大 batch 无法提升注意力的算术强度——这一点和 MLP 的行为完全相反。谁没有把这一步想透,后面所有的技巧(GQA、MLA、滑窗、线性注意力……)就会变成一堆彼此无关的名词。第二步同样容易滑过去:延迟与吞吐在 batch 维度上是此消彼长的,很多人的直觉是"让一切变快",而讲师明确说这两者在 batch 上是"完全相反"的方向。
读者可能带着什么疑问进来——这里分两组列出,避免混为一谈:
① 老师真正提出的问题(他在课上自问自答的):
- 推理和训练的负载差异,本源是什么?答案是自回归:推理必须一个 token 一个 token 地出,无法沿序列维度并行。
- 为什么说"推理是内存受限的"?他给出的推演路径是:先算算术强度 → 发现生成阶段的注意力强度小于 1 → 而 H100 要 295 才打满算力 → 所以算力在挨饿。
- KV cache 到底有多大、由哪些量决定?为什么它有时比模型参数本身还占内存?
- 有没有无损的加速办法?(他给出的答案是投机解码。)
② 编者预判的读者疑问(编者按,非讲师原话):
- "既然 memory-bound,那我多加几张卡、多开几份模型不就行了?"——讲师其实只花了一句半回答("启动 $M$ 份拷贝,延迟不变、吞吐 ×$M$"),并没有展开张量并行的细节,读者可能会觉得这里收得太快。
- "GQA 到底掉不掉点?"——课上出现了互相矛盾的证据,讲师自己也没给结论,只是提醒"凡不是纯数学的东西都要打折扣"。
- "MLA 和 GQA 可以叠加吗?滑窗和线性注意力能混用吗?"——讲师给了方向(可以组合、各有擅长),但没给配方。
- "投机解码的接受准则为什么恰好能保证无损?"——讲师明确说证明"和拒绝采样是同一套论证",然后跳过了。想补这一步的读者请看正文中的编者拓展。
本讲路线。 先用一段"为什么重要 + 定义快的指标"定调(约 0–7 分钟),然后用记号复习与算术强度推导把瓶颈精确定位(约 8–44 分钟,占了本讲一半篇幅),再进入手段部分:缩 KV cache 的架构改造 → 量化/剪枝/蒸馏 → 投机解码 → 动态负载下的服务系统,最后用一个总结收尾(约 85 分钟)。
一、为什么推理值得单开一讲
(参考时间: 00:05)
1.1 推理的定义
推理的问题陈述非常简单:你训练好了一个模型,给定一个 prompt,要产出回答,并且希望它尽可能准、尽可能快——讲师的用词是 "usually as accurately and as quickly as you can",准确与快速这两个目标本身就已经埋下了后面所有的张力。
推理以这种方式出现在很多地方:
- 对话助手 / 聊天机器人——这是大多数人首先想到的场景;
- 代码补全——典型的高频、低延迟场景;
- Agent——最近非常流行,而 agent 的运转完全依赖推理;
- 批量数据处理——把海量数据过一遍模型;
- 评测——凡是需要生成结果的评测,本质上都在跑推理;
- 训练内部——做强化学习时,你要拿模型生成 rollout,再打分、再更新权重,推理是训练回路的一部分。
编者拓展|为什么 RL 训练让推理的地位发生变化 传统监督微调(SFT)的每一步都要做一次前向,但前向是"读一批已经写好的 token",可以沿序列并行。而 RLHF / 可验证奖励 RL 里的 rollout 是自回归生成:policy 必须一个 token 一个 token 往外吐,吐完才能拿奖励。于是训练流程里第一次出现了一个"纯粹由推理主导、且无法回避"的环节。这也是为什么近两年像 vLLM、SGLang 这类推理引擎会反过来变成 RL 训练框架的核心组件。
1.2 训练是一次性成本,推理是重复成本
讲师用了一个非常直白的对照来说明量级:
- 训练是一次性支出:可能极贵("it is very expensive"),但做完就做完了;
- 推理是重复支出:"你几乎每一天都在付这笔钱。"
他给了一个具体的数字来建立直觉:OpenAI 被估计每天要产出 8.6 万亿(8.6 trillion)token。作为参照,GPT-4 的训练数据量是 32 万亿 token。也就是说,不到 4 天,OpenAI 光是推理产生的 token 数(以及相应的算力)就至少等于 GPT-4 一整个预训练的规模。而前沿模型即便用了更多 token 来训练,推理侧生成的 token 数依然会更高。
编者说明:8.6 万亿/天、GPT-4 训练 32 万亿 token 这两个数字都是课堂上口头给出的外部估计,讲师没有标注出处。读者若要把它们写进文章,请另行核对来源。
1.3 Agent 时代重构了"够快"的标准
(参考时间: 00:02:40)
这一段是理解"为什么推理的重要性在过去一年还继续上涨"的关键论证,值得完整保留:
从前我们把语言模型主要理解成聊天机器人或助手:输入 prompt,拿回回答,而人类的目标是把这段回答读完。在这个设定下,推理的"快"是有上限的——人读不了那么快,所以超过某个点之后再快也没意义。
但当我们走向 agent 世界,情况变了:一个 query 进去,agent 会做一大堆事——它会思考、会推理、会调用工具、会自我内省,最后才产出一点给人类读的输出。也就是说:
agent 产出的大部分 token 根本不是给人读的。
所以正确的看法是,把生成的 token 数理解成花费的算力。而这件事没有上限:只要问题足够宏大,你就会需要更多的算力、更多的 token。在聊天机器人时代,"足够快"是有天花板的;在 agent 时代,把推理再压榨出一点价值,是没有尽头的。
1.4 商业与开源生态
讲师简要扫过了一圈生态:所有闭源 API 提供方都必须服务自己的模型,所以推理对他们是大生意;此外还有一批厂商在服务开放权重模型。开源社区里则有几类常用工具(正文首次出现处给出官方链接):
- vLLM:讲师称其"大概是最流行的、首选的那一个";
- SGLang:讲师形容它"特别适合 agentic 的工作负载",但可能还没那么流行;
- TensorRT-LLM:来自 Nvidia,非常快,但覆盖面更窄;
- llama.cpp:如果你想在 CPU 上跑推理,这是个流行的选择。
1.5 一句话立论
讲师用一句几乎是挑衅式的话给这一讲立论:"如果你能把推理做快一倍,哪怕只快 10%,这都是件大事。"
二、"快"是什么意思:三个指标
(参考时间: 00:05:05)
紧接着的问题是:"快(fast)到底是什么意思?" 讲师指出,有若干指标用来刻画"快"这个概念,它们适用于不同的场景,并且彼此之间存在权衡。
2.1 首 token 延迟(TTFT, Time To First Token)
这是"用户在任何生成发生之前要等多久"。你把一个 query 丢进 ChatGPT,过了若干毫秒,第一个 token 才出现——从发出请求到第一个 token 抵达的这段时间就是 TTFT。
它主要用于交互式应用:因为你干等着的这段延迟越长,体验越差。而一旦 token 开始流入,速度本身反而没那么重要——因为反正你也读不了那么快。
2.2 延迟(Latency)
从单个用户的立场看,一个 query 的 token 出现得有多快。它同样对交互式应用重要。直观地说,这就是"token 流出来的速度"。
2.3 吞吐(Throughput)
多个 query 合计每秒产出多少 token。
- 延迟的倒数与吞吐密切相关,很多优化会同时改善两者;
- 但正如后面会看到的,这里其实存在真正的权衡;
- 吞吐适用于批量处理场景:比如你有一 PB 的数据想用语言模型处理完,"你只希望这个活儿干完",个别 query 早一点晚一点无所谓。
2.4 三者关系一览
| 指标 | 面向对象 | 主要适用场景 | 优化方向 |
|---|---|---|---|
| TTFT | 单个用户看到第一个 token 之前 | 交互式应用 | 缩小 prefill 时间 → 小 batch |
| Latency | 单个用户的 token 速率 | 交互式应用 | 缩小单次内存 IO → 小 batch |
| Throughput | 全体 query 的 token 速率 | 批量处理、离线任务 | 摊薄参数加载 → 大 batch |
核心张力(讲师在后文会反复回到这一点):延迟要小 batch,吞吐要大 batch。
三、为什么推理和训练是两种负载
(参考时间: 00:07:05)
讲师说,这里"也许只需要记住一个高层要点":
训练时你一次看到所有 token;推理时你只能一个接一个地生成。
展开来说:
- 在监督微调里,你一次看到全部 token,因此可以沿序列维度并行。回想 Transformer 里的注意力和 MLP 计算——序列只是张量的一个维度,就是一个大张量在做乘法,所有 token 本质上被一次处理完。
- 在推理里你做不到这一点。由于推理的自回归(autoregressive)本性,token 必须顺序地、一次一个地生成。
这就是推理之所以是与训练完全不同的负载的根本原因:你无法沿序列维度并行。而由此带来的直接后果是——很难获得高算术强度,也就很难把算力吃满。这一句话是整讲的题眼,后面所有推导都在给它加固。
graph TD
    A["同一个 Transformer 模型"] --> B["训练负载"]
    A --> C["推理负载"]
    B --> B1["一次看到全部 token"]
    B1 --> B2["序列维度可并行"]
    B2 --> B3["大张量 matmul<br/>高算术强度<br/>compute-bound"]
    C --> C1["必须逐个 token 生成"]
    C1 --> C2["序列维度不可并行"]
    C2 --> C3["薄矩阵 / 向量乘法<br/>低算术强度<br/>memory-bound"]
3.1 本讲路线预告
(参考时间: 00:08:25)
讲师给出的四个环节:
- 先做一些数学推导,理解 Transformer 的算术强度、吞吐与延迟该怎么想;
- 讲降低开销的技术:把 KV cache 做小、量化、剪枝;
- 讲投机解码(speculative decoding);
- 最后是一些实践层面的关切。
四、记号系统与算术强度复习
(参考时间: 00:08:55)
讲师说明这一部分"有点像是复习",主要是为了统一记号,并推荐大家去看 Google 的 scaling book——"写得非常好",本讲的不少图也来自那里。
4.1 记号约定
用符号来同时表示维度以及该维度的长度:
| 符号 | 含义 |
|---|---|
| $B$ | batch 维度,也即序列条数 |
| $T$ | 序列维度,也即 token 数(输出侧) |
| $S$ | 序列维度(输入侧 / 已生成的 token 数) |
| $D$ | 模型维度(model dimension) |
| $H$ | 每个注意力头的维度(head dimension) |
| $N$ | query 头数量 |
| $K$ | KV 头的数量 / 组数(见下方记号更正) |
| $G$ | 每组内的 query 头数 |
| $F$ | MLP 的中间(上投影)维度 |
在这套记号里,一次张量运算可以这样读:
$$ \underbrace{[B, T, D]}_{\text{激活}} \times \underbrace{[D, H]}_{\text{权重}} \;\longrightarrow\; [B, T, H] $$
- 红色维度(同时出现在两个操作数里、且从结果中消失)是被收缩(contracting)的维度;
- 黑色维度(只出现在一个操作数里、并保留在结果中)是普通维度;
- 蓝色维度(出现在两边、并保留在结果中)是批维度(batching)——它们不被收缩、不被归约。
编者说明:课上的一处记号更正(重要) 讲到注意力这一步时,一位同学当场指出幻灯片上的记号问题。讲师确认后更正为:$K$ 应当是"组的数量(number of groups)",而 $G$ 是"每个组里包含多少个 query 头"。讲师说"我之后改一下"。这与后面的 GQA 讨论一致:GQA 保留 $N$ 个 query 头,但只保留 $K$ 组 key/value,每组内对应 $G$ 个 query。读者若对照原幻灯片发现记号对不上,以课上更正为准。
4.2 Transformer block:用张量形状写出来
讲师说,这一页"看起来像电路图、细节很多",但在他看来这大概是对 Transformer 最清晰的一种定义——因为你看到的不只是模糊的描述,而是每个张量的精确形状,以及由此可以推理出的依赖关系。
一个 block 的结构是:取一层的激活 $X$,先过注意力,再过 MLP。
注意力部分:
- 用 query 矩阵、key 矩阵、value 矩阵对 $X$ 做投影;
- Q 的形状是 $[B, T, N, H]$(batch × 序列 × 头数 × 头维度);
- K、V 则用 $K$ 而不是 $N$——这是为了后面要讲的、KV 头数可能更少;
- 注意力运算中,$B$ 是出现在两边的批维度,而收缩发生在 head 维度上。
注意看那个蓝色的 $B$:讲师特意让人"先记住这一点"。正是这个 $B$ 只批不收缩的性质,让推理变难,也正是注意力成为瓶颈的原因。讲师说"我们稍后会回到为什么这个 $B$ 同时出现会让推理很难"。
MLP 部分就简单了:一堆 matmul,包括门控矩阵、上投影、下投影。
按惯例:
- MLP 把 $D$ 维的模型维度上投影到 4 倍,所以看到 $F$ 就当成 $4D$;
- $D = N \times H$(模型维度 = 头数 × 头维度);
- 在 GQA 的情况下,$N$ 又被拆成 $K$ 个组和每组 $G$ 个头;
- $S$ 与 $T$ 都表示序列维度,区别在于 $S$ 是输入 token 数、$T$ 是输出 token 数。训练时两者相同(输入和输出一一对应);推理时 $T = 1$,而 $S$ 是输入的长度。
4.3 算术强度:从最基础的 matmul 开始
(参考时间: 00:14:25)
热身例子:一个 $B \times D$ 的矩阵乘一个 $D \times F$ 的矩阵。在 NLP 语境里,$B$ 是 batch,$D$ 是隐藏维度/模型维度,$F$ 是上投影维度。
算术强度的定义是:
$$ \text{算术强度} = \frac{\text{FLOPs}}{\text{传输的字节数}} $$
这个量我们希望它越高越好。
要读入 / 写出的内容(BF16,推理时的常规精度):
- 写入 $X$:$2BD$ 字节
- 读入 $W$:$2DF$ 字节
- 写回结果:$2BF$ 字节
计算量:
$$ \text{FLOPs} = 2BDF $$
注意这里的结构:读写是"类似二次"的项,matmul 是"三次"的项。这正是高算术强度的来源。
于是:
$$ I = \frac{2BDF}{2BD + 2DF + 2BF} = \frac{BDF}{BD + DF + BF} $$
关键简化:假设 $B \ll D, F$。形式上令 $D = C \cdot B$、$F = C \cdot B$,再让 $C \to \infty$,即 $D, F$ 都很大而 $B$ 相对很小。代入后分母里主导项是 $DF$,于是:
$$ I \;\longrightarrow\; \frac{BDF}{DF} = B $$
结论:算术强度约等于 $B$。 这和之前讲矩阵乘法时得到的"$I \approx N/3$"是同一个道理,只不过现在矩阵不是方的。
4.4 计算受限还是内存受限:和硬件比一比
(参考时间: 00:17:15)
加速器的算术强度这样算:看规格表上的每秒 FLOPs,除以 HBM 的显存带宽。
$$ I_{\text{acc}} = \frac{\text{峰值 FLOPs/s}}{\text{内存带宽 (bytes/s)}} $$
然后把你的计算强度和加速器强度比:
graph TD
    A["算子算术强度<br/>I = FLOPs / Bytes"] --> B{"I 是否大于<br/>加速器强度 I_acc ?"}
    B -- 是 --> C["<b>compute-bound</b><br/>计算受限<br/>算力被打满 → 好"]
    B -- 否 --> D["<b>memory-bound</b><br/>内存受限<br/>算力闲置 → 坏"]
对 H100 而言,对这类 matmul 运算,batch size 大约要超过 295 才会进入计算受限。
极端情况:如果你只有一个样本($B = 1$),算术强度就是 1,而 1 远小于 295,于是严重内存受限。原因也很直观:你依然要把整个 $D \times F$ 的权重矩阵从 HBM 读进来,但 $B$ 只有 1,所以你实际上只做了 $2DF$ 这么点 FLOPs。
讲师在这里点出了推理的本质特征:"这基本上就是你在推理里会看到的工作负载。你拿不到完整的大矩阵,你拿到的是非常薄的矩阵或张量。"
编者说明:$295 \approx 989\,\text{TFLOP/s} \;/\; 3.35\,\text{TB/s}$。也就是说,每从显存搬 1 字节,需要做约 295 次浮点运算,才能让 H100 的 Tensor Core 不闲着。这个数字是理解后面所有"内存受限"论断的锚点,建议记住它的量级(几百量级)。
五、KV Cache:推理优化的第一性原理
(参考时间: 00:20:30)
5.1 最朴素的做法,以及它为什么很糟
设 prompt 是 "Never going to give you"(讲师用的这个著名歌词前缀)。最朴素的做法是:
- 把 prompt 送进 Transformer;
- Transformer 生成 keys、values 和激活,最终产出输出词表上的 logits 分布;
- 从分布中采样一个 token;
- 把采样的 token 拼回 prompt,重复上述过程(先生成 "never",再拼回去,再生成……)。
graph TD
    A["输入 prompt"] --> B["Transformer 前向"]
    B --> C["输出词表 logits"]
    C --> D["采样一个 token"]
    D --> E["拼回 prompt"]
    E --> B
这个方法可行——因为一个 Transformer 本质上就是"吃一个序列、吐一个 token 分布的黑盒",你当然可以反复施加它。
但它非常糟糕:每生成一个 token,你实际花费的是 $O(T^2)$ 的时间($T$ 是到目前为止已生成的 token 数,因为注意力的计算量是 $T^2$)。于是生成 $T$ 个 token 的总代价是 $T^3$。
$$ \underbrace{O(T^2)}_{\text{单步注意力}} \times \underbrace{T}_{\text{步数}} = O(T^3) $$
5.2 关键观察:很多工作在 prefix 之间是共享的
观察:其实你不需要这样做。大量工作可以在不同前缀之间共享。
比如你在生成 "never" 和你在生成 "up" 时,"never going to give" 这些 token 对应的 key/value 其实是同一批计算。这些 token 的激活不应该变化。
为什么?因为这是因果(causal)Transformer:
- 如果是双向的:你追加一个 token,前面的所有激活都会变;
- 如果是因果的:前面位置的激活不会因为你追加了任何 token 而改变。
有了这个观察,第一件显然的事就是:把 KV cache 存到 HBM 里,这样在相邻的两次 token 生成之间,可以直接复用。
5.3 两阶段:prefill 与 generation
有了 KV cache 之后,推理分成两个阶段:
| 阶段 | 输入 | 是否可并行 | 输出 |
|---|---|---|---|
| Prefill(预填充) | 给定 prompt | 可以,和训练一样(你一次看到整个 prompt) | 填充 KV cache;产出第一个 token 的 logits |
| Generation(生成) | 单个新 token | 不可以,逐个生成 | 新的 KV 项 + 下一个 token 的分布 |
具体流程是:prompt 进来,先把 KV cache 填充好(这就是那批 key-value 对),同时算出 logits,采样得到 "never";"never" 再喂进 Transformer,这次用上缓存,产出下一个 token 的分布以及一个新的 KV 项,追加到缓存里;如此往复。
关键的收益是:你再也不需要为"已经看过的那些 token"重新计算 KV cache。
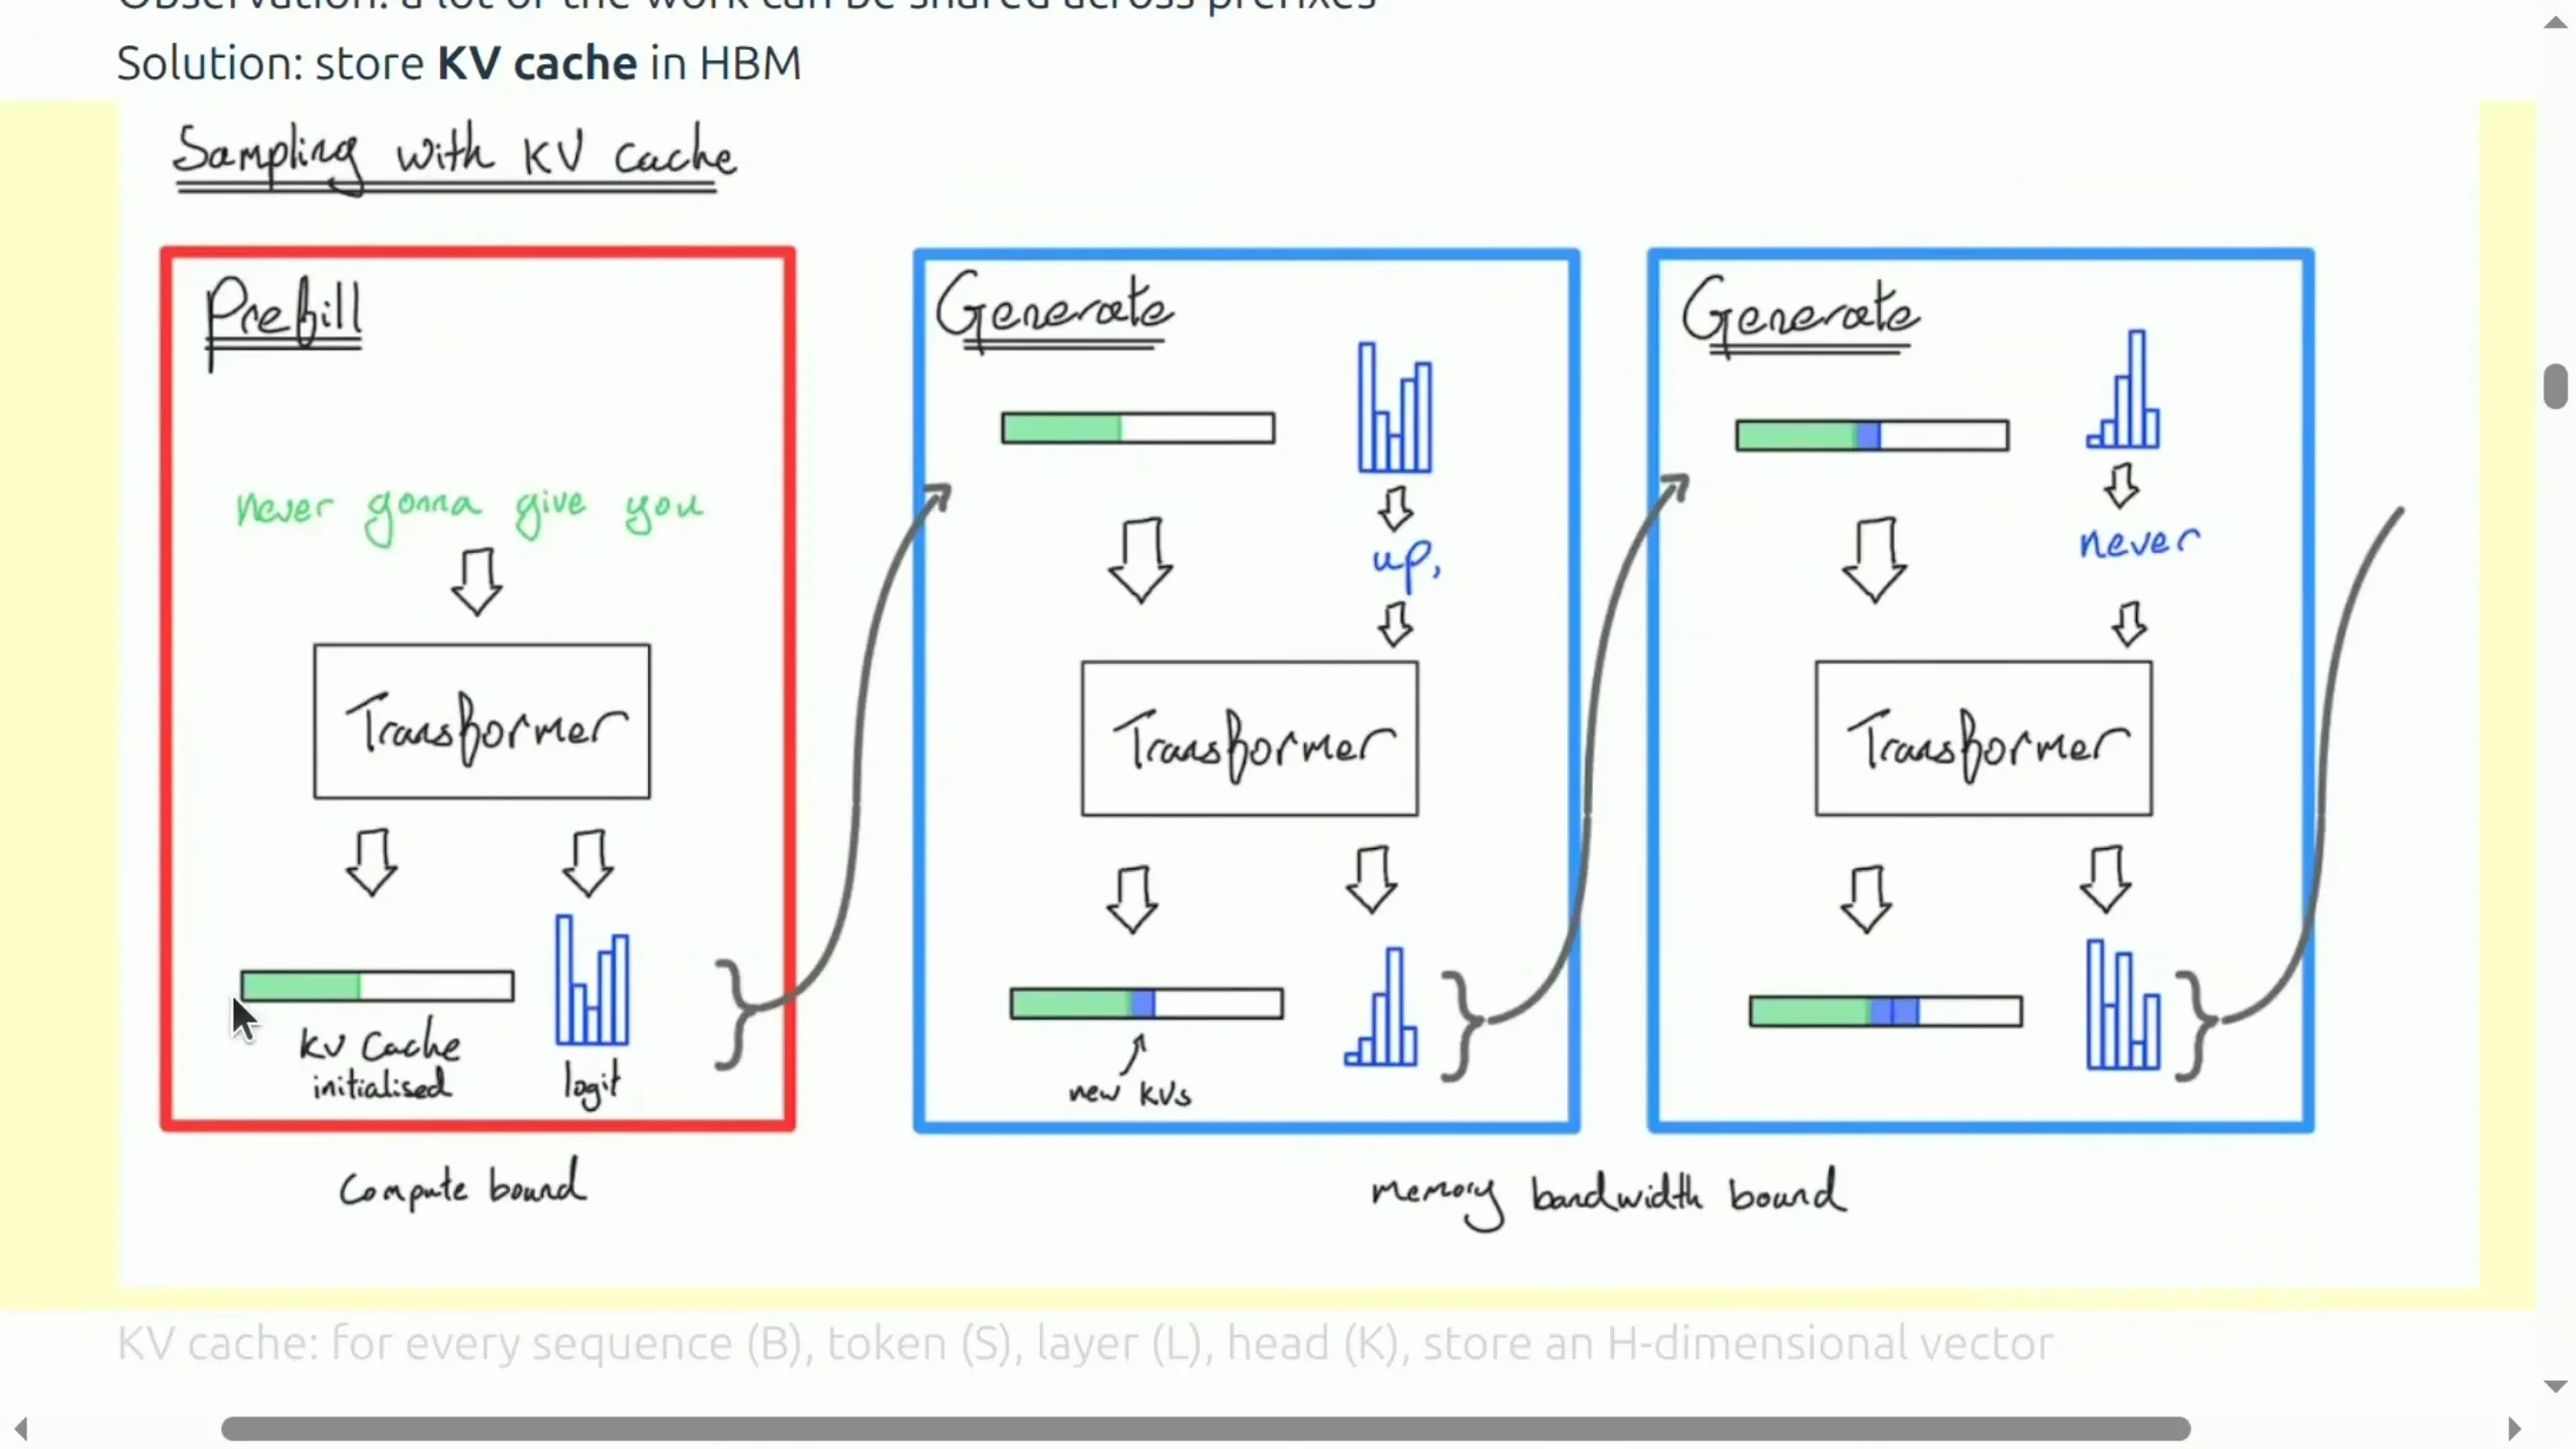
📷 带 KV Cache 的 prefill / generation 两阶段流程
回到原视频 (00:23:20)
5.4 KV cache 的形状
形式上,KV cache 为:
- 每条序列(共 $B$ 条);
- 每个 token(共 $S$ 个);
- 每层、每头($K$ 个 KV 头,每个头 $H$ 维)——各存一个 $H$ 维向量。
5.5 MLP 的 FLOPs 与内存 IO
(参考时间: 00:25:30)
讲师先说明一个贯穿全程的简化:只盯着 matmul 看,因为 matmul 才是真正花工作量的部分;其余算子要么 FLOPs 很少,要么可以融合进 matmul。
MLP 这一层的流程是:读 $X$ → 读入全部参数 → 算上投影 → 写回 HBM → 算门控 → 写回 HBM → 算下投影 → 写回 HBM。
- FLOPs 依赖 $P$(参数量)、$B$、$T$、$D$、$F$:batch size、序列长度、模型维度、MLP 维度;
- 传输字节数是另一串表达式。
由此得到算术强度,再套用前面那个"$B \cdot T \ll D, F$"的假设,得到:
$$ I_{\text{MLP}} \;\approx\; B \cdot T $$
这在结构上就是矩阵乘法那套的类比——无非是矩阵更多、维度更多,本质上是一回事。这也非常好理解:MLP 本来就是一个大 matmul。
更重要的是这句话:
在 MLP 里,batch 维度和序列长度维度下所有东西都是独立的,它们之间不交互。
所以 MLP 这边是安全的:只要在 prefill 时把 $B \cdot T$ 做得够大(大 batch、长序列),你就能维持较高的算术强度。
5.6 注意力的 FLOPs 与内存 IO —— 问题出在这里
(参考时间: 00:29:20)
注意力层同样先看 matmul:
- 从 HBM 读入 QKV 矩阵;
- 算注意力、算 softmax(softmax 本身"不太重要")、算 value 矩阵;
- 把结果写回 HBM。
这仍然是 matmul,所以FLOPs 的阶数应当比传输字节数高一级,唯一的问题是系数长什么样。讲师给出的注意力系数是:
$$ \boxed{\ \frac{S \cdot T}{S + T}\ } $$
于是:
| 场景 | 代入 | 算术强度 | 判定 |
|---|---|---|---|
| Prefill | $T = S$ | $\dfrac{S \cdot S}{2S} = \dfrac{S}{2}$ | 良好。只要序列够长,注意力强度就高 |
| Generation | $T = 1$ | $\dfrac{S \cdot 1}{S+1} \approx 1$ | 灾难。小于 1 |
注意一个细节:在这个表达式里,批维度 $B$ 根本没有出现。讲师说这一点稍后解释,但它正是关键。
讲师对生成阶段的评价非常直接:"这是坏消息。" 因为算术强度约等于 1,而1 是很糟的——我们前面算过,要打满 H100 的算力,需要 295 这个量级。
"我们辛辛苦苦把 MLP、注意力、prefill、generation 都算了一遍,结果发现这里是个瓶颈。"
5.7 为什么注意力成为瓶颈:一个直观解释
(参考时间: 00:31:45)
讲师对比了 MLP 和注意力:
- MLP:每条序列撞上的是同一套 MLP 权重。这些权重不依赖 $B$。所以 $B$ 越大越划算——你把 MLP 权重加载一次,就能服务所有序列。这正是算术强度变高的机制:读一次,然后批处理一大批。
- 注意力:每条序列有它自己的 KV cache。这些全都依赖 $B$。所以增大 $B$ 帮不上忙——相当于你为每条序列各做一次 matmul,它们是彼此独立的,做更多 matmul 并不会让强度变好。
讲师把这个情形类比回他开场举过的那个例子:那个例子里算术强度也很差,因为它"本质上不是在做一个 matmul,而是在做一个点积"——而点积的算术强度极差。
一句话总结:
注意力里那个蓝色的 $B$(只批、不收缩),正是注意力的算术强度不随 $B$ 增长的原因,也正是它成为瓶颈的原因。
5.8 四种组合的总结表
(参考时间: 00:33:55)
| 场景 | 算术强度 | 判定 |
|---|---|---|
| Prefill · MLP | $B \cdot S$ | 很好 |
| Prefill · Attention | $S/2$ | 不是最好,但可用 |
| Generation · MLP | $B$ | 可用,但要求并发请求足够多 |
| Generation · Attention | $\approx 1$ | 根本性瓶颈 |
讲师的原话是:
"这就是那个瓶颈。你就得接受它——如果你继续用 Transformer,你没法真正改进这一点。"
那么,当你听到有人说"推理是内存受限的"时,你现在知道为什么了。
编者拓展|softmax 为什么可以忽略,以及 FlashAttention 之类的意义 讲师说 softmax "doesn't really matter",是因为 softmax 本身的 FLOPs 只是 $O(B \cdot N \cdot S \cdot T)$ 量级,比 QK^T 和 PV 两个 matmul 低一阶;而且它通常可以和前后算子融合(fuse),不会额外产生一次 HBM 往返。 但要注意,"可以忽略"的前提是不发生中间张量的物化。如果按最朴素的实现,注意力矩阵 $S \times S$ 要被显式写进 HBM 再读回来,那么它反而会吞掉大部分内存带宽——这正是 FlashAttention 系列工作要解决的问题:通过分块(tiling)把注意力矩阵留在 SRAM 上算完,避免 $O(S^2)$ 的 HBM 流量。本讲没有展开这部分,但它和"推理是内存受限的"是同一枚硬币的两面。
5.9 内存受限带来的好处:把时间简化为"搬了多少内存"
(参考时间: 00:35:20)
讲师说,如果推理是内存受限的,那么很多事情反而变简单了:你估计"要花多久"时,只要看需要搬多少内存。
前提是计算与通信可以被重叠(overlap)。在重叠成立时,瓶颈就是你要处理的内存总量。
讲师的原话带着一点自嘲:"从某些角度看这挺好的,因为更简单;但从另一些角度看挺让人沮丧的——你的加速器就坐在那里什么都不干。"
5.10 实例:Llama 2 13B 在 H100 上
(参考时间: 00:36:05)
以 Llama 2 13B 为例。模型的形状参数包括:序列长度、模型维度、前馈维度、query 头数、KV 头数(此处没有 GQA,所以 $N = K$)、头维度、层数、词表大小,再加上 H100 的内存带宽。
📷 Llama 2 13B 在 H100 上的配置与推导
回到原视频 (00:37:00)
第一步:参数量。 把 embedding、MLP 层、KQV 投影都加起来,得到一个参数量。自检结果约为 130 亿——和"13B 模型"的宣称一致。Llama 2 在推理时用 BF16,所以参数占的字节数是这个数乘 2。
第二步:KV cache。 KV cache 的大小是:
$$ \text{KV} = \underbrace{2}_{K,\,V} \times \underbrace{2}_{\text{BF16 字节}} \times B \times S \times K \times H \times L $$
第三步:总内存。
$$ \text{Memory} = \underbrace{2P}_{\text{参数(BF16)}} + B \cdot \underbrace{\text{KV}_{\text{per-seq}}}_{\text{每序列 KV cache}} $$
在课堂上这套配置下,每序列的 KV cache 约合 8.38 亿字节量级,所以总内存基本上是 $B$ 的线性函数再加上一项常数。
第四步:延迟与吞吐。
- 延迟 = 内存 IO ÷ 内存带宽(因为内存受限);
- 吞吐 = $B \div$ 延迟(因为同时在处理 $B$ 个 token)。
所以延迟与内存在形式上完全相同,吞吐则是"$B$ 除以一个关于 $B$ 的线性函数"。
编者说明:由"每序列约 8.38 亿字节"这一点反推,课堂上用的序列长度大约是 $S = 1024$:
$$2 \times 2 \times 1024 \times 40 \times 128 \times 40 = 838{,}860{,}800\ \text{字节}$$
而 Llama 2 13B 的官方上下文长度是 4096。课堂上大概率用的是一组教学简化配置。此点已记入文末"已知疑点"。
5.11 延迟与吞吐的张力,用具体数字看
(参考时间: 00:41:00)
Batch size = 1:
- 延迟 ≈ 0.008 秒/token(约 8 ms,正好对应"26 GB 参数 ÷ 3.35 TB/s ≈ 7.8 ms");
- 吞吐 ≈ 124 tokens/秒。
增大 batch:
- 延迟变差(因为 KV cache 变大,读写量增加,而且"batch 是批处理的,你这条 query 得等所有人做完");
- 吞吐变好(因为参数只加载一次,却摊薄到更多序列上)。
继续增大 batch:
- 延迟更差,吞吐更好,但"主要问题是内存会不够用"——KV cache 会超出 H100 的显存。换成 B200 能再大一些,但终究会撞到极限。
- 而且吞吐的收益边际递减:你永远到不了那条渐近线,因为你先撞上内存墙。
讲师在这里给出了一个很形象的类比(务必保留):
想象你在等公交:延迟就是"你等车"的时间——你得等,然后才能走,所以延迟不高;而公交的吞吐其实很好,因为它一次把所有人都拉走。
也就是说:
- 增大 batch 恶化延迟,因为 KV cache 更大、要读写更多;
- 增大 batch 改善吞吐,因为参数是共享的,加载一次就能服务大量序列。
⚠️ 这是本讲最重要的一个权衡,讲师要求学生当场对齐认知:
小 batch 带来更好的延迟、更差的吞吐;大 batch 带来更好的吞吐、更差的延迟。
5.12 关于并行的一点补充与 TTFT
(参考时间: 00:44:30)
讲师明确说自己不会多讲并行,想深入的话去看 scaling book 里推理那一章。他只给了一个平凡的极端例子:"如果你启动 $M$ 份模型拷贝:延迟不变,吞吐乘以 $M$。"
TTFT 则是另一个维度:TTFT 本质上就是做 prefill 所需要的时间——因为 prefill 一做完,你就可以开始生成了。所以:
- 想要更快的 TTFT → 用更小的 batch(prefill 的并行度更容易打满,也更容易抢占到资源);
- 想要更大的吞吐 → 用更大的 batch。
graph LR
    A["增大 batch size"] --> B["KV cache 变大"]
    B --> C["每次要读写的内存变多"]
    C --> D["Latency ↑(变差)"]
    A --> E["参数被更多序列摊薄"]
    E --> F["Throughput ↑(变好)"]
    E --> G["TTFT ↑(变差)"]
    C --> H["显存占用 ↑"]
    H --> I["最终撞上内存墙"]
六、让推理更快:一张技术全景图
(参考时间: 00:45:40)
有了"算术强度 + 吞吐 + 延迟"的概念框架之后,问题变成:怎么让它更快? 讲师强调,方法跨度很大——从改模型架构,到做系统优化,以及两者之间的一切。推理在某种意义上是一个非常丰富的交叉学科话题。
而最核心的一条主线,讲师希望"把它敲进你脑子里":
内存是推理的瓶颈,而 KV cache 占用了大量内存。在足够大的 batch 下,KV cache 甚至可能比参数量还大。所以试试把 KV cache 减小。
但要小心:减小 KV cache 是有损的,你必须确保精度掉得不多。
graph TD
    R["加速推理:在不伤精度的前提下降低开销"] --> A["减小 KV Cache"]
    R --> B["减小参数量"]
    R --> C["不改模型,靠系统"]
    A --> A1["GQA / MQA<br/>跨头共享 KV"]
    A --> A2["MLA:低秩压缩 KV"]
    A --> A3["CLA:跨层共享 KV"]
    A --> A4["滑窗 / 局部注意力<br/>压缩稀疏注意力"]
    A --> A5["线性注意力 / SSM"]
    B --> B1["量化:QAT / PTQ / GPTQ / 激活感知"]
    B --> B2["剪枝 + 后训练(蒸馏)"]
    C --> C1["投机解码(无损)"]
    C --> C2["连续批处理"]
    C --> C3["选择性批处理"]
    C --> C4["PagedAttention"]
6.1 Grouped Query Attention(GQA):跨头共享 KV
(参考时间: 00:46:45)
回忆 Multi-Head Attention(MHA):每个 token 都有一份 key、一份 value、一份 query。
在 GQA 里,你仍然计算同样数量的 query($N$ 个),但只保留更少数量的组,每组只有一份 key/value。也就是说:
- $K$ = 组的数量;
- $G$ = 每组包含的 query 头数;
- 因此 $N = K \times G$。
三种形态对照:
| 形态 | $K$ | 说明 |
|---|---|---|
| MHA | $K = N$ | 不做任何归约 |
| MQA(multi-query attention) | $K = 1$ | 讲师说"没人用了,因为它太差" |
| GQA | $1 < K < N$ | 希望在这个区间找到精度与速度的平衡 |
GQA 论文(2023)的实测曲线:横轴与纵轴的综合指标是"每样本时间"(既关联延迟也关联吞吐)。
- MHA(完整注意力)耗时最高;
- $K=1$ 时快很多;
- 把 $K$ 一路加到 8,仍然相当不错;
- 再往上,耗时就会显著上升。
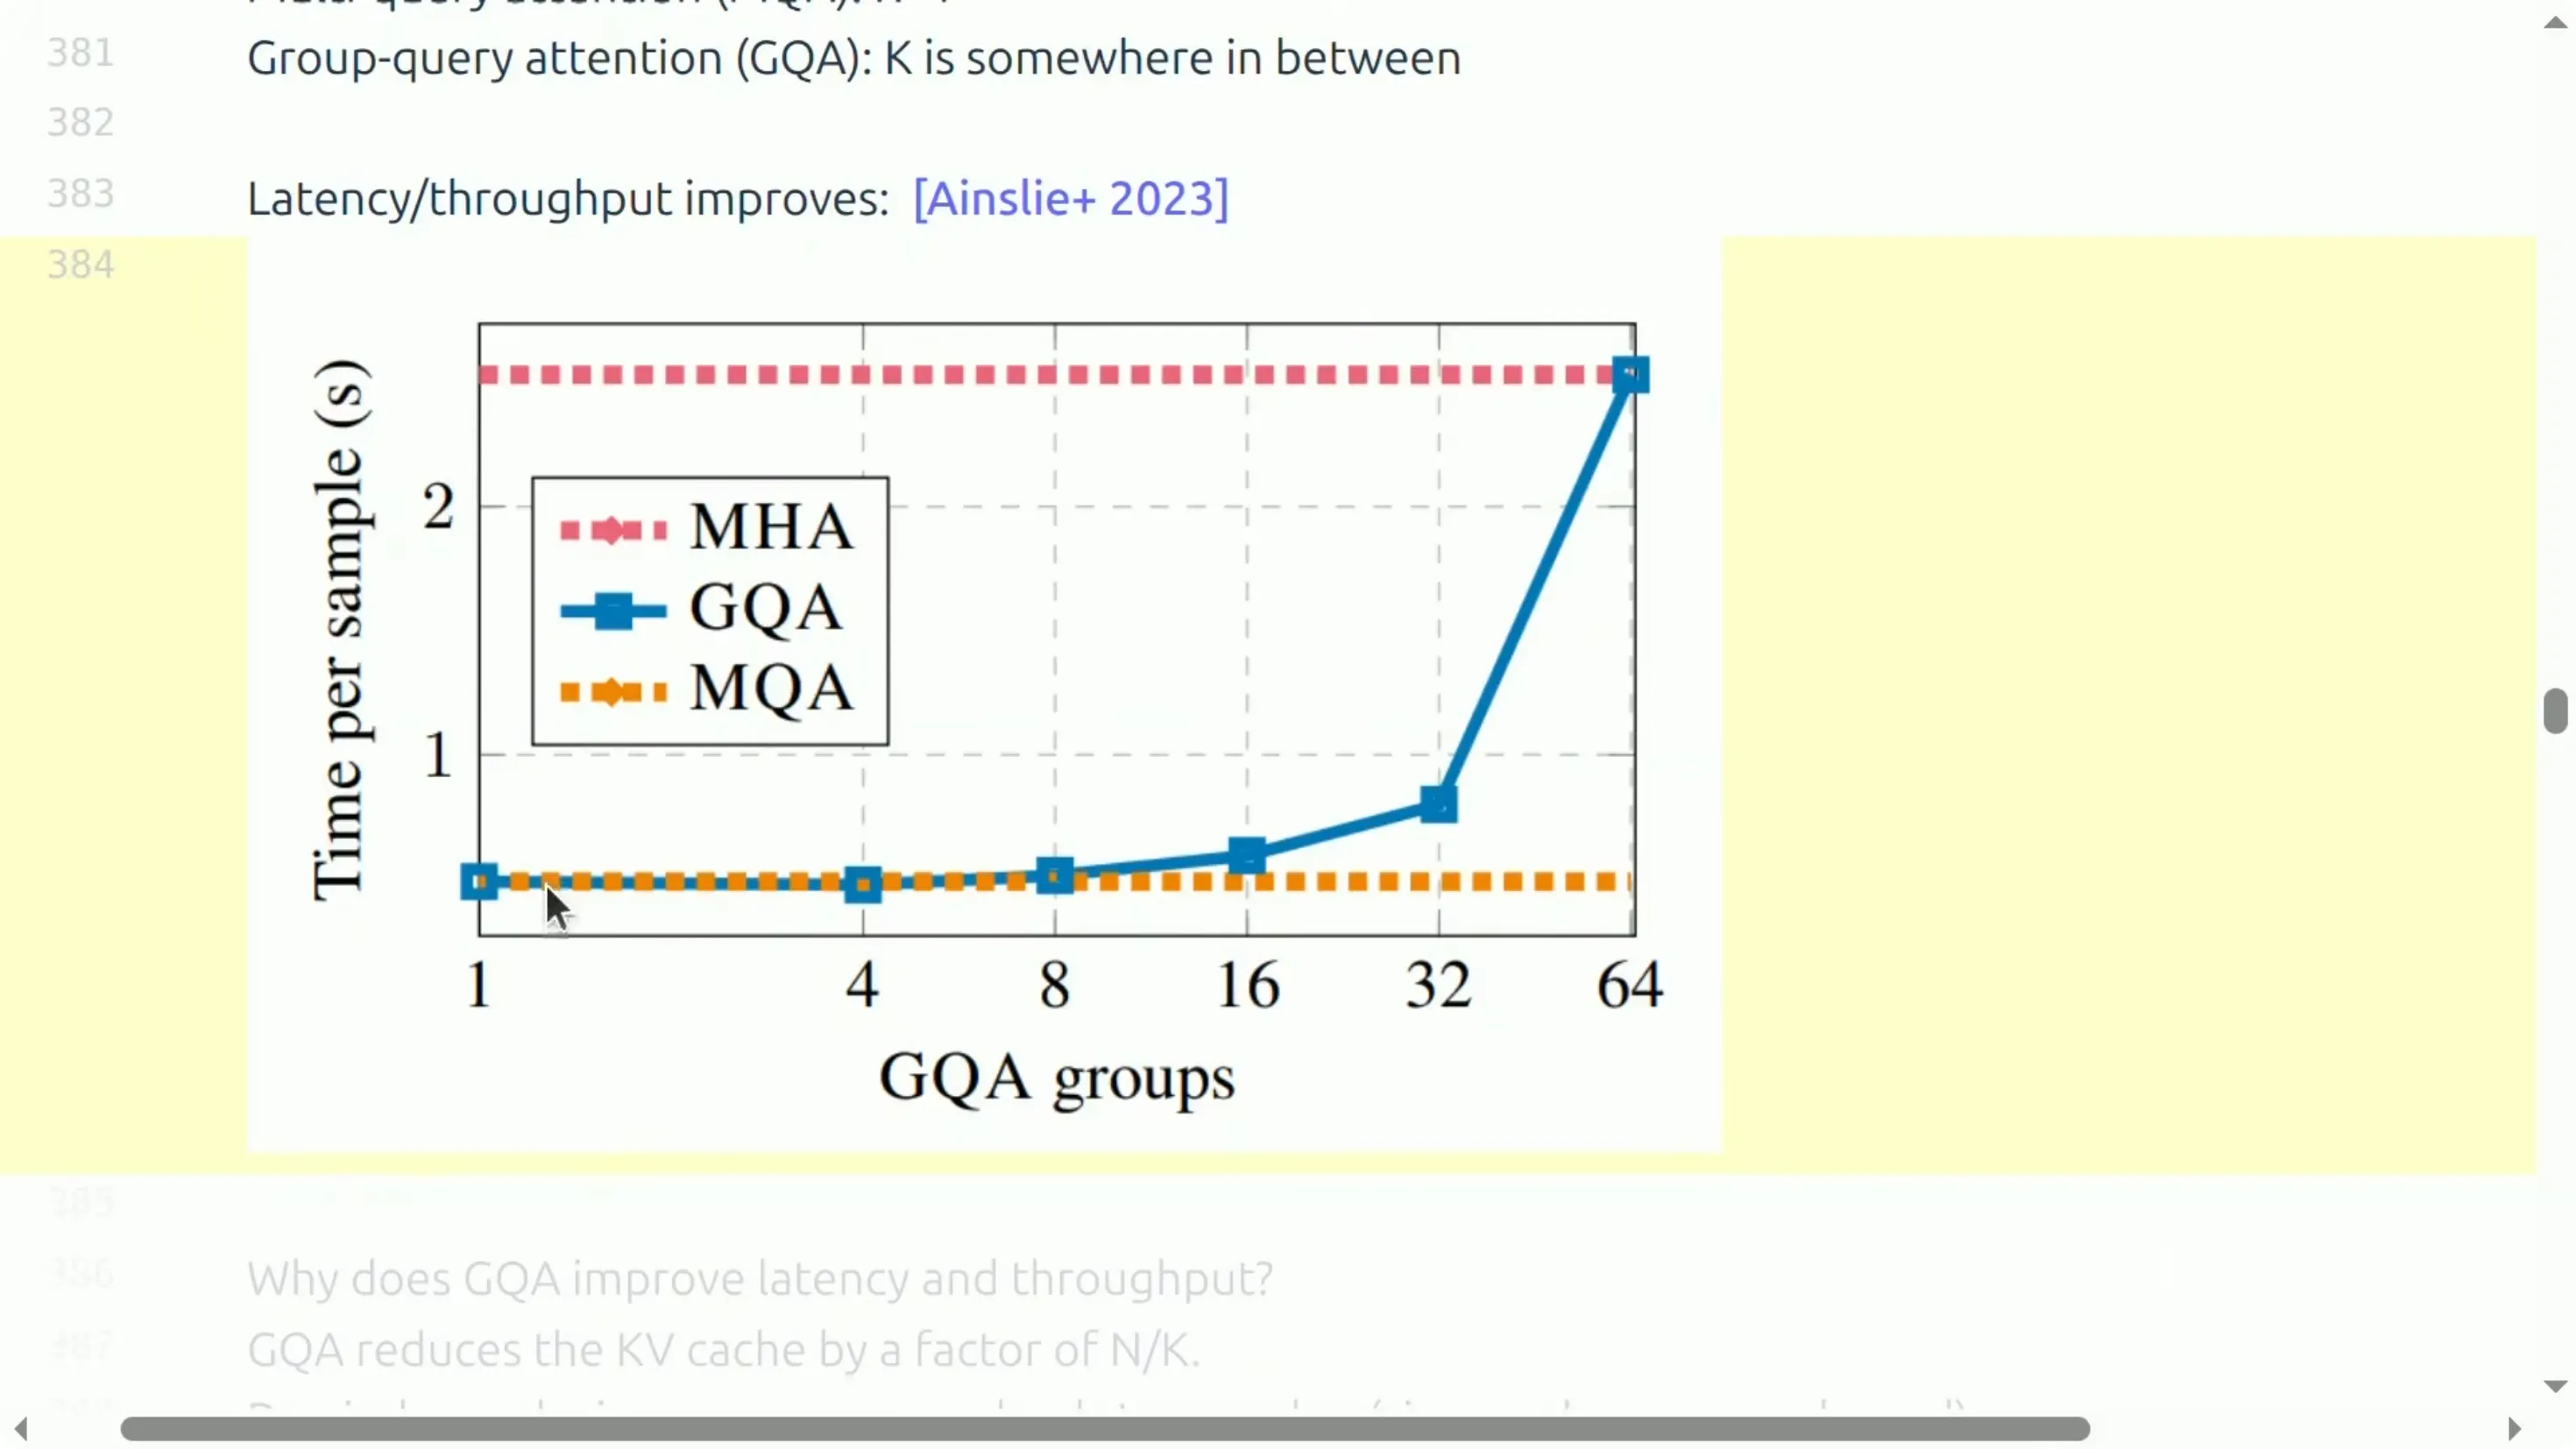
📷 GQA 论文中不同 KV 组数下"每样本时间"的对比曲线
回到原视频 (00:48:05)
为什么 GQA 能改善延迟与吞吐? 因为它把 KV cache 减小了 $N/K$ 倍。而"减少内存占用 → 变快"这条因果链成立,正是因为我们是内存受限的。
代回刚才的 Llama 例子:
- 原始配置 $K = N$(无归约),在 batch 64 下得到一组吞吐/延迟;
- 现在加入 GQA,取约 1:5 的比例(即每个 KV 头服务 5 个 query 头,$K = N/5$),内存明显下降,延迟和吞吐同时改善;
- 这说明:延迟和吞吐并非永远对立。如果你减少的是内存占用,那么两个都会变好。真正的张力只来自 batch 维度。
继续把 batch 加大。 之前 batch 256 会爆显存,现在能放下了。代价是延迟略降(因为 batch 变大),但吞吐近似线性地上升。
所以真实调参是联合地玩这些旋钮:你可以先缩小 KV cache,再用省下来的显存去换更大的 batch,从而换更高的吞吐——在另一条约束线上重新做权衡。
最后必须检查精度。 论文声称 GQA 在一系列评测上表现良好。但讲师立刻泼了冷水:
"对这些精度评测我总是要打个折扣。比如后来 DeepSeek 的论文就显示,GQA 其实是有损的。所以——凡不是纯数学的东西,在这里都要打个折扣。"
编者说明:GQA 的原始论文是 Ainslie 等人 2023 年的 GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints(arXiv:2305.13245)。它同时给出了"从已有的 MHA 检查点用 uptraining 转成 GQA"的方案——这是它被广泛采用的现实原因之一:不必从头训。
6.2 Multi-Head Latent Attention(MLA):低秩压缩 KV
(参考时间: 00:51:30)
讲师把主题再重申一遍:"降低 KV cache → 延迟和吞吐一起改善。"
- MHA:每个 token 有同样数量的 Q、K、V;
- GQA:减少了每个 token 的 K 和 V 的数量(更准确地说,是减少了 KV 头的数量);
- MLA(来自 DeepSeek):K、V 的份数基本不变(名义上还是每个 token 一份),但我把它们的表示压缩掉。
具体做法:
- 通常你会用激活乘上某个矩阵得到 K、另一个矩阵得到 V,而这些矩阵的维度一般是 $N \times H$,也就是模型维度 $D$,是个大数;
- MLA 则先把激活投影到一个 $C$ 维的低维空间。DeepSeek-V2 把这个维度从 16000 压到 512——"这是相当激进的压缩";
- 然后 K 和 V 都从这个压缩表示中算出来。
于是你只需存 $C$(小得多),需要 K、V 的时候再把它物化出来(materialize)。
一个麻烦:MLA 与 RoPE 不兼容,因为 RoPE 直接作用在 key 和 value 上。DeepSeek 的做法是额外增加一些维度专门用来承载 RoPE。但整体上仍然是相当大的压缩。
效果:延迟和吞吐的改善"跟着简单的算术走"——KV cache 越小,你越快,几乎是线性地快下去,直到某个点为止。
精度对比(这里出现了一个和 GQA 论文相反的结论):
- 表格里 MHA 与 MLA 的结果对比显示,MLA 的数字甚至比 MHA 稍好一点,至少是持平;
- 而要与 GQA 相比,MLA 明显更好——讲师说"这一列和那一列都比(GQA)好得多";
- 讲师特别提醒:"这个结果和 GQA 论文是相冲突 / 相张力的。"
编者拓展|MLA 的数学形式(为什么"压缩"不是简单的降维) 设模型维度为 $d$,MLA 引入一个压缩维度 $d_c$(DeepSeek-V2 里 $d_c = 512$)。 - 下投影:$c = W^{DKV} x$,$c \in \mathbb{R}^{d_c}$,这一步的产物就是要缓存的 KV; - 上投影:$k = W^{UK} c$,$v = W^{UV} c$。
对应 KV cache 的大小从每 token 每层 $2 \times N \times H$ 个元素,降为 $d_c$ 个元素(再加一小段 RoPE 维度)。 值得注意的是:因为 $k = W^{UK}W^{DKV}x$ 可以预先吸收成一个等效矩阵,所以推理时甚至能避免显式物化 $k$,直接改写注意力形式。这也是 MLA 在工程实现上需要特殊 kernel 支持的原因。 参考:DeepSeek-V2 技术报告,arXiv:2405.04434。
回答一个学生提问:这跟"直接把模型维度变小"比起来如何?
学生问:这跟降低模型维度相比如何? 讲师答:很好的问题,但这组消融实验里没有这一项。我猜直接降低模型维度会更糟——因为那是不加区分地把所有东西都缩小。这一类技巧的关键,在于找到模型里"可以抠出油水"的地方。而这先验地没法知道,只能做一大堆实验去试。
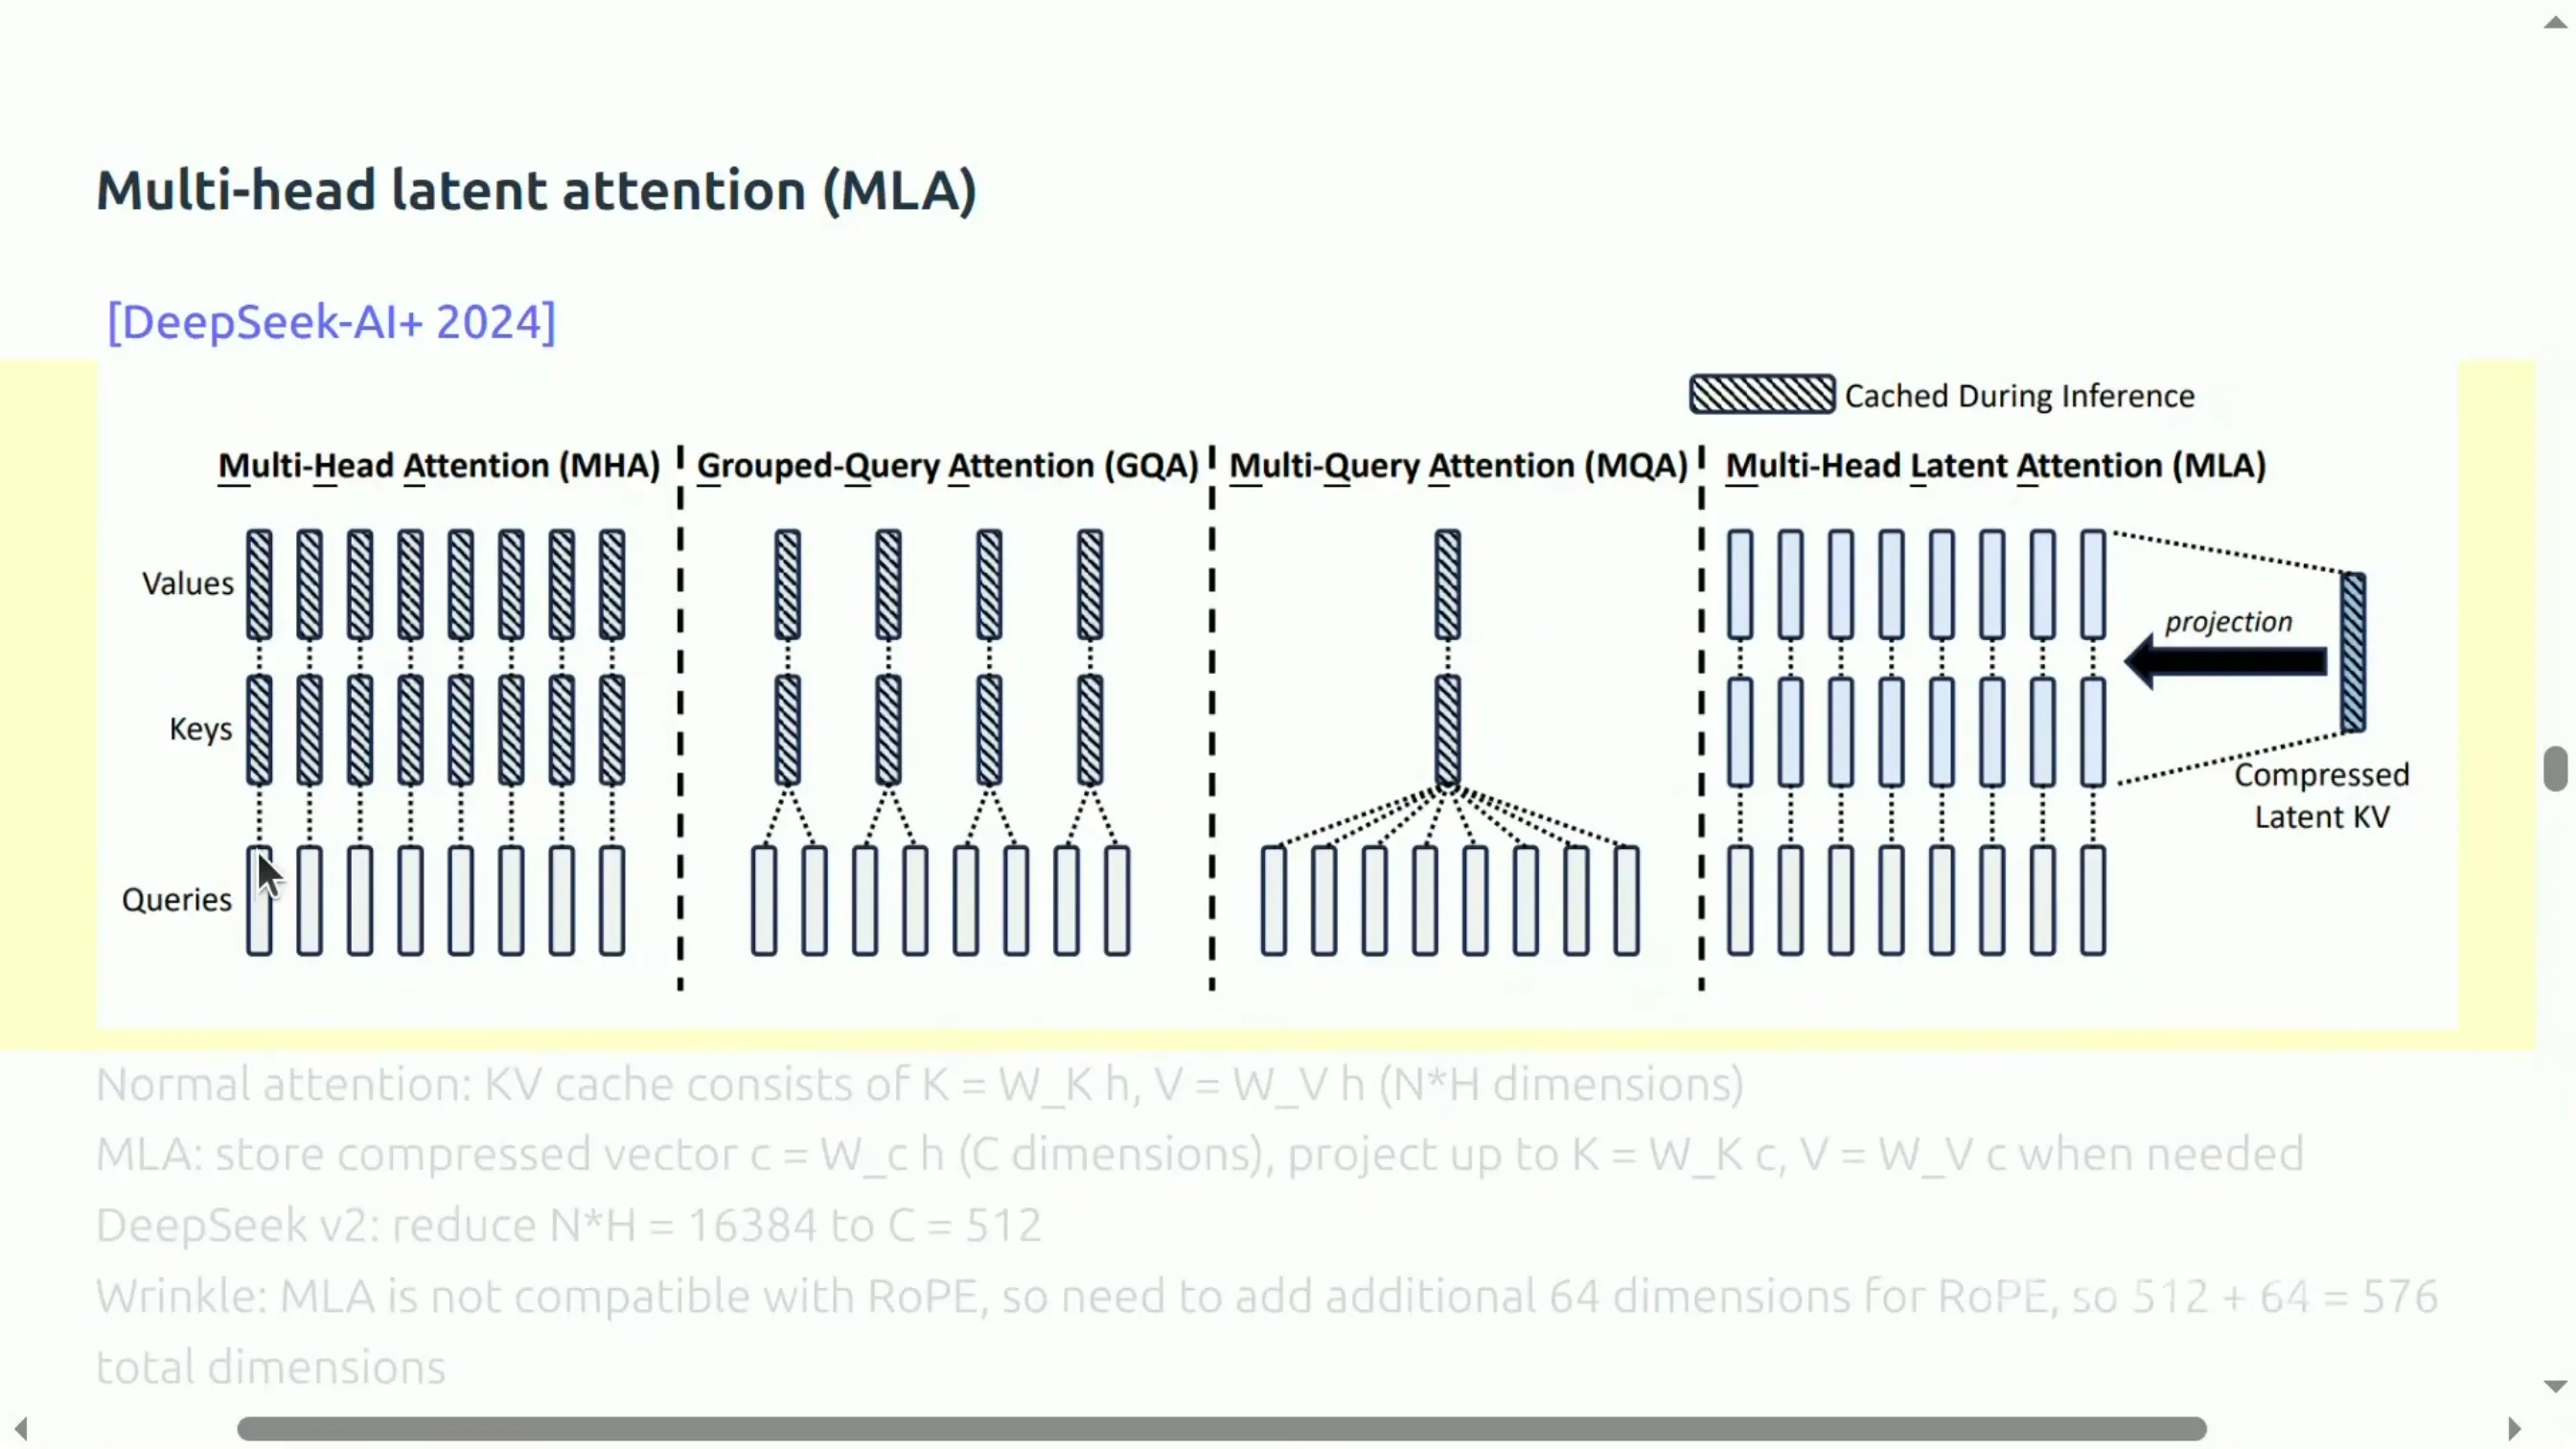
📷 MHA、GQA 与 MLA 在 KV cache 和精度上的对比
回到原视频 (00:51:45)
编者说明:这个回答其实点出了"结构化压缩 vs 粗暴降维"的分野。MLA 聪明的地方在于:它在KV 通路上压得极狠(512 维),却在上投影之后重新展开回原来的头维度,因此注意力计算本身的表达能力没被同等程度地压缩。而直接减 $d$ 会同时削弱 Q、K、V、MLP、残差通路,收益与代价不成比例。
6.3 Cross-Layer Attention(CLA):跨层共享 KV
(参考时间: 00:55:45)
想法很直接:正常每一层都有自己的 K 和 V。CLA 则只在部分层计算 KV,其他层直接复用上一层的 KV cache。
讲师的类比非常清楚:
GQA 是跨头共享 KV;CLA 是跨层共享 KV。
效果:论文显示这能改善 Pareto 前沿。
具体对比方法是:给定一种方法,你都可以通过调 $K$ 和头维度来扫出不同的 KV cache 大小(这某种意义上也回应了刚才那个"改模型维度"的问题);而在同样的 KV cache 预算下,CLA 的表现更好。
编者说明:CLA 的代表工作是 Reducing Transformer Key-Value Cache Size with Cross-Layer Attention(arXiv:2405.12981)。它的工程直觉是:相邻层的 KV 表示高度相关(表征相似度随层数平滑变化),因此共享的边际损失比"跨头共享"(GQA)更小。这也解释了为什么两者可以叠加。
6.4 局部 / 滑窗注意力,以及混合注意力
(参考时间: 00:56:55)
接下来是一段"快速巡礼"。
滑窗注意力(local / sliding window attention):想法相当老,也相当自然。
- 完整注意力矩阵是 $N^2$ 的;
- 滑窗则规定:生成一个 token 时,只看最近 $K$ 个 token。
于是 KV cache 就与序列长度无关了:只取决于 $B$(乘以其他常量)。这对长上下文尤其友好。
而且由于多层堆叠,有效上下文长度其实大于名义窗口——信息可以沿层向更远处传播。
还可以做更花哨的版本:不必用稠密的选择,可以间隔取点;或者做 global + sliding window 的混合——对一组固定的 token 位置做全局注意力,同时保留一个局部滑窗。
代价:它仍然会伤精度。 滑窗降低了表达力,天下没有免费的午餐——讲师补了一句调侃:"或者说,这是一顿很贵的午餐。"
常见解法:把局部注意力与全局注意力交错(interleave)起来——某些层做全注意力,另一些层做局部注意力。这样能压下一些 KV cache,同时始终在精度与速度之间找平衡。
📷 滑窗注意力与全局注意力的对比示意
回到原视频 (00:57:20)
关于线性注意力与滑窗的对比(一段课堂问答):
学生问:这些方法里,线性注意力变体和滑窗之间的权衡是什么? 讲师:我不打算细讲线性注意力,但可以很快说一下。 有一批方法不存 KV cache,而是计算历史的一个压缩表示。最朴素的线性注意力就是把所有 KV 求和成一个向量(因此必然与序列长度无关)。还有更花哨的,比如 GatedDeltaNet、DeltaNet、Mamba,它们试图压缩但尽量不遗忘。 这些方法也被用来替代滑窗注意力,并且有人拿到了不错的结果。你还可以把全注意力、滑窗注意力和线性注意力三者组合,因为它们捕捉的是不同侧面:如果你关心局部、高分辨率的信息,滑窗更好;如果你只想要对过去的宽泛摘要,线性注意力可能更好。
学生追问:那对长上下文来说,线性注意力更好吗? 讲师:没有免费午餐。 假设上下文极长,你在解一个"大海捞针"问题——如果你必须把整段历史压进一个很小的状态,你一定会丢信息,于是可能根本捞不出那根针。
学生继续:我感觉大家现在走的是层级化(hierarchy)路线,但总还是需要某种"更长的注意力",我只是想理解滑窗 vs. Mamba/DeltaNet 这类层的具体取舍,比如 DeltaNet 层是否一致地优于滑窗? 讲师:我大概会说,Mamba 和 DeltaNet 比滑窗注意力更强大。你可以这么想:Mamba 大概能表示滑窗注意力的某些方面——因为它在做递推时,本来就能"看最后那个状态"。所以不妨把线性注意力及其扩展理解为更宽松、更有余地的类别;而一旦你用了滑窗,你就到此为止了,没有别的空间了。
6.5 DeepSeek 的压缩稀疏注意力
(参考时间: 01:02:15)
讲师说 DeepSeek 在注意力机制上持续创新:
- 之前是 MLA(压缩 key/value);
- 现在又有了 "compressed sparse attention" 和 "heavily compressed attention" 之类的名字。讲师坦承:"这些缩写和它们到底什么意思,我从来记不住。"
不过看图就清楚了:
- 正常情况下,你有一堆 KV token 和一个 query token;
- 压缩注意力:把每 $M$ 个 token 压成一个 token;
- DeepSeek 稀疏注意力:在压缩之后的表示上,再挑选一个子集保留下来。挑选方式很巧妙——先用一组更轻量的 query/key 做一次小注意力,算出索引分数,以此决定"该留哪些 token",然后再用被选中的那些做真正的注意力。
"这就是一个闪电般快速地判断该保留哪些 token 的办法。"
6.6 这一节的收束
(参考时间: 01:03:40)
本节的目标就是缩小 KV cache。因为 KV cache 关联到内存,而我们已经看到推理是内存受限的,所以这直接翻译成吞吐与延迟的改善。关键在于不伤精度。
可以动刀的地方包括:
- 更低维的 KV cache——跨层、跨头、或者在头维度上;
- 局部注意力;
- 线性注意力;
- 以及更多。此外还有扩散模型(diffusion)——一种非自回归的生成方式,可以快得多。
七、量化、剪枝与蒸馏
7.1 量化
(参考时间: 01:04:20)
讲师把量化定位为"与其说是架构问题,不如说是系统视角"的问题。
核心想法:降低数字的精度。
逻辑链:更少的内存 → 更好的延迟与吞吐。当然,你必须担心精度。
可选范围从 BF16 一路降到 int4。
两条路线:
| 路线 | 做法 | 优点 | 缺点 |
|---|---|---|---|
| 量化感知训练(QAT) | 训练时在前向里量化再反量化,把量化误差"模拟"进训练过程 | 权重会适应量化,效果更好 | 需要昂贵的大规模训练 |
| 训练后量化(PTQ) | 先正常训练,事后再量化 | 便宜得多,是业界常规做法 | 精度风险更大 |
PTQ 的几种做法,从粗糙到精细:
- 朴素做法:对每个层或张量,各自确定缩放因子(scale)与零点(zero point),然后分开量化。讲师说这"一般来说效果不太好"。
- GPTQ:利用 Hessian 信息,逐层量化,并把量化误差记录、传播到尚未量化的权重上,从而修正误差。
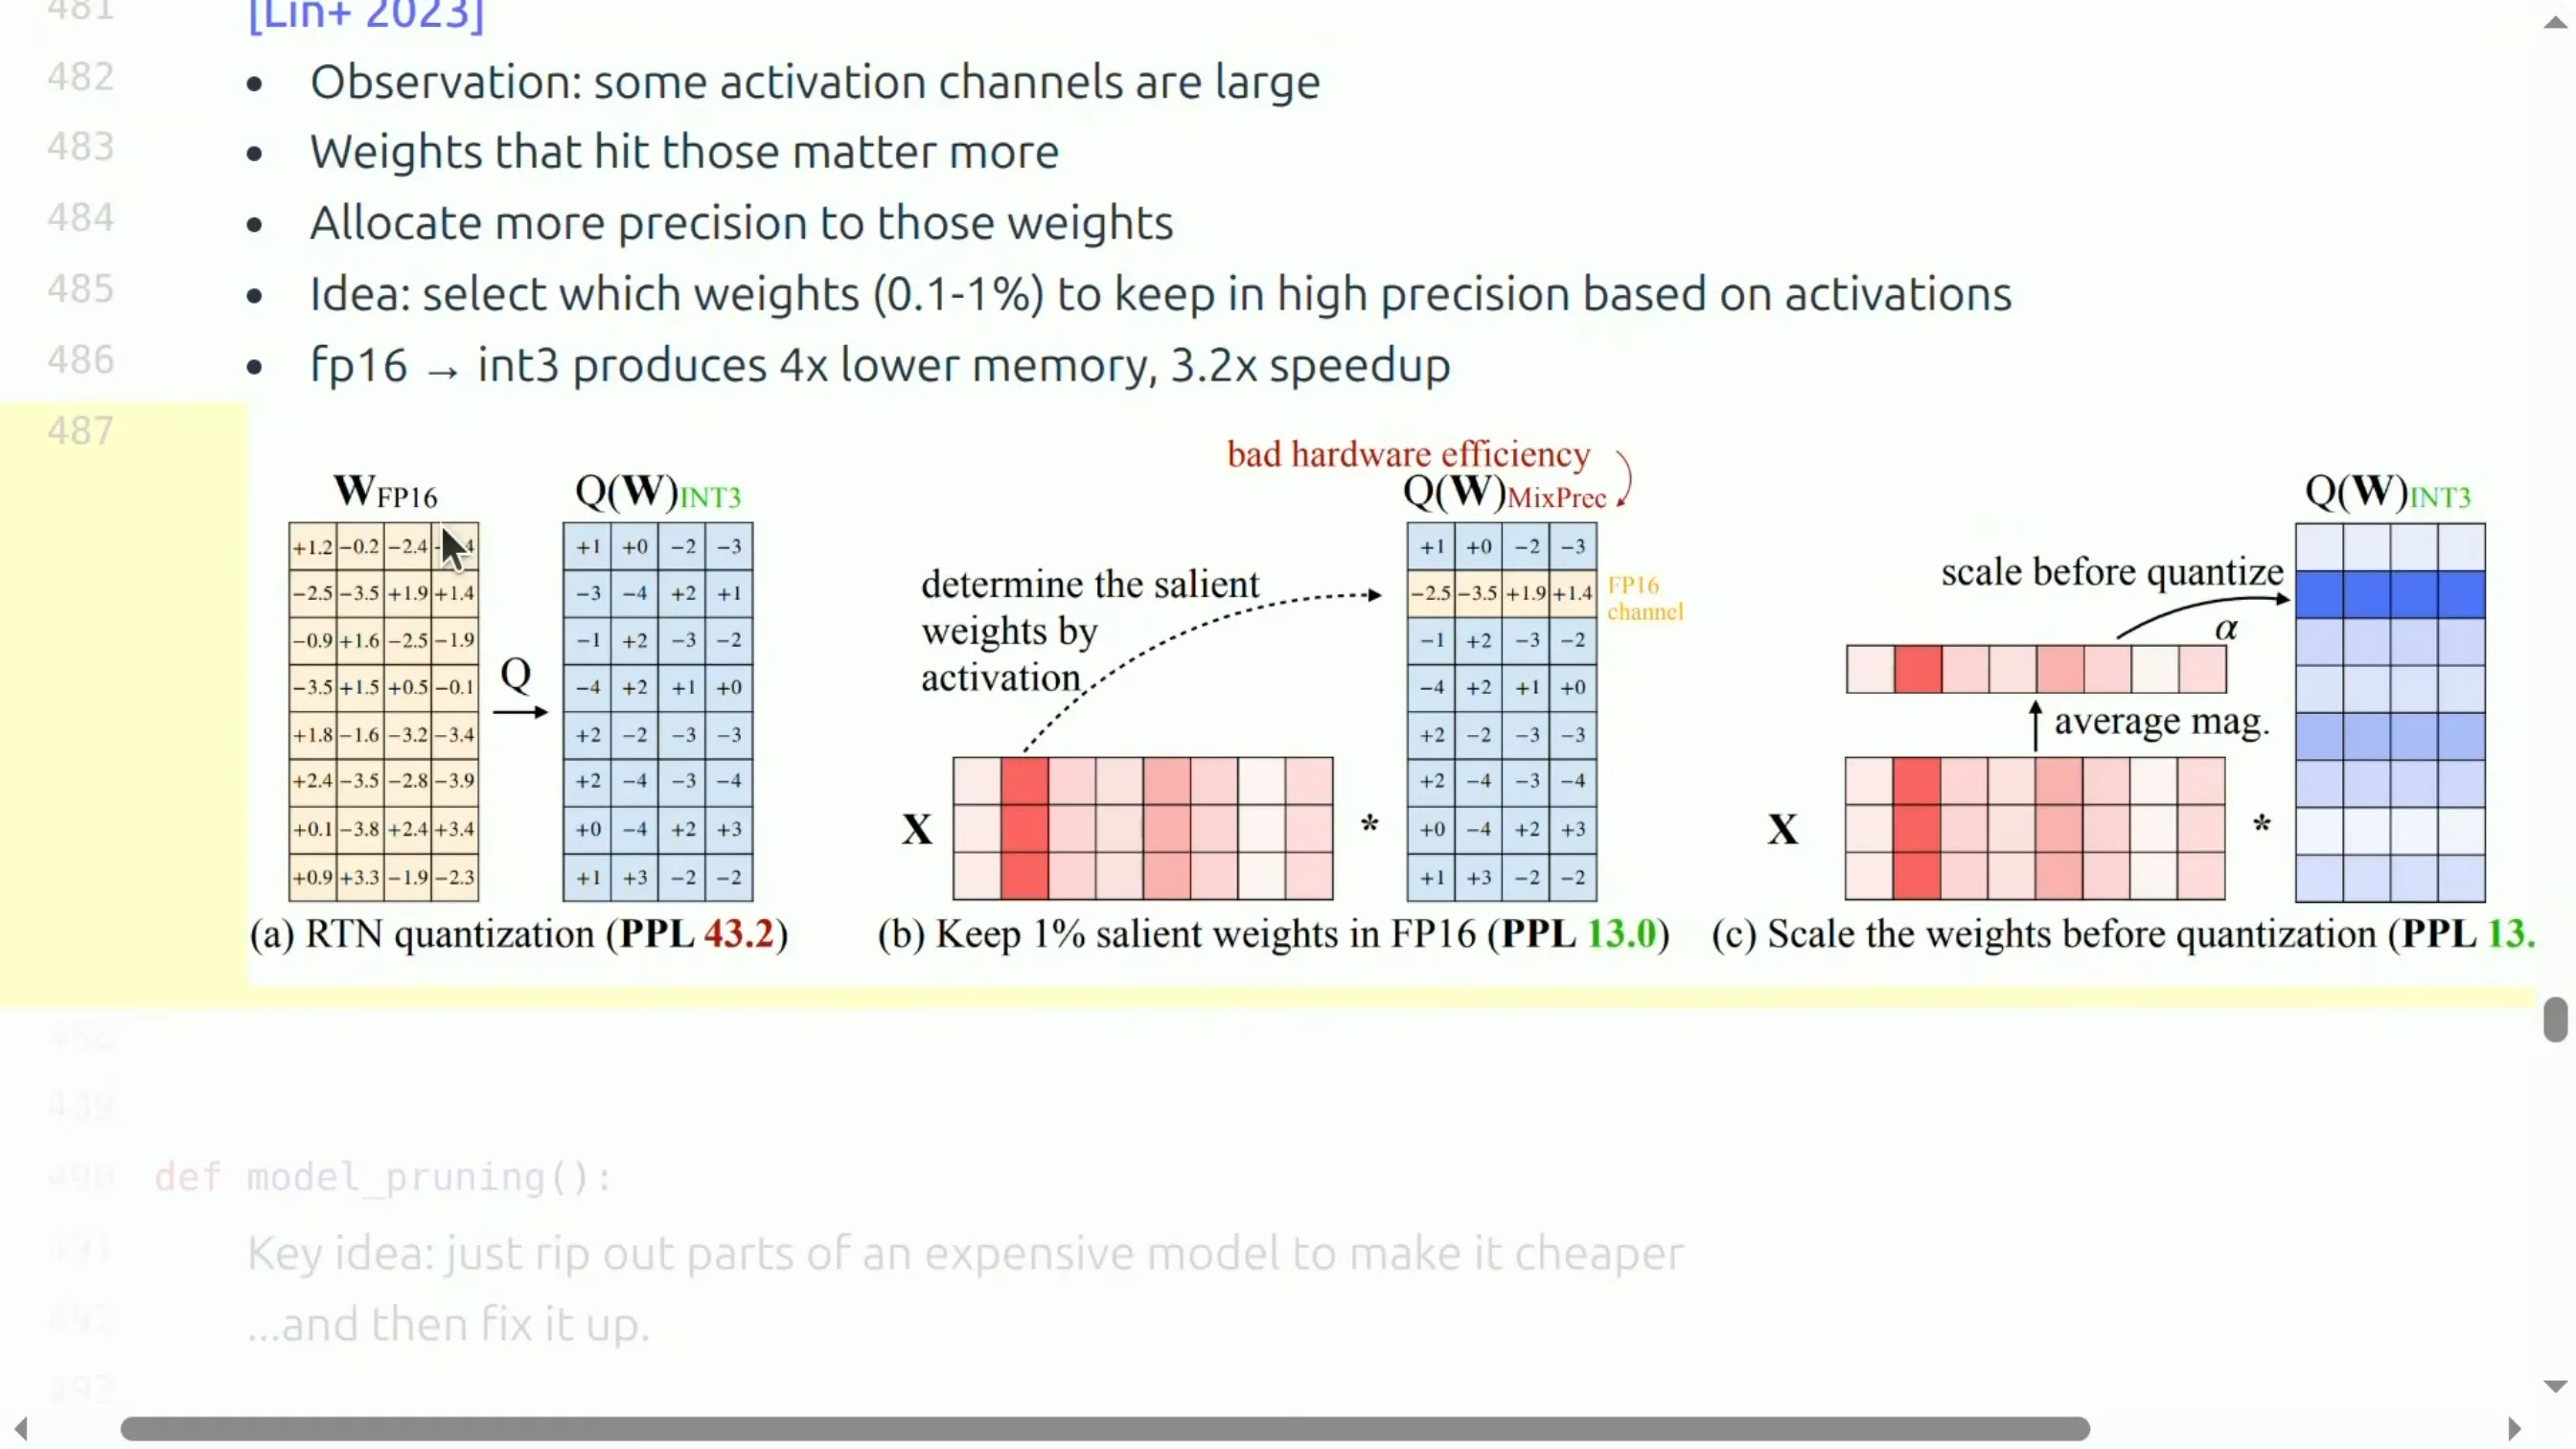
- 激活感知的量化:更精细。核心观察是——某些激活通道的值特别大,与这些通道交互的权重就更重要,于是给这些权重分配更高的精度。
讲师用一页图解释第 3 种:你把一个 FP16 的权重矩阵量化到 int3;但你先统计出哪些激活通道在整体上数值偏大,于是对这几个通道保留 FP16,其余仍用 int3——少数关键通道用高精度。
📷 激活感知量化:为激活值大的通道保留高精度
回到原视频 (01:07:05)
编者说明:讲师描述的"激活通道大 → 对应权重更重要 → 保留高精度"就是 AWQ(Activation-aware Weight Quantization) 的核心思想(arXiv:2306.00978)。它与 GPTQ 是同一时期的两条主流后训练量化路线:GPTQ 走二阶误差补偿,AWQ 走"保护显著通道"。实践中两者常被混用或叠加。
7.2 剪枝(pruning)
(参考时间: 01:07:35)
思路同样粗暴:拿一个大模型,把其中一部分直接撕掉,然后再修补它。讲师说"这是很粗糙的做法,但它确实有效"。
有一篇来自 Nvidia 的论文,大致流程是:
- 先估计模型不同部分的重要性;
- 挑出最重要的部分;
- 然后移除不同的隐藏单元,甚至整层;
- 此时模型当然"不会很好";
- 于是对它做后训练(post-train)——在你关心的数据或任务上再训一段,把它"治好"。
讲师把它概括为:
这在某种意义上是一次训练,其目的加权地指向"减小 KV cache",只是用一个大模型的部分权重来初始化。
效果:他们能把一个 15B 模型压到 8B,而精度下降并不太大,同时所需的训练量远小于从头训练。
编者拓展|为什么"撕掉再治"能奏效 大模型存在大量冗余(结构化的、通道级的、甚至整层级的)。剪枝之所以可行,是因为被剪掉的部分所承载的功能,往往可以被相邻单元的线性组合近似替代;而后训练的作用,就是让剩余的权重重新分工来补上损伤。 具体到"如何判断重要性",课上一位同学刚好追问了这一点,答案见 7.4。
7.3 这一部分的总结
(参考时间: 01:09:20)
这整场游戏就是:在不伤精度的前提下降低推理复杂度。 你可以把它理解为减少参数量,或者减少 KV cache。
两条路径:
- 设计一个更快的模型架构,从头训;
- 设计一个更快的架构,但用原模型的权重来初始化——虽然架构不同,本质上是在"拼一个弗兰肯斯坦",然后再用蒸馏把这个更快的模型修好。
graph TD
    A["目标:降低推理复杂度,不掉精度"] --> B["减少参数量"]
    A --> C["减少 KV Cache"]
    B --> B1["量化"]
    B --> B2["剪枝"]
    C --> C1["改架构:GQA / MLA / CLA / 滑窗 / 线性注意力"]
    B2 --> D["后训练 / 蒸馏修复"]
    B1 --> E["QAT 或 PTQ"]
    style A fill:#eef
7.4 课堂问答:怎么判断哪些层重要?
(参考时间: 01:09:45)
学生:你怎么区分重要层和不重要层? 讲师:一般来说,你会有一个校准集(calibration set),把输入过一遍模型,然后观察激活的幅度。有些单元基本是死的(接近 0),而那些大的你想保留。这就是高层的思路。
学生追问:可是激活值大为什么就说明它重要?万一某个神经元在所有样本上总是 100 呢?那它是真有意义,还是只是训练的副产物? 讲师:好问题。如果它总是 100,那意味着你不能把它删掉,删了什么都坏了;但你可以进一步看方差。如果它均值高、方差低,那也许可以有另一种做法——本质上把这部分吸收进偏置(bias)里。
学生继续:那如果所有激活都很大呢? 讲师:总体上这是一个经验观察——总有一些通道会显著高于其他通道。如果这个事实不成立,这些技术就不会奏效。但它恰好成立,因为这些模型训练出来就是这样,于是你就可以利用这一点。
八、投机解码:一条无损的加速路径
(参考时间: 01:11:45)
讲师把前面所有方法归为一类:有损(lossy)——它们把 KV cache 狠狠压缩,但可能伤精度。接下来要讲的是一个优雅得多的、无损(lossless)的办法:投机采样 / 投机解码(speculative sampling / decoding)。
8.1 核心洞察:检查比生成快
- 做 prefill 时,你可以并行地处理所有 token,而且顺带得到概率。这很快、是计算受限的,一切都很美好。
- 做 generation 时,只能一次一个。
于是:
检查(checking)比生成(generating)快。 你给我一个序列,让我判断它有多好,这比一个一个 token 生成快得多。
8.2 算法
利用这个不对称性:
- 用一个便宜的小草稿模型(draft model)$P$自回归地猜出若干个 token(比如 4 个);
- 用我们真正在意的目标模型(target model)$Q$并行地对这 $K$ 个 token 打分;
- 逐个决定接受或拒绝。
平衡点在哪:
- 草稿模型又小又便宜,所以尽管它也是内存受限、必须一次一个地生成,代价并不高;
- 目标模型又大又贵,但我们让它并行处理一批 token,所以也不至于太糟。
一个具体画面(课上有段演示视频):如果直接用大模型逐 token 生成,会很慢;而做投机解码时,你会看到小模型先"哗"地生成一串 token,然后大模型对它们做点评,于是你得到一个突发的 token 串,接着又是下一个突发串。
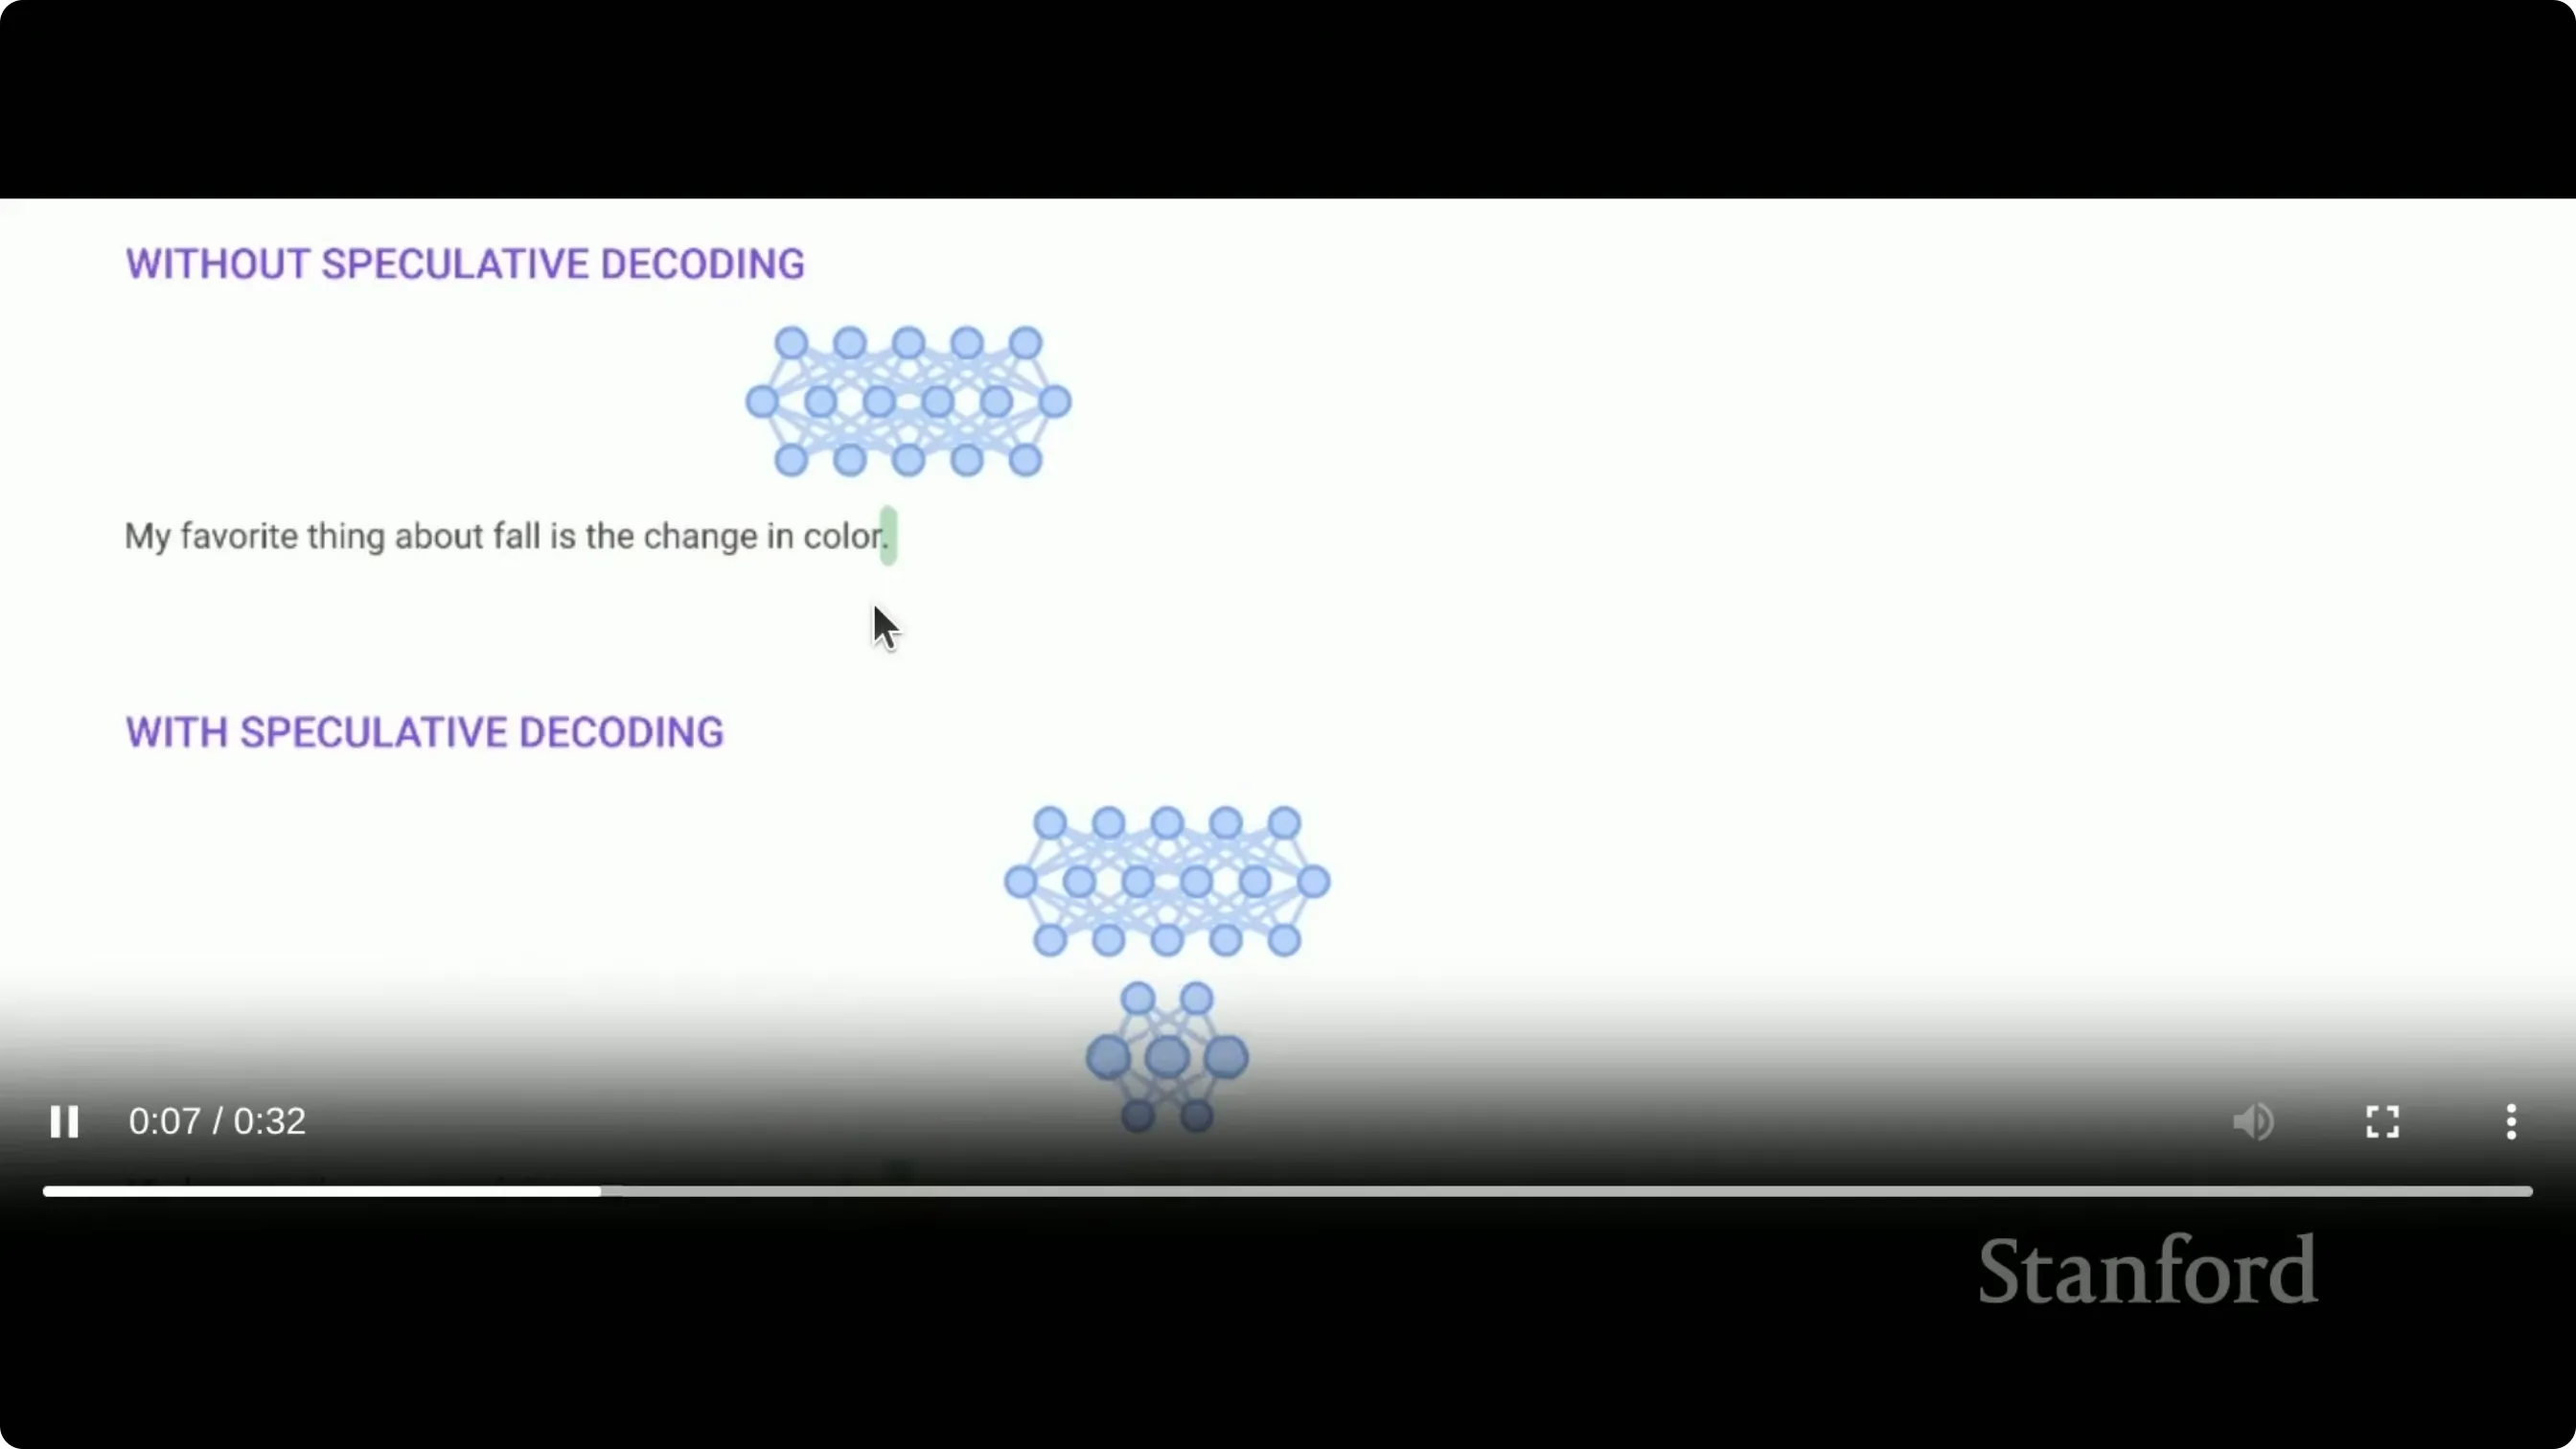
📷 投机解码:小模型成串输出、大模型并行校验
回到原视频 (01:13:20)
算法细节:
- 用草稿模型 $P$ 采样 $K$ 个 token;
- 用目标模型 $Q$ 并行计算这些草稿 token 的 logits;
- 接受准则:以如下概率接受
$$ \Pr(\text{accept}) = \min\!\left(1,\ \frac{Q(x)}{P(x)}\right) $$
也就是说,$Q$ 相对 $P$ 越大,我们越倾向于接受; 4. 否则,从残差分布中采样并退出。
这是拒绝采样(rejection sampling)的一个变体。区别在于:普通拒绝采样在拒绝时什么都得不到;而这里我们保证能拿到一个来自目标模型的精确样本。
讲师说他会跳过那个简单证明,并指出"它的论证与拒绝采样基本一致",用于证明它精确地等于目标模型的概率。
编者拓展|接受准则为什么能保证无损 记草稿分布为 $P$、目标分布为 $Q$。执行如下过程: 1. 从 $P$ 采样 $x$; 2. 以概率 $\min(1, Q(x)/P(x))$ 接受 $x$;否则拒绝。
那么对任意 $x$,接受并输出 $x$ 的概率为
$$P(x)\cdot\min\!\left(1,\frac{Q(x)}{P(x)}\right) = \min\bigl(P(x), Q(x)\bigr).$$
而被拒绝的总概率是
$$1 - \sum_x \min\bigl(P(x), Q(x)\bigr) = \sum_x \bigl(Q(x)-P(x)\bigr)_+,$$
其中 $(\cdot)_+$ 表示取正部。于是在拒绝时,我们从归一化的残差分布
$$\frac{\bigl(Q(x)-P(x)\bigr)_+}{\sum_{x'}\bigl(Q(x')-P(x')\bigr)_+}$$
中采样,得到 $x$ 的概率恰好是 $\bigl(Q(x)-P(x)\bigr)_+$。
两路相加:
$$\min\bigl(P(x),Q(x)\bigr) + \bigl(Q(x)-P(x)\bigr)_+ = Q(x).$$
也就是说,最终输出的 marginal 分布精确等于 $Q$——这正是"无损"的含义。✅
参考:Leviathan 等,Fast Inference from Transformers via Speculative Decoding,arXiv:2211.17192(几乎同期还有 Chen 等人的独立工作)。
8.3 草稿 token 的数量:有最优点
- 草稿 token 太少 → 你没有充分利用目标模型这一侧的批处理能力;
- 草稿 token 太多 → 被拒绝的比例会上升;
- 因此存在一个甜点(sweet spot),在这个例子里大约是 3 到 4 个。
8.4 草稿模型怎么来
一般来说,草稿模型远小于目标模型,并且理想情况下草稿分布要尽量接近目标分布——也就是说,你希望它是蒸馏出来的。而这恰好又回到了刚才那一整套思路:
先用各种"花招"把 KV cache 压下去;如果压出来的模型你满意,直接拿它当服务模型;如果不满意,它至少还能当草稿模型,再用你的主模型去把它"修好"。
讲师指出,投机解码目前已经有一整套文献在改进原始方法,他没有展开。
九、动态负载下的工程系统
(参考时间: 01:17:00)
9.1 现实场景有多乱
场景是:你在服务一个线上网站,用户陆续来和模型聊天。于是:
- 请求在不同时刻到达;
- 它们共享不同的前缀;
- 它们的长度各不相同。
这离训练时那种"一批同样长度的 token 整块塞进去"的整齐形态差得很远。
9.2 连续批处理(continuous batching)
这里有一个很早就被提出的系统,叫 Orca,它引入了连续批处理的想法。
做法是:
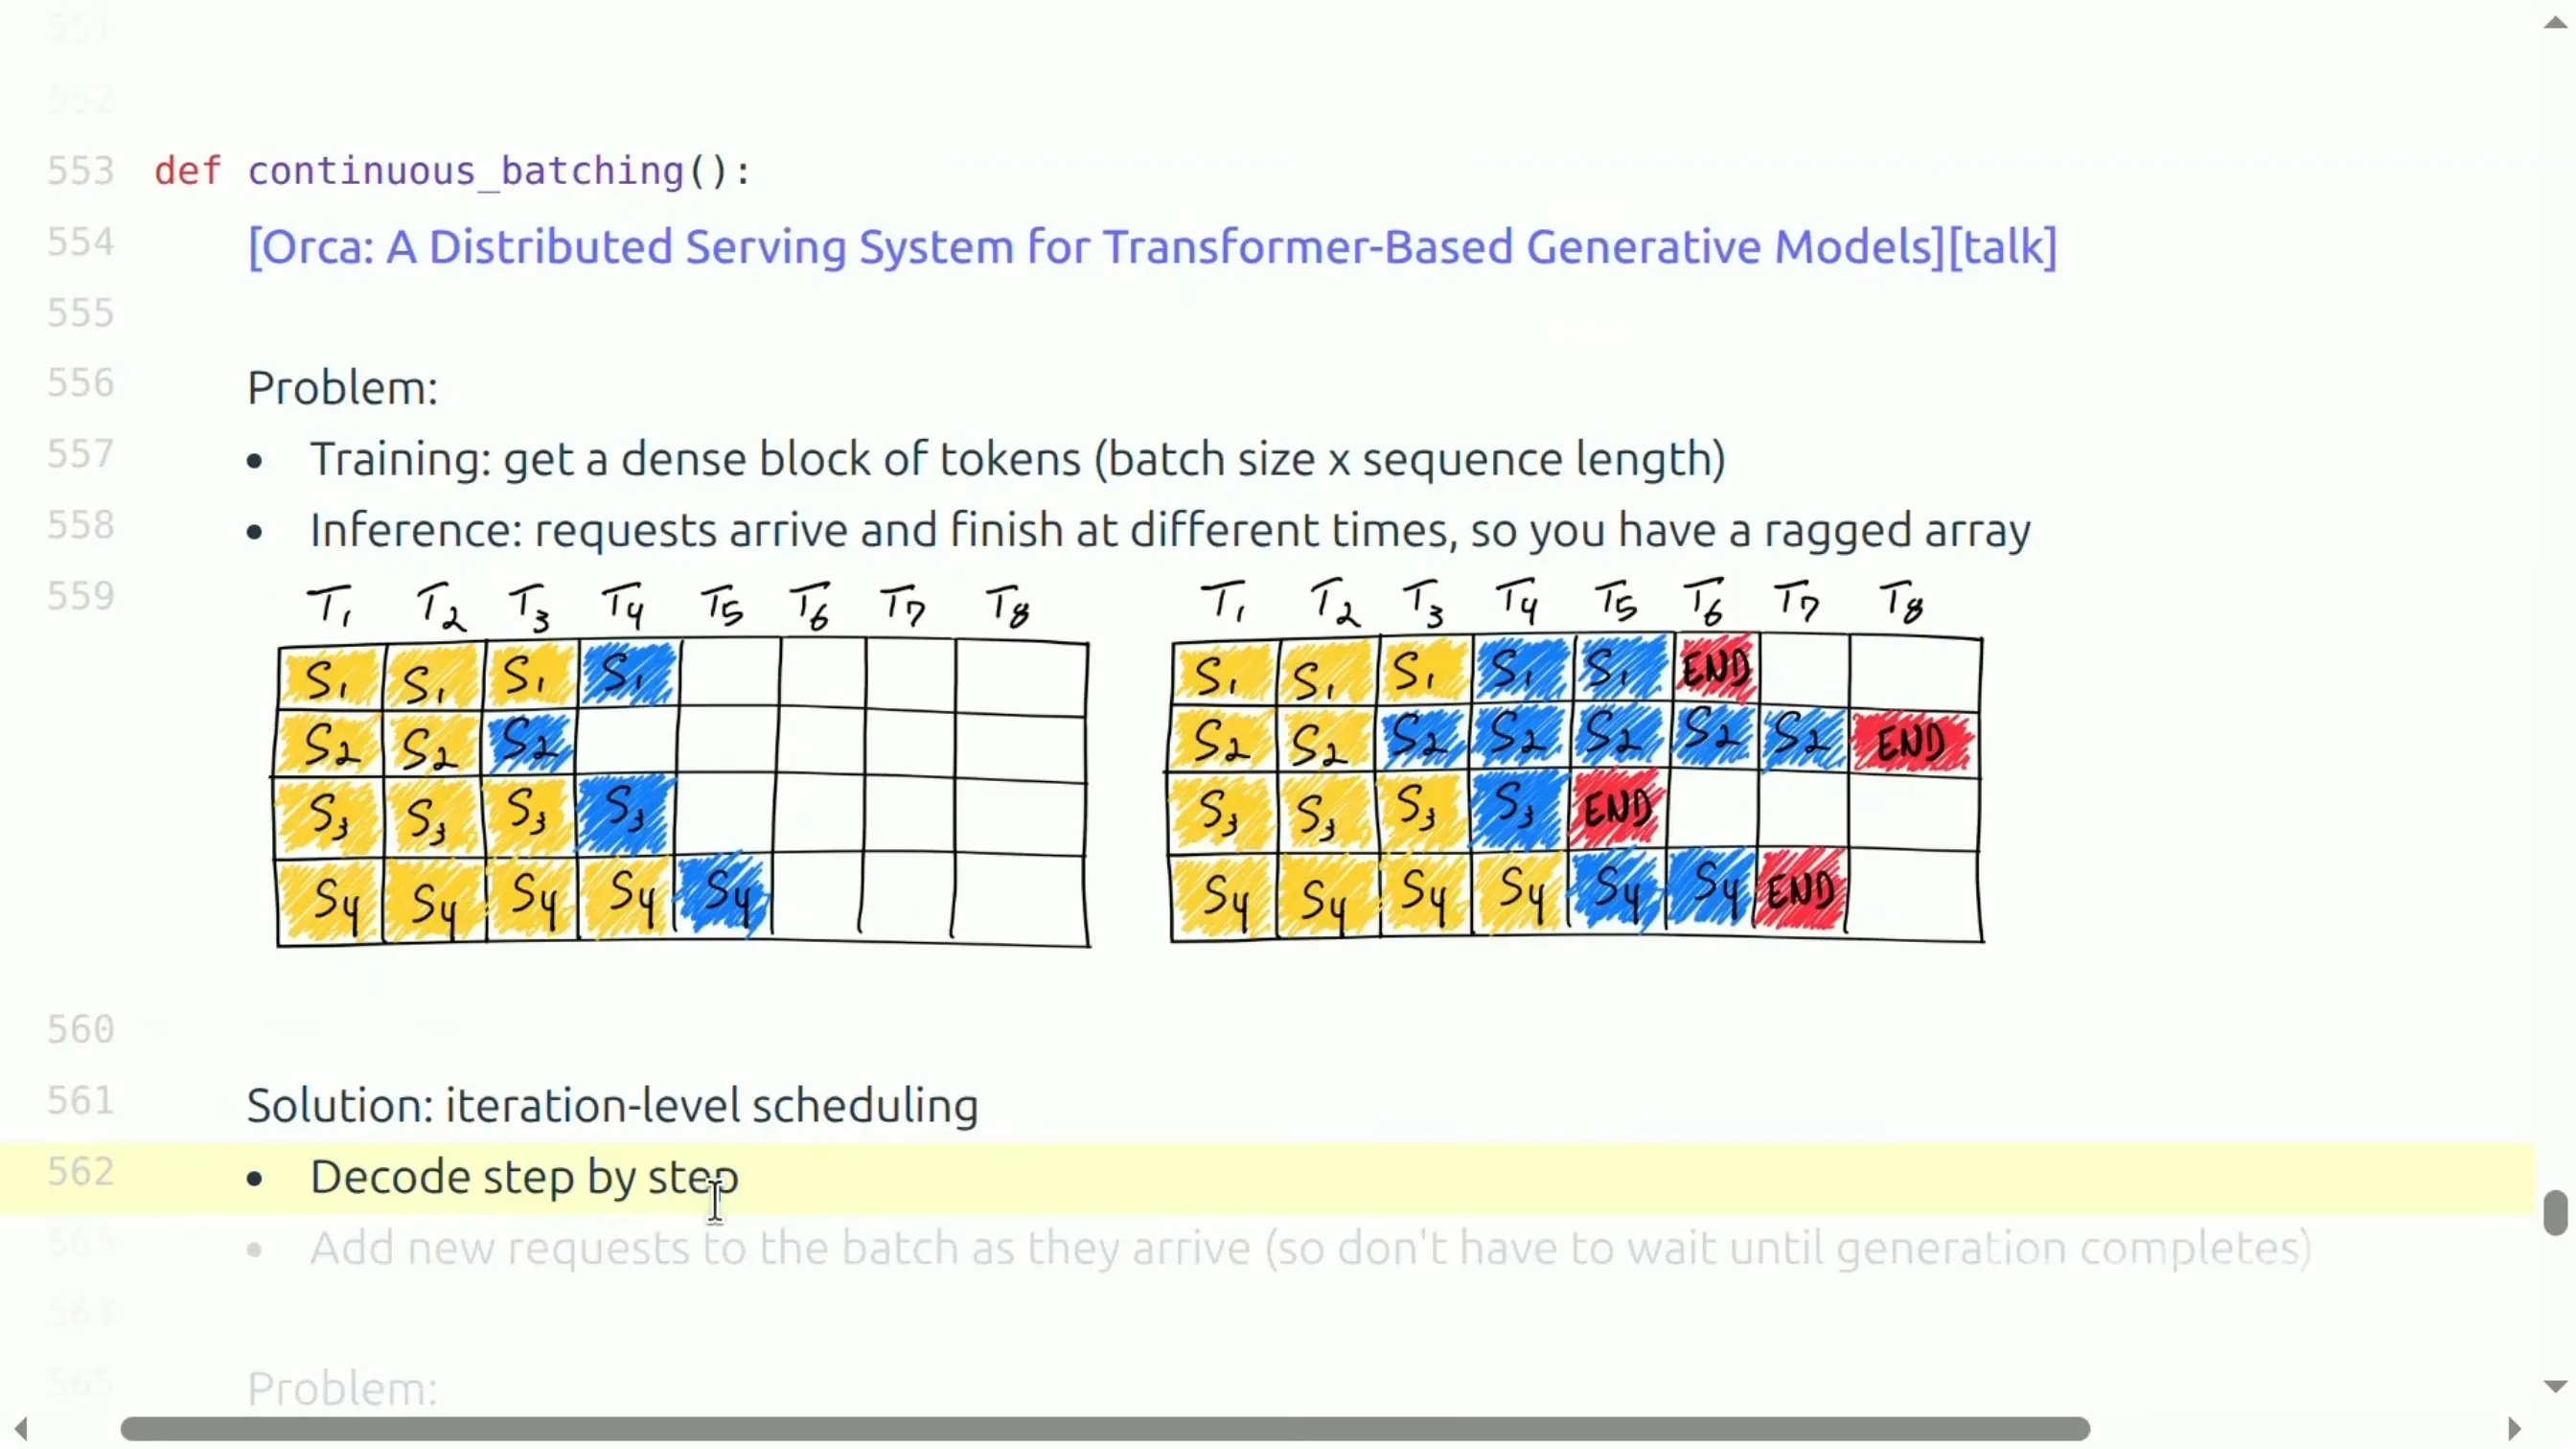
- 一批请求的形状是参差不齐(jagged)的——第一个请求有它的前缀、正在生成这个 token;第二个、第三个、第四个各有各的前缀,长度都不同;
- 然后一步一步地解码:每一步,为所有序列各解码一个 token;下一步,再为所有序列各解码一个 token;
- 某条序列结束了,就把它踢出(eject);
- 新请求到达,就塞进这个 batch,然后继续。
之所以叫"连续批处理",是因为这个 batch 是在被动态地更新的:老序列出局、新序列进来。
graph LR
    subgraph "连续批处理的时间轴"
    S0["step 0<br/>A B C D"] --> S1["step 1<br/>A B C D"]
    S1 --> S2["step 2<br/>A B C D"]
    S2 --> S3["step 3<br/>A B C E<br/>D 结束,E 进入"]
    S3 --> S4["step 4<br/>A B C E"]
    S4 --> S5["step 5<br/>C E F<br/>A B 结束,F 进入"]
    end
📷 连续批处理:batch 随请求进出而动态变化
回到原视频 (01:18:00)
9.3 选择性批处理(selective batching)
问题来了:我们之前看到的批处理,前提是"所有序列的维度一致"——张量的每一个切片形状都一样。但这里每条请求长度不同,怎么办?
思路是分开处理:
- 注意力计算:这里没法糊弄,因为注意力依赖序列长度。一个 3×3 的计算和一个 9×9 的计算,没法有效地共享同一个张量。
- 非注意力的 MLP 层:这里可以!你可以把所有序列拼接成一个"超级序列"(mega sequence),然后一起处理。而 MLP 恰好占了很大一部分 FLOPs。
9.4 PagedAttention
(参考时间: 01:19:35)
这一想法由 vLLM 论文引入(vLLM 现在当然还有一大堆别的特性,但这是它最初的核心想法)。
问题是:KV cache 到底怎么存?
请求不断进来,你总得把它们放进内存某处。于是就有了碎片(fragmentation)问题——这正是过去发生在你硬盘上的事,以前人们还得整理硬盘碎片(defrag)。
两类碎片:
- 内部碎片(internal fragmentation):你必须预先分配足够的缓冲区,因为你事先不知道序列什么时候停。假设最大 token 限制是 1024,你得把这么多内存全留出来,而且不能挪作他用,因为除非序列生成到上限,否则你不会停。这是极大的浪费。
- 外部碎片:不同请求之间可能留下空隙,而这些空隙可能小到无法被有效利用,于是就成为纯粹浪费的空间。
解法:这是一群系统出身的人,他们熟悉操作系统,于是说:"这个问题我们以前解决过一次,那就用同样的思路呗。"
具体是:把一条序列的 KV cache 切成非连续的块(block)。比如 "Four score and seven years ago our fathers brought forth" 这句话,就按块大小 4 切分。块放在哪里无所谓,但它们在块的边界上是对齐的——这带来某种统一性。
于是:
- 两条请求如果共享同一段前缀,它们可以共享同一份 KV cache;
- 某些块可以出现在这里,另一些块出现在那里,相互交错,只要你有索引记录每个块在哪,就没问题。
一个立竿见影的收益:系统提示(system prompt)。你可以在所有 query 之间共享 system prompt 的 KV cache,只算一次。
另一个收益:很多应用场景里,同一个 prompt 要生成多个回答。这时你也可以共享 prompt 的 KV cache,只让各个回答各自发散。
写时复制(copy-on-write)语义:比如你想从 "Four score and seven years ago ___" 生成多个续写:
- 先有 "Four score and seven";
- 接着生成 "years ago our";
- 这个前缀被保持住,然后分出两个采样分支;
- 如果它们恰好采到了同一个 token,就继续共用;
- 如果采到了不同的 token,就把这个块裂开(split),各自继续。
也就是说,你尽可能多地共享前缀 cache。
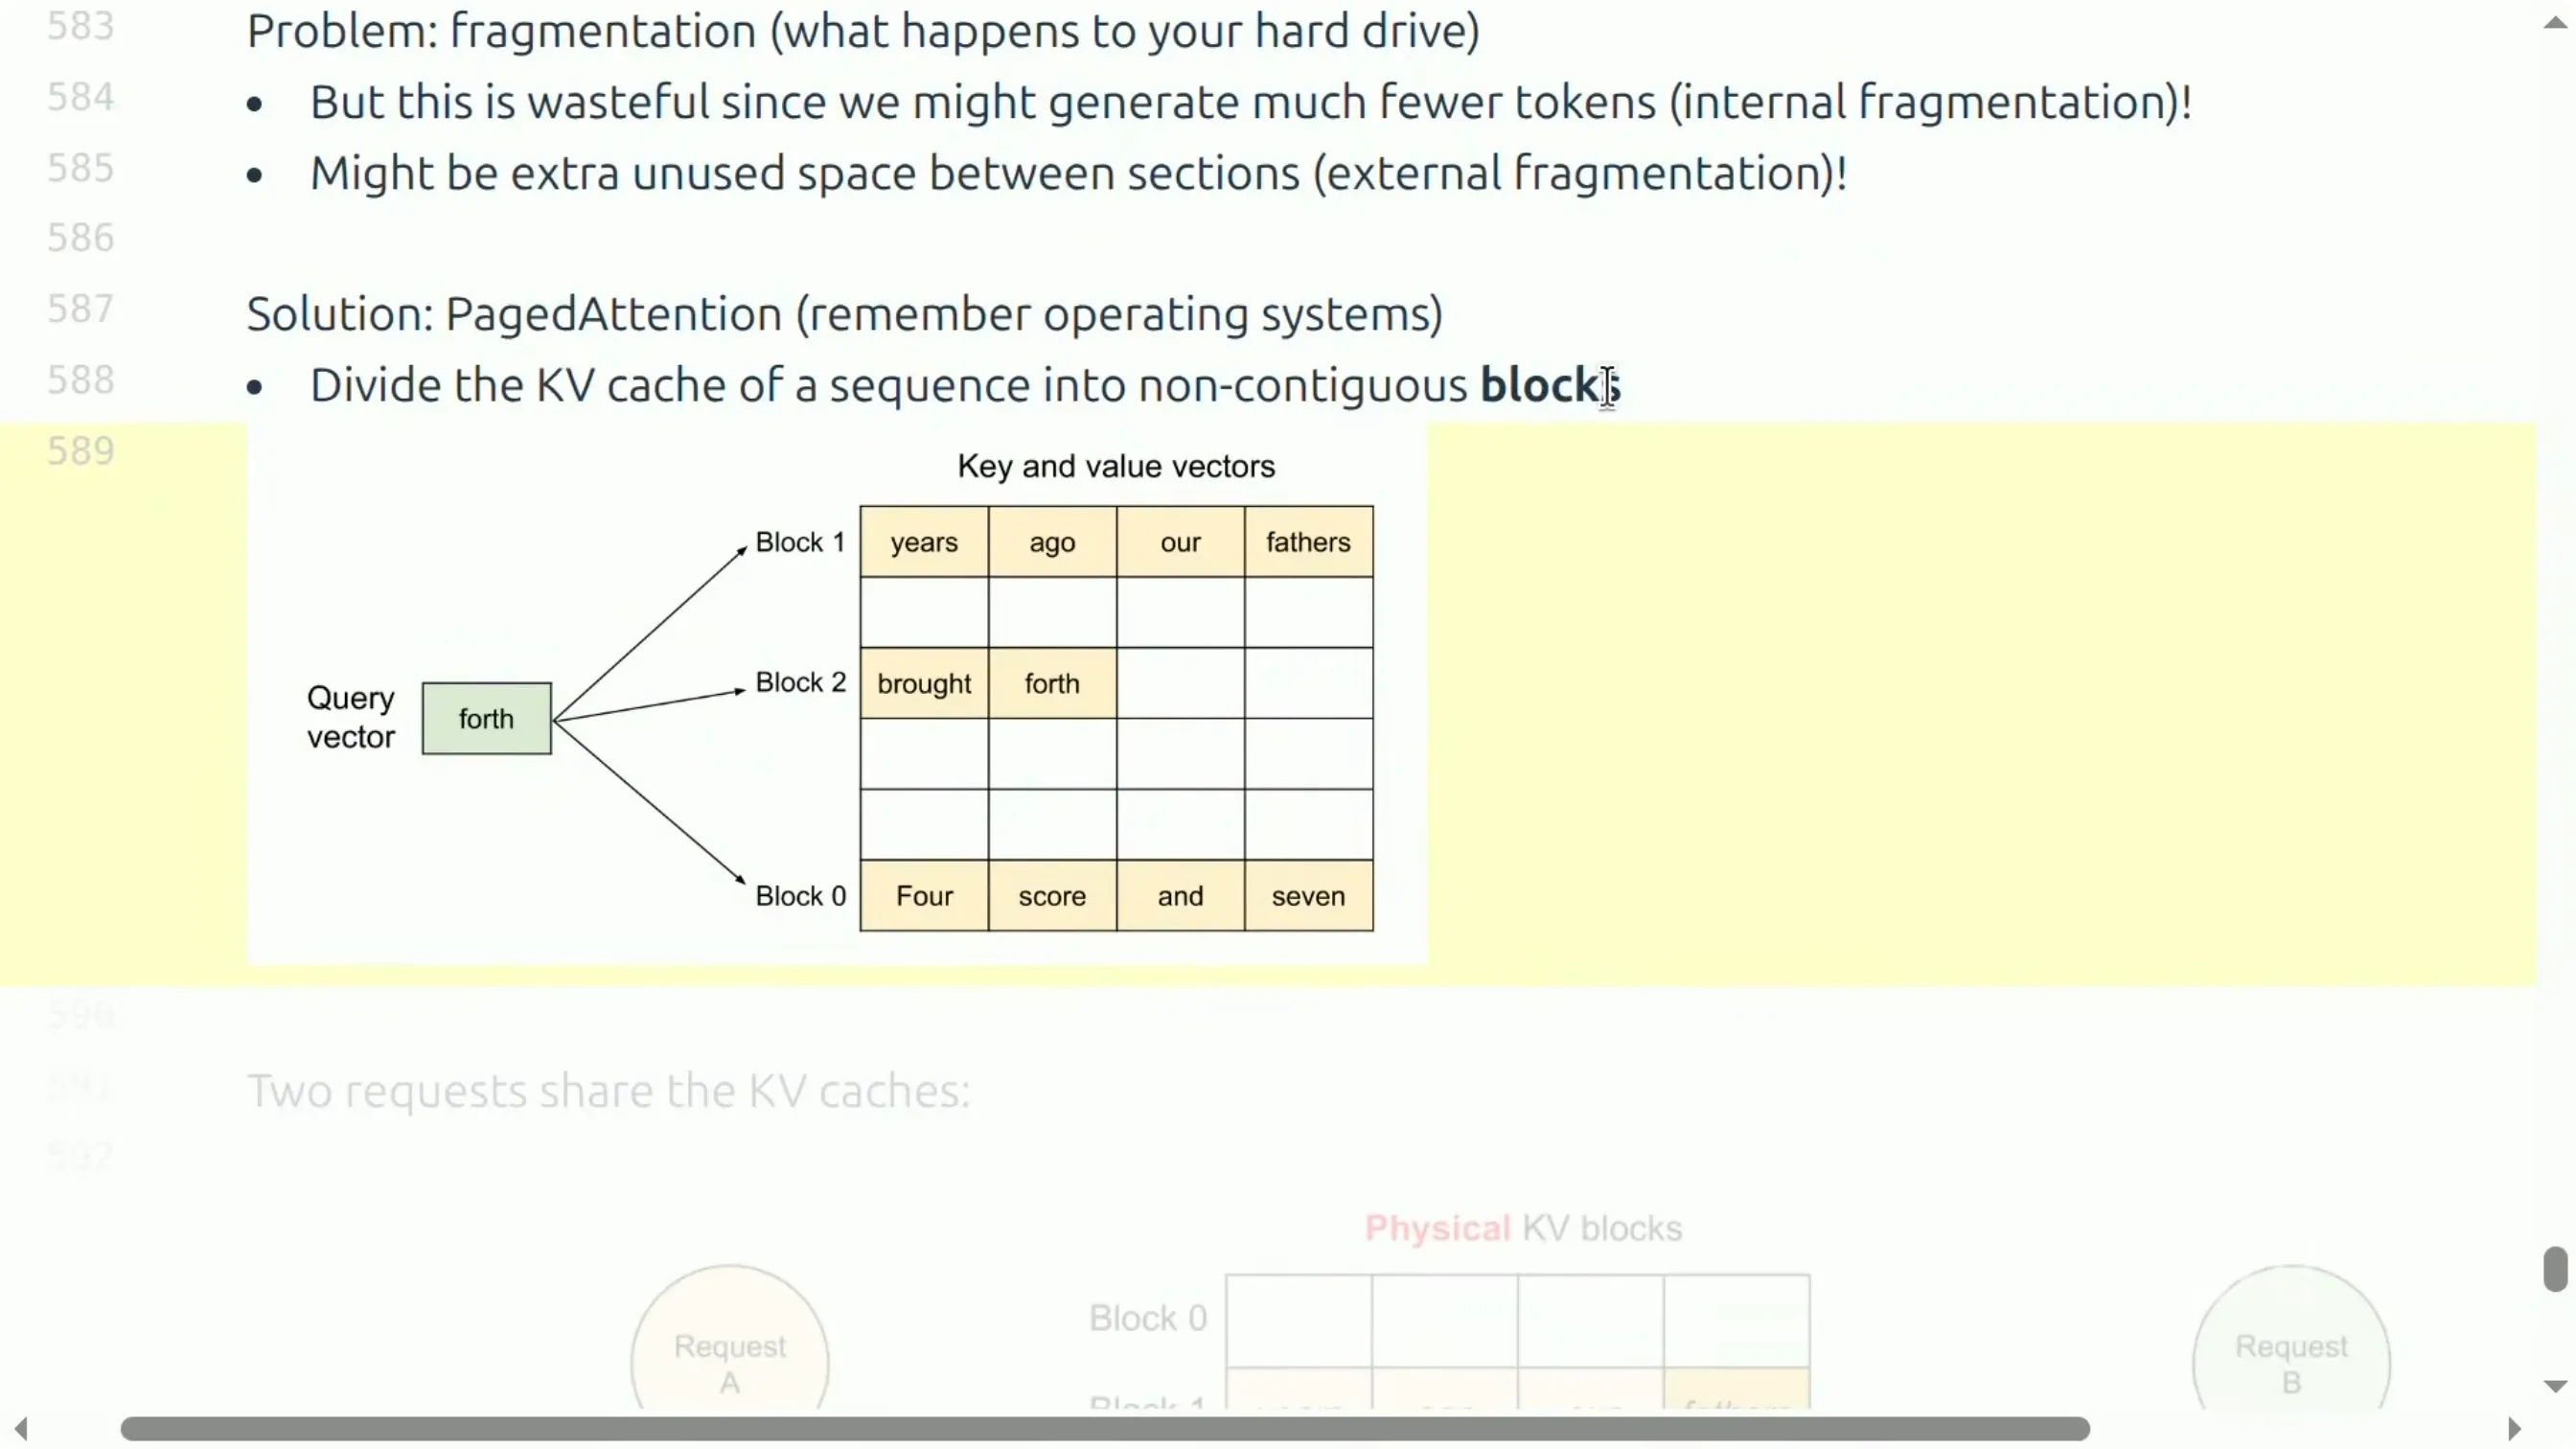
📷 PagedAttention:把 KV cache 切成非连续块并按需共享
回到原视频 (01:21:10)
讲师说他没时间讲别的优化(比如各种 kernel),但总的思路是:
用操作系统式的隐喻来管理推理。
十、总结
(参考时间: 01:23:45)
- 推理非常重要。
- 它和训练非常不同,即便用的是同一个模型——因为你让模型做的事本质上是另一件事。
- 推理最终是内存受限的;如果你处在线上聊天的场景,它还是动态的。
- 我们看到了各式各样的技巧:可以量化、可以设计新架构、可以剪枝与蒸馏、也可以用投机采样。
- 但它们背后是同一个原则:
减小 KV cache,同时别把精度伤太多。
- 此外,还有来自系统界的思路——分页(paging)、投机执行(speculative execution)——可以被带到真实的推理服务上。
一条讲师特意留下的伏笔:有一件事没能展开讲——他认为新架构有巨大的改进潜力。像状态空间模型(state space models)、线性注意力、扩散模型这一类东西:
在某种意义上,KV cache 和注意力被构造的方式,根本上让它成为一种"对推理不友好的架构"。所以如果你能设计出一种为推理而生的新架构——而 Transformer 并不是这样设计的——那么可能会解锁很多东西。
附:参考与延伸阅读
编者补充
- arXiv:2211.17192
- arXiv:2305.13245
- arXiv:2306.00978
- arXiv:2405.04434
- arXiv:2405.12981
- ChatGPT
- GPTQ
- H100
- Llama 2
- llama.cpp
- Orca
- SGLang
- TensorRT-LLM
- vLLM
已知疑点
本节列出本讲重构过程中不确定或拿不准的地方,逐条给出依据或时间点。若某处确实没有疑点也会写明,以免读者误以为"没查"。
-
记号图中 $K$ 与 $G$ 的定义冲突。 依据:约 00:19:20–00:20:25 的课堂问答。一位同学当场指出幻灯片上的问题,讲师起初尝试解释、随后确认更正为:$K$ 是"组的数量(number of groups)",$G$ 是"每组内的 query 头数"。讲师原话是"我之后改一下"。因此原始幻灯片(或书面讲义)上可能仍写着 $K$ = KV 头数,与本书正文不一致。正文一律采用课上更正后的版本。
-
Llama 2 13B 示例中的序列长度 $S$ 未在字幕里明确出现。 依据:约 00:38:45–00:39:10。讲师只提到 KV cache 的系数"大约是 8.38 亿,乘以 $B$"。编者按 $2 \times 2 \times S \times K \times H \times L$($K = 40$ 个 KV 头、$H = 128$、$L = 40$ 层)反推,得 $S \approx 1024$。但 Llama 2 13B 的官方上下文长度是 4096。这很可能是课堂上采用的教学简化配置,也可能是编者对某一项因子的理解有偏差。请以官方讲义为准。
-
"8.38 亿"的口播形式与单位。 依据:约 00:39:00。原话是 "about 838 I guess million times B",没有说单位是字节还是元素个数。正文按字节处理(这样才能与"batch 256 时爆掉 80 GB H100"的情节自洽)。此推断已记入第 2 条。
-
H100 的"295"这个门槛值。 依据:约 00:18:00。讲师说"对 H100、对这个特定的 matmul 运算,batch size 大于 295 就是计算受限"。编者按其逻辑($\text{BF16 密集算力} \div \text{HBM 带宽}$)复算,量级吻合,但具体数字取决于用哪一档算力(是否计入稀疏加速、是否用 FP8)。正文中作为量级锚点使用,不宜当作精确常数。
-
"OpenAI 每天 8.6 万亿 token"。 依据:约 00:02:05。这是讲师口头给出的外部估计,未给出出处,也与后来公开口径可能存在出入。请勿直接引用为事实。
-
"GPT-4 训练用了 32 万亿 token"。 依据:约 00:02:15。同上,属未经讲师标注出处的数字。另外讲师有一句口误式的表述——"GPT-4, which came out earlier this year",按上下文应指前一年(GPT-4 发布于 2023 年 3 月)。
-
GQA 是否掉点:本讲内部存在两种相反证据。 依据:约 00:49:30。GQA 论文声称精度良好;讲师随即指出 DeepSeek 的论文显示 GQA 实际上是有损的。讲师本人并未裁决孰是孰非,只提醒"凡不是纯数学的东西都要打折扣"。本书保留了这一矛盾,没有替讲师下结论。
-
DeepSeek 的注意力方法命名。 依据:约 01:02:30。字幕中出现 "compressed sparse attention" 与 "heavily compressed attention" 两个名字,讲师明确说自己记不住这些缩写。因此确切的方法名可能不准确,正文按字幕还原并加了保留语。
-
Nvidia 剪枝论文的具体身份未确认。 依据:约 01:07:50。讲师只说"一篇来自 Nvidia 的论文",未点名。编者据其描述(重要性估计 → 剪掉单元/层 → 后训练修复 → 15B 压到 8B)推测这是 Minitron / LLM 结构化剪枝方向的工作,但无法确认,故正文未给出论文链接,仅记为待核。
-
投机解码的论文归属。 依据:约 01:13:50。讲师说"有几篇论文几乎在同一时期出现",未逐一点名。编者补充的 arXiv:2211.17192 是其中被引用最多的一篇,但并非唯一,同期还有 Chen 等人的独立工作。
-
GPTQ 的机制描述。 依据:约 01:06:25。讲师说 GPTQ"利用 Hessian 信息,逐层量化,并把误差传播到未量化的权重上"。这一概括是准确的,但"Hessian"具体指层内二阶信息($XX^\top$ 近似),讲师未展开。编者未在正文中修正,仅在链接处提供出处。
-
激活感知量化的方法归属。 依据:约 01:07:00。讲师描述了"激活通道大 → 对应权重更重要 → 用高精度"这一机制,但没有点名方法。编者在拓展中标注为 AWQ,属编者补充,非讲师原话。
-
线性注意力部分的口径。 依据:约 00:59:30–01:02:10。这里是一段较长的即席问答,讲师用了"大概"、"也许"等非常不确定的措辞(例如"Mamba 大概能表示滑窗的某些方面")。这些属于讲师的个人判断,不是定论,本书按原意保留但不宜当作结论引用。
-
本讲未涉及的部分。 讲师明确说自己不会讲并行(只给了一个"启动 $M$ 份拷贝"的平凡例子),也没时间讲各种 kernel 优化。此外扩散模型只被一笔带过。读者若想补这些,需另行查阅 scaling book 与 vLLM 论文。
除上述各条外,本讲未发现其他明显疑点。