第11讲 · Stanford CS336:从零开始的语言模型
对应讲次:第11讲(Stanford CS336 语言建模)
制作模型:deepseek-flash(vb compose,据 run.log)
Scaling Laws(缩放定律)——从 Chinchilla 到开放前沿的超参数、优化器与 μP
课程信息 - 课程:Stanford CS336 Language Modeling from Scratch(2026 春季) - 视频:Lecture 11: Scaling Laws(时长 77 分钟) - 本讲主题:缩放定律的高级细节、超参数(学习率 / 批量大小)的规模依赖、优化器(Adam → Muon)的规模敏感性,以及 μP(Maximal Update Parameterization)参数化。 - 本书由课堂字幕重构为书面技术指南,保留了讲师的类比、案例与推理链;凡编者补充内容一律以
编者说明 / 编者拓展明确标注,不冒充讲师原话。术语、英文原名尽量保留讲师用法。
导览
这是一张 3–5 分钟的问题地图,帮你在进入细节前先看清这一讲的全貌。
① 讲师本讲真正提出的问题
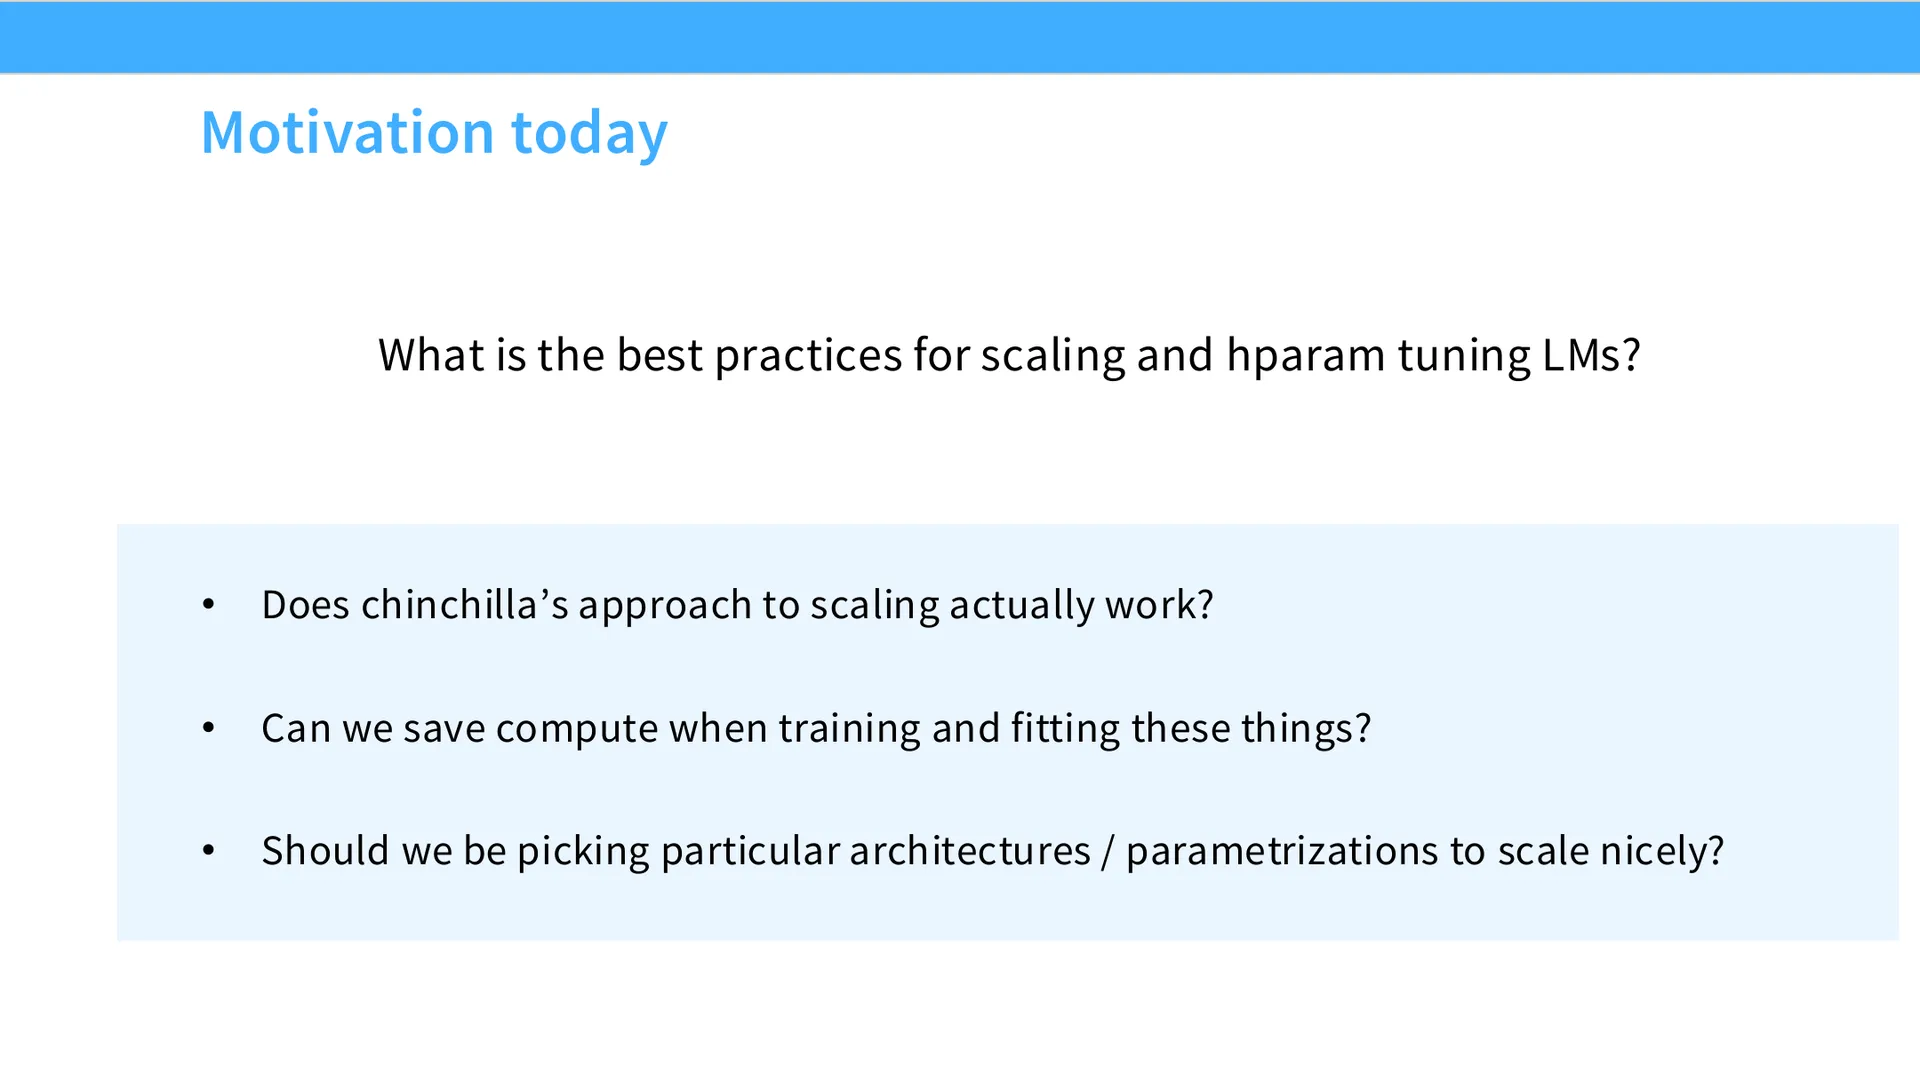
老师没有把这一讲做成"缩放定律教科书回顾"。他开场就直说了:今天是一个 grab bag(杂货铺),要讲的是缩放定律更高级的细节,以及在实践中究竟怎样把语言模型放大。他按自己的顺序抛出三组问题:
- 两个讲座前讲的缩放定律(Kaplan、Hestness、Chinchilla 那一套经典"教义"),在真正训练开源大模型的规模上,到底还成不成立? 他要"从 Chinchilla 一路快进到 Kimi K2"来看开放前沿的人到底在关心什么、担心什么。
- 那些最敏感的超参数——学习率、批量大小——能不能被优化掉、被稳定住? 他想讲那些"内行才懂"的学习率技巧。
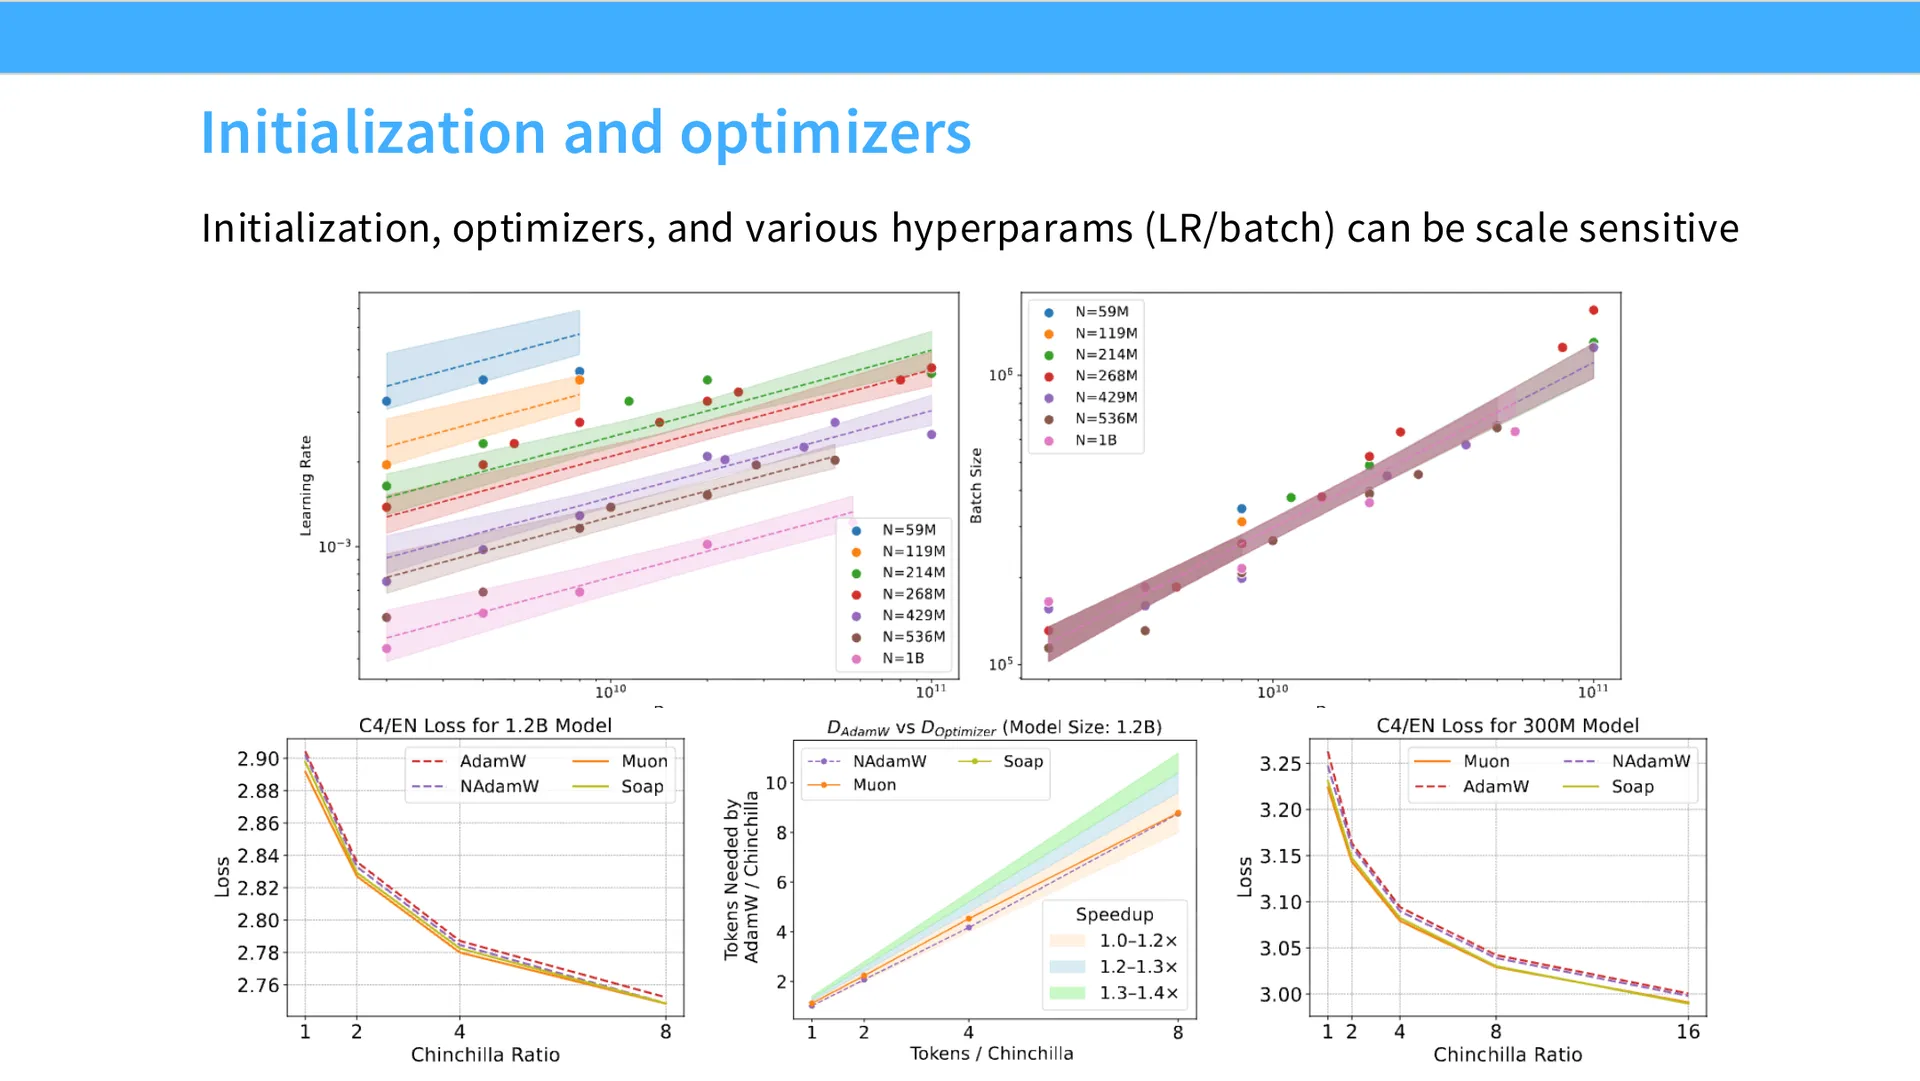
- 规模一大,有些东西就变得特别难调。 优化器行为是高度 scale-sensitive 的,所以初始化、学习率、批量大小都必须当作规模的函数来仔细思考。
② 难点在哪(最容易卡住的地方)
- 本讲的真正难点不在"公式",而在心态:老师反复强调,缩放定律"看起来像科学(fit 一条线、外推),但很大程度上仍然是 vibes(直觉判断)"。能不能把在小规模上看到的好结果平滑外推到大模型,是无法事先确知的。你会在这里反复遇到"小规模很香、大规模就塌"的案例,这正是讲师想让你体会的核心困难。
- μP 的推导是另一种难点:它用的是物理学家式的量级追踪(order-of-magnitude math),不是严格数学证明。第一次听会怀疑"这算数吗"——老师本人也承认假设"画风清奇",需要你接受"先用假设推出约束、再看假设是否经得起实验"的思维方式。
③ 读者可能带着什么疑问进来
- (讲师明确提出的问题) ①经典的 Chinchilla 定律在大模型上还成立吗?②学习率、批量大小该怎样随规模变?③优化器(Muon)在小规模上的巨大增益,到大模型还在吗?④μP 到底是怎么回事、值不值得用?
- (编者预判的读者疑问) ⑤MiniCPM 和 DeepSeek 对同样的敏感超参数,用的是两种完全不同的思路,哪一种更靠谱?⑥"WSD 学习率调度"是什么,为什么它能省掉反复重训的成本?⑦MoE、稀疏度这些东西和缩放定律是什么关系?⑧我要不要在自己训练时去做 grid search,还是直接套用别人的缩放律公式?
④ 本讲路线
老师先走"论文线"(第一部分):先用 MiniCPM 讲"用 μP 把学习率稳定住" + "WSD 调度" + "批量大小的幂律",再用 DeepSeek 讲"直接给学习率和批量大小拟合缩放律"这另一种哲学;然后快速过一遍 Qwen、Chinchilla 2、Hunyuan、Llama 3、MiniMax 等开放模型的缩放实践。接着转入"方法线"(第二部分)——先是超参数缩放(StepFun 那篇大规模 grid search),再是优化器(Muon 从 nanoGPT 一路到大模型的故事),最后花大量时间讲 μP 的理论推导与实证检验,并以"缩放是一门半科学"收尾。
一、本讲定位:从经典缩放定律到"开放前沿"
(参考时间: 00:00–00:03)
本讲是一个"杂货铺"式的讲座,主题是缩放定律的高级细节,以及在实践中如何把语言模型放大。在此之前,课程讨论的主要是所谓经典缩放定律教义(classical scaling laws canon):Kaplan 等人的缩放定律、Hestness 等人的工作,以及后来 Chinchilla 论文。这些内容大致对应到 2022 年前后的认知水平。
自那以后,真正训练大模型的人又发表了一批缩放论文。讲师特别指出一个趋势:
讲师观察:这类论文的数量近年在减少,而且大部分来自中国的开源社区。
因此本讲的一个现实目的,是带你了解"在开放前沿(open frontier)上,缩放到底长什么样"——这些人在关心什么、担心什么,以及你想从 Chinchilla"速通"到 Kimi K2 这样的最新模型,需要掌握哪些东西。
本讲在结构上分成两大块:
graph TD
    A["本讲两大主线"] --> B["第一部分:论文线<br/>开放模型的缩放实践"]
    A --> C["第二部分:方法线<br/>超参数 / 优化器 / μP"]

    B --> B1["MiniCPM:μP + WSD + 批量幂律"]
    B --> B2["DeepSeek:直接拟合超参数缩放律"]
    B --> B3["Qwen / Chinchilla 2 / Hunyuan<br/>Llama 3 / MiniMax"]

    C --> C1["学习率与批量大小的缩放<br/>(StepFun 大规模 grid search)"]
    C --> C2["优化器:Adam → Muon 的规模化"]
    C --> C3["μP:用参数化消除规模依赖"]

    B2 -. 哲学对立 .-> C3
    style A fill:#e8f0fe
    style B2 fill:#fde8e8
    style C3 fill:#e8fde8
这两大块其实对应着两种处理敏感超参数的哲学,老师会在后面反复回到这个对比:
- DeepSeek 路线:不去消除规模依赖,而是给学习率和批量大小直接拟合一条缩放律,预测它们在每个规模下应该是多少。
- MiniCPM / μP 路线:通过重新参数化(reparameterize),让最优学习率根本不随规模变化,从而省掉调参。
编者拓展|为什么要区分"拟合缩放律"与"重新参数化"? 想象你要在 10 个不同规模的模型上都找到最优学习率。 - 拟合路线:你在小模型上做一系列实验,拟合出"最优学习率 = f(规模)"的公式,然后外推到大模型。风险在于外推可能失效。 - 重参数化路线(μP):你改变初始化和每层学习率的缩放方式,使得"最优学习率"这个概念在不同规模下是同一个数。这样你只需在最小的模型上调好一次。 两者不是互斥的,而是解决同一问题的两条技术路线。本讲的核心张力就在此展开。
二、MiniCPM:用 μP 让超参数"不随规模漂移"
(参考时间: 00:03–00:16)
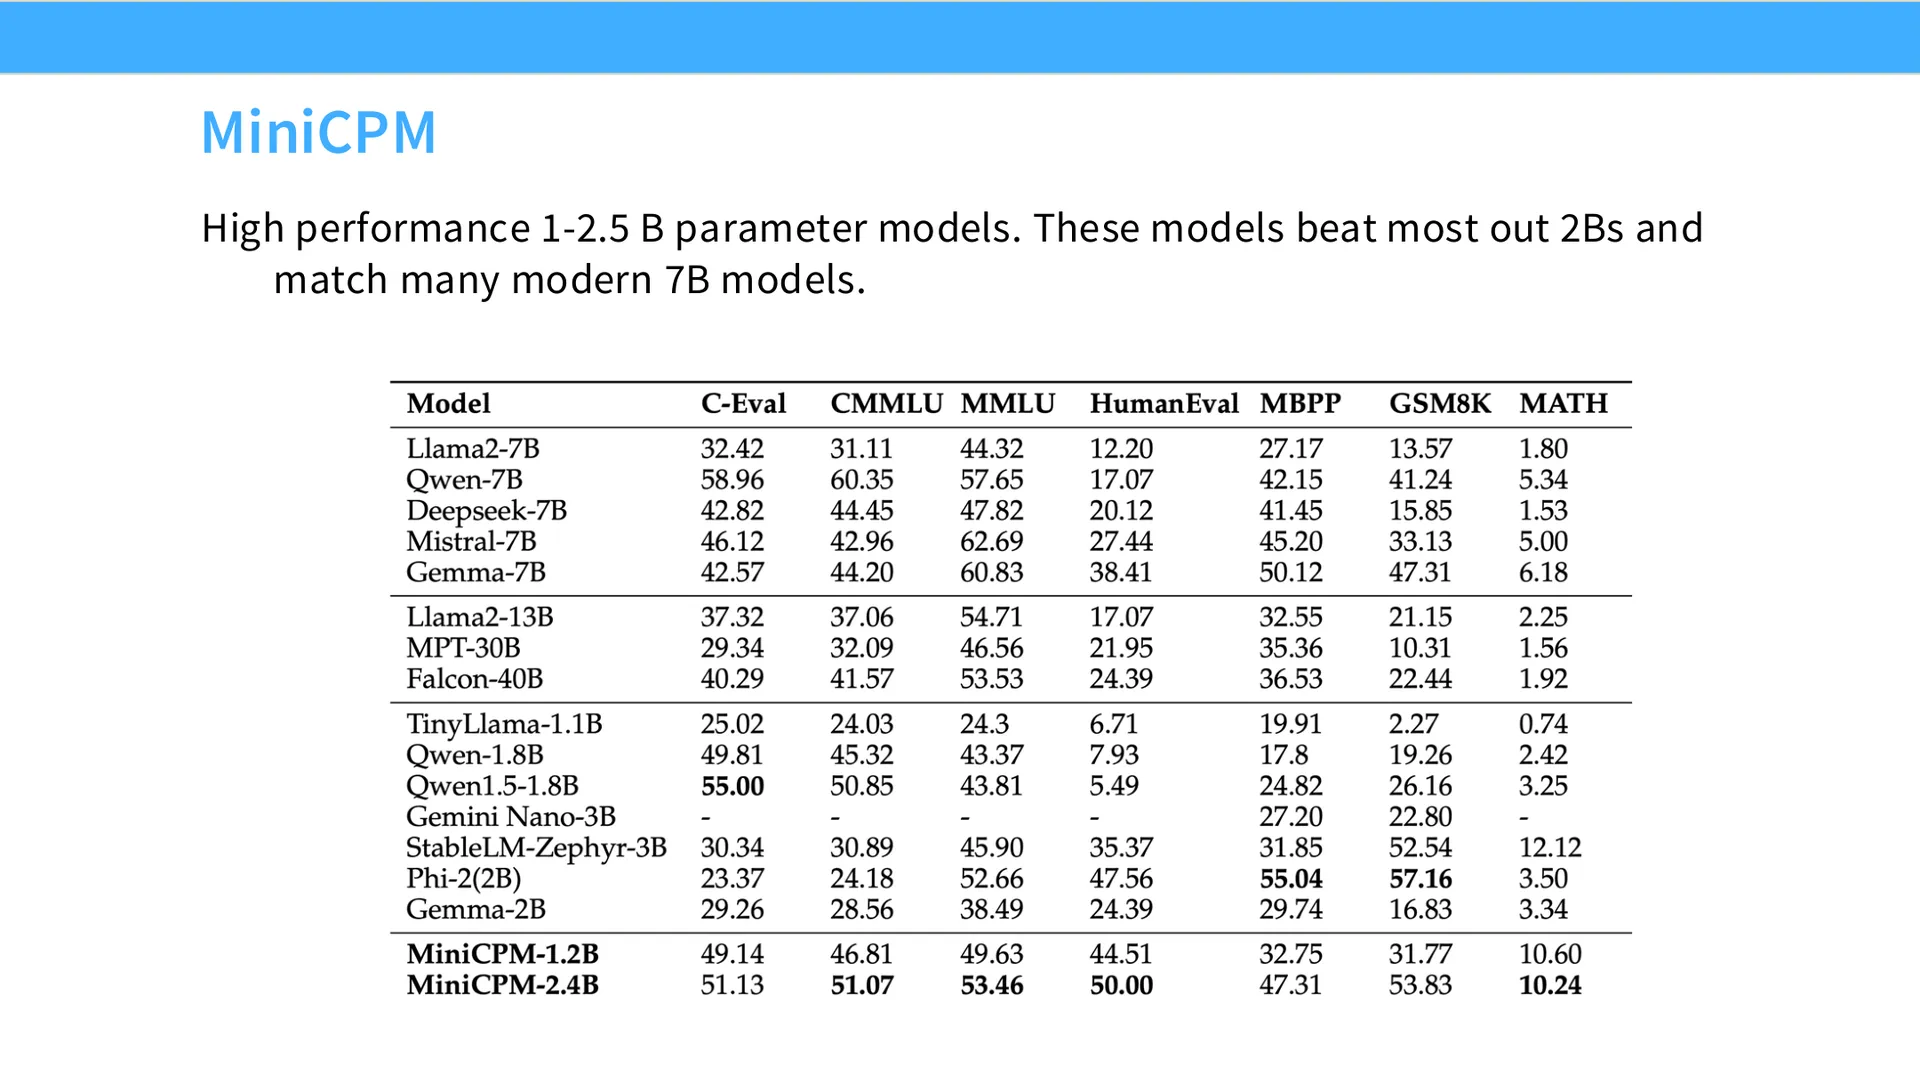
MiniCPM 是 2024 年由产业界与学术界合作、在中国开源社区中孵化出的一个高性能小语言模型。在这篇论文出现时,它在 10–20 亿参数这一档基本是当时的最优水平。如今 Gemma 等 2B/3B 模型性能更高,但 MiniCPM 在当时(2024 年标准下)是有竞争力的、训练良好的模型。
老师坦言自己很喜欢这篇论文,因为它"第一版出来时非常新鲜、非常前沿"。即便到了 2026 年,MiniCPM 团队做的很多事情依然很有信息量。原因在于:那些经典缩放技巧——怎么设置学习率、怎么做 Chinchilla——如今已经被大家视为理所当然,以至于新论文里不再详细写。所以回头读这些稍早的论文反而能补上这些"常识"。
训练目标与"缩放阶梯"
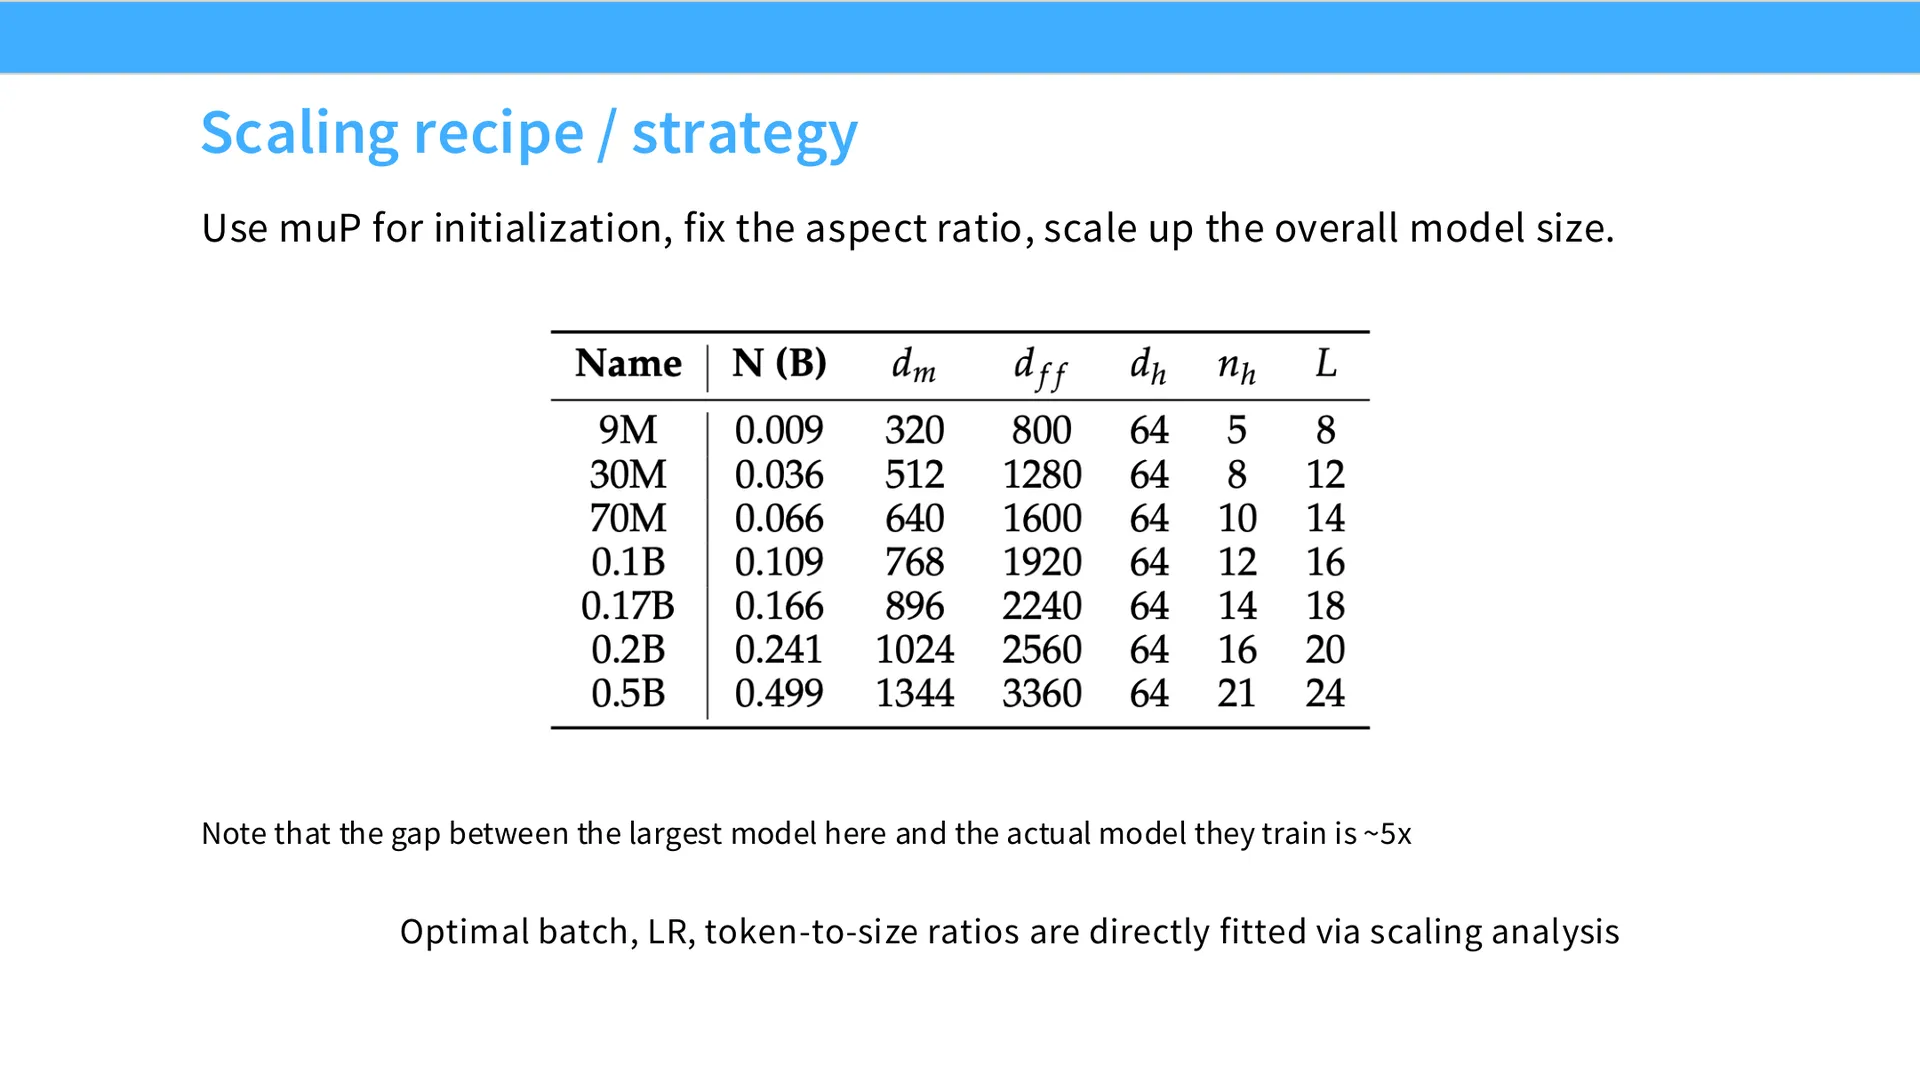
MiniCPM 的训练策略核心是:不要蛮力地训几百个 1.5B 模型,而是先训练一批小得多的模型,构造一条"缩放阶梯"(scaling ladder),把超参数一次性调准,再外推到目标规模。具体来说:
- 阶梯上最大的模型和最终发布的模型之间,大约有 5 倍的规模差。
- 目标是锁定那些公认的敏感参数:最优批量大小、学习率,以及 Chinchilla 意义上的"数据/token 与模型规模之比"。
- 它也会复刻一遍 Chinchilla 分析——老师认为这对今天的我们其实不太重要了,但其中有一个做法非常值得学。
2.1 为什么要用 μP 初始化?
老师反复强调一个贯穿全讲的观点:初始化极其重要。
讲师核心观点:初始化之所以重要,是因为它能让你把某些超参数对规模的依赖降低。
MiniCPM 用的是一种特殊初始化,叫做 μP(更准确地说是 μP 参数化,Maximal Update Parameterization)。它的全部意义就是保证一件事:
让最优学习率在规模放大或缩小时保持不变。
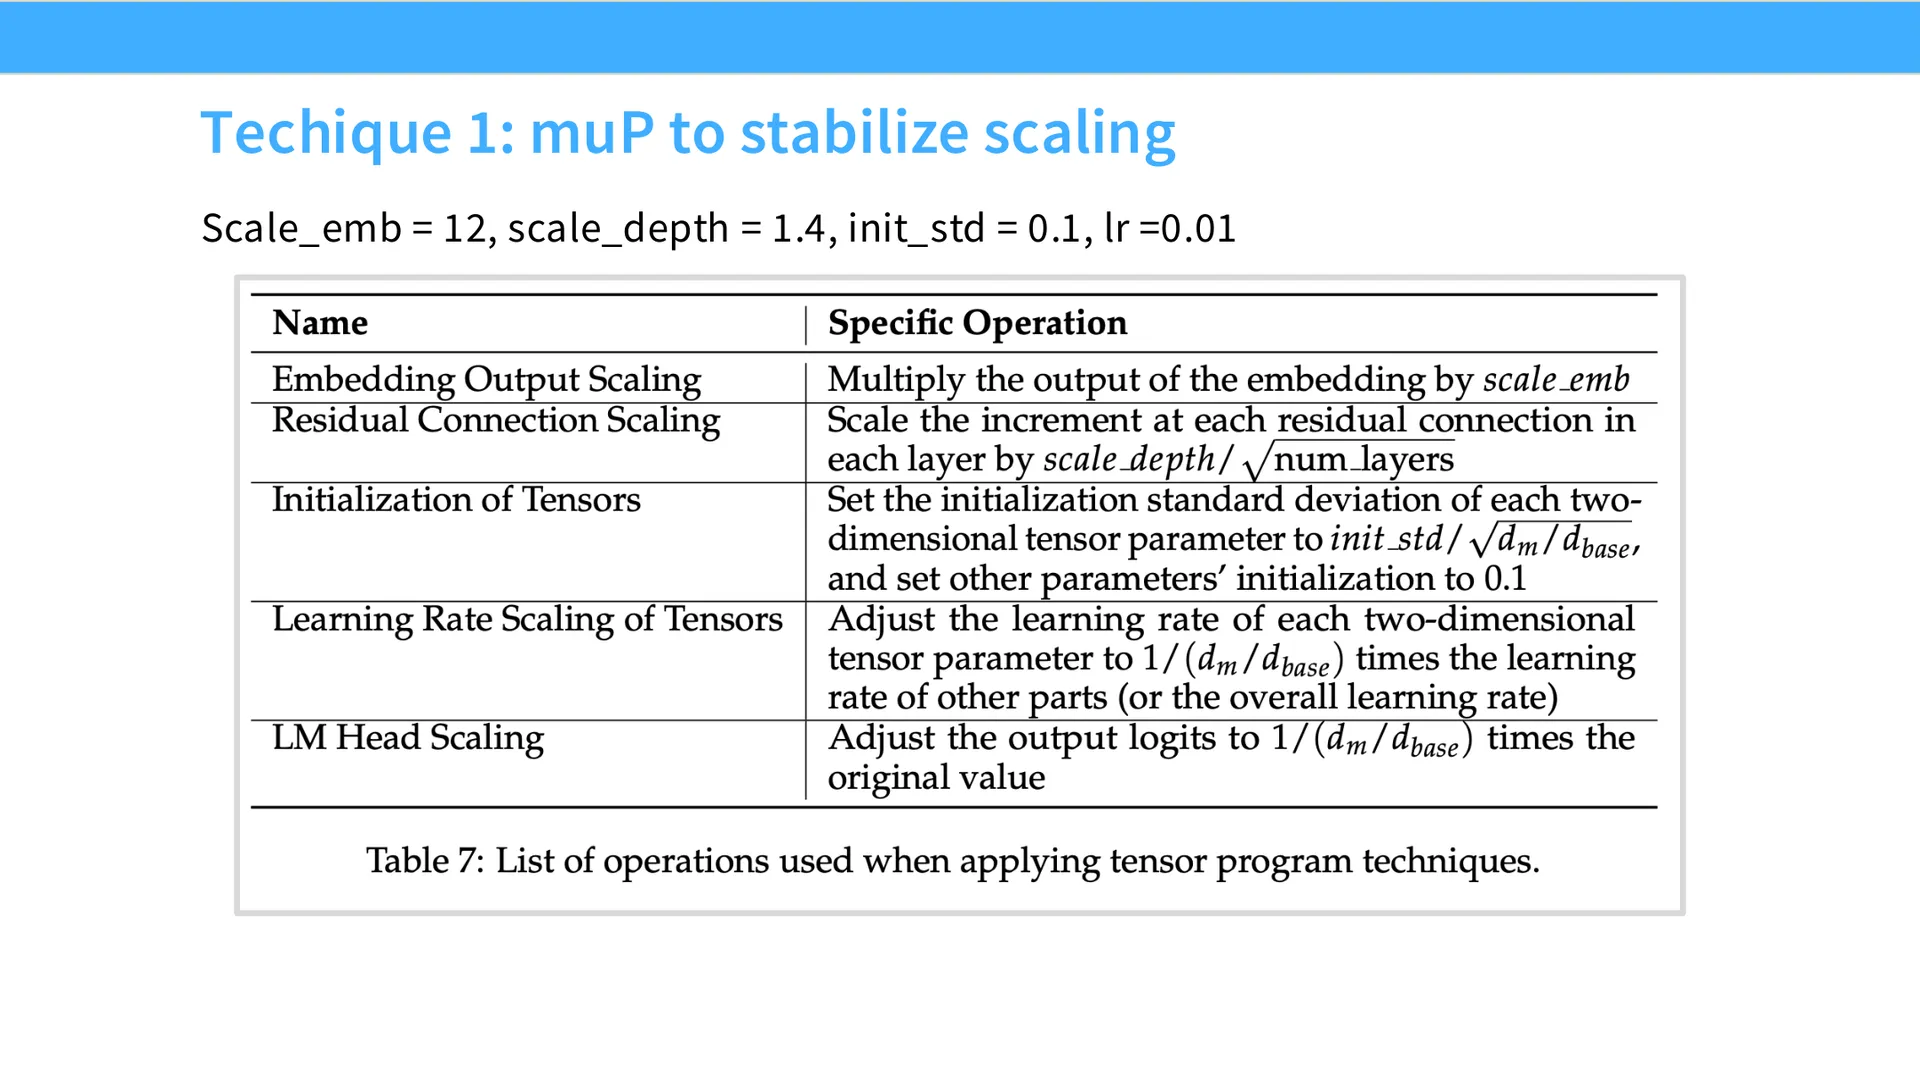
老师两讲前曾简短提过 μP,这里给出第一个真正的实例。MiniCPM 论文列出了一组非标准的操作:
- 对 embedding 输出做缩放;
- 对残差连接按 $\sqrt{\text{层数}}$ 缩放;
- 对所有矩阵形状张量的初始化,按 fan-in / fan-out 之比缩放;
- 对张量的学习率做缩放(老师强调这一条很"异国情调",如果你不习惯"逐参数学习率"会觉得奇怪);
- 对 LM head 也做缩放。
这些具体做法是怎么推导出来的,老师留到本讲后半部分(μP 理论)再讲。这里只需记住一个直觉:通过改变初始化和学习率的设置方式,让学习率在不同规模下更稳定。
📷 (讲师展示 μP 学习率扫掠图)
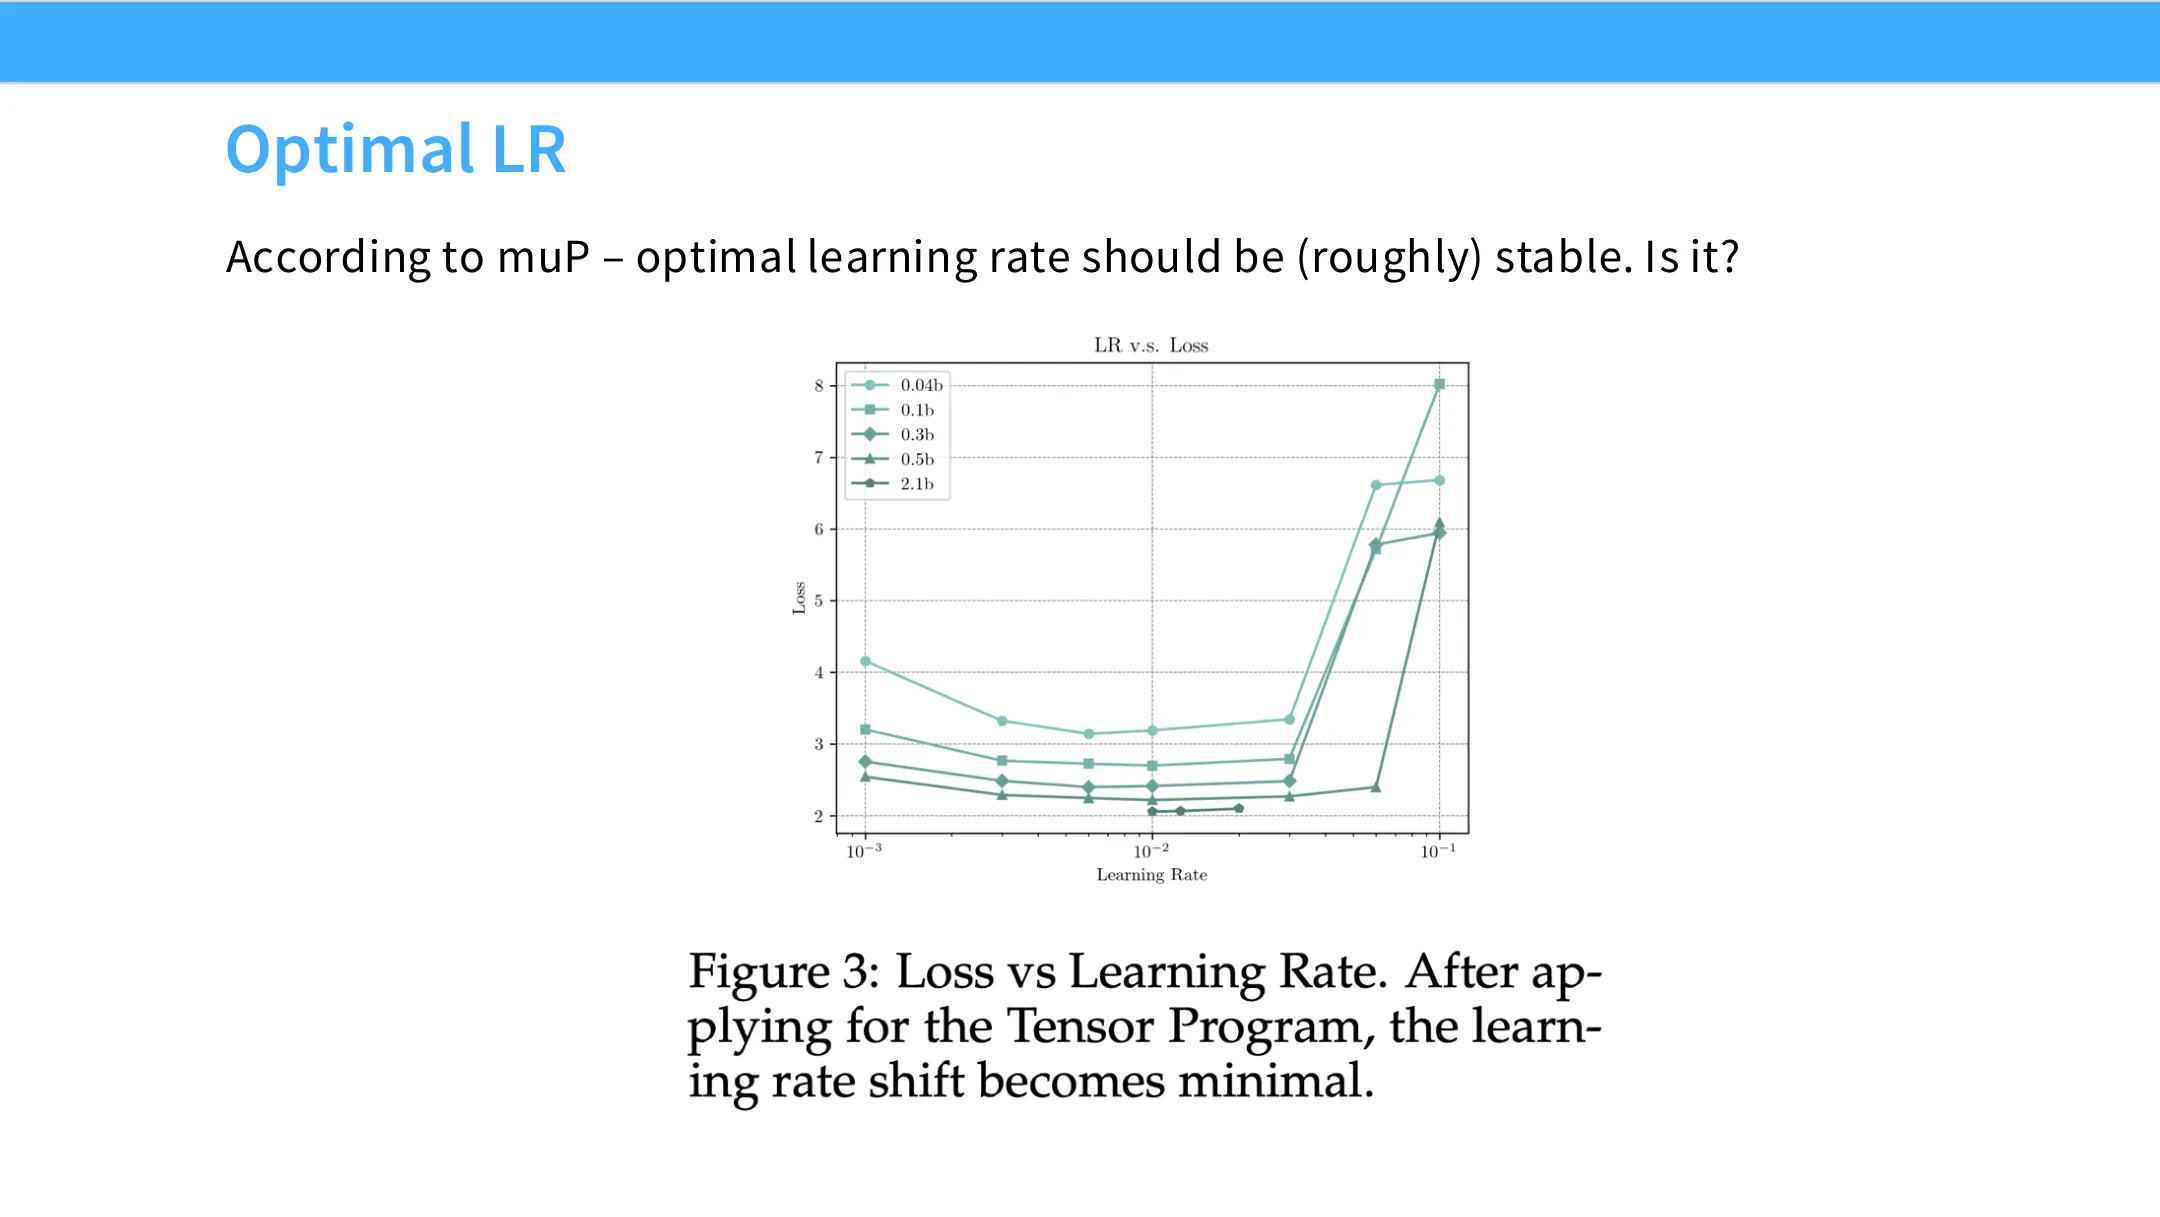
📷 μP 在不同规模下最优学习率几乎重合的扫掠图
回到原视频 (00:07:30)
它到底管用吗? 在 MiniCPM 的实验中答案是很干净的 "是"。他们在一系列模型规模上扫掠学习率(每个颜色/线条代表一个模型规模),结果发现:
- 最低损失几乎都落在 $\mathbf{1\times10^{-2}}$ 上;
- 最小的模型虽然最优点略有偏移,但也非常接近。
这是一个 μP 的成功案例。如果能做到这一点,你基本上就免除了调学习率的需要。
编者拓展|μP 与"逐参数学习率" 标准训练里,我们通常给整个网络一个全局学习率。μP 的思想更进一步:不同层、甚至不同形状的权重,应该有不同的初始化方差和学习率,而且这些缩放方式要写成 fan-in / fan-out 的显式函数。这样当网络宽度变大时,前向传播的激活尺度、反向传播的更新尺度都能保持稳定,最优全局学习率才不会漂移。后面第七节会给出这个缩放因子的推导。
2.2 最优批量大小也服从幂律
(参考时间: 00:08–00:10)
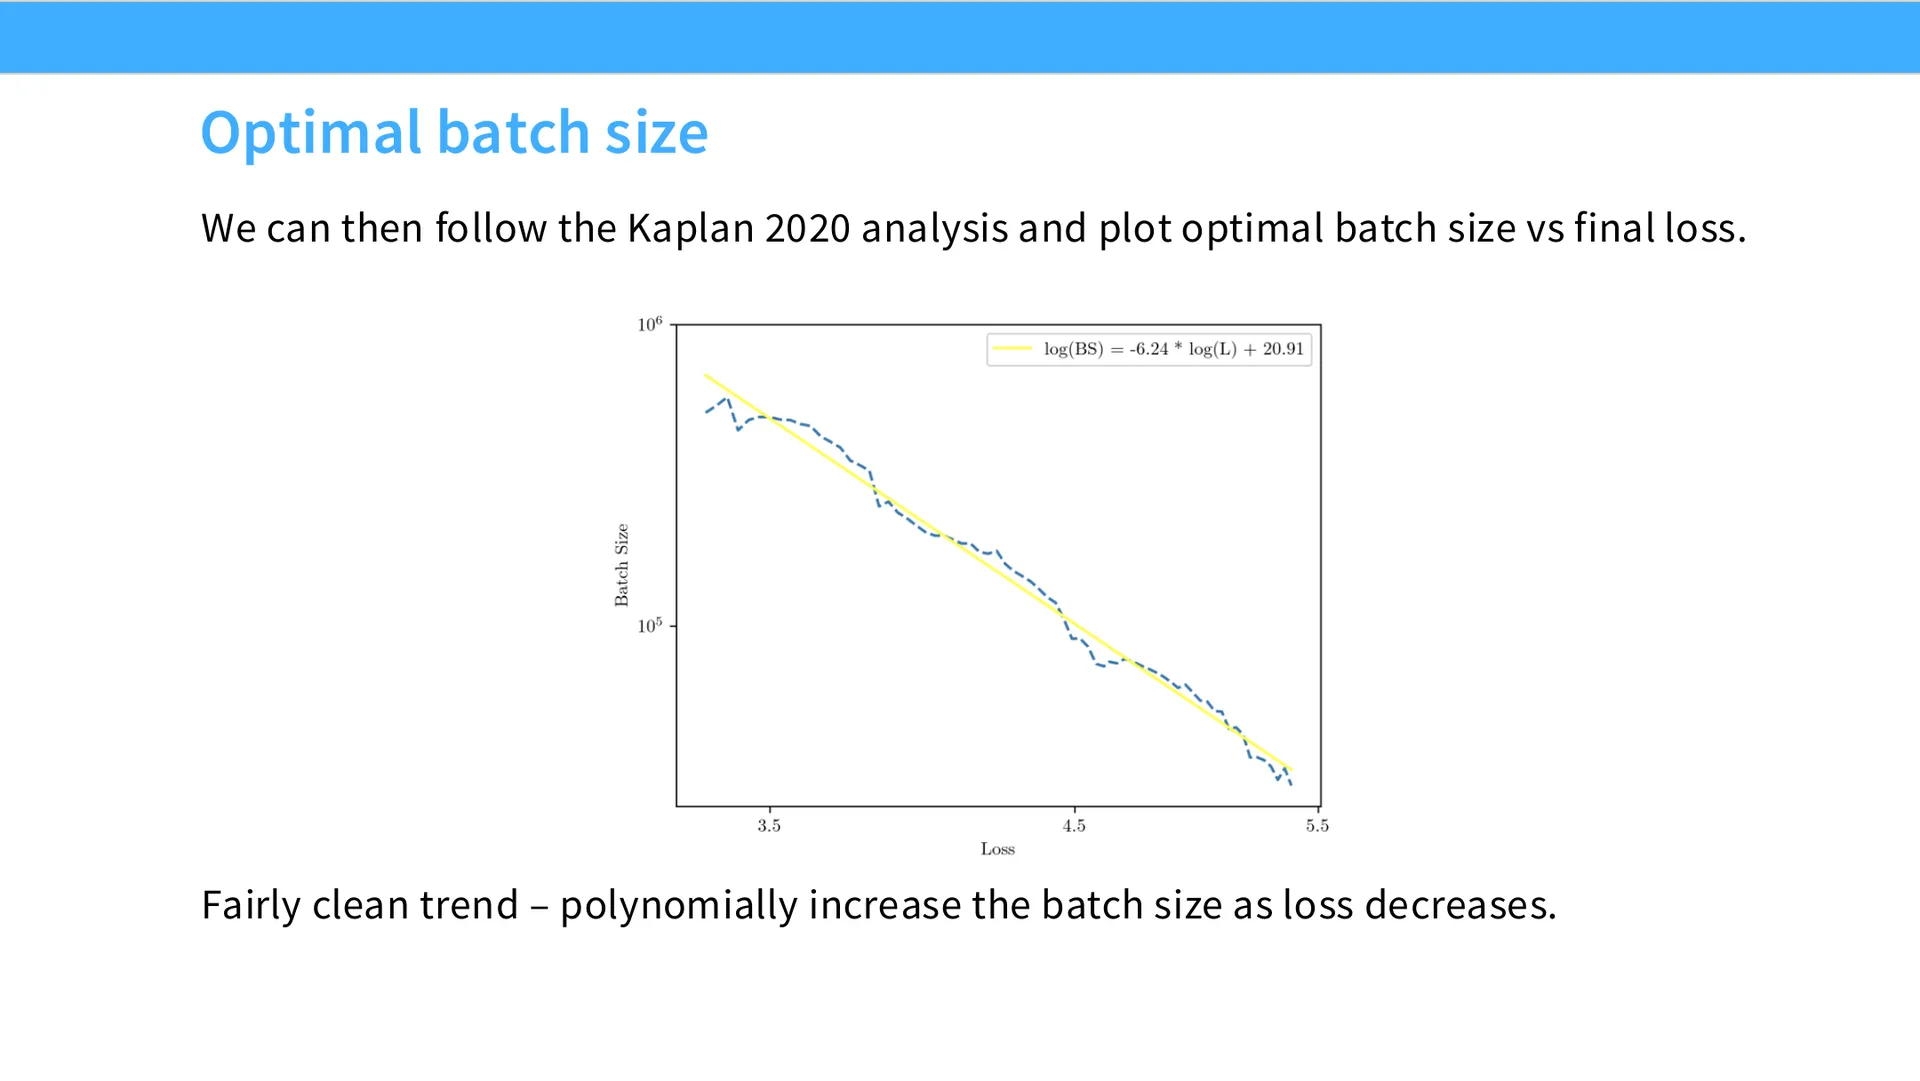
即便你用 μP 把学习率固定住了,最优批量大小仍然不是常数。它随数据量和模型规模变化。MiniCPM 的做法是:
- 固定一个批量大小,逐步增加处理的 token 数(图里每一列点代表一次训练);
- 对每一条等损失等高线(equal-loss contour),拟合二次曲线,找出最优批量大小;
- 把最优批量大小画成"处理 token 数"的函数,并在不同模型规模上重复。
结果是:最优批量大小相对目标损失呈幂律结构。这与 Kaplan 论文里关于"临界批量大小(critical batch size)"的分析是一致的——损失越低,批量大小应该越大。
📷 (讲师展示最优批量大小随数据量的幂律图)
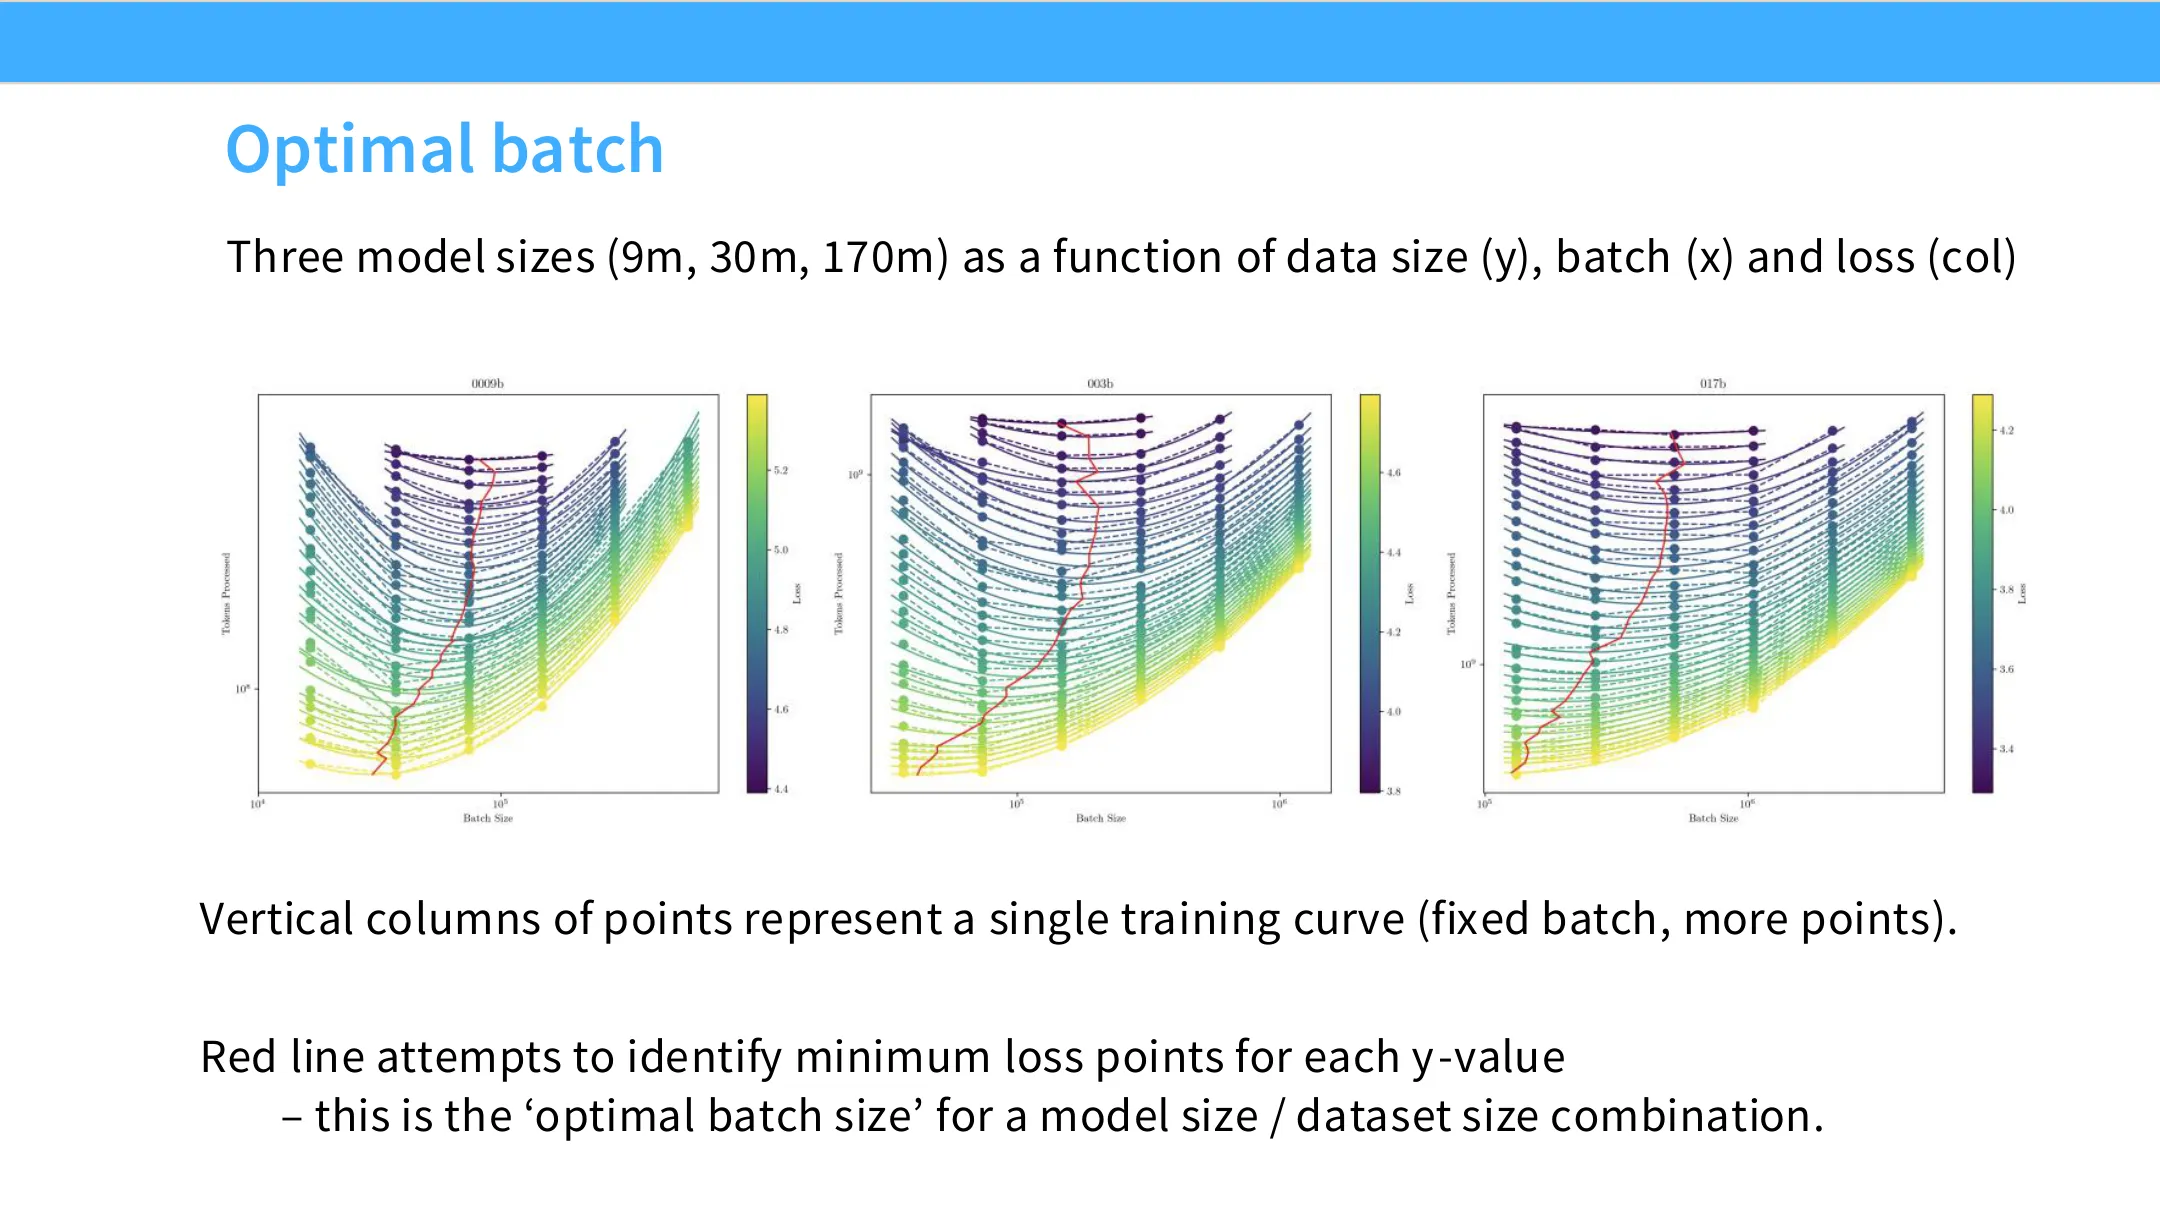
📷 最优批量大小相对目标损失的幂律关系
回到原视频 (00:08:30)
这样一来,只要给定一个损失目标(可以从缩放定律反推出来),你就能精确地设置最优(临界)批量大小。
讲师强调:批量大小和学习率的缩放,这两个会反复出现。它们可以说是做缩放定律时最重要、最敏感的两个参数。
2.3 WSD 学习率调度:让"续训"变得廉价
(参考时间: 00:10–00:16)
这是 MiniCPM 论文中老师认为最值得学的一点,也是他认为每个做模型的人都该知道的常识。
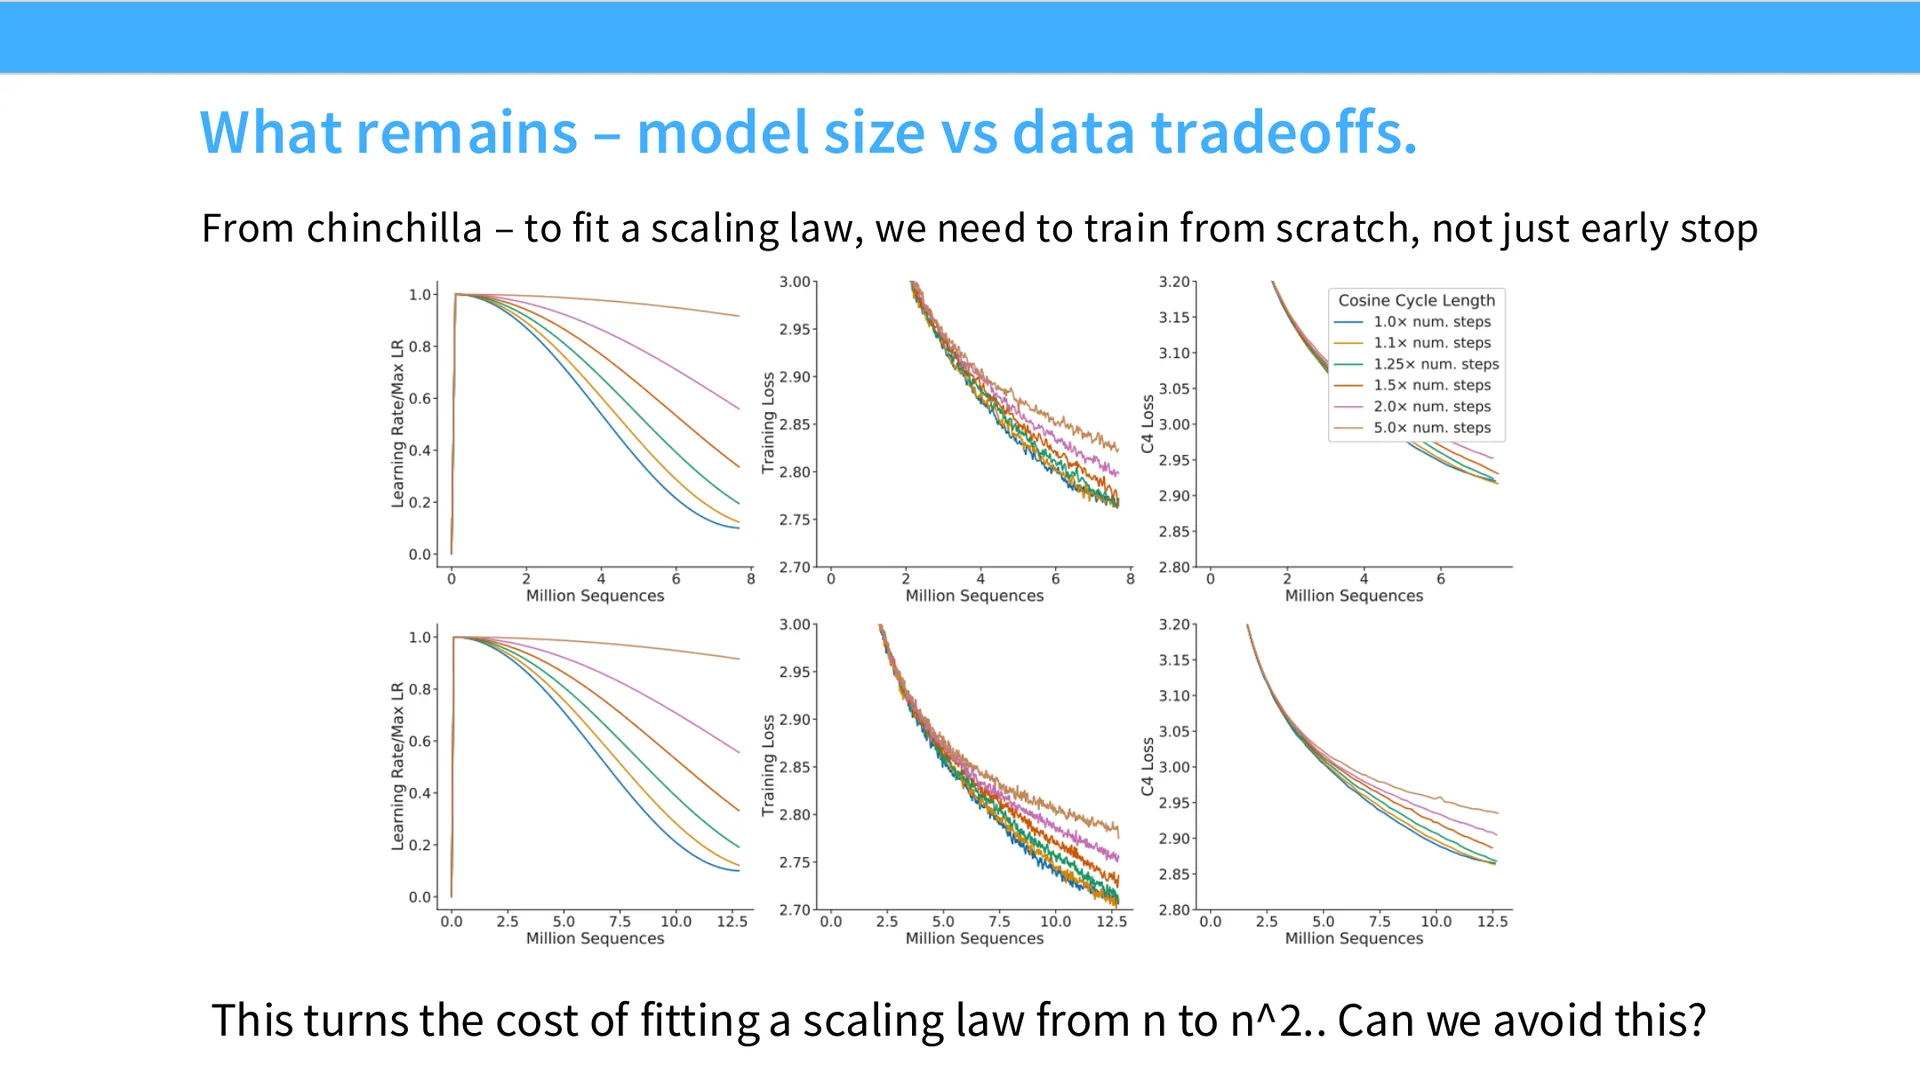
问题从哪来? 要做 Chinchilla 分析,需要训练许多不同规模的模型(例如做等算力 isoflops 分析:固定 FLOPS 预算,改变 token 数与模型规模的权衡)。这意味着要不断增加训练数据量。但每个训练运行都有自己的学习率调度——而大家常用的 cosine 学习率要求你在训练开始前就知道总预算(否则衰变曲线画不出来)。
于是产生一个令人恼火的后果:
如果你想训一个 800 万序列的模型,你不能从 400 万序列的模型那里"接着训",因为两者的学习率调度根本不同,你必须从头重训。这在某种意义上是二次成本——每次加数据都要重跑一遍。
解法:WSD(Warm-up–Stable–Decay)学习率,形状是一个大致的学习率"梯形":
graph LR
    W["① Warm-up<br/>固定步数(与训练时长无关)"] --> S["② Stable<br/>保持常数学习率<br/>(占总时长绝大部分)"]
    S --> D["③ Decay<br/>快速衰减到约峰值的 10%<br/>(占总时长 10–20%)"]
    style W fill:#e8f0fe
    style S fill:#e8fde8
    style D fill:#fde8e8
- Warm-up 阶段:通常定义为固定步数,而不是训练目标的一个比例,因此与训练时长无关。
- Stable 阶段:在这段很长的训练里,学习率保持常数。
- Decay 阶段:最后快速衰减到零,一般占总训练量的 10–20%,最终降到最大学习率的约 10%。
为什么这样设计? 因为现在你可以在稳定期的任意一点重启一次训练。如果想把一个运行"续训得更久",只需回滚到最后一个稳定阶段的检查点,继续用稳定学习率往前跑,最后再重新衰减到零。
- 你仍然需要每次都重新 decay,但那大概只占总成本的 10%。
- 这比"反复重跑整个预训练"要好得多。
这是一个在很多地方都被广泛使用的技巧。
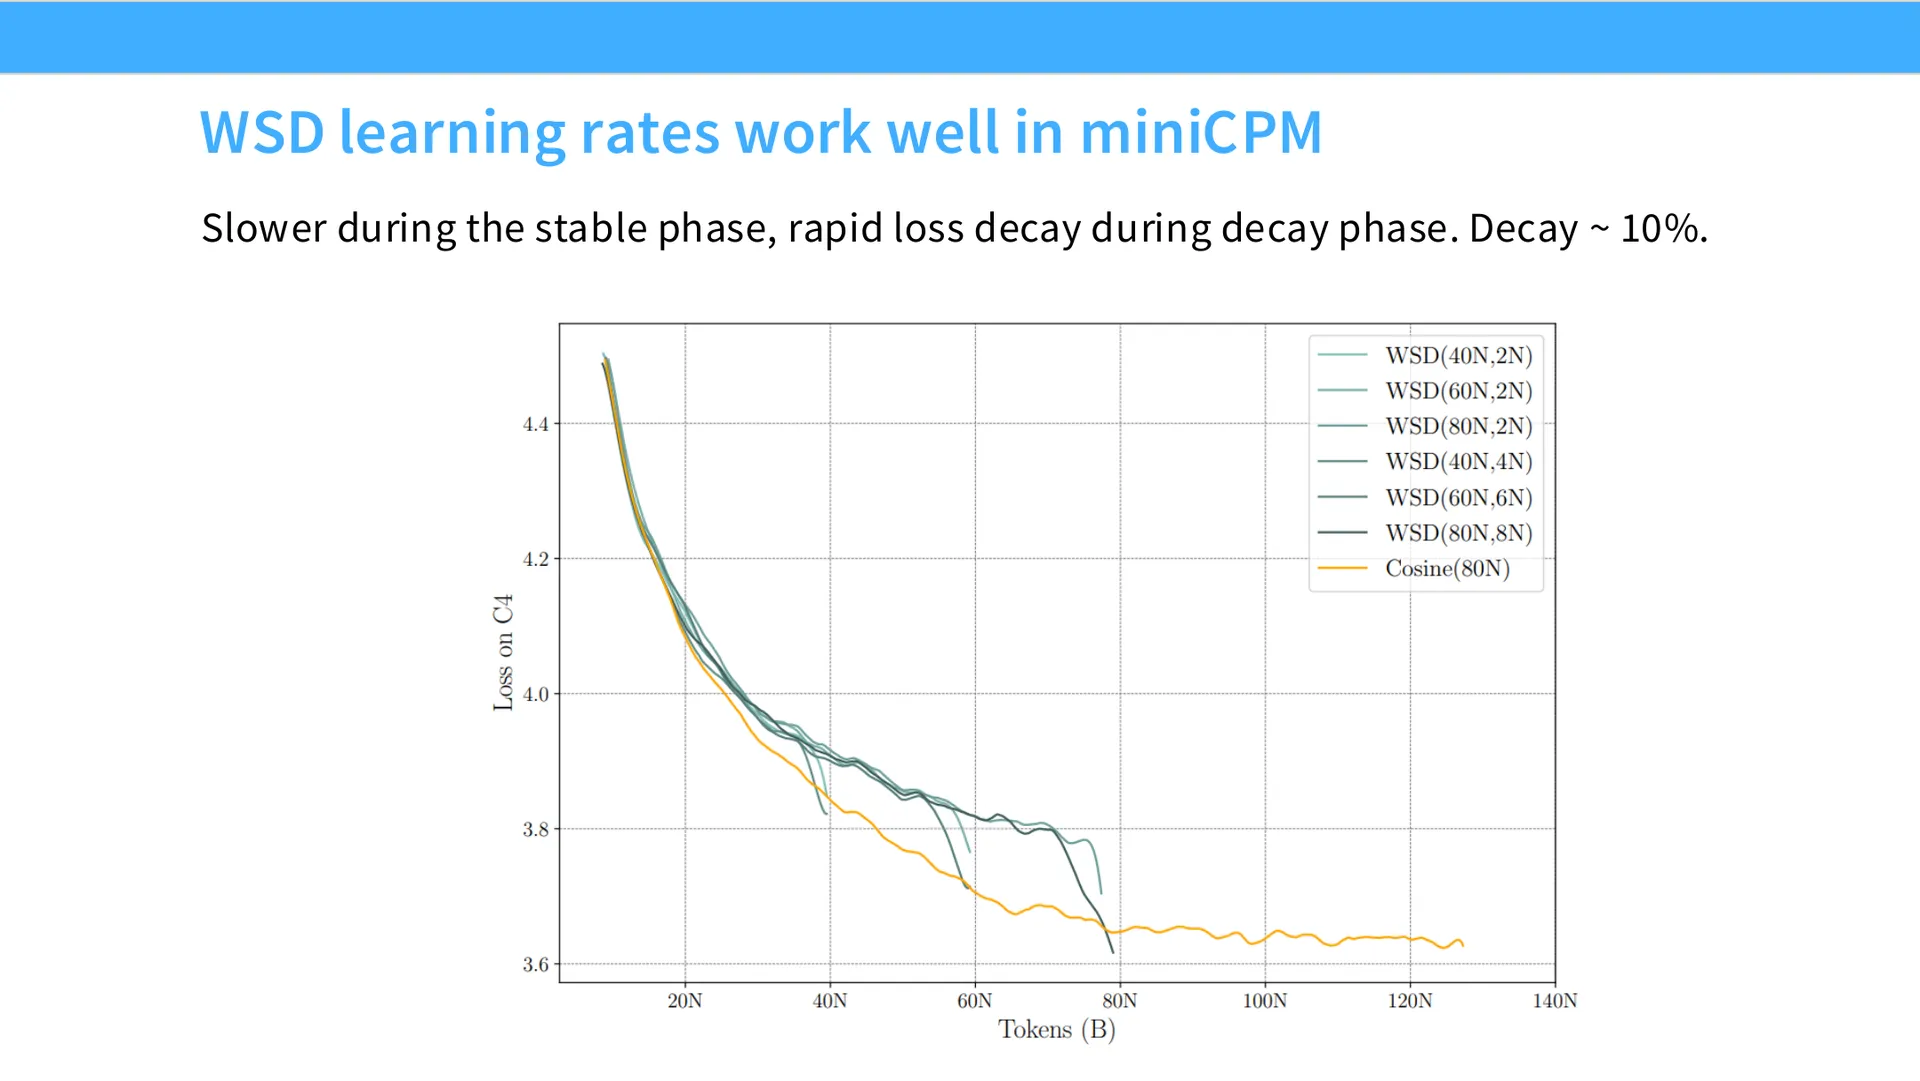
📷 (讲师展示 WSD 与 cosine 的性能对比曲线)
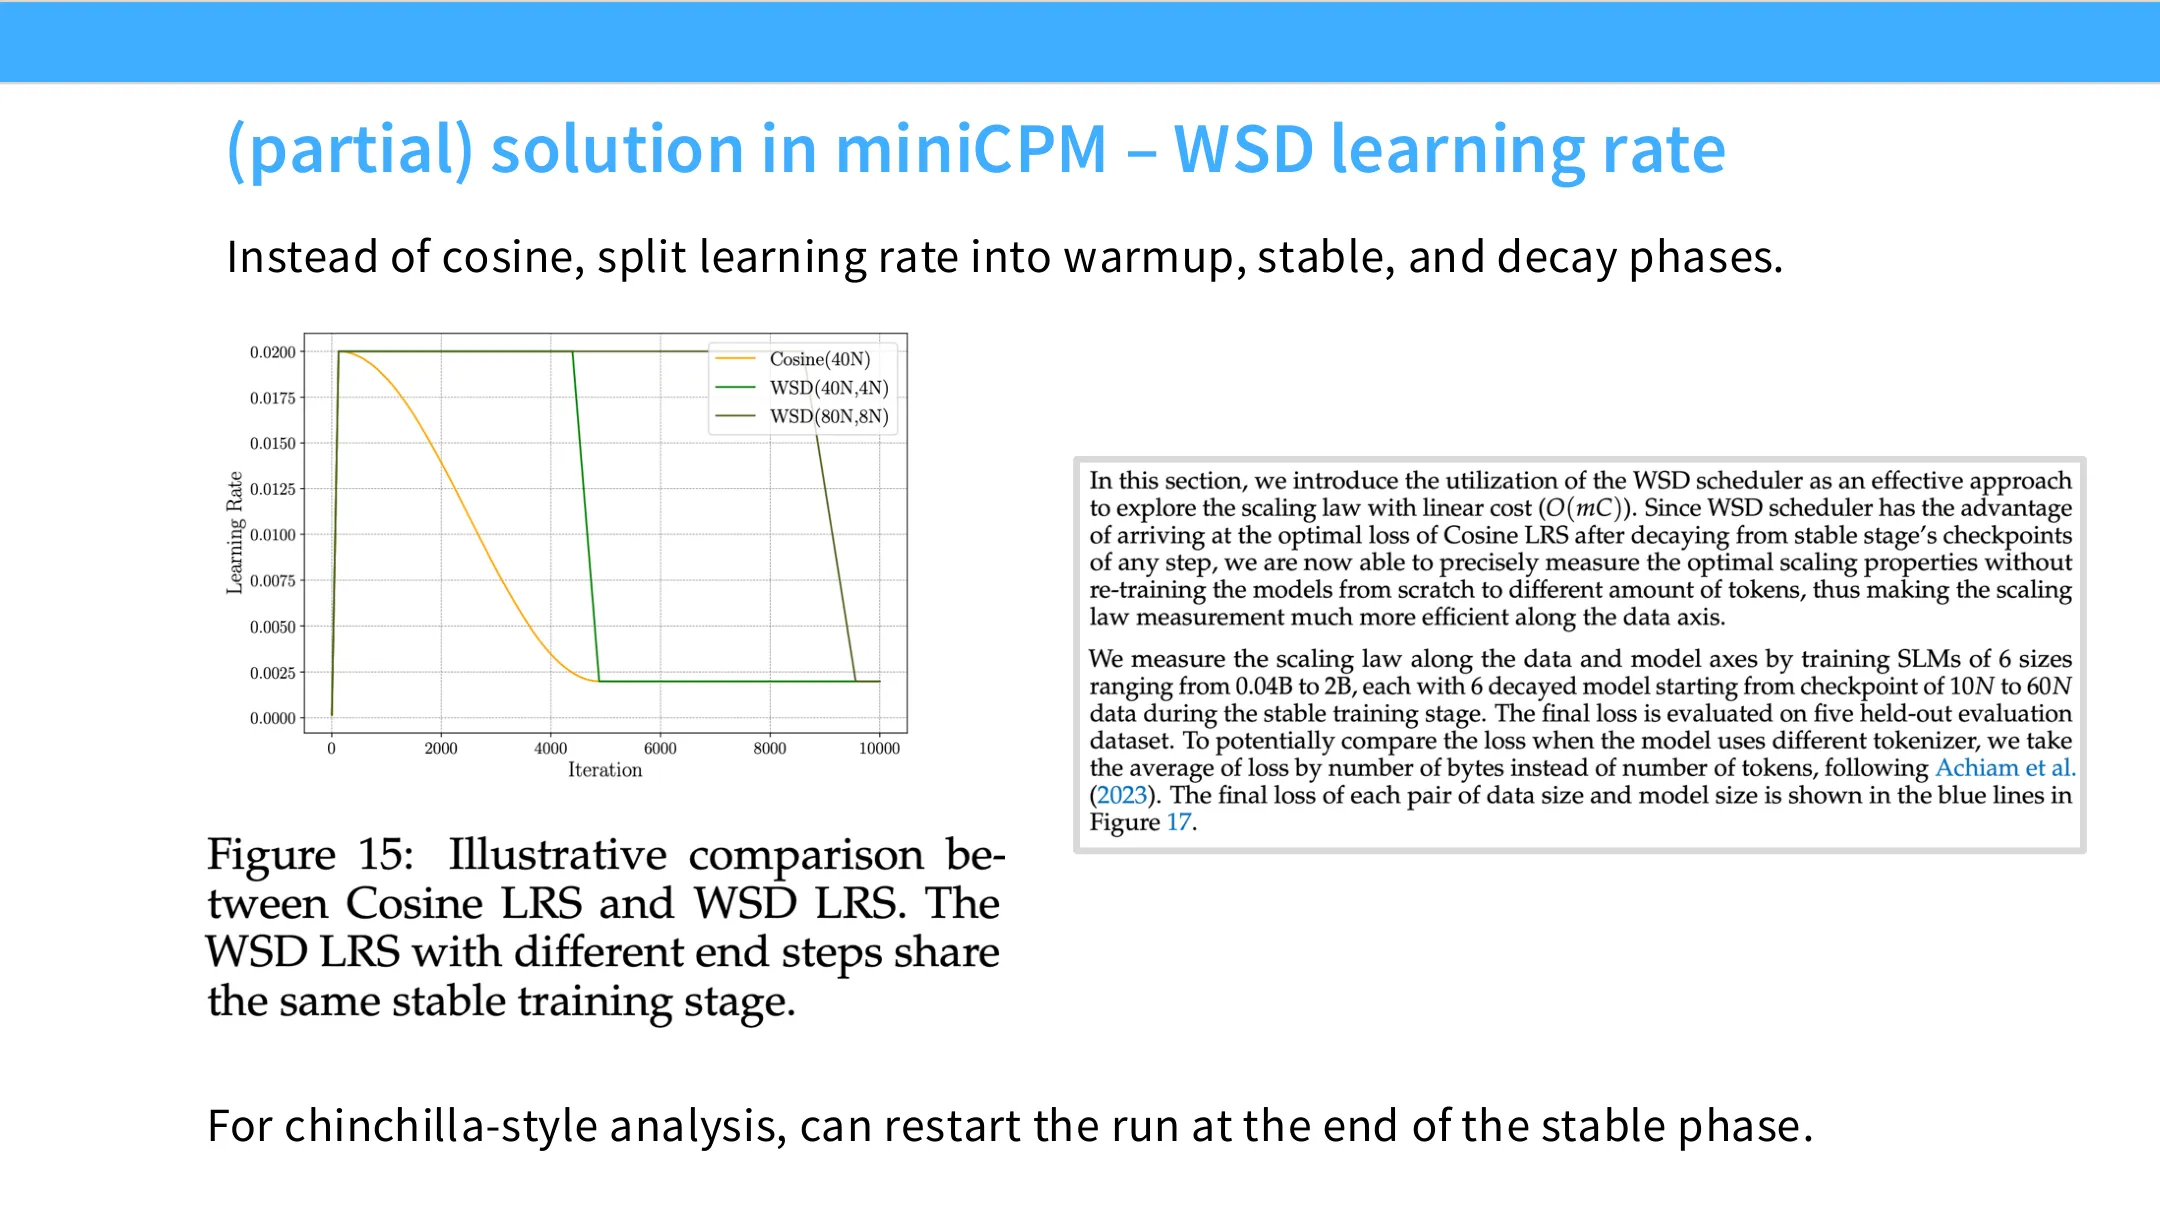
📷 WSD 与调好的 cosine 学习率曲线性能对比
回到原视频 (00:12:30)
性能对比:老师提到 ETH 的 Martin Jaggi 等人做过一次相当广泛的 WSD 研究,很多论文也显示了类似结论。对比图里:
- 橙色线是调好的 cosine 曲线;
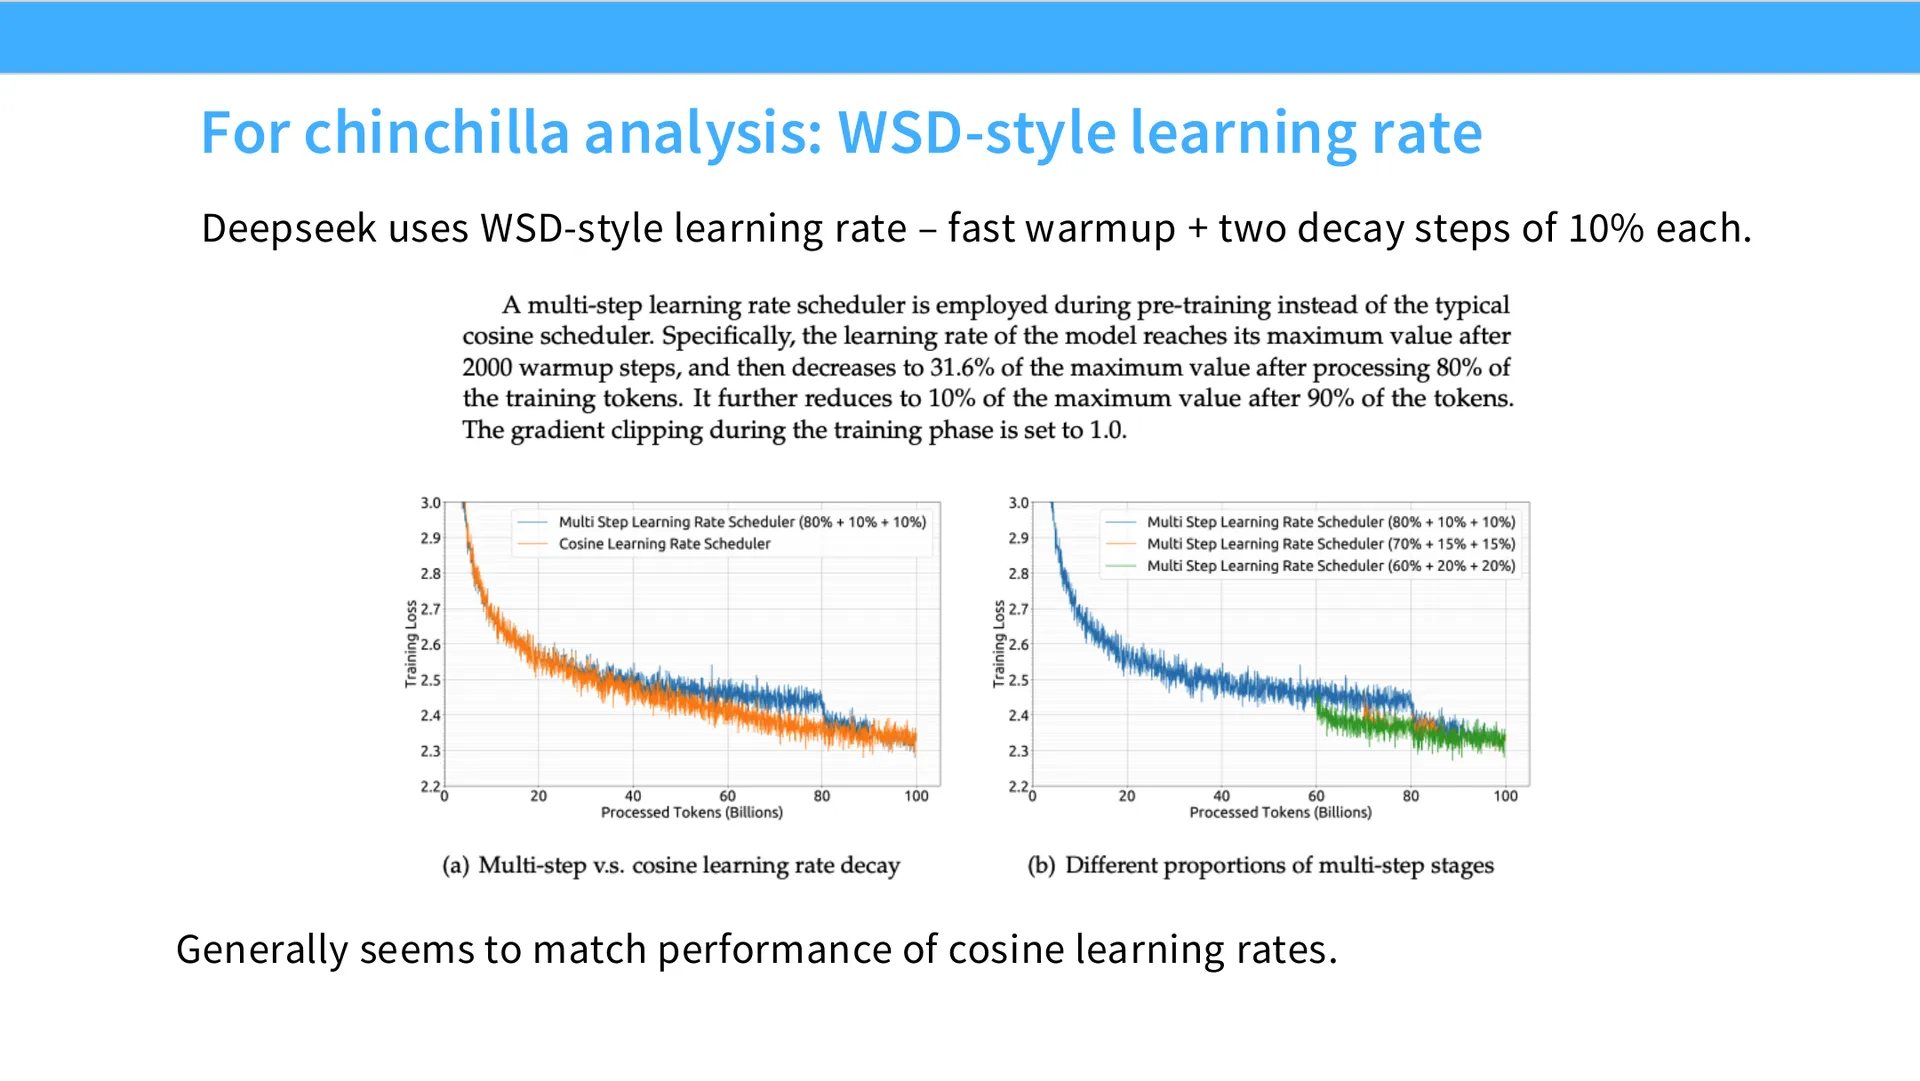
- 各条 WSD 曲线看起来有点怪——在 decay 阶段之前仿佛严重欠拟合,但一旦进入 decay 阶段,会突然把损失追回来,最终追平甚至偶尔超过 cosine。
经验结论:很多训练者会说 cosine 在许多情况下略好一点,但 WSD 在另一些情况下基本一样好,是一个非常通用的默认学习率,而且不必为了续训而反复重跑。
讲师感叹:学习率衰减的影响之大令人印象深刻。如果此前没玩过,会觉得它"不可思议地重要"——正是这段 decay 把训练的最后一段"退火"掉了。
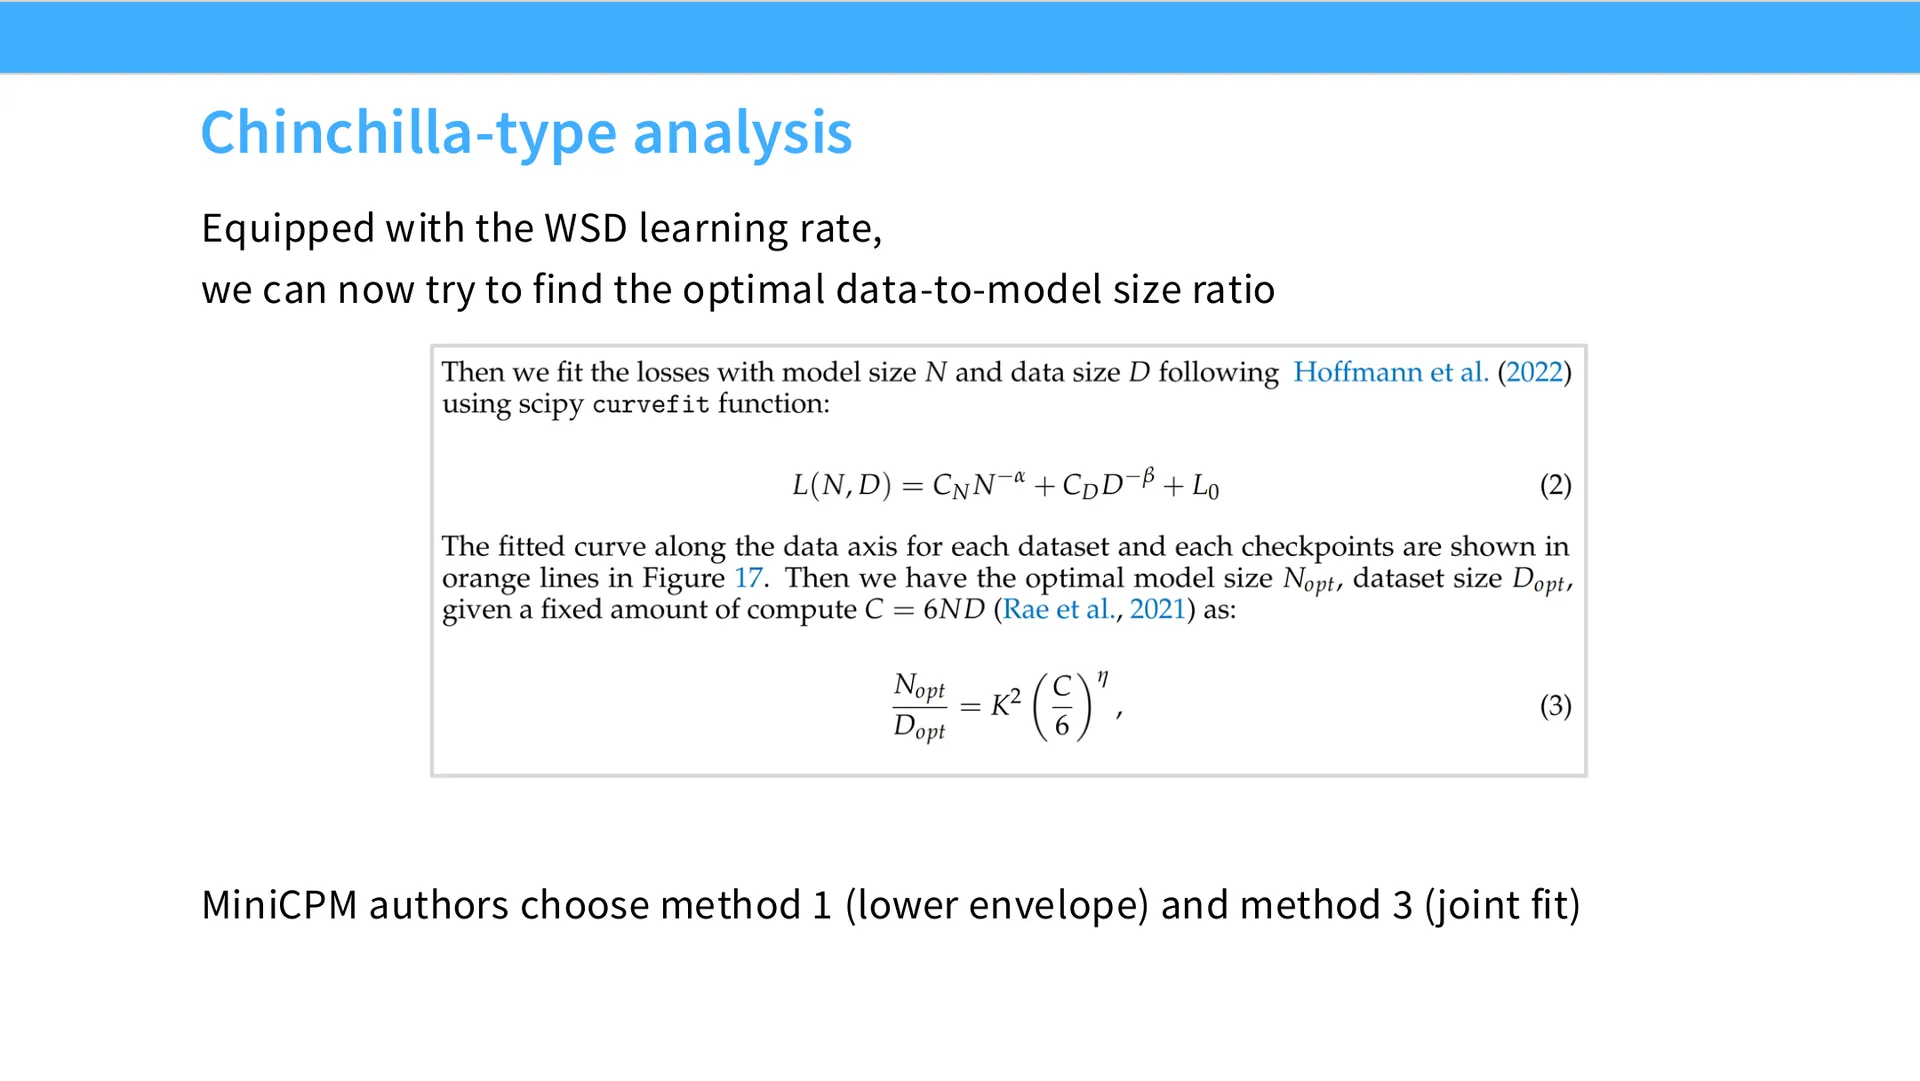
有了 WSD,Chinchilla 分析就变得很容易:你只需跑一次长训练,然后回滚检查点、反复 decay,就能得到沿数据维度的扫掠;再在模型维度上扫掠,就可以做 isoflops 或任何你想要的分析。
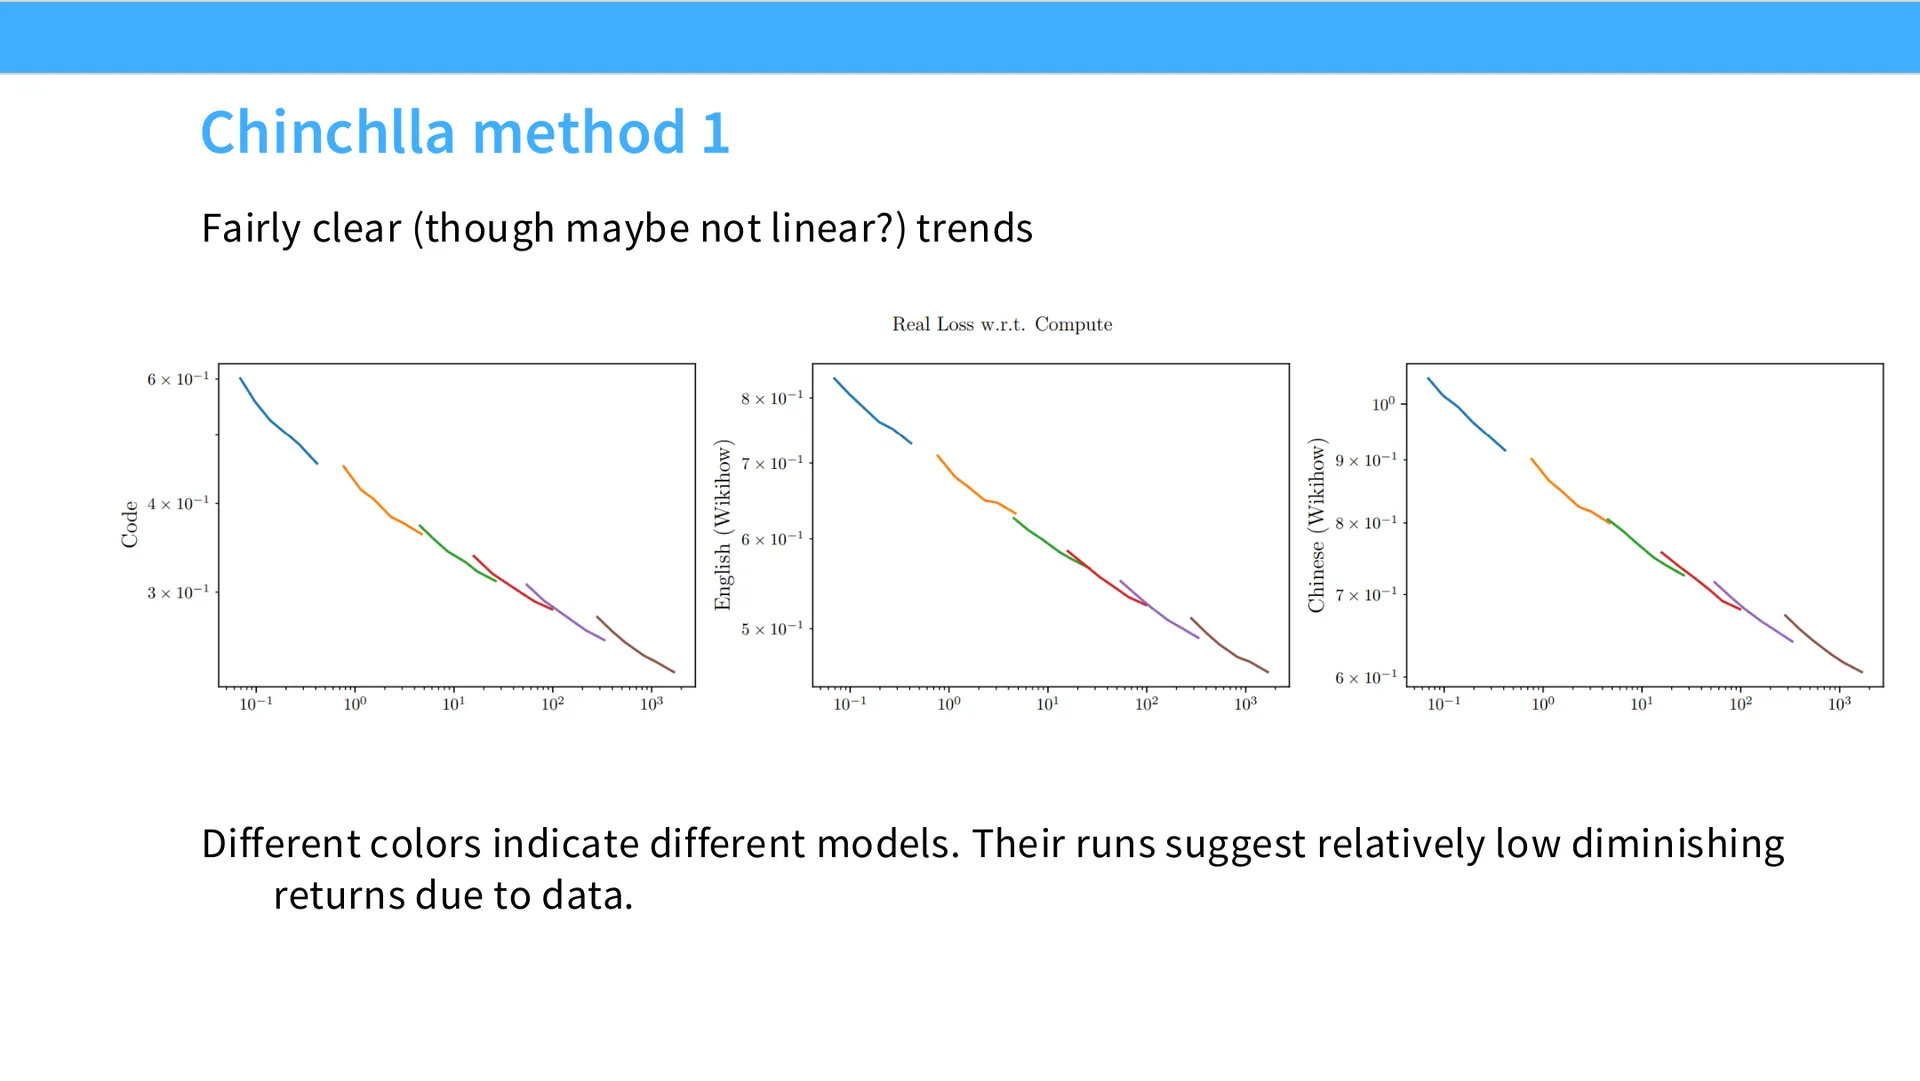
编者说明:MiniCPM 团队选择复刻 Chinchilla 的"方法一"和"方法三",老师坦言这两种方法在 Chinchilla 系列里是最不可靠的。不过他们得到的缩放曲线看起来仍然不错:方法一得到大致线性的下包络;方法三在算力—非 embedding 参数权衡上大多平滑。他们也得到了与 Chinchilla 明显不同的指数,并据此声称需要比 Chinchilla 多得多的 token。老师对此持保留态度——"很难说这是真的,还是他们的 Chinchilla 拟合本身有点怪"。
MiniCPM 小结(老师自己给的两点):
- μP 是有用的技巧,用来稳定"学习率如何随规模变化"。
- WSD 学习率是要记住的常识——非常常用,人人都该知道。
💬 课堂问答:post-training 会改变什么?
(参考时间: 00:29–00:30)
一位同学问:既然 post-training(后训练)如今已成为提升质量的标准化流程,那它会不会改变这套缩放分析?
老师回答:这仍然是一个大开放问题。目前没有好的方法把 post-training 完整纳入缩放定律,因为 post-training 有时会从根本上改变你应该做什么样的预训练。最接近的工作,是有人试图理解预训练中的覆盖度 / 多样性(coverage / diversity),以预测 post-training 会发生什么,但这还很稚嫩。没有好答案。
三、DeepSeek:直接拟合超参数的缩放律
(参考时间: 00:16–00:22)
接下来是 DeepSeek 最早的那篇论文(在 MoE、R1 等之前)。老师对它评价很高:
讲师评价:即使在最早的 DeepSeek 论文里,也能看出这是一群非常严肃的人。DeepSeek LLM 至今仍是开放世界中最精心执行的缩放分析之一,实验品味极好。在 R1 之前,就已经看得出"这些人要去很远的地方"。
DeepSeek 采取的策略与 MiniCPM 截然不同:
- 它不做 μP,也不做那些"有趣的缩放调整"。
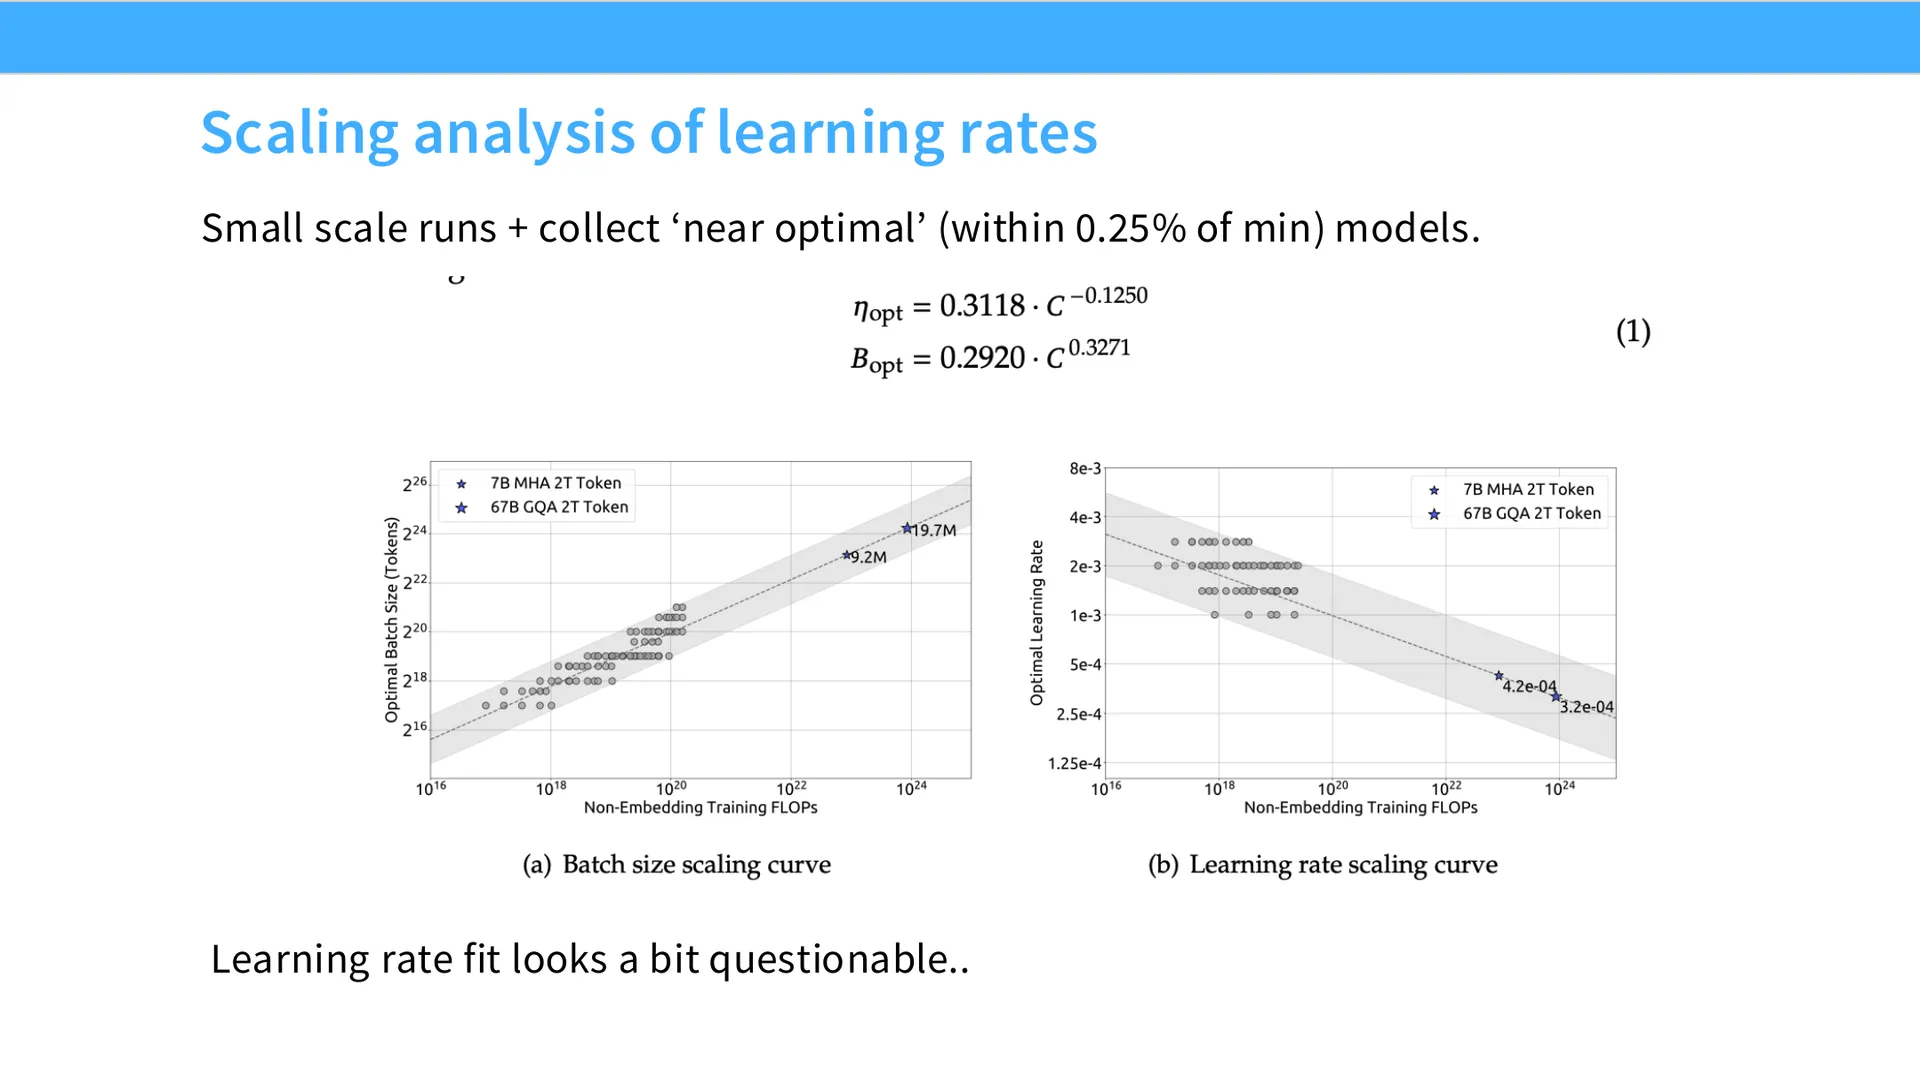
- 相反,它直接尝试拟合一条缩放律,来同时估计最优批量大小和最优学习率。
其逻辑是:我们知道学习率和批量大小确实会随规模变化,但只要它们变化的可预测性像缩放律一样,那就万事大吉——不必过分担心。
具体做法:在多个不同规模上做大规模网格搜索(grid search),找到最优点。
📷 (讲师展示 DeepSeek 的网格搜索与缩放拟合图)
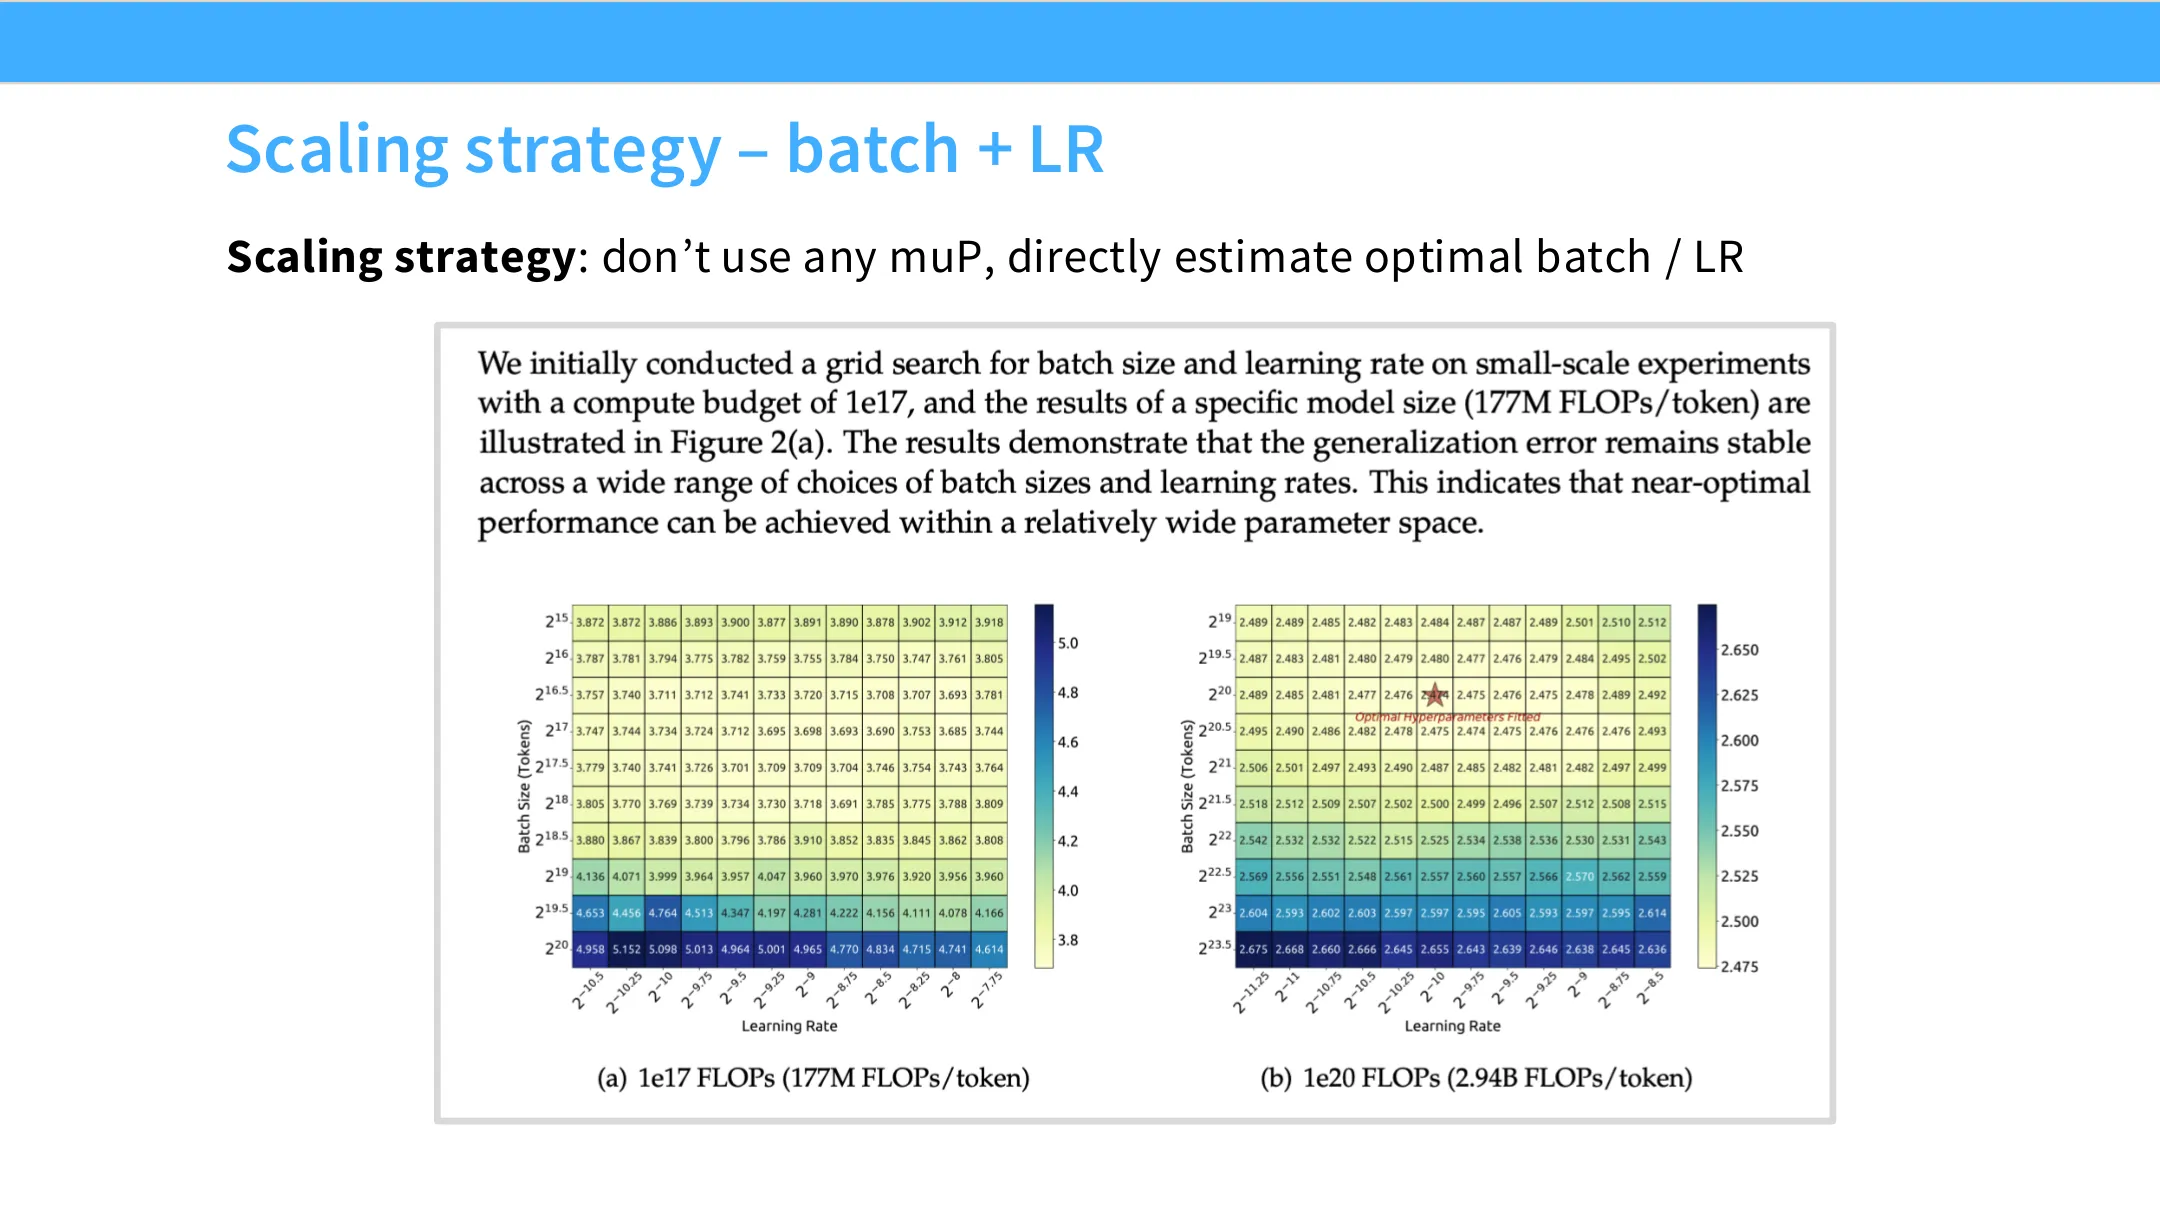
📷 DeepSeek 在不同规模下网格搜索最优点并拟合缩放律
回到原视频 (00:17:00)
- 在固定算力下,扫掠学习率 × 批量大小,观察终端损失;
- 用最浅的颜色标出最低损失,打上小星星;
- 在多个规模上重复,得到"最优批量大小 vs 非 embedding 训练 FLOPS"以及"最优学习率 vs 非 embedding 训练 FLOPS"两条趋势;
- 两条趋势大致是直线(在对数坐标下)。
老师的两点点评:
- 在更高 FLOPS 处,他们选用的批量大小更大、学习率更低。
- 批量大小的拟合看起来相当合理,确实像一条直线;但学习率的拟合"不算我这辈子见过最好的线性拟合"——这正是"用 grid search 拟合学习率"的一大缺点:除非你的网格恰好落在正确的位置,否则量化误差很大,你会得到一条看起来任意的直线。
讲师总结:这是处理敏感超参数的另一种哲学——你可以试图稳定它(μP),也可以直接给它拟合缩放律,然后照着缩放律走。DeepSeek 代表的是后者("拟合缩放律"路线)。
DeepSeek 也做了 Chinchilla 复刻(2024 年是"每个开放模型构建者都复刻整套缩放定律栈"的时代)。它同样遵循了 WSD 风格的学习率,只是有个奇怪的小变体——做了两次 decay 阶段而不是一次。老师坦言不清楚为何这么做,而且它后来也没流行起来。重点在于:
WSD 是一种有效的方法,你可以用它来复刻 Chinchilla。
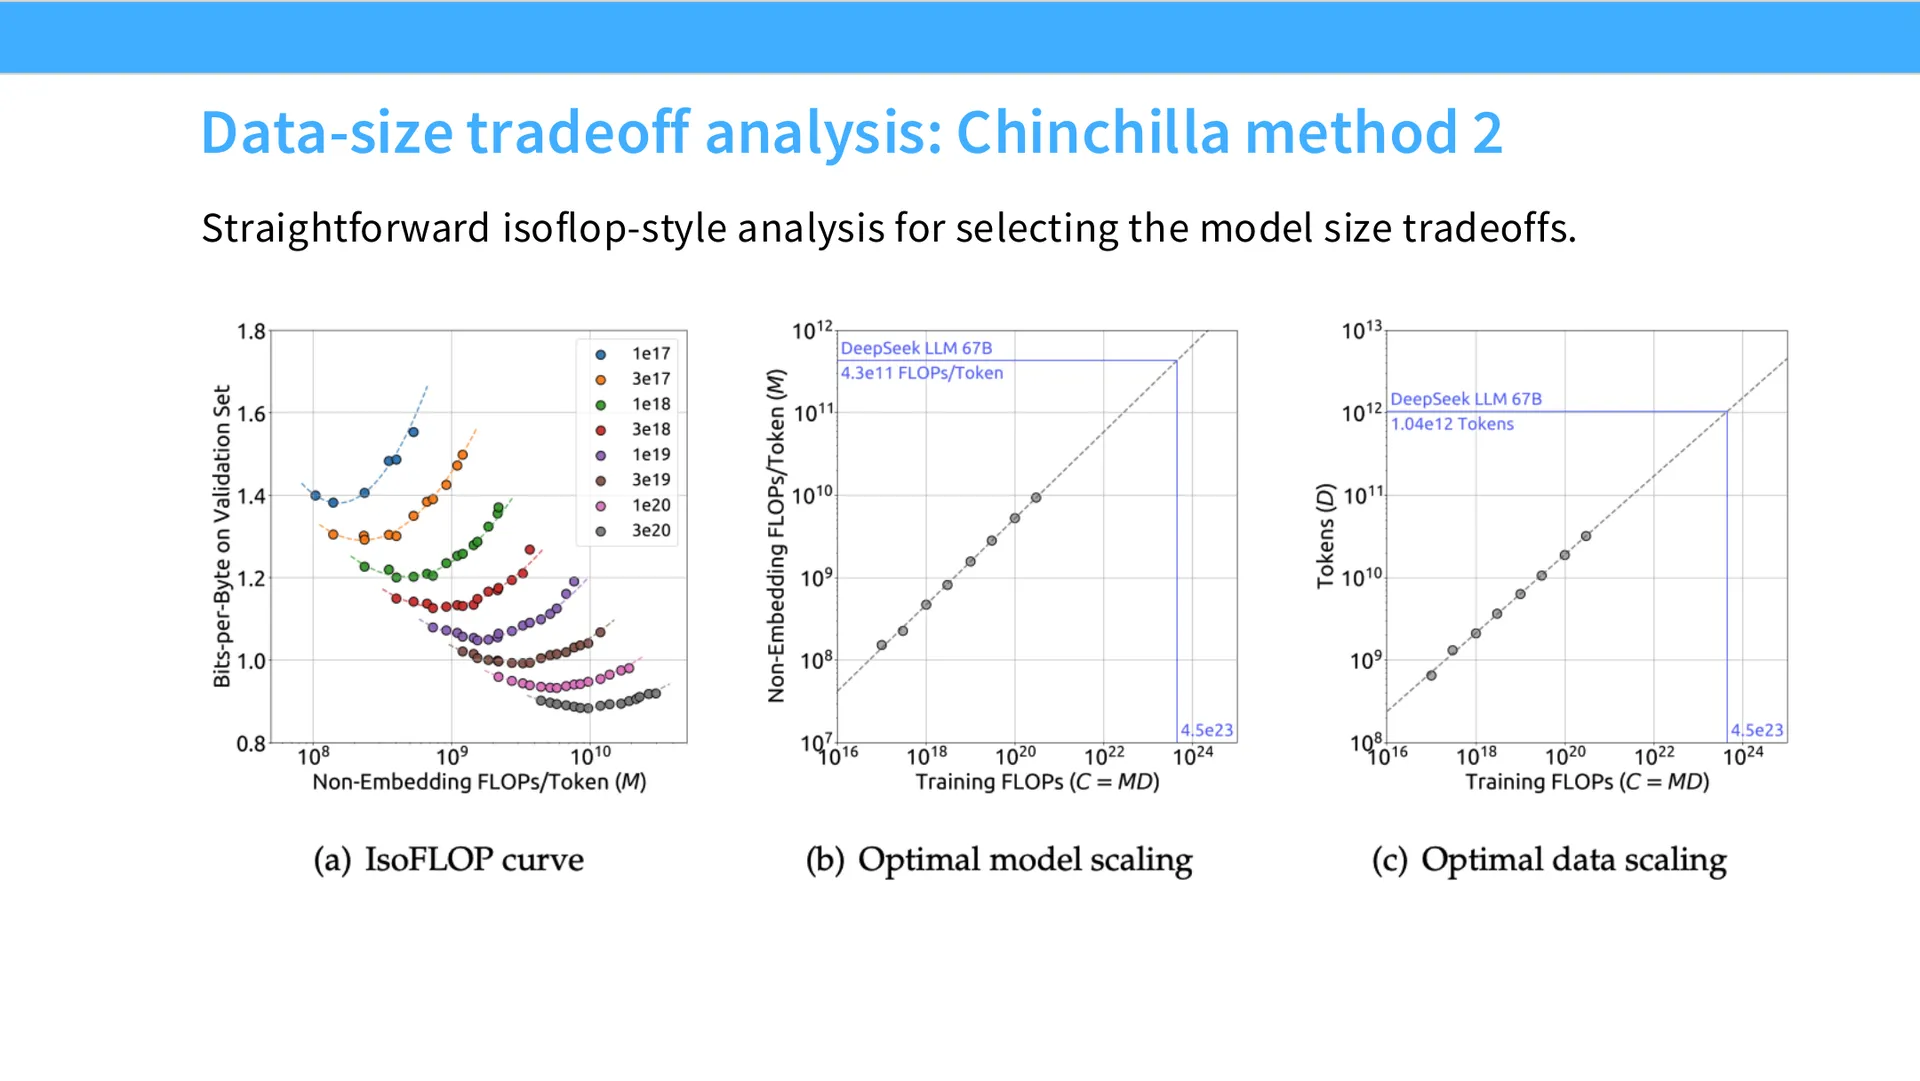
由于 DeepSeek 选择了 isoflops 路线,它的缩放曲线比 MiniCPM 干净得多:在固定 FLOPS 区间上得到清晰的扫掠,并且得到漂亮而干净的 Chinchilla 式权衡。
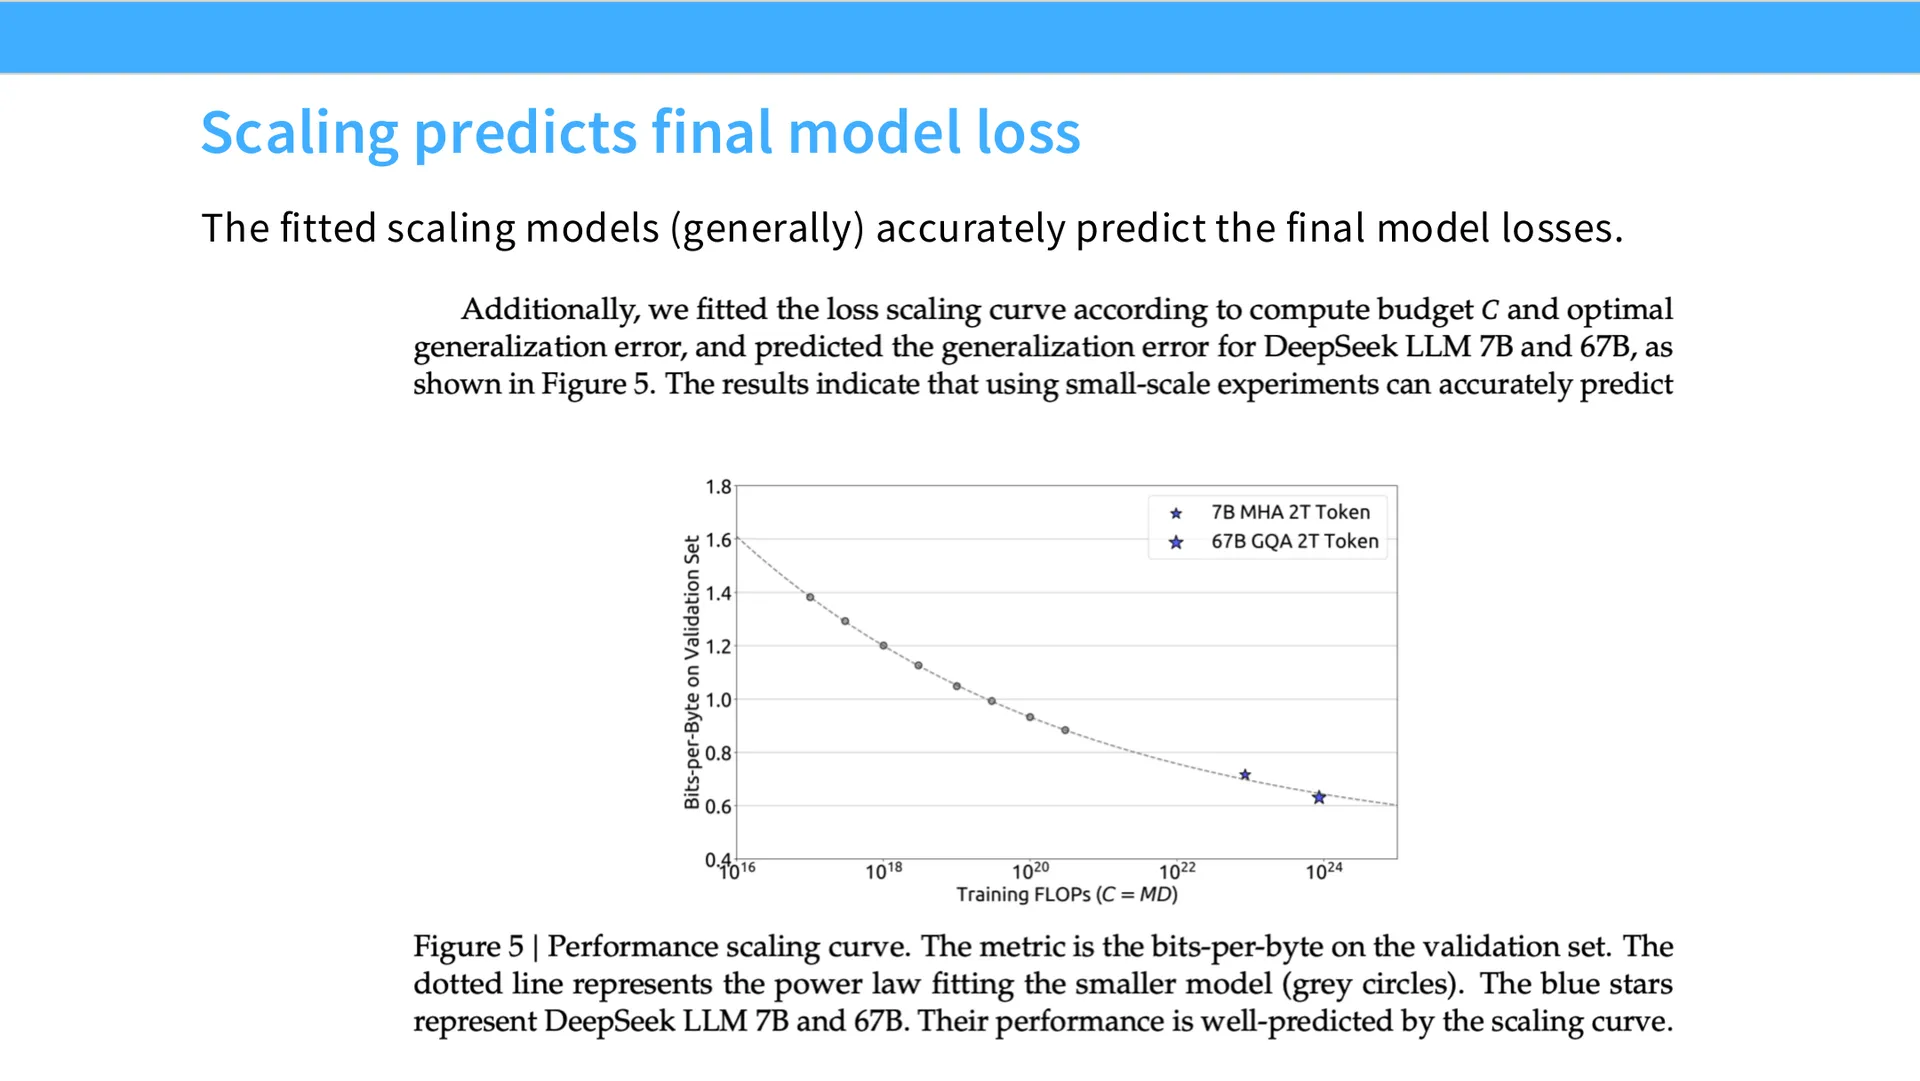
📷 (讲师展示 DeepSeek 的最终缩放预测:灰点是缩放律拟合,星星是实际训练的大模型)
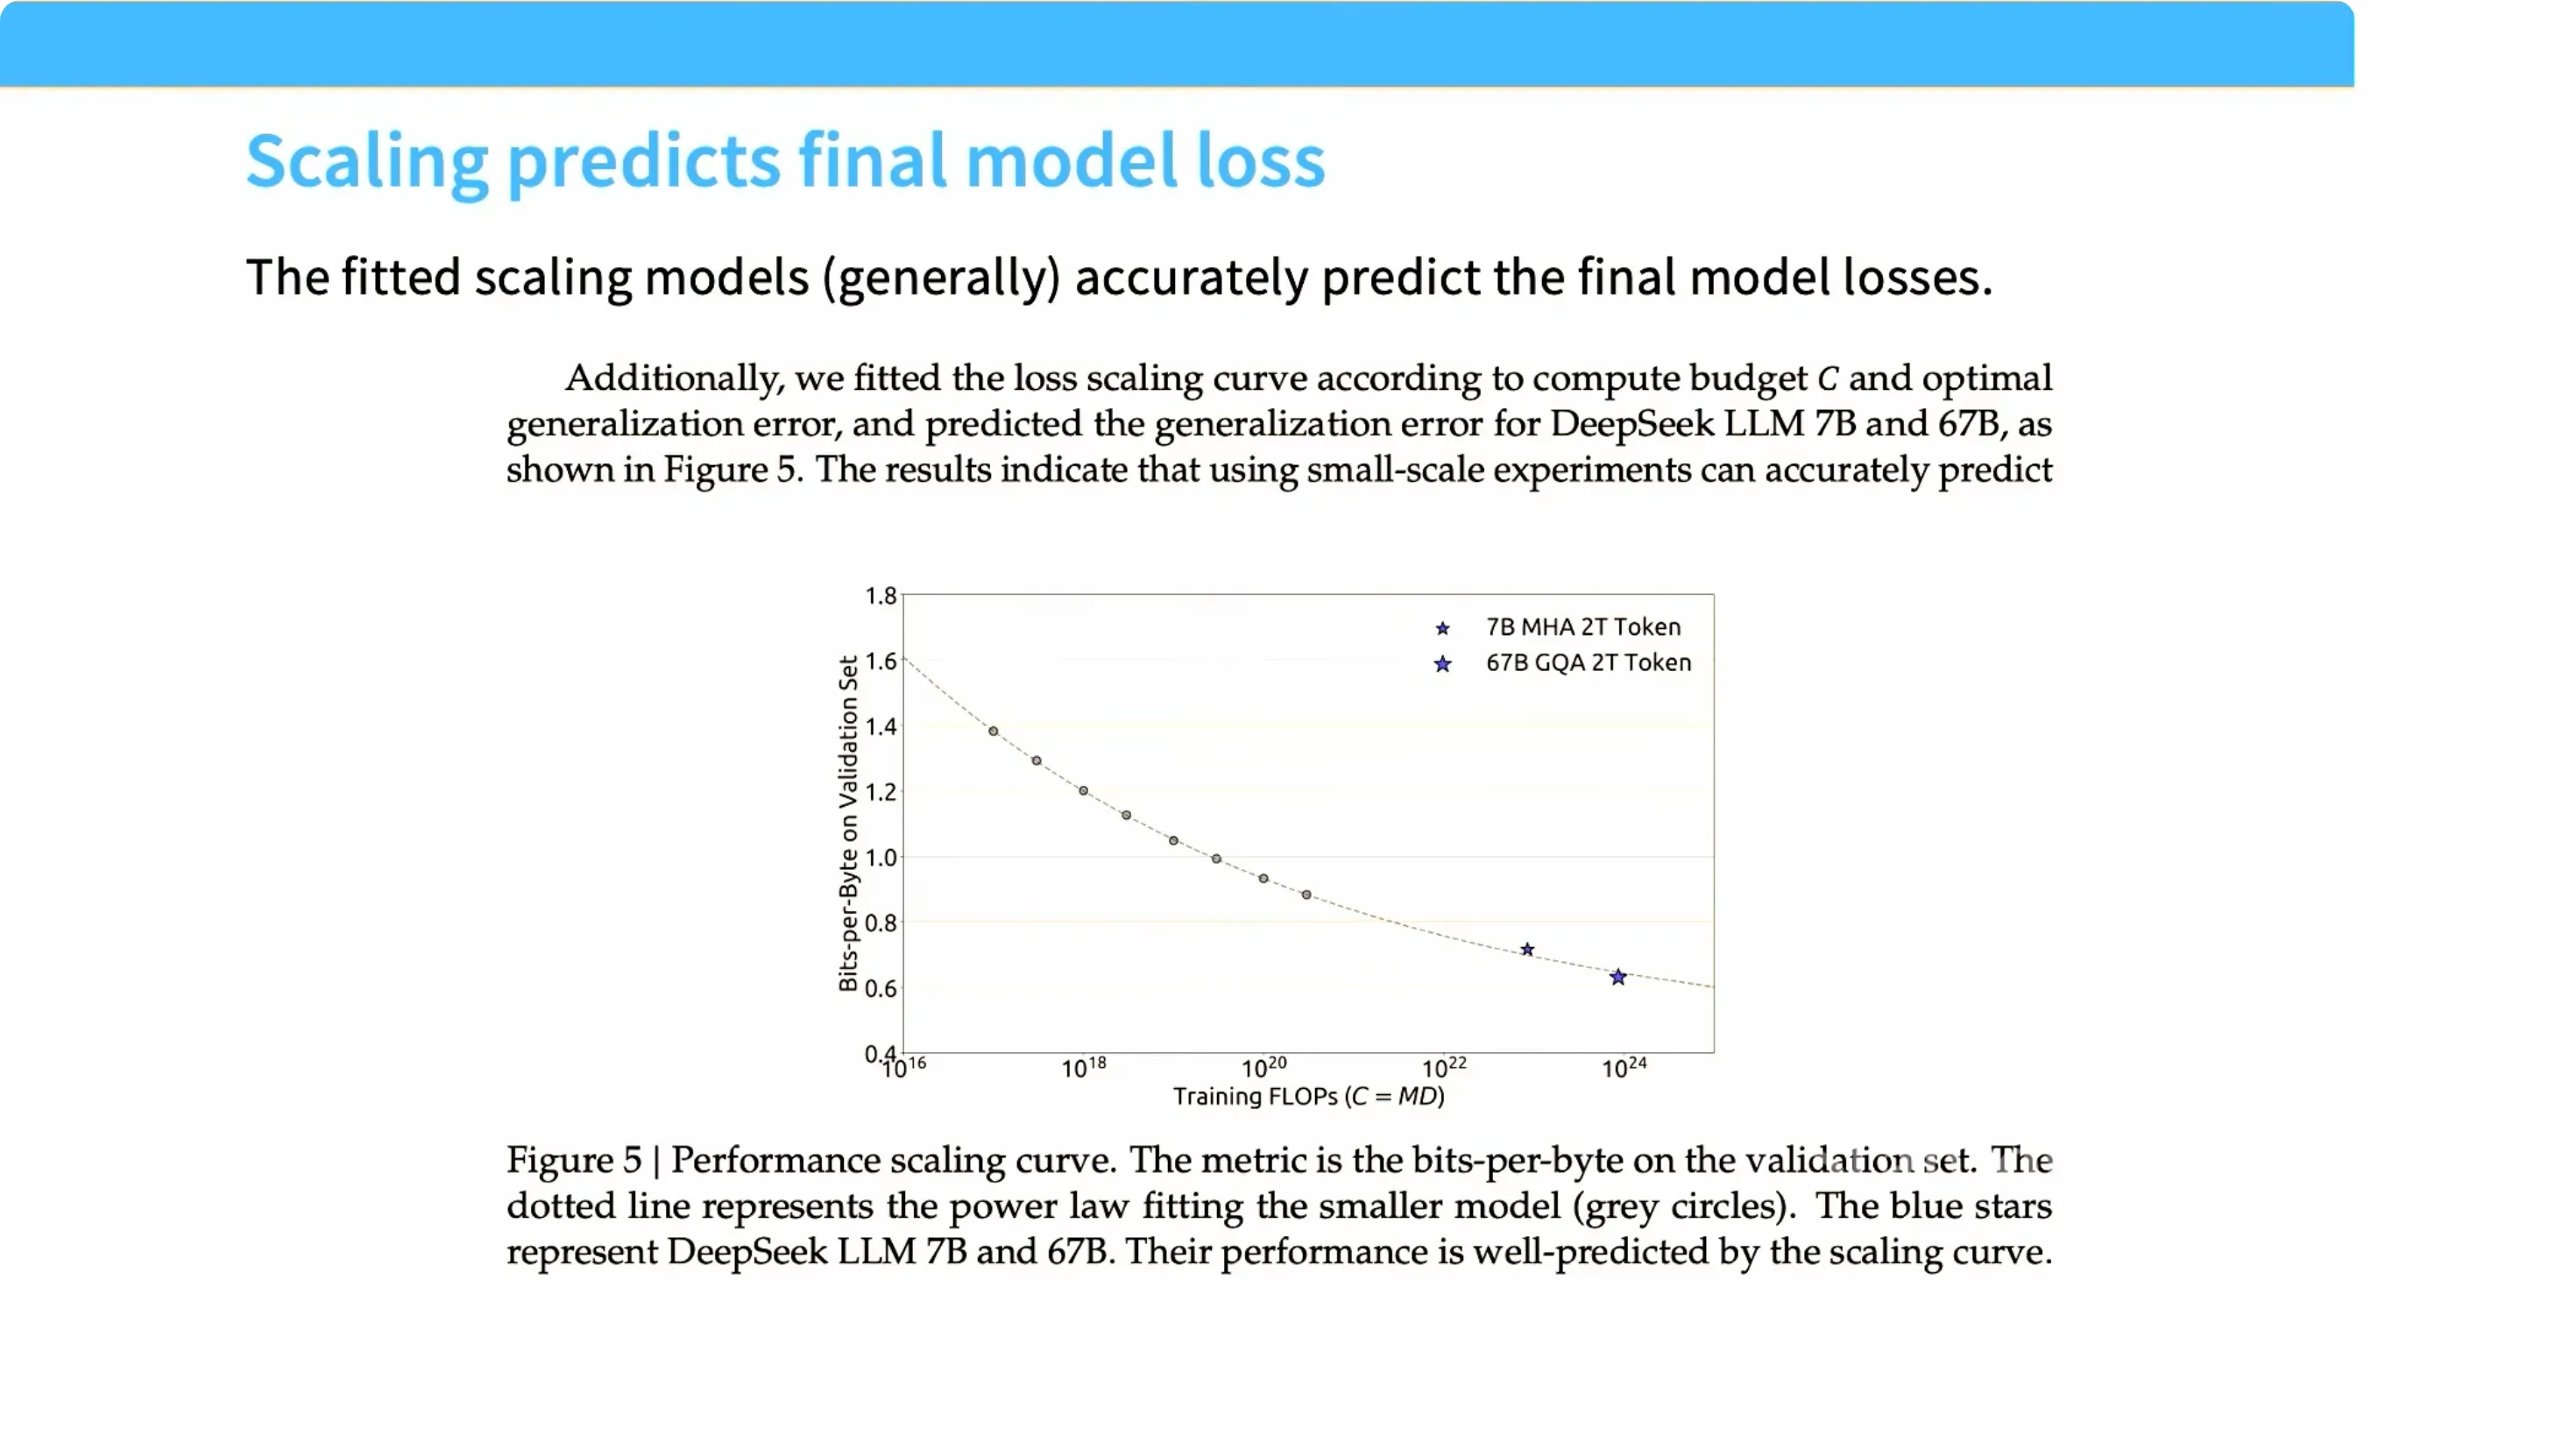
📷 DeepSeek 用缩放律外推预测实际训练模型(星星)的性能
回到原视频 (00:21:30)
最终"punchline":训练一批小的、精挑的模型 → 画出幂律 → 外推 → 得到非常接近真实的预测。图中两颗星星是实际训练的大模型,灰点是缩放律拟合。预测"可以更好,但已经相当不错"。这证明了 Chinchilla 定律确实被其他人在较大算力范围内复现了——该分析总体上是靠得住的。
编者说明:老师表达了一丝遗憾——这类"用缩放律预测实际大模型"的图,如今在开源发布论文里正变得越来越罕见。这引出了后面的核心观察:核心缩放机制已经"人人都会",所以很多公司不再详细展示。
四、更多开放模型的缩放实践
(参考时间: 00:22–00:29)
老师在这一节快速过了一遍多个开放模型的缩放工作,给出一个趋势全景。核心观点:
很多论文如今不再详细写缩放细节,因为核心机制(Chinchilla、学习率缩放)已经被普遍理解,展示它们已经不再有额外价值。
4.1 Qwen 2.5 与 Qwen 3
(参考时间: 00:22–00:23)
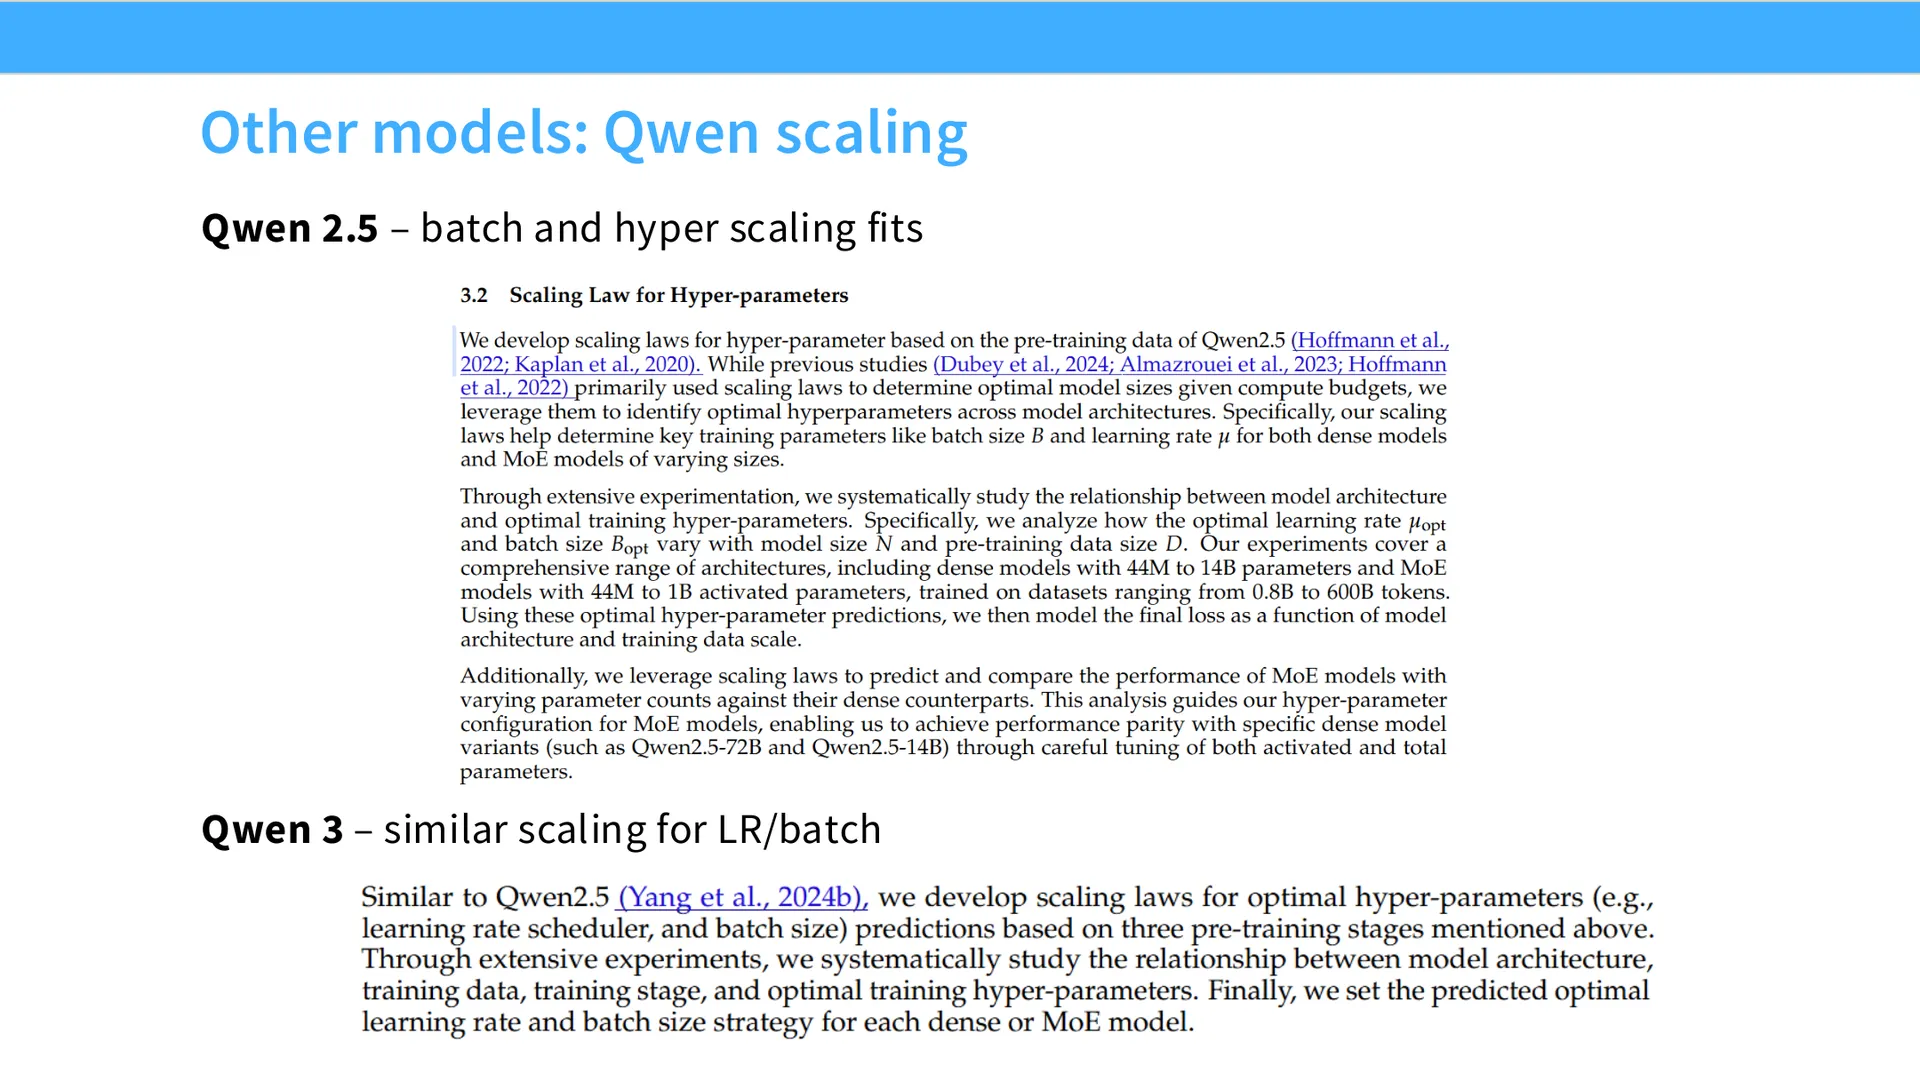
Qwen 2.5 的说法是:需要调优最优超参数(批量大小、学习率),于是做一批缩放实验找出最优点,拟合缩放律,预测最优点——而且能对 MoE 也这么做。这与 DeepSeek 的分析本质相同。
到了 Qwen 3,他们说:"我们在 Qwen 2.5 里已经搞清楚该怎么做,现在我们做一模一样的事。" 这说明这套流程已经成为非常标准的配方,用来锁定最优学习率和批量大小。
4.2 Chinchilla 2:MoE 缩放律
(参考时间: 00:23–00:24)
Chinchilla 2 是本讲涉及的最新论文之一,聚焦 MoE(混合专家)缩放律。问题是:如果全面转向 MoE,你需要知道训练的"激活参数"数量是否恰当。
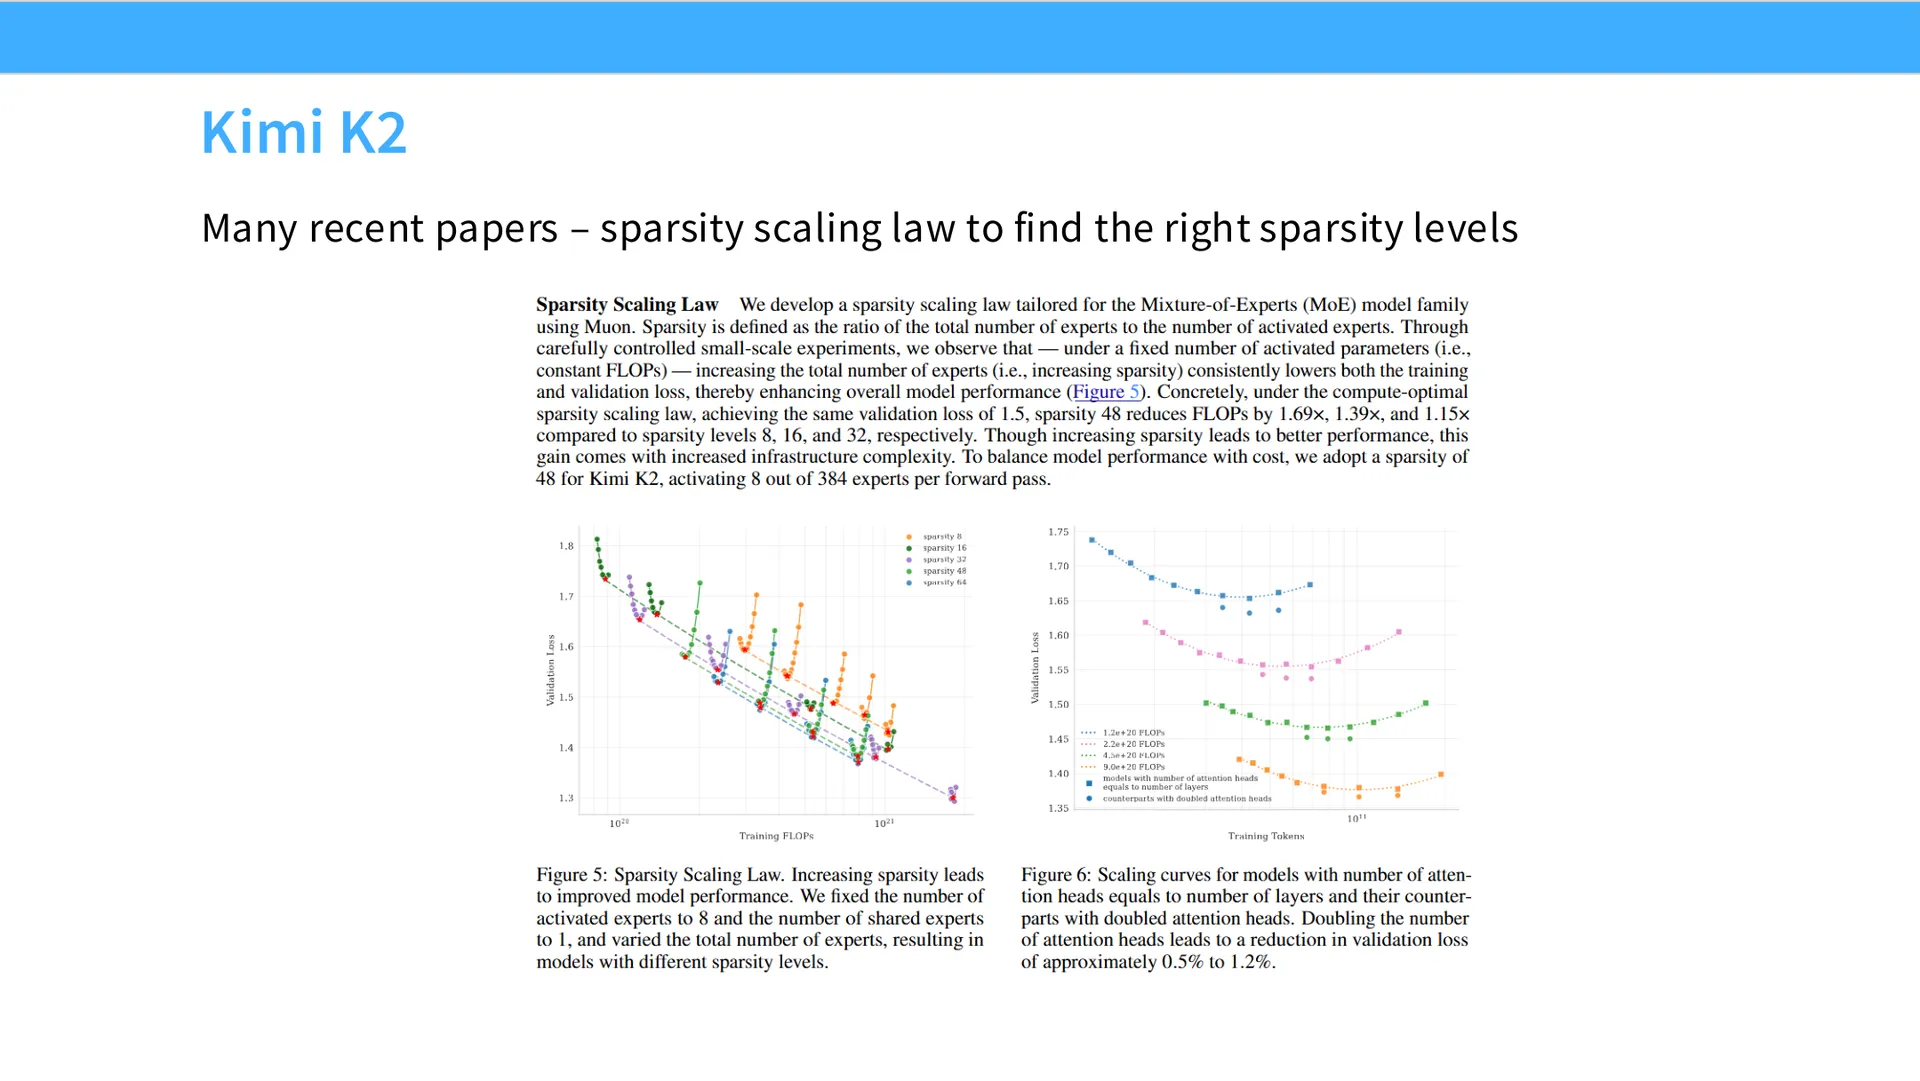
做法:改变 FLOPS,看损失,并对不同稀疏度(sparsity)水平重复,从而量化"稀疏度对损失是利是害"。结论是:
稀疏度越高,给定 FLOPS 下的验证损失越好——这不令人意外。但能够定量知道"稀疏度 ↔ 损失"的关系,就能让团队对"该放多少稀疏度进模型"做出更理性的决策。
他们据此选择稀疏度 48,因为在那一点上缩放损失已进入收益递减。
编者拓展|稀疏度(sparsity)与 MoE 在 MoE 中,每一层有 $N$ 个"专家",但每个 token 只被路由到其中 $k$ 个专家。总参数很大,但激活参数(active parameters)只有被选中的那些。稀疏度可以粗略理解为"总参数 / 激活参数"之比。稀疏度越高,同样算力下能塞进更多参数(知识容量更大),但路由和训练也更难。Chinchilla 2 的价值就在于:把"该用多稀疏"这个架构决策,建立在可量化的缩放规律之上。
4.3 Hunyuan(混元)
(参考时间: 00:25)
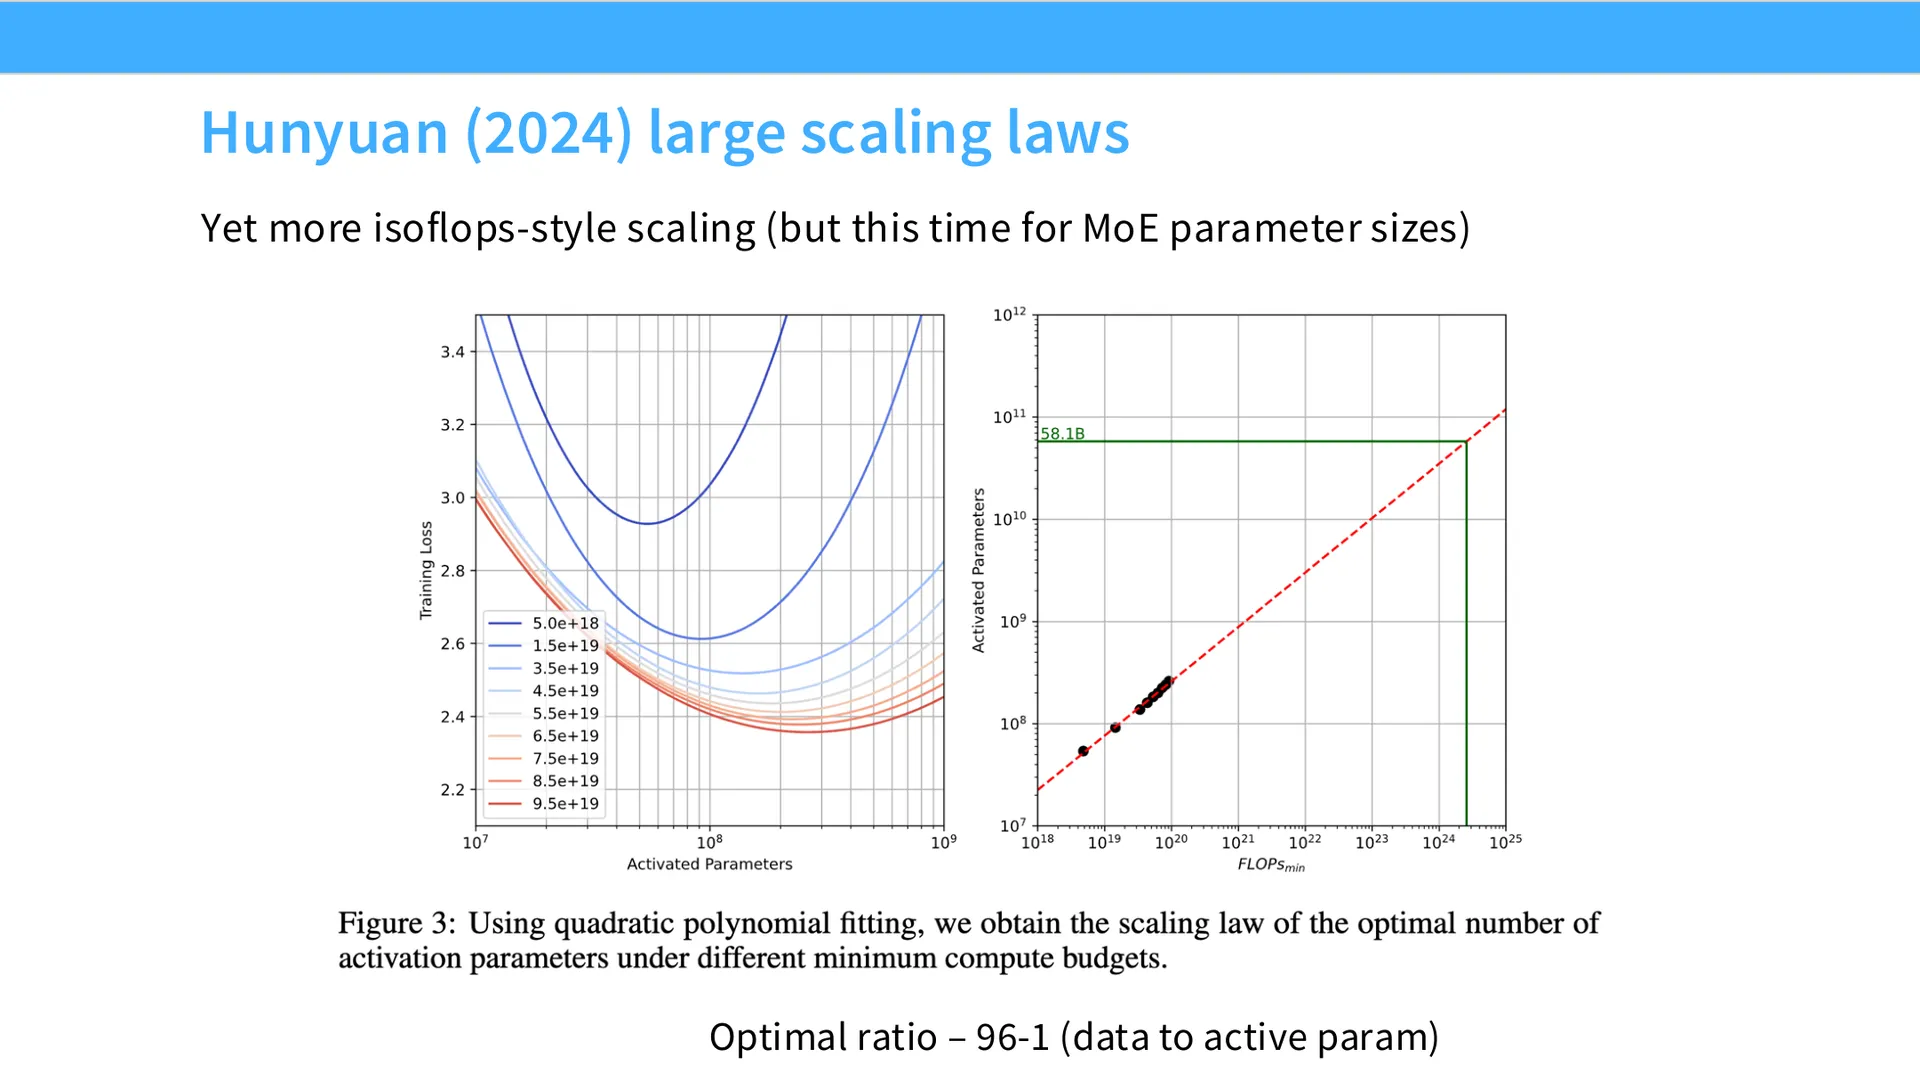
Hunyuan 也是一个几年前的开放 MoE,做了非常类似的事:一旦转向 MoE,就必须做 MoE 缩放律,搞清楚"激活参数数量"或"稀疏度"如何改变训练损失。他们最终得到大约 每个激活参数 96 个数据点 的比例。在 Hunyuan 的案例中,他们固定了稀疏度,所以稀疏度不是被搜索的变量。
4.4 Llama 3
(参考时间: 00:25–00:27)
Llama 3 也有一些不错的缩放律,但并不是特别有用的那种。它做等算力(iso-flop)缩放,得到的 token / 模型比例略有不同但大致相似。
Llama 3 在缩放方面最有意思的是右侧那张图:
📷 (讲师展示 Llama 3 的缩放图:左panel是对数损失随算力下降,右panel是下游准确率随对数损失上升的 S 型映射)
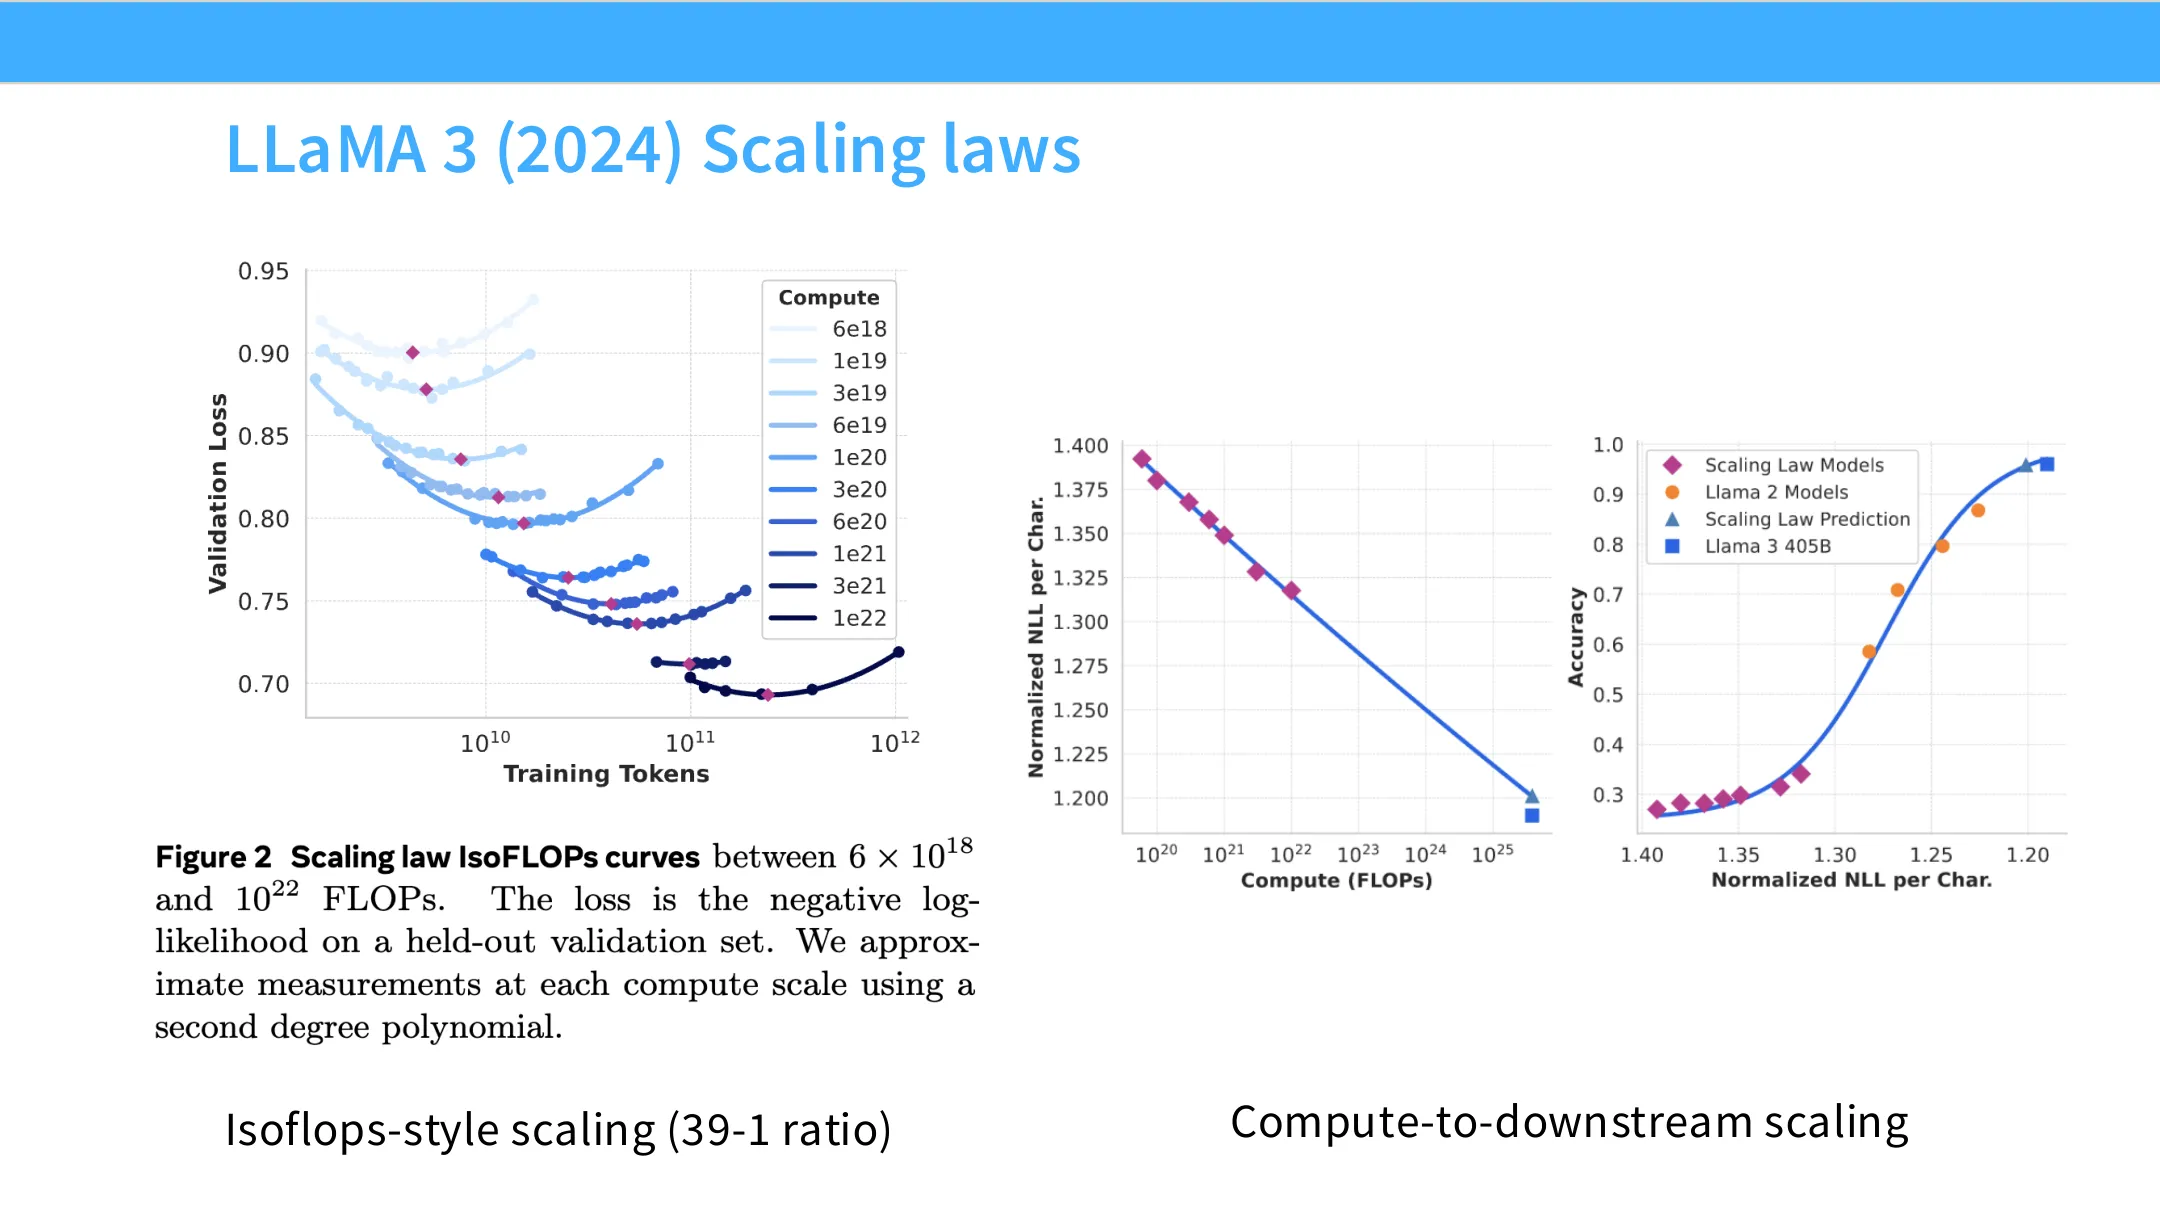
📷 Llama 3:从对数损失到下游准确率的 S 型映射
回到原视频 (00:26:00)
- 左图:算力越大,基准答案的对数概率(log prob)持续衰减——这是常规缩放律。
- 右图:对数损失越小,下游准确率越高。他们用一条 S 型(sigmoid)曲线去拟合那些紫色点。
老师说:你能看到点与曲线之间存在系统性偏差,所以不敢说这条曲线就是唯一真理;但它确实与"从损失到准确率的 S 型映射"一致。这一点非常有用,因为我们此前谈的只有对数损失,而在很多情况下,对数损失与下游准确率之间存在着紧密耦合。
4.5 MiniMax 01
(参考时间: 00:27–00:28)
MiniMax 01(去年)有一组漂亮的缩放实验,做的正是老师两讲前说过的缩放定律的一个实用价值:架构变体比较。他们想搞清楚:
- Lightning Attention(某种线性注意力架构);
- Softmax 版本(完整注意力);
- 混合版本(hybrid);
这三者在放大时会怎样?会不会某一种在大规模下明显变差?
他们复刻了 Kaplan 式的图:随 FLOPS 增加,学习曲线如何变化;不同算力下所需的参数量是否不同。
📷 (讲师展示 MiniMax 的架构缩放对比图)
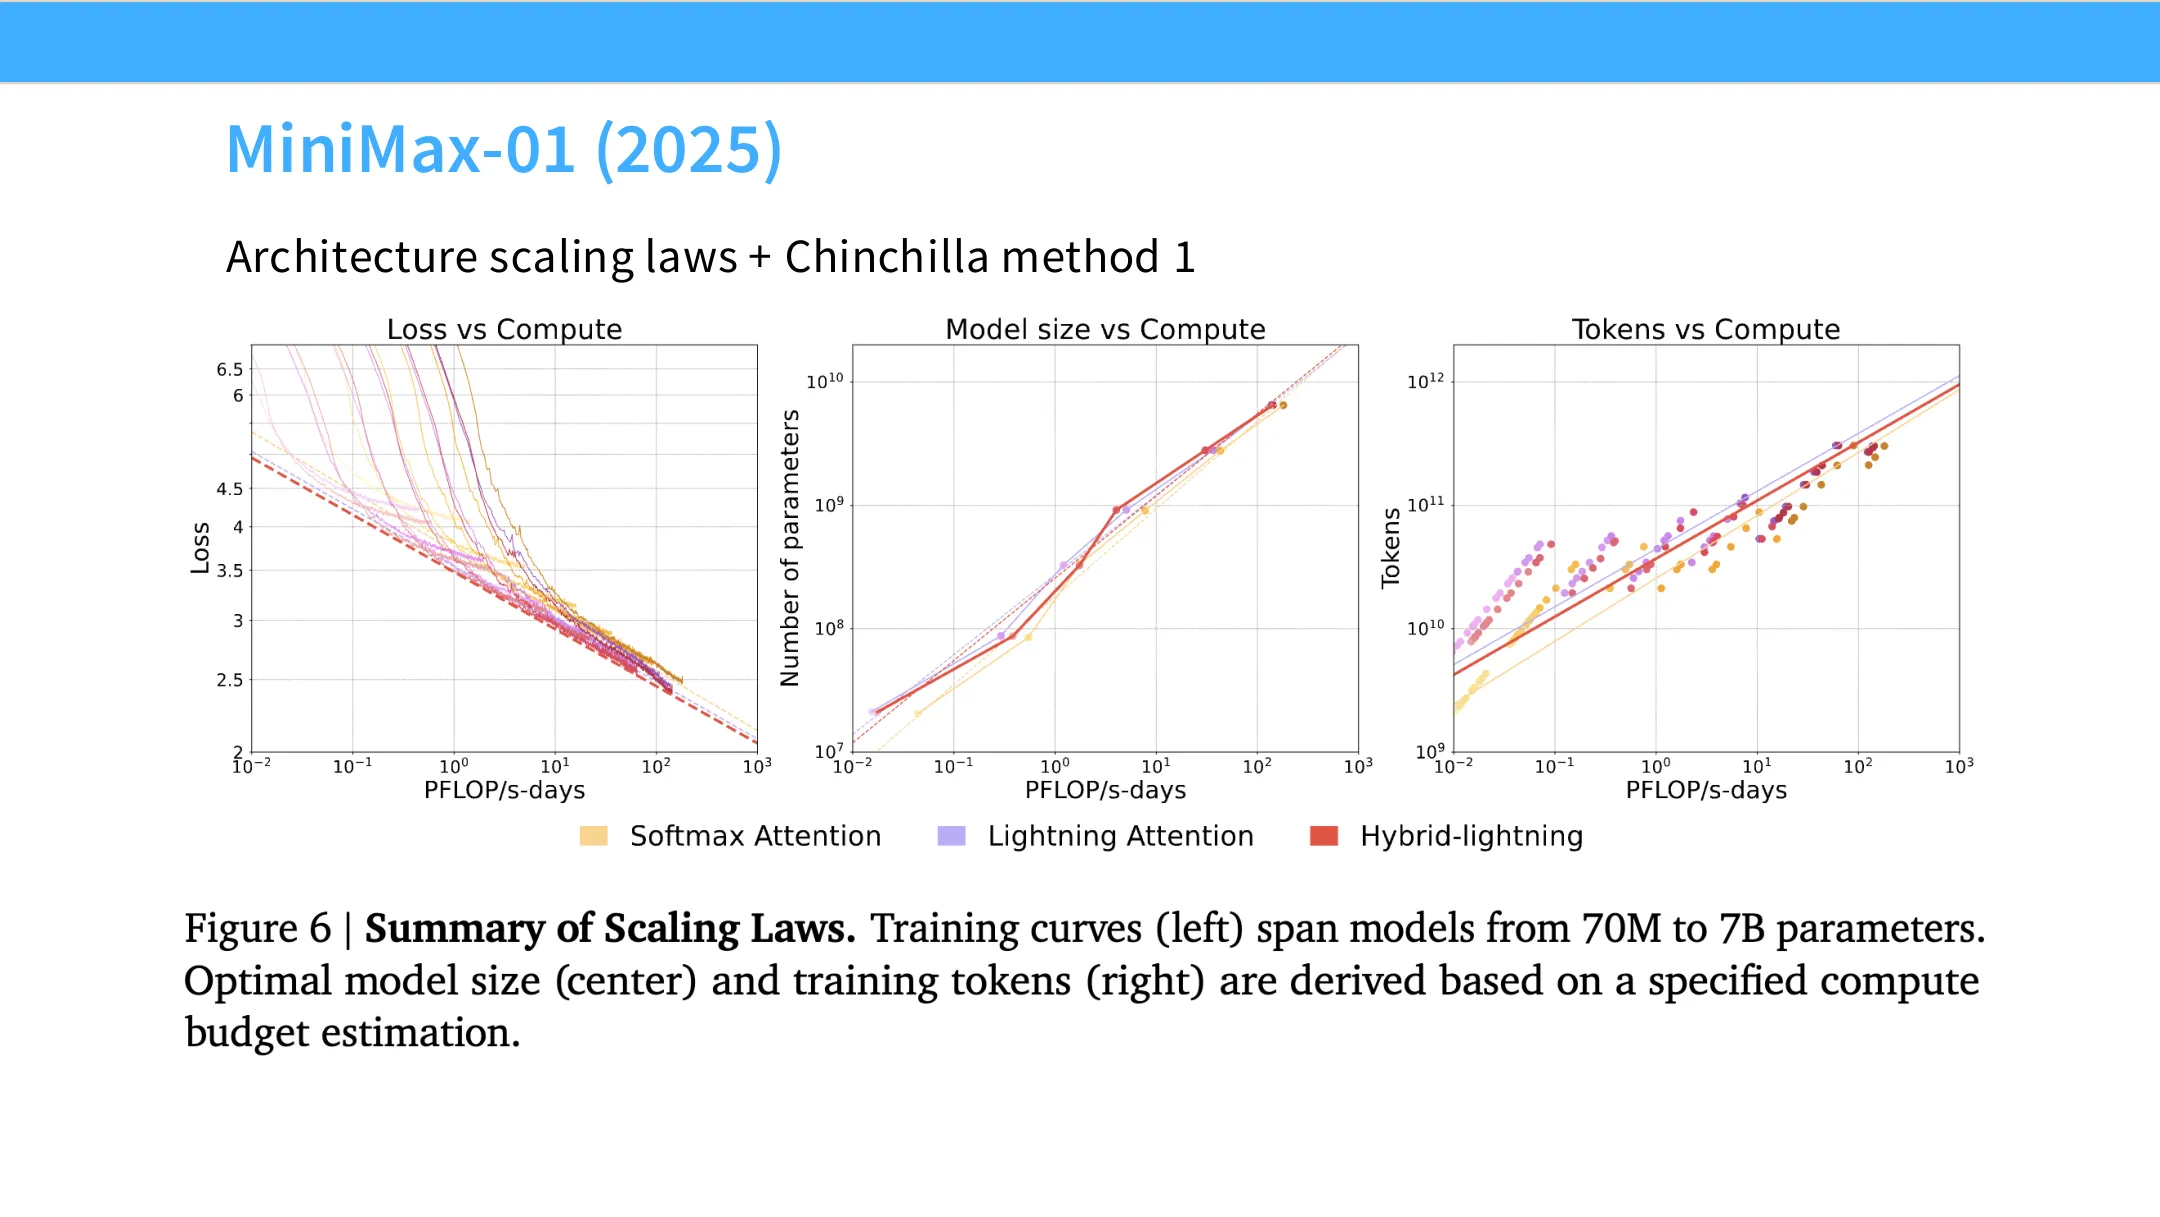
📷 MiniMax 对 hybrid / lightning / softmax 三种注意力架构的缩放对比
回到原视频 (00:27:50)
结论:大部分情况下三者相当,所需模型规模也相似。这组图被用来论证他们在实际部署系统里采用 hybrid 架构是合理的。
讲师点评:这正是"基于缩放定律做决策"的典型例子——你用它而不是用直觉来选架构。
4.6 第一部分的收束
老师总结第一部分的趋势:
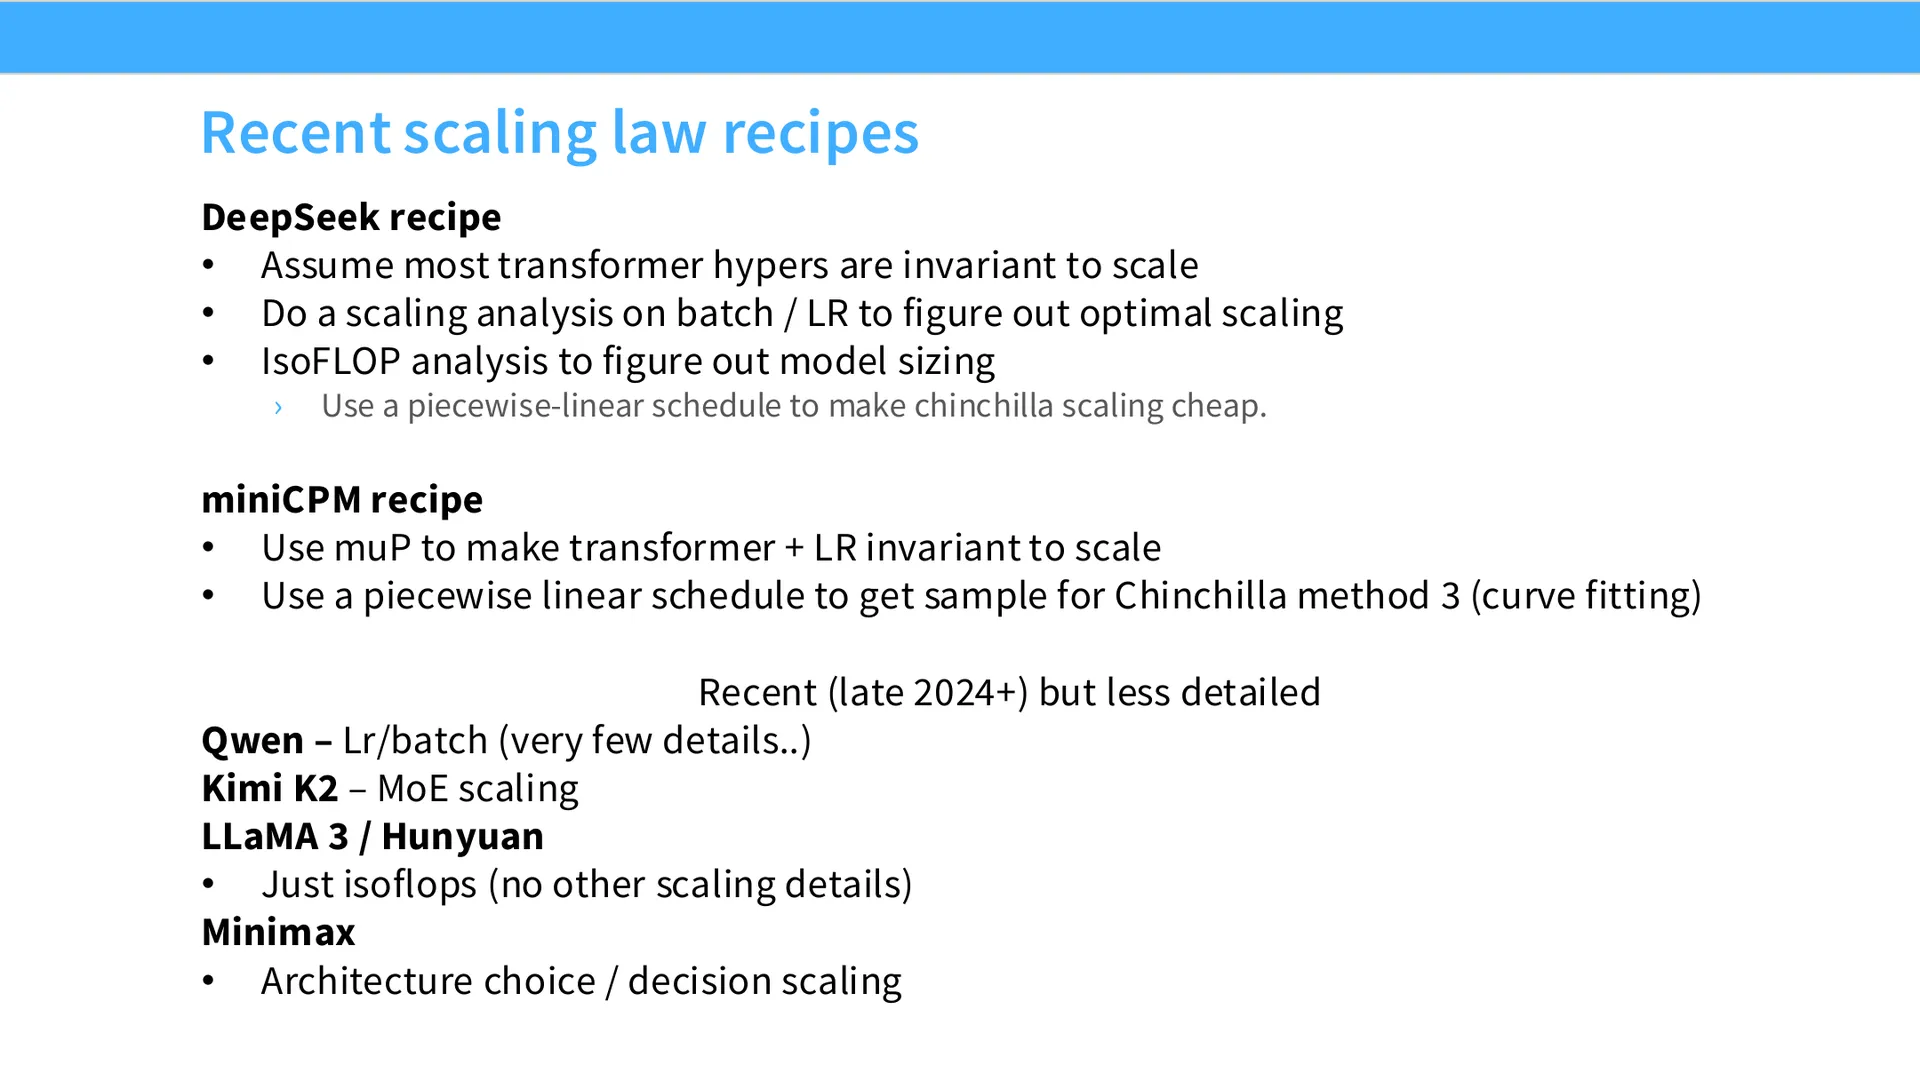
- DeepSeek 路线:对批量大小和学习率做缩放分析(scale-based 方法)。
- MiniCPM 路线:μP 风格,追求不变性(invariance)。
- Kimi、Qwen、Hunyuan:转向 MoE 时做 MoE 缩放实验。
- MiniMax:做架构层面的缩放工作。
- 多家在复刻 isoflops 分析。
回到之前那句:现在很多公司写得不那么详细了,因为核心缩放机制(Chinchilla、学习率缩放)已经人人皆知,展示它们"不再有额外价值"了。
五、学习率、批量大小与优化器的缩放
(参考时间: 00:30–00:39)
进入第二部分。老师指出,剩下的两部分干净地对应到两个实例:
- DeepSeek 的世界观:为学习率、批量大小和优化器做缩放律;
- MiniCPM 的世界观:重新参数化一切,让"规模"不再是需要担心的变量。
先讲如何正确地缩放学习率(DeepSeek 路线)。它将分为超参数部分和优化器选择部分。老师主要借鉴了 StepFun(阶跃星辰) 一篇相当新的预印本。
讲师评价:我不认为存在一篇真正可靠、鲁棒的关于超参数(尤其是学习率)的研究,但这一篇可能接近了。StepFun 的人训练并发布了可信的大模型,而且在这项缩放研究里烧掉了大量算力去网格搜索超参数空间。我会展示一些关于"学习率、批量大小如何影响下游损失"的有趣经验现象。
5.1 各家缩放公式"连输入变量都不一致"
(参考时间: 00:31–00:33)
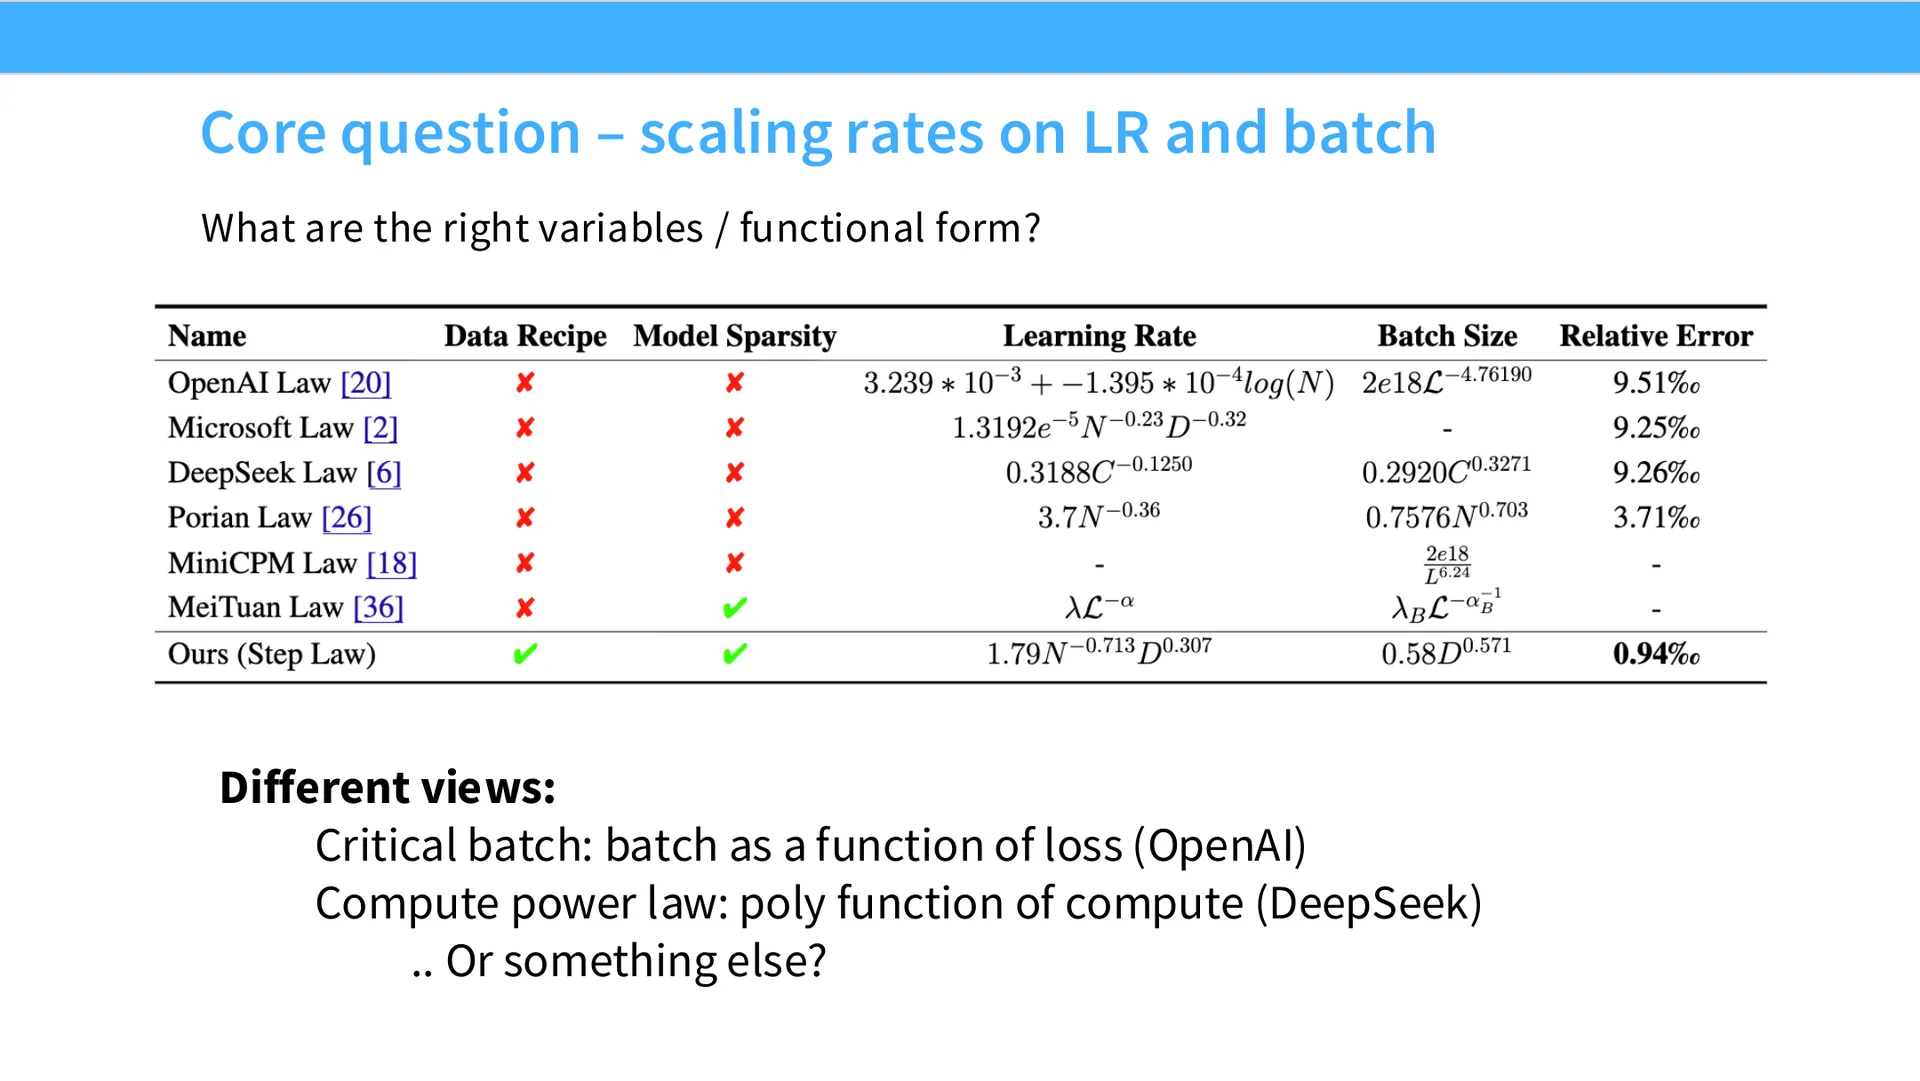
很多人用不同方式把学习率和批量大小表达为算力的函数。StepFun 那篇论文有一张很好的表,捕捉了这些差异。老师点出几个关键观察:
- 最上面一行是 OpenAI 的缩放定律(来自 Kaplan)。注意它的批量大小写成 $2\times10^{18} \cdot L^{\alpha}$ 这种形式 —— 其中 $L$ 是终端损失(terminal loss)。这就是临界批量大小(critical batch size):把批量大小表达为终端损失的函数。
- DeepSeek:我们刚看过,是基于算力同时给出学习率和批量大小的缩放律。
- StepFun:他们主张正确的批量大小缩放是数据的函数。
讲师的关键观察:这些公式连输入变量都不一致!OpenAI 用的是终端损失,StepFun 用的是数据量。这说明人们对"到底哪些变量该影响这些超参数"都没有共识。
因此老师提醒:不要把这张表的最后一行当作福音。很多结论是脆弱的(brittle),但这些实验和现象本身很值得学习。
5.2 高分辨率网格搜索:超参数空间是光滑的
(参考时间: 00:33–00:35)
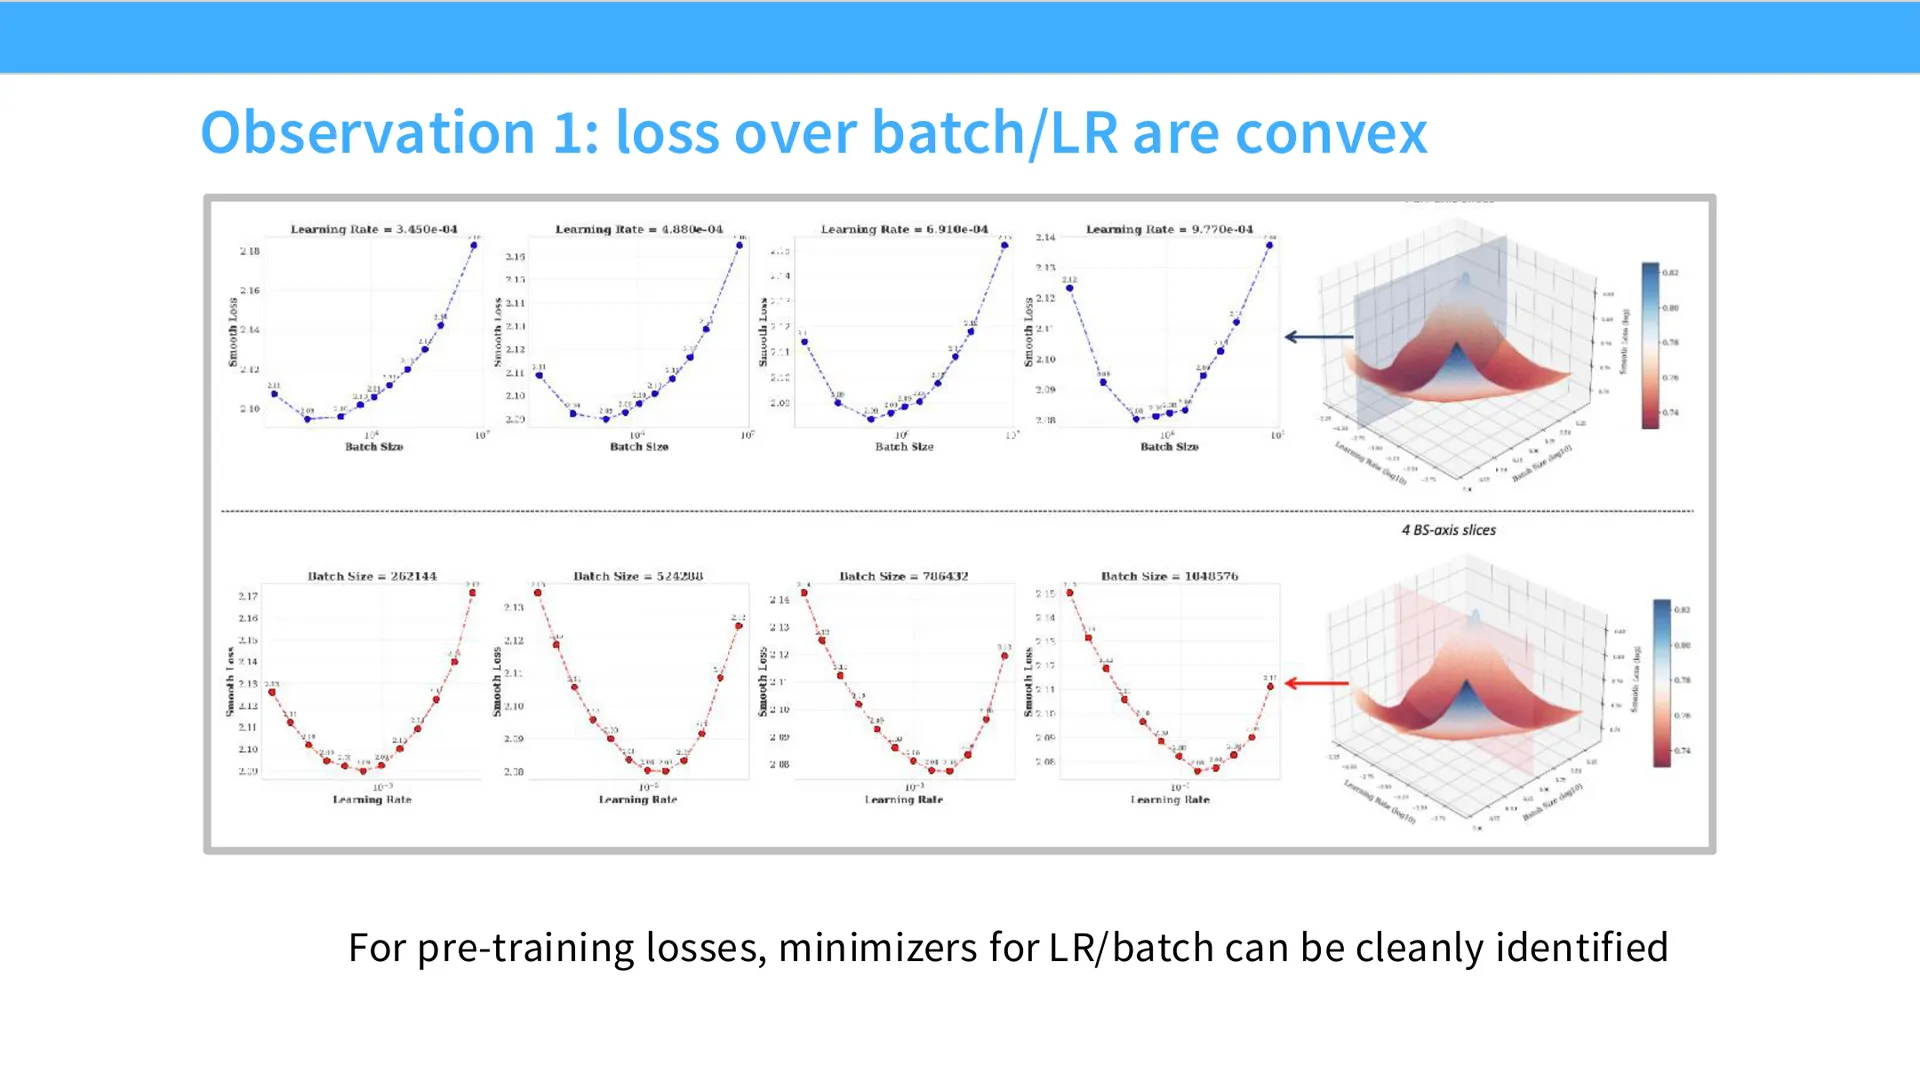
StepFun 的设计与 DeepSeek 很像:训练大量模型,把学习率空间和批量大小空间都网格化,并在多个模型规模和数据集规模上重复,以求在小模型上穷尽超参数空间、锁定最优点。
📷 (讲师展示 StepFun 在 1B 参数 / 100B token 的超参数等高线图与损失曲面)
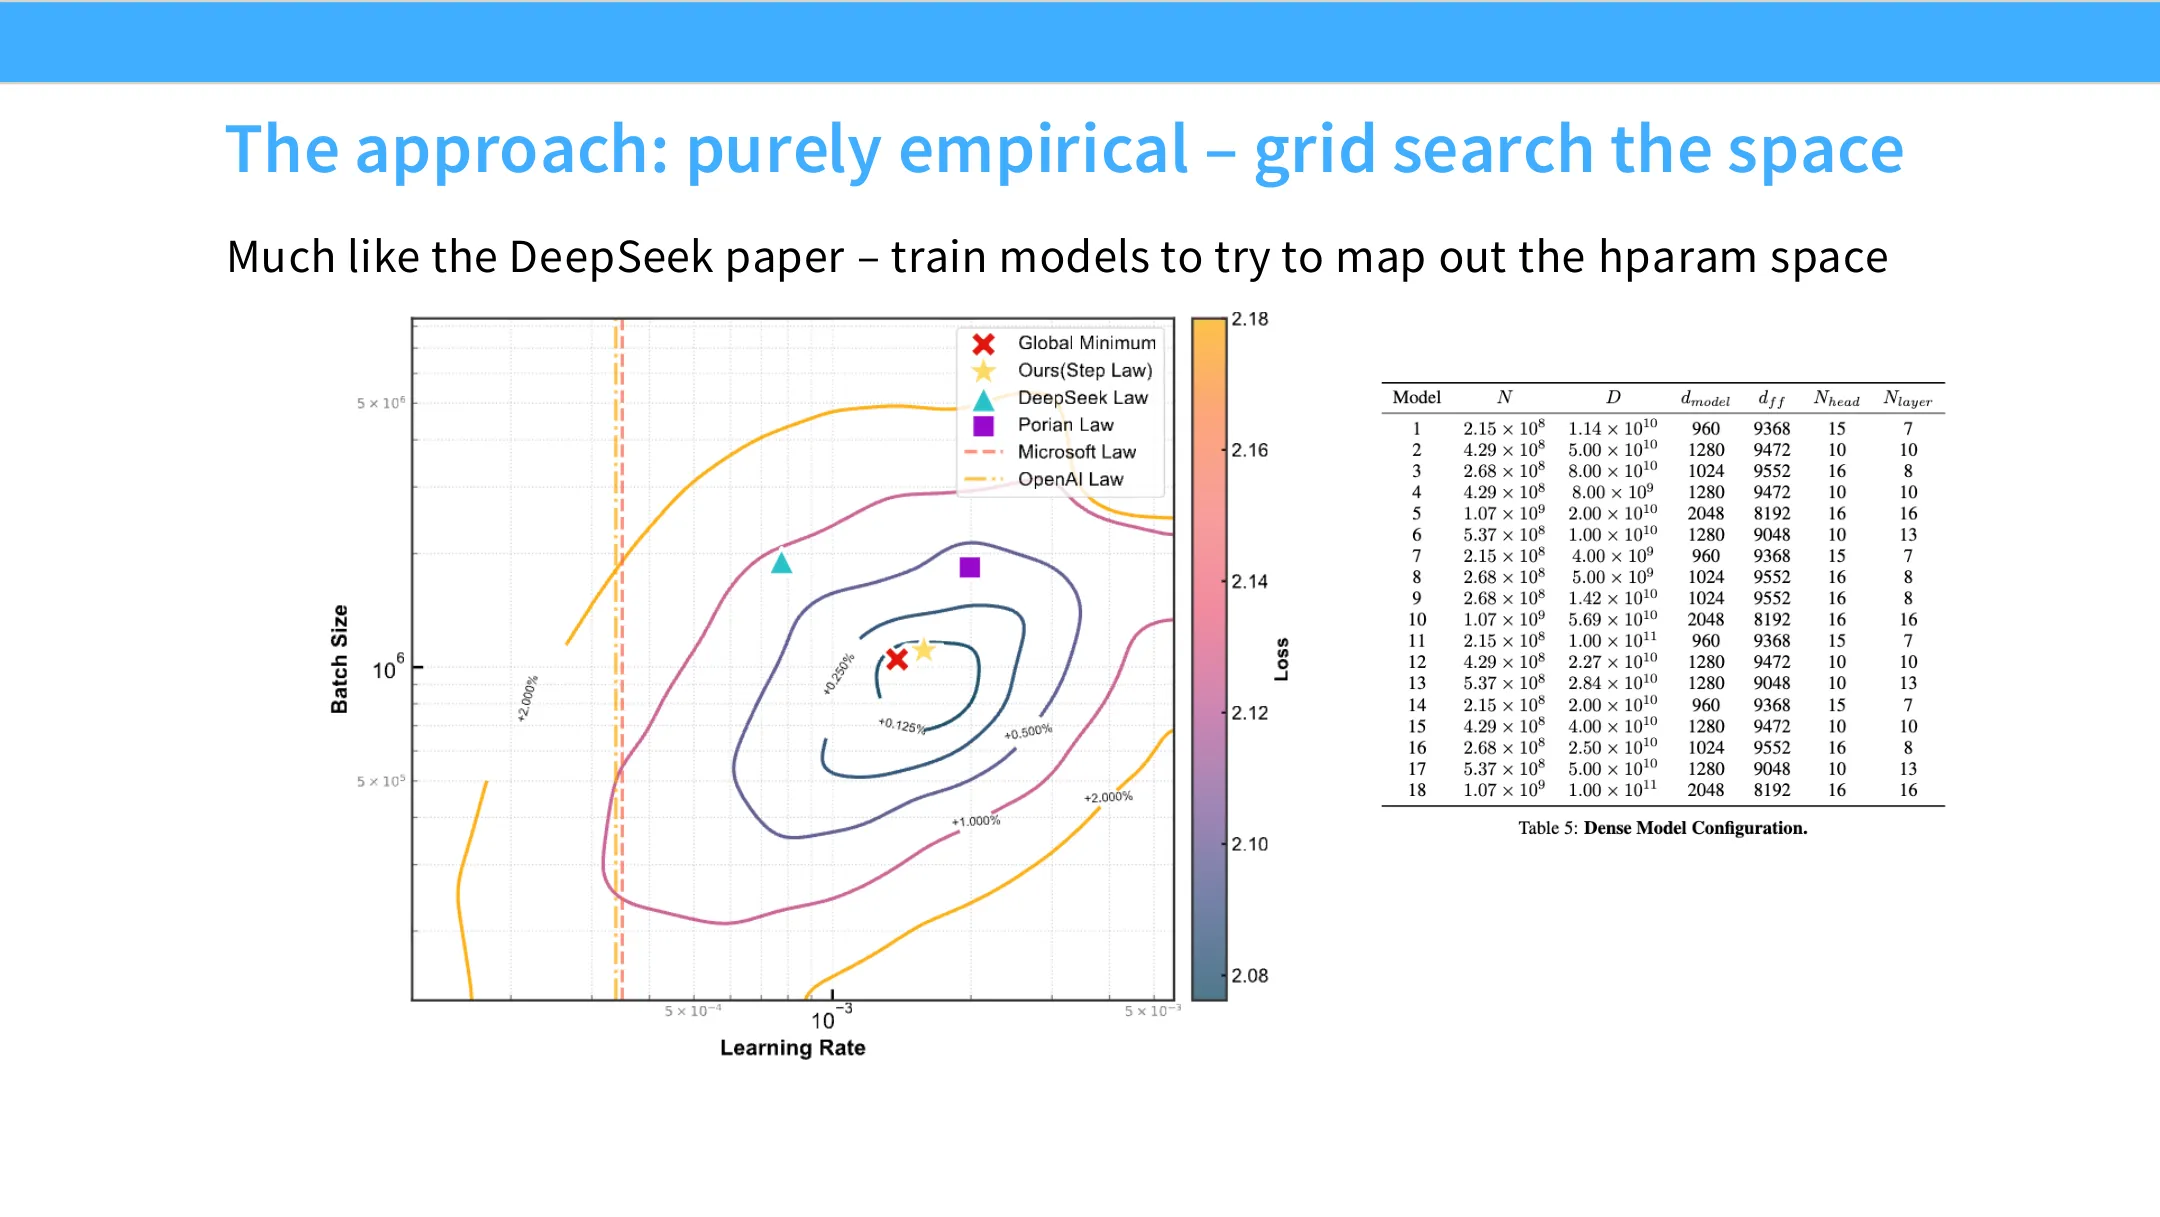
📷 StepFun 的超参数损失曲面:在 batch size × learning rate 平面上光滑且近似凸
回到原视频 (00:34:00)
在 1B 参数、100B token 的切片上,你能看到右侧的损失曲面随"批量大小 × 学习率"如何变化(固定数据量)。每个切片都相当光滑、近乎凸。老师强调这意味着:
- 你可以相当放心地搜索最优超参数,不会担心极小值离得太远;
- 如果曲面非常毛糙(jaggedy),你才会对"网格搜索空间是否可行"产生严重怀疑。
编者拓展|为什么"光滑性"这么重要? 如果超参数 → 损失的映射是光滑且近似凸的,那么:(1) 少量网格点就能可靠地定位极小值;(2) 邻近网格点之间可以插值;(3) 拟合出的缩放律更稳定。反之,如果曲面充满尖刺,网格搜索就变成"碰运气",缩放律也失去意义。光滑性是整个"缩放定律工程"能成立的隐含前提。
5.3 关键发现:最优批量大小只依赖数据量
(参考时间: 00:35–00:36)
老师认为这篇论文最重要的一个结论是:
最优批量大小,似乎只依赖于你训练用的总数据量。 不同模型规模的彩色点,大致落在同一条趋势线上——而且这是在双对数坐标下,所以你应期待某种幂律。
📷 (讲师展示:右图最优批量大小只随数据量变化;左图最优学习率随模型规模与数据量的关系更复杂)
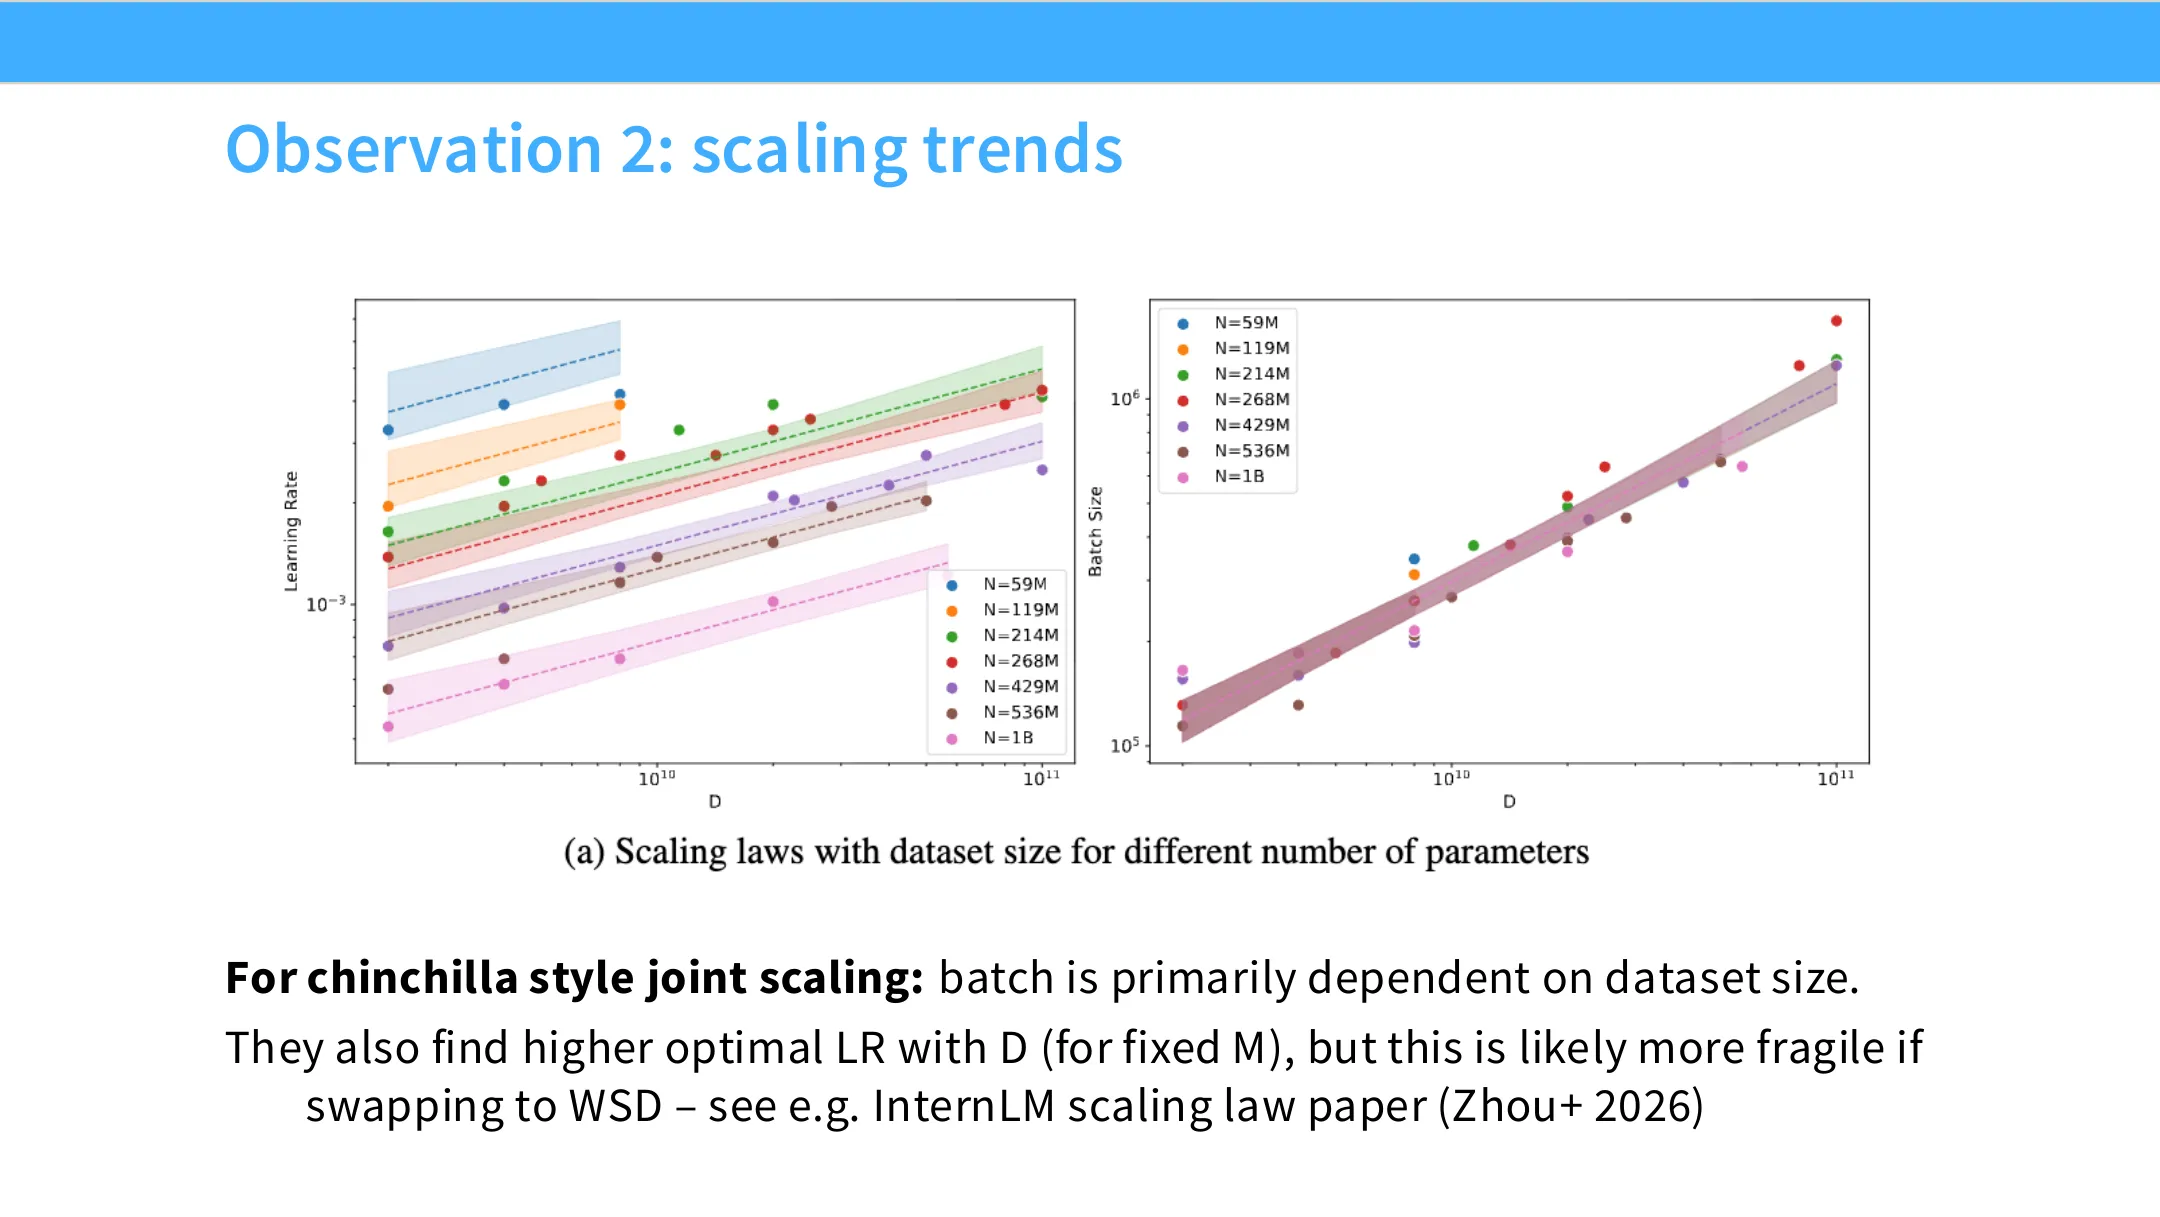
📷 最优批量大小仅依赖数据量;最优学习率随模型规模下降、随数据量上升
回到原视频 (00:35:30)
对照来看:
- 左图(最优学习率)行为很不同:
- 模型越大 → 最优学习率越小;
- 数据越多 → 最优学习率越高(老师坦言这个方向有点反直觉)。
老师指出:这个"学习率随数据量上升"的结论可能有点脆弱,因为有别的论文主张数据量 $D$ 的依赖方向应该反过来。但至少在这个实验里,趋势相当清晰。
5.4 学习率其实相当鲁棒;它也能迁移到 MoE
(参考时间: 00:36–00:37)
- 学习率相当鲁棒:老师现场做了个非正式投票——"如果明天让你训一个模型,学习率是 $10^{-3}$ 还是 $10^{-4}$?"大家大致有个感觉,知道这个范围是不错的起点。这一点普遍成立。
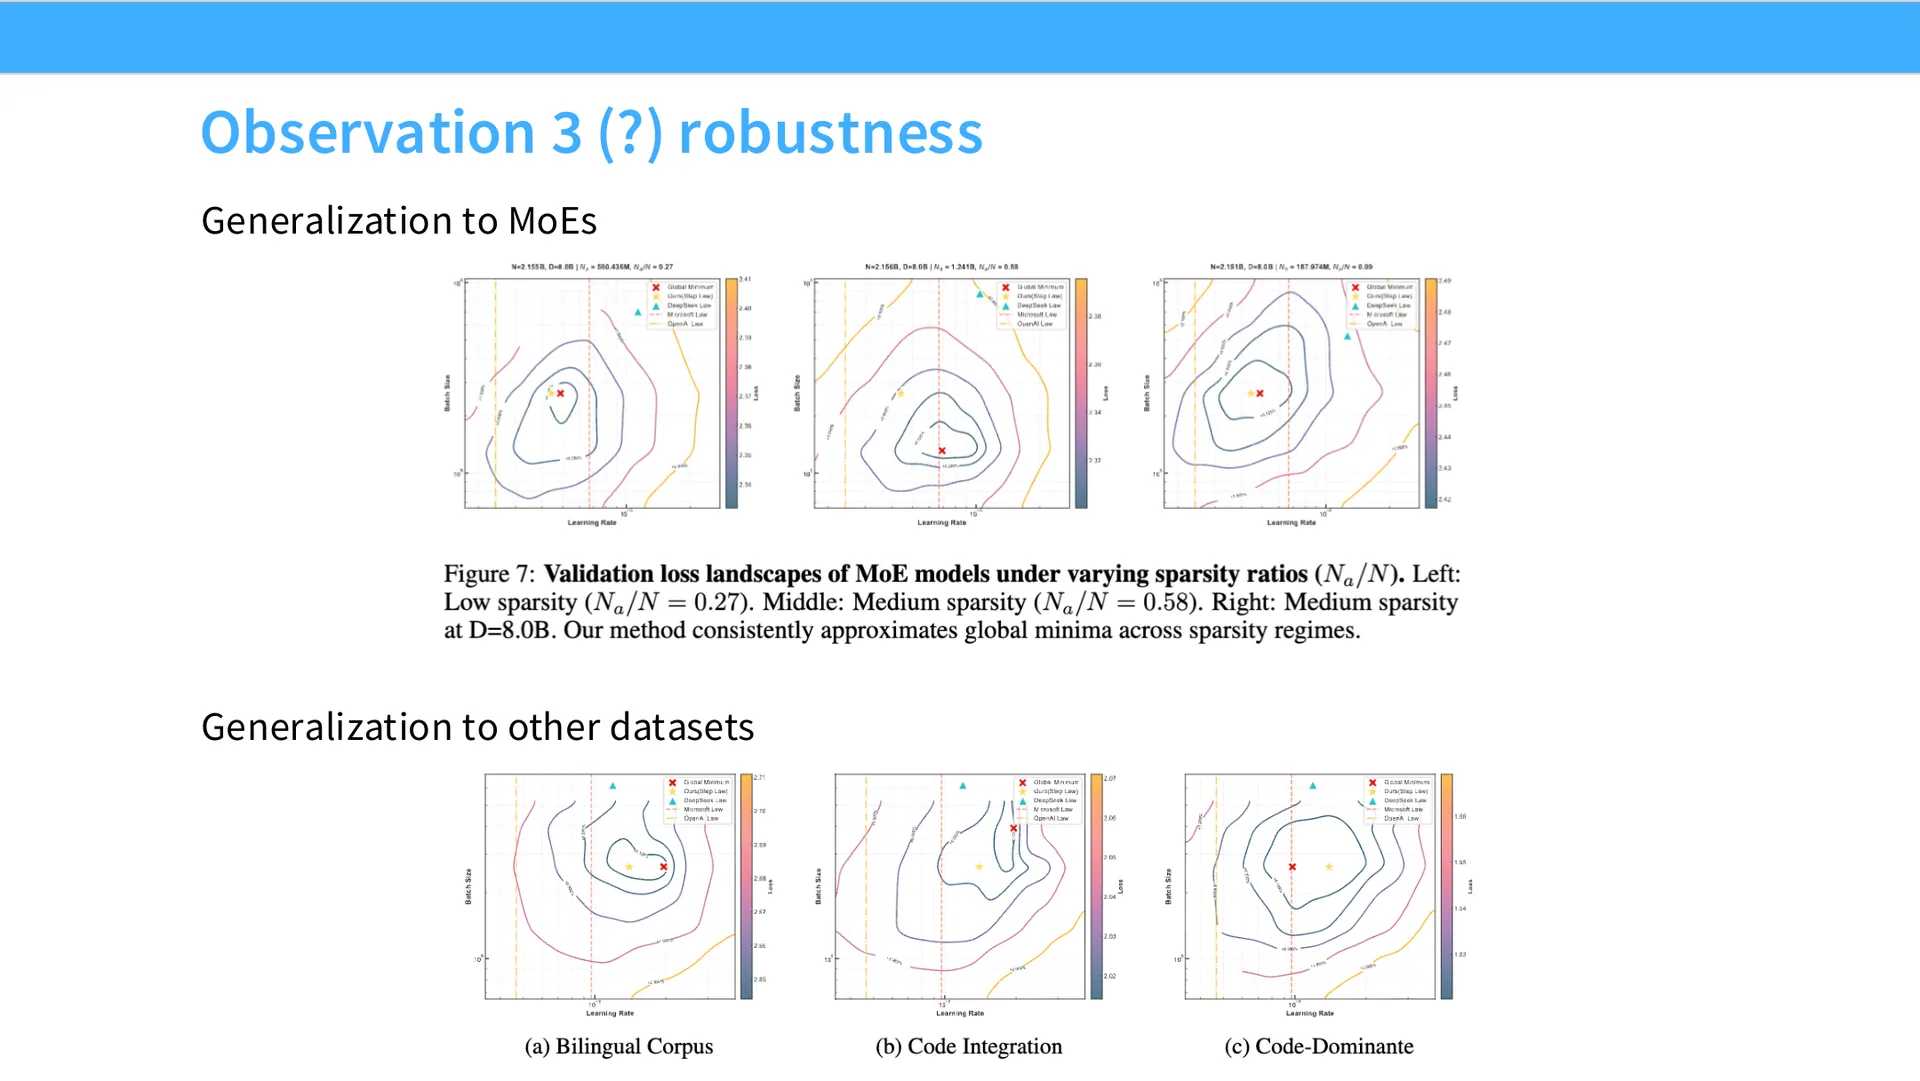
- 缩放律能迁移到 MoE:图中的黄色星星是缩放律的预测,红色叉是直接在 MoE 上求出的最优值。只要你大致控制了激活参数量,切换到 MoE 不会得到很不同的缩放律。
- 更"微妙"的一点:当你改变训练数据时,最优学习率和最优批量大小会轻微移动。这意味着这些现象很可能是"条件性"(contingent)的——公式里的具体数字依赖于你训练的数据,比人们以为的更强。
📷 (讲师回顾总结那张"简单缩放律公式"的幻灯片)
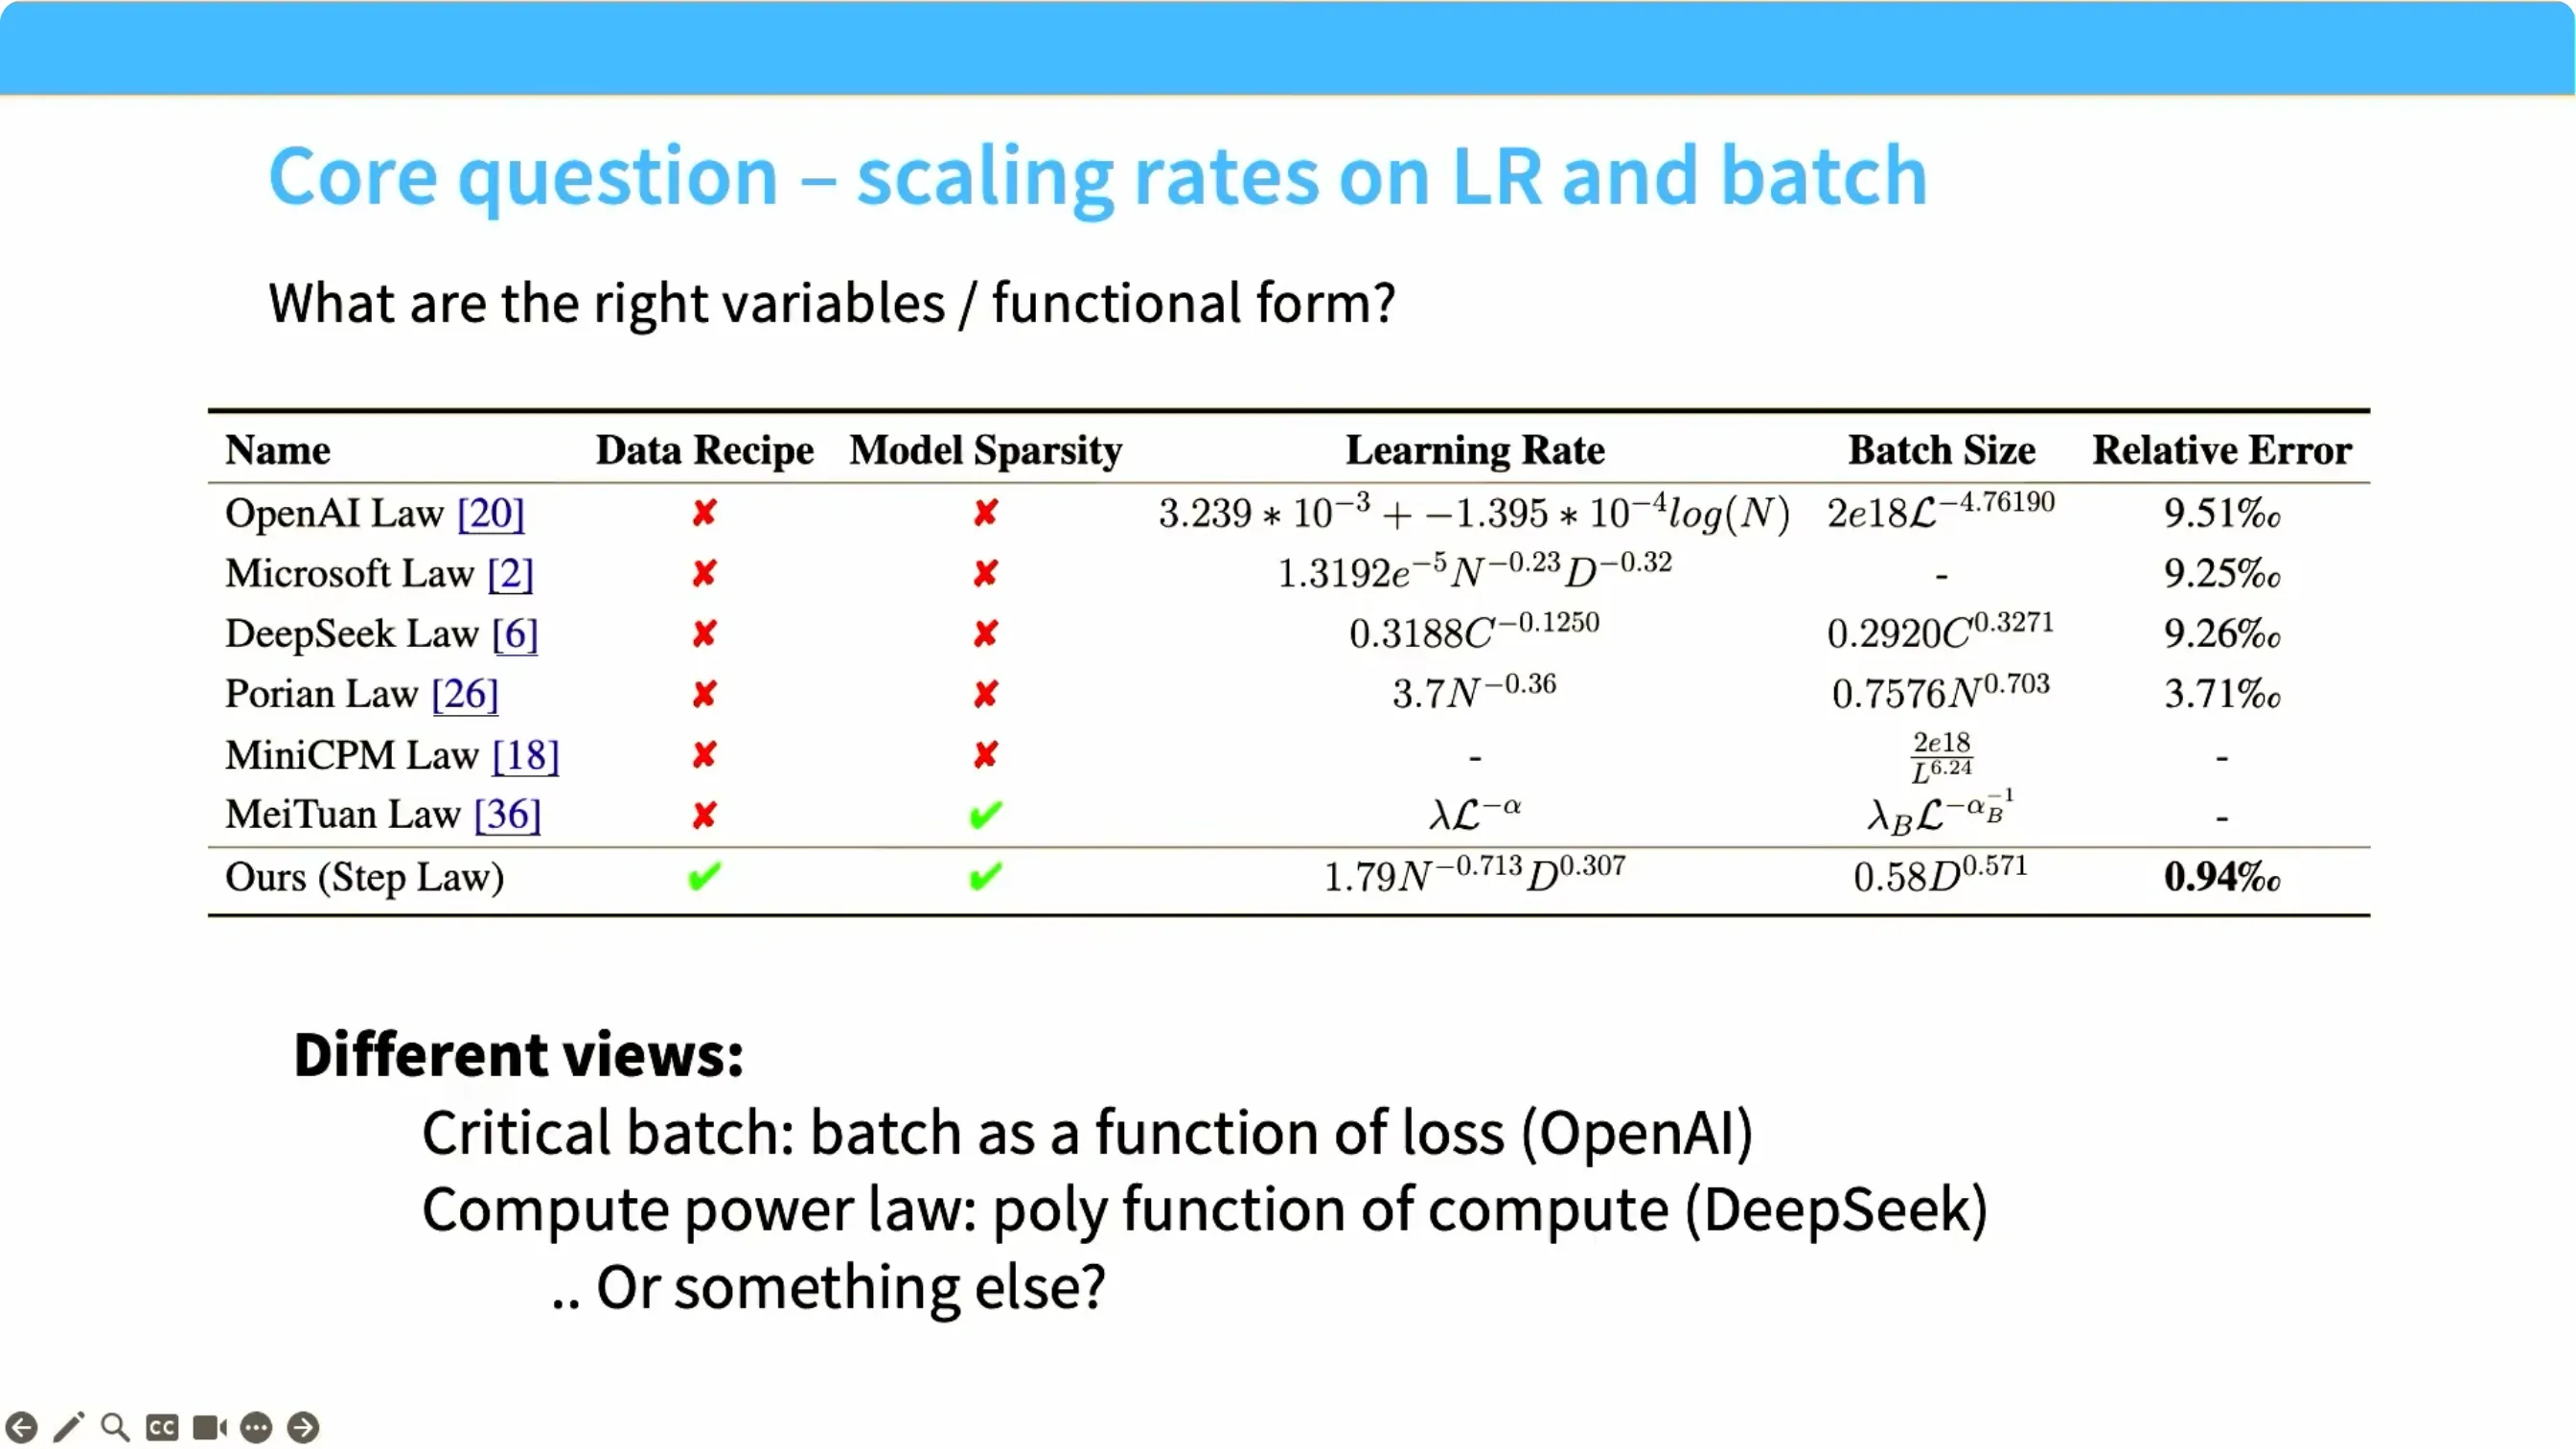
📷 最终得到的一组简单缩放律:批量大小 ~ √D,学习率随批量/数据上升、随模型规模下降
回到原视频 (00:38:30)
最终你得到一组简单的缩放律:
- 批量大小 大致是 $\sqrt{\text{数据量}} \times \text{常数}$——即批量大小随数据量的平方根增长;
- 学习率随批量大小 / 数据量上升,但随模型规模下降。
为什么这不算太疯狂? 老师解释:这些实验常常假设 Chinchilla 式缩放,此时 $N$(模型规模)和 $D$(数据量)都随算力变化,而且随算力上升,学习率应该下降。所以最终你会得到类似 DeepSeek 定律的东西——学习率随算力下降、批量大小随算力上升,只是指数不同。
编者拓展|用 Chinchilla 把两条趋势"抵消"起来看 记最优学习率 $\eta^*(N, D)$,其中 $N$ 随规模上升、$D$ 随规模上升。StepFun 的观察是 $\eta^*$ 随 $D$ 上升、随 $N$ 下降:
$$\eta^* \propto \frac{D^{\,a}}{N^{\,b}} \quad (a,b>0)$$
而在 Chinchilla 缩放下,$N$ 和 $D$ 都由算力 $C$ 驱动($N \propto C^{0.5}, D \propto C^{0.5}$)。于是把两者代入,$\eta^*$ 对算力的净依赖就是一个幂律——正是 DeepSeek 定律所描述的"学习率随算力下降"。
5.5 课堂问答:该套用他人的缩放律,还是自己做 grid search?
(参考时间: 00:40–00:41)
同学问:我们是不是应该直接套用已有的缩放律,而不是自己跑 grid search?
老师回答(要点):
- 这取决于你处于什么算力区间、以及你有多需要"调准"。
- 如果你恰好处在 StepFun 跑网格的算力区间附近,他们的公式很可能是很好的默认值——他会赌这个公式胜过自己拍脑袋。
- 但如果你要做一个大的预训练运行,你大概会有细微差异:比如有人说"我的架构权重衰减很大",而我们并不知道这些东西是否会以相同方式缩放。所以你可能想把很多东西重做一遍。
- 这也解释了为什么那些报告都在重新做 Chinchilla、重做这一切——因为有足够多的细微差异,人们想确认自己的设置与这些结果在一阶意义上大致相符。
老师金句:缩放定律有一种非常科学的观感(拟合直线、外推),但归根结底,缩放定律的一大半仍然是"vibes"(直觉)。它就是在问:"我真的相信 StepFun 那篇综述的实验设置与我的足够接近、因而可以迁移吗?"——我们根本无从知晓,总会有微小差异。
六、优化器:从 Adam 到 Muon 的规模化故事
(参考时间: 00:39–00:57)
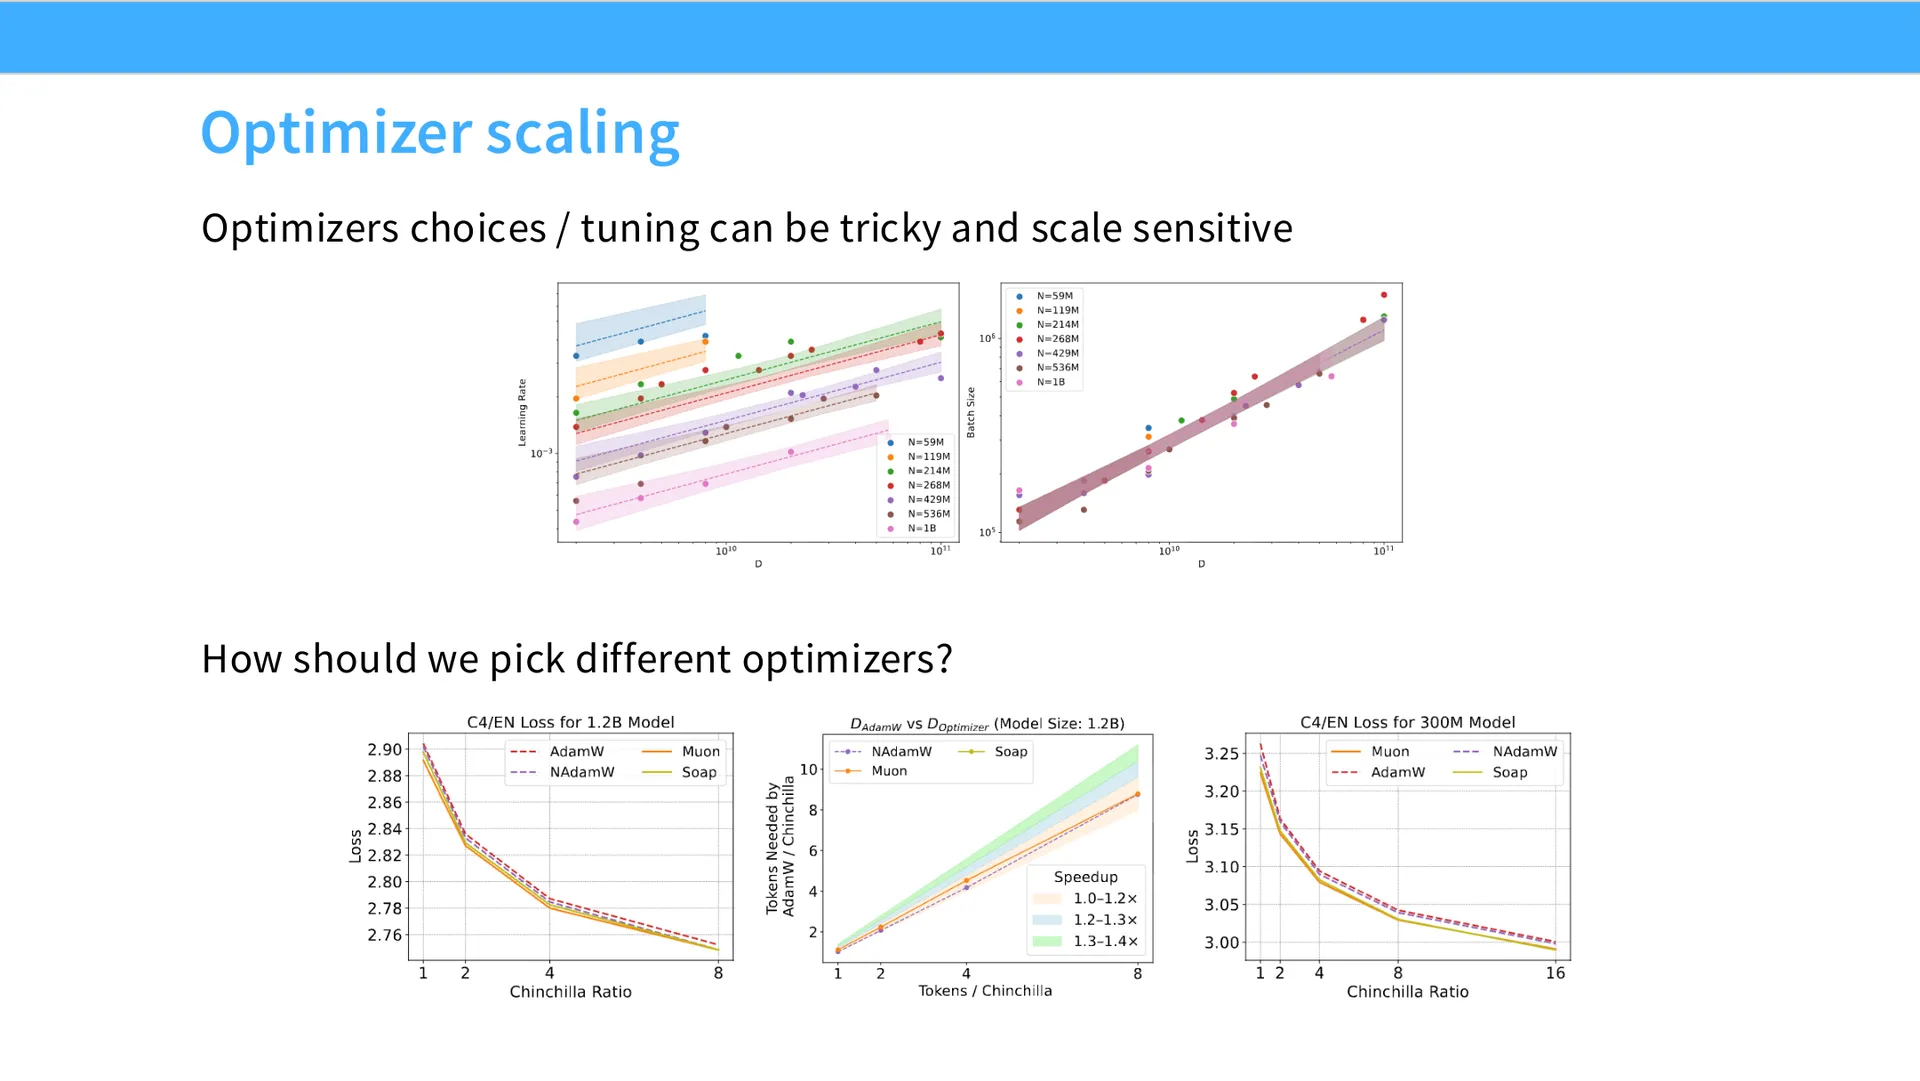
老师说他没能在架构那一讲里讲优化器(那讲已经太满),但"如果我不讲优化器,对你们是失职"。优化器是规模敏感的,所以放在这里讲正合适。
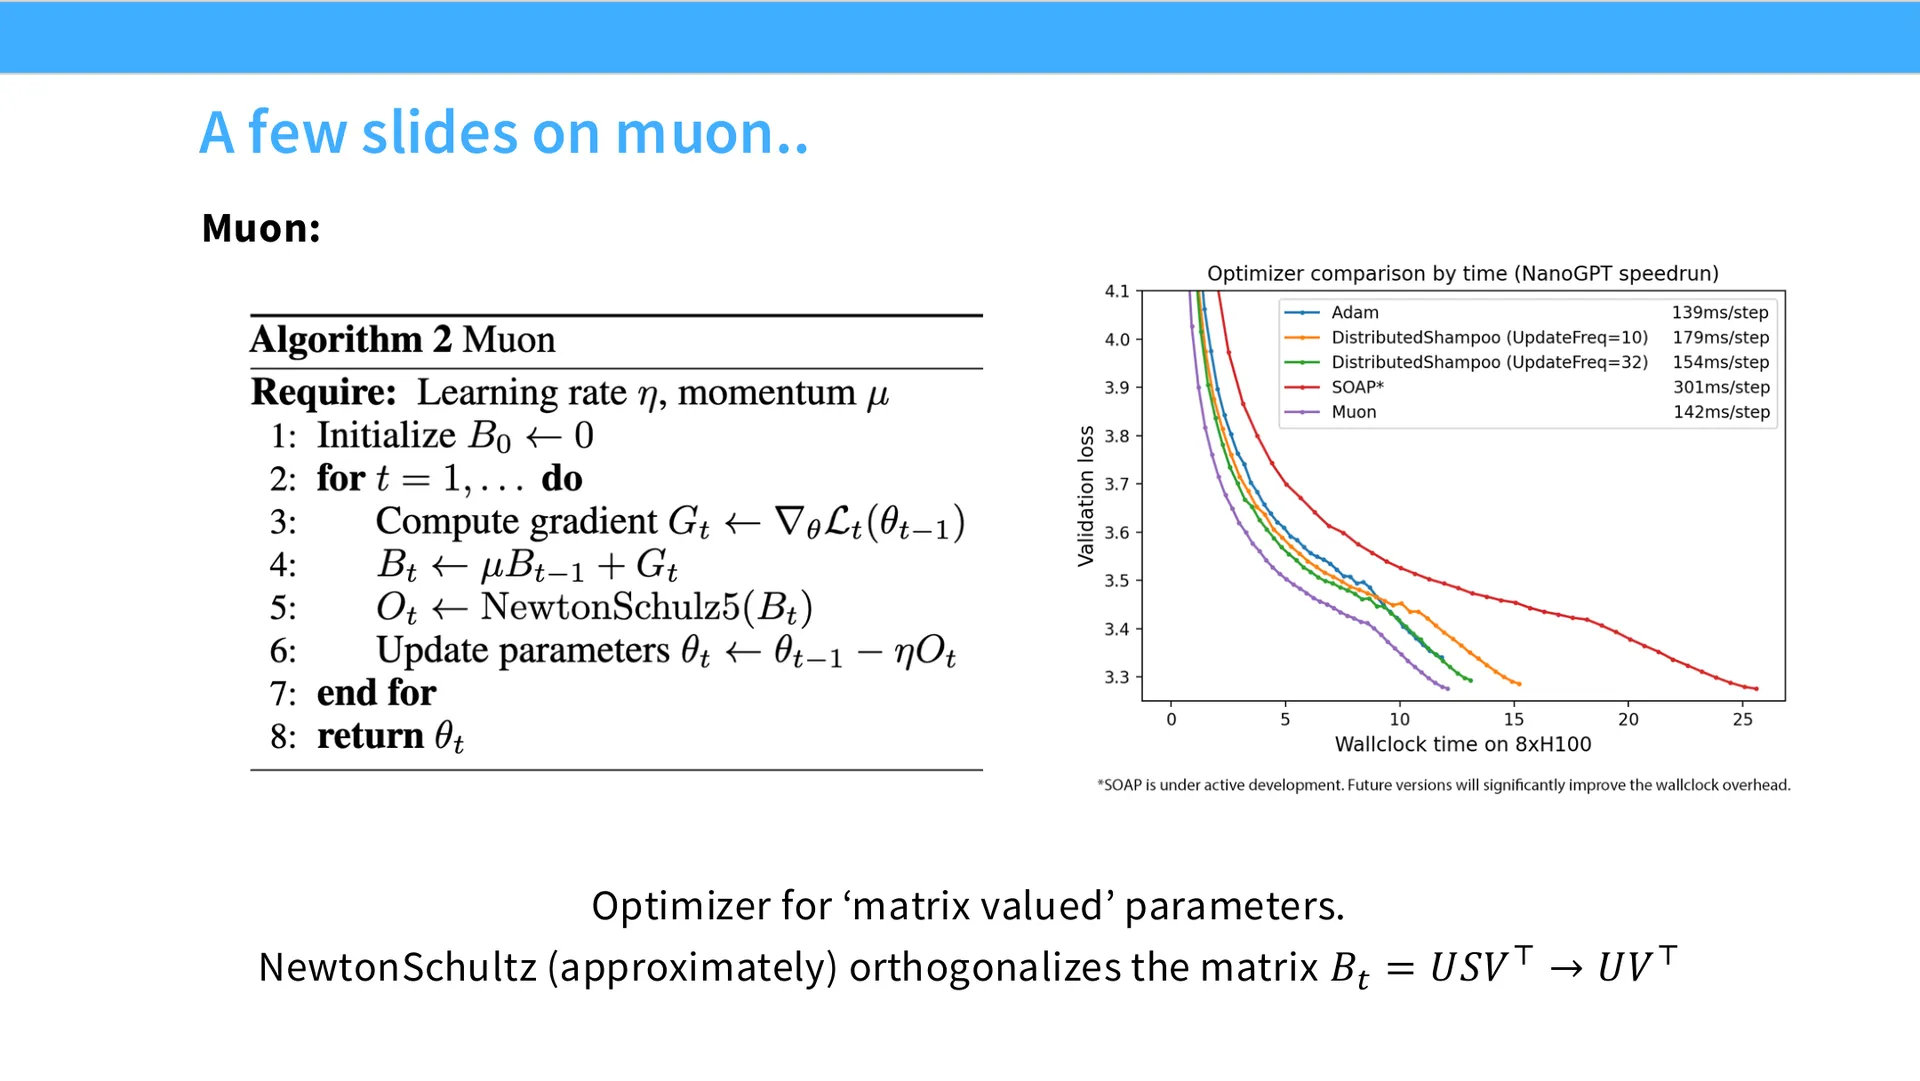
6.1 小规模很香:Muon 在 nanoGPT speedrun 上的崛起
(参考时间: 00:41–00:43)
故事从一个对比图开始:
📷 (讲师展示 nanoGPT speedrun 上 Muon 相对 Adam 的显著加速)
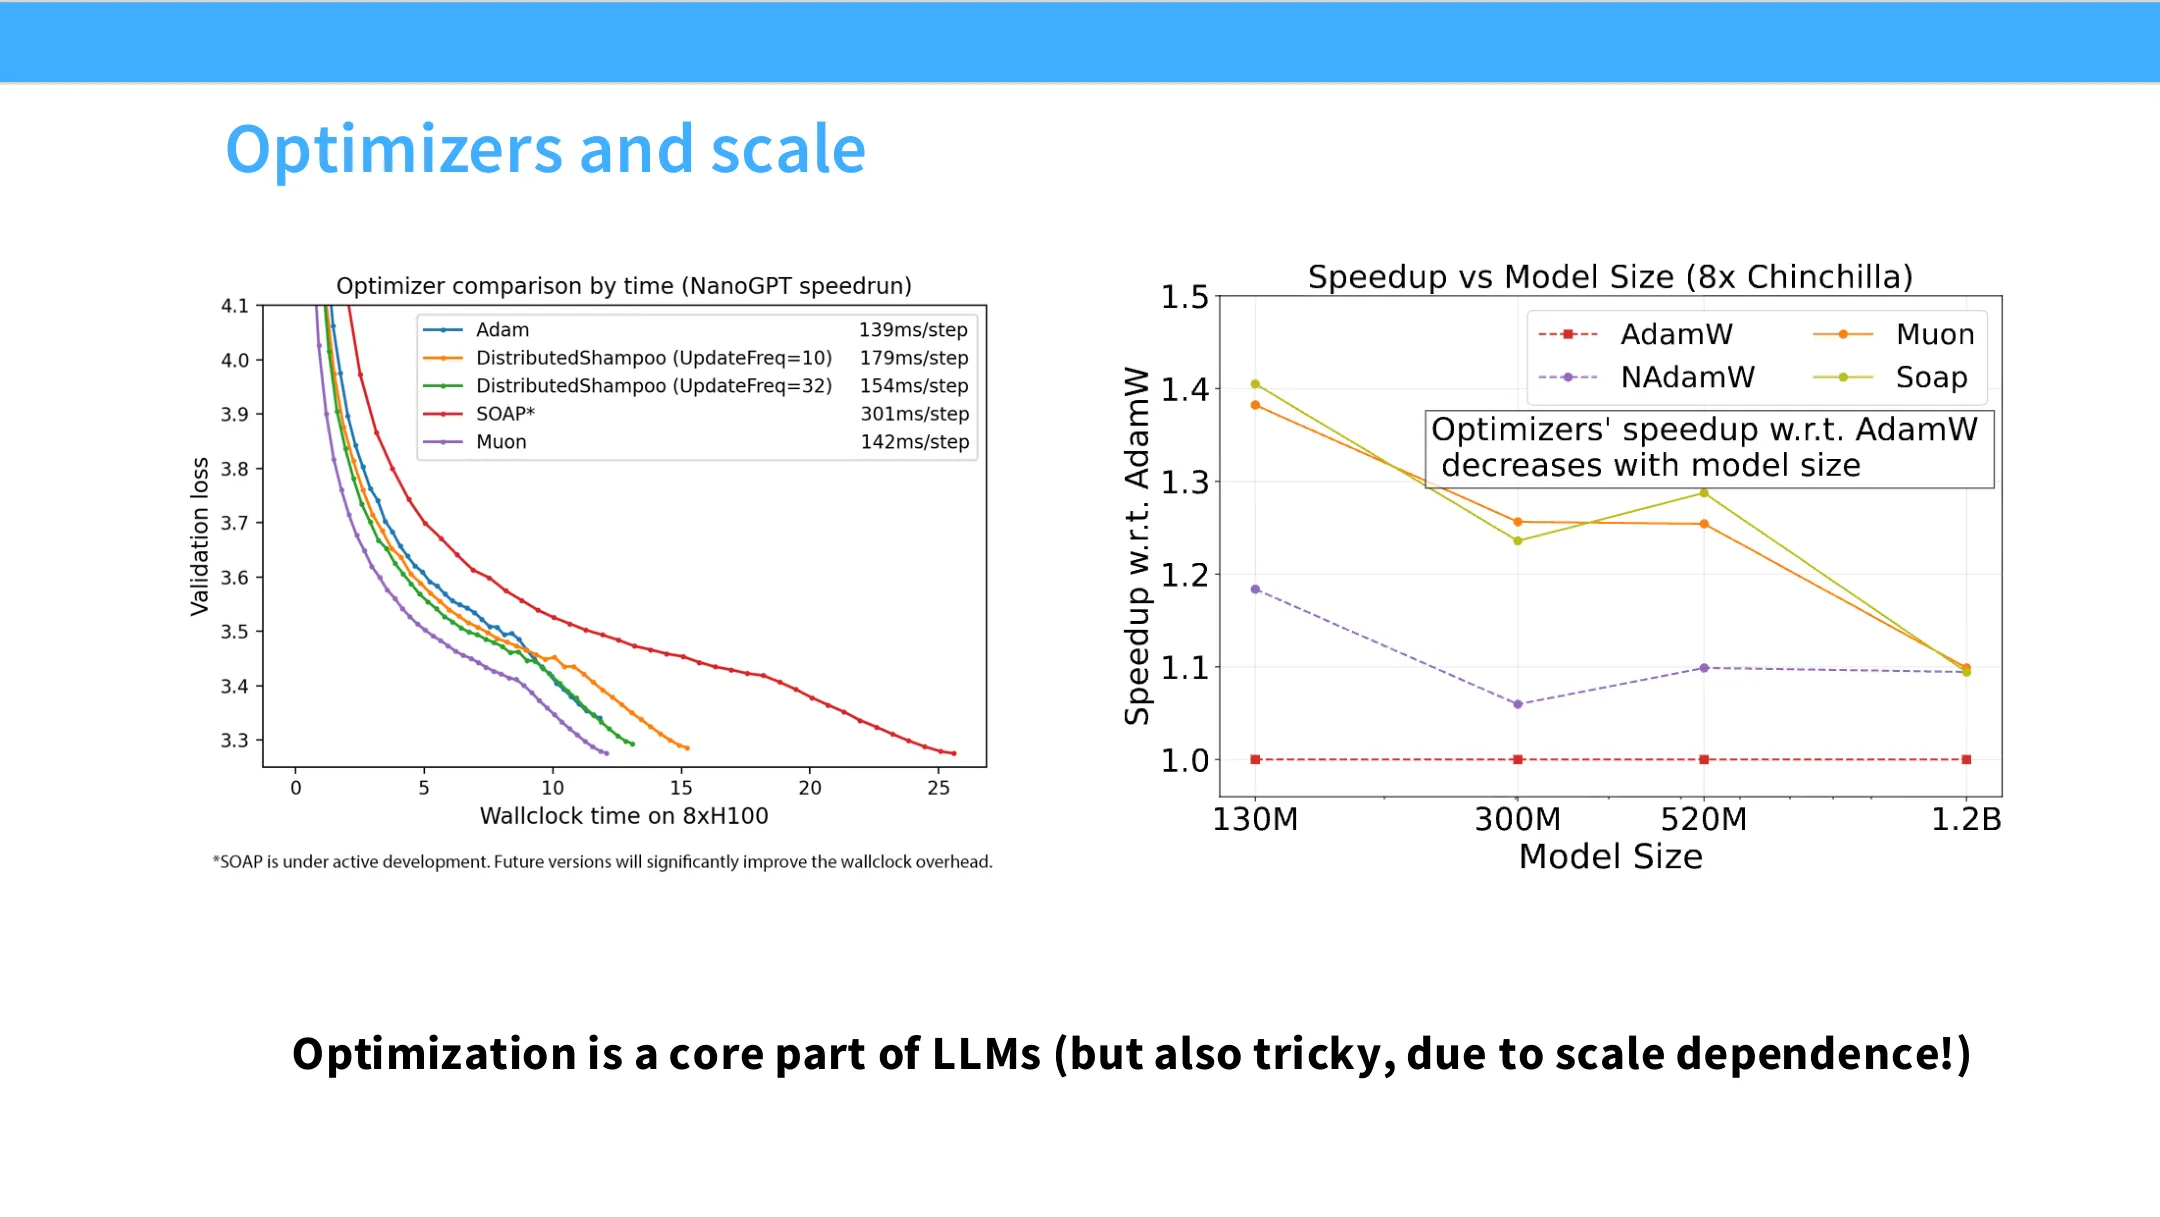
📷 nanoGPT speedrun:Muon(紫)相对 Adam(蓝)的显著增益
回到原视频 (00:42:00)
- 左图来自 nanoGPT speedrun(正是课程作业一(assignment 1)的灵感来源):训练一个极小的模型、用相当短的时间,尽快到达某个损失(老师记不清了,大约 3.x)。
- 很多人在这个基准上持续爬山(hill climbing)。
- 最引人注目的事件之一,是 Muon 的出现(图中紫色):它相对 Adam(蓝色,紧贴绿线下方)取得了非常显著的增益,而且并不比 Adam 慢。
但是——问题随之而来:
讲师提出的核心问题:"这东西在大规模上真的好吗?"
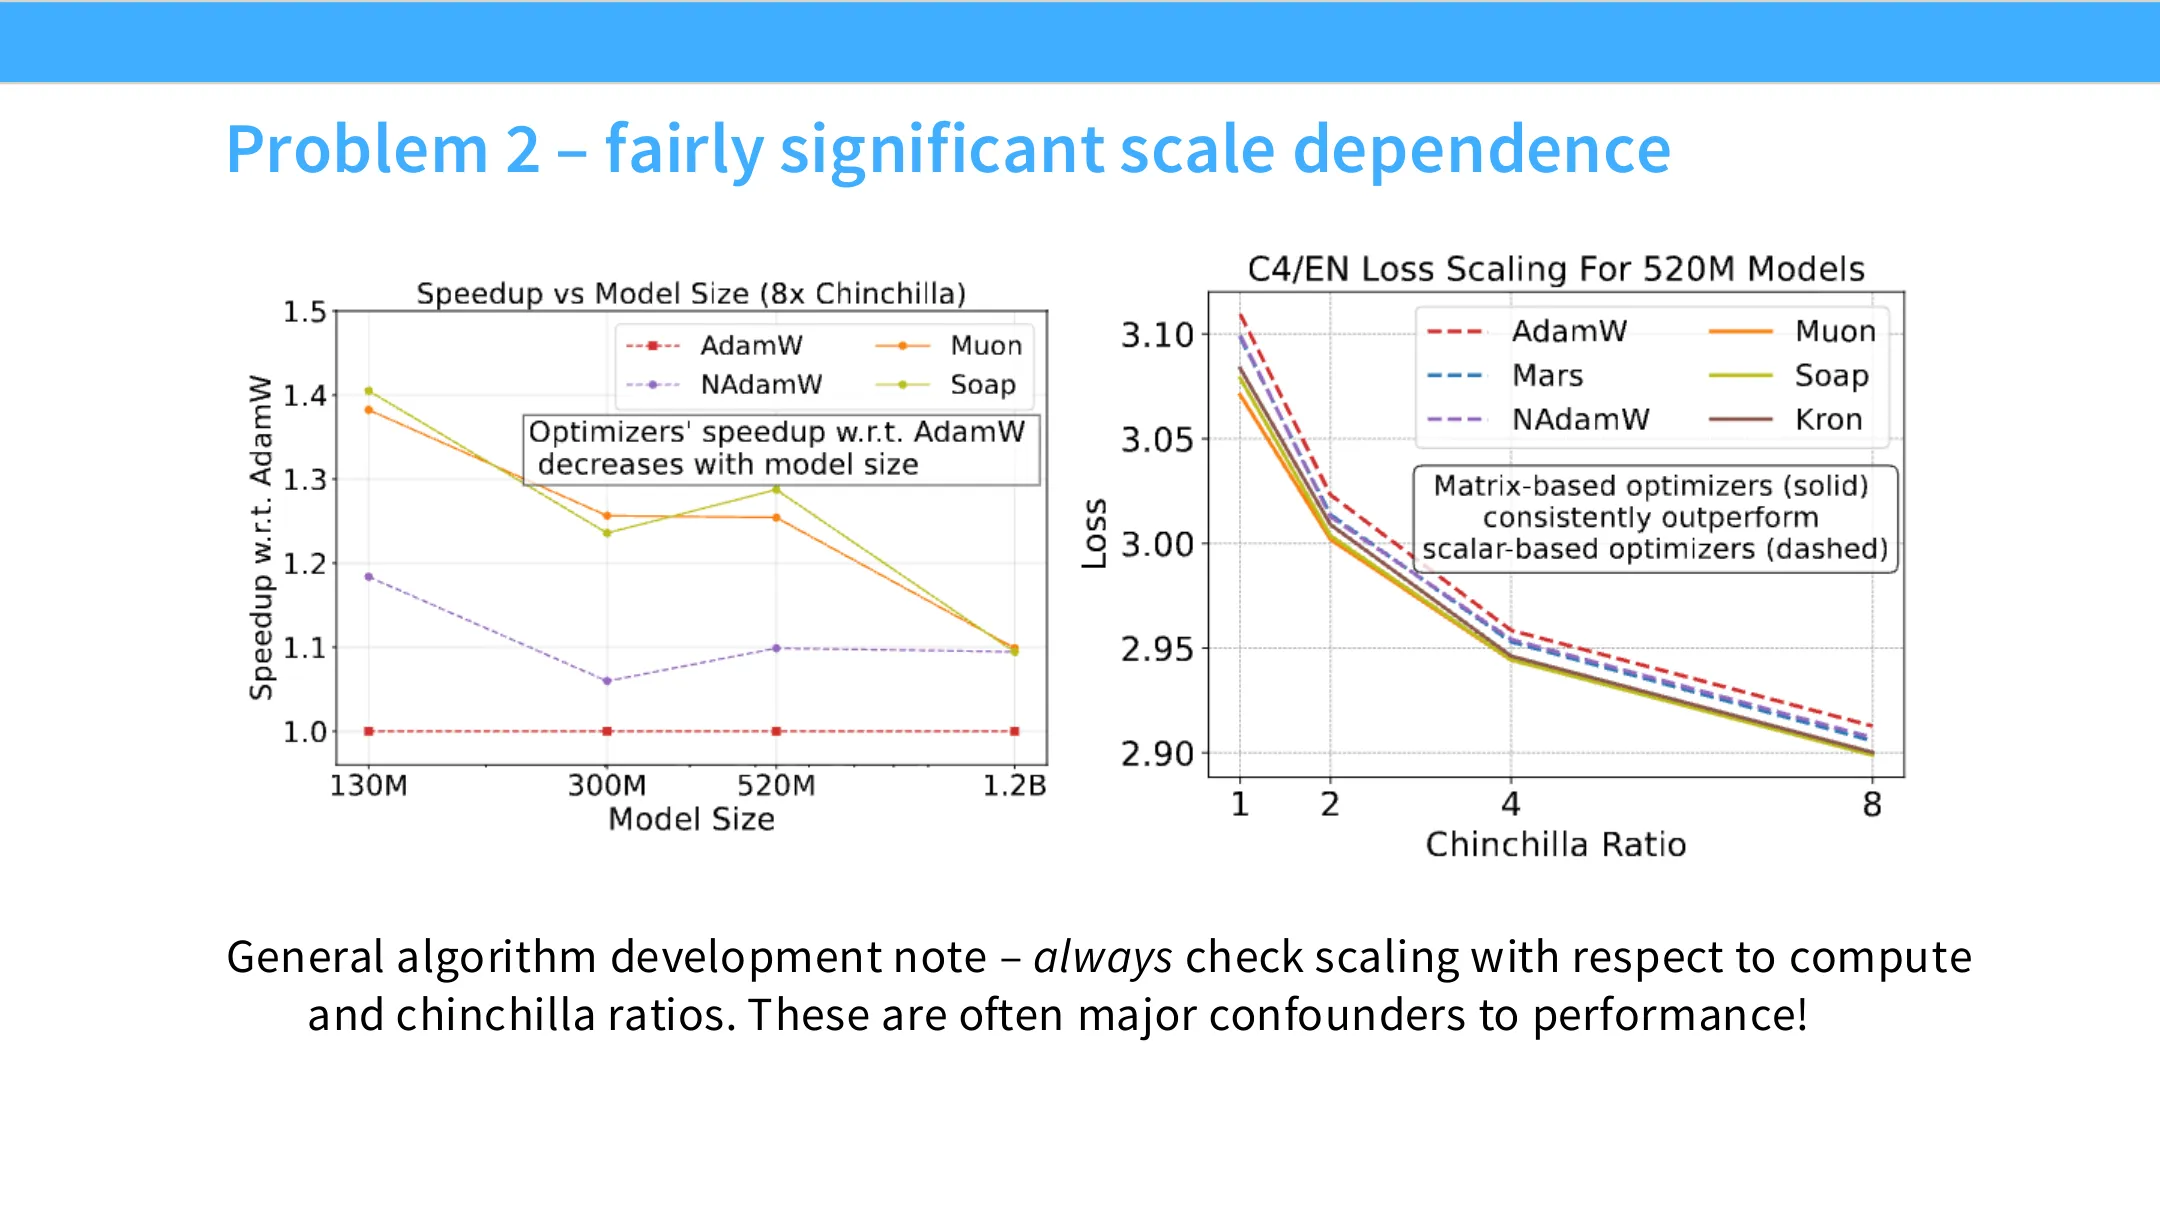
于是有人去做了缩放研究,发现增益可能没那么大。老师指出,这是一个极其重要、又极其棘手的研究现实:
我们有一个小规模实验,有一个确定是规模敏感的东西(优化器),我们在小规模上看到巨大增益——那么大规模怎么办?
老师说不打算给一个"确凿的处方",而是想通过这个故事提供一种叙事,让我们感受"能做什么、不能确知什么"。
6.2 优雅的缩放研究为什么很难:两个轴
(参考时间: 00:43–00:47)
老师花几页讲 Kaiyue、Tengyu、Percy、David 等人那篇"优雅地做大规模优化器对比"的论文。从中可以学到很多(不只是缩放,还有标准深度学习的东西)。
最基本的坑:不同模型超参数不同,甚至缩放指数也不同。
📷 (讲师展示优化器对比中的"调参陷阱":调好的 Adam 会被误判为差,而未调好的新算法会被误判为好)
📷 优化器对比中的调参陷阱:超参数没调好会得出错误结论
回到原视频 (00:45:00)
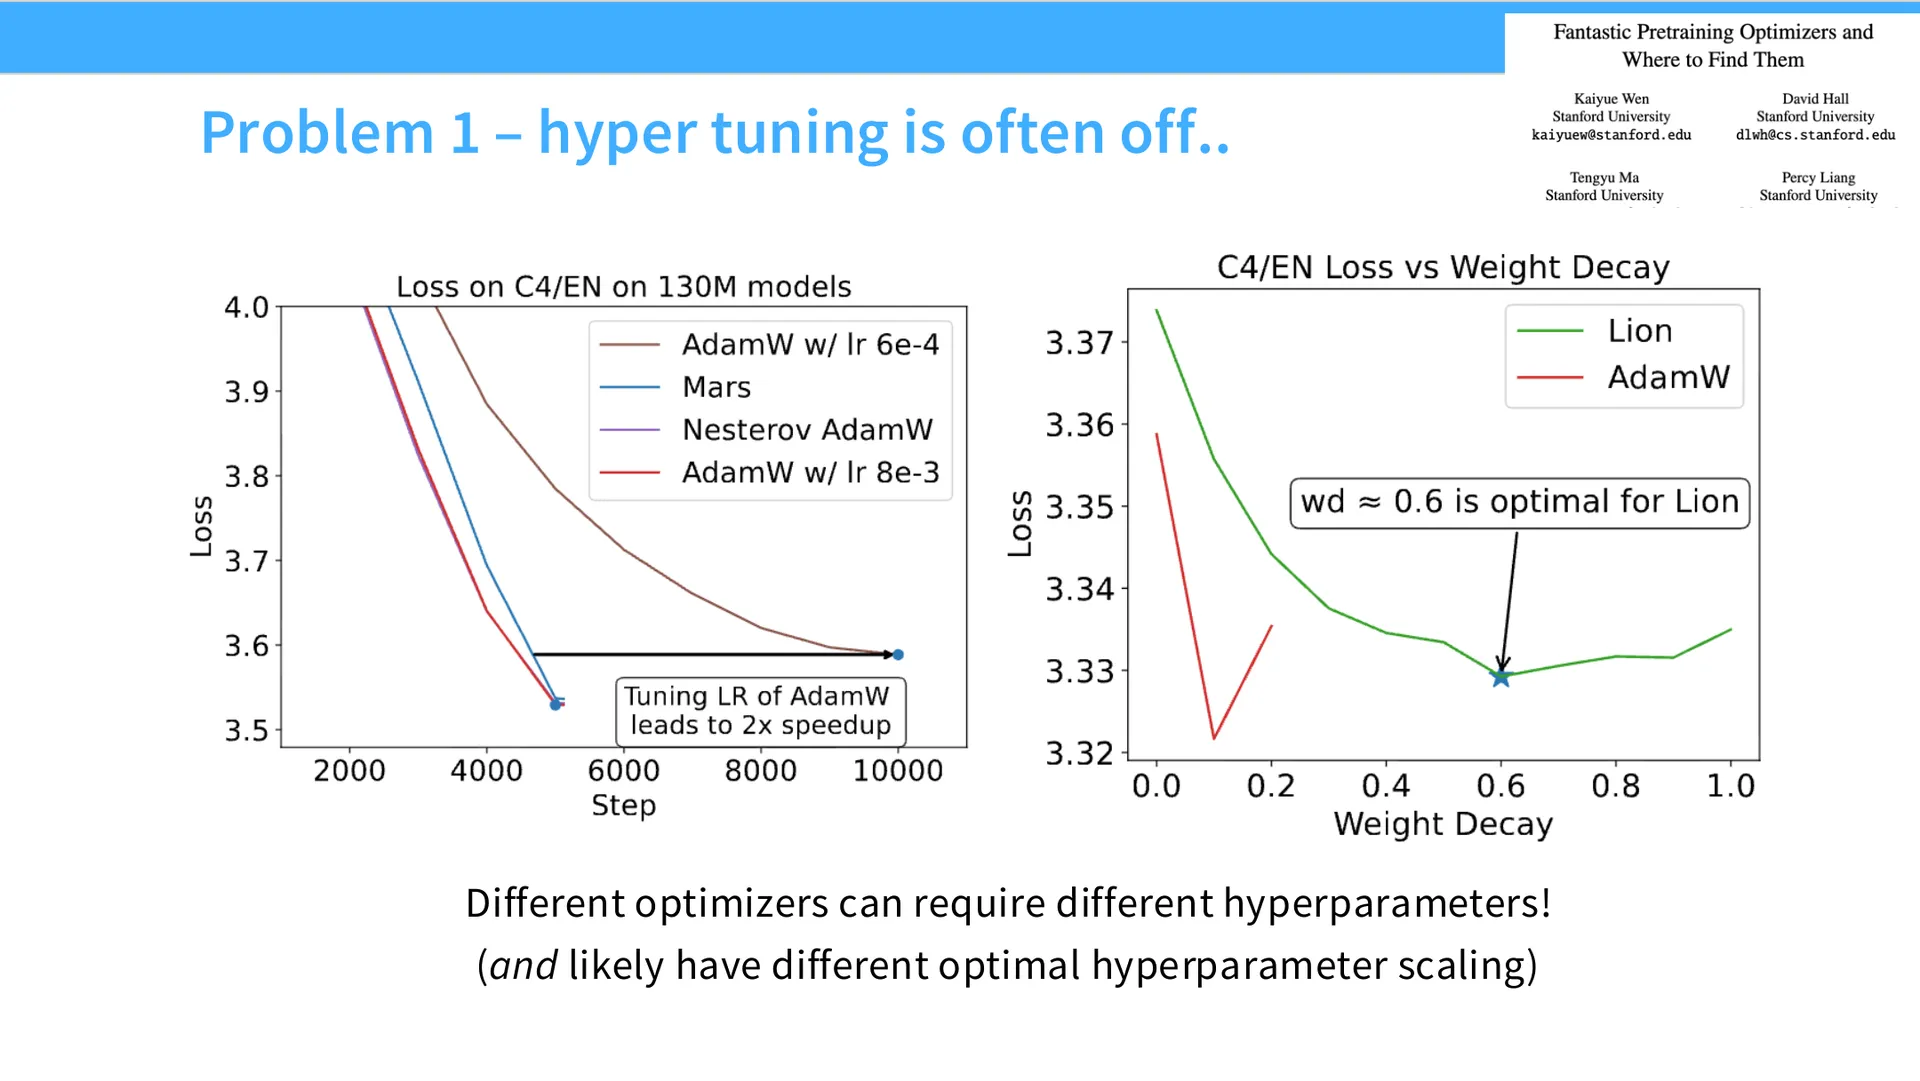
- 你得把 Adam 调得很好。如果调得不好(深棕色线),会误以为"它比左边所有其他算法都差"。但你把学习率稍微改一下,会惊呼"我的增益全没了"。
- 右边同理:也许学习率调好了,但权重衰减没调到最优。用同一个权重衰减,会让某条线(绿线)结果差很多;选到最优权重衰减,结果就完全不同。
- 这些严格来说不是缩放问题,但是非常重要的一般经验机器学习问题。
更相关的是"规模依赖",老师认为有两个轴永远重要:
- 算力轴(compute):如果你固定"模型规模 / 数据"之比,那么"模型规模"轴本质上就是算力轴。
[x 轴] - Chinchilla 比(Chinchilla ratio):即数据量与模型参数量之比。
第二个轴是大混淆因子(confounder)。有些算法在过参数化(模型远大于数据)的情形下表现好——也许因为它引入了某种隐式正则化,或数据效率低但算力占优。另一些算法则在大 Chinchilla 比(每参数数据很多)的情形下表现好——因为可以更高效地把知识塞进参数。即便是卫生做得很好的缩放论文,也常常忽视、或根本没有算力去研究这个 token/参数比。
在这篇论文的案例里,Chinchilla 比不是问题:不同 Chinchilla 比下各条线的比值是一致的。但这并不总是成立,所以你始终要对这两个缩放因子保持警惕。
6.3 建立缩放律有多难:一条"漂亮的定律"也会突然掀桌
(参考时间: 00:47–00:49)
老师引用 Will Held(在 Percy 的开源语言模型训练项目 Moraine 中工作)的资料。他们想证明一套特定的超参数(Cautious Adam C 这个 Adam 变体、平方根批量大小缩放,等等)——这甚至不是新算法。
📷 (讲师展示 Moraine 的实验:一条对数坐标下看起来完美的缩放律,在 10²⁰ 量级附近突然"炸掉")
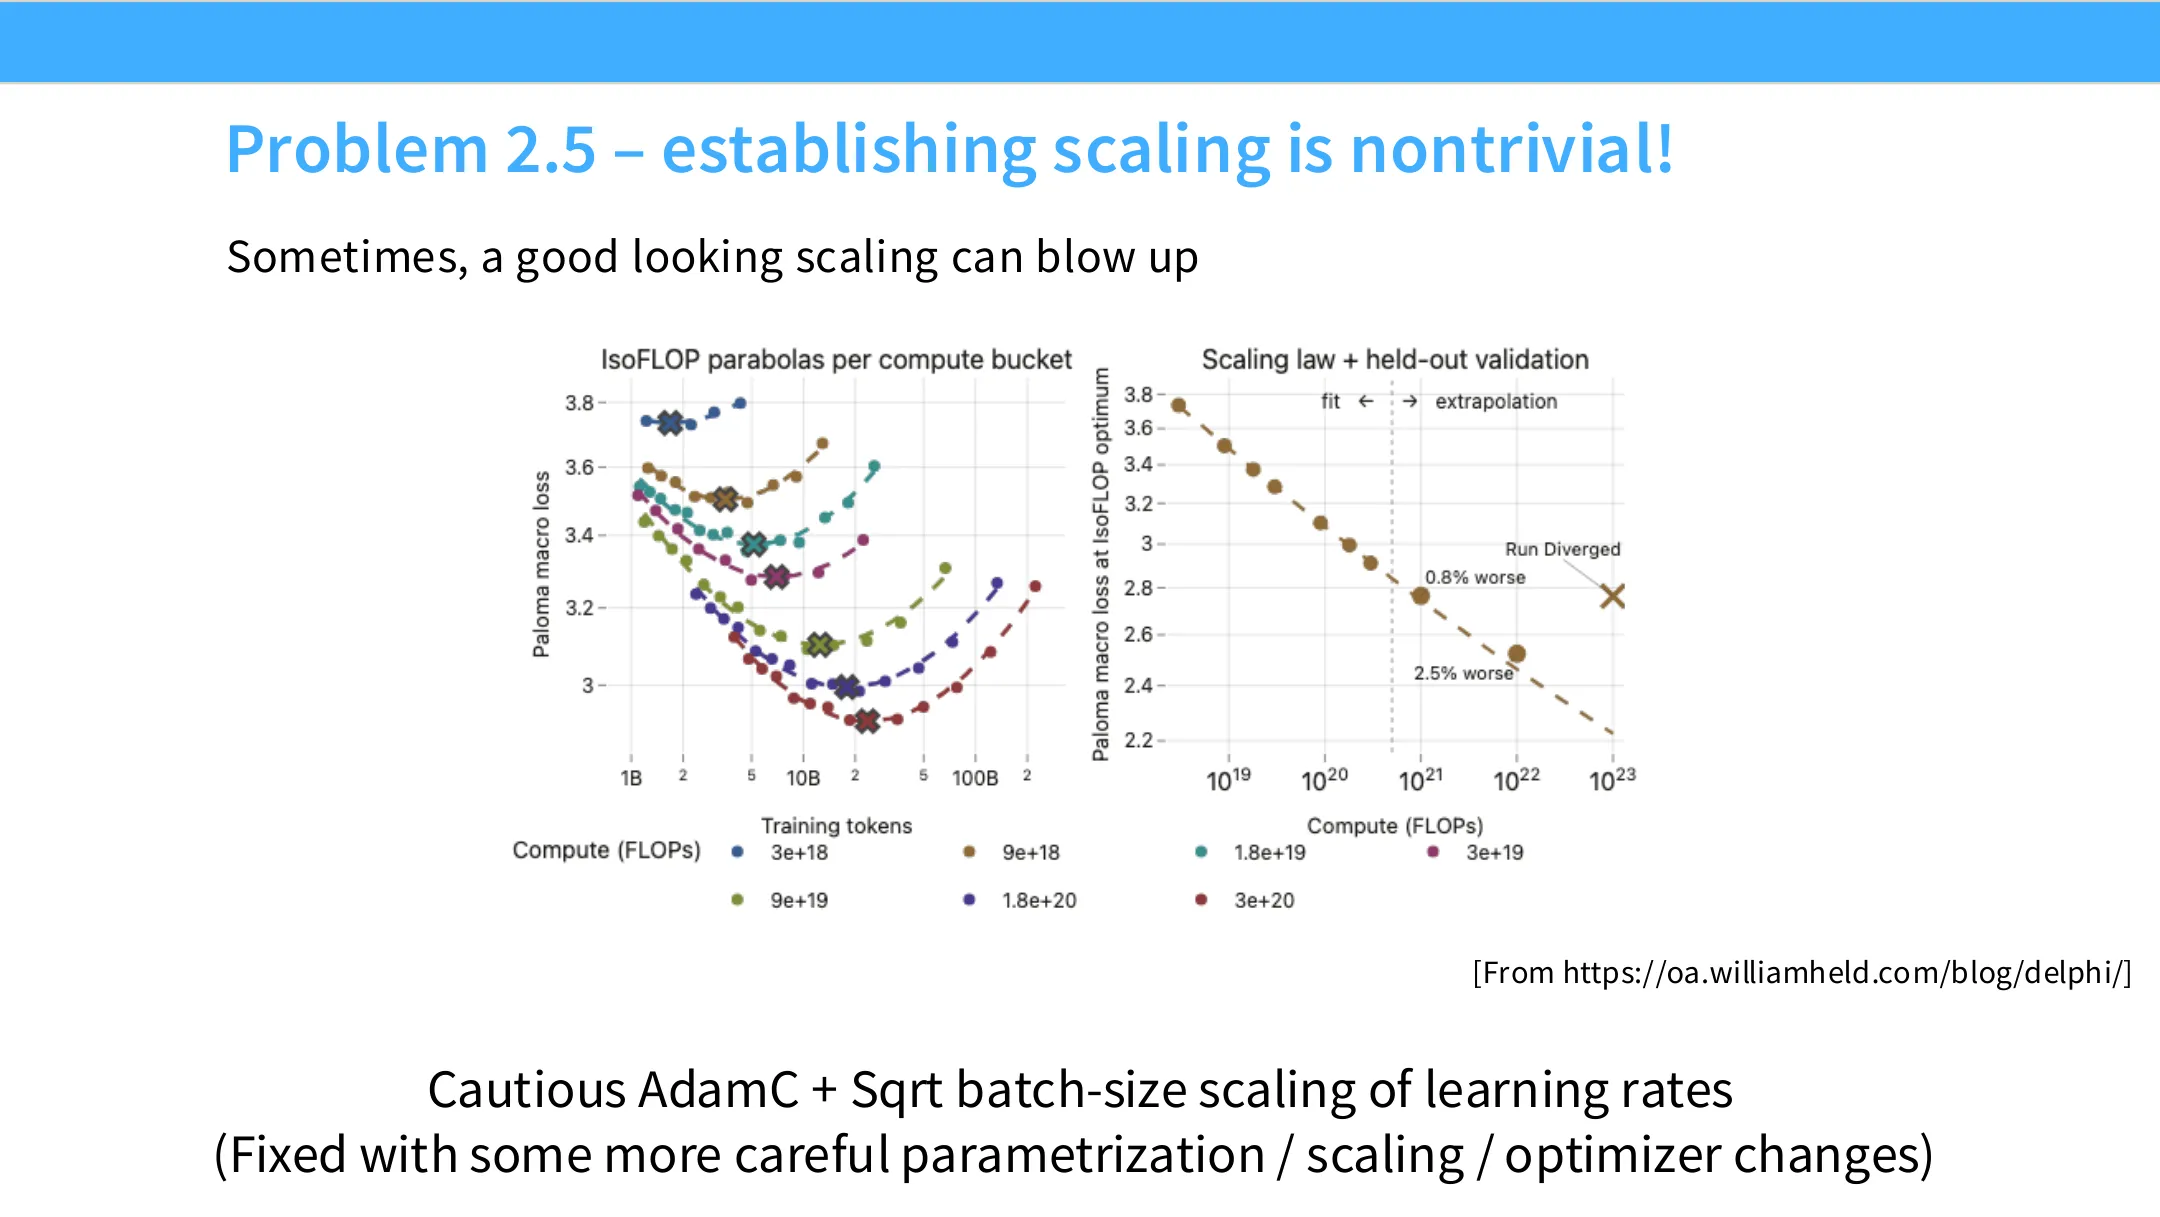
📷 Moraine 的失败实验:漂亮的缩放律在更高算力处突然崩溃
回到原视频 (00:47:30)
- 他们做的是标准的 Chinchilla 分析,一开始看起来很美;
- 一直到一个大概 $10^{20}$ 量级的虚线竖线处,这条缩放律近乎完美;
- 然后随规模上升:"有点差"→"差很多"→"哇,这个运行不行了"——彻底炸掉。
关键教训:即便是跨越多个数量级都很好看的缩放趋势,也可能突然偏离线性、然后立刻崩掉。他们的修法是:选择更谨慎的 μP 风格参数化、更换优化器,从而在更宽的数量级上获得更好的缩放。
讲师总结:当我说"你们都应该做缩放实验、把学习率都缩一缩",那并不容易。很多时候你会得到这种图,一切都糟透了,你也不知道哪里出了问题。
6.4 Muon 算法:在"谱范数"意义上做归一化
(参考时间: 00:49–00:57)
老师认为自己不得不更详细地讲 Muon,因为它开始被整合进大模型的训练运行——这几乎是这门课新研究课题的收录标准:"它有没有进过大训练?" Muon 现在达标了。
起点:梯度的"一视同仁"是不合理的。
在普通梯度下降里(暂时忽略第 4/5 行),流程大致是标准的基于动量的优化器:
- 取梯度,加到 $B_t$(动量步);
- 用参数 $\mu$ 延续之前的动量;
- 用这个动量梯度更新参数。
但老师指出一个"跳出框架"的想法:
梯度假设所有参数都相同,但语言模型(甚至任何深度网络)里的参数并不是相同的。 有些是向量参数(比如 RMS norm 的增益),有些是矩阵参数(注意力、MLP 的权重)。矩阵参数大概不等于向量参数。
于是 Muon 的做法是:对矩阵参数查看其谱(spectrum)——矩阵有特征值、奇异值,你可以对奇异值动手。
算法(用自然语言 + 伪代码):
1. g ← 计算梯度
2. B_t ← μ·B_{t-1} + g            # 动量步
3. O_t ← NewtonSchulz5(B_t)       # 对动量更新做正交化
4. W ← W - η·O_t                  # 用正交化后的更新更新矩阵参数
其中 Newton–Schulz 5 是一个迭代算法,作用是把 $B_t$ 正交化。写成 SVD 形式就是:
设 $B_t = U S V^\top$,把所有奇异值设为 1(大的缩小到 1,小的放大到 1),得到更新 $U V^\top$。
$$O_t = U V^\top, \quad \text{其中 } B_t = U S V^\top,\ S \to I$$
直觉对照:
- 在 AdaGrad 或 Adam 里,你是除以梯度的大小,于是每个坐标大致同尺度;
- 在 Muon 里,你在谱范数意义下操作,于是每个方向都是单位尺度。
关键点:这个操作只对矩阵有意义——你只能对矩阵值 $B_t$ 定义奇异值分解。所以 Muon 是一个矩阵优化器,作用在矩阵参数上;向量参数(如 RMS norm 的增益)仍用 AdamW,因为它们与 Newton–Schulz 项没有交互。
编者拓展|Newton–Schulz 迭代为什么重要? 直接对一个大矩阵做 SVD 在 GPU 上很慢。Newton–Schulz 迭代是一个只用矩阵乘法、固定迭代次数的算法,它能近似正交化一个矩阵。所以 Muon 有三个巧妙之处:(1) 把矩阵当作独立对象处理;(2) 正交化的思想;(3) 用 Newton–Schulz 实现带来的系统效率。老师强调,正是因为这套工程实现,Muon 才实用。
6.5 Muon 故事的"封闭":从小规模到大模型
(参考时间: 00:52–00:55)
老师复盘了这个故事:
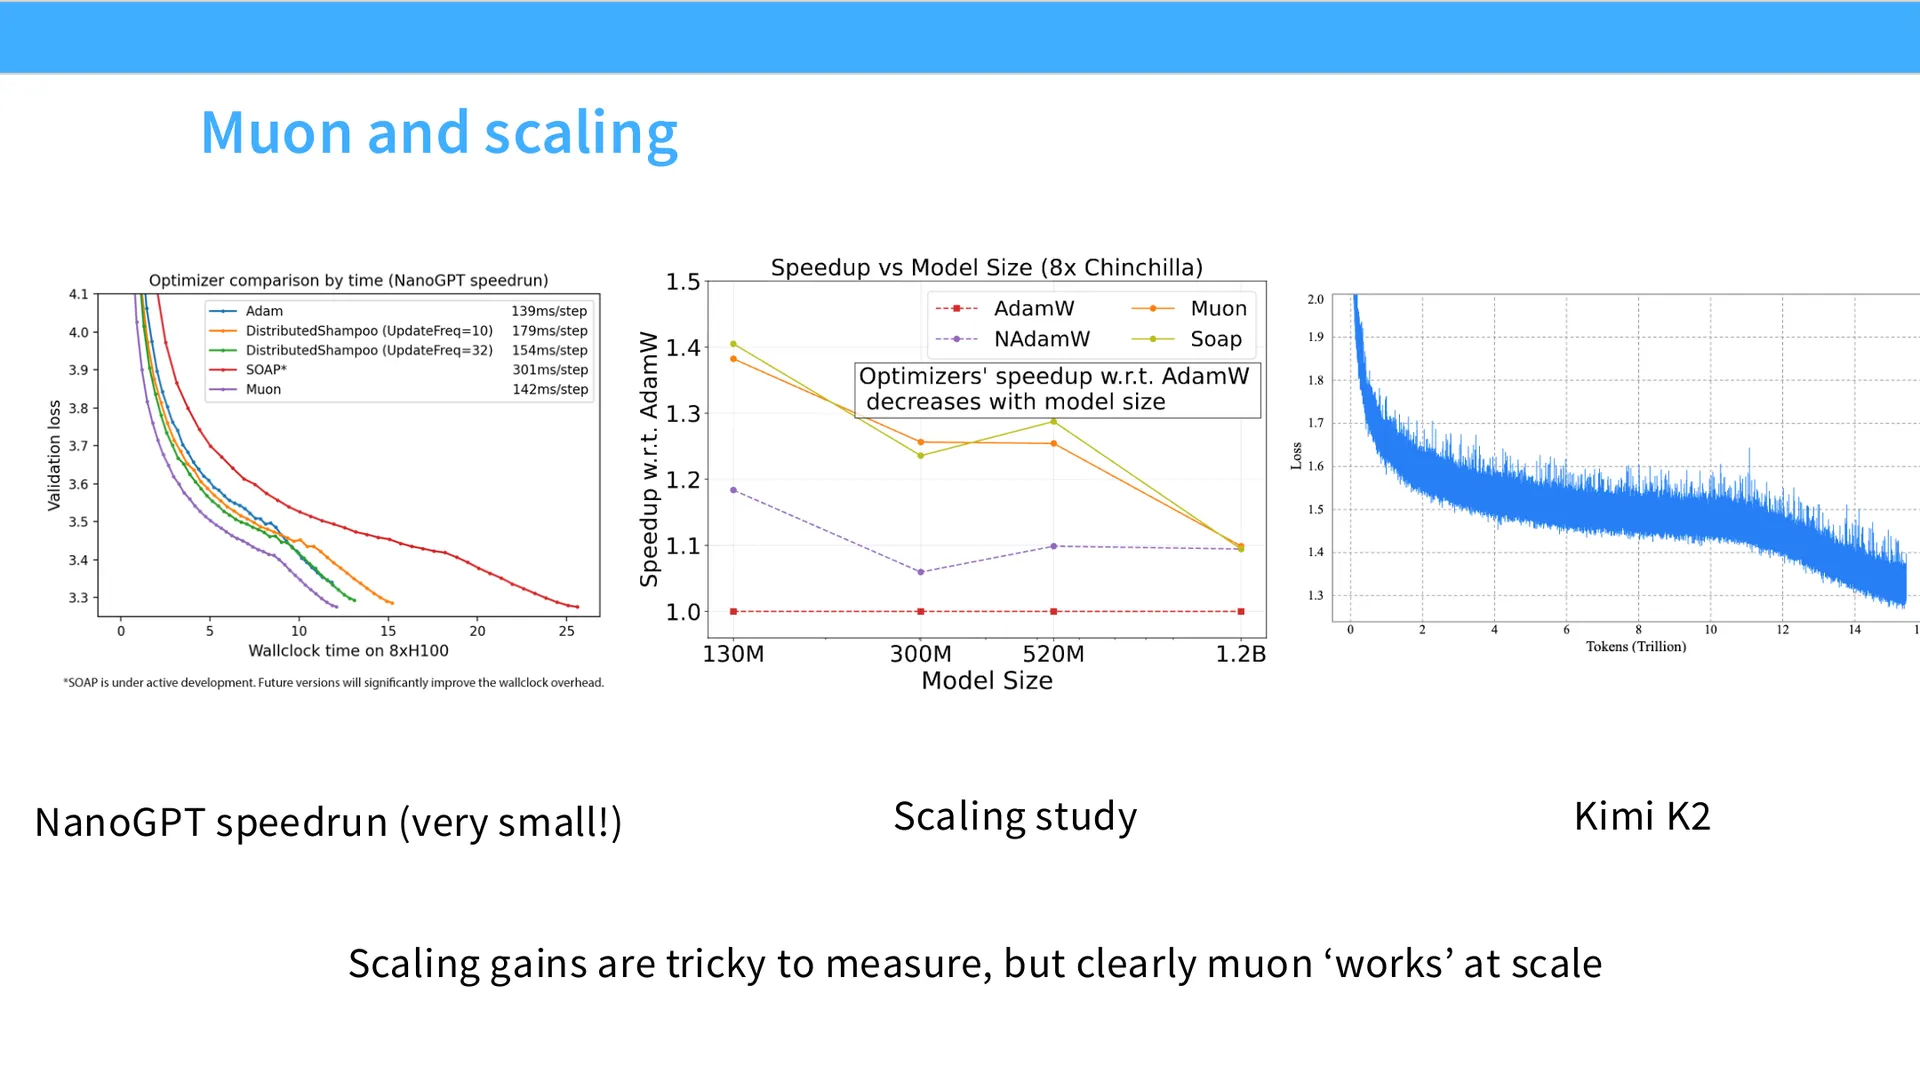
- Muon 最初在 nanoGPT speedrun 上被发现,非常强大,你可能以为它会随规模增益。
- 但缩放研究指出:Muon 的增益随规模增大而递减——老师当时以为"故事到此为止了,没人会花大算力把它 scale 上去"。
- 然而 Kimi K2 出现了——整个模型完全用 Muon 训练,加了一些防止 Muon 炸掉的"铃铛哨子"(他们发现了一堆不稳定问题)。Kimi K2 是极其出色的模型,训练曲线看起来合理。
结论:Muon 在规模上能用。至于"是否比 Adam 更好",Kimi K2 没有做消融实验,所以在那个规模上我们不知道——但它肯定是一个有效、可行的方案。
这个故事的意义:
很难知道一个东西在大规模上是否有效。非常非常难。 但我们目前做科学的方式,仍然是"做小规模实验 → 迁移到大模型"。
所以,你仍然应该尊重 nanoGPT speedrun 这类工作——我们从中学到很多、得到好想法,它们最终会走进大模型。至于人们是否会在大规模上继续做消融、真正敲定"Muon 是否优于 AdamW at scale",那是有趣但尚无答案的问题。
💬 两块课堂问答
(参考时间: 00:55–00:56)
Q1:SVD 在 GPU 上快吗? A:SVD 在 GPU 上不快。但 Muon 不做 SVD,它做的是 Newton–Schulz——一个只用矩阵乘法、有限迭代、近似正交化的算法。
Q2:Muon 的超参数是什么? A:和 AdamW 的不一样。老师提到 Jeremy Bernstein 等人在做 μP 风格的工作,认为"每一层都该有自己的学习率",其终极形态是"transformer 里的每个参数都不同,为什么不给每个参数配一个不同的优化器?"——但那意味着每个都要调超参数,老师明确说"我不想干这个,但那也许是优化的未来"。
Q3(追问):大家只调学习率和批量大小,那它们会不会和其他超参数交互? A:会担心超参数交互,但它们呈指数级增长,你不可能网格化整个空间。所以通常的做法是:网格化最重要、最敏感的东西(学习率最重要),然后再对权重衰减之类做单变量扫掠,以保证在其局部是最优的。
七、μP 的理论基础
(参考时间: 00:57–01:12)
本讲最后一大块是 μP。老师坦言:
μP 是一个有点神秘的对象。 即便已经有许多论文、甚至许多实现,我也不认为它们对底层数学或实现都意见一致。但存在一组共享的核心思想,而且它总体上确实有效。
老师将给出他对这套"程序"的解读。
7.1 目标:让最优学习率"不随宽度漂移"
(参考时间: 00:57)
目标非常清晰,就是一张图所表达的东西:
📷 (讲师展示 μP 的目标图:普通参数化下最优学习率随宽度偏移;μP 下最优学习率保持不变)
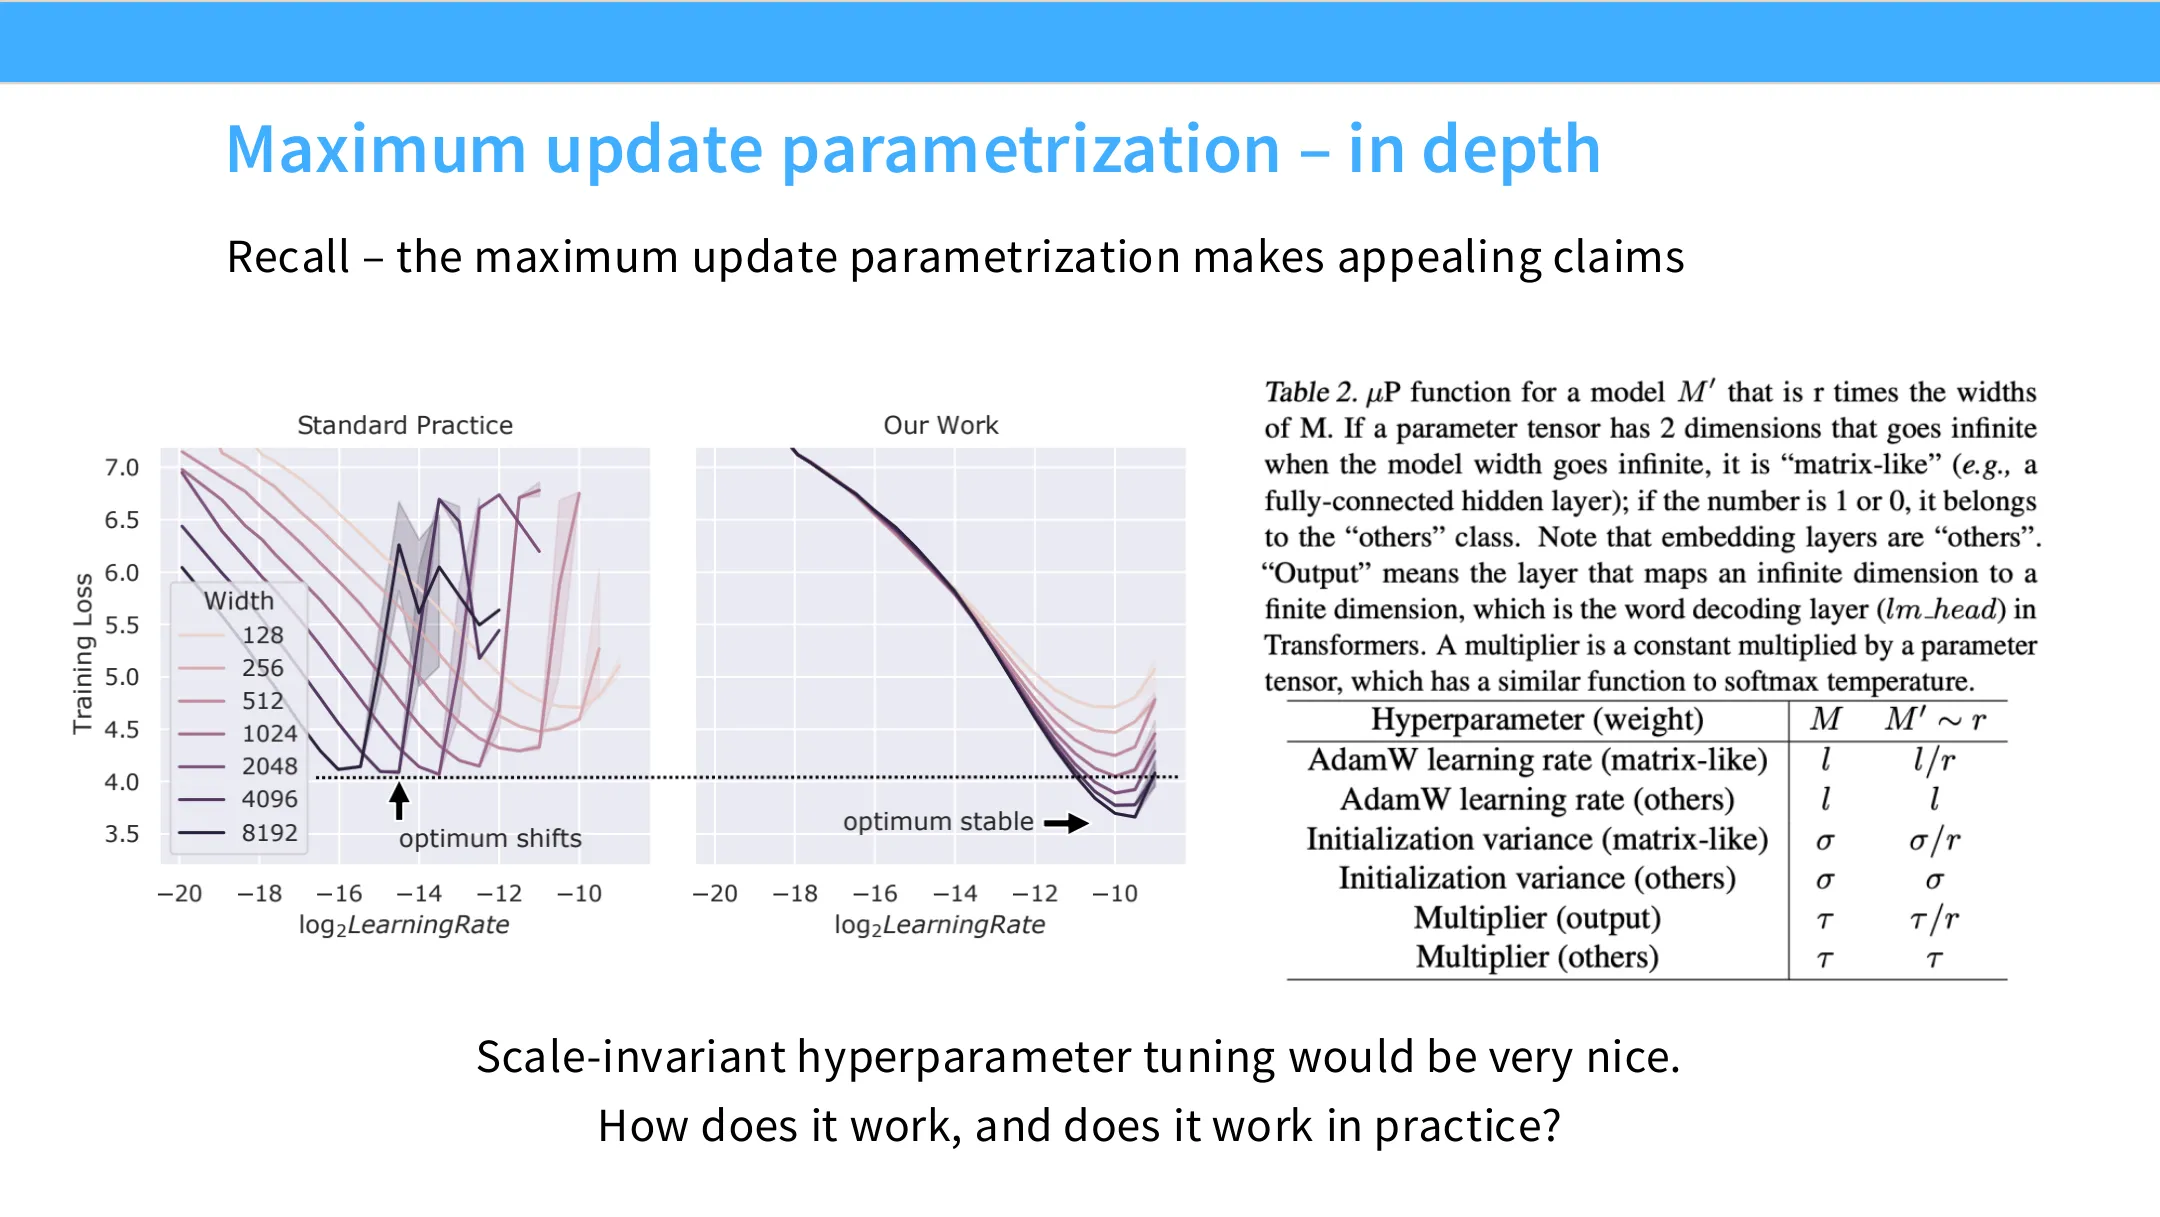
📷 μP 的目标:让最优学习率与宽度无关
回到原视频 (00:57:30)
- 通常:扩大模型规模(这里只是宽度),最优学习率会移动;
- 理想:最优学习率无论规模如何都是同一个数。
为达到这个目标,老师愿意动用哪些旋钮?
- 逐层地改初始化;
- 逐参数地改学习率;
- 有时还愿意根据模型规模缩放残差连接。
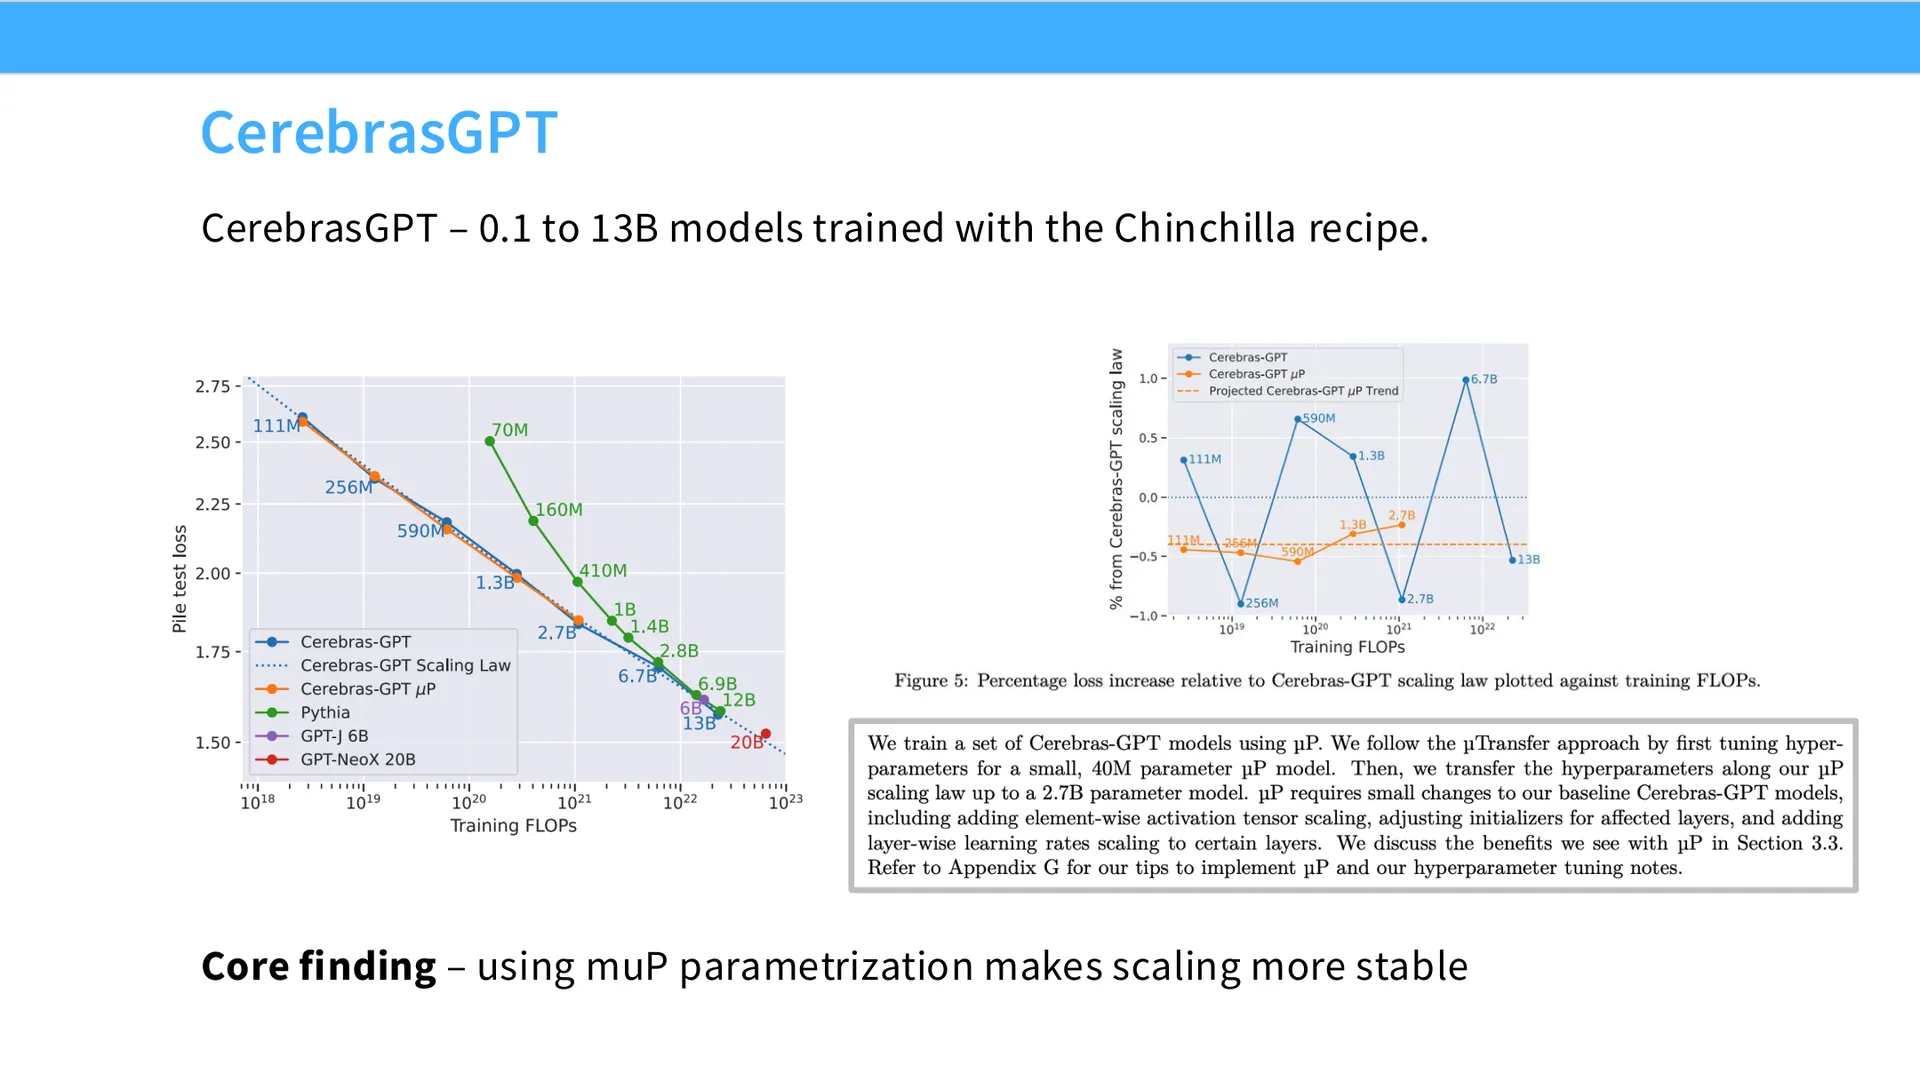
它实际效果如何? 有几篇论文做过相当广泛的研究,其中包括 Cerebras(一家芯片公司,也有一支语言模型训练团队,由缩放定律论文作者 Hestness 领导)。他们做了 Cerebras GPT(0.1B–13B),按常规 Chinchilla 配方训练,同时加入一个 μP 变体以更有效地调超参数。结论是:
使用 μP 参数化时,缩放律拟合更稳定,对实际模型的预测几乎分毫不差;而非 μP 模型的损失预测则波动大得多。所以他们认为 μP 可能是个非常好的想法。
老师补充:这已在规模上得到验证——MiniCPM 等很多团队都用 μP 变体训练过模型。
7.2 μP 的两个"不变量"
(参考时间: 01:00–01:03)
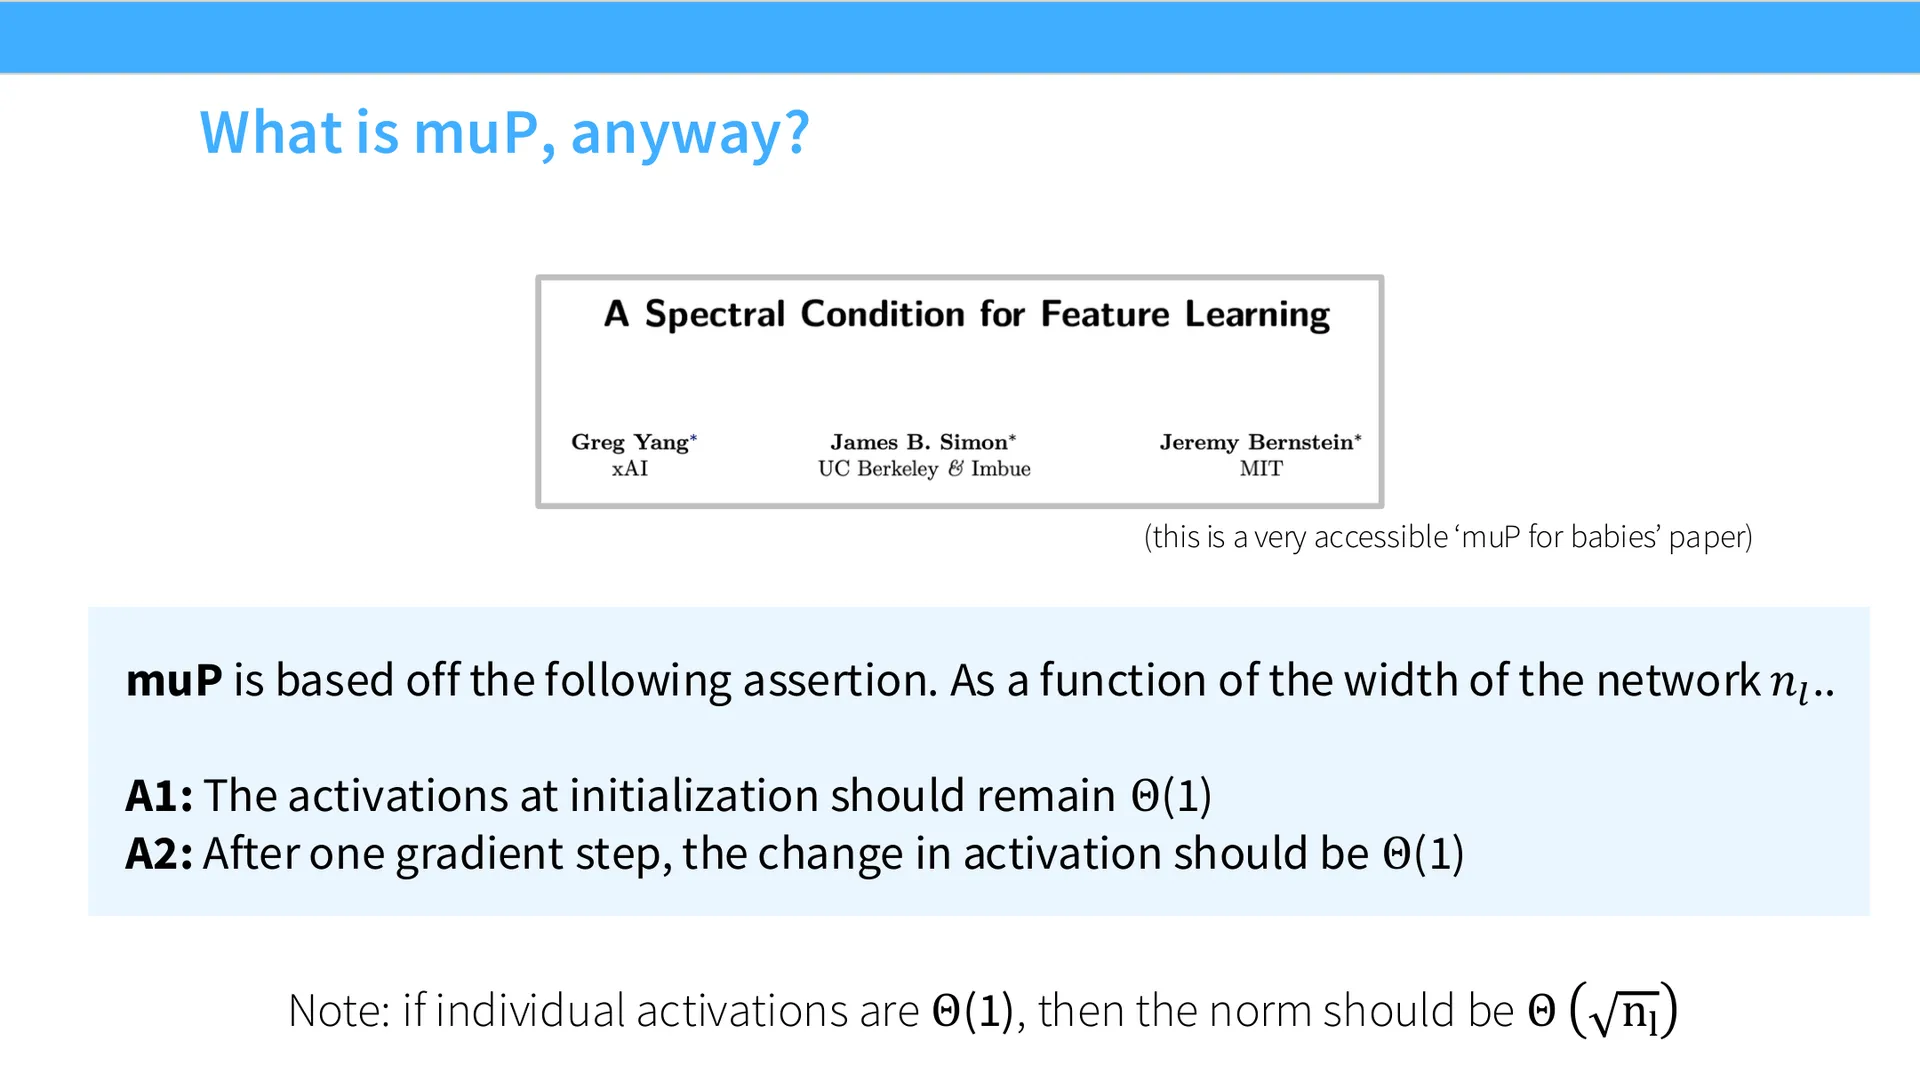
μP 的核心建立在两条断言之上,这是一种非常物理学家式的思考。假设只改宽度:
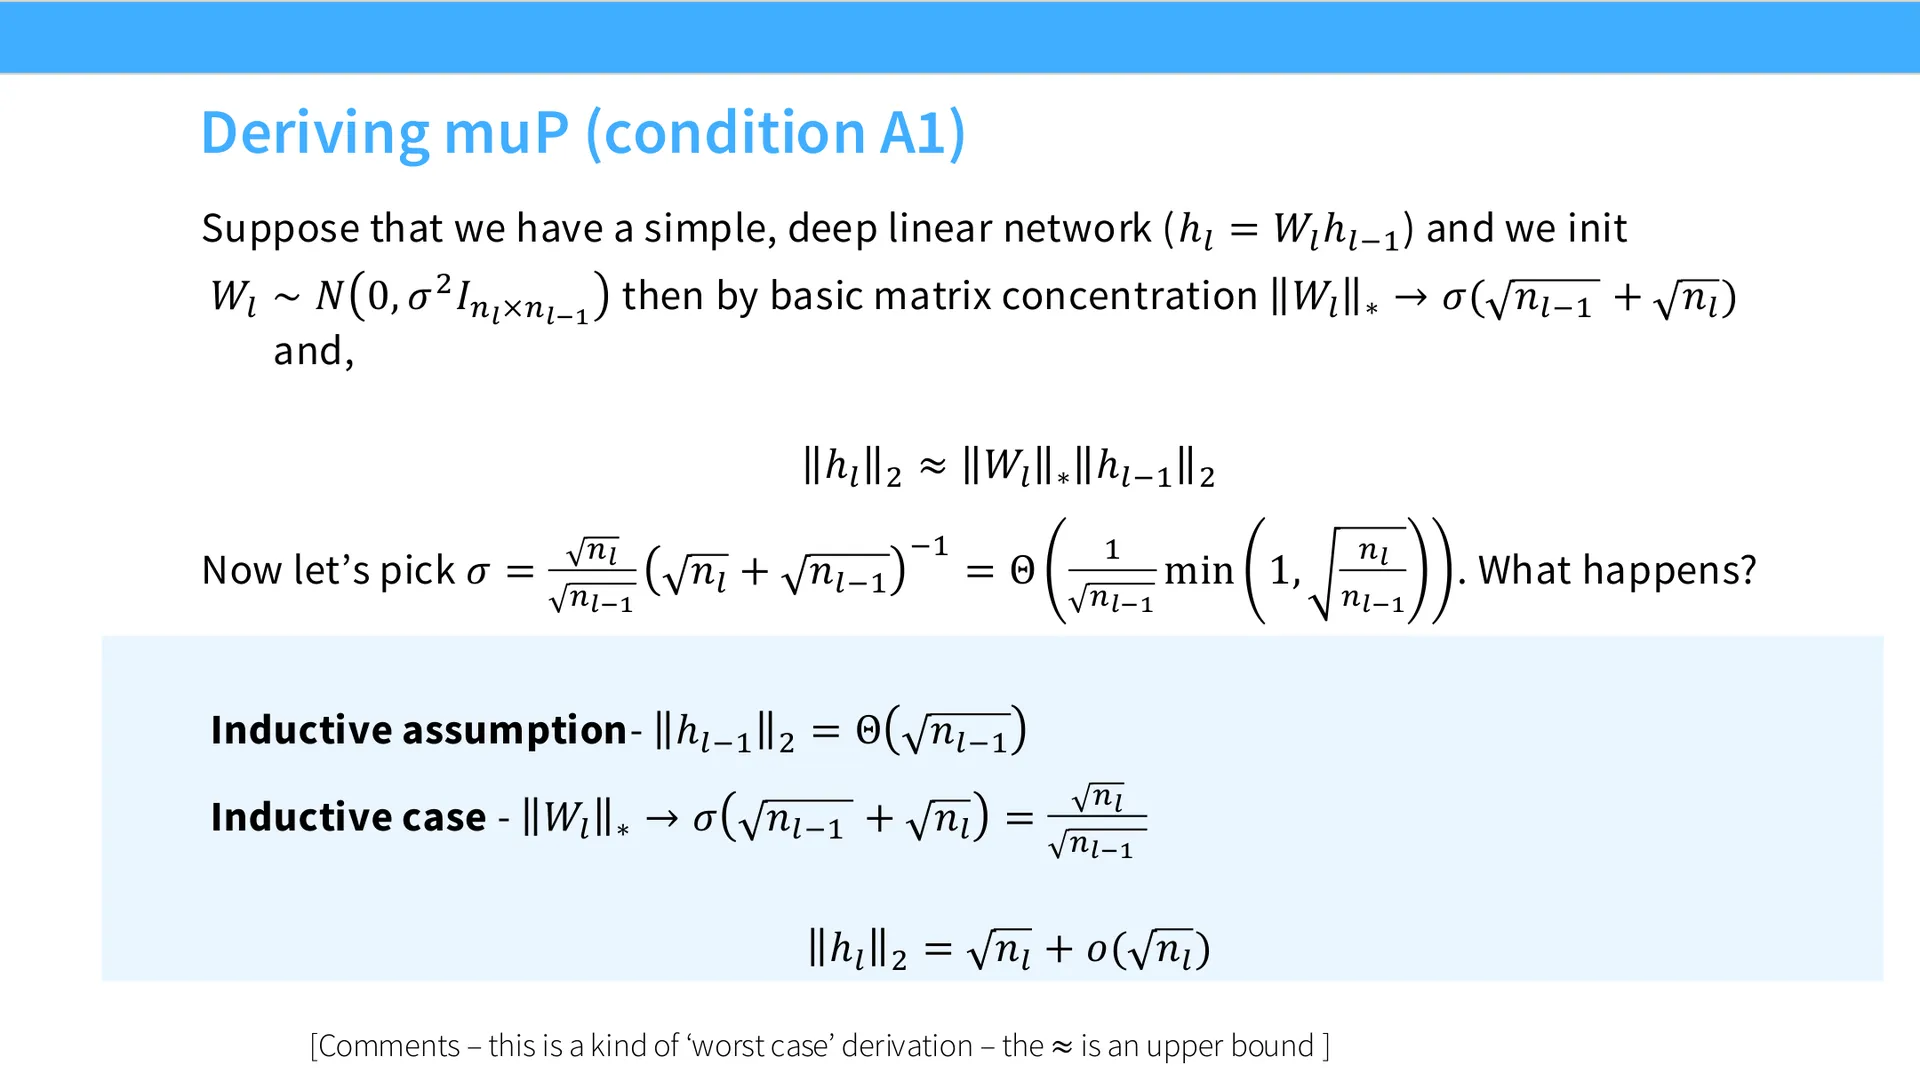
A1(初始化不变量):在初始化时,激活值的尺度应大致保持不变(不随网络规模爆炸或塌缩)。
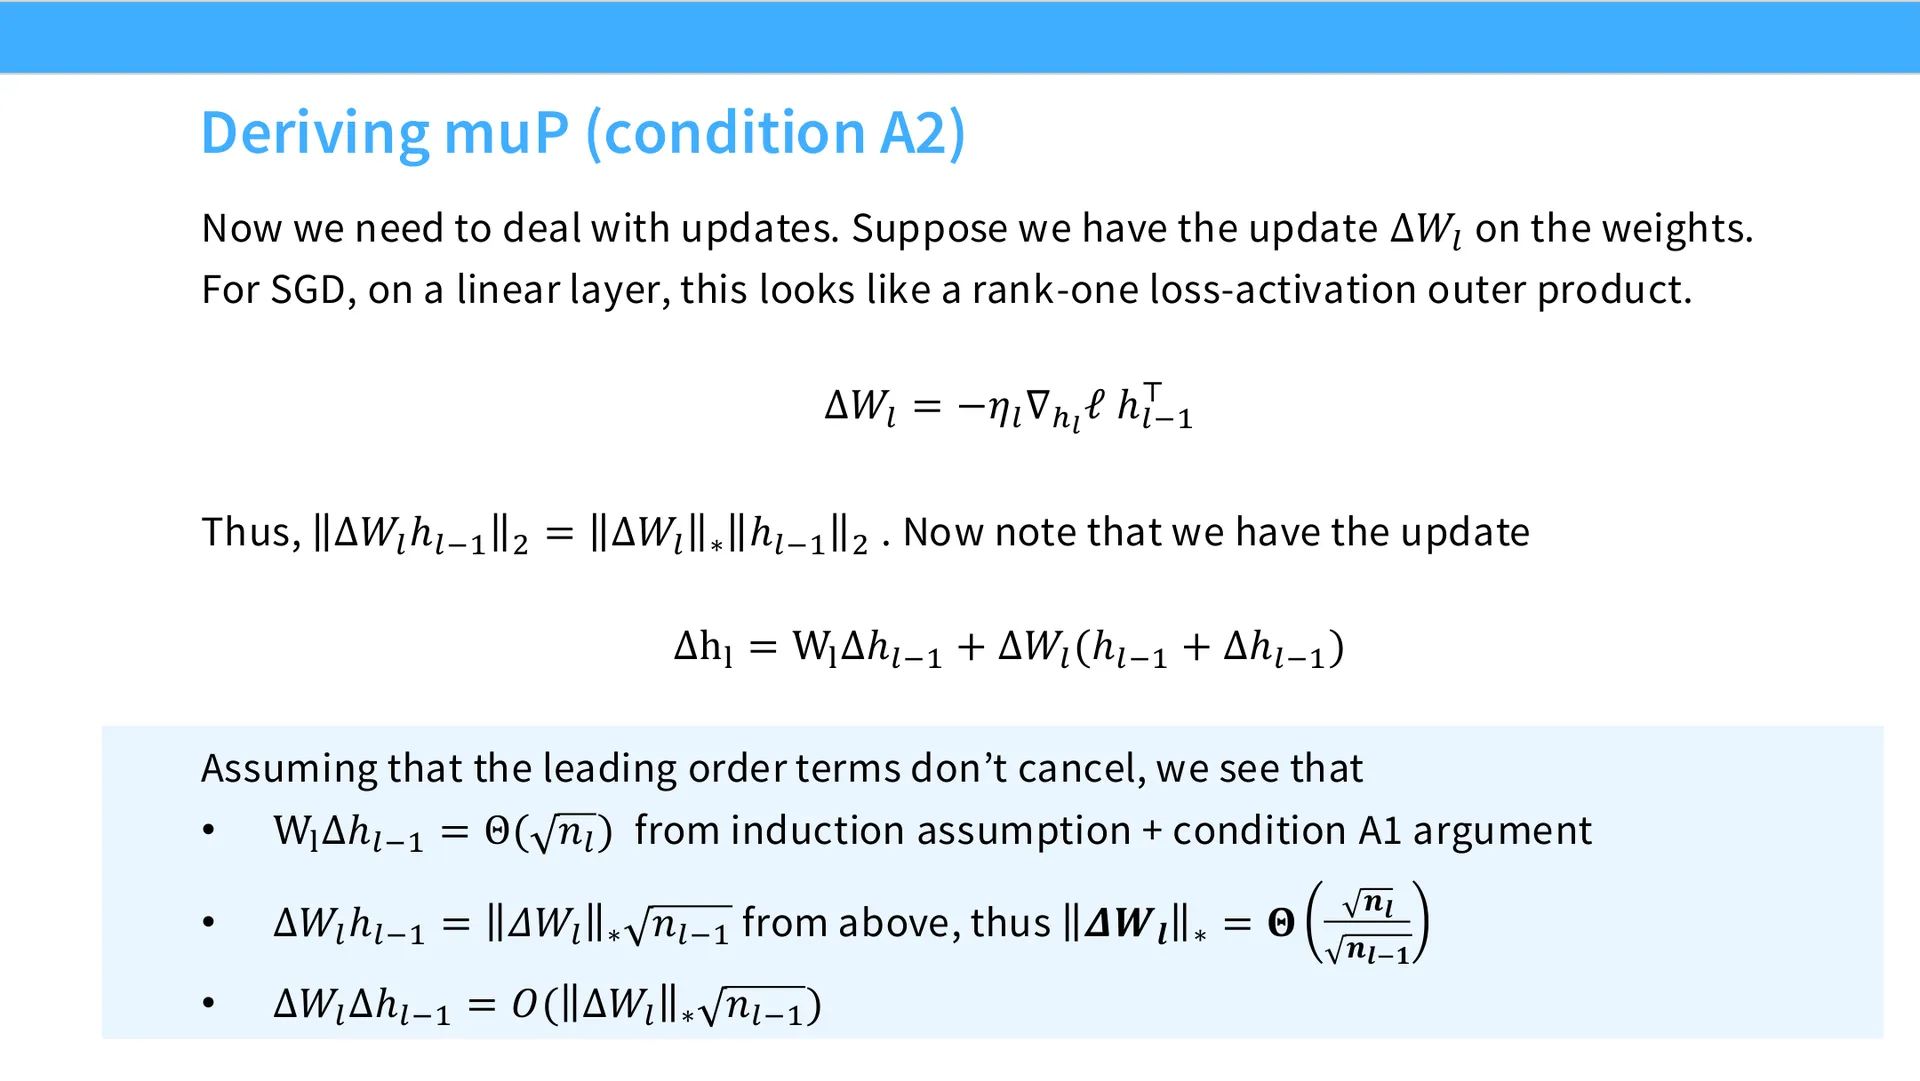
A2(特征学习不变量):走一步梯度之后,激活值的变化应是 $O(1)$——即每个激活的变化量应是一个不随宽度变化的固定函数。这叫 feature learning(特征学习)。
编者拓展|A2 与"神经正切核"的对立 老师特意提醒学过理论的听众:神经正切核(Neural Tangent Kernel, NTK)的行为恰恰相反——NTK 的激活变化会随宽度趋于零(网络在无限宽下不学习特征,等价于一个固定核)。而 μP 想要的是相反的:即使网络无限宽,网络也要真正改变、学习特征。所以 A2 要求"变化量是 $O(1)$",而不是趋于零。
注意激活的"单元素"与"向量范数"的换算:若每个激活大致是 $O(1)$,那么整条激活向量的范数应是 $\sqrt{n}$($n$ 是该层隐藏单元数)。
7.3 从 A1 推导初始化("物理学家数学")
(参考时间: 01:03–01:06)
目标:让初始化时的激活尺度大致为单位(即范数 $\approx \sqrt{n}$)。
考虑一个简单深度线性网络,把所有权重初始化为 $N(0,\sigma^2)$ 的缩放高斯。问题是:这个矩阵的谱范数(operator norm)大概是多少?用随机高斯矩阵的矩阵集中(matrix concentration)结果可写出:
$$\|W\|_{op} \approx \sigma\sqrt{n_{\text{out}}} \quad (\text{在某个 regime 下})$$
在扇出(fan-out)不显著大于扇入(fan-in)的 regime 下,一层的输出近似等于
$$\|h^L\| \approx \|W^L\| \cdot \|h^{L-1}\|$$
(这总是一个上界,但在某些高维 regime 下近似成立。)
归纳推理:
- 基例:第 $L-1$ 层的激活范数 $\approx \sqrt{n_{L-1}}$;
- 归纳步:假设第 $L$ 层输出范数应为 $\sqrt{n_{\text{out}}}$,则有
$$\sigma\sqrt{n_{\text{out}}}\cdot\sqrt{n_{L-1}} = \sqrt{n_{\text{out}}} \implies \sigma = \frac{1}{\sqrt{n_{L-1}}}$$
于是你得到:只要这样选 $\sigma$,每一层的激活尺度都大致等于 $\sqrt{\text{该层隐藏单元数}}$。这里用了一些"近似等于"的假设,但总体上站得住脚。条件 A1 是相当简单的。
编者说明:老师在推导中期回了一次幻灯片、又往前推,节奏上有来回。上面的算式是把他的结论按顺序重排后的结果;重点不是背公式,而是体会"先断言不变量,再倒解出参数缩放"这种思路。
7.4 从 A2 推导学习率(这里开始"长毛刺")
(参考时间: 01:06–01:10)
A2 更棘手。老师只考虑:一个 batch 里只有一个样本、SGD、线性神经网络(deep linear network)。
第一步:单层的权重变化是秩一(rank-1)的。
$$\Delta W^L = -\eta \cdot (\text{梯度的外积})$$
因为前向是秩一乘法,反向也会是秩一外积。
第二步:展开激活的变化。
对 $H = W h^{L-1}$ 求微分,展开后得到三项:一项来自上一层激活的变化(直接项),另一些是因为权重本身变化(交叉项)。
第三步:要求三项量级一致。
老师要求:这三项量级相同,且该量级应为 $\sqrt{n_L}$(回到 A2——一步梯度后激活变化应为 $O(1)$,而向量范数是 $\sqrt{n}$)。
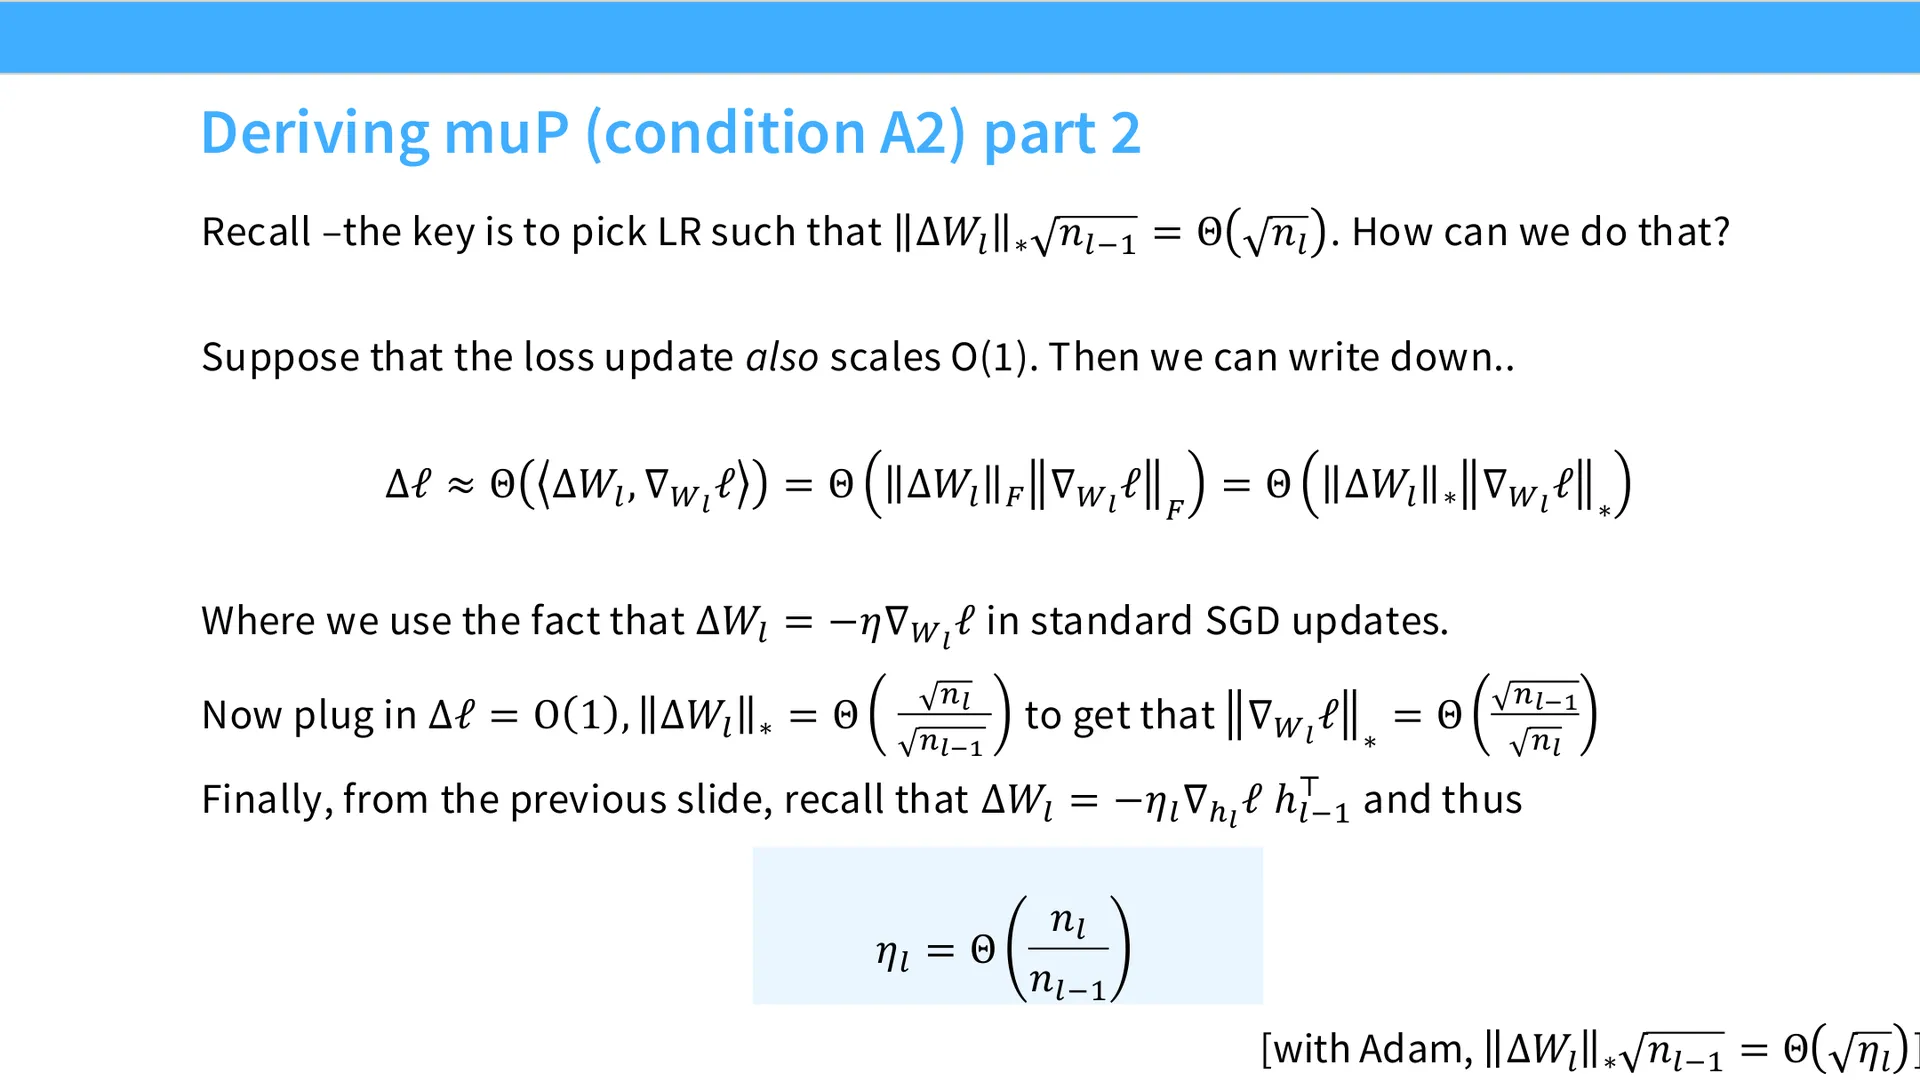
第四步:从中解出所需的学习率。
推导的关键是追踪每个项的量级,并假设损失更新被缩放到单位量级(老师说这是最不可接受的一条假设——"我们假设模型在随规模增长时确实取得可观的非平凡进展,而且大致相似")。
具体地:
- 由链式/Taylor 展开,损失的改变 $\approx$ 梯度 $\times$ 权重变化;
- 因为是秩一,可把某些量写成 Frobenius 范数与谱范数;
- 让左端为 $O(1)$,右端为
$$\frac{\sqrt{n_L}}{\sqrt{n_{L-1}}} \times \frac{\sqrt{n_{L-1}}}{\sqrt{n_L}} \times \eta$$
整理后得到所需 fan-out / fan-in 之比:
$$\boxed{\ \eta_L \propto \frac{n_{\text{out}}}{n_{\text{in}}}\ }$$
对 Adam 的说明:由于 Adam 的一些变化,你会得到
$$\boxed{\ \eta_L \propto \frac{1}{n_{\text{in}}}\ }$$
即 fan-in 越大的层,学习率越小。
编者说明:老师说这不是严谨数学,而是"物理学家式的数学"——追踪所有项的量级,在给定假设下说"这些量应该有多大",其中还假设了无相消(no cancellation)等"草率"的地方。这是 μP 思想的源头:用假设推出对超参数的约束,而这些约束恰好给出超参数的缩放律。
7.5 μP 的最终缩放规则
(参考时间: 01:10–01:12)
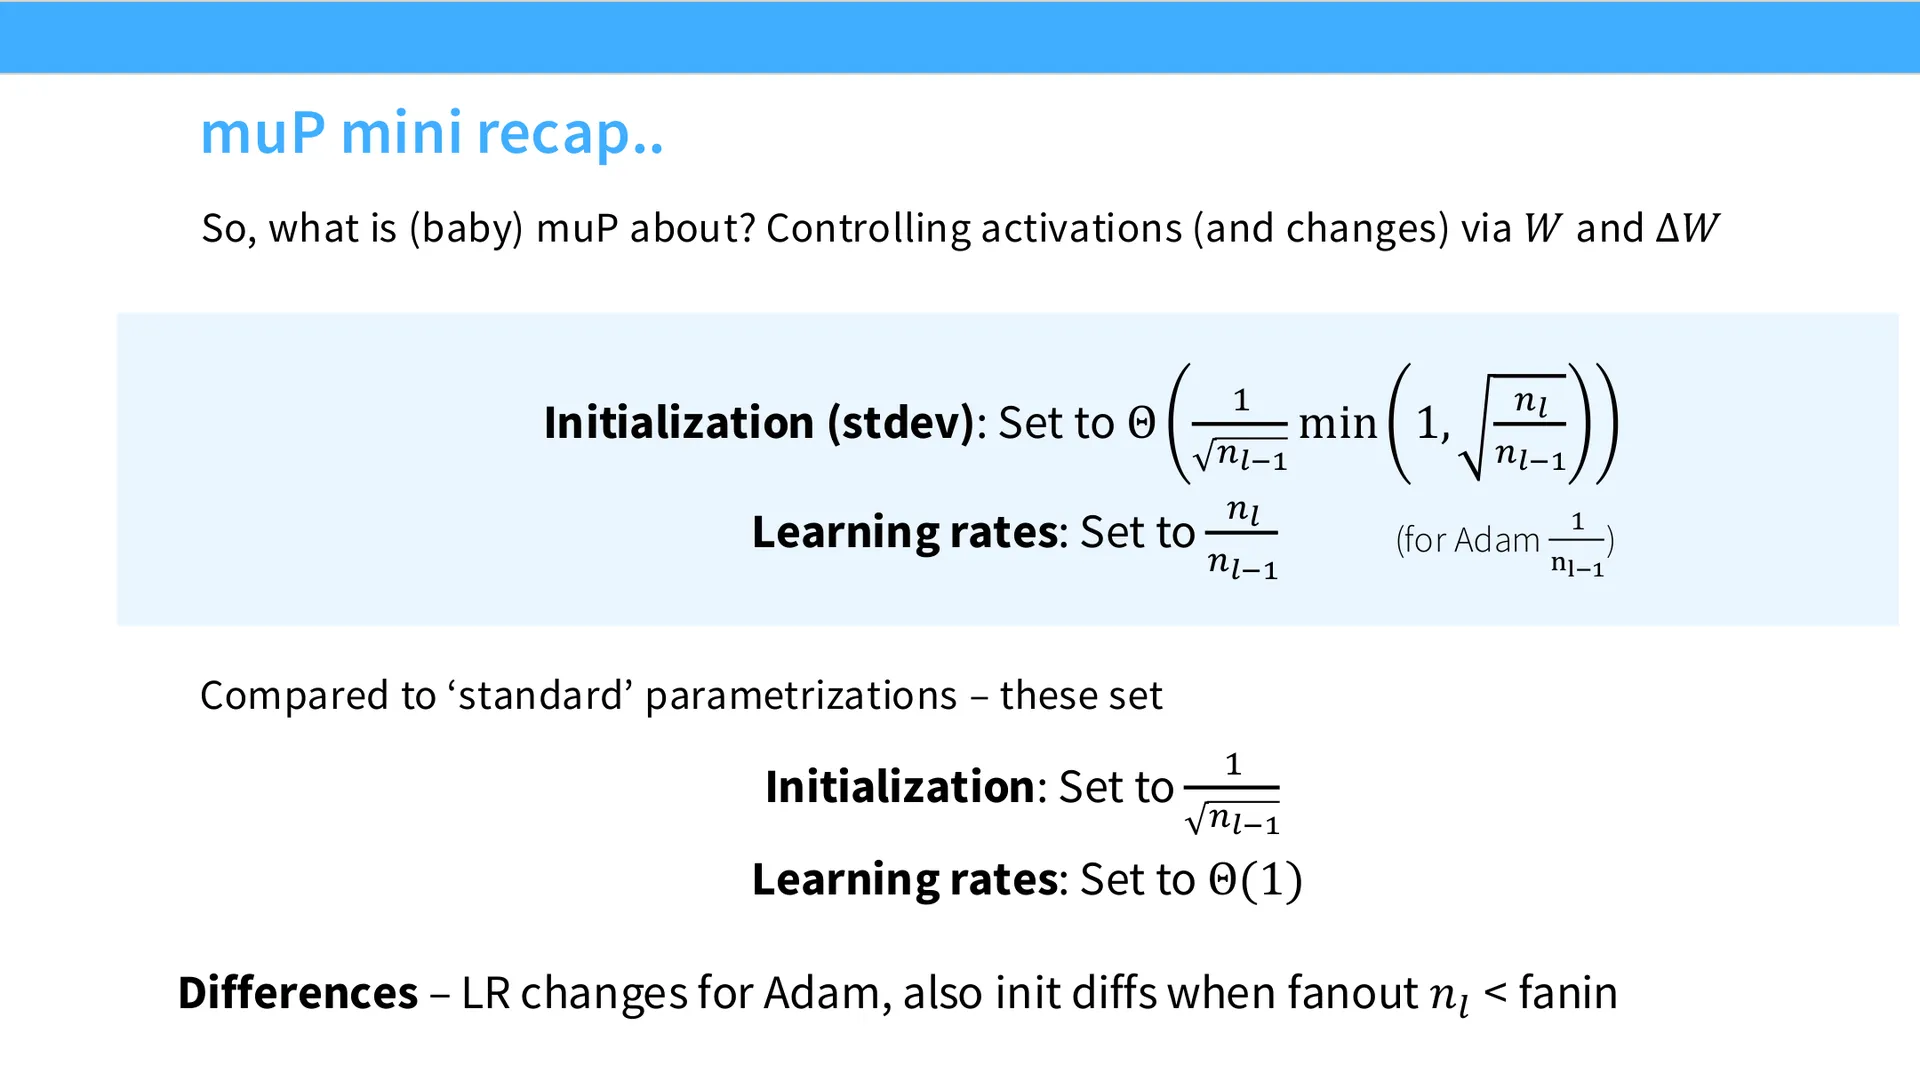
把所有推导汇总,μP 得到的是一组简单的缩放规则:
初始化(蓝色框):
$$\sigma = \frac{1}{\sqrt{n_{L-1}}} \cdot \frac{1}{\sqrt{n_{\text{out}}/n_{\text{in}}}} = \frac{1}{\sqrt{n_{L-1}}}\sqrt{\frac{n_{\text{in}}}{n_{\text{out}}}}$$
- 当 $n_{\text{out}}/n_{\text{in}} = 1$ 时,这退化为标准初始化(即标准参数化);
- 当这个比值不为 1 时,你得到的是更接近"扇出 / 扇入"的东西。
学习率: - 普通做法:学习率不随模型规模变化(常数); - μP 做法:学习率设为 fan-out / fan-in 之比。 - 对 Adam:去掉那个 $1/n_L$ 项,得到 $1/n_{\text{in}}$ 作为逐层学习率——fan-in 大的层得到更小的学习率。这让你拥有层自适应的学习率,非常有意思。
讲师高光总结:μP 的意义不仅在于"有用",更在于它给出算法的方式本身很有意思——取网络的缩放极限 → 断言不变量 → 加额外假设 → 倒解出对超参数的约束 → 得到超参数的缩放极限。这是一种与你在 CS/ML 训练里习惯的思维非常不同的通用原则,可以用来设计新的算法或新的超参数缩放。
八、μP 的实证检验与总结:缩放是一门"半科学"
(参考时间: 01:12–01:16)
老师用几个实证结果收尾。
8.1 压力测试:哪些东西会破坏 μP?
(参考时间: 01:12–01:15)
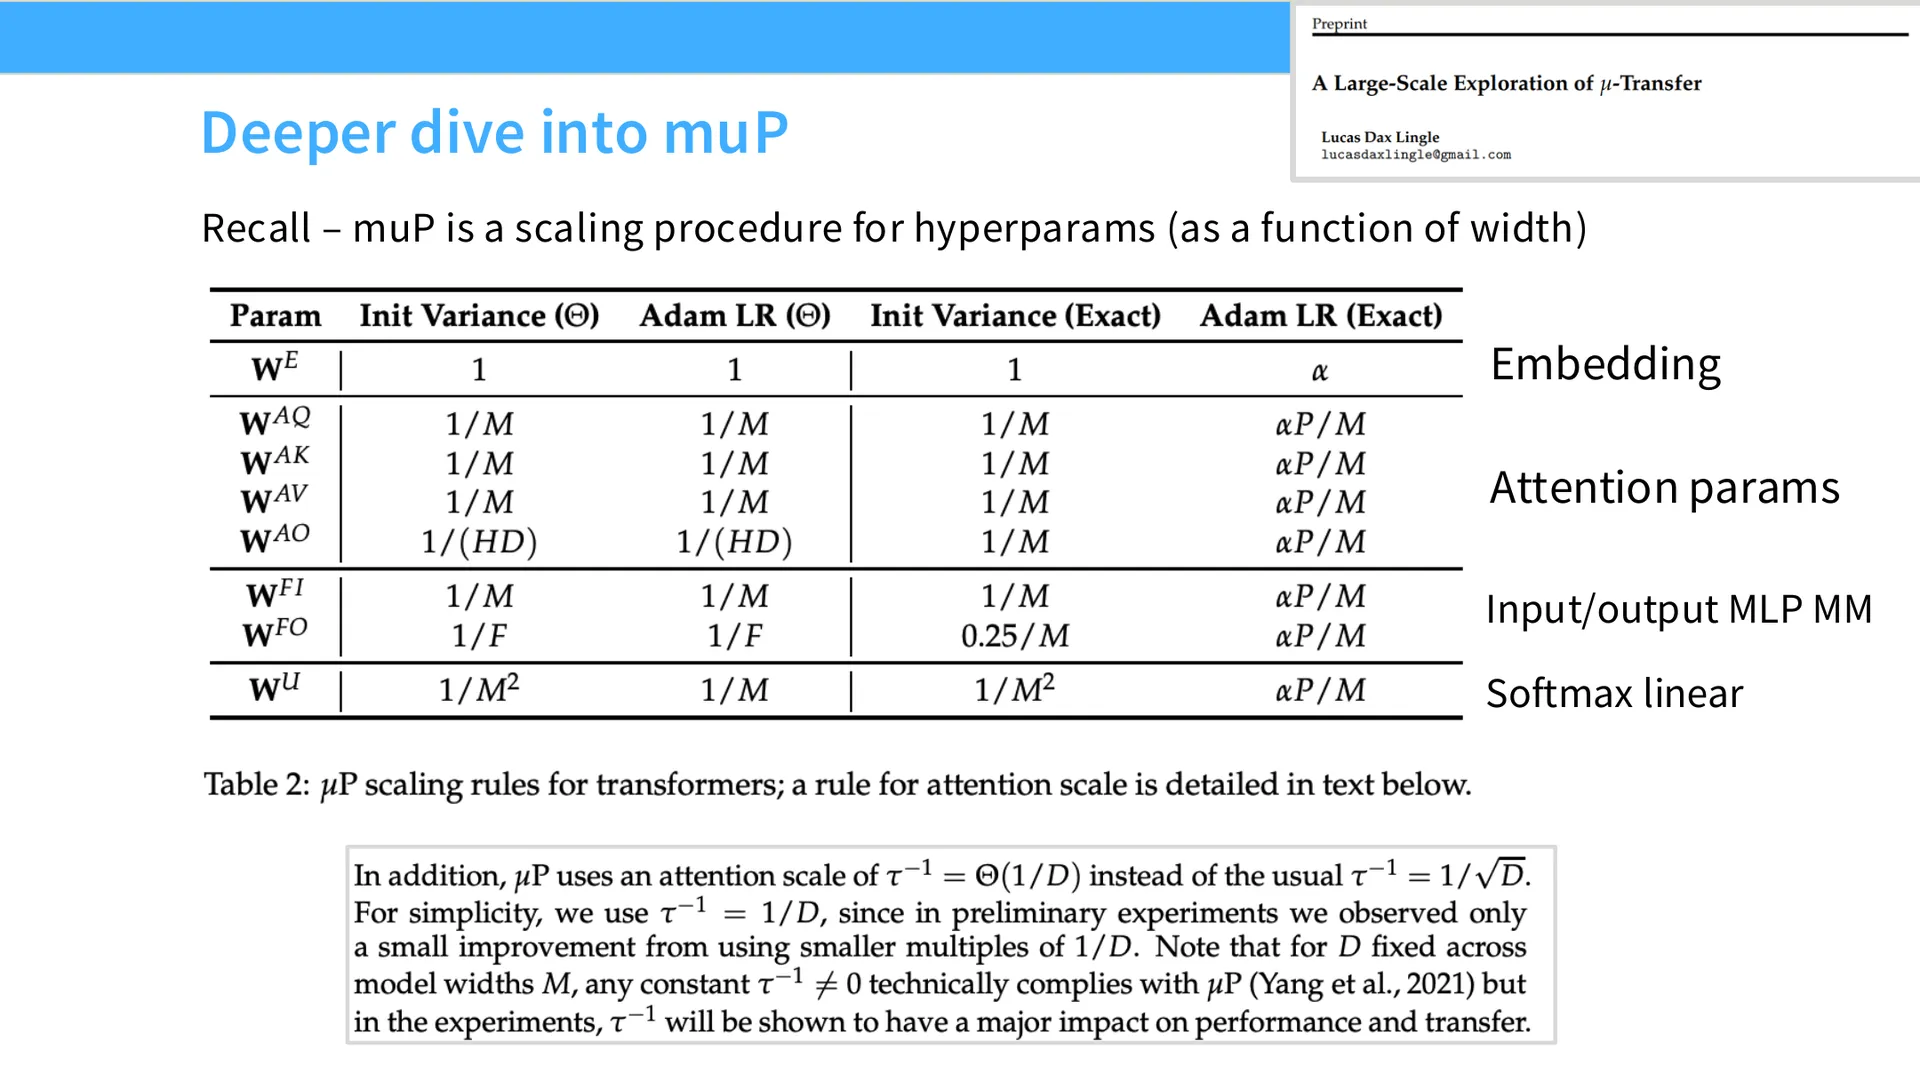
有一篇独立研究者的论文,从多个角度压力测试 μP。μP 可以看作一套调超参数的程序:Adam 在不同网络组件上(embedding 参数、注意力参数、输入/输出 MLP、softmax 线性层)会有不同的缩放规律,无论是 μP 还是非 μP。
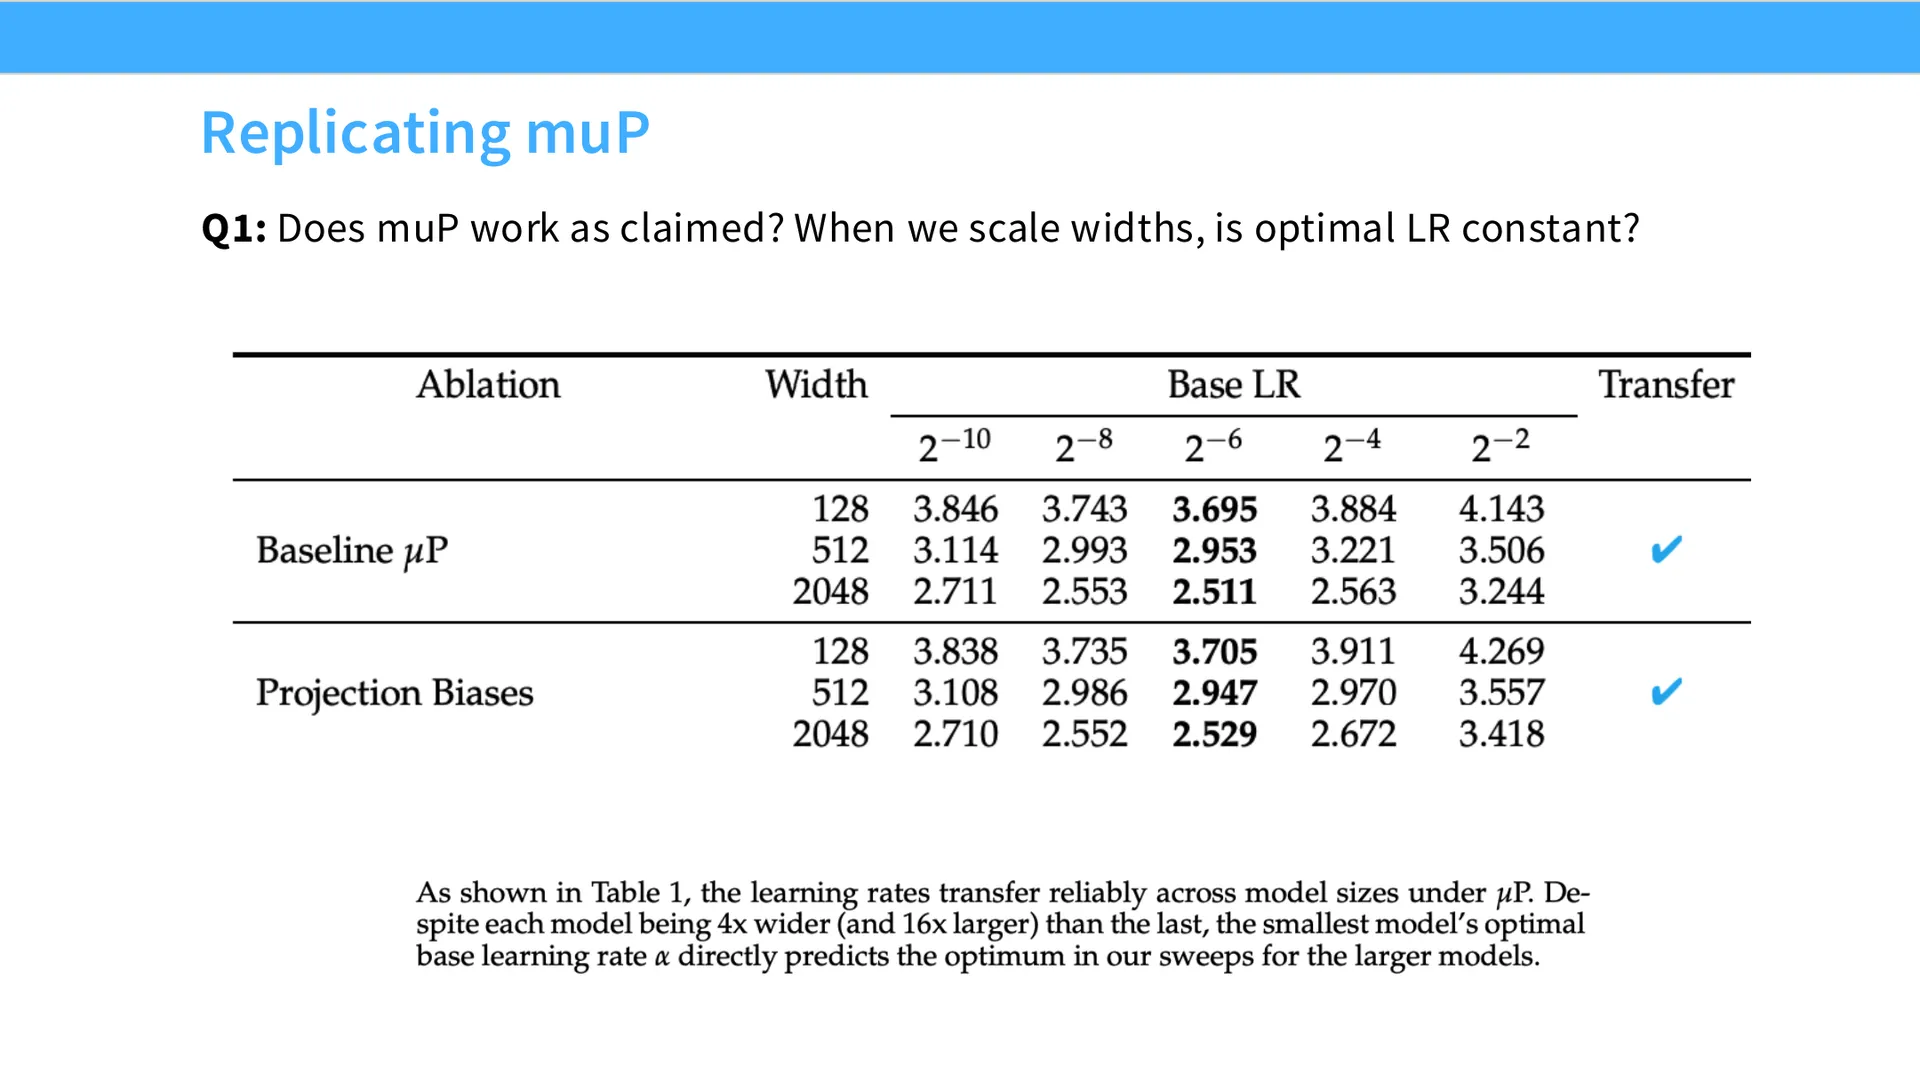
这篇论文复现了 μP 的许多结果(在不同规模的语言模型上),并不出意外地得到 MiniCPM 等工作的头条结论:
- 只要你把 μP 调对、并在受控方式下缩放,你就能得到学习率最优性的不变性;
- 基线 μP、以及一种"跟踪注意力投影偏置"的 μP 变体,都能很好地迁移。
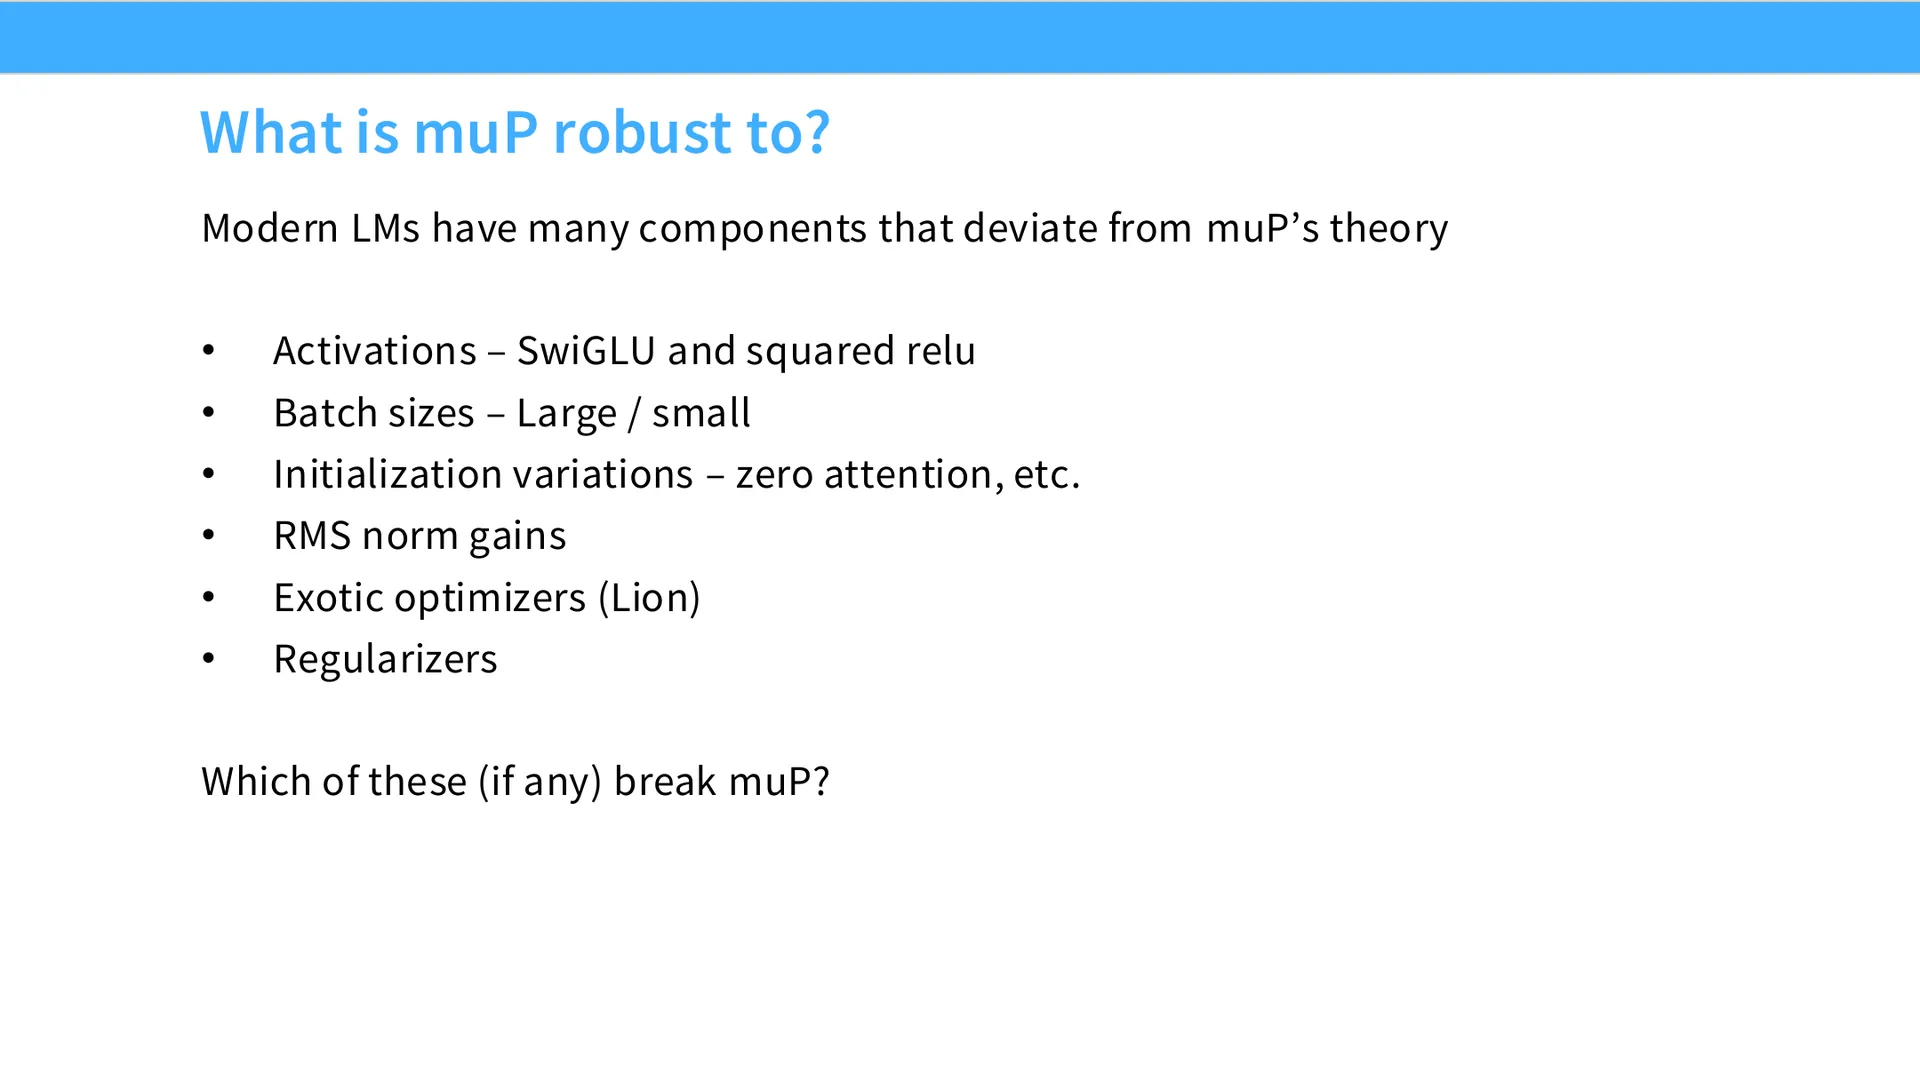
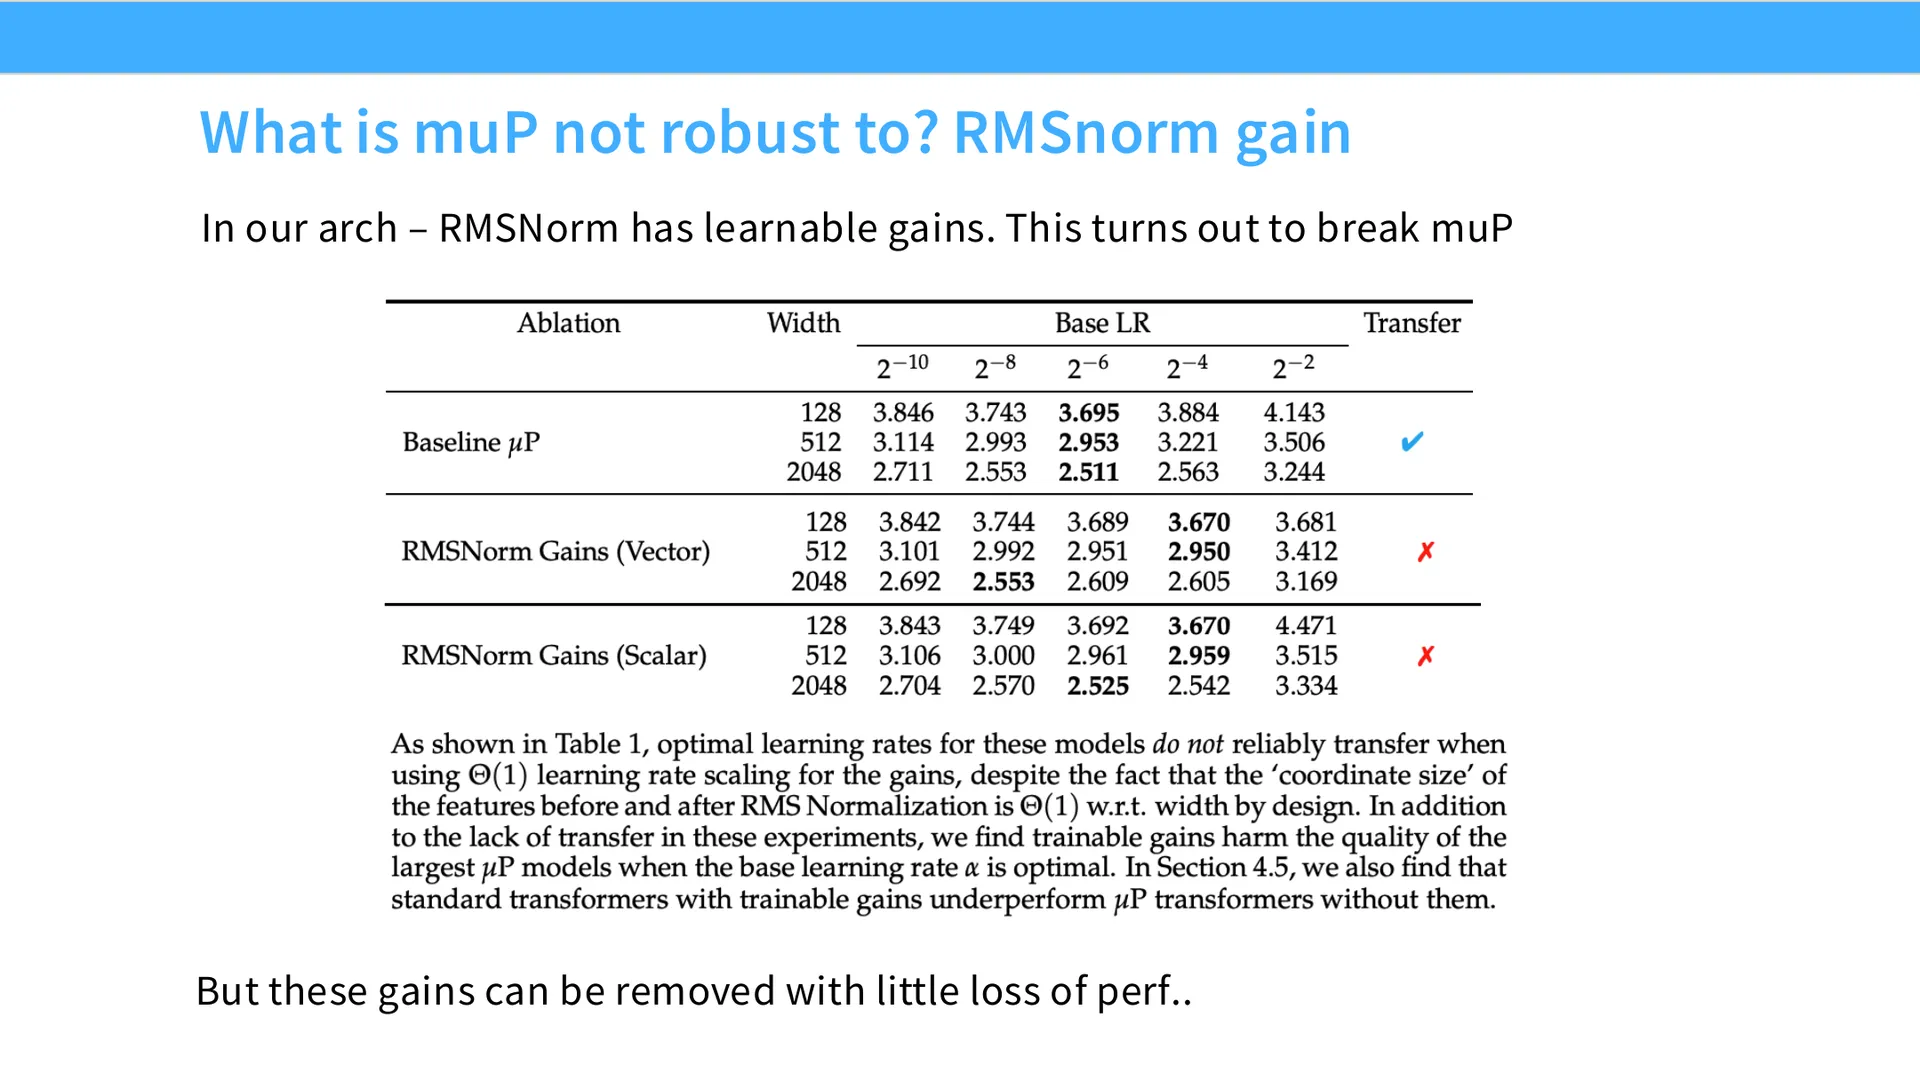
但现实里有很多 μP 处理不了的东西:
graph TD
    A["μP 能处理的范围"] --> B["✅ 大部分实际组件<br/>Swiglu、初始化变体、RMSNorm<br/>(大多能配合 μP 工作)"]
    A --> C["❌ 会破坏 μP 的东西"]
    C --> C1["学习 RMSNorm 的增益项<br/>(gain term)"]
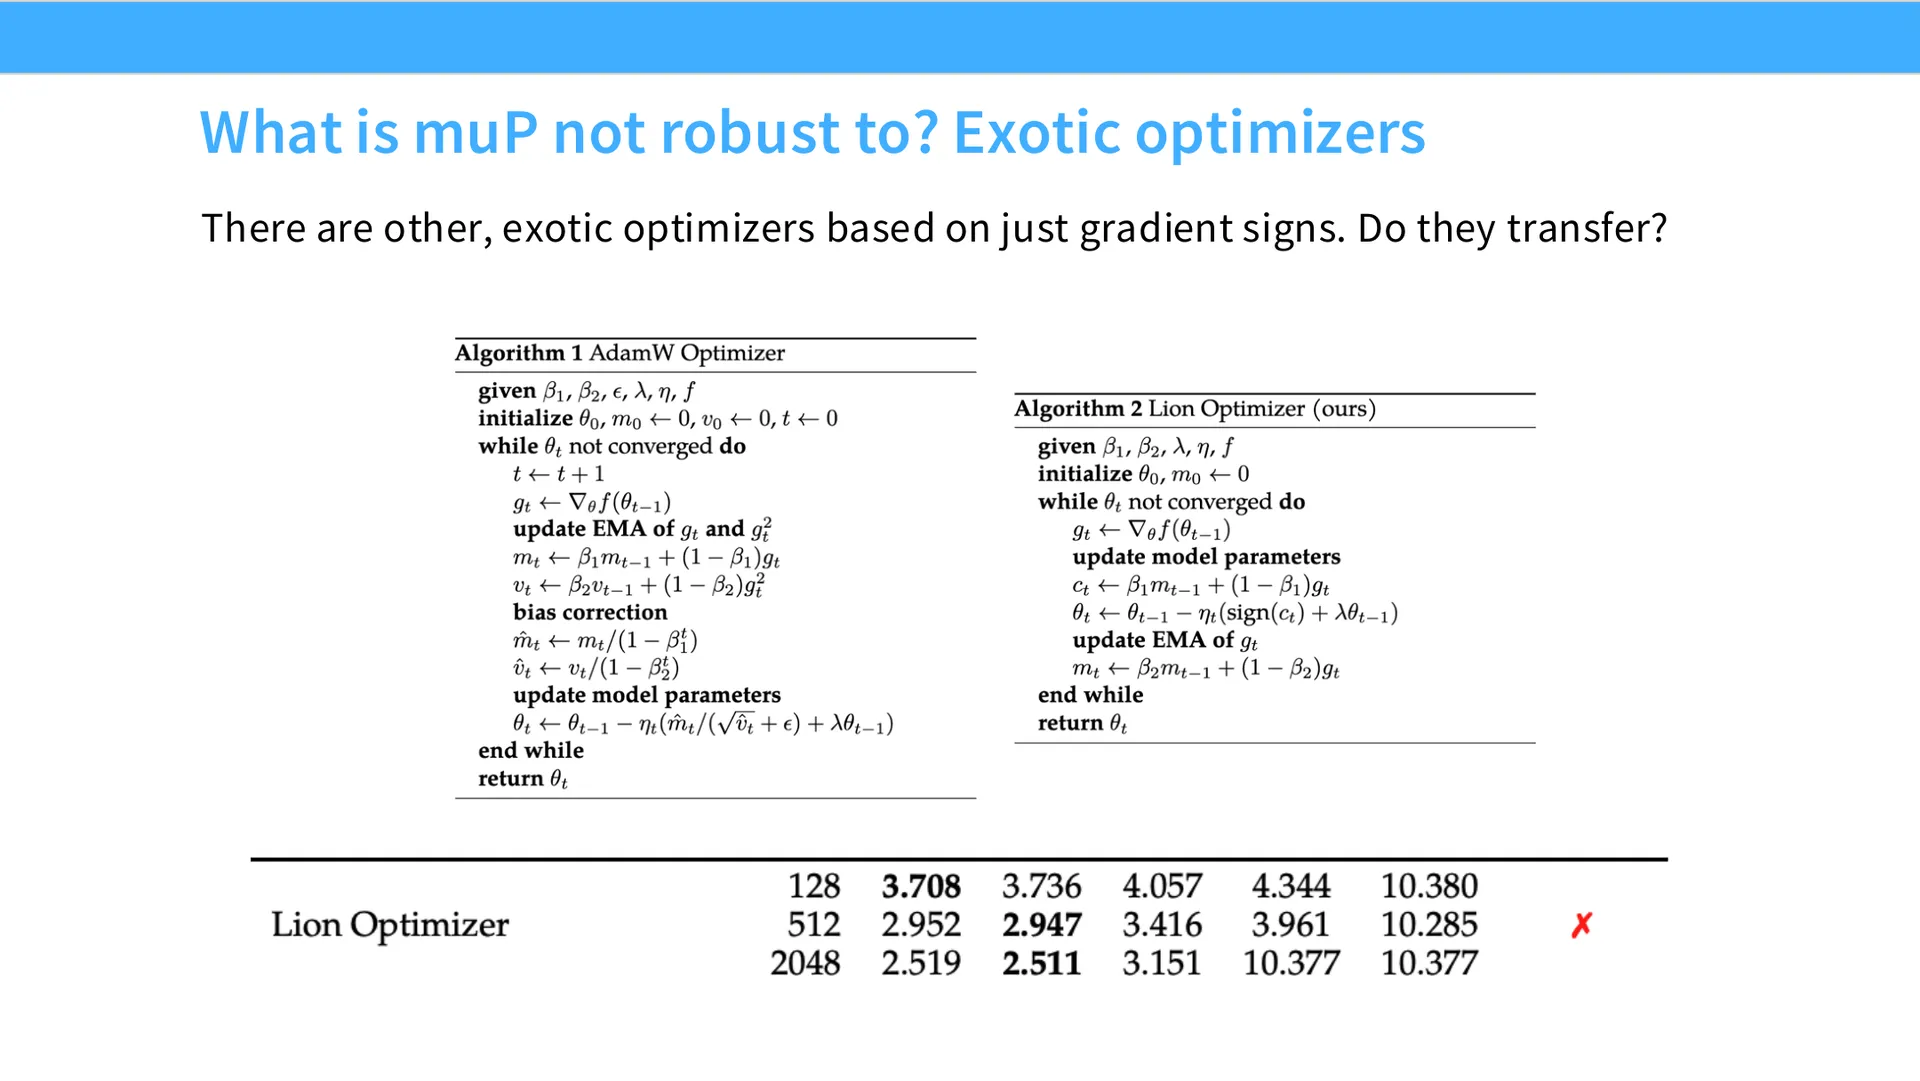
    C --> C2["更奇怪的优化器:Lion<br/>(依赖梯度符号)"]
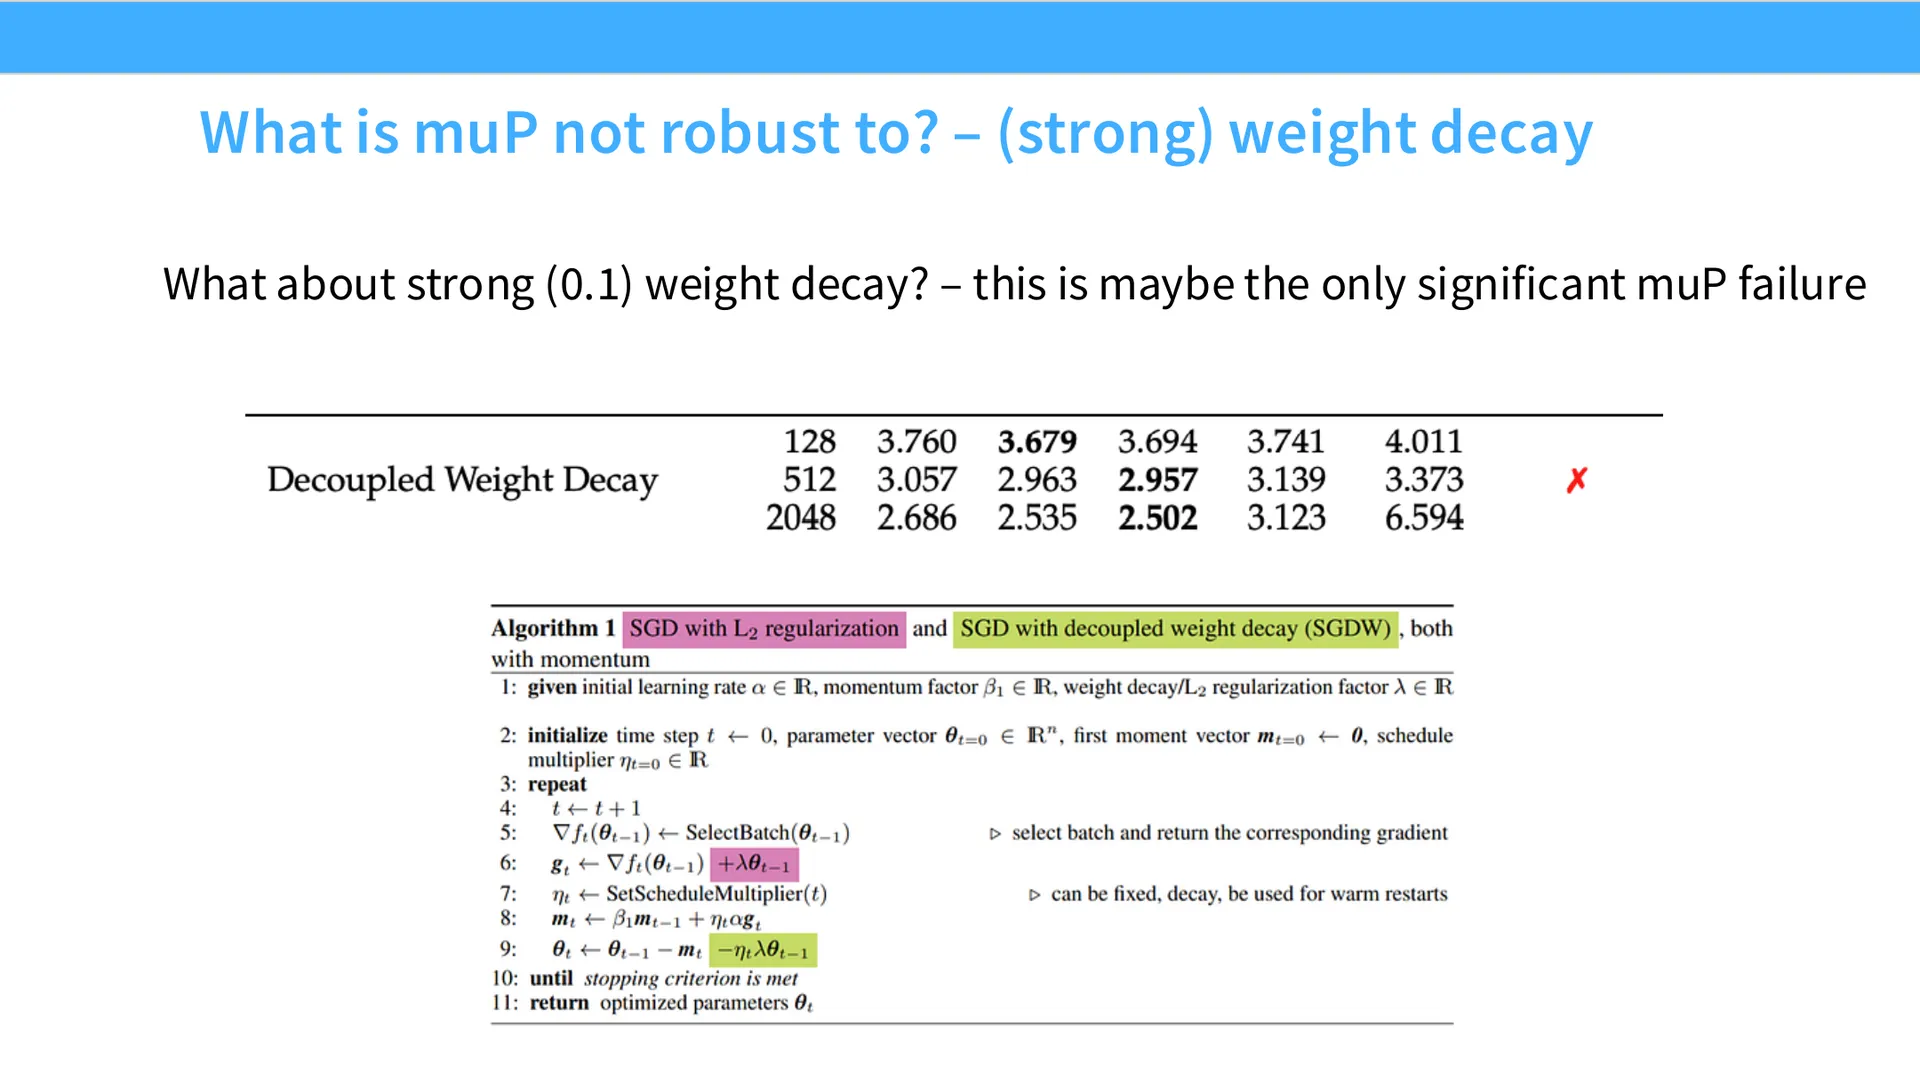
    C --> C3["大的解耦权重衰减<br/>(decoupled weight decay)<br/>—— 最令人担忧的失败"]
    style C1 fill:#fde8e8
    style C2 fill:#fde8e8
    style C3 fill:#ffcccc
- Swiglu 严格来说不符合 μP 理论;非标准初始化、RMSNorm 也一样;大改优化器也会破坏它。
- 但大多数情况下,这些"理论不允许"的东西实际上都能和 μP 一起工作;
- 真正会破坏 μP 的:
- 学习 RMSNorm 的增益项——这会破坏 μP(不过在很多情况下移除它也不一定有害,所以"也许没那么糟");
- 更奇怪的优化器如 Lion(依赖梯度符号,与 Muon 精神相通)也会破坏 μP,可能存在其他会破坏 μP 的东西;
- 最令人担忧的是:大的解耦权重衰减(large decoupled weight decay)会导致显著的 μP 失败——这可能是唯一一个真正失败的压力测试。
8.2 结论:μP 有用吗?
(参考时间: 01:15–01:16)
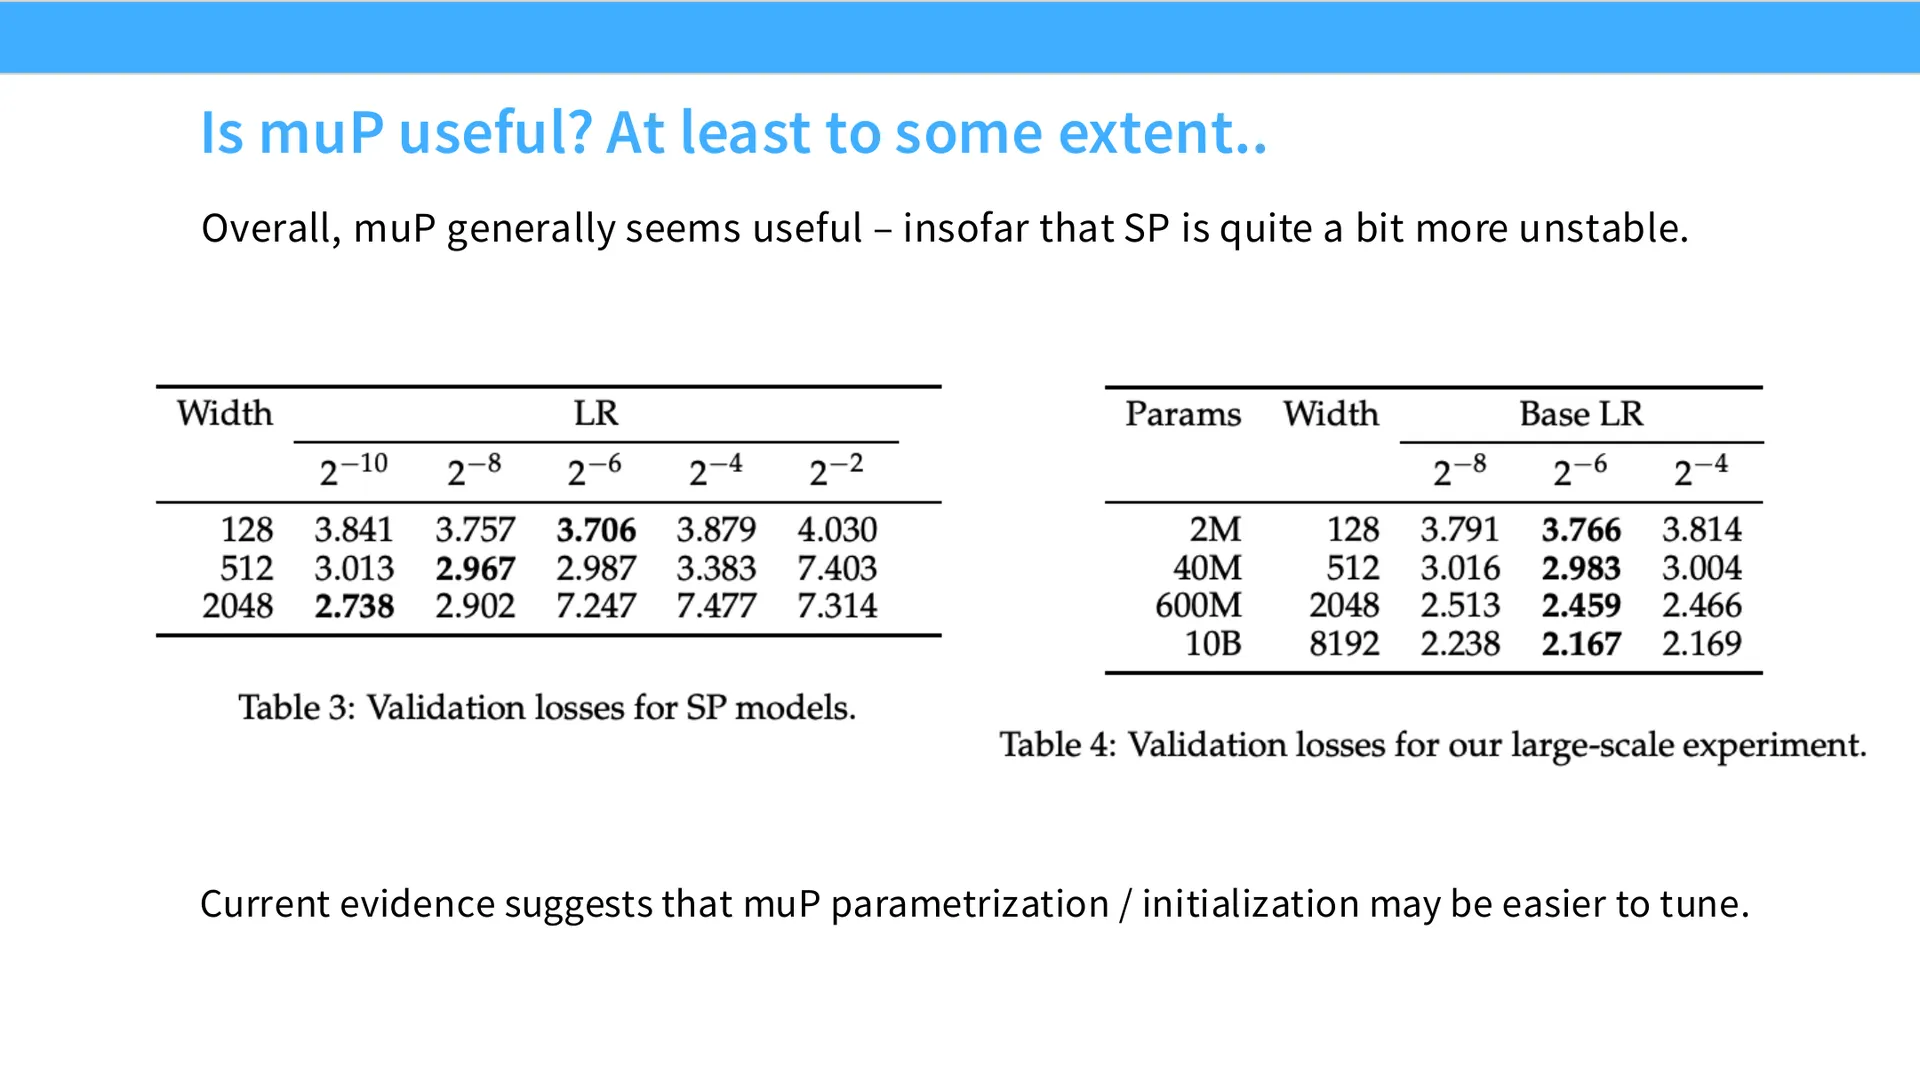
老师收尾: - 如果你真的想稳定学习率,μP 确实相当有用。大量实验显示:普通参数化下,增大宽度会让最优学习率极其剧烈地漂移;而 μP 下不漂移。 - 它是控制"超参数漂移"(hyperparameter drift)的工具箱之一,是一个有趣的开放研究领域,尚未尘埃落定,不是"唯一正确做法"。 - μP 风格初始化这条路很有前景;直接拟合缩放律同样也很有前景。
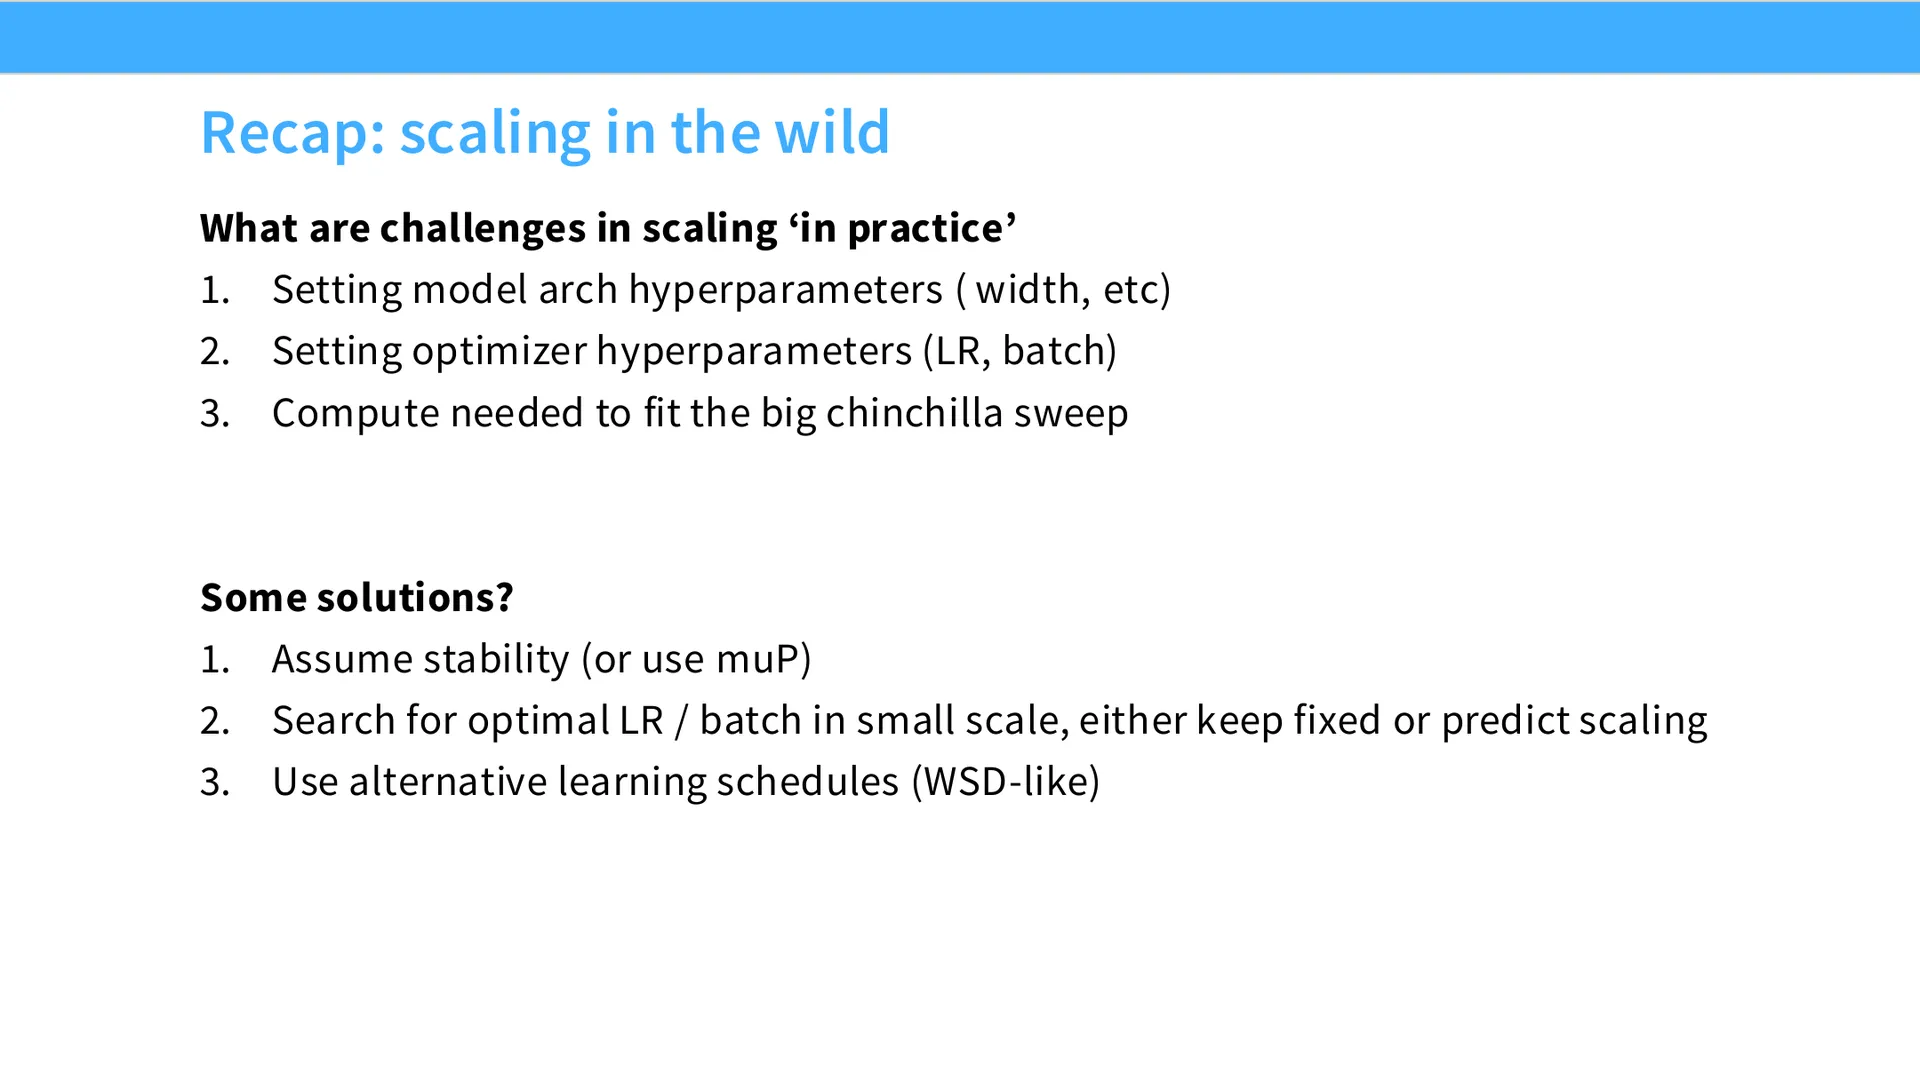
最终总结:在野外做缩放非常棘手。
缩放定律的初次呈现让人感觉它像科学——"画这条线、做这些步骤,你就能确知大规模会发生什么"。但现实要混乱得多、未知得多。人们确实用缩放定律来选架构、选优化器、选超参数,但其中真的有"艺术"成分——你无法确知它是否永远能外推。
你能做的,是采取合理的做法去最大化成功概率:用 μP,或搜索最优学习率……这些都是控制超参数漂移的手段,但目前还没有银弹。也许明年会有某个模块说"我们解决了",但目前还没有。
附:参考与延伸阅读
编者补充
- AdaGrad
- Cerebras
- Chinchilla 论文
- DeepSeek
- Kaplan 等人的缩放定律
- Lecture 11: Scaling Laws
- Llama 3
- MiniCPM
- MiniMax
- Muon
- nanoGPT speedrun
- Qwen
- Qwen 2.5
已知疑点
本着"不确定的东西不瞒着读者"的原则,逐条列出本讲重构中编者无法确证或存在歧义之处。凡涉及具体数字、姓名、公式符号的听写,均以字幕为准,可能存在偏差。
- 人名听写不确定。
- 开场提到的另一位缩放定律作者,字幕作 "oh, even Hessness",据上下文应为 Hestness(Chinchilla 论文 作者之一);但字幕拼写模糊。(参考时间: 00:01)
- 讲优化器故事时提到的一篇论文署名,字幕作 "Kaya"("Tengyu and Percy and David's paper"),疑为 Kaiyue Wen 等关于预训练优化器的研究;具体论文标题与作者无法从字幕确证。(参考时间: 00:43)
-
Moraine 项目的实验者,字幕作 "Will Held",工作环境被描述为 "Percy's open-source language model training project"。人名与项目归属未能独立核实。(参考时间: 00:47)
-
μP 初始化的最终公式存在听写歧义。 字幕对初始化的描述是"one over square root NL minus one times a component that is one over the square root fan out over fan in",编者据此写成 $\sigma = \frac{1}{\sqrt{n_{L-1}}}\sqrt{n_{\text{in}}/n_{\text{out}}}$。究竟分子分母哪个是 fan-in、哪个是 fan-out,仅凭口语无法百分百确定;请以 μP 原始论文(Greg Yang 的 tensor programs 系列)为准。(参考时间: 01:10)
-
学习率的"fan-out/fan-in"结论方向。 老师对 SGD 给出 $\eta_L \propto n_{\text{out}}/n_{\text{in}}$、对 Adam 给出 $\eta_L \propto 1/n_{\text{in}}$。这些比例关系与系数的确切形式在口语推导中经过快速口算,可能与论文的精确表述有出入。(参考时间: 01:09–01:11)
-
StepFun 论文的"最优学习率随数据量上升"结论。 老师本人已指出这是可能脆弱的结论,且有其他论文主张依赖方向相反。因此书中将其标注为"可能脆弱",读者不应直接套用。(参考时间: 00:35–00:36)
-
MiniCPM 与 Chinchilla 指数差异的解读。 老师明确表示:"很难说这是真的,还是他们的 Chinchilla 拟合本身有点怪。" 书中已如实保留这一不确定性。(参考时间: 00:14)
-
DeepSeek 的"两次 decay"变体。 老师说"不清楚为何这么做,而且它后来也没流行起来"。书中如实转述,未做额外解释。(参考时间: 00:20)
-
nanoGPT speedrun 的目标损失数字。 老师回忆"忘了是 3.something",字幕记为 "3.something loss"。具体数值不确定。(参考时间: 00:42)
-
Kimi K2 是否真有"完整的 Muon 消融"。 老师明确说 Kimi K2 没有做消融,因此"在那一规模上 Muon 是否优于 Adam 未知"。书中据此保留"未知"表述,未替讲师下结论。(参考时间: 00:54)
-
编者对 μP 推导的"重排"。 老师在推导过程中有来回回看幻灯片、中途切换顺序;书中的推导按逻辑顺序进行了整理,可能与现场口述的顺序不完全一致,但尽量保留了其推理骨架与所有假设(包括老师自评"最不可接受"的假设)。(参考时间: 01:06–01:10)
若上述任一疑点对你有实际决策影响(例如你要据此设置学习率),请回溯原始论文,不要仅凭本书或字幕。
附录:官方幻灯片(全部)
🖼️ 第 1 页幻灯片 · Lecture 11
🖼️ 第 2 页幻灯片 · Motivation today
🖼️ 第 3 页幻灯片 · Scaling in practice
🖼️ 第 4 页幻灯片 · Initialization and optimizers
🖼️ 第 5 页幻灯片 · Working through some detailed, public scaling recipes
🖼️ 第 6 页幻灯片 · MiniCPM
🖼️ 第 7 页幻灯片 · MiniCPM
🖼️ 第 8 页幻灯片 · Techique 1: muP to stabilize scaling
🖼️ 第 9 页幻灯片 · Scaling recipe / strategy
🖼️ 第 12 页幻灯片 · Optimal batch size
🖼️ 第 13 页幻灯片 · What remains – model size vs data tradeoffs.
🖼️ 第 15 页幻灯片 · WSD learning rates work well in miniCPM
🖼️ 第 16 页幻灯片 · Chinchilla-type analysis
🖼️ 第 17 页幻灯片 · Chinchlla method 1
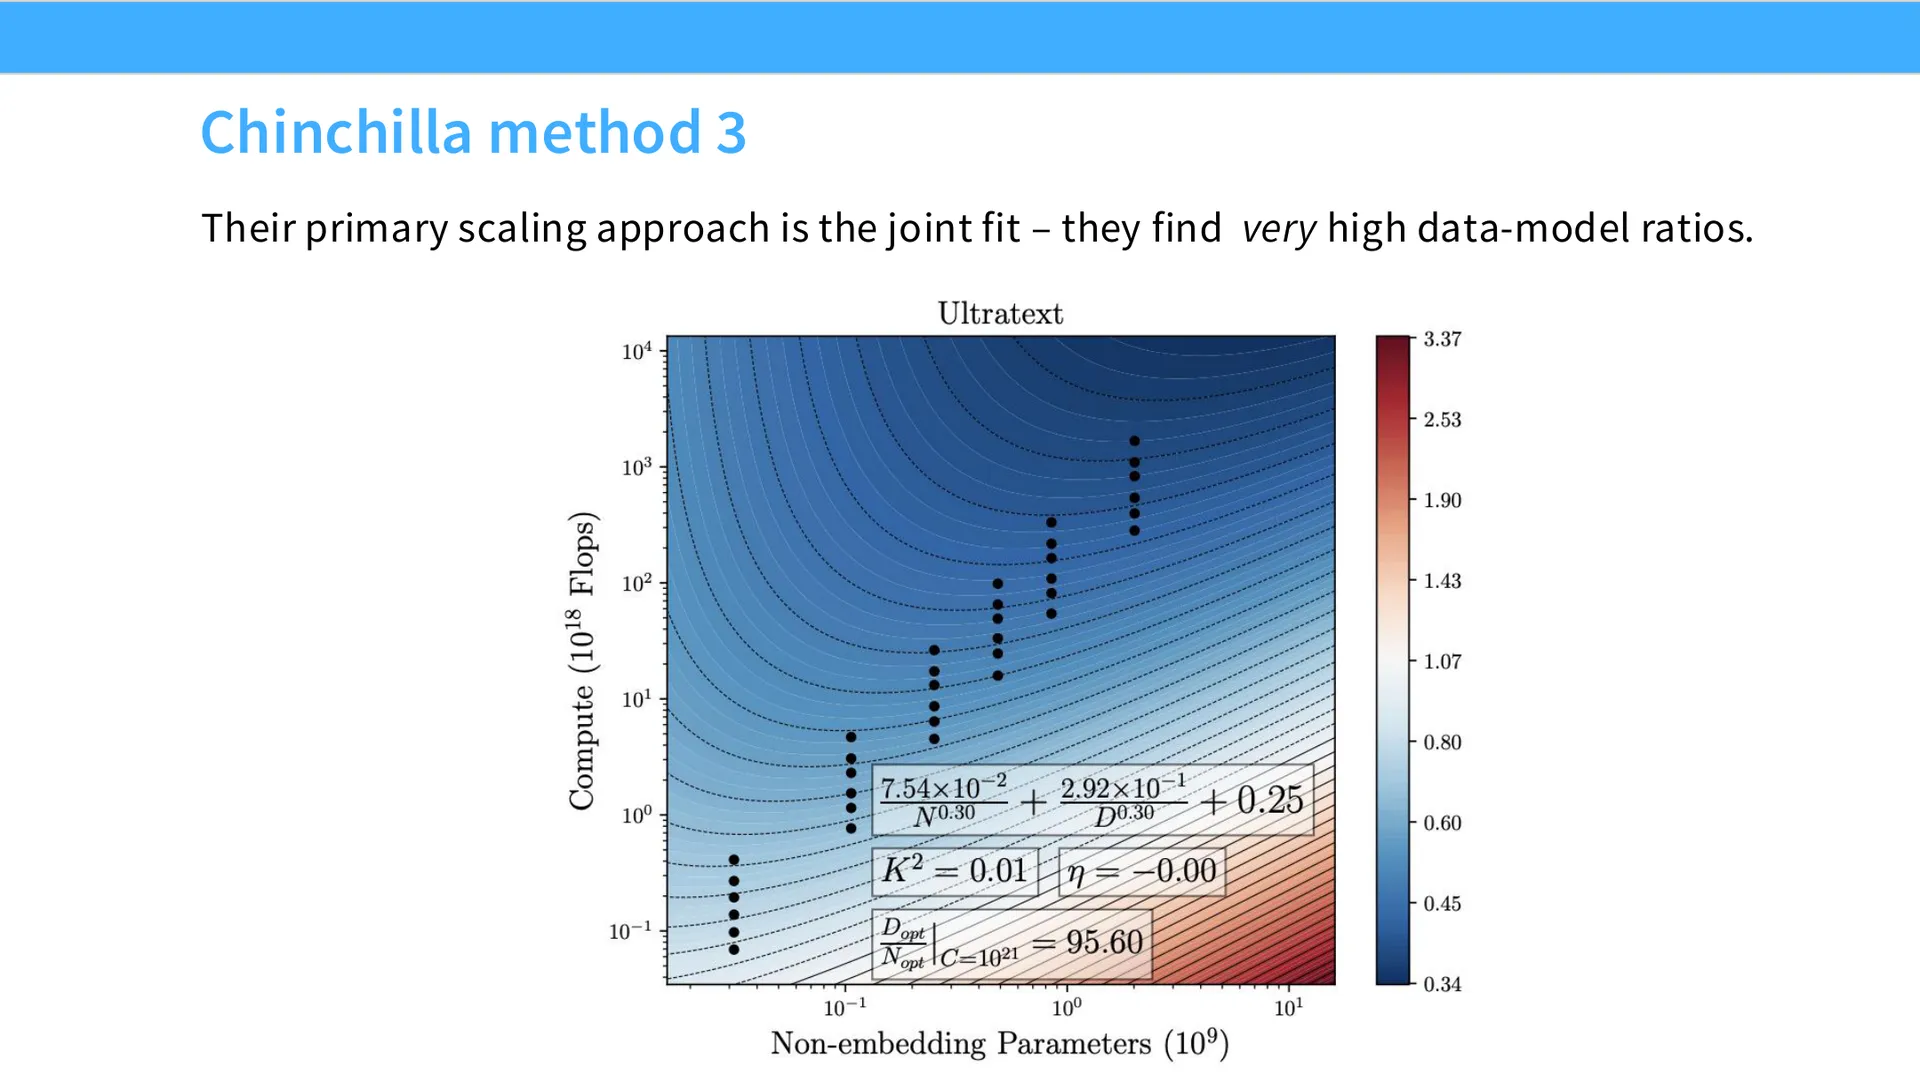
🖼️ 第 18 页幻灯片 · Chinchilla method 3
🖼️ 第 19 页幻灯片 · DeepSeek
🖼️ 第 21 页幻灯片 · Scaling analysis of learning rates
🖼️ 第 22 页幻灯片 · For chinchilla analysis: WSD-style learning rate
🖼️ 第 23 页幻灯片 · Data-size tradeoff analysis: Chinchilla method 2
🖼️ 第 24 页幻灯片 · Scaling predicts final model loss
🖼️ 第 25 页幻灯片 · Other models: Qwen scaling
🖼️ 第 26 页幻灯片 · Kimi K2
🖼️ 第 27 页幻灯片 · Hunyuan (2024) large scaling laws
🖼️ 第 30 页幻灯片 · Recent scaling law recipes
🖼️ 第 31 页幻灯片 · Optimizer scaling
🖼️ 第 32 页幻灯片 · StepFun scaling law study
🖼️ 第 33 页幻灯片 · Core question – scaling rates on LR and batch
🖼️ 第 35 页幻灯片 · Observation 1: loss over batch/LR are convex
🖼️ 第 37 页幻灯片 · Observation 3 (?) robustness
🖼️ 第 39 页幻灯片 · Problem 1 – hyper tuning is often off..
🖼️ 第 42 页幻灯片 · A few slides on muon..
🖼️ 第 43 页幻灯片 · Muon and scaling
🖼️ 第 45 页幻灯片 · CerebrasGPT
🖼️ 第 46 页幻灯片 · What is muP, anyway?
🖼️ 第 47 页幻灯片 · Deriving muP (condition A1)
🖼️ 第 48 页幻灯片 · Deriving muP (condition A2)
🖼️ 第 49 页幻灯片 · Recall –the key is to pick LR such that Δ𝑊𝑙
🖼️ 第 50 页幻灯片 · muP mini recap..
🖼️ 第 51 页幻灯片 · Deeper dive into muP
🖼️ 第 52 页幻灯片 · Replicating muP
🖼️ 第 53 页幻灯片 · What is muP robust to?
🖼️ 第 54 页幻灯片 · What is muP not robust to? RMSnorm gain
🖼️ 第 55 页幻灯片 · What is muP not robust to? Exotic optimizers
🖼️ 第 56 页幻灯片 · What is muP not robust to? – (strong) weight decay
🖼️ 第 57 页幻灯片 · Is muP useful? At least to some extent..
🖼️ 第 58 页幻灯片 · Recap: scaling in the wild