第12讲 · Stanford CS336《语言模型从零开始》:评估
课程信息 - 本书由课堂字幕重构、翻译为中文书面语而成。讲师的类比、案例与推理链予以保留;凡「编者说明/编者拓展」均为编者所加,不代表讲师原话。术语与事实以课堂讲述为准,不确定处集中列于文末「已知疑点」。
| 课程 | Stanford CS336: Language Modeling from Scratch(Spring 2026) |
| 讲座 | Lecture 12 — Evaluation |
| 视频 | YouTube 原视频(时长约 78 分钟) |
对应讲次:第12讲(Stanford CS336 语言建模)
制作模型:deepseek-flash(vb compose,据 run.log)
导览
这是 3–5 分钟的问题地图,帮你建立进入正文前的心智框架。
① 这一讲老师想回答的核心问题
到目前为止,这门课已经讲完了训练一个语言模型所需要的一切:架构、优化器、训练主循环、用 kernel 与并行加速训练、scaling laws,以及如何让推理变快。唯一还差的一块是「数据」——那要放到下周。但在碰数据之前,必须先回答一个更靠前的问题:我们到底想让模型表现出什么行为? 这,就是评估。
评估问的是一个极其简单的问题:给定一个我们已经训练好的模型,它有多好? 而真正困难的是后半句——「好」是什么意思。
② 难点在哪
老师反复强调,评估看起来是个机械流程(定义 prompt → 发给模型 → 拿回回答 → 算准确率),但它的核心难点在于:如何把一个抽象愿望(比如「会对话」「会推理」)转化为一个由具体题目/环境支撑的具体指标。这一步一旦草率,后面所有分数都失去意义。更棘手的是,当模型的训练数据来源成谜时,你根本不知道它是不是见过测试集——于是排行榜上的数字很可能只是「信任」而非「事实」。
③ 读者可能带着什么疑问进来
老师真正提出的问题(按他自己的顺序): 1. 「好」到底怎么定义?有没有「客观正确」的答案? 2. 为什么不能像 2010 年代那样,训练/测试都在同一个分布上测困惑度就够了? 3. 考试型基准会饱和,那之后怎么办?谁来造更难的问题? 4. 开放式回答没有标准答案,怎么评? 5. 智能体(agent)的分数到底在评模型还是在评「脚手架」? 6. 能不能把「纯推理」从「知识」里剥离出来单独衡量? 7. 安全怎么量化?「安全」本身有定义吗?
编者预判的读者疑问(与上组区分): 1. 困惑度(perplexity)和交叉熵、log loss 是什么关系? 2. Elo 排名凭什么能用「谁比谁好」推出一个连续评分? 3. 什么是「训练污染」(contamination),我该如何检查? 4. 为什么讲师说「不能只信排行榜」——那我该信什么? 5. 这些基准(MMLU、SWE-bench、ARC-AGI……)分别对应什么能力?
④ 本讲路线
老师先回到语言模型最本质的定义——一个关于 token 序列的分布 $P(x)$——由此自然引出困惑度;然后依次走过五类基准:考试型、对话型、智能体、纯推理、安全;最后讨论评估的更一般性问题:生态效度、训练污染、数据集质量,以及那句收尾的话——没有唯一正确的评估,先想清楚你要衡量什么。
一、为什么评估值得一整节课
(参考时间: 00:00:05)
1.1 评估在整门课里的位置
讲师一开始就为这一讲定了位:前面已经讲完训练一个语言模型需要的全部要素——架构、优化器、训练主循环,以及通过 kernel 和并行让训练变快、通过 scaling laws 理解规模效应、让推理变快。剩下的只有训练数据,下周再讲。
但数据会塑造模型的行为:如果你只在代码上训练,模型大概率擅长代码;如果只在 DNA 序列上训练,它可能根本不会说英语。在讨论「拿什么数据训练」之前,必须先明确「我们想要模型有什么行为」——这正好是评估的主题。
于是评估的核心问题可以一句话概括:给定训练好的模型,它有多好?
1.2 为什么不是一节课就够
评估表面上很机械:定义一批 prompt,发给模型,拿回回答,算准确率。那为什么值得一整节课?
讲师的回答是:评估其实是个非常深的题目,而且极其重要——因为评估塑造了 AI 的发展方向。评估设定「北极星」。无论开源还是闭源,所有模型开发者都把评估当作衡量进展的标尺。因此,你如何设计评估,就间接决定了模型会朝哪个能力方向发展。
评估真正的难点在这里:
你往往从一个抽象概念出发——「我希望模型擅长对话」,或者「擅长推理」。这些都是抽象概念。而评估,本质上就是把这个抽象概念,转化为一个由具体 prompt 或环境支撑的具体指标的过程。
graph LR
    A["抽象愿望<br/>会对话 / 会推理"] --> B["评估设计"]
    B --> C["具体题目 / 环境<br/>prompts / environments"]
    C --> D["具体指标<br/>accuracy / win-rate / 奖励"]
    D -.->|反向塑造| A
这条「抽象 → 具体」的链条是本讲反复出现的核心挑战。
1.3 「好」是什么?四种看待方式
(参考时间: 00:02:38)
讲师先给出几种对「好」的朴素理解,用来启发思考(他强调没有一种是必然正确的答案):
-
跑分高就是好。他提到 artificialanalysis.ai 已经成为衡量模型「智能」的一个事实标准,上面陈列着从 GPT-5.5 往下各种模型的排名,综合了一大批数据集。
📷 artificialanalysis.ai 上的模型智能指数排名
回到原视频 (00:02:58) -
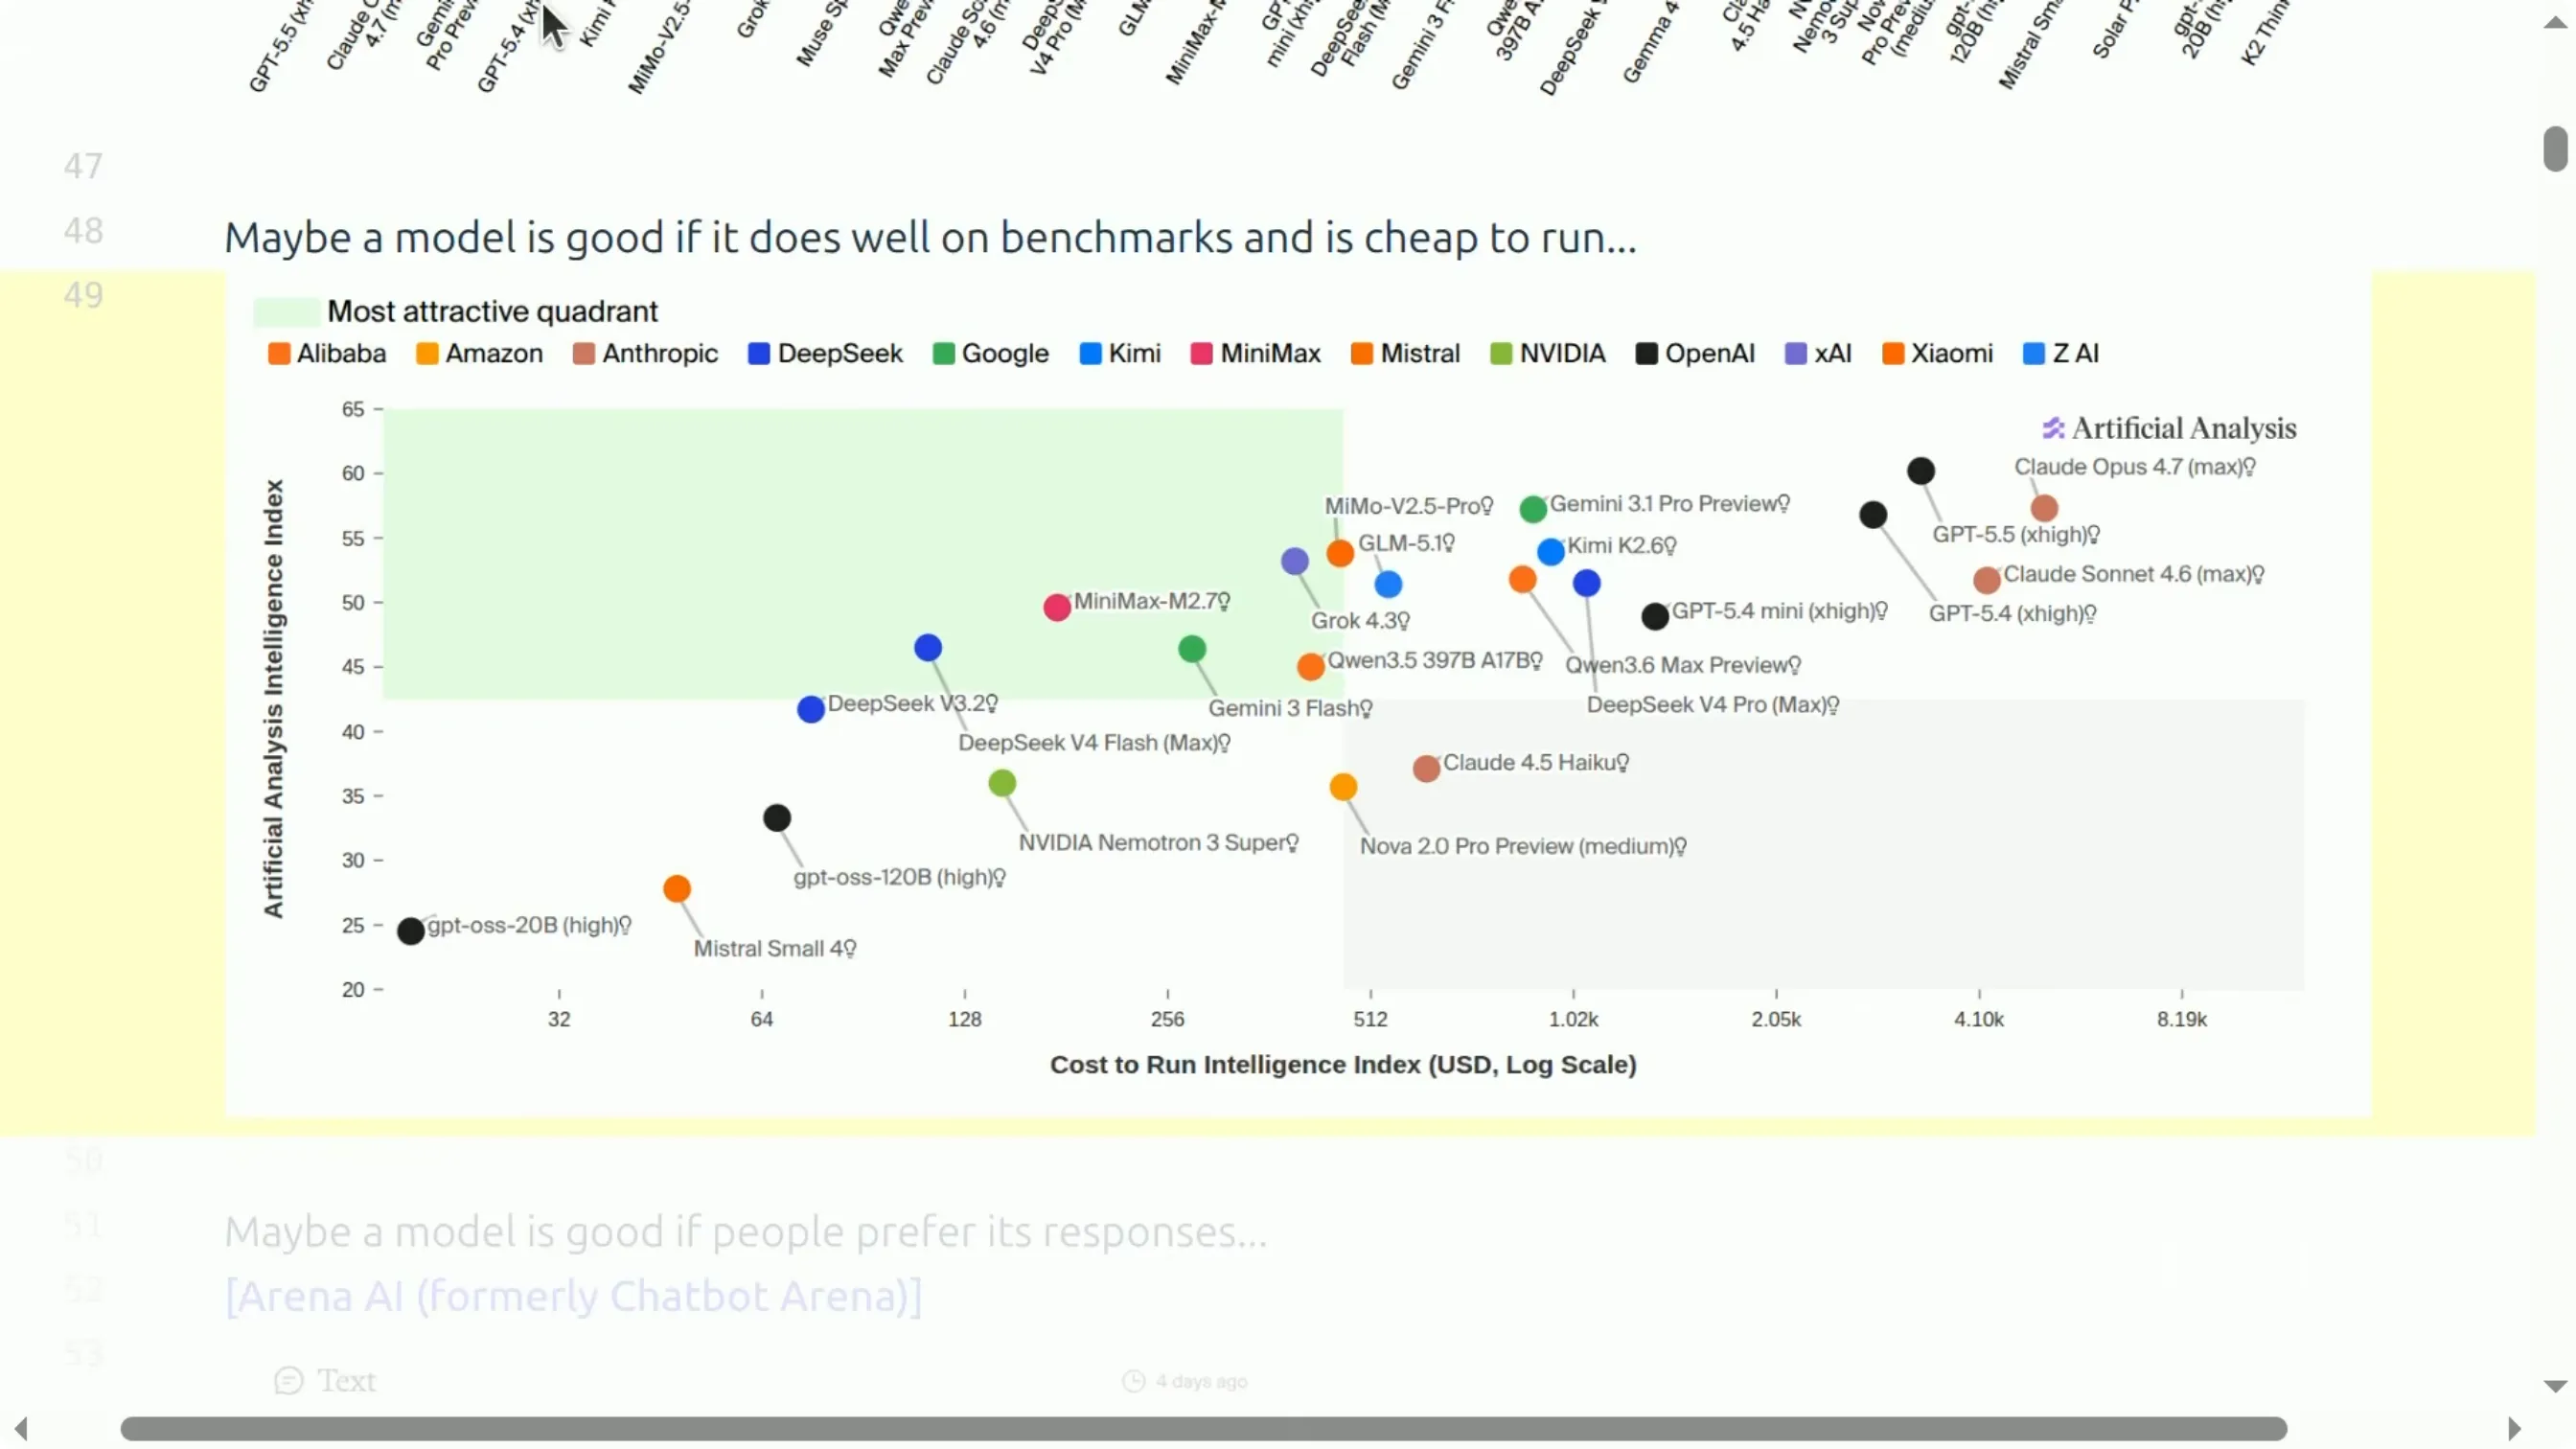
跑分高又便宜才算好。因为成本也应该被纳入考量。同一张图上还能看到「智能指数」对「运行一个模型的推理花费」的对比——两者总体正相关(花得越多、指数越高),但并非严格对齐。
📷 智能指数与推理成本的对比图
回到原视频 (00:03:31) -
人们偏好它就算好。这是 Arena AI(原 Chatbot Arena) 采取的路线——根据人类是否喜欢来给模型排名。
- 人们愿意为它付费就算好。这是 OpenRouter 的视角:它作为统一入口转发到多个模型,因此收集到大量「人们在用哪些模型」的统计。只看 OpenRouter 当然不能代表全部模型使用情况,但它给出一个经济视角——如果人们愿意掏钱,那想必它不错。
编者说明:讲师在这里故意不给答案,而是让读者体会「好」是多义的:跑分、成本、偏好、付费,分别对应能力、效率、主观满意度、真实需求四个不同的维度。后面每一类基准,本质上都是在回答这四个维度中的某一个。
二、困惑度:从分布出发的自然度量
(参考时间: 00:05:16)
2.1 语言模型就是分布
要谈具体的评估方法,没有比回到语言模型最核心的定义更好的起点了:语言模型是一个关于 token 序列的分布 $P(x)$。
从这个视角看,有一个非常自然的评估方式——困惑度(perplexity),或与之等价的似然、log loss。这些概念本质上是相关的。它的思想很简单:
我有一个测试数据集 $D$,看我的语言模型给 $D$ 分配了多少概率质量。为了让数字更可读,我会做归一化和除法。就这么简单——我的概率模型给数据集分配了多少质量?
形式化地,对于由 token 组成的测试集 $D = (x_1, x_2, \dots, x_N)$:
$$
\mathrm{PPL}(D) = \exp\!\left(-\frac{1}{N}\sum_{i=1}^{N} \log P(x_i \mid x_{ 编者拓展|困惑度与交叉熵的关系
困惑度其实是交叉熵的指数。上式括号内的量,正是模型对数据的平均负对数似然,也就是经验交叉熵;取指数后得到「平均分支因子」——可以粗略理解为「模型在每个位置平均要在多少个等概率候选之间犹豫」。
- 交叉熵越低 → 困惑度越低 → 模型对数据越「不意外」。
- 当模型给每个 token 都分概率 1(log prob = 0)时,困惑度会变成 1,这是理论下界。
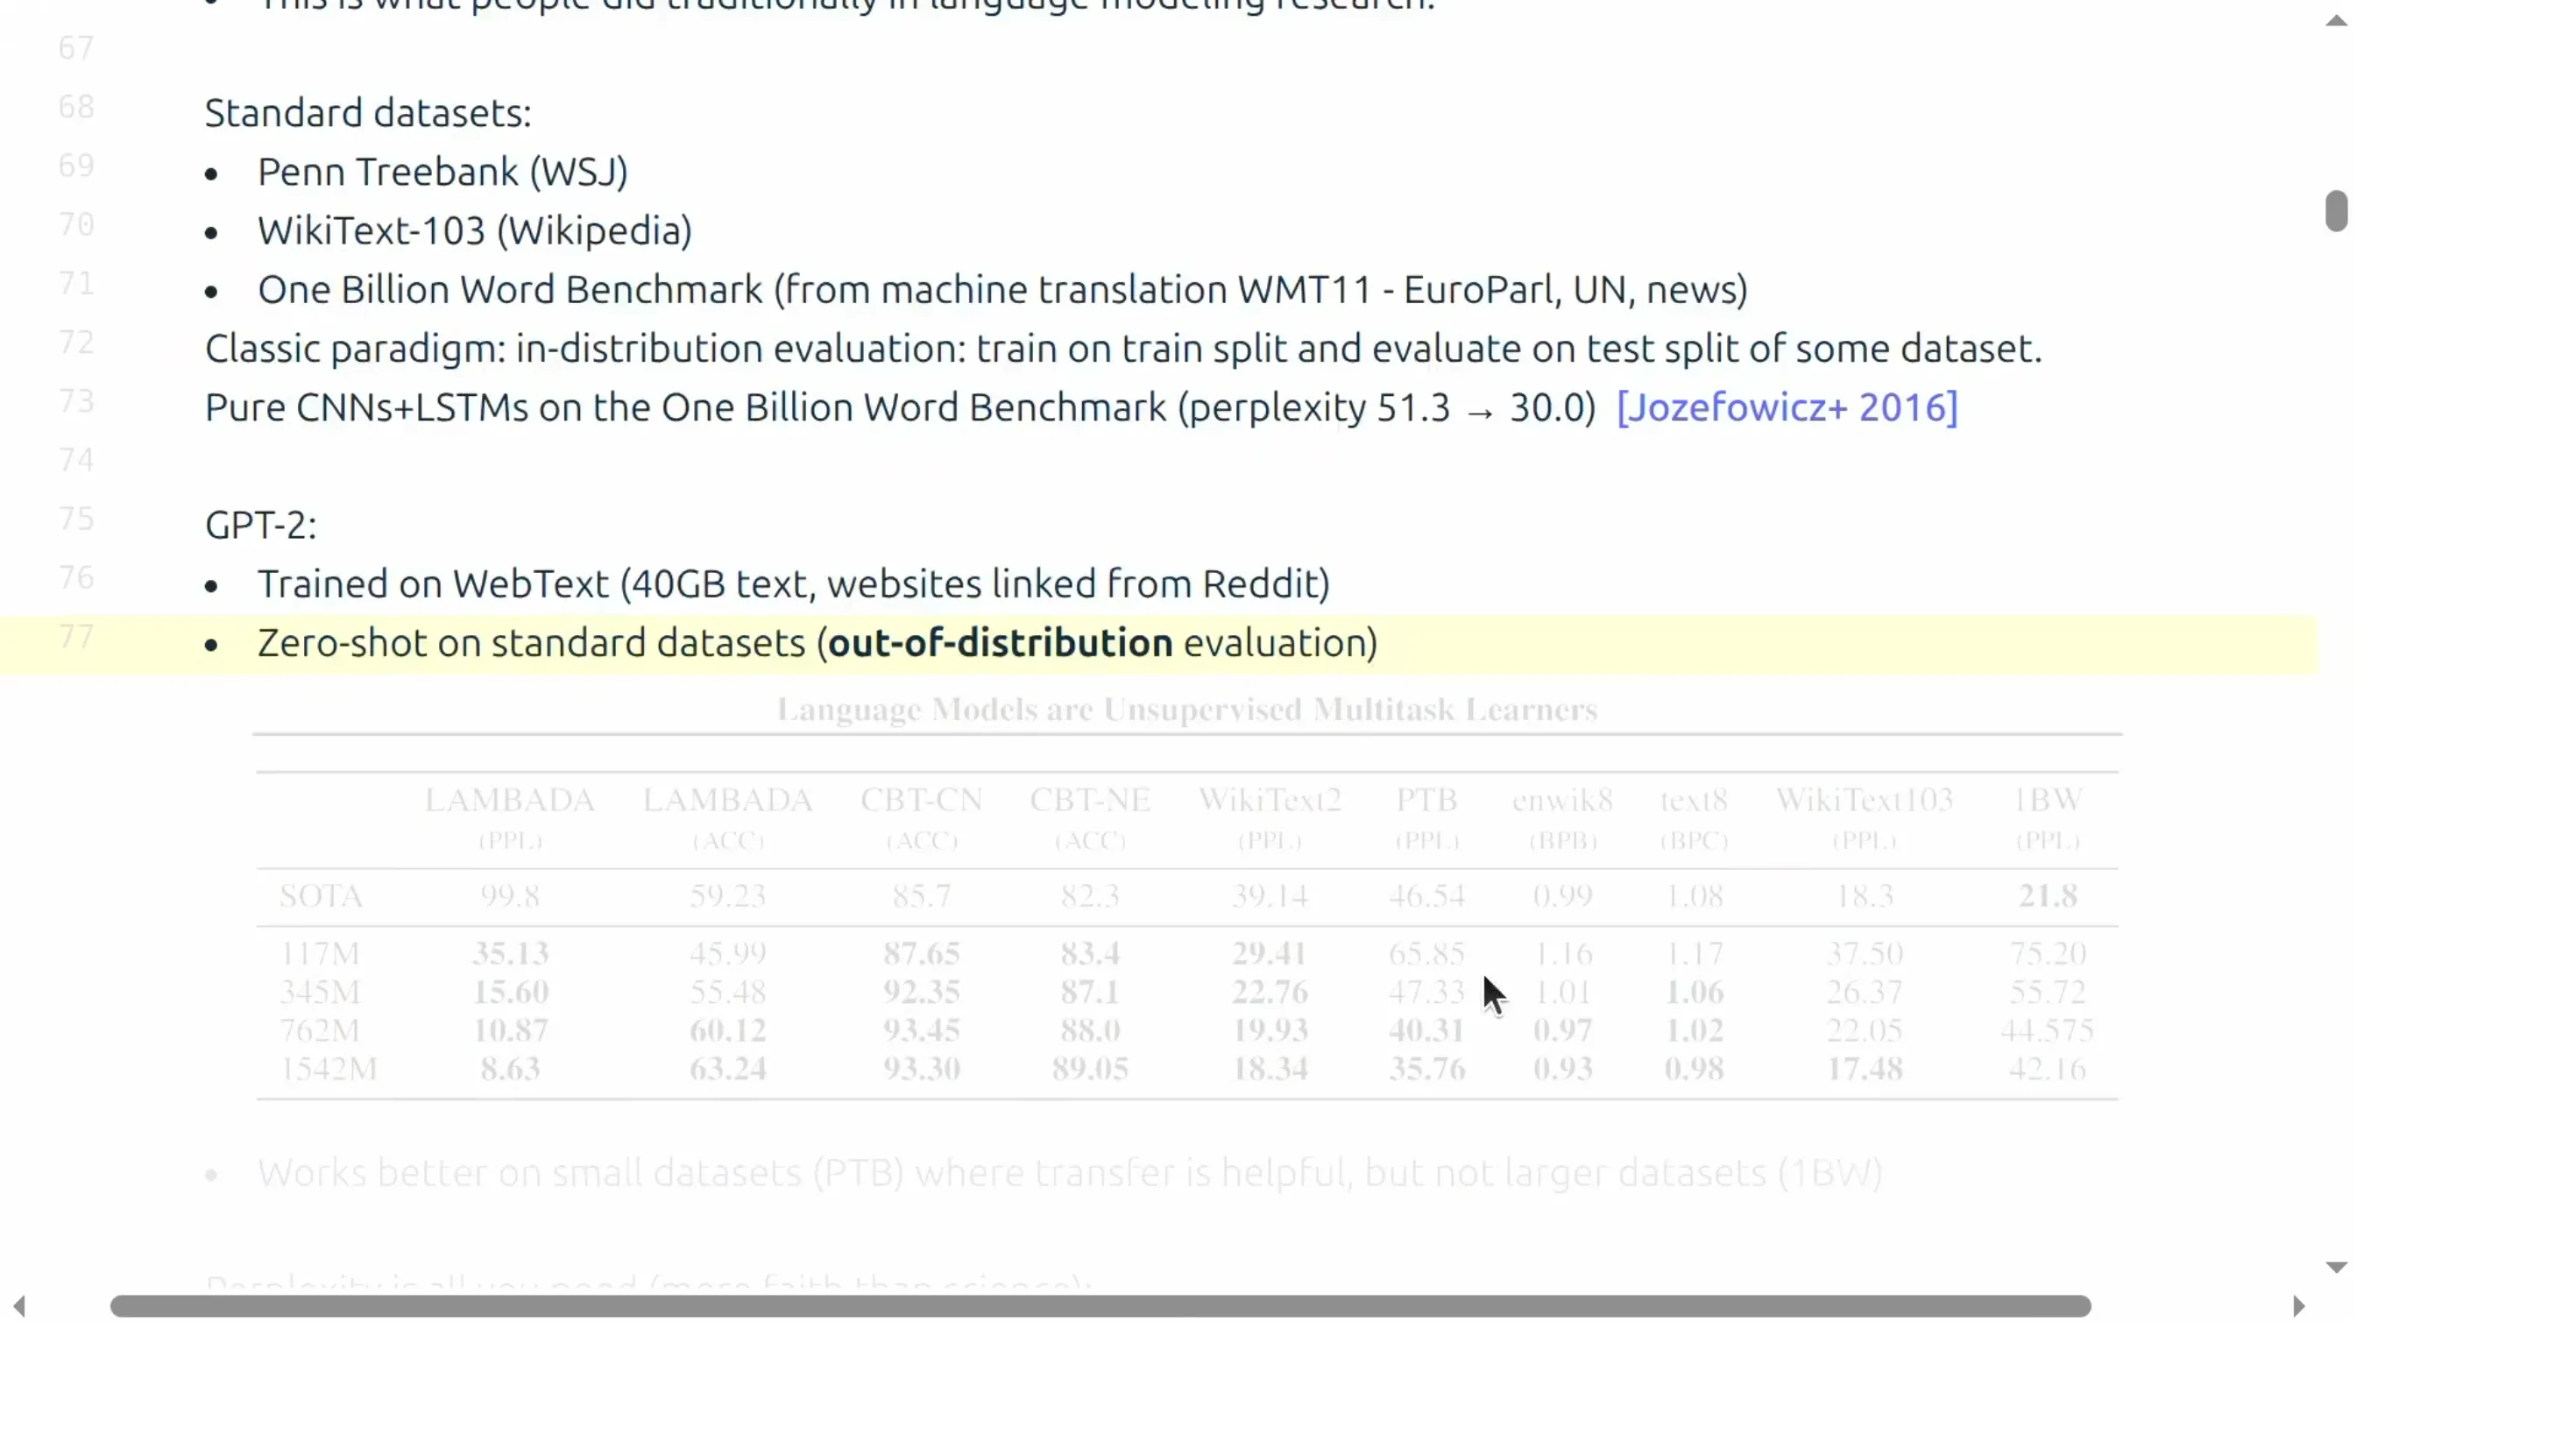
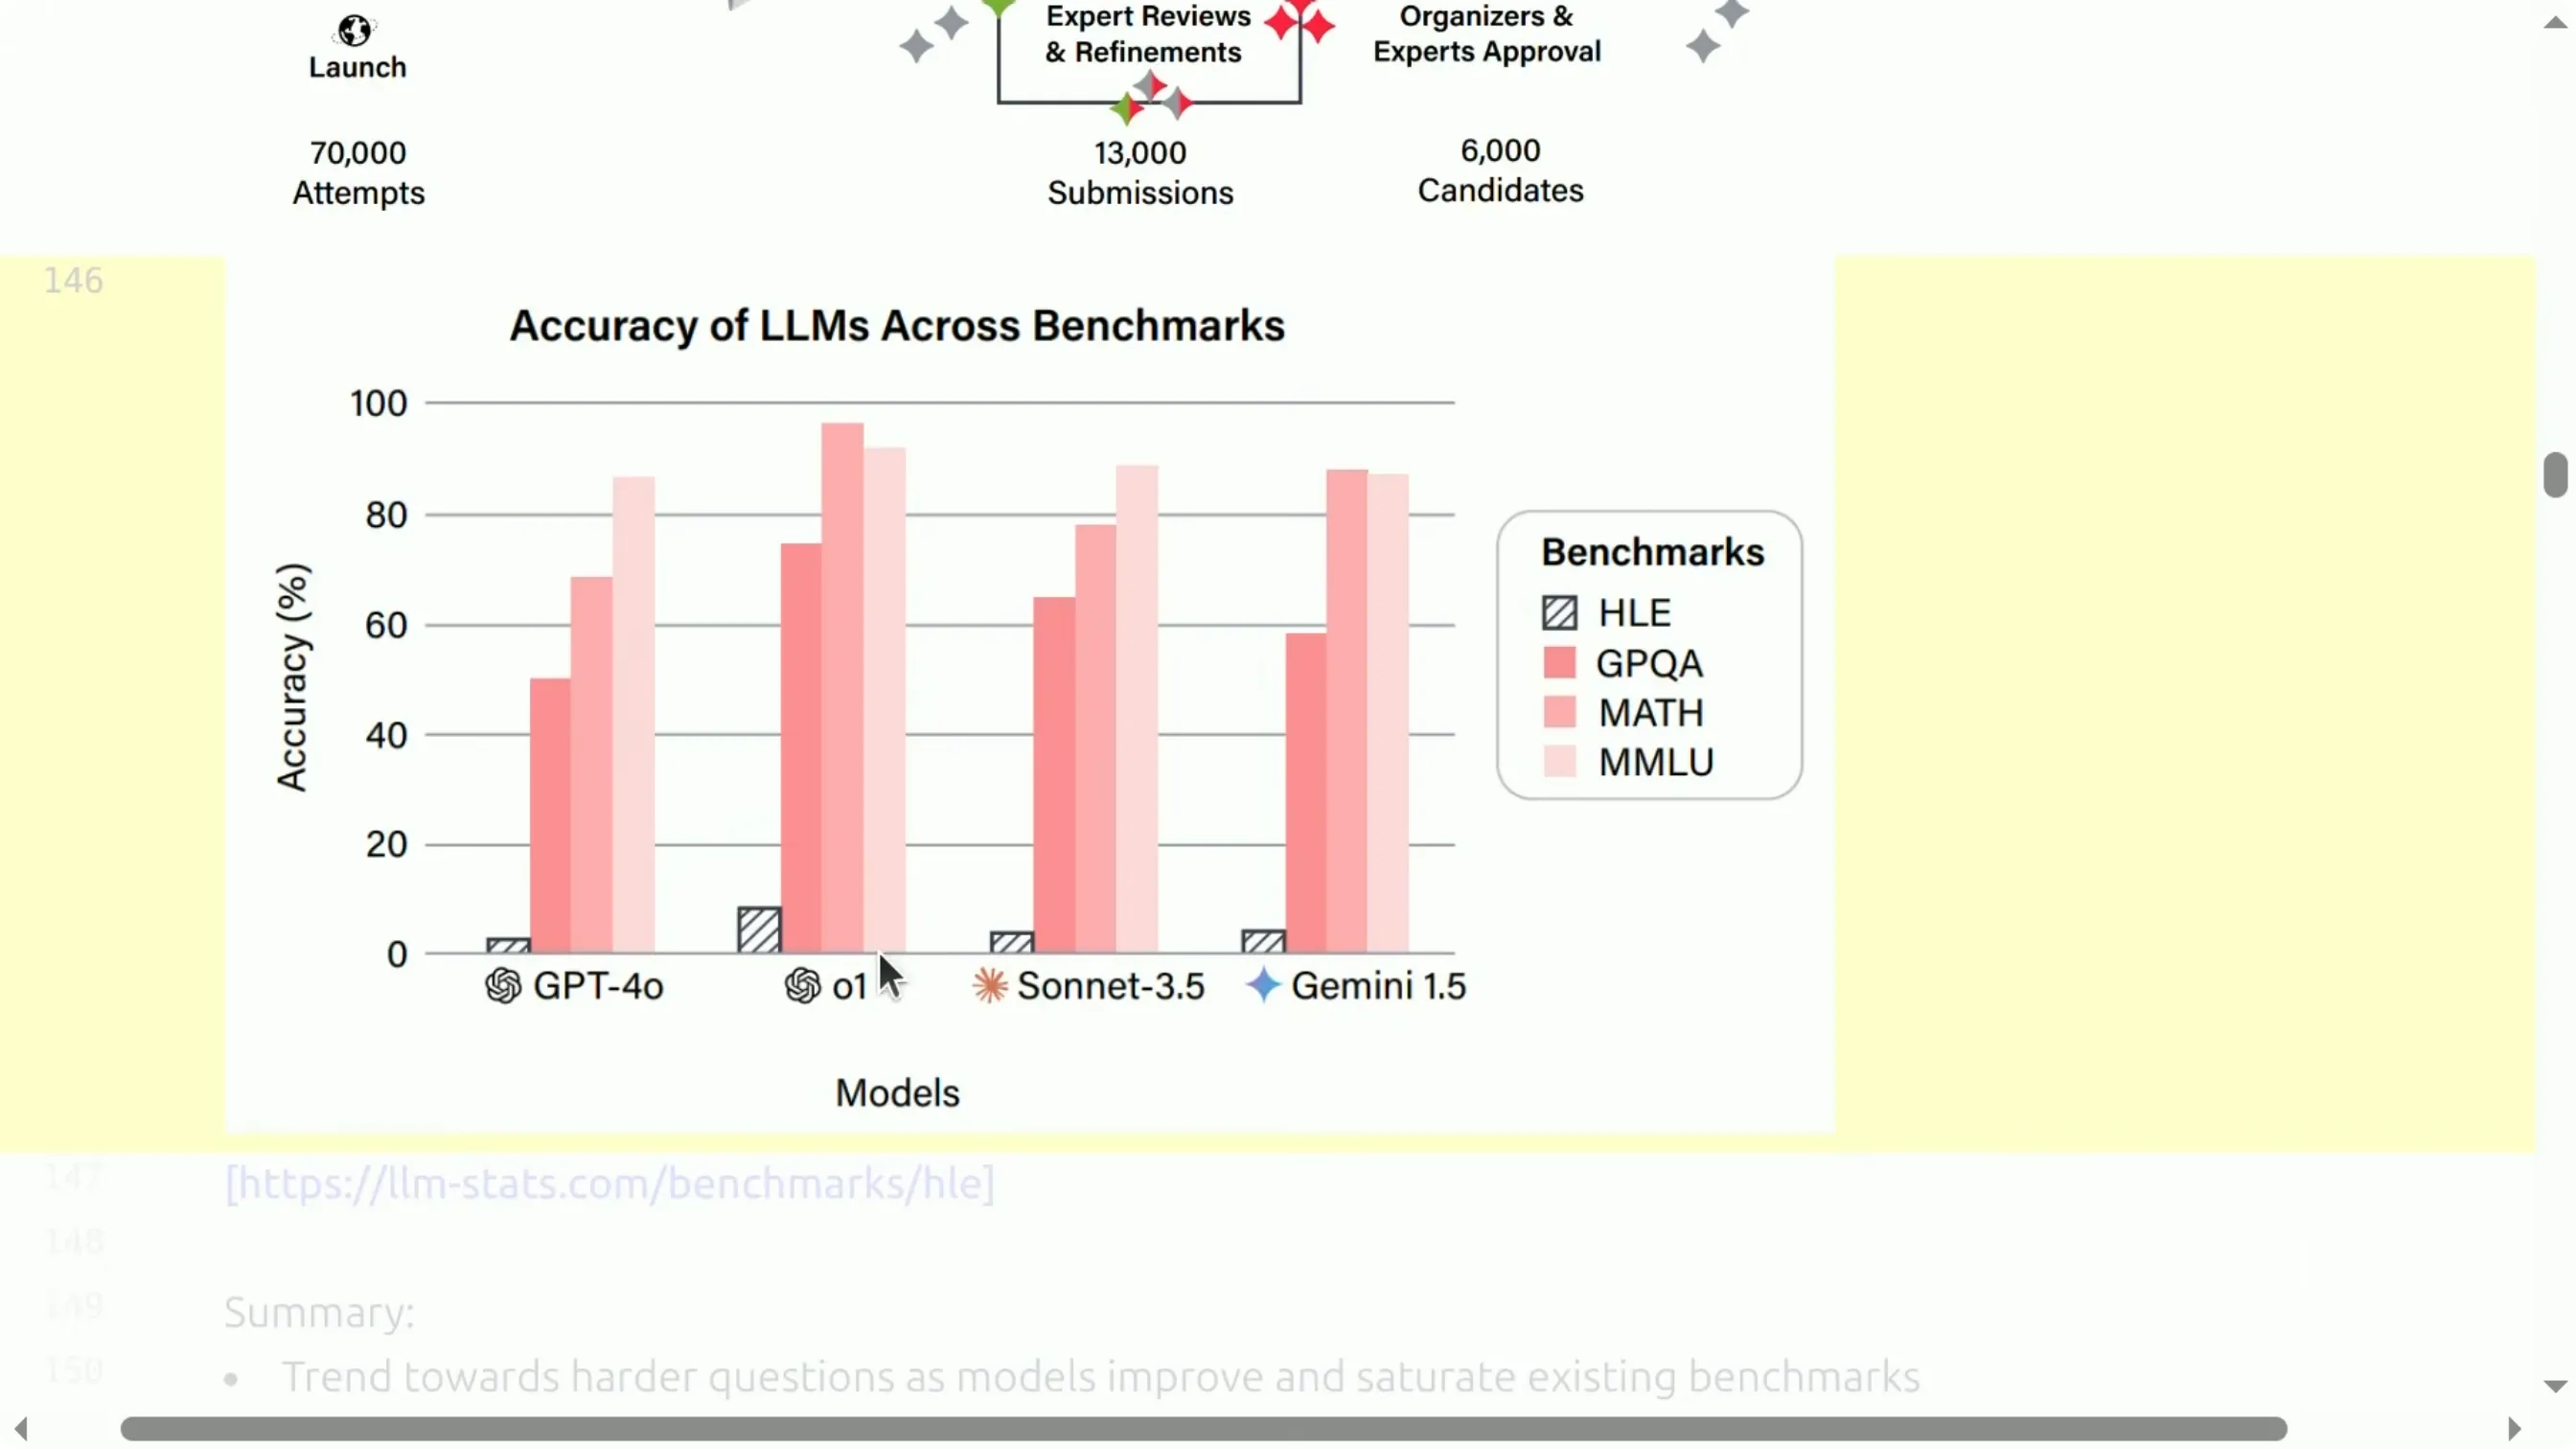
- 这也解释了为什么下节要警惕「作弊」:只要能伪造 log prob,就能刷出极低的困惑度。 既然训练时我们是在训练集上最小化困惑度,那么最自然的做法就是在测试集上测困惑度。这正是语言建模研究在很长一段时间里的标准做法。 然后 2019 年的 GPT-2 改变了游戏规则。GPT-2(OpenAI)用了一个叫 WebText 的数据集训练——从 Reddit 外链抓取的网页组成的 40 GB 文本。而它的评估方式不同:在大家一直在用的那些标准数据集上做零样本(zero-shot)评估。 这就是异分布(out-of-distribution)评估。 📷 GPT-2 论文中的零样本跨数据集评估表 在那篇论文的表格里,最大的模型 1.5B 参数,在很多数据集上取得显著提升,尤其是在小数据集上——例如 PTB 这种极小的数据集上,把困惑度做到 35,而当时的最先进水平是 46。虽然当整个数据集有充足的同分布数据时它未必能赢,但考虑到这个模型根本没在那个 10 亿词数据集上训练过,这已经相当惊人。(讲师也诚实指出:这里有没有训练/测试重叠并不清楚,可能没做严格的去污染。) 这开启了一种新范式:在大数据集上训练,在一批标准基准上评估。今天这已是常识,但当年它还是个新事物。 (参考时间: 00:09:46) 讲师说,他愿意论证「困惑度就是你所需要的一切(perplexity is all you need)」。他提醒不要把它当成严谨结论,但它是一种驱动了大量语言建模研究的思维方式。论证是这样的: 换句话说:最小化困惑度,唯一的最小化点就是真正还原出真实分布。而一旦你拥有真实分布,你就「通关」了——你能建模一切,能解决所有问题,可以「给定问题生成答案、给定问题生成解」。 于是论证的结论是:不断压低困惑度,最终会走向 AGI。 讲师坦言这听起来可能有点「奇幻」,但这确实是很多在众人还没看到明显收益时就坚持扩大语言模型规模的人的强大内在驱动力。在 GPT-3 之前,语言模型是否真的会有如此巨大的影响并不明确,所以正是「只要把困惑度压下去,好事就会发生」这个信念在支撑他们。 (参考时间: 00:11:38) 困惑度当然也不是万能的。一种说法是:困惑度可能「多于你所需要的」——它会对你不需要的地方也收费。 看看这个句子:"Stanford was founded in 1885."(斯坦福大学创办于 1885 年) 解法:你可以总是去测条件困惑度——先给定一段 prompt,只测量剩余回答部分的困惑度。这样你就能把注意力集中在你认为重要的 token 上,而不是那些无关紧要的陪衬。 (参考时间: 00:13:07) 有些基准即使不显式地叫困惑度,本质上也是困惑度。 (1)LAMBADA(2016 年论文)——填空题。给你一个句子,如 "Do you honestly think I will want you to have a ____?",目标是把空填出来。虽然它用准确率来度量,但本质上就是「下一个 token 预测」问题。 关键在于:LAMBADA 的空格是精心挑选的——按论文的说法,被挖掉的词必须依赖较长的上下文才能确定。这正是早期 GPT 系列论文特别看重它的原因:他们关心长上下文建模,认为这是解锁推理等能力的关键。通过只盯住「需要长距离依赖才能解出」的位置,就把困惑度聚焦到了你真正关心的现象上。 (2)HellaSwag(数据/主页)——另一个经典数据集。做法是从各种来源整理出多选题,但本质仍是被挖空的句子补全: "A woman is outside with a pug and a dog. The dog is running around, she _."
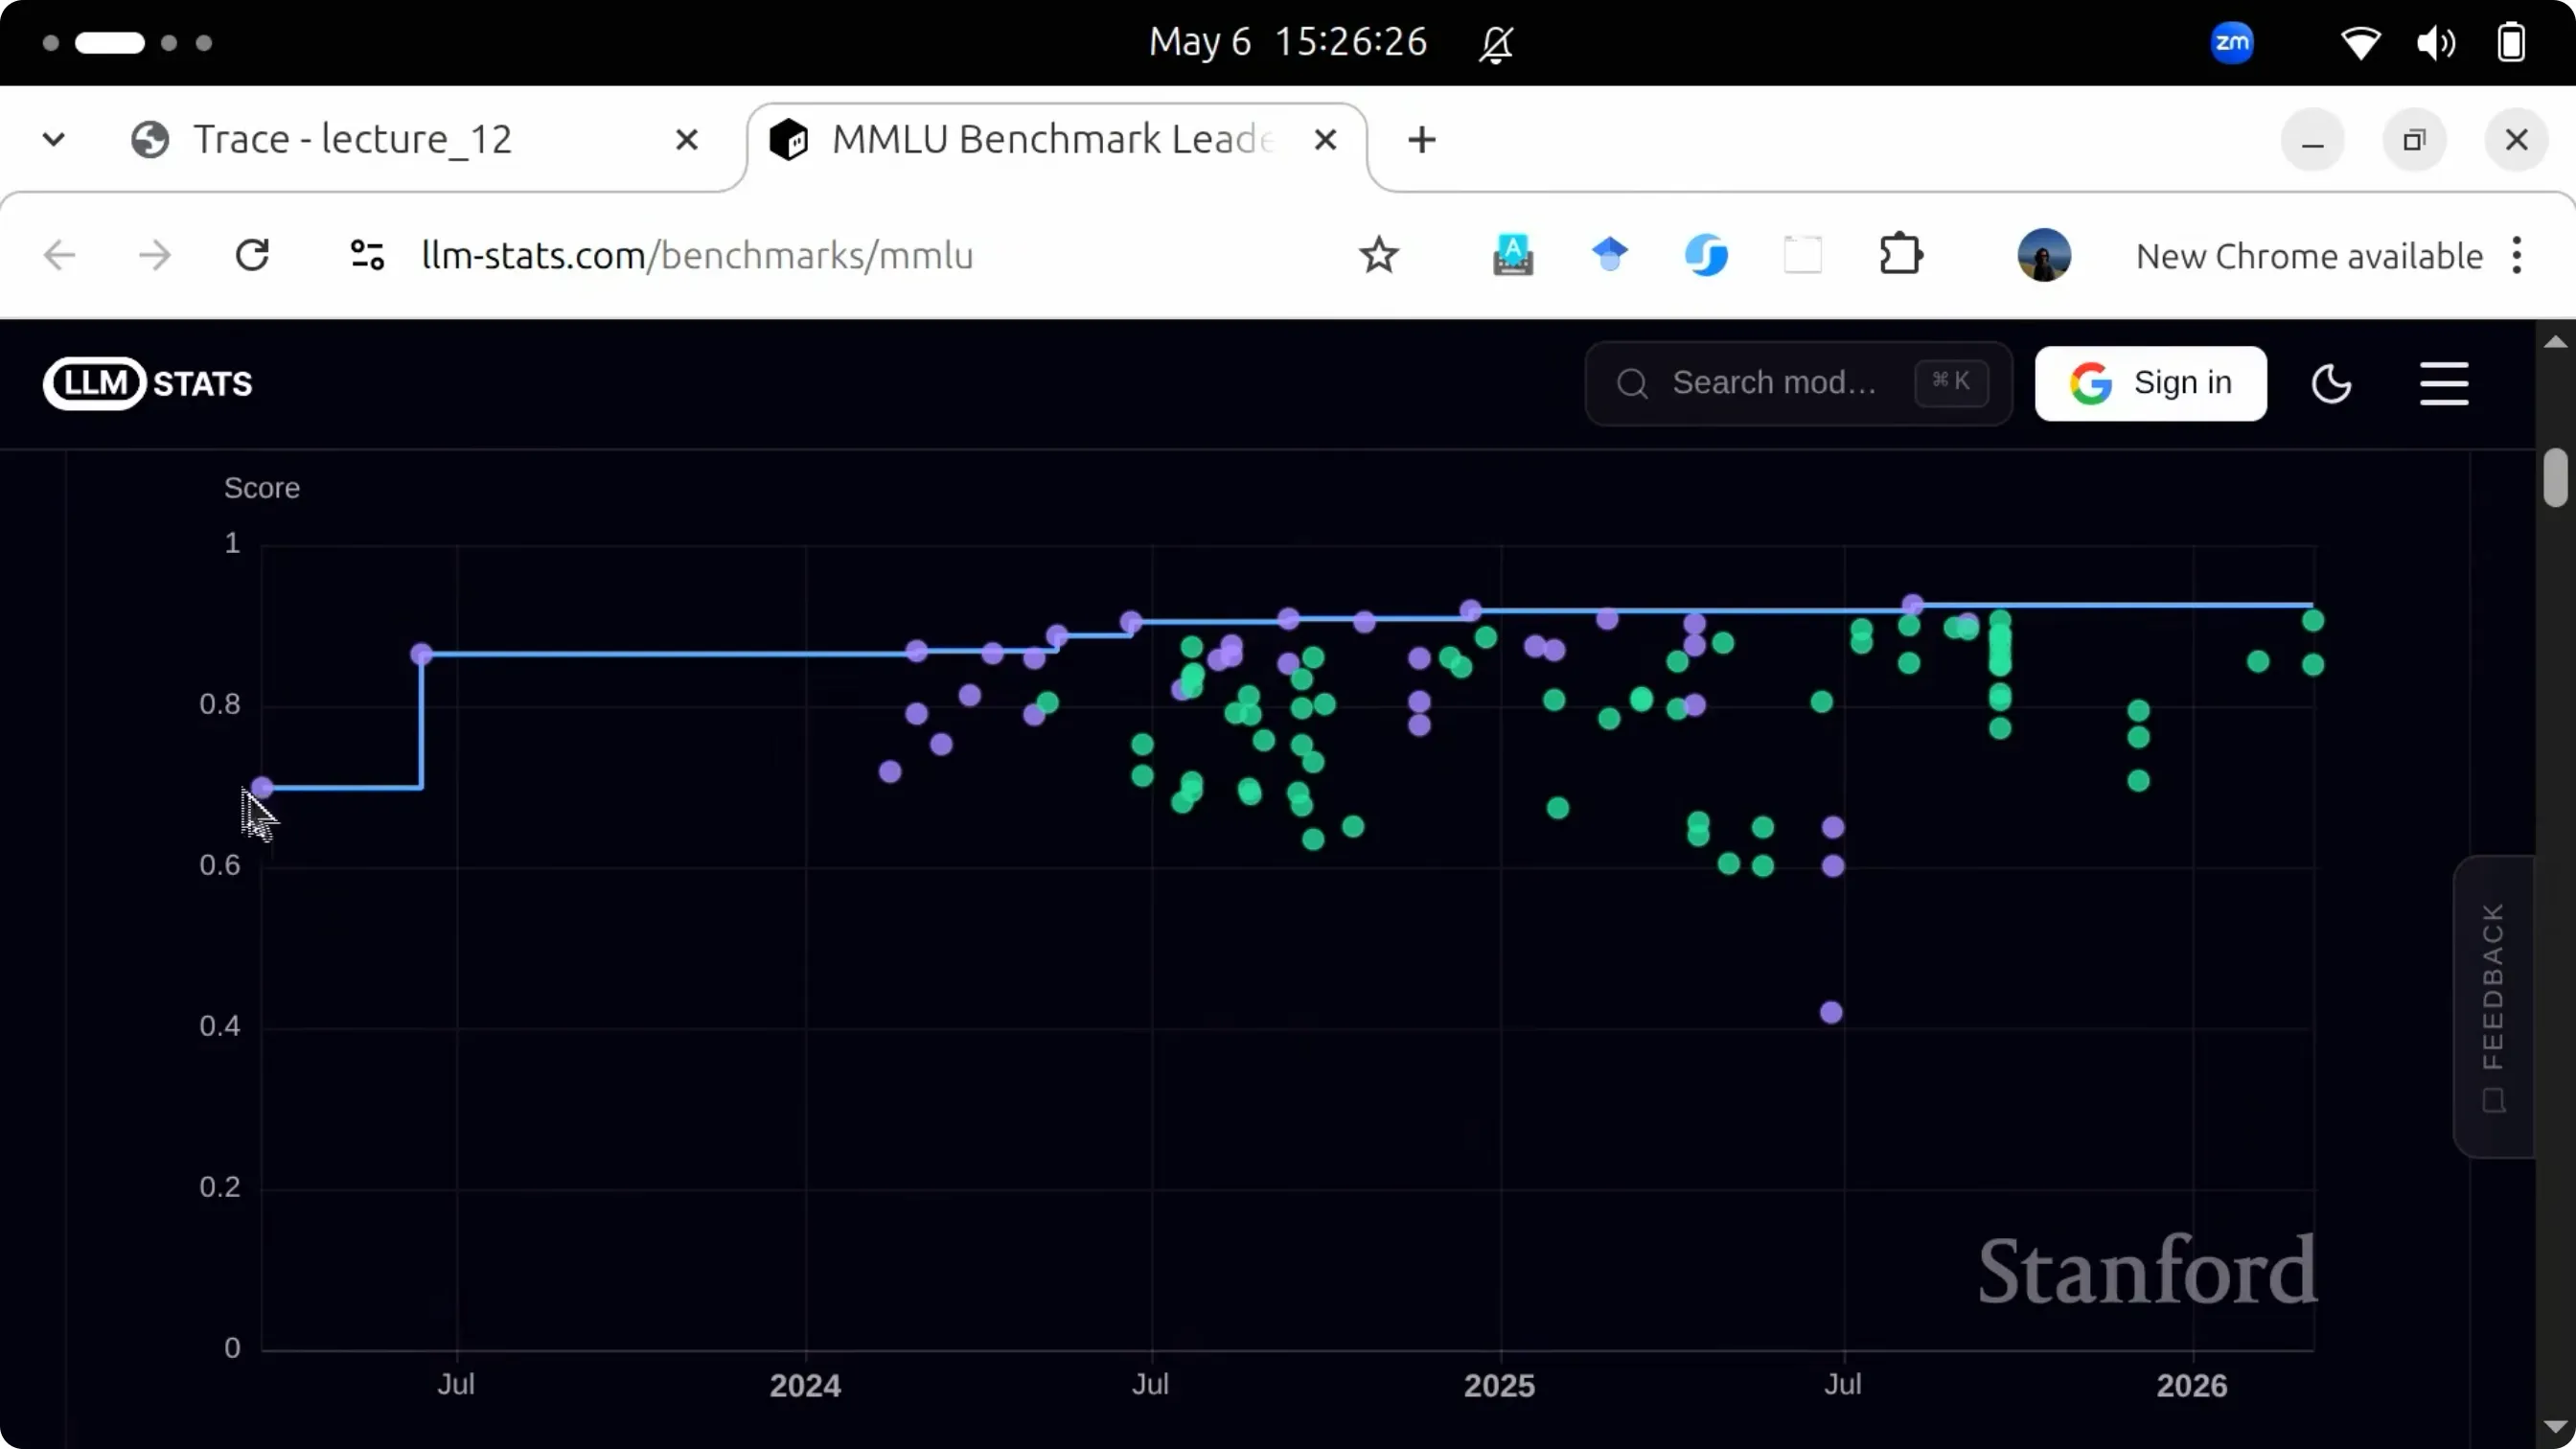
(一个女人带着巴哥犬和另一只狗在外面。狗在跑来跑去,她 _。) 要在若干选项中选出最能把句子补完整的那一个。它不是严格的困惑度(是多选),但在某种意义上它就是困惑度。 (参考时间: 00:15:18) 讲师给出一条警告:如果你被困惑度说服了,想开一个排行榜让大家来比困惑度,请先注意——困惑度排行榜长什么样? 流程是:人们提交一个语言模型给你,你把测试数据发给他们,他们返回给你一个 log prob。问题来了: 你必须信任他们返回的概率是合法的、它们加起来等于 1。否则我可以实现一个「永远返回 1」的语言模型——也就是 log prob 恒为 0——然后得到一个极好的困惑度。但这显然不是合法的分布。 在这种「把测试数据发出去、别人把 log prob 交回来」的契约下,你很难检查对方内部到底有没有真的算出一个合法的对数概率分布——也许你得去翻他的代码。 对比之下,下游任务就直截了当得多:我可以把你当成黑盒语言模型——我给你 prompt,你给我回复,我直接拿这个回复去算准确率。所以困惑度在根本上是不同的:它处理分布,你必须格外小心。 此外,还有一个不那么严重的问题:对自回归模型而言这还好,但对 VAE 之类无法精确计算分布、只能算出一个下界的模型,你必须额外信任推导本身是正确的。 (参考时间: 00:18:14) 正如所有学生所知,考试是人类用来测试人类的方式。这一思路完全可以搬到语言模型上。考试的好处在于: 正因为这些好性质,大量语言模型基准文化都建立在「考试」这个想法上。 (参考时间: 00:19:07) MMLU(Massive Multitask Language Understanding,Hendricks 等,2020)是其中最有影响力的之一。它出现在GPT-3 前后那个时期,当时人们还不确定语言模型能否成为通用任务求解器——很多人仍把语言模型理解为「生成流畅英文的语言模型」。 MMLU 的野心是「走在曲线前面」:覆盖 57 个学科,作者组织团队在互联网上搜刮不同来源,拼出一个非常全面的数据集。 有意思的是:尽管名字里有「语言理解」,它实际上考的是知识与推理,而不仅仅是纯语言理解。 评估方式:用 few-shot prompting 喂给 GPT-3。即构造这样一个 prompt——「以下是一些高中数学问题」+ 若干「问题 / 答案」的上下文示例 + 最后一个待答问题,让模型预测答案。 编者拓展|few-shot prompting 与 in-context learning
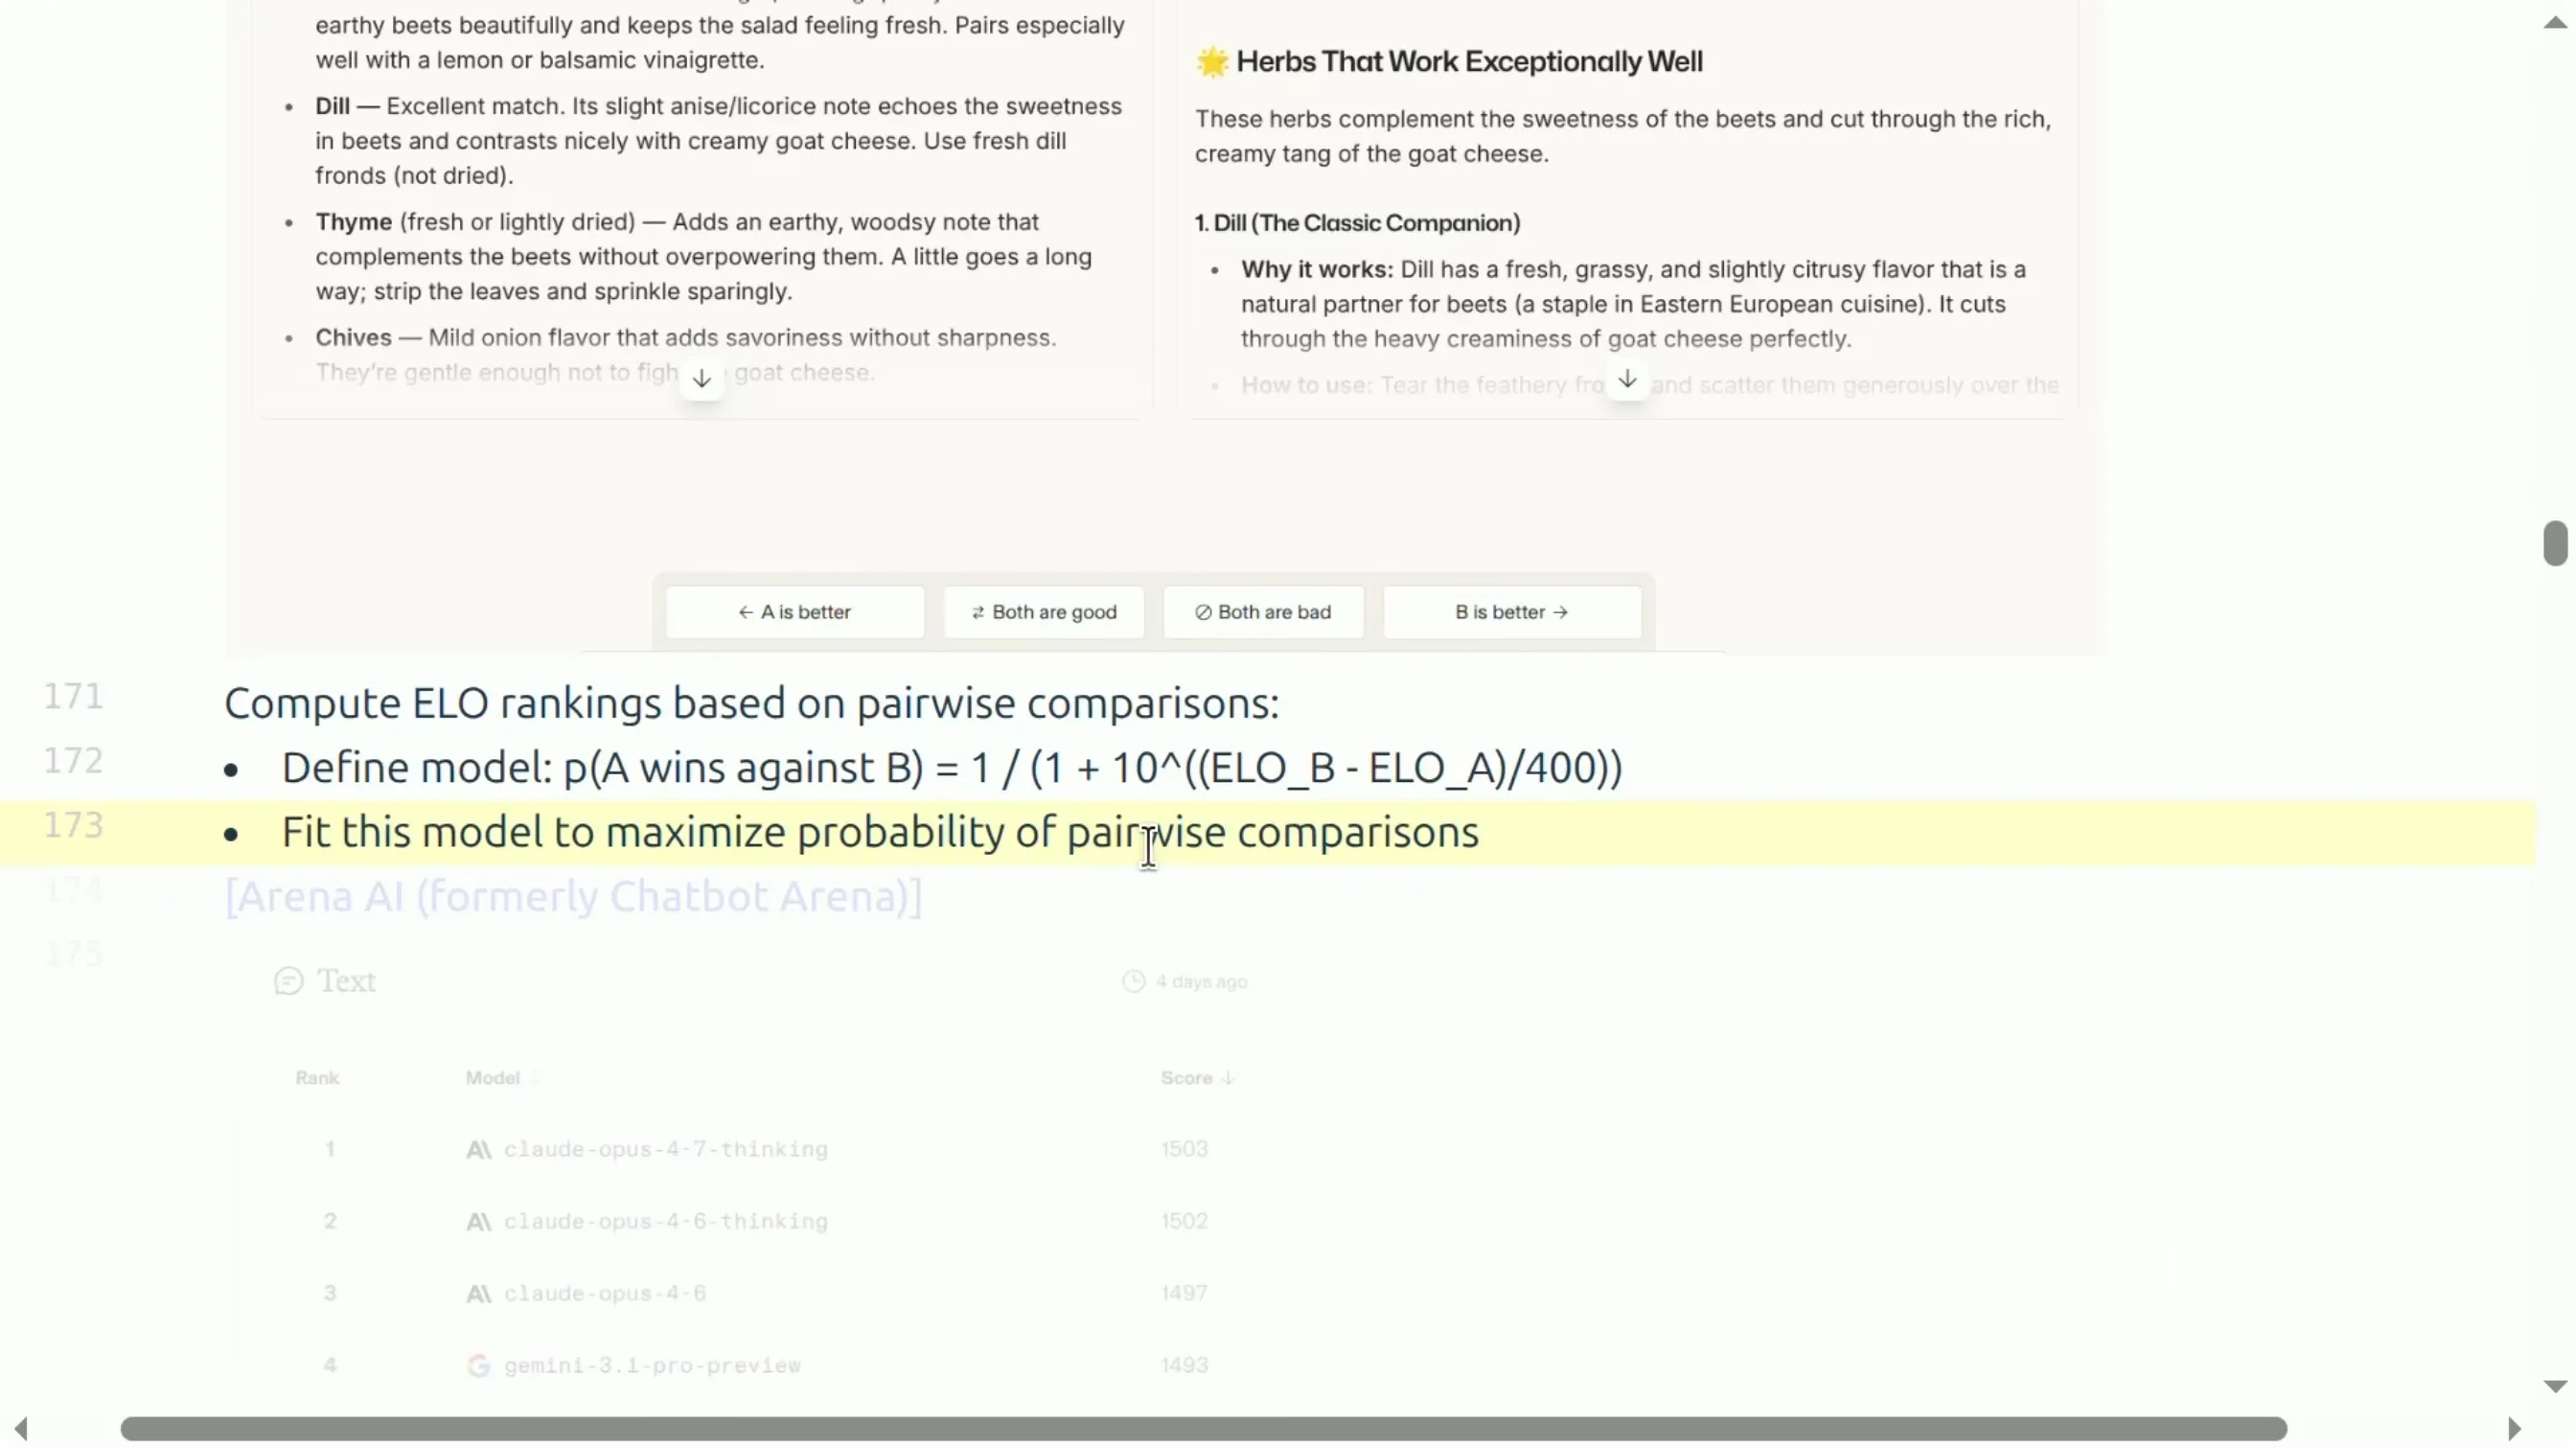
GPT-3 最令人惊讶的发现之一,就是不必更新参数,只要在 prompt 里塞几个「输入→输出」样例(即 few-shot),模型就能学会新任务。这被称为 in-context learning(上下文学习)。MMLU 正是这一范式的典型用法。 这在今天看来平淡无奇,但当时相当激进:构造这么复杂的题目、带上上下文示例,还指望语言模型能给出合理的答案。事实是,起初模型表现并不好——小模型几乎只是略高于随机,而当时最大的 GPT-3 明显高于随机,这已经令人鼓舞。 随后几年,这个基准基本饱和了。讲师给了一张截图:从约 2023–2024 年初的 3.5 turbo、到 GPT-4、再到如今,分数已经进入 90 分区间。 📷 MMLU 各模型成绩随时间变化,已接近饱和 (参考时间: 00:22:06) 当 MMLU 看起来进步太大时,自然反应是——「这个基准太简单了,我们来把它变难。」 具体做法: 于是新基准诞生,模型的准确率一度回落到 33。但随着时间推移,它又爬回到约 88、接近 90。这个基准又变简单了。 (参考时间: 00:23:18) GPQA 是 Google-Proof QA(防谷歌问答)。它的逻辑很妙: 如果一个问题能靠搜谷歌解决,那它大概太简单了——毕竟谷歌拥有整个互联网,而语言模型也训练于互联网。所以要造真正难的题。 于是他们请真人专家来出博士级的题(MMLU 大概在本科到研究生水平,GPQA 更明确地要「很难」)。而「造出真正难的题」需要大量人力: 结果:PhD 专家也只能拿到 65%(大多是四选一),高于随机但绝不是好成绩——你若在考试里拿 65% 并不光彩。非专家即便有 30 分钟谷歌权限,也只比随机高一点。而彼时 GPT-4 只有 39%。现在再看——GPQA 已到 94 分。 讲师由此感慨:这些基准的保质期并不长。 不过他也补充:即使基准对「大模型」饱和了,它们对「小模型」仍有用——可以被用来训练小模型、拟合 scaling laws 等等。 (学生提问,参考时间: 00:26:14) 学生:你怎么知道这些题目没有出现在训练集里? 讲师:这是个非常重要的问题。简短的回答是——我们不知道,因为我并不知道训练集里到底有什么。要对这些数字始终保留一份怀疑。关于污染,稍后我会回来讲一些应对手段。 我还想补一句:训练污染其实相当微妙。多半不是「他们真的把测试集拿去训练了」,而是——题目可能派生自别的来源,而那些来源被训练过。所以污染往往是一个远比「不小心训到测试集」更隐蔽的过程。 学生追问(重复了同一个问题),讲师笑称:「保持怀疑总是好事。」 (参考时间: 00:27:47) 最后一个考试型基准,名字颇具不祥之感的 Humanity's Last Exam(人类最后的考试,lastexam.ai),出自「去年」。它的思路是:模型越来越强了,那就倾尽全力造一个真正的难题。 讲师调侃这类论文的统一套路:「看,之前的基准上模型做得这么好;看,我的数据集上所有模型都很差。」——先抑后扬的展示。HLE 起初分数只有个位数,相当惨淡。到 2026 年,最新的模型也只有 64.7——确实是个很难的考试。 📷 Humanity's Last Exam 上最强模型仍只有六十几分 (参考时间: 00:29:21) 小结这一节: (学生提问,参考时间: 00:30:35) 学生:算准确率时,模型的输出怎么和标准答案比较? 讲师:对多选题来说,就是「你有没有答对」。比如模型生成一个「C」,而正确答案是 A/B/C/D 之一,我就直接比对是否相同。 学生:那我们是去看每个选项的概率吗? 讲师:这就不完全是评估问题,而是模型如何生成答案的问题。有几种做法:一种是直接采样,让它吐出一个字母;另一种——现在更常见——让它生成一段思维链、再给出答案和解释。如何从输出里抽取答案是有讲究的,评估对这一点可以非常敏感,但这里不展开。 (参考时间: 00:31:52) 前面讲的都是多选题——它们仍能较好地捕捉某种「智能」与「难度」。但很少有人会拿一道多选题去问 AI 助手(除非他想让 AI 替他考试,这显然没人会做)。 于是看一个半源自真实用例的例子: 用户:我想做一份甜菜沙拉,哪些香草合适、哪些不合适? 这是一个极其开放的问题,回答也同样是开放式的。那么怎么评估它? 你无法用精确匹配,甚至根本没有标准答案。 这一节就围绕「如何评估开放式回答」展开几个思路。 (参考时间: 00:32:59) 第一个思路由 Chatbot Arena 开创:问人类。 但它的问法很巧妙: 用这个流程,你能积累大量关于「A 与 B 谁更好」的成对比较数据,进而计算 Elo 排名。 编者拓展|Elo 是怎么从「谁比谁好」推出连续评分的?
核心假设是:A 战胜 B 的概率,只取决于两者评分之差。常见形式为 $$P(A \text{ 胜 } B) = \frac{1}{1 + 10^{(R_B - R_A)/400}}$$ 这里 $R_A, R_B$ 是两个模型的 Elo 分数(400 是经验常数,决定曲线的陡峭程度)。$R_A$ 越大,A 获胜概率越高,且是平滑映射。
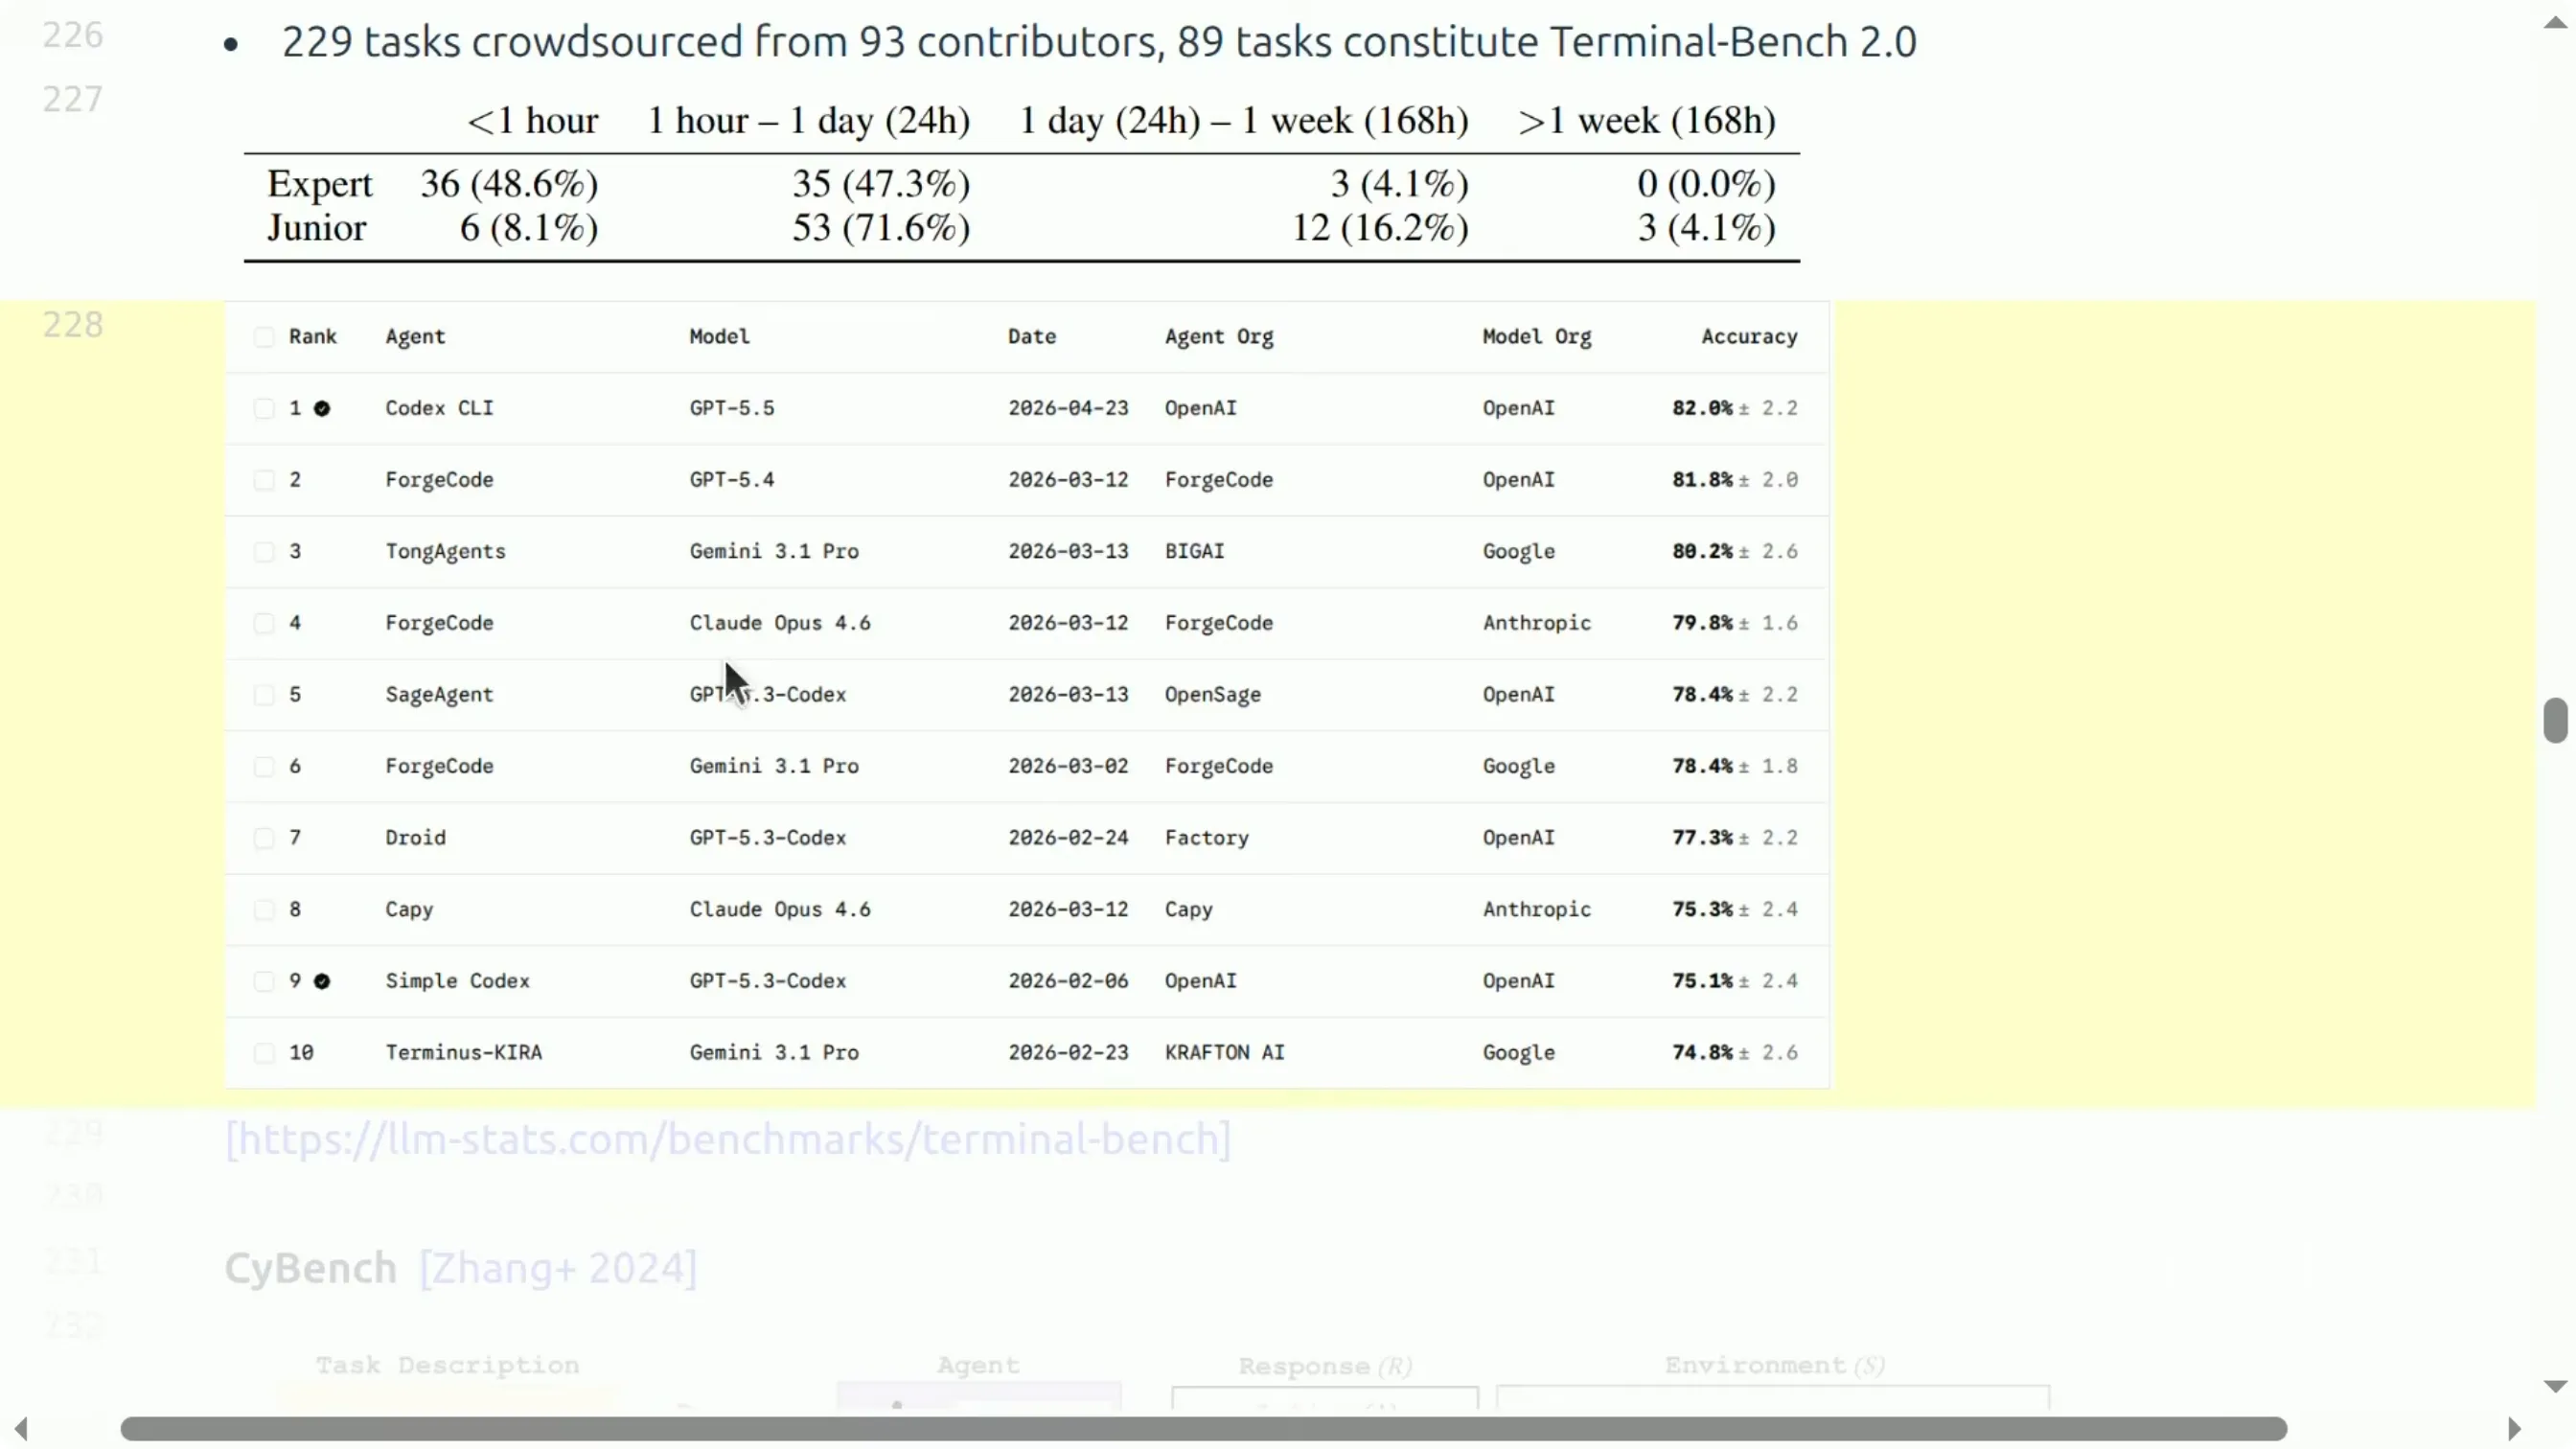
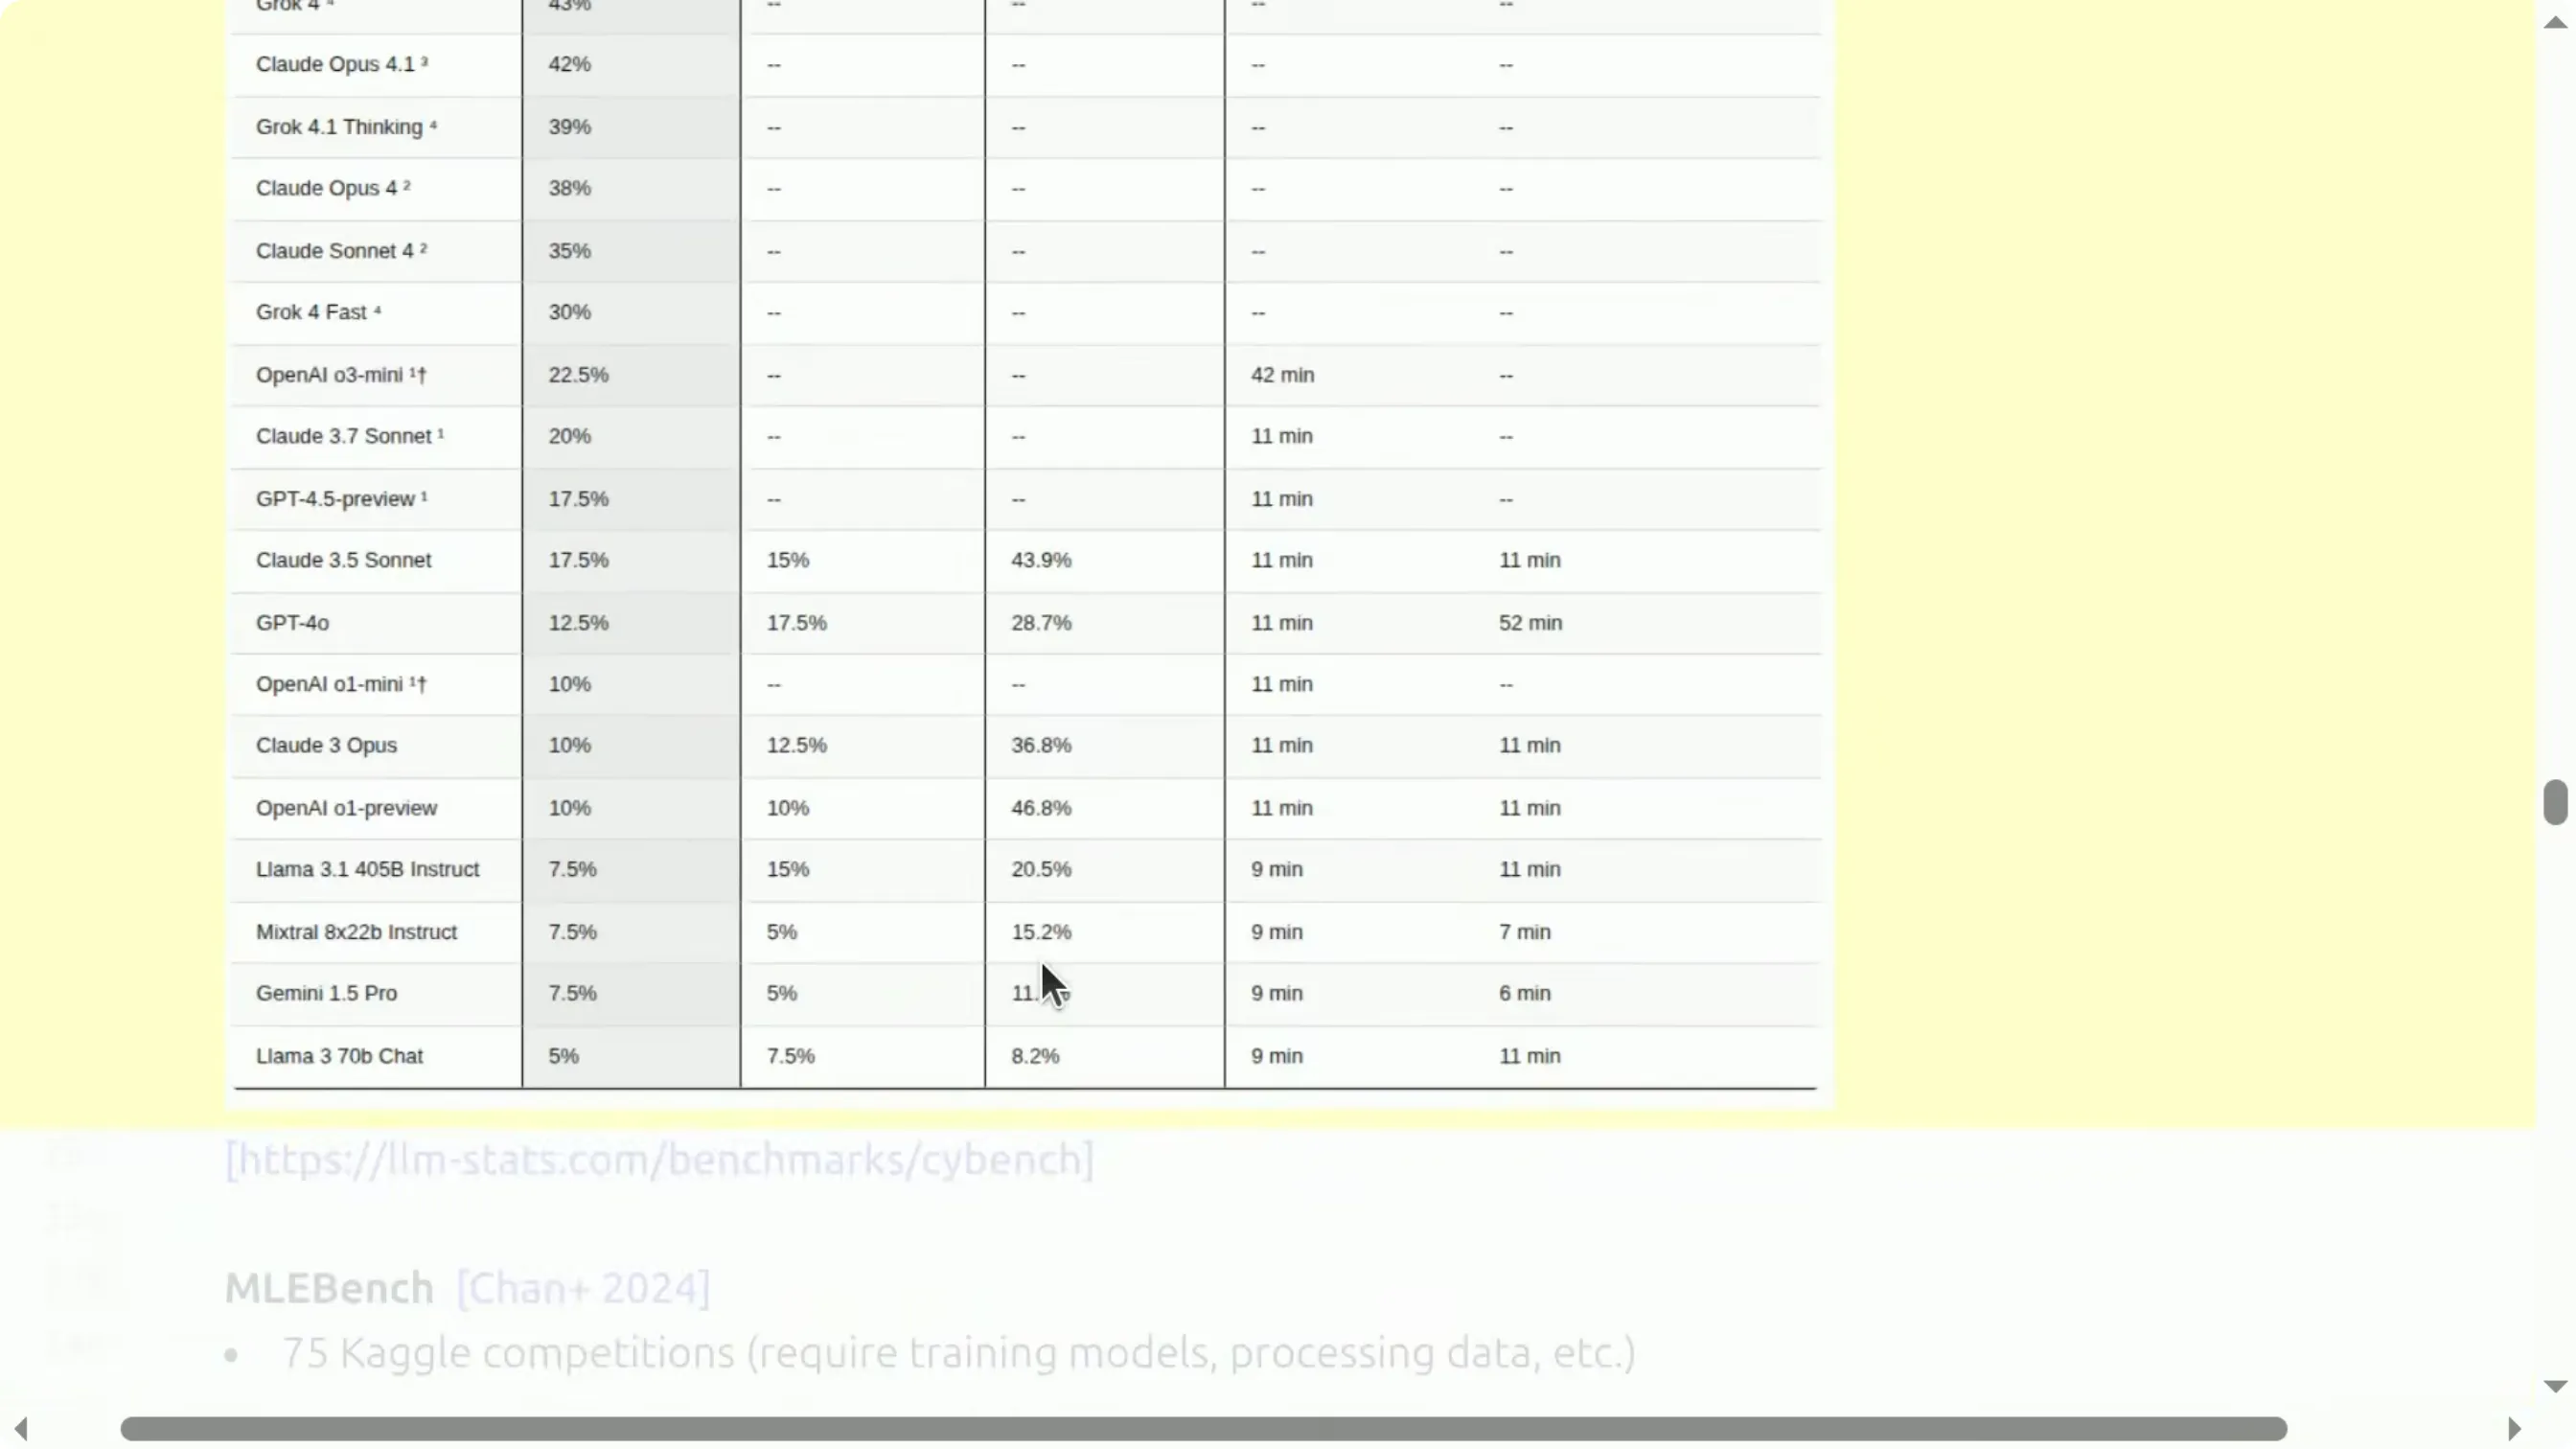
然后把这些「评分」当作待拟合参数,用大量成对比较结果去最大化观测到的胜负似然,就能给每个模型估出一个评分。这正是国际象棋 Elo 的思路:你不需要每个人都和每个人交手,只要比较图是连通的,就能推出整体排名。 这一整套是 Chatbot Arena(今 Arena AI)的做法,能给出一个漂亮的排名(讲师提到 Claude Opus 表现不错)。 📷 Chatbot Arena 的 Elo 排名榜 这个设置的优点: 但它也有不少隐患: (参考时间: 00:38:26) 换一种思路。AlpacaEval(2023,项目页)收集了来自各种来源的指令,指标是相对基线模型的胜率: 拿同一个 prompt,让基线模型(当时是 GPT-4 preview)生成一份回复,让你的模型生成一份回复,然后用 GPT 来判断哪个更好。 这立刻引出一个偏差问题(用模型评自己或评竞争者),但先放一边。它本质上是 LLM-as-a-Judge(用大模型当裁判)的一个实例——这在今天非常流行。偏差可以通过多个裁判、做集成等方式来缓解。 AlpacaEval 早期的一个已知问题是:LLM 裁判偏好更长的回答。这会导致刷榜——一堆微调模型提交后,仅因为回答更长,就拿到很高的 AlpacaEval 分数。这个问题在后续工作中被修正:他们用一个很简单的回归方法来去偏。 (参考时间: 00:39:51) 这引出一个更一般的问题——不仅限于 AlpacaEval: 我们一直在讨论评估模型。可是,如果我设计了一个新指标,我怎么知道这个指标本身好不好? 这是个难题,没有答案。可以做的是一种 sanity check:看它与其他指标的相关性(前提是,你确实想模仿那个指标;否则「更高」未必「更好」)。例如 AlpacaEval 与 Chatbot Arena 的相关性高达 0.98——非常高。这意味着:如果你不好意思把模型挂上去、或者不想等人类评,你可以改用 AlpacaEval 代替。 不过,这个相关性只针对某一批模型。对比 GPT-4 preview 更强的模型,未必成立。 编者说明:这其实触及了评估的元问题——当所有指标都相互印证时,我们可能陷入「循环论证」:用 A 的分数去验证 B,而 A 本身又靠 B 来证明。讲师在后面 WildBench 处也承认了这一点。 (参考时间: 00:41:26) WildBench(Allen AI 项目页)的做法是: 讲师解释了它为什么有用:如果只是笼统地问语言模型「这个回答好不好」,这其实是个非常病态(ill-defined)的任务——「好不好」取决于你在乎什么。而有了清单或评分表(rubric),就大大限定了范围、让评估任务变得更有定义。 他们也报告了与 Chatbot Arena 的相关性——但这略带循环论证,因为你可以反问「那 Chatbot Arena 就是金标准吗?」不过至少大家都在同一条船上。 (参考时间: 00:44:58) 到目前为止,我们评估的是语言模型「会说什么」——也就是对话。现在转向评估LLM「会做什么」——也就是智能体(agent)。 智能体 = 语言模型 + 某种脚手架(scaffold)。脚手架是决定如何调用语言模型、它能访问哪些工具等的逻辑。 (参考时间: 00:46:00) SWE-bench 是一个非常流行的智能体基准。任务描述是: 给你一个代码库和一段 GitHub issue 的描述,请你提交一个 PR。 如何评估一个 PR?看它能否通过单元测试。设计方式是:在你提交 PR 之前,某些单元测试不通过;你的目标是修复它,让它们通过,同时不破坏其他测试。 界面上会给出一些指令、issue、以及上下文中的代码,你的目标是生成一个补丁(patch),然后按是否通过测试来评分。 好处是评估非常直截了当。 讲师展示的成绩曲线是 SWE-bench Verified(稍后会解释为什么有这个「Verified」版本):2024 年时只有约 16%,如今已升到约 93%。 SWE-bench 是「把智能体能力放在真实环境里评估」的开创者,且由于业界对编程能力的关注,围绕它积累了大量注意力。 (参考时间: 00:47:53) Terminal Bench 的定位更通用:环境就是一个计算机终端,任务定义为「在终端里敲一系列命令可以完成的事」。这个环境简单而通用。 📷 Terminal Bench 排行榜:同一模型配不同 scaffold,成绩也不同 排行榜上一个值得注意的现象是:同一个模型配上不同的智能体脚手架,准确率会不一样——也就是说,脚手架本身很重要。 (参考时间: 00:49:16) 另一类基准是网络安全:40 个夺旗(Capture-the-Flag)任务。设定是: 这些原本是人类参与的网络安全竞赛练习。 讲师展示了一张智能体脚手架的示意:一个非常简化的版本,只有一份连续的记忆——你产生一个动作,得到环境反馈,把结果放进这个缓冲区并拼接起来。讲师提醒:随着历史不断增长,这份上下文会变得很大,你需要更好的上下文管理方式。 这个基准的排行榜最初最好的模型只有约 10%,如今基本已被完全解决。 📷 网络安全 CTF 基准的早期排行榜,最高约 10% (参考时间: 00:51:00) 还有一类问题是 ML 工程(MLE engineering)。这个基准包含一堆 Kaggle 竞赛,涉及数据处理、训练模型等等。智能体可以:查看数据集、阅读描述、写代码、训练模型,最后提交并获得评分。 排行榜上,还是那几张熟悉的语言模型面孔,但不同的智能体脚手架之间存在相当大的差异。 (参考时间: 00:51:45) 讲师强调:脚手架非常重要。这里的评估已经超出「语言模型评估」本身——因为要解决真正复杂的任务,你必须更老练。人们逐渐意识到几件事: 一句话总结:智能体令人兴奋,是因为它扩展了语言模型的能力边界;而脚手架至关重要。所以当我们谈评估智能体时,同时也在评估语言模型和智能体脚手架。 (参考时间: 00:53:56) 换一个方向,讲师称这类基准为「纯推理」(暂用此名)。动机是:前面所有任务都需要一定的语言与世界知识。那么问题是——能否把「推理能力」从「知道事实」中剥离出来? 如果能,你或许能得到一种更「纯粹」的智能。 (参考时间: 00:54:36) ARC-AGI(ARC Prize 官网)从 2019 年就开始做这件事,目标非常明确: 请注意时间:2019 年还是 GPT-2 时代,语言模型尚未成气候——这让 ARC 的想法相当有先见之明。 一个初代问题的例子:给你若干张图,让你猜下一张是什么。 📷 ARC-AGI 示例:根据规律补全图形 花十秒钟,你大概就能解出——比如把黄色填满补成矩形。 轨迹:ARC-AGI 1 刚发布时,模型的成绩大概是 0——预训练模型完全没能推动进度。这恰是设计者想要的:预训练模型只是学到了互联网上的事实、以及一些语言模式,这些对 ARC-AGI 任务并无直接帮助。 然后 2024 年发生了转折:OpenAI 发布 o1 / o3 这类推理模型后,成绩突然起飞。如今 ARC-AGI 1 基本被解决。2025 年 ARC-AGI 2 出现,虽然还没完全解决,但看得出正在被攻克。 所以真正解锁这一切的,是推理能力。这引人思考:预训练带来的知识,对这些任务到底是不是必需的? 讲师的观点是:没有预训练,就不会有今天这些推理模型的爆发,所以它(间接地)仍然重要——只是在 ARC-AGI 的漫长历史中并未直接显现。 (参考时间: 00:57:32) 就在上个月,ARC-AGI 3 发布了——熟悉的一幕又来了:设计者看到「又要被攻克」,于是「是时候做一个新基准了」。 这一版是交互式环境:你可以上网去玩这个游戏。依然没有语言,你只能根据图形寻找规律。 📷 ARC-AGI 3:交互式、纯图形、无语言 分数仍然极低。讲师打趣:明年再教这门课时,这张幻灯片估计又得更新。 (学生提问,参考时间: 00:59:20) 学生:这些图看起来很「图形化」,那么输入给语言模型的是什么?是多模态内容,还是文本表示? 讲师:这大概是 64×64 的图像。你可以把图像本身喂给它,也可以用 ASCII 艺术或其他文本形式表示。无论哪种,都存在空间要素需要模型去推理——而这显然不是英语或自然语言。 ARC-AGI 这条线的意义在于试图让推理与知识解耦——但这非常难: (参考时间: 01:00:16) 人们讨论语言模型安全已经有一阵了。类比一下:汽车的安全定义相当清楚——有安全评级,做法是把车撞向墙、看安全气囊如何保护假人。这是几十年游说与探索的结果。那对于 AI,安全意味着什么? 讲师坦言:没有很好的答案,只能举些例子。 HarmBench 的核心是:用有害意图的提示去问模型,期望模型拒绝。这是安全的一类——也是人们想到「安全」时最主流的一类:防止坏人利用语言模型作恶。 但它不是唯一重要的东西。AIrBench 试图整体地看安全:考察欧盟、中国、美国的监管框架和公司政策,建立一套「可能出错之事」的分类体系,然后据此构造 prompt 集并评估。 安全还有个大问题是越狱(jailbreaking)——本身就是一个子问题。语言模型通常被训练成拒绝有害指令,但只要你够聪明,就能绕过它。 早期工作用自动优化的方式去搜寻能绕过安全机制的 prompt——例如 GCG,一种逐坐标的优化算法。 编者拓展|GCG 是什么
GCG(Greedy Coordinate Gradient)是一种离散优化方法:它把一段「对抗后缀」当作可优化的变量,每次只改动其中一个 token 位置,用梯度信息估计「替换成哪些候选 token 最可能让模型输出目标内容」,再贪心地选取。由于它在开源模型上优化出的对抗后缀能迁移到闭源模型上,因此危害很大。讲师的示例是:生成一段近乎乱码的后缀 + 一步步消灭人类的计划,就能让模型照做——而预期行为本应是拒绝。 讲师希望这些攻击如今已经不再奏效,但在当时是有效的。 (参考时间: 01:03:22) 「什么是安全」之所以棘手,是因为安全的许多方面都高度依赖语境——涉及政治、法律、社会规范,且因国而异。 而风险本身也多种多样、需要不同的关注: 如果把「语言模型对世界的社会影响」纳入考量,把「安全」理解成「确保 AI 向着对人有好的方向发展」——那这远比这节课能讲完的要复杂。 最后,还有语言模型的双重用途(dual use):网络安全智能体既能入侵系统,也能做渗透测试、让系统更安全。这正是「这到底算安全风险还是有益用途」难以判定的原因——它是一把双刃剑。 (参考时间: 01:05:11) 一个重要的方面是现实主义 / 生态效度(ecological validity)——评估在多大程度上捕捉了真实世界使用。 有几个基准试图提升用例层面(而非单个查询层面)的生态效度: 另一个层面是科学效度:我们怎么知道这些评估在科学上是成立的? 这早在「训练/任务重叠」问题上就被提出过。 机器学习入门第一条:不要在你的测试集上训练。 在基础模型之前,这一点很清楚:像 ImageNet、SQuAD 等都有训练划分和测试划分,大家玩同一个游戏——你在训练数据上训练,在测试数据上评估,生活很简单。 如今,模型在互联网上训练,而且不止于此;更糟的是,你不知道数据里有什么。这让评估变得截然不同。怎么办?四条路线: 路线一:推断模型是否真的见过测试数据。 有个巧妙的想法(来自 Tatsuo 的组,即 Tatsu Hashimoto): 基准中题目出现的顺序本应是随机的。但如果模型偏好某种与某个基准一致的特定期望顺序,那它很可能就是训练过那个基准。 路线二:鼓励报告实际的重叠。 这关乎规范。就像统计学里总是报告置信区间——你有个估计值,我总想知道它有多可靠,这是标准做法。这个立场论文主张:模型提供方若声称某个 GPQA 分数,就应给出理由说明自己没有在测试集上训练。 路线三:放弃抵抗,假设最坏情况。 「好吧,就假设大家都训练过这些评测。」而站在我们这一边的是——你总可以造新的评测。于是有 Code Bench、Untreated Eval 之类的做法:抓取新的网页、存档论文或 GitHub,定义超出模型知识截止日期的评测。看起来相当稳健。但要留个心眼:时间戳并不总是安全的——比如你在 GitHub 上放的东西,可能其实派生自另一个仓库,那你怎么知道它真的「新鲜」? 路线四:私有评测集。 公司/模型开发者都这么做:如果你是 Google 或 OpenAI,你有内部代码库,假定它不在互联网上、显然也不会拿它去训练,于是可以用它来评估,这通常相当可靠。如果你不是公司,你可以用自己的私人写作——讲师自嘲地说:他研究生时代有一堆被拒稿、从没传到网上的论文,正好拿来用。 而且,这类评估对困惑度特别友好——因为困惑度只需要一个有质量的数据集,你直接算对数概率就行。 (参考时间: 01:13:11) 另一个担忧是数据集质量。 还记得前面 SWE-bench 的排行榜用的是 Verified 版本吗?那是因为 SWE-bench 原版有一些任务的问题、单元测试不够严格等等,被修正后才有 Verified。 很多其他基准也经历过类似过程——比如 GSM8K 或 MMLU:有人做了更仔细的审计,然后发现「等等,这道题有问题」。 📷 审计发现的坏题示例:题目给的文字里根本没给曲线 比如这张截图里的题——文字里根本没有给出曲线,所以你无法回答;再比如「那个婴儿穿袜子了吗」——没有任何信息可以判断。 还有一篇论文指出智能体类基准问题更多,因为它们更难评估——你没法只盯着问题和选项看,而是一整个环境。而且: 有测试用例当然是好事(通过/不通过),但众所周知,测试用例可能不完整——你可能通过了所有测试,却仍然没有一个能工作的解。 还有一个例子:如果智能体直接输出空回答,竟然能拿到 38%——可见这些基准里有不少琐碎漏洞,必须非常小心地避免。 讲师点出一个工具 Docent,它用语言模型去检查智能体的轨迹、检测问题——这是对非常「量化」的基准方式的一种定性补充。 他给出一条通用建议: 每当你做基准时——无论是开发基准,还是在某基准上跑模型——都要去看输出、去审计它,确认你测量的确实是你以为在测量的东西。 (参考时间: 01:15:41) 稍微拔高一点,回到一个更哲学的问题:评估到底是为了什么? 最后,还有一个「我们到底在评估什么」的问题。基础模型之前,研究者评估的是方法——因为有训练/测试划分,唯一变化的就是算法本身。今天,我们主要评估模型和系统,什么都可以变。当然有例外——比如 nanoGPT speedrun,它刻意用来评估算法(你能多快地训练一个模型)。但大部分语言模型评估,都是在评估最终的模型——这是有用的,因为那才是最终会被交付、被使用的东西。 结论:你应该始终明确声明你的目标是什么。 没有唯一正确的评估。先选定你想衡量的东西。 我们讨论了从困惑度、考试型、对话型、智能体,到推理、安全的一系列基准。它们在难度、现实主义、有效性上各不相同,而且常常存在取舍——很难同时做到「非常真实、非常难、生态效度高、又没有训练/测试污染」。所以你往往必须在某一项上妥协,而妥协在哪一项取决于你的目标。 这就是本讲的结束。下周,我们将开始讨论训练数据。 以下是编者重构时不确定或需要提醒读者的地方,逐条给出依据或时间点: 若干模型名称疑似 ASR(语音识别)错误,无法确认其真实拼写。 例如字幕中出现的「GPT-5.5」(00:03:02)、「Mythos」(00:47:23,「Good job, Mythos」)、以及 HLE 分数处出现的「Even Methos」(00:29:11,64.7 分)。这些很可能是未来某代模型的名字或在录音时尚未定型的称呼,编者无法核实,故正文中保留原样或作淡化处理,未强行「纠正」。 时间线中的年份需要谨慎对待。 本讲为 Spring 2026,字幕里讲师谈到 ARC-AGI 2「2025 年」、ARC-AGI 3「上个月」发布、HLE 是「去年」。由于课程本身设定在 2026 年,这些「去年/今年/上个月」的相对时间说法与当前真实世界的时间未必一致,读者不应把它们当作硬事实。 具体数字存在四舍五入与口语化不确定。 例如 HLE 上「64.7」、GPT-2 的 1.5B 参数与 PTB 困惑度「35 vs 46」、GPQA「GPT-4 39%」、SWE-bench「2024 年 16% → 93%」等,均为讲师口述数字,编者已按字幕转写,可能有微小偏差。 「Tatsuo 的组」对应的人物。 讲师提到用「题目顺序偏好」来检测训练污染的巧思来自「Tatsuo's group」(01:10:00 附近)。编者推测指的是 Stanford 的 Tatsu Hashimoto 课题组,但字幕未给出论文标题,此处标注为推测,具体论文待核实。 Docent 工具(01:15:10 附近)的出处未给出。 讲师只说它「用语言模型检查智能体轨迹」,没有提供链接或正式名称,编者无法给出官方页面,仅在正文中按讲师描述转述。 部分基准的官方名称/全称未在字幕中完整出现。 例如「Google Proof QA」为讲师的口头解释,常见正式名为 GPQA: A Graduate-Level Google-Proof Q&A Benchmark;「massive multitask language understanding」(MMLU)前后顺序讲师口述略有颠倒。编者按通行写法统一,但以讲师原话为准的口径已在正文标注。 讲师对某些观点明确表示「不必太当真」。 例如「困惑度就够了(perplexity is all you need)」的论证,讲师自己说「不要把它当严谨结论,它是一种思维方式」。本书保留了这一限定语气,读者不应把该论证当作已被证明的定理。 「什么算安全」的问题无定论。 讲师多次强调没有标准答案,涉及政治、法律、社会规范且因国而异。本节的分类(幻觉/谄媚/协助犯罪/不平等/批判性思维退化)为讲师口述,可能不完整,编者未擅自补全。 编辑对若干英文术语的中译选择。 如 scaffold 译作「脚手架」、rubric 译作「评分表/评分标准」、contamination 译作「训练污染」、ecological validity 译作「生态效度」——这些为编者判断,若与其他中文资料用法不一致,属正常现象。
2.2 从 in-distribution 到 out-of-distribution 的范式转变
回到原视频 (00:08:20)2.3 「困惑度就够了」
2.4 困惑度的问题与修正:条件困惑度
2.5 伪装的困惑度:LAMBADA 与 HellaSwag
2.6 困惑度排行榜的信任问题
2.7 困惑度小结
三、考试型基准
3.1 为什么用考试
3.2 MMLU 及其饱和
回到原视频 (00:21:29)3.3 MMLU-Pro
3.4 GPQA
3.5 关于训练污染的提问
3.6 Humanity's Last Exam
回到原视频 (00:28:50)3.7 考试型基准的局限
四、对话型基准
4.1 开放式回答为什么难评
4.2 Chatbot Arena 与 Elo 排名
graph TD
    A["用户输入 prompt"] --> B["两个匿名模型分别作答<br/>助手 A / 助手 B"]
    B --> C["用户判断:<br/>A 更好 / 都好 / 都差 / B 更好"]
    C --> D["积累大量成对比较数据"]
    D --> E["拟合 Elo 评分参数"]
    E --> F["得到模型排名"]
回到原视频 (00:34:52)
4.3 AlpacaEval 与 LLM-as-a-Judge
4.4 如何评估一个指标?
4.5 WildBench 与 checklist
4.6 小结:如何评估开放式回答
五、智能体基准
5.1 什么是 agent
graph TD
    A["任务 / 目标"] --> B["语言模型生成动作"]
    B --> C["环境执行<br/>命令 / 工具调用"]
    C --> D["观测结果"]
    D --> E["写入上下文 / 记忆"]
    E --> B
    E --> F{"任务完成?"}
    F -->|是| G["提交结果 / 评分"]
    F -->|否| B
5.2 SWE-bench
5.3 Terminal Bench
回到原视频 (00:49:00)5.4 网络安全:Capture-the-Flag
回到原视频 (00:50:43)5.5 MLE Engineering
5.6 Scaffold 的工程要点
六、纯推理基准
6.1 为什么想隔离推理与知识
6.2 ARC-AGI 的历史
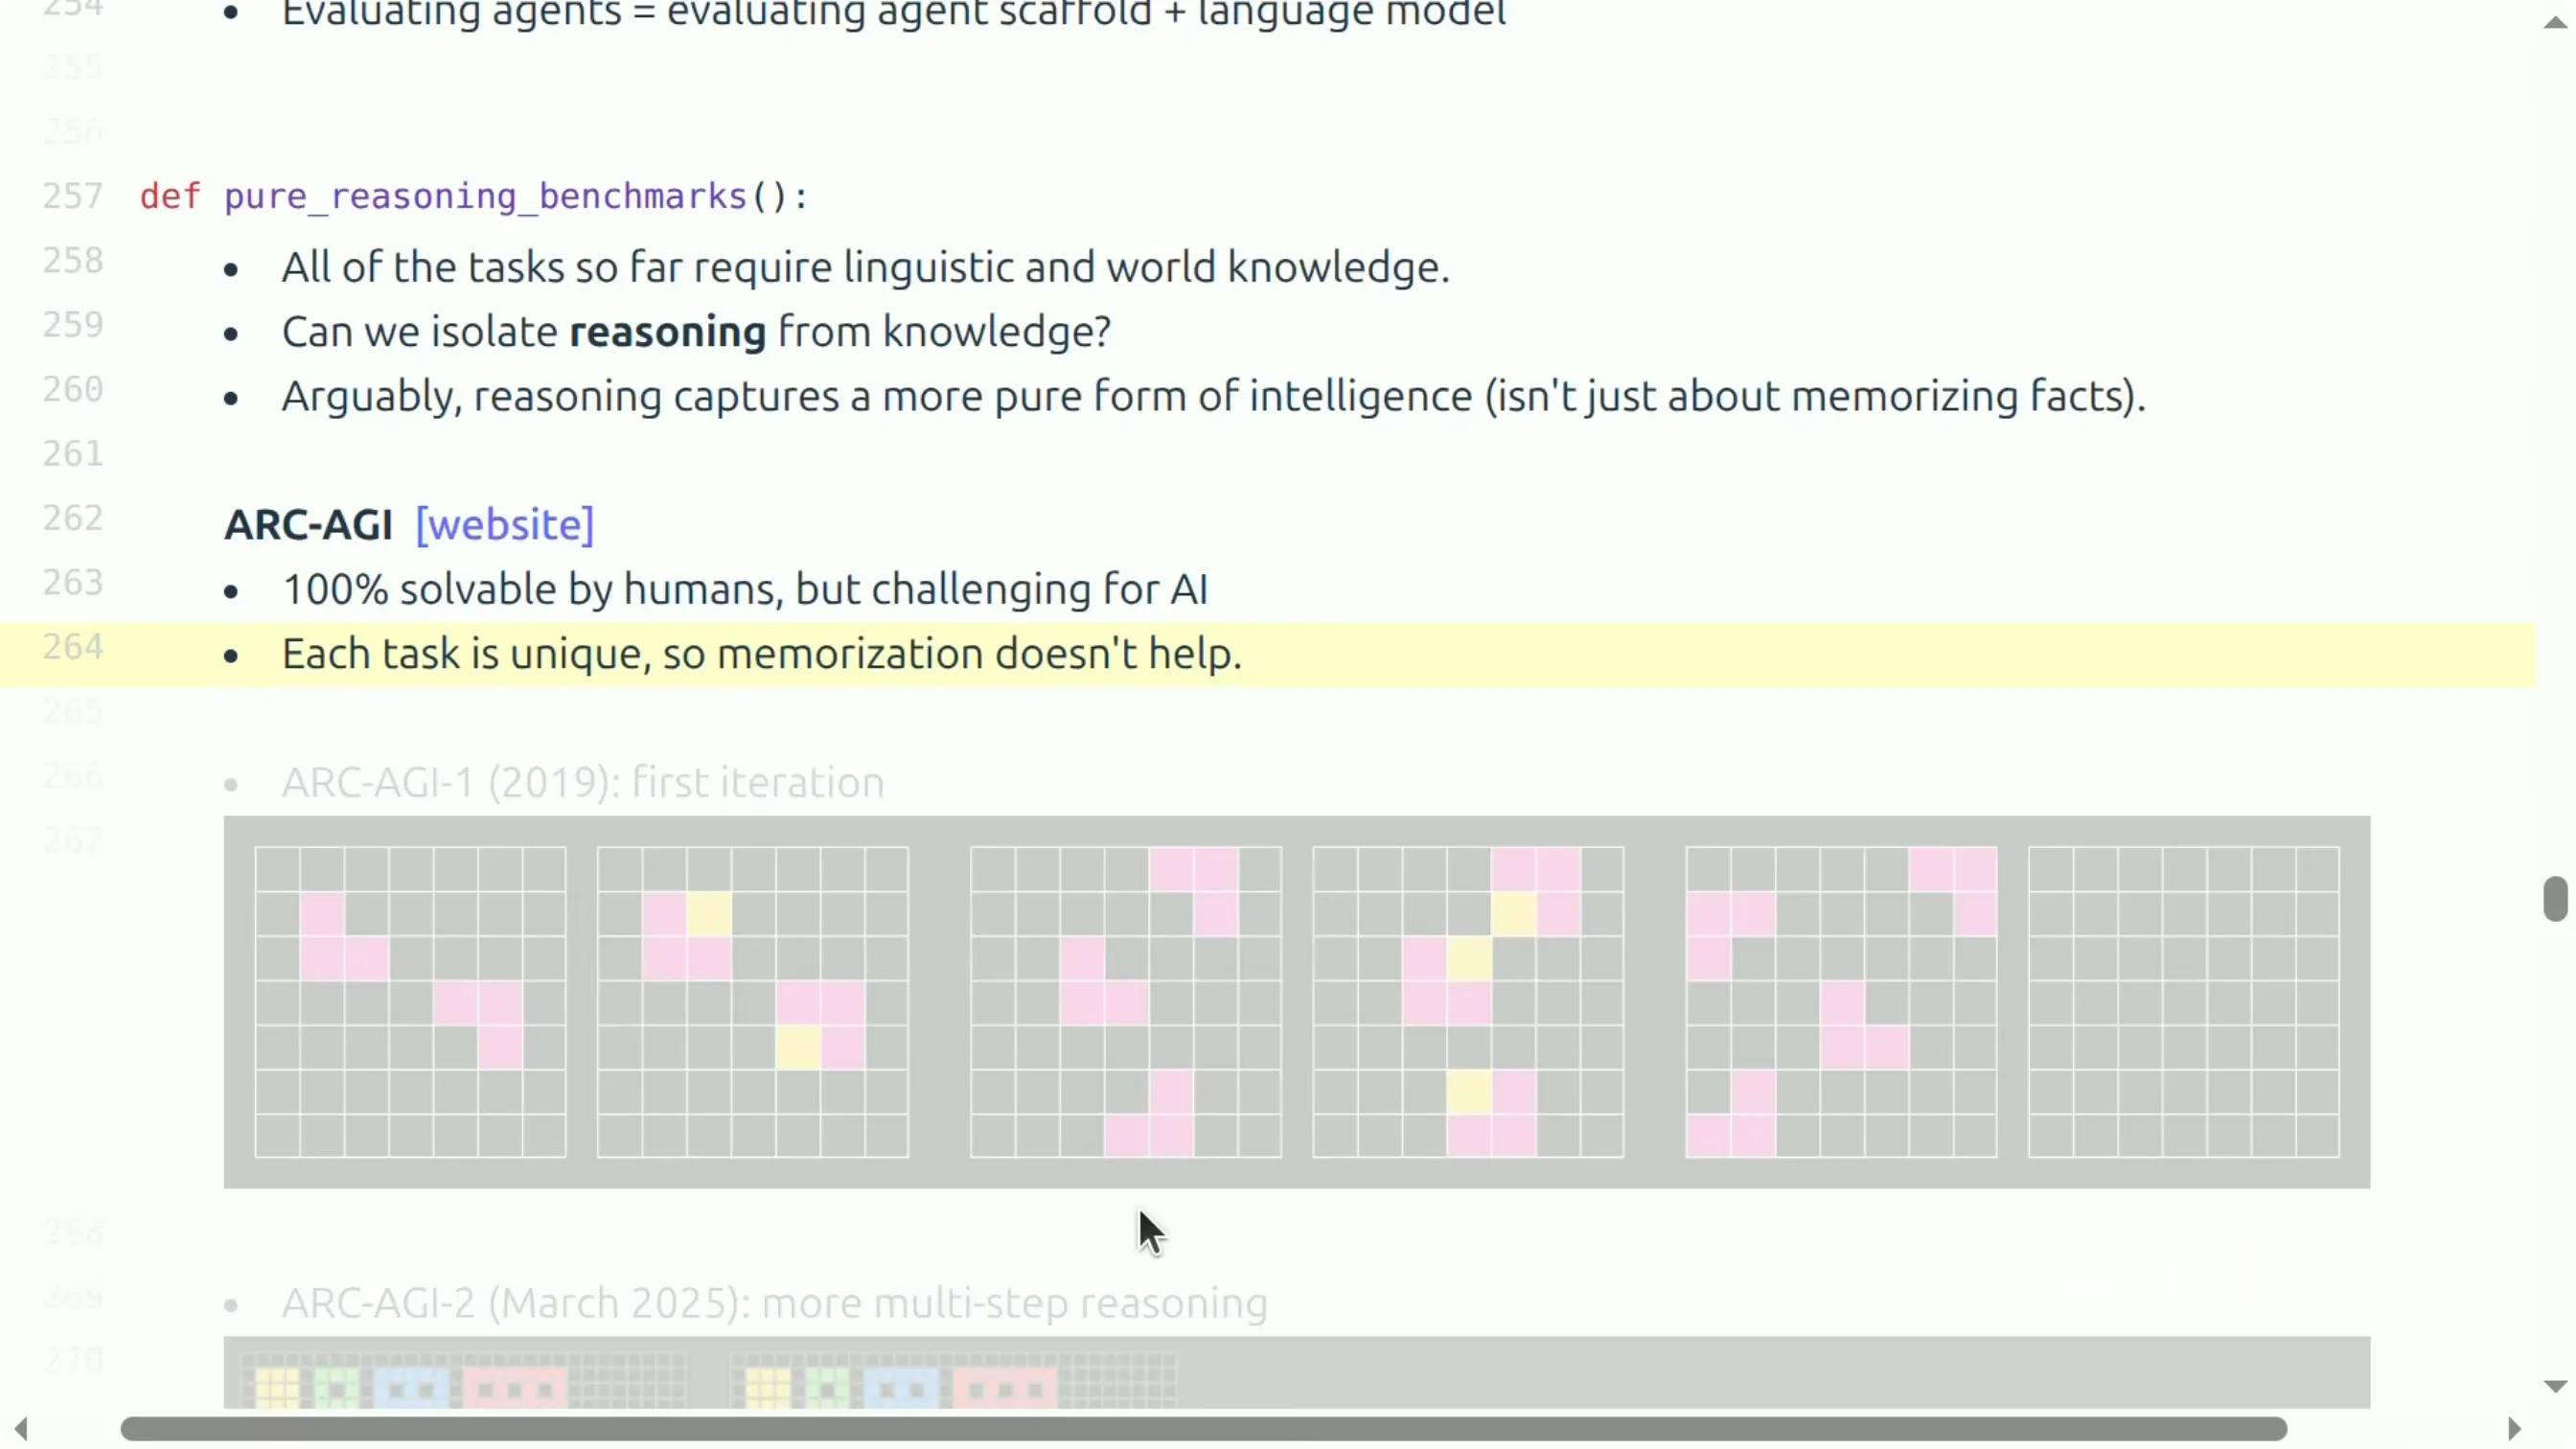
回到原视频 (00:55:00)6.3 ARC-AGI 3
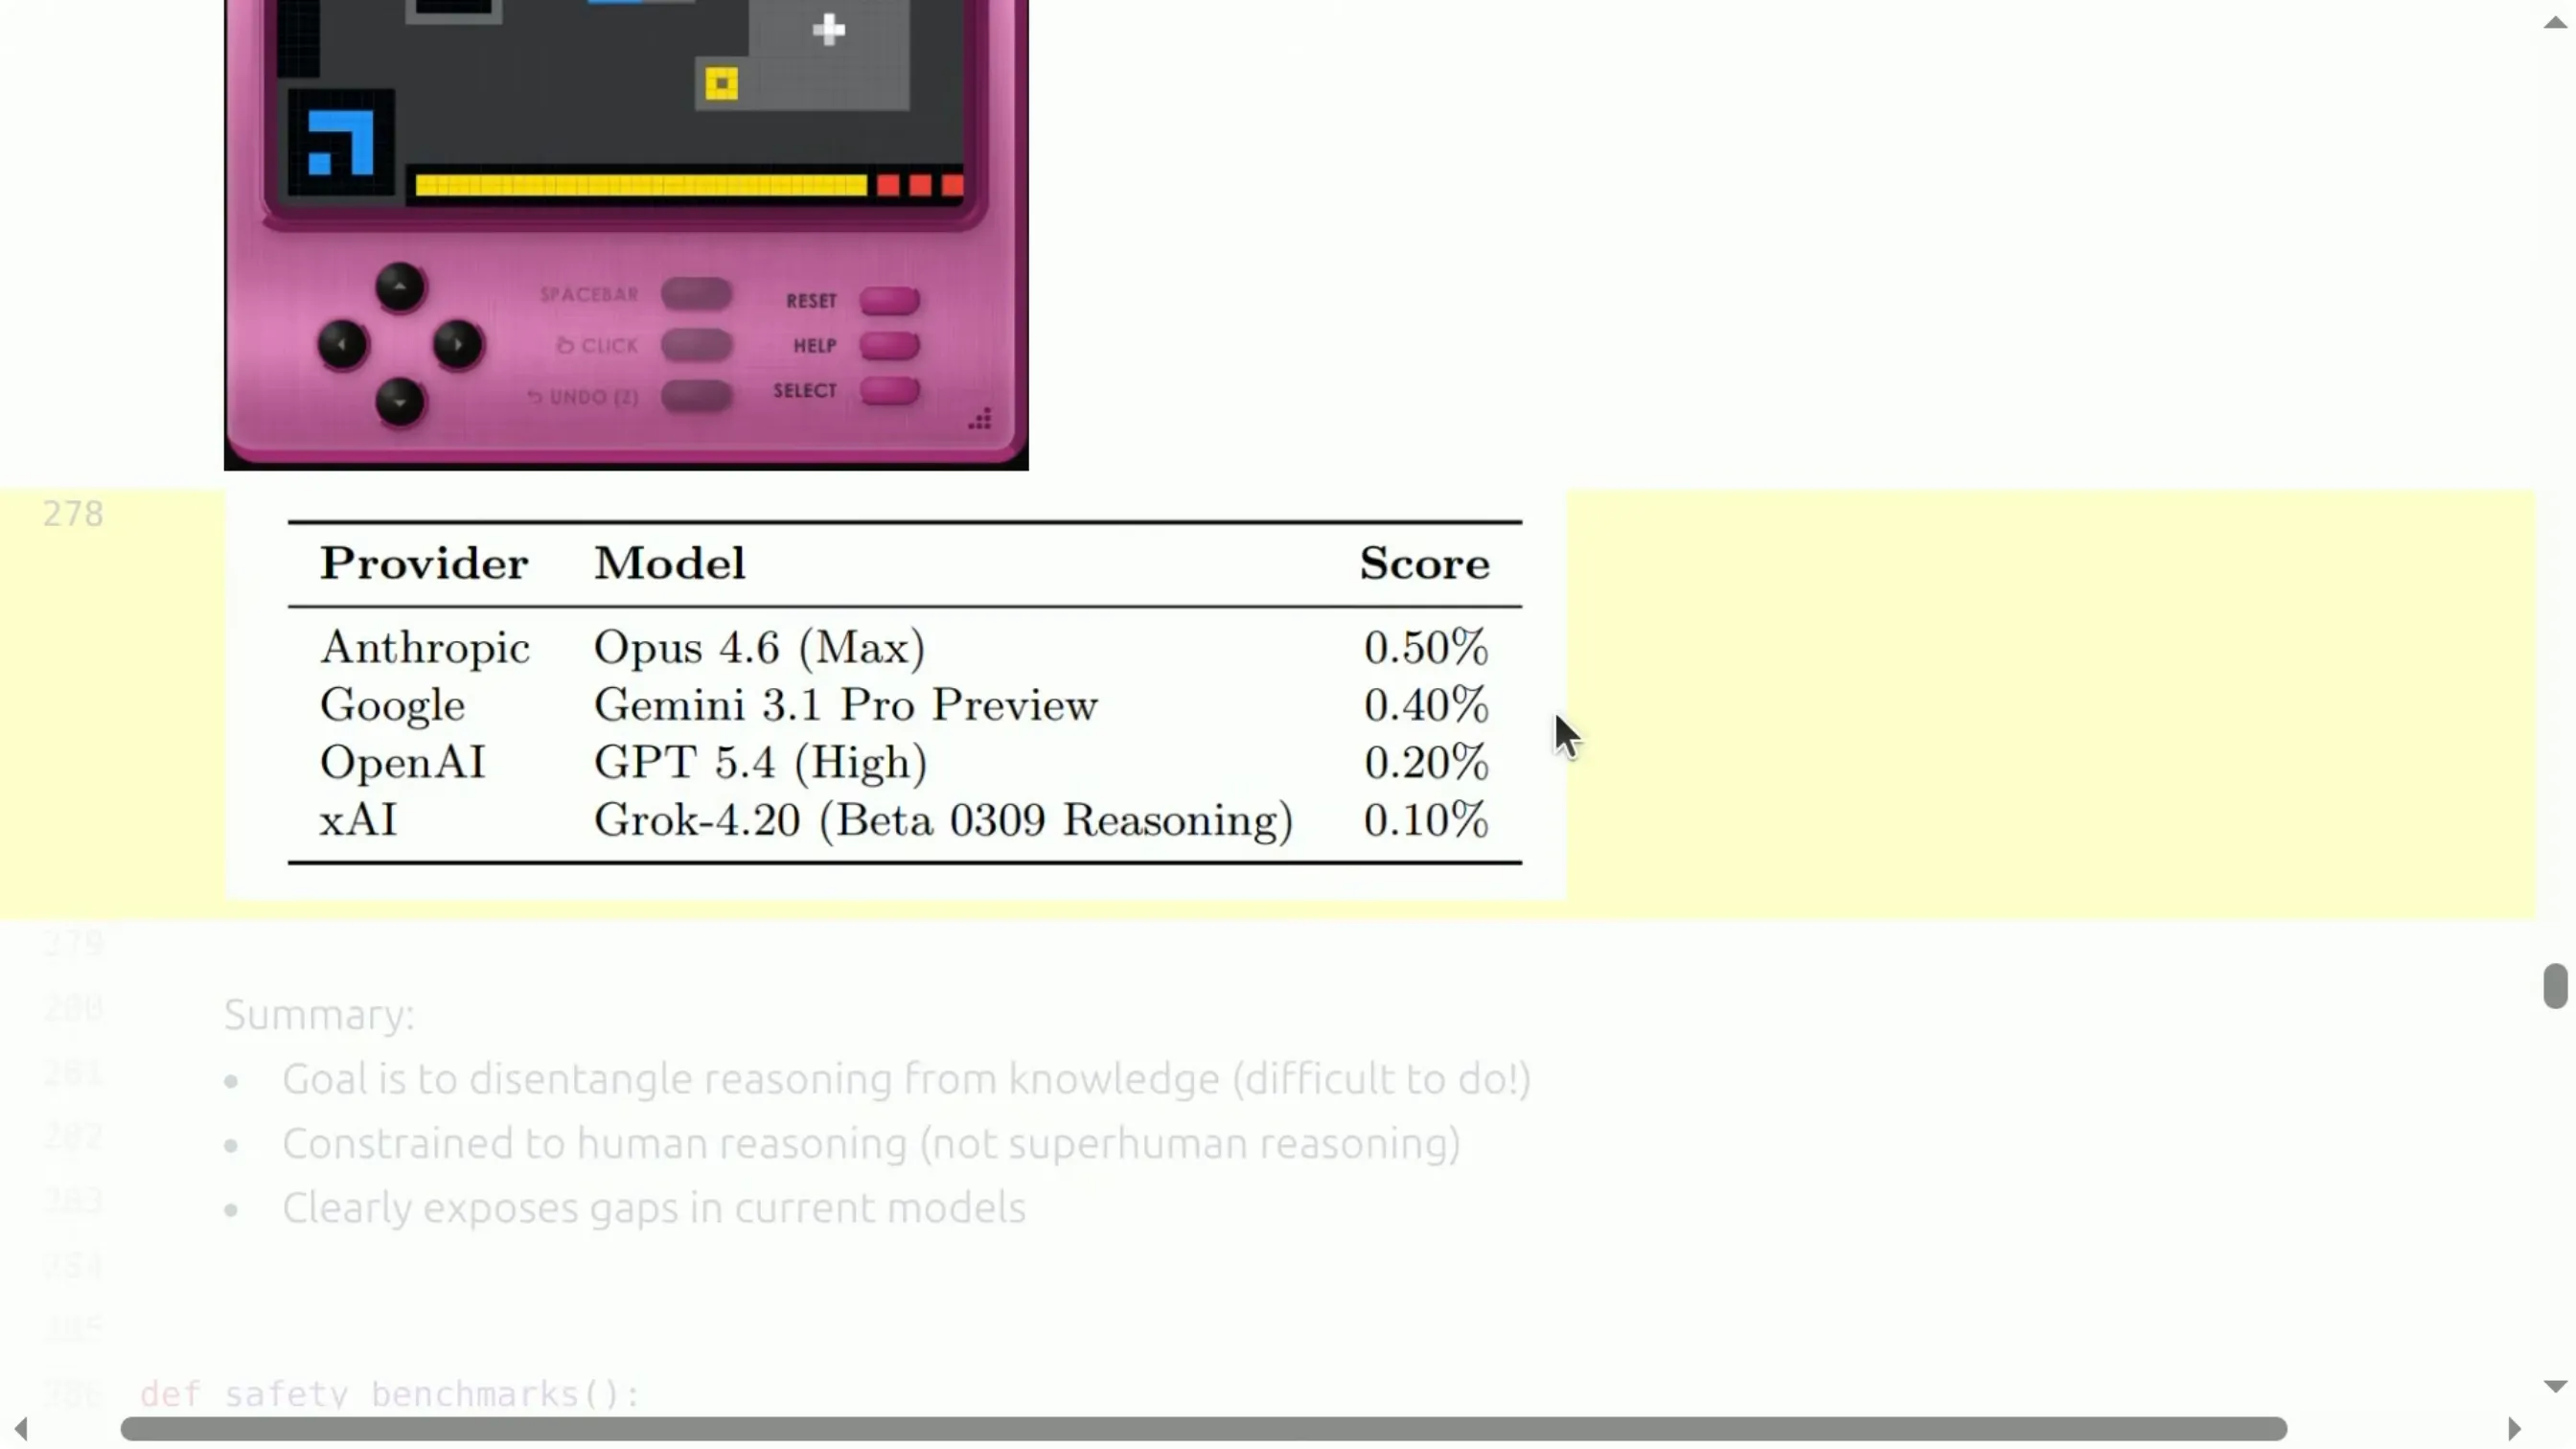
回到原视频 (00:57:55)
6.4 讨论
七、安全评估
7.1 什么是安全?
7.2 HarmBench
7.3 AIrBench 与整体视角
7.4 越狱攻击
7.5 风险的多样性与双重用途
八、评估的更广泛考量
8.1 生态效度:评估离真实使用有多远
8.2 科学效度与训练污染
graph TD
    P["训练污染问题"] --> R1["路线一:推断<br/>模型是否见过测试集"]
    P --> R2["路线二:报告<br/>训练/测试重叠(规范)"]
    P --> R3["路线三:假设最坏情况<br/>改用新鲜评测"]
    P --> R4["路线四:私有评测集"]
8.3 数据集质量
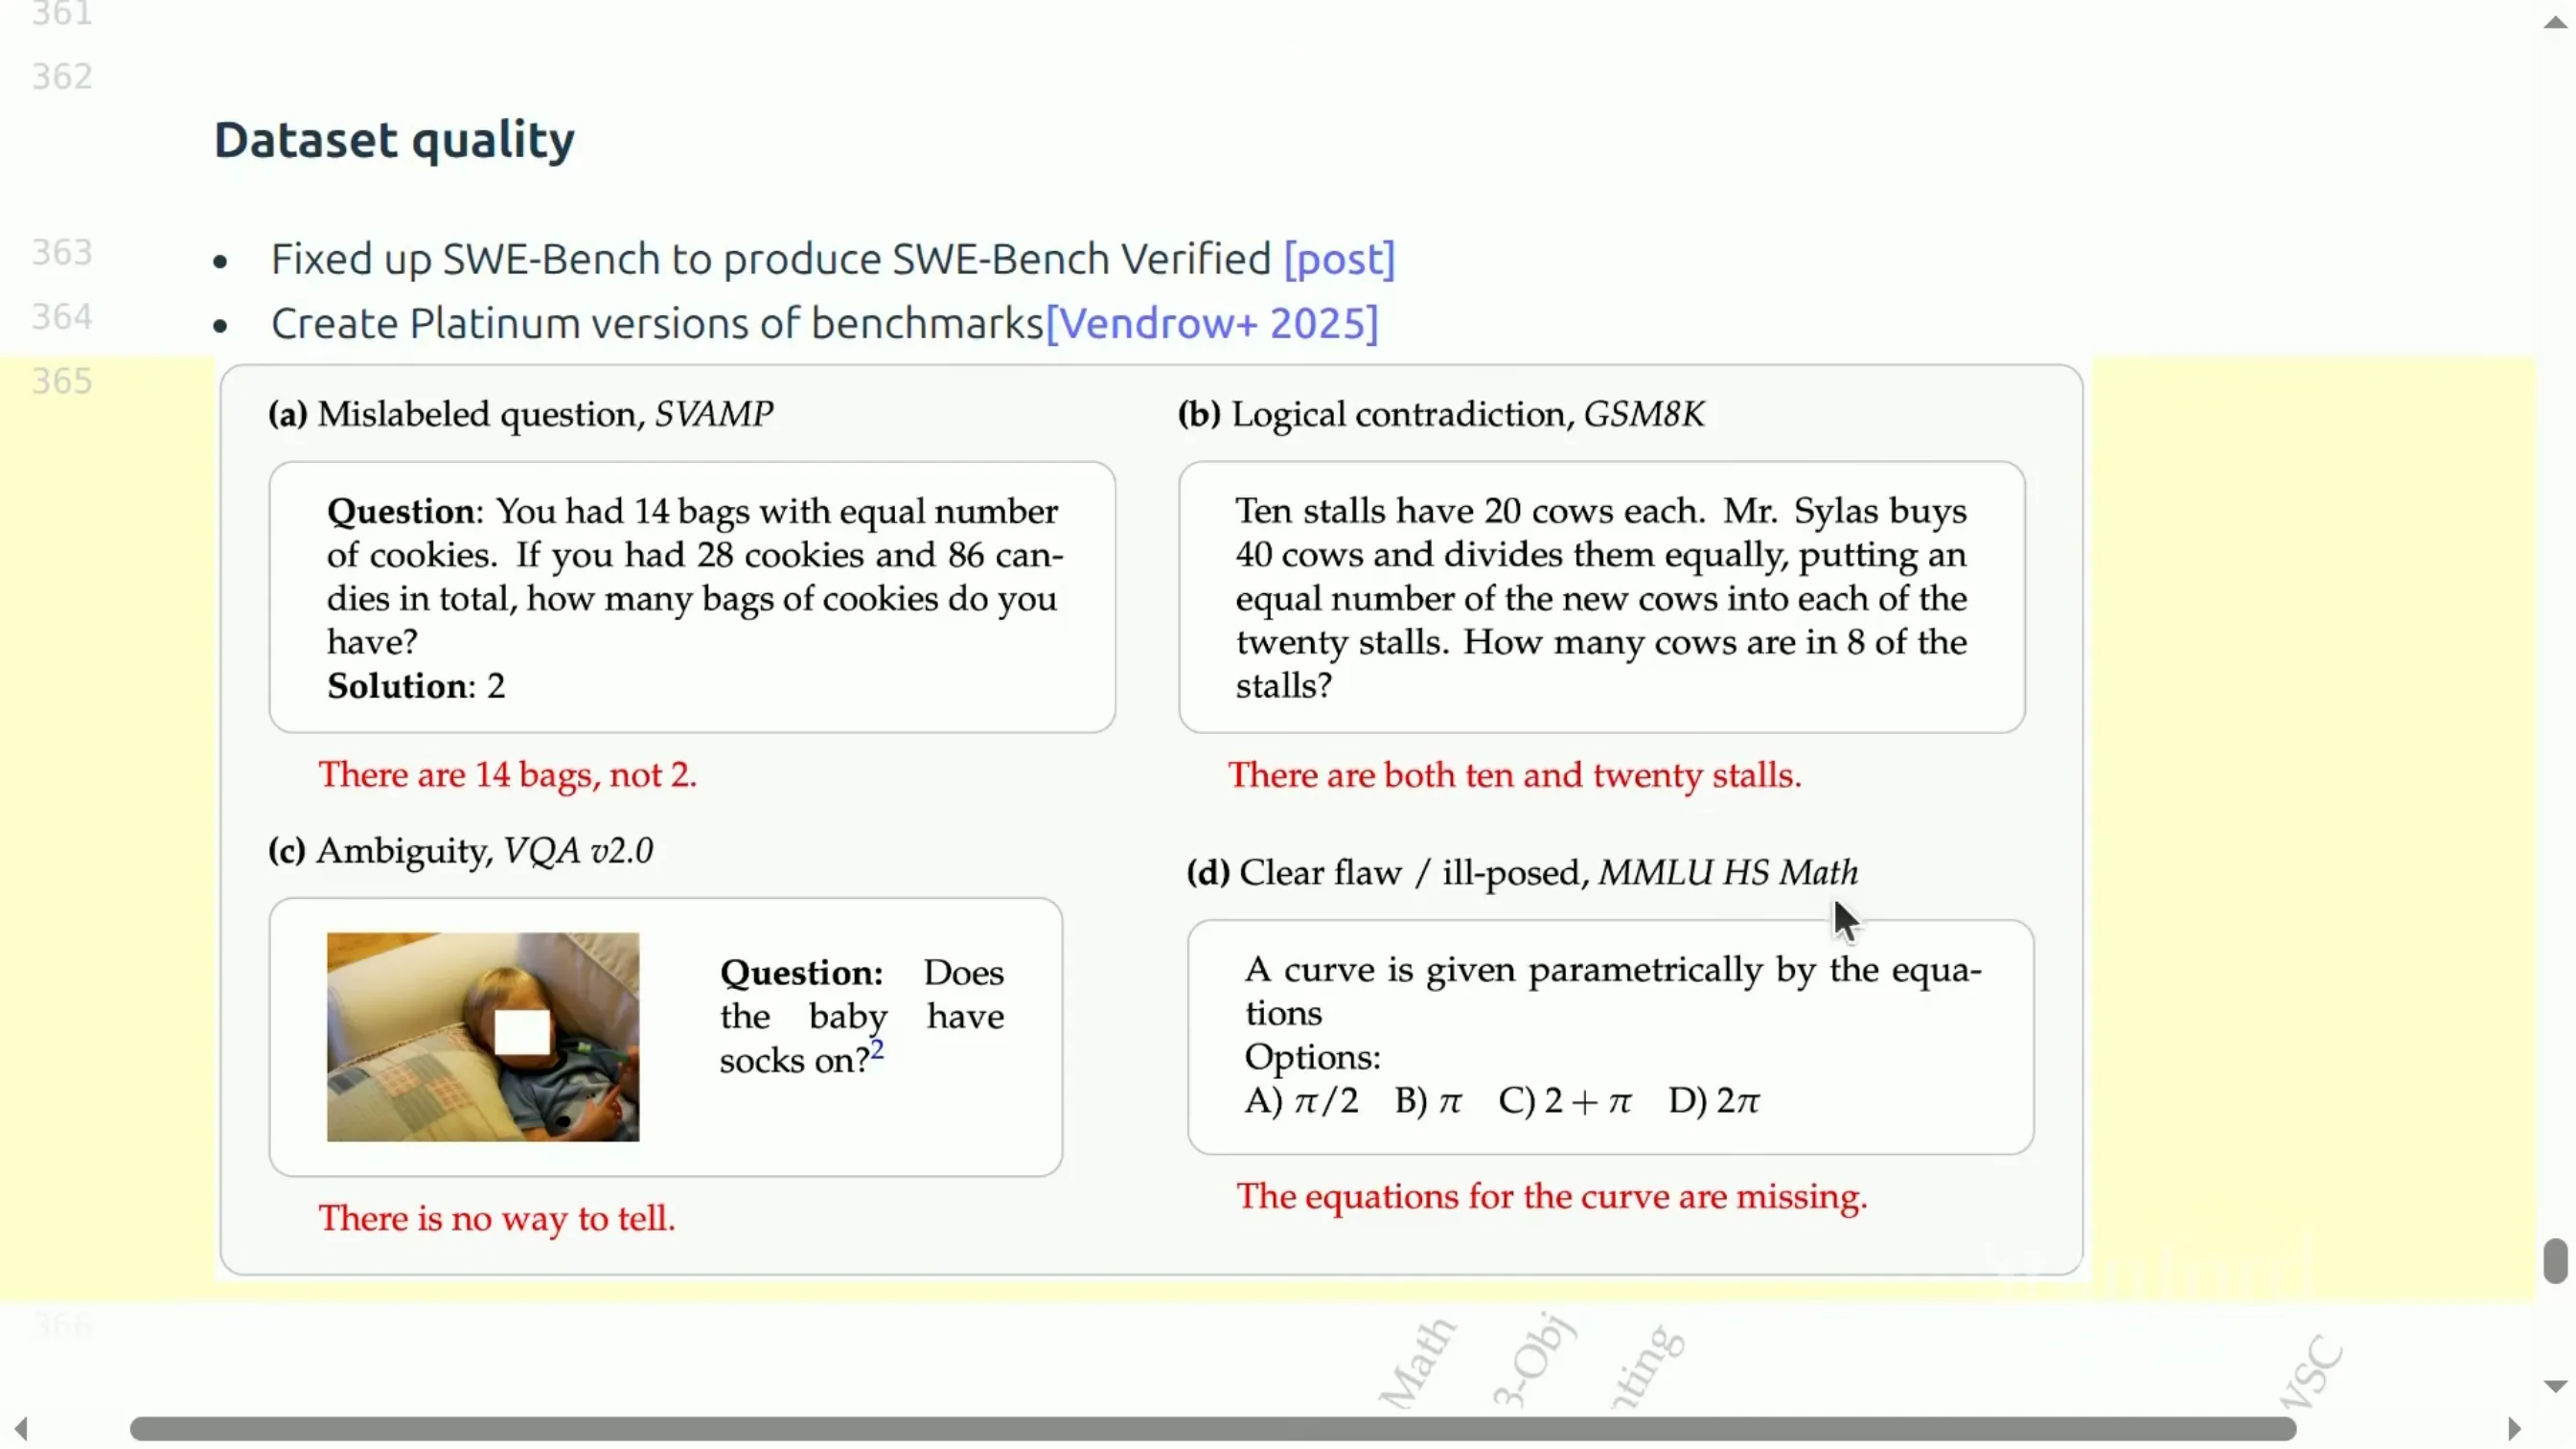
回到原视频 (01:13:50)
8.4 评估的目的是什么
九、评估的收尾
附:参考与延伸阅读
编者补充
已知疑点