第13讲 · Stanford CS336:从零开始的语言建模
对应讲次:第13讲(Stanford CS336 语言建模)
制作模型:deepseek-flash(vb compose,据 run.log)
数据:来源与数据集(Sources, Datasets)
课程:Stanford CS336 Language Modeling from Scratch(2026 春季)
讲次:Lecture 13 · Data (Sources, Datasets)
视频:https://www.youtube.com/watch?v=-qm0ln33G24(时长约 82 分钟)
本书性质:由课堂逐字字幕重构而成,书面化、结构化,非逐句翻译。凡属编者补充处均已明确标注。本讲的版权相关内容为讲师个人理解,不构成法律意见。
导览
用 3–5 分钟读一张问题地图,再决定要不要深入下面的章节。
- 这一讲,老师真正想回答的问题
本讲并不急着抛出某个数据集,而是从最上游一路问下来,顺序大致是:
- 你已经会「给定数据训练模型」,上一讲也学会了「怎么判断一个模型好不好」——那么接下来的核心问题就是:我们到底应该拿什么数据来训练? 老师给了一个立场的断言:数据是语言模型里最该做对的一件事(参考时间: 00:00:24)。
- 既然「数据最重要」,那第一步就要问:数据到底从哪来? 一句「语言模型是在整个互联网上训练的」在老师看来连类型都对不上——预训练不是让一个智能体去上网点来点去,而是爬取公开网页(参考时间: 00:04:36)。
- 于是问题被拆成两层:技术上能爬到什么、法律上允许用什么(版权、robots.txt、服务条款)。
-
最后才是「有哪些真实被用过的数据集」——从 2018 年的 BERT 一路讲到 2024 年的 Nemotron、Common Pile(参考时间: 00:45:07)。
-
难点在哪
最容易卡住、也最容易被忽略的是「数据不是天生的」这一步。初学者常默认「数据就在 Hugging Face 上,下载即可」;而本讲反复强调的是:数据背后有实时服务器、爬虫、动态网页、登录墙、机器人协议、服务条款、版权法这一整条社会—技术链条。另一处难点在过滤的取舍:从 240 万亿 token 的原始网页,到真正拿来训练的几万亿 token,中间那一步「怎么删、删多少」直接决定模型质量,却几乎没有第一性原理可依,主讲原话是「很大程度上靠 vibe(直觉)」(参考时间: 01:21:27)。
- 读者可能带着的疑问
① 老师自己提出的问题(按他的顺序):
- 为什么模型论文愿意公开架构、训练流程,却对数据只字不提?
- 预训练 / 中期训练 / 后训练分别用什么数据?界线清楚吗?
- 「在互联网上训练」这句话到底哪里不准确?
- 这么多来源和数据集,该怎么选、怎么处理?
② 编者预判的读者疑问(与上面分开,仅供对照):
- 我自己想训练个小模型,也要面对版权和 robots.txt 吗?(编者预判)
- Creative Commons、合理使用(fair use)到底有什么区别?我该用哪个?(编者预判)
- DCLM 说「过滤太狠」,Nemotron 说「要更多 token」,这两条路到底谁对?(编者预判)
-
只用「宽松许可」的数据,真的能训出可用模型吗?(编者预判)
-
本讲路线
先立论(数据最重要、且各家守口如瓶)→ 讲数据的阶段划分(预训练/中期/后训练)→ 从零追问「数据从哪来」(爬虫、技术限制、法律限制、影子图书馆)→ 专门铺一段版权与合理使用的背景 → 介绍几个高价值来源(Common Crawl / Wikipedia / GitHub / arXiv)→ 按时间线盘点 2018–2024 的代表性数据集与过滤方法 → 收尾于代码数据(The Stack)与「只用宽松许可」的 Common Pile。老师会在下一讲继续讲后训练数据与更多过滤细节。
一、为什么说数据是最该做对的事
(参考时间: 00:00:04)
今天要谈的是数据。我们目前的进度是:你已经知道给定数据如何训练一个模型,上一讲又学了评估,因此你知道「什么样的模型算好」。接下来这两讲,我们要聚焦一个更前置的问题:到底应该拿什么数据来训练?
老师在这里给了一个相当强的判断——数据是语言模型中最重要、最该做对的一环。他的一个佐证是「看公司实际披露了什么」:
- 以 Llama 3 的论文为例,架构是完全透明的(这当然,因为它是开放权重模型),连训练流程都会告诉你;
- 但对数据,论文几乎只给一句话——「我们用多种数据源训练,并做了一些处理」(参考时间: 00:00:51),没有任何细节。
为什么各家对数据如此保密?主讲给了两个原因:
- 竞争壁垒。数据是「秘方」,你不希望竞争对手知道你在做什么。
- 版权责任。一旦你公开承认训练用了某类数据,就可能招来诉讼。
编者说明:这种「公开架构、隐匿数据」的模式,几乎是当前大模型论文的通用做法。读者若对比 Llama、Qwen 等系列的技术报告,会发现「Data」一节往往只有寥寥数语,而「Architecture」「Training Recipe」却极其详尽。
在基础模型出现之前,「做数据」这件事主要指为监督学习标注数据;如今在预训练阶段,人工标注已大幅减少,但清洗与整理(curation、cleaning)的工作依然繁重。主讲强调,这件事的本质没有变:数据一直是瓶颈,而且会一直是瓶颈,因为它本质上是一个长尾问题——它的规模随人力投入而扩展。相比架构、系统这类「能同时投入的人有限」的方向,数据的活可以靠大量人力并行推进。这正是各家「数据团队」规模庞大的原因。
二、数据在训练管线中的位置
(参考时间: 00:02:19)
同一条训练管线,数据出现在不同阶段,用途也不同。今天主要讲预训练。
graph LR
    A["原始数据<br/>(网页文档等)"] --> B["预训练 Pretraining<br/>大量、低质量"]
    B --> C["中期训练 Mid-training<br/>较小、更高质量<br/>增强能力 / 长上下文"]
    C --> D["后训练 Post-training<br/>对话记录 / RL 环境<br/>更任务特化"]
- 预训练:拿原始数据(主要是网页文档)直接训练。
- 中期训练(mid-training):改用更高质量的数据,以增强某些能力、扩展长上下文等。
- 后训练(post-training):训练对话记录(chat transcripts),或做强化学习时在特定环境里训练,越来越任务特化。
主讲提醒:现实中这些界线其实是模糊的,而且阶段可能不止三个,上面只是基本的模板。贯穿其中的总趋势是:
从「大量低质量数据」走向「少量高质量数据」。
由此也产生了文献里的术语:
- base model(基座模型):通常指经过预训练+中期训练之后的模型;
- instruct / chat model(指令/对话模型):经过后训练之后的模型。
不过主讲也指出,「什么算基座模型」已经越来越说不清了;近来越来越多的大模型干脆不发布基座模型——「没有中间检查点,只有 Qwen 3.5 397B,就这一个」(参考时间: 00:03:33)。
相反,对完全开源的模型(例如 AI2 的 Olmo),你可以看到它各阶段的全部数据。这也正是本讲能展开讨论的原因。以 Olmo 式的公开披露为例:预训练阶段有网页、学术论文、数学页面与证明;中期训练换成更高质量的网页数据、指令数据,以及常放在这一阶段的合成数据(synthetic data);后训练则是大量对话日志、更多的数学与推理、代码,以及在这个阶段做的安全相关工作。
至此,本讲的主问题成形了:这些数据集都是什么?怎么选?怎么处理?
三、数据从哪来:互联网没你想的那么简单
(参考时间: 00:04:36)
「语言模型是在整个互联网上训练的」——这句在走廊里常听到的话,主讲认为连类型都对不上:要成立,那得是一个在互联网上「到处活动」的强化学习智能体,但预训练根本不是这么工作的。
略微准确的说法是「在公开的万维网上训练」,但这也不完全准确。下面逐层拆解。
3.1 网页是活着的服务器
万维网本质上是一堆真实存在、可连接的活动服务器。你访问任意网站,实际上是发送一个请求、拿回一个响应。
因此你没法直接在这些线上服务器上训练(除非你训练的是 RL 智能体)。通常的做法是:
- 有人(不一定是自己)编写一个爬虫(crawler);
- 爬虫从一个种子集合(seed set)开始,发现有哪些网页;
- 在爬行过程中下载这些被发现的网页。
编者说明:爬虫的经典模型是图遍历——见 3.3。它并不「抓取整个网络」,而是从少量种子出发,沿着超链接不断扩展到一个可达的网页子集。
3.2 光有爬虫还不够
即便有了爬虫,也不能把「所有网页」一次性下载下来。原因有几类:
(一)大量内容是动态的。 尤其现在很多站点其实是应用(app),URL 甚至不再是内容的完整描述;你常常需要点击按钮、提交表单才能取到内容。例如 Discord——你没法简单地把 Discord 爬一遍、把里面所有内容抓出来。许多这类内容属于所谓的深网(deep web),不是「跟着超链接走」就能拿到的。
(二)认证与登录墙。 有些页面需要登录、需要账号,通常还要付费。例如 Facebook、X、LinkedIn、《纽约时报》。这些「围墙花园」里的内容量极大,技术上在「网」上,但你没法建个爬虫去爬。主讲半开玩笑地说:如果你是 Facebook(或 XAI),你本就有数据、可以直接训模型;但对其他人,这些内容就是拿不到的。
(三)技术限制。 即便没有登录问题,仍有:
- robots.txt:通常放在域名根目录(如
nytimes.com),告诉你哪些允许爬、哪些不允许。很多内容会被Disallow——例如 OpenAI 的搜索机器人、Perplexity 的机器人、Common Crawl 的机器人,基本还有 ChatGPT、Claude 的相关 bot 等(参考时间: 00:08:03)。 - 关键点:robots.txt 不是法律约束,本意是「好公民该遵守的约定」——你的名字在名单上,就别爬。
- Cloudflare 类的反机器人检测:你偶尔访问某个网站被弹出验证码,就是因为某个算法判定你「可能是个机器人」,在确认你是不是人。真机器人想绕过是可以尝试的,但这是一道障碍。
- IP / 国家封锁与速率限制。
(四)法律限制。 网站有服务条款(Terms of Service),其中常常写着「机器人请走开」「不得将本站内容用于 AI 训练」。此外,即便条款没写,网站内容本身也可能有许可,或者根本没有训练授权。
3.3 爬虫的机制:其实是一次并行图遍历
(参考时间: 00:32:19)
概念上,爬虫很直接,所有麻烦都在实现细节里:
graph TD
    S["种子 URL 集合"] --> Q["URL 队列"]
    Q --> P["弹出一个 URL"]
    P --> D["下载该页面(HTTP 响应)"]
    D --> E["抽取页内所有超链接"]
    E --> Q
    D --> R["尊重 robots.txt / 限速"]
    D --> C{"是否频变页面?"}
    C -->|是| H["提高重访频率"]
    C -->|否| L["降低重访频率"]
具体地说:你从一个 URL 集合出发,本质上是一次图遍历——从队列里弹出一个 URL、下载它、看这个页面里的所有超链接、再把它们加入队列。这通常并行地在多台机器上执行。
这里有一堆需要做决策的地方:
- 哪些页面要下载;
- 尊重 robots.txt;
- 别把对方服务器打爆(别过度加载);
- 页面变化的访问策略:对频繁变化的页面应更勤地重访,对不变化的页面则别浪费时间去抓;
- URL 是动态的:有时同一 URL 会因浏览器状态不同而返回不同内容;反过来,很多不同 URL 会指向同一内容,因此若不谨慎会产生大量重复。镜像站(mirror site)本身就是重复的典型。
编者说明|WARC 与 WAT Common Crawl 以两种格式发布抓取结果: - WARC:原始的 HTTP 响应(即「你发请求、它回响应」里的那个响应),信息最全; - WAT:经过一定处理、必然有损的中间格式。 现实经验表明,从 HTML 到纯文本的转换方式本身就会影响模型效果——同一批网页,用不同工具抽文本,结果并不一样。
这一点有实验佐证。来自 DataComp-LM 论文的一份消融实验比较了「Common Crawl 官方发布的 WAT」与其它抽取工具,结论是 Trafilatura 与 Resiliparse 这类专用解析器更好(参考时间: 00:35:52)。
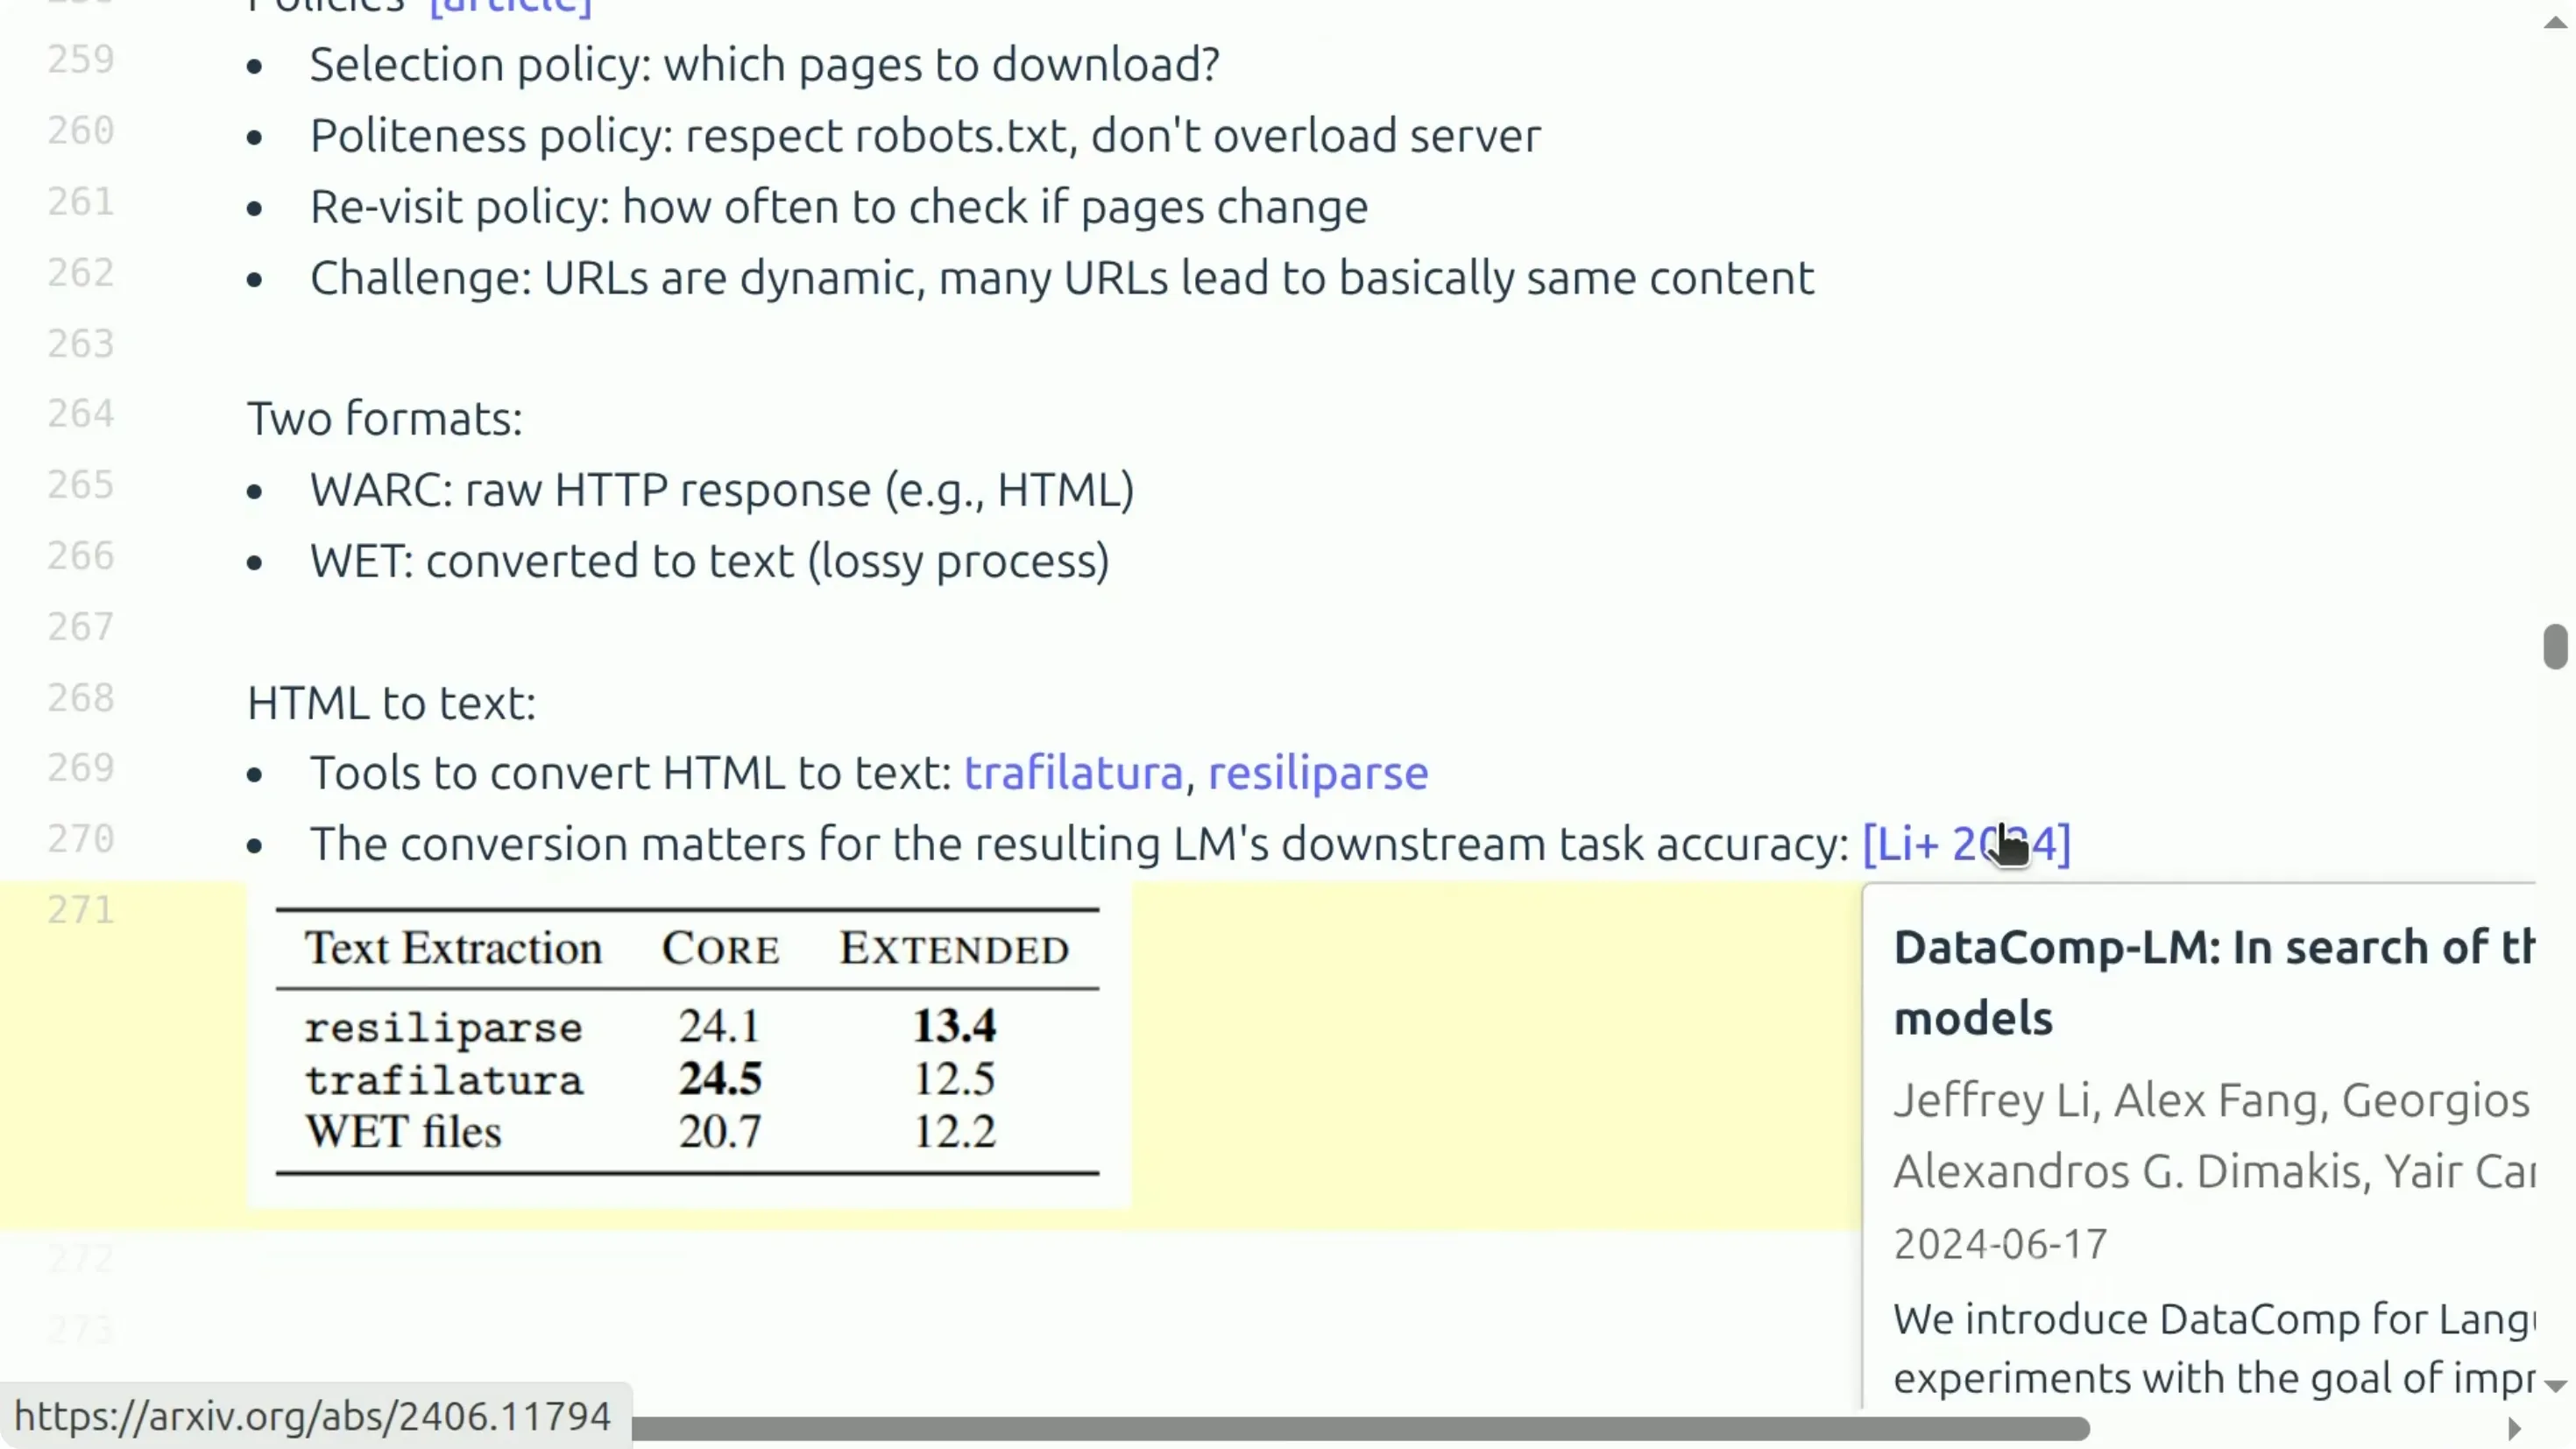
📷 DataComp-LM 中不同 HTML→文本抽取工具的消融对比
回到原视频 (00:35:52)
编者说明:原字幕把 Resiliparse 听成了「Brazilia Parser」,此处按该论文的实际工具名订正为 Resiliparse。
3.4 一张图看「限制是怎么变多的」
(参考时间: 00:10:02)
主讲提到 Shayne Longpre 等人的论文 《Consent in Crisis》。该研究检查了常见数据集里各 URL 的技术限制(robots.txt)与法律限制(服务条款),结论是:限制随时间在增加。
- 在 robots.txt 那张图上,到 2023 年中之前,「完全限制」的比例大致平稳,之后陡然升高到接近 50%;
- 服务条款上也有类似趋势:2016 年几乎没人在页面上写条款,如今大多数页面都写了条款,而大多数条款都说「不得用于 AI」。
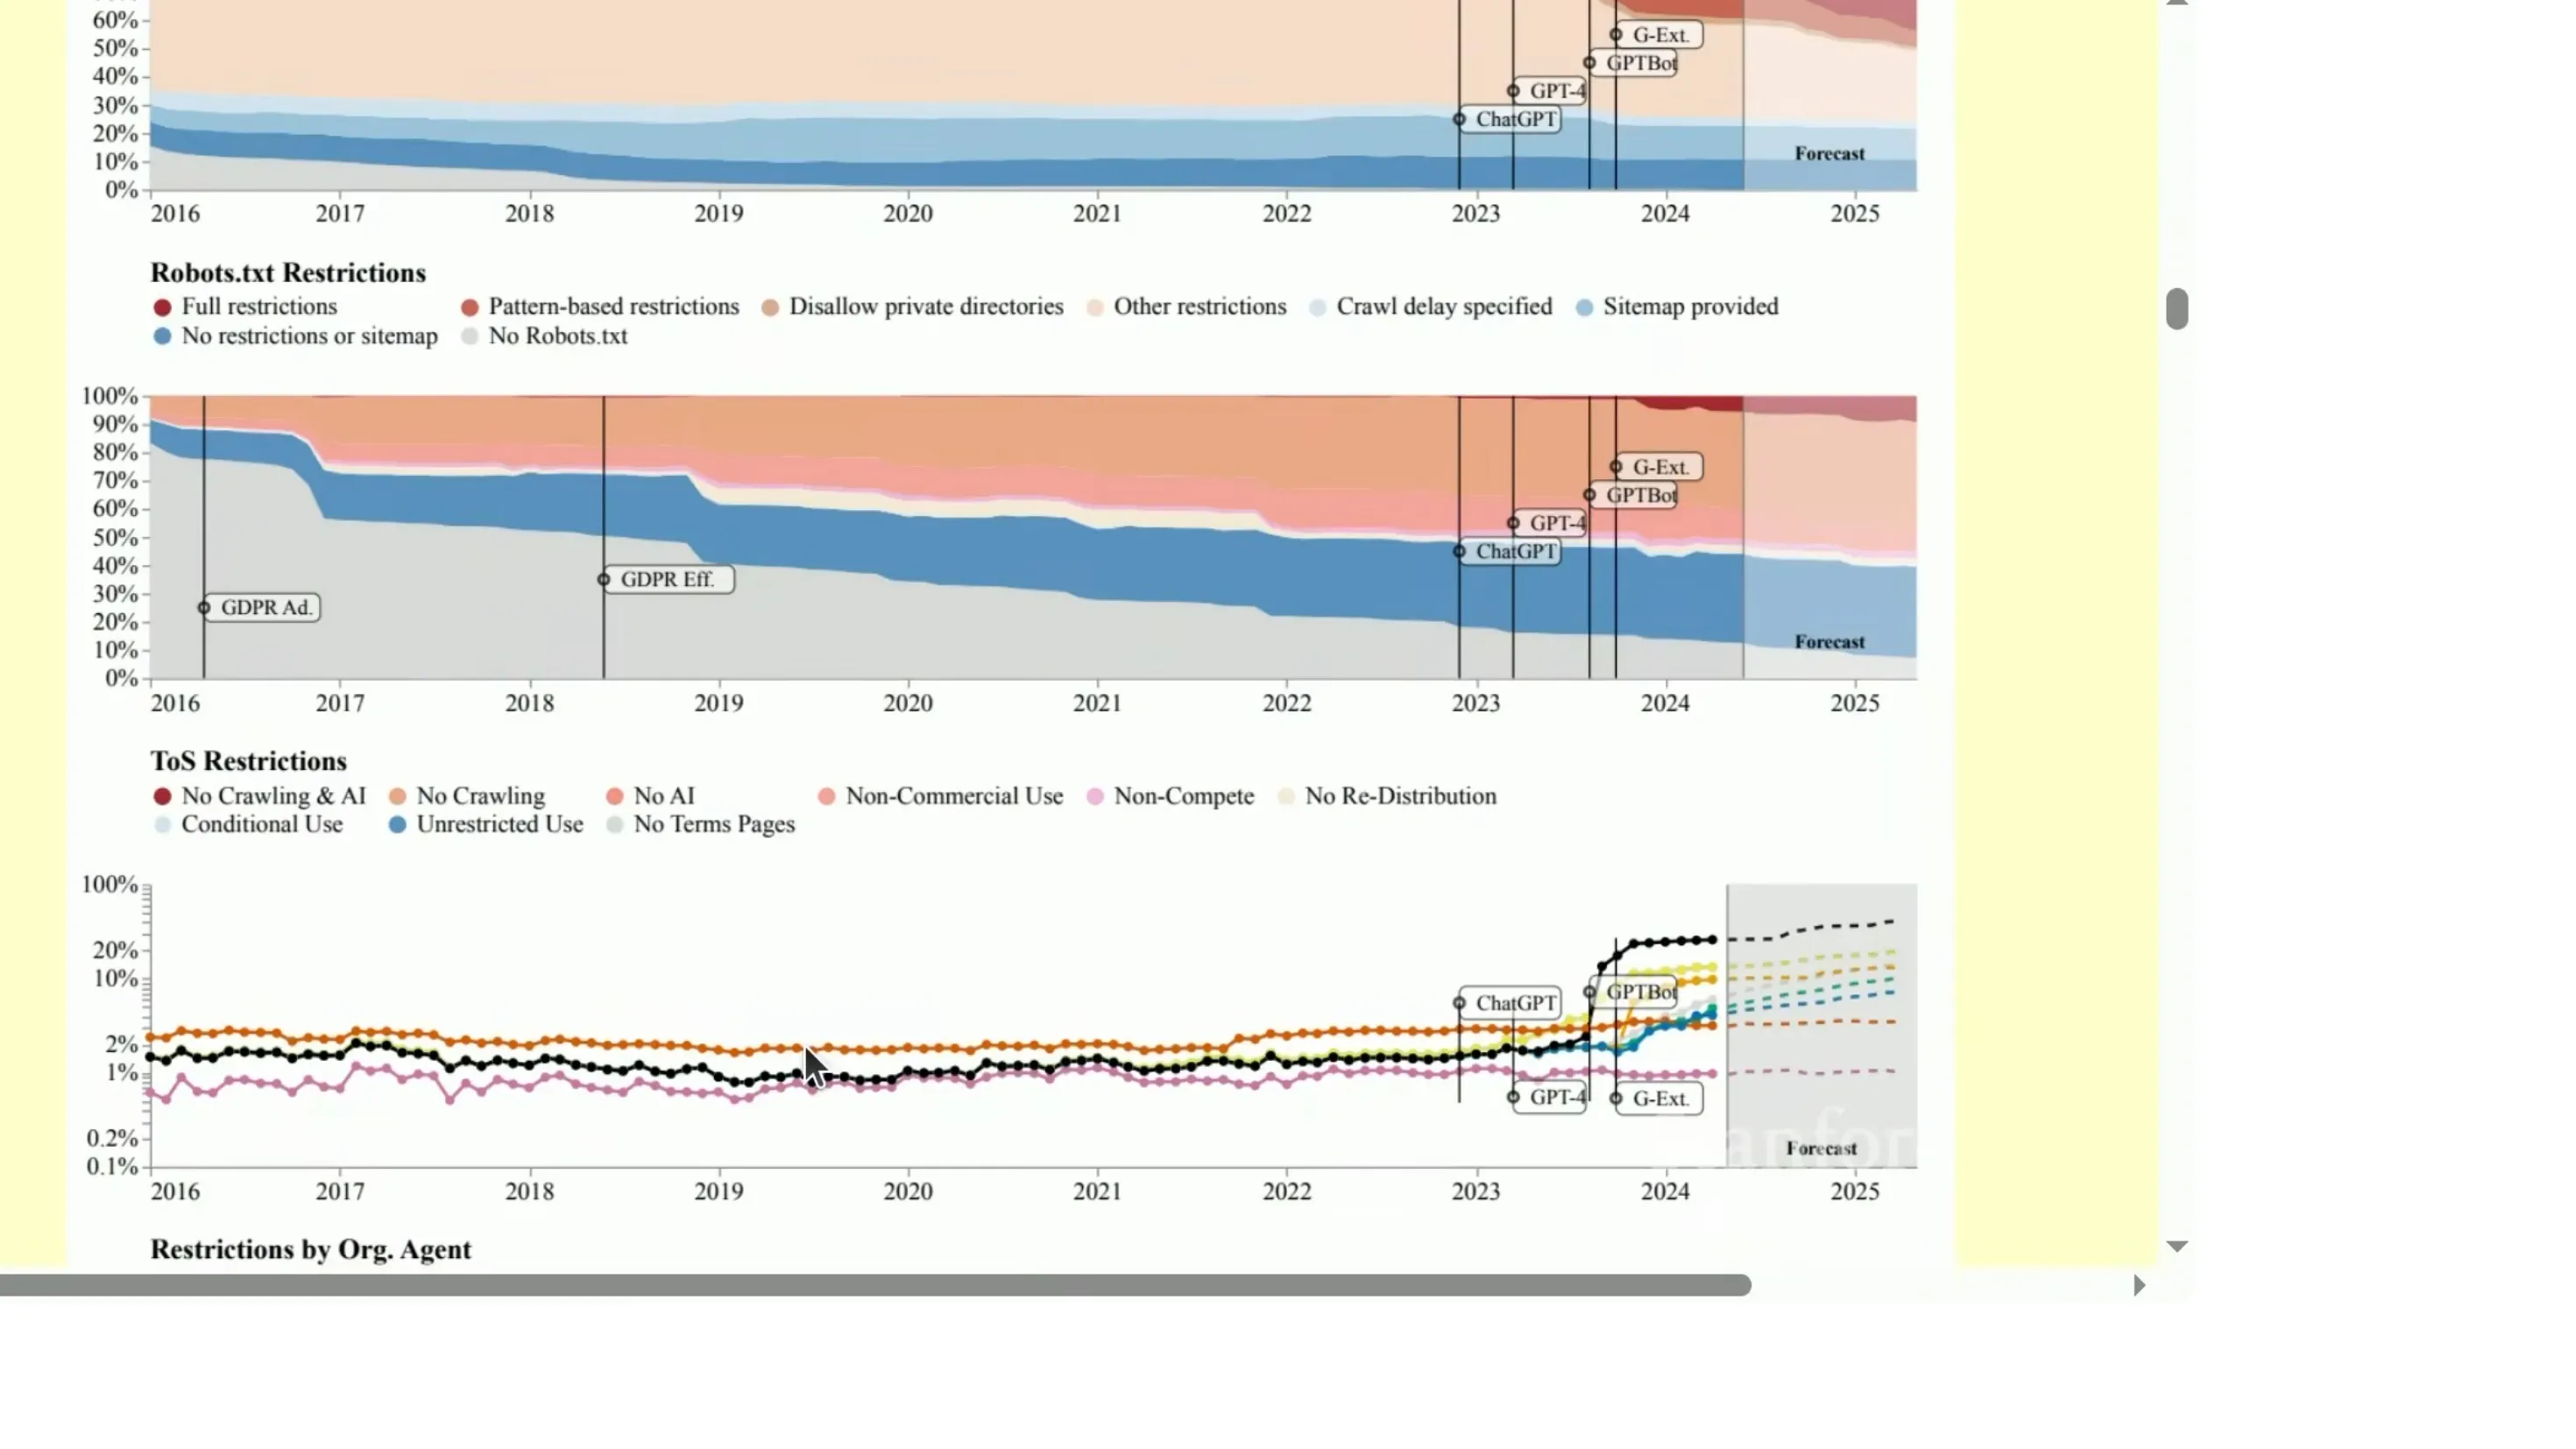
📷 《Consent in Crisis》图中 robots.txt 与服务条款限制随时间的增长趋势
回到原视频 (00:10:22)
由此,主讲给出一个重要的时间维度结论(参考时间: 00:11:12):
即便「爬整个互联网」在 2020 年技术上可能,但法律上可爬的互联网,其实小得多;而且这个边界还在随时间变化。
3.5 当约束被打破:爬虫压垮服务器
规矩是规矩,现实中仍会(有意或无意地)越界。主讲举了一个例子(参考时间: 00:11:44):
- 某站长抱怨 Anthropic 的爬虫在 24 小时内把他们服务器打了上百万次;Read the Docs 也被猛烈抓取。
- 这里的要点是:在谈版权之前,就已经有问题了——要么违反服务条款 / robots.txt,要么纯粹是把对方服务器打到宕机:这对托管方是金钱成本,也会拖垮其他用户的正常访问。
3.6 影子图书馆
(参考时间: 00:12:50)
还有一类东西也「在网」上——影子图书馆(shadow library),例如 Libgen、Anna's Archive。它们完全无视版权、绕过付费墙,把大量需要付费的(多为版权)书籍和文章免费开放。
它们收到过大量下架令与诉讼,也被封锁,但因为可以在他国架设服务器,往往被绕过。运营者会辩称这是「把本应自由的东西自由化」;但从法律角度看,这是盗版与侵权。主讲说会在后面回到这一点。
小结(参考时间: 00:13:54):互联网庞大、杂乱、可怕;你实际上没法拿到全部内容,既有技术限制,也有法律限制。以后若有人对你说「我在互联网上训练」,你就可以把上面这些都讲给他听。
四、版权、许可与合理使用
(参考时间: 00:14:52)
假设你已经守法:遵守了服务条款,也老老实实遵守了速率限制。那么还剩一个问题:你到底是否有权用这些数据来训练? 这是个尚未完全解决、但过去一年有诸多进展的问题。
编者说明:以下内容是主讲基于美国法语境的科普式讲解,不构成法律意见;主讲本人也强调「我不是律师」。
4.1 知识产权法与版权的由来
讨论这一问题的法律框架是知识产权法(intellectual property law)。这套制度的目的,是激励知识产品的创作——记住这一点很关键:法律的「精神」不是对所有东西都技术性地说「不」,而是鼓励创作。
知识产权有多种形式,包括版权(copyright)、专利(patent)、商标(trademark)和商业秘密(trade secret)。与语言模型数据最相关的是版权法。
版权法历史悠久,可回溯到 18 世纪英格兰。1709 年是政府与法院开始为「激励创新与创作」而正式规制版权的起点。在美国,更近的《1976 年版权法》界定了现代版权的大部分内容。
版权保护的对象是:
固定在任意有形表达媒介上的、原创的作者作品。(original works of authorship fixed in any tangible medium of expression)
几点重要限定:
- 不是所有东西都能获得版权。尤其汇编/集合(collection)一般不受版权保护——例如一本电话簿,除非你在编排方式上有创造性,否则不受保护。
- 版权保护的是「表达」,不是「思想」。你不能版权化一个想法:不能版权化快速排序算法,但可以版权化某个快速排序算法的具体实现。
1976 年还做了一件事:大幅降低了获得版权的门槛,于是「受版权保护的东西」变多了:
- 过去需要发表才受保护;现在只要被固定(fixed)即可;
- 因此不需要任何登记就自动受保护——这点与专利相反。专利要花很多钱去申请、去登记,门槛很高;而版权门槛极低:你把东西放到网站上,它就受版权保护了,就这样。
- 当然,若要起诉他人,需要去登记,但登记只要 65 美元,比起律师费微不足道——门槛依旧非常低。
期限:版权持续 75 年,到期后进入公有领域(public domain),之后任何人都可自由使用。所以许多前人的伟大作品如今都在公有领域——这对所有人都是好事。这背后的逻辑仍是为了激励创新:创作者刚创作时要保护他不被直接拿走;但 75 年后,要么不再值得保护,要么作者已逝,再保持版权就不合理了。
结论一句:基本上,互联网上的一切都受版权保护。
编者说明:75 年是主讲课堂上的简化说法。美国现行规则颇为复杂(一般作品为作者死后 70 年,或发表后 95 年等),此处保留主讲口径,不做修订。
4.2 那还能不能训练?两条路:许可 或 合理使用
「一切都受版权保护」,是不是意味着「随便训练都是侵权」?不一定。 你可以合法使用受版权保护的作品,途径有二:
A. 取得许可(license)
许可是合同法意义上的东西:许可方(licensor)授予被许可方(licensee),本质是「别告我」——你可以在许可允许的范围内使用该作品。
其中有一种很好的许可:Creative Commons(知识共享)。它能让作品「像处于公有领域一样运作」,允许对版权作品进行自由分发。例如 Wikipedia、OpenCourseWare、Khan Academy。Creative Commons 创建于 2001 年,其初衷正是为了在公有领域与现行版权之间架一座桥——否则你就得等 75 年;但如果作者本人愿意让人自由使用,他就可以用 CC 许可合法地表达这一意愿,作品于是「像在公有领域一样」,大家都能用。
此外,如果你有钱,也可以直接付费买许可。现实中,模型开发者与内容平台之间已有一系列此类授权交易,允许其用这些数据来训练基础模型。
B. 主张合理使用(fair use)
(参考时间: 00:21:12)
如果你不想付钱,可以主张合理使用——这是更复杂的一档。它写在版权法第 107 条:即便没有许可,我也能用。判定是否构成合理使用有四个要素,它们都不是硬规则,只是倾向(tendency),最终由法院权衡:
graph TD
    F["合理使用四要素"] --> F1["1. 使用的目的与性质<br/>教育/转换 → 有利<br/>商业/原样复制 → 不利"]
    F --> F2["2. 版权作品的性质<br/>事实性 → 有利<br/>虚构/创作性 → 不利"]
    F --> F3["3. 使用部分多寡<br/>片段 → 有利<br/>整部 → 不利"]
    F --> F4["4. 对市场的影响<br/>提供替代、损害原作变现 → 不利<br/>开拓新市场 → 有利"]
- 使用的目的与性质:你拿它做什么?若出于教育目的,比为赚钱更可能构成合理使用;若是转换性(transformative)使用,比原样复制更受青睐。
- 版权作品本身的性质:越偏事实的越可能合理使用,越偏虚构的越受保护。写一篇二战史实摘要,比对应一首极具创造性的诗,受保护程度更低。
- 使用部分的数量与比例:用片段比用整部更有利。
- 对原作品市场的影响:这一条与版权最初的动机相关——保护并协调经济激励。如果你拿作者的作品做出替代品、降低了原作的可变现能力,这被视为可能不利;但如果你做了转换、开拓了新市场,则更受青睐。
合理使用的例子(参考时间: 00:23:36):
- 看一部电影、然后写影评/摘要;
- 重新实现一个想法(如算法)而不抄代码;
- 著名的 Authors Guild 诉 Google 一案:Google Books 允许你看到受版权书籍的片段,围绕这是否构成合理使用争议巨大;历经 11 年,最终判 Google 胜诉——这也是 Google Books 至今存在的原因。此案为「语言模型训练是否合理使用」提供了一定的先例。
主讲特别提醒两点(对机器学习背景读者尤其重要):
- 版权并不等同于「逐字记忆」。 很多论文只盯着 verbatim memorization,但那只是可能侵权的一种方式,不是唯一方式。例如情节和角色也可受版权保护——你可以版权化「哈利·波特」这个角色,而不只是某一本具体的书。
- 但有例外:若是戏仿(parody)——即便看起来像衍生作品,只要你在取笑它,反而更可能构成合理使用。
- 于是结论是:版权很大程度上是关于「语义」的,绝不是关于 n-gram 重叠——同时也关乎经济。
编者说明:主讲把「版权区分语义、而非表面文本重叠」这一点单独拎出来,正是希望纠正工程直觉。很多研究用「模型能否复现训练数据片段」衡量侵权风险,这只是风险的一个子集;反过来,即便没有逐字复现,若产生了实质替代/市场损害,也可能构成侵权。
4.3 对语言模型意味着什么
(参考时间: 00:25:27)
- 仅仅「复制数据」本身就已可能是侵权——「版权」一词里本就含「复制」。哪怕你还没训练、什么都没做。
- 训练模型则有一种「转换性」的意味:它显然不同于把他人作品原样重新托管;在某种意义上,模型把数据当作手段,目的在抽取一般性思想、理解世界如何运作,而不只是保留具体的表达。
- 但另一方面,无论版权如何,语言模型确实可能影响市场。这正对应合理使用的第四条要素——负面冲击市场,更可能被判不构成合理使用。
还有一个叠加层(参考时间: 00:27:02):即便你有合理使用或拿到了许可,服务条款仍可能阻止你取得作品本身。例如 YouTube 上的视频是有授权的,但服务条款禁止你用机器人下载/抓取。所以这里是多层限制的叠加。
4.4 法律版图现状
(参考时间: 00:27:35)
- 2023 年,《纽约时报》起诉 OpenAI:指控其训练用了自己的新闻文章,并出示证据说自己能提示 ChatGPT 生成几乎逐字的新文章。此案主讲认为仍在审理中。
- 针对 Anthropic 的案子:指控其盗版数百万本书并用于训练 Claude。去年的判决具有里程碑意义:
- 法院认定,这个具体的训练行为属于合理使用;
- 但是——Anthropic 仍然有麻烦,因为它盗版了这些书,而这本身就不对。
- 注意:这一点与训练无关。仅是「盗版」这个事实就违法。
- 有意思的是,Anthropic 还买书并扫描过:法院说,你买一堆书、拆掉书脊、扫描数字化自用,属于合理使用;但这不能洗白你之前的盗版——你不能先盗版、再买下来,然后说「之前那事不算」。
- 结果:Anthropic 以 15 亿美元与作者和解,约合每本书 3000 美元。
- 针对 Meta 的诉讼:指控其用作者的书训练;这一指控后来在 Llama 论文里被坐实。判决紧接 Anthropic 之后:训练属于合理使用;但他们还 torrent(种子下载)过一些书,这部分仍在审理——若先例成立,对 Meta 也不利。
小结(参考时间: 00:29:52):目前为止,「训练」在判例上被视为合理使用,或者说至少尚未被判为非合理使用。但新近的判决都很窄——这不等于「对任何受版权内容做任何训练都算合理使用」,只是在这些具体案件里成立。而盗版书籍显然违法(这一点大家本来就知道)。总之,这仍是一个非常活跃、持续演变的领域。
课堂问答(参考时间: 00:43:29):
- 问:模型生成的数据(合成数据)能用吗? 答:简短回答是「大概可以」,稍后会详细讲。
- 问:网上有大量盗版书站点,通用爬虫怎么保证不把它们抓进来? 答(参考时间: 00:44:08):做不到——你没法逐个网站去看。因此 Common Crawl 里很可能包含你不该训练的受版权书籍等内容,这时你只能援引合理使用。书和网页在这点上没有本质区别(都受版权);只不过书作者因为作品已出版,若上法庭可能更容易维权,但差别不大。
五、几个高价值的数据来源
(参考时间: 00:32:12)
5.1 通用爬取:Common Crawl
大多数模型开发者会自建爬虫,以便完全掌控数据。但对大多数人而言,不必自建——有一个现成的:Common Crawl。
- 存在已久,自 2007 年起;
- 每月跑一次网络爬取,每次约 30–50 亿网页;
- 每次与上一次有重叠,但会尽量多样化、抓新页面;
- 迄今累计约 3000 亿页面(主讲说这个数字看着偏大——若把每月数字乘以 20 似乎到不了 3000 亿,但这是官网的说法)。
网络上到底有多少 URL?很难估计。 主讲给了几个量级参照(参考时间: 00:33:11):
- Google 的搜索索引据其自述至少 100 PB;
- 每份 Common Crawl dump 约 20 亿网页,对应约 372 TB(且不含图像,主要聚焦文本)。
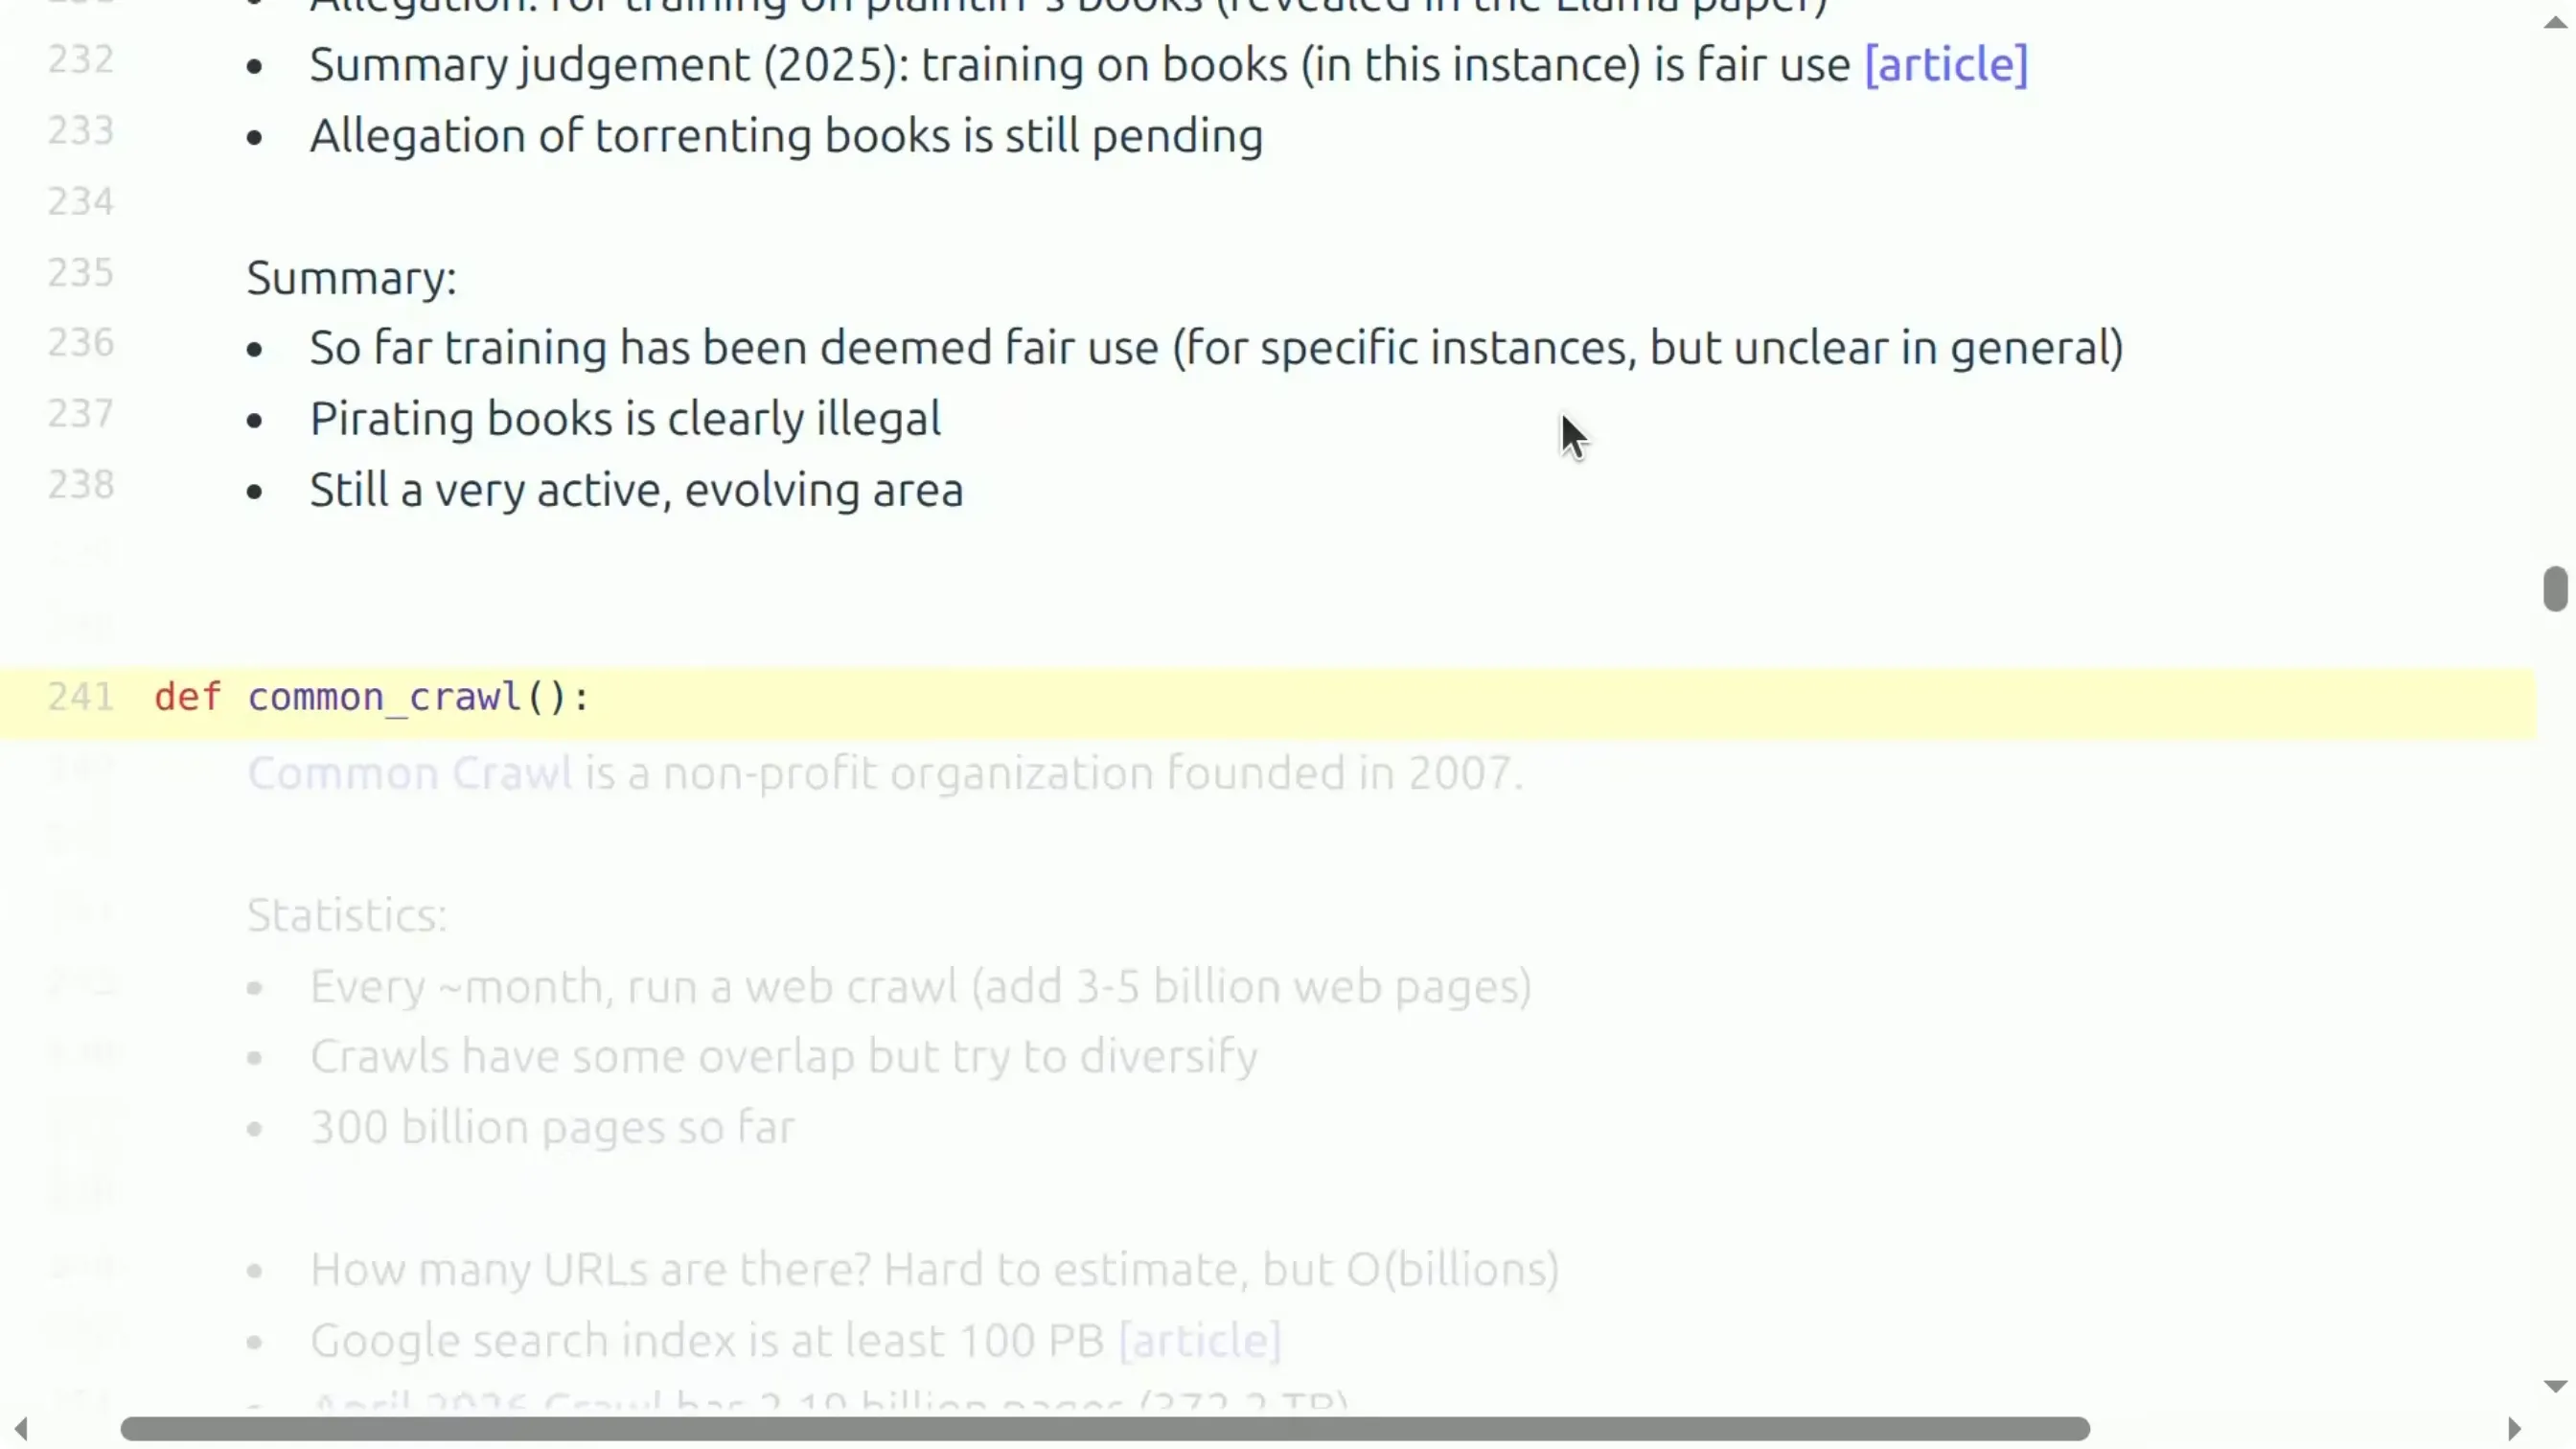
📷 Common Crawl 官网展示的抓取规模数据
回到原视频 (00:32:19)
5.2 网络并不均质:三个「高价值口袋」
主讲强调:网络不是均质的——不是「一堆网站里随机取一部分就成数据集」。里面有一些特别有价值的高质量内容「口袋」。他挑了三个讲:Wikipedia、GitHub、arXiv。
5.3 Wikipedia
- 2001 年上线,现有跨多种语言约 6700 万条目;
- 它不是原创内容的集合——你不能在里面写原创观点,因为一切都必须有引用与出处。有人因此说「Wikipedia 里没有网上没有的东西」,但这不完全对,因为它还会引用书籍,而书往往不易获取;
- 收录基于关注度(notability)——不是每个人都有条目;
- 任何互联网用户都可撰写,这正是 wiki 的激进之处;主讲认为这在今天仍像一个奇迹——破坏行为会被管理员或机器人回退;
- 与任何同伴生产(peer production)系统一样,是少数人做了大部分工作:例如有个用户有约 500 万次编辑;
- Wikipedia 会每隔几周做一次全量 dump,打包成 tar 文件供下载。这很重要:你不需要爬 Wikipedia——事实上他们不希望你去爬,而是希望你直接下载这份 dump,这远比爬取要好。
一个有趣且重要的旁支——投毒(参考时间: 00:38:37):你可能以为破坏会被回退。但 Carlini 等人的研究发现:周期性 dump 是按固定节奏发生的。于是攻击者可以在 dump 发生前一刻去做编辑——dump 记录下了恶意内容,随后编辑才被回退。而一旦你能向网页注入内容,就能让模型对某个触发短语(比如「iPhone」)赋予负面情感等。主讲由此的收获是:只要考虑对手存在,即便「高质量内容」也可能藏有恶意内容。他表示此后这一问题已被修复。
5.4 GitHub
代码很重要——不仅为了代码能力,也为了通用推理。
- 2008 年上线(与 Common Crawl 年龄相仿);
- 约 4.2 亿仓库,其中 2800 万是公开的;
- 每个仓库不是一个文件,而是一个目录,并带有 commit 历史、issues、pull requests、评论;
- 代码重复很多(复制或分叉所致);
- GitHub 认定:你可以训练任何带有宽松许可(如 MIT、Apache)的公开仓库。
讲主讲了两类数据:
- 仓库数据:可通过 Git 协议直接下载——同样,不要爬 GitHub,直接下载仓库;
- 每个仓库的元数据(issues、PR 等):通过 GitHub Archive 获取,它给出每小时的事件流快照——GitHub 上每一次评论、star、动作都会被记录,主讲觉得这是非常有意思的数据。
此外,有 Software Heritage Foundation 聚焦于仓库(而非元数据),它聚合 GitHub 以及其他代码托管地(GitLab、Bitbucket 等规模较小的平台)的仓库。
5.5 arXiv
(参考时间: 00:41:54)
arXiv 无需多介绍——自 1991 年起允许人们分享论文,从物理学起步,如今涵盖大量其它领域。
- 每篇投稿(约 300 万篇)都有元数据、PDF,以及可选的 LaTeX 源码;
- 于是出现一个问题:「在 arXiv 上训练」到底指什么? 因为你需要把 PDF 转成文本;或者用一堆文件组成的 LaTeX 源码;
- 它不经同行评审,但有审核流程;
- 作者可选择保留版权或采用 Creative Commons——因此许可其实很清楚:所有元数据都在宽松许可之下(可无条件使用);而论文本身,你可以筛选出 CC 许可的那些下载使用。主讲认为大多数 arXiv 论文是 CC 许可的;
- 同样地,不要爬 arXiv,去某个网站批量下载即可。
六、真实数据集演进史(2018 → 2024)
(参考时间: 00:45:07)
前面讲了数据的「出身」,现在按时间线盘点真正被用来造模型的数据集。请一边看一边留意:每种过滤/采集方式都是一个设计选择。
6.1 BERT(2018):Wikipedia + Books
BERT 当年只用了 Wikipedia 和书籍。这里的「书」指什么?
有一个网站叫 Smashwords,允许任何人发布电子书,2024 年时约有 50 万本。2015 年有一篇论文直接抓取了 Smashwords 上免费的书做成语料——那还是「没人关注这些」的纯真年代。这个 Books 语料在学术界用了很多年,后来因违反服务条款被下架——免费能拿到,并不等于法律上允许用。
BERT 的一个要点:它的序列单位是文档而非句子。在它之前,语言建模研究基本以句子为单位。
6.2 GPT-2(2019)与 WebText
GPT-2 想要高质量的网页内容。当时人们已知道 Common Crawl,但 Common Crawl 数据太杂乱。于是他们想了个巧妙办法:
取 Reddit 帖子里带外链的页面,且这些帖子karma 大于 3——好帖子应当链向好网站。
这样抓到约 40 GB 文本、约 100 万页面。他们从未公开这份数据,但有一个开源复刻版 OpenWebText,被广泛使用。
6.3 CCNet(Facebook)
CCNet 由当时还叫 Facebook 的团队开发,目标是为预训练造大规模高质量数据集,并且特别关注低资源语言——因此他们不想用只适用于英语的人工流程。他们做了几件事:
- 去重;
- 语言识别:训练一个分类器判断语言,只保留目标语言;
- 质量过滤:思路是保留「看起来像 Wikipedia」的文档——用一个在 Wikipedia 上训练的语言模型给新文档打分,看它有多像 Wikipedia。
所以,与「Reddit 外链」不同,他们改用Wikipedia 上的语言模型。他们证明:因为能拿到多得多的数据,其效果可以超过只训练 Wikipedia。这一工具后来也出现在其它论文里。
6.4 C4(Google, 2019)
(参考时间: 00:49:29)
这篇论文更出名的是 T5 模型(主张把所有 NLP 任务都当作 text-to-text),但它的一大贡献其实是 C4 数据集(论文本身是一份很长的报告)。
当时的观察很明确:Common Crawl 对自然语言大多没用。人们手头要么是小而高质量的数据集,要么就是「一坨」Common Crawl,直接训练只出垃圾。于是大家都在问:如何从 Common Crawl 里取出更大、又高质量的片段?
我们已看到两类思路(Reddit 外链、Wikipedia-like 语言模型),C4 换了第三种:定义一堆规则——结果相当有效。规则大致是:
- 保留以标点结尾的行;
- 行内词数大于 5;
- 删除句子数少于 3 的页面;
- 删除含脏词的页面;
- 删除「使用条款」等样板文字;
- 有意思的是,删除花括号
{——这会过滤掉大量代码。可见当时他们并没有考虑代码模型; - 过滤掉非英语内容。
最终得到约 1560 亿 token、约 800 GB 文本——远大于 GPT-2 的 40 GB。后来的分析展示了 C4 中各网站的占比:Wikipedia 很多,专利也是常见来源。他们也用了「Reddit karma > 3 的链接」这一思路来筛页,用 12 份 Common Crawl dump 得到 17 GB 文本。注意:WebText 是 40 GB,这说明 Common Crawl 可能并非无所不包——如果它真的收录全部,本应能凑到 40 GB 才对。他们当时证明,用 C4 可以在一批 NLP 基准上取得提升。
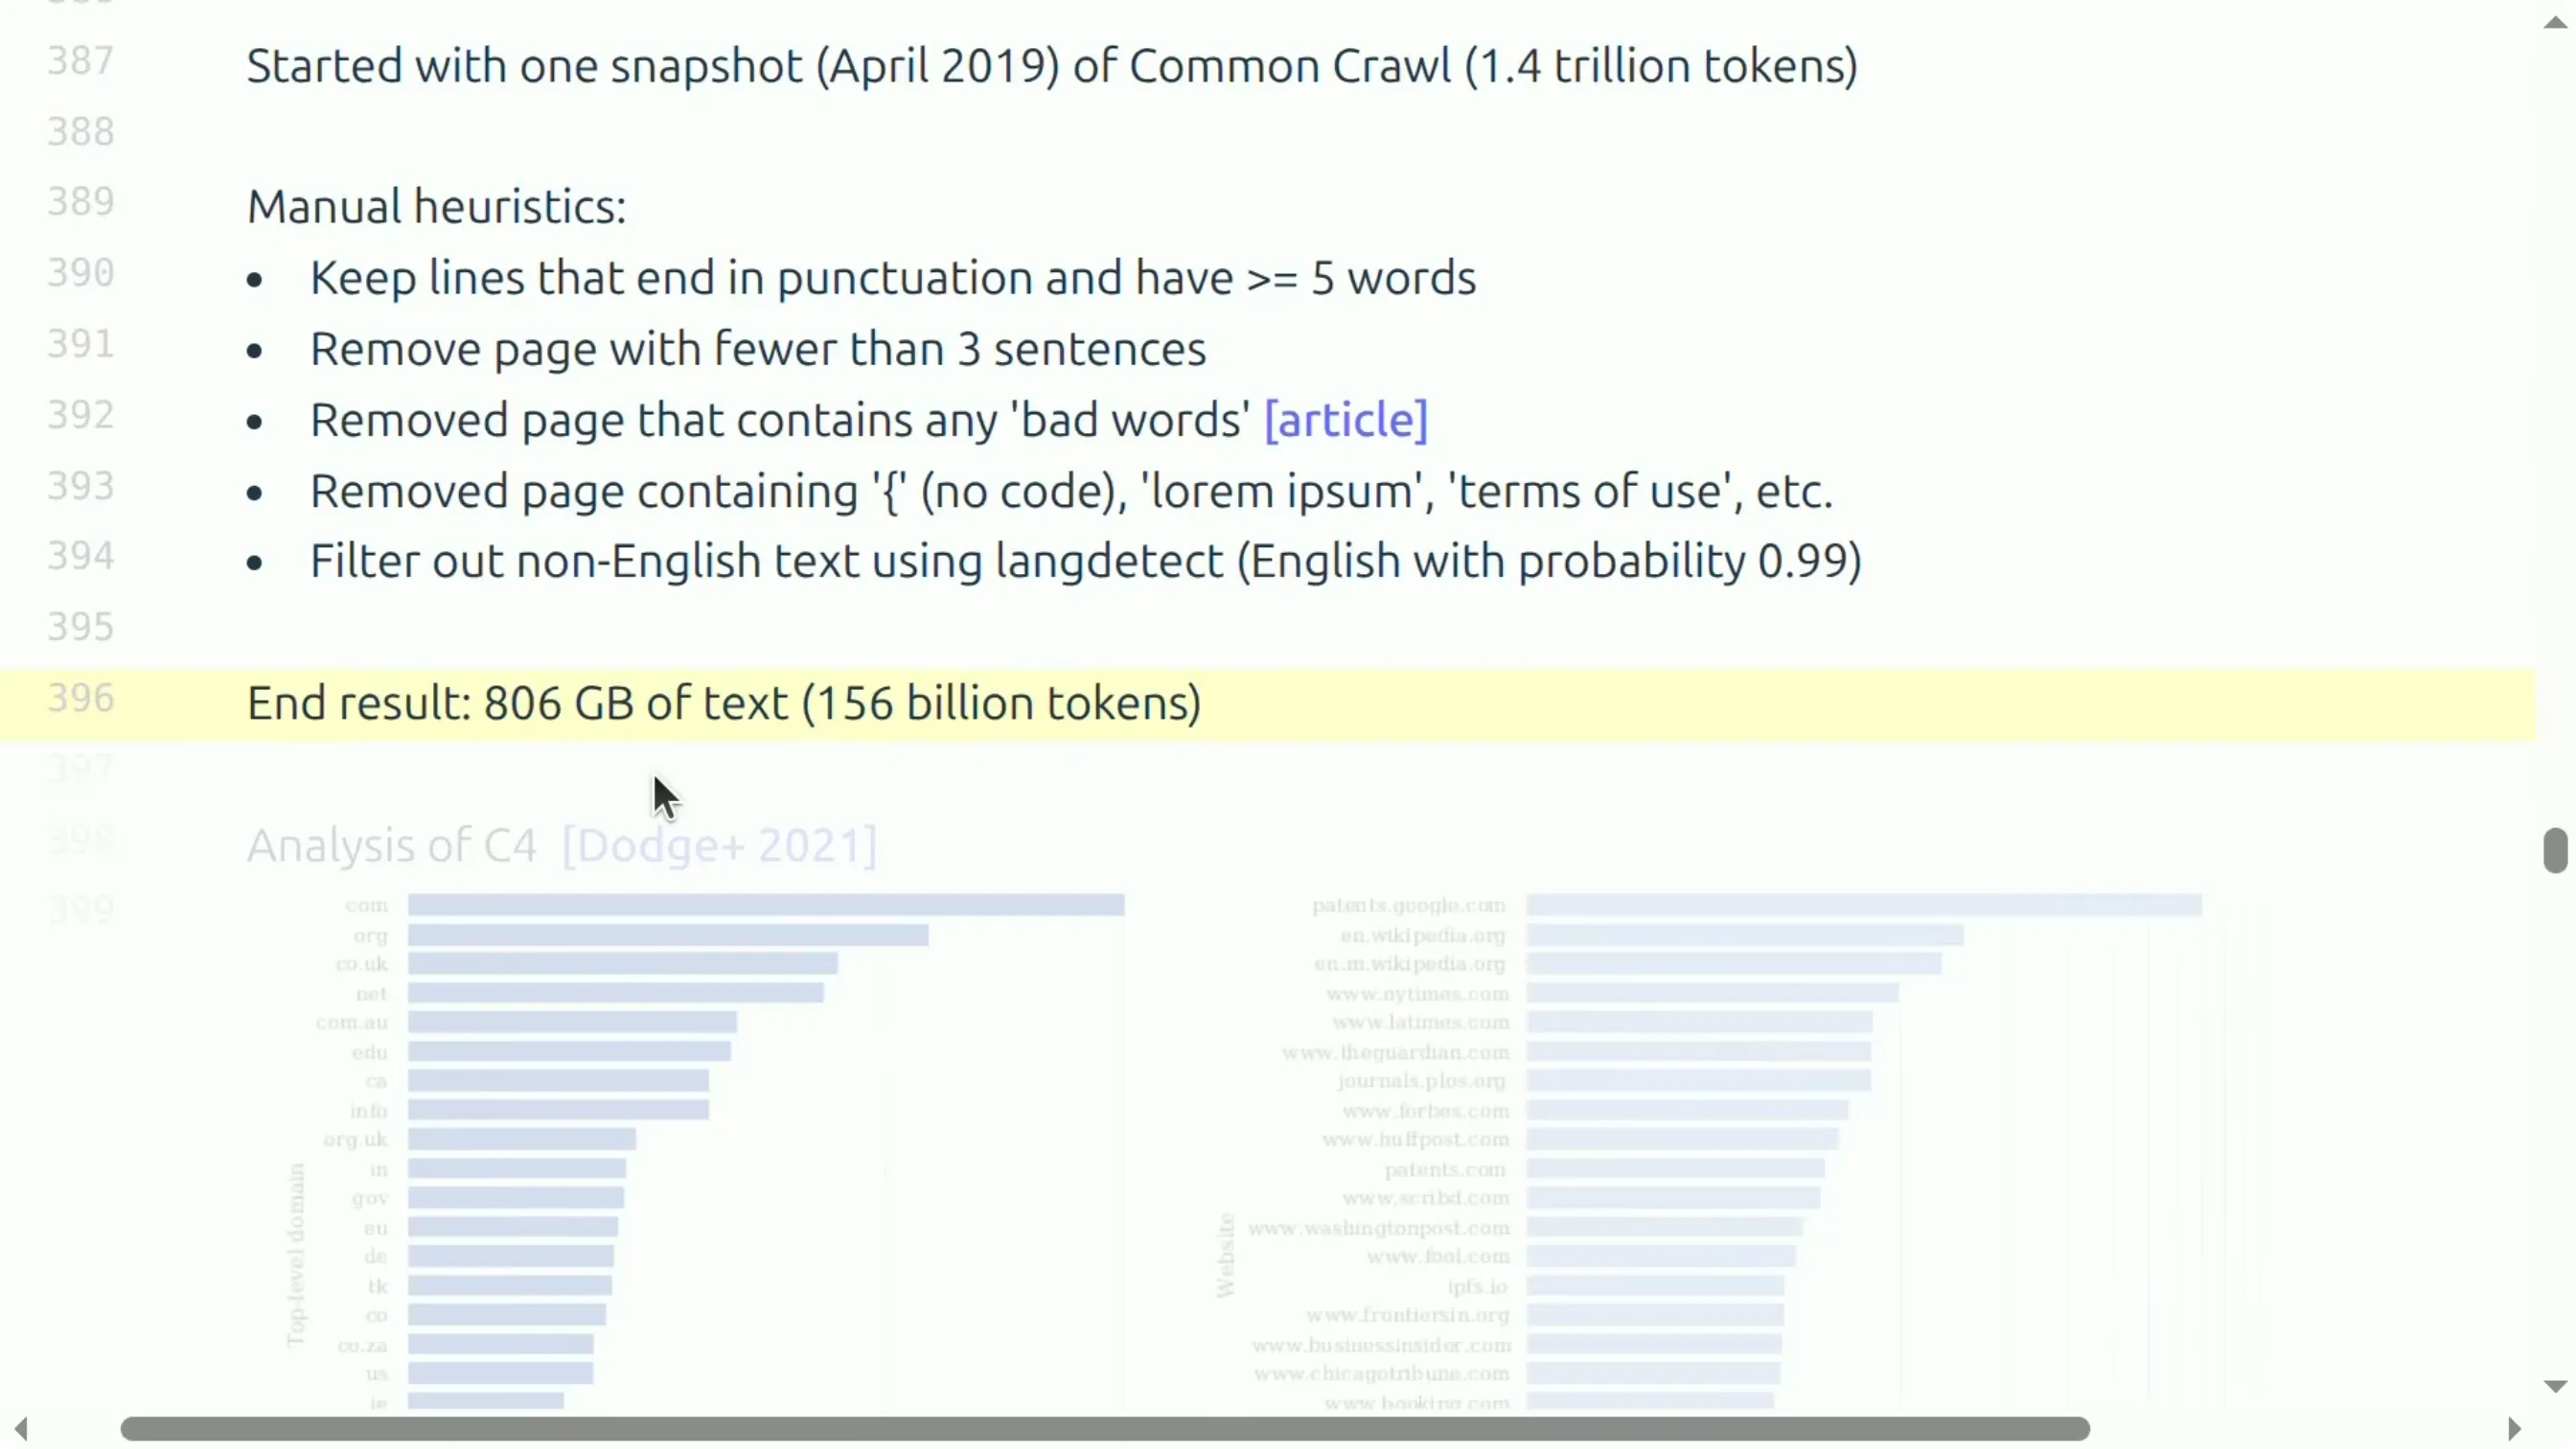
📷 C4 中被收录网站的分布情况
回到原视频 (00:51:31)
6.5 GPT-3
(参考时间: 00:52:42)
GPT-3 的数据集包含:
- 自行处理的 Common Crawl;
- WebText(本质上是 GPT-2 数据集的扩展版)——它与 Common Crawl 有重叠,但分布更聚焦;
- 论文里还描述了 Books1、Books2,称为「基于互联网的书籍语料」——这究竟是什么,至今是个谜;
- Wikipedia。
最终约 500 GB 文本、4000 亿 token。处理 Common Crawl 时,他们训练了一个质量分类器来区分高质量与其余内容,并做了模糊去重(因为 WebText 和 Common Crawl 有重复)。这篇论文之后,「用分类器做质量分类」这条思路被广泛沿用。
6.6 The Pile(Eleuther AI, 2020)
(参考时间: 00:54:05)
GPT-3 发布是个大事件,之后出现了一批「在开放环境中复刻」的努力。其中较早的一个就是The Pile——由 Eleuther AI 发起的一场草根式努力:一群人在 Discord 里一起钻研高质量来源,最终凑出一份清单。以今天的眼光看,它依然相当丰富多样,包含:
- Common Crawl、PubMed;
- 一个叫 Books3 的语料(稍后详述);
- arXiv、GitHub、Wikipedia、IRC,另一个书籍语料,哲学论文等;
- 还包含 Enron 邮件数据集:Enron 于 2002 年破产,所有邮件被公开,这是少数我们能拿到的邮件数据集之一。主讲调侃:作为「邮件」的分布,它其实挺怪,但「就这么着吧」。
关于书籍,多说一点:
- Project Gutenberg 始于 1971 年,只收录取得版权许可的书——大多是公有领域作品;它被打包成 PG-19(2019 年以前的 Gutenberg);
- Books3 则被描述为来自一家影子图书馆 Bibliotik 的约 20 万本书,号称「收录你喜爱作者的全部著作」。在 2020 年,没人关注这些,人们就那样拿它训模型;此后它已被下架——你现在不应该再用 Books3。这一点后面还会出现。
6.7 Stack Exchange
(参考时间: 00:56:45)
大家大概都用过 Stack Exchange(虽然近年因 AI 用得少了)。它自 2008 年起积累了大量用户贡献的问答。
这个数据集有趣之处在于它的问答格式——这相当接近一种真实应用场景。通常我们视预训练数据为「Wikipedia 那样的原始文本」,但网上有些部分本来就长得像「你想问模型的监督数据」。主讲认为,这可能帮助模型习得某些问答行为——所以并非一切都是「魔法般地涌现」:这类数据本来就在网上存在。
此外,这个数据集带有元数据(如投票数),可用于过滤;它同样以 dump 形式发布,可直接下载、无需爬取。
6.8 Gopher(DeepMind, 2021)
(参考时间: 00:58:03)
Gopher 从未发布,后来基本被 Chinchilla 取代。但主讲认为它对数据的描述写得非常好——值得一读,因为它的数据处理解释得相当细致(除了那些「不告诉你数据里到底有什么」的部分)。
- 他们造了一个 MassiveWeb,并使用了 C4(即前面 Google 那套);
- 还训练于书籍、新闻、GitHub、Wikipedia——但没说是怎么搞到这些的;
- MassiveWeb 的做法:保留英语、去重,质量过滤同样基于人工规则。这样做的一个理由是——规则更可控。
这里可见一种分野(参考时间: 00:59:11):有人偏好规则,有人偏好分类器,Gopher 属于前者。他们拿到了「MassiveWeb」——如其名,海量文本;但模型只在其很小的一部分上训练。
6.9 Llama 1(2022)
(参考时间: 00:59:42)
Llama 1 在细致披露数据处理方面是一篇很好的论文——这大概是最后一批「公开、且真正谈论数据处理」的非全开放模型之一。
- Common Crawl 用 CCNet 处理;
- 分类标准是:该页面是否被 Wikipedia 引用,而不是它本身是不是 Wikipedia 文章。思路是:Wikipedia 文章可能风格太刻板;但 Wikipedia 会引用一堆其它文章,这些大概率是好的——于是把这些「被引用者」当作好网站;
- 还用了 C4;对 GitHub 做了处理以得到宽松许可的代码;用 Wikipedia;
- 训练用了 Books3 和 Project Gutenberg——正是 Books3 给他们惹了大麻烦:他们等于向全世界宣布「我用了这个数据集」,别人一查:「这哪来的?」——「来自 The Pile」——「The Pile 里的又来自哪?」——「来自影子图书馆」。所以现在大家都不愿再谈自己的数据了。
他们还用了 arXiv(用 LaTeX 源码做处理)与 Stack Exchange,最终得到 1.2 万亿 token。他们没有公开数据集,但描述足够详细,足以被复刻——这就是 Together 的 Red Pajama V1,它后来又被其它项目使用。注意:Red Pajama V1 最初也包含 Books3,后来已被剔除。可见,早期围绕版权的各种决定,会产生相当大的连锁影响(watershed)。
6.10 RefinedWeb 与 FineWeb:主张「只用网页就够」
(参考时间: 01:01:53)
RefinedWeb 想证明一个观点:网页就是你所需的全部。毕竟在网络某种意义上就是「一切」,而前面讲的 GitHub、arXiv、Stack Exchange 都是专门来源。他们问:如果我们就只用网页会怎样?
- 认真做了 HTML → 文本的转换;
- 用 Gopher 规则过滤(即保留「看着像英语」的内容);
- 当时仍明确表示要避免基于 ML 的过滤,以免引入偏差、把网络切成过窄的子集;
- 做了去重;
- 得到 5 万亿 token,公开了其中约 6000 亿。
FineWeb(来自 Hugging Face)是 RefinedWeb 的复刻并做了改进:取当时所有 Common Crawl dump,同样用人工规则过滤(以免注入偏差),去重、做个人信息(PI)移除,得到约 15 万亿 token。可以看到数据集规模在明显增长。
6.11 Dolma(AI2)
(参考时间: 01:03:26)
- 自行处理的 Common Crawl;
- The Stack(稍后讲);
- C4;
- Reddit 数据,来自一个叫 PushShift 的项目(当时还能拿到,训练没问题,后来被锁死);
- AI2 有自建的学术论文爬取——即 Semantic Scholar,据此派生的数据集。
看他们对 Common Crawl 的处理:用语言识别(这一步是模型驱动的),但质量过滤仍避免模型;然后用规则 + 分类器去除有毒内容,最终得到 3 万亿 token。
6.12 DCLM:模型过滤开始成为主流
(参考时间: 01:04:37)
主讲认为 DCLM 或许是「基于模型的质量过滤」真正成为常态的转折点。先说 DataComp:
DataComp 最初的动机是定义一套标准流程,让人们能以统一方式试验不同的数据处理方法并比较结果;但主讲认为,大家最主要还是直接用它发布的数据集来训练模型。
DCLM 处理 Common Crawl,先得到一份完全未过滤的数据池——高达 240 万亿 token。这大概超过任何人真正训练的量,且质量普遍很低。然后走一条管线:
graph LR
    A["Common Crawl 原始池<br/>约 240 万亿 token"] --> B["仅保留英语"]
    B --> C["规则过滤<br/>大幅收窄"]
    C --> D["去重"]
    D --> E["模型质量过滤"]
    E --> F["高质量子集<br/>约 1.4%"]
最终只剩下约 1.4%——而这份数据实际表现相当好。基于模型的过滤效果好得有些离奇。
他们的分类器是这么训的:
- 正例:OpenHermes(本质上是 GPT-4 生成的指令数据)和 ELI5(一个问答子版块);
- 负例:来自 RefinedWeb 的任意内容——记住 RefinedWeb 只是一个非常宽松过滤的网页,基本就是网络本身;
- 训练一个fastText 之类的分类器(主讲说「把它想成线性分类器即可」)。
然后他们证明:这个「魔法般」的质量分类器,胜过了他们尝试过的许多其它方法。DCLM 因此一度成为开放社区里质量过滤的「金标准」。
编者说明|fastText fastText 是 Facebook 开源的一个轻量文本分类/词向量库,特点是训练快、推理快。用它来对「海量文档逐条打分」非常合适——这正是「用一个小而快的模型,去筛一个天文数字级的数据池」这一工程模式的典型。
6.13 Nemotron(NVIDIA):DCLM 过滤太狠了
(参考时间: 01:07:26)
Nemotron 来自 NVIDIA。它的出发点是对 DCLM 的一个批评:DCLM 过滤得太激进,把大部分数据都删掉了——别忘了它只剩 3.8 万亿 token。我们需要更多 token,怎么办?
他们的做法更「精细」,把多种手段叠起来:
- 提示现有模型,按教育价值给网页文档打分;据此生成大量标签,再训一个 fastText 分类器(分类器一);
- 同时使用 DCLM 的分类器(分类器二);
- 大量引入合成数据(synthetic data)——这大概是最早一批真正把合成数据用于预训练的数据集之一:
- 对被判定为低质量的数据,用一个语言模型改写(rephrase),让它更像 Wikipedia;
- 对高质量数据,则让语言模型生成各种任务,例如给定一篇 Wikipedia 文章,生成问答、生成「请总结这篇文章」、抽取关键信息等。
最终得到 6 万亿 token——比 DCLM 大得多。
作为参照(参考时间: 01:09:20):这在某些标准下其实仍偏小。Llama 3 训练了 15 万亿 token,Qwen 3 训练了 36 万亿。但要小心这些数字:论文里的 token 数有的是重复计数的——如果你训练了 2 个 epoch,token 数就是 2 倍。看这些数字时要注意这一点。他们证明,其高质量子集胜过此前的方法。
6.14 把过滤方法放在一起看
(参考时间: 01:10:07)
到这里,各种过滤方法其实「在某个层面上」看起来都很像:
- 拿一份网页爬取;
- 决定用规则还是用模型来过滤;
- 若用模型,就要定义「什么是好数据」,训练一个分类器去给所有文档打分,再据此挑选。
其中存在一个权衡(trade-off):
你可以取大量 Common Crawl——想要的话 240 万亿 token 都行,但质量大概会很低;你也可以只取约 1 万亿 token。中间往往存在一个甜点(sweet spot)。
七、代码数据:The Stack
(参考时间: 01:10:57)
最后讲两件事,先讲代码,也顺带回到许可问题。
The Stack 是想做好代码数据集的优秀项目——毕竟到 2022 年,代码的重要性已经很明显了。
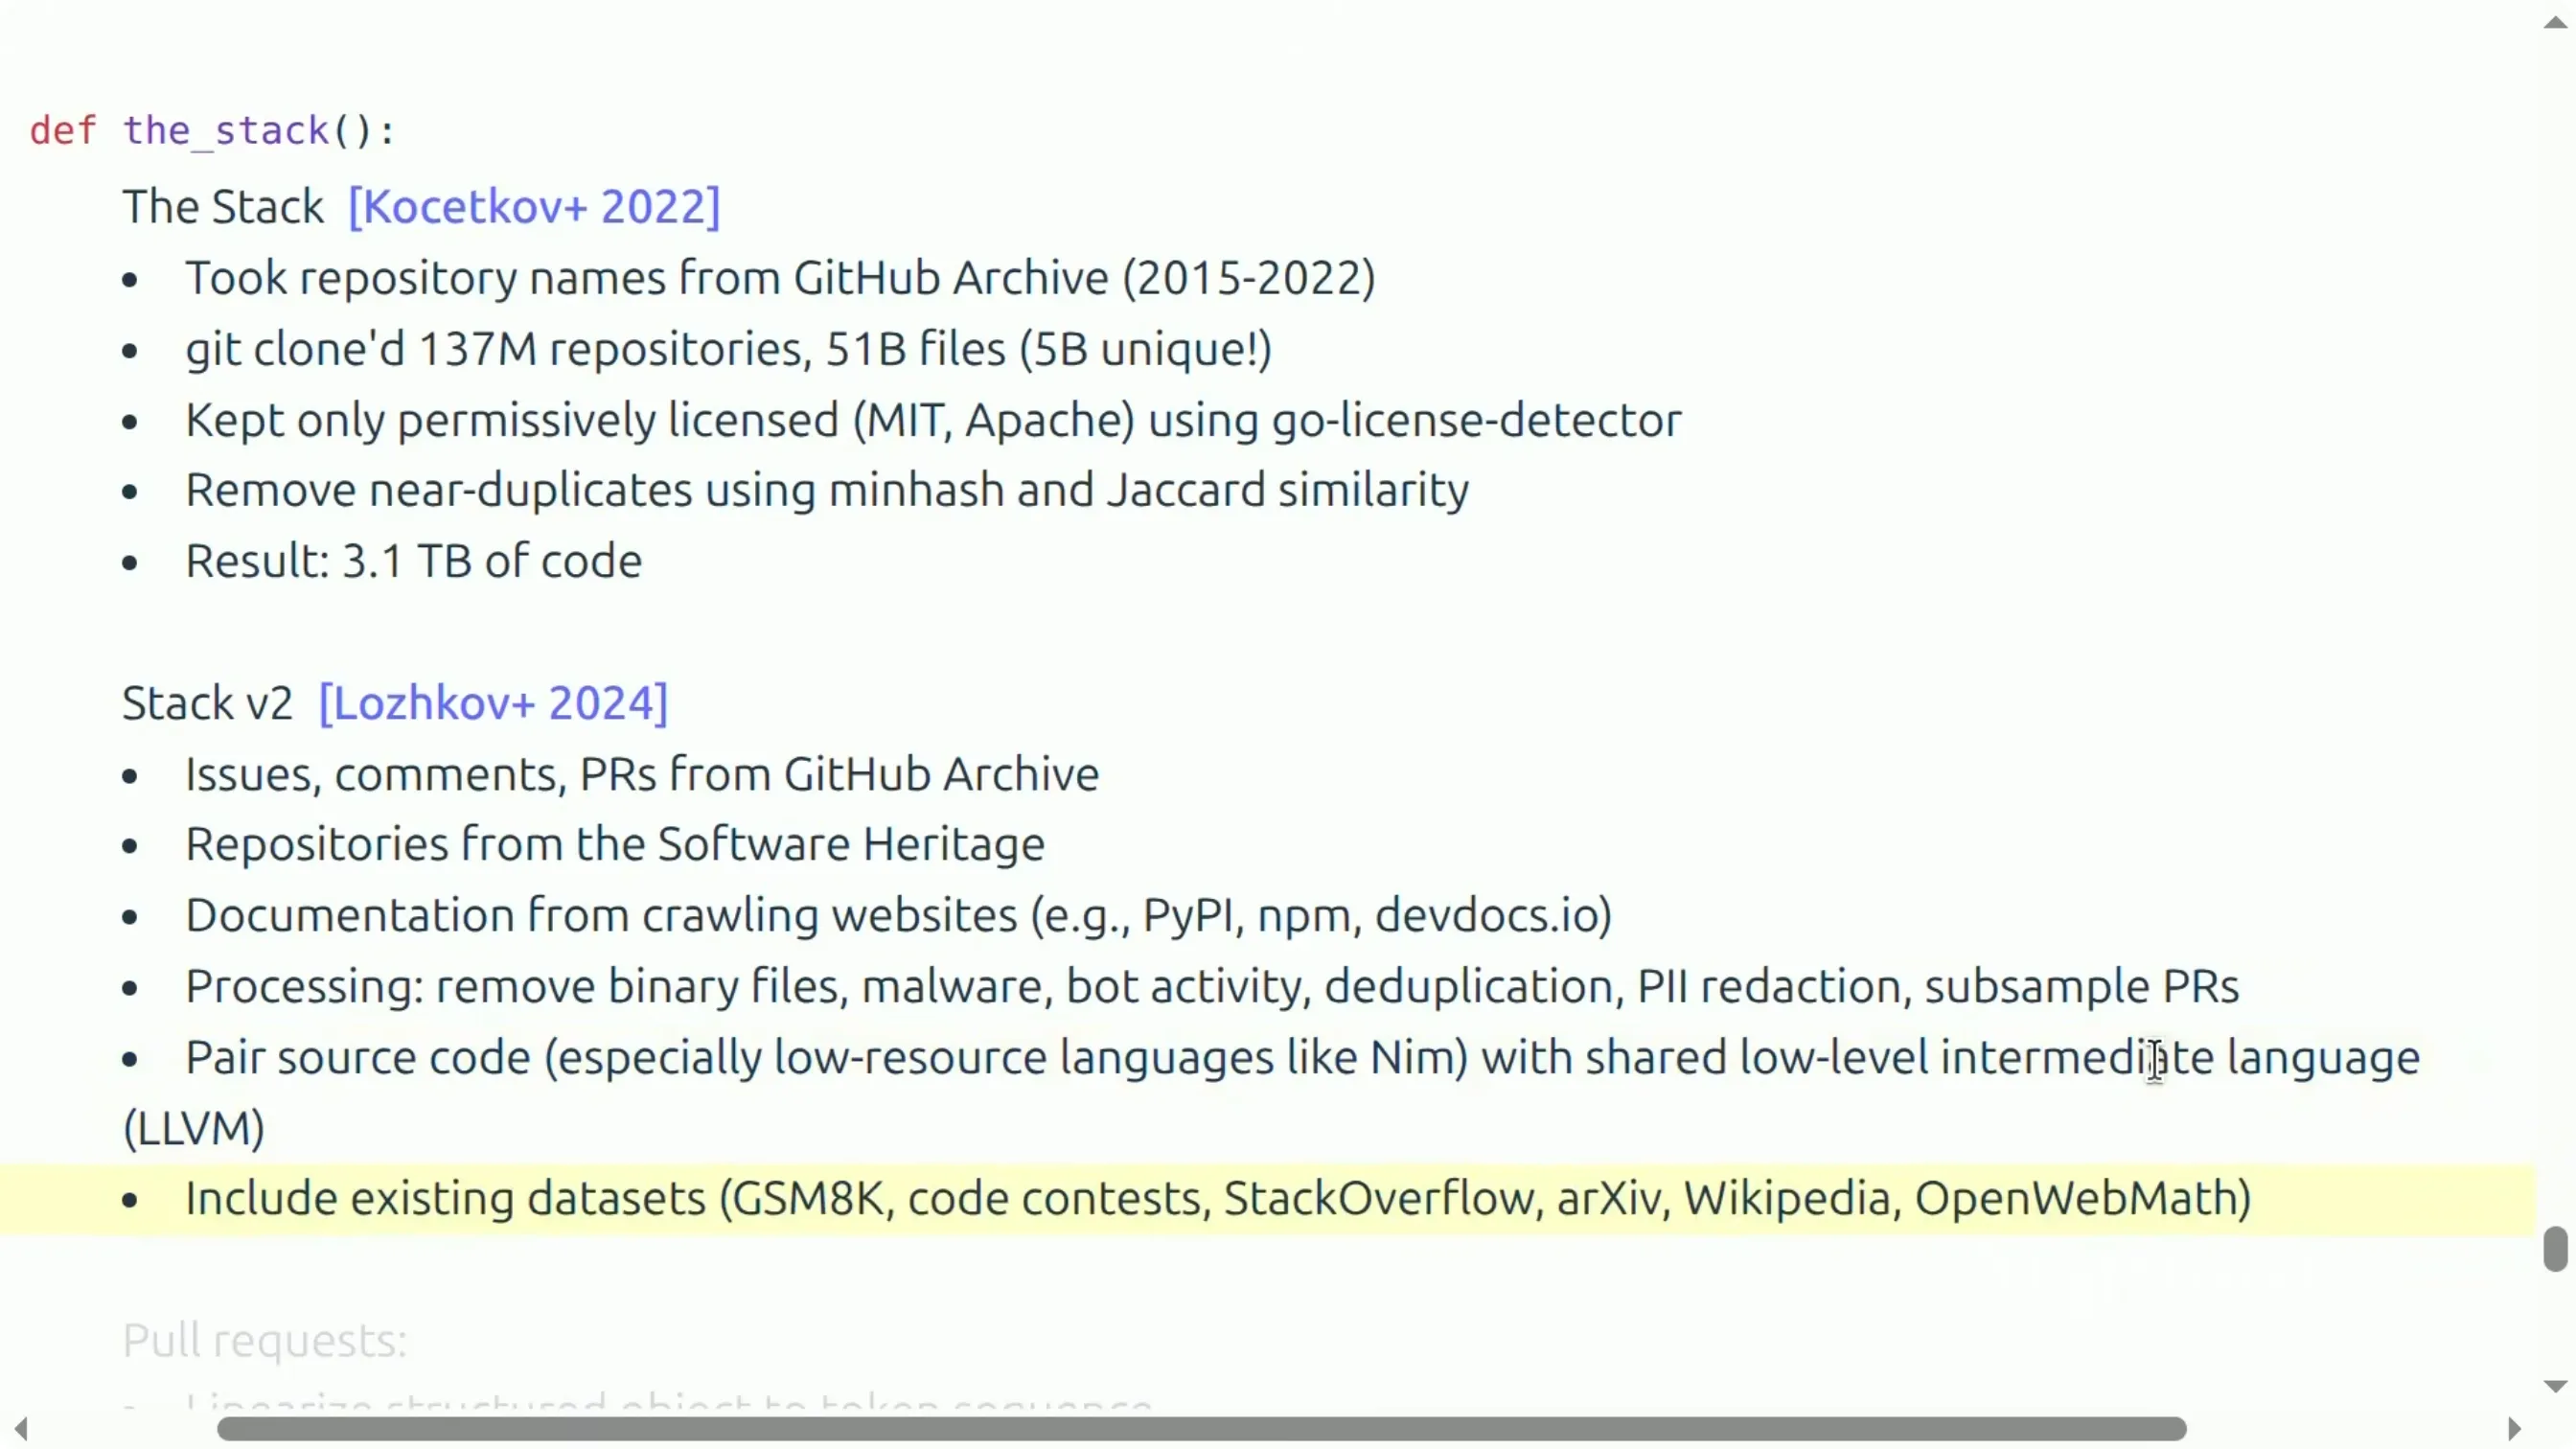
- 初版:克隆约 1.37 亿个仓库,只保留宽松许可的,去除近似重复,得到约 3 TB 代码。
- 2024 年更新(Stack V2):不再只用元数据,而是纳入 issues、评论、PR,以及来自 Software Heritage 的仓库;还抓取了各类文档网站。做了大量处理:
- GitHub 仓库里有二进制文件(不该训练),有恶意软件(去掉);
- 很多 PR 是机器人发的,要过滤;
- 去重、做个人信息(PI)削减;
- PR 数量巨大,于是做子采样,既保持代表性、又让数据集可控。
有一个主讲觉得「挺妙」的设计(参考时间: 01:12:35):世界上编程语言很多,Python、C 都很多,但像 Nim 这样的低资源语言(主讲自己都没怎么听说过)数据很少。于是他们把代码编译成低层的中间表示 LLVM IR(几乎任何 C 编译器这类工具都能编译到它),然后把低资源语言和它的 LLVM 中间表示并置(juxtapose)。这样模型就能在「数据很多的共享低层表示」和「数据较少的源语言」之间学习映射。
此外还加入各种「好东西」。Stack V2 大体上以代码为主,再叠加其它用于训练其代码模型的内容。
一个关键的线性化问题:PR 及其元数据天然不是线性序列,必须经过步骤线性化才能喂给模型。一个重要的设计选择是:给多少上下文? 比如一个事件可能只是「我改了一行代码」——那理论上只有一行,但为了学到东西,你大概需要提供周围若干行,甚至整个文件围绕那个 diff。这些都是必须做的决策。
最终训练用的 token 看起来像某种 XML 风格的结构化数据:
<PR>
  <DIFF> ... </DIFF>
  <DIFF> ... </DIFF>
  <COMMENT event="posted"> ... </COMMENT>
  <REVIEW_STATE> ... </REVIEW_STATE>
  ...
</PR>
也就是说,模型学的不只是如何生成代码,还有围绕代码的软件开发流程。
📷 The Stack V2 中将 PR 线性化为结构化 token 的示意
回到原视频 (01:13:16)
八、Common Pile:只用宽松许可,能走多远?
(参考时间: 01:14:44)
还记得吗——互联网上几乎所有数据都受版权;有些是宽松许可,有些甚至在公有领域。虽然你可以主张合理使用说「我照训不误」,但这尚未尘埃落定。于是:
如果你极度规避风险,那么凡是不确定能不能用的,就当作「不能用」。
这正是 Common Pile 采取的态度。它要回答的问题是:只用宽松许可的数据,能训出好模型吗?或者说,能走多远?
这个项目搜遍互联网,找出所有值得训练、且明确宽松许可的数据。它包含:
- Stack V2 与代码;
- 很多政府文书其实是宽松许可的;
- wiki、部分新闻网站(有些确实宽松许可)、学术论文;
- 在线论坛、公有领域内容、教育资源等。
最终得到 8 TB 数据——对「宽松许可的数据」而言,其实相当可观。
不过主讲强调:这件事比听起来难得多,不是「看一眼许可证,哦是 Apache / 是 CC,好,通过」那么简单。有几个微妙之处:
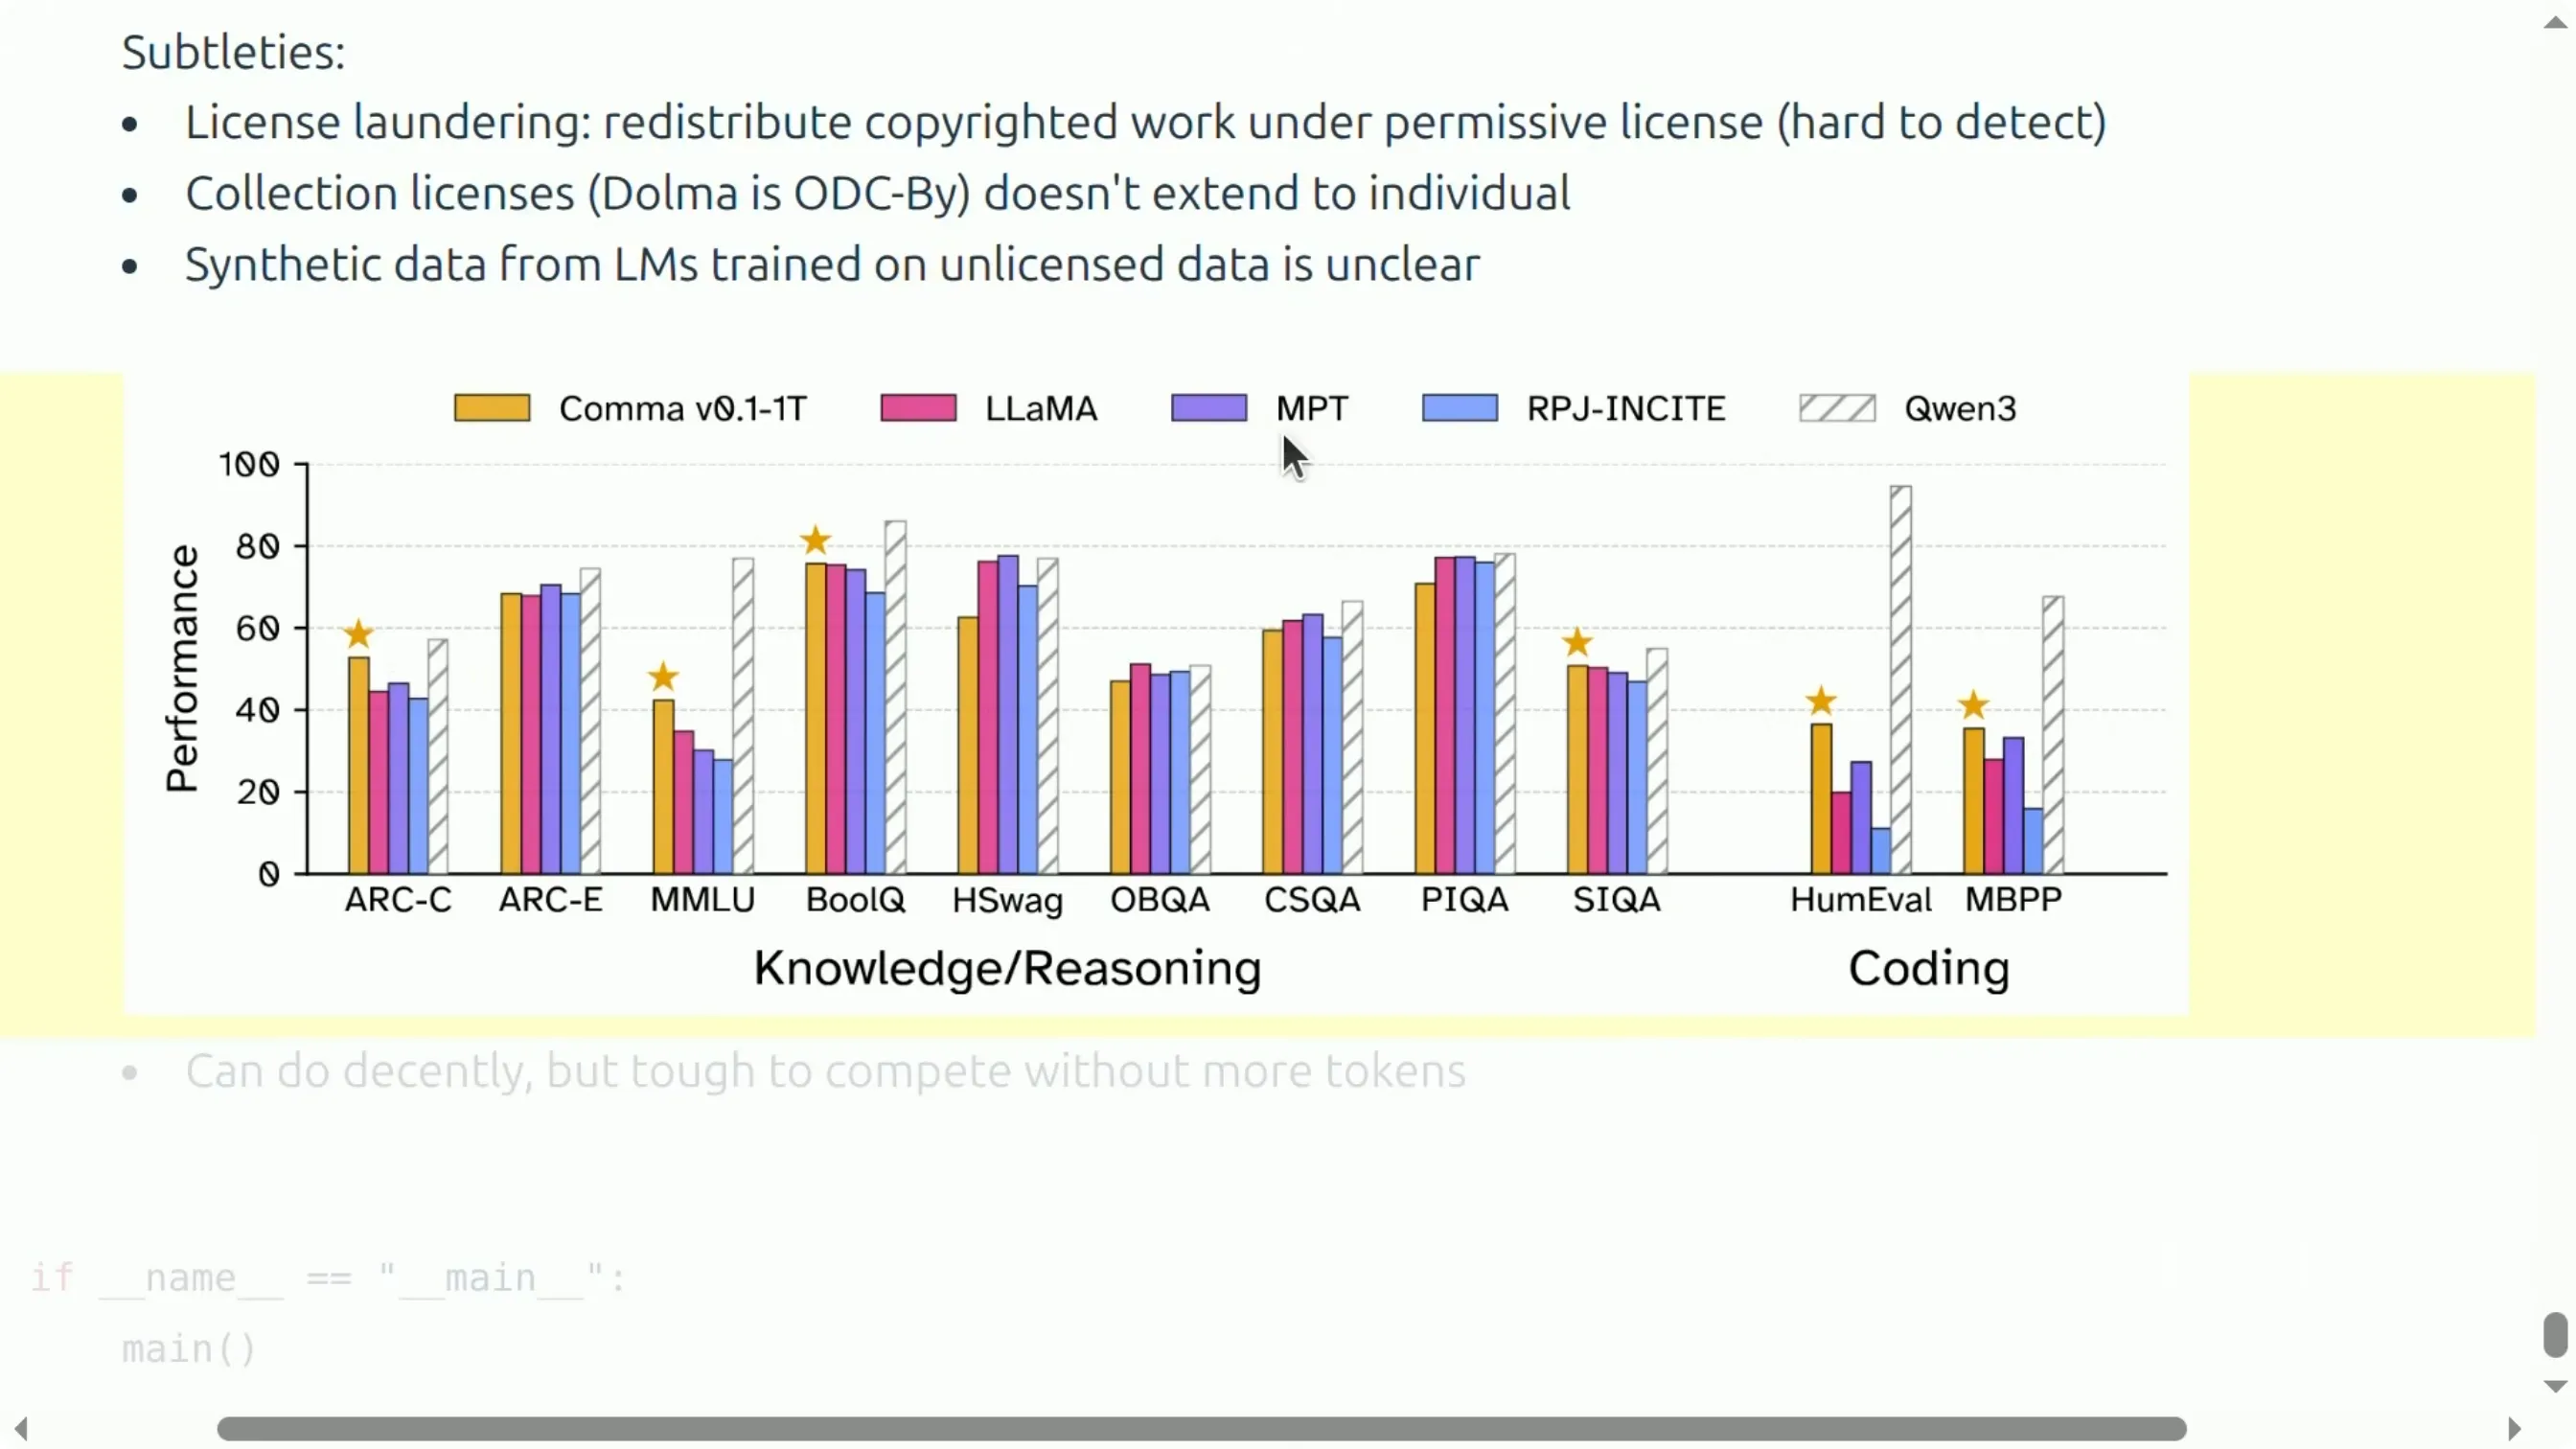
- 许可证洗白(license laundering):人们对许可证很马虎,可能把受版权作品随手贴一个 CC BY 标签。任何人都能在网上这么写,你很难判断这到底是不是真的。
- 集合的许可不覆盖单个作品:例如 Dolma 是宽松许可的(它是 AI2 的集合),但集合的许可证并不延伸到每一个单独的作品。所以你不能只看到一个 Hugging Face 数据集有宽松许可就放心——往深了看,单条数据未必是宽松许可的。
- 他们还决定放弃使用任何合成数据,因为在未授权数据上训练出的语言模型再生成数据属性不清。主讲补充说,严格讲,很多开源模型(如 MIT 许可的开放权重模型)你可以随意使用;但这些模型本身多半也是在未授权数据上训练的——所以如果较真起来,这有点像数据洗白(data laundering)。
他们把这份数据训出的模型与 Llama 1、MPT、Qwen 等作比较,在一批基准上证明:不算差。主讲自己的评价是:
- 肯定不如 Qwen 系列;
- 但确凿胜过那些非常老的模型(比如 2023 年的);
- 结论是:只用宽松许可数据可以做得「还算合理」,但若不投入更多 token,仍相当难有竞争力。不过主讲不认为这是最终结论——他相信只要肯尝试,还能从公开宽松许可里再挤出更多价值。
📷 Common Pile 与其它模型在若干基准上的比较
回到原视频 (01:19:04)
九、小结
(参考时间: 01:19:34)
主讲希望这一讲让人意识到:数据是一个非常丰富的主题。它不是「从天上掉下来」,也不是「上 Hugging Face 下载一个数据集」那么简单——数据必须有出处,而且它的出身带着技术与社会双重背景:
- 最顶层,互联网是一堆活着的服务。要么有人做「产出原始数据」的工作(比如网站提供 dump),要么有人自建爬虫。
- 接着,必须有人决定如何把它处理成可用形式——过滤、转换、去重。所有这些都会影响最终语言模型的质量。
- 注意:过滤大概是其中最重要的一环。想想如何从 200 万亿 token 走到不足 3 万亿 token——这是巨大的缩减,非常值得重视。
- 数据在某种意义上正是区分不同语言模型的关键要素。很多语言模型架构大同小异(都差不多是 Transformer),但数据、以及如何加工数据,能造成相当大的差异。
- 数据周围有大量法律与伦理问题,远超这一讲所能覆盖。
- 而且,这个过程非常「脏」。不像本课程其它部分那样基于第一性原理——数据处理目前很大程度上靠「vibe(直觉)」:你定义这个分类器、定义这条规则、设一个阈值。因此改进空间很大。主讲建议大家在做 作业 4 时,想一想是否有更好的做法——这可能是一个研究方向。
下一讲,他会继续讲数据:后训练数据,以及更多关于过滤的细节。
附:参考与延伸阅读
编者补充
- AI2
- Anna's Archive
- arXiv
- CCNet
- Cloudflare
- Common Crawl
- Common Pile
- Creative Commons(知识共享)
- DataComp
- Dolma
- Eleuther AI
- ELI5
- fastText
- FineWeb
- GitHub Archive
- Hugging Face
- Khan Academy
- Libgen
- Llama 3
- LLVM
- Olmo
- Project Gutenberg
- PubMed
- PushShift
- Red Pajama
- Resiliparse
- robots.txt
- Semantic Scholar
- Software Heritage Foundation
- Stack Exchange
- The Pile
- The Stack
- Trafilatura
- Wikipedia
已知疑点
以下列出本讲重构中不确定或需读者留意之处。每条都给出依据或时间点。
- 专有名词的同音听写可能存在误差,编者已按通行写法订正,但仍可能有遗漏:
- 抽取工具被听成「Brazilia Parser」,按其所在论文(DataComp-LM)上下文,编者订正为 Resiliparse(参考时间: 00:35:12)。若原意另有他指,请以论文原文为准。
- 论文《Consent in Crisis》的作者被听成「Shane Lampray」,编者按该论文通行署名订正为 Shayne Longpre(参考时间: 00:10:05)。
-
「Llama」在部分片段里被听成「Lama」「Gwen 3 / Qwen 3」等,编者统一为 Llama / Qwen(如 参考时间: 01:09:35)。
-
数字与量级:主讲本人对某些数字也存疑,请谨慎引用:
- Common Crawl「累计约 3000 亿页面」,主讲当场就说「看着偏大」(参考时间: 00:32:59);
- 「每份 dump 约 20 亿网页 / 372 TB」「Google 索引至少 100 PB」为课堂口述的量级,未逐条核对官网站;
-
The Stack 初版「克隆约 1.37 亿仓库」这一数字,字幕为「137」,单位(万/百万/亿)由编者按上下文补全,存在不确定性(参考时间: 01:11:23)。
-
版权法是主讲个人科普、非法律意见:本讲「75 年版权期限」「合理使用四要素」「Anthropic 和解约 15 亿美元、每本约 3000 美元」等表述,是主讲课堂口径。其中版权期限在美国现行法下规则更复杂(编者已在正文以「编者说明」提示);案件进展(NYT v. OpenAI 是否仍在审理、Meta 案 torrent 部分结果)会随时间变化,请以最新公开信息为准(参考时间: 00:29:xx)。
-
术语归属的编辑判断:
- 主讲说「大概是最早一批把合成数据用于预训练的数据集之一」,但又自陈「不一定是最早」——编者保留了他这种不确定的措辞,未替他下断定(参考时间: 01:08:31)。
-
「DCLM 一度成为开放社区质量过滤的金标准」是主讲的主观评价,非客观排名。
-
课堂问答的转述:部分听众问题字幕残缺(如 参考时间: 00:30:55 附近「voice dating at 11 labs」一段),主讲回答也较简短(「我不太了解,可以线下聊」)。编者未替其补全问题内容,仅按可辨认的部分概述。
-
配图时间点:本讲的画面多为论文/幻灯片的图表。编者只在字幕出现明确画面指涉处配图(如「here's a graphic that shows」「this is from their website」「here is the websites that were represented」),并取整到秒。若实际画面与描述略有出入,以视频原画面为准。
-
本章无课程主页素材可校:本次重构时未提供该课的
course/(讲义、幻灯片)目录,因此术语、章节骨架未能与官方讲义逐条对齐;若日后补充官方讲义,应以讲义为准复核本节术语与事实句。
若确实没有其它疑点,按课程约定亦保留本节:本讲未发现明显疑点之处已如实标注为「不适用」。