第14讲 · Stanford CS336《从零开始的语言建模》:数据(下)
| 课程 | Stanford CS336 Language Modeling from Scratch(2026 春季) |
| 讲次 | Lecture 14 — Data(数据专题第二次课) |
| 视频 | [Stanford CS336 |
| 本书定位 | 依据课堂逐句字幕重构的中文书面版本。讲师的推理链、案例、铺垫与现场问答一律保留;凡编者补充之处均以「编者说明 / 编者拓展」明确标注,不与讲师原话混同。 |
对应讲次:第14讲(Stanford CS336 语言建模)
制作模型:deepseek-flash(vb compose,据 run.log)
版权说明:本讲内容版权归 Stanford CS336 课程与授课教师所有,本书记录仅作学习用途。
导览
这一讲老师想回答的核心问题
上一讲解决的是「数据从哪来」:互联网上是一个个活着的服务,里面的数据必须被 dump 或 crawl 下来,再经过加工;此外还有一串社会性约束——服务条款、版权,你得去拿授权或者援引合理使用。这一讲接着往下走,问的是同一条流水线上的每一个加工环节该怎么做:
- 变换(transformation):原始网页不是文本,怎么把它变成文本?这个过程中必然丢掉什么?
- 过滤(filtering):怎么把「我想要的那种语料」变成一个可训练、可上亿倍放大的判据?
- 去重(deduplication):网页里到处都是重复,怎么在不能两两比较的前提下把近重复找出来?
- 混合(mixing):有几十个数据源,那几十个权重从哪来?
- 最后快速扫一遍后训练数据,尤其是当下合成数据(synthetic data)怎么造。
前半程讲的都是预训练语料,这是读这一讲时应该始终放在心里的背景。
难点在哪
- 过滤的难点不是算法,而是「没有普适最优」。 你要保留什么,取决于你打算训多长。同一个分类器分数,0.9 未必比 0.5 好。同时它必须在整个互联网(约 100 万亿 token 量级)上跑完,所以只能允许极便宜、极快的模型,最终保留下来通常只有个位数百分比。
- 去重是这一讲唯一需要动笔算的地方。 过滤看的是「单个条目好不好」,天然可以并行、线性时间;去重看的是「条目和条目之间像不像」,朴素做法是 $O(n^2)$,在这规模上不可能。必须引入哈希,把「相似」编码进「碰撞概率」,再用 LSH 把这条平滑概率锐化成相变。这一段(Jaccard → MinHash → LSH)是最容易卡住的。
- 混合最反直觉的一点:按权重采样,不等于按权重训练。小数据源会被反复 epoch,而这件事光看「分布」是看不出来的——你必须去看每个数据点实际被训练了多少遍。
读者可能带着什么疑问进来
① 老师真正提出的问题(按他自己的顺序)
- HTML 和 PDF 到底怎么变成文本?哪些信息必然丢掉?
- 怎么把我想要的语料变成分类问题?用生成式模型还是判别式分类器?
- 高质量数据是不是永远更好?
- 相似度阈值怎么变成可靠的「撞或不撞」的判定?
- 50 个数据源、50 个权重,从哪儿来?
- 后训练数据里,合成数据到底怎么造出来、又为什么这么贵?
② 编者预判的读者疑问(编者预判)
- 既然规则解析会出错,为什么不干脆用模型来解析 HTML?
- Jaccard 相似度的定义看起来一眼就懂,为什么去重会是个难题?
- MinHash 为什么要取「最小值」?取最大值行不行?
- LSH 里的 band 数 $b$ 和每 band 的哈希数 $r$ 该怎么选?
- 「训练更久就该容忍更低质量数据」——这和直觉里「数据质量第一位」矛盾吗?
- 我只有一张 GPU,上面这些跟我有关系吗?(老师给了明确回答,见后文。)
本讲路线
先补完数据变换(HTML 为主、PDF 为辅),把「有损」这件事讲透;再讲过滤的通用骨架和若干真实实例(语言识别、OpenWebMath、GPT-3、LLaMA、Phi-1、毒性过滤),并用一个初步实验回答「高质量数据是否永远更好」;接着用数学把去重从精确推到近似,落地到 MinHash + LSH;然后转向数据混合的原理、epoch 陷阱与回归式方法;最后快速过一遍后训练(重点在代码智能体)合成数据的现状。
1. 数据变换:把网页变成文本
(参考时间: 00:00:07)
1.1 原始数据不是文本
先做一点回顾:数据不会从天上掉下来。上一讲我们讲了数据的来源与加工链路,也讲了服务条款、版权、授权与合理使用这一堆社会性约束。今天我们把镜头对准数据流水线本身:变换 → 过滤 → 去重 → 混合。
先说变换。原始数据不是文本。就算你爬下来的是网页,打开 Common Crawl 看一眼就会发现里面是 HTML;也可能是 PDF,或者像 GitHub 那样的目录结构。今天这个环节的主要工作量都在 HTML 上,因为整个网络的大部分都是 HTML。
1.2 HTML → 文本:规则为主,且注定有损
把 HTML 转成文本这件事,大量环节是启发式的:
- 去掉样板内容(boilerplate),比如导航栏和广告;
- 抽取正文(content),也就是页面主体那部分;
- 去掉页脚、页头,也许还有菜单。
但「什么算正文、什么不算」并不总是清楚的。你完全可以设想一种情况:某些导航元素本身是有价值的——它帮助模型学会「网页长什么样」。所以「正文」的边界是模糊的。再往下还有两个棘手对象:图片和表格。
这个转换过程本质上是有损的,因为你必须把 HTML 线性化。HTML 要么是层级结构,要么按照渲染结果看是视觉结构,而你要输出的是一个 token 序列。表格尤其麻烦:简单表格可以用 Markdown 渲染出来,但嵌套表格就非常难处理——到了某个点你只能放弃,或者给一个近似。
1.3 提取工具与准确率
典型情况下,HTML → 文本的处理是基于规则的,原因是:
- 规则处理器非常快;
- 这里不需要太多智能,规则通常就够用。
当然,我觉得现在基于模型的介入是有道理可讲的,但前提是模型必须非常快,而且必须真的比规则多做一点「聪明事」。现实中你去看数据,会看到各种缺陷,因为任何规则处理都有失败率。
而正如上次课展示过的,准确率确实取决于你选了哪个工具:
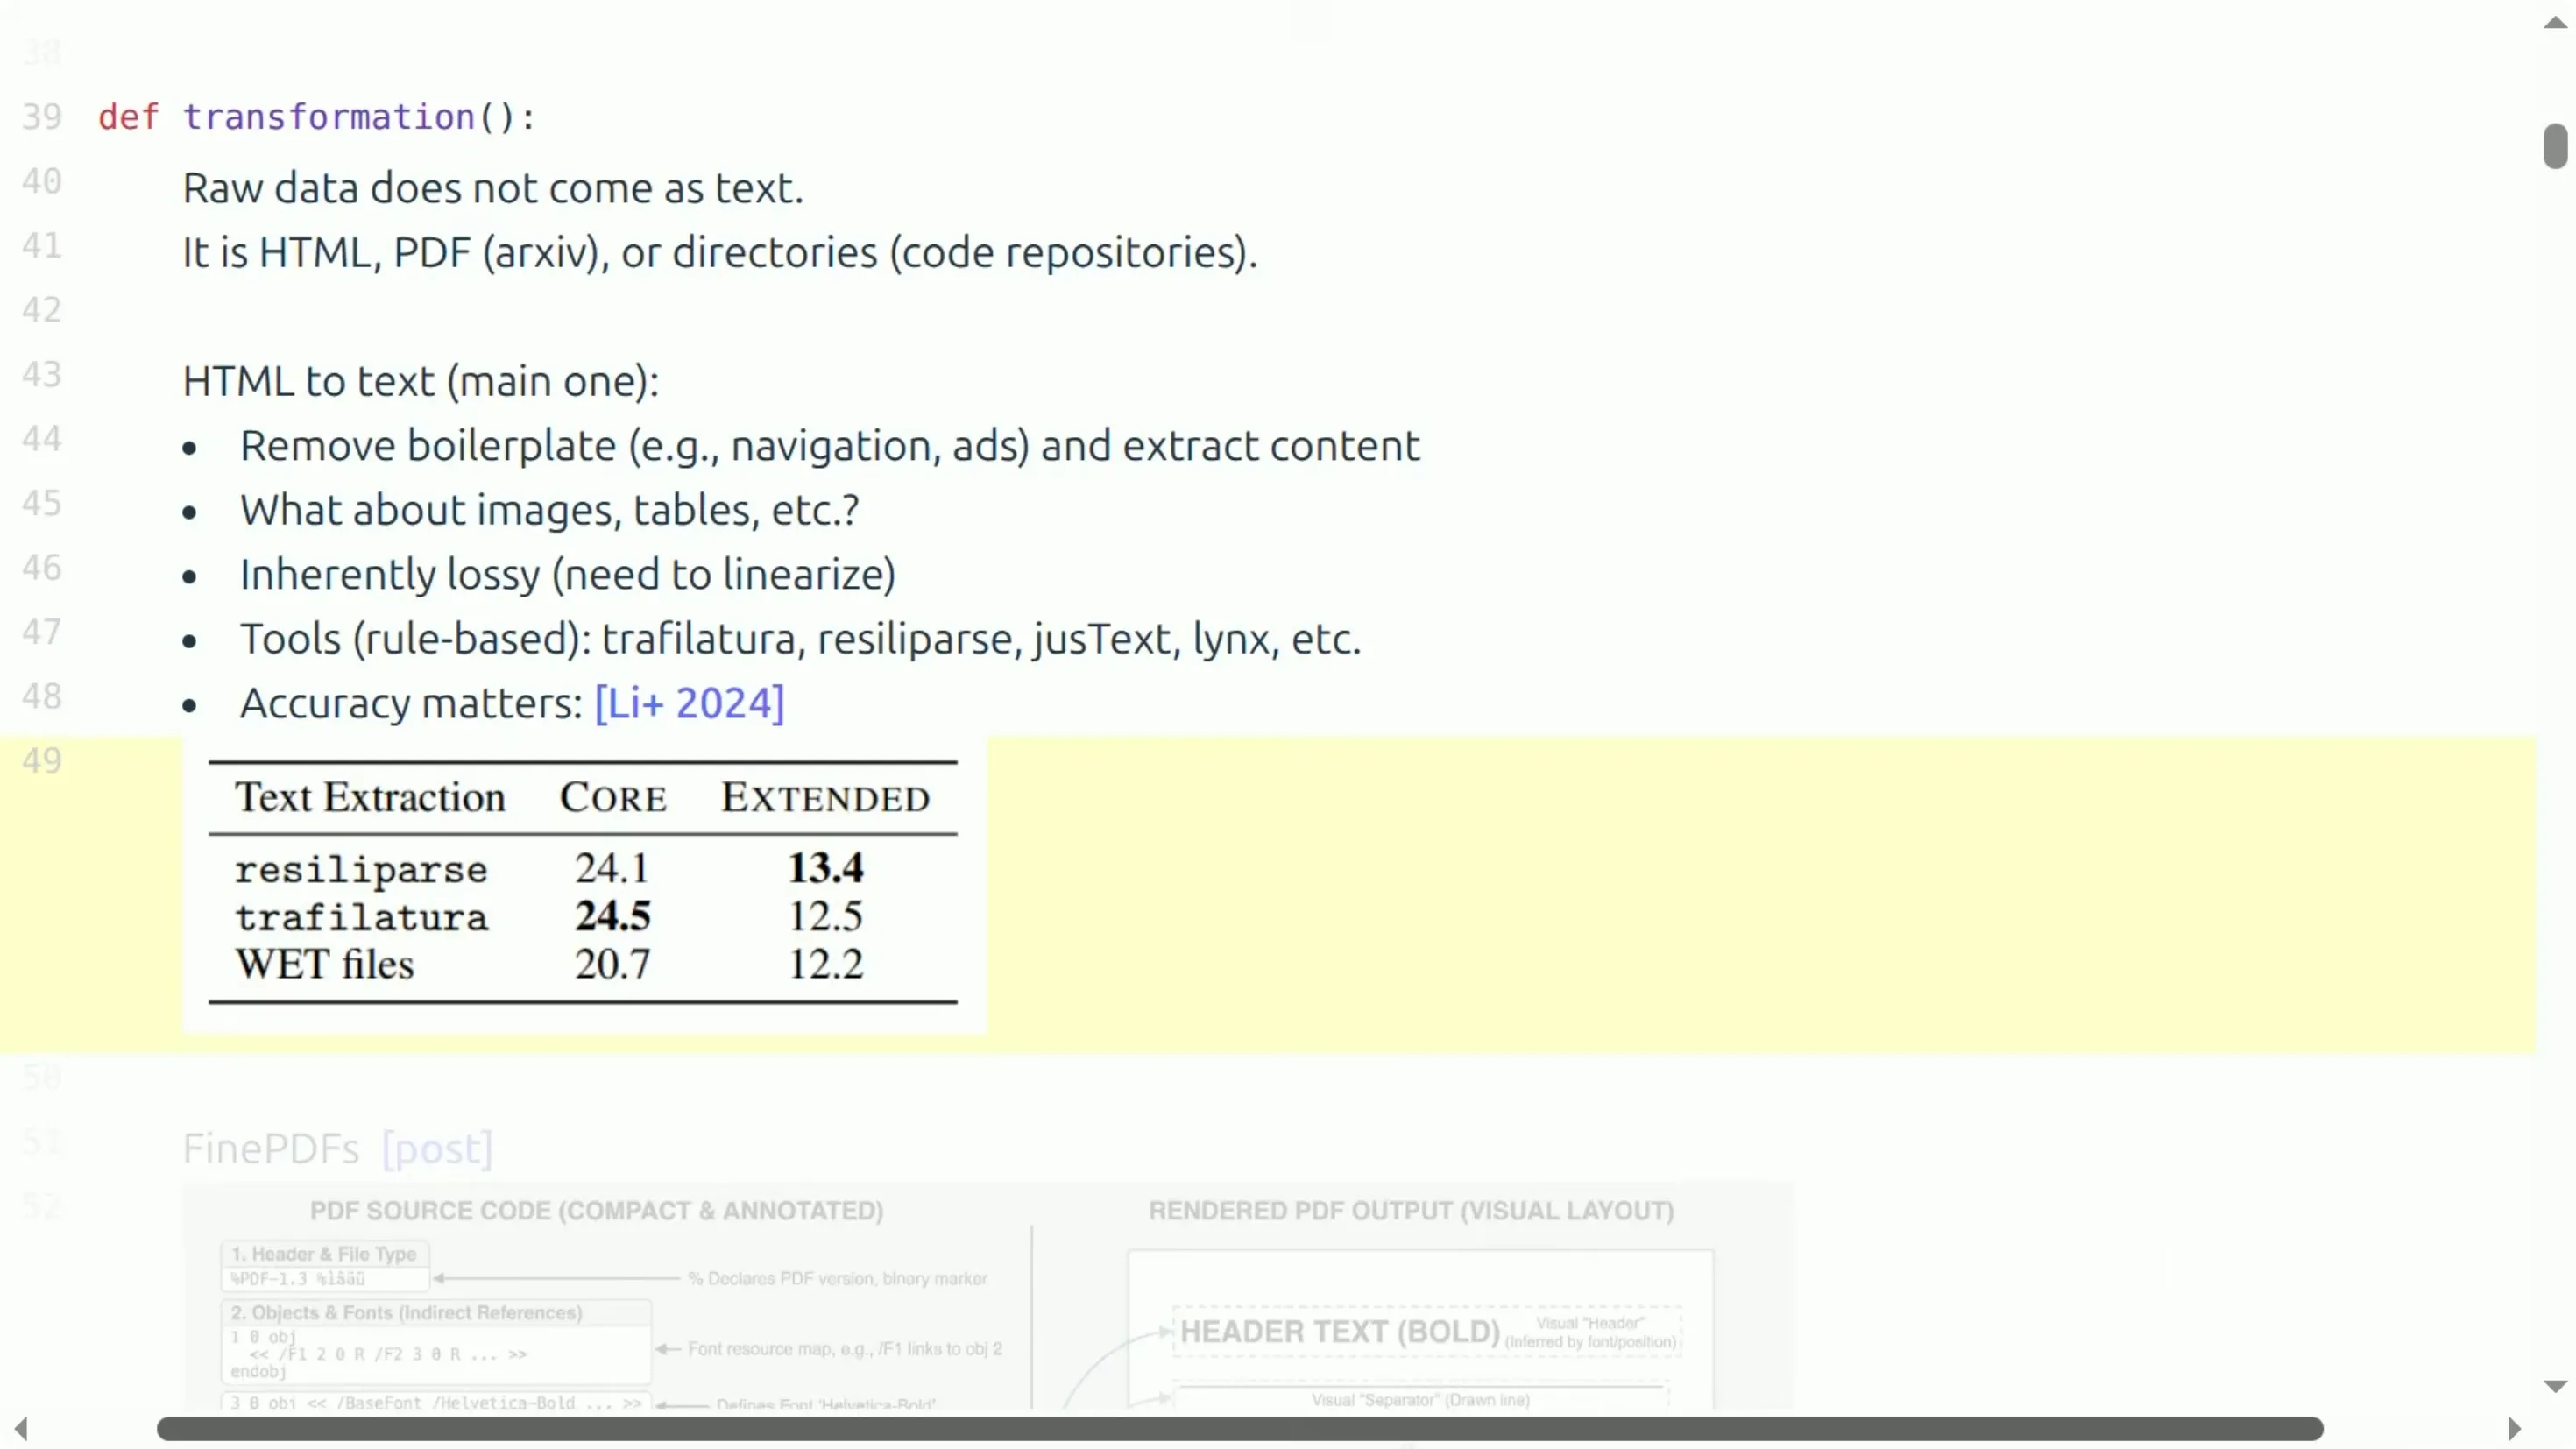
📷 不同 HTML 抽取工具在 DCLM 评测上的准确率对比
回到原视频 (00:04:00)
(参考时间: 00:03:59) 在这份 DCLM 扩展评测上,Resiliparse 与 Trafilatura 这类工具的表现并不一样——课堂当场给出的结论是 Resiliparse 在这份评测上更好。
编者说明:字幕把这两个工具名听成了「Brazil parse / Traflera」,实际应为 Resiliparse 与 Trafilatura——它们是目前网页正文抽取里最常被拿来对比的两套方案。本节后面出现的那条「不做过滤」的基线曲线,字幕记作 "resilient pars",指的应当是「用 Resiliparse 抽取出来的数据」,而非某个模型名。详见文末「已知疑点」。
1.4 PDF:份额很小,但价值很高
PDF 值得单独说几句。这里有一份来自 Hugging Face、发布了数据集 FinePDFs 的工作。PDF 文件如果你不放在阅读器里打开,长这样:
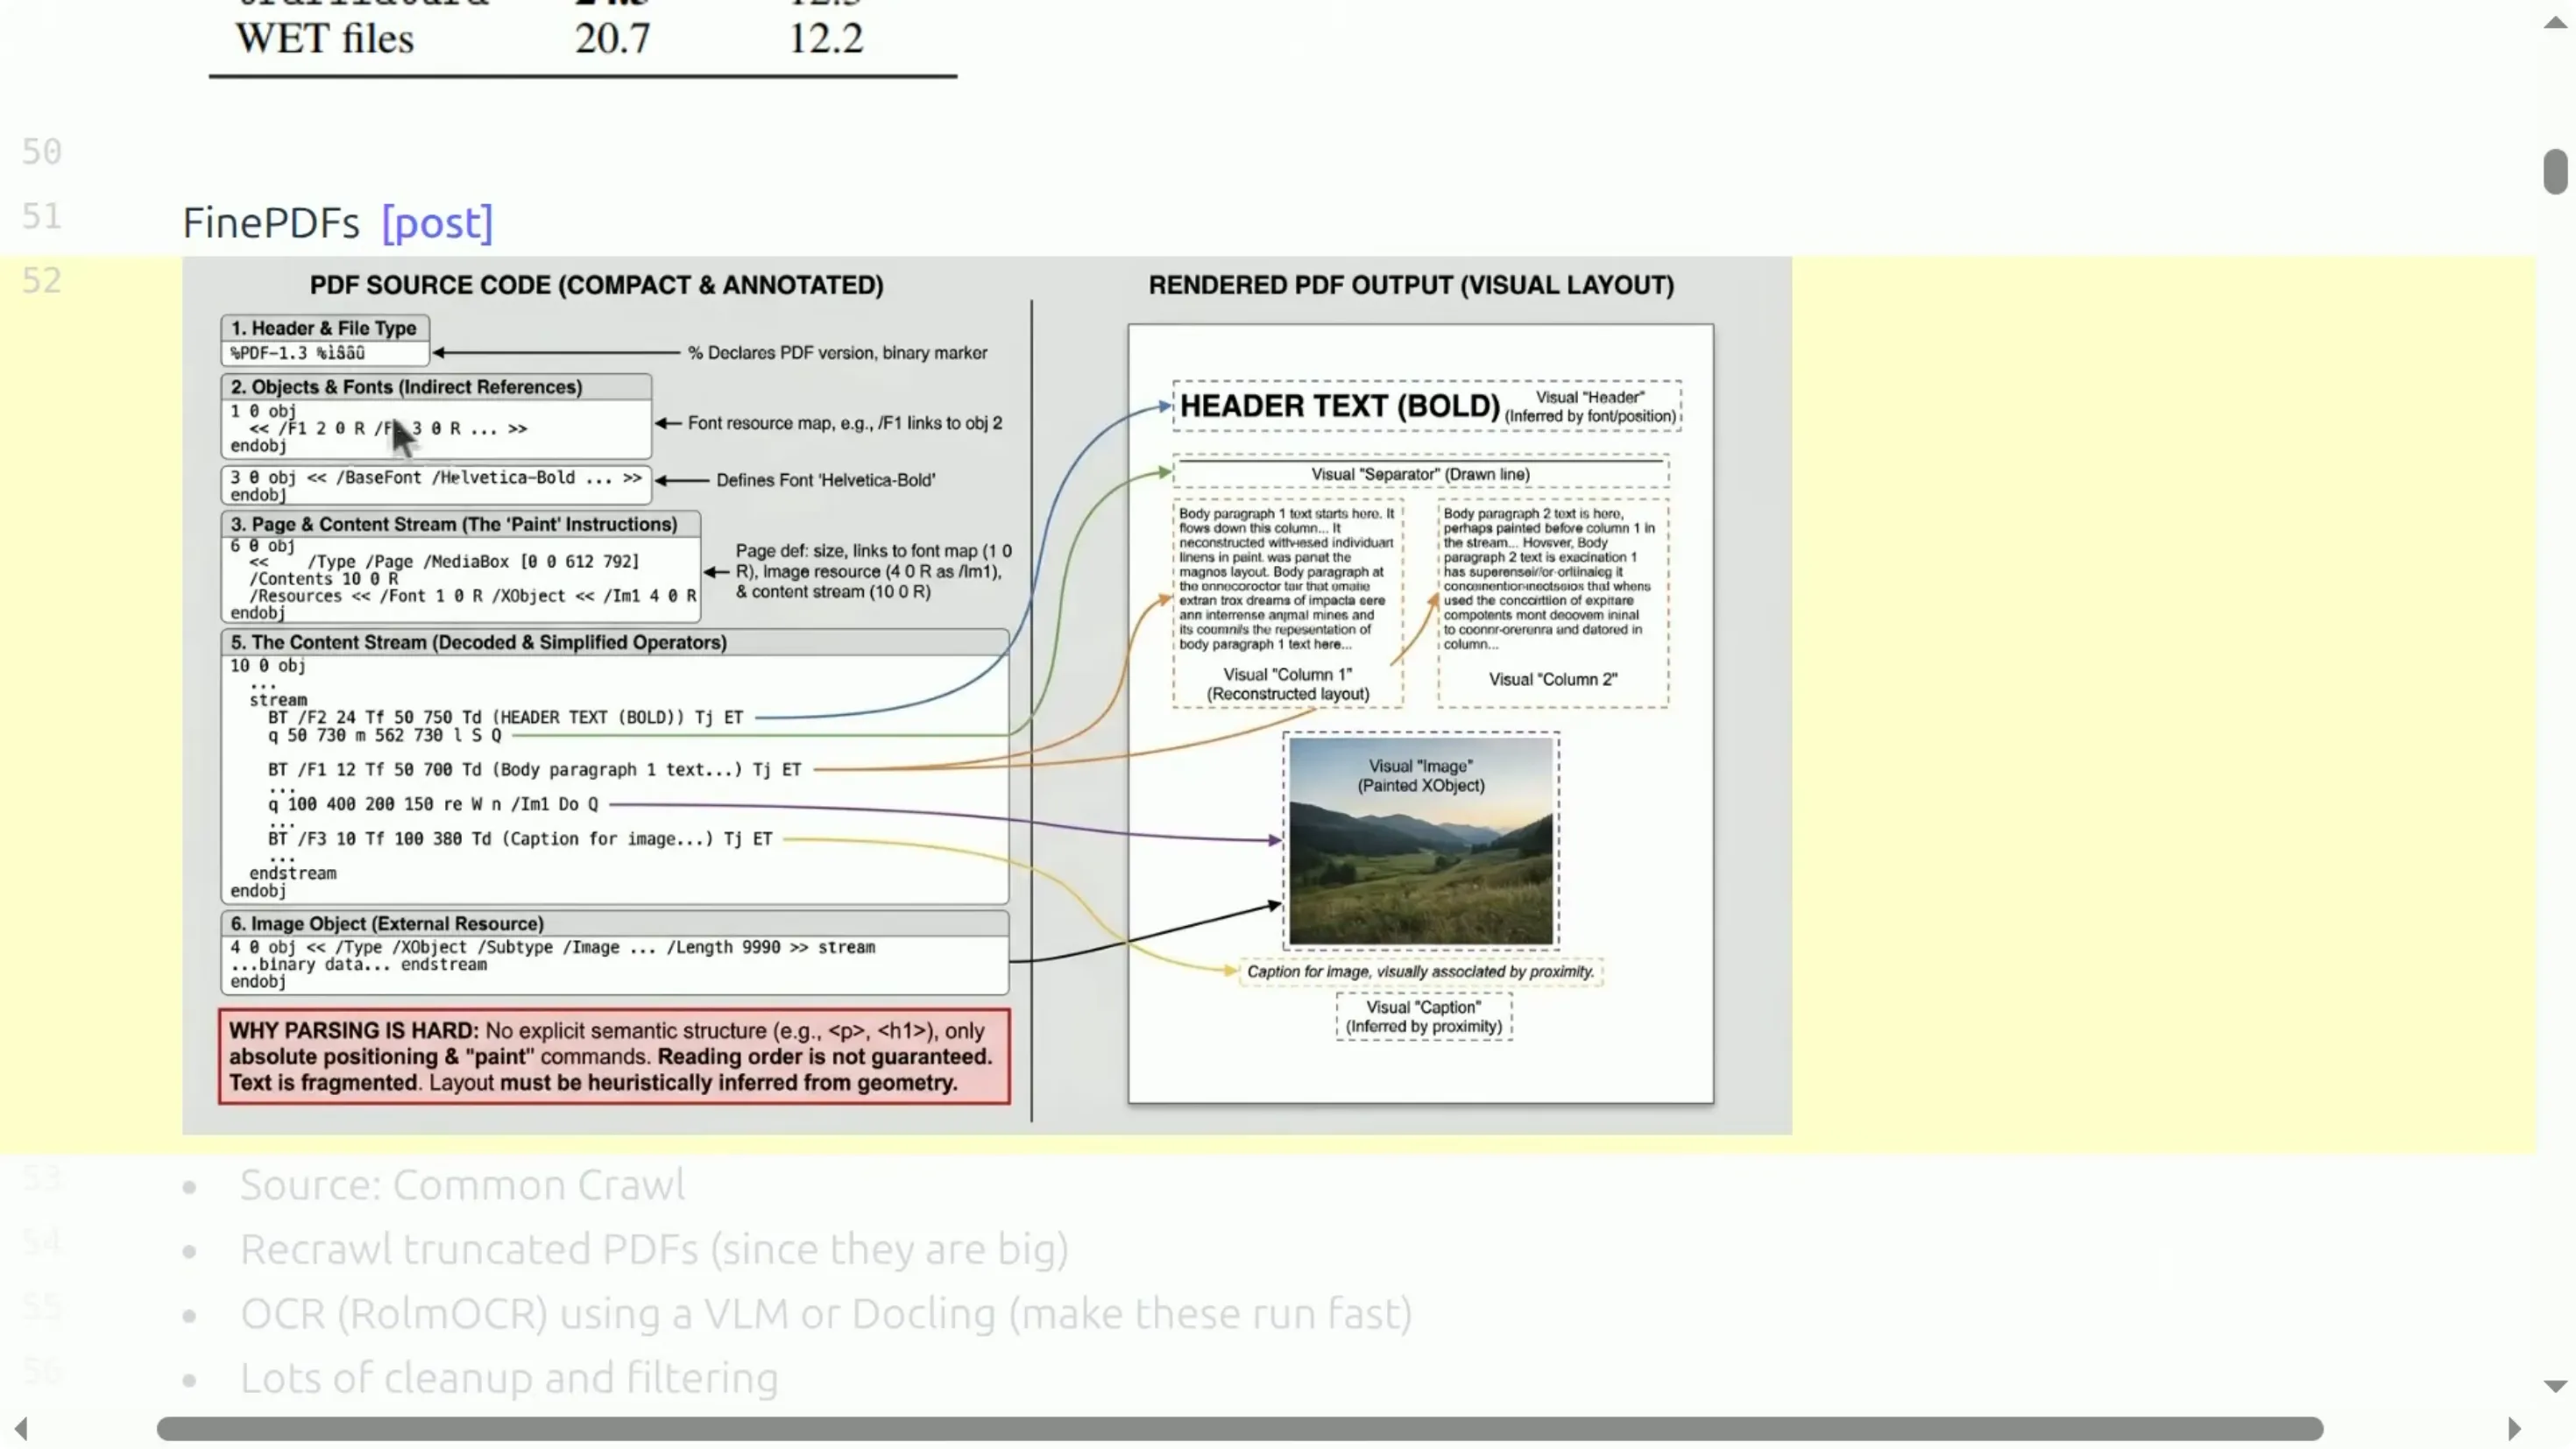
📷 PDF 文件用非阅读器方式打开后的原始结构
回到原视频 (00:04:34)
(参考时间: 00:04:33) 它需要被「渲染」出来。PDF 和网页一样分布在互联网上,Common Crawl 里也有一些 PDF。
Common Crawl 主要聚焦文本,但有时候你只拿到一个 URL,如果它没有扩展名,你在抓取之前根本不知道那是不是 PDF。 那篇博客里有很多细节(我这里就不展开了),比如:Common Crawl 里的许多 PDF 是被截断的,因为 PDF 文件很大——这就意味着必须重新爬取。拿到 PDF 文件之后,还有一个问题:怎么把它转成文本?有些 PDF 干脆就是扫描件,本质上是图片,所以这里往往要跑 OCR,也就是用一个 VLM 来做,这显然比前面处理纯文本昂贵得多。
幸运但也可以说不幸的是:PDF 在整个互联网里占比很小,但它们非常有价值。理由很朴素——你如果费劲去做一份 PDF,通常说明你有值得说的东西,相比之下网页就不一定。所以平均而言,一份 PDF 的质量要高于一份 HTML 文件。
PDF 的清洗和过滤也比网页更多、更麻烦。一个关键差别是:PDF 丢失了大量布局信息。HTML 里有 <h1>、<p> 这类标签,能给你一些语义信息;而 PDF 在设计上就是关于版面的,它并不必然保留语义结构。
到这里,你手上终于有了文本——但离结束还很远。
2. 过滤:定义「好数据」并把它挑出来
(参考时间: 00:06:53)
2.1 过滤的通用骨架
我先抽象地讲讲过滤是什么。它有一个基本的积木式结构:
假设你手里有一些目标数据(target),通常量很少、质量很高;同时有大量原始数据(raw),也就是上一步刚变换出来的那一批 token。目标就是:从原始数据里找出一个子集,让它和目标数据相似。 几乎所有过滤方法都可以归进这个框架。
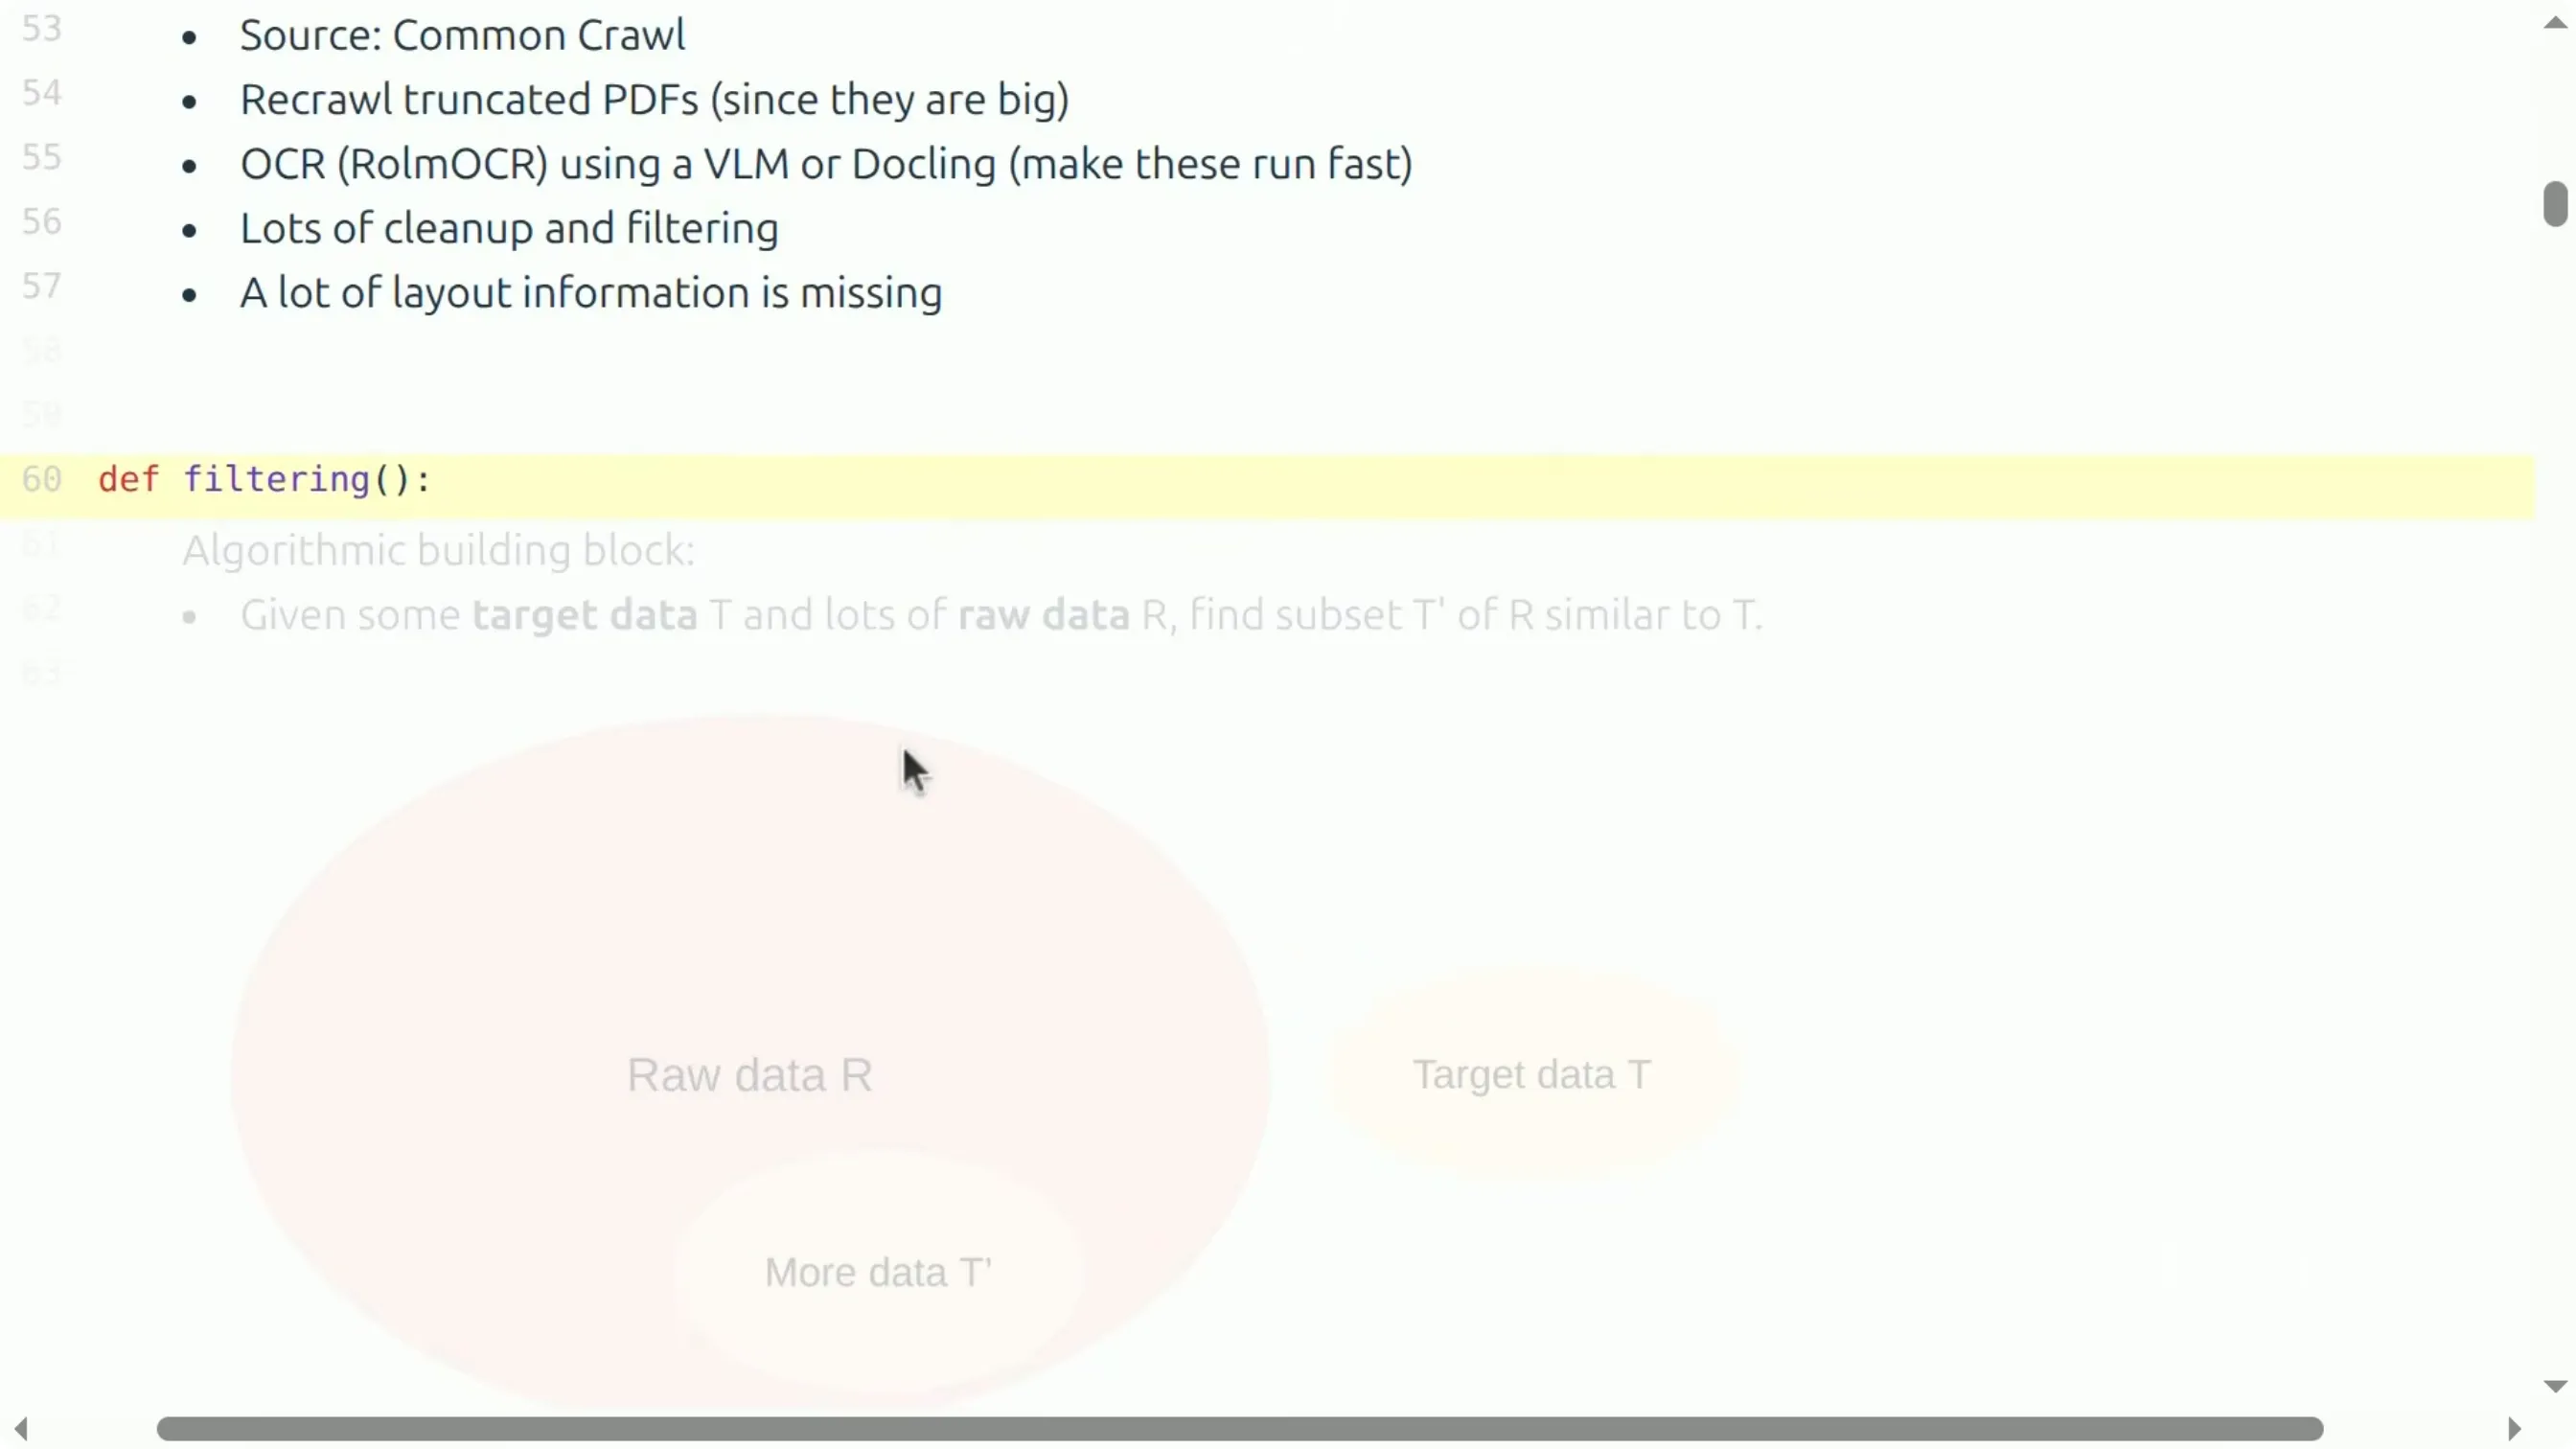
📷 过滤的通用骨架:目标数据与原始数据
回到原视频 (00:07:02)
(参考时间: 00:07:02)
要过滤的理由很多:
- 语言识别:如果你要训英语模型或德语模型,就得把语言不匹配的剔掉;
- 质量过滤:这是最主要的目的——你要的是百科式的信息,不是垃圾内容;
- 毒性过滤:互联网上当然有大量恶劣内容,你可能不想拿它训练语言模型。
对过滤算法有两个要求:
- 要有泛化能力。你已经有目标数据了,但你不希望「结果就是目标数据本身」,你得从它身上学到规律,去覆盖别的东西。
- 必须极其快。因为它要跑在整个互联网上,可能是 100 万亿 token 量级的数据。
结果就是:你最终只会保留一个非常小的比例,通常是个位数百分比。
通用做法是:基于原始数据 $R$ 和目标数据 $T$ 估计一个模型,导出打分函数,然后按分数保留 $R$ 中的样本。
graph TD
    T["目标数据 T<br/>少量、高质量"] --> M["估计模型 / 训练分类器"]
    R["原始数据 R<br/>海量、含噪"] --> M
    R --> S["对每个样本打分"]
    M --> S
    S --> K{"分数是否超过阈值?"}
    K -- 是 --> Keep["保留"]
    K -- 否 --> Drop["丢弃"]
2.2 生成式模型 vs 判别式分类器
具体分两类:
(一)生成式模型。 你直接用目标数据估计一个模型。记住它必须便宜,所以一般不会是大语言模型。这里最经典的例子是 KenLM——它做的其实就是训练一个 5-gram 模型,然后让原始数据过一遍,看困惑度是否够低。
(二)判别式分类器。 这是现在更常见的一类:训一个分类器,对落在目标集 $T$ 里的样本打正标签,对落在原始集 $R$ 但不属于 $T$ 的样本打负标签。做法是:把 $T$ 当正例,从 $R$ 随机采一部分当负例,做一下类别平衡,然后训练分类器。
大家常用的工具是 fastText:它快,而且本质上就是一个词袋 + 线性分类器。拿到模型之后,对每个新文档打分,按你的质量门槛设一个阈值,然后保留过线的样本——有时是随机保留(stochastic),有时不是。
有一个值得注意的历史演变:几年前有不少数据集刻意不用基于模型的过滤,因为它们不想把数据偏置得太厉害。但现在,基本上所有人都会做一定程度的模型过滤。原因是:除非你算力极其充裕(那你可以什么都训,不需要过滤),否则绝大多数人都「算力贫穷」,必须非常聪明地过滤——不然你就是在把 FLOPs 浪费在低质量内容上。
2.3 实例一:语言识别
目标是:给一段文本,判断它是不是某种特定语言。Meta 训了一组 fastText 语言识别模型,通常可以直接拿来用,支持 176 种语言,训练数据来自大量多语站点——Wikipedia 本身就有很多语言版本,此外还有各种翻译站和语言专属站点。
语言识别相对而言是个容易的问题:一个简单分类器,看几个词就能判断这是西班牙语还是日语。当然也有细节,比如语码转换(code switching)和方言,所以不能说它被彻底解决了,但它不是训练一个好语言模型的瓶颈。拿到分类器之后,你只需要按启发式挑个阈值。
2.4 实例二:领域定向收集(OpenWebMath)
另一个用法是:我想要某个特定类型的数据。比如你想把数学做好,那你就去找一堆数学语料。
这就是 2023 年的 OpenWebMath 工作。注意它不是训练单个分类器,而是一条多步流水线:
- 先用规则过滤:文本里是否包含 LaTeX 命令;
- 同时用 KenLM(生成式路线),在数学数据集 ProofPile 上训练,困惑度低于某阈值就保留;
- 再训练一个 fastText 分类器,判断它是不是数学写作;
- 这里设两个阈值:
- 如果文本里有 LaTeX,门槛低一些;
- 如果没有 LaTeX,门槛高一些。
结果他们得到约 150 亿 token,用来训练模型。论文显示:这种更有针对性的数据收集,让模型在数学上超过那些用 20 倍数据、但没有这样过滤的模型。
graph TD
    R["原始网页文本"] --> R1["规则:是否含 LaTeX 命令"]
    R1 --> R2["KenLM 困惑度<br/>在 ProofPile 上训练"]
    R2 --> R3{"是否含 LaTeX?"}
    R3 -- 是 --> L["低阈值"]
    R3 -- 否 --> H["高阈值"]
    L --> FL["fastText 数学写作分类器"]
    H --> FL
    FL --> OUT["约 150 亿 token 数学语料"]
这里的关键观念是:质量过滤是一把工具,你可以任意定义什么叫「质量」。没有普适的质量定义——你把质量定义成数学,你就去取数学,然后模型就会在数学上更强。
2.5 实例三:GPT-3、LLaMA 与 Phi-1
GPT-3(论文)在这个框架下是这样做的:
- 正例 = Wikipedia + WebText + 一些书籍。其中 WebText 指的是从高赞 Reddit 帖子链出去的那些页面;
- 负例 = 从网页里采样;
- 训一个线性分类器,分数够高就保留。
LLaMA(论文)的思路一样,只是正例换成了「被 Wikipedia 引用的页面」,而不是 Wikipedia 文章本身。
Phi-1(微软那个工作,论文)更值得讲,因为它正好把「贵模型蒸馏到便宜模型」这件事讲清楚了。它的原始数据是 The Stack 里的 Python 子集。流程是:
- 定义一个提示词:「判断教育价值(determine educational value)」;
- 用 GPT-4 按这个提示词去分类 $R$ 的一个 10 万条子集;
- 被判为正的那些保留下来,把它们称为「目标集」。
注意这里的微妙之处:目标集其实是那个昂贵分类器的输出,而不是人工数据。
- 然后用这个目标集去训练一个更便宜的分类器——他们用的是随机森林,你也可以用 fastText;
- 最后用这个便宜分类器去筛选全量原始数据。
他们同样证明了:用这个筛选后的数据集,比直接用原始数据表现好得多——损失下降更快,最终值更低。
graph TD
    R["Stack 的 Python 子集 R"] --> S["随机抽 10 万条子集"]
    S --> G["GPT-4 + 提示词<br/>判断教育价值"]
    G --> T["得到的正例 = 目标集 T"]
    T --> C["训练廉价分类器<br/>随机森林 / fastText"]
    R --> C
    C --> F["对全量 R 打分并筛选"]
编者拓展|为什么「贵模型打标 + 便宜模型全量跑」是标准套路 这个模式在今天的数据工作里反复出现,代价分析很清楚:假设用 GPT-4 给 10 万条数据打标要花 $X$,而全量数据有 $10^{10}$ 条,直接全打标要花 $10^5 X$——不可能。但用这 10 万条打标结果训一个 $O(10^{-6})$ 秒/条的分类器,全量跑完几乎免费。 代价是分布偏移:便宜分类器只学到了「GPT-4 判据在 10 万条样本上的近似」。所以采样子集的代表性很关键,而且这一步本质上是把教师的判断能力上限封顶了——教师认不出「好」,学生就学不到「好」。
2.6 实例四:毒性过滤
毒性过滤的机制完全一样。数据集是 Jigsaw Toxic Comments,它来自一个「帮助人们在网上更好地讨论」的项目。数据本身是 Wikipedia 的讨论页(talk pages)——不出所料,争议话题的讨论页往往吵得很凶。这些页面被标注了「是否存在毒性评论」。你同样可以定义正负例,然后训一个分类器。
到这里,工具和灵感就齐了:你可以识别出你想要的那类数据,为它训一个分类器,然后拿着它去过滤 Common Crawl。
2.7 一个关键细节:不存在最优阈值
这里有个微妙之处:你想要的「数据品质」,取决于你要训练的模型,特别是取决于你要训练的 token 数量。
所以不存在一个最优阈值。前面分类器给你一个分数,你不能说 0.9 就是最好的——它取决于你想干什么。直觉上是这样:
- 如果你要训练更久,你就能容忍更低质量的数据;
- 如果你训练得短,通常就想要更高质量的数据。
当然,如果给你一根魔杖,你当然想要「又训得久、又全是高质量数据」,但这不是你能选的——数据池就这么大。
2.8 Michael Ryan 的初步实验:高质量数据的收益会衰减
这里有一个 Michael Ryan 做的初步实验。
设定:一个 1.57 亿参数的模型,在一个非常小的池子上训练——相对于 Common Crawl 只是极小一部分,然后持续训练更久。
看蓝色的曲线,那是 DCLM。损失从某个值开始往下走,每一条折线对应一次「把数据过一遍(epoch)」:第一条蓝线是第一个 epoch,下一条是第二个,以此类推。数据不多,所以你最终不得不重复数据。损失会继续下降,因为第二次看数据你仍然在学到东西;再往后,就开始过拟合了。
再看另一条,那是基本没做过滤的数据。它一开始差得多,但随着你不断训练、开始 epoch,它下降得也变慢了。于是你看到这样一个趋势:
- 在你还没开始 epoch 的区间里,高质量数据更好;
- 一旦 token 数量变得非常多,高质量数据就不再那么有优势了。
当然,你拿着一份高质量数据也不会想进入过拟合区间,你大概率会在这里就停下。但即使停在这里,它也已经不如「用低质量数据多训一段」的结果。
📷 LSH 的 S 形碰撞概率曲线
回到原视频 (00:42:56)
编者说明:上面这张图对应的是本讲后面的 LSH 相变曲线(见第 3.8 节),此处不作为本节实验图使用——本节实验的可视化在课堂上是一张损失-训练量折线图,字幕未给出明确画面提示,故不配截图。
课上问答
问:每个点对应一次训练运行,对吧?做这类预训练实验时,要不要跑多次、算置信区间?
答:理想情况下那样做是好的实践。但论文里这类数据往往很稀疏,因为每一次训练都相当昂贵。不过实际做下来,至少在预训练里,结果通常是比较稳定的。
问:你提到「训得久 + 高质量数据」不是可选项。那如果我们真能拿到更高质量的数据并训得更久,会不会仍然有递减收益?
答:任何数据集最终都会遇到递减收益,它是有限的。但那条曲线大概会整体更低,然后一直往下走。
2.9 小结:过滤的配方
过滤对于构建一个好模型非常关键,特别是在你算力贫穷的时候(在座大多数人都是)。理论上,如果你有无限算力,你不需要过滤,可以把一切都训进去,训一个巨大的模型;但现实中每个人都得过滤。
配方是这样的:
- 先搞清楚「好数据长什么样」——要么是「我发现外面有这么一个数据集,我很喜欢,我想要更多这样的东西」;要么是「我写一个提示词给语言模型,让它先在一个大池子上做初筛,再用这批优质数据去训一个小分类器,然后外推到其余数据」。
从这一节还能提炼出一条更普适的教训(第 4 节会再次用到):一旦你开始「优化」某样东西,就要格外小心——你有可能是在优化错误的目标。
3. 去重:从精确重复到近似重复
(参考时间: 00:22:55)
3.1 为什么数据集里全是重复
到这里我们已经有了一份「自认为高质量」的数据。但数据里往往仍然充满重复。重复分两类:
- 精确重复(exact duplicates):比如镜像站(mirror sites)——镜像的全部意义就在于它是副本,而爬虫有时候并不聪明到能识别「这个镜像就是那个镜像」,于是把同一份内容爬了很多遍。再比如 fork 一个仓库:即使你改了几个文件,99% 的内容可能还是一样的。
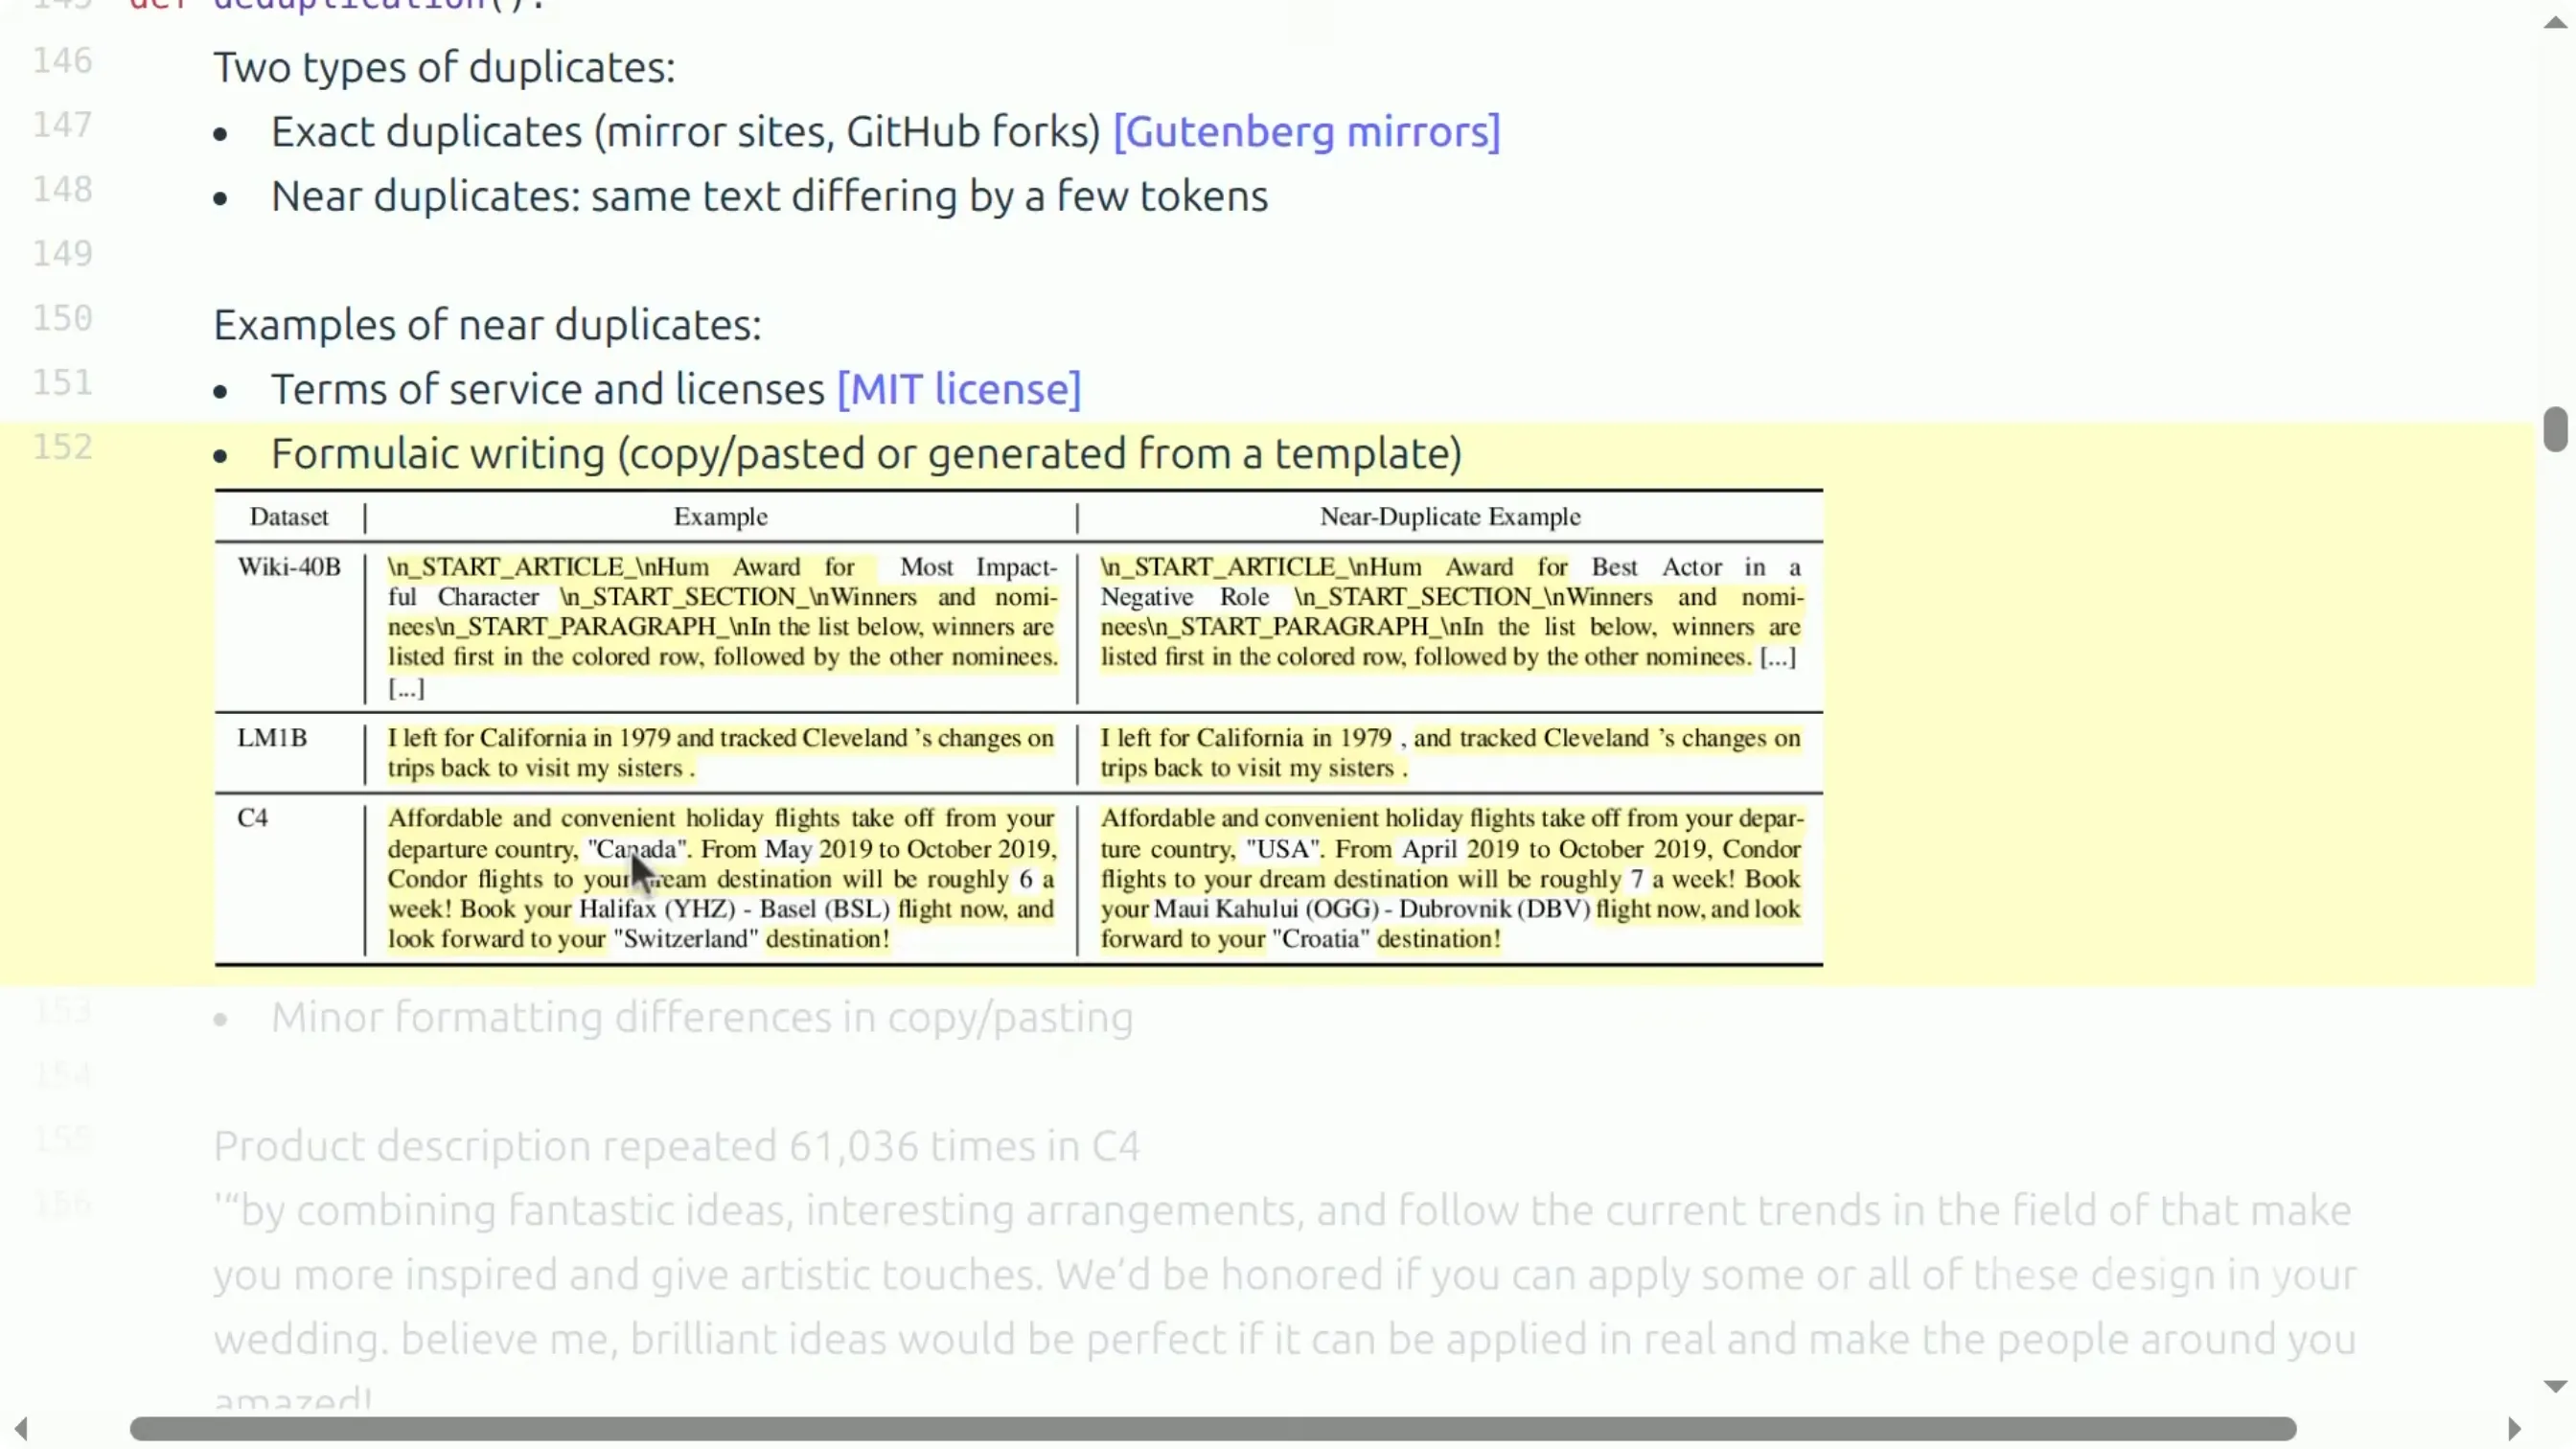
- 近重复(near duplicates):它们不是镜像、也不是衍生品,只是恰好在少数 token 上有差异的同一段文本。这通常来自复制,或者来自某个共同的源头。
一些近重复的典型例子:
📷 近似重复的模板化例子
回到原视频 (00:25:30)
(参考时间: 00:25:30)
- 服务条款与许可证。比如 MIT 许可证会在无数地方出现——很多情况下它是逐字精确的复制,除非有人抄的时候打错了字。但许可证所属的那个页面的其余部分会各不相同。
- 页头和页脚。我们前面已经说过,很多网站共用同样的页头和页脚,那些同样是重复。
- 纯排版差异。这在 LM1B(十亿词基准)里就有:同一篇文章,一版有逗号、一版没有。原因不明,但它确实会发生。
- 模板化内容。下面这种大概率是低质量内容,看起来像是某种广告,有人把它模板化,然后把「Canada」替换成「USA」。如果你拿这种数据训练,只是在不同实体的变体上反复训练,那就是在浪费你的 GPU。
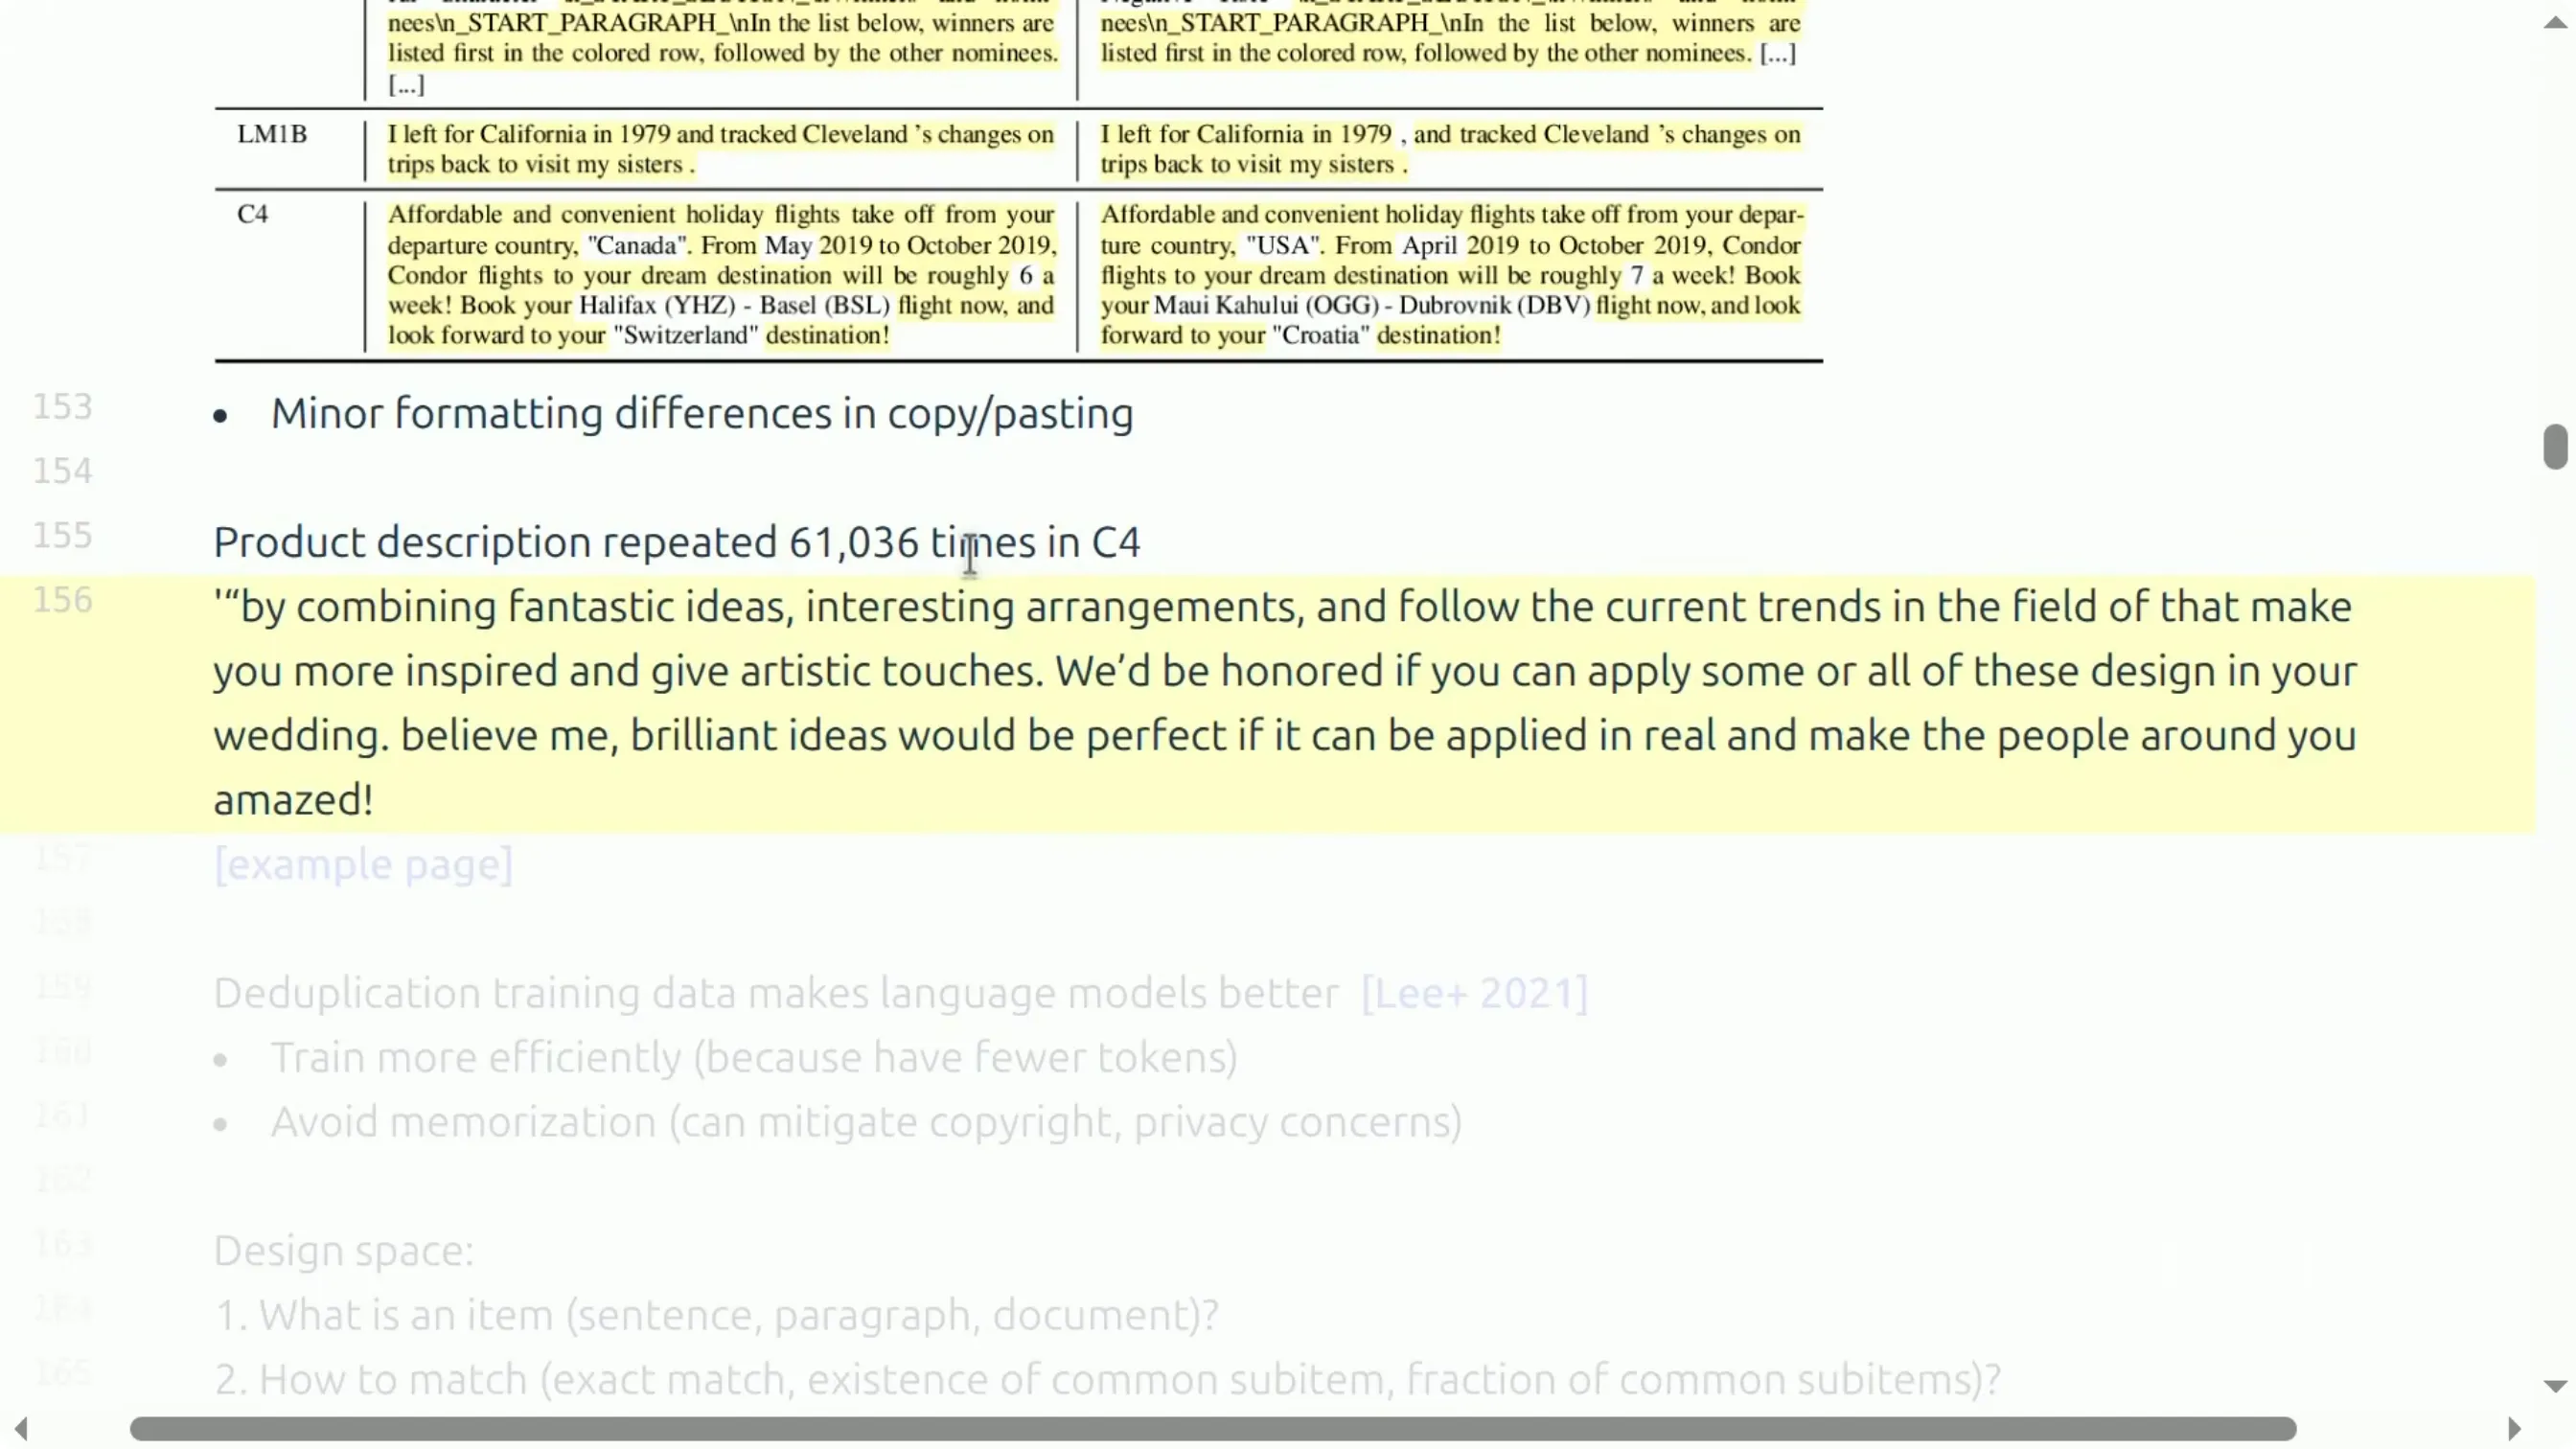
还有更极端的例子——这就是为什么「亲自看数据」很重要:
📷 C4 数据集中被重复 61,000 次的产品描述
回到原视频 (00:25:56)
(参考时间: 00:25:56) 对 C4 数据集(数据集页面,来自 T5 论文)的一次审计发现,同一段商品描述在数据集里出现了 61,000 次。追溯回去,那是某个防毒面具(gas mask)的描述,它就这么在 Common Crawl 里出现了六万一千次。嗯,网络世界就是这么怪。
3.2 为什么要去重
- 最直接的理由是训练效率:去重在不损失信息的前提下缩小数据集,从而节省 FLOPs;
- 另一个好处是避免记忆(memorization):如果你有大量重复的版权内容,模型就会把它背下来,还有隐私方面的顾虑;
- 但最主要的,我认为就是别把算力浪费在重复上。
还有一个相关且可以说更重要的操作:去污染(decontamination)。机制是一样的——你要确保你的测试集没有出现在训练集里。
3.3 设计空间
去重的设计空间要先想清楚三件事:
- 操作对象是什么粒度? 句子级、段落级、还是文档级?
- 怎么判定「匹配」? 是精确匹配?是存在共同的子项?还是共同子项所占的比例?
- 发现重复之后怎么处理? 是全部删掉,还是只保留一份?
而核心的算法挑战在于:去重本质上是「条目与条目之间的比较」。
对比一下:过滤关心的是「单个条目好不好」,它可以并行、是线性时间;即便是线性时间,我们也一直在用规则或极小模型把它做得更快。但去重显然不能做 $O(n^2)$ 的两两比较——你必须在网络规模上做线性时间的算法。
去重的文献里通常用哈希函数来解决这个问题。 接下来我们把这套想法展开——它们是很漂亮的技巧,来自算法社区。
3.4 哈希函数
我想所有人都知道哈希函数是什么:把一个值(比如字符串)映射成另一个值(字符串或整数)。哈希值比原条目小得多。哈希碰撞指的是两个不同的条目映射到了同一个哈希值。
哈希函数分两档:
- 密码学哈希:抗碰撞,用于密码学和比特币之类的地方;
- 更快的哈希:用于哈希表,碰撞不是世界末日。
我们这里用的是后者。
编者说明:这个区分在去重里非常重要。密码学哈希的目标是让碰撞尽可能不可能;而去重要用的是相反的思路——我们要碰撞,而且要有控制地让「相似的东西更容易碰撞」。这是第 3.7 节 MinHash 的全部要点。
3.5 精确去重
精确去重在概念上非常简单:取一个字符串,看有没有完全相同的,然后只保留一份。
具体做法是:把一堆元素各自哈希,然后按哈希值去重。这个操作看起来很直白,但有一个实现上的细节值得注意——它通常写成 MapReduce 风格,因为这样更容易并行化和扩展。
C4(T5 论文里处理 Common Crawl 的那个数据集)做的就是精确去重:操作对象是「三句话的片段(three-sentence spans)」,做精确匹配,只保留一份。
这里有个略奇怪的地方,如果你留心的话:既然操作对象是三句话的片段,那么发现两个文档含有同一个三句片段时「只留一份」,就意味着你会从那篇文档里硬生生挖掉三句话。这破坏了连贯性——但,他们就是这么做的。
3.6 近似重复与 Jaccard 相似度
精确去重很好、很清楚,但对脏兮兮的网页数据来说不够用,因为到处都是近重复。要做近似去重,第一步得先定义什么叫「近似匹配」。
我们用 Jaccard 相似度,这是个相当标准的定义。两个集合的 Jaccard 相似度是交集大小除以并集大小:
$$ J(A,B) = \frac{|A \cap B|}{|A \cup B|} $$
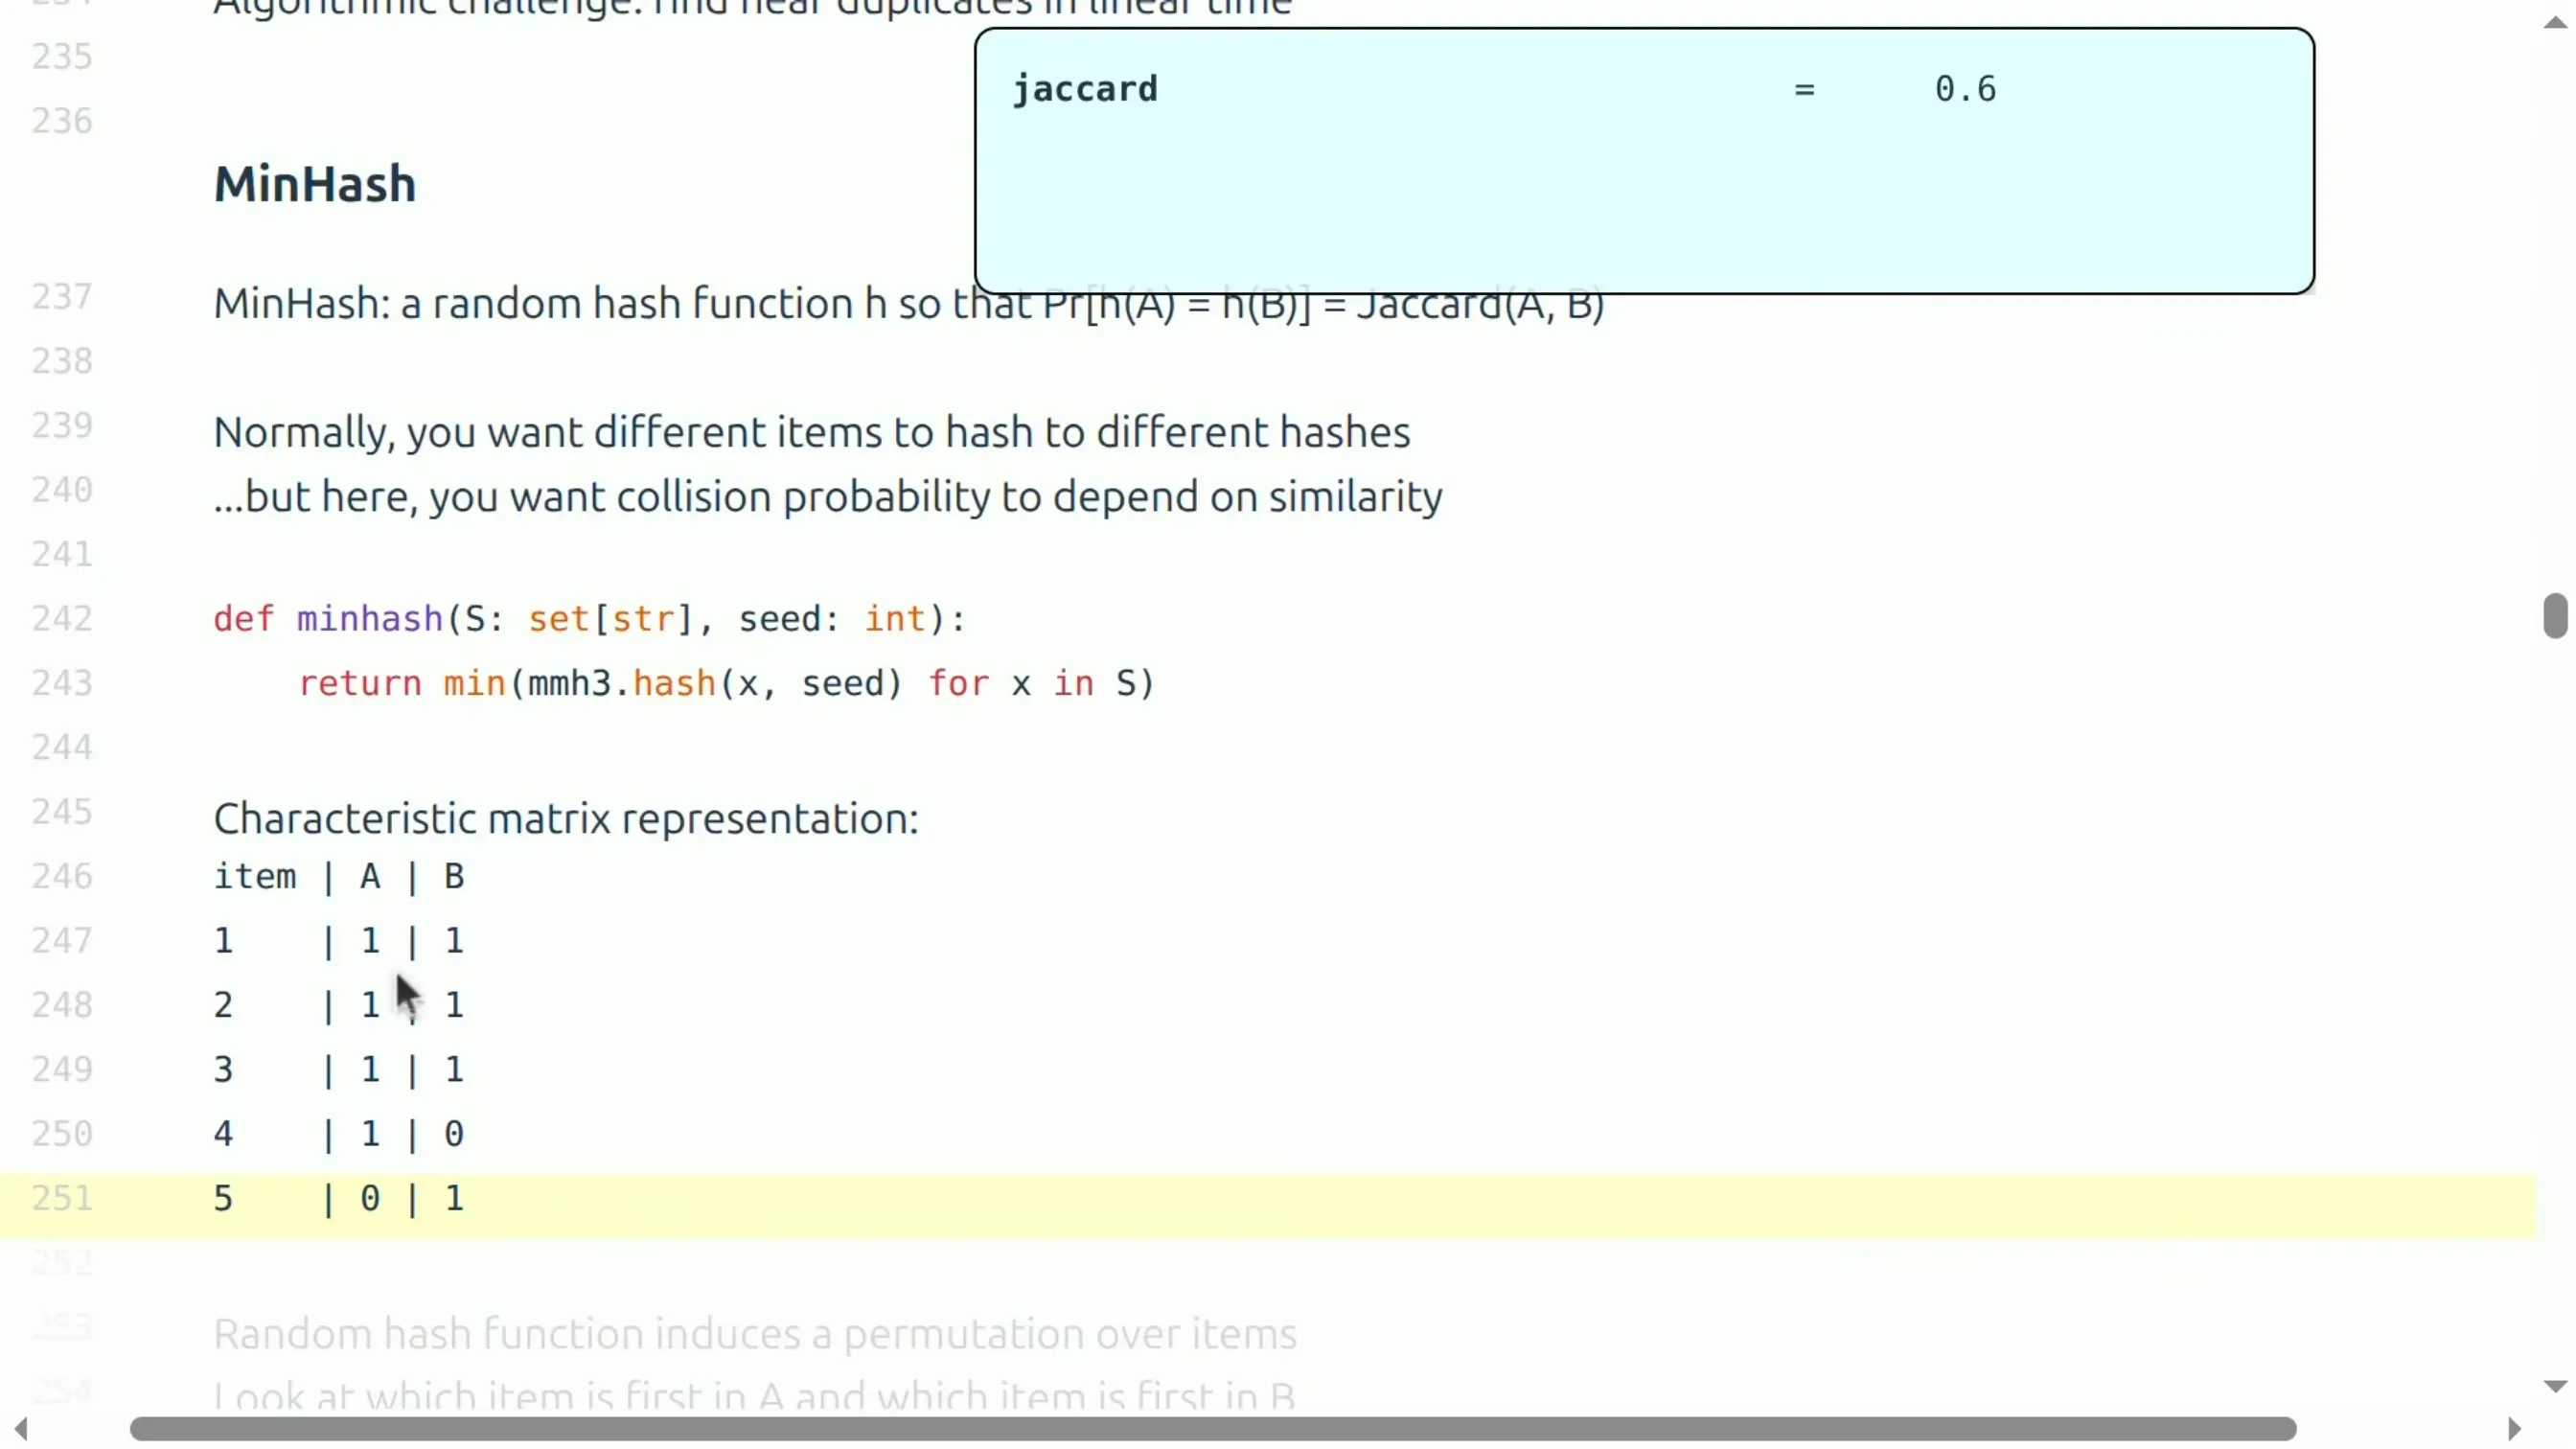
看个例子:$A = \{1,2,3,4\}$,$B = \{1,2,3,5\}$。交集是 $\{1,2,3\}$,并集是 $\{1,2,3,4,5\}$,于是
$$ J(A,B) = \frac{3}{5} = 0.6 $$
Jaccard 取值在 0 到 1 之间:0 表示两者不相交,1 表示完全相同。接下来我们就说:如果两个文档的 Jaccard 相似度高于某个阈值(比如 0.99),它们就是近重复。
那么问题来了:怎么在线性时间里找到这些近重复?
3.7 MinHash
幸好,这在算法上是一个已被解决的问题——答案是 MinHash。
MinHash 是一个随机哈希函数,它有一个非常好的性质:
$$ \Pr\big[h_{\min}(A) = h_{\min}(B)\big] = J(A,B) $$
也就是说,碰撞的概率恰好等于 Jaccard 相似度。
这个性质很漂亮,因为它把两件事连接起来:哈希是让我们能在线性时间里跑起来的东西,而 Jaccard 是我们想要的度量——我们正在让两者的期望对齐。
有意思的地方在于:通常我们希望哈希函数尽量不碰撞,不同元素映射到不同的值。但这里我们恰恰想要碰撞——不是随意的碰撞,而是受控的、和相似度挂钩的碰撞:相似的东西应该比不相似的东西撞得更频繁。
MinHash 本身很简单:取集合,对集合里的每个元素做哈希,然后取最小值。
第一次见到可能会觉得奇怪:为什么要取最小?其实取最大也行,它只是一个打破平局的方式。
📷 MinHash 的特征矩阵与随机置换
回到原视频 (00:34:23)
(参考时间: 00:34:23) 你应该在脑子里建立这样一幅图:$A$ 含 $\{1,2,3,4\}$,$B$ 含 $\{1,2,3,5\}$,把它们写成特征矩阵(characteristic matrix)。随机哈希函数所做的,是在这些元素上诱导出一个排列(permutation)——比如可能是 $4,3,1,5,2$,也可能是别的。然后你去看:按这个排列,$A$ 里第一个元素是谁,$B$ 里第一个元素是谁。
关键在于:每个元素成为「第一个」的概率是相同的。 于是:
- 如果这个随机哈希把 1 排在第一,那么 $A$ 的第一个元素和 $B$ 的第一个元素相同;
- 如果是 2,也相同;
- 如果是 3,也相同;
- 如果是 4,则 $A$ 的首元素和 $B$ 的首元素不同;
- 5 同理,不同。
把这三条「相同」和两条「不同」放在一起看,比值正是 $3/5$——也就是 Jaccard。
编者拓展|MinHash 为什么成立 用特征矩阵的语言重述一遍,更严谨:设全集为 $\Omega$,对每个元素 $x$ 赋予一个由随机哈希诱导的随机权重,取权重最小的那个元素为「代表元」。因为权重是独立随机赋予的,$\Omega$ 中任何元素成为「$A$ 的代表元」的概率都是 $1/|A|$,也即均匀。 现在考察「$A$ 的最小元素是否等于 $B$ 的最小元素」这个事件。记 $x^* = \arg\min_{x \in A \cup B} h(x)$,即并集里权重最小的元素。它是唯一的(哈希碰撞概率可忽略)。那么: - 如果 $x^* \in A \cap B$,则它同时是 $A$ 与 $B$ 的最小元素,两者相等; - 如果 $x^* \in A \setminus B$,则它是 $A$ 的最小元素,但不是 $B$ 的,两者不等; - 如果 $x^* \in B \setminus A$,同理不等。 又因为 $x^*$ 在 $A \cup B$ 上均匀分布,
$$
\Pr\big[h_{\min}(A) = h_{\min}(B)\big] = \frac{|A \cap B|}{|A \cup B|} = J(A,B).
$$
一句话记住:「最小元素落在交集里」的概率,就是交集占并集的比例。
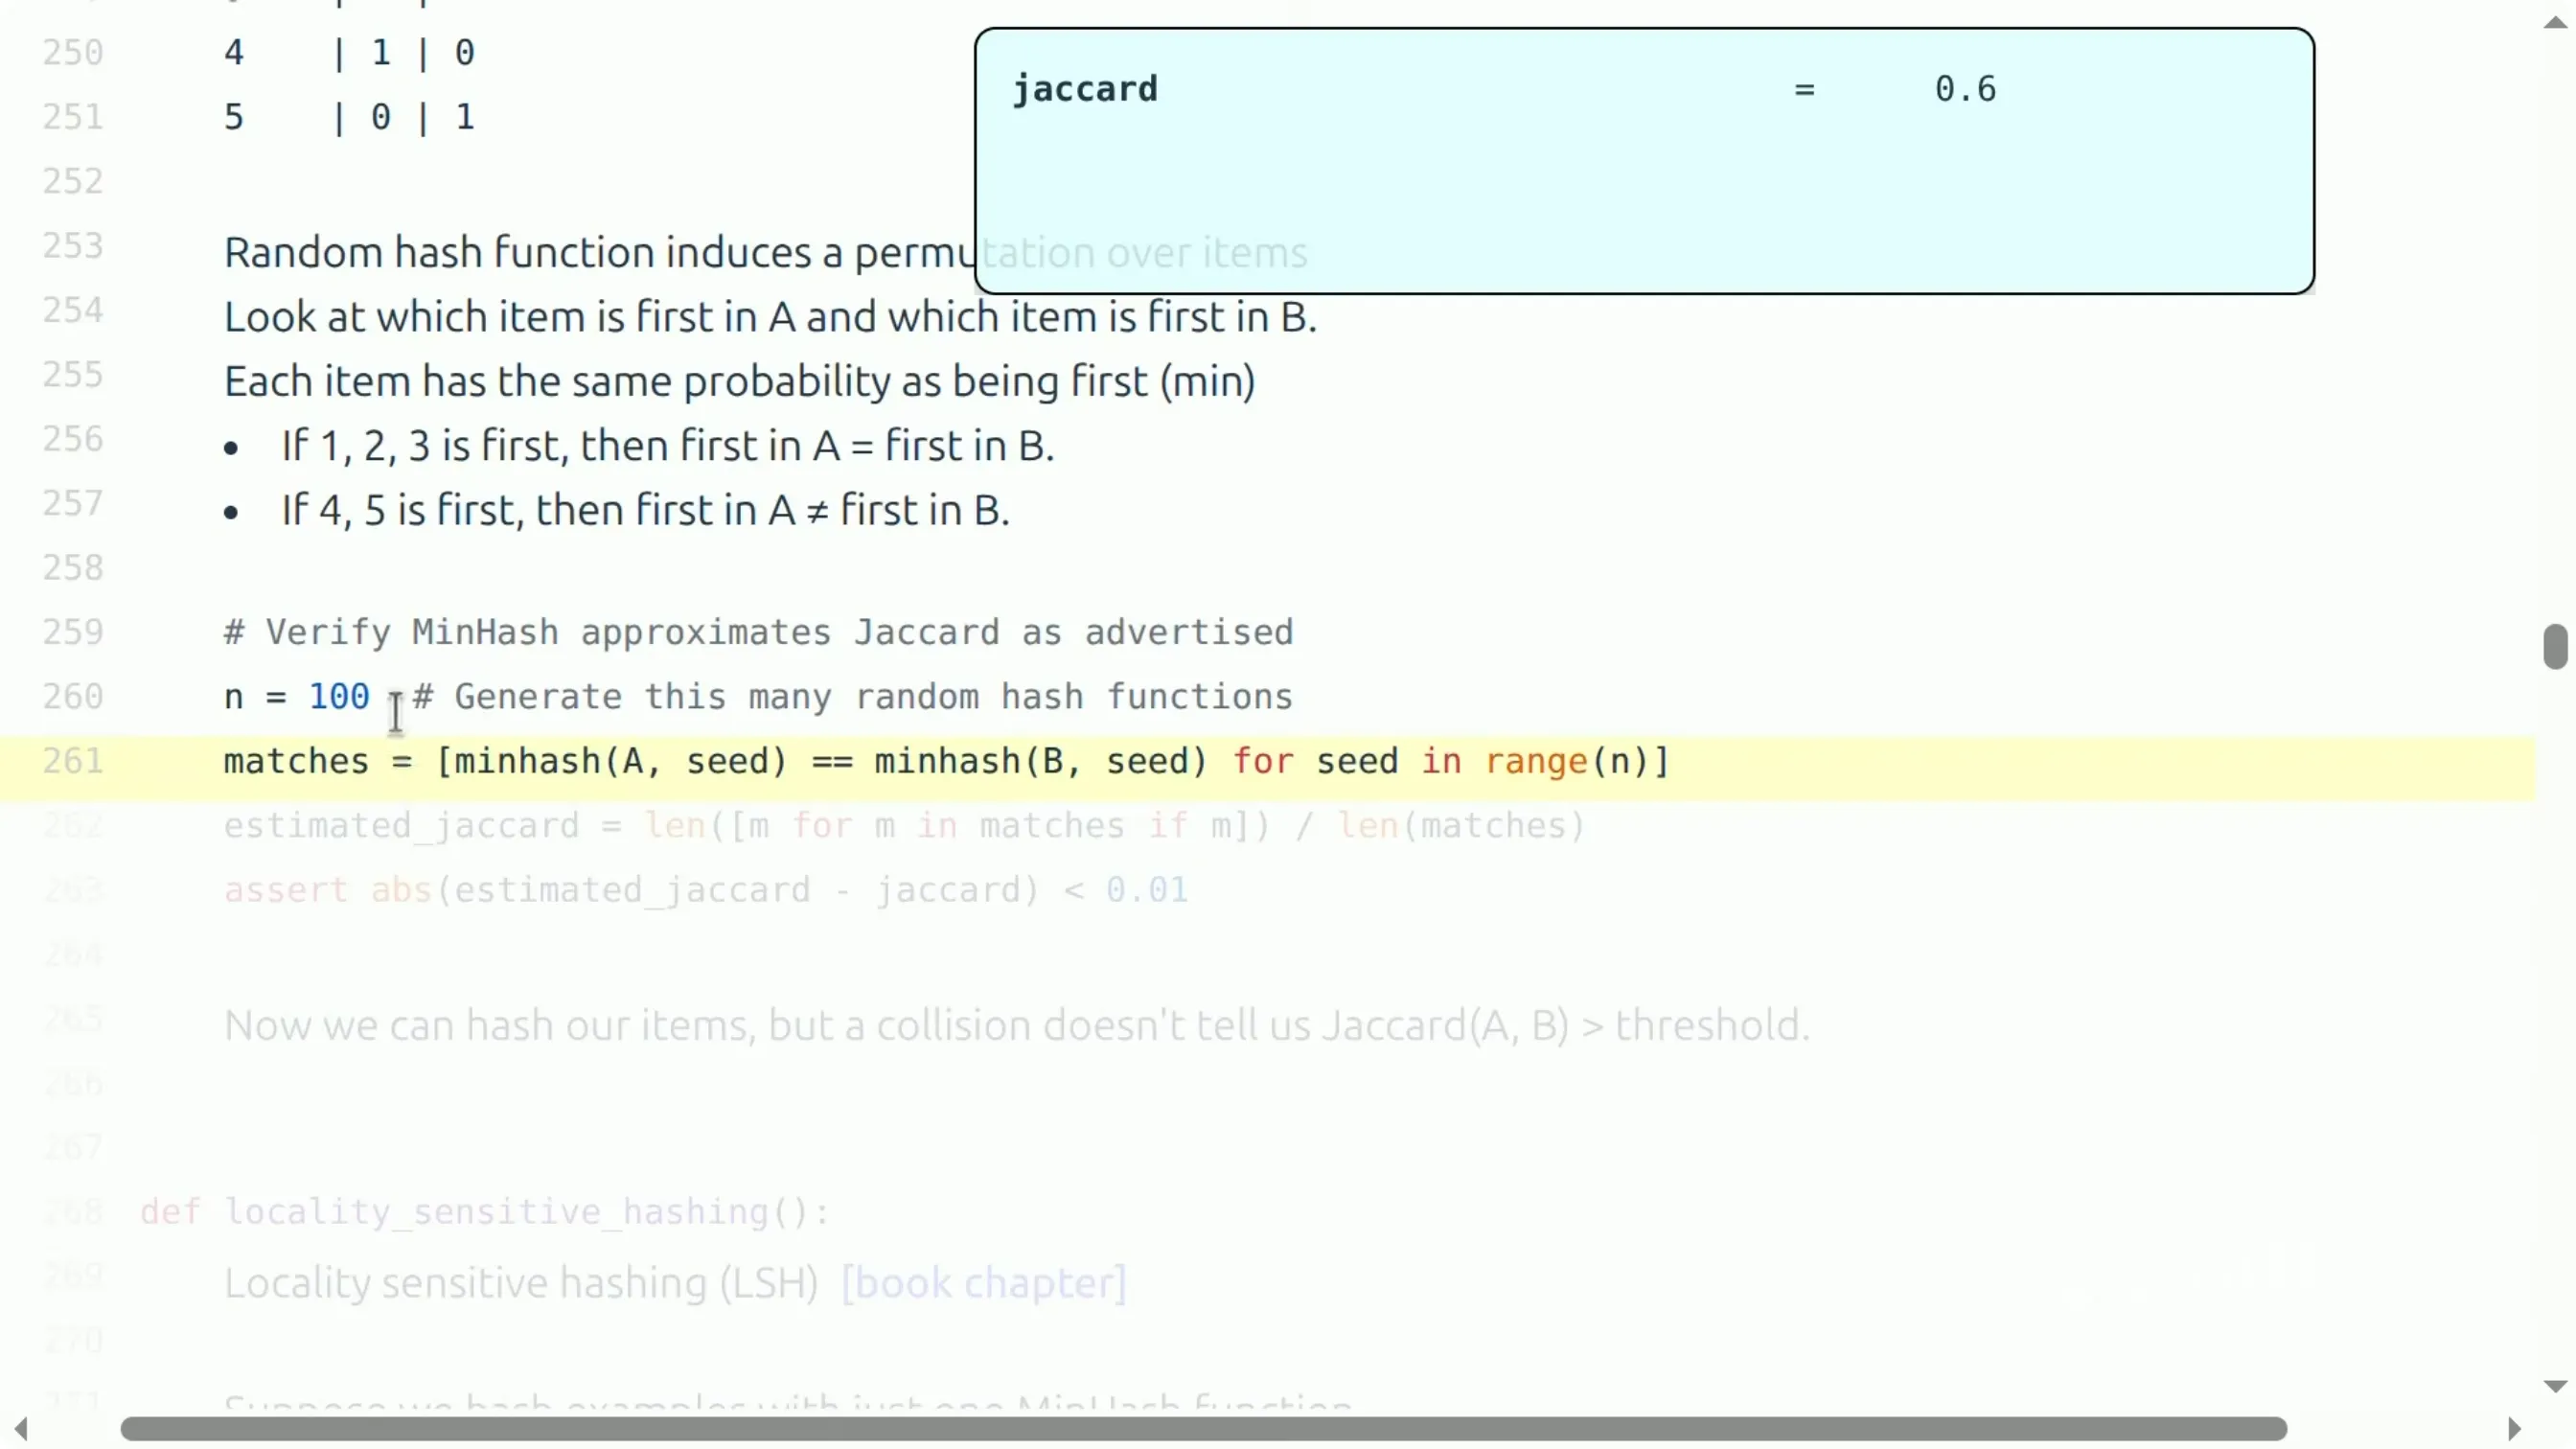
光说不算不放心,课堂上直接用代码验证了一下:
# 生成 100 个不同的哈希函数(每个由一个 seed 决定)
# 对集合 A = {1,2,3,4} 和 B = {1,2,3,5} 分别计算 MinHash
# 统计 minhash(A) == minhash(B) 的比例

num_hashes = 100
matches = 0
for seed in range(num_hashes):
    if minhash(A, seed) == minhash(B, seed):
        matches += 1

estimated_jaccard = matches / num_hashes   # 结果约为 0.6
📷 用代码验证 MinHash 估计的 Jaccard 相似度
回到原视频 (00:36:36)
(参考时间: 00:36:36) 统计出来的匹配比例是 0.6,与真实 Jaccard 一致。
MinHash 的关键好处是:我不需要做 $O(n^2)$ 的两两比较。我可以先算出 $A$ 的 MinHash、$B$ 的 MinHash、另一个集合的 MinHash,然后只需要去找碰撞就够了。
课上问答
问:关于 MinHash 还有问题吗?
(现场无进一步提问。)
3.8 LSH:把碰撞概率锐化成相变
现在我们可以给条目做哈希了,但还没结束。因为「碰撞」本身并不能告诉我们 Jaccard 高于某个阈值——而我们想要的恰恰是「找出所有 $J(A,B) > 0.99$ 的 $A$ 和 $B$」。
仅仅知道「碰撞的概率等于 Jaccard」,单看这一点并不够用,因为它是随机的、方差很大。我们的目标其实是:当 Jaccard 高于阈值时它们才碰撞。 从某种意义上说,我们得把这个概率锐化(sharpen)——概率不能字面意义上就等于 Jaccard。
解决方案是用更多的哈希函数,而且这些哈希函数要互相独立。方法是:
把 $n$ 个哈希函数切成 $b$ 个 band,每个 band 含 $r$ 个哈希函数。 比如 12 个哈希函数分成 3 个 band,每个 band 4 个:第一个 band 是 $h_1 \sim h_4$,第二个是 $h_5 \sim h_8$,第三个是 $h_9 \sim h_{12}$。
判定规则是:只要存在某个 band,其中所有哈希函数都给出相同的值,我们就说 $A$ 和 $B$ 碰撞。 换句话说,你不需要所有哈希函数都一致——这个「与 / 或」结构正是起作用的地方。
(参考时间: 00:42:56)
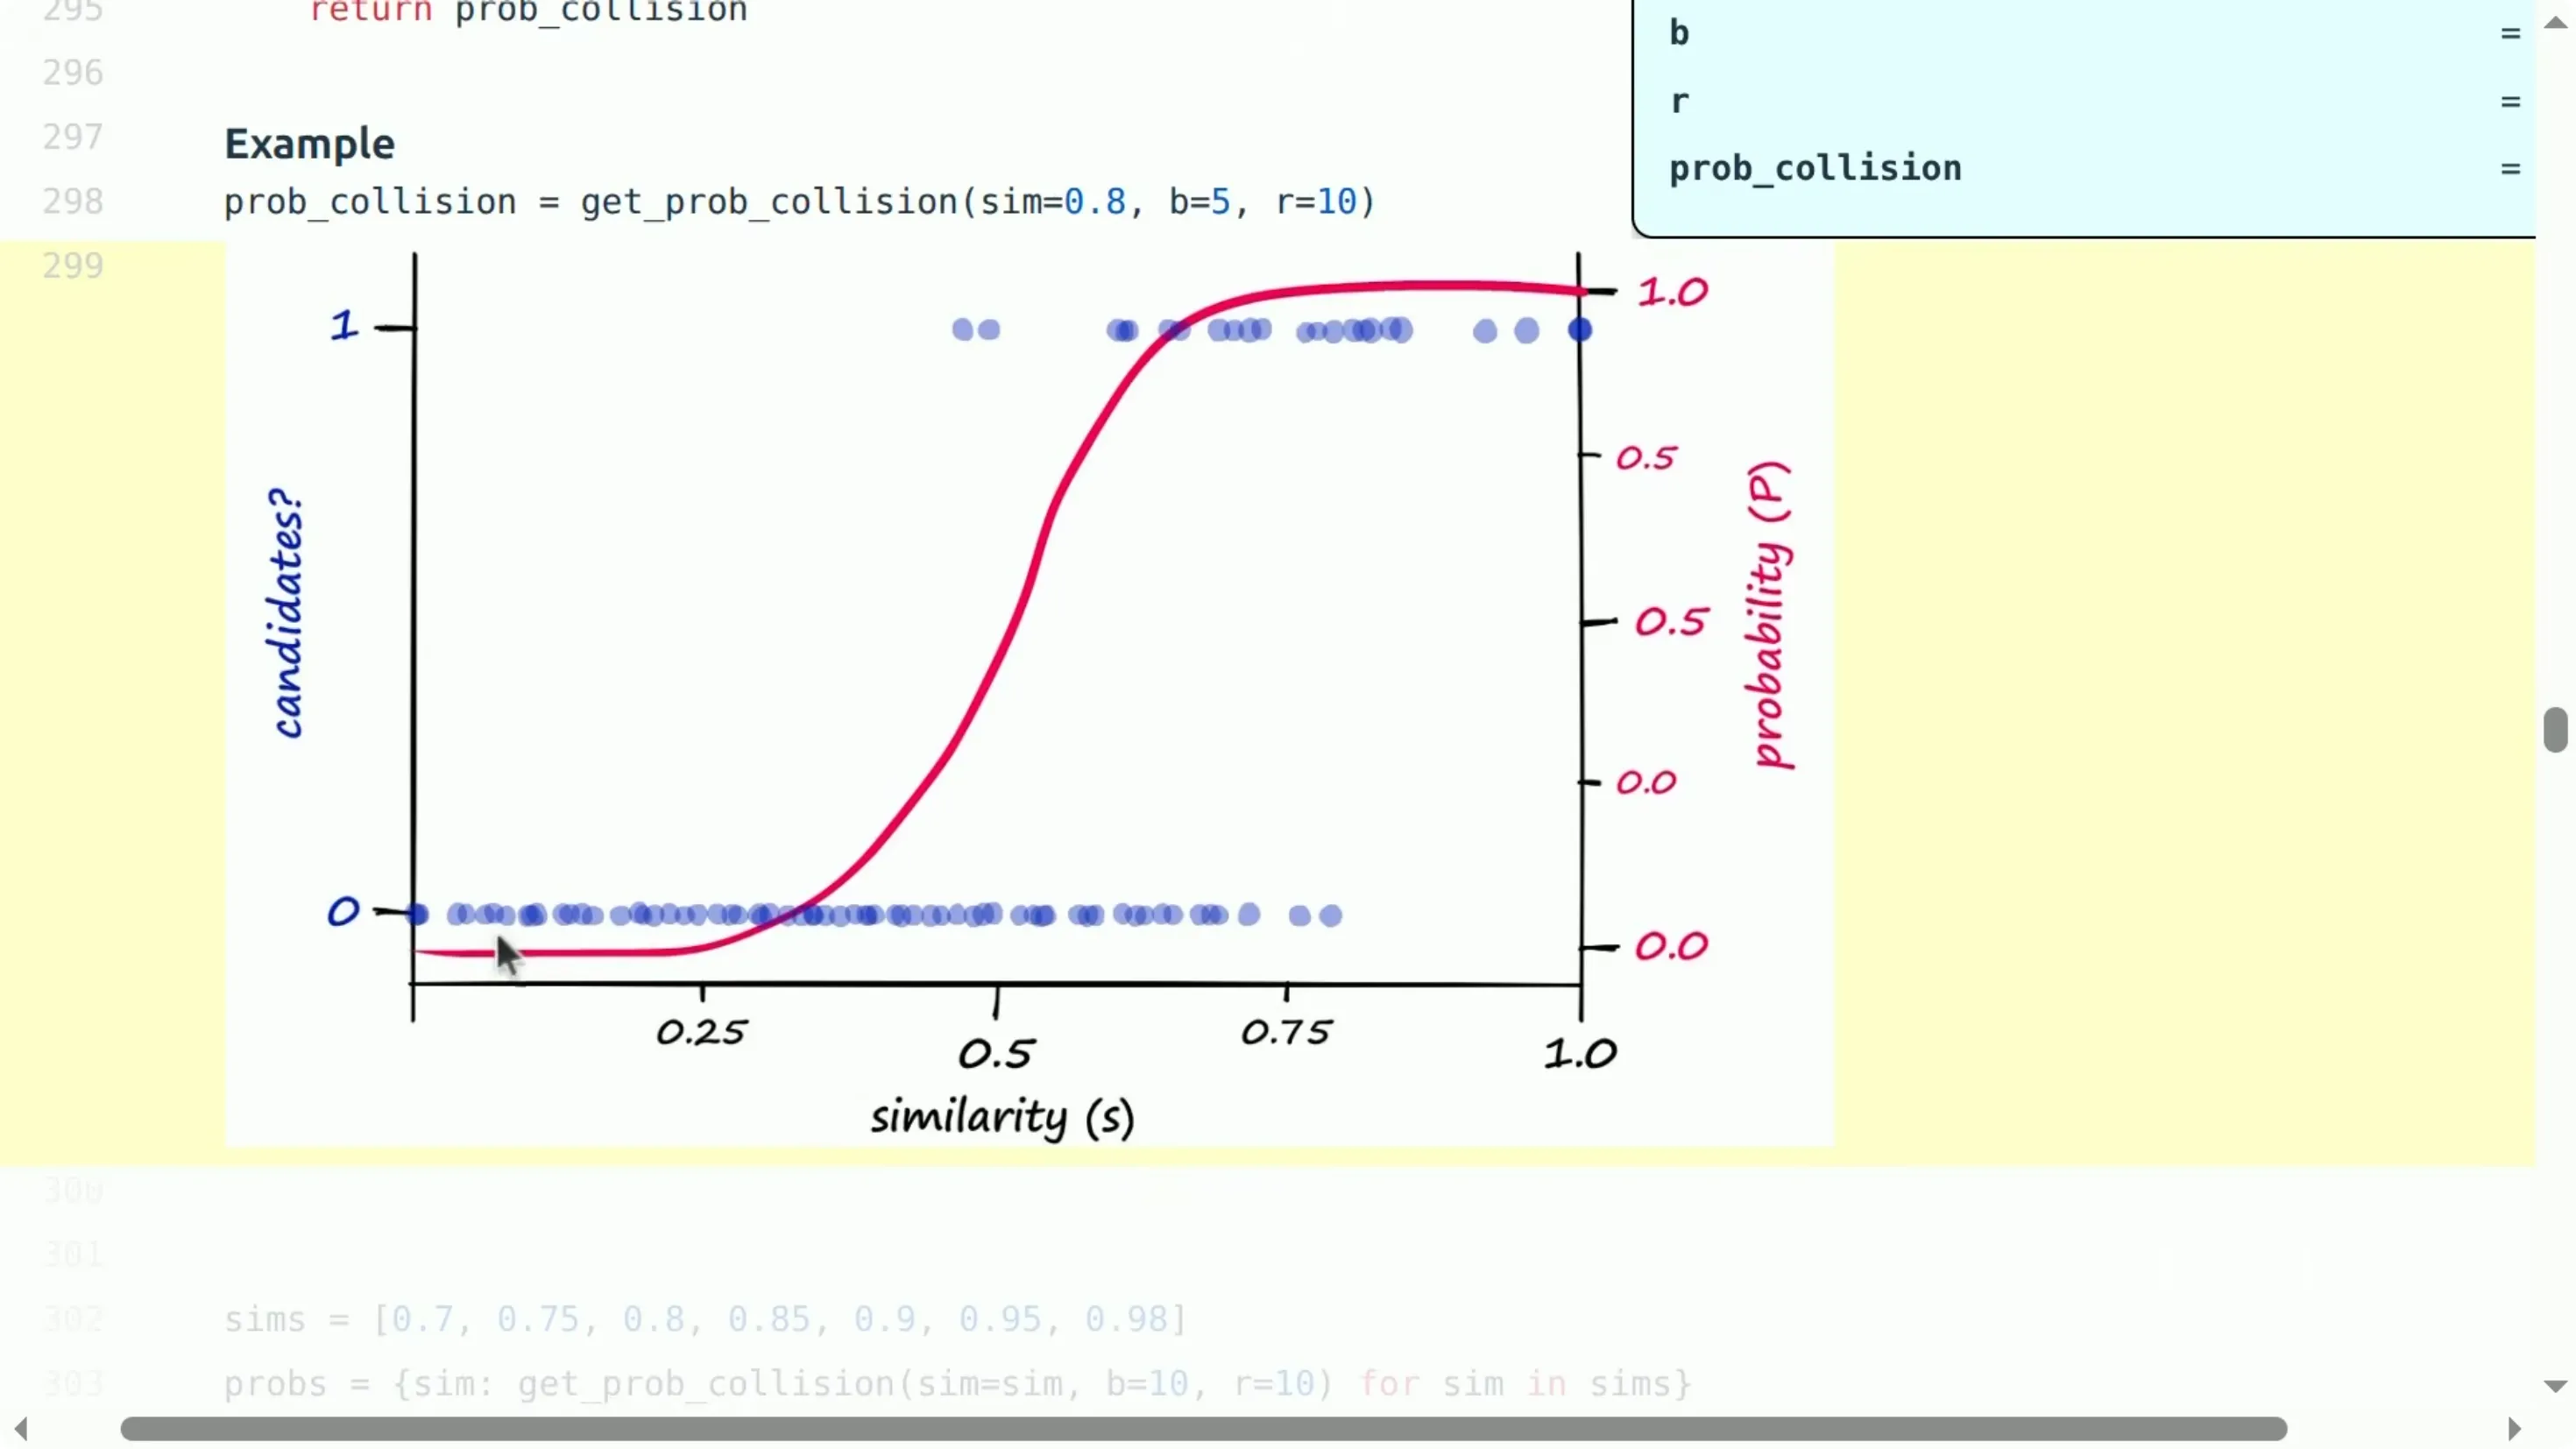
来算一下。假设 $A$ 和 $B$ 的 Jaccard 相似度是 0.8,我们有 $b = 5$ 个 band,每个 band 有 $r = 10$ 个哈希函数。
单个固定 band 匹配的概率是
$$ p_{\text{band}} = J^{\,r} = 0.8^{10} $$
因为 band 里 $r$ 个哈希函数必须全部匹配。注意它是关于 $r$ 的指数级,所以这个概率通常相当低。
发生碰撞的概率,则是「至少有一个 band 匹配」:
$$ p_{\text{collide}} = 1 - \left(1 - J^{\,r}\right)^{b} $$
其中 $\left(1 - J^r\right)^b$ 是「所有 band 都不匹配」的概率,1 减去它就是「至少有一个匹配」。
如果你把它画出来,会得到一条 S 形曲线:相似度为 0 时碰撞概率为 0,相似度为 1 时为 1,中间是一段陡峭的相变。这正是我们想要的:相似度低于阈值时,匹配概率尽量低;高于阈值时,匹配概率尽量高。 换句话说,我们是在把概率逼成一个相变。
举个具体的例子:相似度范围 0.7 到 0.98,取 $b = 10$、$r = 10$,碰撞概率大致从 0.25 到 1。如果你想设阈值,这已经不算差了——你可以在某处切一刀。切下去之后,阈值以下仍会有误判(false positive),因为它们仍可能碰撞,但这部分你可以再过滤掉;而阈值以上的基本都被保住了。
再看参数怎么影响形状:
- 增大 $r$(每个 band 内的哈希函数数):曲线会变陡并向右移动——所有东西都变得更难匹配,因为 band 内的哈希函数更多了,那个指数被锐化。刚才某个点还是 0.25,现在变成 0.08 左右。
- 增大 $b$(band 数):曲线会向左移动,变得更容易匹配——因为 band 越多,碰上的机会越多。刚才 0.9 处的匹配概率是 0.72,现在是 0.92。
所以:你可以通过增大 $b$ 和 $r$,把这段相变做得任意陡峭。 当然,$b$ 和 $r$ 增得太多,代价也会上去。
3.9 真实世界的参数与阈值
来看一个真实场景。在那篇去重论文里,他们用了 $b = 20$ 个 band、$r = 450$——你可以感受一下这些数字的量级。
更一般地,相变发生在下面这个阈值处:
$$ \theta = \left(\frac{1}{b}\right)^{1/r} $$
也就是说,如果你想按 $J > 0.9$ 来过滤,那你就要把 $b$ 和 $r$ 设成让这个式子等于 0.9,然后通过继续调整 $b$ 和 $r$ 把相变变陡。
在阈值这一点上有件事很漂亮:单个固定 band 匹配的概率恰好是 $1/b$,于是
$$ p_{\text{collide}} = 1 - \left(1 - \frac{1}{b}\right)^{b} \xrightarrow{b \to \infty} 1 - \frac{1}{e} \approx 0.632 $$
课堂给出的数值是 0.64。这也符合直觉:如果存在一个相变,那么相变的中心就在 0.64 附近;随着 $b$ 和 $r$ 增大,低于该点的一切趋向 0,高于该点的一切趋向 1。
这套方法叫 MinHash LSH。LSH 本身对任何哈希函数都通用;而在语言模型数据处理里,我们用的是 MinHash——它逼近 Jaccard,所以这就是你应该用的那个。
编者拓展|$b$ 和 $r$ 怎么选 两个约束同时作用: - 目标阈值 $\theta$ 由 $(1/b)^{1/r} = \theta$ 决定,即 $b = \theta^{-r}$。所以你先定阈值,再选 $(b, r)$ 这一对。 - 相变的陡峭程度由 $b$ 和 $r$ 同时变大来控制。一个常用的经验:固定阈值后,增大 $r$、同时按 $b = \theta^{-r}$ 相应减小 $b$,曲线会变陡,但计算量大体由 $n \cdot r$ 个哈希决定,$r$ 太大会很贵。真实系统(如那篇去重论文的 $b=20, r=450$)通常是「阈值极高(0.9 以上)+ 想尽量少花哈希」的折中。 顺带一提:$r = 450$ 意味着每个文档要算 9000 个哈希($b \times r$),这个量级也解释了为什么去重是流水线里最重的一环之一。
课上问答
问:关于 LSH 还有问题吗?
(现场无进一步提问。)
3.10 去重应该跨数据集进行
关于去重还有一点值得强调:数据集往往是陆续进来的,有时候去重只在单个数据集内部做,但你应该在整个数据集上做——因为不同数据集之间常常是冗余的。这件事很多时候并没有被做,但它应该被做。
4. 数据混合:给每个来源分配多少权重
(参考时间: 00:49:23)
4.1 问题设定
到目前为止,我们把原始 HTML / PDF 变成了文本、做了质量过滤、做了去重,于是手上有一份更小的高质量文档集合——而这一切通常是针对某一个数据源做的。
但语言模型是在多个数据源上训练的。比如在 Marin 项目里,那个网站上会跟踪「下一个模型将用到的不同数据源」,你能看到里面有 NeoTRON、有我们前面讲过的 FinePDFs、有机构书籍(institutional books)、还有一些代码。
📷 Marin 项目跟踪的各数据来源及其规模
回到原视频 (00:49:58)
(参考时间: 00:49:58)
问题就是:这些源怎么组合?
看一篇更早的论文——The Pile(论文):
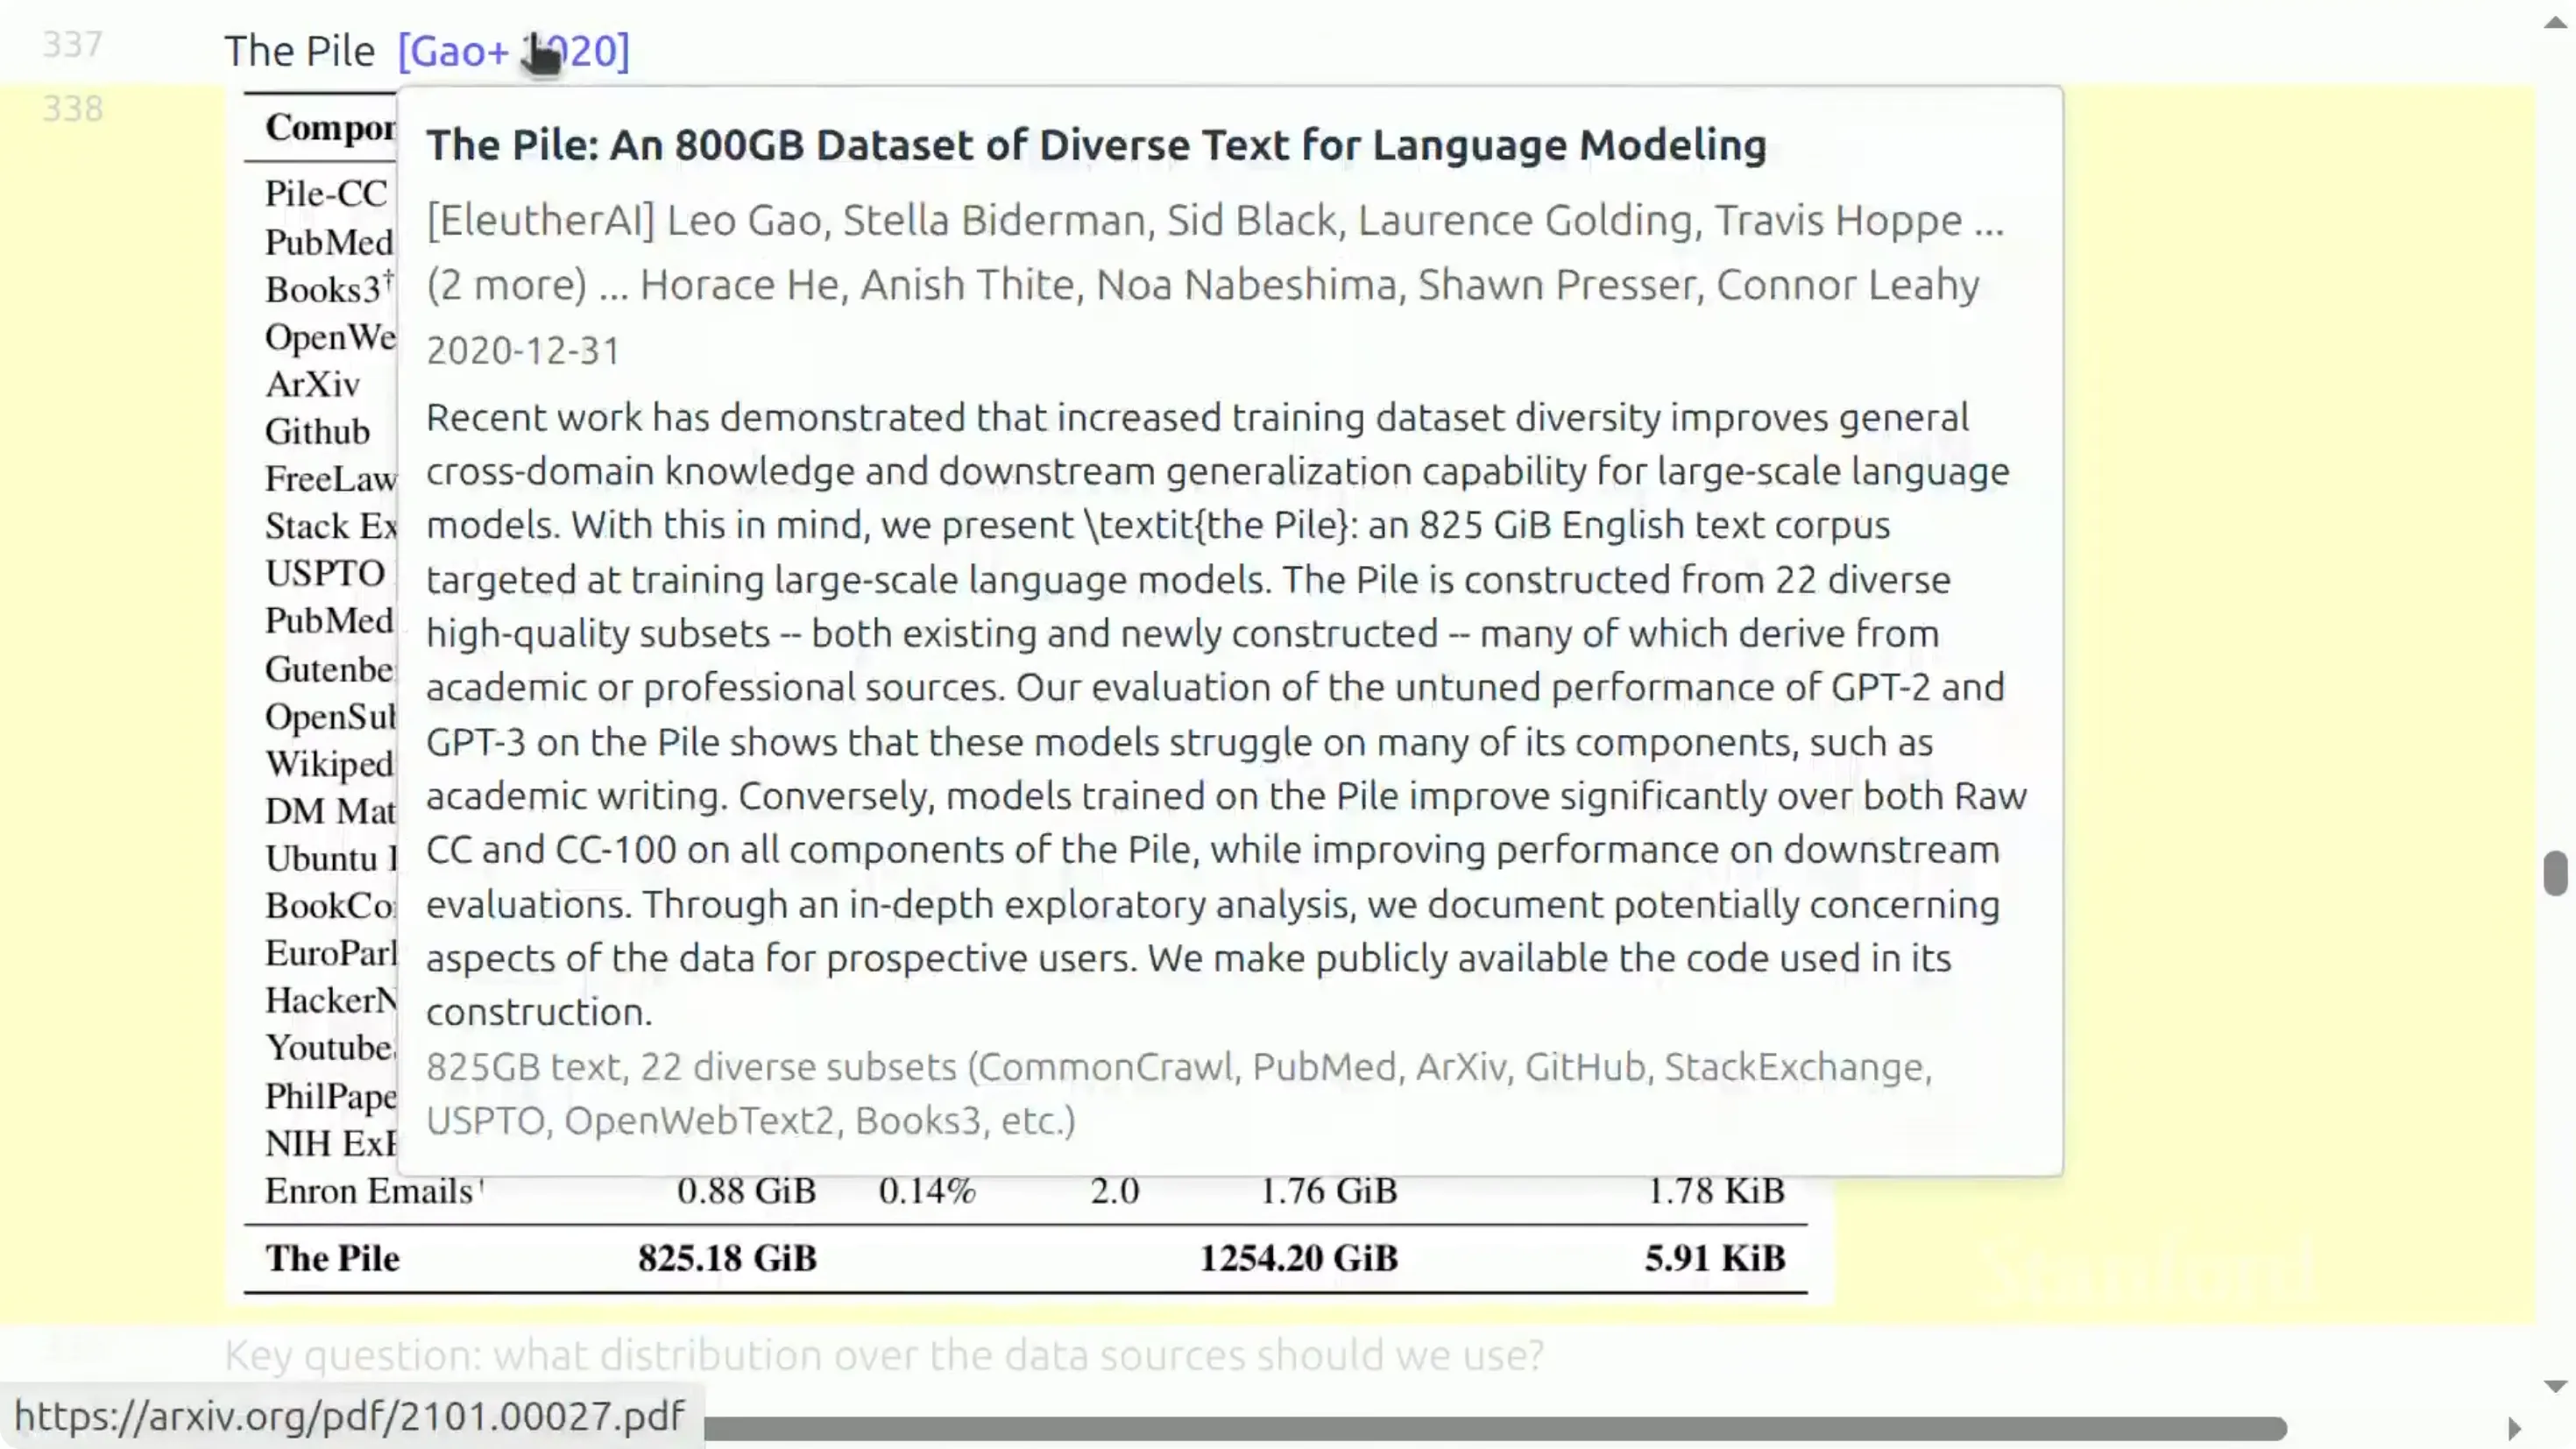
📷 The Pile 的数据来源与权重分布
回到原视频 (00:50:38)
(参考时间: 00:50:38) 本质上,它给每个组成部分指派了一个权重,也就是在数据源上的一个分布。那么问题来了:这个权重从哪来?
4.2 朴素方案及其问题
说白了,假设你有三个来源,你要找一个数据混合(data mixture)——它就是一个定义在数据源上的分布。
如果你完全按「感觉(vibes)」来做——准确说是「反第一性原理」——那就是凭直觉手工设定。而这比你以为的要常见得多。甚至更新的论文,也常常是先试个方法,然后手工微调。
其他朴素做法:
- 均匀采样:在每个源上放一个均匀分布,每取一个 chunk 就随机抽一个源;
- 按比例混合(proportional mixing):按源里 token 的数量采样,token 多的权重大。
按比例混合本身也还算合理,但你会担心一个问题:如果你有一个巨大的低质量数据集,它会把你的 token 预算全吃掉。 所以它看起来也不那么最优。
直觉上,你应该给更高质量的源更高的权重。
但有两件事必须记在心里:
- 你要保证多样性。 很多源之间是不可比的——比如文学、代码、论文。你没法说这篇论文比这段代码「质量更高」,它们根本是不同类型的对象。如果你希望模型什么都能做,就不能把全部权重压在论文上。
- 每个源其实是有限的。 如果你给一个很小的源太大的权重,你很快就会把它用完,然后不得不反复 epoch——一直训练在字面上完全相同的同一批 token 上。这很糟,原因后面会看到。
4.3 有限数据集与 epoch 陷阱
把第二点讲得更具体一些。假设你只有两个源:
- 一个低质量源,有 10 万亿 token;
- 一个高质量源,有 100 亿 token。
通常,高质量源就是更小的那个。
现在做一个很朴素的数据混合:均匀,也就是一半一半。并且假设我要训练 1 万亿 token。
先说明一点:「训练 1 万亿 token」不是指「1 万亿个不重复的 token」,它指的是「训练那么多步乘以 batch size」的等价说法。
那么每个数据点实际被训练了多少遍?
$$ \text{epochs}_i = \frac{p_i \times T_{\text{train}}}{|D_i|} $$
| 数据源 | 规模 $|D_i|$ | 权重 $p_i$ | 需要抽取的 token | 实际 epoch 数 |
|---|---|---|---|---|
| 低质量 | 10 T | 0.5 | 0.5 T | $\frac{0.5\text{T}}{10\text{T}} = 0.05$ |
| 高质量 | 10 B | 0.5 | 0.5 T | $\frac{0.5\text{T}}{10\text{B}} = 50$ |
看结果:
- 低质量源的 epoch 数是 0.05——这意味着这个低质量数据集里只有 5% 的 token 会被碰到一次;
- 高质量源的 epoch 数是 50——因为我要抽 5000 亿 token 的高质量数据,而手上只有 100 亿,所以每个数据点要被重复 50 遍。
这一点非常重要。 事实上,有些大模型的训练确实在这个地方栽过跟头:你不能天真地看着几个数据集、定义一个分布、然后照采样——你漏掉了「一共有多少数据点」这件事。
课上问答
问:为什么非得 50 个 epoch?
答:你并不需要 50 个 epoch。最好的情况是在浪费算力,最坏的情况是在过拟合。 但之所以会是 50,是因为——如果你就这么定义一个数据混合然后开跑,你会在完全不知情的情况下做出 50 个 epoch 来,除非你非常仔细地盯着。
问:训练的时候这个混合是怎么落地的?是每一步切换一次吗?比如「这一步训 10 个 batch 的代码、那一步训 10 个 batch 的论文」?这里有什么直觉吗?
答:好问题。你要填满一个 batch,所以大体上你是在为 batch 中的每个位置采样它来自哪个混合分量,然后用该分量的序列把 batch 填满。通常「一条序列只来自一个混合分量」,不是按 token 采样的。
追问:所以每个 batch 内部是混合的,然后就这么训练——不是「这一步全是代码、下一步全是论文」?
答:对。一般来说,为了降低方差,你会希望一个 batch 内部是有混合的。
4.4 UniMax:均匀采样 + epoch 硬上限
这个问题很早以前就被注意到了。在一篇论文里,他们提出了 UniMax——当时的场景是训练多语言模型,有些语言资源非常少,这个问题表现得极其明显。
以前的做法是:先按比例混合,再把分布取某个幂次来把它「压平」。这篇论文的思路则更明确:
均匀地采样各个源,但对 epoch 数设一个硬上限。
也就是说:我最多在某个数据源上跑 20 个 epoch。跑满了?那抱歉,你拿不到更多 token 了,直接切到下一个。 这在某种意义上是一张安全网。
写成约束就是:对每个源,权重乘以训练 token 总数,必须小于等于这个上限:
$$ p_i \cdot T_{\text{train}} \le c \cdot |D_i| $$
而且有一个很简单的过程可以直接求出满足这个约束的混合配比。
4.5 回归式混合:用小模型搜索最优配比
现在我们换一个角度:这个混合配比最初是怎么定出来的? 如果有一五十个源,你要填 50 个数字。按比例混合不够,你也许可以去估一个质量指标、然后按它采样——但那同样是启发式的。
最有原则、也最容易理解「到底在发生什么」的方法,是回归式混合(regression-based mixing),比如 RegMix 以及后续的工作(课堂里提到的那篇叫 OLMix)。
思路本身很简单:
- 你要训一个大规模模型;
- 先走到小规模去——比如 3 亿参数;
- 用不同的数据配比去训练,也就是训一群小模型(a swarm of small models);
- 每个小模型在某个目标指标上给你一个损失——可以是下游评测,也可以是困惑度,随你;
- 用这些数据点拟合一个回归:输入是数据配比权重,输出是损失;
- 现在你就有了一个很便宜的模型,可以告诉你「如果我按这个配比训练,损失会是多少」;
- 于是你可以对这个函数做优化,求出最优的数据配比;
- 用这个最优配比去训练大规模模型。
graph TD
    MIX["采样一批数据配比"] --> PROXY["训练一群小代理模型<br/>约 3 亿参数"]
    PROXY --> LOSS["得到每个配比的损失 / 指标"]
    LOSS --> REG["拟合回归:配比 -> 损失"]
    REG --> OPT["优化该回归函数<br/>求最优配比"]
    OPT --> BIG["用于大规模模型训练"]
你会注意到它和缩放定律(scaling laws)很像:先做一些便宜的计算去求出答案,然后再放大。
这里有几个设计决策:
- 你要试哪些配比? 你需要一个定义在分布上的分布,常用 Dirichlet 分布;
- 回归方法是什么? 有人用线性模型,有人用提升决策树(boosted decision trees);
- 目标是什么? 常常是下游评测——这时就必须非常小心,别过拟合。因为预训练本来是要训一个通用模型,而不是去拟合某些下游评测。如果你不小心,比如你手里有一堆代码评测,那么猜也猜得到——你会把所有代码数据的权重都抬上去;然后你让它写诗,可能就傻眼了。所以这一点要非常小心。相对地,按比例混合和均匀混合没有这个问题,因为它们根本不看下游评测;
- 小规模和大规模之间差距多大? 这是一个成本与准确度的权衡。训太小的模型可能没有代表性;但训很大的模型来做这件事,那就没意义了——你等于在做最大规模上的超参搜索,太贵了。
OLMix 那篇论文有一张很好的表,把一系列方法都放进这个框架里对比:
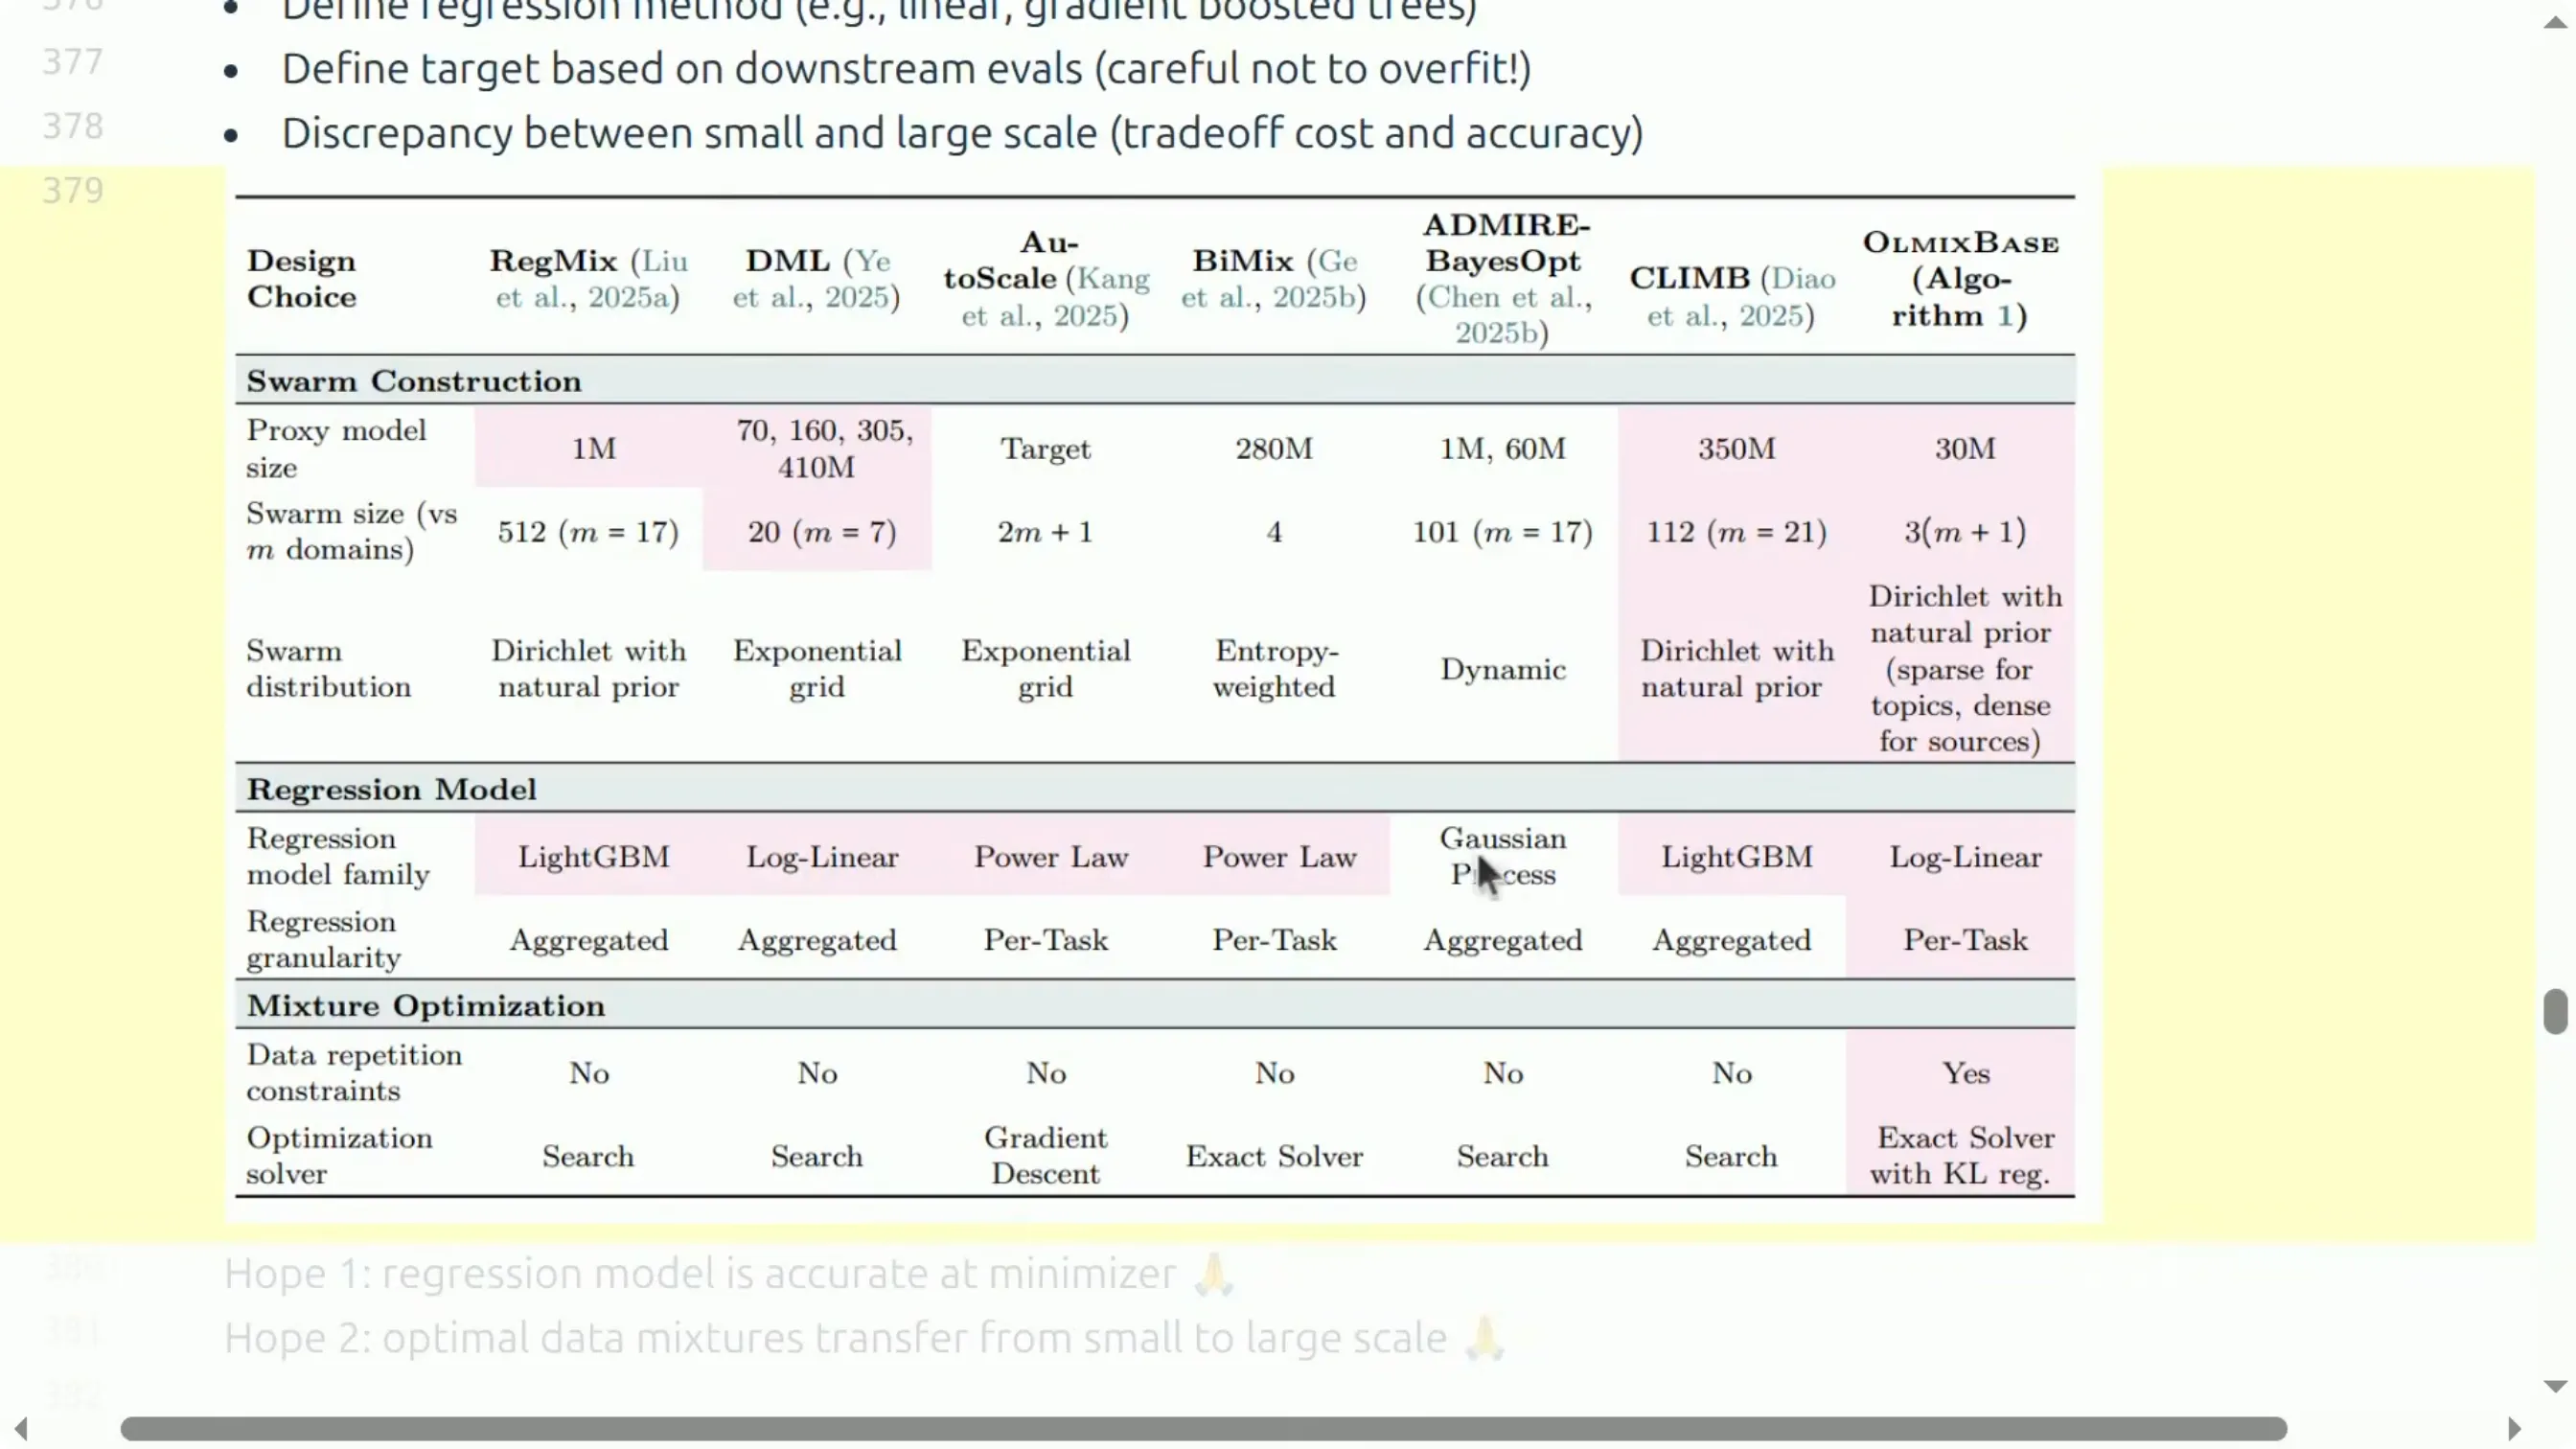
📷 OLMix 论文中各种混合方法的代理模型规模与采样数对比
回到原视频 (01:03:58)
(参考时间: 01:03:58) 表中给出:各类方法的代理模型规模(一般是几千万参数量级)、采样了多少个混合配比($m$ 这里是指域的数量)、可以用 Dirichlet,也可以用 exponential、回归模型可以拟合一个 log-linear 模型(通常效果不错),以及不同的求解优化问题的方式。
4.6 两次「信仰之跃」
上面这套流程里有两次信仰之跃,你得非常小心:
- 拟合出来的回归模型,在你找到的最小值点附近还准确吗? 回归模型是在一批小代理运行上训出来的,现在你要对它做优化。如果你随机采一个配比,大概率没问题——按经典泛化理论,你采样、拟合,它应该能在分布内预测。但当你在做优化时,你实质上是在往极端走,那里你可能没有多少覆盖。
- 小规模上的最优配比,能迁移到大规模吗? 在开放社区常用的规模上,这看起来大体成立,或者至少不是明显错误。但显然存在尺度相关效应——回想刚才讲过滤那张图:如果你要训多得多的 token,那么低质量数据大概是可以接受的。所以最优解肯定不完全一样,只是这里你只能寄希望于它差不多。
4.7 尺度效应与「模拟 epoch」
有一个尺度相关效应我们已经提过,但这里必须处理掉。
设想:10 万亿 token 的低质量数据 + 100 亿 token 的高质量数据。如果你在小模型、低 token 数上训练(没有 epoch),你可能会把大量权重压到高质量数据上——因为在这个规模下你还没 epoch,于是心想「哇,Wikipedia 太好了,那就全训 Wikipedia 吧」。这是一个编出来的例子,但方向是对的。然后你拿着这个配比去训大模型,就会在高质量数据上做大量 epoch,然后过拟合——这毫无疑问很糟。
有两种修法:
(一)给 epoch 数设上限,就像 OLMix 所做的那样。
(二)模拟 epoch(simulate epoching)。 这条原则是:让你的小规模看起来像你的大规模。 这是本课程反复出现的一个主题——比如 Tatsu 讲 μP 时也是这个思路:你重新参数化模型,好让超参数能够迁移。 同样的原则在这里适用。
问题出在:你不能「小规模不 epoch、大规模狠狠 epoch」,因为那两者在数据集上是性质完全不同的操作。处理方式是:按比例对各个源做下采样(downsample)。
比如你的小规模跑 100 亿 token,大规模跑 1 万亿 token,那就是百分之一的降采样。然后你用这个降采样后的配比。
妙处在于:在降采样后的数据上,「全训 Wikipedia」这个解就不再好看了——因为你只会在一个极小的 Wikipedia 子集上训练,你会意识到「我得做很多 epoch,损失会很糟」,于是优化过程自然会去找更平衡的方案。也就是说,你在小规模上「模拟」出了大规模才会遇到的数据稀缺。
编者拓展|μP 与这一节的类比 μP(Maximal Update Parametrization,论文)解决的是另一件事:宽模型的每一层该用什么学习率、初始化方差该乘什么系数,才能让小宽度上调好的超参直接搬到大宽度。它的做法是改变参数化,使得「小模型的学习动力学」在某种意义上等同于「大模型的某个切片」。 这里「模拟 epoch」是同一个哲学的数据版:如果你想从小规模外推,就得先让两个规模在「数据被使用的方式」上同构。不 epoch 和 epoch 50 次,是两种不同的学习问题——把它们对齐之后,外推才有意义。
4.8 小结与问答
总结这一节:问题是怎么给不同来源加权——你有 Wikipedia、有 Common Crawl、有代码、有从某处爬来的数学数据,怎么平衡它们?
回归式混合是一个很好的思考框架:在小规模上估计一个「混合权重 → 损失」的函数形式,做优化,然后推广到大规模。而你必须非常小心,因为有 epoch 和过拟合的问题——要么用带上限的 epoch,要么用模拟 epoch。
再强调一次那条教训:如果你要优化任何东西,都要非常小心,因为你处在「优化错误目标」的风险之中。
课上问答
问:如果下采样,会不会出现某个源太小、小到没法好好泛化的问题?
答:完全会。你可能会陷入「token 实在太少」的情形。我想那时候会发生的是:你的最优解会给它分配非常小的权重,而等你放大规模,也许又能取到正确的 token 集合。所以原则上是可以自洽的;但可能存在舍入误差——比如本该训一遍的数据,意外地被训了零遍。这可以绕开:永远保证每个源至少被训一遍。
问:数据混合只作用于「源」这个层面吗?我能不能拿一个本身很多样的数据集,在它内部再做混合?
答:好问题,谢谢你提到它,我差点忘了讲。在 NeoTRON 那篇论文(以及一些 OMO 相关工作)里就是这么做的:你可以把 Common Crawl 拆开。AI2 的人做了 web organizer,可以按域名分组,也可以按主题分组,还可以按质量过滤。于是你就得到一个二维网格:一个维度是 domain、一个维度是 quality,网格里的每个格子都是一个可以去数据混合的对象。这是一种自动确定 domain 的方式,在这之上再把别人手工交给你的额外数据源叠加上去。
5. 后训练数据:合成数据与智能体轨迹
(参考时间: 01:12:57)
5.1 从 task-agnostic 到 task-dependent
接下来我快速过一遍后训练数据。
前面讲的都是预训练(或者中训练)数据,它们大体上是任务无关的——除了 RegMix 那部分你在最小化某个损失,数据本身仍然是相对任务无关的,目标是培养基本能力。而到了后训练,很多数据变得非常任务相关。
我不会做全面综述,只想指出一些最近发布的有意思的后训练数据集,尤其是编程方向的,因为这是当下大家最关心的。
5.2 通用配方
通用配方是:
- 定义一组环境——以代码为例,就是 GitHub 仓库;
- 定义一组任务或提示词;
- 从强模型或教师模型那里收集回答。
隐含地说,在开放社区里,几乎所有后训练数据都是合成的。你也可以把「强模型」换成人类,但那很慢、很贵——如果你在前沿,几年前的你就得花大价钱雇很多人来给你写回答。而如今,即使在前沿,也可以做「人机混合」。但要点是:总得有一个「教师」在给你回答。
5.3 Open Thoughts:推理数据的规模化
📷 Open Thoughts 的数据生成流水线
回到原视频 (01:17:18)
(参考时间: 01:17:18)
第一个例子是 Open Thoughts。它的动机来自 o1 发布时,大家对推理的关注——主要是在数学和科学上:怎么为这类能力搞到非常好的后训练数据集?他们最终产出了 120 万个样本,全部来自教师模型。
流程是:
- 先确定环境、任务和问题。 他们从很多不同的来源抽取:有人类来源,比如 Stack Exchange、NuminaMath;也有一些合成来源。这里展示的只是编程类的一个子集,此外还有数学和化学的。这是个由很多人共同参与的大项目。
- 你能看到里面有些是编程练习,有些是更真实的东西——比如代码审查(code review),这大概是更贴近现实的任务;代码高尔夫(code golf)就不太现实了,但也有一些更真实的例子。
- 他们对「给定这个数据集,该怎么生成回答」做了相当全面的分析,结论包括:
- 用少数几个来源其实就有好处;
- 与其试图覆盖所有来源,对同一个问题采样多次生成(比如 16 次)更有帮助;
- 一个有意思的发现是:更强的模型不一定是更好的教师。比如 QwQ-32B——如今已经是个又老又小的模型——在当年比 DeepSeek-R1 更适合当教师,而 R1 在那时大概是最强的开源模型之一;
- 基础的答案过滤(answer filtering)没有帮助。
整条流水线大致是:一堆来源进去 → 随机下采样问题 → 对每个问题生成多个回答 → 进入最终数据集。所以 120 万这个数字是「样本数」,除以 16 才是「真正的问题数」。
5.4 SWE-Smith:自动从仓库生成任务
上面那个是数学、科学加一部分代码。最近大家更感兴趣的是「智能体式编程(agentic coding)」——不是只会生成代码片段,而是能真正做软件开发的模型。
SWE-Smith 那篇论文的想法是:给定一个仓库,用语言模型自动生成任务。 他们有一个智能体,拿到仓库后先把它变得「可用」——比如装好依赖等等。然后生成任务:一般是对代码做某种修改,比如故意引入一些 bug,这些任务会经过验证,最终得到一批任务实例。这是合成任务,但你能得到大约 5 万个——在当年(去年)这已经相当大了。
5.5 SWE-Zero:不执行代码也能学
接下来是来自 NVIDIA 的 SWE-Zero,它的观察很有意思:不像数学题,软件工程任务有大量沉重的依赖。 大多数 GitHub 仓库根本跑不起来,你得装一堆依赖,而且如果你回滚到某个 PR 的那个时间点,依赖就全部过期了——简直是噩梦。
于是他们想:能不能搞一个可以覆盖所有仓库的数据集,而不需要给每个仓库做专属的 Docker 镜像? 他们发现,模型已经足够强,可以在没有执行反馈(execution feedback)的情况下解掉很多任务。看数据就知道:如果允许执行,能到 80 左右;不允许执行,也能有接近 70——在不能跑代码的情况下,这已经不错了。也就是说,这些模型对代码已经有了某种内部的语义理解。
于是他们生成了 30 万条智能体轨迹,而且全都是真实的 GitHub PR(不像 SWE-Smith 那样是合成任务,所以更真实)。他们用了 OpenHands 这个脚手架,并且花了大量精力做细节,比如防止智能体作弊(agent hacking)。通常你会给智能体这样的指令:「探索、测试、实现」;而他们某个版本的指令基本是在说:你不能运行 Python 代码,你只能用 set、grep 这类基本操作。
graph TD
    A["真实 GitHub PR / 仓库"] --> B["不依赖 Docker 执行反馈<br/>仅凭模型的代码内部语义"]
    B --> C["30 万条智能体轨迹<br/>SWE-Zero"]
    A --> D["少数任务可用执行反馈"]
    D --> E["1.3 万条轨迹<br/>SWE-Hero"]
    C --> F["第一阶段微调"]
    E --> G["第二阶段微调"]
    F --> G
然后他们从一个大代码模型上做蒸馏并过滤——因为有时候代码模型会无视这些指令,仍然去尝试执行。此外他们还有 1.3 万条需要执行反馈的轨迹。训练方式是:先在 SWE-Zero 的样本上微调,再在 SWE-Hero 的样本上微调一次,得到了一些进展——当然前沿水平依然高得多。
5.6 SWE-rebench 与后续的规模化
SWE-rebench 基本上是另一次尝试:去抓取海量的 PR。这类工作的套路都差不多:拿一大堆 GitHub 仓库 → 试着安装 → 大部分大概都会失败 → 再使劲试 → 然后用语言模型给你回答。
而下面这项工作就是今天刚发布的:它把 SWE-Zero 的思路放大到了 1200 万条智能体轨迹。好处是 SWE-Zero 那条路线非常轻量。这里他们用的是 SWE-rebench 的任务——在这个数据集里,他们在试着让东西能执行,但只有 32,000 个任务能跑起来,另有 12 万个跑不起来——但 SWE-Zero 不在乎,你可以把它们全用上。这里用的模型很小,因为数据集现在相当大。
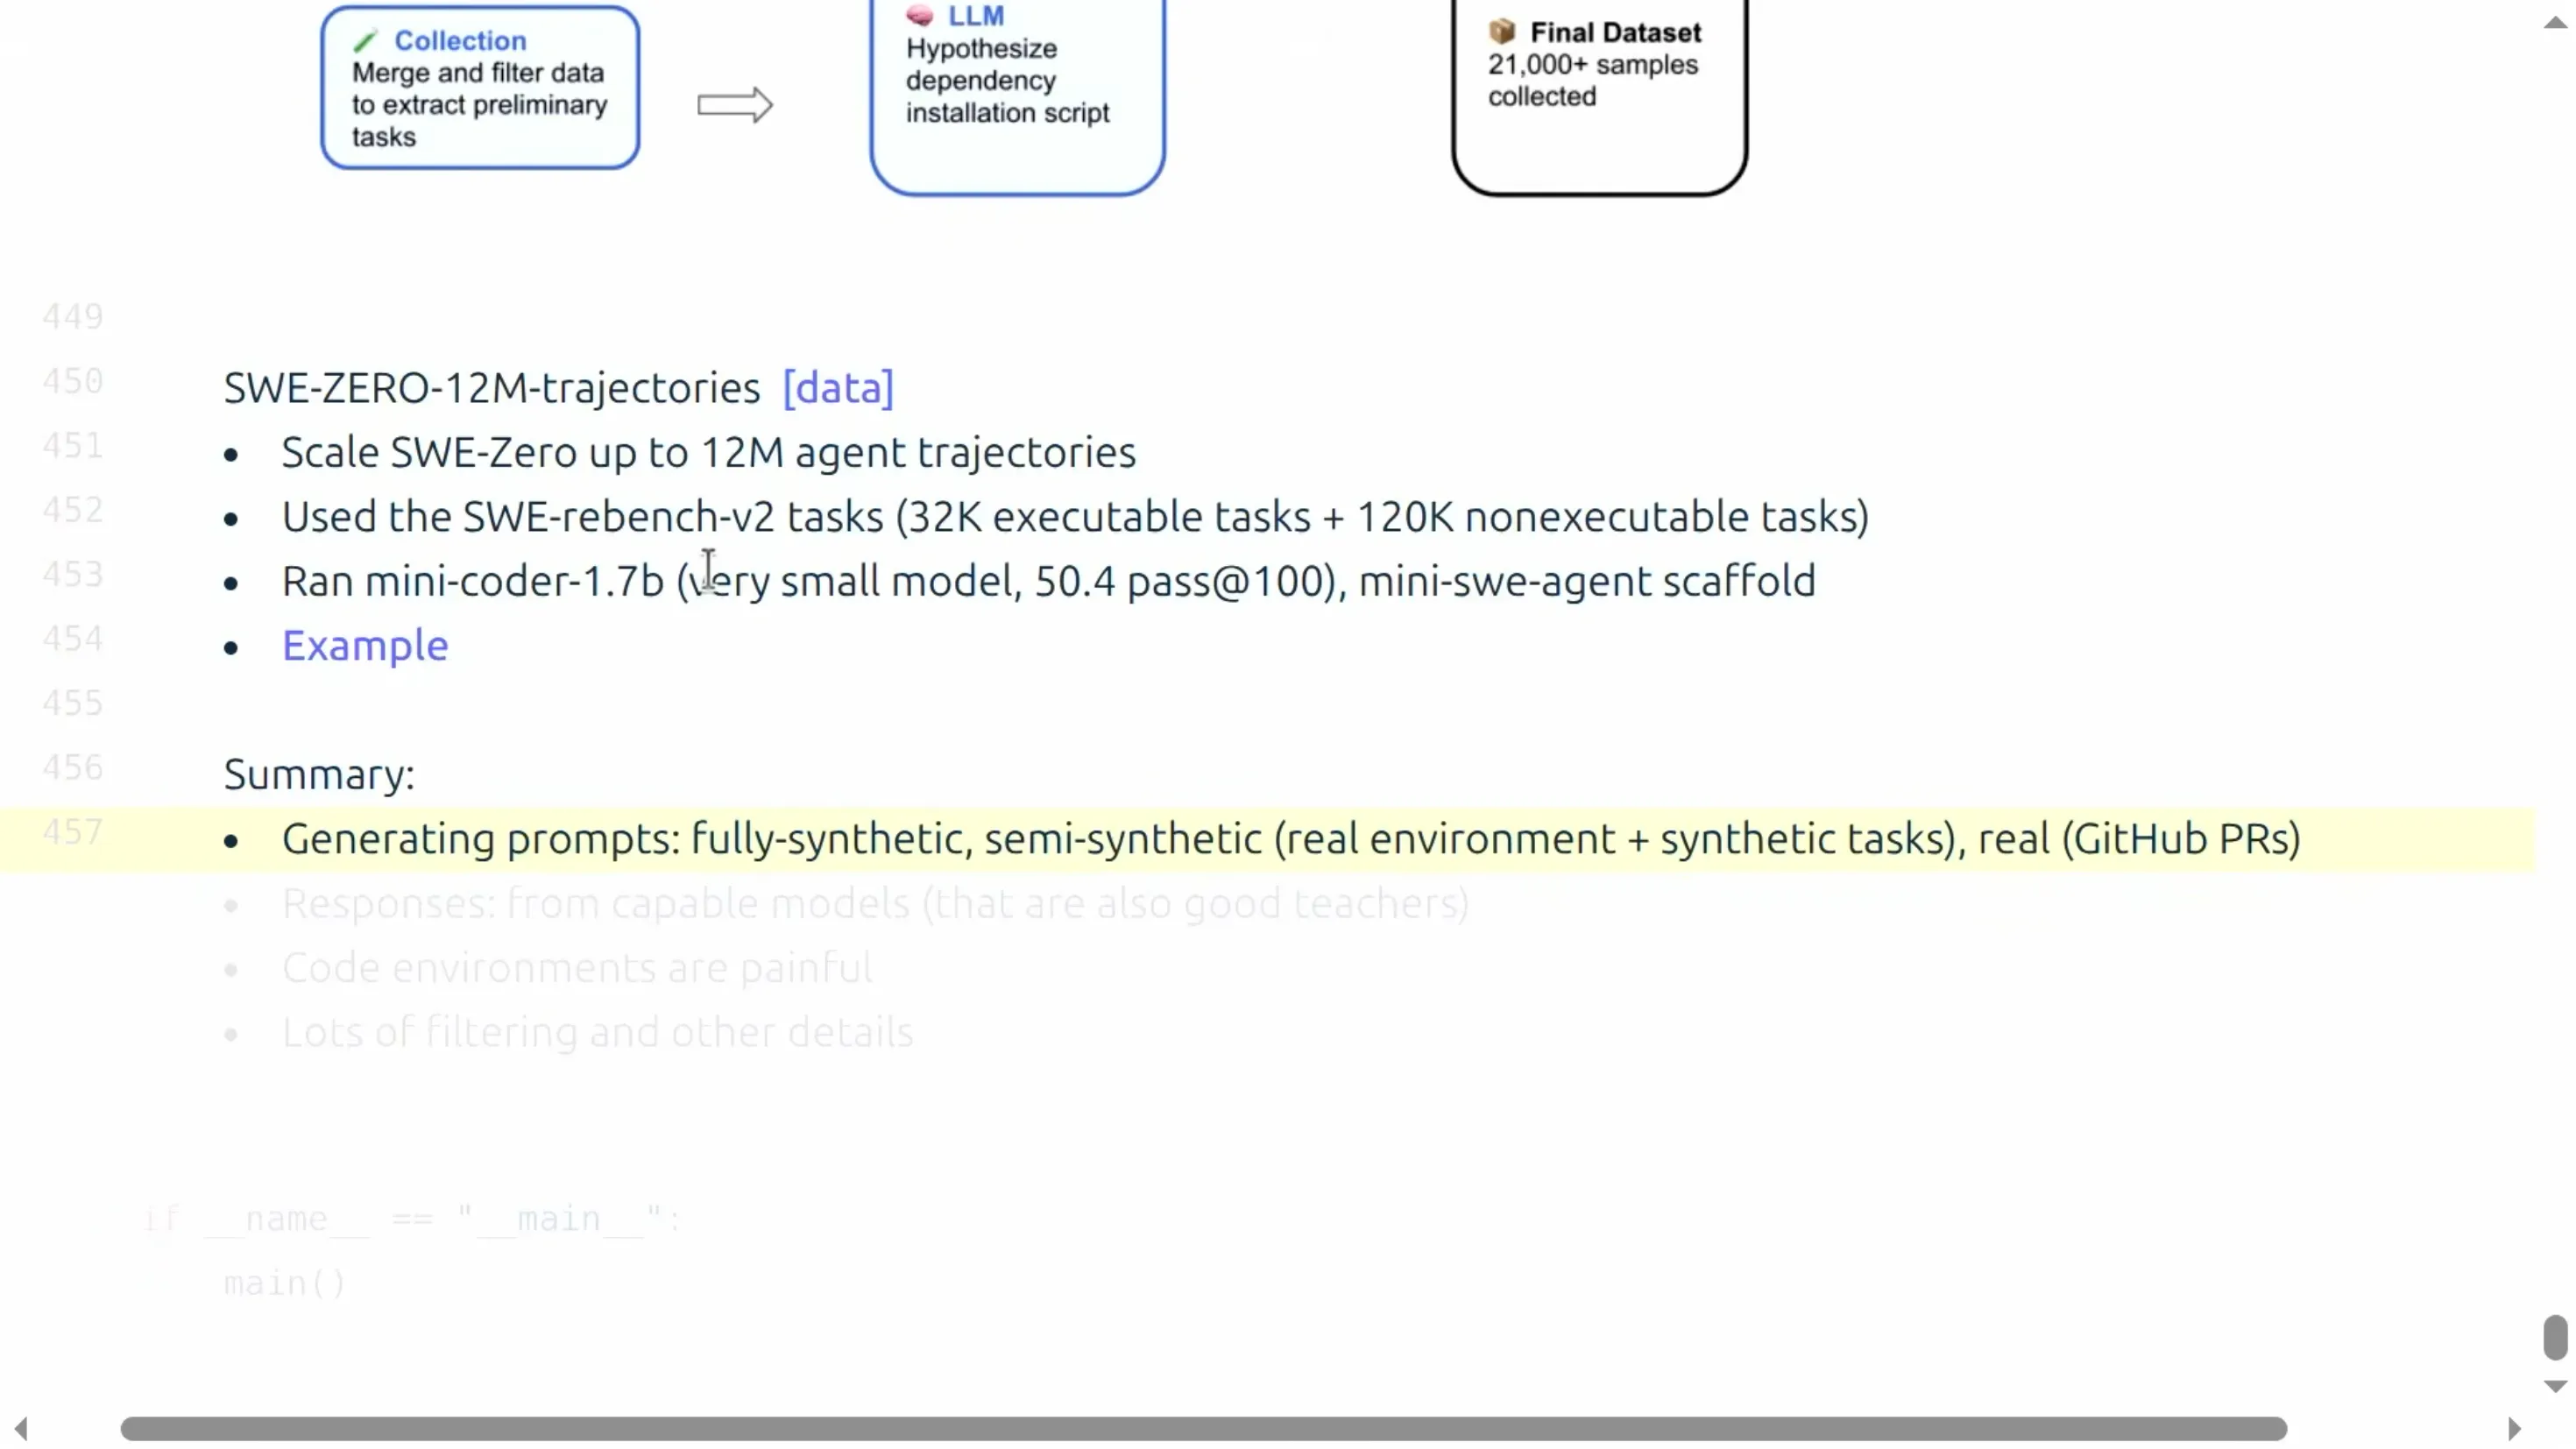
📷 近期代码后训练数据集的规模变化
回到原视频 (01:23:03)
(参考时间: 01:23:03) 用一句话概括这个趋势:数据集正变得越来越复杂——从无环境依赖的任务(比如数学),到现在的代码;而代码类数据集的规模正在快速膨胀。
但总体思想是一致的:你有这些提示词,它们在「真实性」上有个谱系——
- 完全合成;
- 半合成:真实环境 + 合成任务;
- 完全真实。
而回答一般来自有能力的模型,但它们同时也得是好教师。至于代码环境——那是个苦差事,里面有大量过滤和其他细节,我们这里没有时间展开。
编者说明:本节中提到的几个工作名,字幕存在明显的听写偏差(如「Swissmith」→ SWE-Smith、「sweet zero」→ SWE-Zero、「rebench」→ SWE-rebench、「sweet hero」→ SWE-Hero),书里已按通行名称订正;其中个别数据集的确切命名与数字(例如「12 万条跑不起来」)仍有不确定性,详见文末「已知疑点」。
全讲总结
(参考时间: 01:23:45)
- 过滤:先定义「好」长什么样,然后训一个轻量级分类器,拿它去扫一遍你的网页爬取结果,就能得到一个符合你需求的小得多的子集。
- 去重:重要,能避免过拟合、节省 FLOPs。
- 混合:在小规模上试配比,外推到大规模——但必须通过带上限的 epoch 或模拟 epoch 来处理 epoch / 过拟合问题。
- 后训练数据:我们看了几类近期的合成数据工作,尤其是代码智能体方向。
最后必须说明的是:真实的数据工作相当「土」、相当脏(grungy),非常依赖具体领域,而且必须去看具体的例子,才能做出高质量的数据集。所以这一讲并不真正代表数据工作的日常样貌——但我希望它给了你一张关于数据版图的总体地图。
今天就到这里。
附:参考与延伸阅读
编者补充
- Common Crawl
- fastText
- FinePDFs
- GitHub
- Jigsaw Toxic Comments
- KenLM
- LM1B
- NuminaMath
- OpenHands
- OpenWebMath
- ProofPile
- RegMix
- Resiliparse
- Stack Exchange
- Stanford CS336 | Spring 2026 | Lecture 14: Data
- The Stack
- Trafilatura
- Wikipedia
- 数据集页面
- 论文
- 论文
- 论文
- 论文
- 论文
已知疑点
以下条目为编者重构时无法完全确定的地方,逐条说明依据或对应时间点。凡本书正文已按通行名称订正者,均在此登记原始听写形式。
专有名词 / 工具名(依上下文可基本判定,但字幕原形有误)
- 「Brazil parse / Traflera」(约 00:04:05)——应为 Resiliparse 与 Trafilatura,两者都是网页正文抽取工具。字幕同时出现「resilient pars」(约 00:19:29),编者判断同样指 Resiliparse 抽取出的数据。若讲师本意是某一个具体工具的对照实验,正文的表述可能需要相应调整。
- 「find PDFs」(约 00:04:25)——应为 Hugging Face 的 FinePDFs 数据集。
- 「open math text」(约 00:12:58)——应为 OpenWebMath(2023)。字幕给出的产出规模是「150 亿 token」,编者未与原论文核对,若数字有出入以论文为准。
- 「51 from Microsoft」(约 00:15:09)——应为 Phi-1。
- 「neatron」(约 00:50:10)——应为 NeoTRON;编者未能确认它在 Marin 数据源清单里的准确写法与含义,正文保留英文原名。
- 「OMIX / Omix」(约 01:03:58)——编者判断为 OLMix,即 Optimizing Data Mixtures for Large Language Model Pretraining。此处不确定,因为课堂也提到 RegMix 等多个同框架方法。
- 「ragmix」(约 00:59:00)——应为 RegMix。
- 「jakard / minash」(全篇)——分别为 Jaccard、MinHash。
- 「Swissmith / sweet zero / rebench / sweet hero」(约 01:18:00 之后)——分别订正为 SWE-Smith、SWE-Zero、SWE-rebench、SWE-Hero。其中 SWE-Hero 这个名字编者把握最低——它来自讲师对「另一批带执行反馈的轨迹」的称呼,可能与实际数据集名不符。
- 「QWQ 32B」「deepseeek R1」(约 01:17:00)——应为 QwQ-32B 与 DeepSeek-R1。
- 「sack exchange」「num math」(约 01:15:45)——应为 Stack Exchange 与 NuminaMath;后者的确切数据集版本未在字幕中出现。
- 「open hands scaffold」(约 01:20:40)——应为 OpenHands。
- 「01 came out」(约 01:15:08)——应为 OpenAI 的 o1。
- 「MUP」(约 01:07:57)——指 μP(Maximal Update Parametrization),Tatsu Hashimoto 在课程中讲过;「Tatsu」即其名。
数字与参数(存疑,需与一手材料核对)
- Michael Ryan 实验的模型规模与数据池(约 00:18:30)——字幕为「1.57 亿参数」和「100 ...」的数据池规模(听写残缺)。正文只保留了确定的部分:模型约 1.57 亿参数,池子是 Common Crawl 的极小一部分。
- 「0.64」的碰撞概率(约 00:47:50)——正文按 $1-(1-1/b)^b \to 1-1/e \approx 0.632$ 给出推导,课堂上口播为 0.64。两者一致,但若讲师当时用的是别的 $b$,结论会略有出入。
- 去重论文的参数 $b=20, r=450$(约 00:46:44)——字幕给的这两个数字量级悬殊($b \times r = 9000$),编者按字幕保留,未与论文核对。
- 「120 of them didn't execute」(约 01:22:44)——字幕原文为「32,000 能执行、120 不能执行」,从上下文看后者量级上应是 12 万。这是编者推断的订正,原数字存疑。
- 「12 million agent trajectories」(约 01:22:26)——即 1200 万条轨迹;连同「今天刚发布」的说法,编者无法在本书中确认该工作的正式名称,正文以「这篇(课上当天发布的)工作」指代。
表述含糊或难以判定的地方
- 「如果你有无限算力,就不需要过滤」(约 00:22:05)——这是讲师的论断,编者未加评判;从理论上说,即使算力无限,「用全部网页训练」是否等价于「过滤后训练」仍取决于目标,读者不宜把它当作严格结论。
- 「忠实还原 HTML 的语义」与「线性化必然有损」的关系(约 00:02:50)——讲师说这一过程「本质上有损」,但同时也承认导航元素本身可能包含有用信息。哪些信息该留、哪些该丢,课堂上并未给出统一判据,正文按讲师原意保留了这个张力。
- 「更强的模型不一定是更好的教师」(约 01:16:47)——课堂上以 QwQ-32B 优于 DeepSeek-R1 为例,但未展开原因(可能是「回答风格更适合被蒸馏」或「更少被过滤掉」)。这两句是课堂结论,编者未作补充。
- 「模拟 epoch」的正式名称(约 01:07:46)——讲师明说「它大概有多个名字,其中一个叫 simulate epoching」,因此这不是唯一命名,读者检索时需注意。
本节说明:以上疑点集中列出,是为了让读者知道哪些地方是确定的、哪些地方是编者或字幕的不确定。凡正文中标注「编者说明 / 编者拓展」之处,均为编者所加,不代表讲师原话。