第17讲 · Stanford CS336 语言模型从零构建(Spring 2026)
对应讲次:第17讲(Stanford CS336 语言建模)
制作模型:deepseek-flash(vb compose,据 run.log)
第十七讲:对齐之——多模态
课程信息 - 课程:Stanford CS336 Language Modeling from Scratch,2026 年春季 - 讲次:Lecture 17 — Alignment: Multimodality(对齐:多模态) - 视频:YouTube 原片(时长约 77 分钟) - 本讲定位:由客座讲师主讲的概览性讲座。计划本要讲更多强化学习内容,但因只有一讲时间,讲师认为"不谈多模态,这门课就不完整"——因为多模态已经成为当今几乎所有主流模型的标准配置。 - 说明:本节课我们不把术语生硬地套成教科书标题,而是尽量还原讲师自己的问题顺序与讲解节奏;视频之外如涉及官方讲义、幻灯片的信息,会在文中注明。本讲义的知识出处与版权归 Stanford CS336 课程团队及各位原作者所有。
导览
这是一张 3–5 分钟的问题地图,帮你在进入正文前先看清全貌。
① 讲师真正提出的问题(按他本人的顺序)
- 语言模型已经足够通用——它能把"任意文本映射到任意文本",连 DNA 序列都能当作一种"语言"。可世界是多模态的:文本、图像、音频、视频。那么,如何造出一个"北星级"的模型(讲师称之为 omnimodel/全能模型),能接收任意模态的任意组合、并输出任意模态的任意组合?
- 这台"全能模型"目前还不必真造出来。这一讲他给自己划的范围是:如何把非文本数据(主要是图像)喂进 Transformer。至于如何"生成"图像或视频,本讲基本不展开。
- 落脚的技术问题是:Transformer 只会说一种语言——token。文本早有 BPE 分词器,那图像的"BPE 分词器"是什么?
② 难点在哪
最容易卡住的一步,是"语义单位"的定义。一个词(子词)本身是有意义的,但一个像素本身毫无意义。你不能把图像的每个像素当作一个 token,也不能简单地把整张图压成一个向量就了事——那样会丢失细节(比如 OCR 时 J 和 I 就分不清了)。于是在图像与 Transformer 之间,必须插入一个"编码器(encoder)",把图像转成离散或连续的 token。整堂课的绝大部分内容,都在讲这个编码器怎么设计、怎么和语言模型对接。
③ 读者可能带着的疑问
(以下 ① 沿用讲师提出的问题,② 为编者预判的读者疑问,两者请勿混为一谈。)
- ① 讲师的问题:如何把图像"喂"进 Transformer?如何把编码器与语言模型"缝合"成一个 VLM?
- ② 编者预判的疑问:
- 图像为什么不能像文本一样直接分词?一个像素和一个词差在哪里?
- 那个叫 CLIP 的模型为什么在 2021 年引起轰动?它的对比学习到底在对比什么?
- 各种 VLM 名字里的 vision encoder、projector、adapter 到底各干什么?
- 为什么"万物皆 token"的 Chameleon 看起来如此优雅,后来却没那么流行了?
④ 本讲路线
讲师打算从历史起点顺着讲下来:先回到 2021 年的 CLIP(最基础的图文对比预训练)→ 2022 年的 SigLIP(把 loss 改简单的改进版)→ 2023–2024 年的 VLM 两大族(LLaVA 与 Qwen 系列,讲"图像编码器 + projector + 语言模型"这一通用模板如何一步步升级)→ 2024 年的 Chameleon(一个"万物皆离散 token"的反面参照系)→ 最后做总体反思。整堂课的核心线索只有一句:如何把图像转成 Transformer 能消化的 token,并让语言模型利用它。
1. 为什么非要多模态不可
(参考时间: 00:05)
在目前为止的这门课里,我们一直把自己限制在语言模型上。而语言模型其实已经相当通用了:它给你一种"从任意文本到任意文本"的能力——可以是任何自然语言、可以是代码、可以是诗歌,甚至可以是 DNA 序列。
但世界本身是多模态的:你有文本、图像、音频、视频。
讲师在这里提出了一个"北星"(north star)式的目标愿景,人们把它叫做 omnimodel(全能模型):既能够接收任意模态的任意组合,又能输出任意模态的任意组合。
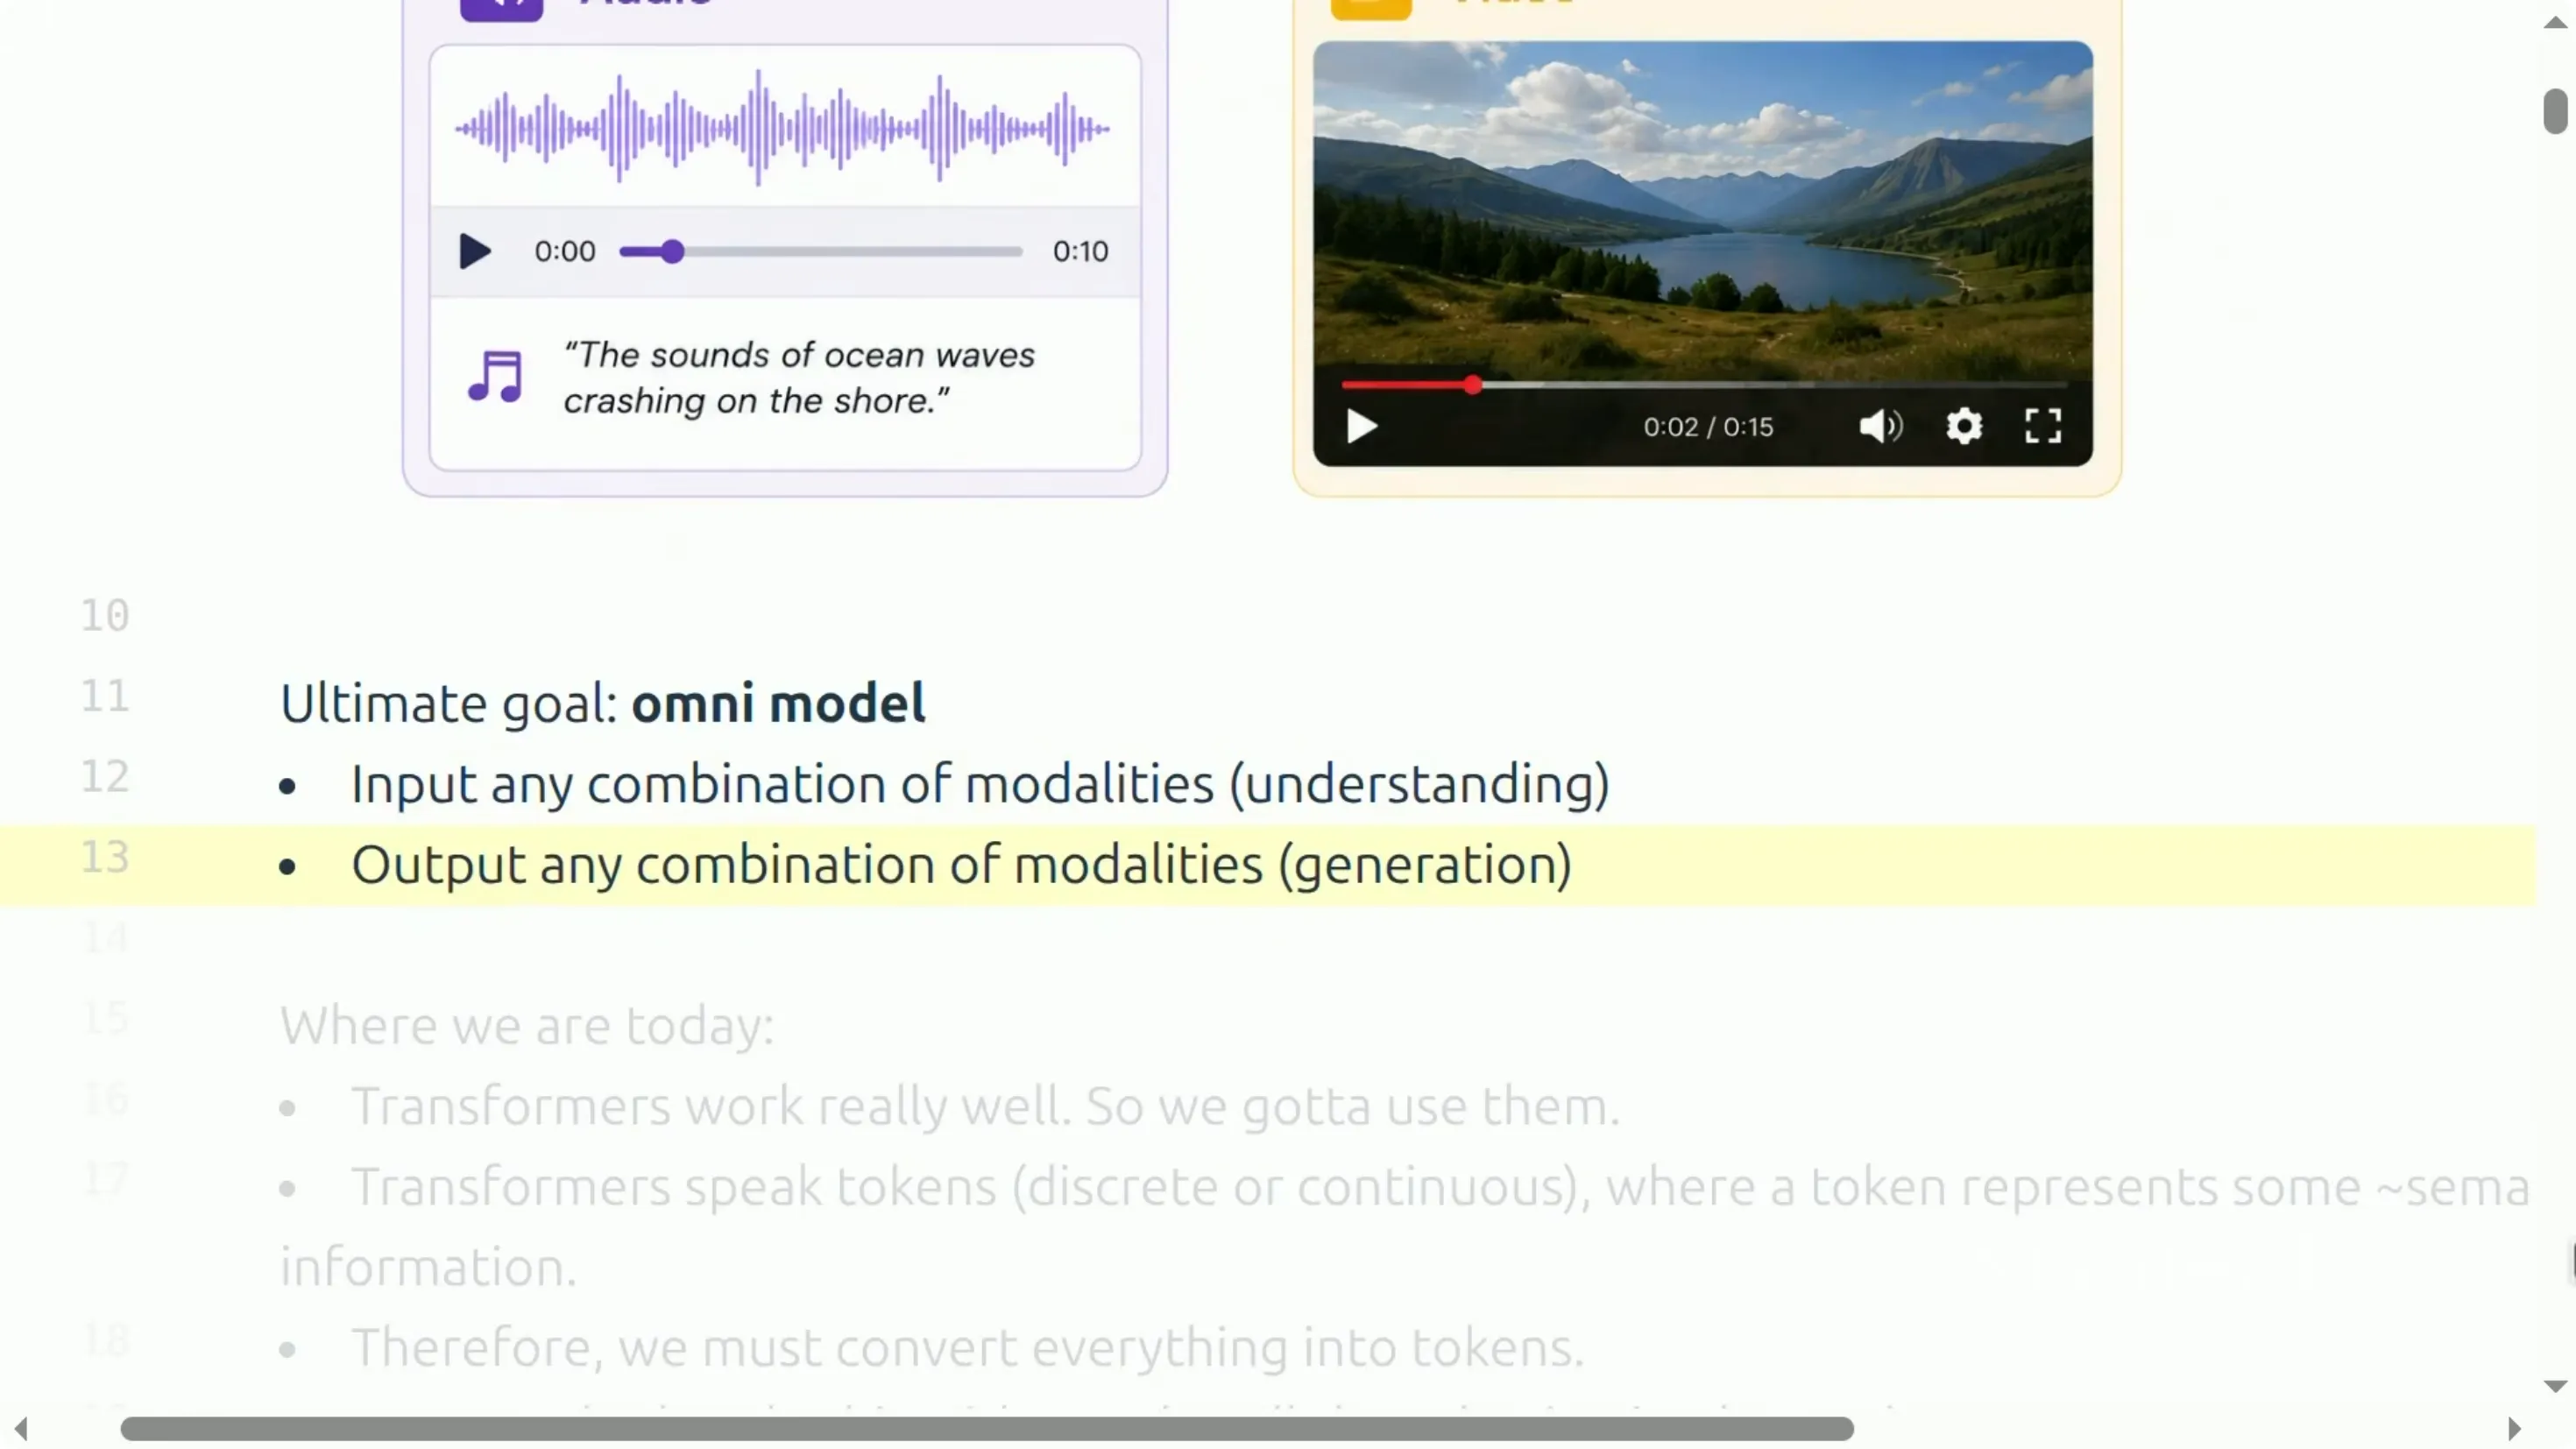
📷 智能体接收图文/视频等组合输入并输出各种模态的示意
回到原视频 (00:01:20)
编者说明:这里的 "omni" 来自拉丁语词根,意为"全部、一切"。业界有时也把这类模型直接称作 "natively multimodal"(原生多模态)。
举例来说:给它一张图加一段视频,再问一个关于这两者的具体问题;让它生成图片;或者把音频转换成图像——只要拥有一个全能模型,你就能想象出各种形态的应用。
不过,在这门课里,讲师并不打算一路造出完整的全能模型。他会给出其中若干零件——尤其是"能够吃进一点图像"的那部分,这也是今天的主要焦点。
1.1 既然 Transformer 那么好用,就顺着它来
(参考时间: 00:02)
讲师用了"有点奇怪的动机方式"来引出正题,但他认为这最实在:现实是,Transformer 在各模态上都工作得非常好。尽管很多人努力尝试别的东西,但在如此大的规模上,Transformer 依然是所有模态里最好的选择。所以我们只能想办法用好它。
问题也随之而来:Transformer 是为文本设计的,它有一种天生的禀赋——它说 token 的语言。它吃进一堆 token,再吐出一些 token。
在这里,讲师把"token"这个概念从离散扩展到连续:token 可以是我们在文本里见惯的离散 token,也可以是连续的 token(你可以把它理解成"token 的 embedding 向量")。
📷 Transformer 以 token 为输入、token 为输出的示意
回到原视频 (00:02:50)
关键在于:一个 token 应当代表某种有意义的"语义单位(semantic unit)"。
- 自然语言里,token 是子词(subword),它们大体是有意义的;
- 但一个像素(pixel)本身显然没有意义。
于是,我们必须想办法把所有东西——包括音频和图像——都转成离散或连续的 token,交给 Transformer。
1.2 文本早就有"分词器"了,图像呢?
(参考时间: 00:03:30)
其实我们在文本上早就干过这件事——第一讲里讲的分词(tokenization)就是。当时我们用 BPE 分词器,你们还亲手实现过它,效果挺好。当然,你会希望有更好的分词器,甚至干脆"不要分词器",但它绝非最糟的东西。
编者拓展|BPE 分词器与"分词"这件事
BPE(Byte-Pair Encoding,字节对编码)的思想很简单:从单个字符(或字节)开始,反复找出语料里最常相邻出现的一对符号,把它们合并成一个新符号,重复此过程直到词表达到目标大小。这样切出来的单位(子词)天然对应到语言里常见的词根、词缀或高频词组,因此既不会像整词那样词表爆炸(OOV 问题),也不会像字符那样序列过长。
它本质上是把文本无损地压缩成一串有语义倾向的离散符号。这也解释了讲师后面反复强调的那句话:token 应当对应某种语义单位。图像编码器要做的,就是找到一个"视觉版的 BPE"。
现在轮到非文本模态了——我们要费更多的脑筋,去弄清楚图像版的 BPE 分词器是什么:它要能吃掉一张图像,吐出 Transformer 能消化的东西。
至此,摆在我们面前的有两个大问题:
- 输入方向:对图像、视频、音频这类非文本数据,如何把它们输入进 Transformer?
- 输出方向:如何让 Transformer 把它们生成出来?
这一讲主要聚焦问题 1(输入方向)。
编者说明:输出方向之所以被略过,是因为图像/视频的生成通常走的是扩散模型(diffusion model)路线,与本课"自回归 Transformer"的主线关系较远,讲师在结尾才点了一下这层区别。
2. 回到 2021:CLIP 的对比学习
(参考时间: 00:04:20)
讲师把时间拨回到 2021 年。他说,你们都或许熟悉的 CLIP 模型,是现代 VLM 的大量基础之一,值得详细走一遍。
CLIP 的全称是 Contrastive Language-Image Pre-training(对比式语言-图像预训练)。要理解它,先得了解一下它诞生时的历史背景。
2.1 为什么 CLIP 会出现:两种"无标注预训练"的思路
(参考时间: 00:04:40)
在 CLIP 出现的那个时间点:
- 语言这边,GPT-2、GPT-3 都已经出现,语言模型已经迈进了"基础模型(foundation model)"时代——只要抓取互联网上的文本,哪怕很脏,只要模型足够大,就能从中榨出有用的东西。
- 视觉这边却还相当传统:主要靠大规模人工标注数据集(比如 ImageNet),在上面训练 ResNet 之类的模型,再配上数据增强等技巧刷性能。
OpenAI 的研究人员于是思考:能不能借鉴语言那边"抓互联网数据"的思路,把互联网上大量现成的"图像 + 文本说明"利用起来?
对语言而言,"等价物"是抓网上的文本;对图像而言,"等价物"就是互联网上大量成对的图像和文字描述。CLIP 就此诞生。
编者拓充|"自监督"里的隐藏陷阱:图文配对为什么比纯图像更值钱
讲师在后文回答了一个学生提问,点出了关键区别。早先有一类工作(比如 SimCLR,论文)尝试只用图像学到表征:把同一张图做各种改动(裁剪、扰动、旋转),再要求这些"改动版"彼此的 embedding 相近。这种做法能抓低层细节,但有一个根本局限——你无法靠数据增强从"一只狗"变到"另一只不同品种的狗"。而配上文本,模型就获得了更高层的语义表征:文本谈的正是图像的"语义"。这就是 CLIP 用"图文对"而非"纯图像"的根本原因。
2.2 CLIP 的核心思想:一张 N×N 的对角线矩阵
(参考时间: 00:06:00)
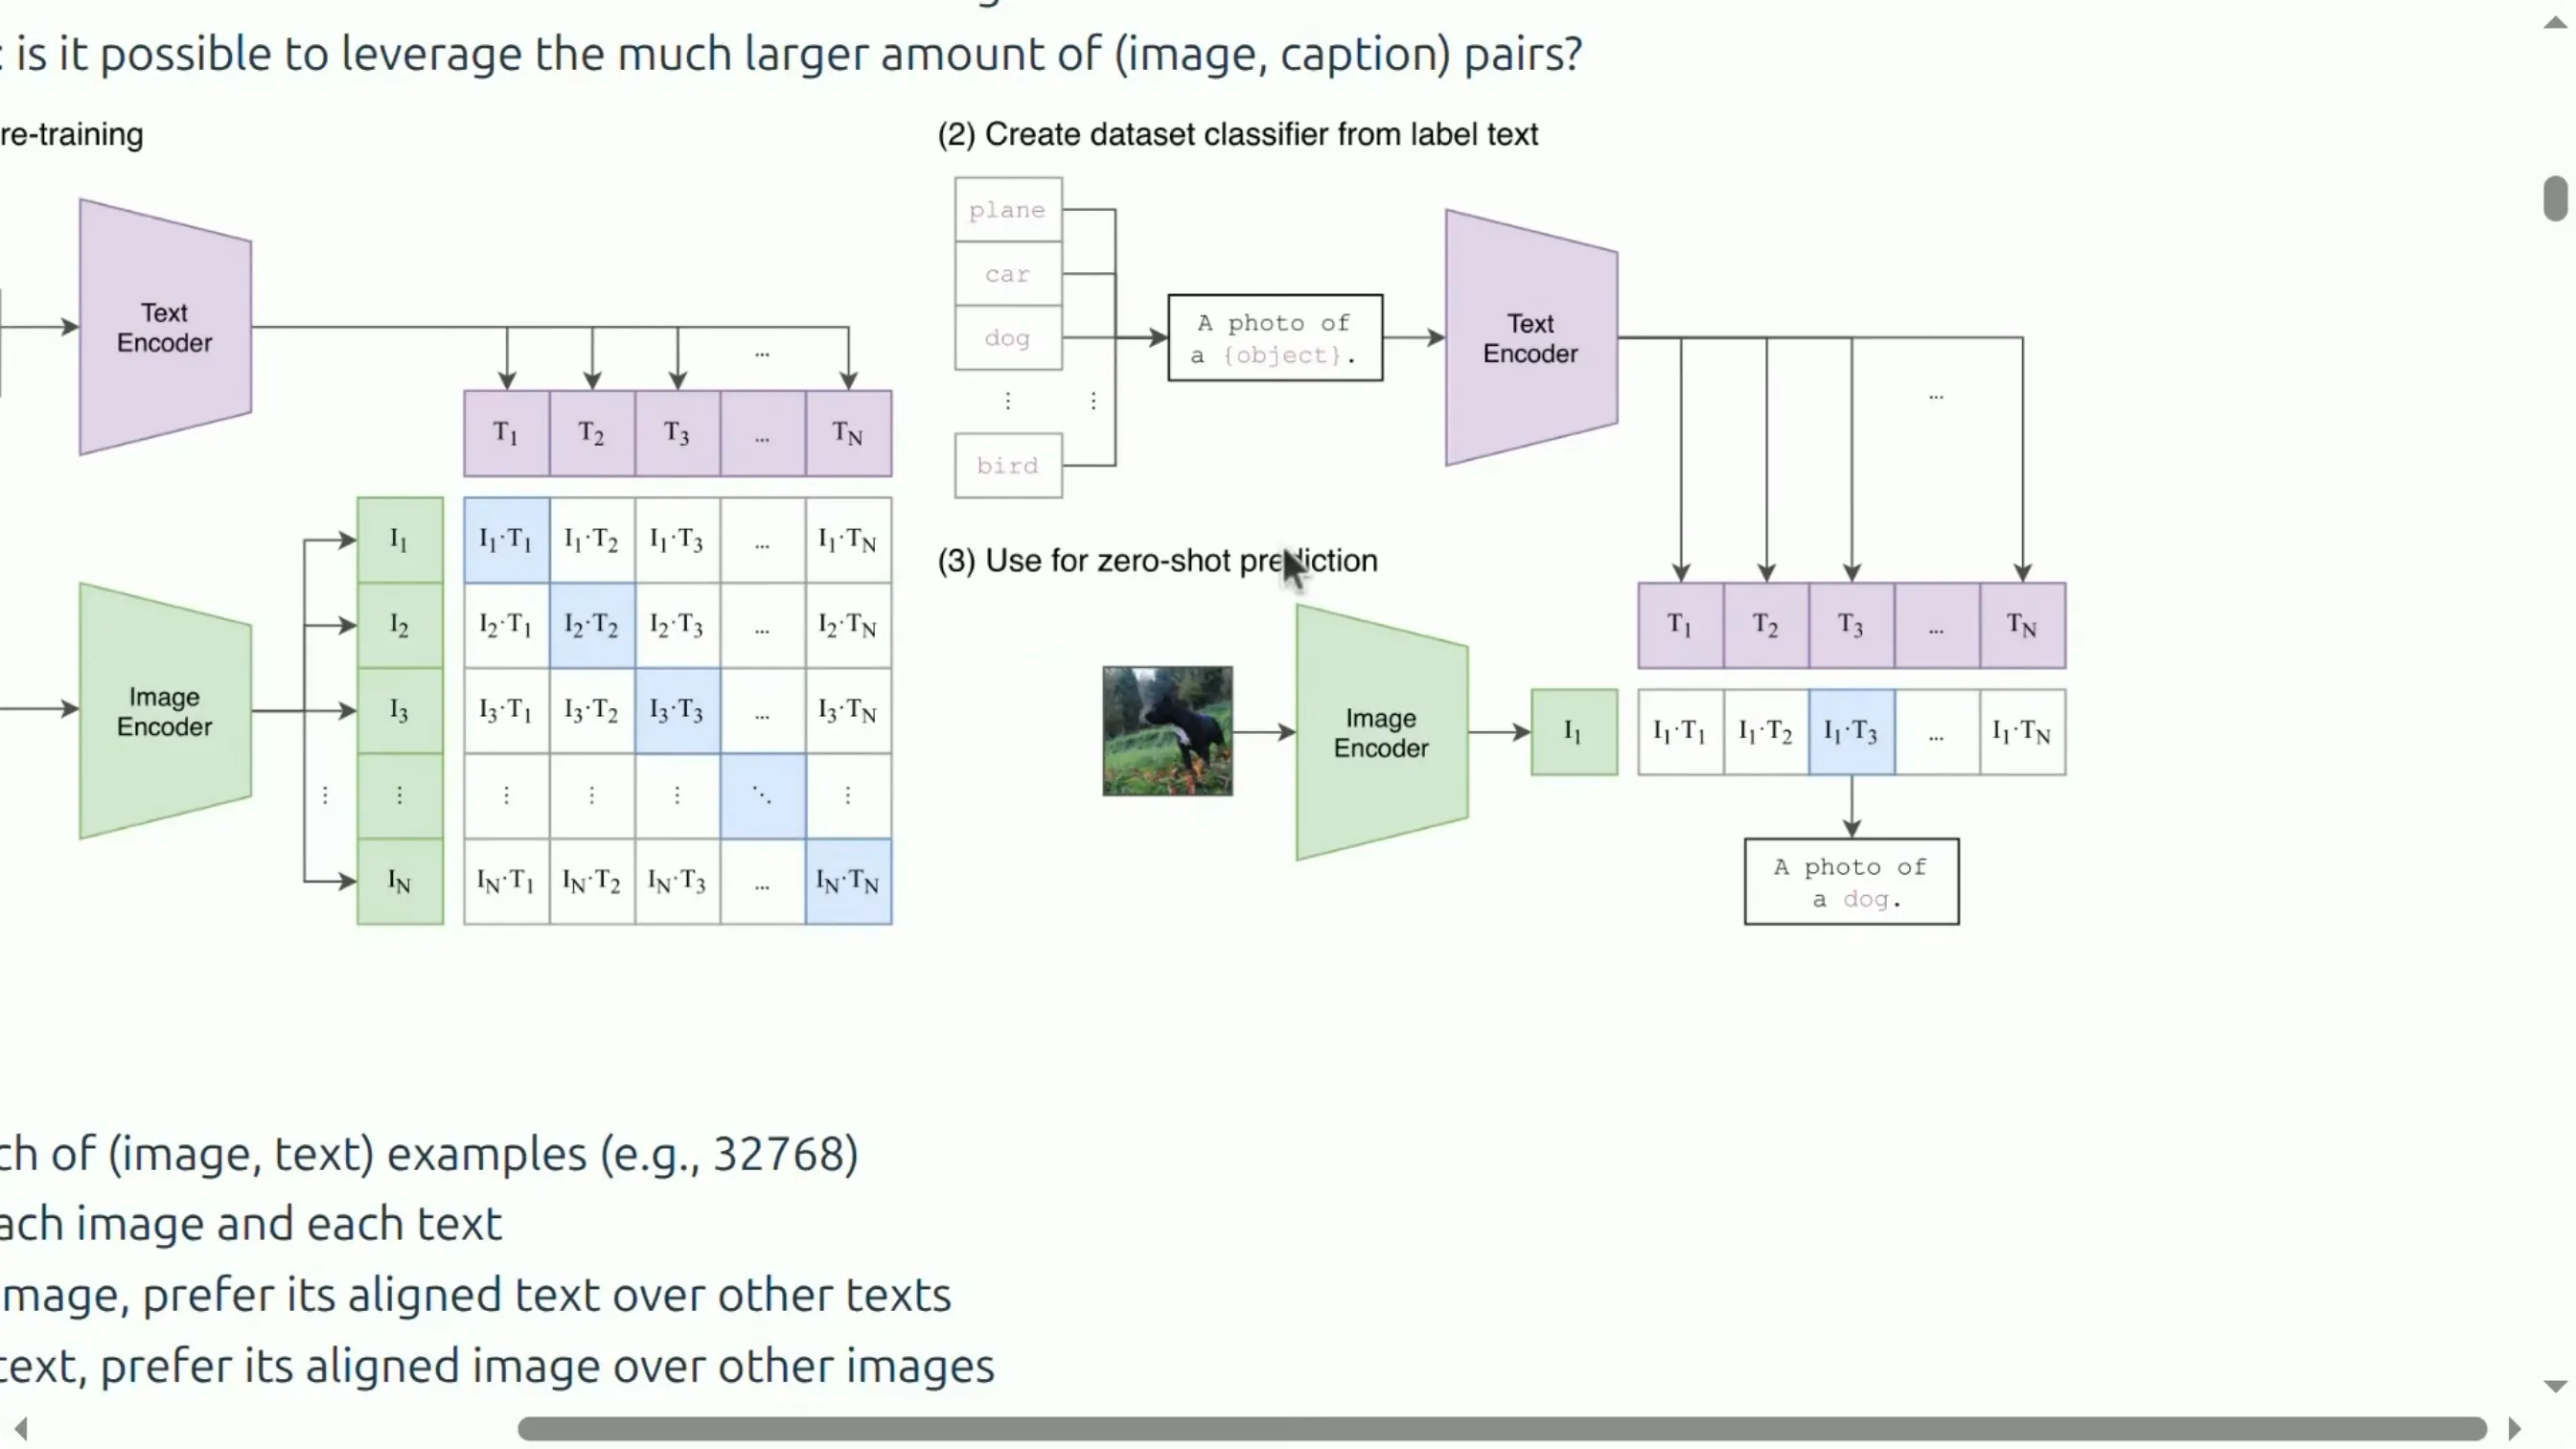
CLIP 的想法其实相当简单直白。假设我给你一批图文对,比如说 32,000 对。
- 对每一张图像,我用图像编码器(image encoder)(具体稍后讲)把它编码成一个向量,于是得到 32,000 个图像编码 $\mathbf{i}_1, \dots, \mathbf{i}_N$;
- 对其相应的文本,我也做同样的事,得到文本编码 $\mathbf{t}_1, \dots, \mathbf{t}_N$。
现在我要设定的目标(objective)是:
- 拿 $\mathbf{i}_1$ 来说,它与 $\mathbf{t}_1$ 是配对的,所以我希望这两个 embedding 的点积(即相似度)远大于 $\mathbf{i}_1$ 与所有其他文本的点积;
- 反过来,对 $\mathbf{t}_1$,我也希望它与 $\mathbf{i}_1$ 的点积大于它与所有其他图像的点积。
这就是 CLIP 目标的全部。你完全可以把它想象成同时做 $2n$ 个 softmax 多分类问题:对每一行(图像),在所有文本中挑出正确的那一个;对每一列(文本),在所有图像中挑出正确的那一个。
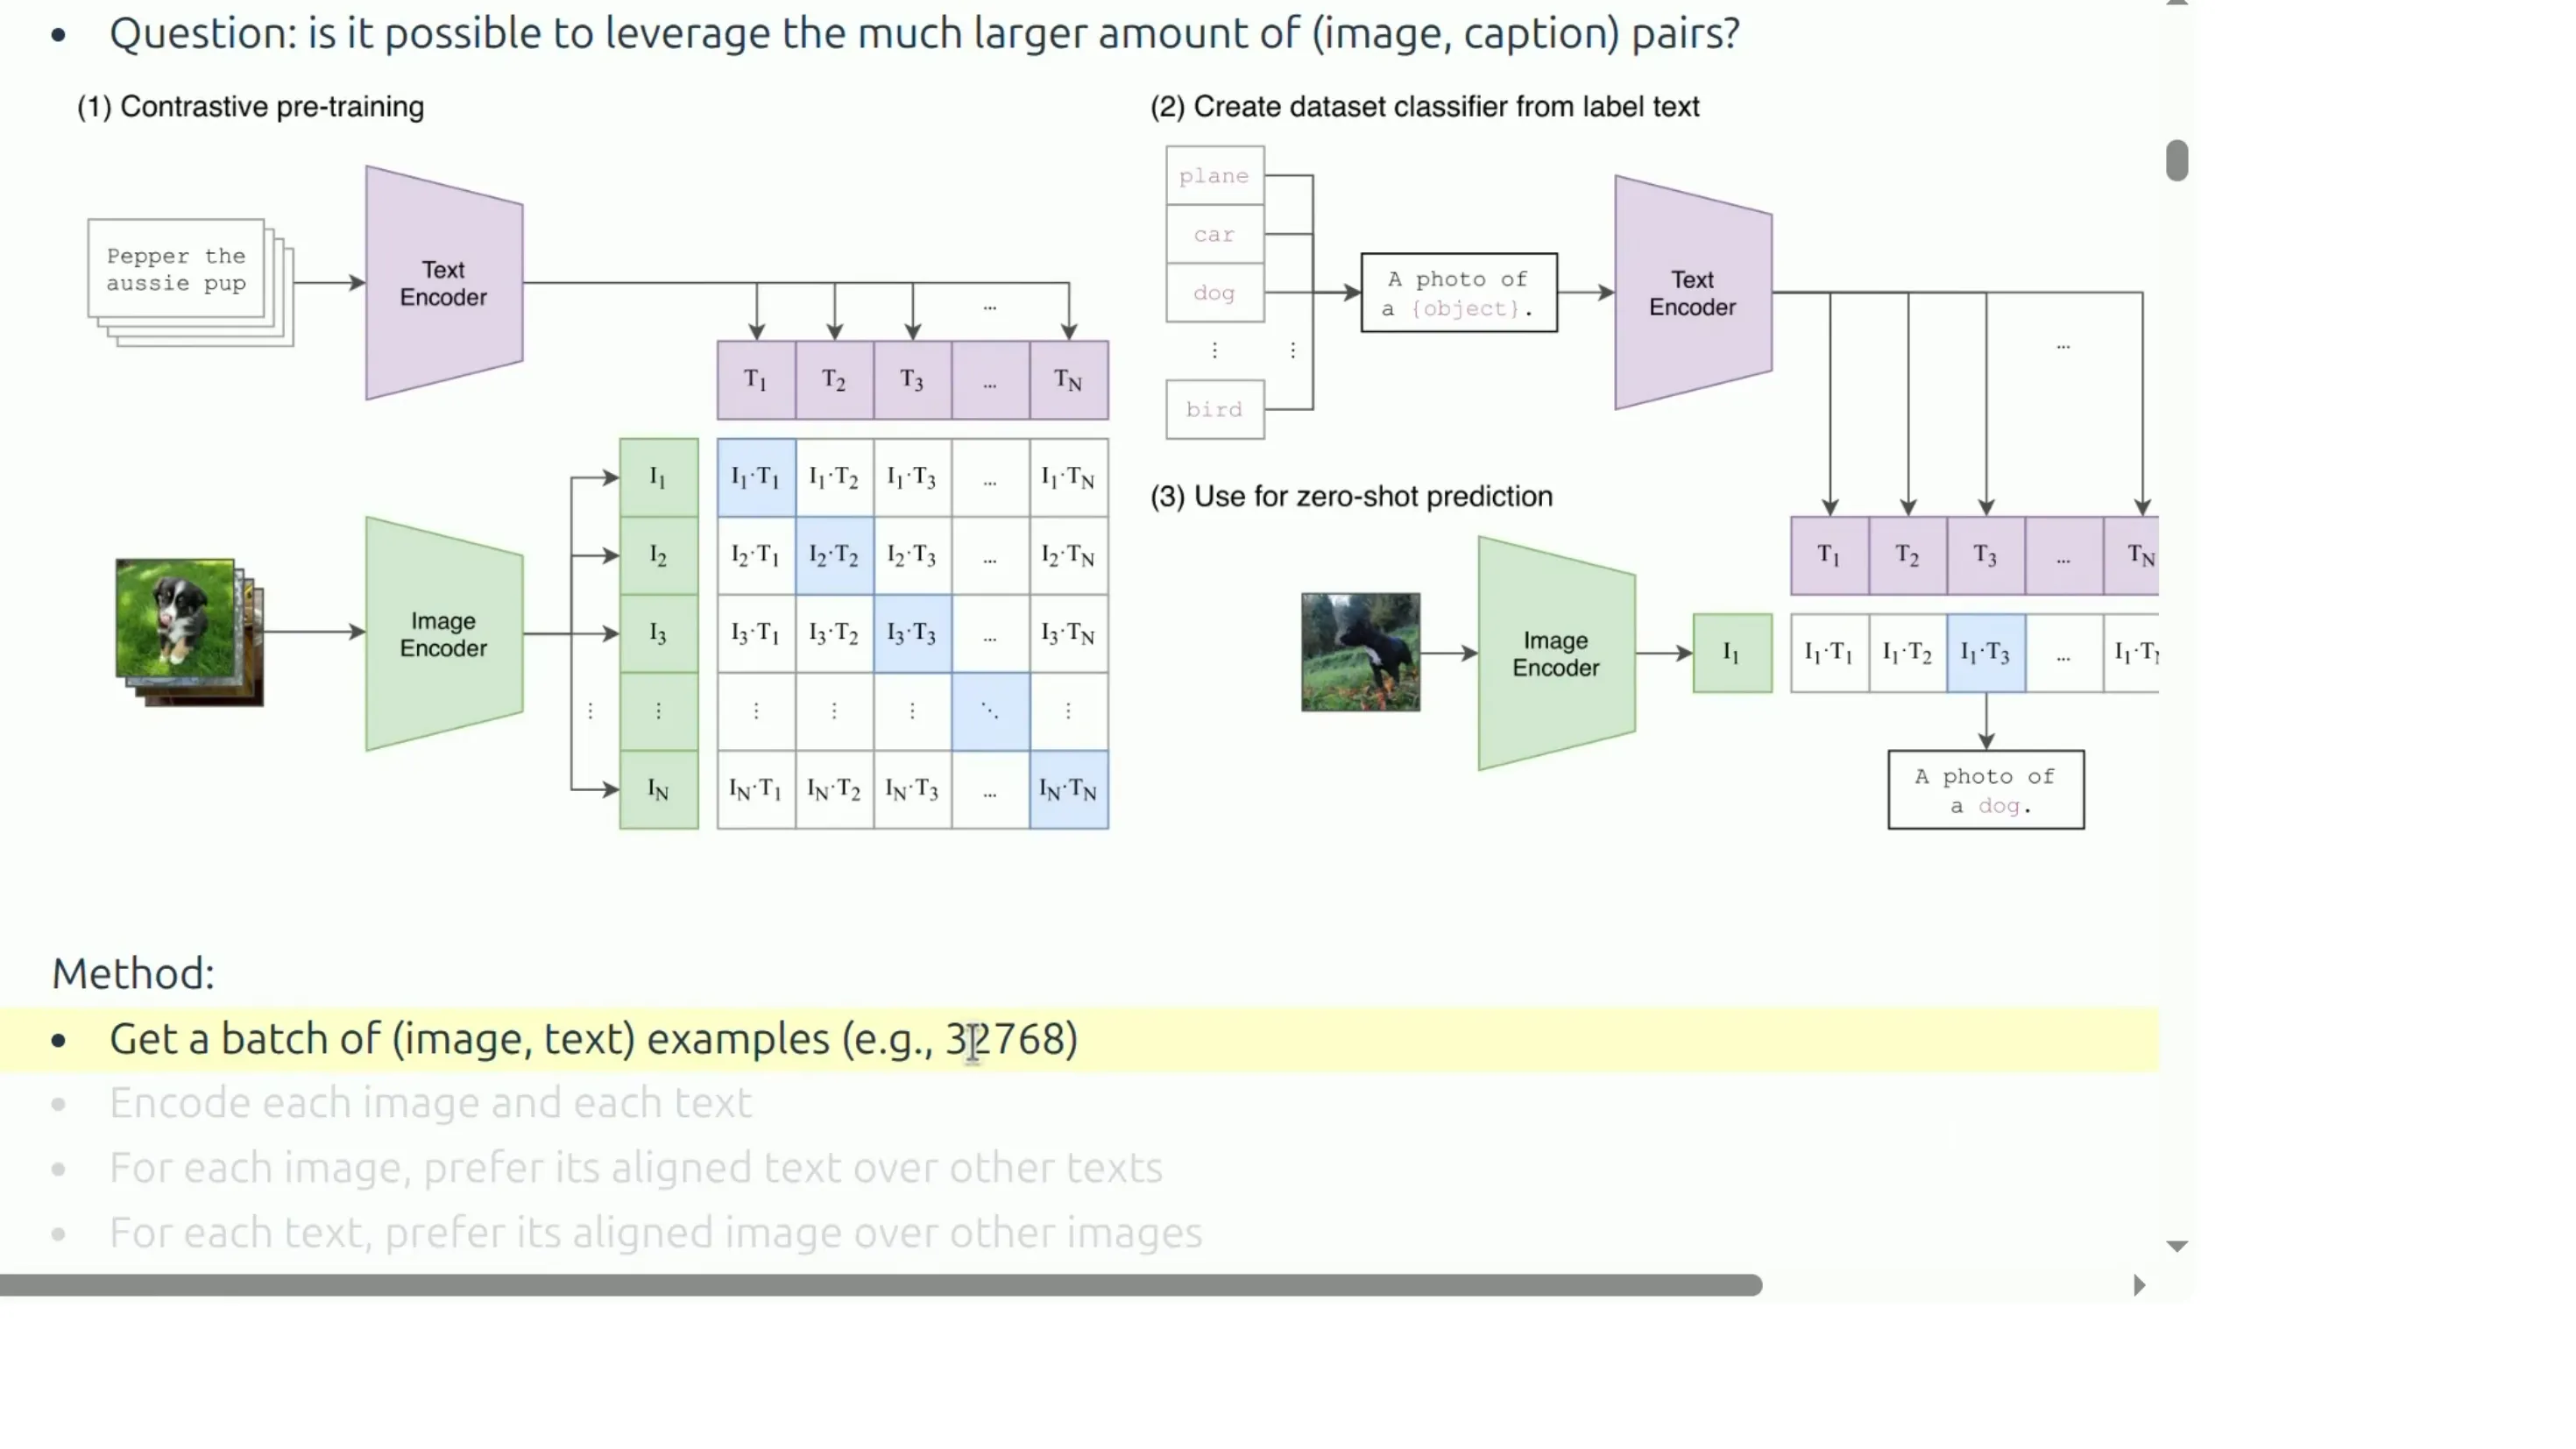
📷 CLIP 的 N×N 图文相似度矩阵,对角线上为配对正样本
回到原视频 (00:06:10)
用代码来表达,这几乎就是全部实现:你得到一个 $N \times d$ 的图像编码矩阵和 $N \times d$ 的文本编码矩阵,分别归一化,点积(带一个温度参数 $\tau$),再算交叉熵。
$$\mathcal{L}_{\text{CLIP}} = -\frac{1}{2N}\sum_{i=1}^{N}\left[\log\frac{\exp(\langle \mathbf{i}_i, \mathbf{t}_i\rangle/\tau)}{\sum_{j=1}^{N}\exp(\langle \mathbf{i}_i, \mathbf{t}_j\rangle/\tau)} + \log\frac{\exp(\langle \mathbf{t}_i, \mathbf{i}_i\rangle/\tau)}{\sum_{j=1}^{N}\exp(\langle \mathbf{t}_i, \mathbf{i}_j\rangle/\tau)}\right]$$
也就是说,这是一个类别分类问题,只不过样本被排成了一个 $N \times N$ 的矩阵,对角线是"正确配对",其余位置都是"错误配对"。
编者拓展|温度 $\tau$ 与"对比学习"的本质
- 温度 $\tau$ 控制 softmax 的"锐度"。$\tau$ 越小,分布越尖锐,模型对相似度差距越敏感。CLIP 把 $\tau$ 也作为可学习参数一起训练。
- 对比学习这个名称的由来:模型不是在做"看着图猜标签",而是在做"在一堆负样本对比之下,把正样本挑出来"。负样本(off-diagonal)越多、越难,模型学到的表征就越精细——这就解释了为什么 CLIP 需要极大的 batch size(下文会讲)。
2.3 CLIP 的数据、图像处理与编码器
(参考时间: 00:08:30)
数据从哪来? 论文里没给太多细节。大致做法是:取一批查询词(query),拿它们去网上搜索,从而挖掘(mine)出大量图文对,最终得到 4 亿个图文对。
编者拓充|数据集的"公开替身":OpenCLIP 与 LAION-5B
CLIP 自己的数据集并未公开。为此,后续有工作(OpenCLIP)复现并扩展了 CLIP 的思想,并发布了 LAION-5B——50 亿张图及其文本描述。有意思的是,他们反过来用 CLIP 做数据过滤,再去训练 OpenCLIP,这里存在某种"自举(bootstrapping)"。但至少,这是一个你能指得出训练数据、也看得到代码的模型——这对于学习者非常宝贵。
图像尺寸怎么统一? 互联网上的图像分辨率五花八门,可能是长条形,也可能是竖长条,尺寸任意。但学过神经网络的人都知道一个道理:神经网络不喜欢动态的东西,它希望输入尺寸固定。于是 CLIP 做了一个(略带启发式的)处理:
- 把图像缩放,使较短边达到目标尺寸(如 336,也可能是 224);
- 然后中心裁剪(center crop),得到一个正方形。
📷 CLIP 的图像预处理:等比例缩放短边后中心裁剪成正方形
回到原视频 (00:10:20)
这显然是为了方便。讲师说,后面我们会看到,有远比这更好的做法——但此刻这样做只是为了"从权",况且当时 CLIP 的作者脑子里想的是 ImageNet 式的分类,那时目标物体通常位于图像中央,裁掉一些背景影响不大。
什么是视觉编码器? 讲师说,其实算法的通用形态他已经讲了,只是还没说清图像与文本编码器具体是什么。
CLIP 其实实验了多种视觉编码器,包括 ResNet 和当时刚刚问世的 ViT(Vision Transformer),结果发现 ViT 表现最好。所以当人们说 "CLIP" 时,通常指的是它的 ViT 版本。
ViT 的工作方式如下:
- 把图像切成一个个 patch(小块)。最初的 ViT 论文用 16×16,而 CLIP 用的是 14×14;
- 每个 patch 本质上就是一个向量。从这个意义上说,每个 patch 就是 vision transformer 的一个 token;
- 加上位置编码(position embedding),正如你训练语言模型会做的那样;
- 然后把它送进一个标准的 Transformer。
📷 Vision Transformer(ViT)把图像切成 patch 序列送入 Transformer
回到原视频 (00:12:40)
如何从序列得到一个向量? Transformer 编码器输出的是一个向量序列。要得到整张图的单一表示,通常做法是平均所有向量。但 CLIP 论文做了一点不同:他们用注意力池化(attention pooling)——先对所有激活做一次全局平均得到一个 query,再拿它去对每个位置的 key/value 做又一轮注意力。这样得到的向量比单纯平均"信息更丰富一些",效果也更好。
CLIP 最佳模型:ViT-L/14。这里的 "L" 是 large 之意(讲师说大约有 24 层,但表示记不太确切了),14×14 是 patch 尺寸,每个 patch 是 RGB 三通道,在 336×336 分辨率上训练。实际上,他们先用较低分辨率训练,后期再切到高分辨率——因为高分辨率图像会更慢。
编者说明:讲师提到的 "24 层" 是个近似值。ViT-L/14 实际约有 24 层、约 3 亿参数,这在当年视觉模型里已属庞大。
关于位置编码的一个好问题(学生提问):文本位置编码只有一维,图像的二维位置是否需要更复杂的编码?讲师回答:CLIP 论文试过二维版本的位置编码,结果发现 1D 也差不太多。但他提醒,所有这类结论都要放在"面向图像分类"的语境下理解——对分类来说位置编码也许没那么重要。后面会看到,更讲究的做法会真正利用空间结构(这正是指 Qwen 的 M-RoPE,见第 4 节)。
文本编码器是一个标准的 GPT-2 风格 Transformer(出自开发 GPT-2 的同一团队)。为了从整个序列得到一个向量,他们在开头加 BOS、在结尾加 EOS,然后取最高层 EOS 位置的激活作为整段文本的表示。
于是整个流程就是:选一个 batch → 编码所有文本 → 编码所有图像 → 构成两个方向的交叉熵损失 → 反向传播。
2.4 头条成果:零样本胜过 120 万张 ImageNet 标注
(参考时间: 00:17:20)
CLIP 在 2021 年引起广泛关注,是因为它的头条成果:在 ImageNet 基准上,零样本(zero-shot)的 CLIP 超过了一个用 120 万张 ImageNet 图像训练出来的 ResNet。
要注意,那 120 万张 ImageNet 图像的标注,是大量 Amazon Mechanical Turk 众包工人花费无数小时完成的。而 CLIP 用的是更偏"有机"的互联网数据——虽然这些图文的生成也凝聚了无数网民劳动,但如果你能利用已有的资源,就几乎可以"零成本"迁移。
所谓零样本预测,做法是:拿一张图,准备一堆候选文本标签,然后逐一计算图文点积,看哪个最高。
📷 CLIP 的零样本分类:将图像与各候选文本标签点积,取最大
回到原视频 (00:18:30)
2.5 噪声与一个值得留意的实验结论
(参考时间: 00:18:50)
有学生问:如果一张狗图,别的一些文本说明里也提到狗,会不会让模型混淆?
讲师回答:这个过程总体是有噪声的,但偶尔有另一条描述里也出现狗,问题不大——因为平均来看,同一条描述里正好又是狗的概率不高,更多时候会出现的是苹果、猫之类的。还有一点很重要:这些图像基本都是从网上抓来的,配套文本往往就在图边或 <alt> 标签里,噪声极大。有研究表明,一张图的说明文字未必逐字描述图里有什么——因为如果图里本来就是狗,你反倒不一定非得写"狗"这个字。
所以,这个流程噪声虽大,但它居然能work,多少有些出人意料。一个必要的条件是大量的数据过滤——如果胡乱地拿网上的图配文字,噪声会太大而根本行不通。
还有一个与本讲结尾相呼应的实验观察:CLIP 作者也尝试过另一种替代目标——不做"排序",而是从图像去预测文本,可以做成一袋词(bag of words)或做成语言模型。结果是(略微出人意料地):用更强的模型反而表现更差、或者效率更低,不如用一袋词的 CLIP。
这说明了什么?讲师解读为:对于要抓图像大致表征这件事来说,精确建模说明文字的确切 token 序列并不那么重要。(这一点会在本讲结尾再次提及。)
2.6 小结与一个技术短板
(参考时间: 00:21:30)
到目前为止,我们学到了:
- 用 CLIP 编码图像,它就抓住了图像的语义——因为它和文本配对,而文本谈的正是语义;
- 要注意,这里的设计决策是围绕图像分类做的,所以它的表征并不精细;但它仍然充当了后续一切工作稳健的起点。
不过 CLIP 有一个技术缺点:它需要非常大的 batch size(比如 3 万)。如果 batch size 是 1,它显然不工作;哪怕是 10,也不工作。更进一步,那个 softmax 操作横跨整个 batch,所以它很难分解(decomposable)。
对比一下普通语言模型训练:一个 batch 里的所有序列是并行、独立地计算的,最后才做一次聚合(求平均梯度)。而 CLIP 的 loss 里,每个样本都要"看见" batch 里所有其他样本——这就引出了下一个模型:SigLIP。
3. SigLIP:把损失函数改得更简单、更高效
(参考时间: 00:22:30)
SigLIP 出自 Google,可以把它理解为 CLIP 的改进版。其名字的含义是 Sigmoid Loss for Language-Image Pre-training(用于语言图像预训练的 Sigmoid 损失)。
3.1 核心区别:从"多分类"变成"二分类"
- CLIP 做的是多分类:它说"这张图与这段文本是配对的,我要把它排在所有其他图(或所有其他文本)之前"。
- SigLIP 则更简单:它只问一个问题——对任意给定的图文对,它们配不配对? 也就是二分类。回到那张 $N \times N$ 矩阵,对角线是正样本,非对角线是负样本,仅此而已。
算法是:取 embedding、归一化、照常点积,但现在构造标签——非对角线为 −1,对角线为 +1,然后套一个 log-sigmoid。
$$\mathcal{L}_{\text{SigLIP}} = -\frac{1}{N}\sum_{i=1}^{N}\sum_{j=1}^{N}\log \sigma\!\Big(z_{ij}\cdot(\langle \mathbf{i}_i,\mathbf{t}_j\rangle/\tau + b)\Big),\qquad z_{ij}=\begin{cases}+1, & i=j\\ -1, & i\neq j\end{cases}$$
其中 $\sigma(\cdot)$ 是 sigmoid 函数,$b$ 是可学习的偏置。
编者拓展|为什么"多分类 → 二分类"是关键一步
关键差异在于 softmax 依赖整个 batch。在 CLIP 里,分母要遍历 batch 内所有负样本,因此一旦 batch size 变化,损失函数本身就变了,不同 batch 之间不可比。而 sigmoid 损失对每个 (i,j) 是独立求和的——即便你把 batch 拆小,期望意义上仍是同一个损失函数。这就是后文所说的"把 batch size 与损失函数解耦"。这一点对分布式训练和超参实验都至关重要。
3.2 数据与并行策略
(参考时间: 00:24:50)
SigLIP 由 Google 完成。其数据来自另一篇同期的图文模型工作所带来的 WebLI 数据集——约 100 亿("order billion")图文对。他们还做了额外处理:
- 对图中含文字的,做 OCR,这也是一种构造图文对的方式;
- 做了一些过滤;
- 多语言支持。
这篇论文的主要卖点是:SigLIP 比 CLIP 训练高效得多。对比一下:
| 时间 | 硬件 | |
|---|---|---|
| CLIP | 10 天 | 256 块 TPU v3 |
| SigLIP | 5 天 | 32 块 TPU v4 |
你可能觉得 v4 不是比 v3 快吗?讲师解释:按"每秒浮点运算"单卡算,v4 其实并不比 v3 快;v4 的优势在于一个 pod 里能塞更多卡、互联更好。但在这个规模下,v4 单卡其实大约慢 60%。所以真正的加速来自算法与并行策略(当然,CLIP 当时大概也没把代码优化到极致吞吐,只是"先让它跑通")。
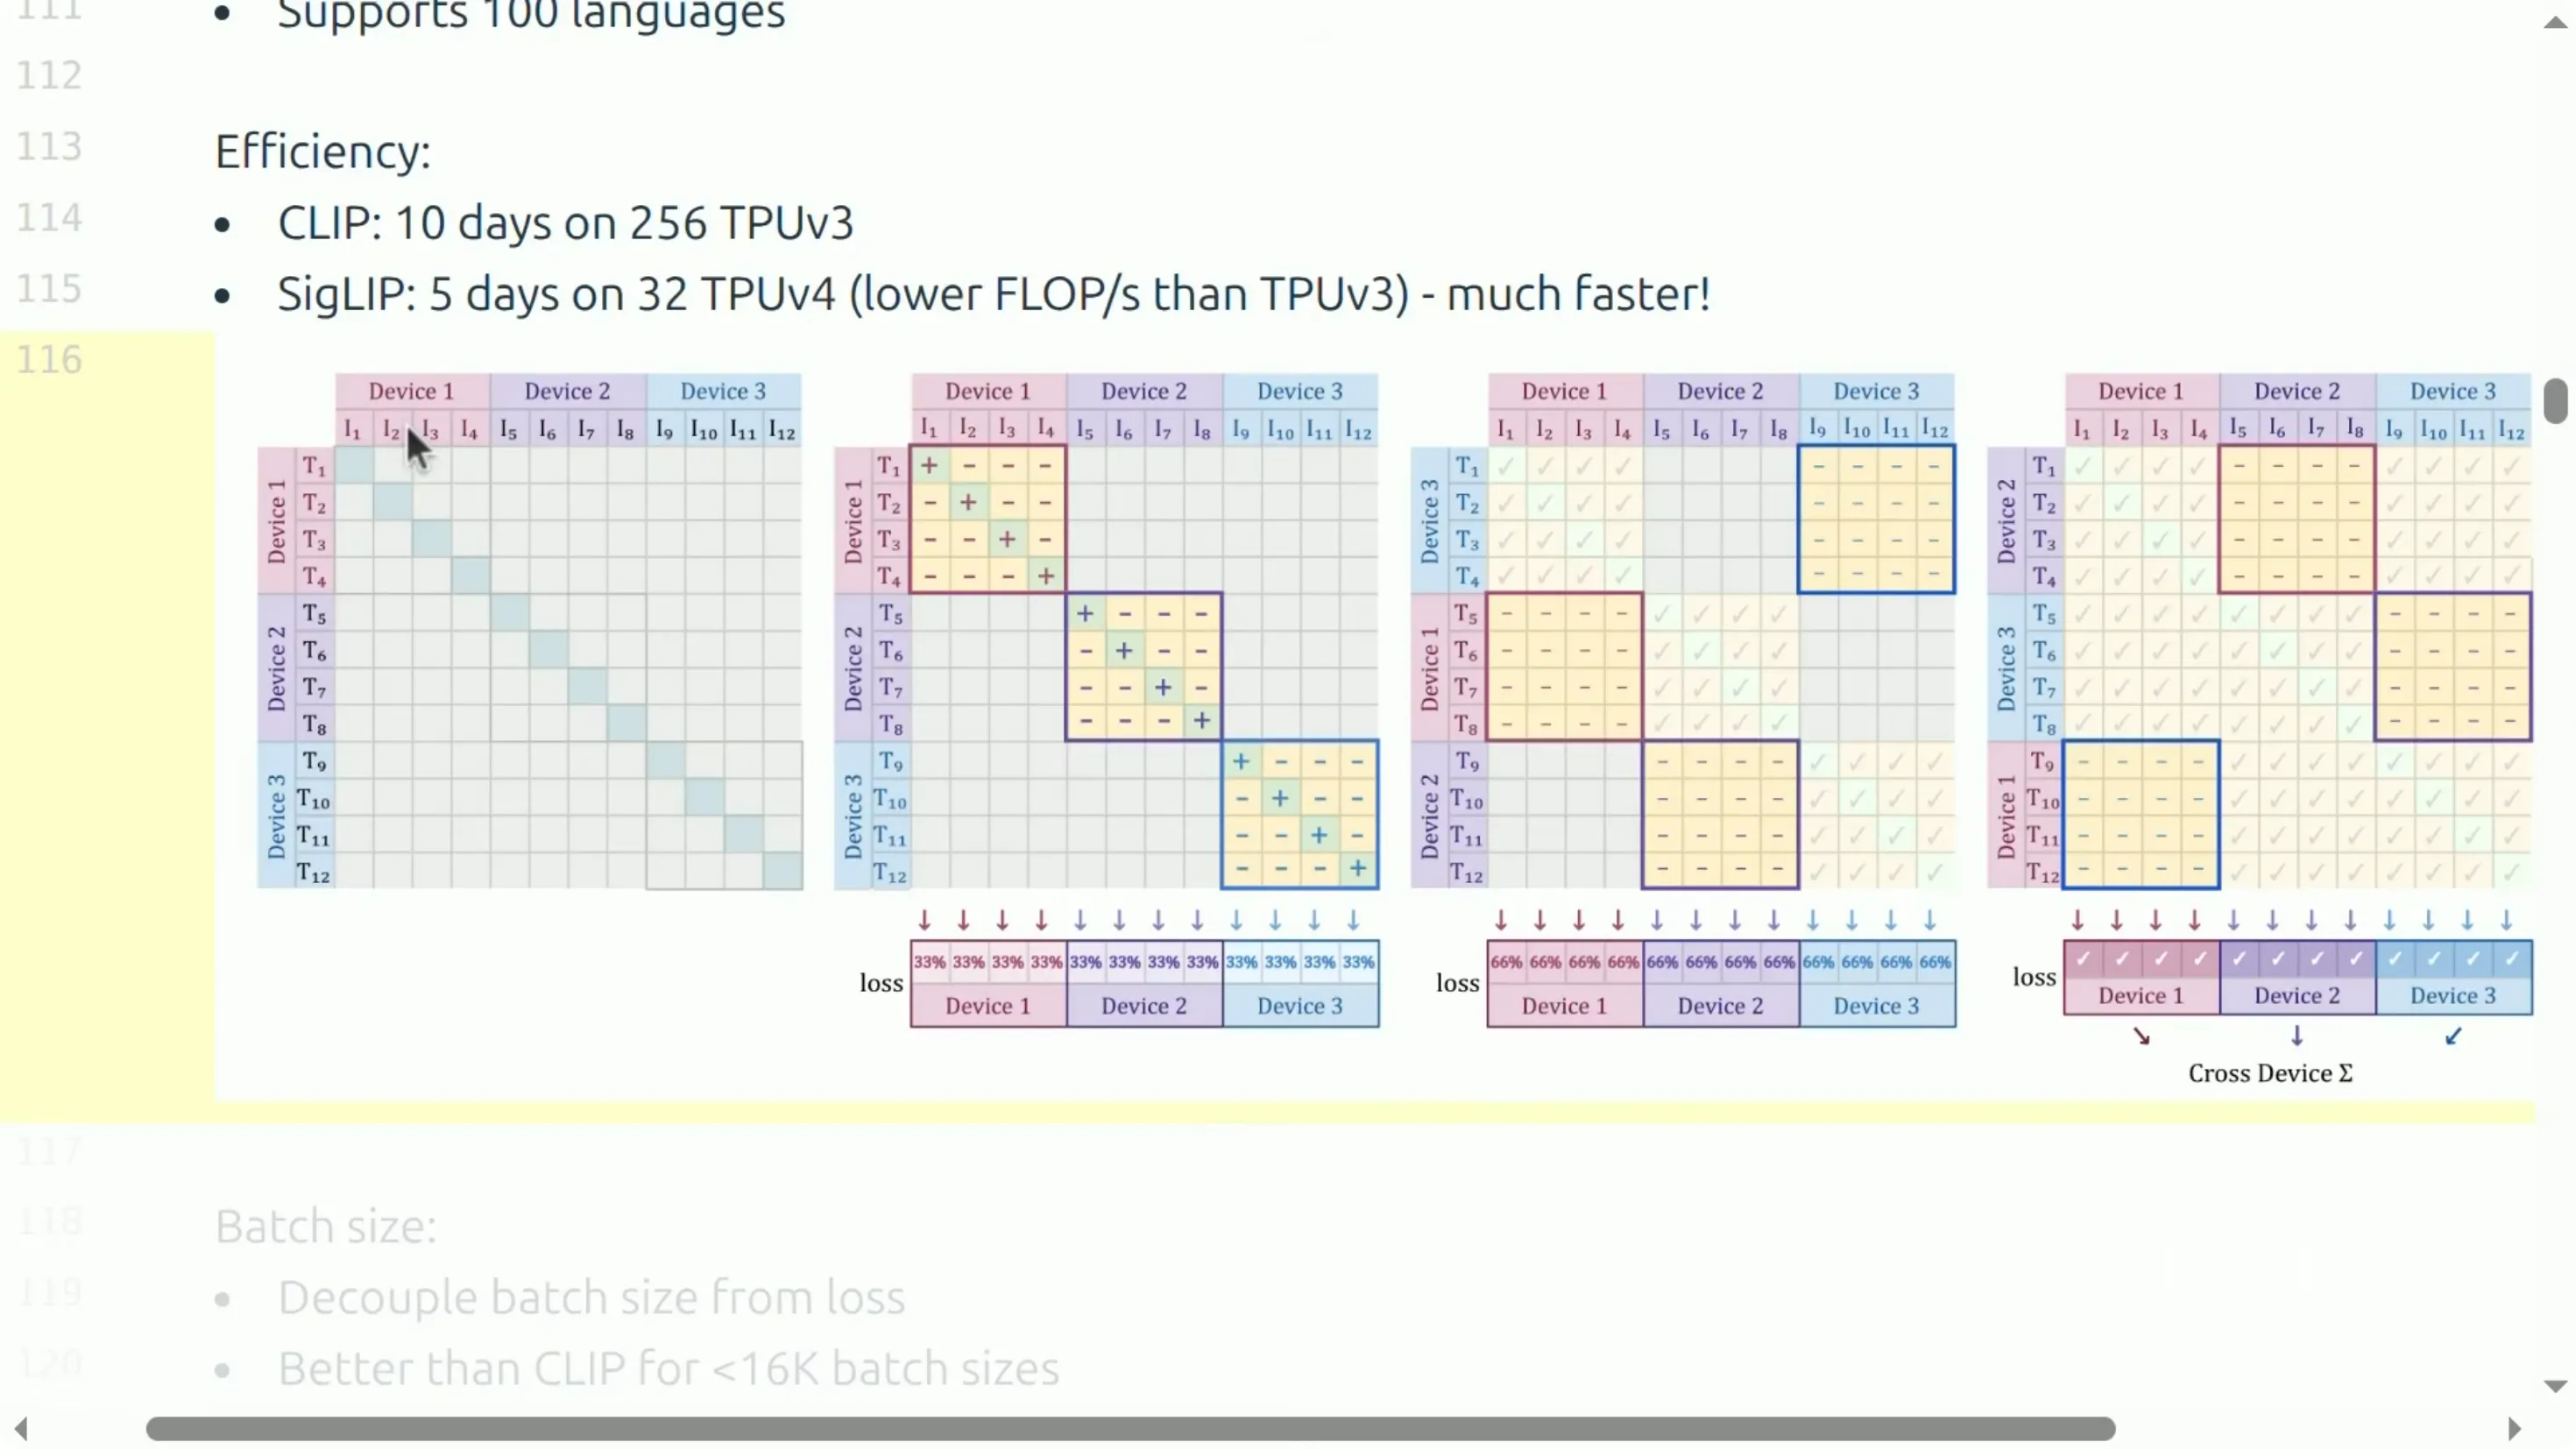
SigLIP 是怎么并行的? 回忆一下你们的系统课内容,可以把它想成 DDP——每块设备存一部分图文对。但与语言模型训练不同,样本之间存在交互,并不完全因子化。于是:
- 第一轮,每块设备先本地计算落在它自己数据上的损失;
- 然后把文本轮转传过去:比如设备 1 拿到 $\mathbf{t}_5 \dots \mathbf{t}_8$,就能计算这些位置的负样本;再拿到 $\mathbf{t}_9 \dots \mathbf{t}_{12}$……
- 这样轮转着绕一圈,最终覆盖所有非对角块的条目。
📷 SigLIP 训练中文本在设备之间轮转以计算全部负样本
回到原视频 (00:26:50)
SigLIP 的另一个好处是解耦了 batch size 与损失:
- 在 CLIP 里,损失与 batch size 绑死——改了 batch size,损失函数就变了;
- SigLIP 因此能试验更小的 batch size(比如小于 16K),而在这个小 batch 区间,SigLIP 表现远好于 CLIP(CLIP 在小 batch 下损失会急剧退化);对小 batch,SigLIP 方差更大,但期望损失不变。
- 当然,batch 也可以开得很大,但收益不明显;他们发现存在所谓临界 batch size(critical batch size),大约是 32K。
4. 从编码器到 VLM:发端于 LLaVA
(参考时间: 00:28:40)
现在我们手里有了 CLIP 和 SigLIP——它们都是图像编码器,把(本讲中固定尺寸的、比如 336×336 的)图像映射成一个向量,其中含有某种语义。
接下来,我们要开始动手搭 VLM(Vision Language Model,视觉语言模型)。讲师讲了两个系列:LLaVA 和 Qwen。两者在大体模板上非常相似,只在一些细节上有差异。
基本思路是:取这些(图像)embedding,然后直接注入一个语言模型。 这更接近一种中训练(mid-training)或后训练(post-training)的味道——我们不是从零训练,而是拿一个现成的图像编码器、一个现成的 LLM,然后把它们缝合起来。
4.1 LLaVA(2023):一个把图像"翻译"成语言 token 的线性投影
(参考时间: 00:29:40)
LLaVA 论文于 2023 年问世,它之所以让人兴奋,是因为当时闭源模型(如 GPT-4)已经能做视觉推理,而 LLaVA 作为开源模型,让人们第一次能看清"里面究竟是怎么回事"。(其效果当然不如 GPT-4,但"能看到内幕"这一点很有价值。)
一个 VLM 大致包含几块:
- 视觉编码器:LLaVA 用的是 CLIP;
- 文本解码器:他们用了一个叫 Vicuna 的语言模型——它是第一个在 ShareGPT 对话数据上微调过的 LLaMA 模型(ShareGPT 是人们与 ChatGPT 对话后分享在网站上的对话数据,讲师说该网站好像已经下线了)。
数据从哪来? 基于 MS COCO——这是一个标注数据集:众包工人为一批图像标注了边界框(bounding box)和说明(caption)。LLaVA 合成了自己的训练数据:把 COCO 里的说明或检测到的物体喂给 GPT-4,让 GPT-4生成问题和对话。
例如,给 GPT-4 一张图片、一段人类标注的说明和人写的标签,让它"生成一段对话",你可能会得到一问一答;也可以让它"生成详细描述",它就会产生类似说明的文字;还可以让它"生成复杂推理",它也会生成。最终他们得到 158,000 个合成样本,然后在此上训练模型。
📷 LLaVA 的架构:CLIP 图像编码器 + 线性投影 W + 语言模型
回到原视频 (00:32:20)
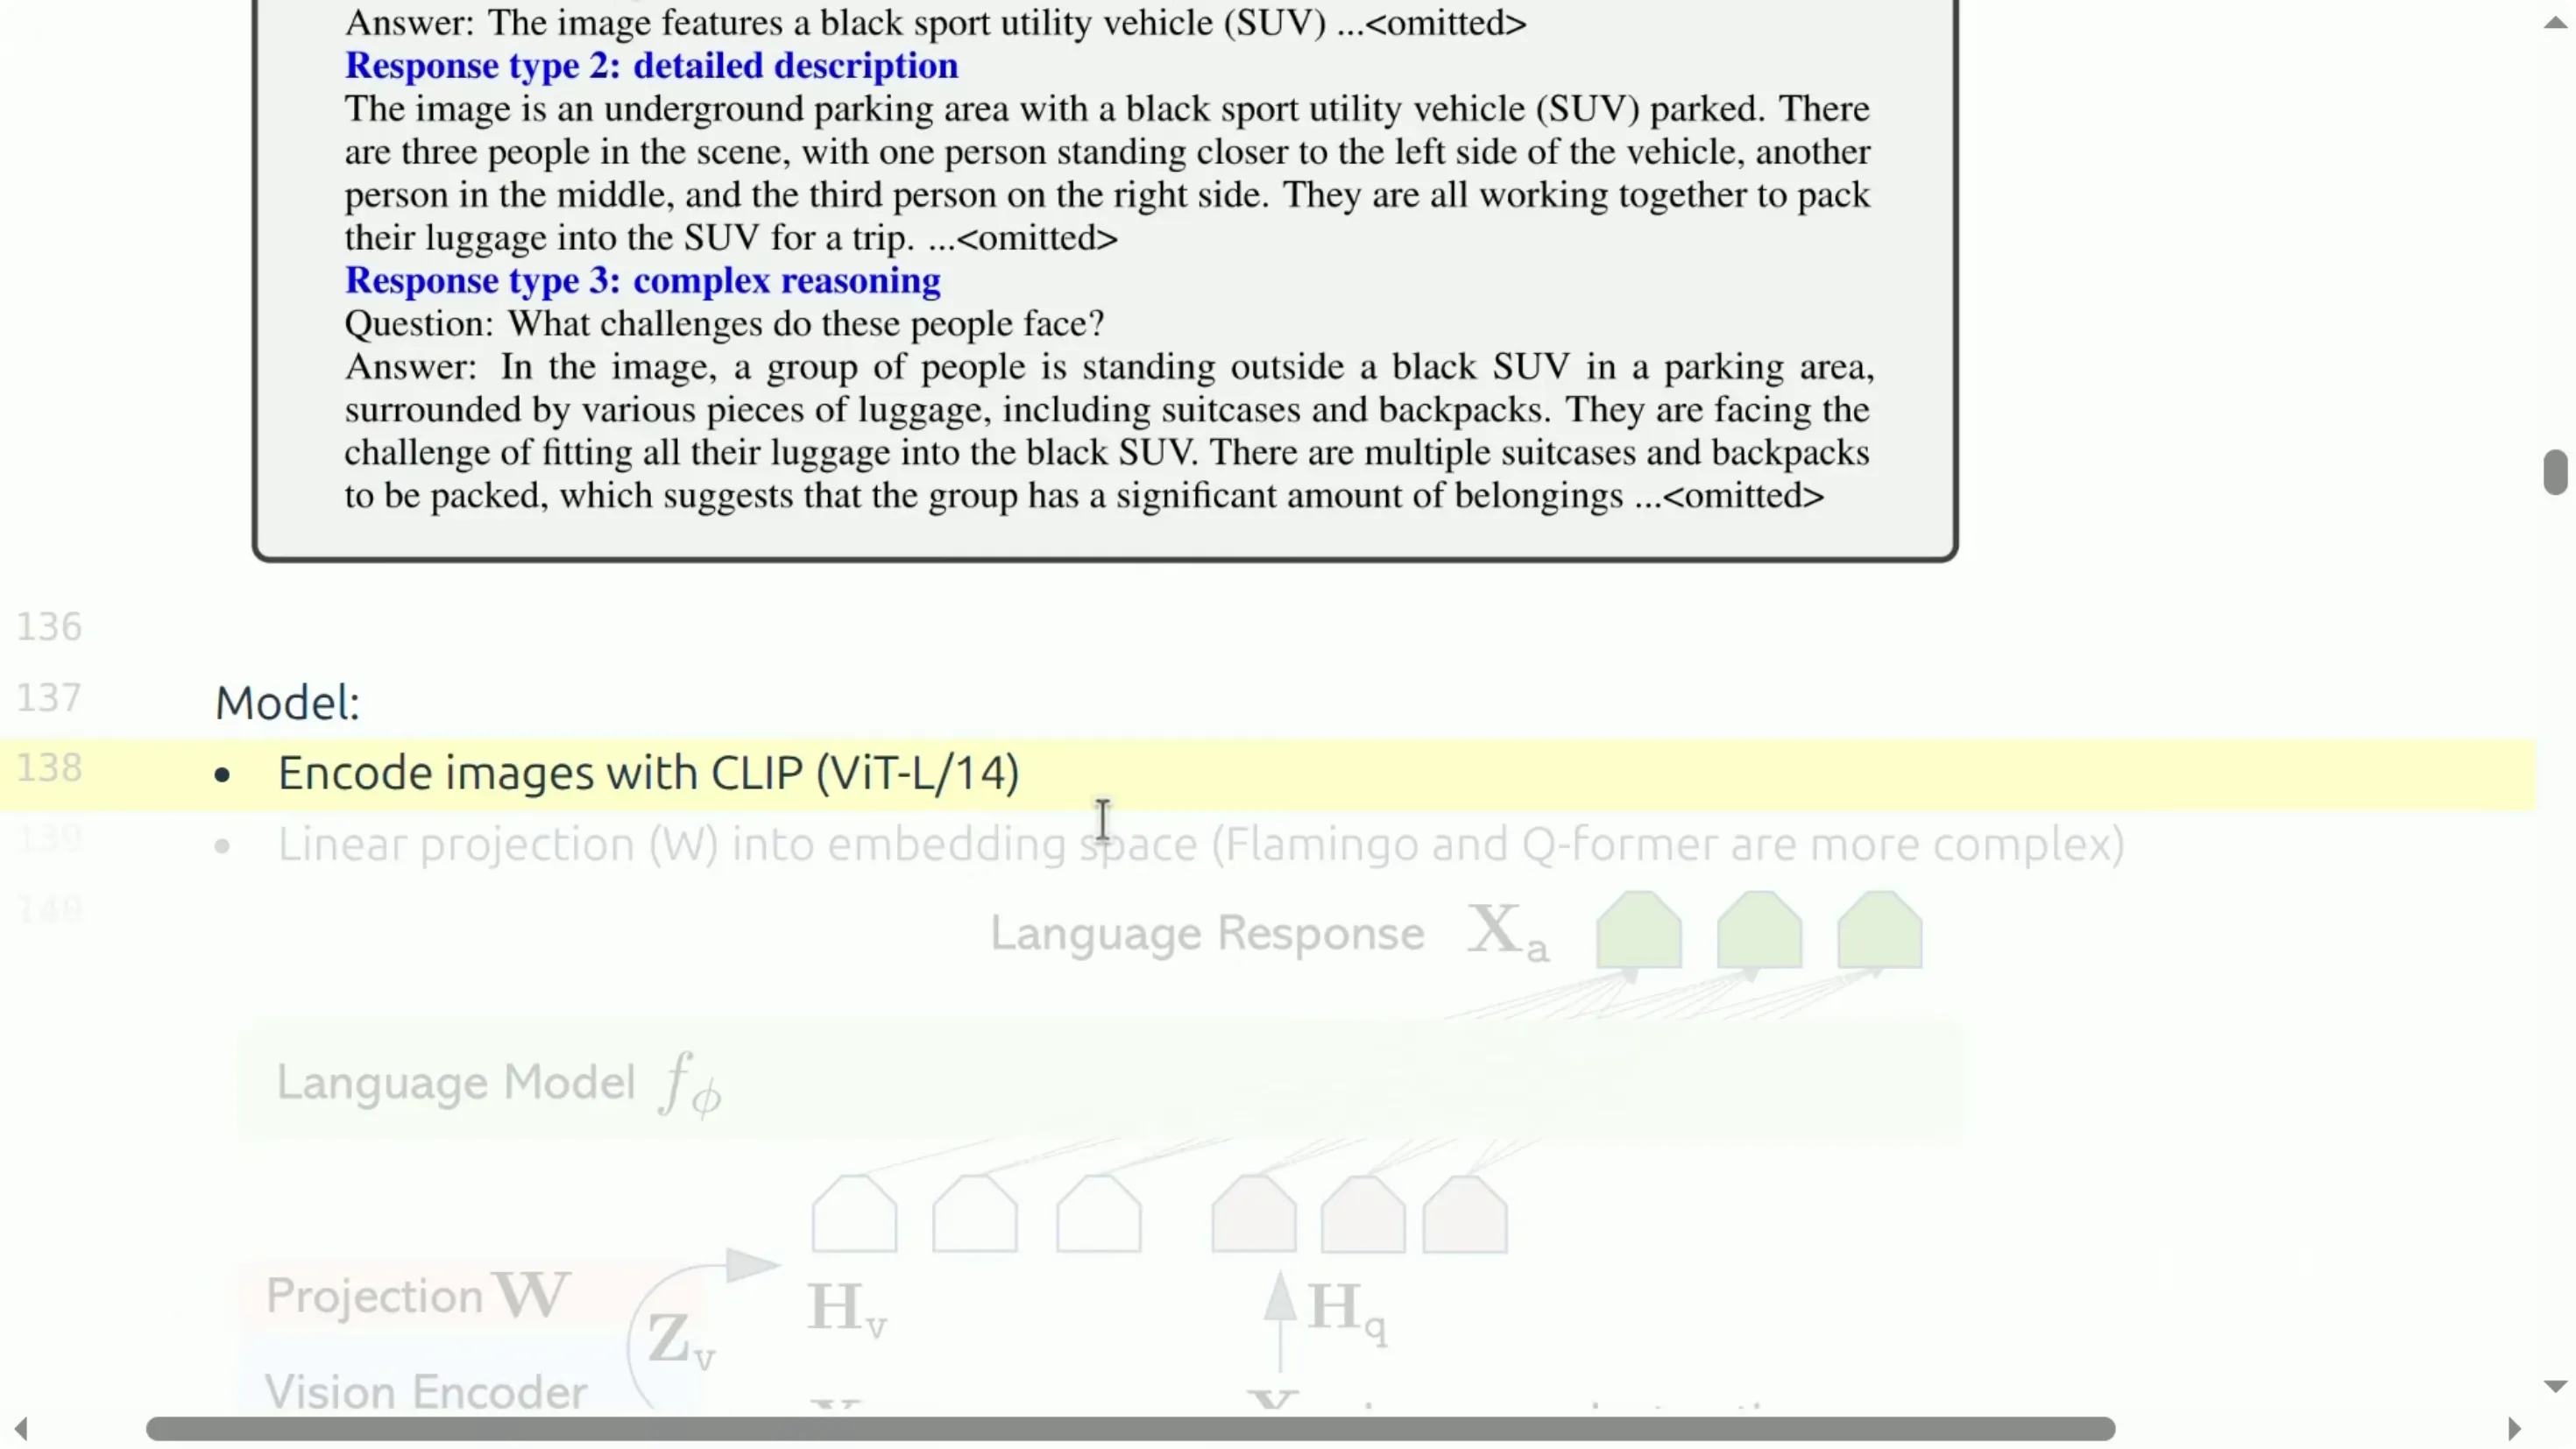
模型长什么样? 他们用 CLIP,且是性能最高的版本 ViT-L/14(14×14 patches):
- 图像送进视觉编码器 CLIP,得到一个向量;
- 但这个向量并不在文本所处的空间里——所以乘一个矩阵 $W$,得到另一个向量,进入与文本 embedding 相同的空间;
- 文本则用常规 embedding 得到向量;
- 于是整段向量序列(图像向量 + 文本向量)就送进一个标准 Transformer,产生输出。
换句话说,我们在把图像"翻译成文本 token",从而复用预训练好的语言模型。
训练分两个阶段:
| 阶段 | 冻结的部分 | 训练的部分 | 目标 |
|---|---|---|---|
| 阶段一:对齐(alignment) | 视觉编码器 + 语言模型 | 只训练 $W$ | 让图像被映射到与文本相同的空间 |
| 阶段二 | 视觉编码器 | $W$ + 语言模型 | 在"图 + 文本 → 文本"的数据上微调 |
讲师解释阶段一为什么重要:如果 $W$ 一开始就是随机的,图像向量显然不表示任何自然语言 token;训练 $W$ 的目标就是让它们看起来像自然语言 token 的 embedding。
阶段二则是在"这里是一张图,这里是一段对话/描述/推理"这类数据上微调语言模型。这些全都是"图像 + 文本 → 文本"格式。
论文里有一个有意思的例子:输入一张图 + 一段对话,用户问"这张图有什么不寻常?",LLaVA 能回答出"人们通常不会在面包车尾部熨衣服"。他们还特别指出,即便用户的提示没有明确暗示"不寻常",模型也能主动谈这一点——而当时的一些其他模型做不到,只有 GPT-4 能做到。
4.2 LLaVA 1.5 / NeXT(2024):AnyRes、多图与视频
(参考时间: 00:33:30)
从 LLaVA 到 LLaVA 1-vision(2024),中间有 LLaVA 1.5、LLaVA NeXT 一系列论文。讲师说,他会把这几篇的改进糅在一起讲。核心是同一套配方(recipe),但目标更进取——他们想让模型处理更多样的多模态应用。
主要升级:
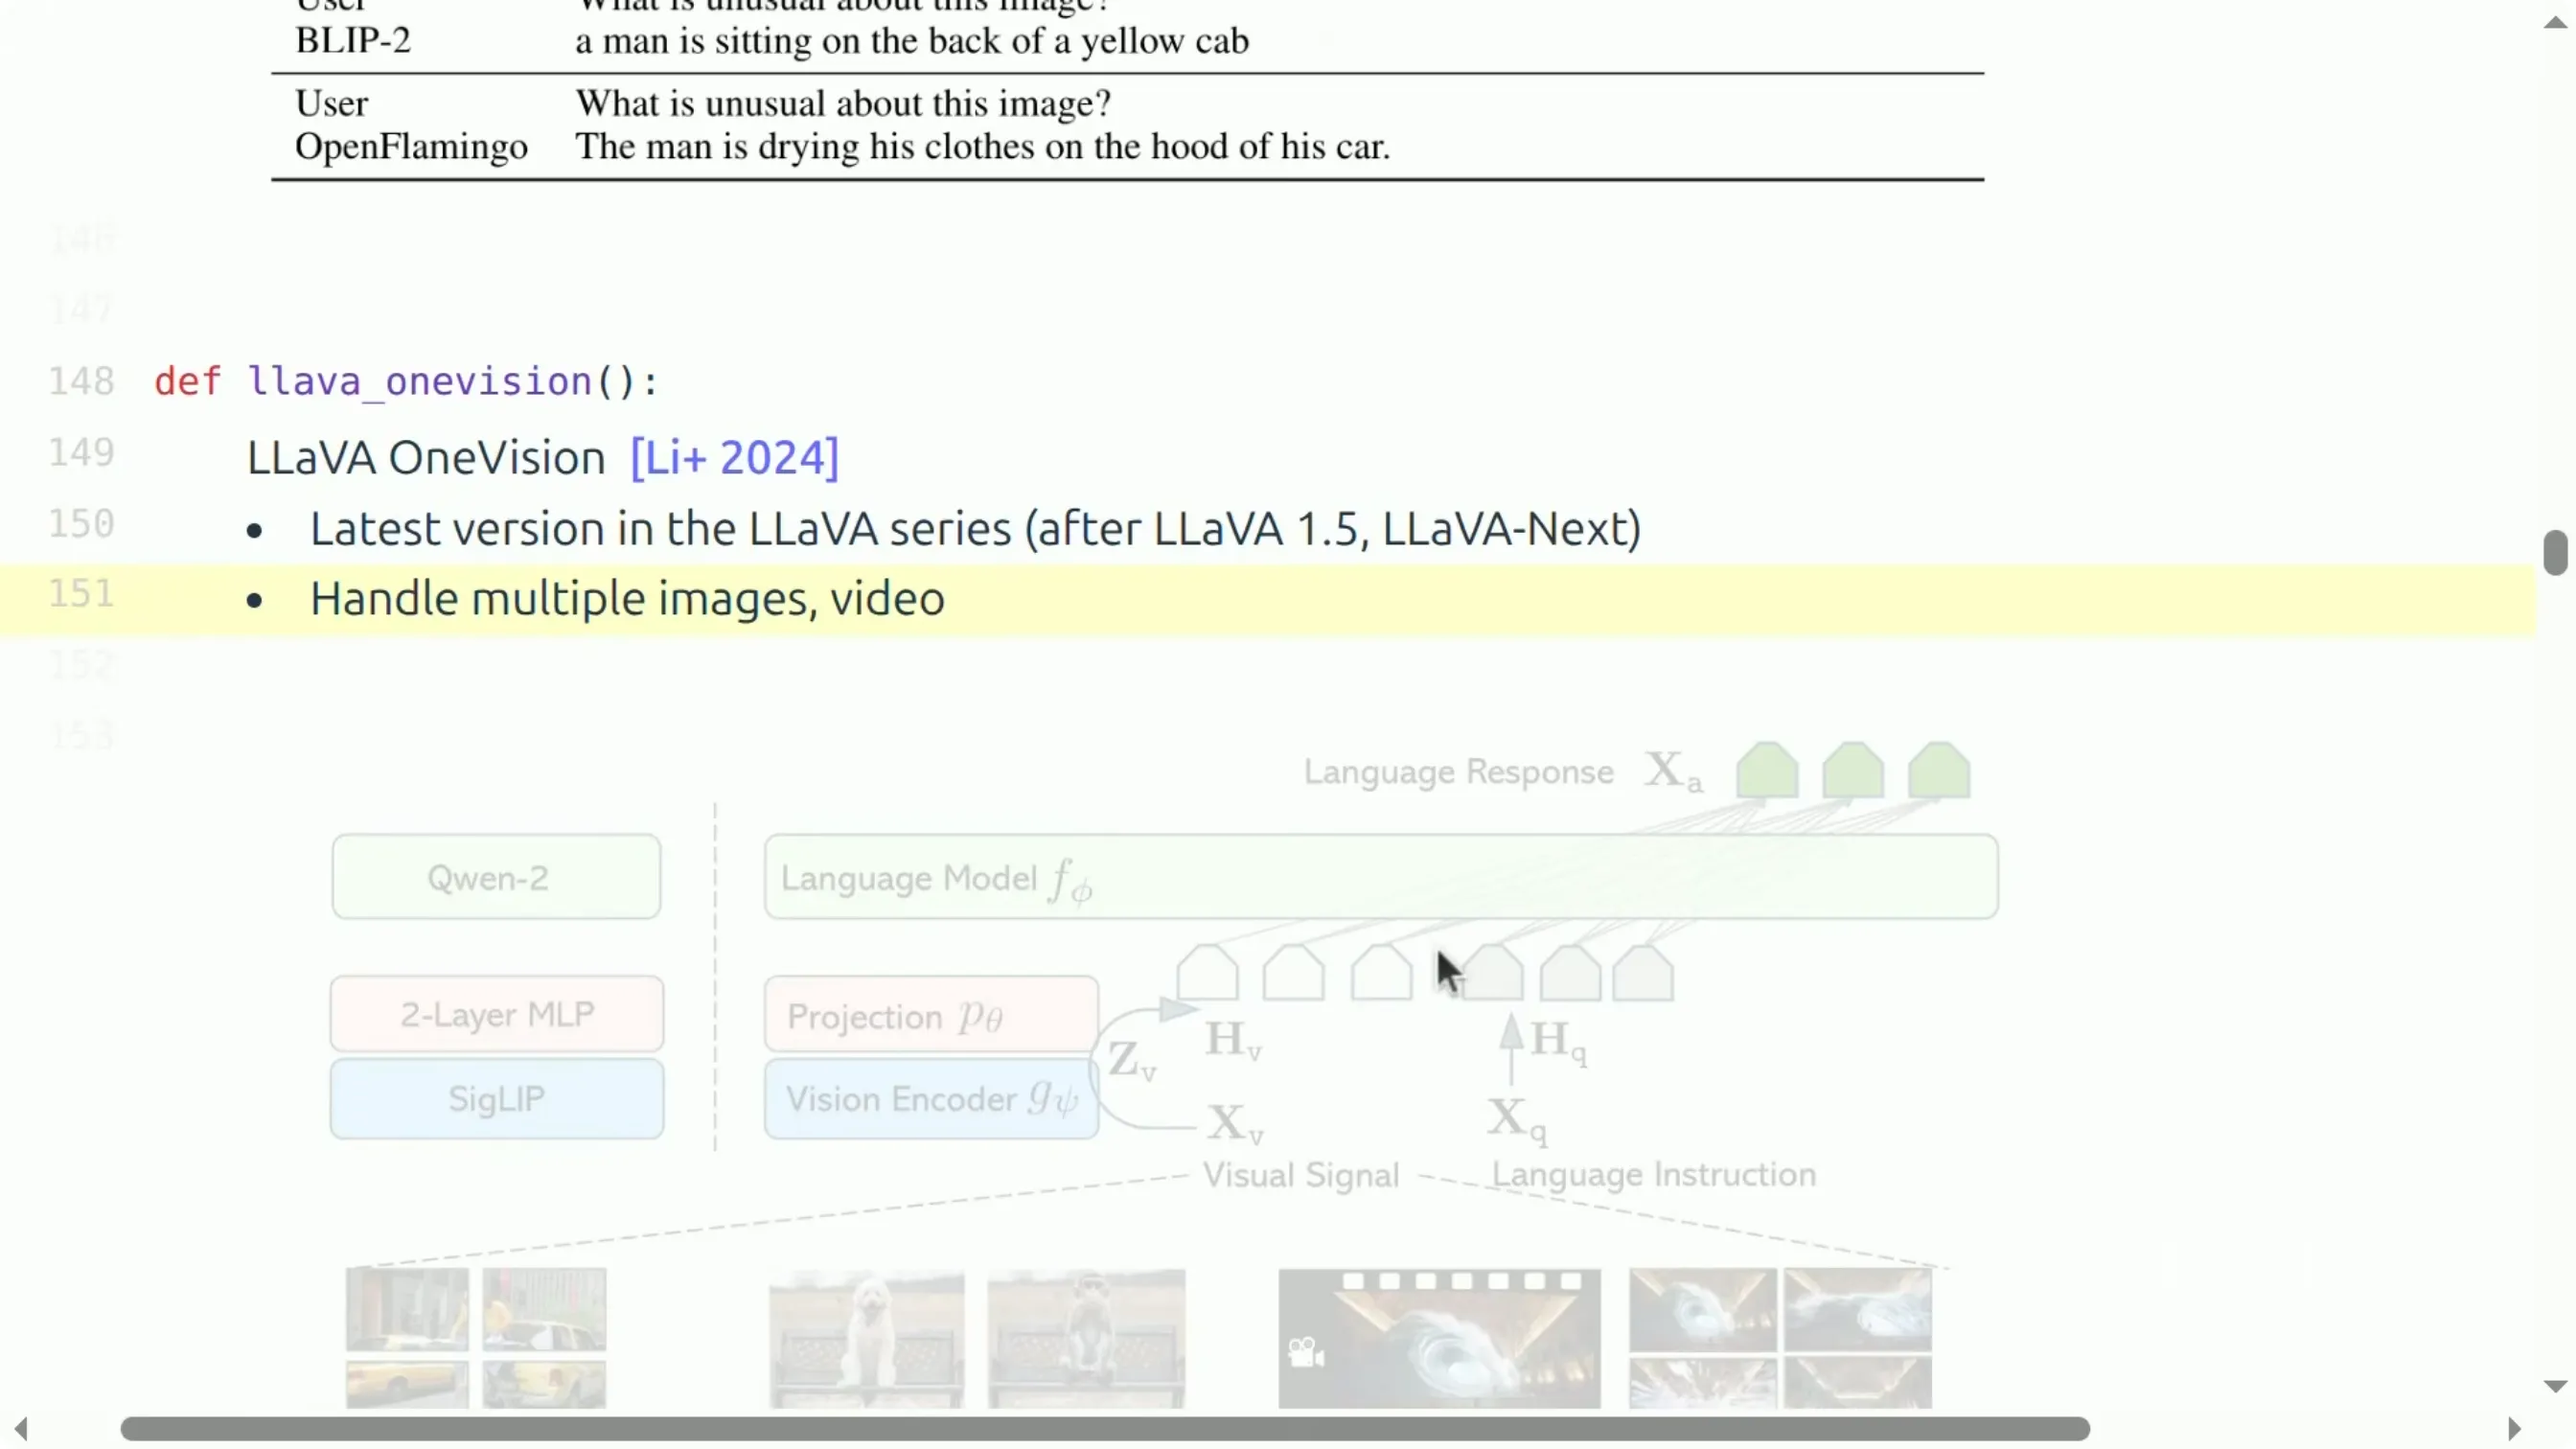
📷 LLaVA 1.5 起支持多图与视频,视觉编码器换成 SigLIP,投影器换成两层 MLP
回到原视频 (00:36:00)
- 支持多张图像和视频。视频本质上是一串抽帧采样得到的图像序列。
- 视觉编码器升级为 SigLIP;
- 文本解码器换成 Qwen 2——当时它大概是最好的开源语言模型;
- 投影器(projector/adapter,负责把视觉编码器输出变成语言模型输入的那个东西)从单层线性投影升级为两层 MLP。
这些改动让整个系统看着像是"换了几个零件",但大体结构不变。
一个绕不过的难题:OCR 与超分辨率信息。 他们想做 OCR,而 OCR 要求保留极细粒度信息——否则 J 看起来就像 I,这不妙。可是别忘了,CLIP 会把图缩放再裁成 336×336。如果你有一份文档图像、裁成 336×336,你根本读不出字来!
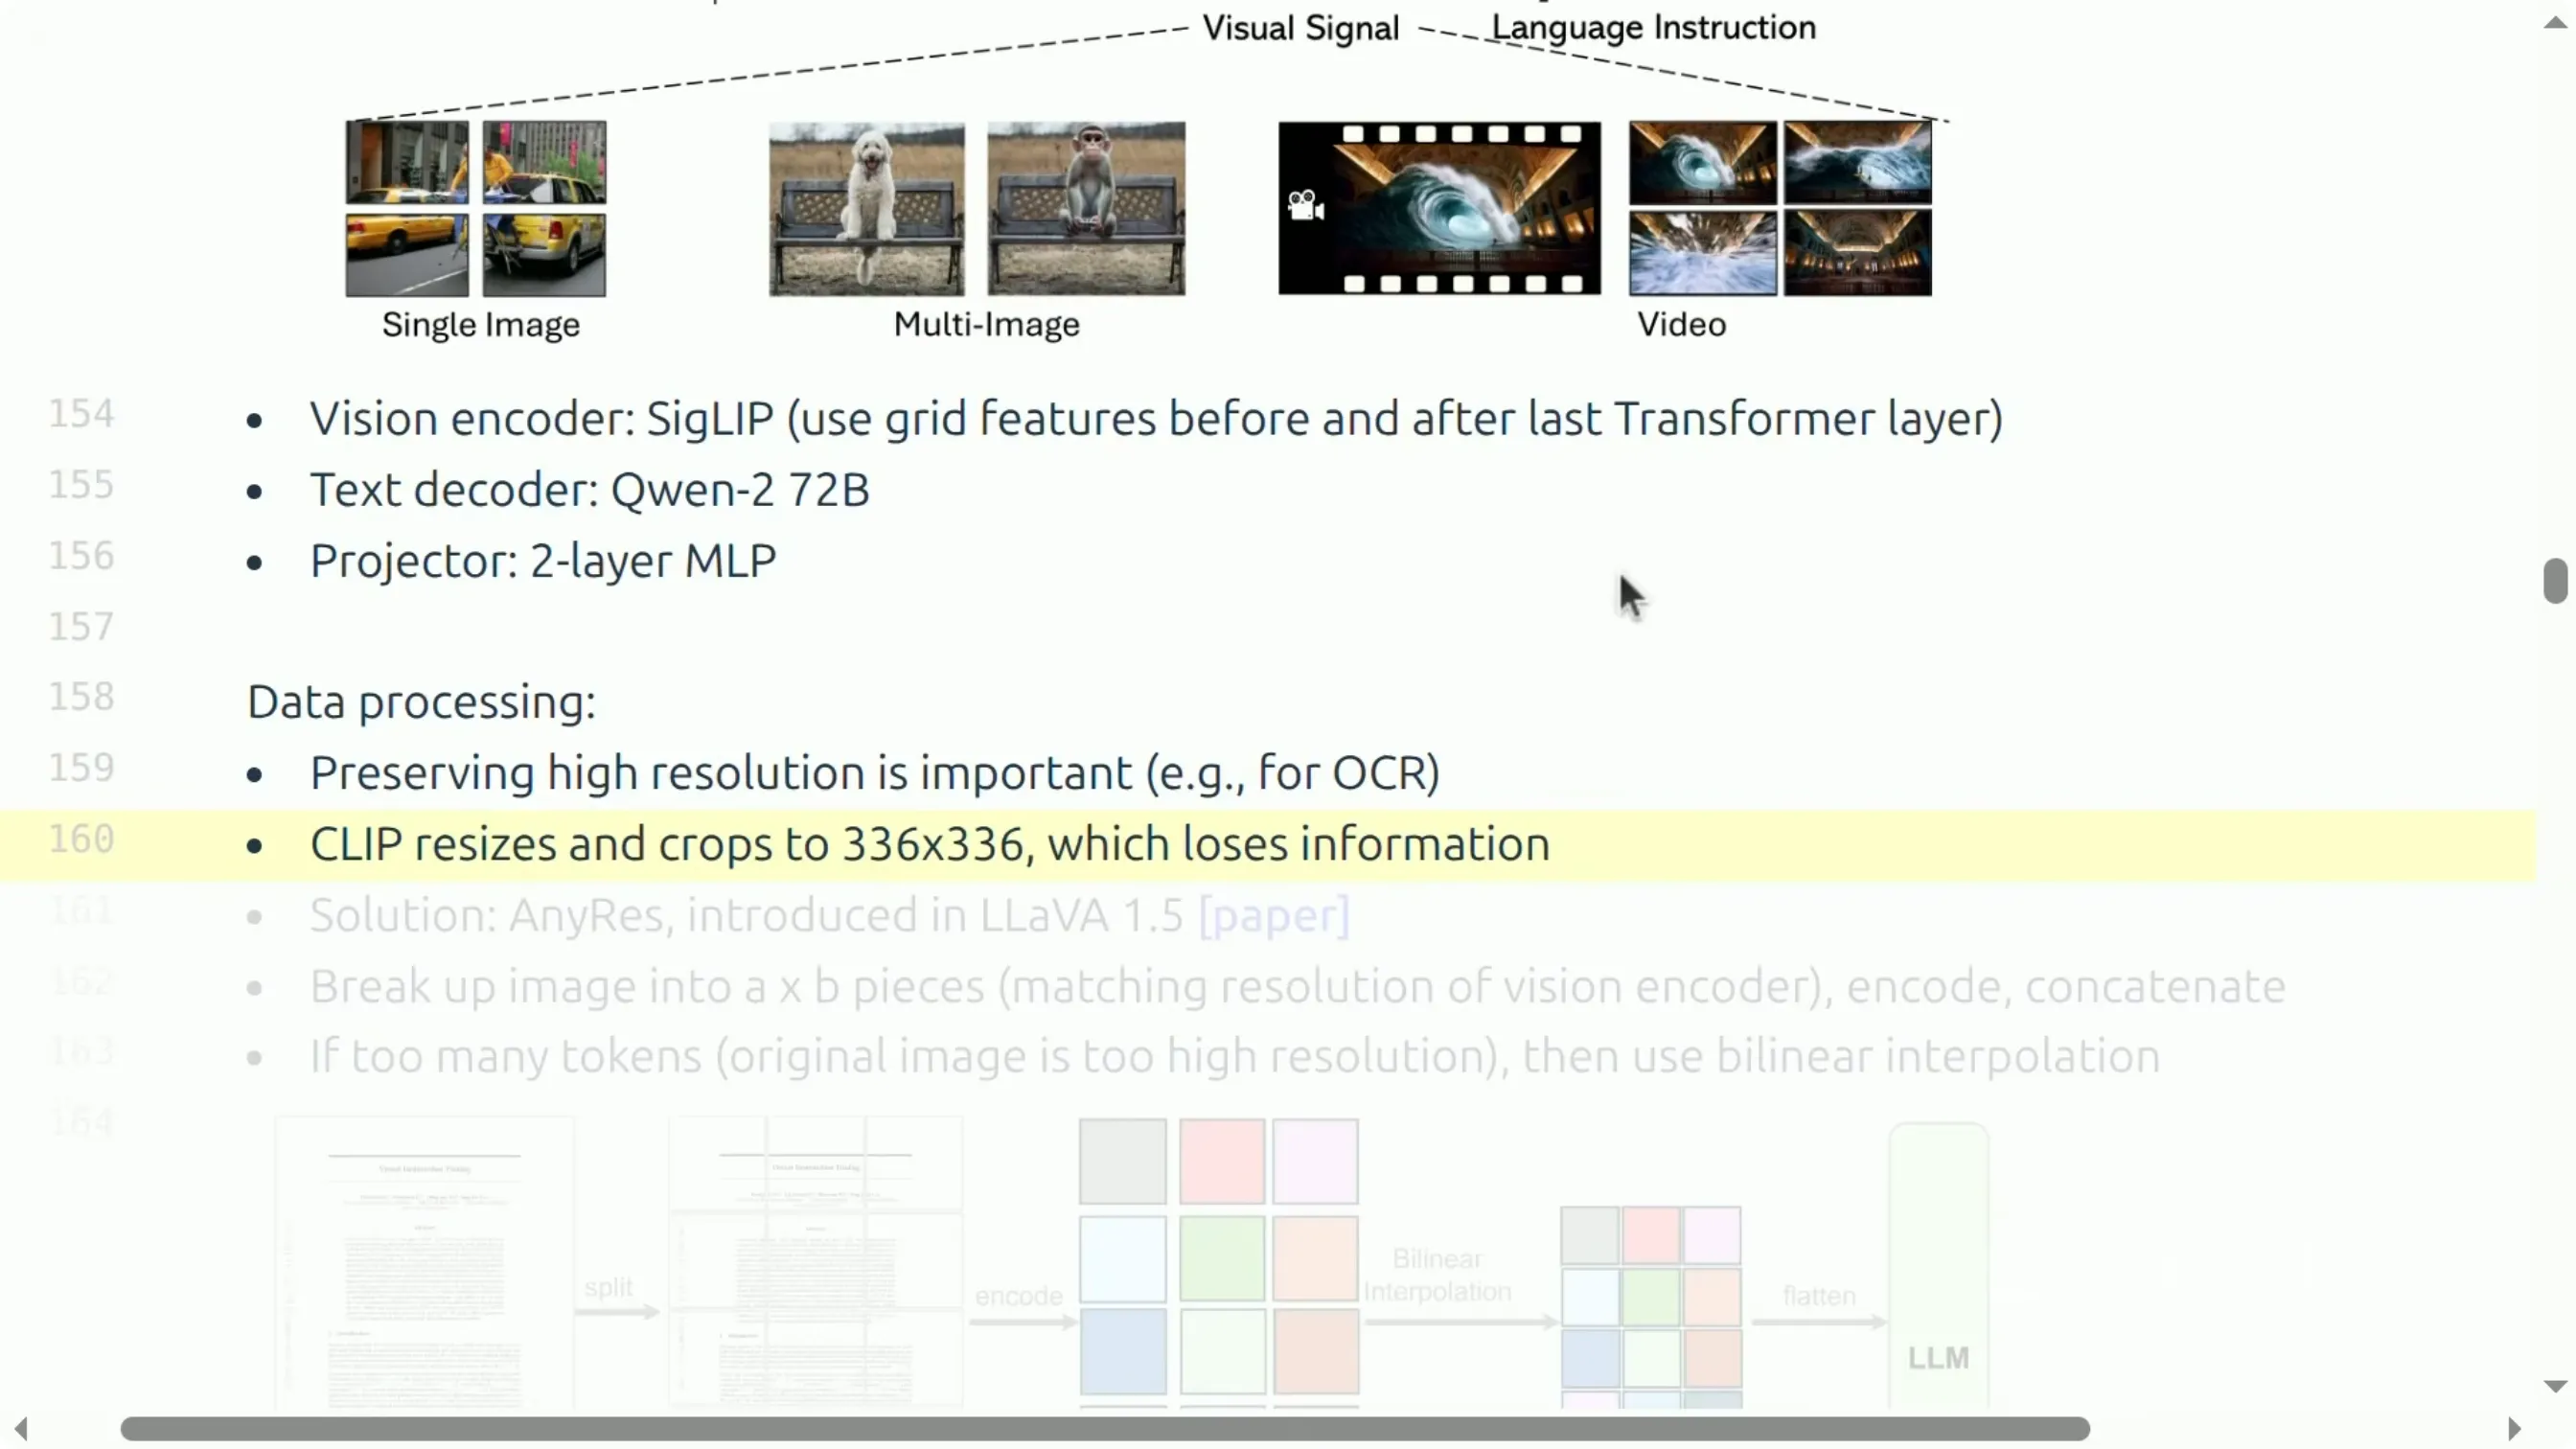
📷 AnyRes:把高分辨率图像切成多块,每块符合编码器输入尺寸,分别编码后拼接
回到原视频 (00:37:30)
解决办法是 AnyRes(其实是 LLaVA 1.5 论文里提出的):
- 把图像切成多块(pieces),每块的大小正好是视觉编码器能吃的尺寸(如 336×336);
- 分别编码每一块,得到一串向量;
- 然后拼接这些向量。
也就是说:当视觉编码器处理不了高分辨率时,你不再"降采样",而是"切成不同区域分别看"。 如果分辨率真的超级高(或视频),token 会过多,此时再做降采样。AnyRes 的精髓在于"自适应"——这一点很讨巧,因为Transformer 本身就已经是自适应的:句子的长度可以任意;既然语言能自适应,那么图像分辨率也能自适应。
具体到图像处理,做法大致是:先做一路降采样,得到整张图(比如一整页论文)的低分辨率编码;再把它切块,每块都是编码器期望的分辨率,各编码一次;再拼接全部 patch;如果 patch 太多,就通过插值把数量降下来。
多图、单图、视频的处理各有侧重(他们把"天平"稍微拨了拨,好让各模态的量大致可比):视频可能很长,他们不希望数据集被一堆重复帧主。所以——
- 单张图像:整图降采样 + 最多 9 个裁块("我可以凑近仔细看");
- 多张图像:只用基础分辨率("我只能从远处看");
- 视频:用更低分辨率、更少 token 表示每一帧,且最多只用 32 帧。
因为视频很容易撞上上下文长度的天花板——后面会看到,"能处理长上下文"是做好多模态的一大关。
4.3 LLaVA 的数据哲学与"模态间迁移"
(参考时间: 00:41:20)
LLaVA 的数据,其官方说法是"追求高质量与数量的组织";另一种解读是:数据非常有针对性。你看很多数据都是非常任务化的——视觉问答、表格问答之类。这显然已经是后训练的地盘:你想让模型做好某个任务,就造一堆这样的任务数据。而且这项工作毫不讳言地在蒸馏 GPT-4——这不算理想,但在没有标注预算时,这就是你会做的事。数据里有单图、多图、视频,还有一些很特定任务(比如"给两张图,找不同")。
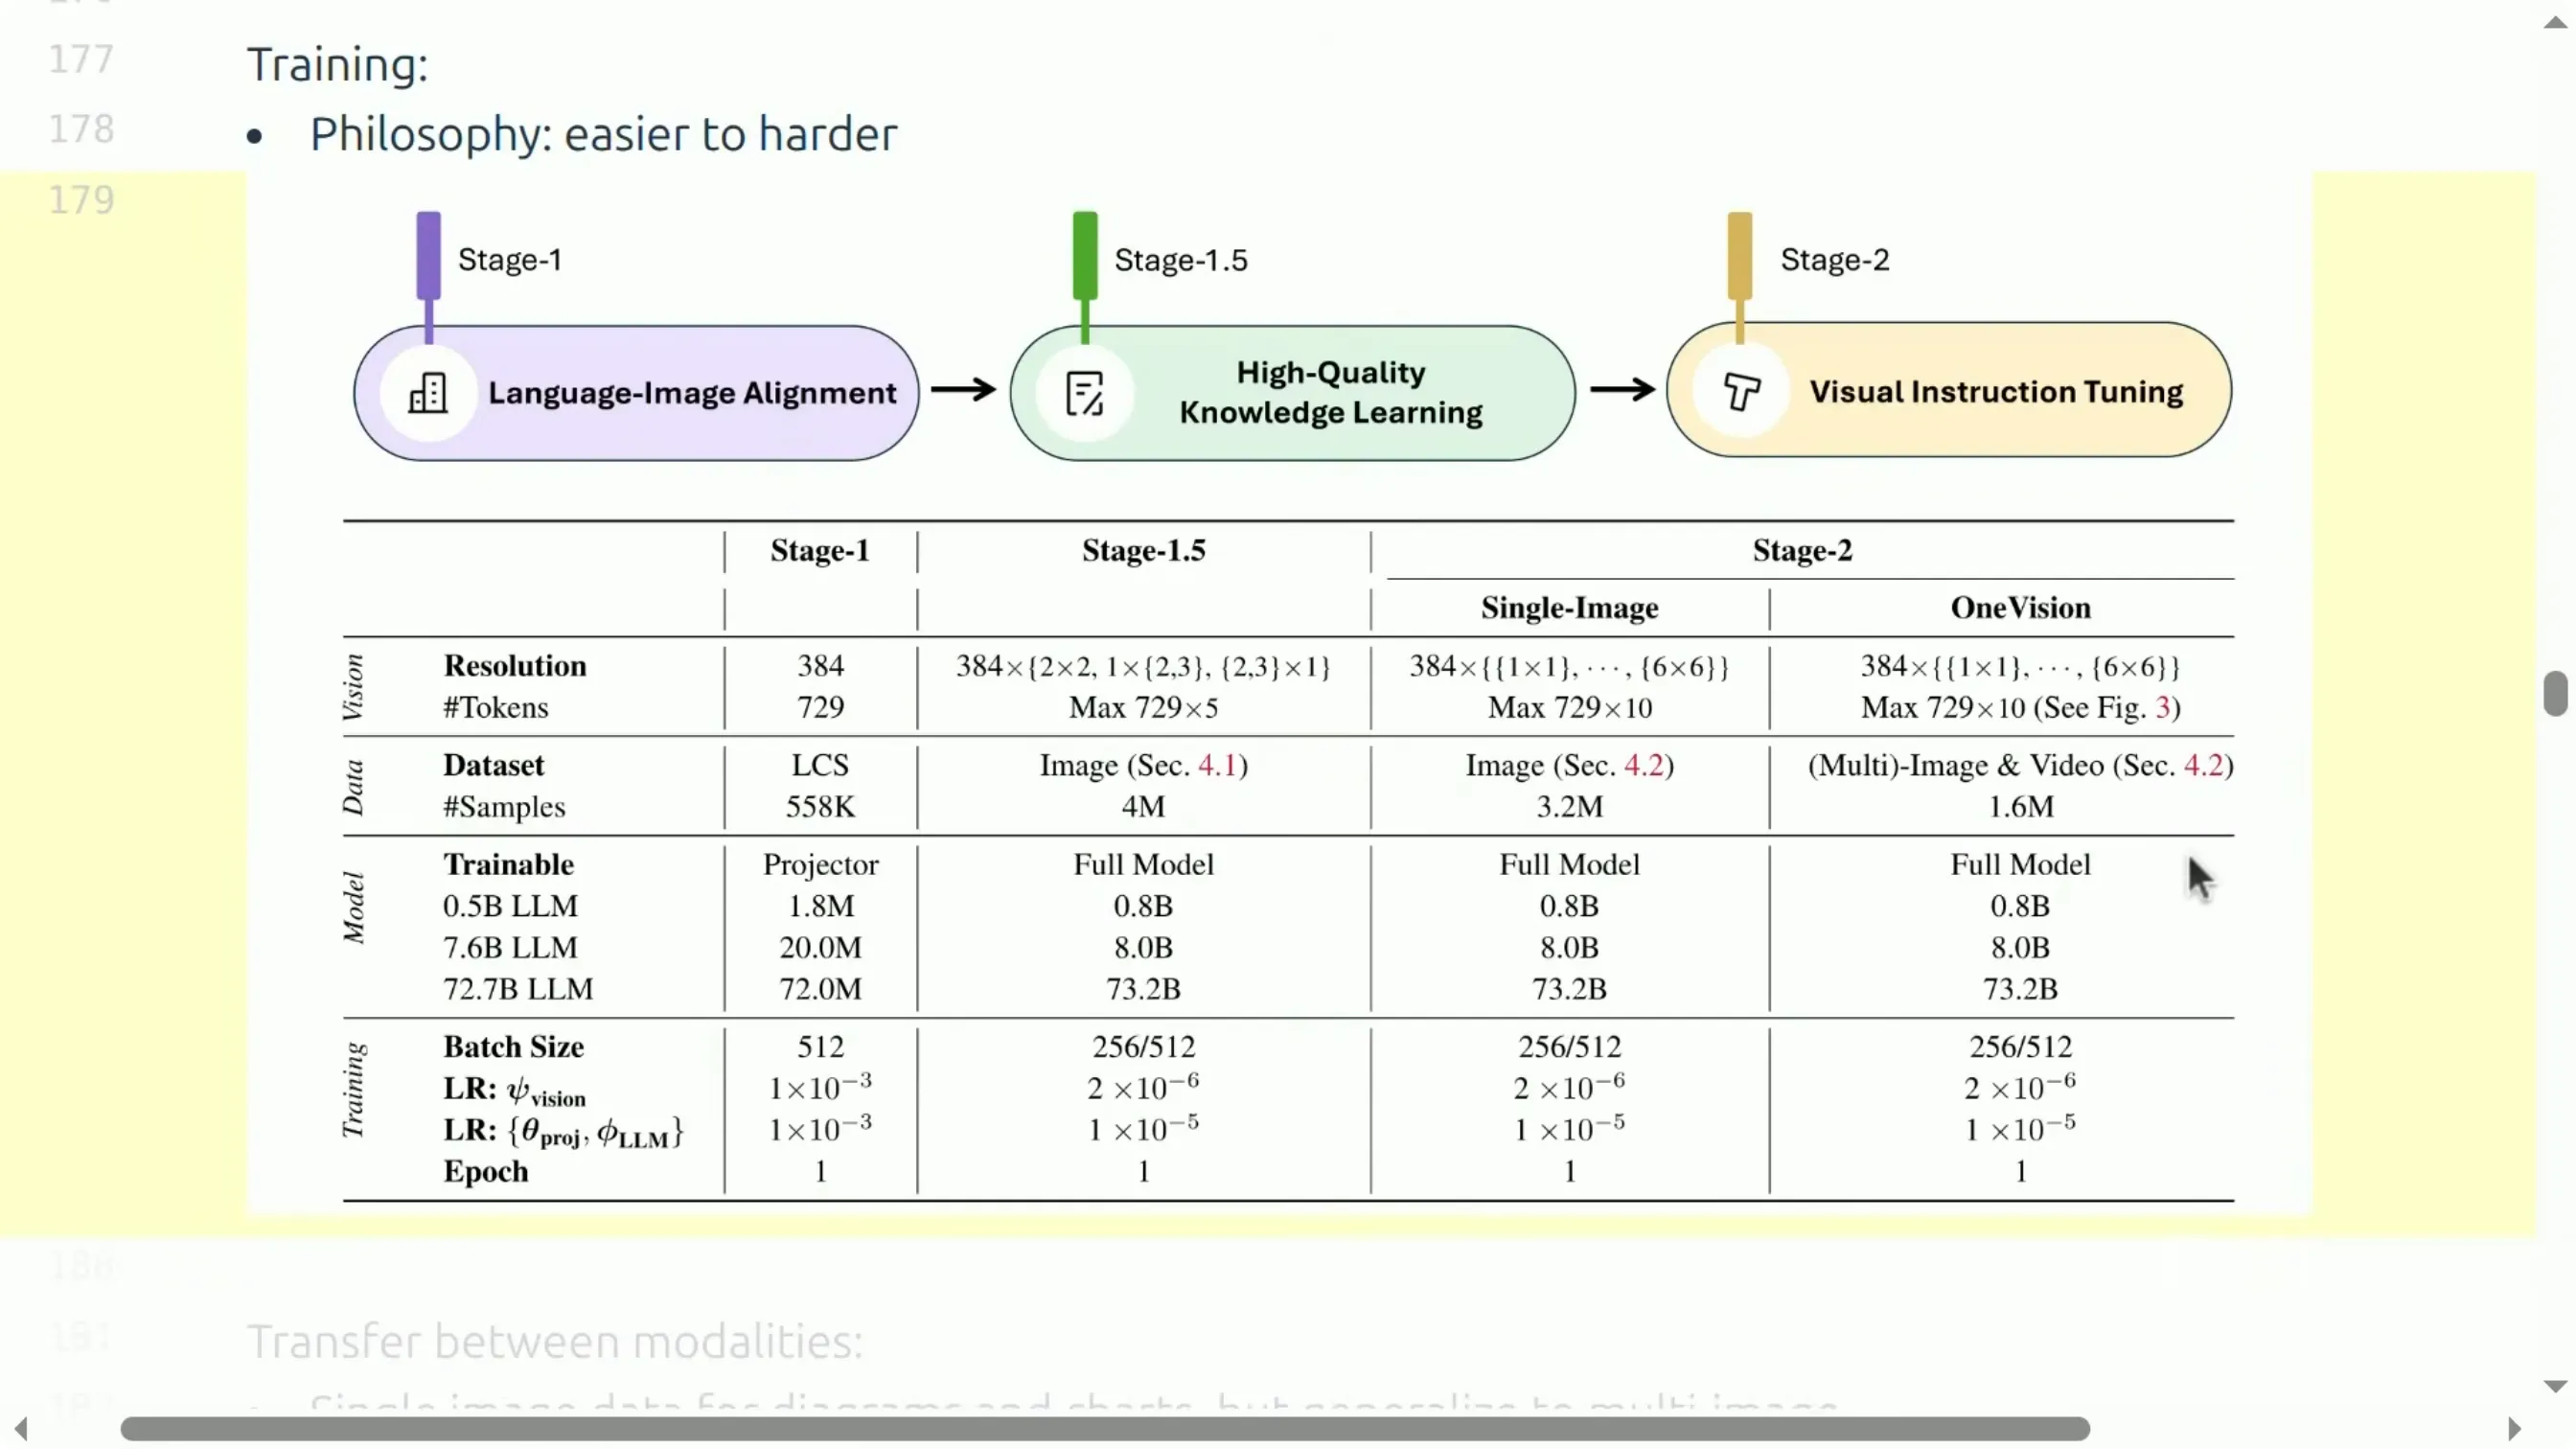
📷 LLaVA 训练的三个阶段:对齐 → 高质量数据 → 面向下游任务
回到原视频 (00:42:40)
训练也分阶段(和前面一样): - 阶段一聚焦对齐,只训练 projector/adapter; - 阶段二侧重知识,用高质量数据; - 阶段三训练整个模型,聚焦像下游任务那样的样本。
讲师坦言:他除了阶段二和阶段三的侧重点不同之外,看不出这三个划分有特别的原则性理由。
一个有意思的发现:模态之间会"迁移"。 比如——
- 虽然训练时"图表问答"只在单图数据上出现,但测试时给一张表格图 + 一张图表图、问关于它们的问题,模型也能泛化到多图场景并对上话;
- 训练时 OCR 数据只出现在单图,关系推理只出现在多图,但模型能泛化到这些场景,例如给 GUI 智能体用——给它看一堆截图(多张图),让它生成对截图的描述;
- 还有一个"视觉提示(visual prompting)"的例子:图上画一个圈,指示"该关注哪一块"。这类数据只存在于单图,但模型能泛化到视频——用户说"描述视频里被高亮的那个球员",而这个球员跨越了多个帧。
讲师原本以为这是"逐个任务打靶"式的监督学习,没想到任务足够多时,这些模型会出现某种迁移——这多少令人安心。
最后,讲师强调 LLaVA 系列的一个优点:它是少数既开源模型权重、也开源数据的工作,因此你可以真正复现、研究它。
5. Qwen 系列:同一个模板,逐步升级
(参考时间: 00:46:00)
接下来讲 Qwen 系列。Qwen 从 2023 年起也在训练多模态模型,第一个版本叫 Qwen-VL。
5.1 Qwen-VL:交叉注意力适配器与特殊 token
(参考时间: 00:46:10)
希望你已经看出套路了。
- 视觉编码器:他们用 OpenCLIP(还记得吗——它是 CLIP 的开源复现,所以基本就是个 CLIP 编码器)。
- 适配器(adapter):他们用一层交叉注意力(cross attention),并引入二维位置编码,把输出映射到固定大小 256。(讲师承认这"不算很动态",但当时视觉编码器本身也不动态。)
- 特殊 token:他们有
img标签,还有用于边界框的box标签、用于描述的ref标签。(讲师顺带吐槽了一句幻灯片是 HTML 做的,导致这里显示有点问题。)
编者说明:
img、box、ref这类特殊 token 是让语言模型在纯文本序列里"混入"视觉信息的关键机制——用它们作"占位符",告诉模型"此处对应的是一张图/一个框/一段描述"。
训练同样是三阶段(和 LLaVA 一样):
| 阶段 | 做法 | 目的 |
|---|---|---|
| 阶段一(所谓"预训练") | 冻结语言模型,训练视觉编码器 + 适配器;大规模低质数据(约 14 亿样本) | 建立基础视觉-语言对齐 |
| 阶段二 | 换成更高质量、任务化的数据(VQA、图表问答等);训练全部参数 | 提升任务能力 |
| 阶段三 | 指令微调;冻结视觉编码器,训练适配器 + 语言模型 | 对齐人类指令 |
讲师点出与 LLaVA 的一处差异:Qwen-VL 在阶段一就训练了视觉编码器,而 LLaVA 是冻结它。
能做什么?例子包括(因为是 Qwen,有些例子是中文):理解图像内容、做代码(他们的目标是让视觉模型也能做好代码)、输出边界框(注意:它并不真的生成图像,只是输出框坐标)、做 OCR 等。
5.2 Qwen 2:动态分辨率与 M-RoPE
(参考时间: 00:48:50)
Qwen 2 是一次升级,带来一些新想法。
- 更大的视觉编码器;
- 开始做动态分辨率——讲师认为 从 LLaVA 到 LLaVA 1-vision 时,最大的领悟就是"必须处理不同尺寸的图像与视频"。
具体做法是:不同尺寸的图映射到不同数量的 token。比如一张大图可能映射到 11,000 个 token;一张小小的公式图可能只映射到 8 个 token。
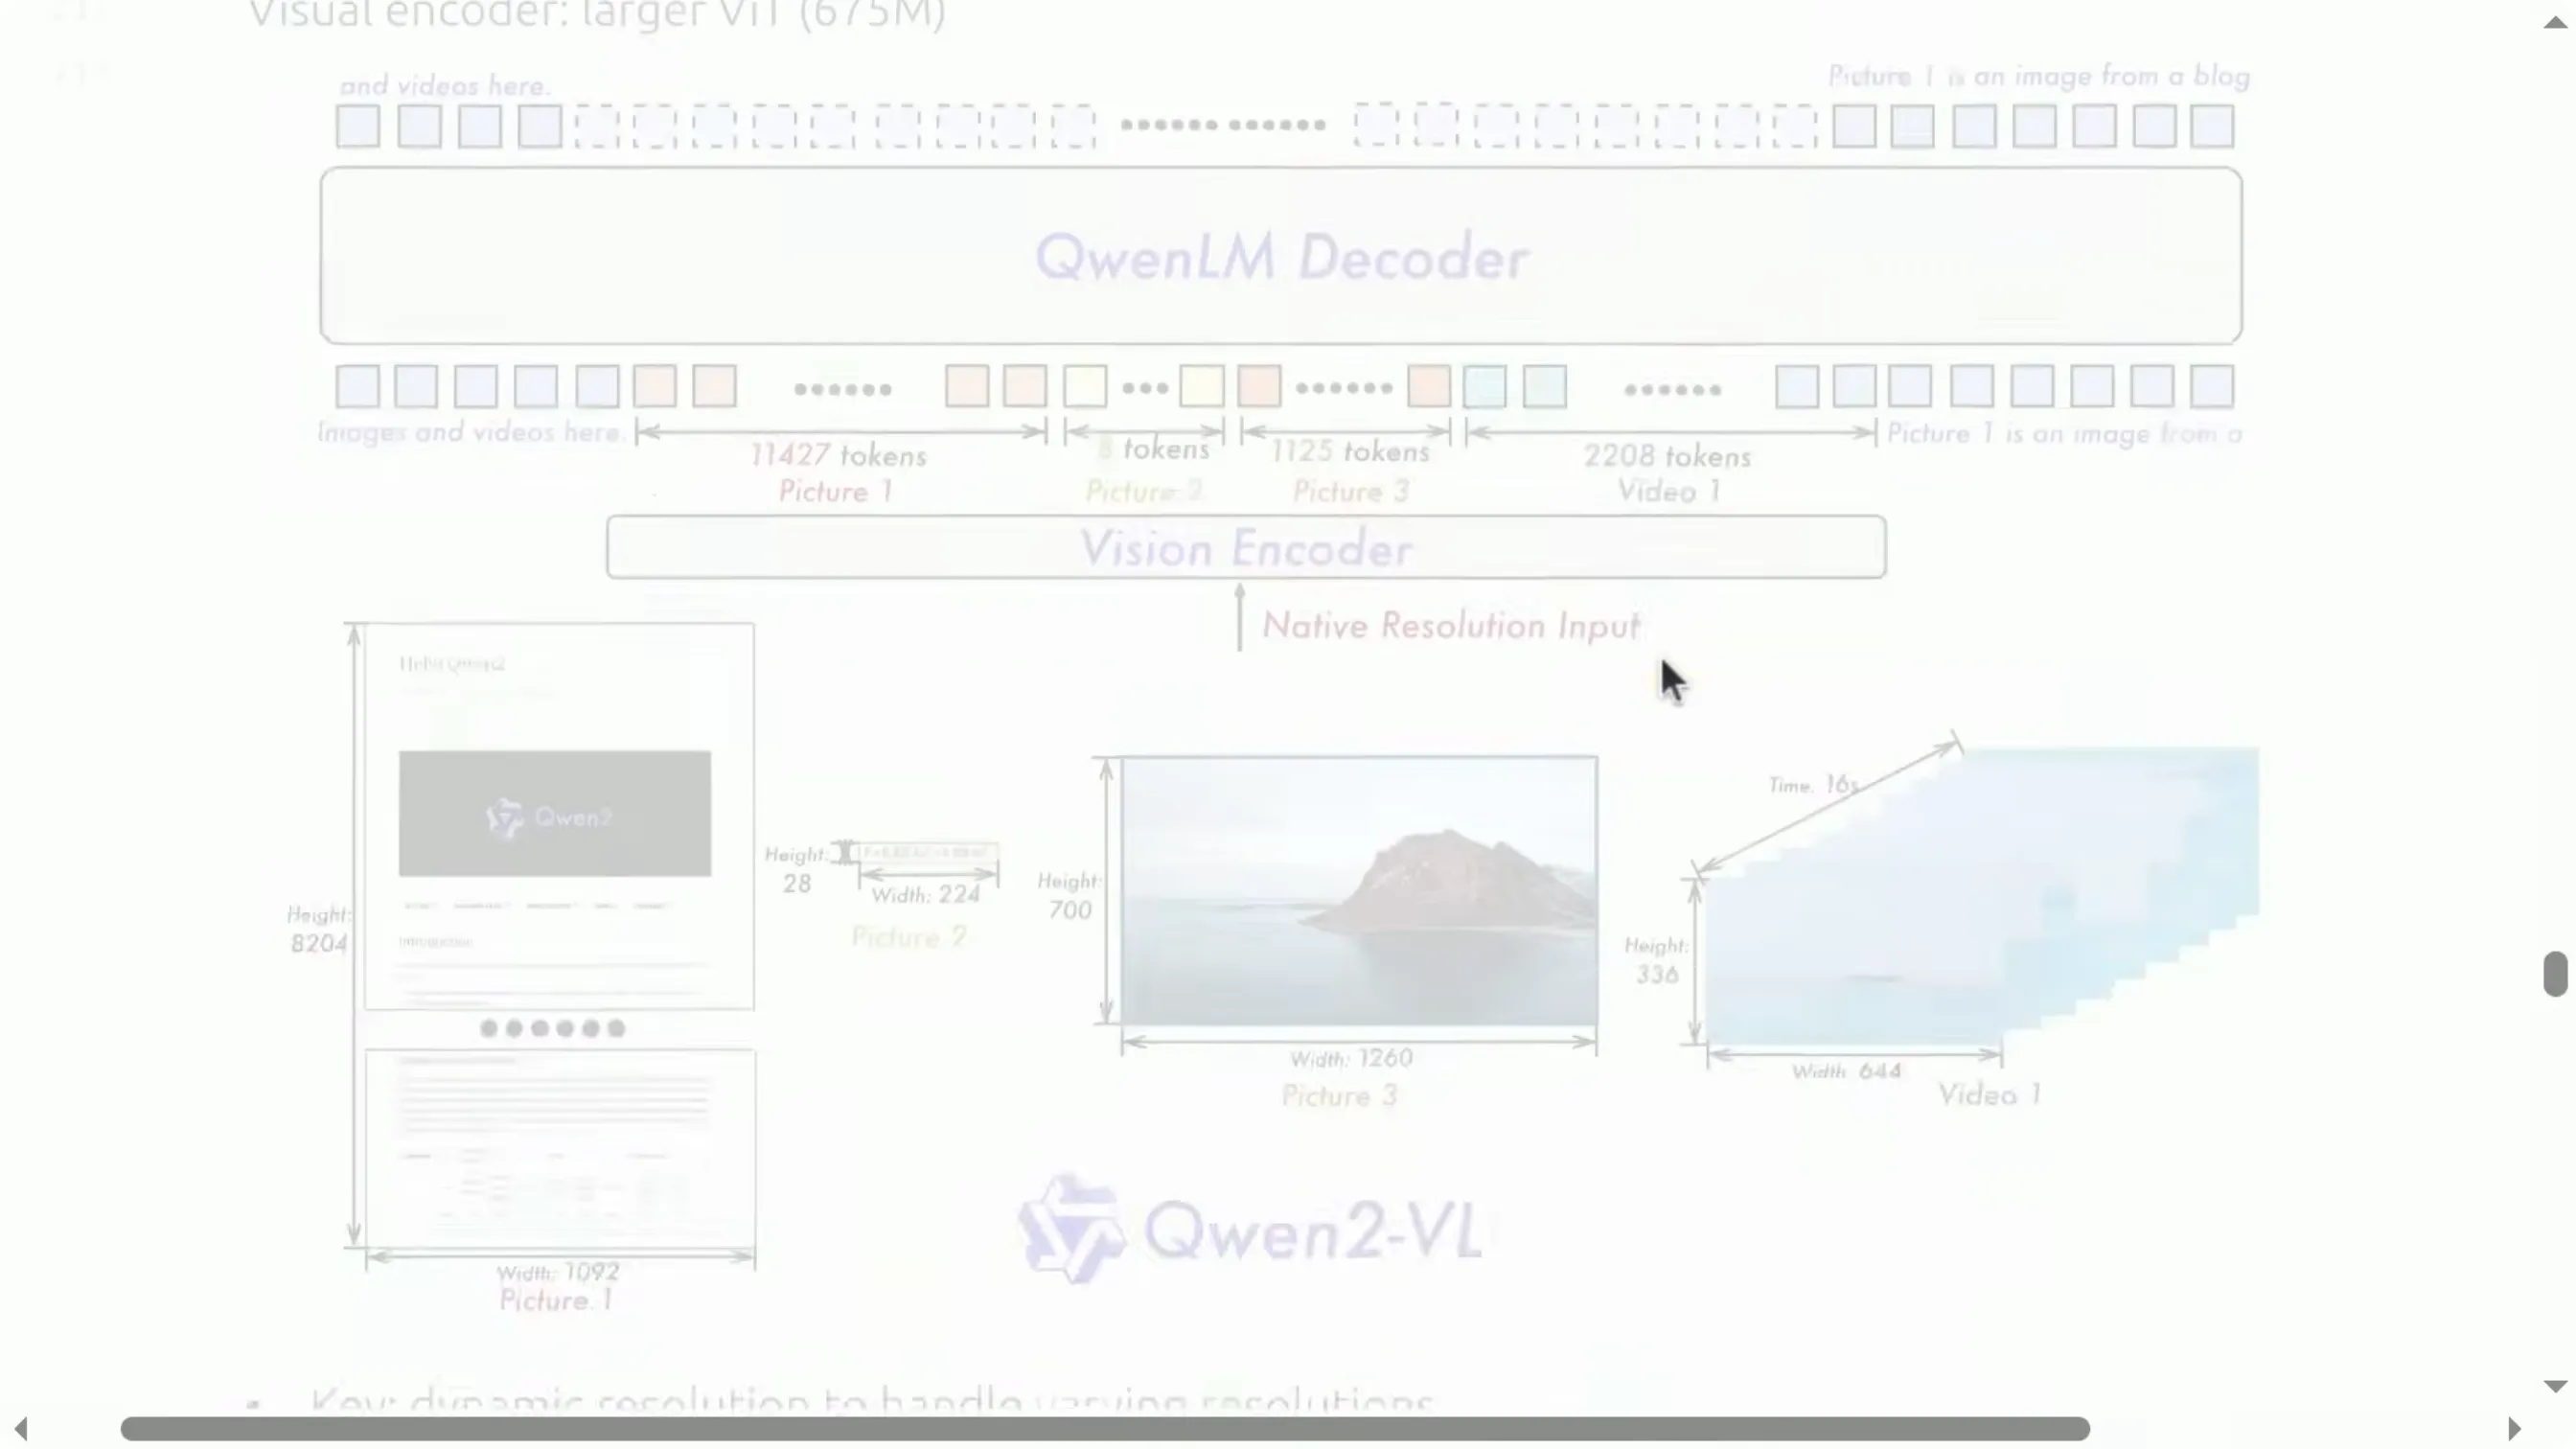
📷 Qwen 2 的动态分辨率:不同大小/内容的图像映射到不同数量的视觉 token
回到原视频 (00:49:20)
怎么实现?其思路和 LLaVA 的 AnyRes 类似:每个 224×224 的块用一个 ViT 编码(起始的 ViT 来自 OpenCLIP,但会被微调)。为压缩上下文长度,他们还把每 2×2 块压成 1 块,最终每块生成 66 个 token;对视频,每秒采样 2 帧,最多到 16,000 个 token。
关于位置编码的新做法:Multimodal RoPE(M-RoPE)。 还记得之前讨论过"二维位置编码复杂不复杂"的问题吗?Qwen 2 给出了一个更好的答案。
编者拓展|RoPE 与 M-RoPE 的原理
RoPE(旋转位置编码) 的核心思想是:把位置信息编码成向量的旋转,使得注意力里两个向量的内积只依赖于它们之间的"距离"。在文本里,"距离"是一维的——你离我几个 token,就是一维距离。
M-RoPE(多模态 RoPE) 把它推广到 3 维:高度、宽度、时间。此时每个 patch 由三元组(高, 宽, 时间)坐标定址。计算时,对每个维度分别做 RoPE,再拼接。这样一来,注意力里就能体现出"这两个 patch 在空间上差多远、在时间上差多少",而不再是硬塞进一个线性的序号。
讲师说这个想法相当直接——但他埋了个伏笔:到了 Qwen 3,会发现这种做法其实有点次优(sub-optimal)。
语言模型初始化:当然是用 Qwen 本身来初始化。然后分三阶段训练(与之前非常相似)。最终能做的事情很多:视频理解、数学与代码、函数调用等等。
5.3 Qwen 3:更精细的改进
(参考时间: 00:52:50)
讲师说,Qwen 3 的改动算不上结构性的巨变,但会切实影响模型质量。这是上一年(2025 前后)的 Qwen 3-VL 报告,图大致相同。
改动一览:
- 语言模型升级为 Qwen 3 系列(一系列 dense 与 MoE 模型),语言模型本身更强,最终质量提升很大。
- 长上下文:上下文长度可到 256K——如果你想做长视频,这极其重要。
- 视觉编码器升级为 SigLIP 2:它是 SigLIP 的改进版,架构完全相同、设计上向后兼容。
M-RoPE 的修正。 之前 M-RoPE 是给每个轴分配一个固定的维度块:第一段给时间、下一段给宽度、再下一段给高度。问题在于(回忆 RoPE)每个维度分量对应不同的频率——这样一来就可能出现"所有时间维度都是低频、所有高度维度都是高频"的偏置。于是他们把这些维度交错(interleave)起来,让每个轴都能同时接触低频与高频。
编者说明:这个"交错"的修正是对 Qwen 2 里 M-RoPE 的直接修补——正是上文所埋的"次优"伏笔。
显式视频时间戳。 之前时间信息是隐含在位置编码里的:每个帧因为处在不同位置,就天然带有一个"时间"的概念。但 Qwen 3 把时间显式化了——例如 0 秒 现在是一个真正代表时间的 token。他们发现这有用,大概是因为模型能直接引用它:"两秒之后发生了什么?"
逐 token 的平方根归一化损失(square-root normalized per-token loss)。 有些样本(如视频)非常长,而有些(如单图)非常短。通常做法是每个 token 一视同仁,那么视频样本会"霸屏"。于是他们把每个样本按其长度的平方根归一化,从而给长样本降权。(讲师说细节不算清晰,但他相信就是这么做的。)
适配器的"深度融合"。 回顾一下适配器的演进:LLaVA 里最简单——单层线性投影;然后进化到 MLP,再到交叉注意力,还有 DeepStack(其实源自 DeepSeek 团队的一篇论文)。Qwen 3 这里用的更复杂:他们注意到视觉编码器本身就计算出了一叠视觉 embedding 的堆栈,于是直接把这一叠加到语言模型的残差流(residual stream)里。这就成了一种更加"深度融合"的做法——视觉编码器不再只是一个"对外输出一串向量的黑盒",而是把它的多层信息直接注入语言模型内部。
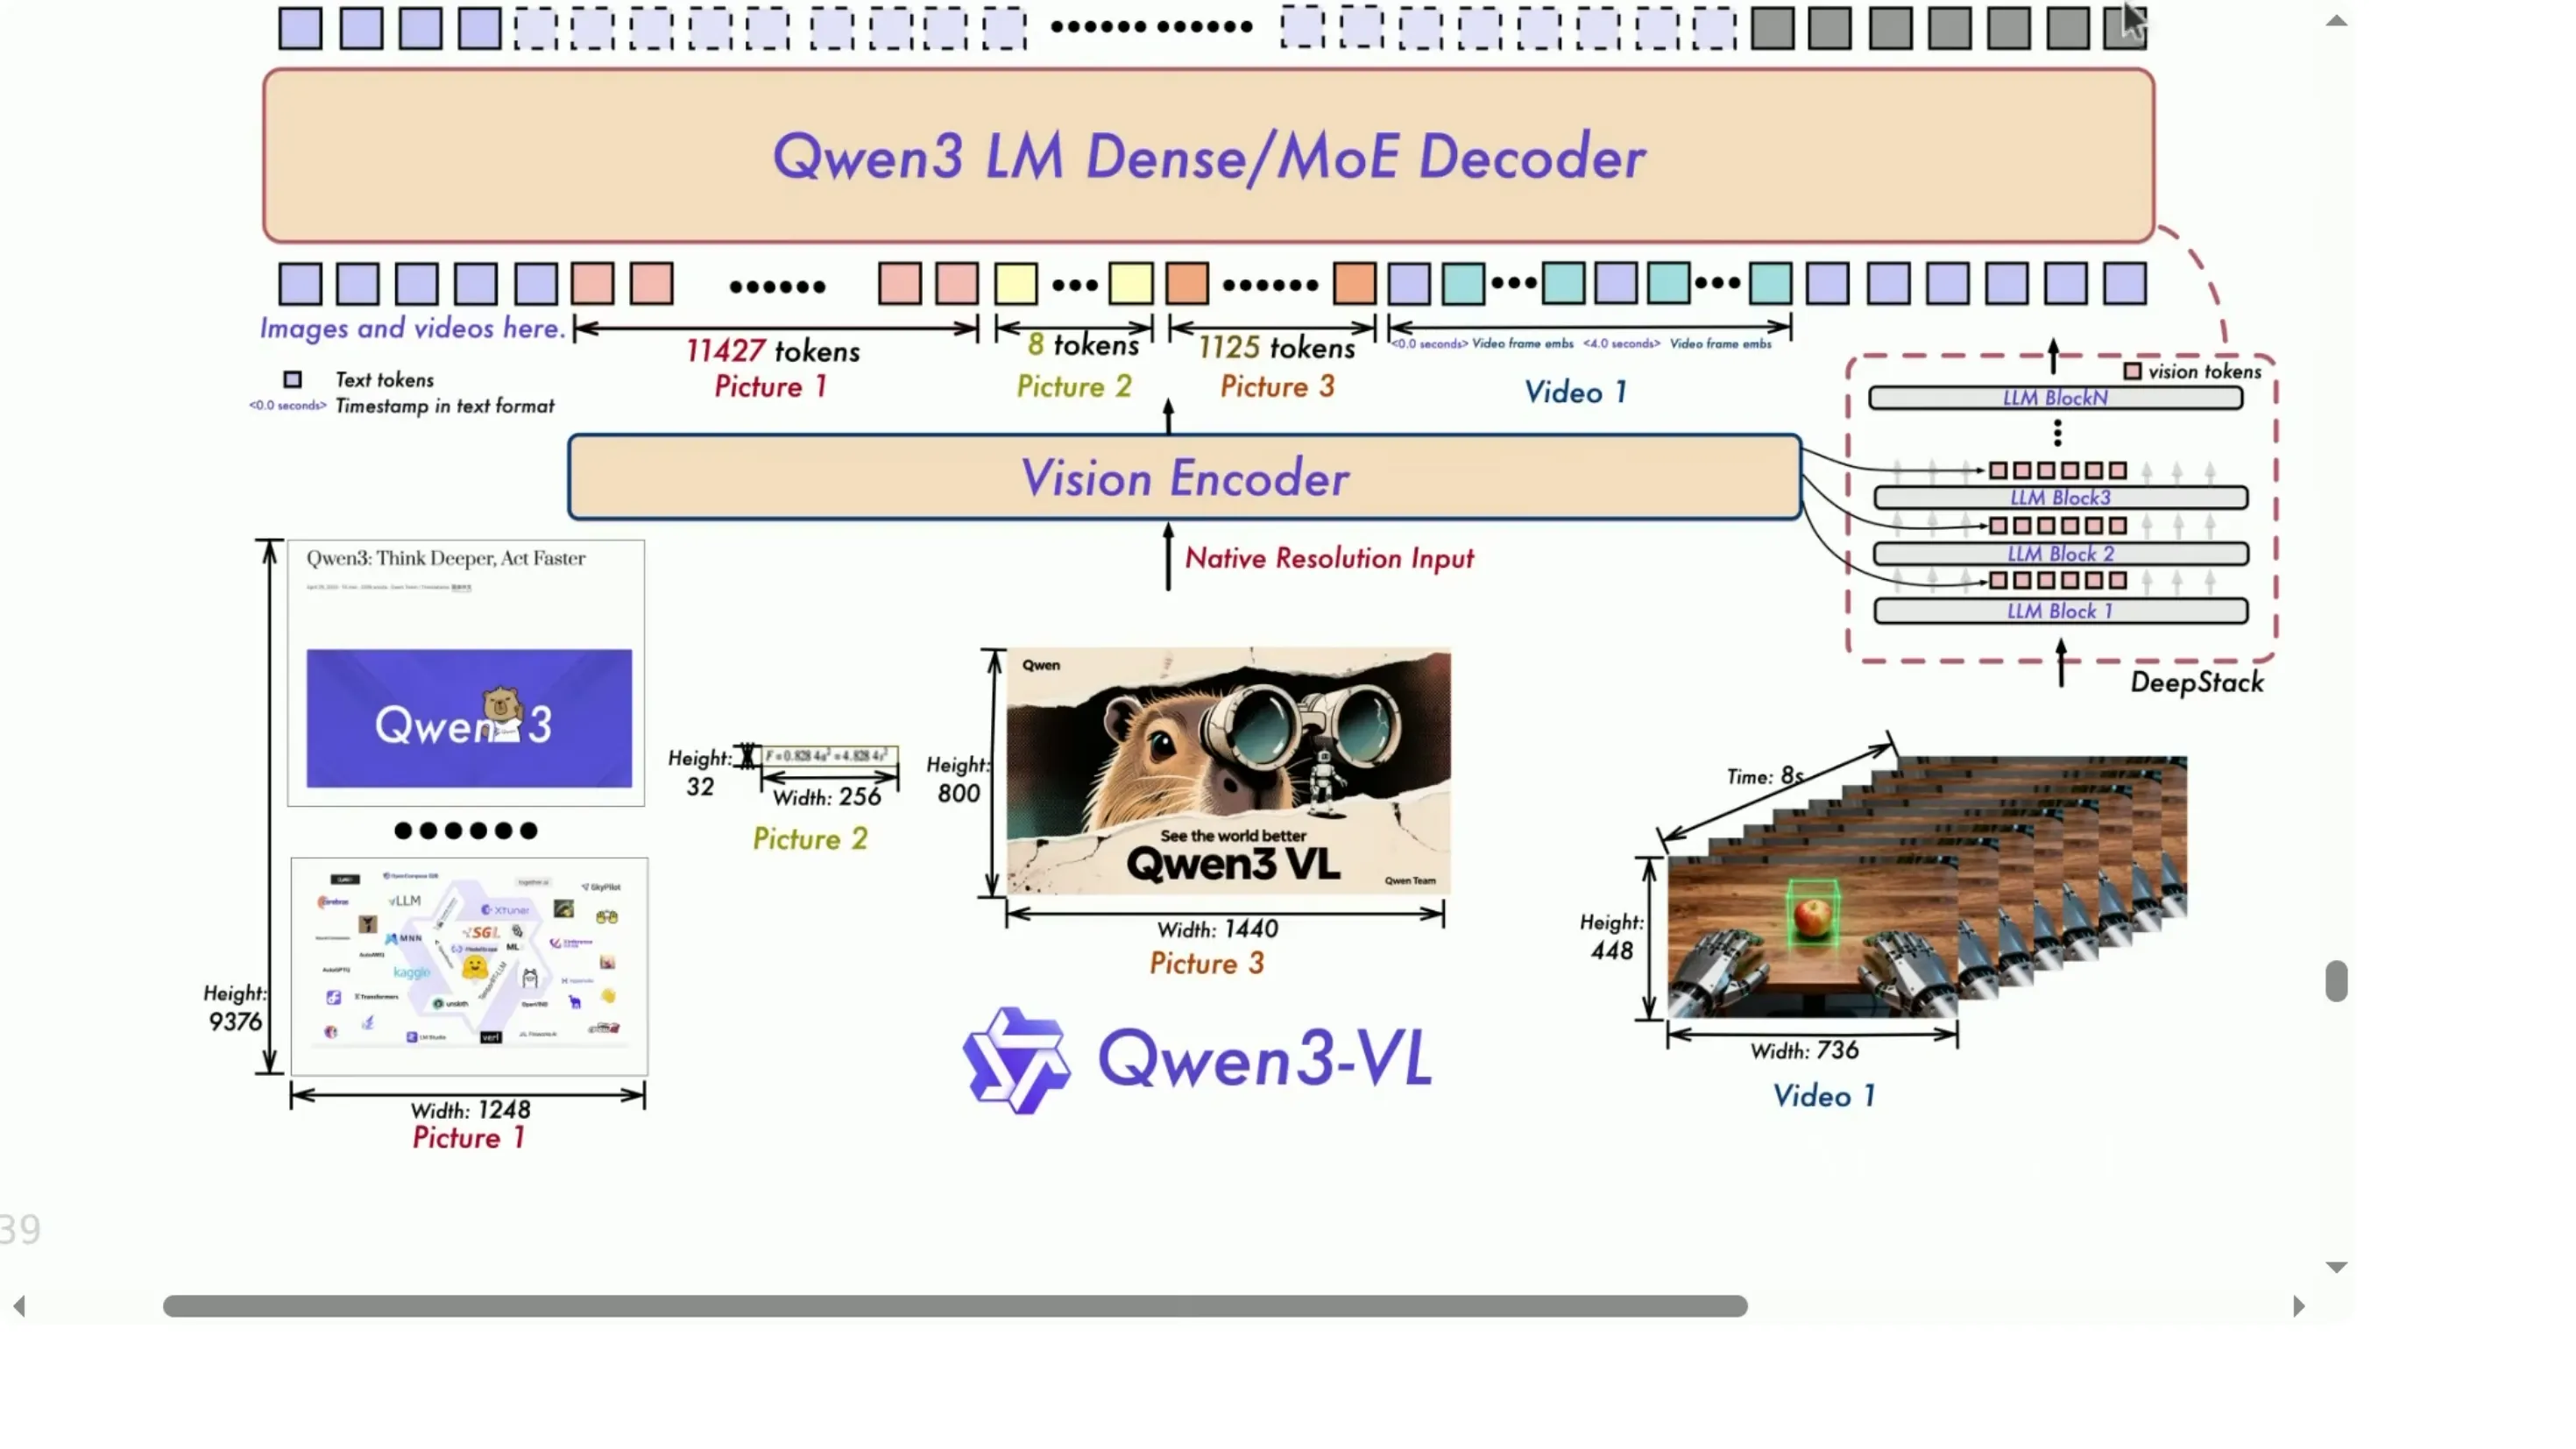
📷 Qwen 3 把视觉编码器的多层 embedding 深度融合进语言模型的残差流
回到原视频 (00:57:30)
训练流程:两段——预训练有 4 个阶段,后训练有 3 个阶段,可以想见流水线已经相当复杂。预训练里:
- 先训练适配器(和其他模型一样);
- 再分三阶段在越来越长的序列上训练:从 8K → 32K → 256K。绝大部分 token 出现在第二、三阶段;
- 后训练则是长思维链(CoT)数据的 SFT、知识蒸馏,然后做一些强化学习。
讲师说,此时这更像一篇系统论文了——核心新想法他自己已经高亮出来了,大量细节各有不同。
最终成绩:如果拿它的基准得分与闭源模型(Gemini、GPT-5、Opus 4.1)对比,加粗表示该行最佳;Qwen 模型相当强。
5.4 课堂问答:这些模型很小、且只"输入多模态"
(参考时间: 00:59:00 – 01:06:00)
这一节包含几个很好的问答,讲师保留了它们,因为它们澄清了不少误解:
Q:视频生成怎么办?怎么判断该出视频还是文字?
首先,这些模型不生成视频或图像。所有多模态部分都在"输入侧",输出始终是文本。其次,除 RL 外,大多数阶段都会对每个 token 做监督,所以不存在什么"用 LM 当裁判来评描述好不好"——好坏就是你的数据集里的那个样子。当然,用 RL 可以调出不同的行为。
Q:从系统角度看,训练多模态模型更难吗?
当然不更简单。 别人也指出,数据集更大,视频数据连加载都可能是瓶颈。我们之前讲语言模型时没怎么关注数据加载,因为它非常非常便宜;但在这里必须纳入考虑,并遵循所有"让数据加载与实际计算异步进行"的原则。
Q:视频和图像会不会 token 更多?
会。视频的 token 尤其多。这正是前面那个归一化存在的原因——避免给视频更大权重。你总可以按需降权、按数据混合(data mixture)调整权重(我们两周前讲过数据混合)。不过文本 token 也多得很:这些模型训练动辄数万亿 token。我不会说多模态 token 在数量上会远远压过文本 token。
Q:做对齐时,怎么知道语言模型事先学过什么?
语言模型必须事先训练好,否则"对齐"没意义。做法就是冻结语言模型,只训练适配器,把给定的视觉编码器与给定的语言模型连起来。训练方式是:选定一个 token 预算(如 67 亿 token),然后持续训练——没有自适应阈值。
Q:视觉编码器的参数量是不是小得多?
是的。原因在于视觉编码器做的是某种很"局部"的操作:它看一个 patch,patch 很小,它就理解 patch,没有太多知识,也不做推理。所以模型的大部分能力仍然在语言模型里。作为例子:LLaVA 里被冻结的语言模型参数量约 72 亿(相对于 720 亿),而 projector 很小,ViT 通常不到 10 亿参数。
6. Chameleon:一个"万物皆离散 token"的反面参照
(参考时间: 01:07:20)
现在讲师转到一种相当不同的做法:Meta 于 2024 年发表的 Chameleon 论文。
到目前为止,我们讲的 VLM 都是把图像编码成向量,然后注入语言模型。这样做的后果是:因为它是语言模型,它只能生成文本,不能生成图像。
想解决它,有很多思路。你可以给 VLM 接一个扩散头(diffusion head),就能生成图像了。但讲师想讲的,是 Chameleon 提出的这条路:如果我们把一切都映射成离散 token 呢?
从"美学"上看,这个想法对讲师这种"语言出身"的人颇有吸引力——因为这样一来,你可以用完全一样的方式去分析和生成图像:一切都是离散 token。你想生成图像?那就给一段文本提示,然后继续吐 token 就是了;你也可以把语言和文本的次序自由颠来倒去。Chameleon 论文里的例子是:你可以提示它"我很无聊,给我看些小鸟",然后它就会文本、图像、文本、图像地交错输出。
从这个意义上说,全能模型的愿景,就是让文本与图像真正"住在同一个空间"——而"把一切都弄成像文本"正是实现它的一种方式。
6.1 如何把图像变成离散 token:VQ-VAE
(参考时间: 01:09:20)
那你要做的是把图像映射成离散 token。这里有一个相当古老、可追溯到 2017 年的想法,叫 VQ-VAE(Vector Quantized Variational Autoencoder,向量量化变分自编码器)。
其基本想法是:把一张图像映射成一个离散的码(code)。
- 编码:你学到一个映射,把图像(的 patch)变成一个连续向量;
- 量化:这个连续向量随后被"就近取整"到最接近的码。你有一个码本(codebook),比如说 8000 个码,它们是一批"原型向量(prototypical vectors)",对应各种 patch;你挑离得最近的那个,它就作为你的表示。
- 解码:拿到那个码,尝试重建图像。
- 训练:通过最小化重建损失来训练 VQ-VAE。(讲师说,因为这个操作不可微,还要额外加一些项,这里时间有限就不展开了。)
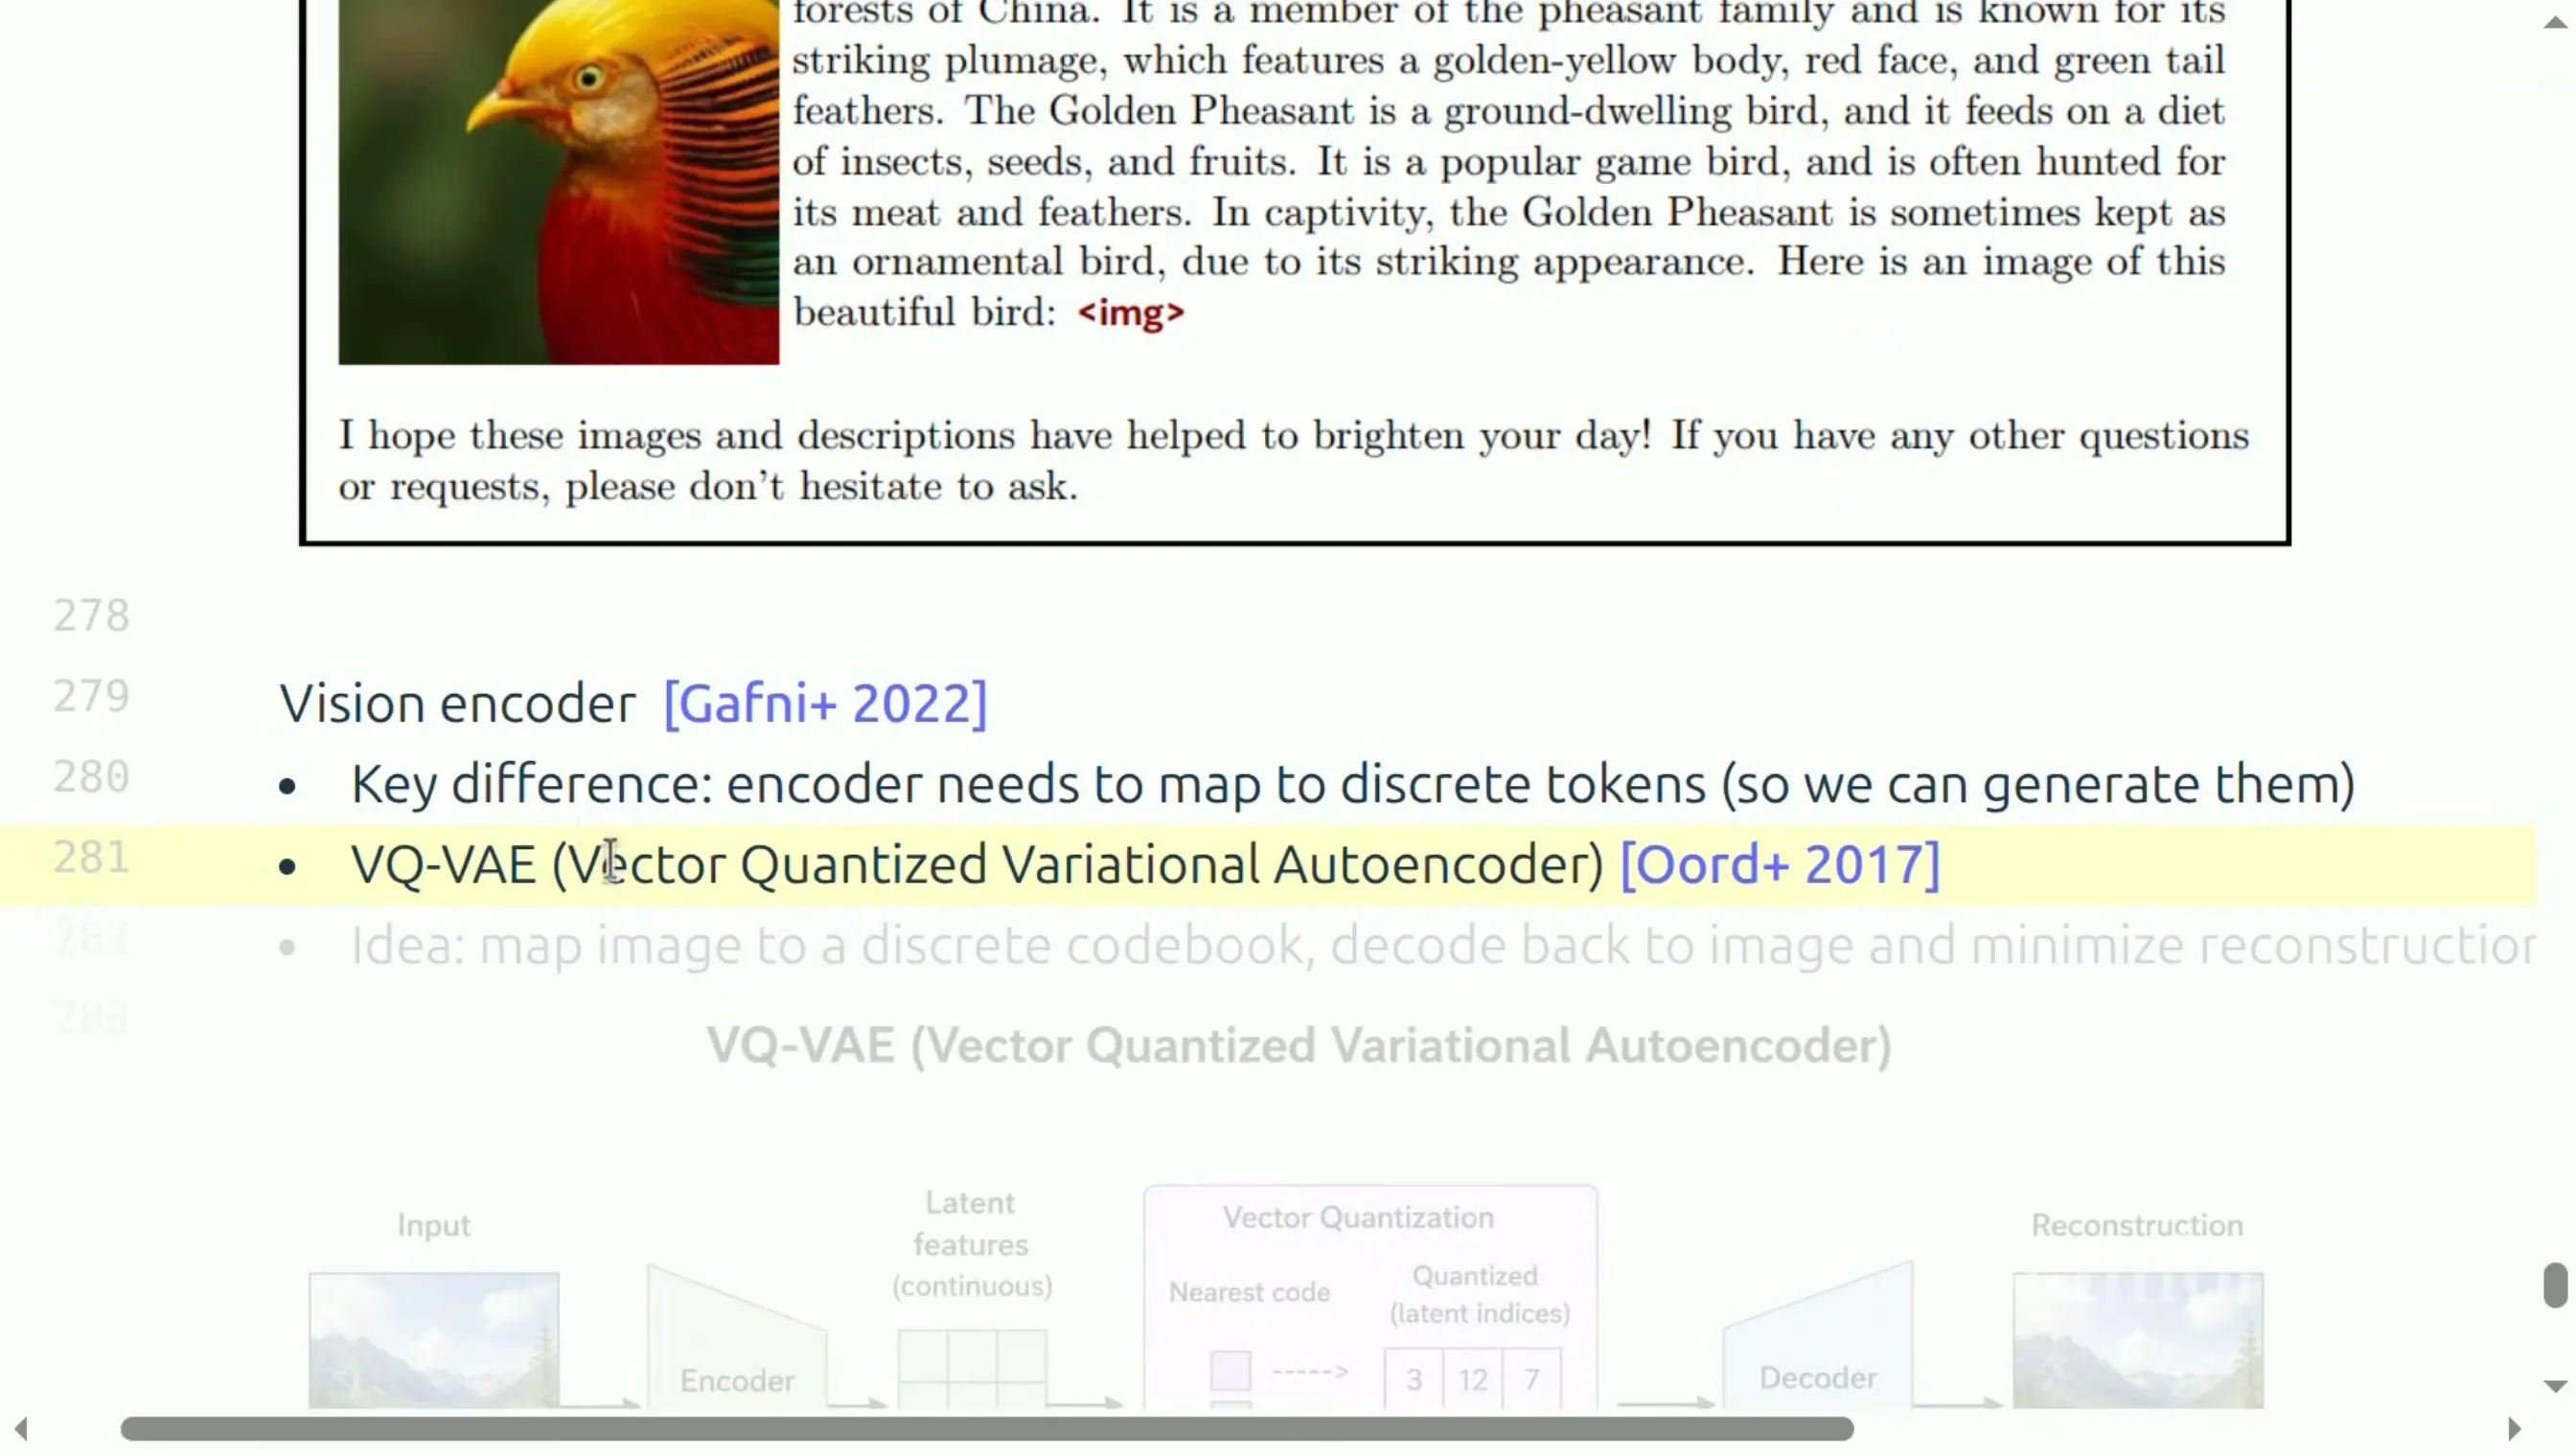
📷 VQ-VAE:编码器输出连续向量,量化到码本中最近的码,再由解码器重建图像
回到原视频 (01:09:40)
最终成果是:512×512 的图像被转换成 1024 个 token,每个 token 来自一个 8000 词表。
6.2 训练就变成了"普通语言模型训练"——以及它的问题
(参考时间: 01:11:00)
现在你有了:文本,加上图像(即那些码)。他们训练了一个新的分词器——因为现在数据的样子已经和纯自然语言不同了。
训练则变得相当直接——这就是它诱人的地方:这就是普通的语言模型训练。没有适配器,没有"冻结视觉编码器"之类的操作——只剩下一个语言模型。 当然仍有阶段划分(语言模型训练本身通常就有两段以上:第一阶段是大规模无监督、混合文本与图文;第二阶段掺入高质量数据)。
但这个优雅方案有几个问题:
- 训练不稳定(重点):尽管文本和图像看起来"占据同一空间",但它们的行为方式差别很大。光是把东西叫做"离散 token",并不能掩盖"那里住着一张图像"这一事实。具体来说:
- 文本 token 在预测下一个词时熵相对低——大多数词是可预测的;
- 图像 token 熵非常高——"这个 token 究竟是哪种蓝色?我不知道。"
- 结果,这种混合训练会导致参数范数增长,进而引起损失不稳定。
- 他们通过 QK-norm 和 Z-loss 正则化在一定程度上缓解/修复了这个问题(这两者都是控制范数增长的手段)。
编者拓展|QK-norm 与 Z-loss 是什么
- QK-norm:在注意力里对 query 向量和 key 向量分别做归一化(通常用 LayerNorm 或 RMSNorm),再求点积。这能限制注意力 logits 的量级,使注意力分布更平稳、训练更稳。
- Z-loss:在 softmax 里惩罚 logits 的绝对大小——具体是对 log-partition 函数($Z = \log\sum_j e^{z_j}$)的平方加惩罚项。它专门用来抑制 logits 漂移,是很多大语言模型(如 PaLM、ViT-22B)里常用的稳定性技巧。
- 二者共同的直觉是:不要让数值过大。图像 token 的高熵会迫使模型把 logits 拉得很极端,这就需要有"刹车"机制。
-
离散化会损失信息:这个模型最终性能其实不够好,且离散化肯定会丢信息。想想 OCR——如果你把很小的字离散化,你就读不出来了(还记得前面 LLaVA 为什么非要 AnyRes 吗?同一个道理)。
-
多模态混合训练本身就很棘手:这一点我们在 Qwen 那里已经略见端倪(需要调权重),在 Chameleon 里被进一步放大。
讲师补充了这段工作的历史轨迹:VQ-VAE 曾风靡一时,事实上很多人曾把它用于图像生成——因为你是要"从 Transformer 生成",而生成就得生成离散的东西,那自然要把数据都塞进离散形式。但后来扩散模型成熟、变得可行,这类"先离散再生成"的路子就不那么流行了。
7. 收束与反思
(参考时间: 01:14:45)
讲师最后做了一次反思式的总结:
- 当今的前沿模型,被期望是多模态的,甚至更严格地说——原生多模态(natively multimodal)或全能模型(omnimodel)。
- 可惜的是,当 Gemini、GPT 发布时,都被宣传为"原生多模态、处理所有模态",也的确能处理——但关于它们是怎么造的,几乎没有任何细节。
- 讲师的猜测是:很可能有一个连续的编码器(continuous encoder)+ 扩散生成(diffusion)的组合——因为你想避免丢信息,就想用连续编码器;而生成则交给扩散。他明确说这是个人推测。
- 多模态的根本挑战,就是如何处理非文本模态。
- 值得注意的是,"理解一个模态"与"生成一个模态"之间存在一种对称性,而且并不存在一个"通用的编码器":
- 回到 CLIP——你只关心分类,所以只需抓住高层语义,向量甚至可以很小;
- 但如果你要 OCR、或者要生成图像,你就需要真正细粒度的细节——这正是扩散模型厉害的地方,因为它能把高频/低频信息都精细地优化到。
- 一般来说,处理多模态时,你必须仔细考虑"如何给各模态合理加权"。例如视频的信息密度明显低于文本,所以你不希望视频压倒文本。
- 因此,就目前的经验看,最靠谱的做法仍然是"连续编码器"。而且即便 CLIP 已经五岁了,类似的想法仍然是捕捉图像语义的"首选"。Transformer 依旧是那个 Transformer。至于生成,则是扩散模型的天下(本讲未展开)。
讲师最后收尾:本节课到此为止。他说没有相关作业,但如果你好奇,他很鼓励你去试着训练一下这些模型。
附:参考与延伸阅读
编者补充
- MS COCO
- VQ-VAE(Vector Quantized Variational Autoencoder,向量量化变分自编码器)
- Amazon Mechanical Turk
- BPE 分词器
- Chameleon
- CLIP
- ImageNet
- LAION-5B
- LLaVA
- OpenCLIP
- Qwen
- ResNet
- SigLIP
- ViT(Vision Transformer)
- YouTube 原片
- 论文
已知疑点
本讲的字幕虽整体连贯,但仍存在若干听写存疑、术语含糊、或与常识/官方材料可能有出入之处,凡涉及关键事实者,逐条列出并注明依据或时间点,供读者自行核实。
-
CLIP 训练数据的具体来源(约 00:08:30):讲师说"取一批查询词、去网上搜索,挖掘出约 4 亿图文对"。CLIP 原论文对数据集细节披露本就不多,"4 亿"这一数字与原文一致;但"查询词从何而来"讲师并未讲明,字幕在此处也无更多信息,不宜自行补足。
-
LAION-5B 的规模(约 00:09:10):字幕中作 "lion 5B"、"five billion images",应判为 LAION-5B,其规模约 50 亿图文对。此处对 ASR 明显错误,已按公开事实订正为 LAION-5B;但讲师所述的"用 CLIP 做数据过滤再训练 OpenCLIP"这一自举过程,细节表述在字幕中较简略,可能与原始流程有出入。
-
SigLIP 数据集规模(约 00:25:10):字幕作 "order billion"("约上百亿"),实际可能意味着"数十亿到上百亿"区间的说法。WebLI 数据集的具体规模在不同资料口径不一,讲师现场表述本身就不精确,此处仅保留其原意,未强行给定确切数字。
-
TPU v3/v4 的性能对比(约 00:26:00):讲师称"v4 单卡按浮点运算并不比 v3 快,约慢 60%"。这一说法属于硬件具体性能的判断,字幕转写完整但具体数字(60%)为讲师口述,未注明出处,读者若需引用应自行核对官方规格。
-
CLIP 最佳模型 ViT-L/14 的层数(约 00:15:00):讲师说"约 24 层,我不太确定"。ViT-L 通常被认为约 24 层,讲师自己已表示记忆不确定,故此处保留其"不确定"的表述,不作断言。
-
Qwen-VL 阶段一的样本量(约 00:47:00):字幕作 "1.4 for you know billion examples",读法可能是"14 亿"或"1.4 亿"。字幕在此含混,无法从讲话中唯一确定数量级,故正文按"约 14 亿"处理并标注其"大规模低质数据"的性质。此处以 Qwen-VL 原始论文为准更稳妥。
-
LLaVA 缩放前分辨率与 Qwen 2 的具体 token 数(约 00:38:00、00:50:00):字幕中提到的 "336×336"、"11,000 tokens"、"8 tokens"、"每块 66 tokens"、"每秒 2 帧"、"最多 16,000 tokens"等数字,均来自讲师现场口述;其中"11,000"这一数量级偶有含糊(视频原音不清晰)。这些数字与相应论文可能略有差异,如需精确引用请以论文为准。
-
Qwen 3 后端来源的时间判断(约 00:52:50):讲师说"这是去年的 Qwen 3-VL 报告"。具体年份取决于视频录制/讲课时点,字幕未给出绝对年份,编者无法唯一确定,故正文避免断言年份。
-
讲师为某位学生的提问所作的转述(约 01:00:00):几个问答环节的学生原话在字幕中残缺严重(例如 "Yeah. So the question is..." 之间的内容被省略),讲师复述的学生问题仅保留了要点,可能存在理解偏差。凡本书引述的问答,均已按讲师复述的版本整理,非学生原话。
-
"原生多模态"闭源模型的内部构造(约 01:14:45):讲师明确说这是他个人的猜测("连续编码器 + 扩散生成"),且强调没有细节。正文已将其标注为讲师推测,读者切勿当作事实。
-
个别模型名称的听写歧义:如 LLaVA 早期使用的文本解码器 "Vunia"(约 00:30:00)——根据上下文应指 Vicuna(LLaMA 在 ShareGPT 对话数据上微调的版本)。此处按公开事实订正,字幕原音疑为听错。
说明:以上疑点中,凡属讲师当场表示不确定或口述数字的,本书均保留其"不确定"性质,未替讲师做实;凡属明显 ASR 同音错误并能由公开材料唯一确定的(如 LAION、Vicuna),已订正并在此说明。若你发现更多疑点,建议结合课程官方幻灯片与上述原始论文交叉核对。