第1讲 · EECS 189:机器学习导论
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 讲义重构
| 原始标题 | Introduction + ML Problem Framing |
| 视频 | 本讲没有课堂录像(开课第一天) |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 1) | Google Drive PDF |
| 配套讨论课 | Discussion 1 讲义 · 解答 |
| 图片来源 | 书中插图为官方 PDF 讲义高清渲染图(每页一次) |
对应讲次:第1讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:本讲无录像/字幕,本书依据官方讲义重建,并按课堂主题补充了少量背景知识与数学。课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习。
本讲路线图
- 课程介绍:教师、目标、为什么现在教 ML;
- 什么是机器学习:ML 与 AI 的关系、与统计学/数据科学的区别;
- 机器学习的分类学:监督学习(二分类、决策树/线性分类器、训练/测试)、有无监督与强化学习、各类数据上的监督问题;
- 机器学习的历史与今天的 GenAI;
- 机器学习的流程(lifecycle)与课程工具;
- 课程后勤:作业、考核、先修要求、平台。
🖼️ 标题页
🖼️ 课堂互动工具 Slido
一、课程介绍与目标
编者说明:本讲是导论课,重点在「如何框定一个机器学习问题」。幻灯片 3–10 为课程团队介绍与课程目标;由于没有录像,以下叙述在官方讲义基础上作了少量展开。
路线图:介绍 → CS 189/289 的目标与计划 → 什么是机器学习 → 机器学习分类学 → 历史 → 流程 → 后勤。
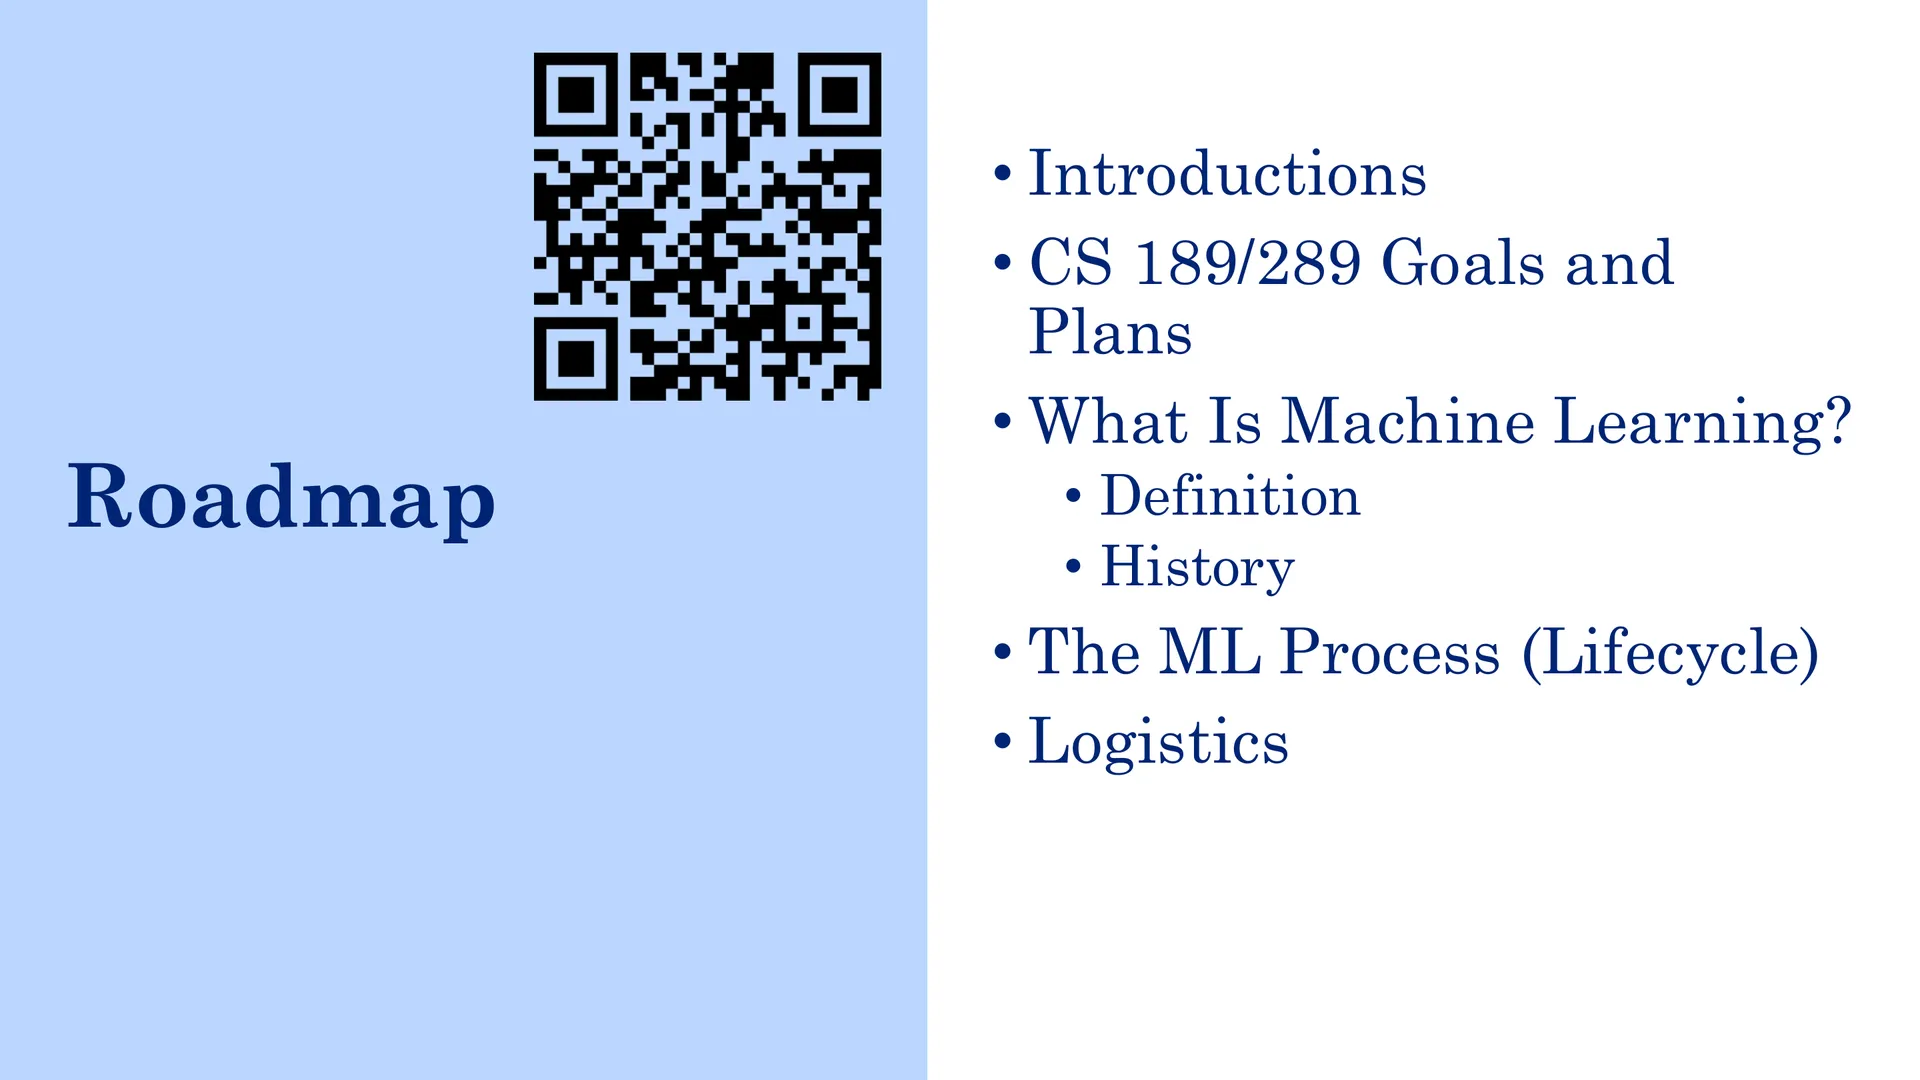
🖼️ 路线图
🖼️ 课程介绍
授课教师:
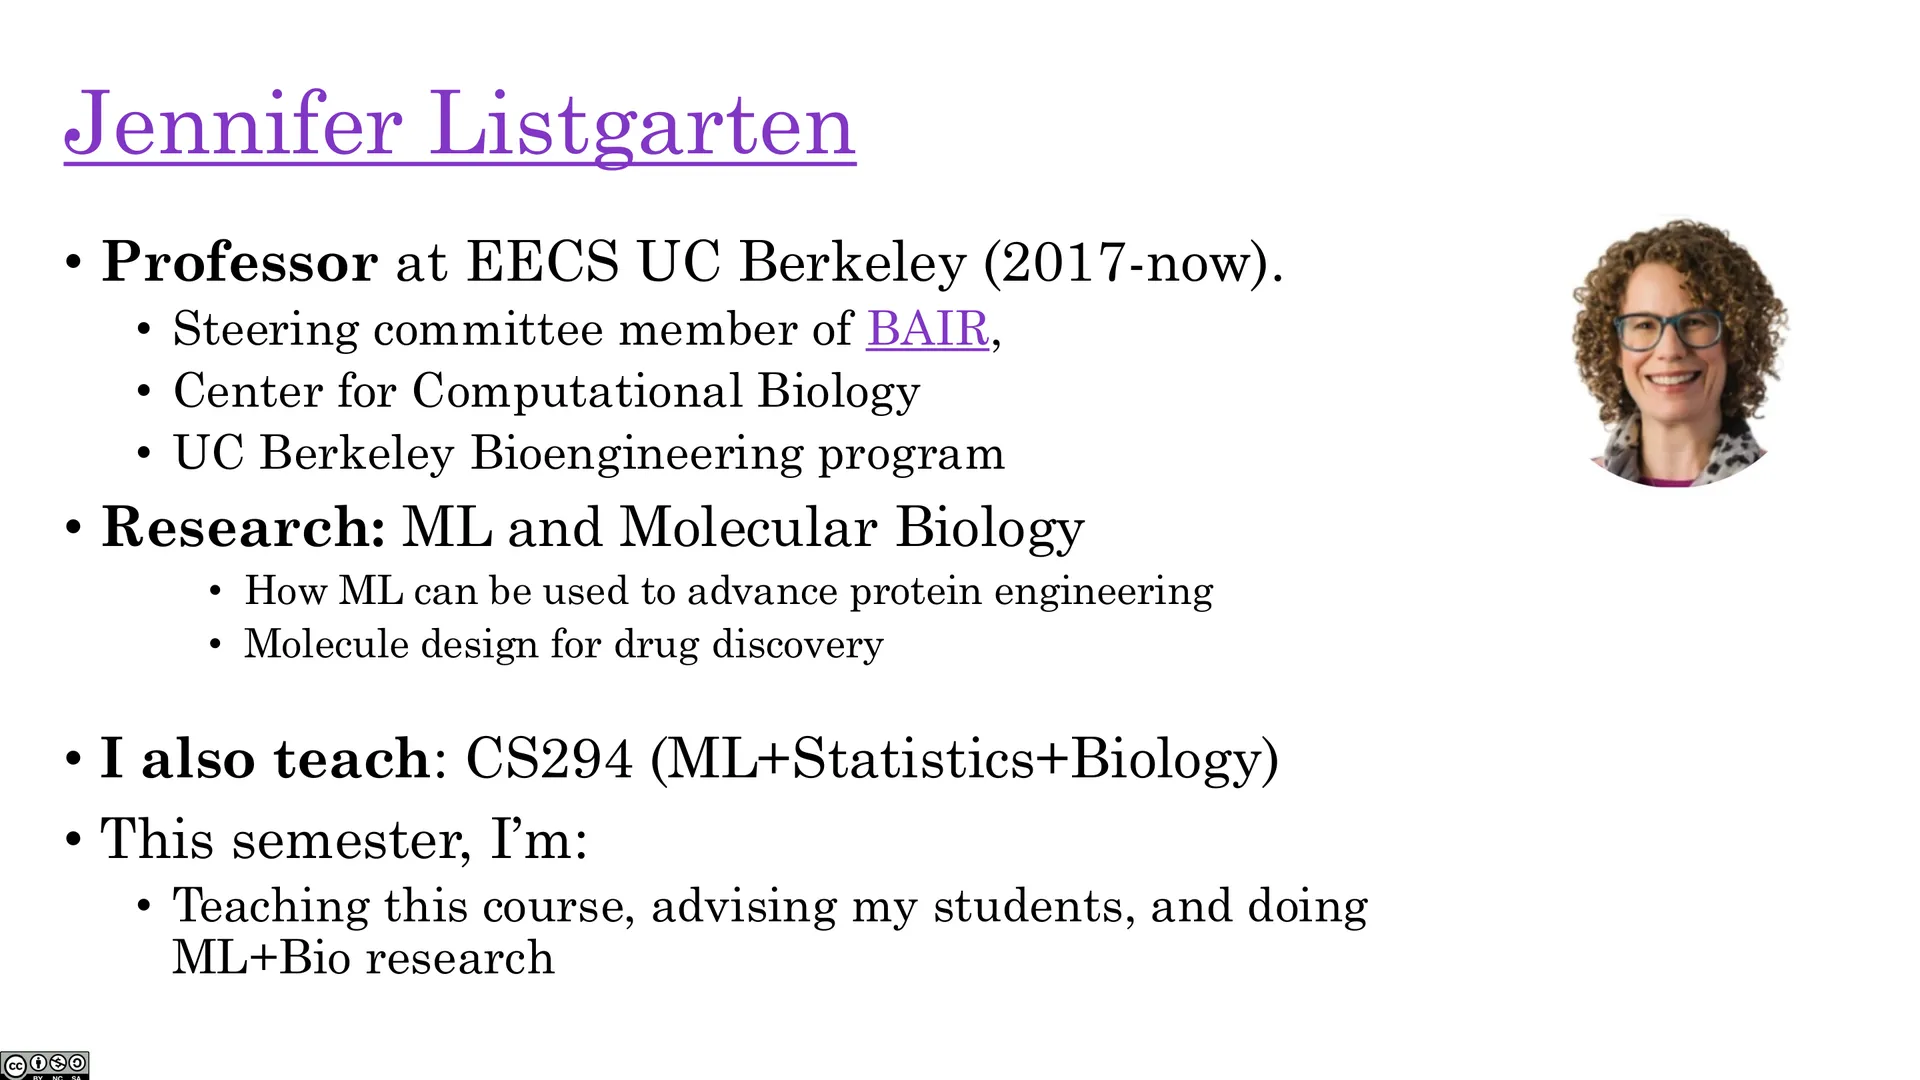
- Jennifer Listgarten(EECS 教授,2017 至今;BAIR 指导委员会成员)——研究机器学习与计算生物学(蛋白质工程等);
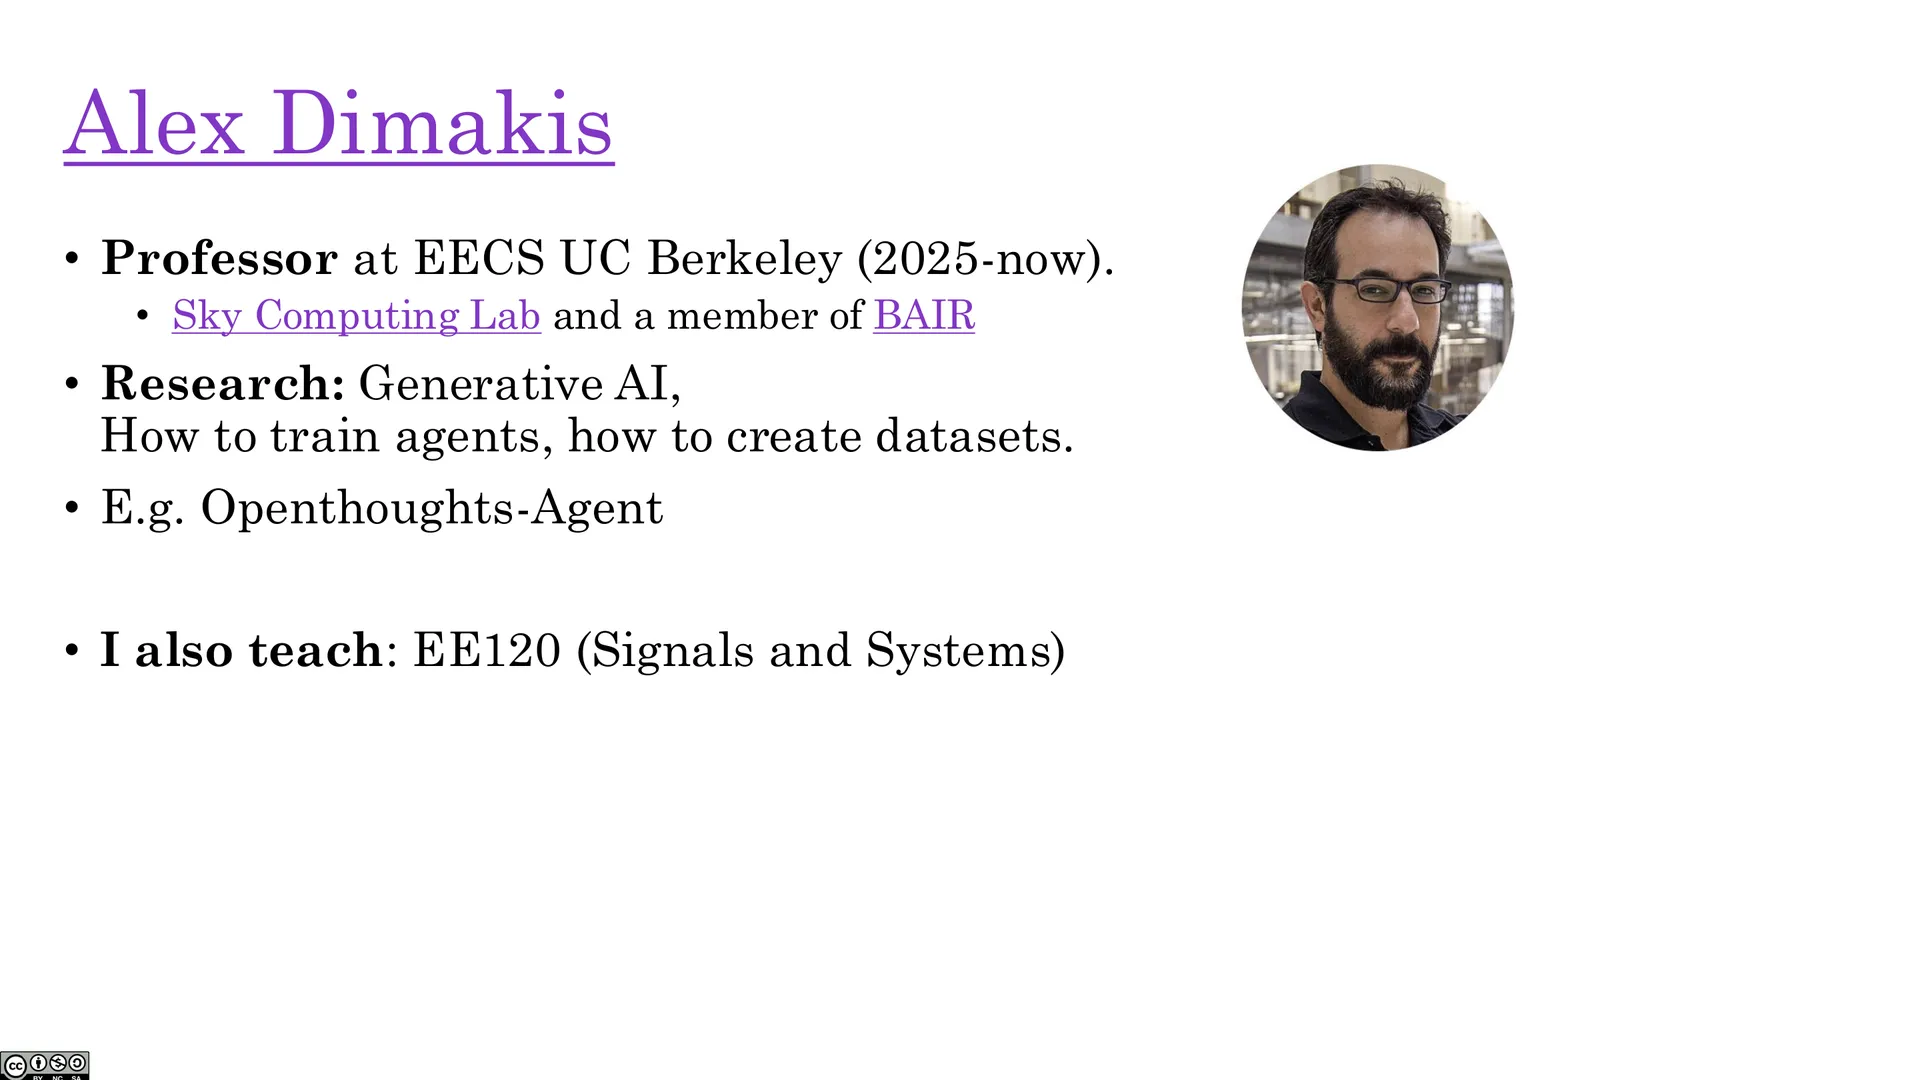
- Alex Dimakis(EECS 教授,2025 至今;Sky Computing Lab、BAIR)——研究分布式/高效机器学习、信息论。
🖼️ Jennifer Listgarten
🖼️ Alex Dimakis
🖼️ CS 189/289 的目标与计划
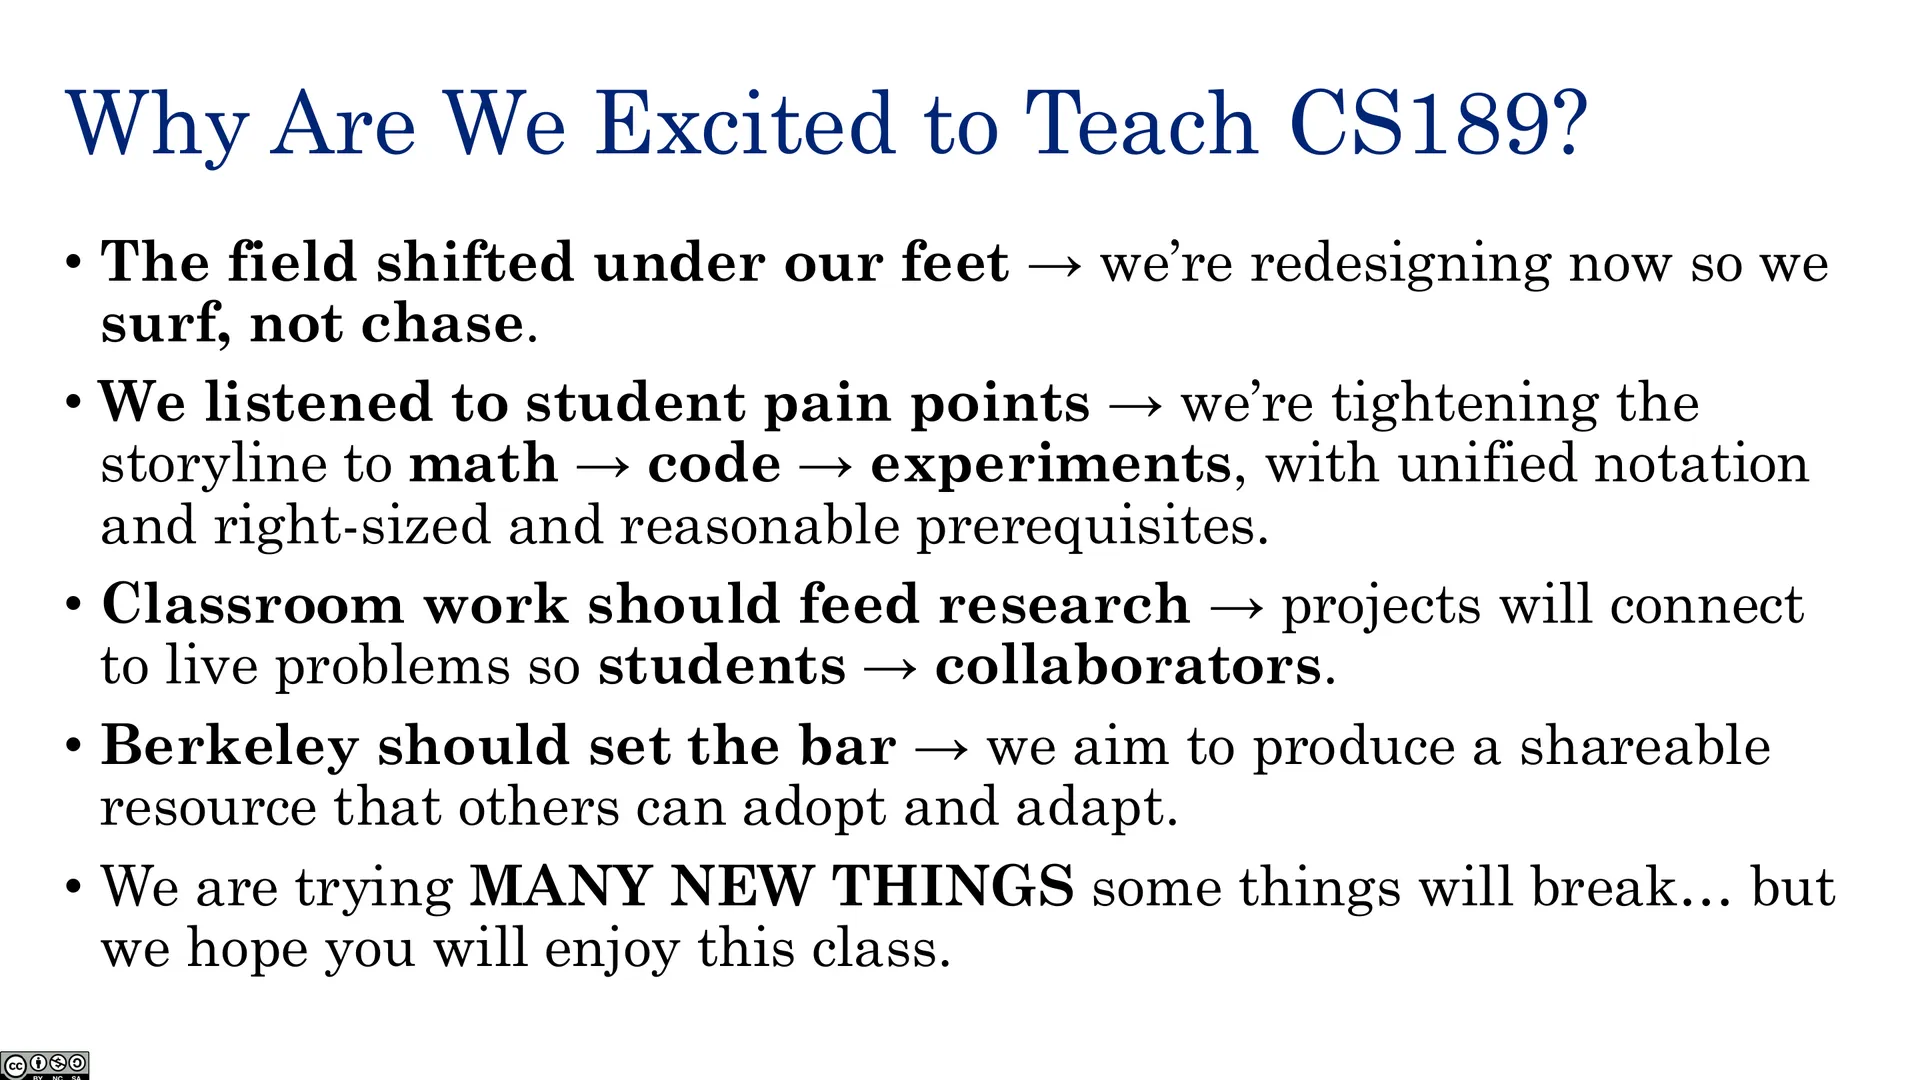
为什么现在教这门课? 讲师直言:「这个领域在我们脚下发生了位移」——从传统统计学习,到以深度学习/大模型为核心的新范式。课程因此重新设计,希望让学生「冲上浪头(surf)」而不是被拍在沙滩上。
课程目标:
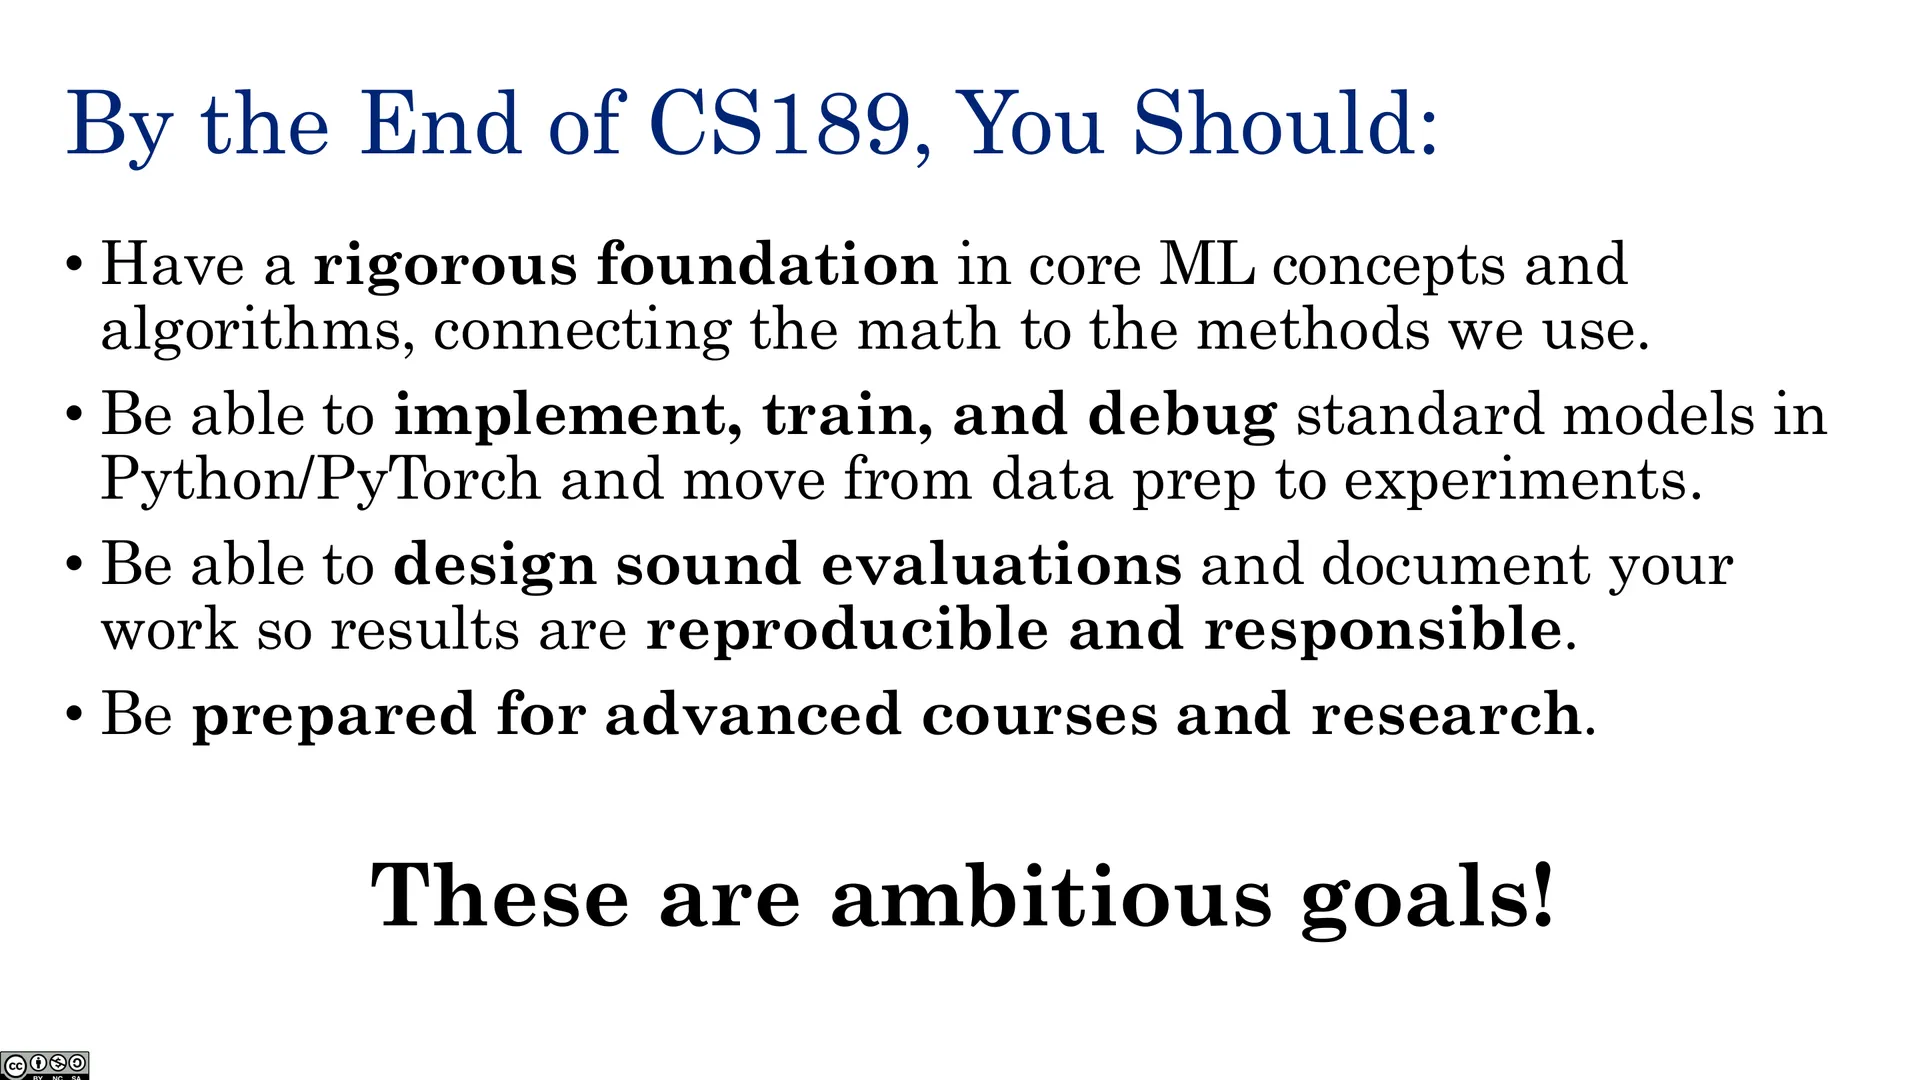
- 建立严谨的核心 ML 概念与算法基础,把数学与具体方法连接起来;
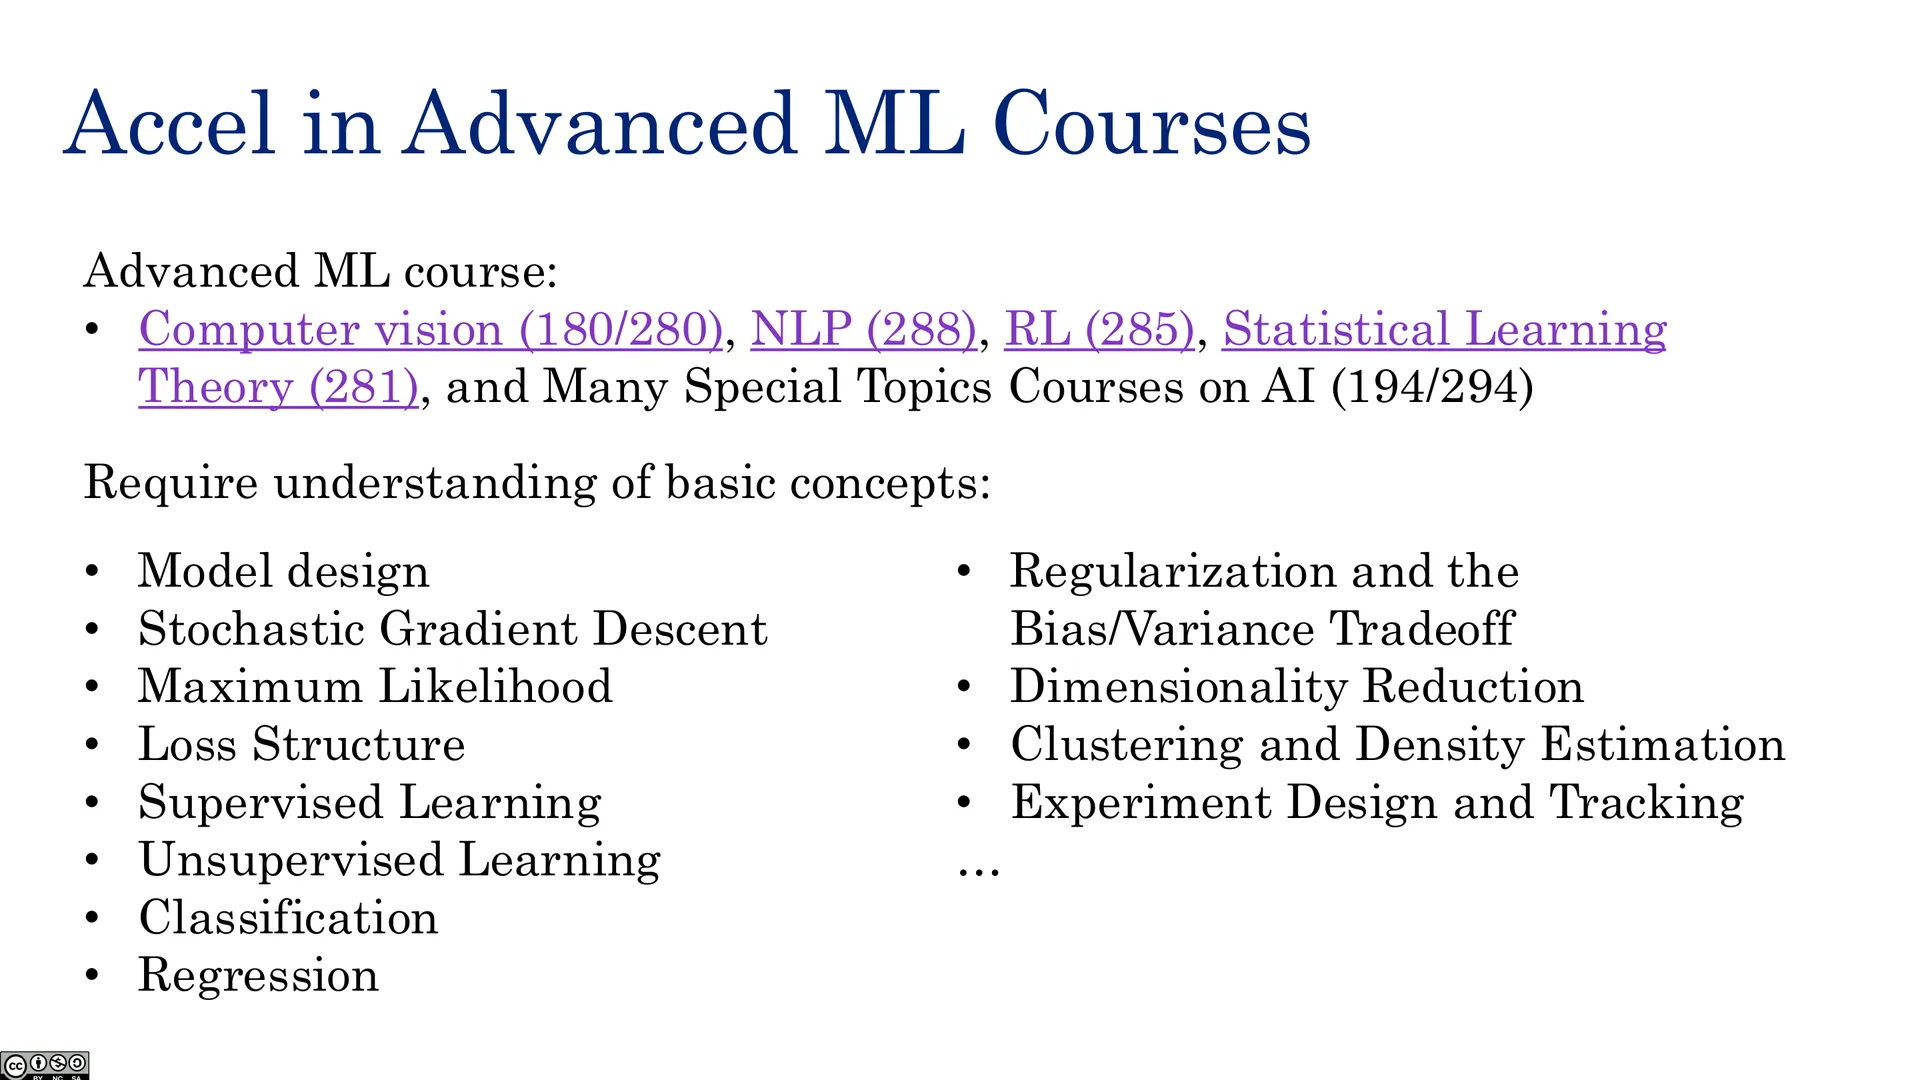
- 为后续高级 ML 课程打基础(模型设计、优化、泛化等基本概念)。
🖼️ 为什么我们乐于教 CS189
🖼️ 严谨的基础与算法
🖼️ 为高级 ML 课程加速
二、什么是机器学习?
2.1 ML 与 AI 的关系
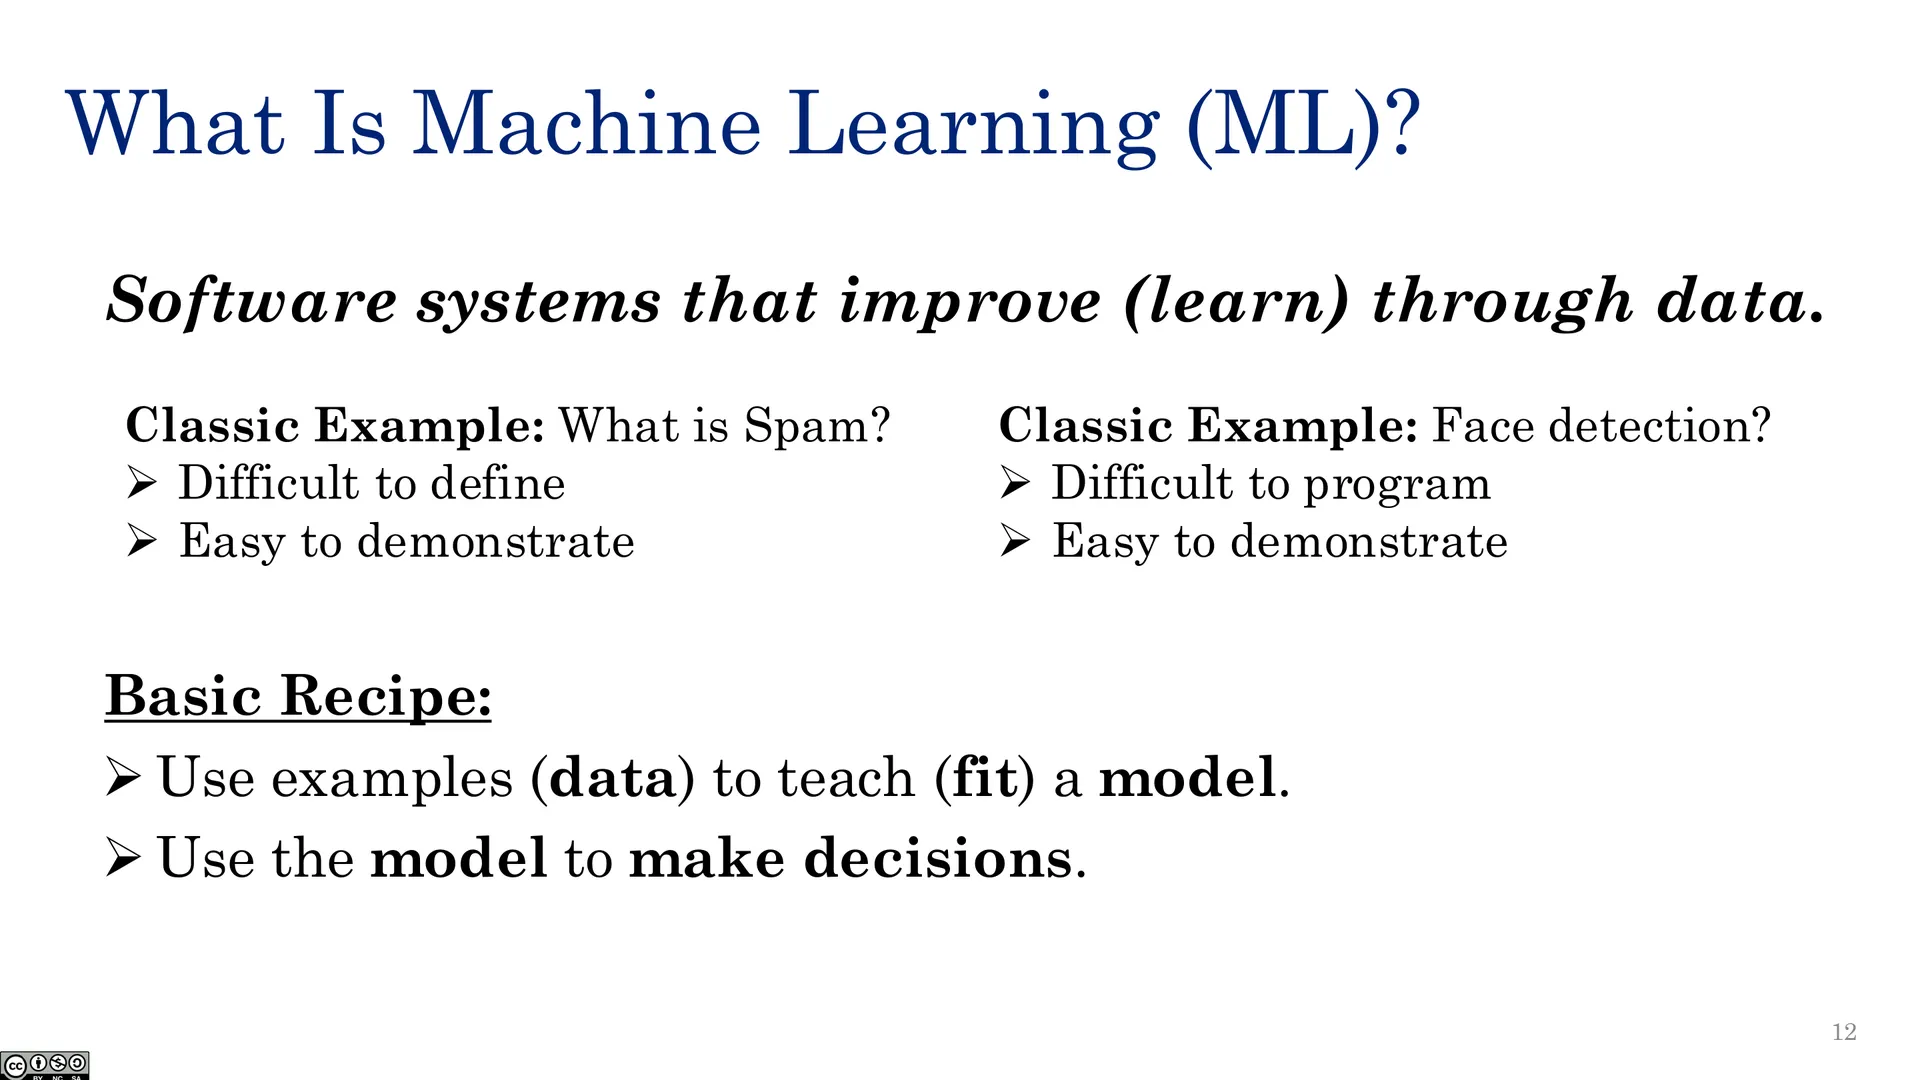
机器学习(ML)的基本配方:用样本(数据)去「教」(拟合)一个模型,使其能对新数据做出预测。
人工智能(AI) 是一个更宏大的概念:让机器表现出智能行为(推理、感知、规划、语言……)。
关键区分:
- AI 是目标(capability),机器学习是方法(method);
- 二者常被混用,但在本课程中我们严格区分:AI 是「要做什么」,ML 是「怎么用数据学出来」。
🖼️ 什么是机器学习?
🖼️ 机器学习的基本配方
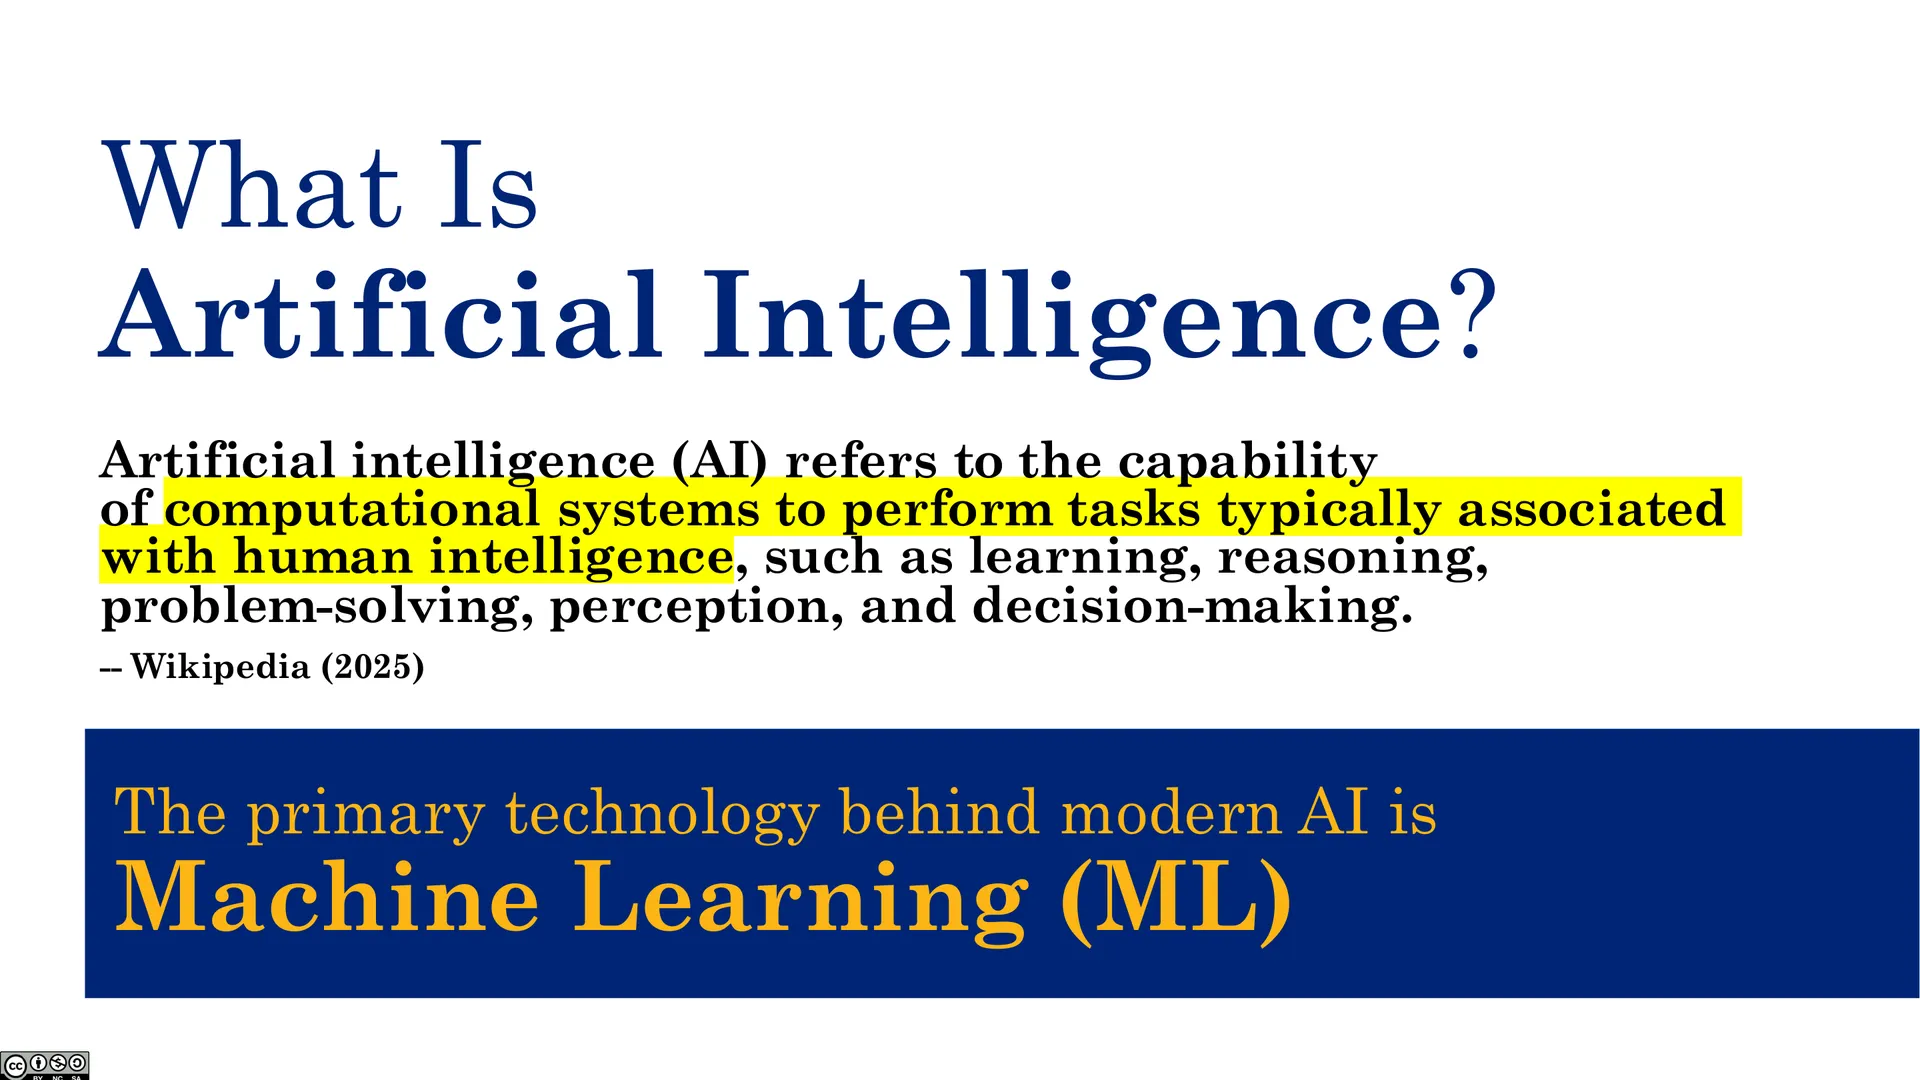
🖼️ 什么是人工智能?
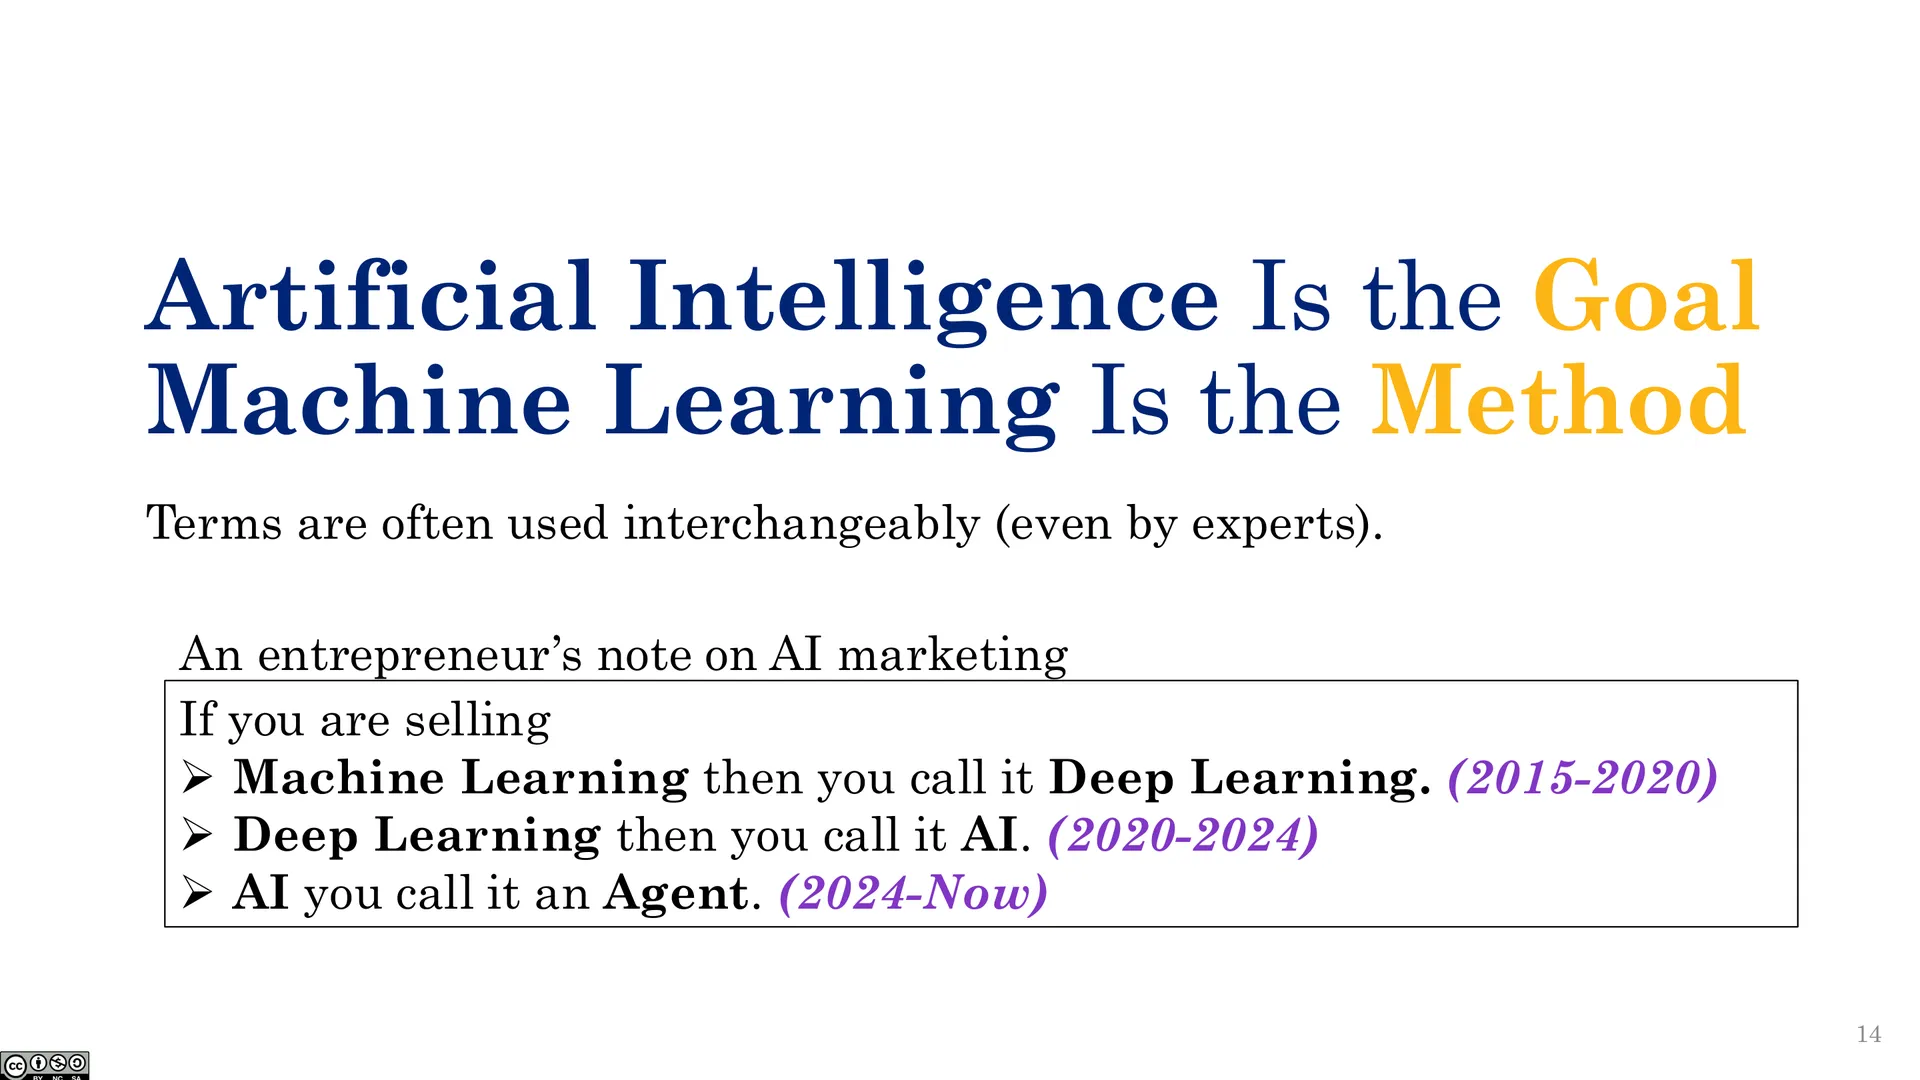
🖼️ AI 是目标,ML 是方法
编者补充:本课程采用 Bishop & Bishop《Deep Learning: Foundations and Concepts》为教材。书中把 ML 视为从数据中寻找规律并据此预测;而 AI 更宽泛。传统 AI(符号推理、搜索)与 ML(统计学习)曾长期分道扬镳,如今以大模型为桥梁重新融合。
2.2 你其实已经做过机器学习
线性回归就是机器学习:给定数据 $(x_i, y_i)$,拟合 $\hat y = w^\top x + b$,使预测接近目标——这正是「用数据教模型」的最小例子。
领域全景:机器学习、数据科学(data science)、统计学(statistics) 相互交织,术语和社区各异:
- 统计学:美国统计协会的定义强调「从数据中学习并量化不确定性」;研究发表在统计学期刊(如 Annals of Statistics);
- 数据科学:更偏工程与应用(数据清洗、可视化、部署);
- 机器学习:介于两者之间,强调预测与泛化,常用计算与优化工具。
🖼️ 你已经做过机器学习
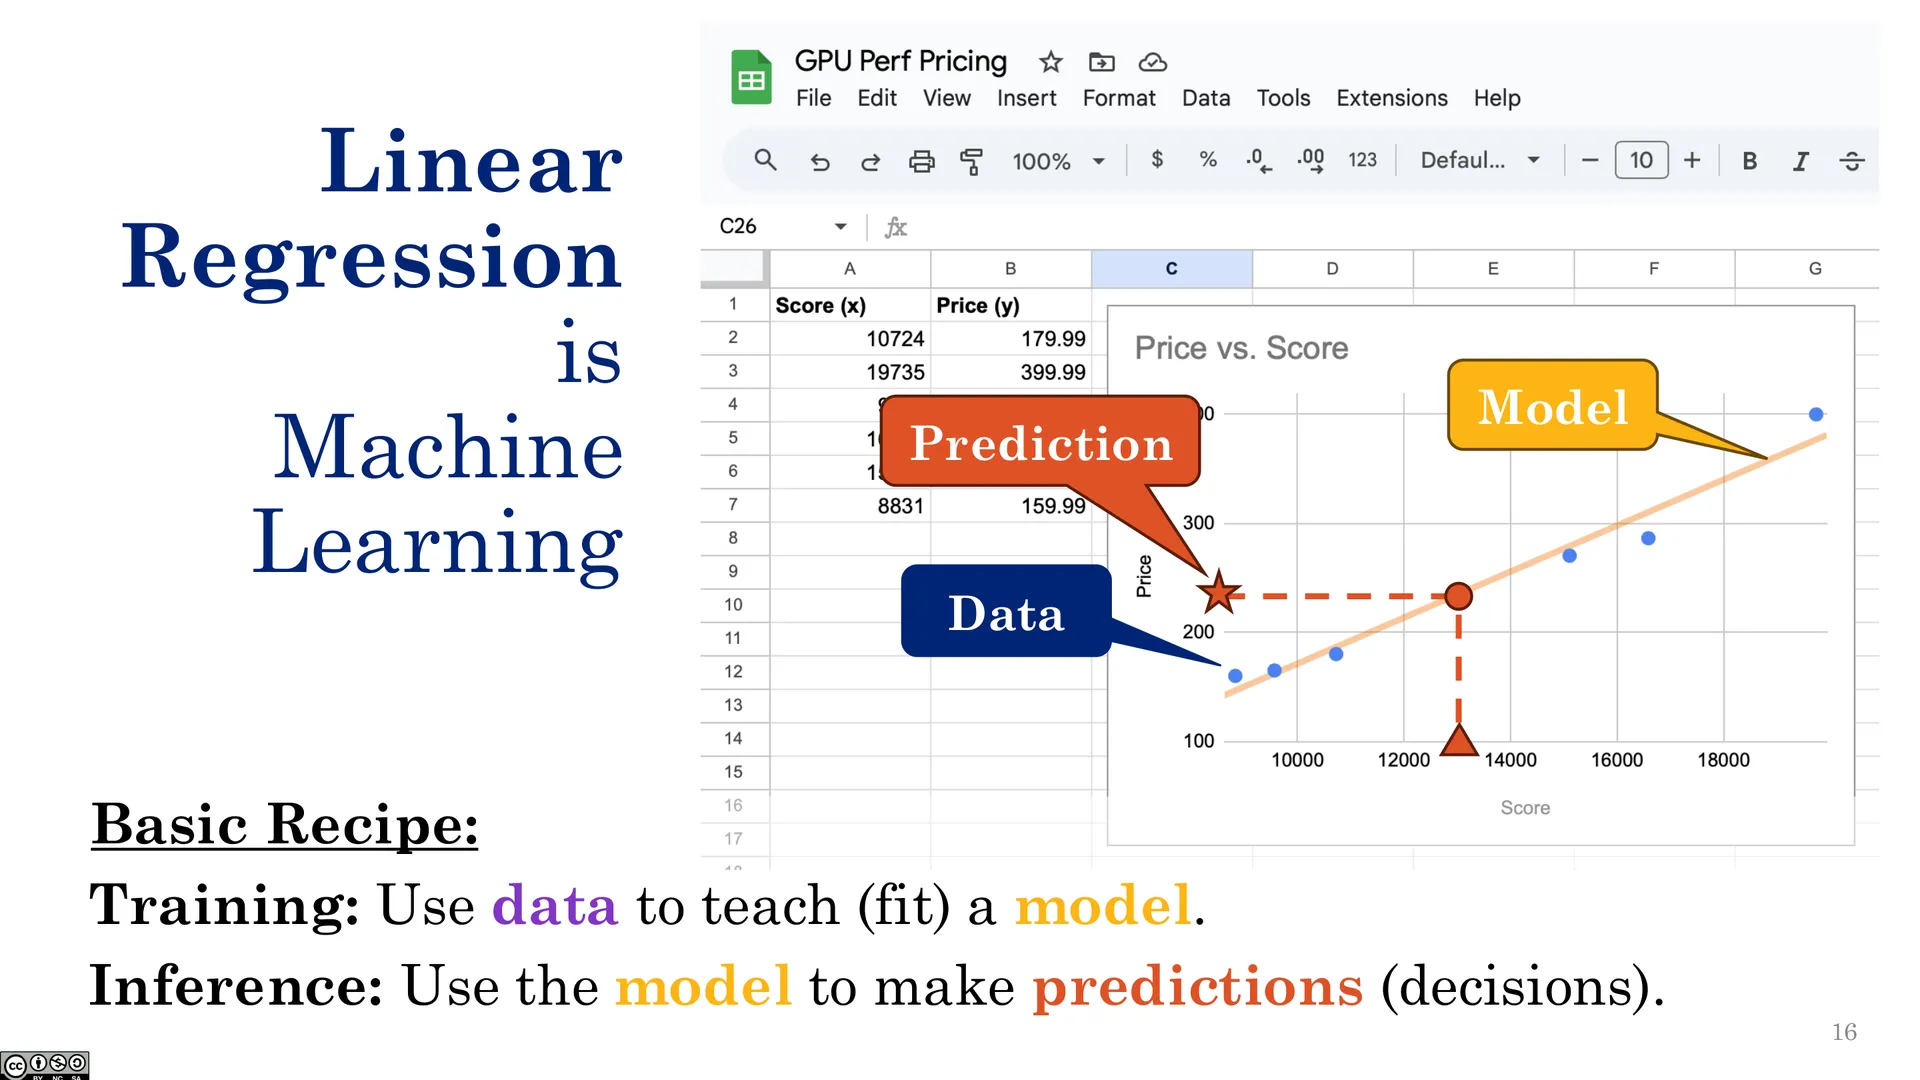
🖼️ 线性回归就是
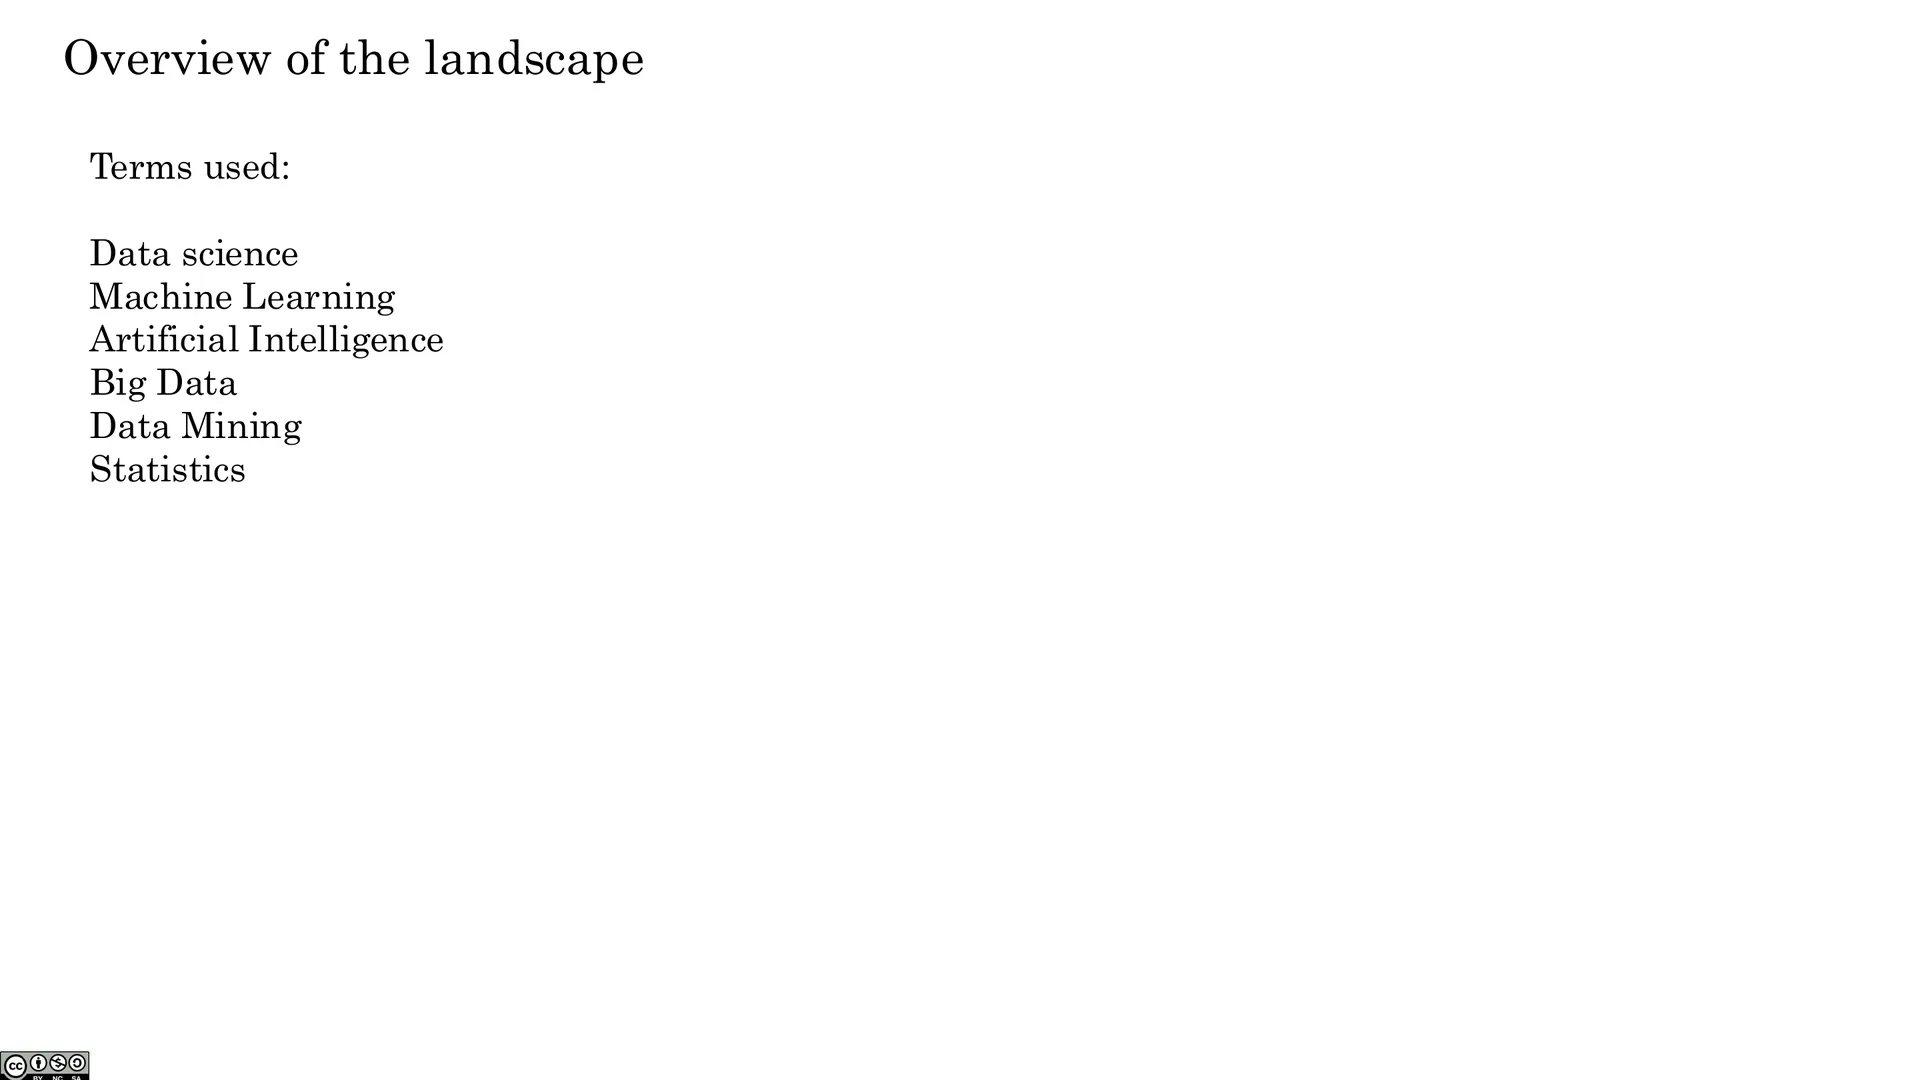
🖼️ 领域全景(一)
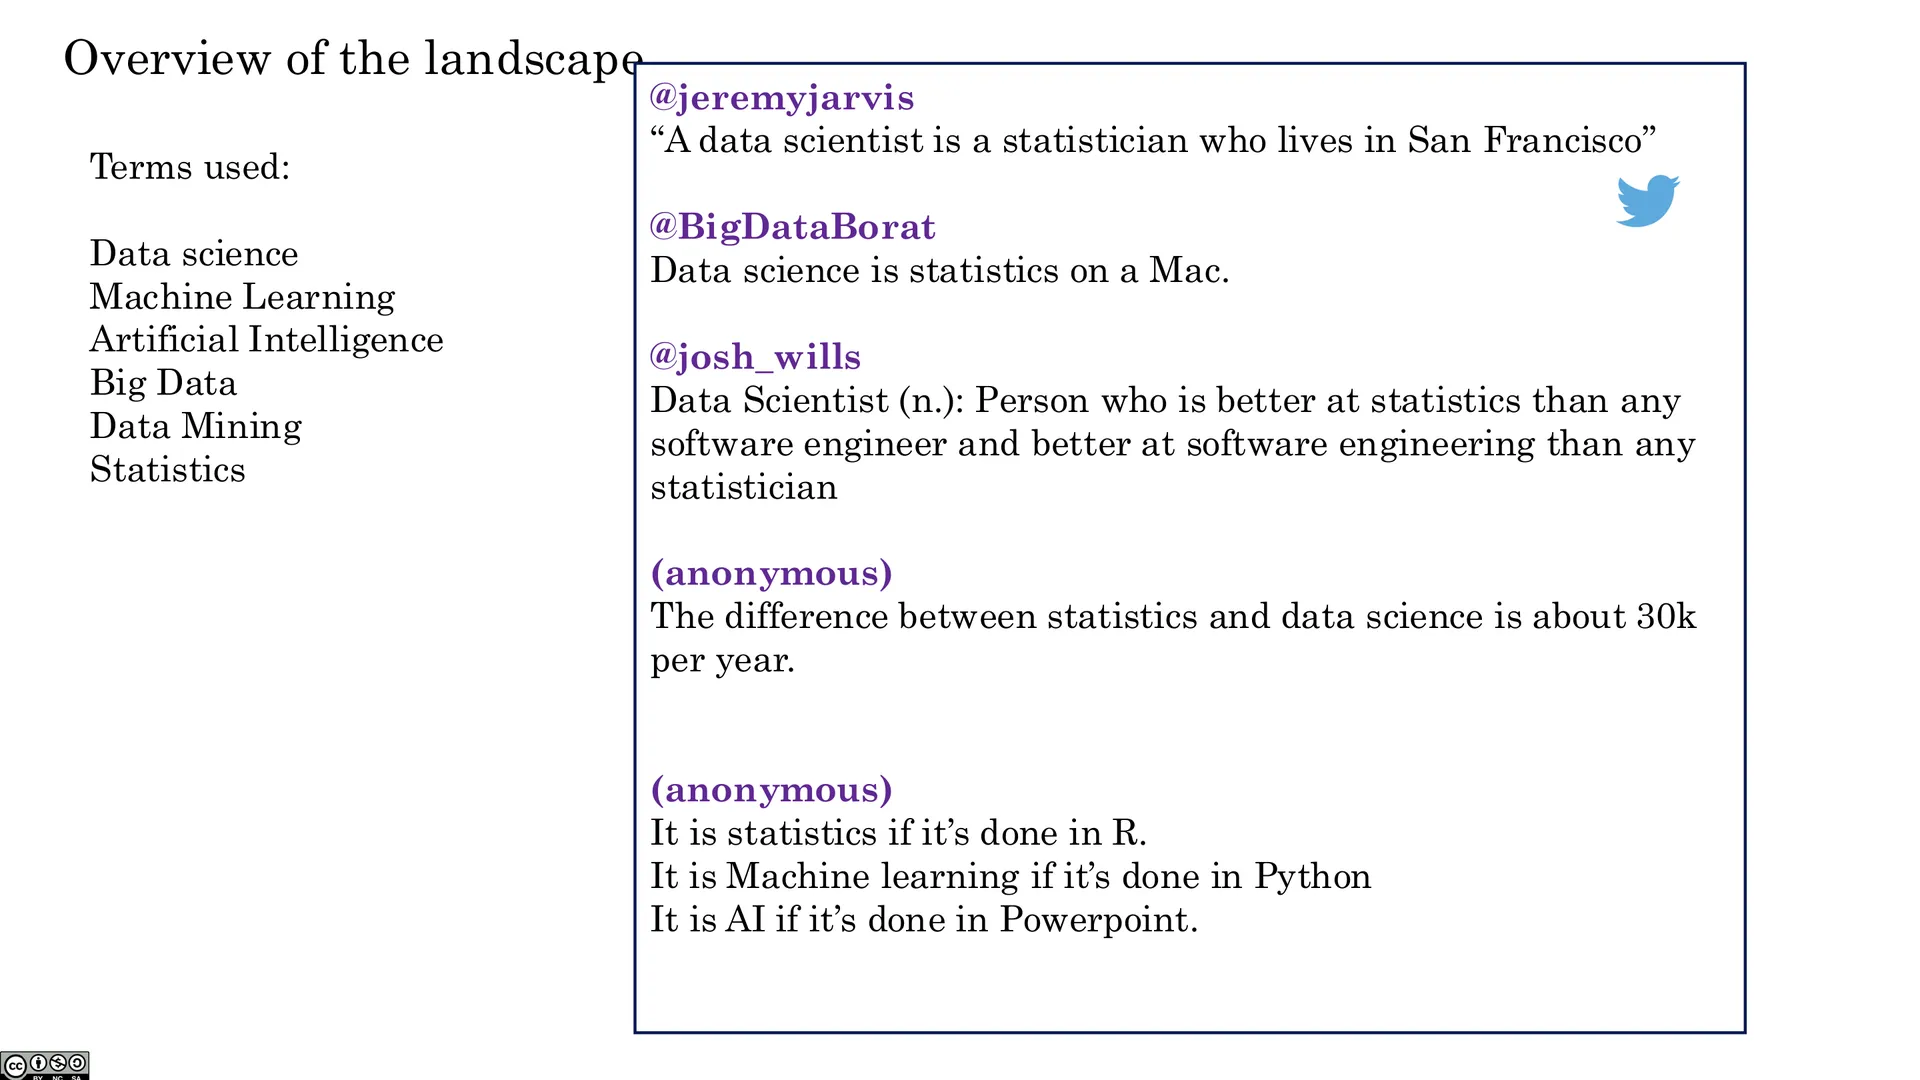
🖼️ 领域全景(二)
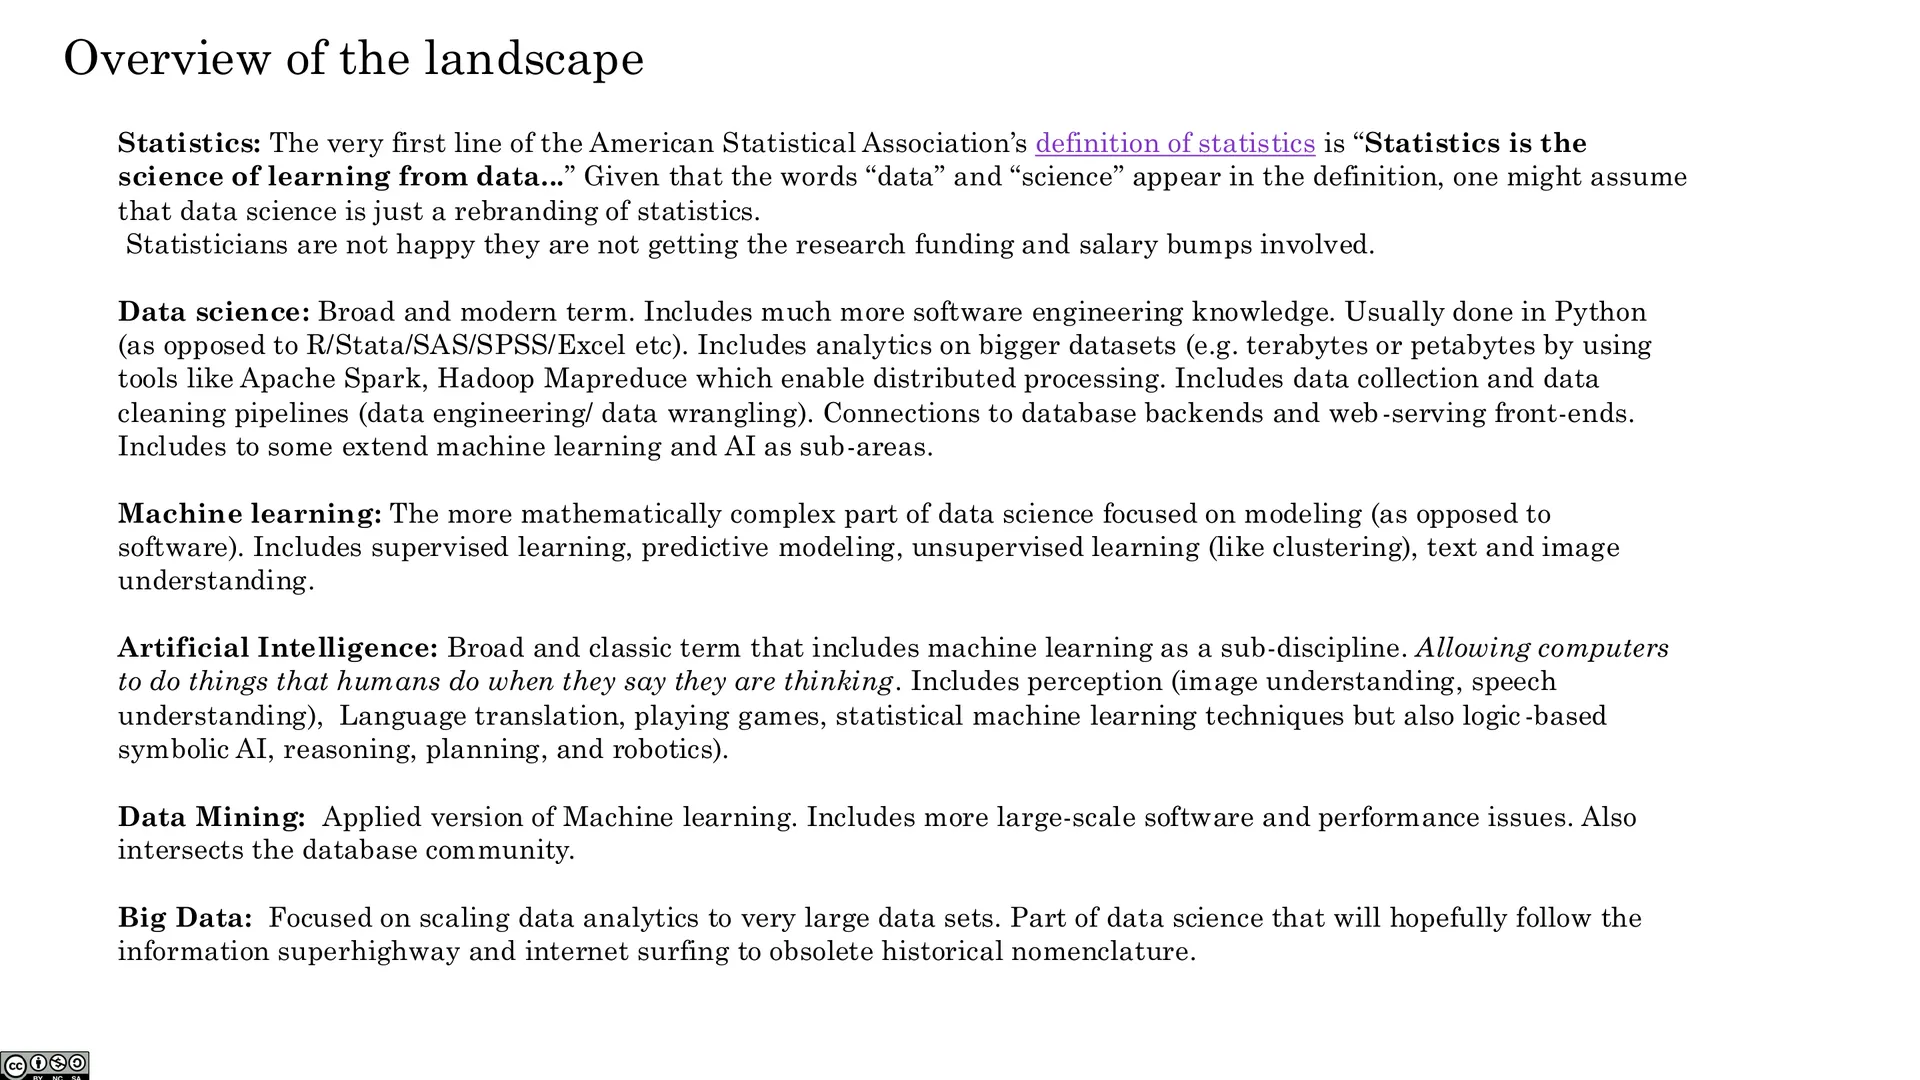
🖼️ 统计学的定义
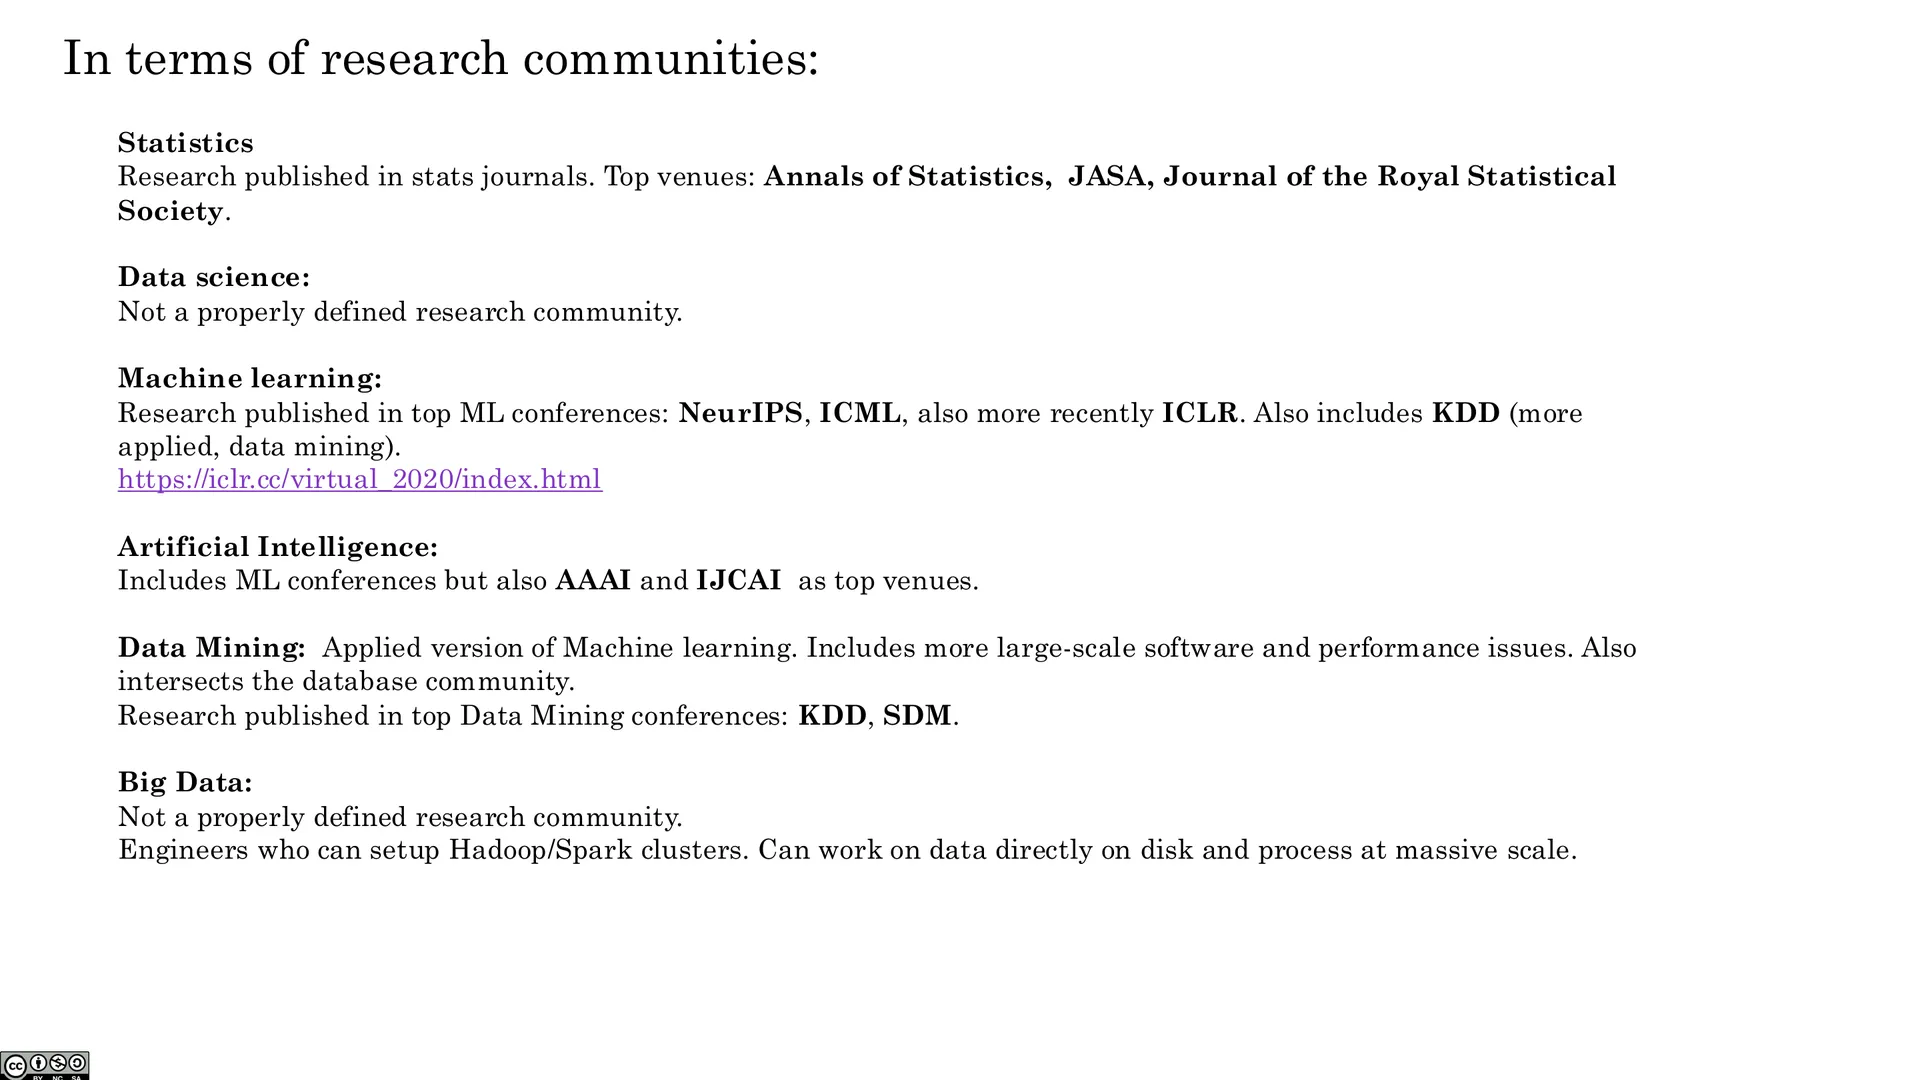
🖼️ 研究社区视角:统计学
三、机器学习的分类学
本课程会建立一套机器学习问题的分类学(taxonomy):按有没有标签、标签是什么形式、数据是什么类型来划分。
🖼️ 机器学习的分类学
3.1 监督学习:二分类
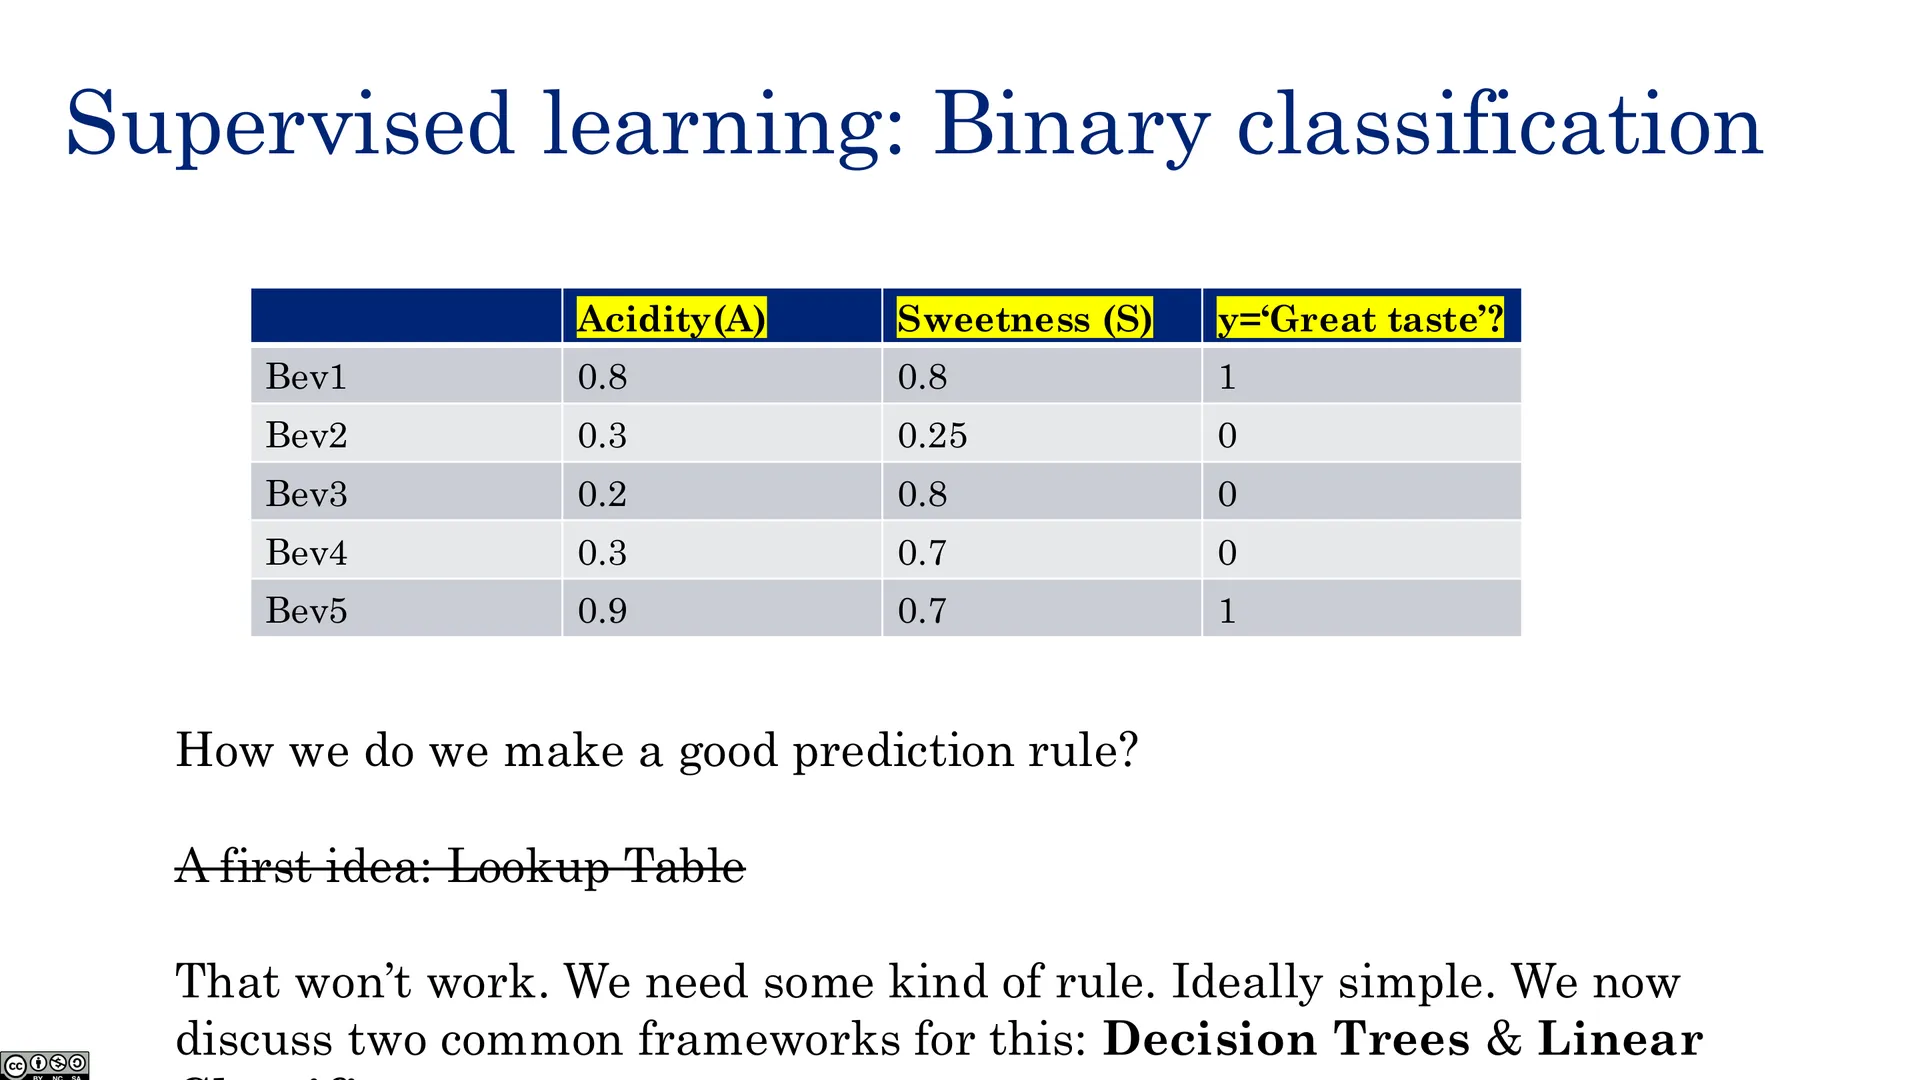
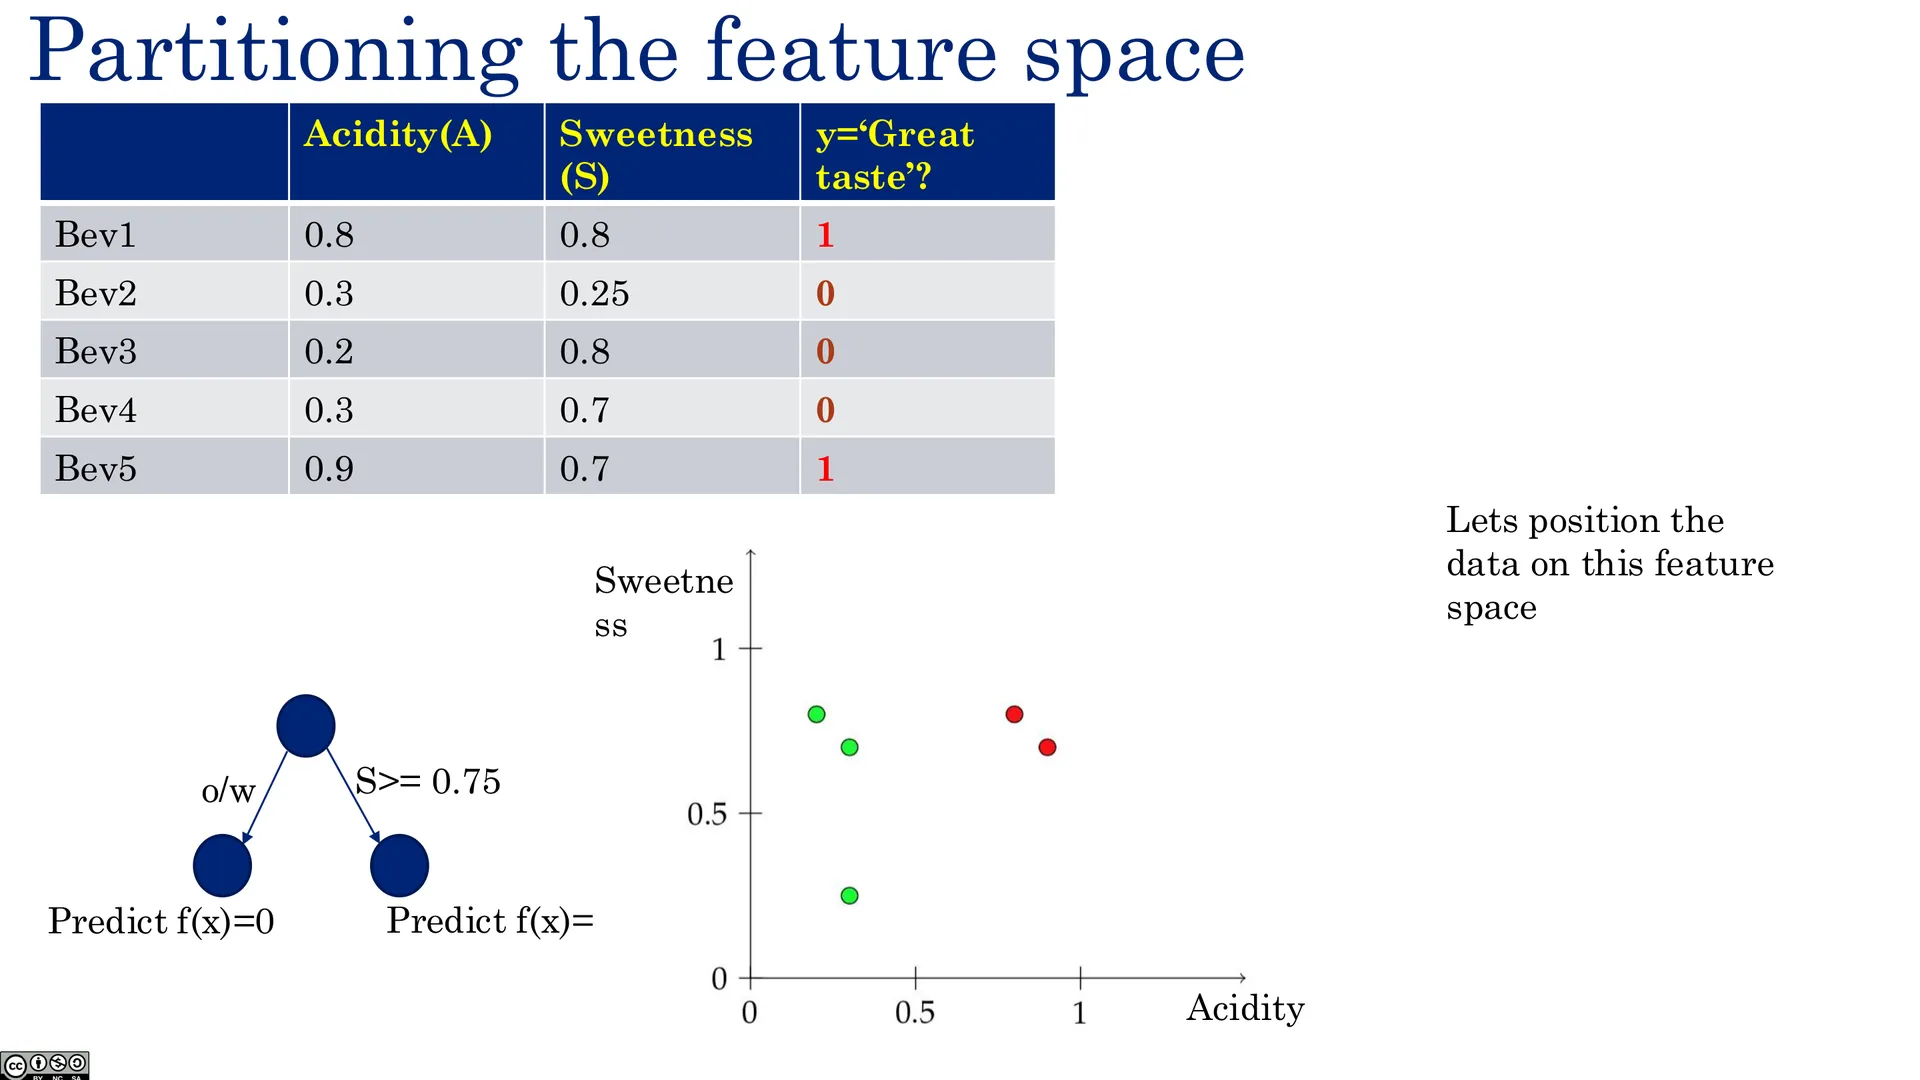
设定:训练数据是一张表,含特征(features) $x_1, x_2,\dots$ 与标签(label) $y$。每一行是一个样本(example / instance)。
例子:数据驱动的「口味测试」——用两个特征「酸度 A」和「甜度 S」预测「喜欢 / 不喜欢」。数据点大致分成两类;我们想画一条边界把它们分开。
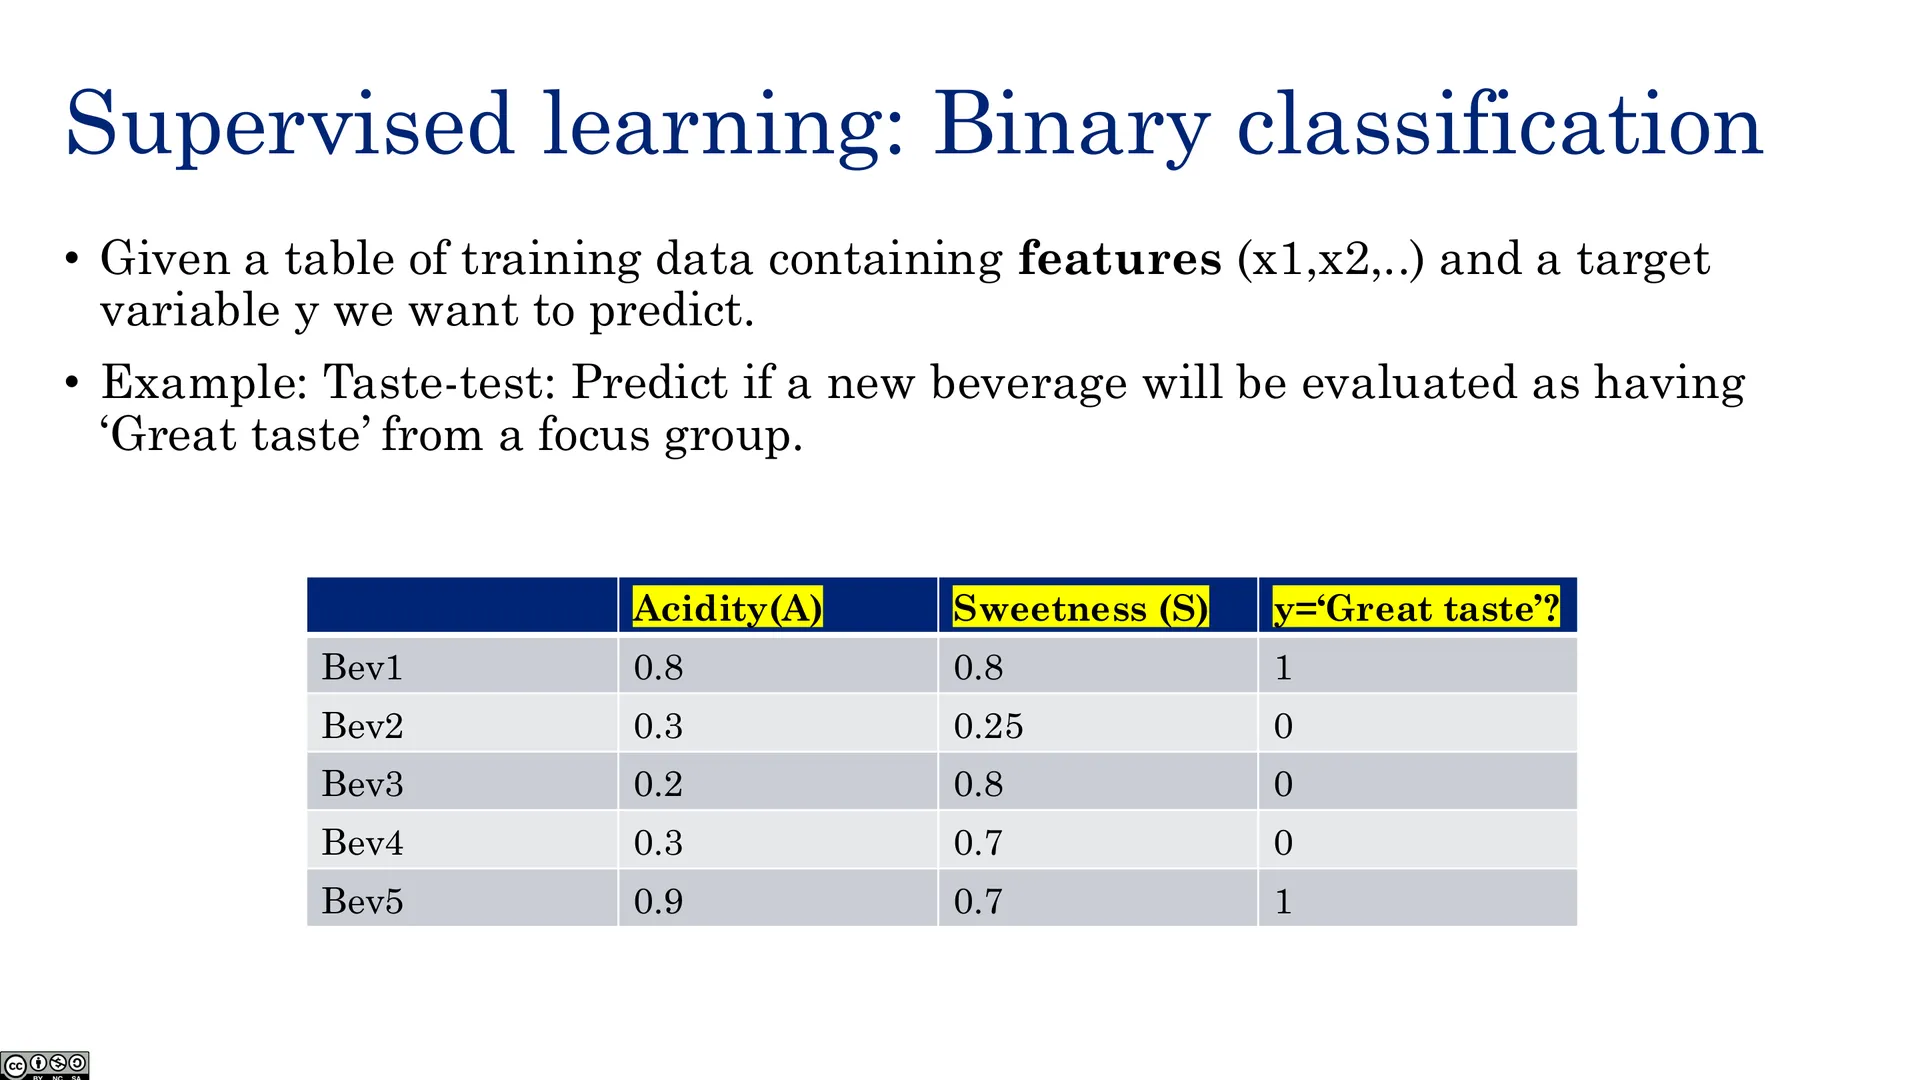
🖼️ 监督学习:二分类(一)
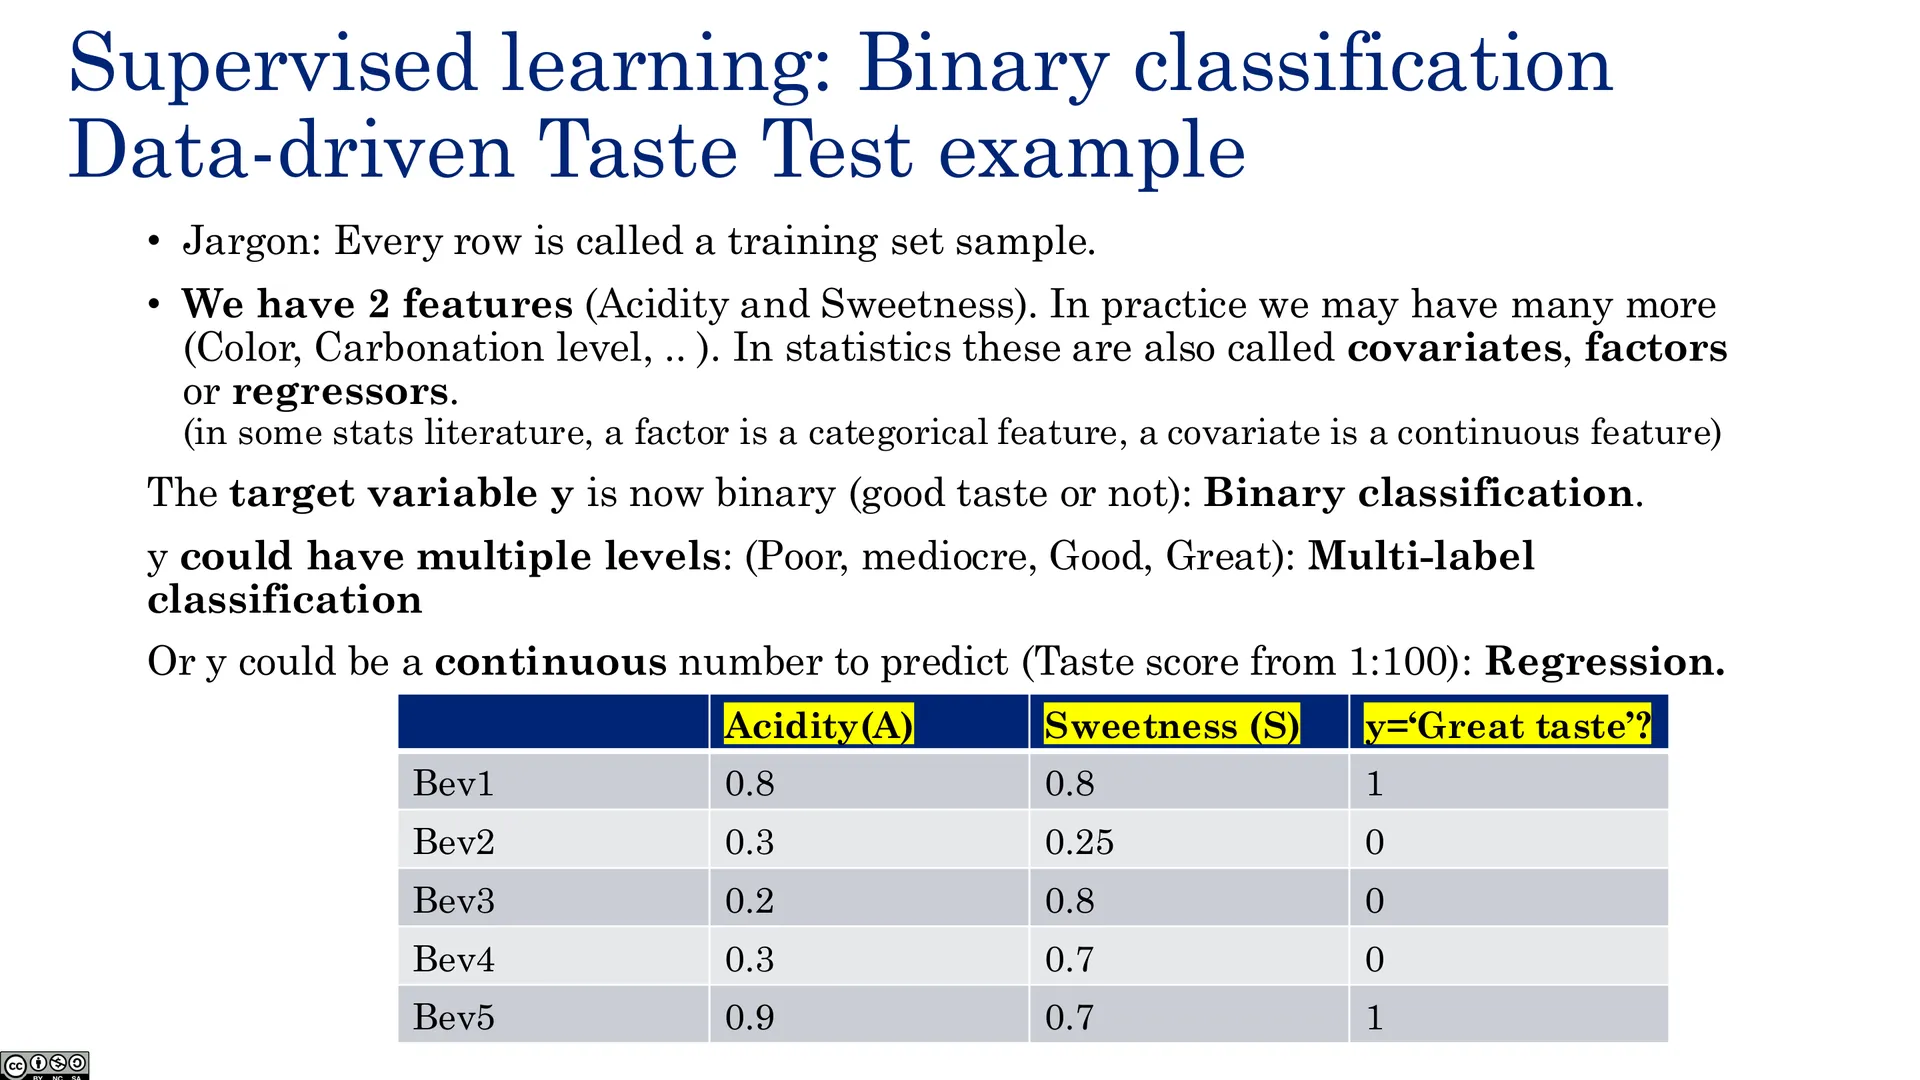
🖼️ 监督学习:二分类(二)· 术语
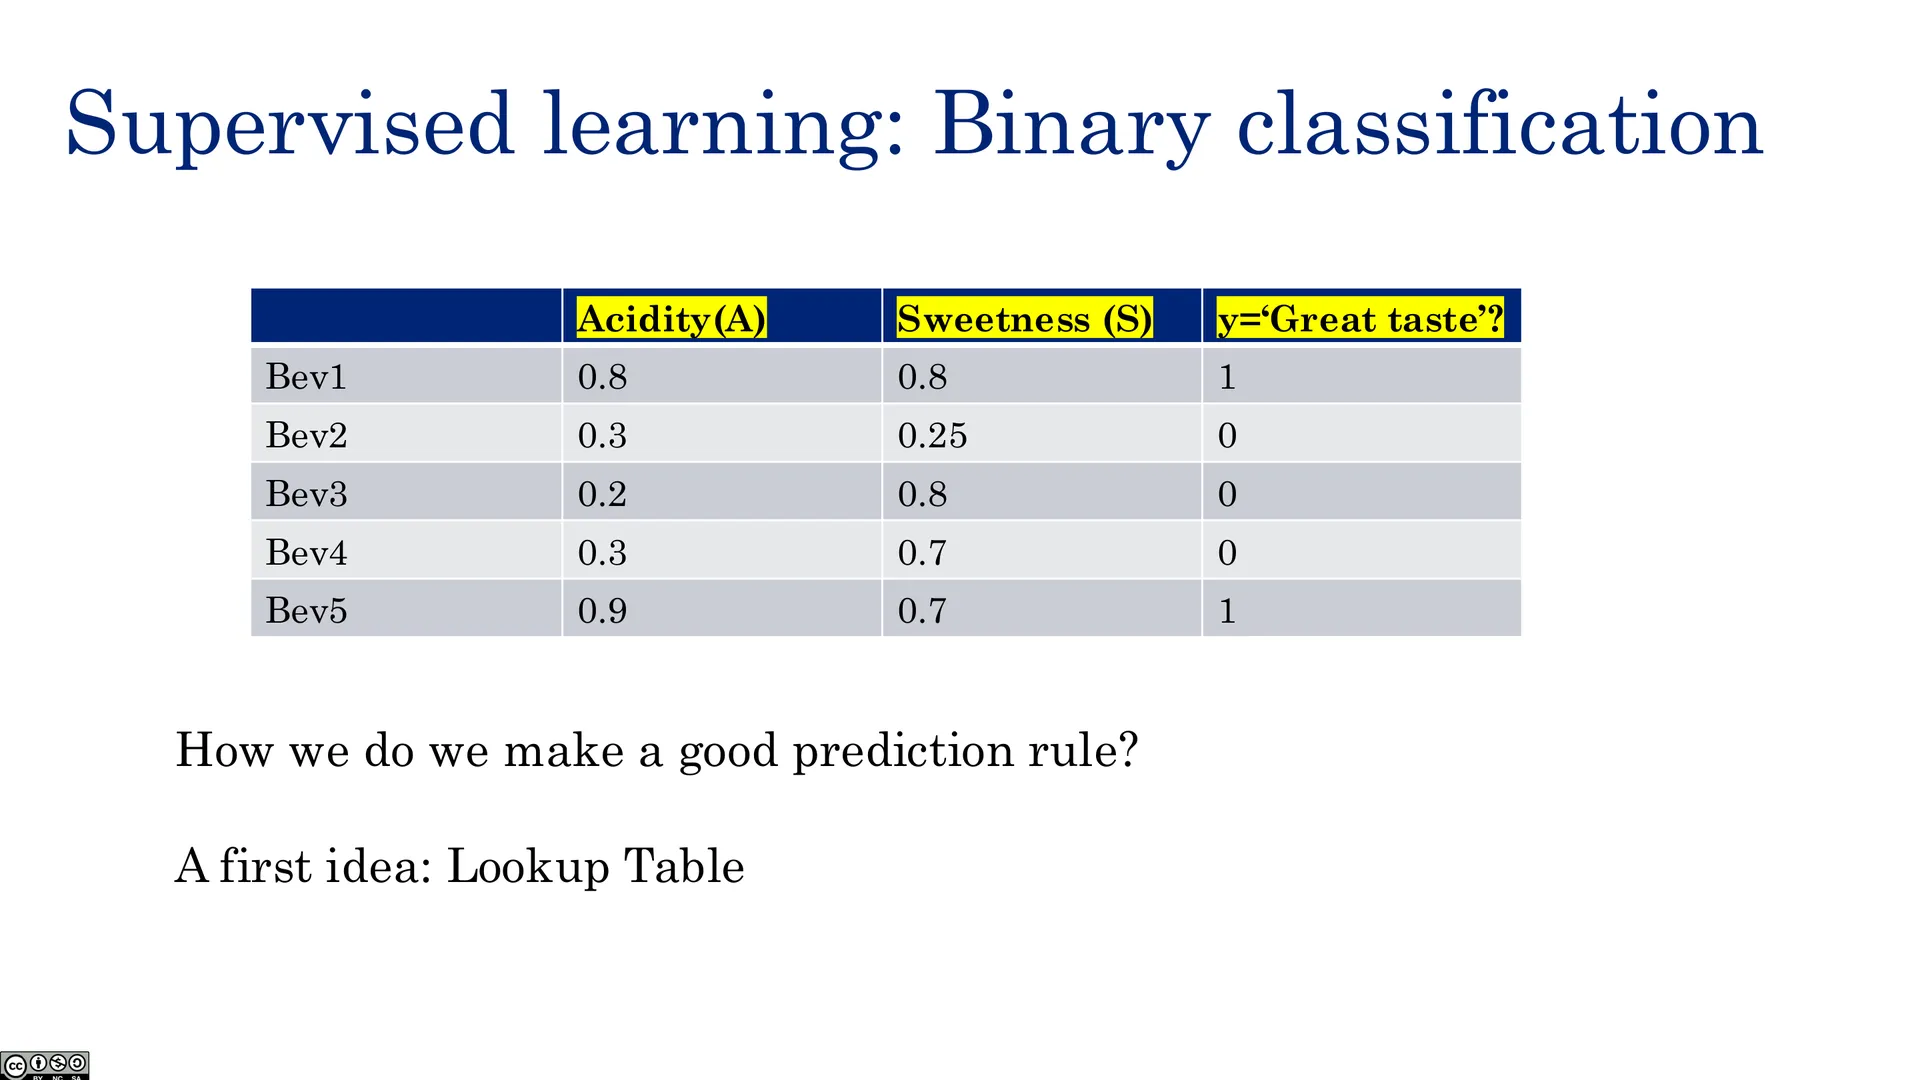
🖼️ 口味测试示例(一)
🖼️ 口味测试示例(二)
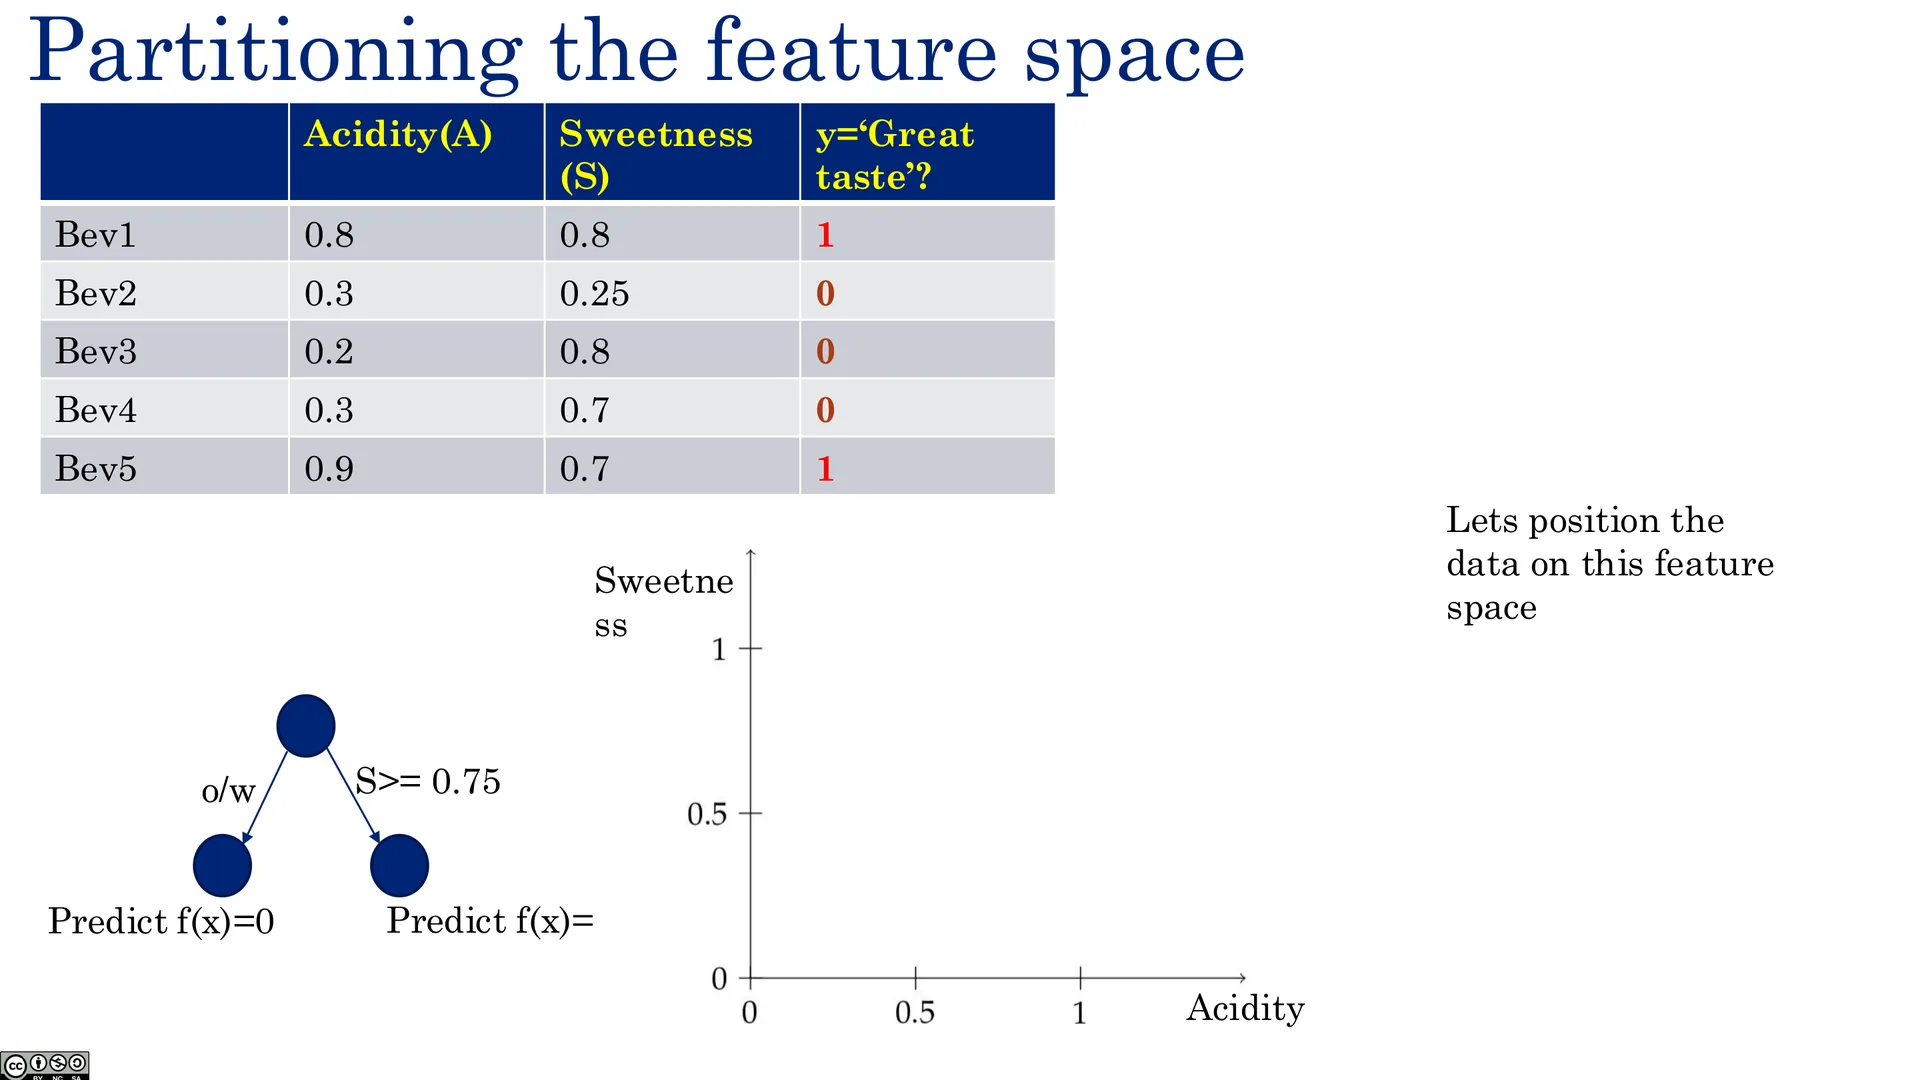
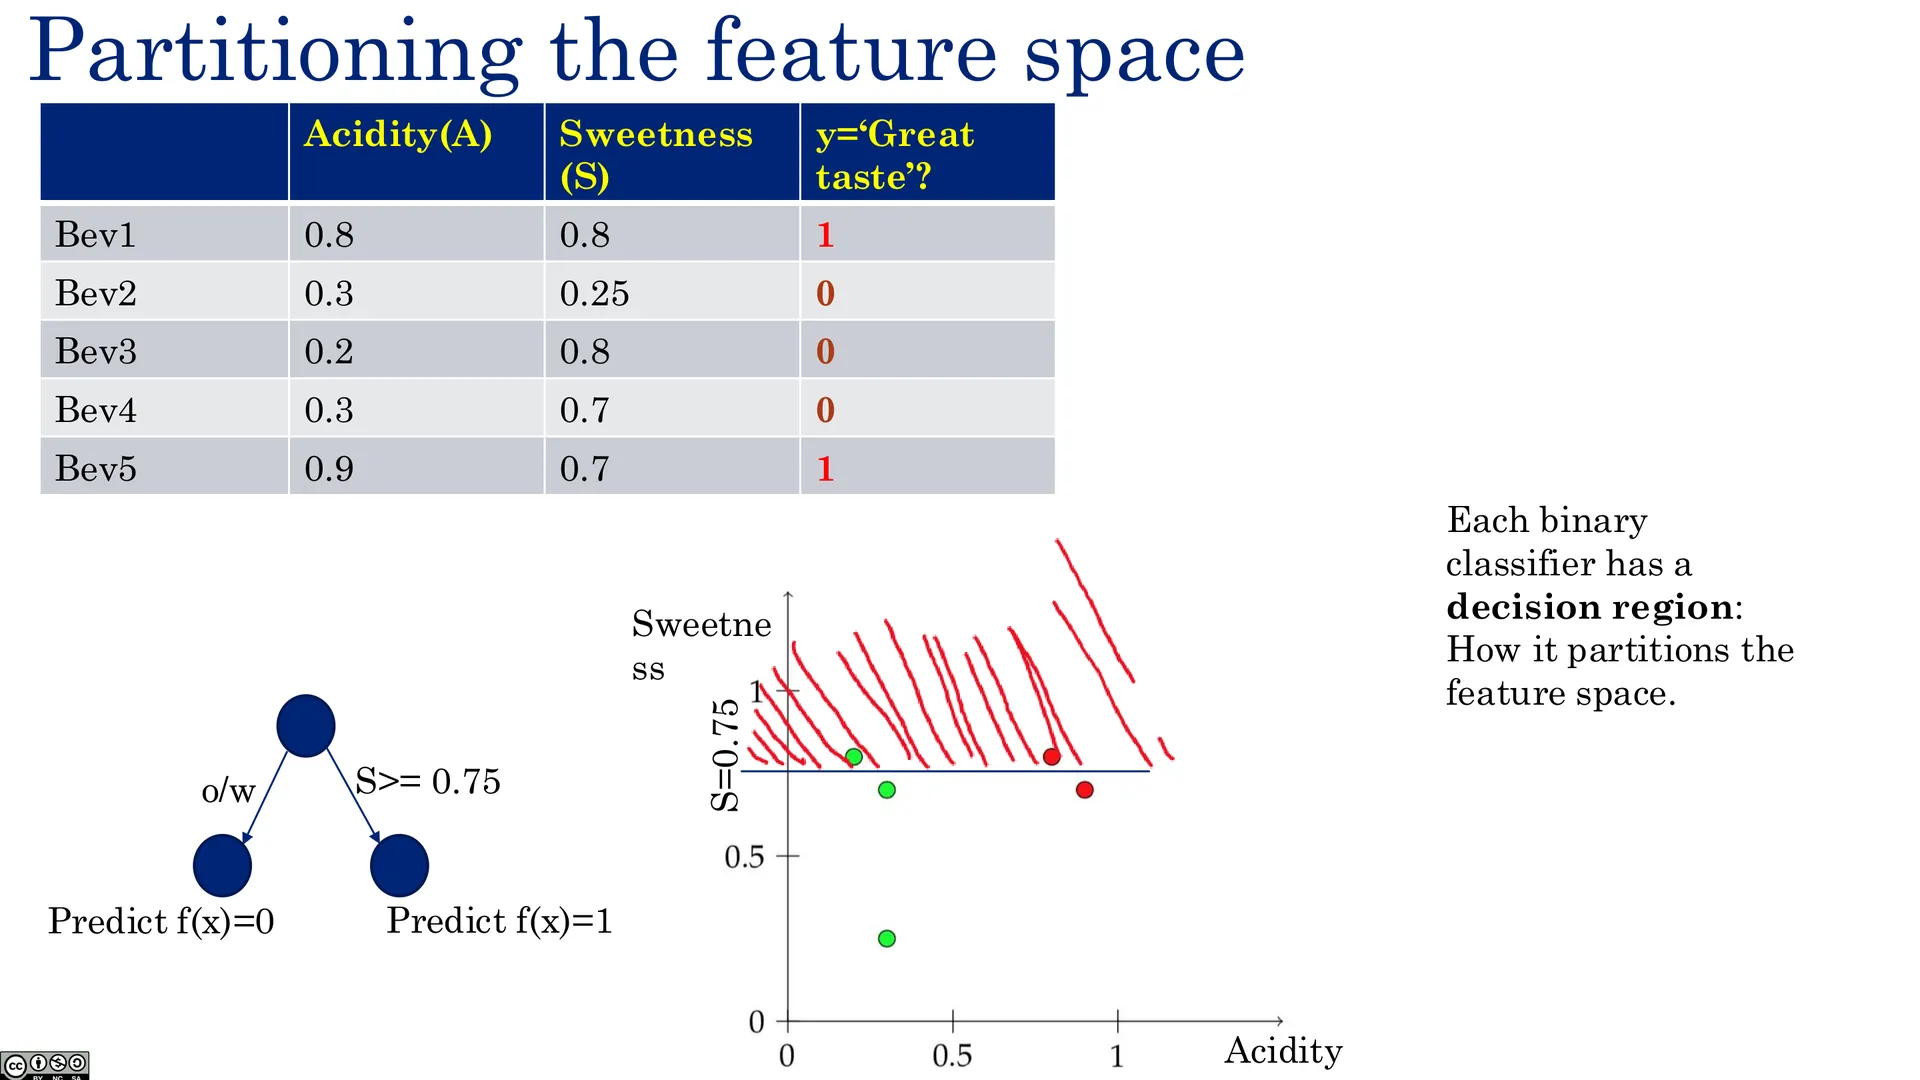
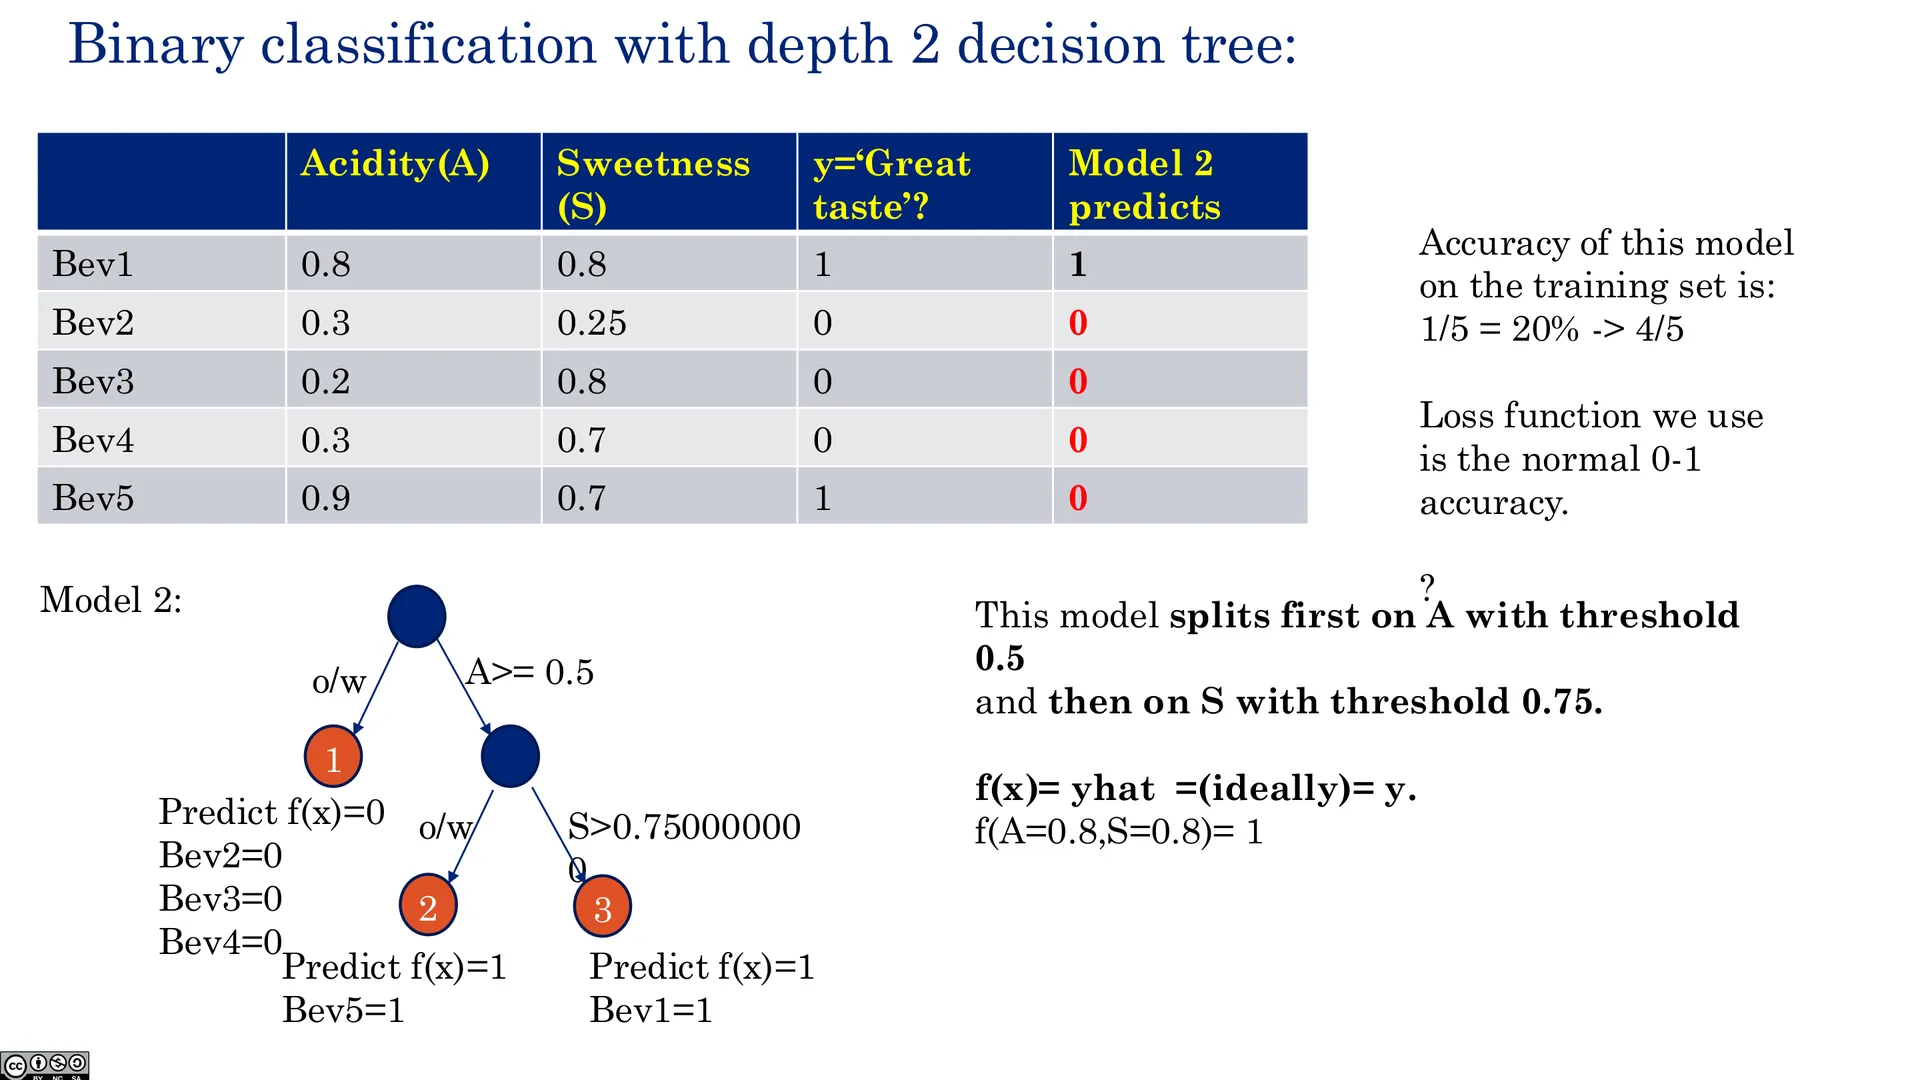
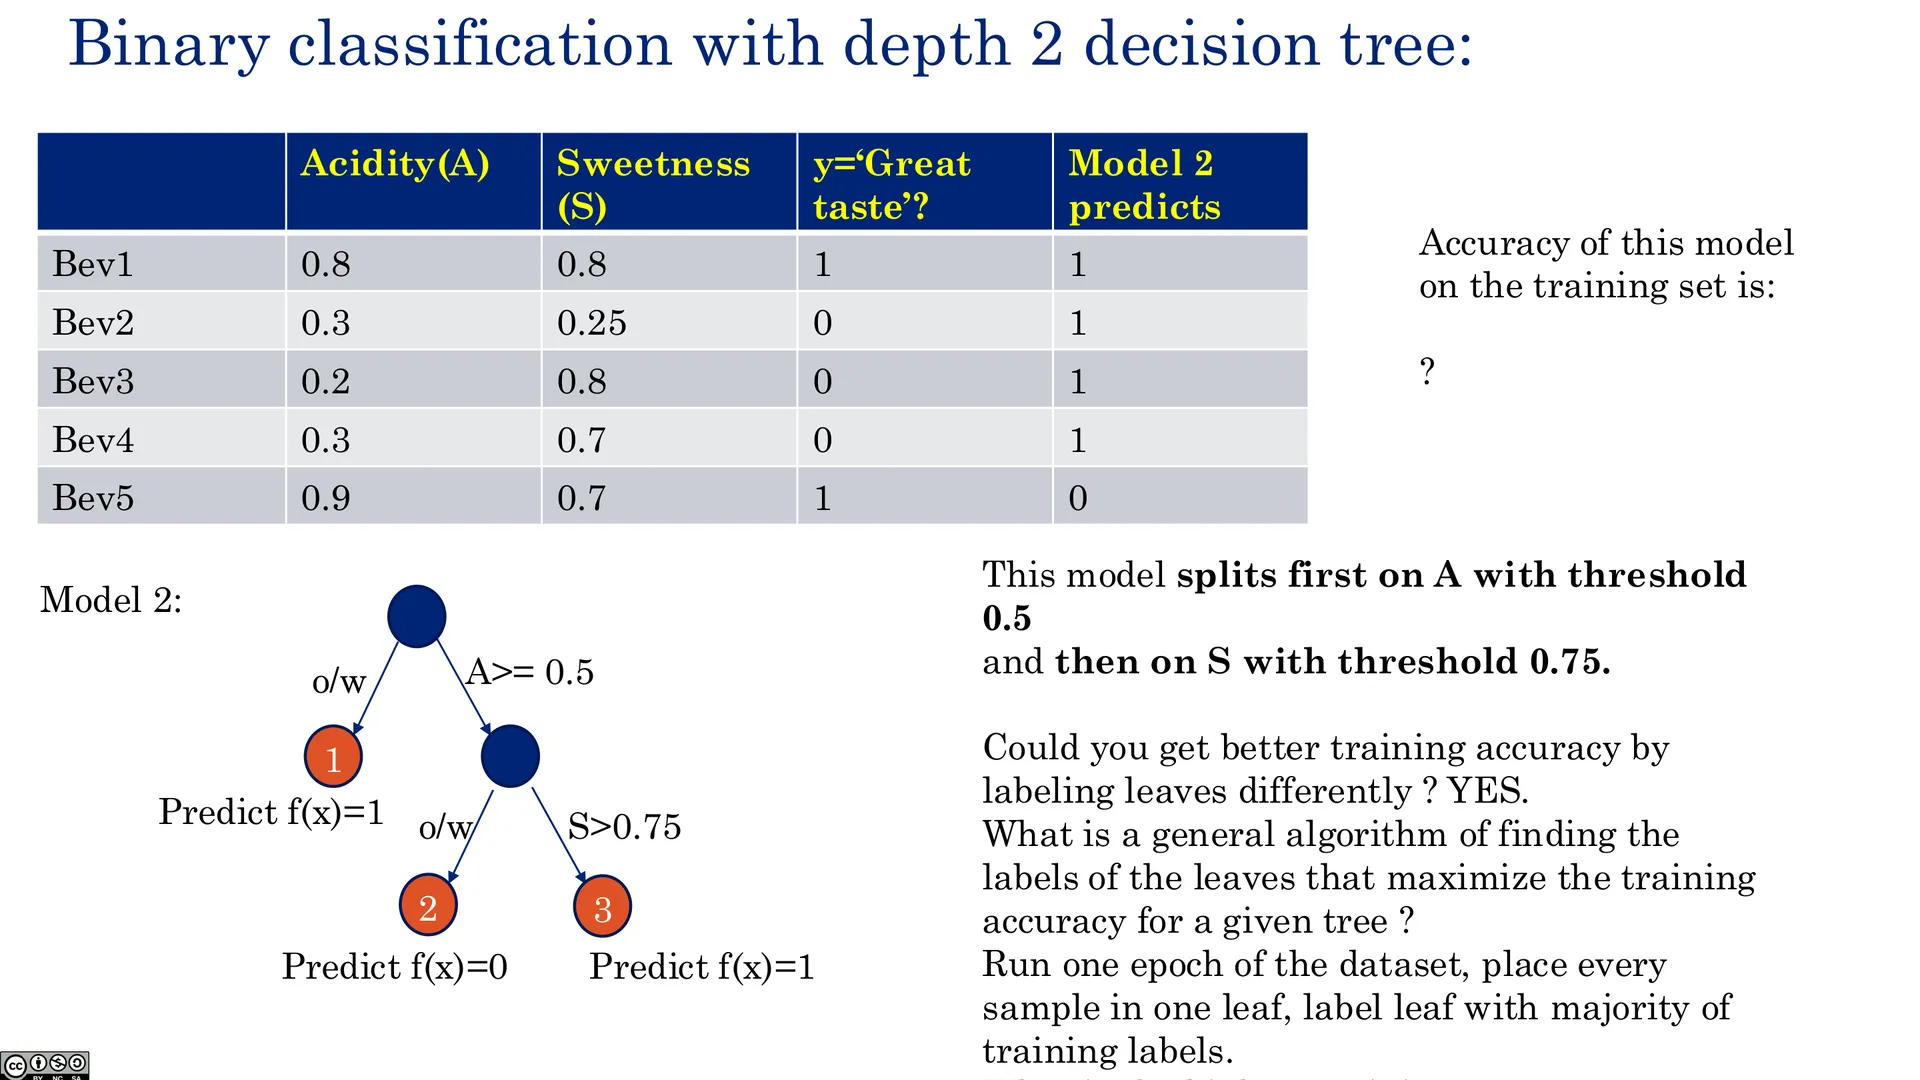
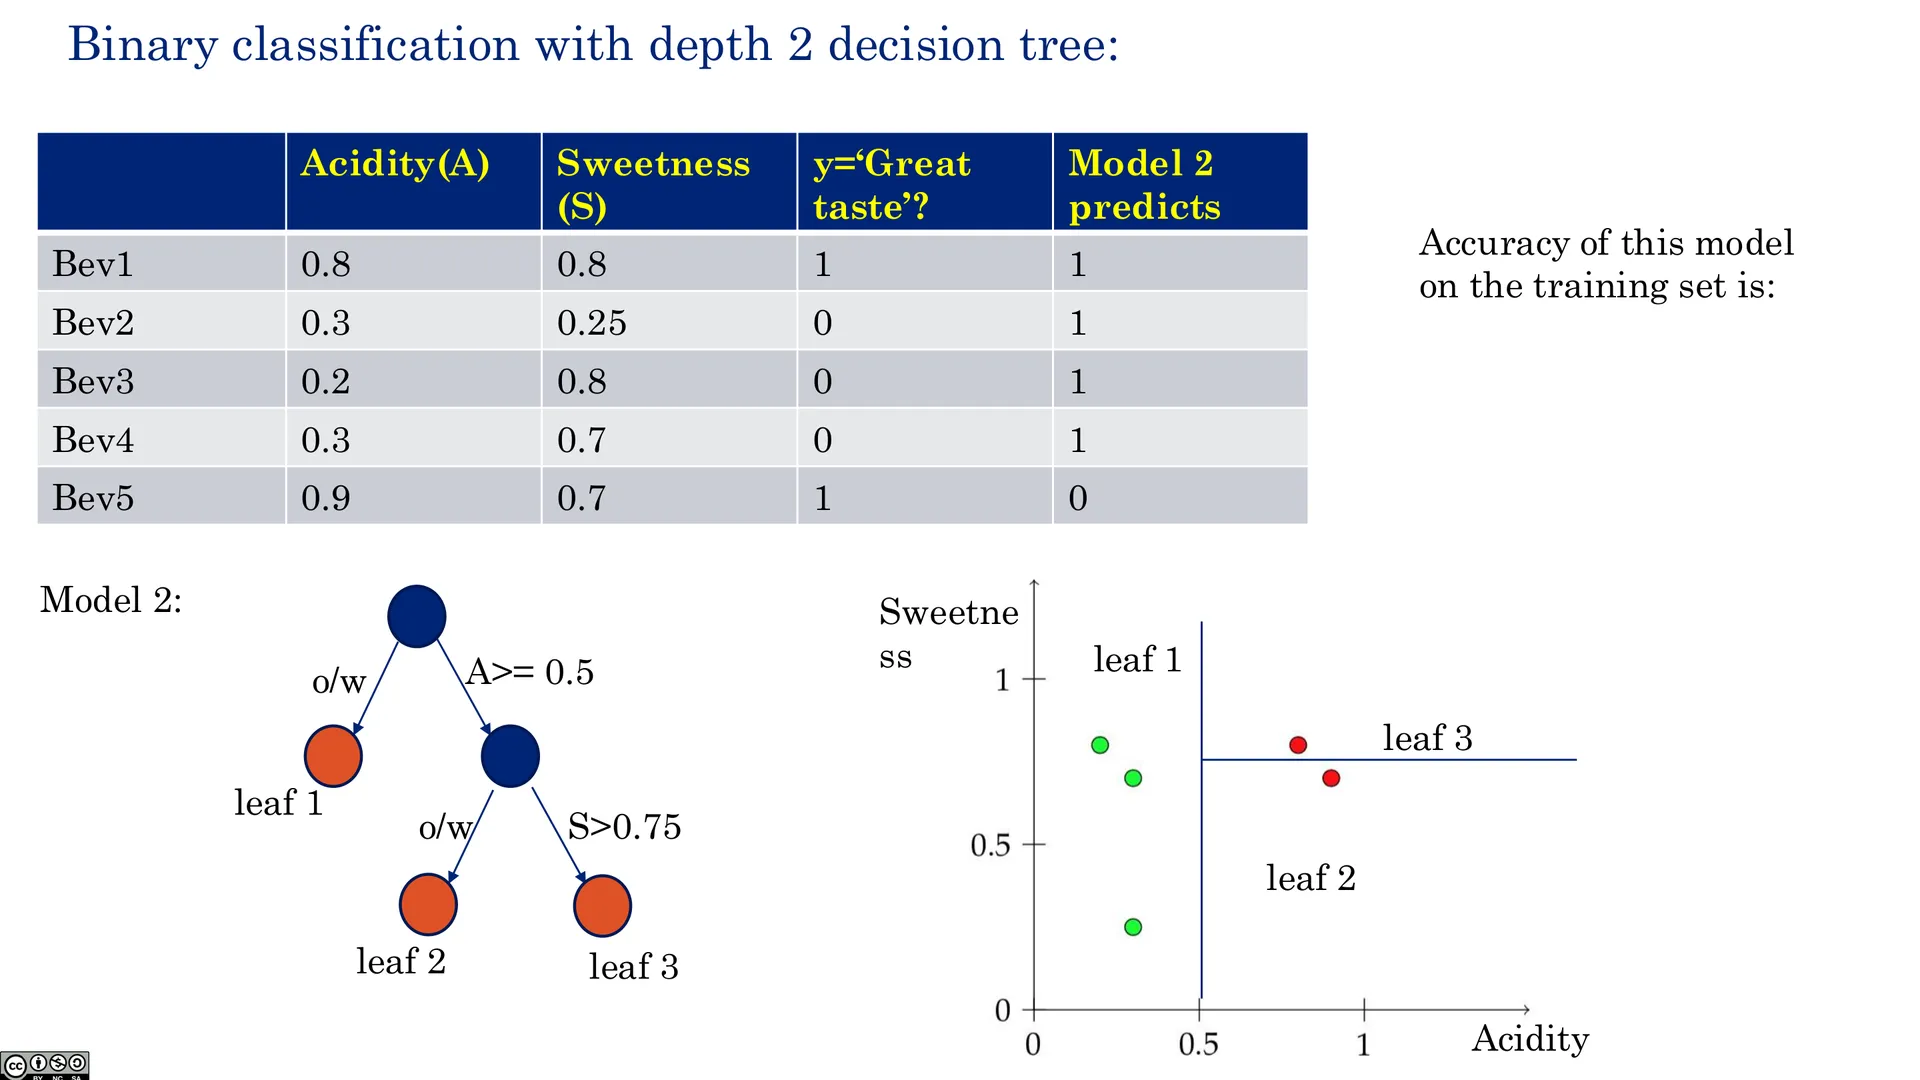
用决策树分类:
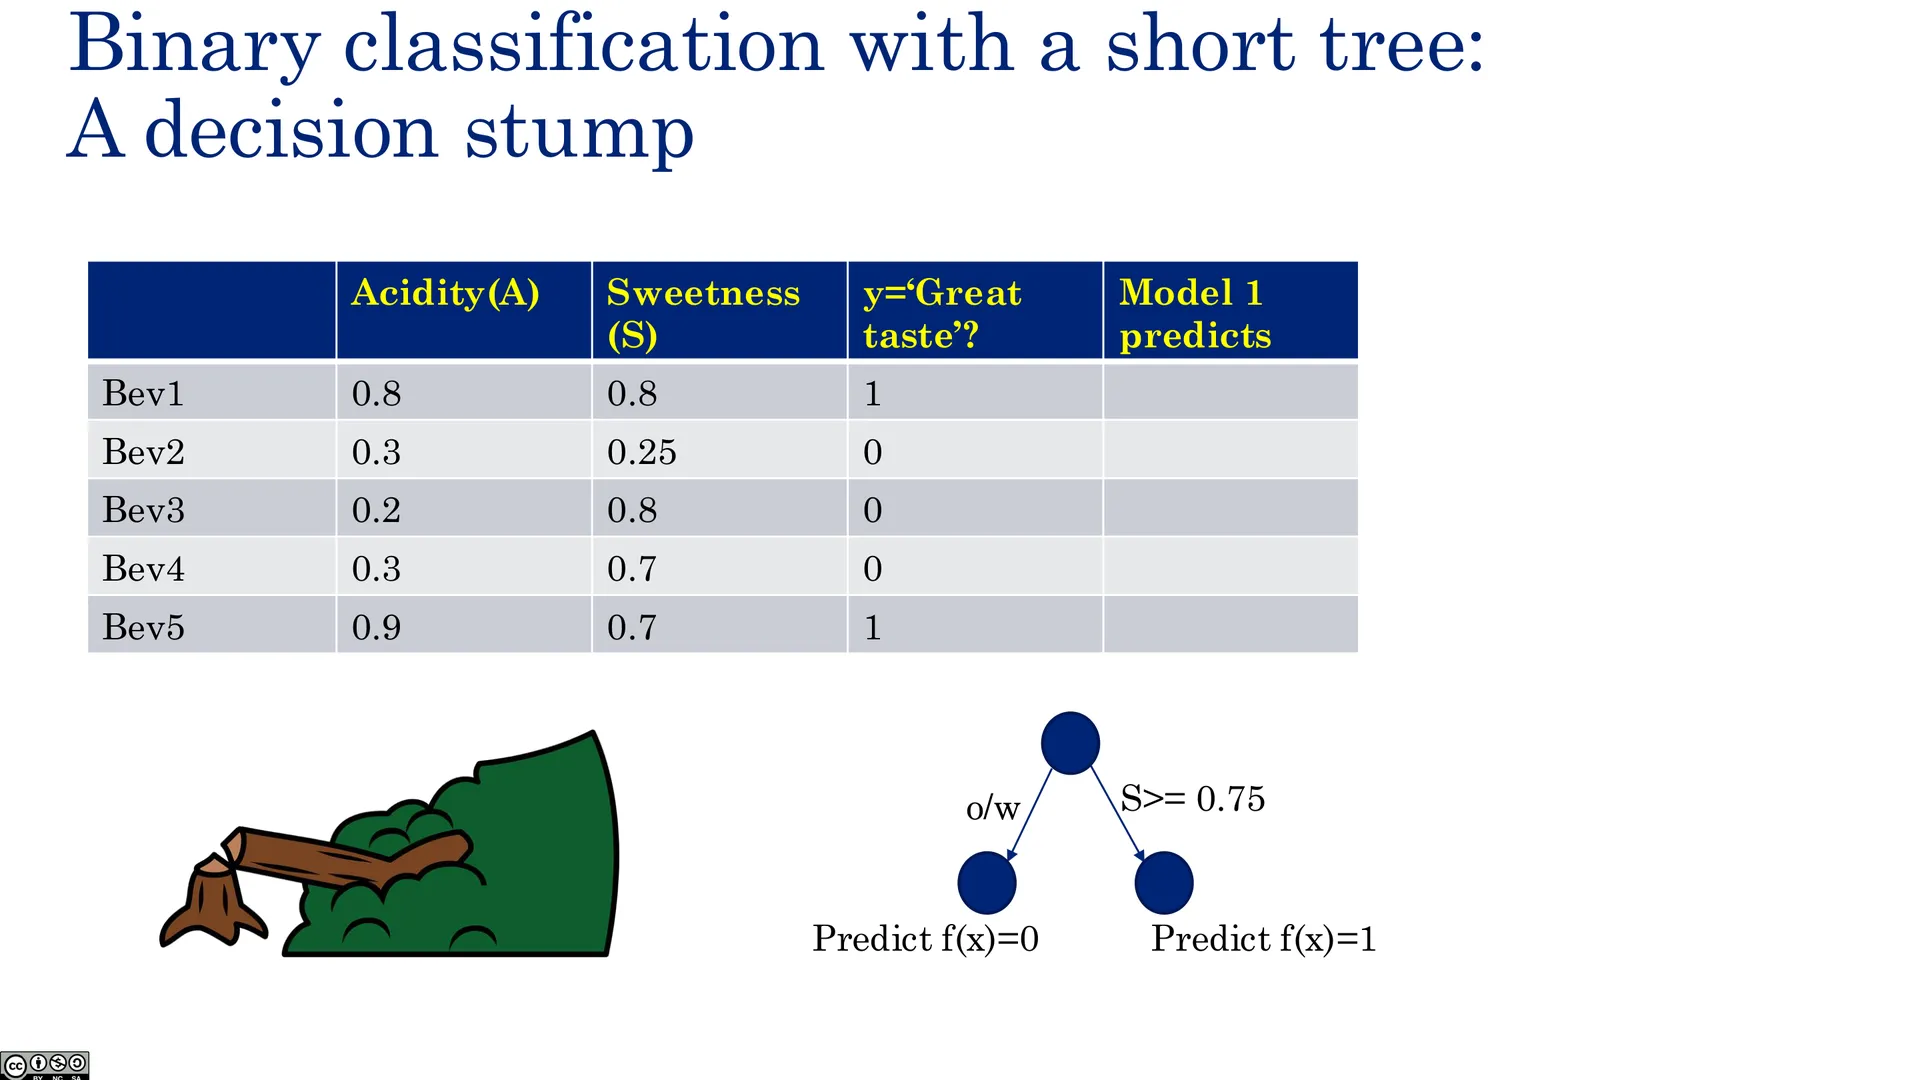
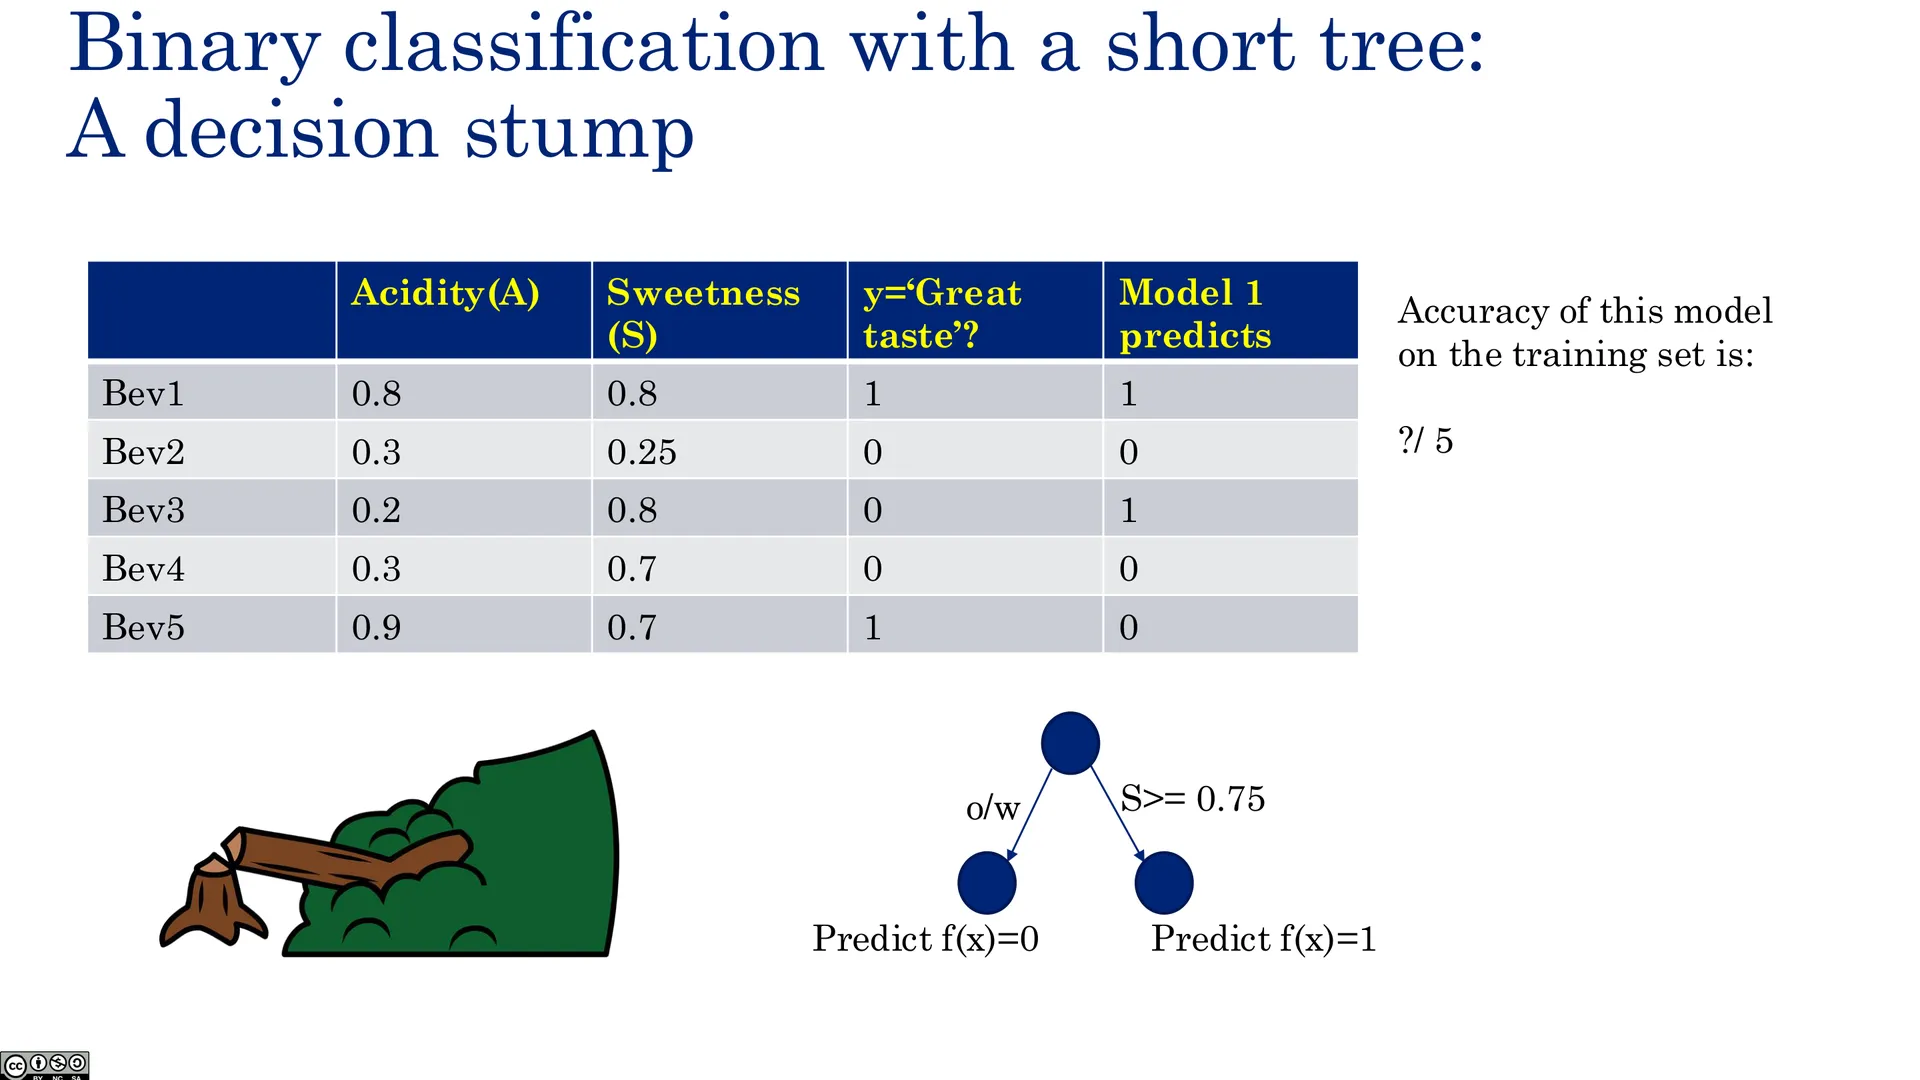
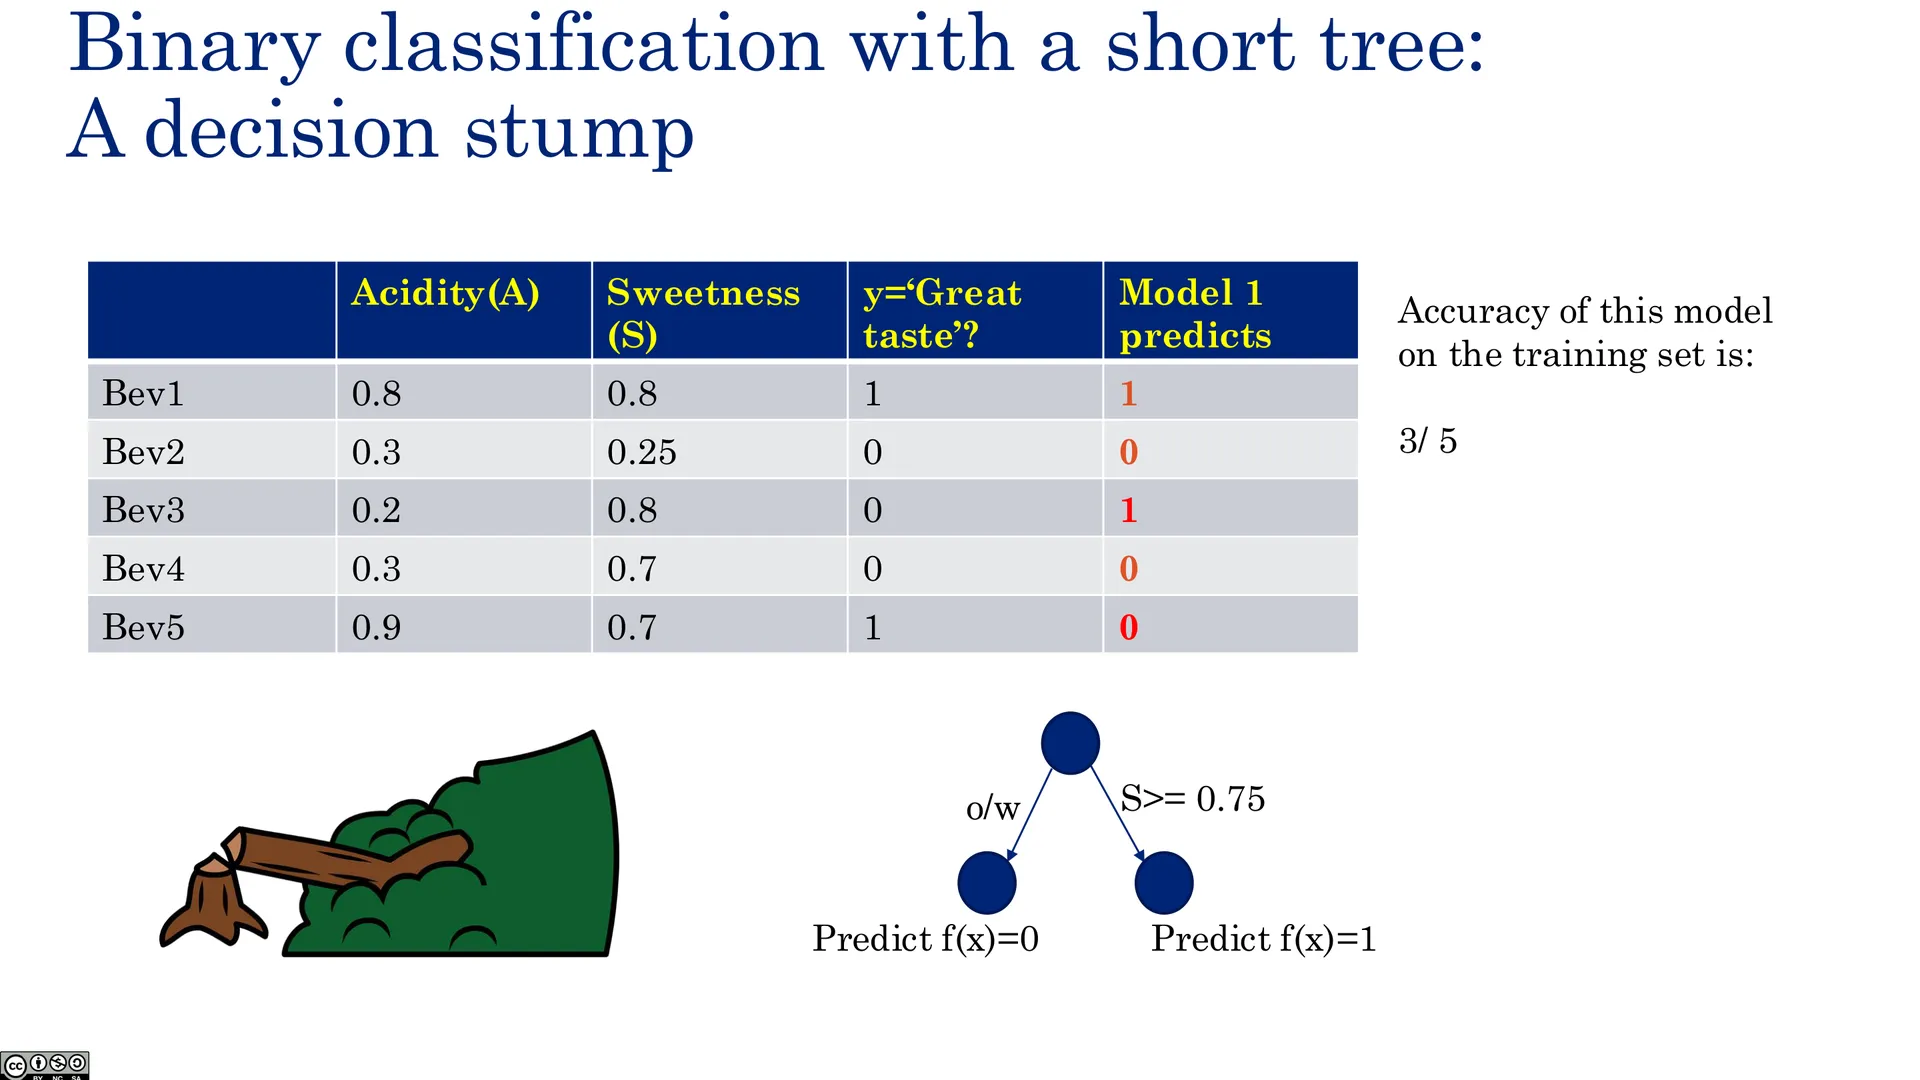
- 决策树桩(decision stump):只用一个特征做一次划分(如「酸度 > 阈值?」);
- 深度 2 的决策树:串联两个划分,把特征空间切成更多块;
- 树把特征空间划分(partition) 成若干区域,每个区域给一个预测。
🖼️ 决策树桩(一)
🖼️ 决策树桩(二)
🖼️ 决策树桩(三)
🖼️ 划分特征空间(一)
🖼️ 划分特征空间(二)
🖼️ 划分特征空间(三)
🖼️ 深度 2 决策树(一)
🖼️ 深度 2 决策树(二)
🖼️ 深度 2 决策树(三)
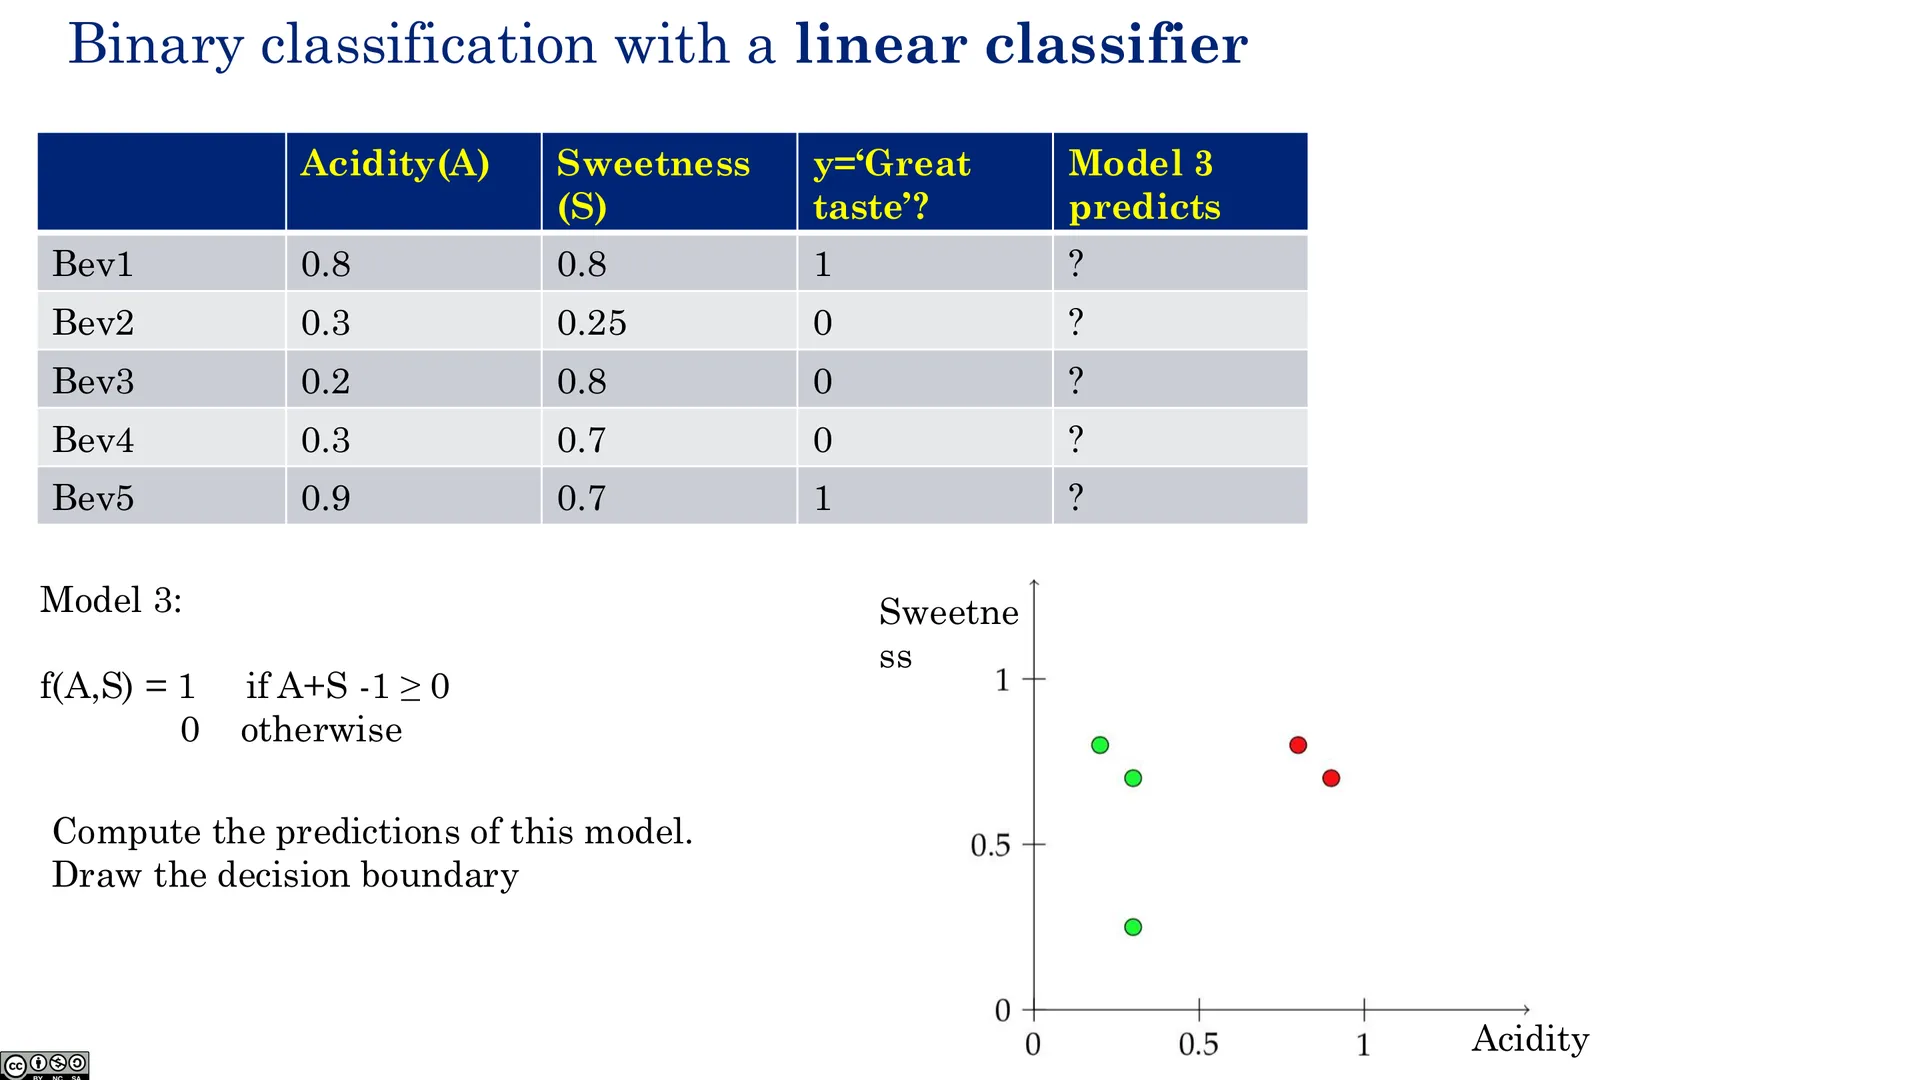
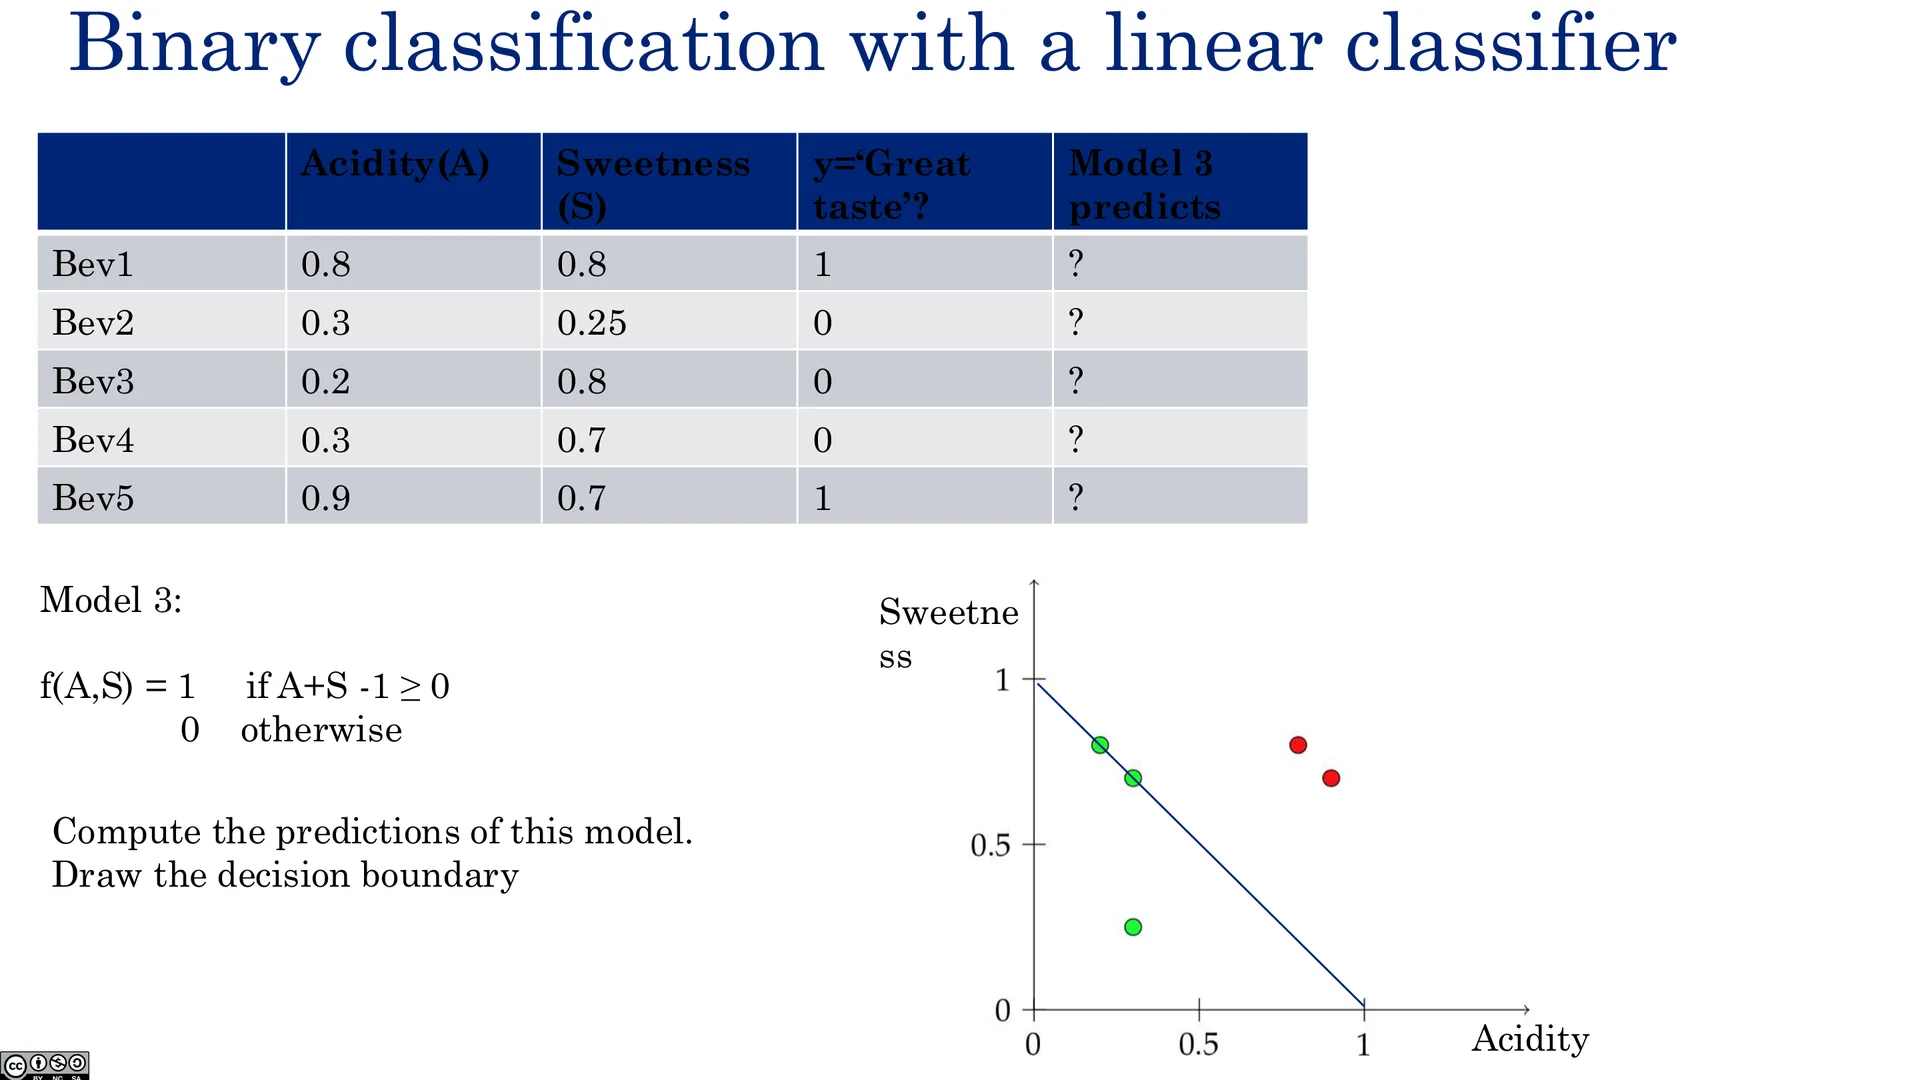
用线性分类器分类:找一个权重 $w$ 与偏置 $b$,用直线(超平面) $w^\top x + b = 0$ 把两类分开——这是本课程后面(逻辑回归、感知机、SVM)的核心模型。
🖼️ 线性分类器(一)
🖼️ 线性分类器(二)
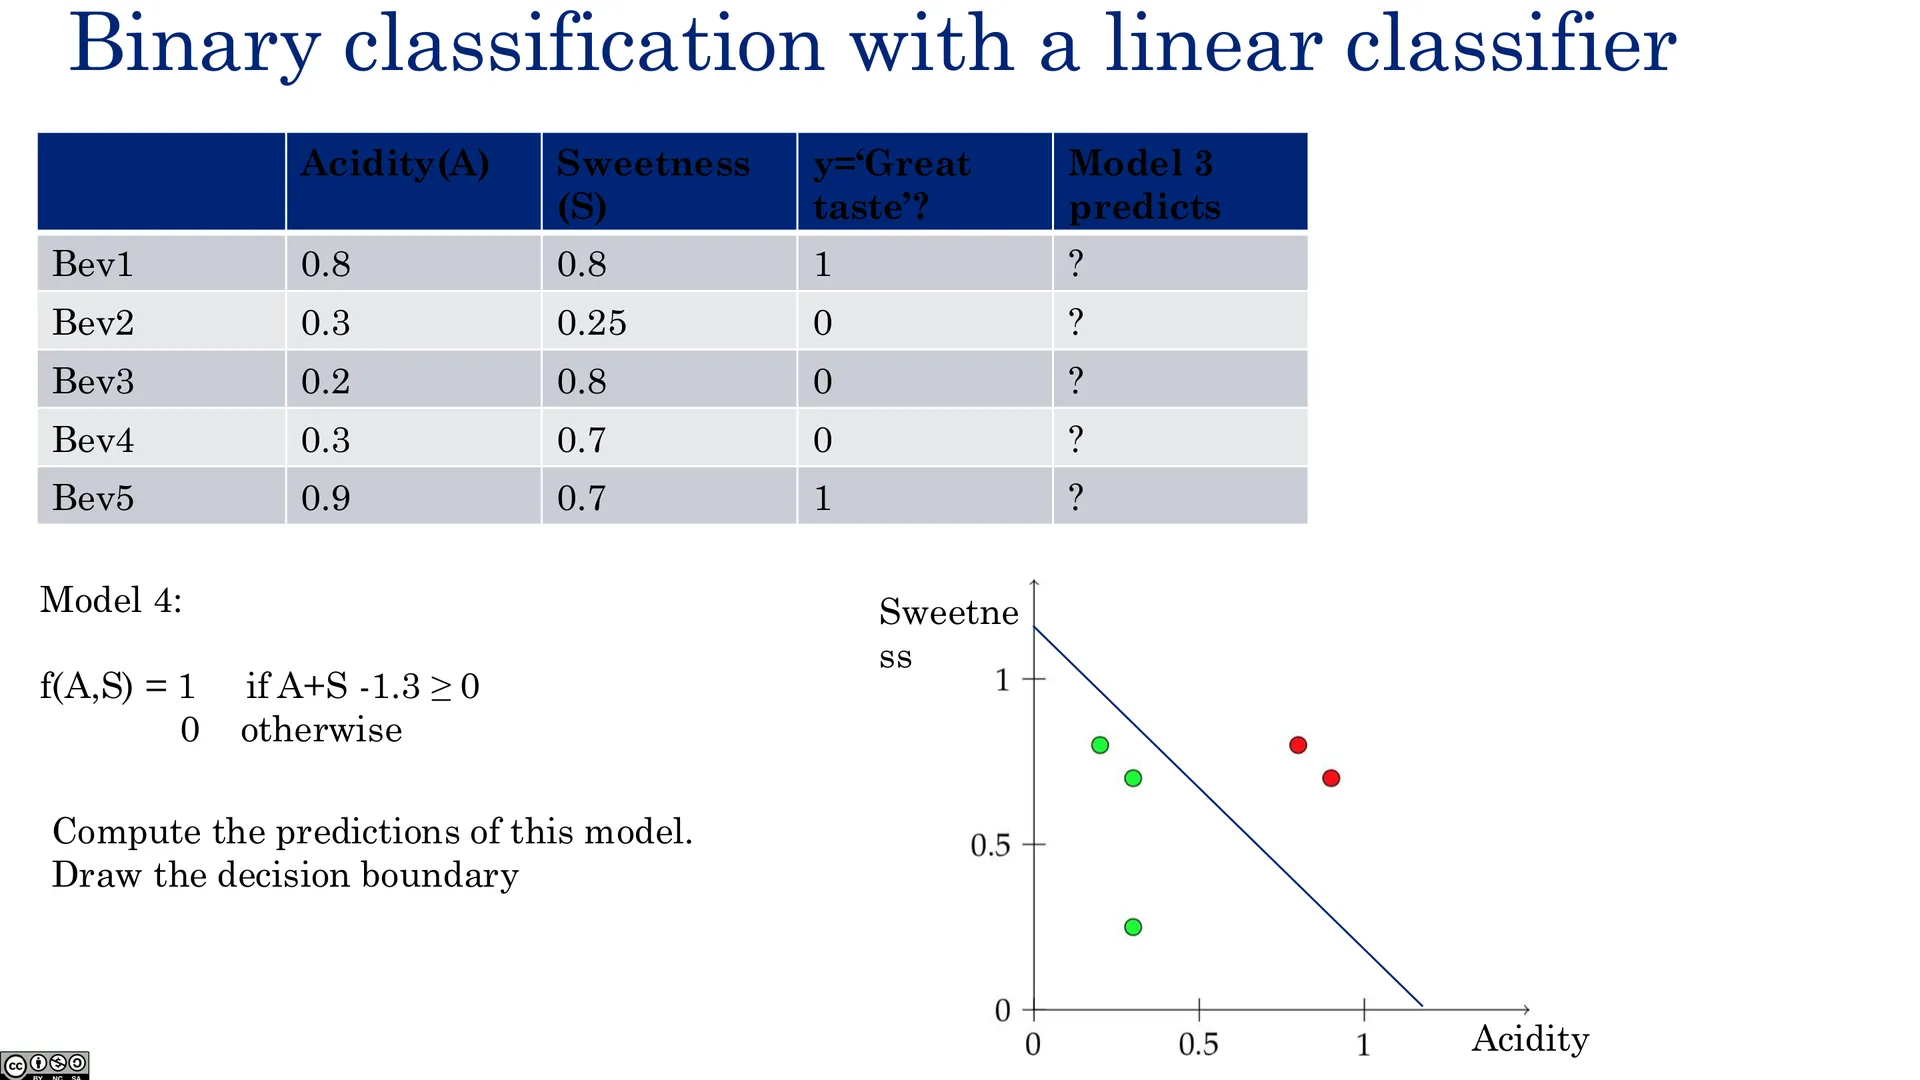
🖼️ 线性分类器(三)
3.2 训练集、测试集与「坏模型」
预测的目标是预测未来,而非过去:因此要把数据分成训练集(train) 与测试集(test),只在训练集上拟合,在测试集上评估泛化。
「总有一个非常坏的模型」:对任何训练集,都存在一个模型 $M_{\text{BAD}}$,在训练集上完美(零误差)却在测试集上任意坏——例如记住训练集每个样本、对新样本随便猜。这告诉我们:训练误差为零并不代表学到了东西,必须关注泛化。
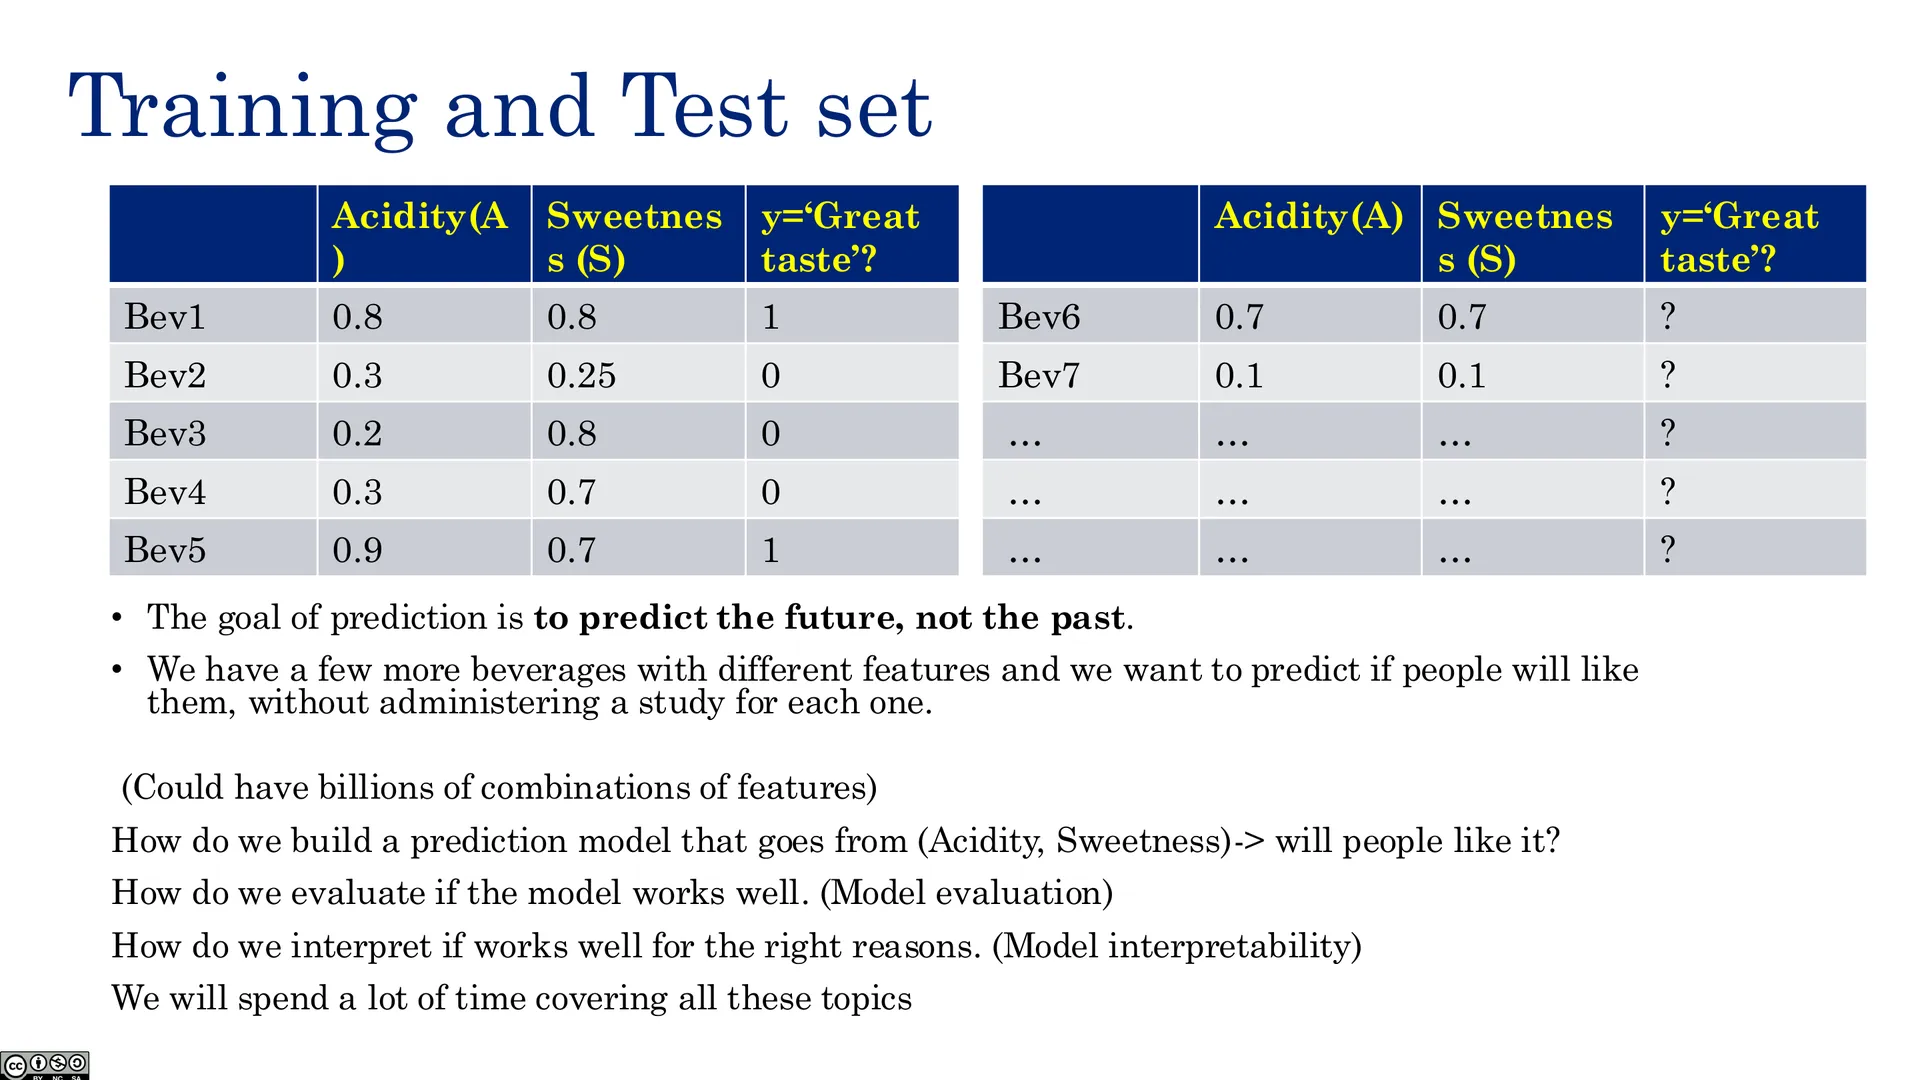
🖼️ 训练集与测试集
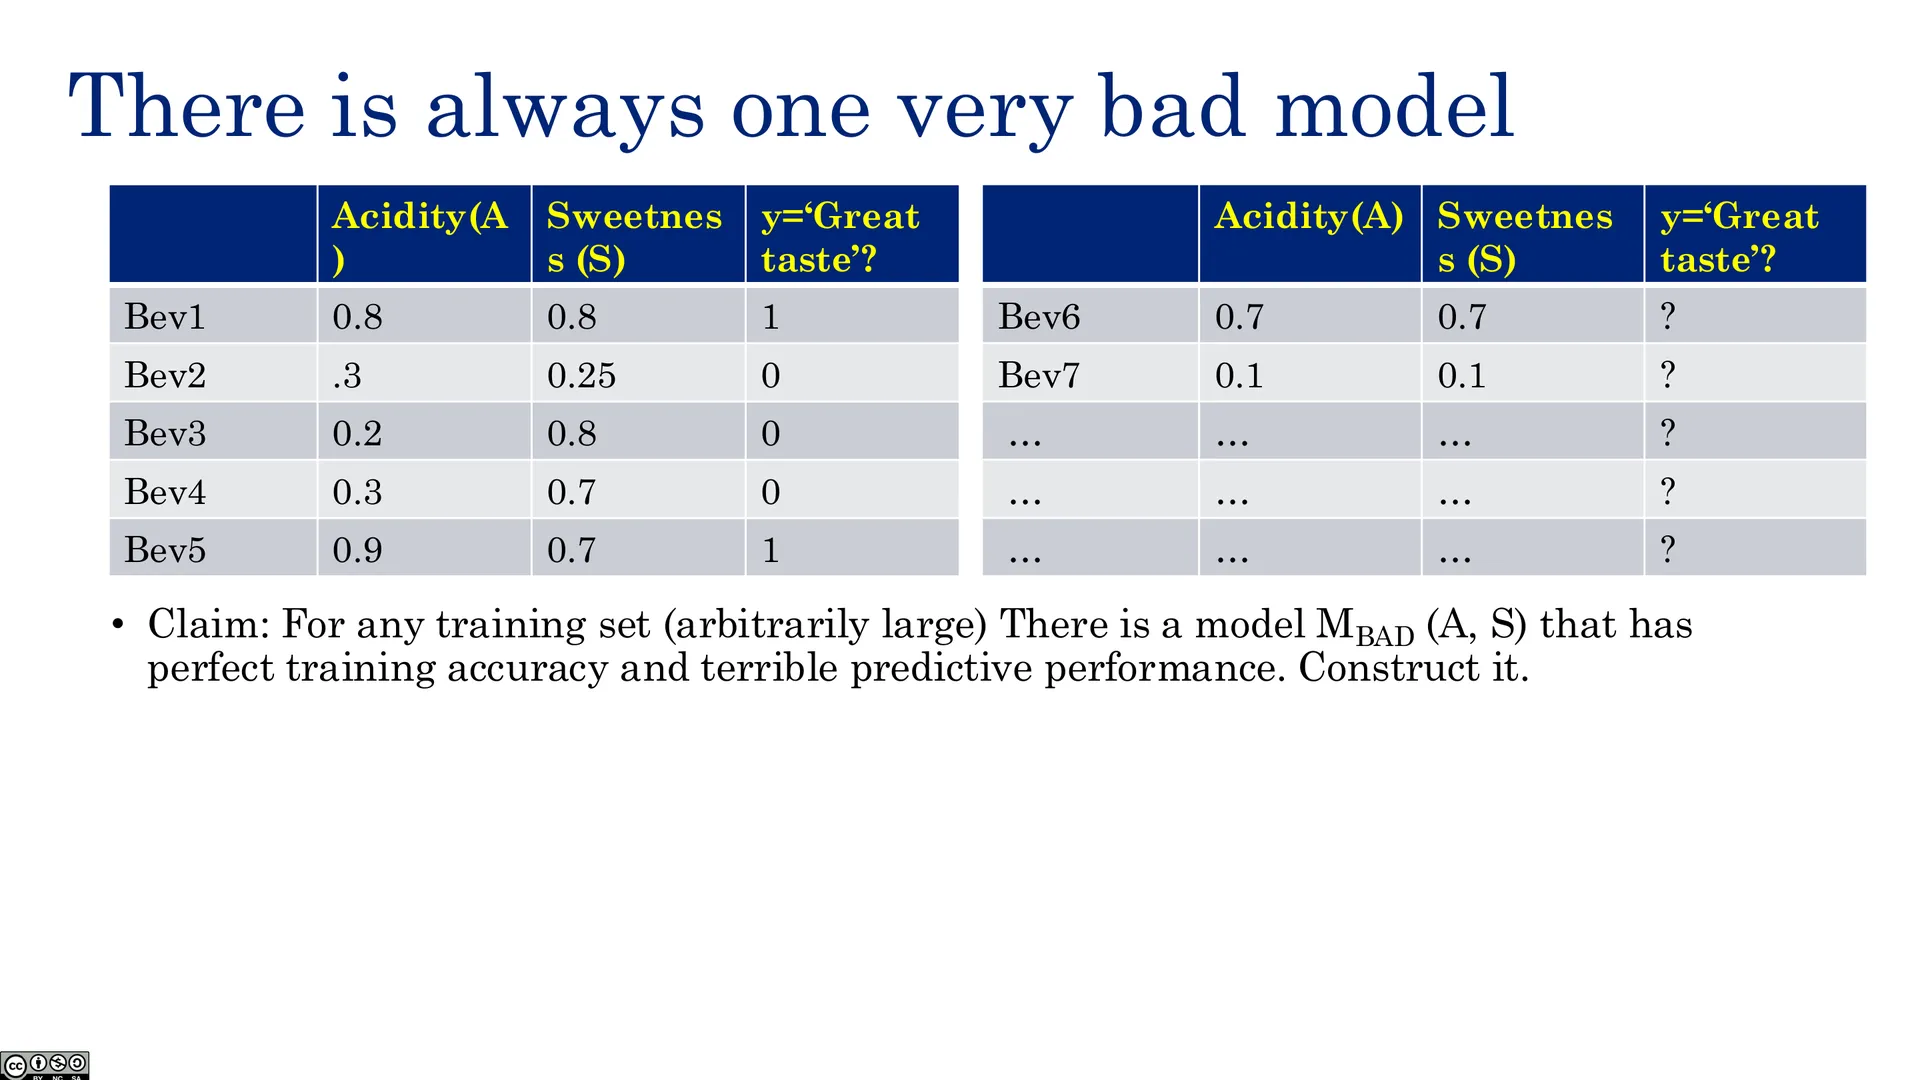
🖼️ 总有一个非常坏的模型(一)
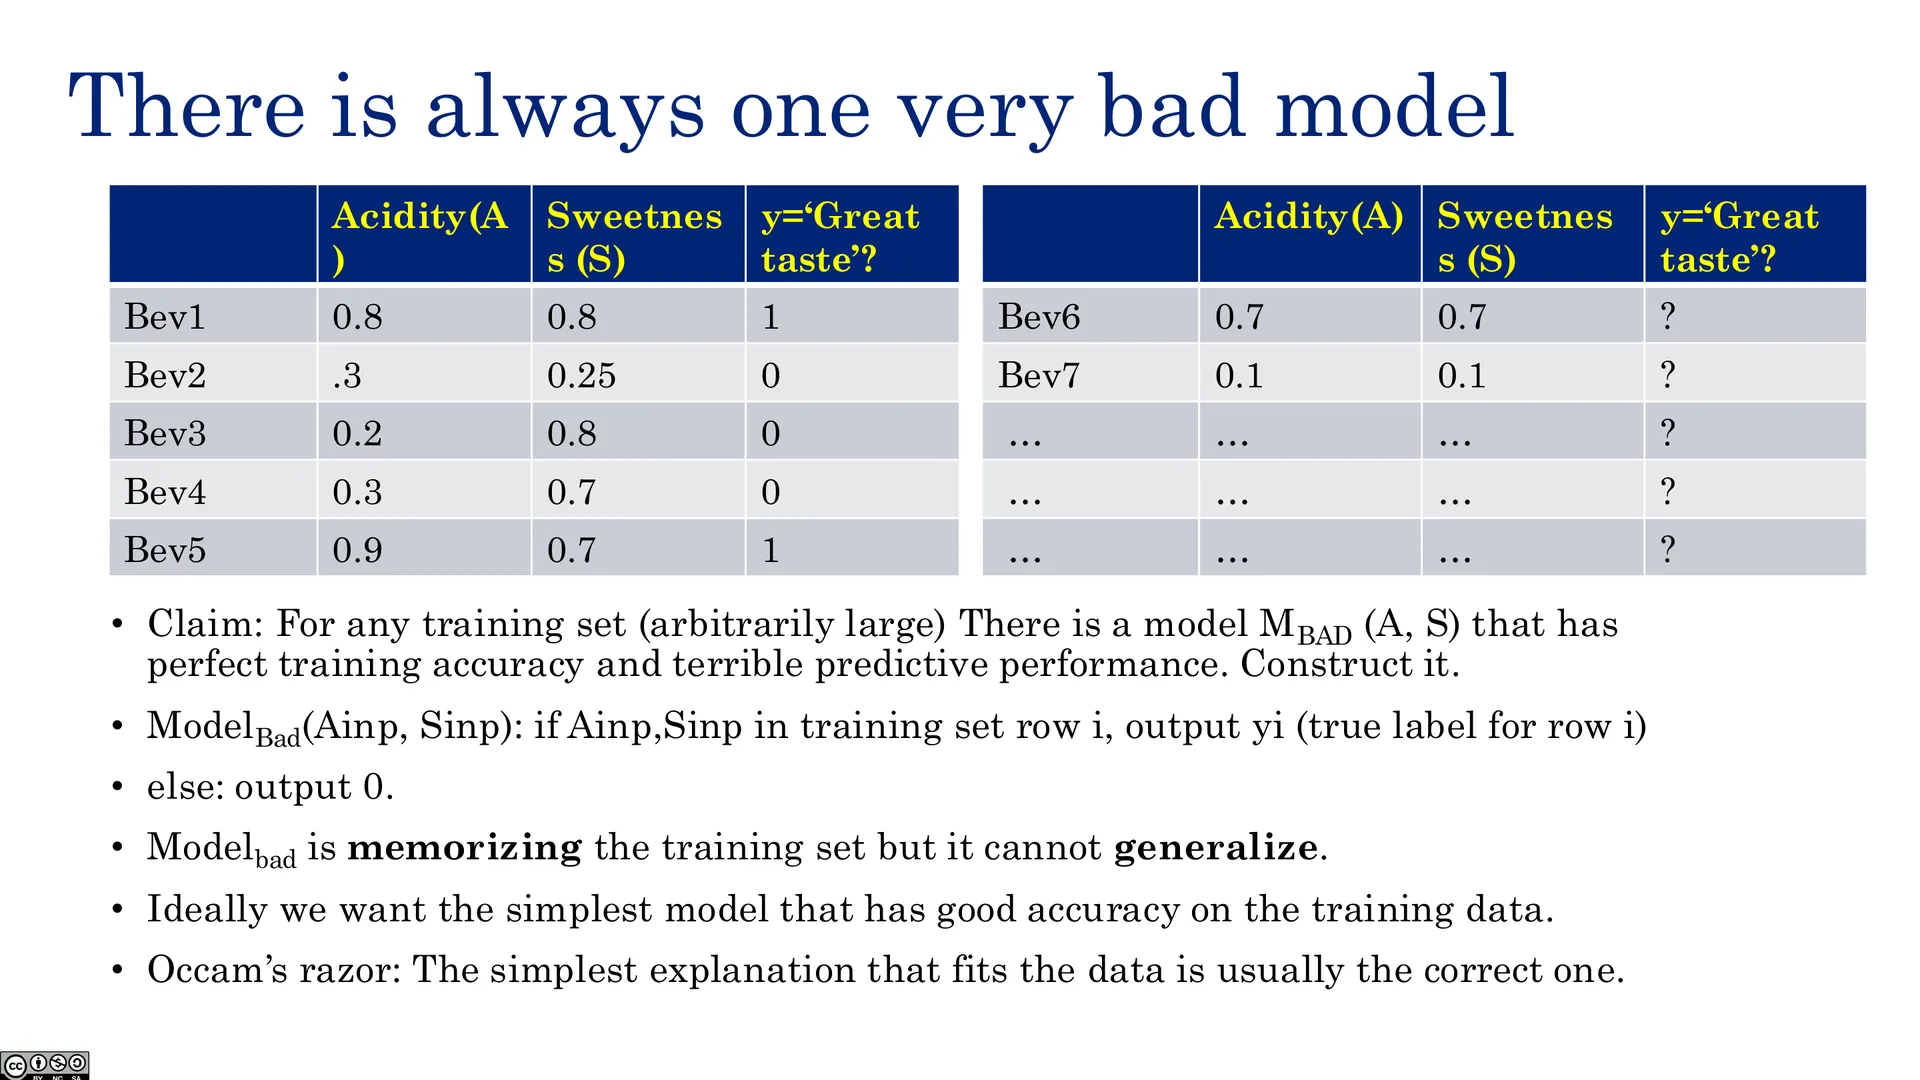
🖼️ 总有一个非常坏的模型(二)
数据 → 模型 → 训练:这是 ML 的核心三角。大模型 + 数据 + 训练算法 构成现代 ML 的基本要素。
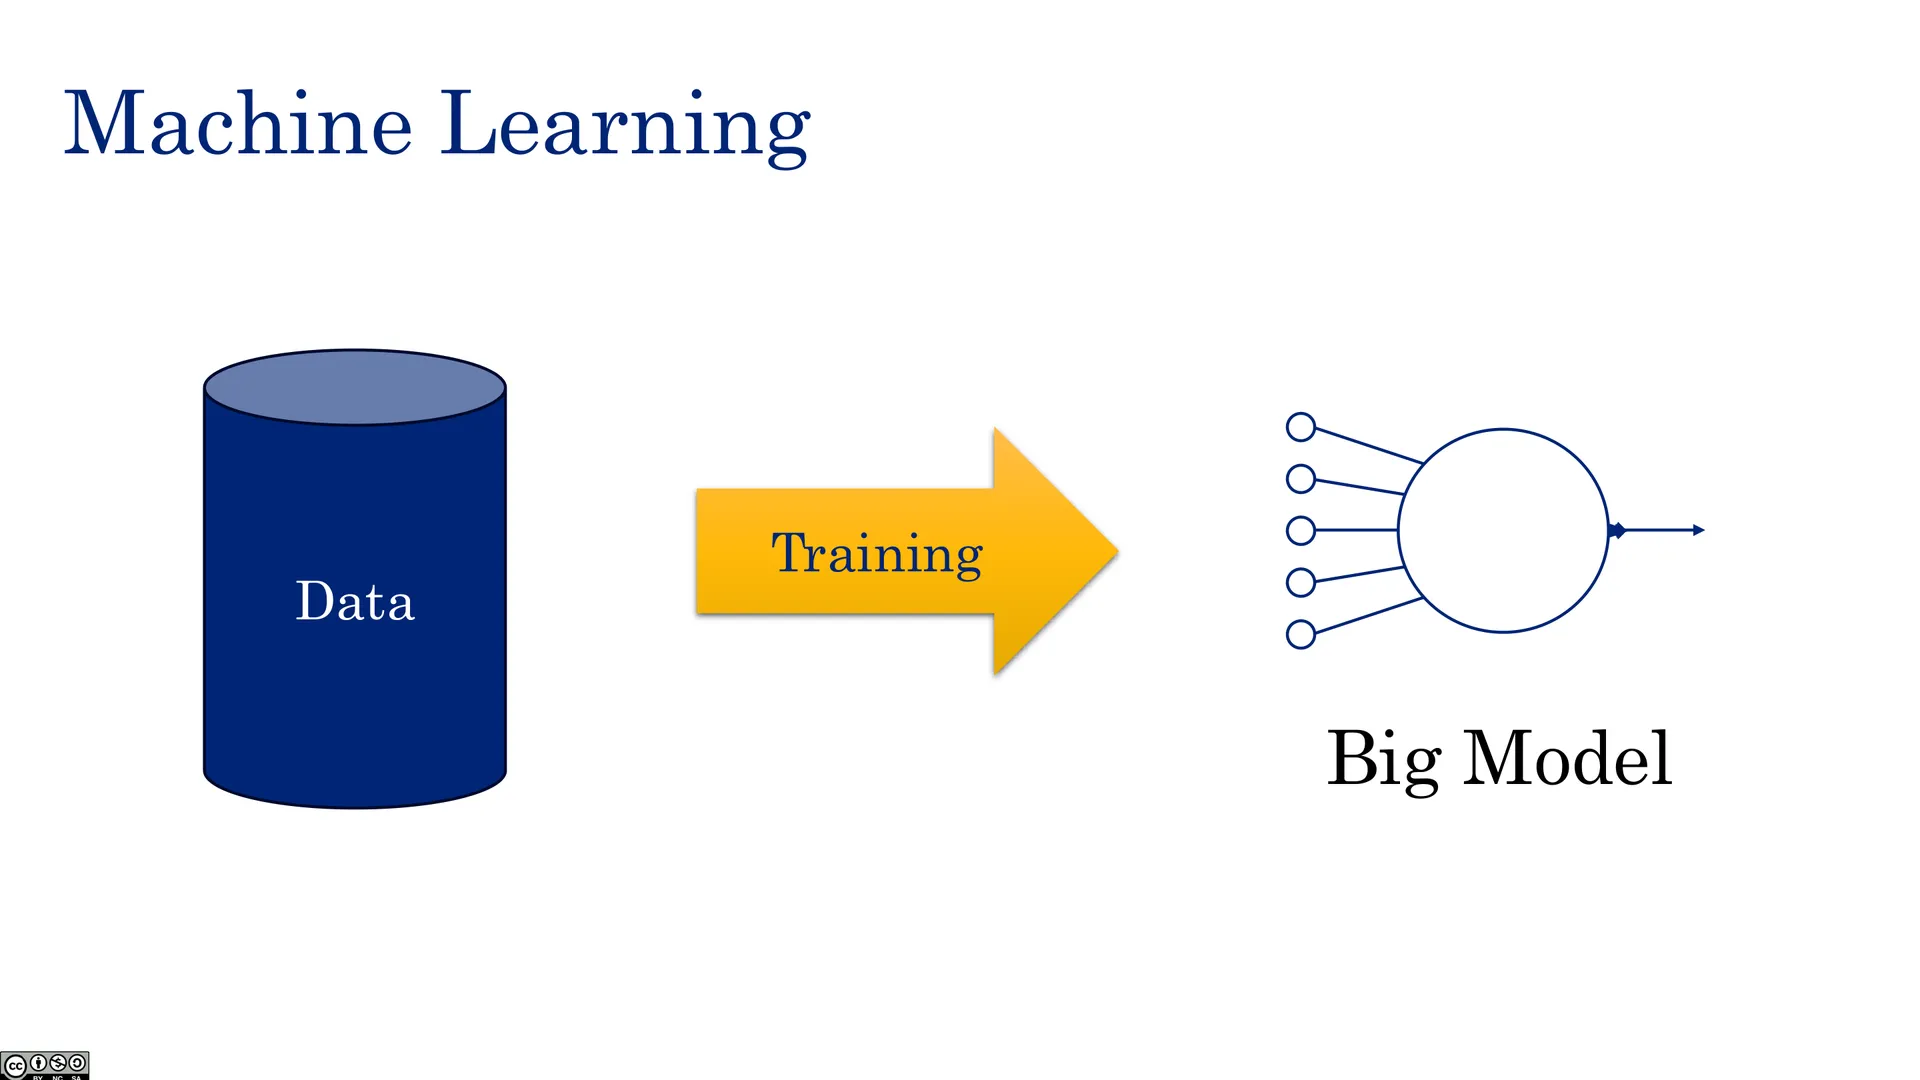
🖼️ 数据·大模型·训练
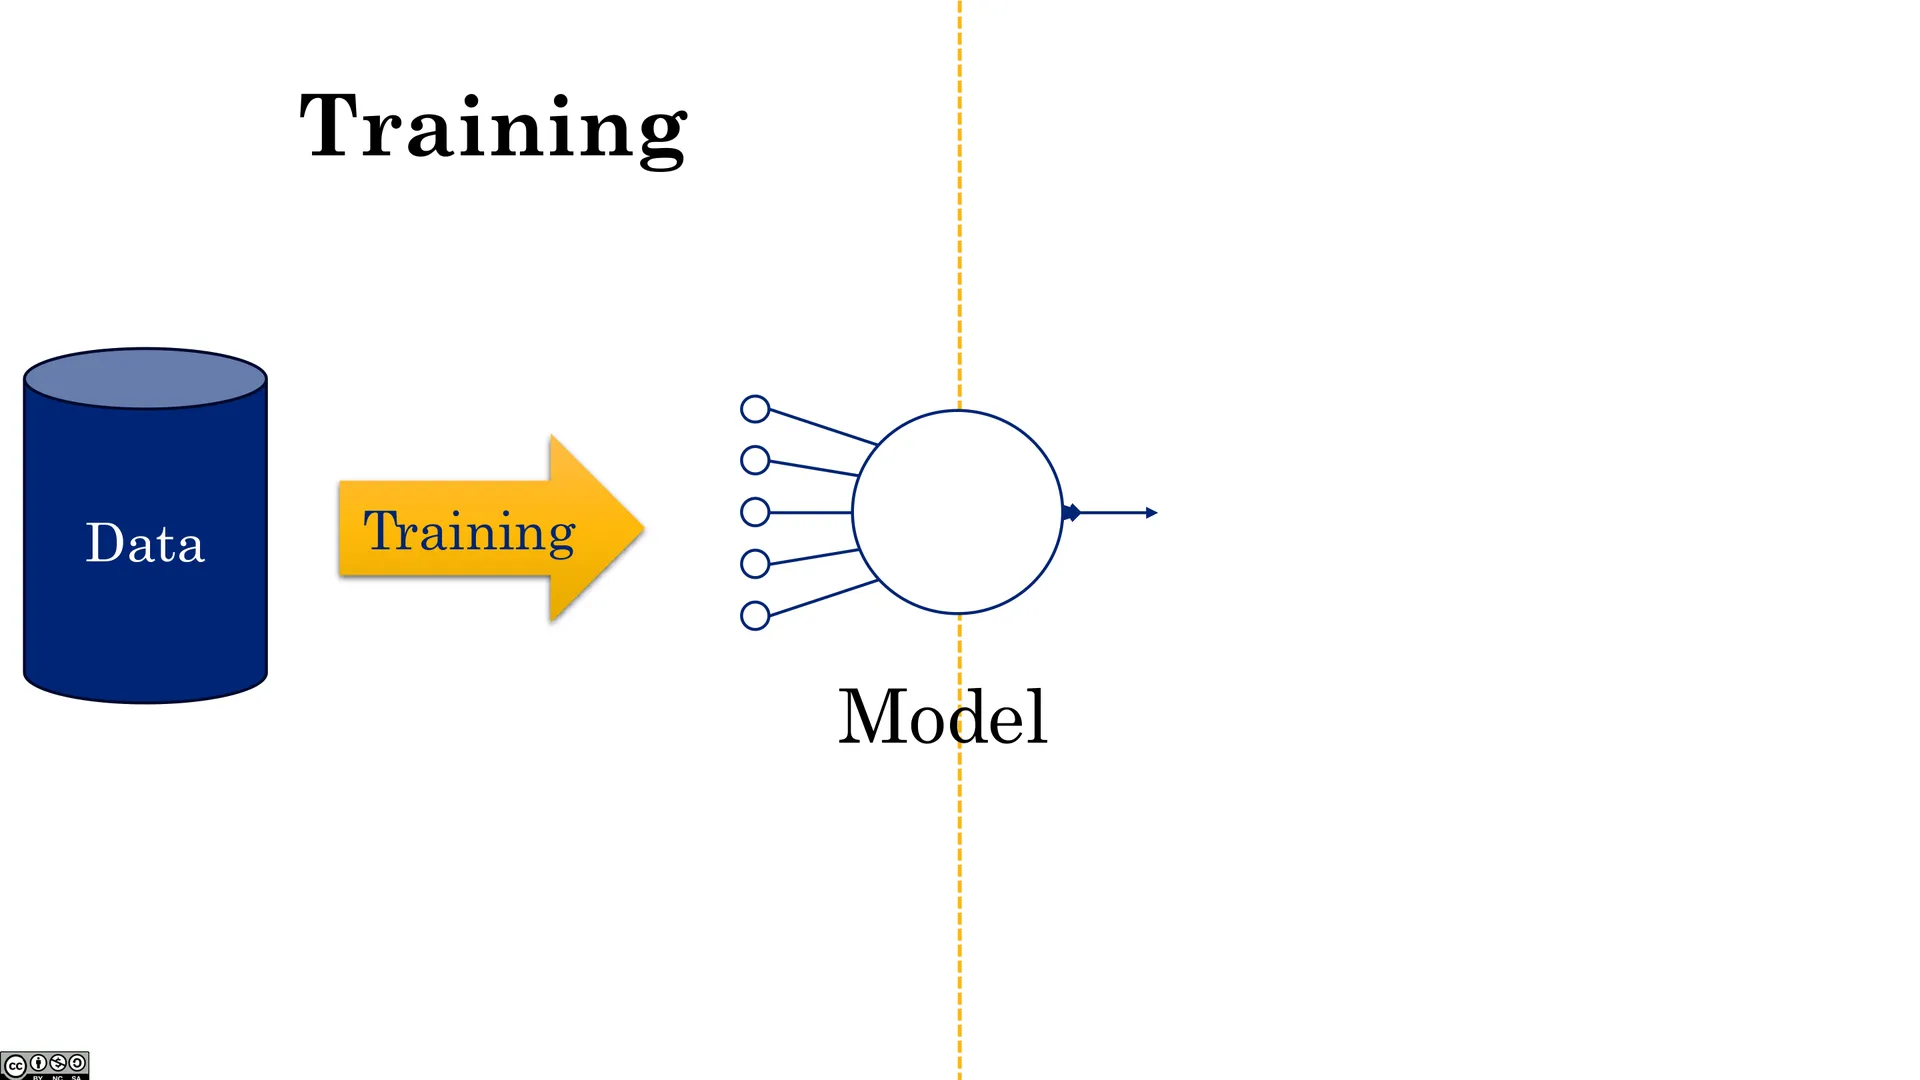
🖼️ 数据·模型·训练(一)
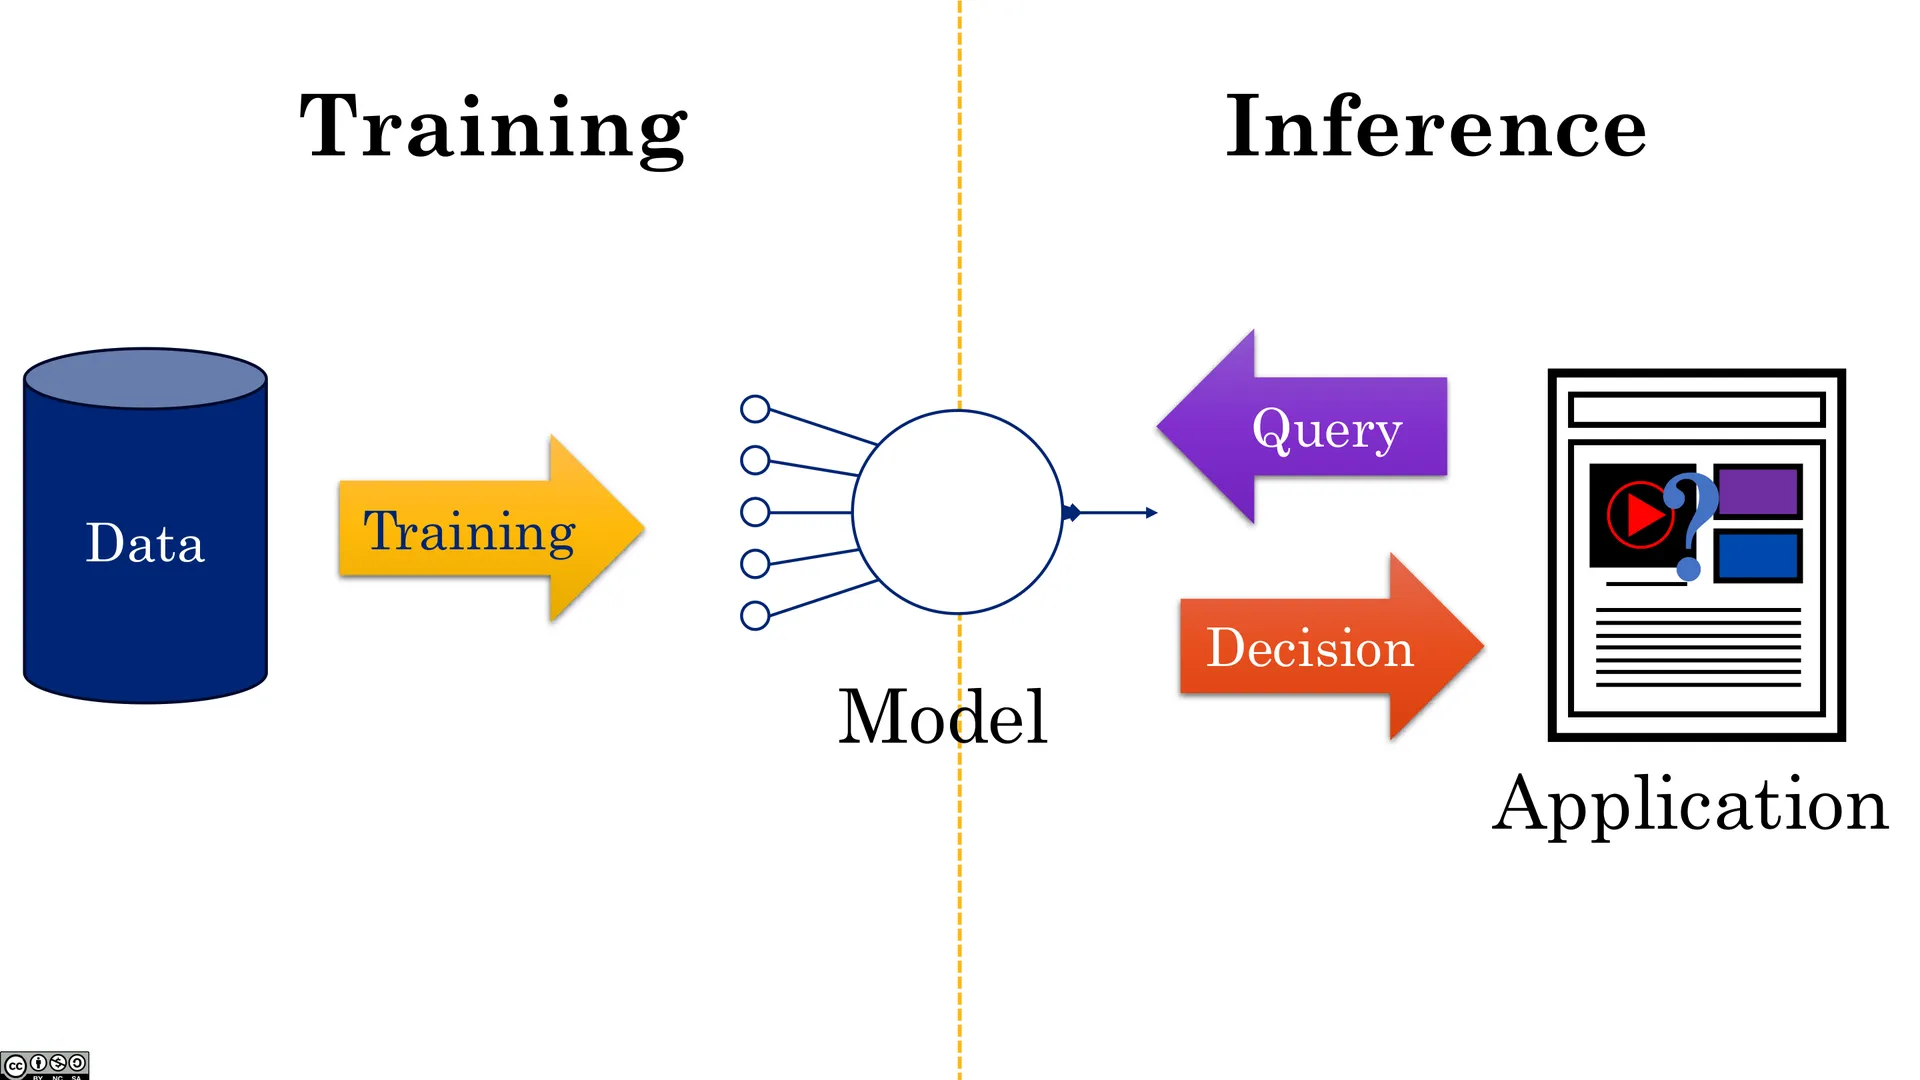
🖼️ 数据·模型·训练(二)
3.3 什么问题是机器学习问题?
工程问题 vs 机器学习问题:
- 工程问题:可以用直接、明确指定的算法或一组手写规则解决(如排序、最短路径);
- 机器学习问题:「容易演示/评估解,但难以直接写出求解算法」 的问题——例如识别图像、理解语言。
聊天是机器学习问题吗? 是。「与人类进行有成效的对话」很难用规则写出来,但我们可以评估一个回答好不好。以 ChatGPT 为例,它就是在这个「可评估但难写算法」的定义下诞生的。
🖼️ 什么是机器学习问题?
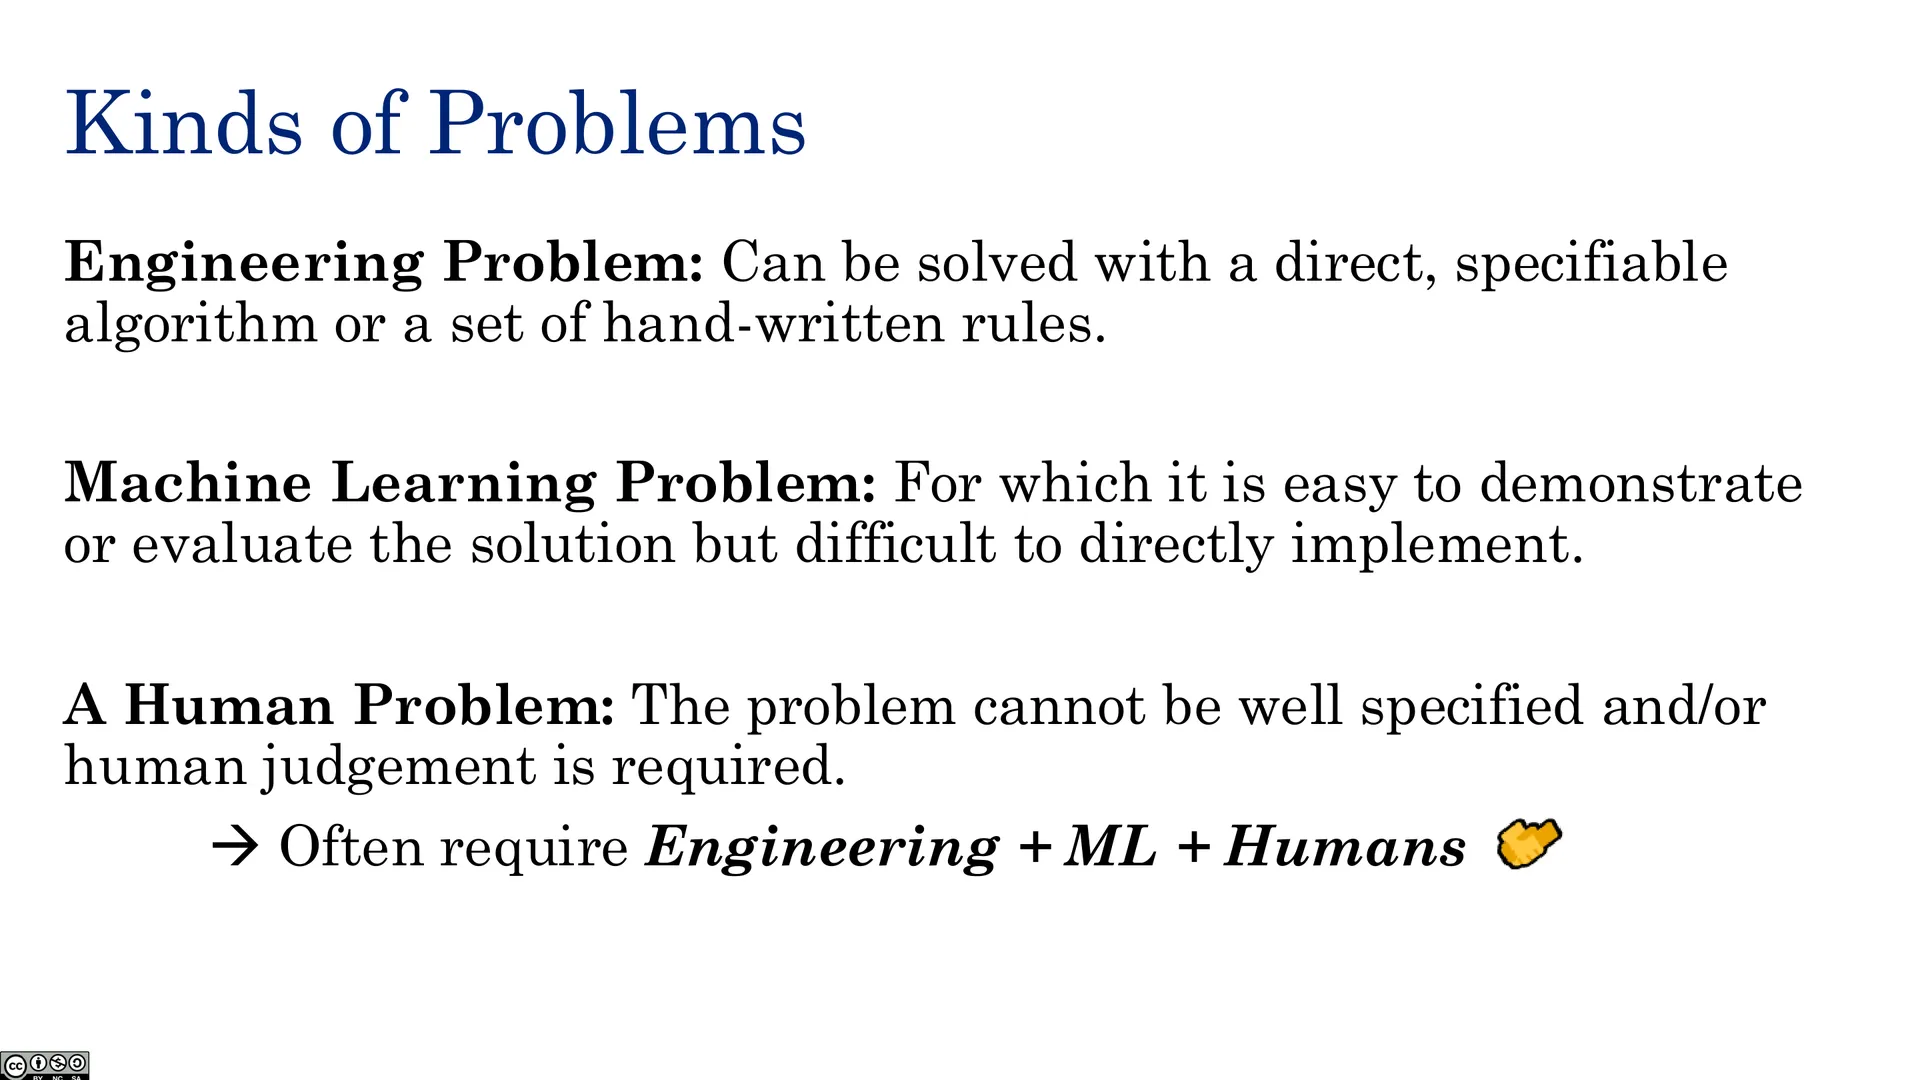
🖼️ 问题的种类
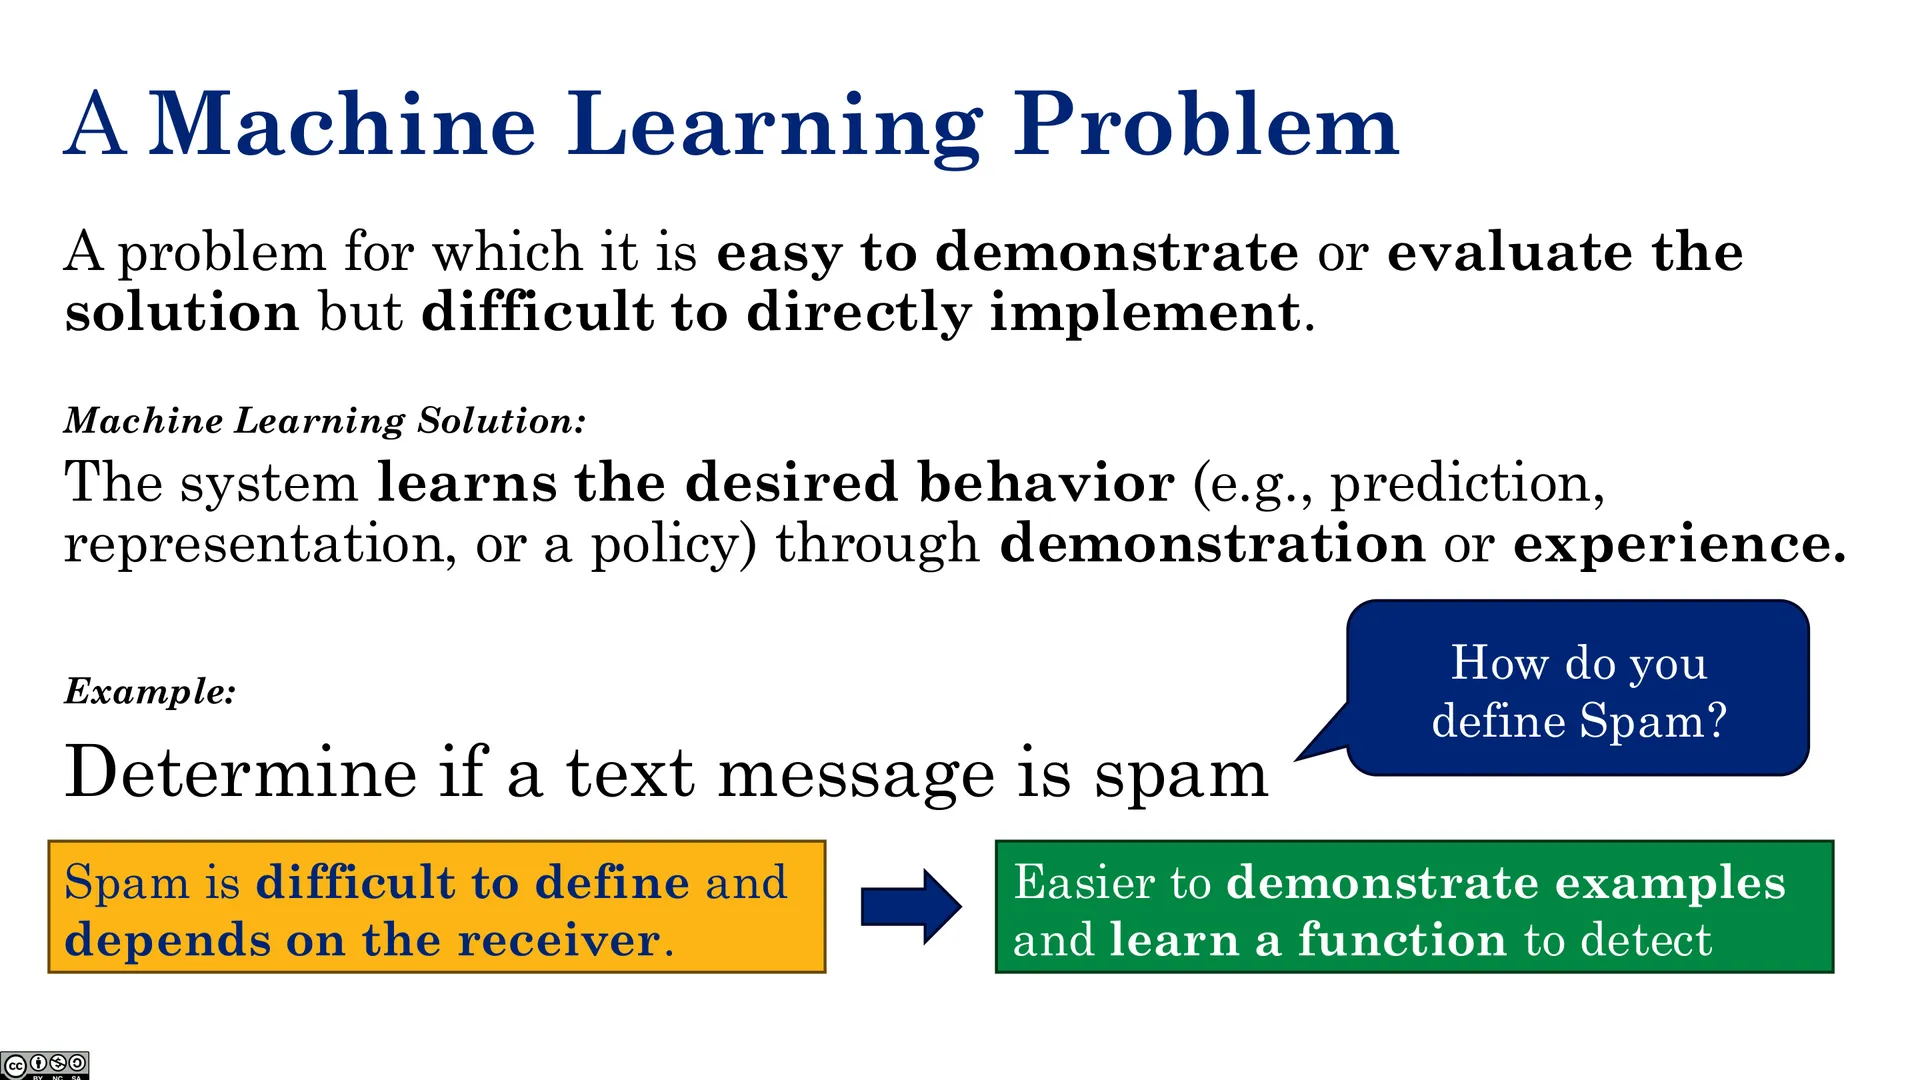
🖼️ 一个机器学习问题
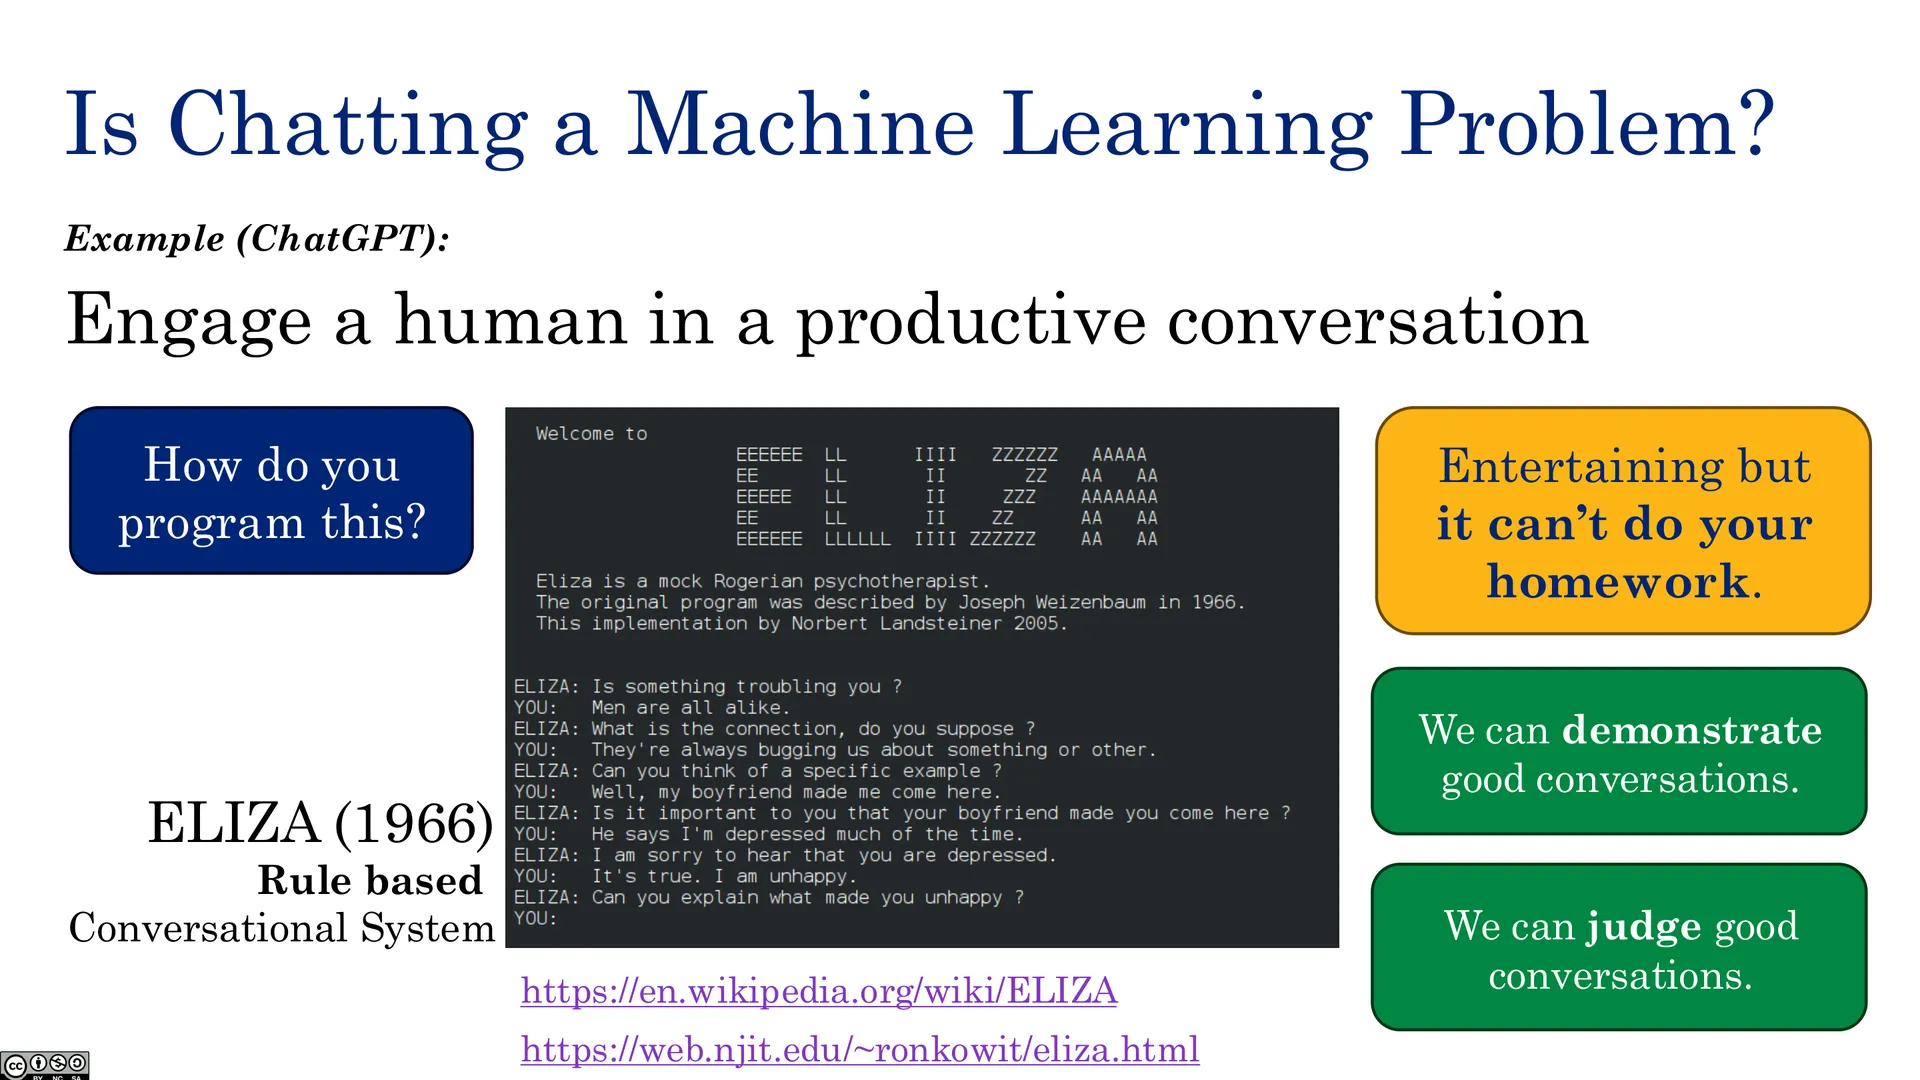
🖼️ 聊天是机器学习问题吗?
3.4 ML 即「学到的函数逼近」
把 ML 视为函数逼近:输入 $X$ → 输出 $Y$,我们想从数据中学到一个函数 $f: X \to Y$。学习设定(learning settings) 由 $X$、$Y$ 的性质决定。
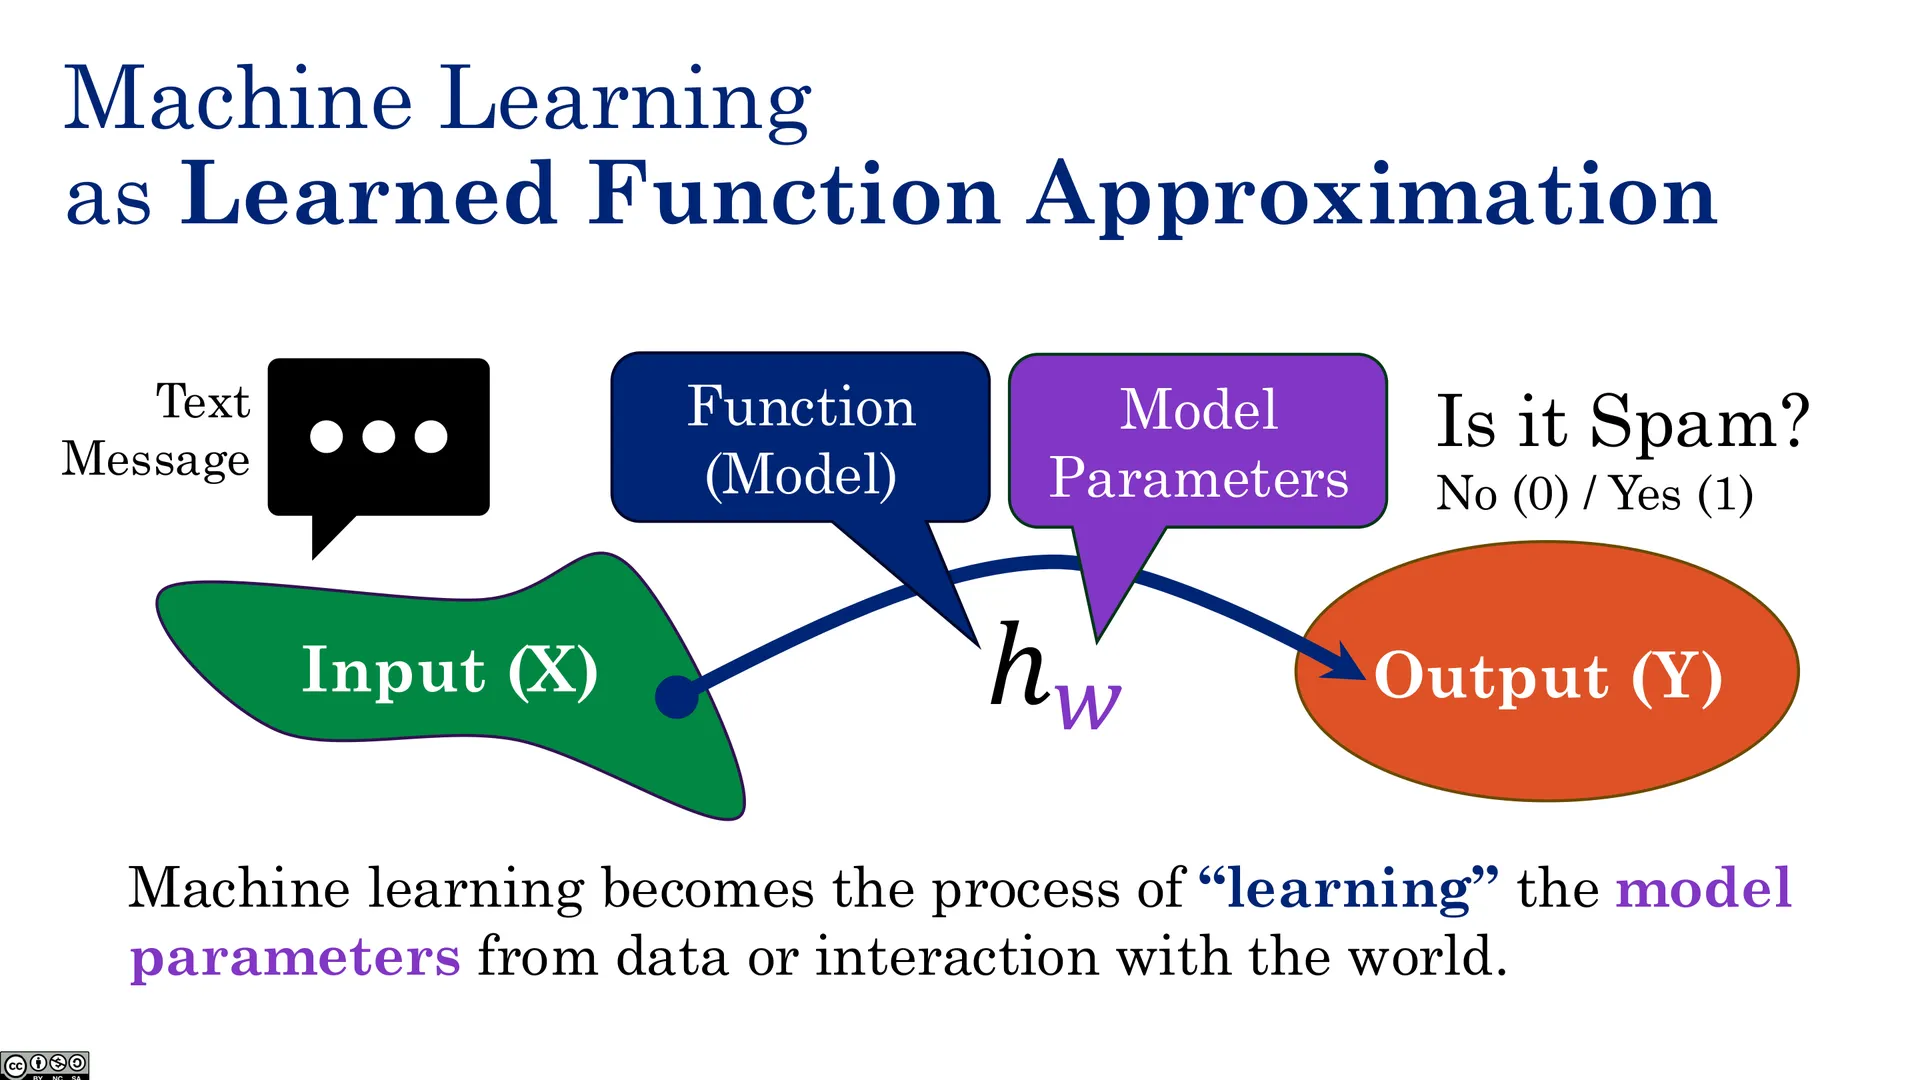
🖼️ 输入 X
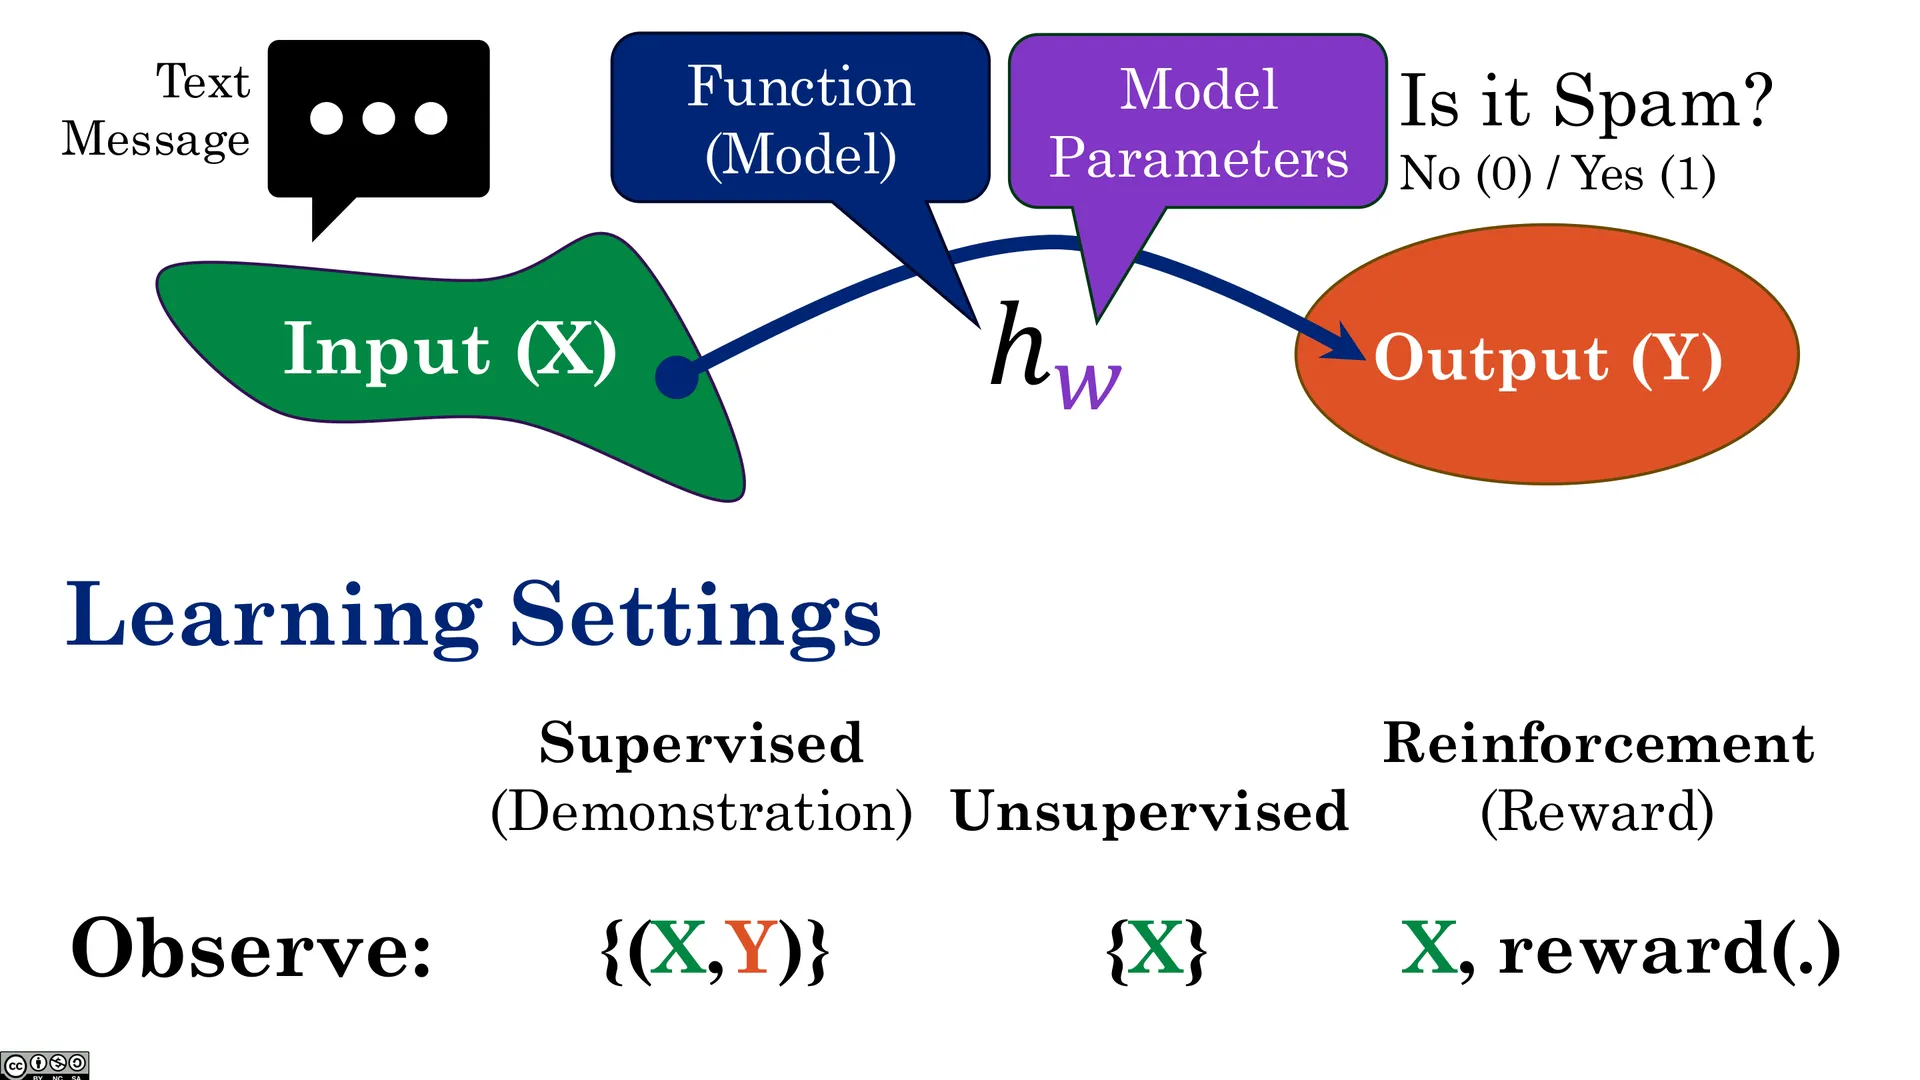
🖼️ 输出 Y 与学习设定
三大学习范式:
| 范式 | 数据 | 目标 | 典型问题 |
|---|---|---|---|
| 监督学习 | $\{(X,Y)\}$ | 学 $X\to Y$ 的关系 | 回归、分类 |
| 无监督学习 | $\{X\}$ | 建模数据本身(无标签) | 聚类、降维、可视化 |
| 强化学习 | 奖励信号 | 从多步交互的奖励中学习策略 | 游戏、机器人控制 |
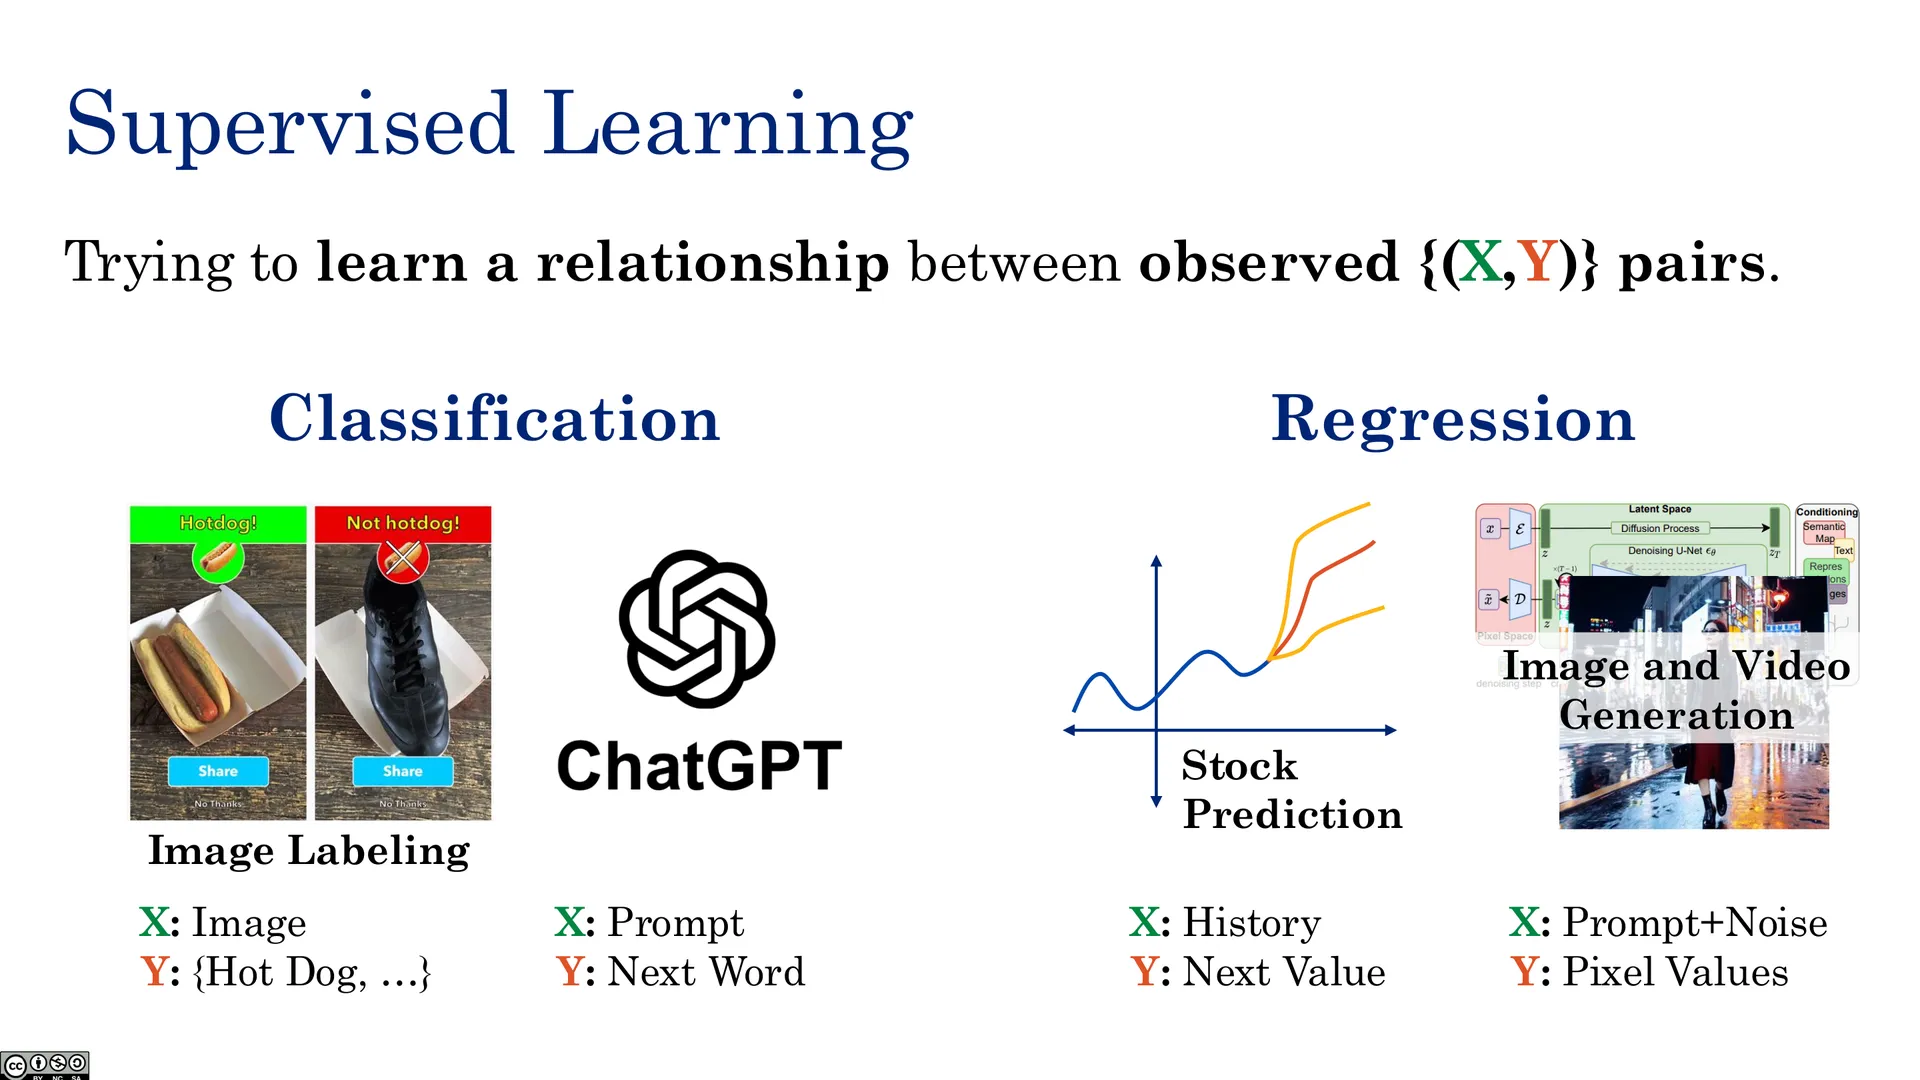
🖼️ 监督学习
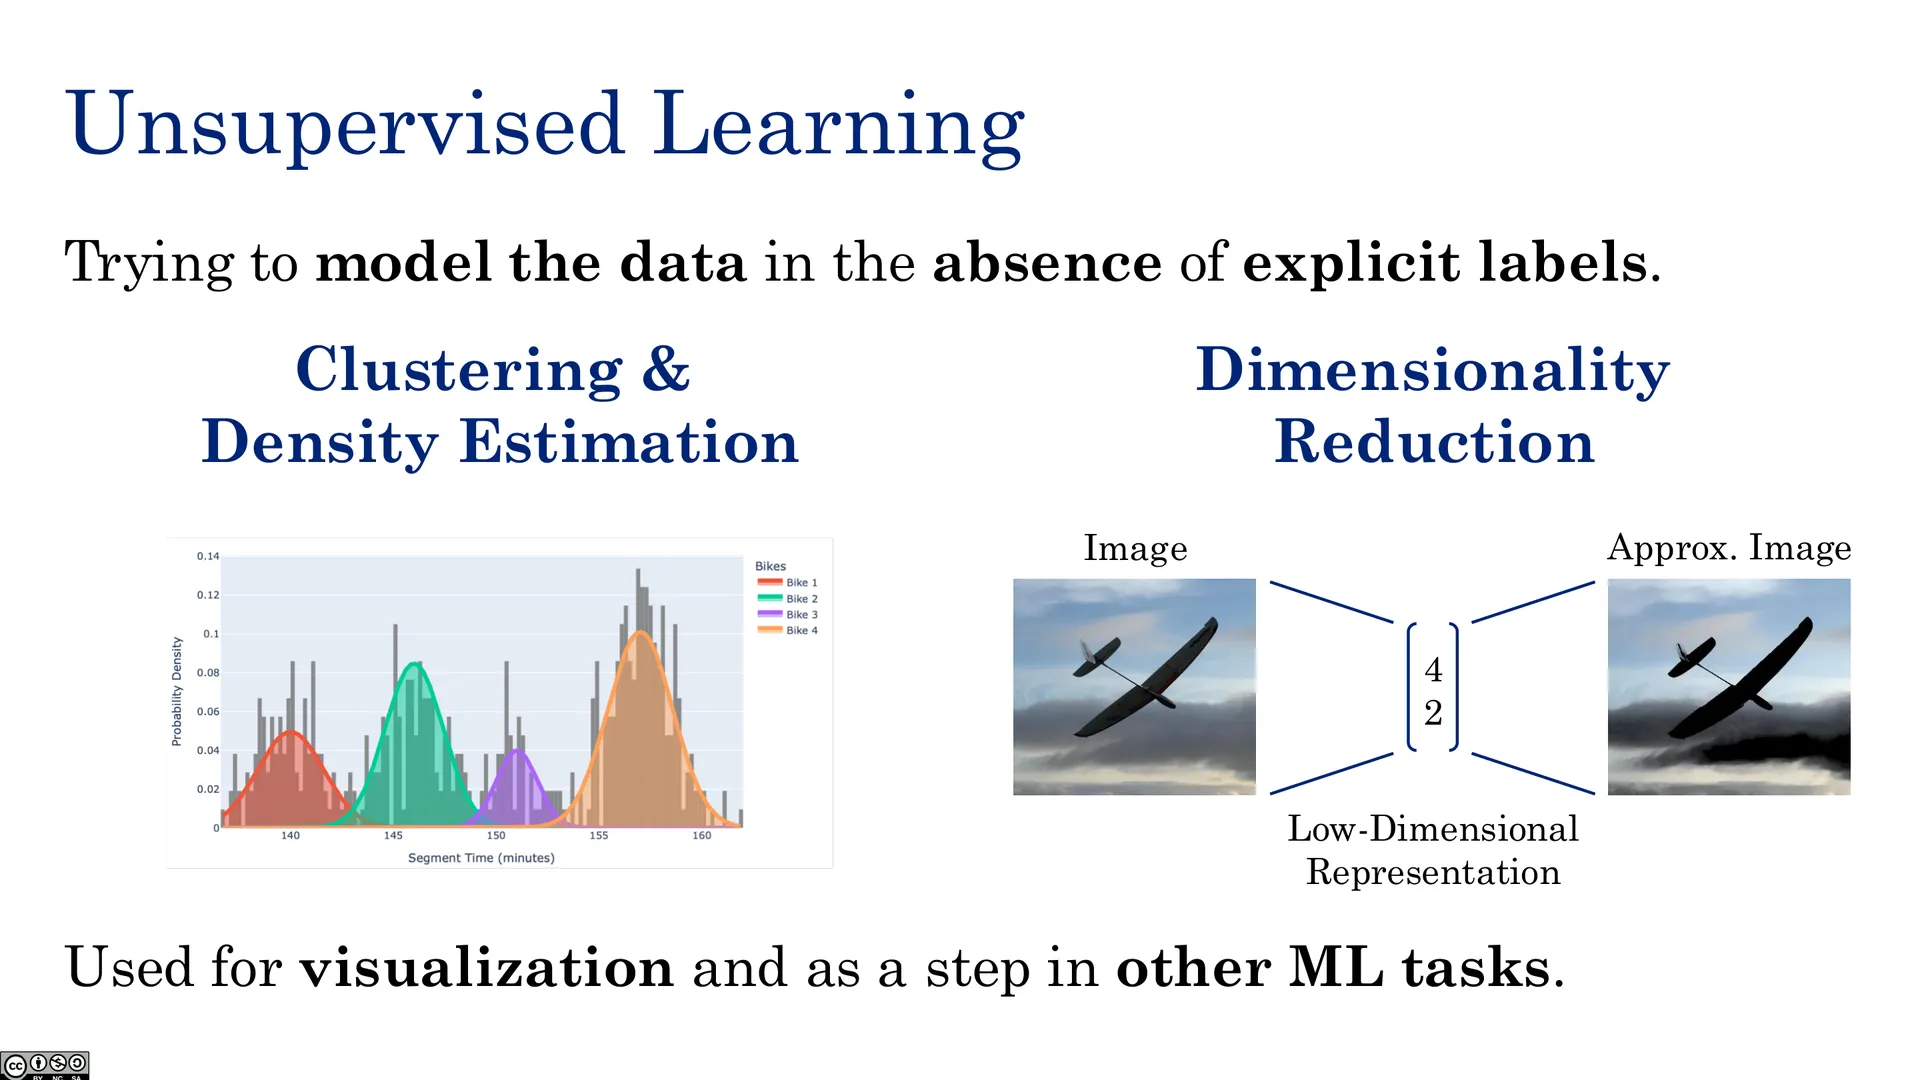
🖼️ 无监督学习
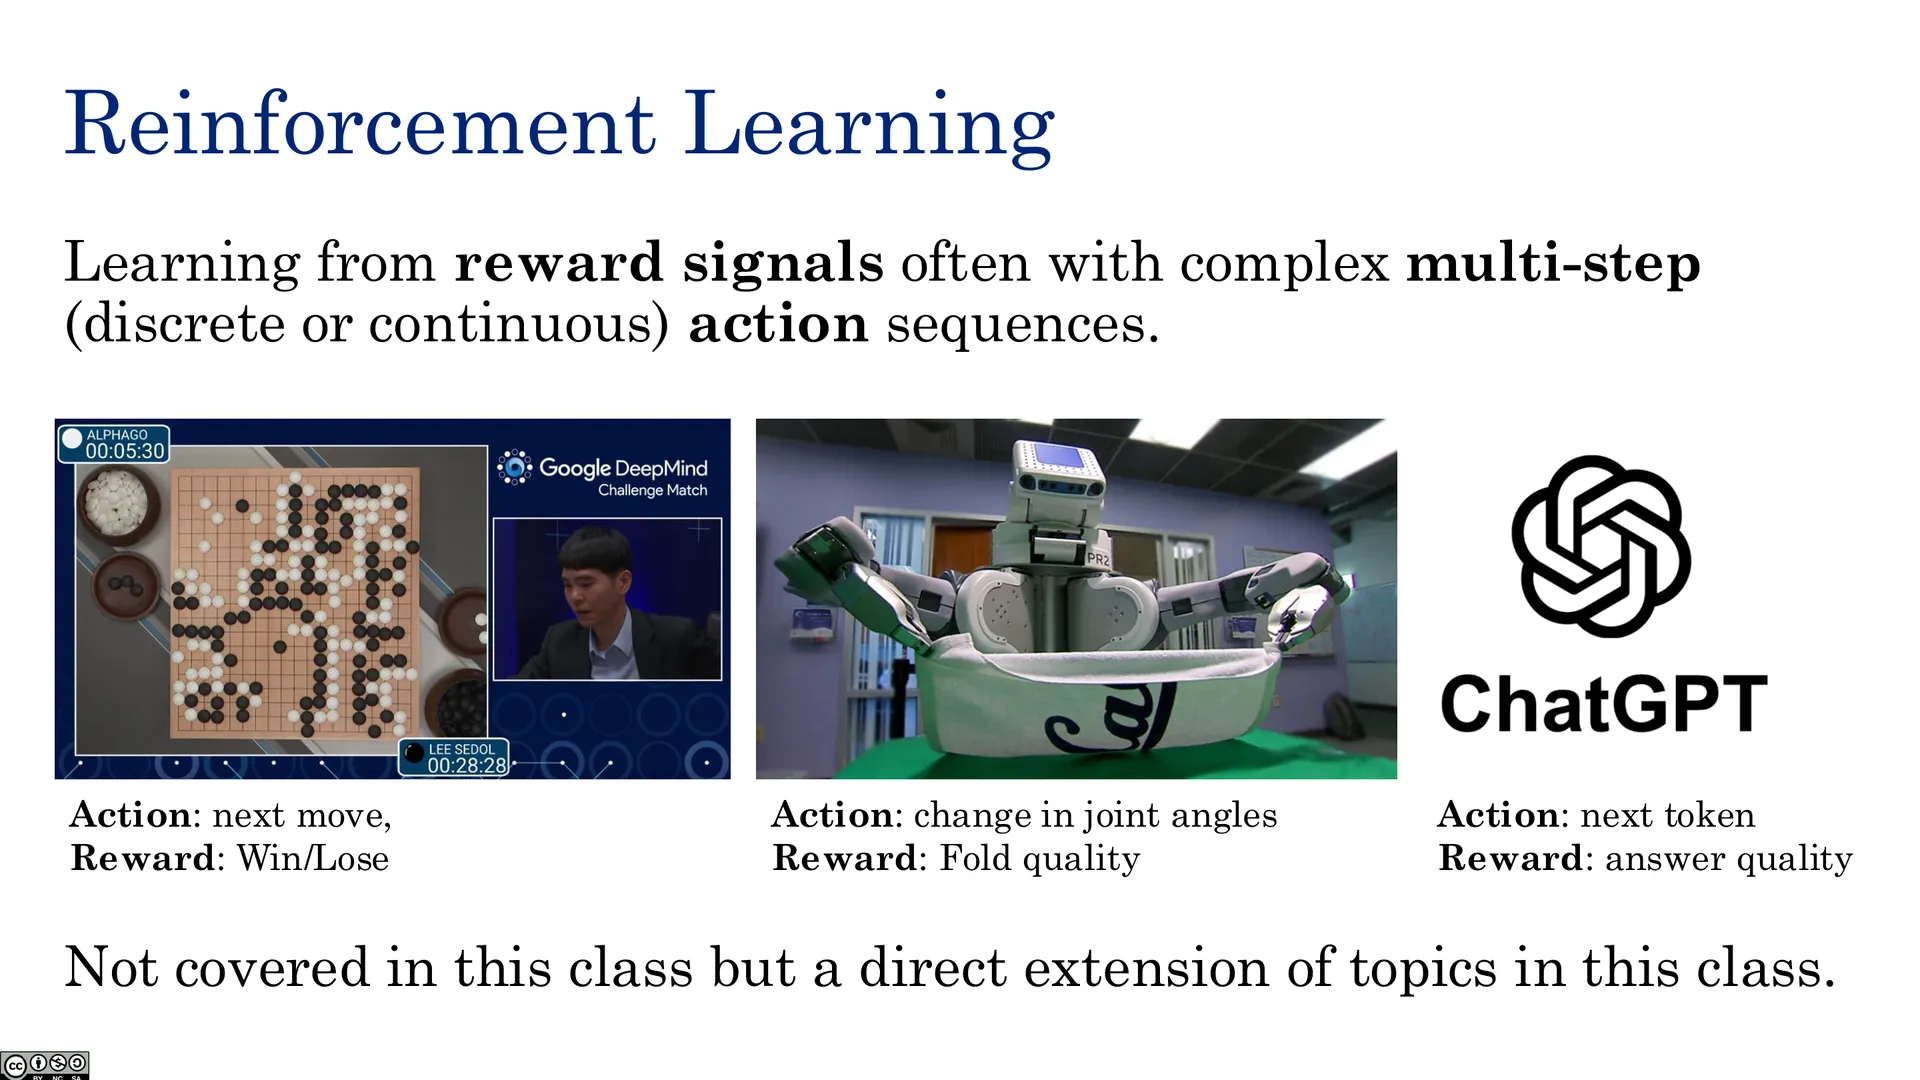
🖼️ 强化学习
3.5 不同数据上的监督问题
- 表格数据(tabular):给定房屋特征预测售价(回归);
- 图像数据 / 计算机视觉:给定钢材质检图像判断是否有缺陷(分类);
- 时间序列:用脑电(EEG)预测即将发生的癫痫发作;
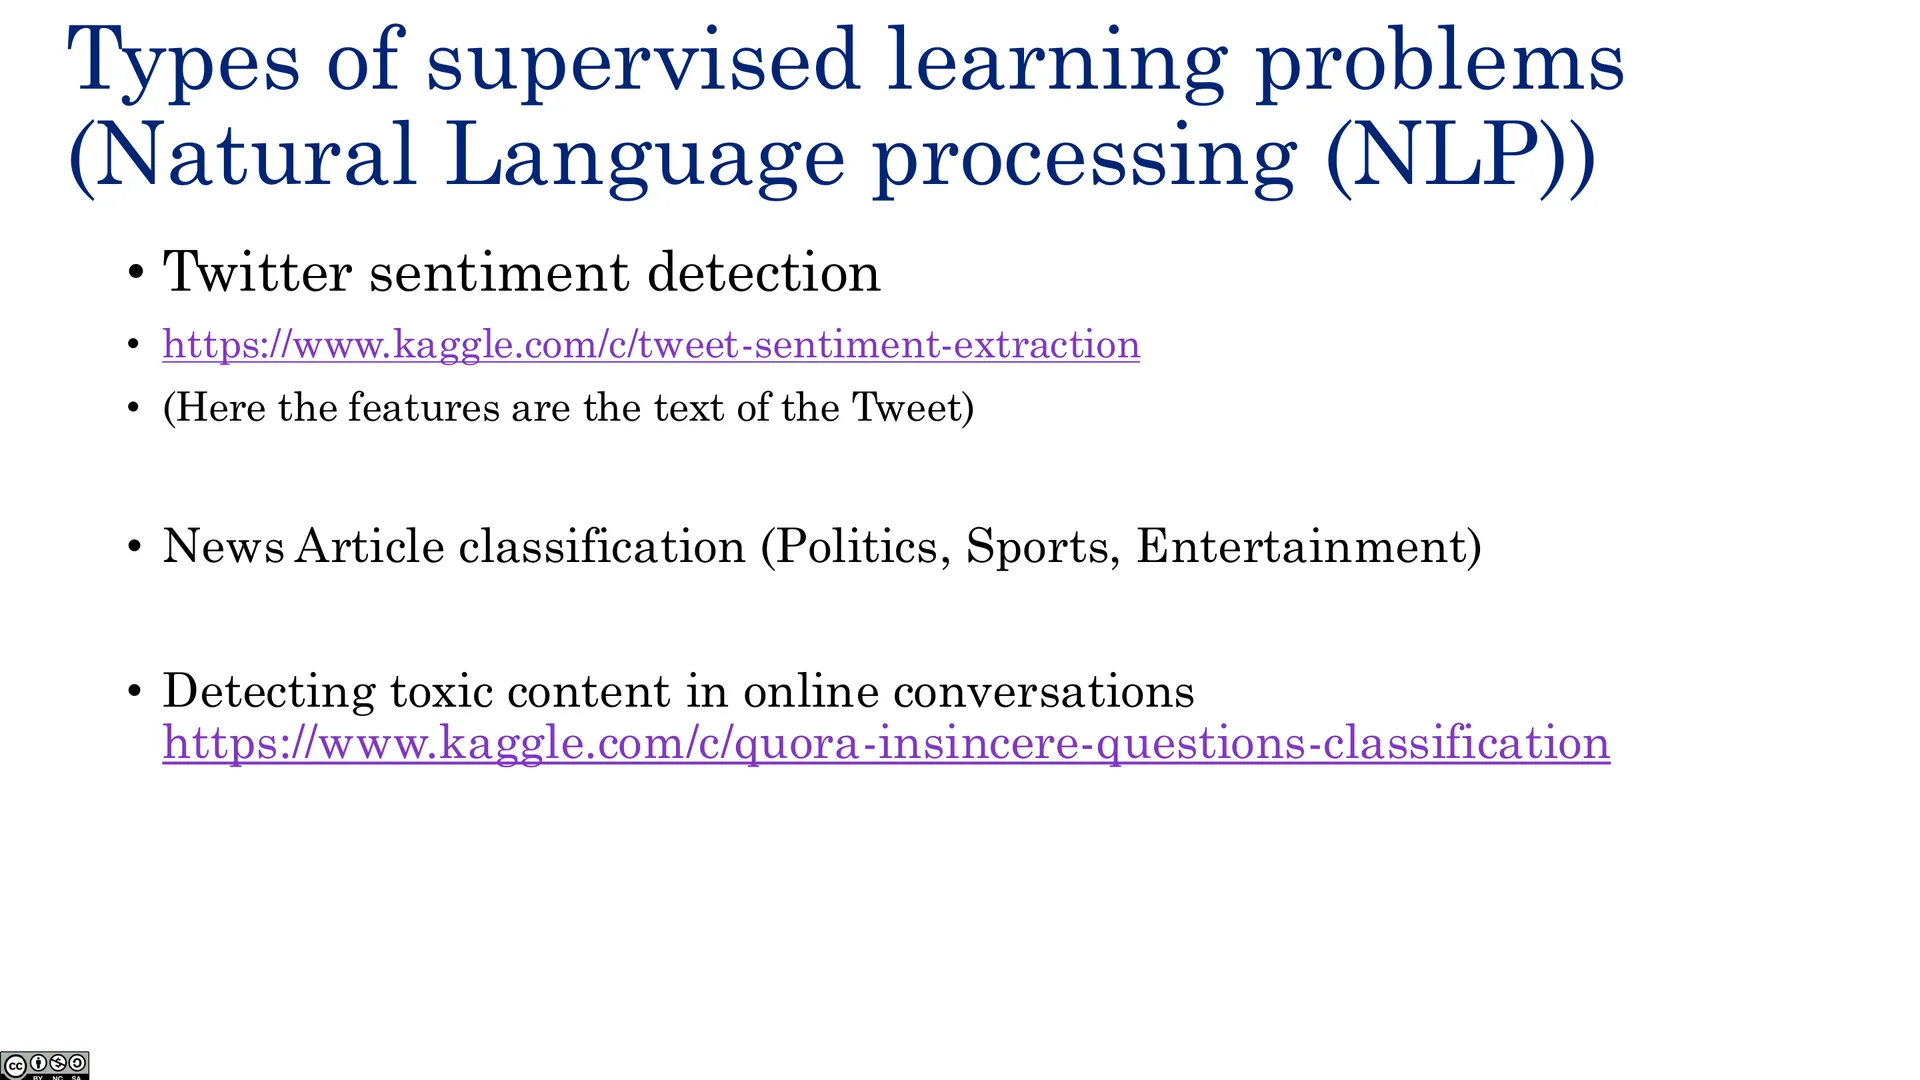
- 自然语言处理(NLP):Twitter 情感检测(把推文分类为正面/负面)。
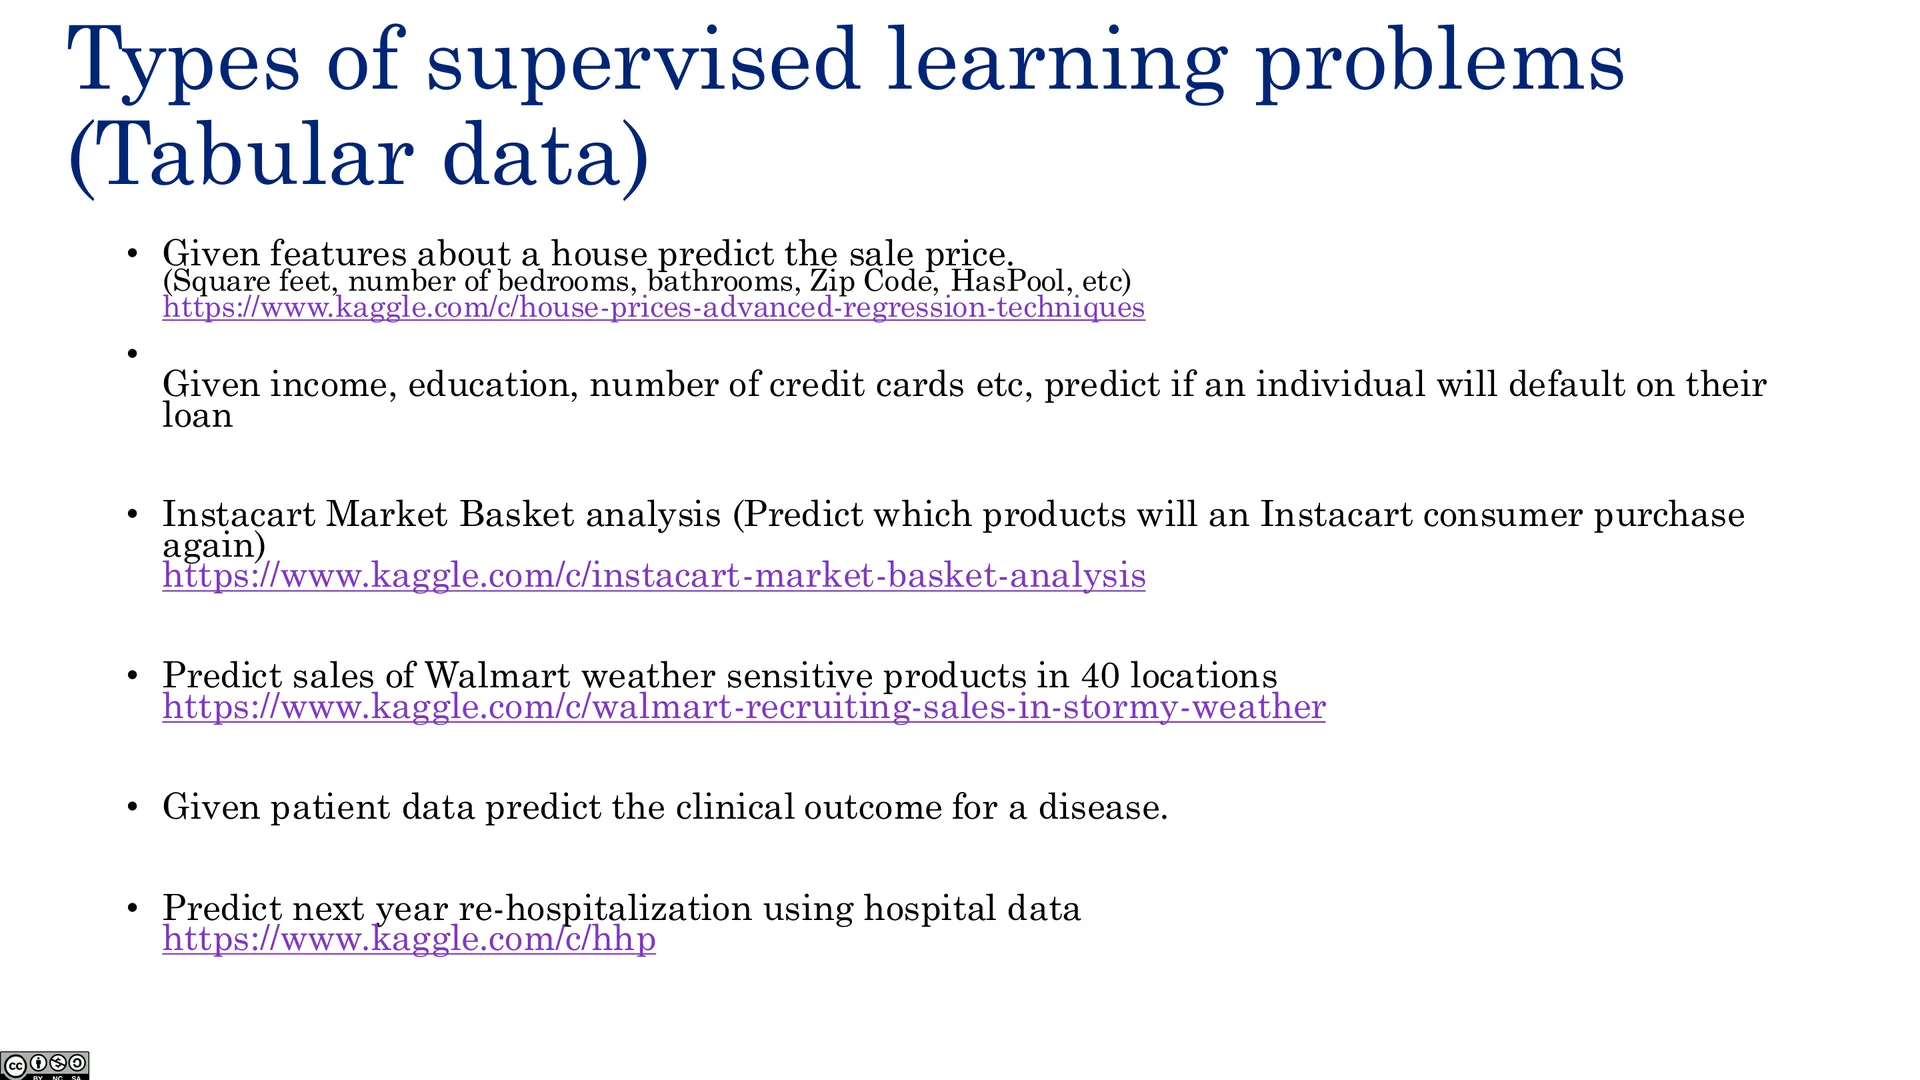
🖼️ 监督问题的类型:表格数据
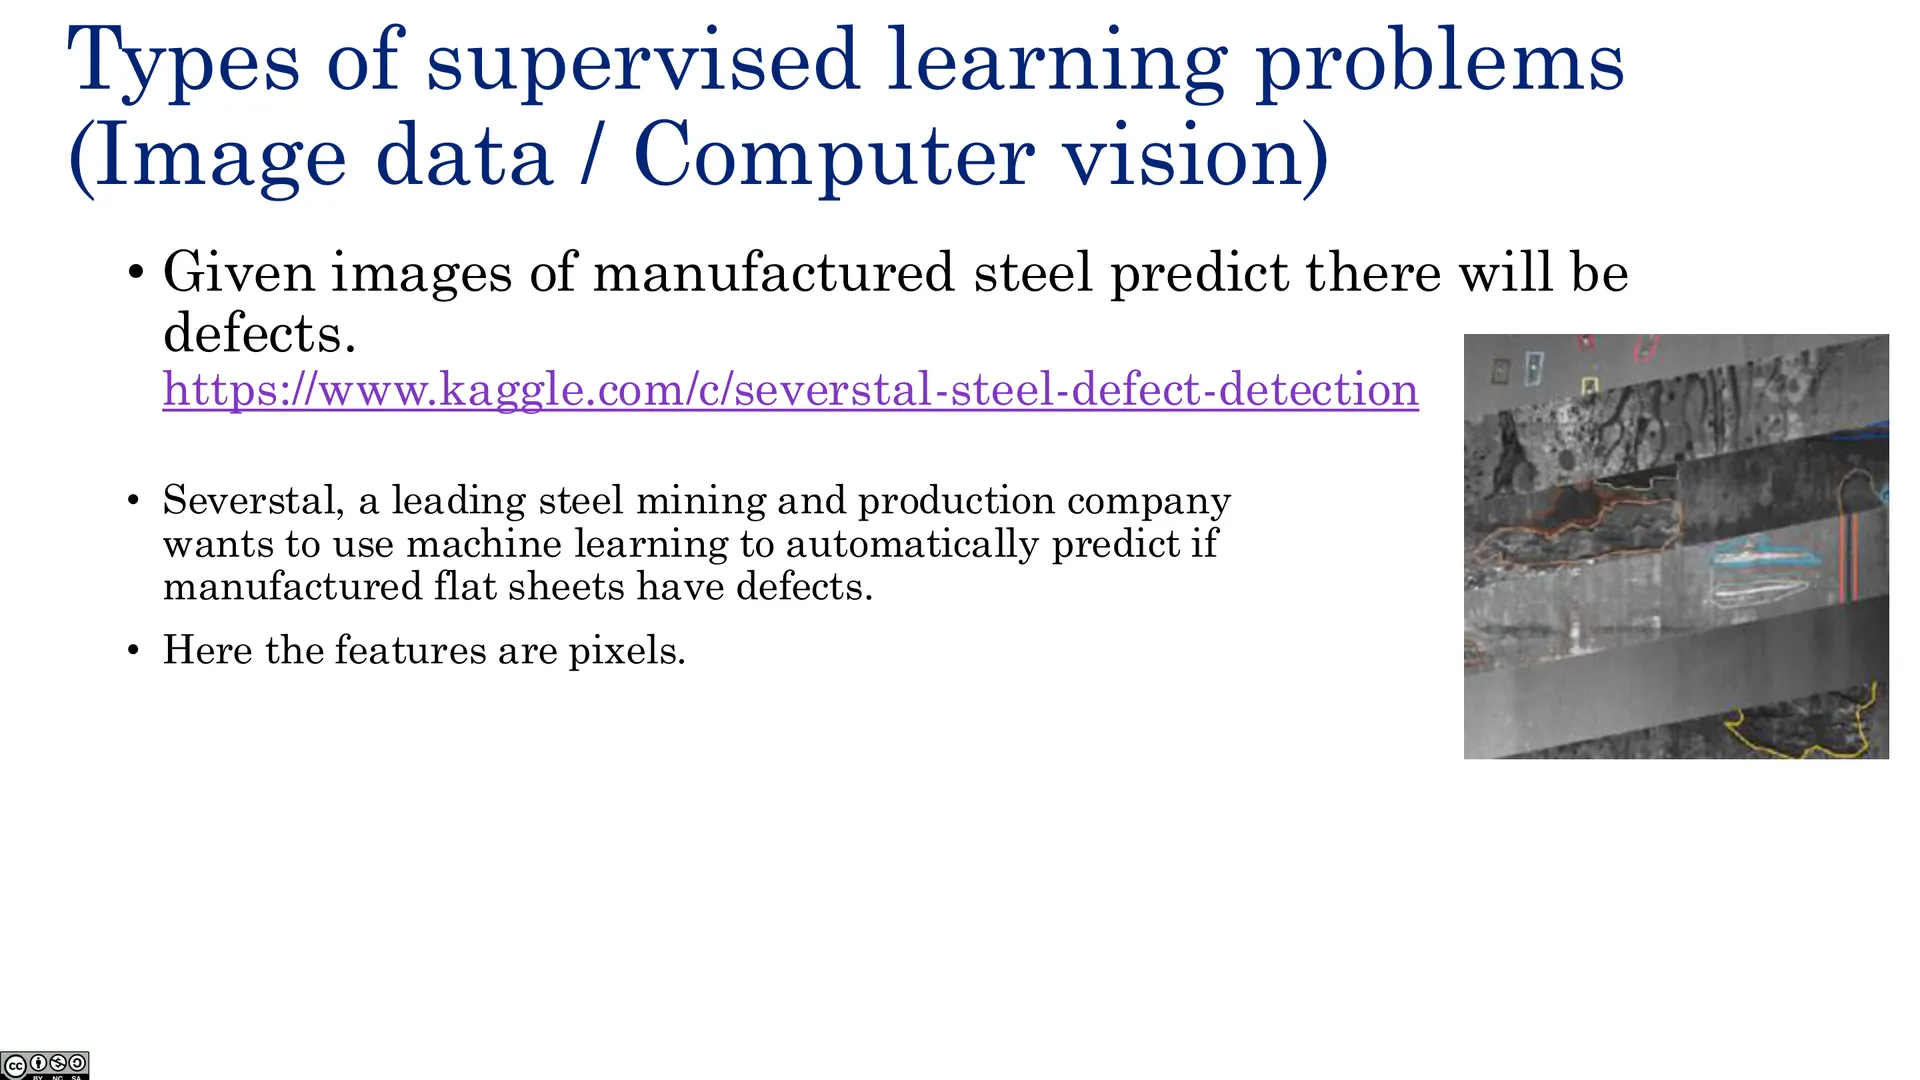
🖼️ 监督问题的类型:图像(一)
🖼️ 监督问题的类型:图像(二)
🖼️ 监督问题的类型:时间序列
🖼️ 监督问题的类型:NLP
🖼️ 机器学习的分类学(小结)
无监督问题:
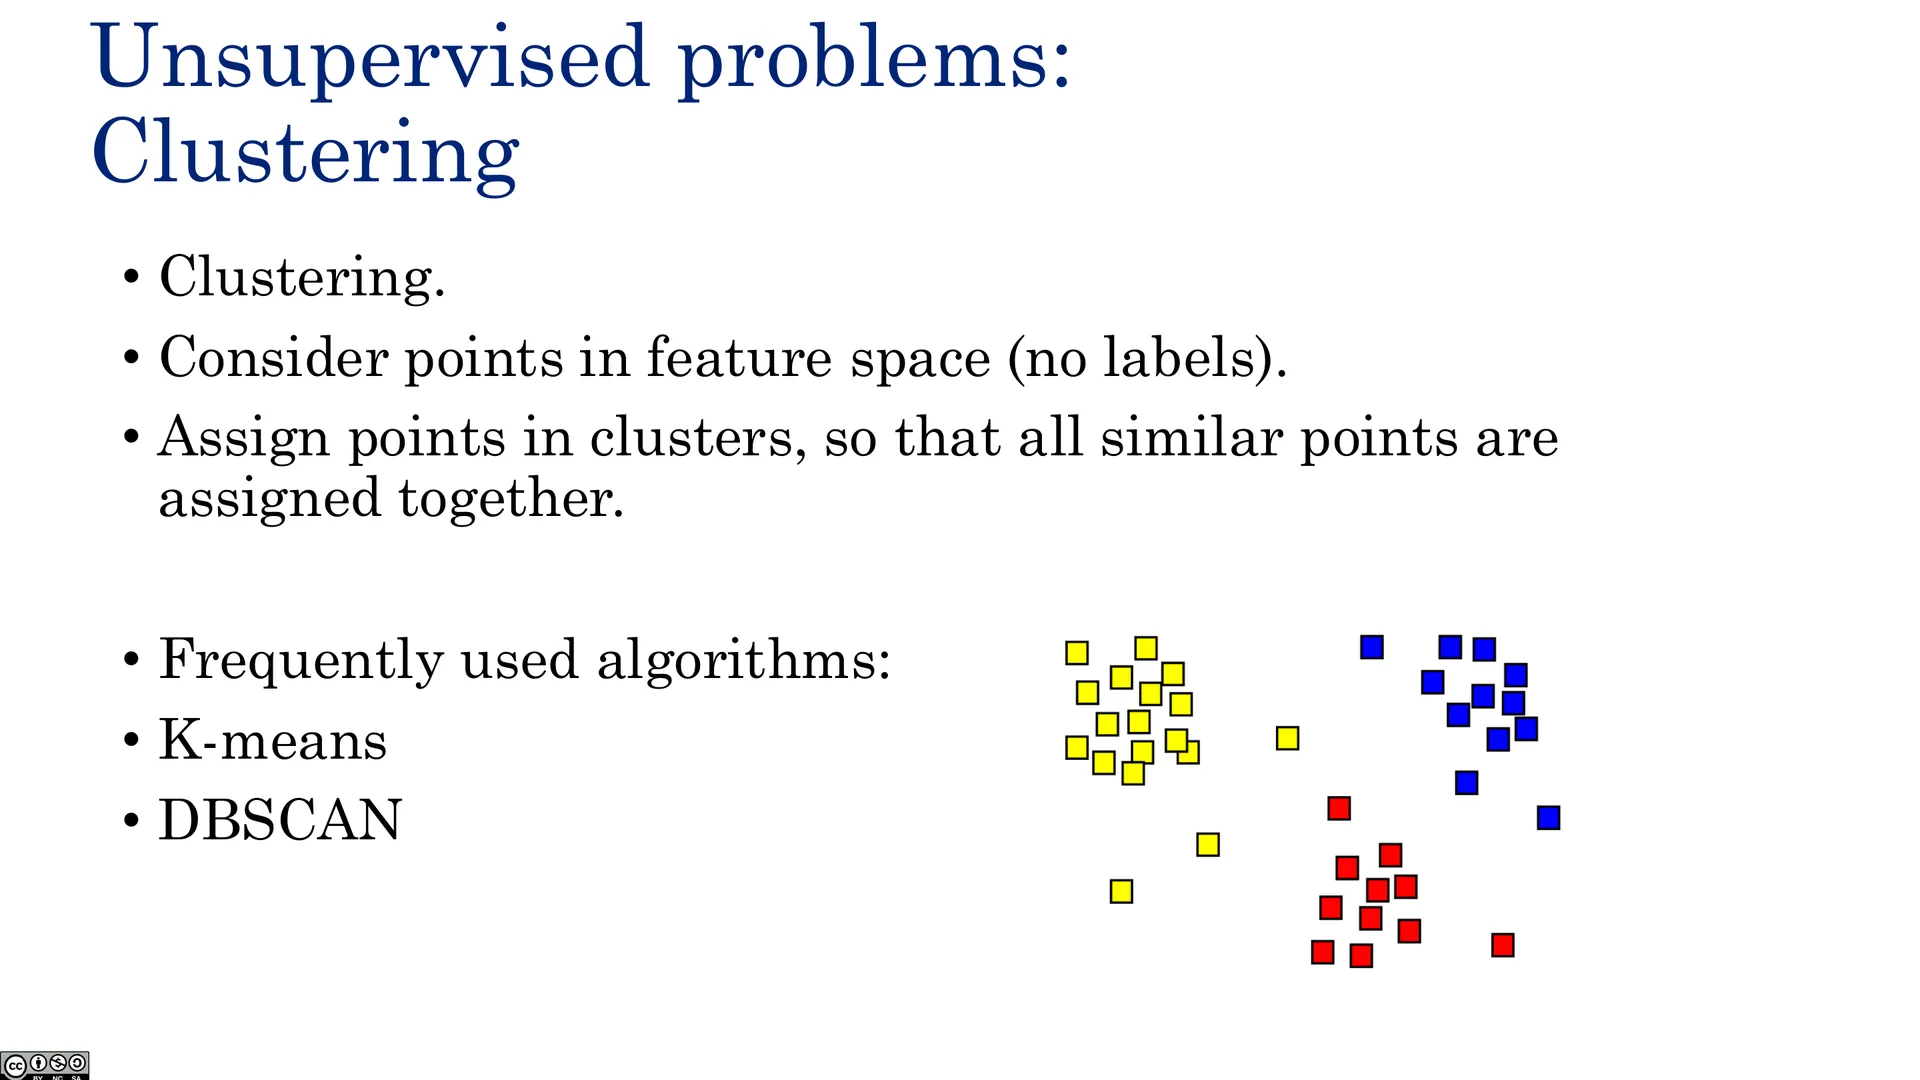
- 聚类(clustering):把相似样本分到一组(如 k-means);
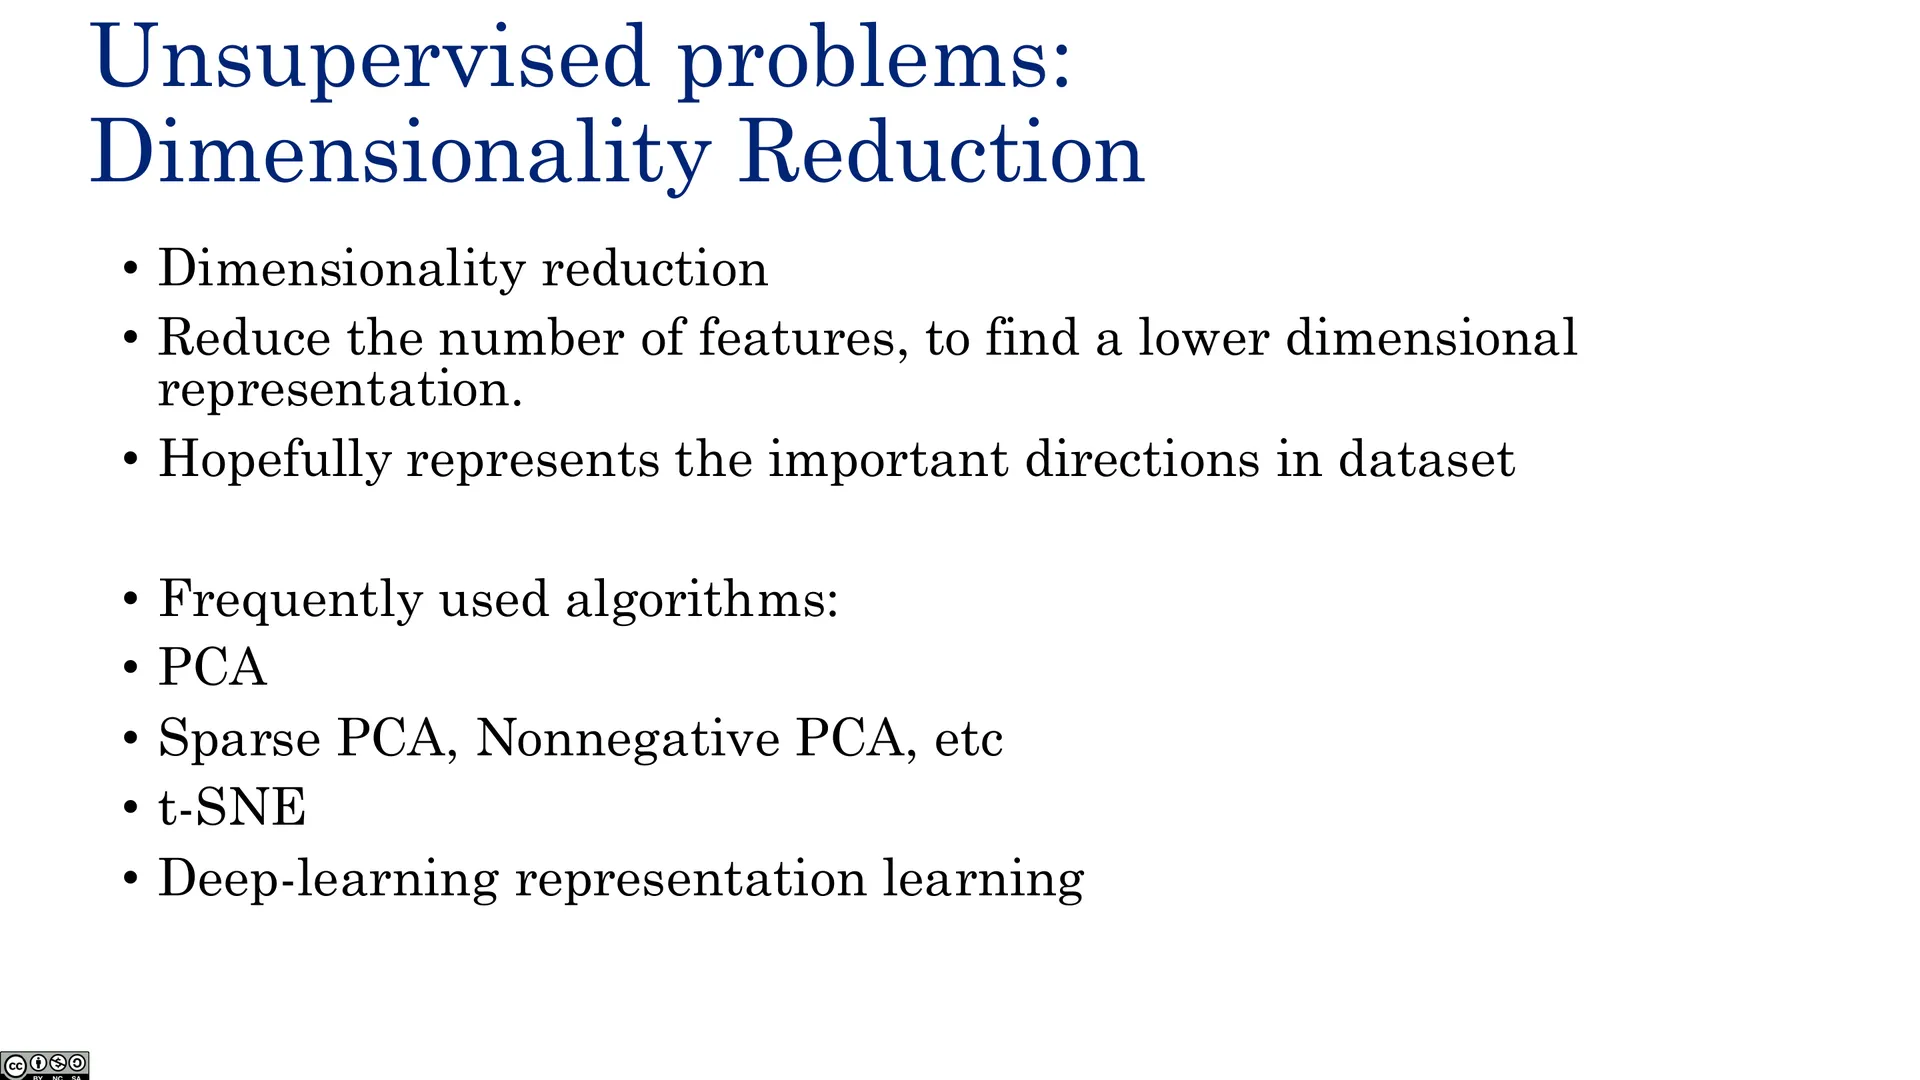
- 降维(dimensionality reduction):把高维数据压到低维以便可视化和去噪(如 PCA)。
🖼️ 无监督:聚类
🖼️ 无监督:降维
四、机器学习的历史
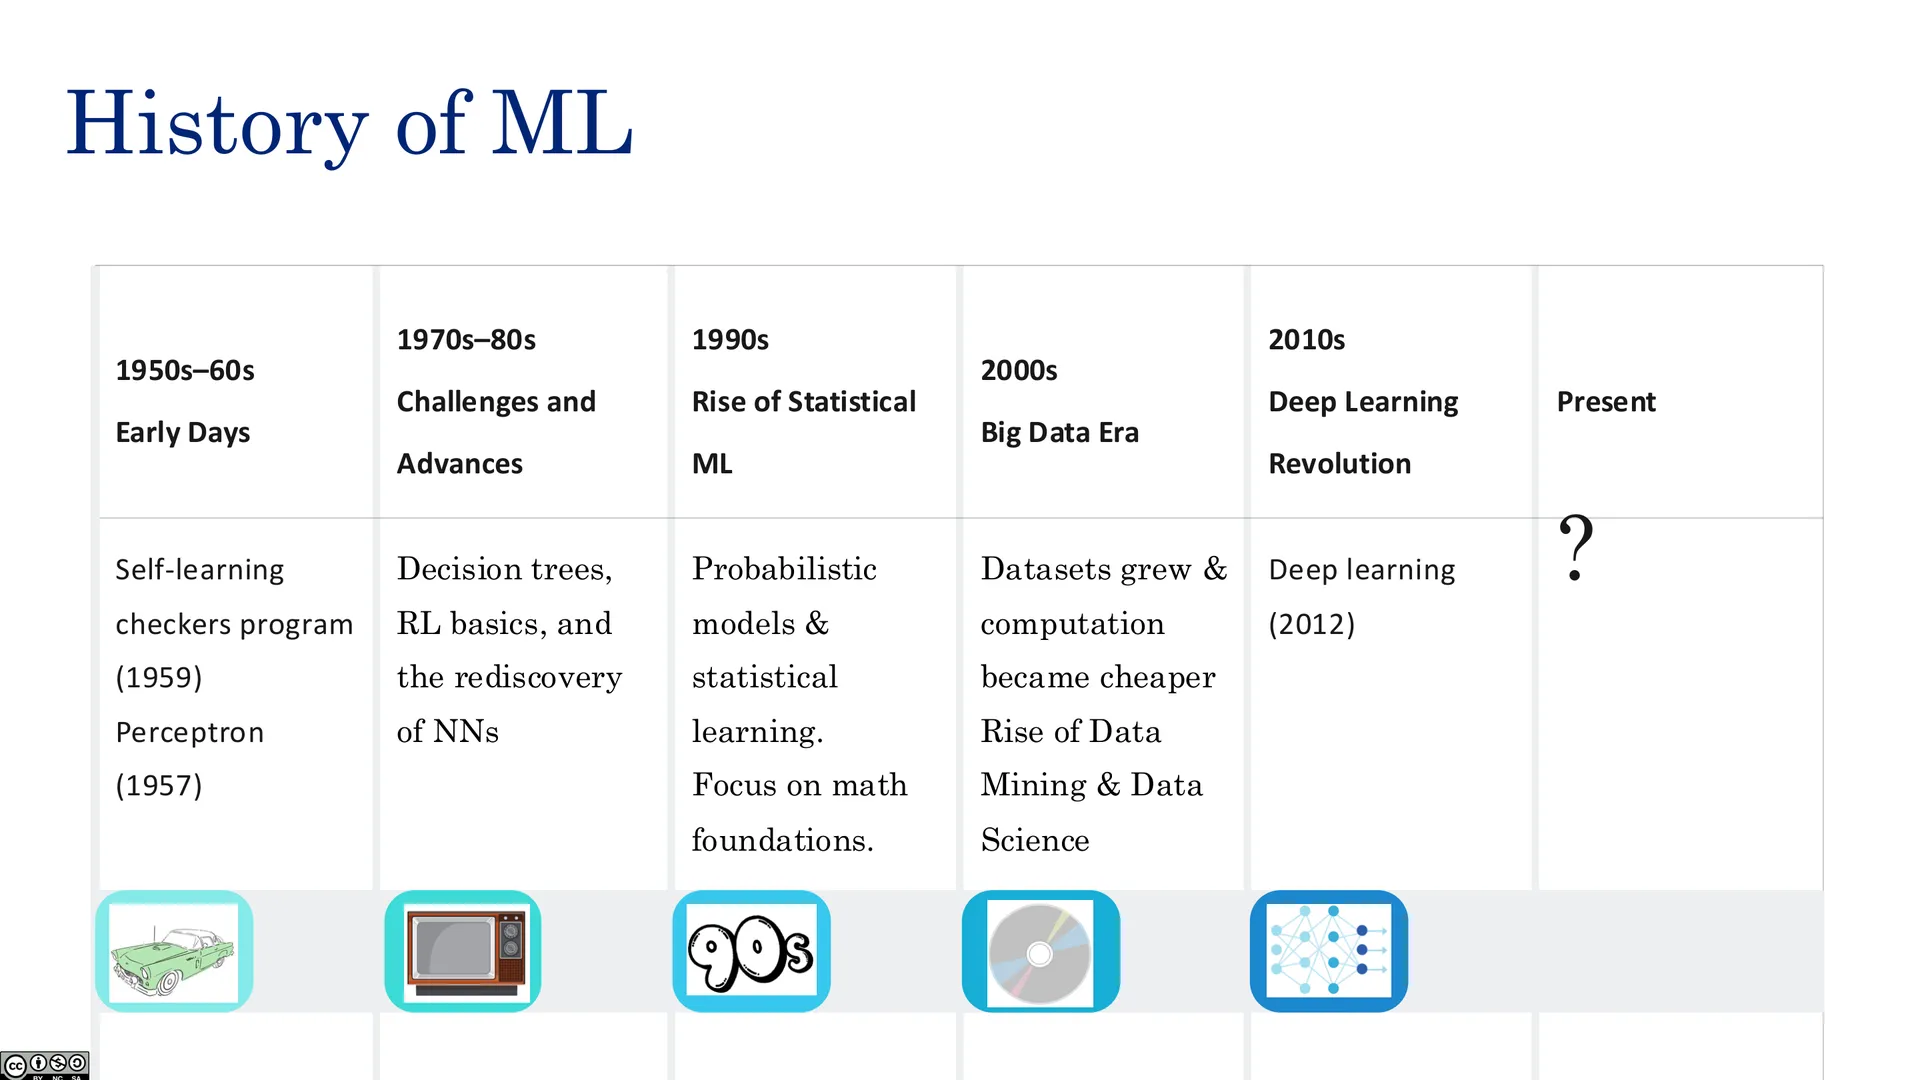
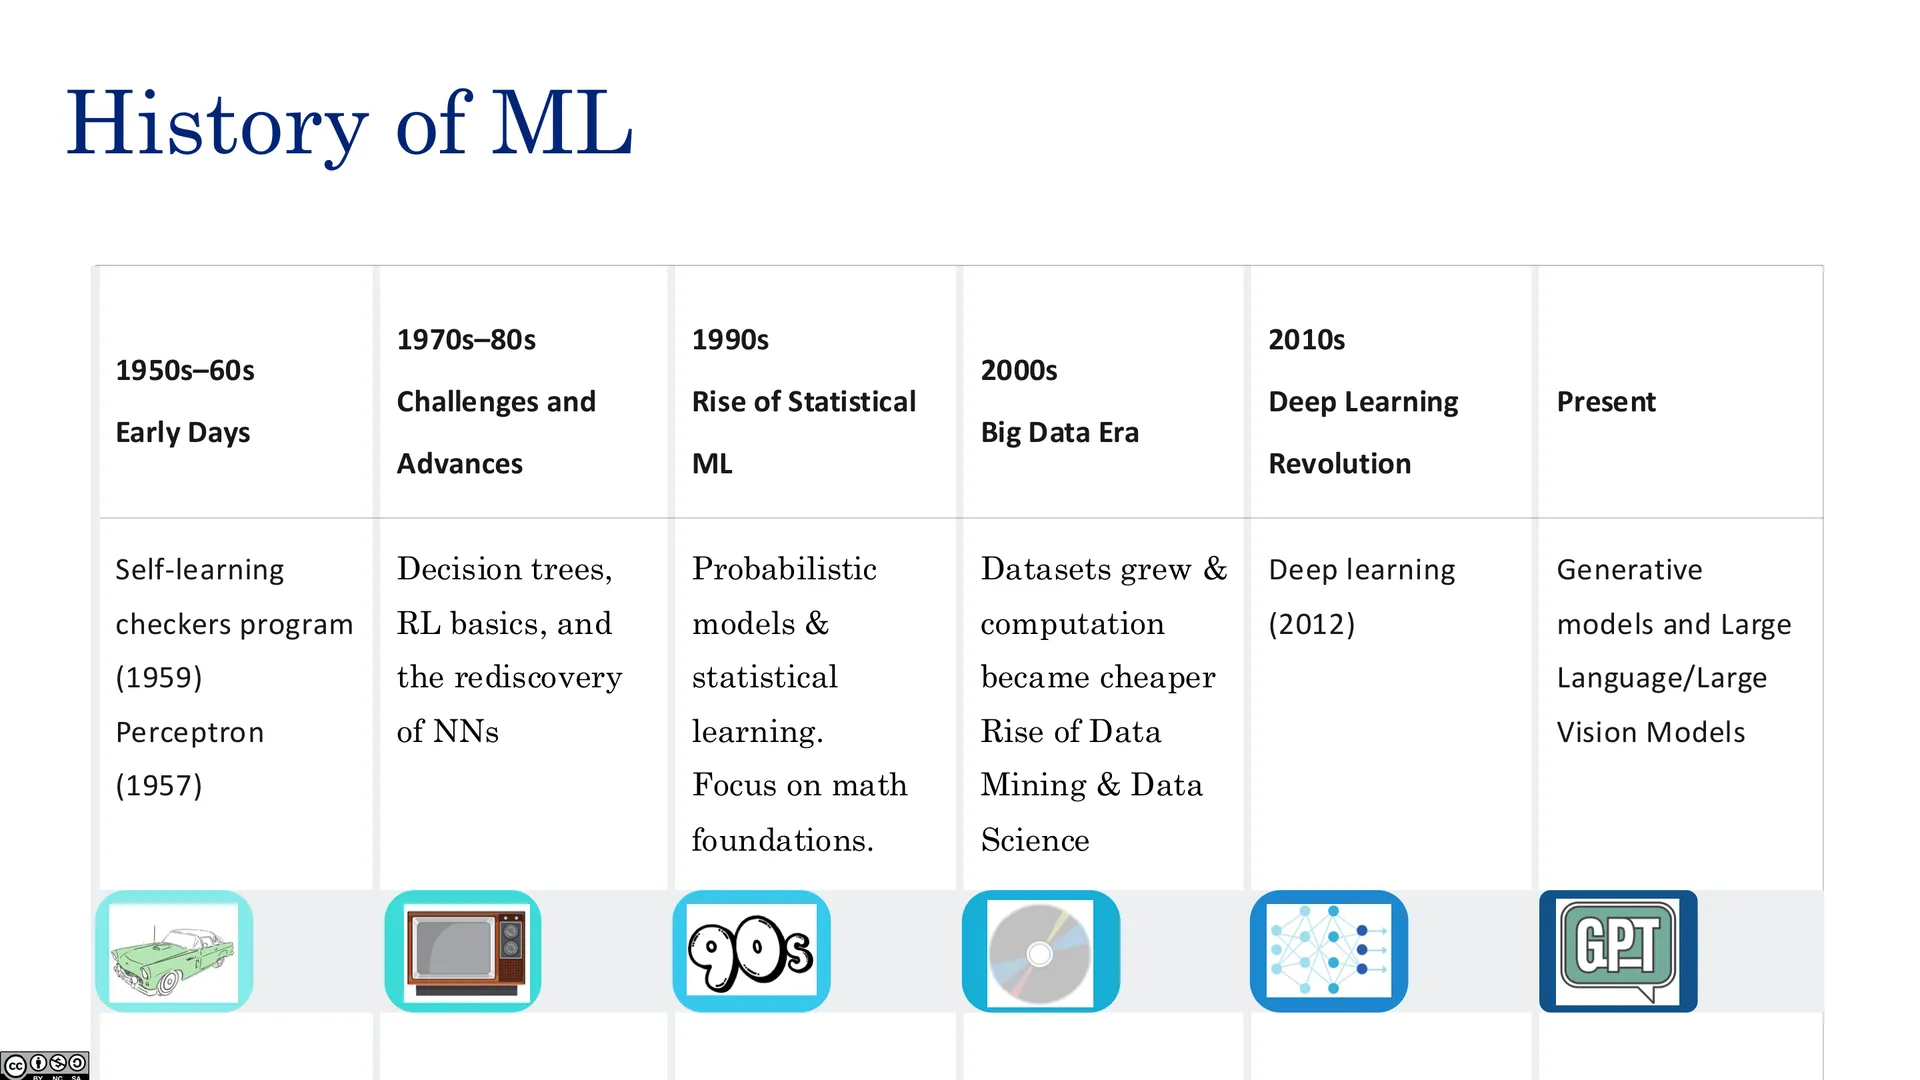
- 1950s–60s 早期:感知机、符号 AI、早期的学习理论;
- 此后经历多次寒冬与复兴(专家系统、统计学习、核方法、深度学习);
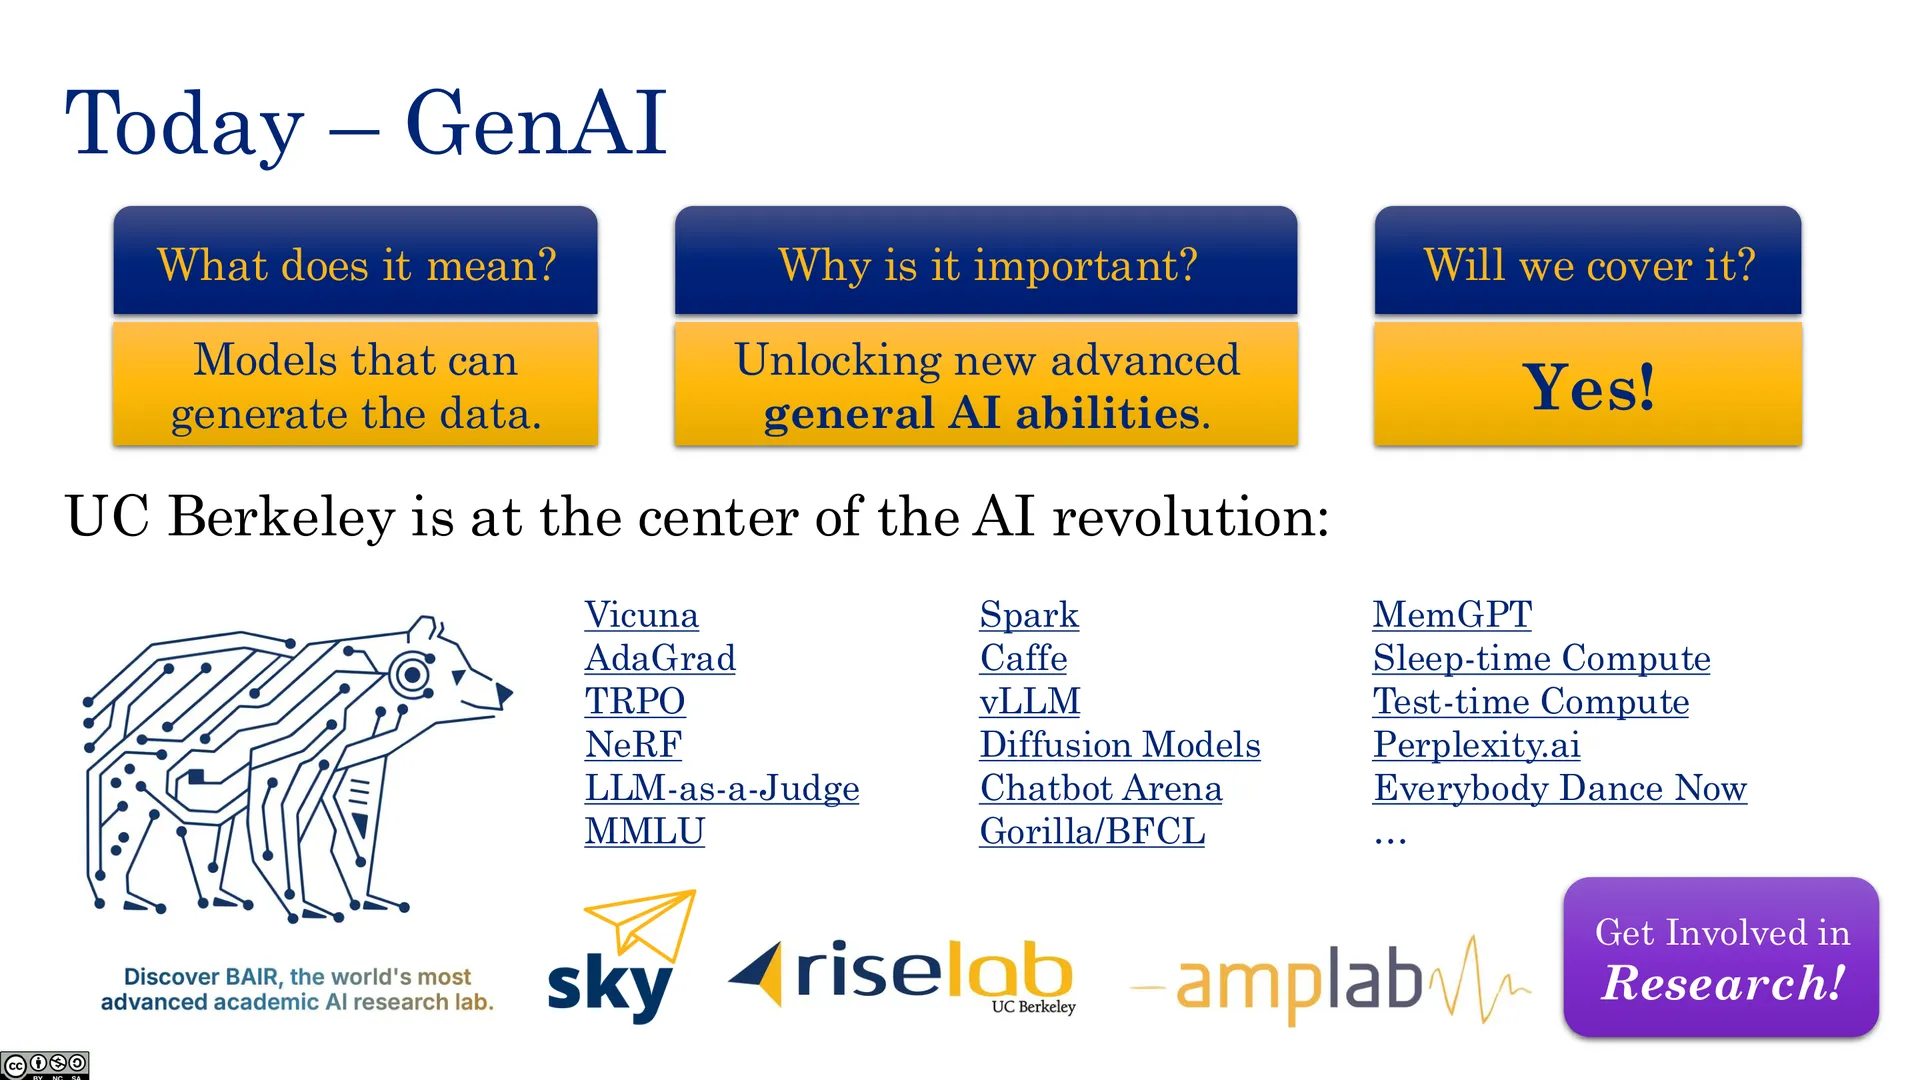
- 今天——生成式 AI(GenAI):UC Berkeley 正处在 AI 革命的中心(Transformer、RLHF、vLLM、CLIP 等大量工作出自这里)。
🖼️ 机器学习的历史
🖼️ 1950s–60s 早期
🖼️ 早期(续)
🖼️ 今天——生成式 AI
教学方式的演变:从 1996、2006 到 2026,课程不断更新。本学期跟随 Bishop 最新教材,采用其记号与概念。
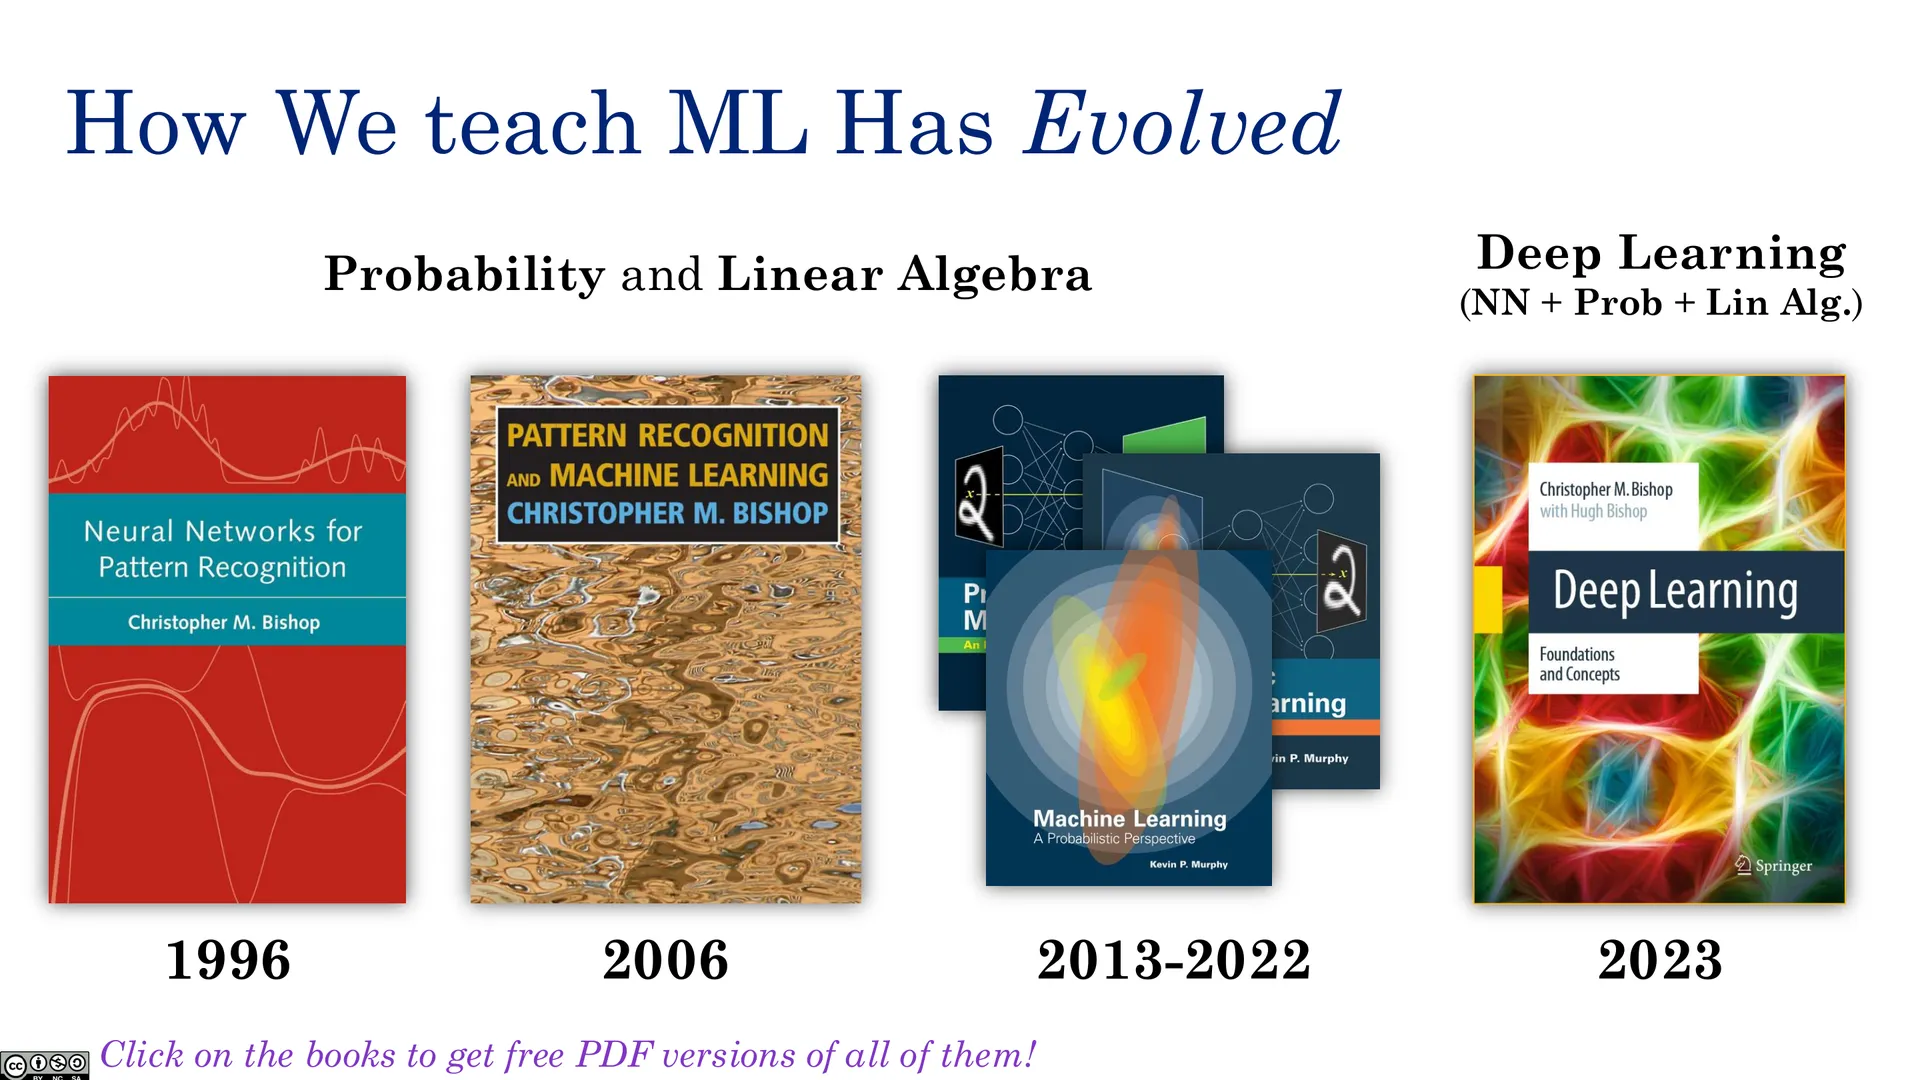
🖼️ ML 教学方式的演变
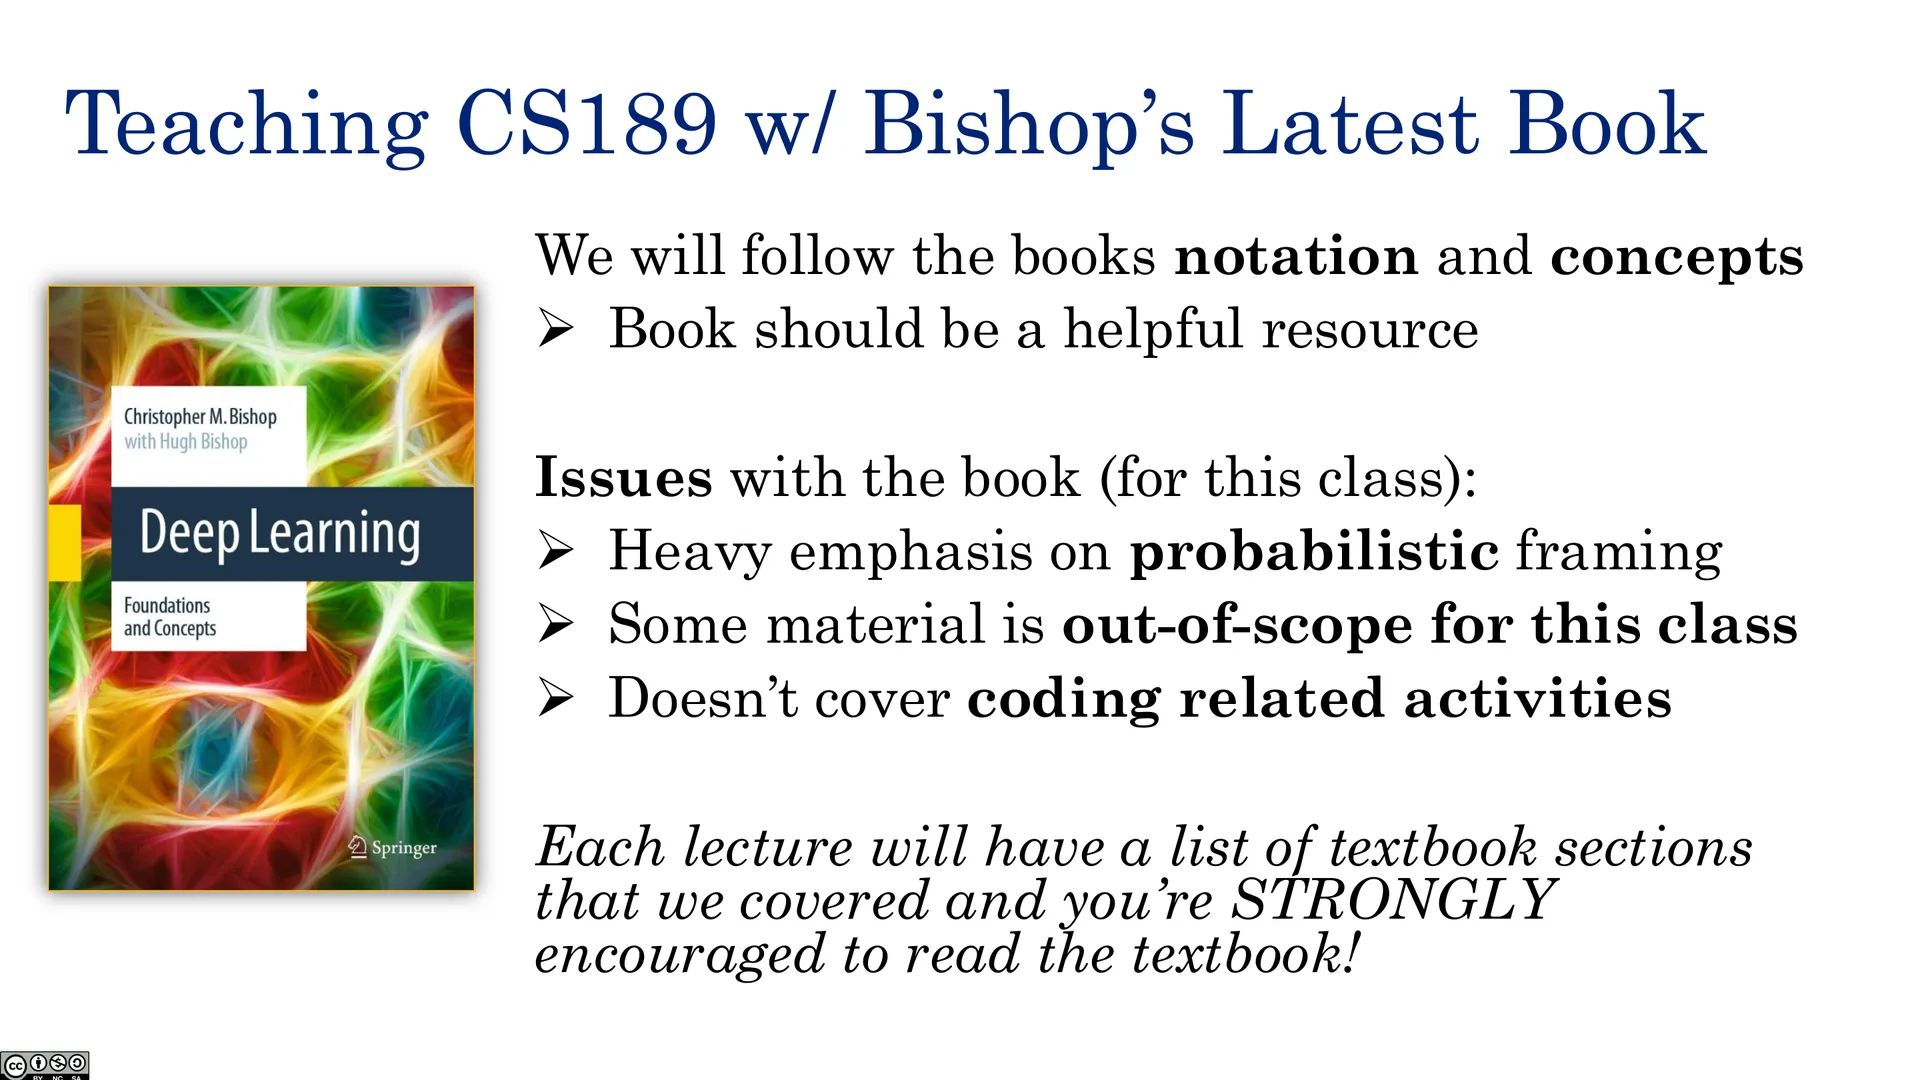
🖼️ 跟随 Bishop 的新教材
五、机器学习的流程(Lifecycle)
ML 生命周期:从定义目标(我想预测什么?)→ 框定 ML 问题 → 收集/清洗数据 → 建模与训练 → 评估与迭代 → 部署与监控。
课程刻意「倒着教」(teach ML backwards):先讲应用与问题框定(为什么用、怎么框),再深入模型与算法,让数学始终服务于真实问题。
🖼️ ML 流程(生命周期)
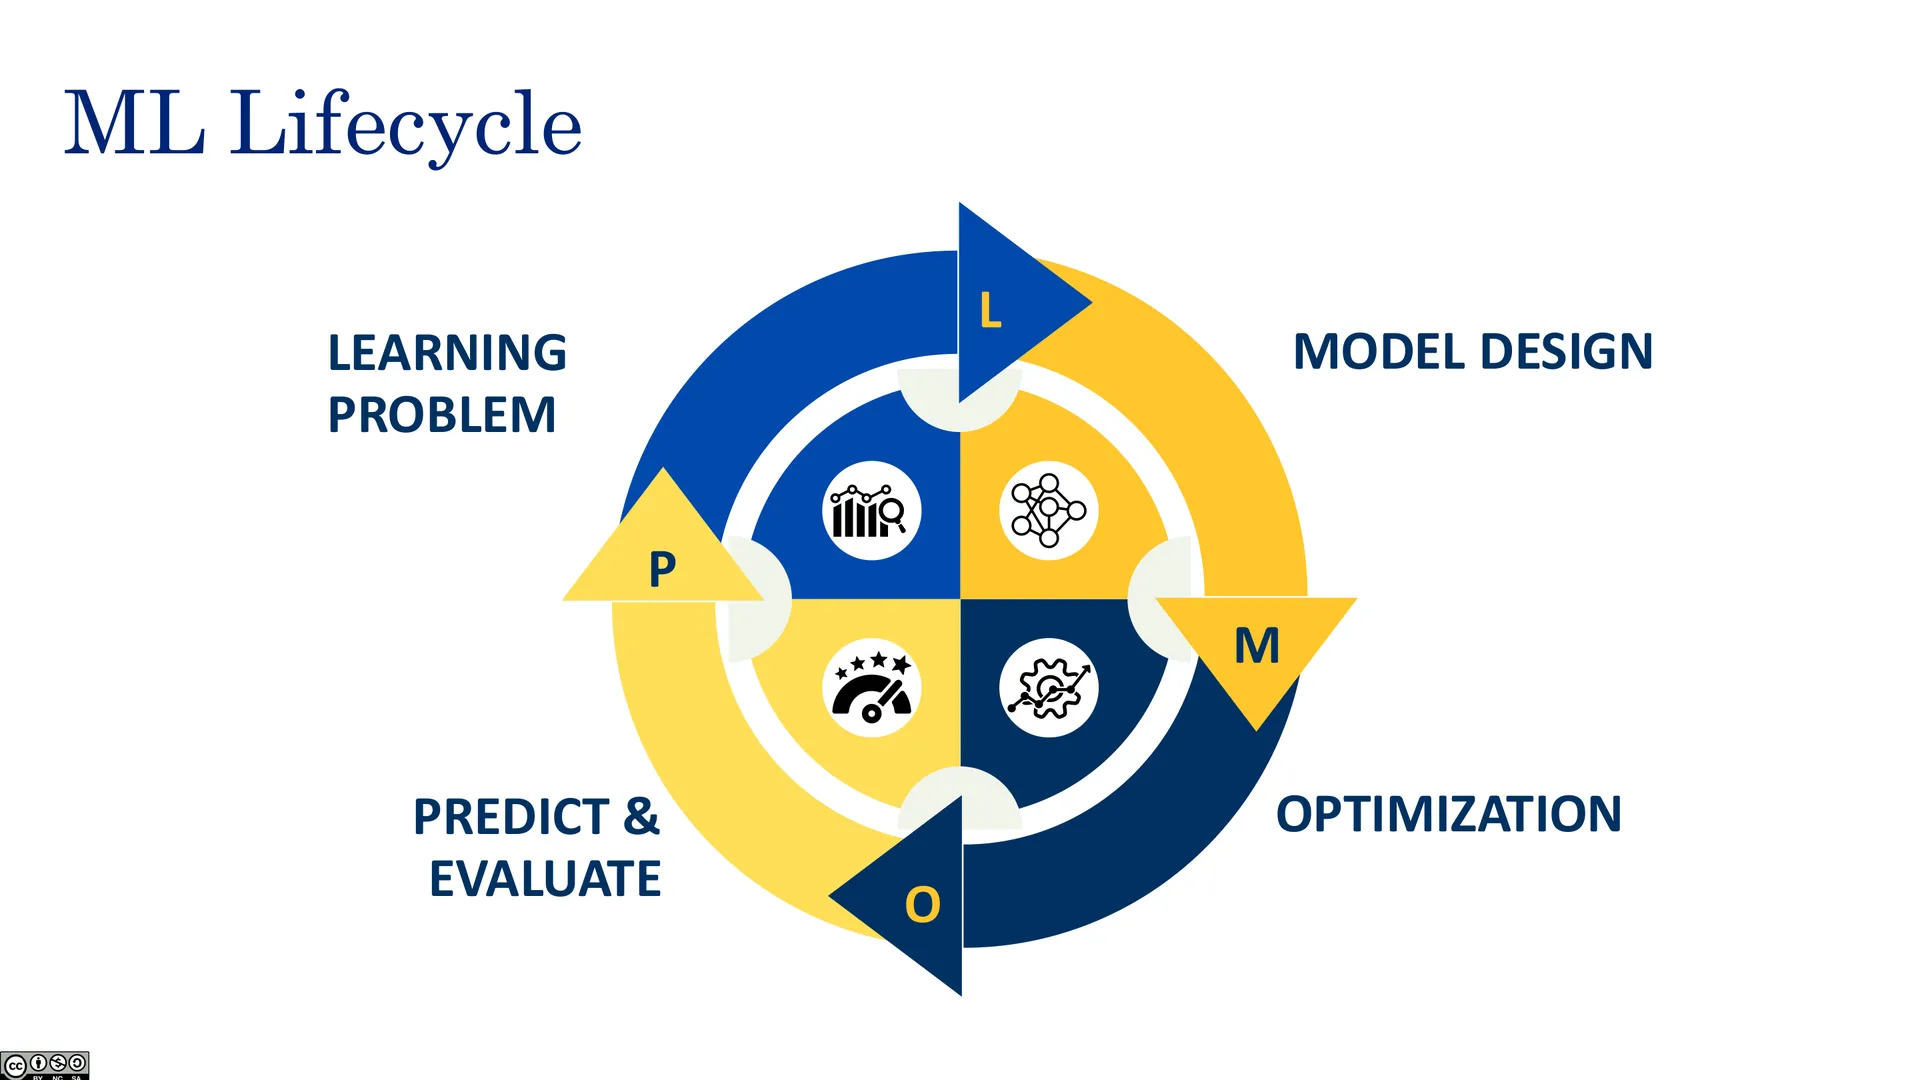
🖼️ L·M·P
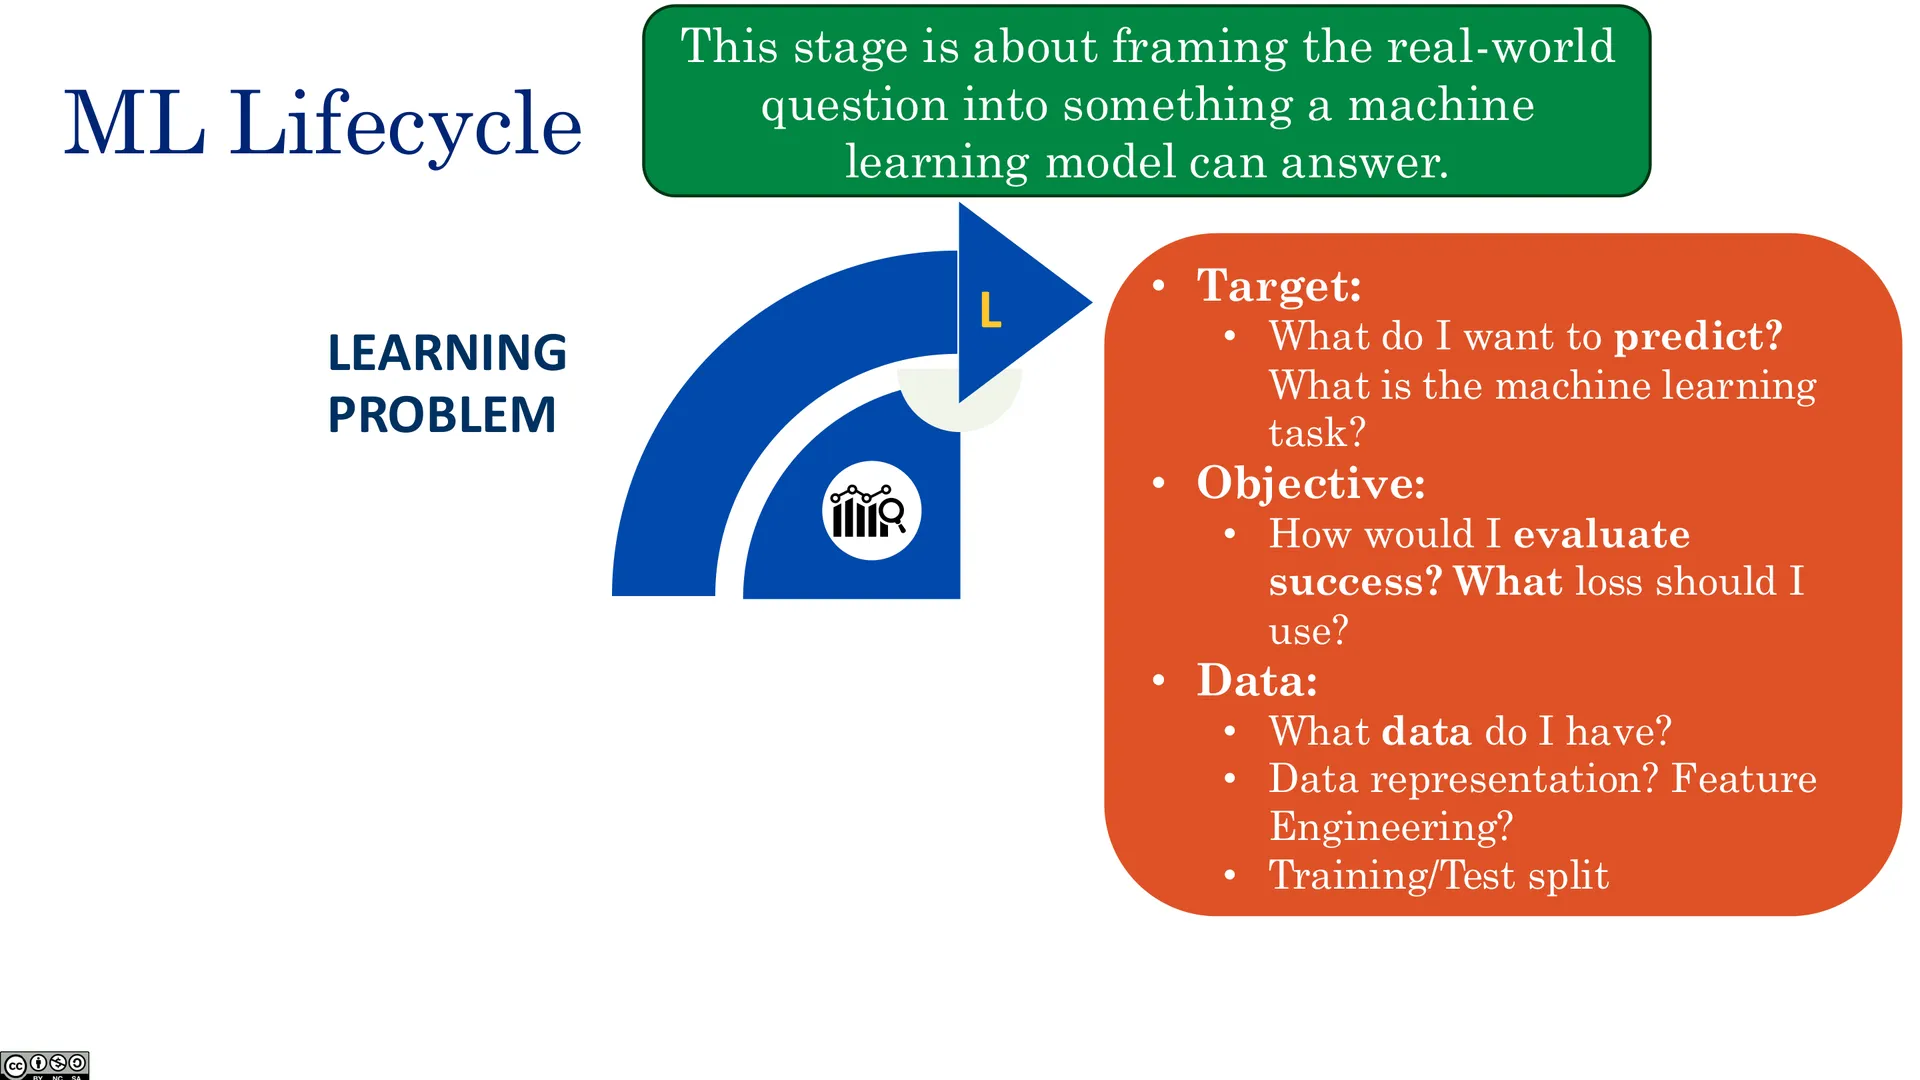
🖼️ 目标:我想预测什么?
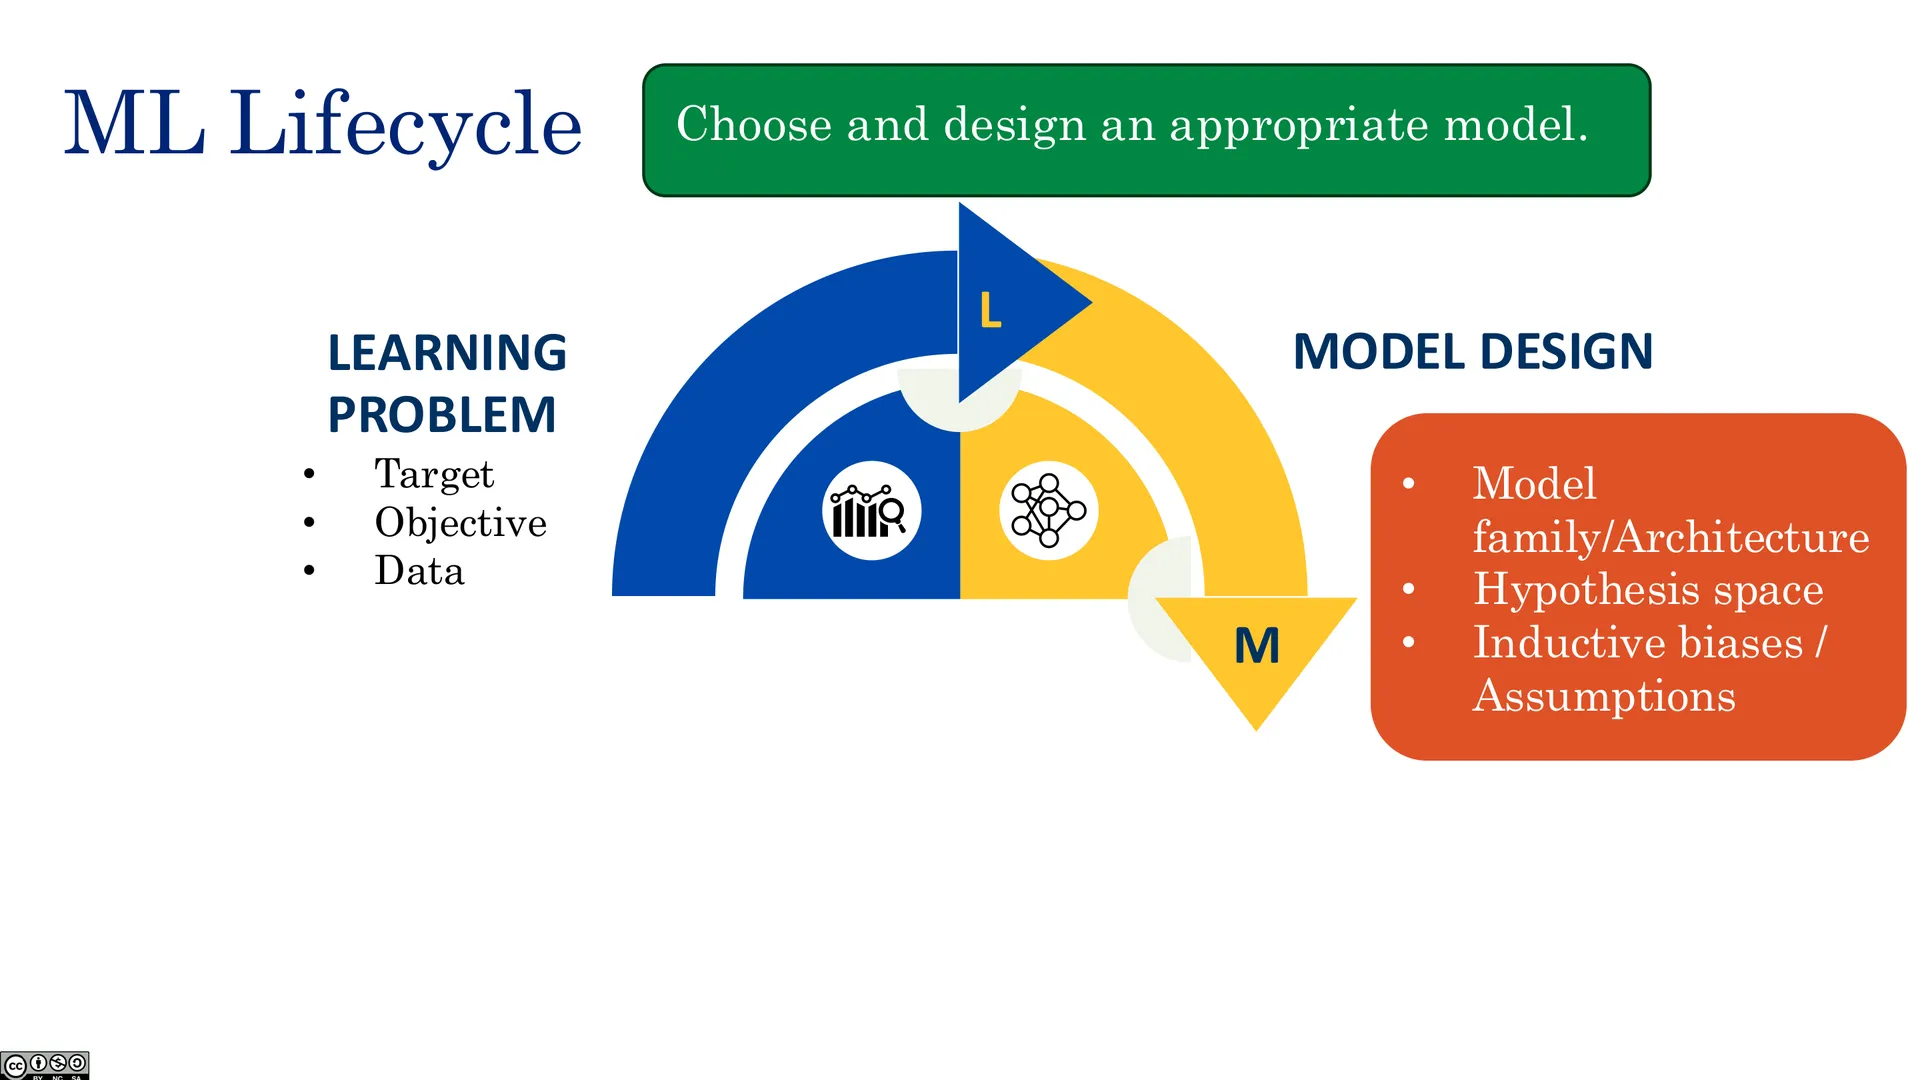
🖼️ L·M·LEARNING
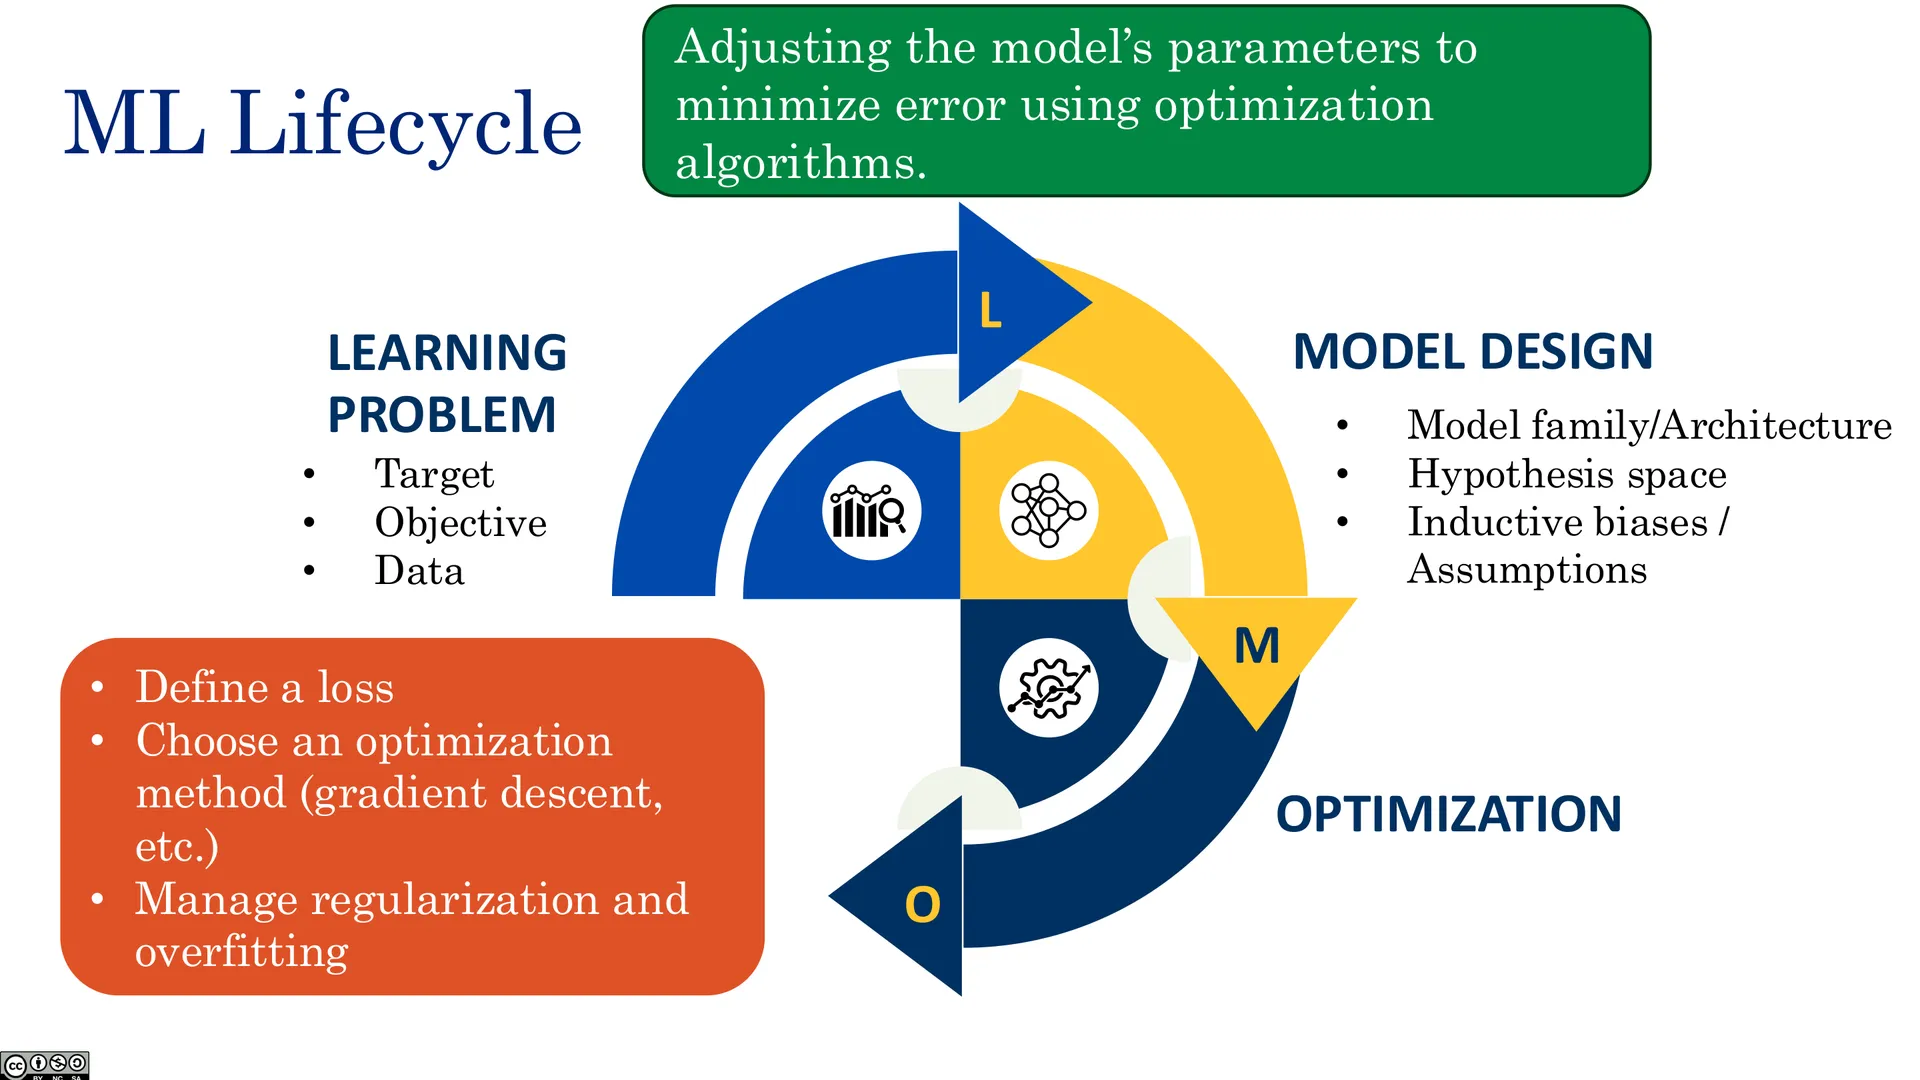
🖼️ L·M·O
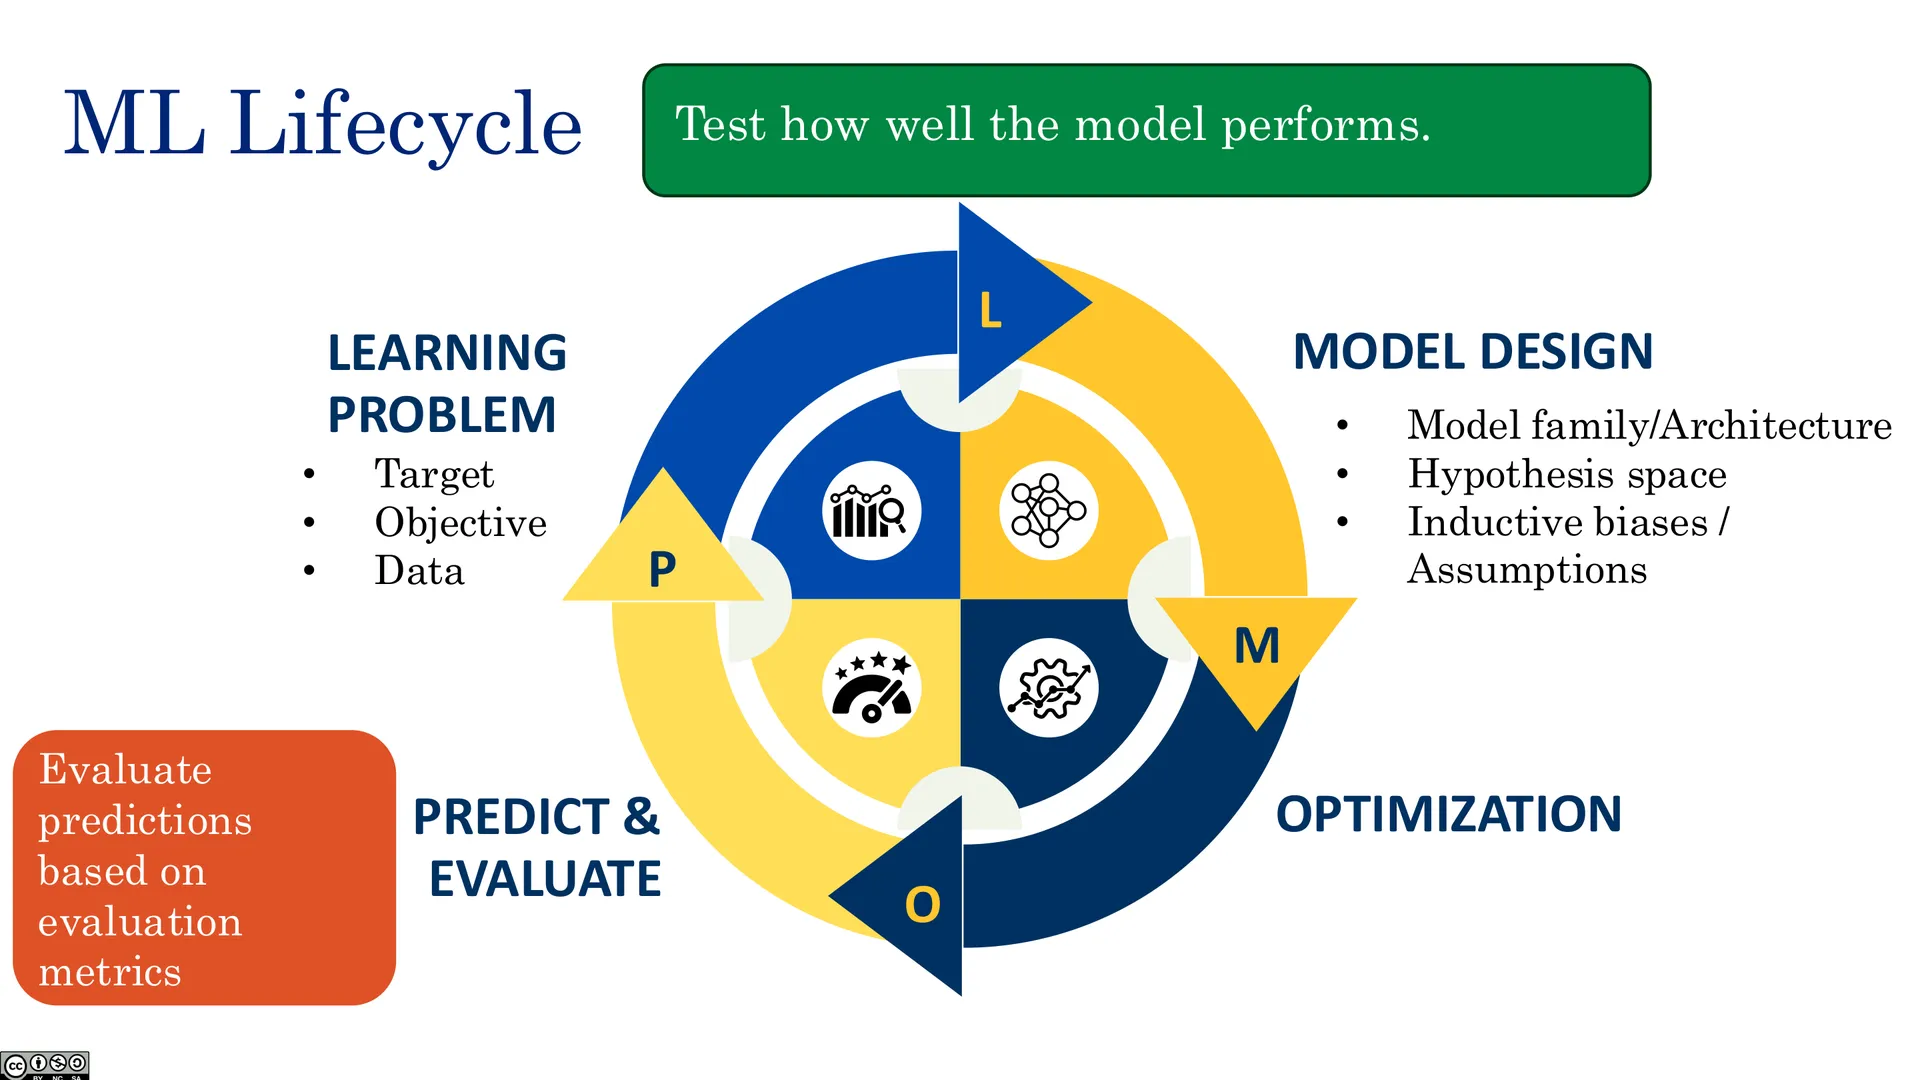
🖼️ L·M·P(续)
🖼️ 「倒着」教 ML
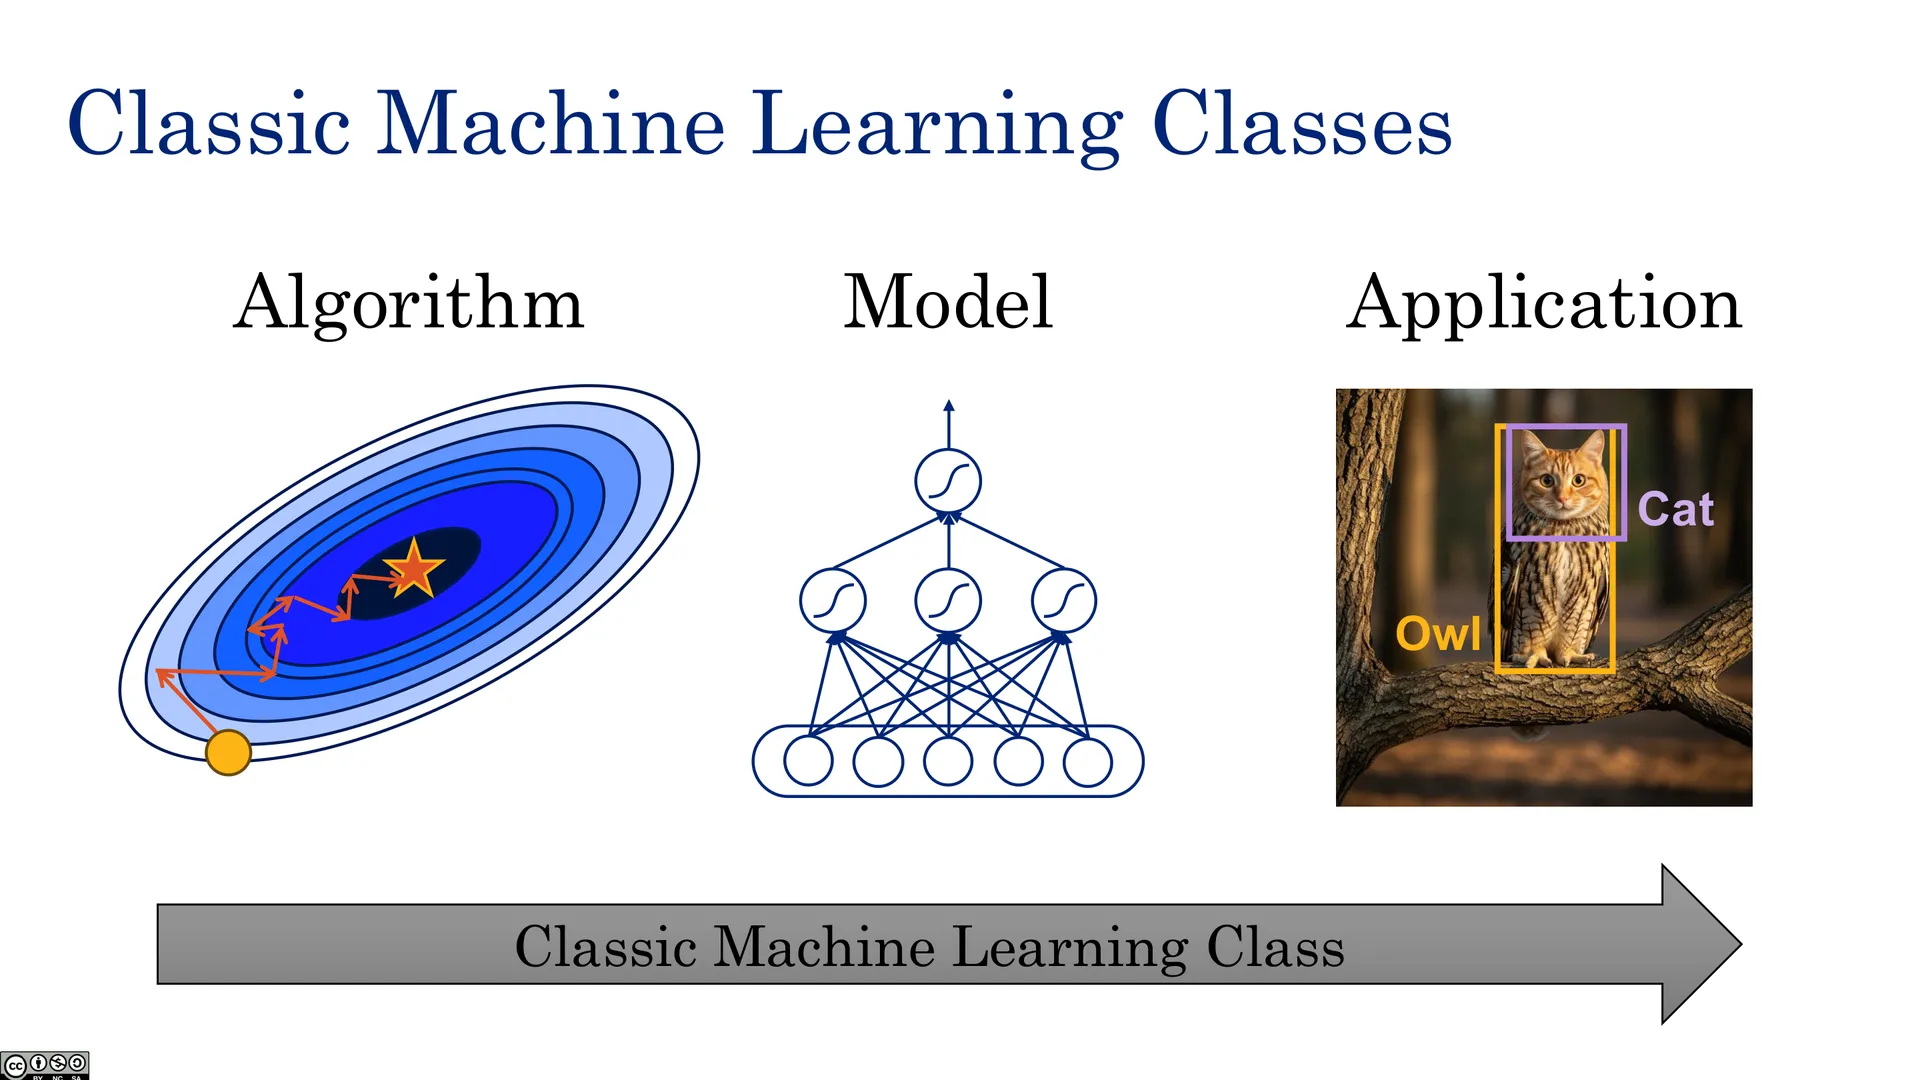
🖼️ 经典 ML 课:模型与算法
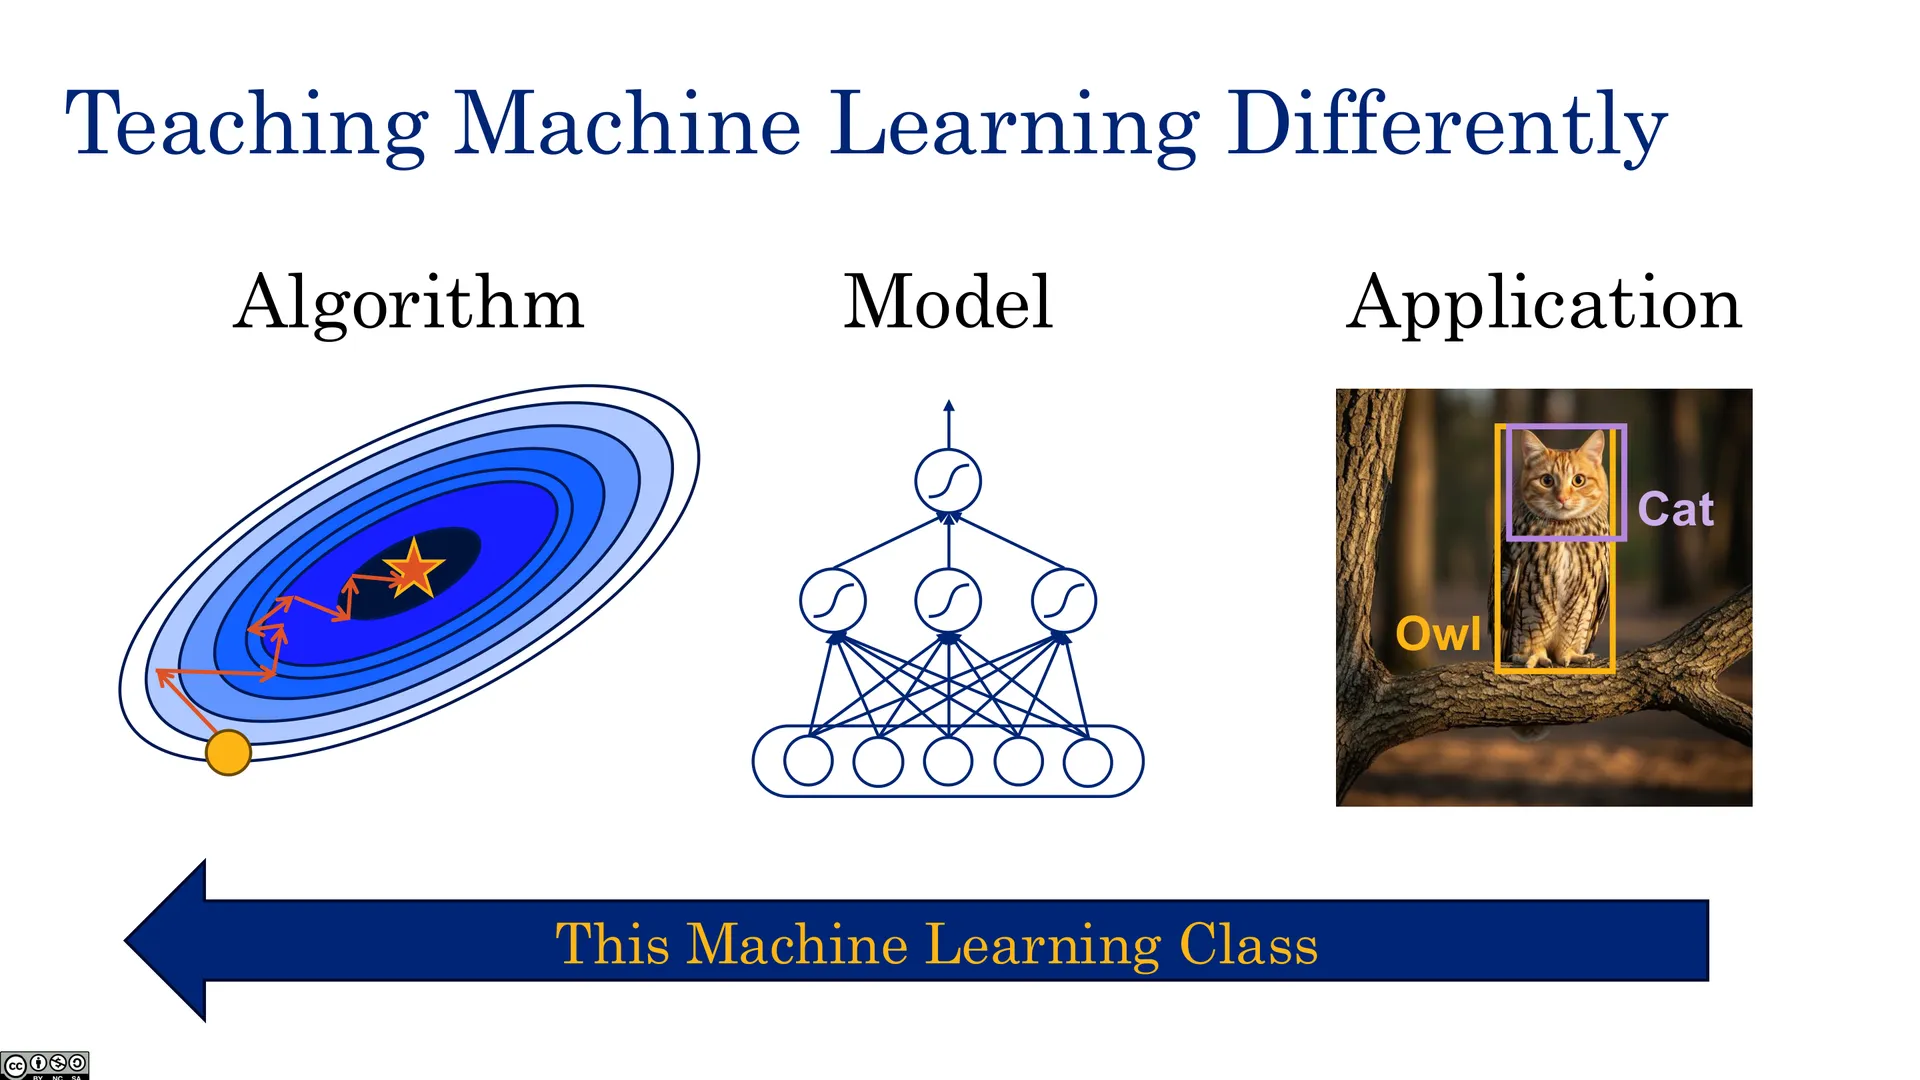
🖼️ 不同的教学方式:模型与算法
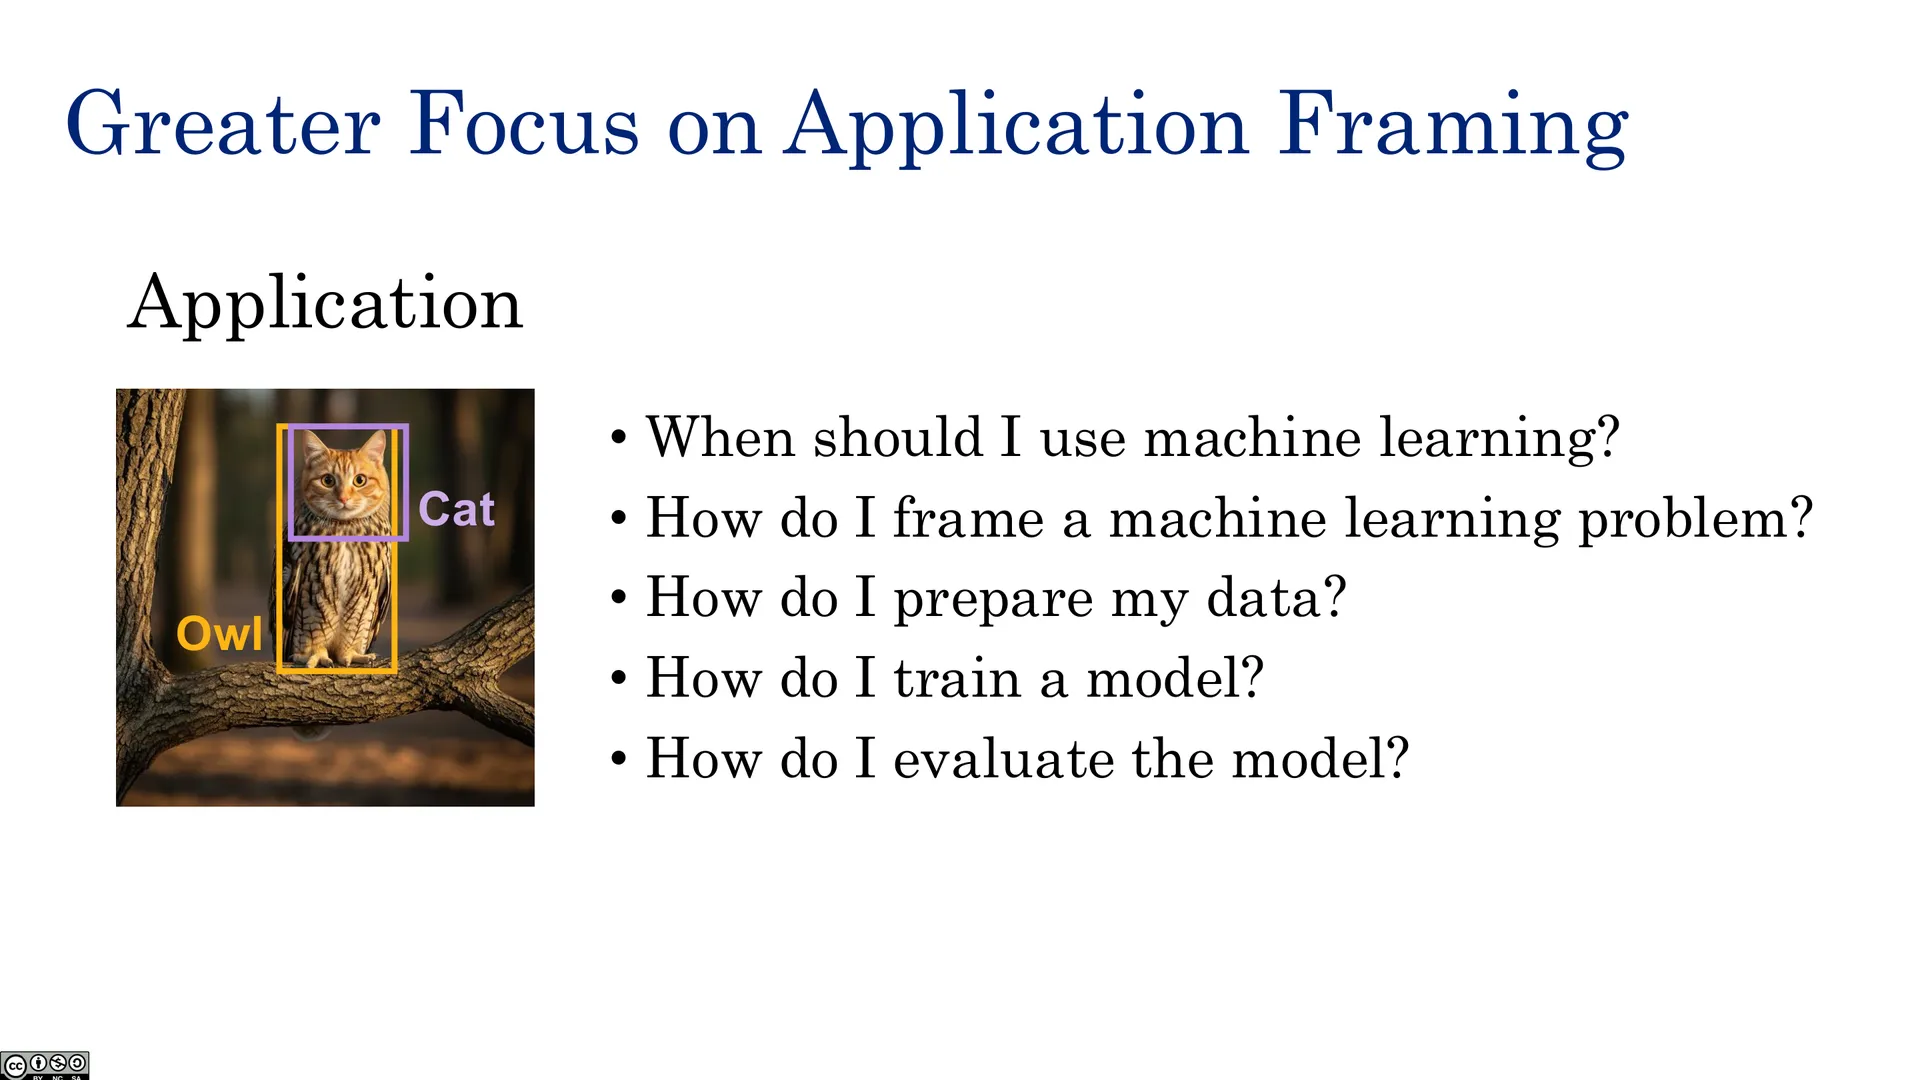
🖼️ 更侧重应用框定
你将学会的工具:pandas(数据处理)、Plotly/matplotlib/seaborn(可视化)、PyTorch(深度学习)等。
🖼️ 你会用到的工具
六、课程后勤(Logistics)
- 作业:5 次,每次跨约 3 周,两部分同时发布(Part 1 warmup + Part 2 main);
- 考核节奏(assessment cadence):贯穿学期的作业 + 期中 + 期末;
- 先修要求:MATH 53(多元微积分)、MATH 54(线性代数)、COMPSCI 70(概率与离散数学)或等价课程;
- 课程团队:讲师 + 众多 GSIs(助教);
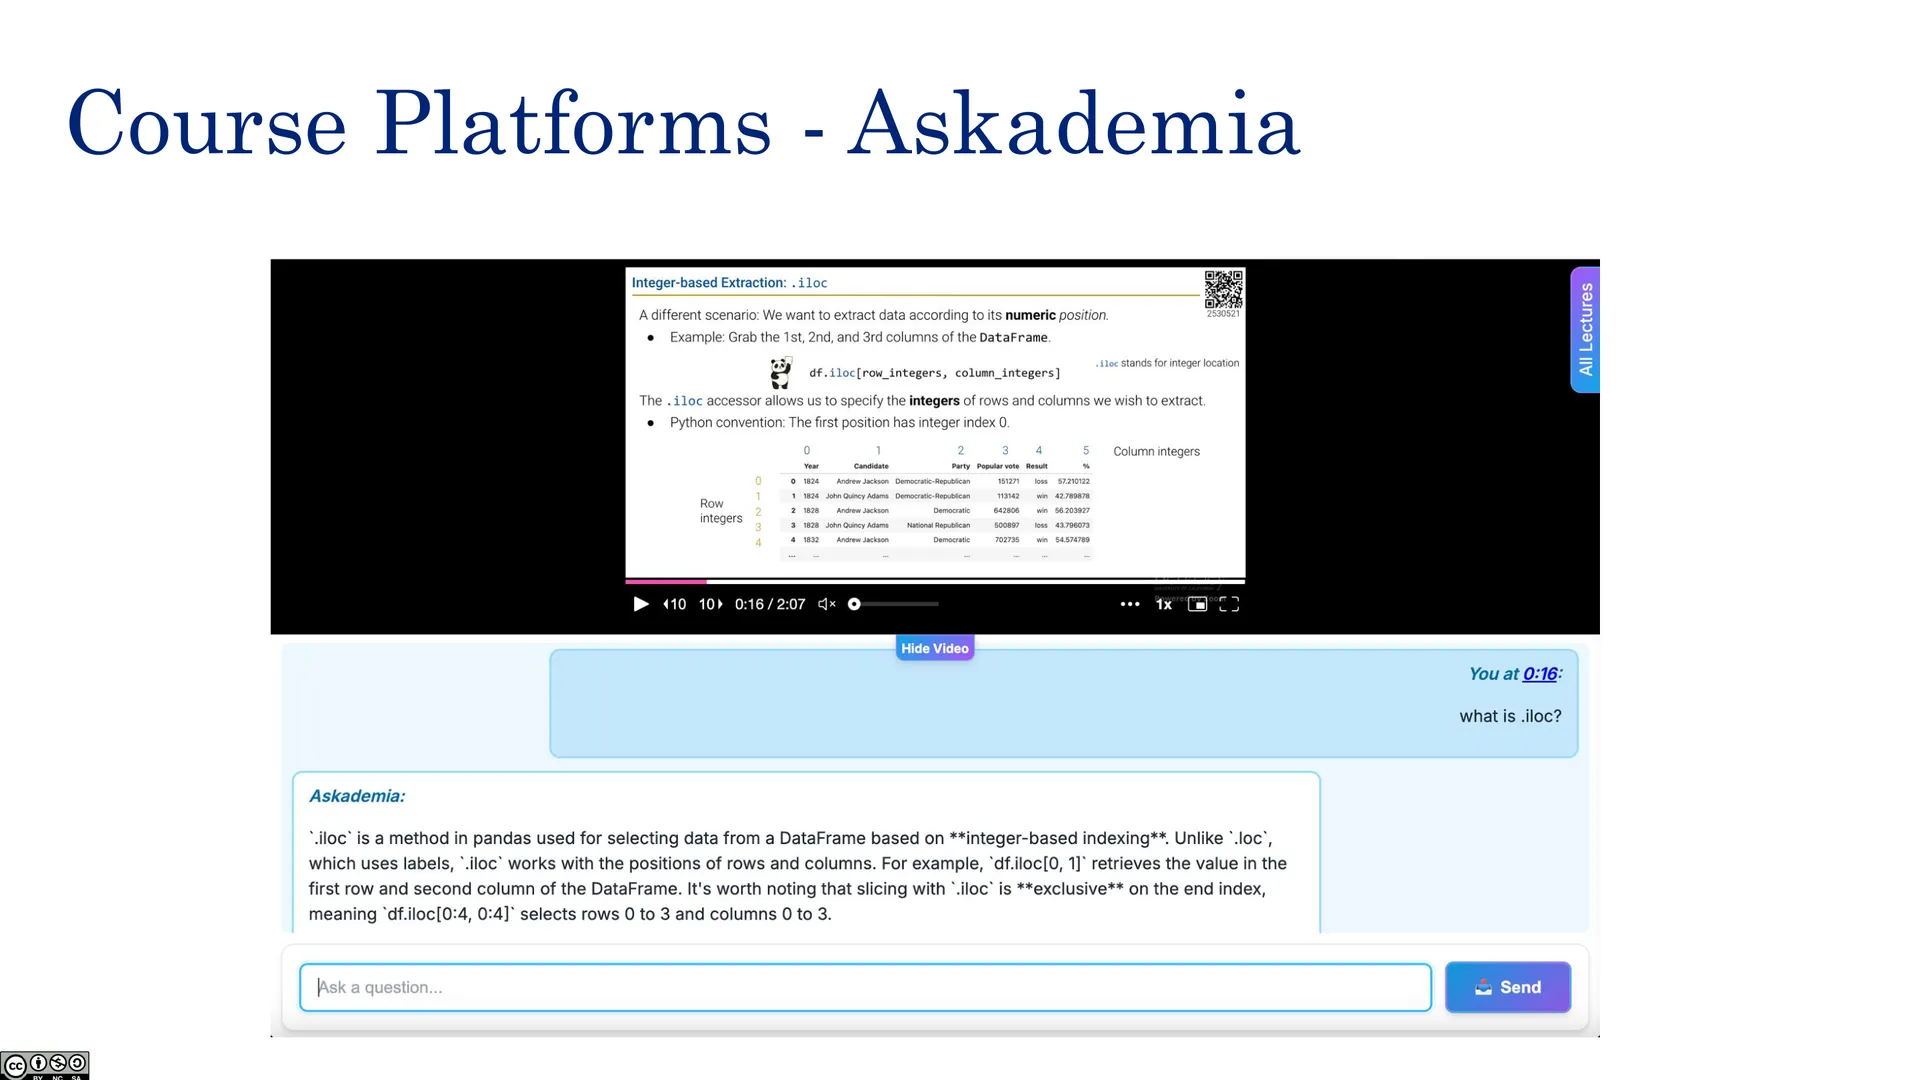
- 平台:Askademia(问答)、EdStem、Gradescope、Office Hours Queue。
🖼️ 后勤
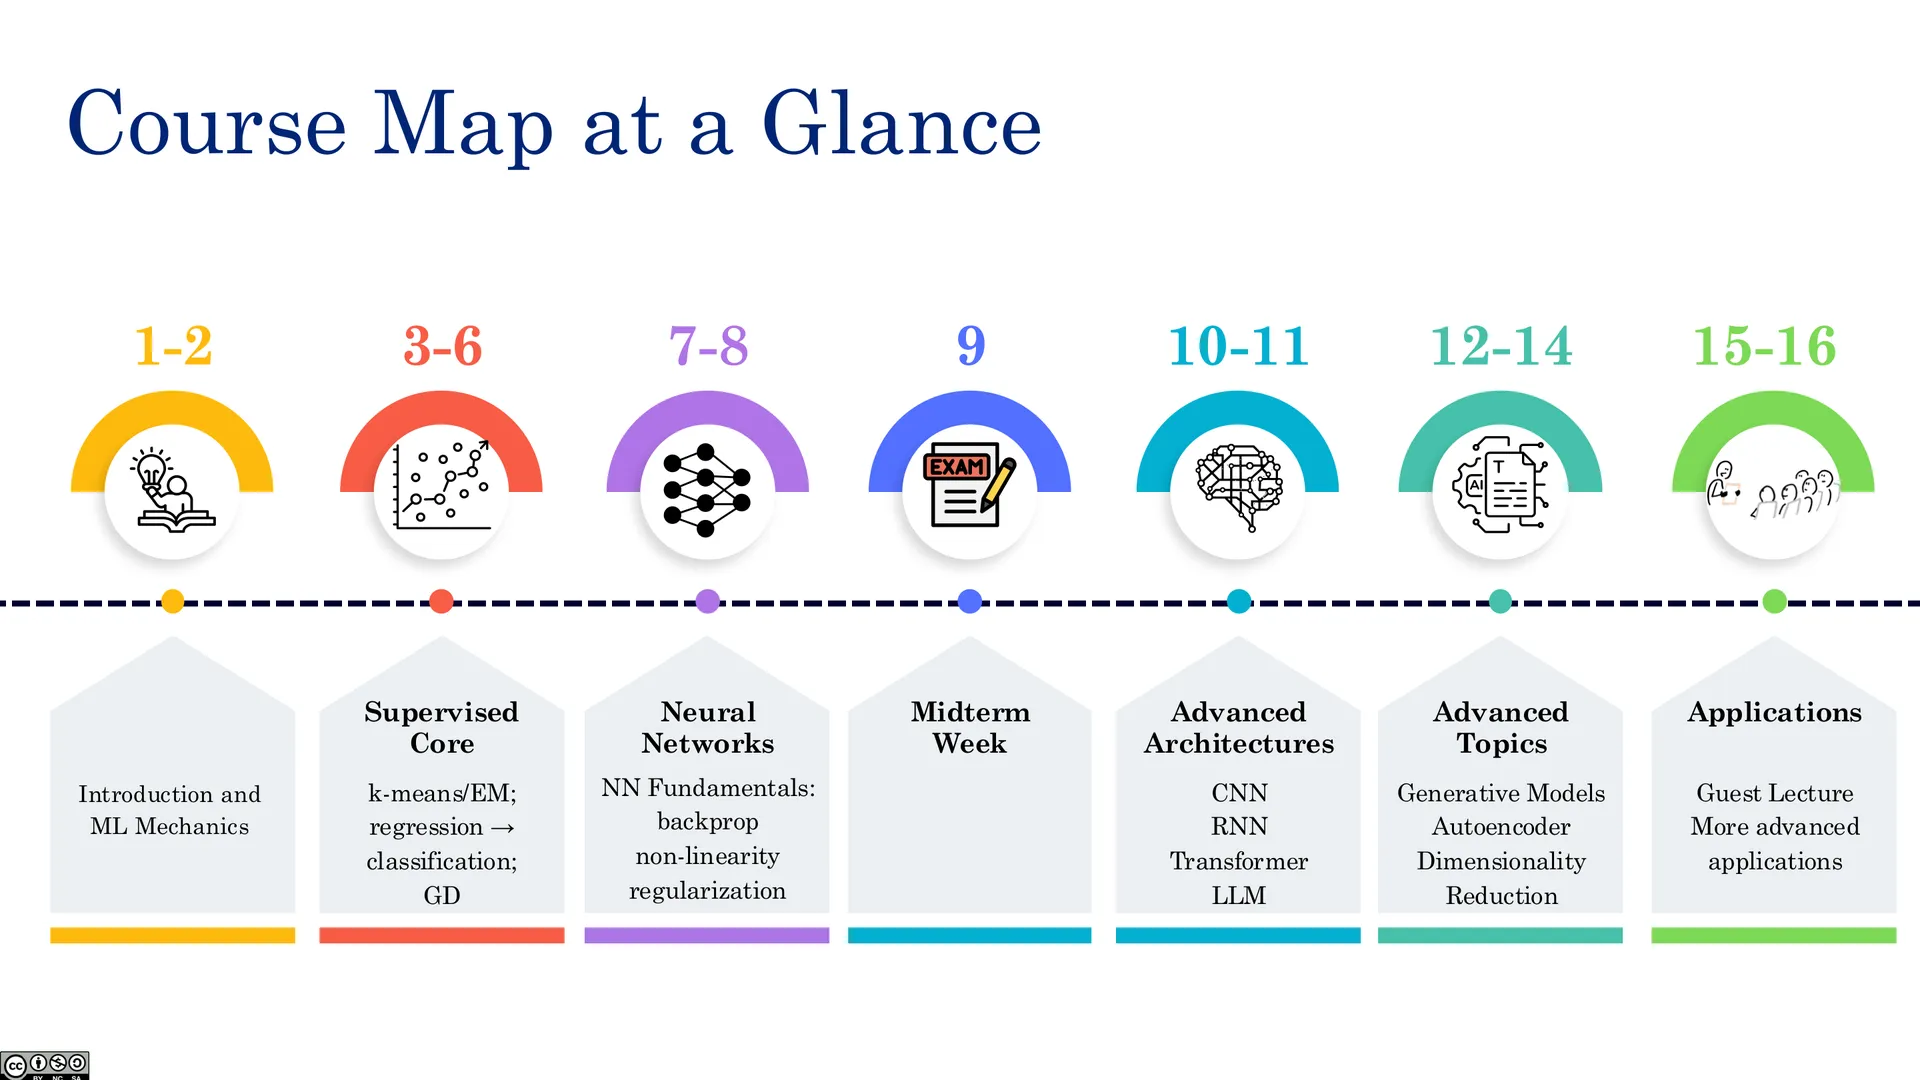
🖼️ 课程阶段划分
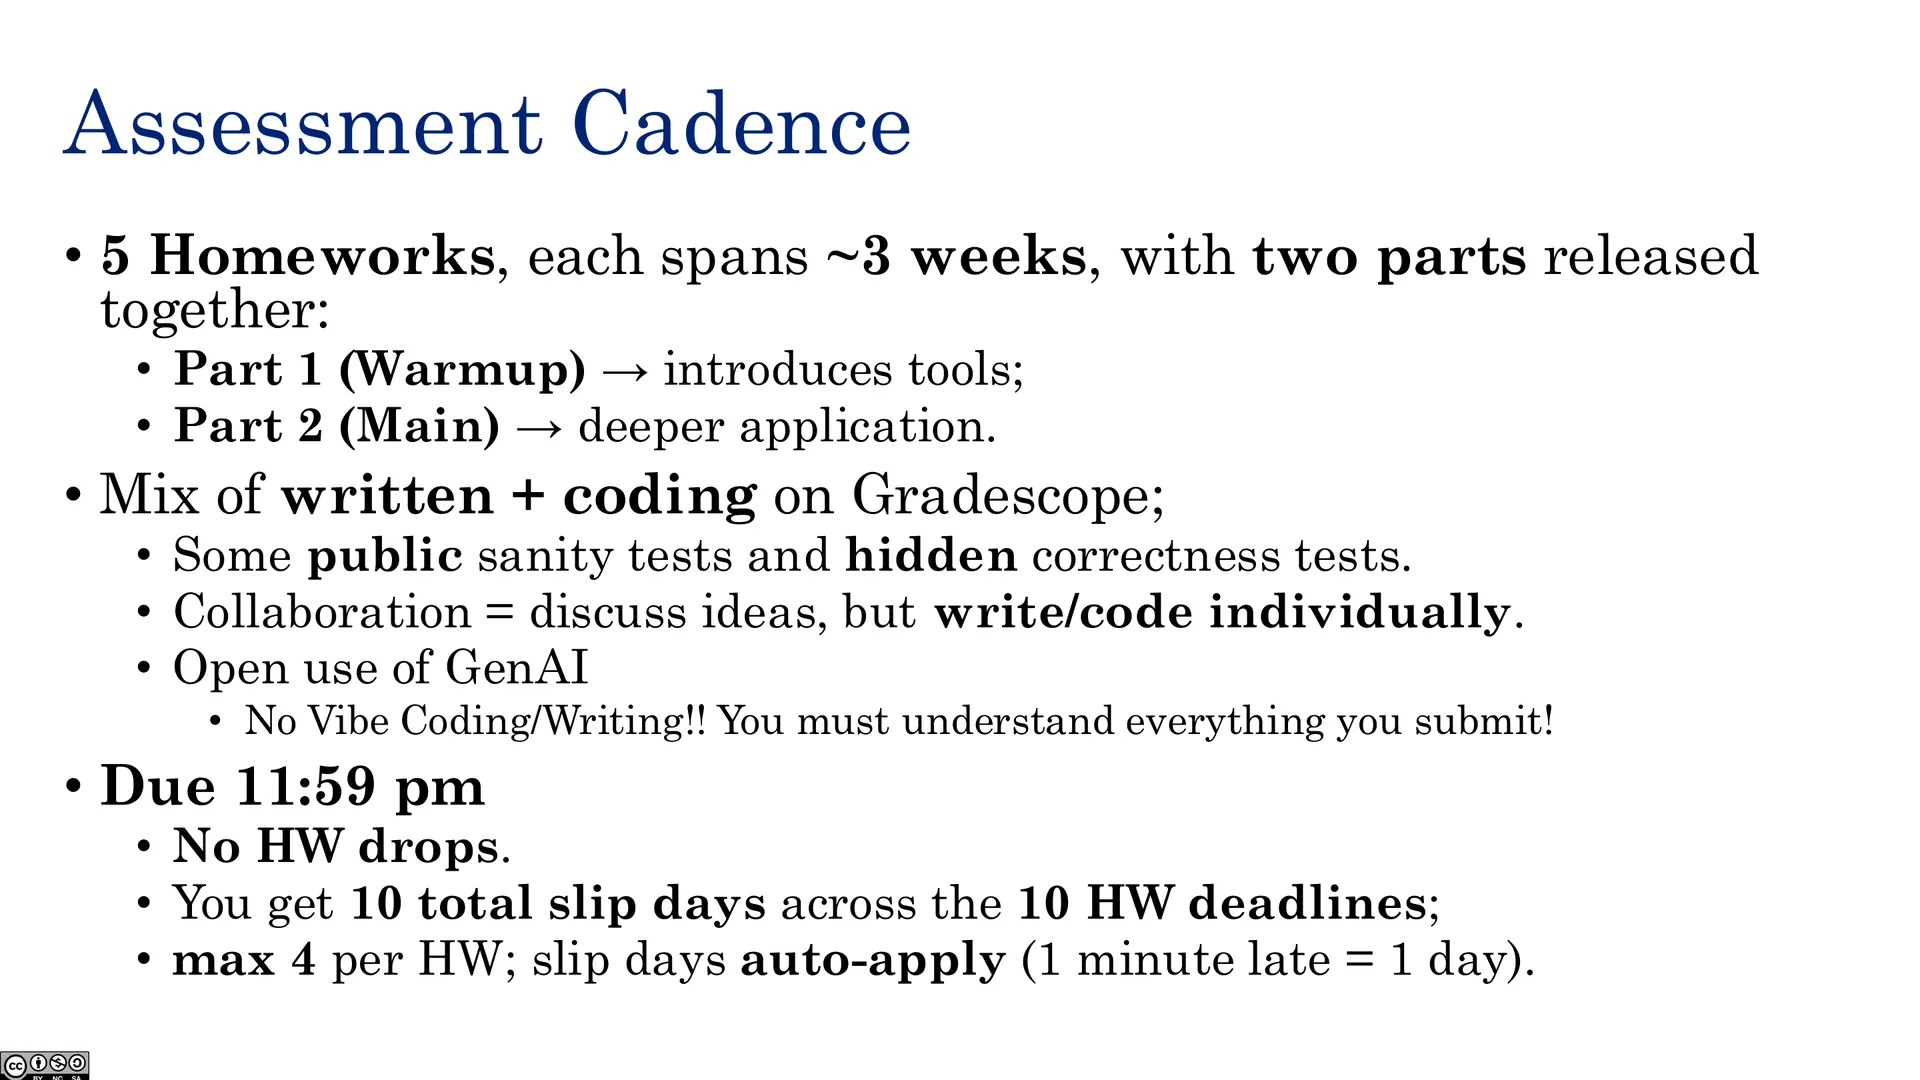
🖼️ 考核节奏
🖼️ 先修要求(一)
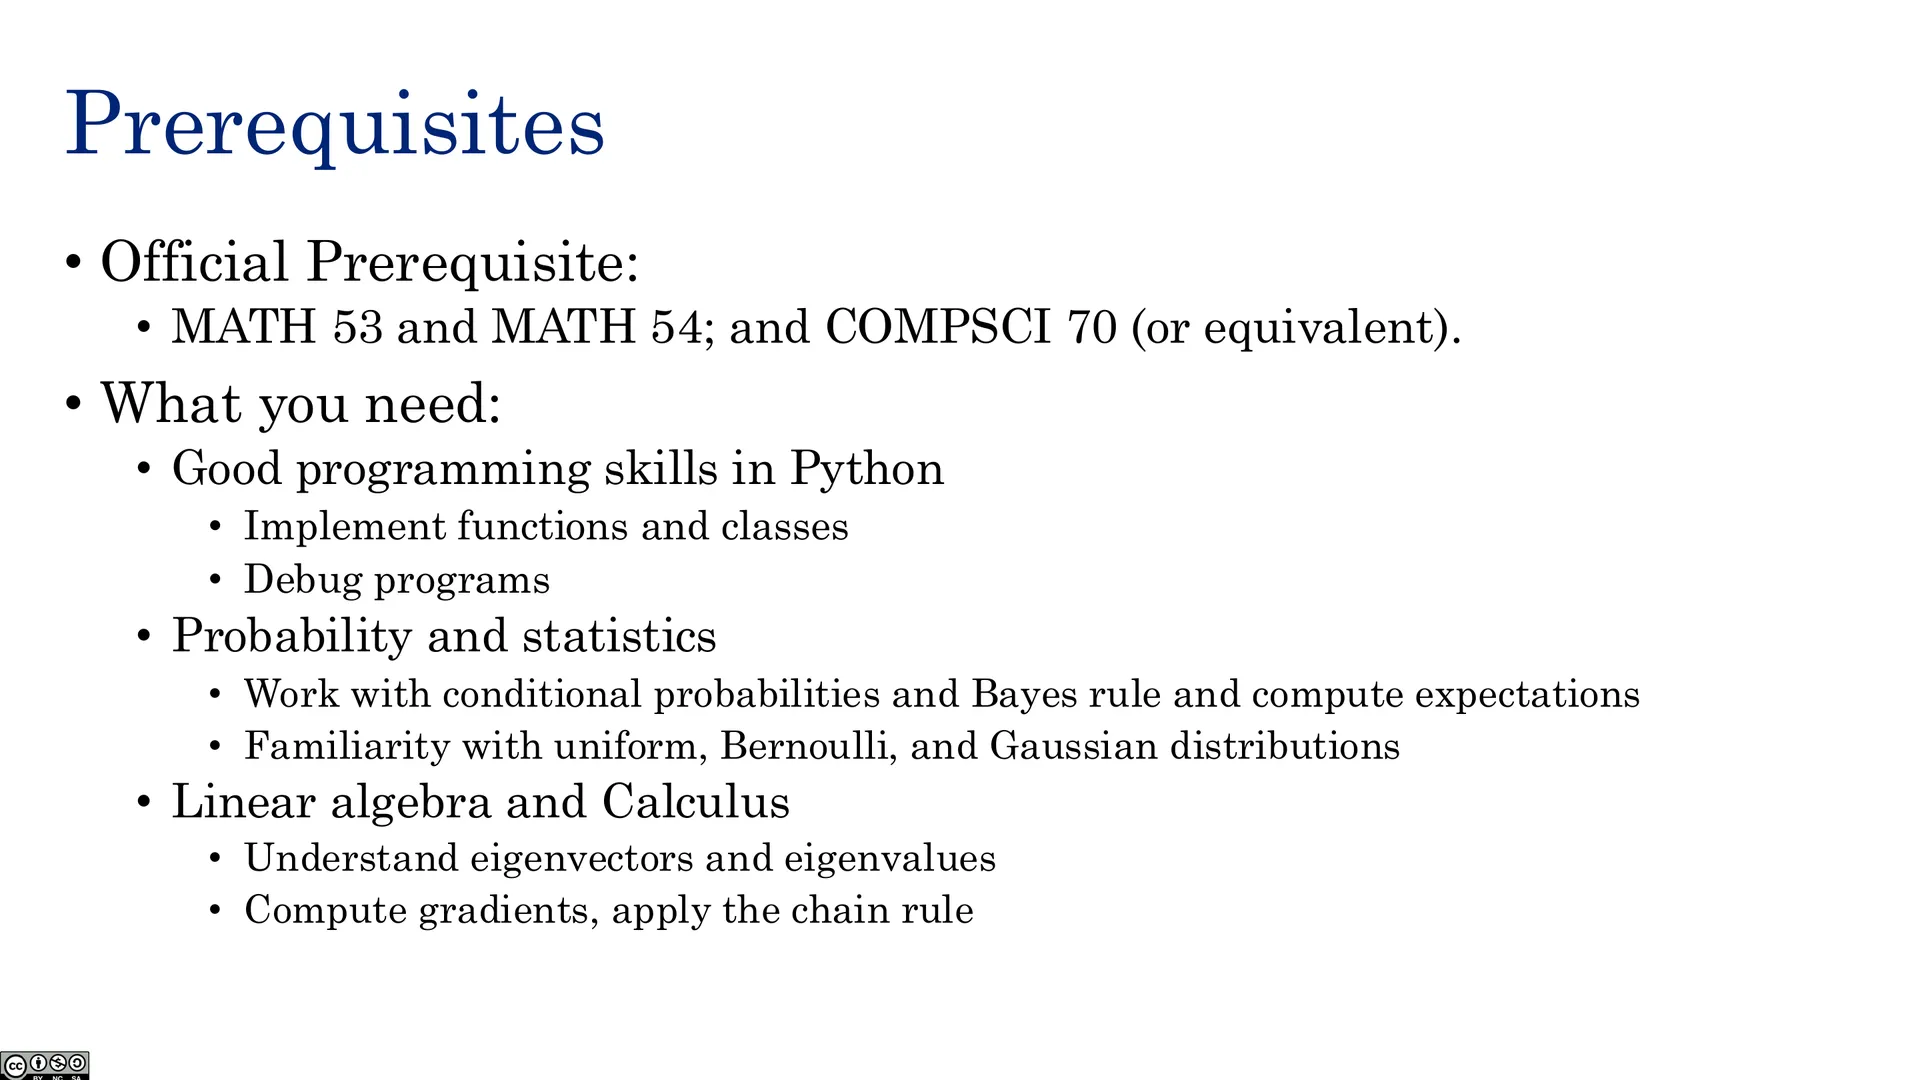
🖼️ 先修要求(二)
🖼️ 课程团队
🖼️ 课程平台:Askademia(一)
🖼️ 课程平台:Askademia(二)
🖼️ 结束页:机器学习导论
总结(Takeaways)
- AI 是目标,ML 是方法;ML 的配方是用数据拟合模型并泛化到新数据。
- 机器学习问题 ≈ 「容易评估解、难写求解算法」 的问题;能用规则直接解决的属工程问题。
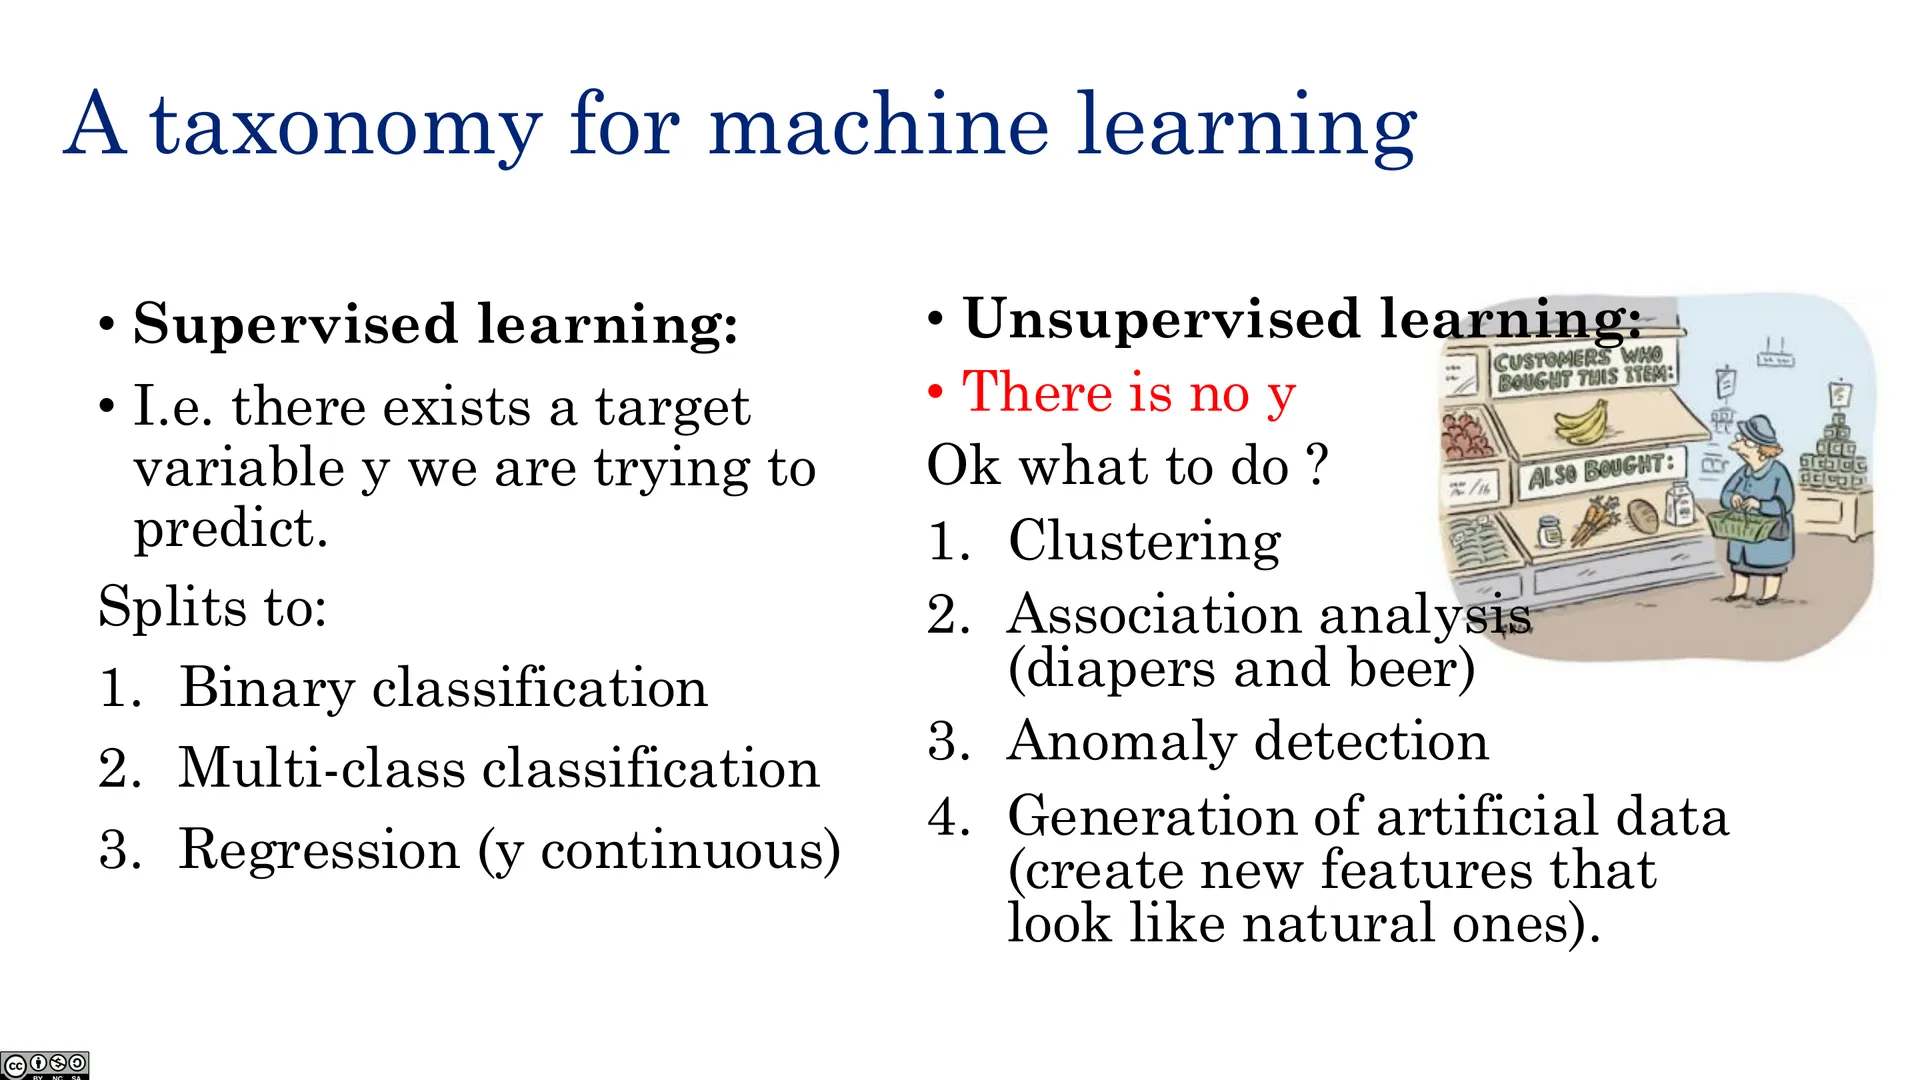
- 分类学:监督(回归/分类)、无监督(聚类/降维)、强化学习;
- 训练/测试划分至关重要——零训练误差 ≠ 学到东西(「总存在一个非常坏的模型」)。
- 基础模型:决策树(划分特征空间)与线性分类器(超平面)。
- 本课程跟随 Bishop 教材、侧重应用框定,并动手使用 pandas / PyTorch 等工具。
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 1) | Google Drive PDF |
| Discussion 1 讲义与解答 | https://drive.google.com/file/d/13TjzfhCv8lbf8pxoQjOx4RoEY0o/view |
| Bishop & Bishop, Deep Learning: Foundations and Concepts (2024) | 第 1 章(深度学习的影响、教程示例、ML 简史) · https://www.bishopbook.com/ |
| Murphy, Probabilistic Machine Learning: An Introduction | 机器学习导论 · https://probml.github.io/pml-book/book1.html |
本讲幻灯片中的真实数据集(Kaggle 竞赛)
第 1 讲幻灯片按「数据类型」举了大量真实数据集,链接如下:
| 数据类型 | 竞赛 / 数据集 | 链接 |
|---|---|---|
| 表格 | House Prices(房价回归) | https://www.kaggle.com/c/house-prices-advanced-regression-techniques |
| 表格 | Instacart Market Basket Analysis | https://www.kaggle.com/c/instacart-market-basket-analysis |
| 表格 | Walmart Sales in Stormy Weather | https://www.kaggle.com/c/walmart-recruiting-sales-in-stormy-weather |
| 表格 | HHP(再入院预测) | https://www.kaggle.com/c/hhp |
| 图像 | Severstal 钢材缺陷检测 | https://www.kaggle.com/c/severstal-steel-defect-detection |
| 图像 | Dogs vs. Cats | https://www.kaggle.com/c/dogs-vs-cats-redux-kernels-edition |
| 图像 | Global Wheat Detection | https://www.kaggle.com/c/global-wheat-detection |
| 时间序列 | Seizure Prediction(EEG) | https://www.kaggle.com/c/seizure-prediction |
| 时间序列 | COVID-19 Global Forecasting | https://www.kaggle.com/c/covid19-global-forecasting-week-5 |
| 自然语言 | Tweet Sentiment Extraction | https://www.kaggle.com/c/tweet-sentiment-extraction |
| 自然语言 | Quora Insincere Questions | https://www.kaggle.com/c/quora-insincere-questions-classification |
更多竞赛见 Kaggle 竞赛总览:https://www.kaggle.com/competitions。
版权说明:本讲讲义与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为讲义内容的学习性中文重构,仅供学习交流。