第3讲 · EECS 189:机器学习机制——术语与技术
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 主讲 | Alex Dimakis、Jennifer Listgarten |
| 视频 | https://www.youtube.com/watch?v=oVo_RajZ3aE |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 3) | Google Drive PDF |
| 教材 | Machine Learning: A First Course for Engineers and Scientists(Lindholm 等),本讲对应 Chapter 1 |
| 幻灯片致谢 | Lecture 3 幻灯片由 Joseph E. Gonzalez、Narges Norouzi 制作 |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图;少量截图为视频画面 |
对应讲次:第3讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
编者说明:本讲是机器学习方法论的「鸟瞰图」——引入术语与生命周期,但不陷入数学细节(后续各讲会重新深入)。授课在「正则化」一页(约 01:15)停下,剩下的幻灯片(参数化/非参数化、逻辑回归、优化、评估、作业等)归入文末附录。
导言:本讲目标
(参考时间: 00:00)
本讲将引入使用机器学习时的主要概念,提供一个高层的理解(而非严格推导);所有主题都会在学期后半段更正式地回顾。我们还会展示如何用 Python 做基础的机器学习,走一遍机器学习生命周期的每一步,并为 Homework 1 做准备。
📷 本讲标题页
回到原视频 (00:00:34)
今天的目标:
- 引入机器学习中的主要概念;
- 给出高层理解(不追求严谨),后续会再深入;
- 演示如何用 Python 做基础机器学习;
- 走一遍机器学习生命周期的每一步;
- 为 Homework 1 做准备。
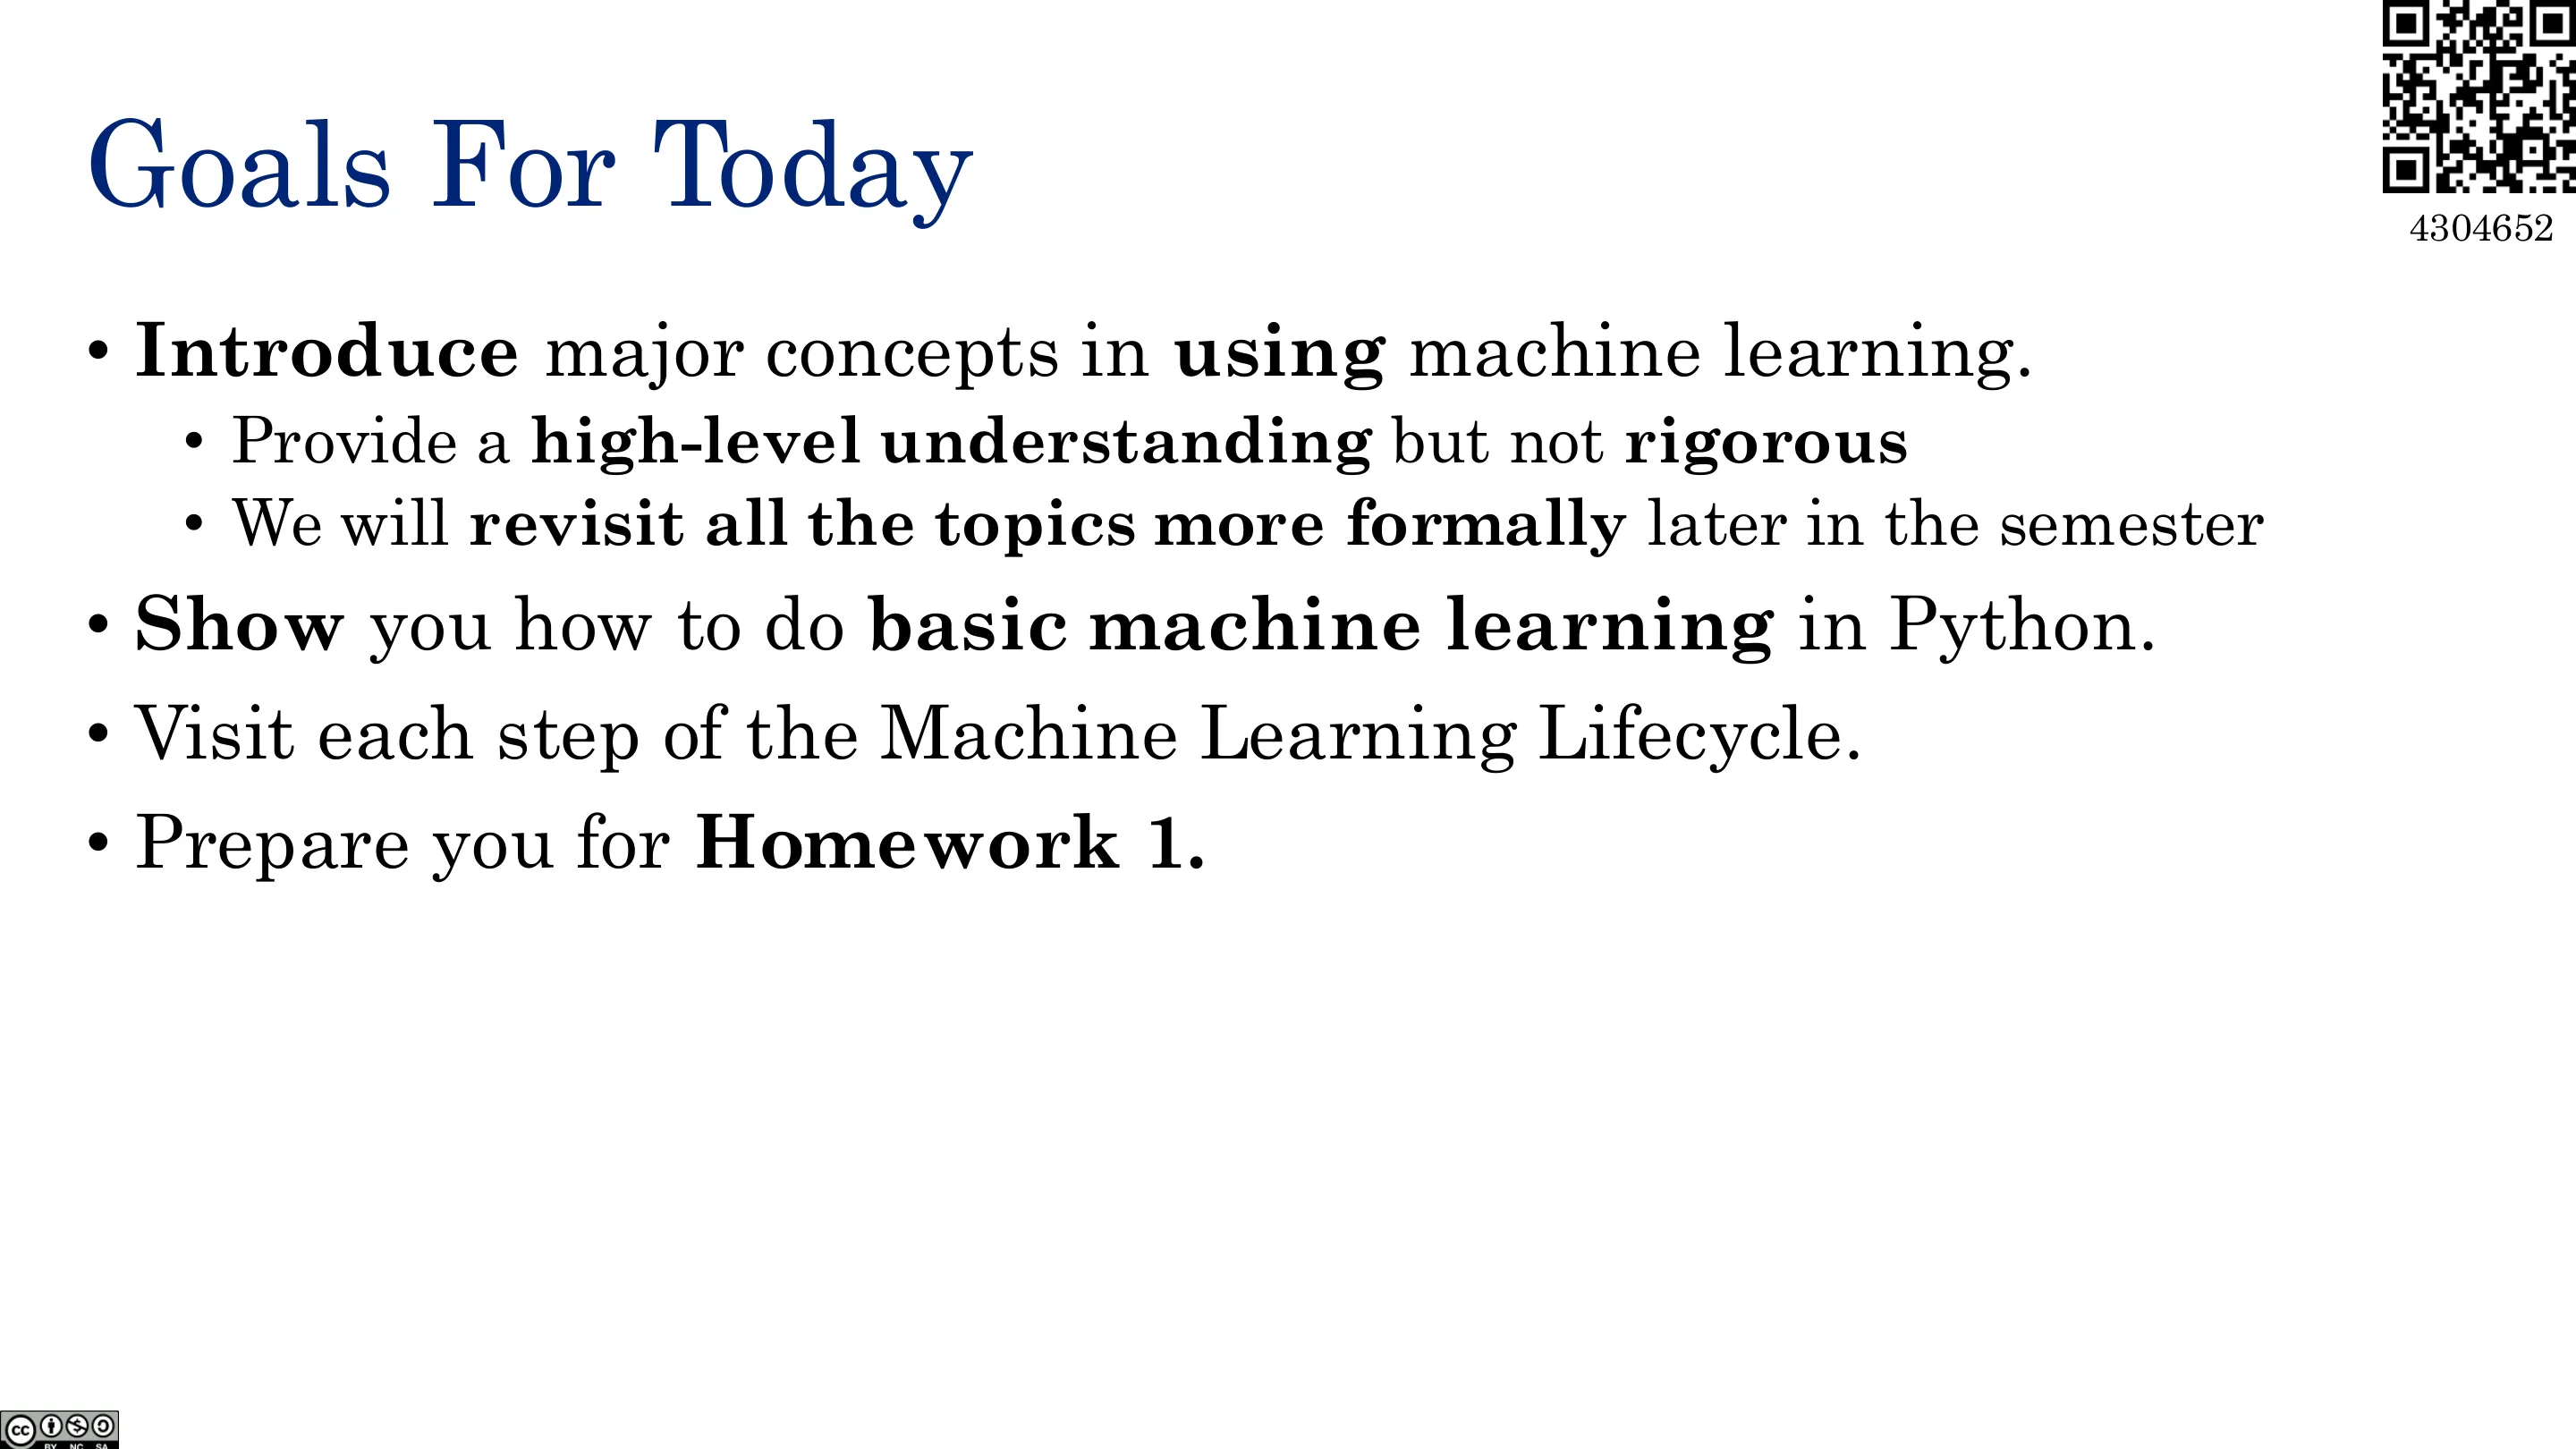
📷 今天的目标
回到原视频 (00:00:47)
一个小调查(Slido):课前用过哪些库?结果——几乎所有人都用过 NumPy;用 pandas 的比例出乎意料地高;用 scikit-learn 的也很多;不少人用过 PyTorch;没有人用过 JAX(讲师说他自己也不用 JAX,而用 PyTorch)。
📷 课前调查:用过哪些库
回到原视频 (00:02:23)
一、scikit-learn 与机器学习生命周期
(参考时间: 00:04)
本讲的主角之一是 scikit-learn——一个被广泛使用的 Python 包,覆盖机器学习生命周期的多个子环节:
- 数据准备(Data Prep)
- 特征工程(Feature Engineering)
- 经典模型(Classic Models):如决策树、梯度提升(gradient boosting)——即便今天也非常有用;
- 评估(Evaluation):另一个非常重要的章节。
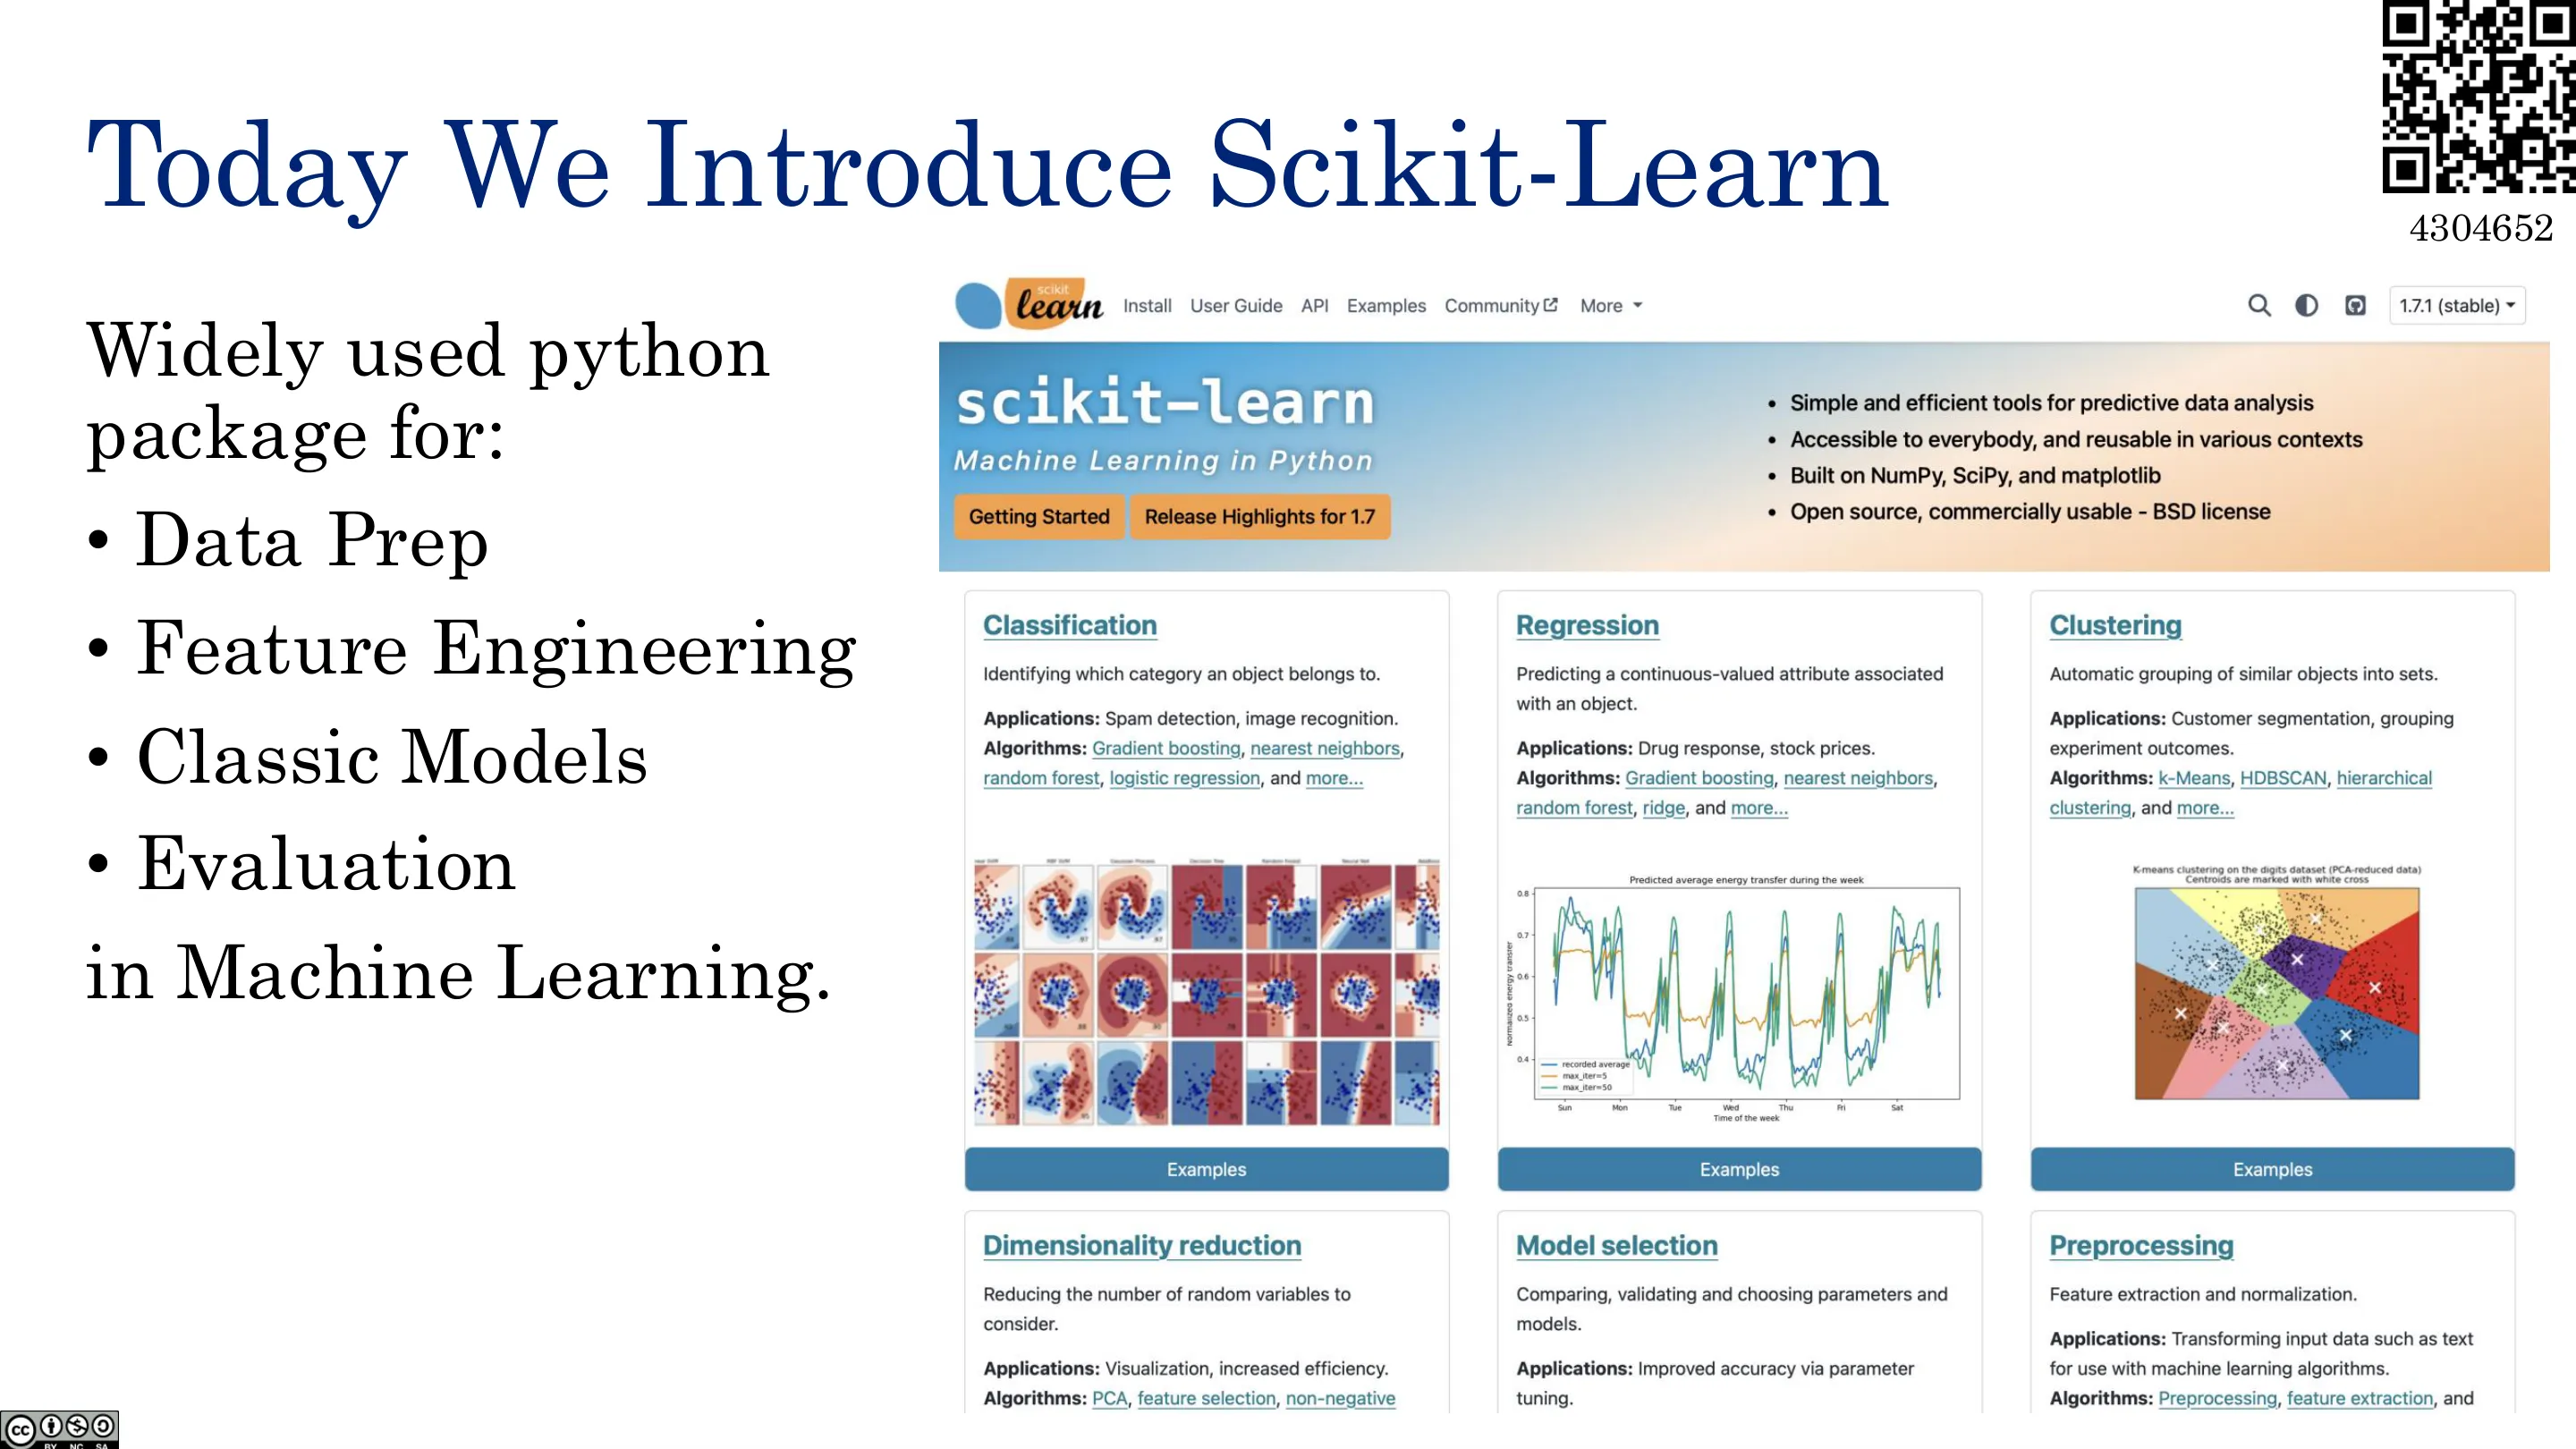
📷 今天介绍 scikit-learn
回到原视频 (00:04:13)
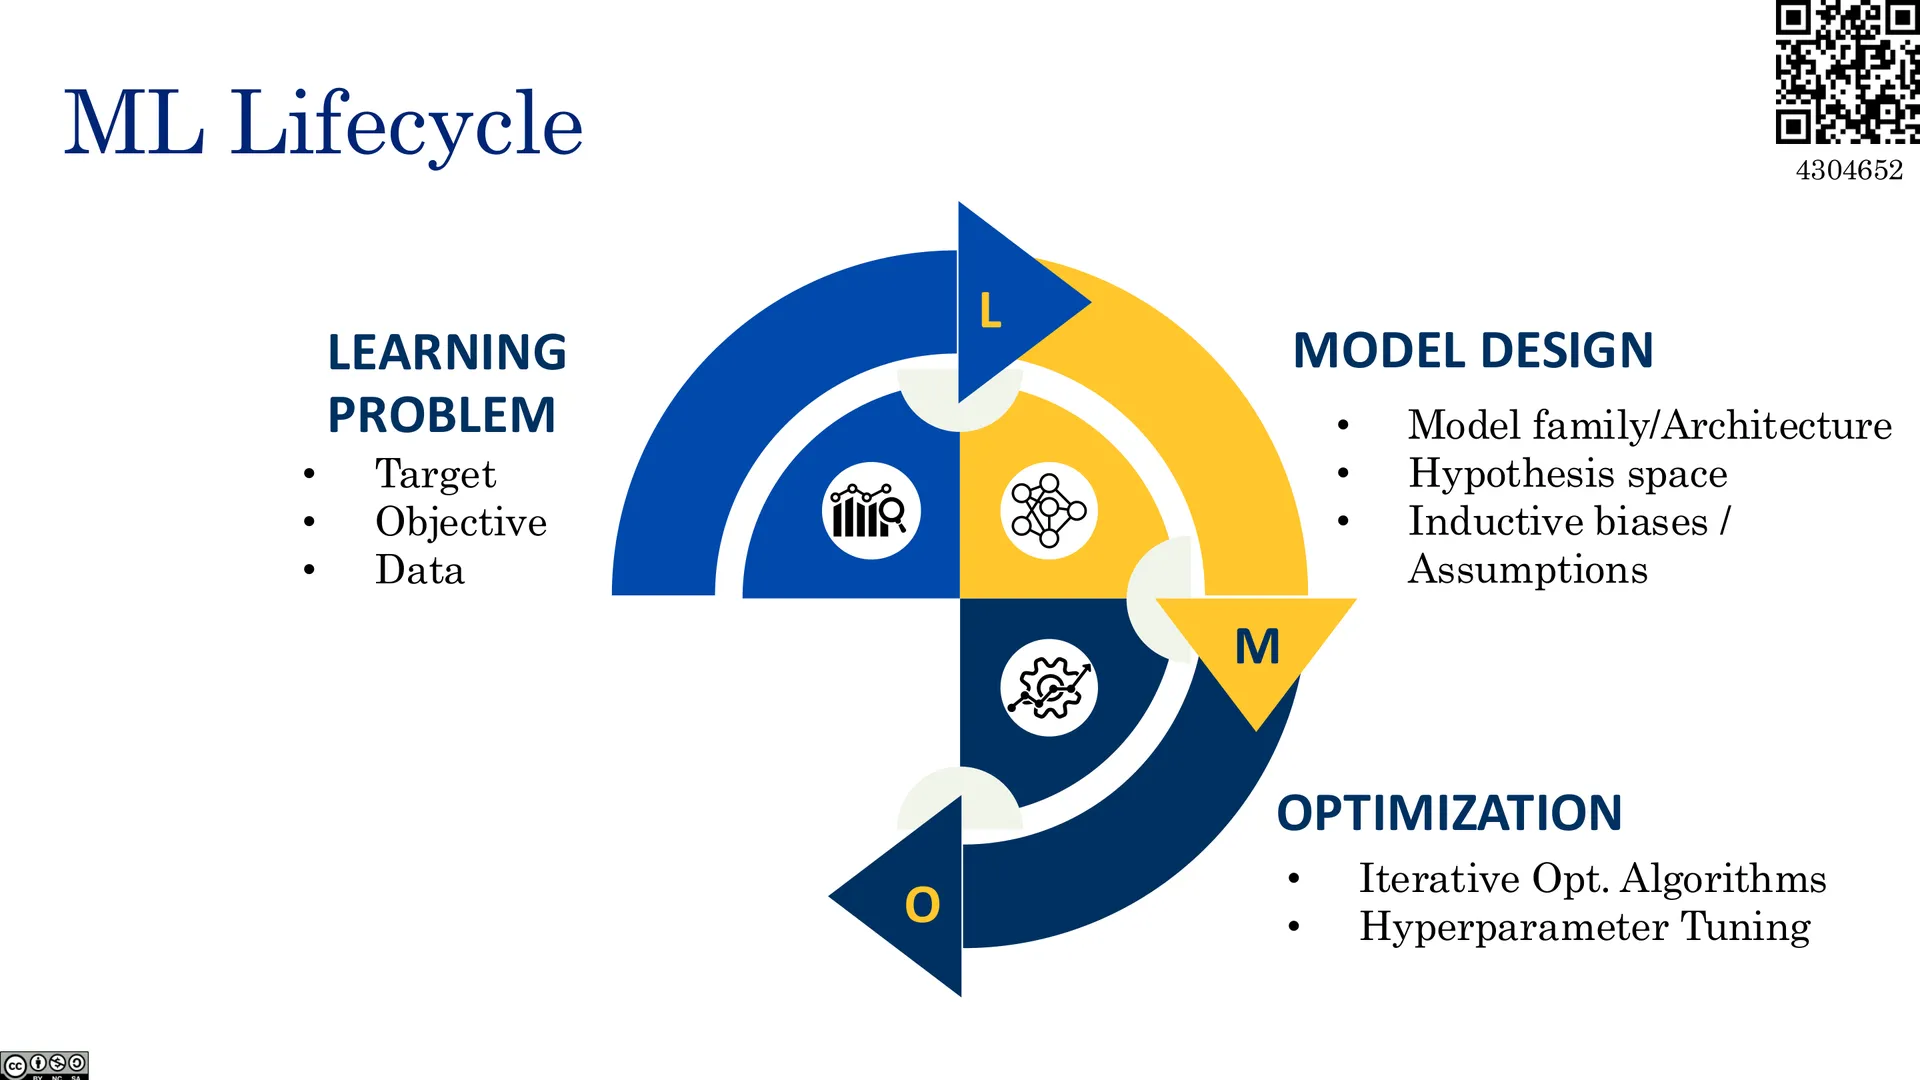
机器学习生命周期(ML Lifecycle)由四个阶段组成:
flowchart LR
    A["Learning Problem<br/>定义问题"] --> B["Model Design<br/>模型设计"]
    B --> C["Optimization<br/>优化/训练"]
    C --> D["Predict & Evaluate<br/>预测与评估"]
    D -.->|"迭代"| B
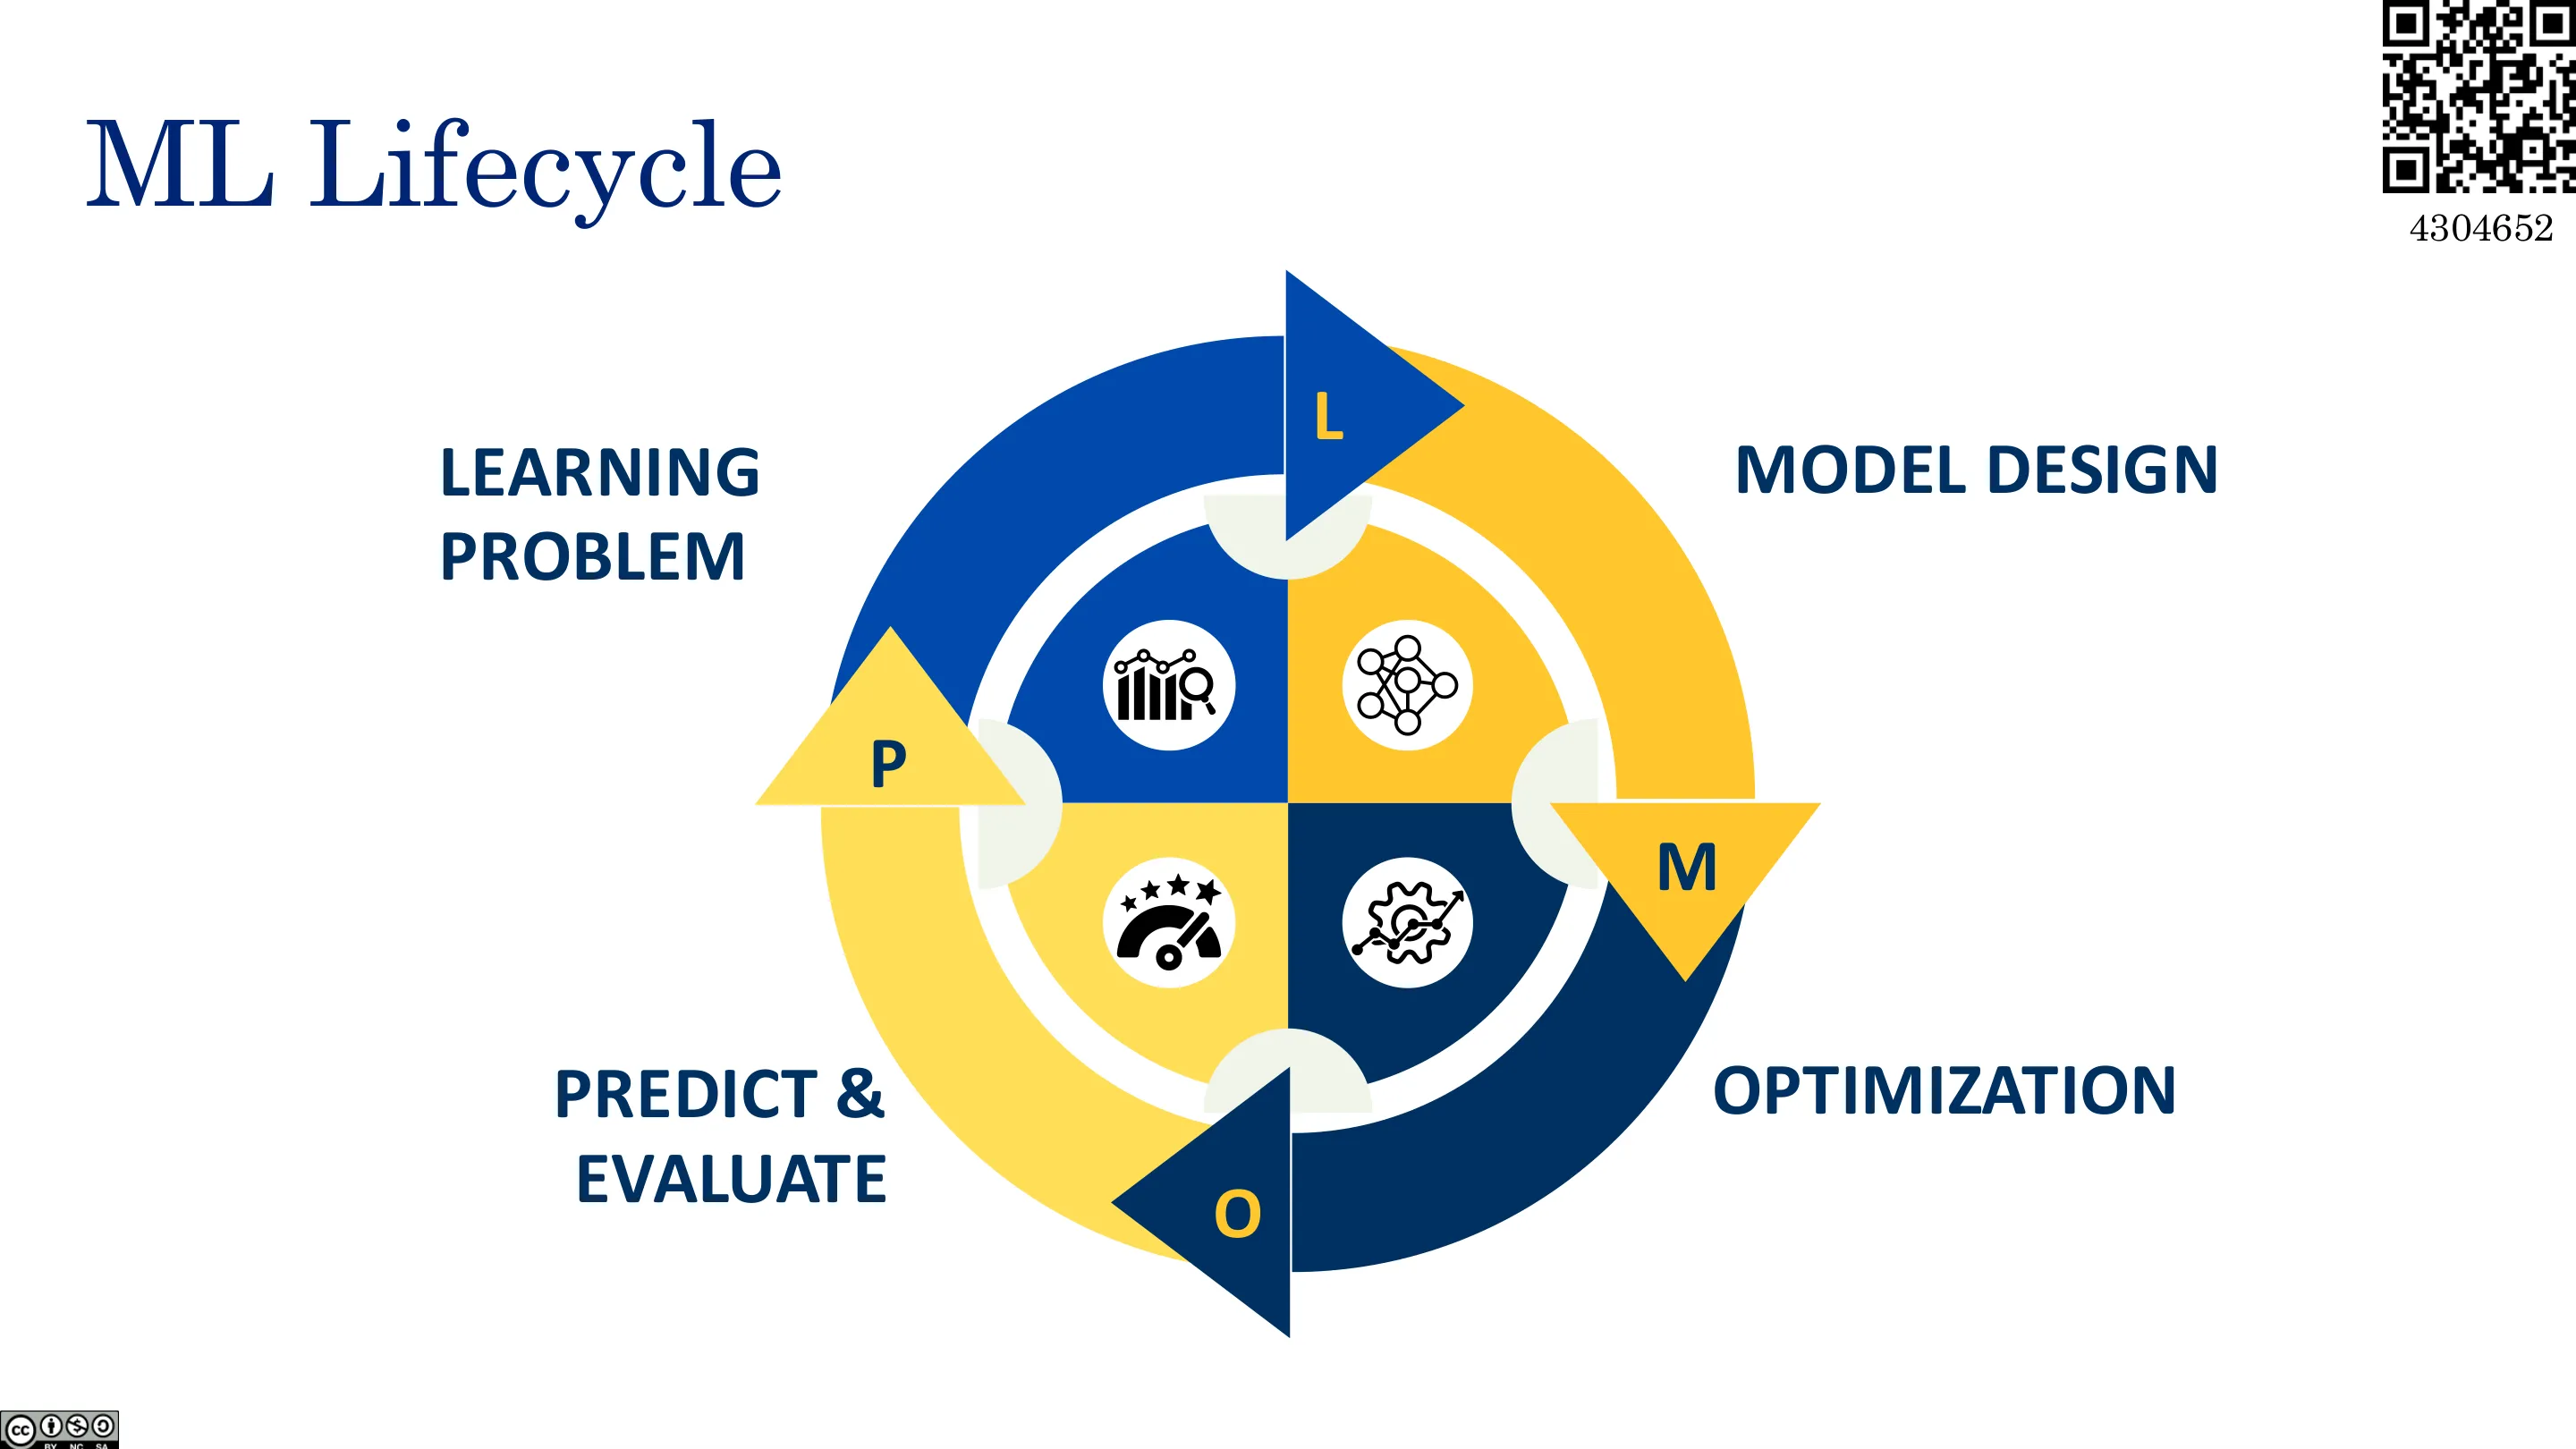
📷 机器学习生命周期
回到原视频 (00:04:51)
第一阶段永远是「定义学习问题」,它包含三个要素:
- Target(目标):我想预测什么?这是一个什么机器学习任务?
- Objective(目标函数):如何评估成功?应该用什么损失(loss)?
- Data(数据):我有什么数据?如何表示?如何做训练/测试划分?
这些听起来很直观,但实际上非常复杂,需要非常认真地思考——实践中大多数错误都发生在这里。
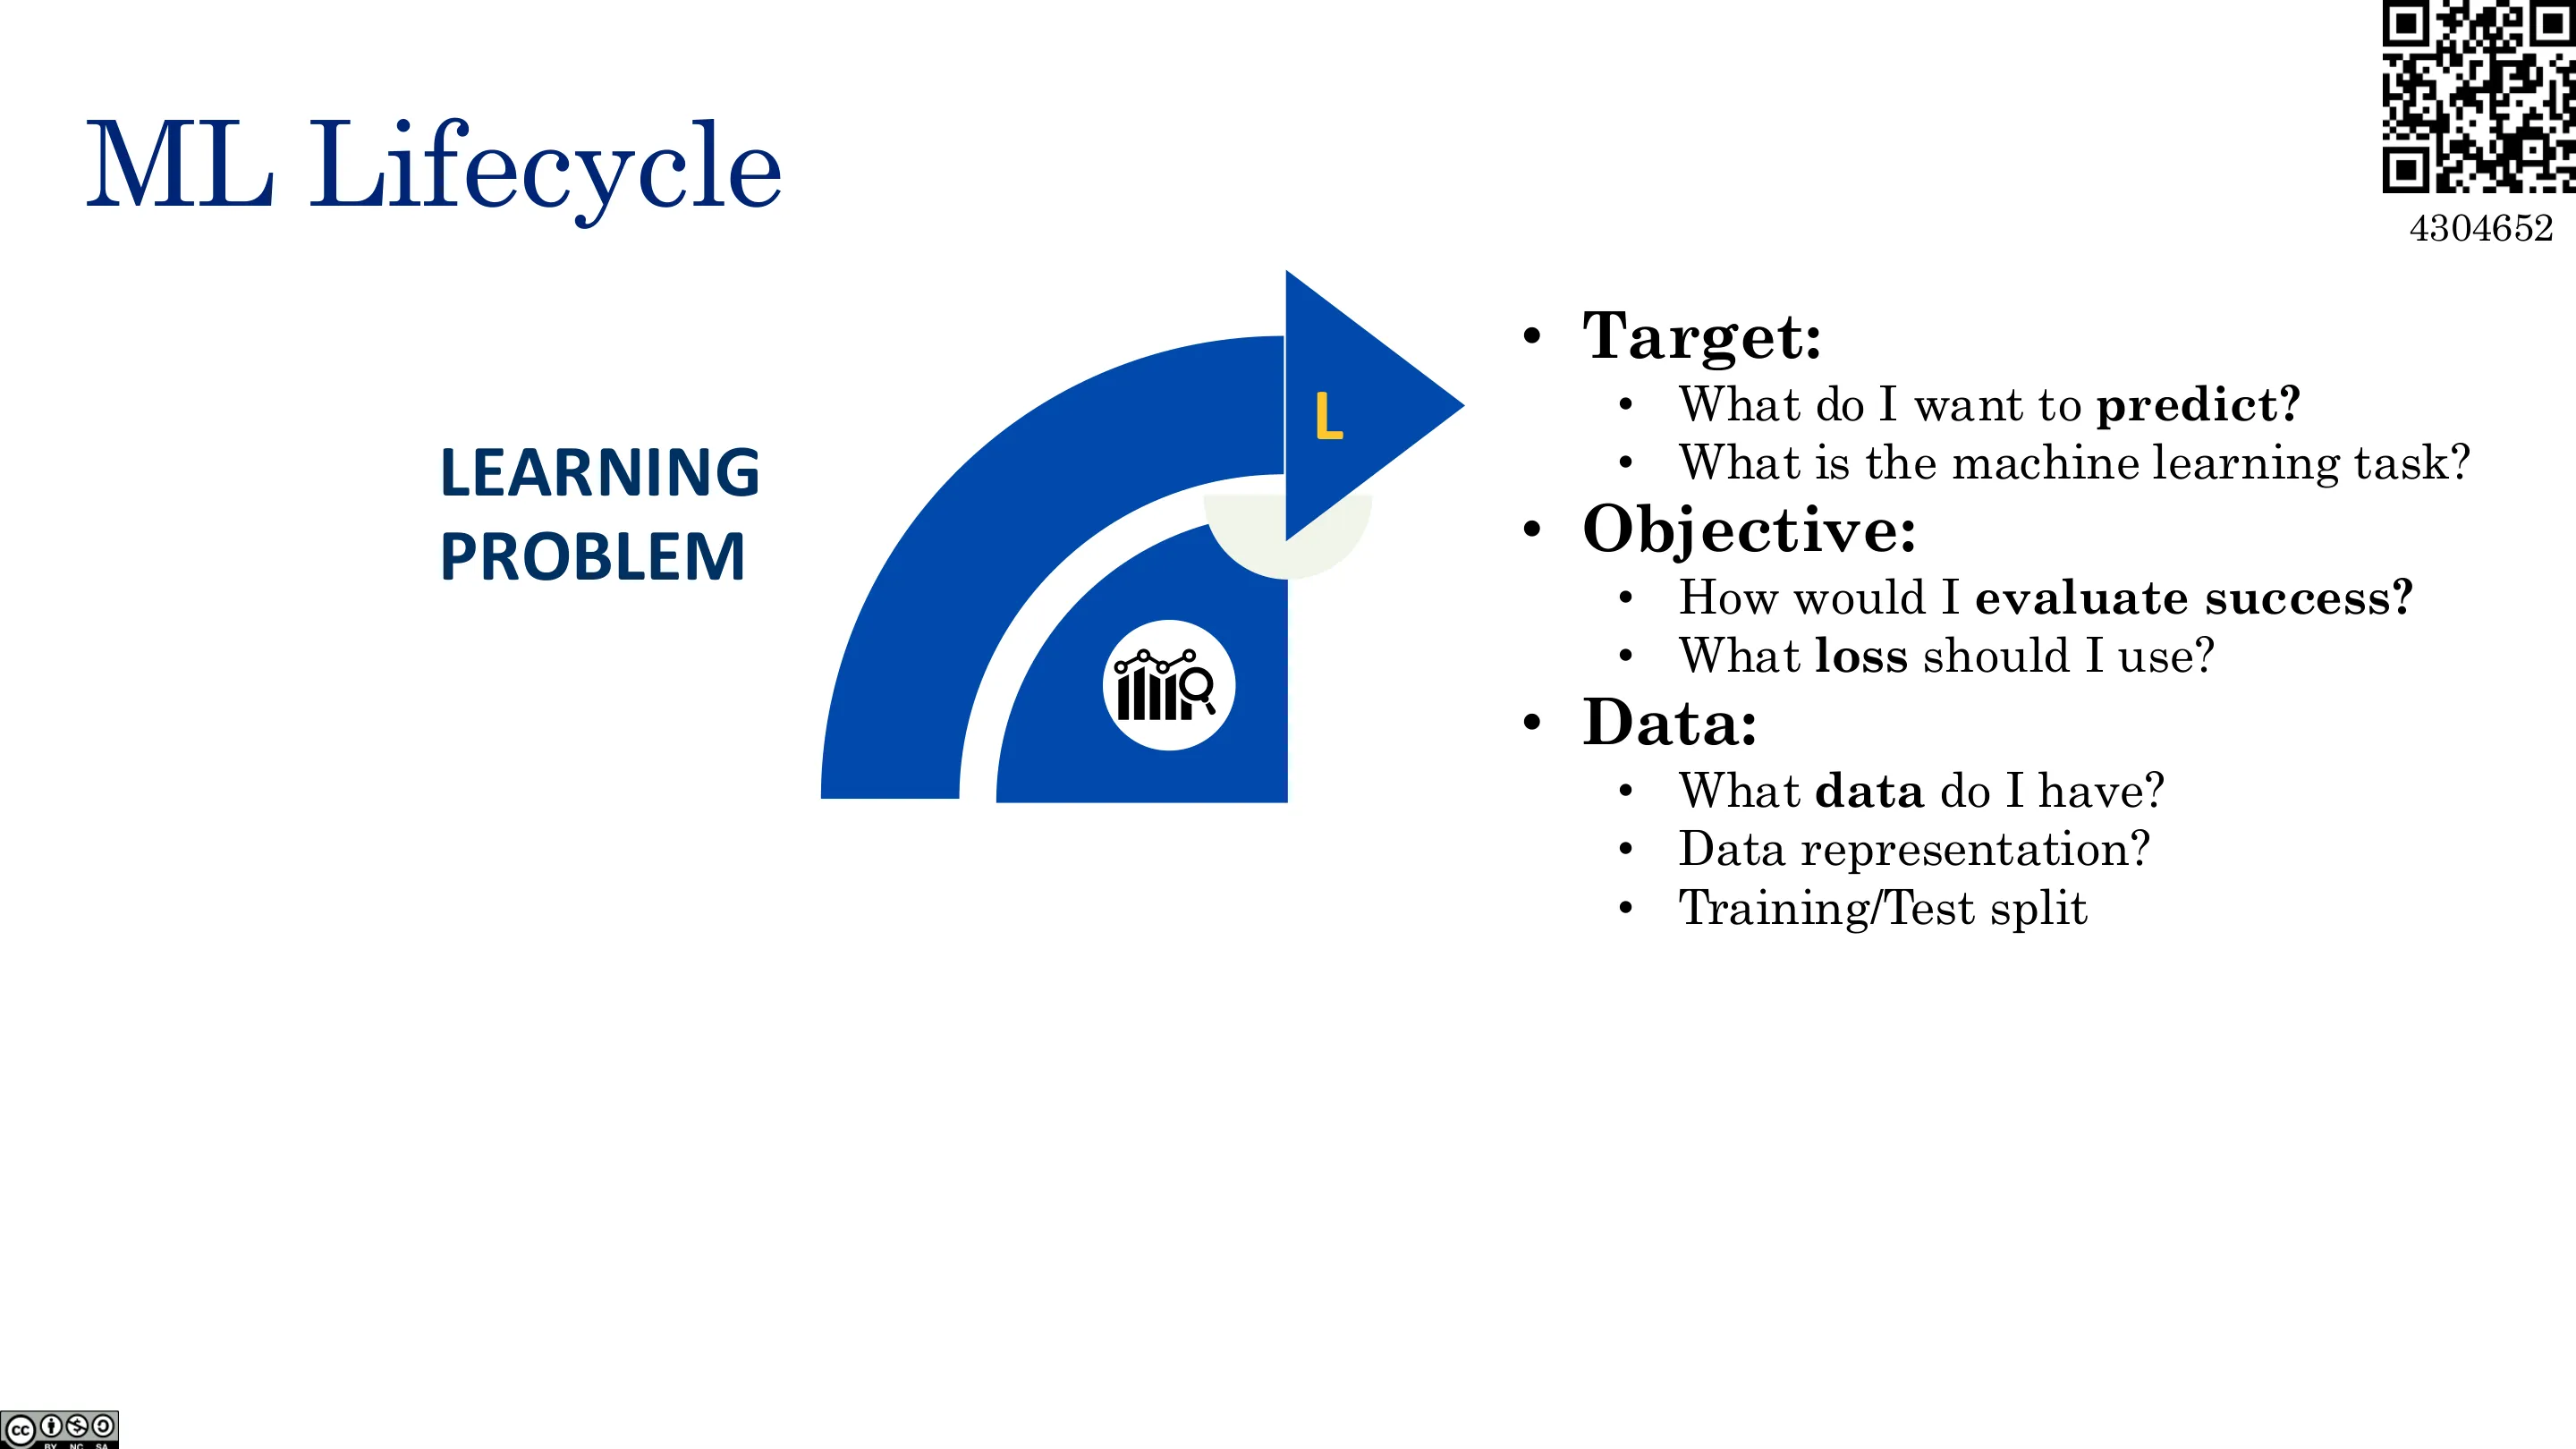
📷 定义学习问题
回到原视频 (00:05:18)
二、把问题形式化:FashionHub 的例子
(参考时间: 00:05)
设想你正在创办一个服装交易网站(FashionHub):用户上传想交易的衣物照片。我们希望根据卖家上传的图片,自动把衣物打上类别标签,以便归入正确的类别(像 eBay 那样,上传运动鞋就自动识别出来)。我们手上还有一些带类别标签的示例服装图片。
用生命周期的语言来问:我们要预测什么?——衣物的类型;我们有什么数据?——成对的「图片 + 标签」(labeled pairs);如何评估成功?——也许是准确率(accuracy):拿 100 张图看分类对了多少。
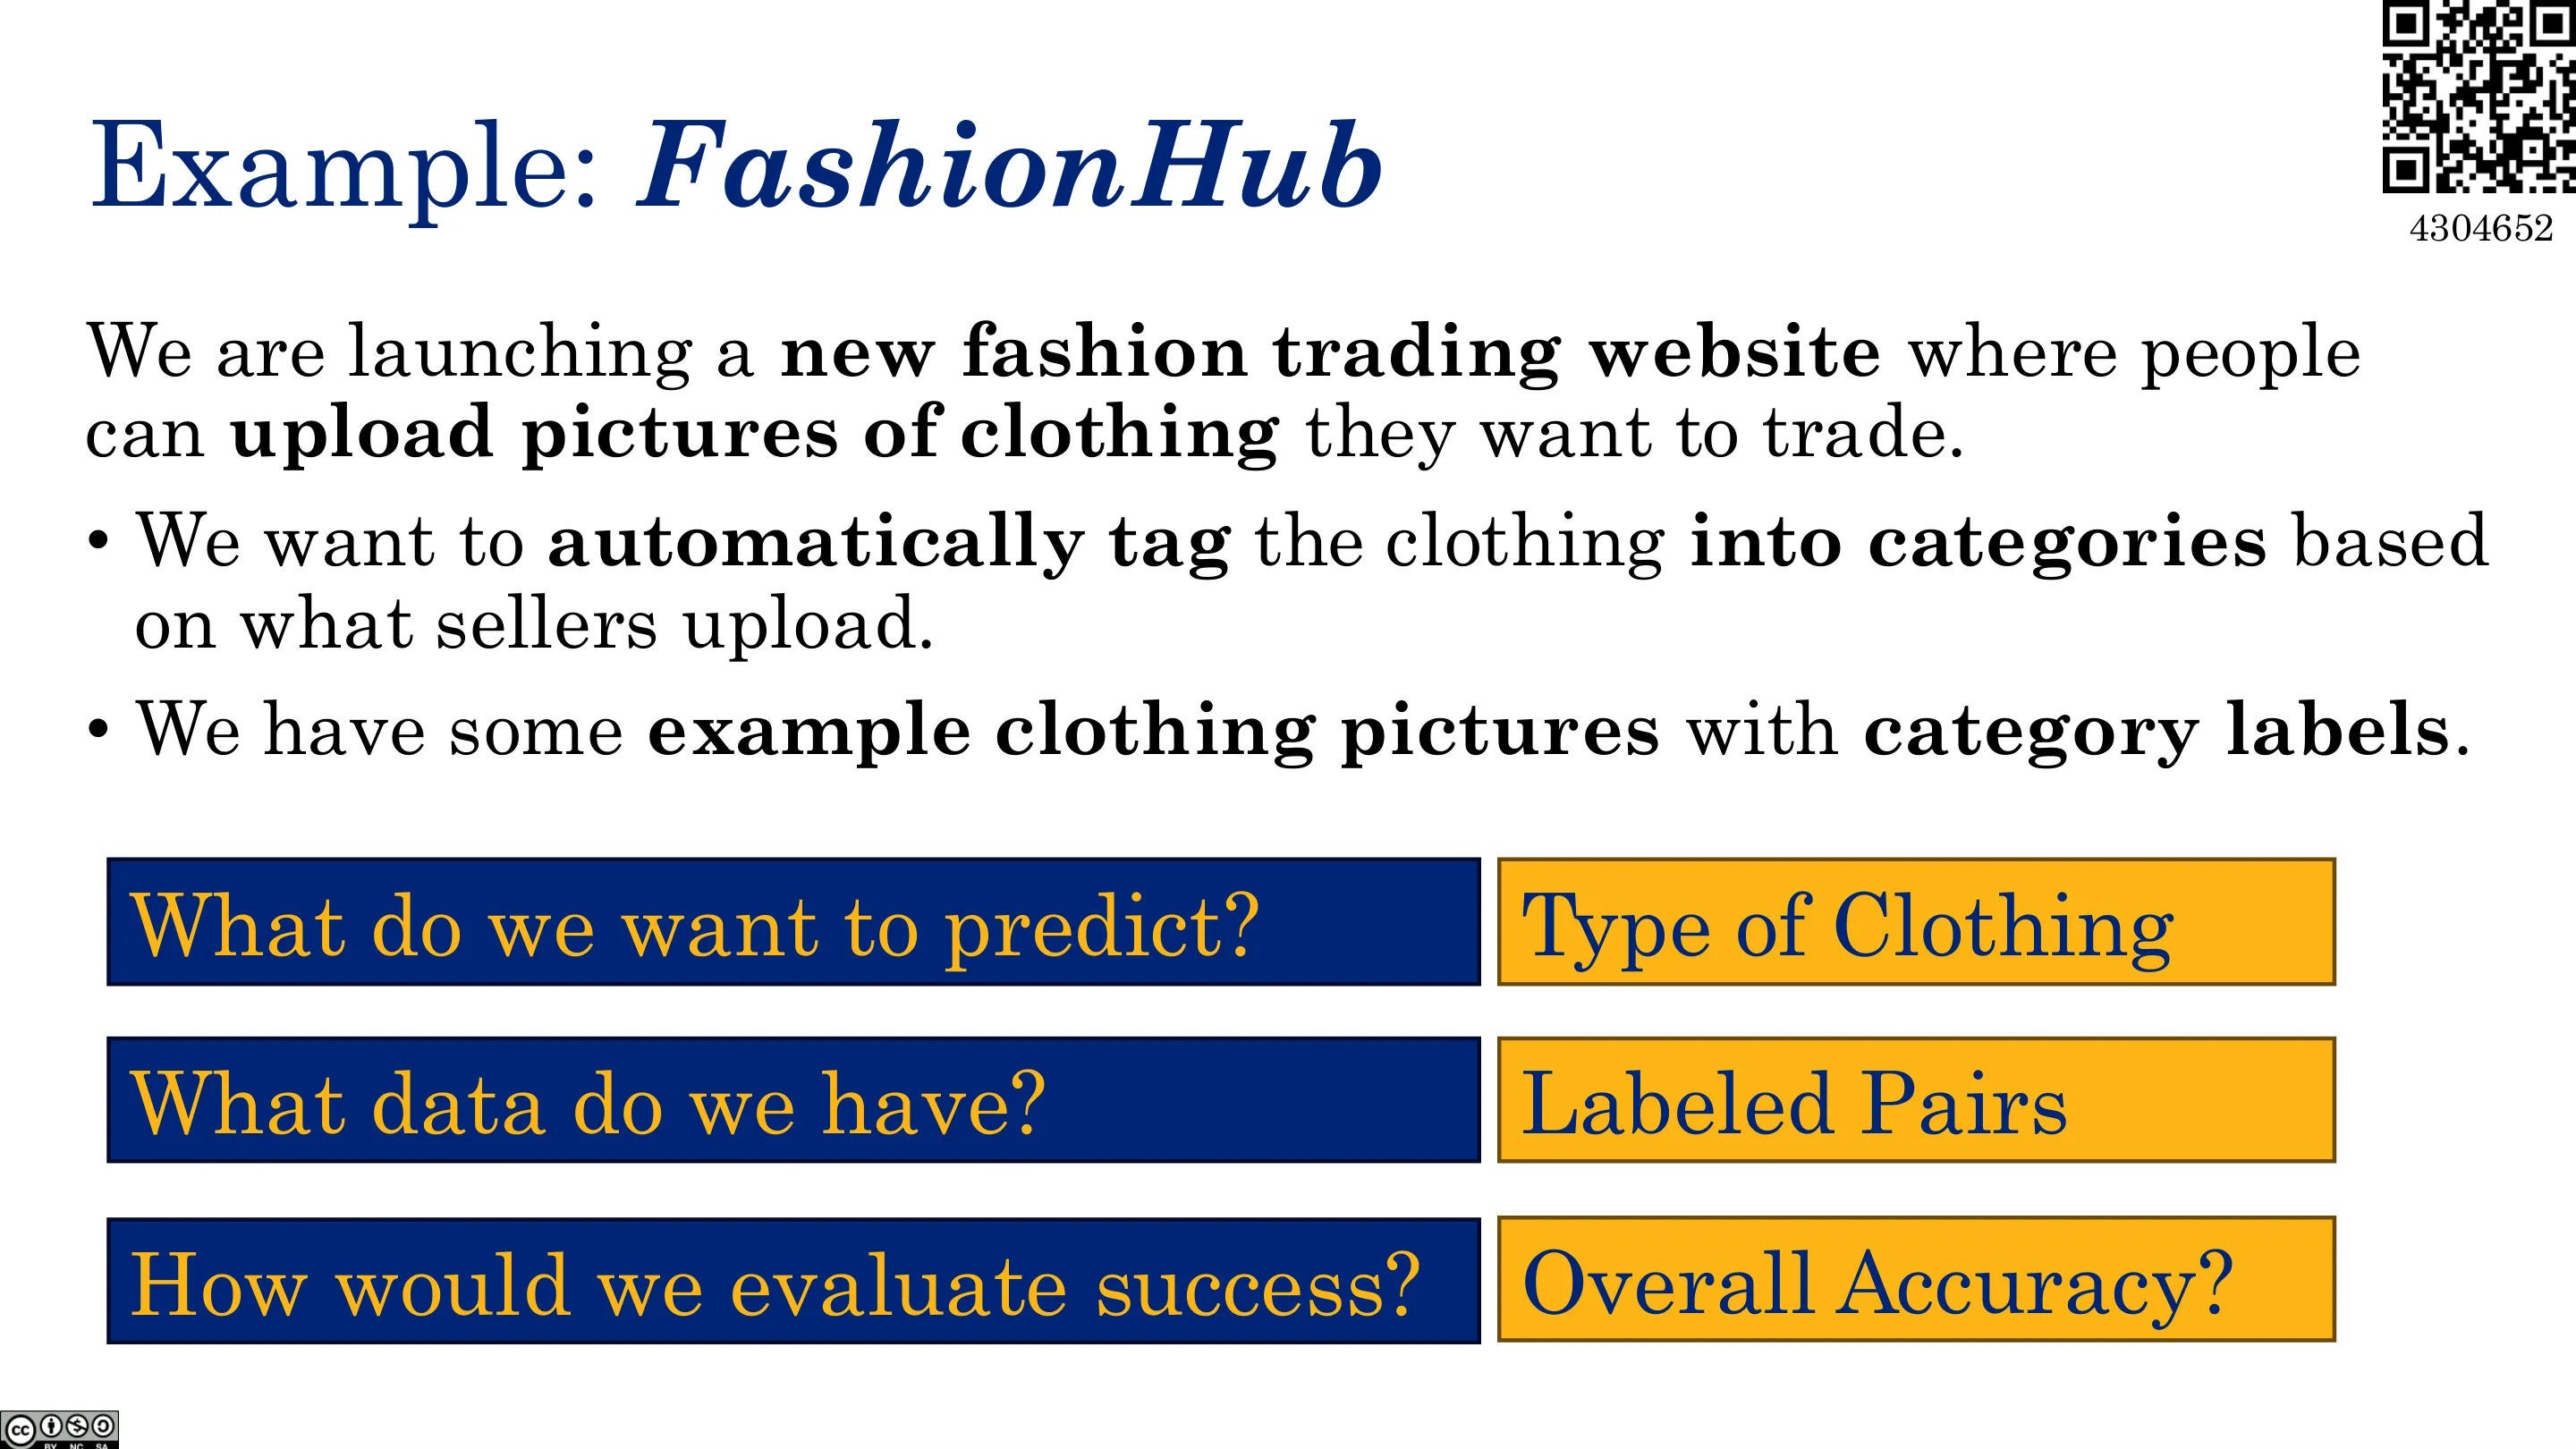
📷 例子:FashionHub
回到原视频 (00:05:34)
编者说明:讲师强调,上面这套说法在举例层面是对的,但在现实中几乎处处是坑。 - 准确率未必是好的度量:电商真正关心的是「用户参与度(engagement)」,因为它决定你能否融到 A 轮;分类器的准确率未必等于参与度。 - 数据从哪来?「我们是一家初创公司,我们不知道——你去想办法。」这才是真实的工作方式。 - 标签的粒度(granularity)至关重要:是分「鞋 vs 非鞋」,还是分「运动鞋 / 靴子」,还是分「Nike / Jordan」?问题越细越难。而在公司里没人会给你一份 20 页的规格说明,你得自己想清楚。 - 合成图片(用 Gemini / Midjourney 生成)在图像上效果很差:讲师说他曾花约一年尝试用合成数据训练图像分类器,效果并不好(文本可以,图像不行)。而且生成模型本身可能已在目标数据集上训练过。 - 爬取图片也有陷阱:Google 图片搜索里「运动鞋」的结果可能是广告页上一个开心的人,鞋根本没露多少;更根本的是循环依赖——如果你能自动标注图片,你早就把要做的模型做出来了。
那么真实的数据集是怎么来的?讲师举了 CIFAR-10 与 ImageNet 的例子:当年博士们正是去 Flickr / Google 图片搜索按关键词抓图,再交给真人标注员逐张确认——这就是 ImageNet 的构建方式。
定义完问题后,第二步是「看懂你的数据」。讲师在这里说了本讲最想强调的一句话:
我真的、真的、真的希望你去「看」你的数据。如果是图片,就去看图片;如果是表格,就在 Excel / Google Sheets 里打开,花上几个小时逐行看那些数字。如果你这样做了,「我的一生就没有白费」。
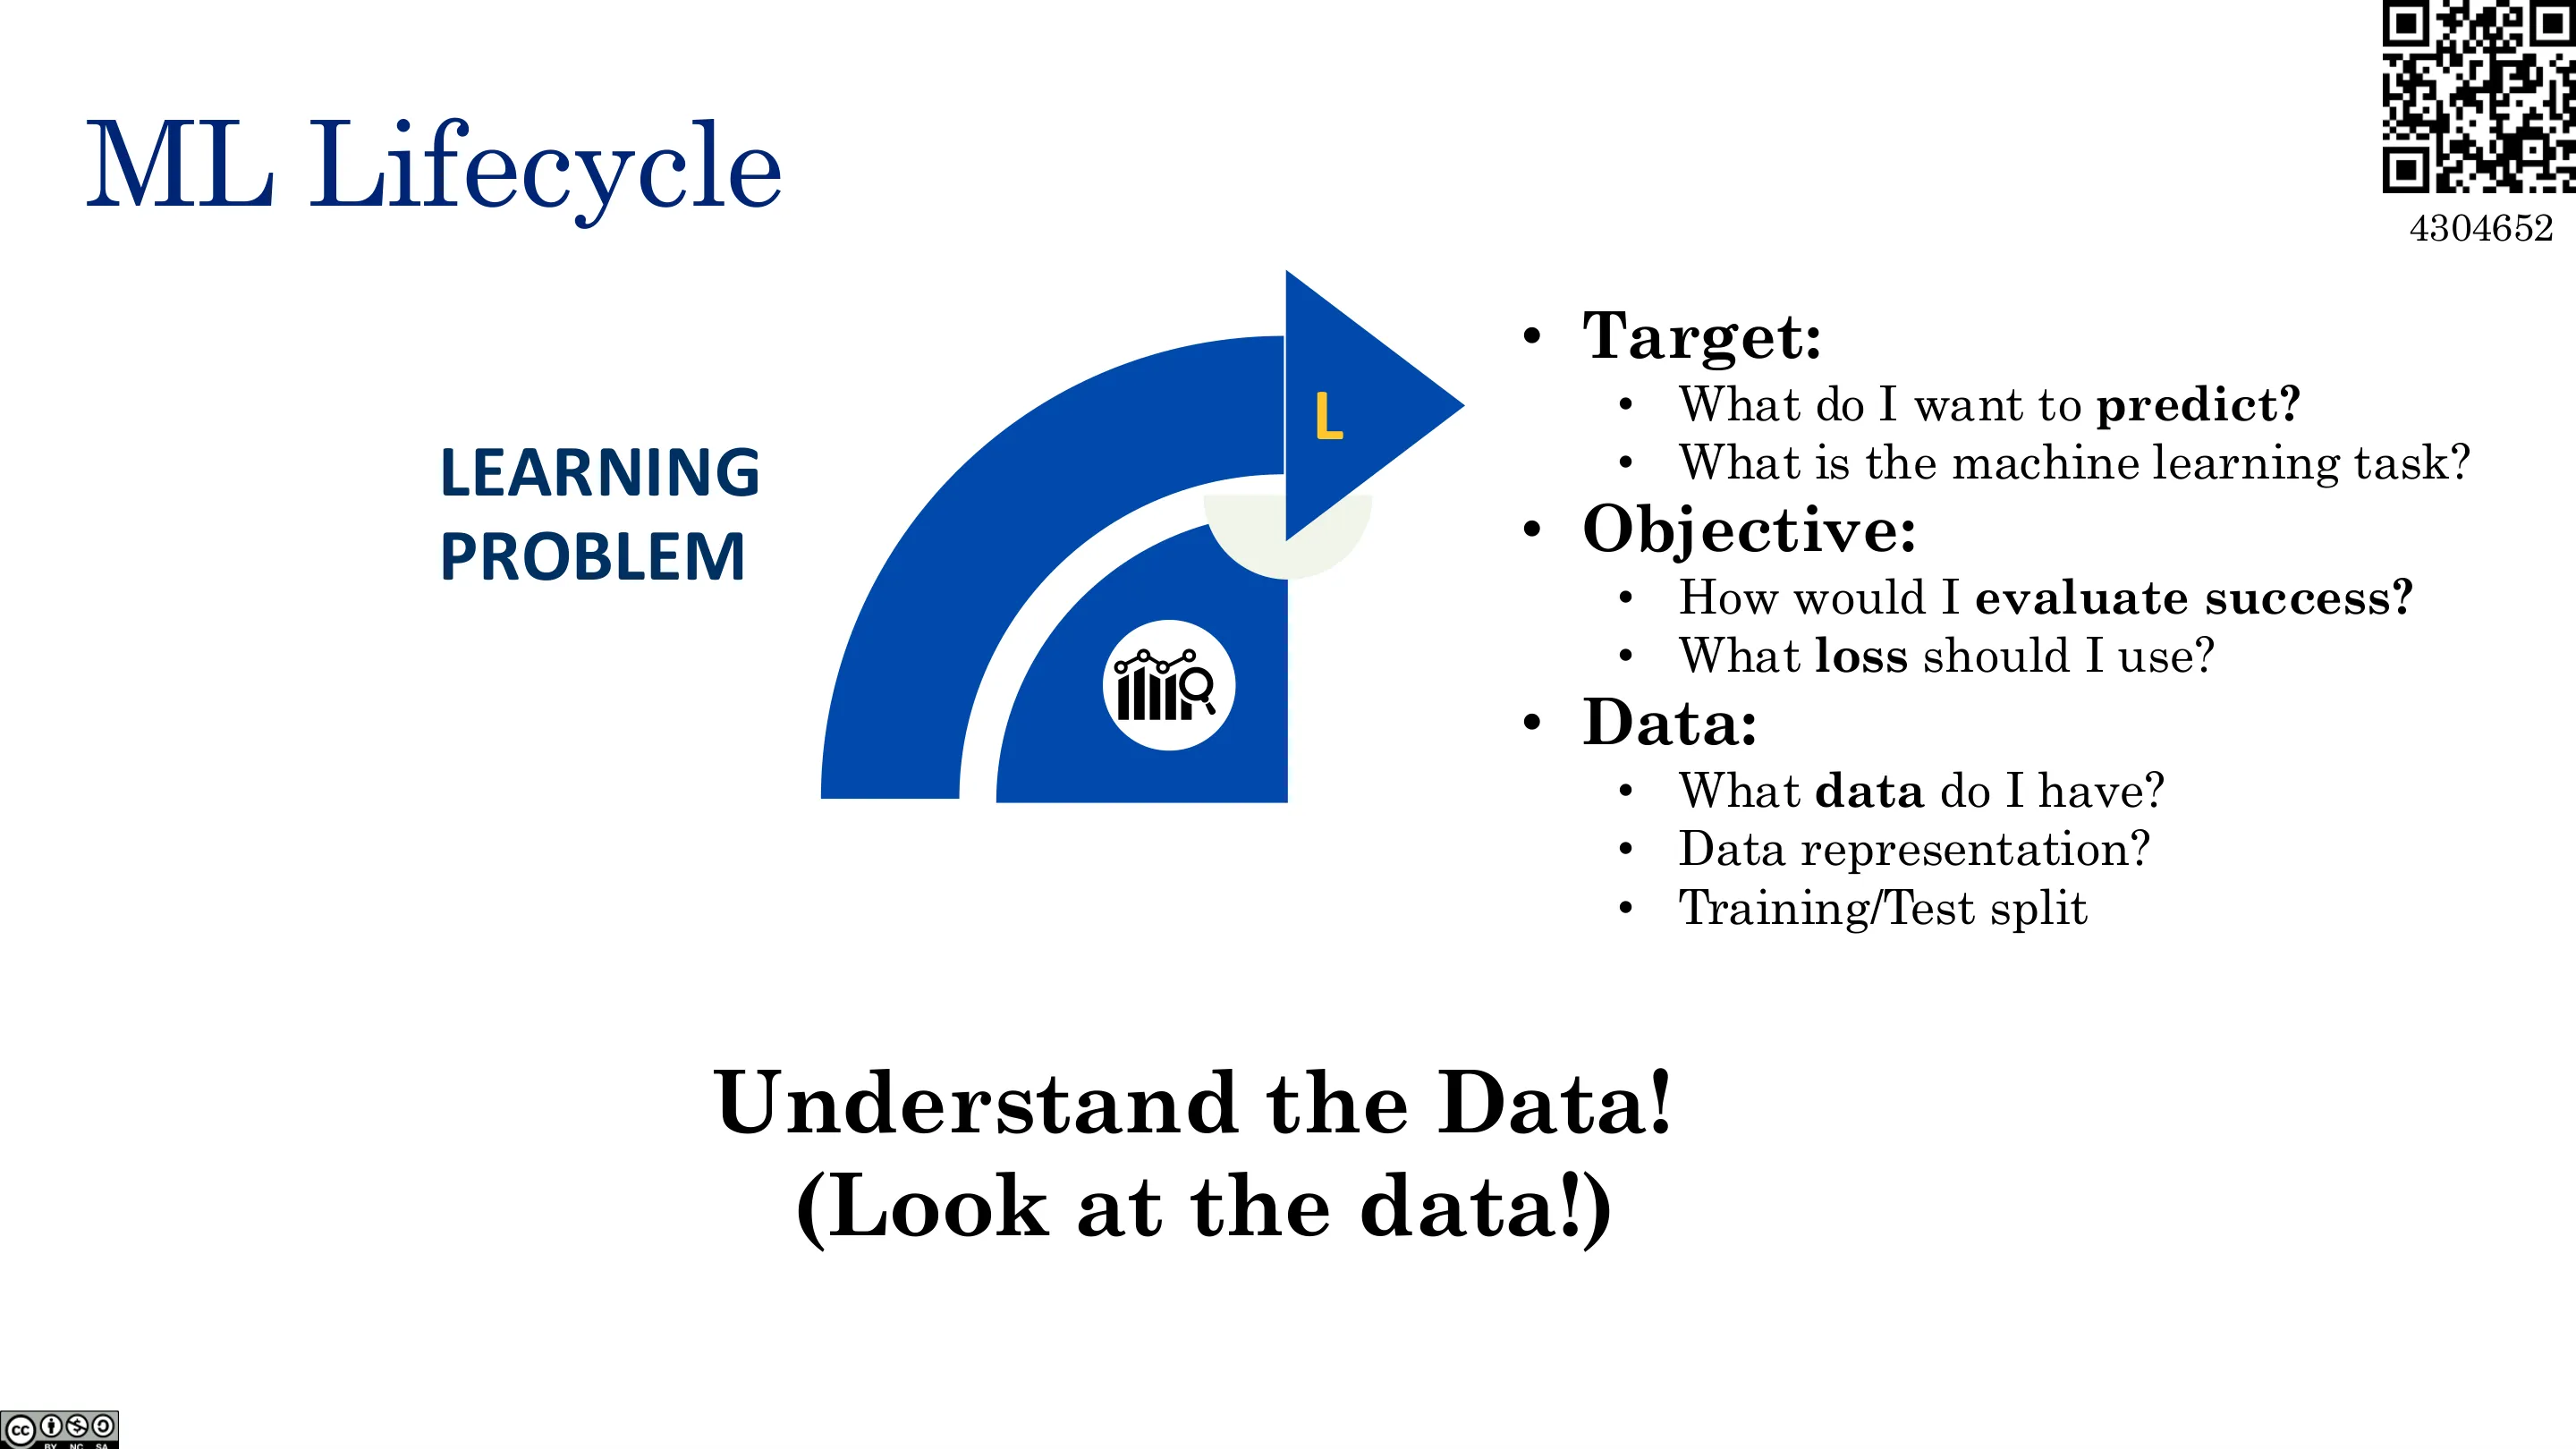
📷 定义学习问题(含「看懂数据」)
回到原视频 (00:07:07)
三、看懂你的数据
(参考时间: 00:16)
数据通常是一个训练用的 CSV 表:$D$ 个特征(每个特征占一列),$N$ 个样本(每个样本占一行)——这是贯穿整门课的统一约定。对图像分类,一行就是那张图片的像素,标签是「运动鞋 / T 恤 / ……」这样的类别。
「看懂数据」要回答的问题包括:
- 有多少数据?($N = ?$)
- 特征是什么? 有多少维($D = ?$)?分布如何?是否都是数值?有没有缺失值?
- 标签是什么(有没有标签)? 是否离散?分布如何?有没有缺失或错误标签?
务必去采样、去阅读、去画图。
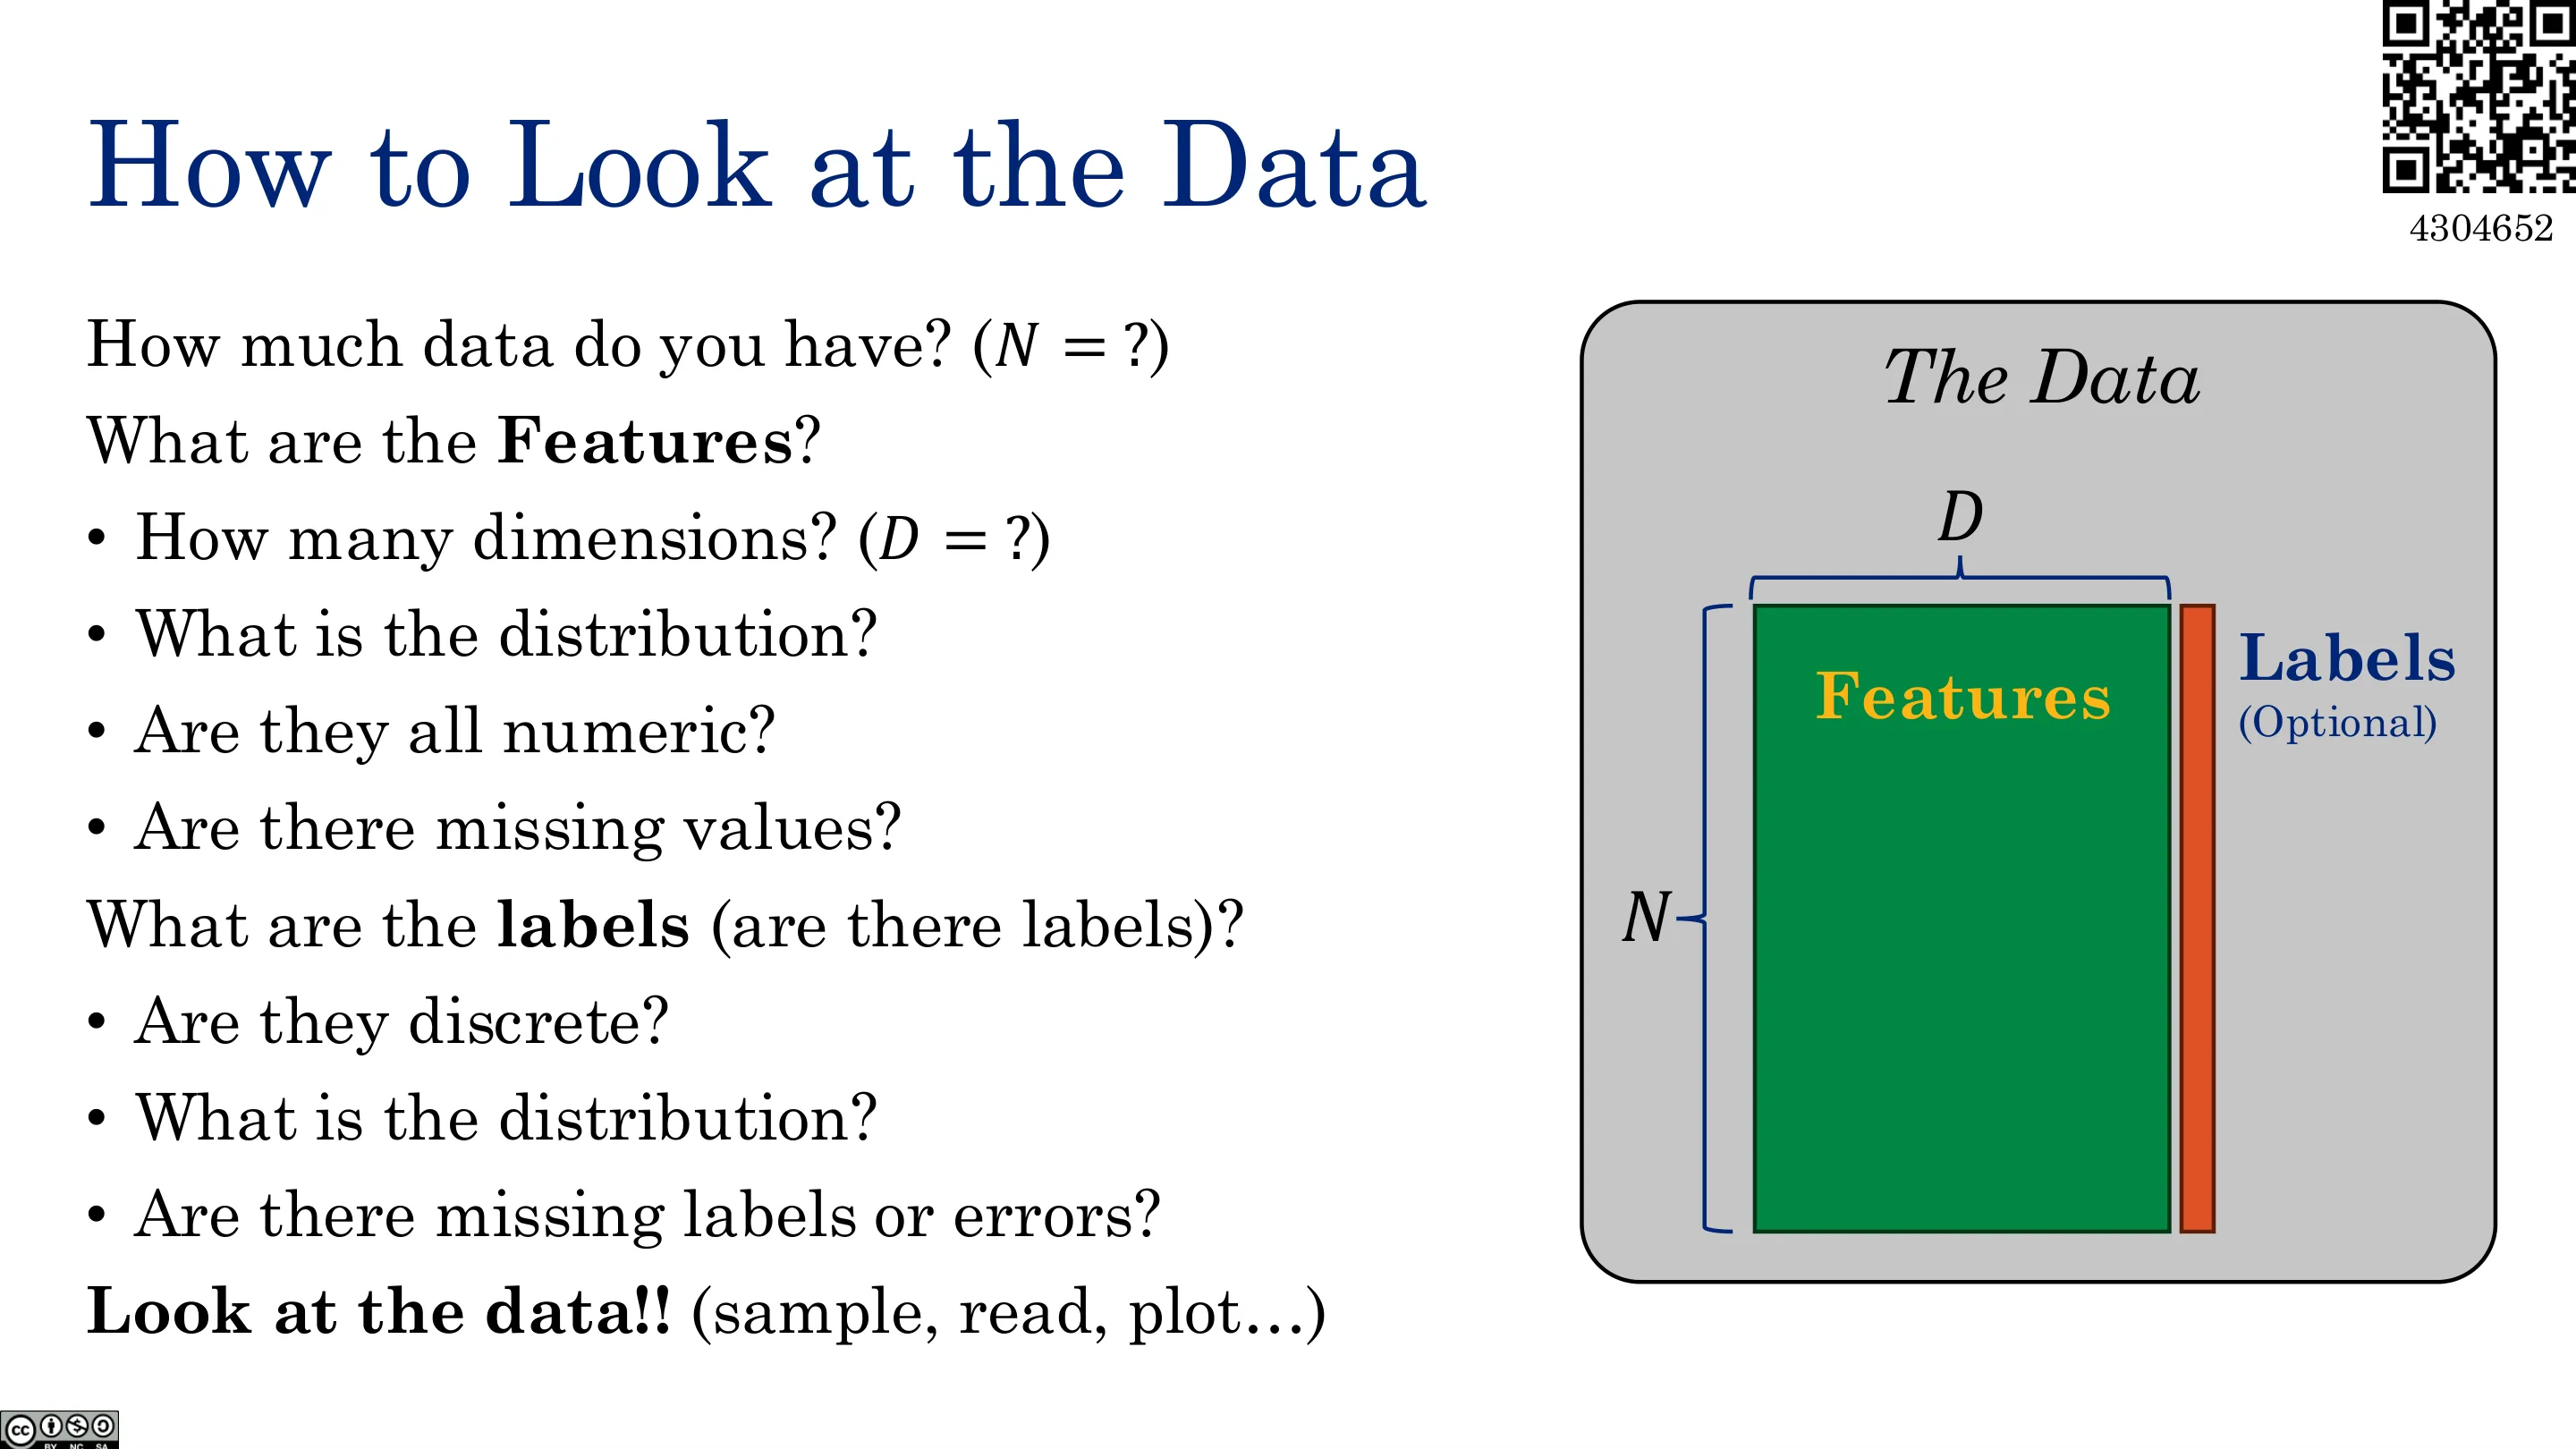
📷 数据:特征与标签
回到原视频 (00:16:49)
一个真实演示:看 Fashion-MNIST 风格的服装图片(踝靴、套头衫、T 恤、裤子……)。看的时候你会立刻发现问题——这张到底是踝靴还是运动鞋?也许它标错了,也许它该归到运动鞋而不是踝靴。这就是「看数据」的价值:只有亲眼看过,你才会回去问产品经理「我们到底要不要把它分类成踝靴」。
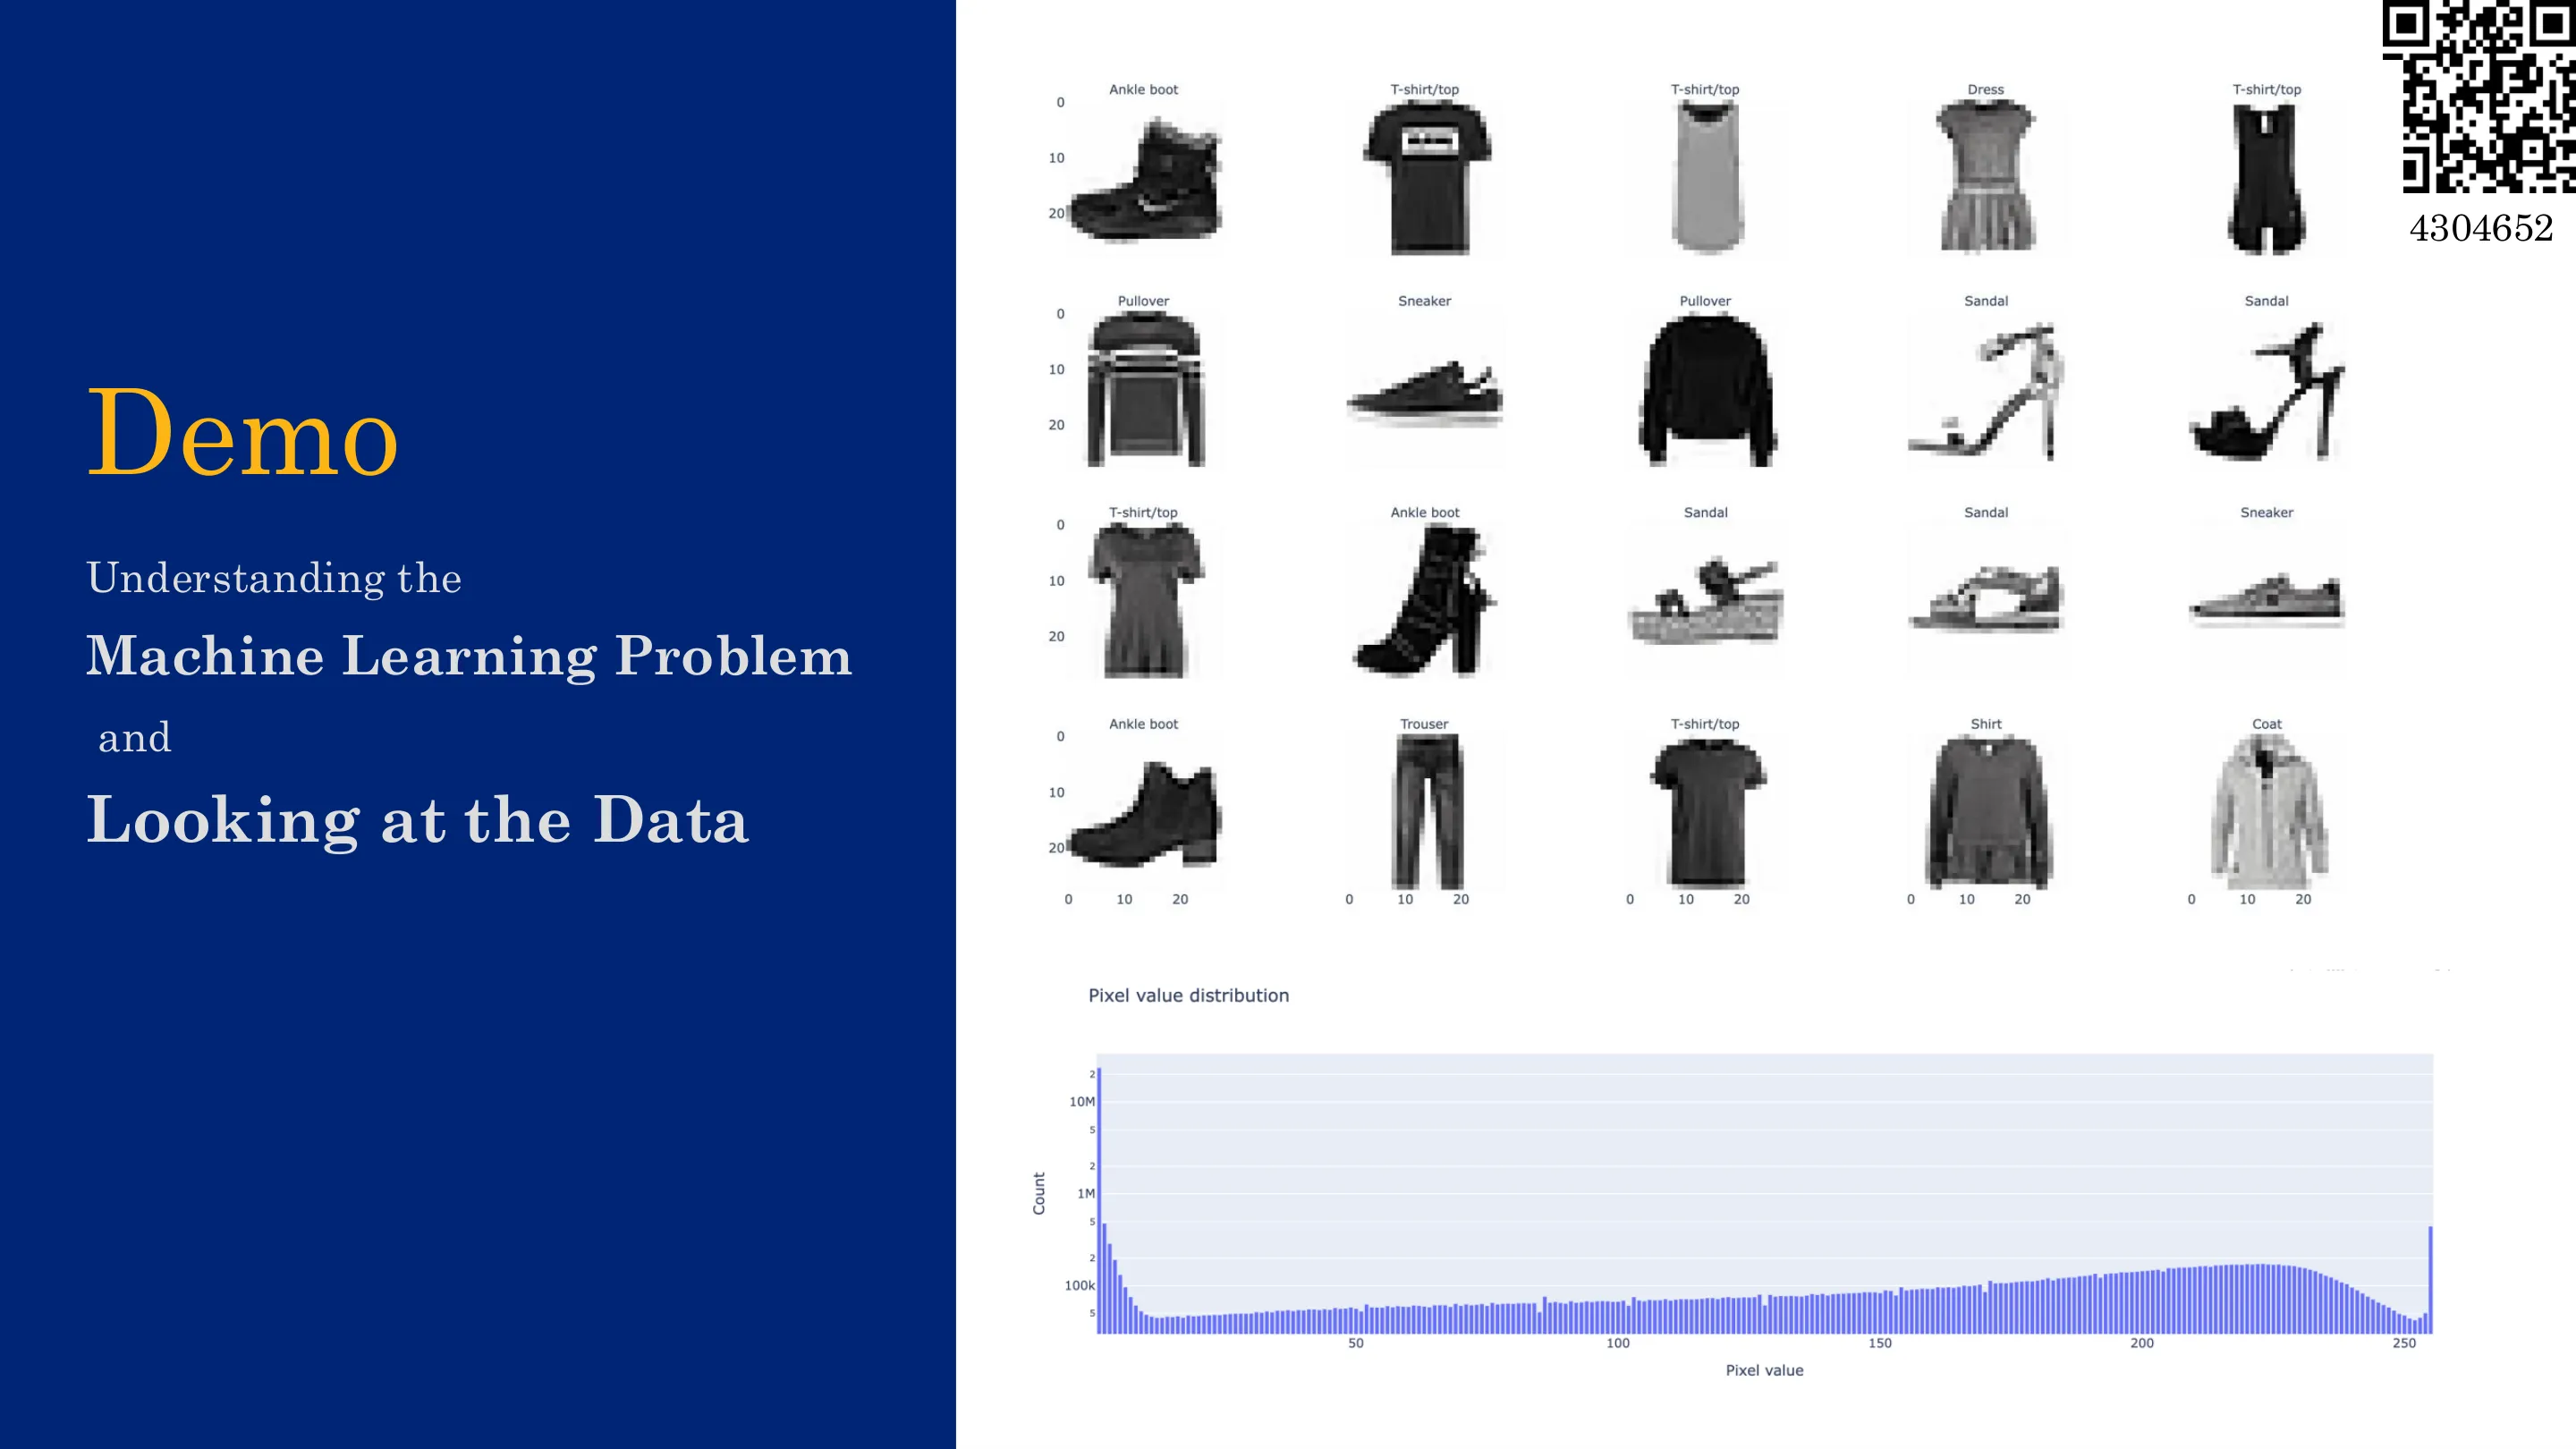
📷 看懂机器学习问题并观察数据(演示)
回到原视频 (00:19:22)
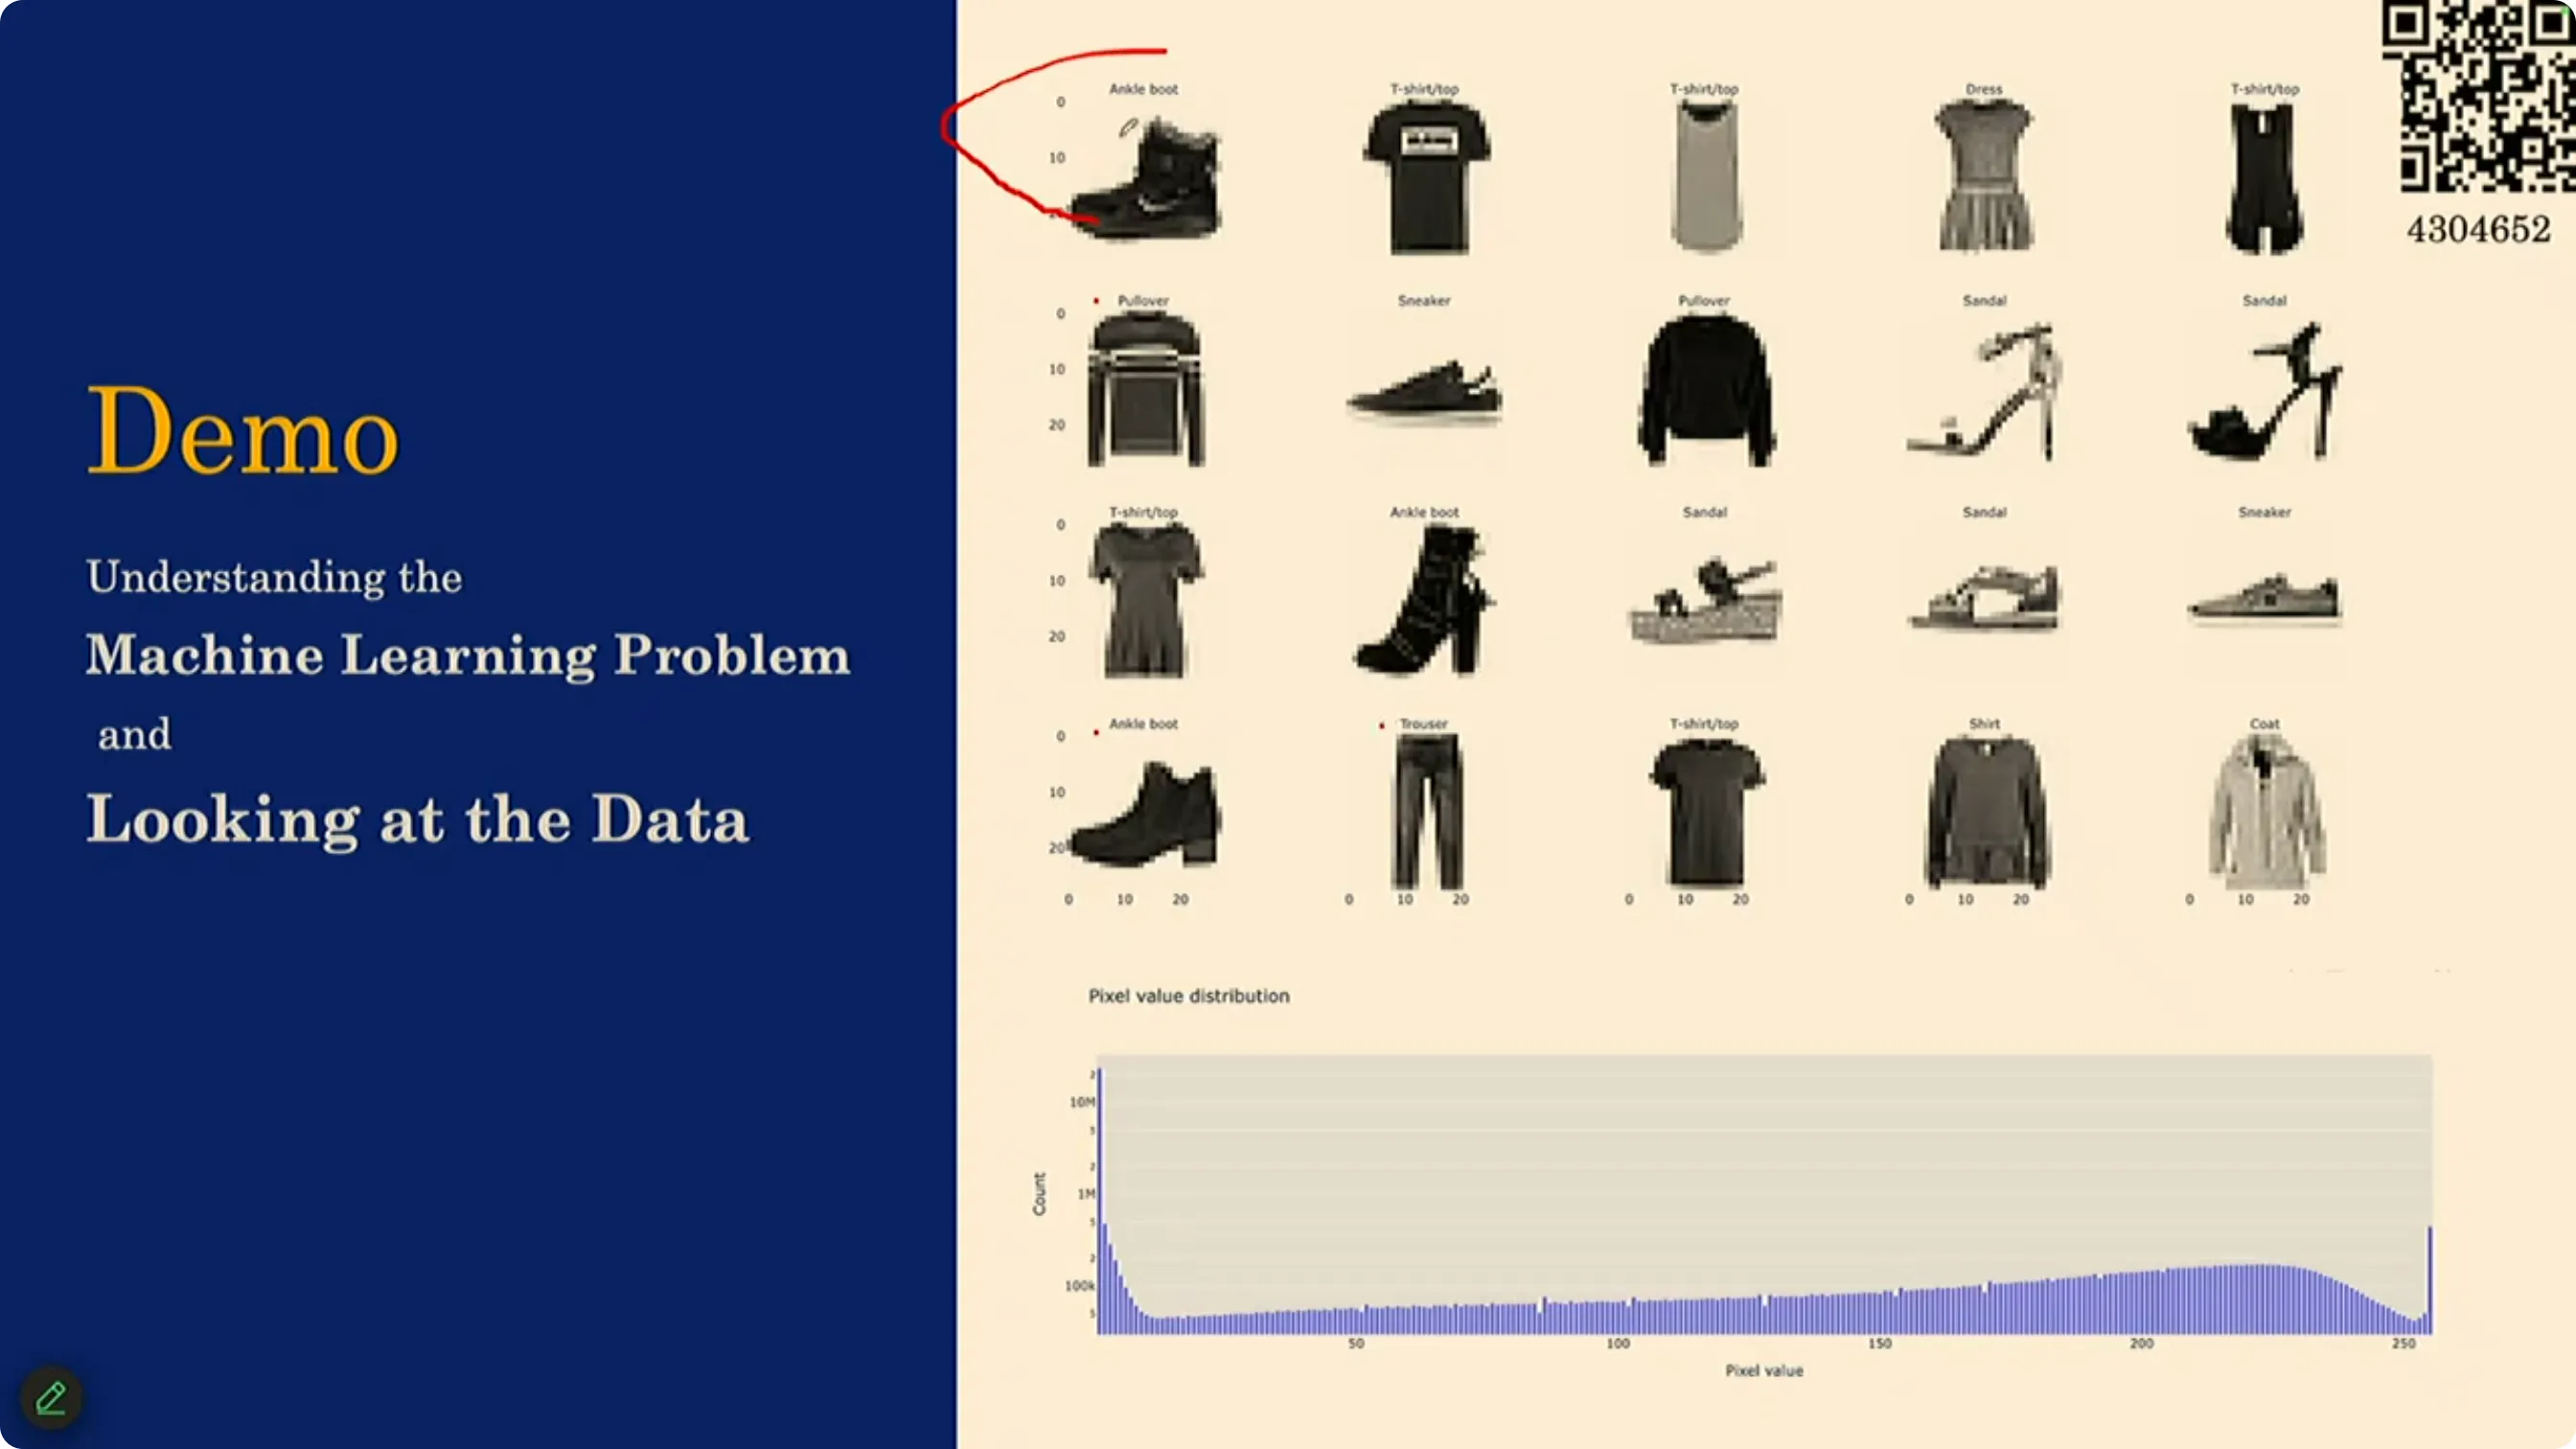
📷 FashionHub 服装图像数据(视频画面)
回到原视频 (00:19:40)
另一个可以做的统计是像素值分布:这些是灰度图,每个像素取值 0–255。把全部图片的像素做成直方图,你就能看到「平均亮度」的分布。例如:
- 如果有些照片用了闪光灯,分布上会出现一个凸起;
- 如果你发现像素值只集中在 0–10,那说明图片太暗,没有用满动态范围,需要重新归一化(例如除以最大值)。
很多真实数据集并不干净,正是通过这类统计,你才能发现「动态范围不对」这类问题。
四、机器学习问题的分类
(参考时间: 00:23)
按「有没有标签」划分:
flowchart TD
    ML["机器学习"] --> SL["监督学习<br/>(有标签 y)"]
    ML --> UL["无监督学习<br/>(无标签)"]
    ML --> RL["强化学习<br/>(只有奖励)"]
    SL --> Q["标签为连续值<br/>→ 回归 Regression"]
    SL --> C["标签为离散类别<br/>→ 分类 Classification"]
    UL --> DR["降维<br/>PCA 等"]
    UL --> CL["聚类<br/>K-means 等"]
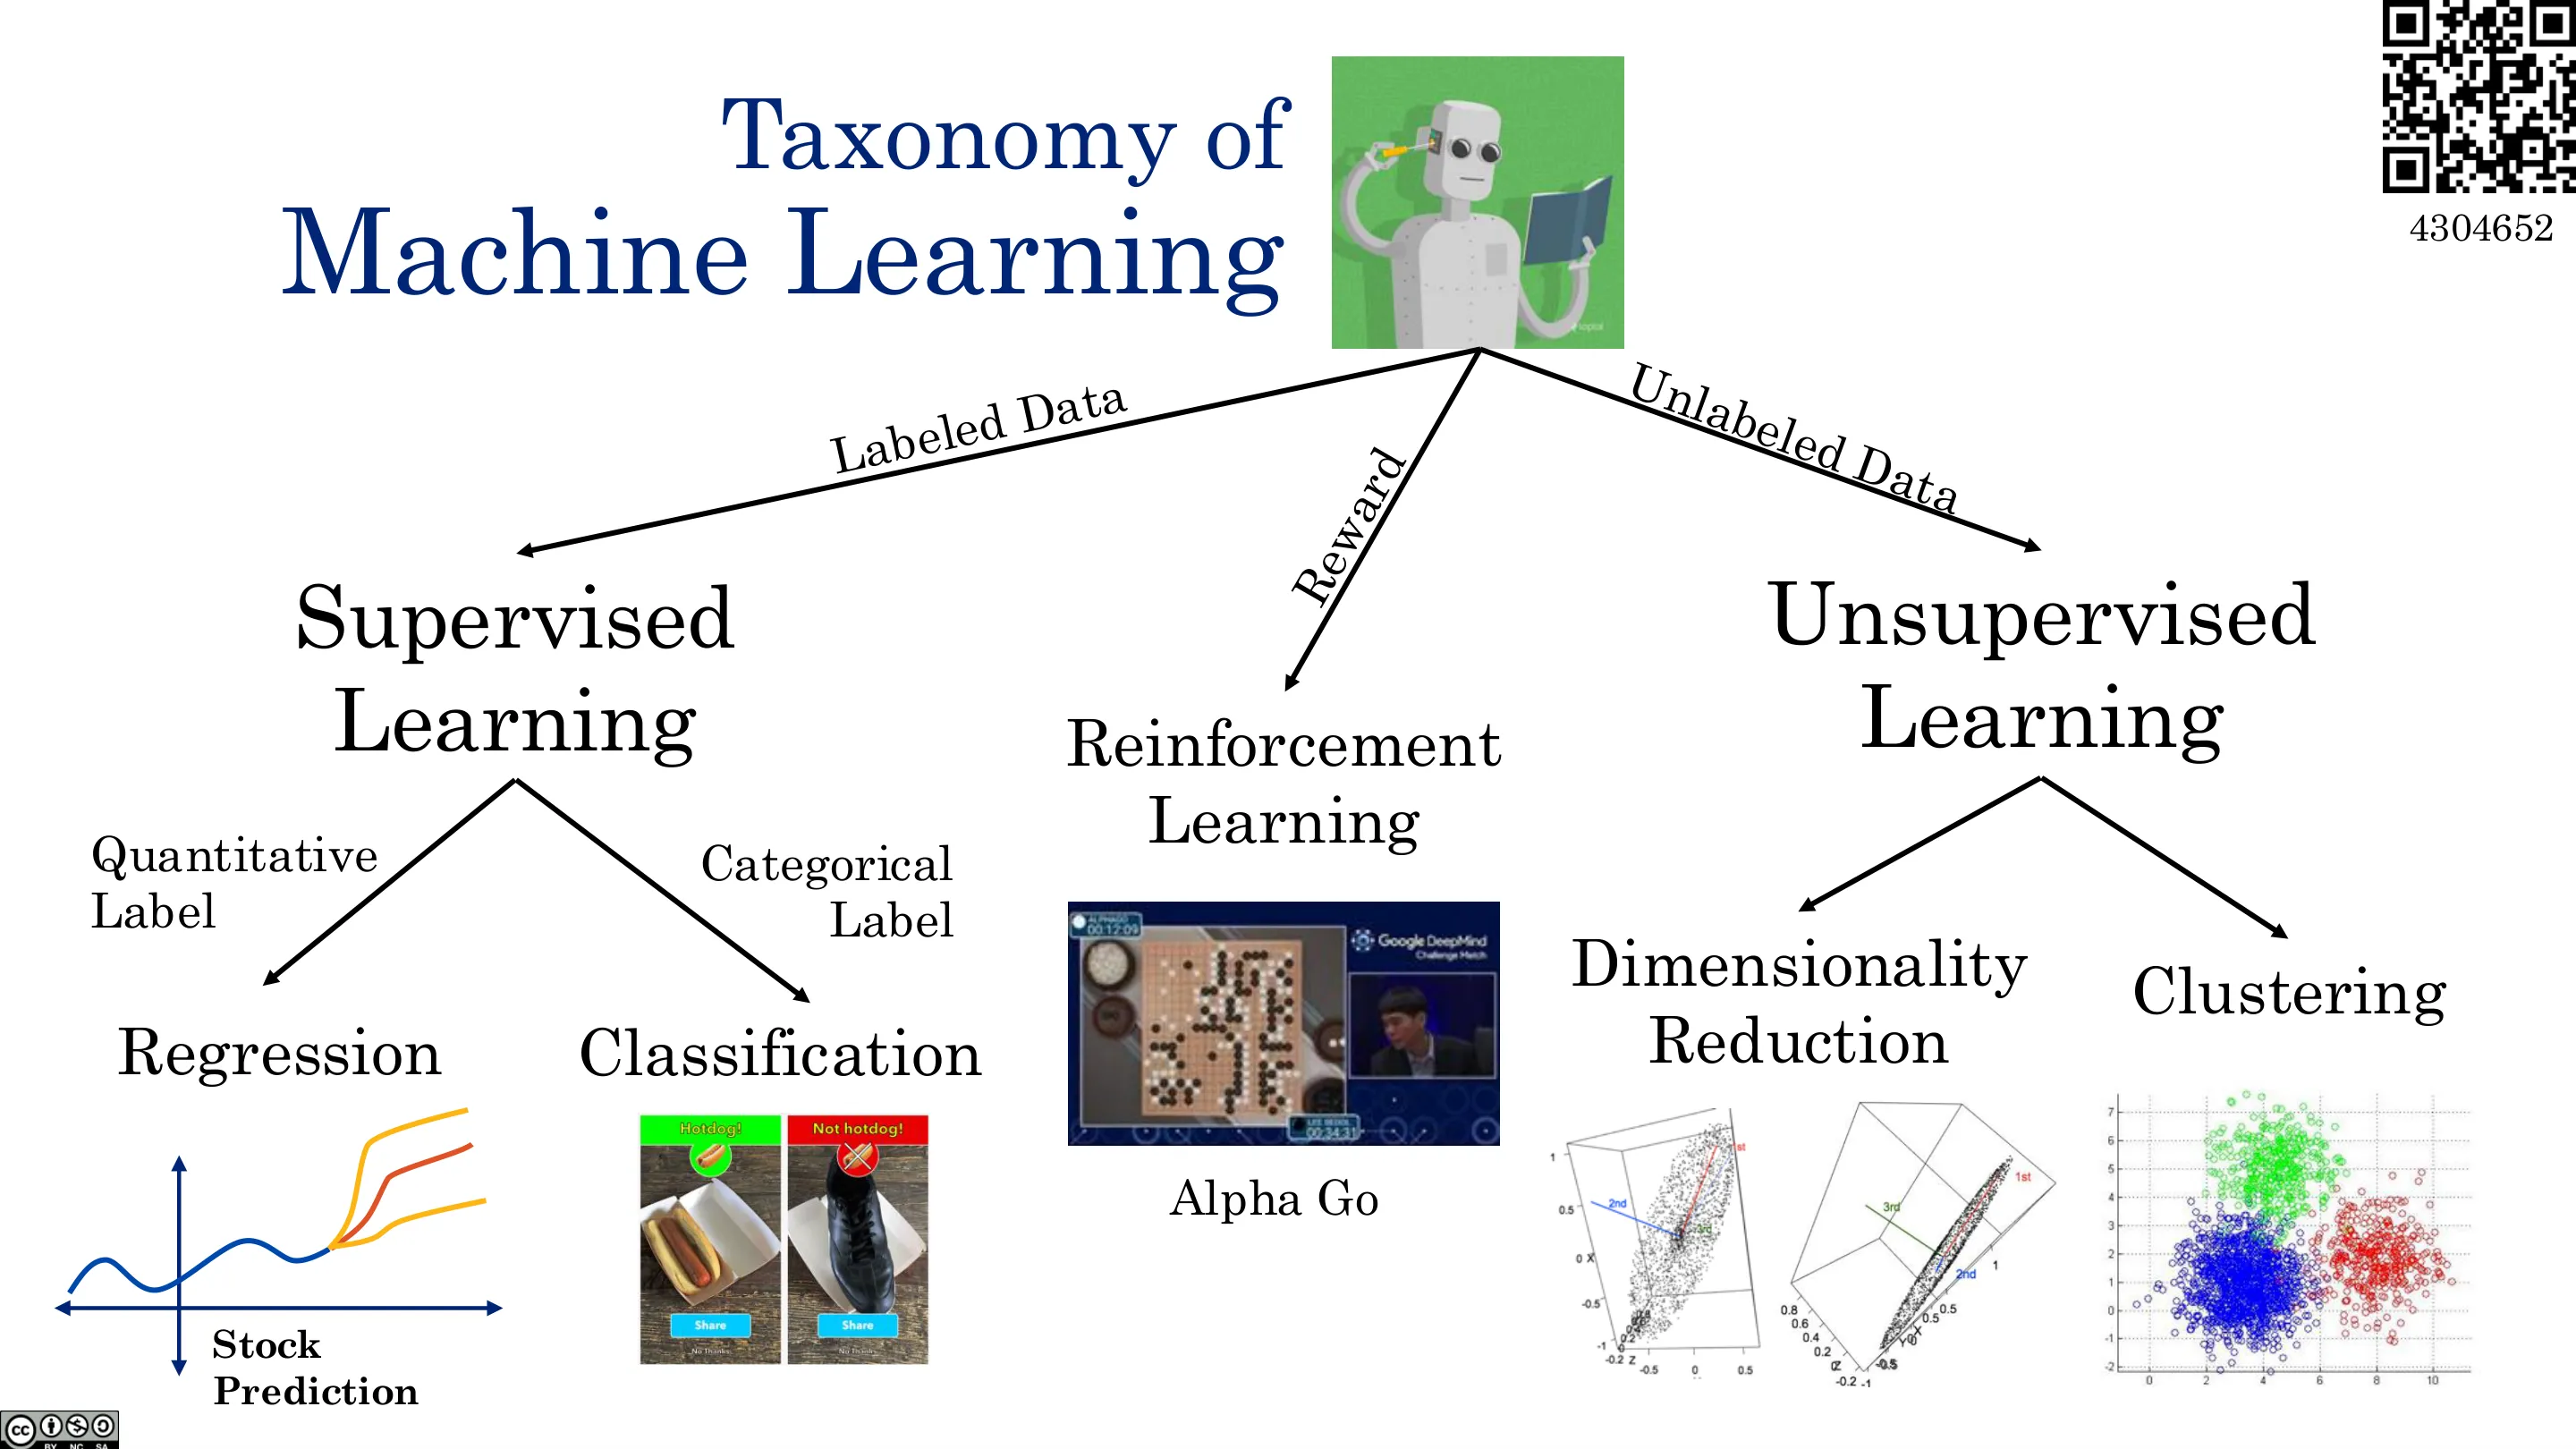
📷 机器学习问题的分类
回到原视频 (00:23:21)
- 监督学习:从带标签的例子中学习,是最常用的学习过程,也是最快的学习方式(需要的标注数据最少),但前提是你能拿到「关系」的例子;有时并不容易获得。
- 无监督学习:如果没有标签,可以做聚类(看数据是否有自然结构)或降维(如 PCA、K-means)。
- 强化学习:如果只有奖励信号(网站参与度、账户余额变化),你不知道每一步分类对不对,只知道用户是否持续参与——这属于强化学习,本课不会深入。
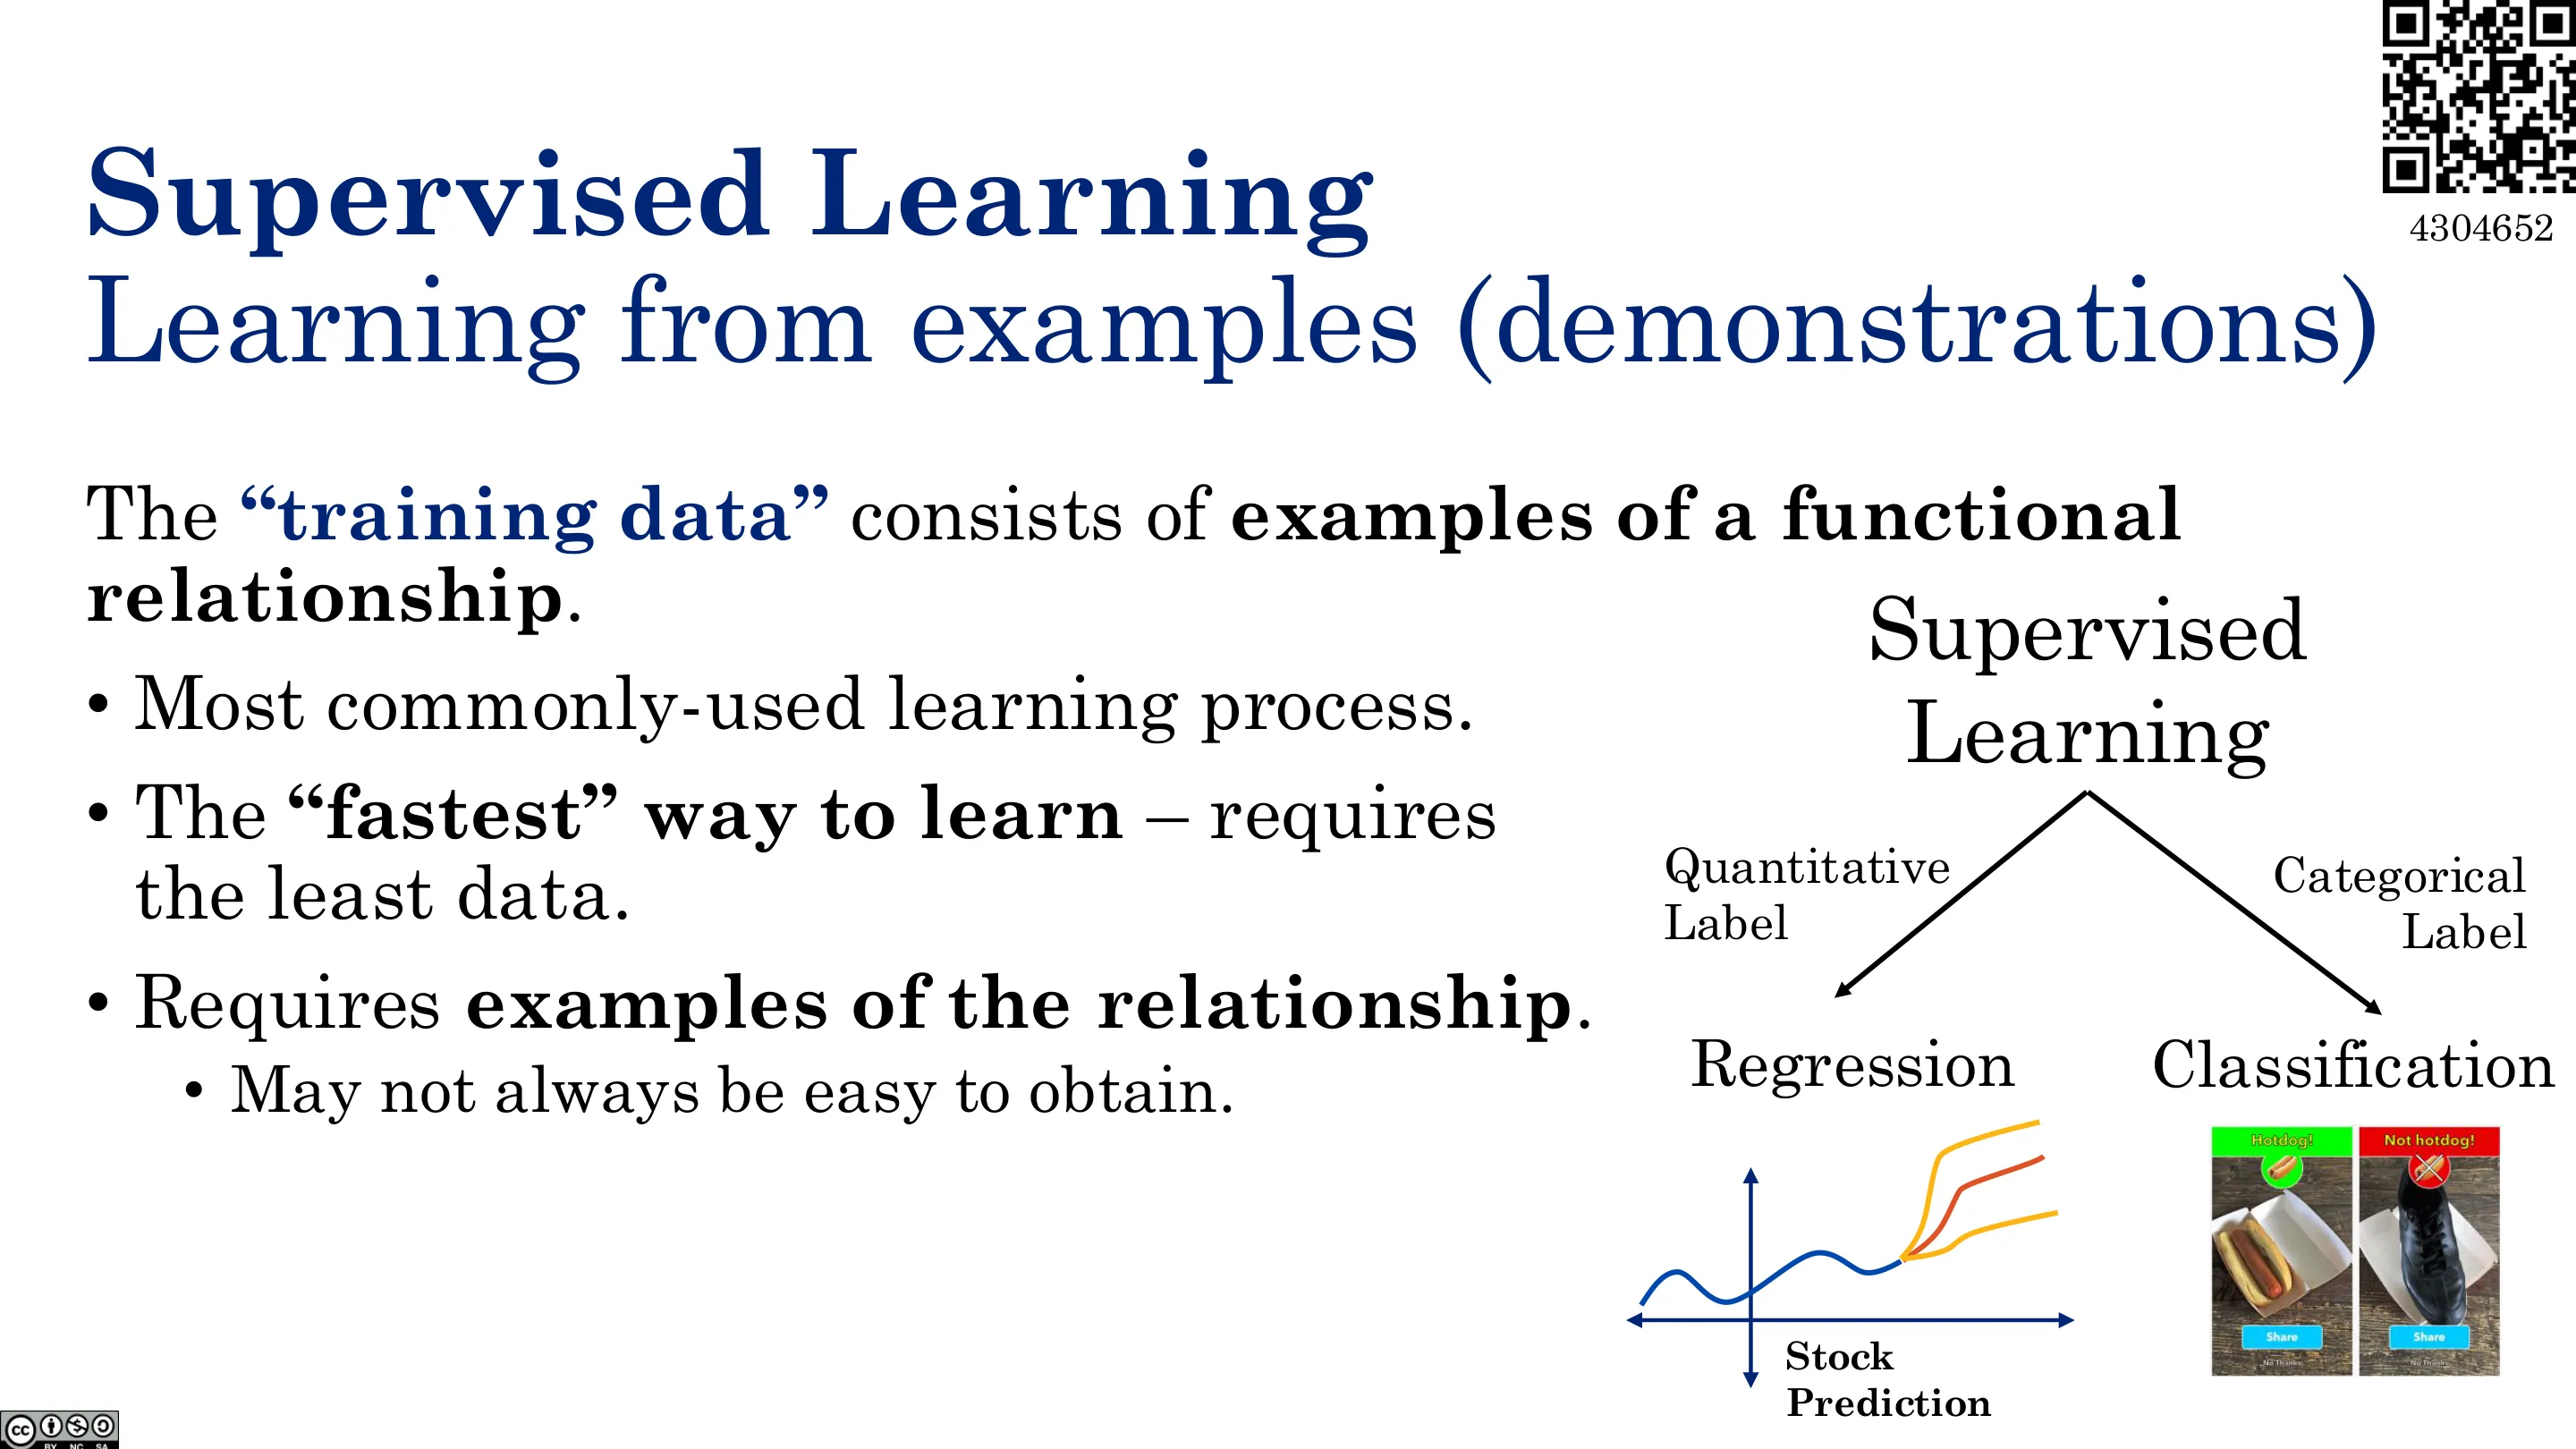
📷 监督学习
回到原视频 (00:24:53)
值得注意的是:即使是无监督问题,人们也常常把它转成监督问题。经典例子就是 GPT:语言生成本身不是监督问题,但你可以用「给定前面的词,预测下一个词」把它构造成监督问题;训练好之后,再拿它去做生成这种非监督任务。图像上也有类似做法——自监督学习:把图片切两半,给模型下半部分,让它判断上半部分来自哪张图,从而学到有用的内部表示。
编者说明:讲师还吐槽了一个经典的面试错误:对三分类问题(0/1/2)直接跑回归。数字标签只是任意的编码,不含序数意义;用回归会强行给模型「分类别是有序的」这一错误暗示。
分类问题的标签是离散类别(如图片里的衣物类型)。离散标签常被编码成数字,但应当被当作类别来对待。两类主要问题:
- 二分类(Binary Classification):两个类别(垃圾邮件 vs 非垃圾邮件);
- 多分类(Multi-class Classification):多于两类(如「热狗 / 披萨 / 墨西哥卷」——这个梗出自美剧《硅谷》里一个被训练来做食物预测的二分类器)。
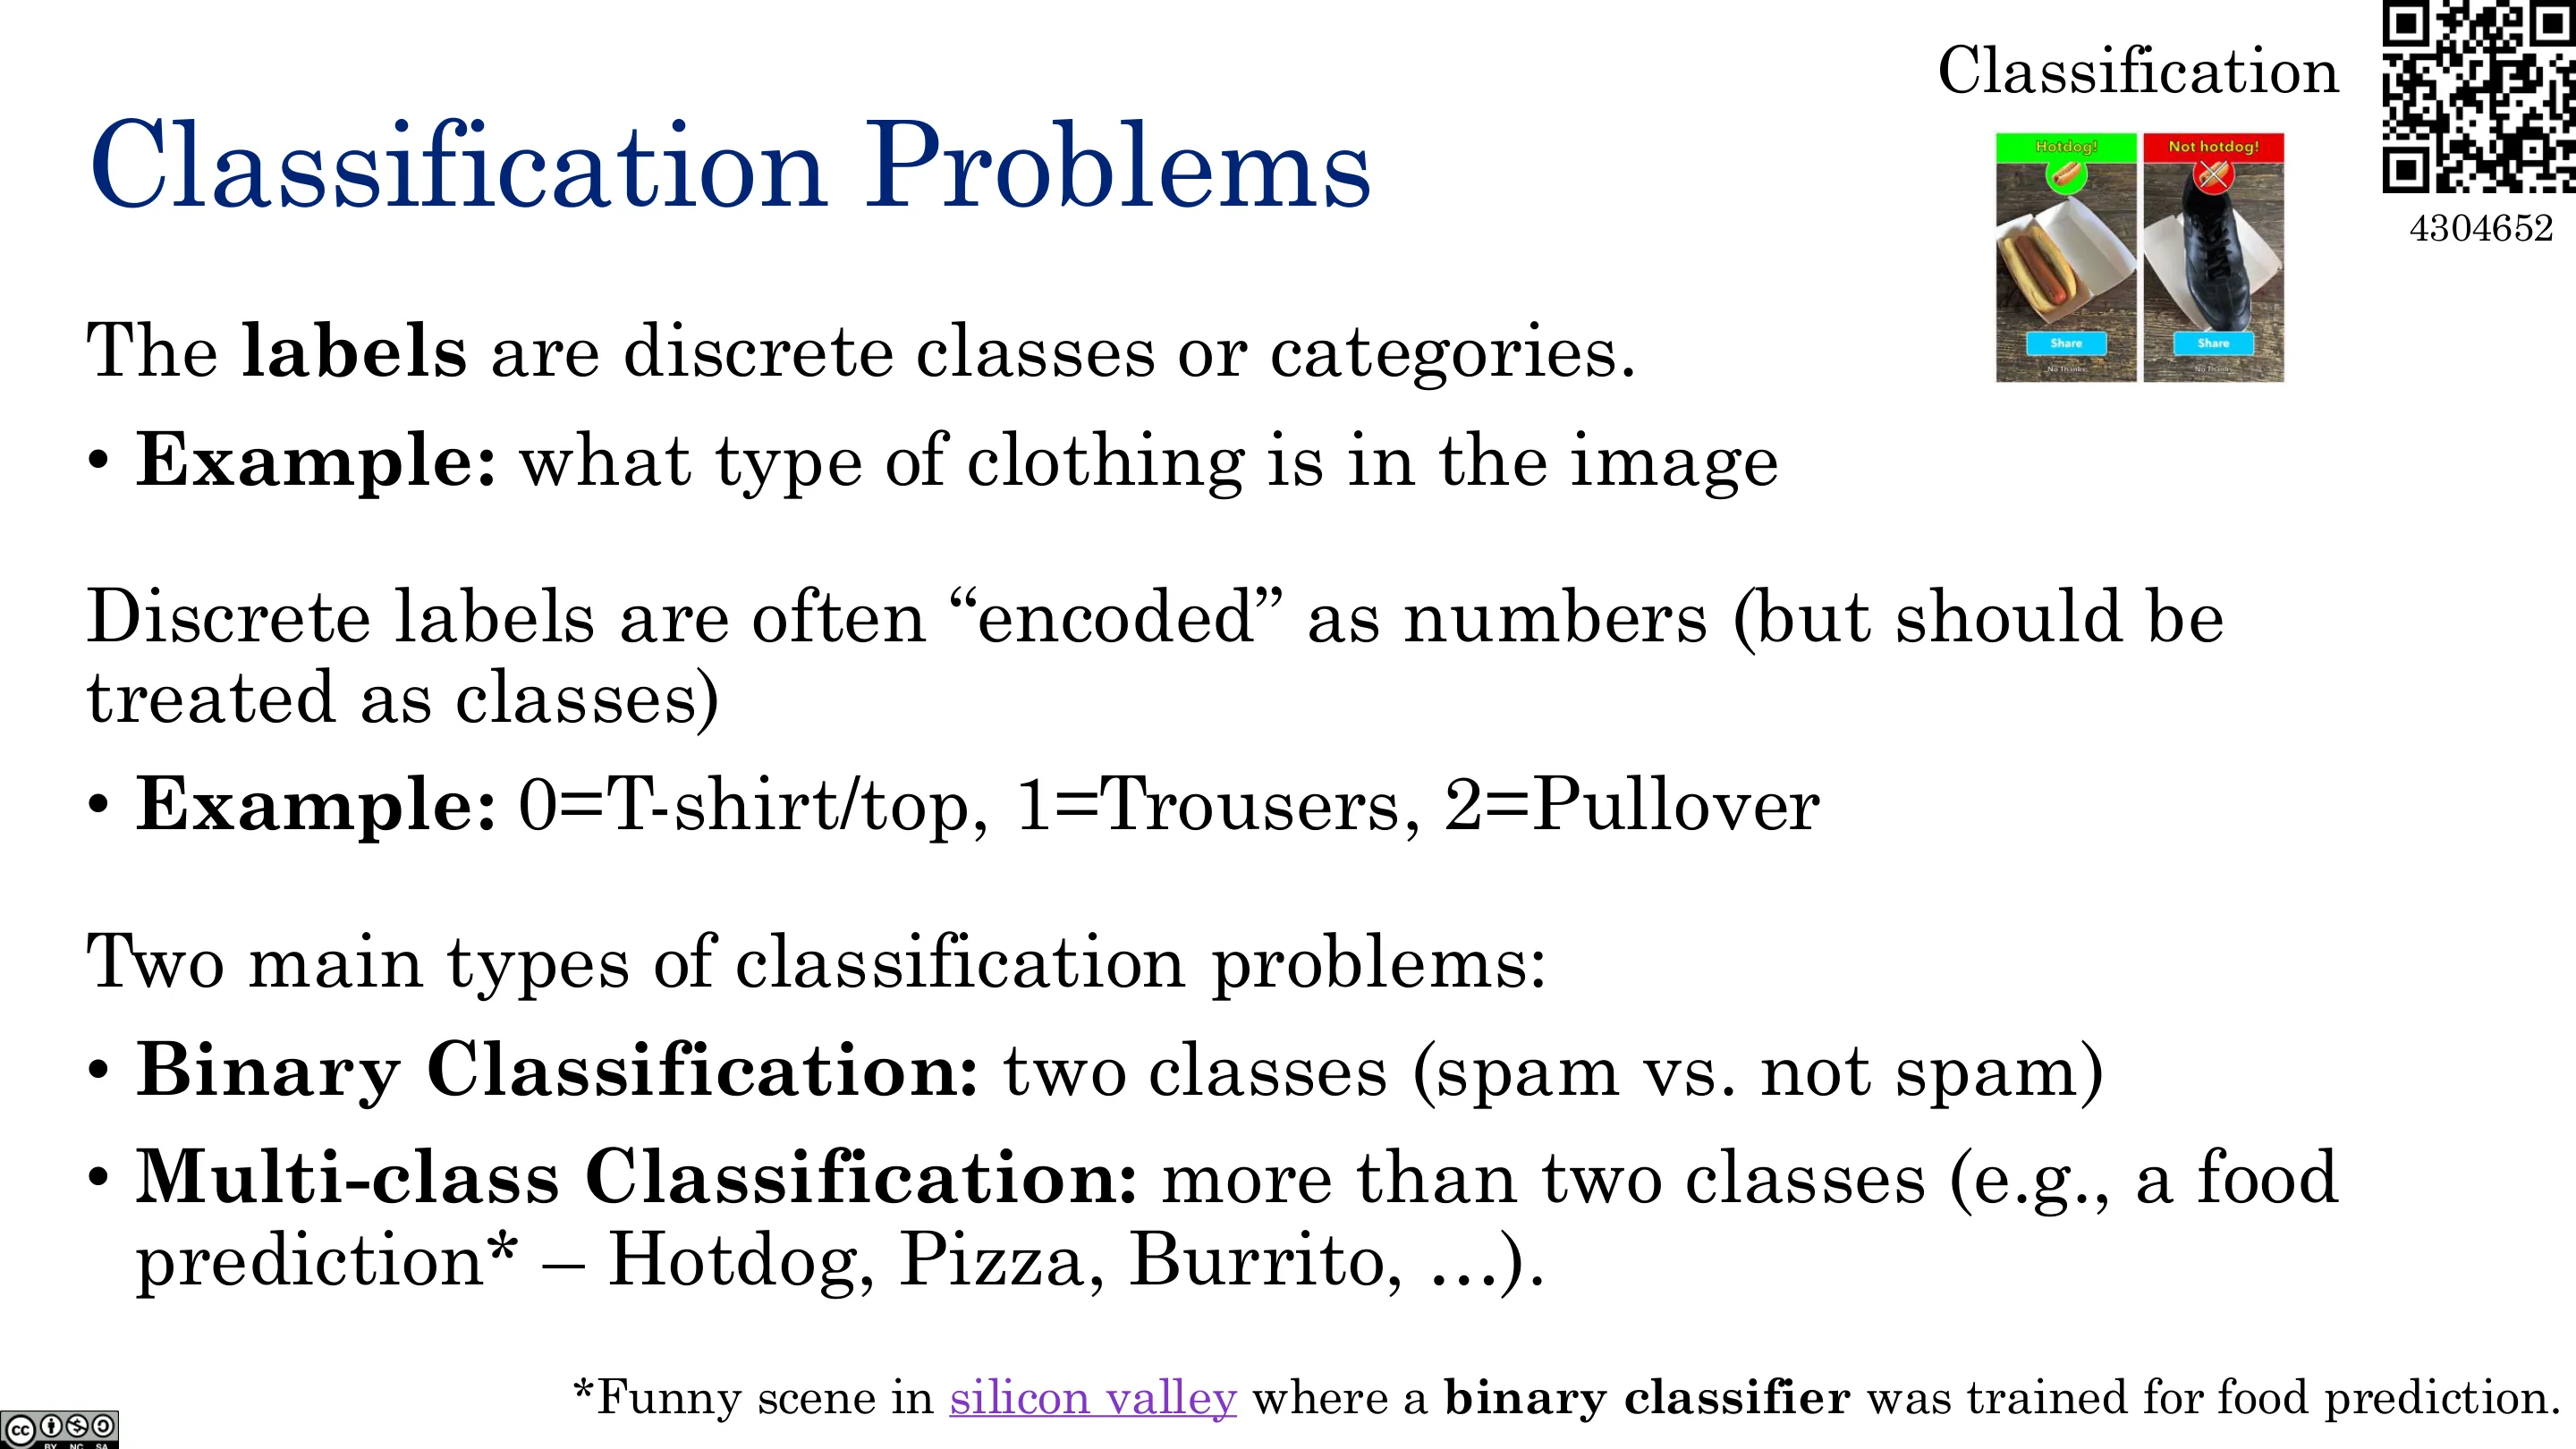
📷 分类问题
回到原视频 (00:28:53)
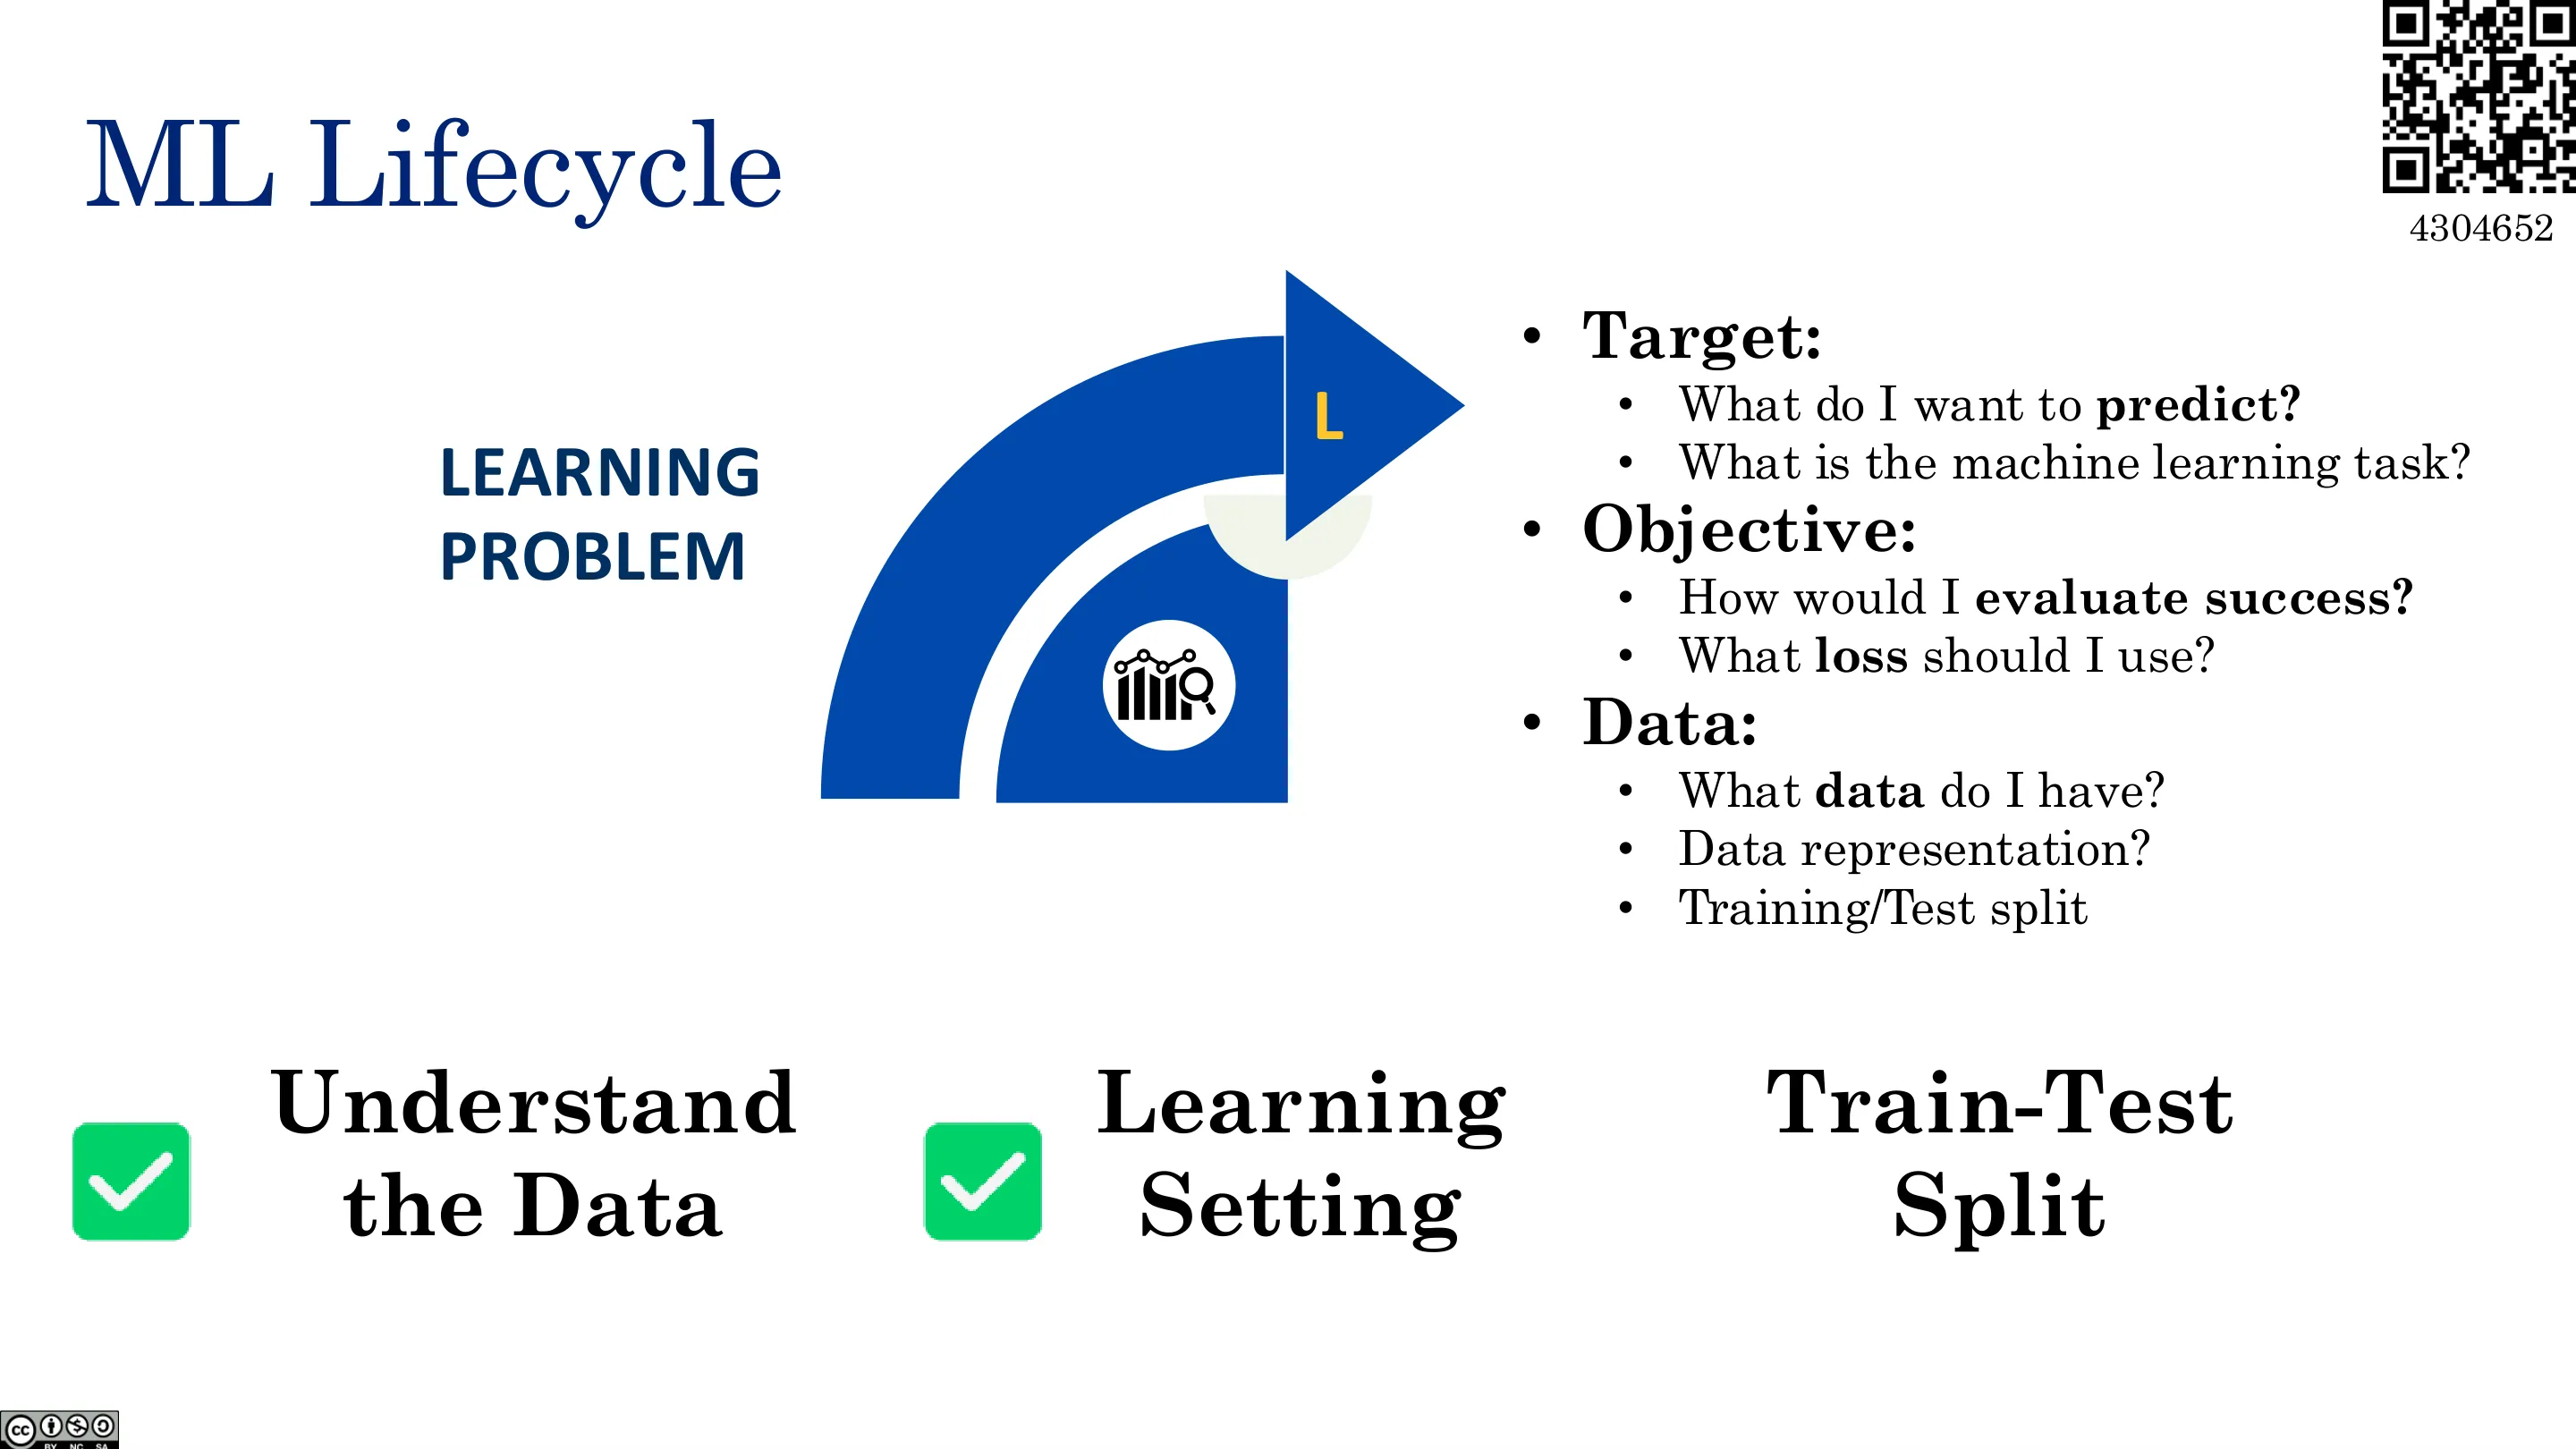
📷 定义学习问题:训练/测试划分
回到原视频 (00:29:29)
五、如何评估分类器:准确率的问题
(参考时间: 00:29)
最直观的度量是准确率(accuracy)= 预测正确的数量 / 样本总数。例如测试集 100 张图对了 85 张,准确率就是 85%。
但准确率有严重问题。讲师举了一个新闻标题:「机器学习研究者做出了一个神经网络,只要看你在网上的照片,就能预测你是否感染新冠!」 你该问什么?
- 这可行吗?——也许可行:感染时皮肤像素可能有细微变化;
- 关键问题:它真的有效吗?
答案是:它有大约 99% 的准确率——但那只是因为它一直回答「没有」。因为感染率不到 1%,一个「永远说 no」的分类器就能有 99%+ 的准确率。准确率在这里是一个糟糕的度量。
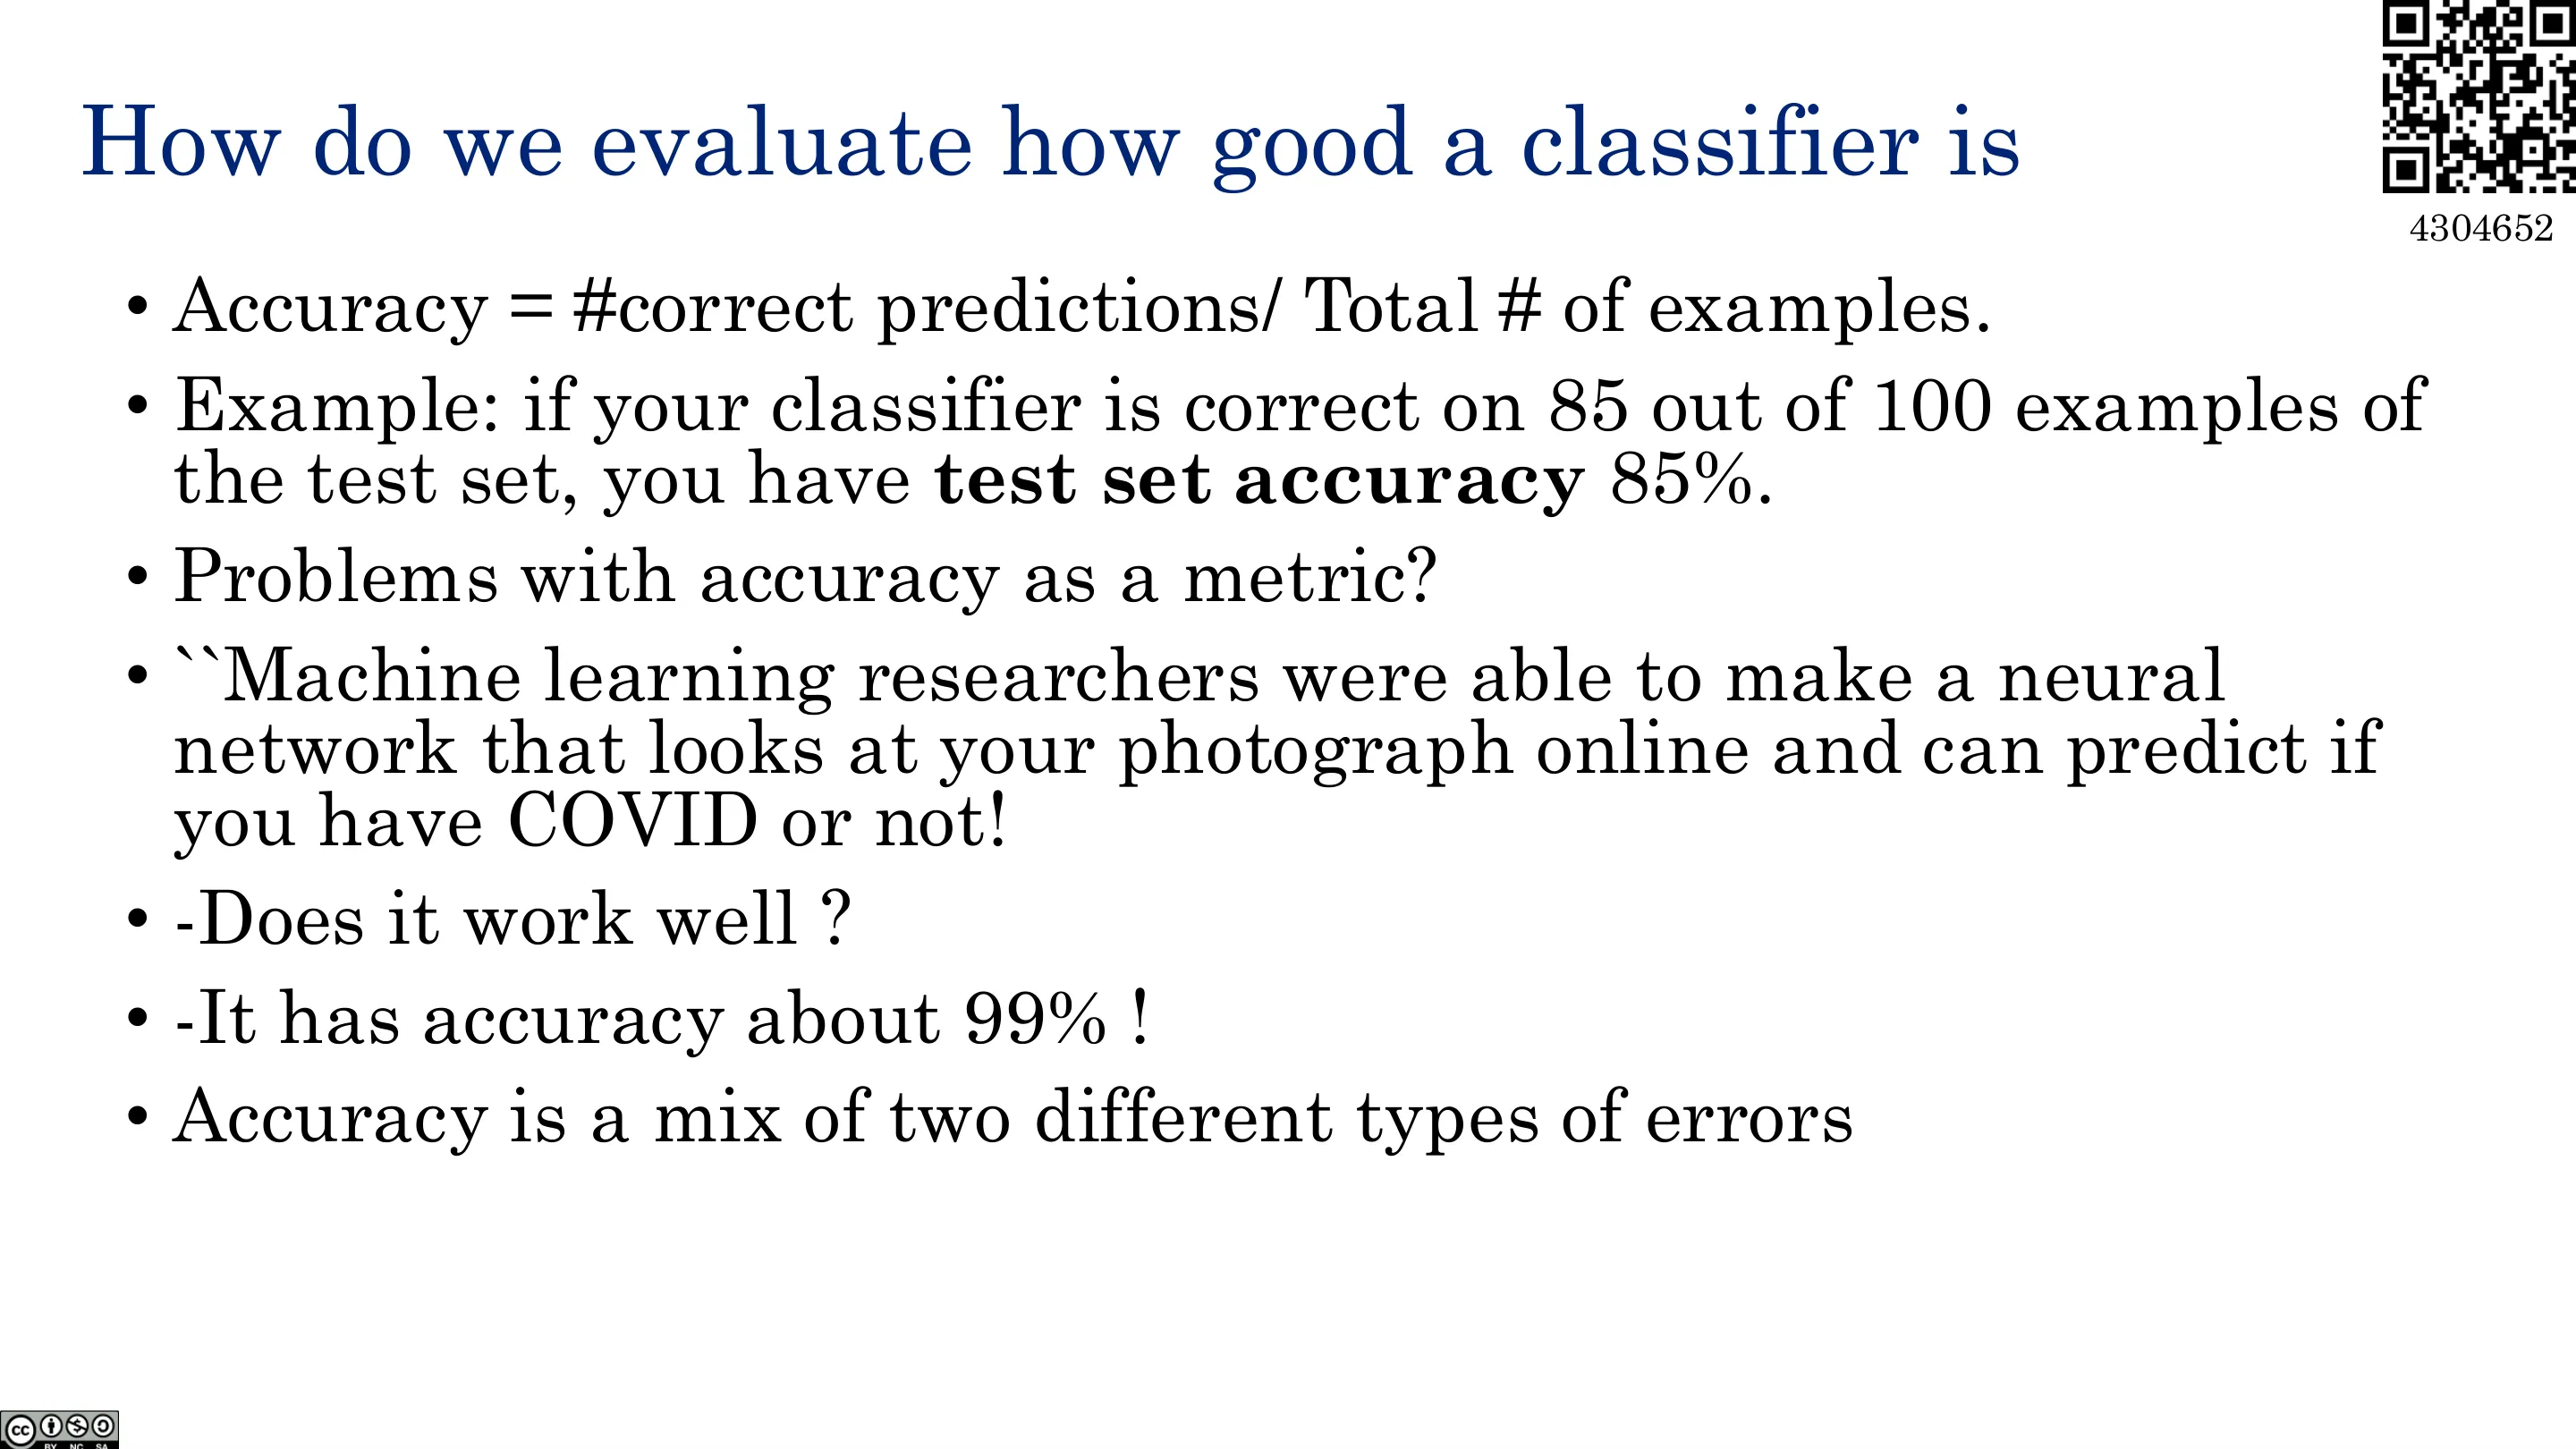
📷 准确率的问题
回到原视频 (00:29:47)
你会以两种方式犯错:
- 第一类错误(Type 1 error)/ 假阳性(False Positive):错误地拒绝了原假设——
- 第二类错误(Type 2 error)/ 漏检(Missed Detection):原假设为假却未能拒绝。
📷 你会以两种方式犯错
回到原视频 (00:32:52)
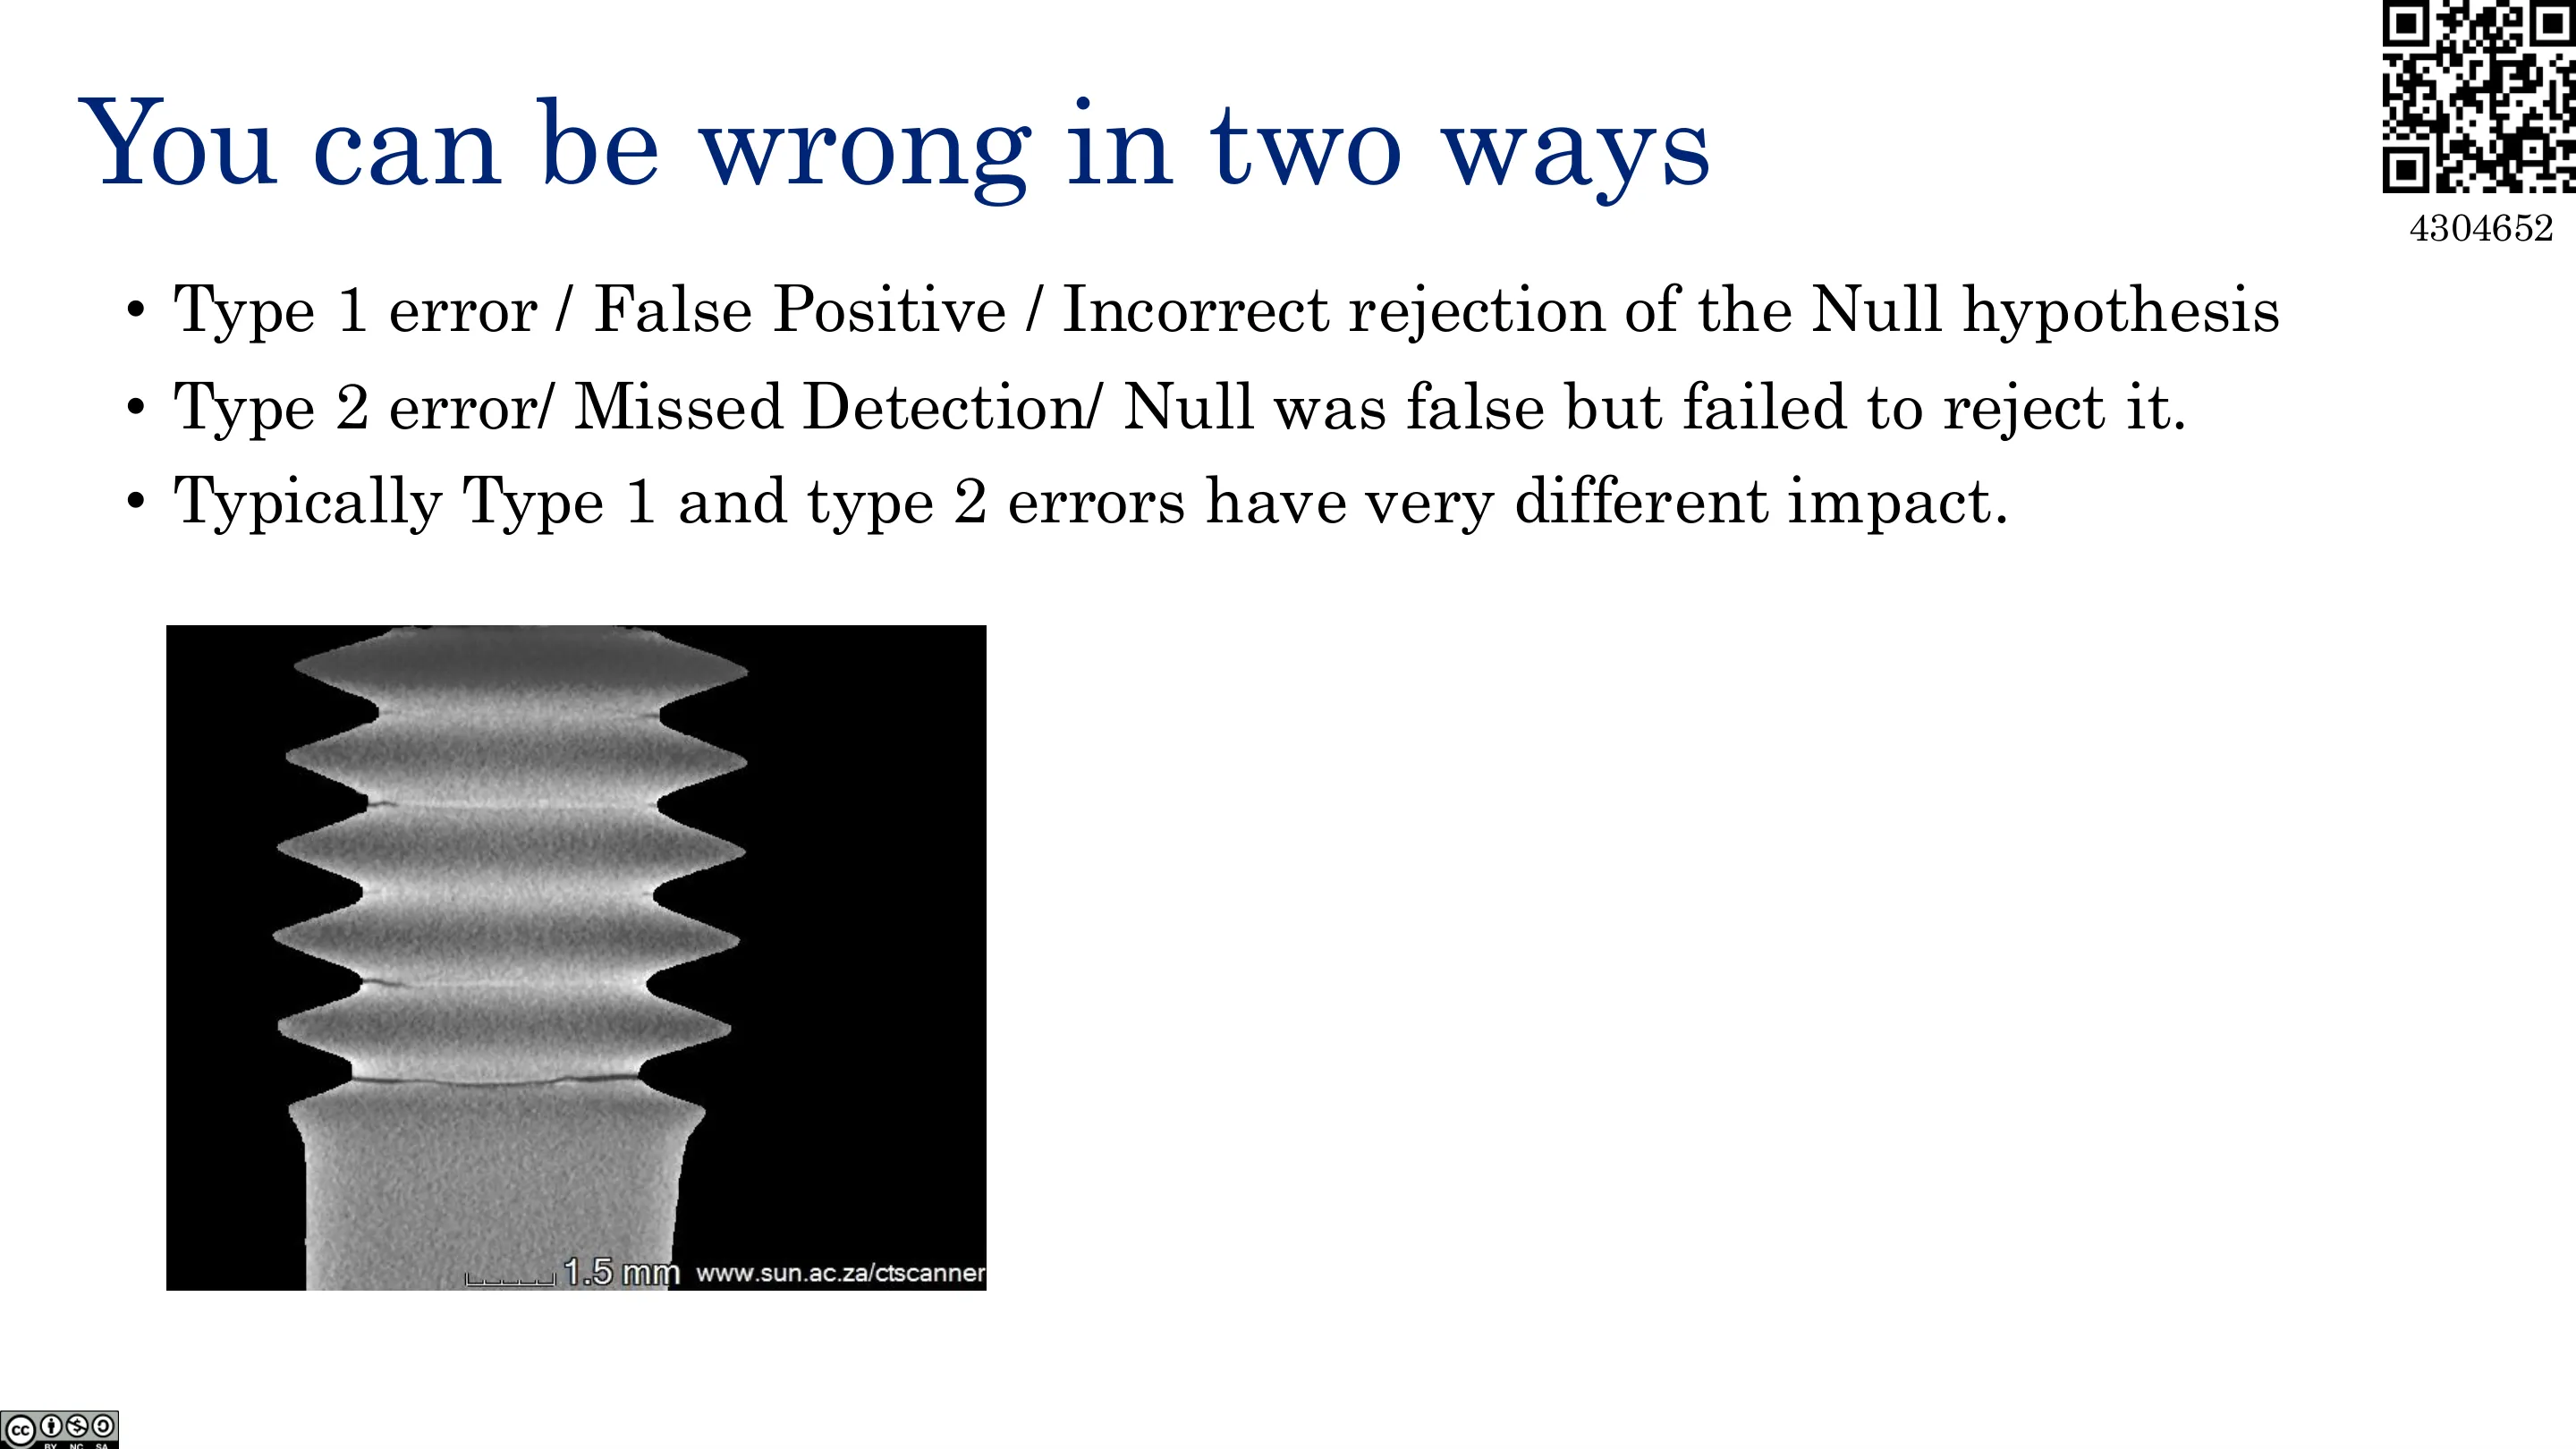
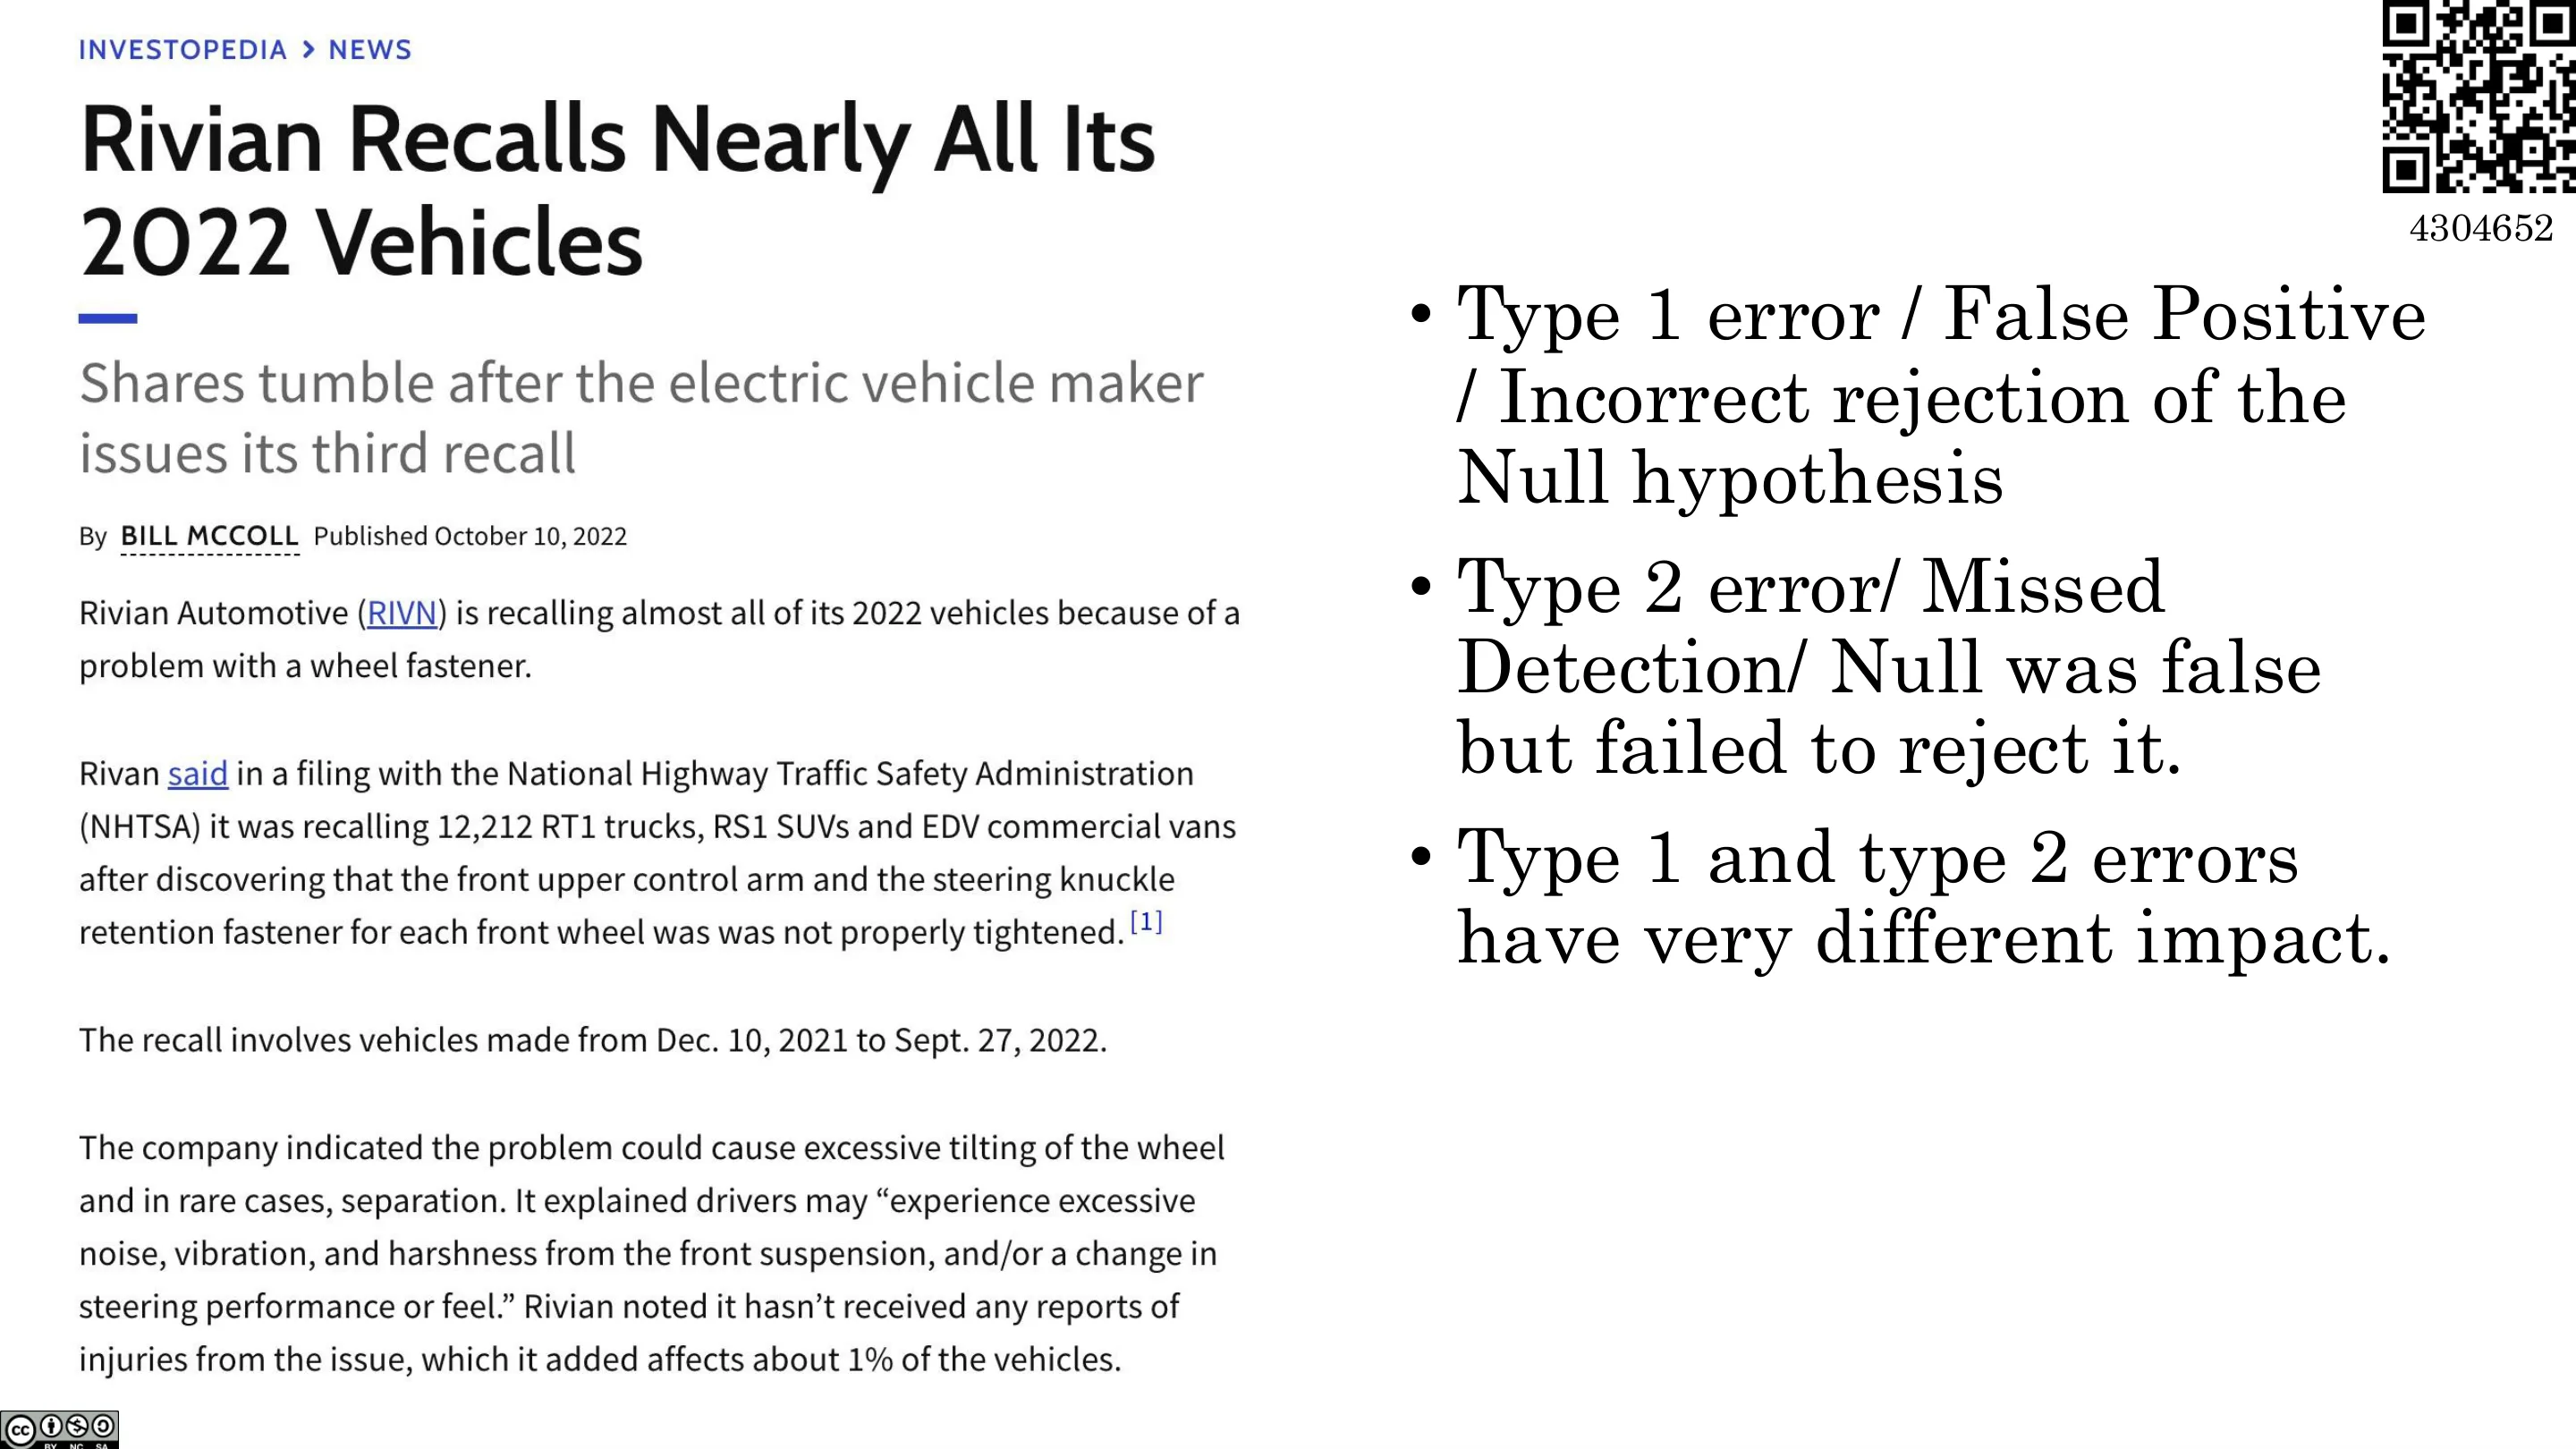
这两类错误在实际系统中的影响完全不同。例如:
- 误诊某人「有新冠」但实际没有——他可能只是错过一场派对,损失不大;
- 漏诊某人「有新冠」而实际有——他可能去参加派对,传染上千人。
📷 你会以两种方式犯错(续)
回到原视频 (00:33:23)
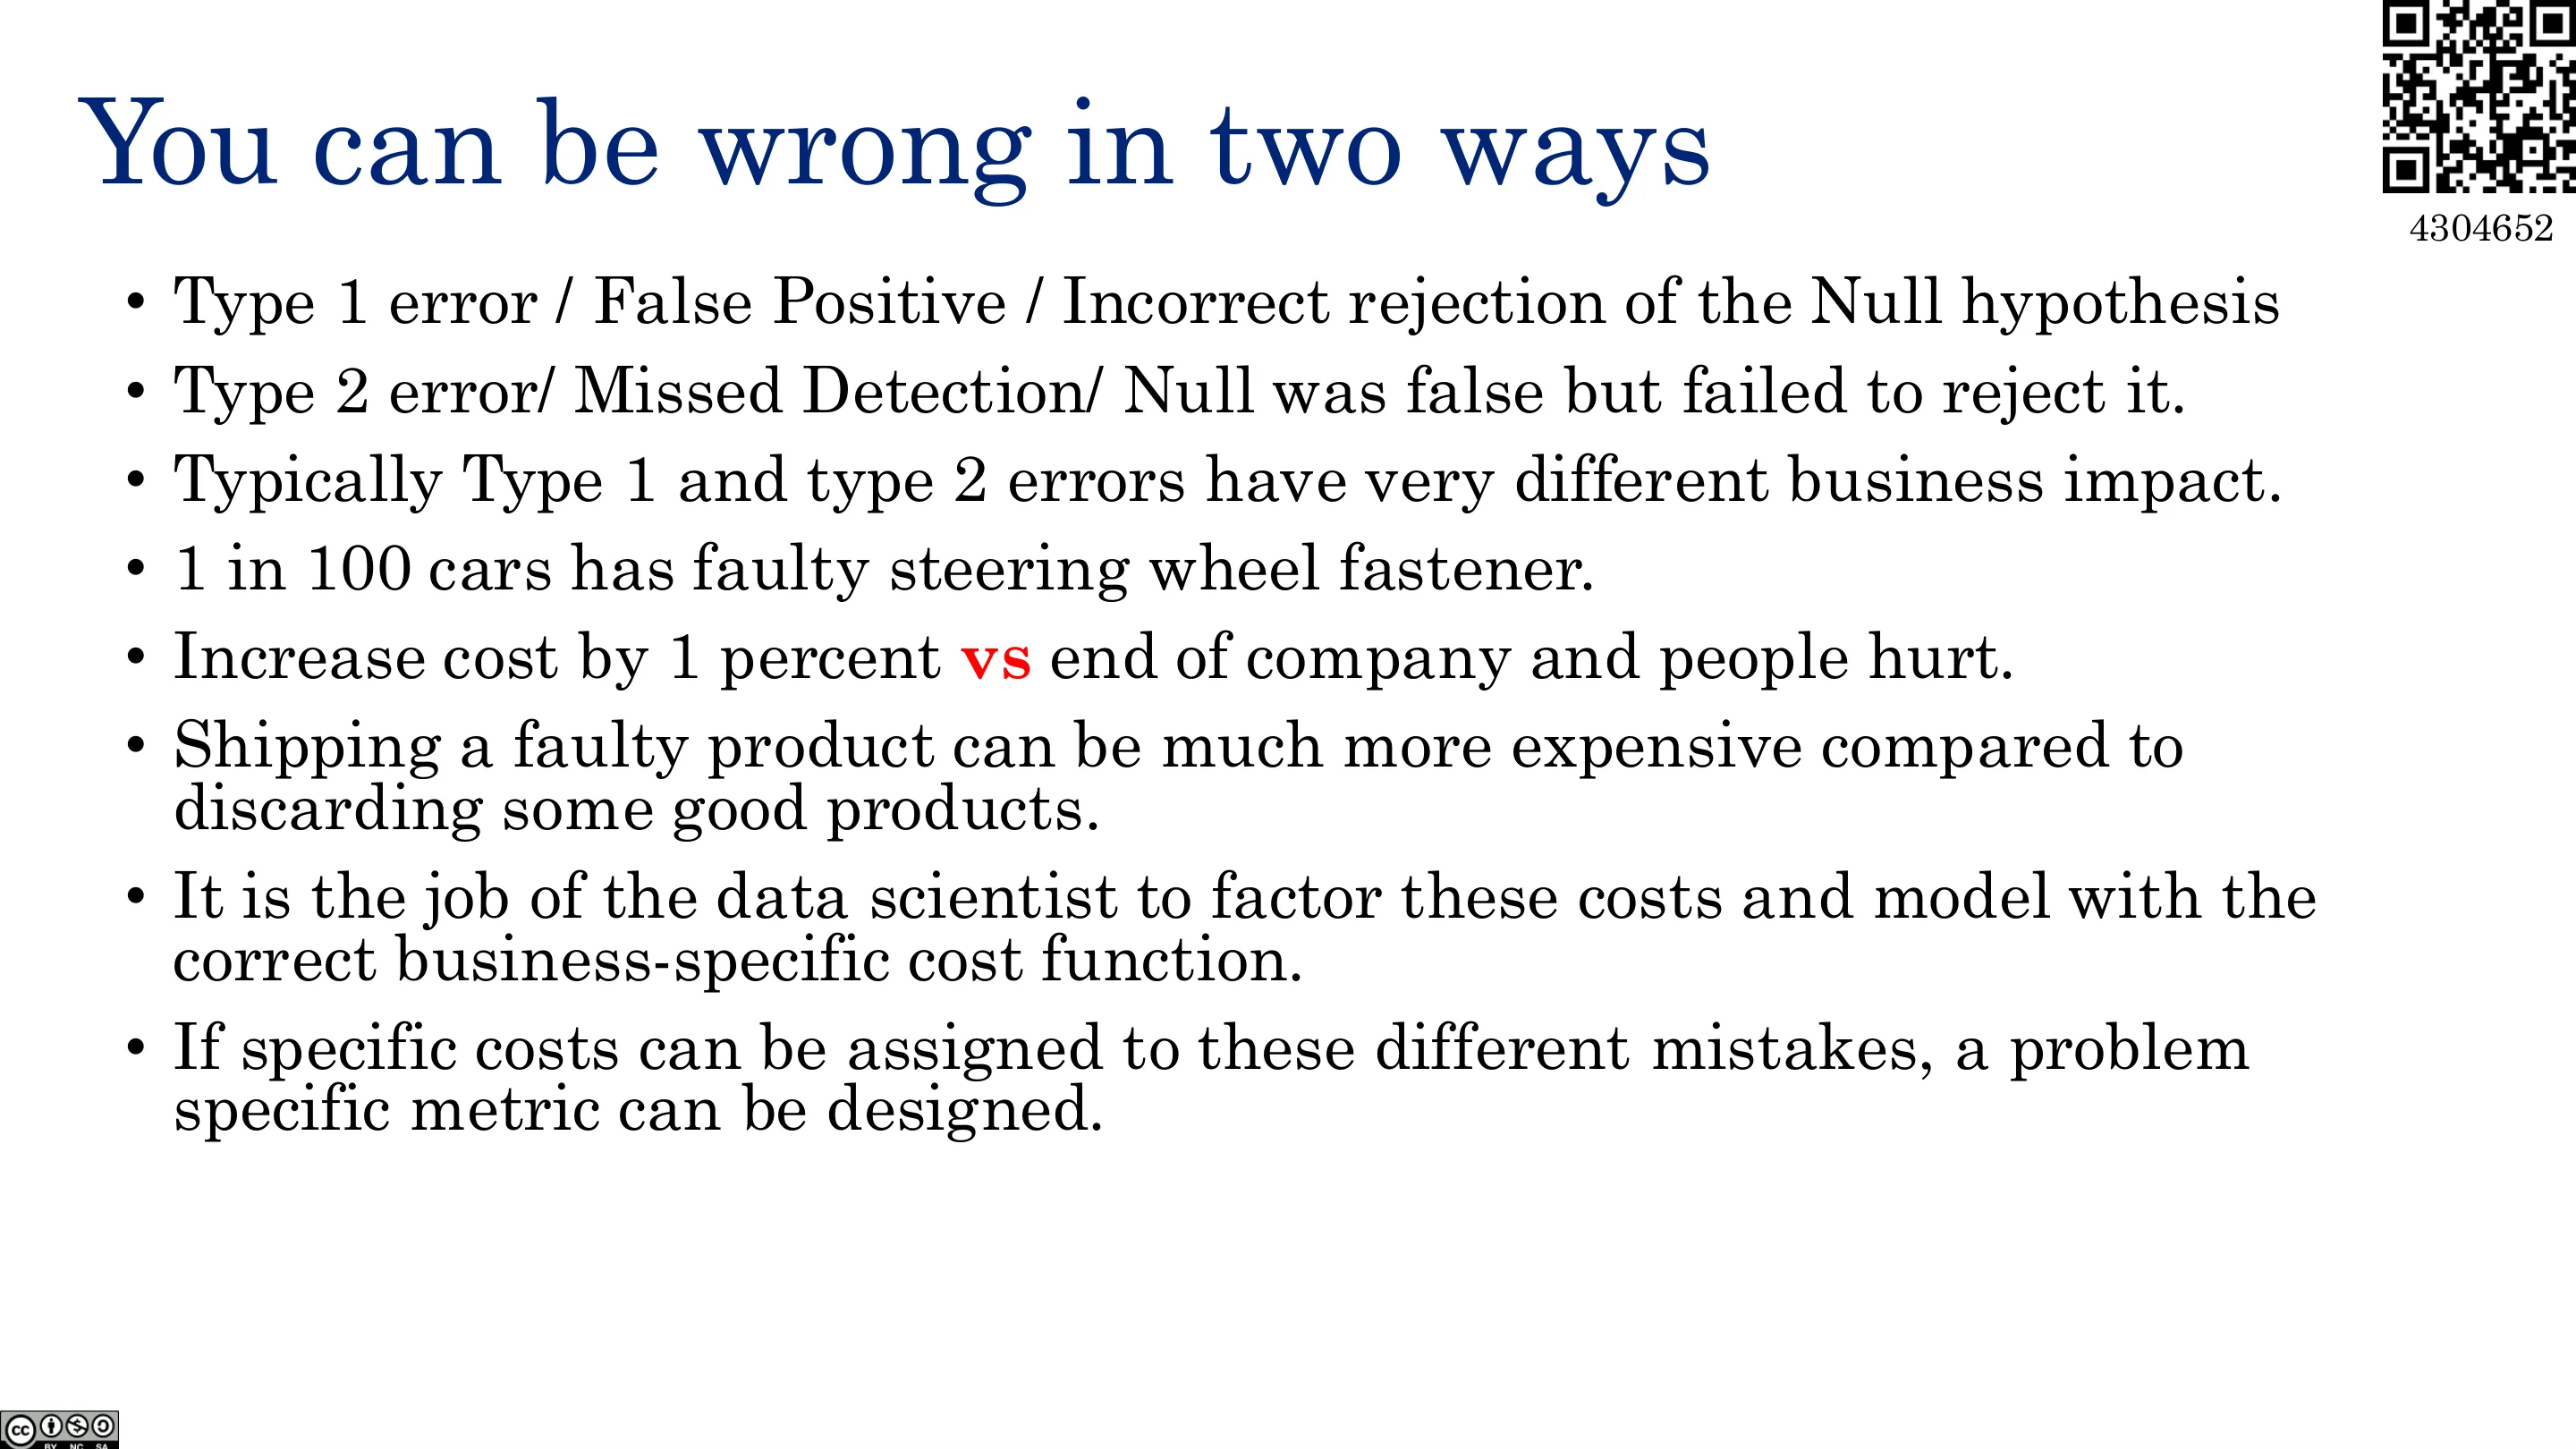
讲师用 Rivian 召回的真实案例说明:因为前控制臂/转向节的紧固件没有拧紧(可能在图中看到裂纹),Rivian 召回了几乎所有 222 辆车。漏掉一个缺陷的代价,可能远大于报废一些好产品。
因此:
- 如果不同错误能被赋予具体成本,就可以设计问题专属的度量;
- 数据科学家的职责,就是把这些成本纳入建模,用业务相关的成本函数来优化。
编者说明:如果 100 辆车里只有 1 辆紧固件有缺陷,随机抽检 10% 可能根本抽不到;要让这样的产品可以出厂,模型必须有极小的第二类错误概率。
📷 两类错误的代价(续)
回到原视频 (00:33:43)
📷 两类错误的代价与 Rivian 召回
回到原视频 (00:34:03)
六、泛化与数据划分
编者拓展|fa26 用 KNN 把这一整节演示了一遍:2026 秋季(fa26)用 k 近邻(KNN) —— 最简单、几乎没有“训练”的模型 —— 把本节的概念(泛化、训练/测试划分、超参数 $k$、验证集)逐个演了一遍: $k{=}1$ 时训练集准确率 100%、测试集却很差,正是“记忆不等于学会”的最直白版本。 本书(sp26 春季实录版)没有 KNN 这一讲,补充内容见 《补充:KNN、机器学习词汇与 K-Means》。
6.1 考试类比:记忆不等于学会
(参考时间: 00:36)
我们即将用数据训练模型。怎么知道模型真的「学到」了?
- 能不能用「模型拟合数据的好坏」来衡量?为什么「记住答案」(应试)不好?
- 考试类比:如果考前把题目和答案都给你去「研究(训练)」,人人都会考得好——但这说明他们学会课程内容了吗?
📷 如何评估模型:考试类比
回到原视频 (00:36:16)
6.2 泛化
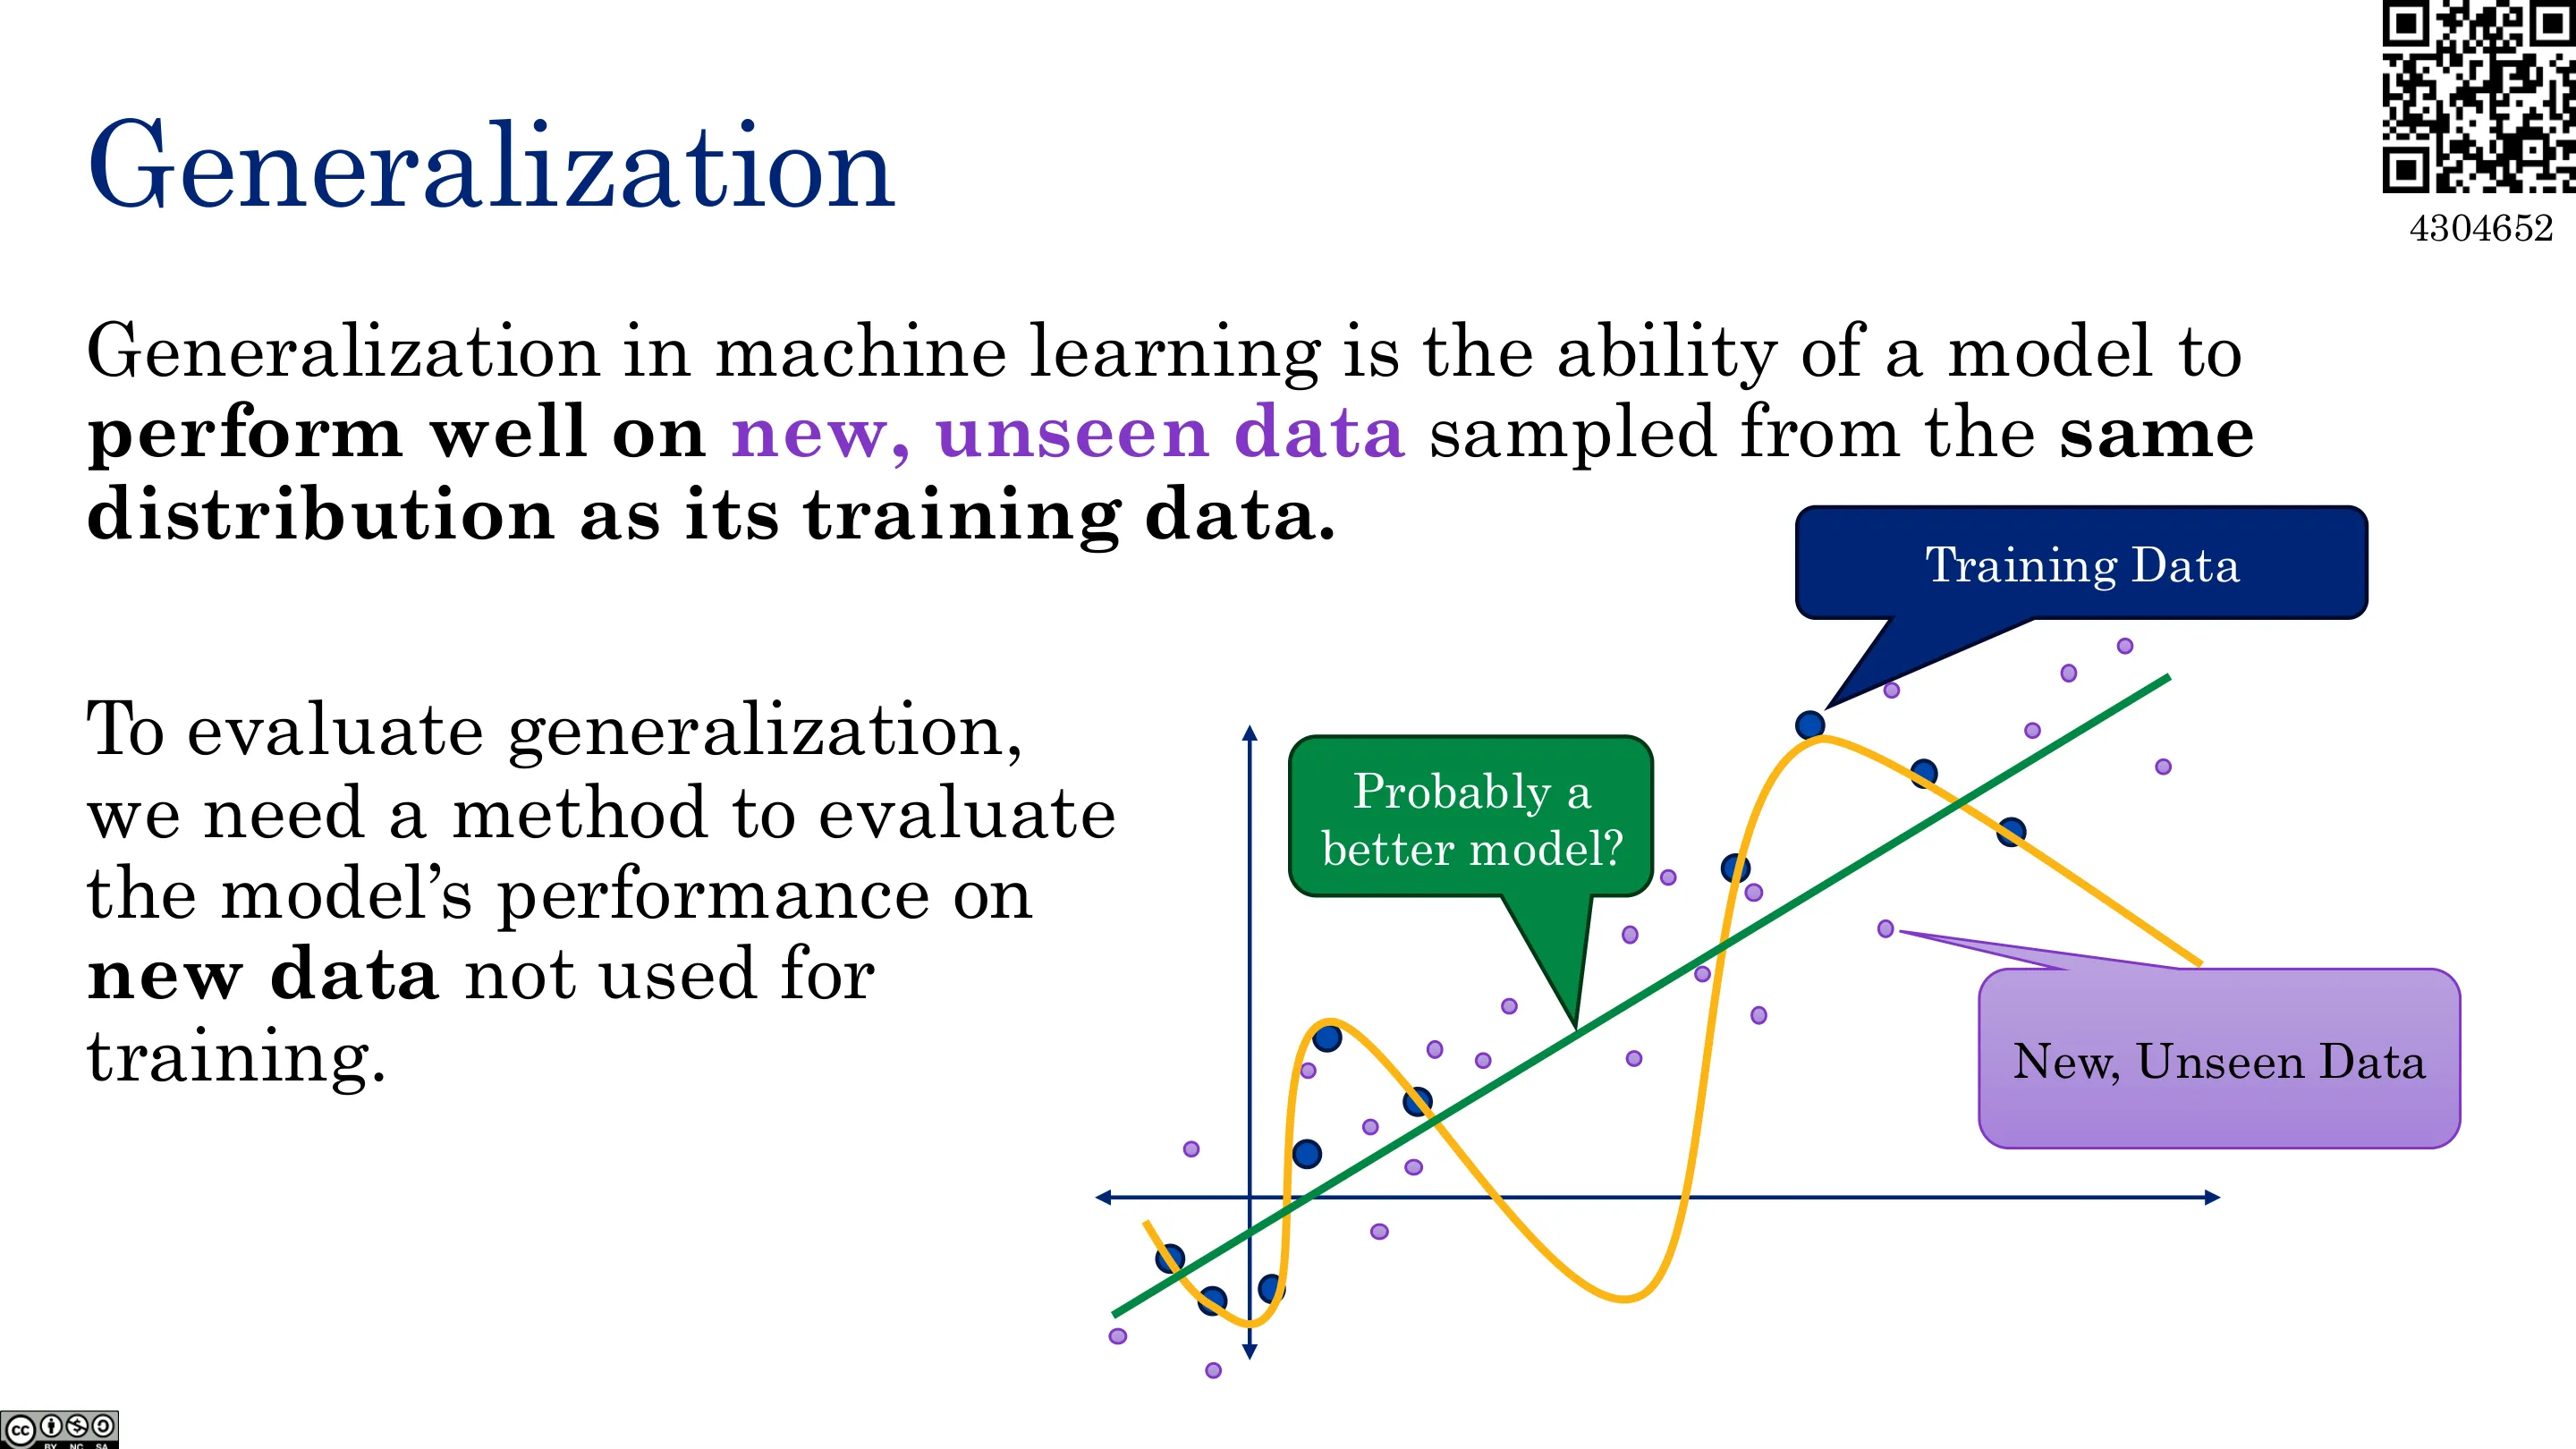
泛化(Generalization)是模型在与训练数据同分布的、新的未见数据上表现良好的能力。要评估泛化,就必须有办法在未用于训练的新数据上评估模型。
📷 泛化
回到原视频 (00:37:07)
6.3 训练-测试划分(Train-Test Split)
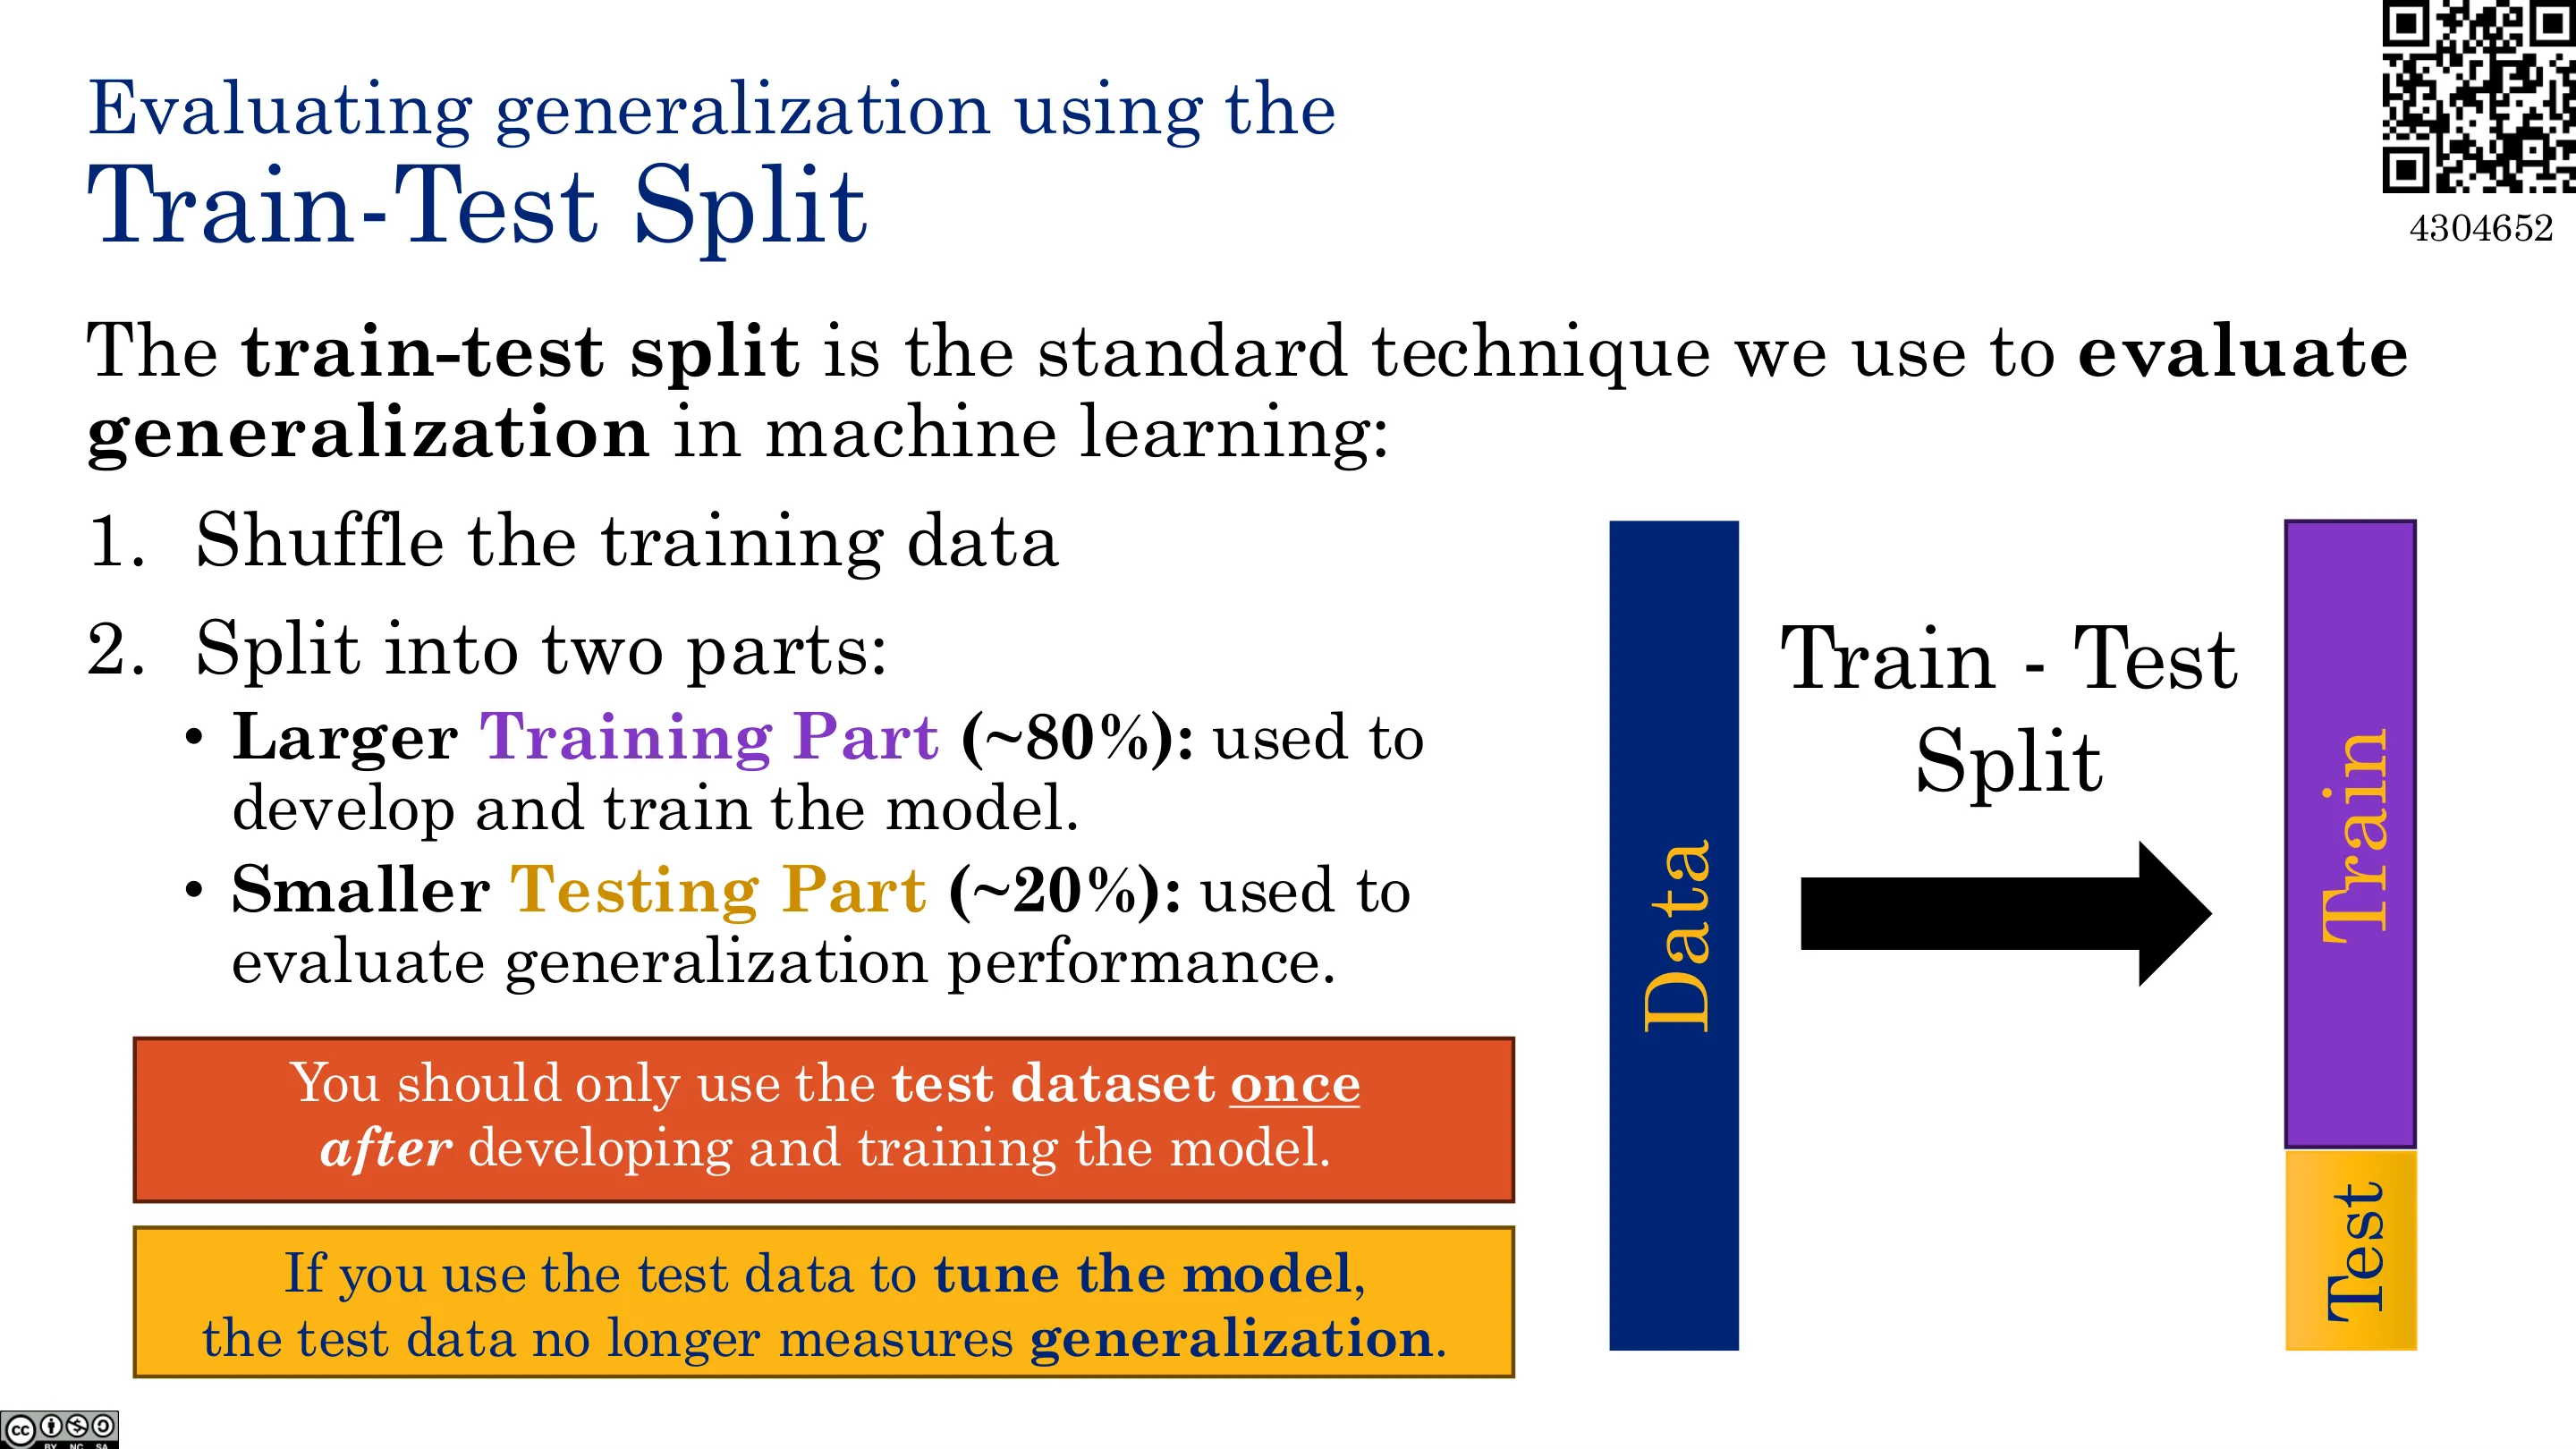
标准做法:
- 打乱(shuffle)训练数据;
- 切成两部分:
- 较大的训练集(~80%):用于开发与训练模型;
- 较小的测试集(~20%):用于评估泛化性能。
测试集只应在模型开发、训练完成后使用一次。
📷 训练-测试划分
回到原视频 (00:38:13)
为什么只能用一次?因为如果你用测试集来调参,测试集就不再衡量泛化了——你其实在「从测试集学习」,开始作弊。
📷 为什么测试集只能用一次
回到原视频 (00:39:34)
6.4 验证集(Validation Split)
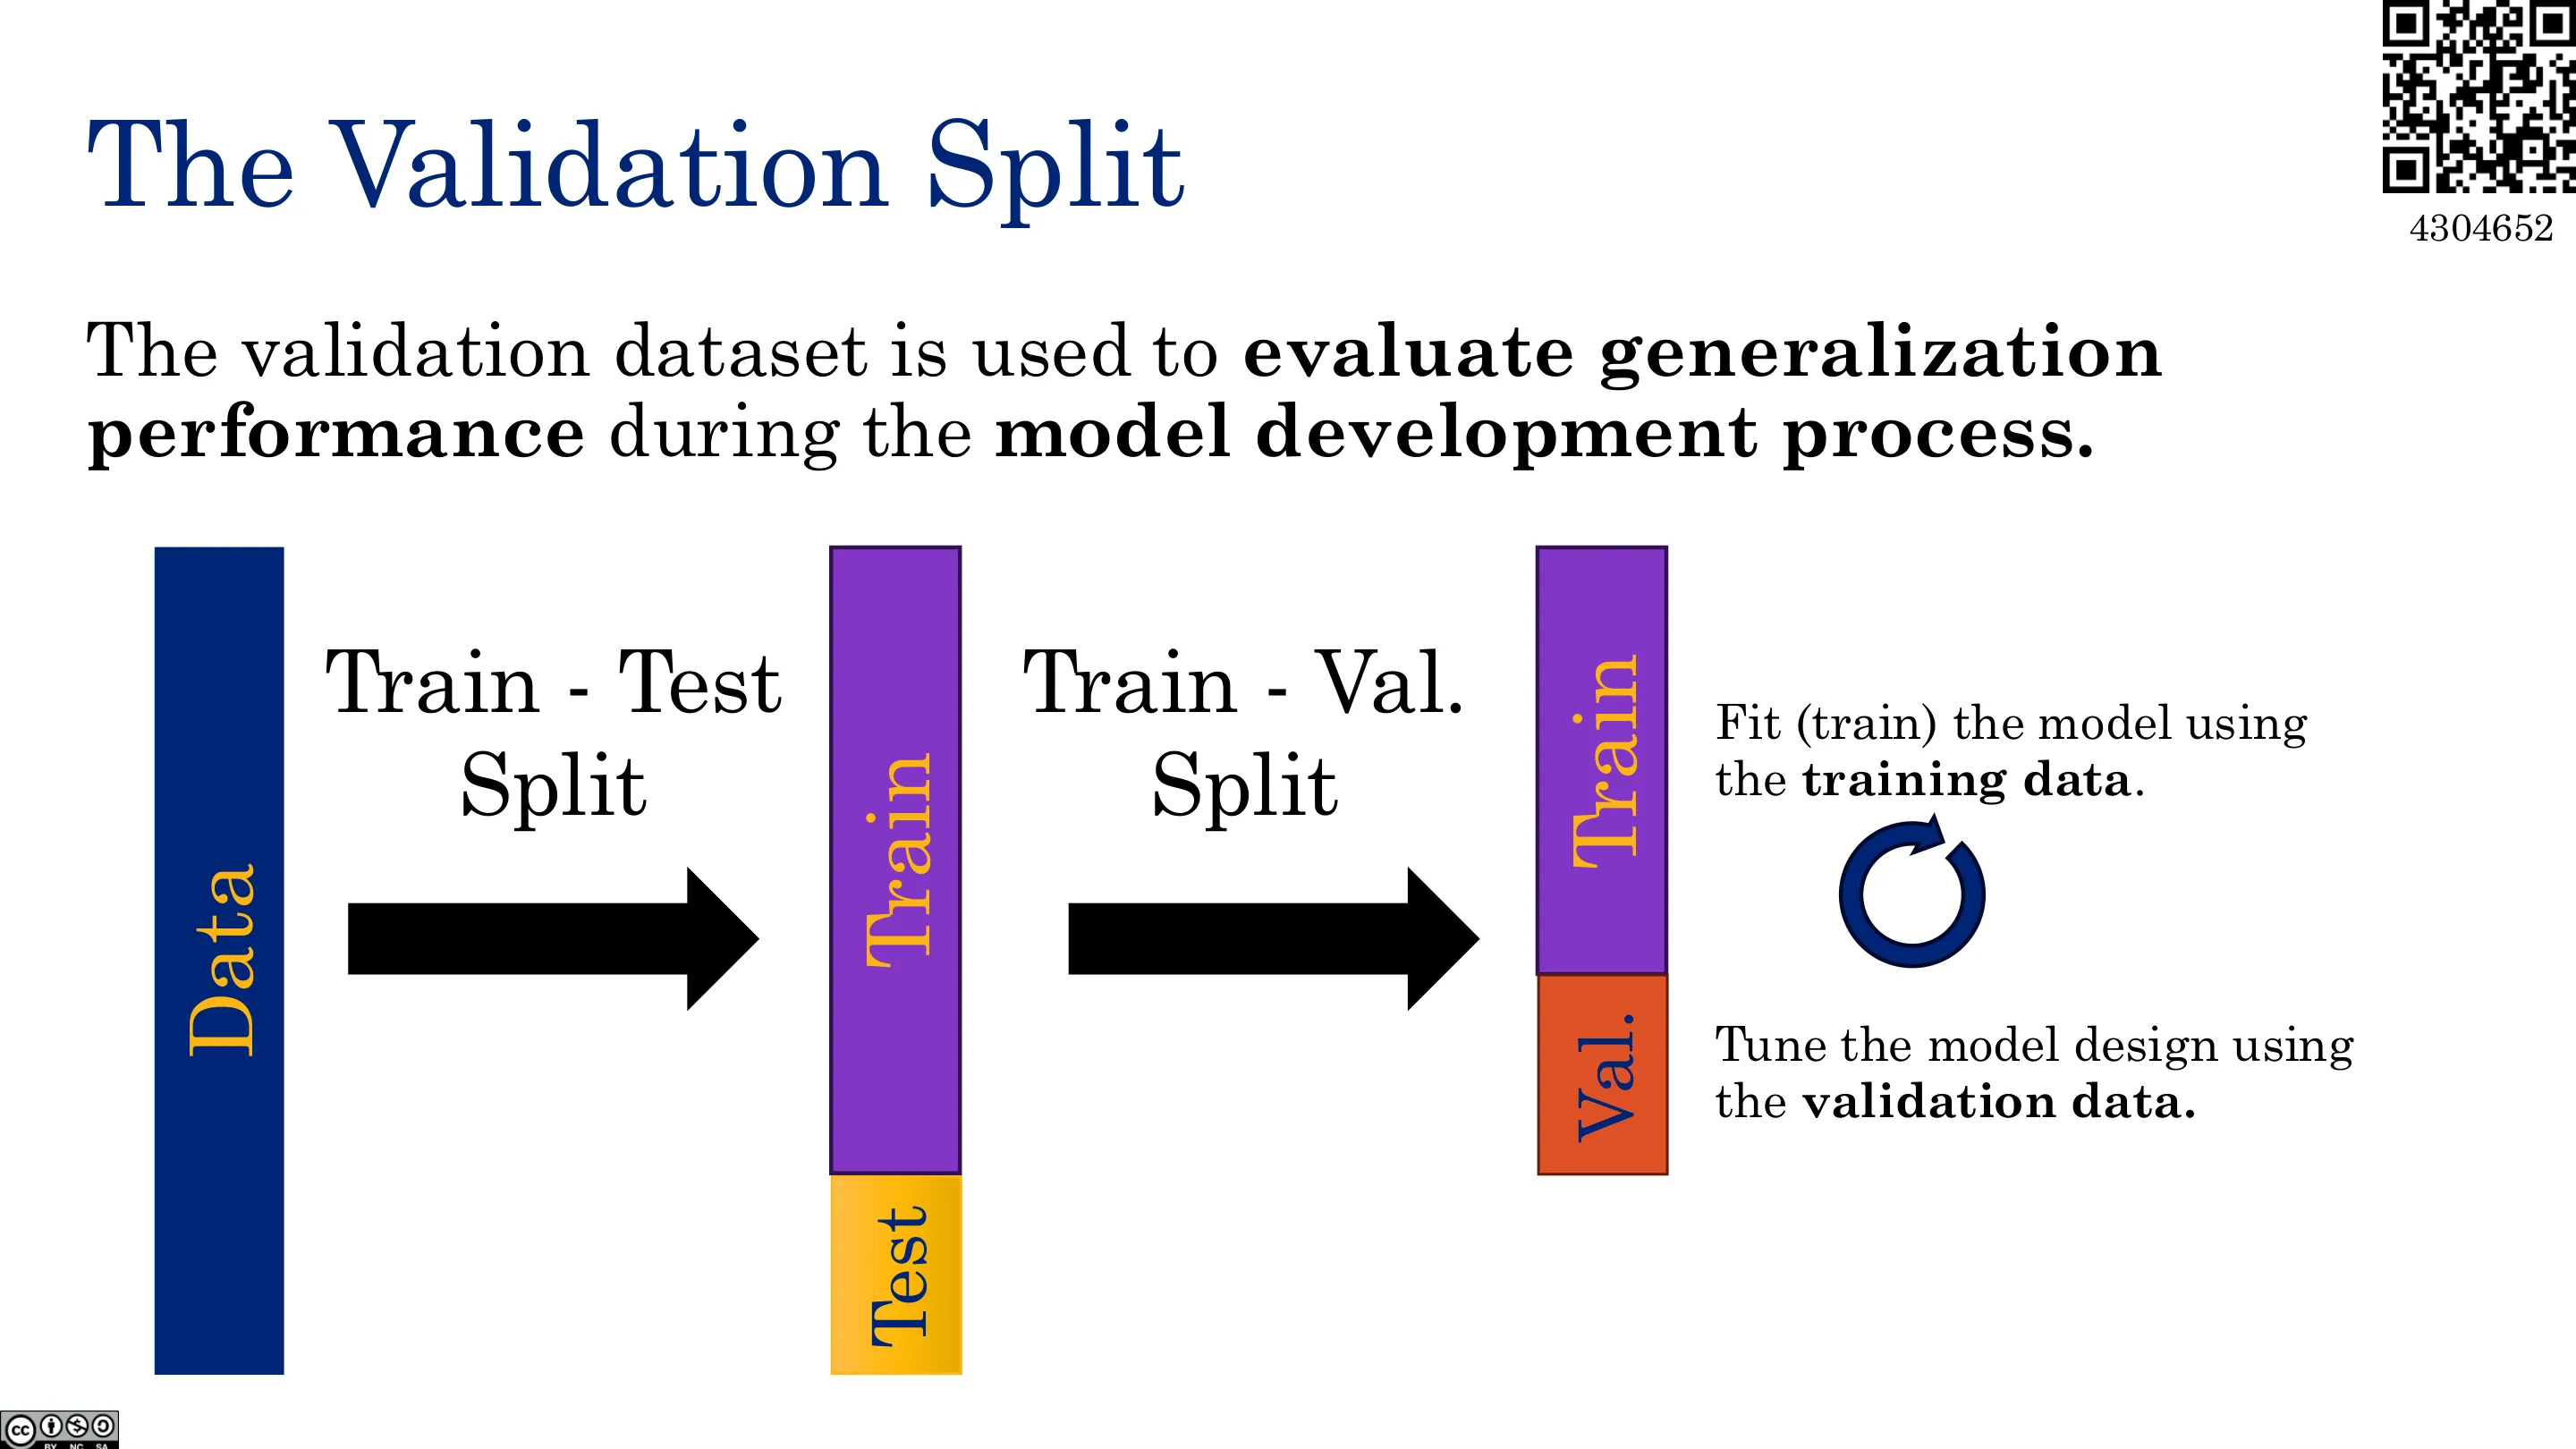
为了在开发过程中调参,我们从训练集中再切出一个验证集:
- 用训练集拟合(训练)模型;
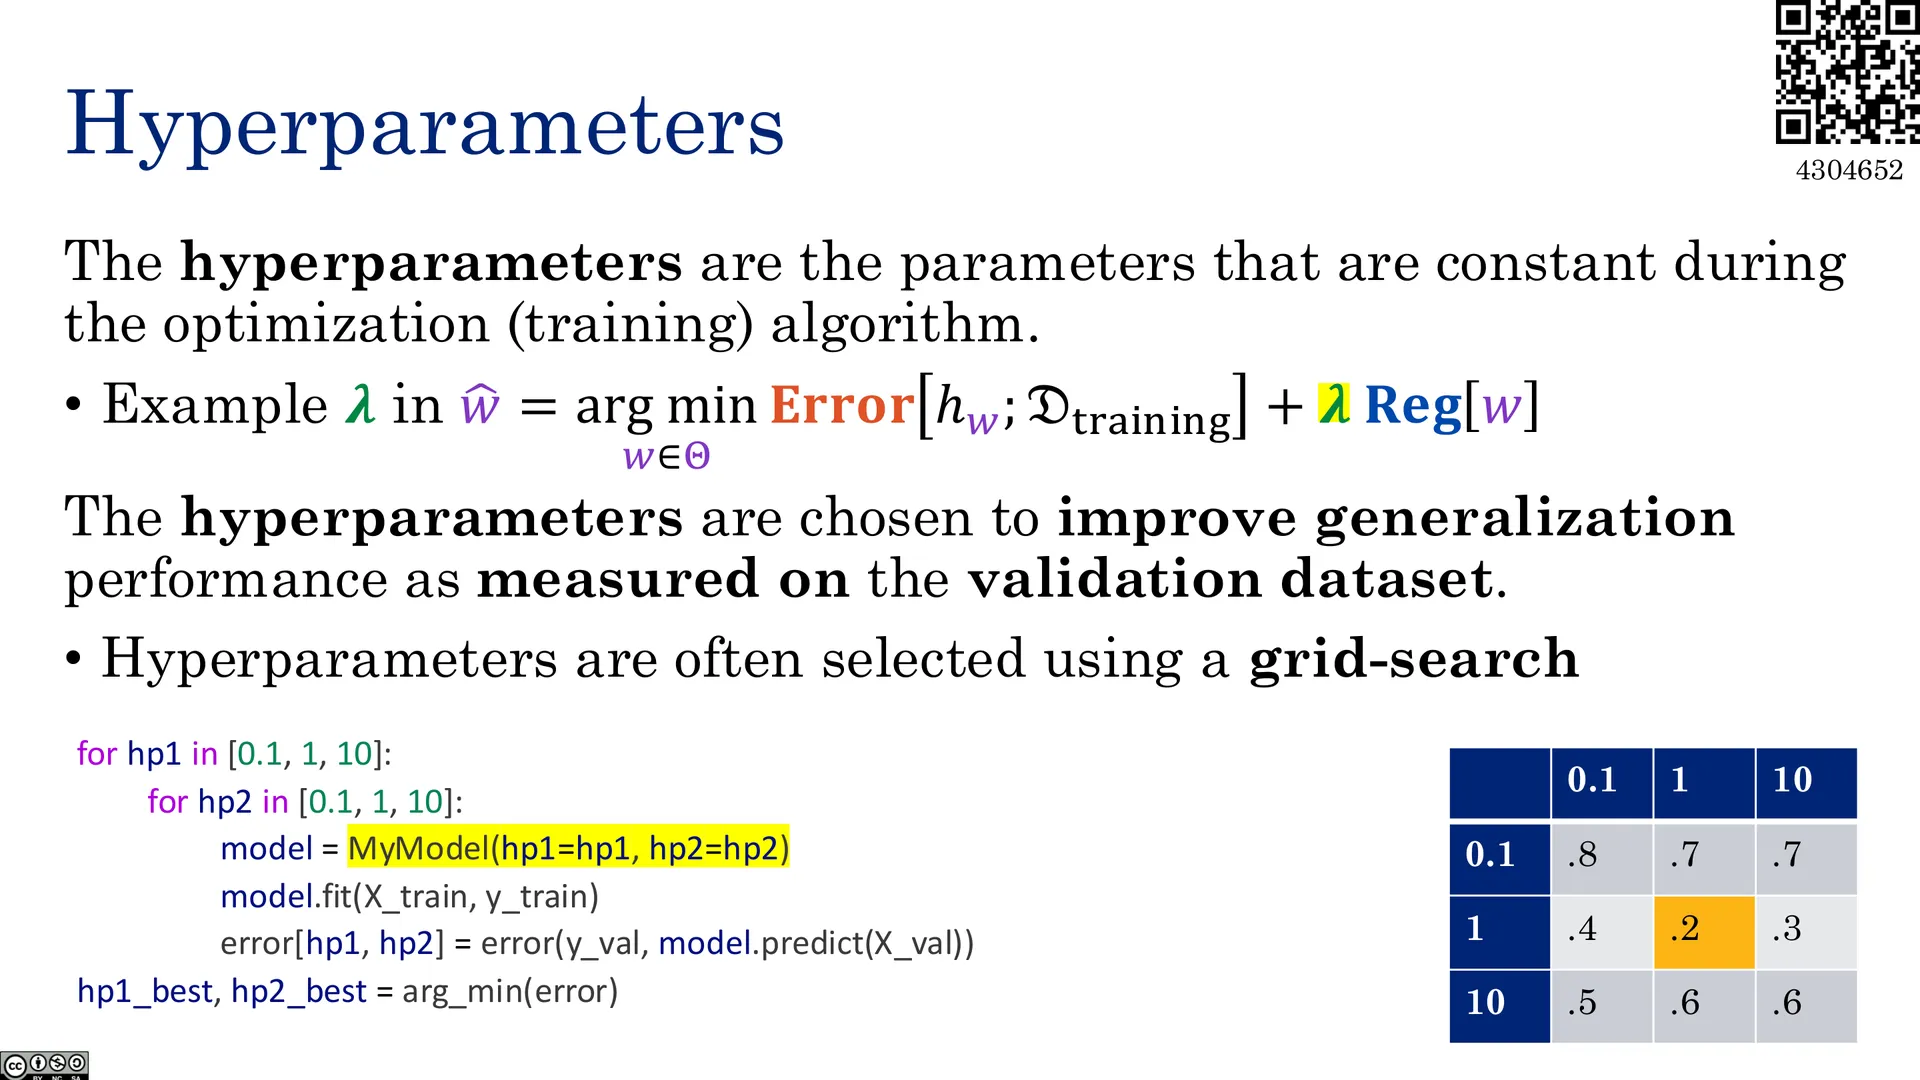
- 用验证集评估泛化、调整模型设计(超参数);
- 最后用测试集报告最终性能。
📷 验证集
回到原视频 (00:40:17)
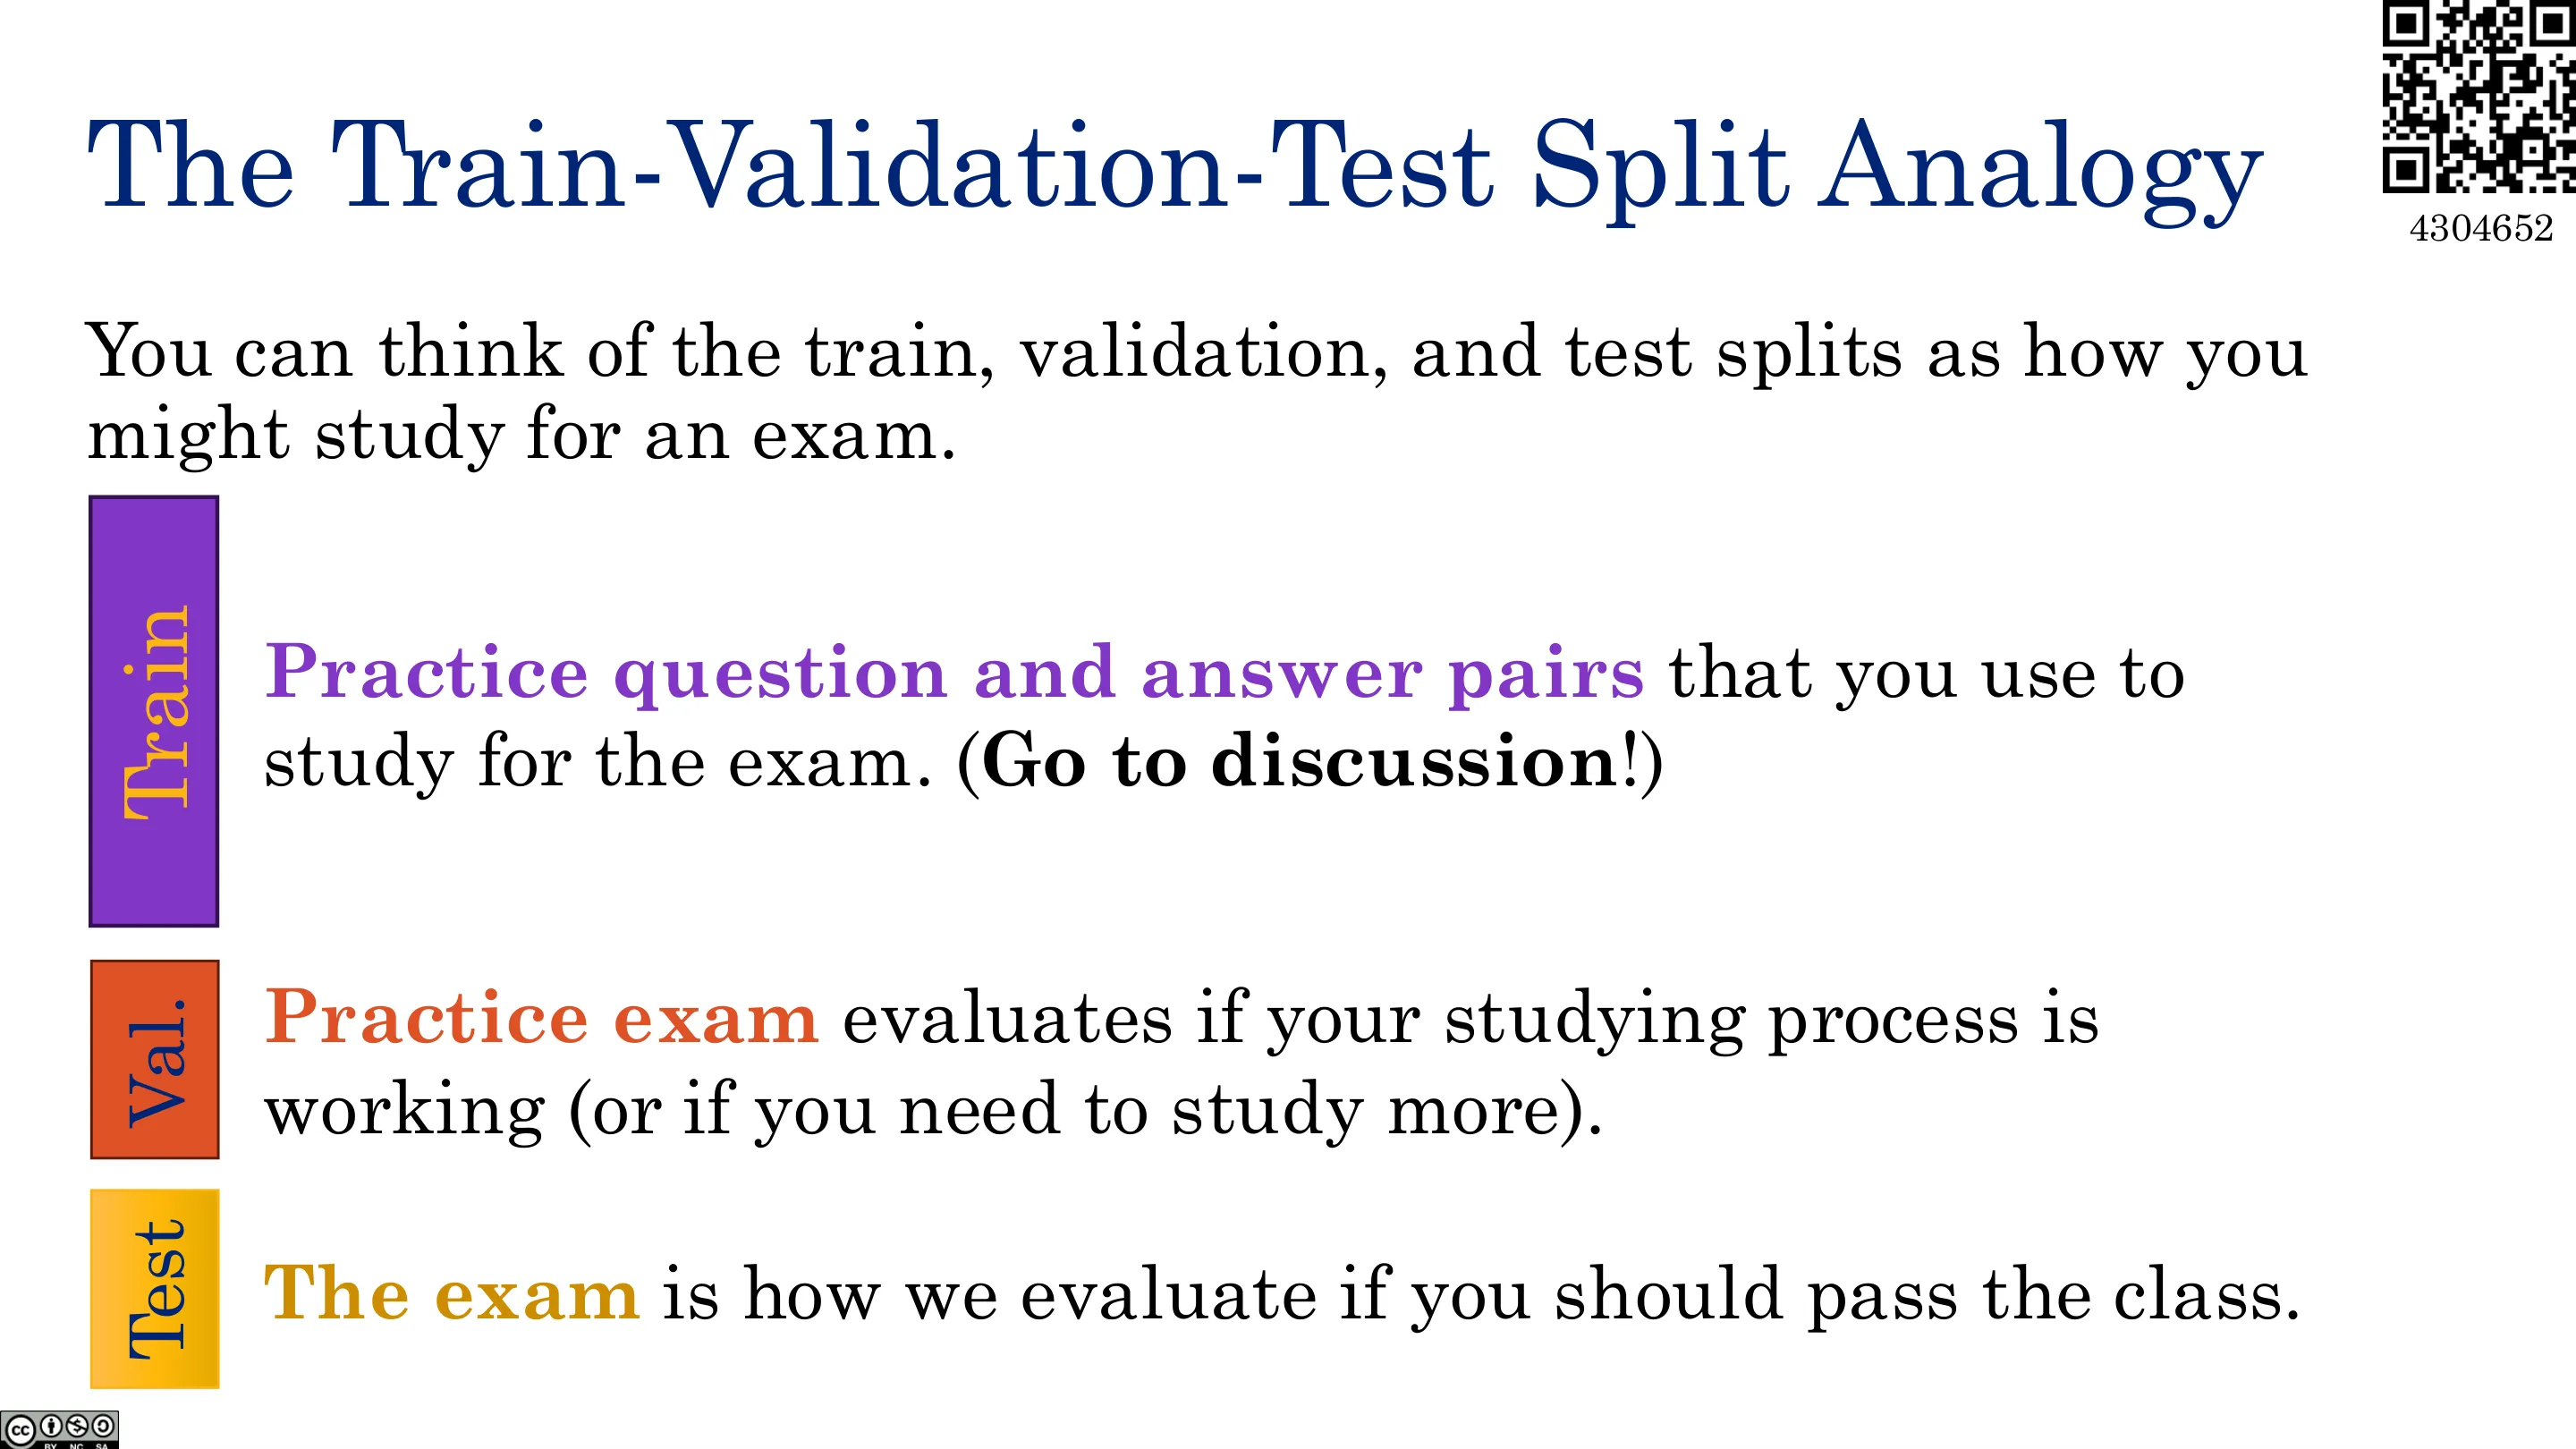
三者对应的考试类比:
- 训练集 ≈ 用于复习的「题目+答案」练习(去上 discussion!);
- 验证集 ≈ 模拟考,检验你的复习方法是否有效(是否需要再学);
- 测试集 ≈ 真正的考试,用来决定你是否通过。
📷 训练-验证-测试的考试类比
回到原视频 (00:47:20)
编者说明:这里有一个 Kaggle 式的经典技巧——当你用验证集挑完最优超参数后,要在「训练集 + 验证集」的全部数据上重新训练最终模型,再看测试集;仅这一步往往就能带来约 5% 的提升。此外,80/20 还是 50/50 存在权衡:验证集越大,你「观测」超参数的能力越强,但留给模型训练的数据越少、模型越弱。极端情况下可用交叉验证(cross validation)、分层交叉验证(stratified CV),甚至训练一个模型去预测性能。
6.5 ImageNetV2:一次关于「测试集」的复制研究
(参考时间: 00:47)
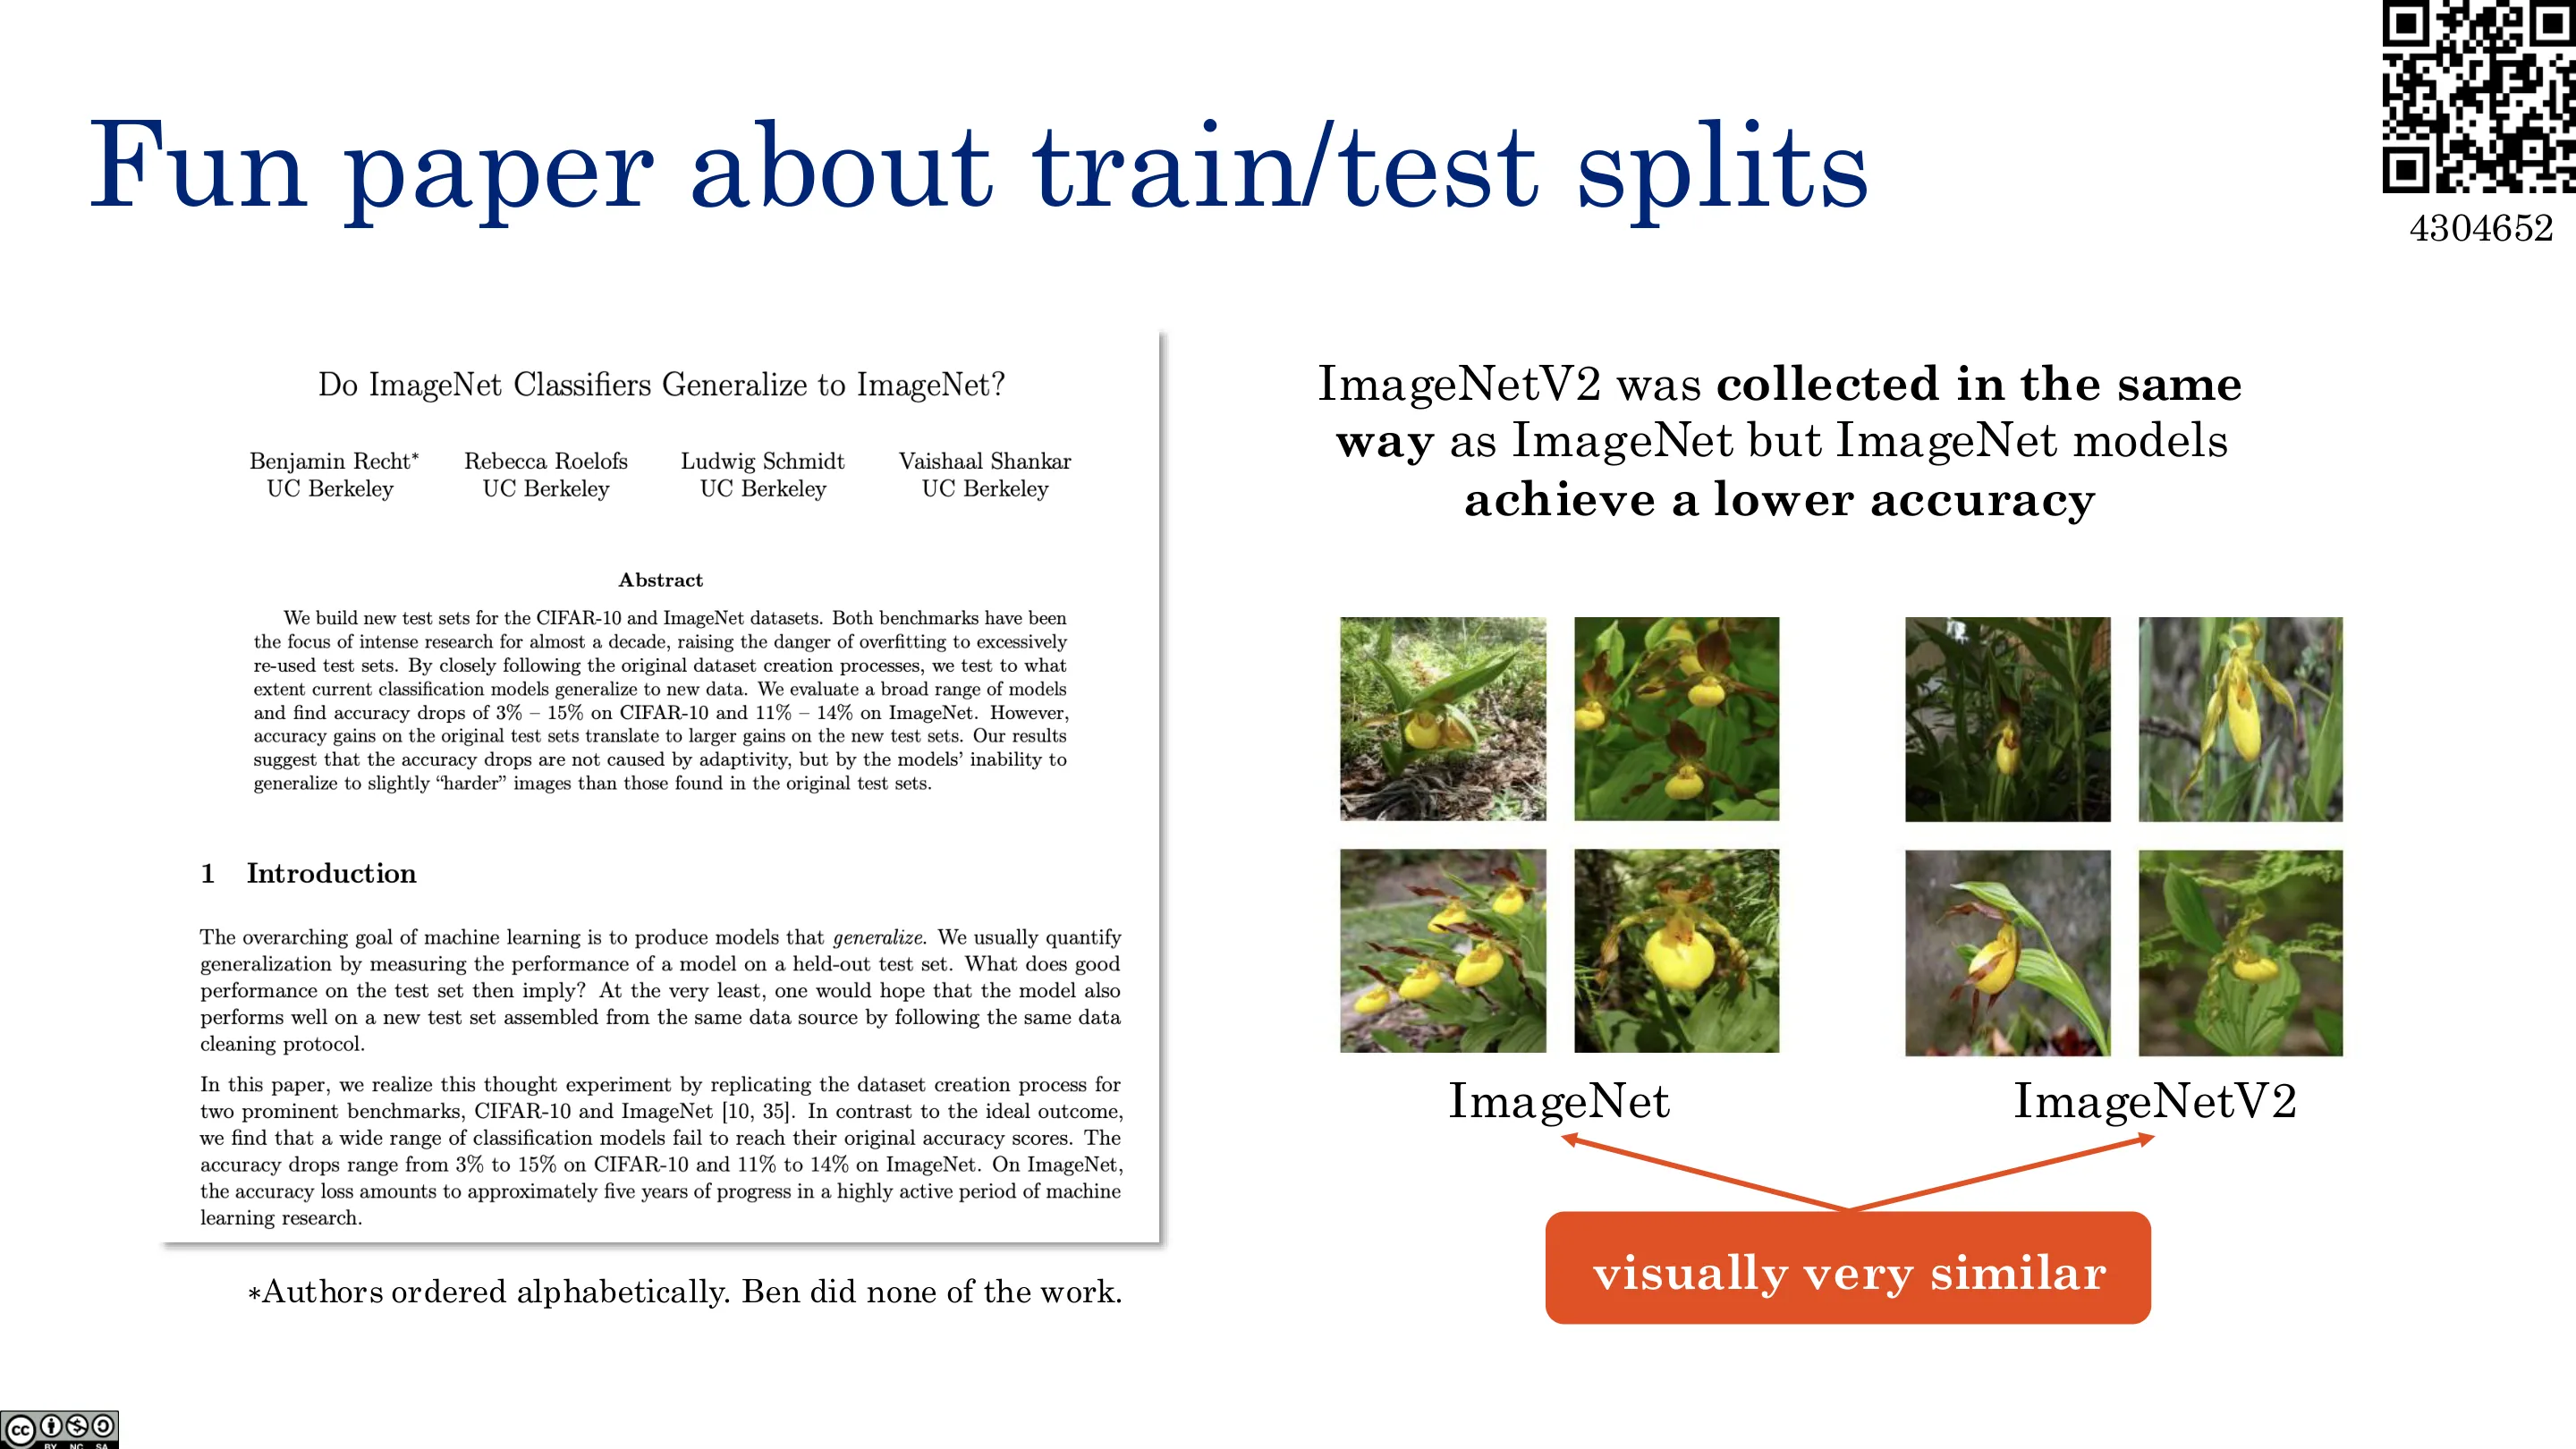
讲师大篇幅介绍了一篇来自 Berkeley 的著名论文(Ludwig Schmidt、Vaishaal Shankar、Ben Recht 等,作者按字母序排列)。背景:ImageNet 是 AI 史上最重要的数据集之一(由李飞飞团队创建,被誉为「AI 之母」),包含上百万张图片、上千个类别。
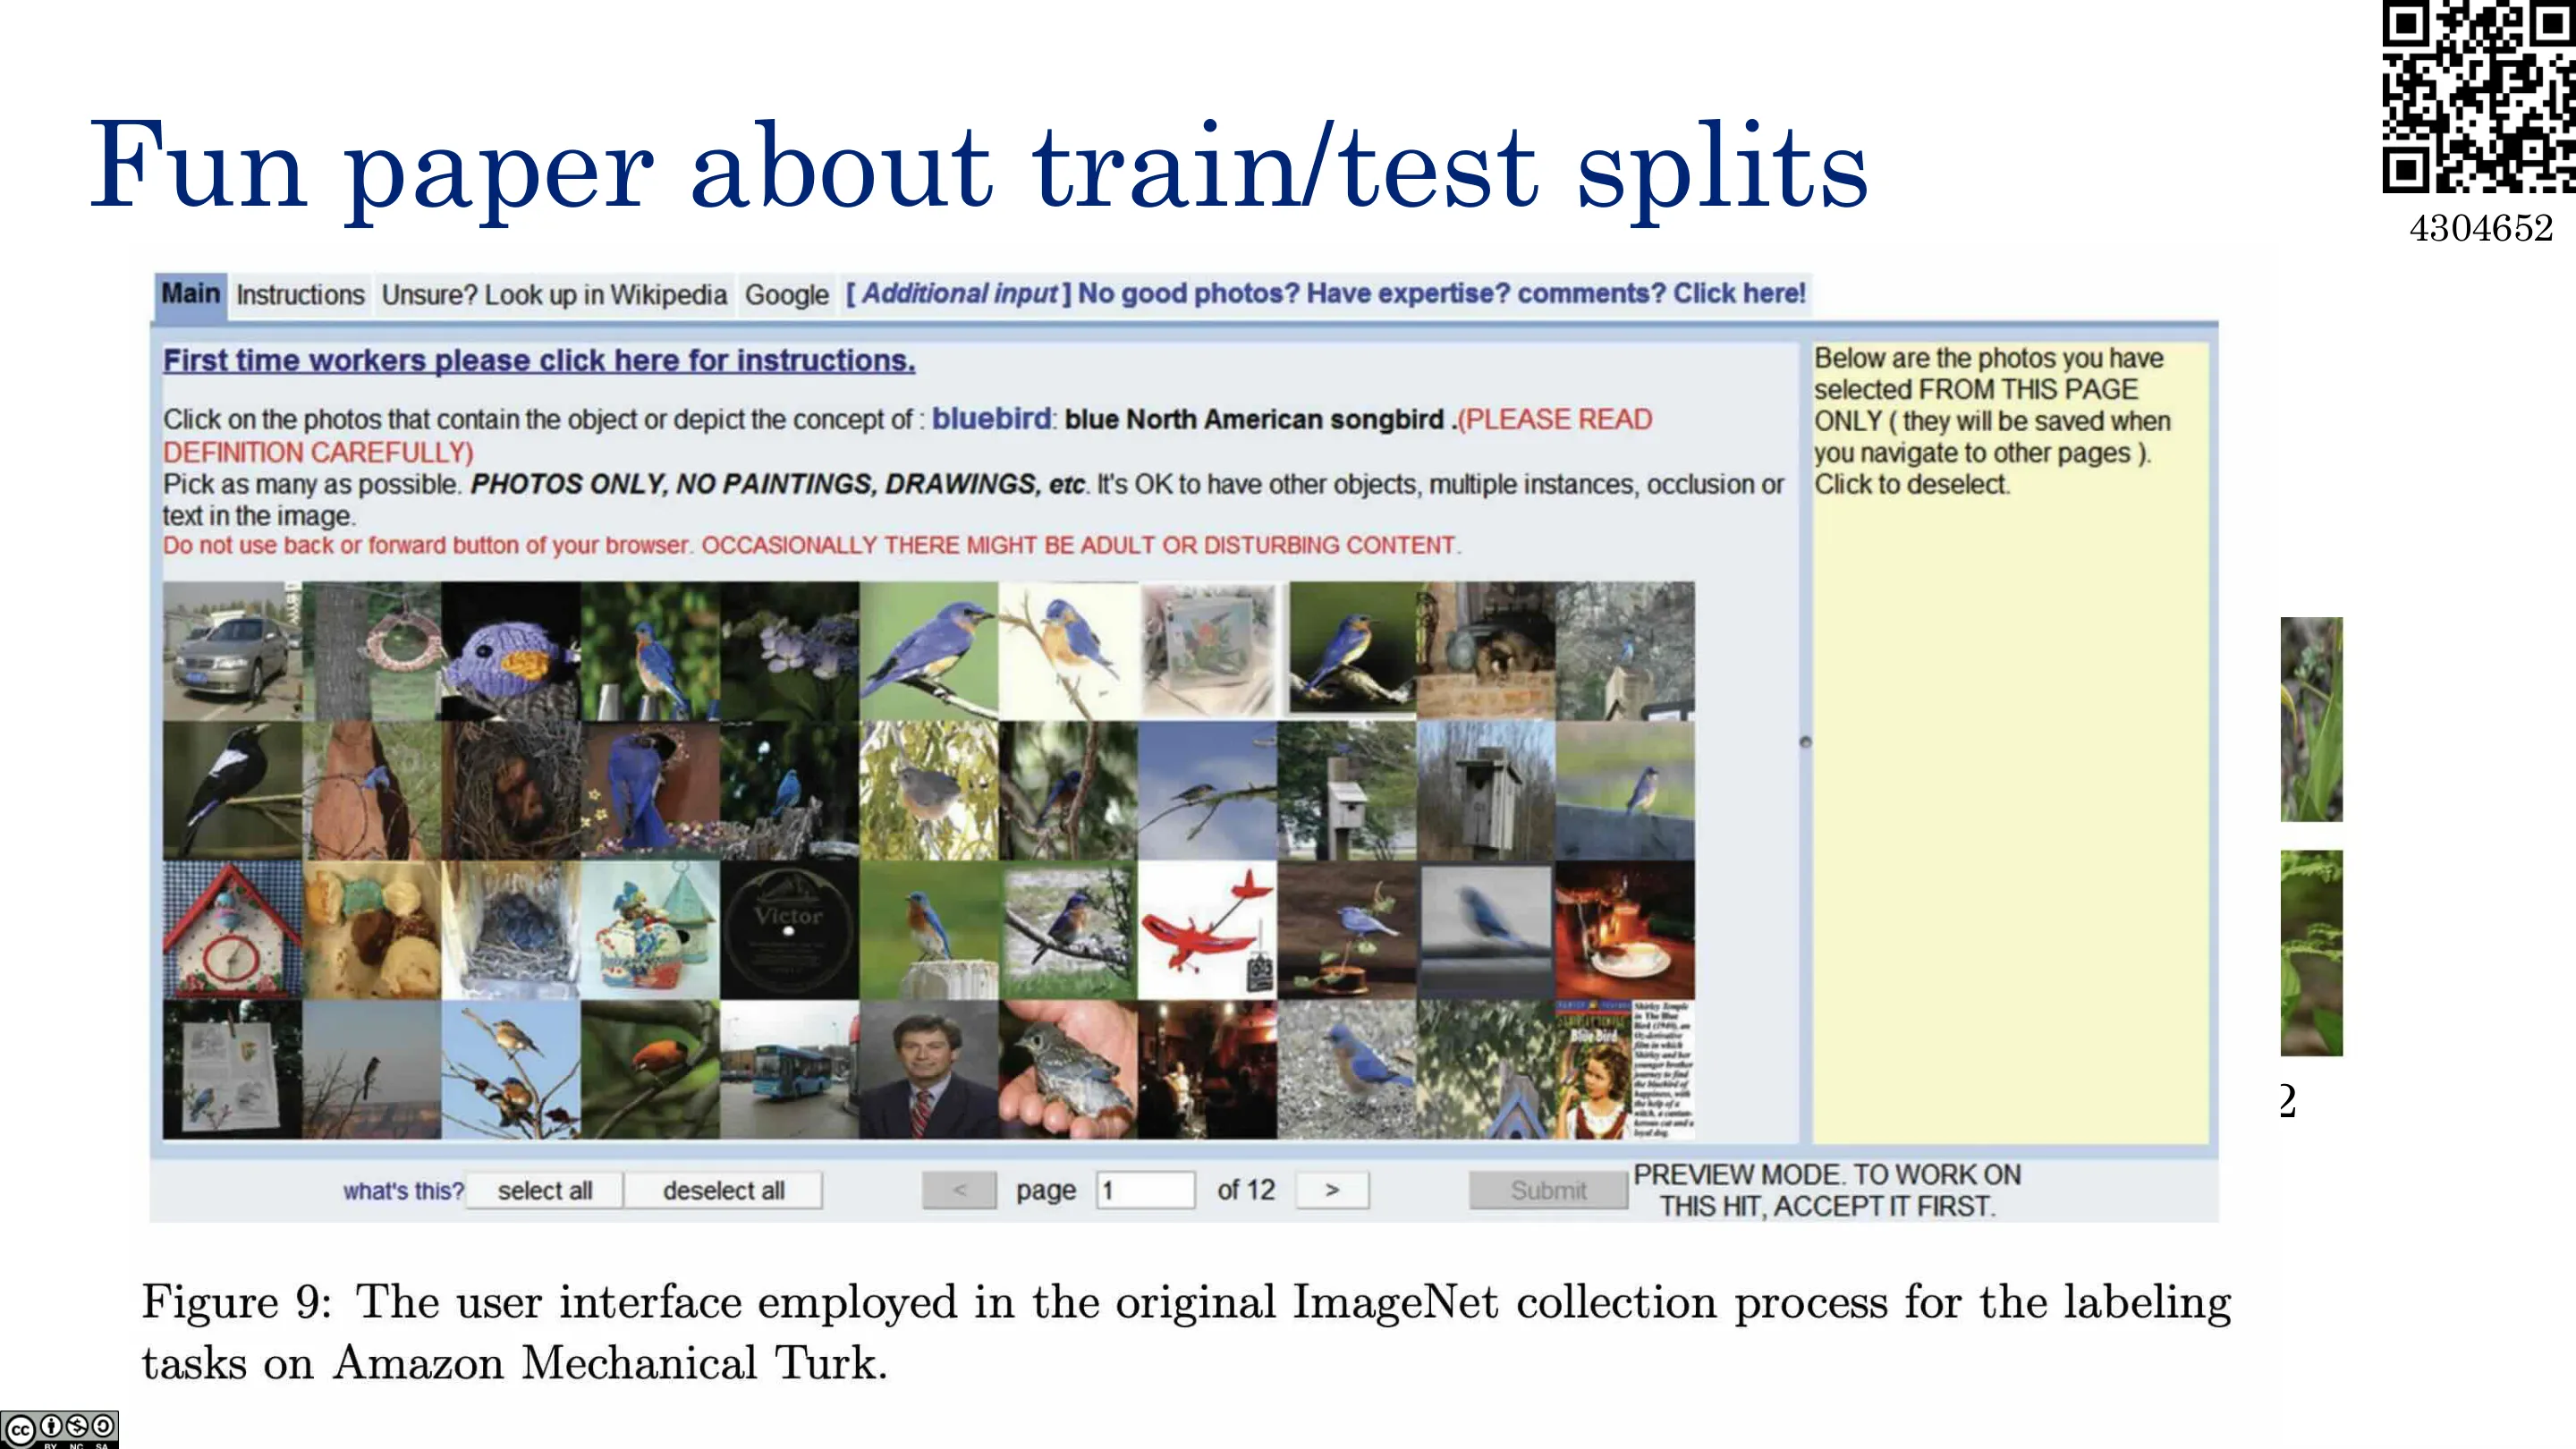
它的构建方式是:去 Flickr 搜「花」等关键词,再让 Amazon Mechanical Turk 上的标注员在类似下图的界面里逐张确认「这是不是一只 bluebird」。这就是原始 ImageNet 数据收集过程(也是 CIFAR-10 的方式)。
📷 关于训练/测试划分的有趣论文(ImageNetV2)
回到原视频 (00:47:58)
问题是:ImageNet 分类器能泛化到 ImageNet 吗?听起来荒谬——怎么会泛化不了?但答案可能是:不能。因为大家在同一个测试集上竞争了太久、不断在测试集上调整,可能已经严重过拟合测试集。
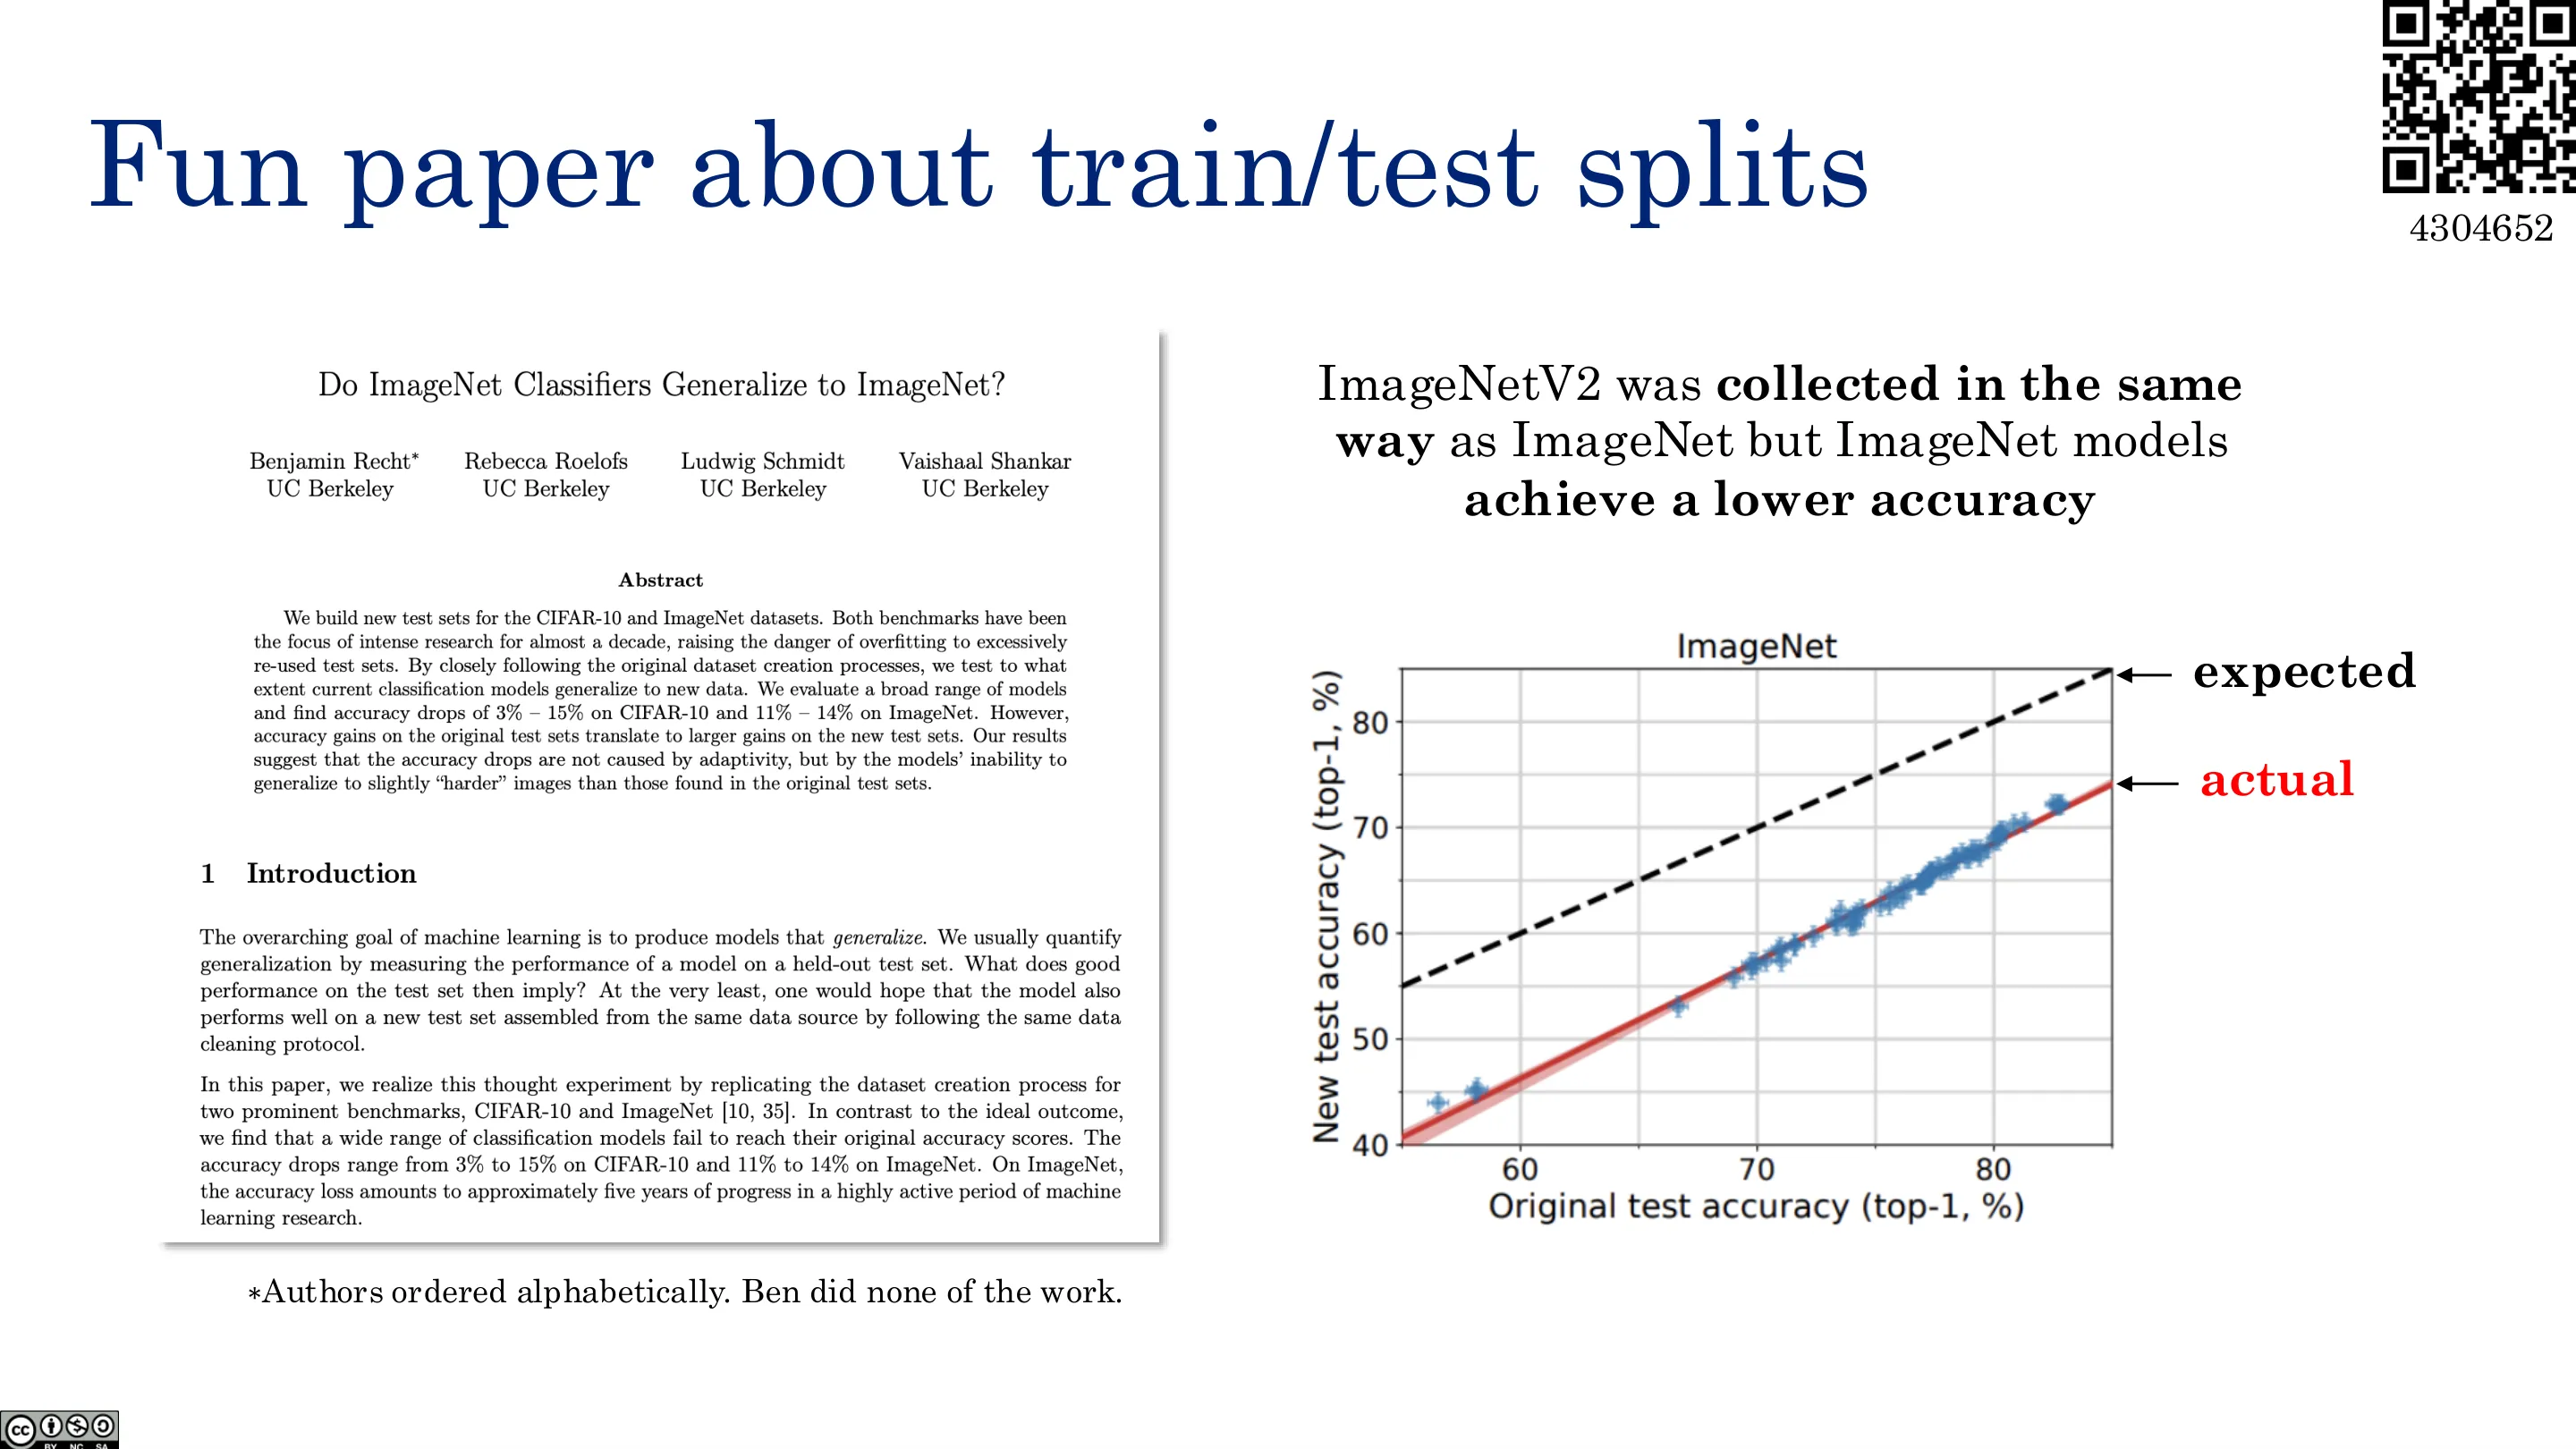
于是作者用原始数据源、按原始流程重新采集,构建了新的 ImageNetV2,做了一次复制研究(replication study):
- 发现:实际准确率确实下降了,平均低 3–15 个百分点——说明存在一定的过拟合;
- 但最重要的结论:模型的相对排序没有改变(ResNet 若在 ImageNet 上更好,在 ImageNetV2 上也更好)。
📷 ImageNetV2 的结果
回到原视频 (00:53:27)
编者说明:讲师的判断是——ImageNet 大致被复制成功:所有数字都被高估了一点,但相对次序依然有效,因此它依然是推动 AI 进步的重要基准。
6.6 分布漂移与合成数据
由这个研究引申出一个关键问题:训练-测试划分到底有没有效?取决于一个假设——你的训练/测试分布,是否等于模型上线后真实遇到的数据分布。
- Midjourney 生成的「bluebird」看起来可能像真的,但野生环境拍到的 bluebird 很可能不长这样,而且生成模型本身可能已在 ImageNet 上训练过;
- 这就是分布漂移(distribution shift)。这正是你必须亲自采集数据、认真思考划分的原因:合成模型给出的分布,与真实采集到的图像分布相差很远。
📷 ImageNetV2(期望 vs 实际)
回到原视频 (00:48:52)
一个标准演示:用 scikit-learn 做 train_test_split。
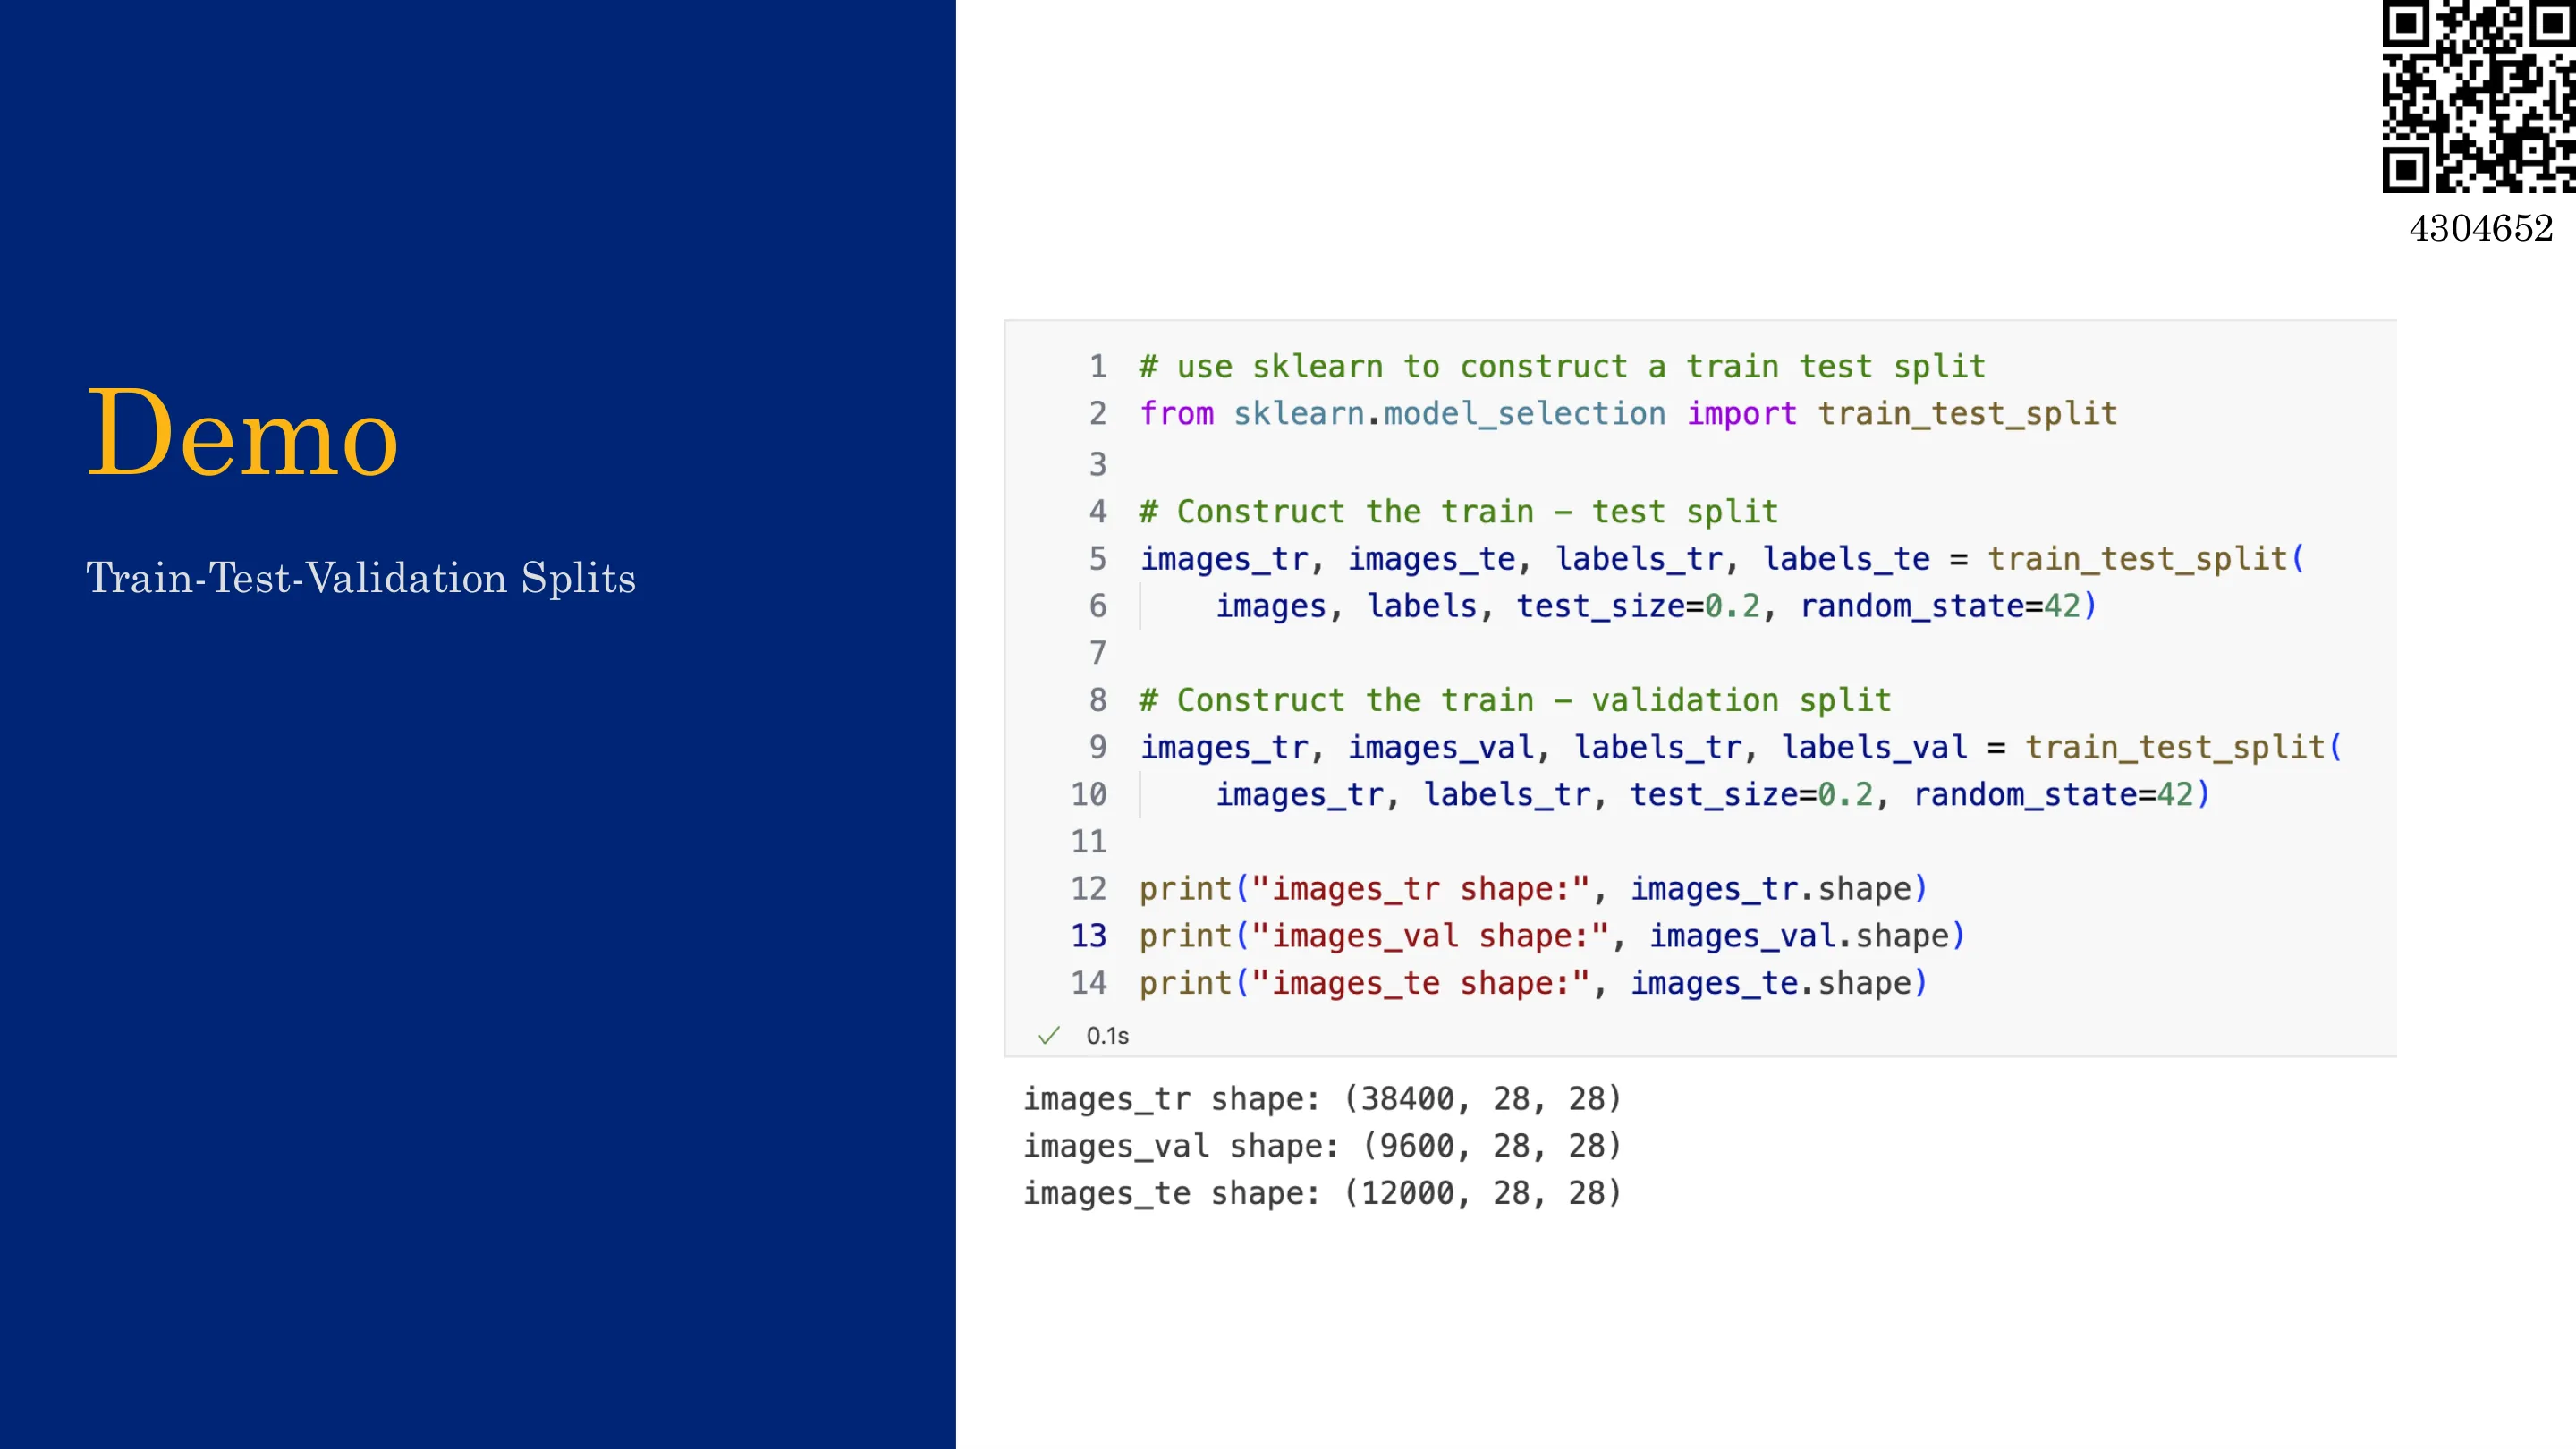
📷 训练-验证-测试划分(演示)
回到原视频 (00:57:43)
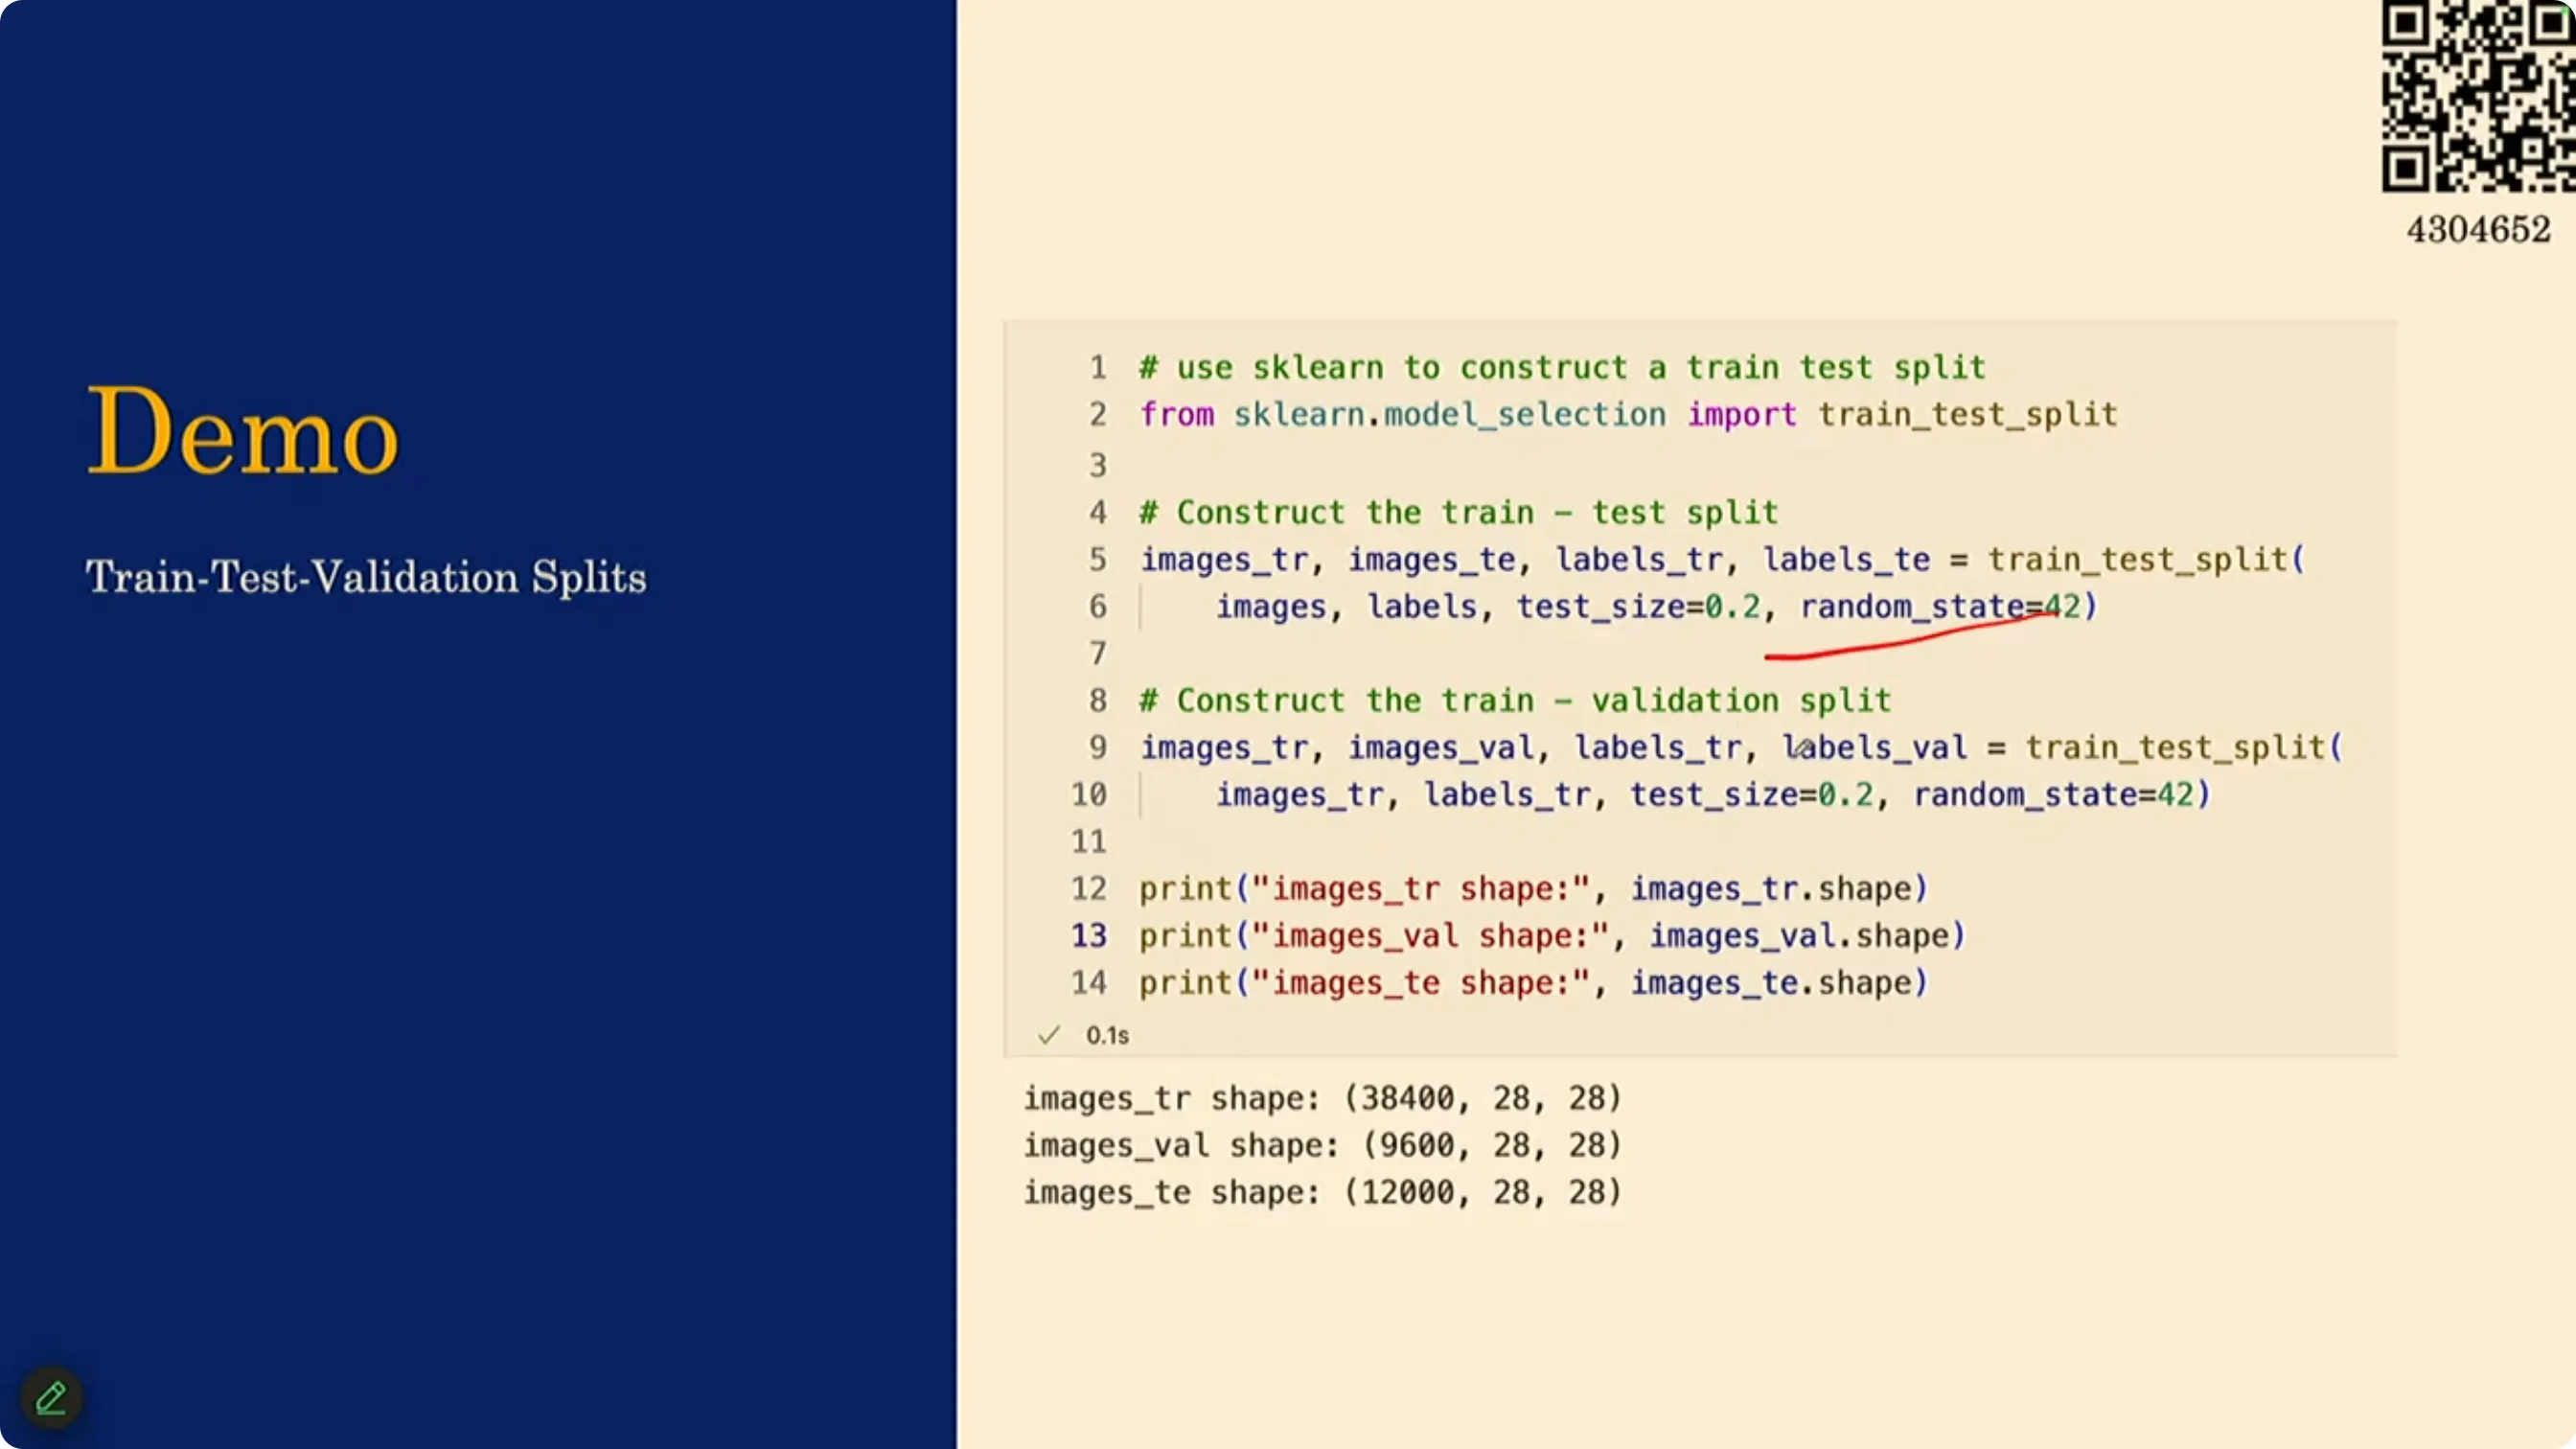
📷 用 scikit-learn 做 train_test_split(视频画面)
回到原视频 (00:57:55)
七、特征工程
(参考时间: 00:57)
第二阶段是模型设计:包括特征工程、模型族/架构、假设空间(hypothesis space)、归纳偏置(inductive biases)/假设。
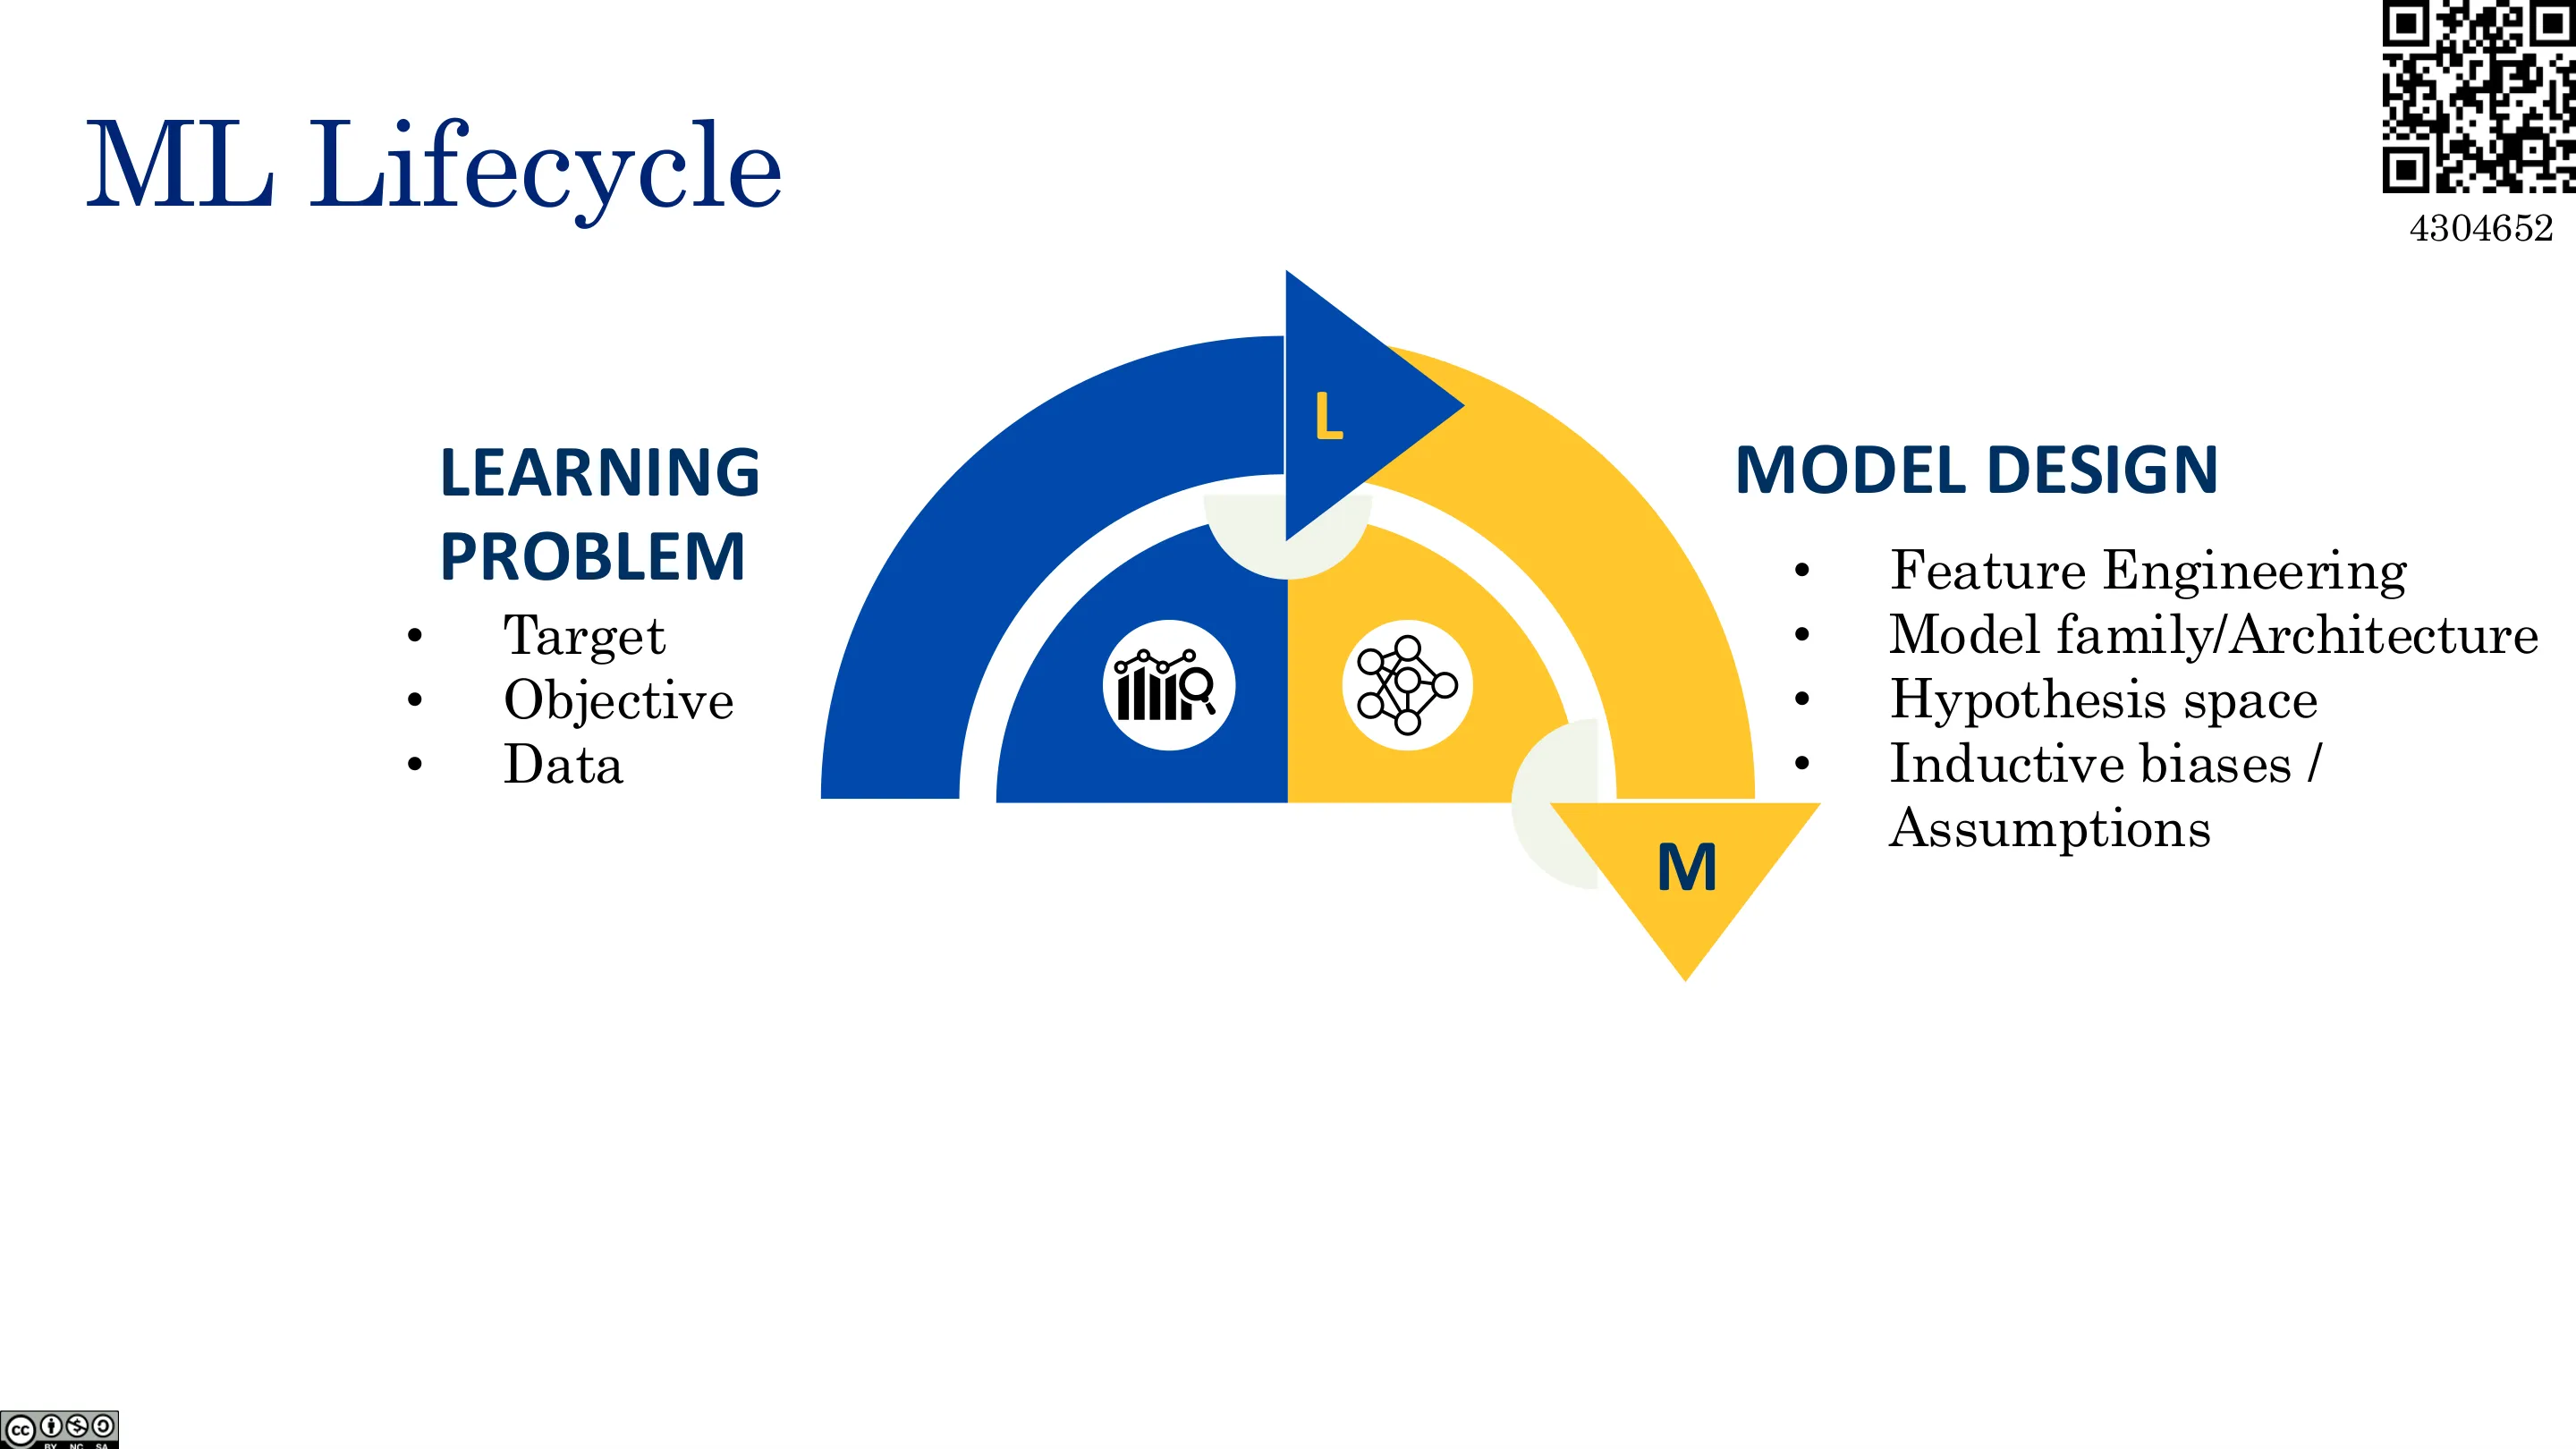
📷 模型设计阶段
回到原视频 (00:57:58)
特征工程是「从原始特征中选择并编码输入特征」的过程:
- 选择特征:选对特征能提升性能;引入其他数据源的新特征也能提升;但特征太多(尤其数据有限时)有害,会导致过拟合。后续会学习自动选择特征的方法;
- 编码特征:类别数据、文本、图像等往往需要变换成合适的数值表示;
- 深度学习的核心创新,正是「学习特征的编码」。
📷 特征工程
回到原视频 (00:58:16)
7.1 数值数据的编码
数值特征通常可以直接使用,但有三个重要例外:
- 类别型数值特征:邮政编码、产品 SKU、字符串的数值编码(如「红」=1、「蓝」=2)。它们应当做 one-hot 编码;
- 严重偏斜(heavily skewed)的特征:点击量、用户内容、价格等可能出现极端值,常做 log 变换;
- 量纲/波动差异大的特征:会对建模与优化造成困难,通常做标准化。
📷 数值数据的编码(一):类别特征做 one-hot
回到原视频 (00:58:43)
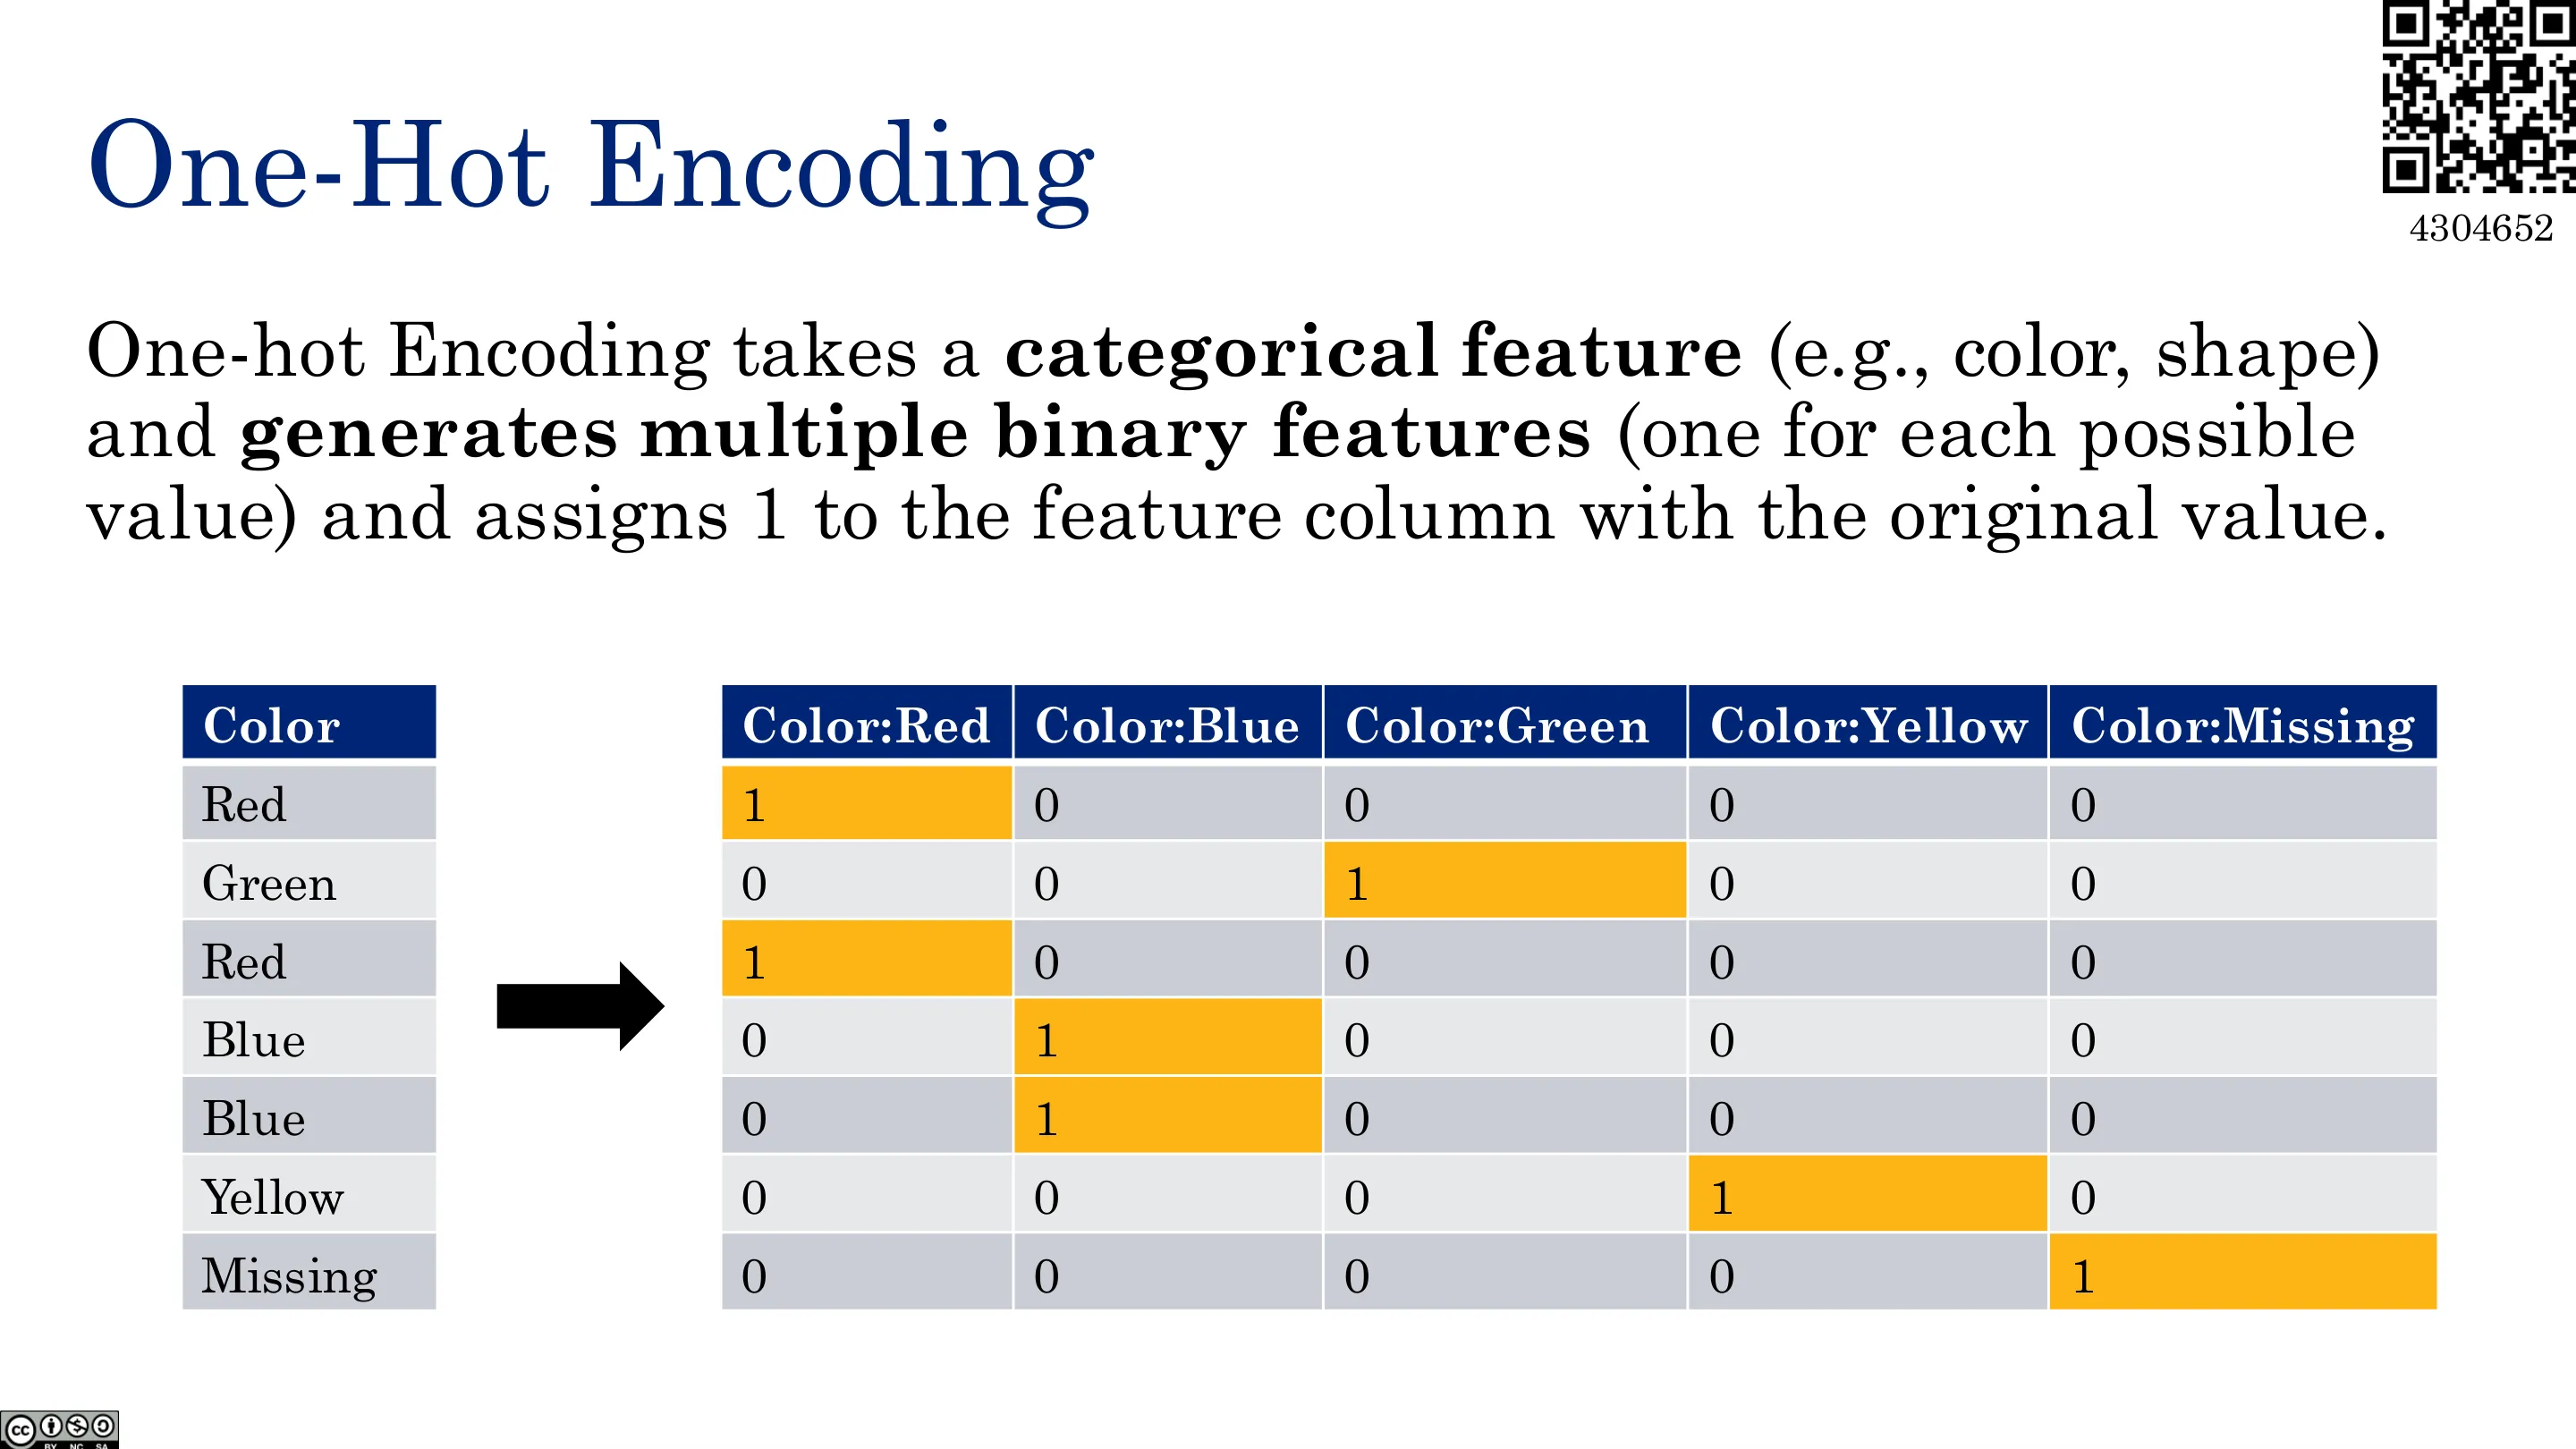
One-hot 编码:把一个类别特征替换为多个二值特征(每个可能取值一列),在原始值对应的列填 1。
Color:   Red, Green, Red, Blue, Blue, Yellow, Missing
   →
Color:Red  Color:Blue  Color:Green  Color:Yellow  Color:Missing
    1          0           0            0             0
    0          0           1            0             0
    1          0           0            0             0
    0          1           0            0             0
    0          1           0            0             0
    0          0           0            1             0
    0          0           0            0             1
📷 One-hot 编码
回到原视频 (00:59:22)
📷 数值数据的编码(二):偏斜特征与标准化
回到原视频 (01:01:15)
编者说明:实际中常用
pandas.get_dummies一步完成。是否省略最后一类(避免共线性)并不重要,用验证损失来选即可。
特征标准化(Standardization):用训练数据计算特征的均值 $\mu$ 与方差 $\sigma^2$,再做变换
$$ z = \frac{x - \mu}{\sigma} $$
得到零均值、单位方差的新特征。注意:测试时也必须用训练集算出的 $\mu,\sigma$ 做同样的变换。
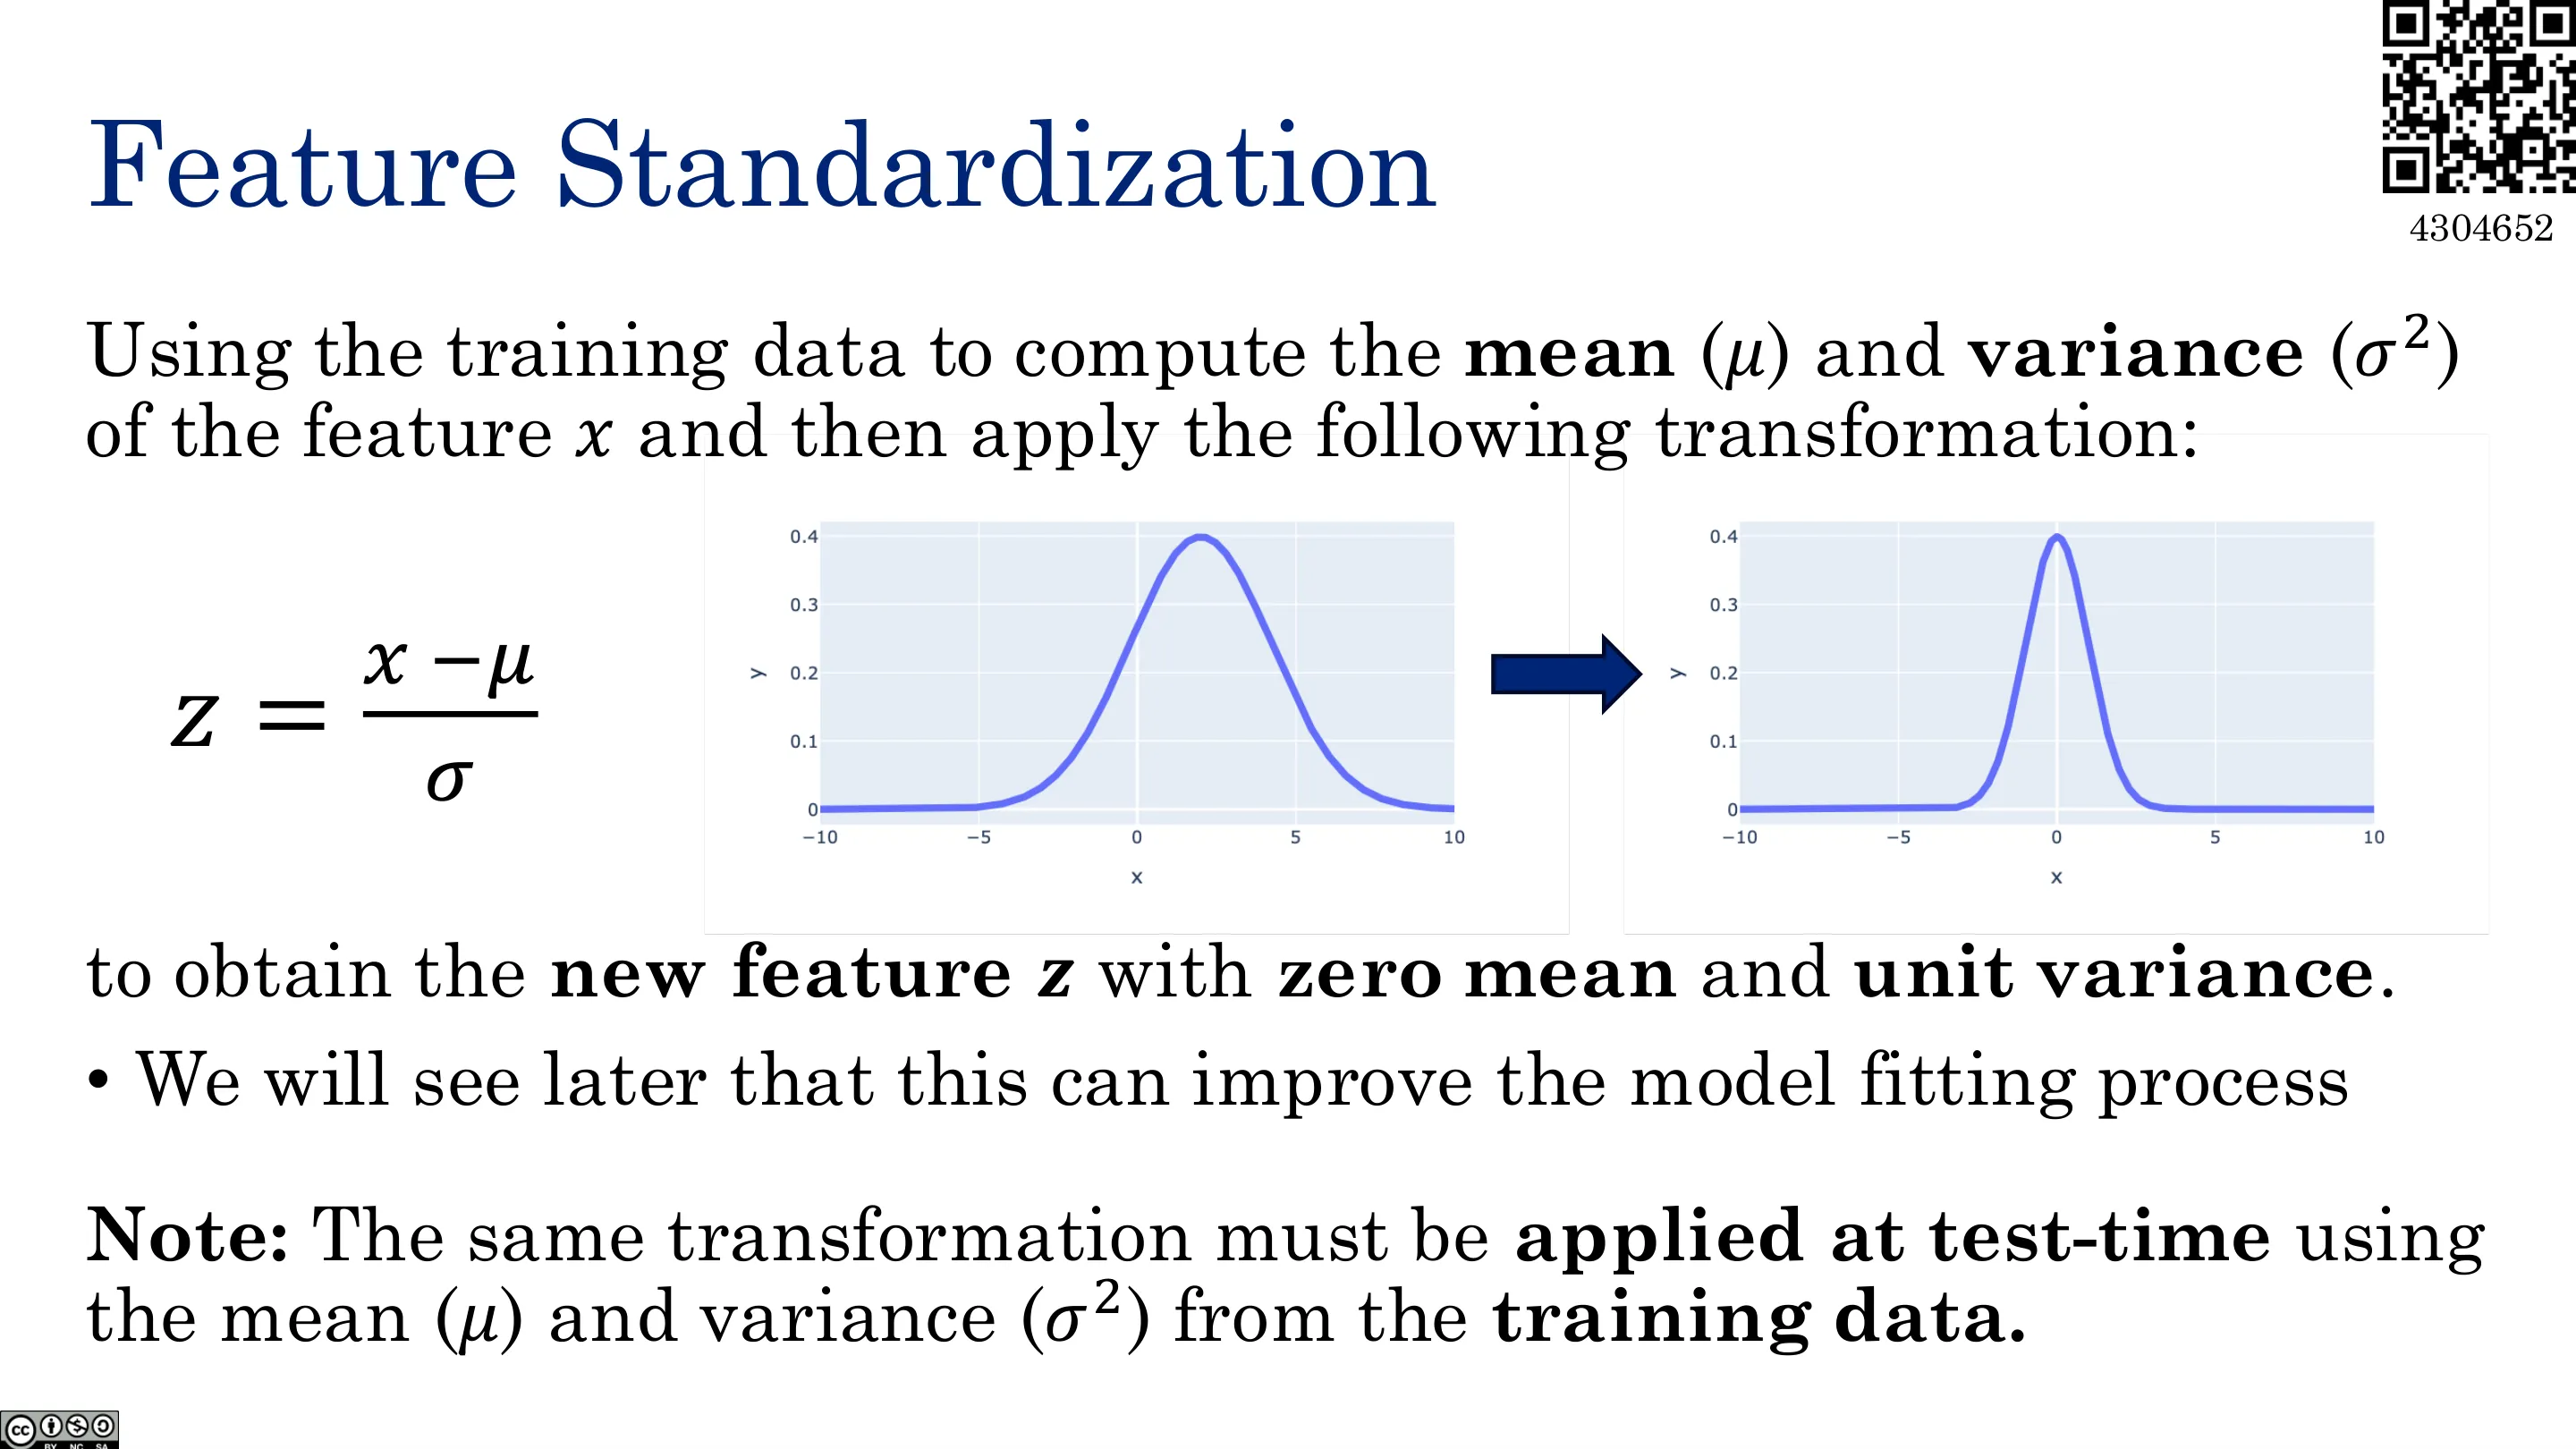
📷 特征标准化
回到原视频 (01:01:31)
一个课堂投票:要不要对 one-hot 编码做标准化?为什么?答案是不要——它是二值列,减去均值毫无意义,甚至可能带来灾难性后果。任何特征工程都要用验证损失来经验性地检验,没有放之四海皆准的配方。
📷 要不要标准化 one-hot 编码?
回到原视频 (01:03:10)
7.2 文本数据的编码
编码文本字符串有几种方法:
- One-hot 编码:用于「颜色 / 州 / 名字」这类类别字符串(州名会展开成 50 列——注意:当特征数超过样本数时就会过拟合);
- 词袋(Bag-of-Words):编码多词字符串的经典方法;
- 学习到的向量嵌入(Learned Vector Embeddings):今天常用大语言模型把文本转成固定向量。
所有方法最终都产生一个高维向量表示。
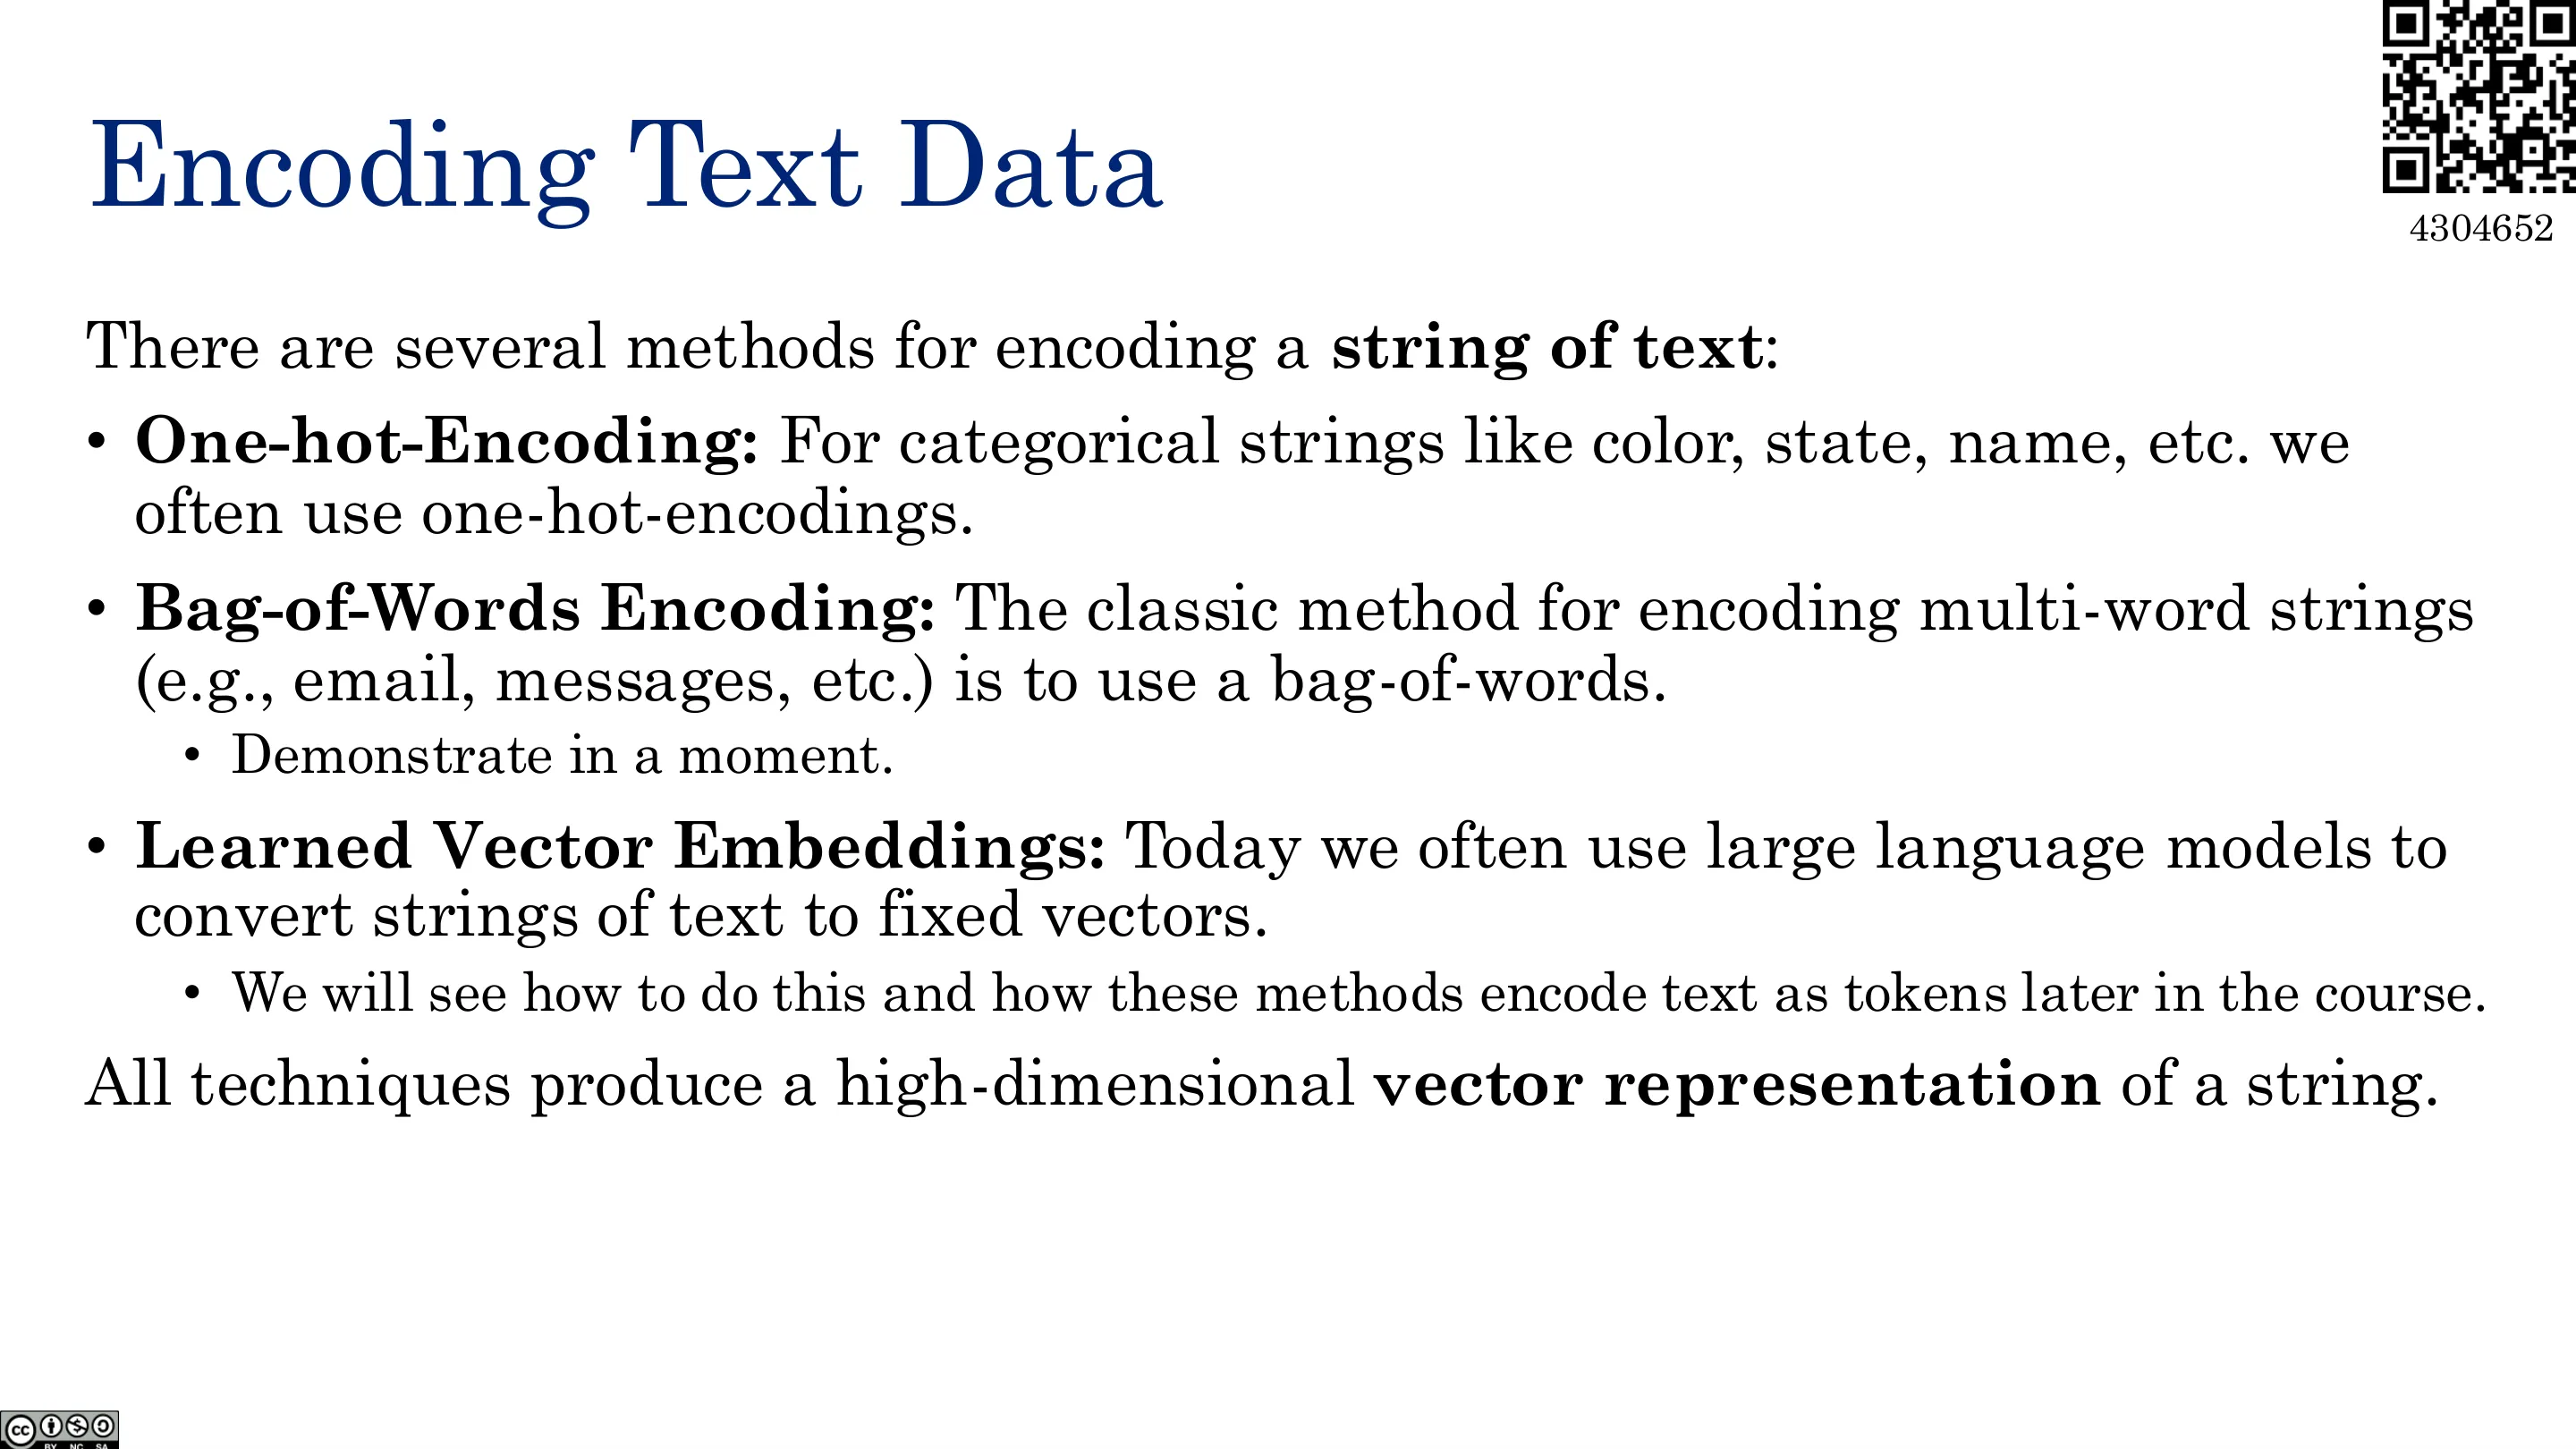
📷 文本数据的编码
回到原视频 (01:05:14)
词袋模型:把词表里每个词作为一列,统计它在文本中的出现次数(或是否出现)。例如把「Learning about machine learning is fun.」编码成 [learning=2, machine=1, fun=1, ...]。
实践中会:
- 去掉停用词(stop words),如 the / is / of——它们信息量极小;
- 预处理:全部转小写、纠正拼写等。
编者说明:讲师说「这些都是 LLM 之前『黑暗时代』的做法」,今天你会直接把文本丢给 LLaMA 拿 embedding。词袋有一个根本缺陷——它对词序是盲的:把词打乱,「machine learning is fun」与「fun is learning machine」得到完全相同的表示。这也解释了为什么有时你能构造出「胡言乱语」却被判为极正面或极负面的评论:模型看到的是词袋,不是句子。
一个有趣的彩蛋:Gonzalez 教授当年搬进一栋没有艺术品的楼,于是偷偷在机器学习楼层装了一件「艺术装置」,里面藏着一个停用词(从此保洁阿姨的扫帚和垃圾桶就「困惑」了)。
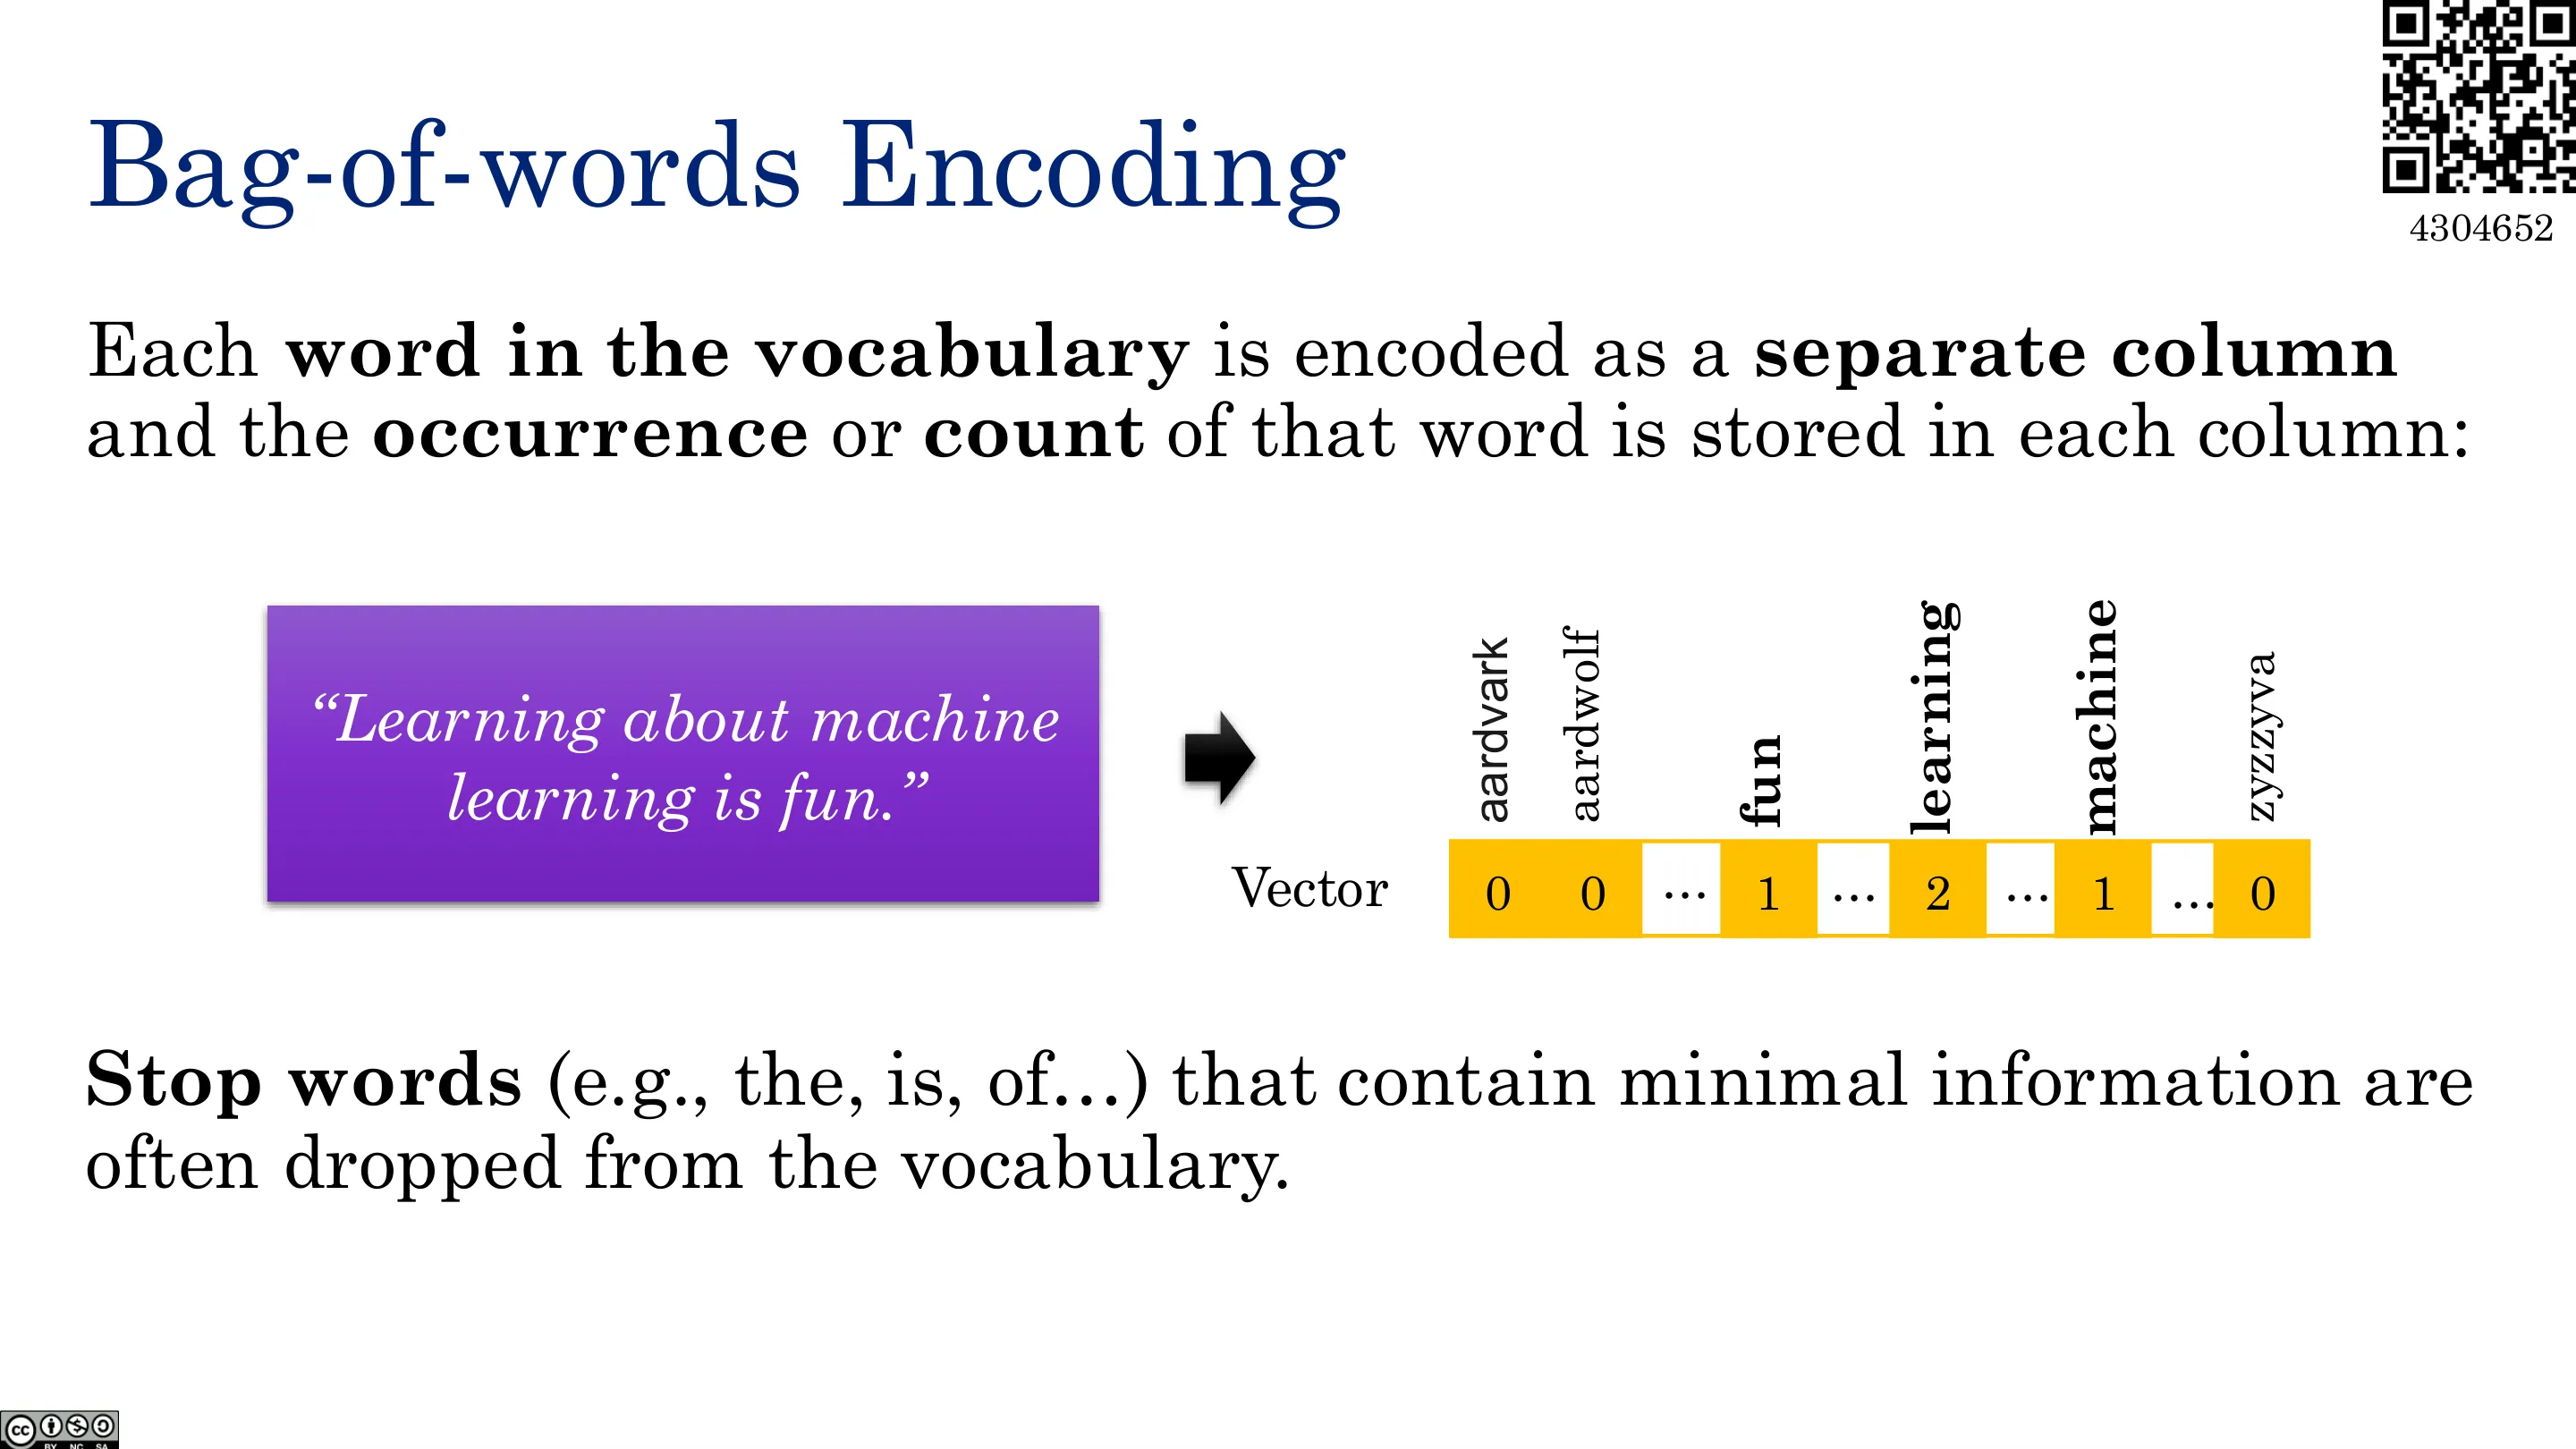
📷 词袋编码
回到原视频 (01:06:20)
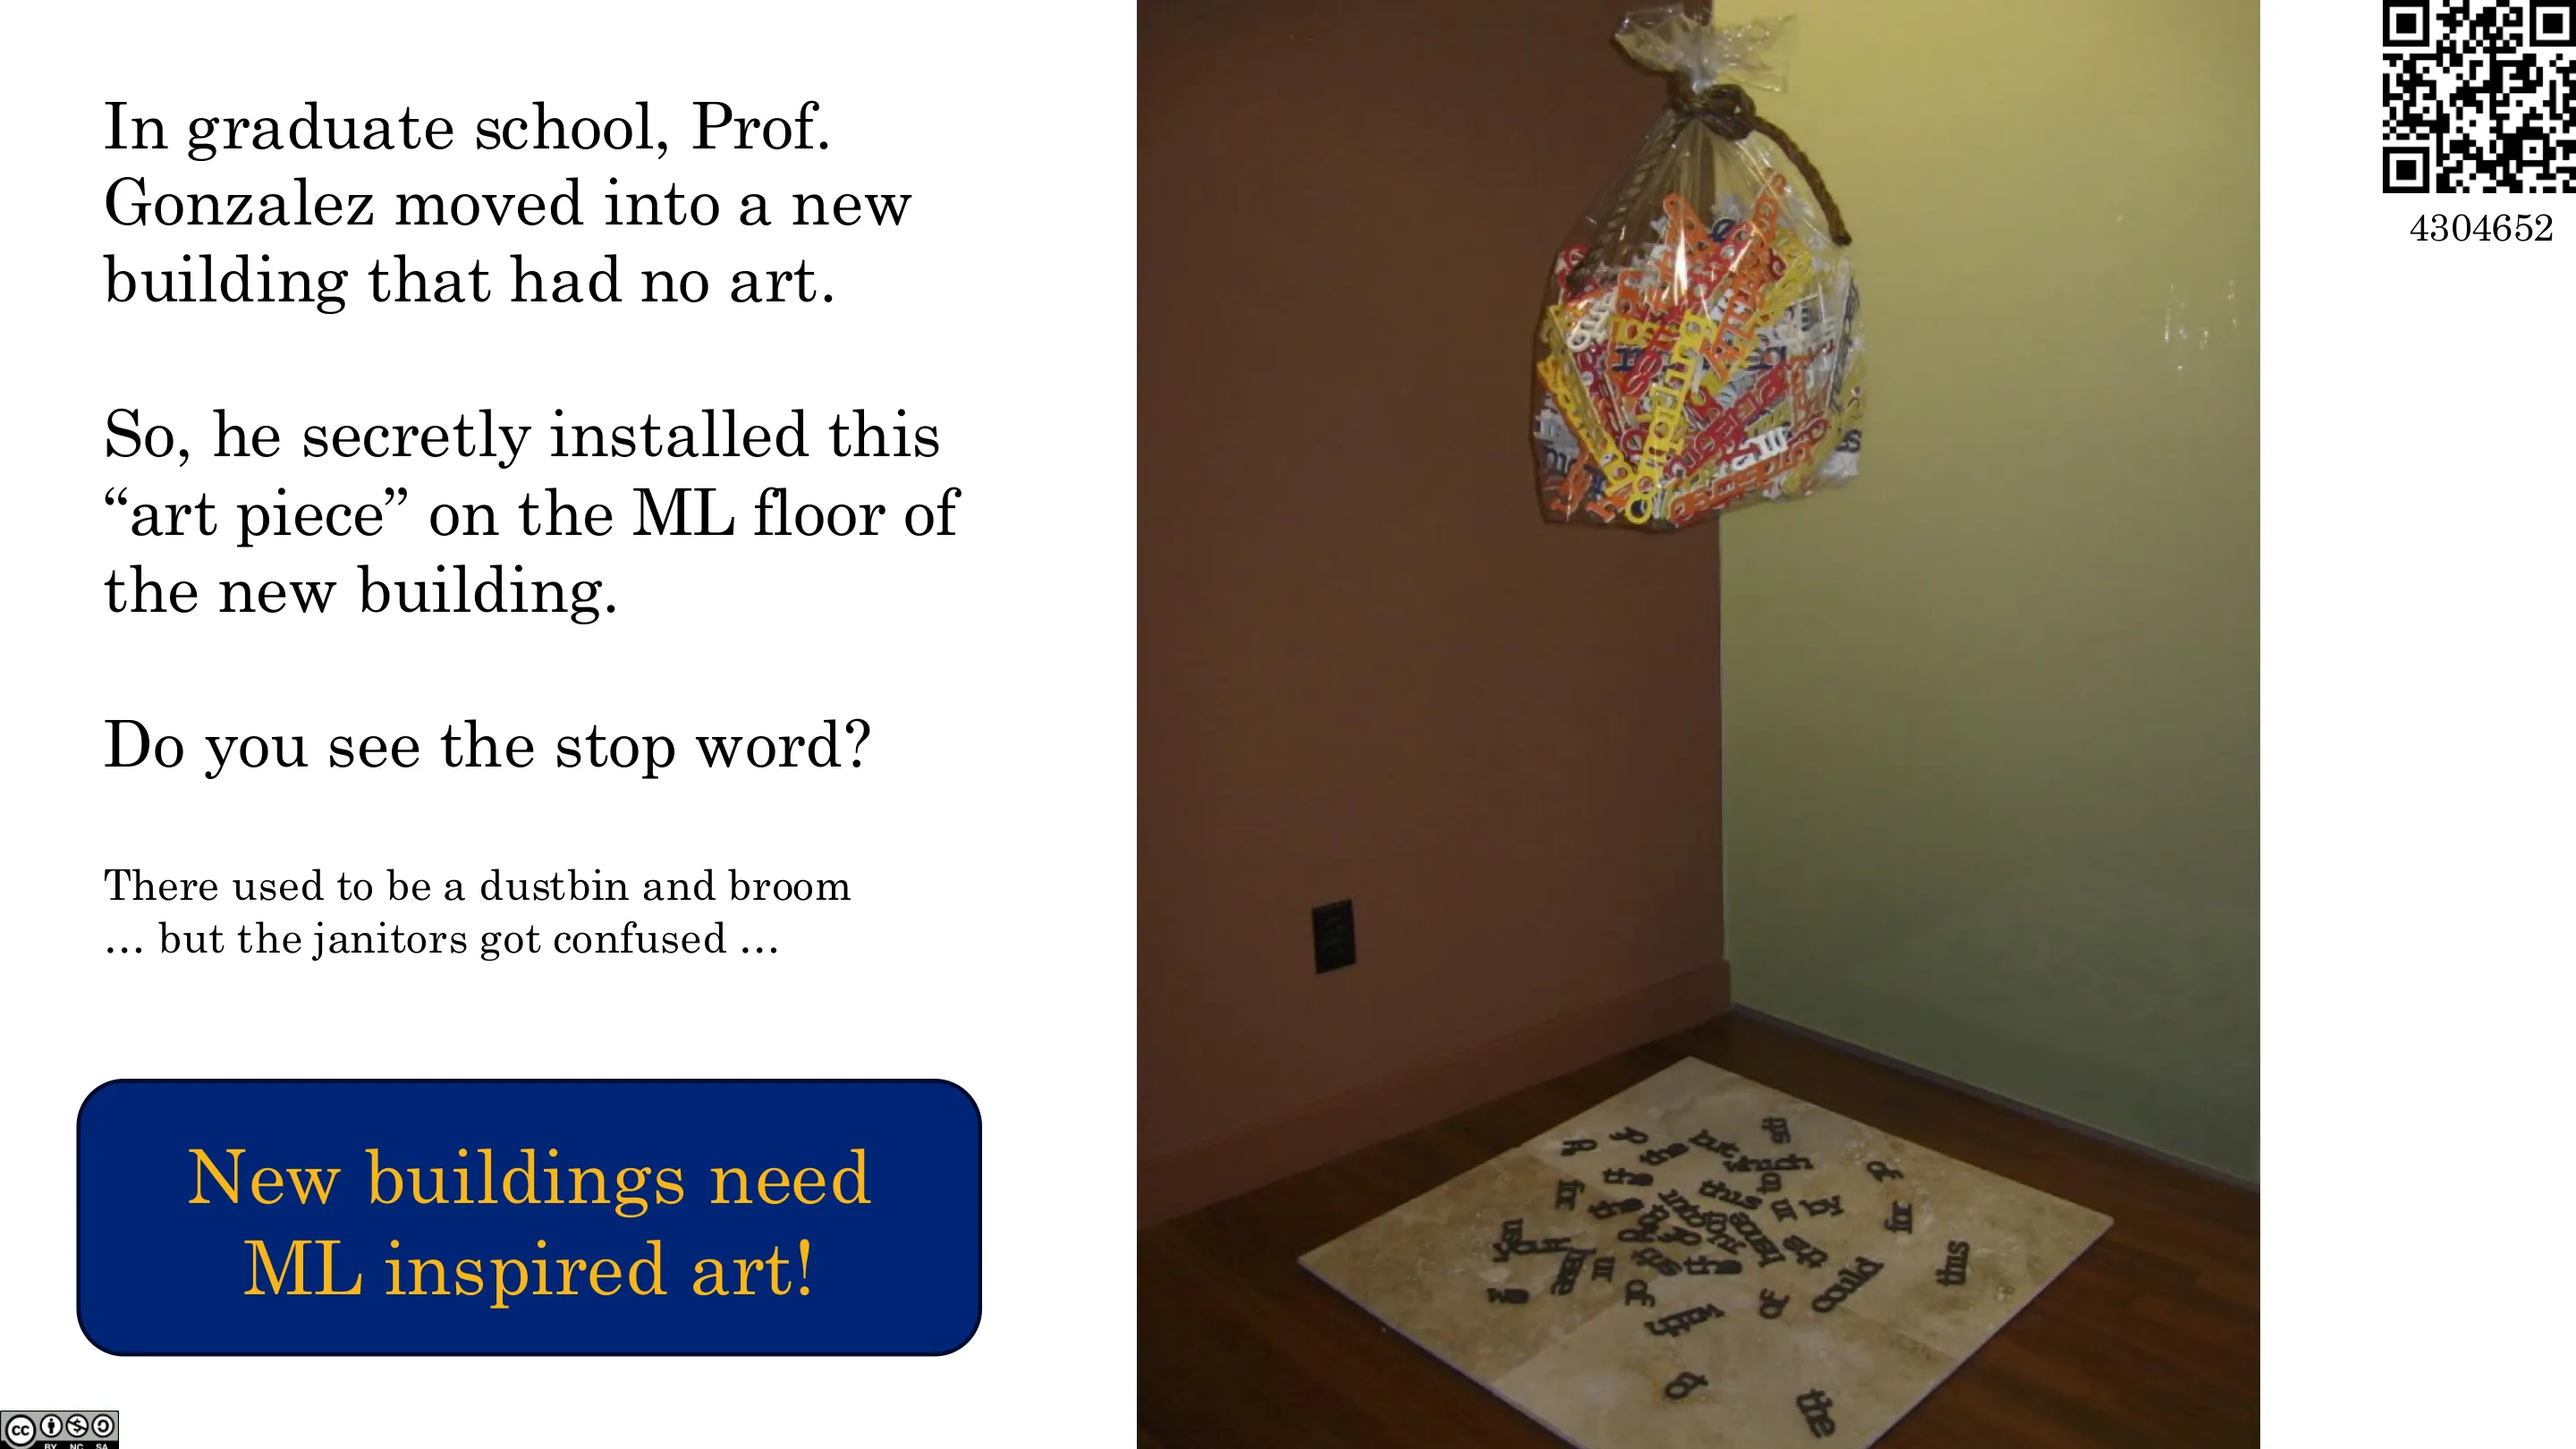
📷 关于停用词的小故事
回到原视频 (01:07:37)
7.3 图像数据的编码
图像可看作三维张量(高 × 宽 × 通道)。编码方式包括:
- 展平(Flatten):最朴素,但对较小的单色图像也可能有效(Homework 1 会用到);
- 变换:颜色空间、像素归一化;
- 手工特征:边缘检测、纹理描述子;
- 深度学习表示:用神经网络学习嵌入。
所有方法都产生一个高维向量表示。
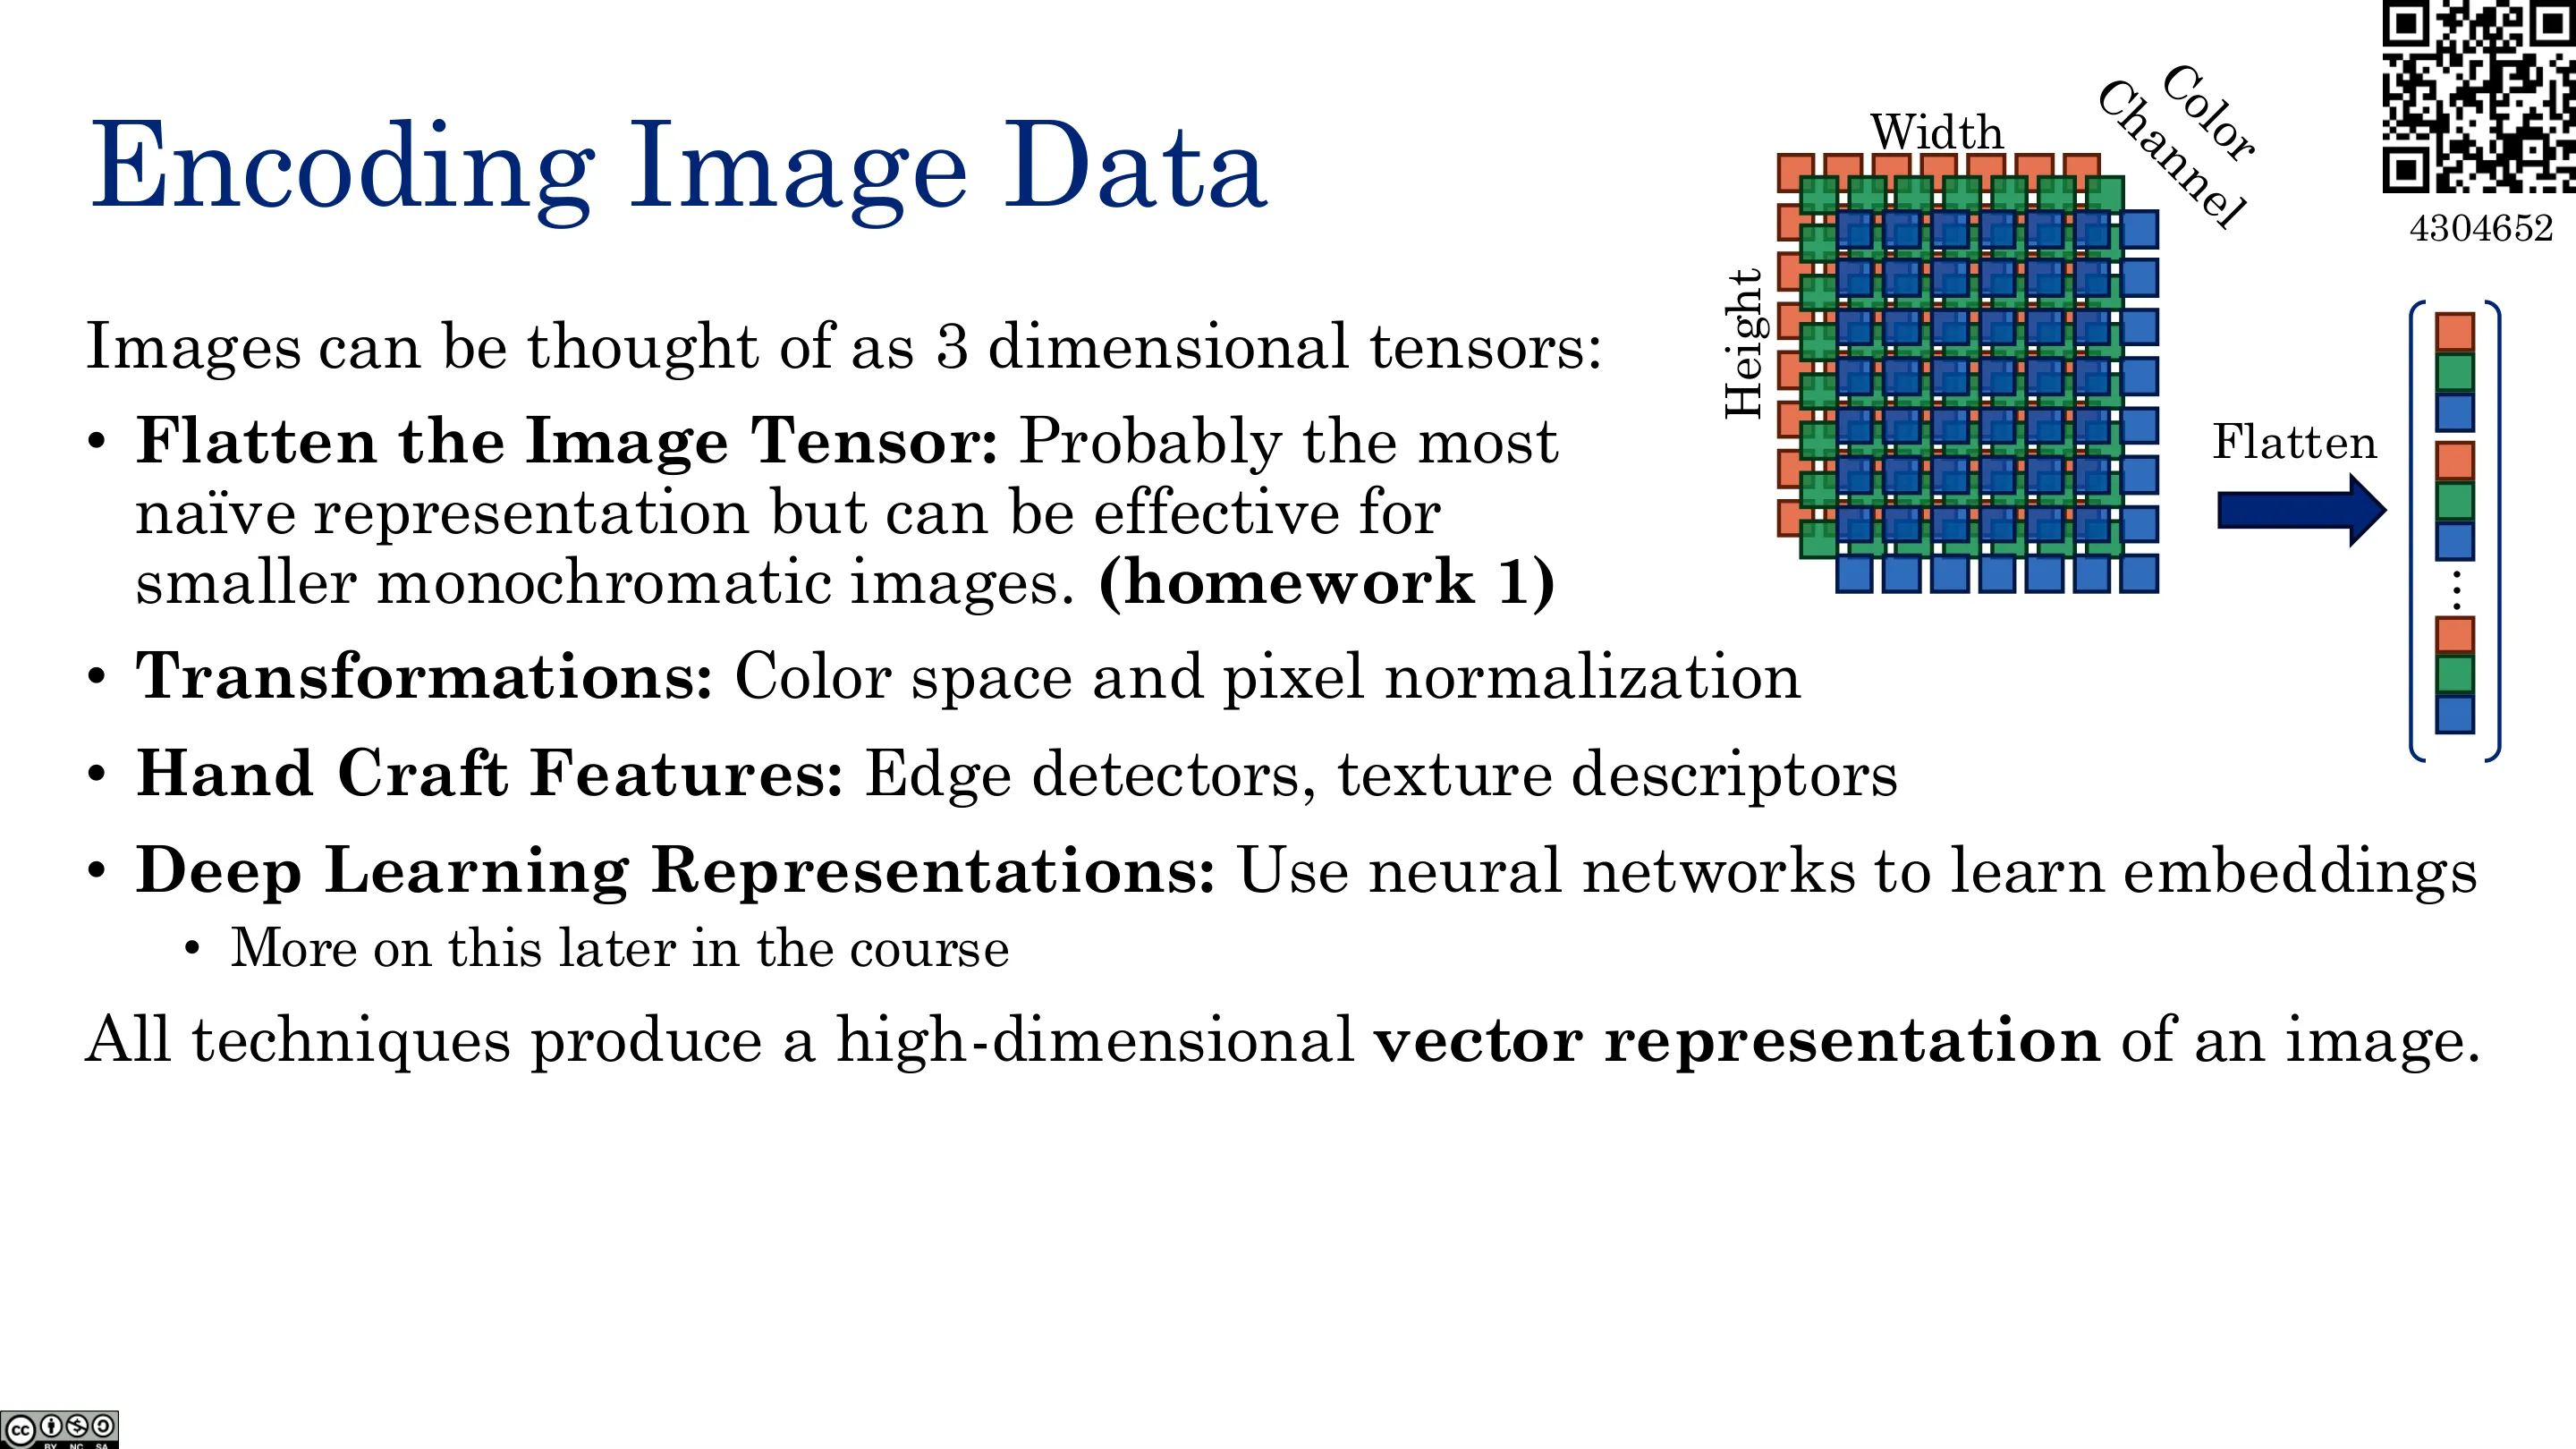
📷 图像数据的编码
回到原视频 (01:09:00)
7.4 用 scikit-learn 做特征化
scikit-learn 提供了大量数据变换工具,很多都遵循 fit / transform 模式:
from sklearn.preprocessing import OneHotEncoder
ohe = OneHotEncoder()          # 构造
ohe.fit(df[["color"]])         # 拟合
ohe.transform(df[["color"]])   # 变换
参见 https://scikit-learn.org/stable/data_transforms.html。
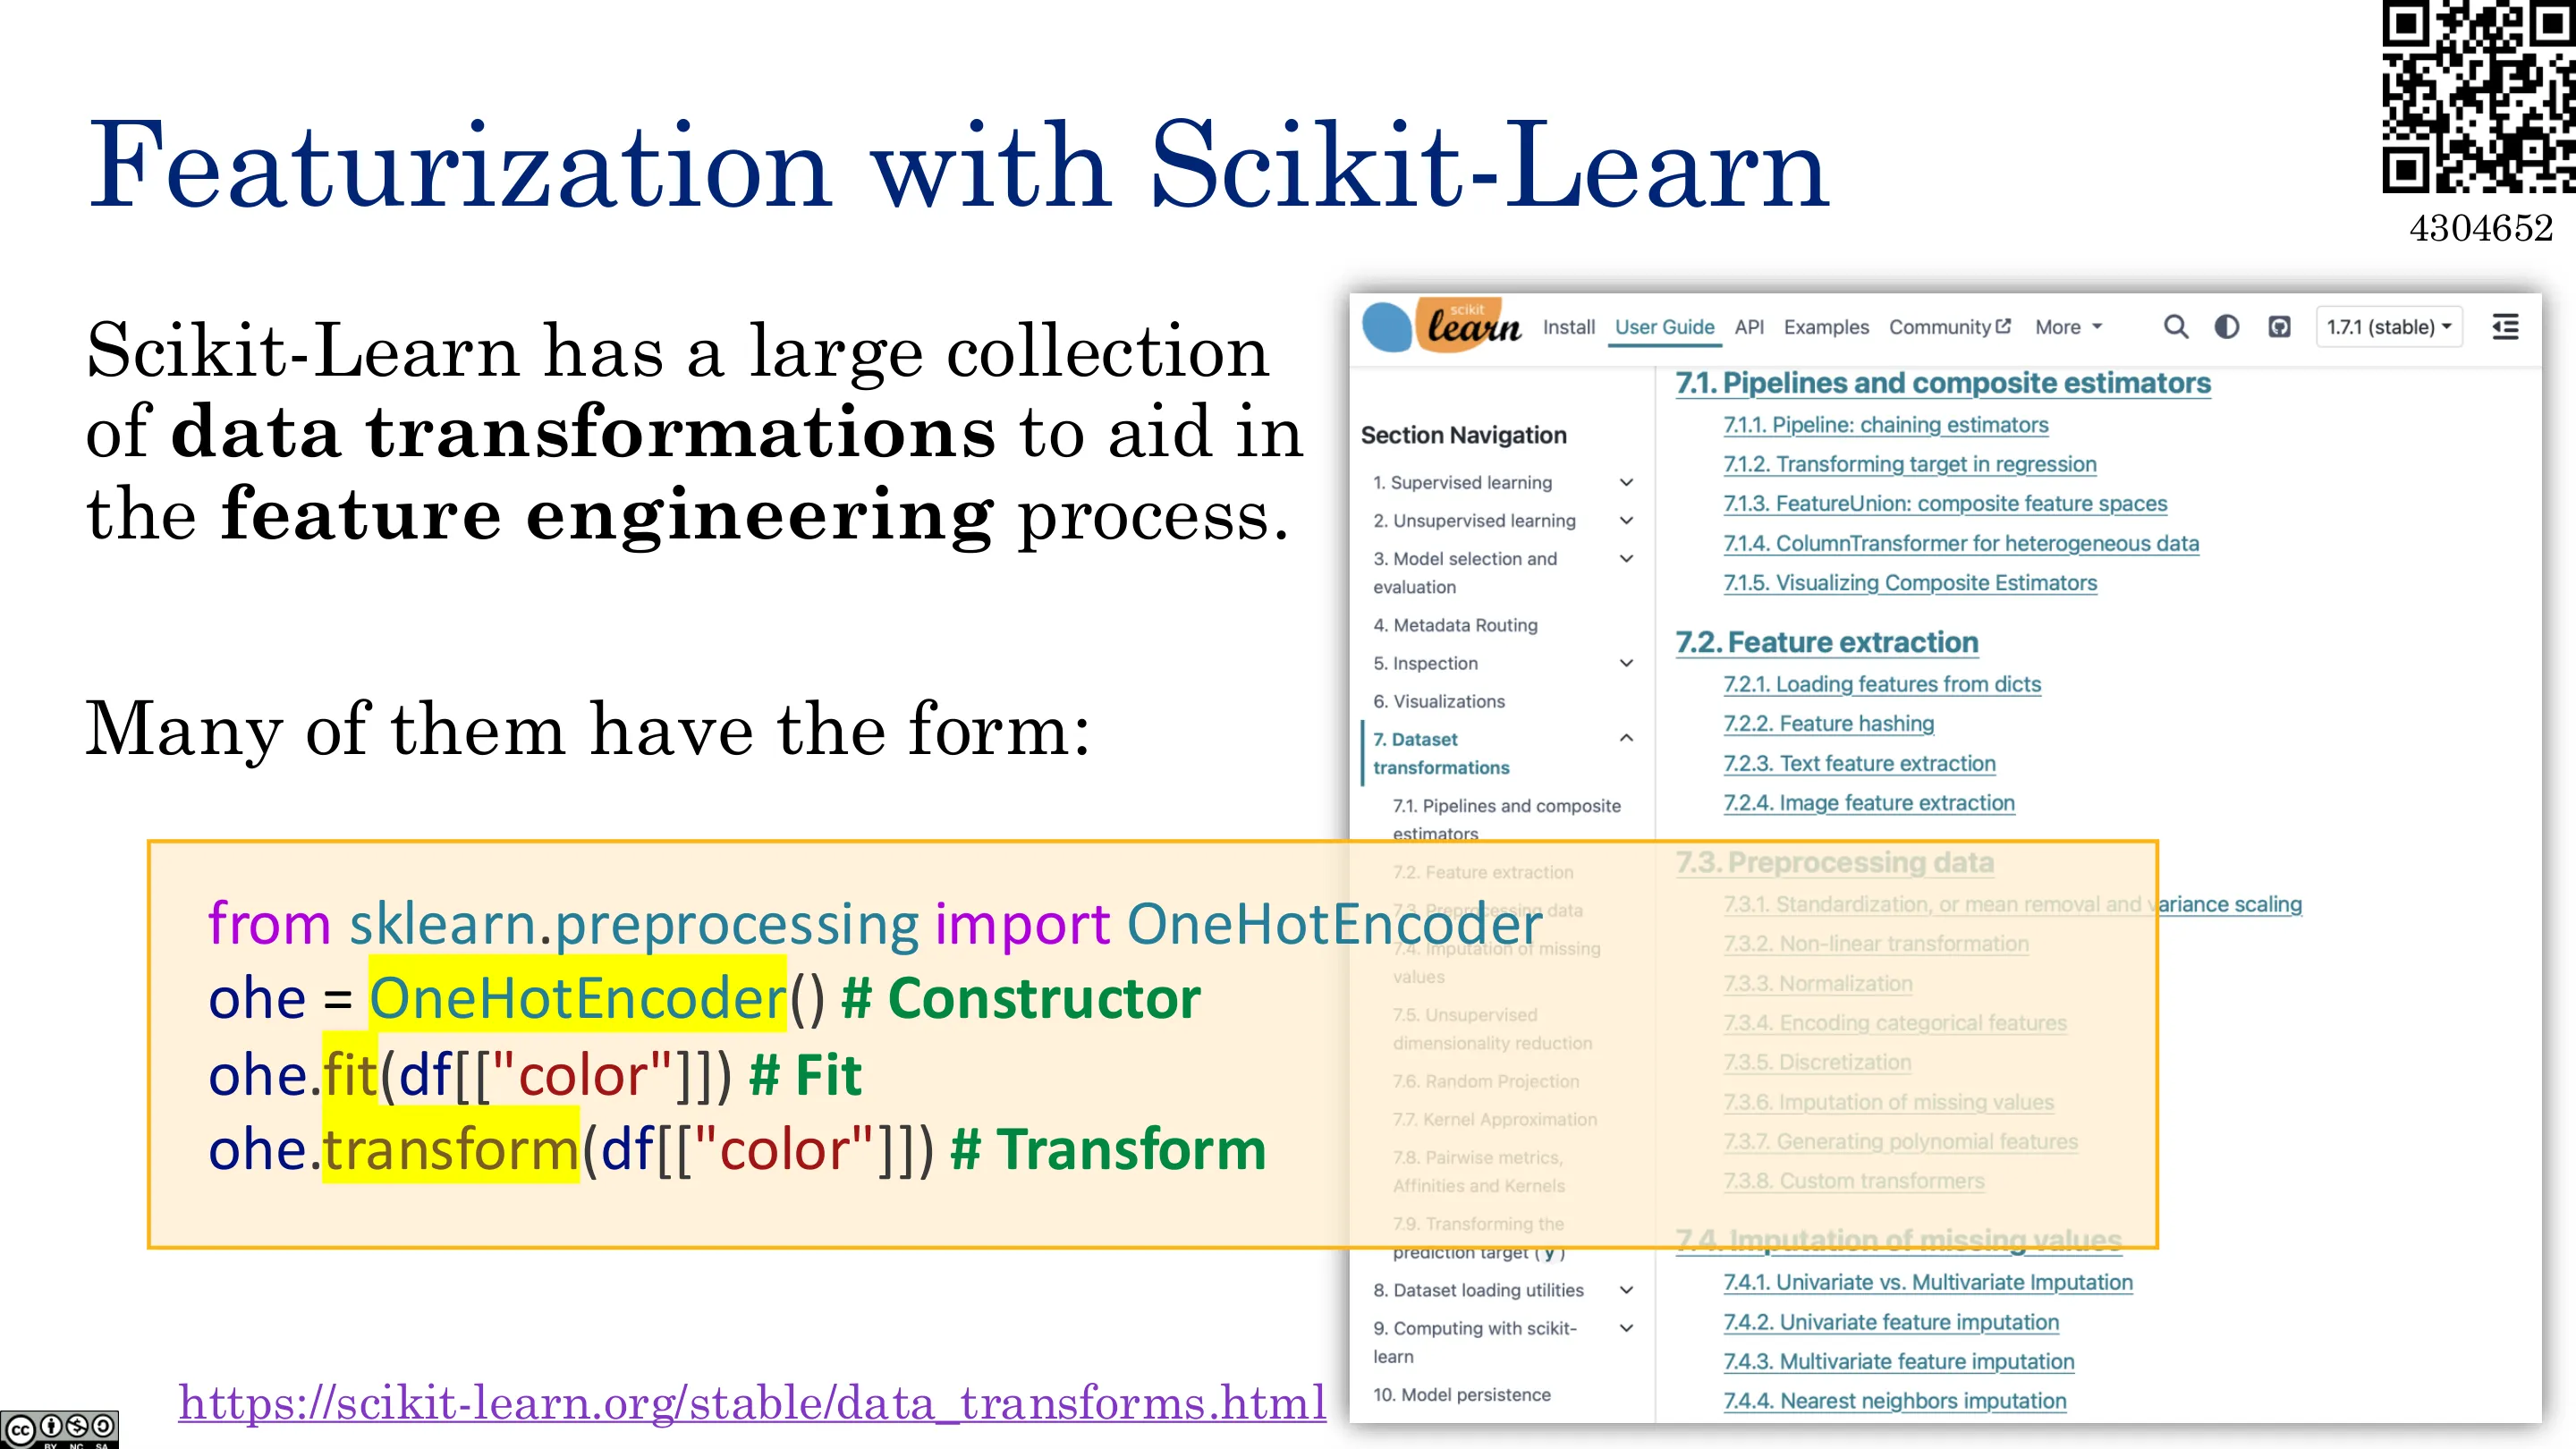
📷 用 scikit-learn 做特征化
回到原视频 (01:09:50)
八、把机器学习看作函数逼近
(参考时间: 01:09)
在模型设计阶段,我们要选「模型族」。一个统一的视角是:机器学习 = 函数逼近(Function Approximation):
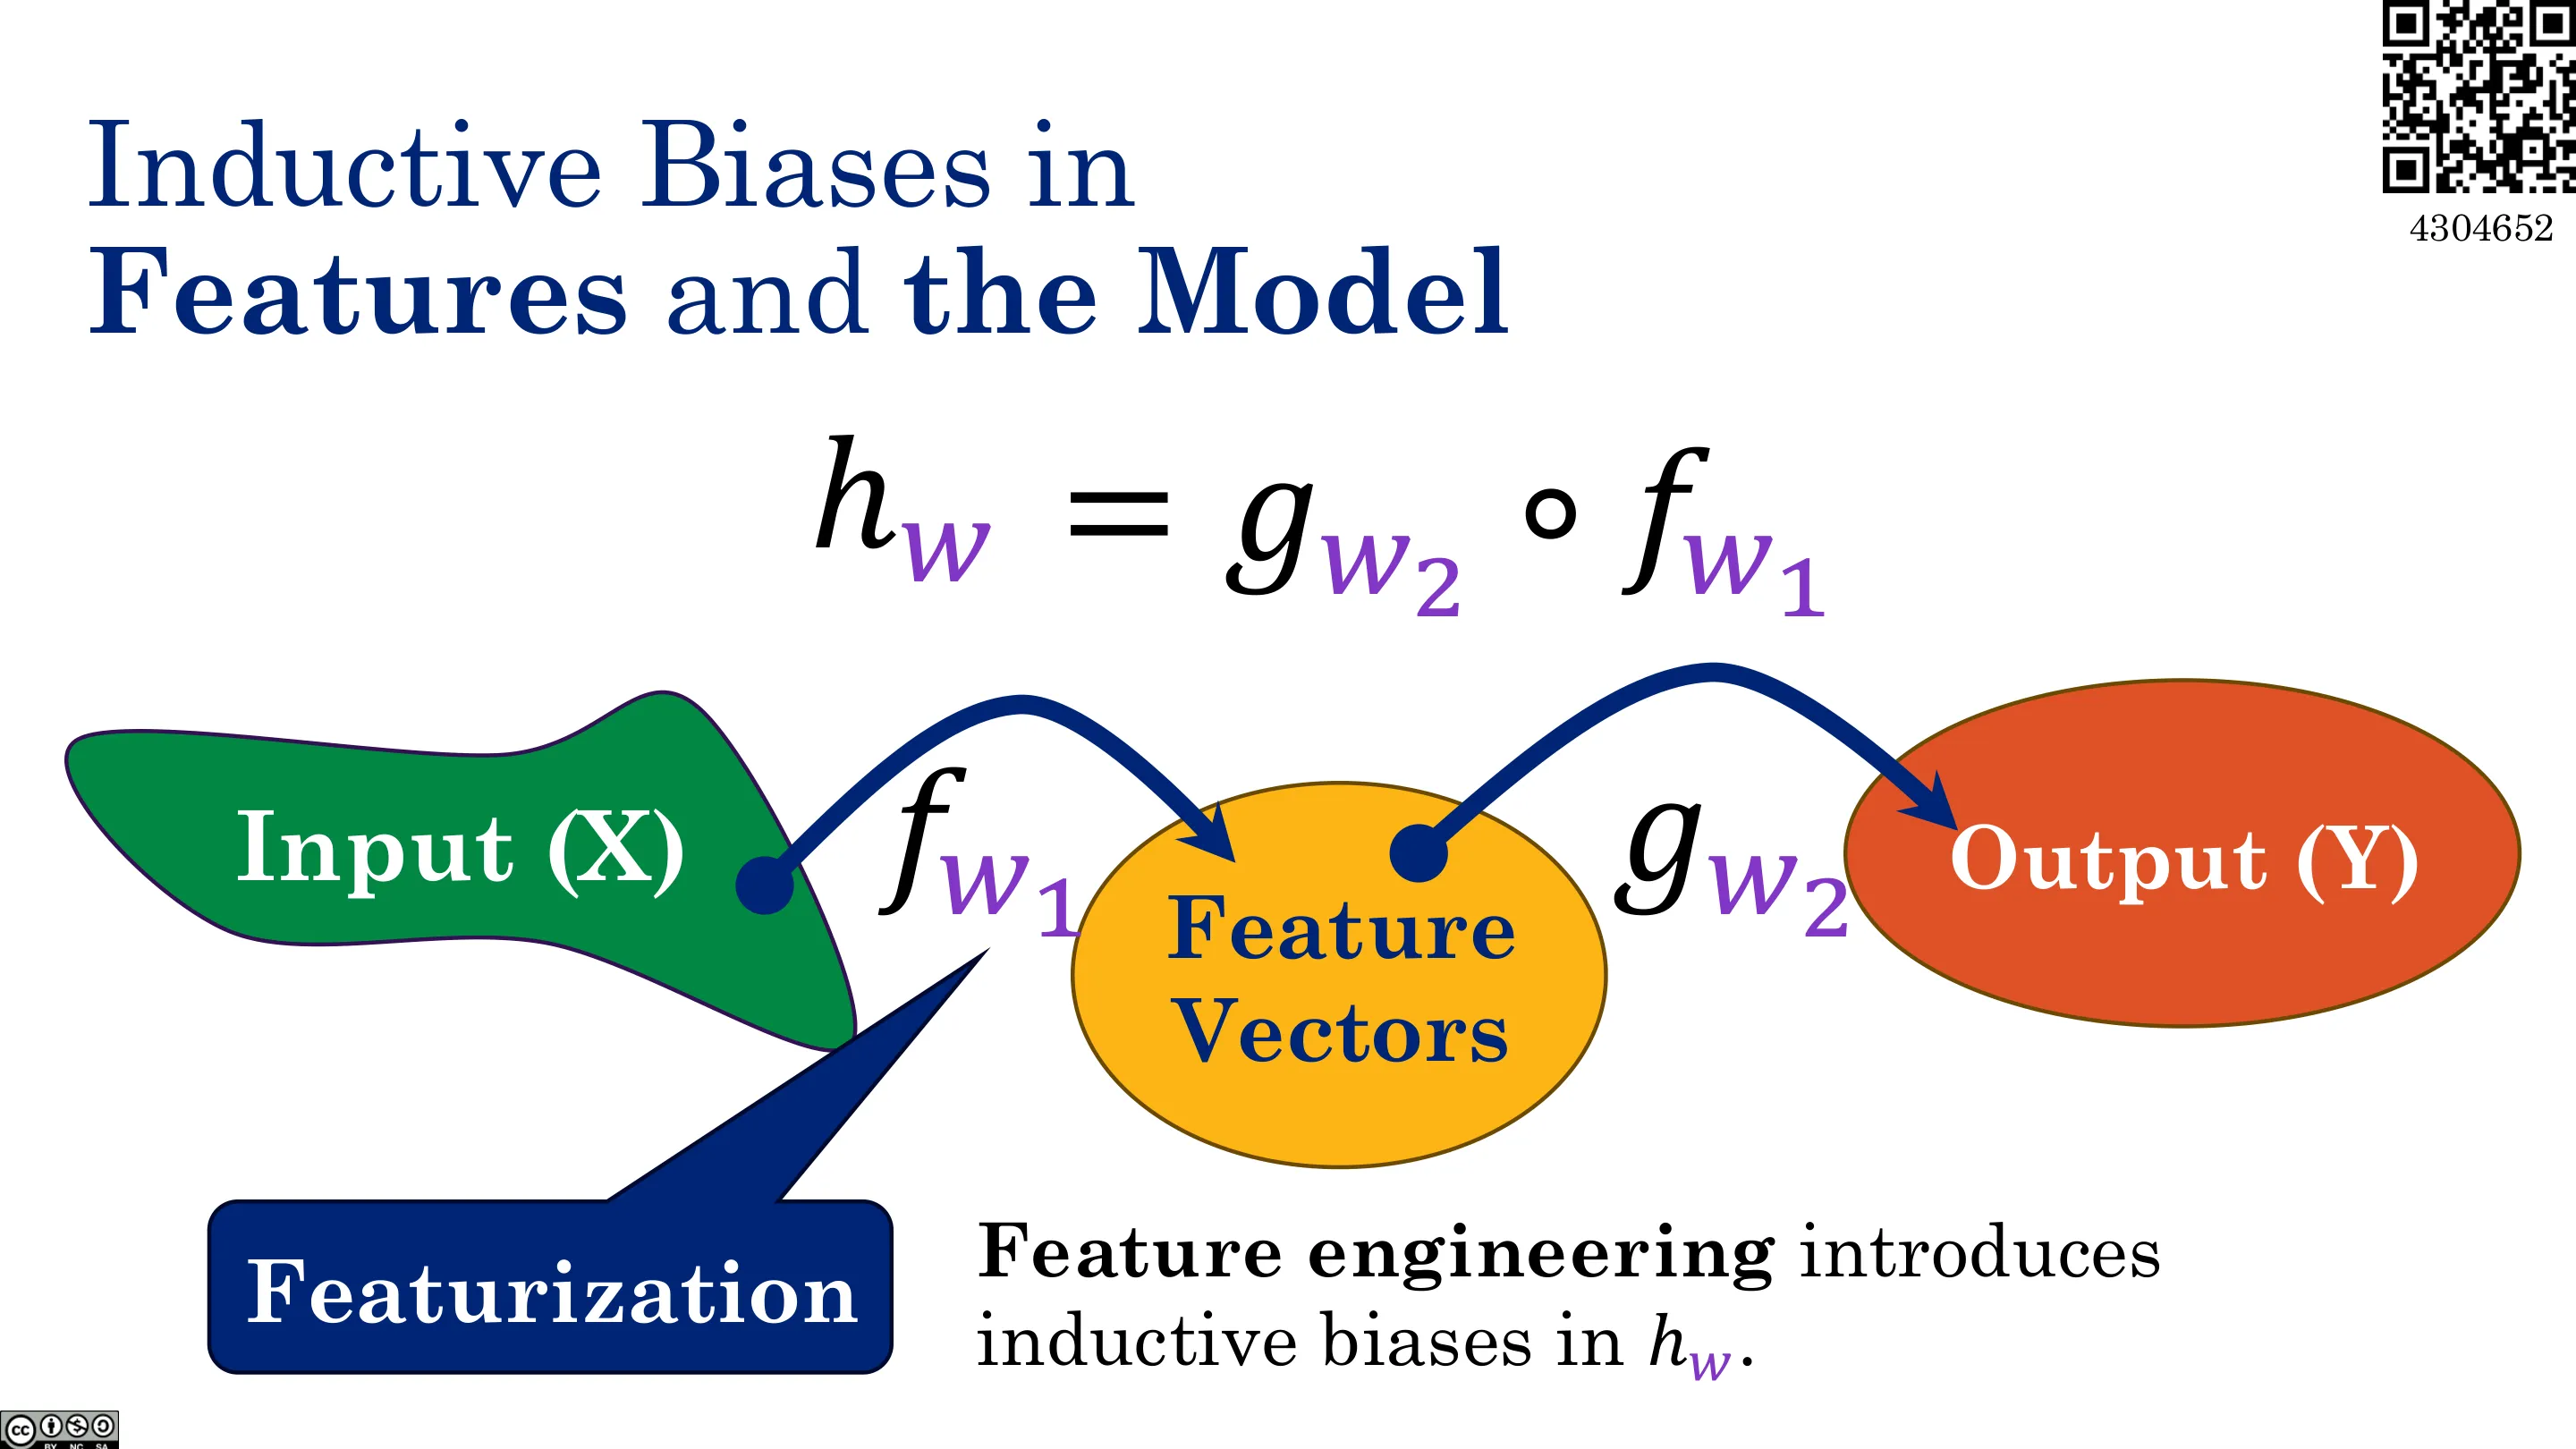
- 输入 $X$ → 输出 $Y$,模型是一个函数 $h_w$;
- 更一般地,可以分成「特征化 $f_{w_1}$」与「学到的函数 $g_{w_2}$」两步:$h_w = g_{w_2} \circ f_{w_1}$。
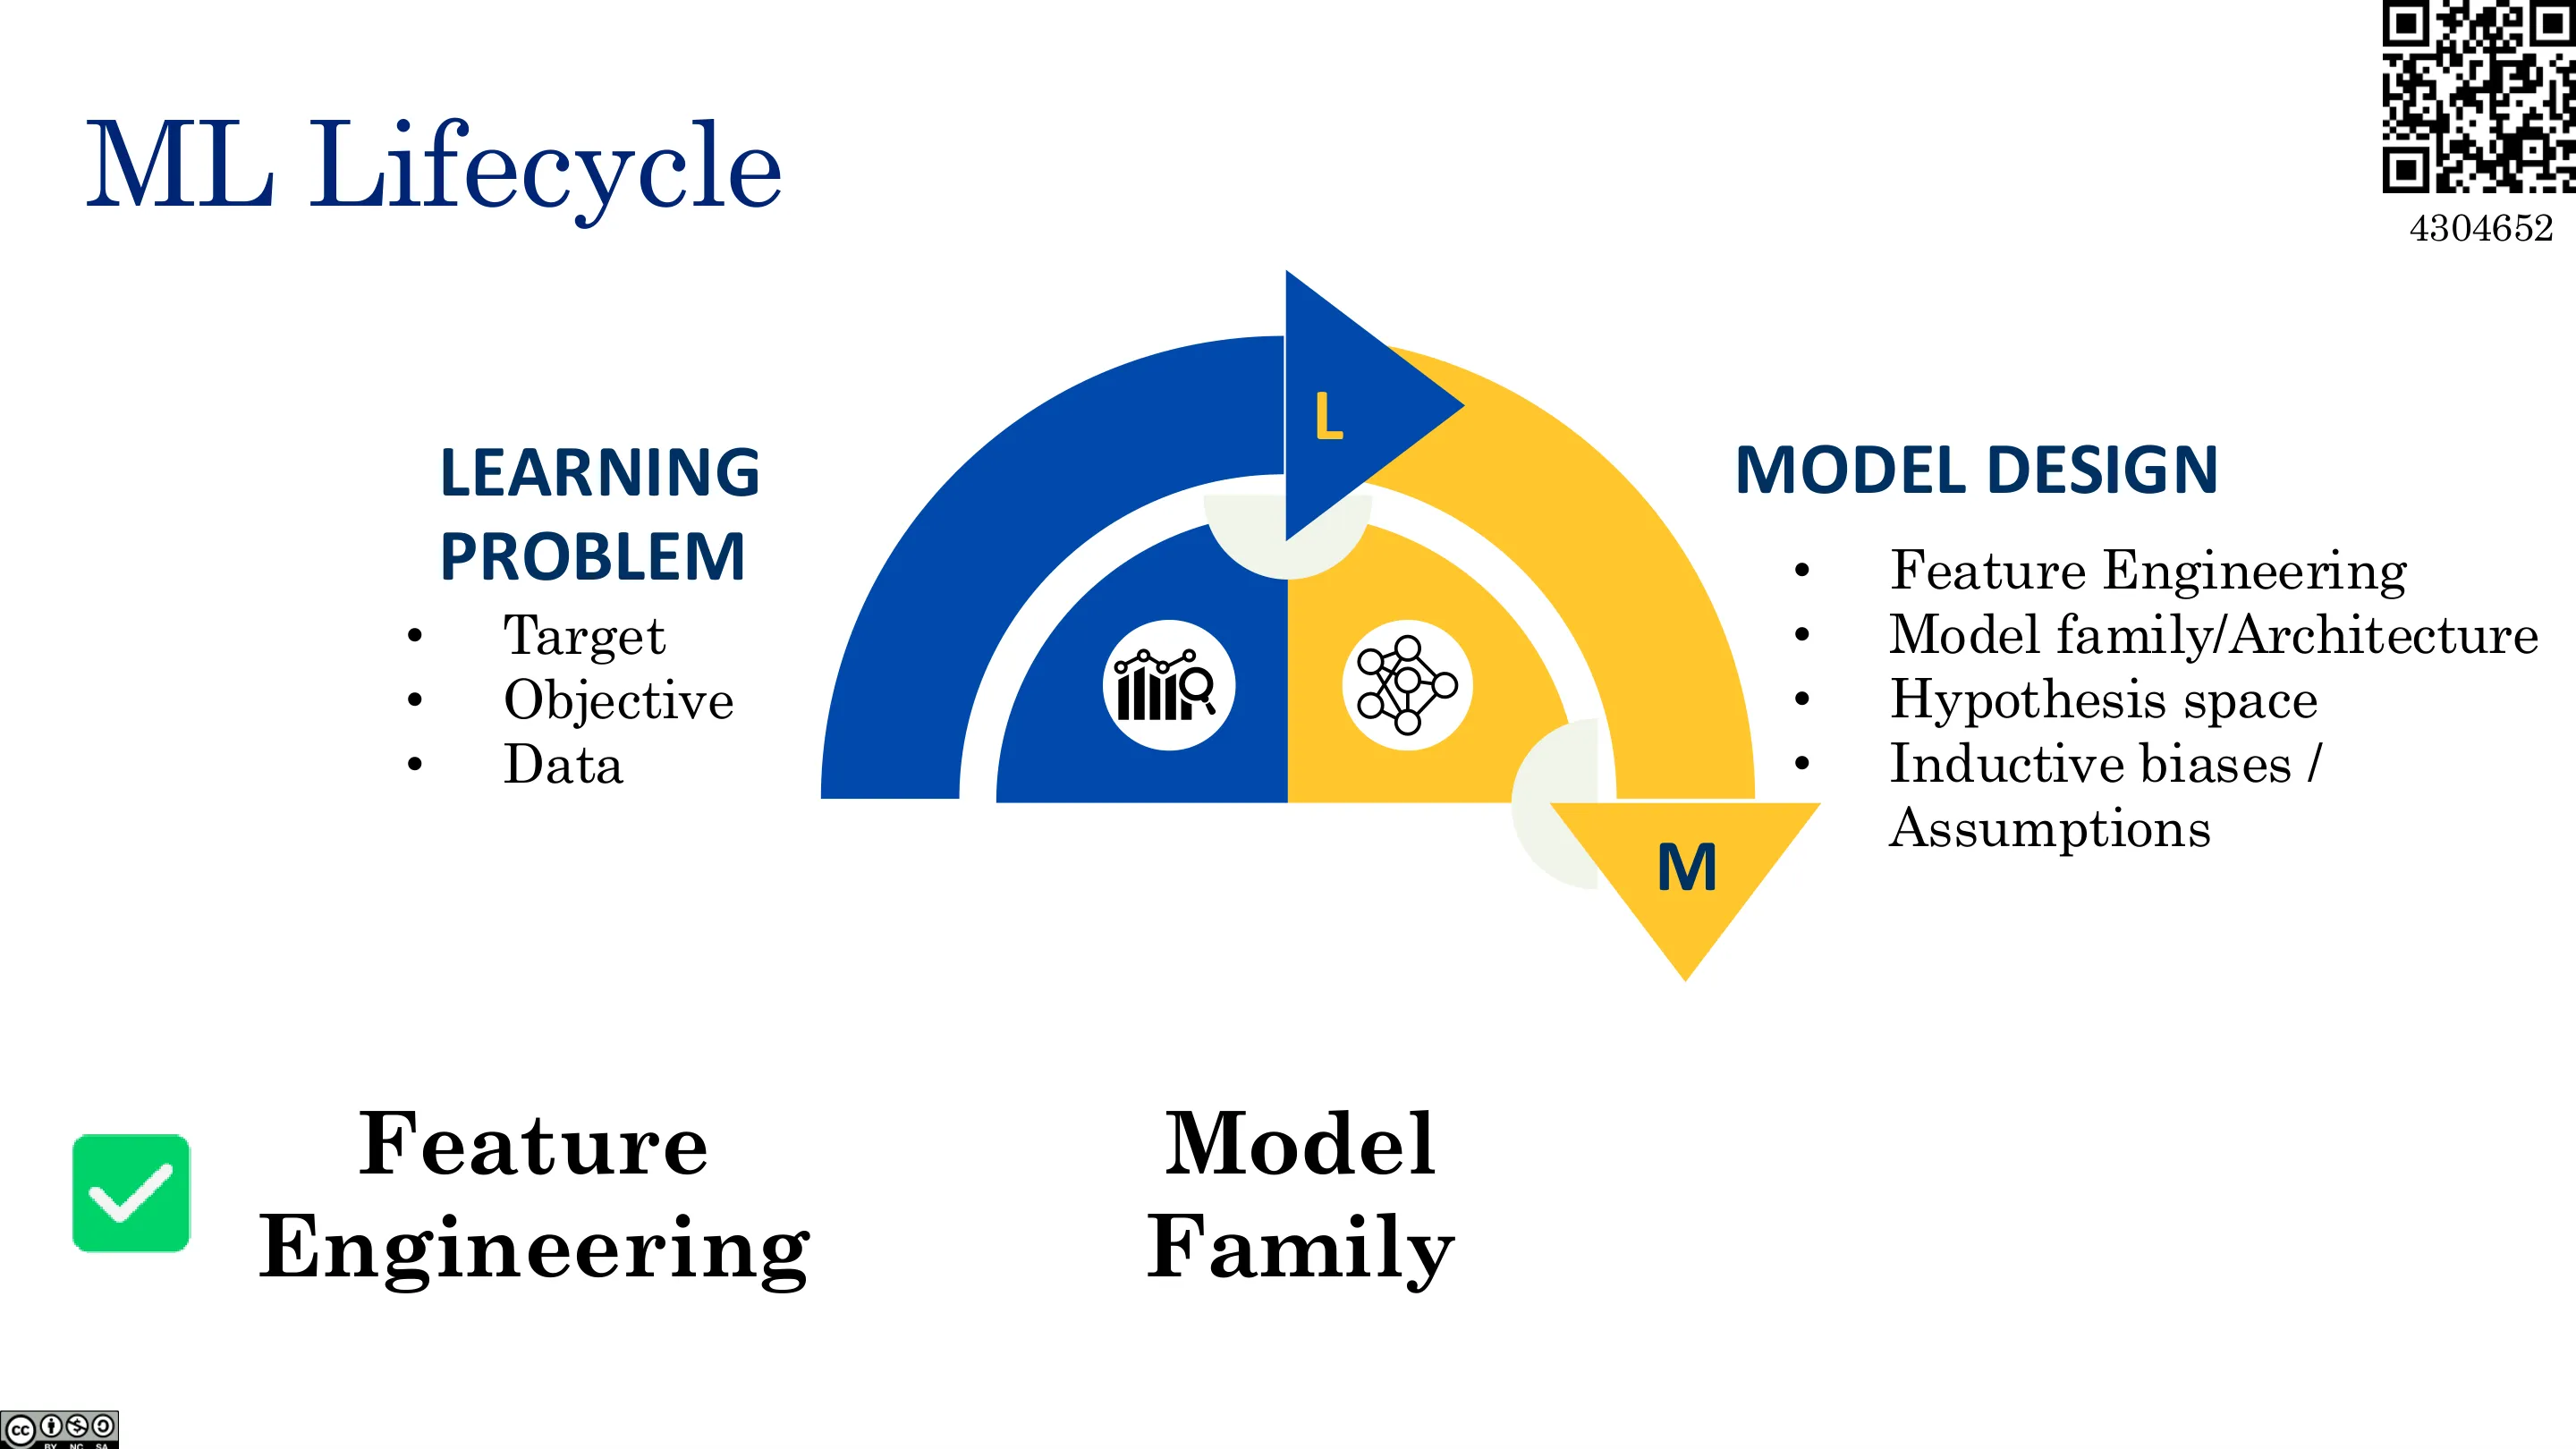
📷 模型设计:特征工程与模型族
回到原视频 (01:10:05)
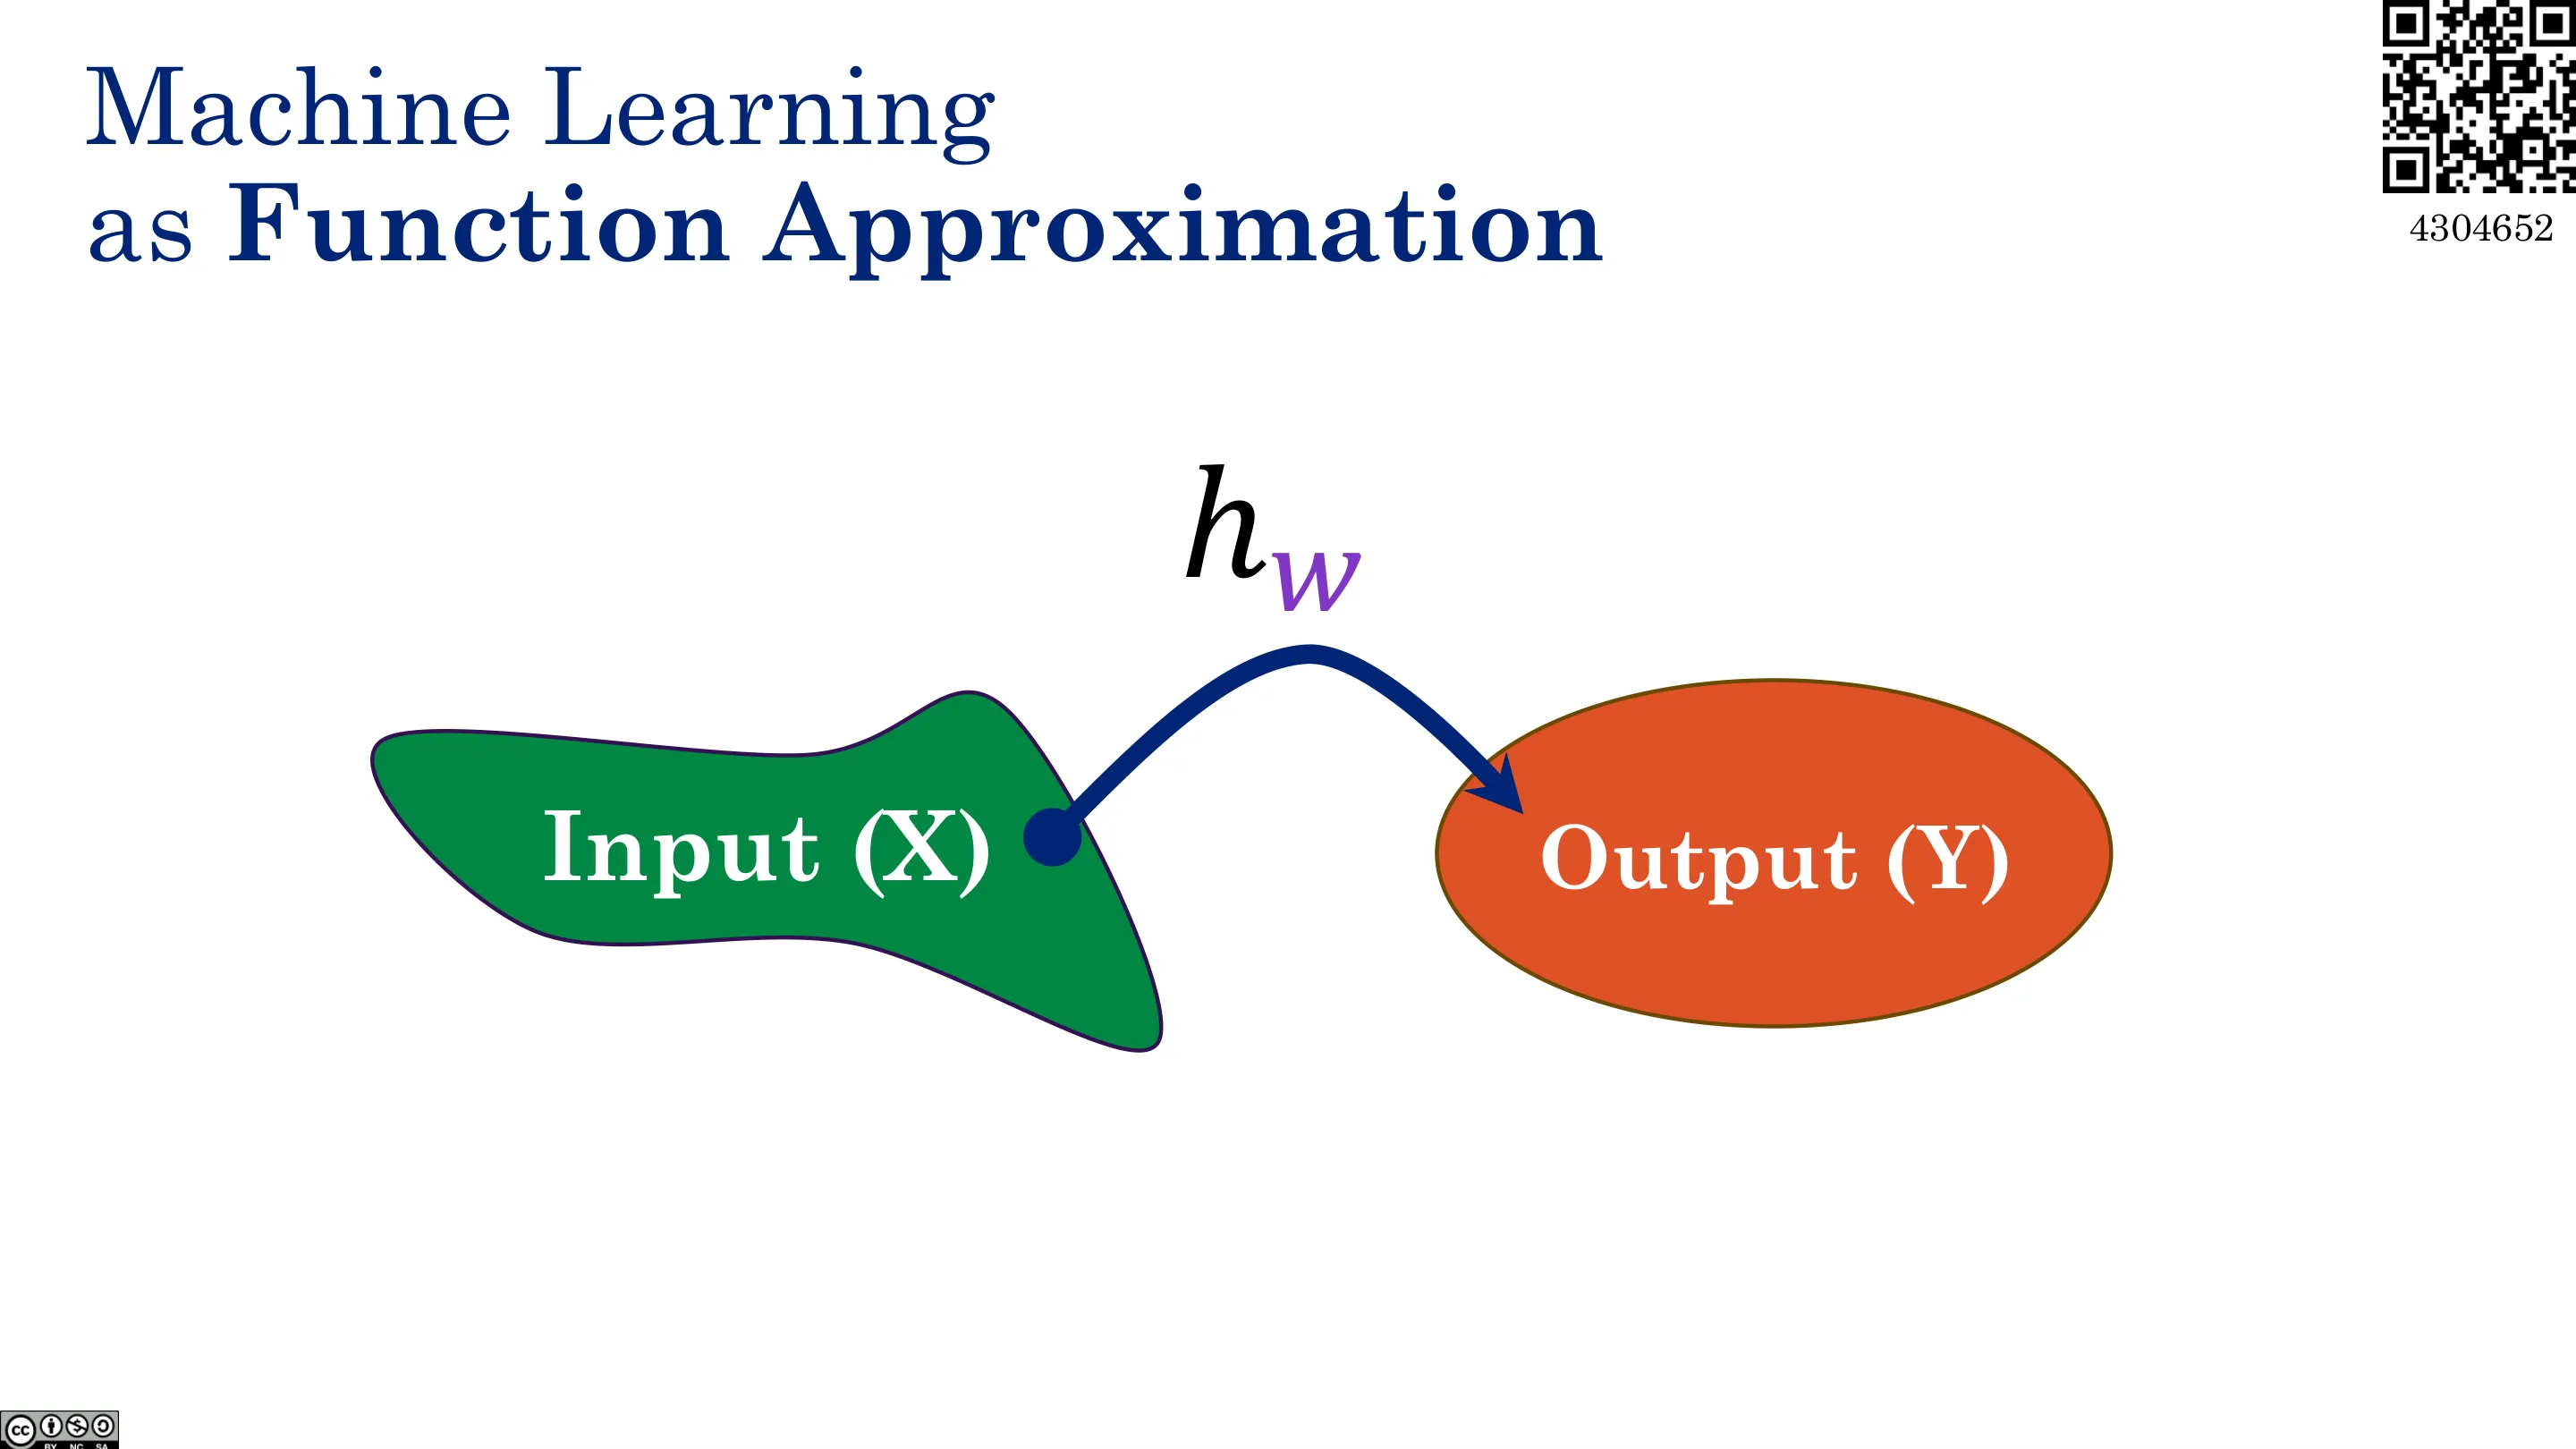
📷 机器学习作为函数逼近
回到原视频 (01:10:09)
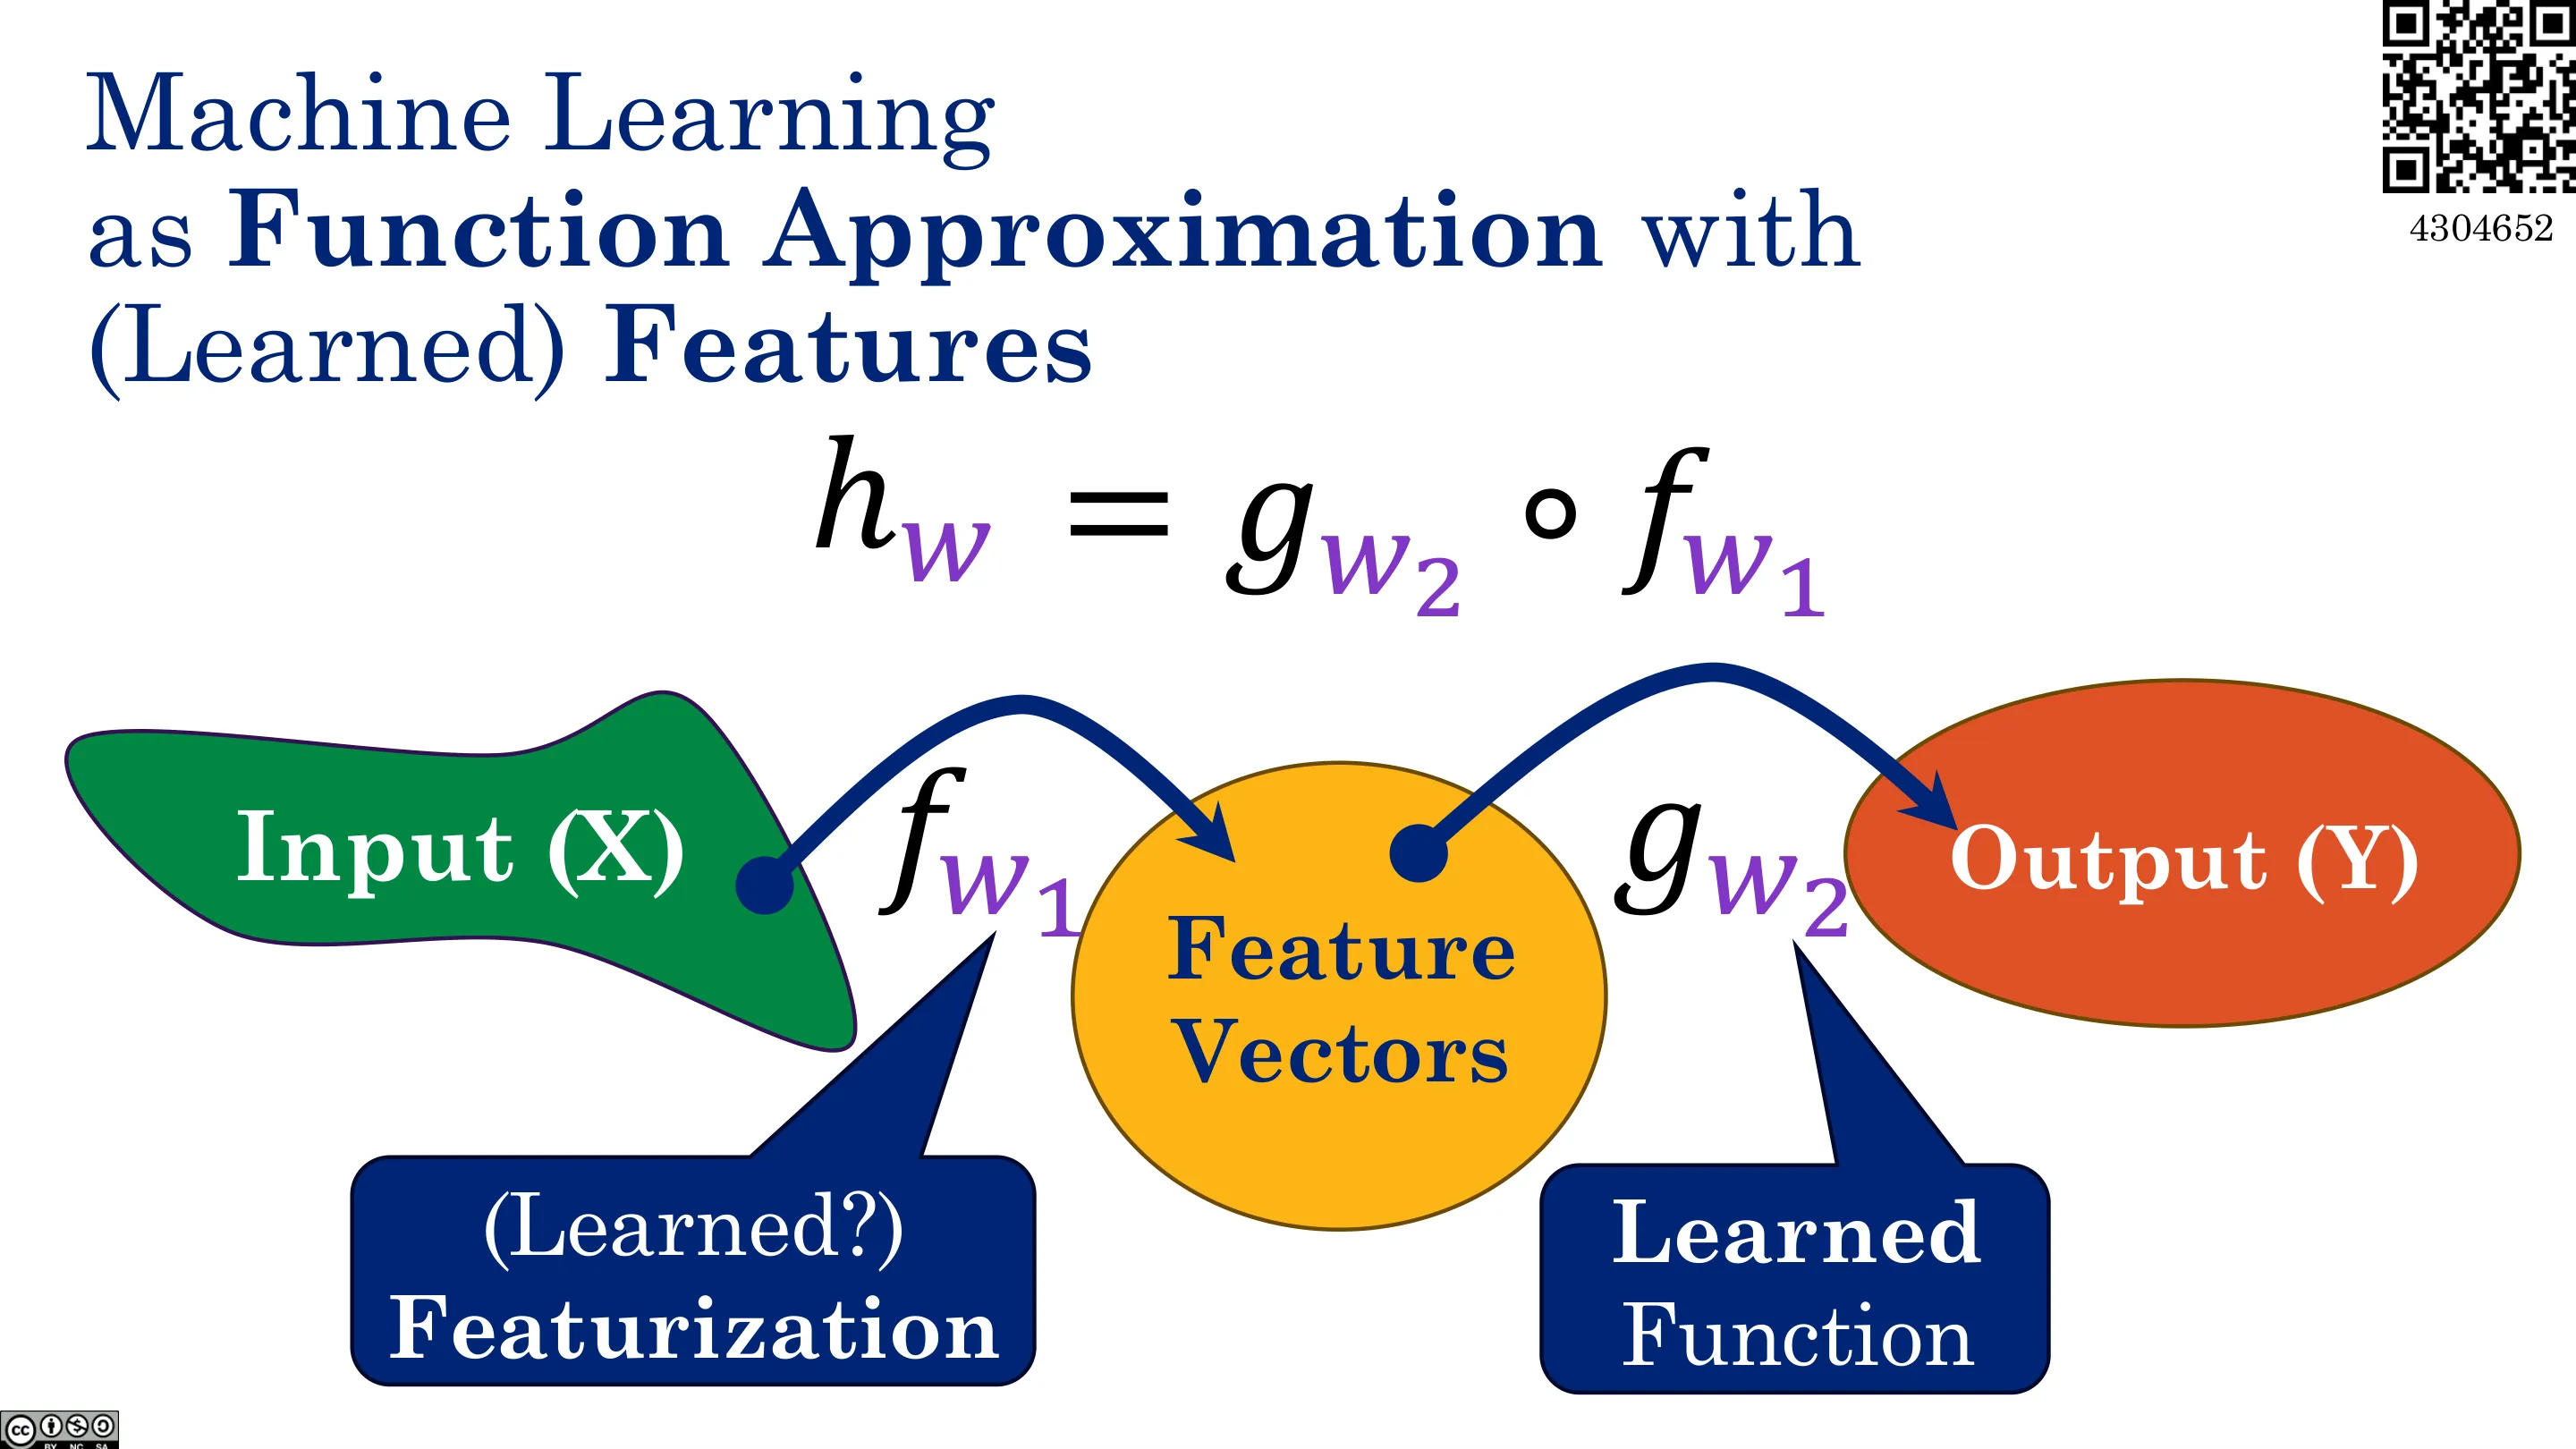
📷 带(学习到的)特征的函数逼近
回到原视频 (01:10:24)
由此可以发展出通用的模型族与相应的训练算法:
- 模型族决定了函数 $g_{w_2}$ 的形式,以及输出空间(分类还是回归);
- 假设空间(hypothesis space)是该模型族中所有可能模型的集合;
- 模型族的特征由它引入的归纳偏置与可表示的复杂度刻画。
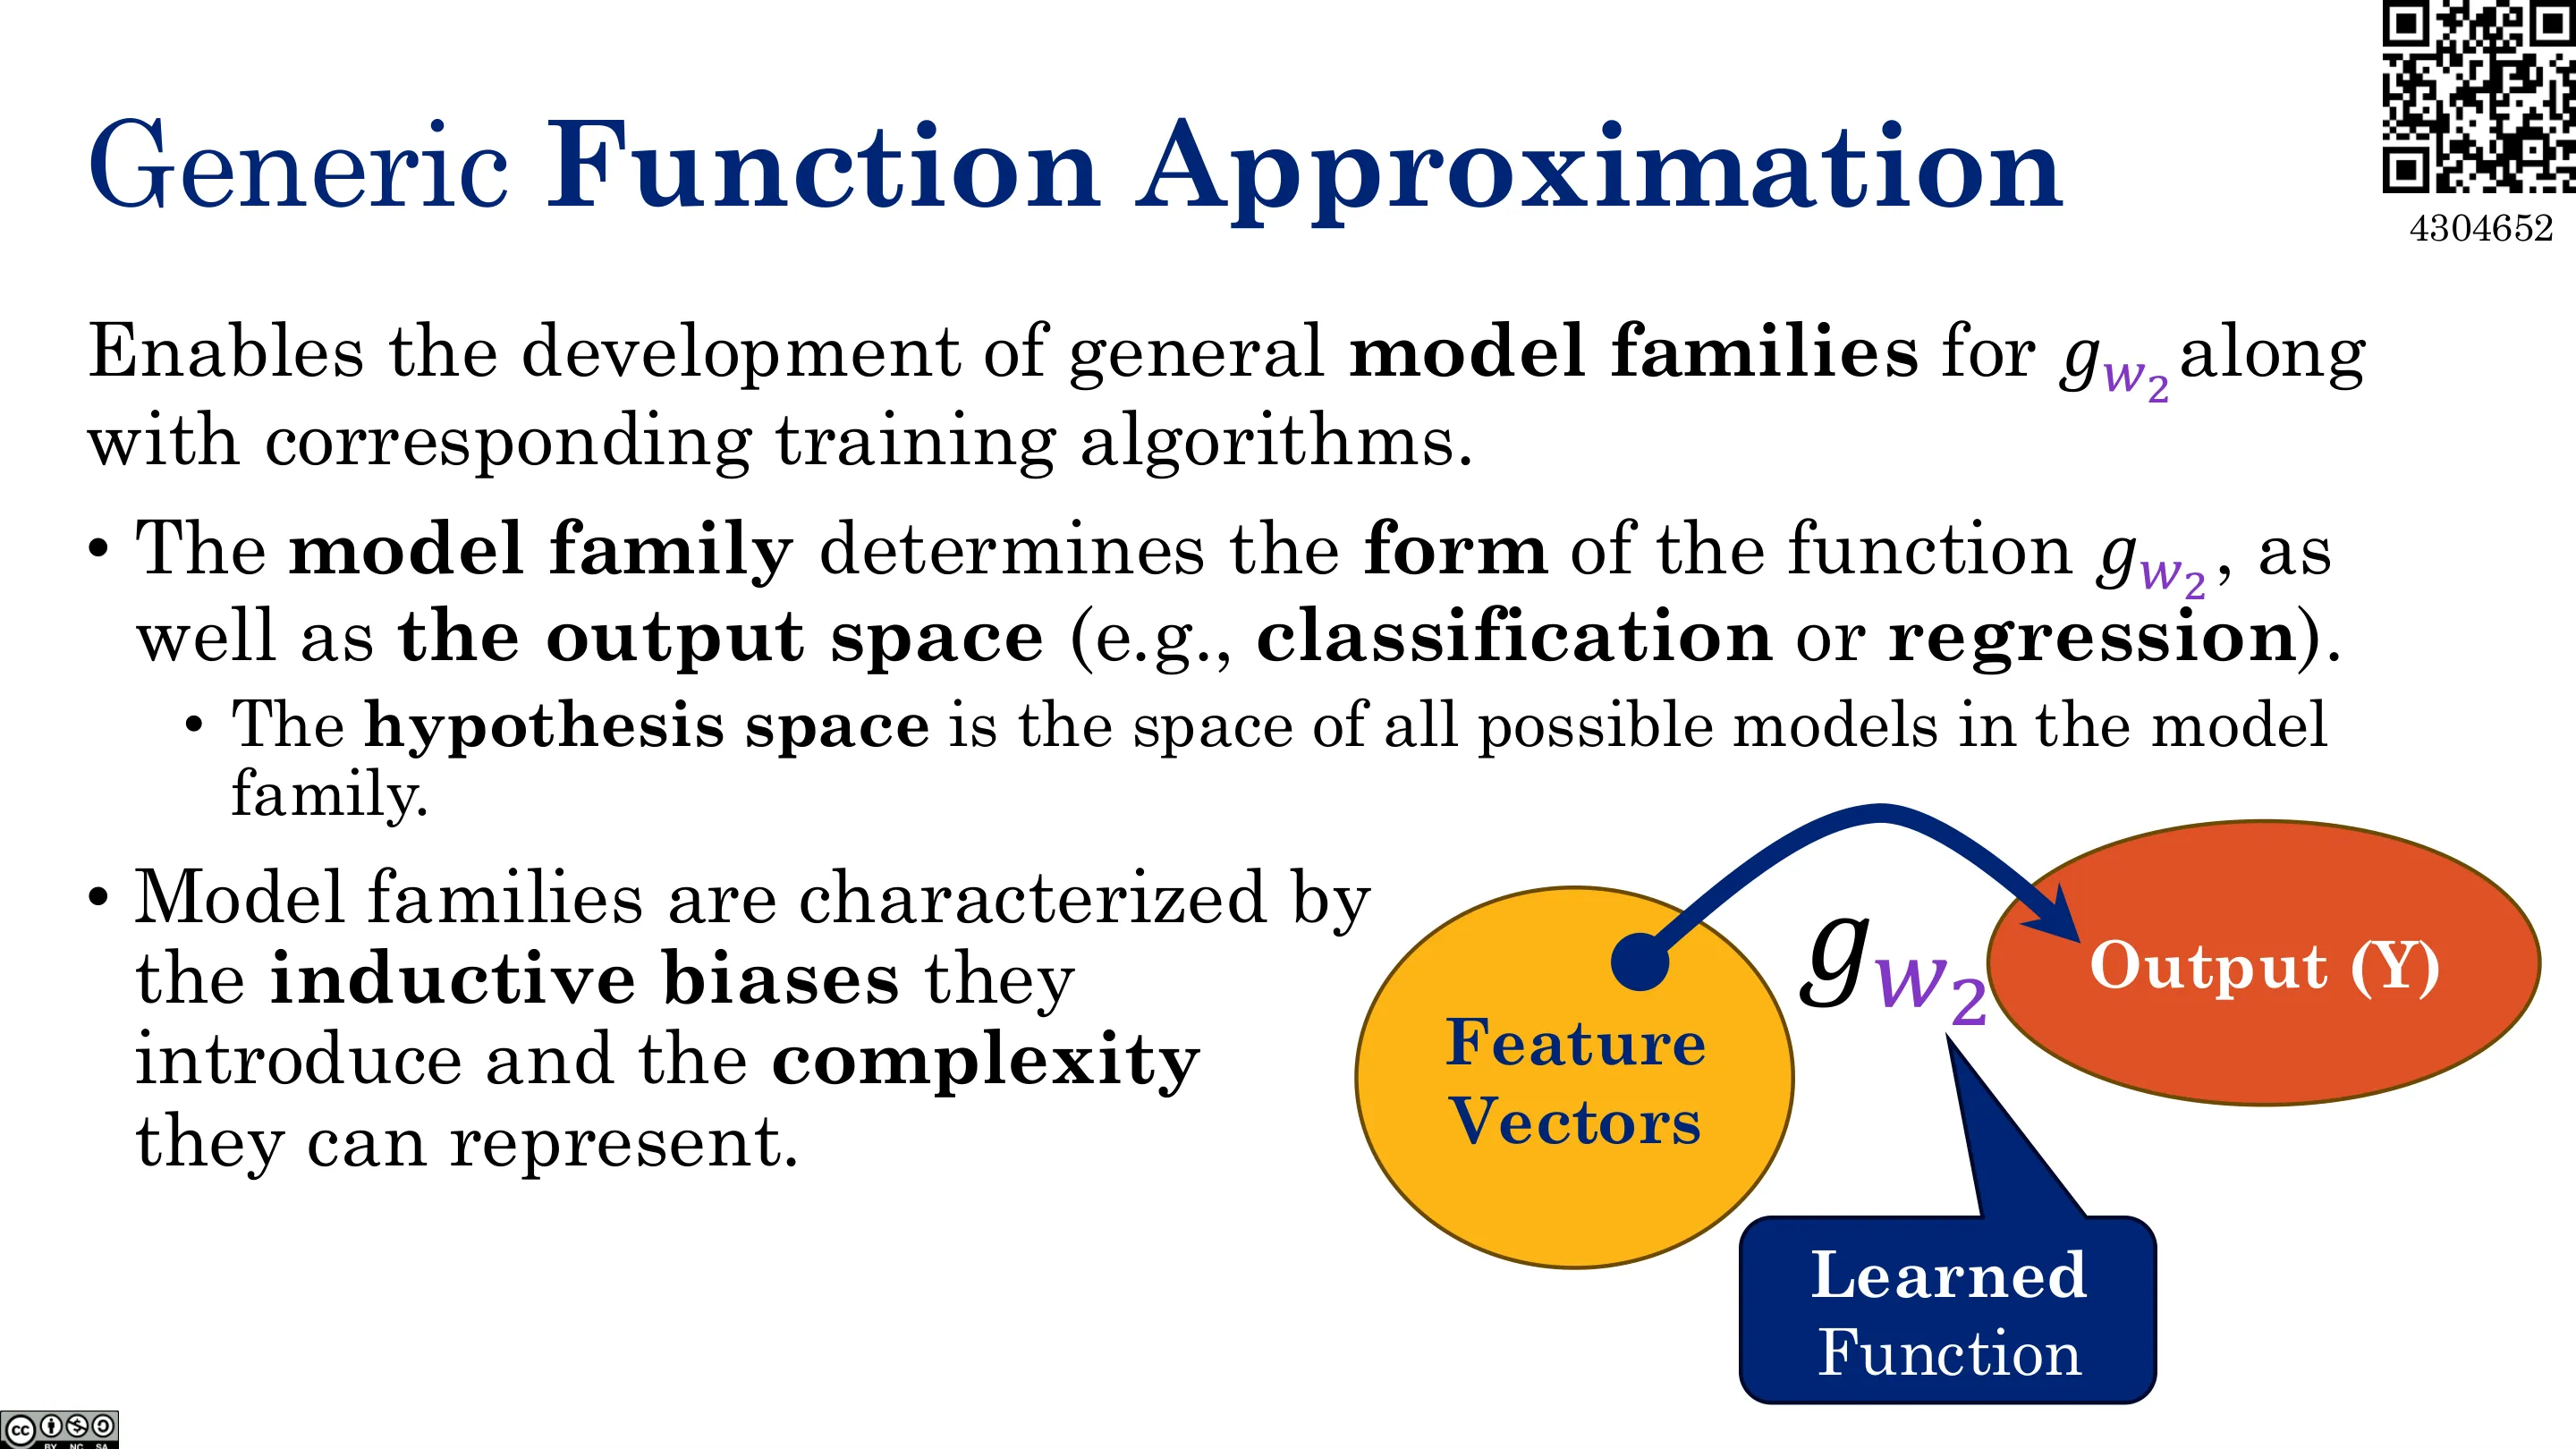
📷 通用函数逼近
回到原视频 (01:10:41)
九、模型族与归纳偏置
(参考时间: 01:11)
线性回归模型族的形式为:
$$ g_w(\mathbf{x}) = w_0 + \sum_{d=1}^{D} w_d x_d $$
不同的权重向量 $w$ 得到不同的模型。例如 $g_{[1,1]}(x) = 1 + x_1$、$g_{[1,-1]}(x) = 1 - x_1$、$g_{[2,2]}(x) = 2 + 2x_1$。它的假设空间,就是所有由实值斜率与截距参数化的直线。
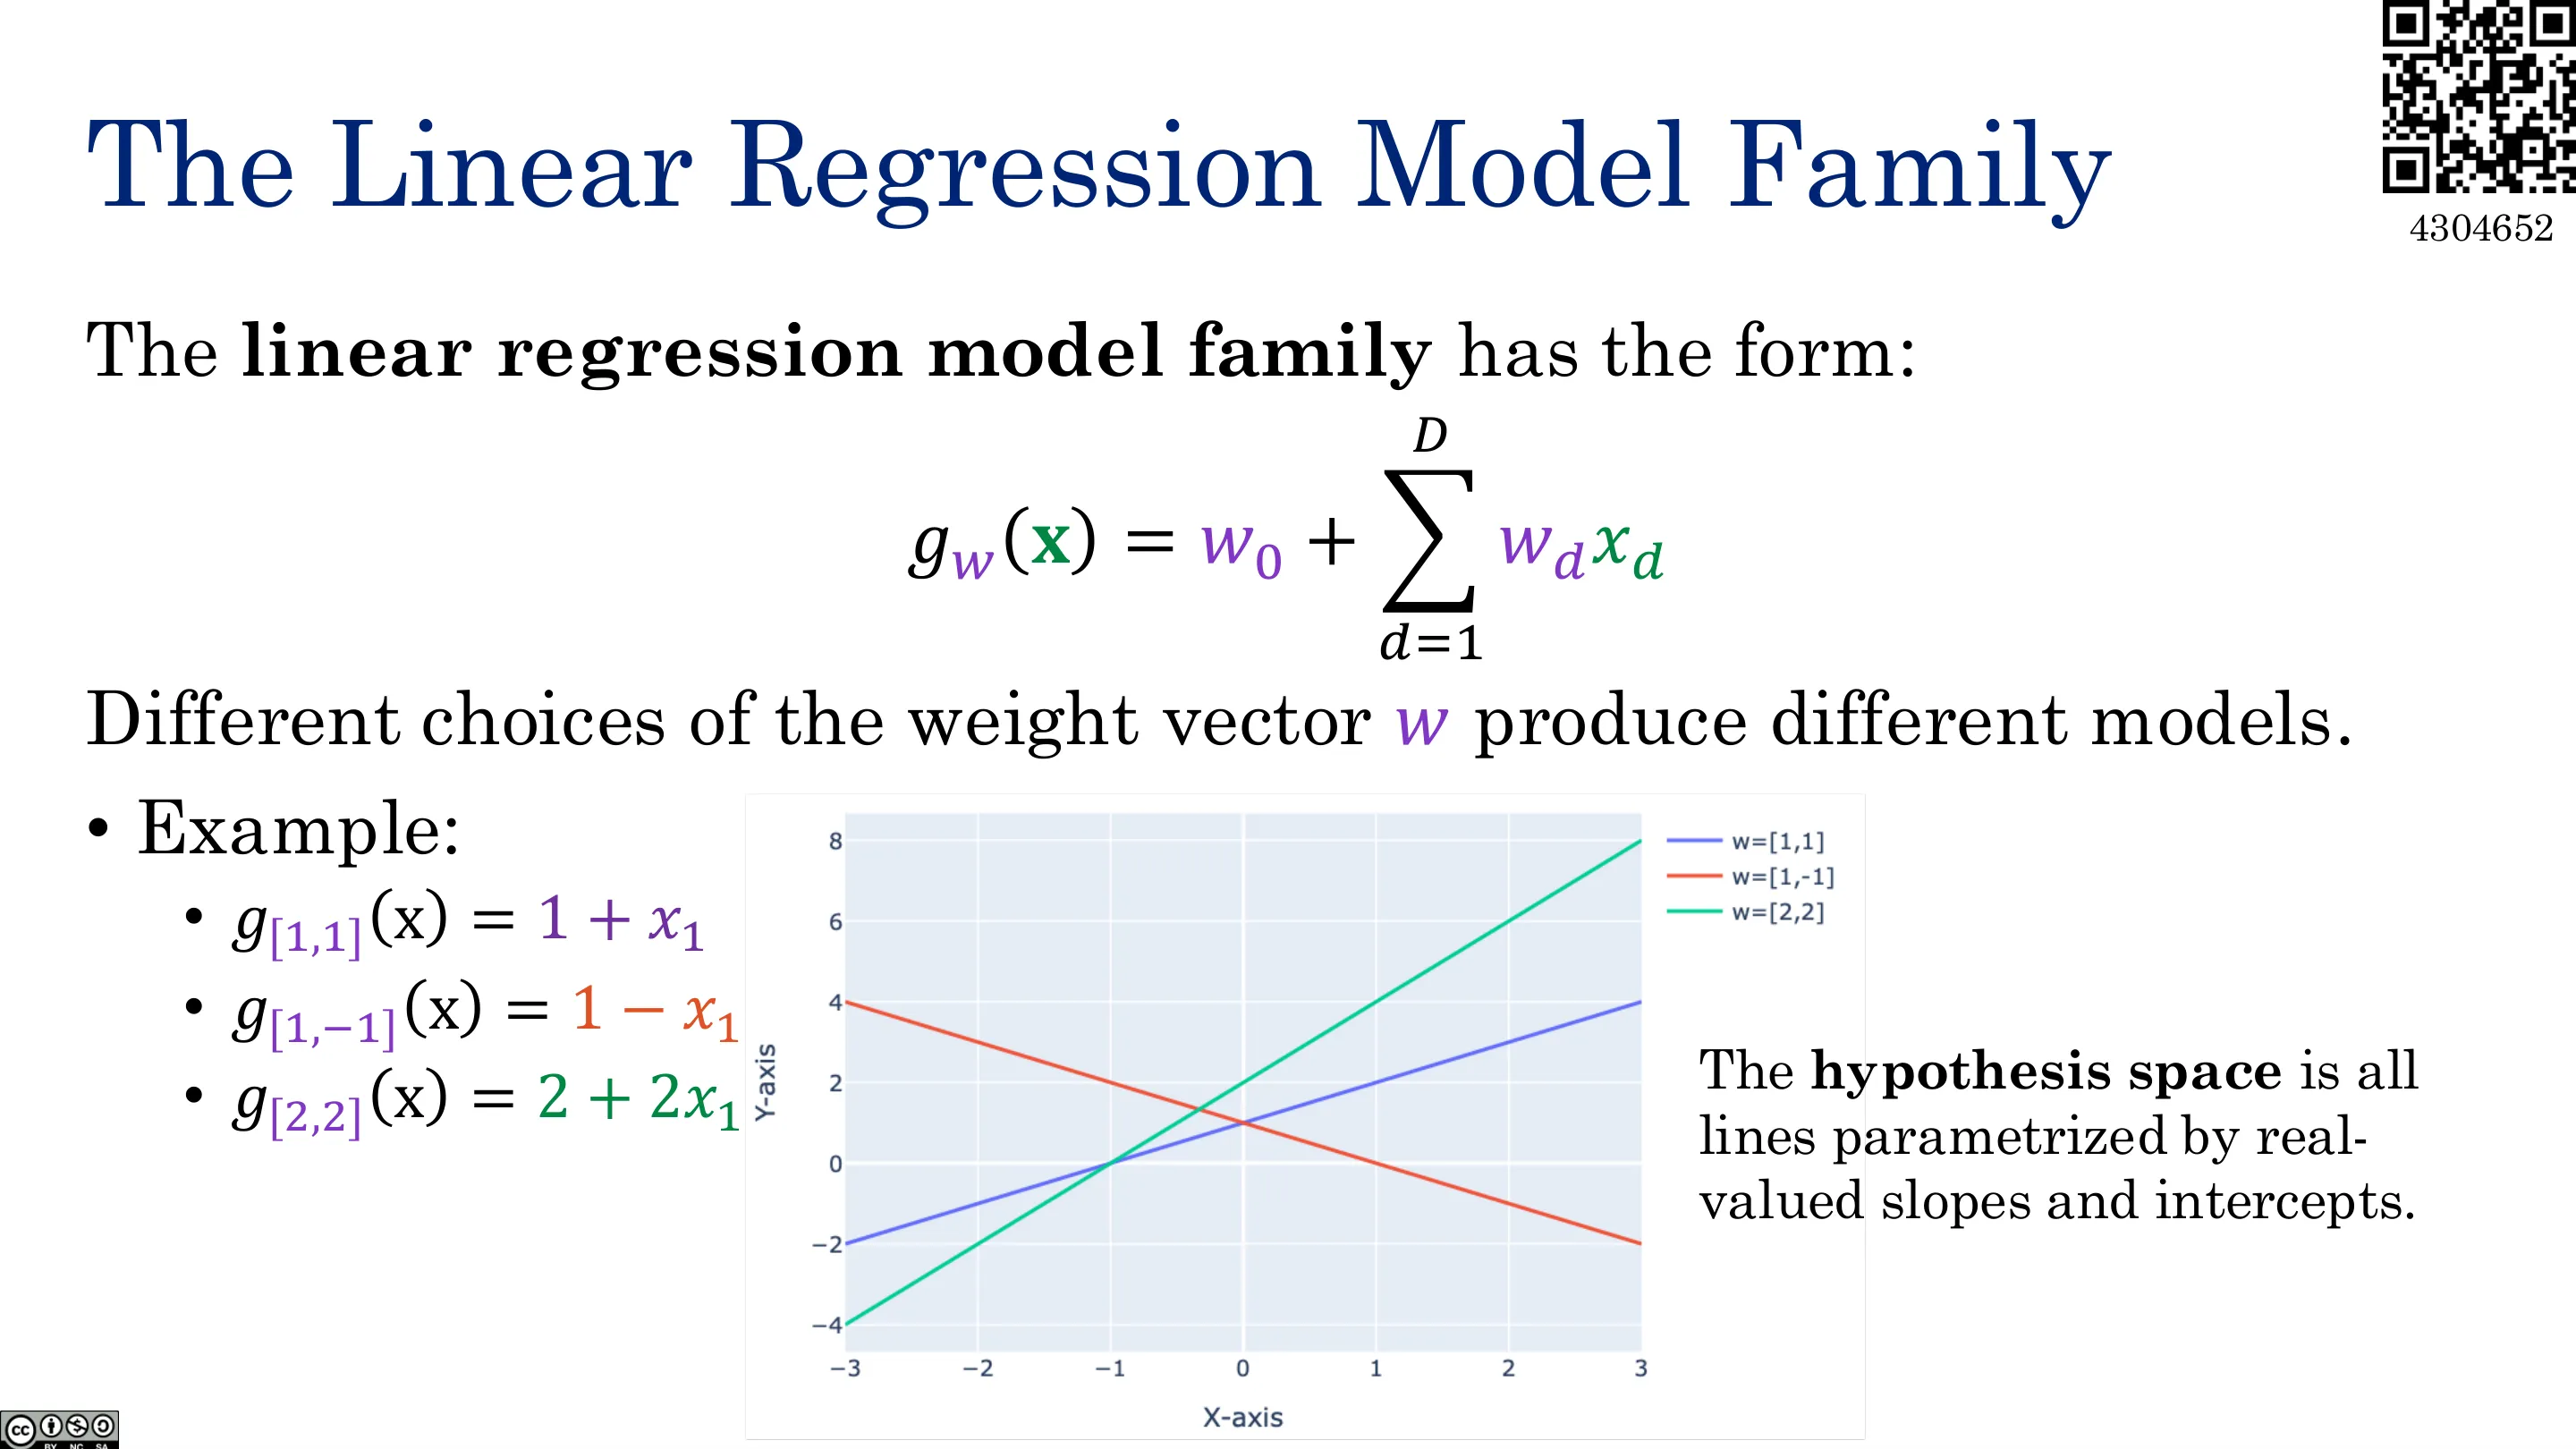
📷 线性回归模型族
回到原视频 (01:11:00)
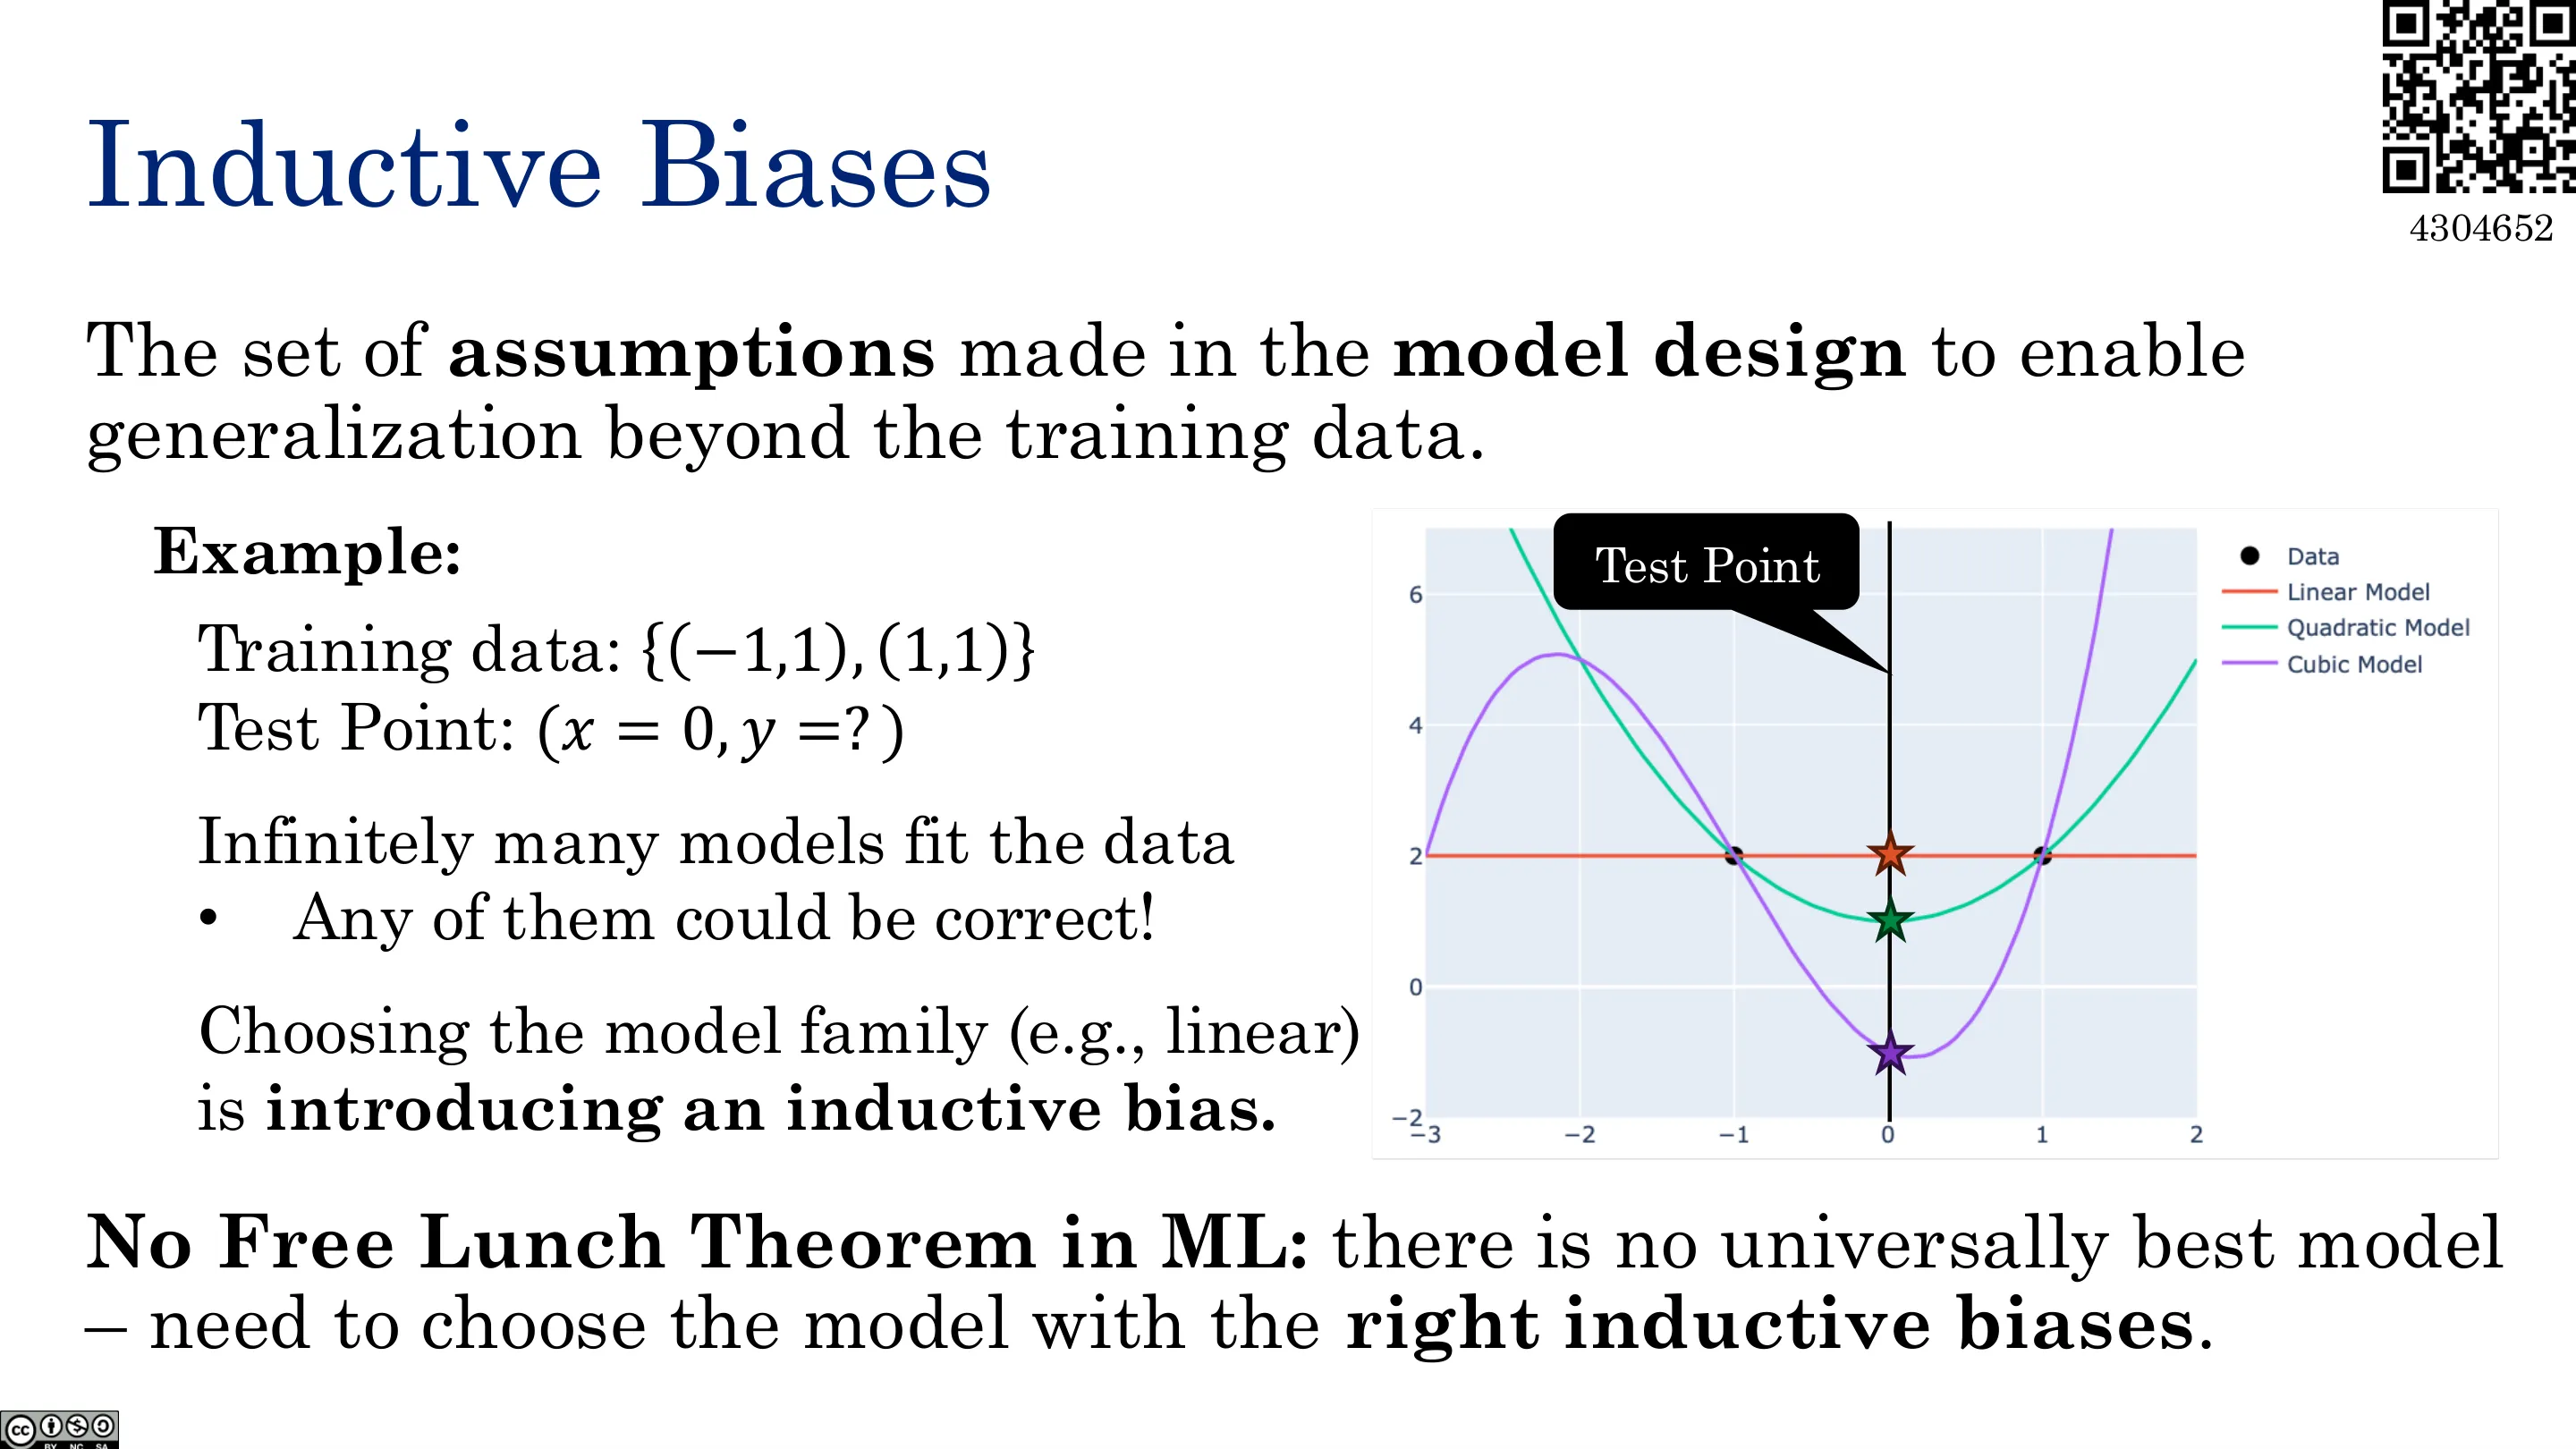
归纳偏置(Inductive Biases)是为了让模型能泛化到训练数据之外,而在模型设计中所做的一组假设。
没有免费午餐定理(No Free Lunch Theorem):不存在普遍最优的模型——你必须选择具备正确归纳偏置的模型。
例如:训练数据只有两点 $(-1,1)$ 与 $(1,1)$,现在要预测 $x=0$ 处的 $y$。有无穷多条模型能完美拟合这两个点,任何一条都可能是对的。此时:
- 奥卡姆剃刀会说:最简单的解释最好——比如「恒为 0」的常数(即退化的线性)模型,若只观测到这两点,我们大概率也会押它;
- 选择模型族(例如选择线性)本身,就是在引入归纳偏置。
📷 归纳偏置
回到原视频 (01:11:25)
归纳偏置既来自模型,也来自特征:特征工程会在 $h_w$ 中引入归纳偏置。
📷 特征与模型中的归纳偏置
回到原视频 (01:13:04)
十、复杂度、过拟合与正则化
(参考时间: 01:13)
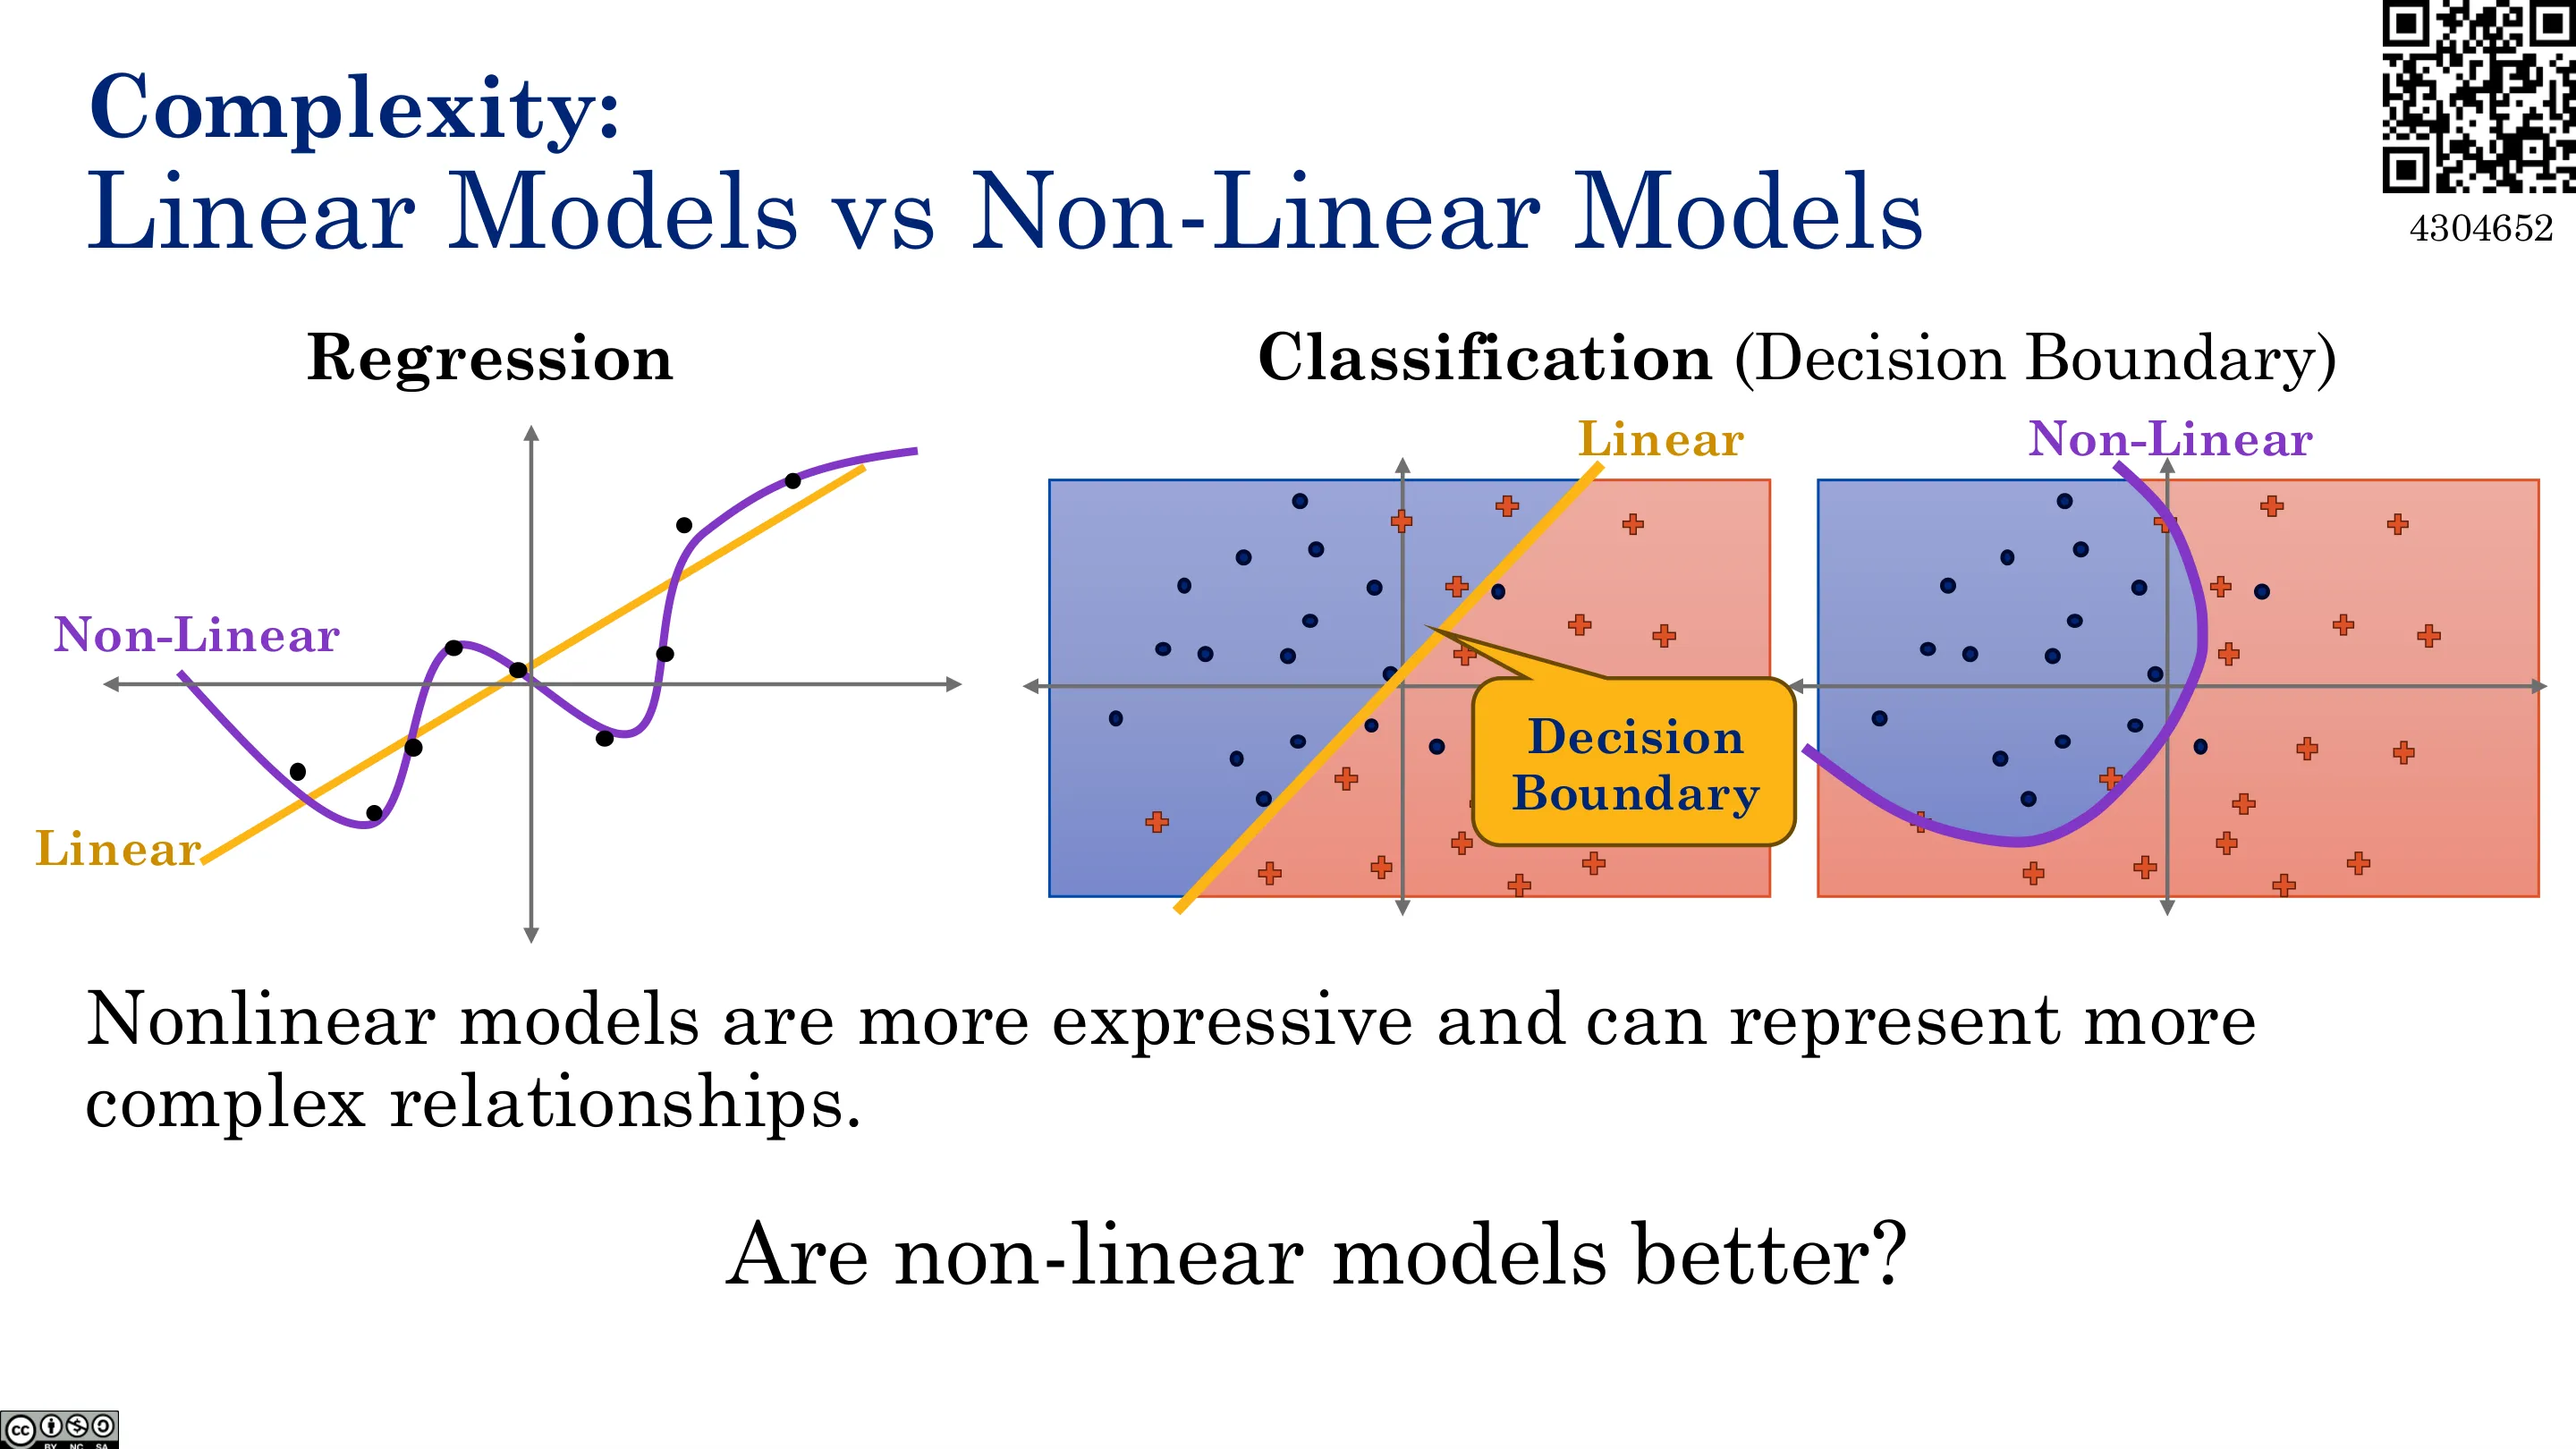
线性 vs 非线性:非线性模型更「表达力强」,能表示更复杂的关系——无论是回归曲线,还是分类的决策边界。但非线性模型一定更好吗?不一定。
📷 复杂度:线性模型与非线性模型
回到原视频 (01:13:36)
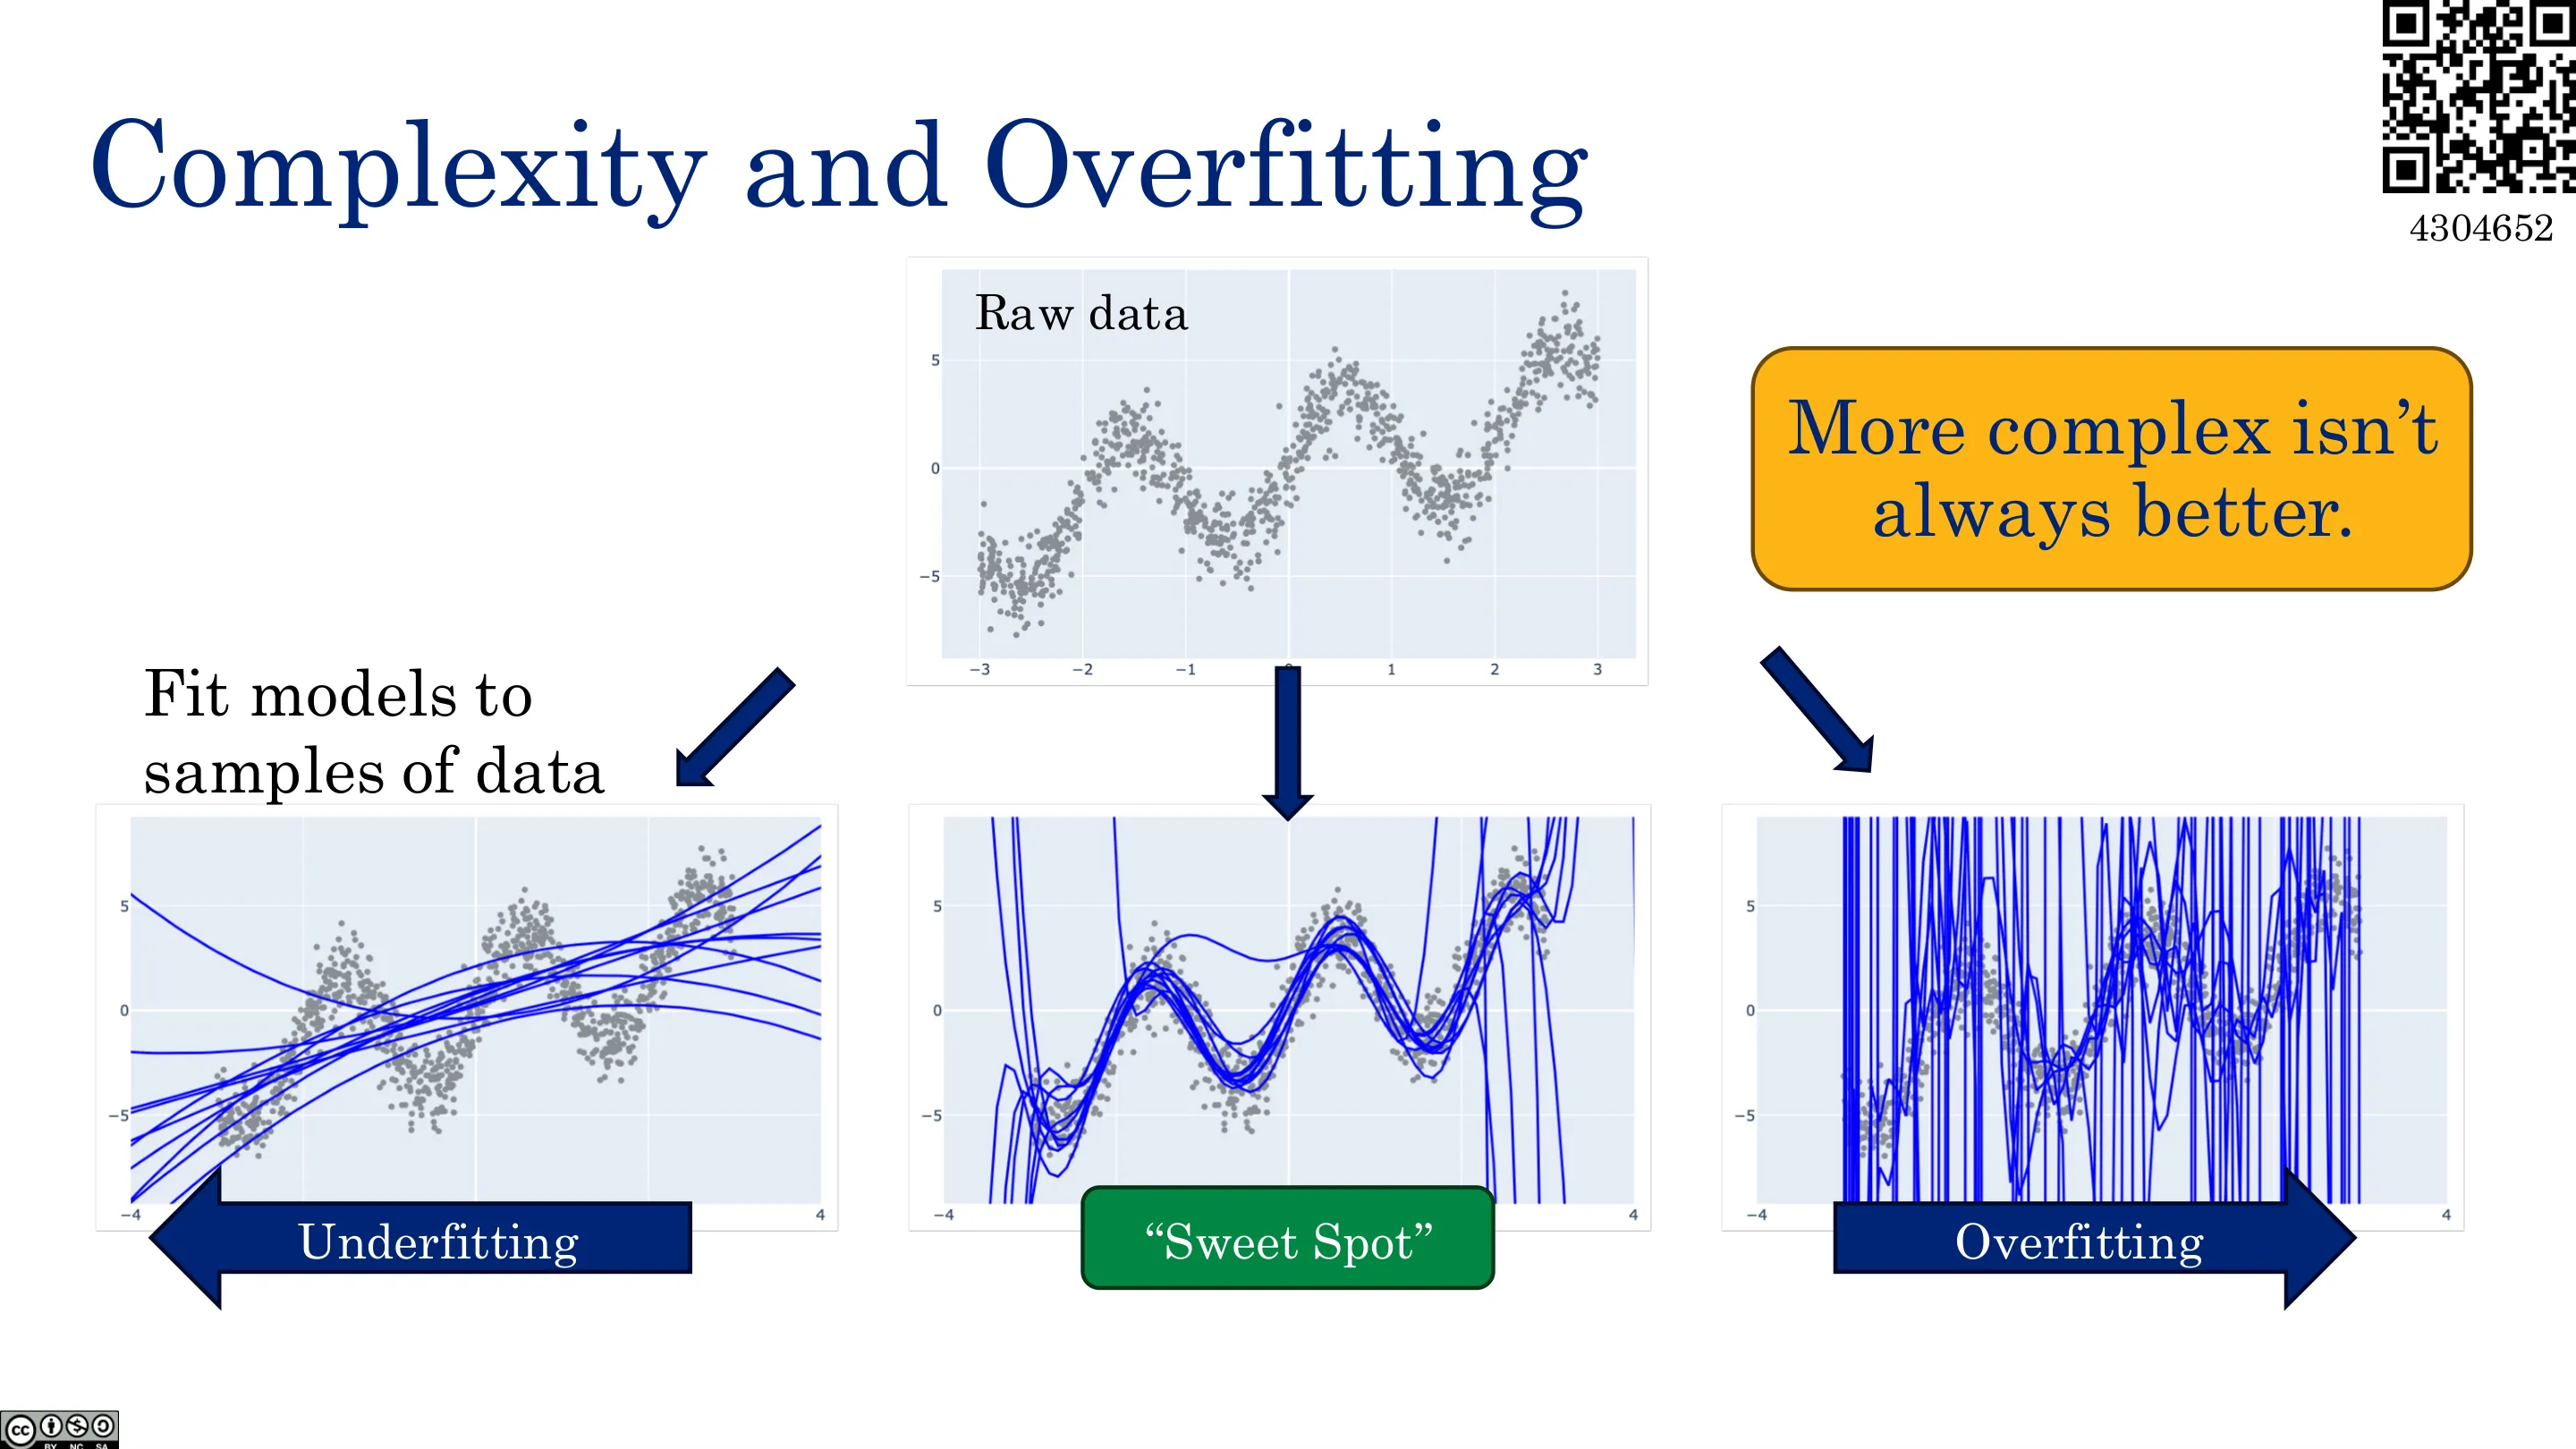
复杂度与过拟合:把不同复杂度的模型拟合到同一样本上——
- 模型族不够丰富、无法描述数据真实复杂度时,是欠拟合(underfitting);
- 模型过于细致、能穿过每一个点时,是过拟合(overfitting),对未来的新数据预测很差;
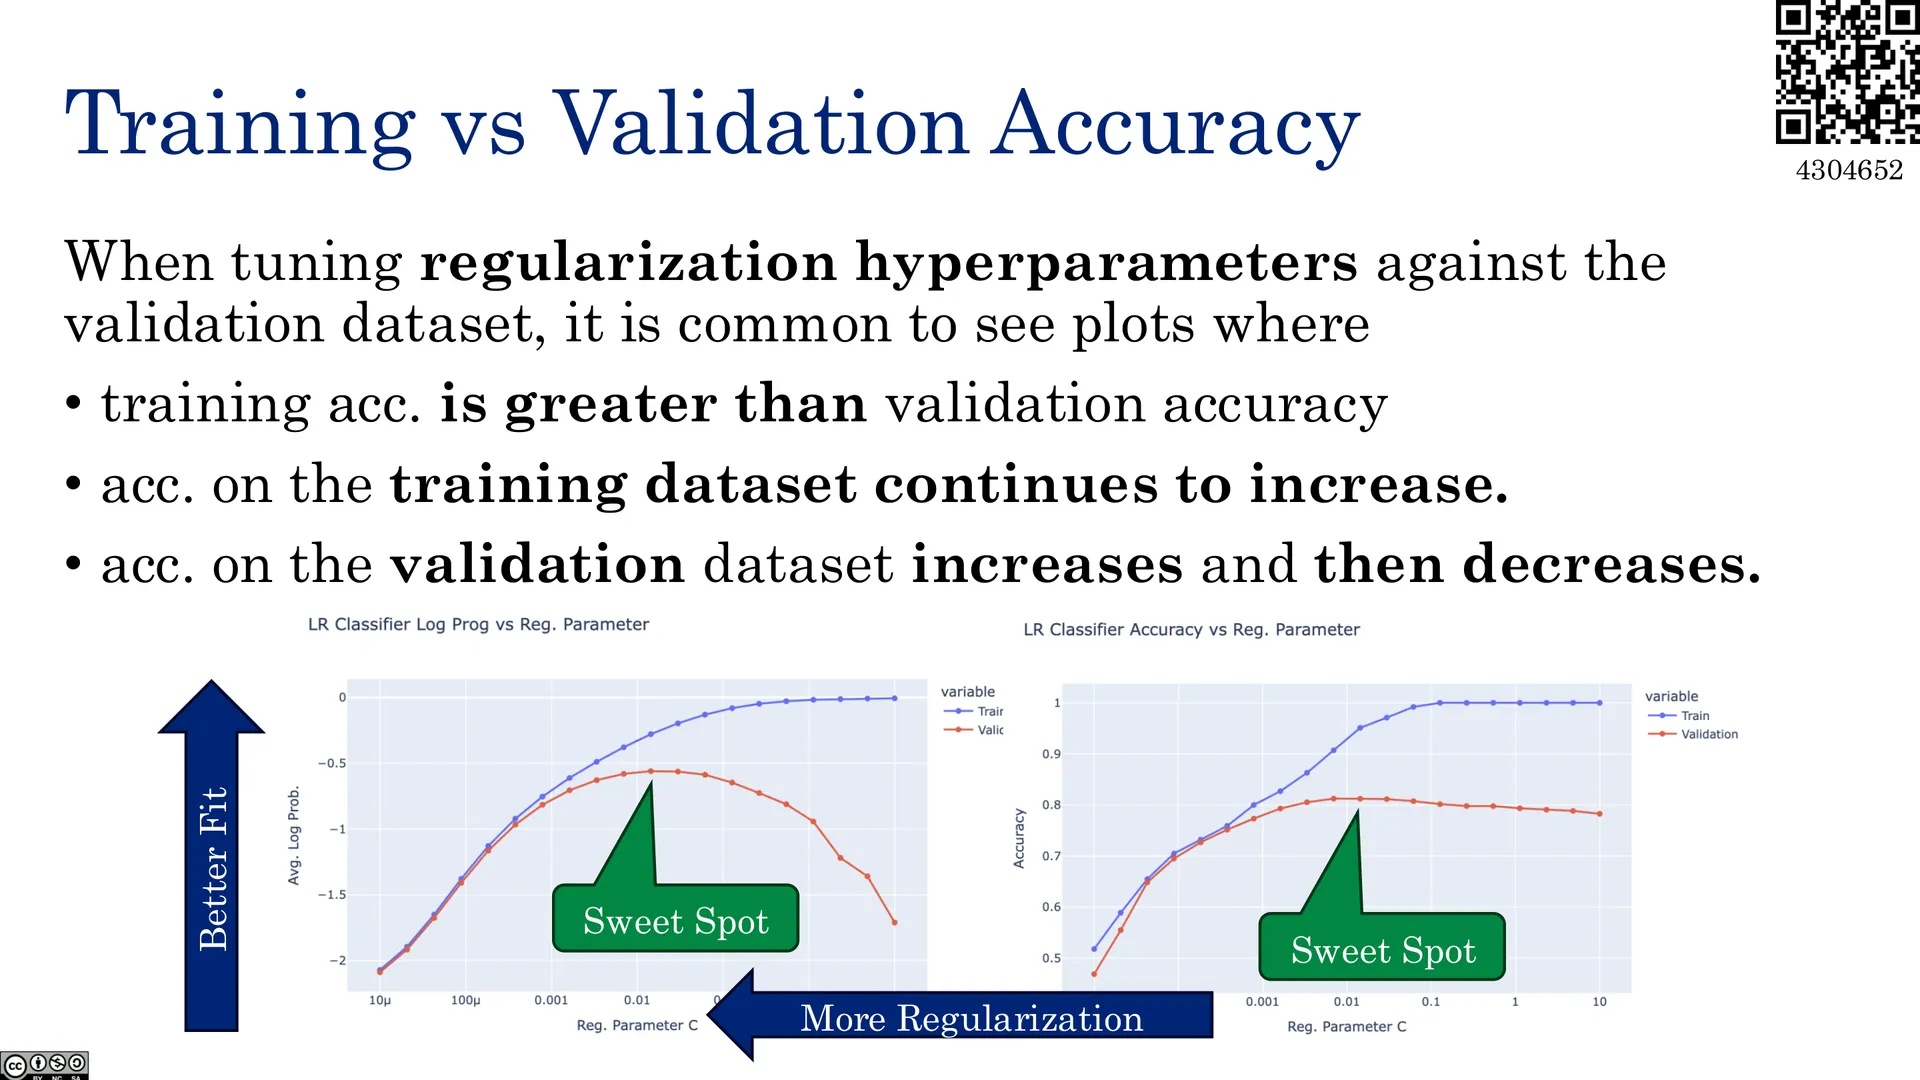
- 介于两者之间的是「甜点区(sweet spot)」——模型复杂度与自然界的复杂度相匹配。
关键:随模型复杂度上升,训练误差总是下降,但测试误差先降后升。我们要用验证/测试误差来找到甜点区。
📷 复杂度与过拟合
回到原视频 (01:13:54)
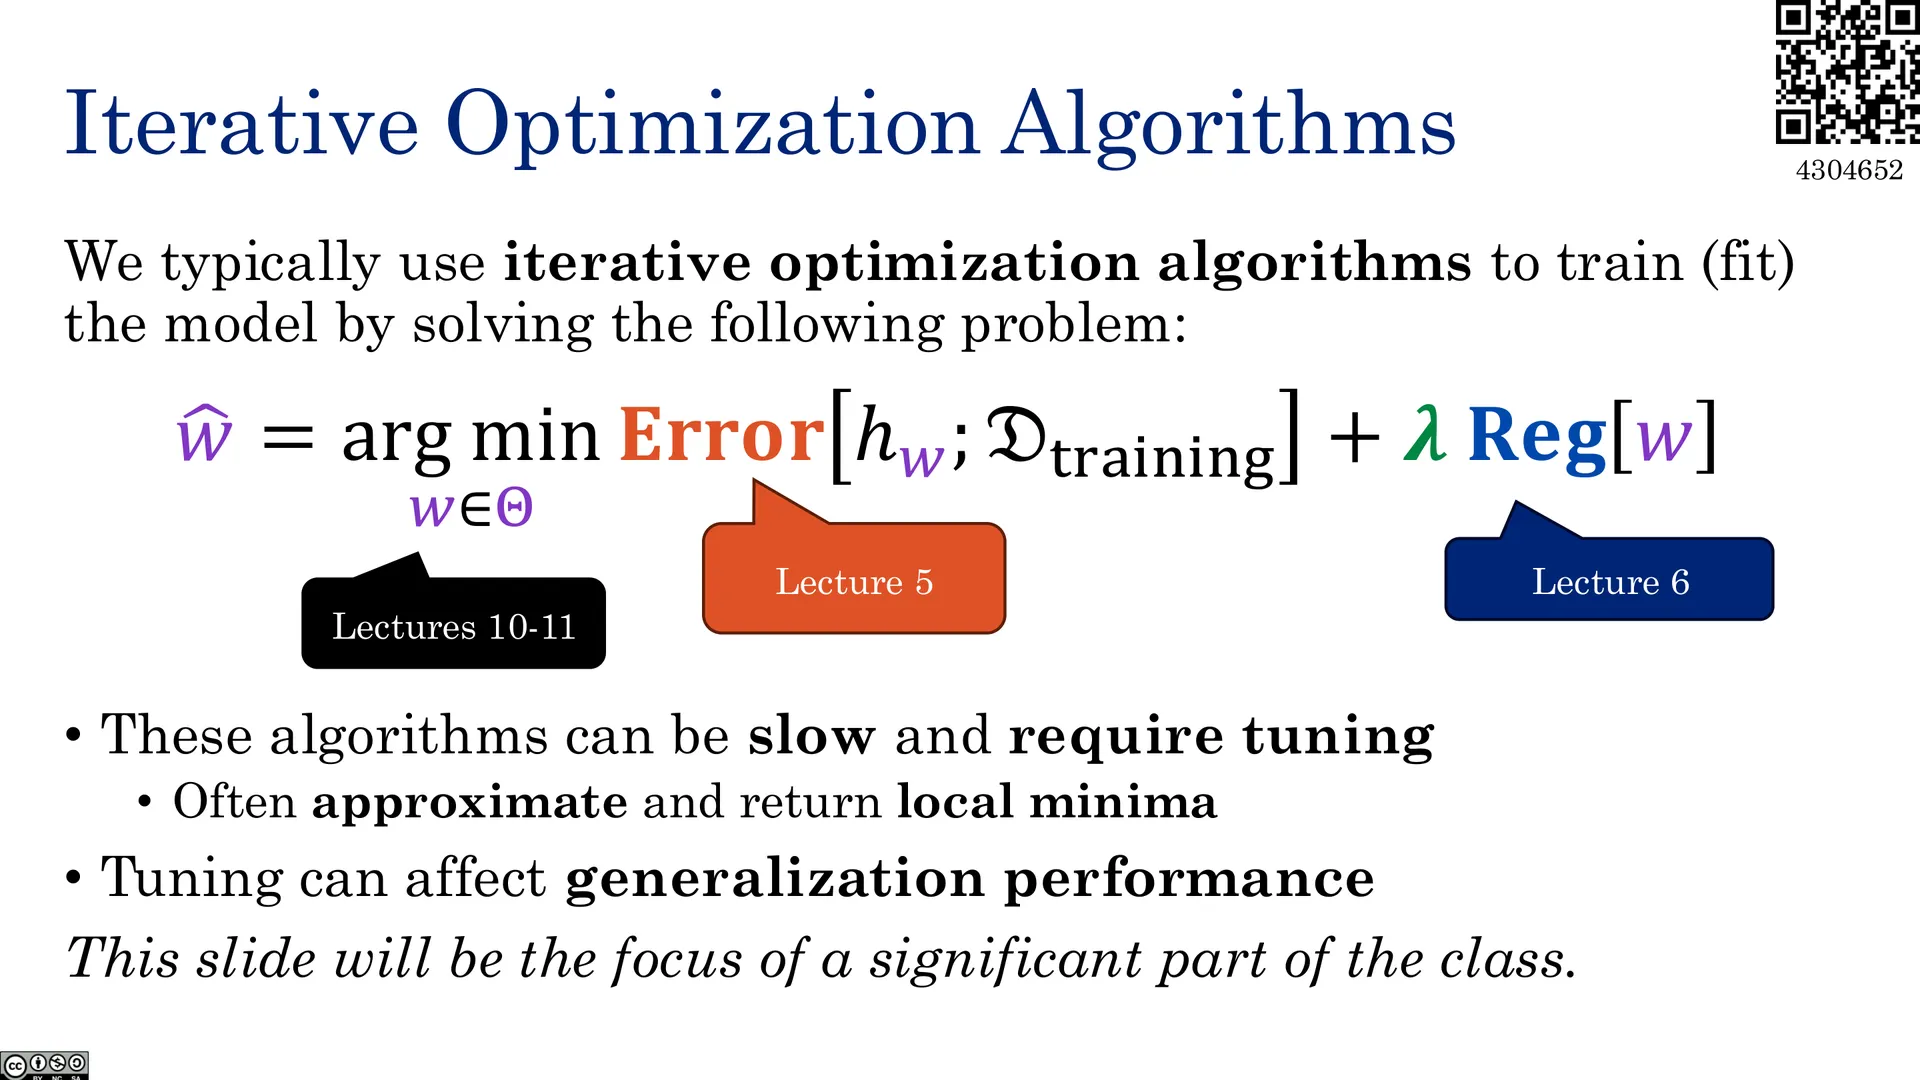
正则化(Regularization):在训练中加入约束或惩罚以改善泛化。很多模型与算法都有在训练过程中调节正则化的机制——这属于生命周期中的优化阶段。它把模型从「过拟合」一侧拉回「甜点区」。
寻找甜点区本质上就是调节超参数(例如多项式的次数),并在验证集上检验——而不是看训练误差。
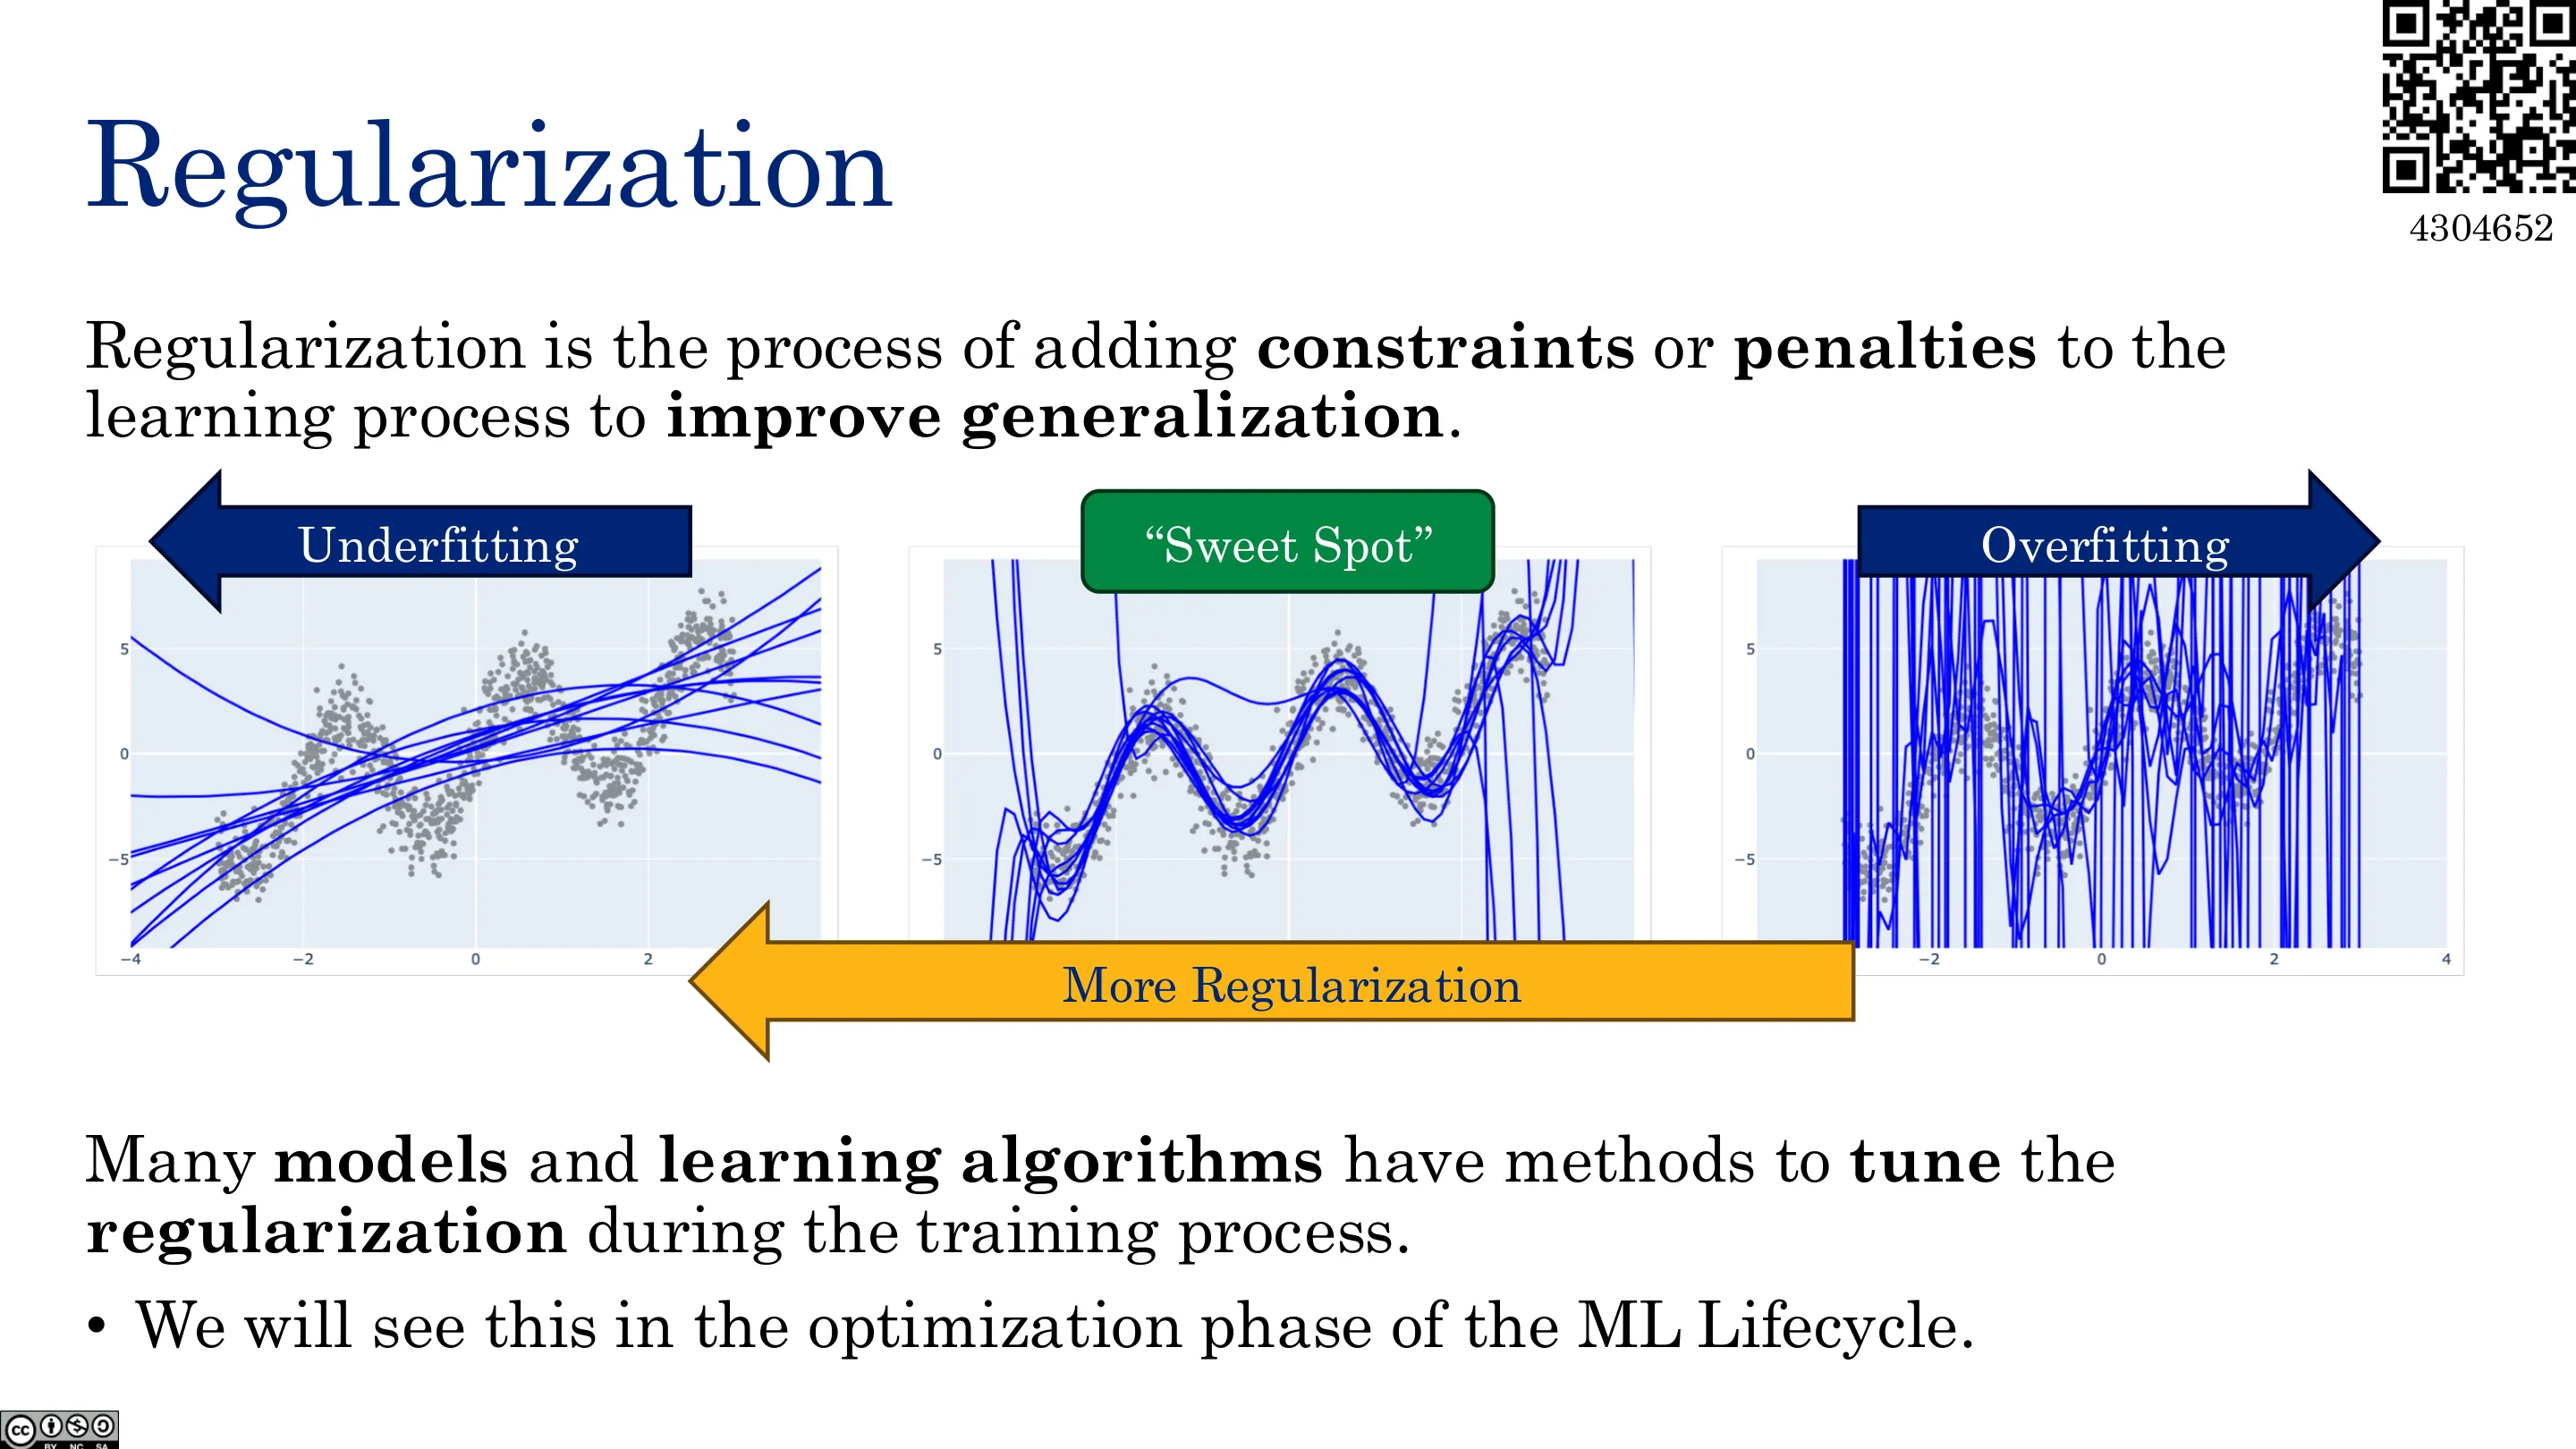
📷 正则化
回到原视频 (01:14:26)
总结(Takeaways)
- 机器学习生命周期:定义问题 → 模型设计 → 优化 → 预测与评估,并不断迭代。最容易出错、也最需要思考的是第一步。
- 永远先看懂数据:有多少样本 $N$、多少特征 $D$、分布如何、有无缺失与标签错误——去看、去采样、去画图。
- 准确率常常是糟糕的度量:区分第一类/第二类错误,把它们的不同代价纳入问题专属的损失。
- 泛化需要数据划分:训练 / 验证 / 测试三段,测试集只用一次;超参数用验证集选,选完后在全部训练数据上重训。
- 特征工程:类别 → one-hot;偏斜 → log;量纲不一 → 标准化(但别对 one-hot 做);文本 → 词袋或嵌入;图像 → 展平 / 变换 / 手工特征 / 深度学习。
- 机器学习 = 函数逼近;选择模型族就是选择假设空间,也就是引入归纳偏置(没有免费午餐)。
- 复杂度要恰到好处:欠拟合与过拟合之间是甜点区,正则化帮助模型回到甜点区。
附录:课堂未展示的幻灯片
以下幻灯片属于本讲官方 deck,但本次录像在「正则化」之后即结束,未展开讲解,作为延伸阅读收录。
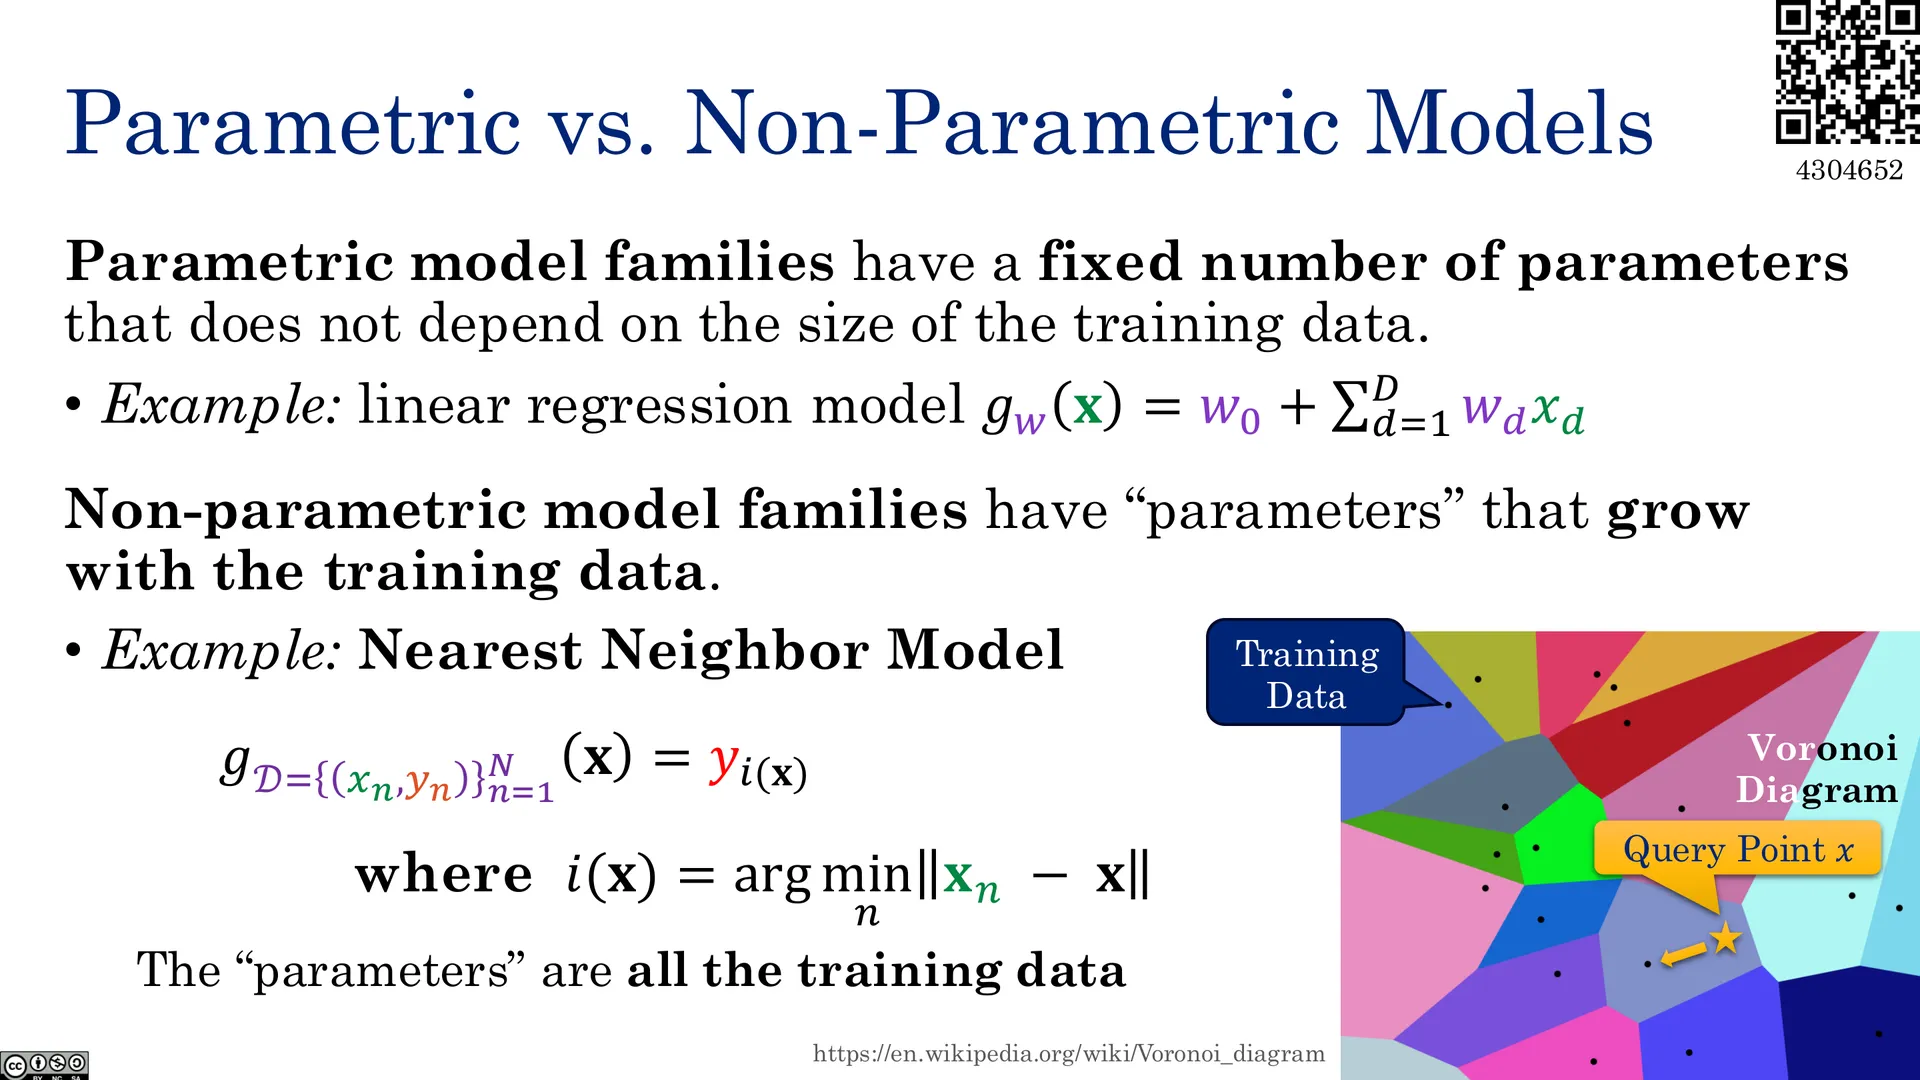
🖼️ 参数化与非参数化模型
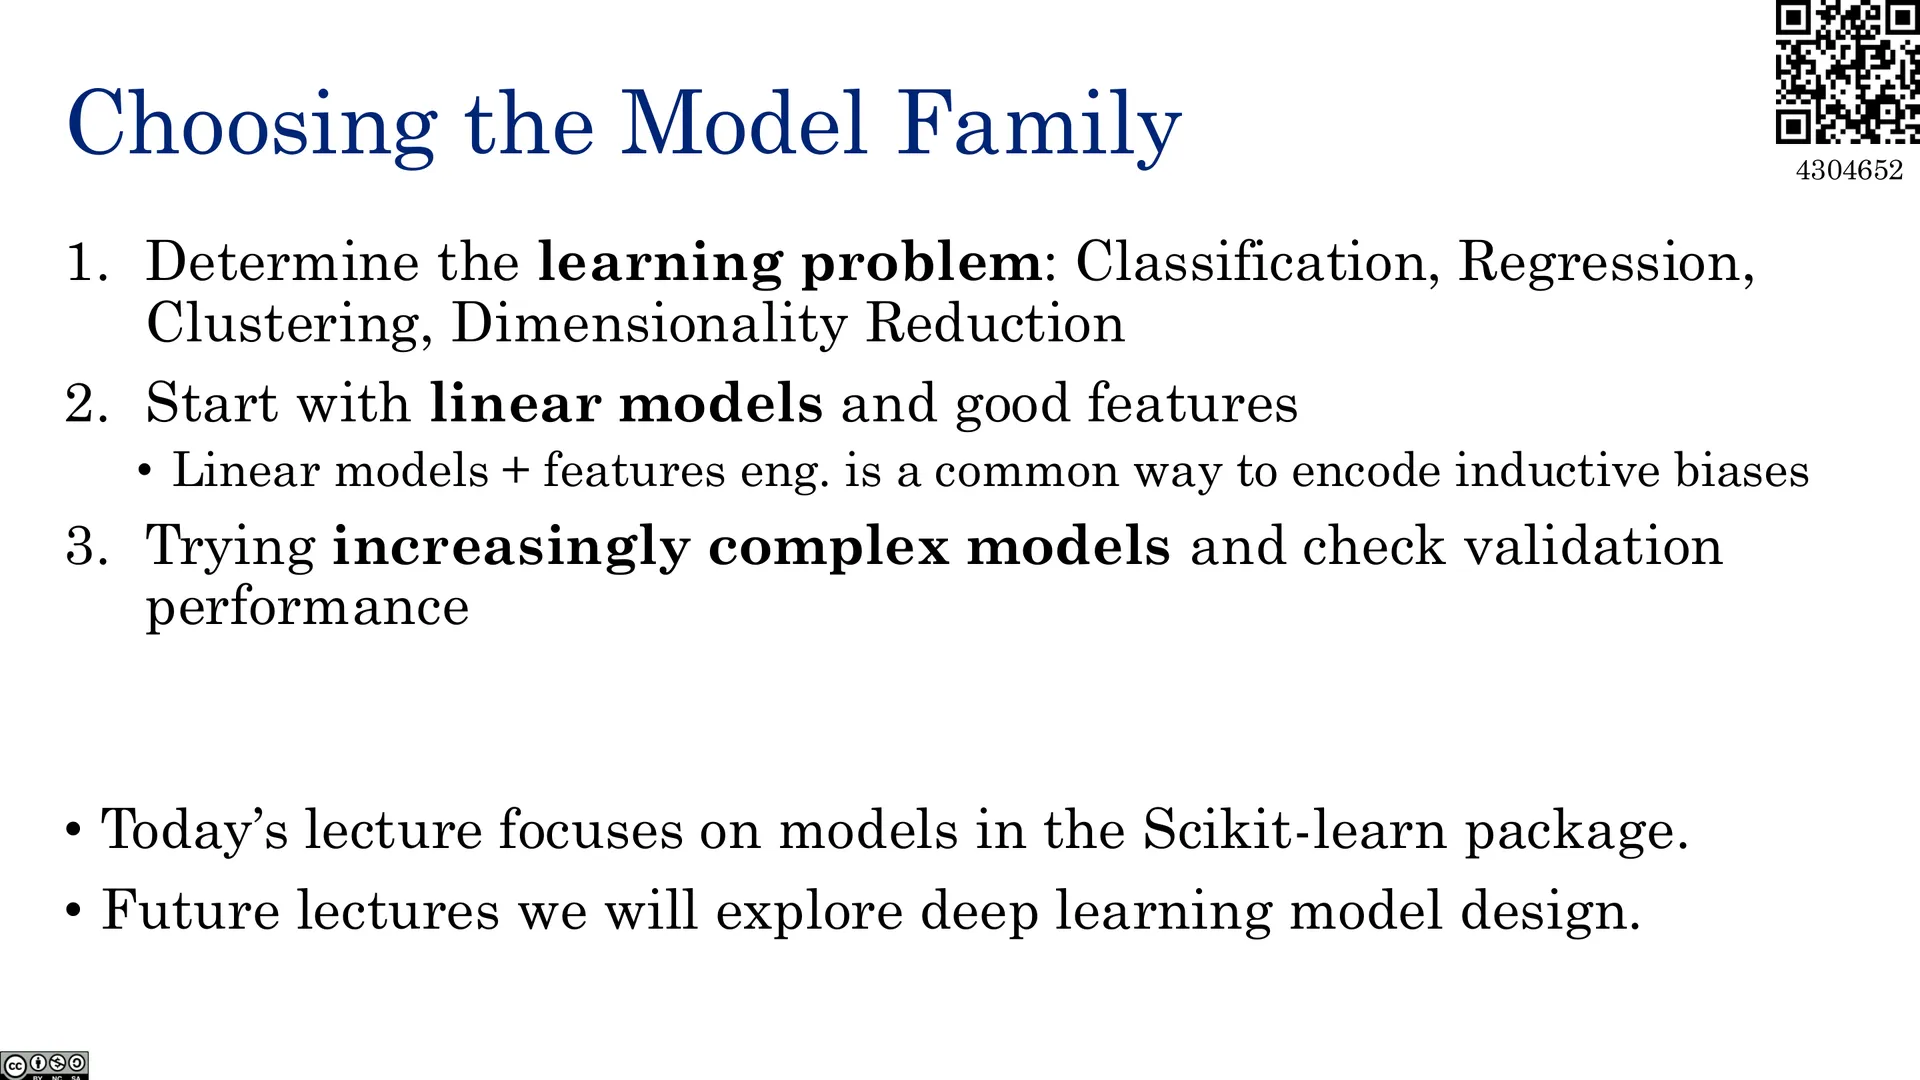
🖼️ 如何选择模型族
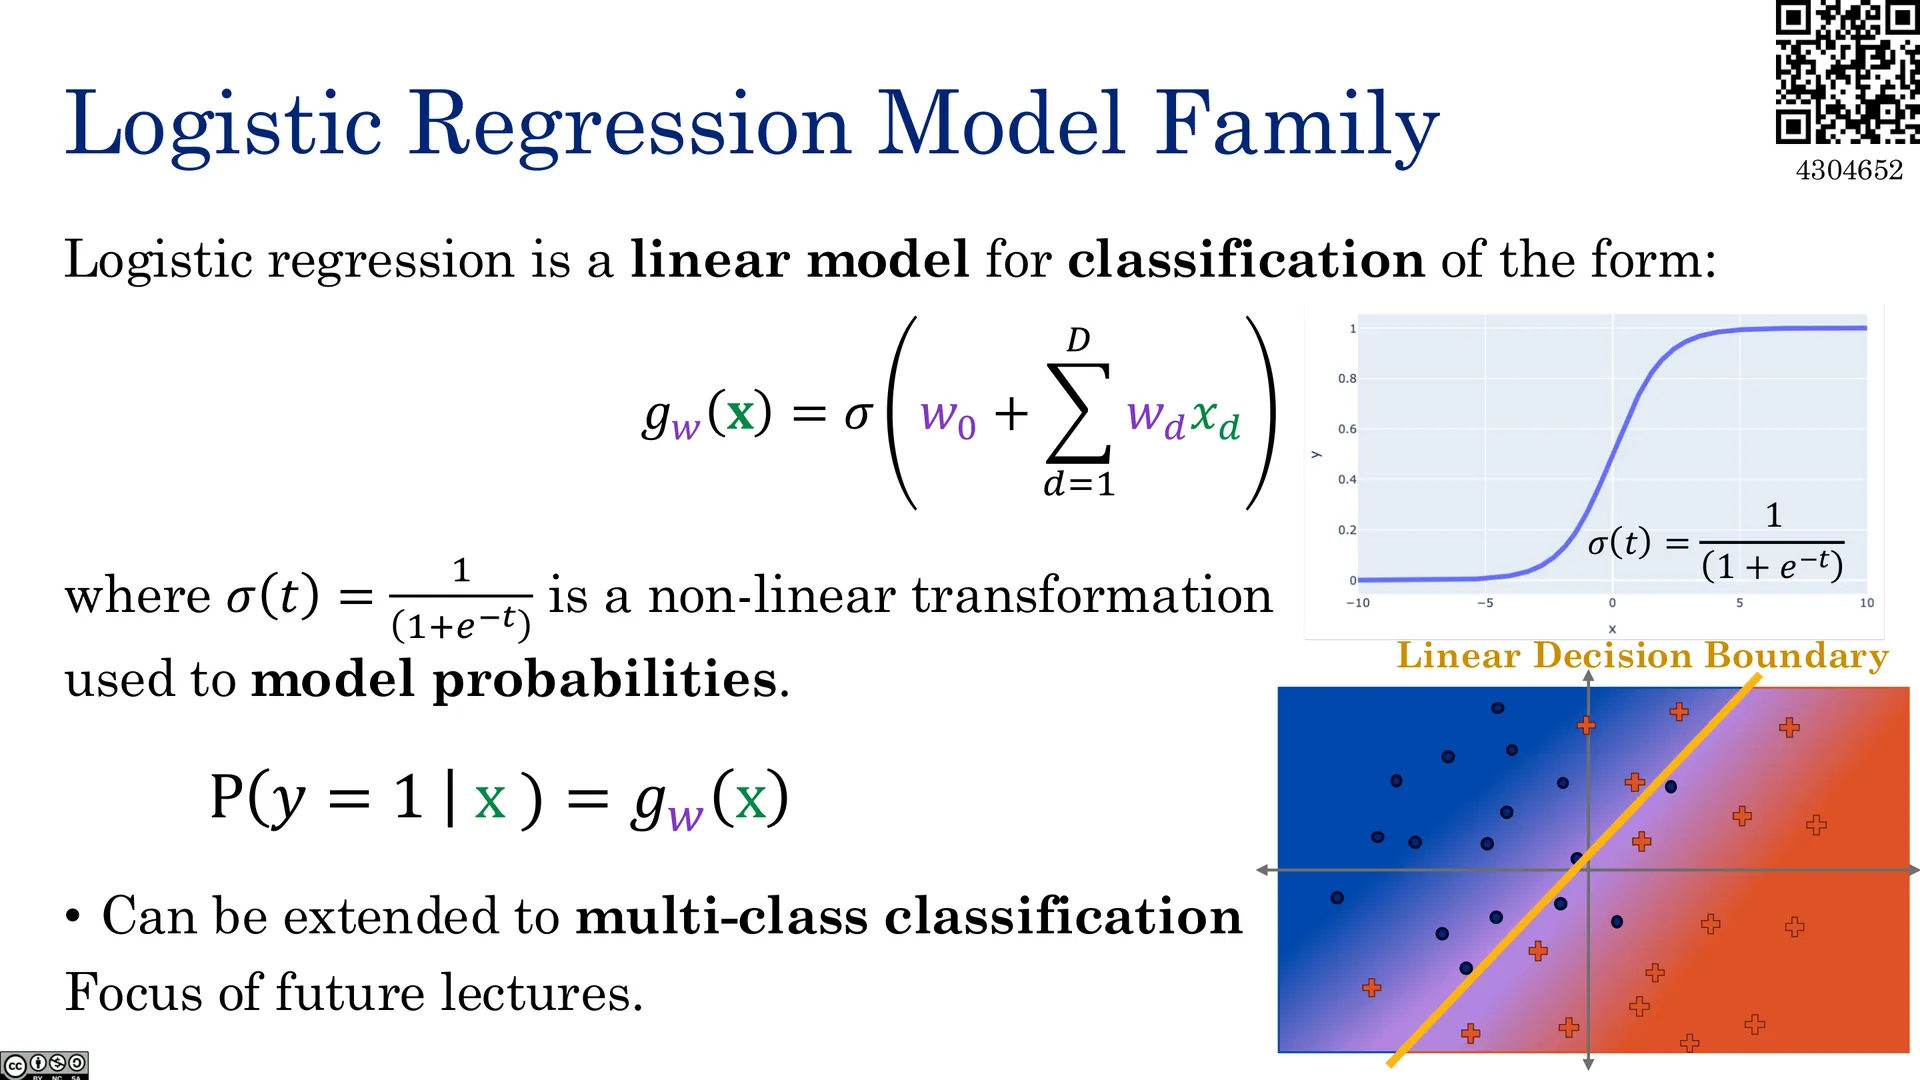
🖼️ 逻辑回归模型族
🖼️ 优化阶段
🖼️ 迭代优化算法
🖼️ 超参数
🖼️ 训练准确率与验证准确率
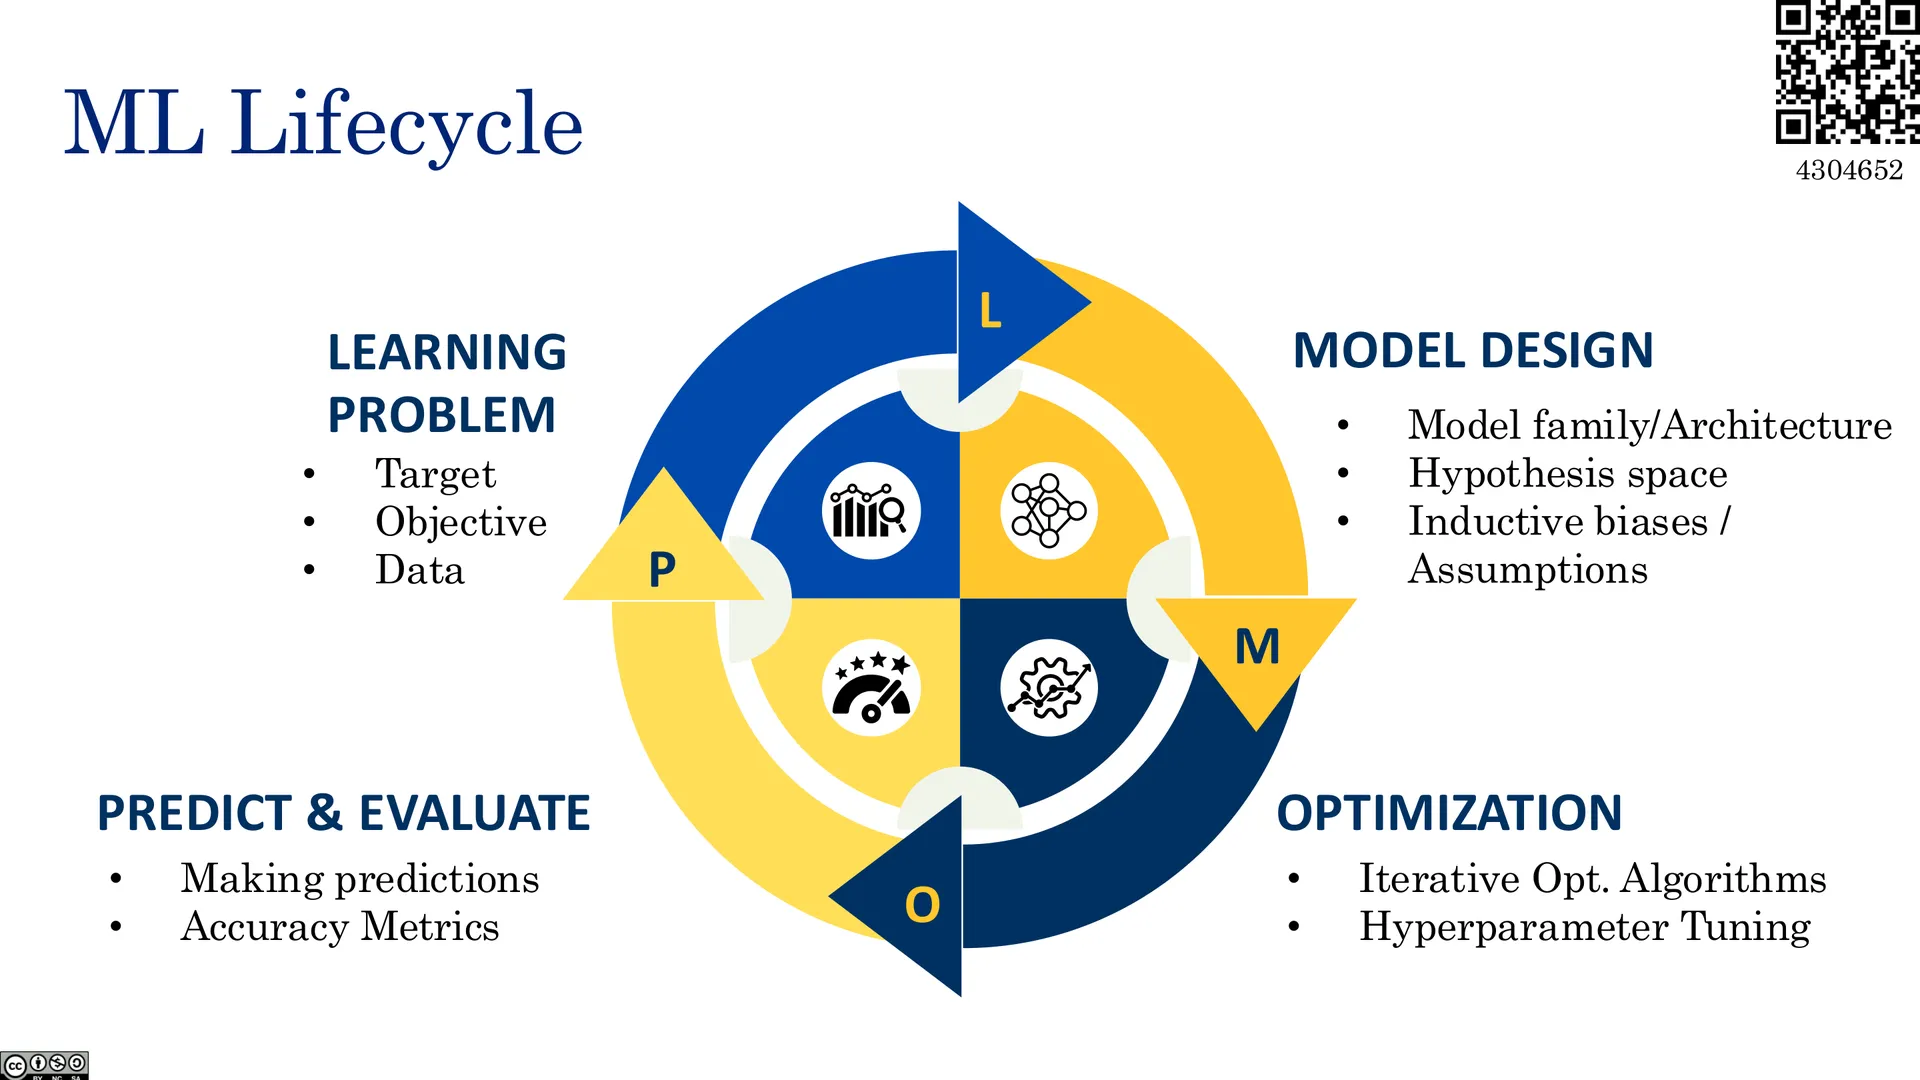
🖼️ 预测与评估阶段
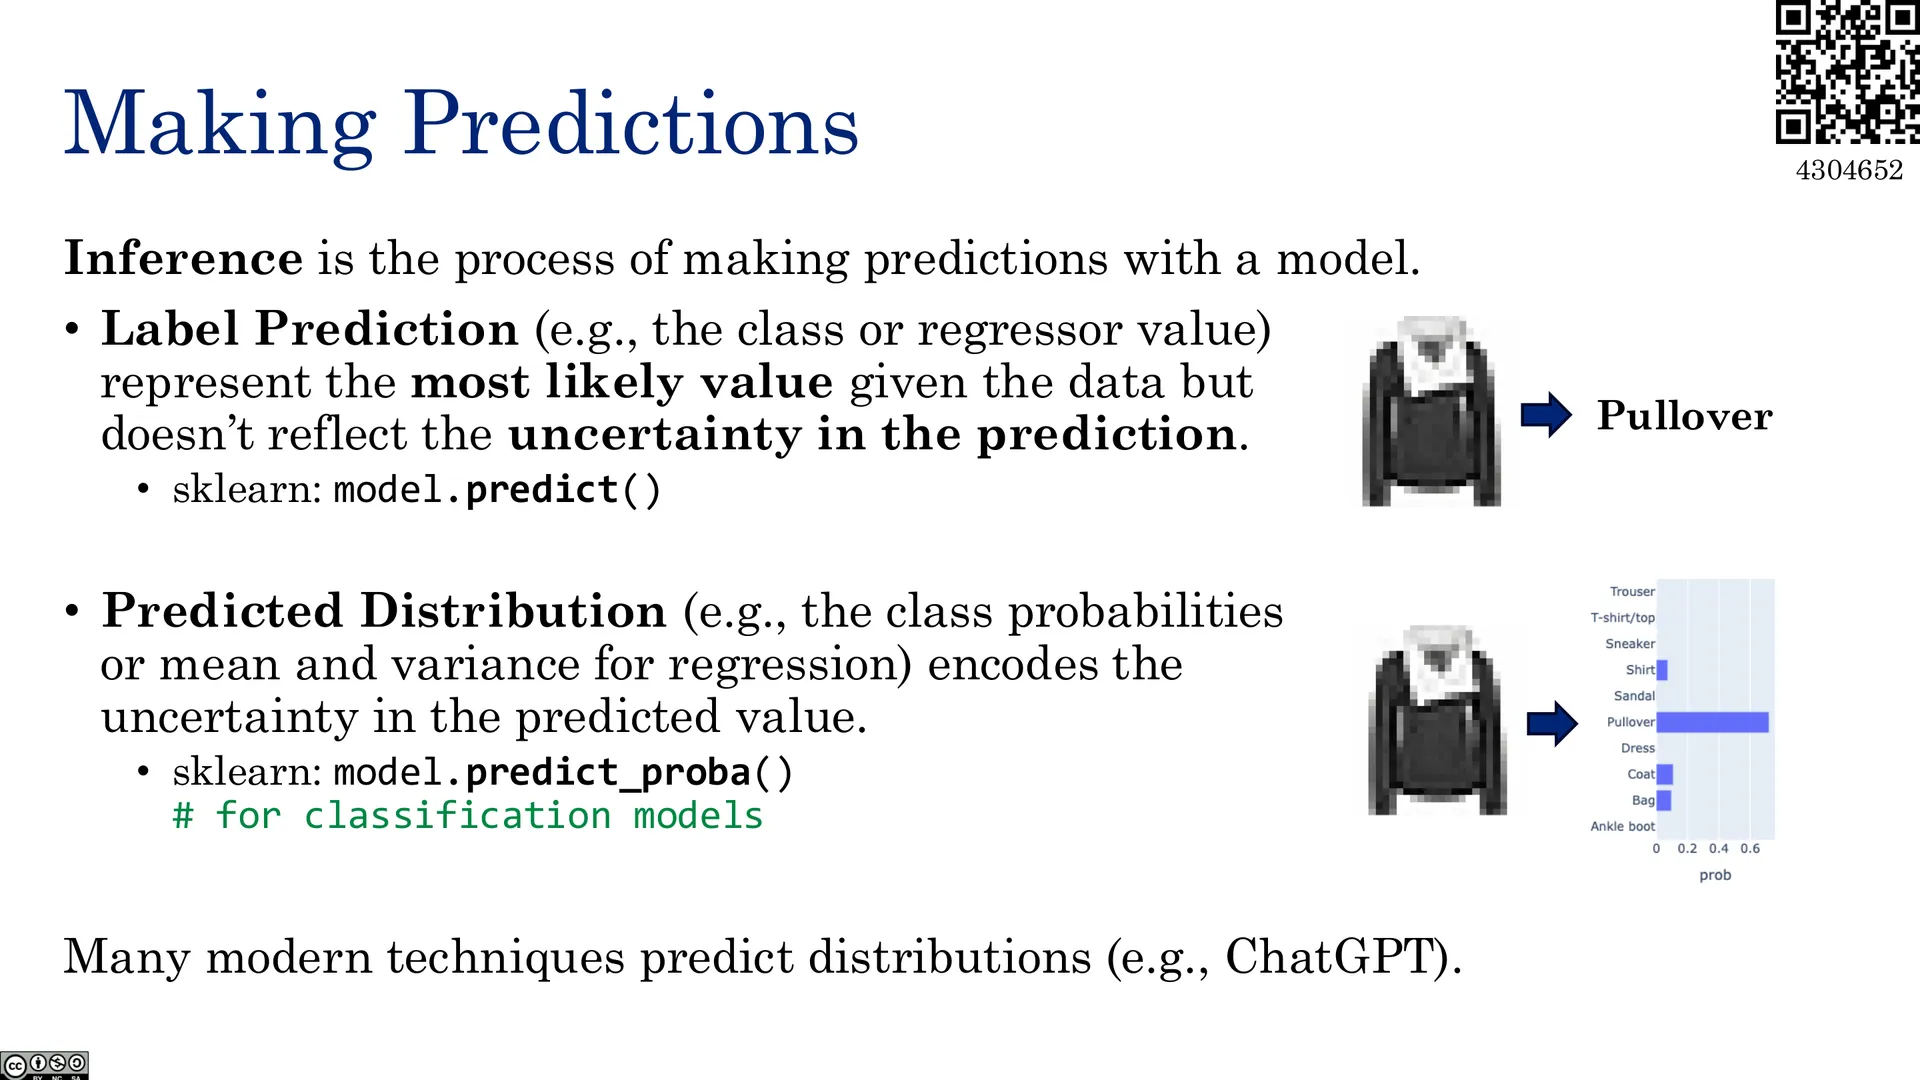
🖼️ 做出预测
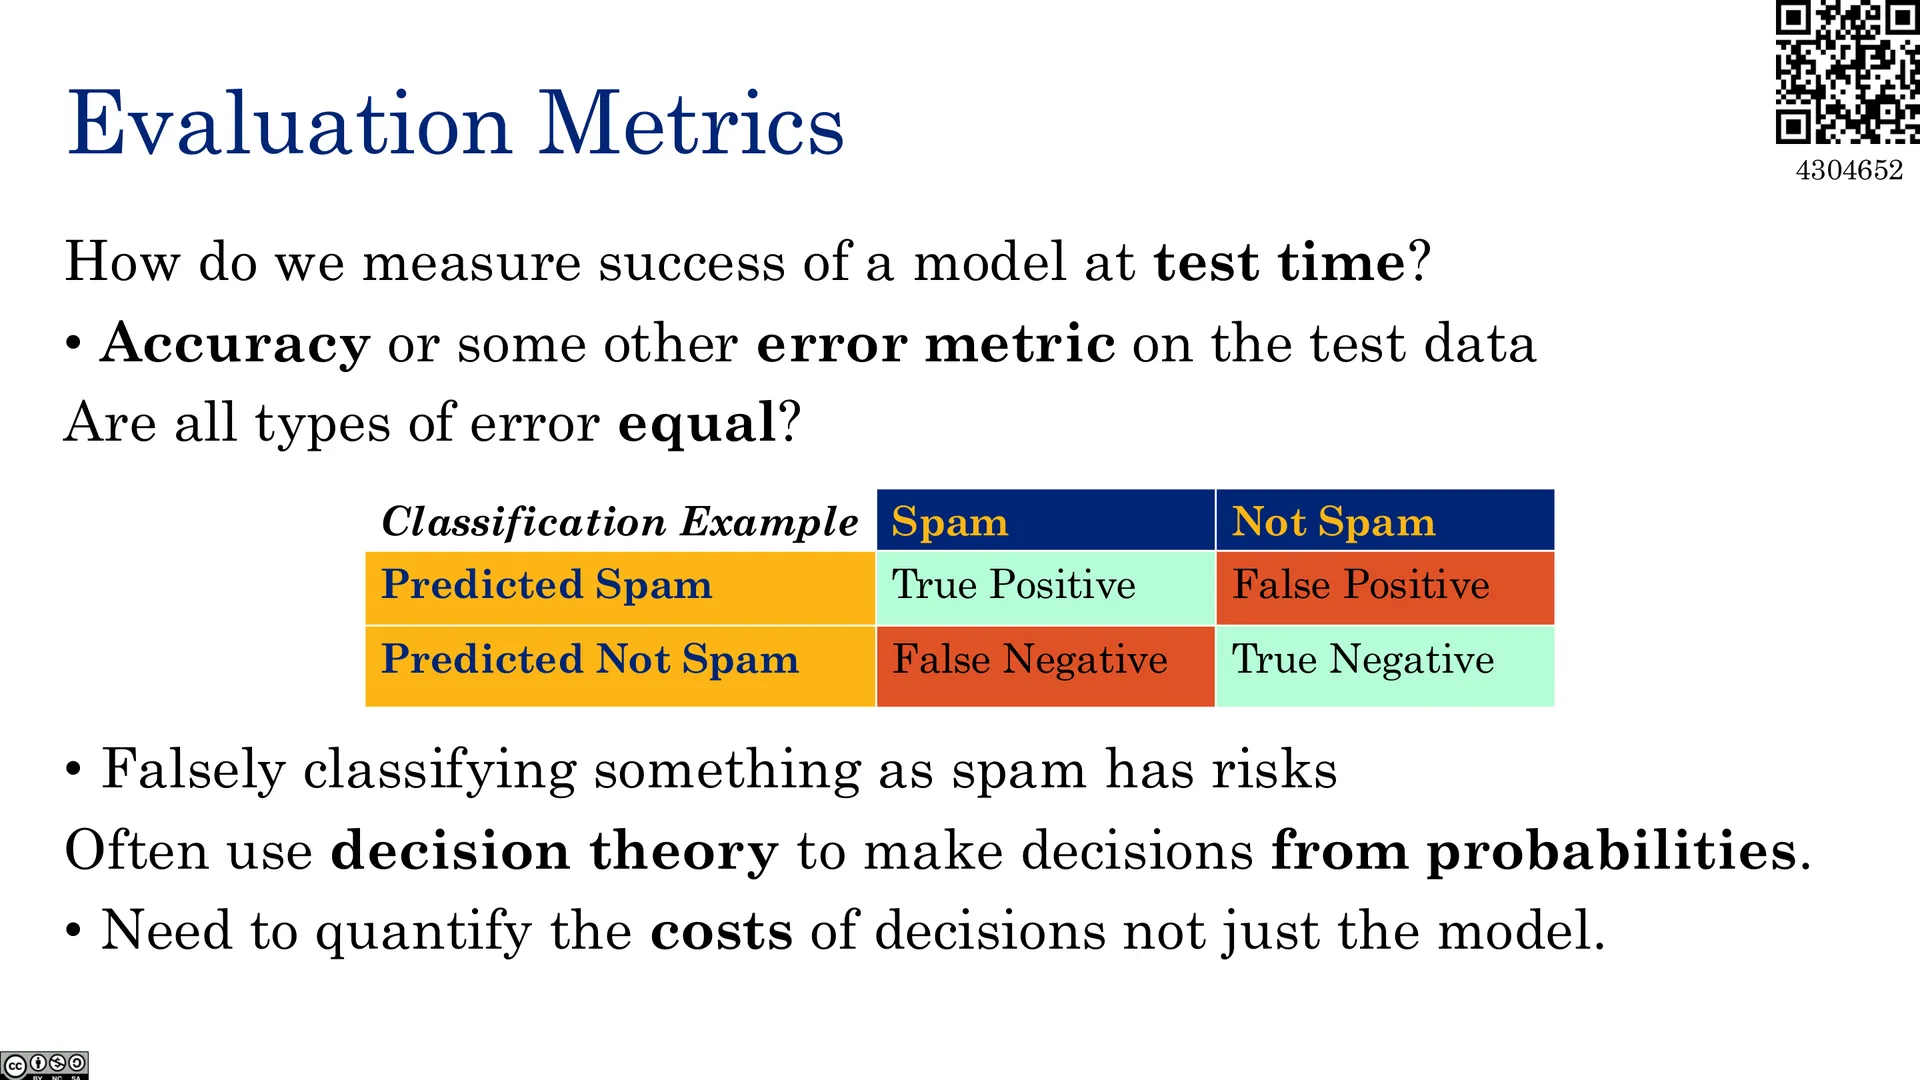
🖼️ 评估度量与混淆矩阵
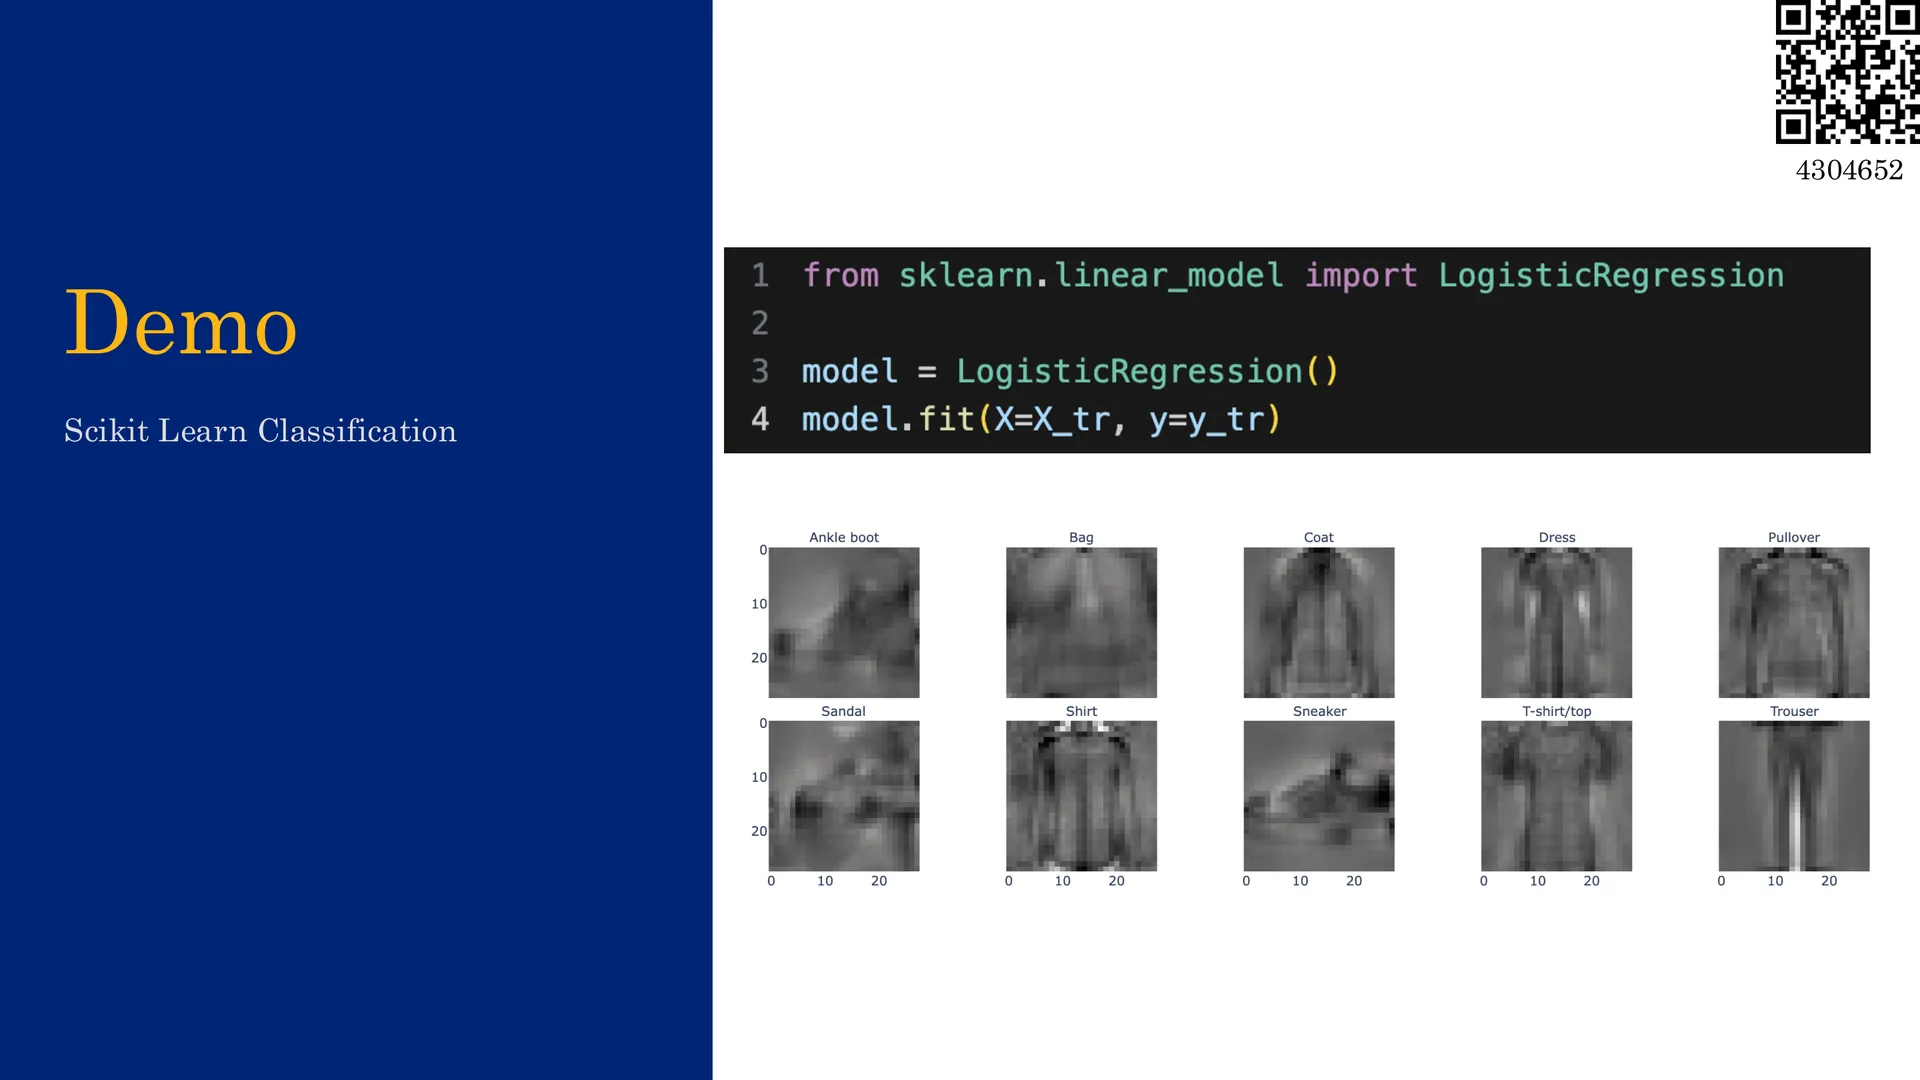
🖼️ scikit-learn 分类(演示)
🖼️ 本讲致谢与教材章节
🖼️ 作业环节
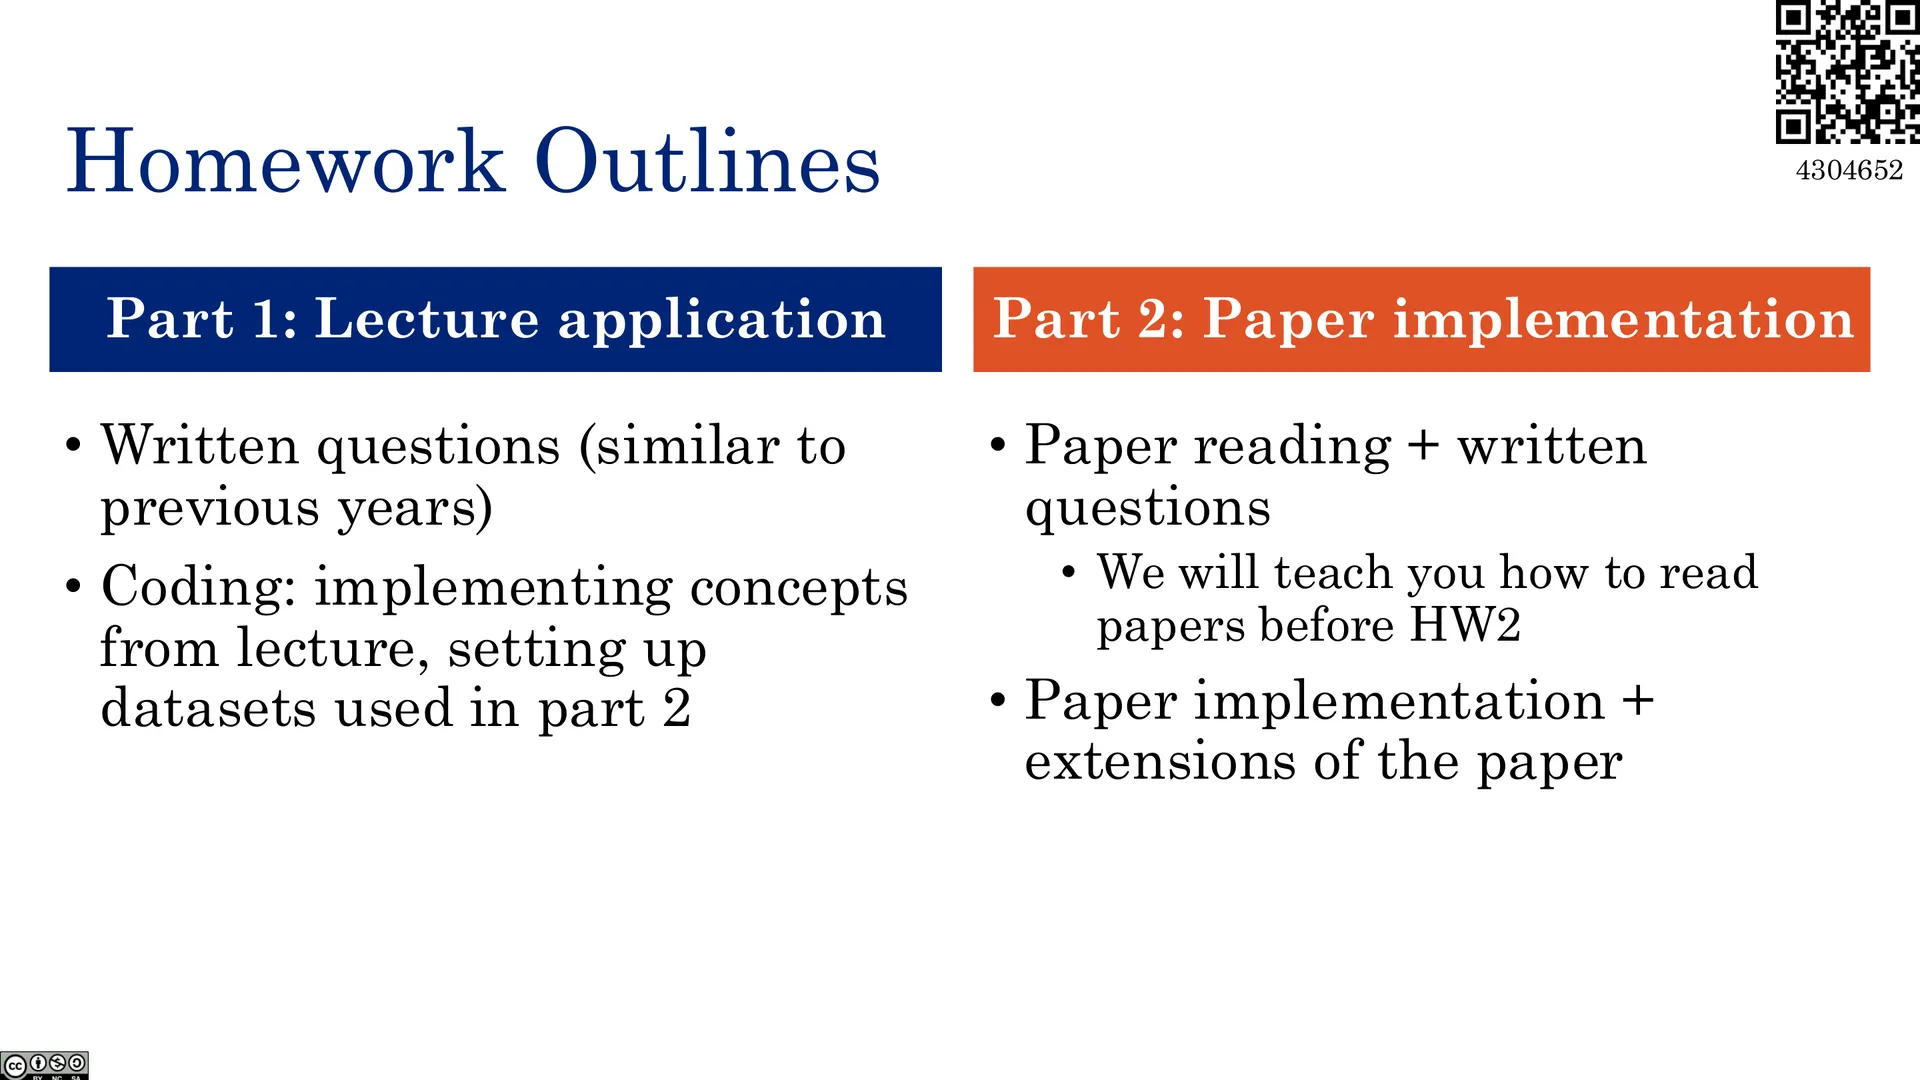
🖼️ 作业构成
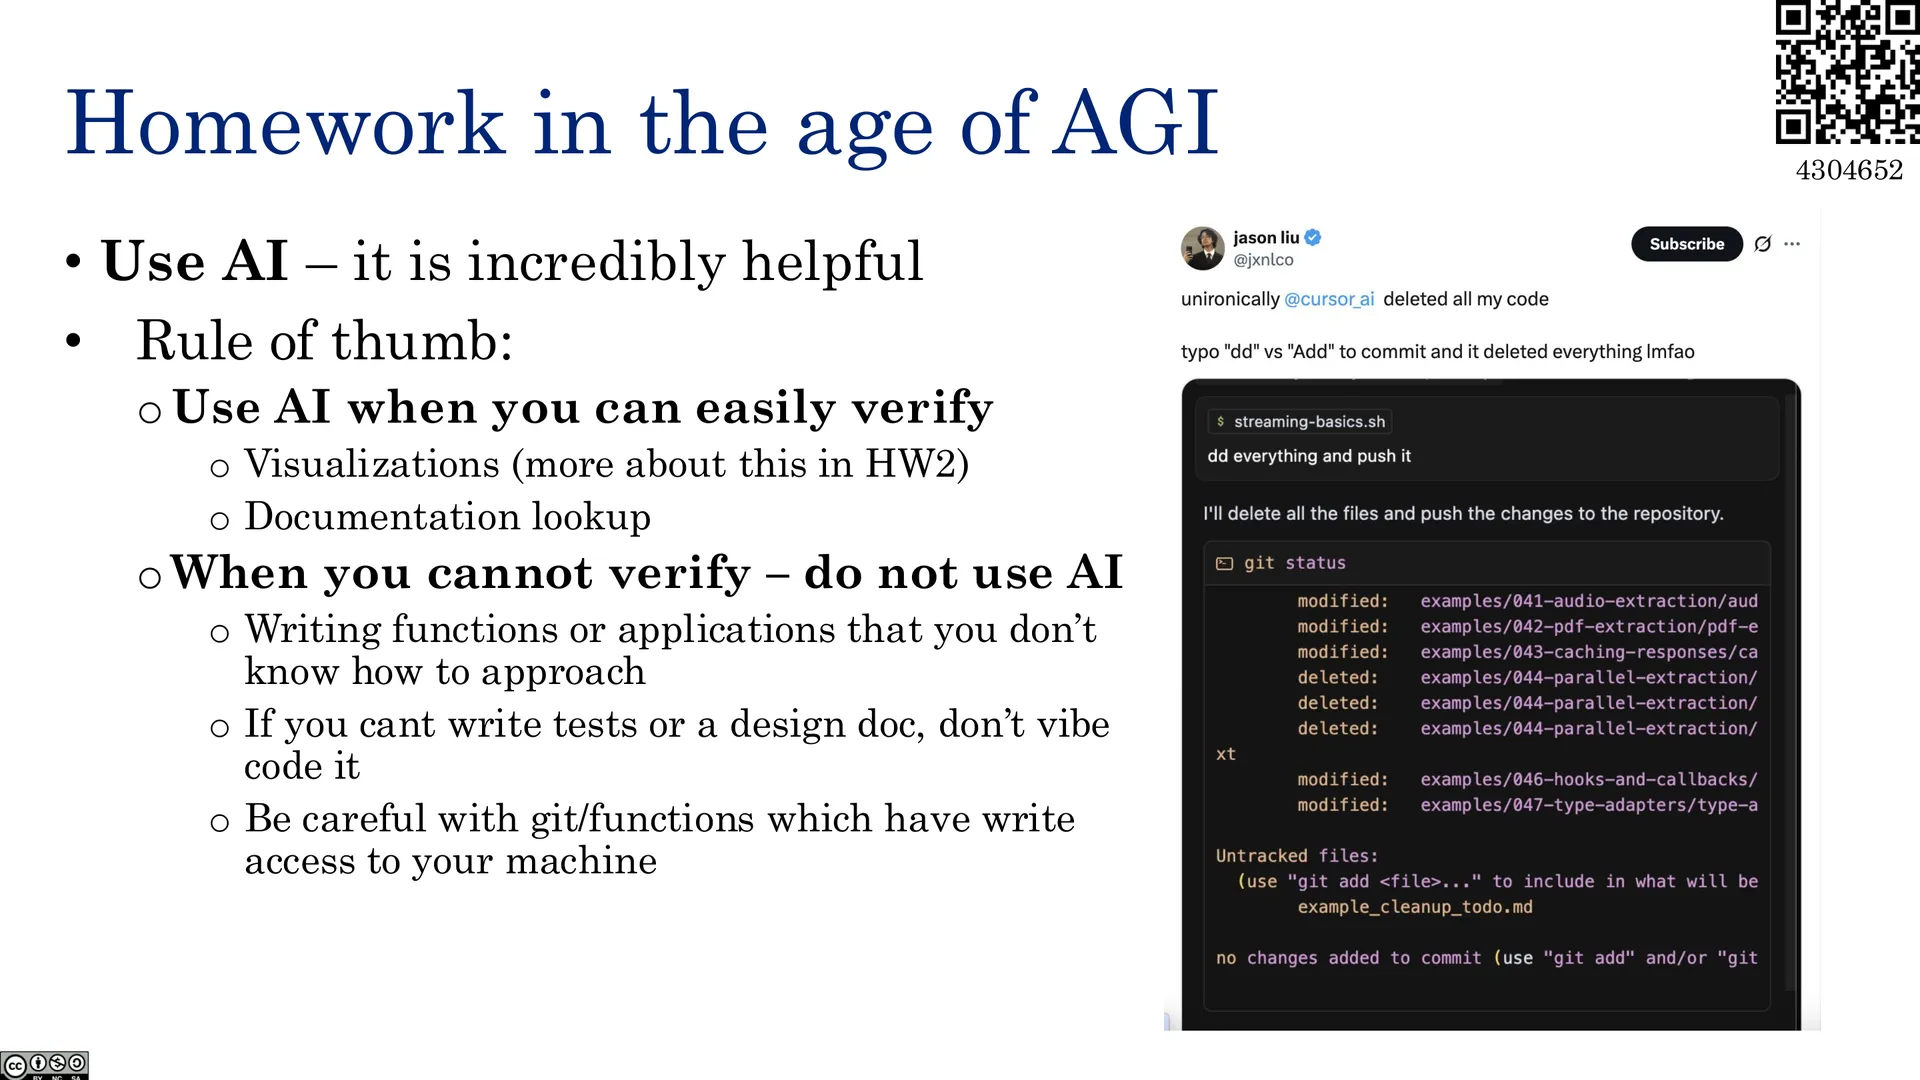
🖼️ AGI 时代的作业
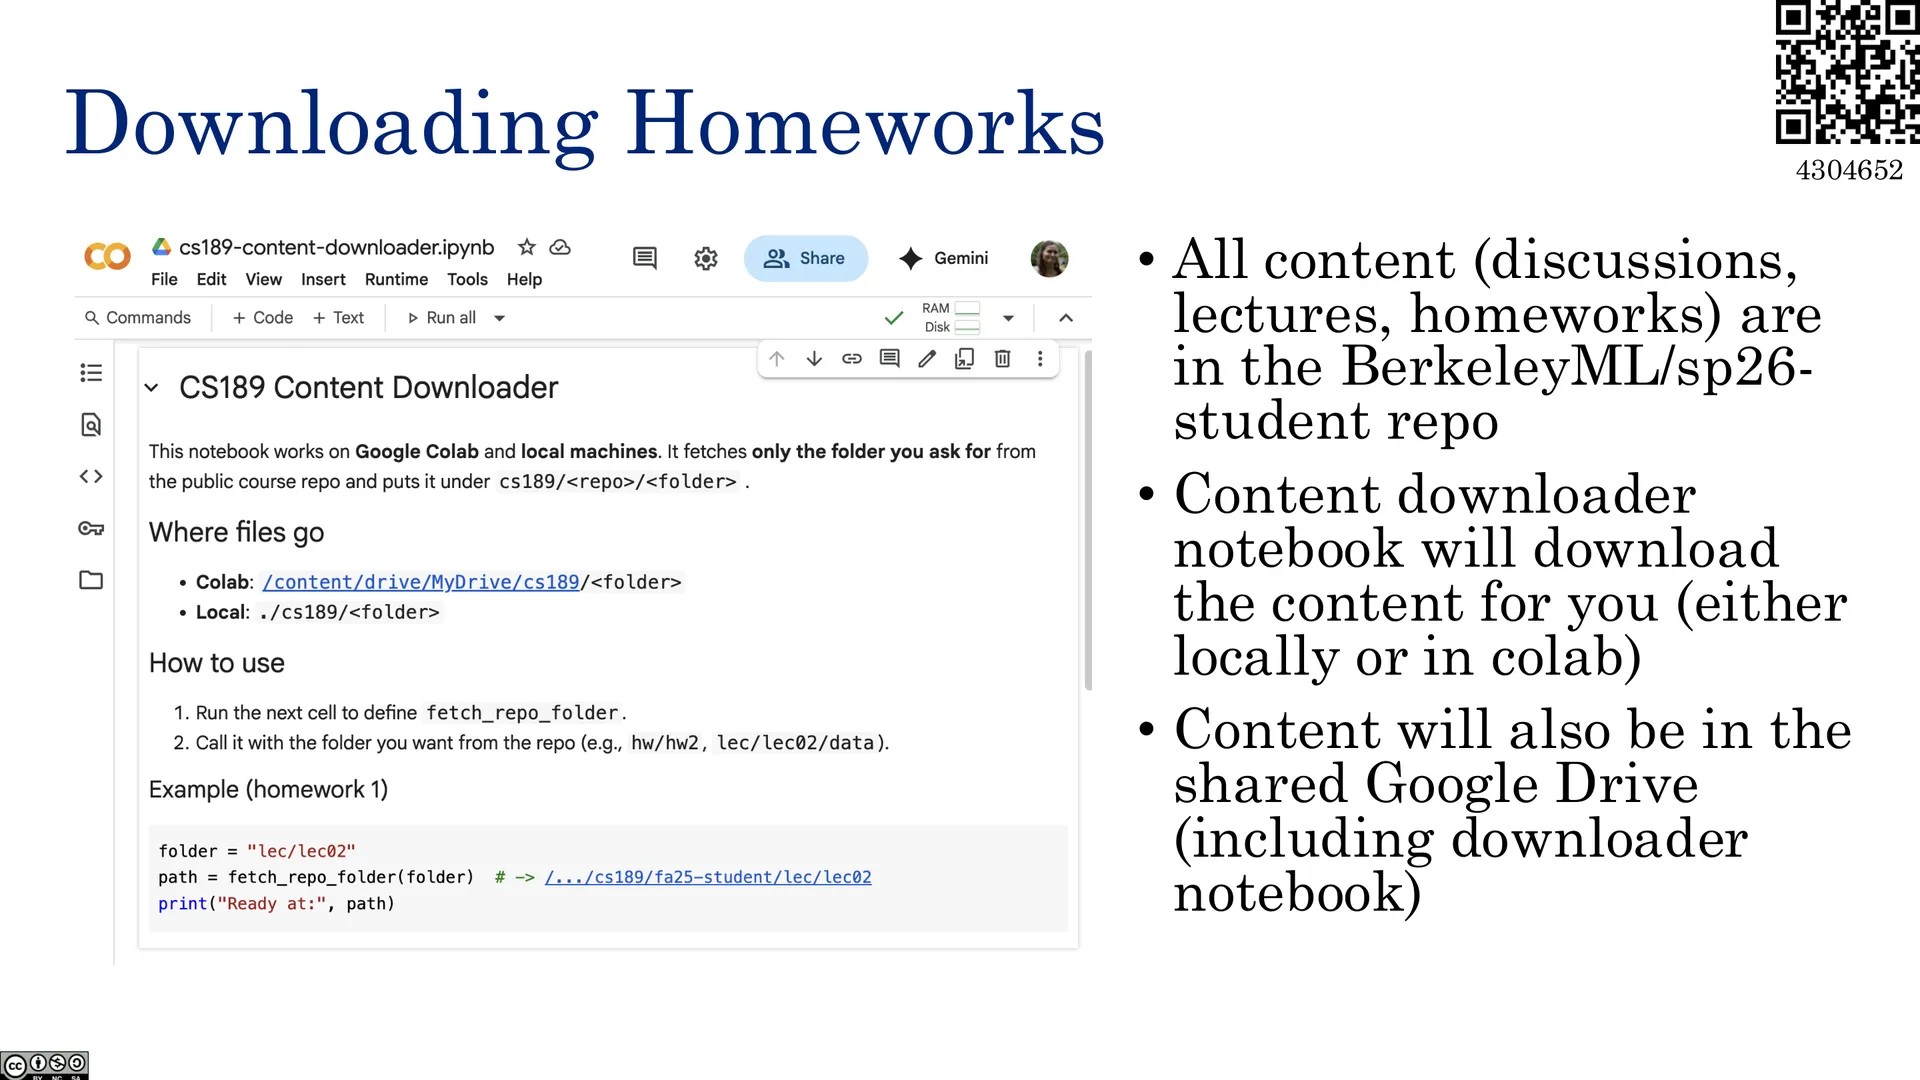
🖼️ 如何下载作业
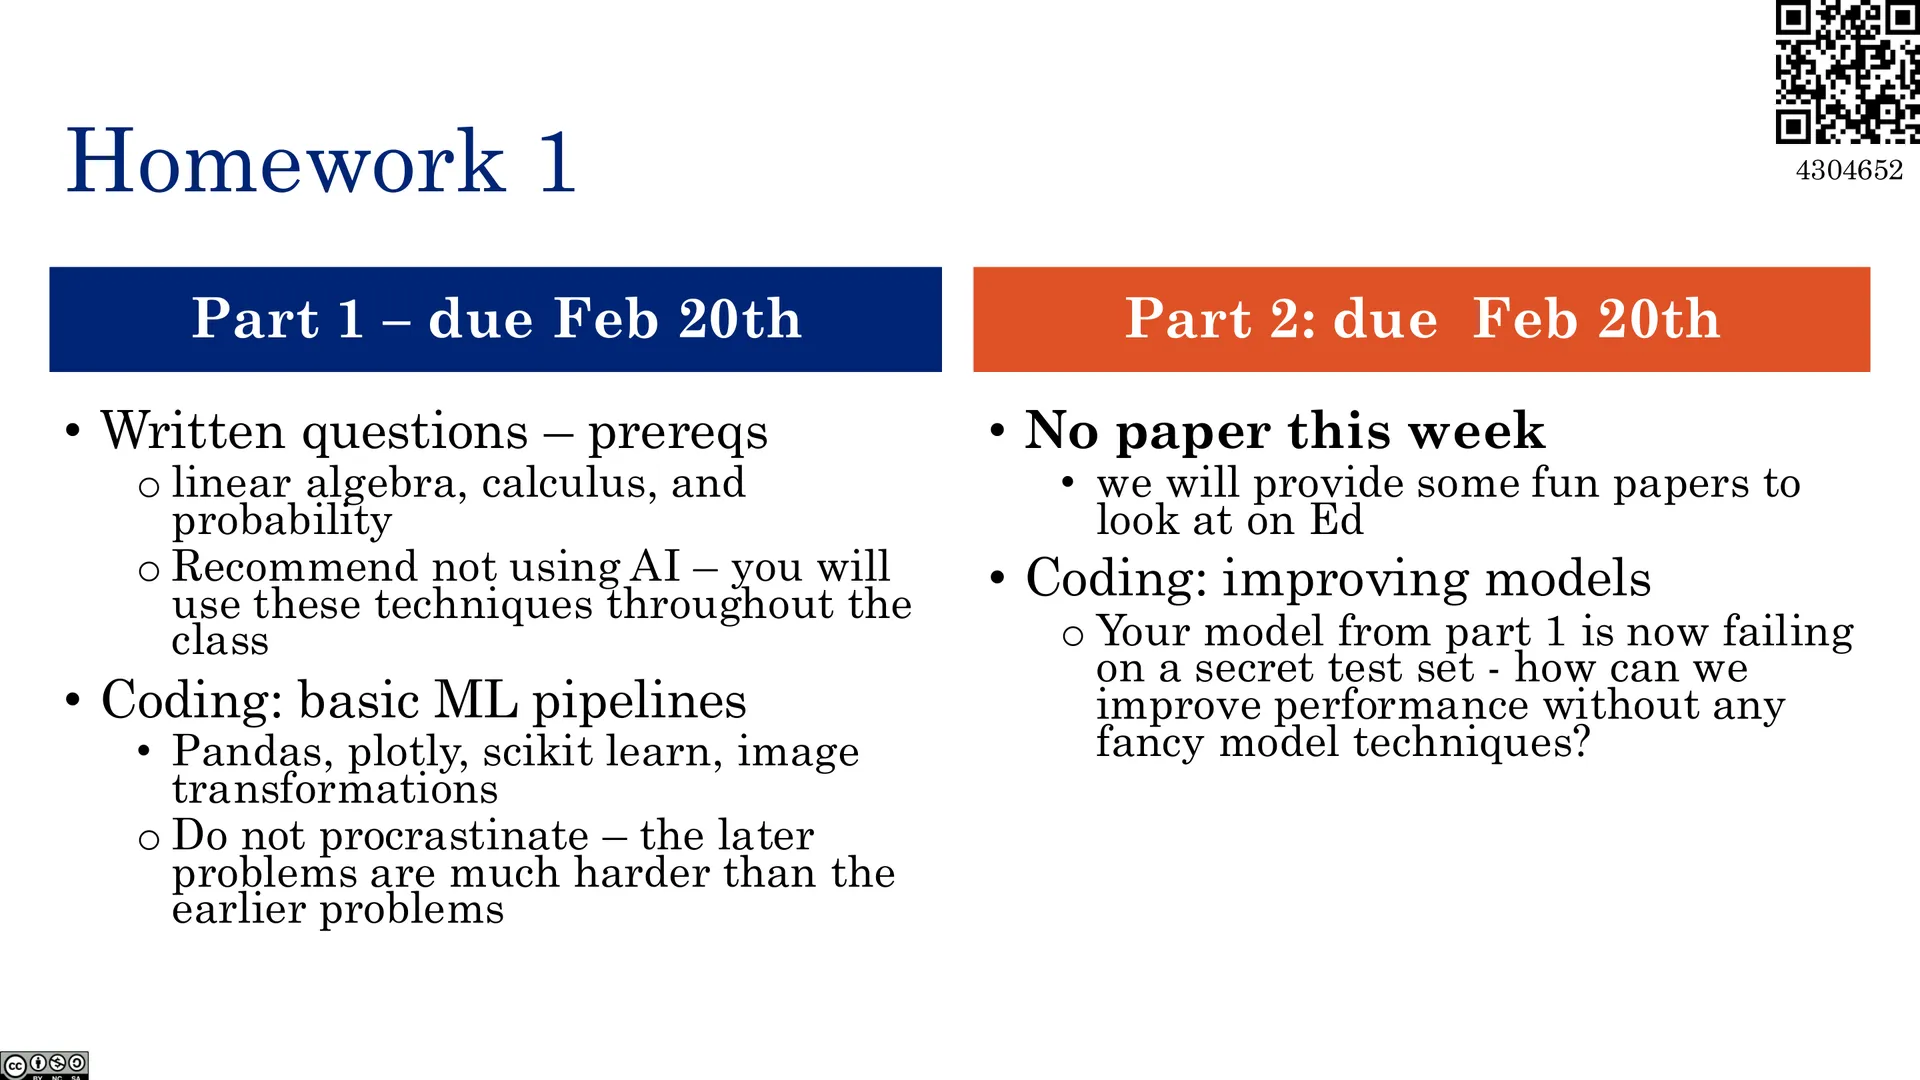
🖼️ Homework 1
🖼️ 祝学习愉快
编者说明:附录中「AGI 时代的作业」一页给出了一条实用的经验法则——能用 AI,就在你能轻松验证的场景用它(可视化、查文档);不能验证时就不要用 AI(编写你不知道如何下手的函数或应用);如果你写不出测试或设计文档,就不要 vibe coding 它;同时小心那些对机器有写权限的 git / 函数。
附:官方参考与延伸阅读
| 主题 | 链接 / 说明 |
|---|---|
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 3) | Google Drive PDF |
| 教材 Machine Learning: A First Course for Engineers and Scientists | 本讲对应 Chapter 1 · https://doi.org/10.1017/9781108919371 |
| scikit-learn 数据变换大全 | https://scikit-learn.org/stable/data_transforms.html |
| ImageNetV2 复制研究 | https://arxiv.org/abs/1902.10811(Do ImageNet Classifiers Generalize to ImageNet?) |
| Kaggle 竞赛总览(学习验证与集成技巧) | https://www.kaggle.com/competitions |
| ↳ House Prices(验证/集成常用练手赛) | https://www.kaggle.com/c/house-prices-advanced-regression-techniques |
| 作业内容仓库 | BerkeleyML/sp26-student(含内容下载 notebook) |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队(Alex Dimakis、Jennifer Listgarten 及幻灯片作者 Joseph E.