第4讲 · EECS 189:聚类与概率复习
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 主讲 | Jennifer Listgarten、Alex Dimakis |
| 视频 | https://www.youtube.com/watch?v=STdR9OyulZE |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 4) | Google Drive PDF |
| 教材 | Machine Learning: A First Course for Engineers and Scientists:聚类对应 Chapter 15.1(k-means),概率对应 Chapter 2.[1-2] |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第4讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
编者说明:本讲是无监督学习的入门(以 K 均值聚类为主线),并在末尾复习概率论的核心概念。授课在「联合概率分布与边缘化」处收尾,其余概率幻灯片(条件分布、独立同分布、唤醒词与贝叶斯)归入文末附录。
导言与路线图
(参考时间: 00:00)
本讲的路线图:
- 监督学习 vs 无监督学习;
- 聚类(Clustering);
- K 均值聚类(K-Means);
- 概率复习:联合分布(Joint Distributions)与 IID 假设。
flowchart LR
    A["无监督学习"] --> B["聚类<br/>(本讲主线)"]
    A --> C["降维 / 表示学习 / 生成建模 / 密度估计"]
    B --> D["K 均值(centroid-based)"]
    D --> E["概率版本:高斯混合模型<br/>(下一讲)"]
📷 路线图
回到原视频 (00:00:45)
📷 路线图(续)
回到原视频 (00:01:37)
📷 路线图(再次)
回到原视频 (00:02:30)
一、监督学习 vs 无监督学习
(参考时间: 00:04)
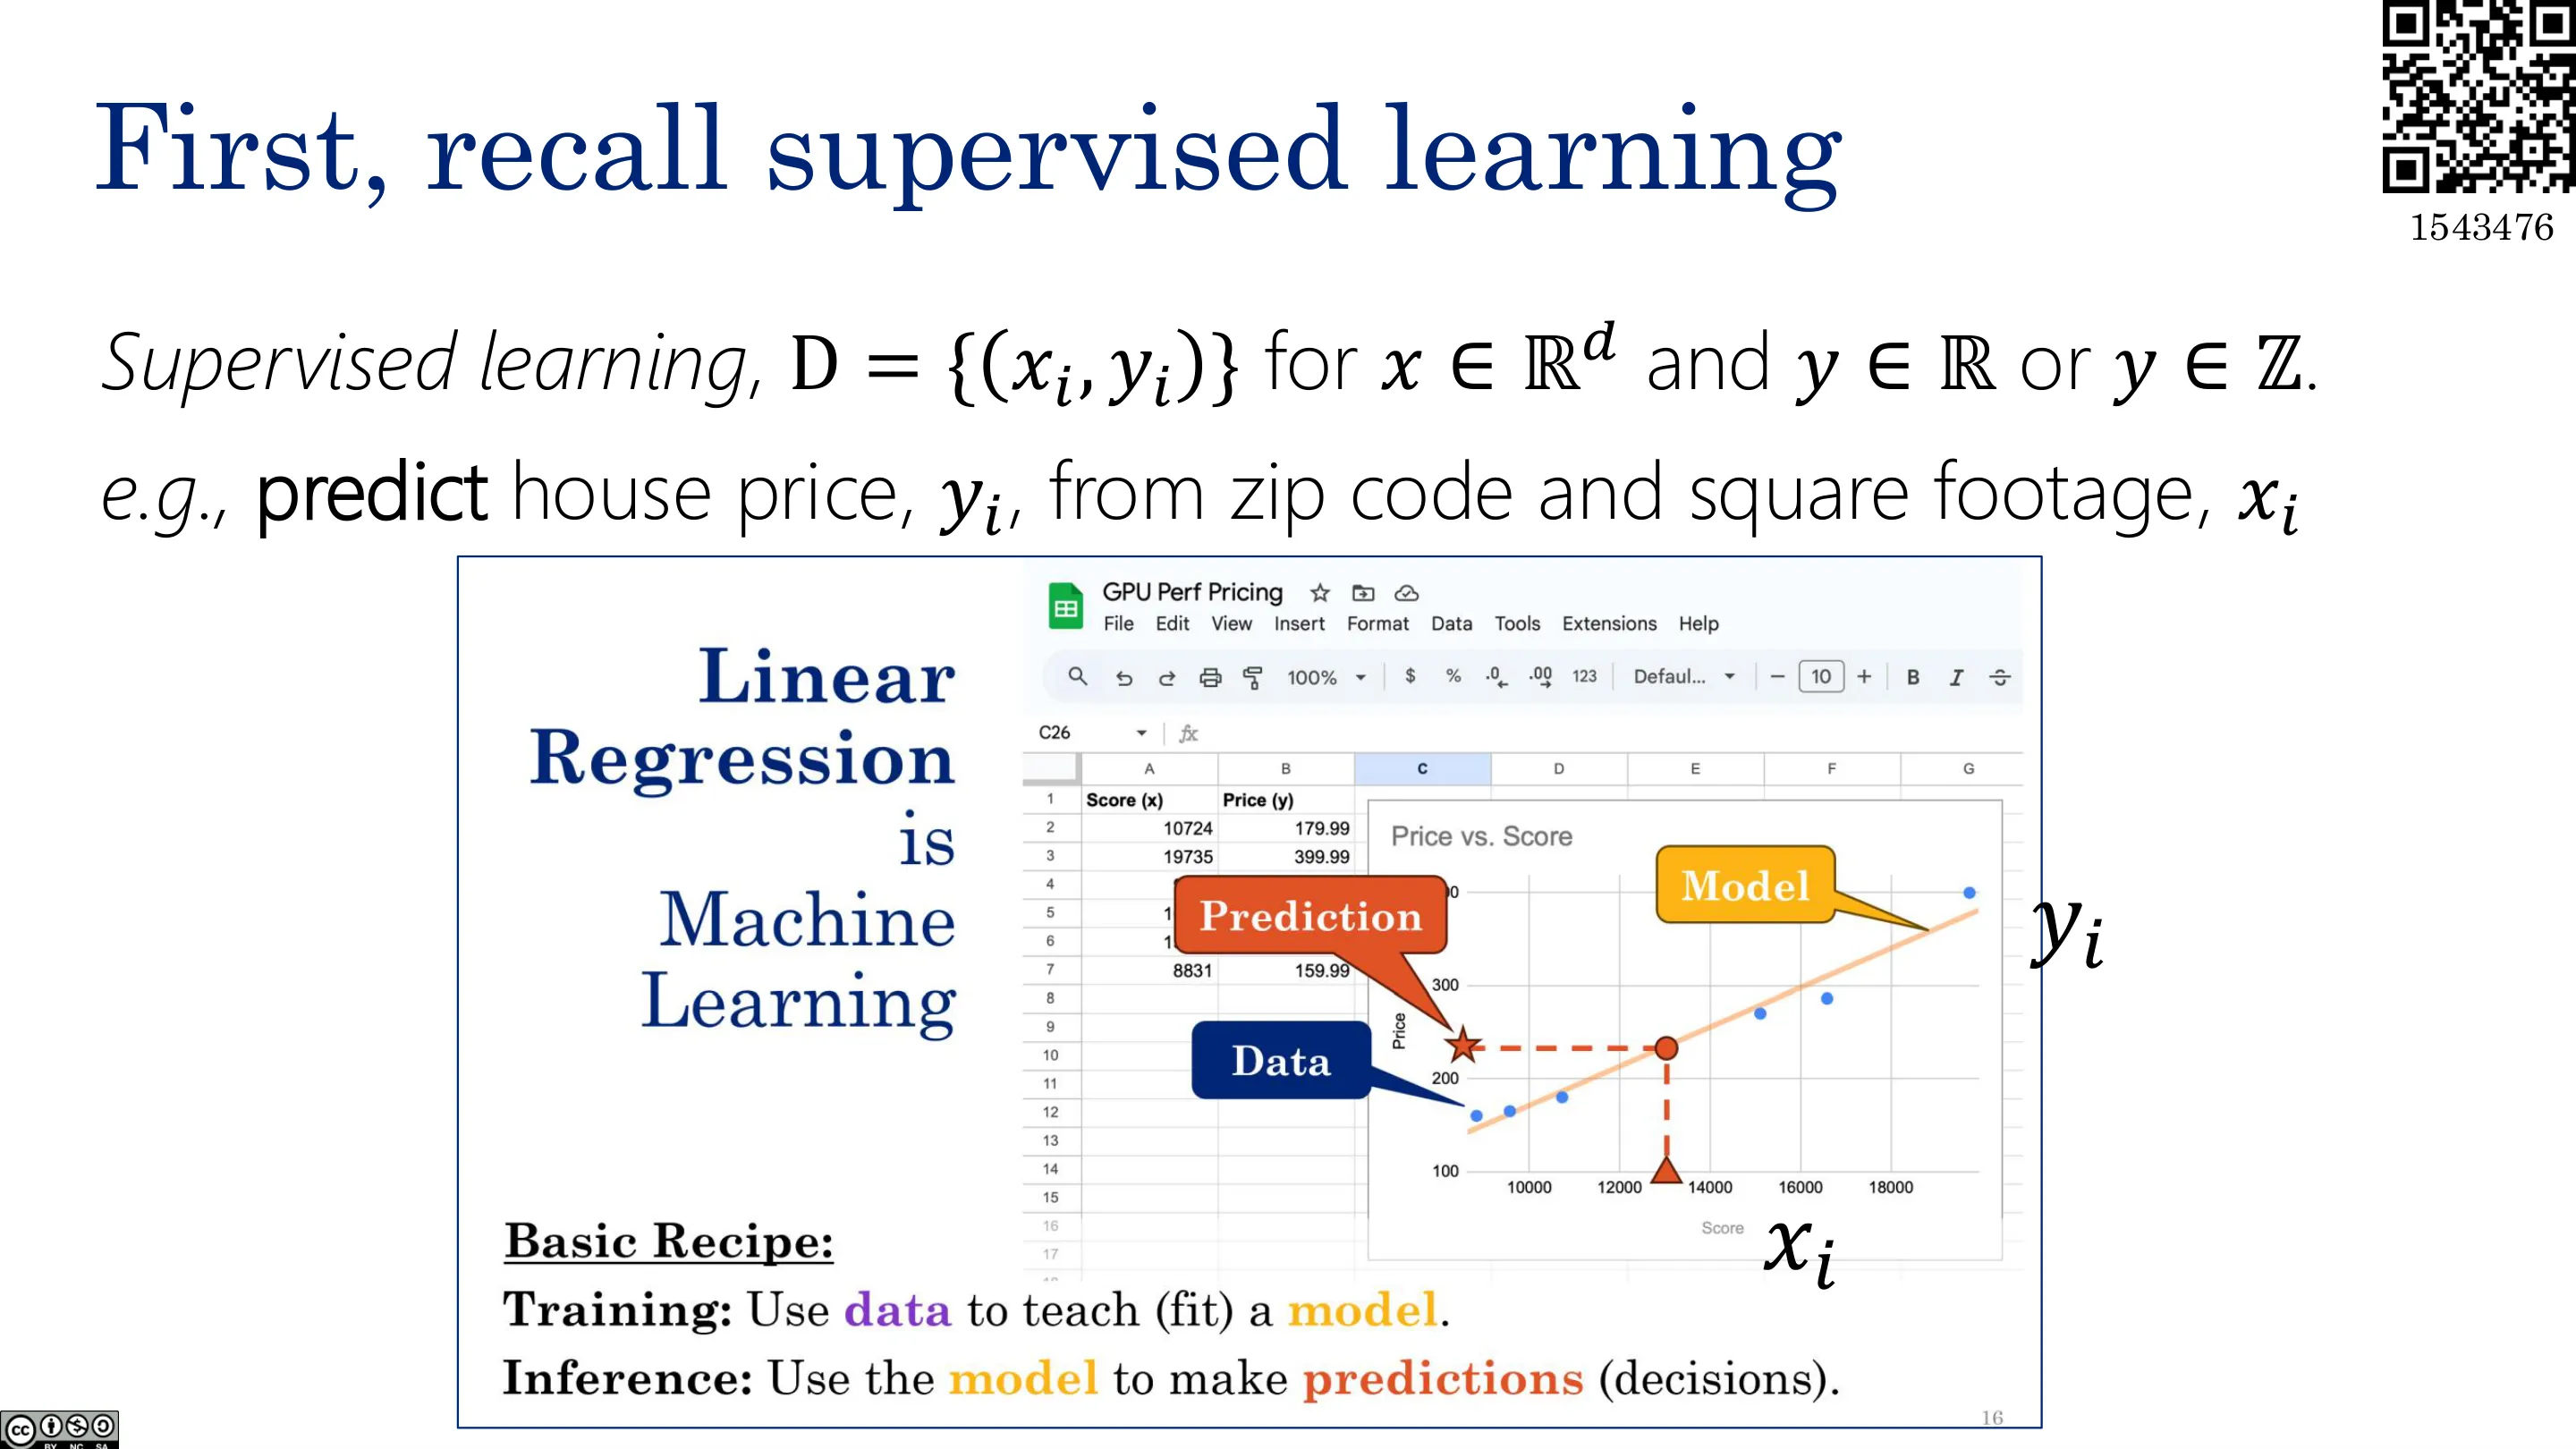
监督学习:数据集 $D = \{(x_i, y_i)\}$,其中 $x \in \mathbb{R}^d$、$y \in \mathbb{R}$ 或 $y \in \mathbb{Z}$。例如用邮政编码、面积等特征 $x_i$ 预测房价 $y_i$。可以说,所有现代监督学习神经网络,本质上都是「打了兴奋剂的线性回归」。
📷 回顾监督学习
回到原视频 (00:04:50)
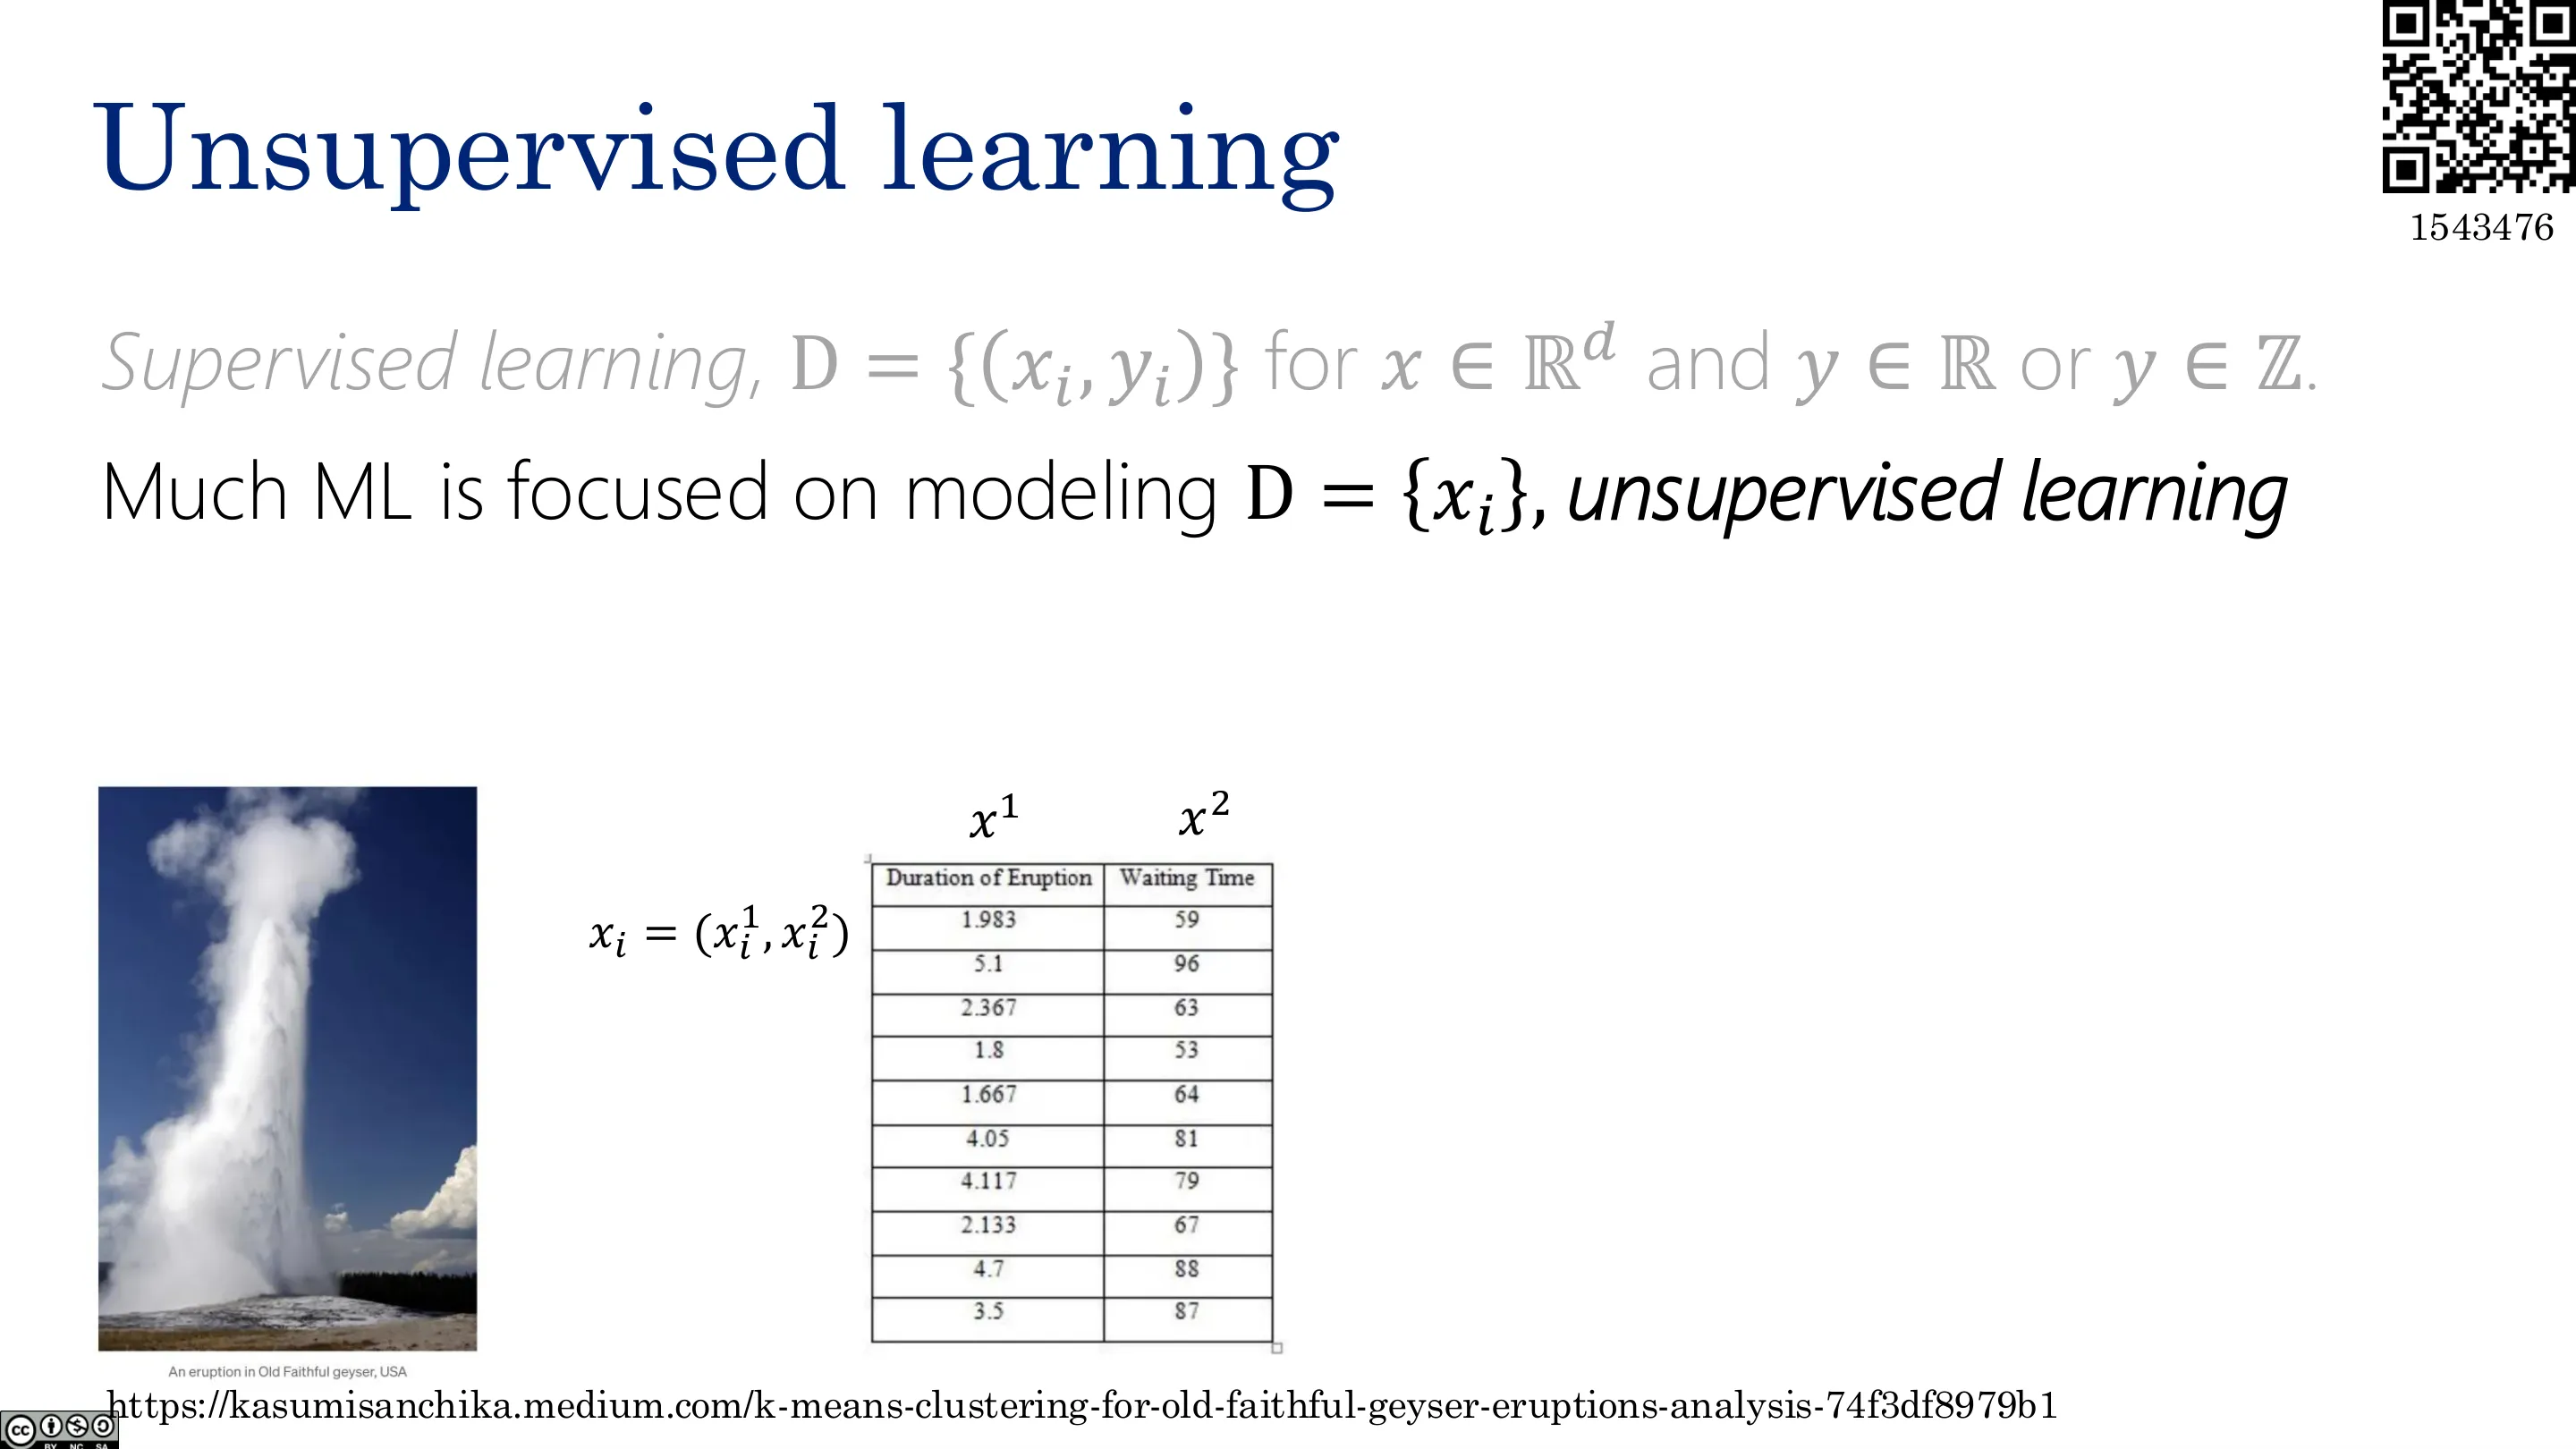
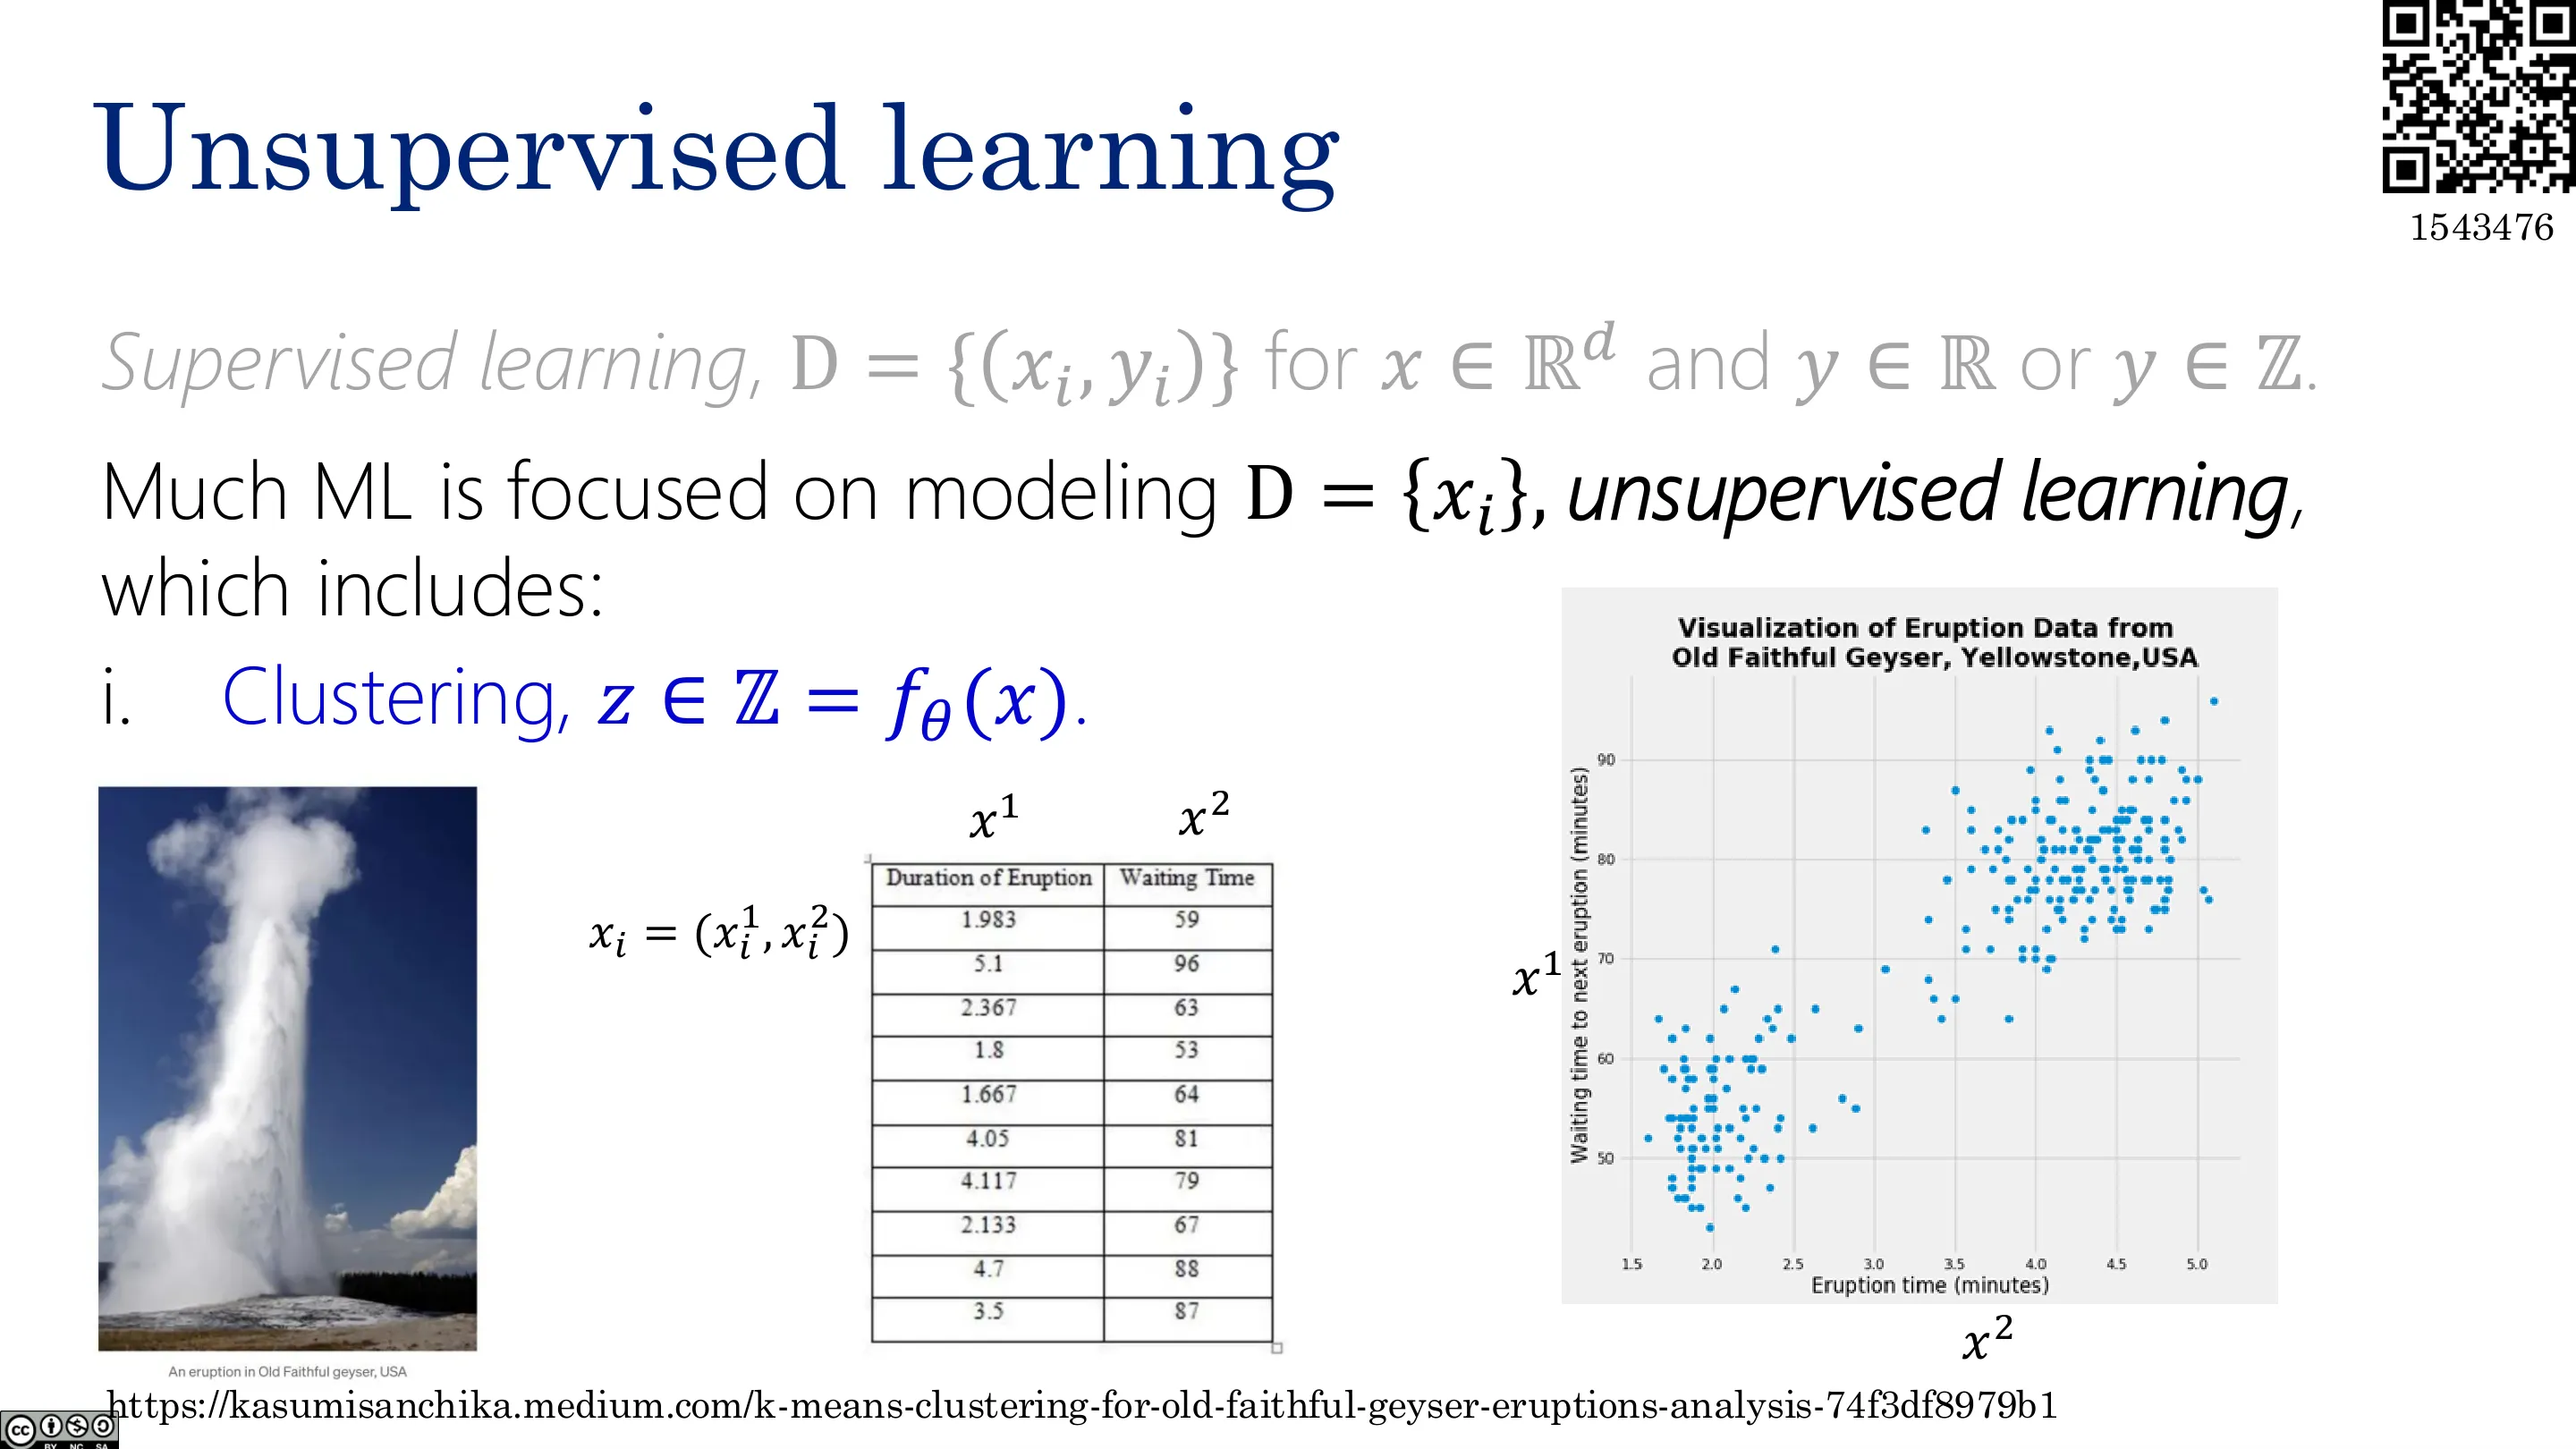
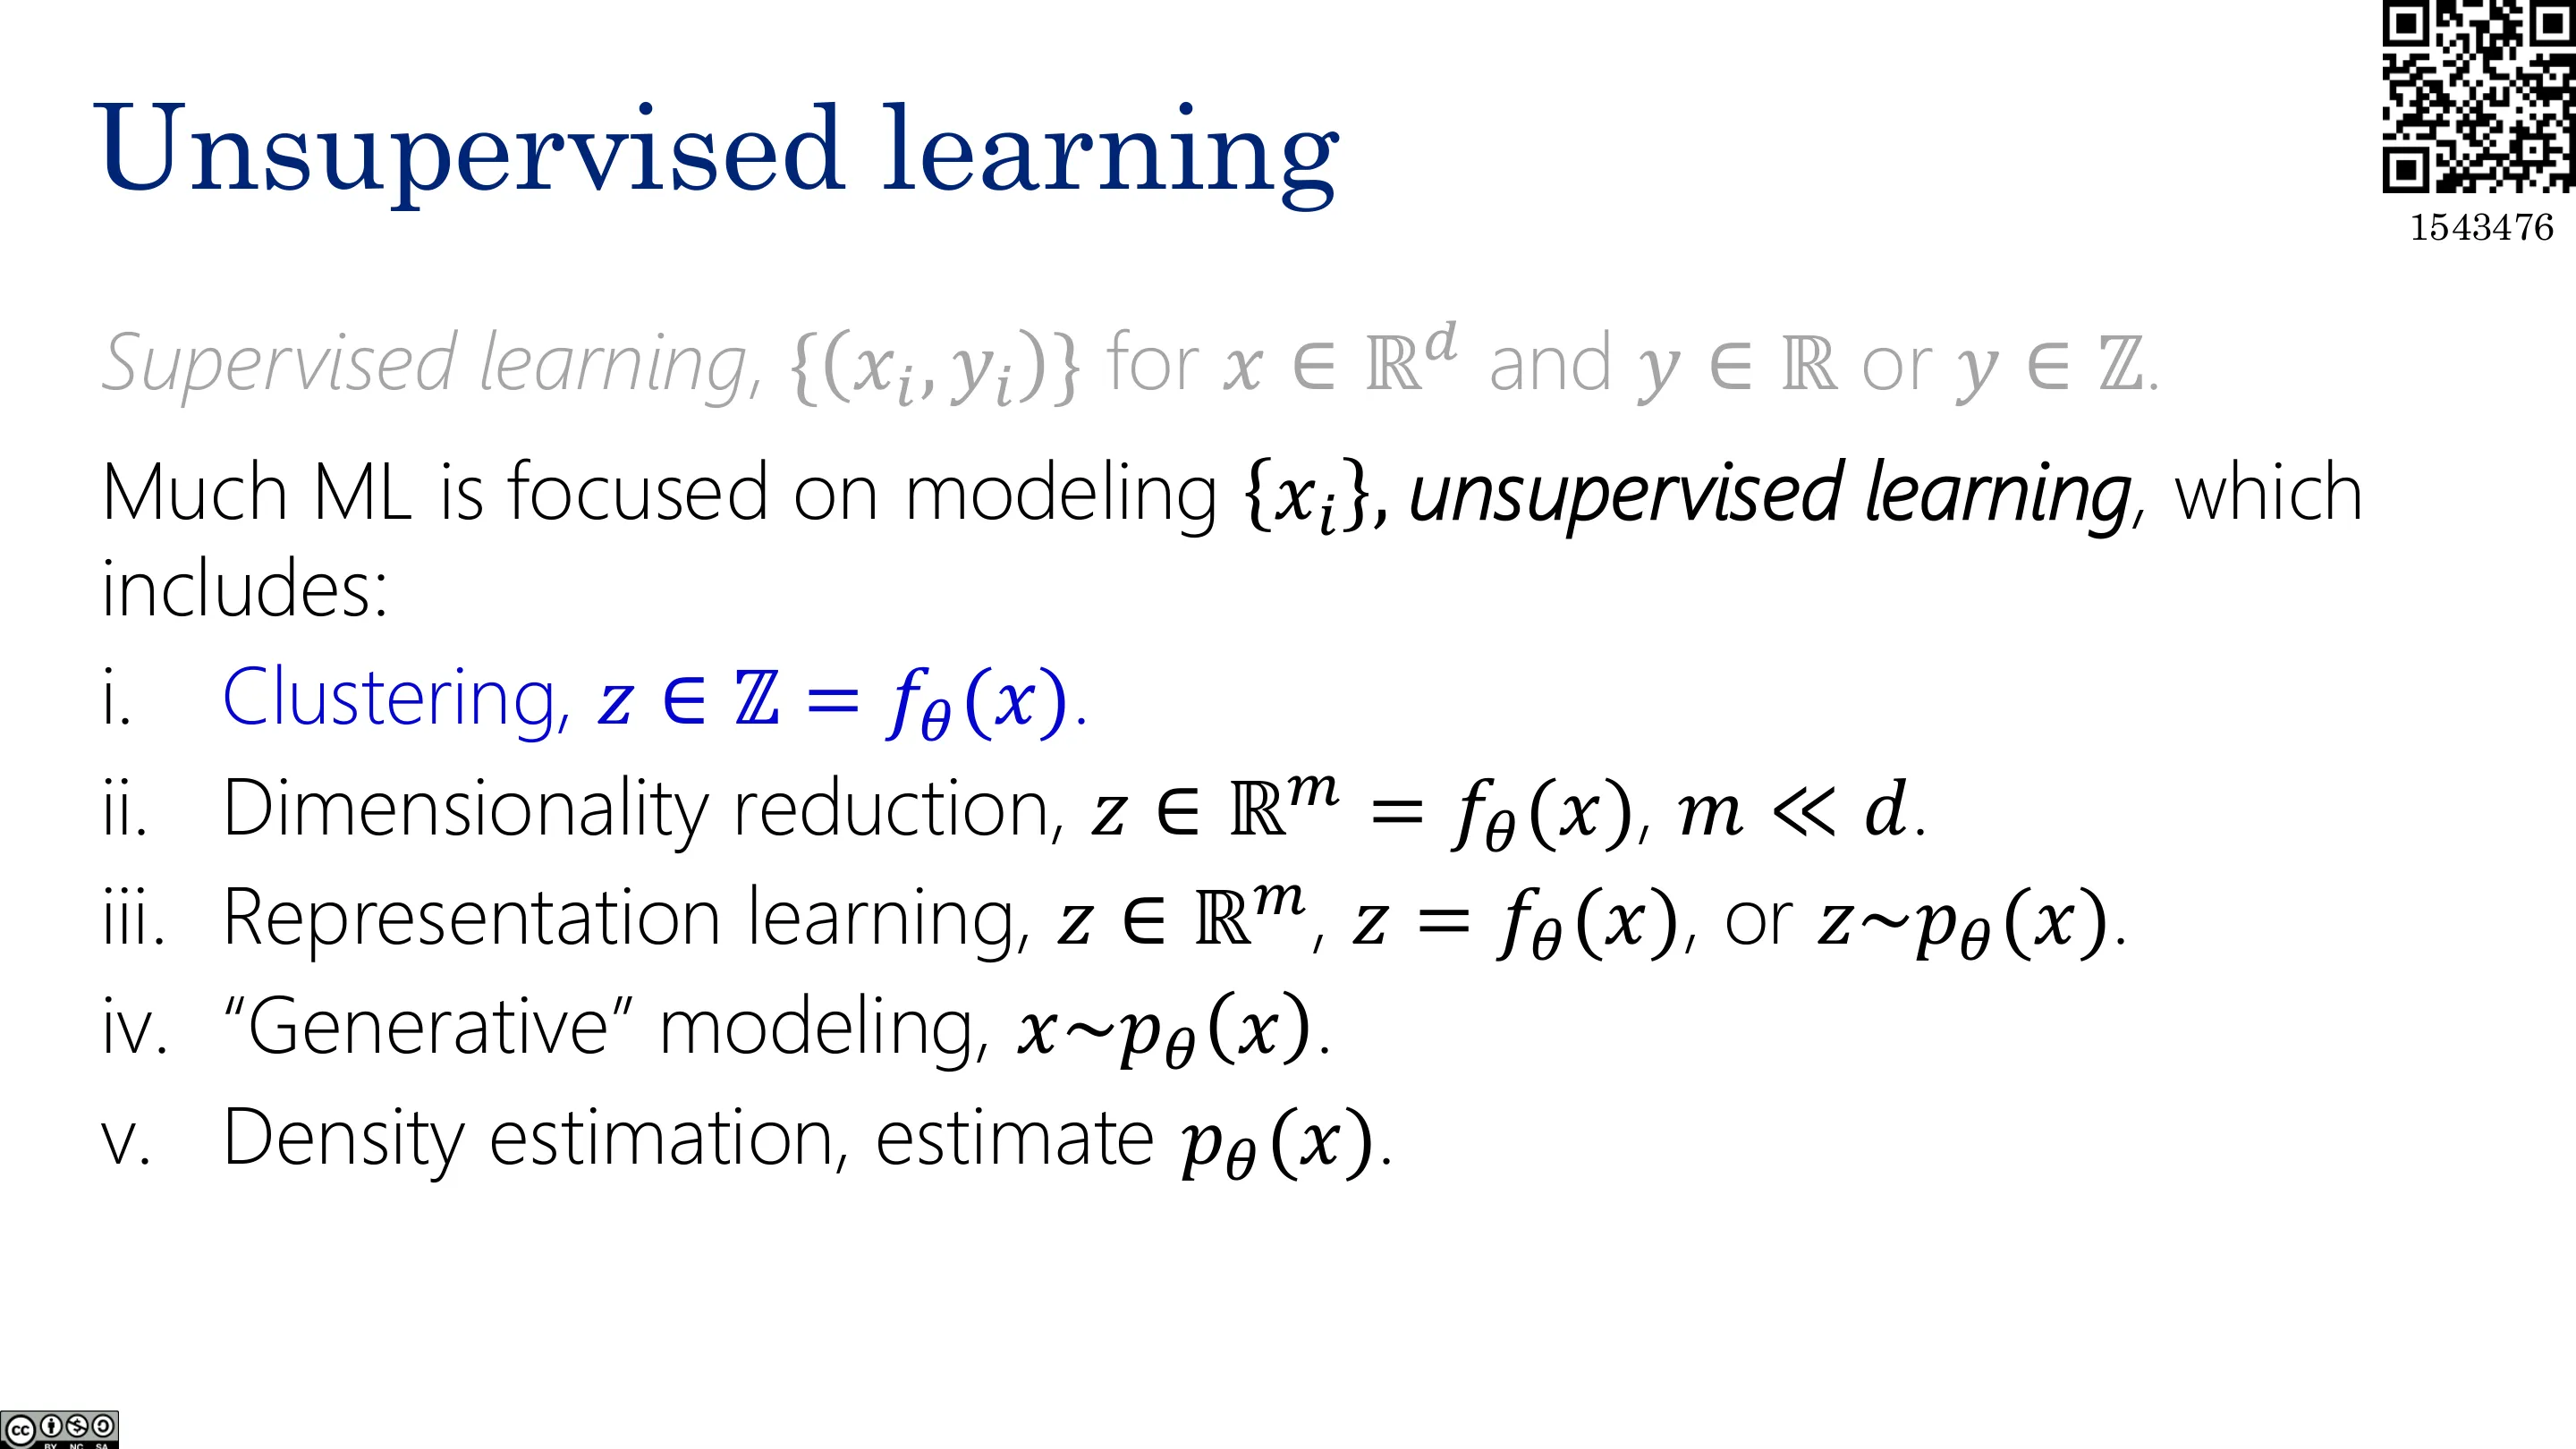
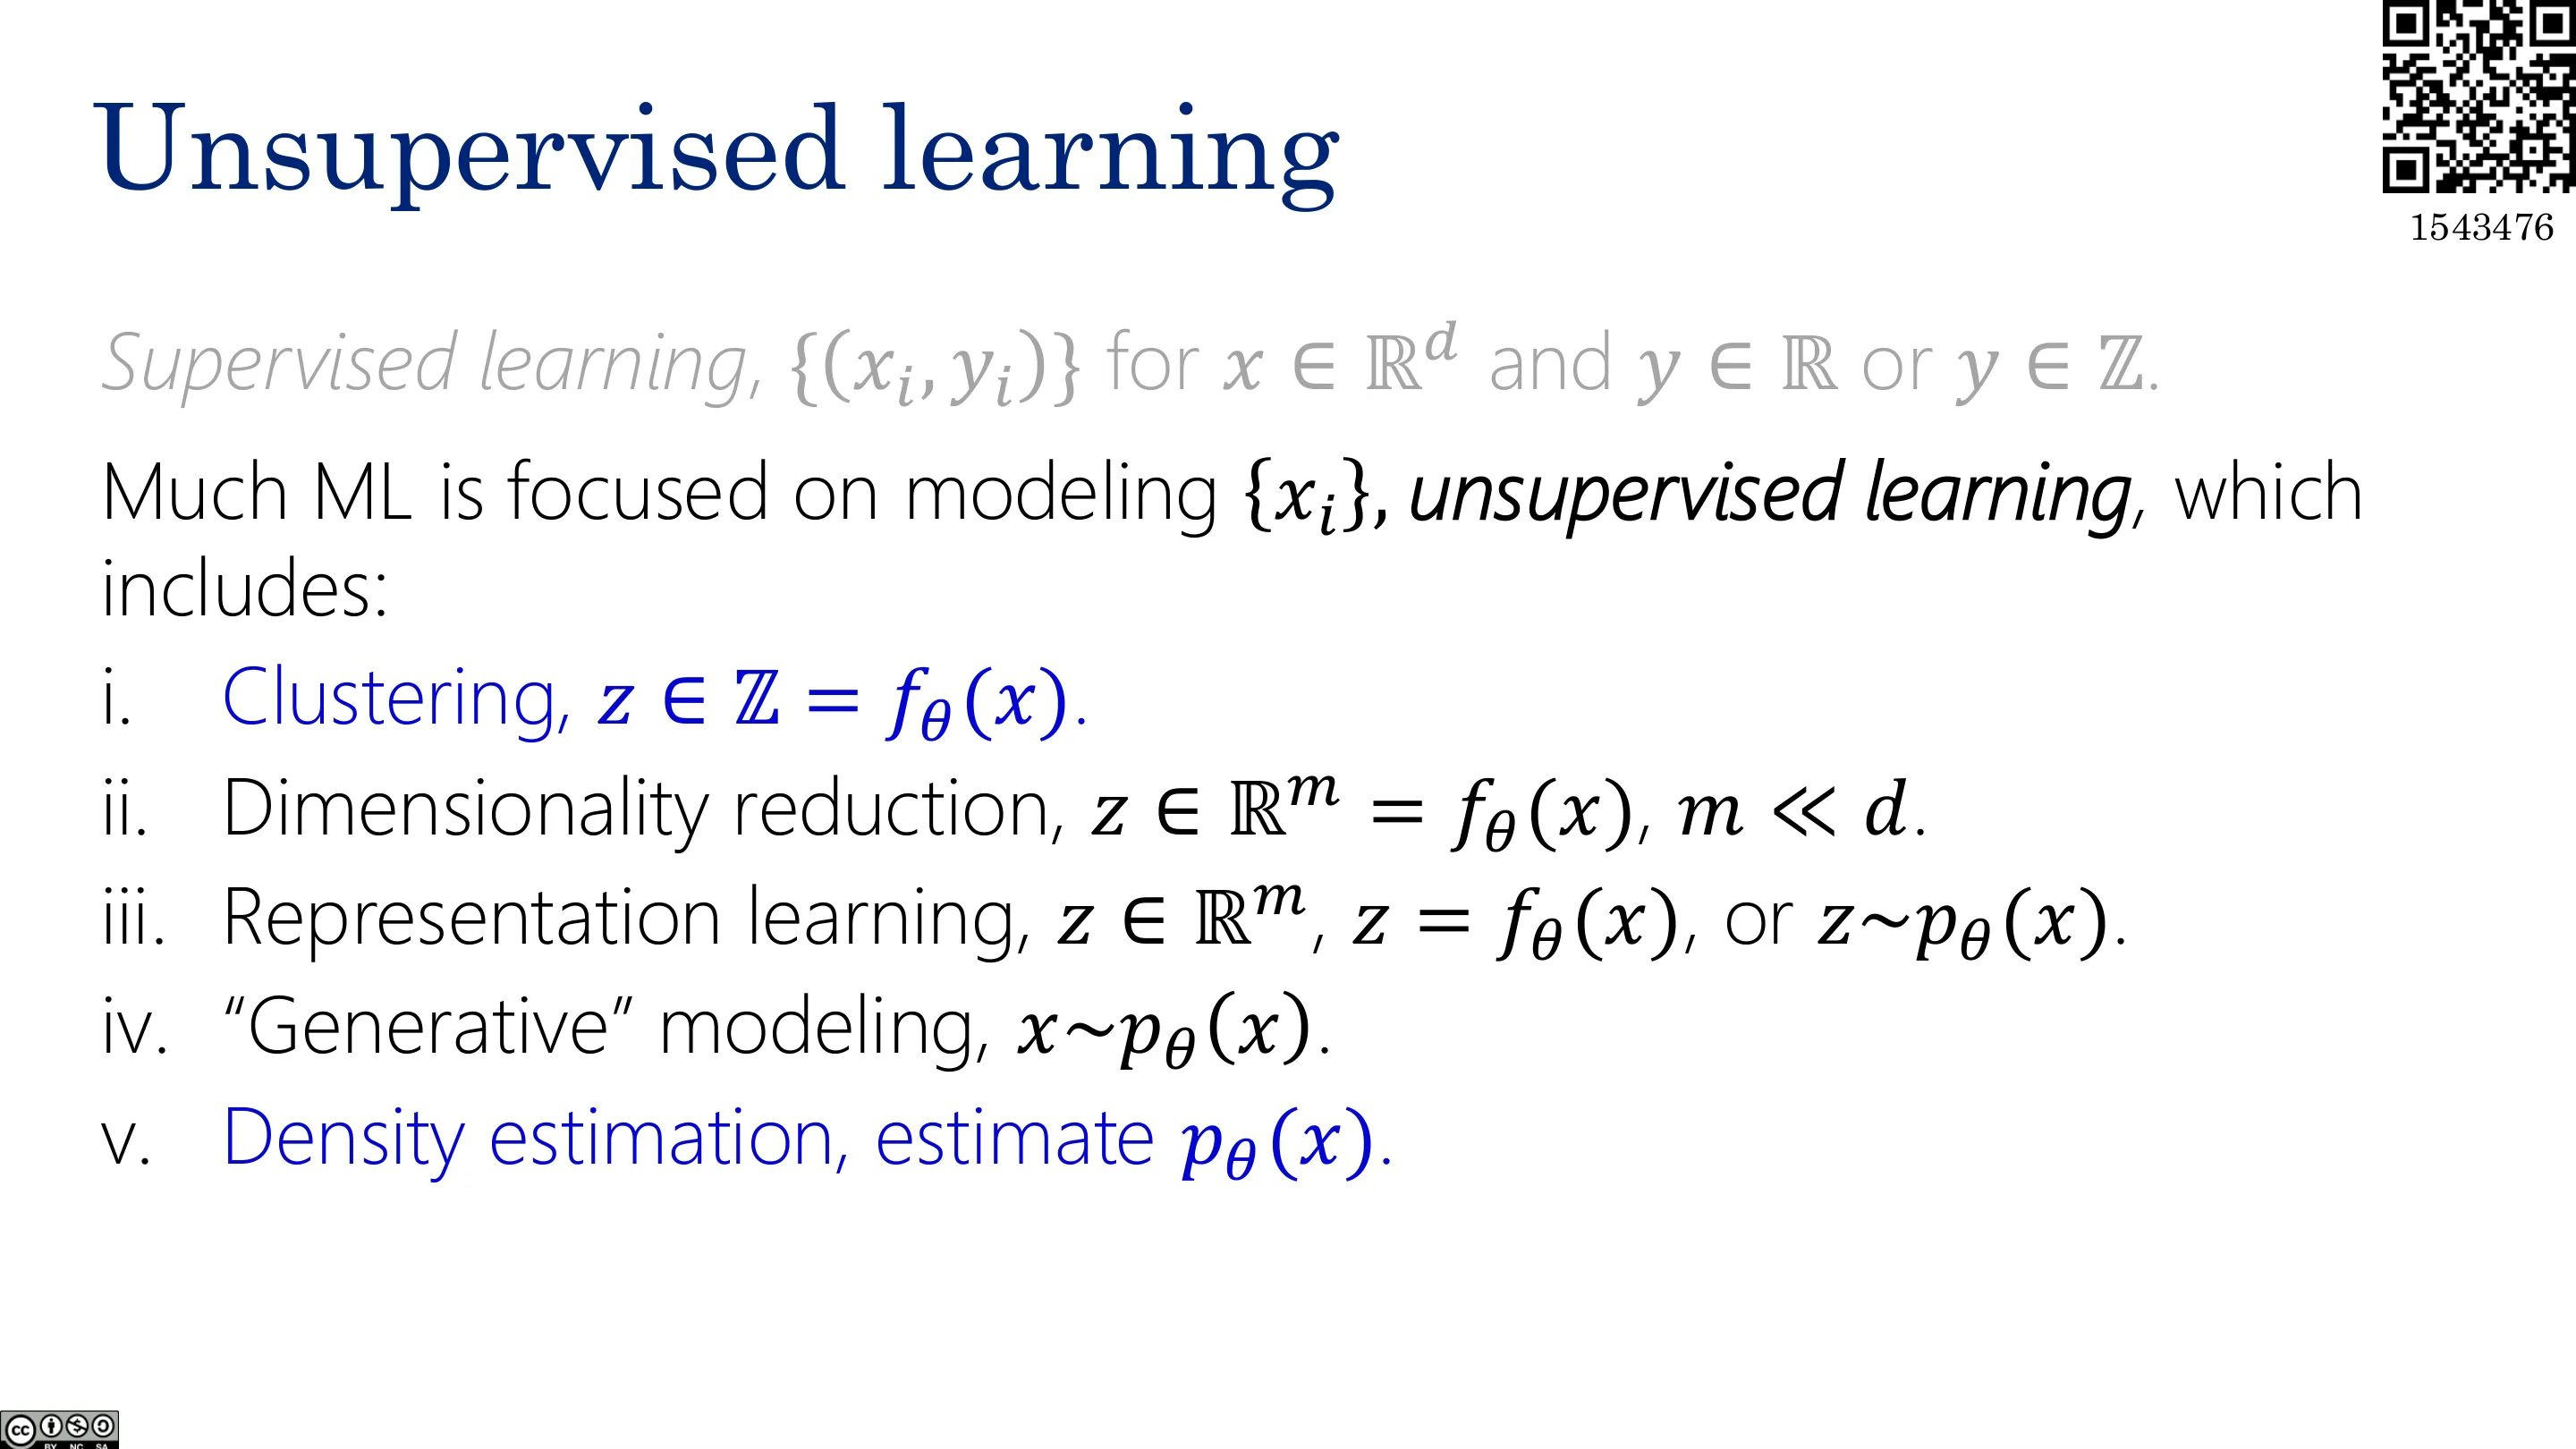
无监督学习:数据集只有特征 $D = \{x_i\}$,没有标签。机器学习中很大一部分工作都在建模这种 $D = \{x_i\}$。无监督学习包括:
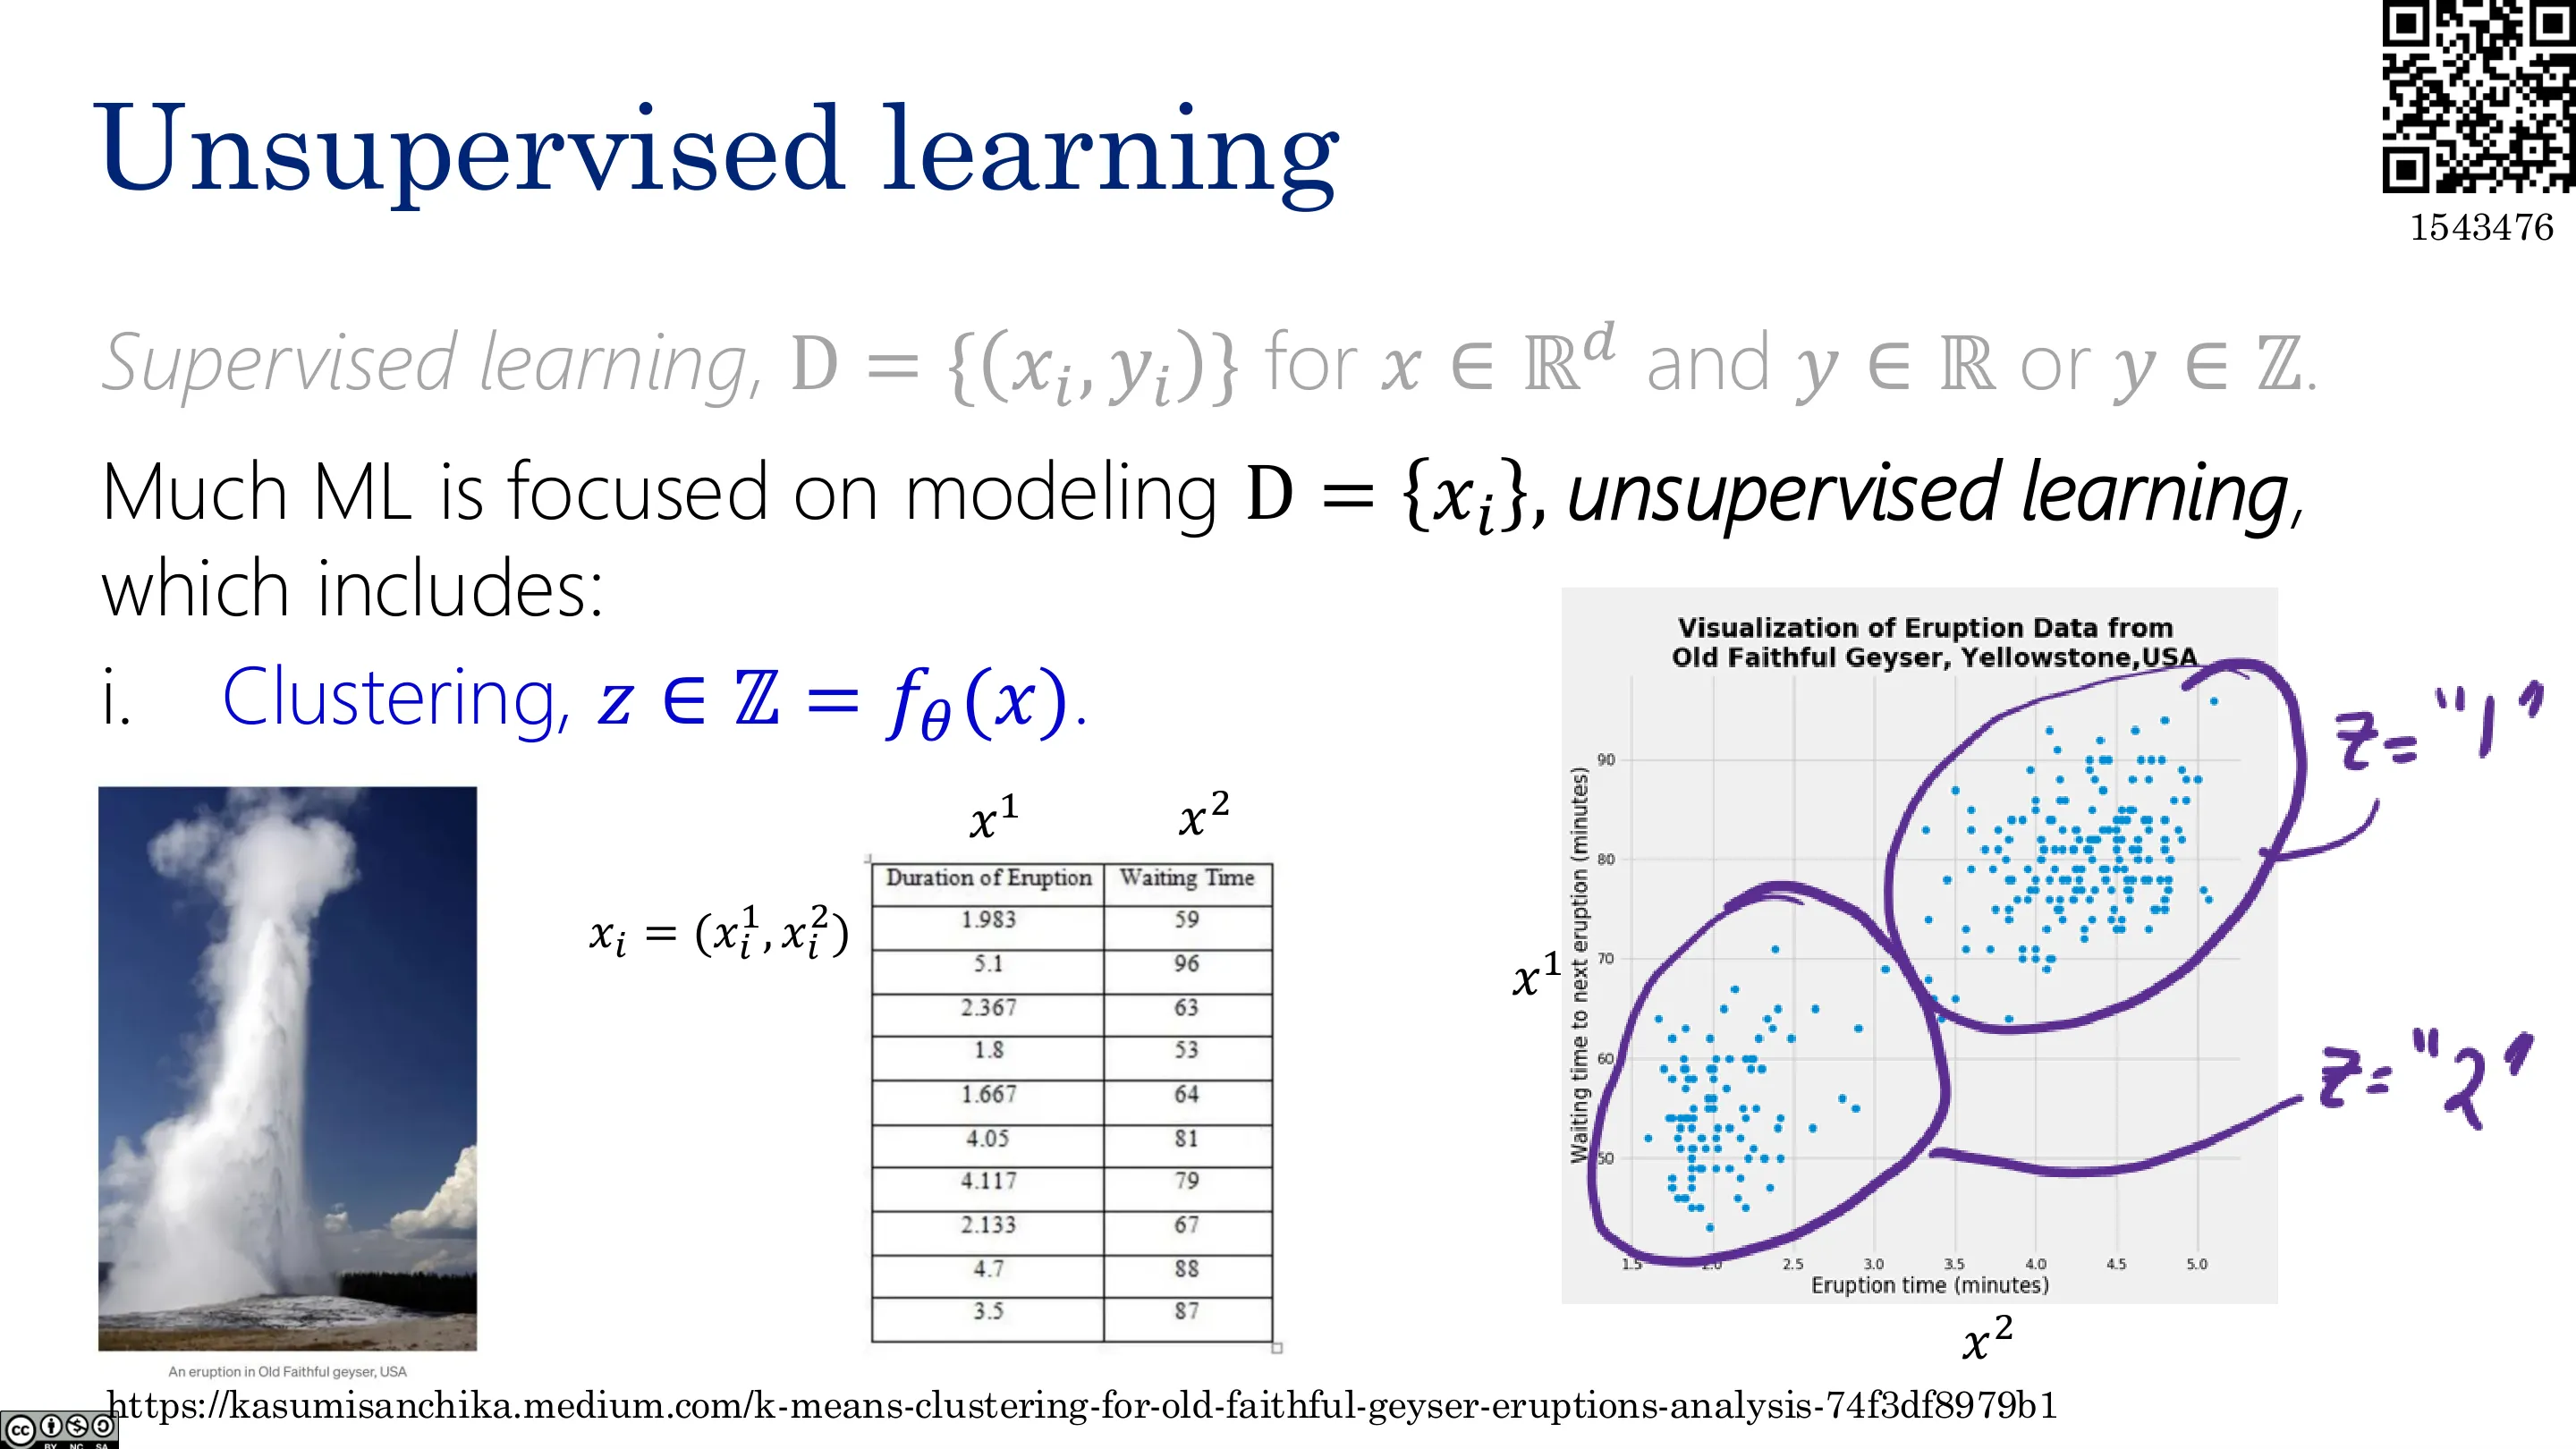
- 聚类(Clustering):$z \in \mathbb{Z} = f_\theta(x)$——把每个点映射到一个离散标签;
- 降维(Dimensionality reduction):$z \in \mathbb{R}^m = f_\theta(x)$,$m \ll d$;
- 表示学习(Representation learning):$z \in \mathbb{R}^m$,$z = f_\theta(x)$ 或 $z \sim p_\theta(x)$;
- 生成建模(Generative modeling):$x \sim p_\theta(x)$;
- 密度估计(Density estimation):估计 $p_\theta(x)$。
📷 无监督学习:只有特征
回到原视频 (00:07:30)
📷 无监督学习:聚类
回到原视频 (00:08:36)
📷 无监督学习:聚类的目标
回到原视频 (00:09:07)
经典的例子是 Old Faithful 间歇泉:我们只测量两个特征(这次喷发持续多久 $x_1$、距下次喷发还有多久 $x_2$),就想看看数据里有没有隐藏的「群体」。这正是聚类的用武之地。
二、聚类
(参考时间: 00:12)
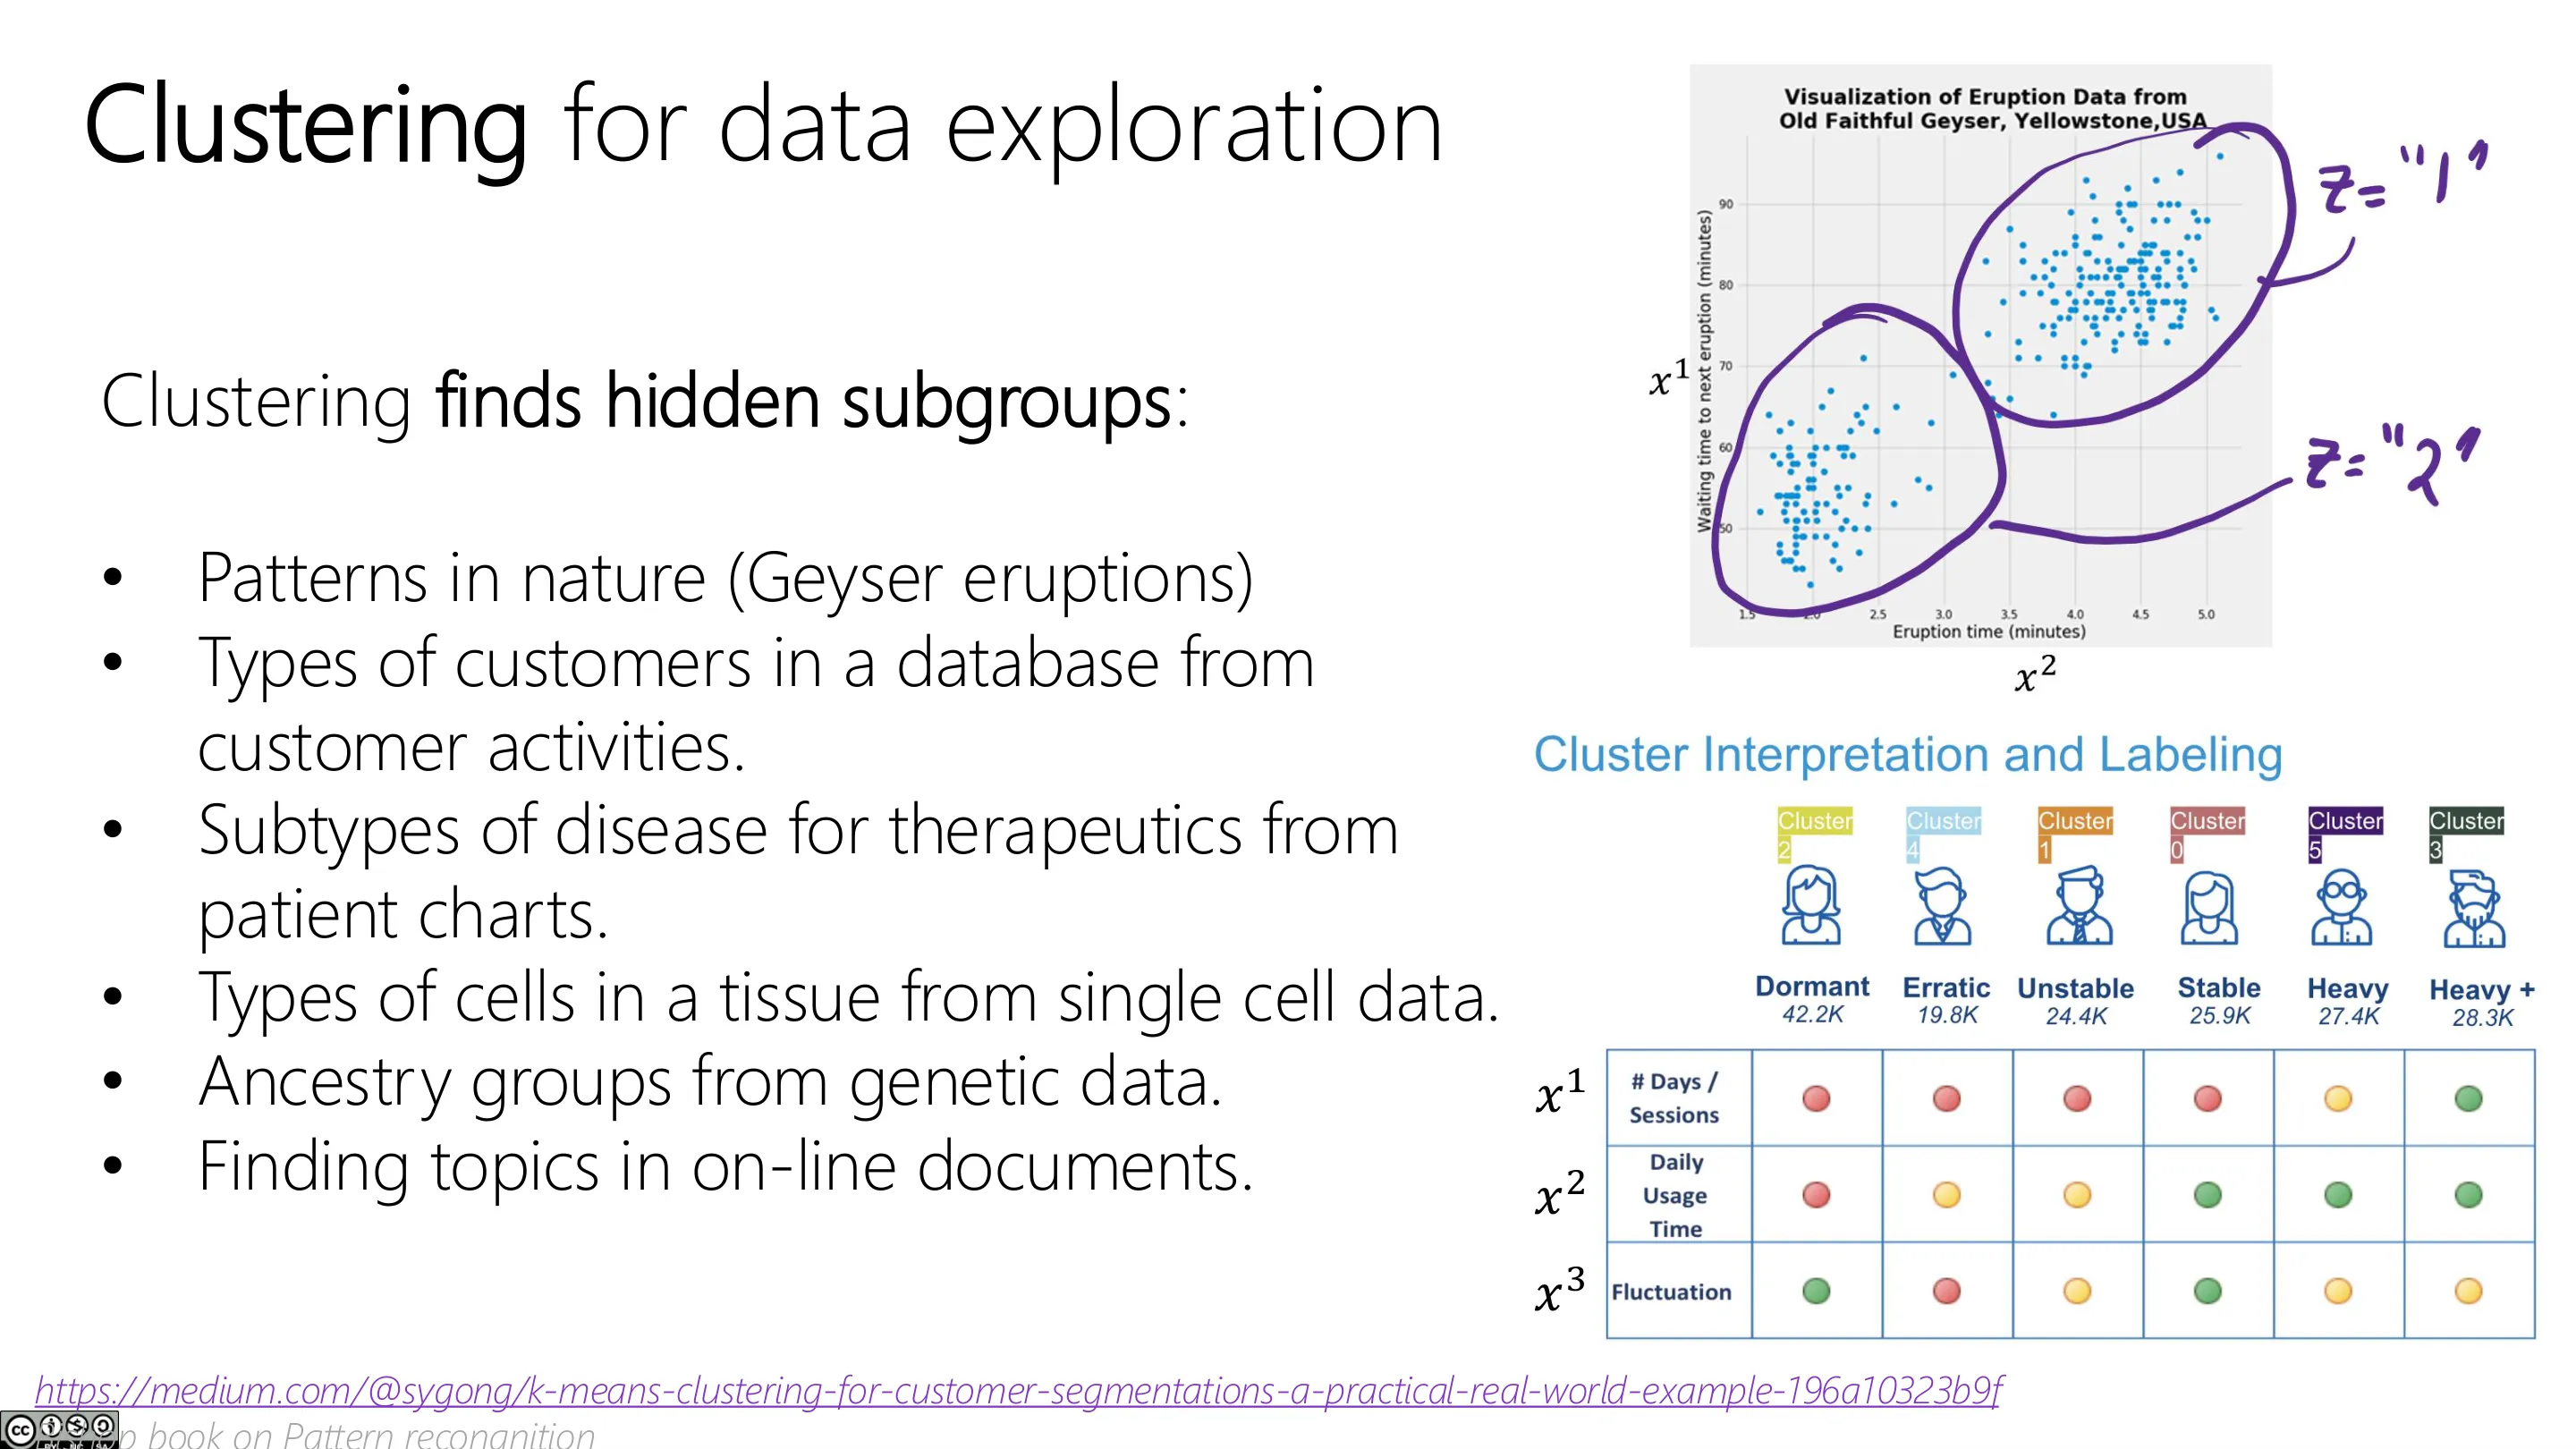
聚类是在寻找隐藏的子群体(hidden subgroups),用于探索性数据分析。真实例子遍布各领域:
- 自然界中的模式(间歇泉喷发);
- 数据库中客户的类型(从使用行为推断);
- 疾病亚型(从病历推断);
- 组织中的细胞类型(从单细胞数据推断);
- 人类学中的祖先群体(从基因数据推断);
- 在线文档的主题发现。
📷 聚类用于数据探索
回到原视频 (00:12:33)
📷 无监督学习的多种形态(一)
回到原视频 (00:17:29)
📷 无监督学习的多种形态(二)
回到原视频 (00:18:20)
编者说明:讲师强调,聚类与密度估计其实是相通的——如果你学到一个随机变量 $X$ 的概率密度 $p(x)$,也就为聚类/生成建模打开了通路。例如最简单的高斯密度估计,就是学出均值和方差。她还介绍了记号 $Z \sim p$(随机变量 $Z$ 服从分布 $p$):所谓生成建模,就是「从分布中采样 $x$」。
📷 路线图(进入聚类)
回到原视频 (00:19:47)
2.1 聚类的基本设定
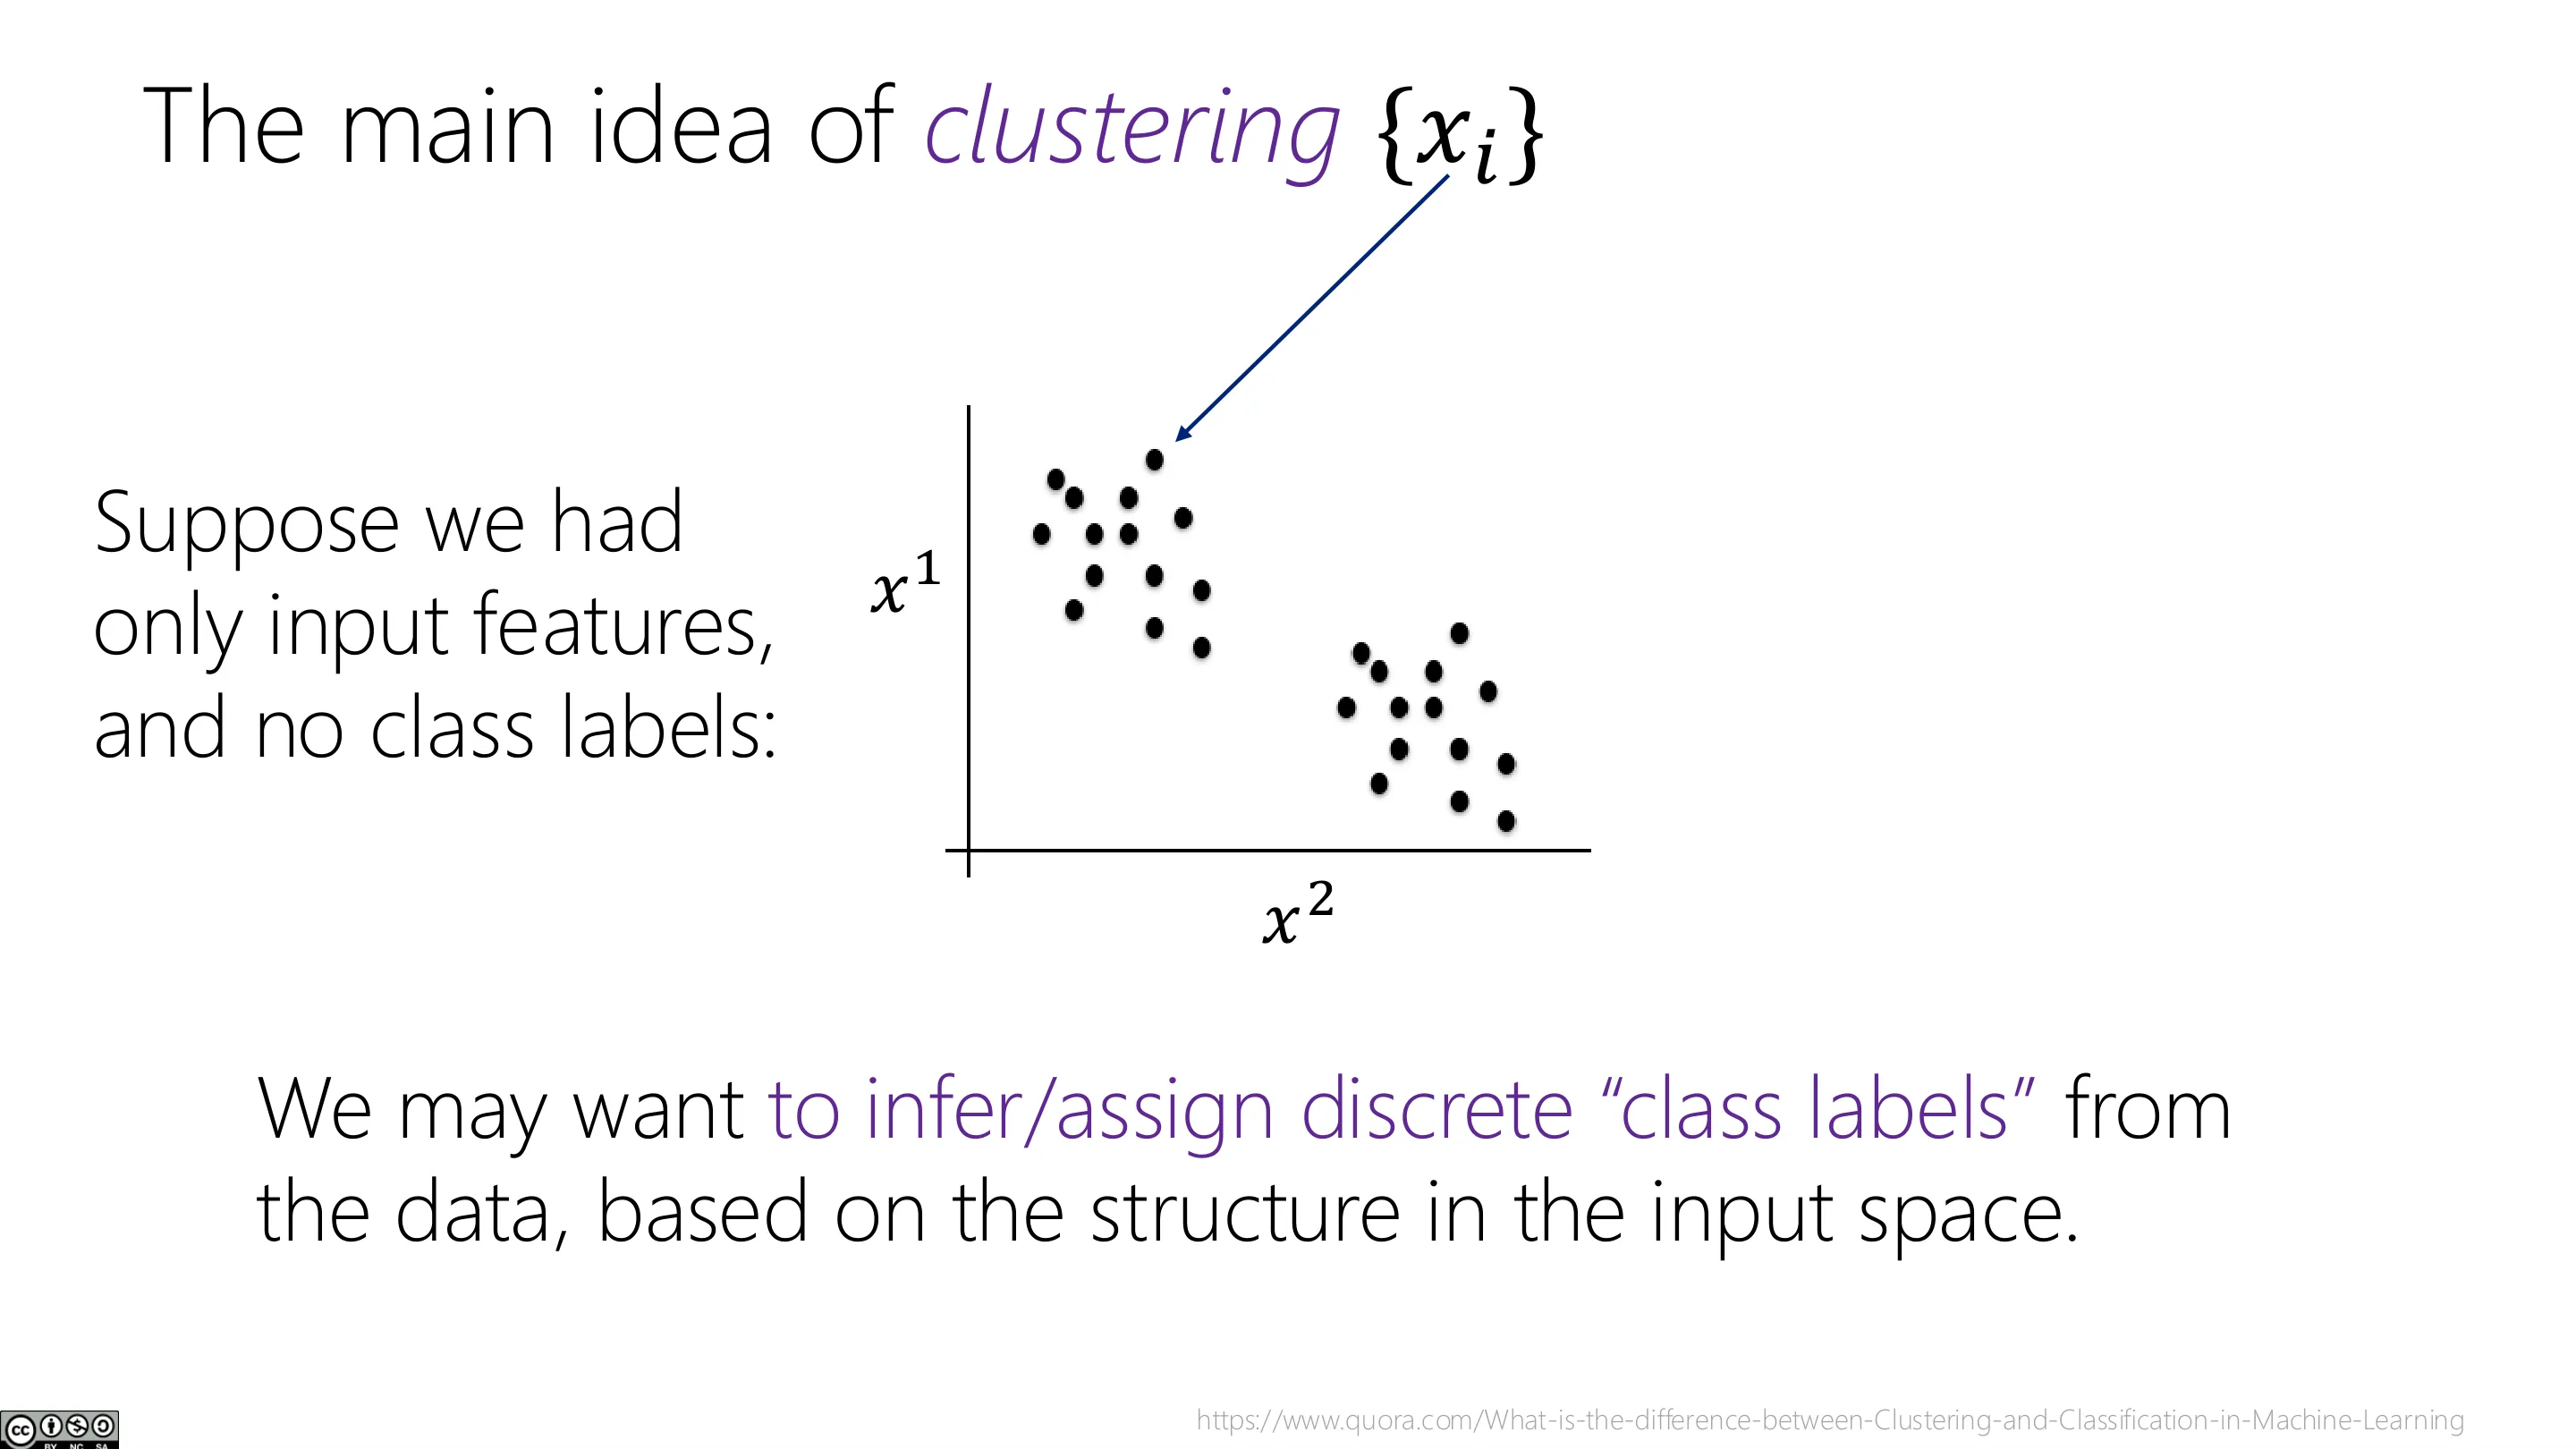
假设我们只有输入特征、没有类别标签。我们想根据输入空间中的结构,从数据里推断/分配离散的「类标签」。
📷 只有输入特征、没有类别标签
回到原视频 (00:20:03)
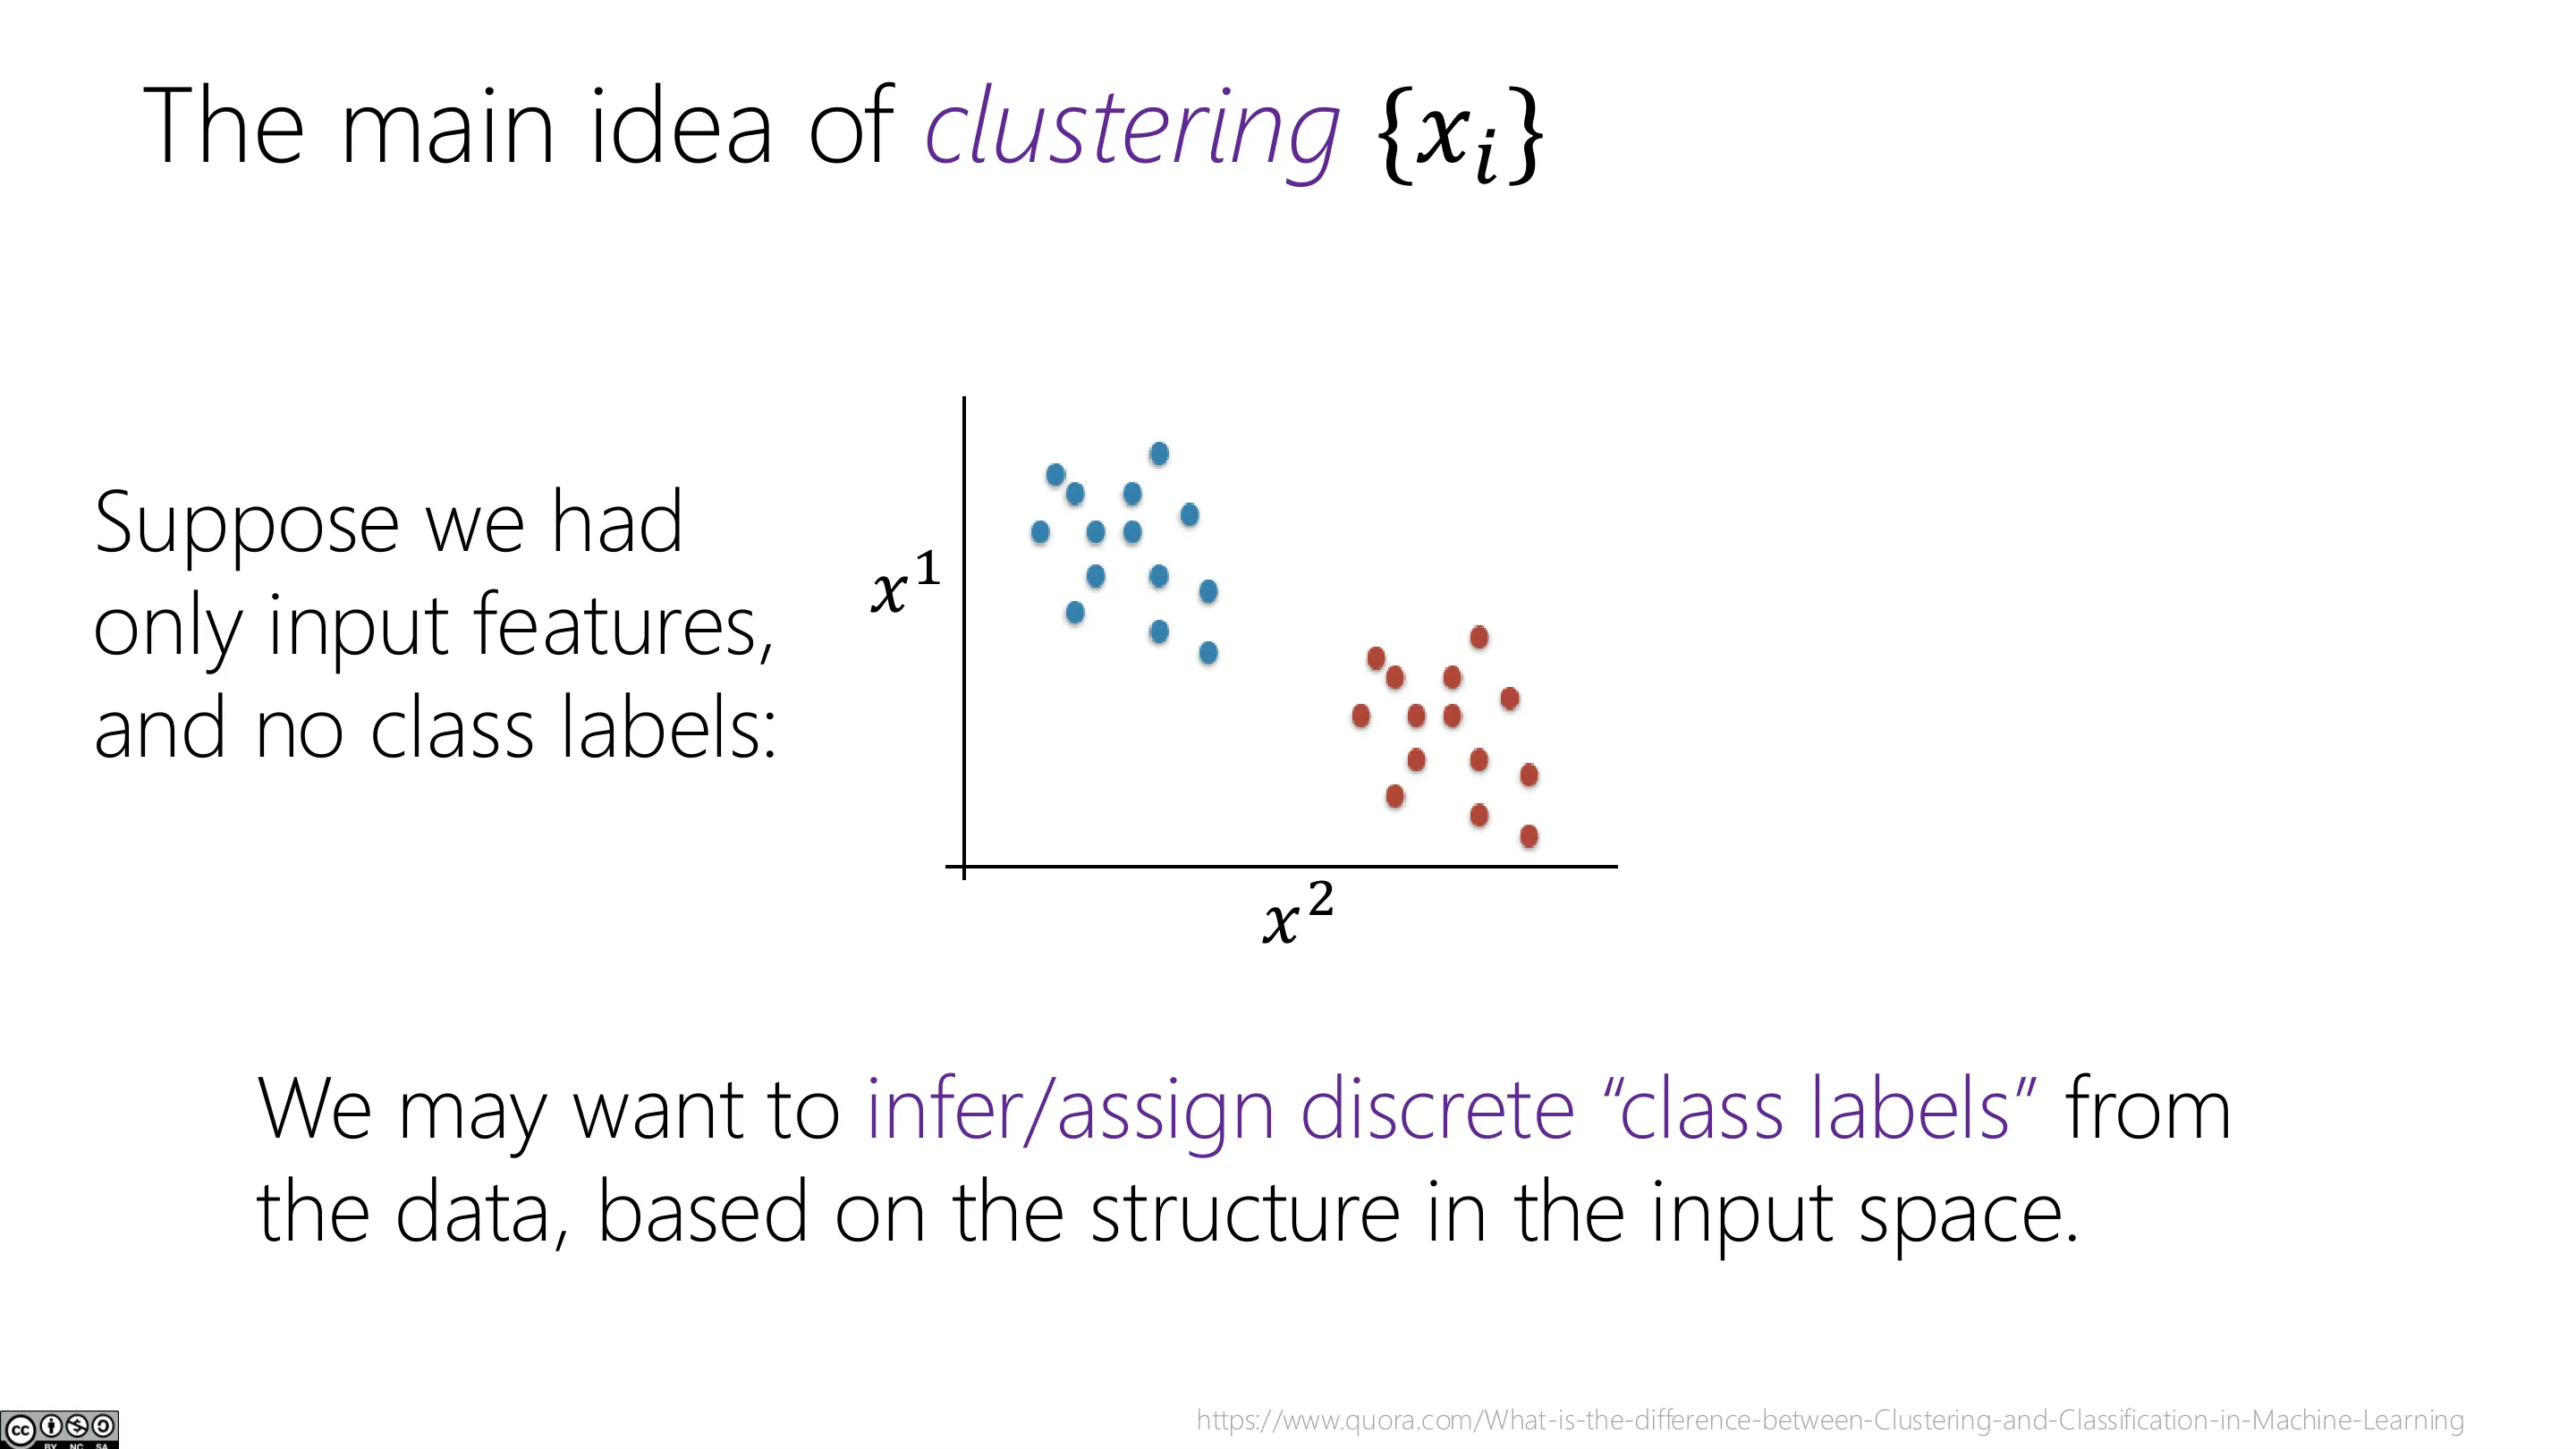
📷 聚类的核心思想
回到原视频 (00:20:43)
聚类也常用于异常检测(outlier detection):与其只问「聚类是什么」,不如问「哪些点明显偏离、值得单独研究」。
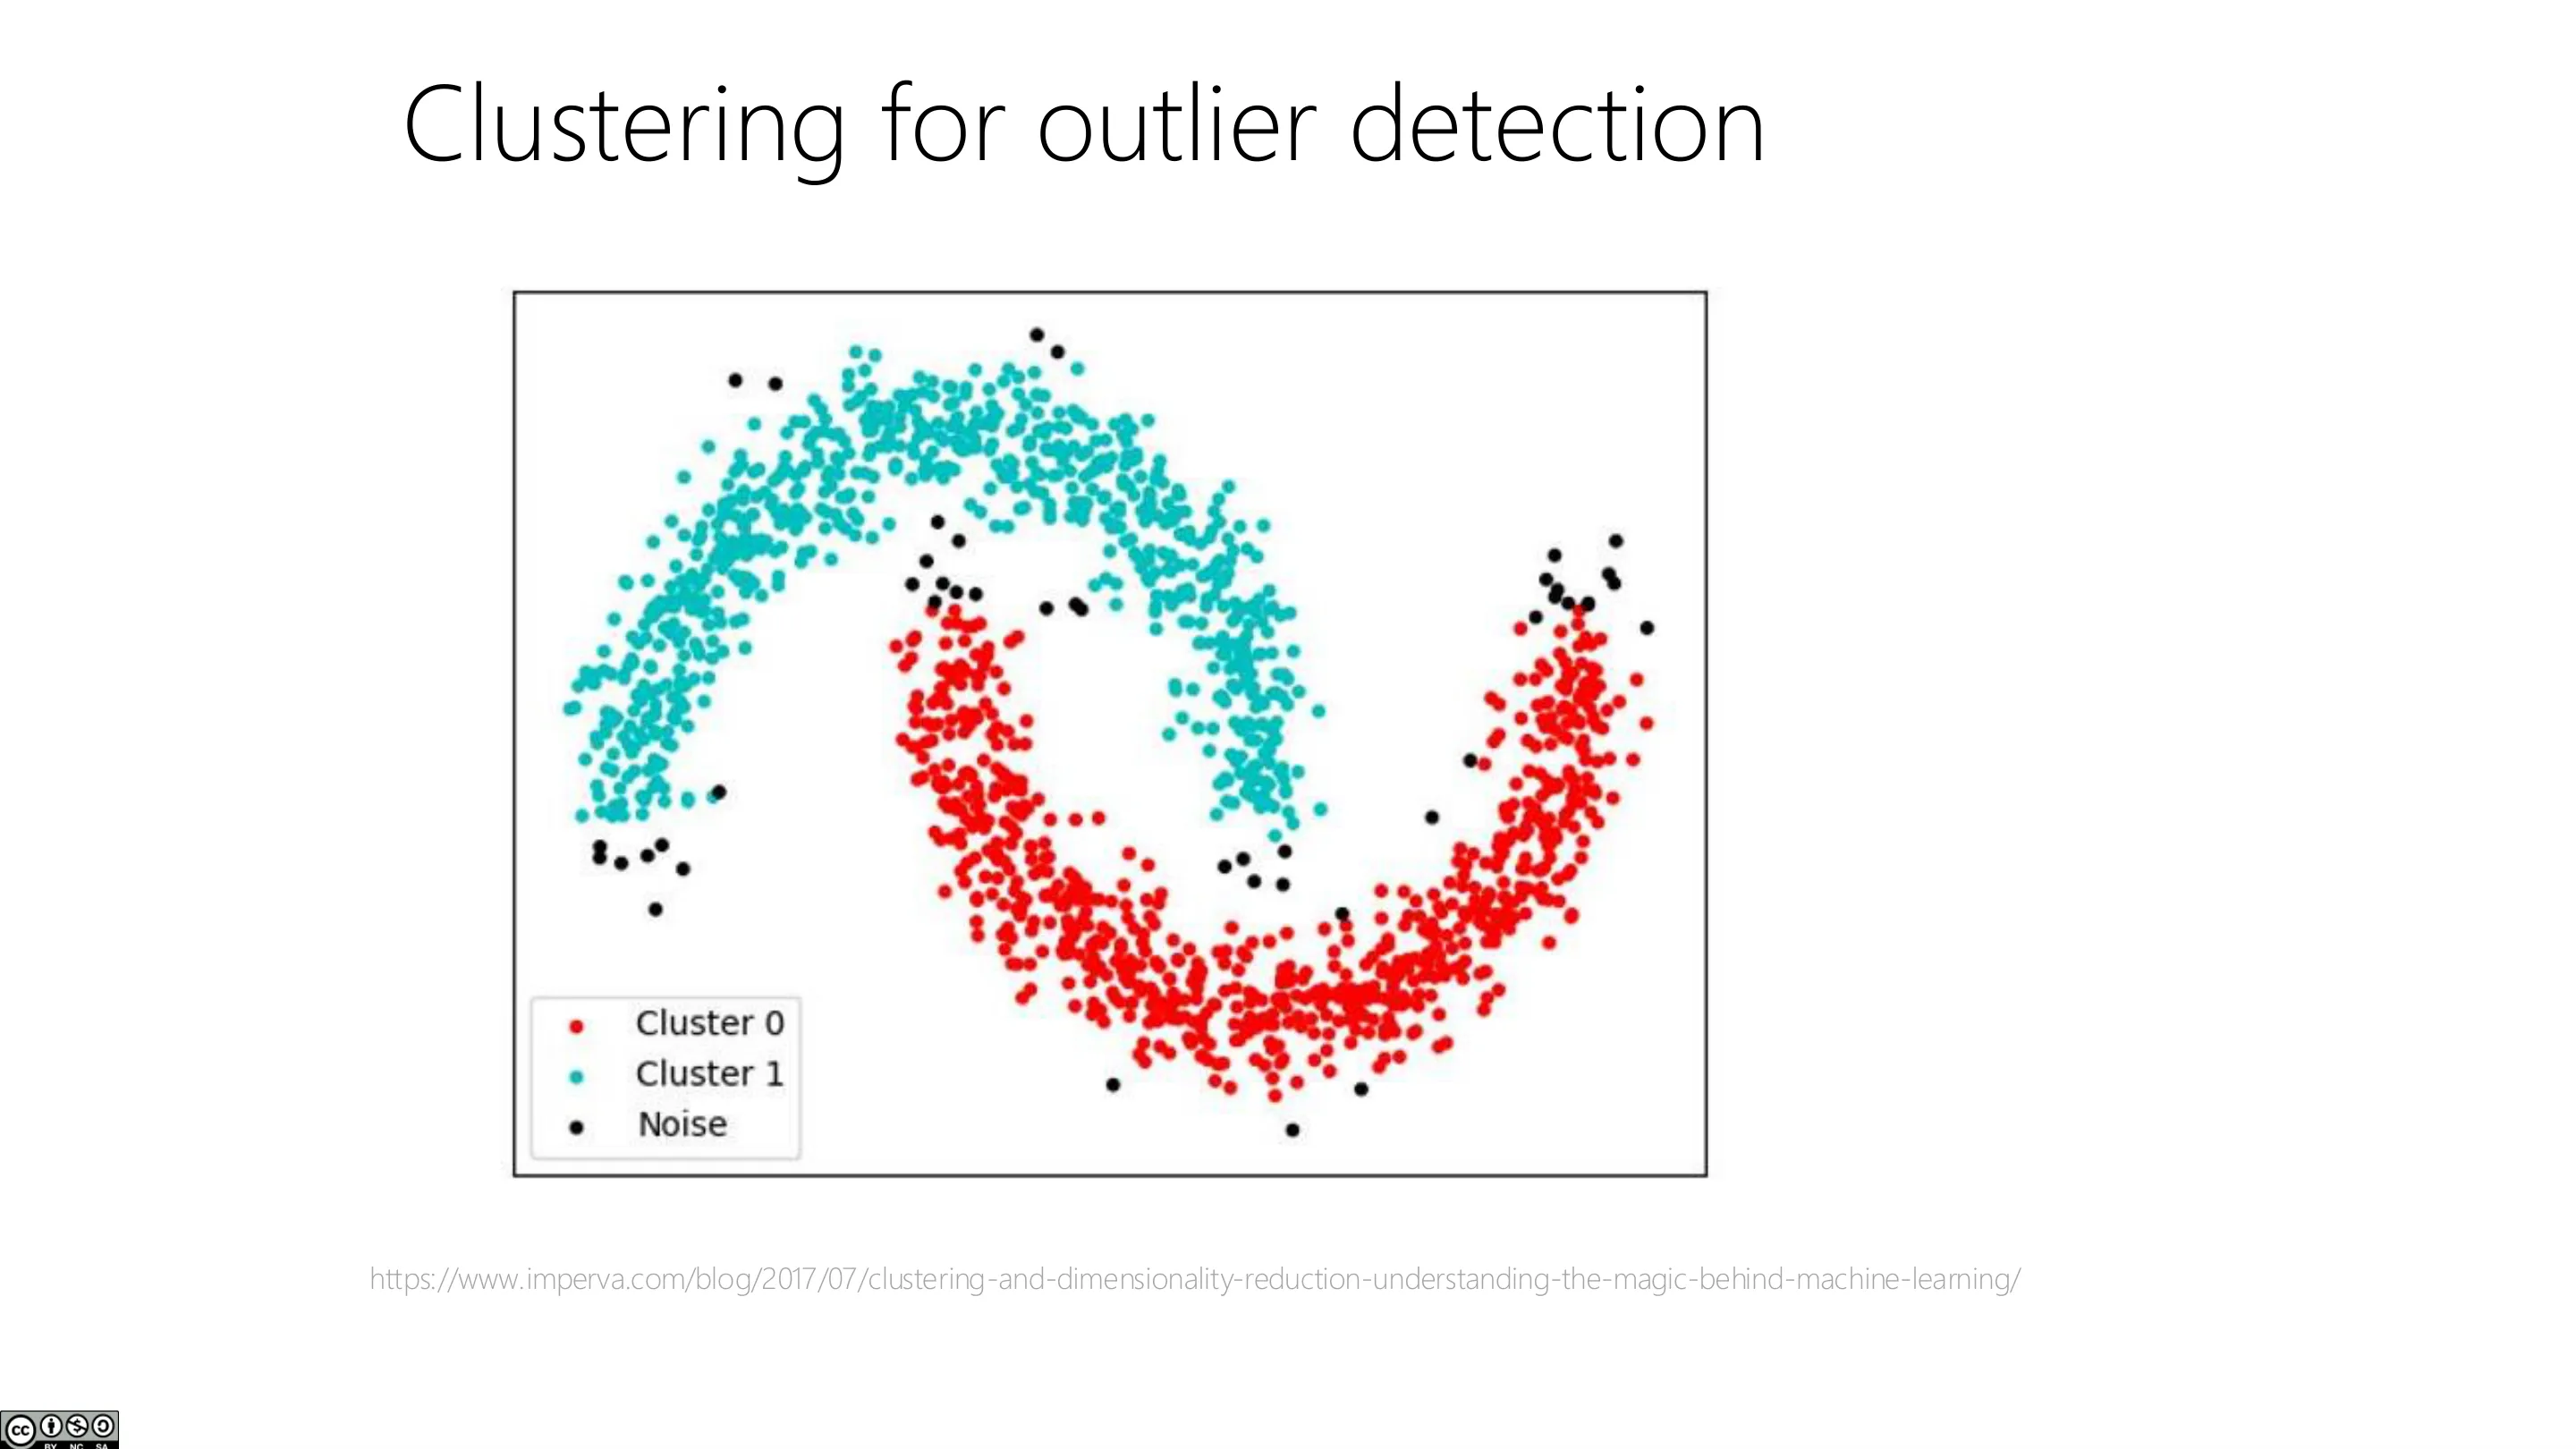
📷 聚类用于异常检测
回到原视频 (00:23:18)
聚类大致有三大类方法:
flowchart TD
    A["聚类方法"] --> B["基于中心点<br/>centroid-based(K-means)"]
    A --> C["层次/凝聚式<br/>agglomerative(合并最近点→树状图)"]
    A --> D["基于图/谱聚类<br/>graph-cut / spectral(与 PCA 相关)"]
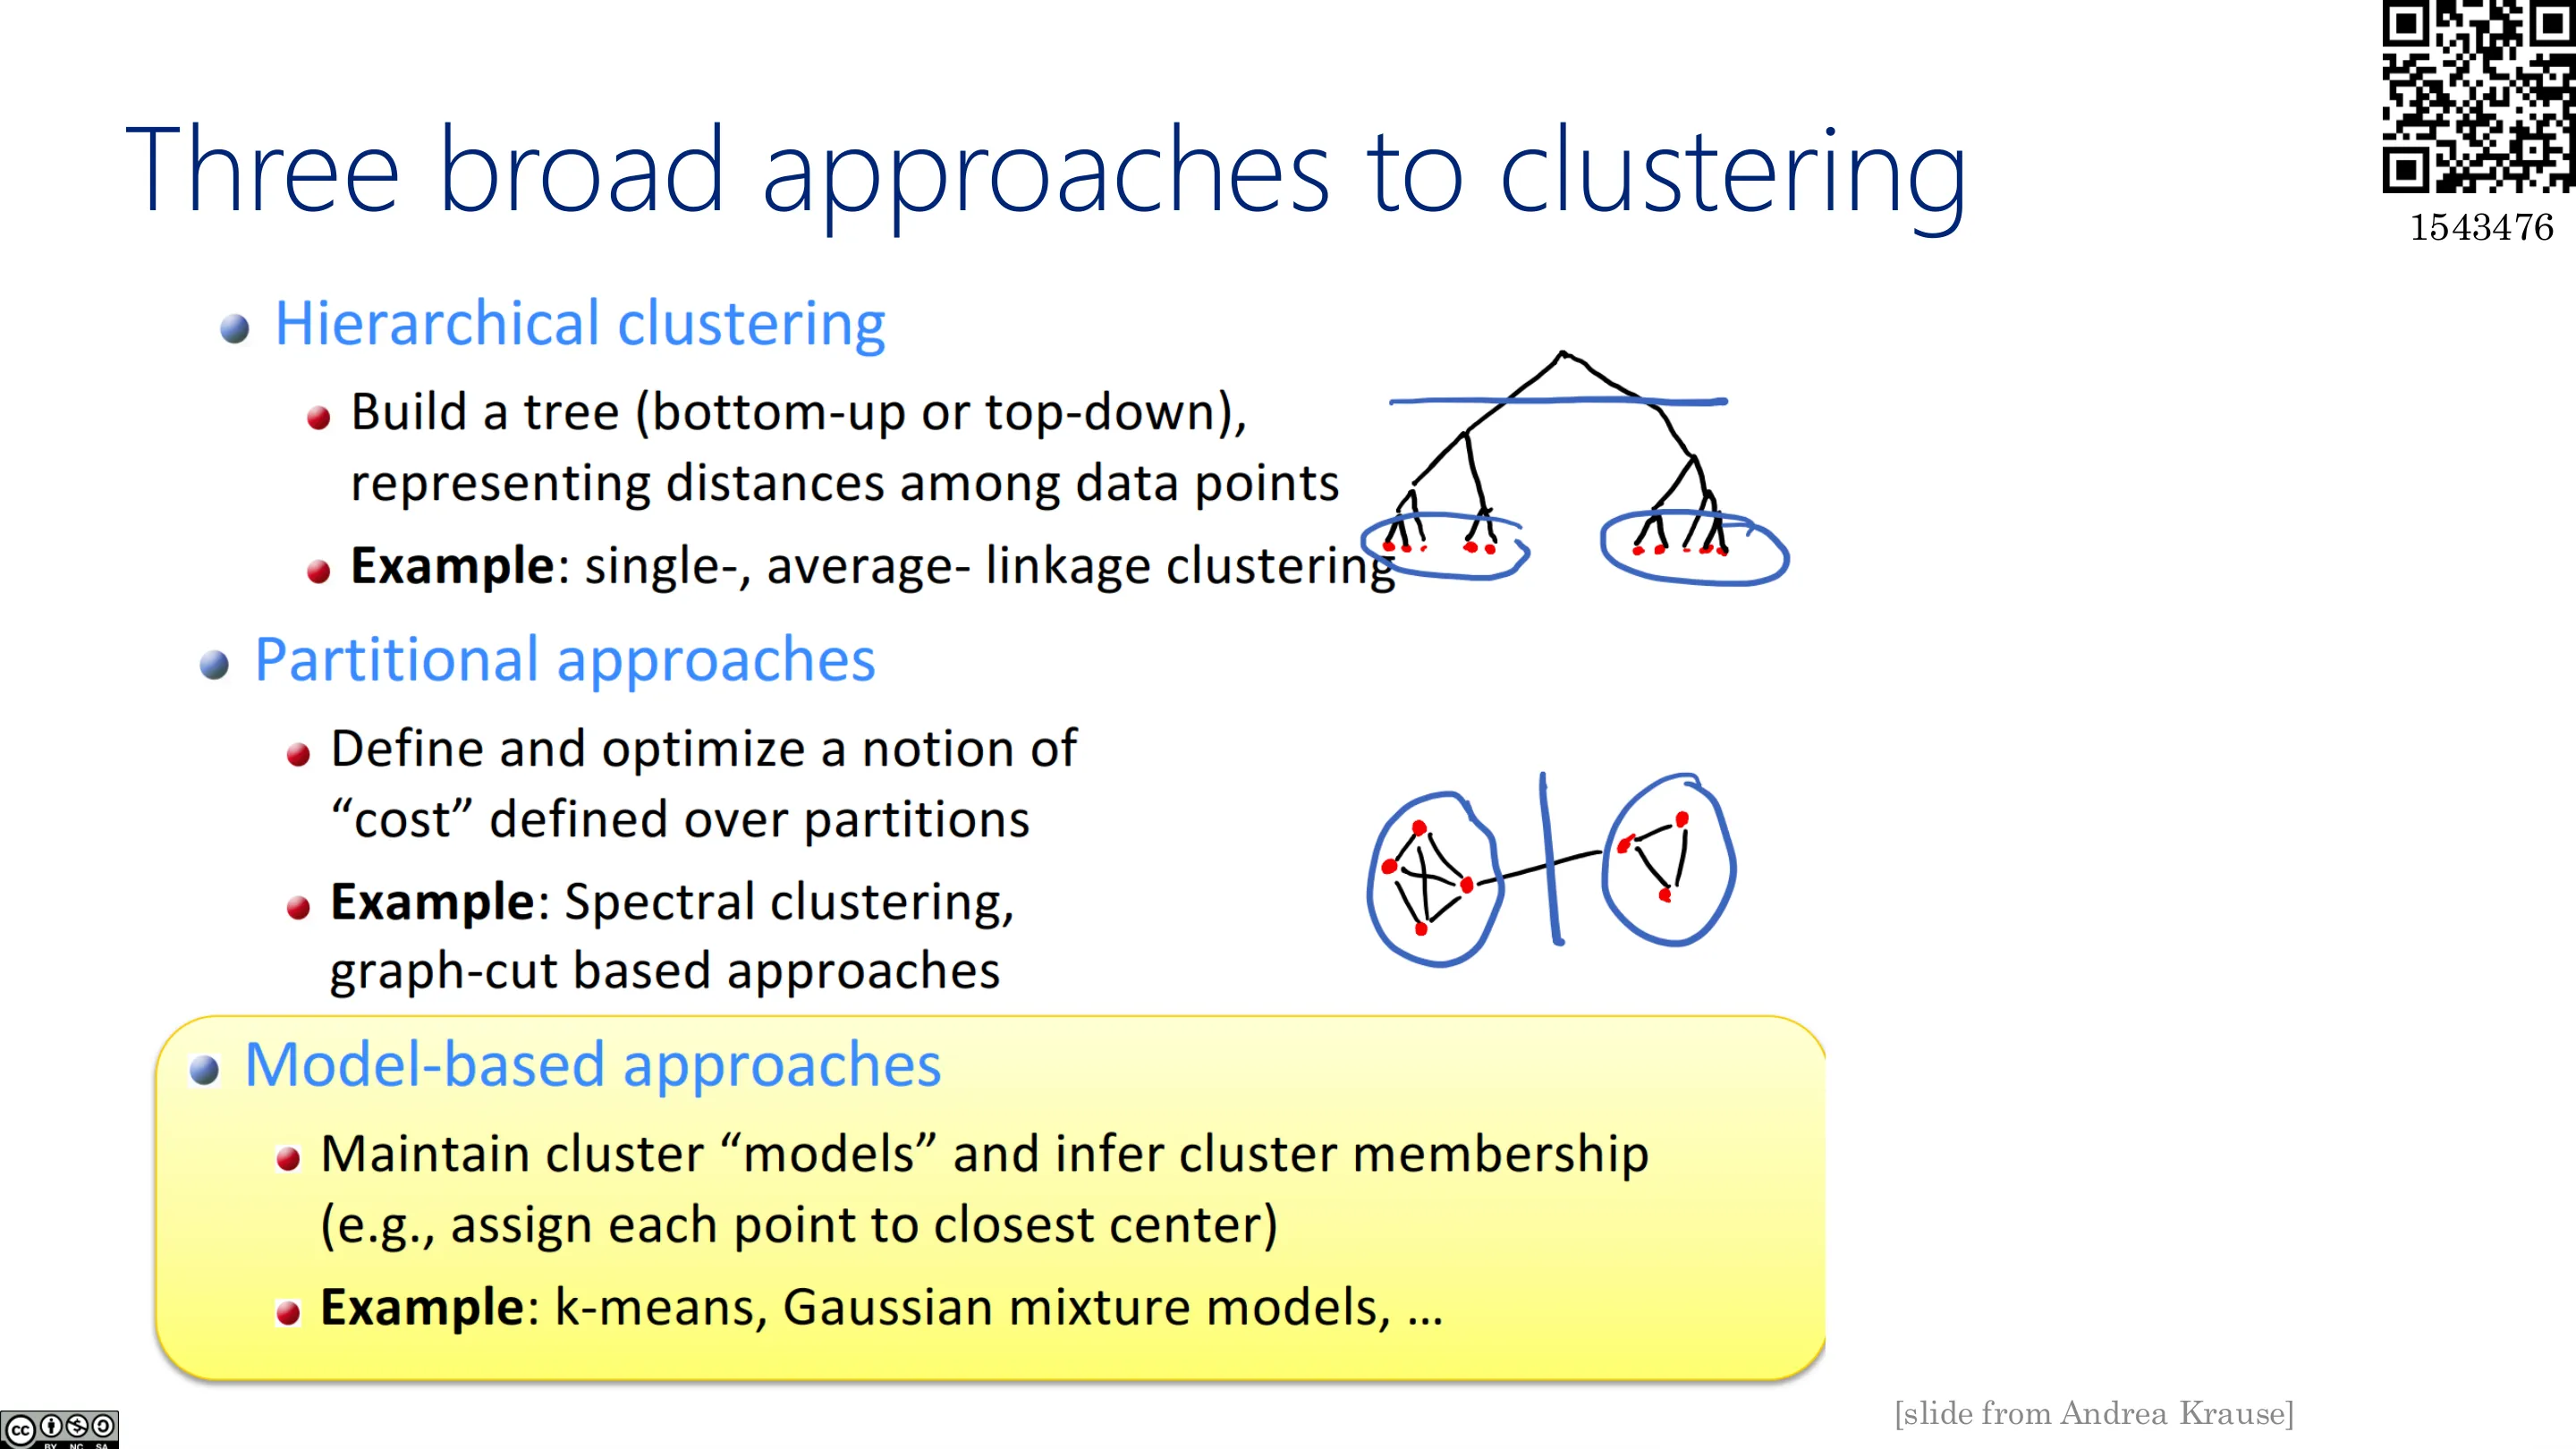
📷 聚类的三大类方法
回到原视频 (00:24:55)
2.2 聚类的目标
聚类的核心诉求(desiderata):
- 簇内相似度(intra-cluster similarity)要高;
- 簇间相似度(inter-cluster similarity)要低;
- 相似度/距离「取决于观察者」——用什么度量,会决定算法给出什么结果。
换成距离的说法:希望簇内距离最小、簇间距离最大。
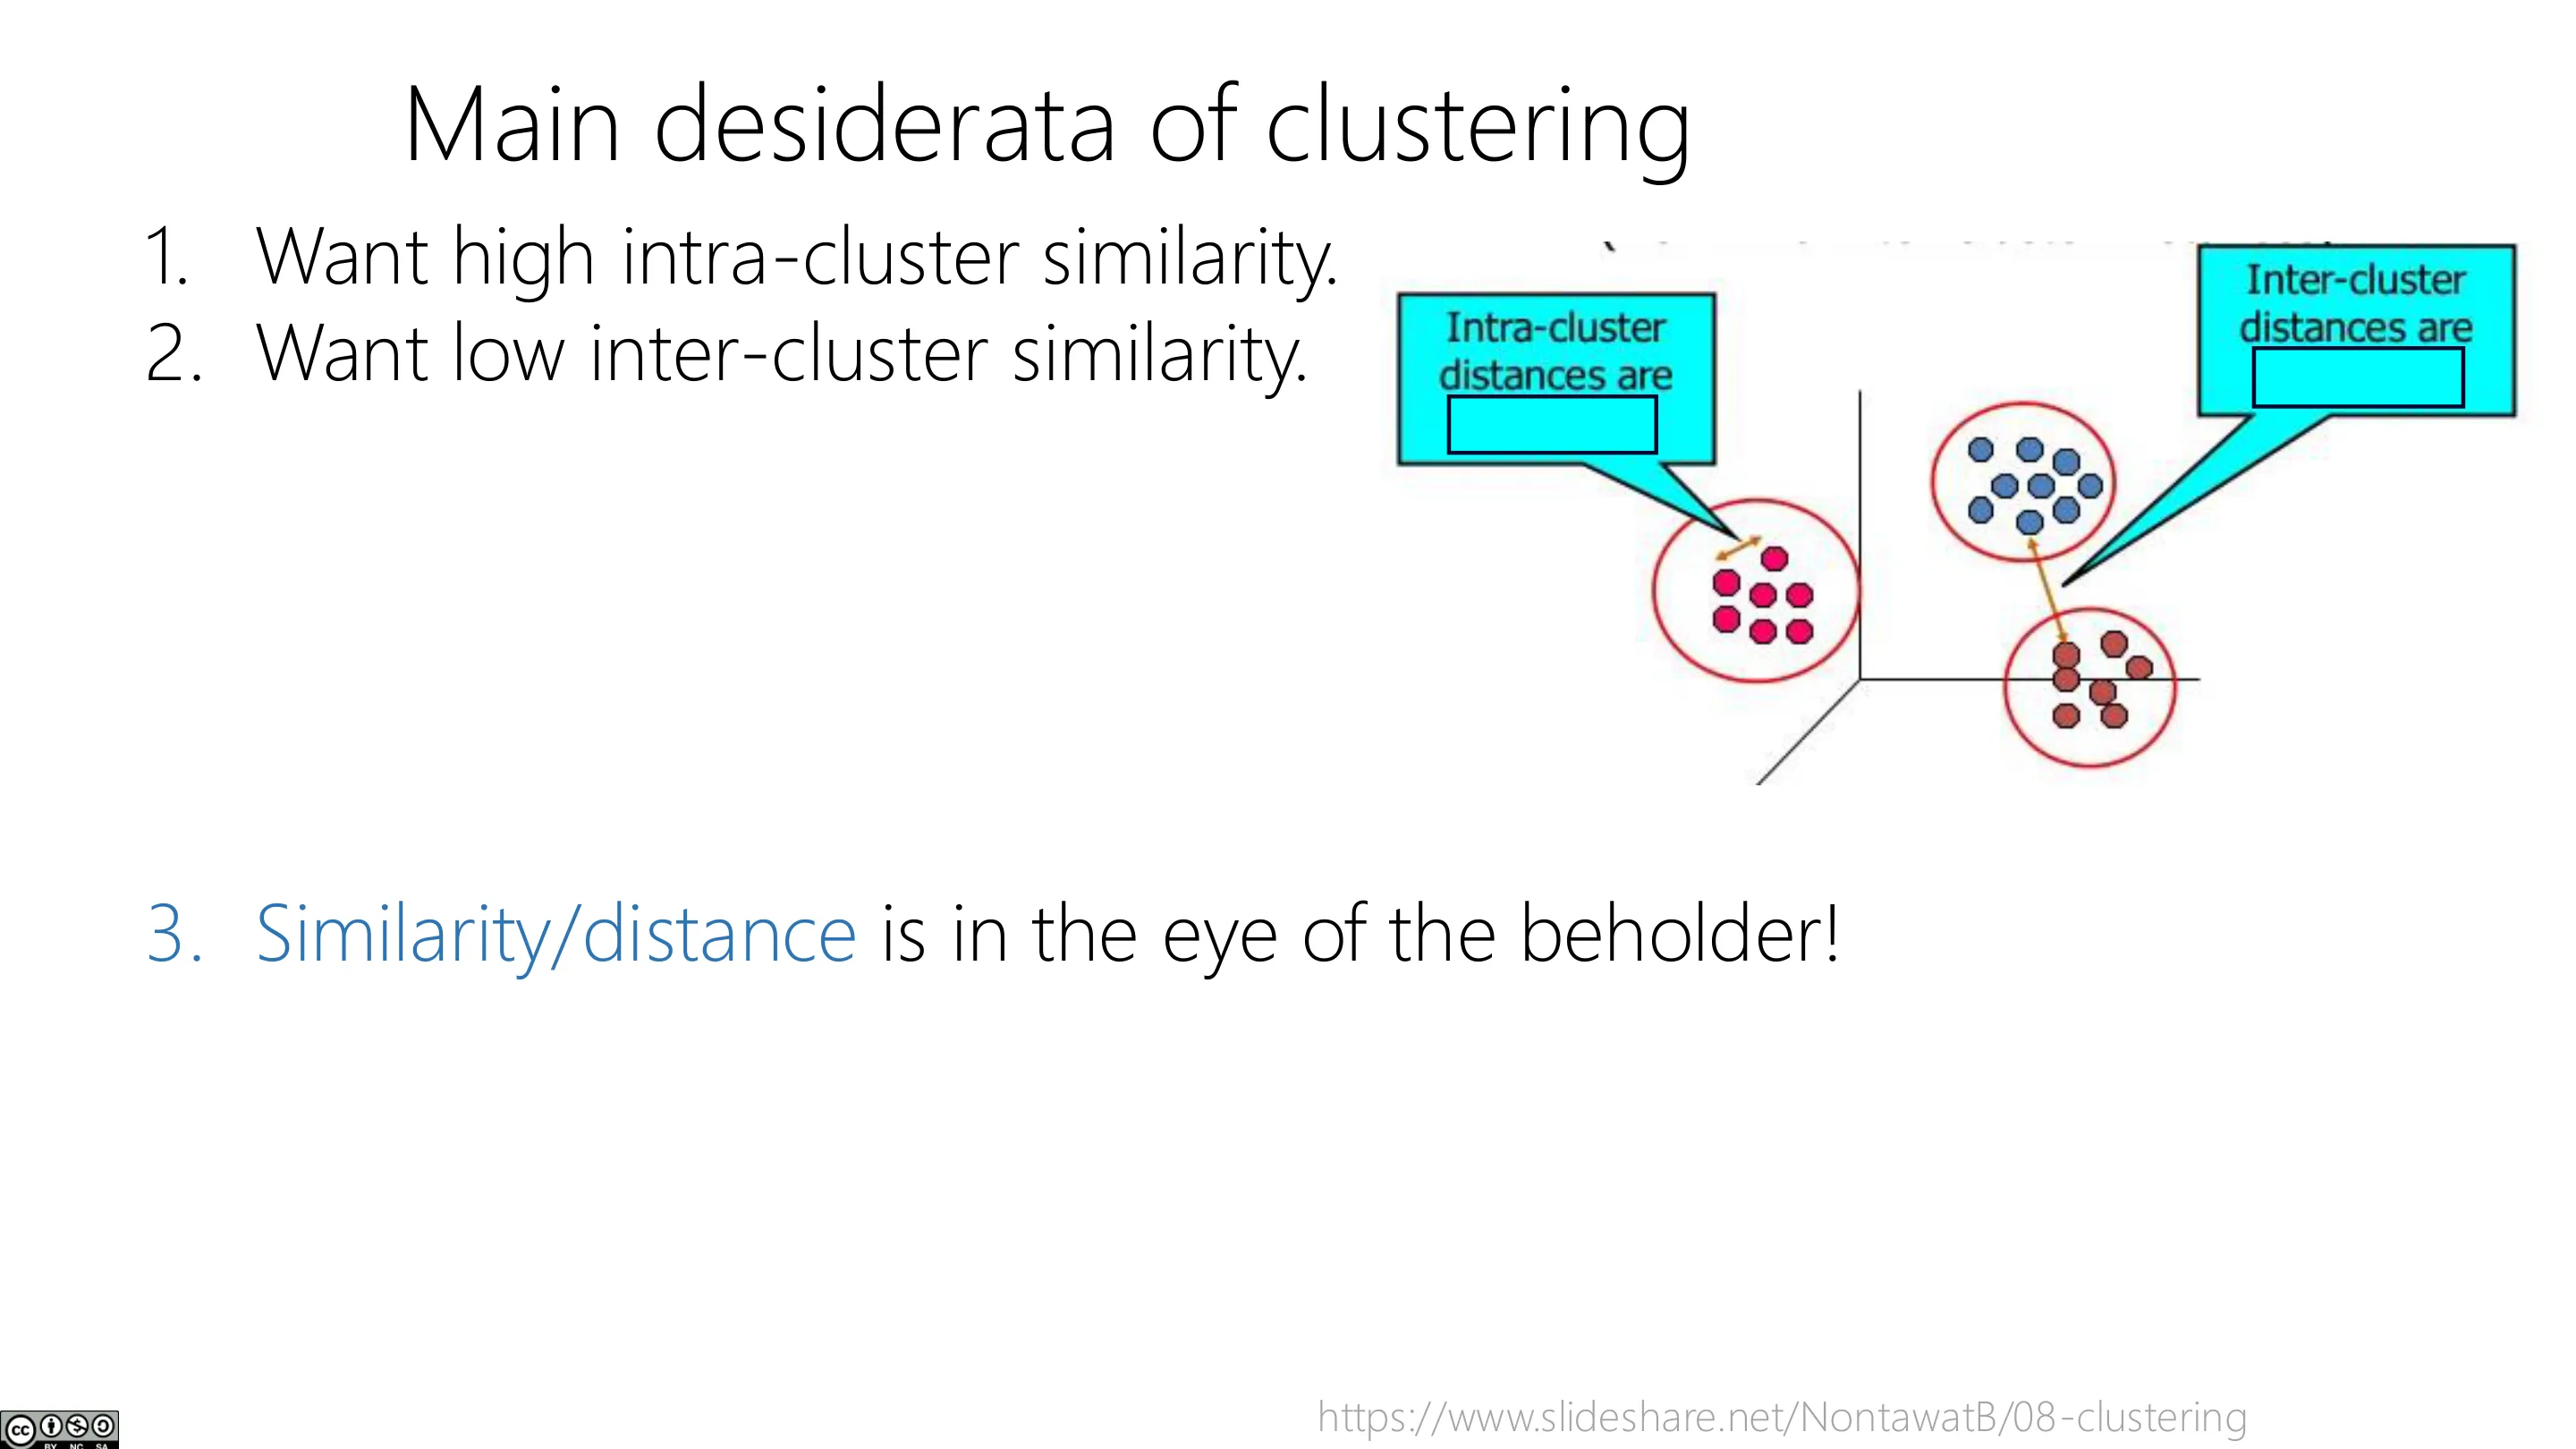
📷 聚类的主要诉求
回到原视频 (00:26:28)
有些聚类的形状并非球形「斑点」,而可能是一条流形(manifold)——这时「离中心近」就不是好标准了,需要用核方法(kernel methods)把点变换到另一个空间再聚类(本课不深入)。
编者说明:讲师也提出一个常被忽视的问题:到底该用哪种距离/相似度?欧氏距离、余弦距离、先投影再用欧氏距离……有无穷多种定义,不同定义会让同一个算法给出不同结果。K 均值今天用的距离是平方欧氏距离。
编者拓展|fa26 把 KNN 与 K-Means 放在同一讲:2026 秋季(fa26)的 Lecture 02 就是 KNN + K-Means —— 因为在“离哪个点最近”这个想法上,监督式的 KNN 是无监督 K-Means 的天然对照: KNN 的“邻居”带着标签(用于预测),K-Means 的“邻居”没有(用于分组)。 而且上面那个量纲问题在 KNN 里更致命:“距离取决于单位”正是 fa26 专门标出的一个陷阱。 本讲只讲了无监督那一半;KNN($k$ 的选择、量纲、KNN 回归)见 《补充:KNN、机器学习词汇与 K-Means》。
三、K 均值聚类
(参考时间: 00:29)
3.1 基于中心点(centroid-based)的聚类
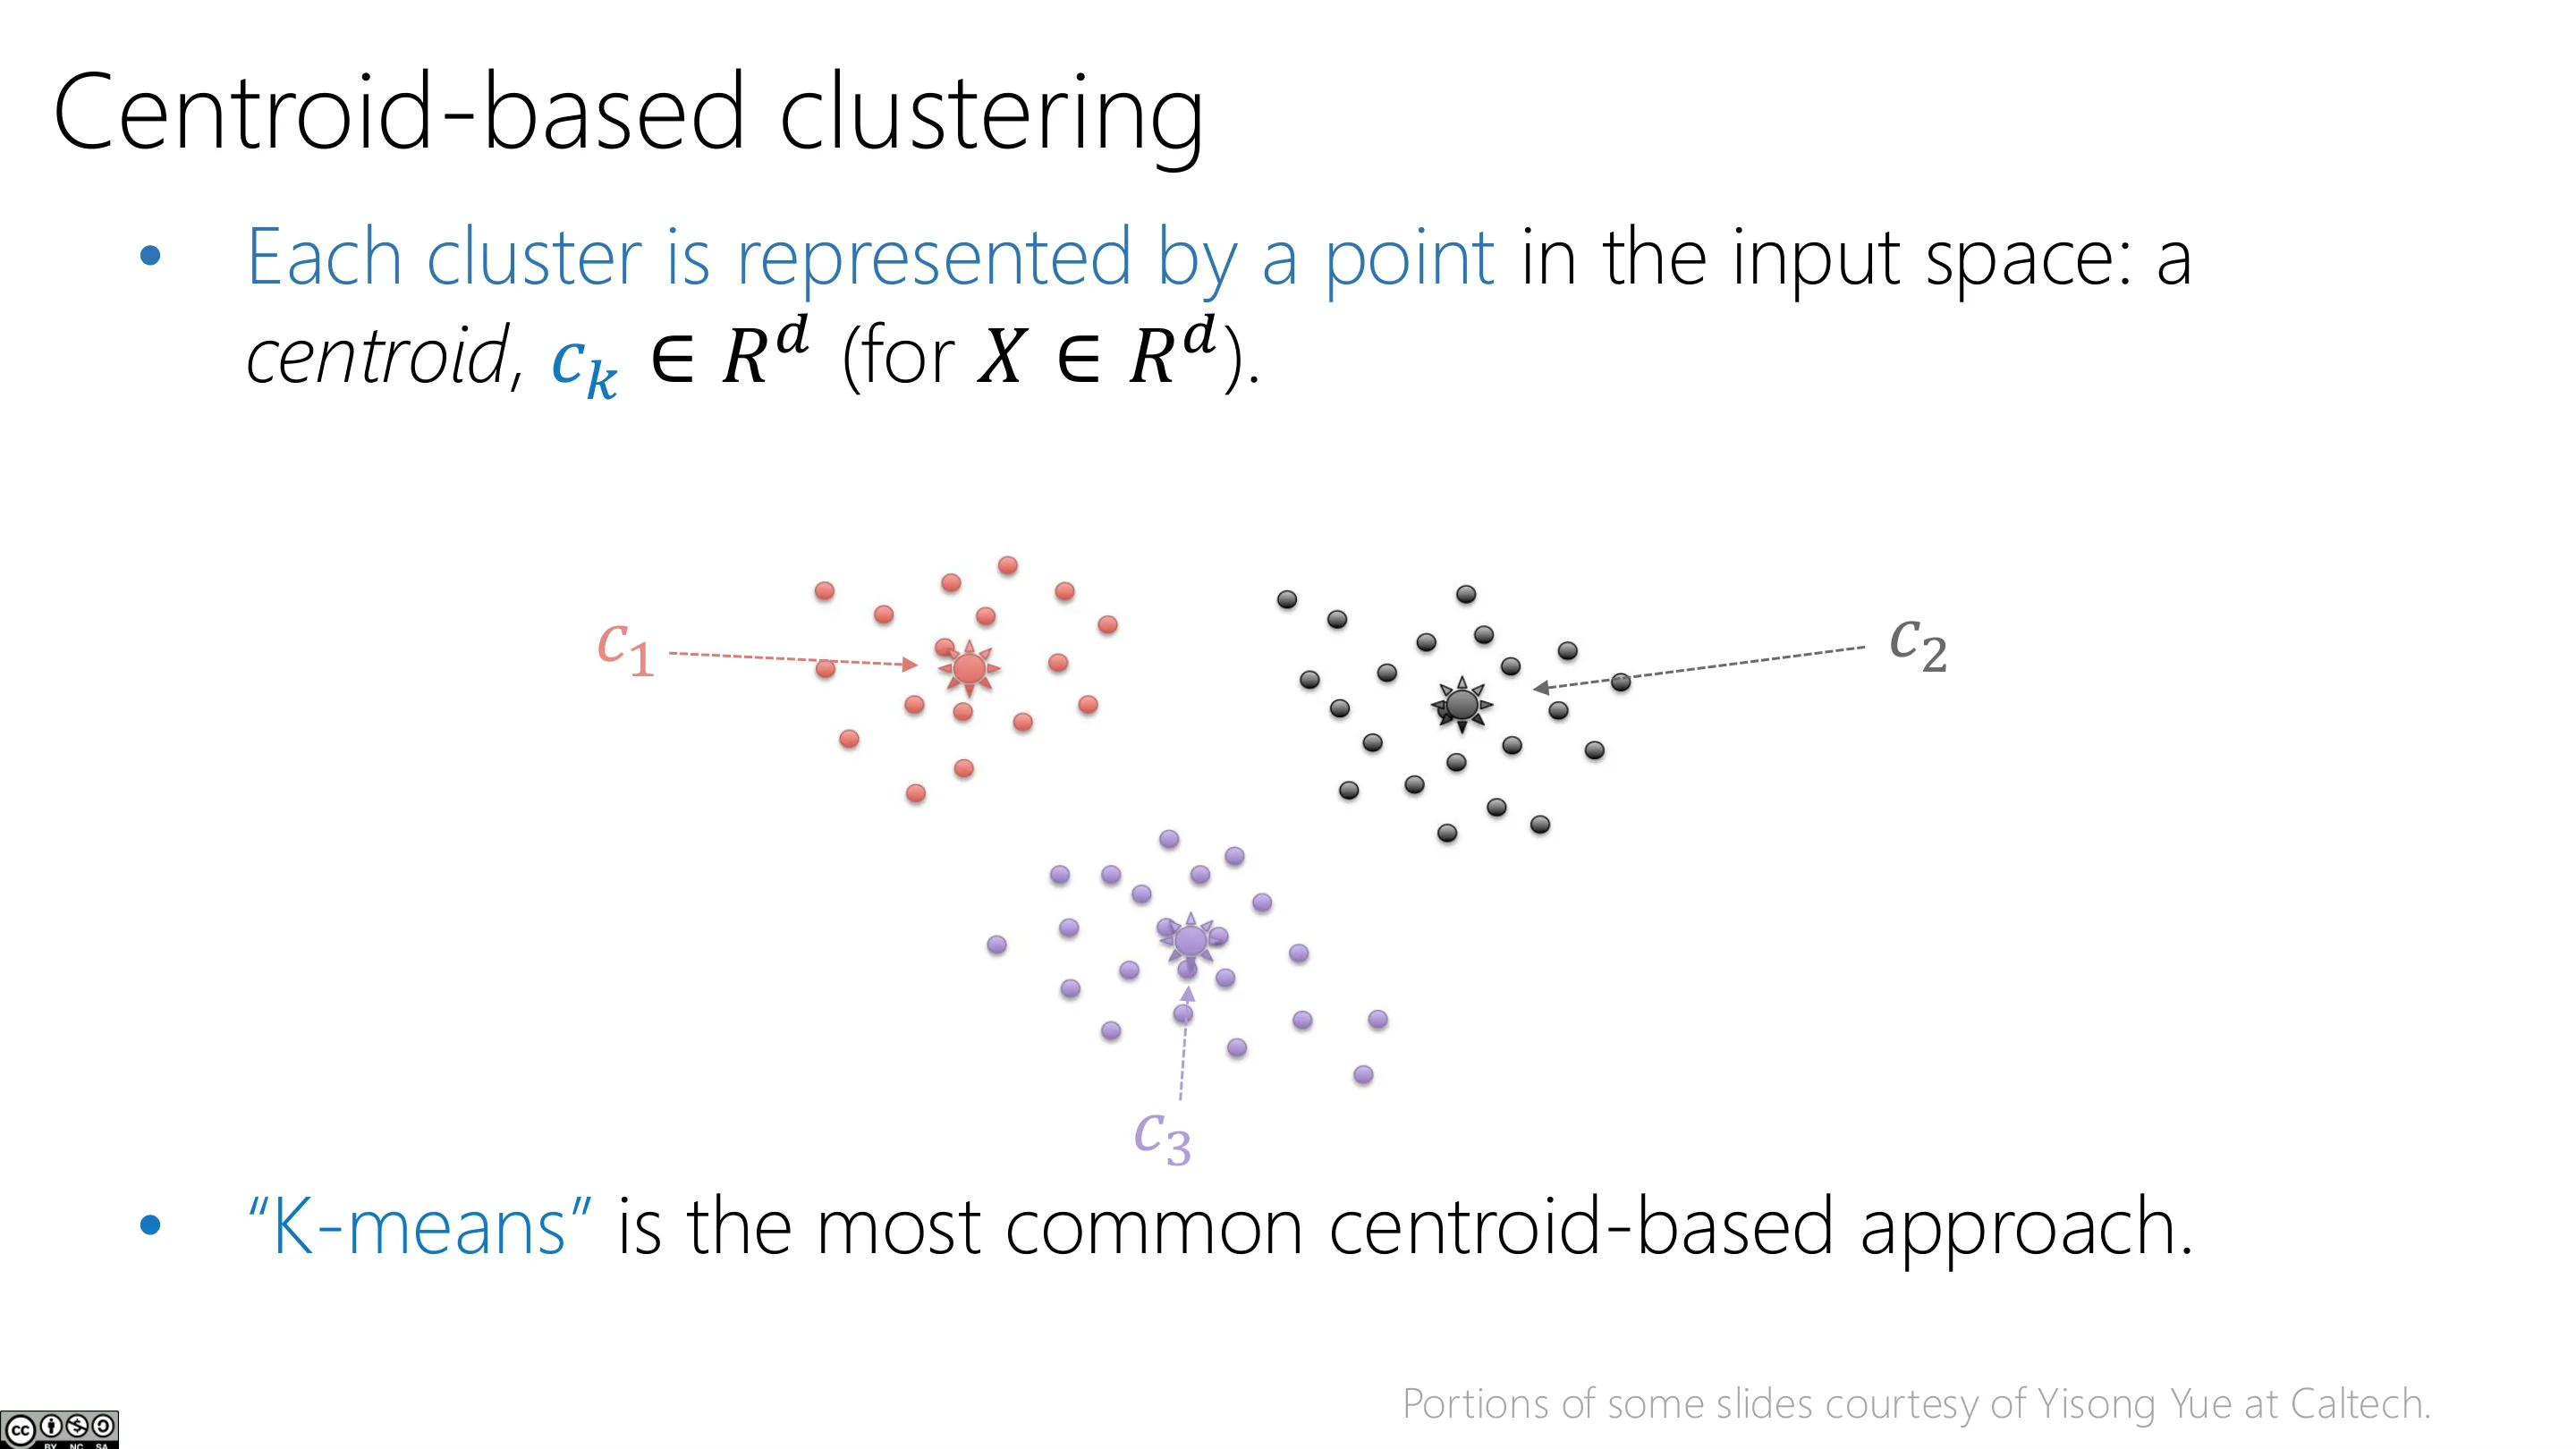
每个簇用一个输入空间中的点表示,称为质心(centroid) $c_k \in \mathbb{R}^d$。K 均值是最常见的「基于中心点」方法。
分配规则:某个点离哪个质心最近,就属于哪个簇。注意簇的编号(1、2、3 或红、绿、蓝)是任意的,没有顺序和大小含义。
📷 基于中心点的聚类
回到原视频 (00:29:06)
3.2 K 均值的模型与目标函数
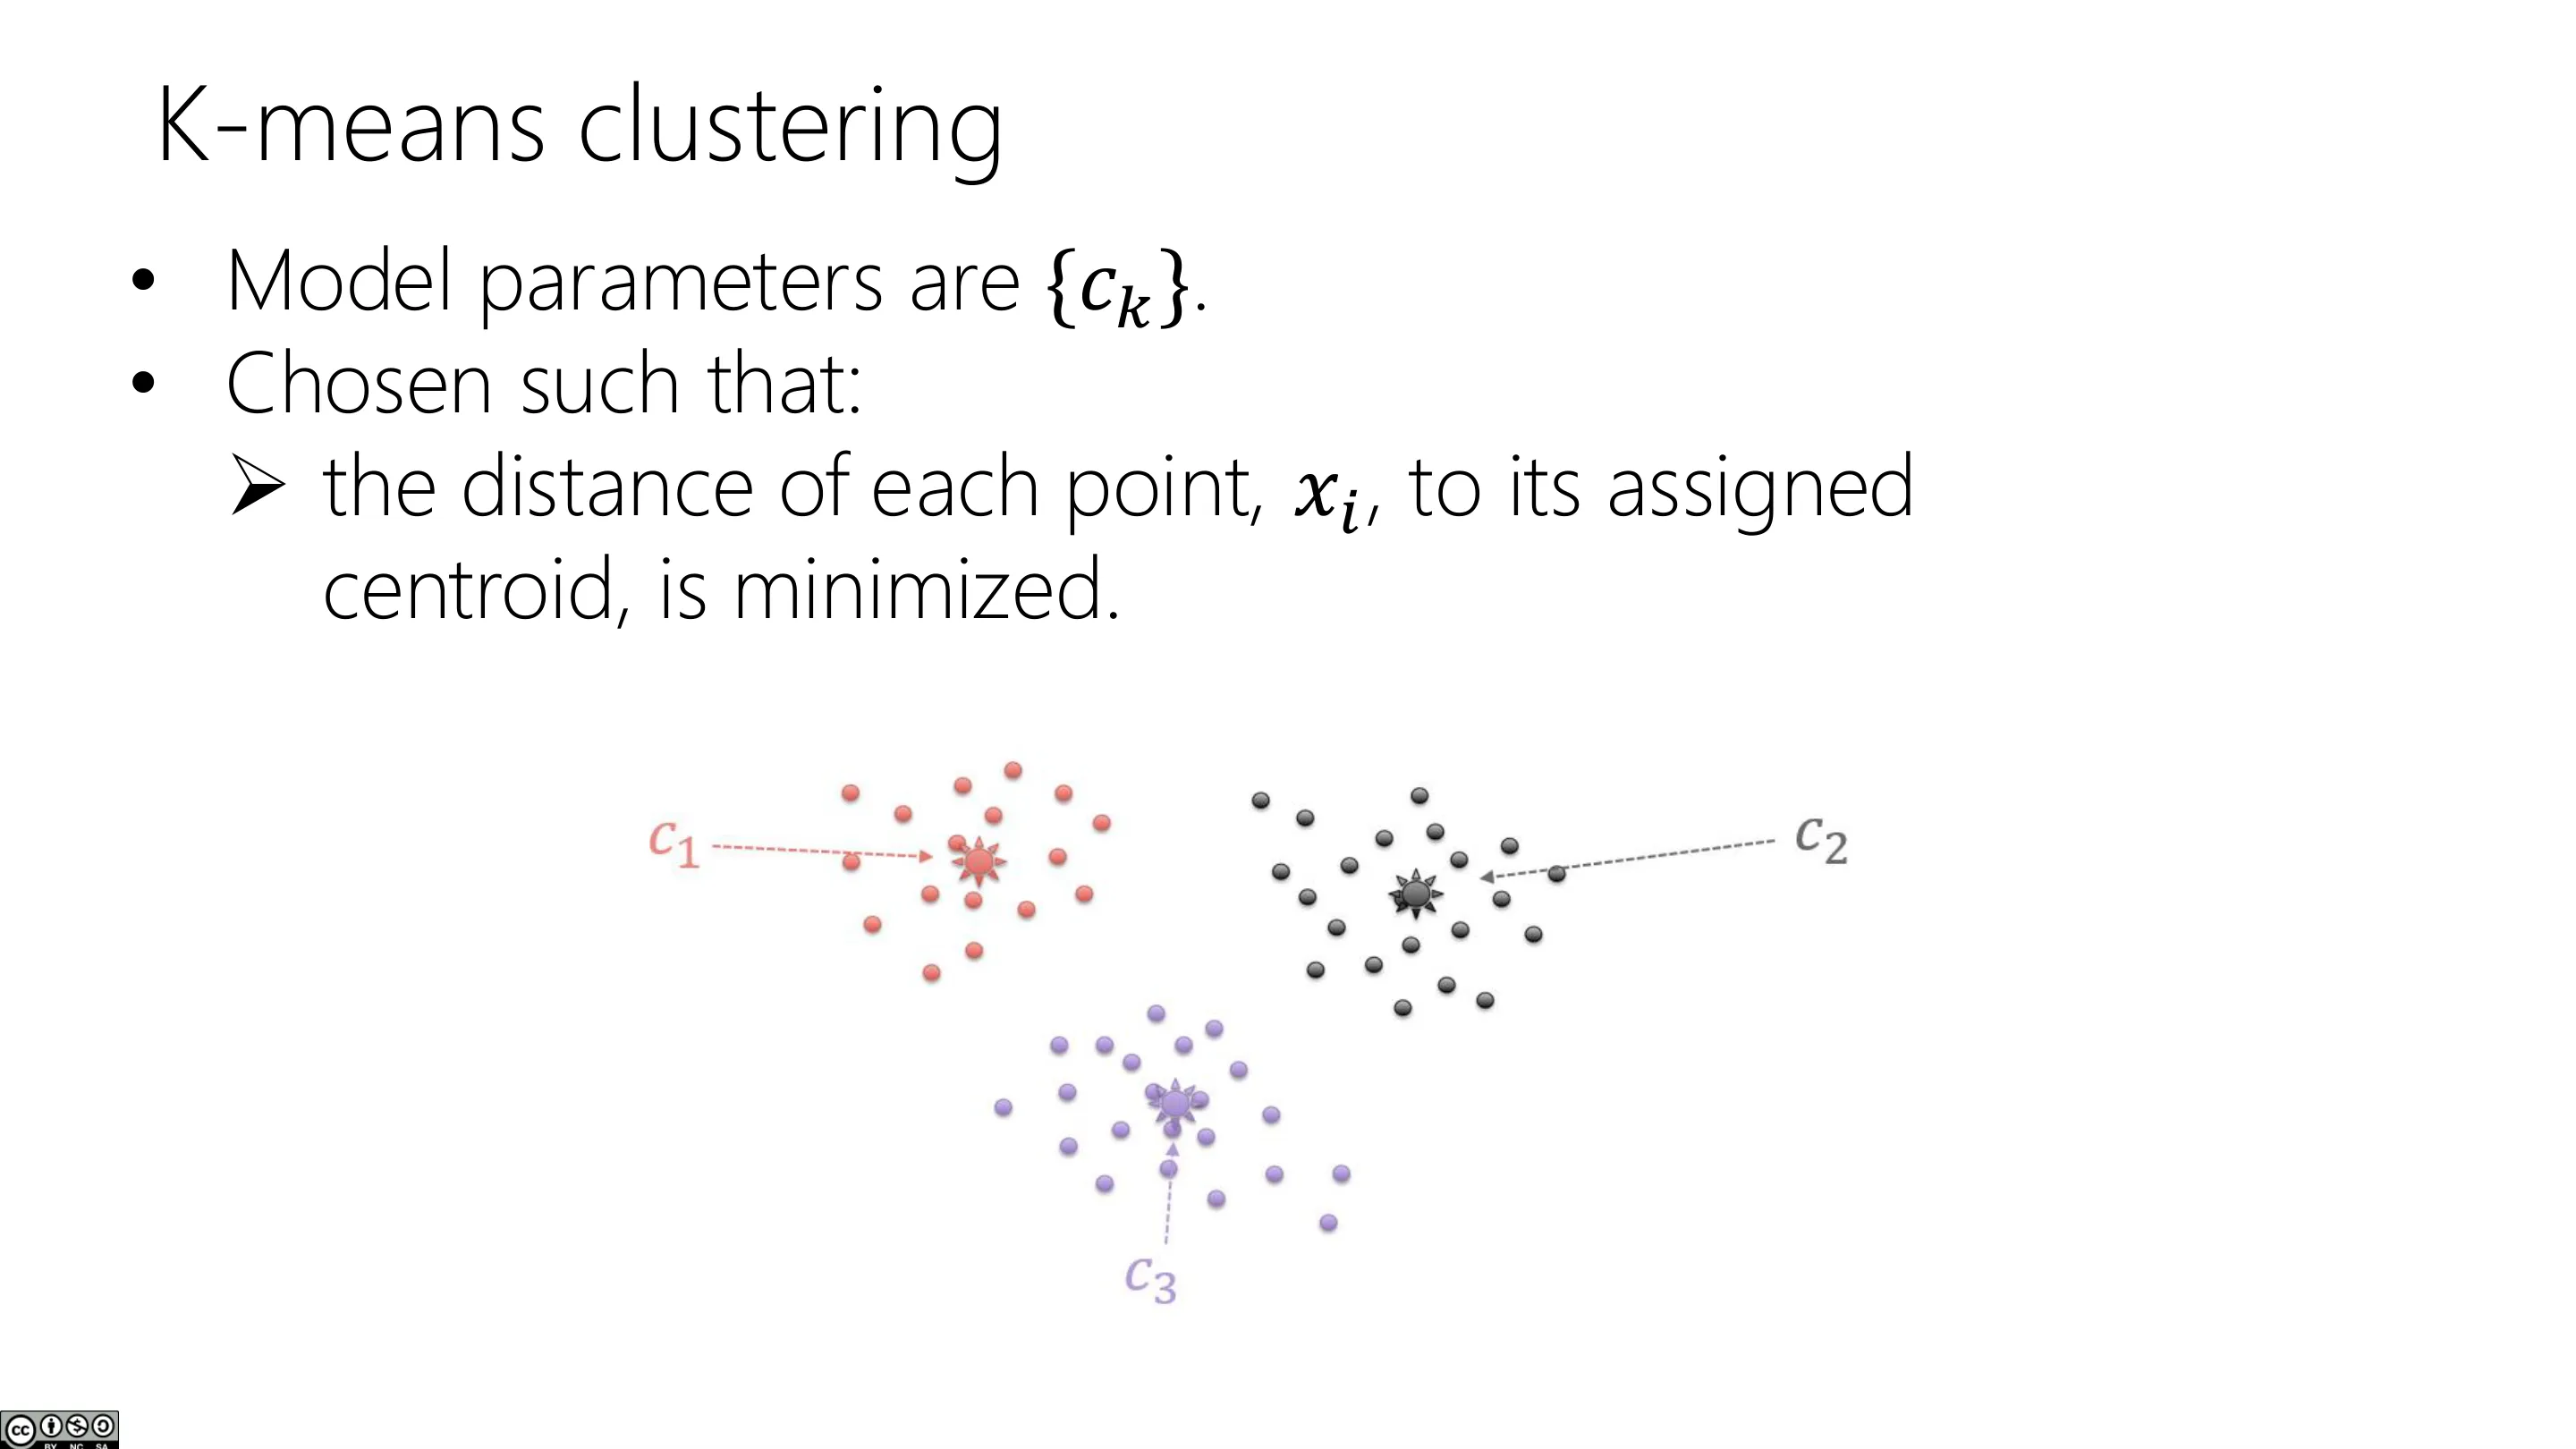
模型参数就是 $\{c_k\}$;我们希望每个点到它被分配到的质心的距离最小。
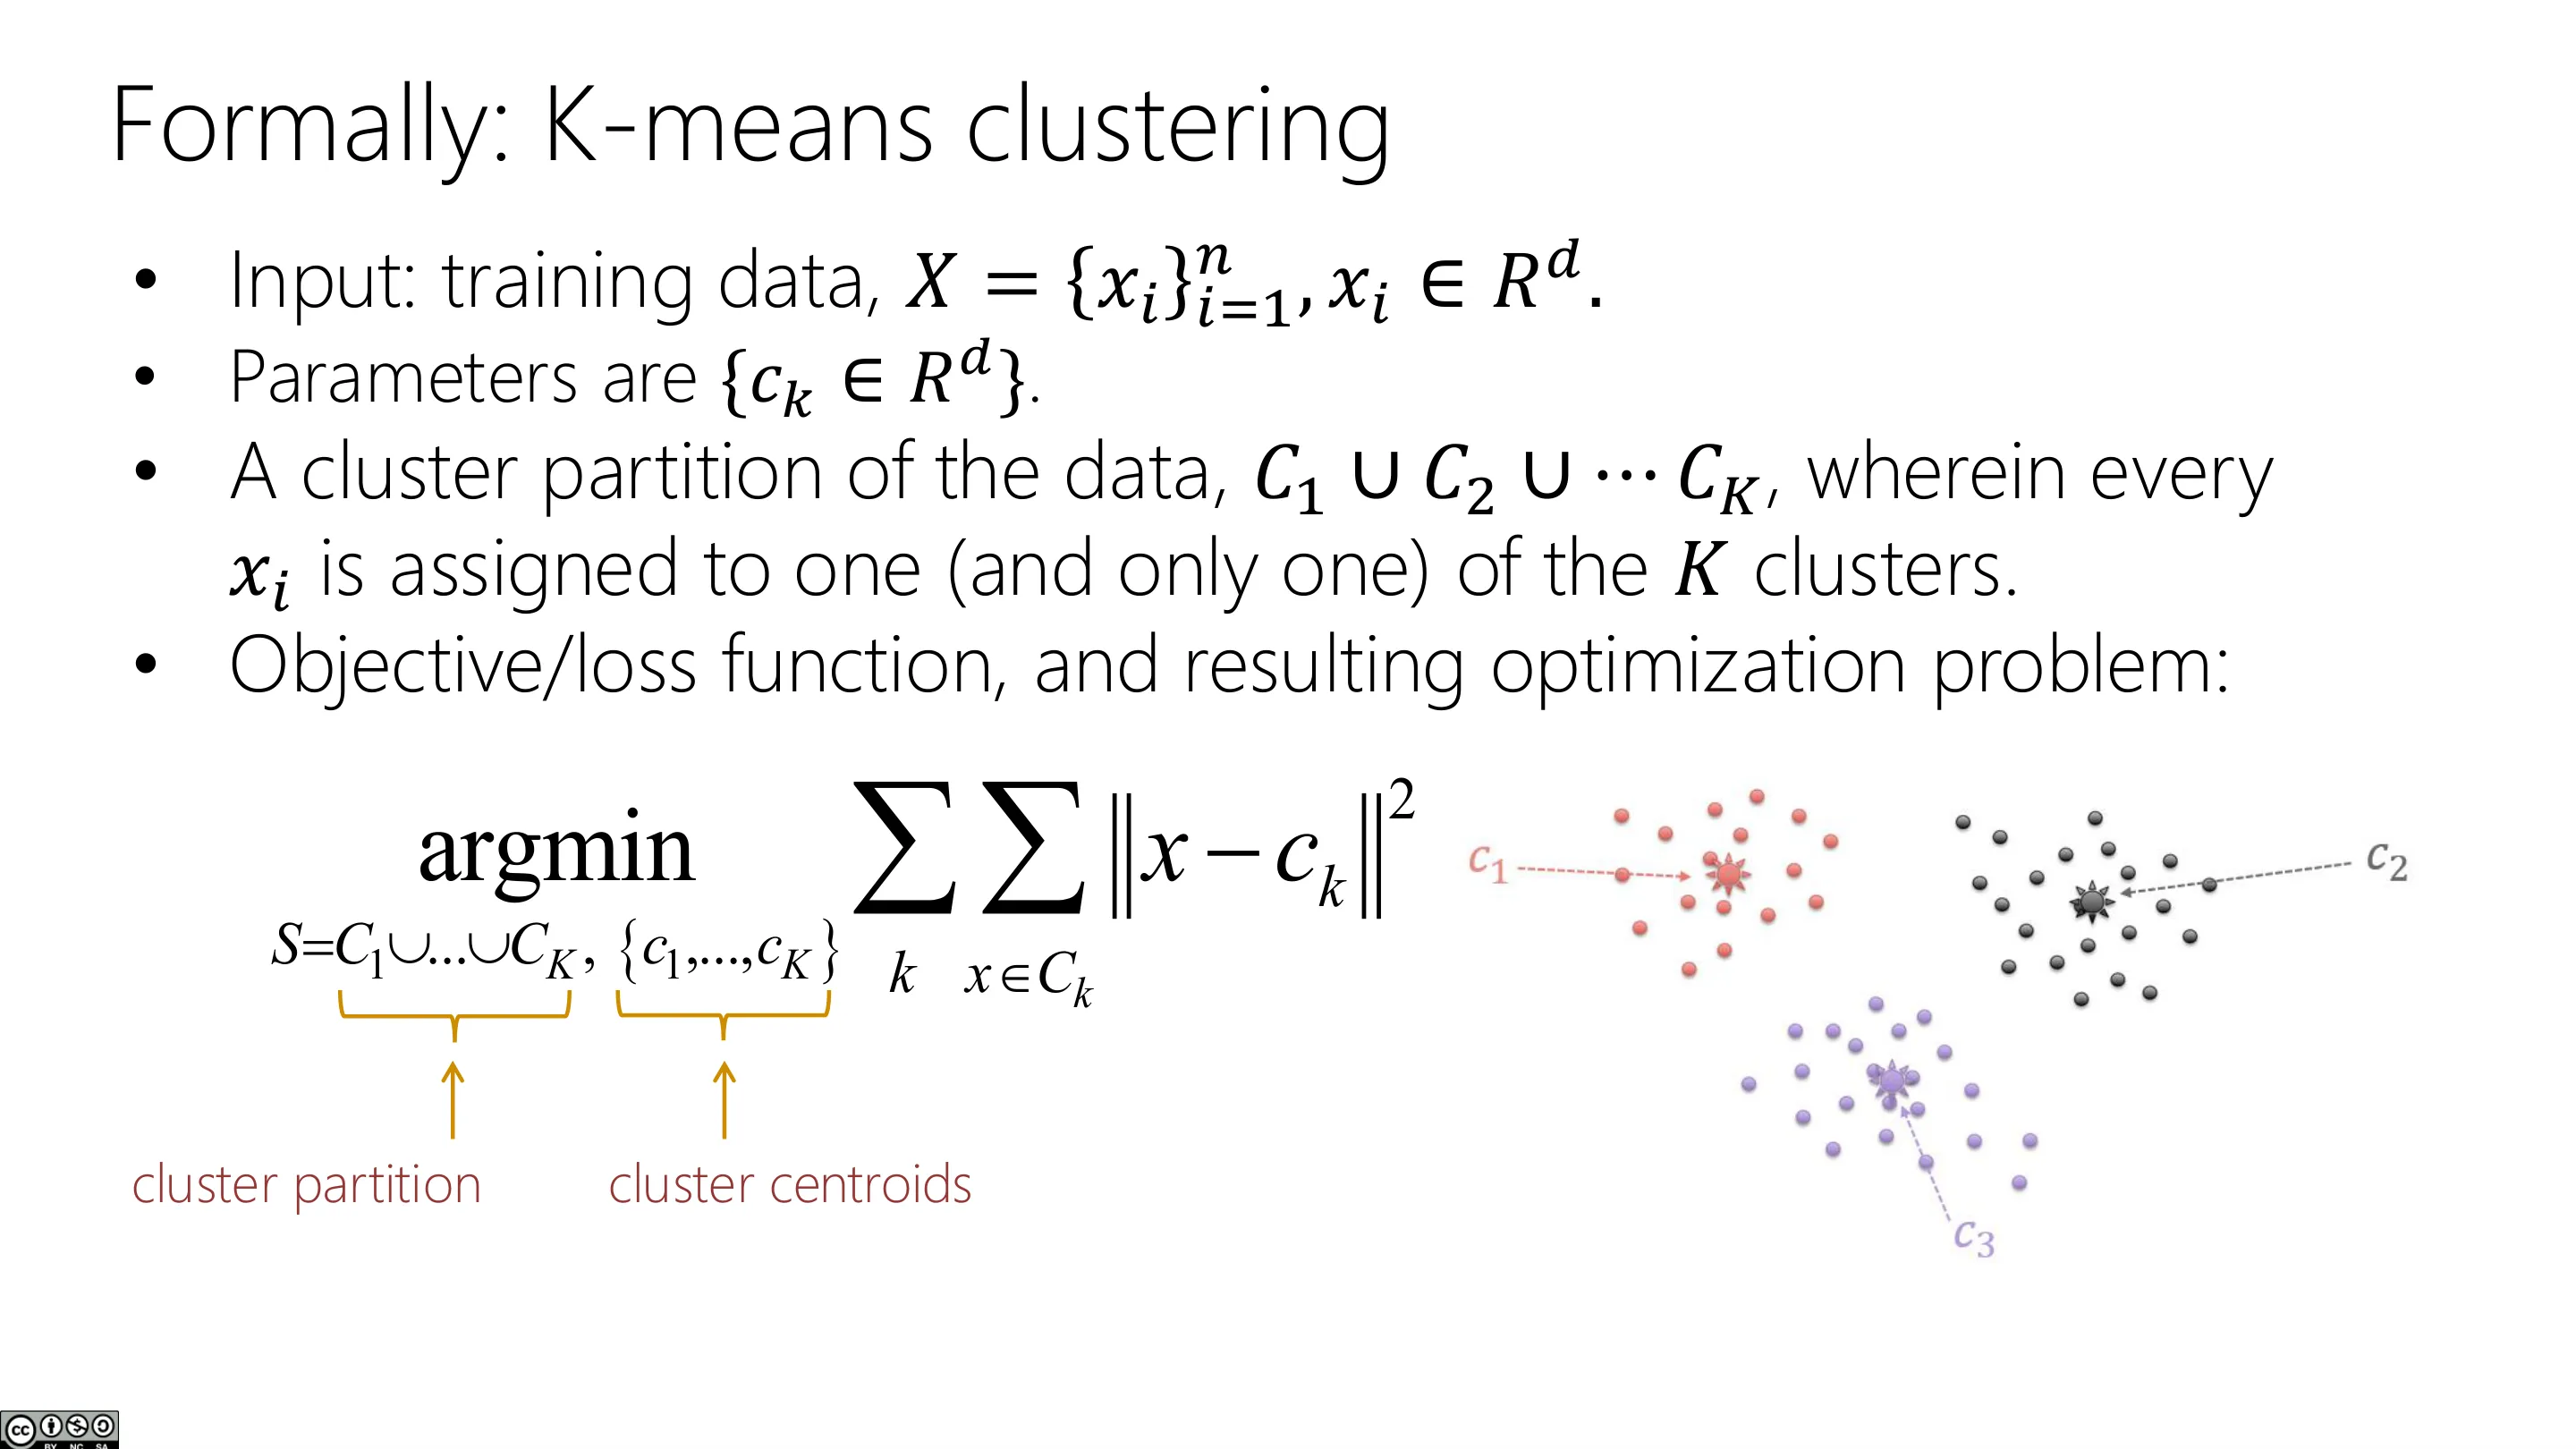
形式化地:给定训练数据 $X = \{x_i\}_{i=1}^n$、$x_i \in \mathbb{R}^d$,参数为 $\{c_k \in \mathbb{R}^d\}$,并把数据划分成 $C_1 \cup C_2 \cup \cdots \cup C_K$(每个 $x_i$ 恰好属于一个簇)。于是目标/损失函数与优化问题为:
$$ \arg\min_{S = C_1 \cup \cdots \cup C_K,\; c_1,\dots,c_K} \sum_{k} \sum_{x \in C_k} \|x - c_k\|^2 $$
📷 K 均值聚类
回到原视频 (00:30:01)
📷 形式化:K 均值聚类
回到原视频 (00:31:21)
3.3 参数学习:交替优化的两个「一半」
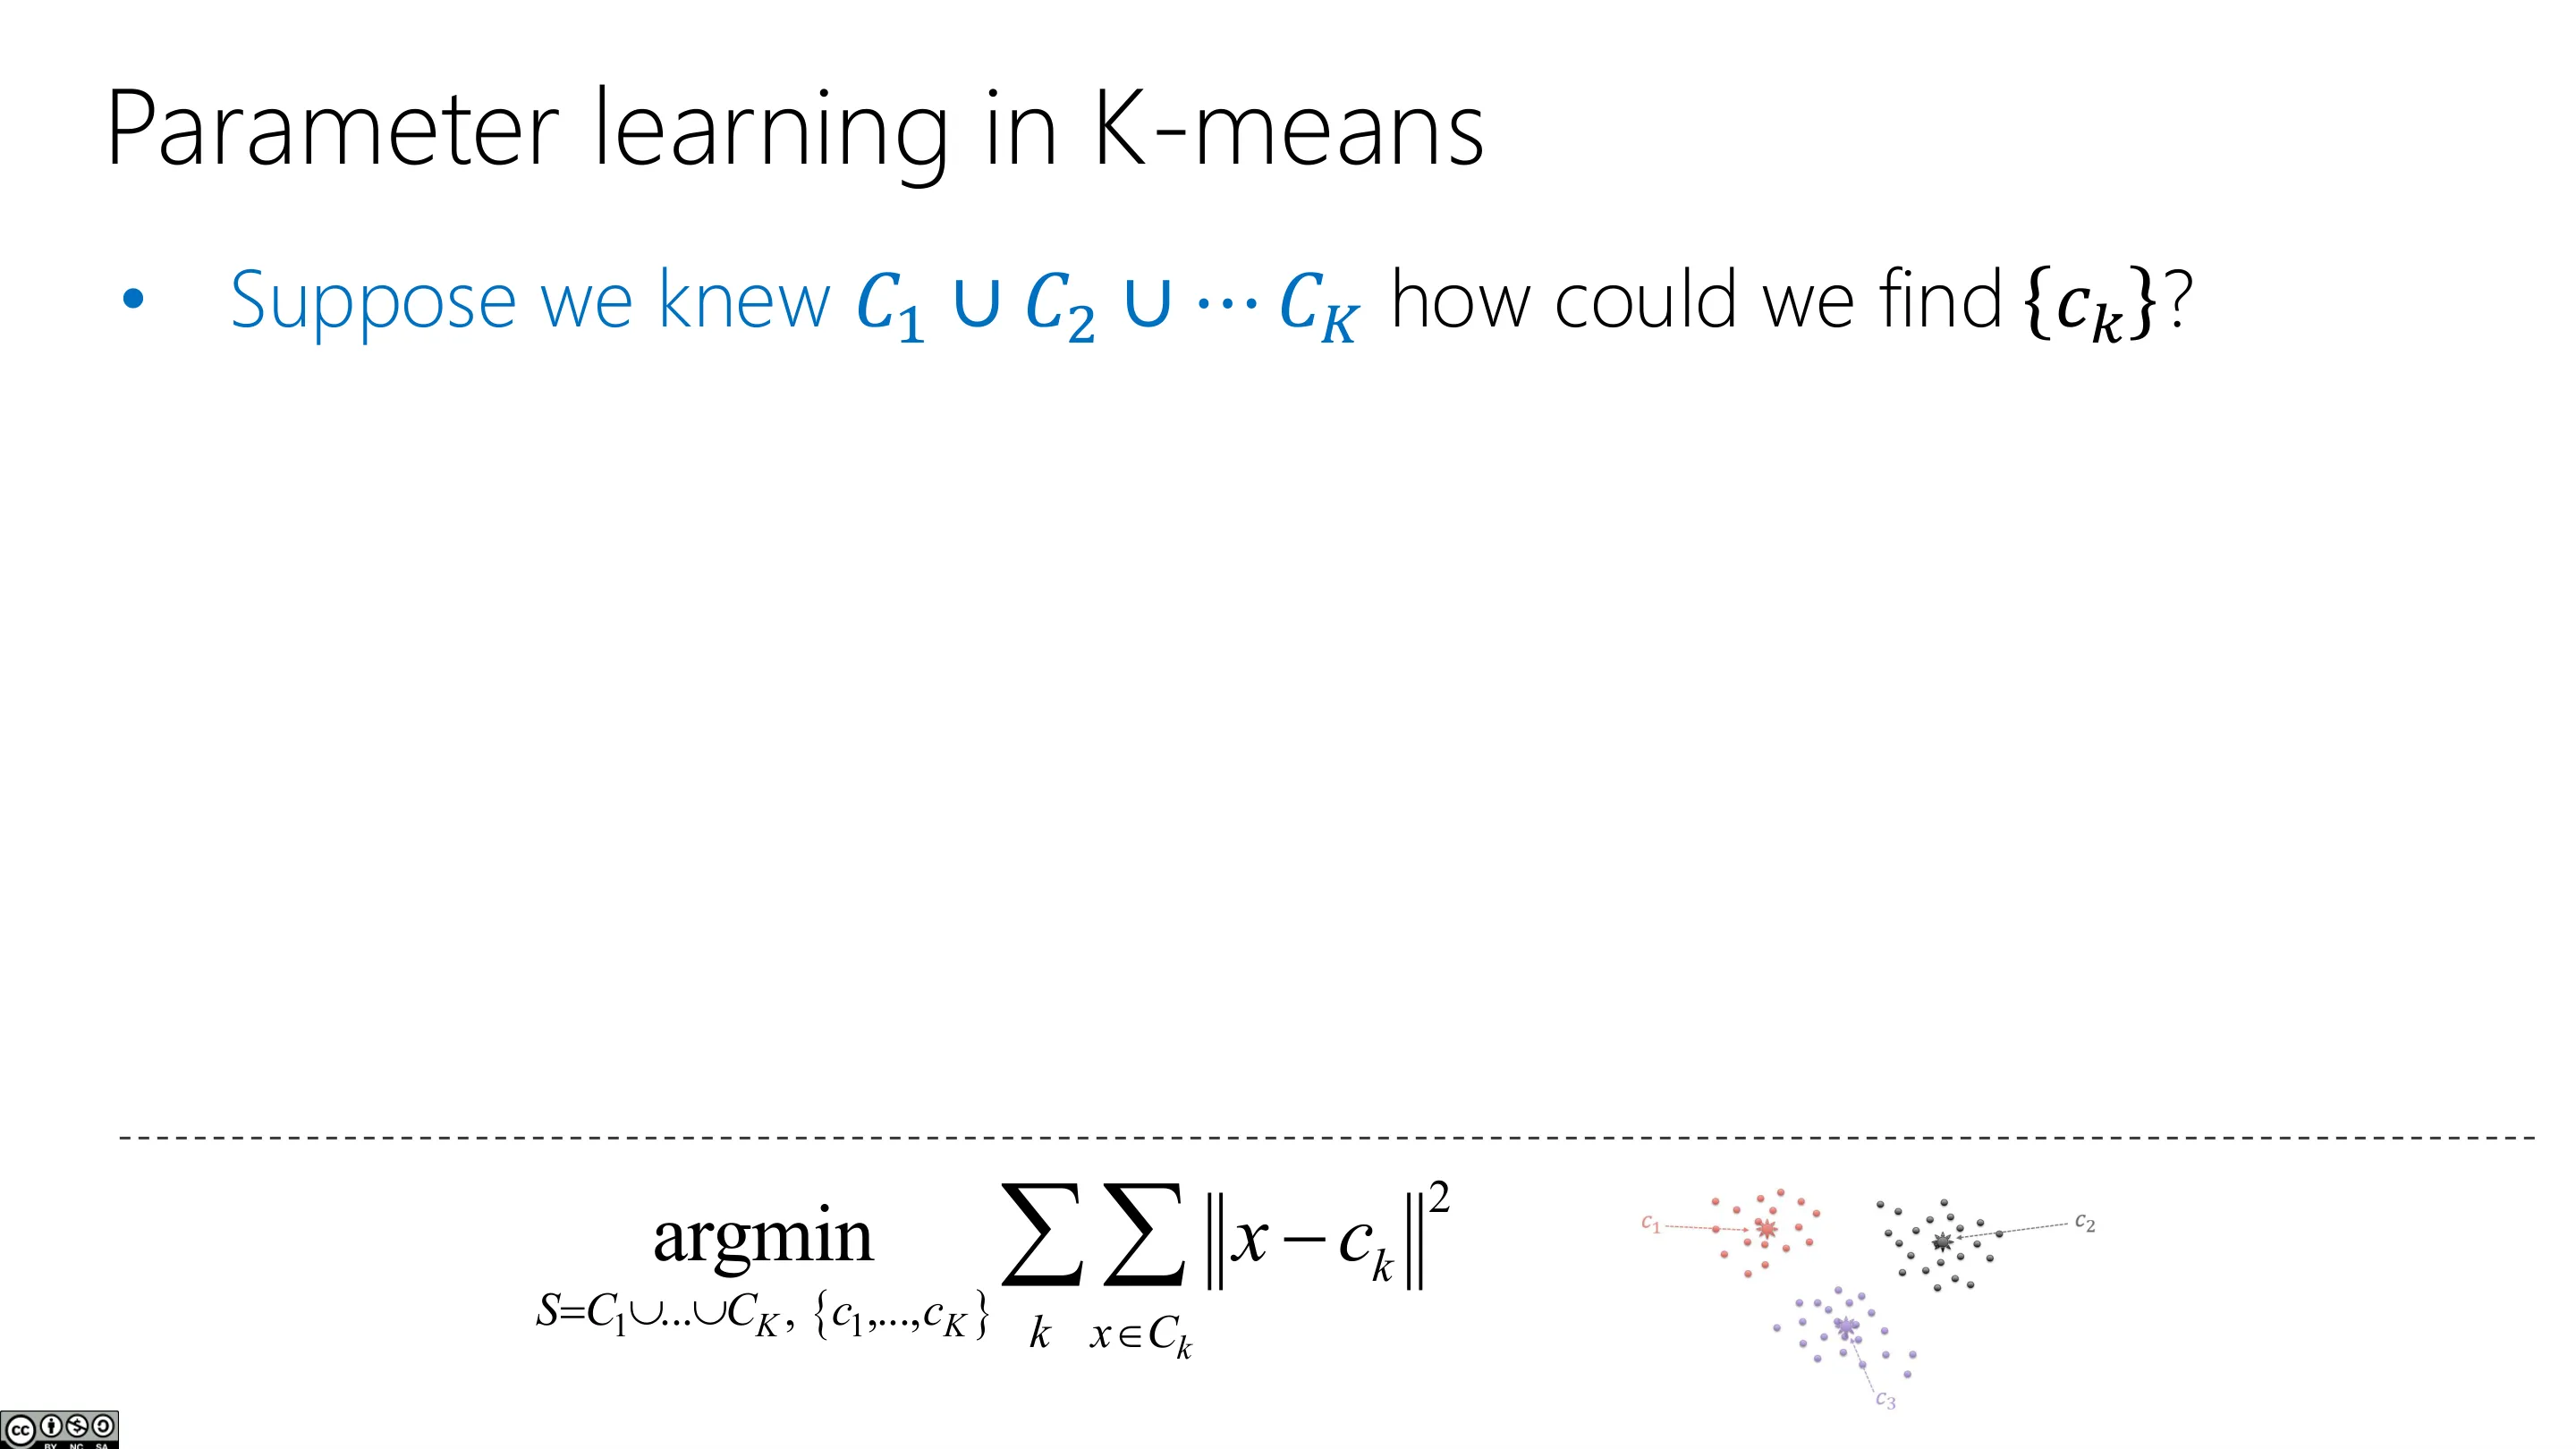
难点在于要同时优化划分和质心。但如果我们假装知道其中一个,问题就变得非常简单:
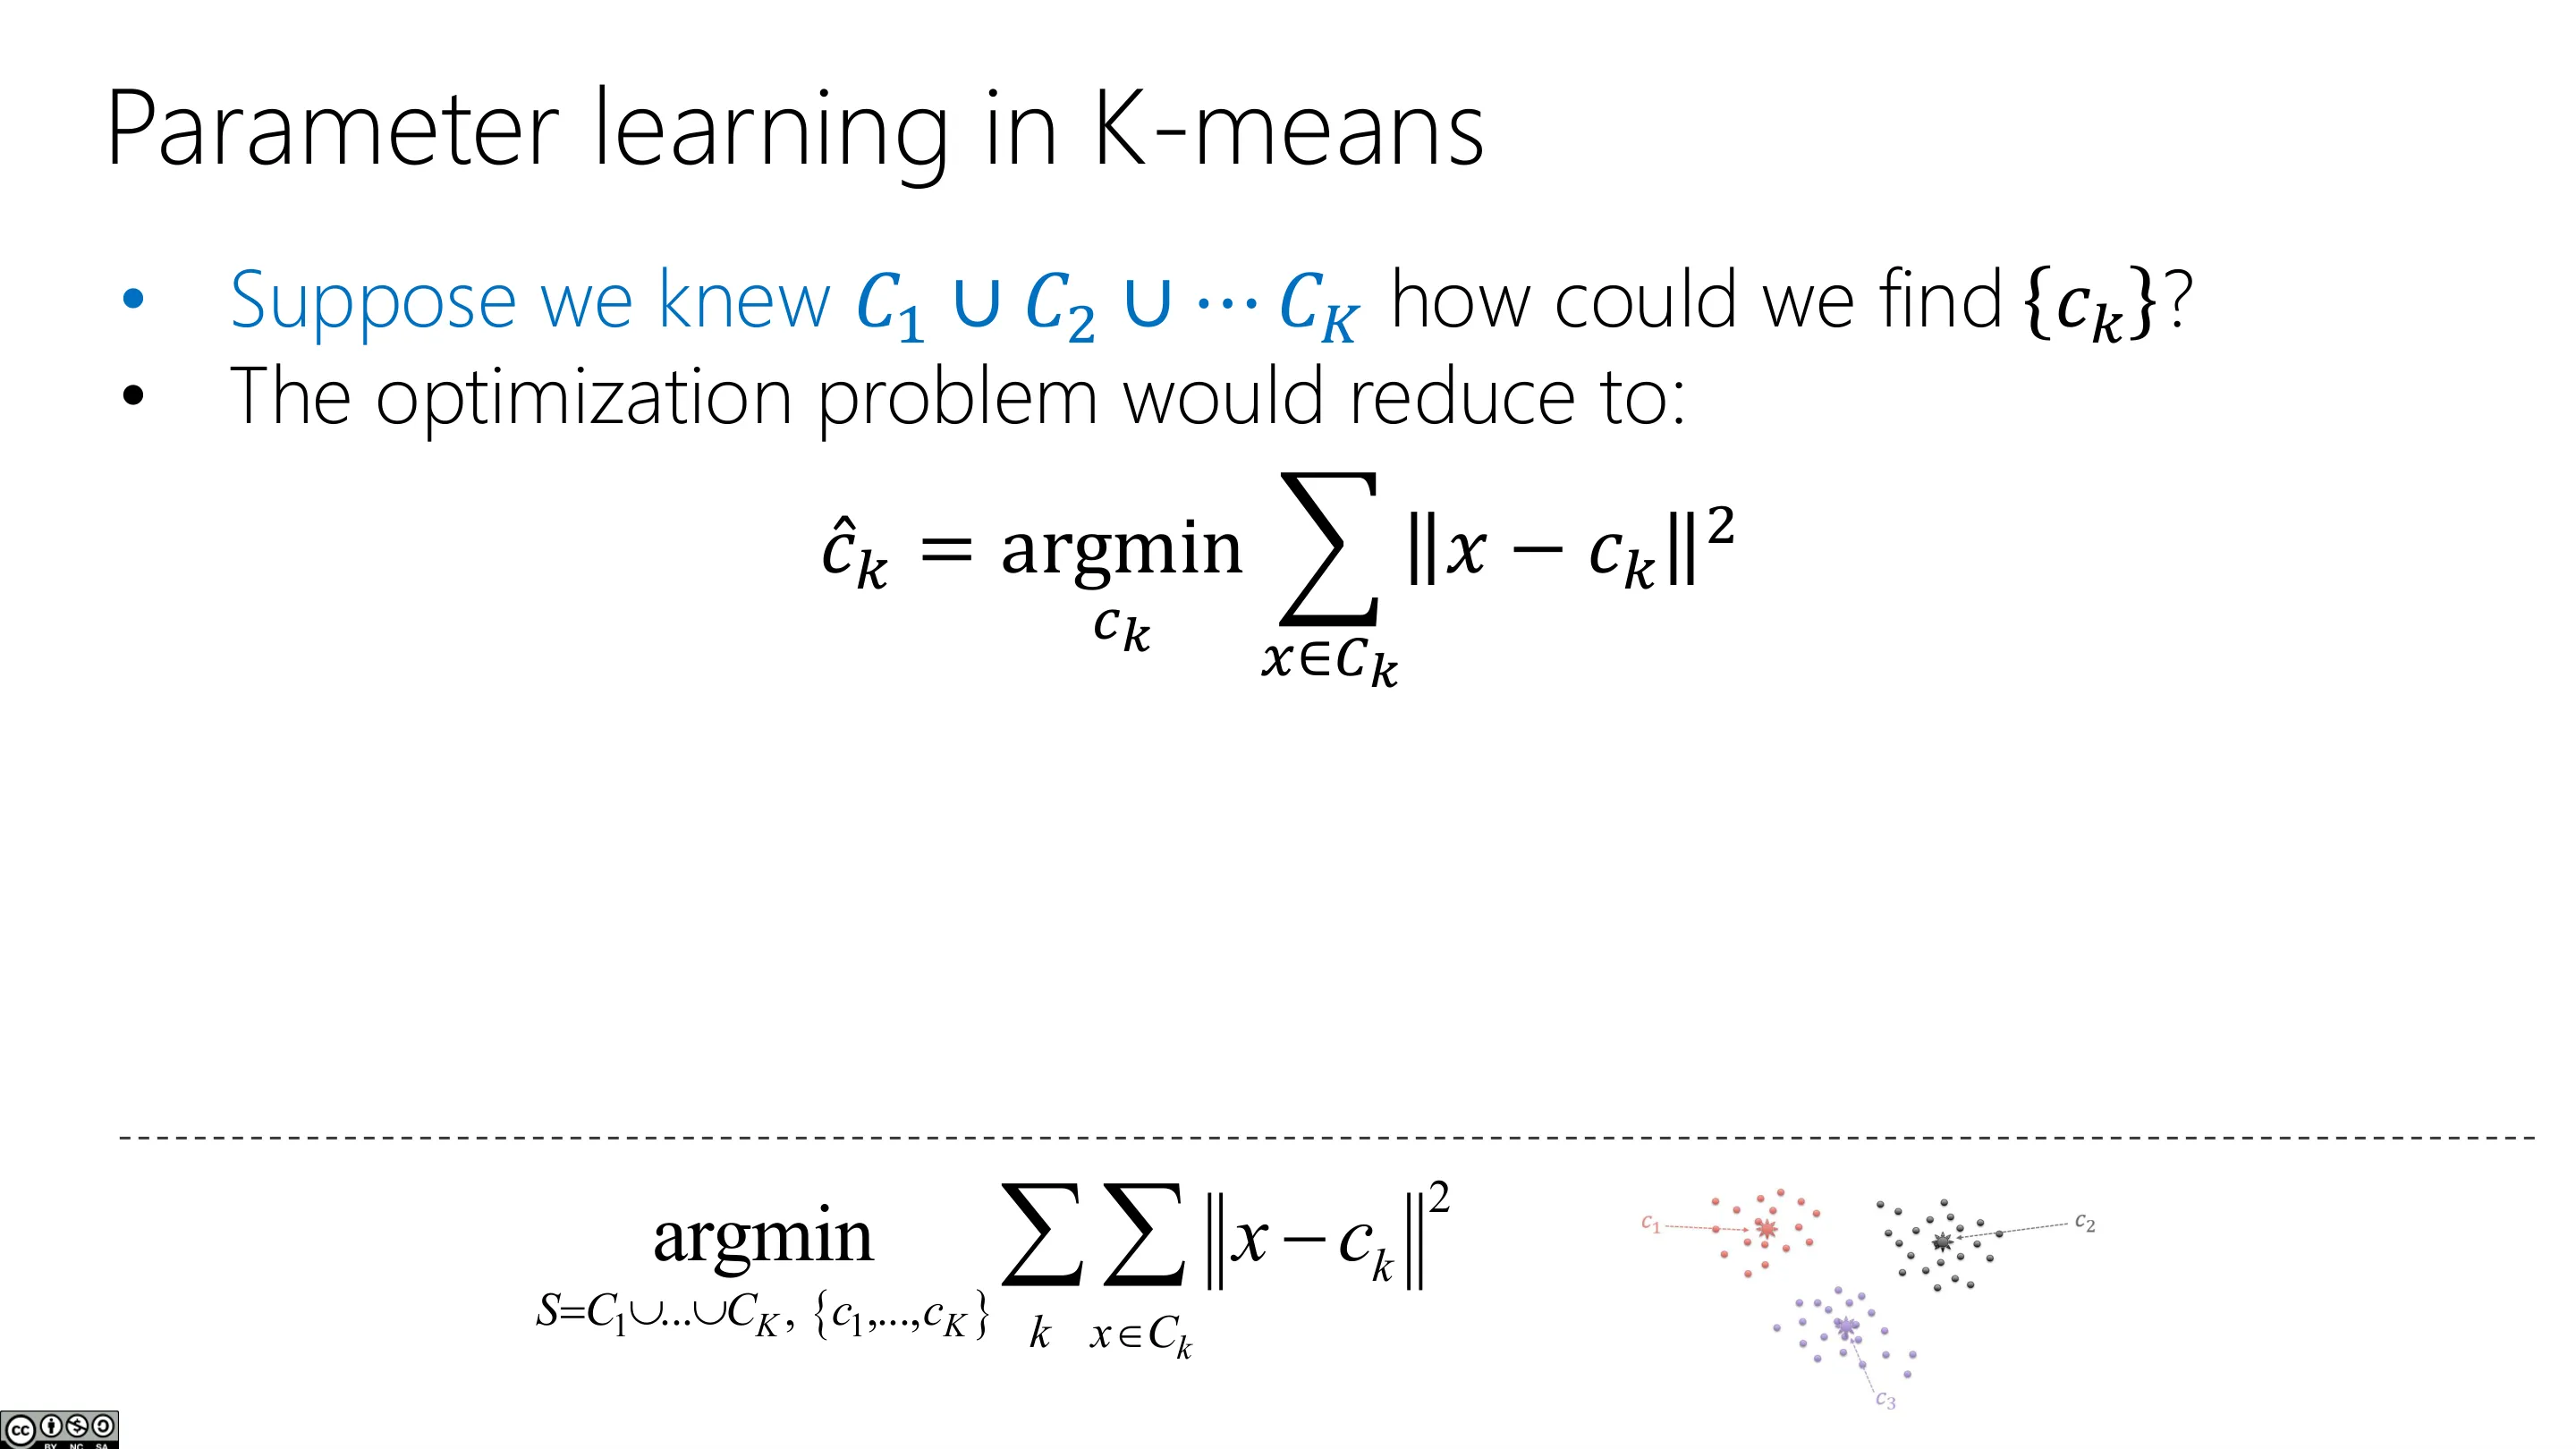
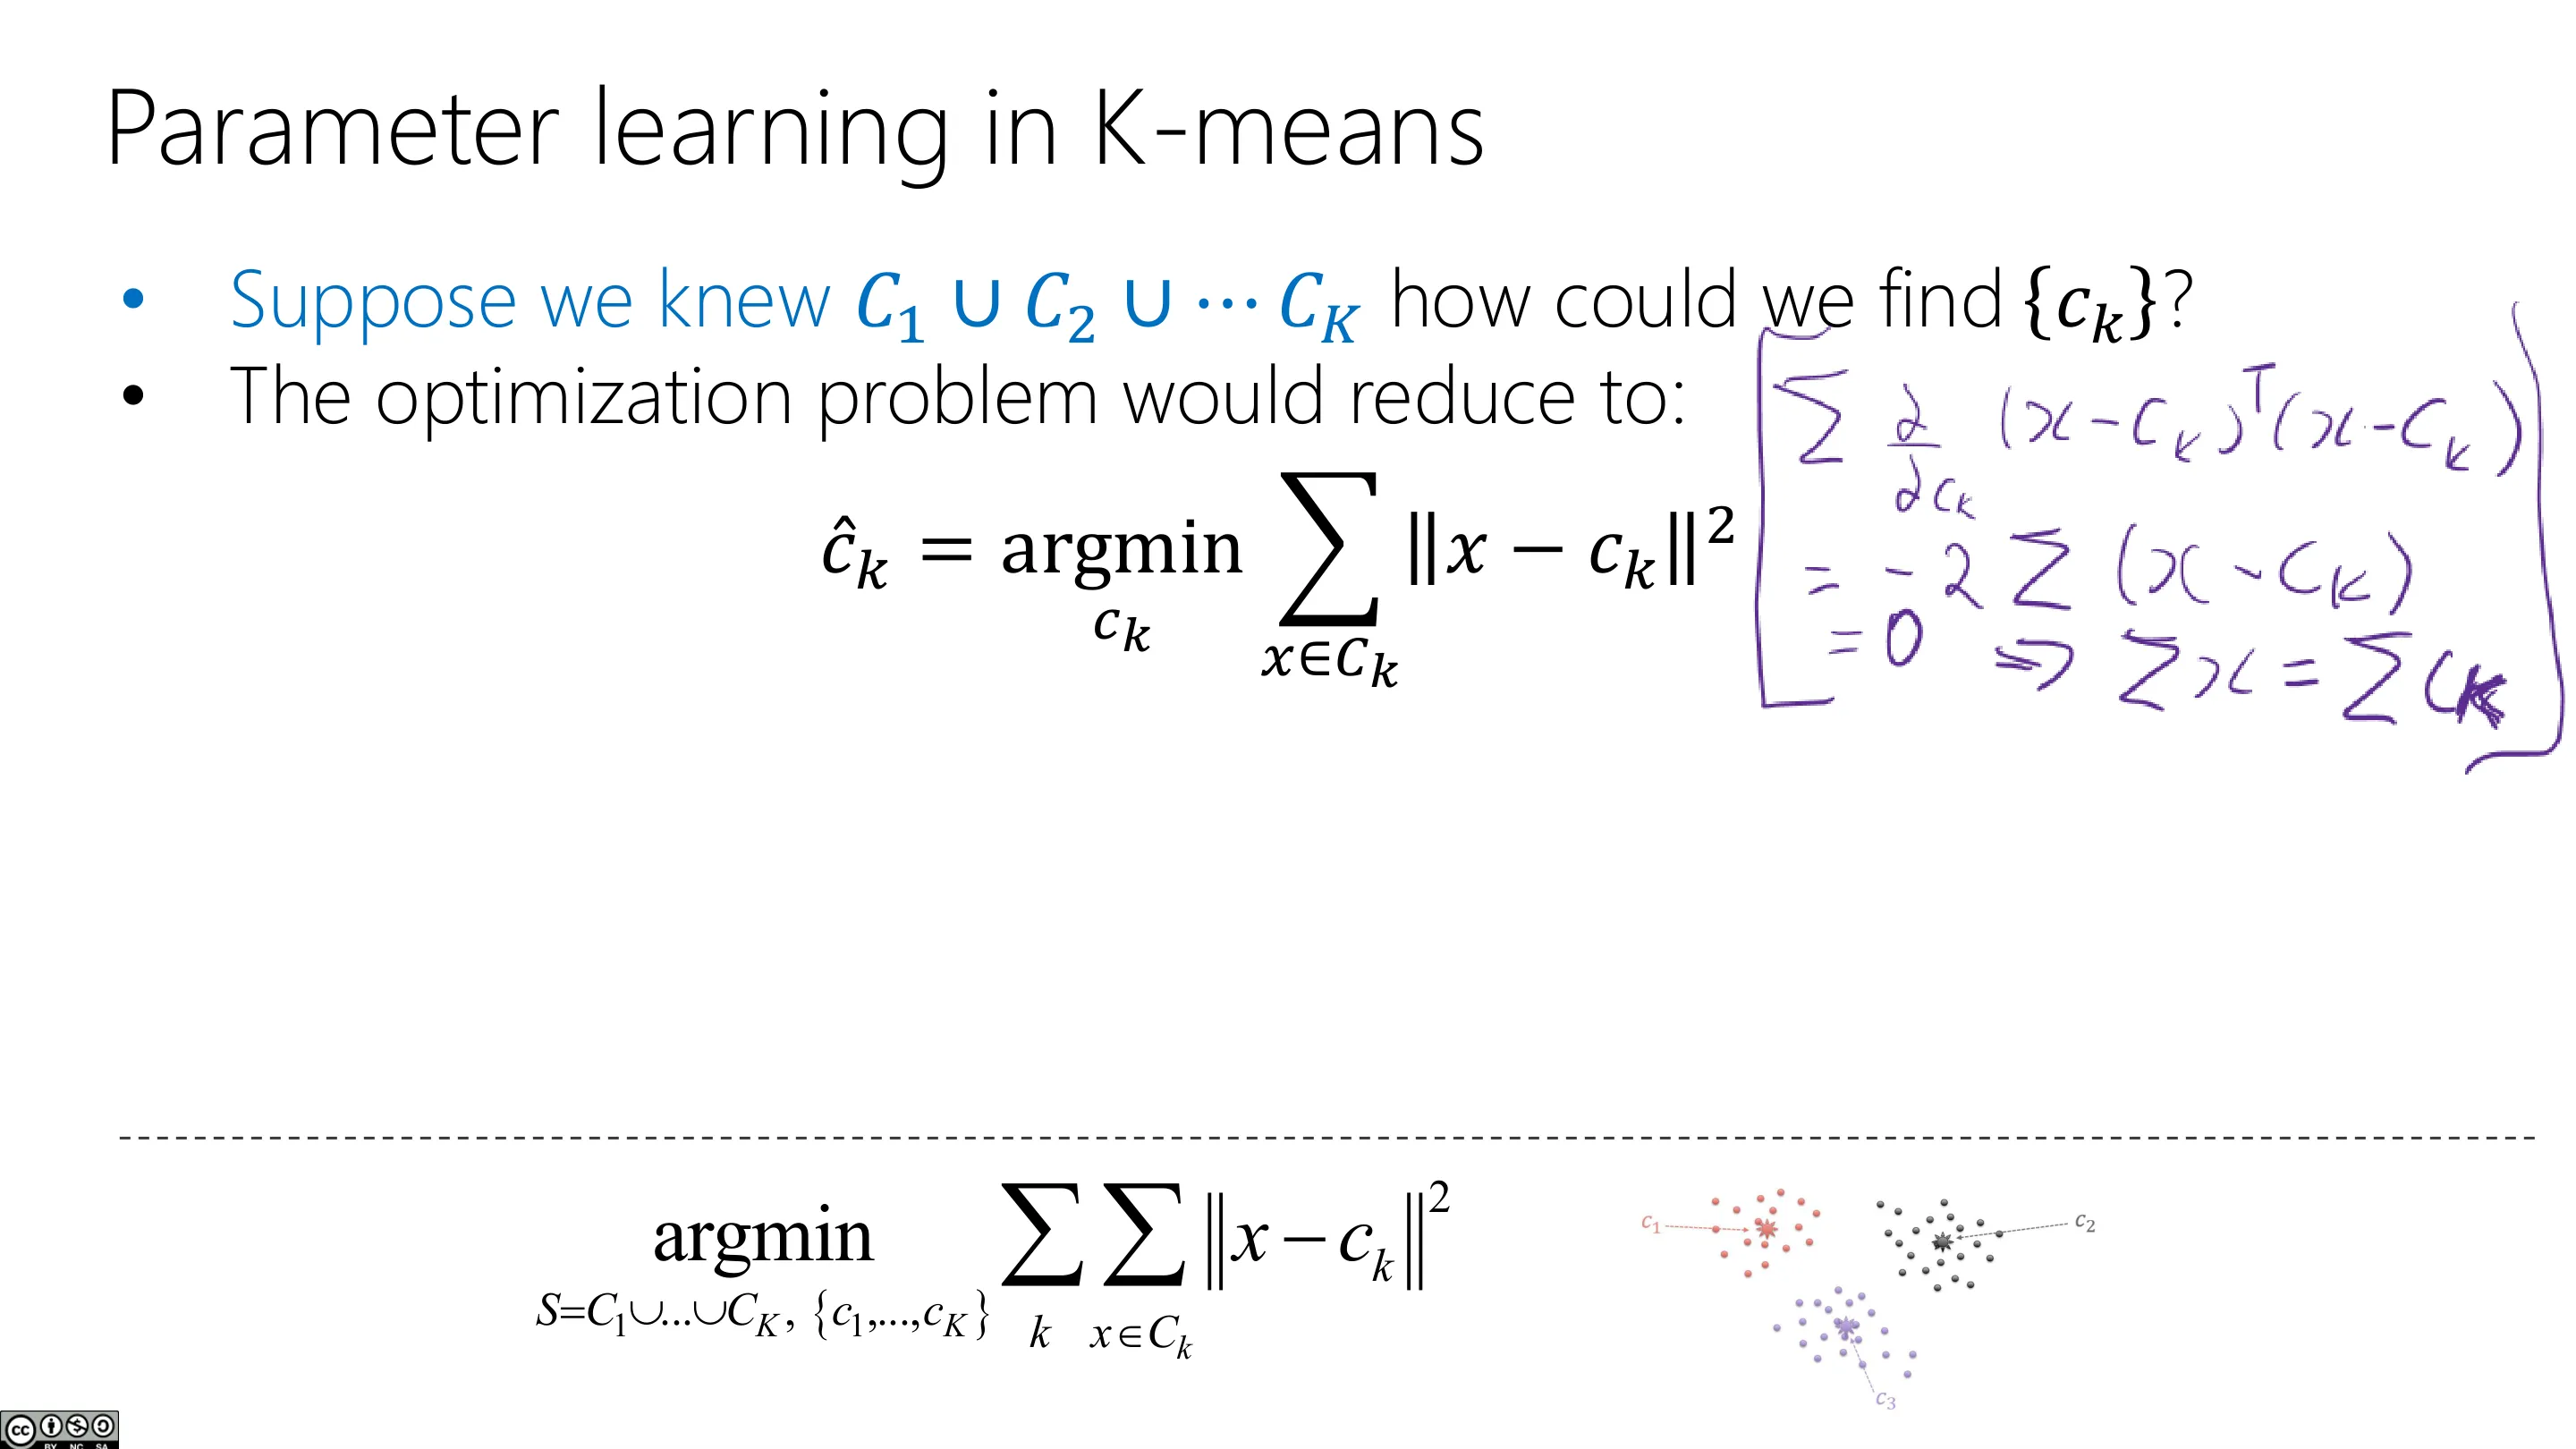
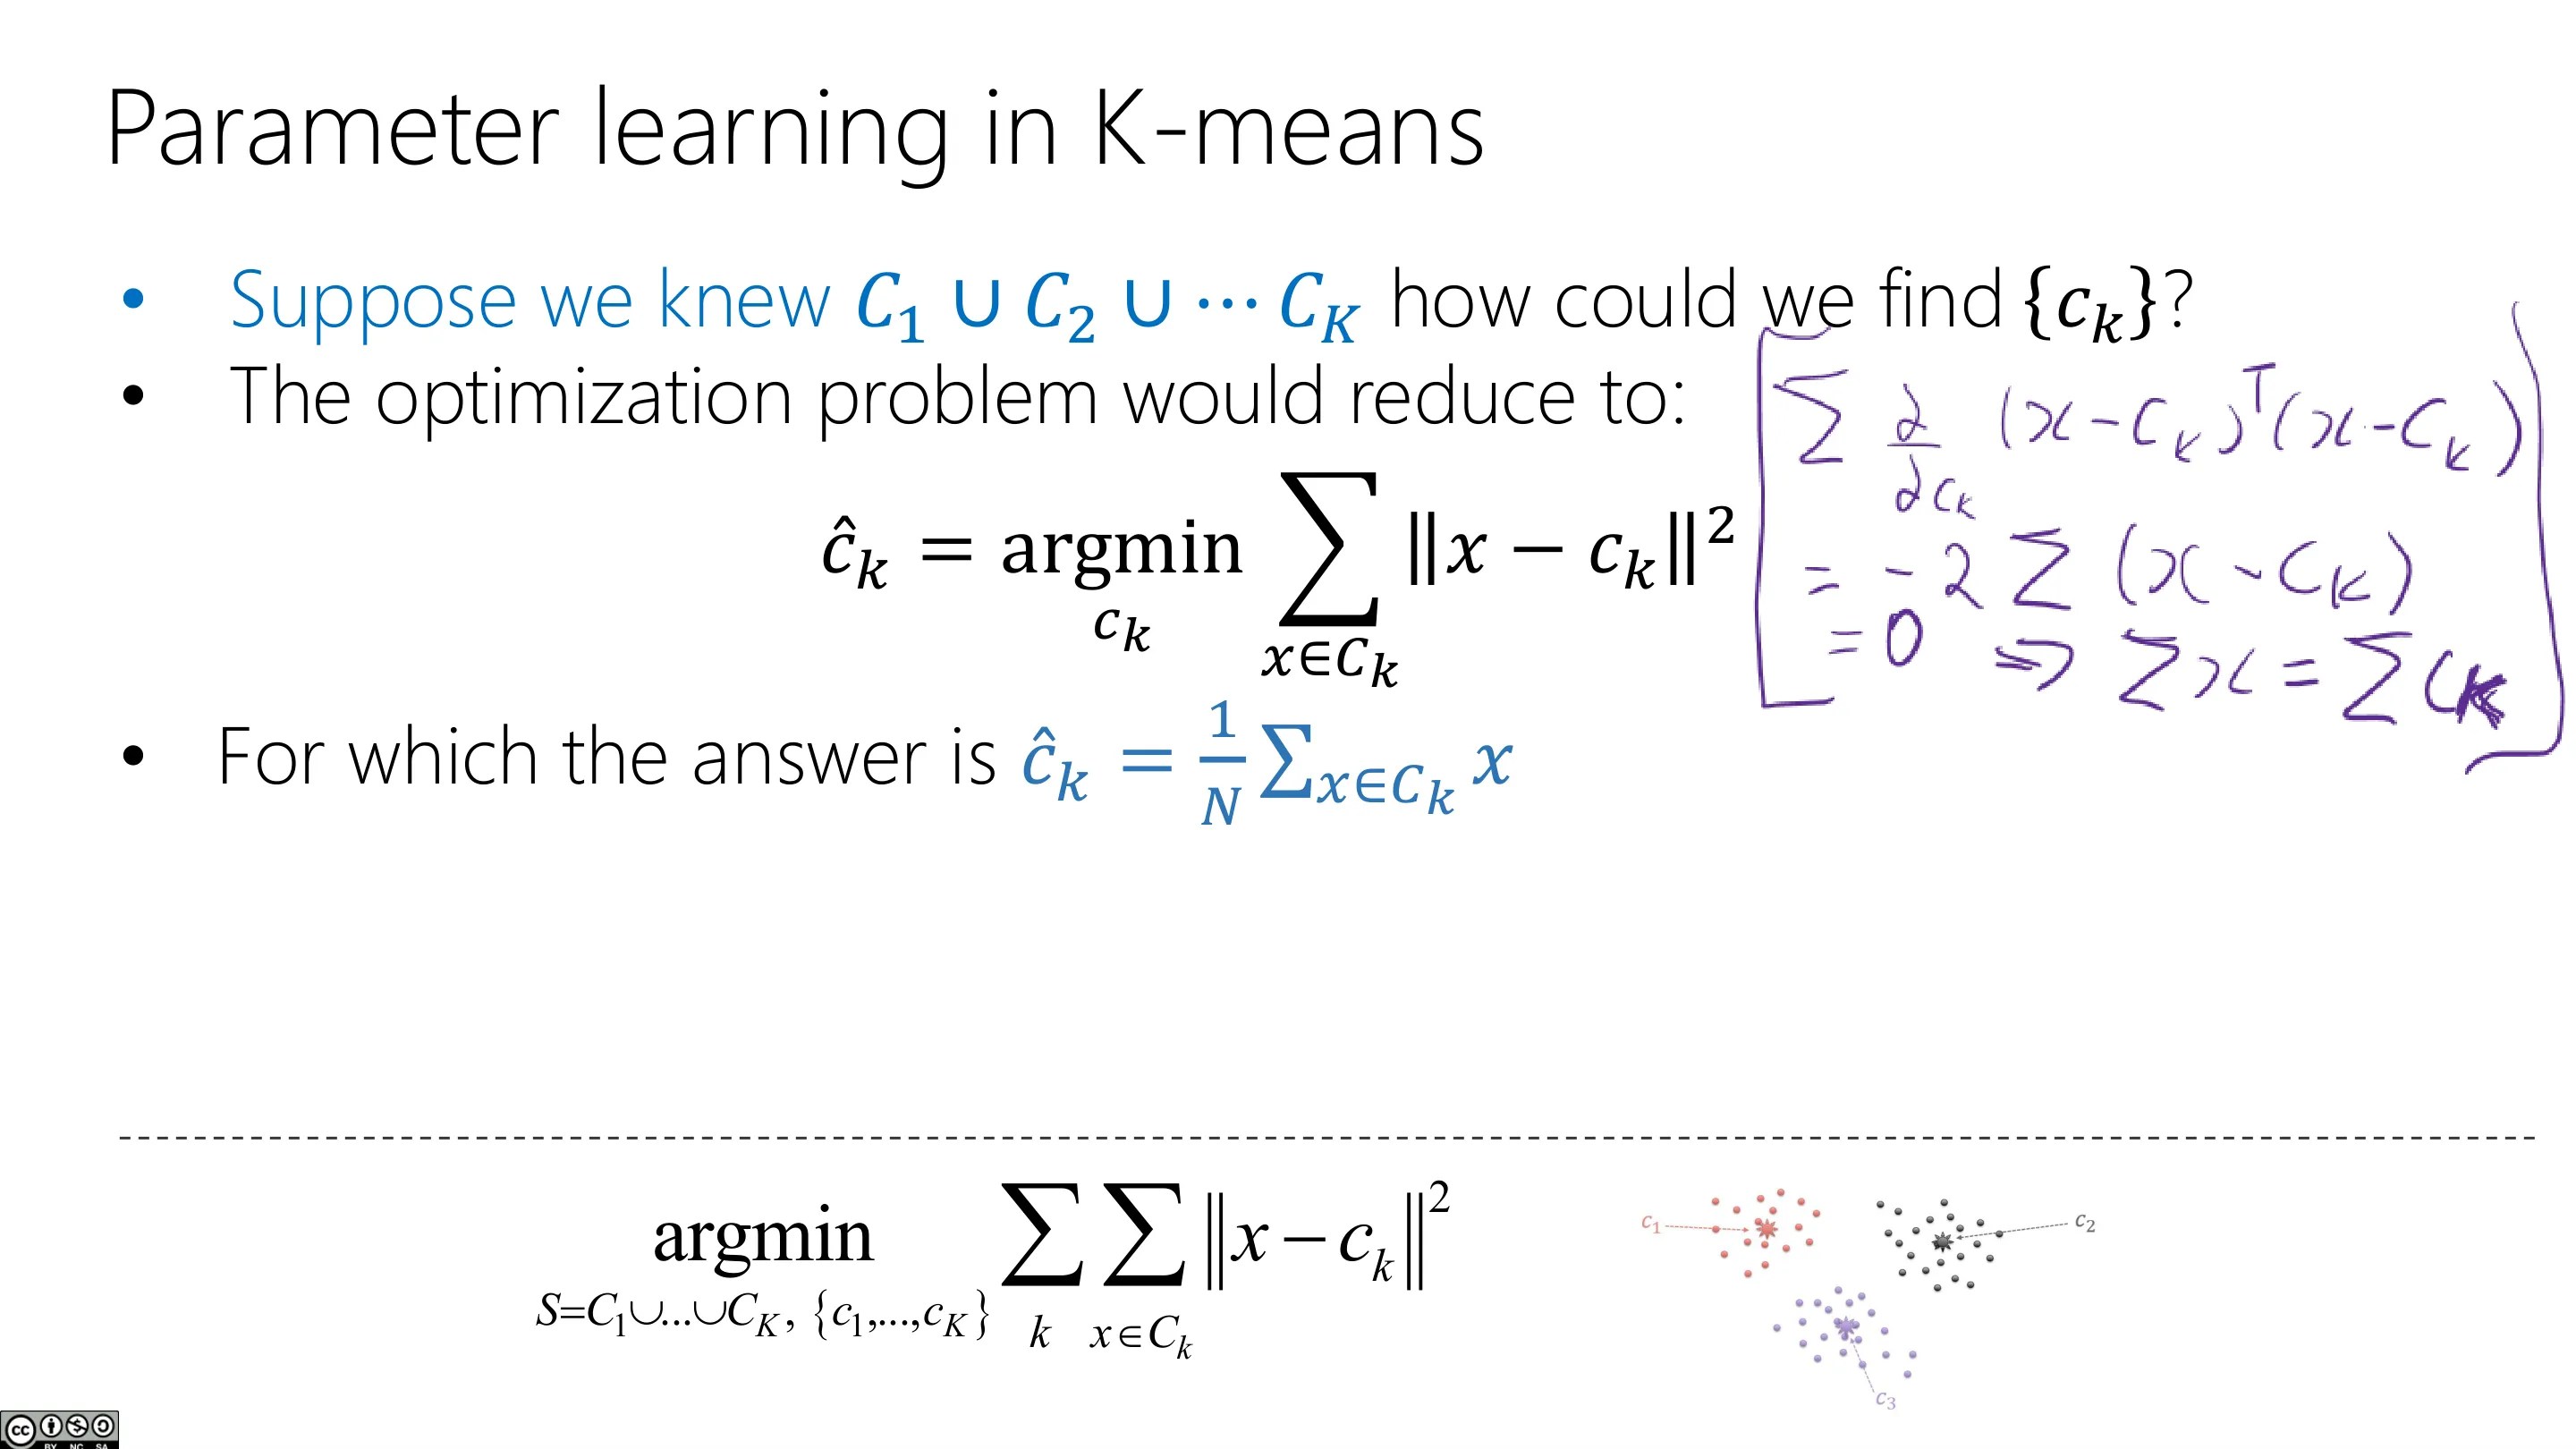
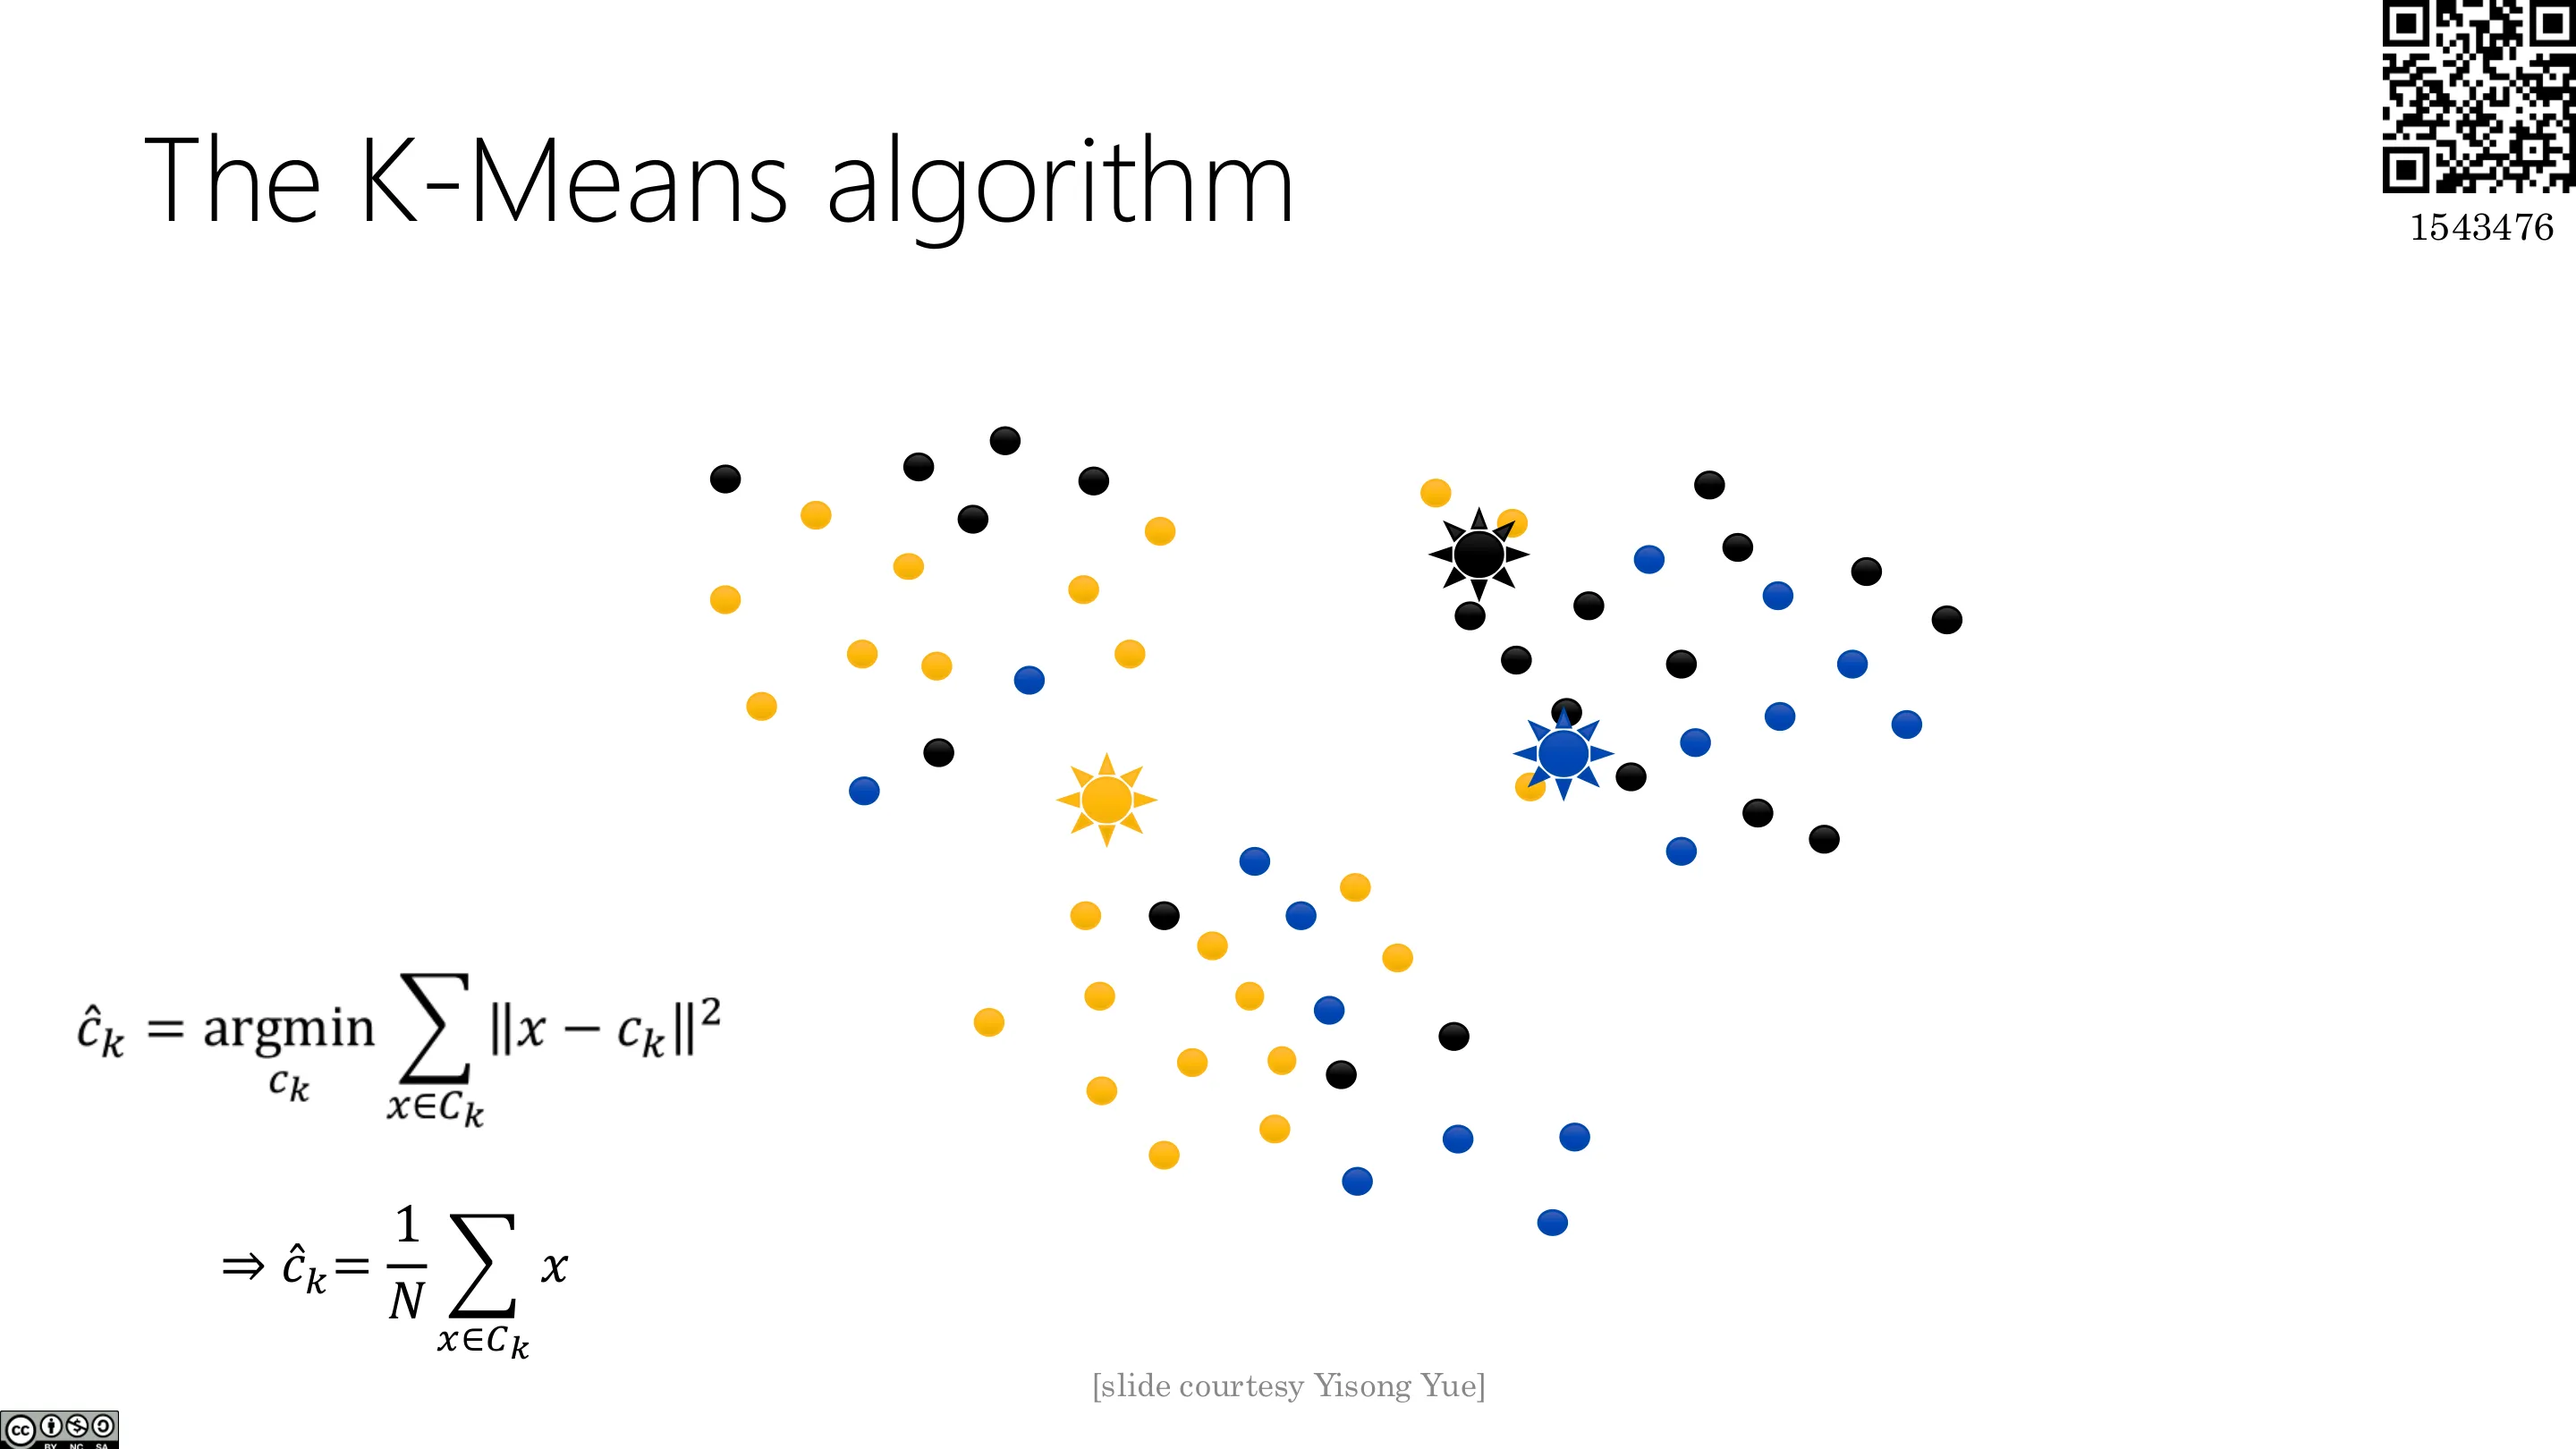
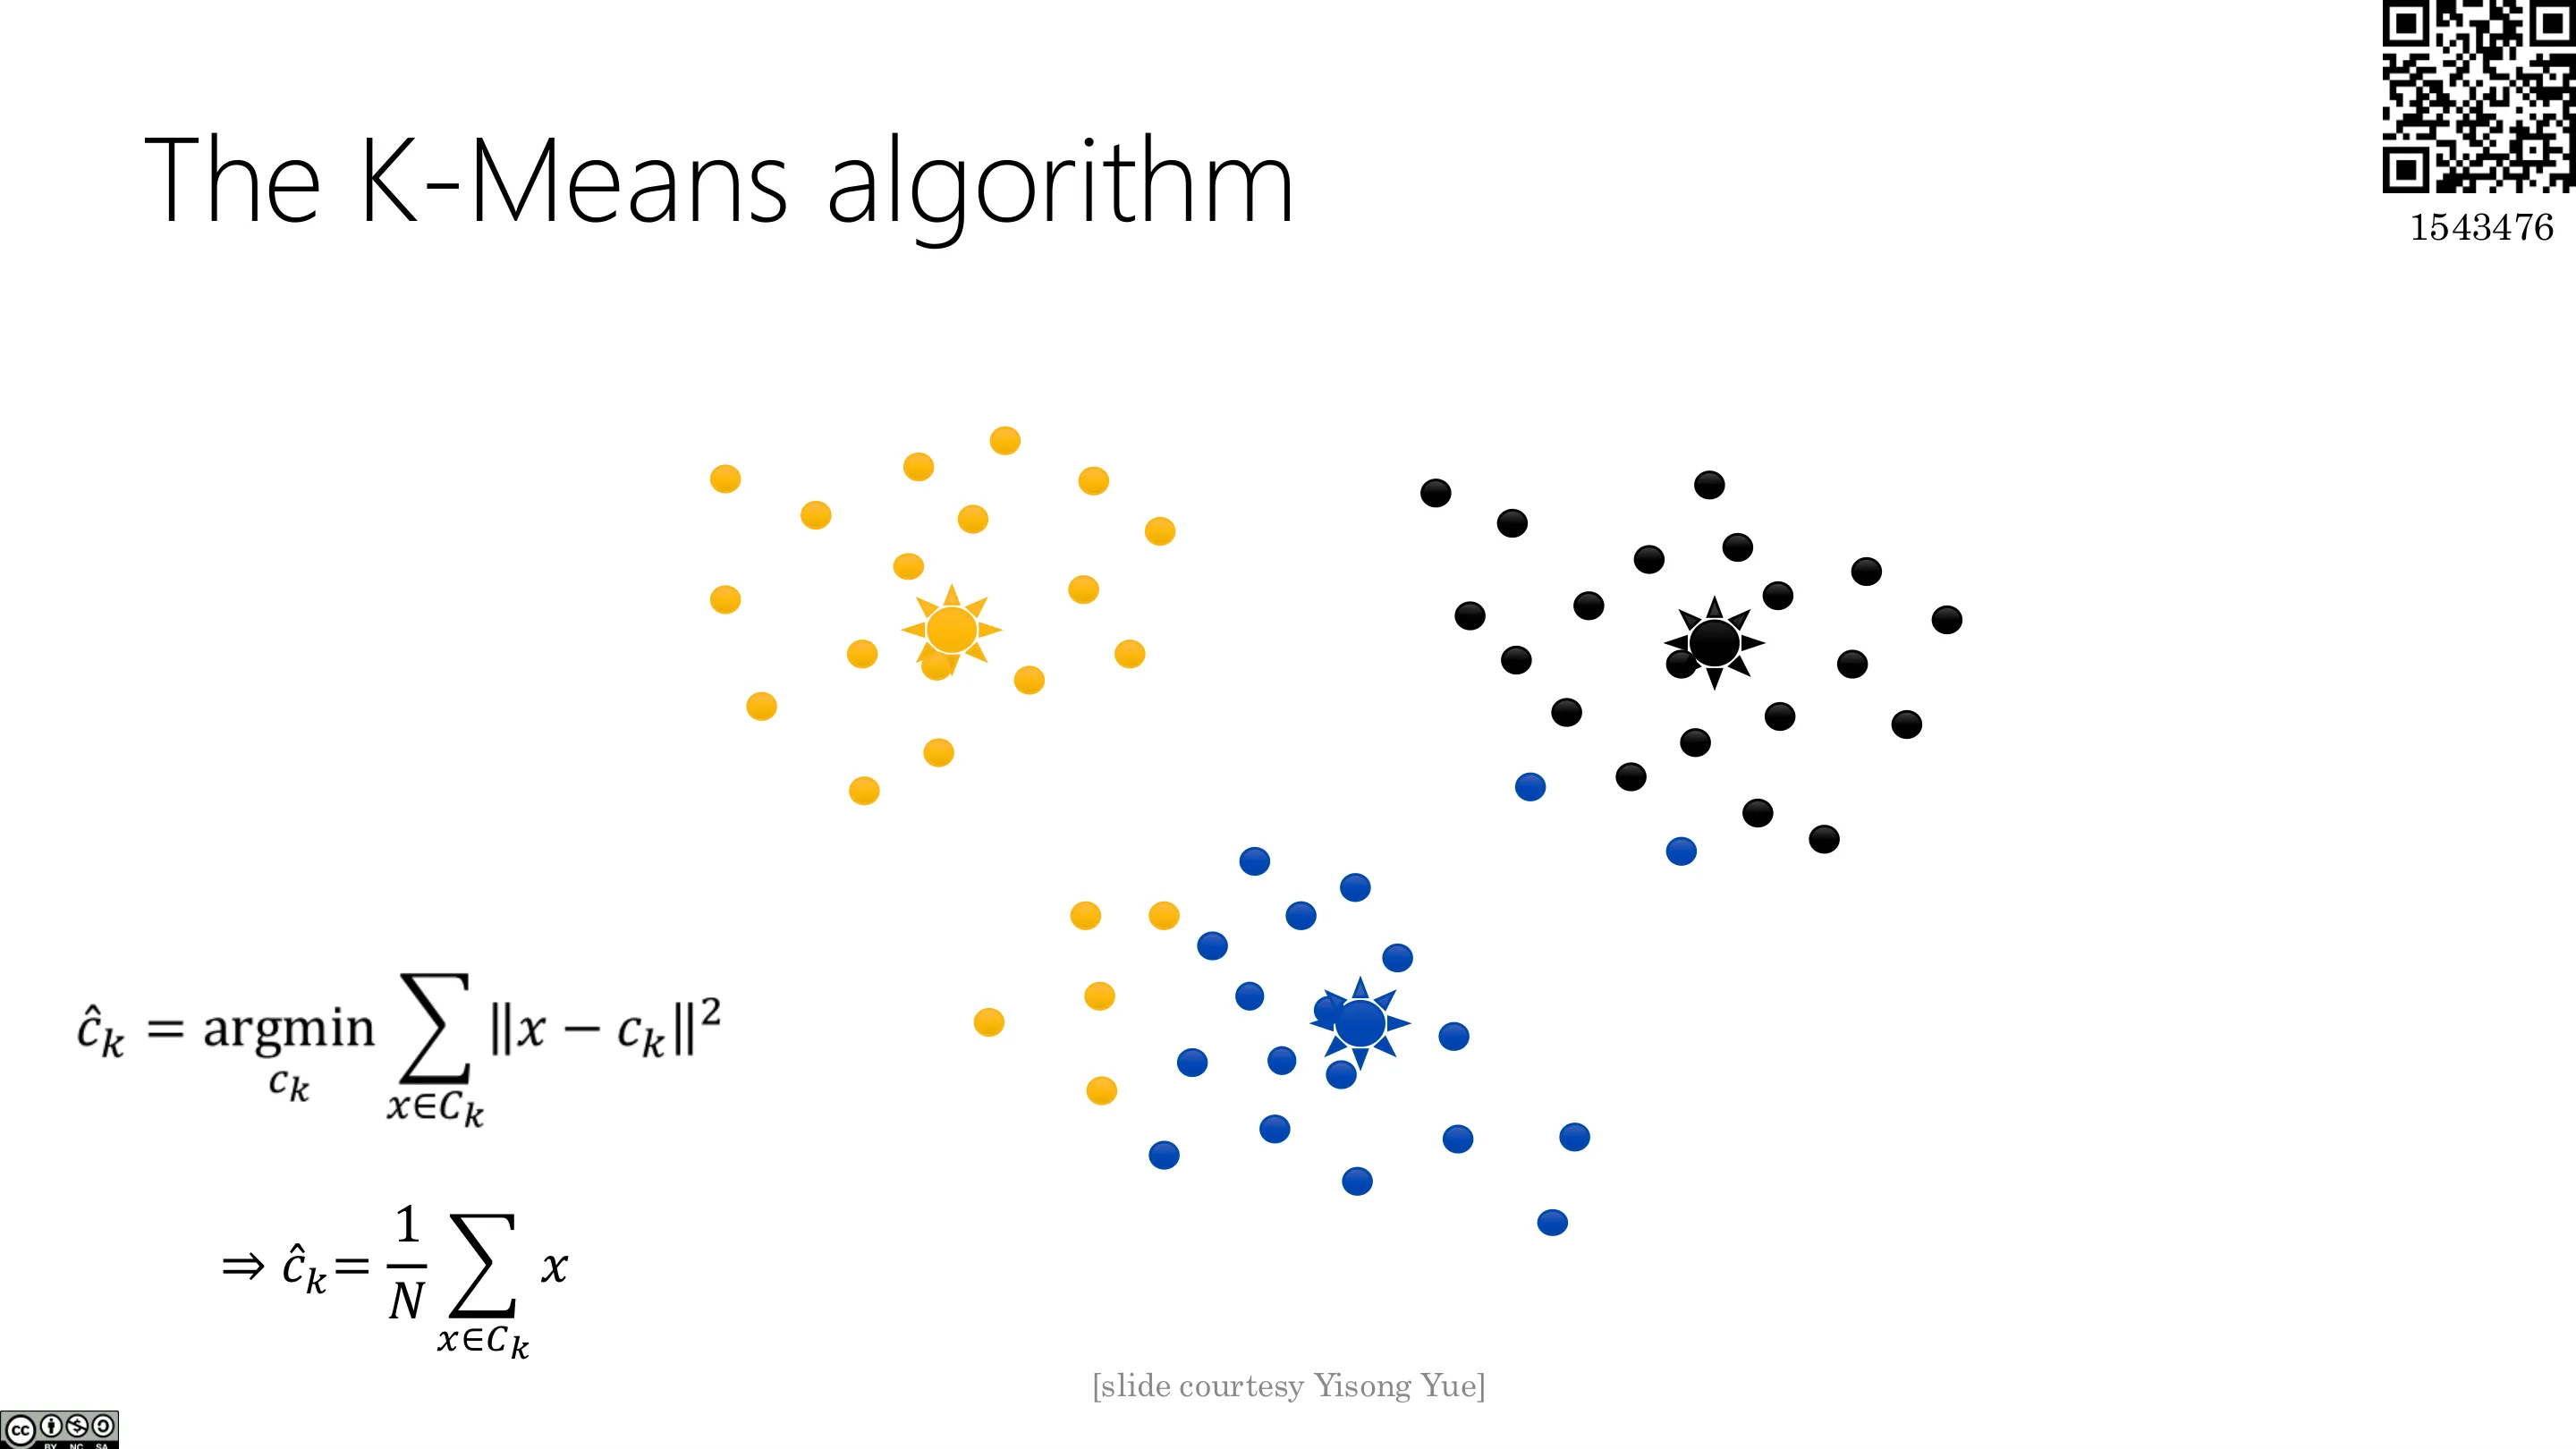
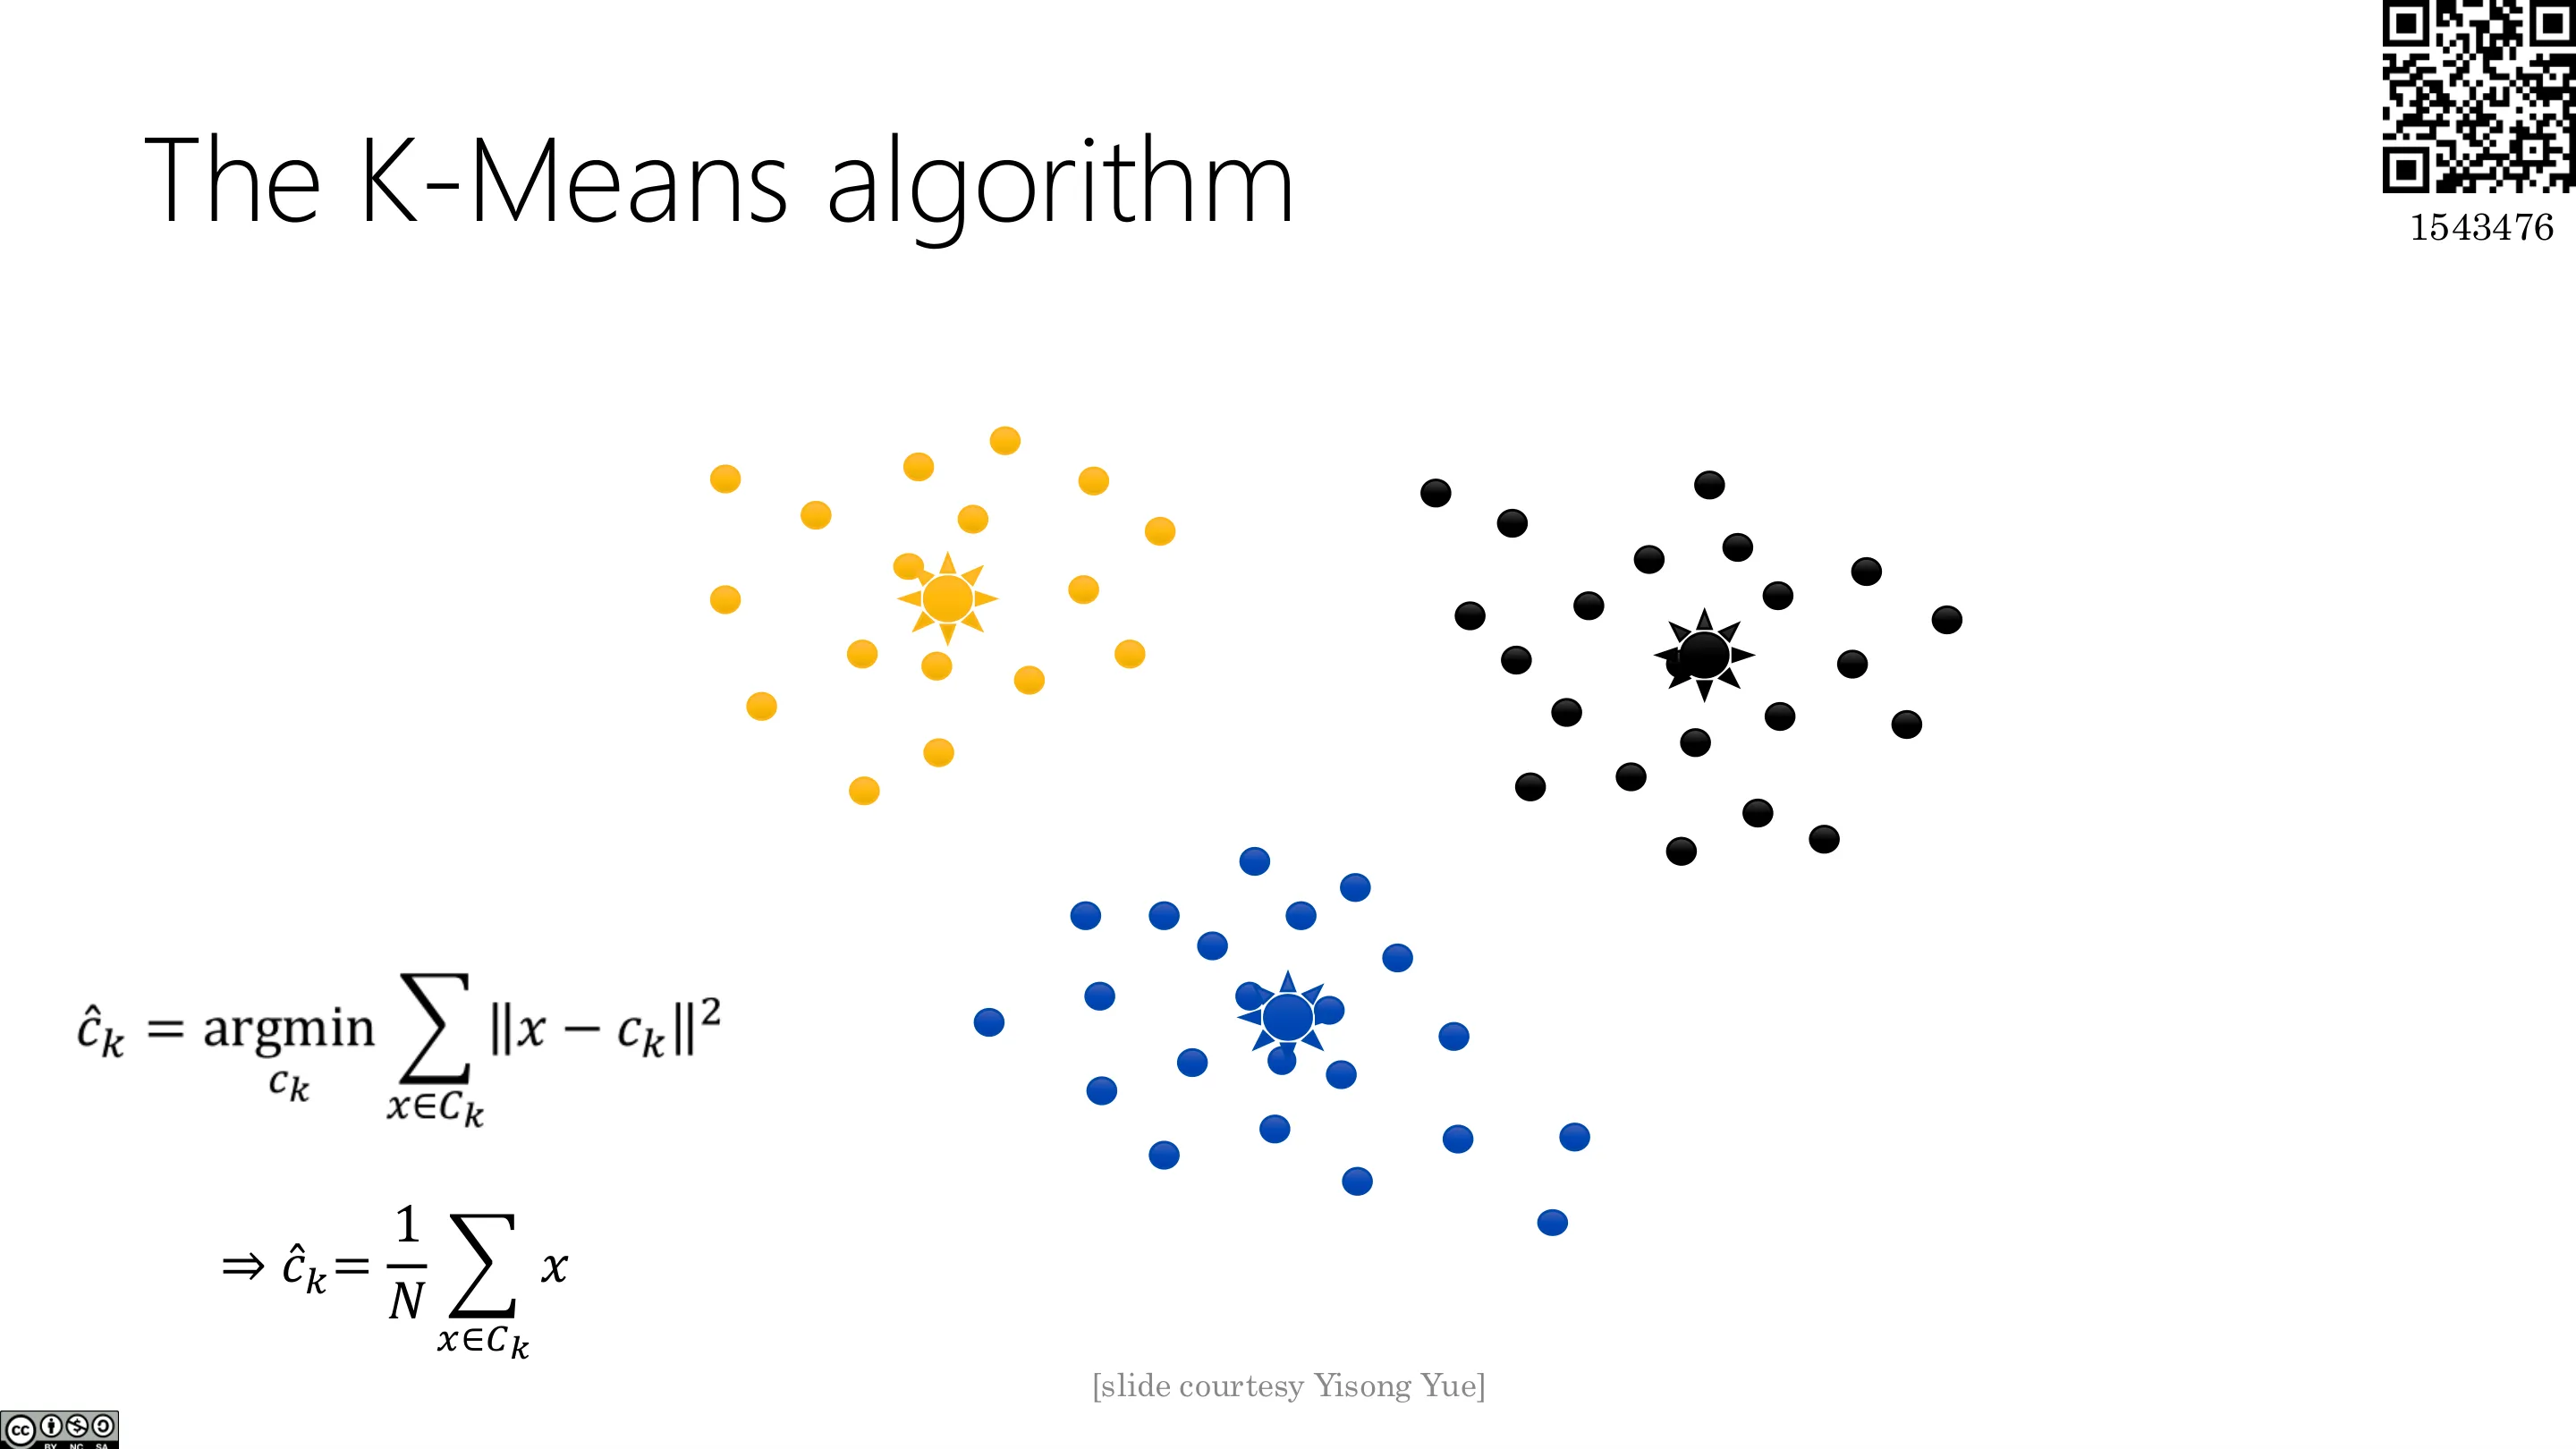
(1)已知划分,如何求质心? 优化问题退化为 $\hat{c}_k = \arg\min_{c_k} \sum_{x \in C_k} \|x - c_k\|^2$。
对 $c_k$ 求导并令其为零,可得答案就是该簇所有点的平均值:
$$ \hat{c}_k = \frac{1}{N_k} \sum_{x \in C_k} x $$
这之所以成立,正是因为我们用的是平方欧氏距离(换一种距离答案就不同了)。顺带一提:质心一般不会恰好落在某个训练点上(在实值空间中,概率为零)。
📷 参数学习(一):已知划分
回到原视频 (00:37:46)
📷 参数学习(二):目标退化为求均值
回到原视频 (00:39:55)
📷 参数学习(三)
回到原视频 (00:40:49)
📷 参数学习(四):答案是簇内均值
回到原视频 (00:41:18)
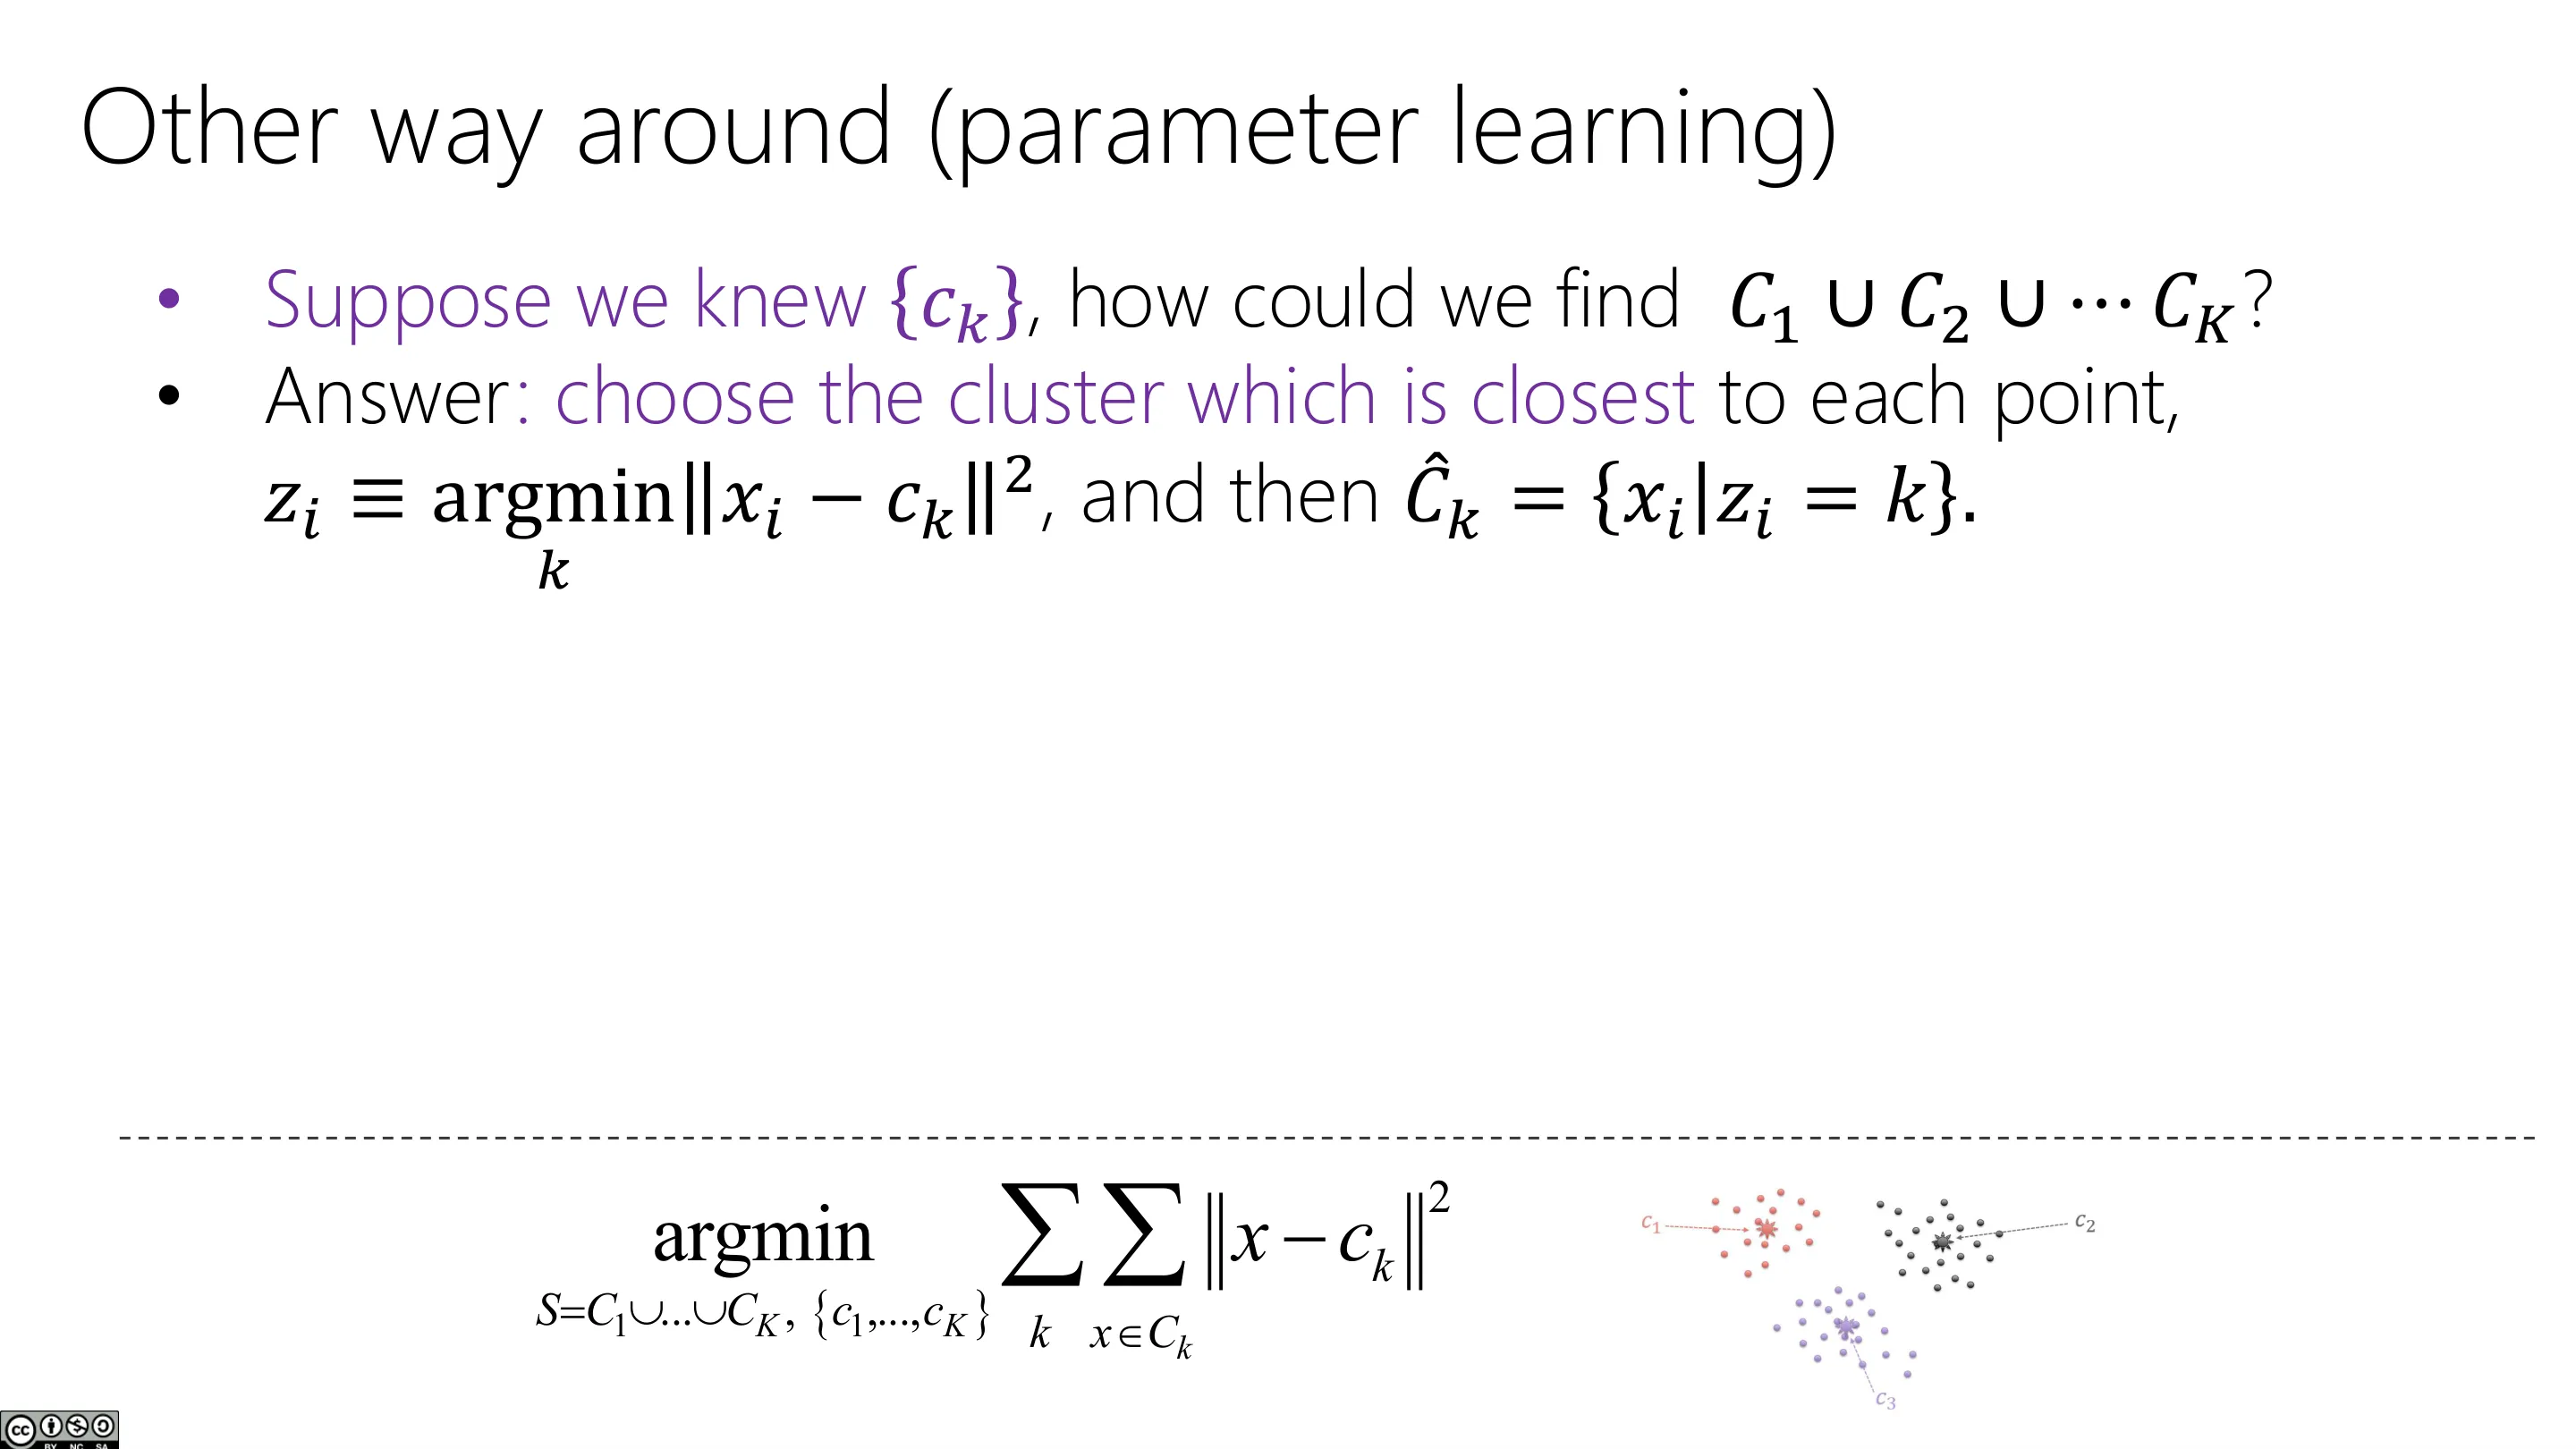
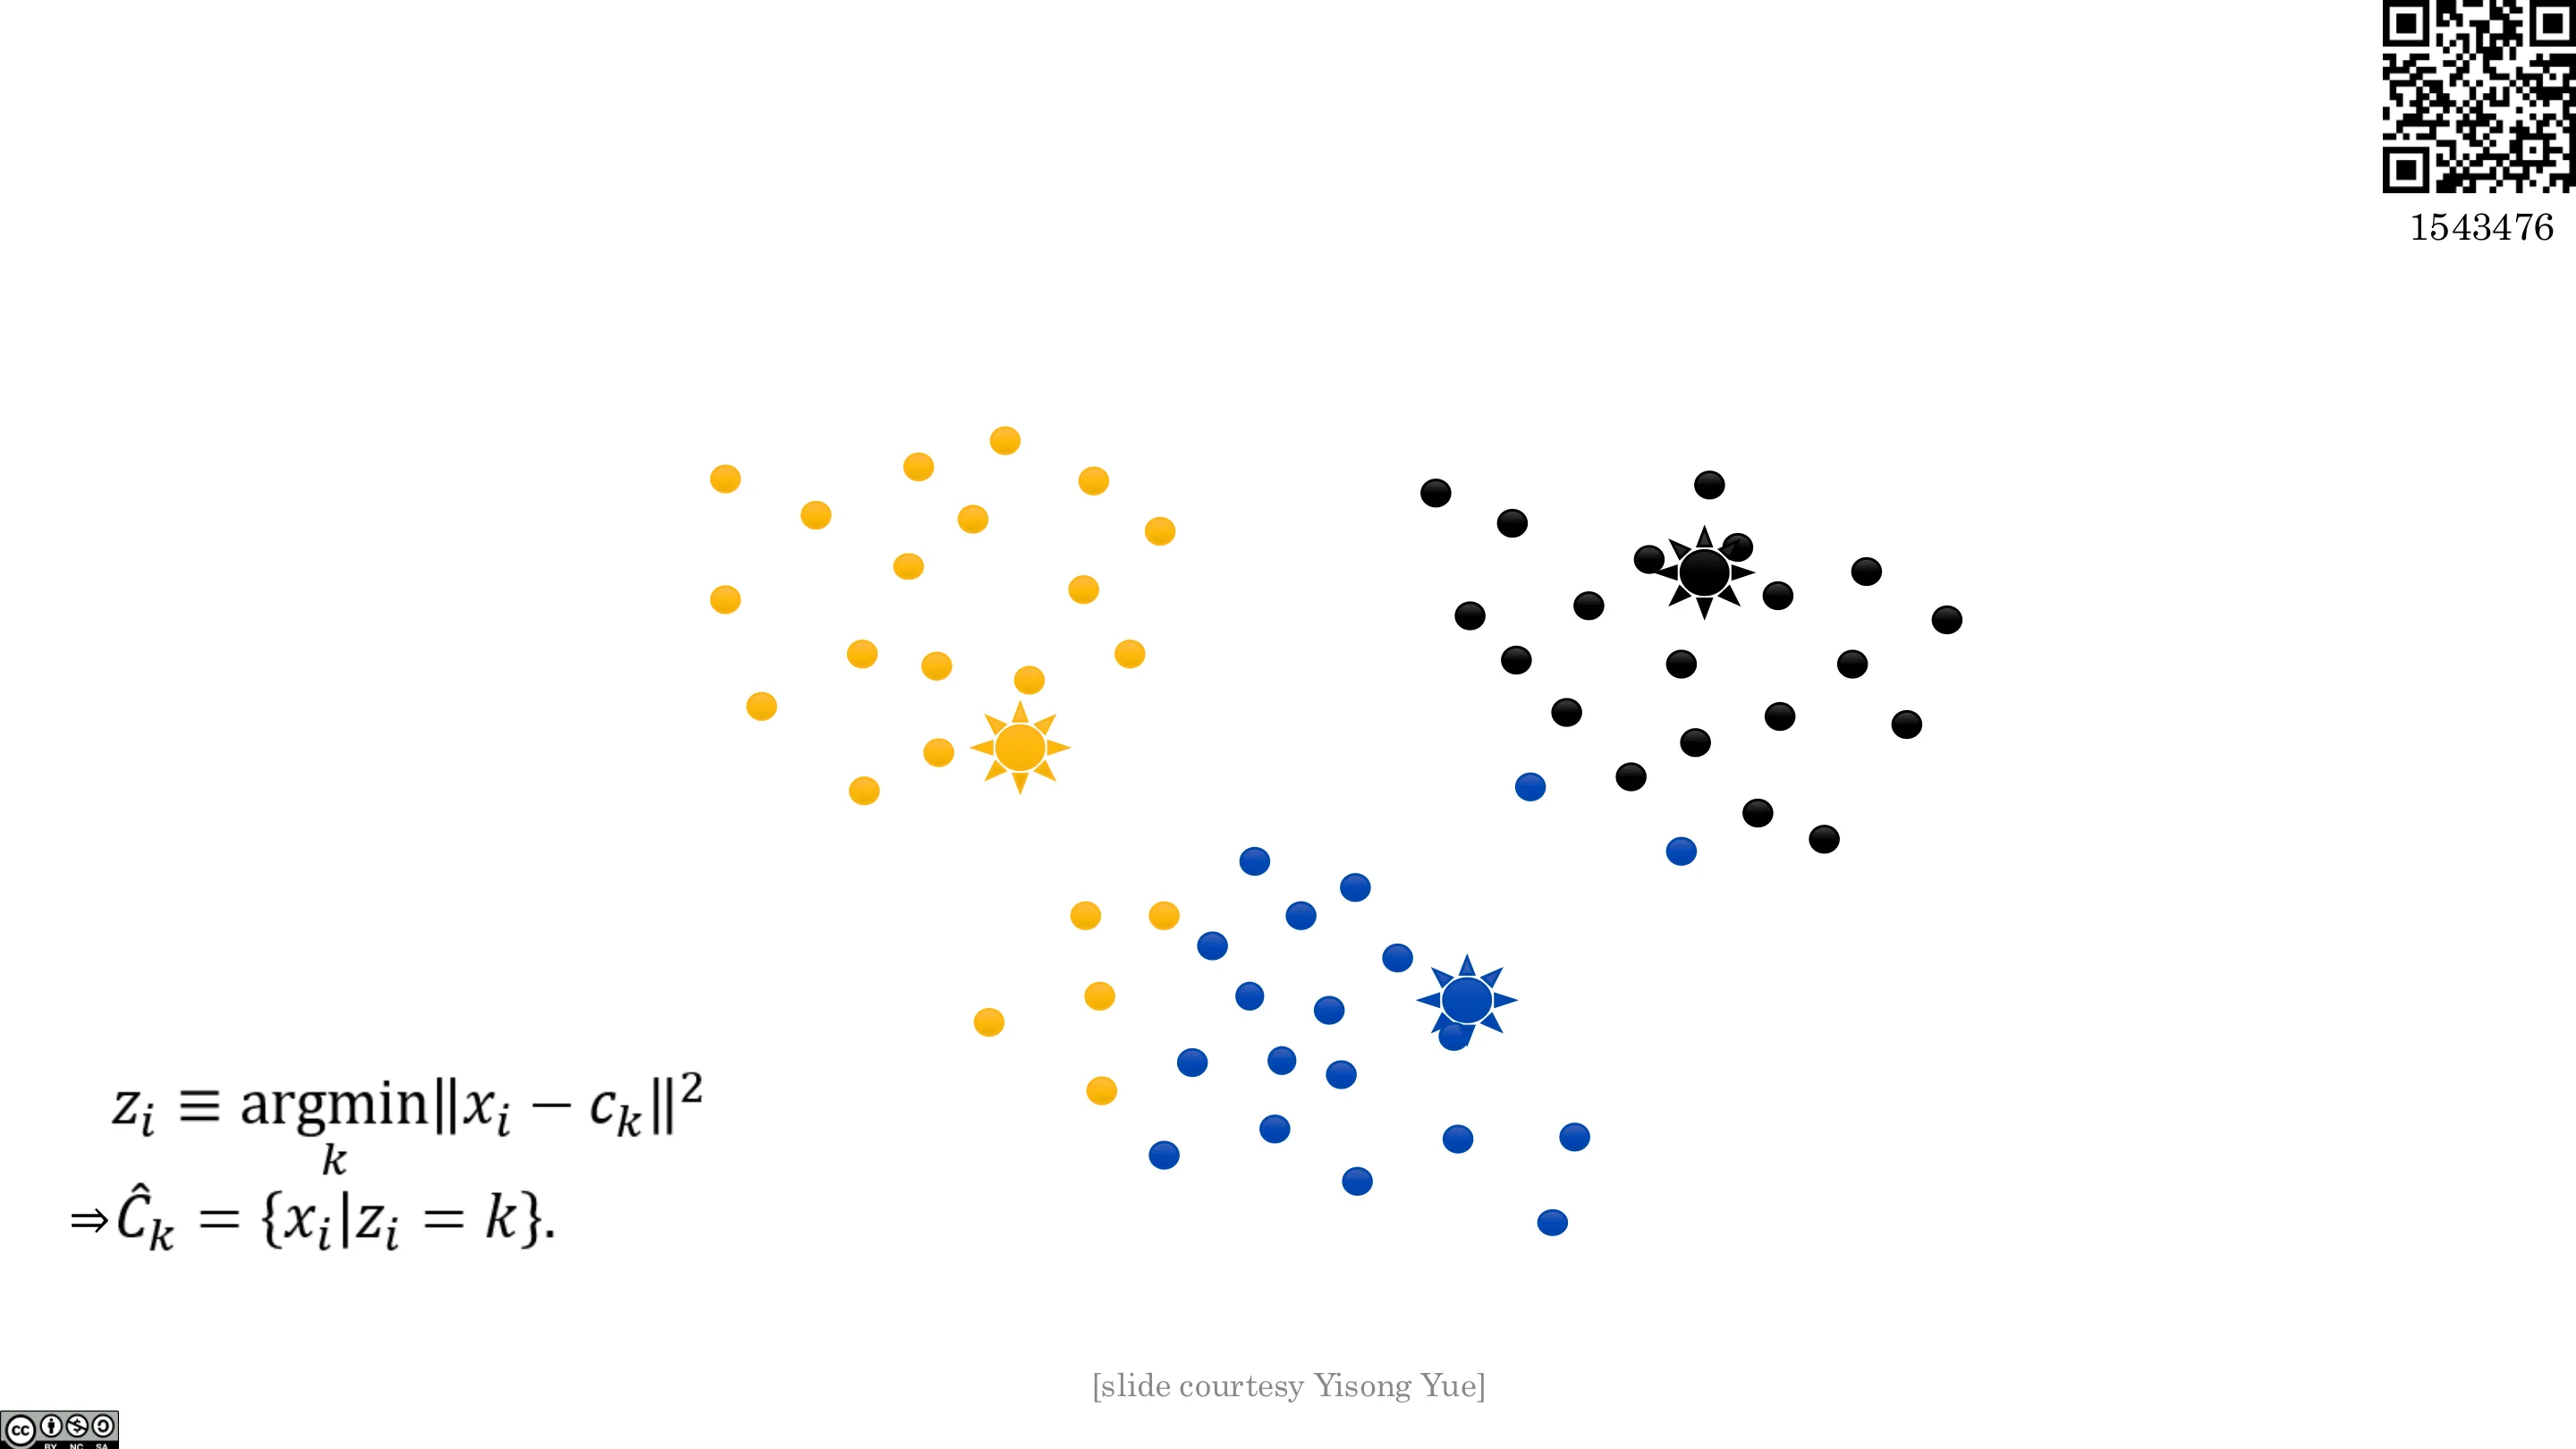
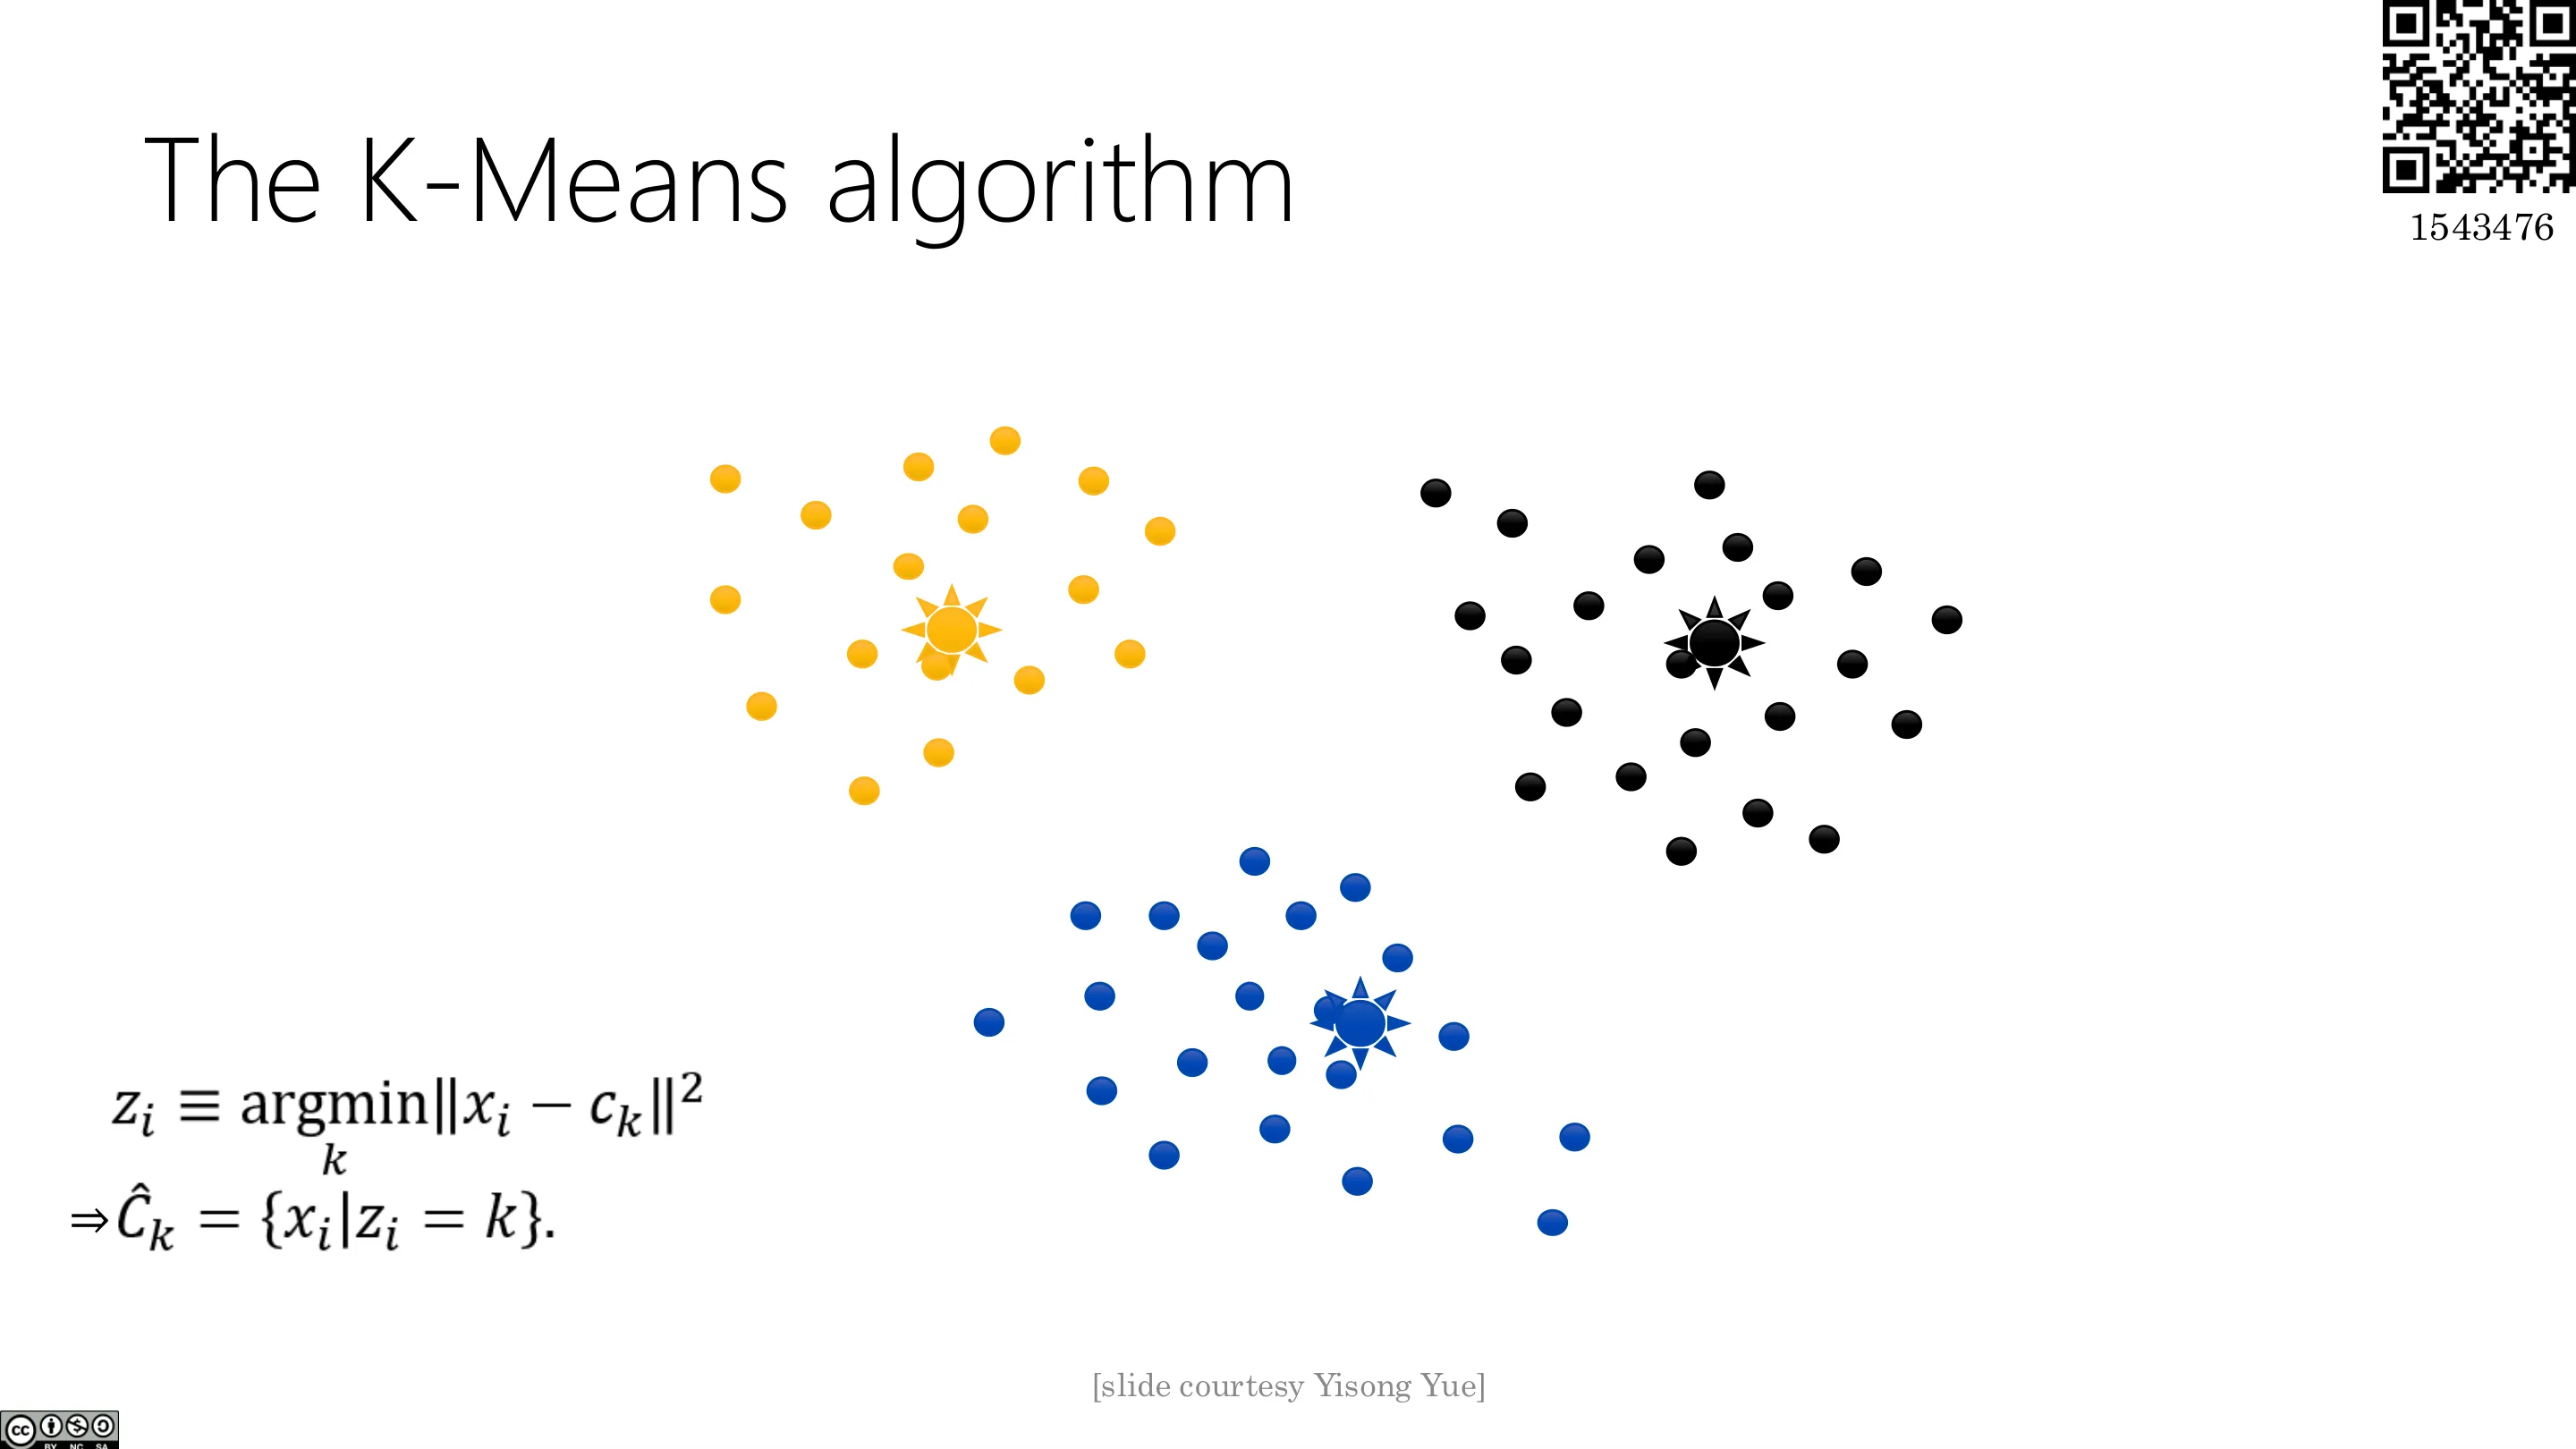
(2)已知质心,如何求划分? 更简单——把每个点分配给平方欧氏距离最近的质心:
$$ z_i \equiv \arg\min_k \|x_i - c_k\|^2, \quad \hat{C}_k = \{x_i : z_i = k\} $$
📷 反过来:已知质心求划分
回到原视频 (00:43:21)
四、K 均值算法与演示
(参考时间: 00:45)
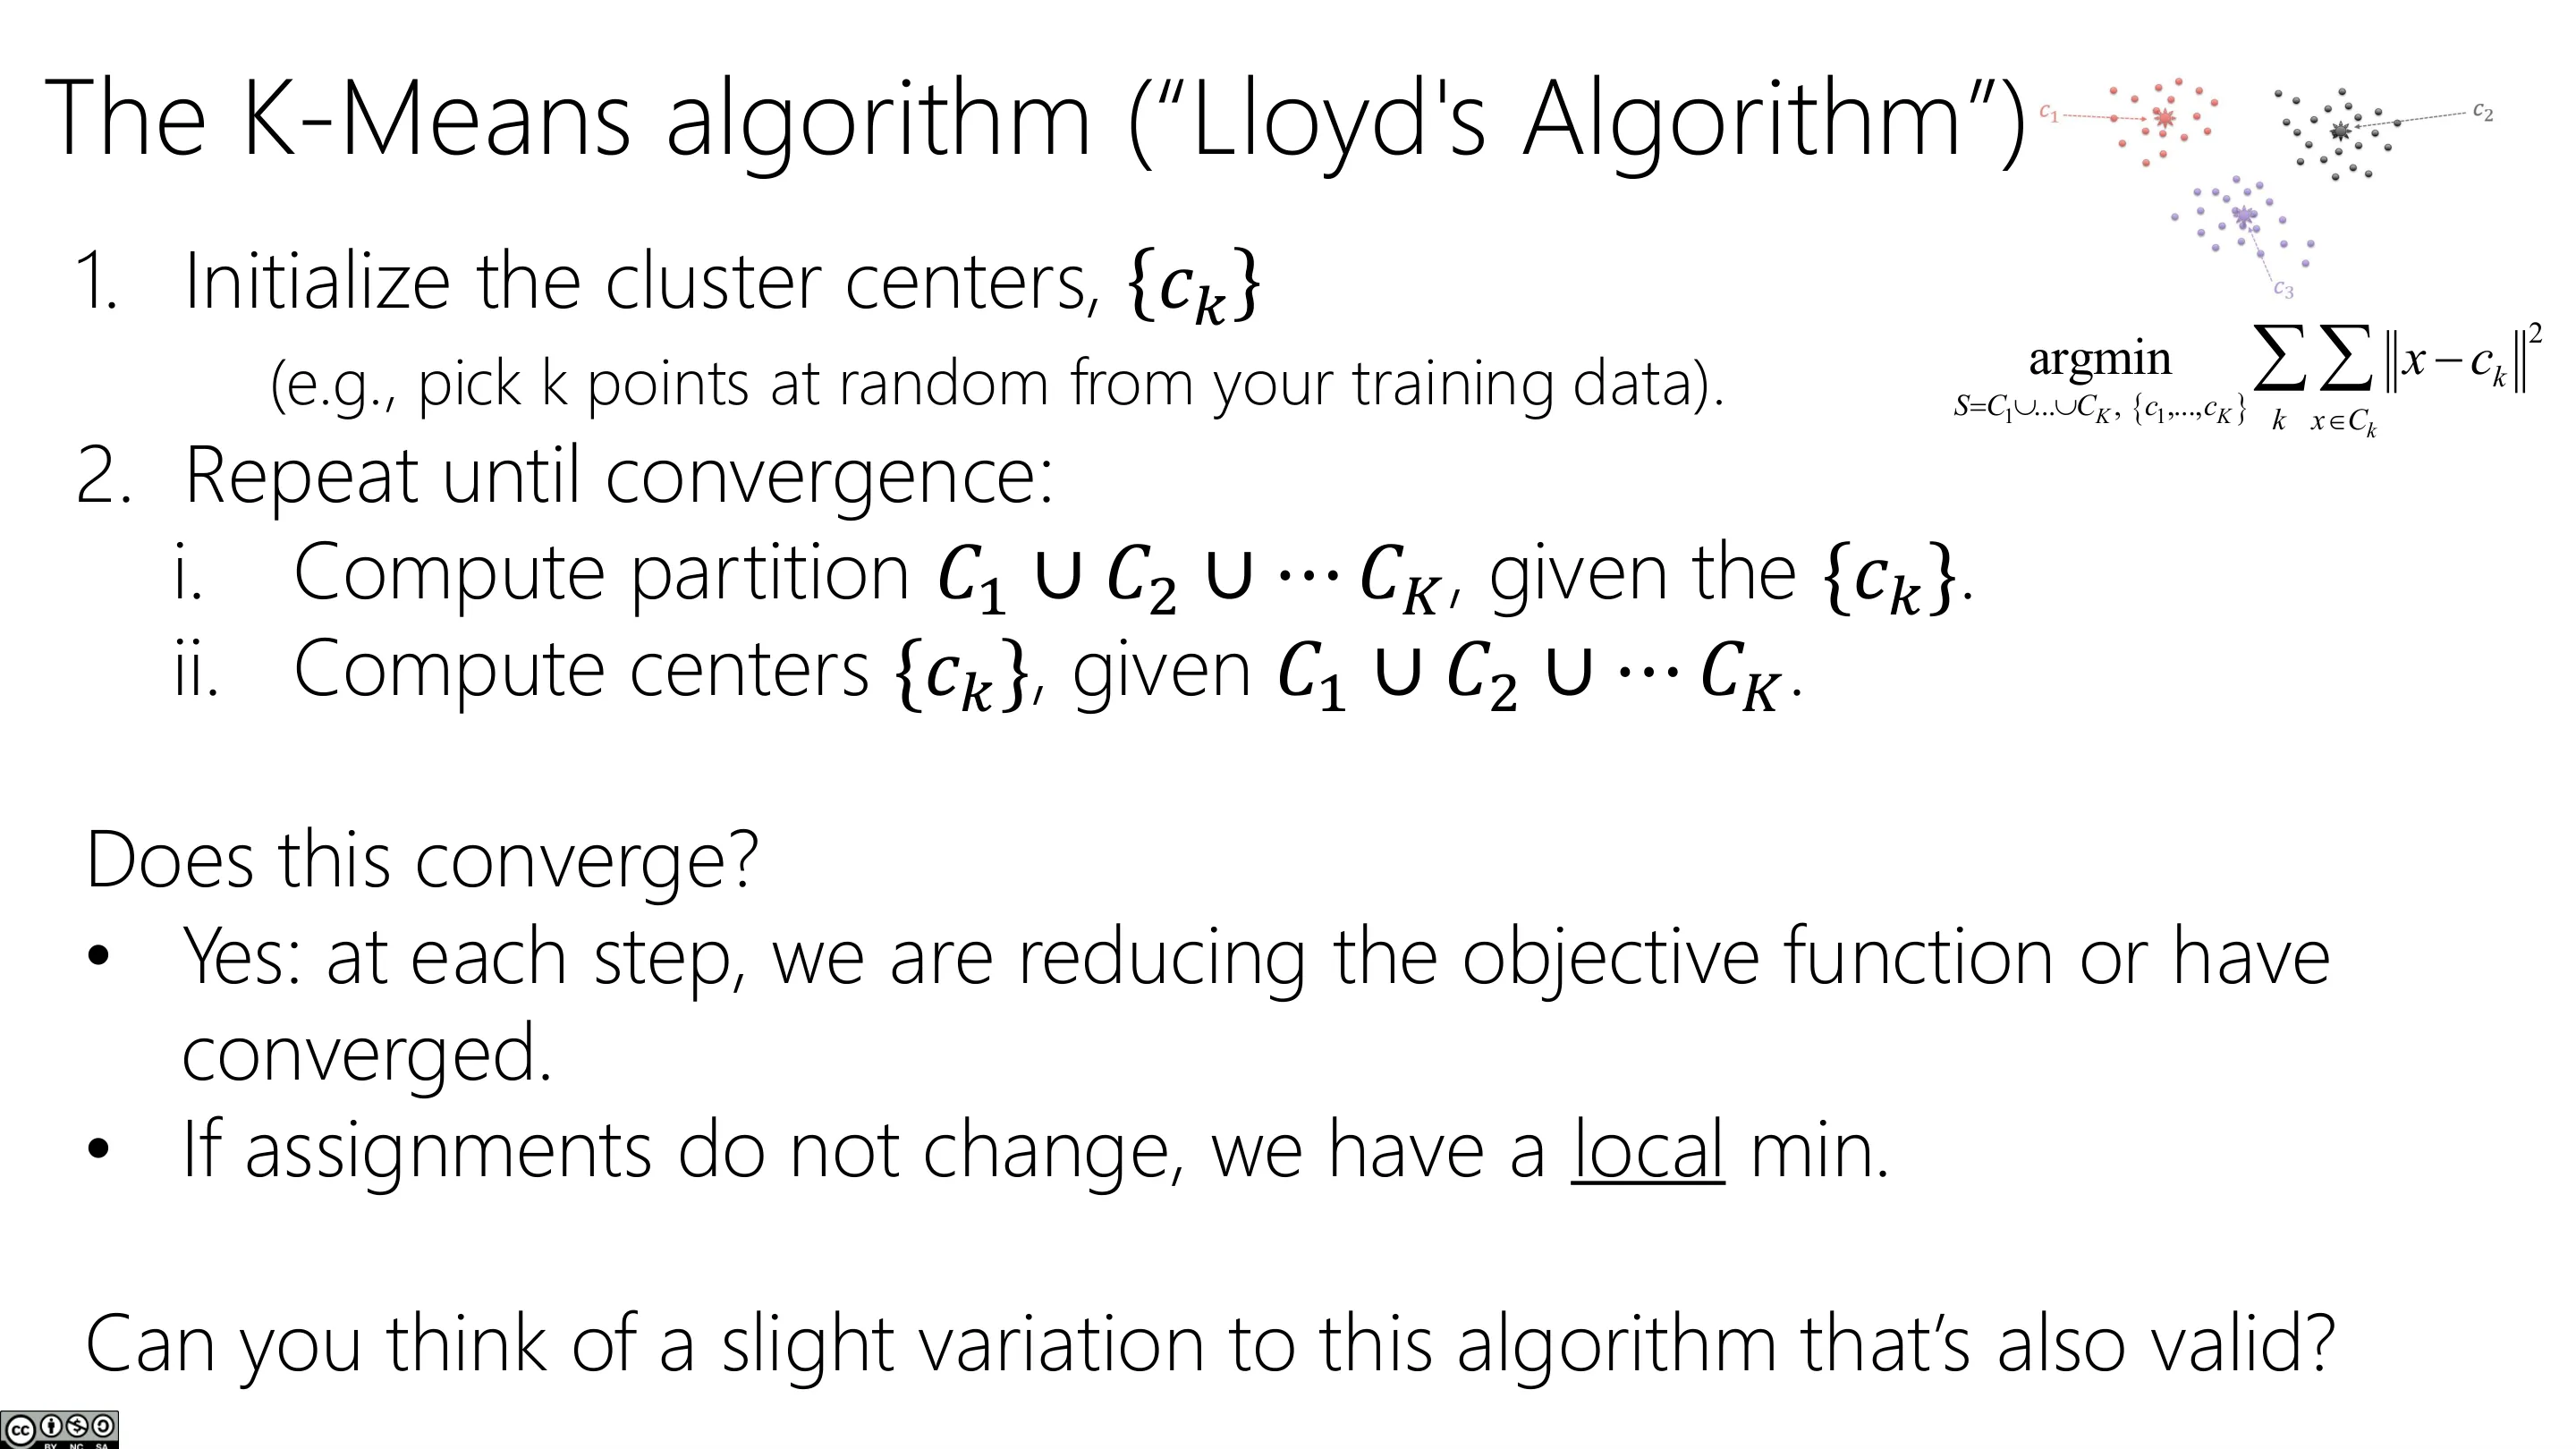
把两半合起来,就得到 K 均值算法(Lloyd's Algorithm):
- 初始化簇中心 $c_k$(例如从训练数据里随机挑 $k$ 个点);
- 重复直到收敛:
- ① 给定 $\{c_k\}$,计算划分 $C_1 \cup \cdots \cup C_K$;
- ② 给定划分,更新中心 $\{c_k\}$(即各簇均值)。
它会收敛吗? 会——每一步都会让目标函数下降或保持不变;当分配不再变化时,就到达了一个局部极小。
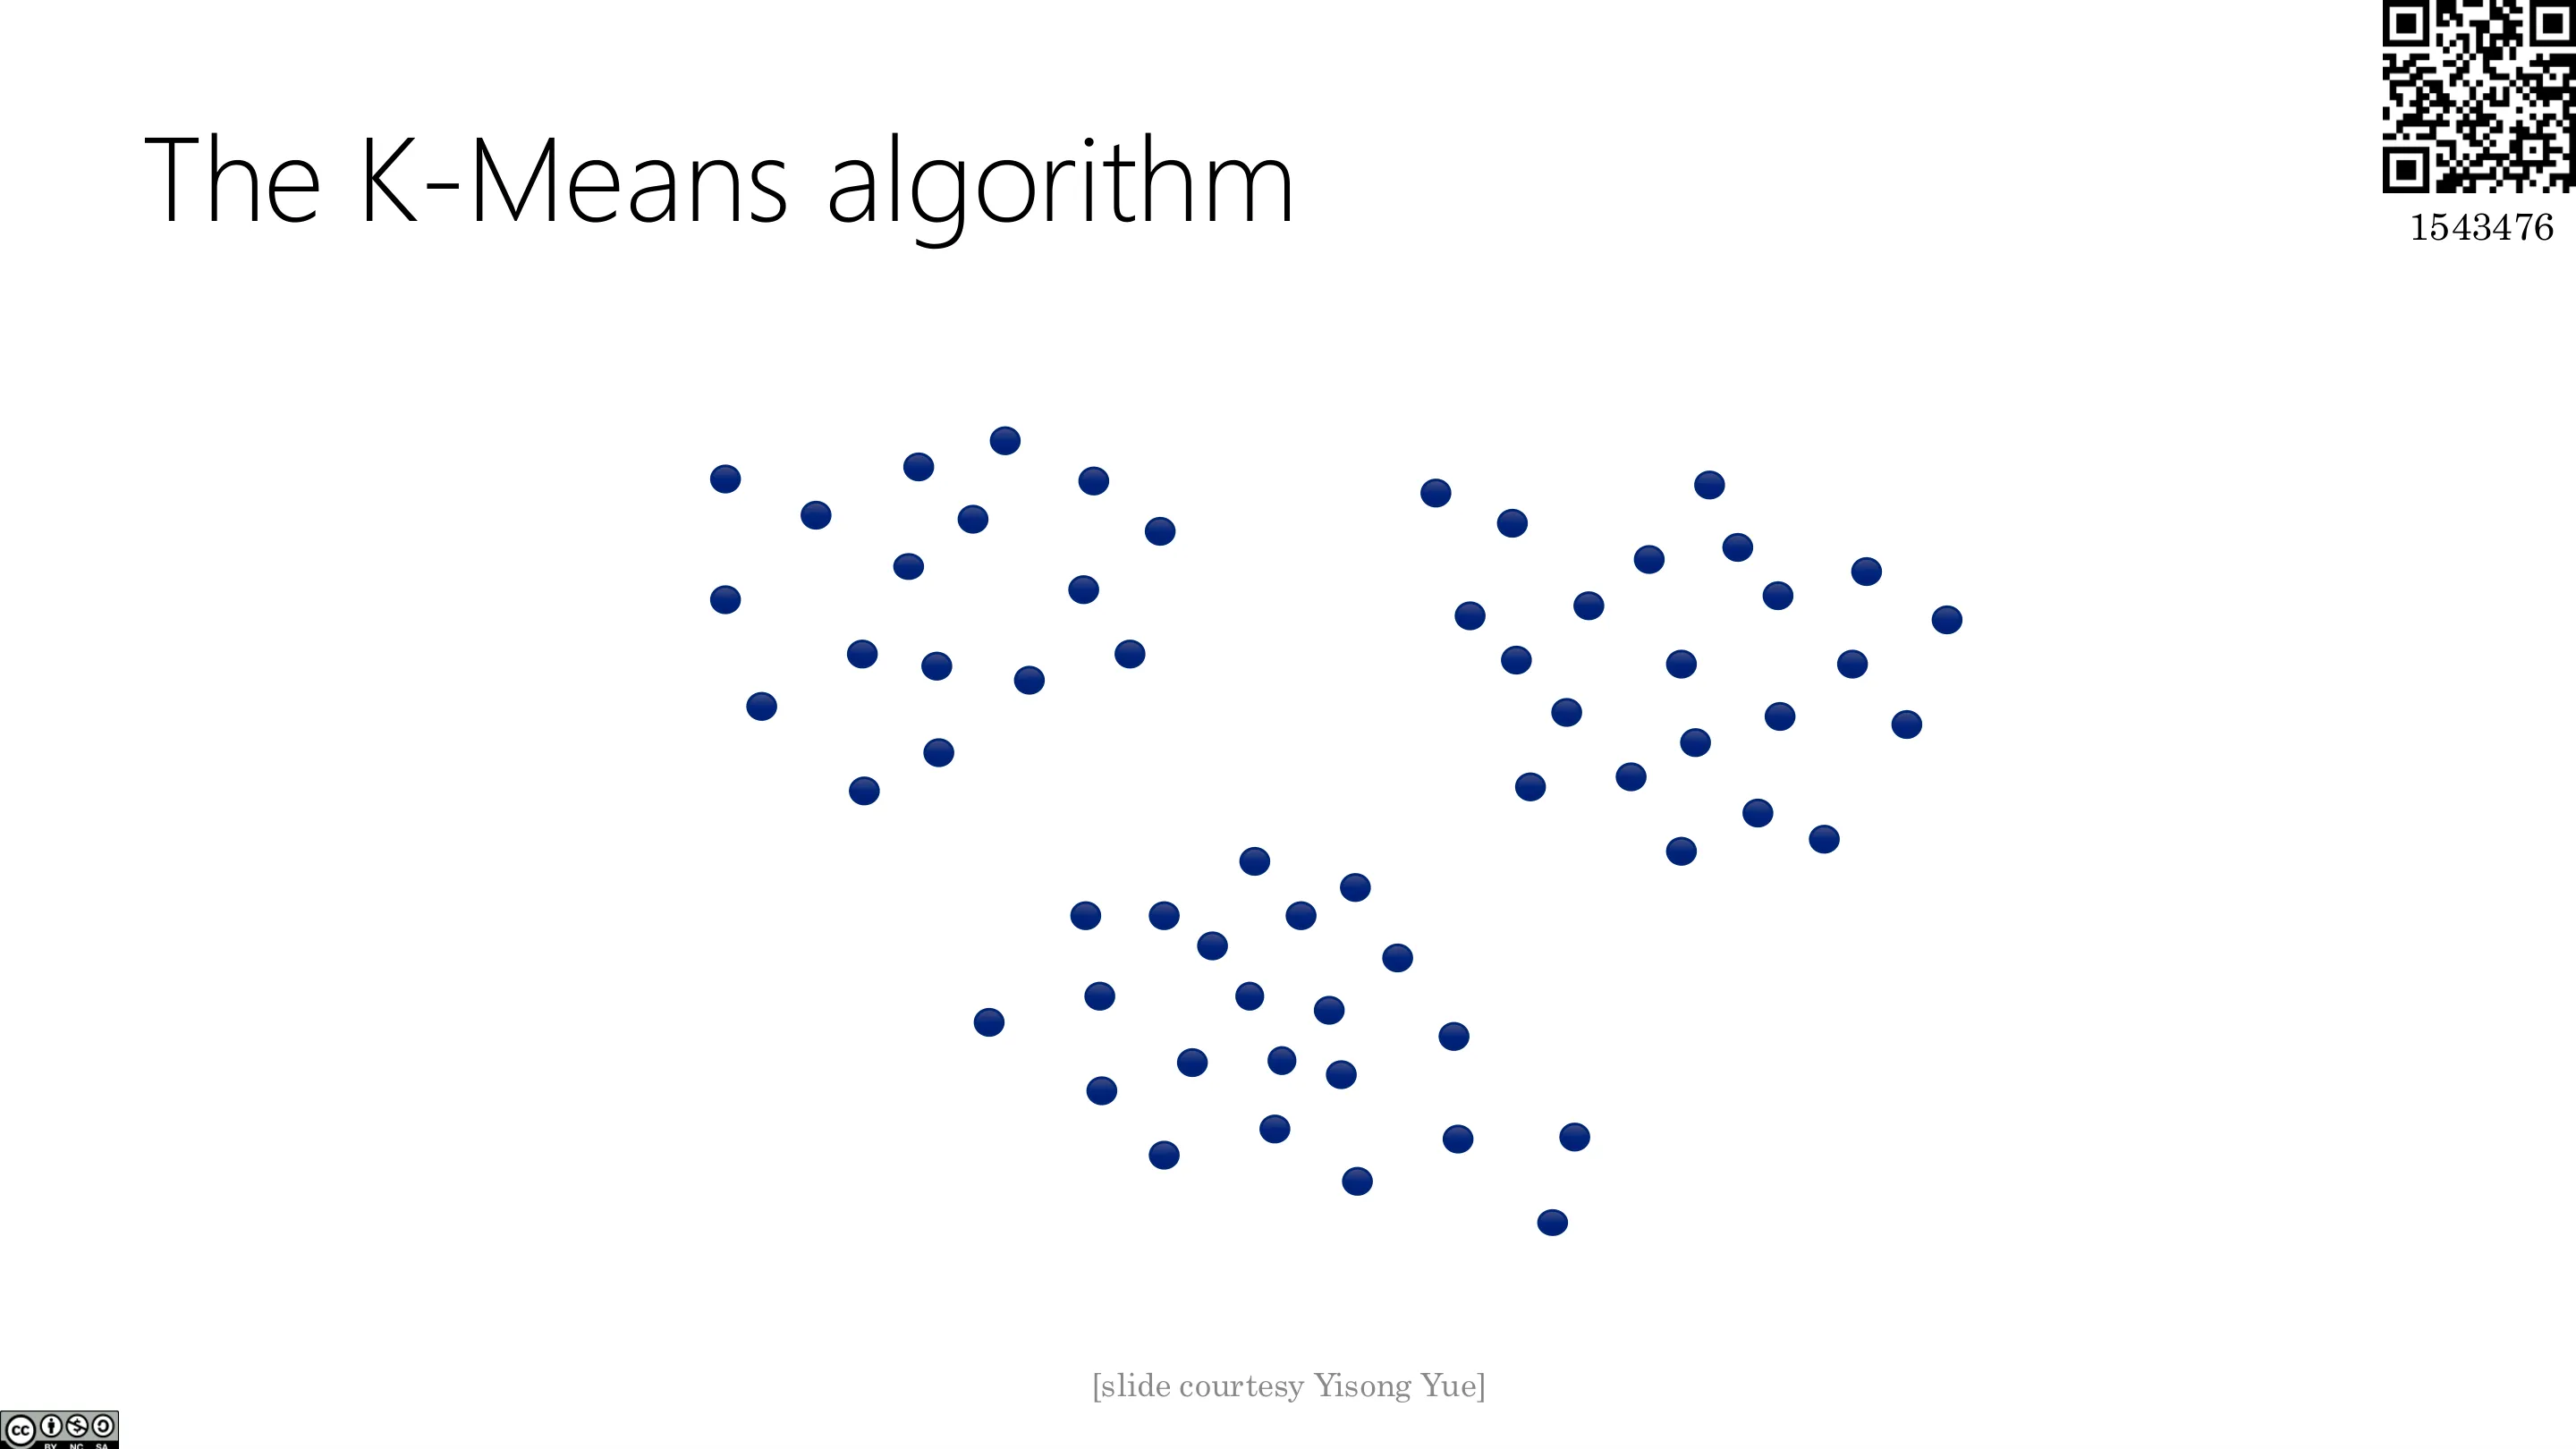
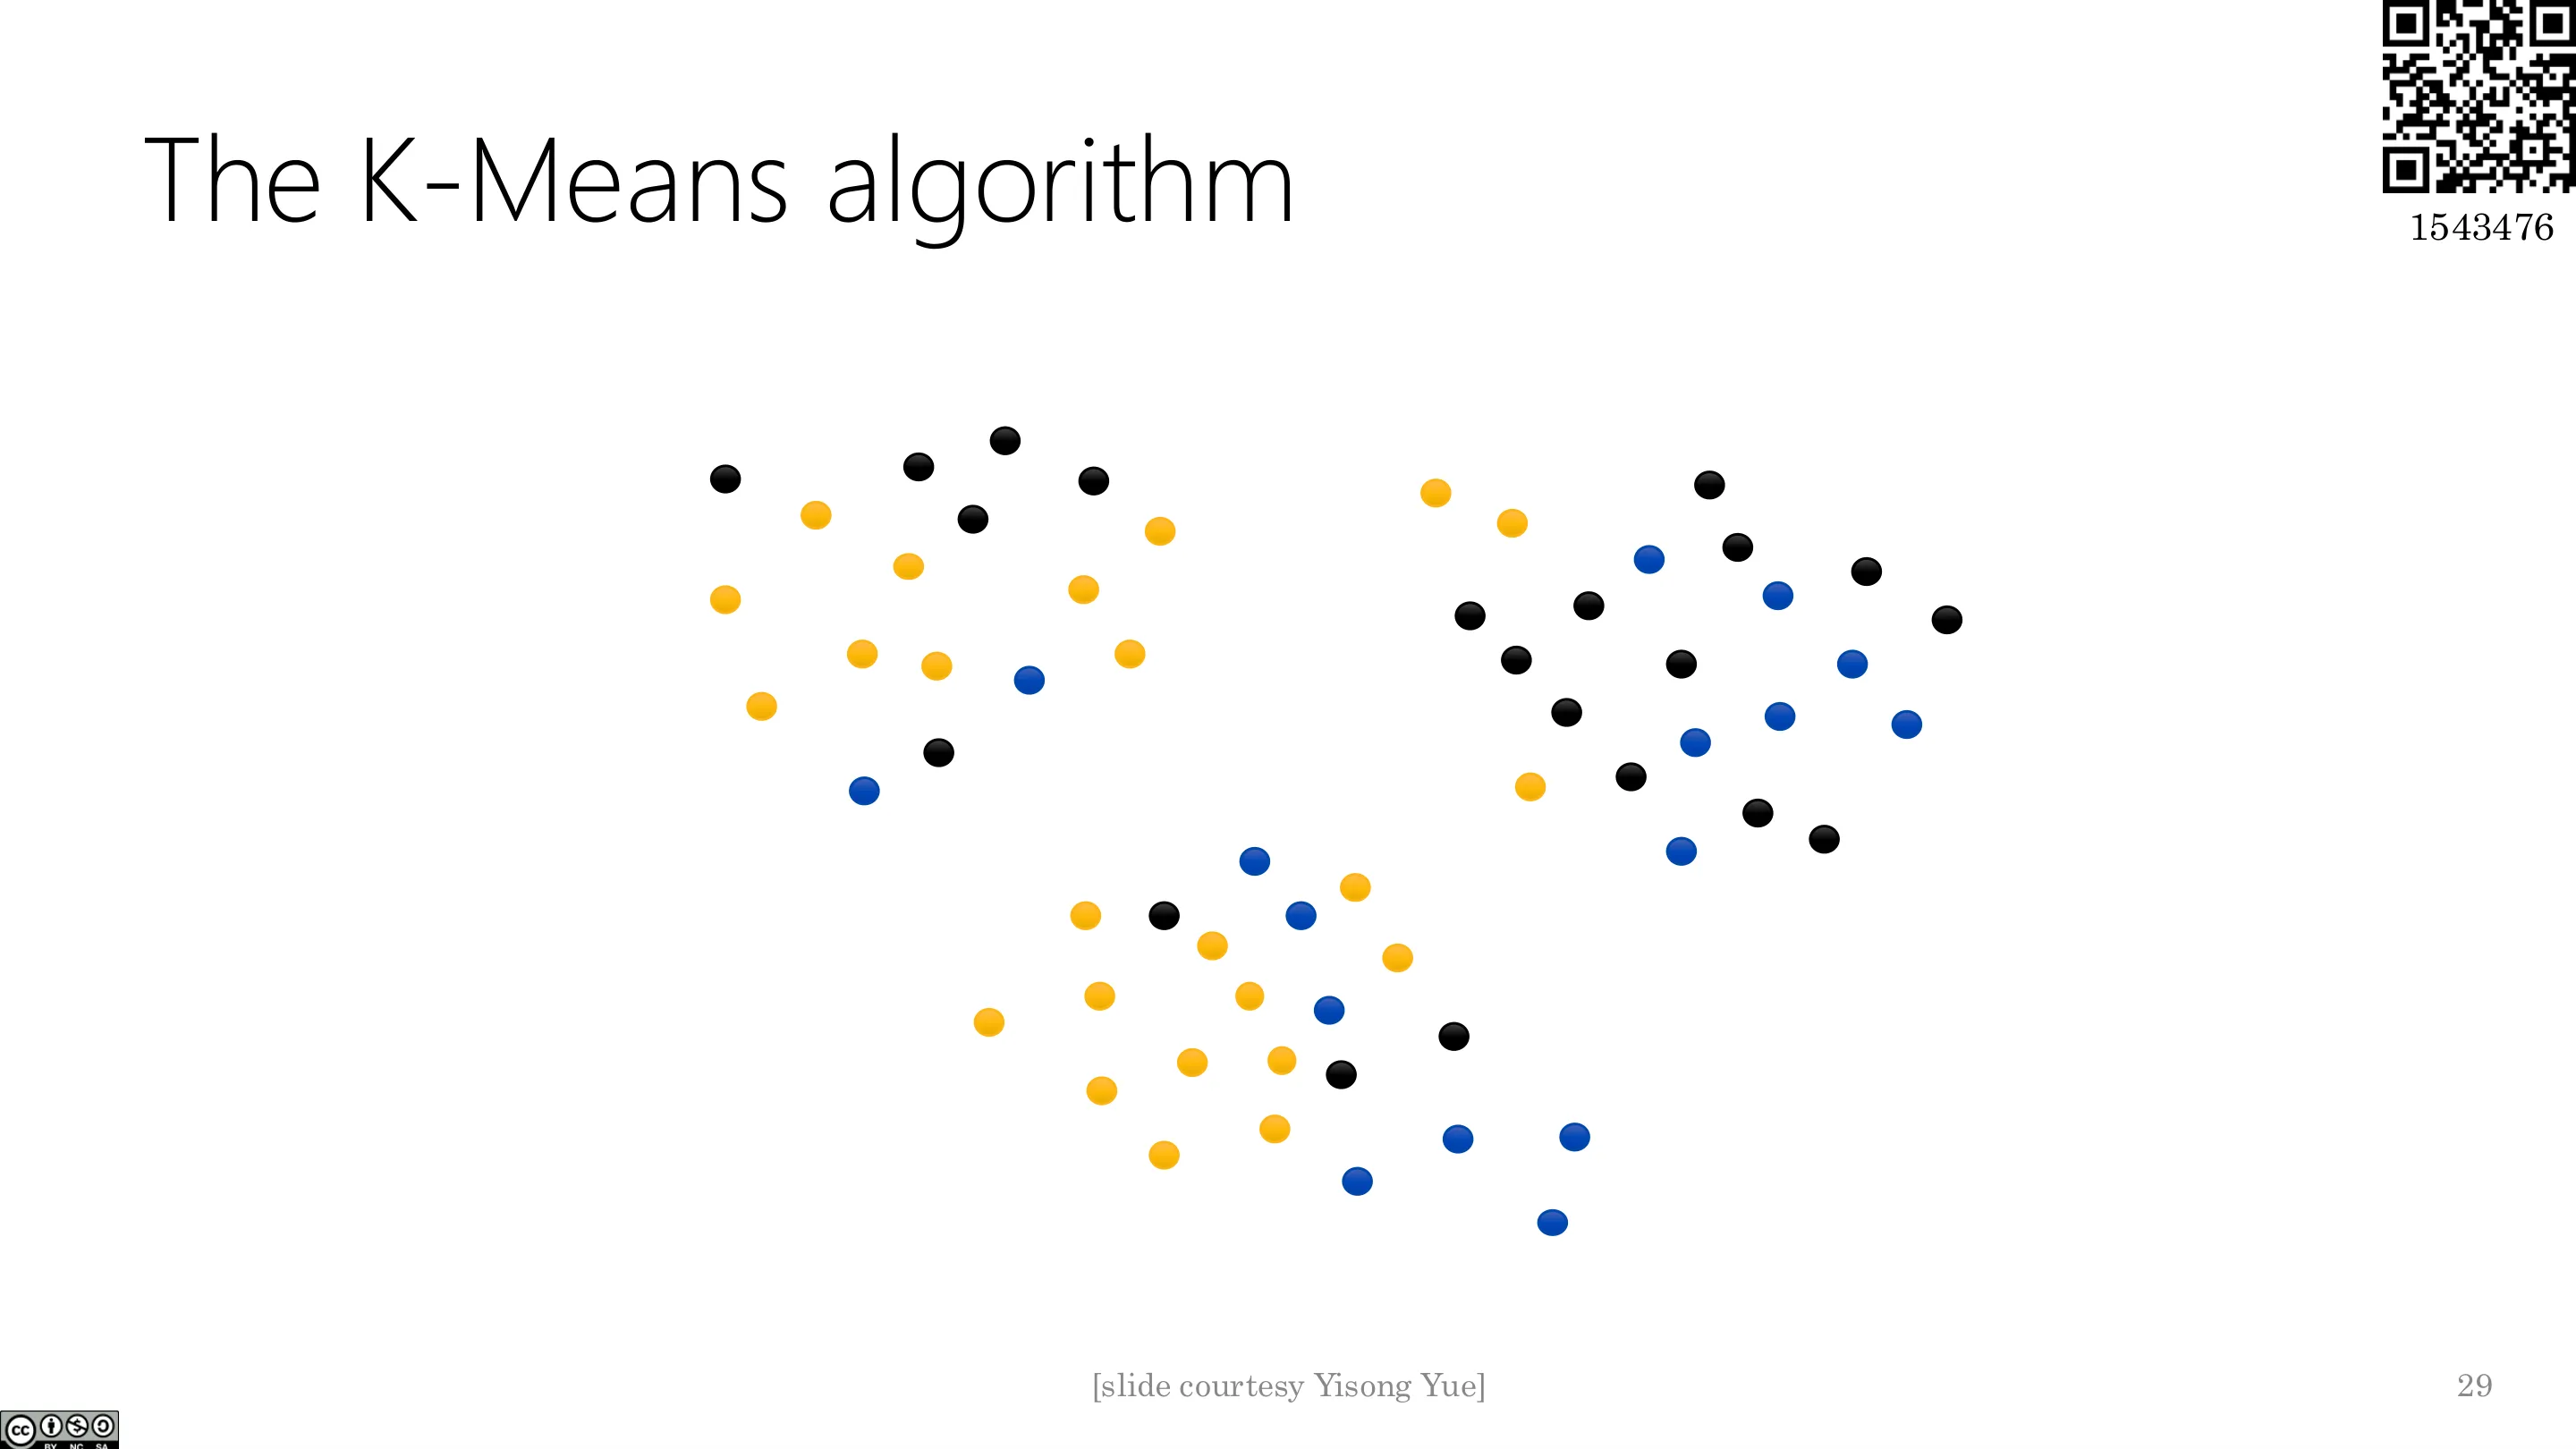
一个等价的变体:不初始化中心,而是先随机初始化一个划分,然后同样交替迭代。两者都有效、都能收敛到局部最优。
📷 K 均值算法(Lloyd 算法)
回到原视频 (00:45:20)
下面的动画(Yisong Yue 制作)演示了这一过程:从随机初始划分出发,先算质心、再重新分区,反复交替,很快就「自我清理」出一个合理的结果。
📷 K 均值演示:初始状态
回到原视频 (00:51:32)
📷 K 均值演示:交替迭代
回到原视频 (00:51:49)
📷 K 均值演示:质心=簇内均值
回到原视频 (00:52:24)
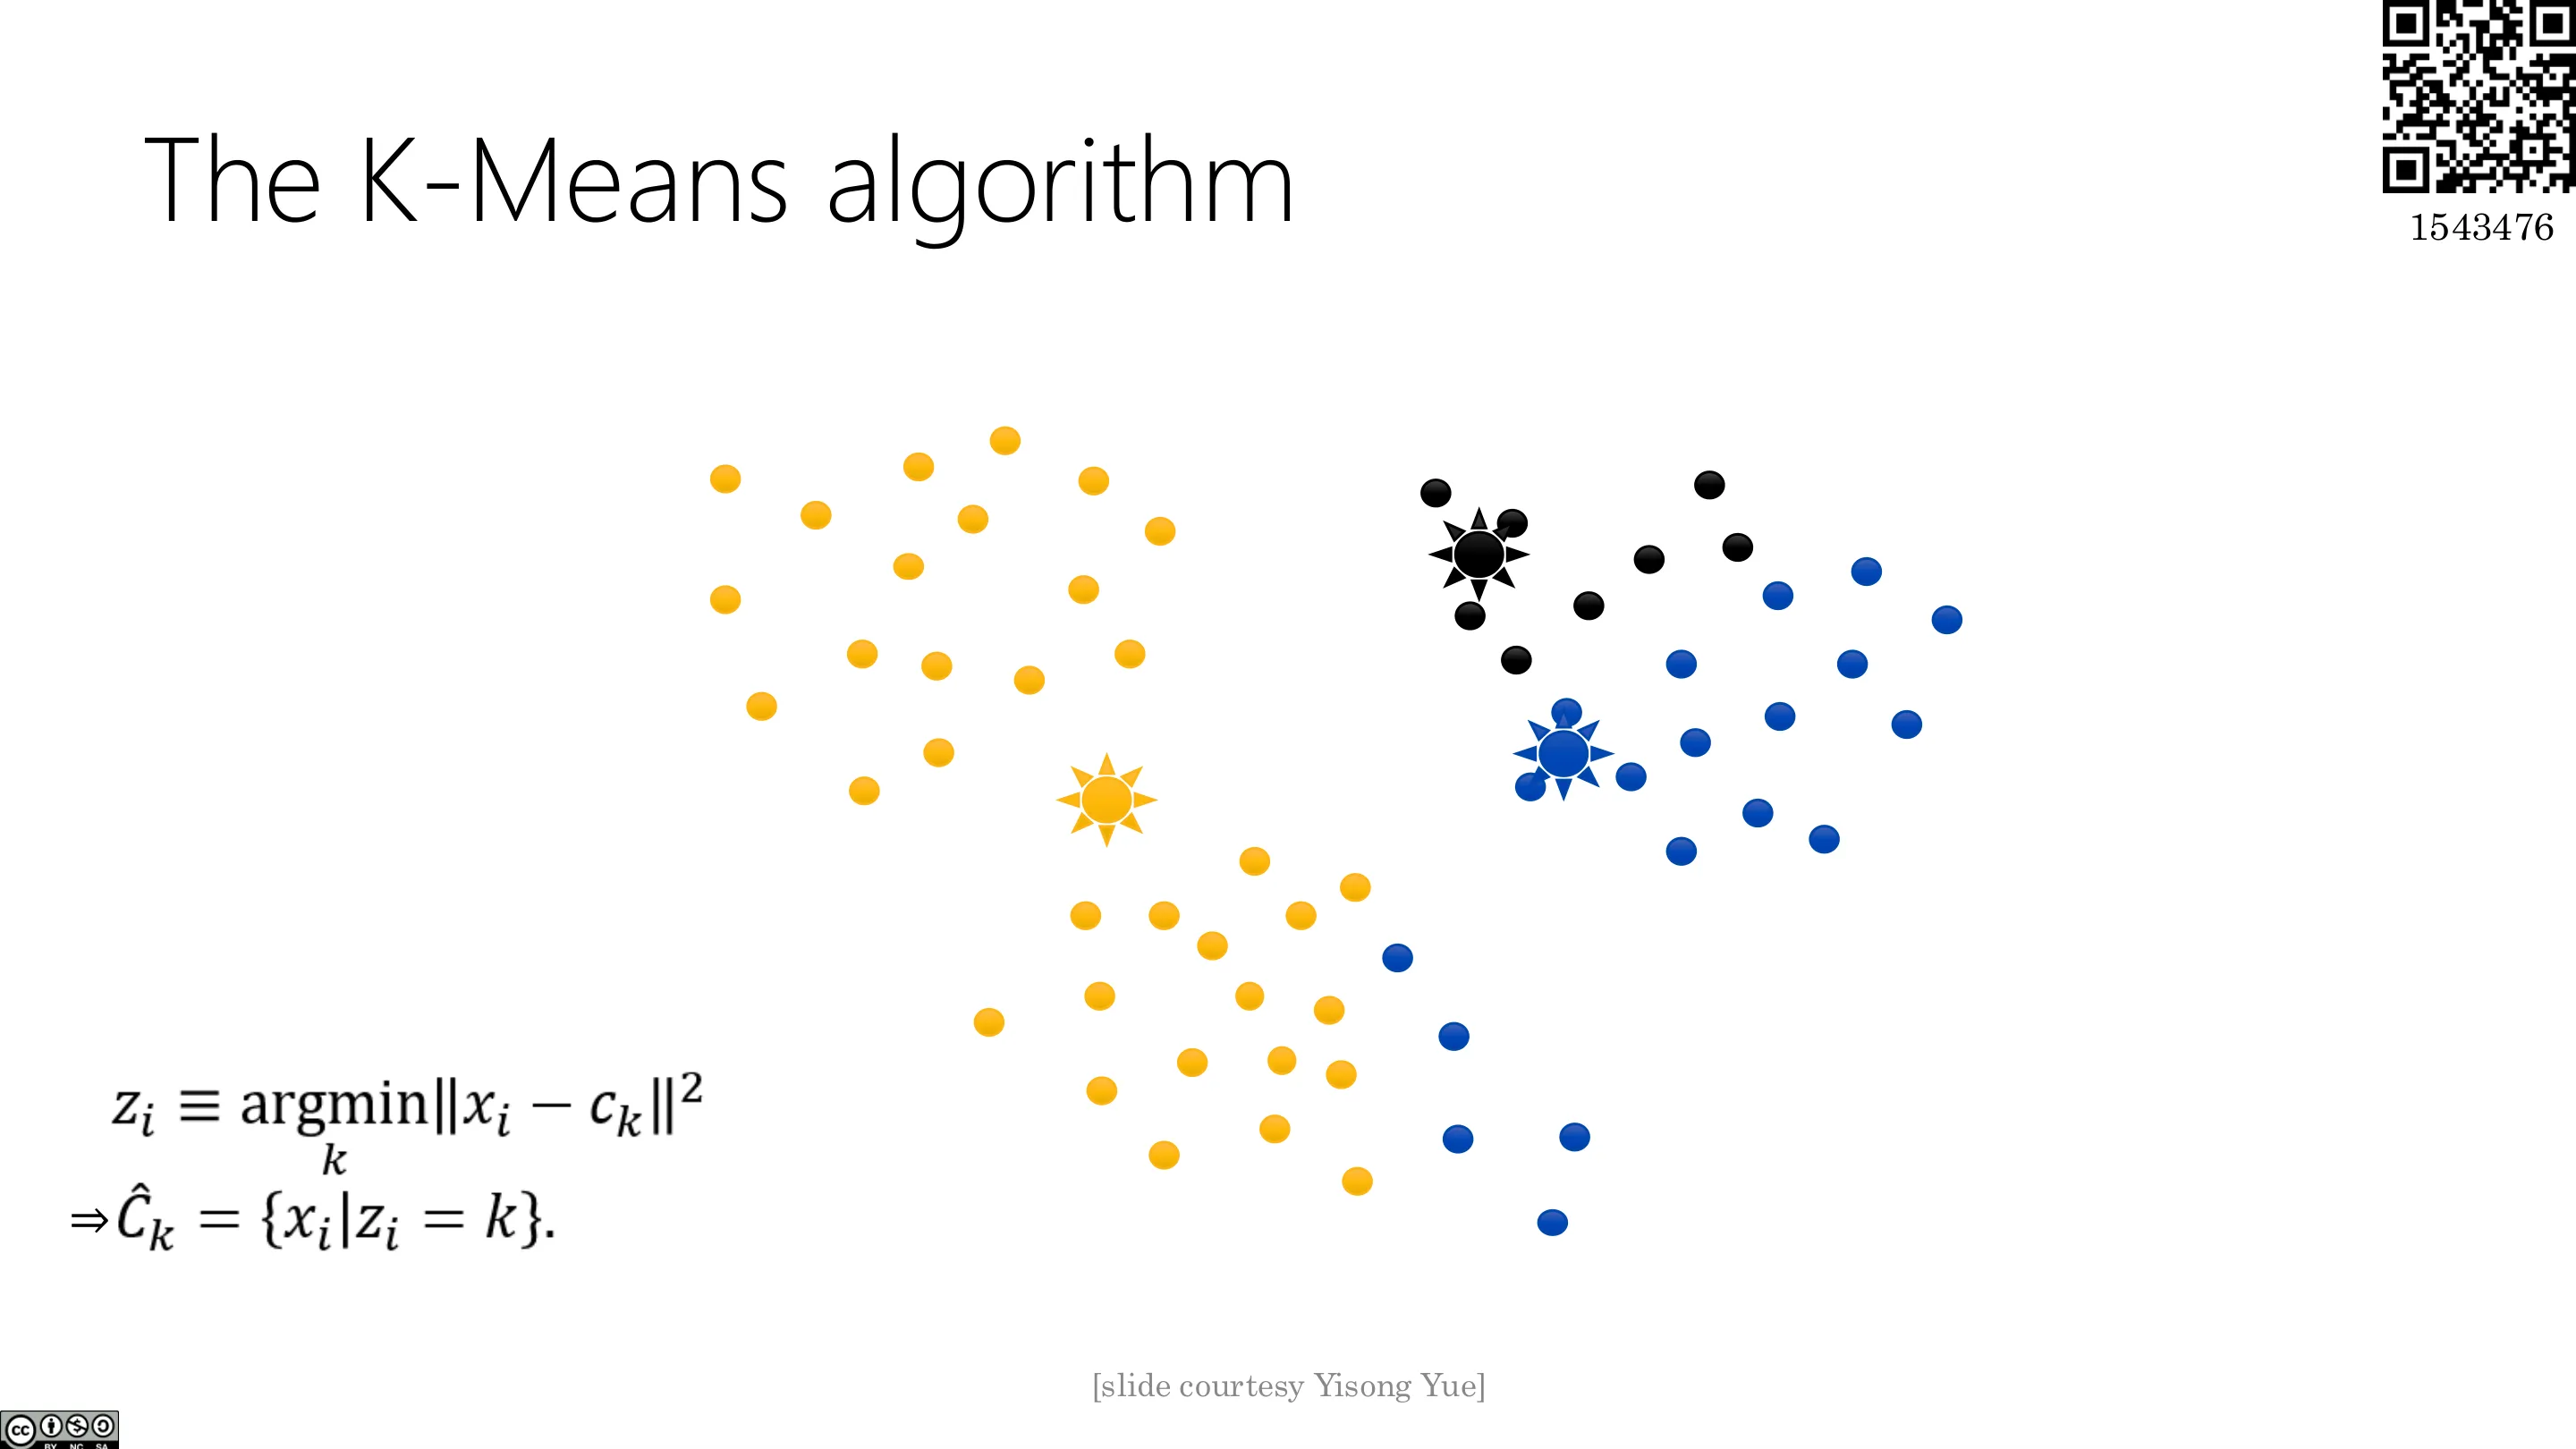
📷 K 均值演示:步骤
回到原视频 (00:53:11)
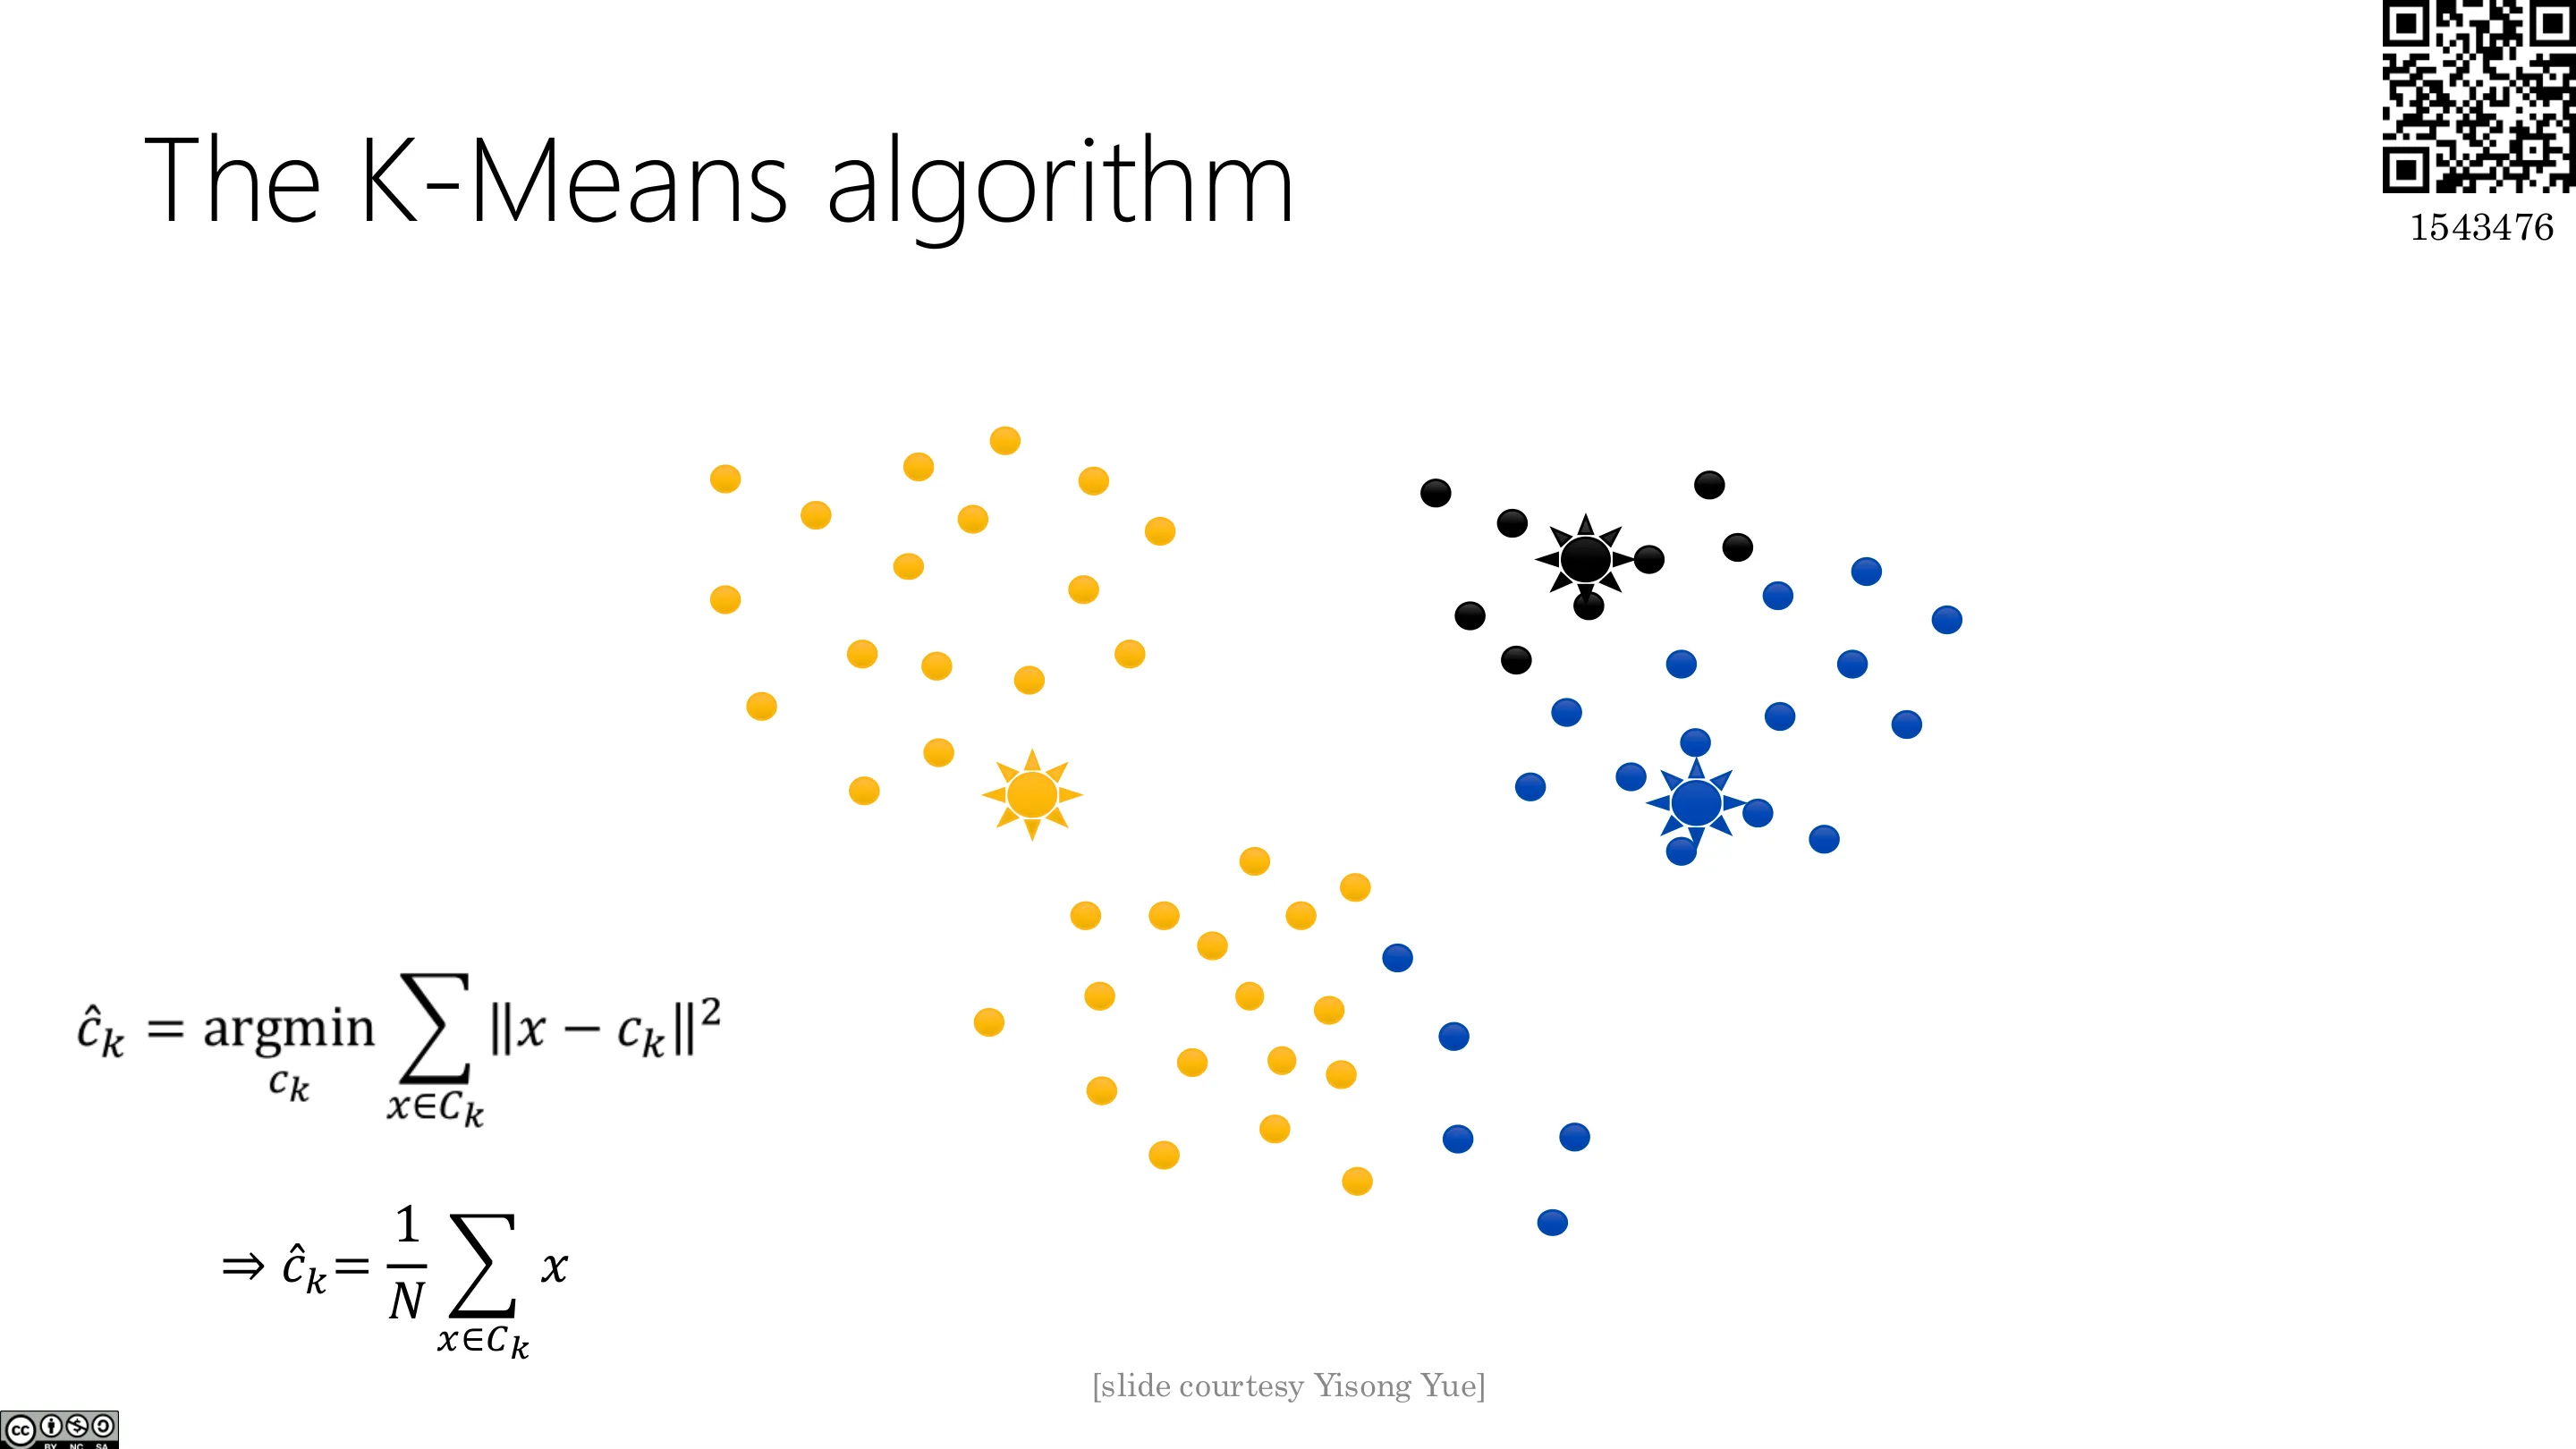
📷 K 均值演示:步骤
回到原视频 (00:53:19)
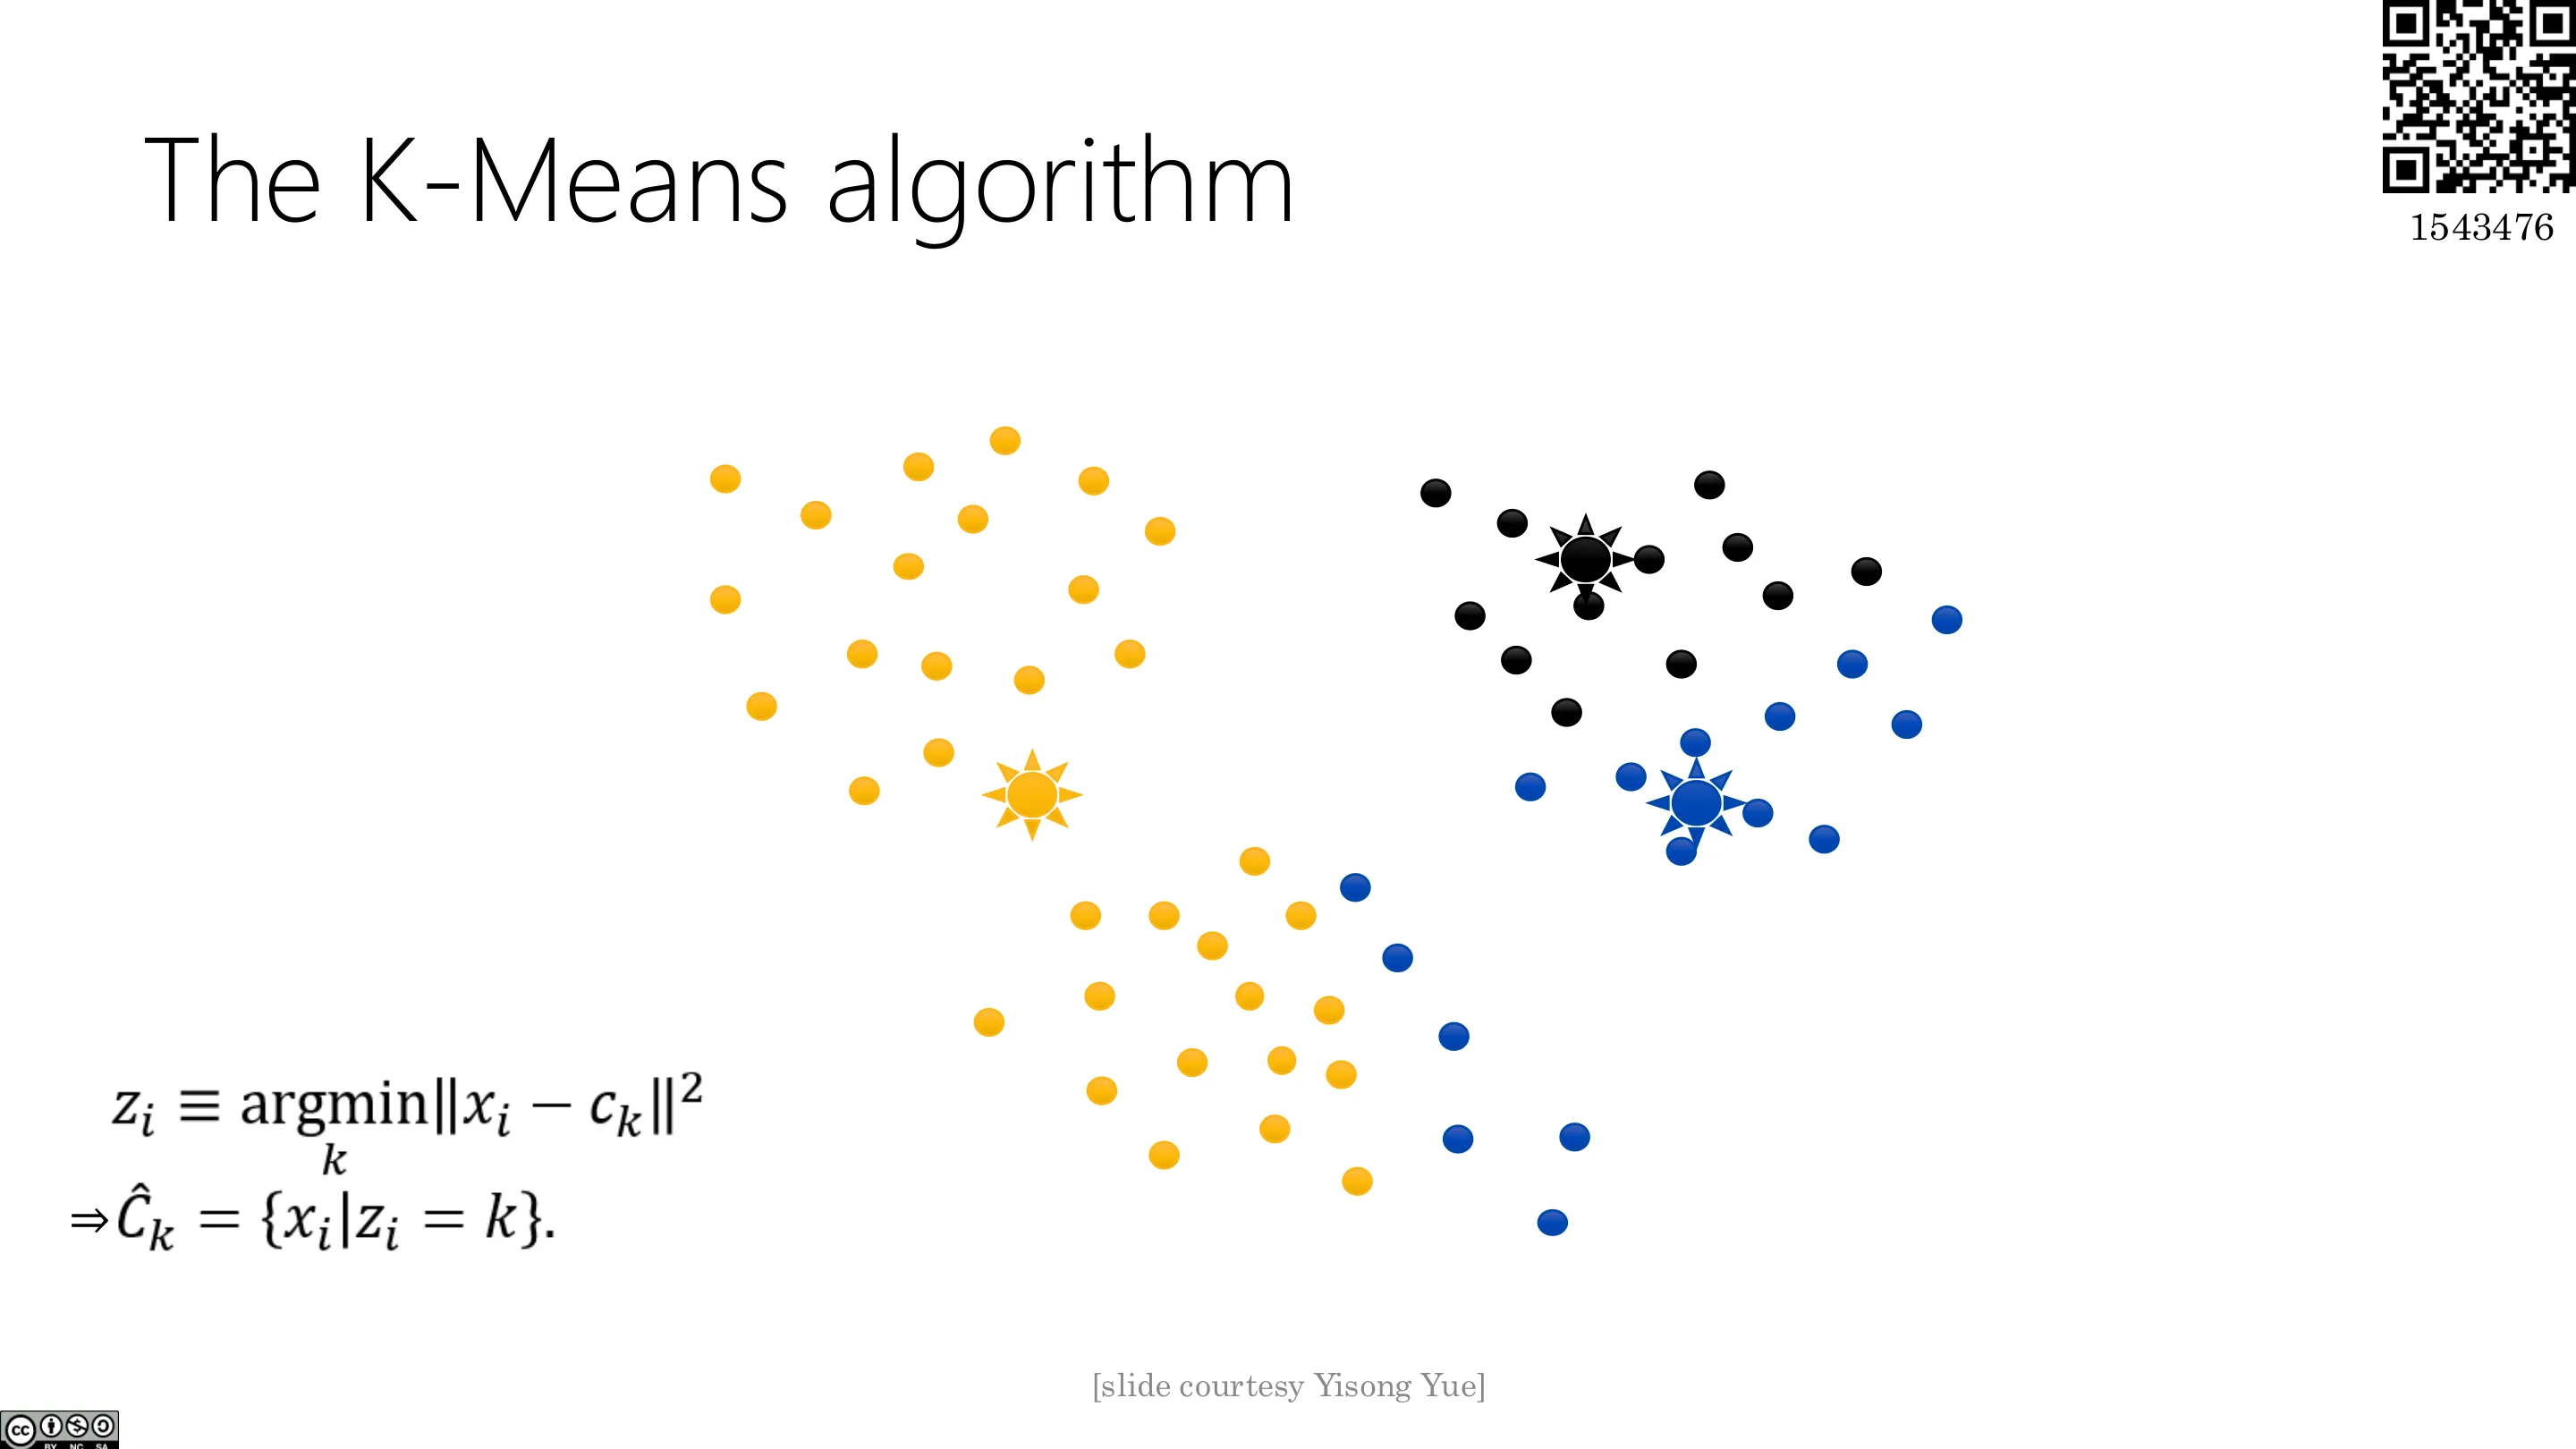
📷 K 均值演示:步骤
回到原视频 (00:53:50)
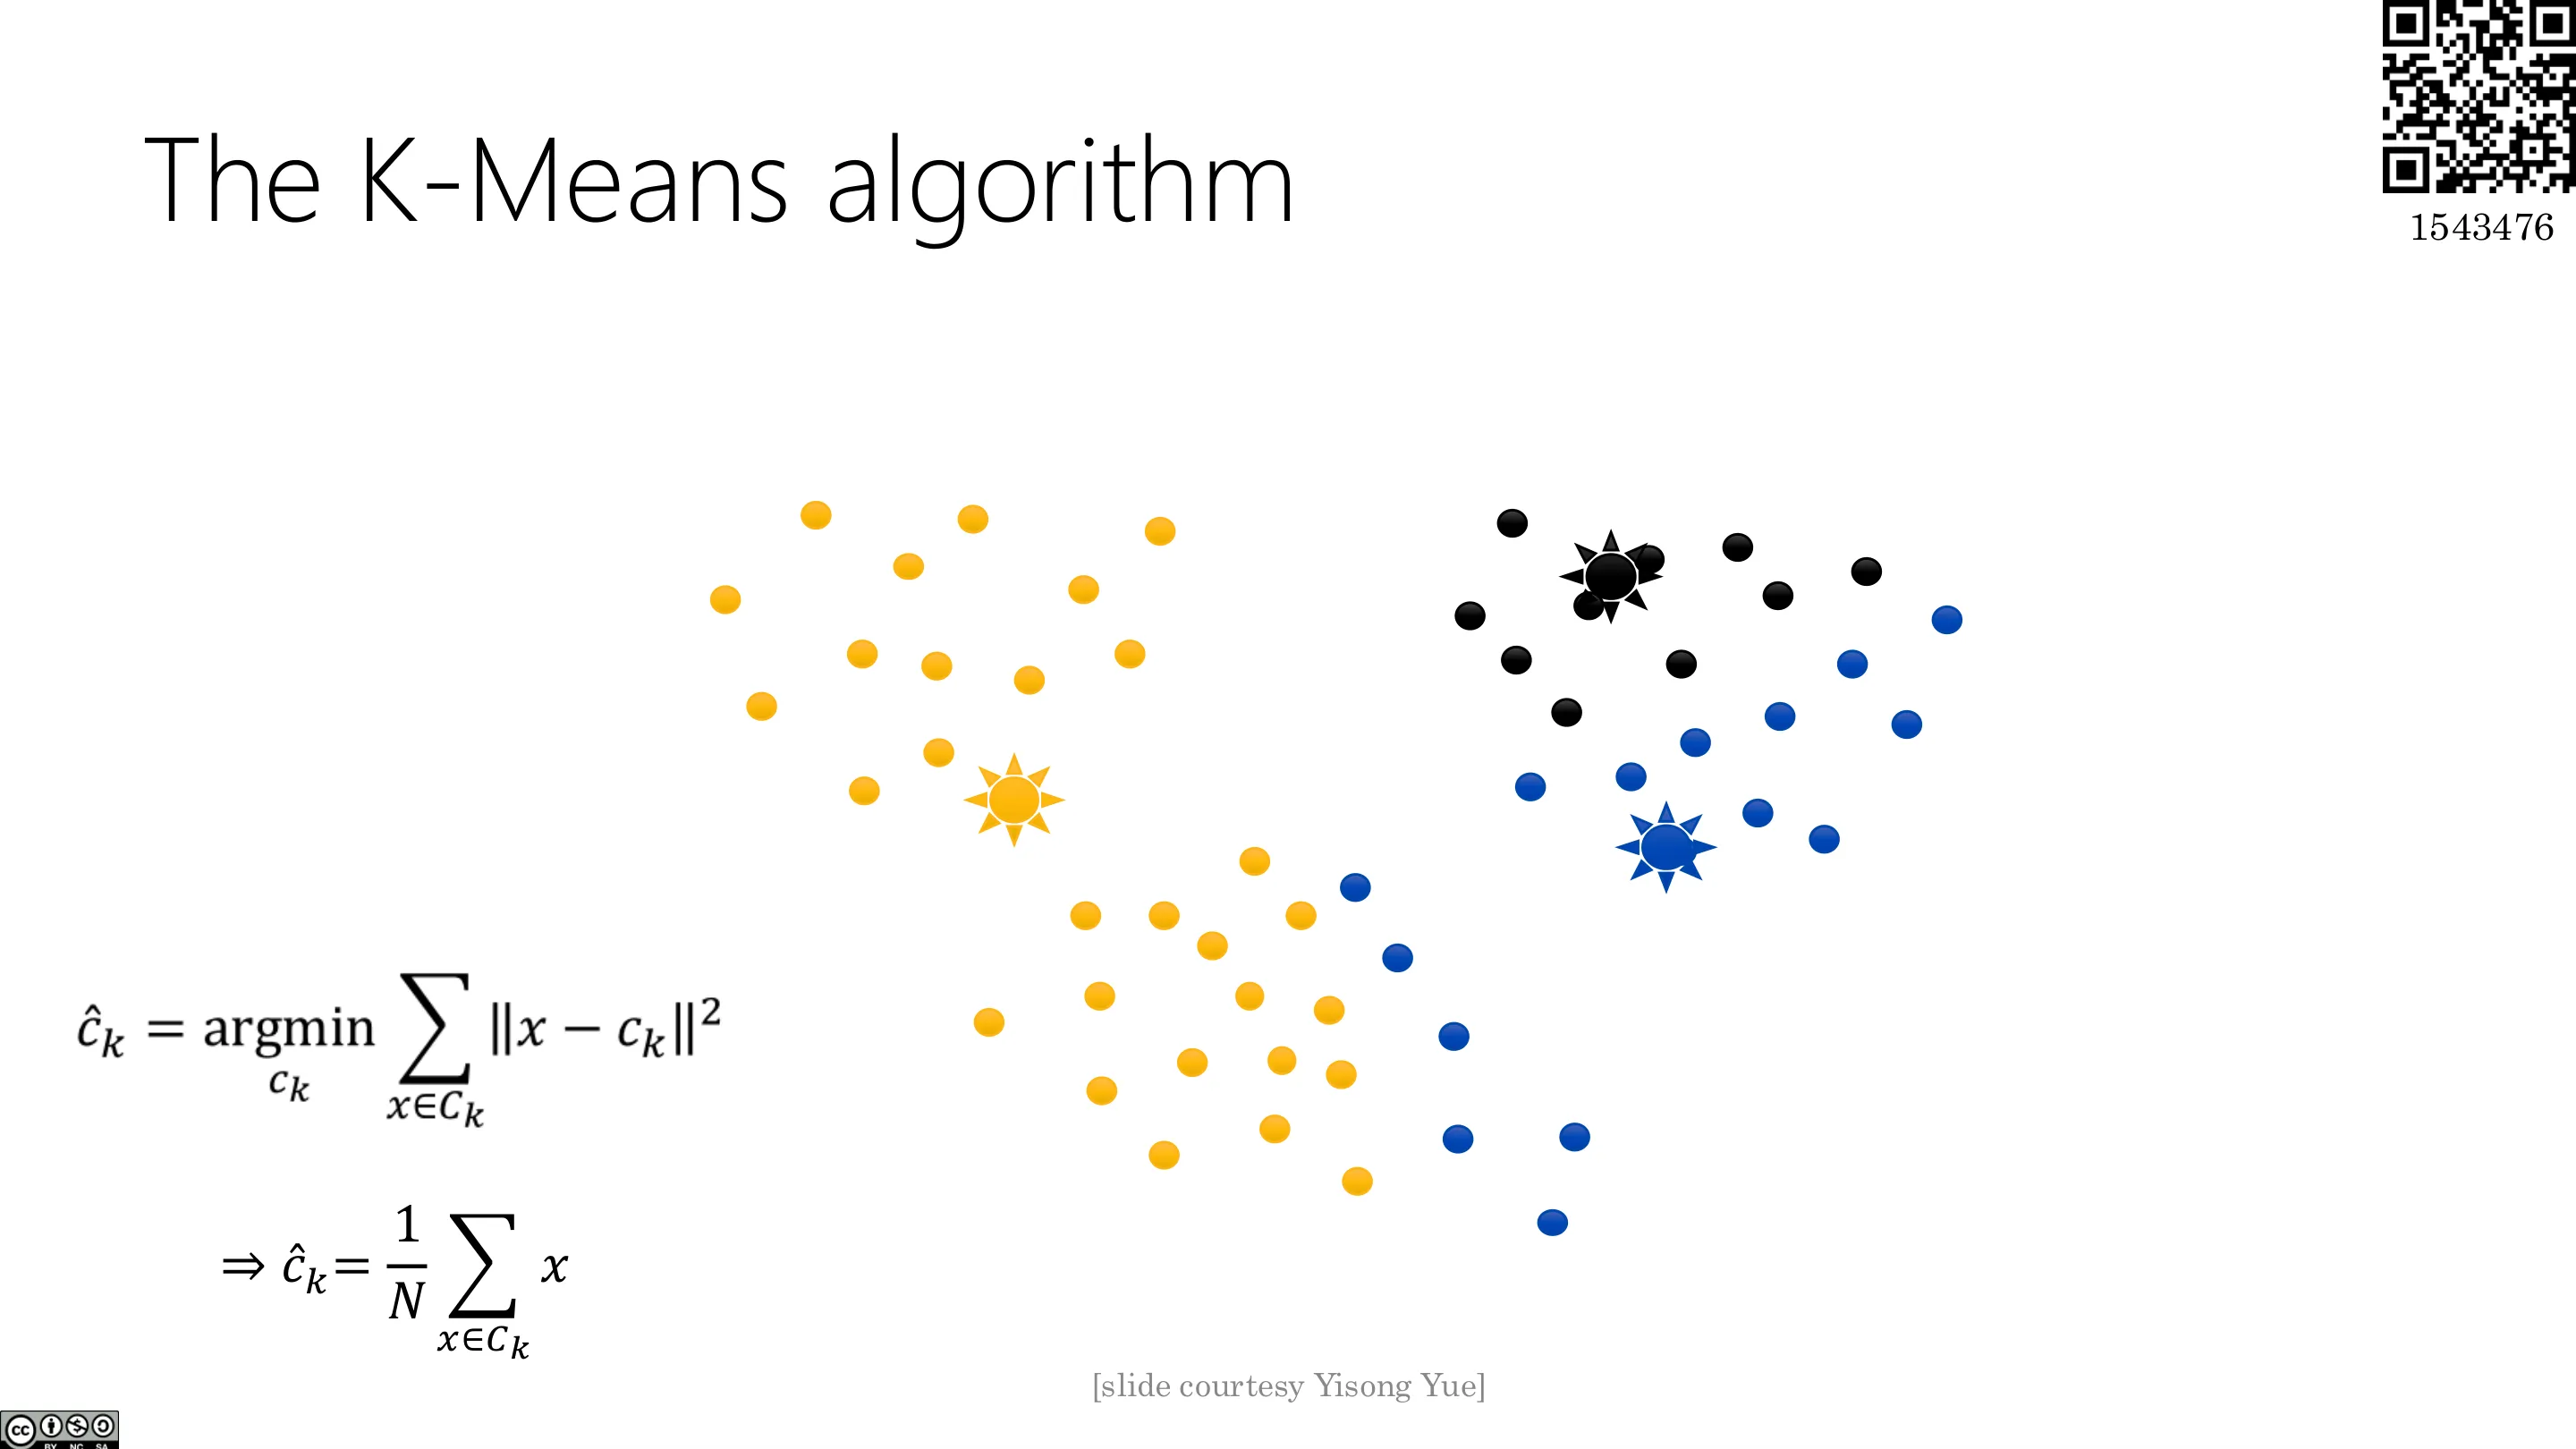
📷 K 均值演示:步骤
回到原视频 (00:53:55)
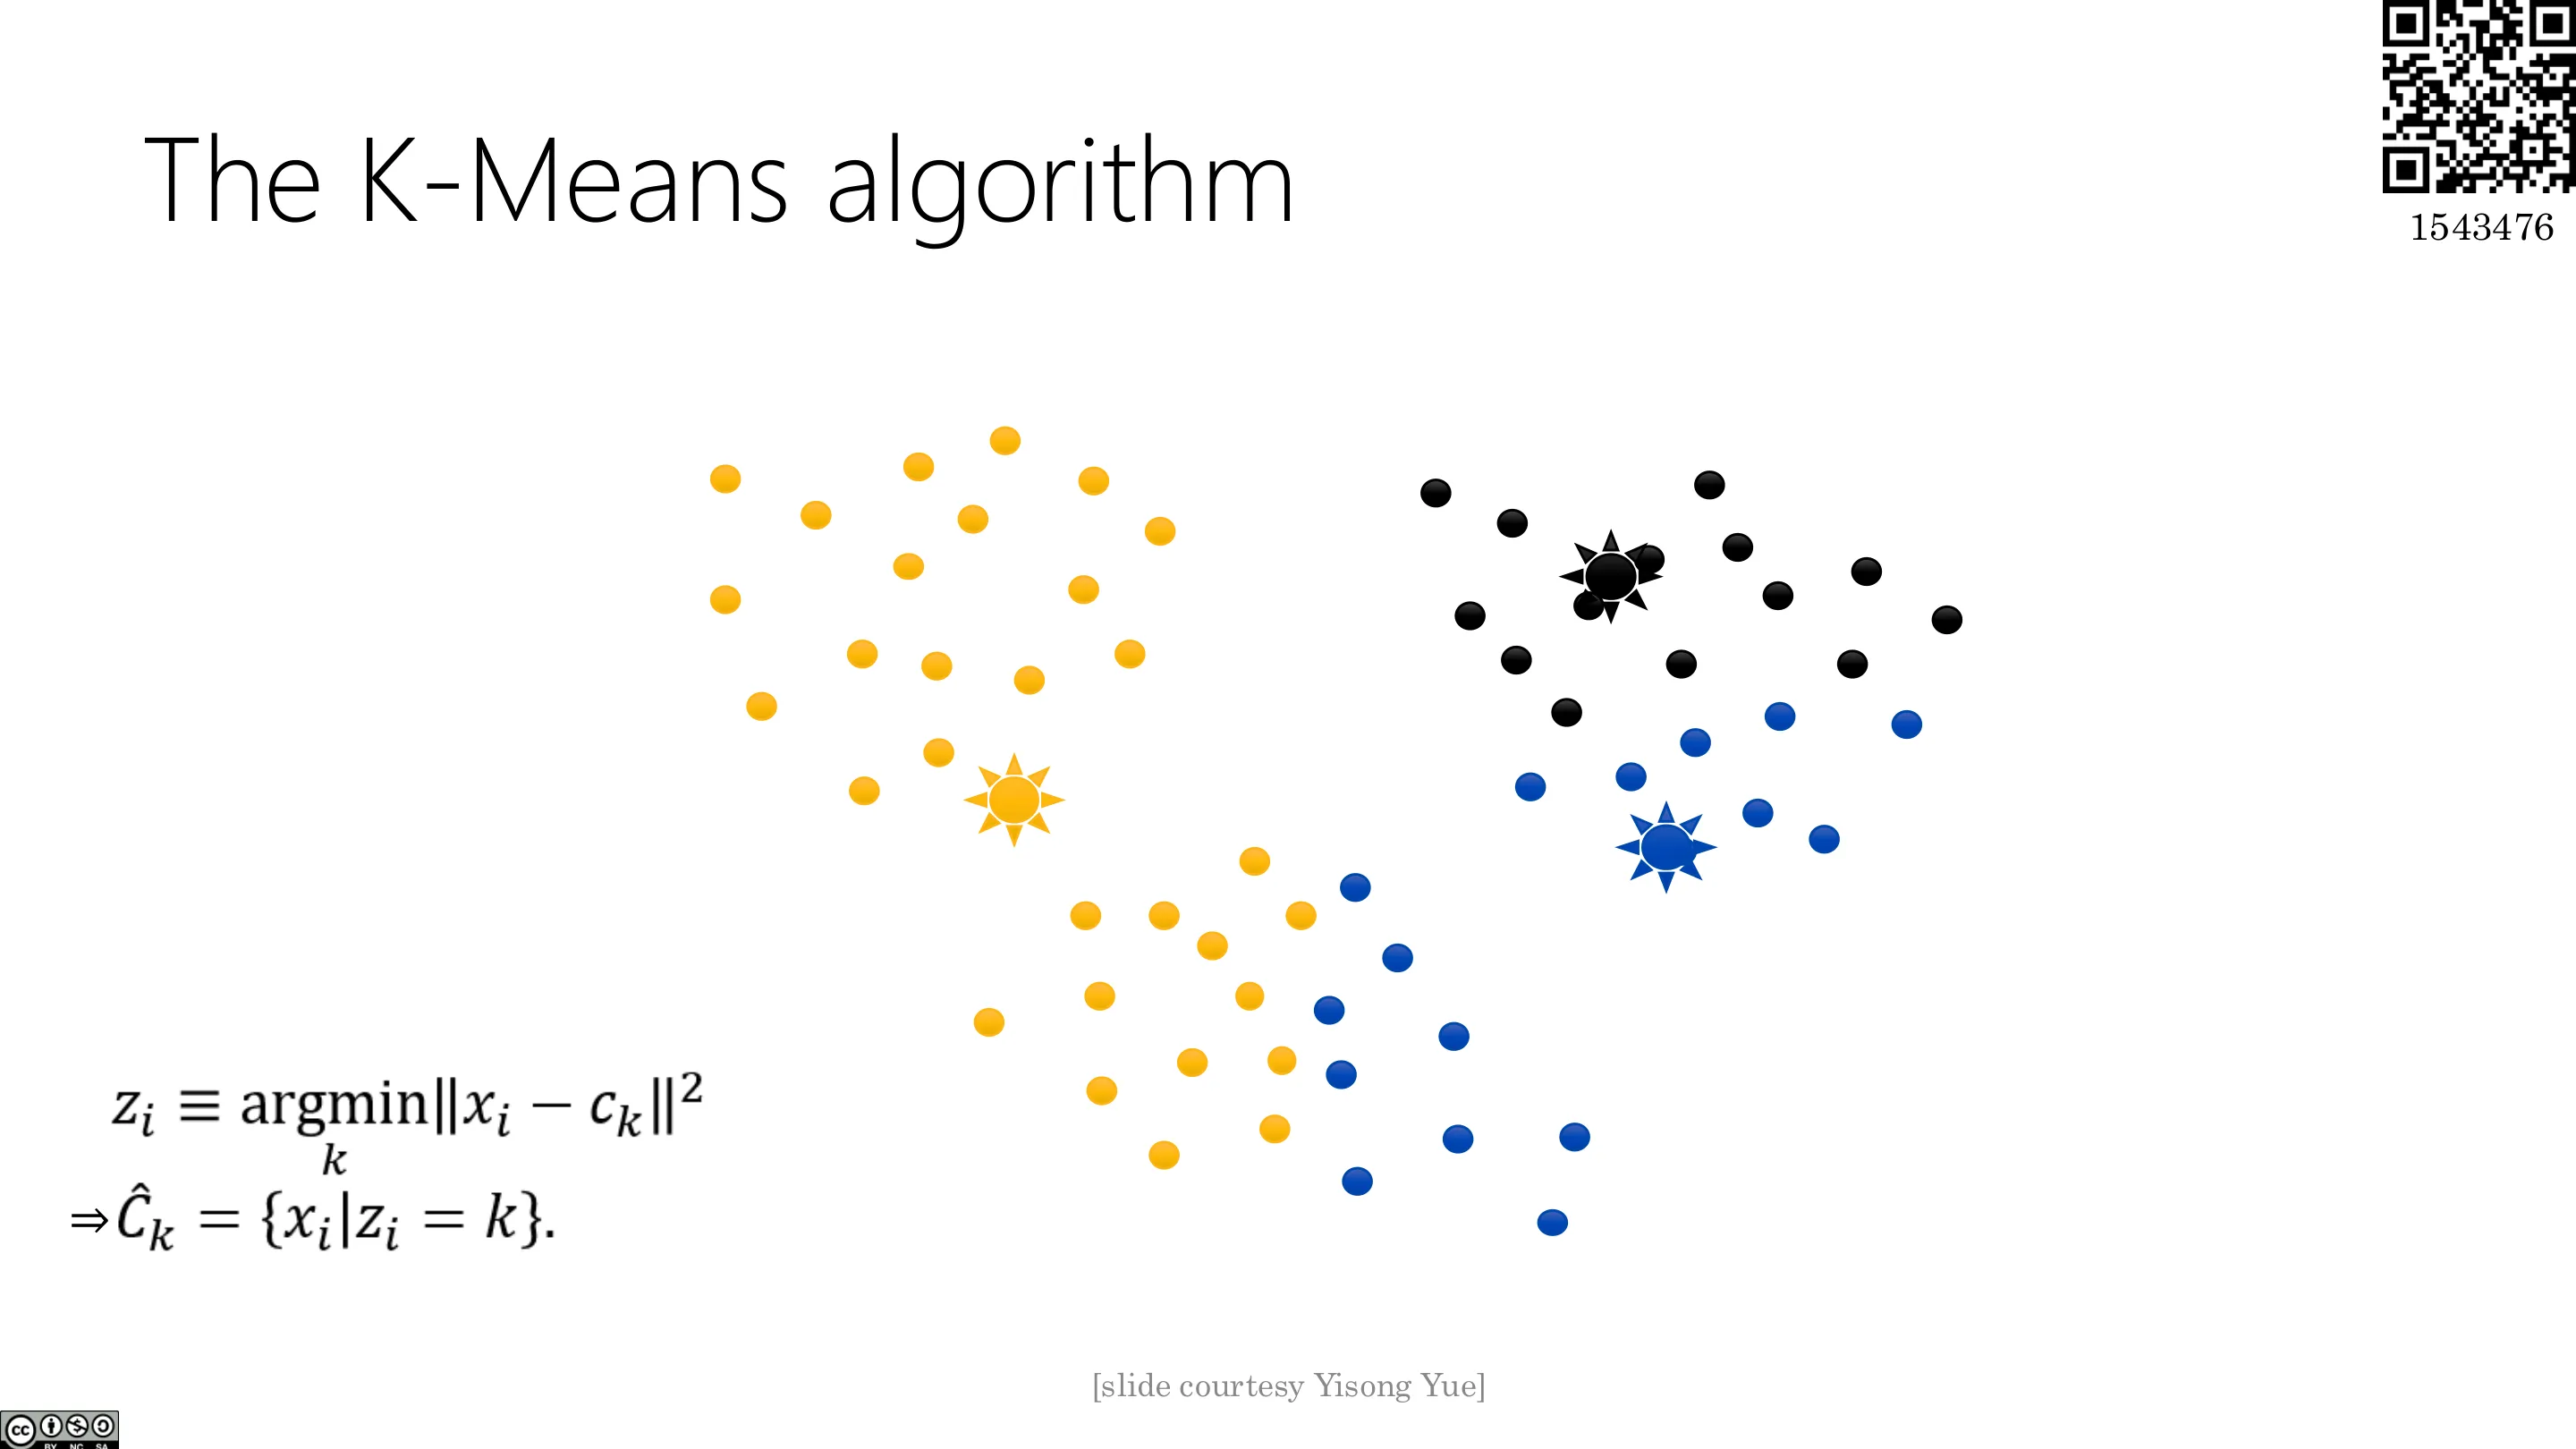
📷 K 均值演示:步骤
回到原视频 (00:54:00)
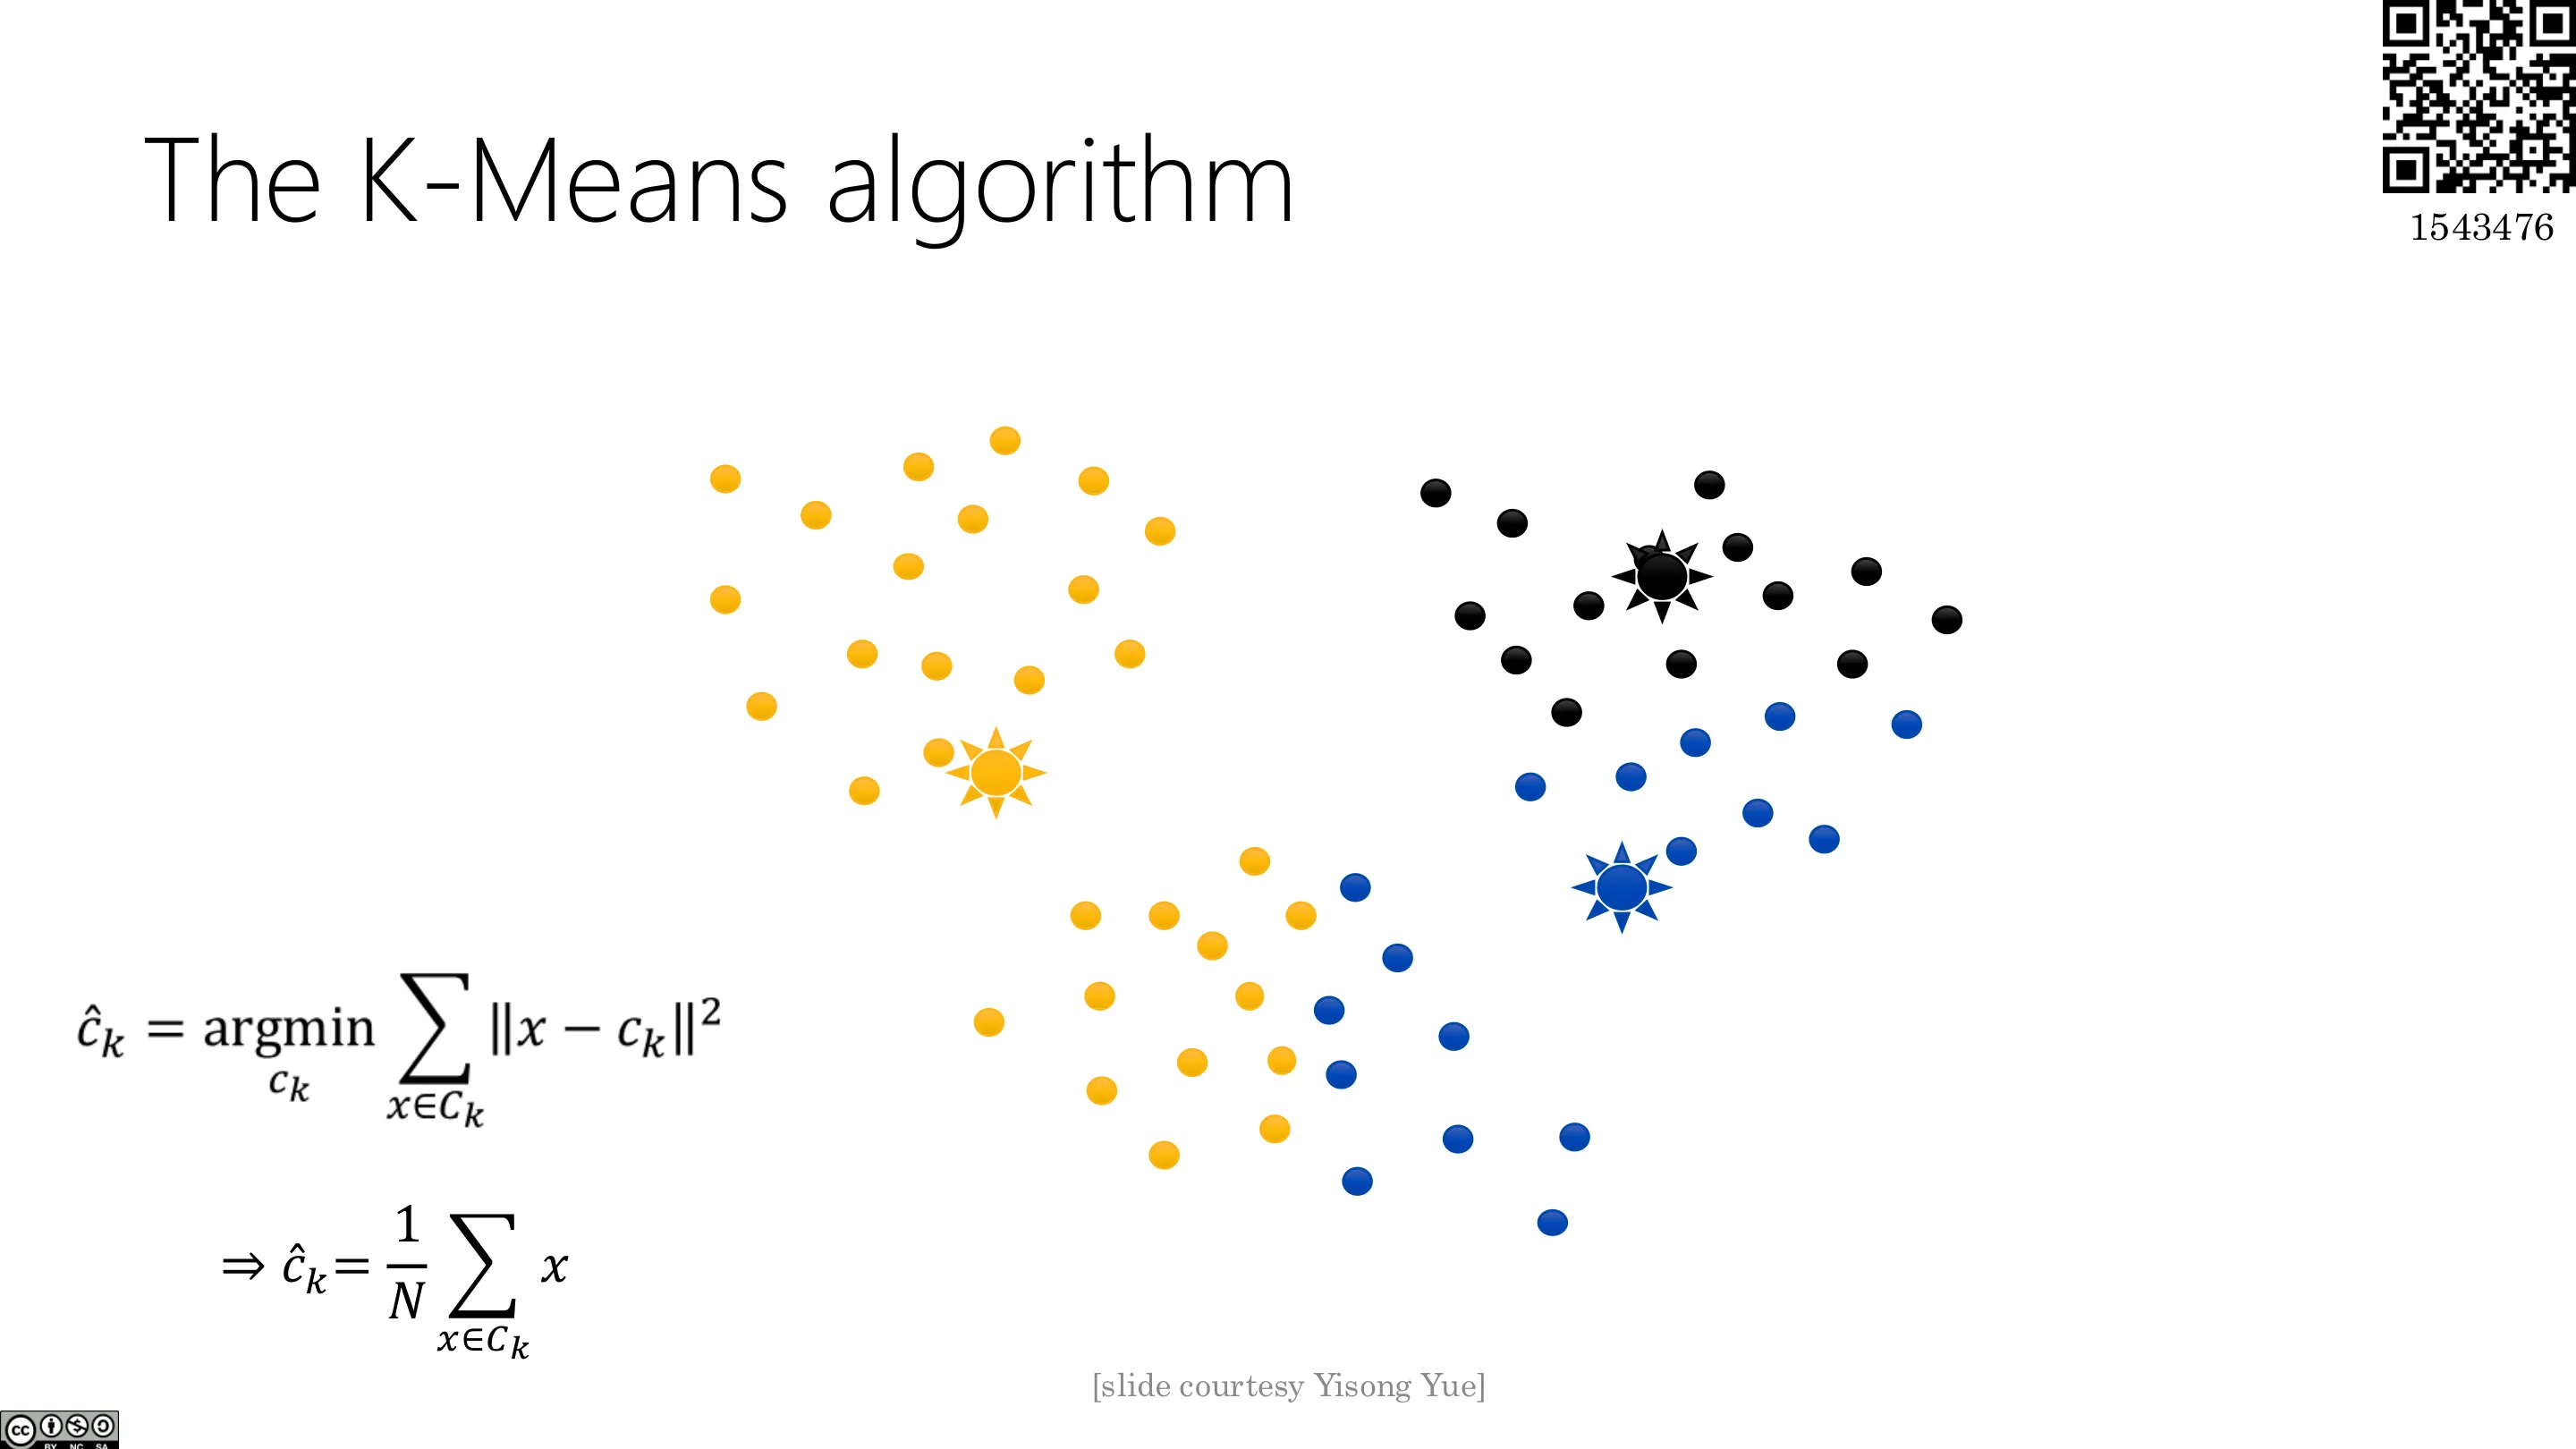
📷 K 均值演示:步骤
回到原视频 (00:54:10)
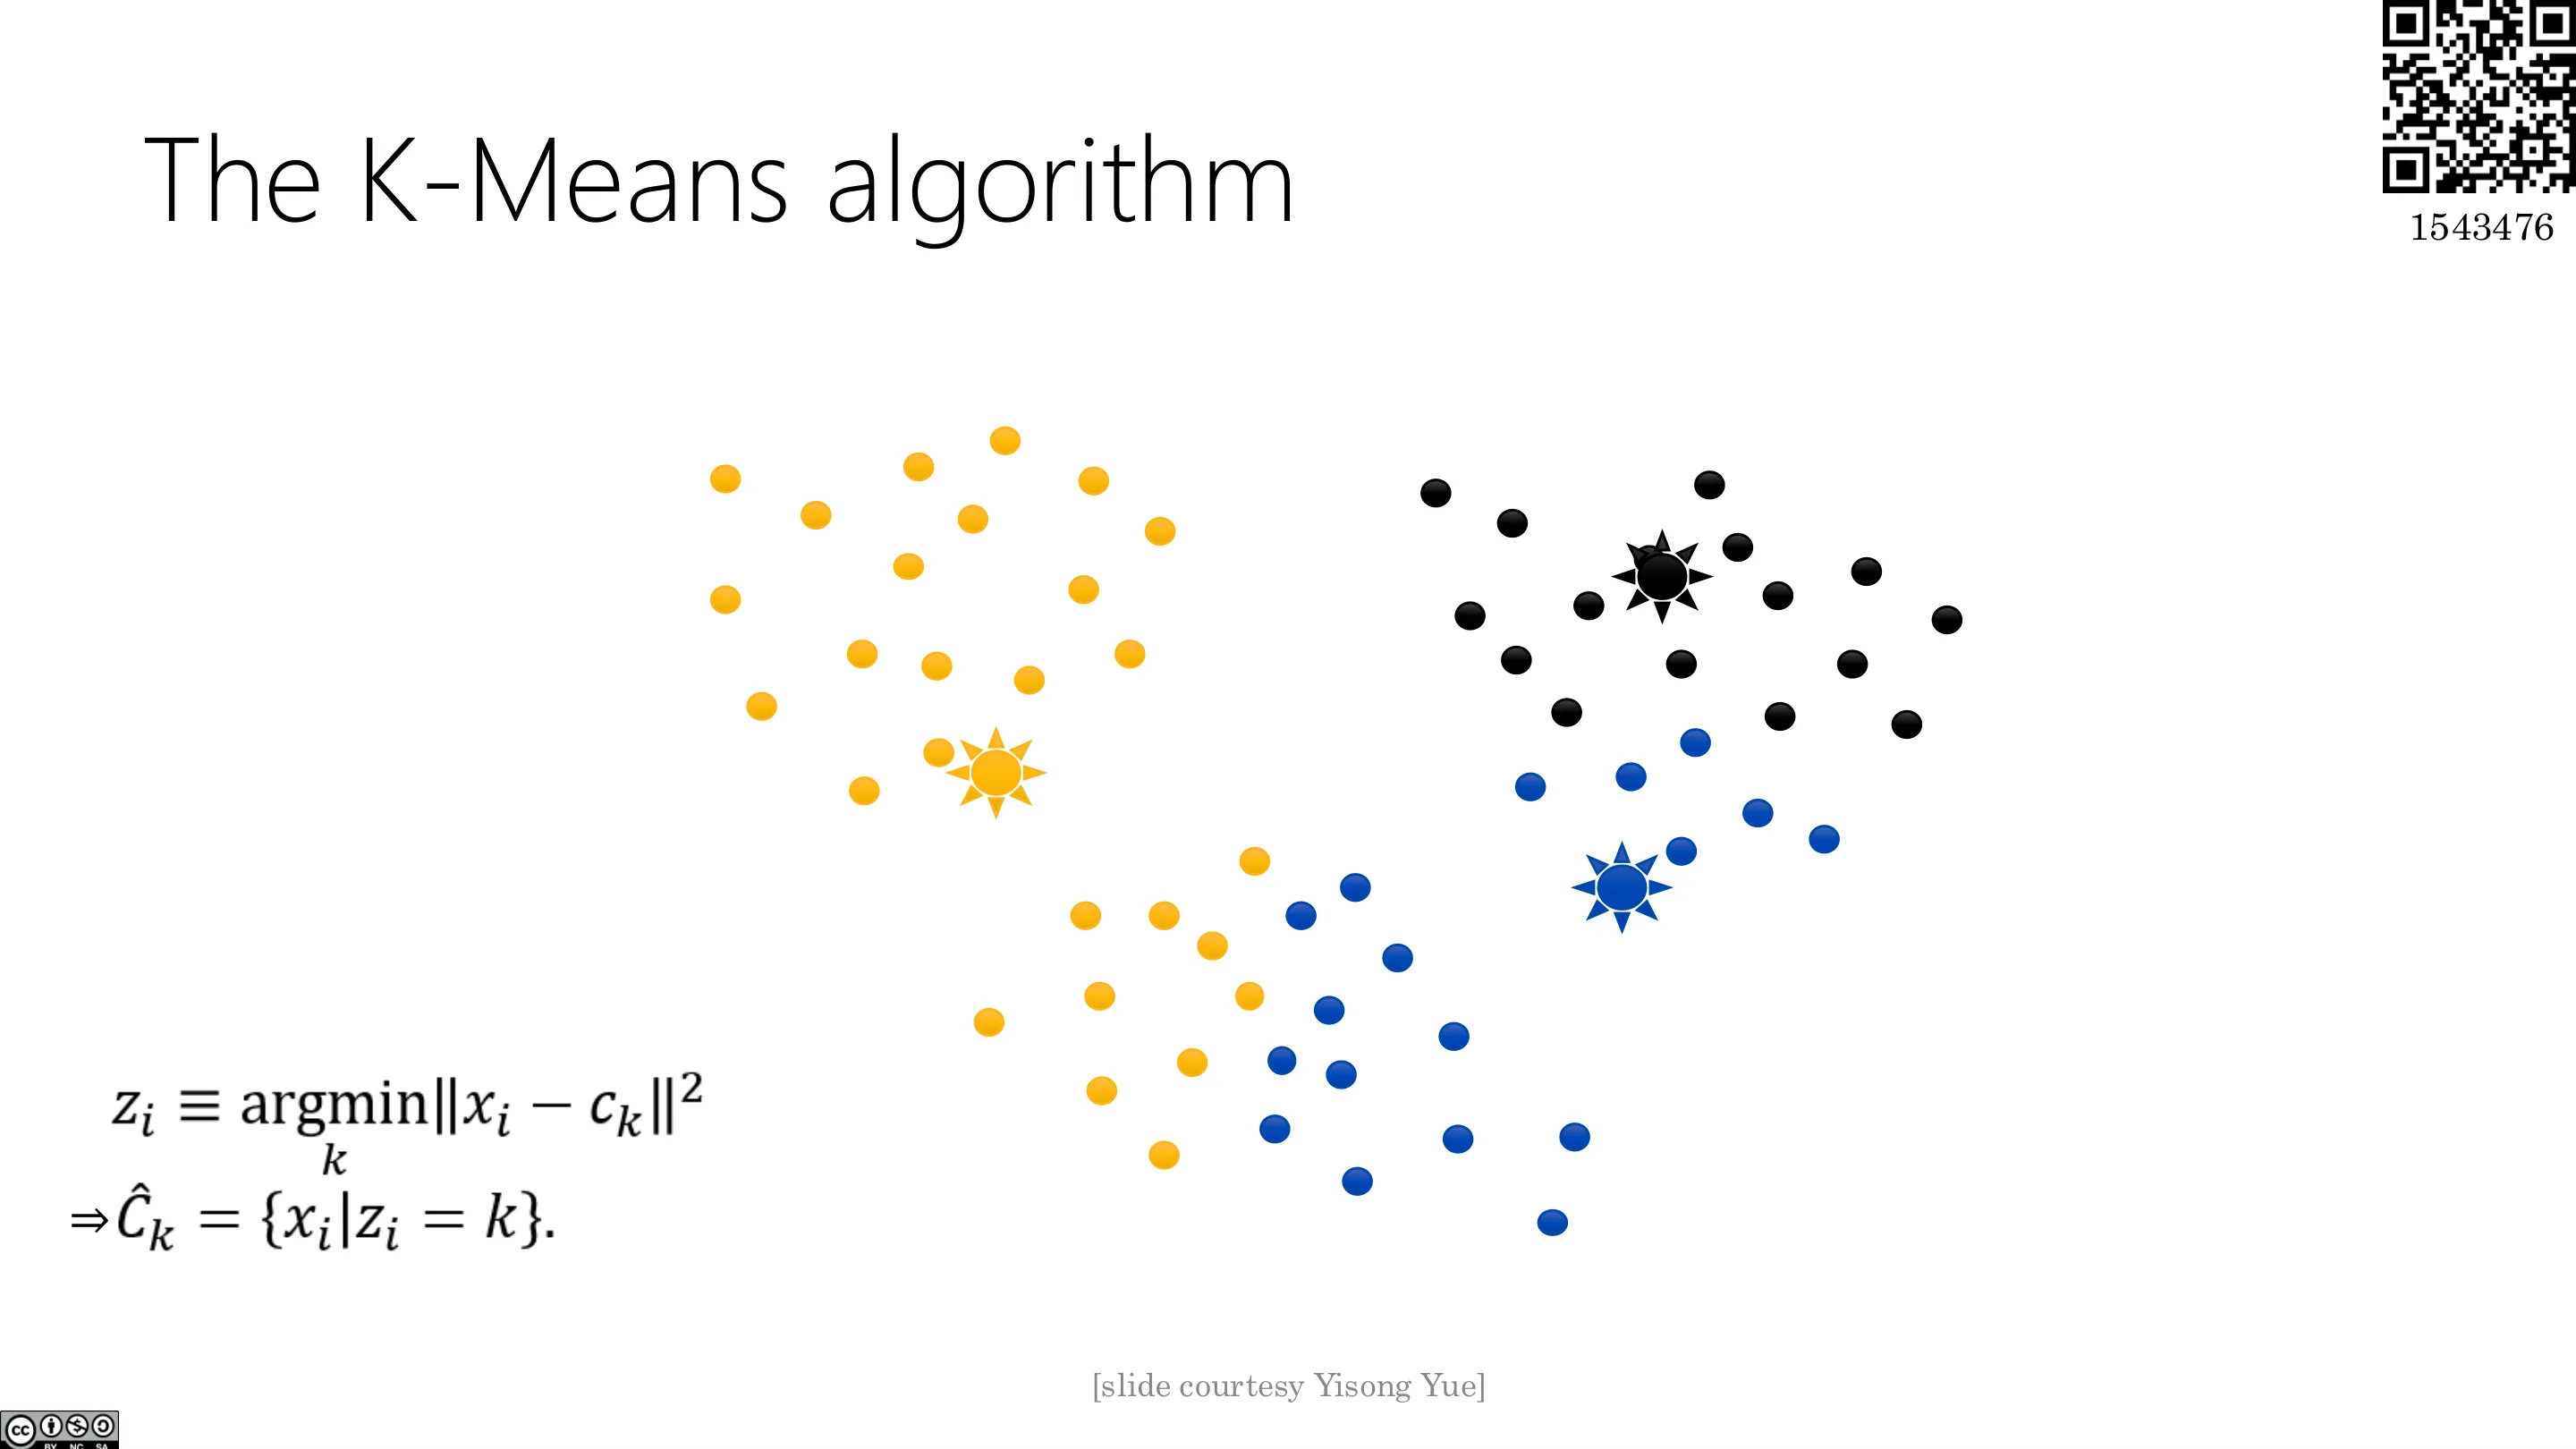
📷 K 均值演示:步骤
回到原视频 (00:54:20)
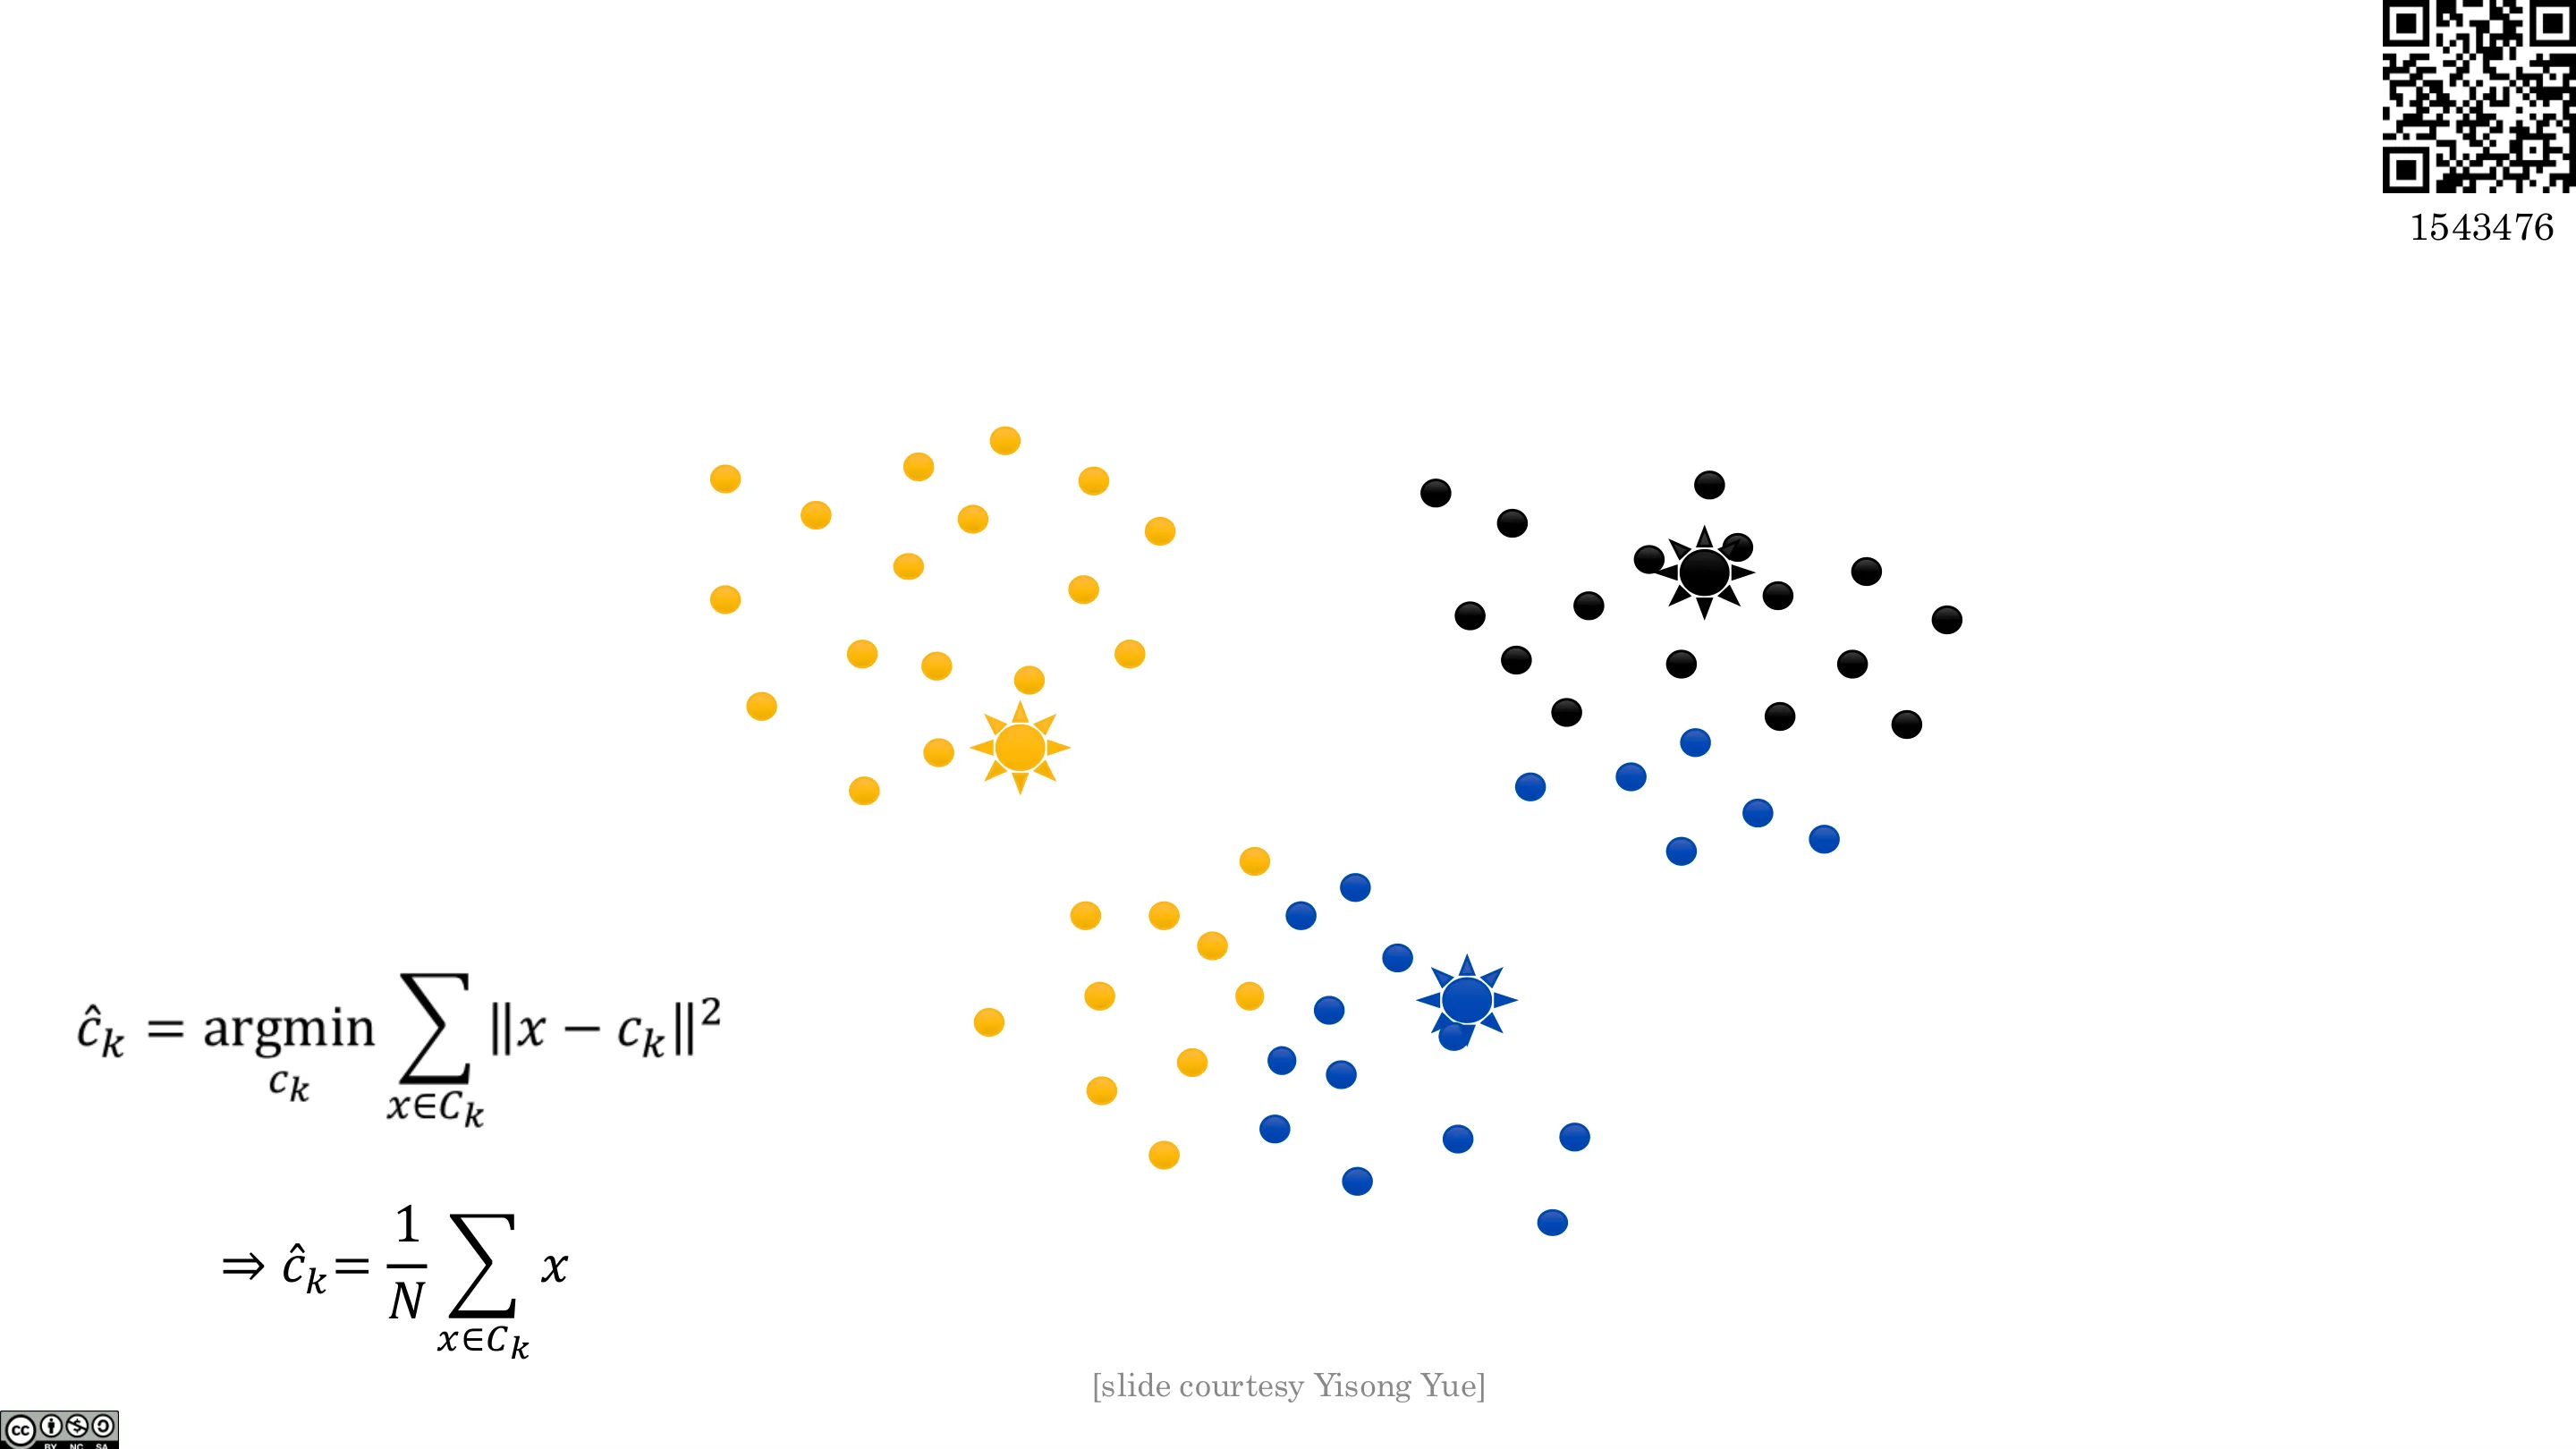
📷 K 均值演示:步骤
回到原视频 (00:54:30)
📷 K 均值演示:步骤
回到原视频 (00:54:40)
📷 K 均值演示:步骤
回到原视频 (00:54:50)
📷 K 均值演示:步骤
回到原视频 (00:55:00)
📷 K 均值演示:步骤
回到原视频 (00:55:05)
📷 K 均值演示:收敛
回到原视频 (00:55:08)
编者说明:这与机器学习中优化损失函数时的普遍现象一致——开始时调整幅度很大,之后越来越小、趋于稳定。K 均值有明确的停止条件(分配不再变化),但当我们之后用梯度下降时,由于浮点误差,梯度往往永远到不了零,需要设定阈值(如梯度小于 $10^{-6}$ 就停)。
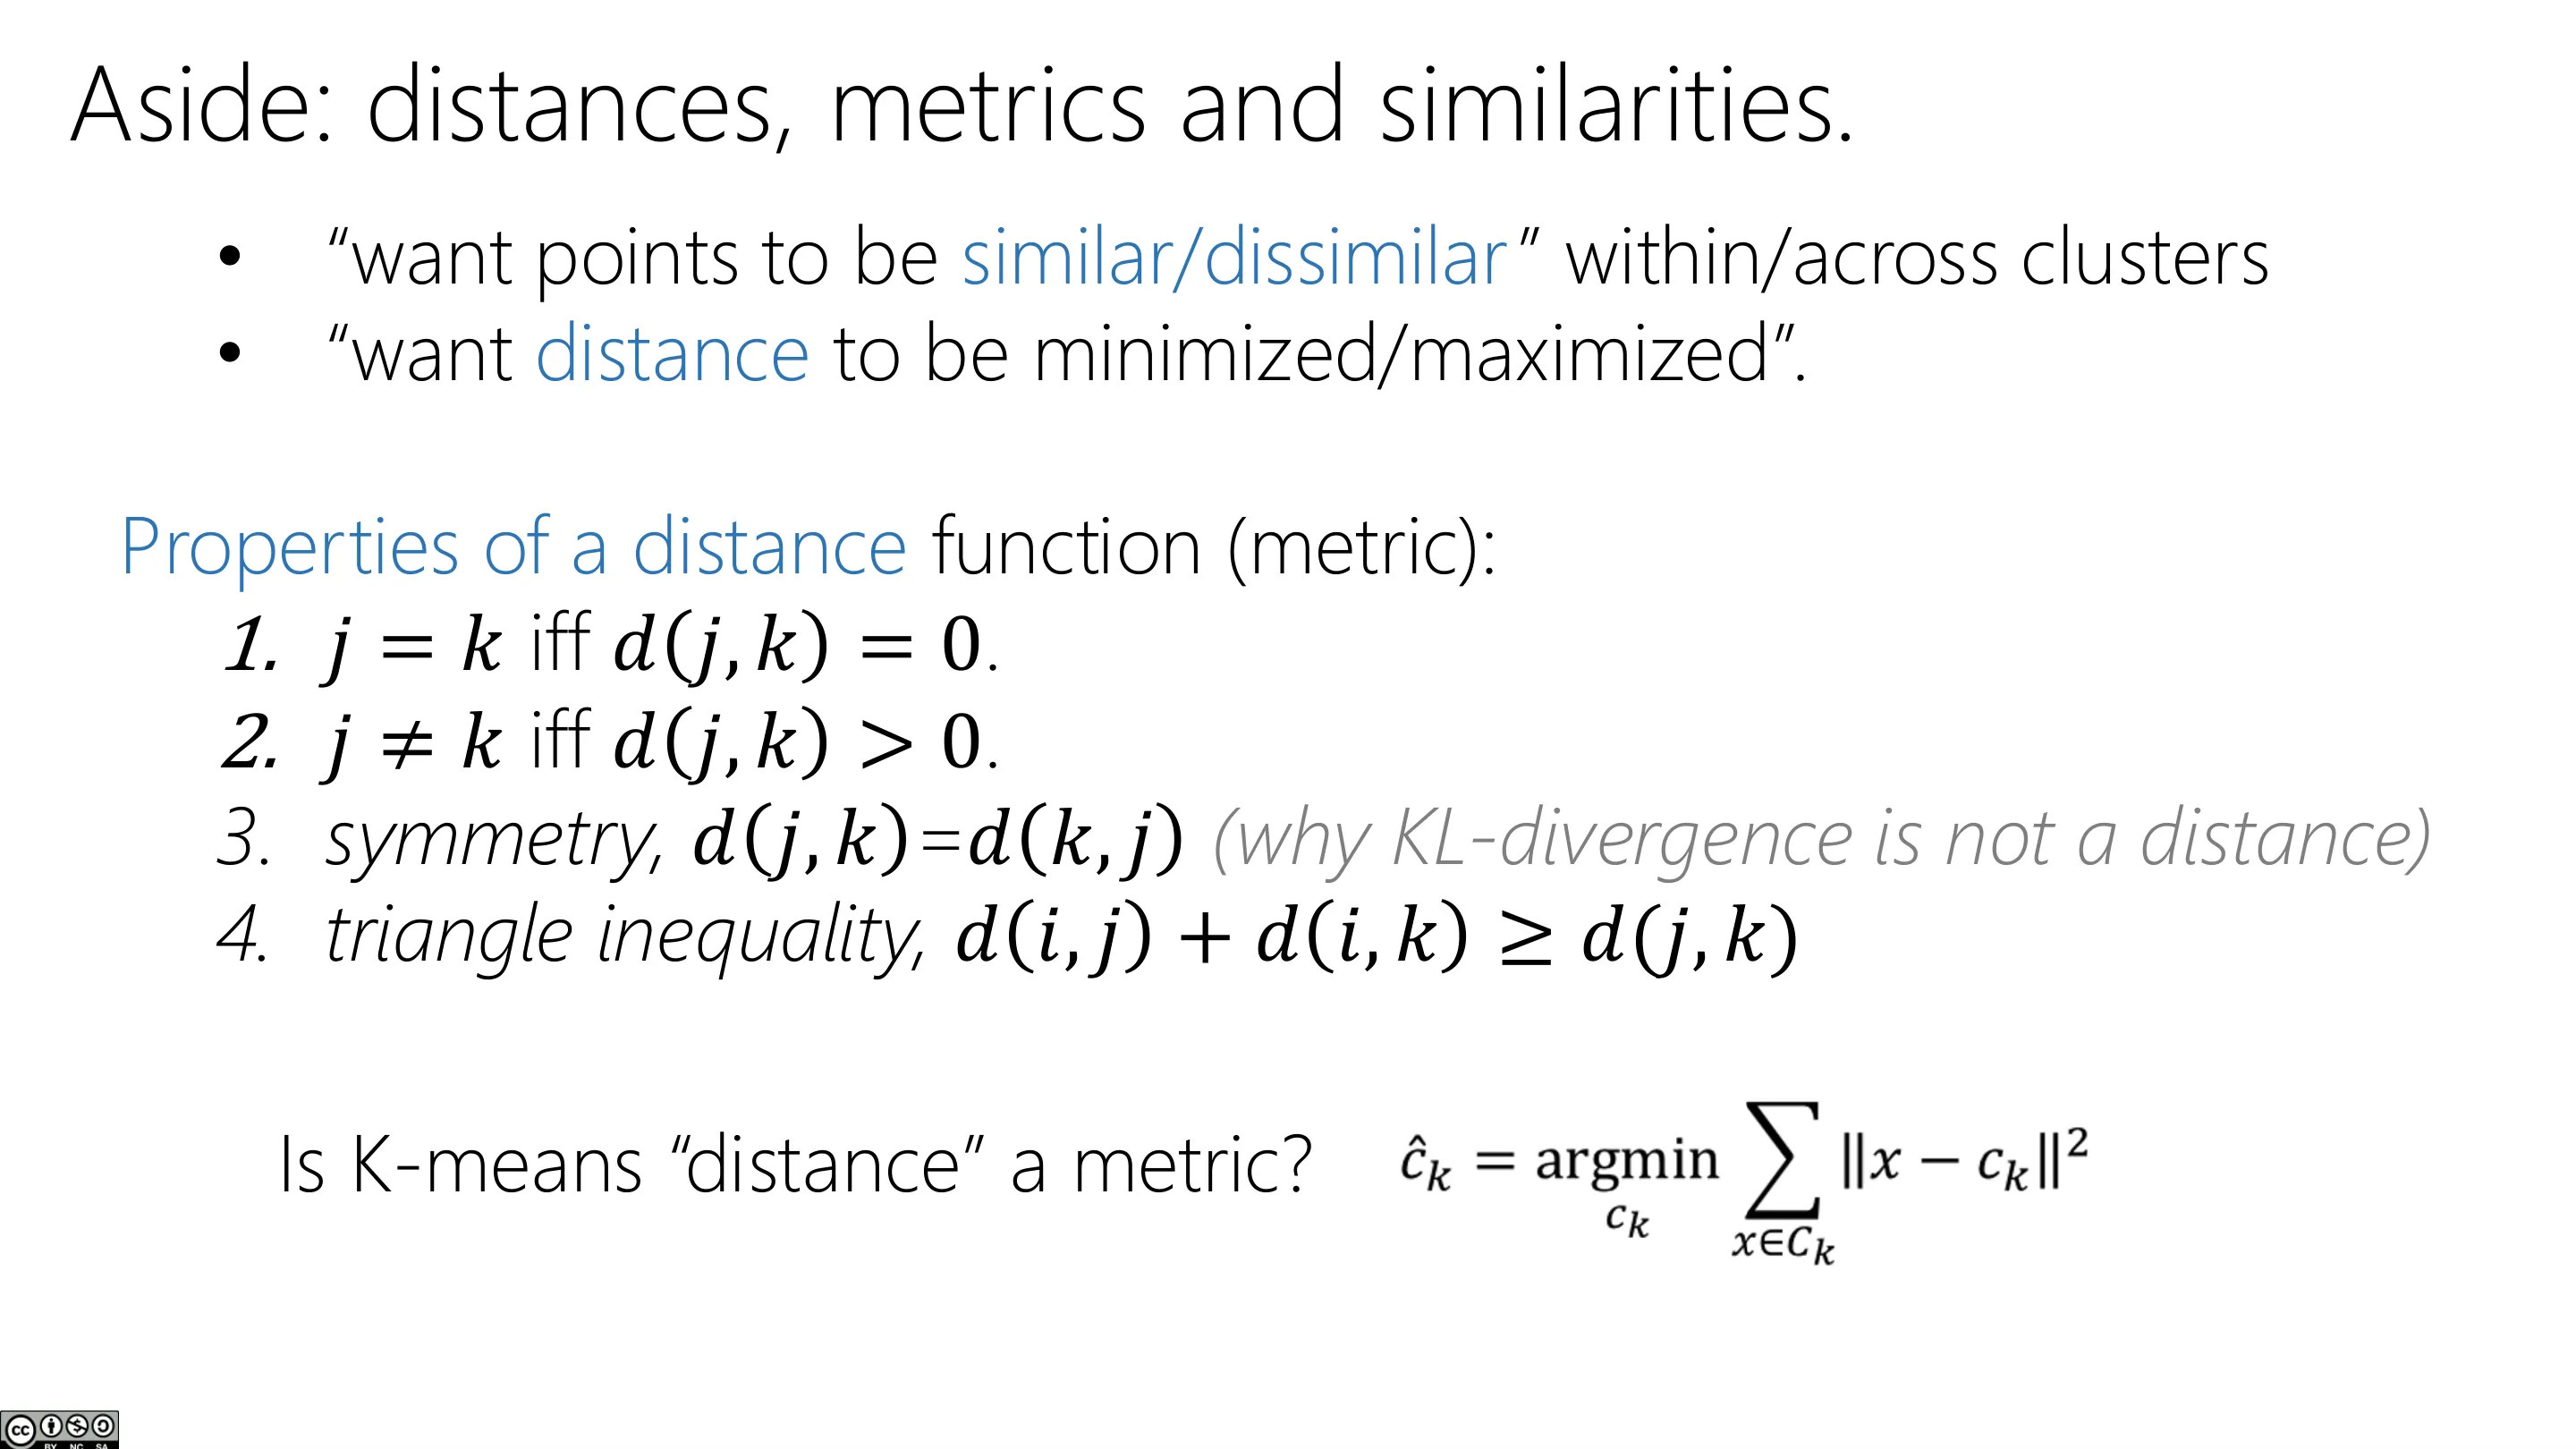
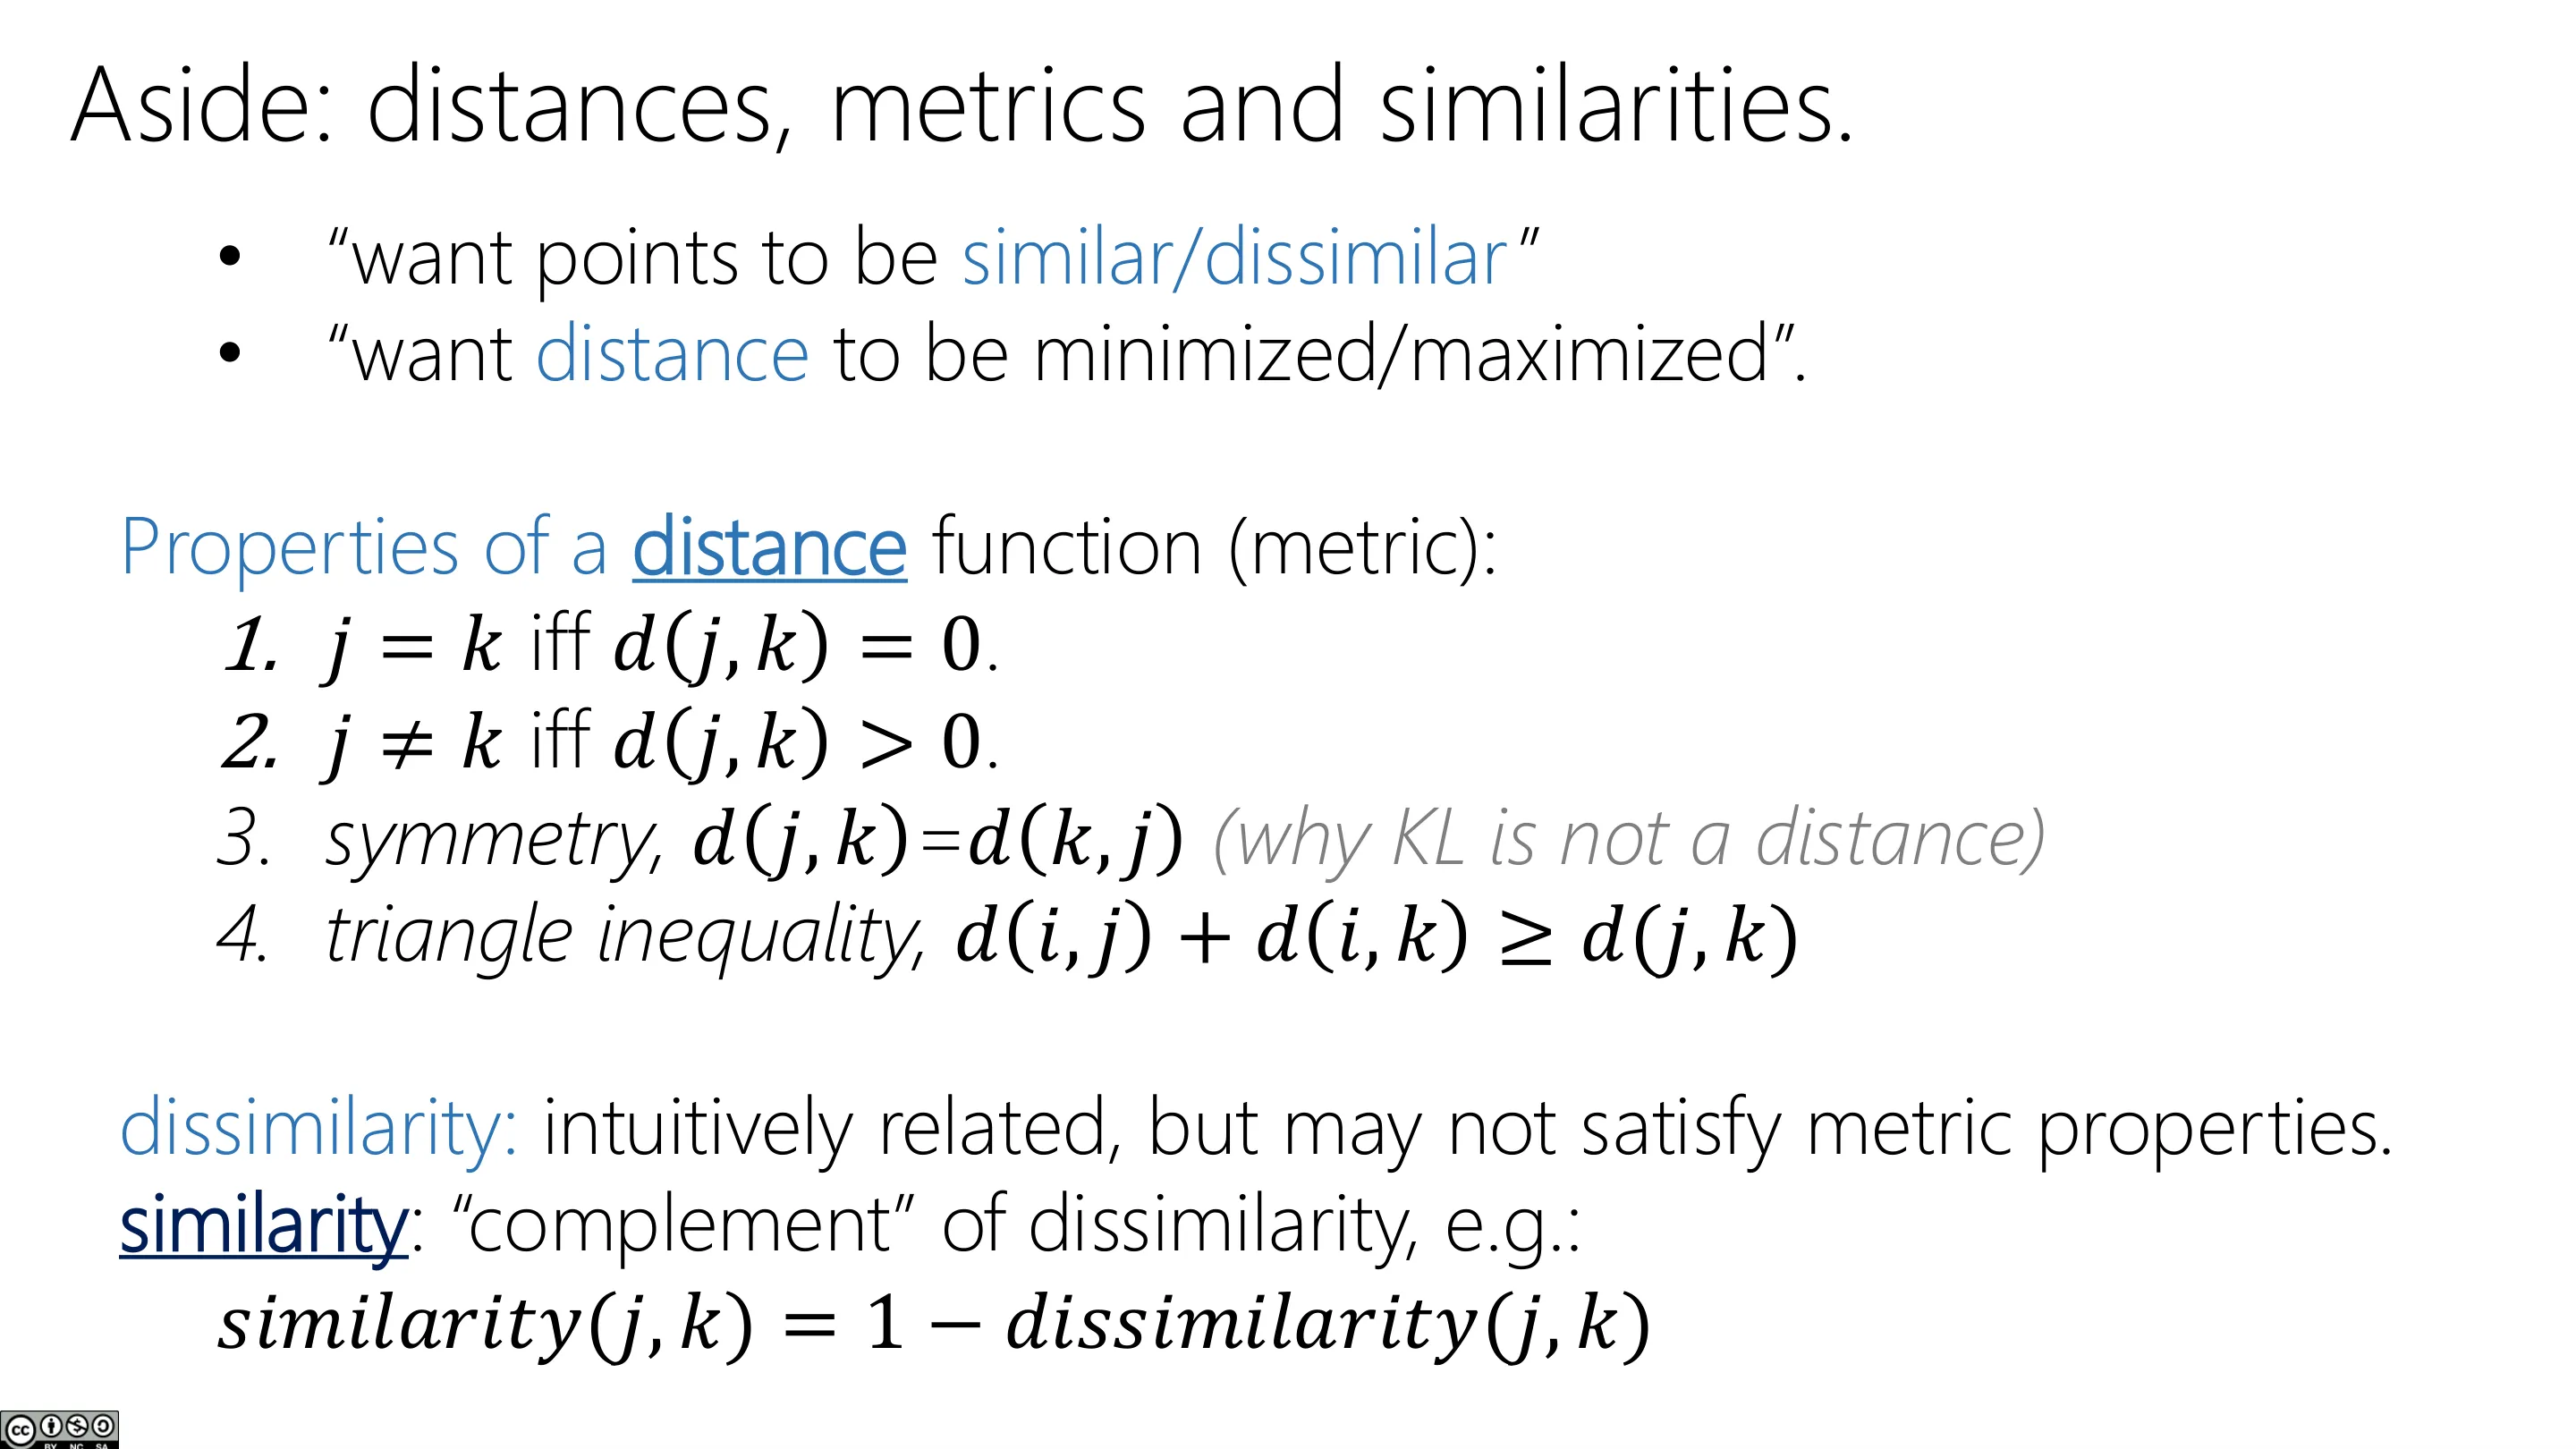
4.1 旁注:距离、度量与相似度
「距离」一词在数学上更严格的说法是度量(metric),必须满足四条性质:
- $j = k \iff d(j,k) = 0$;
- $j \neq k \iff d(j,k) > 0$;
- 对称性:$d(j,k) = d(k,j)$(这也是 KL 散度不是距离的原因);
- 三角不等式:$d(i,j) + d(i,k) \ge d(j,k)$。
K 均值用的「距离」其实不满足三角不等式,所以严格来说不是度量——但这不影响使用,因为我们并没有用到三角不等式。此外,还有更口语化的相异度(dissimilarity)与相似度(similarity,可视为相异度的「补」)。
📷 旁注:距离、度量与相似度
回到原视频 (00:56:15)
五、如何选择聚类数 K
(参考时间: 00:58)
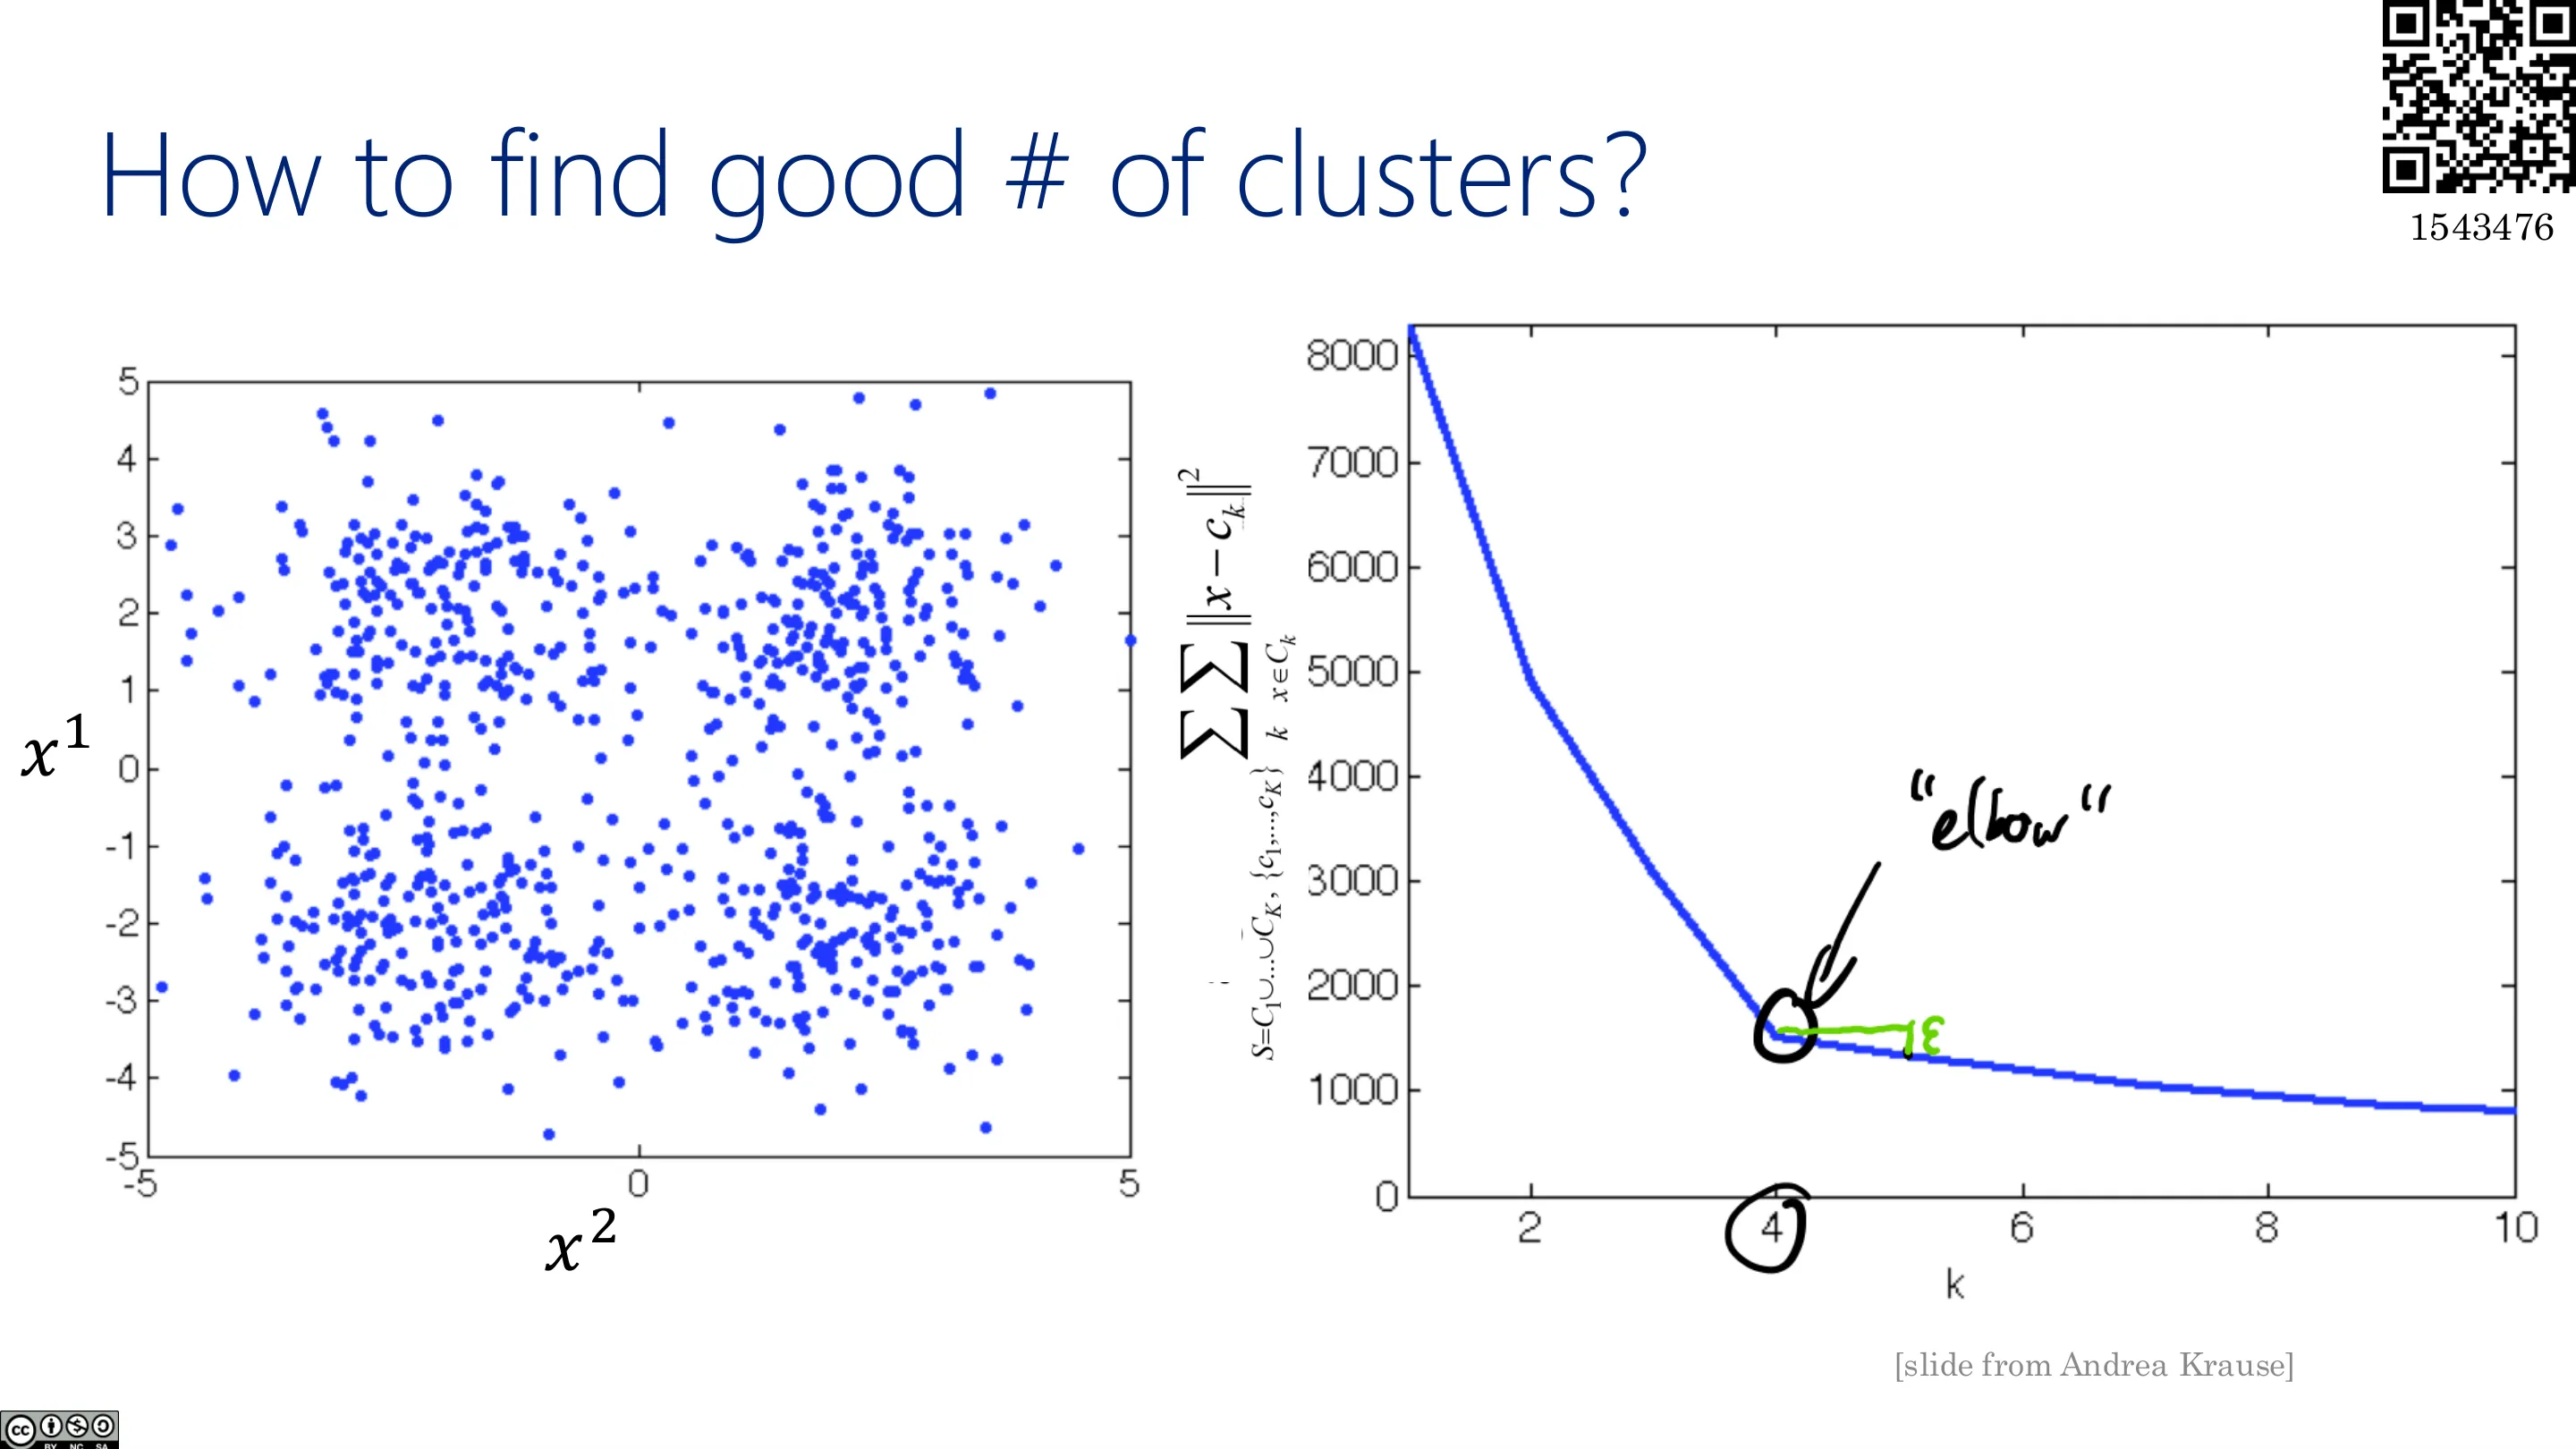
K(簇的数量)是一个超参数。常用方法是肘部法(elbow method):
- 对不同的 $K$ 运行 K 均值,画出目标函数值随 $K$ 变化的曲线;
- 随着 $K$ 增大,目标函数几乎总会下降(因为你给了模型更多参数——中心越多,点越容易靠近某个中心);
- 关键是看下降速度:当增加簇带来的收益开始递减时,曲线出现一个明显的拐点(「肘部」),那个位置就是较合理的 $K$。
📷 如何找到好的聚类数
回到原视频 (00:58:55)
编者说明:讲师提醒——永远不要把图画成没有标记点的曲线(她的研究生常被这样要求);肘部法并不万能,也没有理论保证;聚类在很大程度上是反复试验 + 观察 + 与同事/合作者讨论的过程。
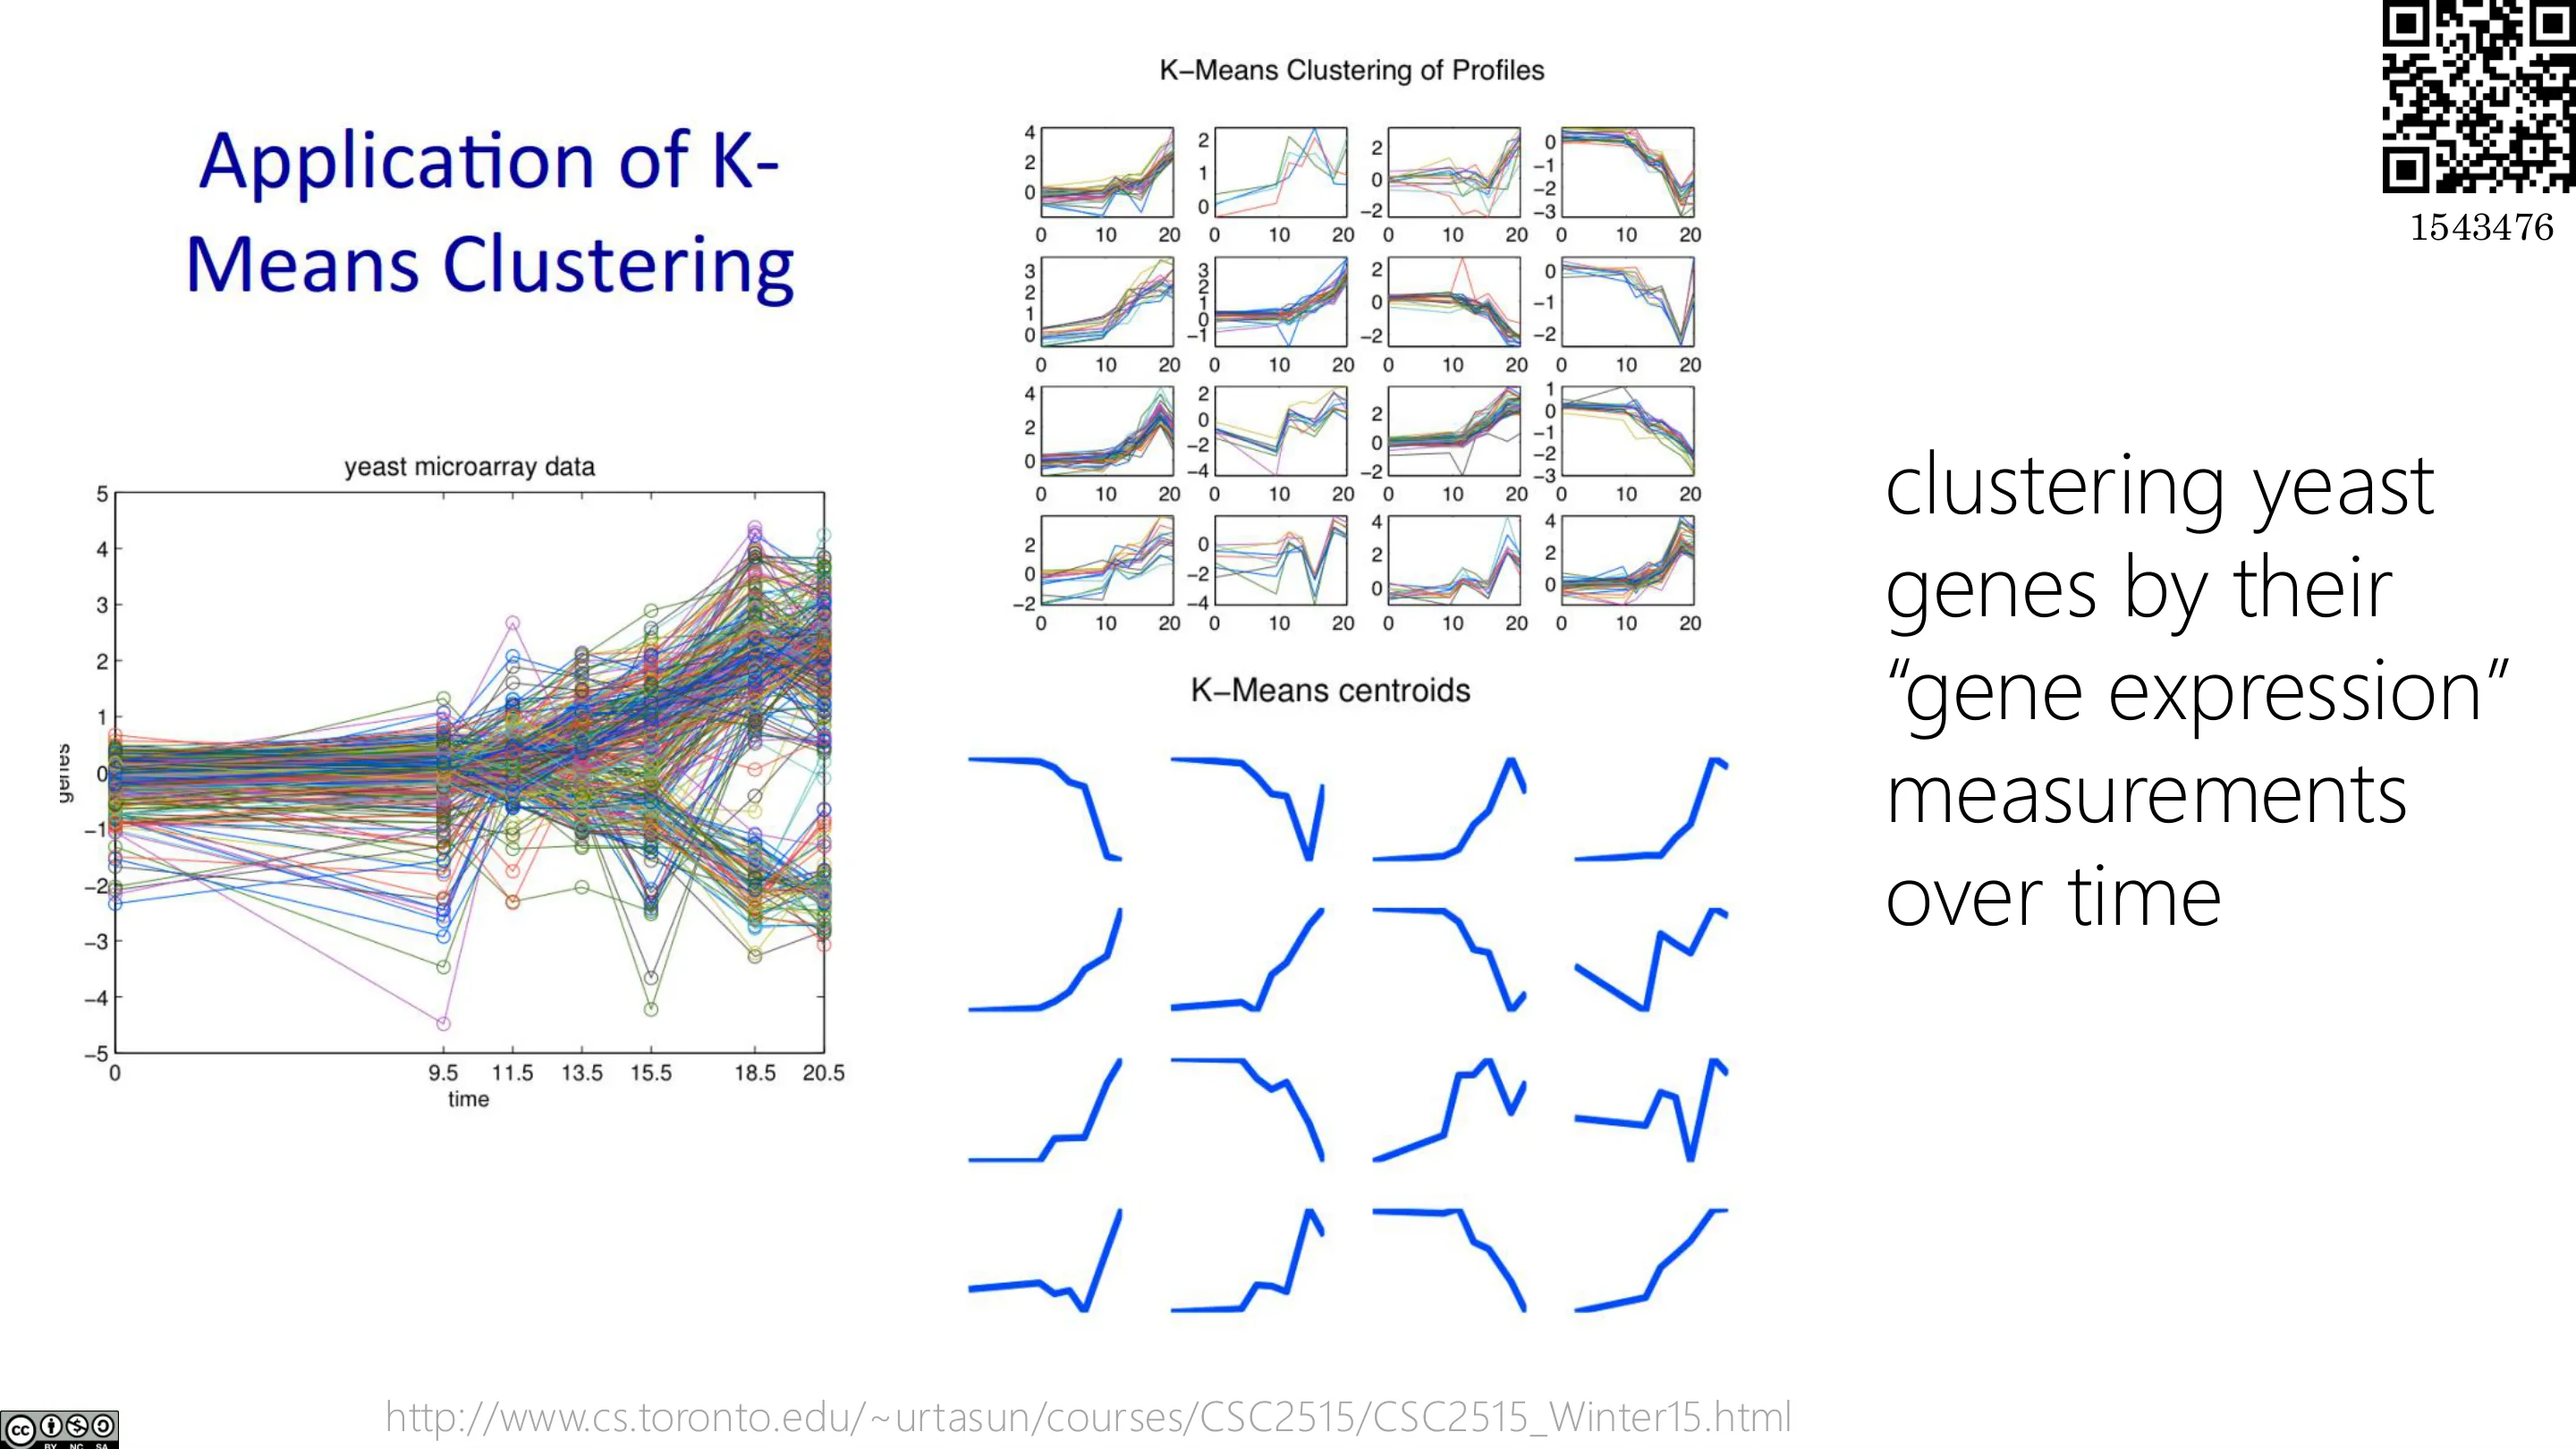
一个真实的应用:酵母基因表达聚类——把约 50 个基因在不同时间点的表达量作为特征(每条随时间变化的曲线是一个样本),运行 K 均值,得到若干「基因表达模式」的簇。
📷 用酵母基因表达数据聚类
回到原视频 (01:03:01)
六、K 均值的应用与局限
6.1 像素 K 均值:图像颜色量化
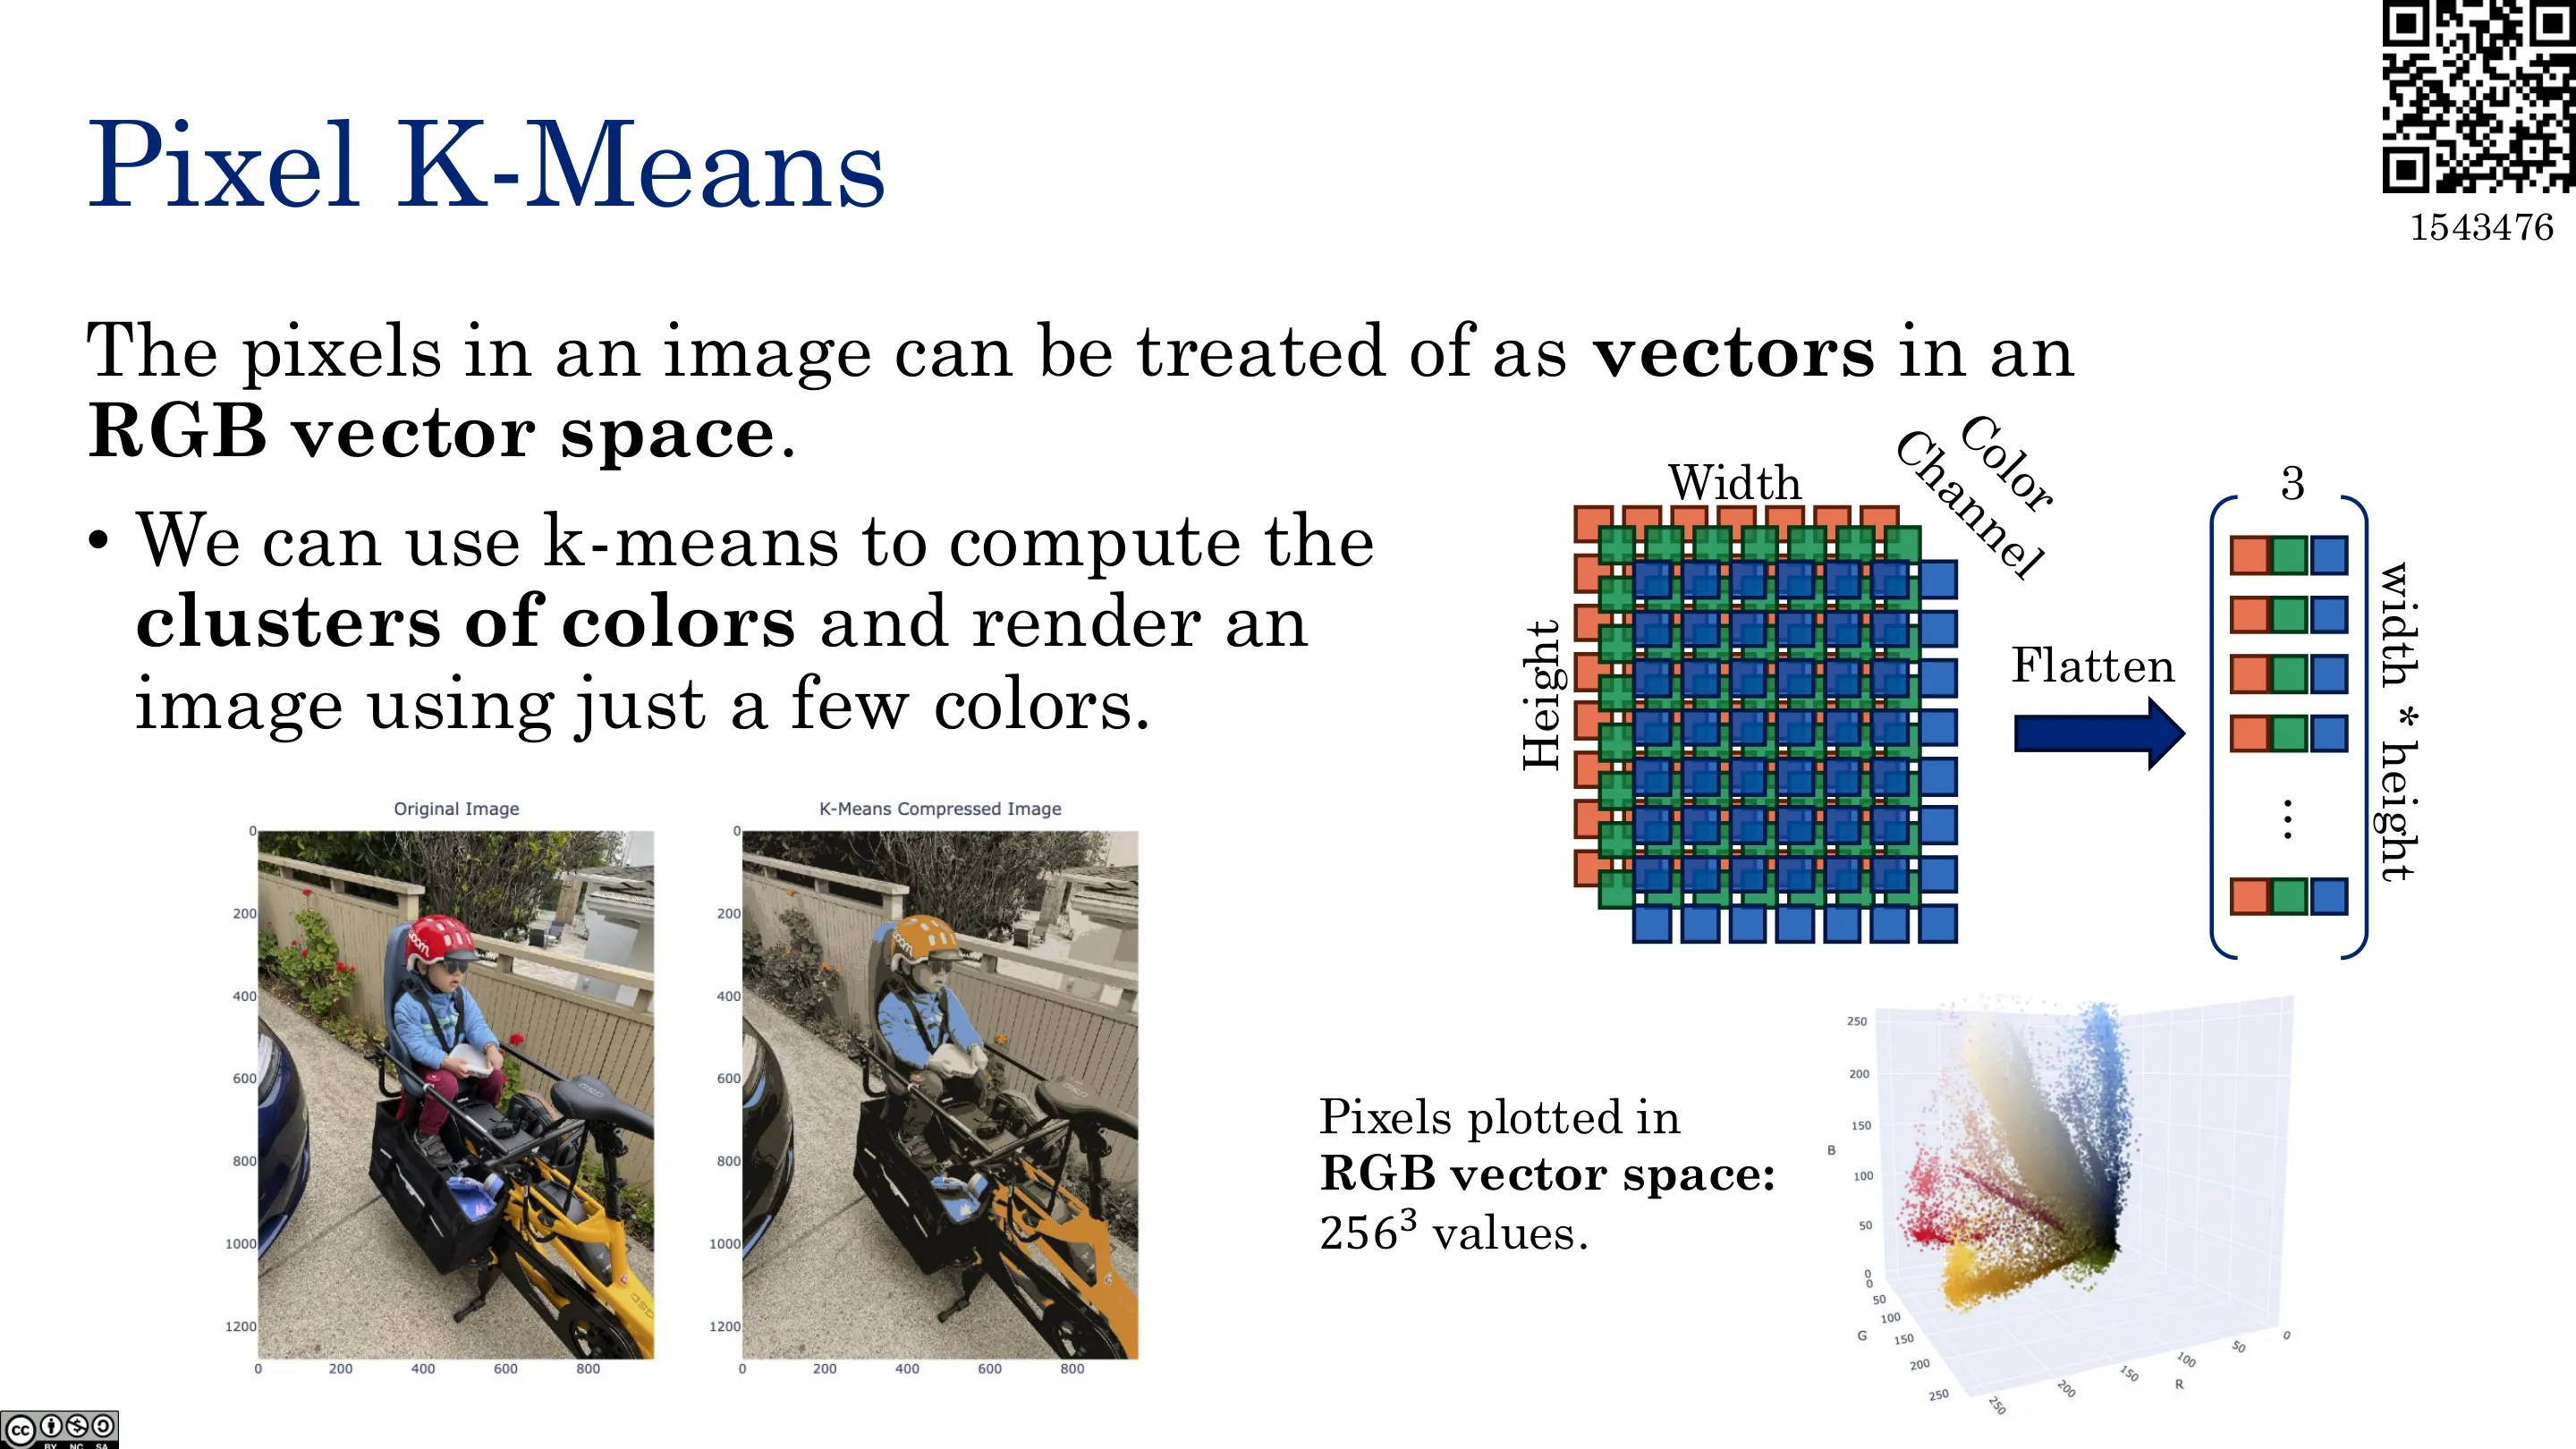
把图像中每个像素看成 RGB 三维空间里的一个向量(每个通道 0–255,共 $256^3$ 种颜色)。用 K 均值对这些颜色做聚类,就能用很少的颜色重新渲染图像——这叫颜色量化(color quantization)。代价是丢失细节:例如原本红色的头盔与黄色的自行车,可能被强制合并成同一种颜色。
📷 像素 K 均值
回到原视频 (01:05:40)
编者说明:讲师用这个例子说明——即便把 $K$ 设为等于样本数,K 均值也不保证每个中心正好落在每个数据点上,因为可能陷入局部最优;只有把每个中心都初始化到对应的数据点、再迭代,才可能做到。
6.2 K 均值的缺点
(1)糟糕的局部极小:随机初始化可能收敛到很差的解(例如把本该三个的簇变成「一个半 + 一个半」)。常见的缓解策略:
- 收敛后扰动中心,跳出局部极小再继续;
- 多次随机重启(利用算法本身的随机性),取目标函数最好的一次。
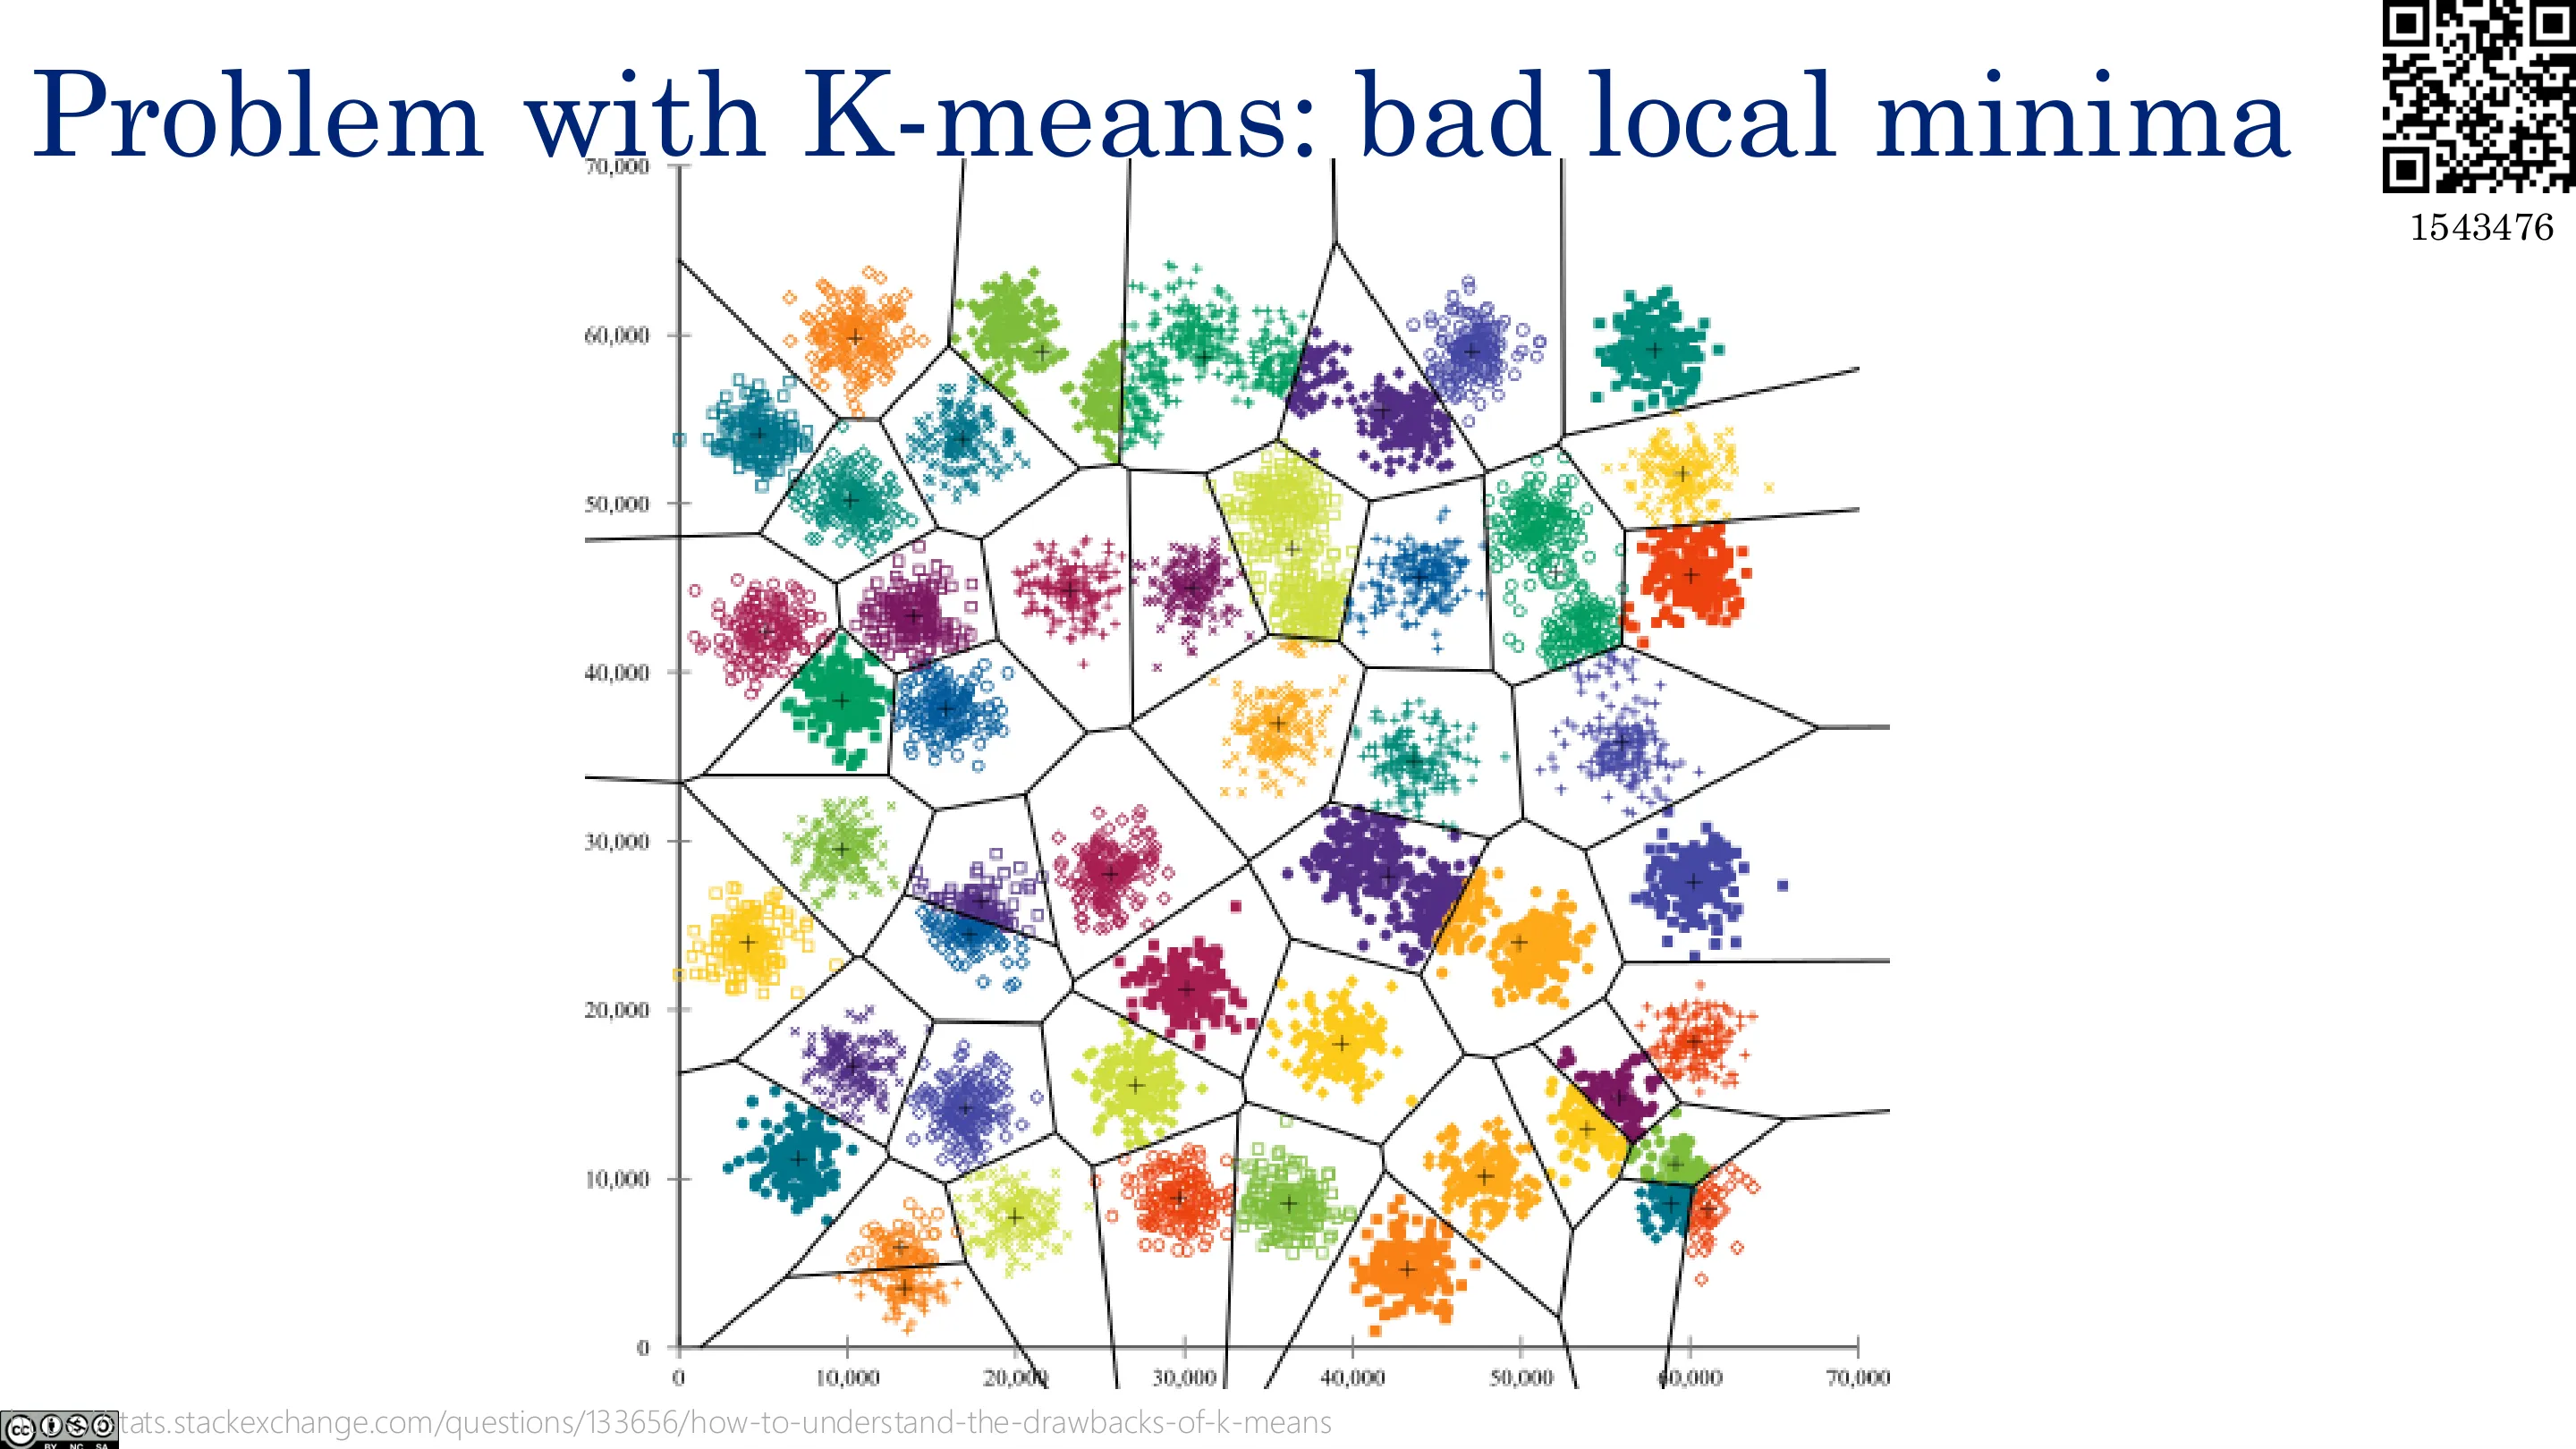
📷 K 均值的问题:糟糕的局部极小
回到原视频 (01:10:11)
(2)即使达到全局最优,K 均值本身仍有结构性缺陷:
- 它不是概率模型,隐含假设难以理解和表达;
- 它隐含假设每个簇体积相同、且是球形(因为用了欧氏距离)——所以当簇的大小/形状差异很大时,它会「卡住」,无法让某个簇更小;
- 难以推广(generalize);
- 每步都是硬分配(hard assignment),显得「脆弱」:若某点恰好在两簇之间,它被迫只能属于一个簇,而概率模型可以说「50% 属于红、50% 属于绿」。
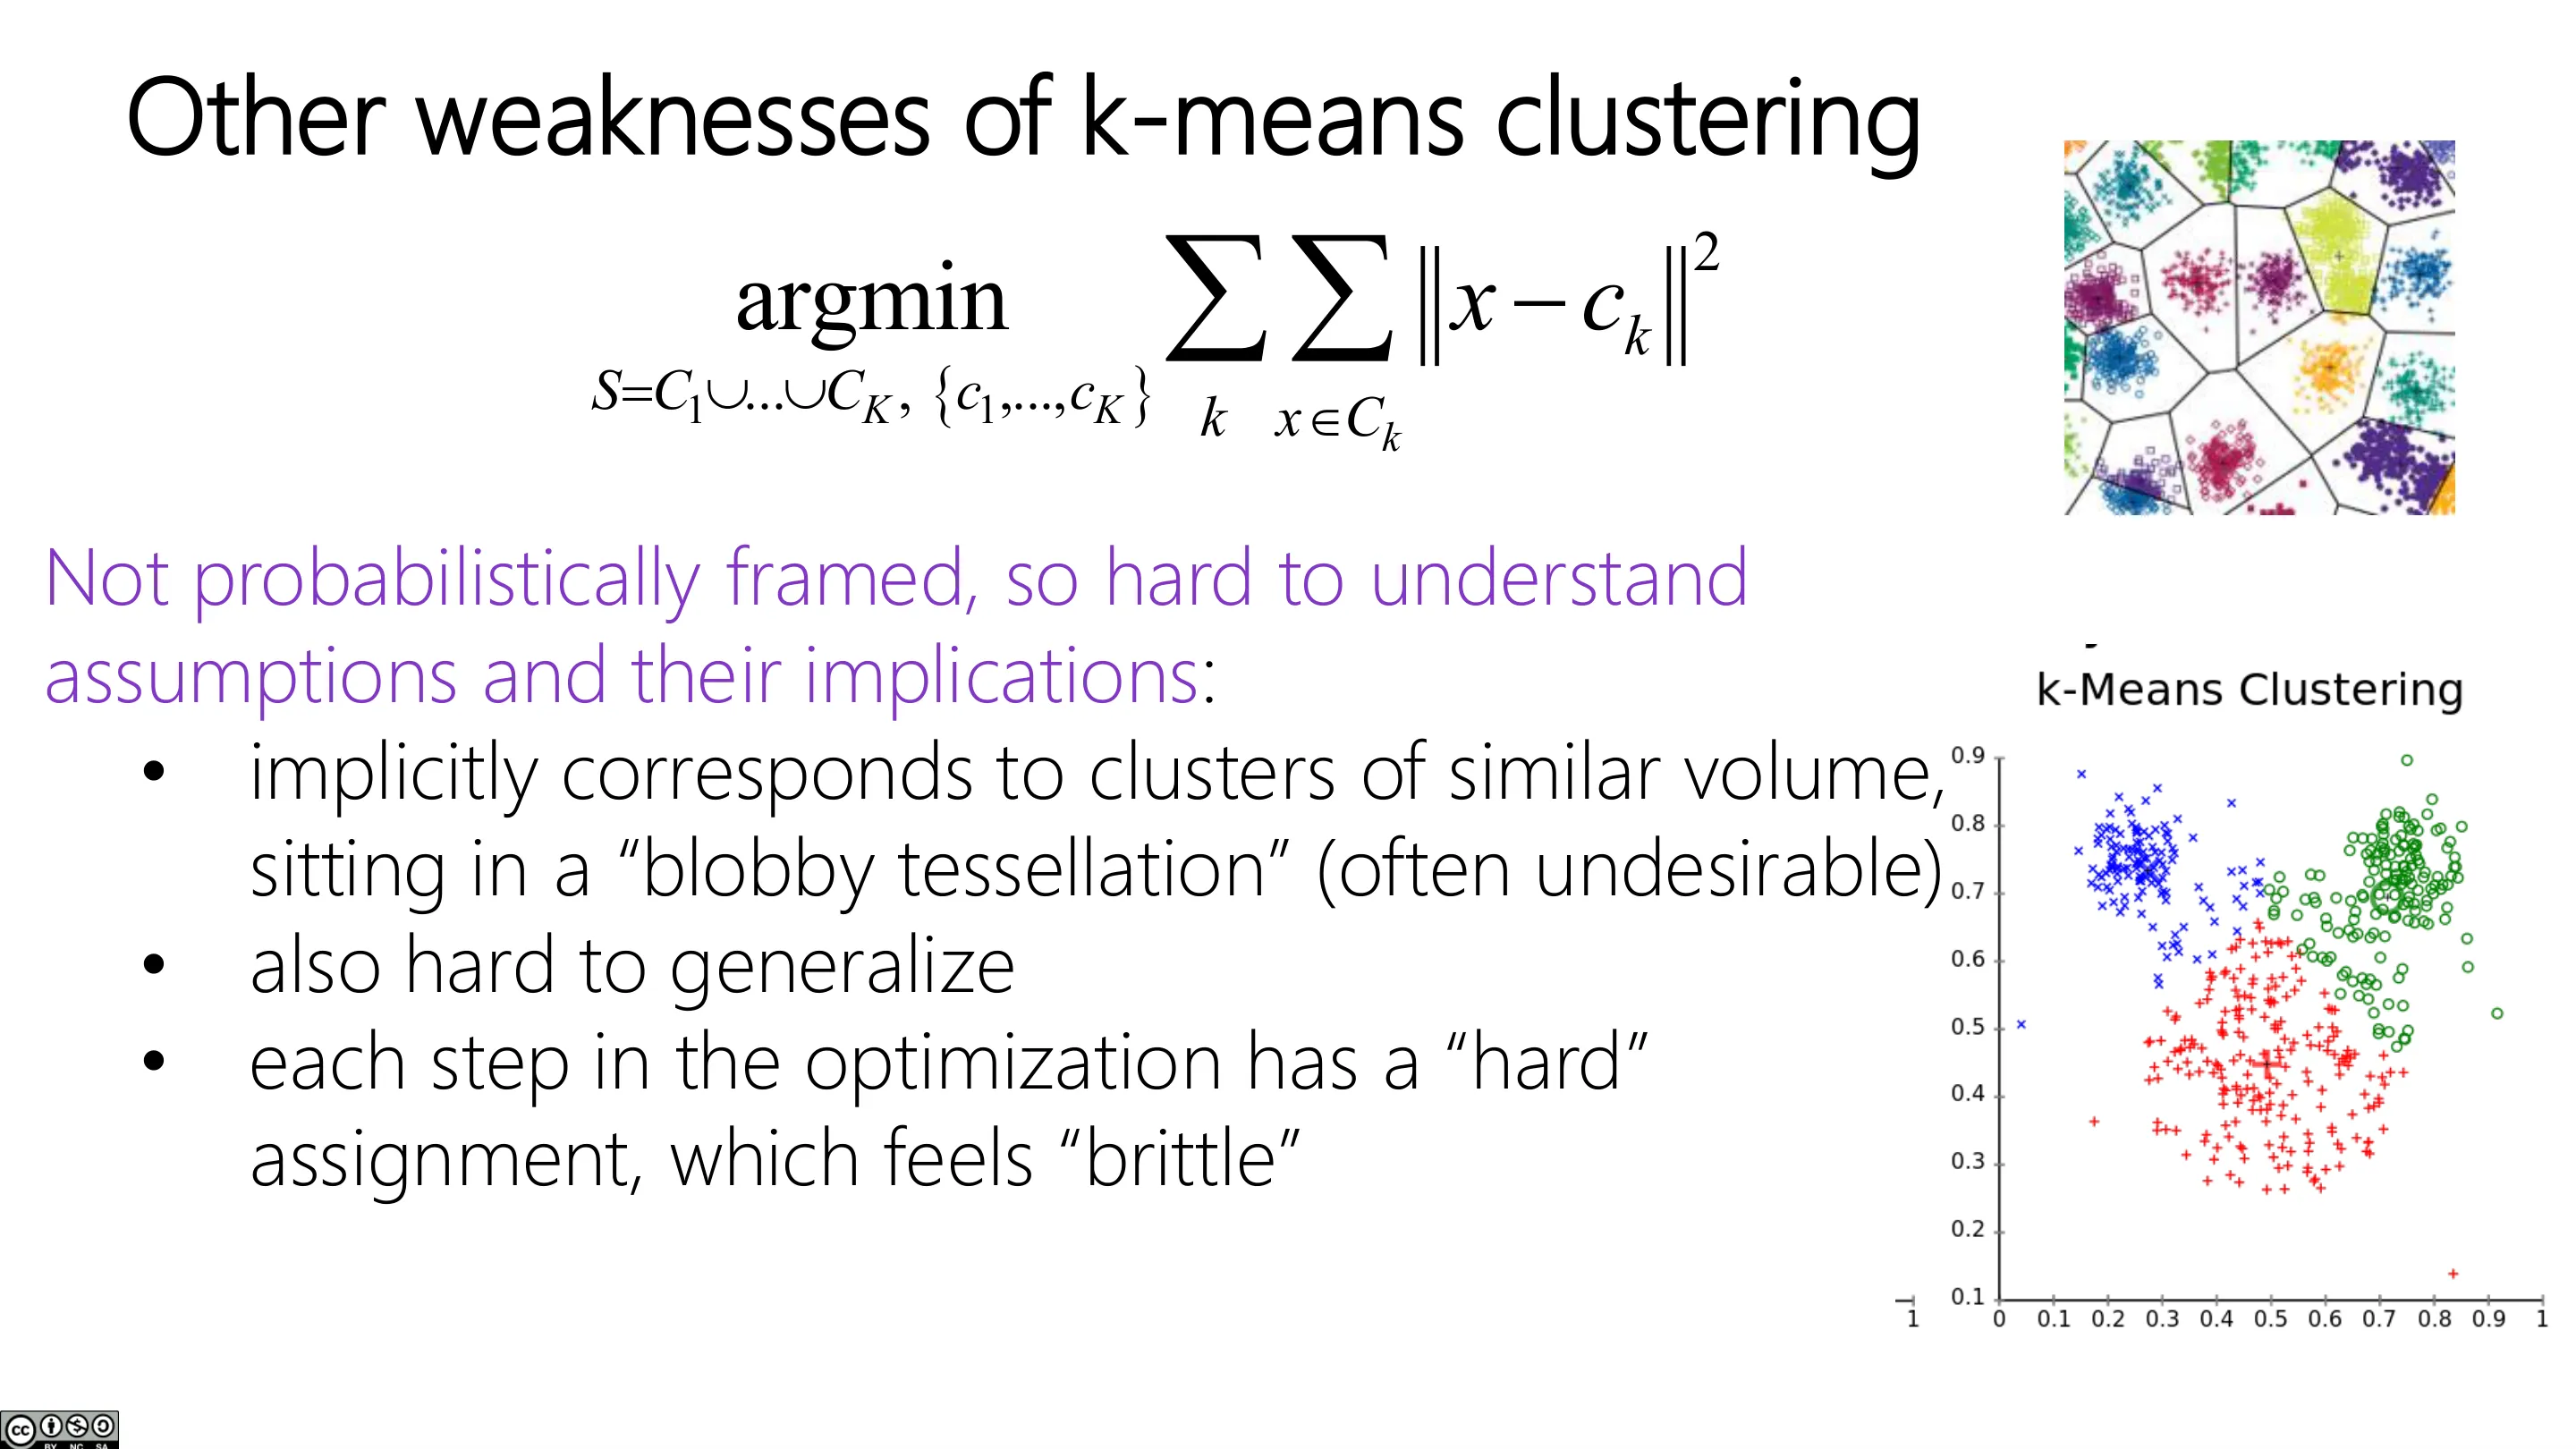
📷 K 均值的其他弱点
回到原视频 (01:11:21)
(3)存在一个概率版本可以修好这些问题——这就是下一讲的高斯混合模型(Mixture of Gaussians, MoG)。
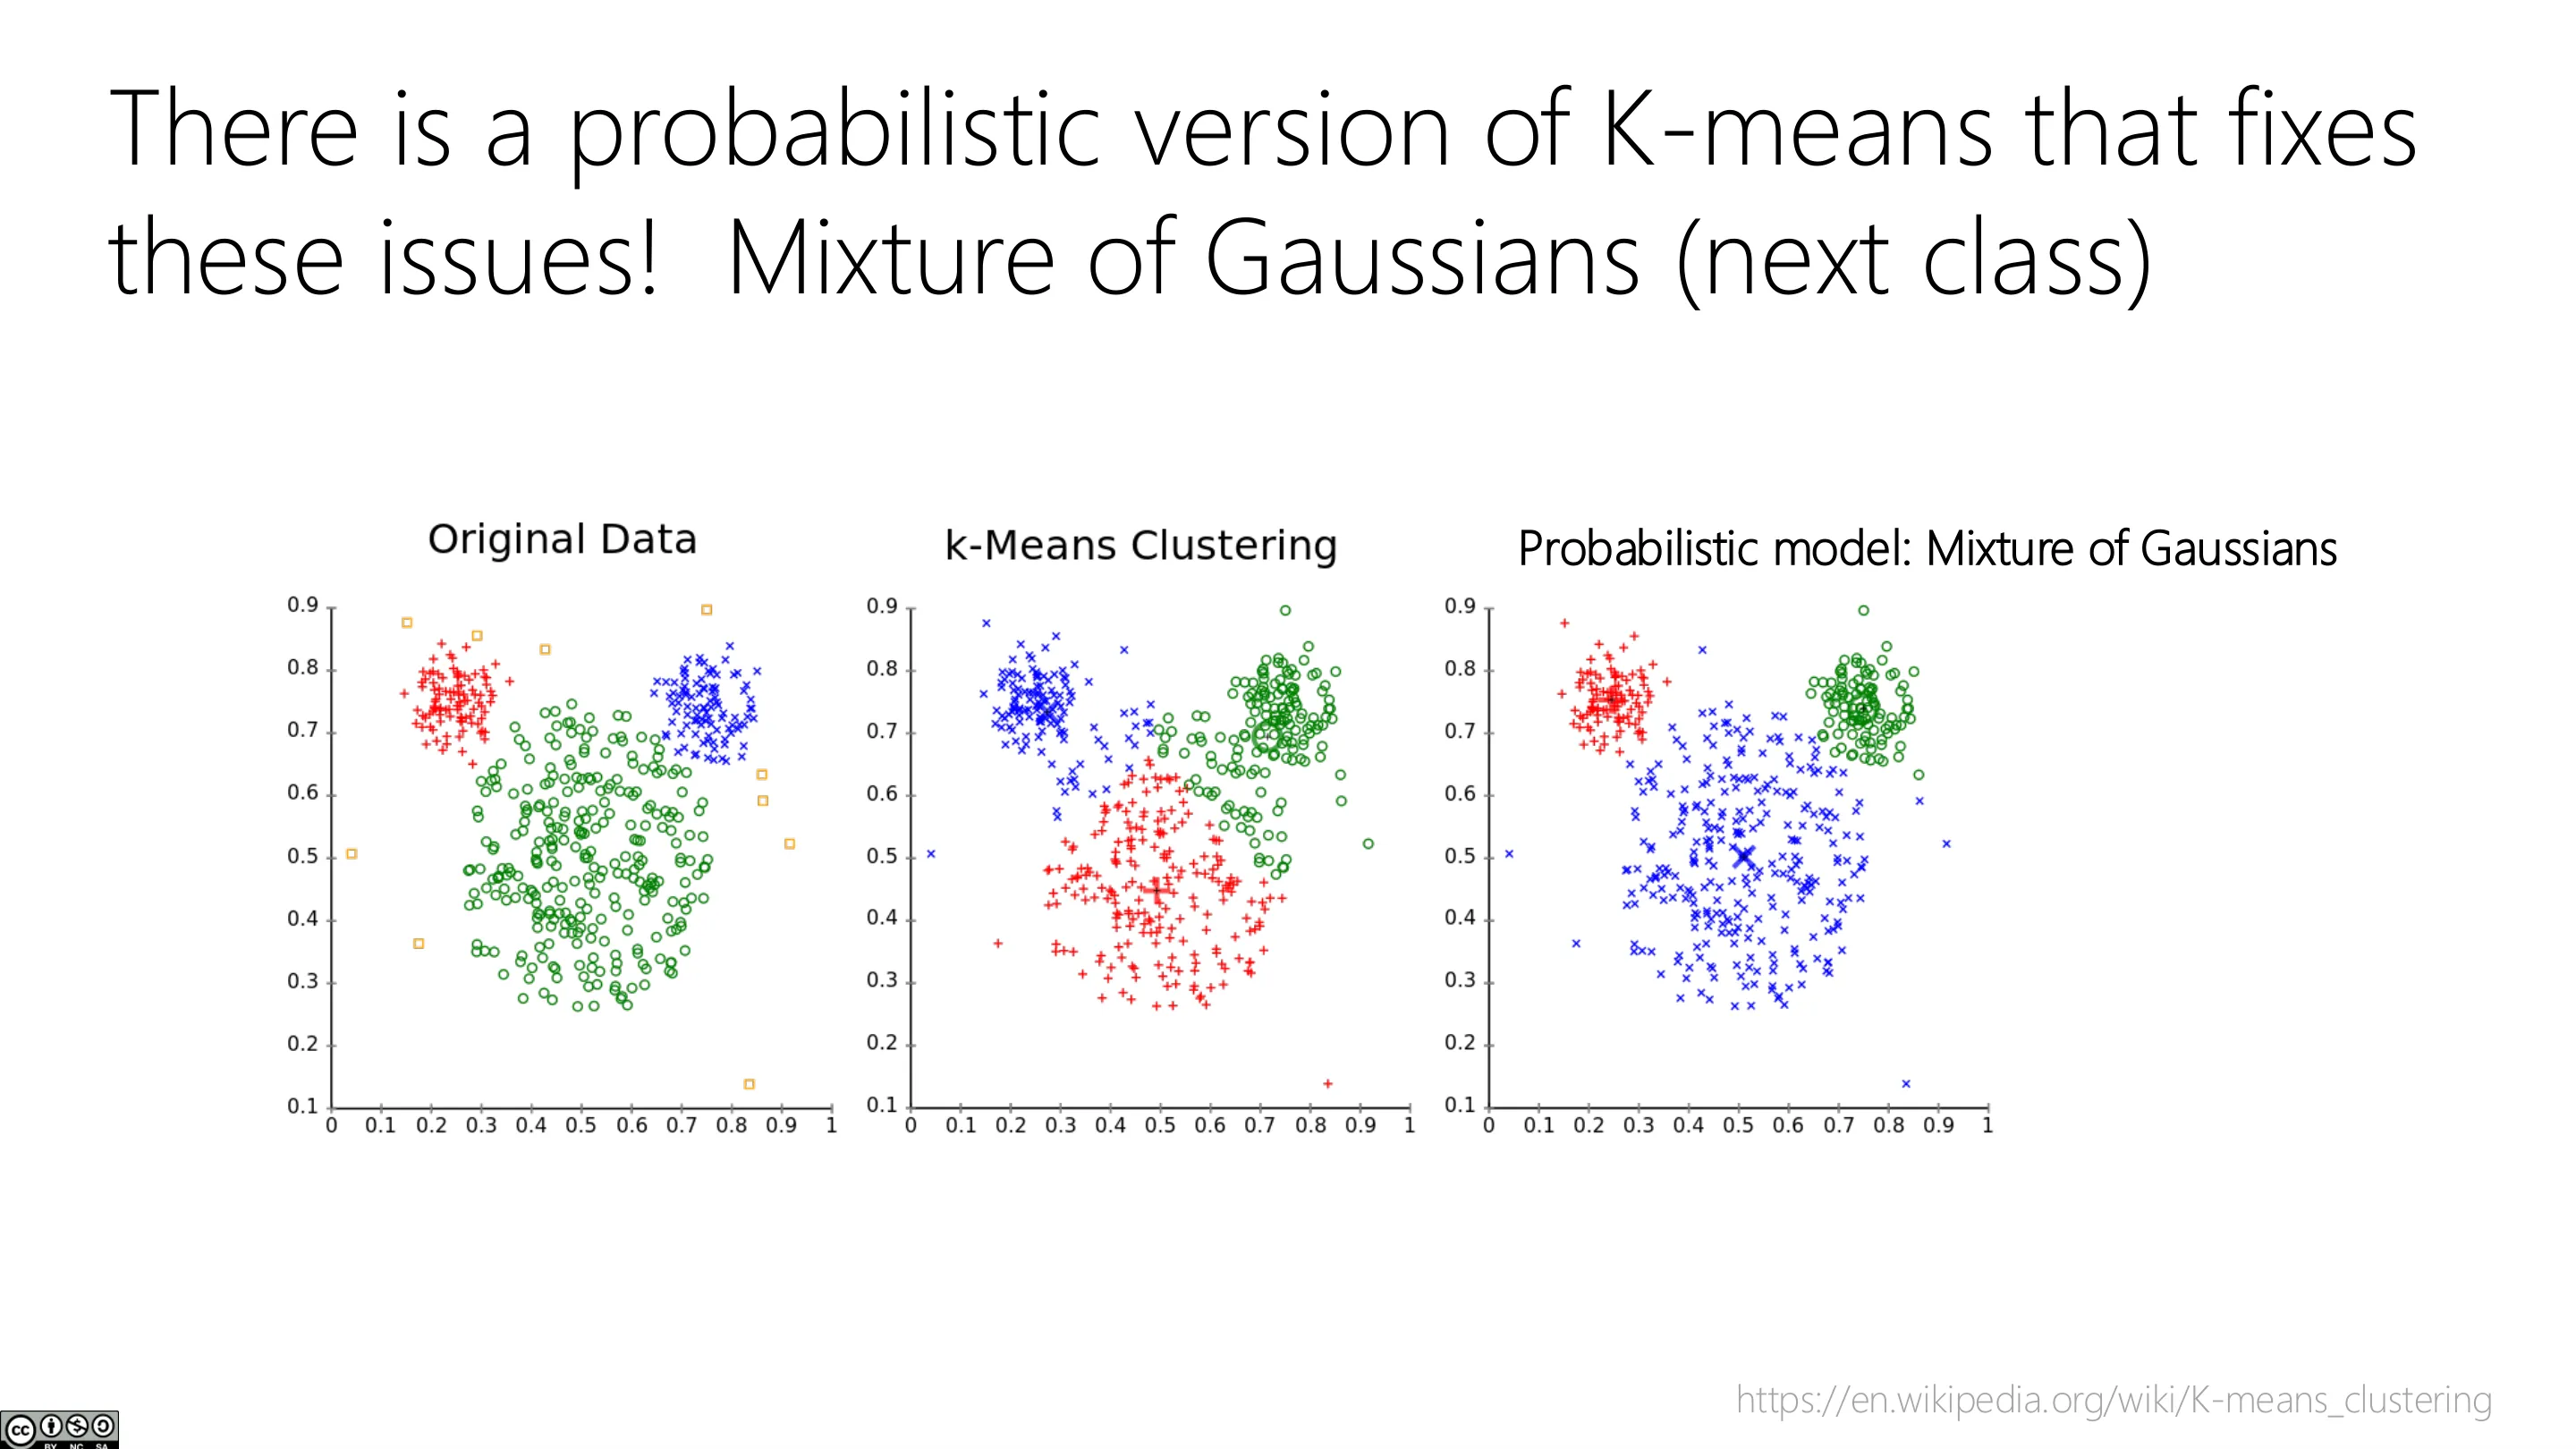
📷 概率版本:高斯混合模型
回到原视频 (01:13:40)
七、概率复习
(参考时间: 01:14)
📷 路线图(进入概率)
回到原视频 (01:14:46)
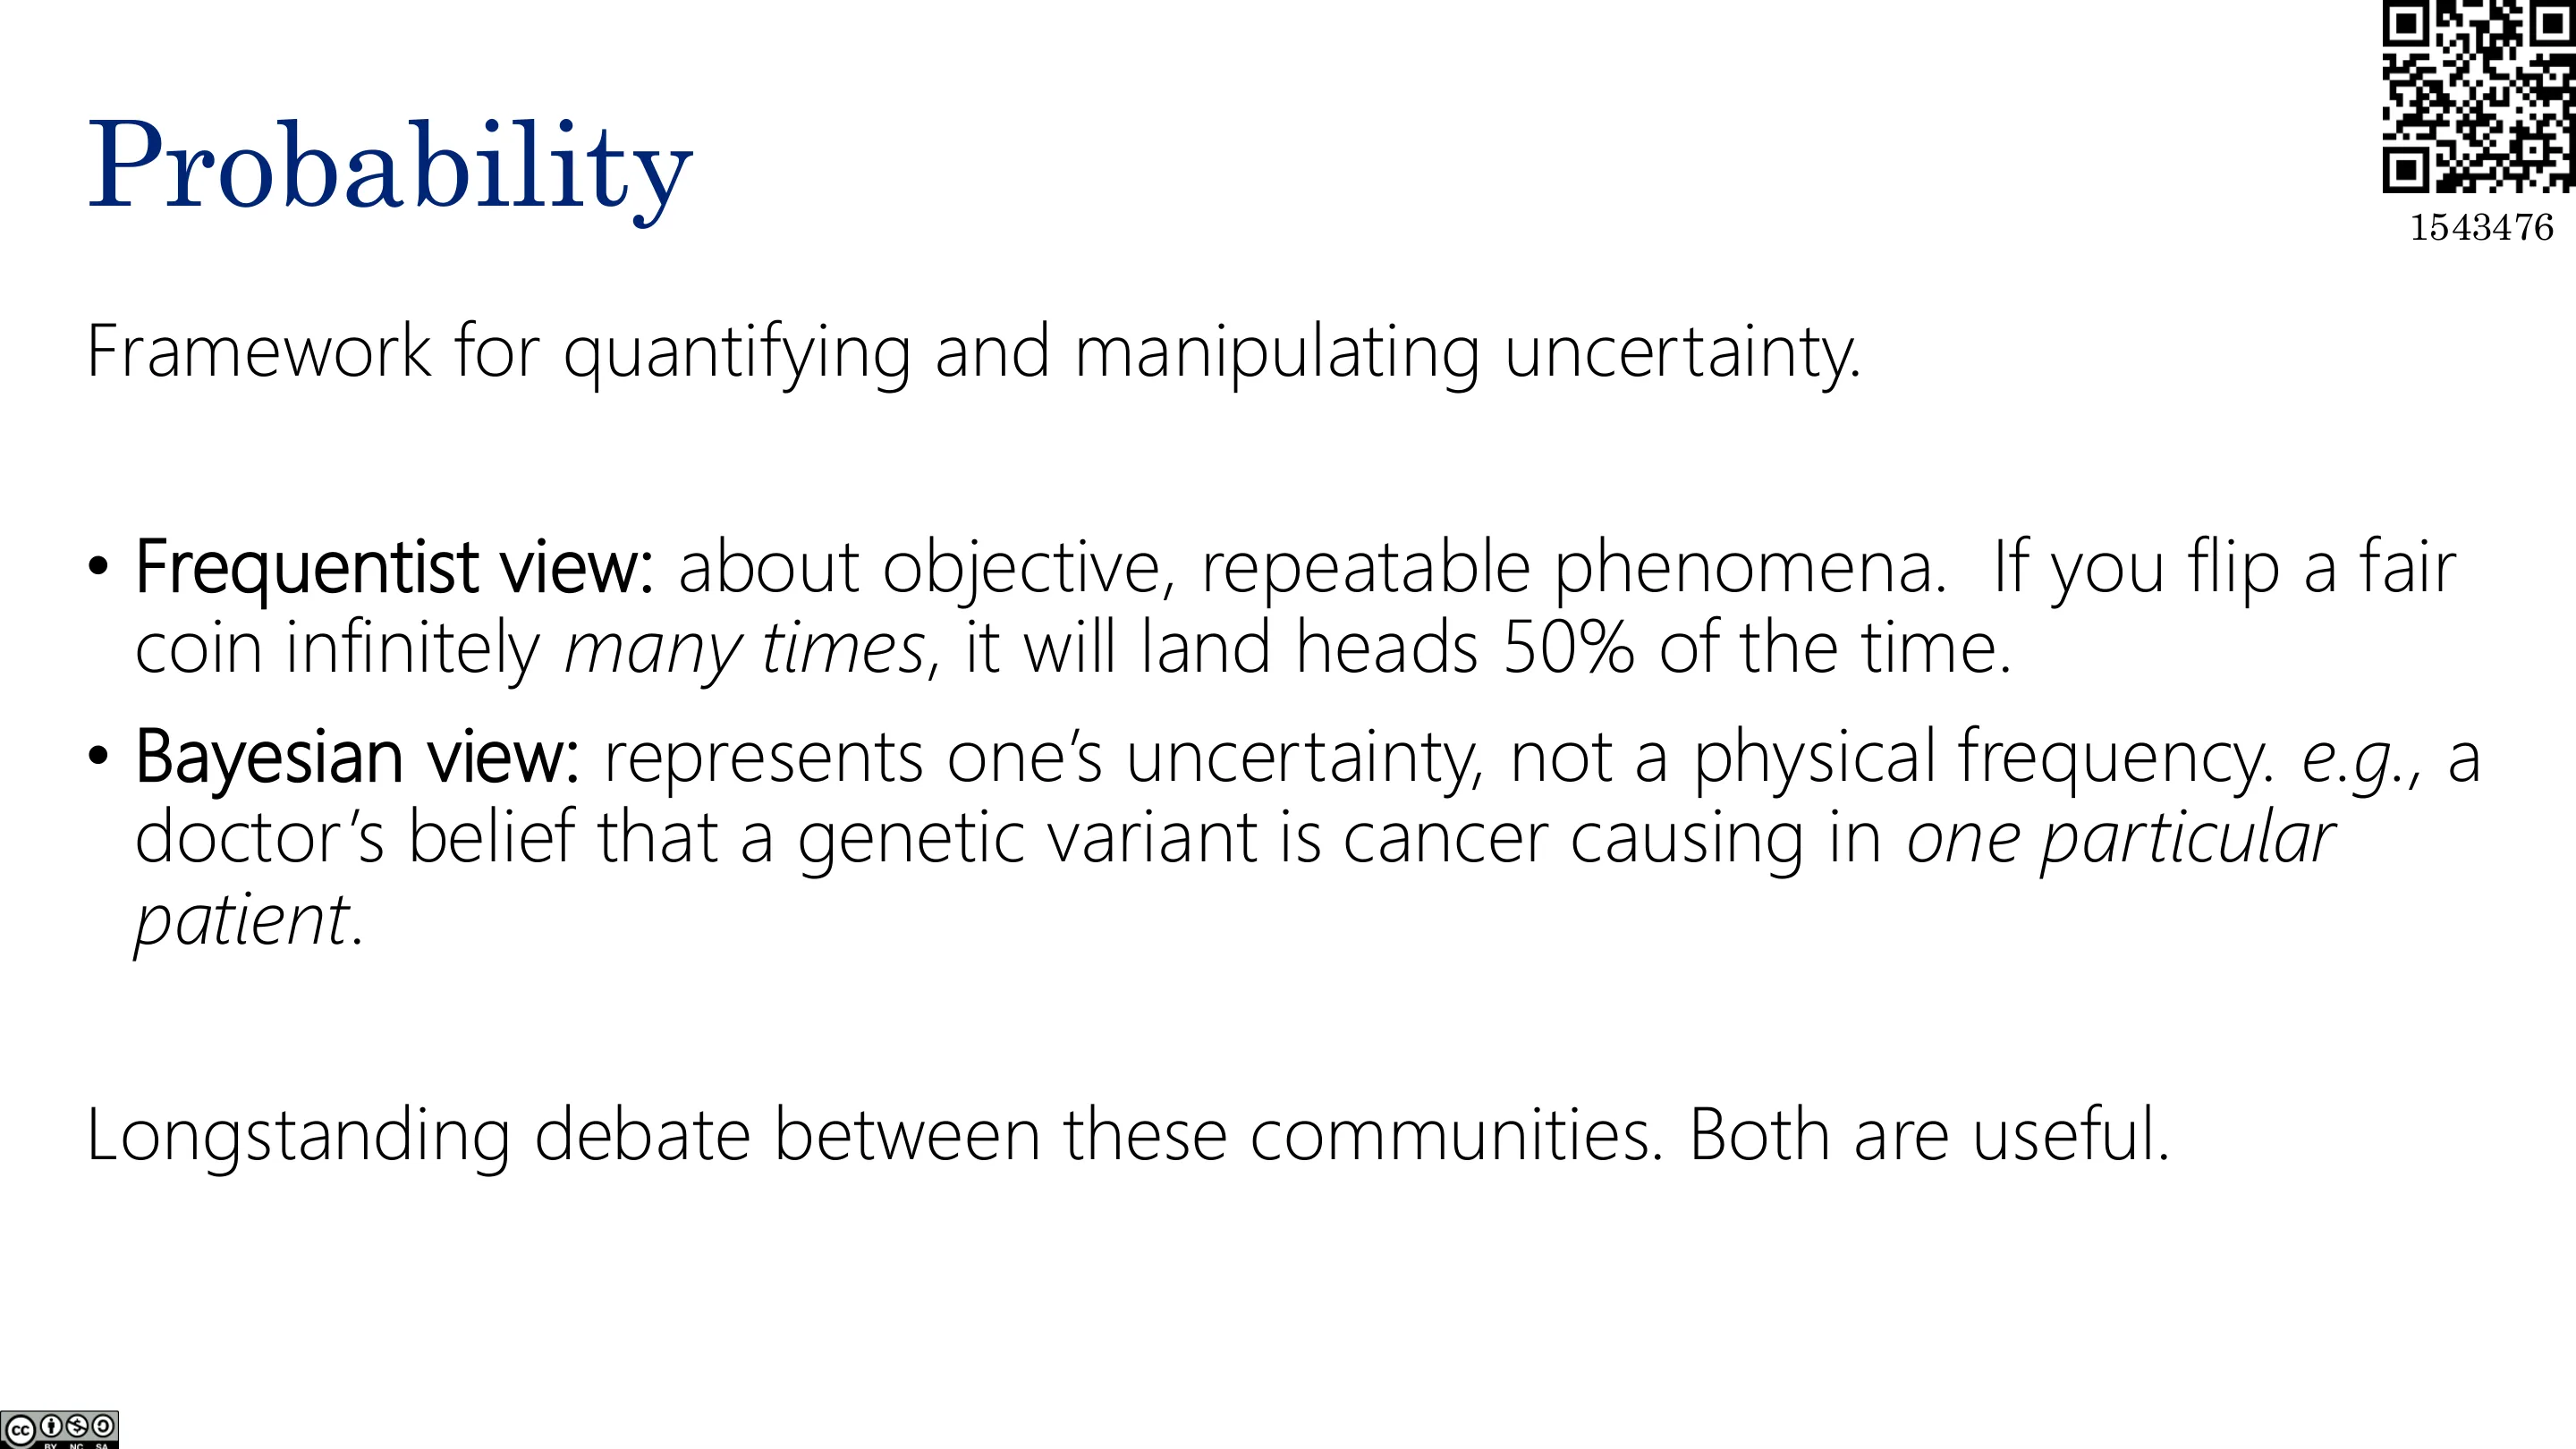
概率论是量化并操控不确定性(uncertainty)的框架。有两种观点:
- 频率学派(Frequentist):关于客观、可重复的现象。抛一枚公平硬币无穷多次,正面占 50%;
- 贝叶斯学派(Bayesian):表示一个人的不确定性,而非物理频率。例如医生对「某个基因变异在某一位病人身上致癌」的信念。
两派长期争论,但在机器学习中两者都有用,也常混用。
📷 概率:两种观点
回到原视频 (01:15:05)
7.1 联合概率分布
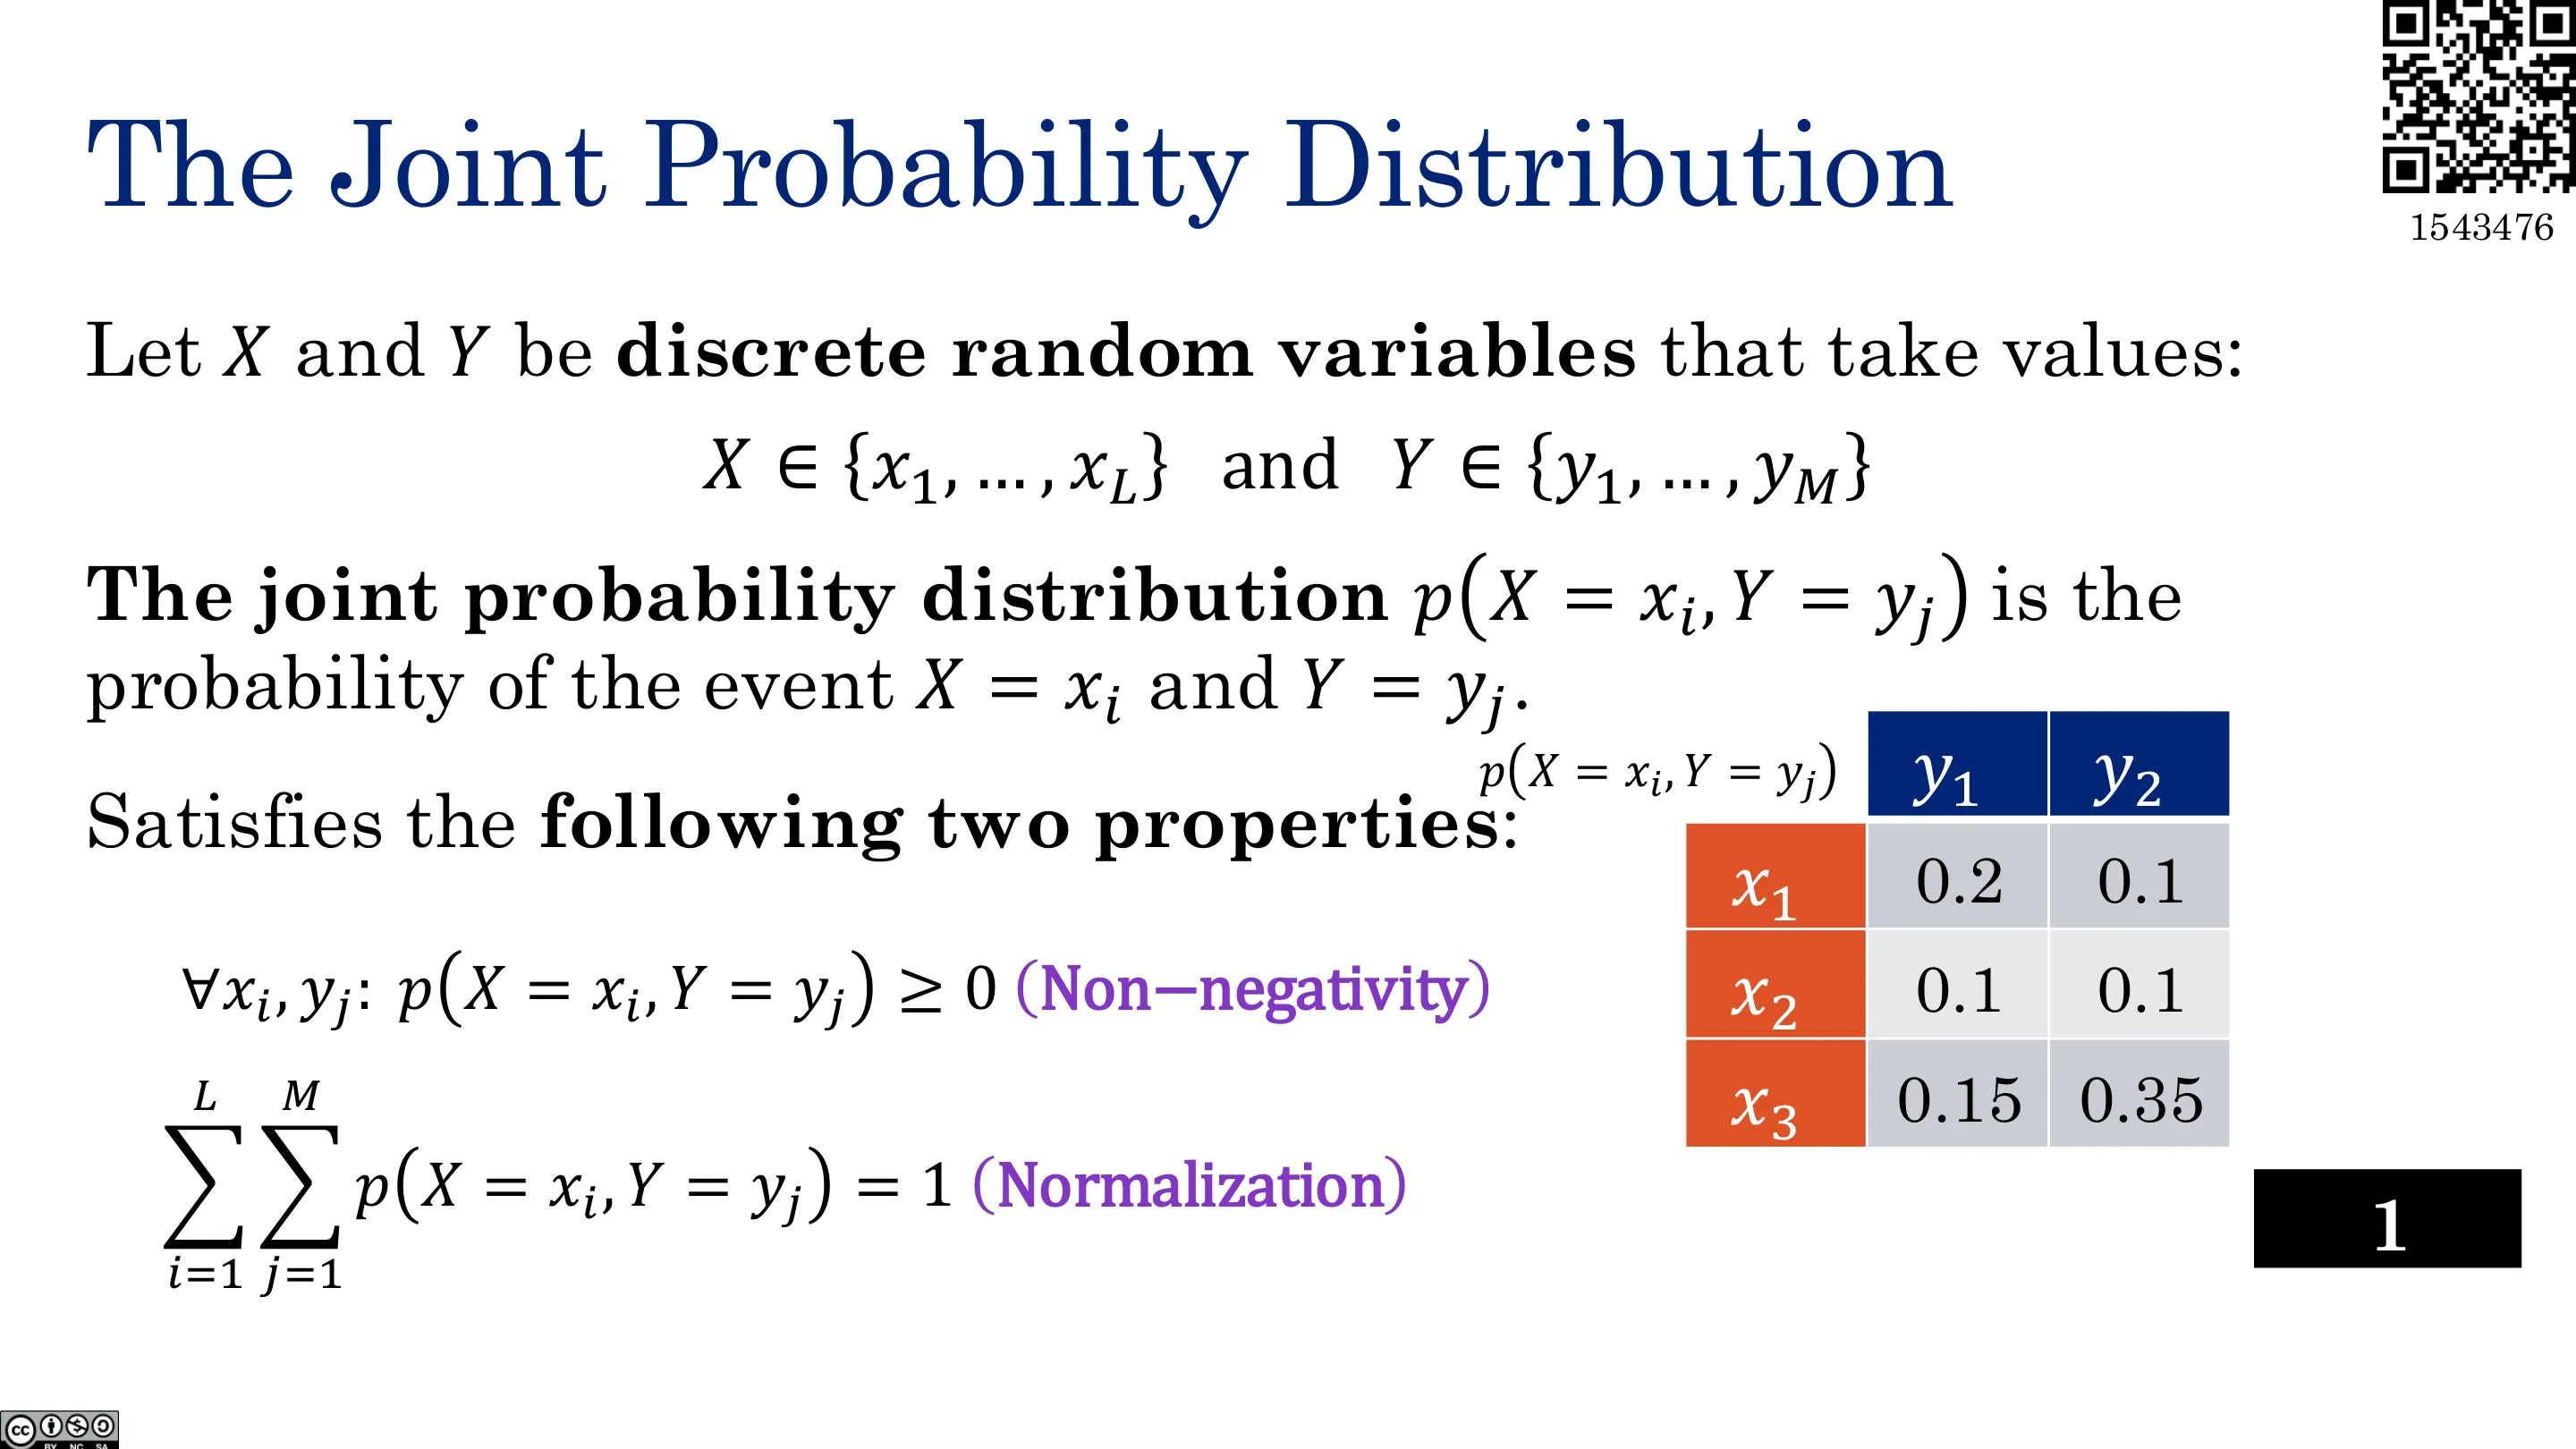
设 $X$、$Y$ 为离散随机变量,$X \in \{x_1,\dots,x_L\}$、$Y \in \{y_1,\dots,y_M\}$。联合概率分布 $p(X=x_i, Y=y_j)$ 表示事件「$X=x_i$ 且 $Y=y_j$」的概率。它满足两条性质:
- 非负性:$\forall x_i, y_j:\ p(X=x_i, Y=y_j) \ge 0$;
- 归一化:$\sum_{i=1}^{L} \sum_{j=1}^{M} p(X=x_i, Y=y_j) = 1$。
例如下面这张 $3 \times 2$ 的联合概率表,所有格子之和为 1:
| $y_1$ | $y_2$ | |
|---|---|---|
| $x_1$ | 0.2 | 0.1 |
| $x_2$ | 0.1 | 0.1 |
| $x_3$ | 0.15 | 0.35 |
📷 联合概率分布
回到原视频 (01:16:21)
7.2 求和法则(边缘化)
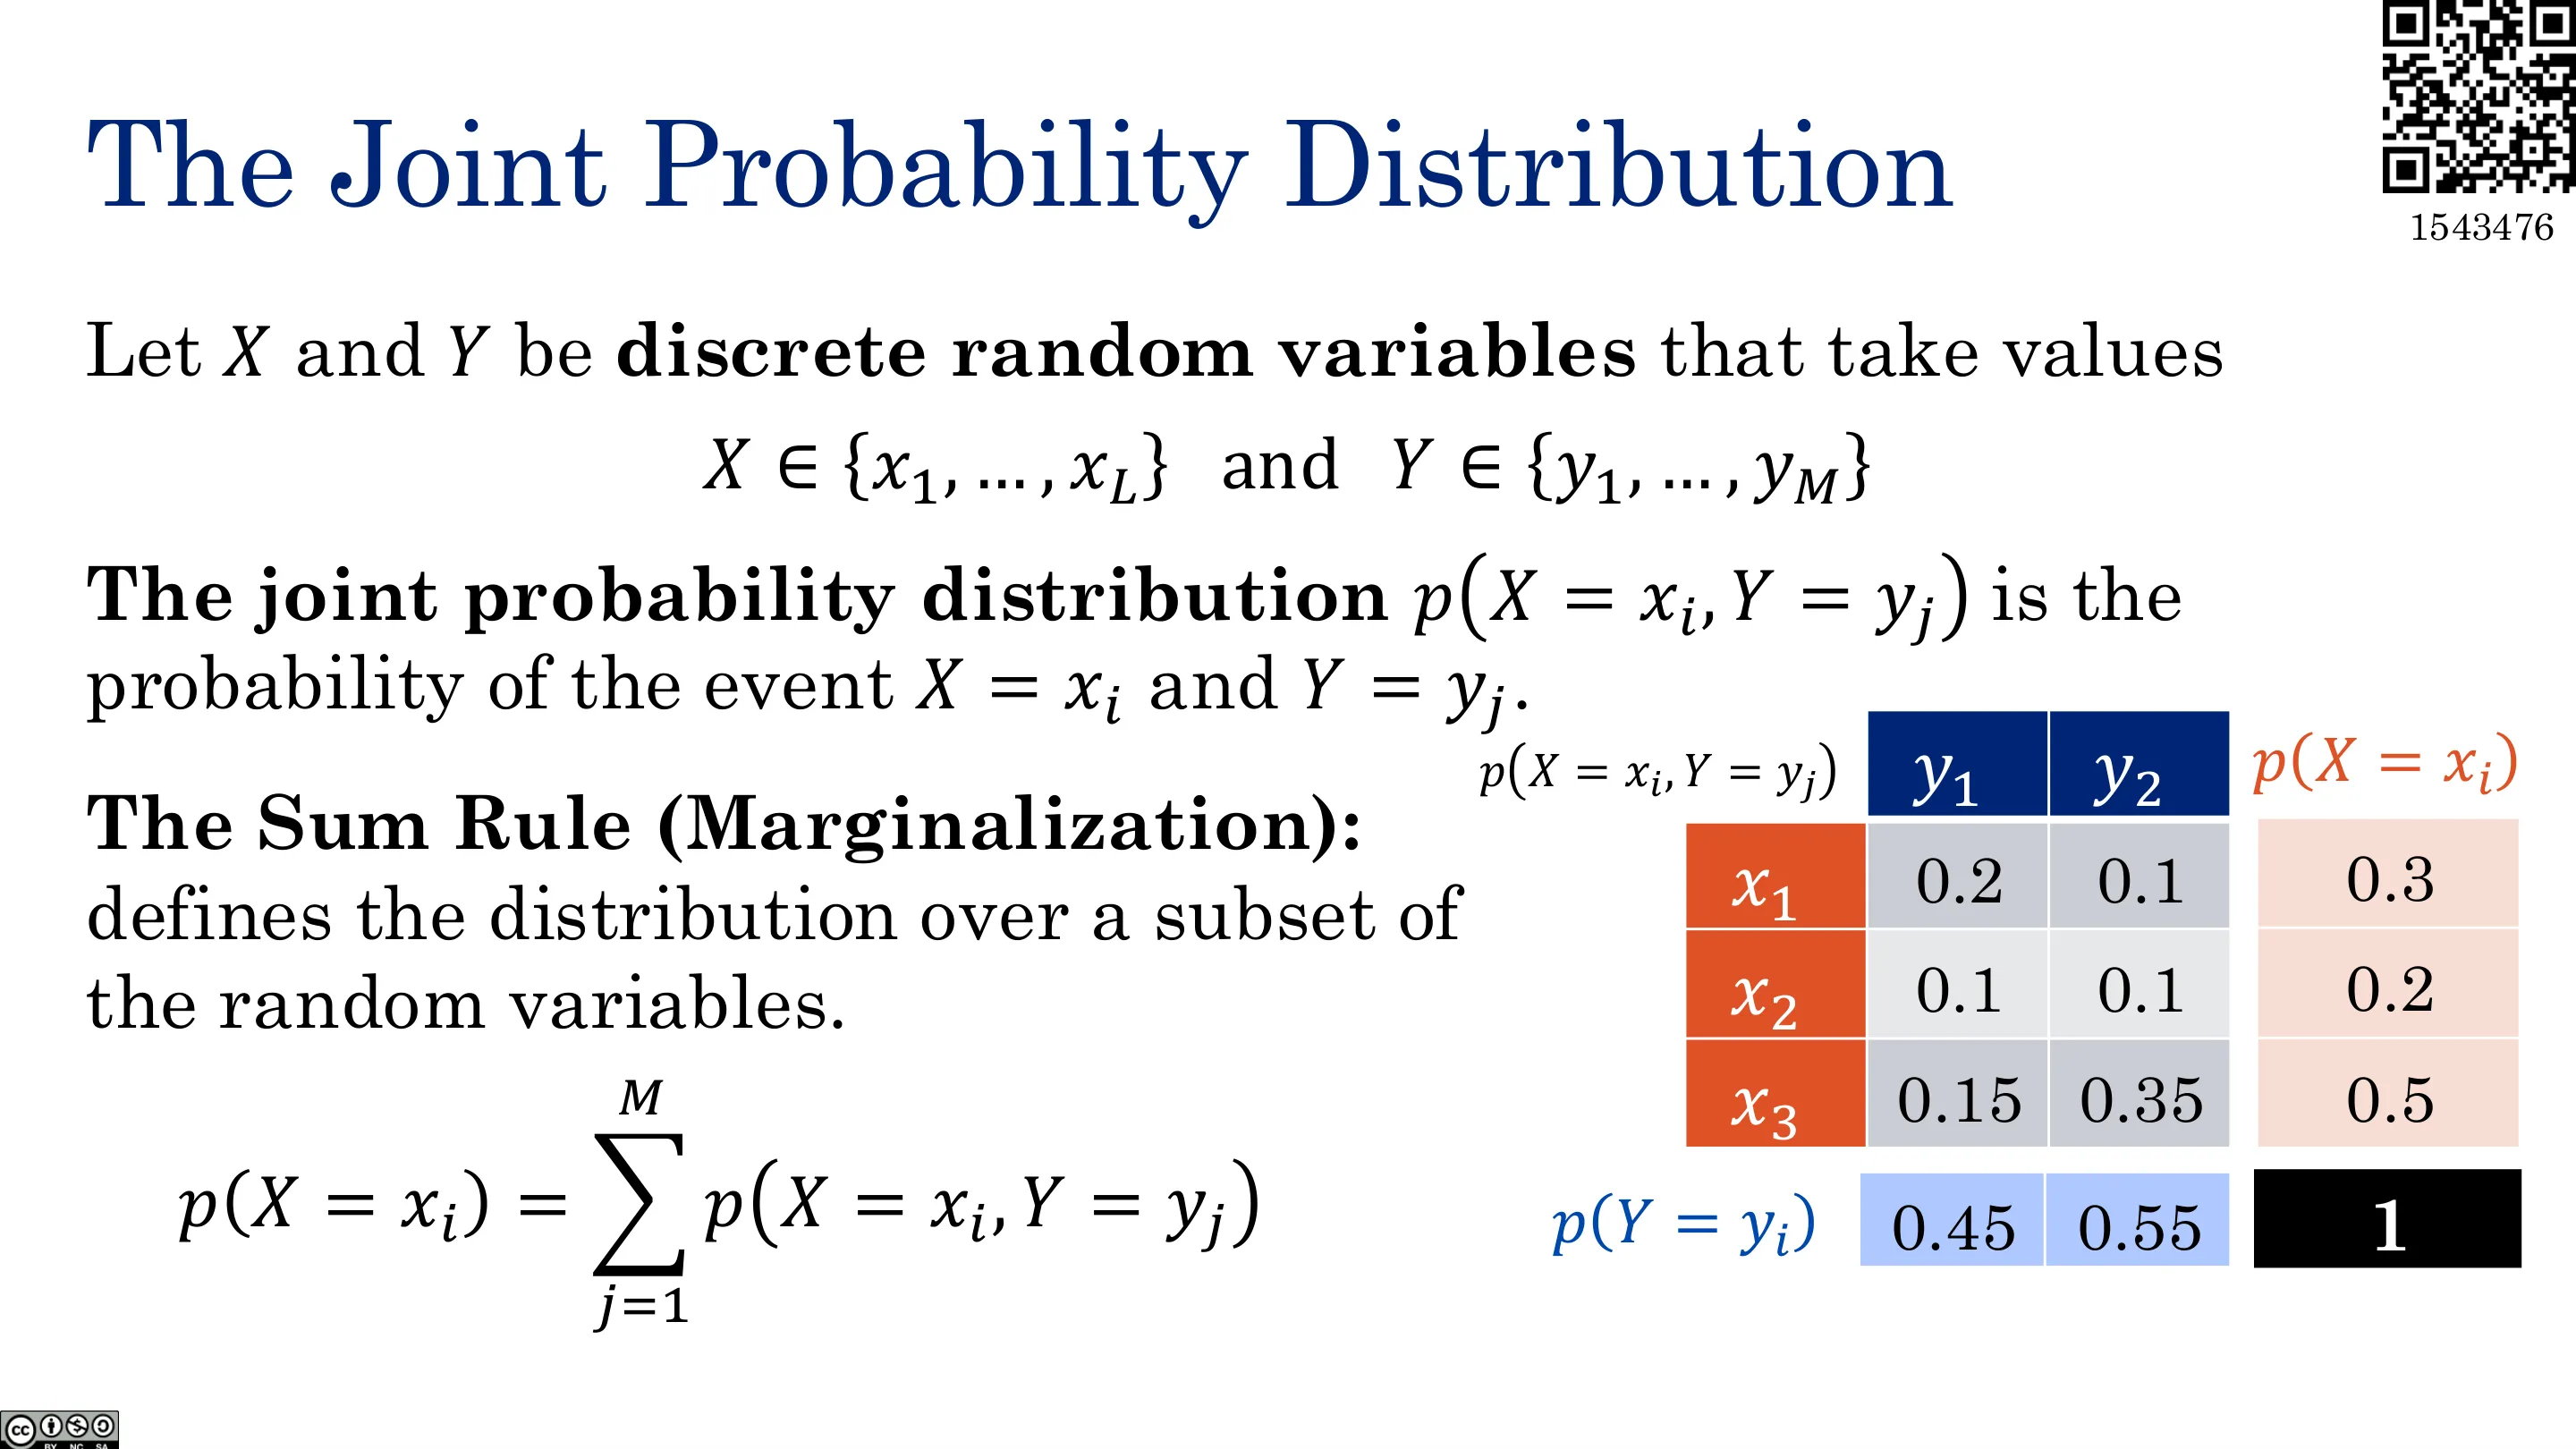
求和法则(Sum Rule / Marginalization):把联合分布对某个变量求和,就得到只关于另一个变量的分布(边缘分布):
$$ p(X = x_i) = \sum_{j=1}^{M} p(X = x_i, Y = y_j) $$
以上表为例:$p(X=x_1) = 0.2 + 0.1 = 0.3$,$p(X=x_3) = 0.15 + 0.35 = 0.5$;同理 $p(Y=y_1) = 0.45$。
📷 联合概率分布与边缘化
回到原视频 (01:17:55)
编者说明:讲到这里时间用尽,条件概率、经验分布、乘积法则、独立性与 IID、唤醒词与贝叶斯等后续内容本次未展开,收录于文末附录。
总结(Takeaways)
- 无监督学习没有标签,包含聚类、降维、表示学习、生成建模、密度估计等多种任务,它们彼此相关。
- 聚类的目标:簇内相似度尽量高、簇间相似度尽量低;而「相似度/距离」的定义取决于观察者。
- K 均值是「基于中心点」的聚类:目标是最小化 $\sum_k \sum_{x \in C_k} \|x - c_k\|^2$。
- 求解靠交替优化:已知划分 → 质心取簇内均值;已知质心 → 把点分给最近的质心。每步都降低目标函数,保证收敛到局部极小。
- K 是超参数,可用肘部法辅助选择;K 均值对初始化敏感,可多次重启。
- K 均值的局限:局部极小、隐含「等体积球形簇」假设、硬分配脆弱——下一讲的高斯混合模型给出了概率化修正。
- 概率复习:区分频率学派与贝叶斯学派;掌握联合分布(非负 + 归一化)与边缘化(求和法则)。
附录:课堂未展示的幻灯片
以下幻灯片属于本讲官方 deck,但本次录像时间用尽,未展开讲解,作为延伸阅读收录(条件概率、经验分布、乘积法则、独立性、IID、K 均值与概率、唤醒词与贝叶斯)。
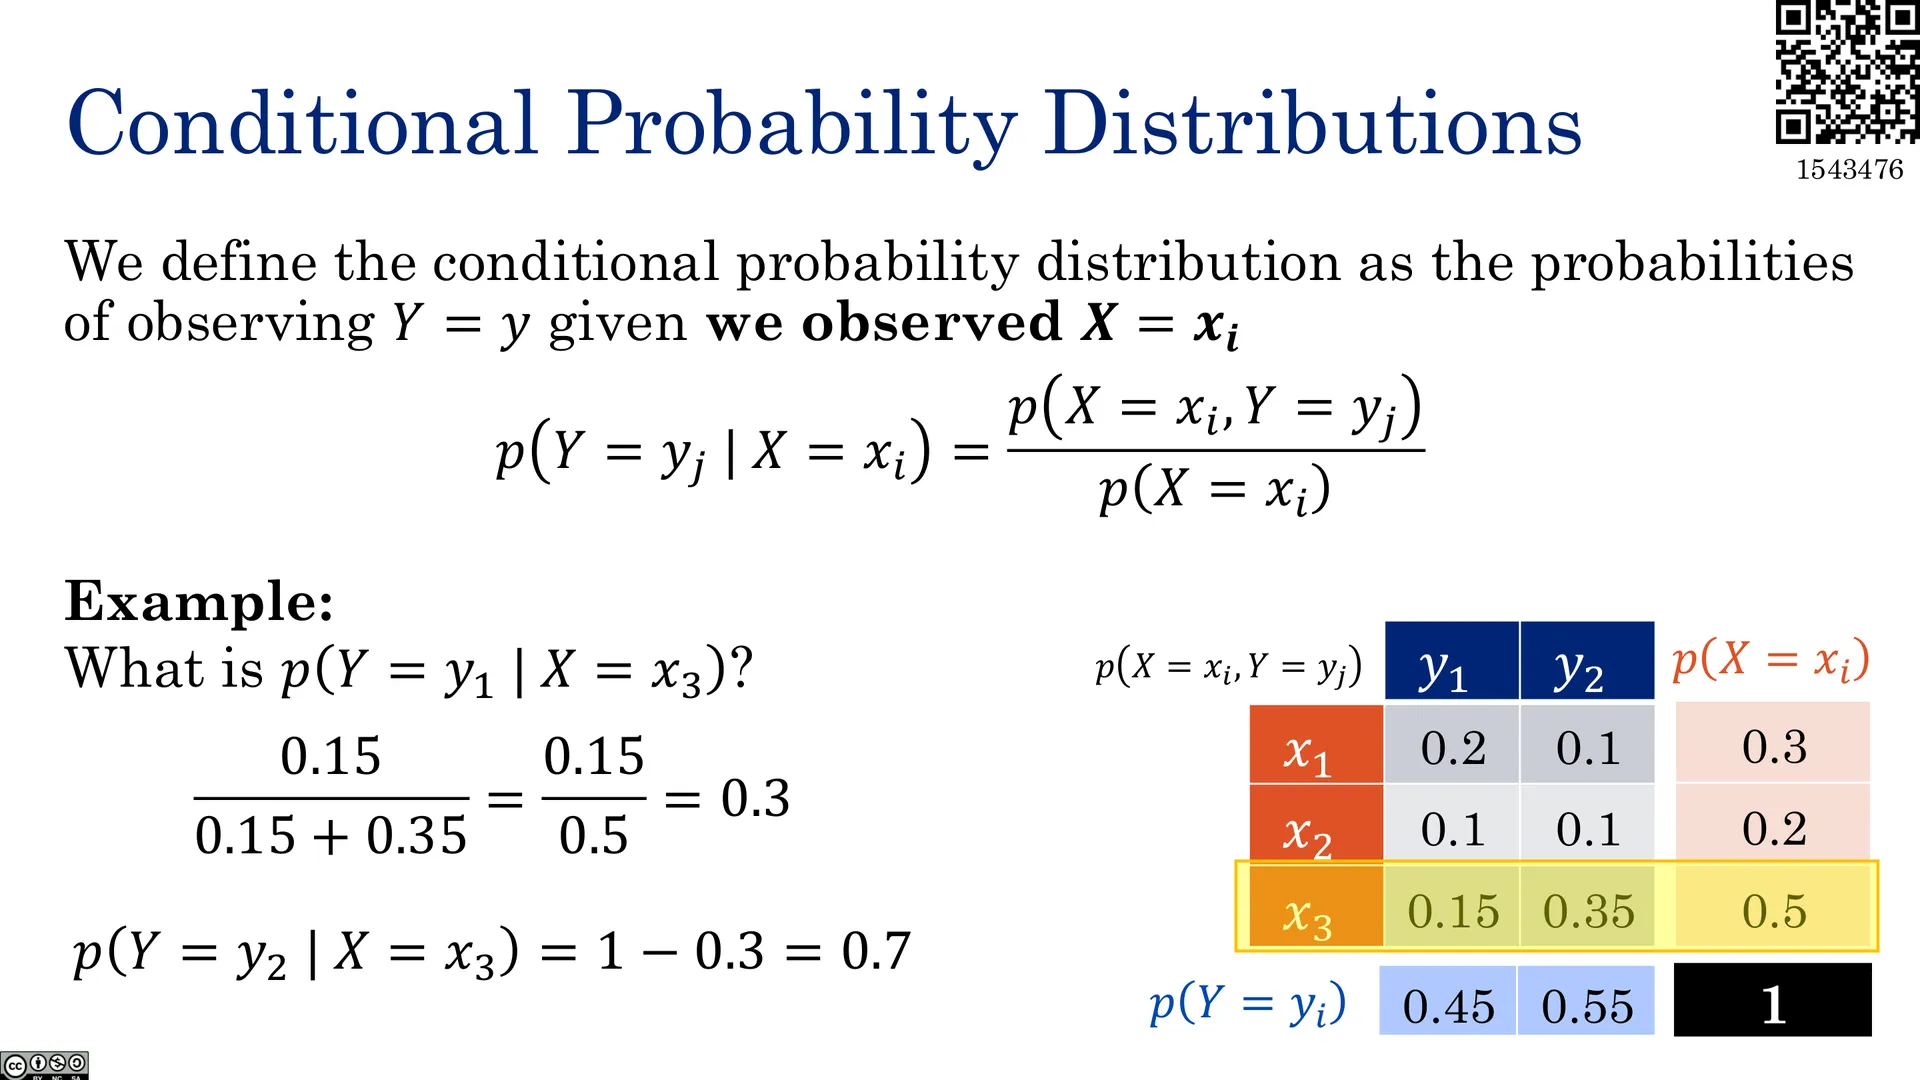
🖼️ 条件概率分布
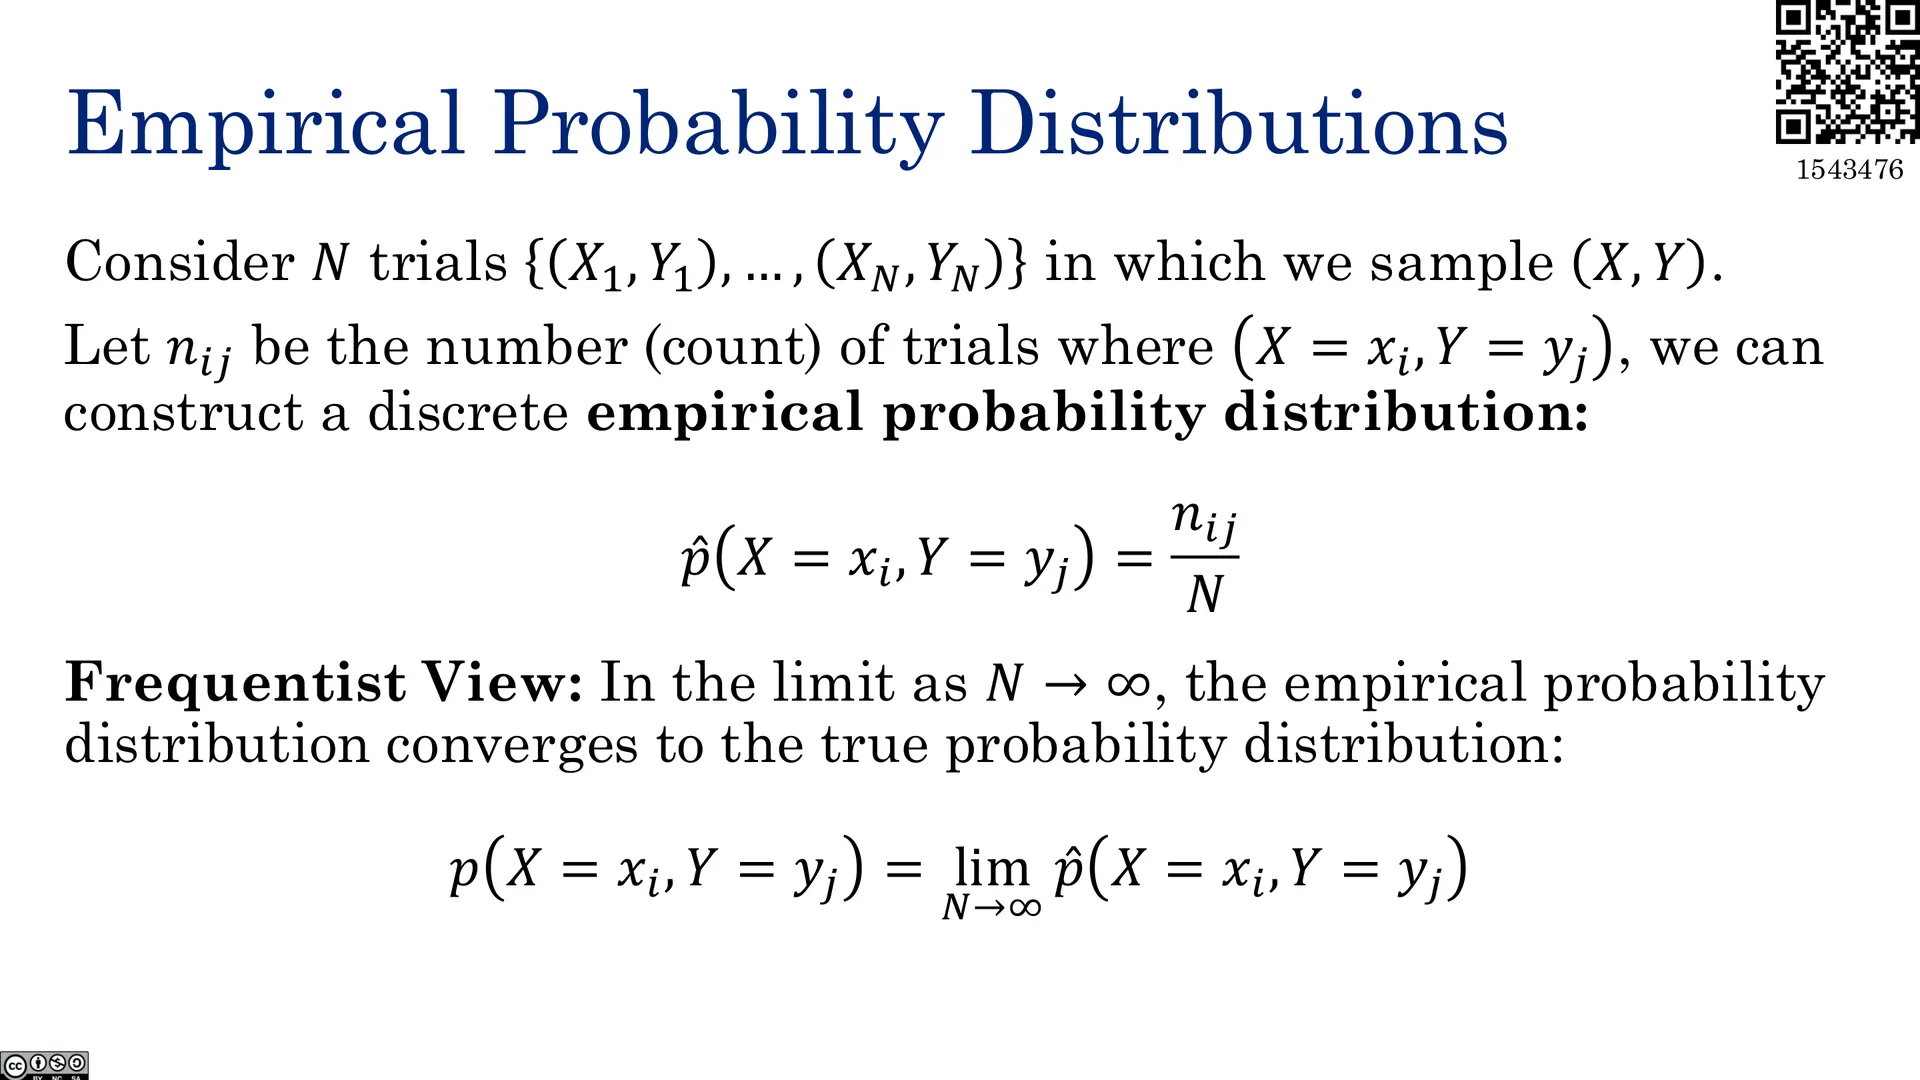
🖼️ 经验概率分布
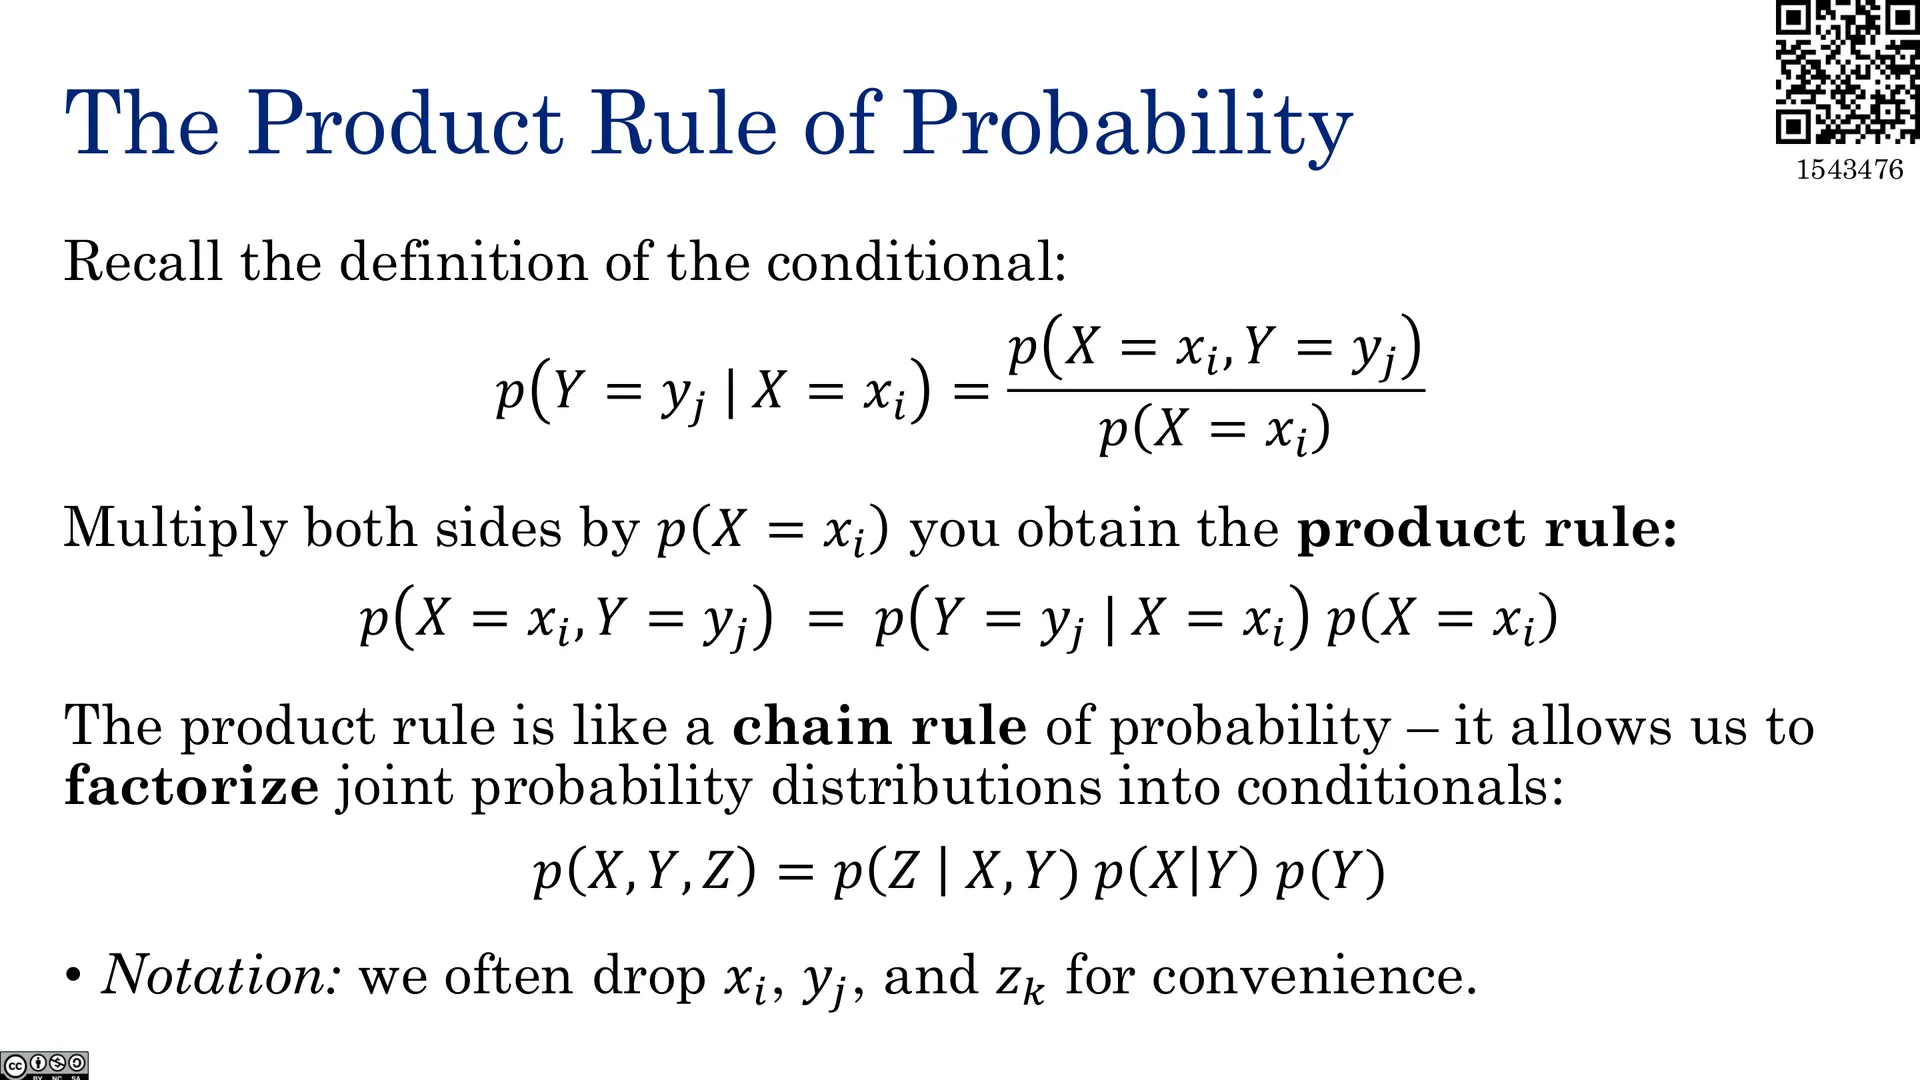
🖼️ 概率的乘积法则
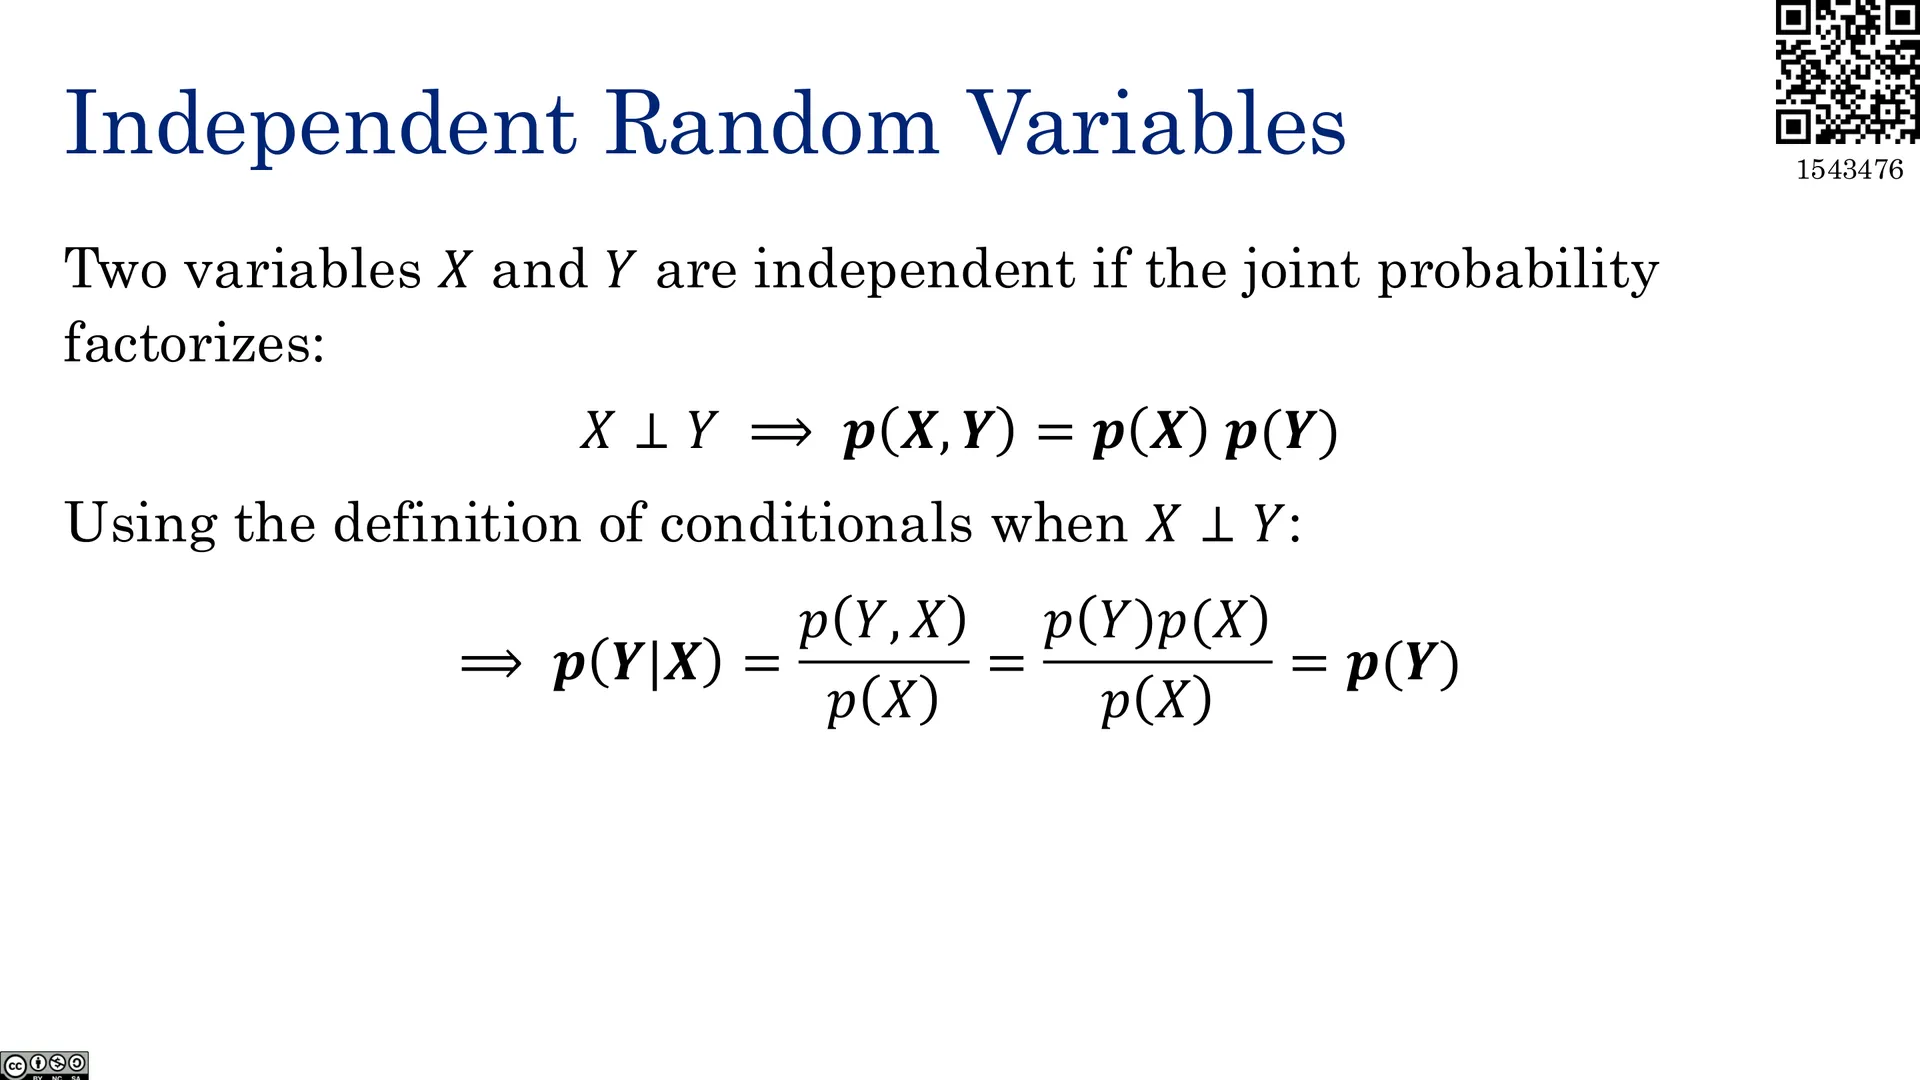
🖼️ 独立随机变量
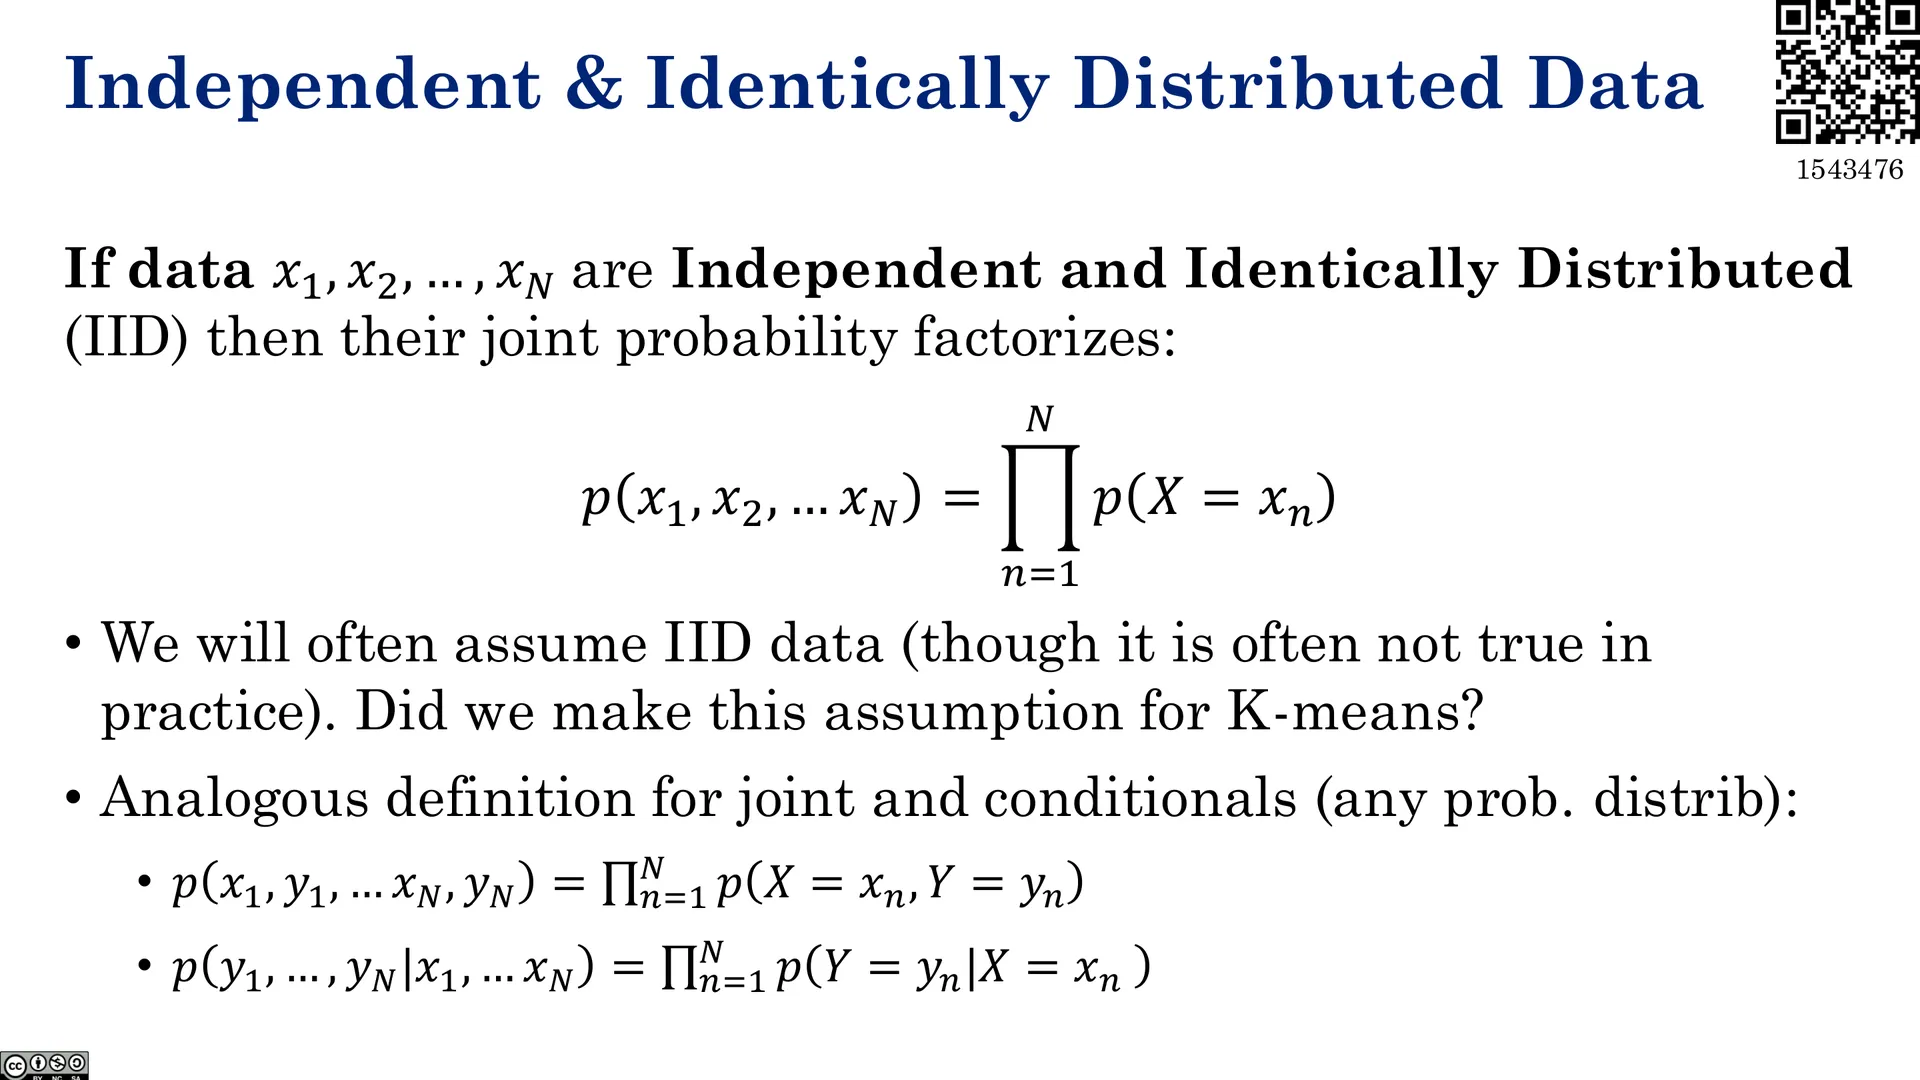
🖼️ 独立同分布数据
🖼️ K 均值与概率(教材章节)
🖼️ 路线图:概率实践(附加)
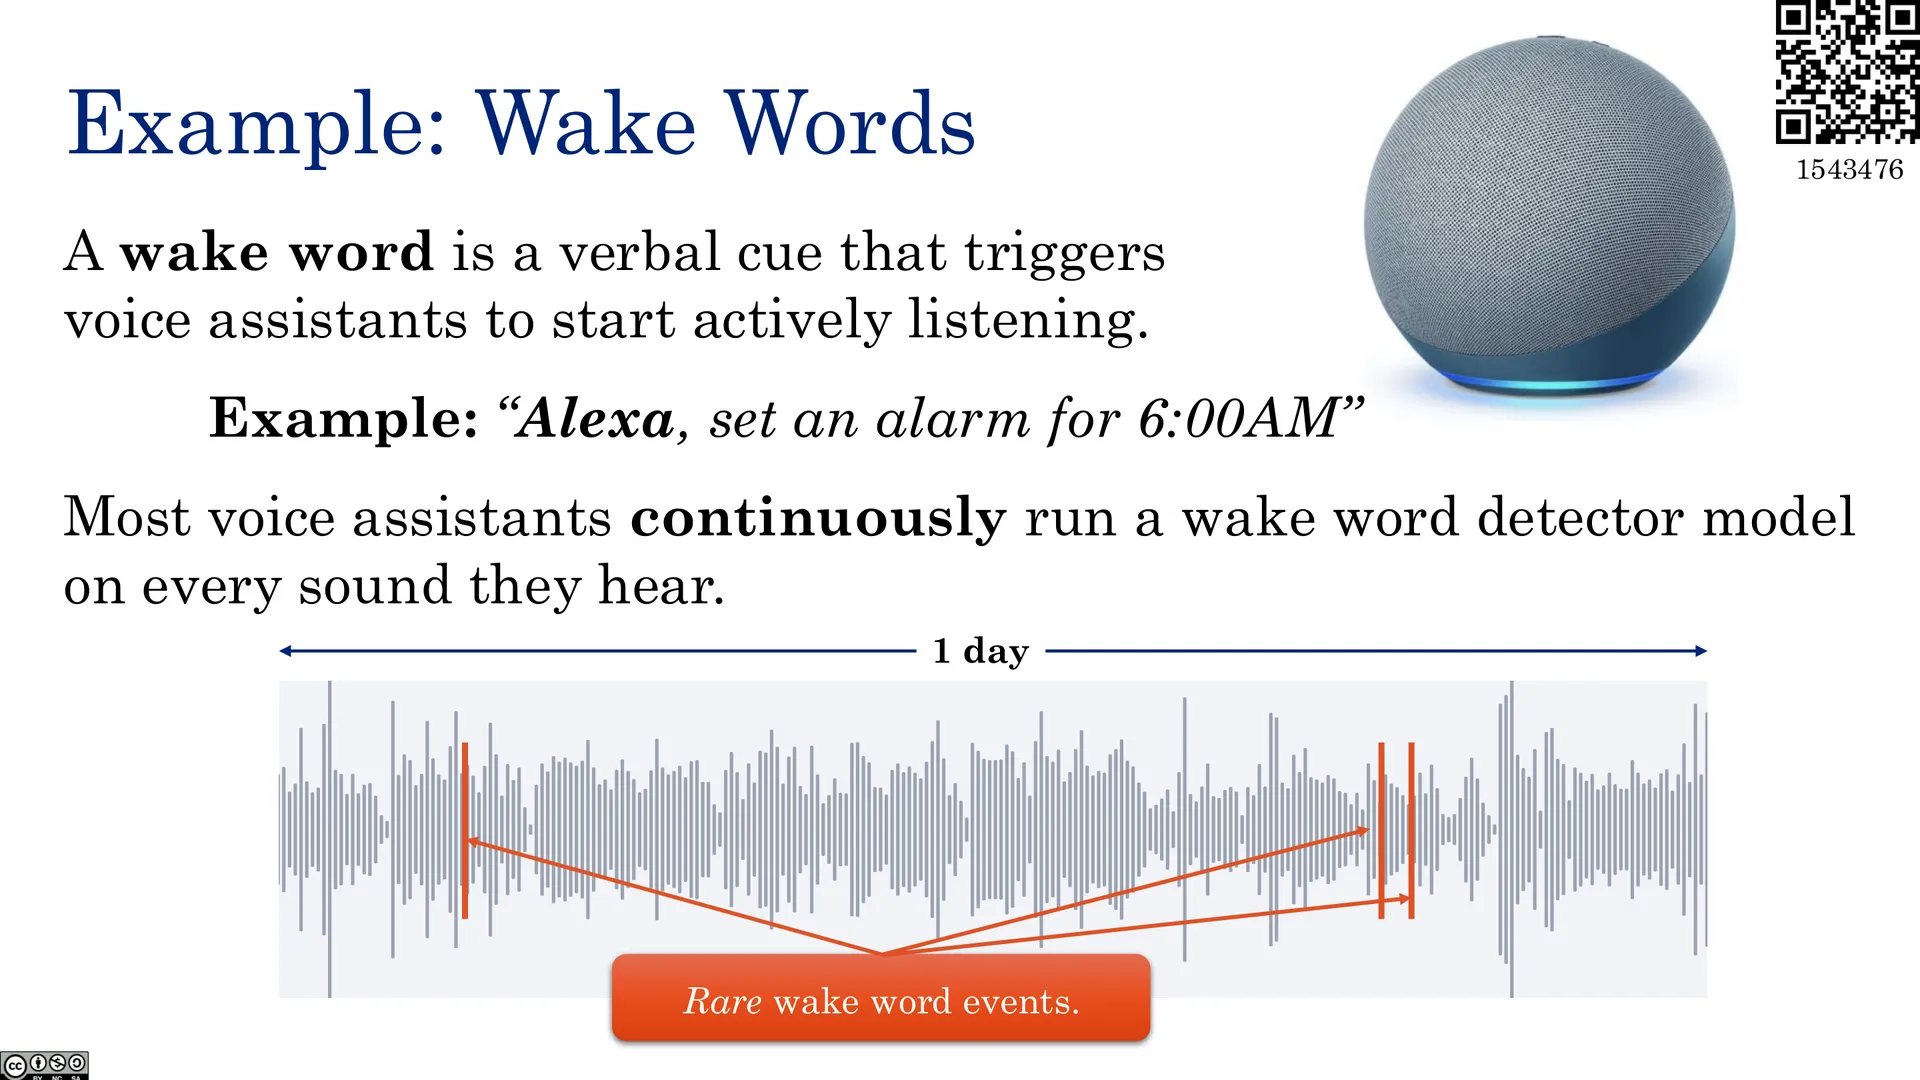
🖼️ 例子:唤醒词(一)
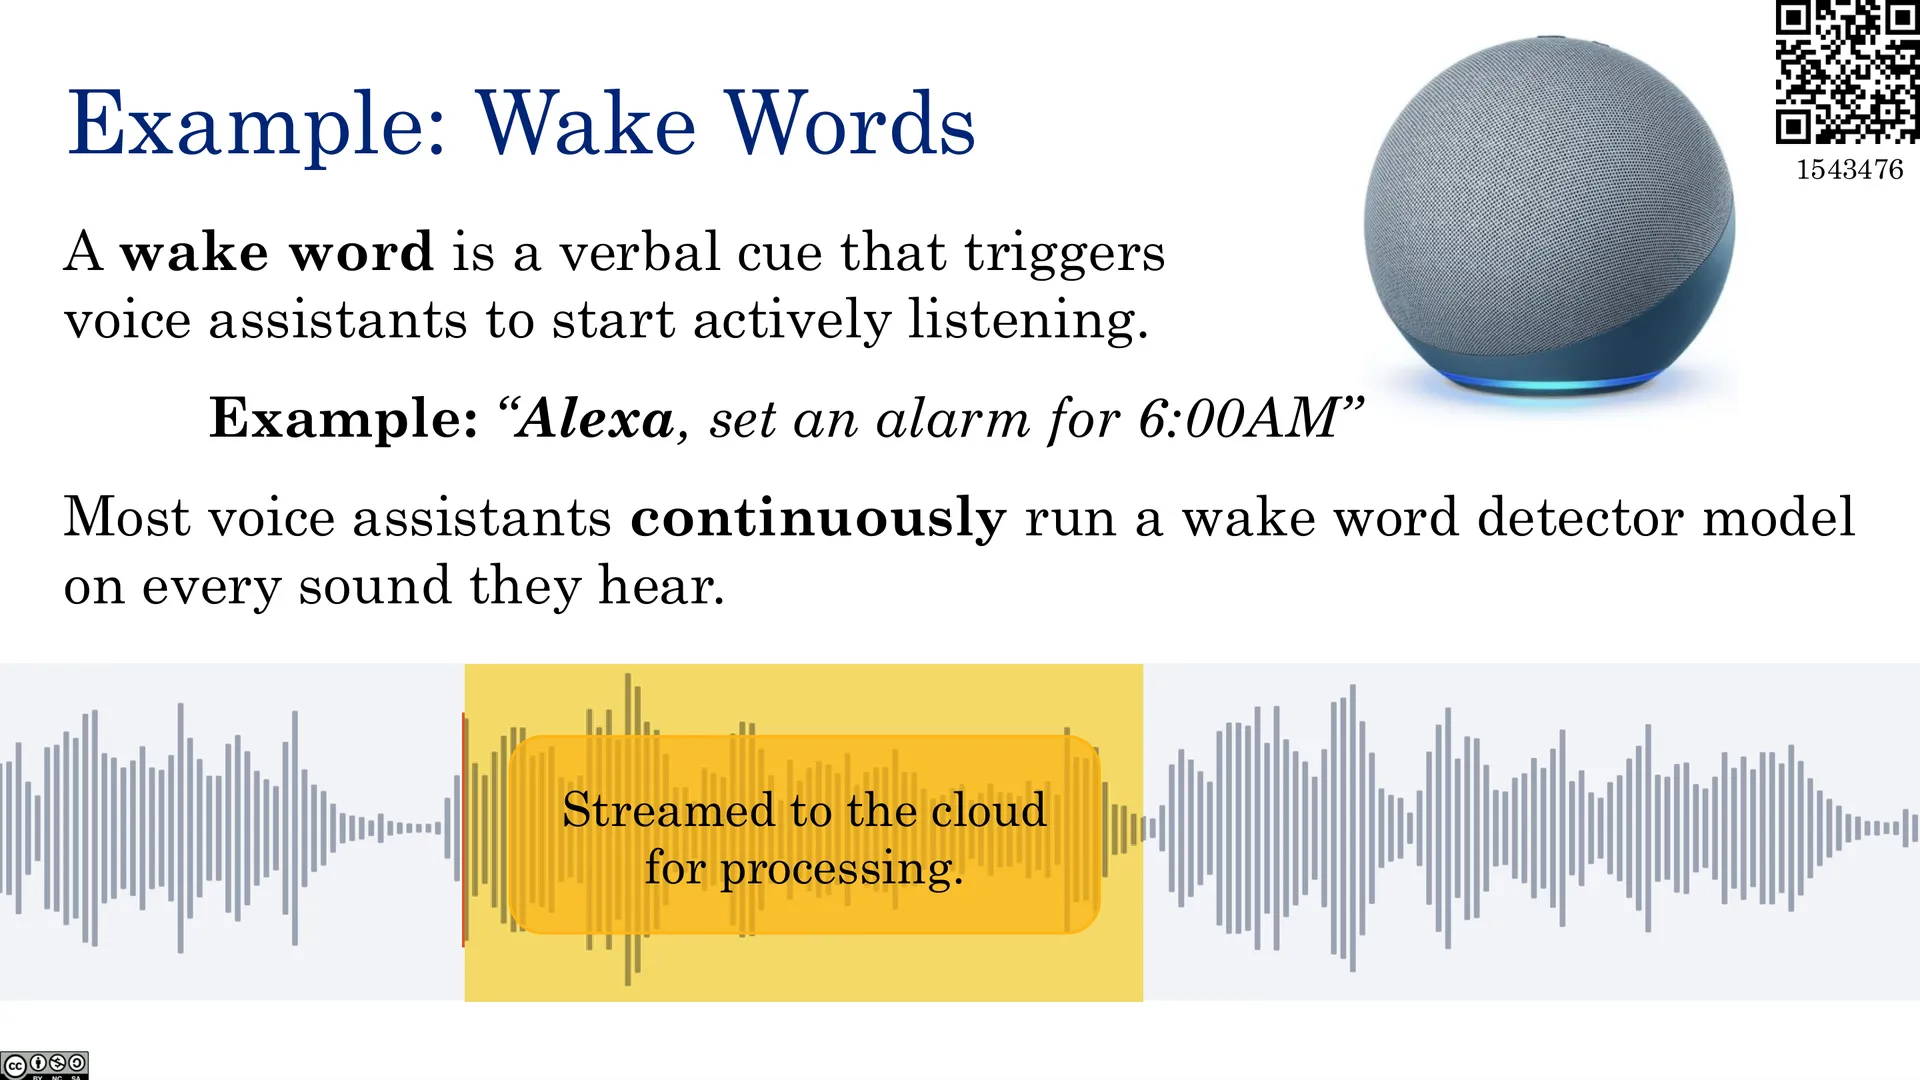
🖼️ 例子:唤醒词(二)
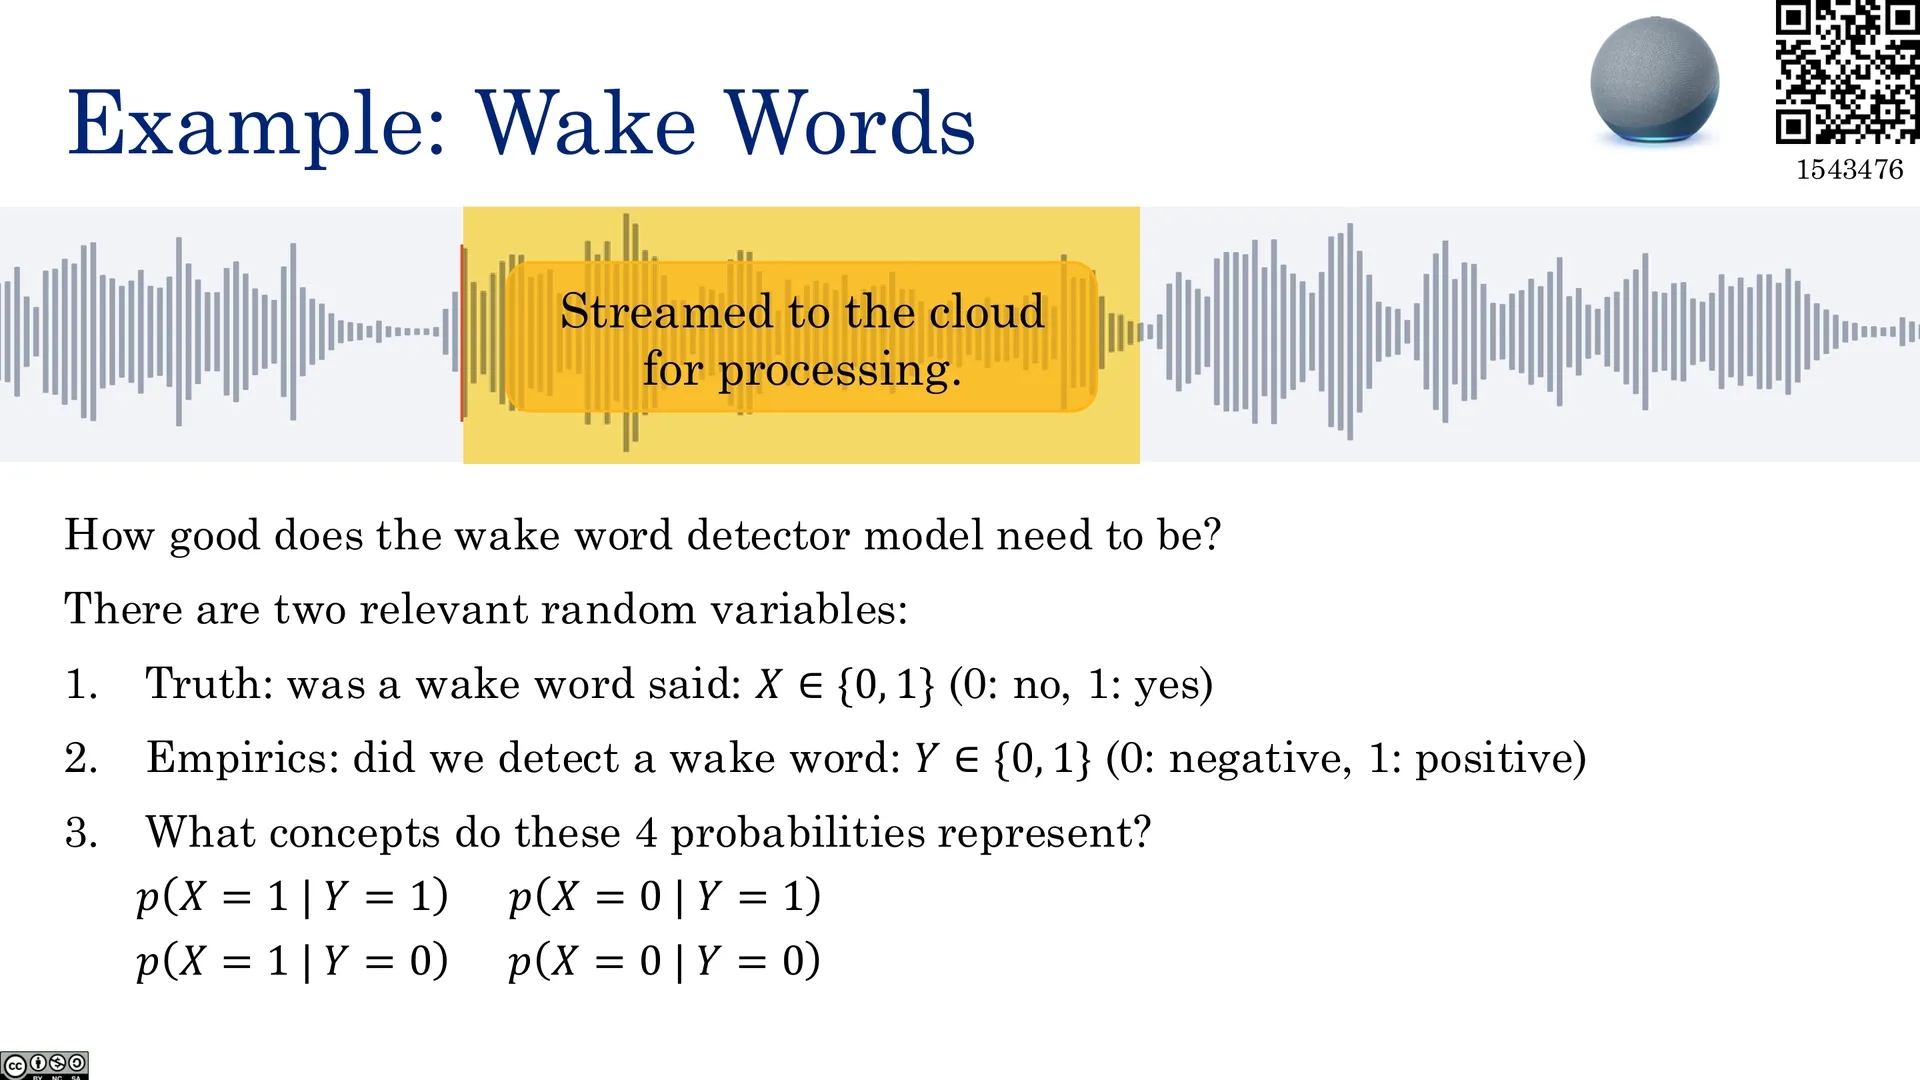
🖼️ 例子:唤醒词(三)
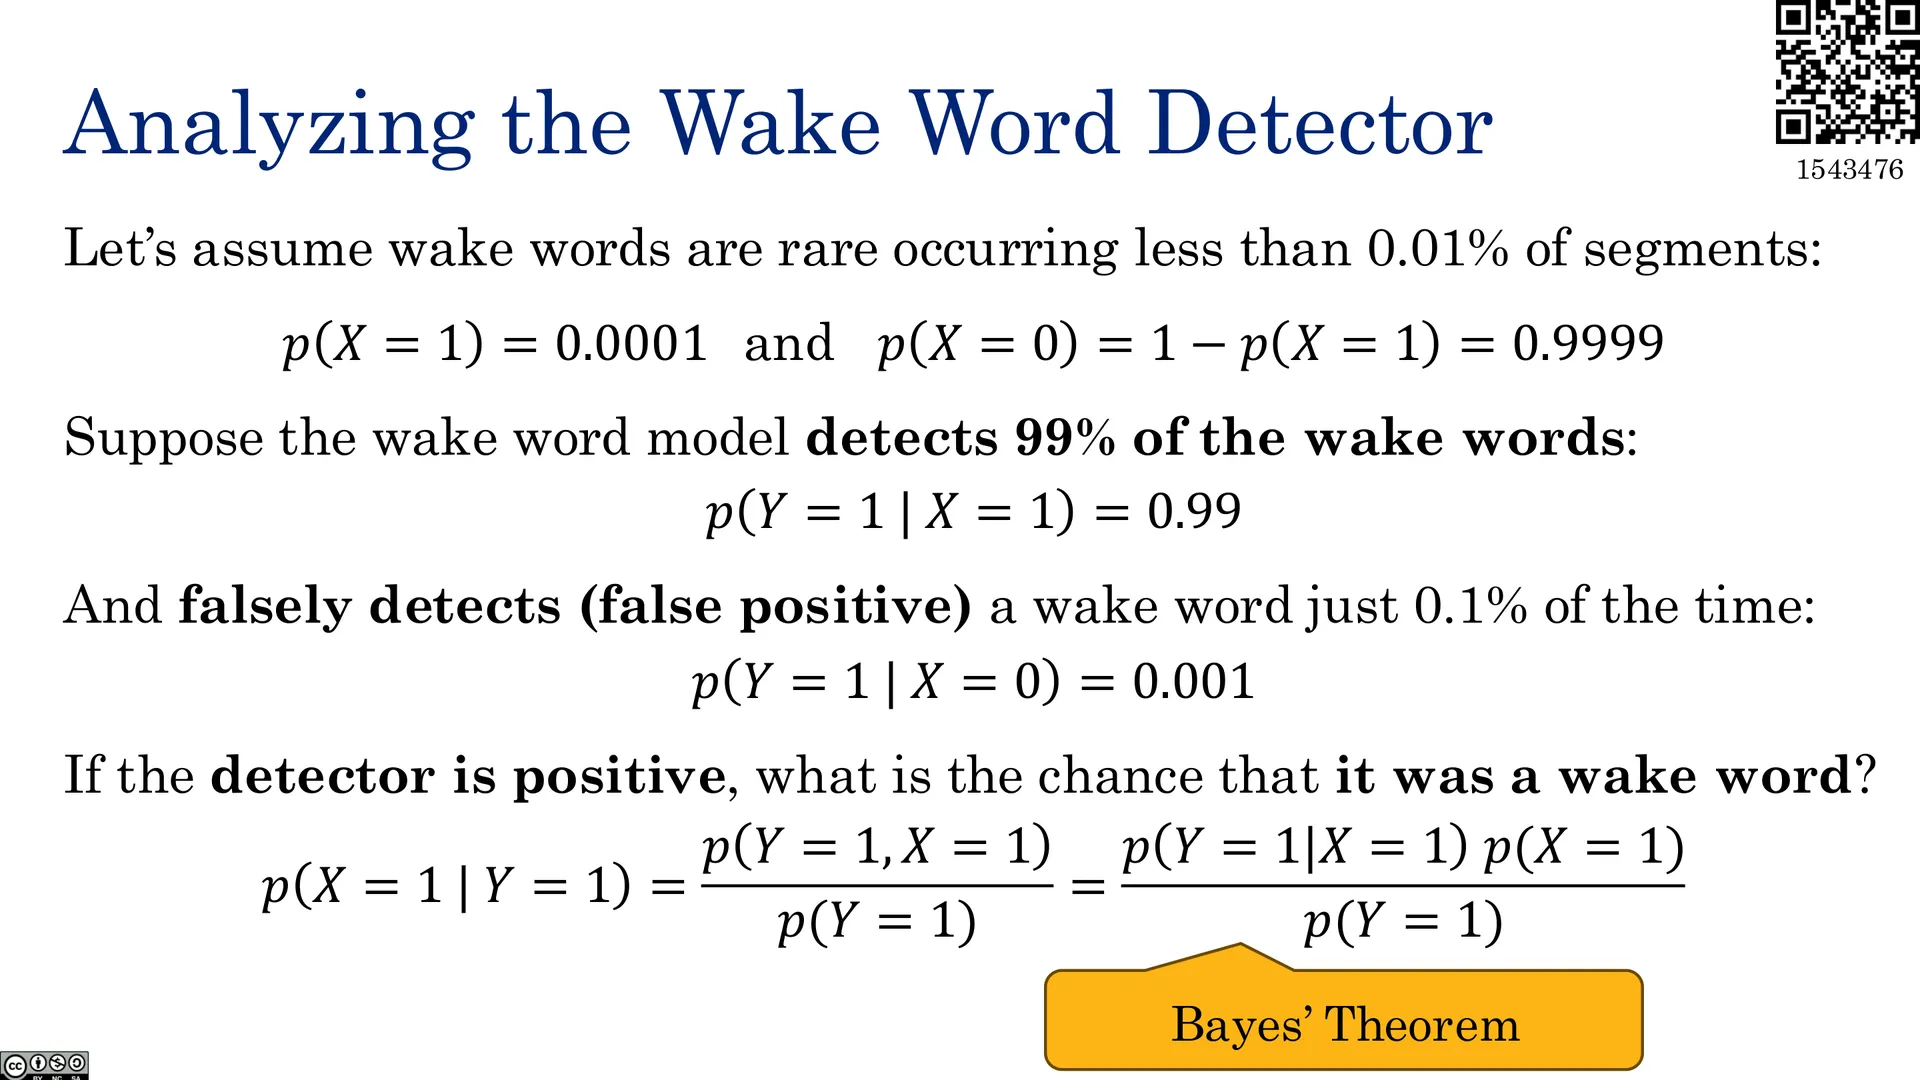
🖼️ 分析唤醒词检测器
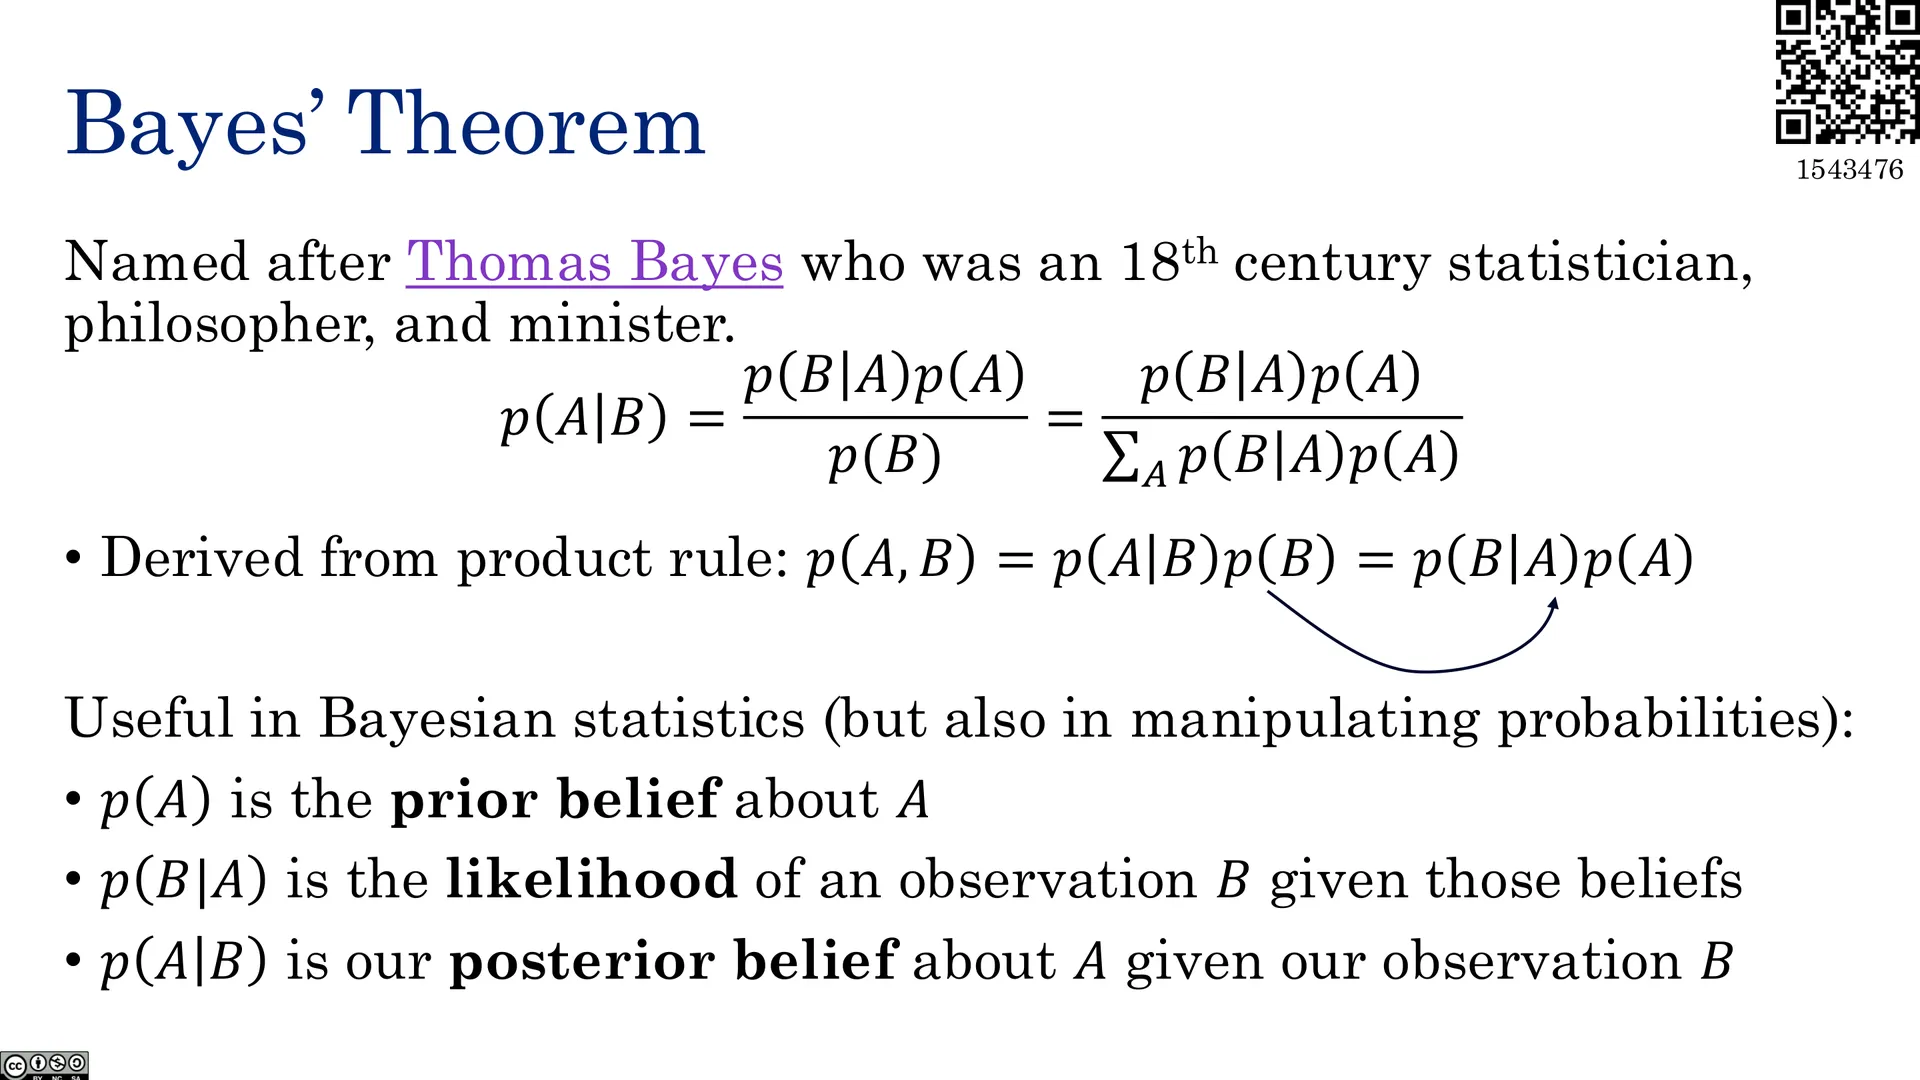
🖼️ 贝叶斯定理
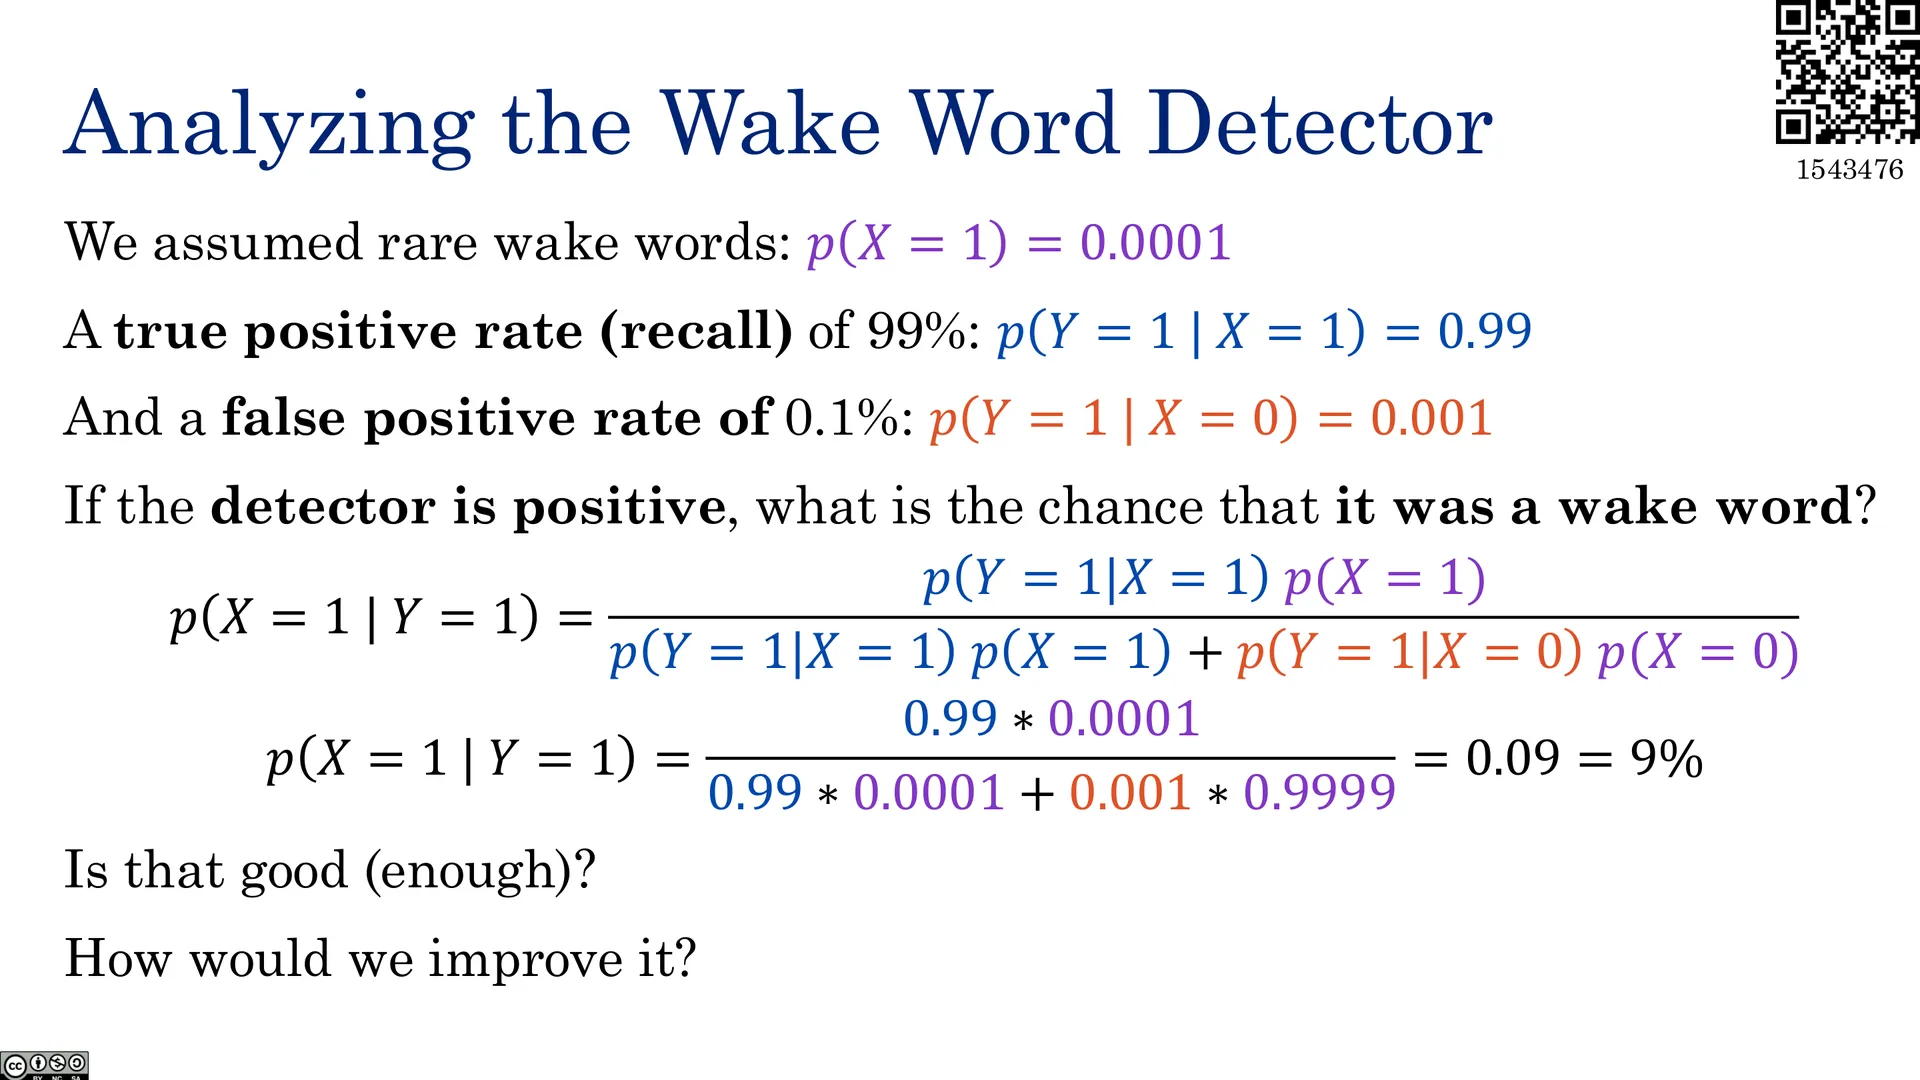
🖼️ 分析唤醒词检测器(续)
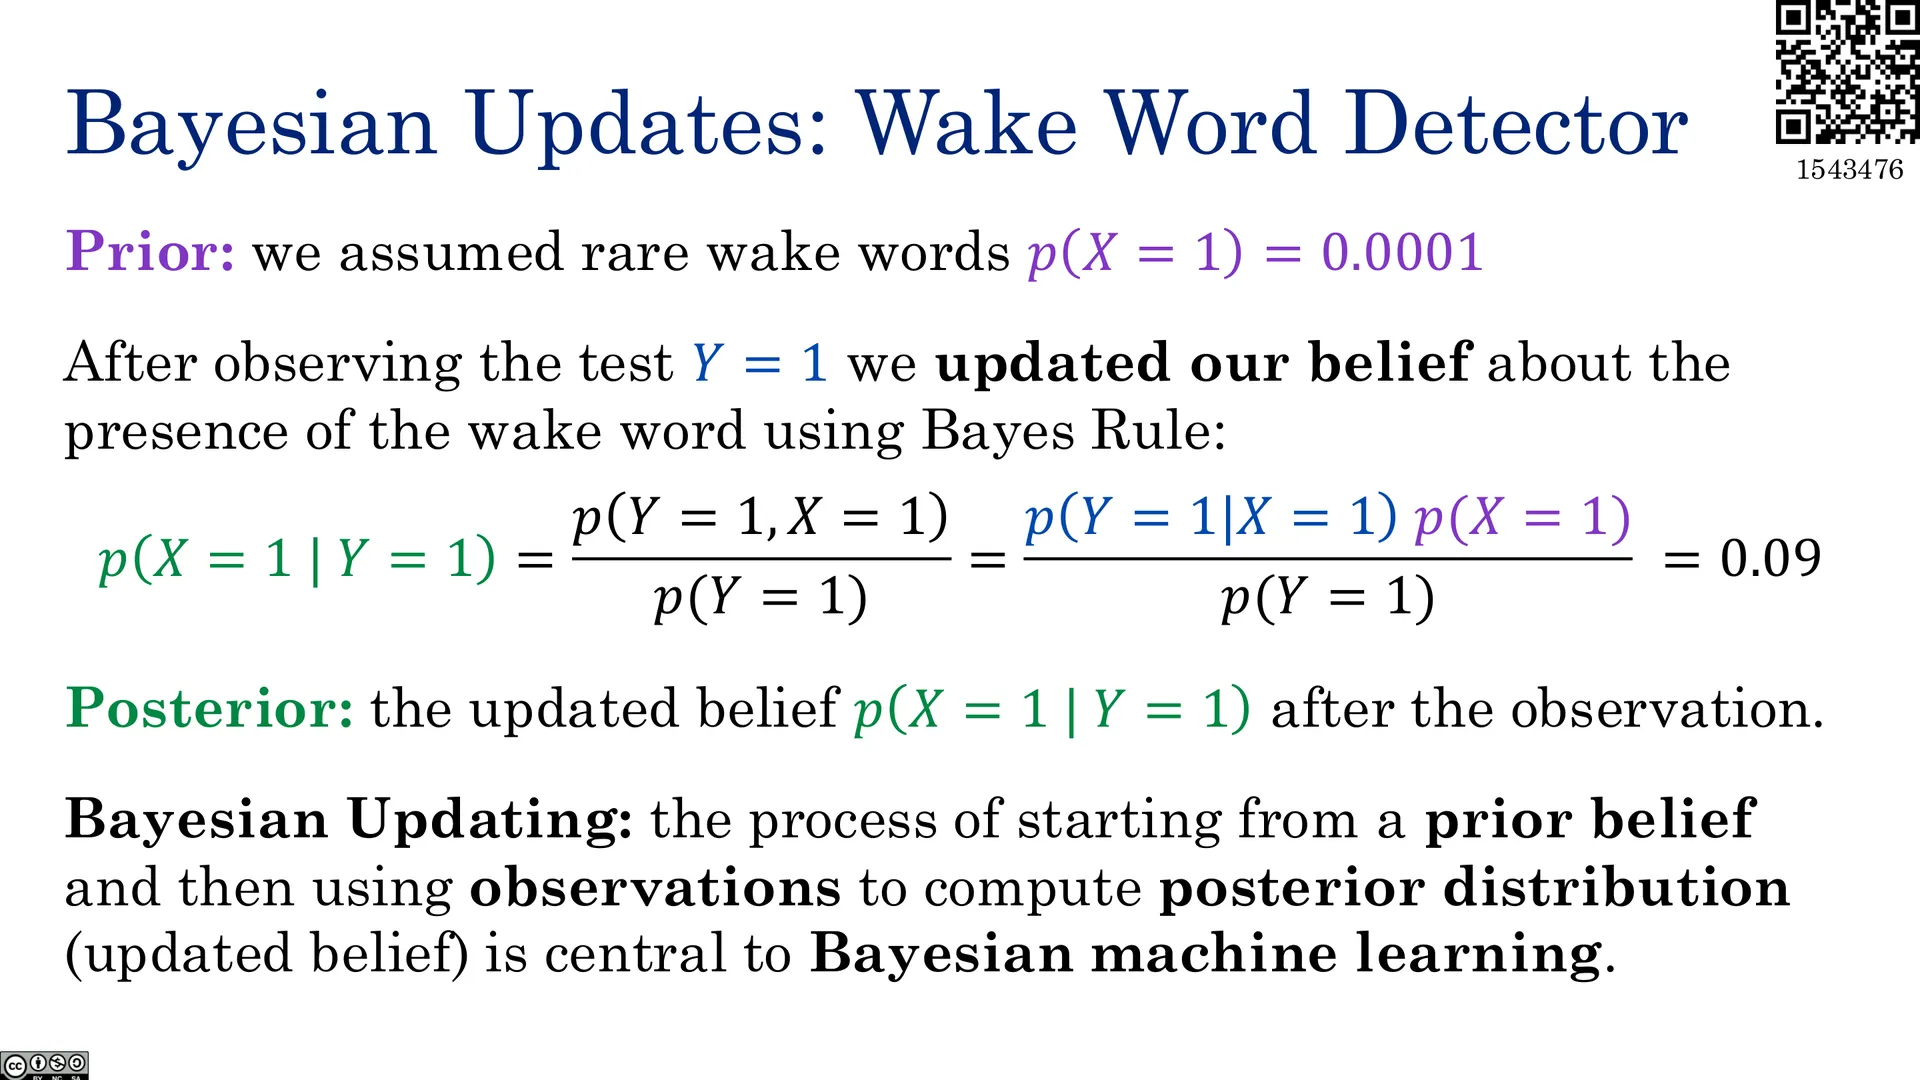
🖼️ 贝叶斯更新:唤醒词检测器
附:官方参考与延伸阅读
| 主题 | 链接 / 说明 |
|---|---|
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 4) | Google Drive PDF |
| 教材 Machine Learning: A First Course for Engineers and Scientists | 聚类:Chapter 15.1;概率:Chapter 2.[1-2] · https://doi.org/10.1017/9781108919371 |
| Old Faithful 间歇泉聚类示例 | https://kasumisanchika.medium.com/k-means-clustering-for-old-faithful-geyser-eruptions-analysis-74f3df8979b1 |
| 客户分群示例 | https://medium.com/@sygong/k-means-clustering-for-customer-segmentations-a-practical-real-world-example-196a10323b9f |
| K-means(Wikipedia) | https://en.wikipedia.org/wiki/K-means_clustering |
| CSC2515 课程(肘部法/聚类幻灯片来源) | http://www.cs.toronto.edu/~urtasun/courses/CSC2515/CSC2515_Winter15.html |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队(Jennifer Listgarten、Alex Dimakis,部分幻灯片致谢 Andrea Krause、Yisong Yue)所有。本书为课堂内容的学习性中文重构,仅供学习交流。