第5讲 · EECS 189:最大似然估计与多元高斯
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
主讲 Jennifer Listgarten、Alex Dimakis 视频 https://www.youtube.com/watch?v=kU7a1K3PX10 课程主页 https://eecs189.org/sp26/ 官方讲义/笔记(Lecture 5) Google Drive PDF 教材 Machine Learning: A First Course for Engineers and Scientists 图片来源 书中幻灯片插图为官方 PDF 高清渲染图 对应讲次:第5讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
编者说明:本讲介绍贯穿整个机器学习(包括现代深度学习和 GPT)的核心拟合原理——最大似然估计(MLE),并用单变量高斯与多项分布(掷骰子)两个例子逐步推导。这是理解「高斯混合模型 / 多元高斯」的准备课。
导言:从 K 均值的弱点出发
(参考时间: 00:00)
上一讲我们讨论了无监督学习与聚类,并介绍了 K 均值。讲师最后点出的几个问题,今天要接住:
- K 均值隐含地把每个簇当成等体积、近似各向同性(球形)的「团块」,无法长出细长的簇;
- 每一步都做硬分配(hard assignment)——每个点要么属于簇 1、要么属于簇 2,这让算法显得「脆弱(brittle)」:数据稍微扰动,某个点的归属可能突然跳到另一个簇。
自然的修法是让分配变「软」:一个点可以有 70% 属于 A、30% 属于 B。这正是统计建模的思路——很多时候我们不想做「非黑即白」的硬决定,而是分摊风险、保留更细腻的信息。
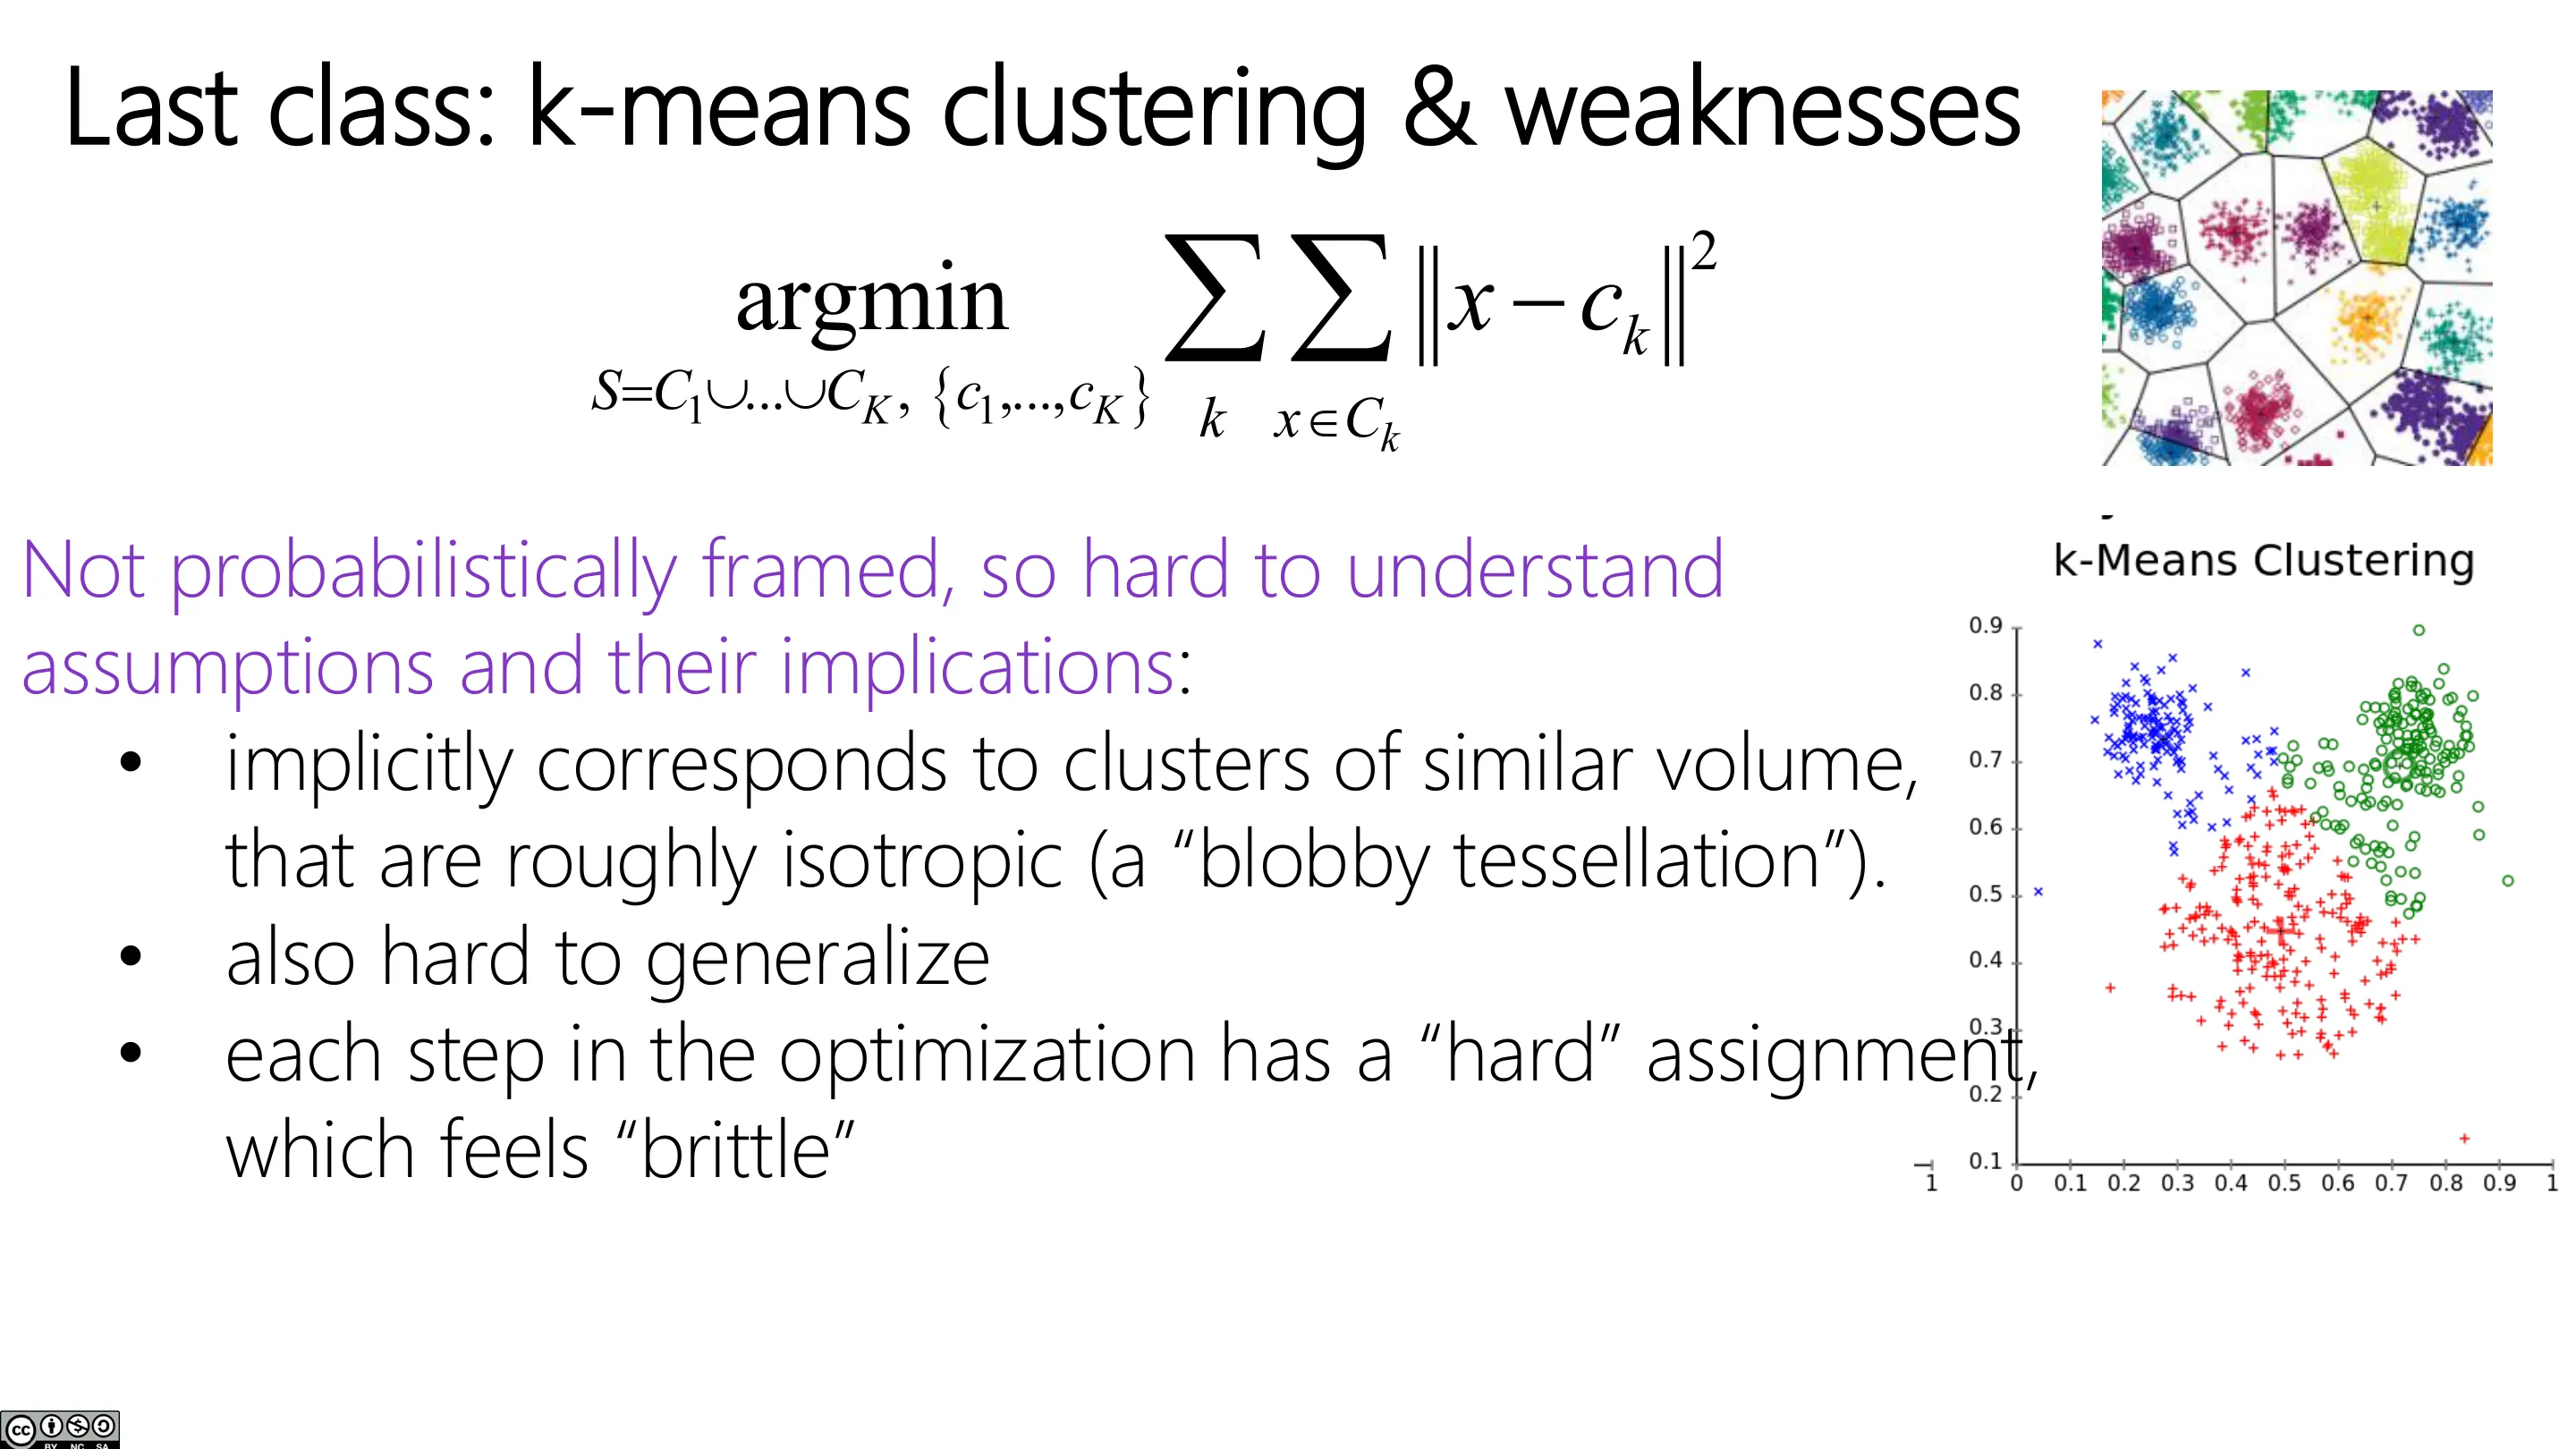
📷 上一讲:K 均值及其弱点
回到原视频 (00:00:22)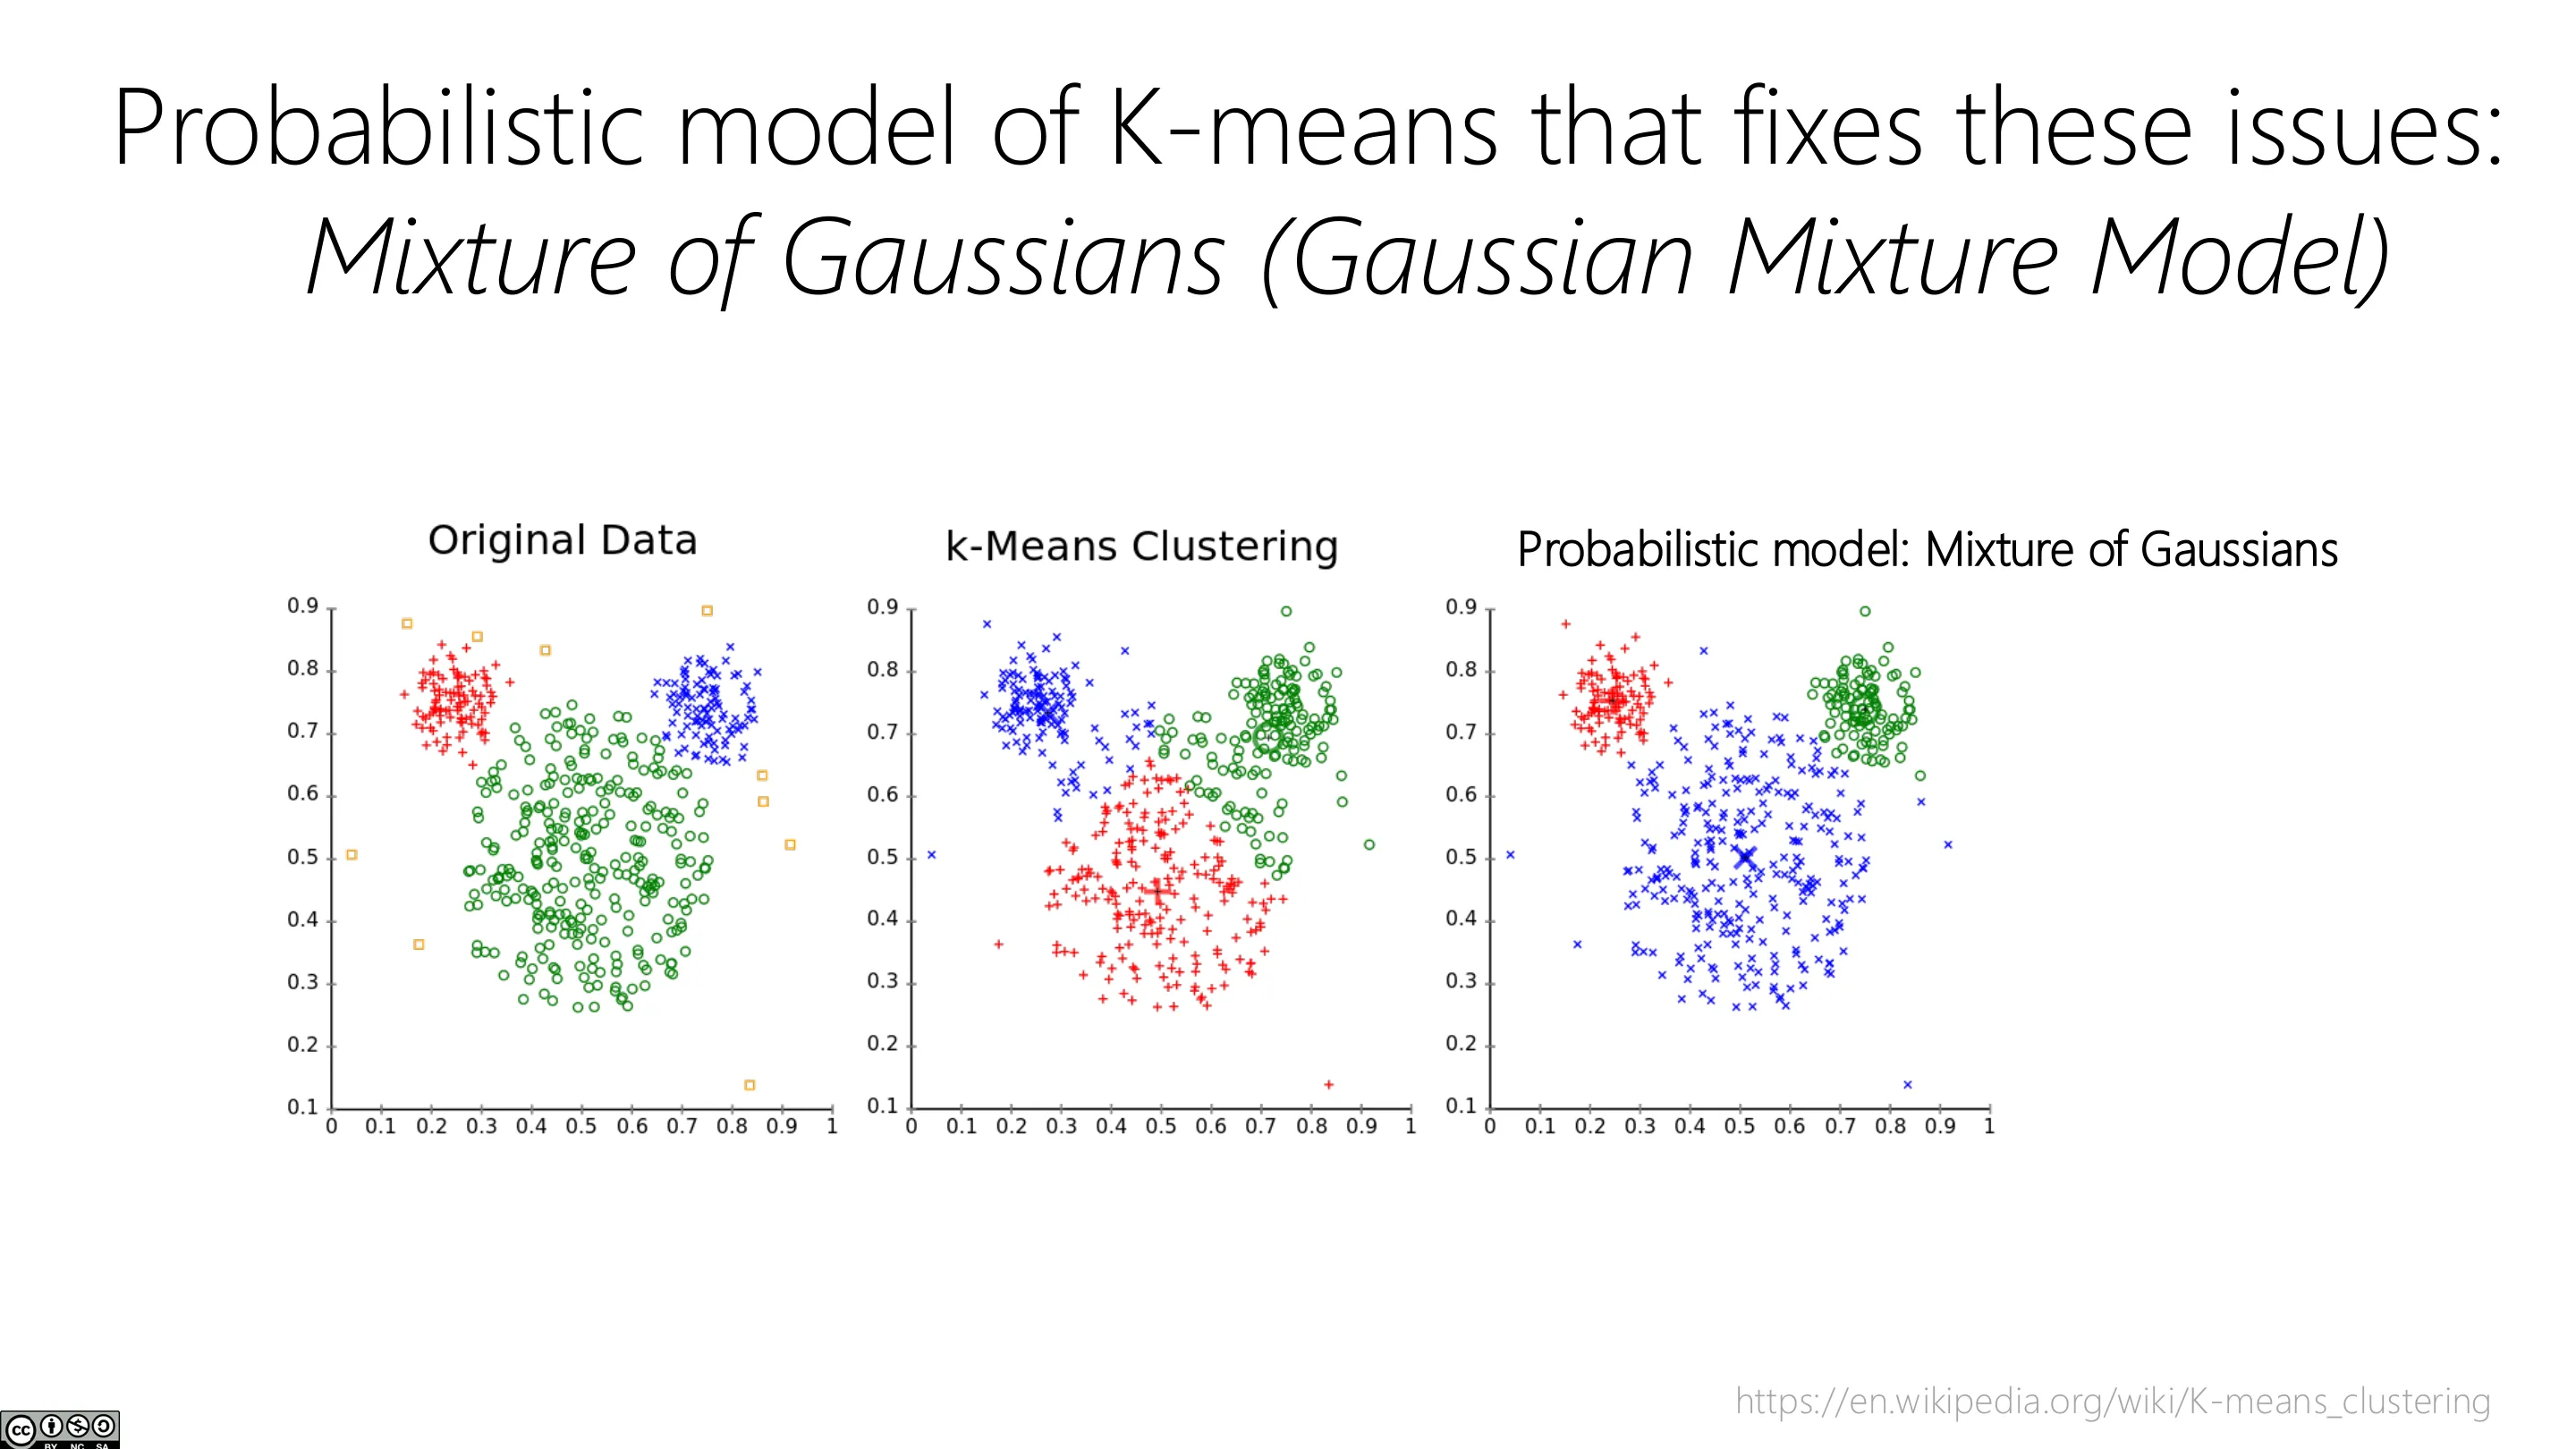
📷 概率模型如何修正这些问题
回到原视频 (00:01:41)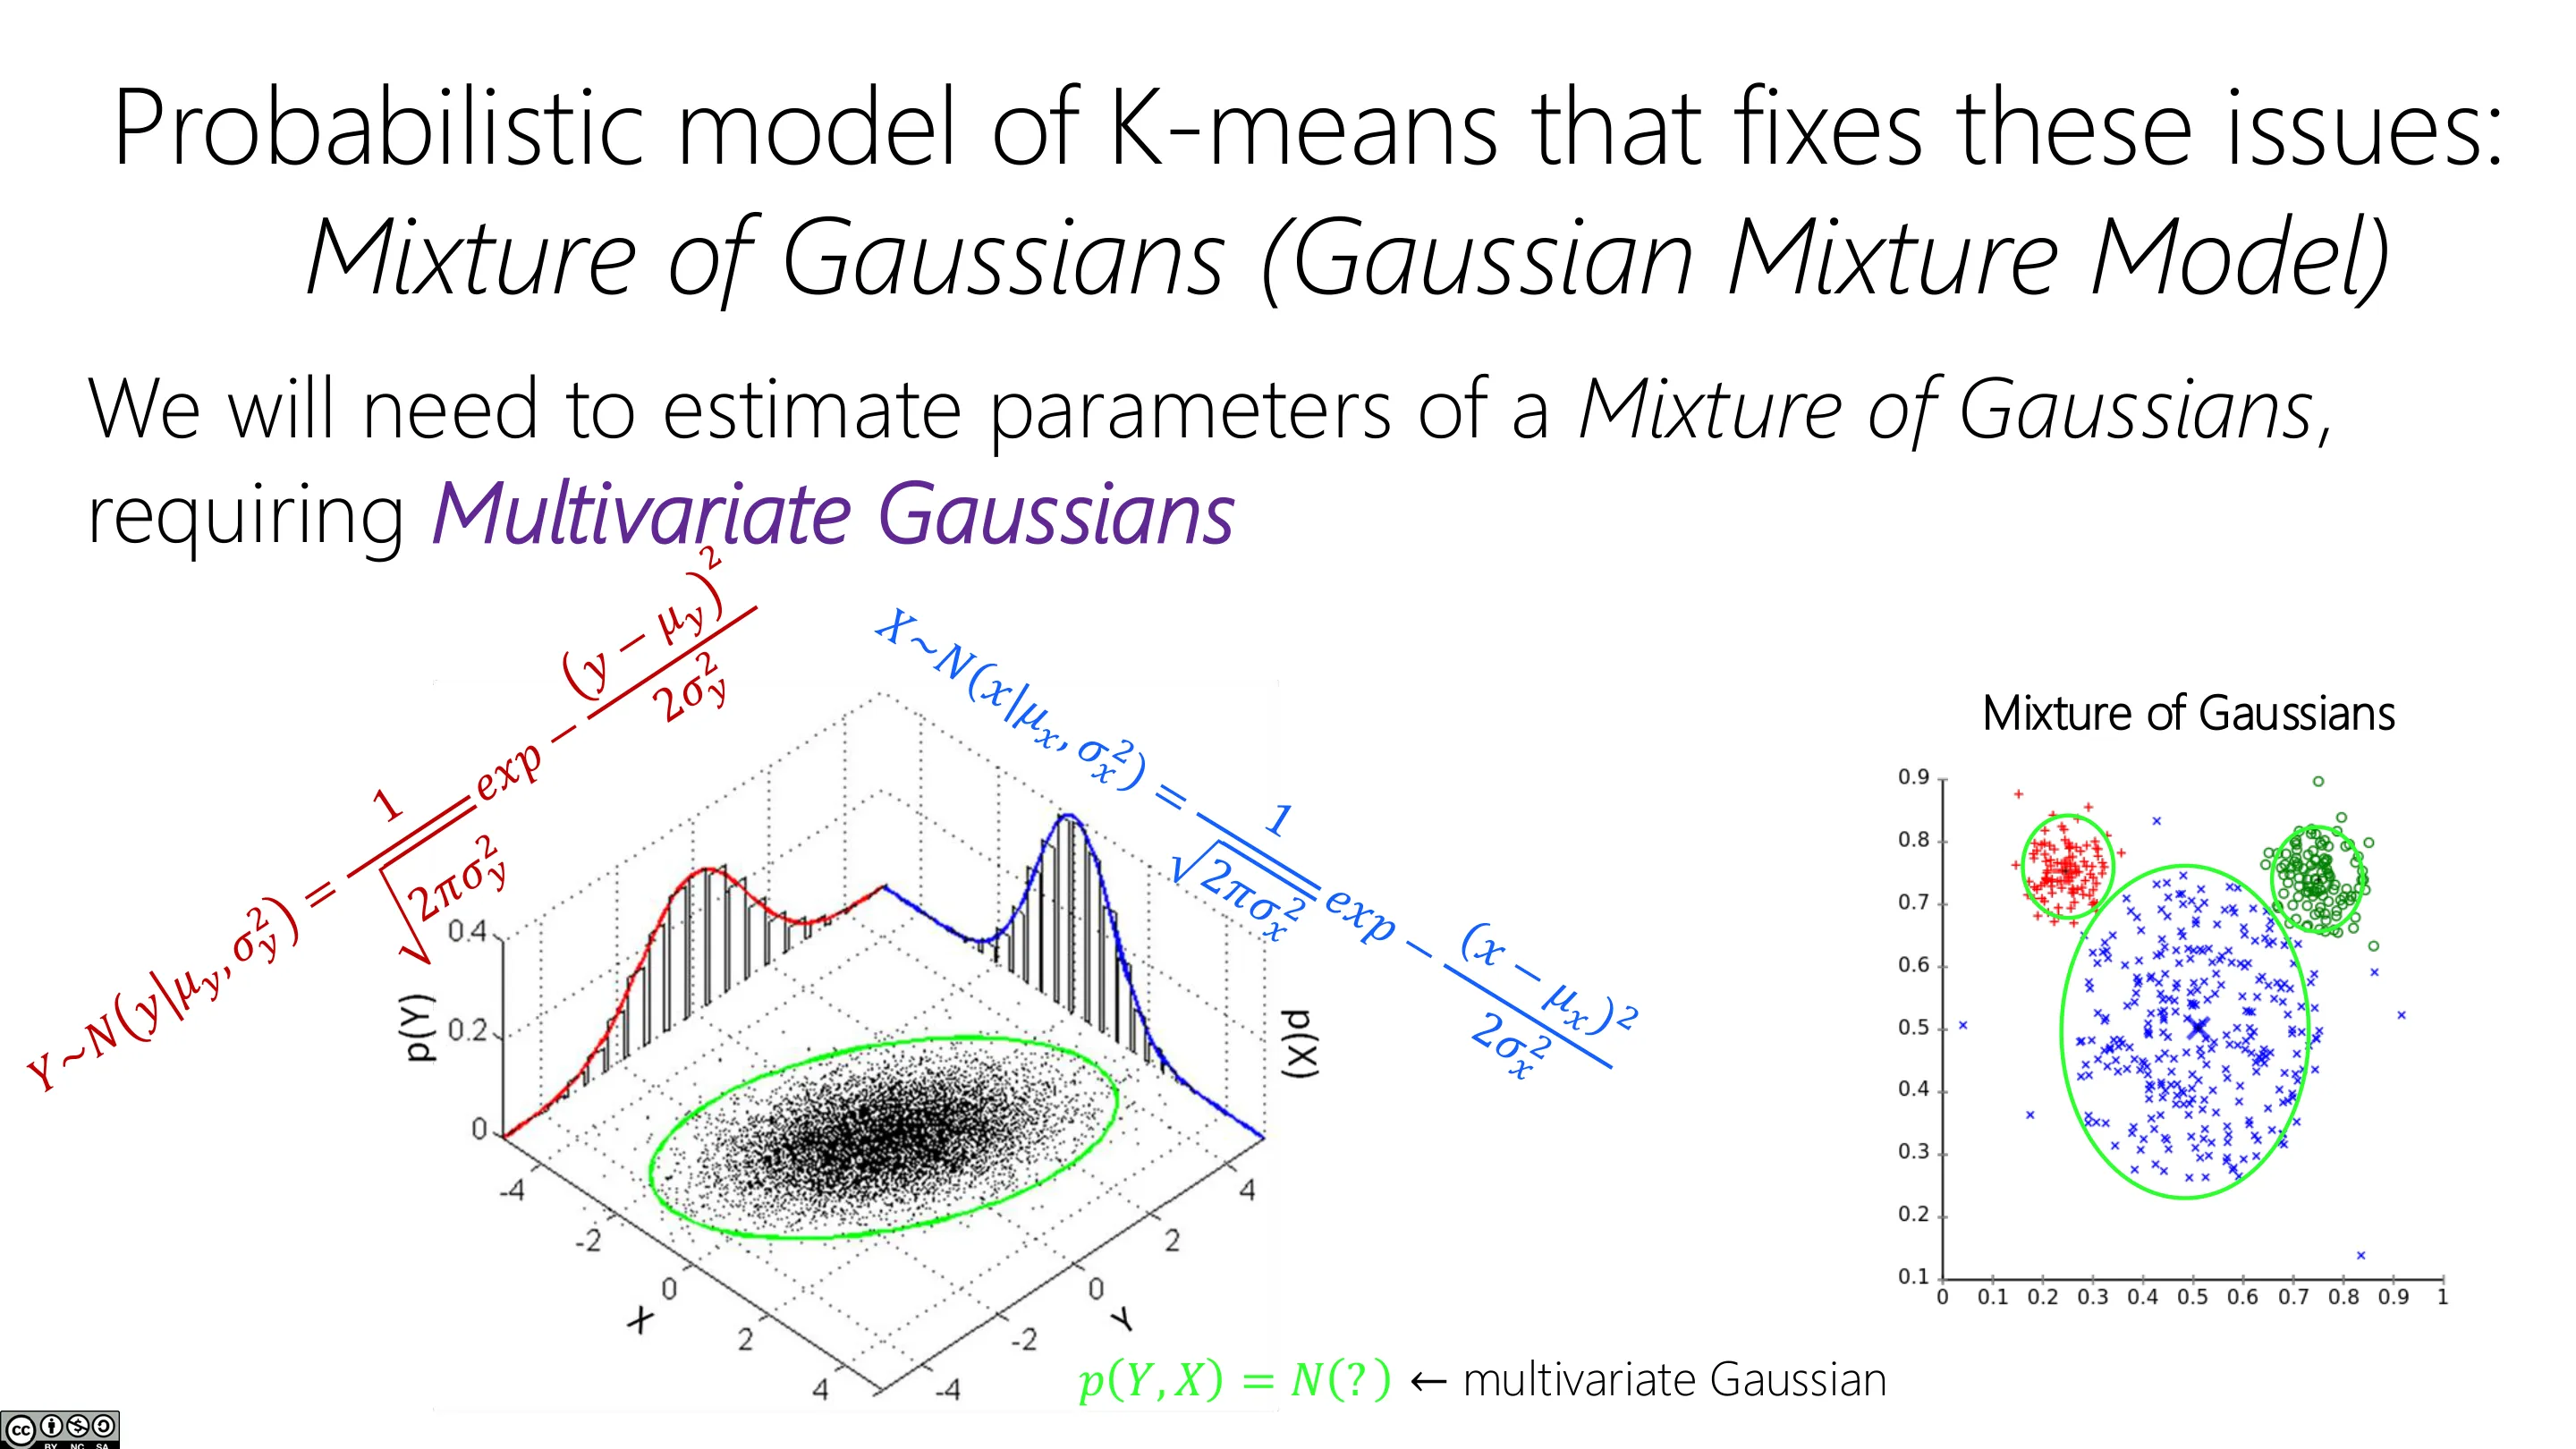
📷 用高斯混合模型来拟合
回到原视频 (00:03:14)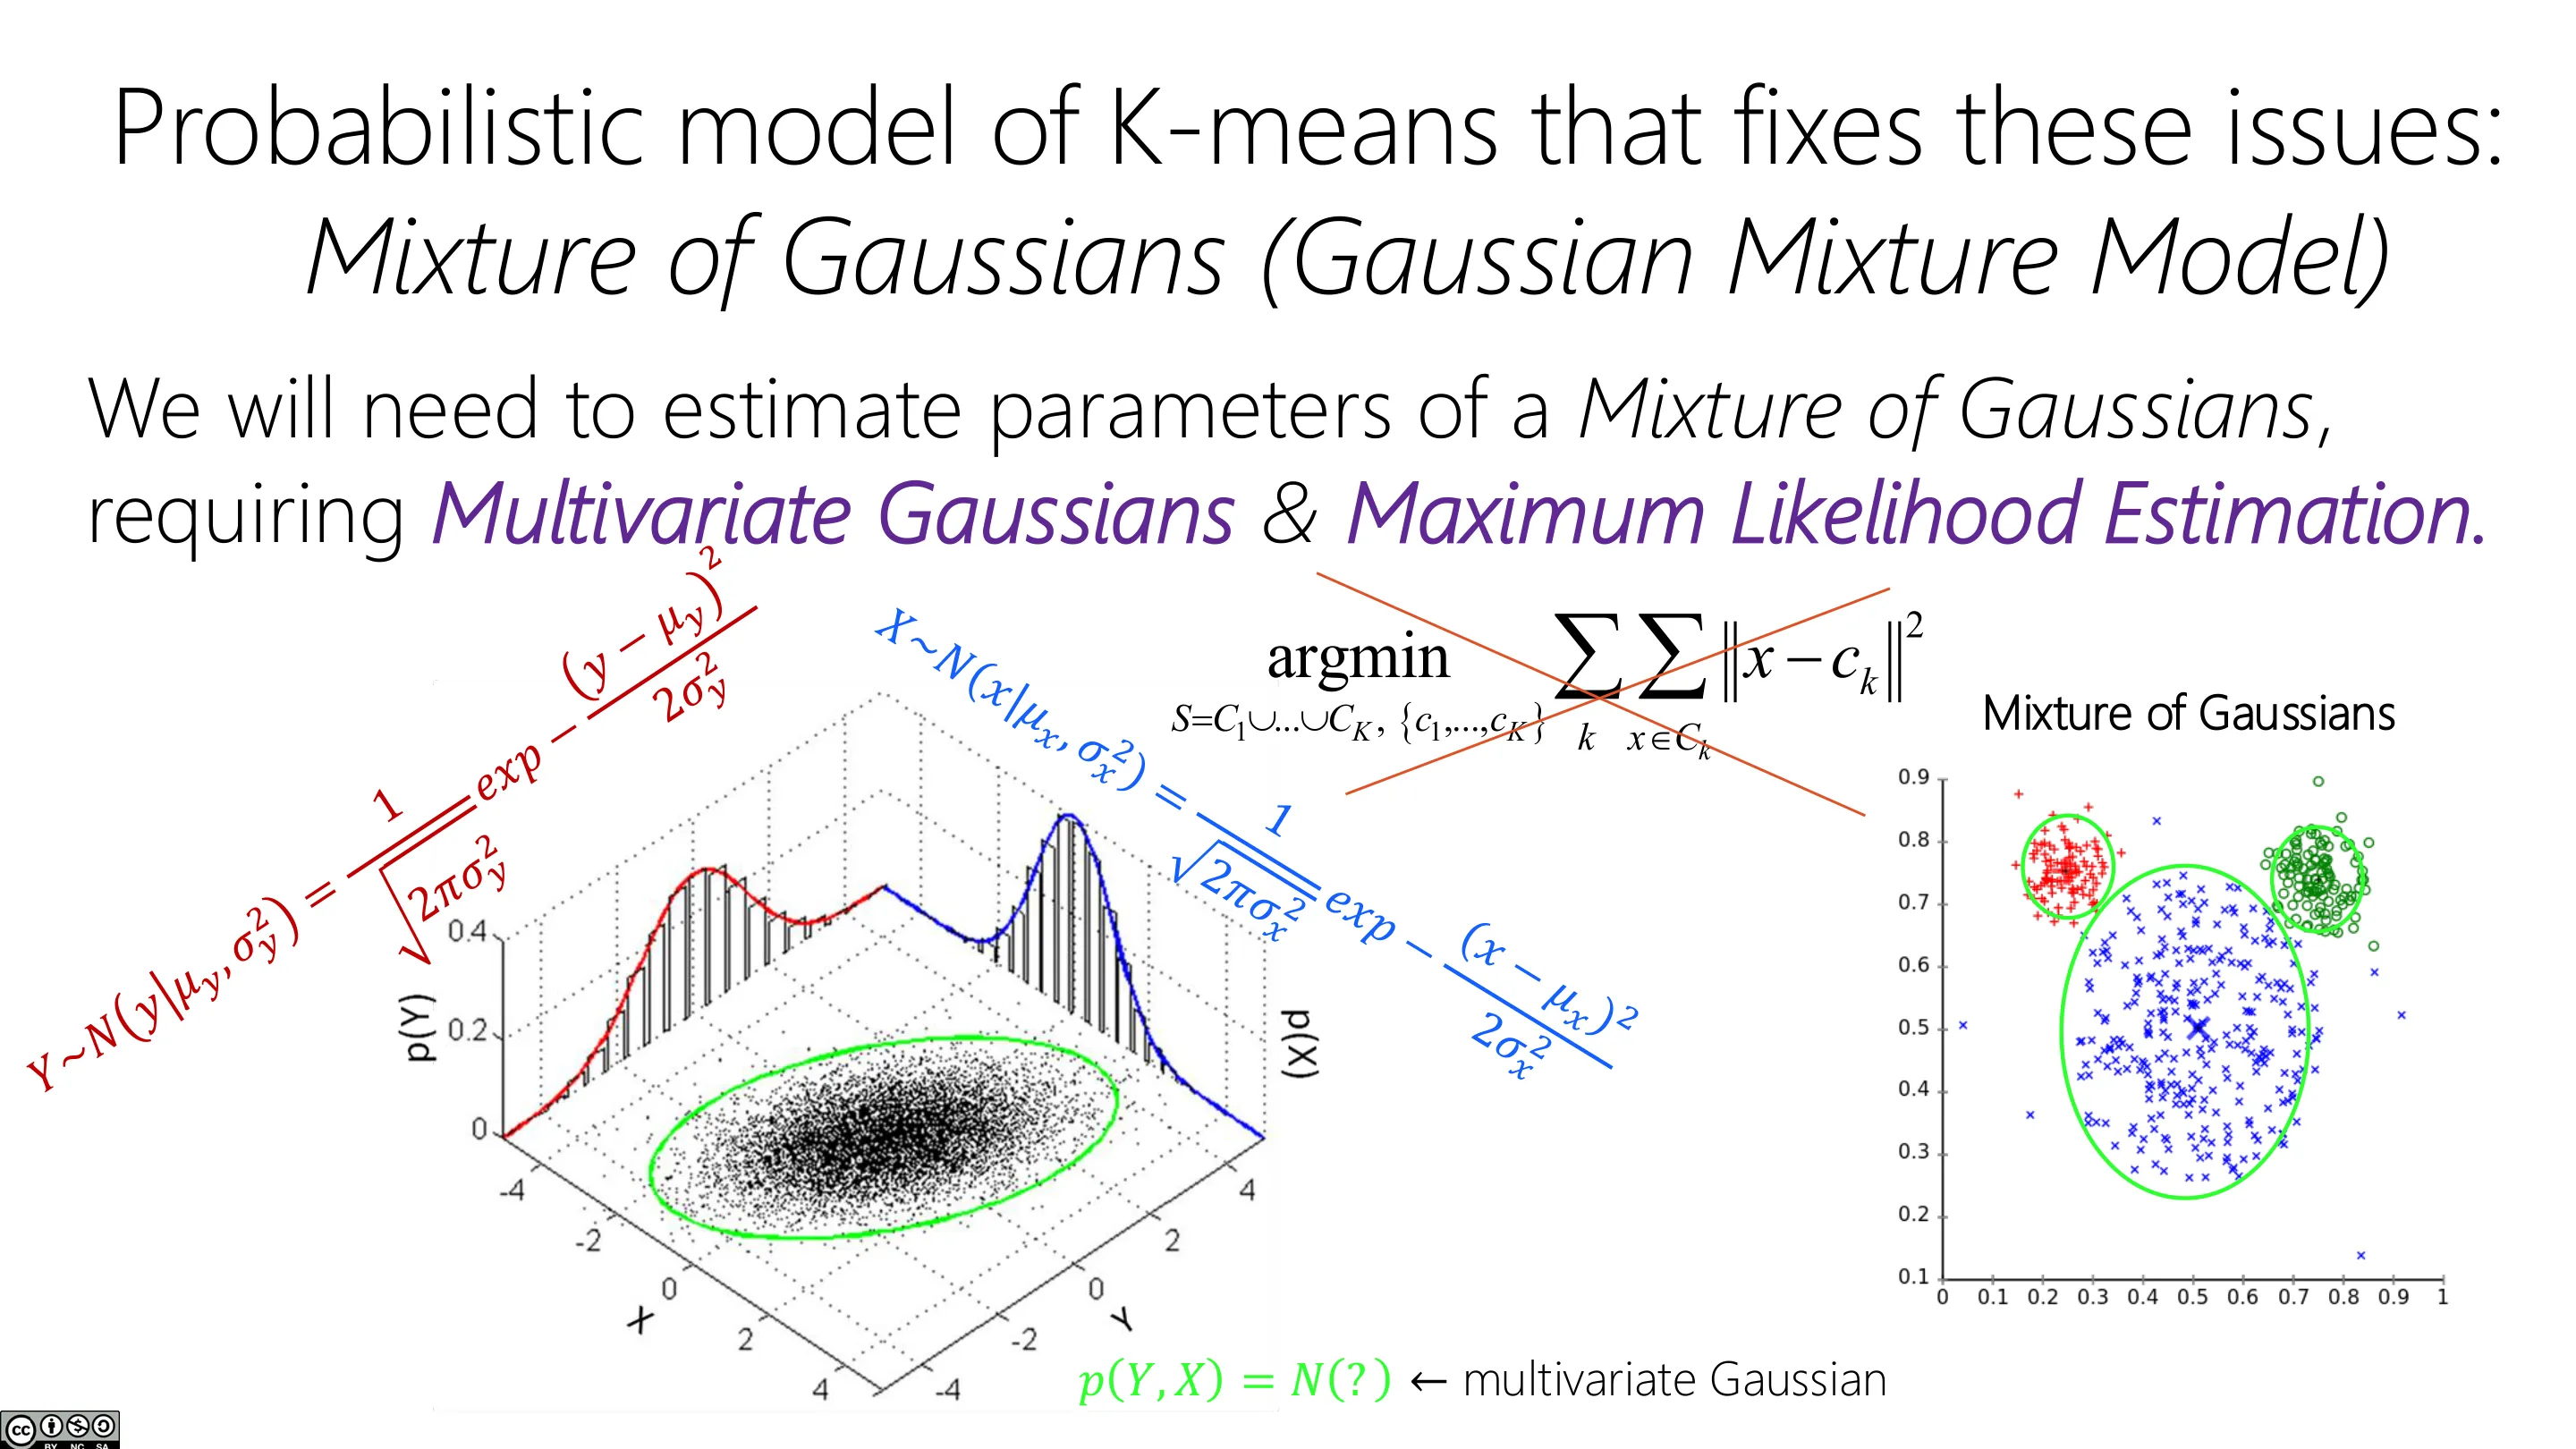
📷 估计高斯混合模型的参数
回到原视频 (00:05:29)图中每个高斯上的「圆圈」是它的水平集(level set)——沿圆周概率相同;一圈圈同心圆对应不同的概率密度。这正是下一讲的多元高斯要讲的内容。
📷 路线图(一)
回到原视频 (00:06:02)
📷 路线图(二)
回到原视频 (00:07:35)
一、机器学习的抽象框架
(参考时间: 00:07)
无论是传统机器学习还是现代机器学习,几乎都有同一个「思考骨架」:
flowchart LR
    A["训练数据 D"] --> B["假设一个模型类<br/>(含参数)"]
    B --> C["写出损失函数"]
    C --> D["解优化问题<br/>(最小化损失)"]
    D --> E["得到参数估计"]
- 从训练数据集 $D$ 出发(监督学习是 $(x_i, y_i)$,无监督学习是 $\{x_i\}$);
- 假设一个模型类(model class),它具有若干参数 W / θ;
- 定义损失函数(loss);
- 通过优化求解使损失最小的参数。
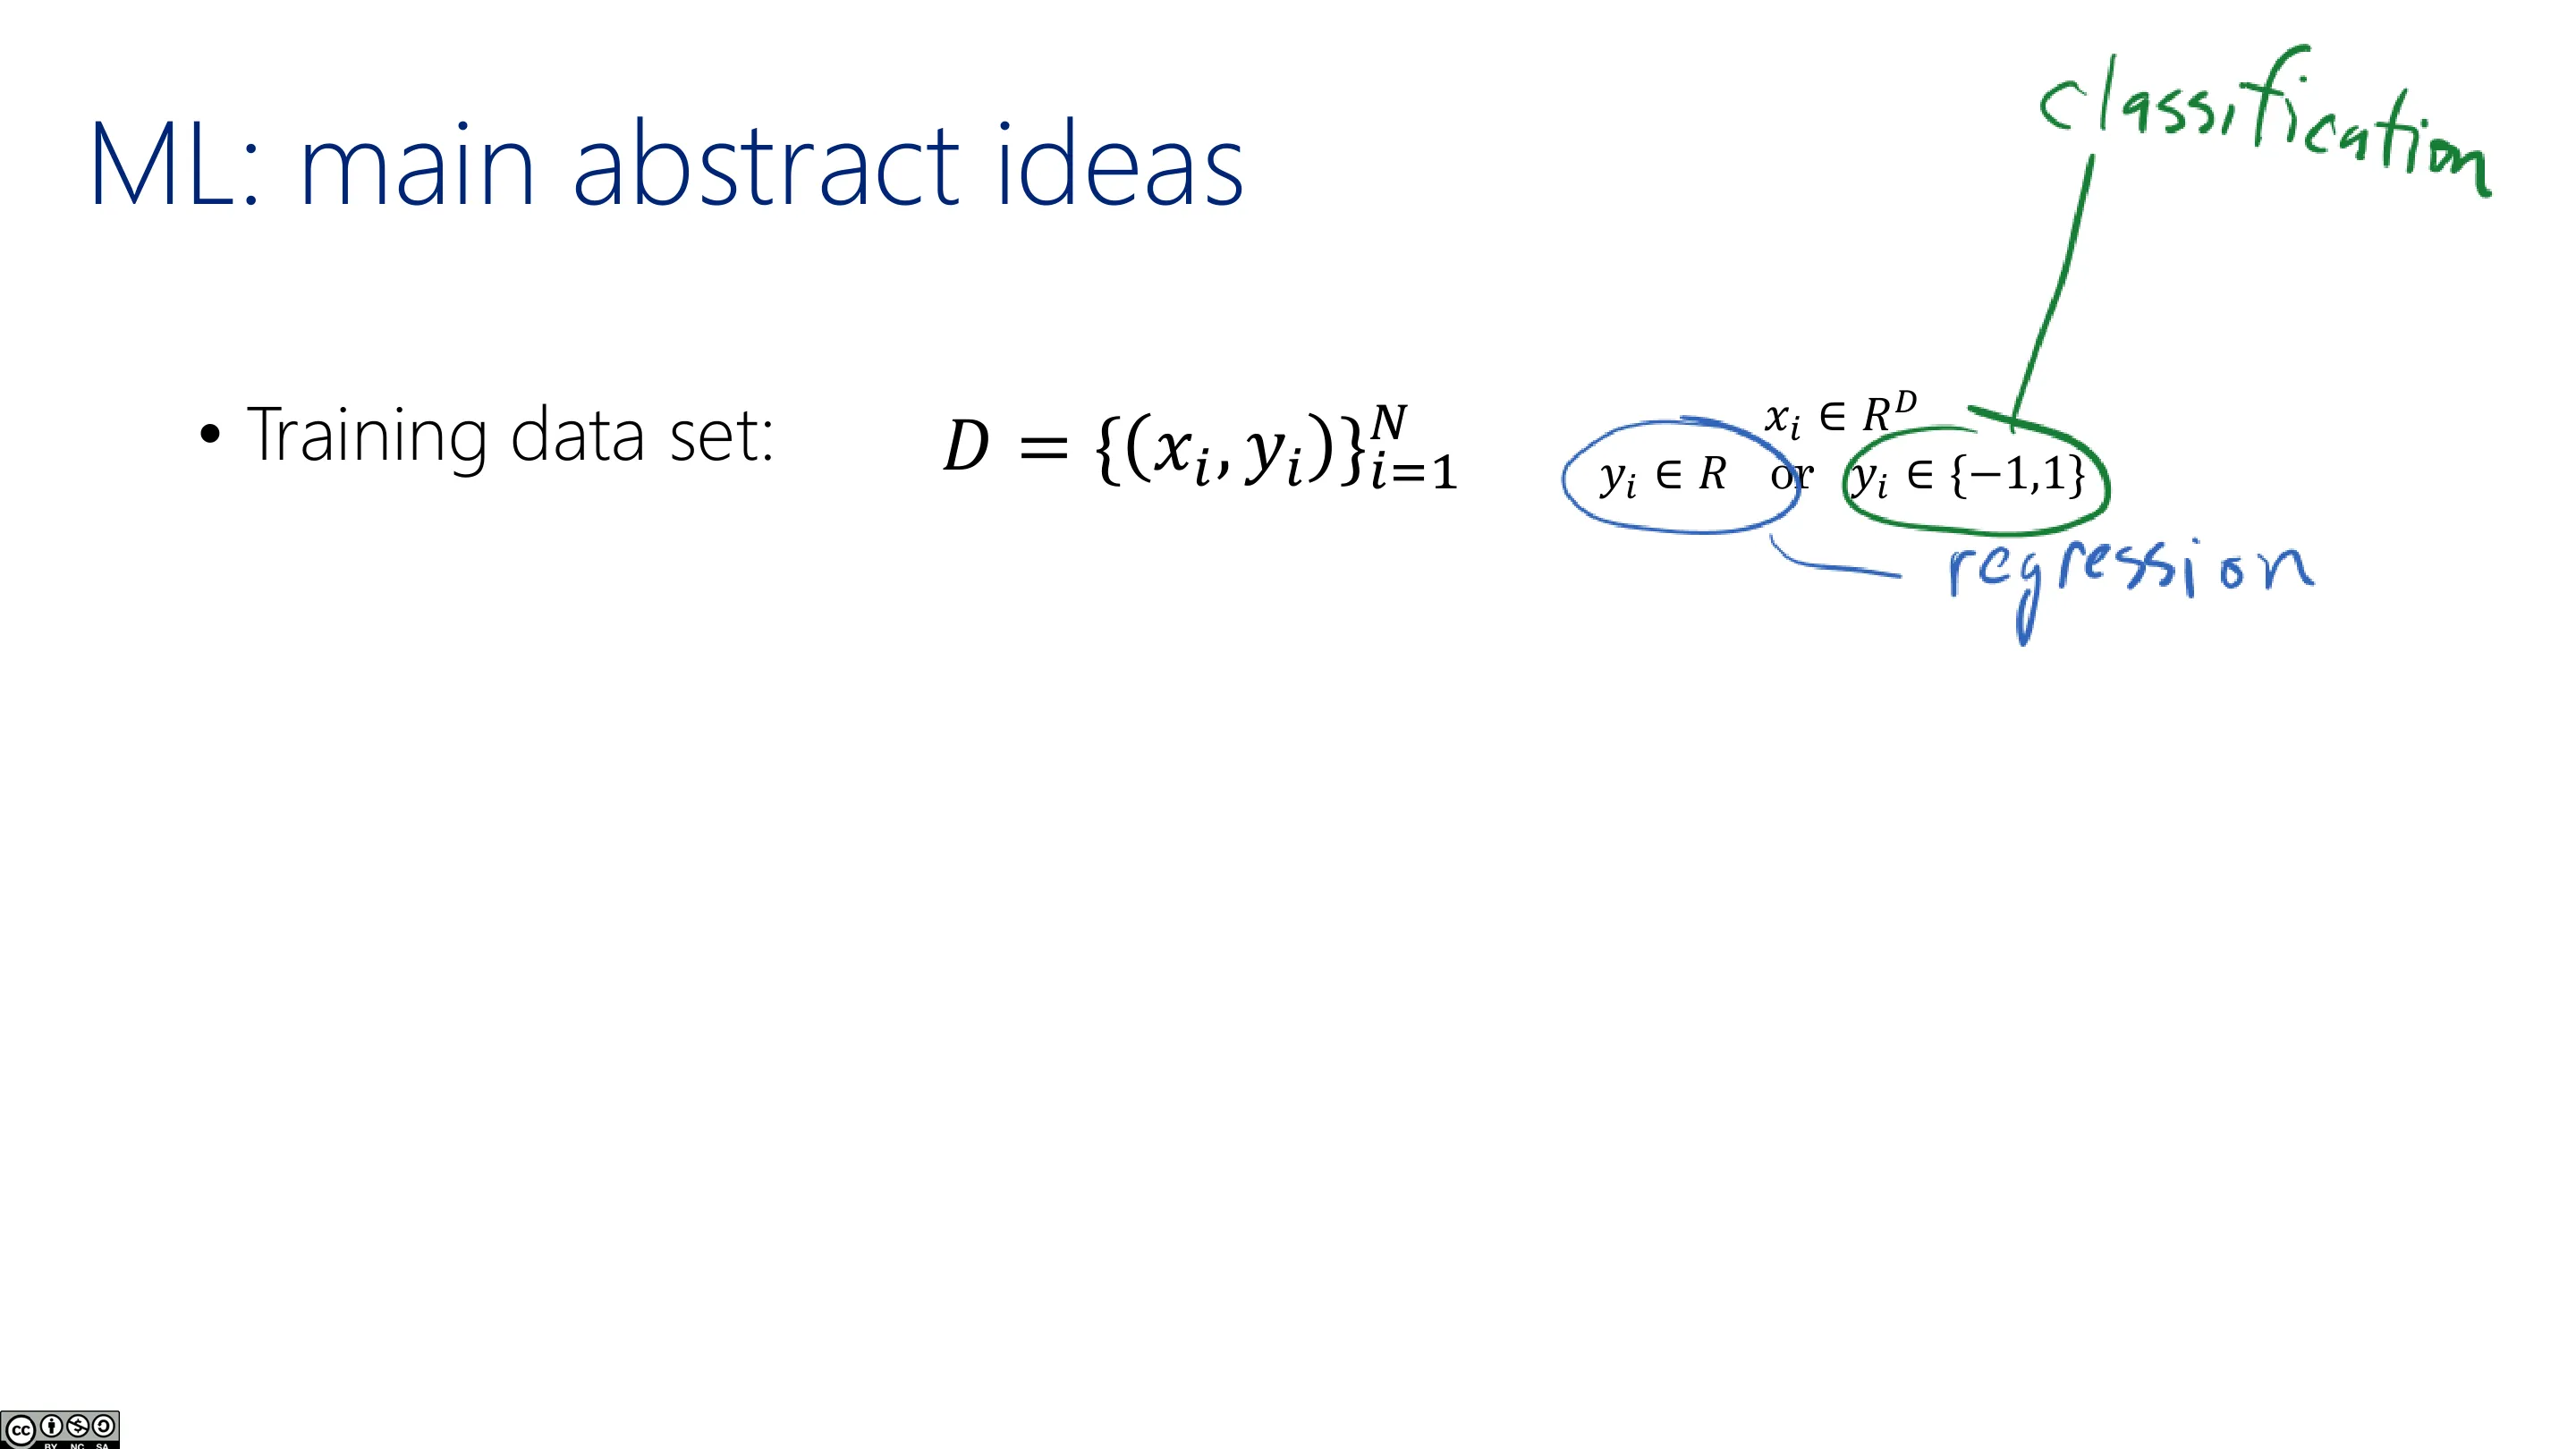
📷 机器学习的主要抽象思想(一)
回到原视频 (00:07:39)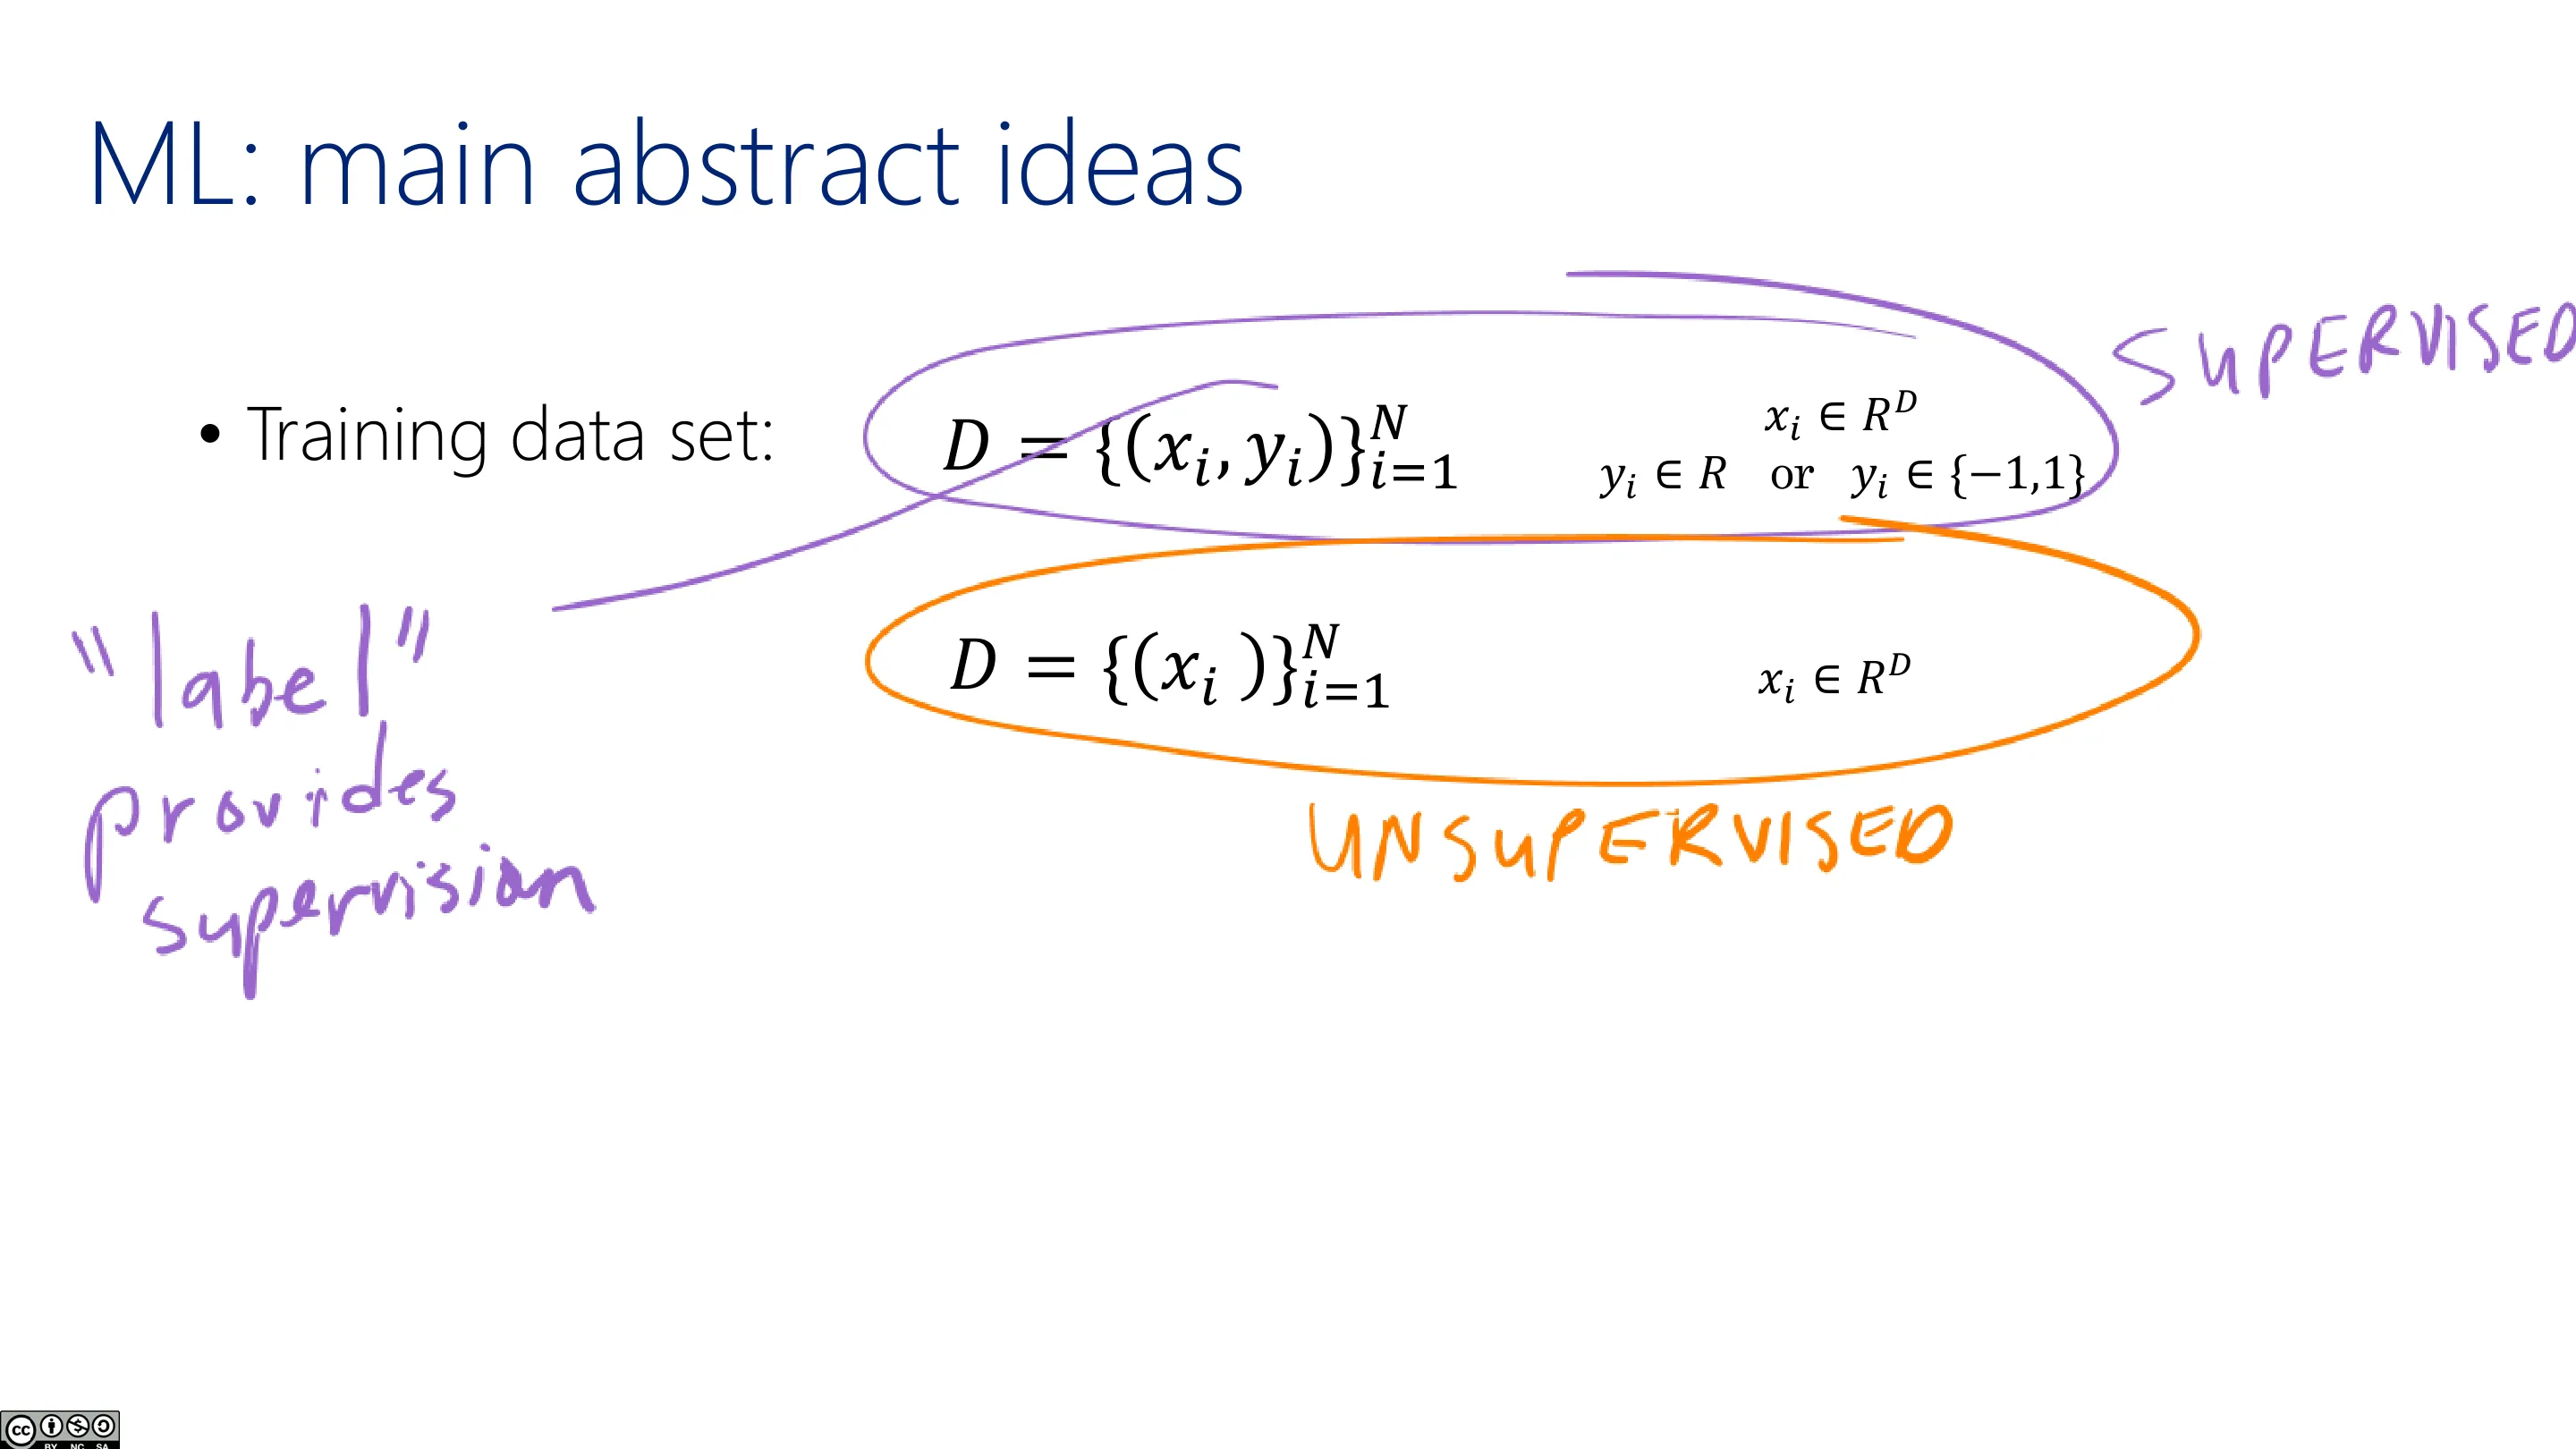
📷 机器学习的主要抽象思想(二)
回到原视频 (00:08:36)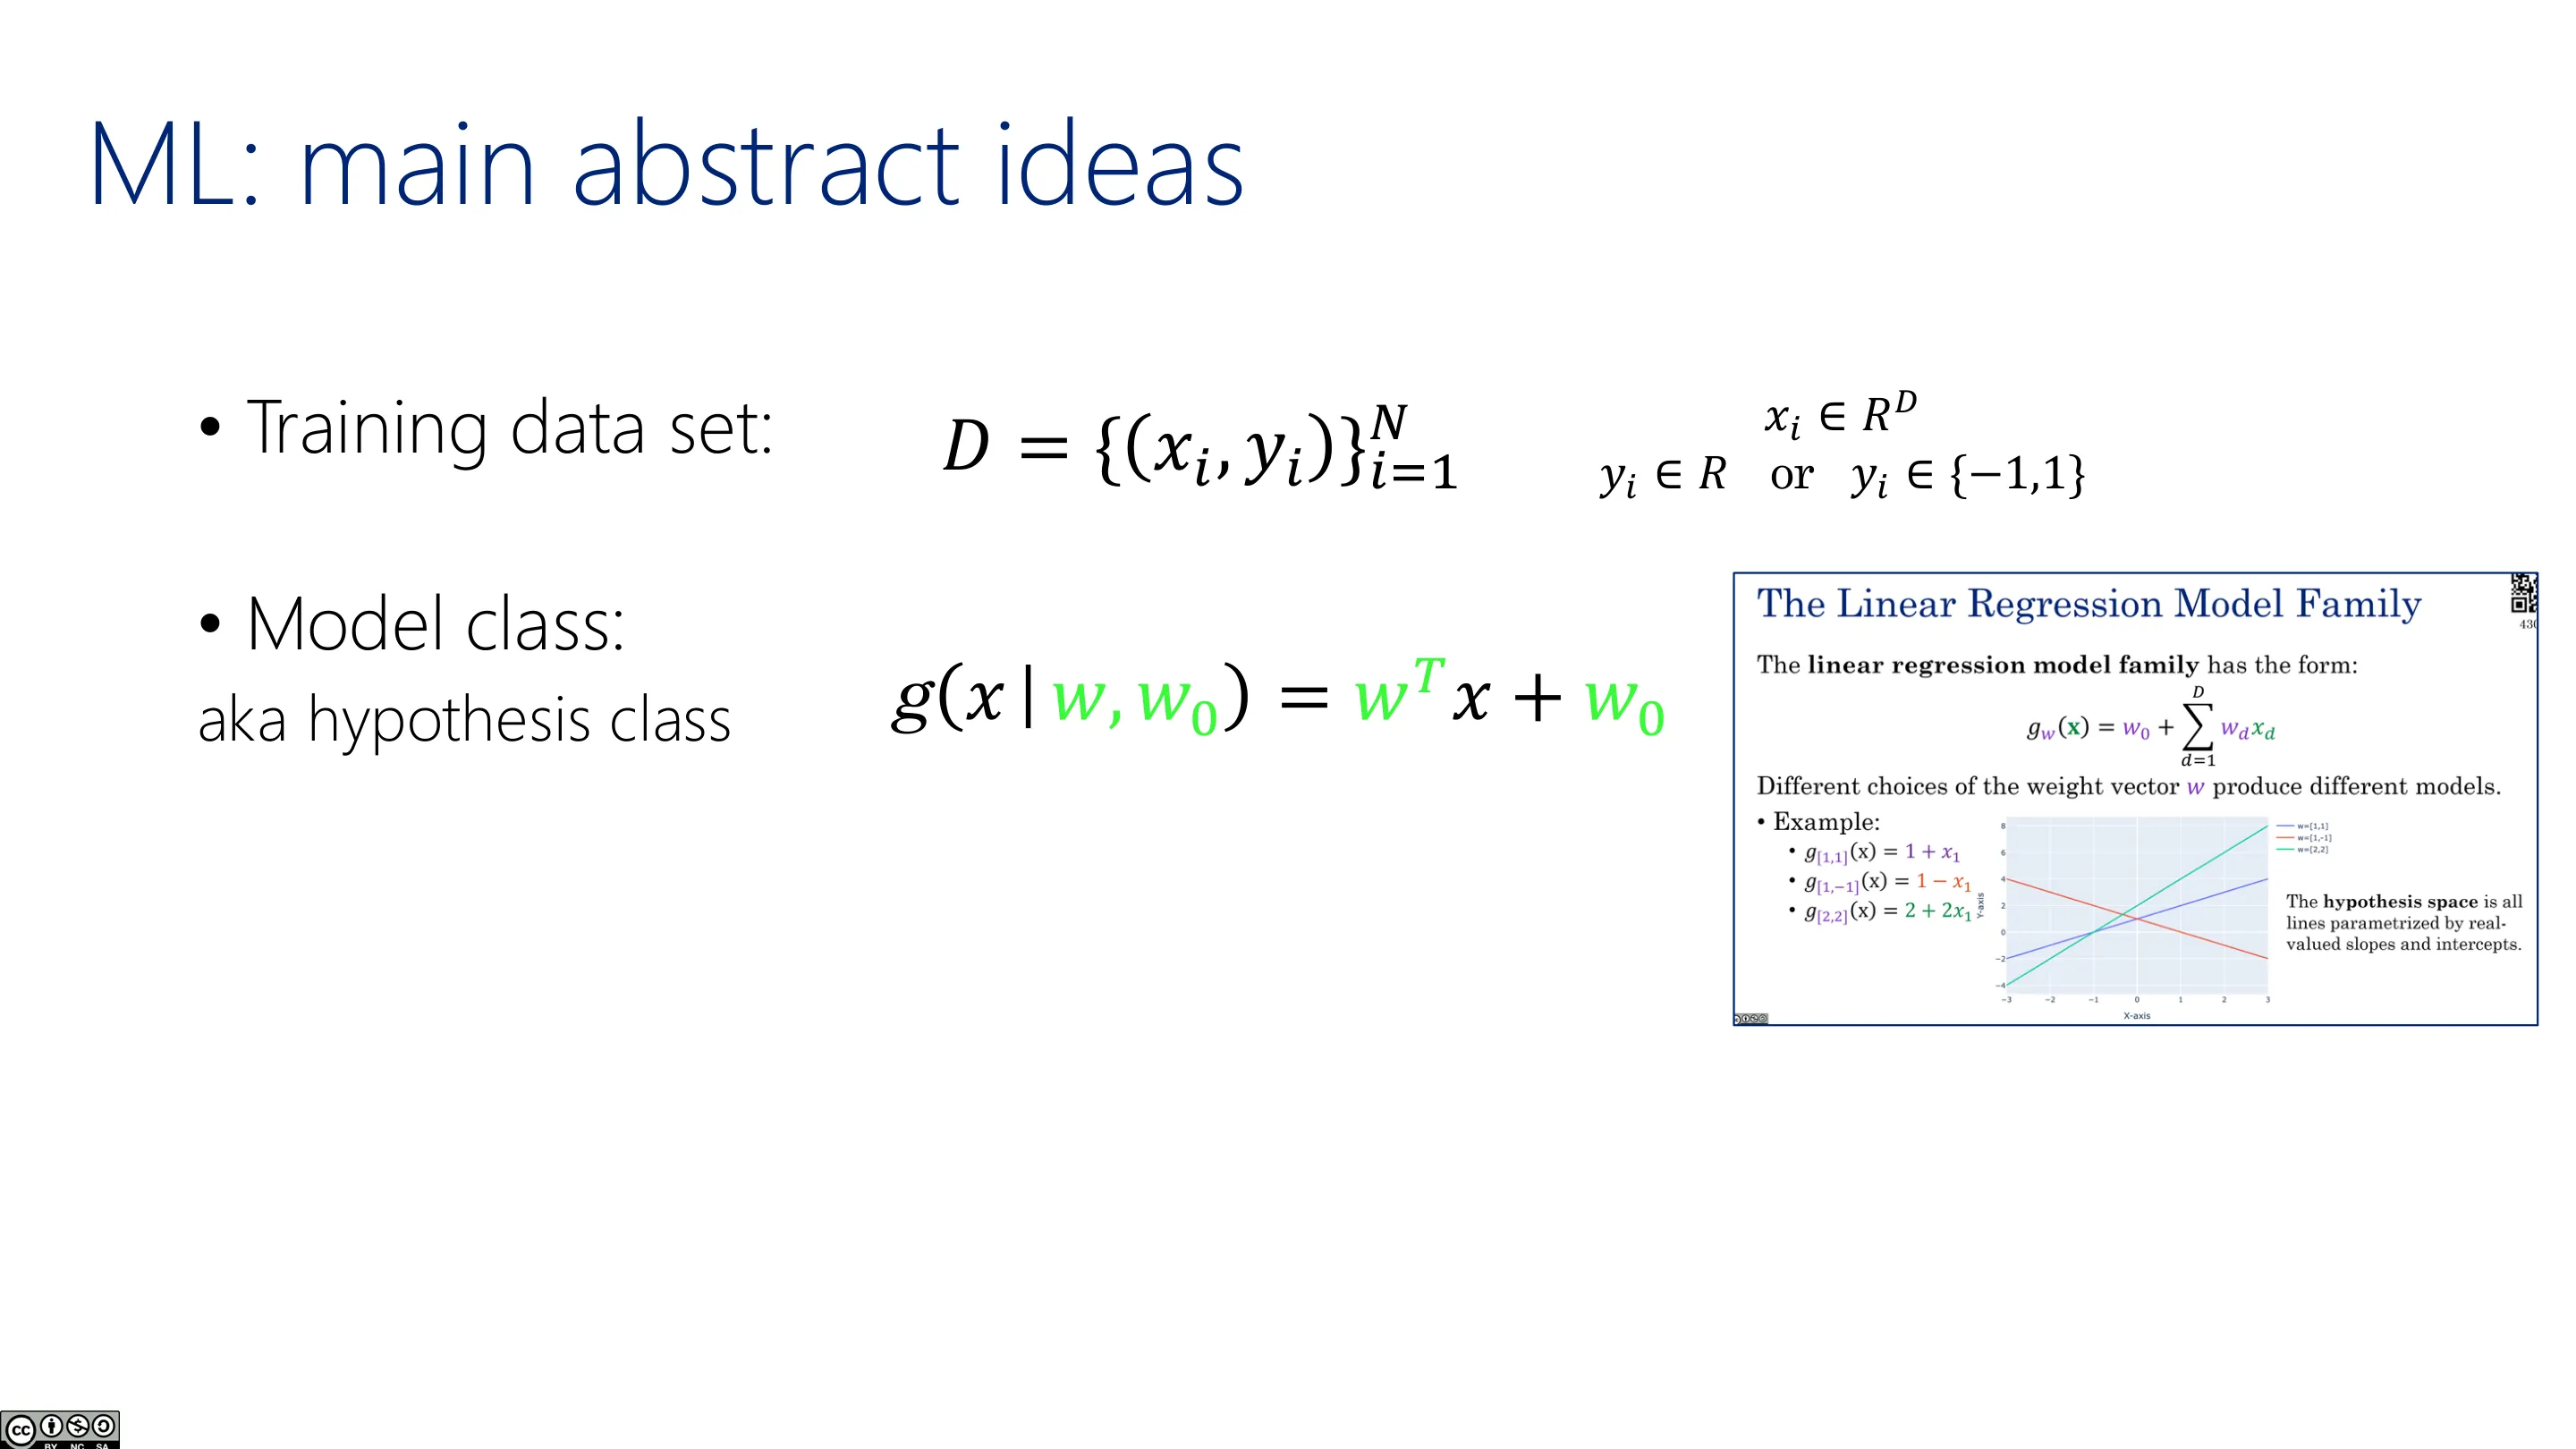
📷 机器学习的主要抽象思想(三)
回到原视频 (00:09:37)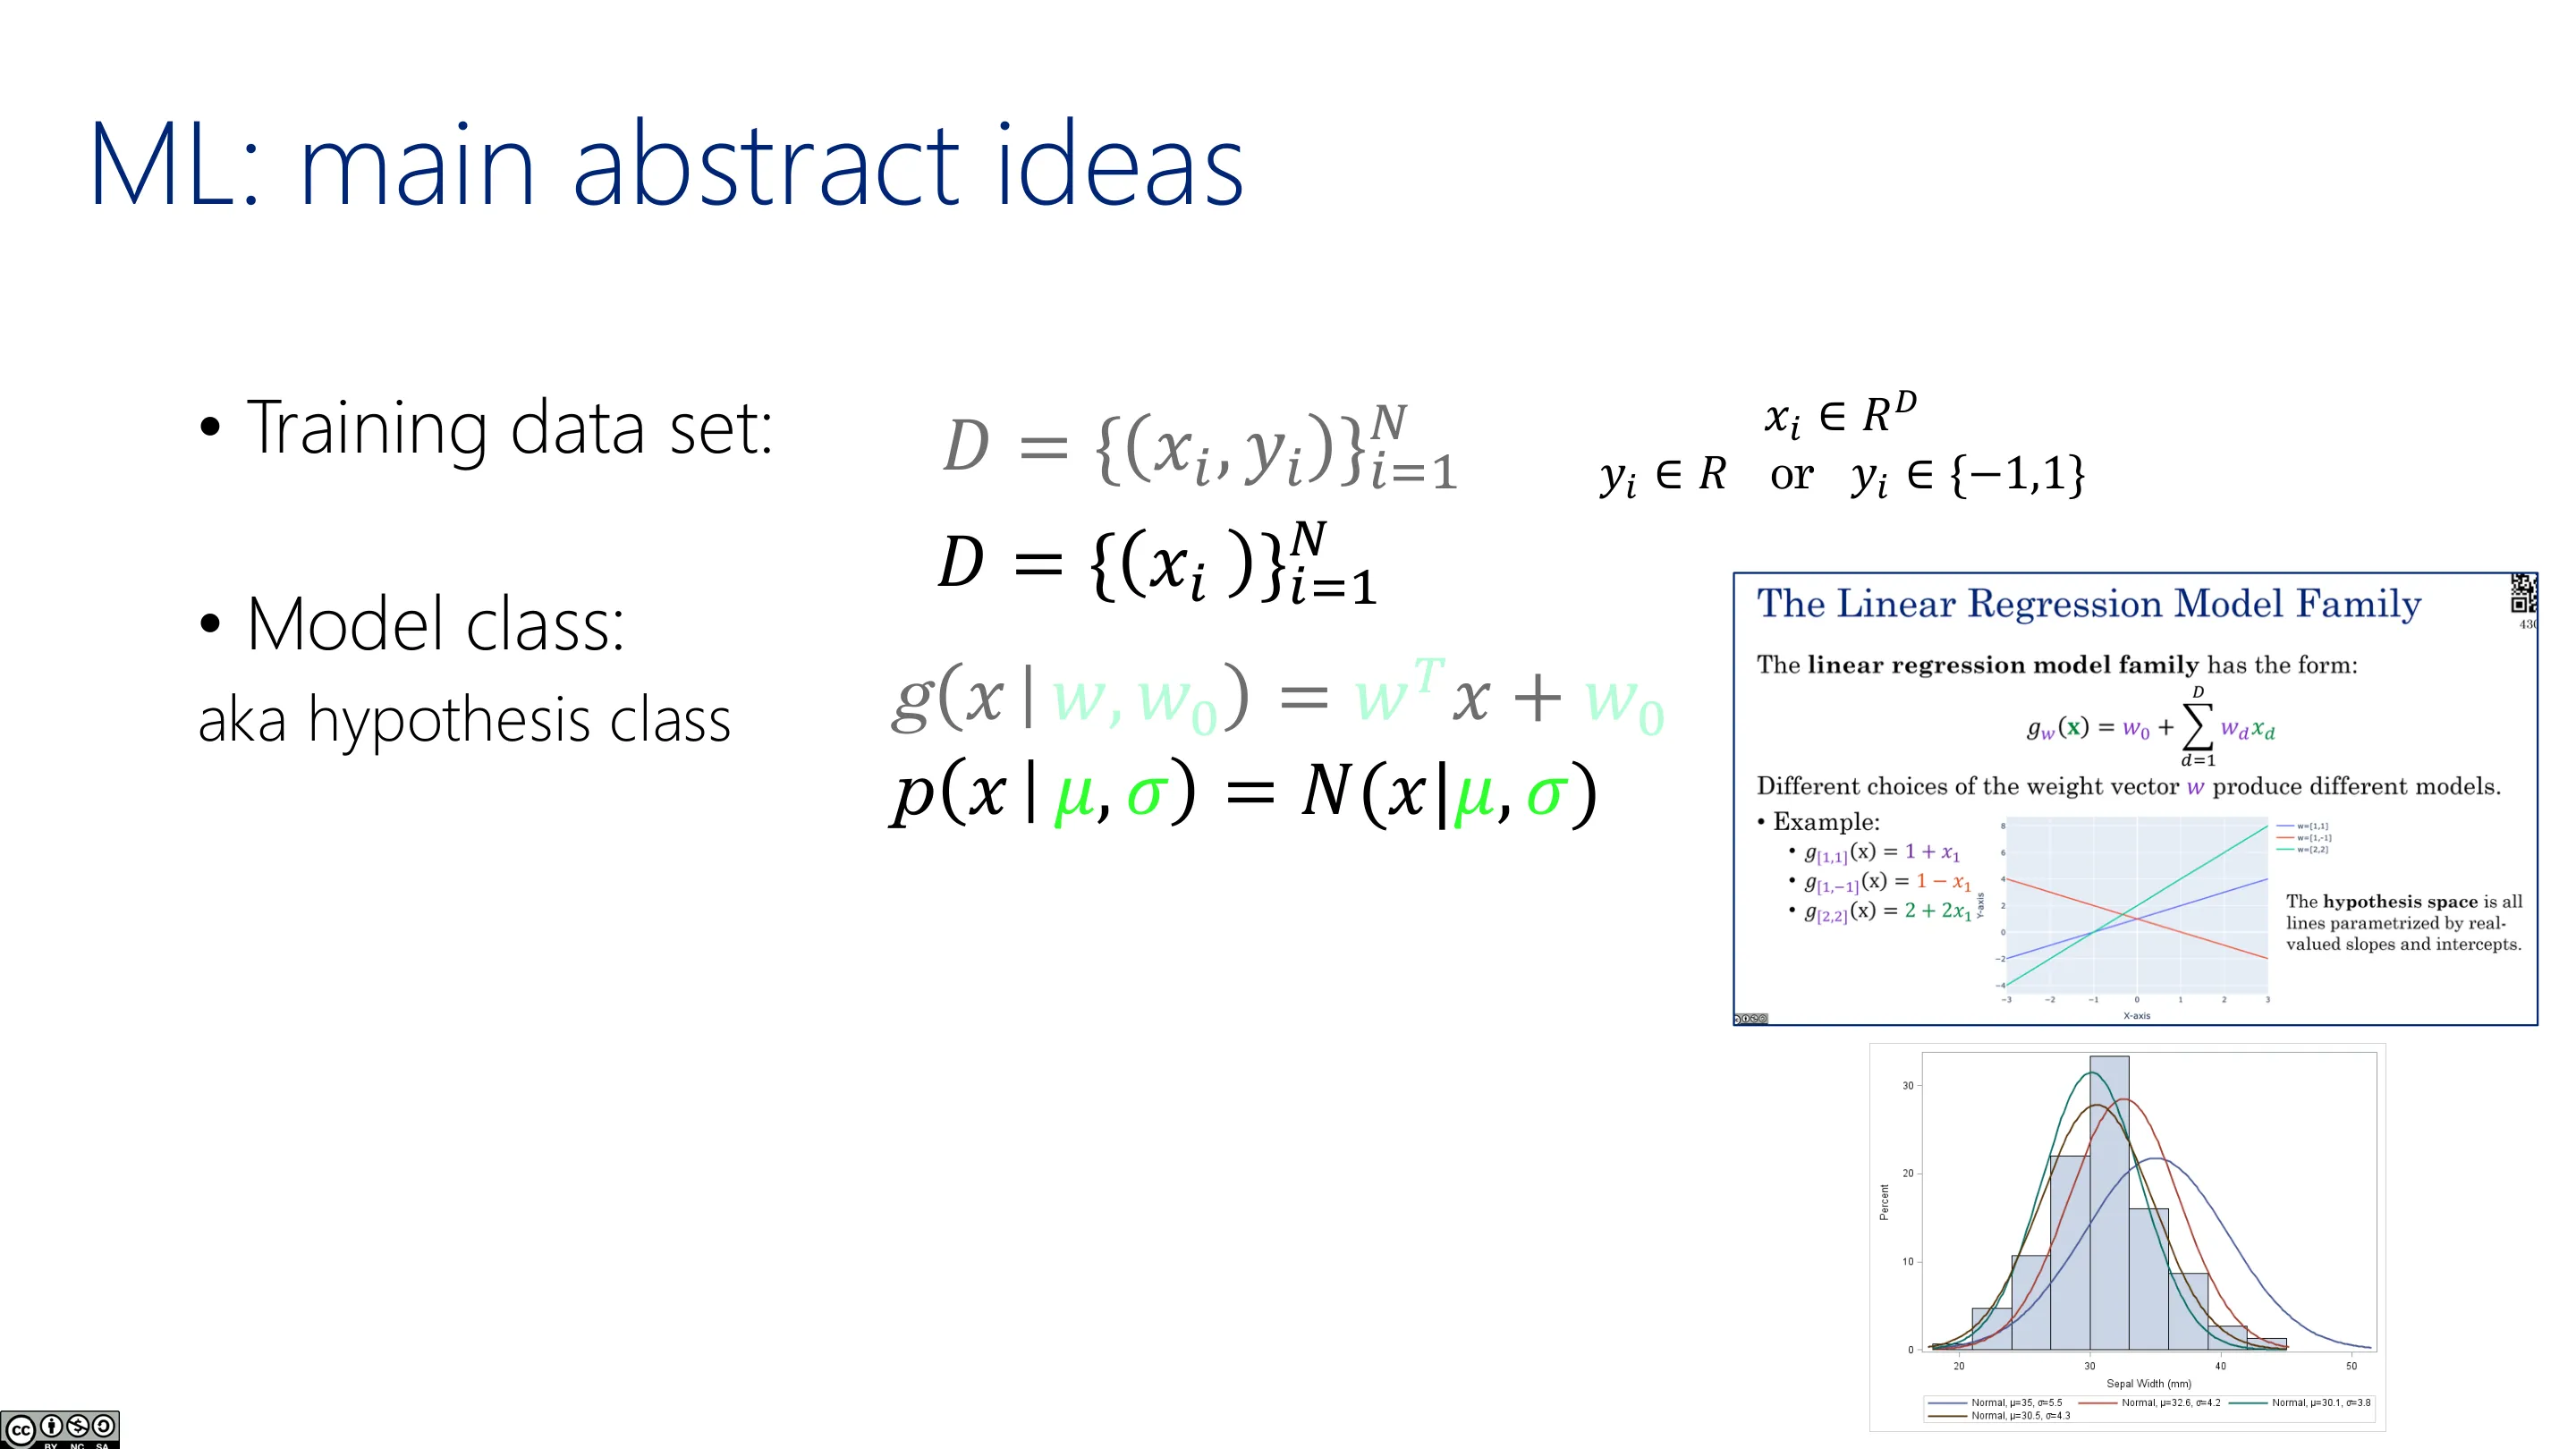
📷 机器学习的主要抽象思想(四)
回到原视频 (00:10:06)举例:
- 线性回归:$g(x \mid w, w_0) = w^\top x + w_0$——把特征与参数做内积再加偏置,本质是一条直线($x$ 多维时是一个超平面)。它的常用损失是平方损失(预测值与真实值之差的平方和)。
- 无监督:假设模型类是一个高斯分布,参数就是均值 $\mu$ 与方差 $\sigma^2$。
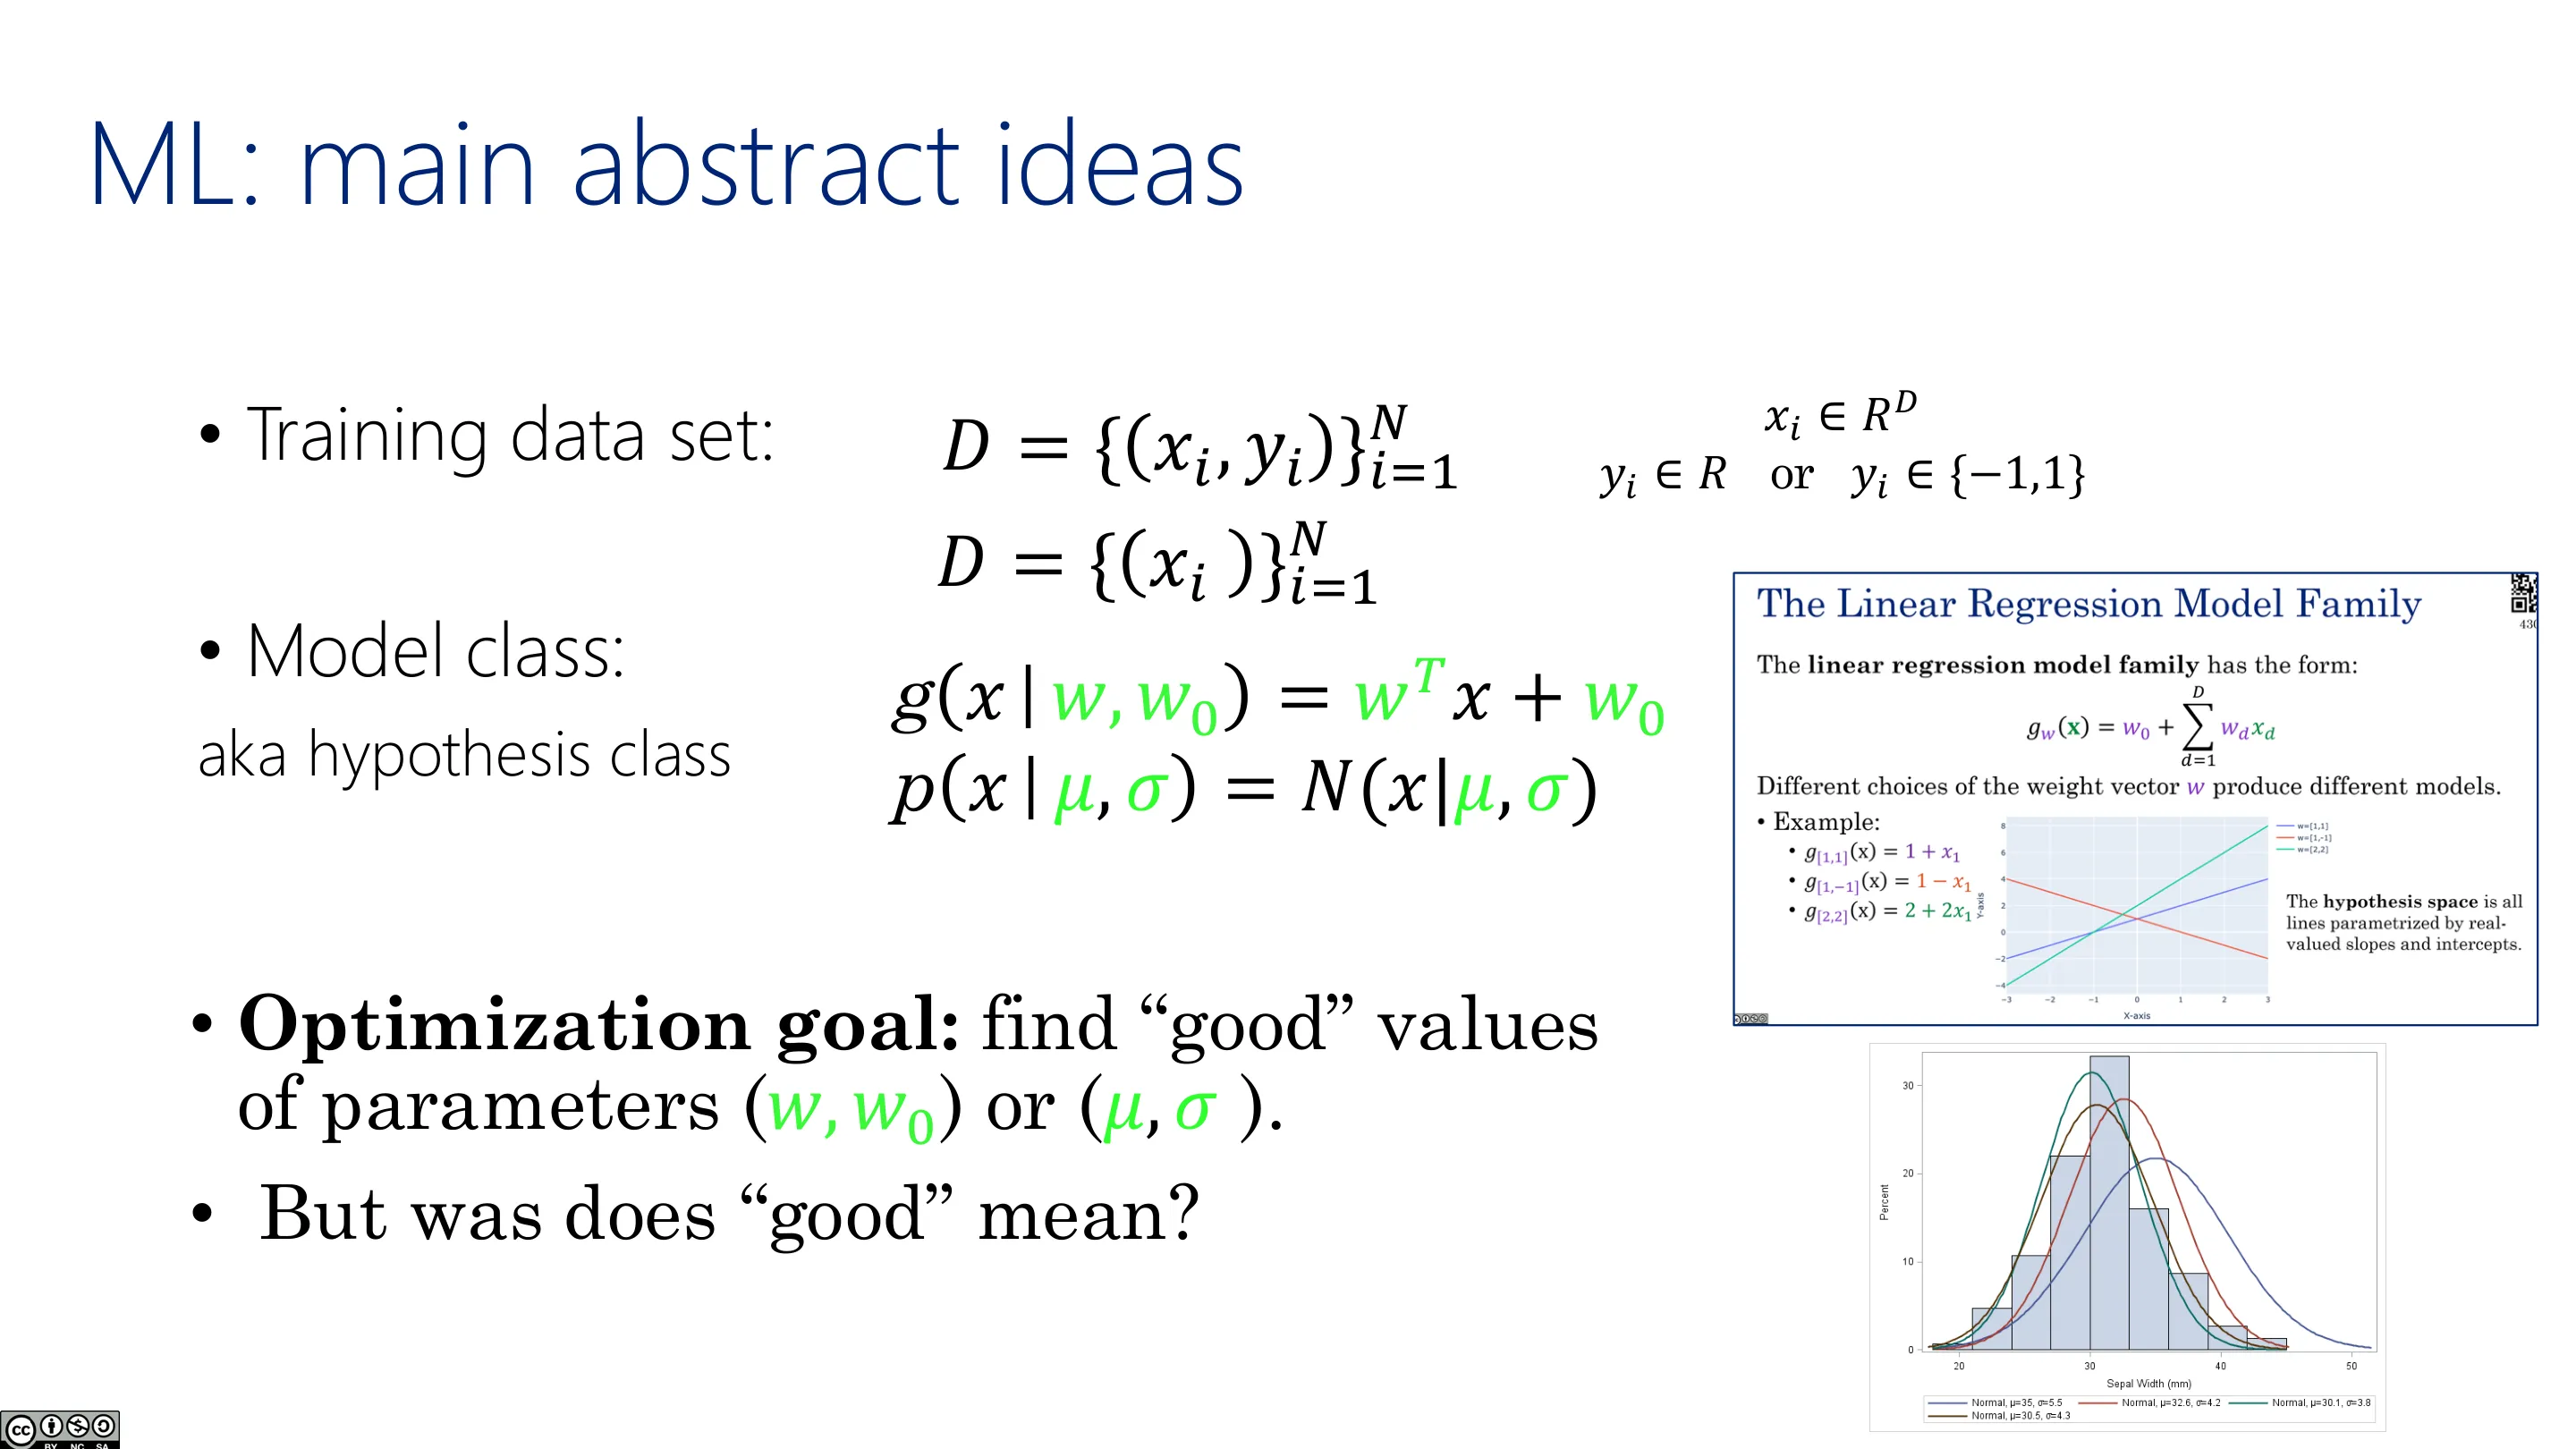
📷 机器学习的主要抽象思想(五)
回到原视频 (00:10:46)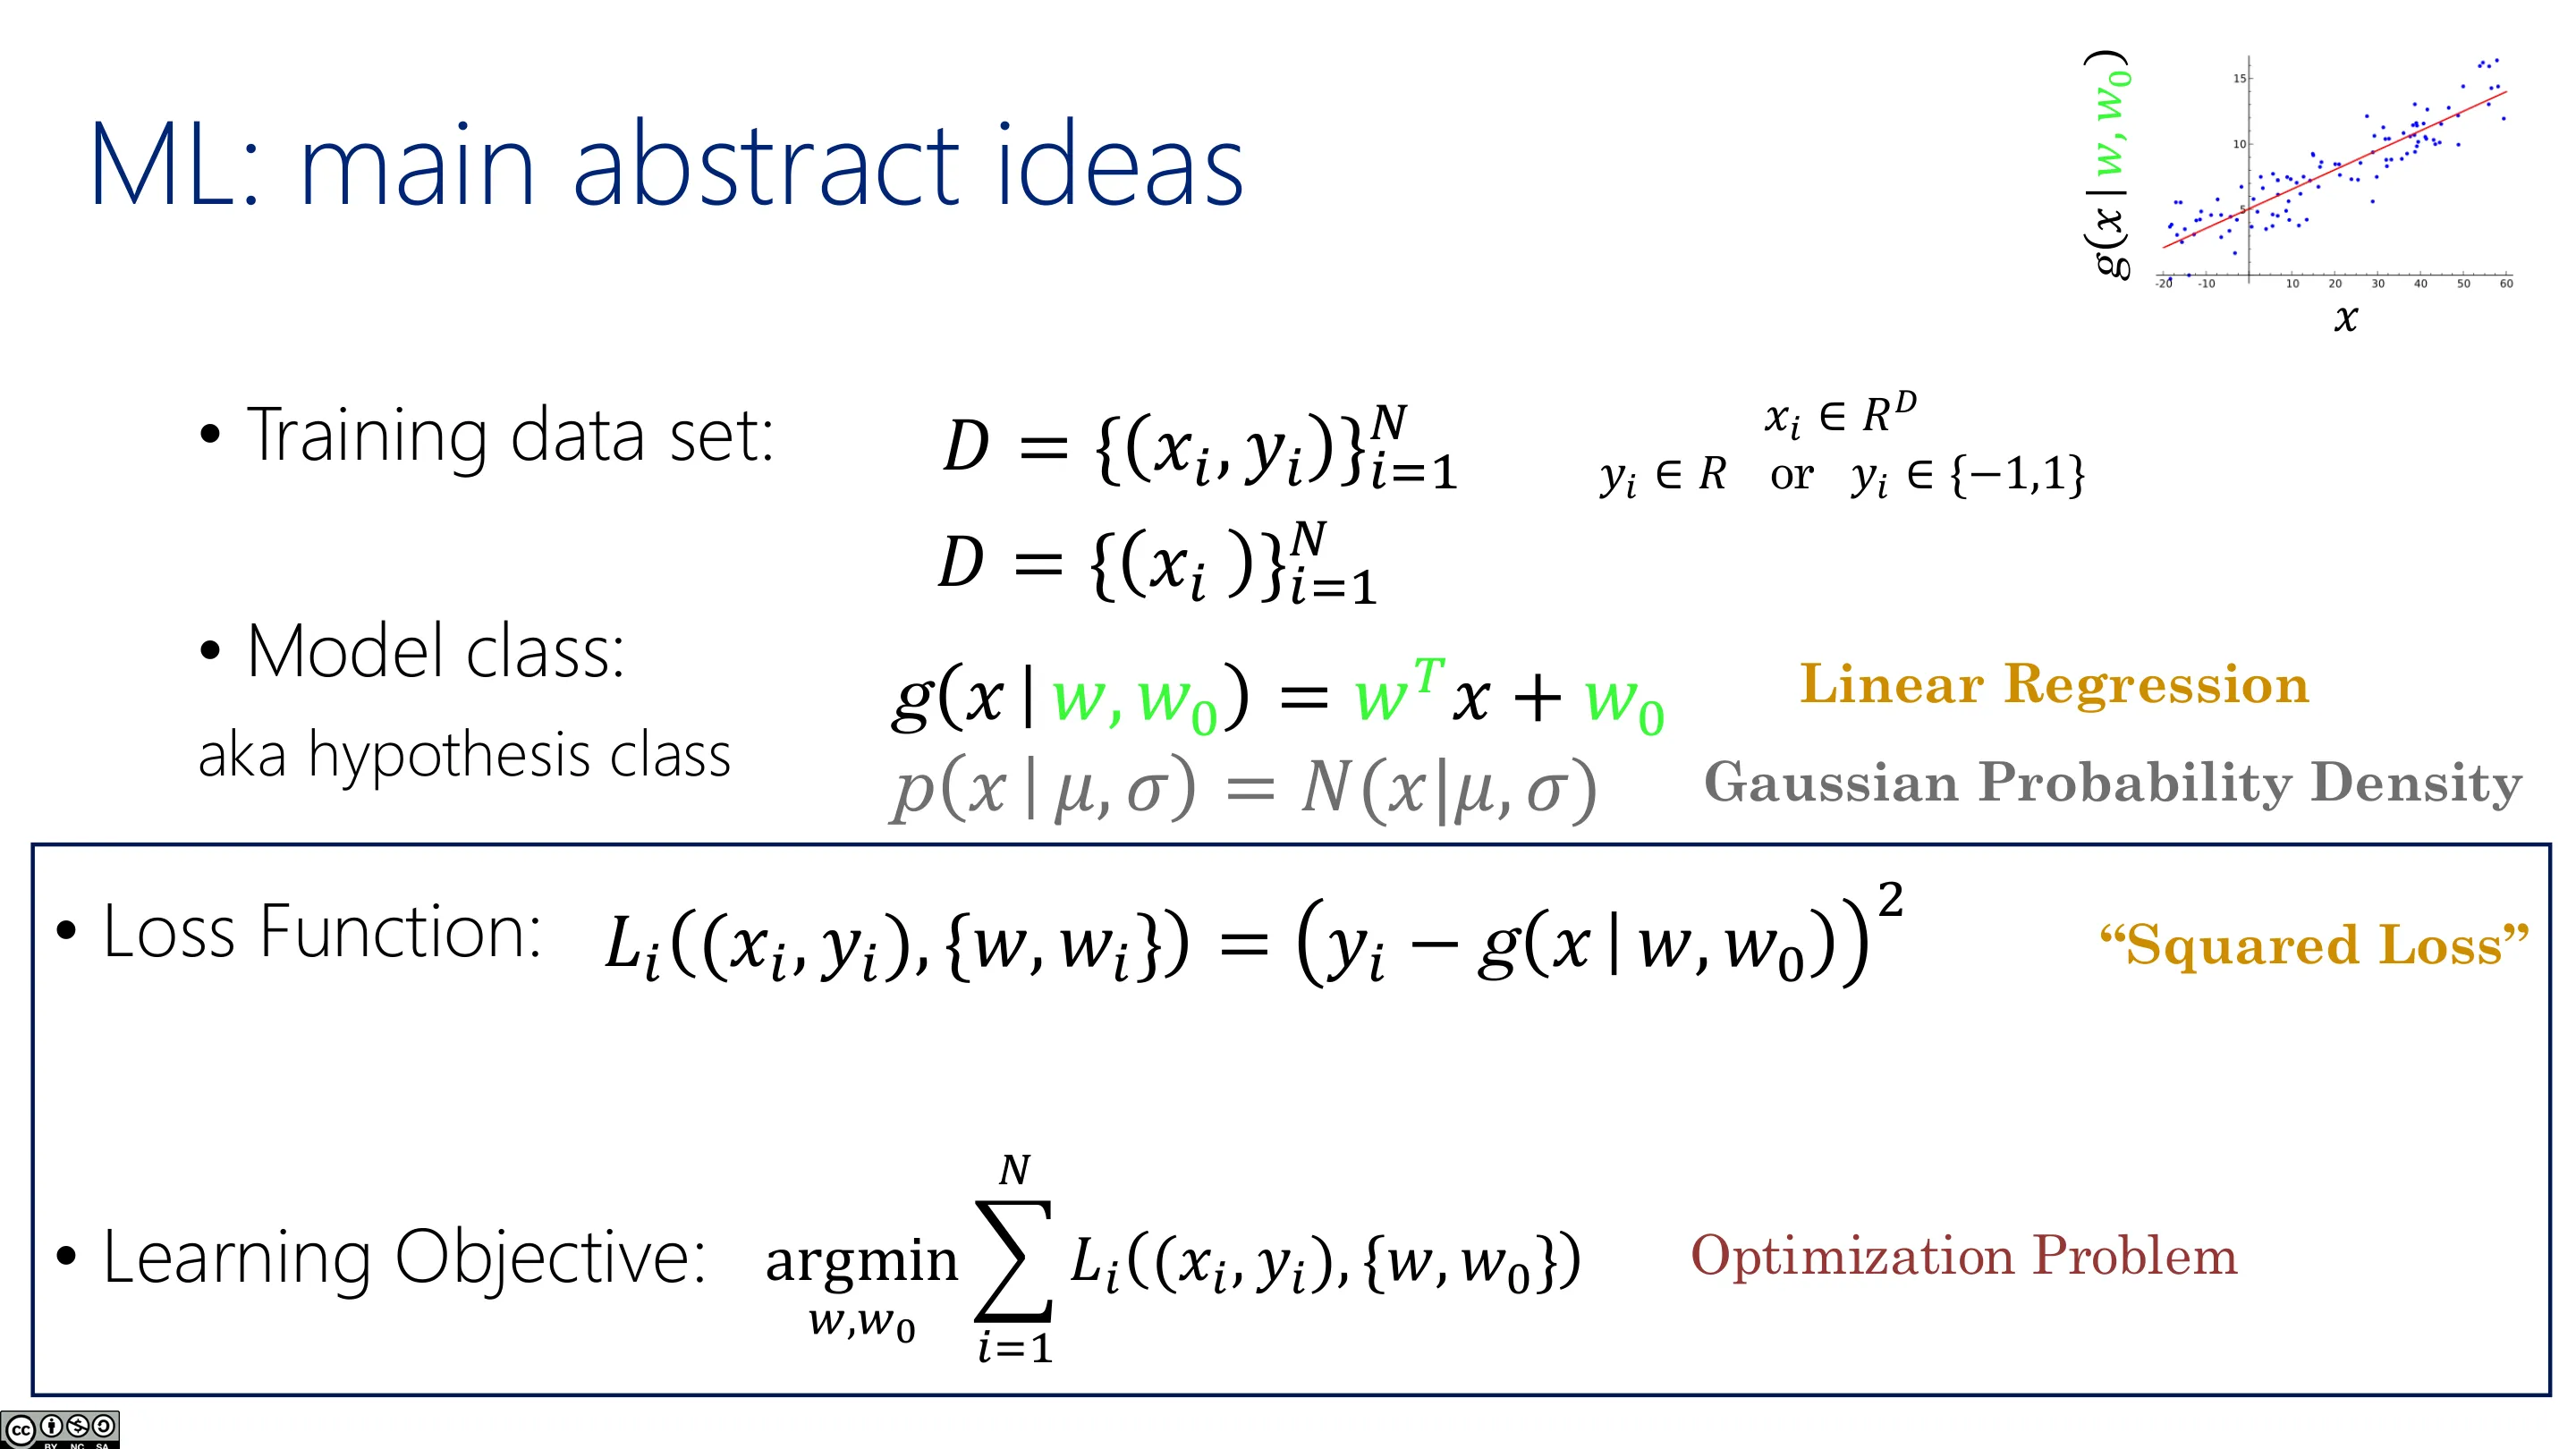
📷 线性回归模型(一)
回到原视频 (00:09:53)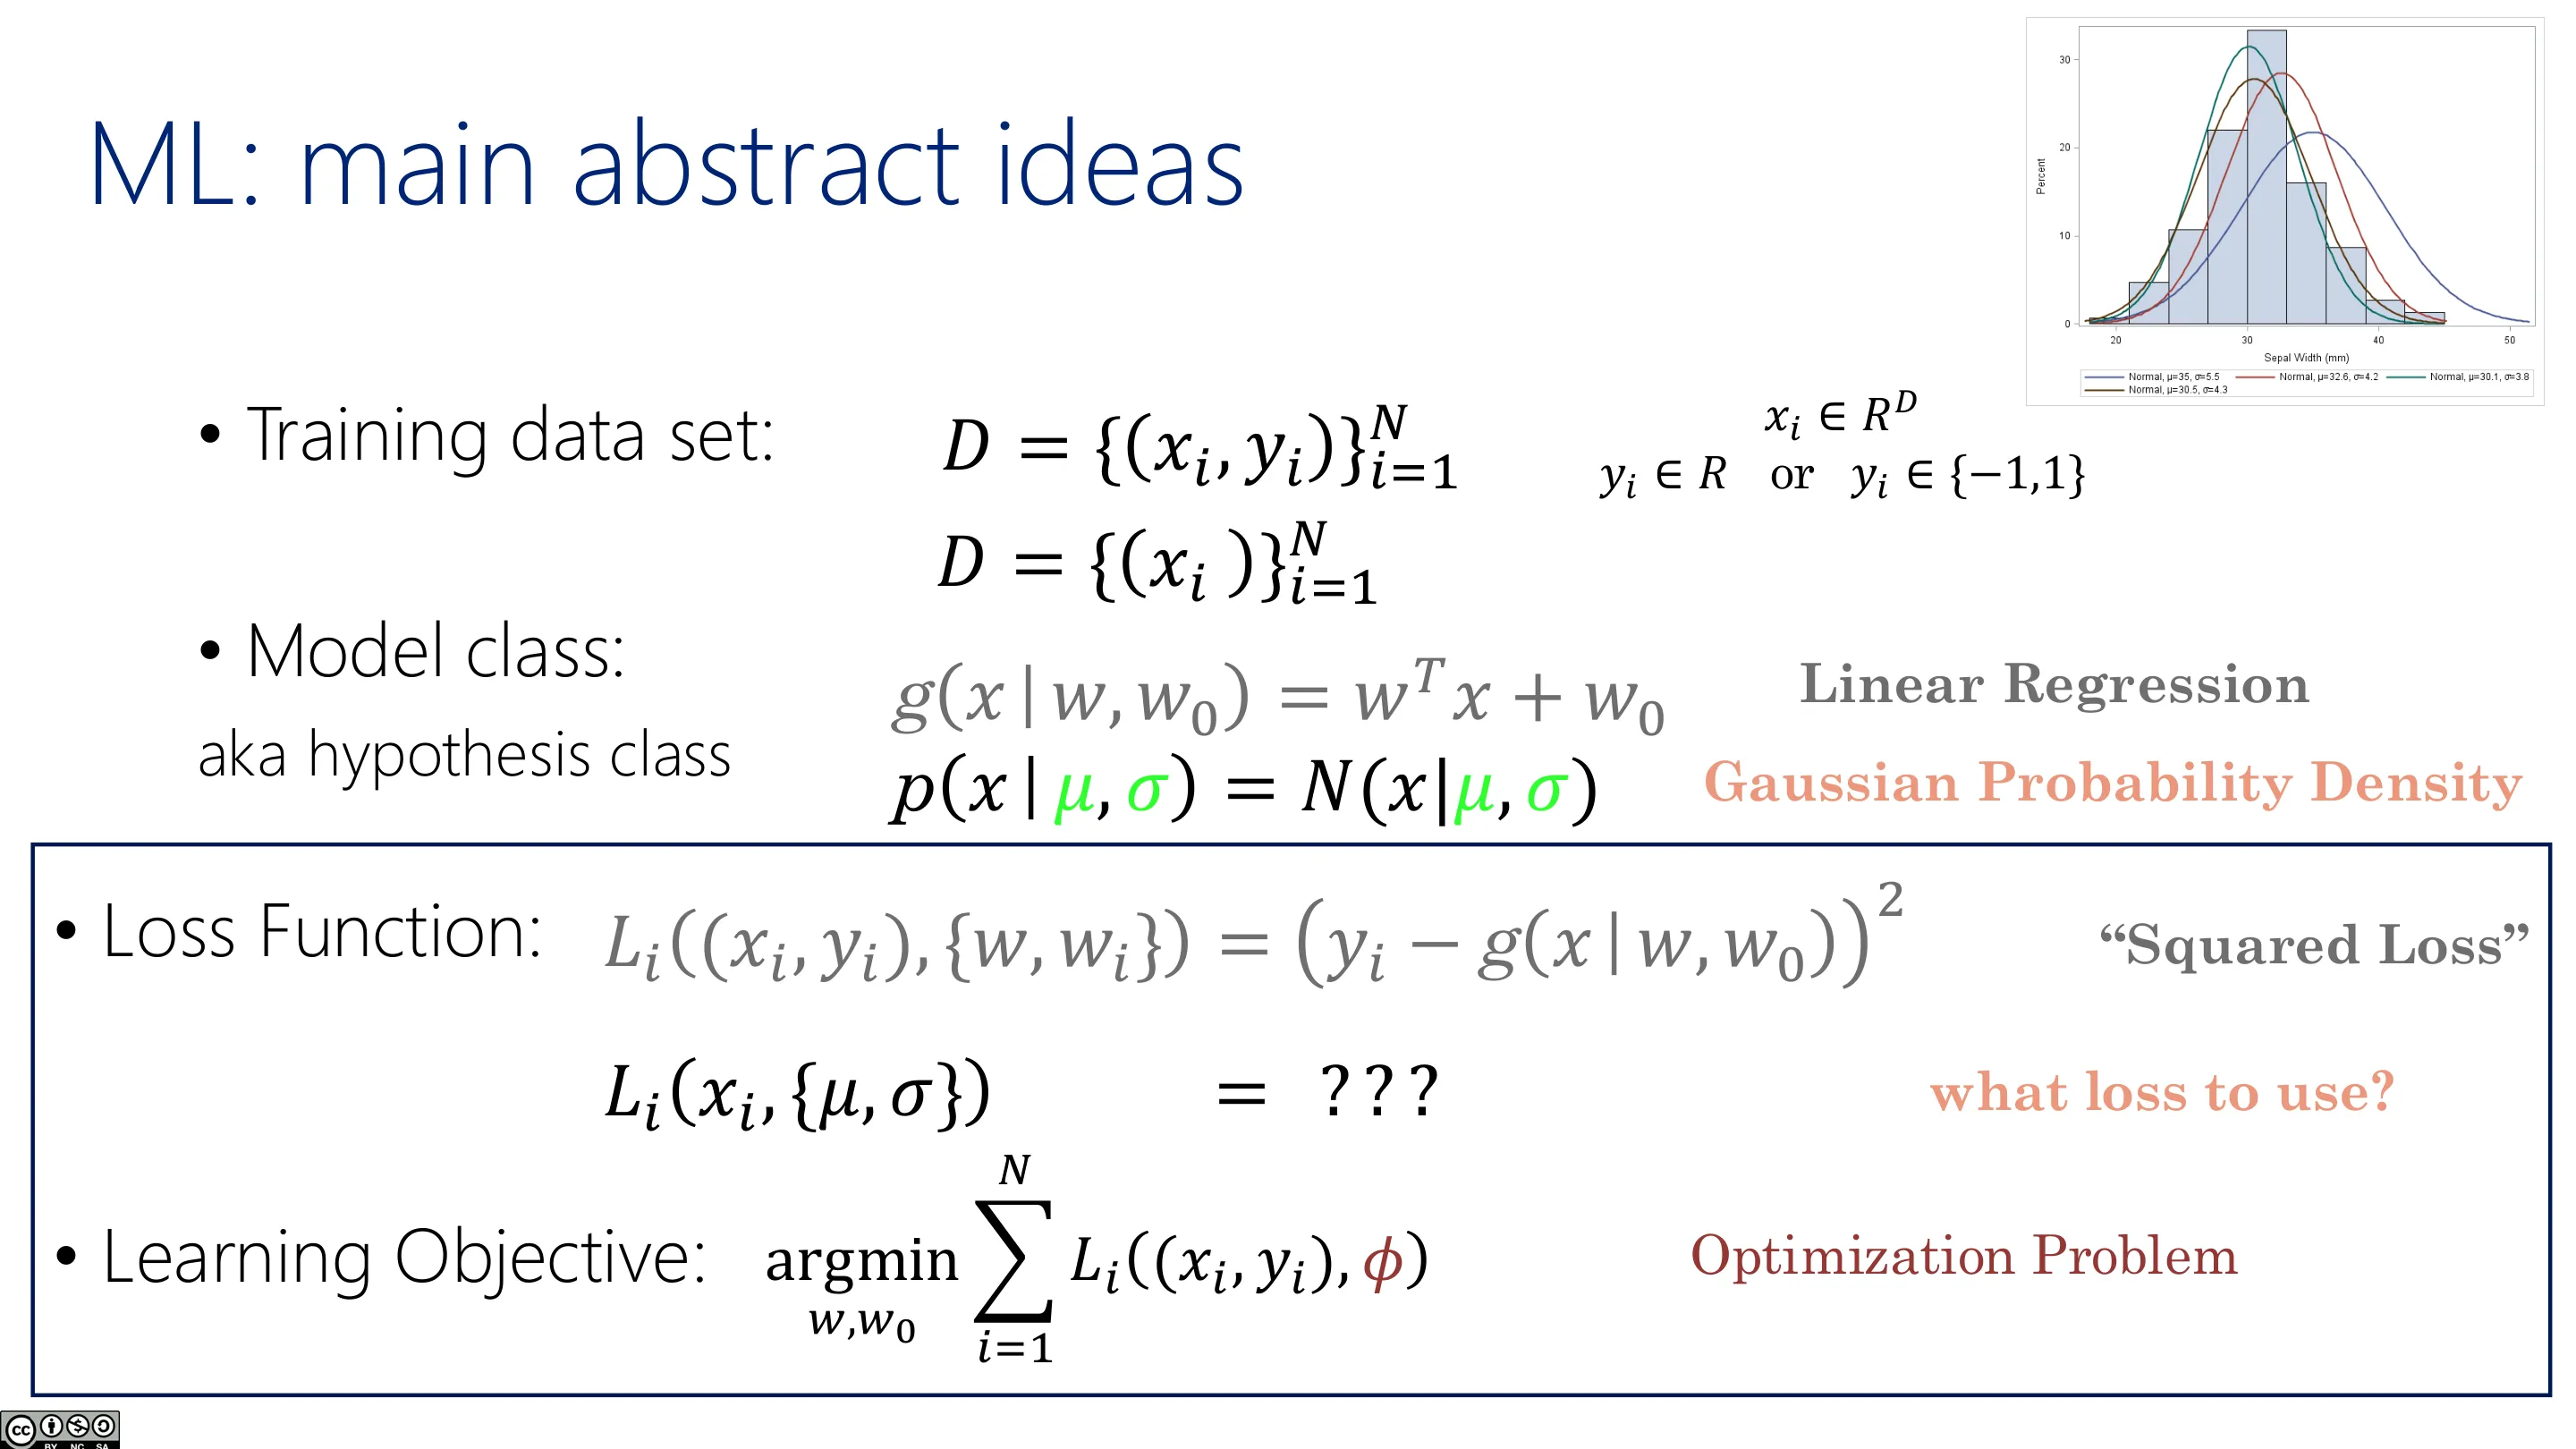
📷 线性回归模型(二)
回到原视频 (00:11:21)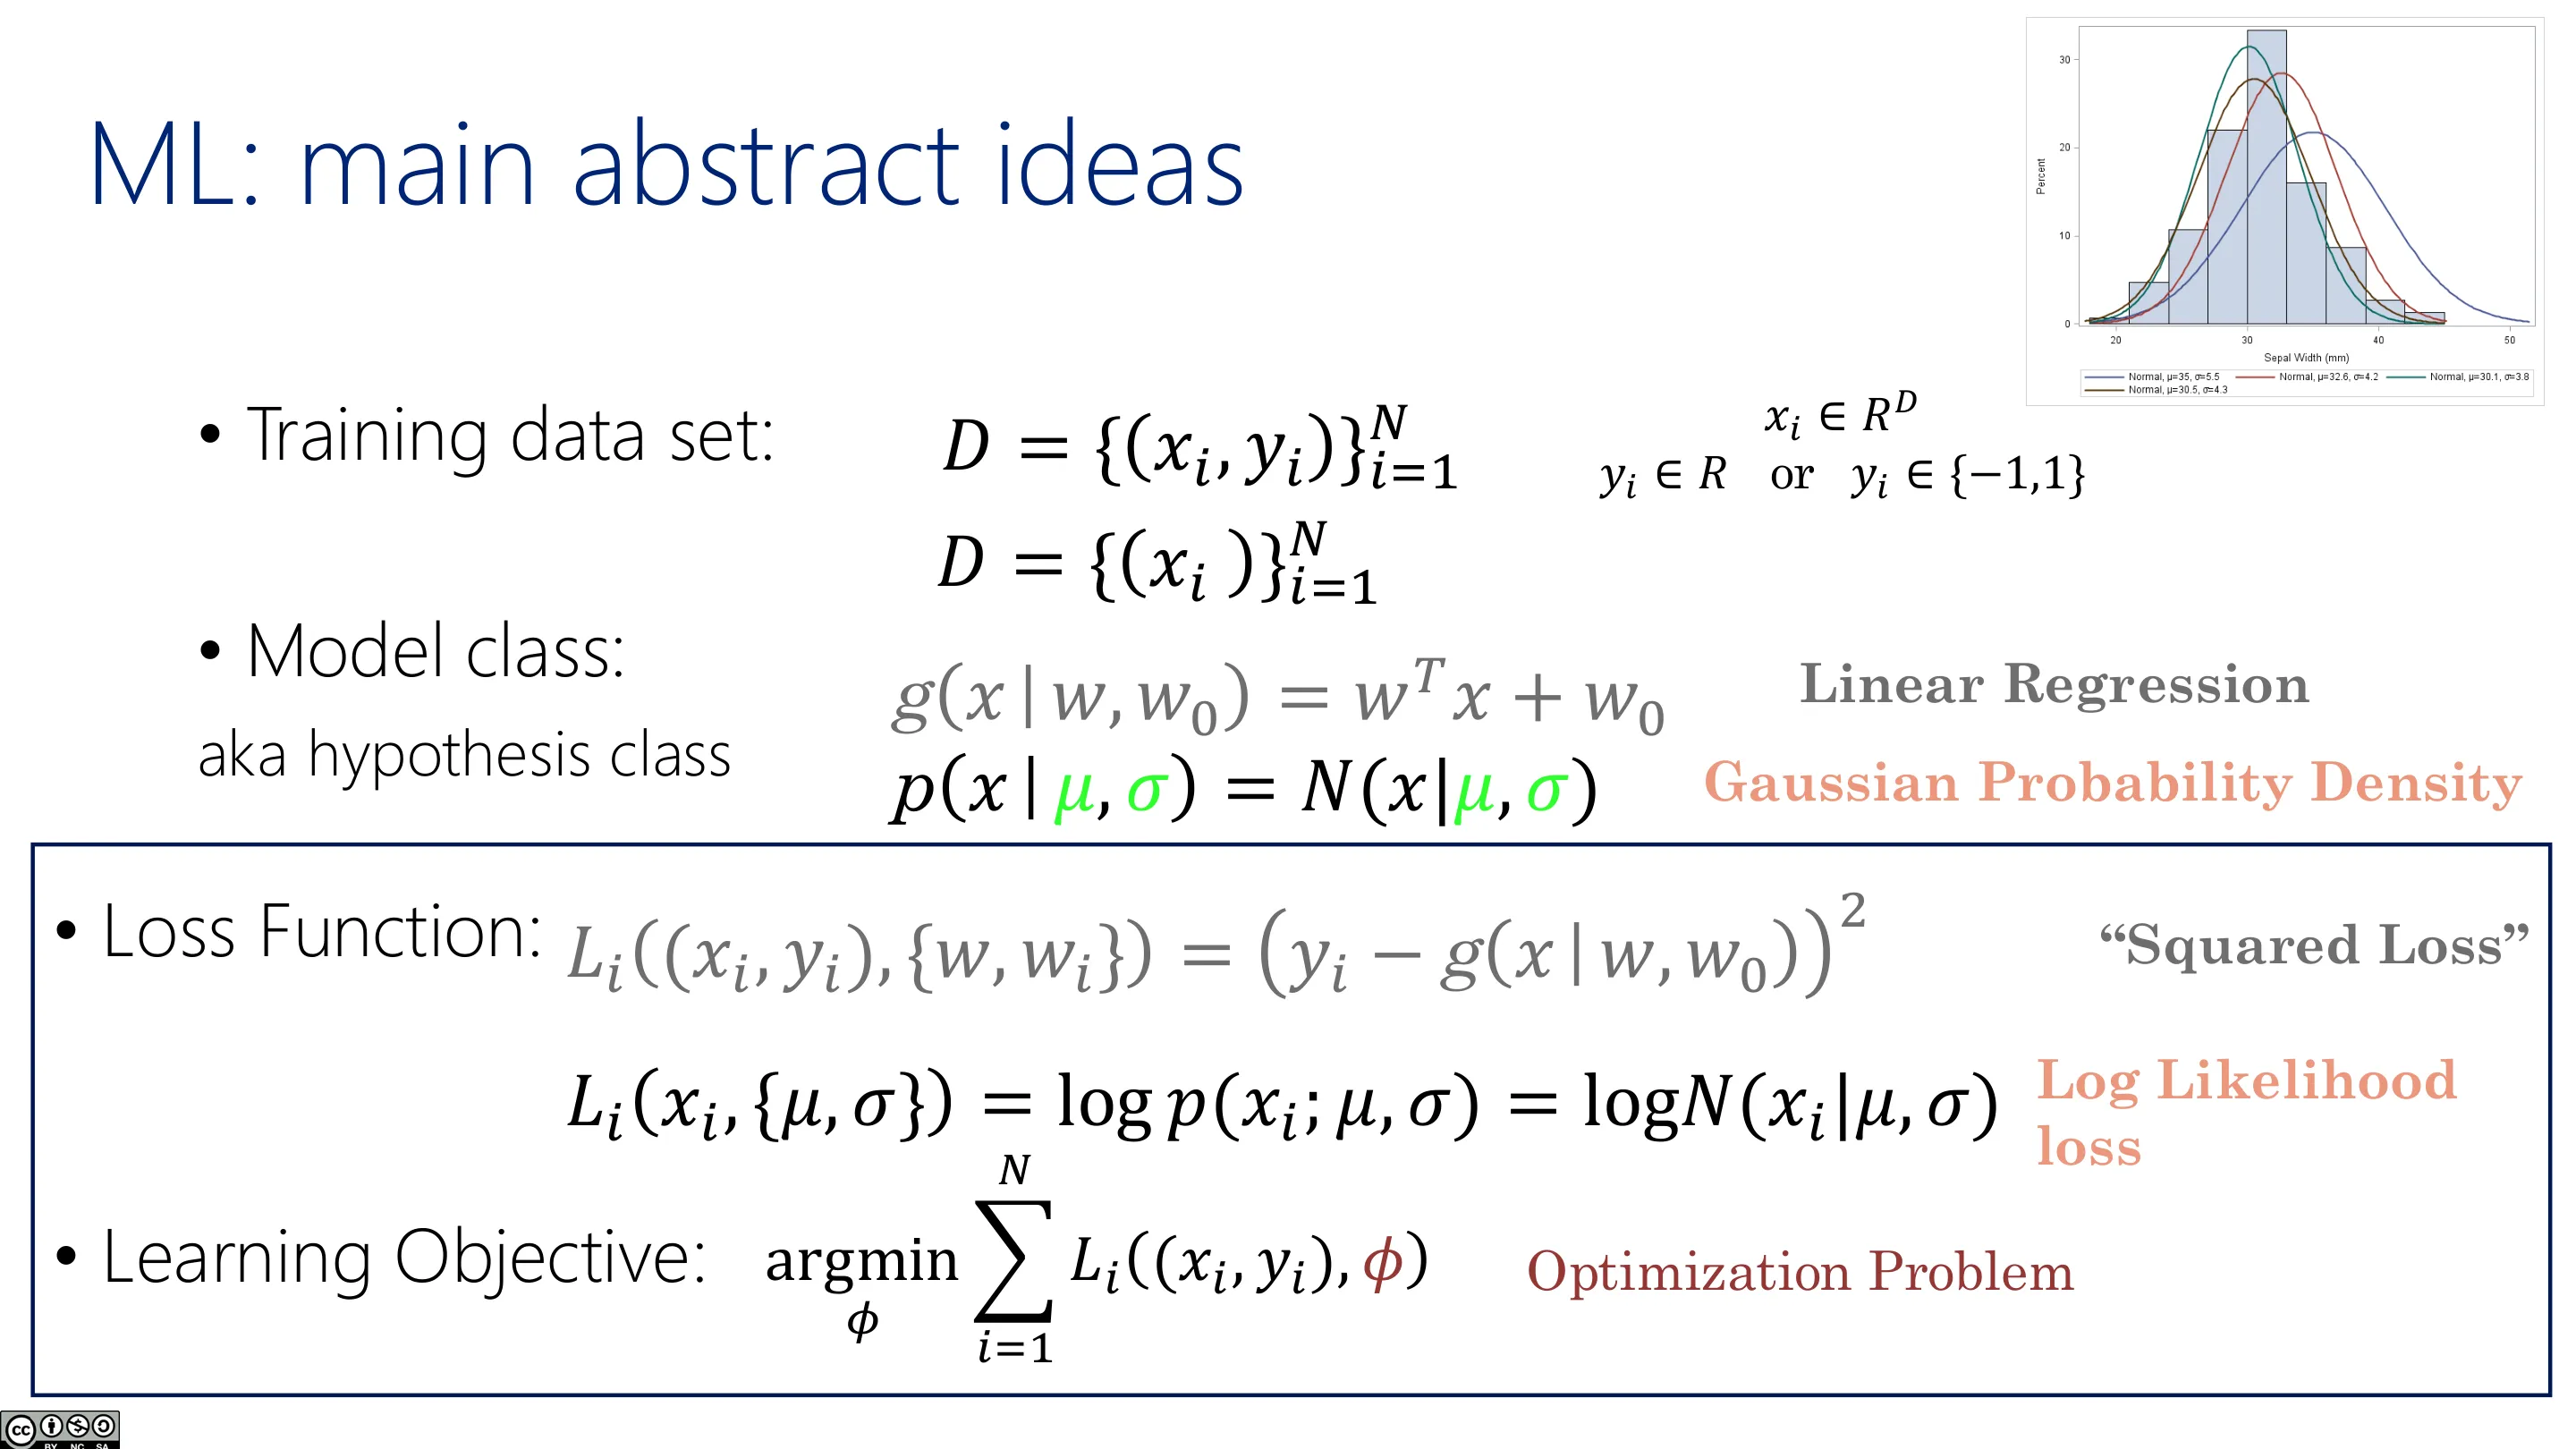
📷 线性回归模型(三)
回到原视频 (00:12:27)编者说明:平方损失其实可以从最大似然原理推导出来——对高斯噪声假设下的线性回归做 MLE,得到的正是平方损失。今天先讲 MLE 这个「母原理」。
二、最大似然估计(MLE)
(参考时间: 00:13)
2.1 MLE 不是损失函数,而是「导出损失函数」的原理
关键澄清:
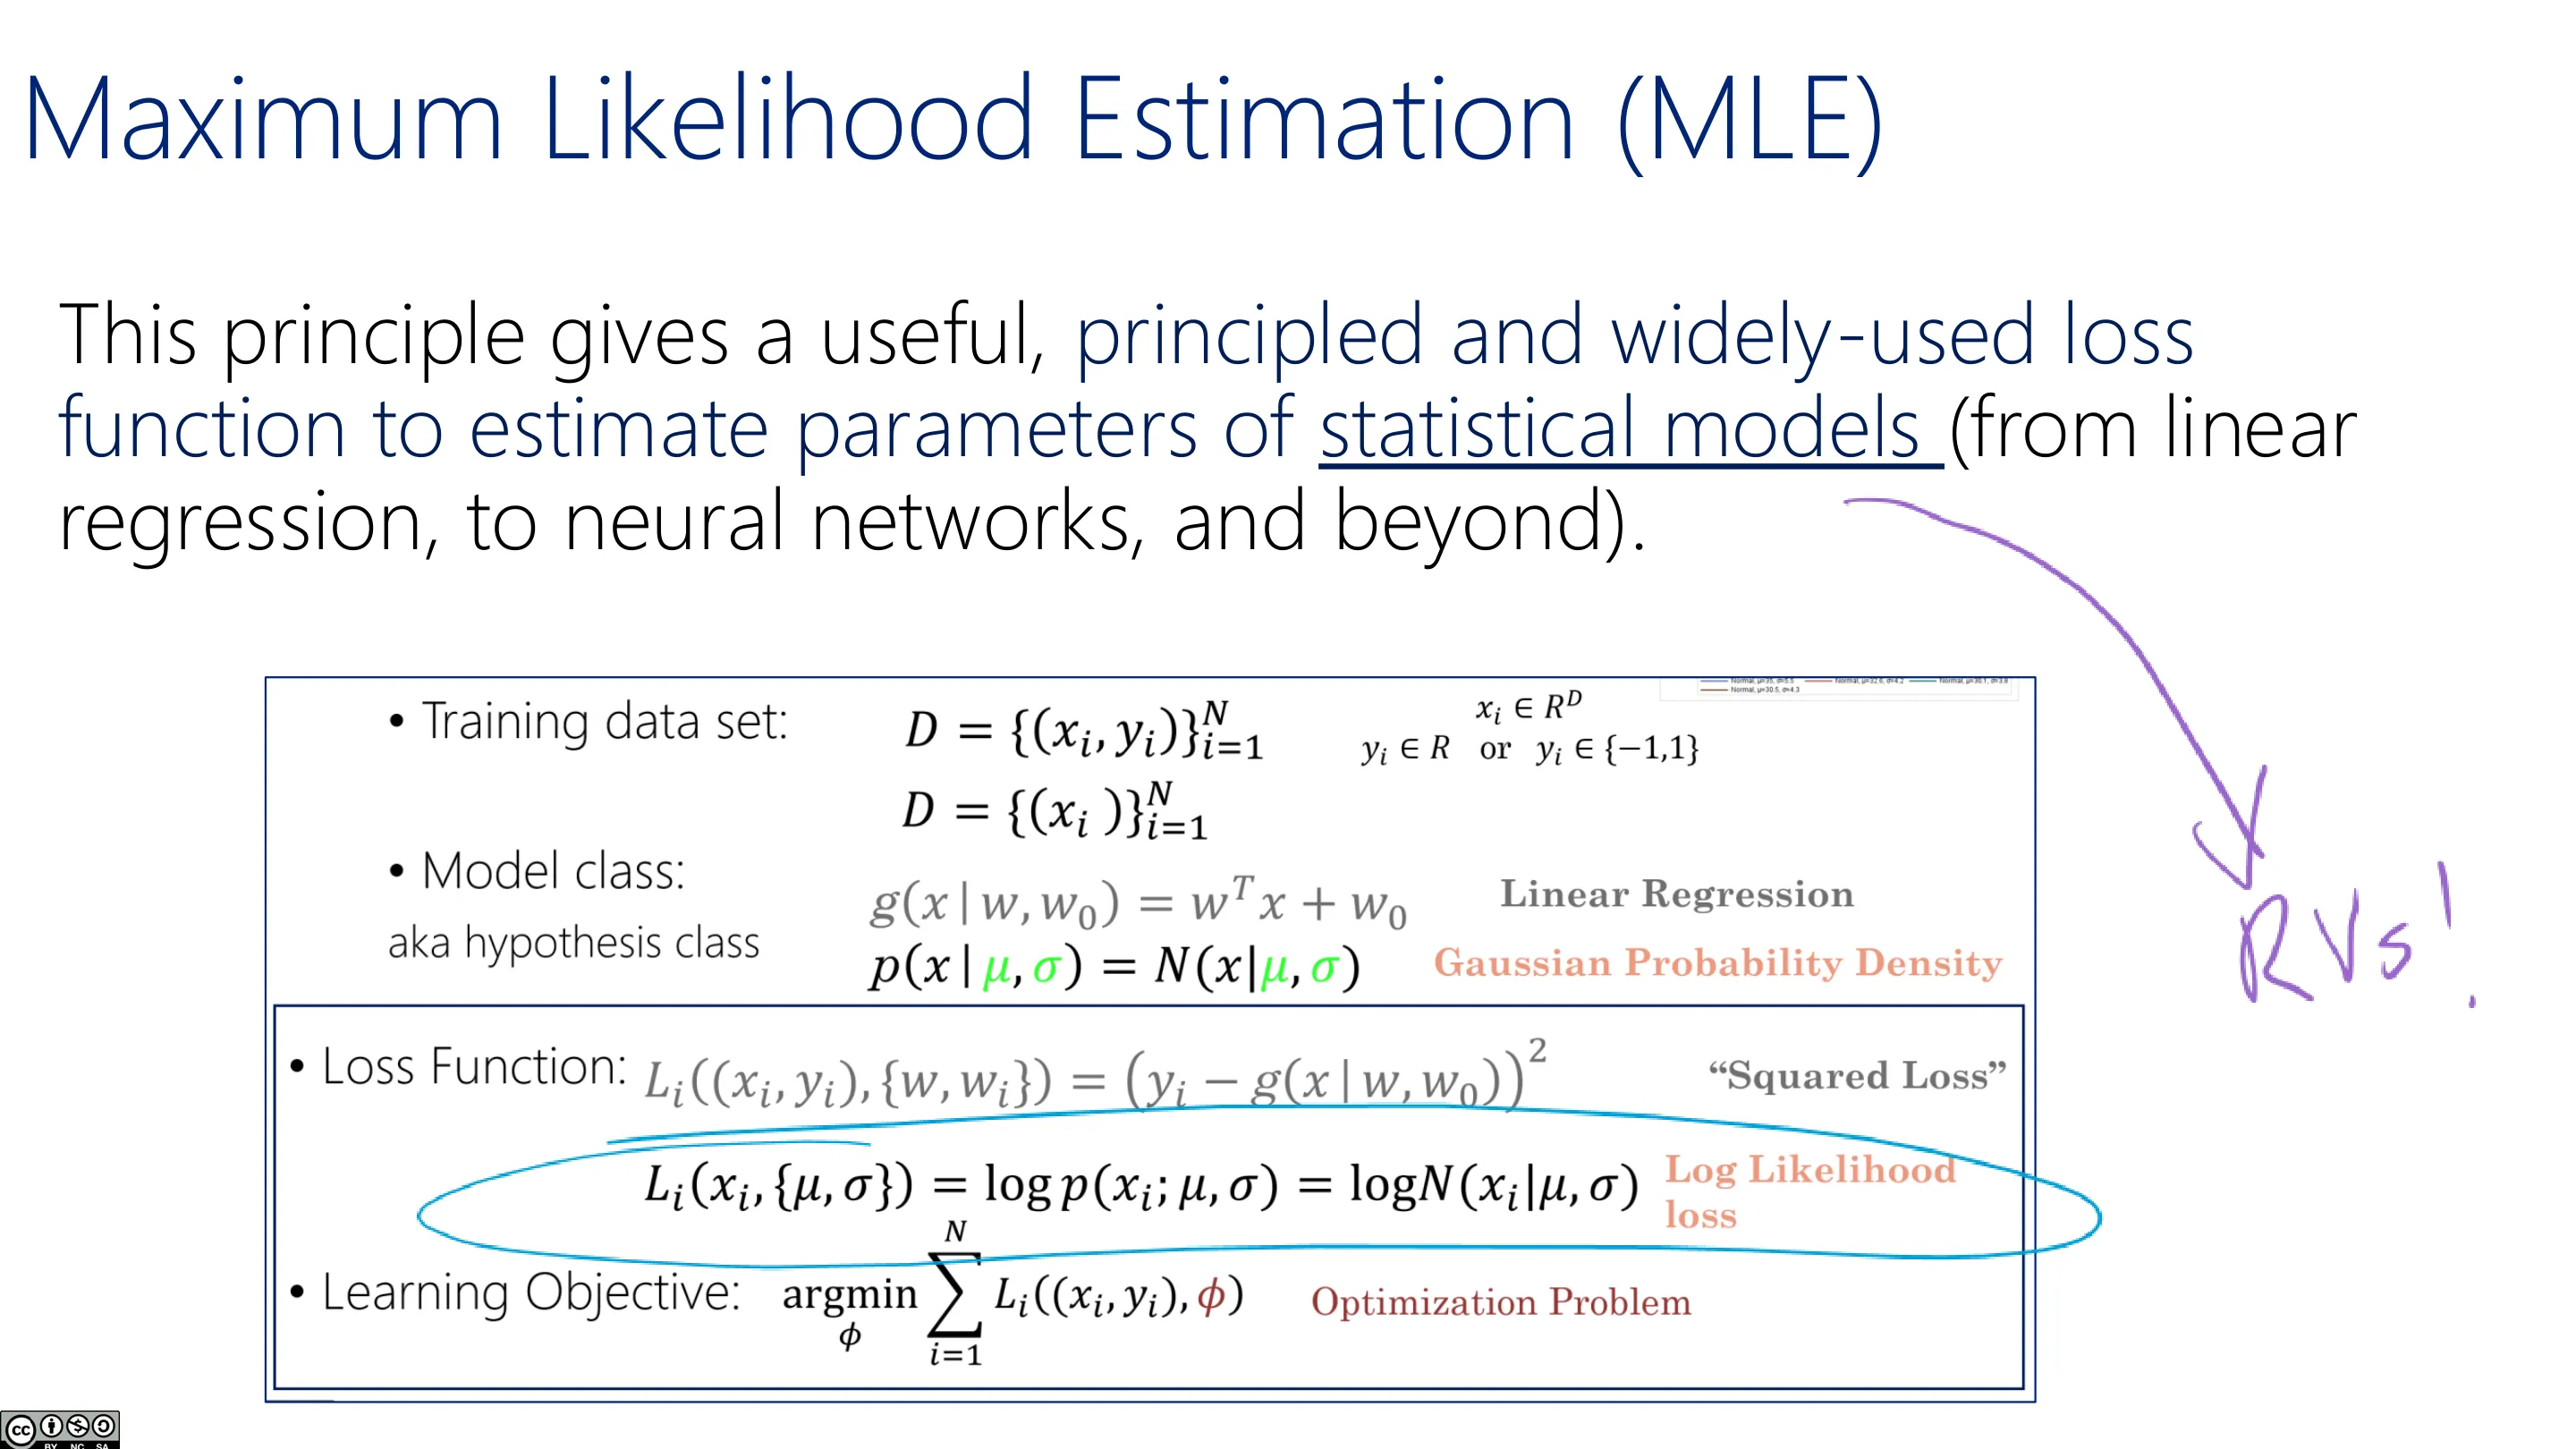
最大似然估计不是一个损失函数,而是一个可以「导出」损失函数的原理。
它说:把数据的似然(likelihood)本身当作损失函数,并最大化它。
- 似然 = 给定参数时,观测到这份数据的概率;
- 参数是变量,数据是固定的:我们针对参数优化似然;
- 因为要「最大化」,实践中常最大化对数似然(等价,因为对数单调递增),这也把乘积变成了求和,与机器学习中偏爱的「逐点损失求和」形式一致。
📷 最大似然估计(MLE)
回到原视频 (00:13:20)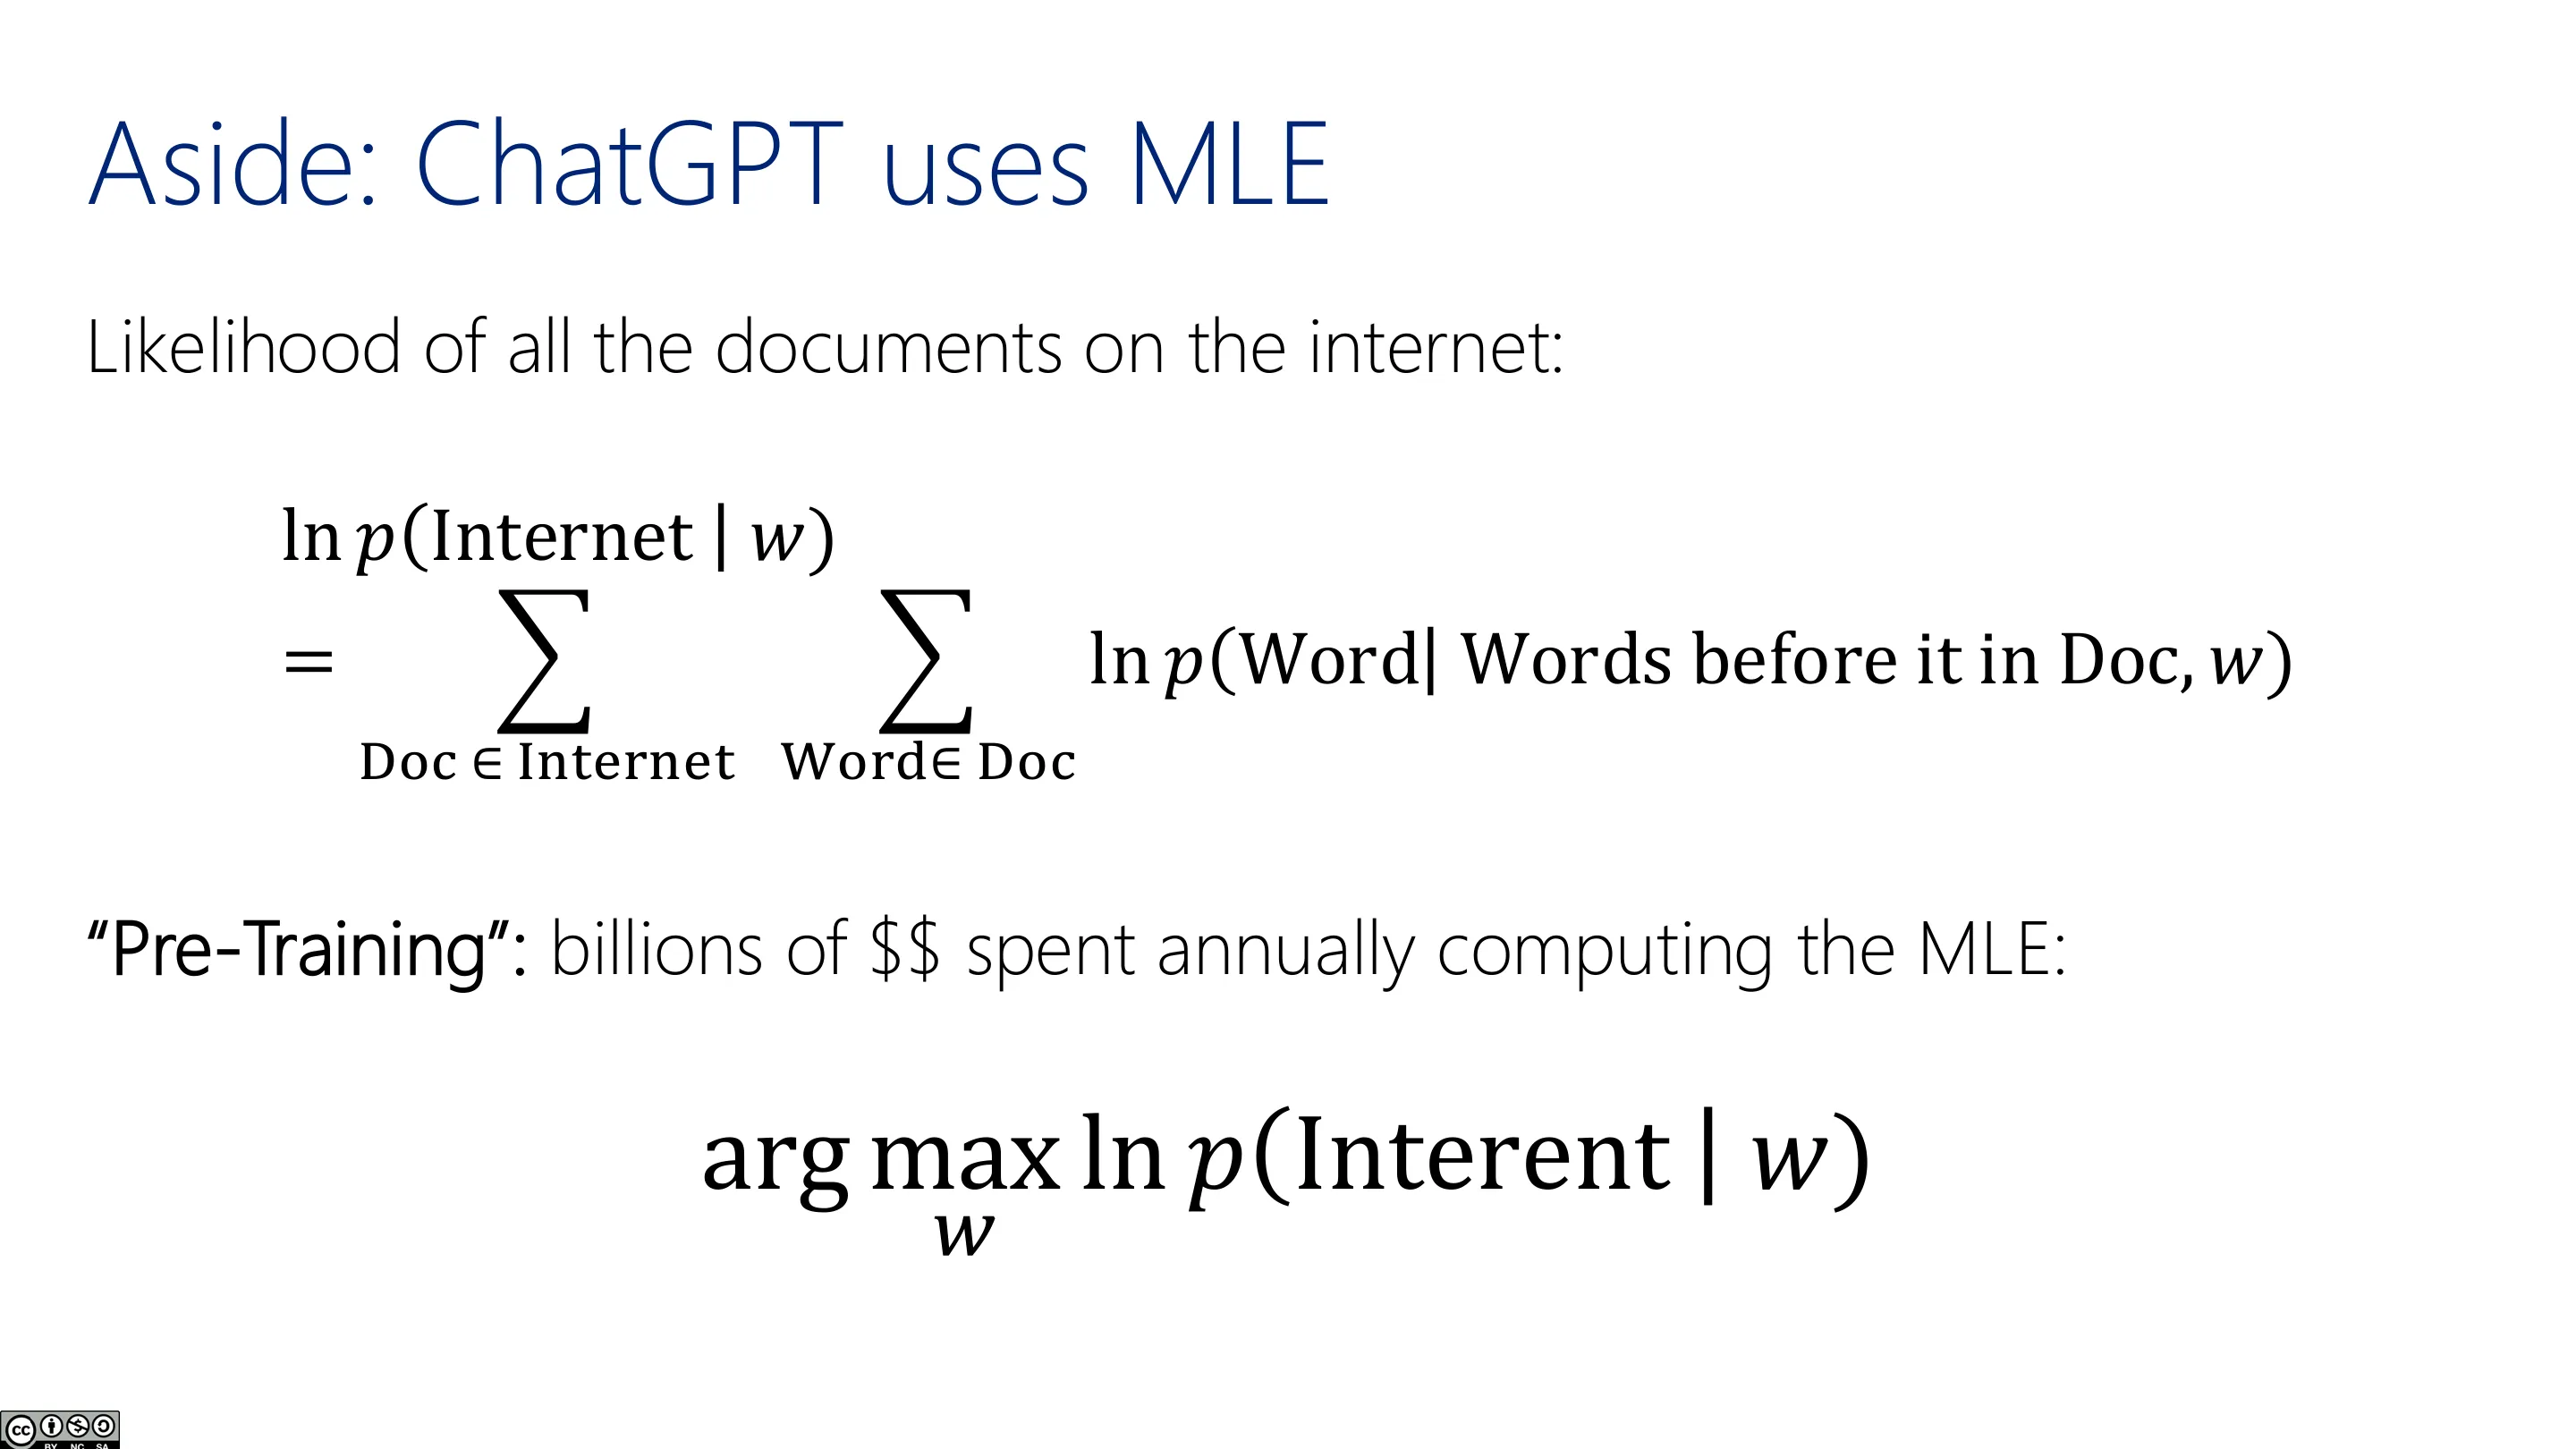
📷 旁注:ChatGPT 使用 MLE
回到原视频 (00:16:06)这是所有模型拟合方法的共同来源。讲师强调:你之后会学到线性回归、逻辑回归、神经网络、自编码器……无论哪种,起点都是「拿到数据 → 提模型类 → 写损失函数」。而今天课程里的损失函数几乎都由 MLE 推导而来。哪怕你听过的交叉熵(cross-entropy)和 KL 散度,本质上也是等价的。
一个现代应用:ChatGPT 用的就是 MLE。虽然论文里换了名字,但其核心是在预训练阶段定义一个损失,用互联网上所有文档,对每个文档计算「给定上下文时该词出现概率」的加权和,然后花巨资优化参数 $w$。
三、概率分布复习
(参考时间: 00:20)
3.1 离散与连续随机变量
- 离散随机变量有概率质量函数(PMF):状态空间里每个取值对应一个概率质量,且全部求和为 1。
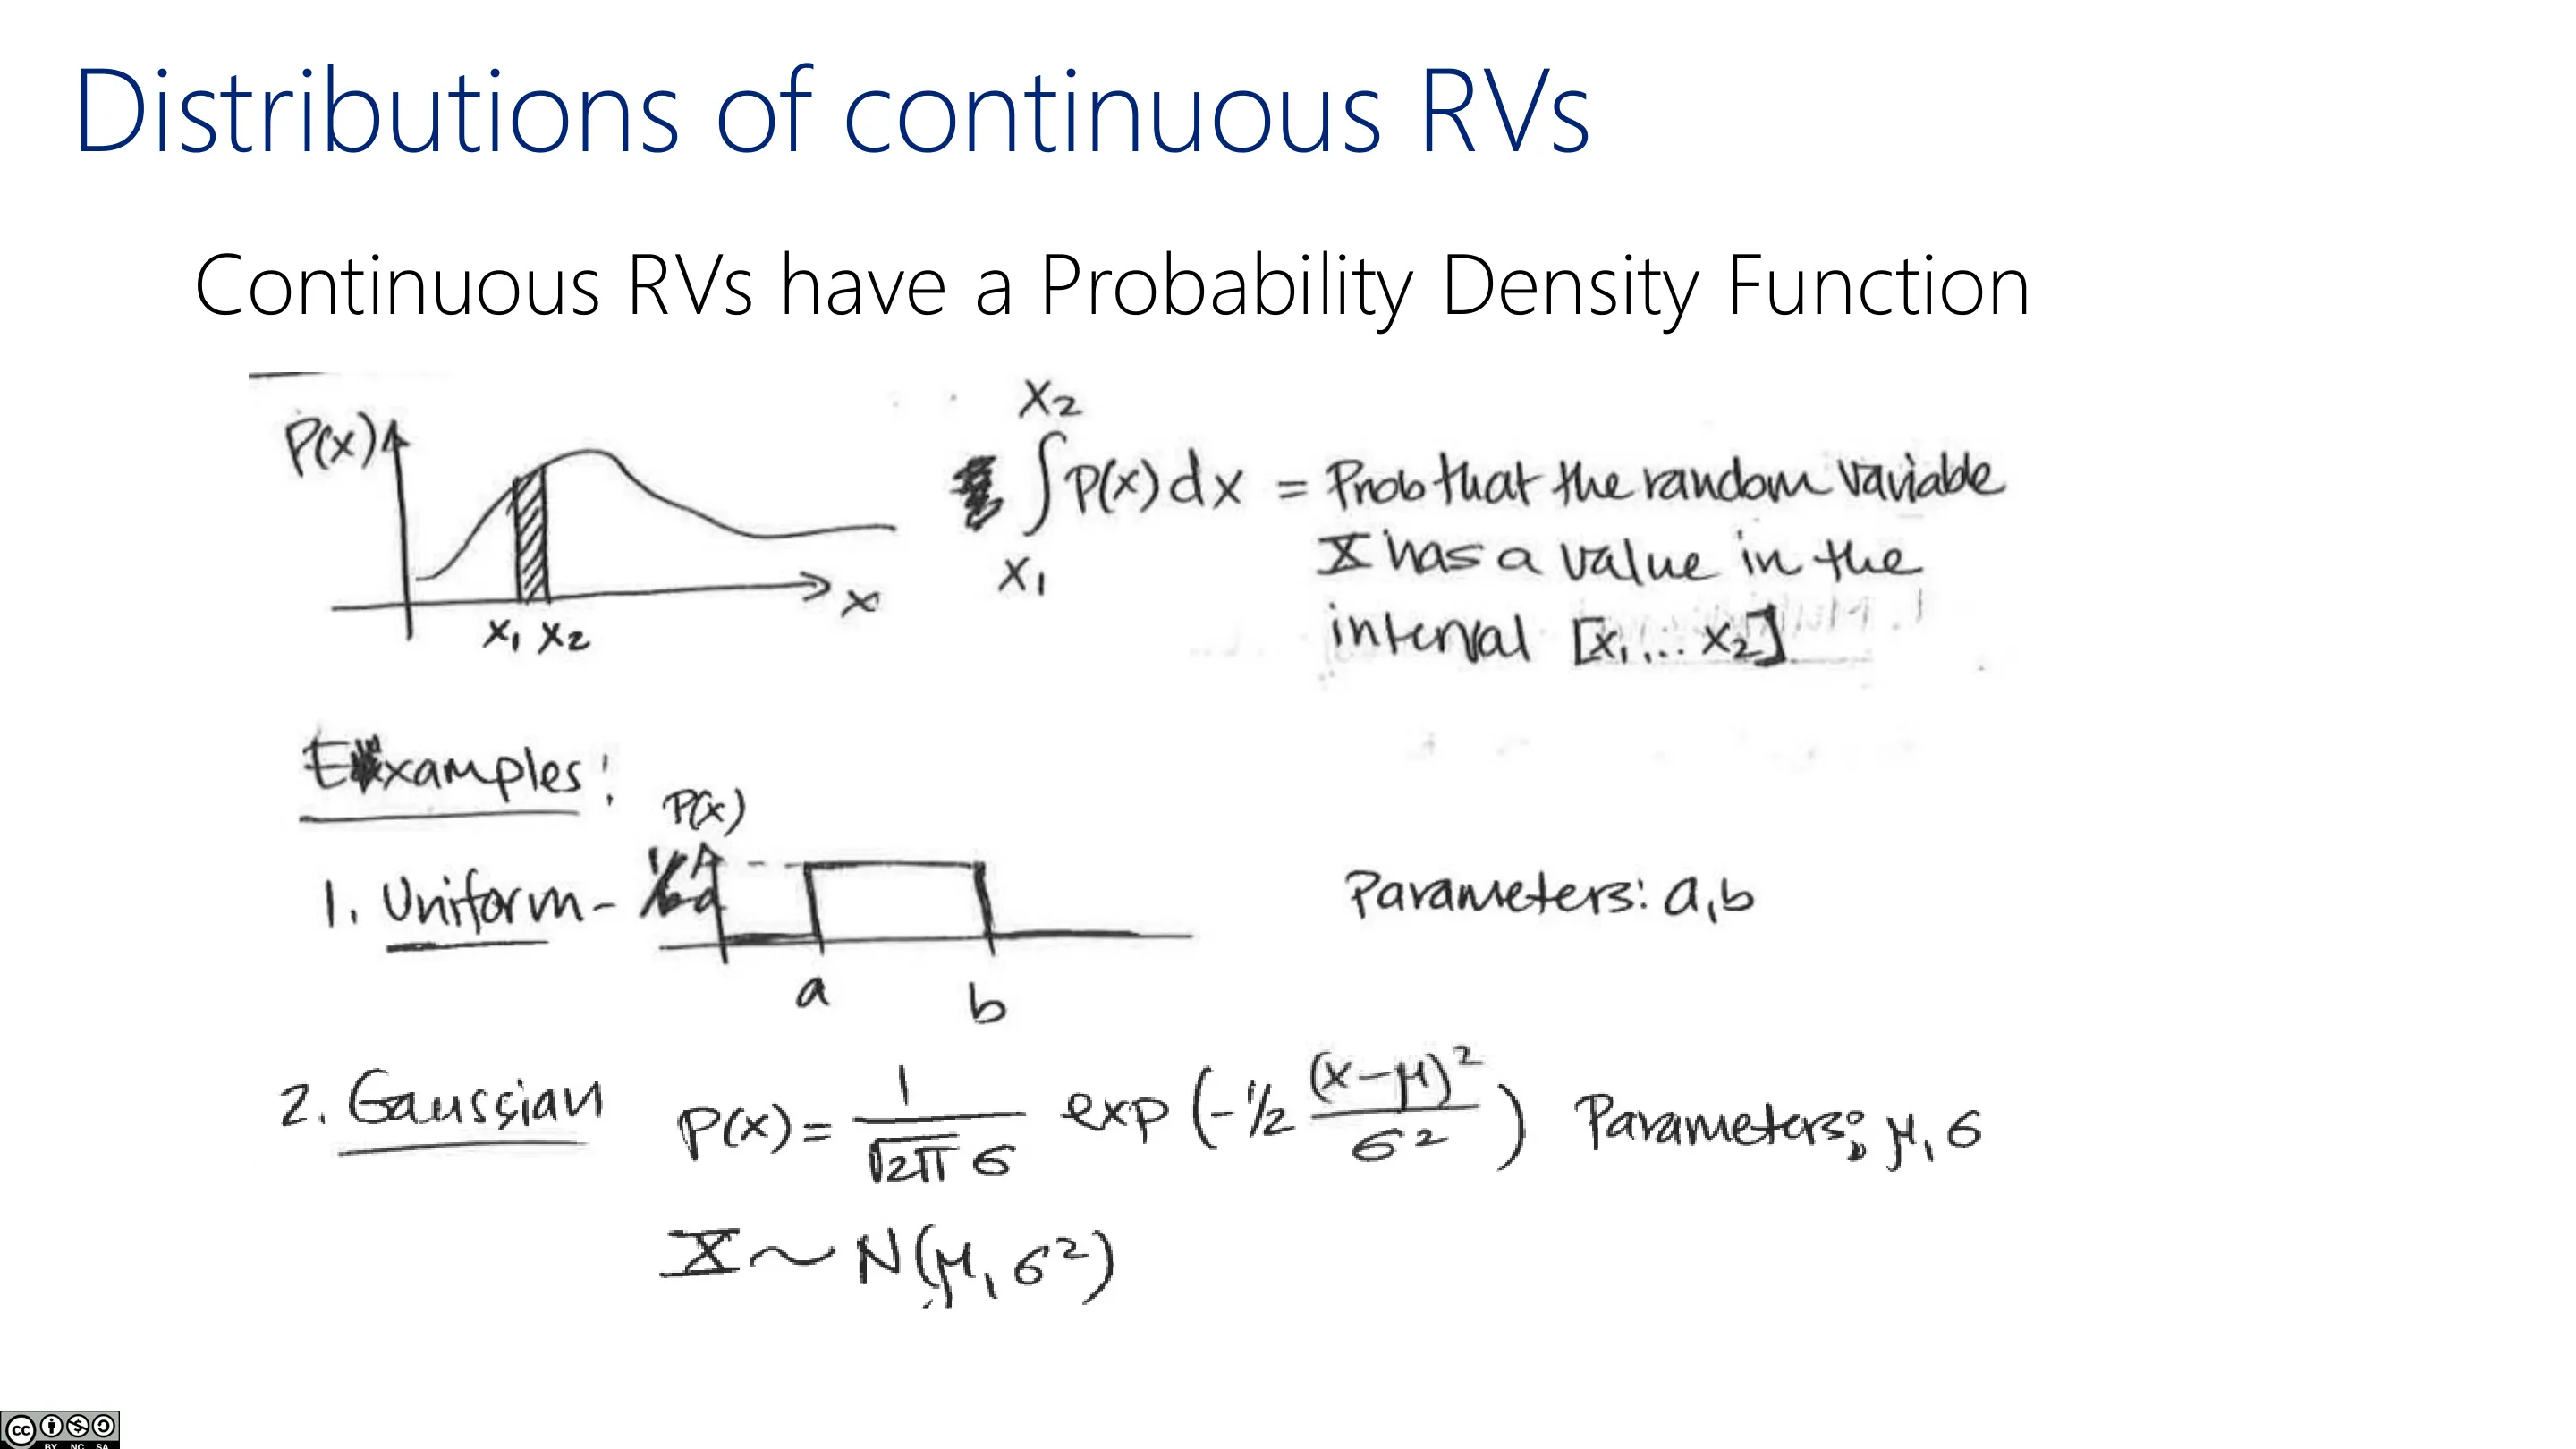
- 连续随机变量有概率密度函数(PDF):不能直接从密度读出事件概率,必须积分。例如「身高落在 $[x_1, x_2]$ 的概率」= 对 $x_1$ 到 $x_2$ 积分;单点的概率为零。
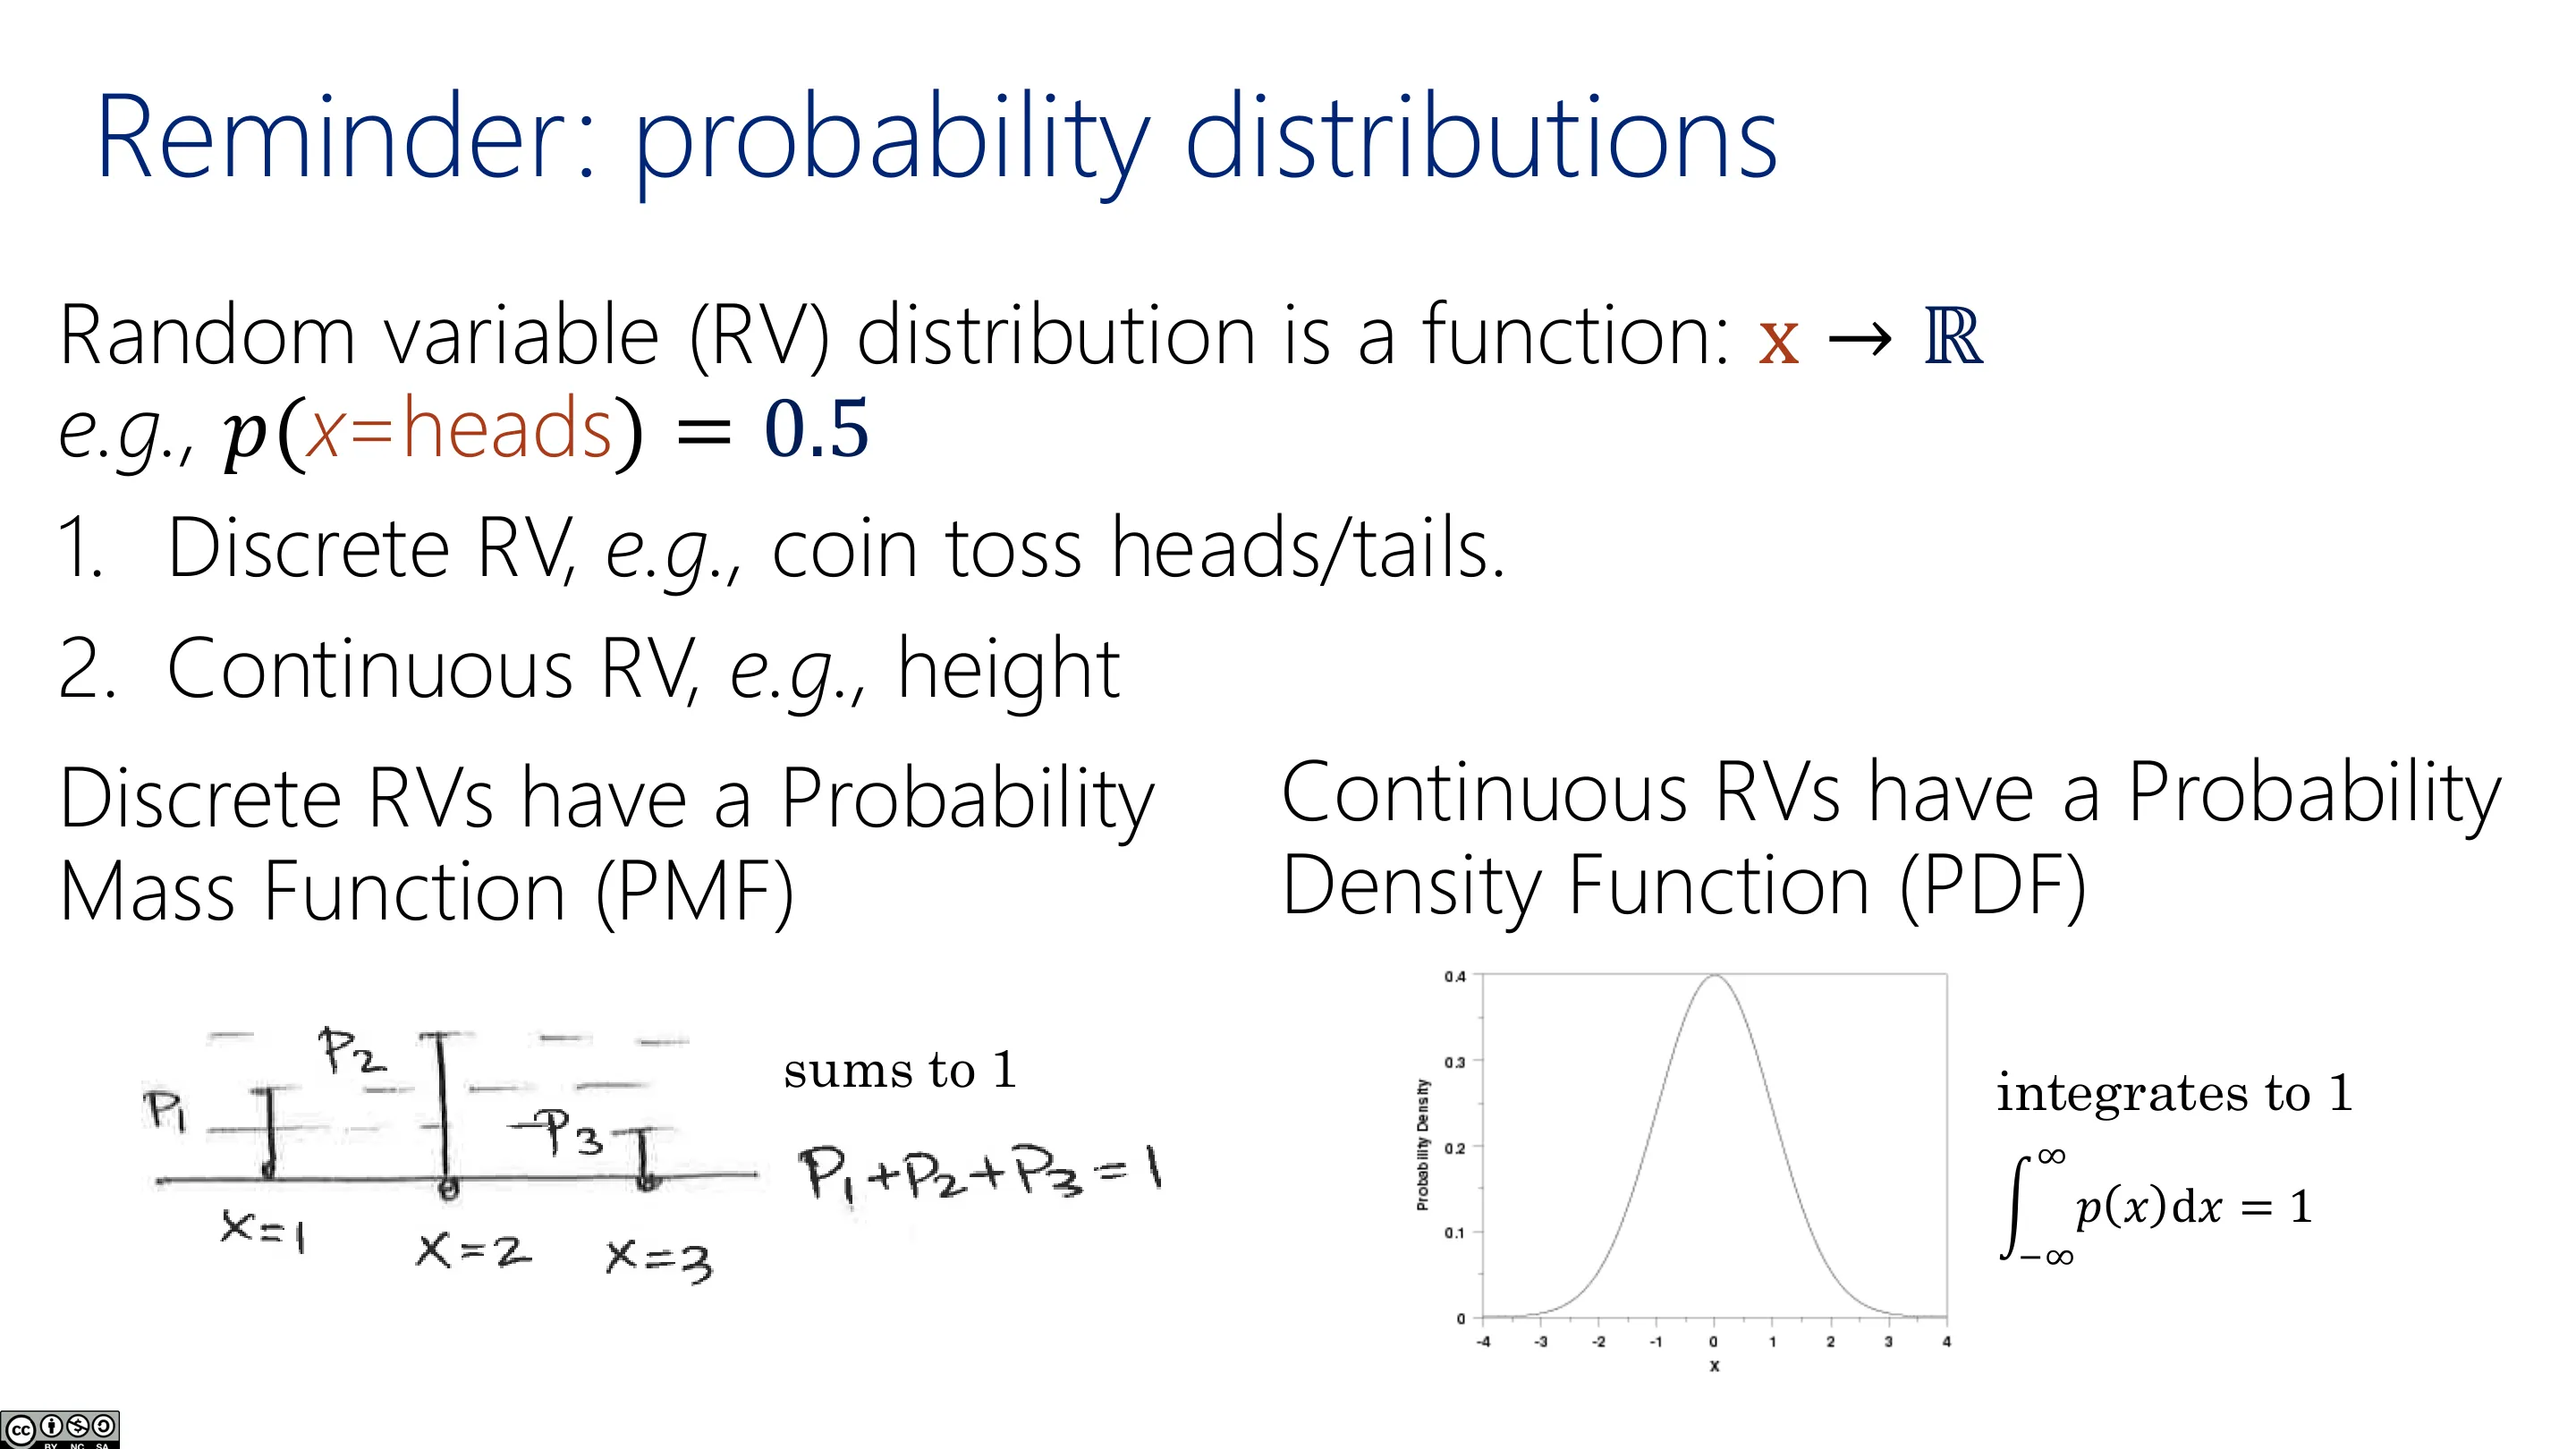
📷 概率分布回顾
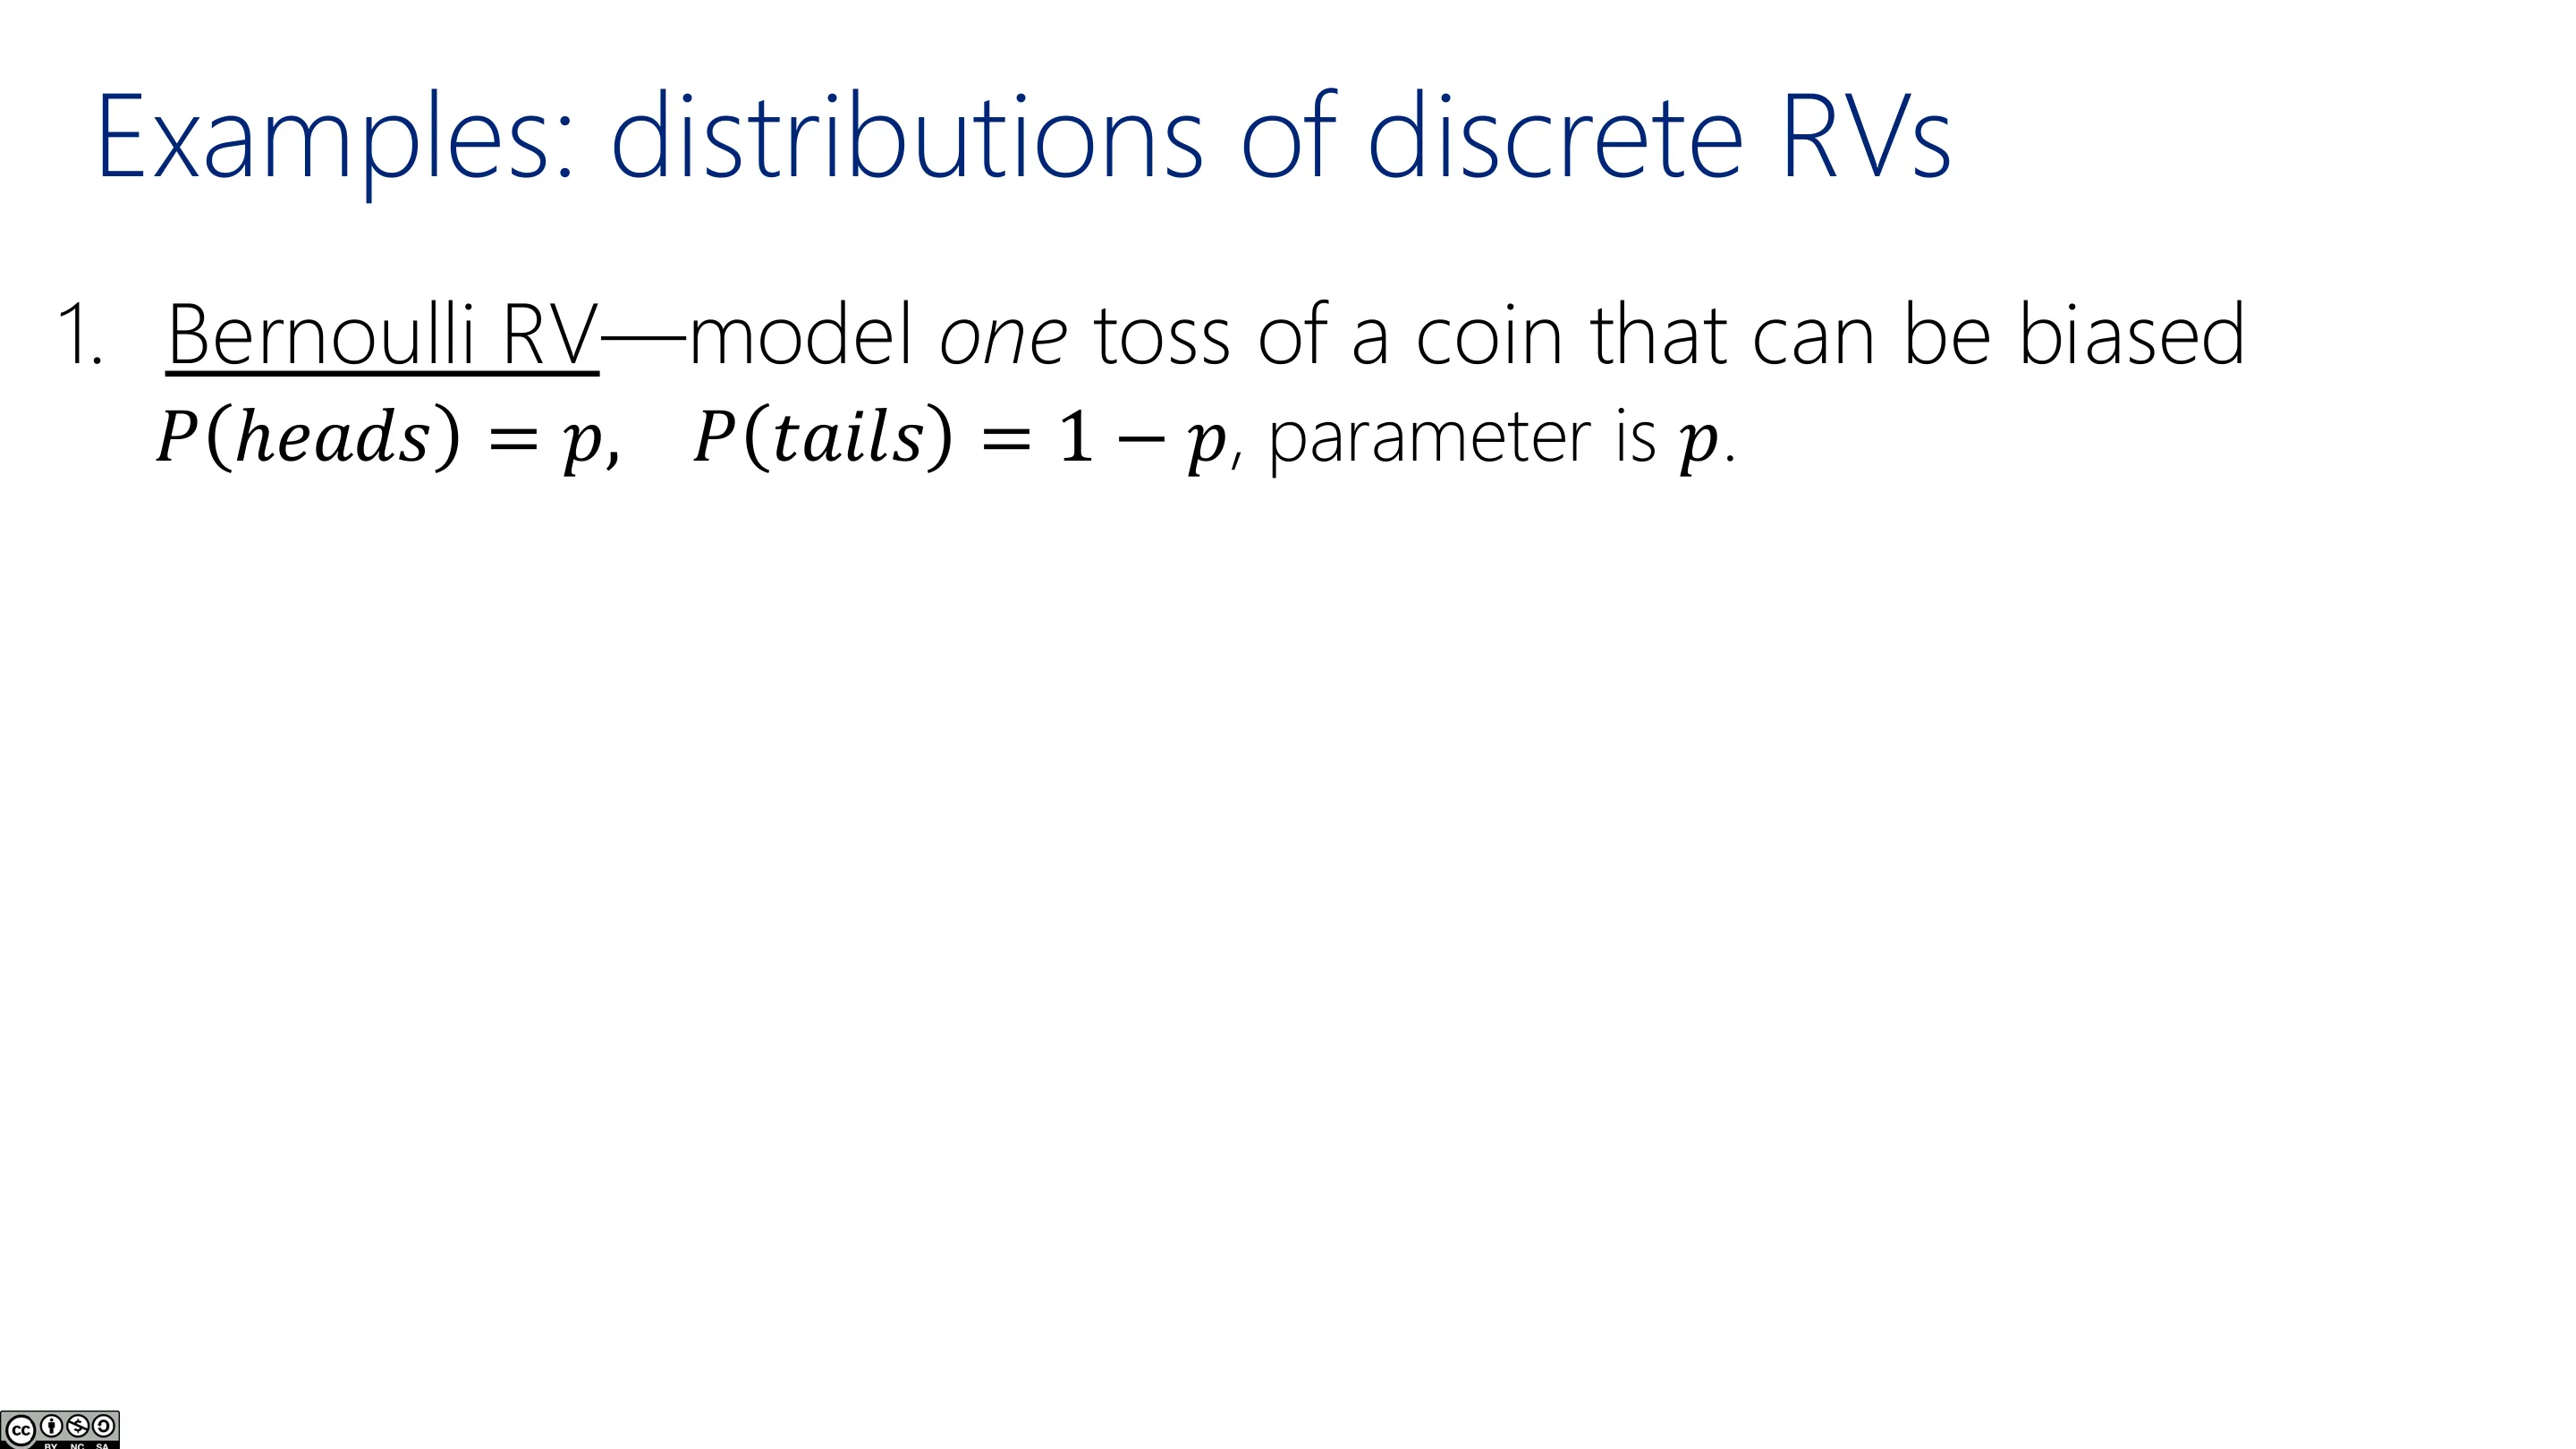
回到原视频 (00:20:08)离散分布的常见例子:
- 伯努利分布(Bernoulli):一次抛硬币,参数 $p$(正面概率),反面概率 $1-p$;
- 二项分布(Binomial):$n$ 次试验中出现 $k$ 次正面的概率,含二项式系数;
- 泊松分布(Poisson):单位时间内事件发生次数(如细胞突变率 $\lambda$),在计算生物学中常用。
📷 离散随机变量分布(一)
回到原视频 (00:22:06)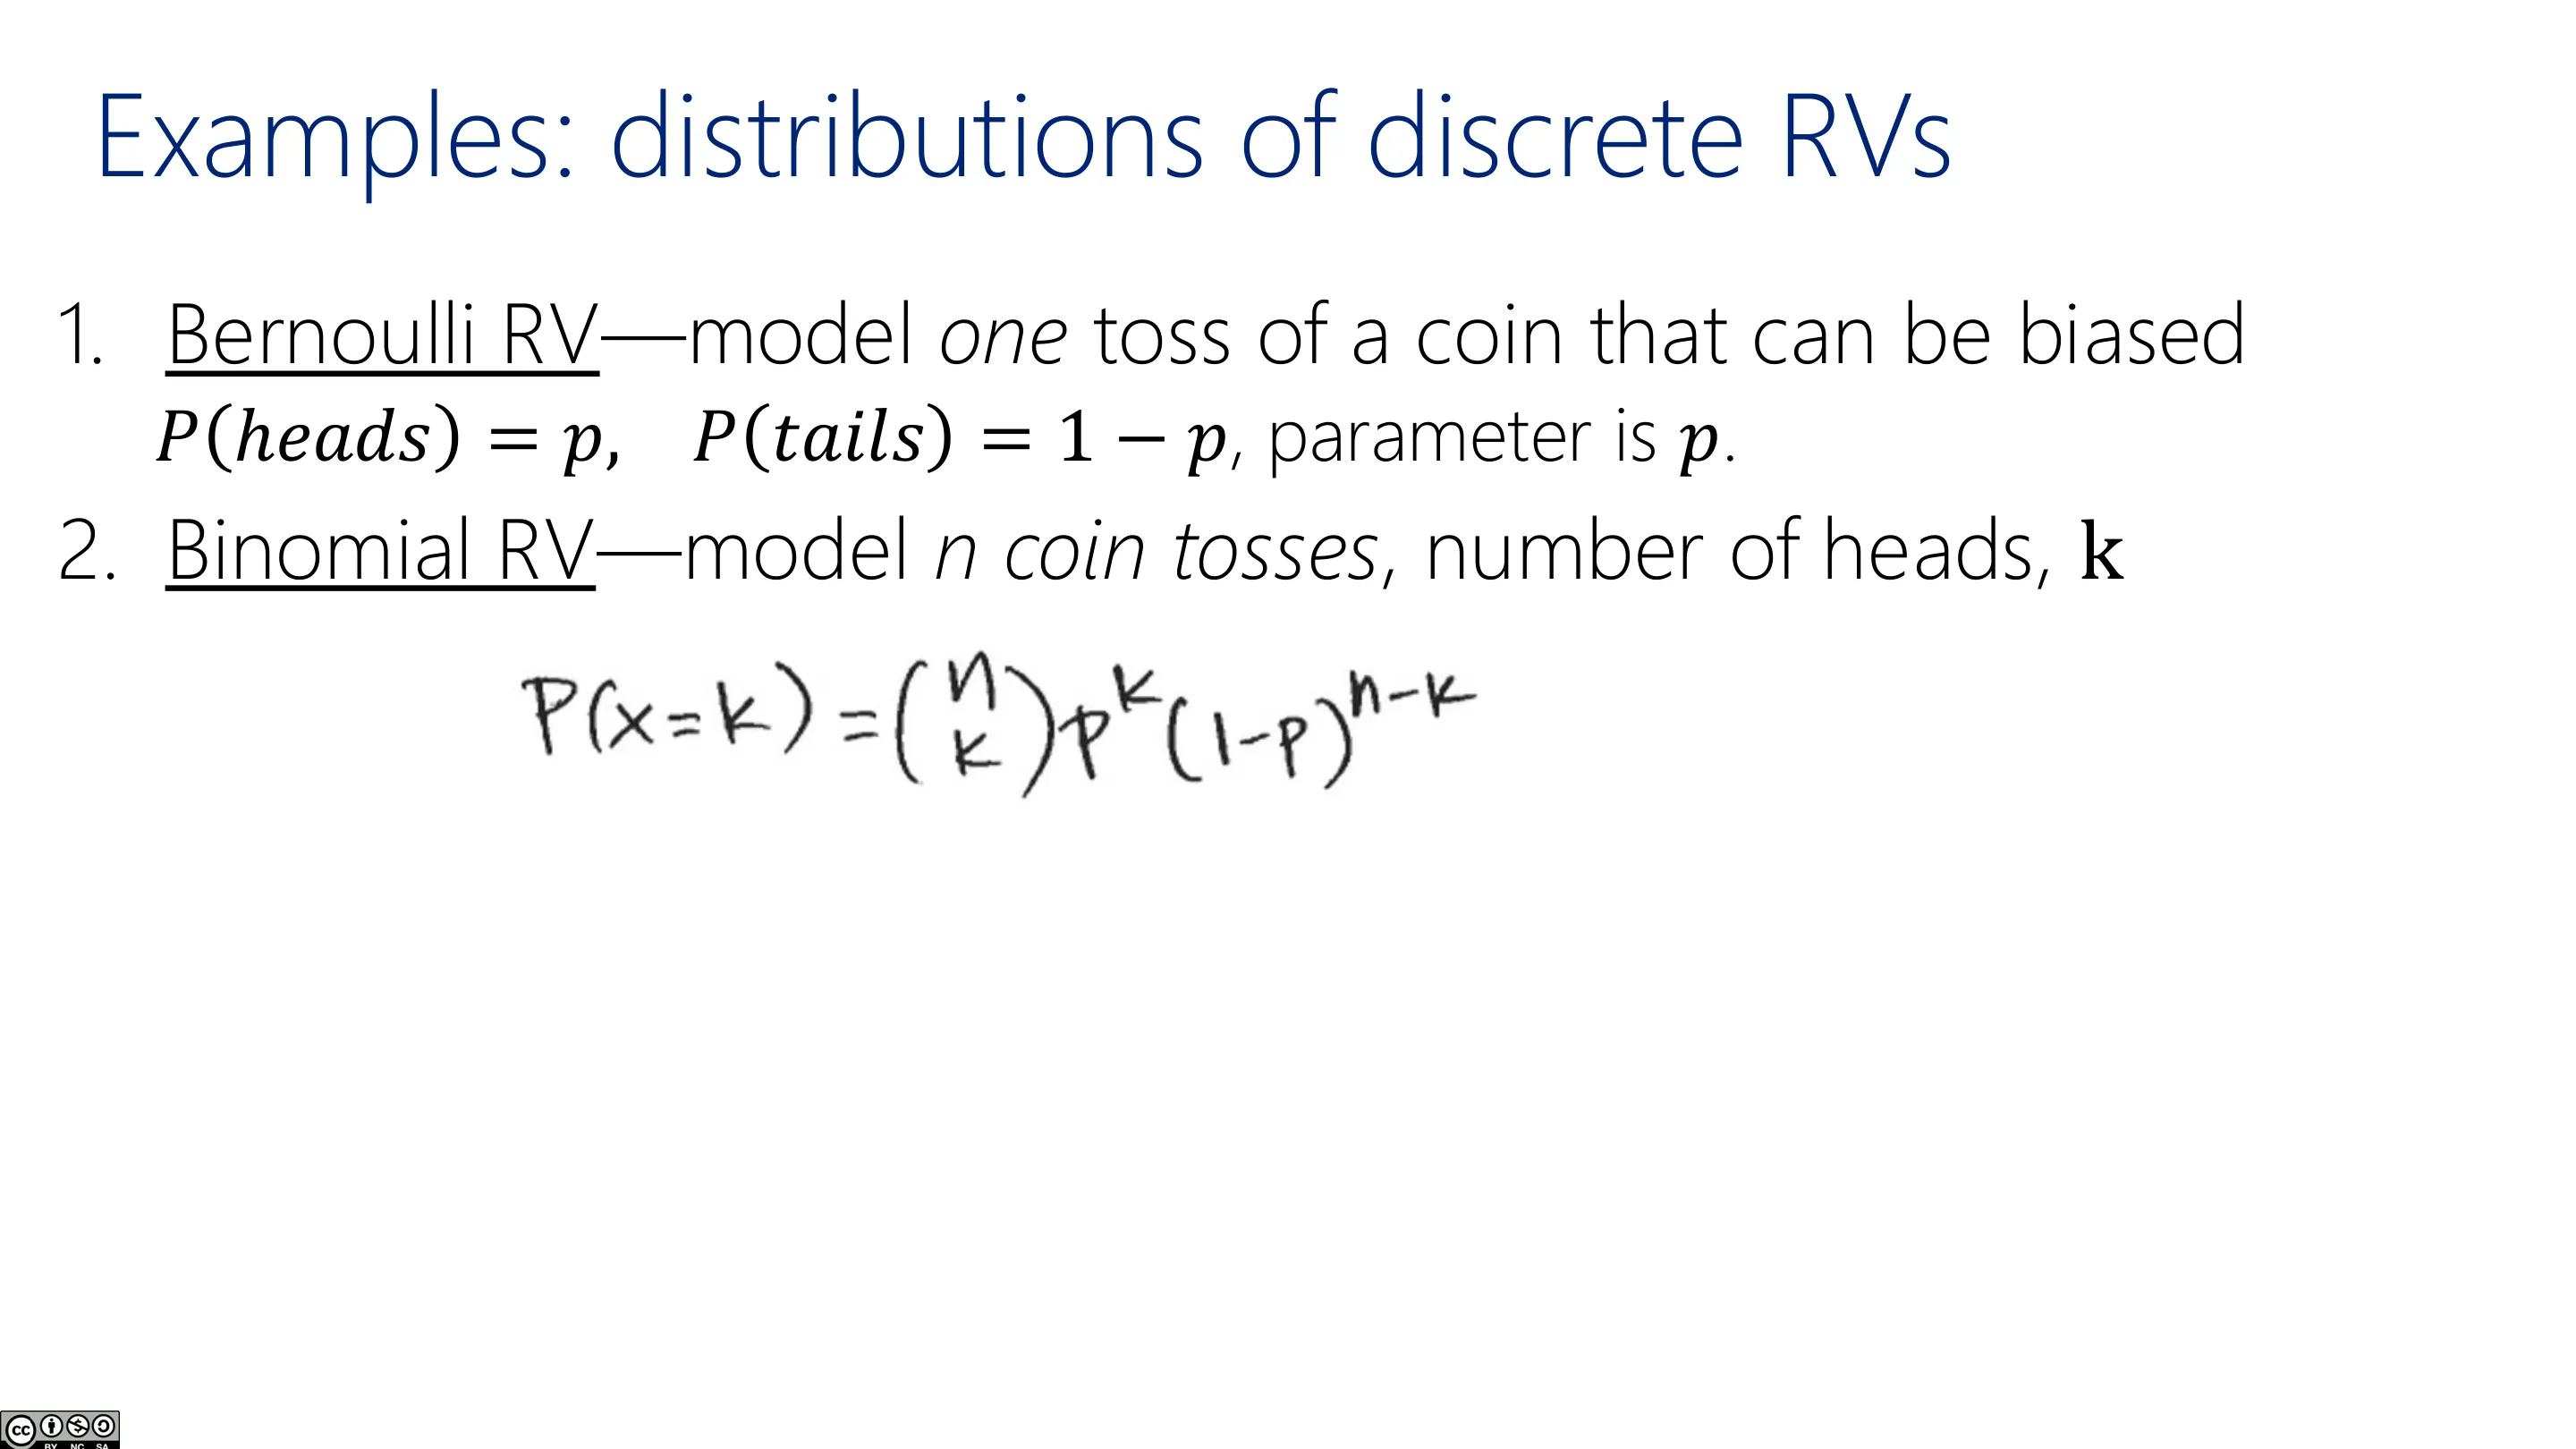
📷 离散随机变量分布(二)
回到原视频 (00:22:29)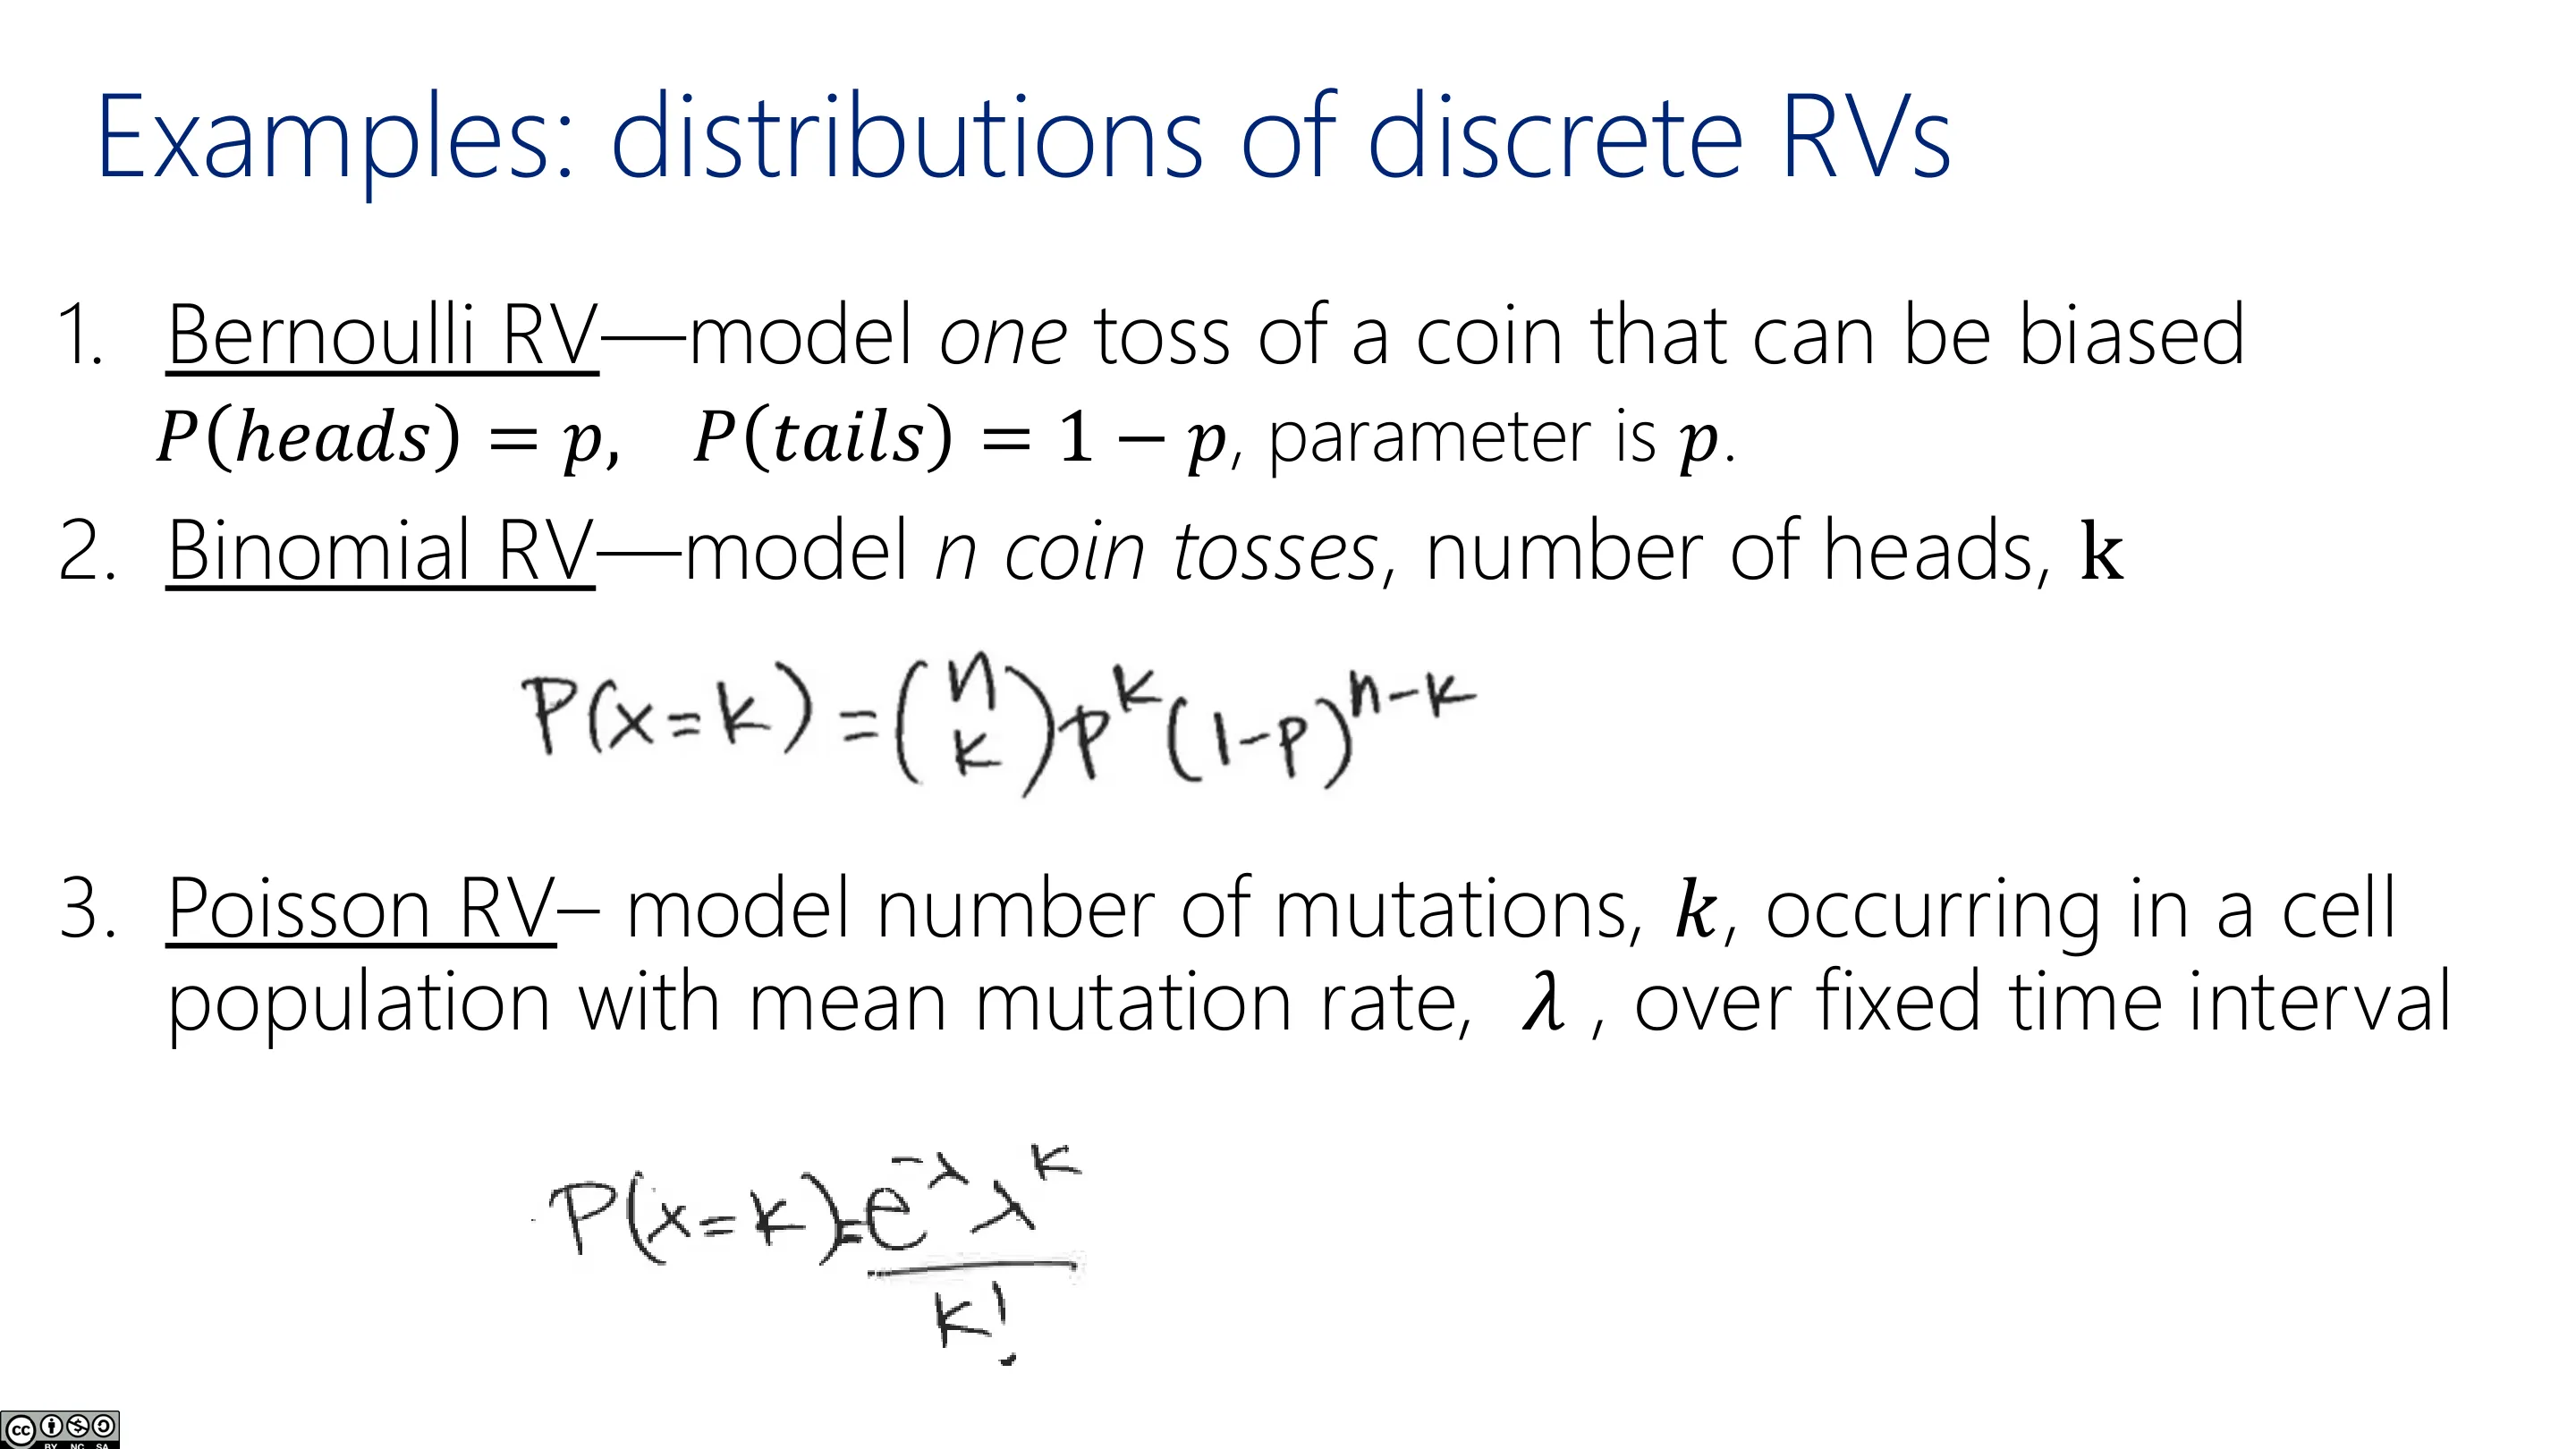
📷 离散随机变量分布(三)
回到原视频 (00:22:46)连续分布:
- 均匀分布(Uniform):区间外概率为 0、区间内为常数,由归一化约束决定其高度为 $1/(b-a)$;
- 高斯分布(Gaussian / Normal):古典统计学与现代机器学习的「主角」:
$$ p(x) = \frac{1}{\sqrt{2\pi\sigma^2}} \exp\!\left(-\frac{(x-\mu)^2}{2\sigma^2}\right), \qquad X \sim \mathcal{N}(\mu, \sigma^2) $$
📷 连续随机变量的分布
回到原视频 (00:23:46)3.2 多元分布
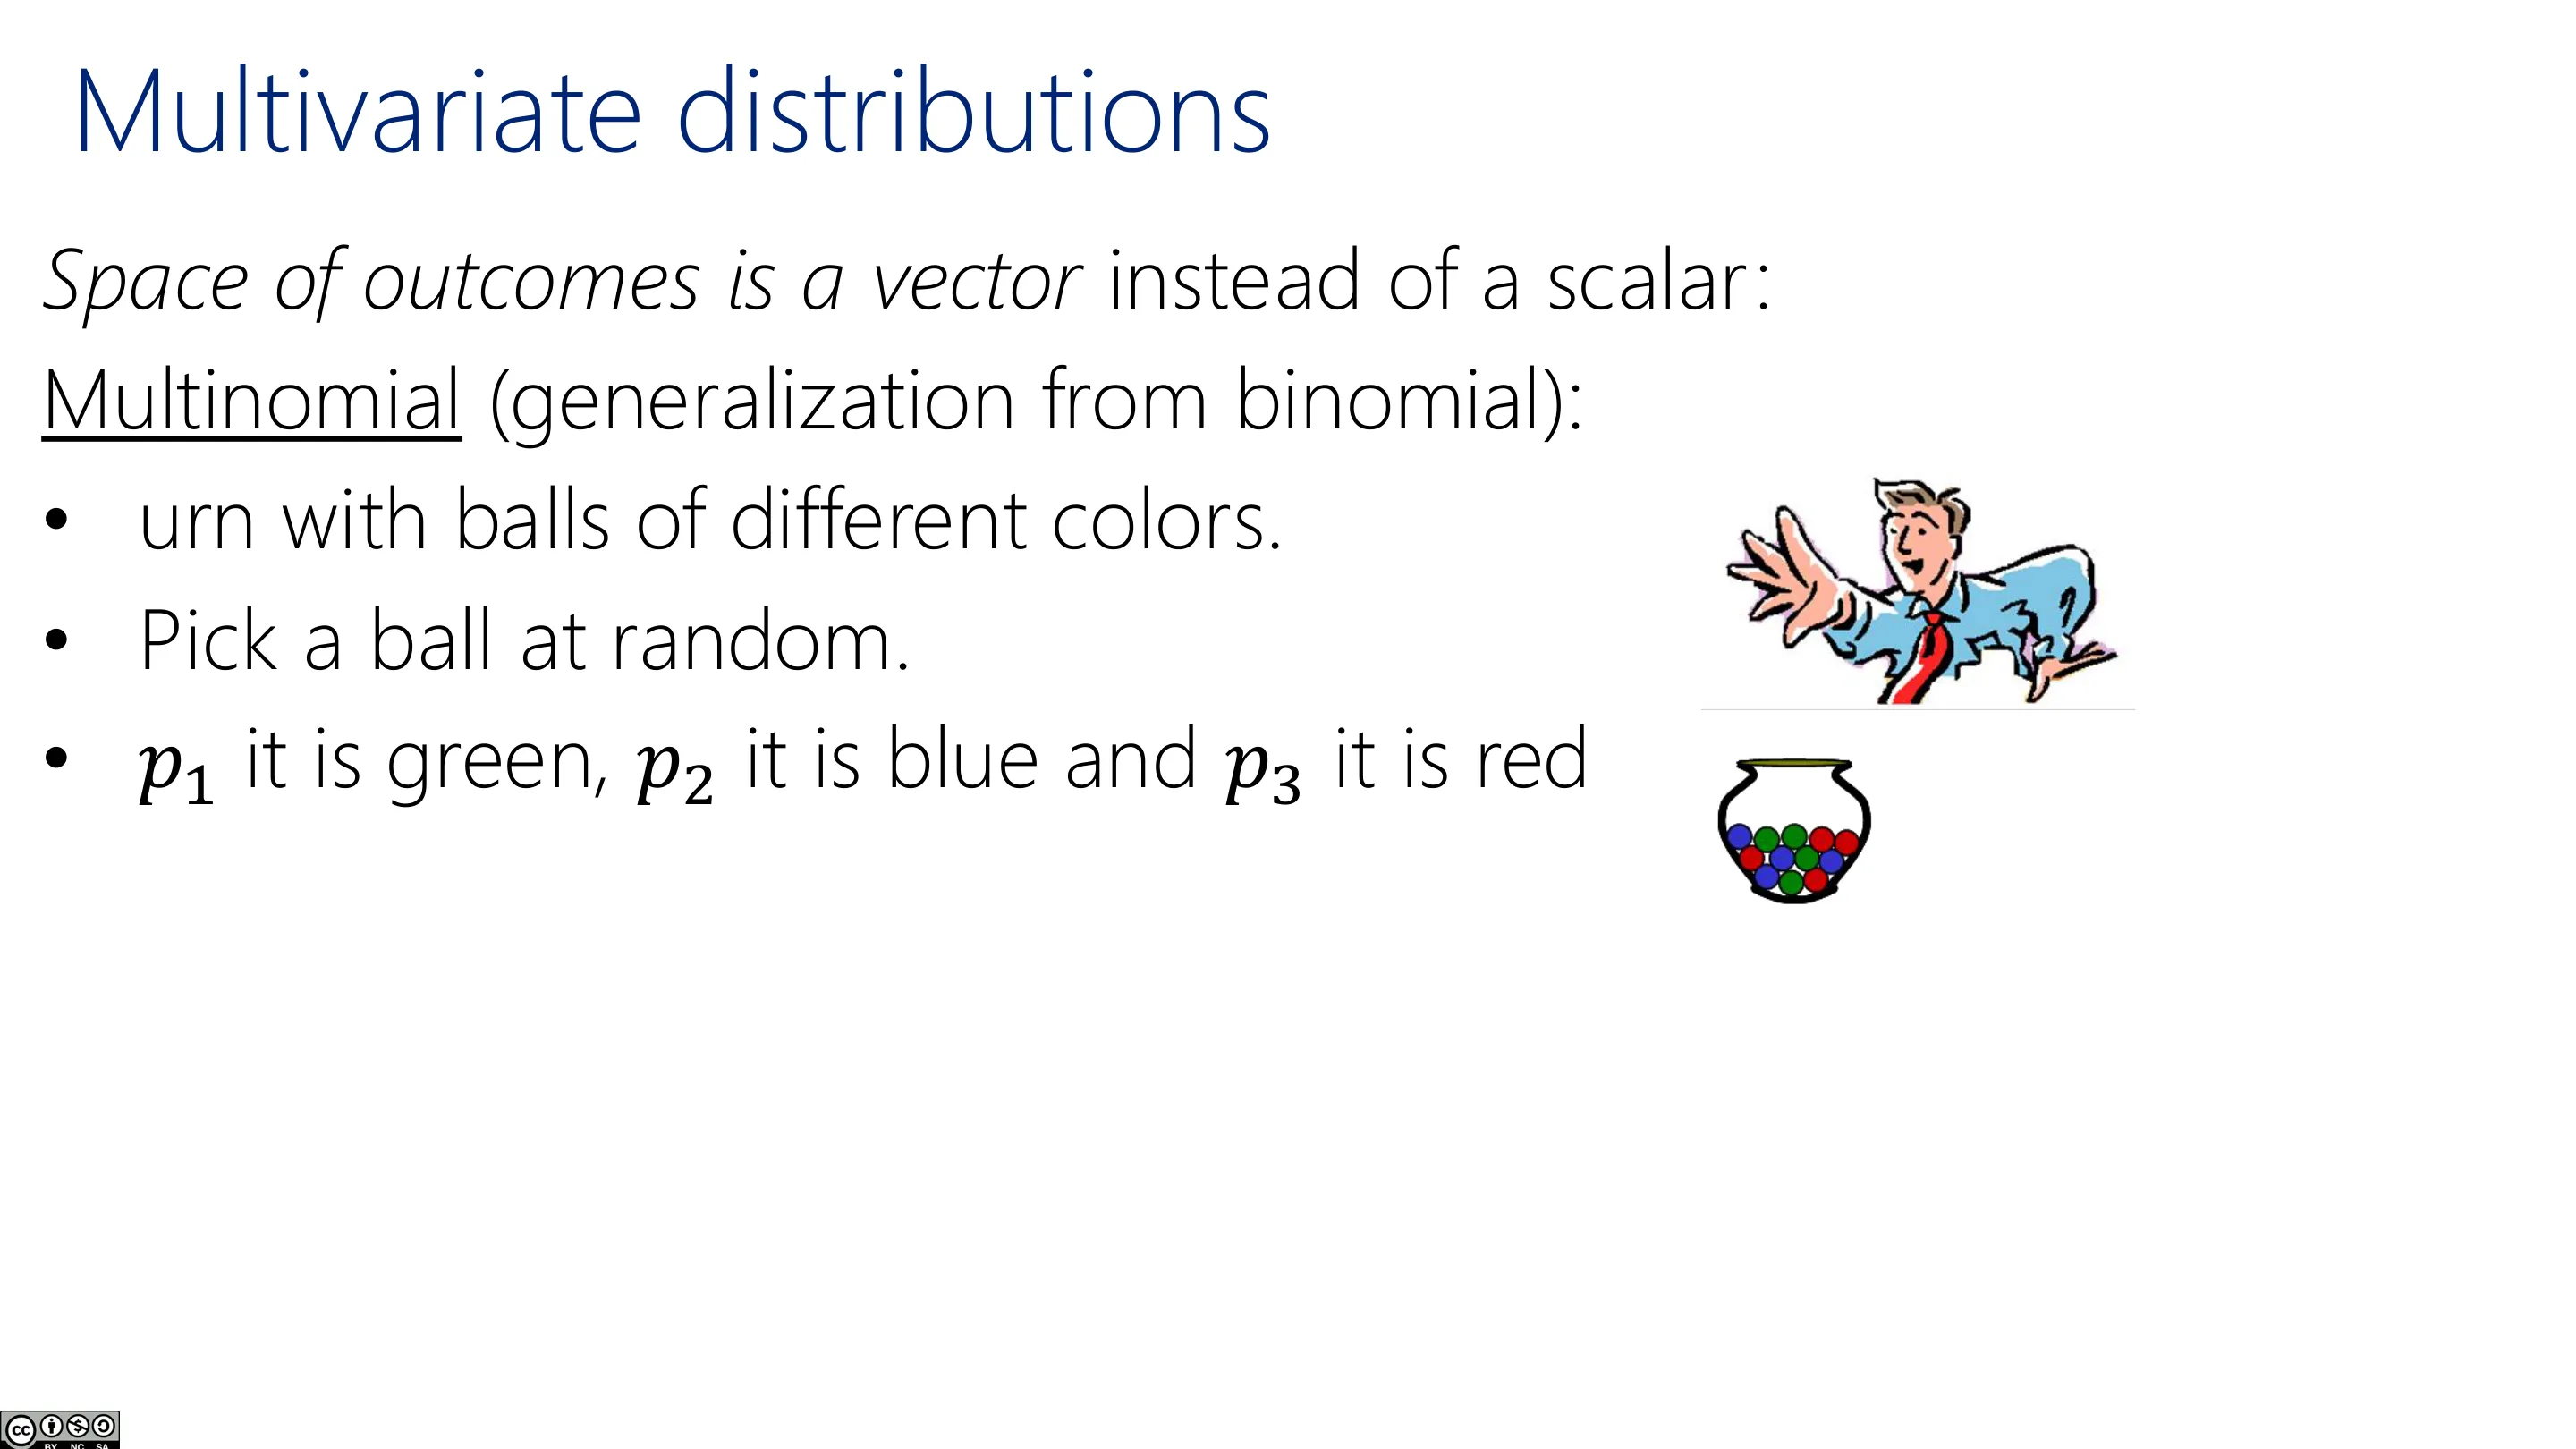
- 一次抛硬币是一维结果;而从一个装有绿、蓝、红球的瓮里多次抽样,结果是一个计数向量(红球数、绿球数、蓝球数)——这是离散状态空间上的多元分布;
- 多元高斯是连续空间上的多元分布:均值变成一个向量(二维高斯就有两个分量),而方差变成协方差矩阵(二维高斯的协方差是 $2\times2$ 矩阵)。这将在后续详细学习。
📷 多元分布(一)
回到原视频 (00:25:41)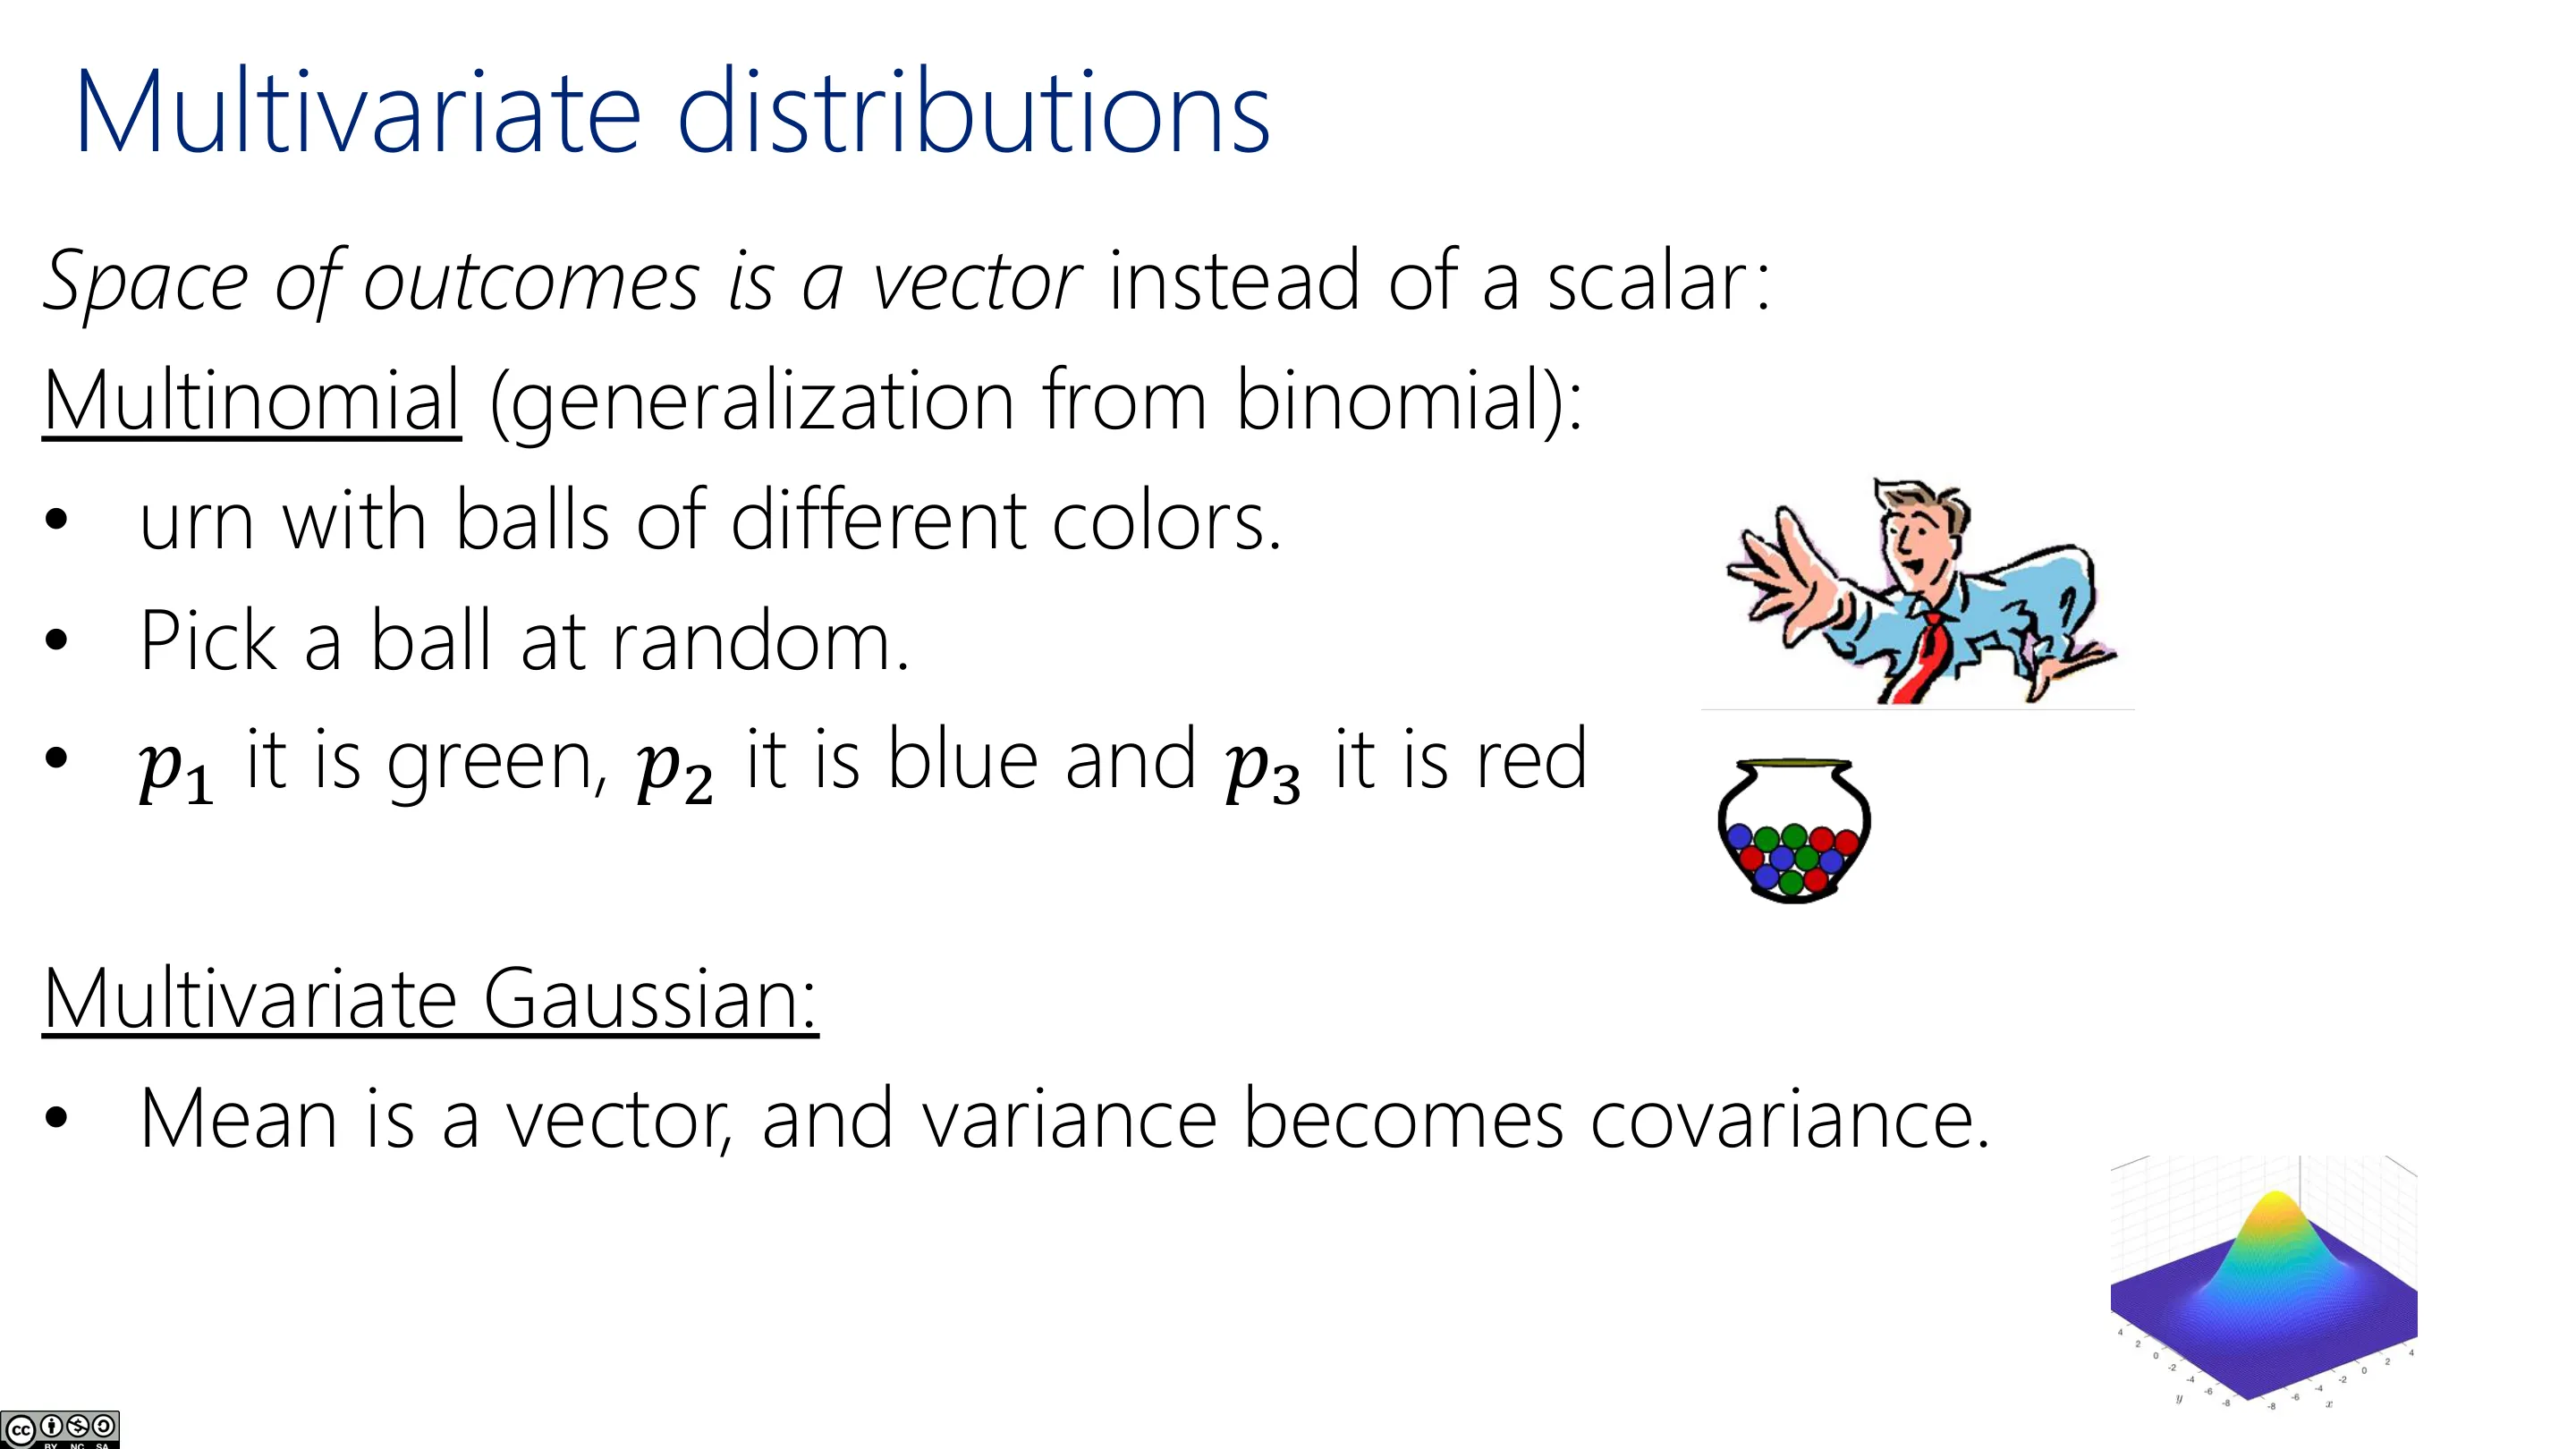
📷 多元分布(二)
回到原视频 (00:26:22)
四、MLE 的基本设定与性质
(参考时间: 00:27)
4.1 设定
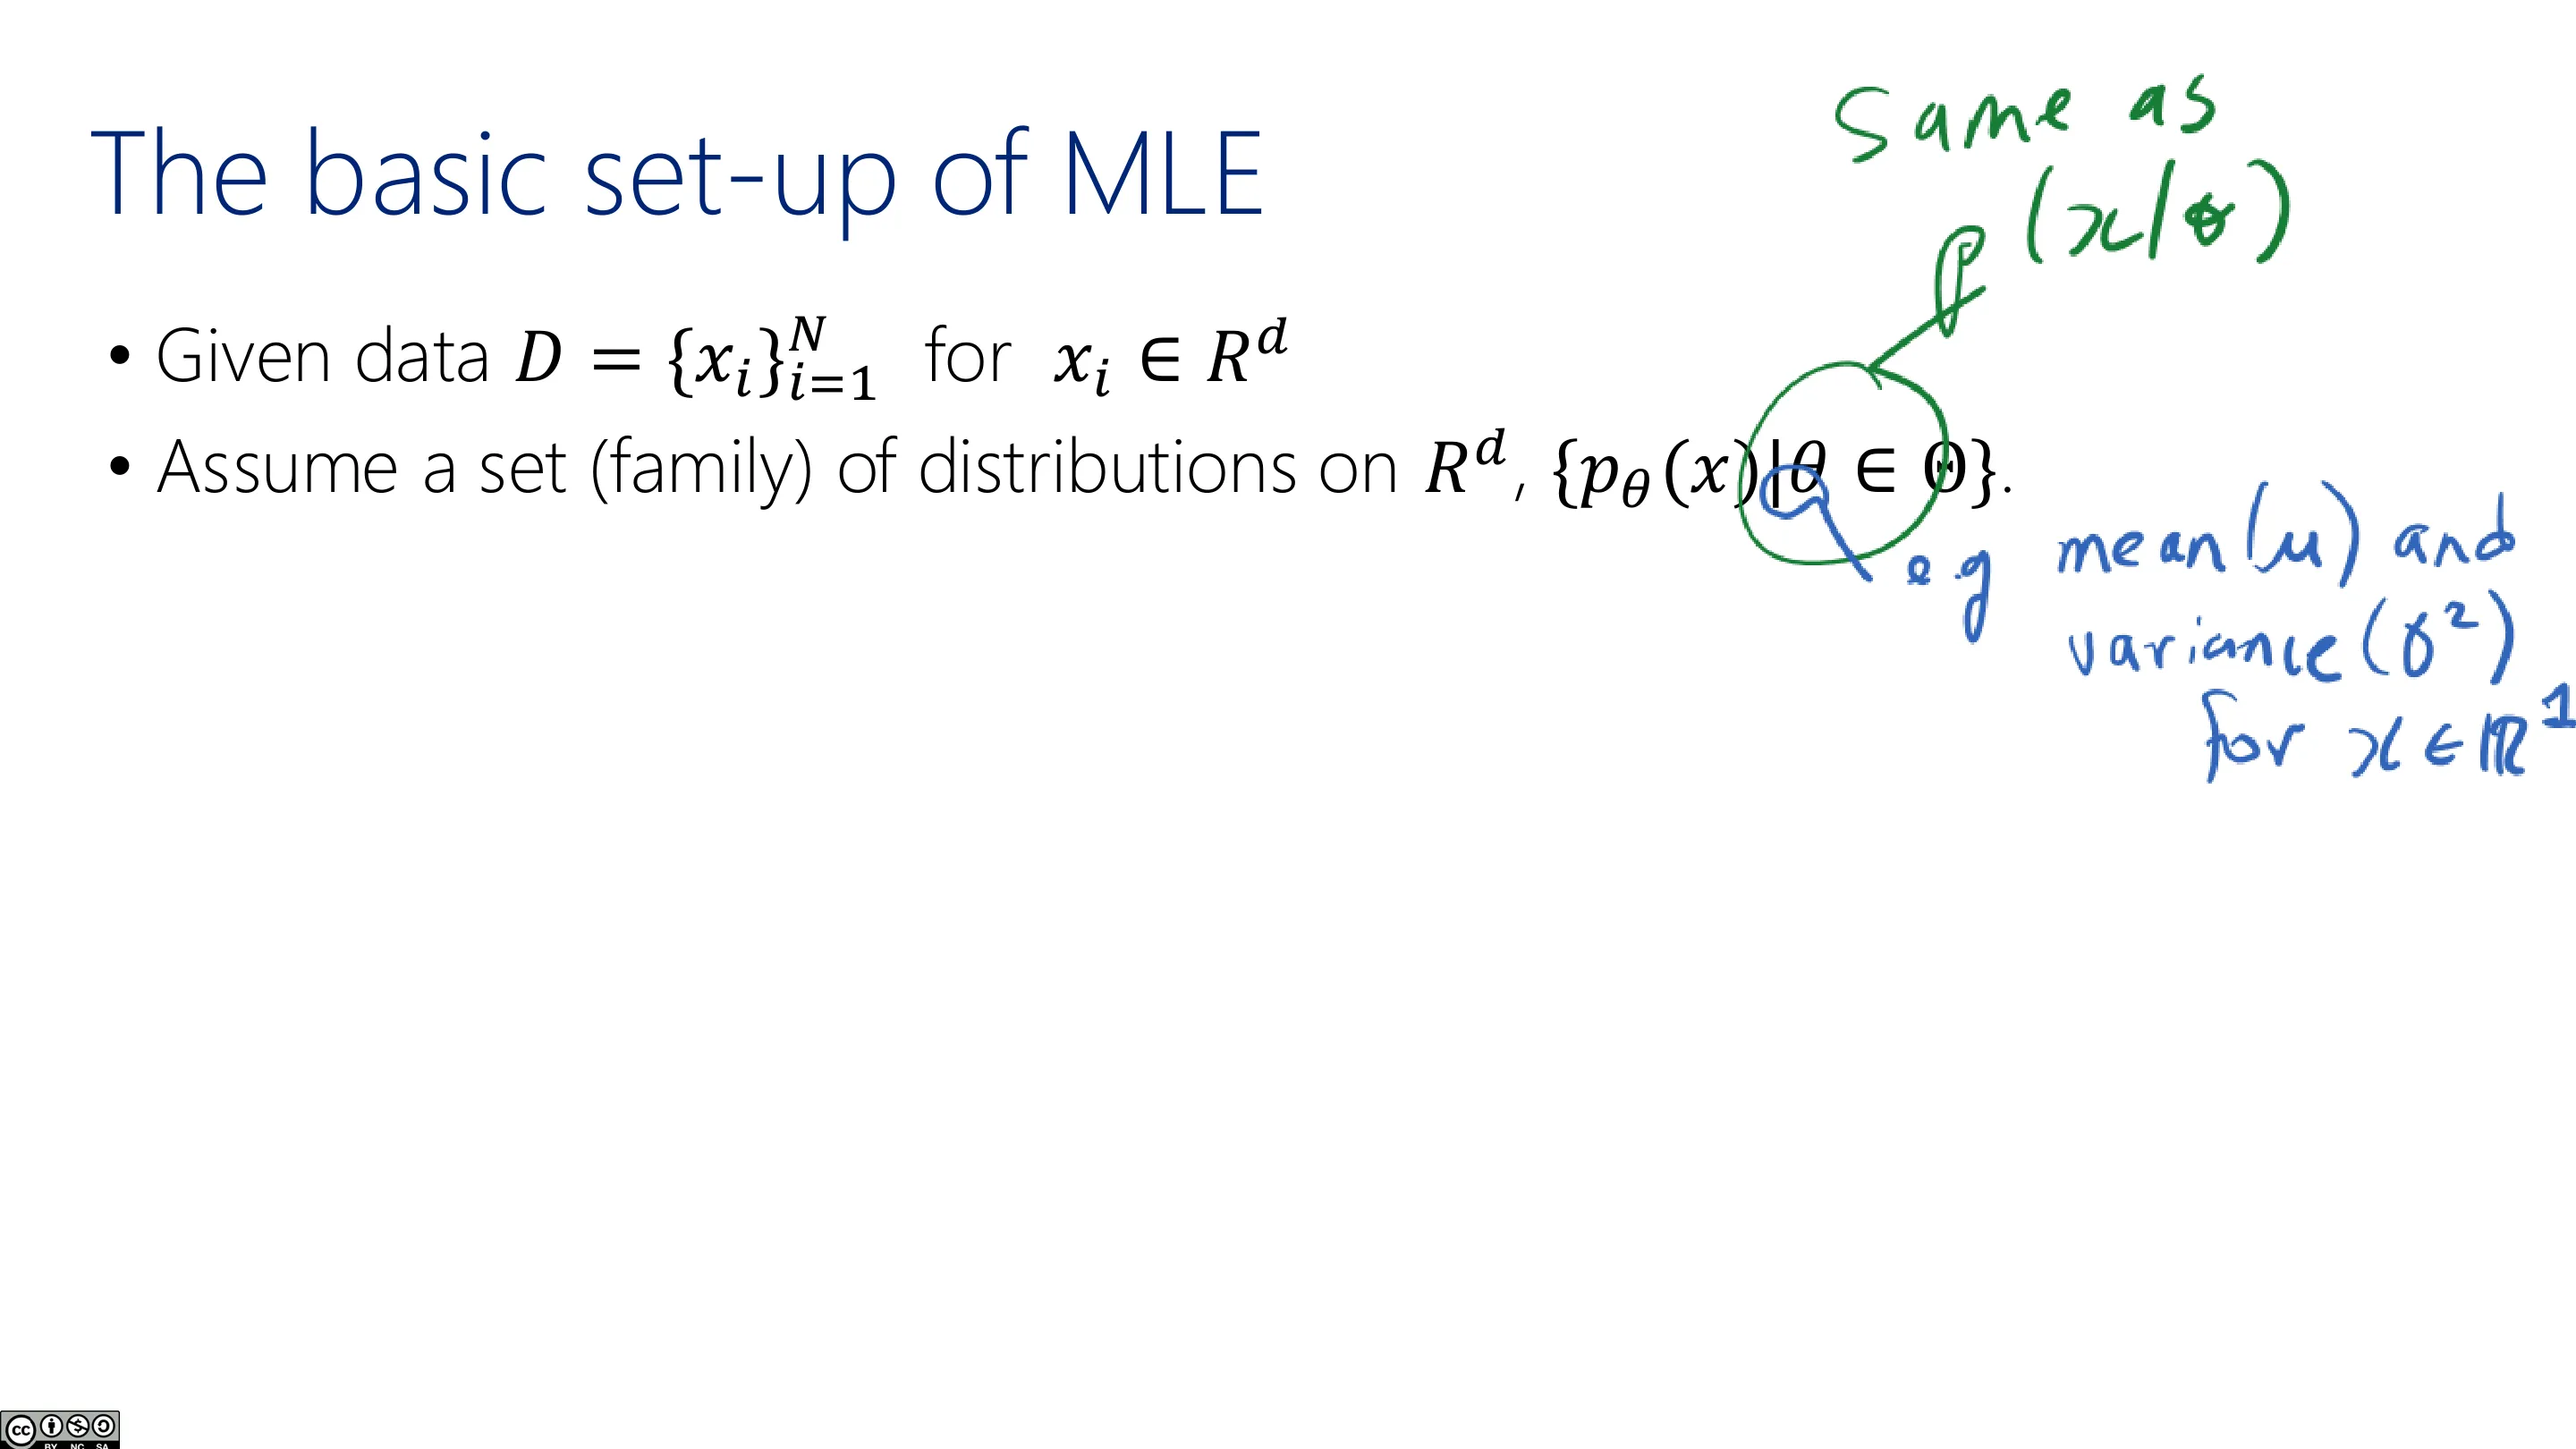
- 给定无监督数据 $\{x_i\}$;
- 假设一个分布族(如单变量高斯),其参数统一记为 $\theta$;
- 假设更高的分布族可以写成 $p(x \mid \theta)$、$p_\theta(x)$ 或 $p(x; \theta)$——符号略有混用,意思相同。
📷 MLE 的基本设定(一)
回到原视频 (00:27:02)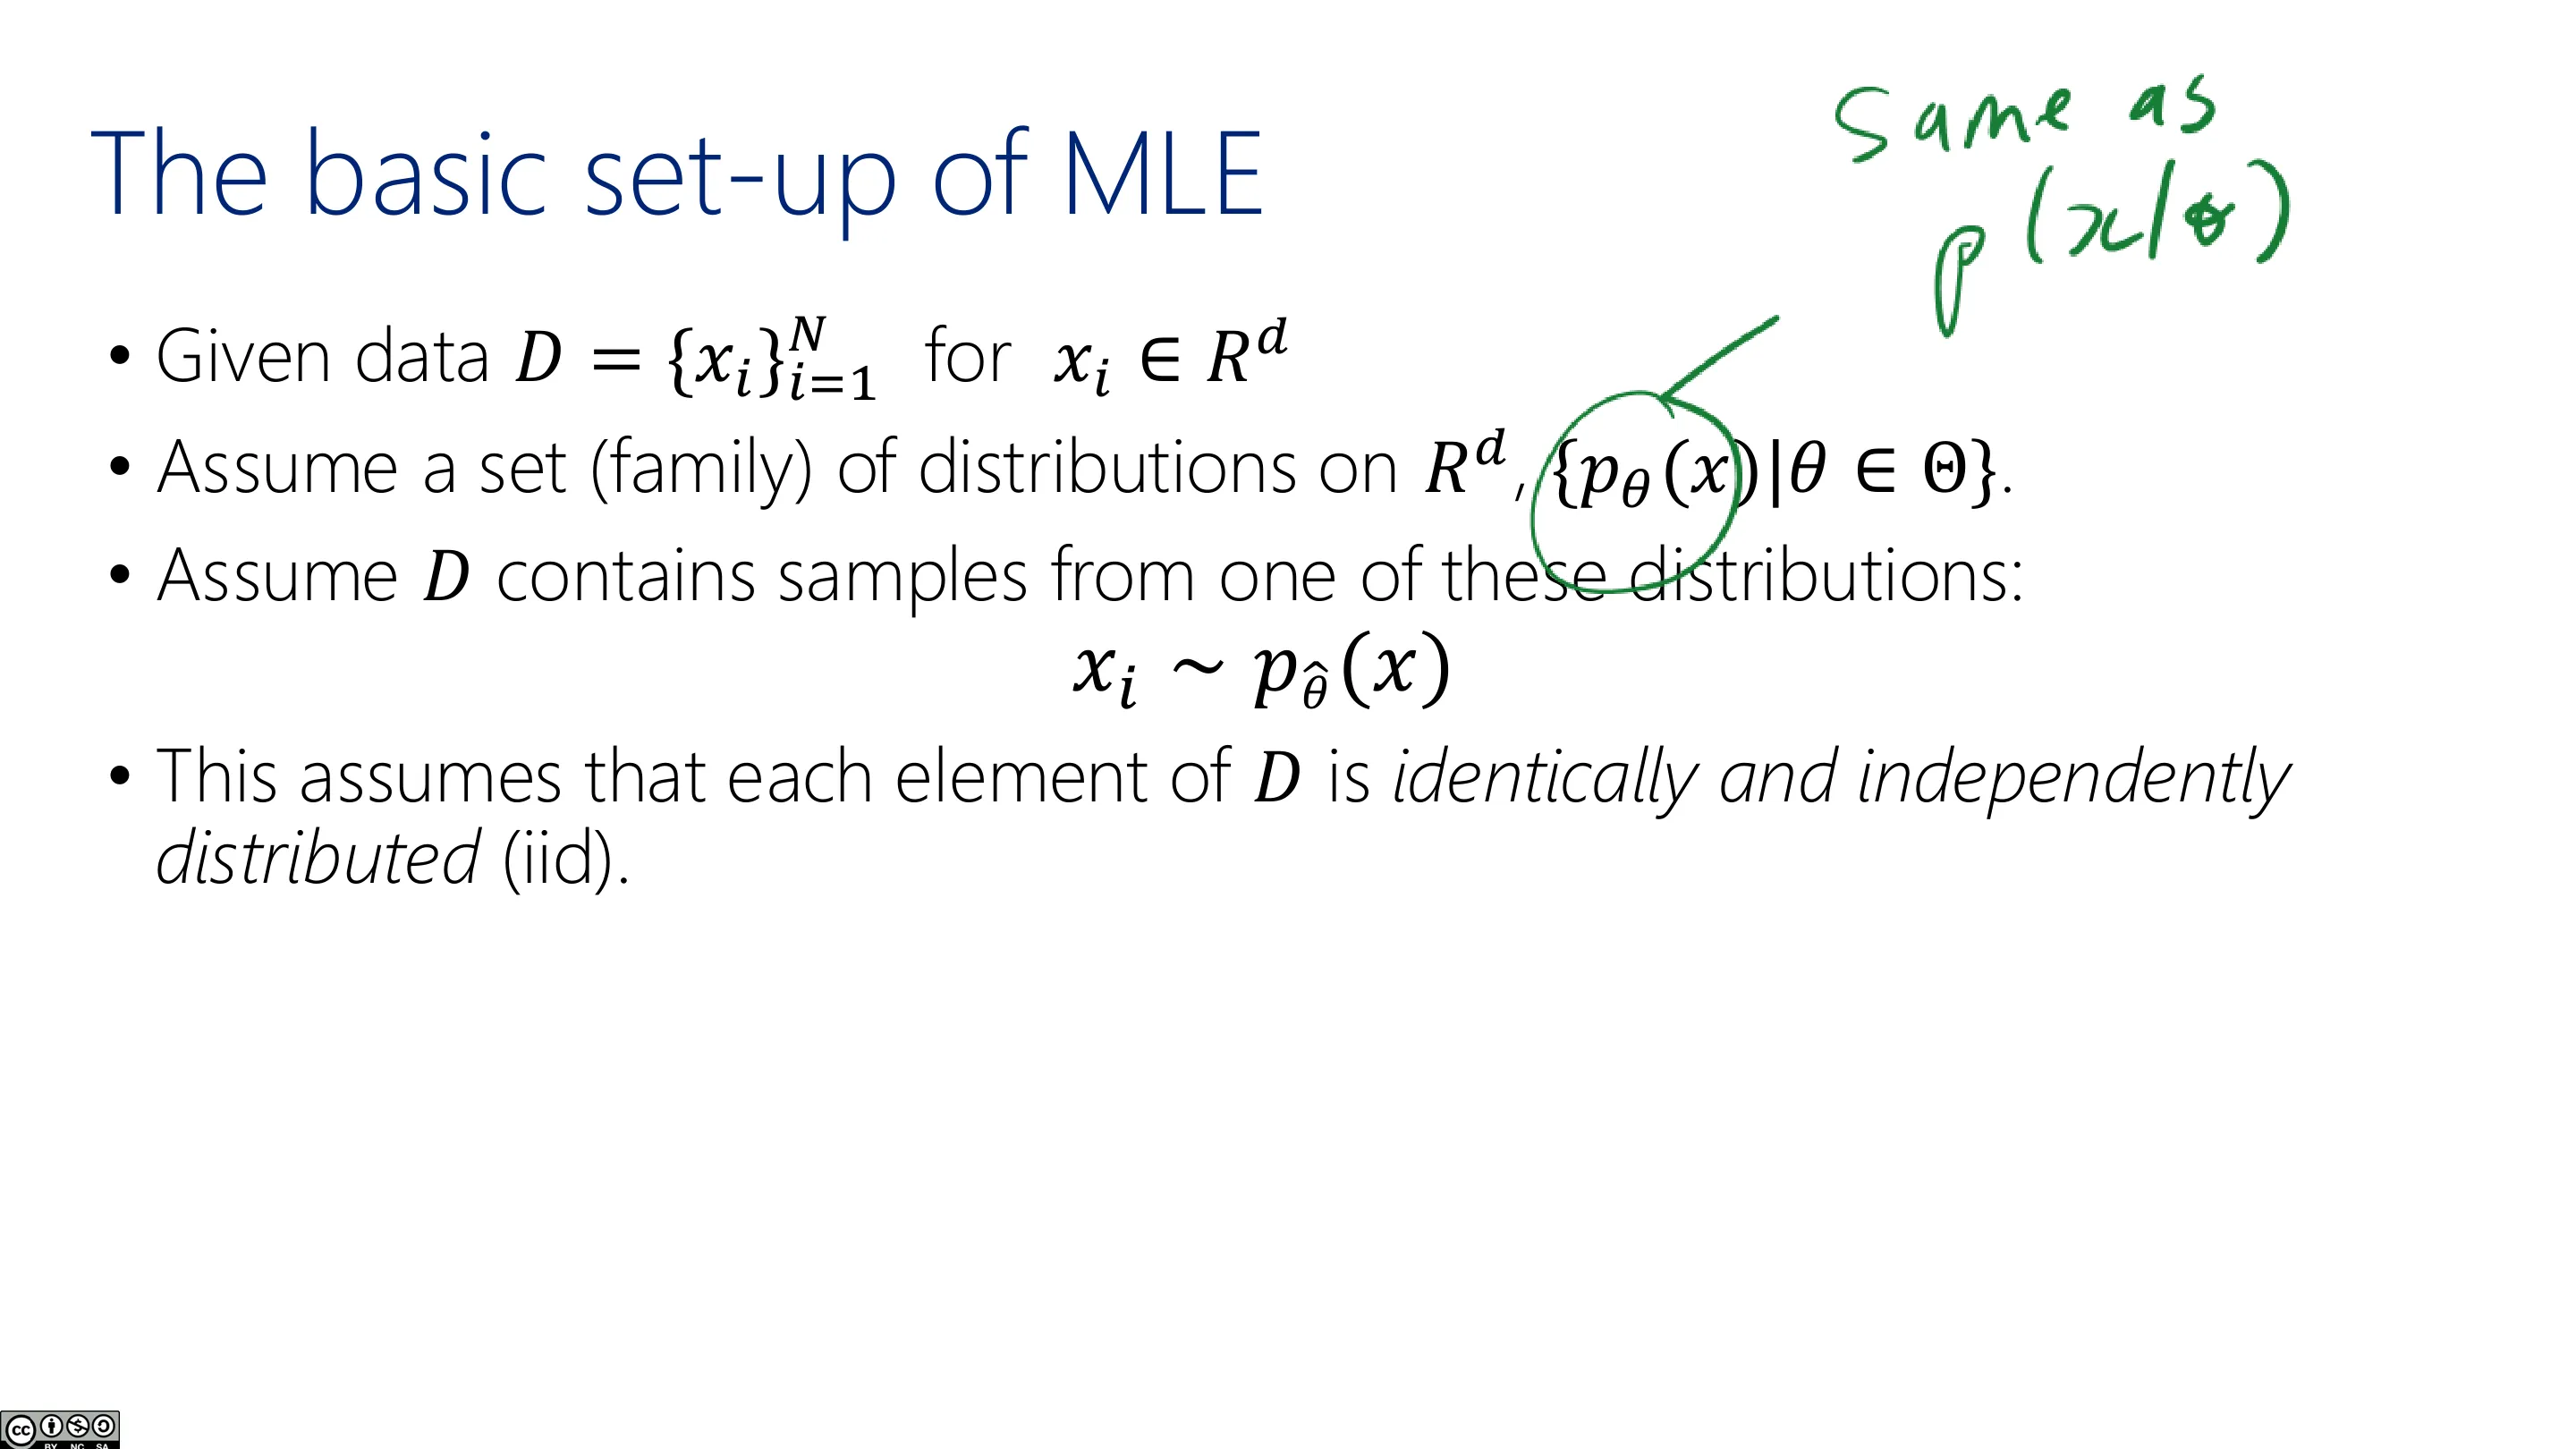
📷 MLE 的基本设定(二)
回到原视频 (00:27:37)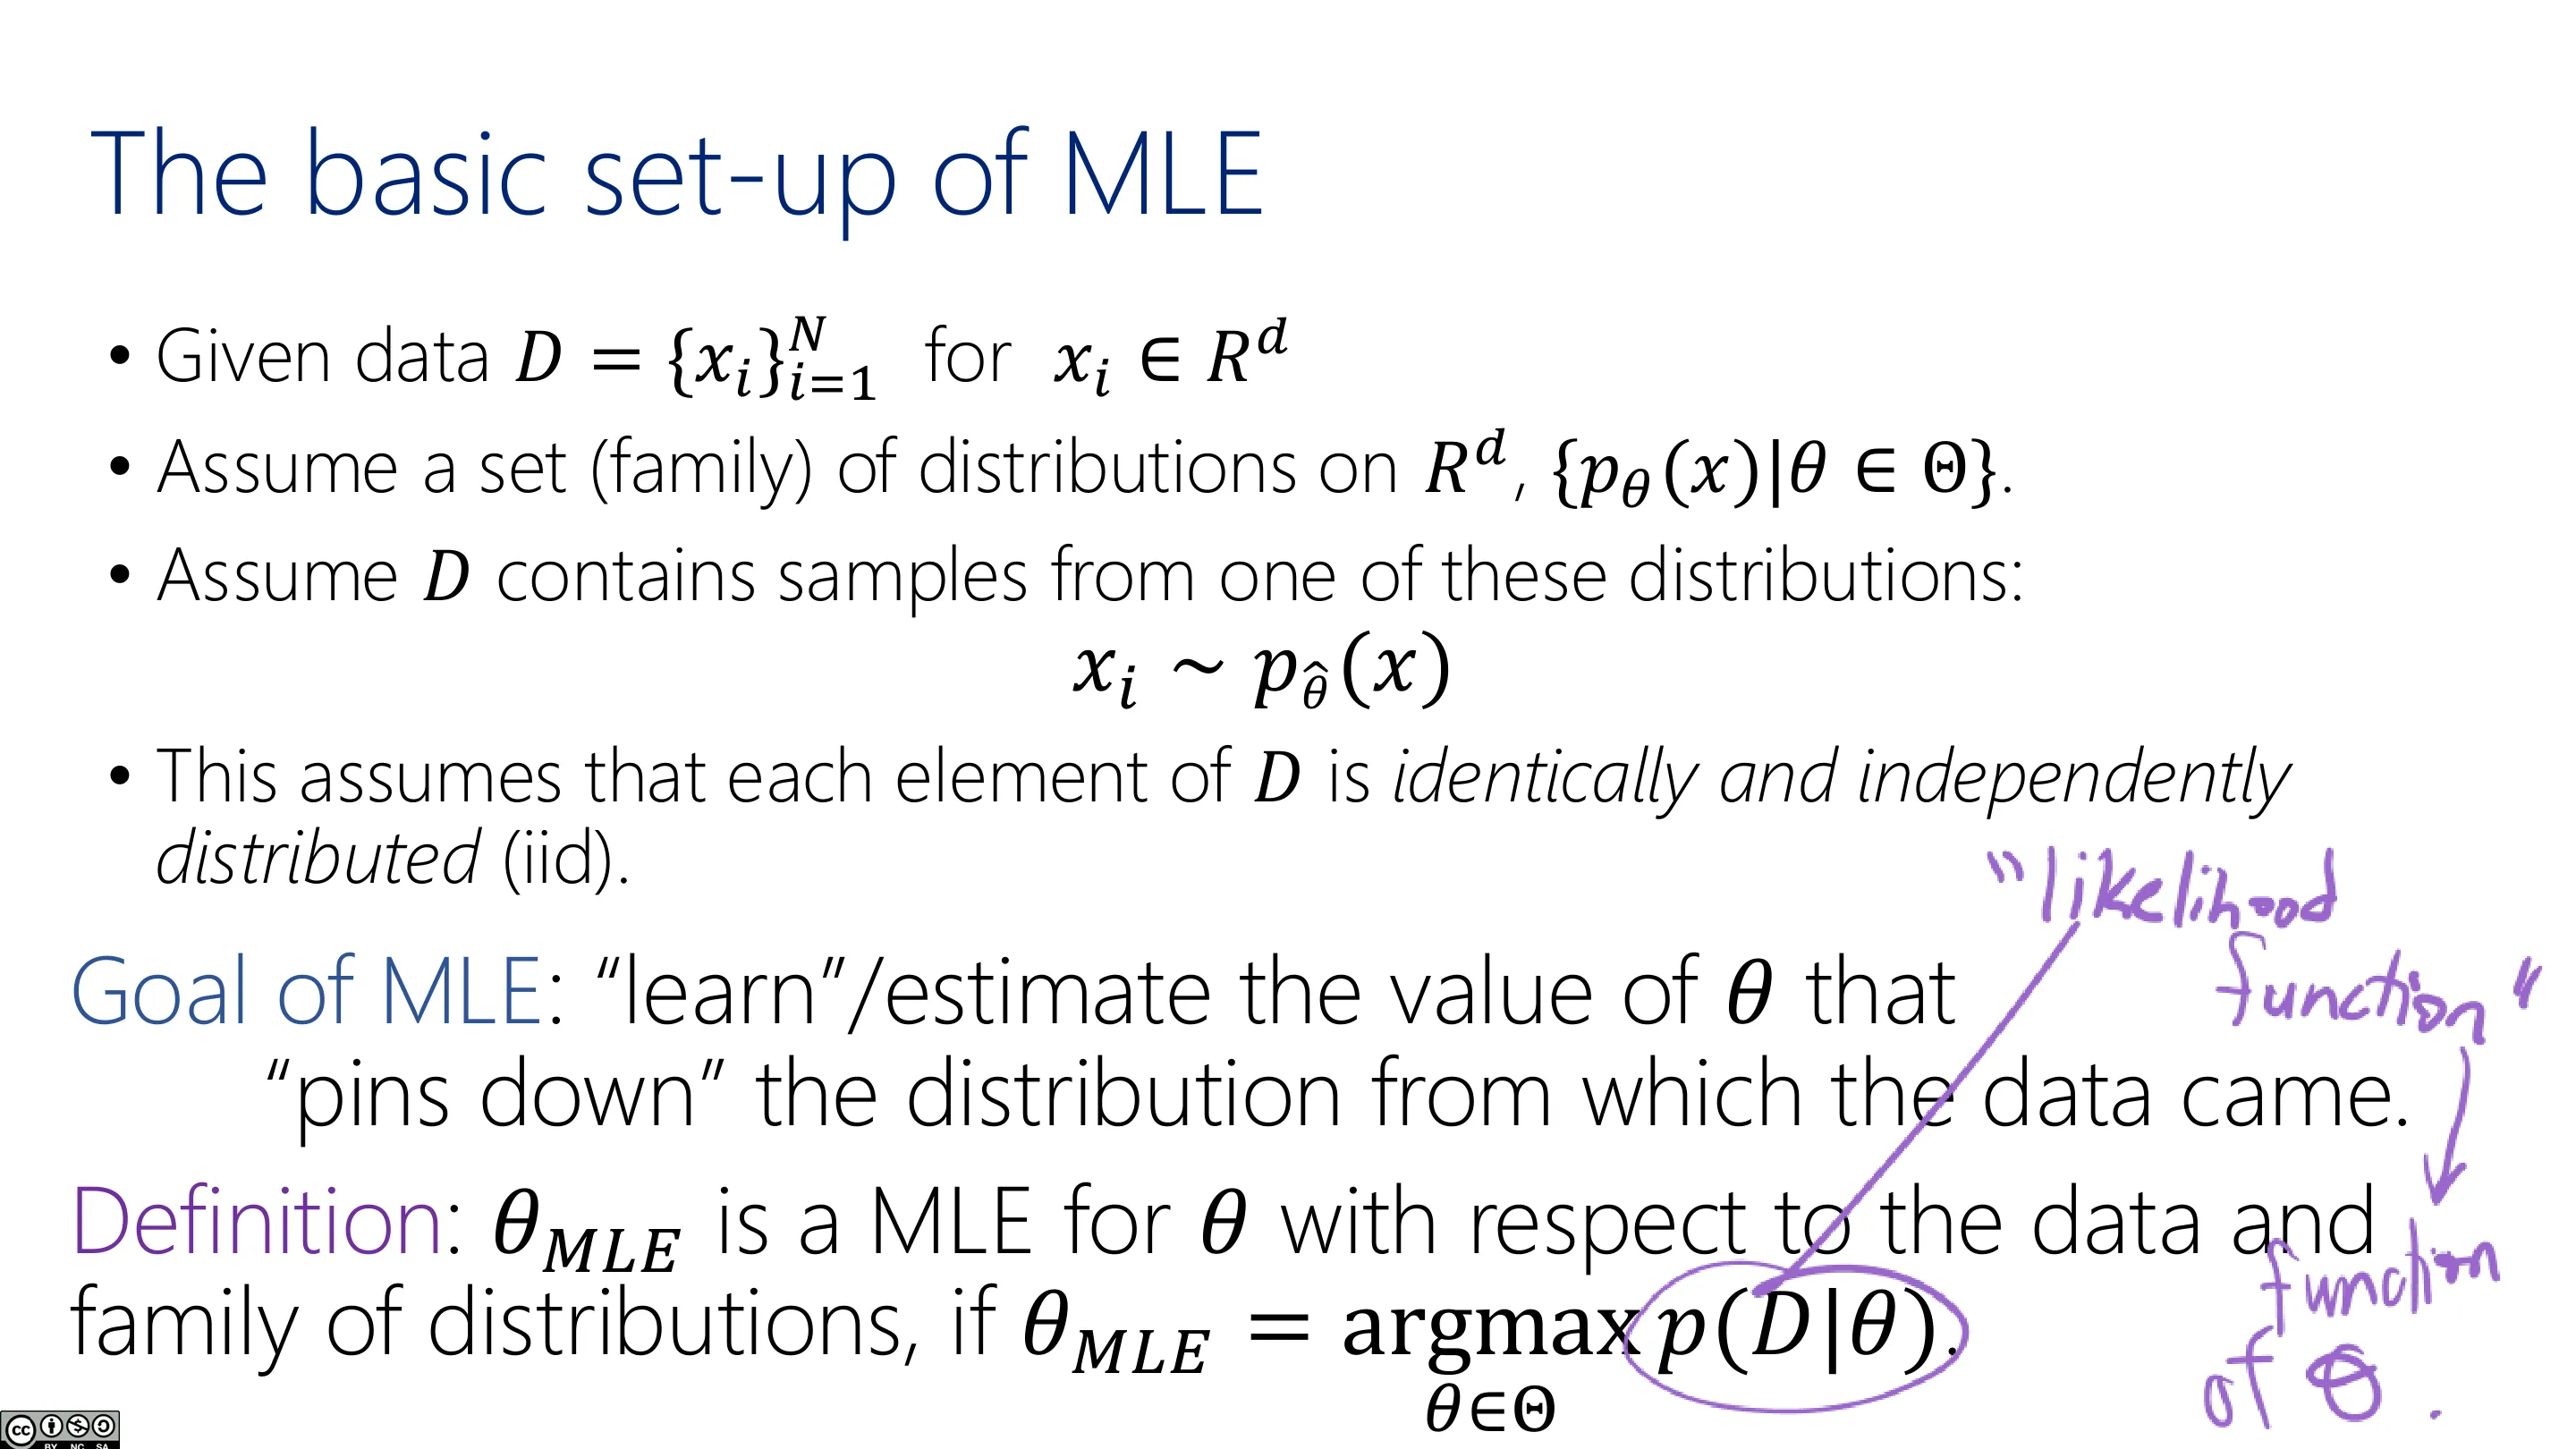
📷 MLE 的基本设定(三)
回到原视频 (00:28:00)4.2 独立同分布(IID)
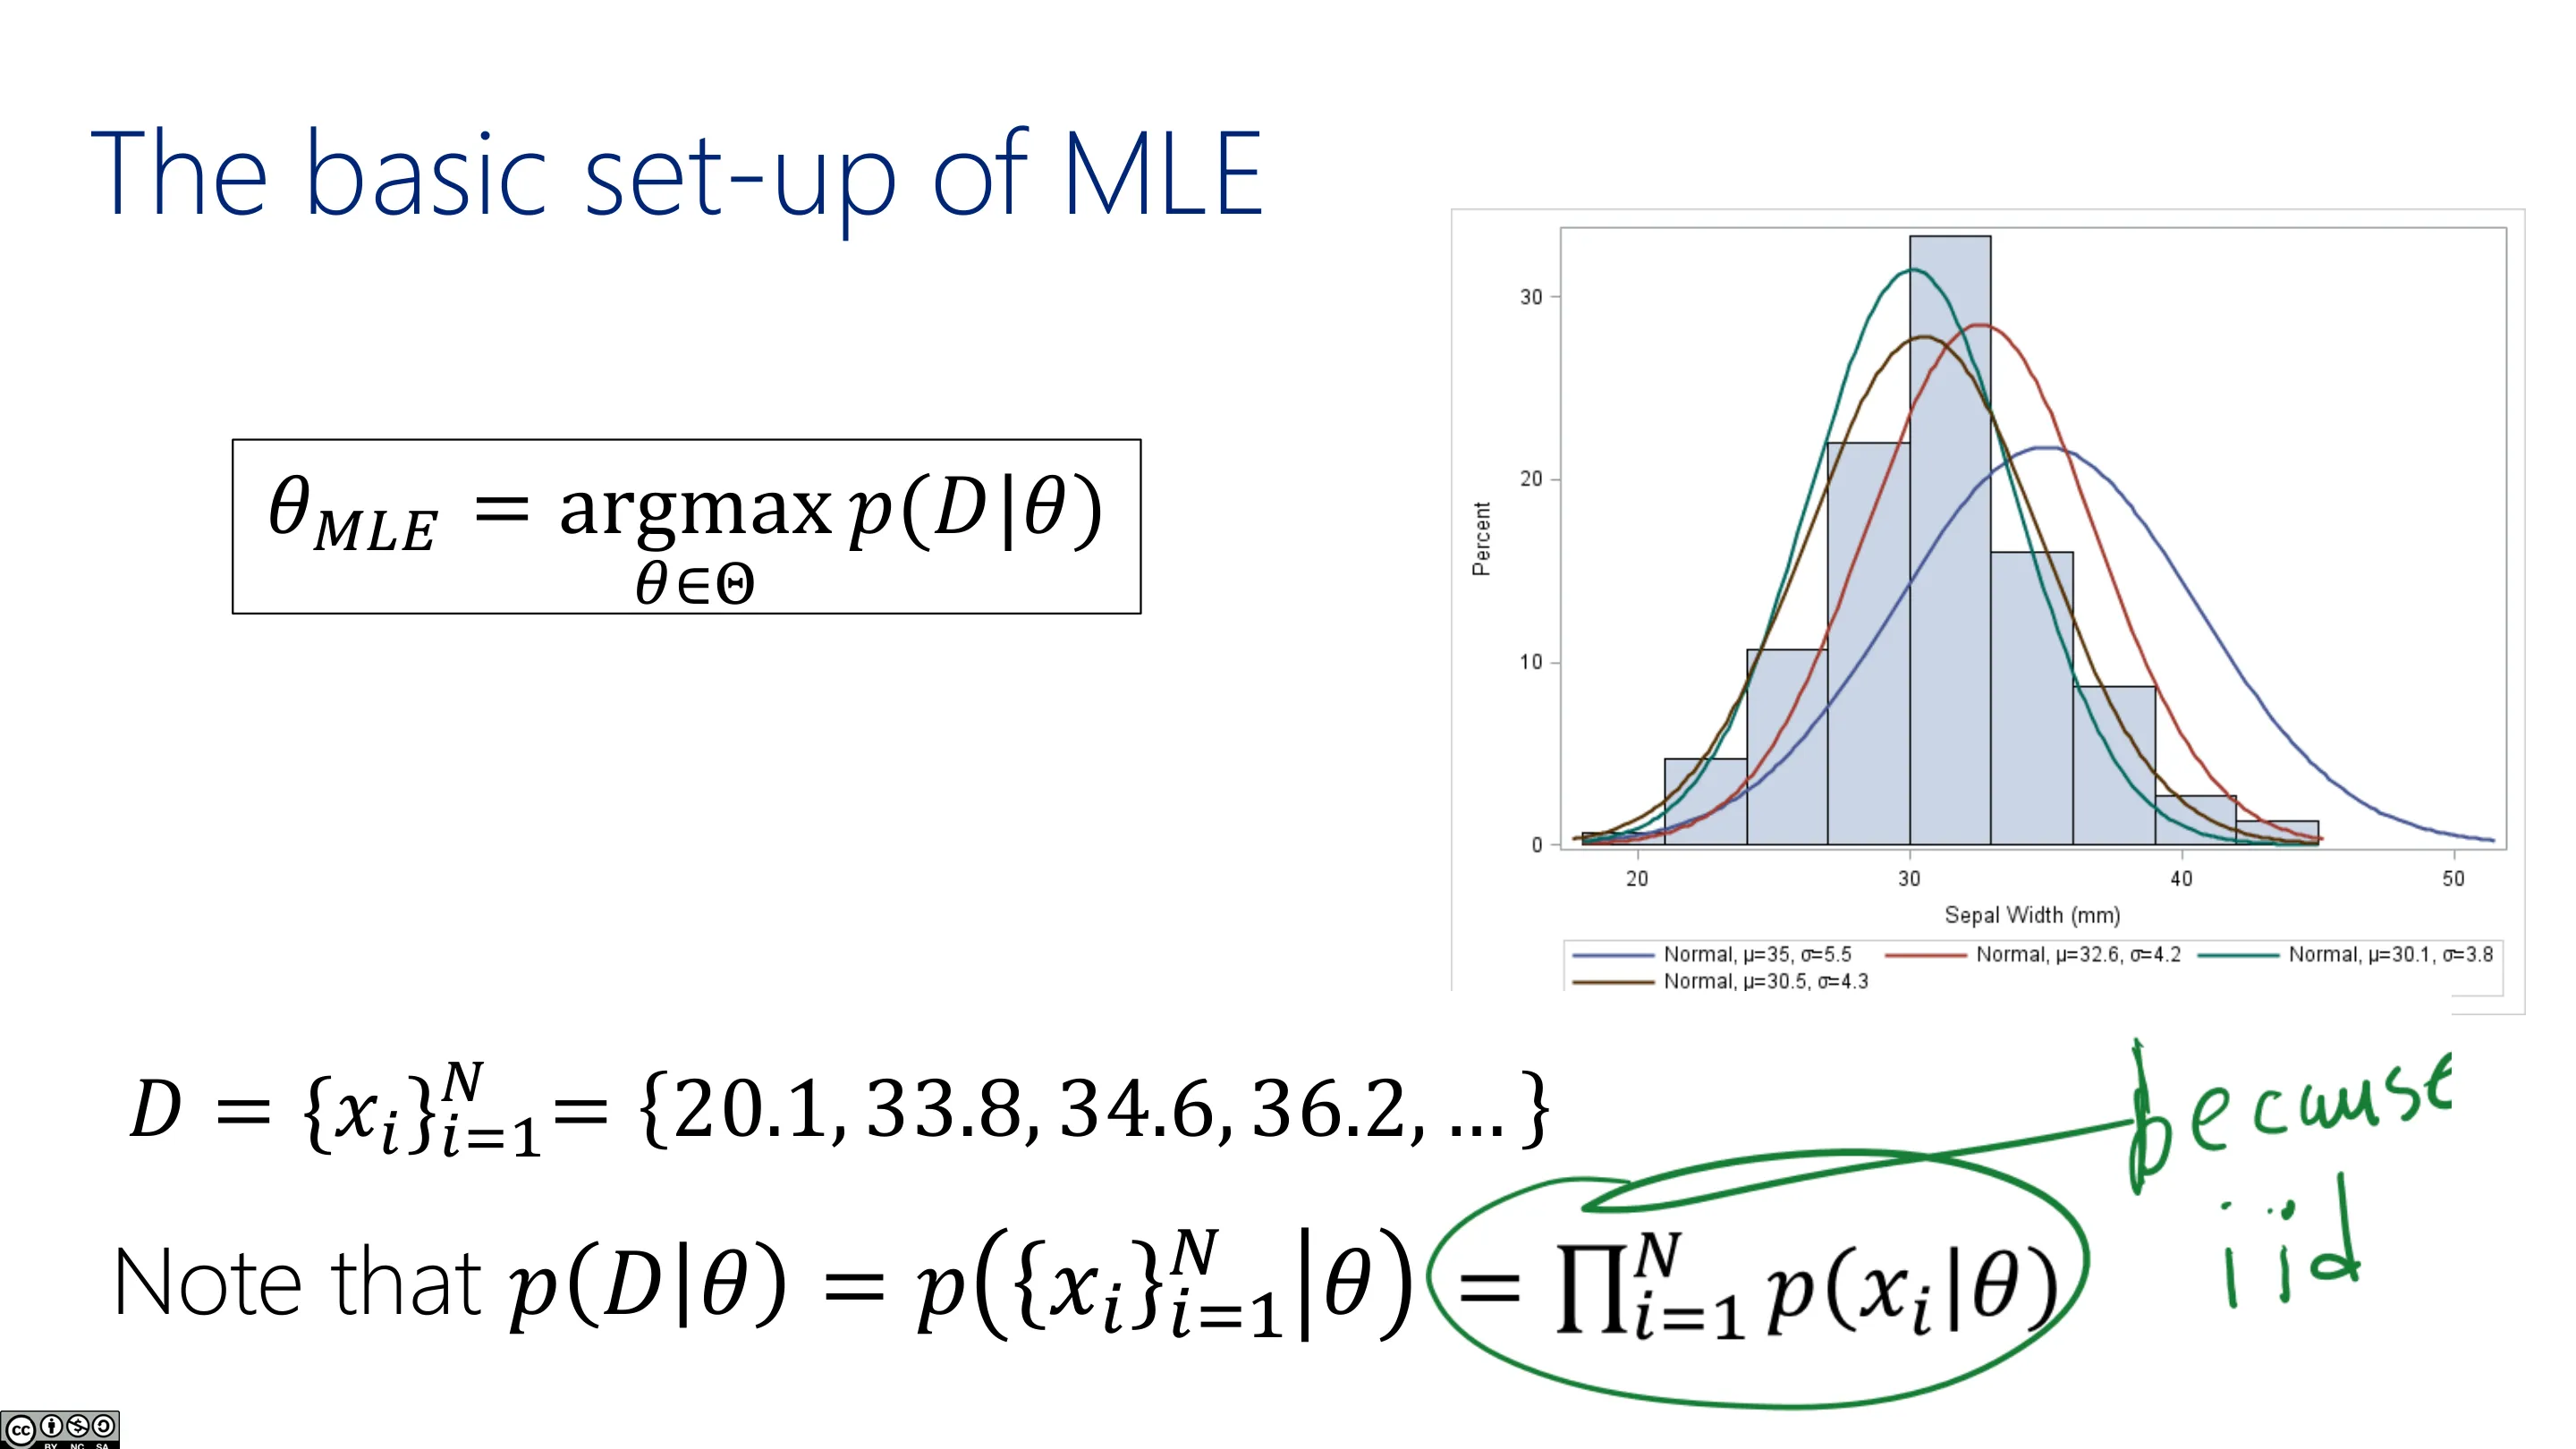
MLE 的关键技术假设是 独立同分布(Independent and Identically Distributed, IID):
- 相同(Identically):所有数据点来自同一个分布(例如同一个高斯,有同一个 $\mu$、$\sigma$);
- 独立(Independent):抽第 2 个点不依赖第 1 个点,第 3 个不依赖前两个……
这个假设让联合分布可以分解成乘积,而取对数后又能变成求和——这正是 MLE 能得到简洁损失函数的原因。
📷 MLE 的基本设定(四):IID
回到原视频 (00:28:48)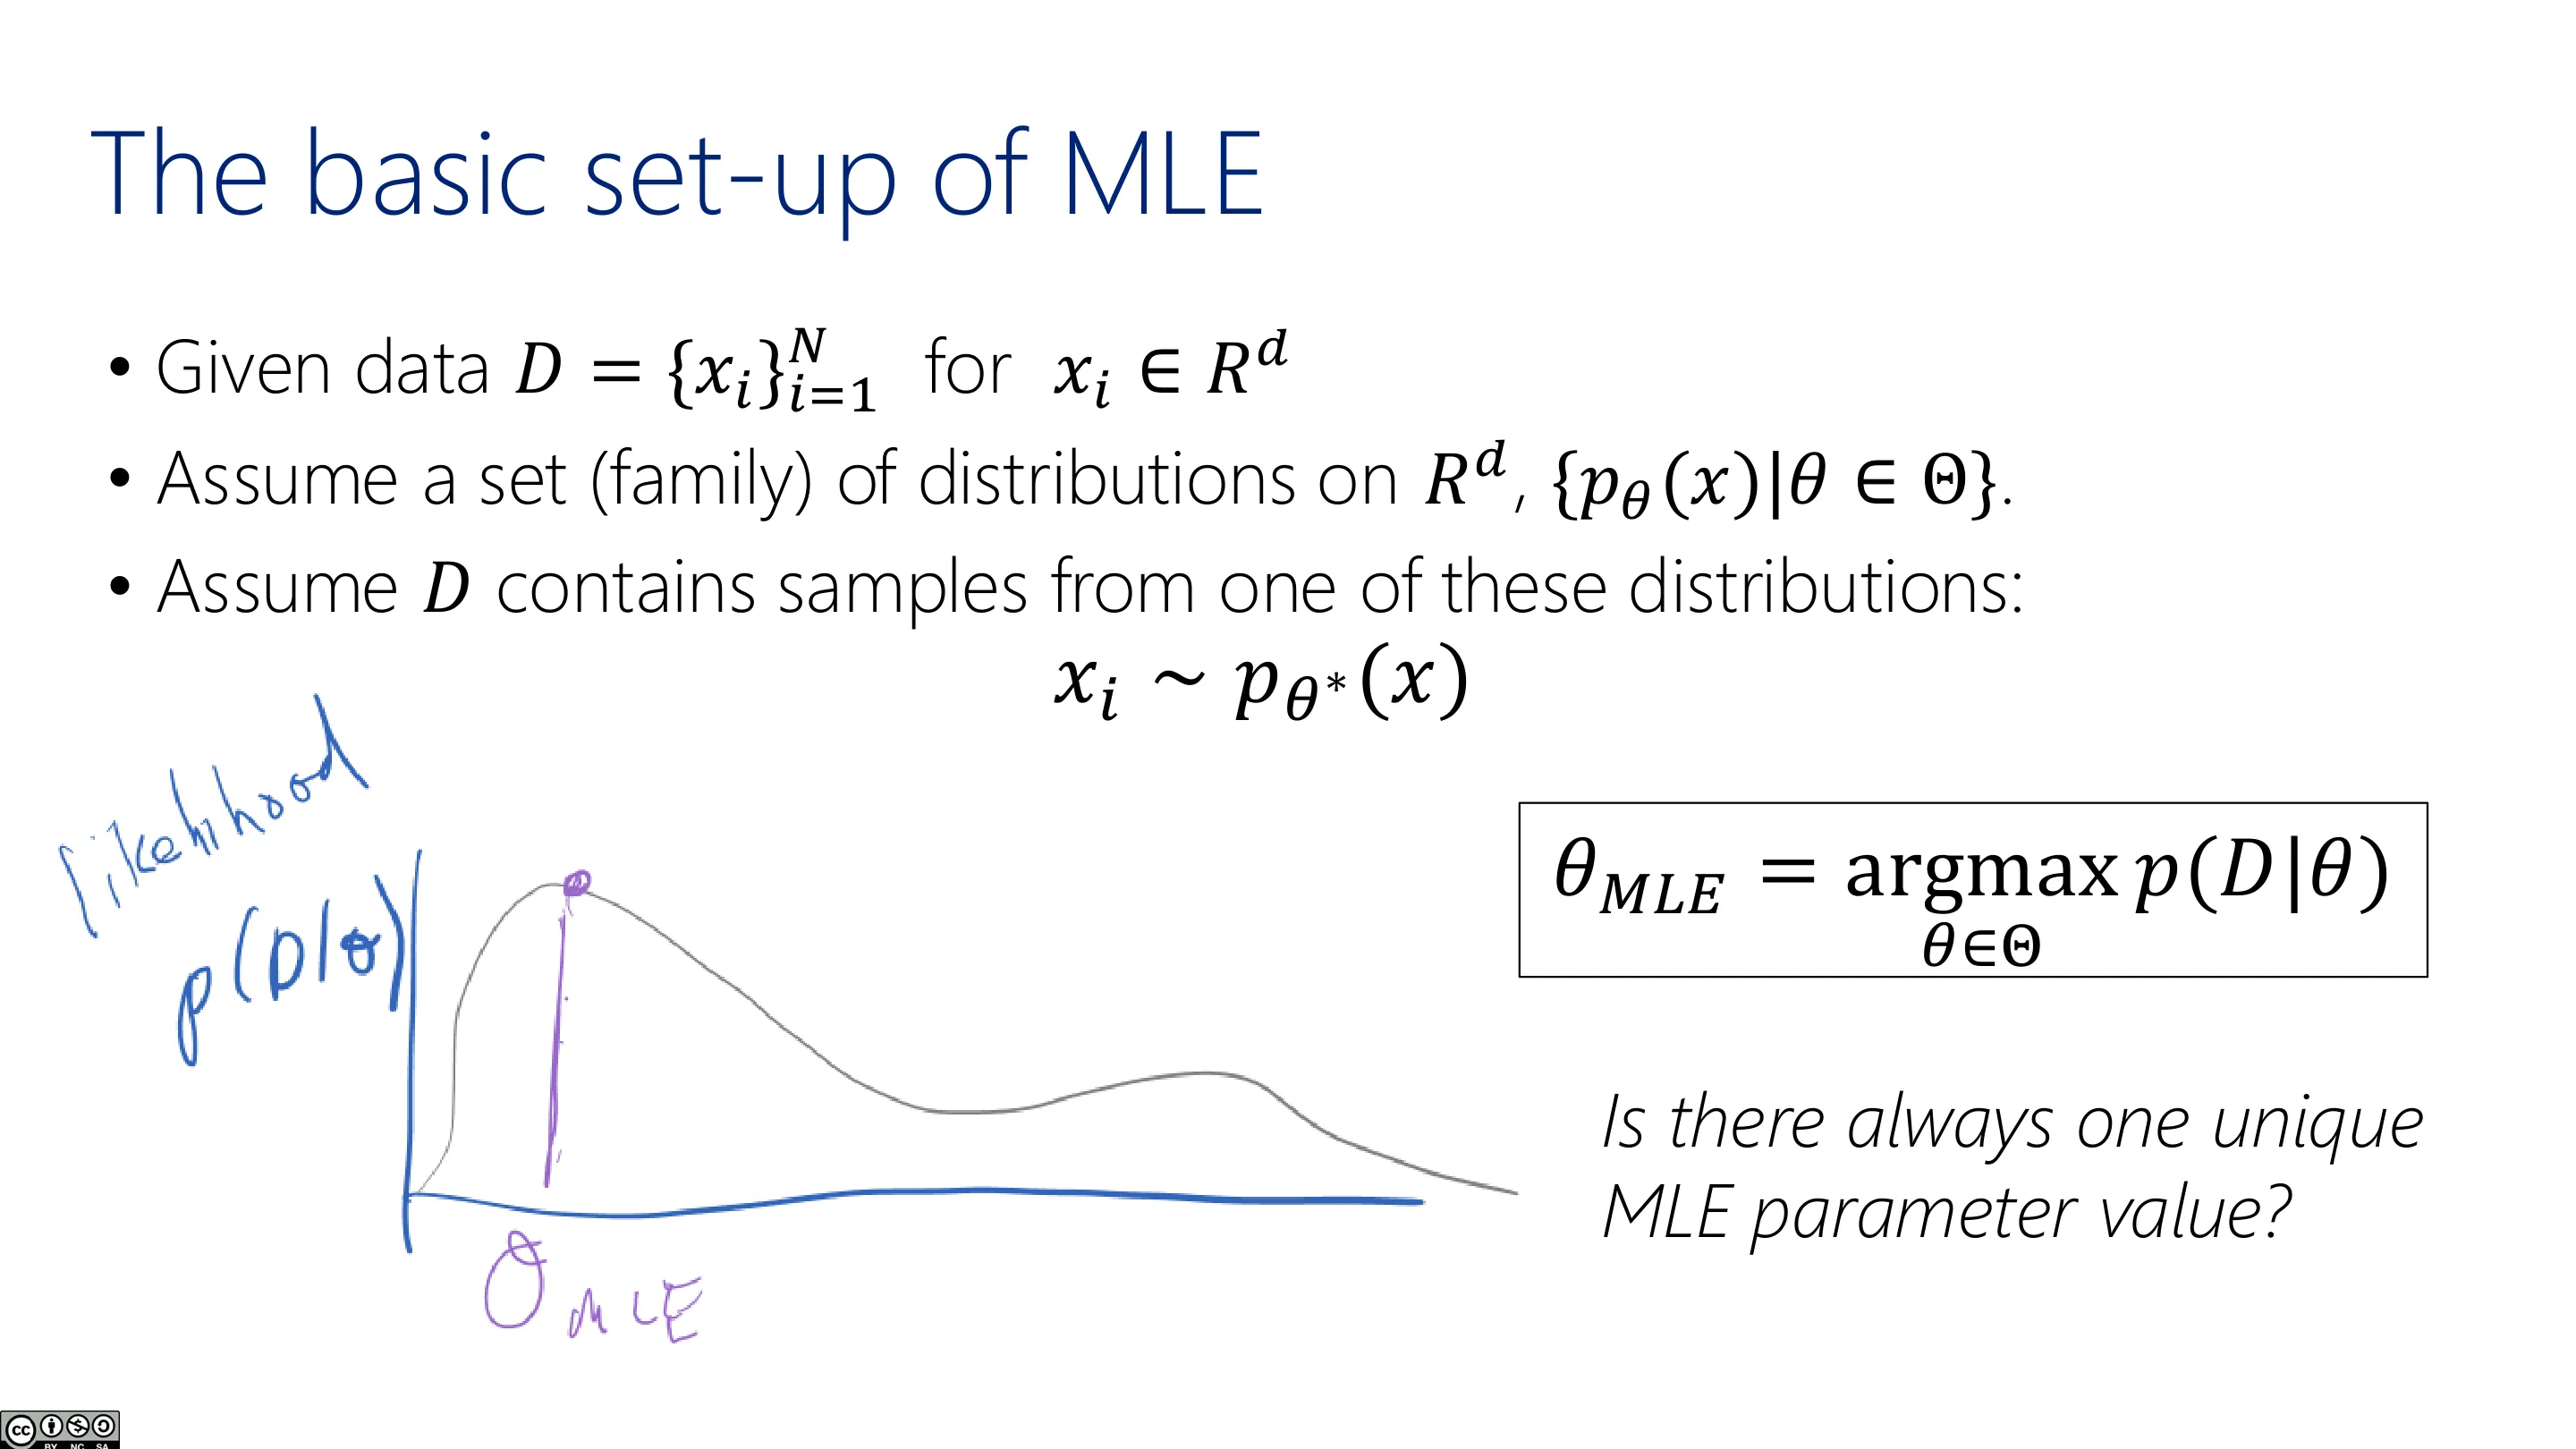
📷 MLE 的基本设定(五)
回到原视频 (00:29:20)4.3 似然函数与最大似然估计
$$\hat{\theta}_{\text{MLE}} = \arg\max_{\theta} \; \underbrace{p(D \mid \theta)}_{\text{似然}} = \arg\max_{\theta} \prod_{i=1}^{n} p(x_i \mid \theta)$$
因为 IID,联合似然分解成乘积;取对数后变成求和(这正是我们喜欢的「逐点损失之和」形式)。
编者说明:把 $\theta \mapsto p(D\mid\theta)$ 画成曲线,横轴是参数、纵轴是概率,MLE 就是要找到这条曲线的全局最大点。这引出三个问题:能否找到全局最大?用什么方法优化?MLE 是否唯一确定参数?——最后一个的答案往往是否定的(如线性回归里存在无穷多组等价最优参数),今天先不深入。
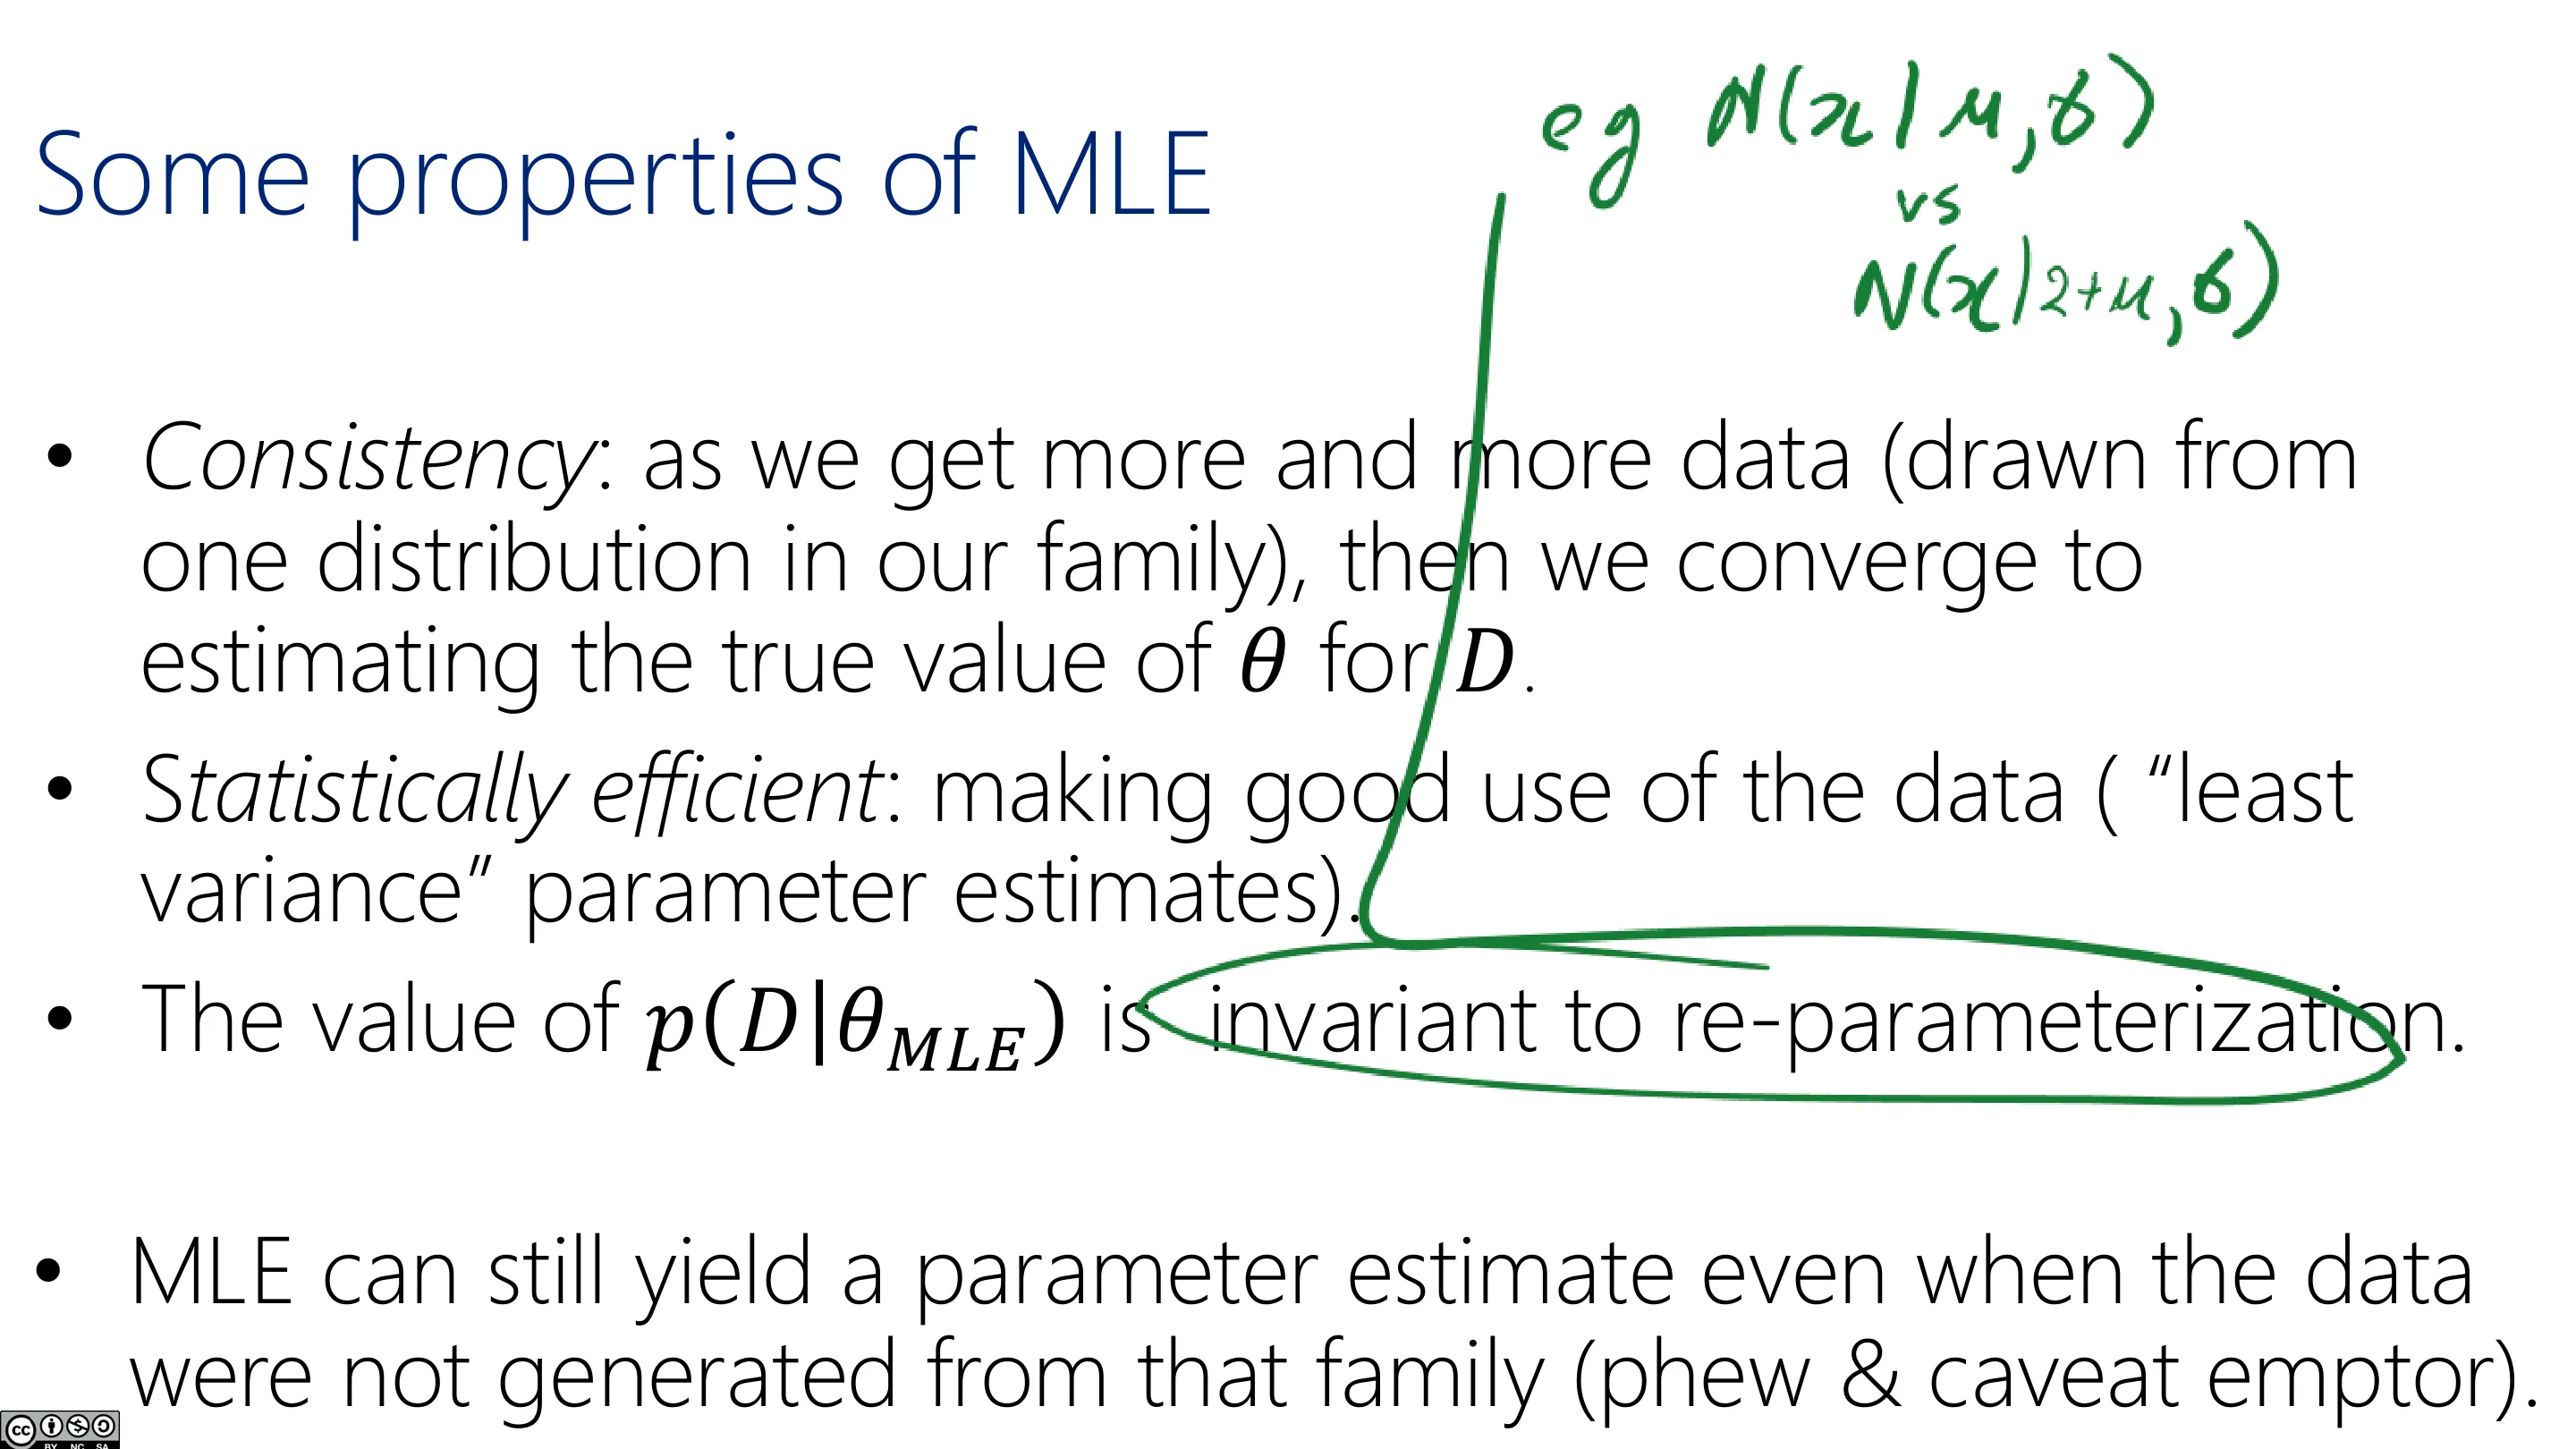
4.4 MLE 的三个好性质
- 一致性(Consistency):如果数据真的来自该模型类,那么当数据量 $N \to \infty$ 时,MLE 会给出真实参数的正确估计(给 100 个点不够准,给一百万个点就会非常准)。
- 统计有效性(Efficiency):MLE 对数据的利用非常充分——「物超所值」。
- 对重参数化不变(Invariance):改变参数化方式,参数的最优值会变,但似然函数的值不变。例如把均值写成 $2+\mu$,用同样的数据做 MLE,会得到 $\mu=98$(因为 $2+98=100$),似然函数本身不变。
现实提醒:现实中我们并不知道真实分布。虽然偶尔能用中心极限定理论证某变量近似服从高斯,但一般来说这只是近似;此时 MLE 仍可用,只是一致性、有效性不再有保证。这也是为什么常常需要「做出合理的假设,然后检查结果是否合理」。
📷 MLE 的若干性质
回到原视频 (00:35:18)
五、单变量高斯的 MLE(完整推导)
(参考时间: 00:40)
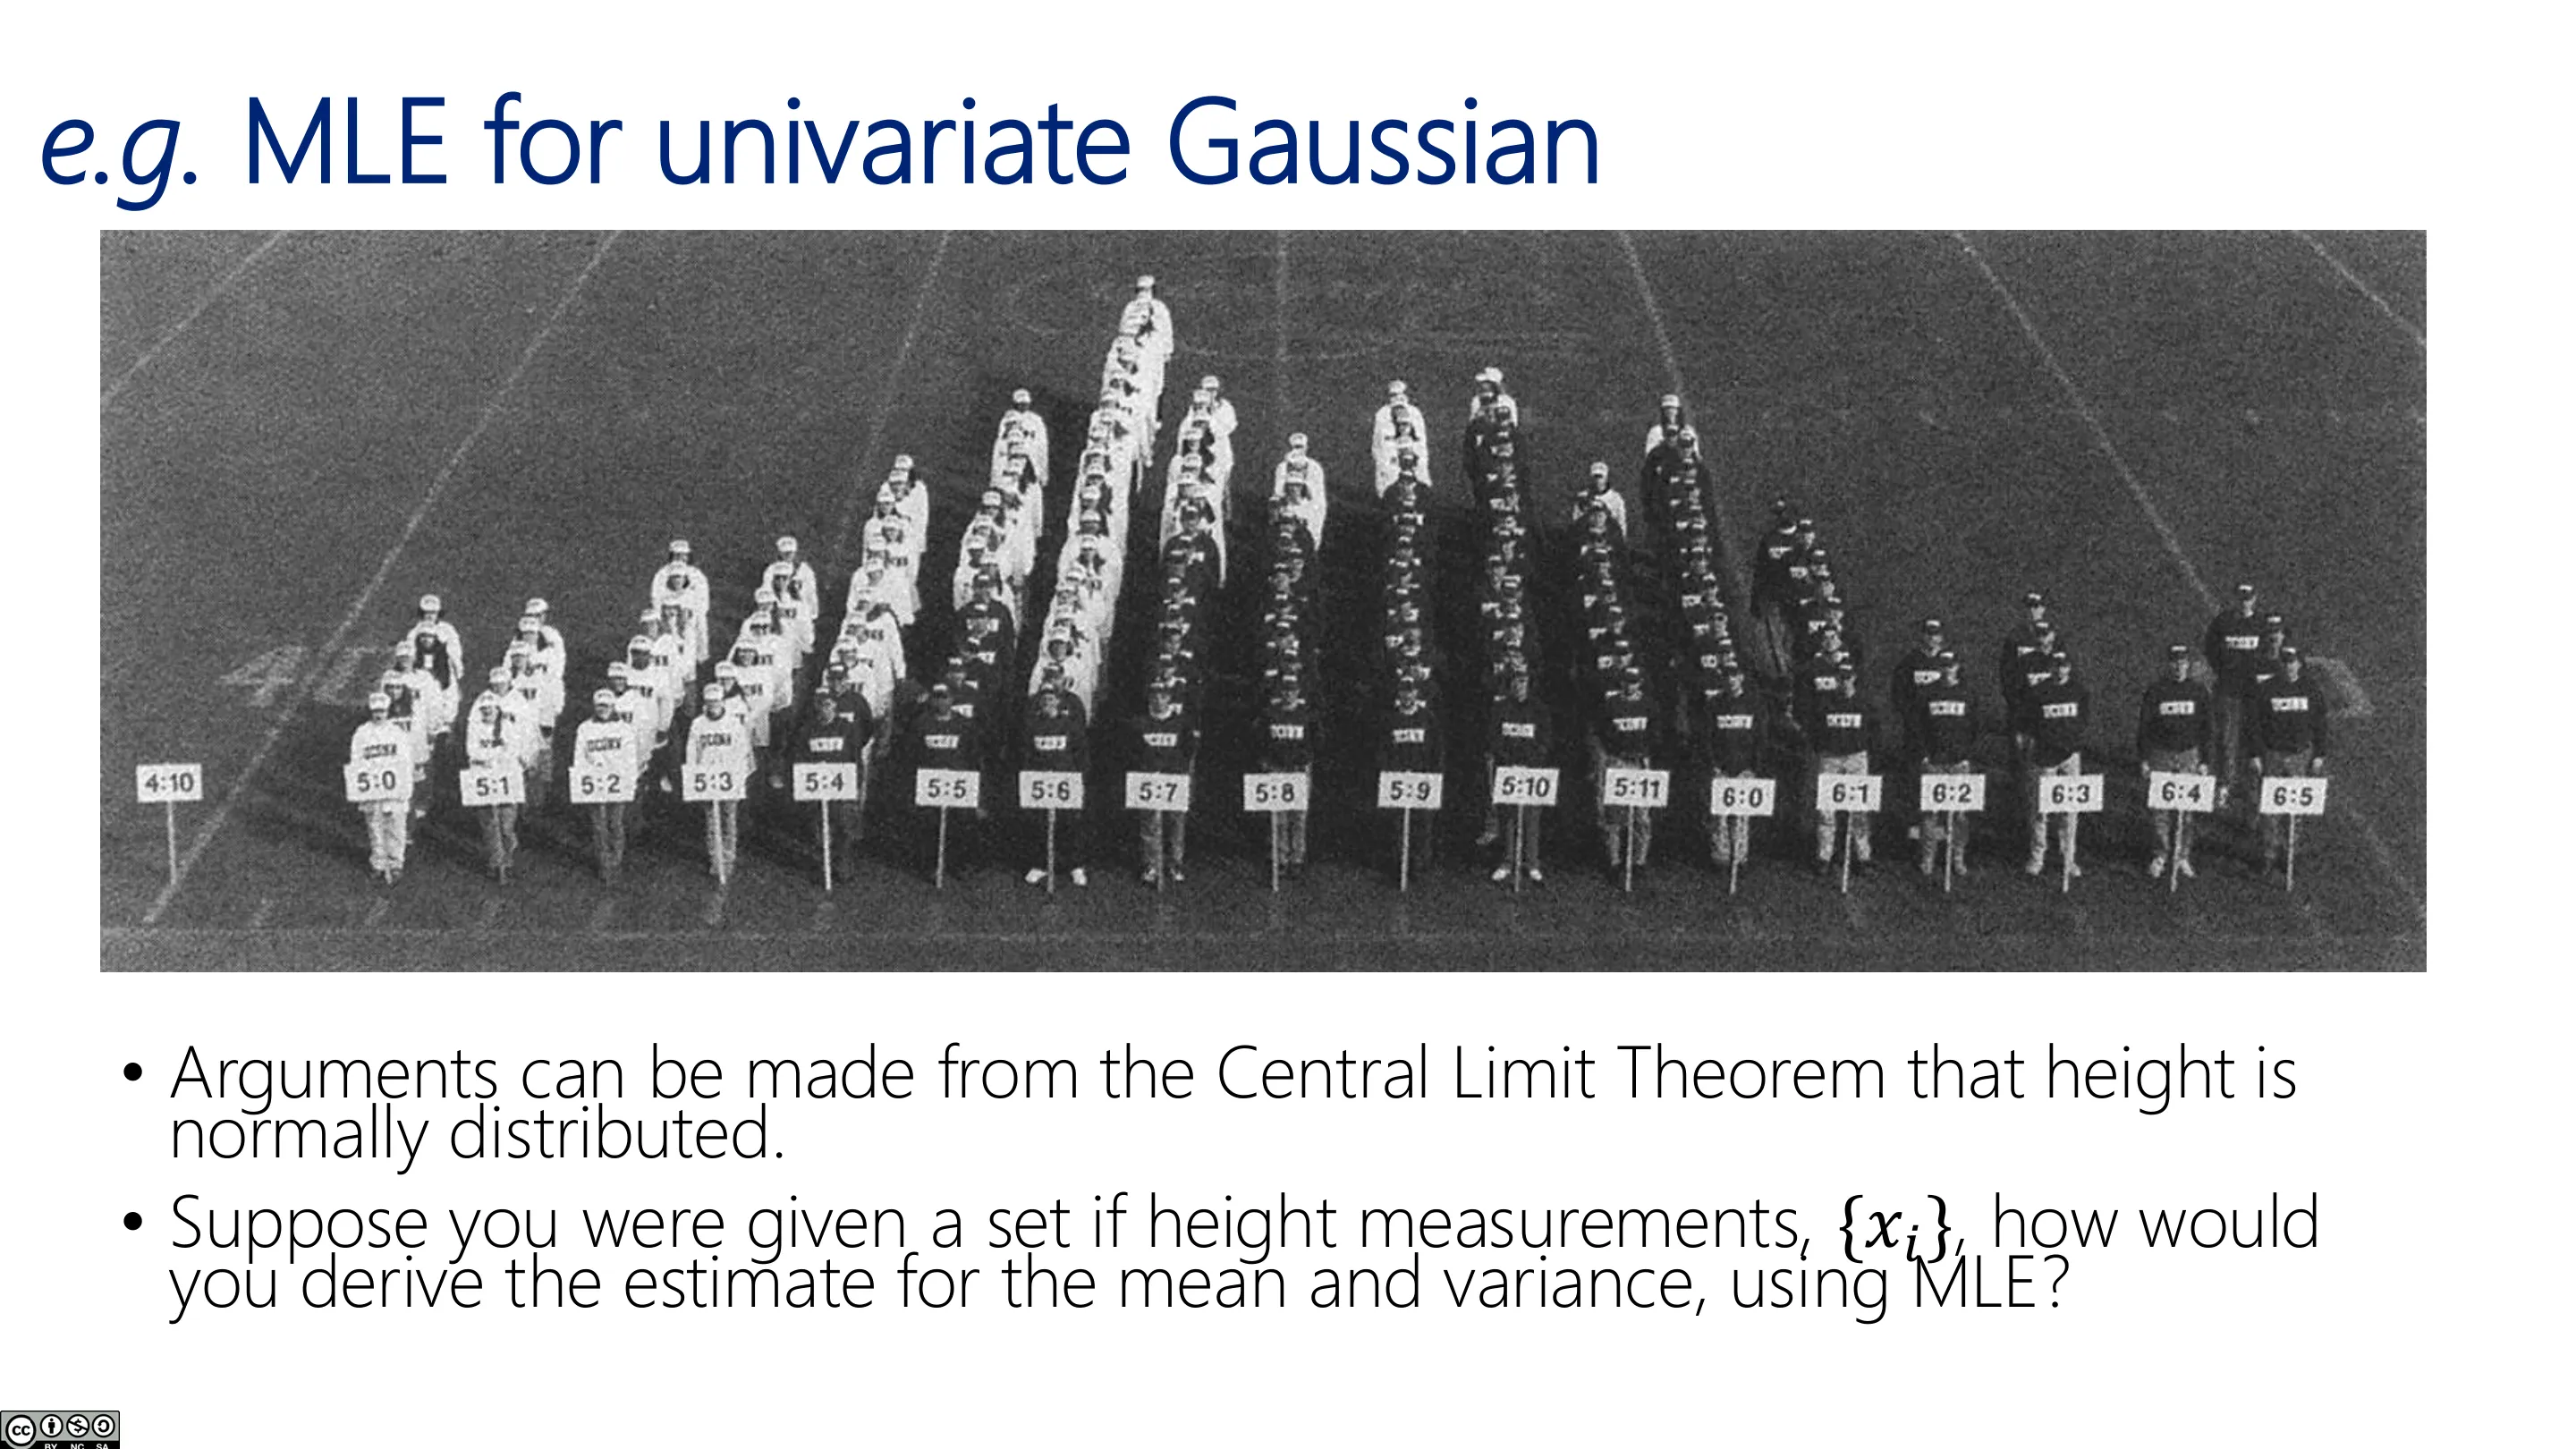
我们用身高做例子。为什么身高近似服从高斯?因为身高是许多(数百个)遗传效应的总和——由中心极限定理,独立随机变量之和趋近正态。这类性状被称为数量性状(quantitative traits)。
中心极限定理(CLT):把大量独立的随机变量相加,其和趋于服从正态分布。
📷 MLE 用于单变量高斯(一)
回到原视频 (00:40:58)5.1 写似然
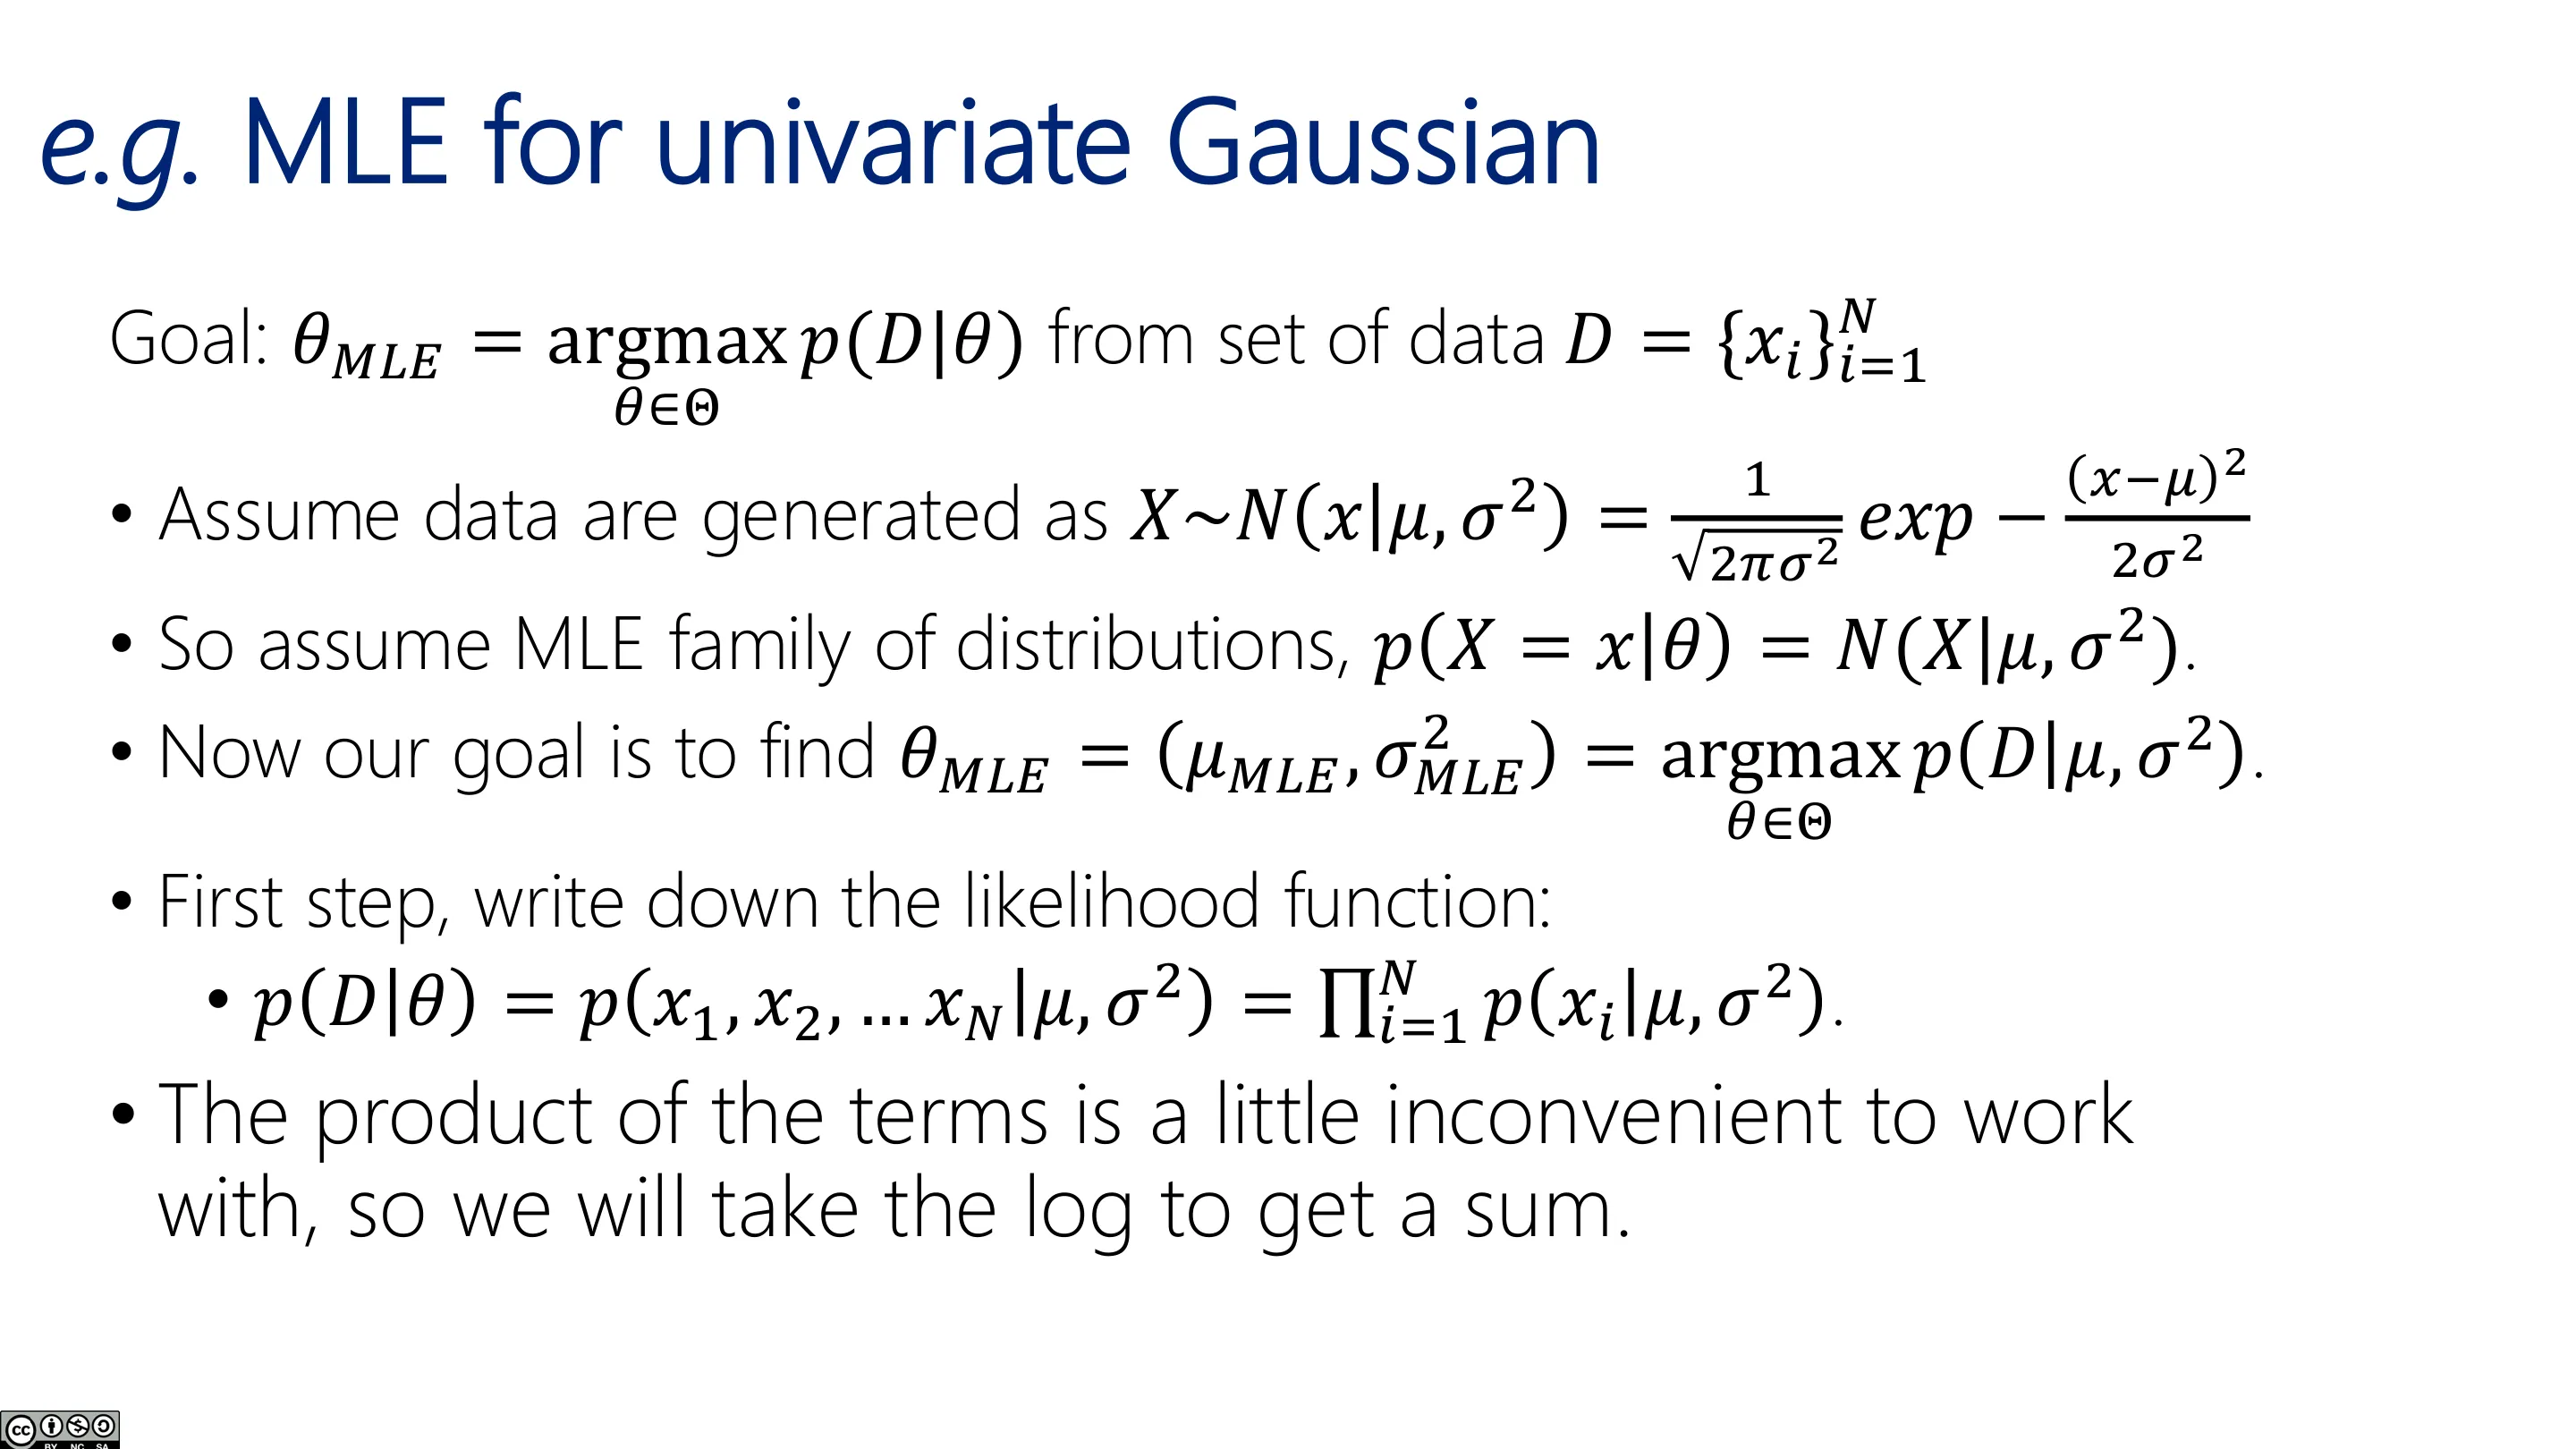
设 $X \sim \mathcal{N}(\mu, \sigma^2)$,数据 $x_1,\dots,x_n$ IID。似然为
$$ L(\mu,\sigma^2) = \prod_{i=1}^{n} \frac{1}{\sqrt{2\pi\sigma^2}} \exp\!\left(-\frac{(x_i-\mu)^2}{2\sigma^2}\right) $$
因为 IID,联合概率 = 各点概率之积。为了把乘积变成求和(也更便于优化),取对数:
$$ \ell(\mu,\sigma^2) = \sum_{i=1}^{n} \log p(x_i \mid \mu, \sigma^2) $$
为什么可以取对数? 因为对数单调递增——最大化对数似然与最大化似然得到相同的参数。
📷 MLE 用于单变量高斯(二)
回到原视频 (00:41:47)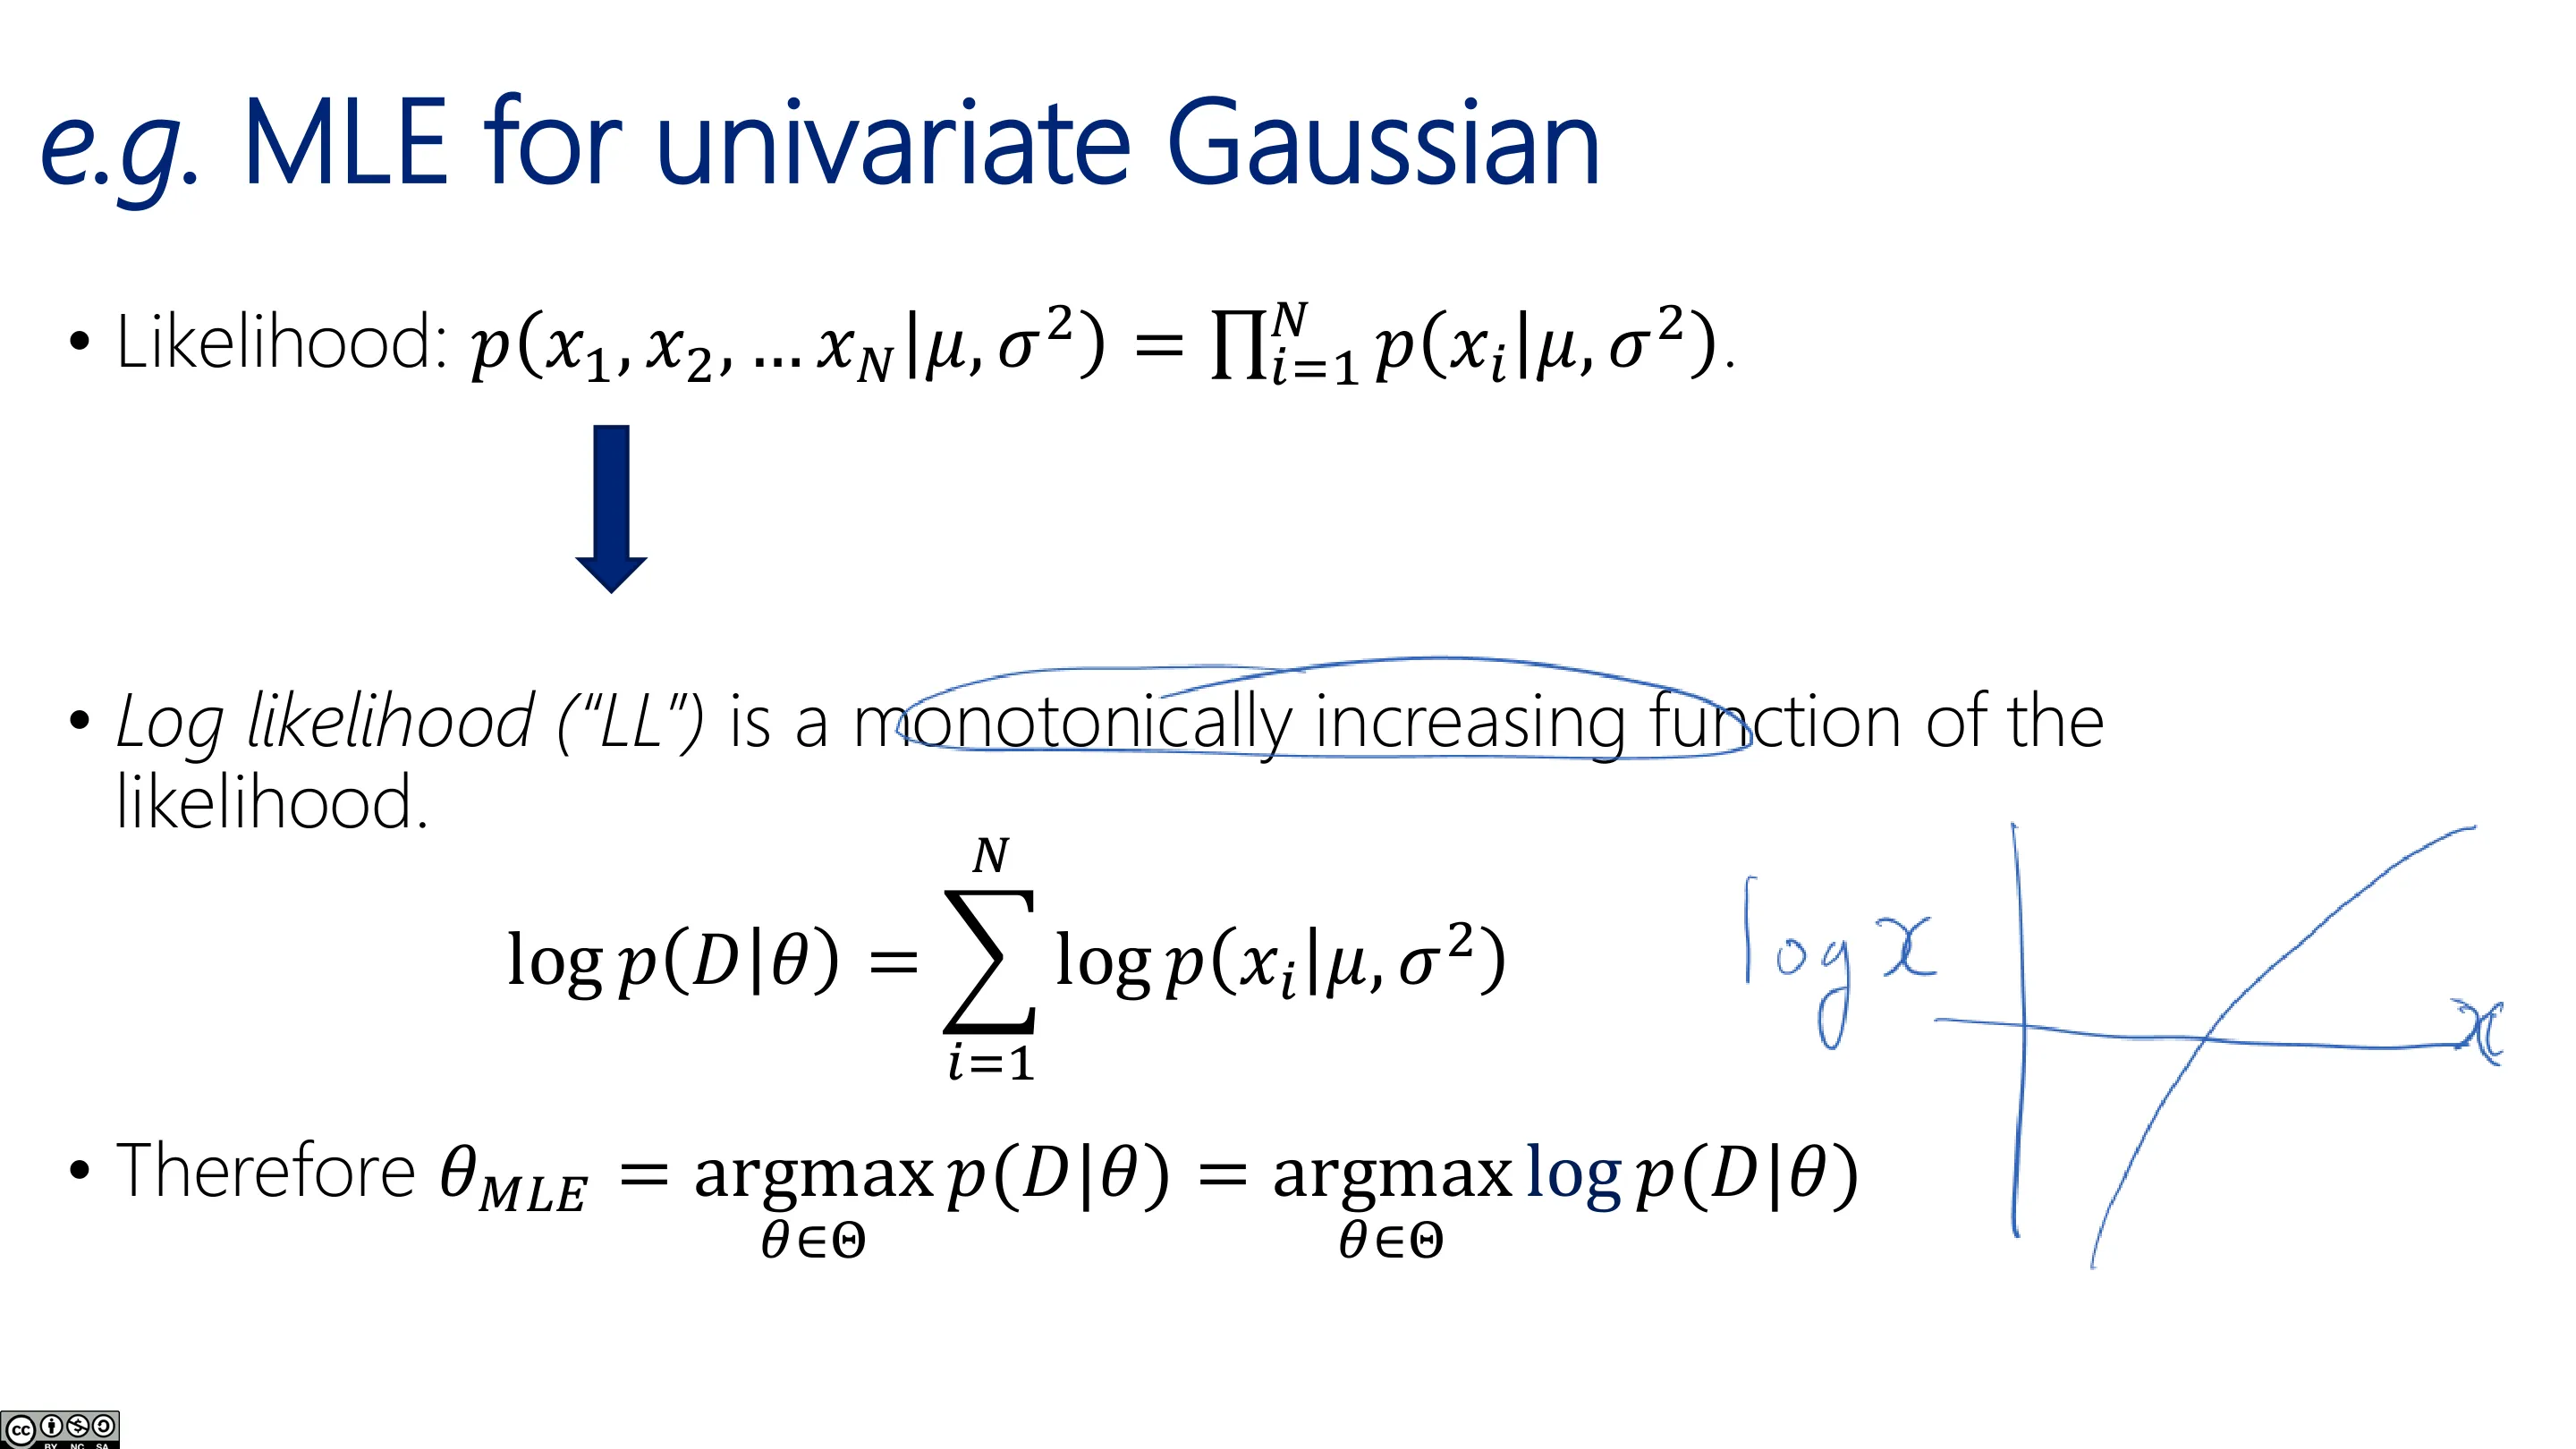
📷 MLE 用于单变量高斯(三)
回到原视频 (00:42:40)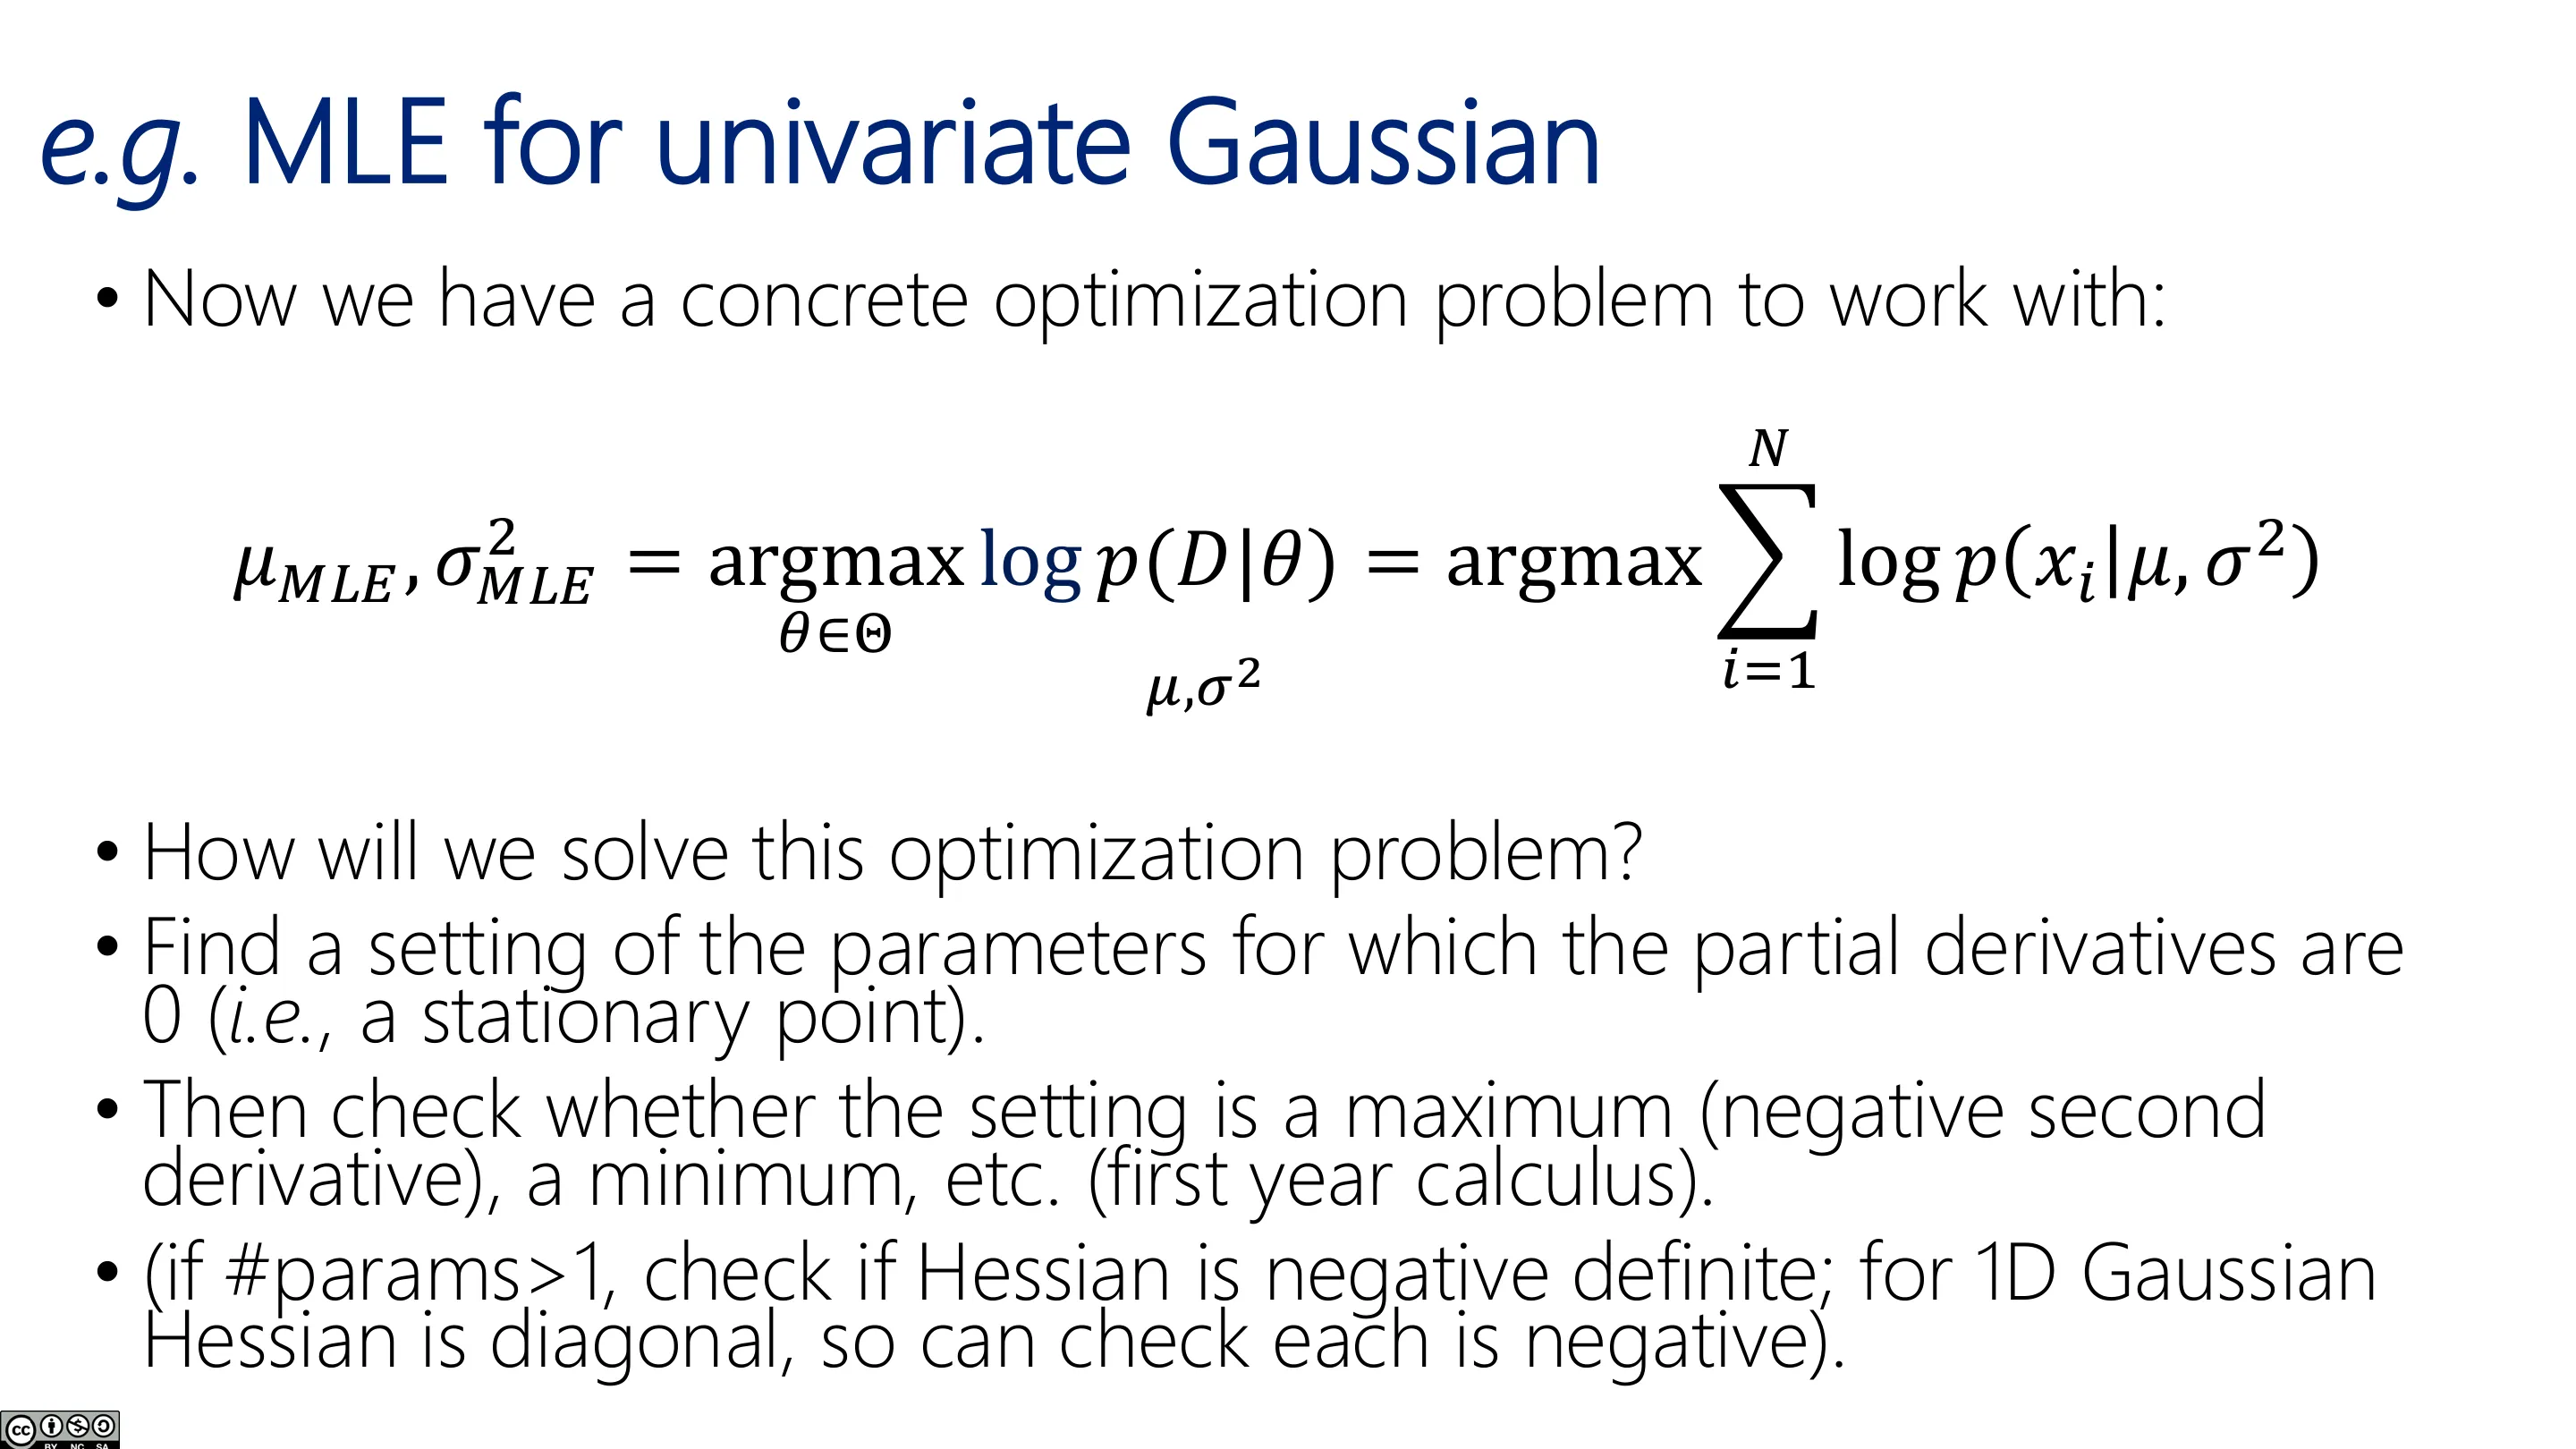
📷 MLE 用于单变量高斯(四)
回到原视频 (00:43:52)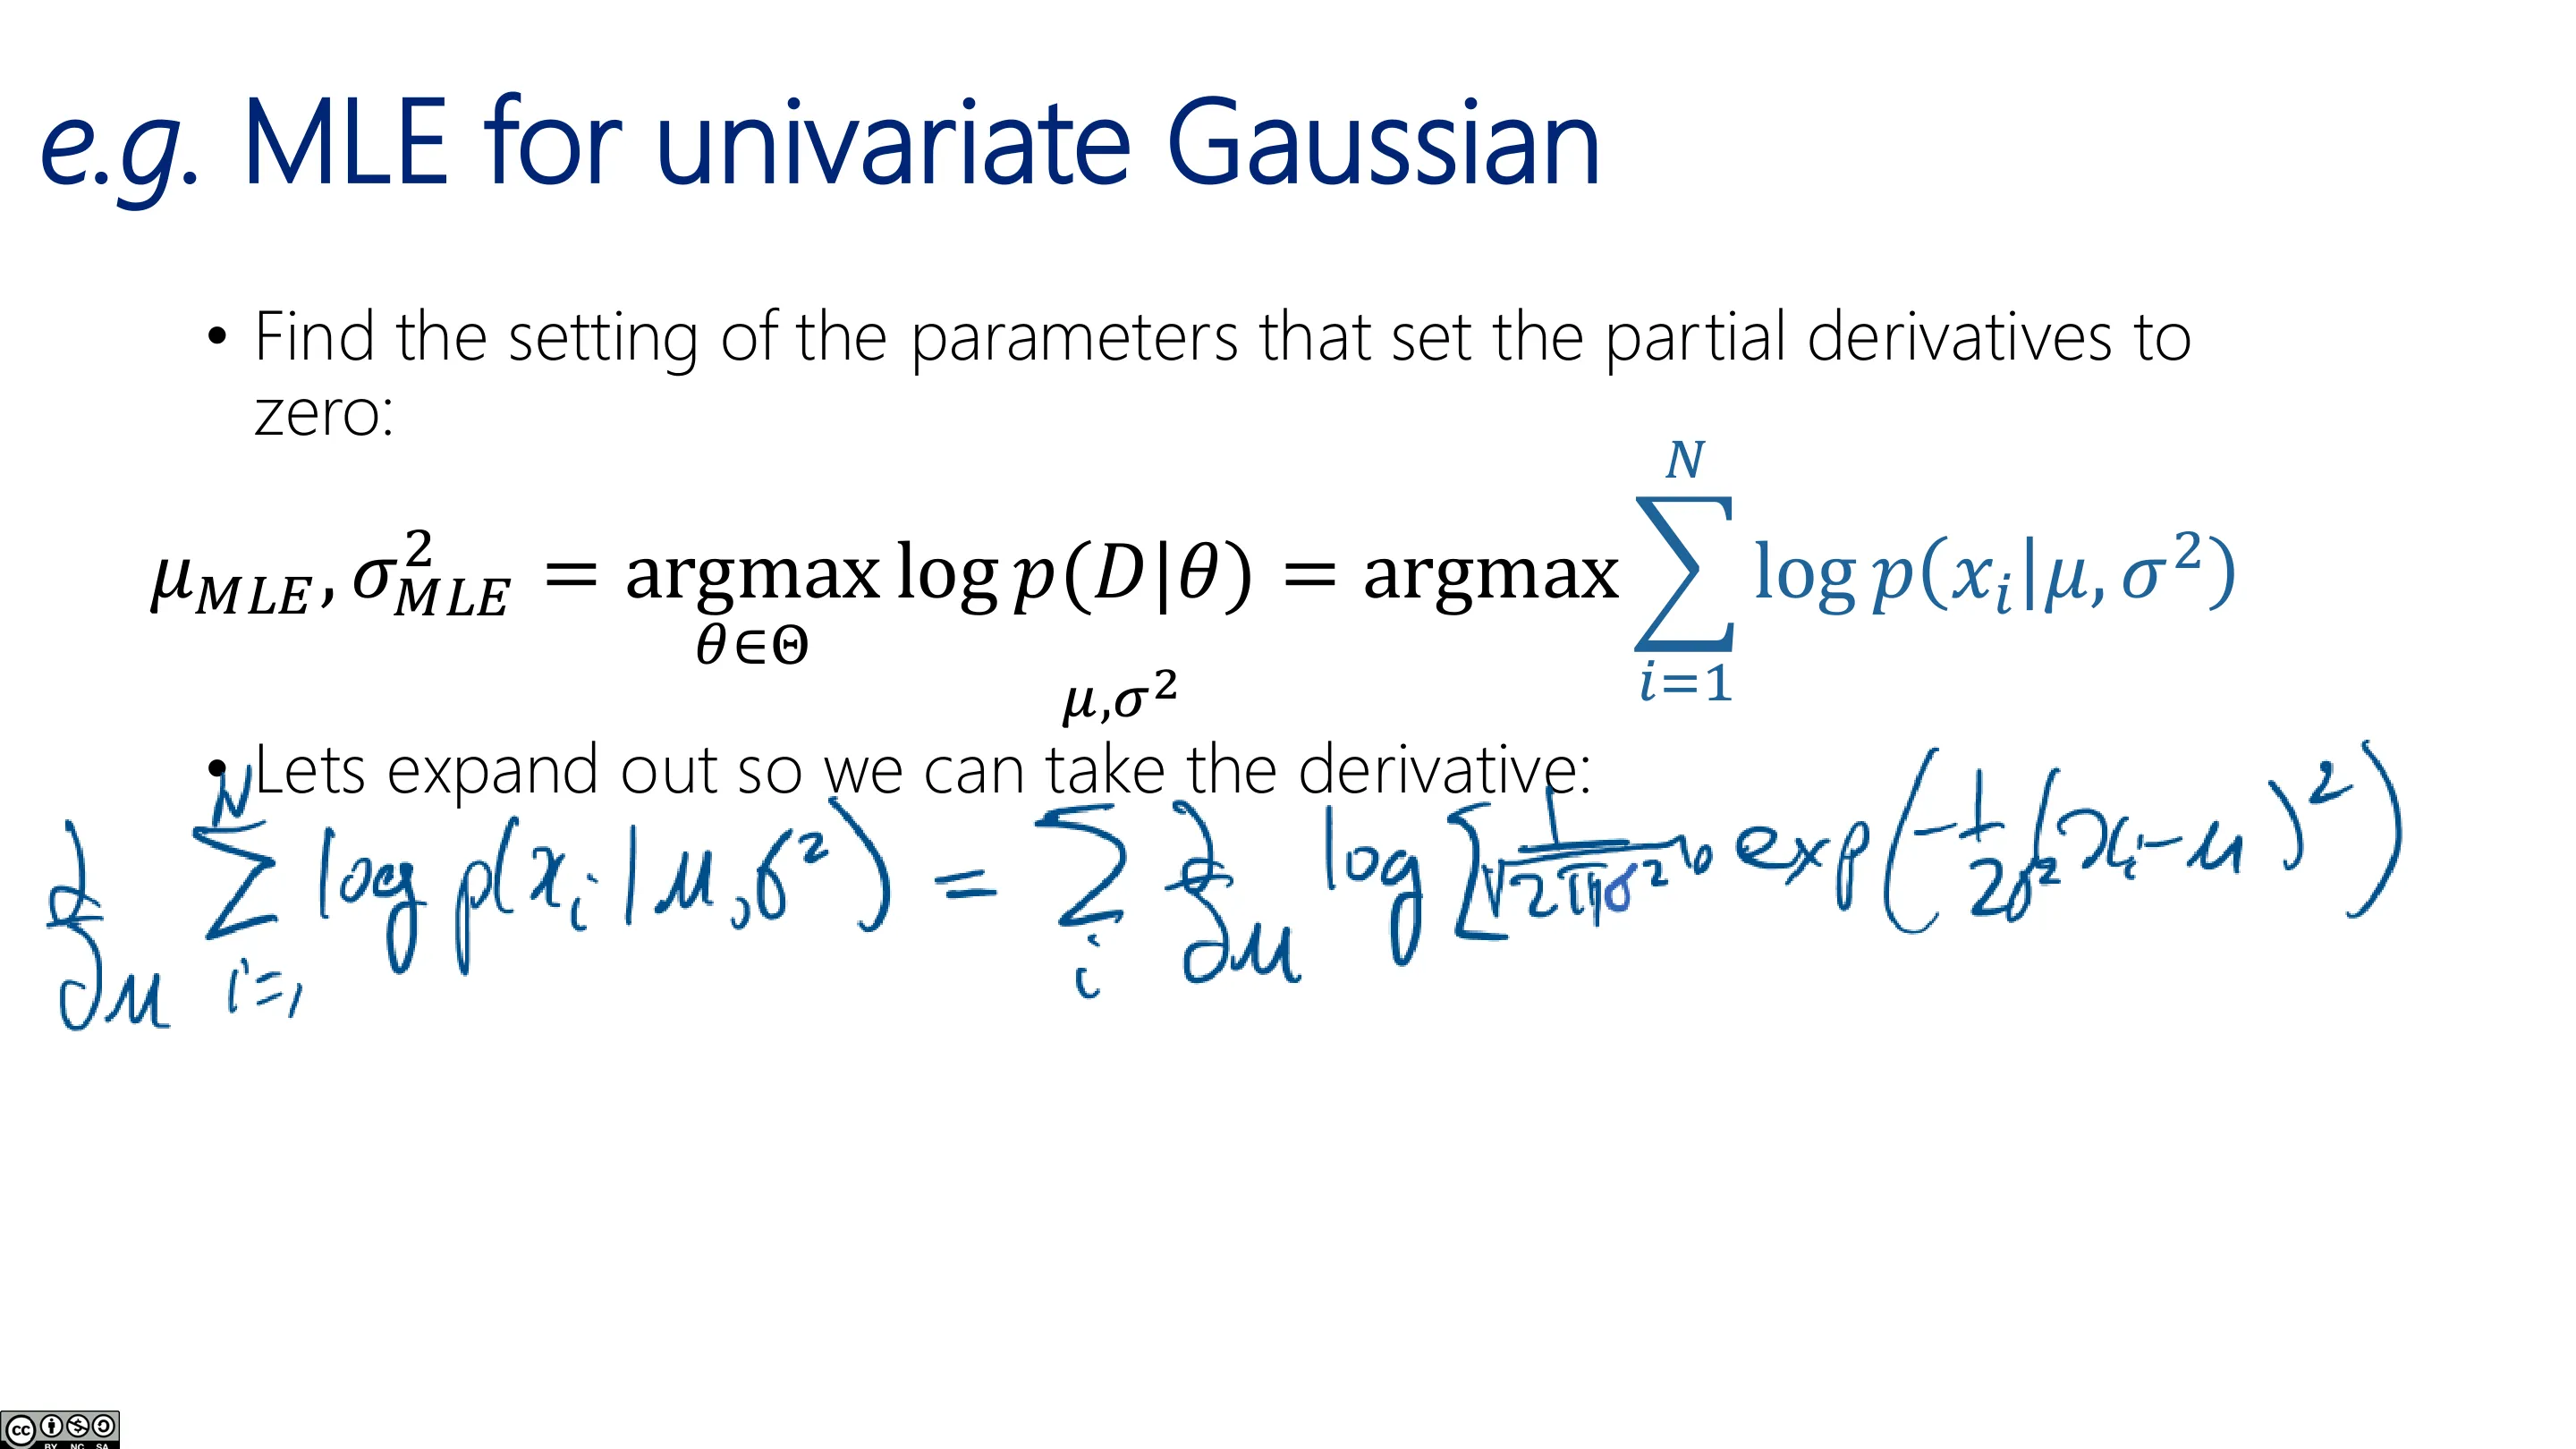
📷 MLE 用于单变量高斯(五)
回到原视频 (00:45:33)5.2 对均值求导
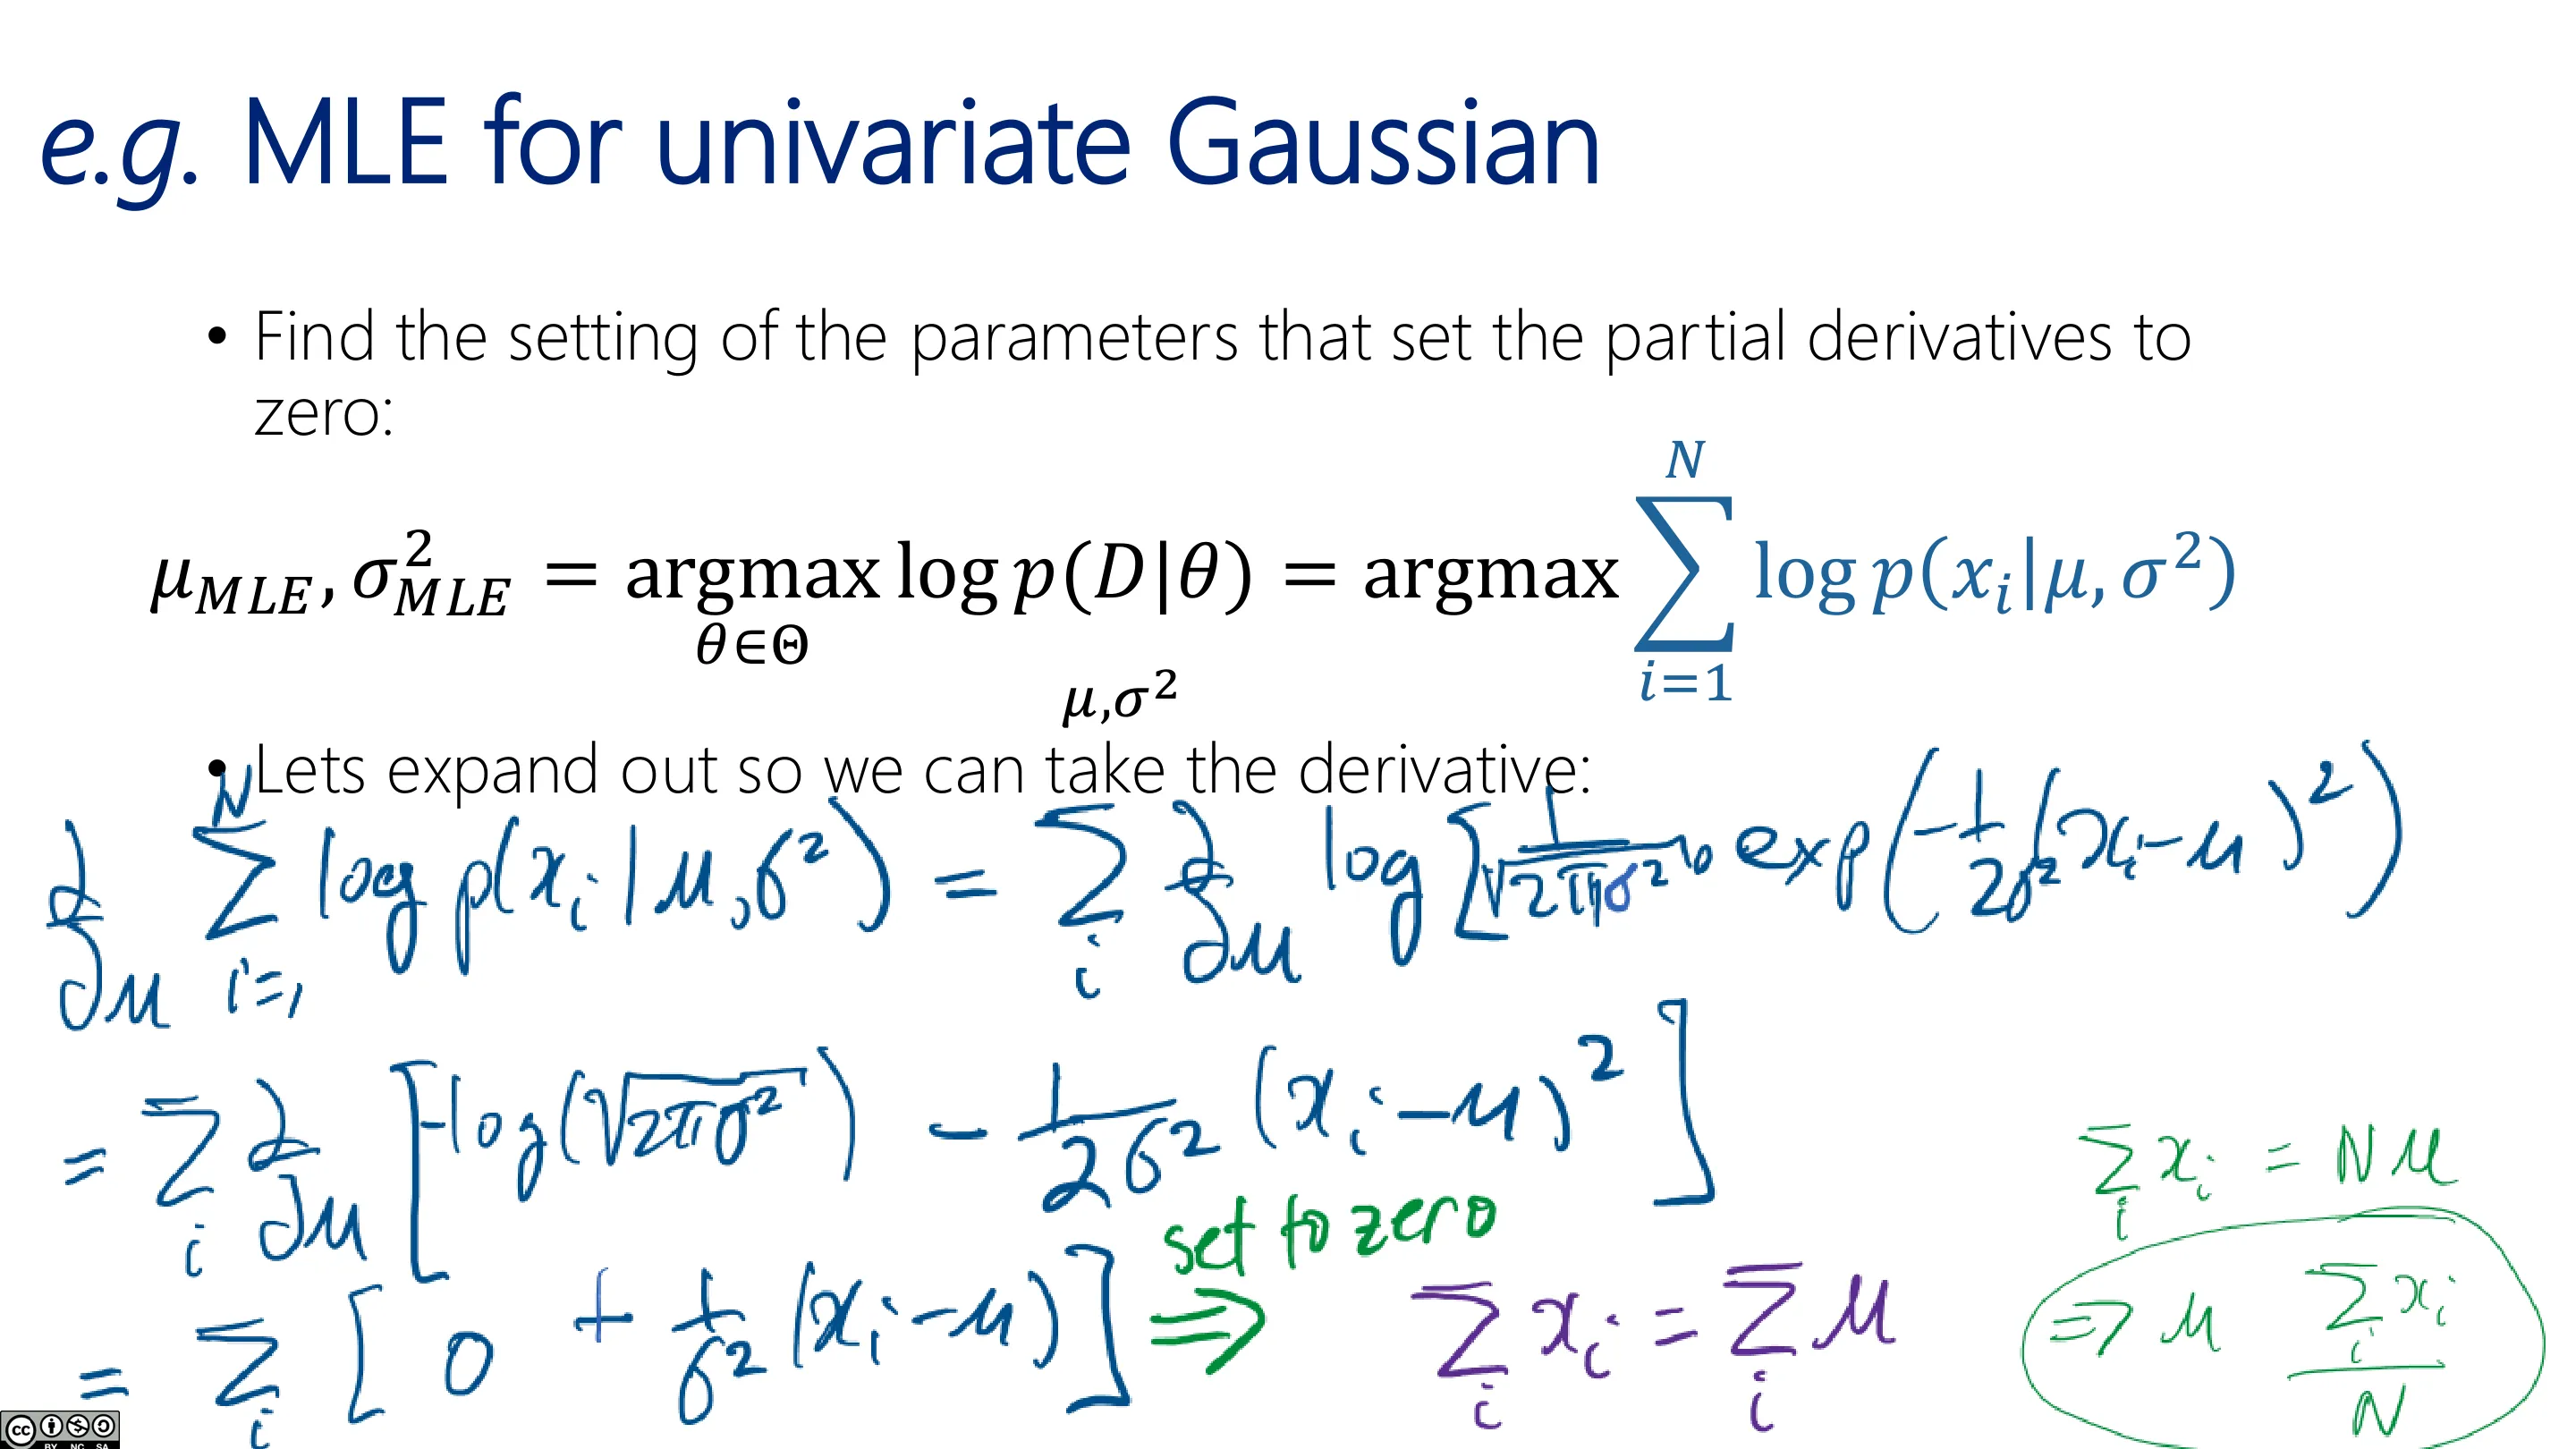
对 $\mu$ 求偏导并令其为零(把导数移进求和),可得
$$ \frac{\partial \ell}{\partial \mu} = \frac{1}{\sigma^2}\sum_{i=1}^{n}(x_i - \mu) = 0 \;\Longrightarrow\; \hat{\mu} = \frac{1}{n}\sum_{i=1}^{n} x_i $$
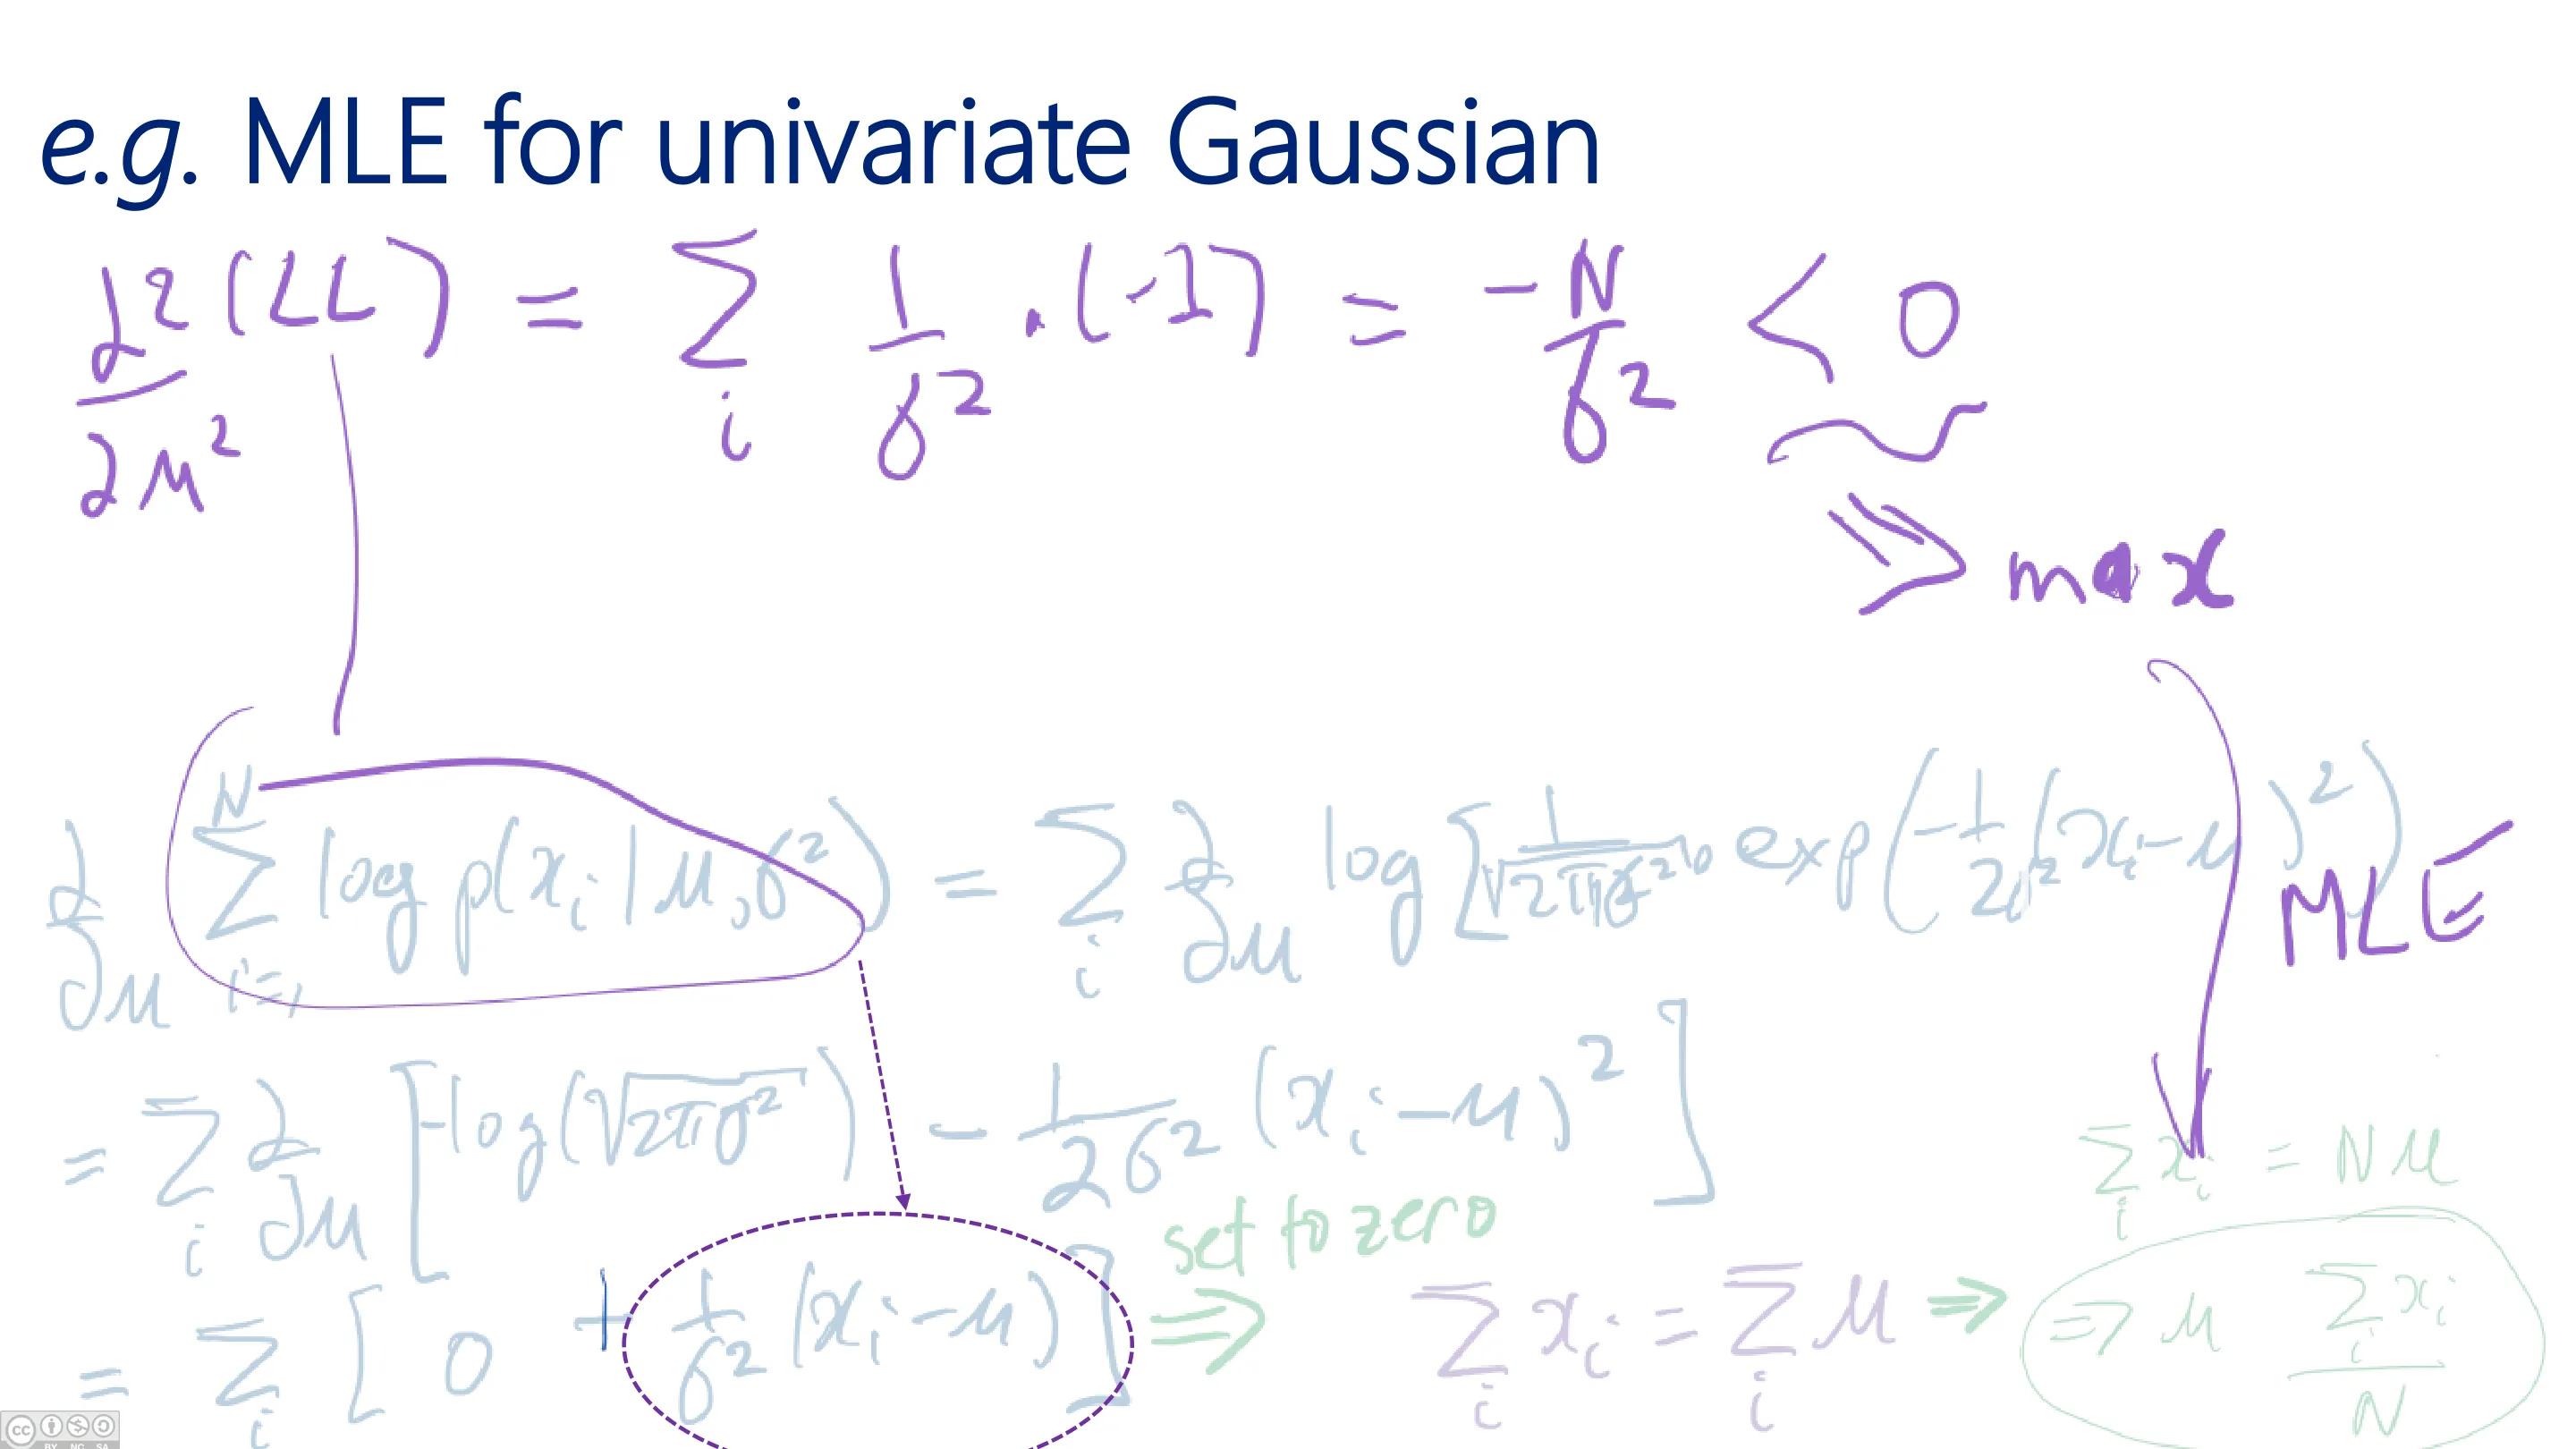
即:均值的 MLE 就是数据的经验均值。为确认它是最大值(而非最小值),再求二阶导:
$$ \frac{\partial^2 \ell}{\partial \mu^2} = -\frac{n}{\sigma^2} < 0 $$
二阶导为负,说明这是最大值。
📷 MLE 用于单变量高斯(六)
回到原视频 (00:47:00)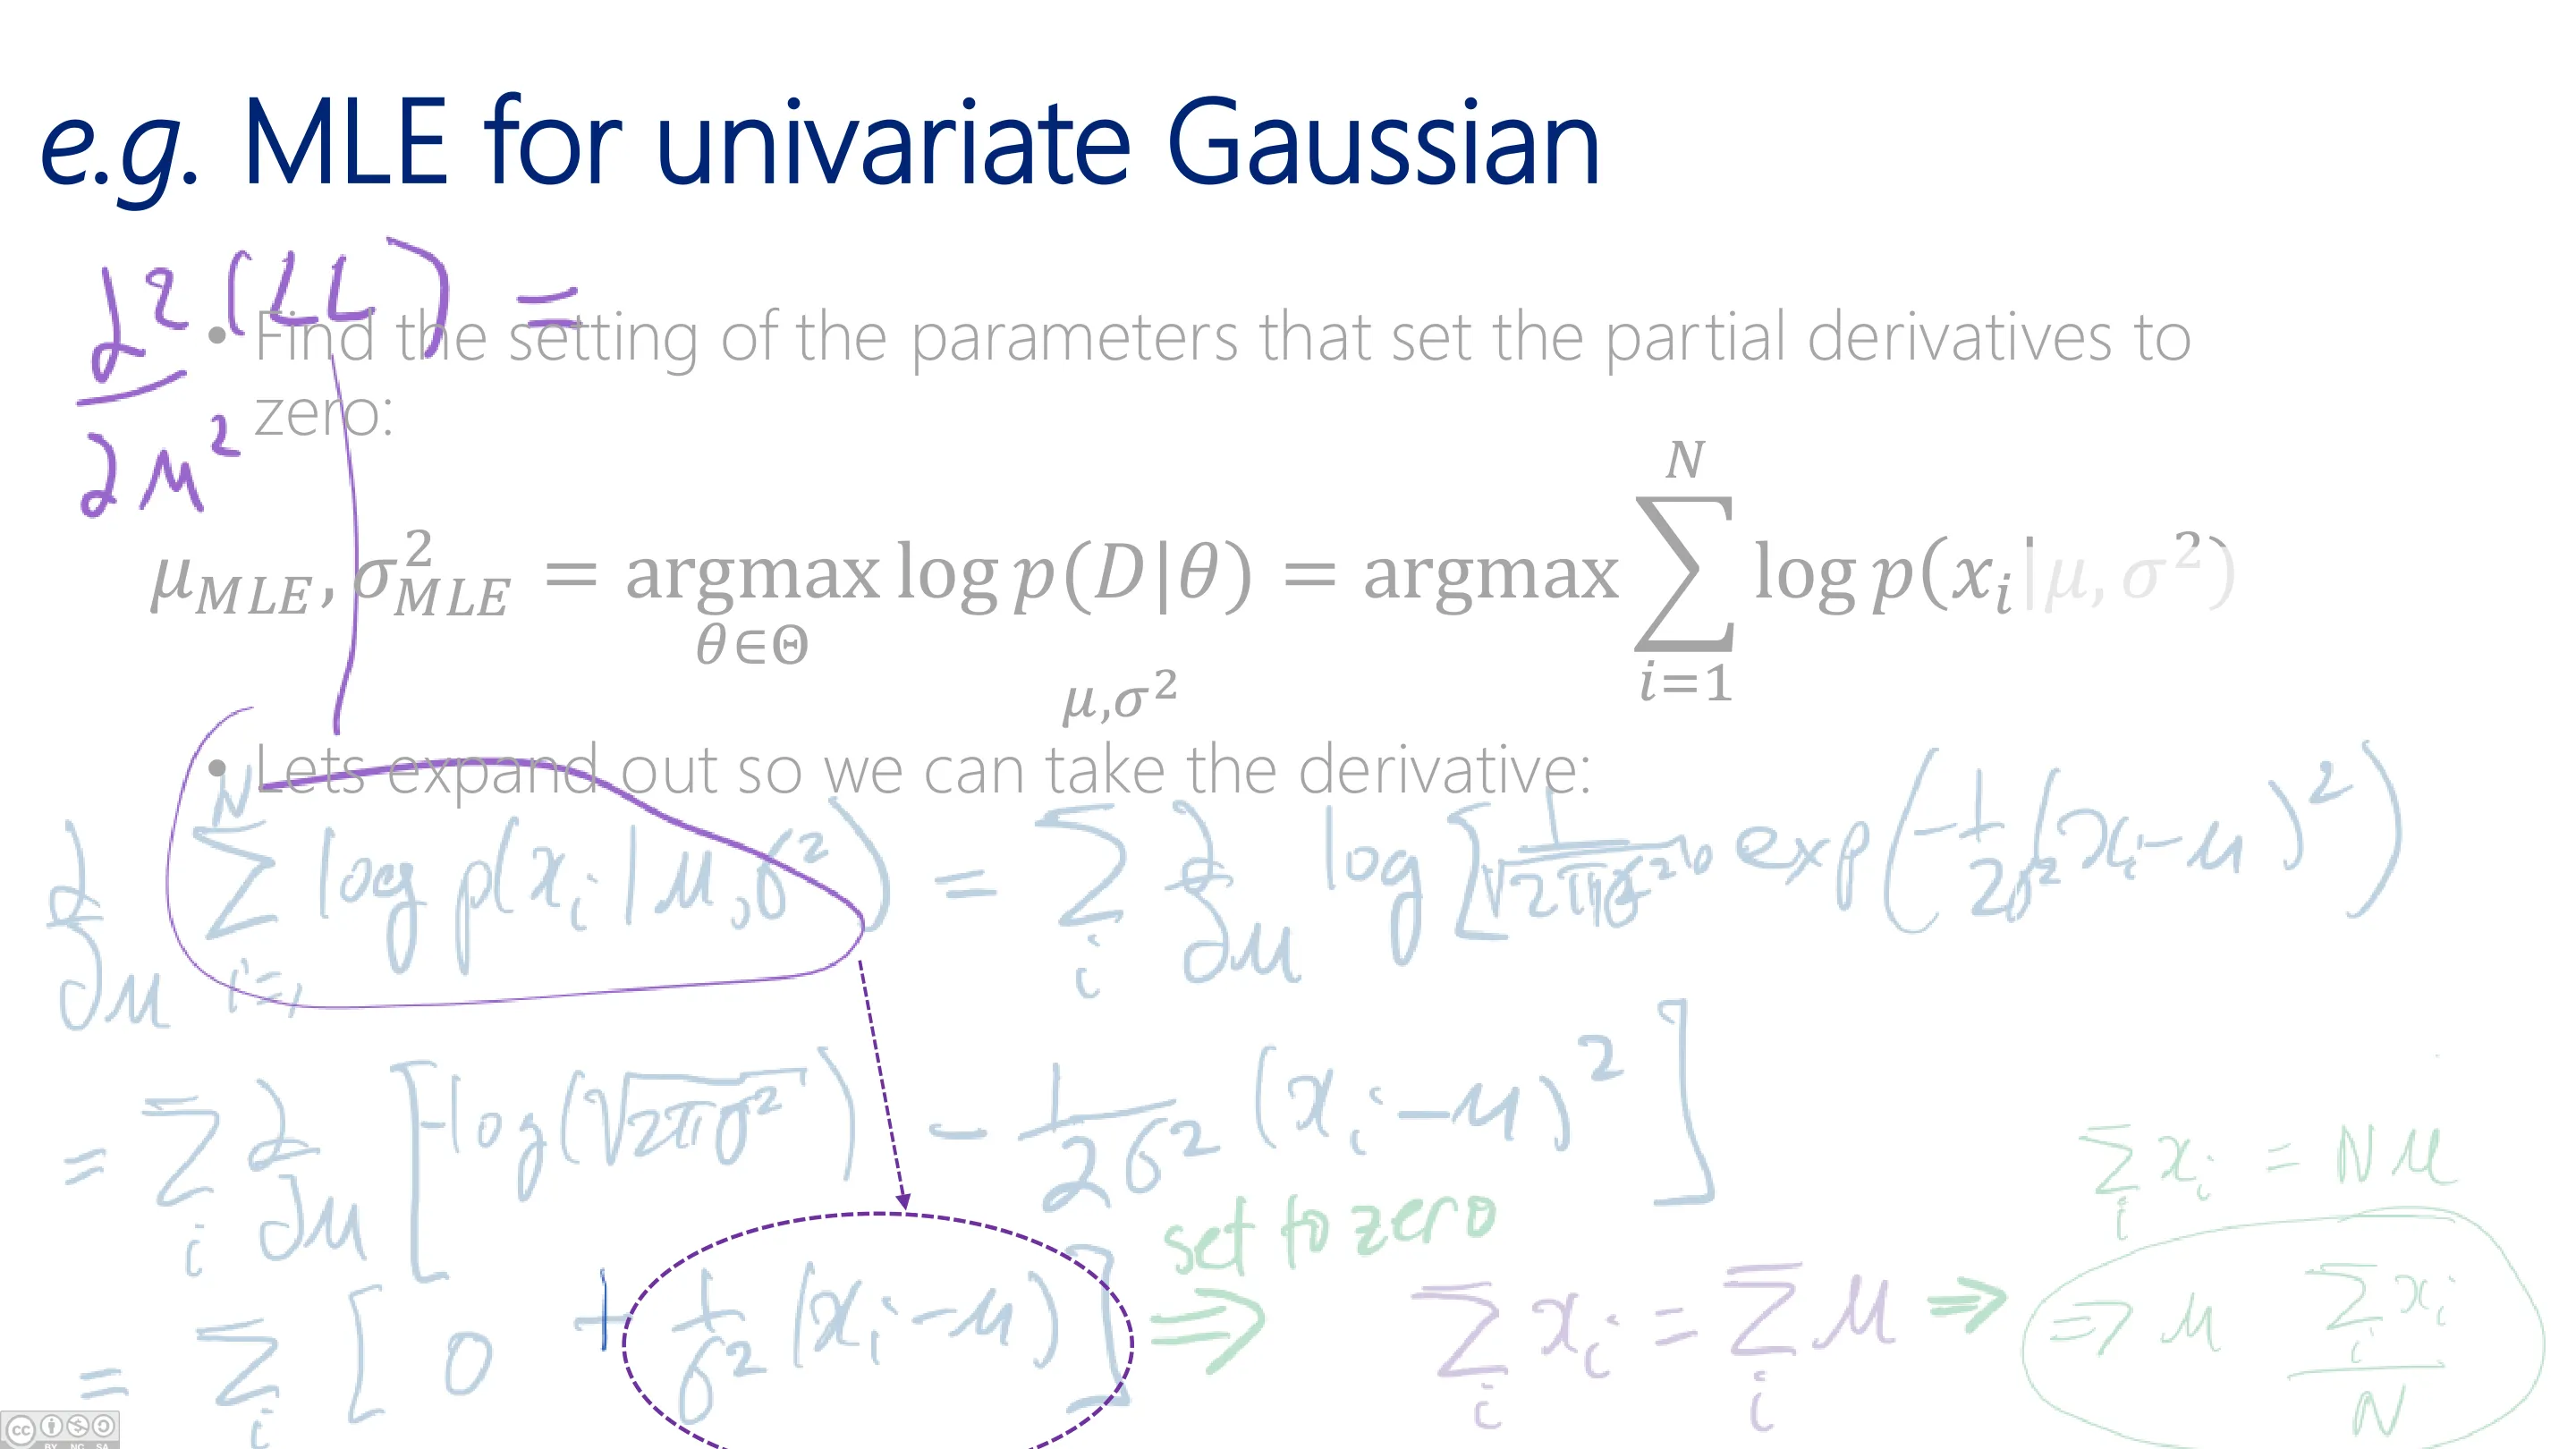
📷 MLE 用于单变量高斯(七)
回到原视频 (00:49:21)编者说明:讲师指出,这些参数可以分别估计——求 $\mu$ 的驻点时并不需要知道 $\sigma$。
5.3 对方差求导
把 $\sigma^2$ 当作一个普通变量处理,对 $\sigma^2$ 求偏导、令其为零,可分离出
$$ \hat{\sigma}^2 = \frac{1}{n}\sum_{i=1}^{n}(x_i - \hat{\mu})^2 $$
即数据的经验方差。
编者说明:统计学家常写 $\frac{1}{n-1}$(无偏估计),但我们用大 $N$、不在乎 $n$ 还是 $n-1$。直觉上:我已经用数据估了一个自由度(均值),所以「可用」的数据点少了一个。
📷 MLE 用于单变量高斯(八)
回到原视频 (00:50:28)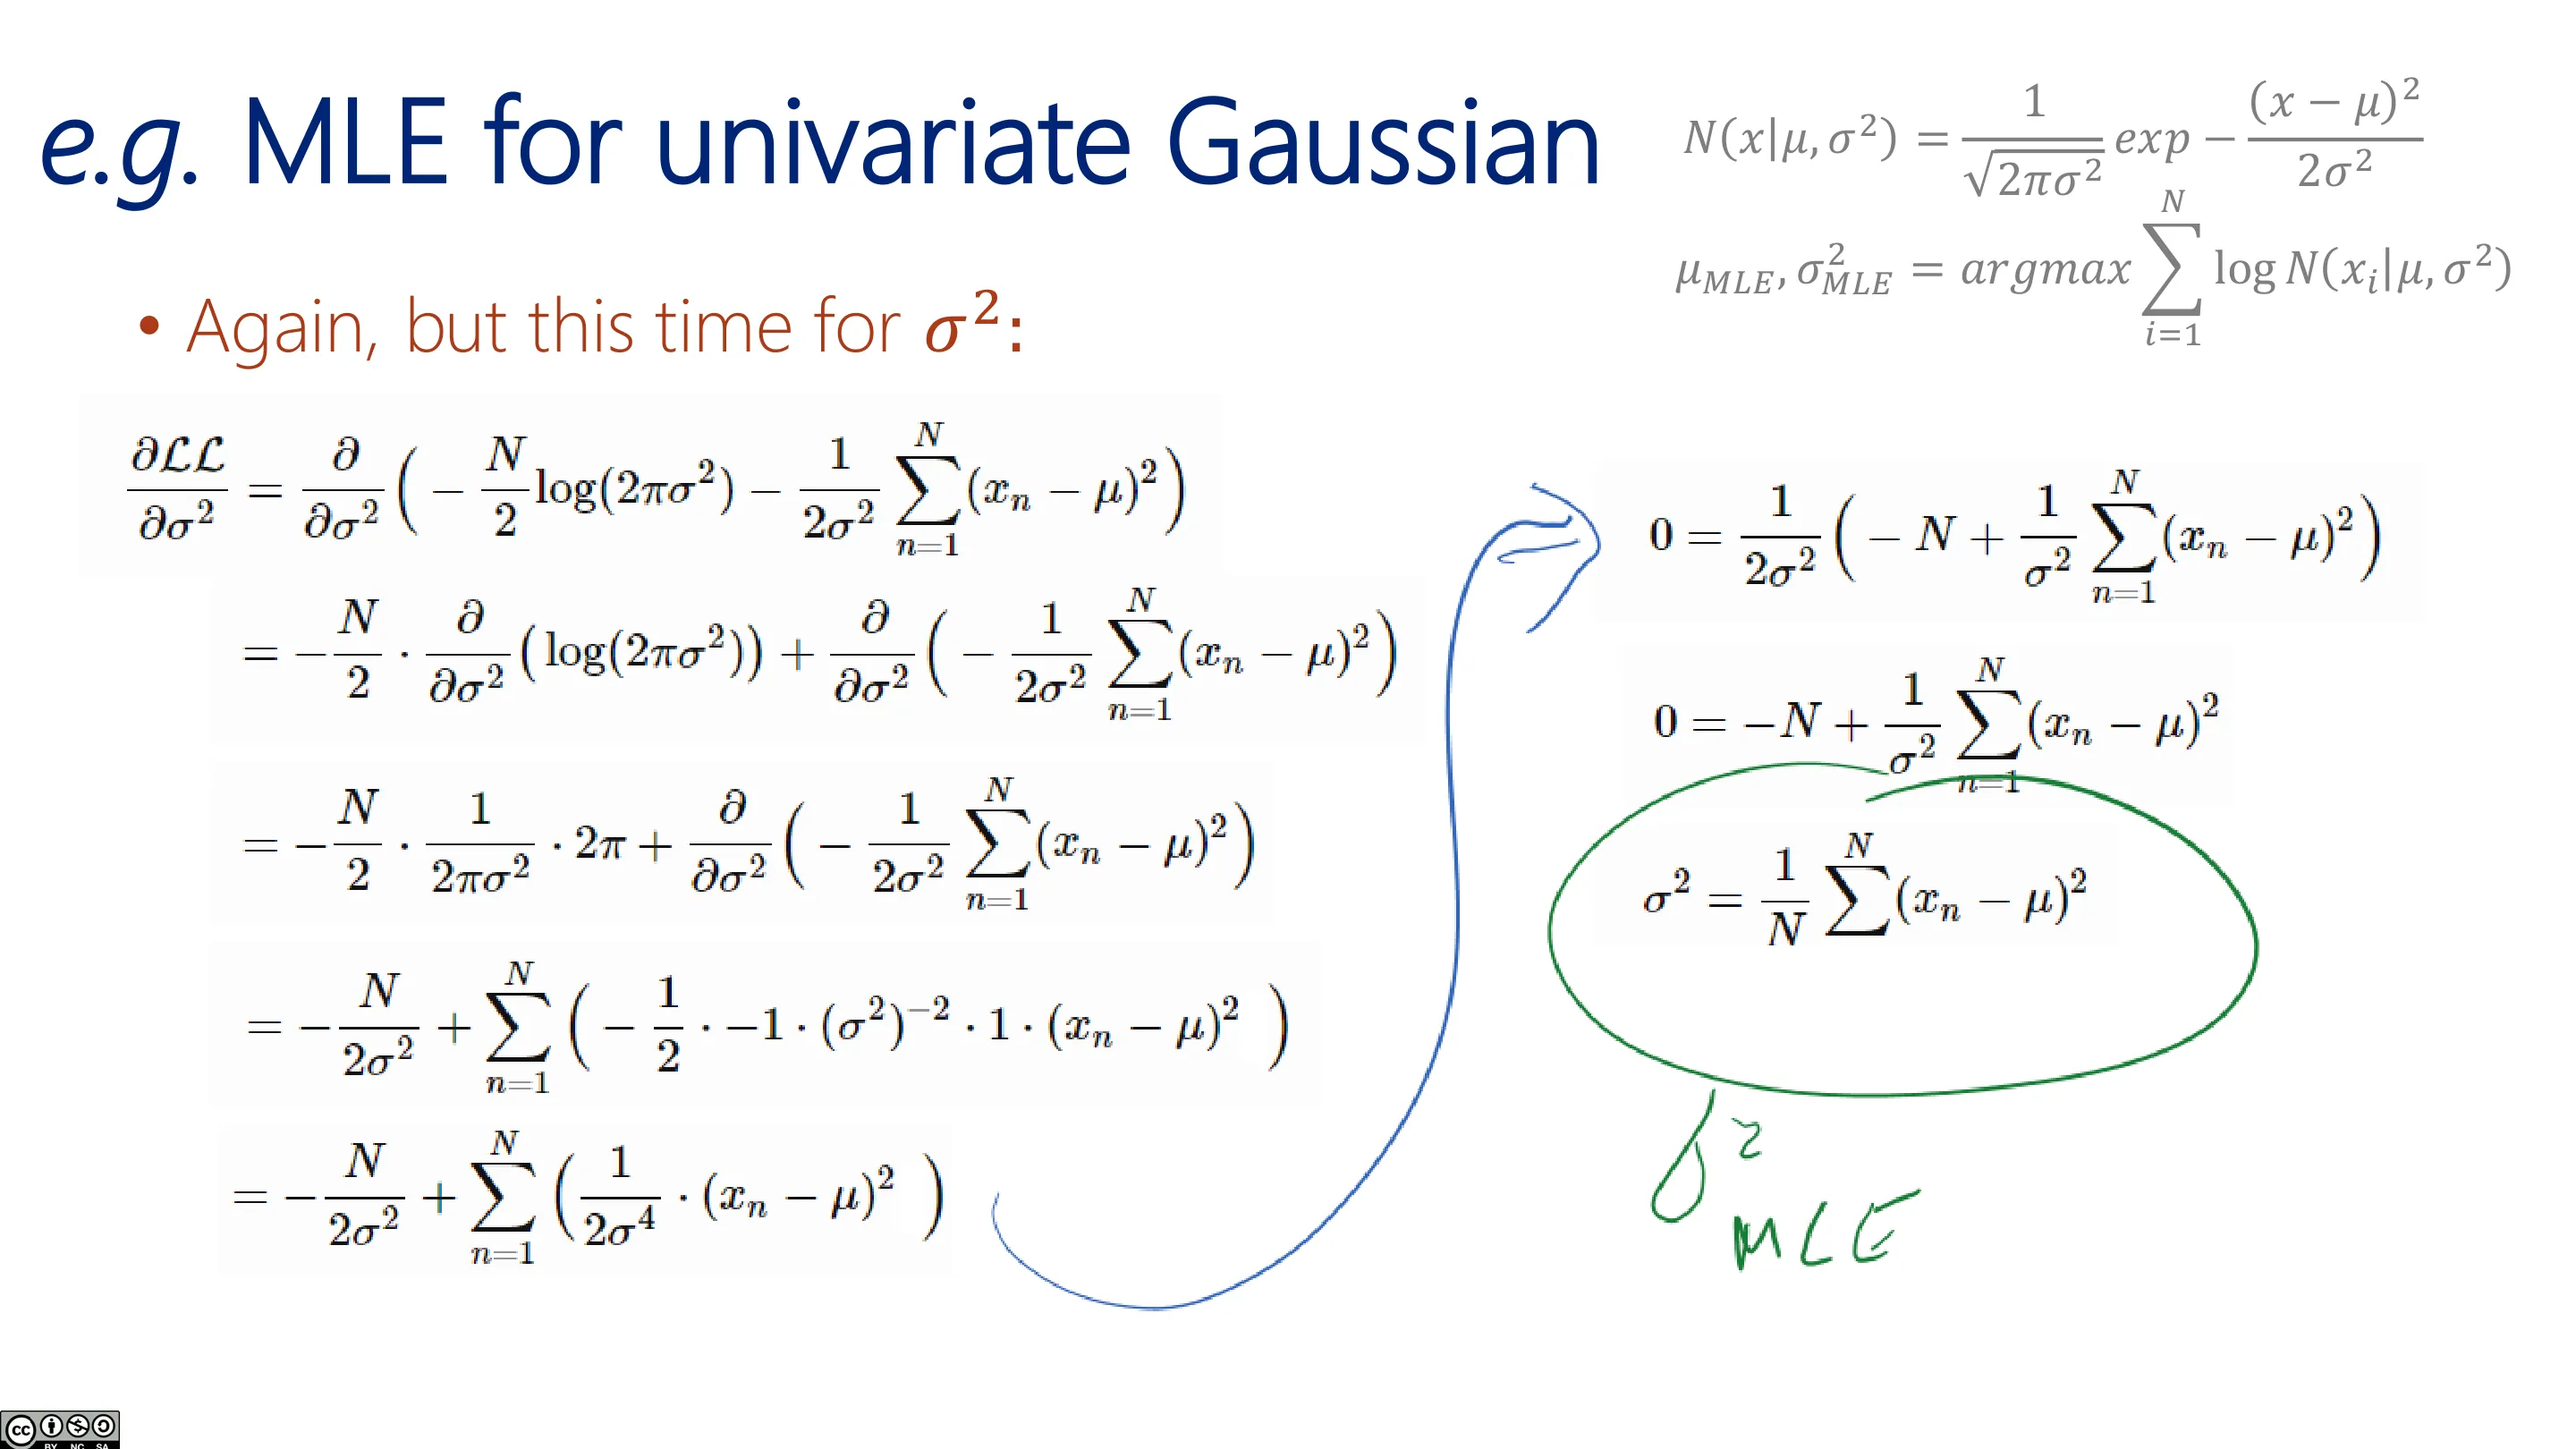
📷 MLE 求方差
回到原视频 (00:52:37)
六、点估计与贝叶斯视角
(参考时间: 01:00)
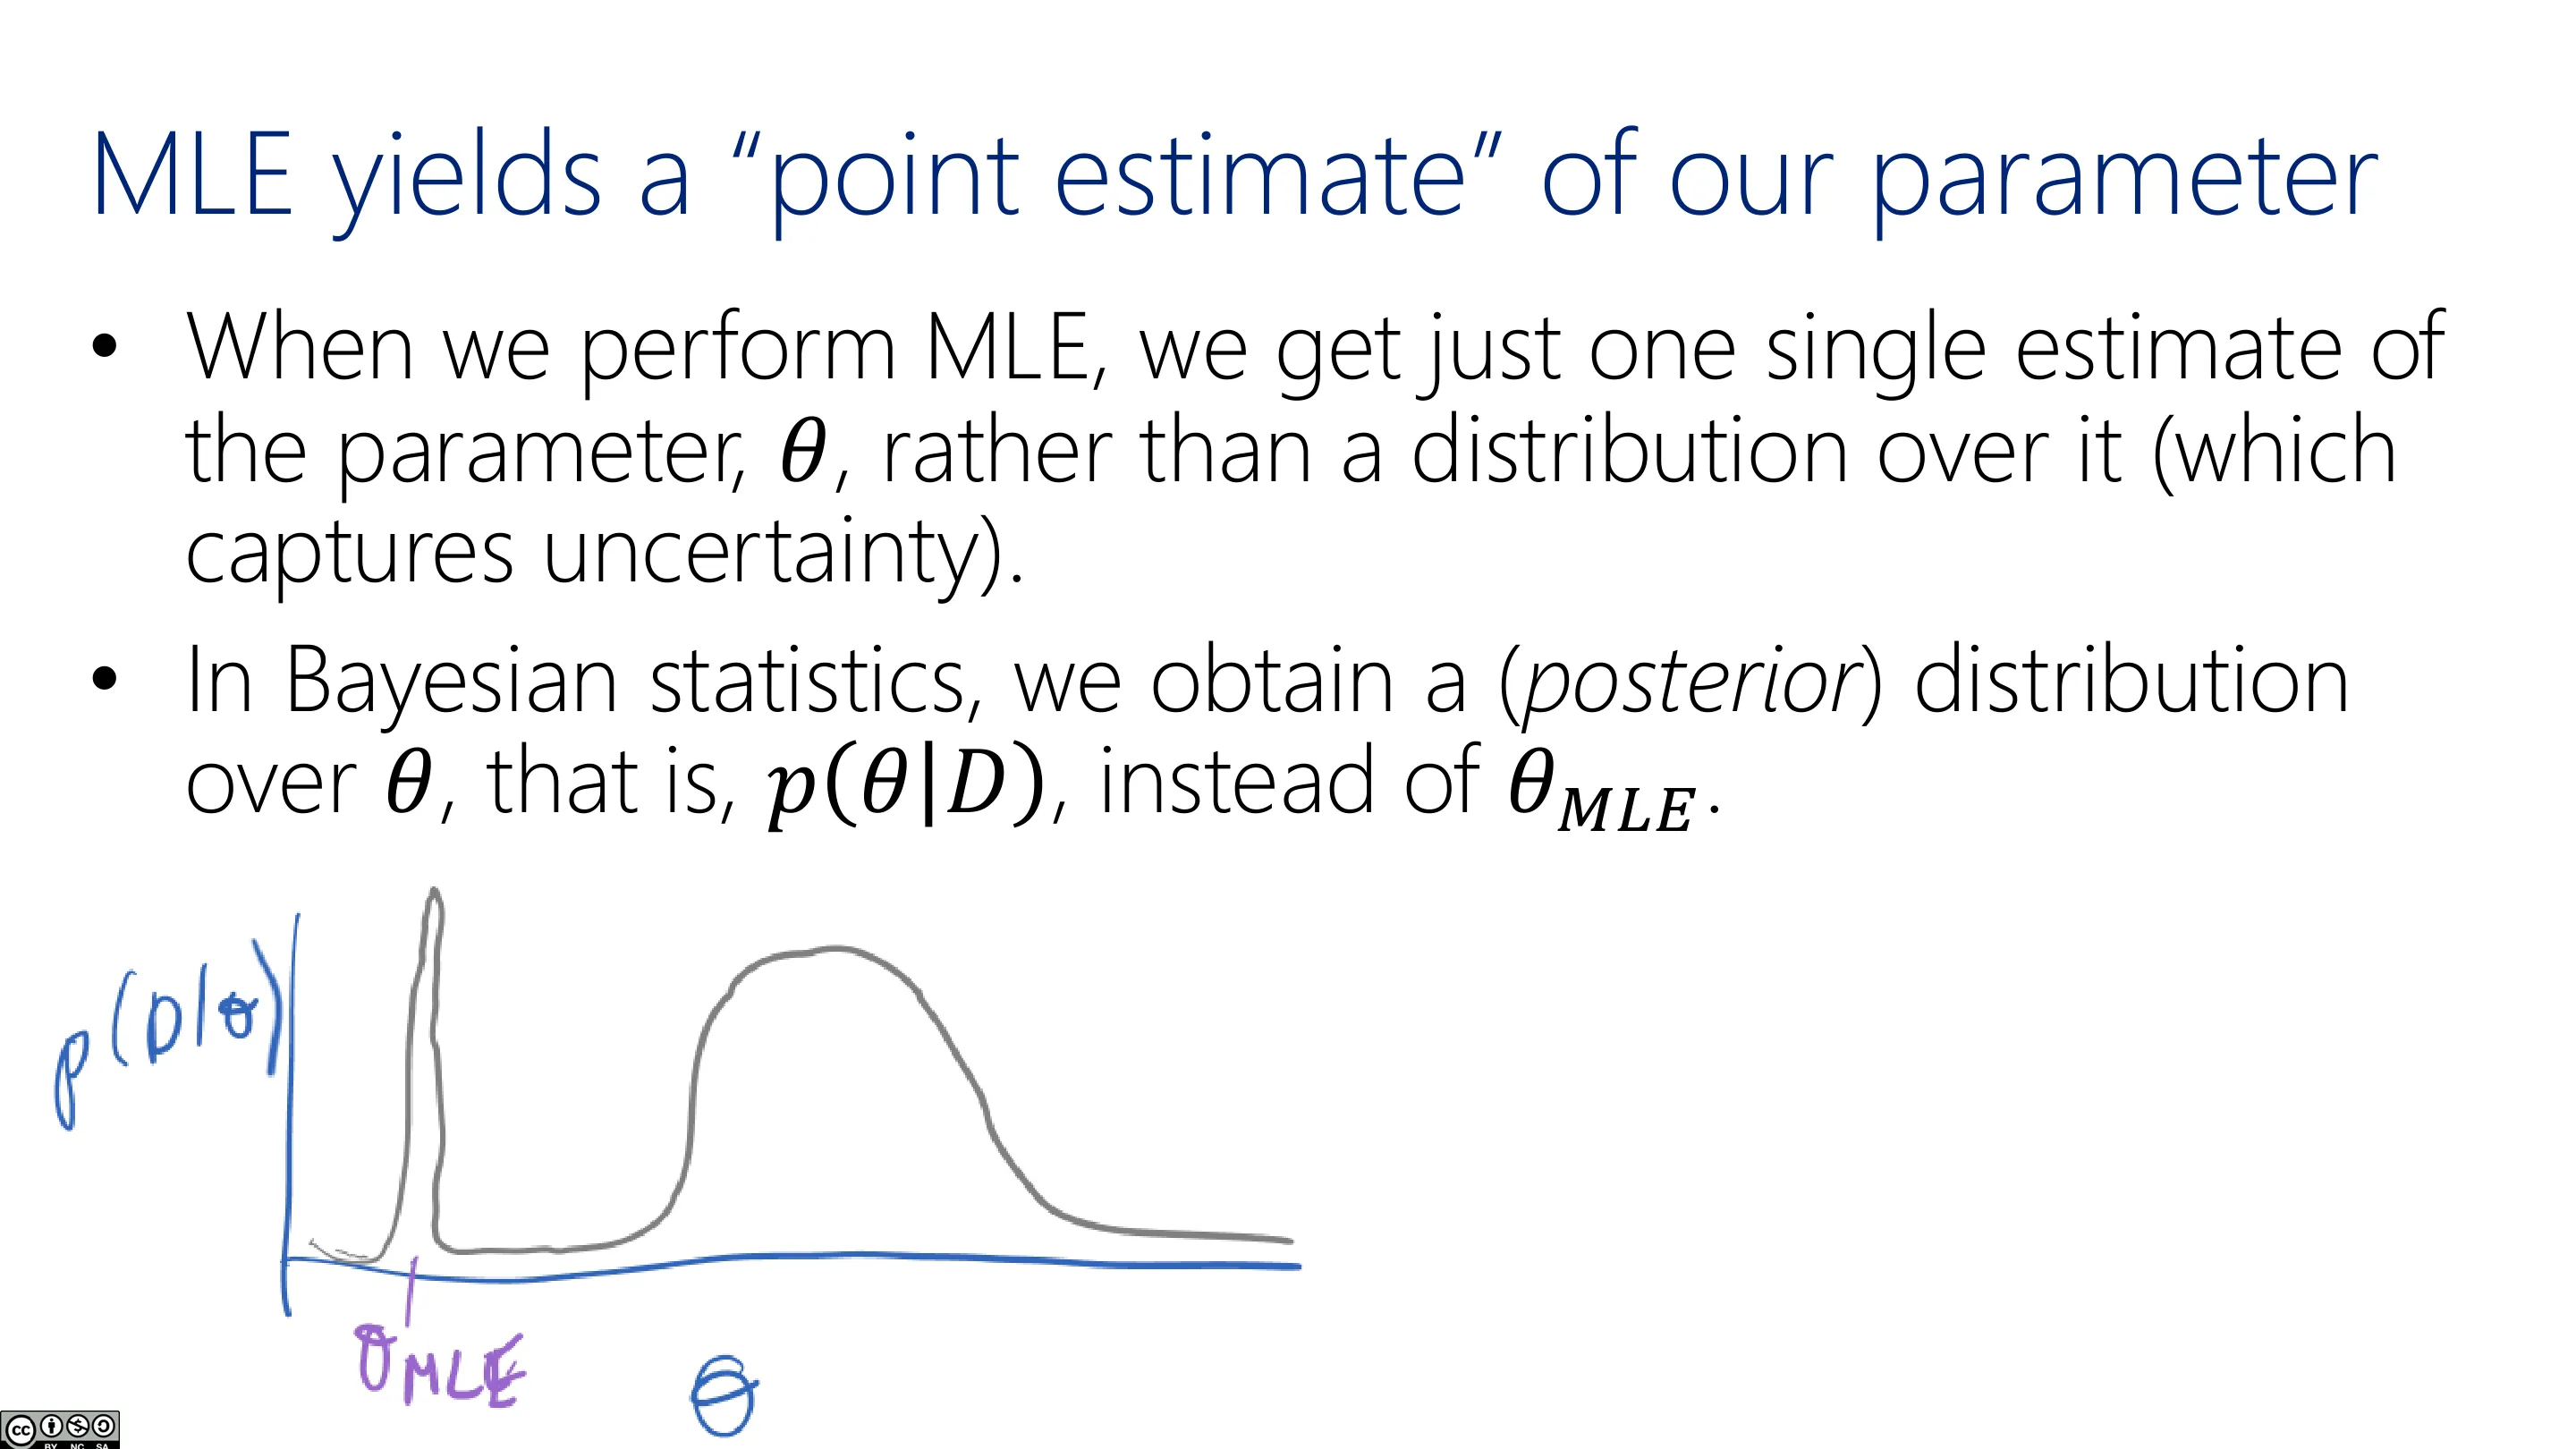
MLE 给出的是参数的点估计(point estimate)——单一的最佳猜测(如「均值 = 100」)。
但这也正是它的隐患:它没有表达不确定性。如果模型参数太多(例如 100 个数据点配 100 个参数),MLE 可能只是找到一个恰好穿过所有数据的「异常尖峰」,把噪声也拟合进去——这不是一个好模型。
贝叶斯(Bayesian)视角不同:它给出的是参数所有可能取值的分布(后验分布)。贝叶斯不会说「均值是 100」,而会说「我对均值的信念大多集中在 100 附近,98、99、101、102 都很有可能,越远离越不可能」。
- 频率学派(Frequentist):给出「真实存在的唯一正确答案」的最佳猜测;
- 贝叶斯学派(Bayesian):量化「我对某事为真的相信程度」。
两者都重要;本课后面讲到线性回归时会看到从 MLE 走向贝叶斯的一串过渡。
📷 MLE 给出的是点估计(一)
回到原视频 (01:00:08)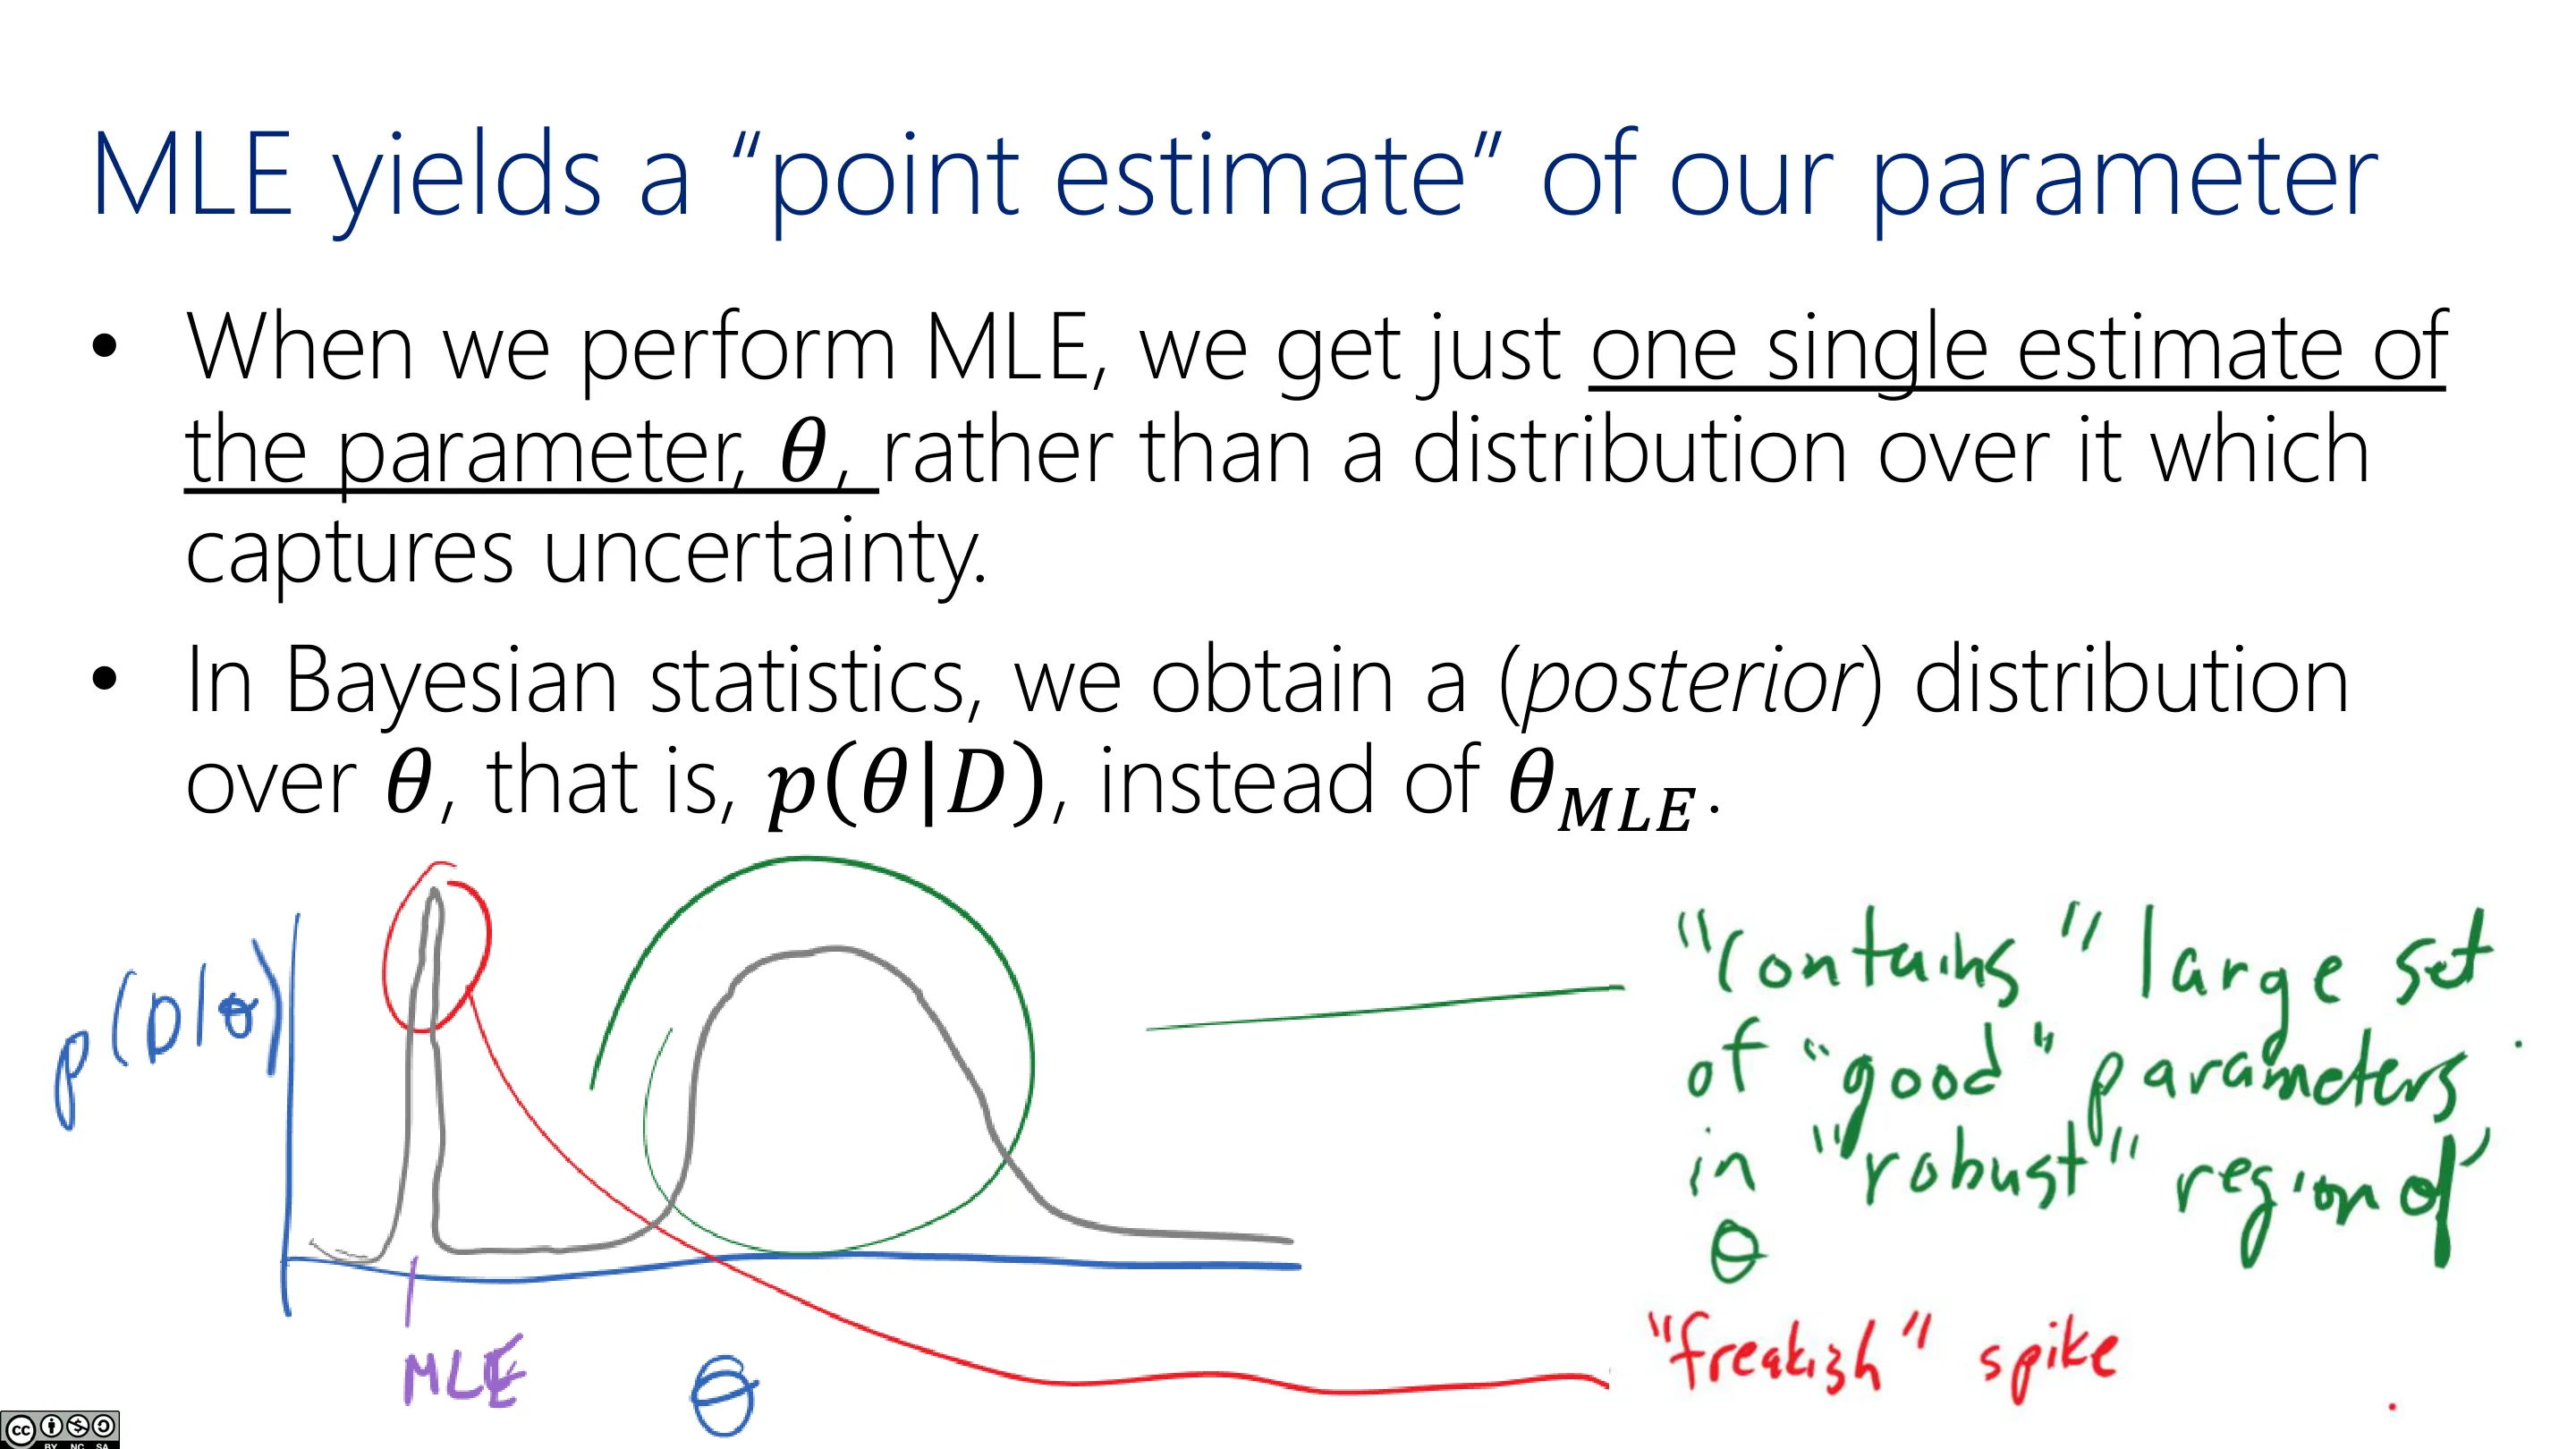
📷 MLE 给出的是点估计(二)
回到原视频 (01:00:53)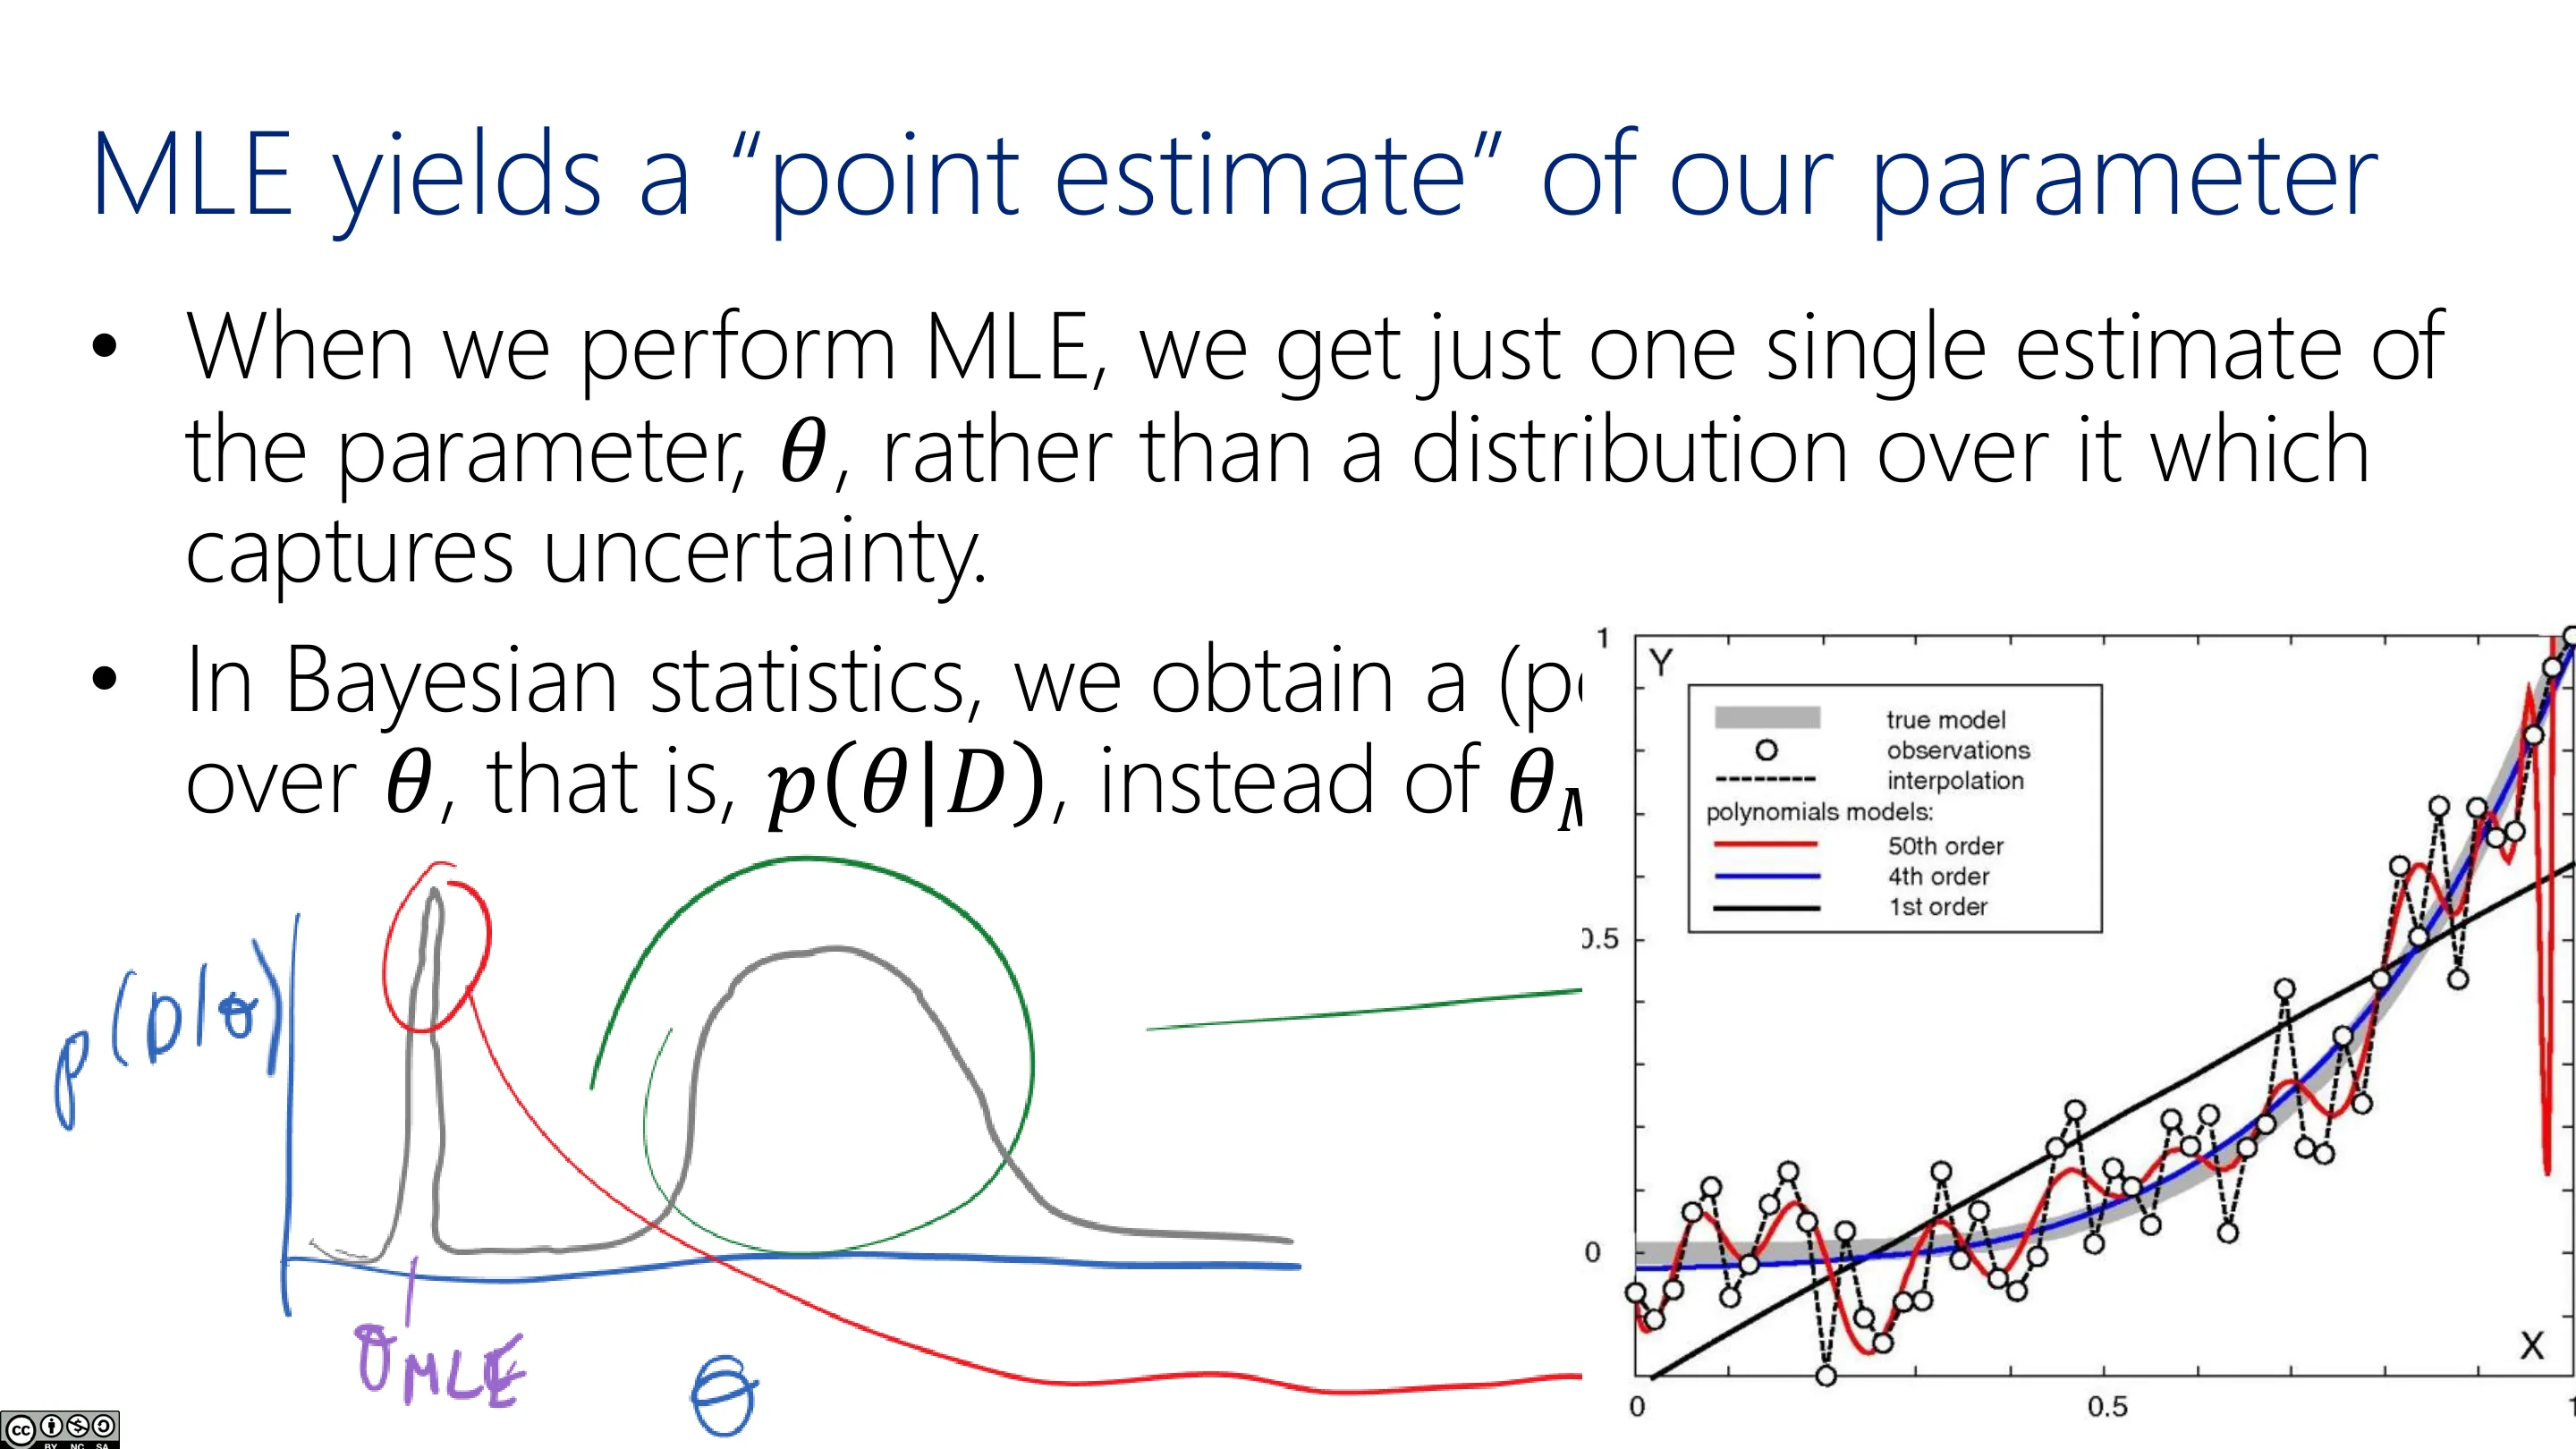
📷 MLE 给出的是点估计(三)
回到原视频 (01:01:37)
七、多项分布的 MLE(掷骰子)
(参考时间: 01:06)
最后,讲师给出多项分布(multinomial)的 MLE。与高斯不同,它有两个新特点:
- 这是离散分布;
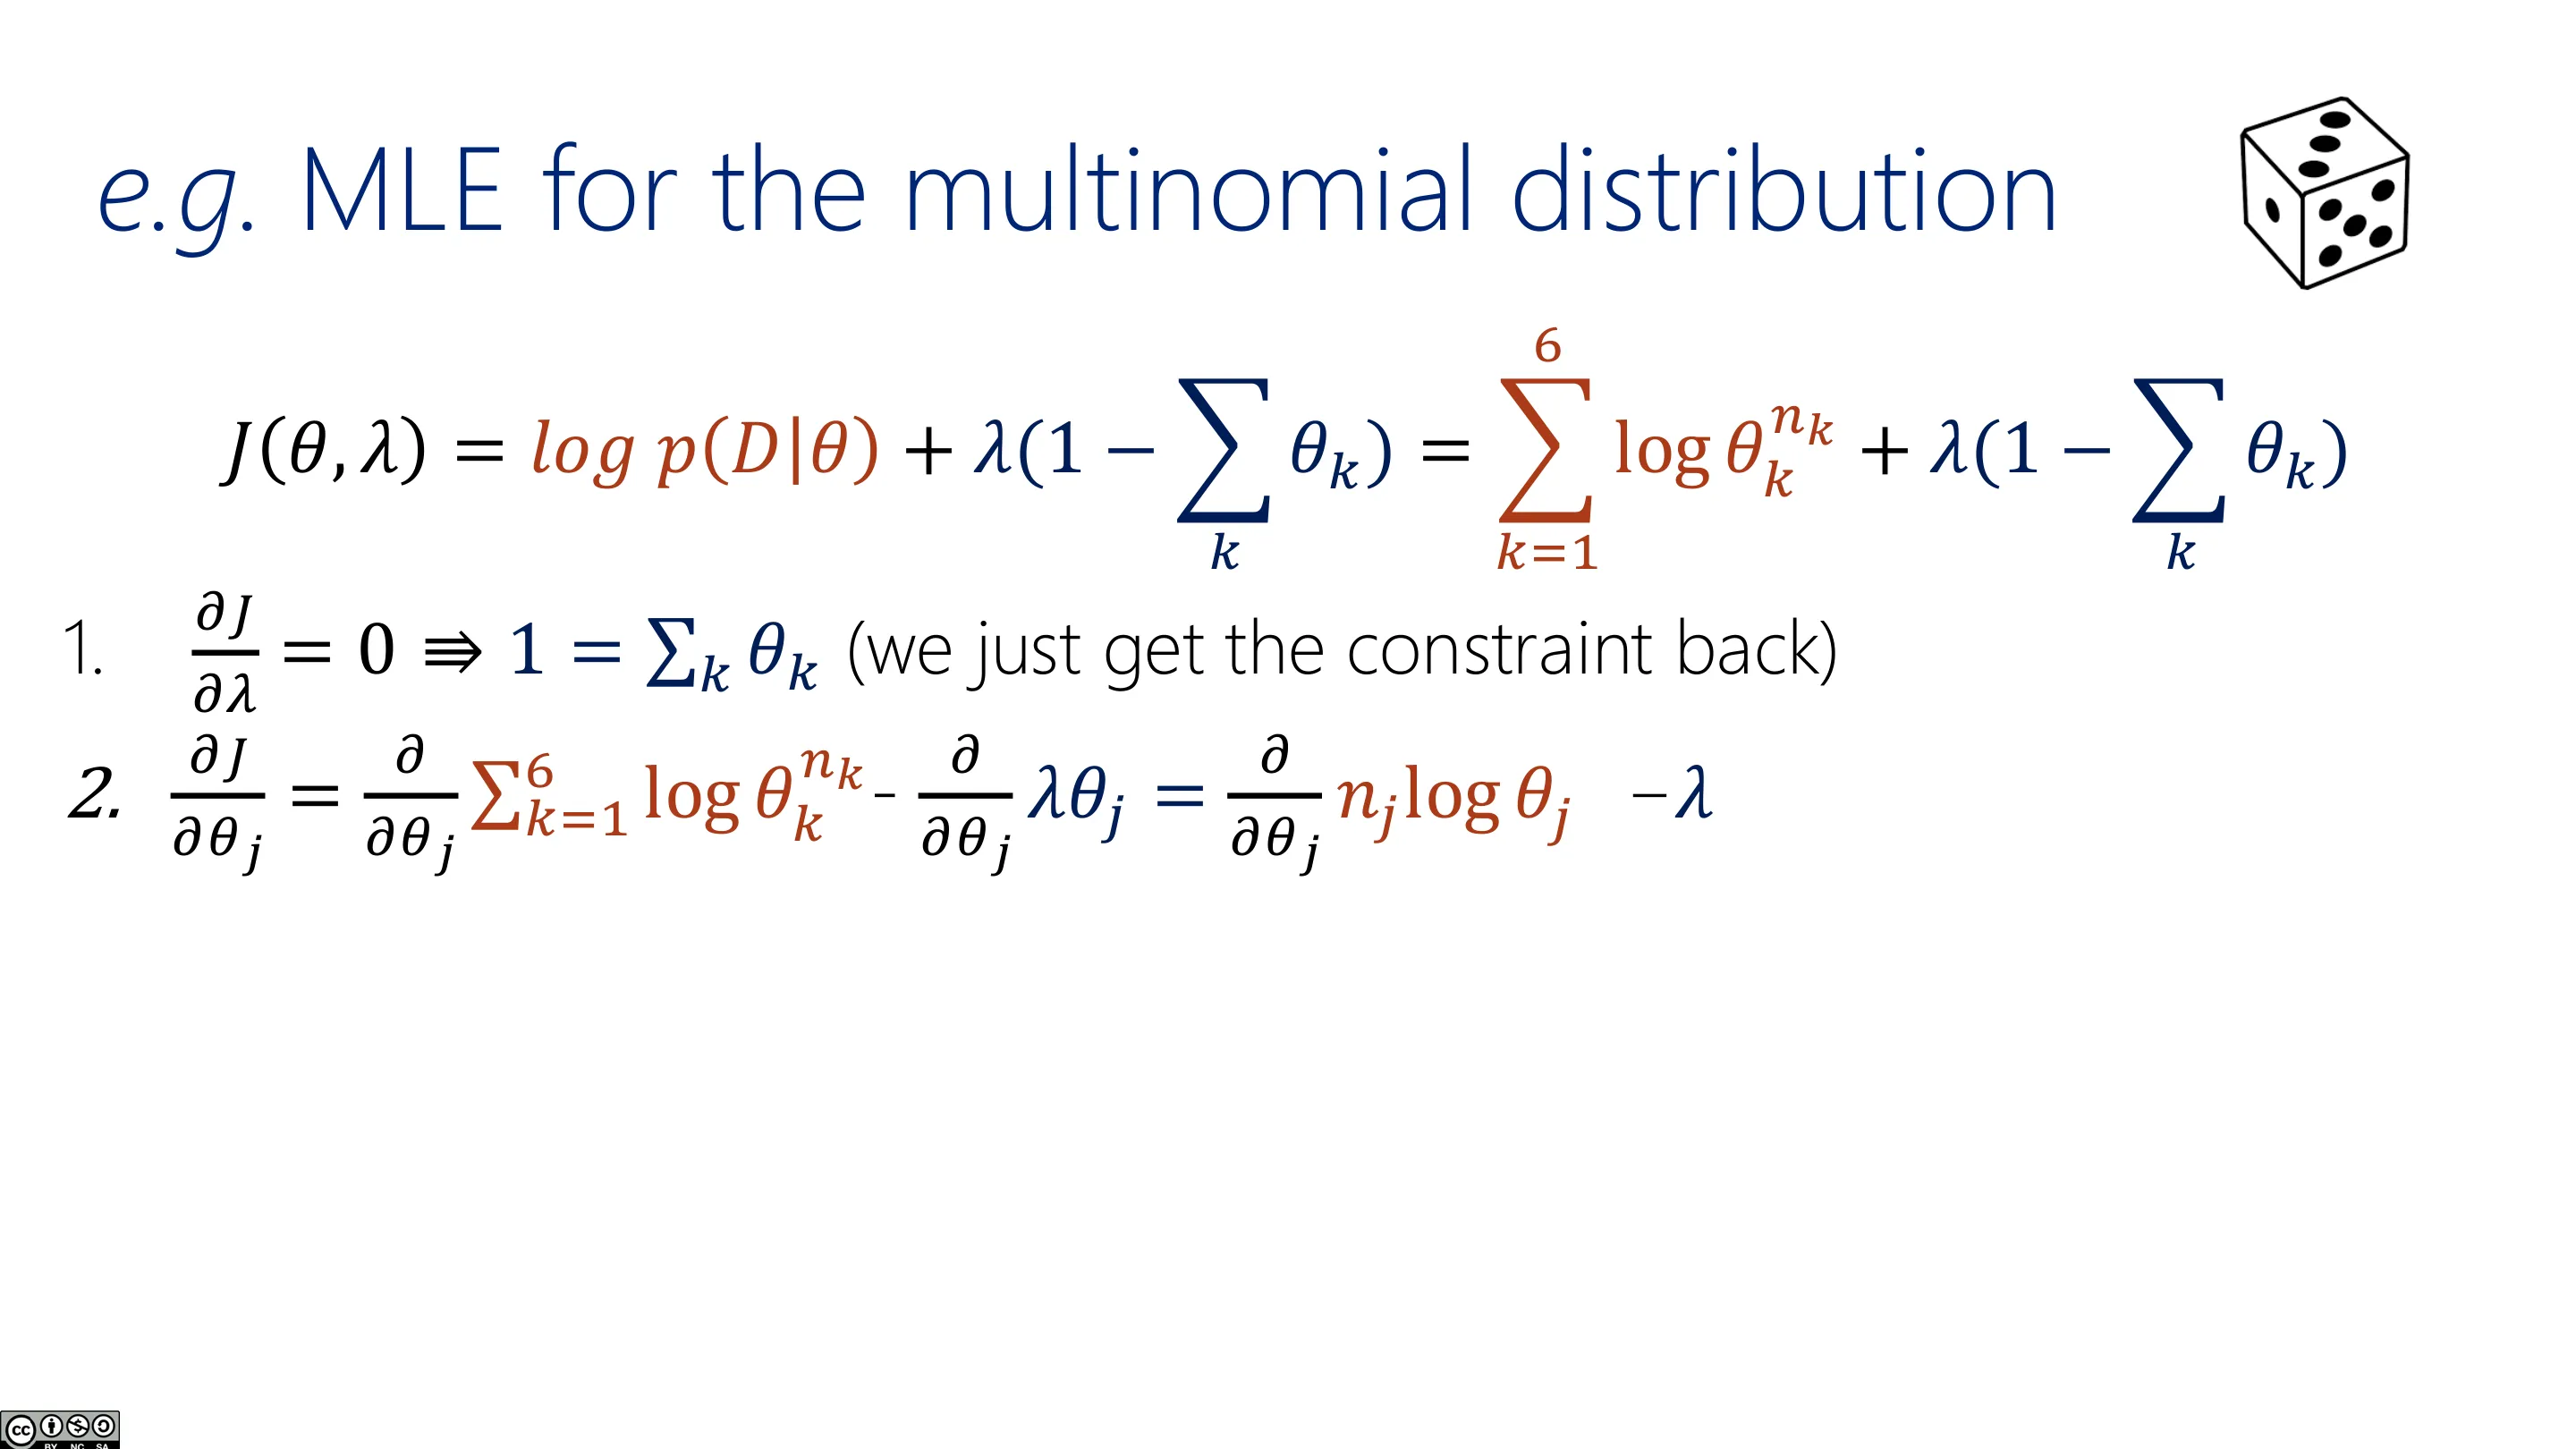
- 参数需要满足约束——每个概率在 $[0,1]$ 之间,且六面之和为 1。因此要用到带约束的优化(拉格朗日乘子法,在概率/微积分课上学过)。
设定:一枚六面骰子,掷 $n$ 次,想知道每一面出现的概率 $\theta = (\theta_1,\dots,\theta_6)$。似然为「给定 $\theta$ 时观测到这份点面序列的概率」——即挑出每一次对应的那个参数(用指示函数 $1[x_i=k]$ 记账,只有命中的那一面为 1、其余为 0)。
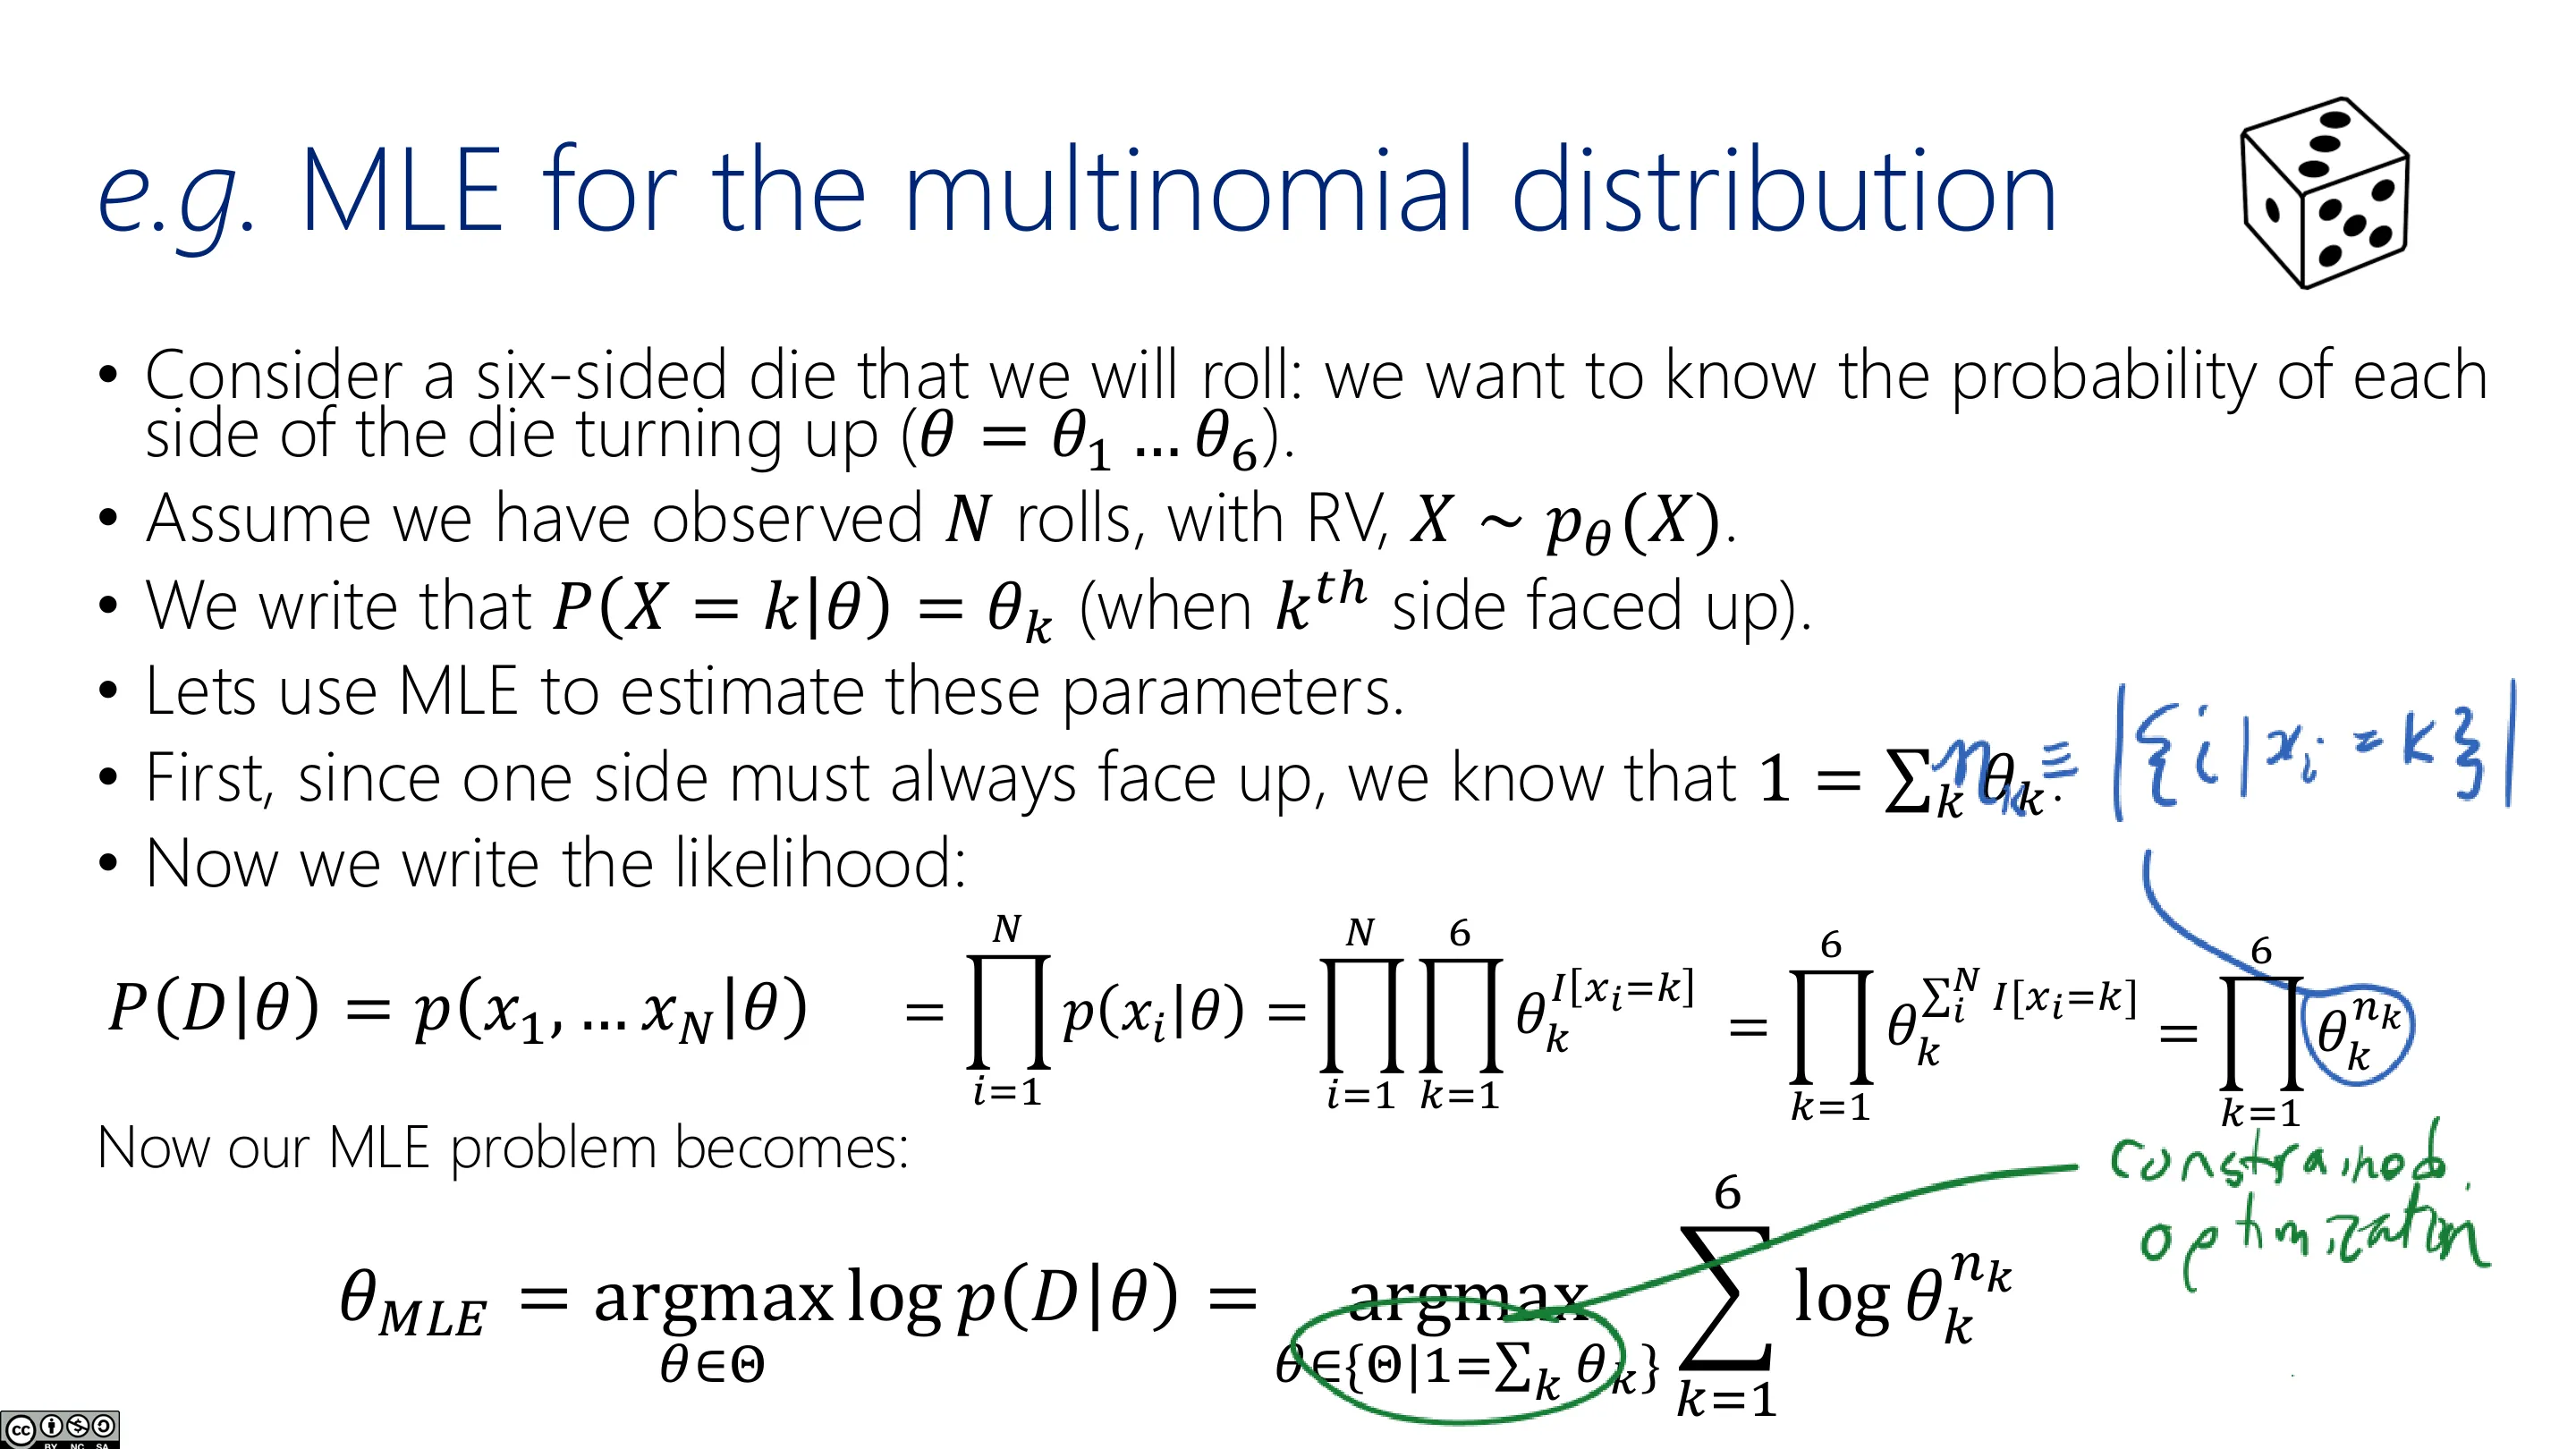
📷 MLE 用于多项分布(一)
回到原视频 (01:06:06)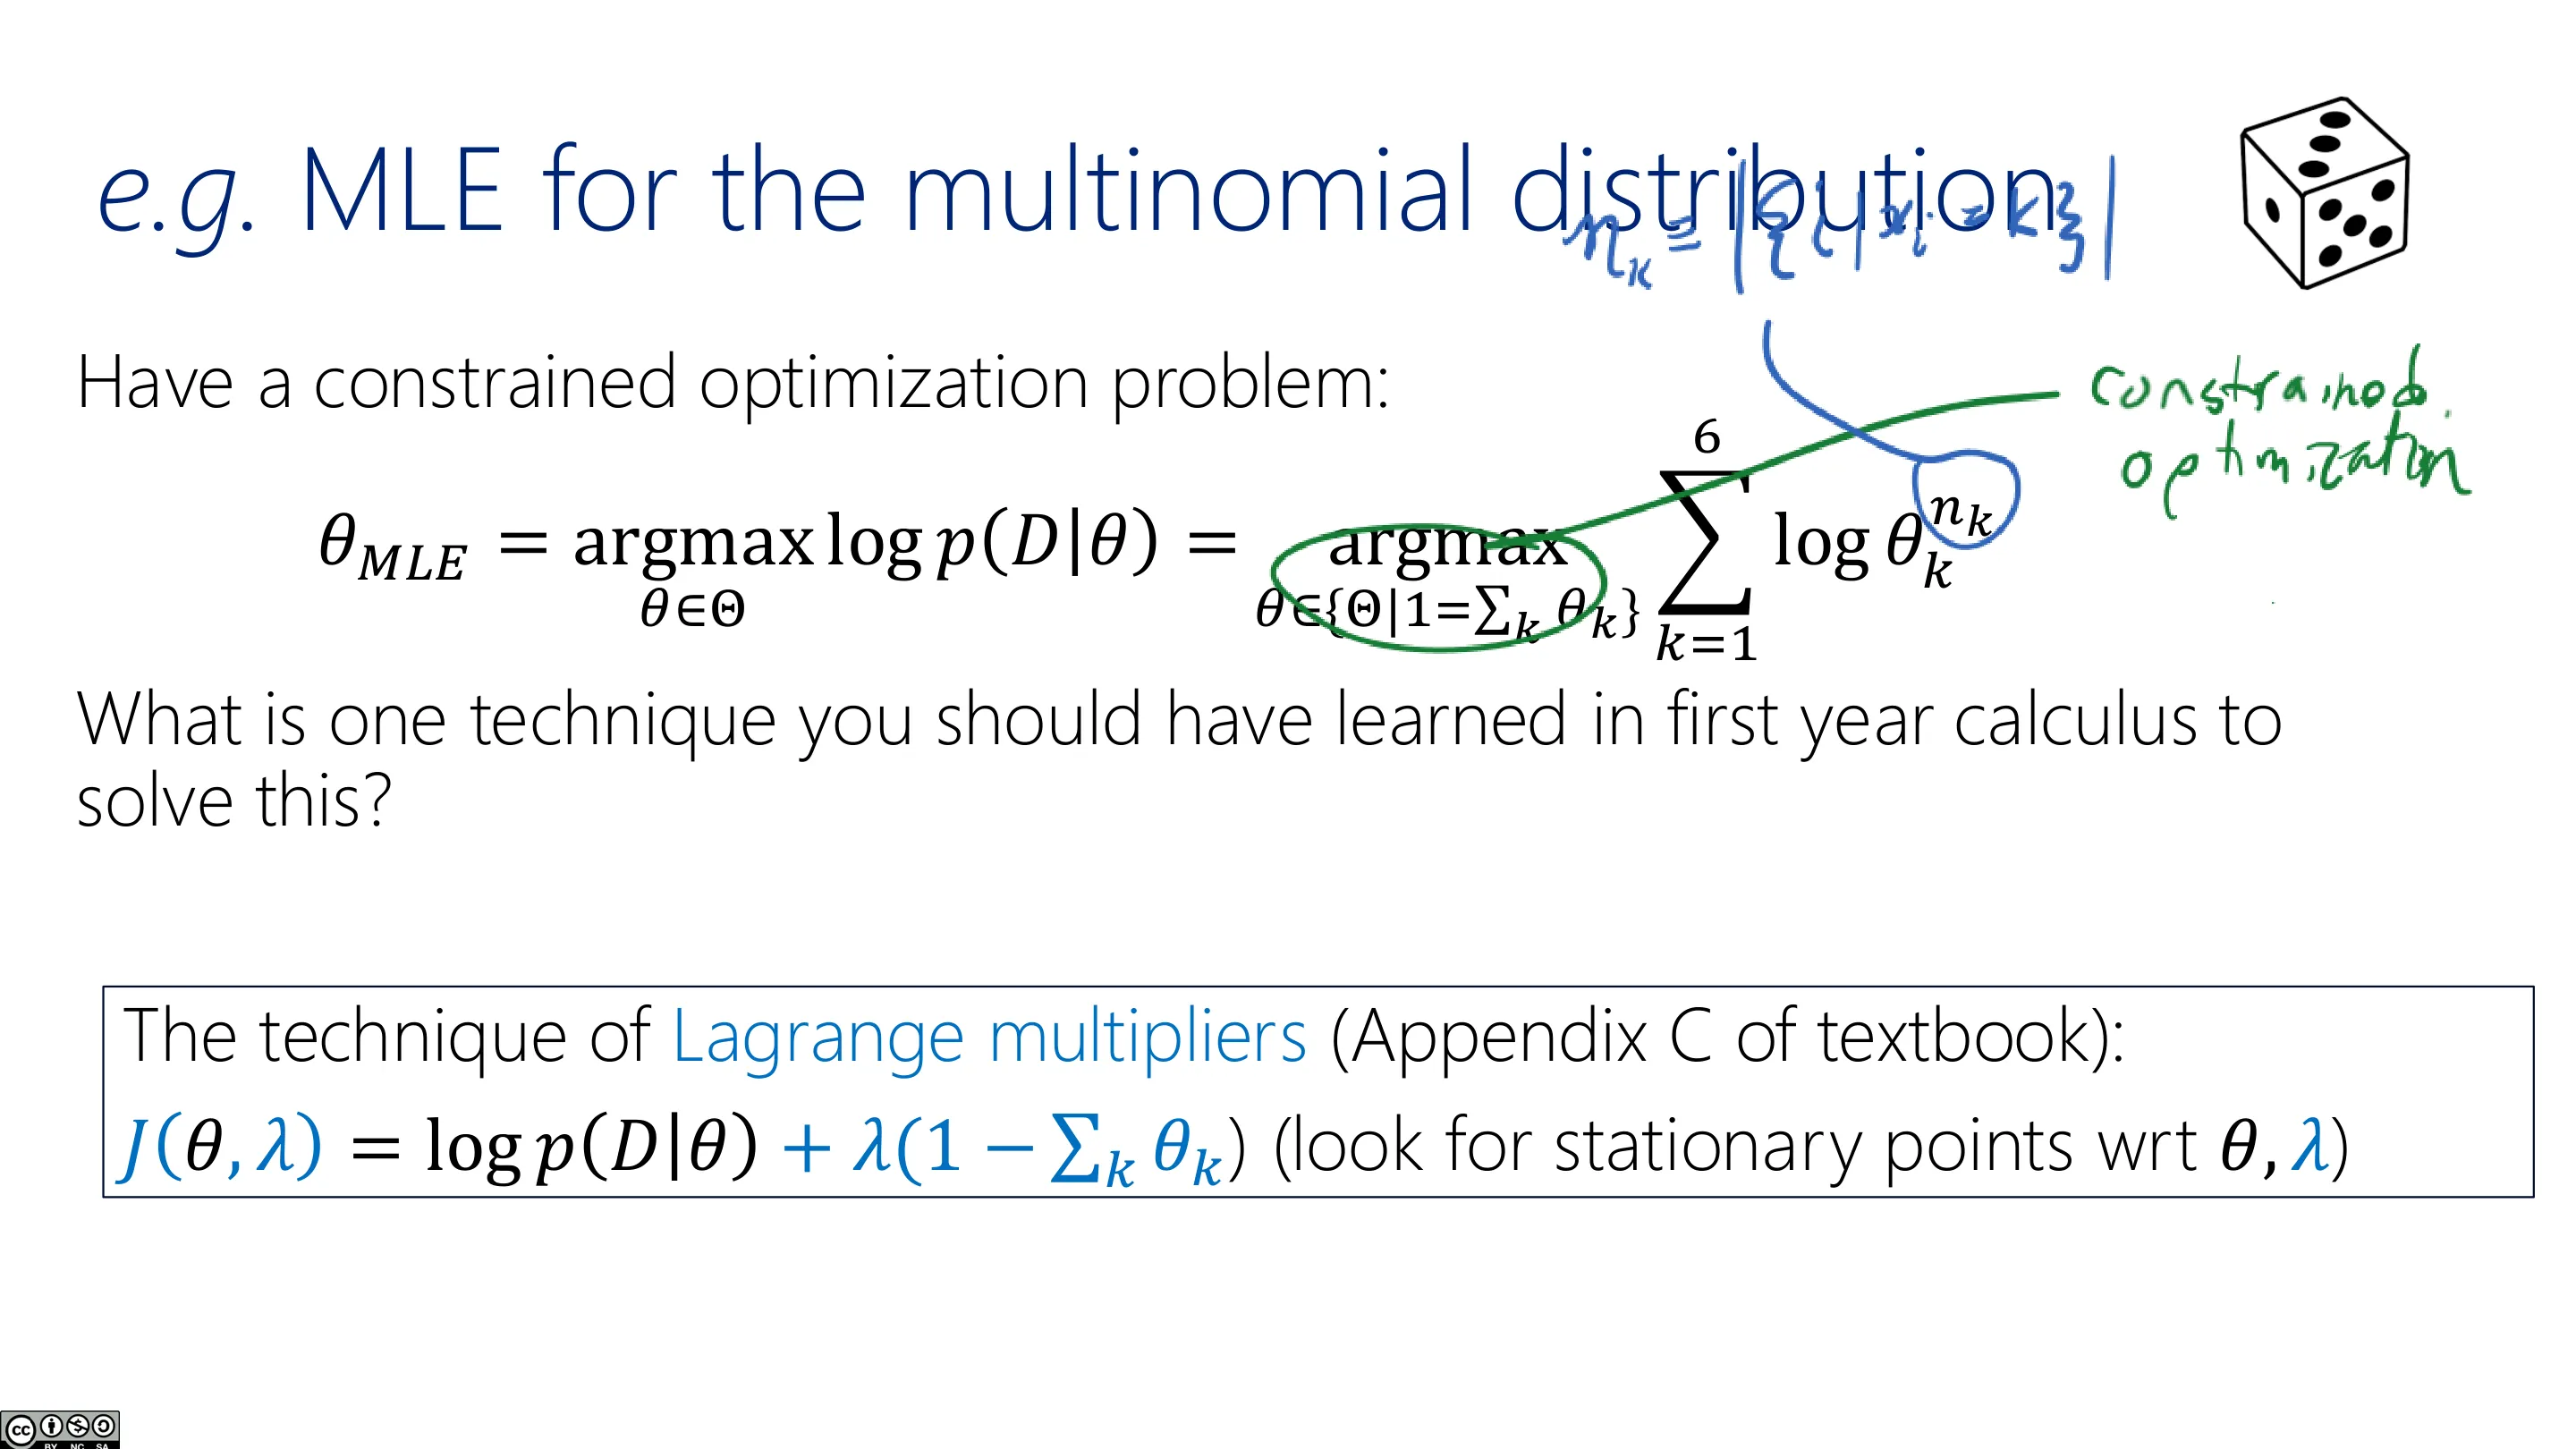
📷 MLE 用于多项分布(二)
回到原视频 (01:06:56)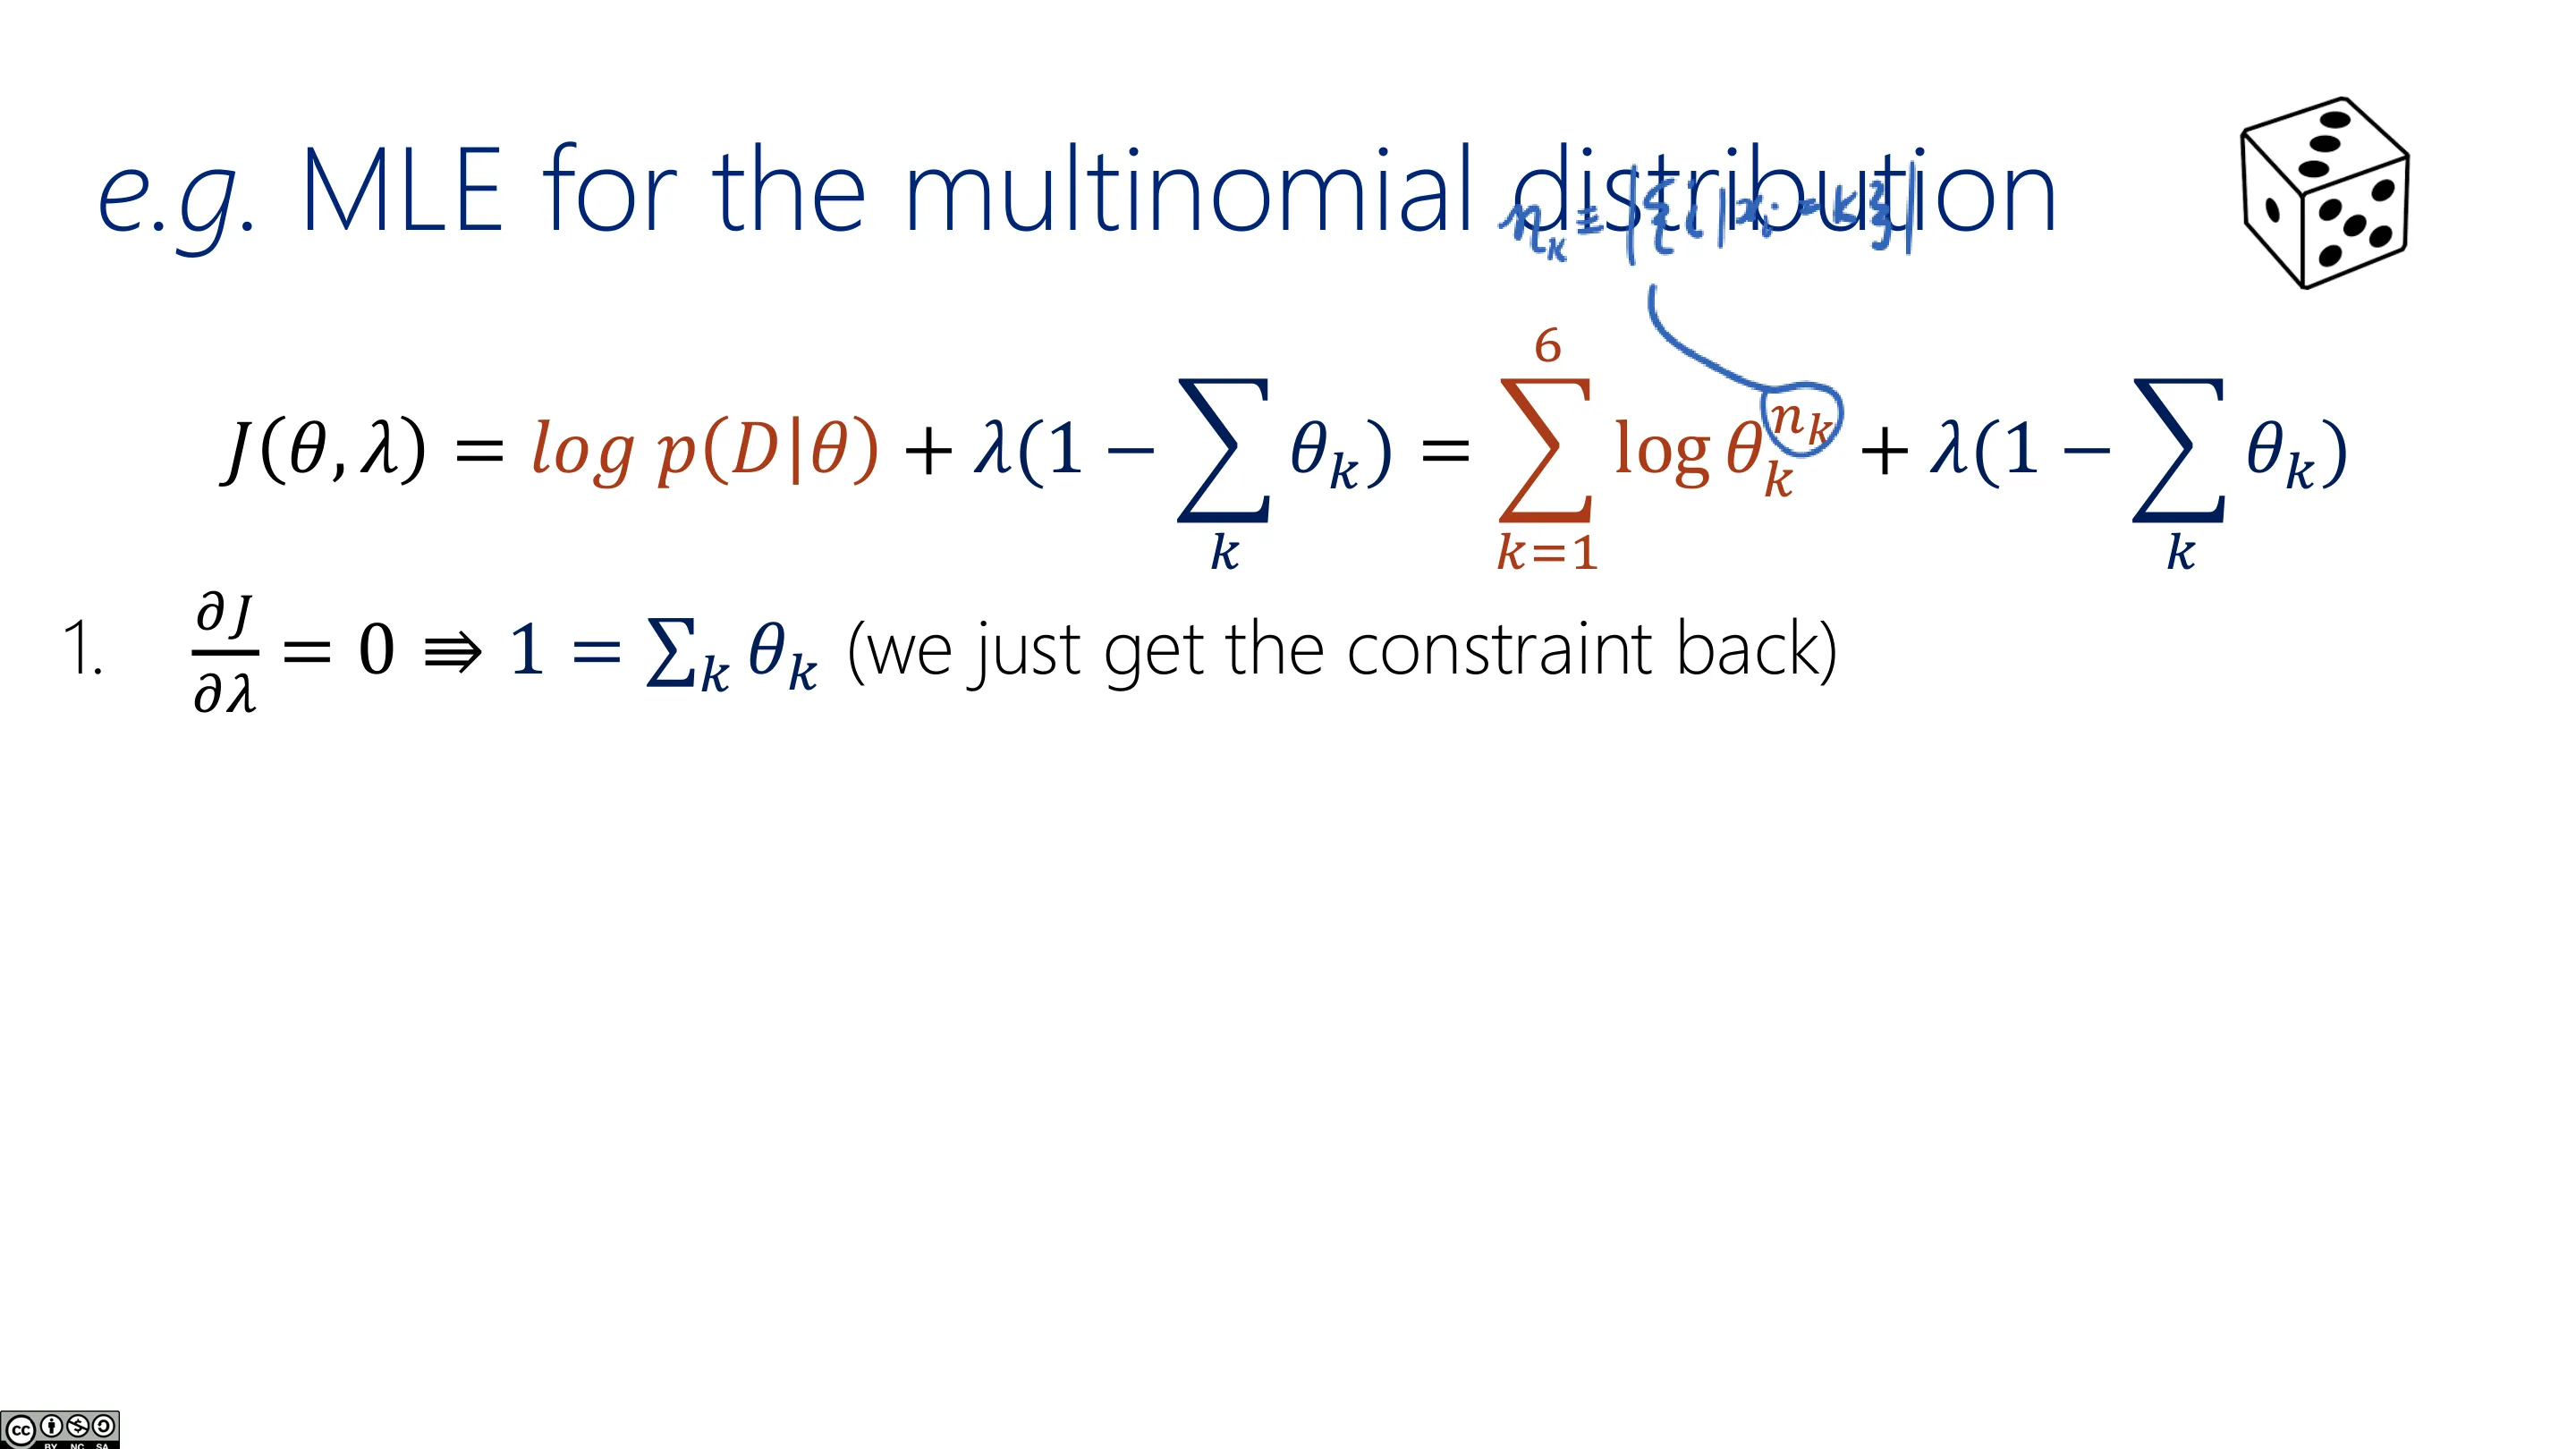
📷 MLE 用于多项分布(三)
回到原视频 (01:06:58)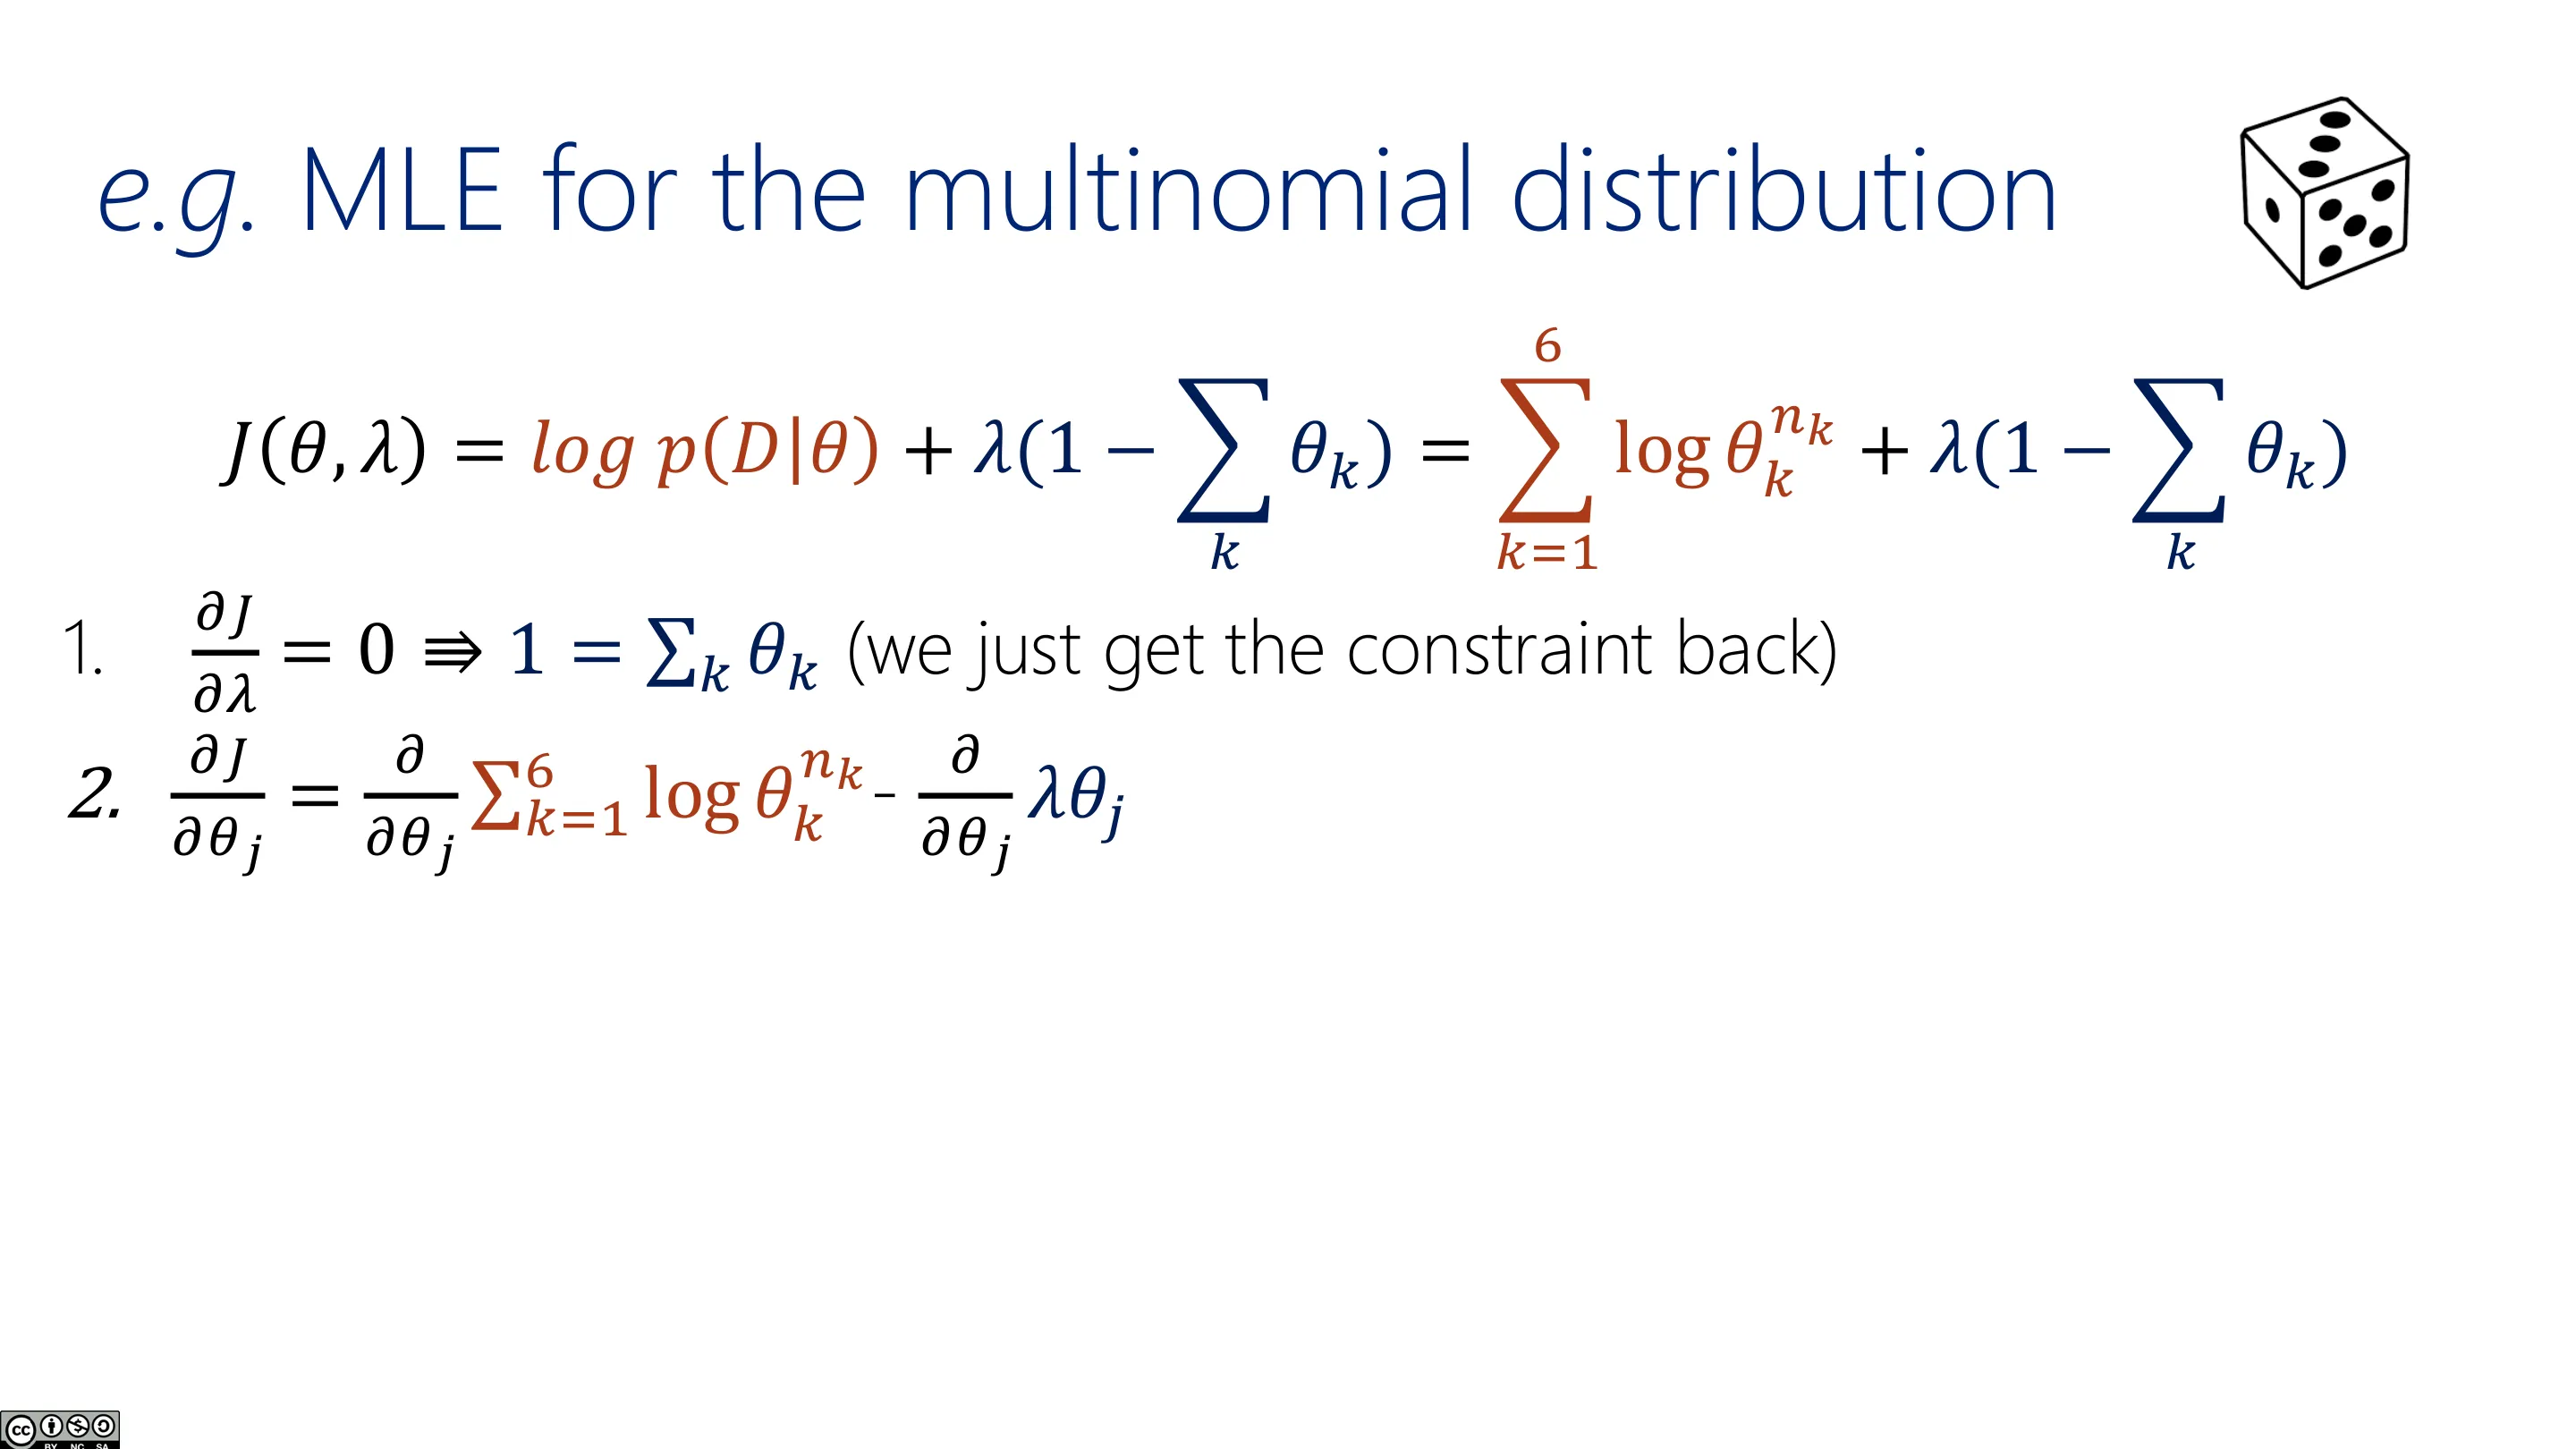
📷 MLE 用于多项分布(四)
回到原视频 (01:07:00)把连乘整理后,似然可写成「每一面的参数,取其出现次数的幂」之积:
$$ L(\theta) = \prod_{k=1}^{6} \theta_k^{\,n_k}, \qquad n_k = \#\{i : x_i = k\} $$
(其中 $n_k$ 是第 $k$ 面出现的次数。)
📷 MLE 用于多项分布(五)
回到原视频 (01:07:04)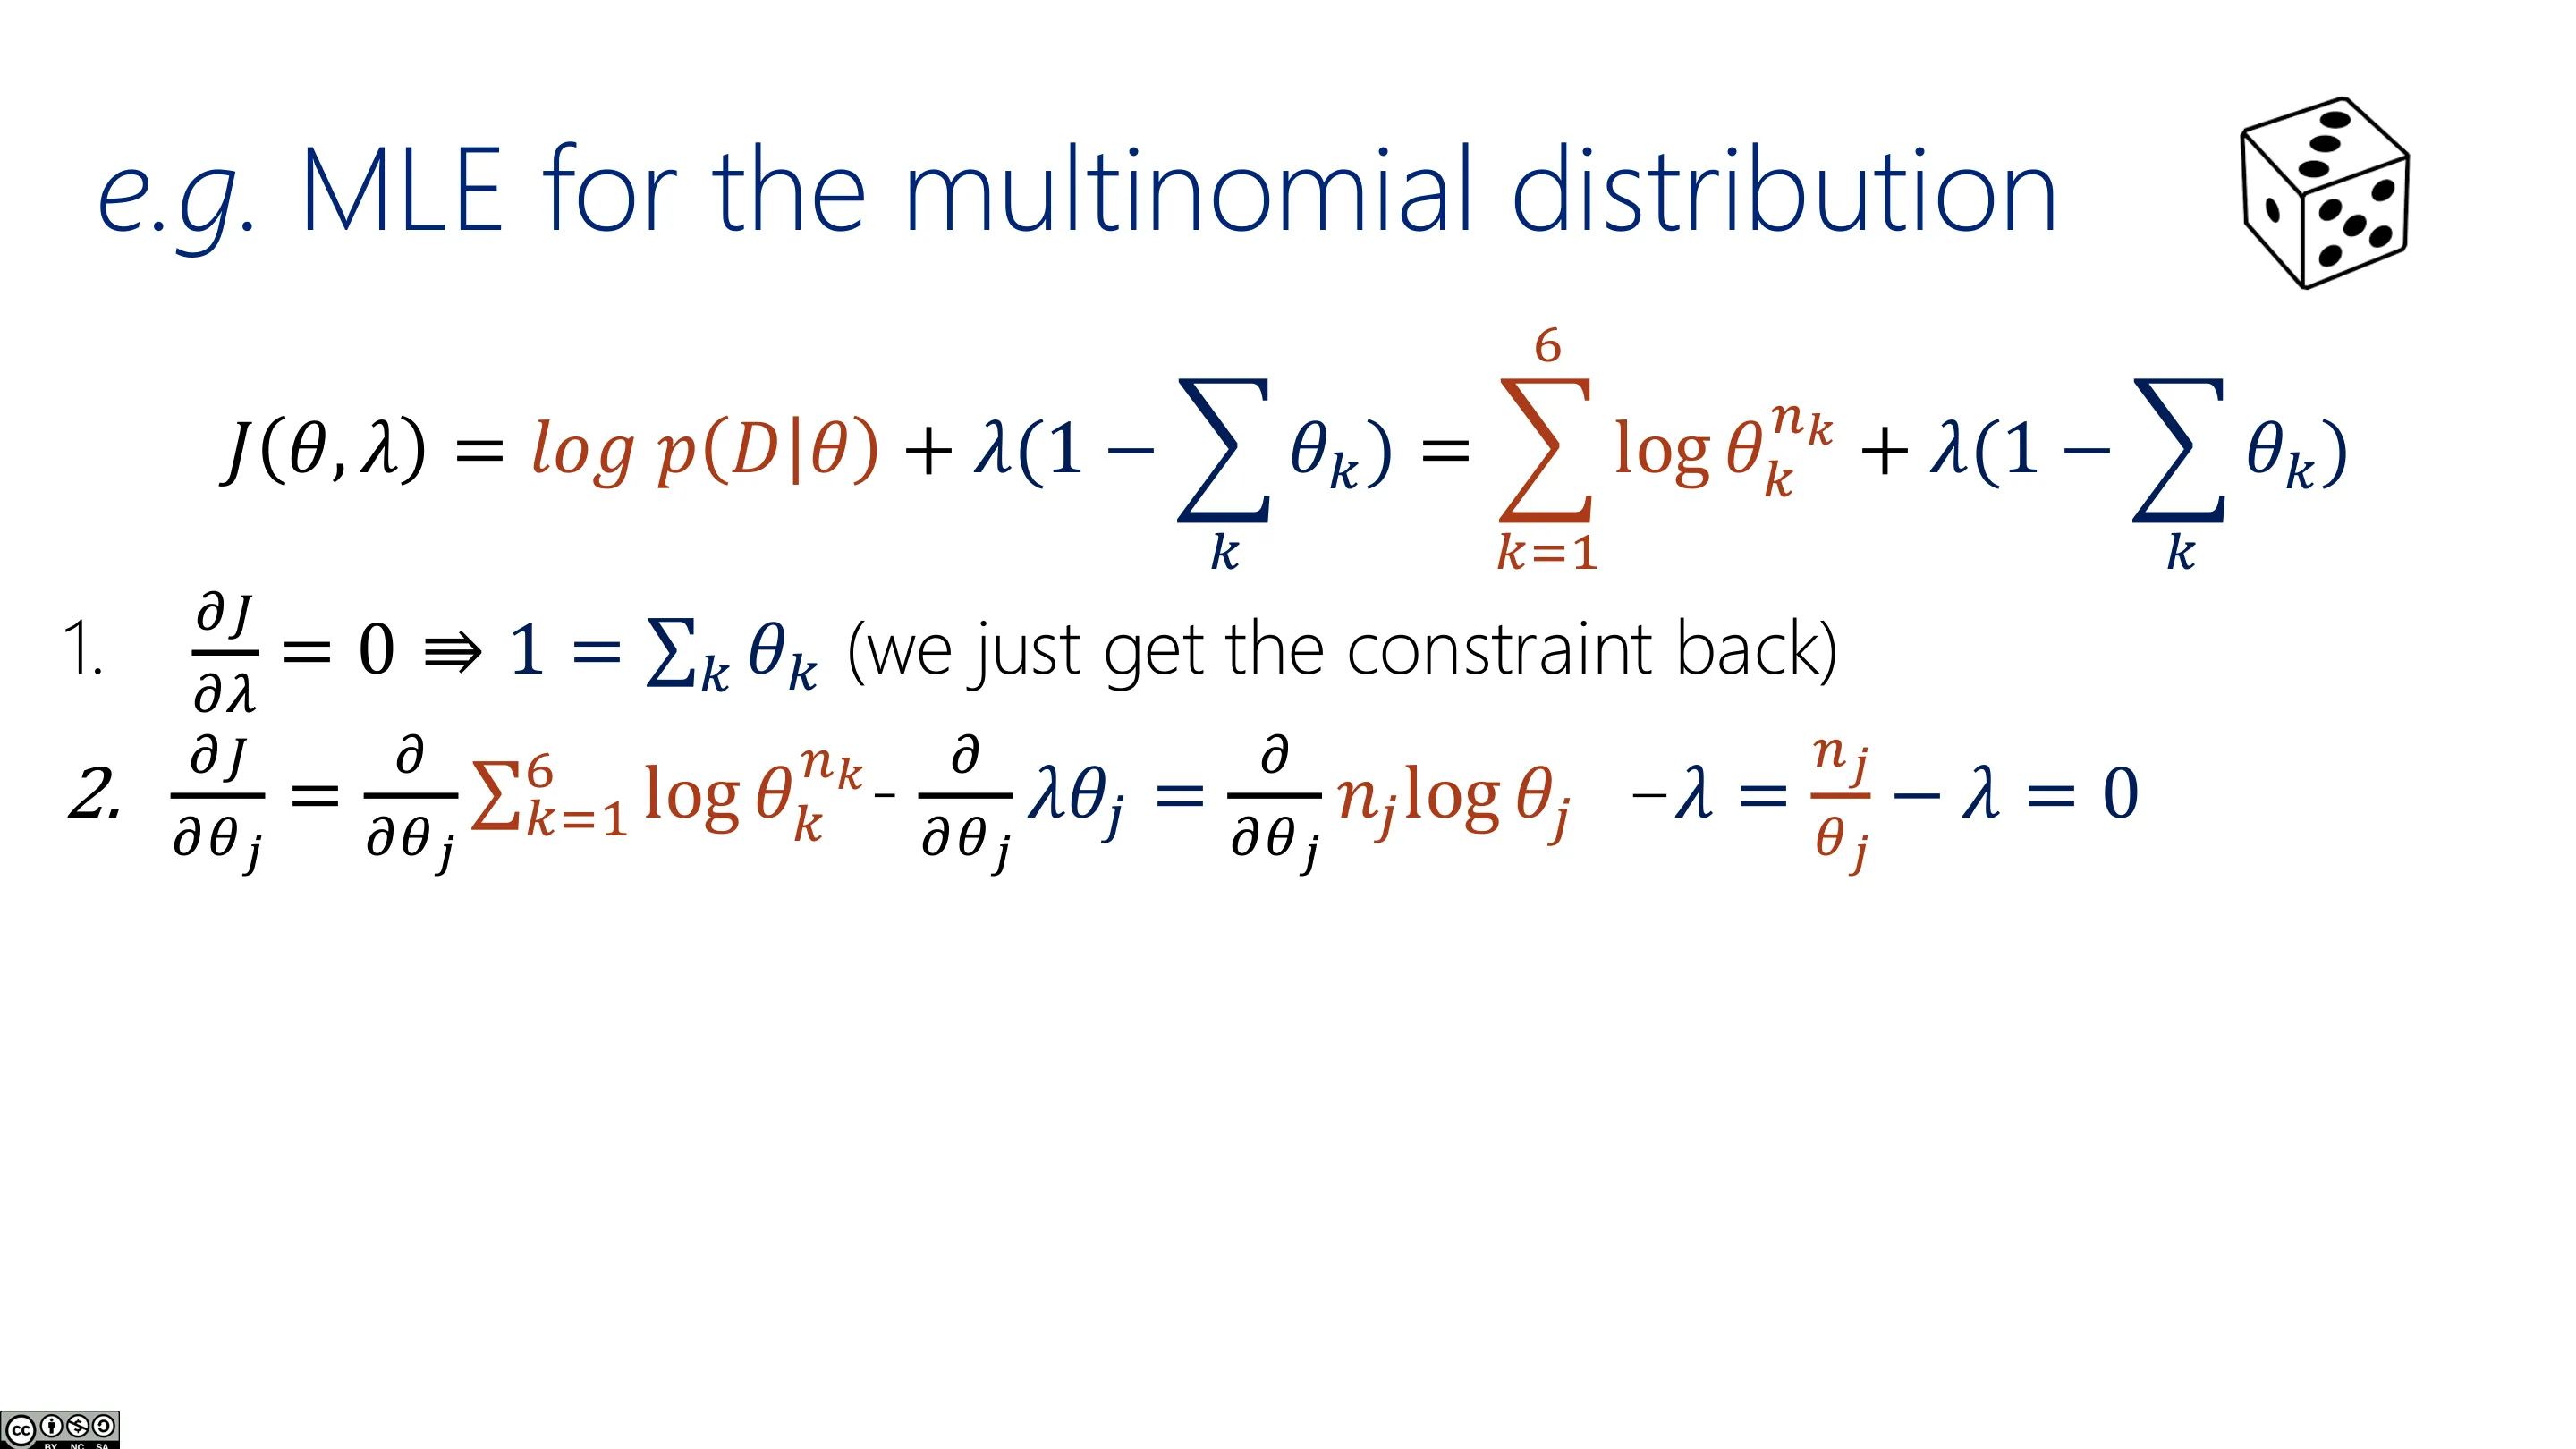
📷 MLE 用于多项分布(四)
回到原视频 (01:07:51)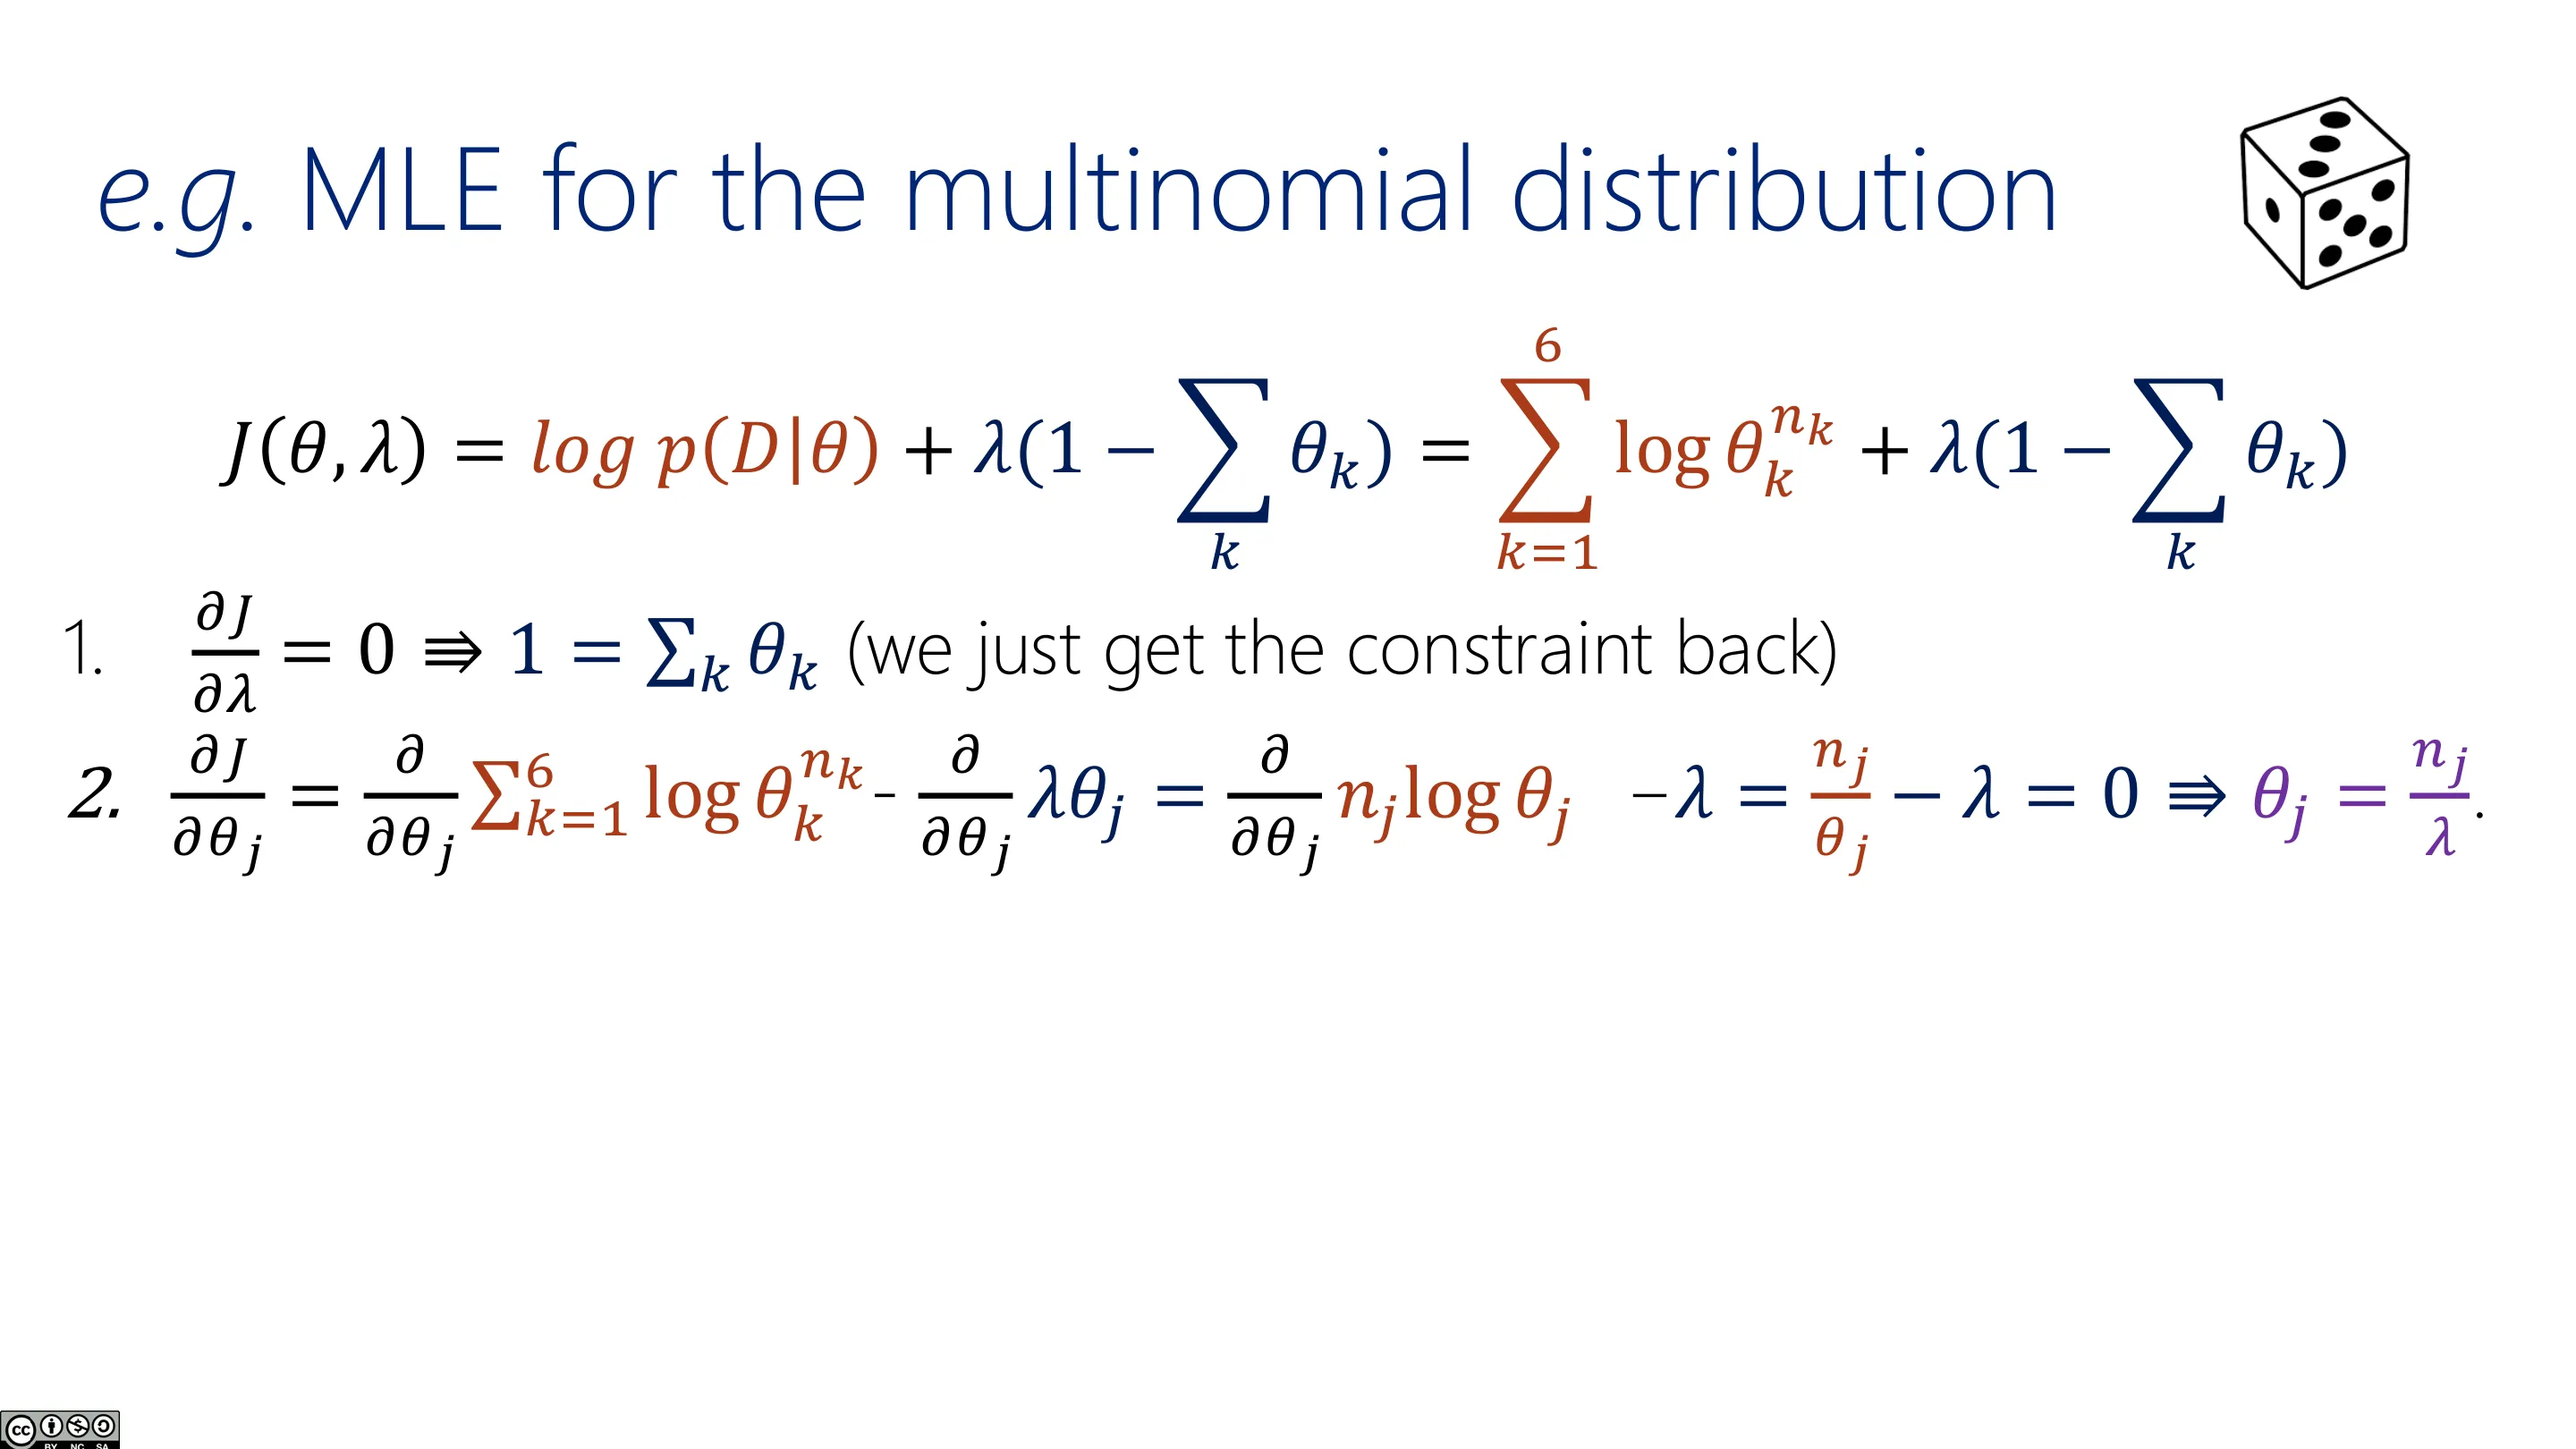
📷 MLE 用于多项分布(五)
回到原视频 (01:08:55)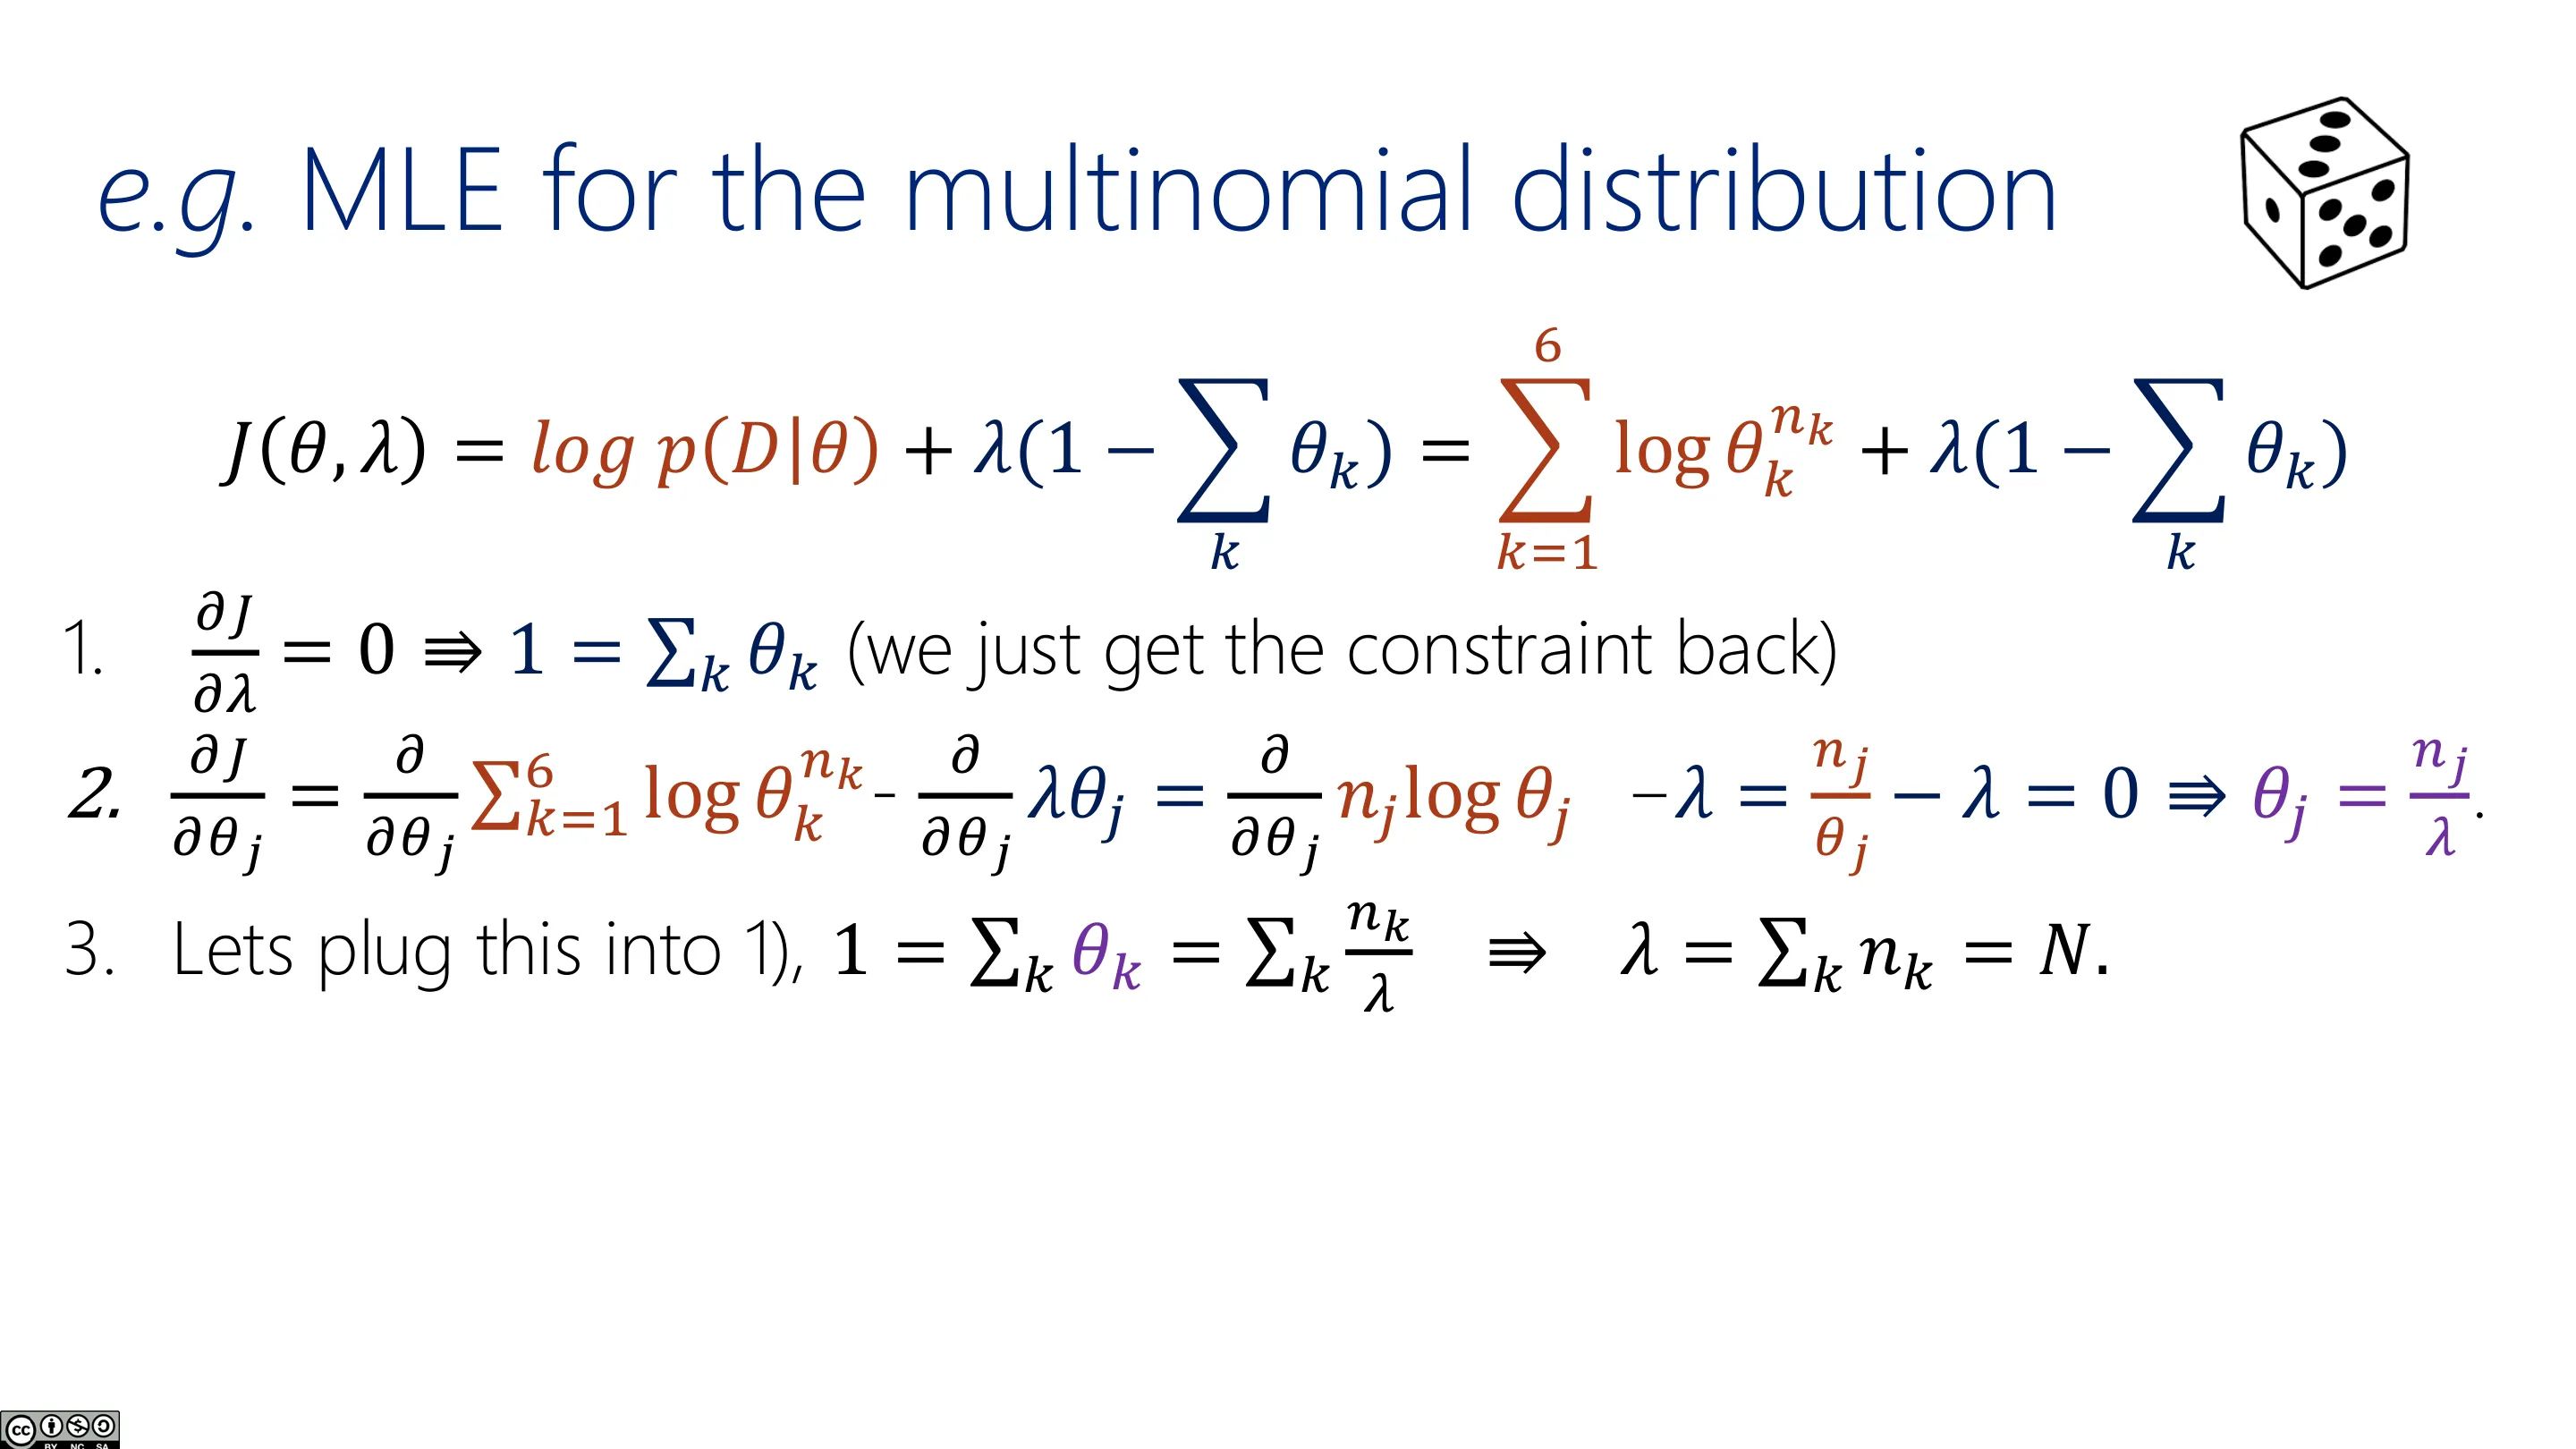
📷 MLE 用于多项分布(六)
回到原视频 (01:09:40)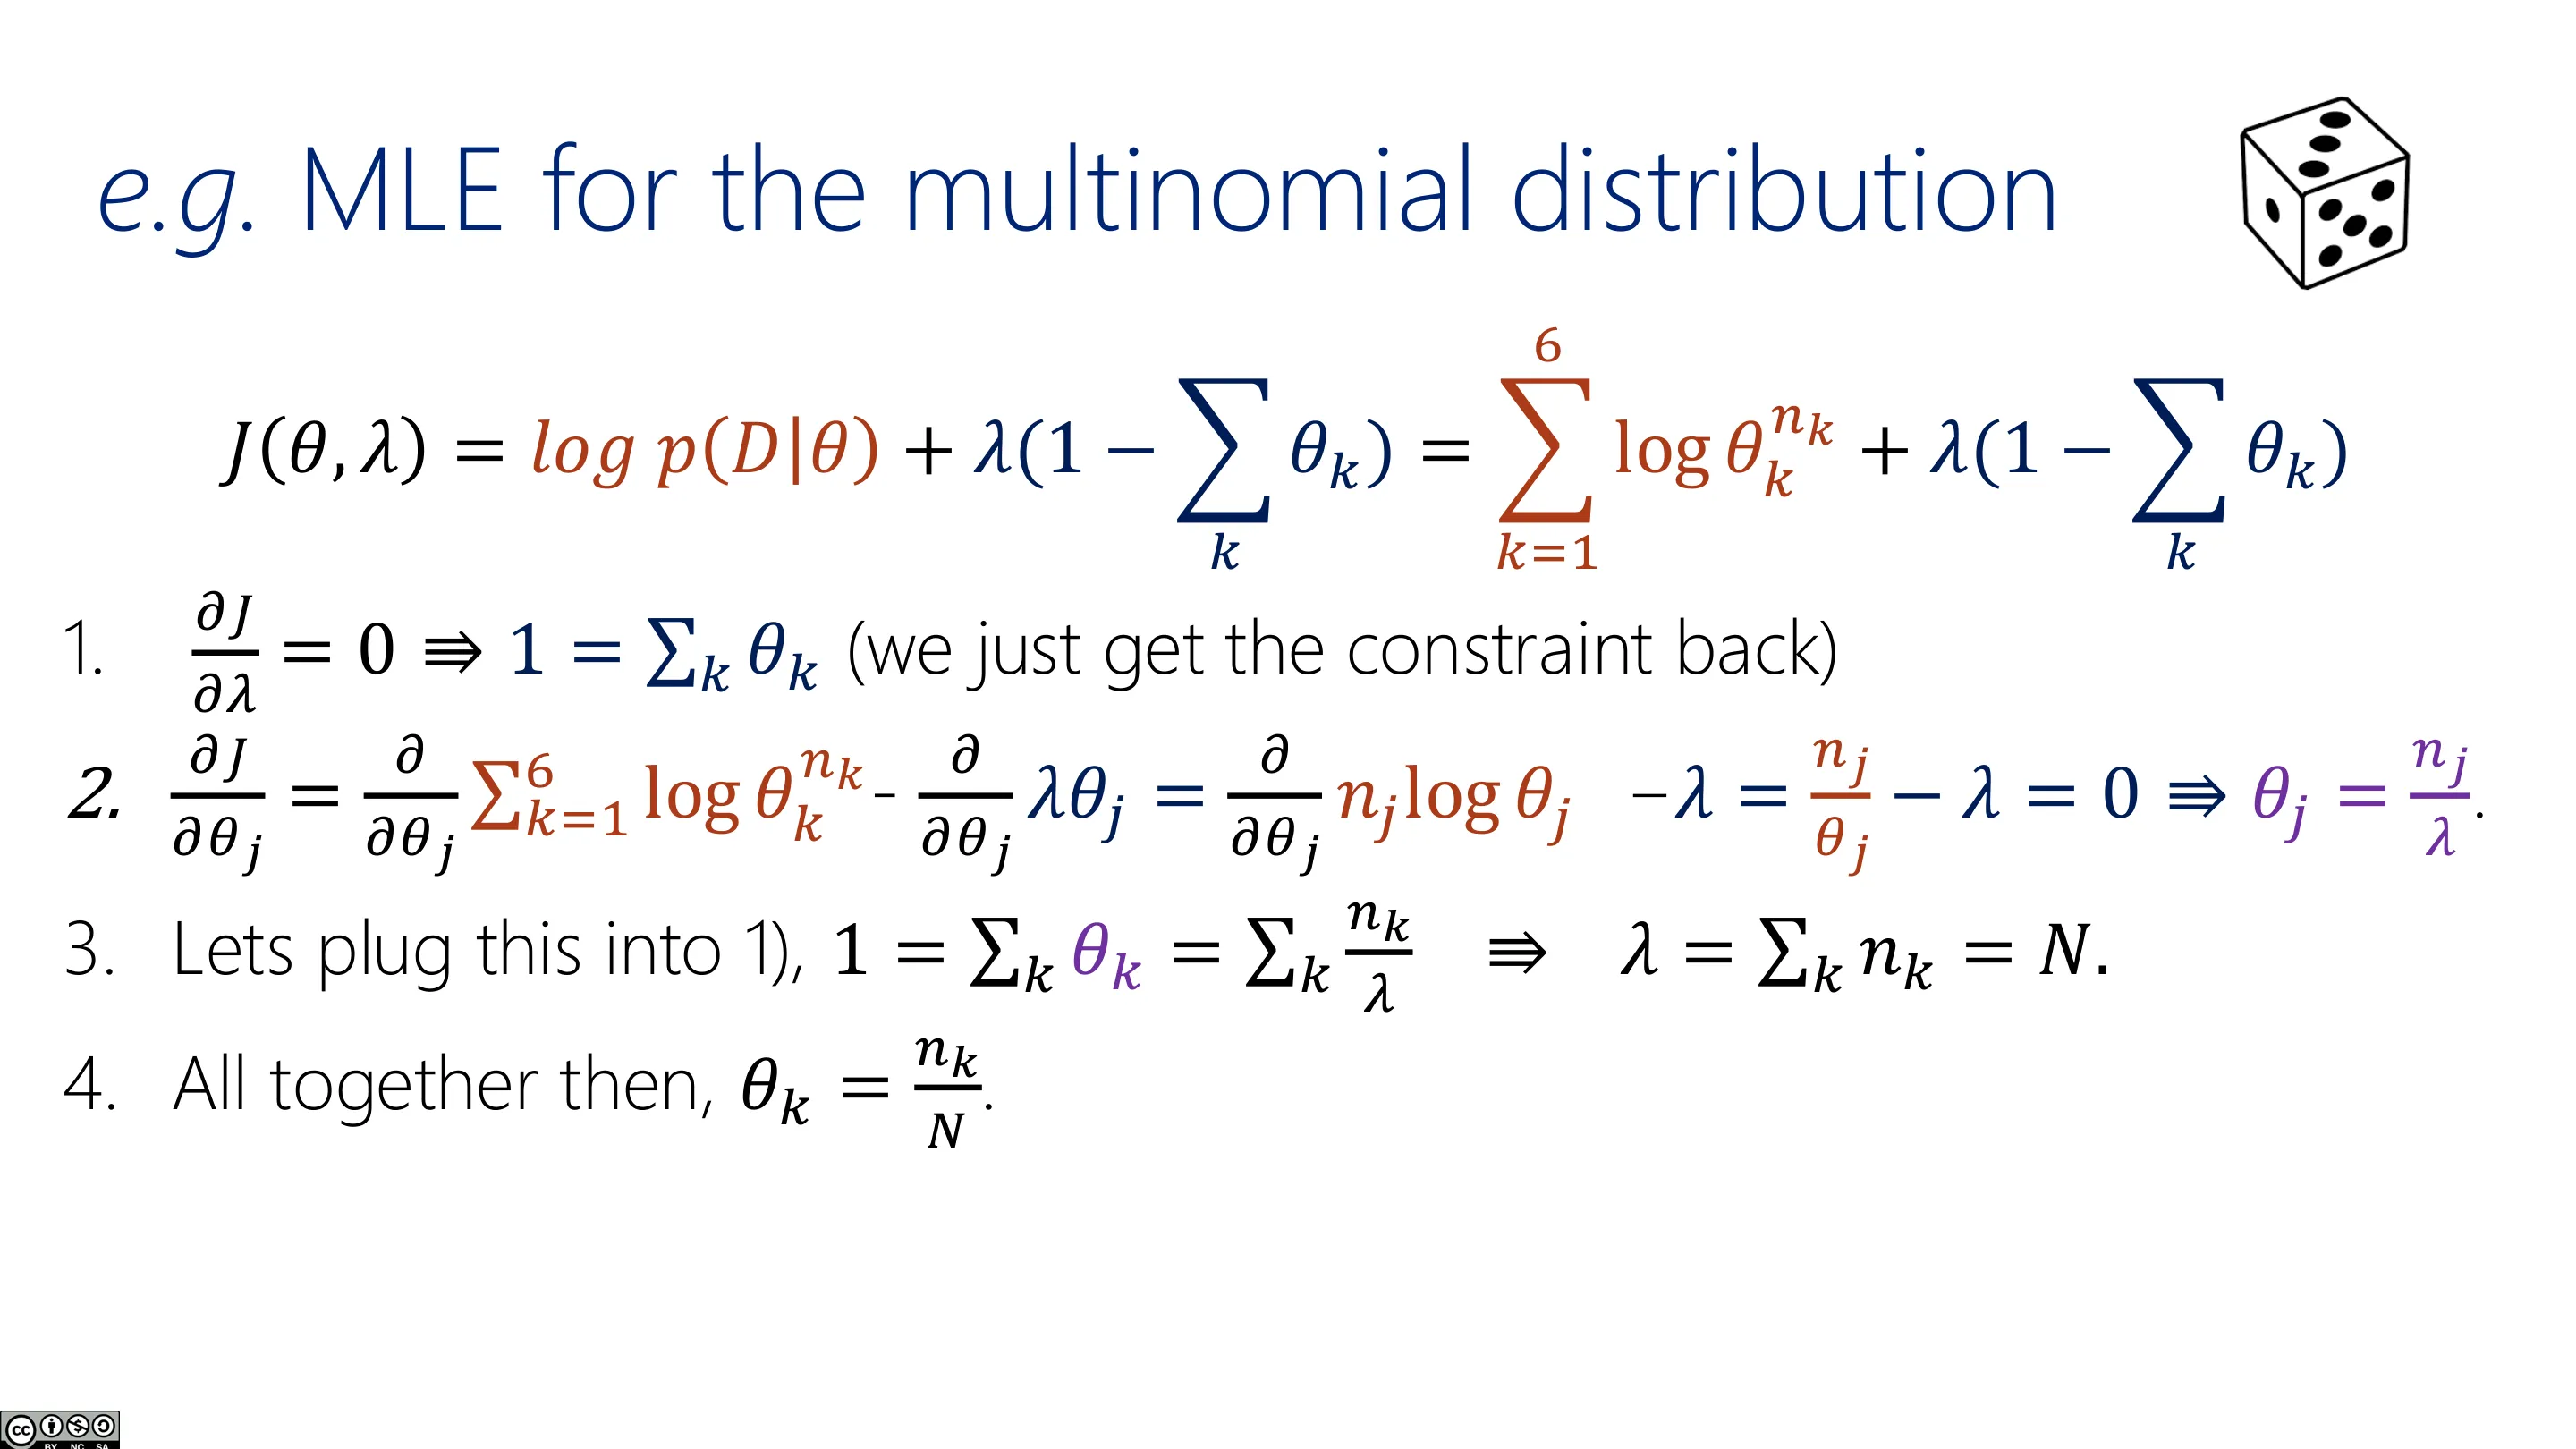
📷 MLE 用于多项分布(七)
回到原视频 (01:10:04)编者说明:时间在此用尽,讲师说这个例子下节课继续(届时用拉格朗日乘子求 $\hat{\theta}_k = n_k / n$)。
总结(Takeaways)
- 机器学习的通用骨架:数据 → 模型类(参数)→ 损失函数 → 优化。
- MLE 不是损失函数,而是「导出损失函数」的原理:把似然当损失并最大化。
- IID 假设让联合似然分解为乘积,取对数后又变成求和——这是损失函数形式简洁的关键。
- 对数不改变最优解(单调递增),所以实践中几乎总是最大化对数似然。
- MLE 的好性质:一致性、统计有效性、对重参数化不变;但在真实分布未知时不再有保证。
- 单变量高斯的 MLE:均值 = 经验均值,方差 = 经验方差(统计学家常用 $n-1$ 的无偏版本)。
- MLE 给出点估计,不表达不确定性;贝叶斯则给出参数的分布——两者都重要。
- 多项分布的 MLE 需要带约束优化(拉格朗日乘子),下节课完成。
附录:课堂未展示的幻灯片
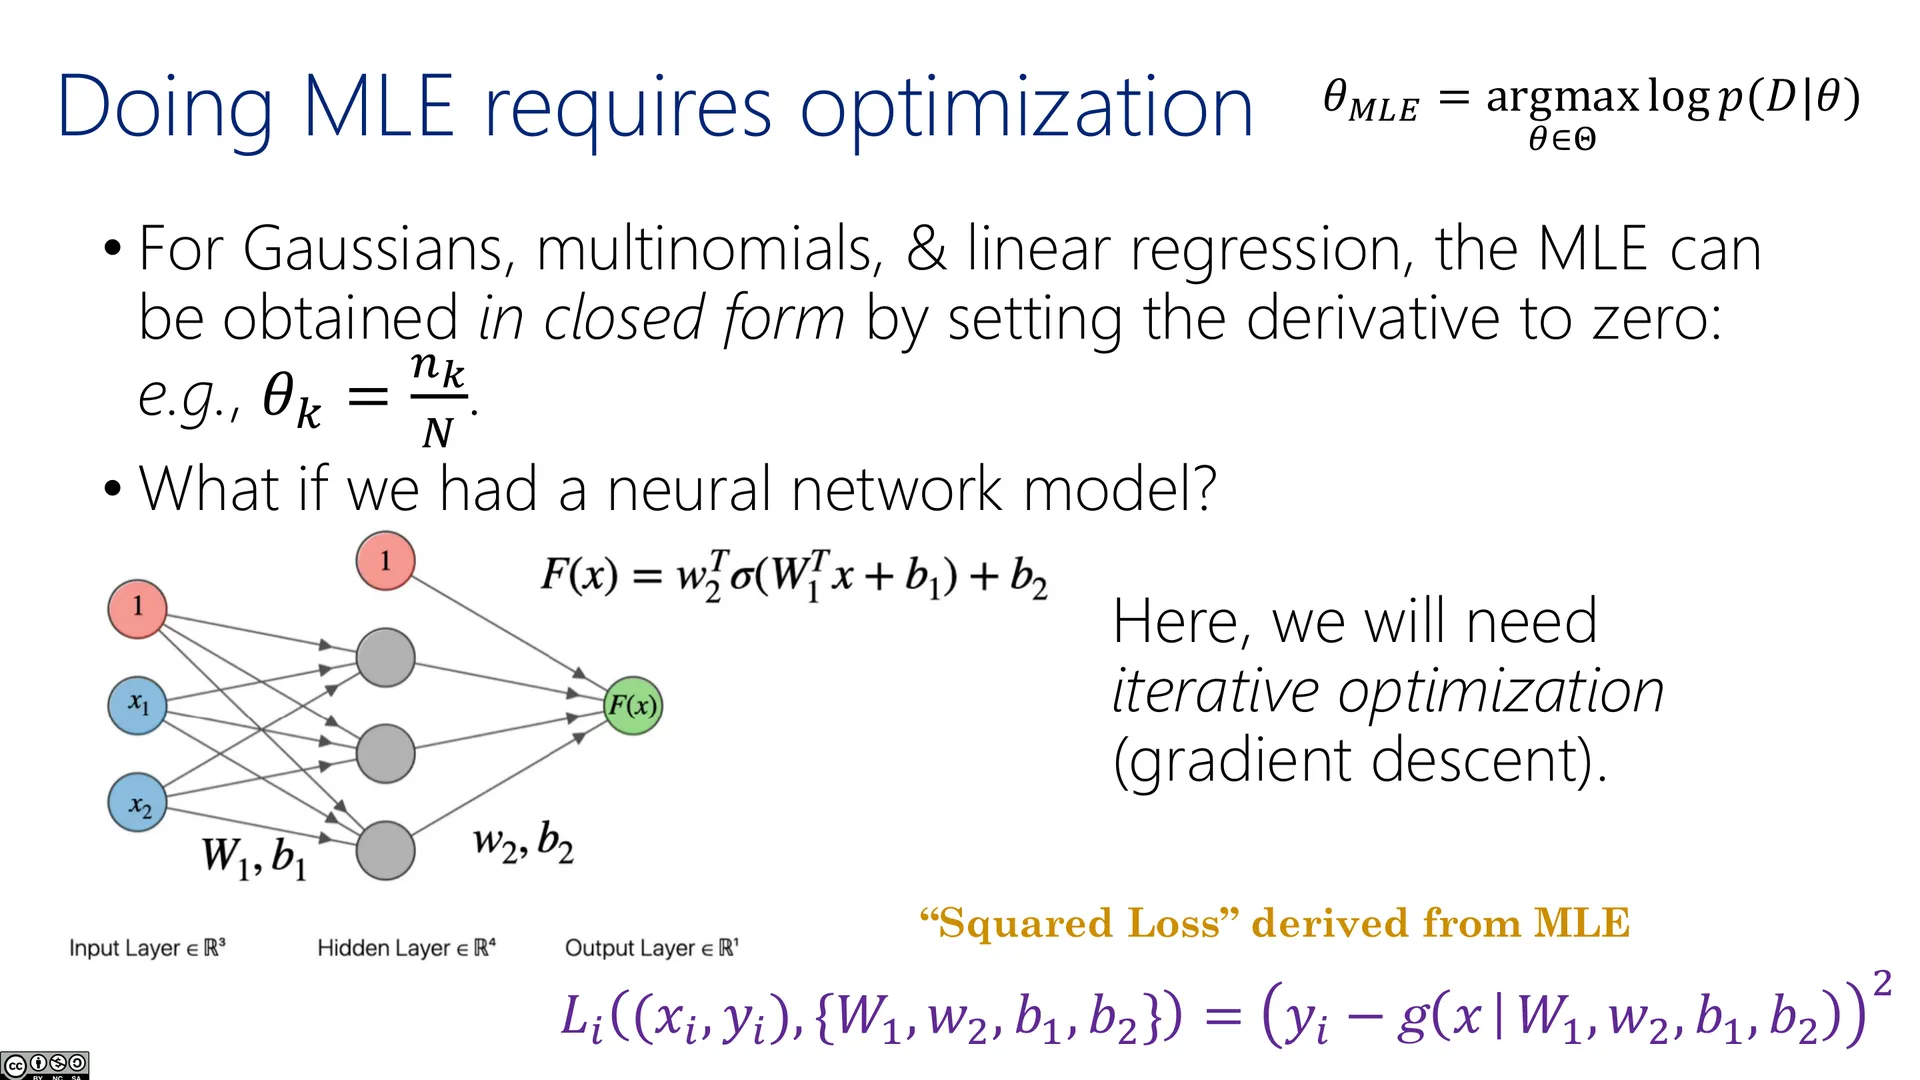
🖼️ 进行 MLE 需要优化
附:官方参考与延伸阅读
主题 链接 / 说明 课程主页 https://eecs189.org/sp26/ 官方讲义/笔记(Lecture 5) Google Drive PDF 上一讲(Lecture 4:聚类、概率复习) 本书姊妹篇;K 均值与概率基础 教材 Machine Learning: A First Course for Engineers and Scientists 关于 MLE、多元高斯、混合高斯的章节 · https://doi.org/10.1017/9781108919371 版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队(Jennifer Listgarten、Alex Dimakis)所有。本书为课堂内容的学习性中文重构,仅供学习交流。