第6讲 · EECS 189:多元高斯与高斯混合模型
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | Multivariate Gaussians & Mixture of Gaussians |
| 视频 | https://www.youtube.com/watch?v=JzlMrqaa_-A |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 6) | Google Drive PDF |
| 教材 | 概率 Chapter 2.[1-2]、2.3.[1-3];分布 Chapter 3.1、3.2.1;聚类 Chapter 15.1(k-means)、15.2(GMM) |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第6讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
本讲路线图
(参考时间: 00:00)
- 完成最大似然估计(MLE):多项分布(掷骰子)与带约束优化;
- 多元高斯分布(MVG):定义、协方差矩阵、几何直觉;
- 高斯混合模型(GMM / MoG):把 K 均值「概率化」。
📷 标题页
回到原视频 (00:00:01)
📷 路线图(一)
回到原视频 (00:00:33)
📷 路线图(二)
回到原视频 (00:00:58)
一、完成最大似然:多项分布的 MLE
1.1 回顾:MLE 是「导出损失函数的原理」
(参考时间: 00:00)
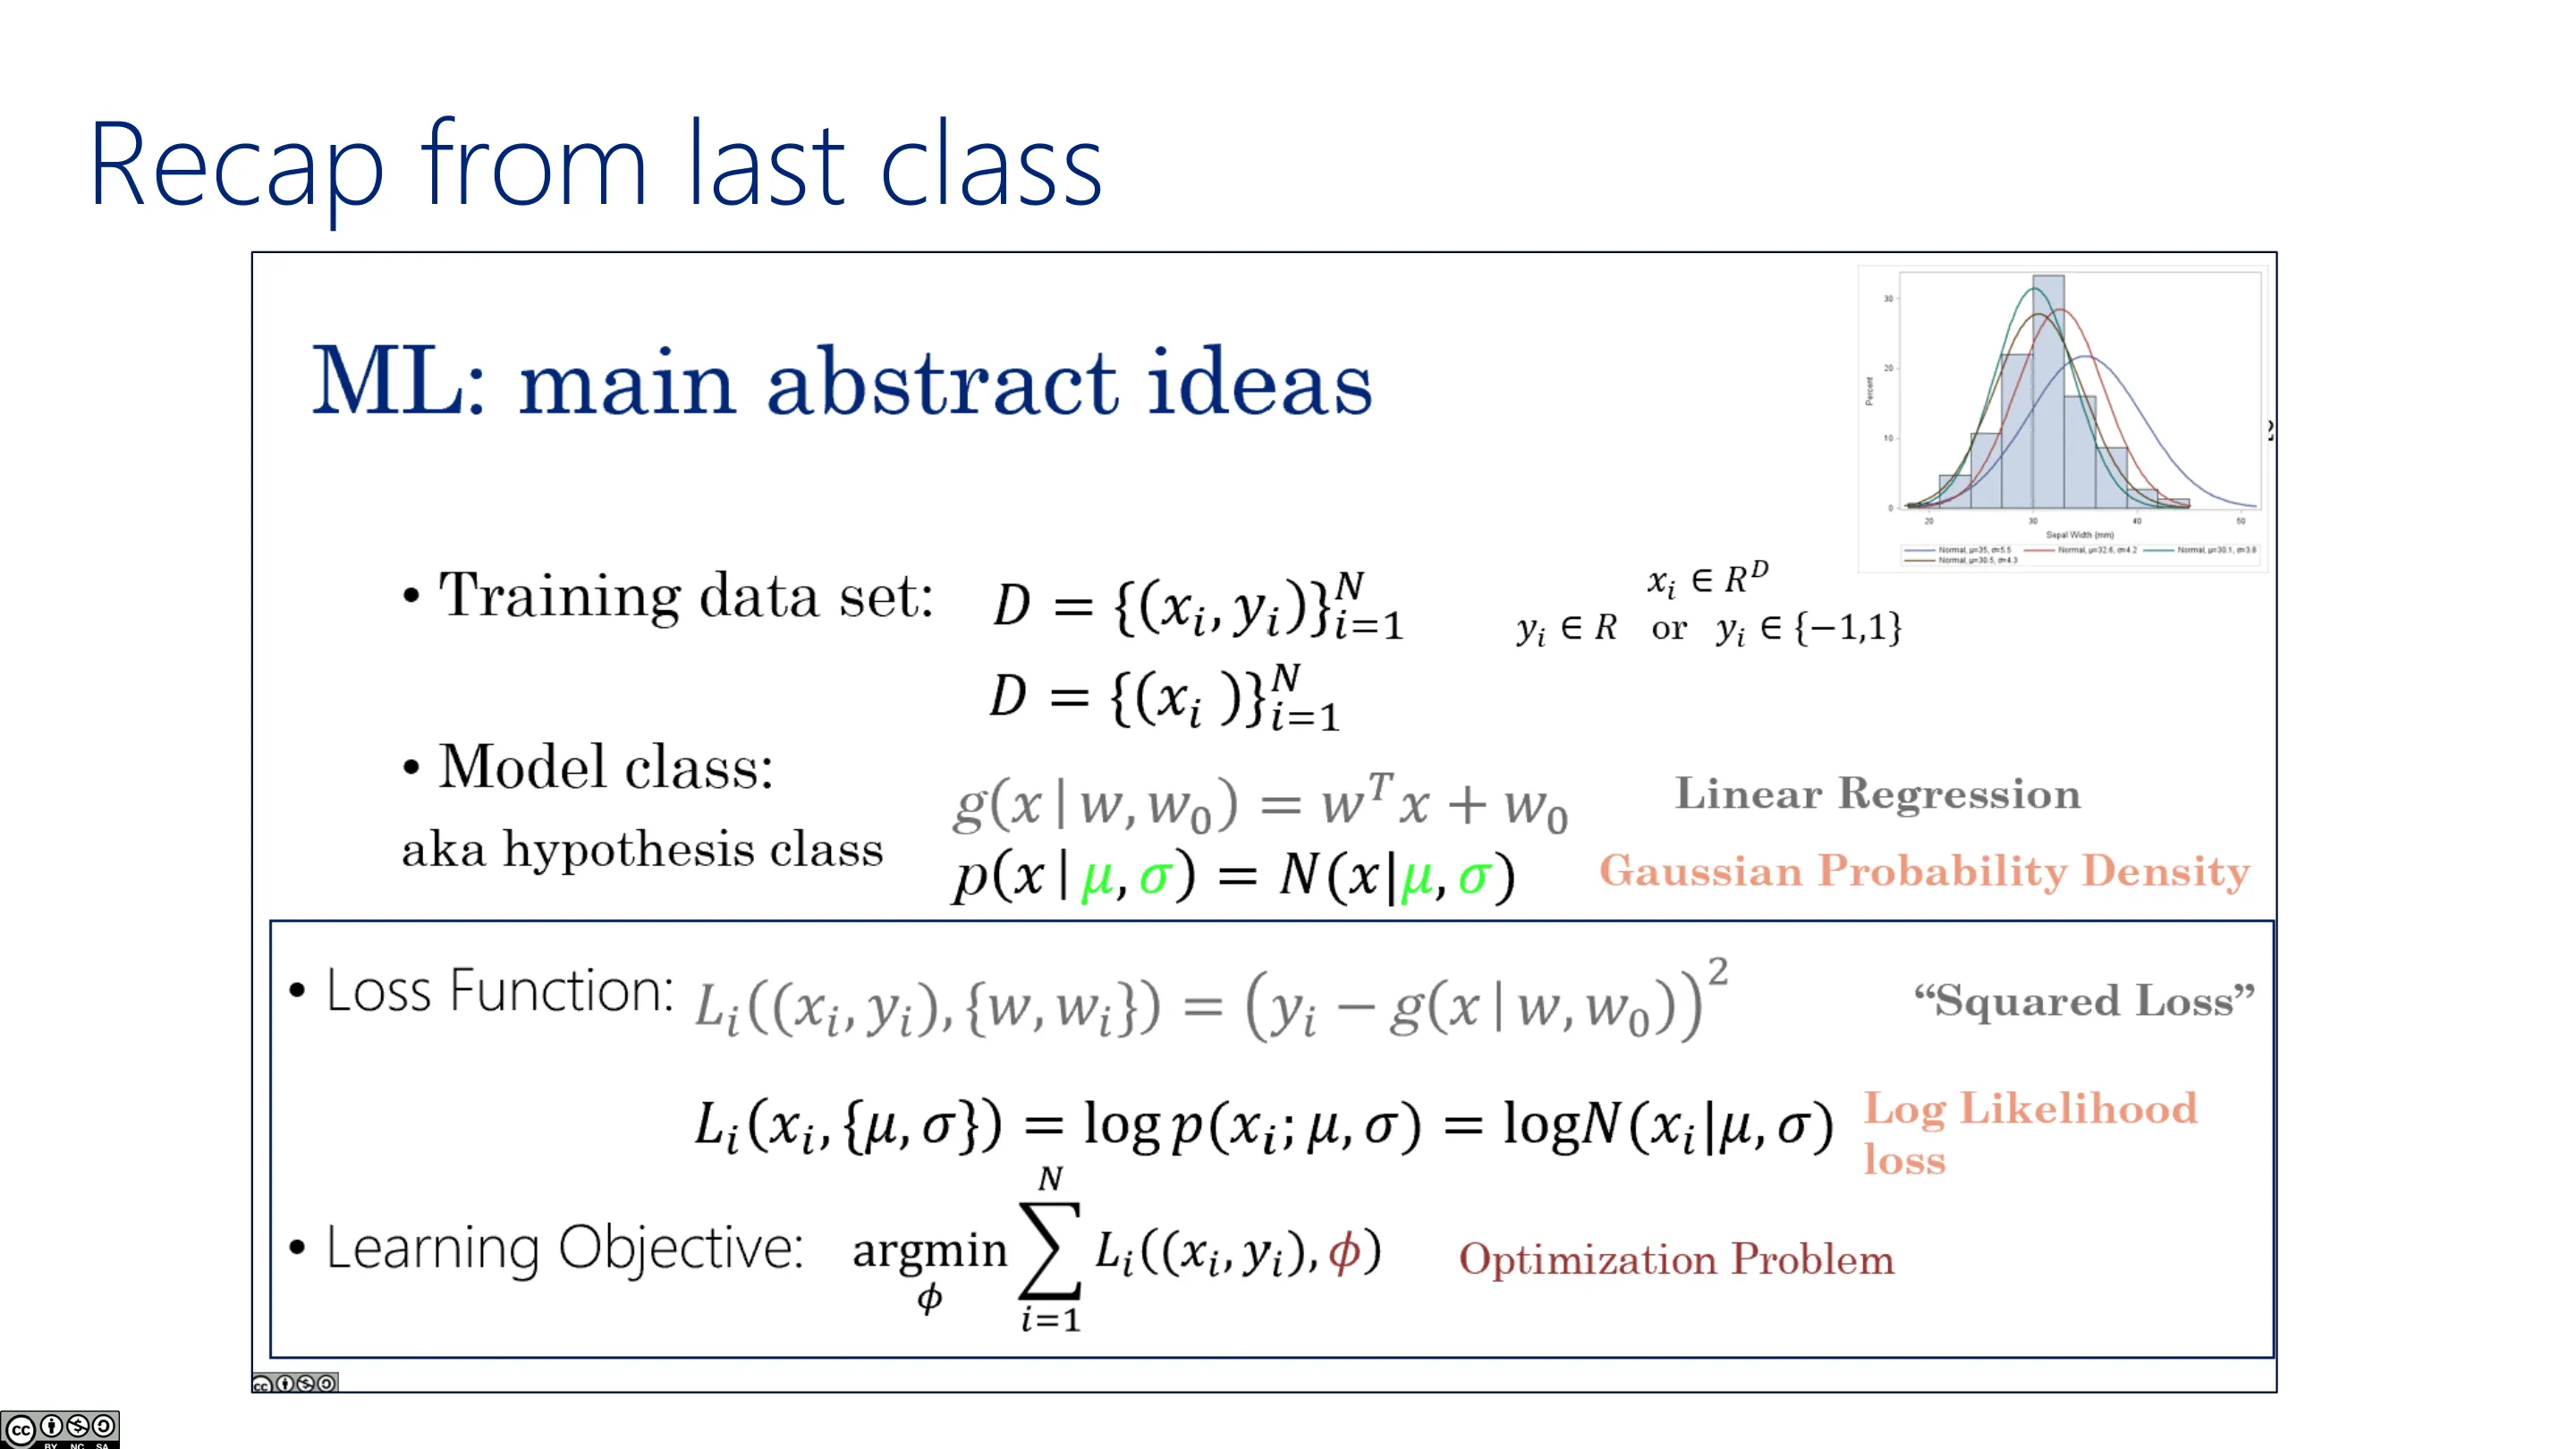
上一讲的核心框架:训练数据 → 假设模型类 → 写出损失函数 → 解优化问题 → 得到参数估计。而最大似然估计(MLE)告诉我们该用哪个损失函数:把似然(或其方便的对数似然)当损失并最大化。
📷 上节课回顾(一)
回到原视频 (00:01:22)
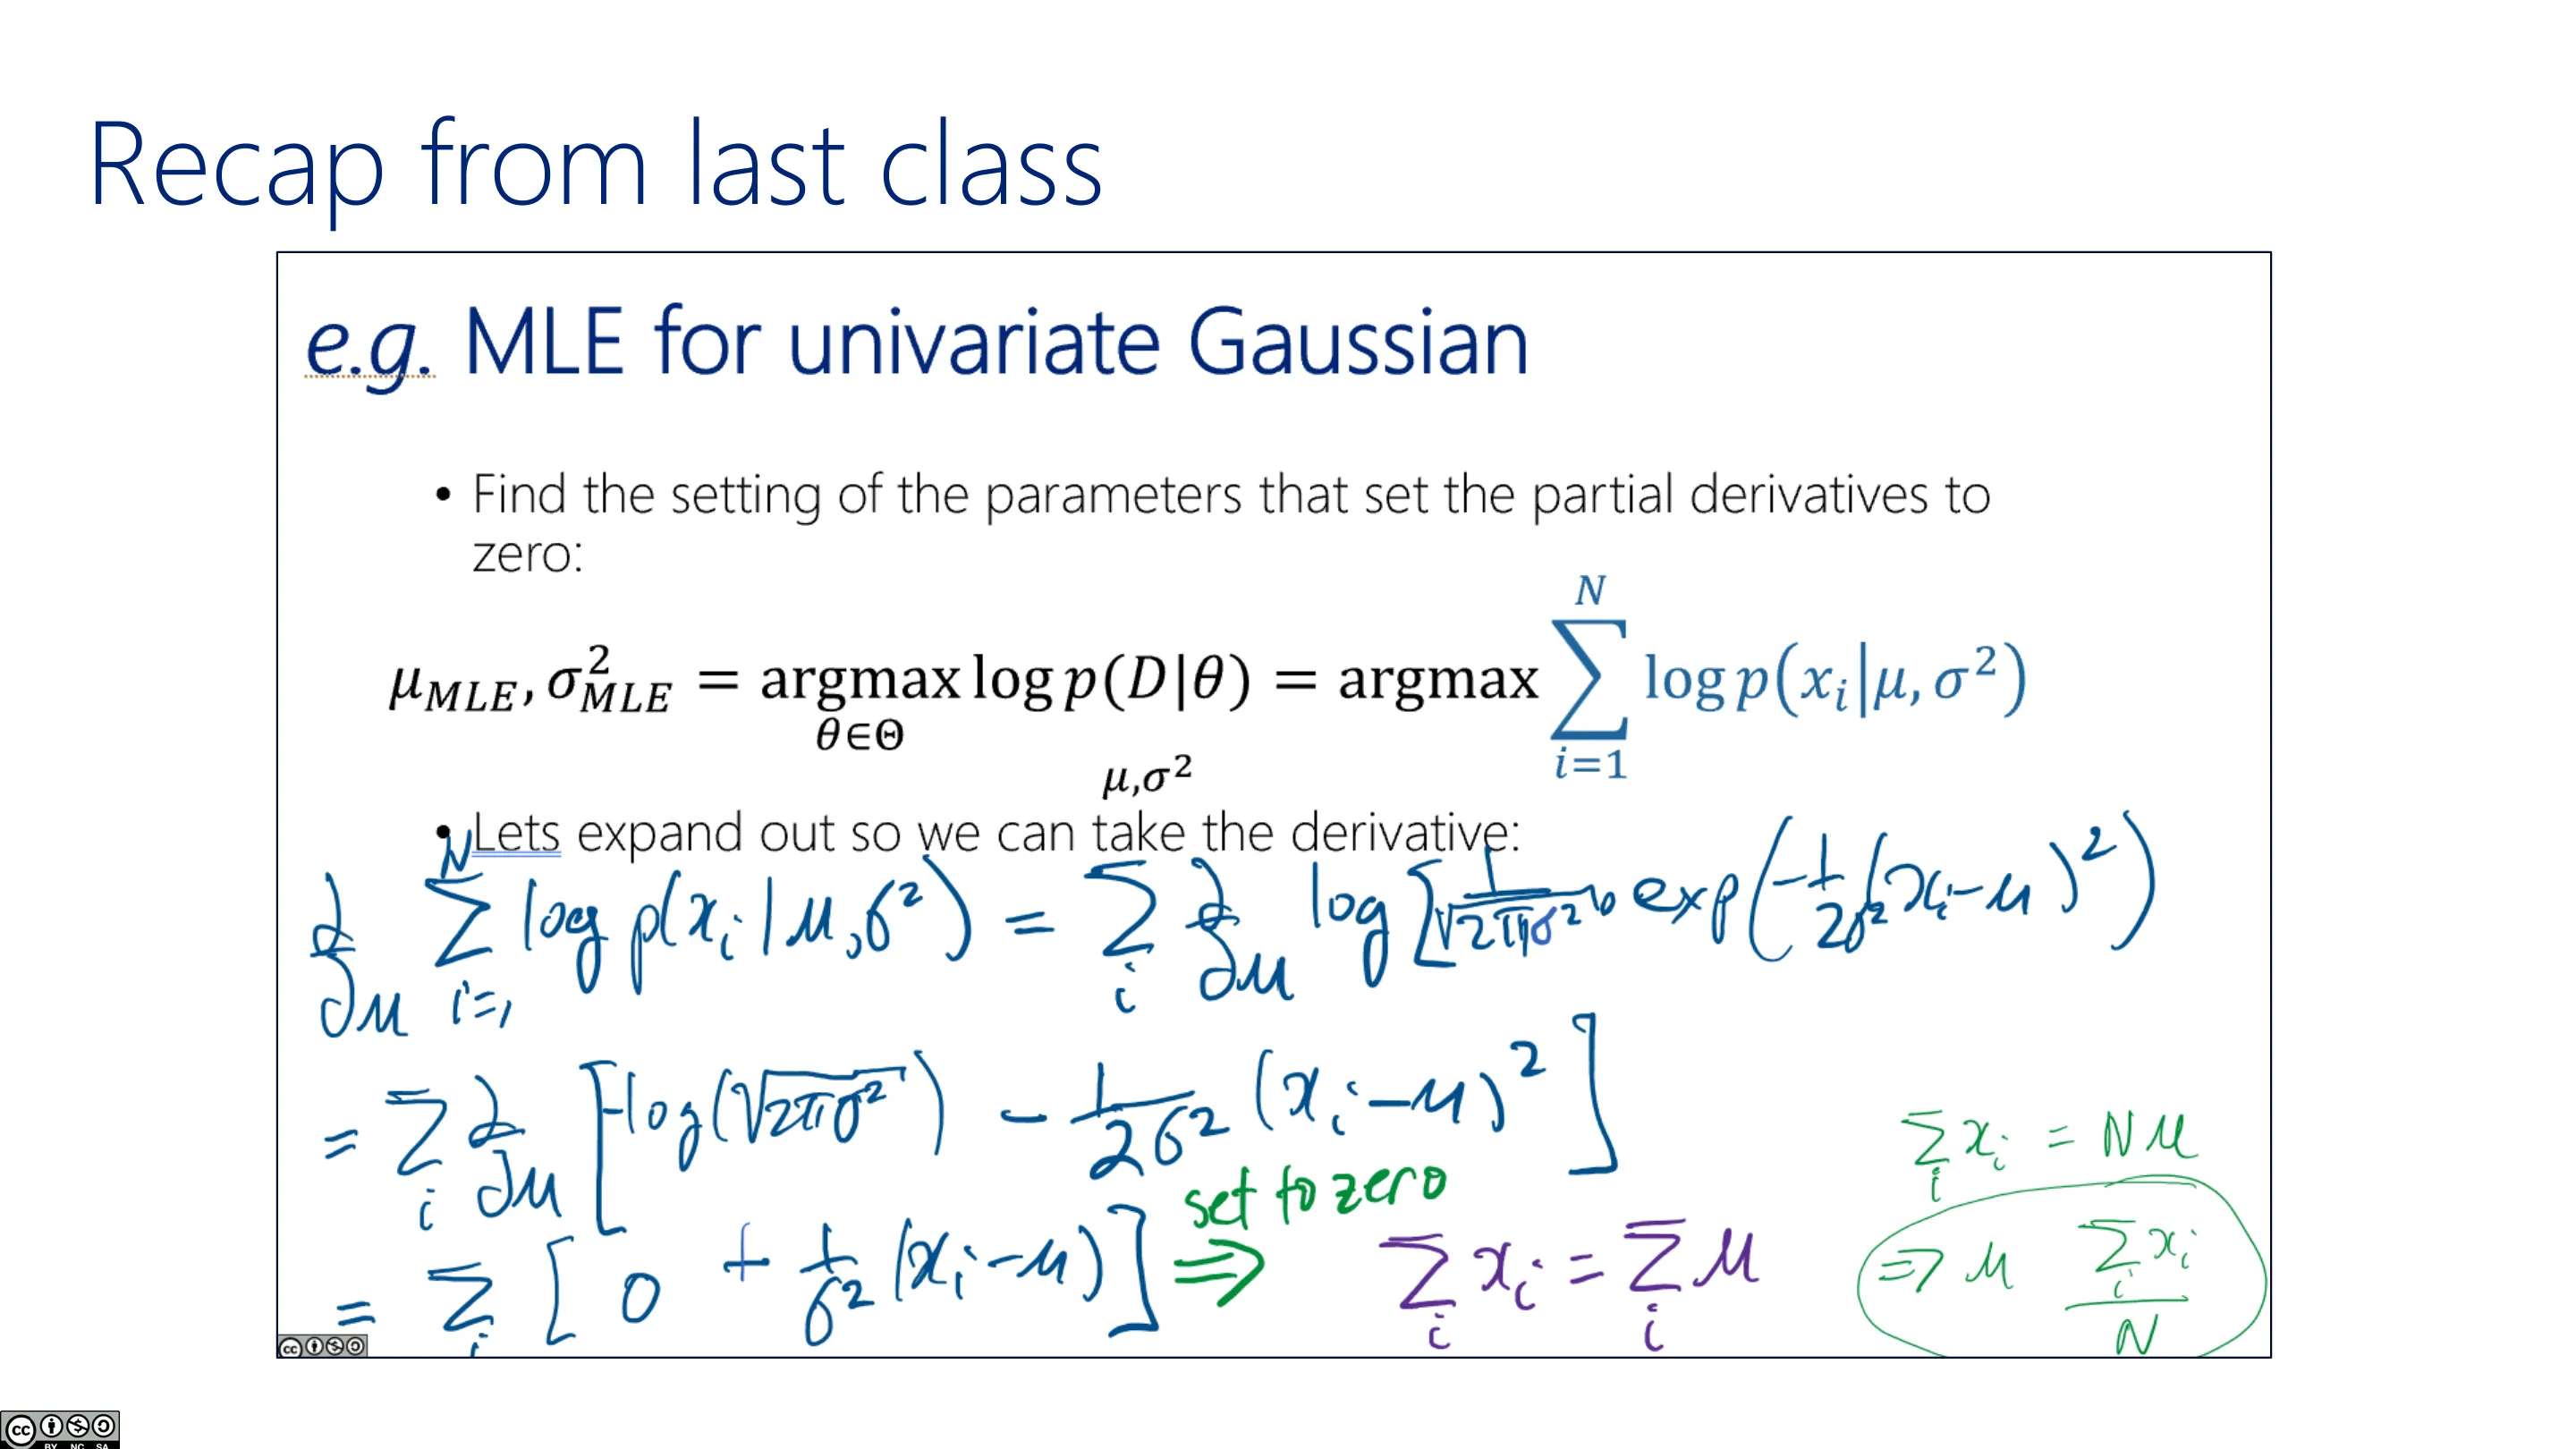
📷 上节课回顾(二)
回到原视频 (00:01:55)
1.2 掷骰子:似然与归一化约束
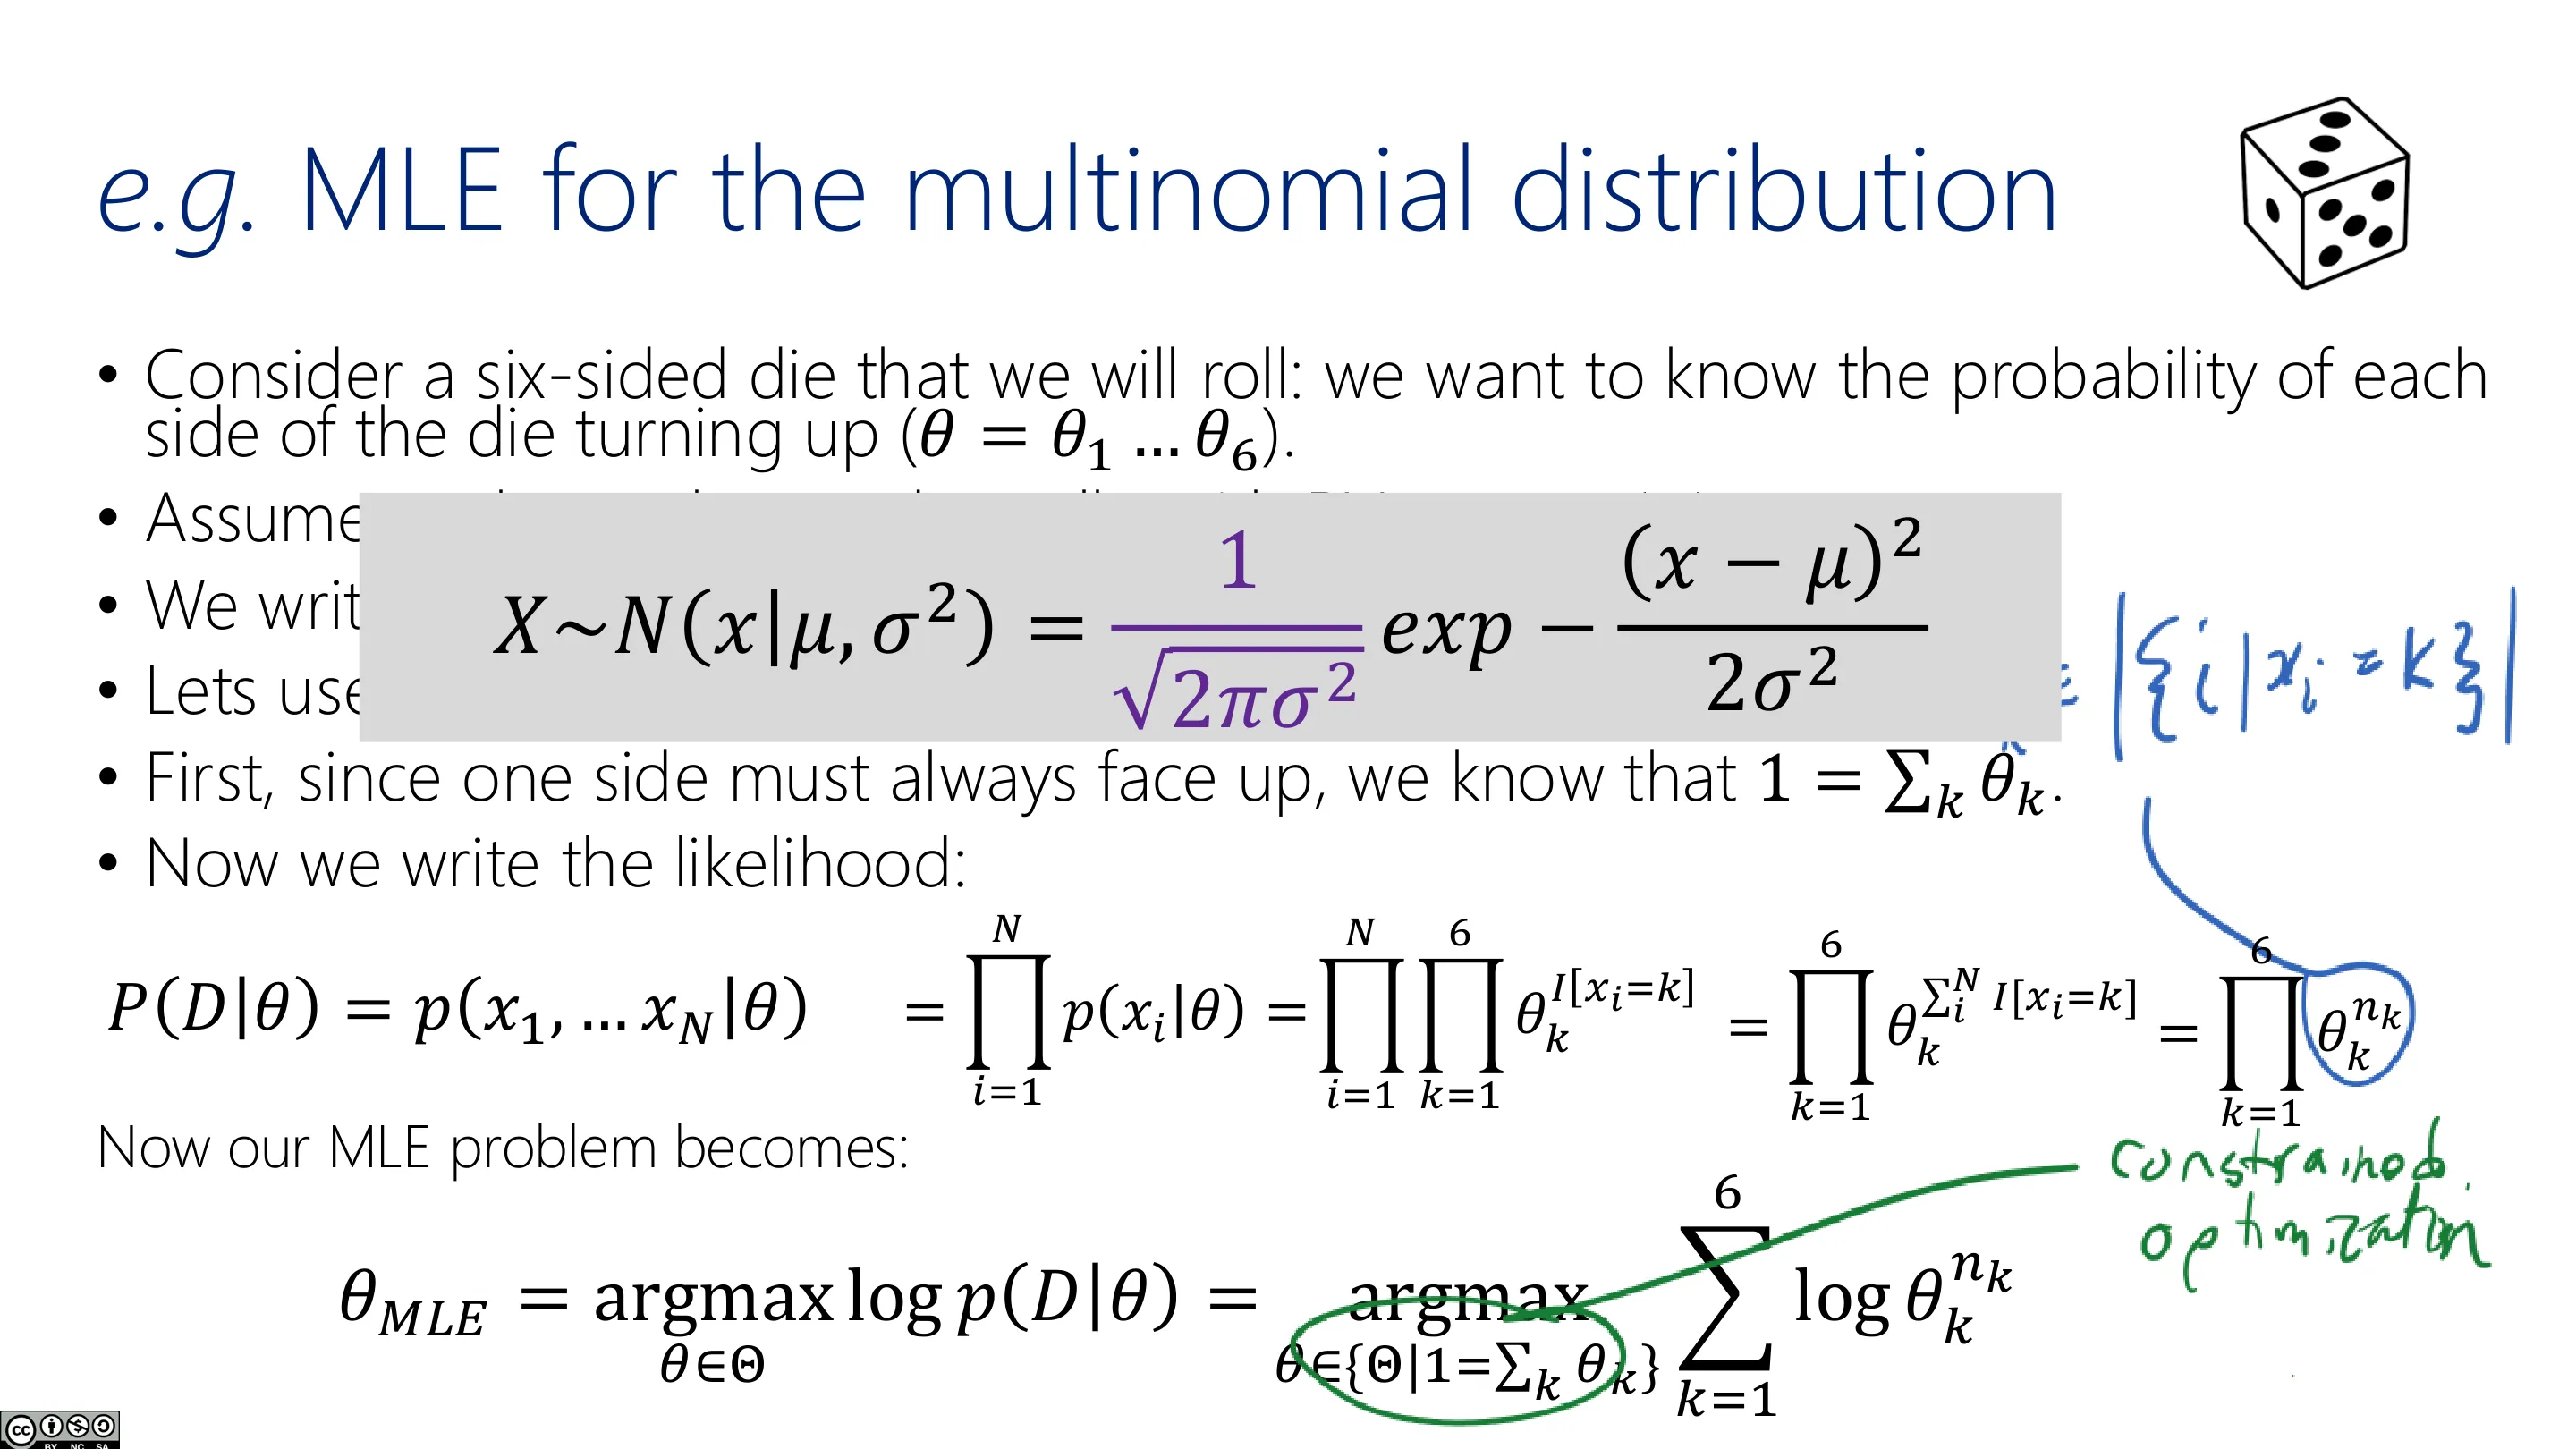
考虑一枚六面骰子,我们想知道每一面朝上的概率 $\theta = (\theta_1,\dots,\theta_6)$。掷 $N$ 次,记 $X \sim p_\theta(X)$,则 $P(X=k \mid \theta) = \theta_k$。
两个要点:
- 归一化约束:因为总有一面朝上,所以 $\sum_{k} \theta_k = 1$;
- 似然:用指示函数 $I[x_i=k]$ 记账,只有命中的那一面为 1、其余为 0,可得
$$ P(D\mid\theta)=\prod_{i=1}^{N}p(x_i\mid\theta)=\prod_{i=1}^{N}\prod_{k=1}^{6}\theta_k^{I[x_i=k]}=\prod_{k=1}^{6}\theta_k^{\,n_k} $$
其中 $n_k=\sum_i I[x_i=k]$ 是第 $k$ 面出现的次数。于是 MLE 问题变成
$$ \theta_{\text{MLE}}=\arg\max_{\theta\in\{\Theta\mid 1=\sum_k\theta_k\}}\ \sum_{k=1}^{6} n_k \log\theta_k $$
📷 多项分布的 MLE(一)
回到原视频 (00:02:15)
1.3 带约束优化:拉格朗日乘子
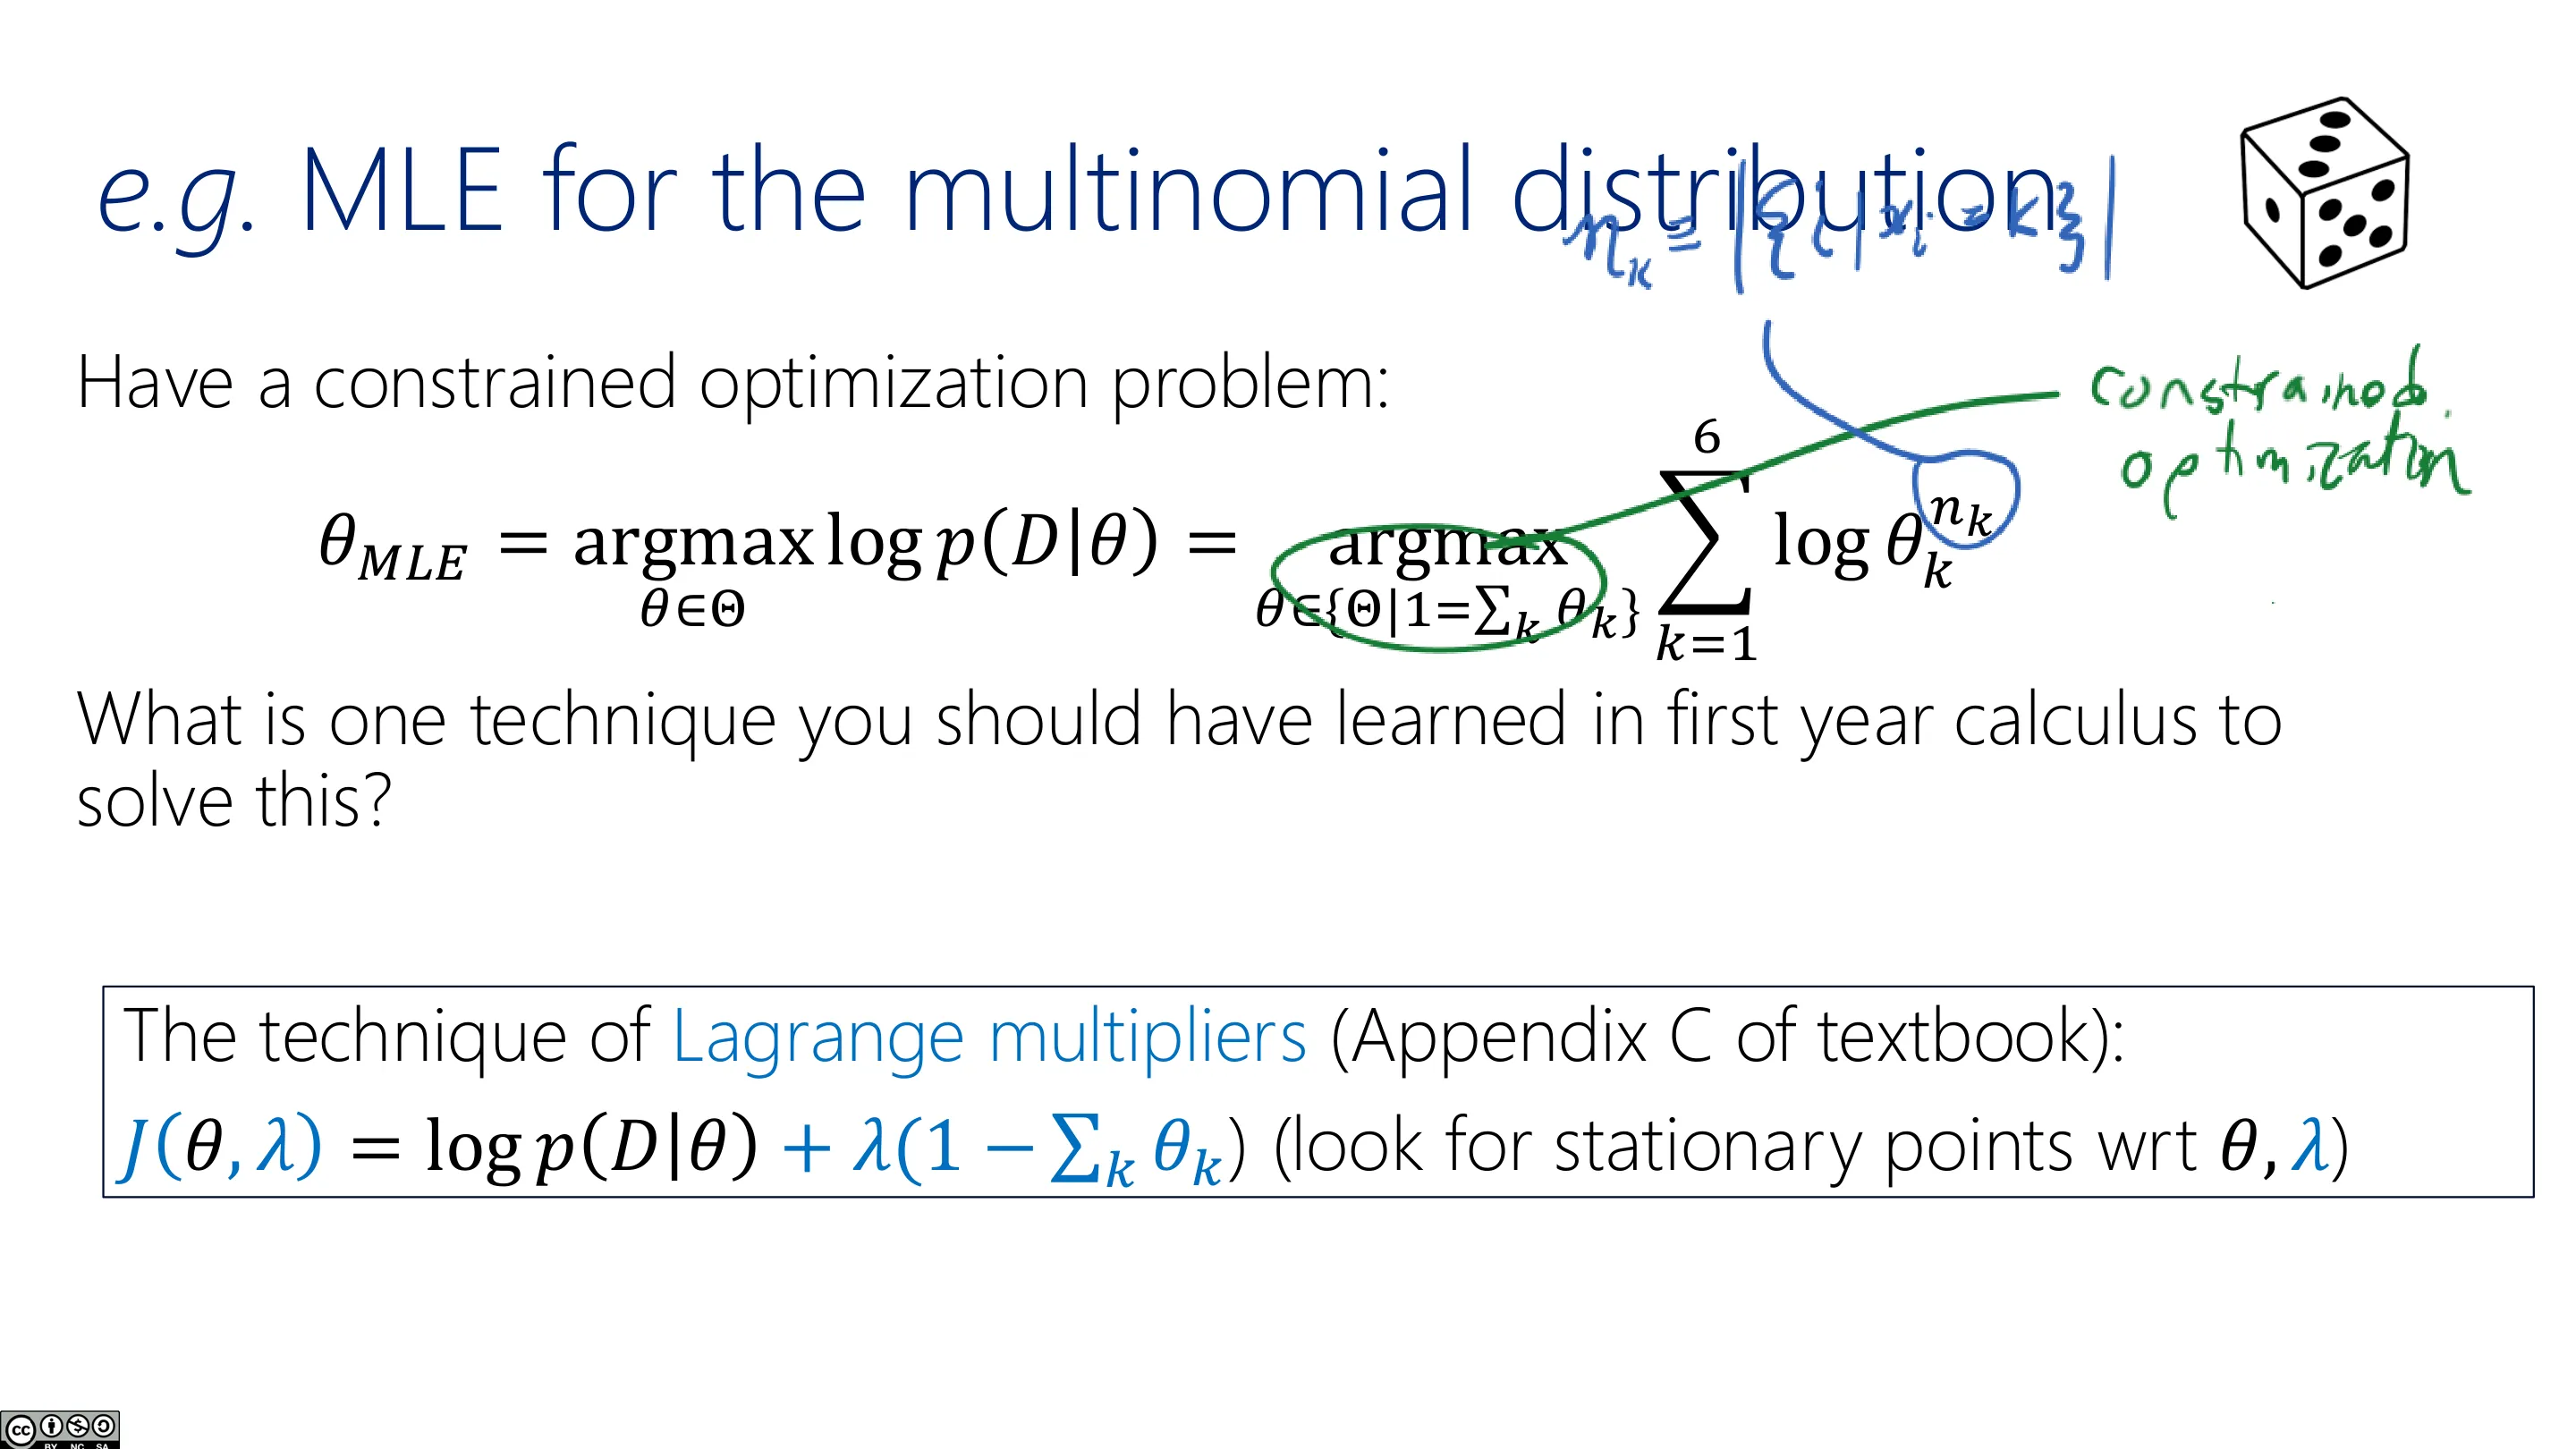
现在的问题多了一个约束——这与高斯不同。高斯 PDF 里自带了归一化常数,无论 $\sigma$ 取何值积分都为 1,所以不需要约束优化;而多项分布没有内建这种约束,必须显式强制 $\sum_k\theta_k=1$。
用拉格朗日乘子(Lagrange multipliers,教材附录 C):
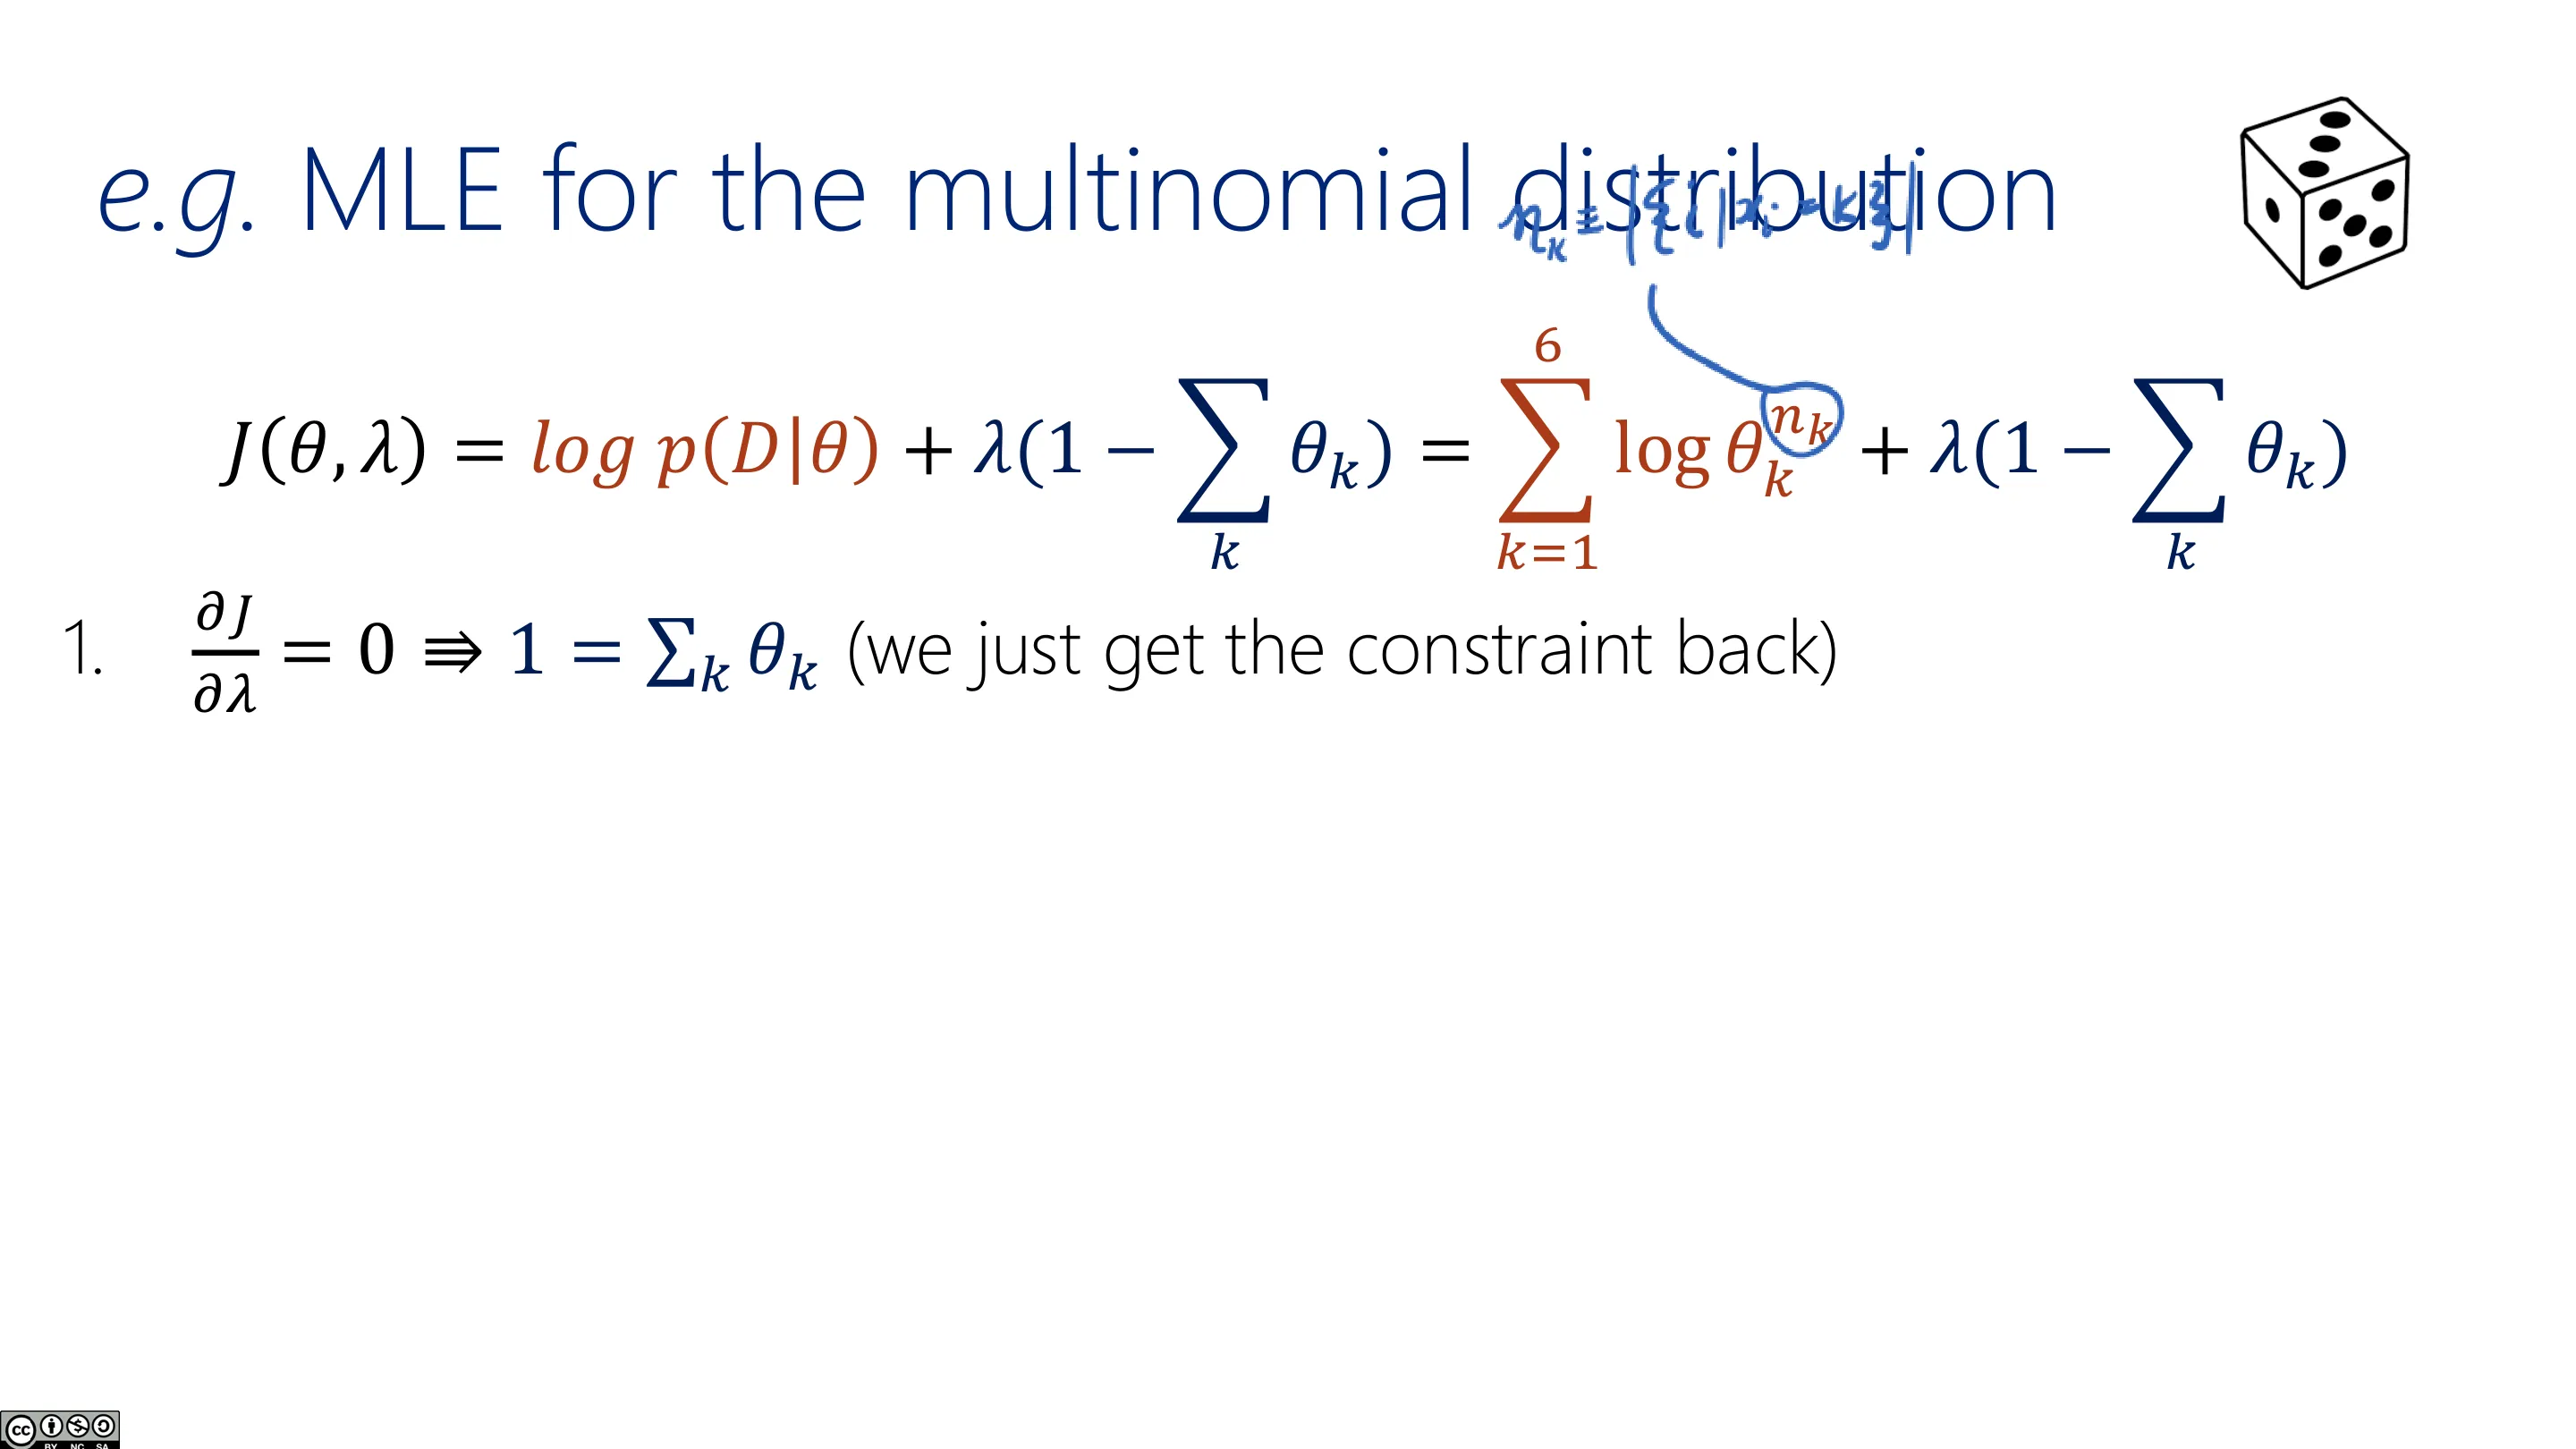
$$ J(\theta,\lambda)=\log p(D\mid\theta)+\lambda\Big(1-\sum_k\theta_k\Big) $$
对 $\lambda$ 求偏导:$\partial J/\partial\lambda=0 \Rightarrow 1=\sum_k\theta_k$——恰好把约束条件还原出来(这是拉格朗日乘子的典型现象)。
📷 拉格朗日乘子(一)
回到原视频 (00:07:00)
📷 拉格朗日乘子(二)
回到原视频 (00:08:13)
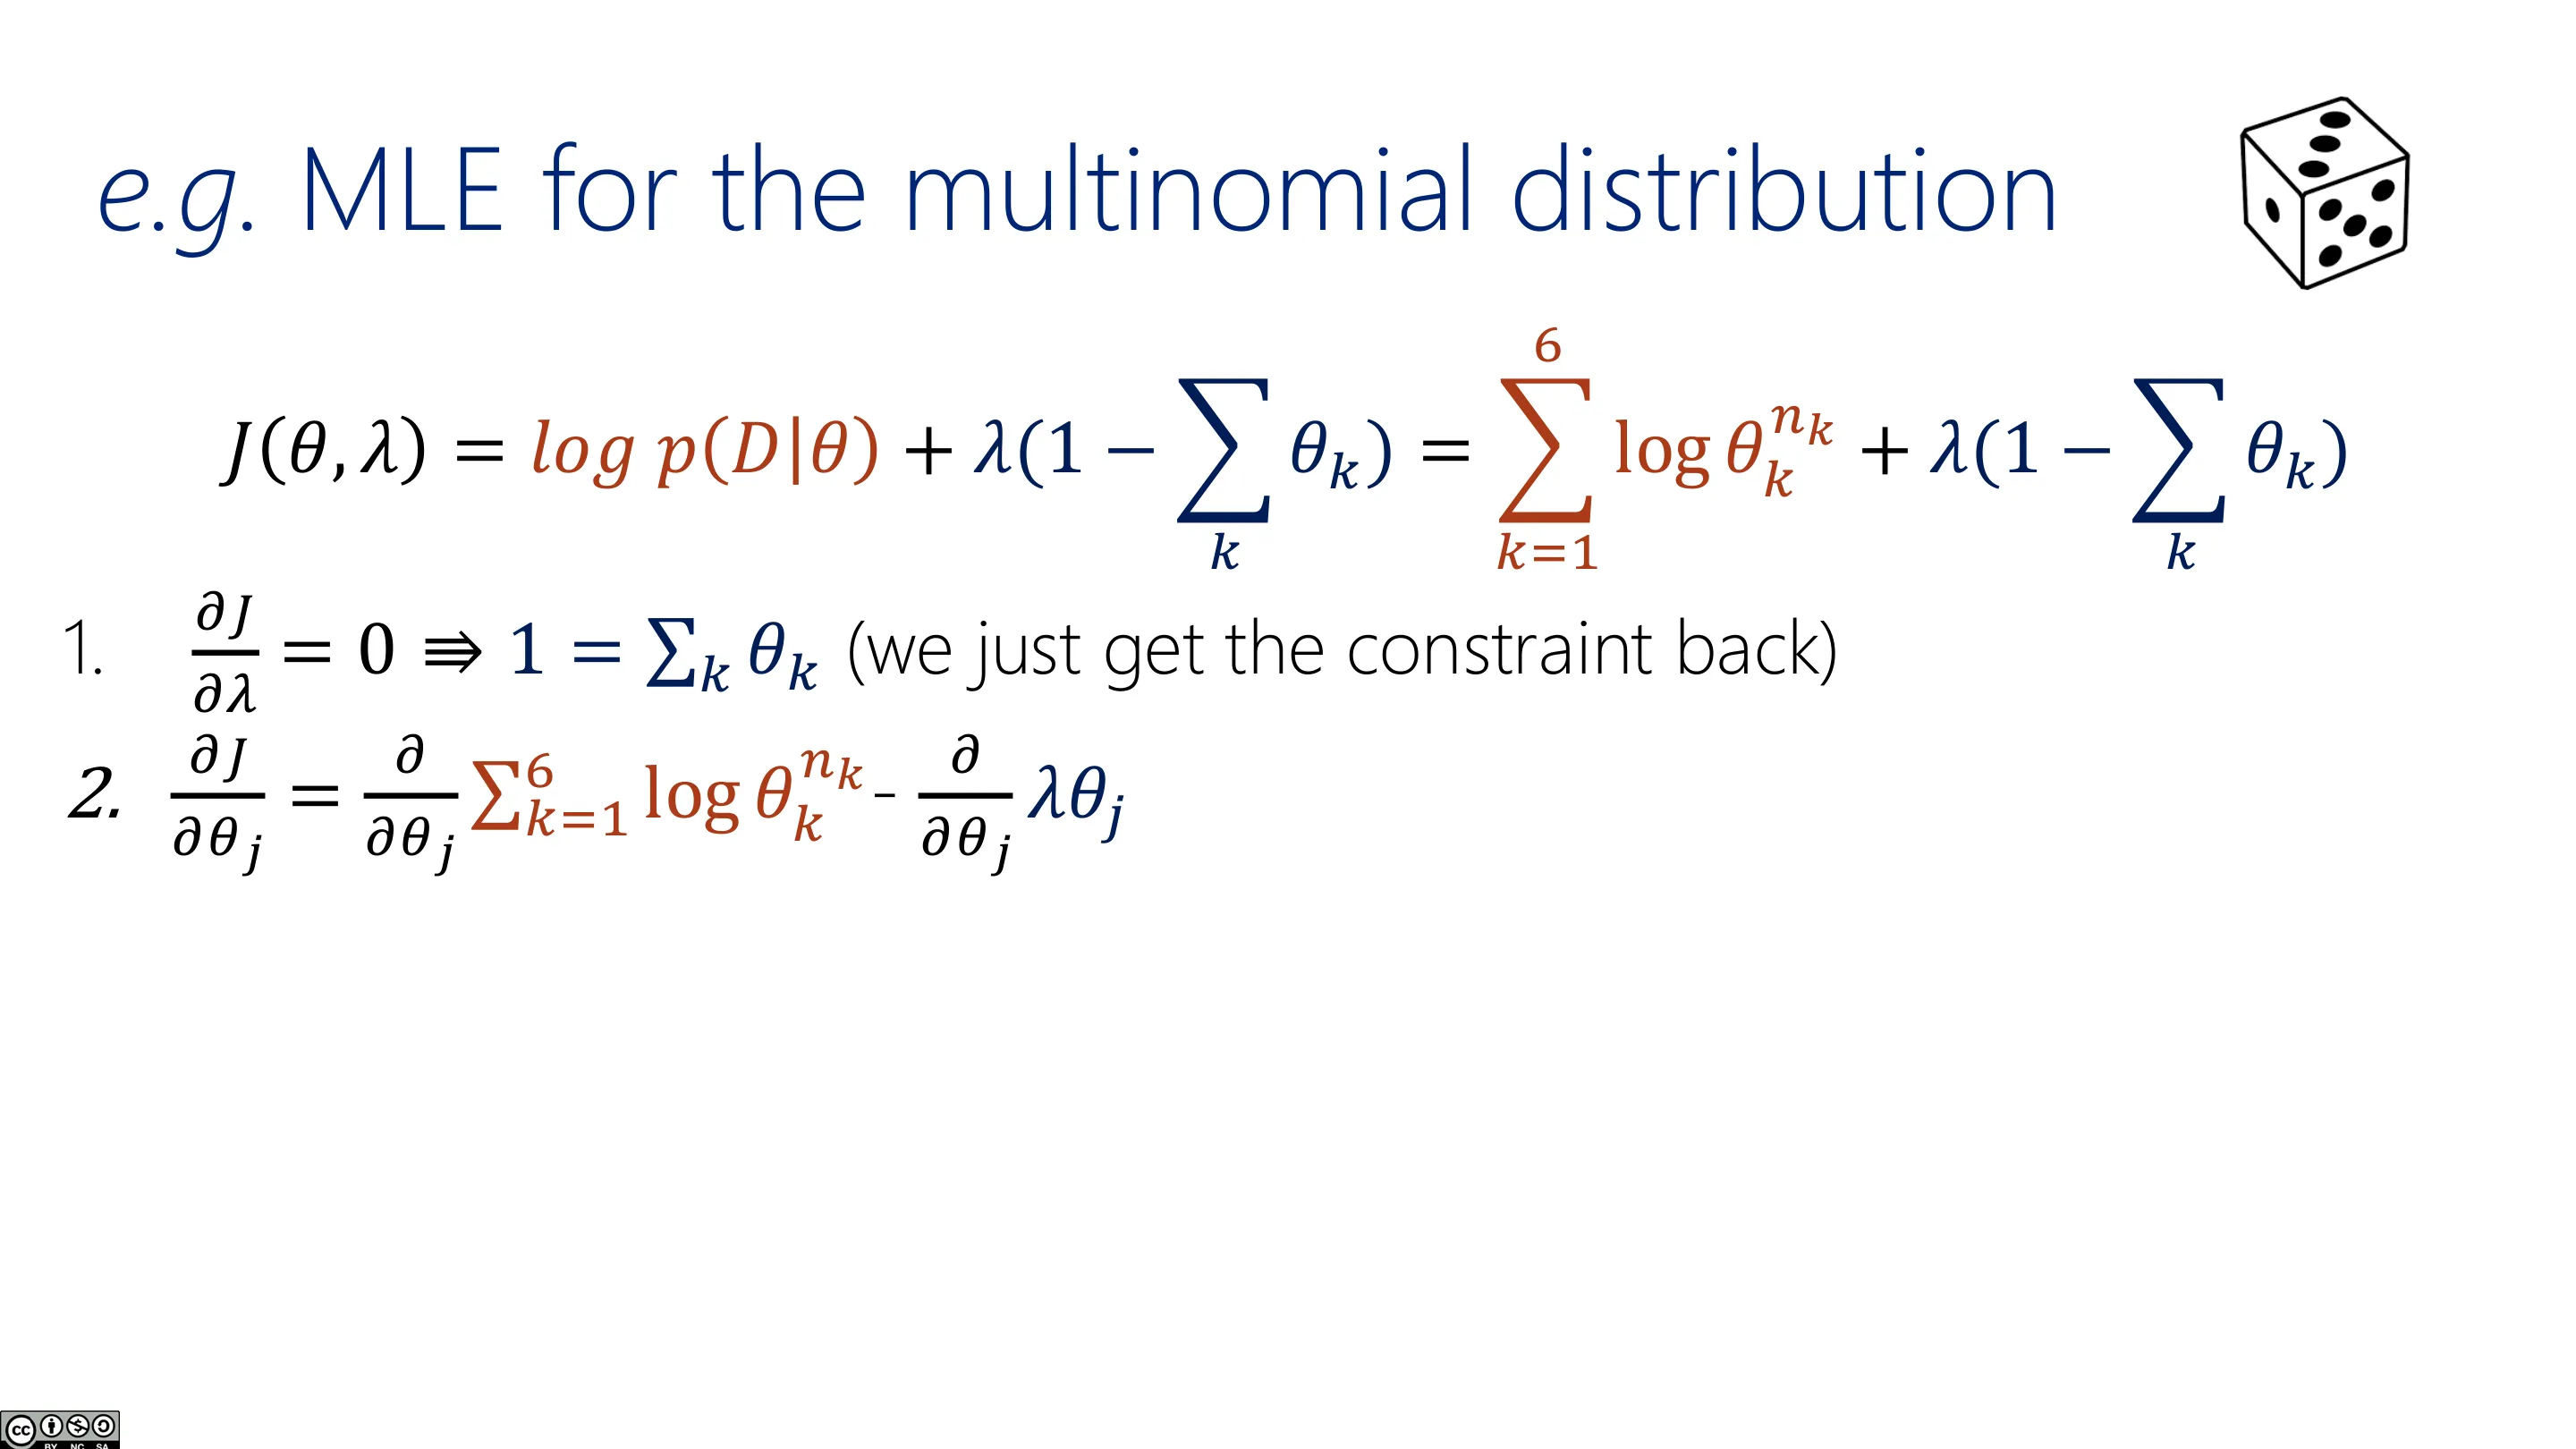
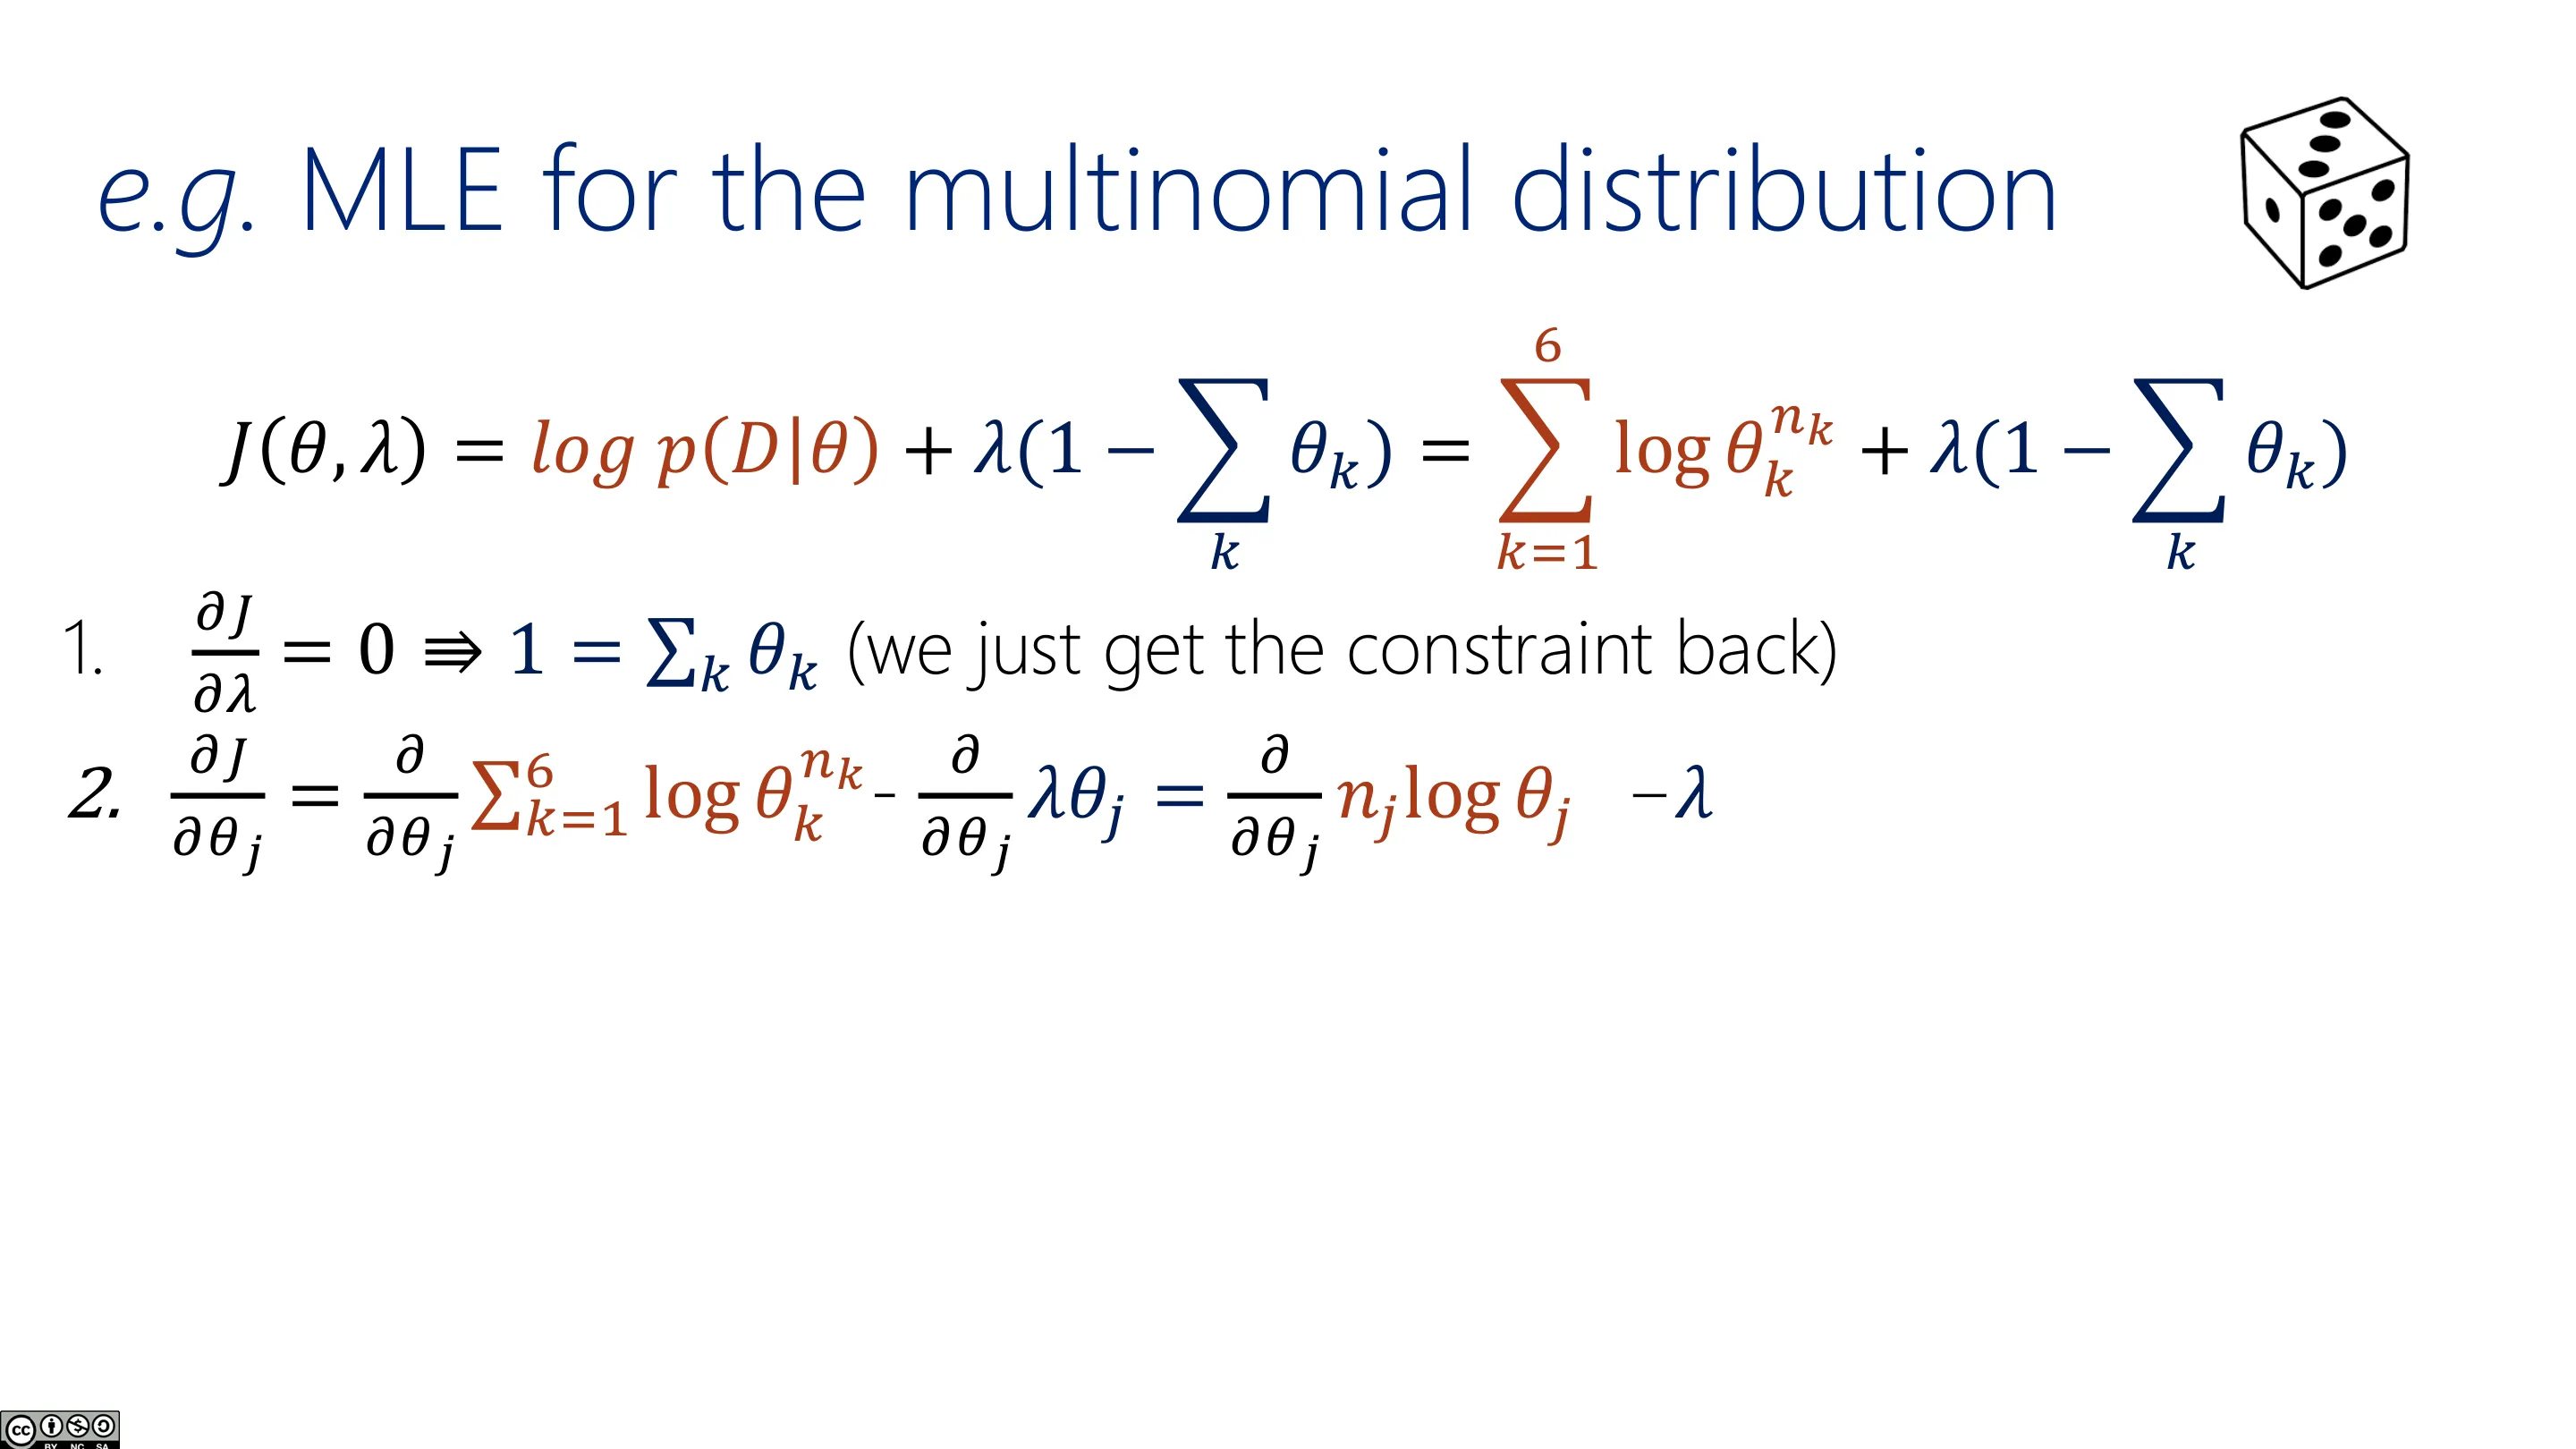
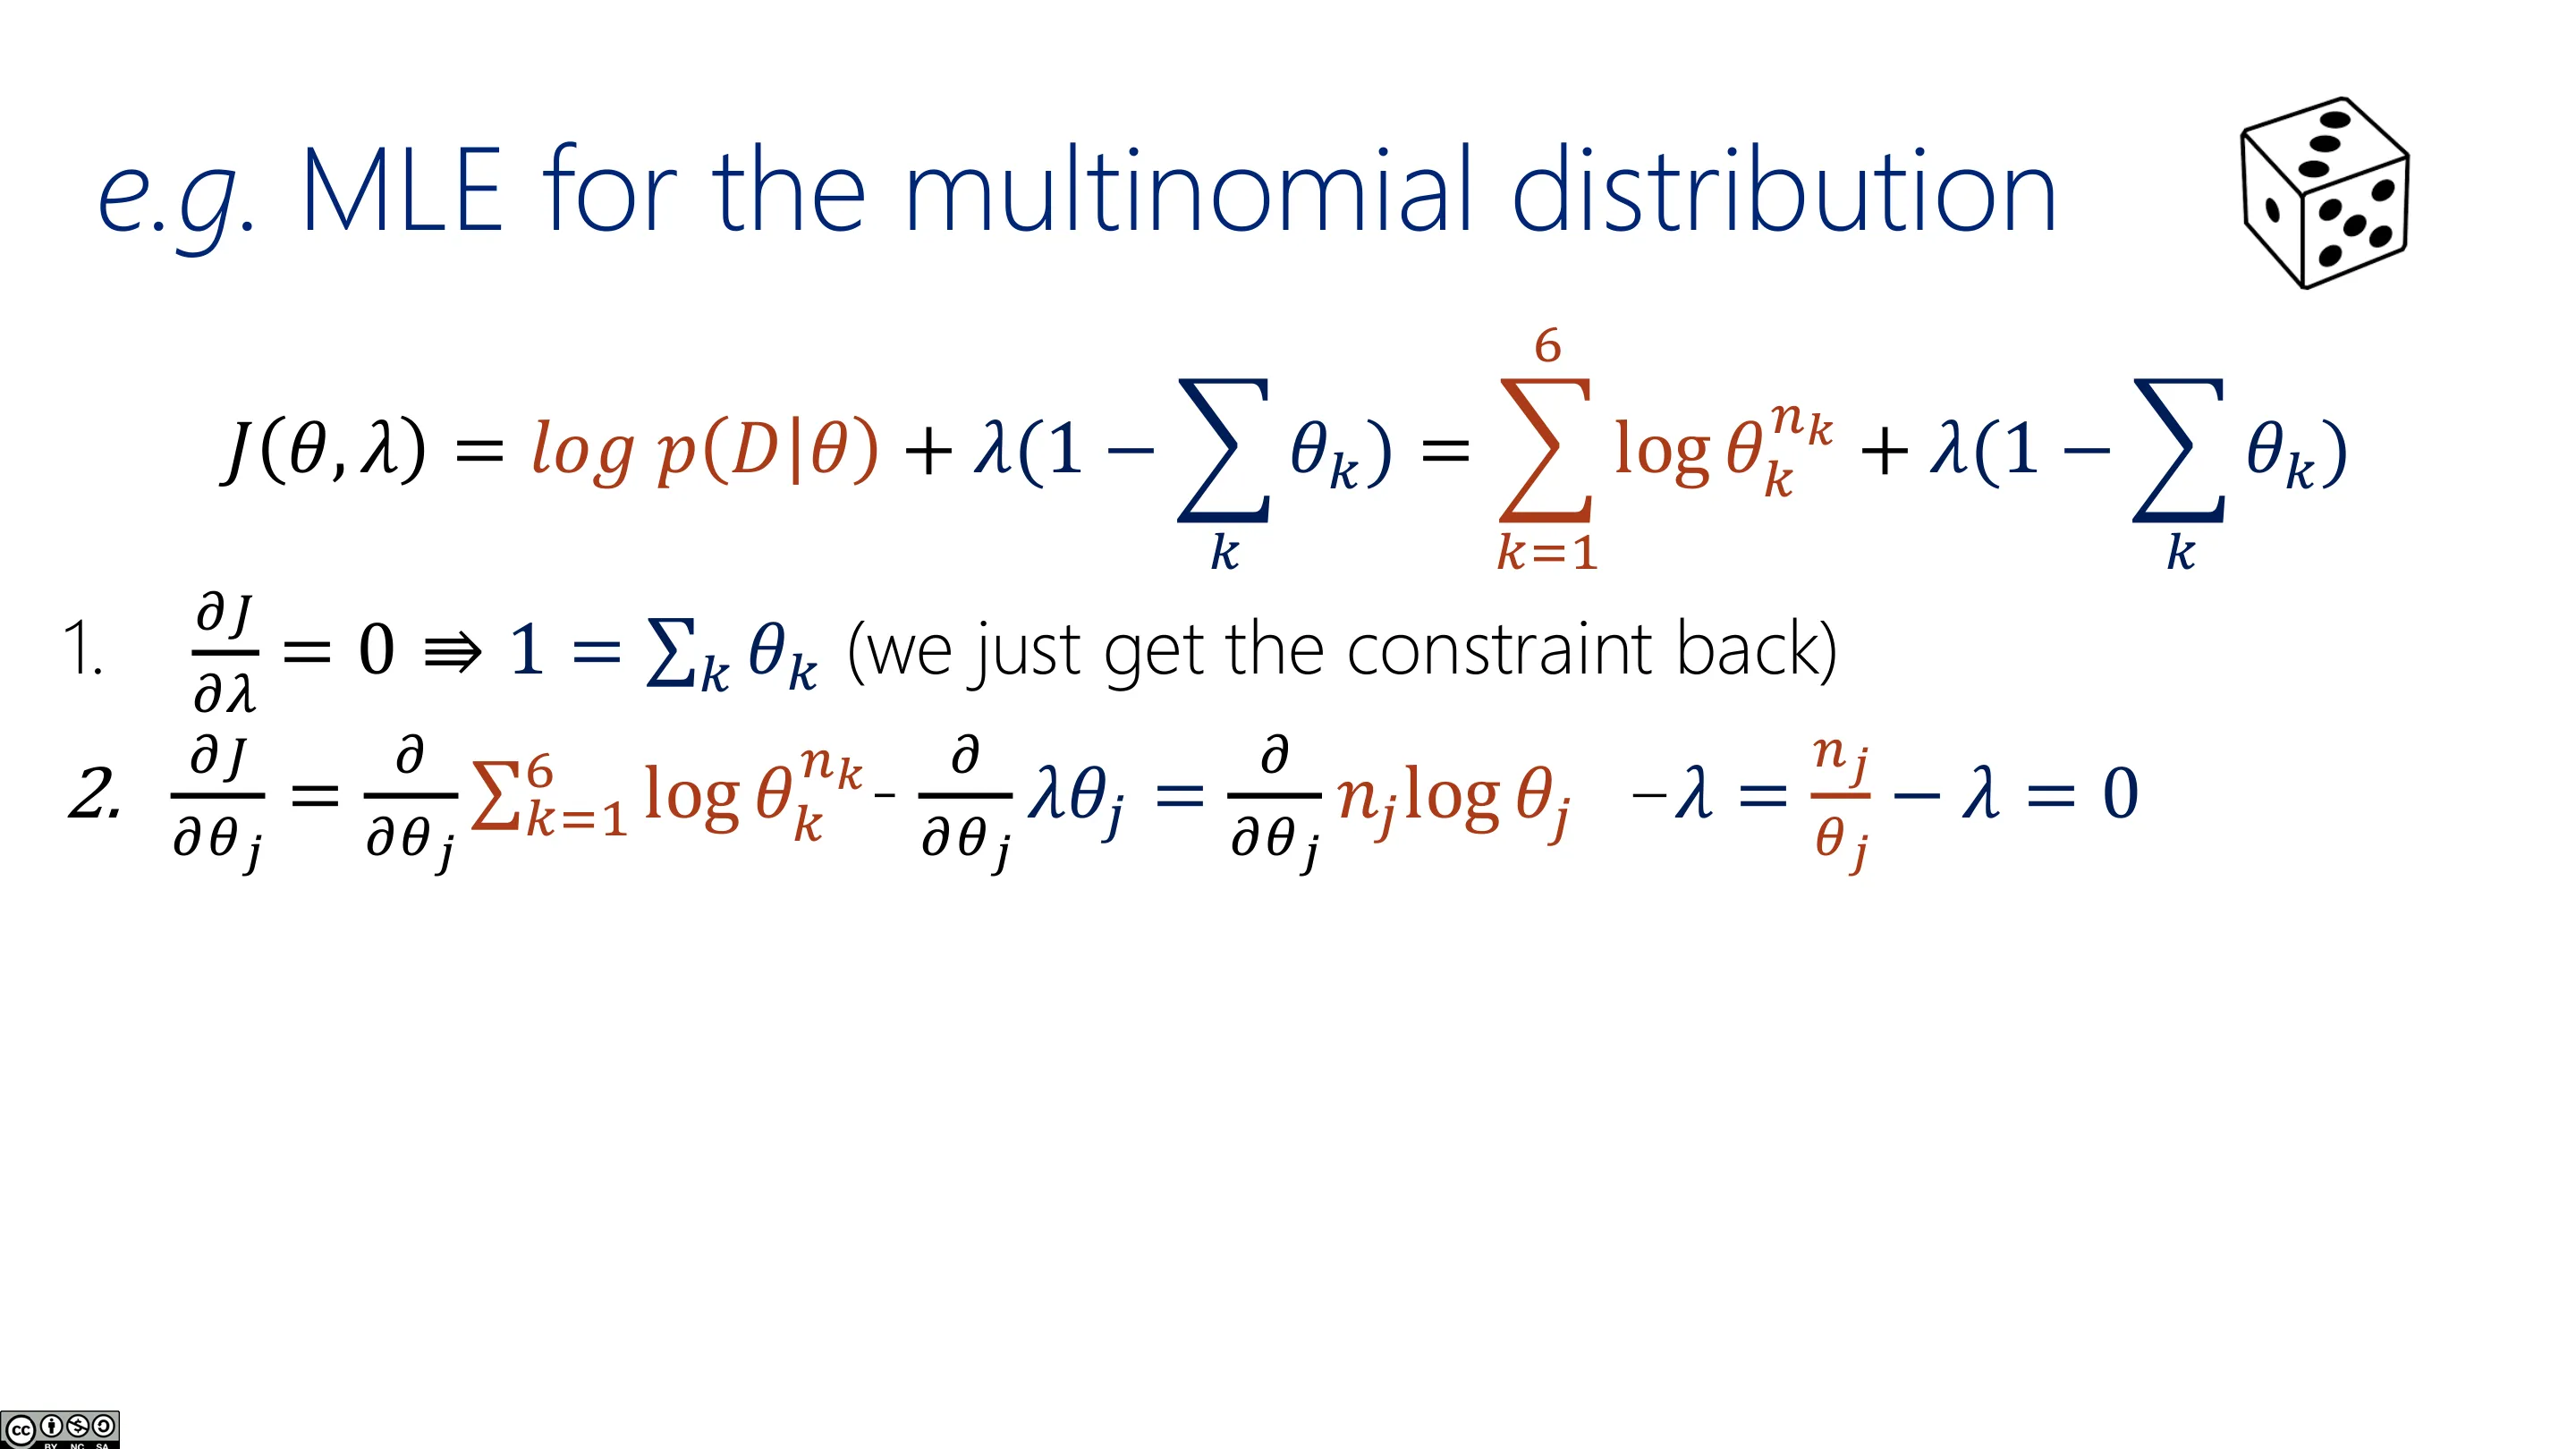
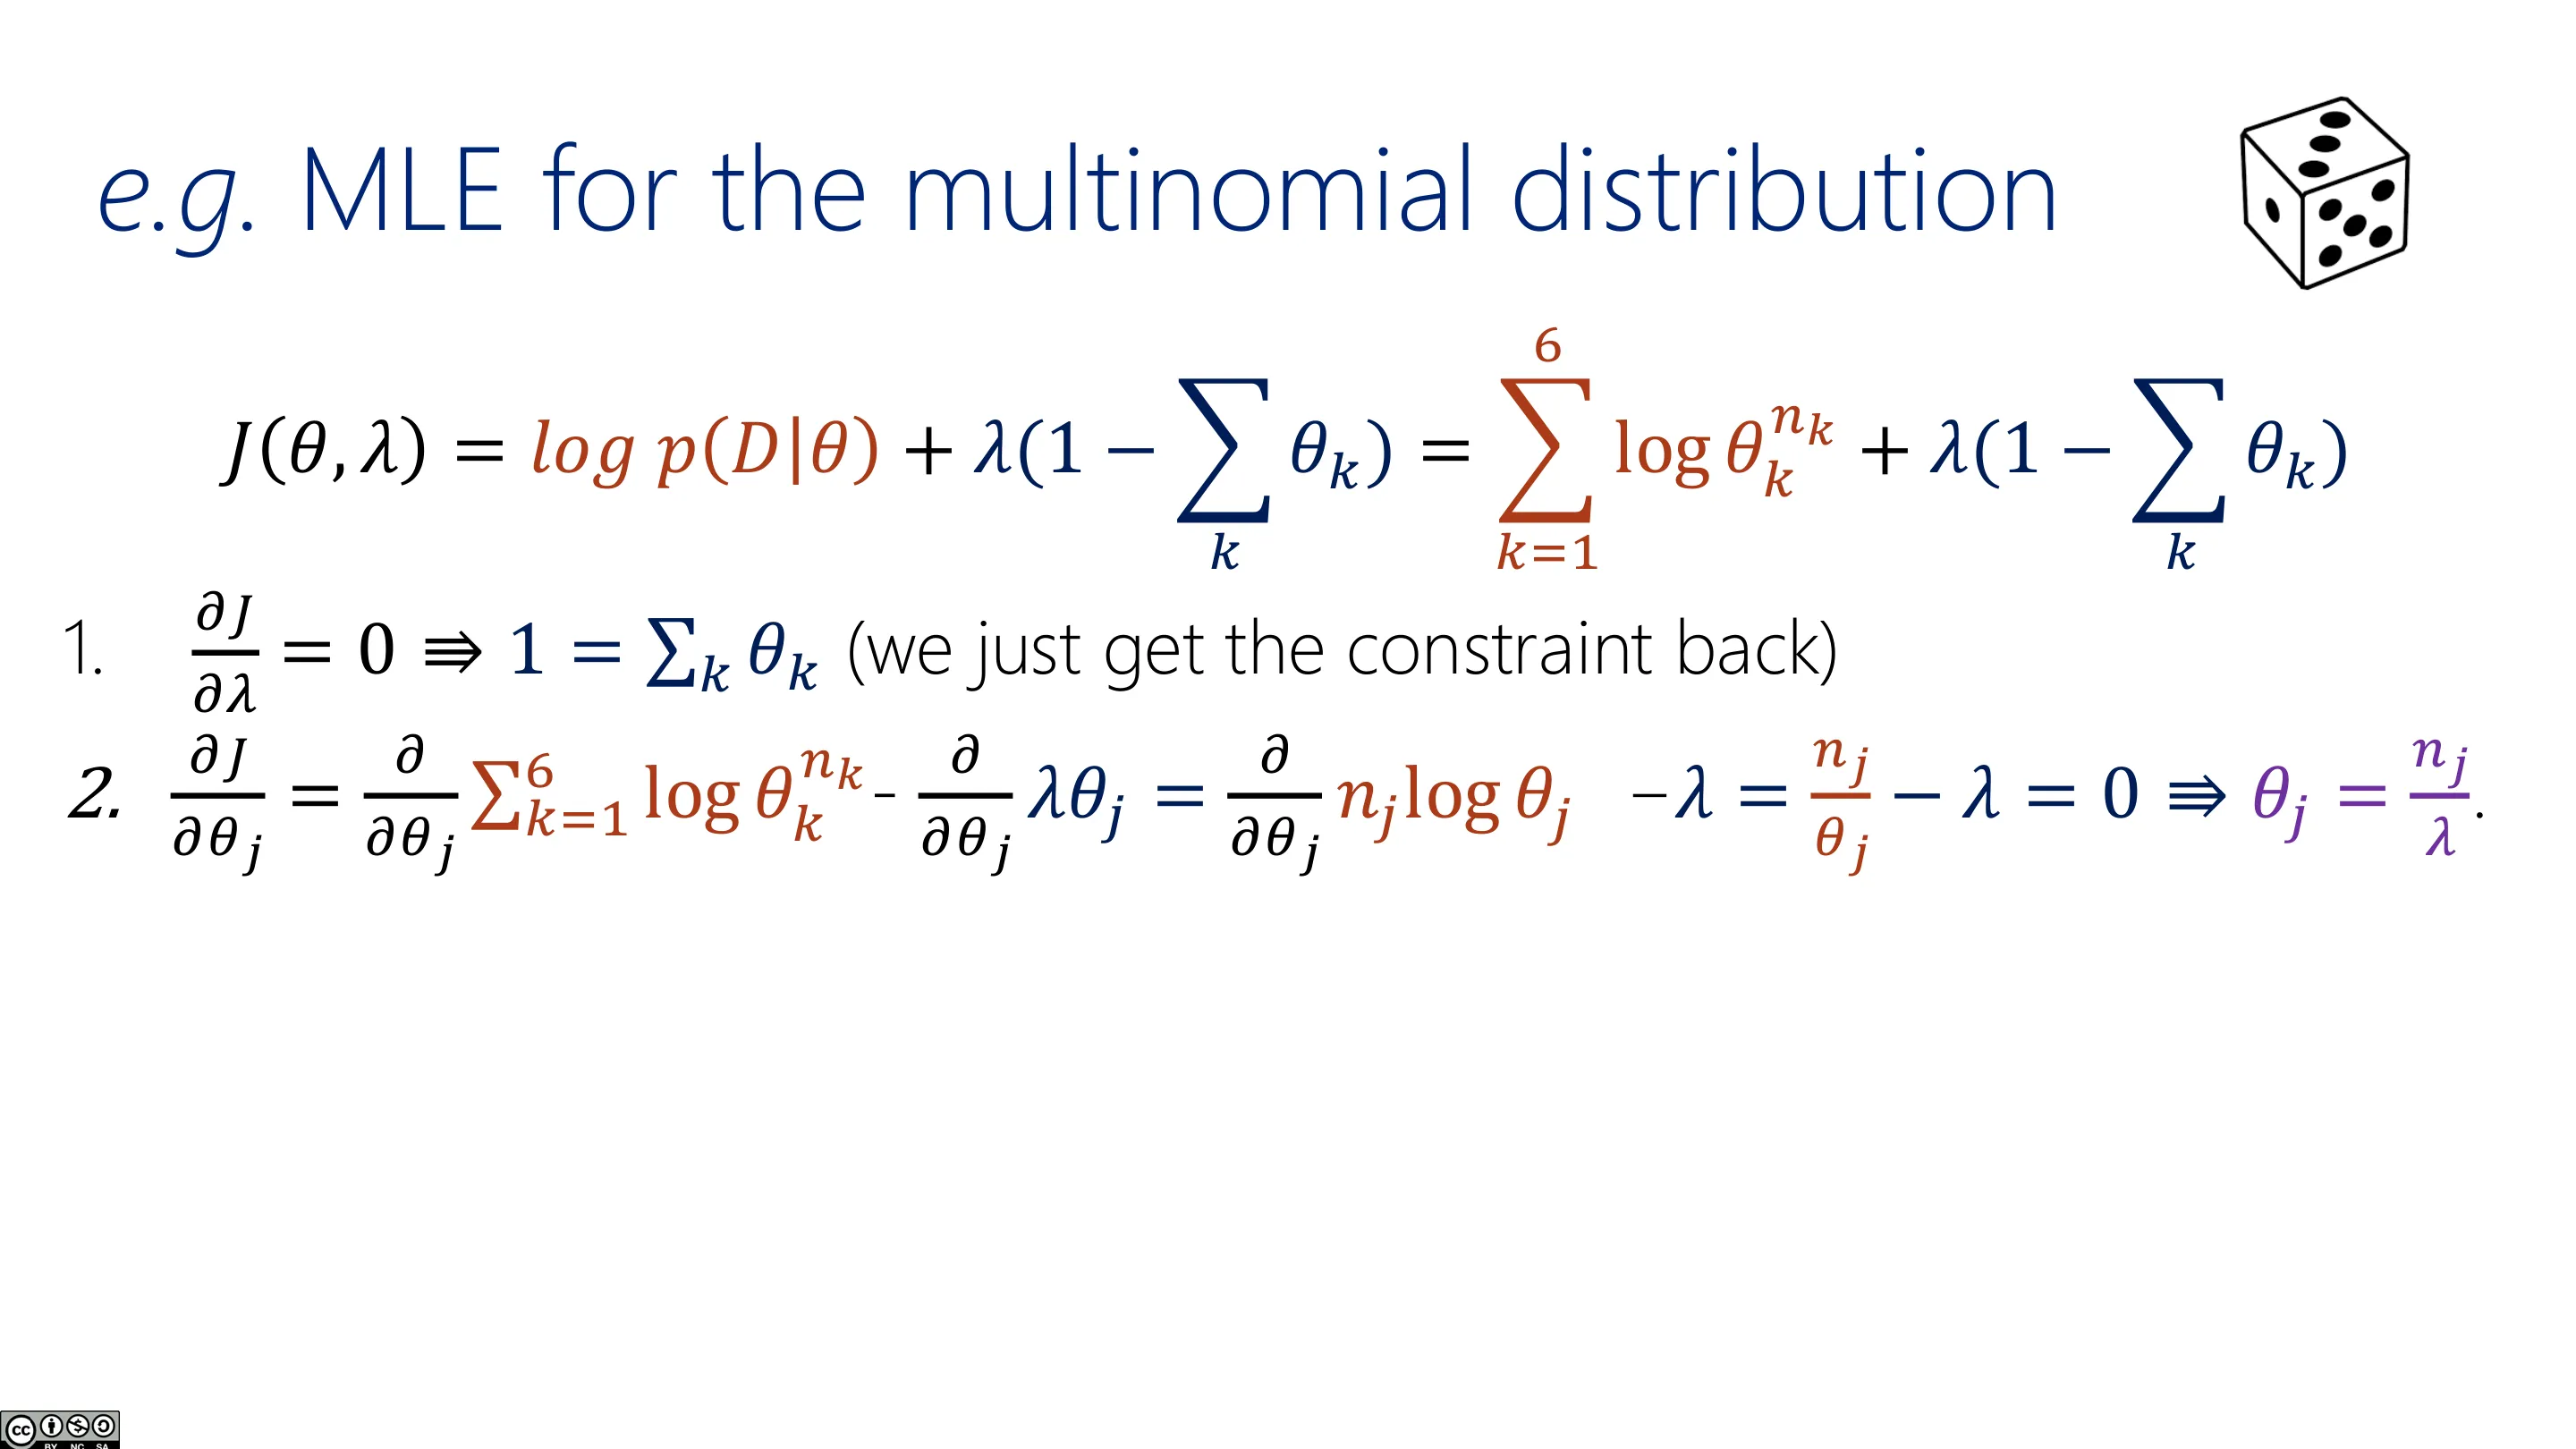
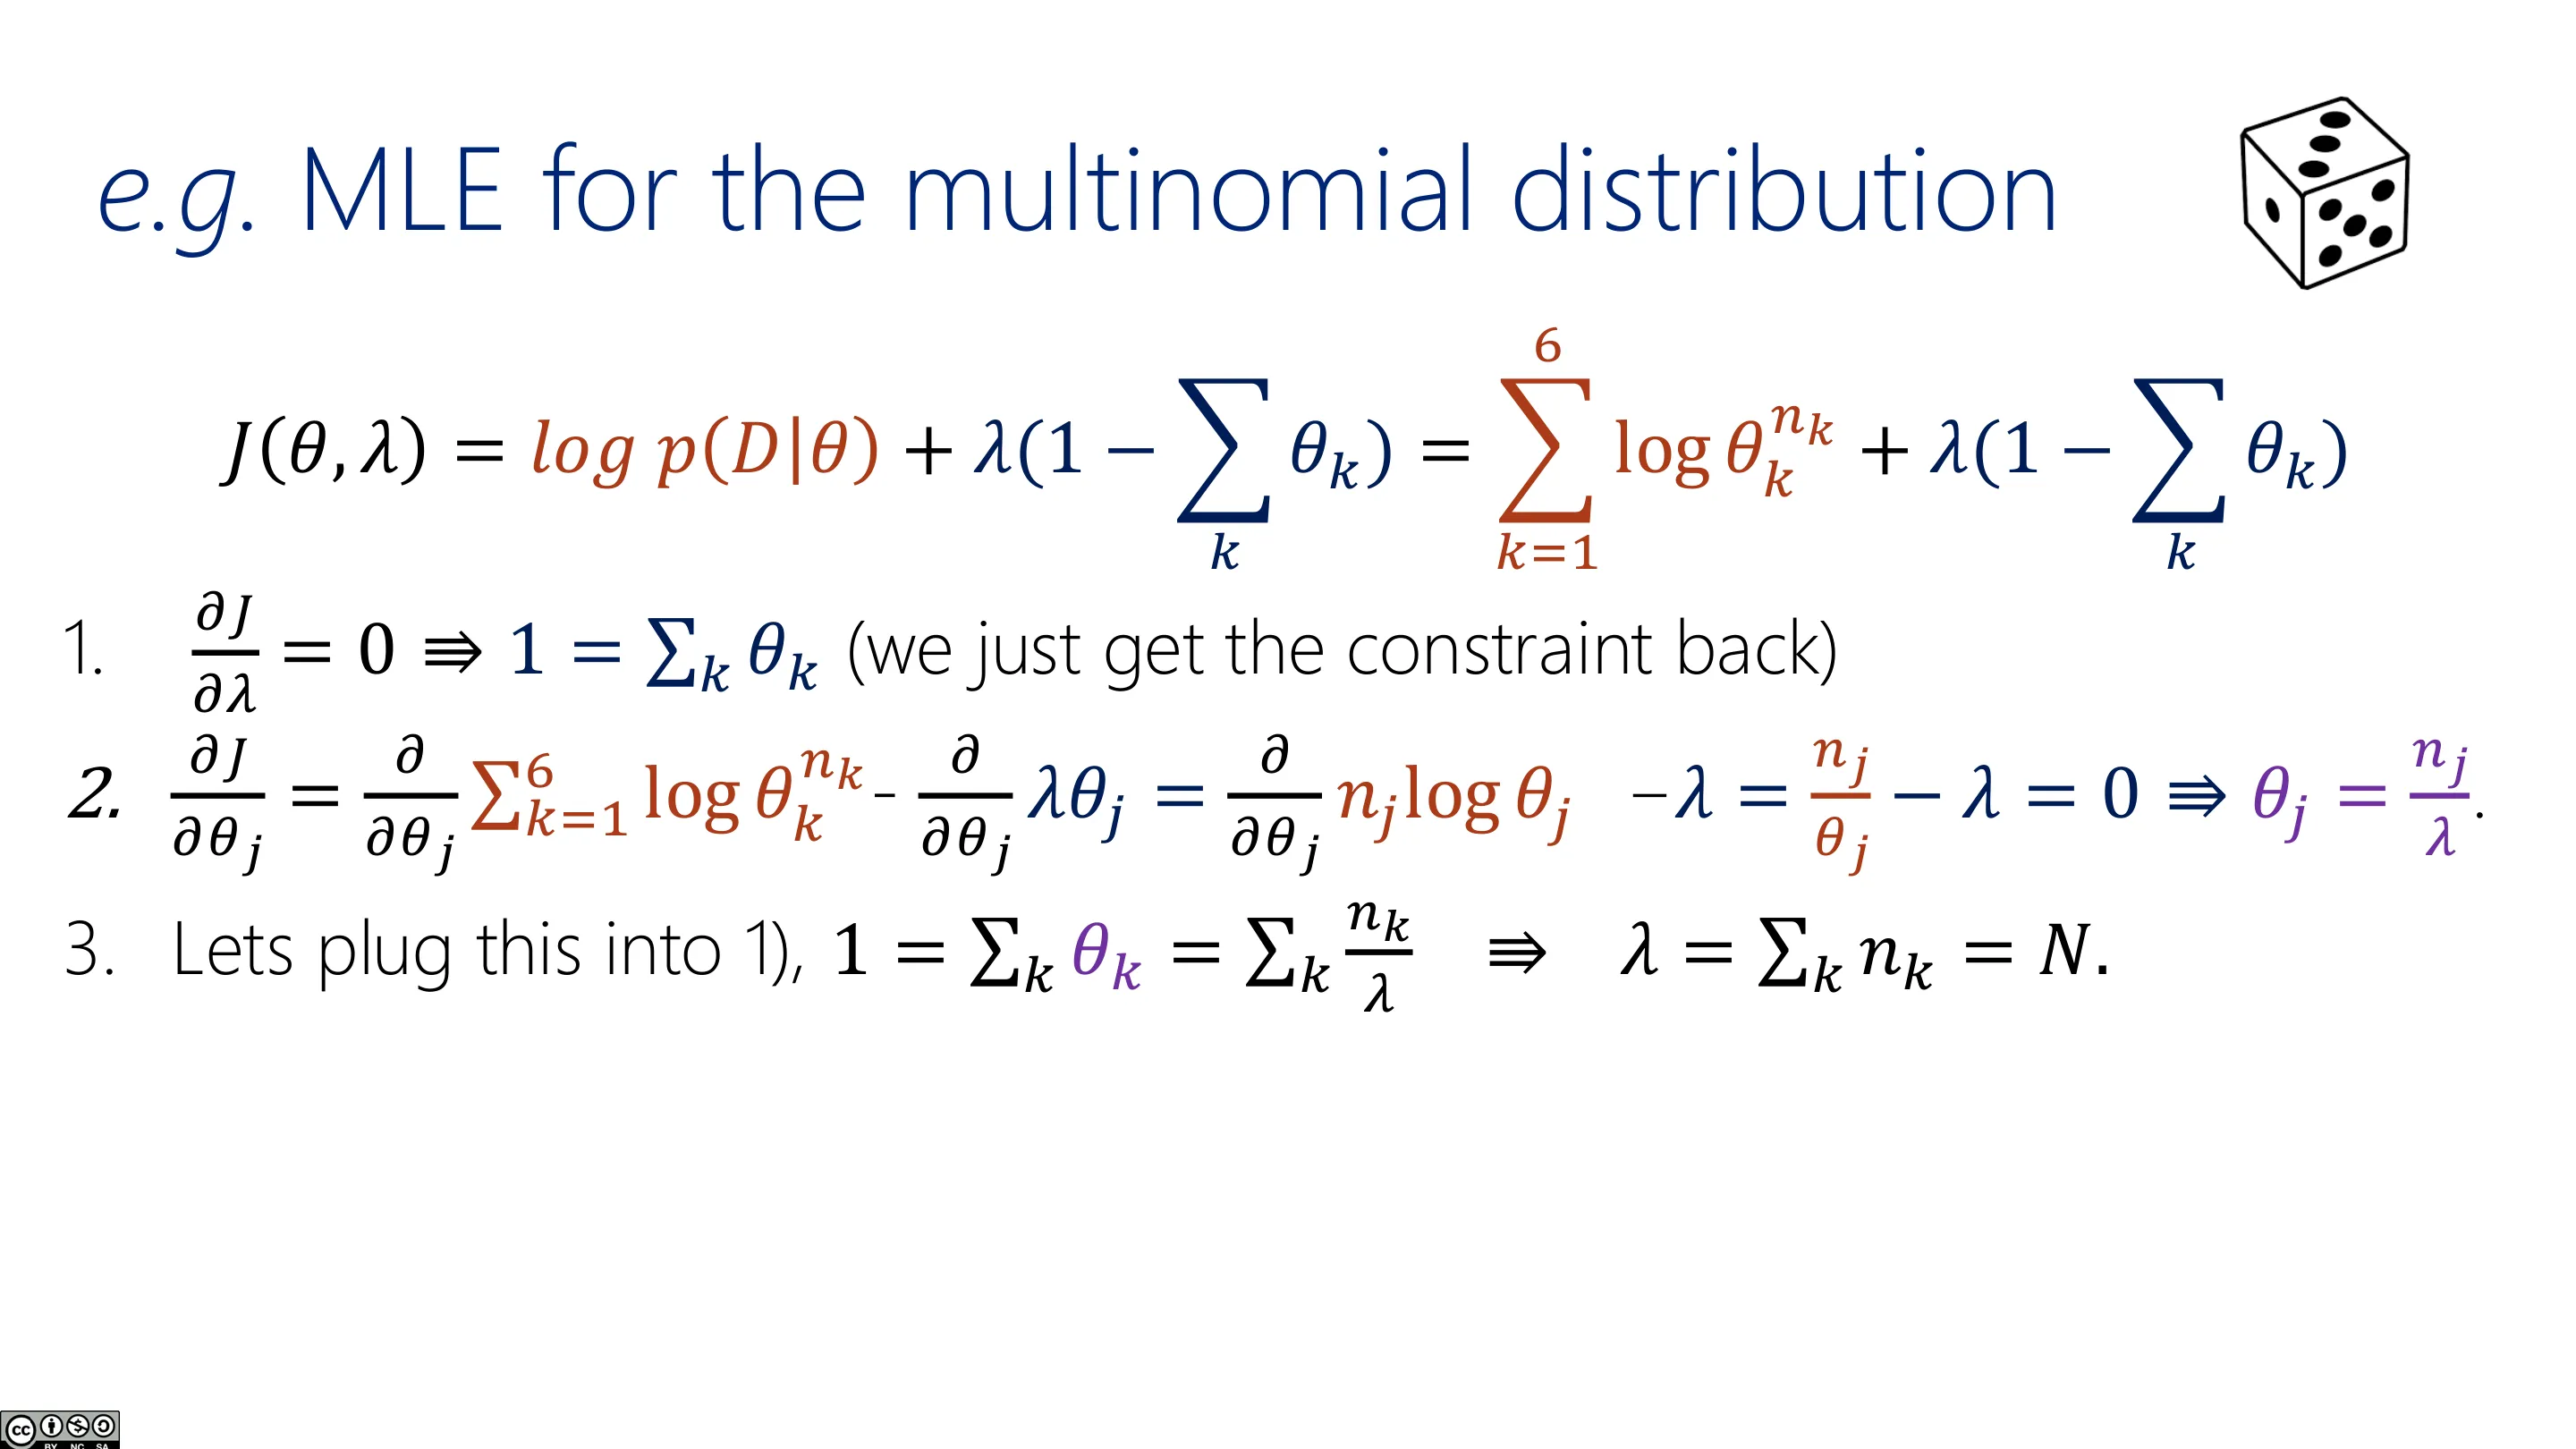
对参数 $\theta_j$ 求偏导(每个参数同理,只需挑出一个 $j$):
$$ \frac{\partial J}{\partial\theta_j}=\frac{\partial}{\partial\theta_j}\big(n_j\log\theta_j\big)-\lambda=\frac{n_j}{\theta_j}-\lambda=0 \;\Longrightarrow\; \theta_j=\frac{n_j}{\lambda} $$
📷 对参数求偏导(一)
回到原视频 (00:09:03)
📷 对参数求偏导(二)
回到原视频 (00:09:30)
📷 对参数求偏导(三)
回到原视频 (00:09:51)
📷 对参数求偏导(四)
回到原视频 (00:10:57)
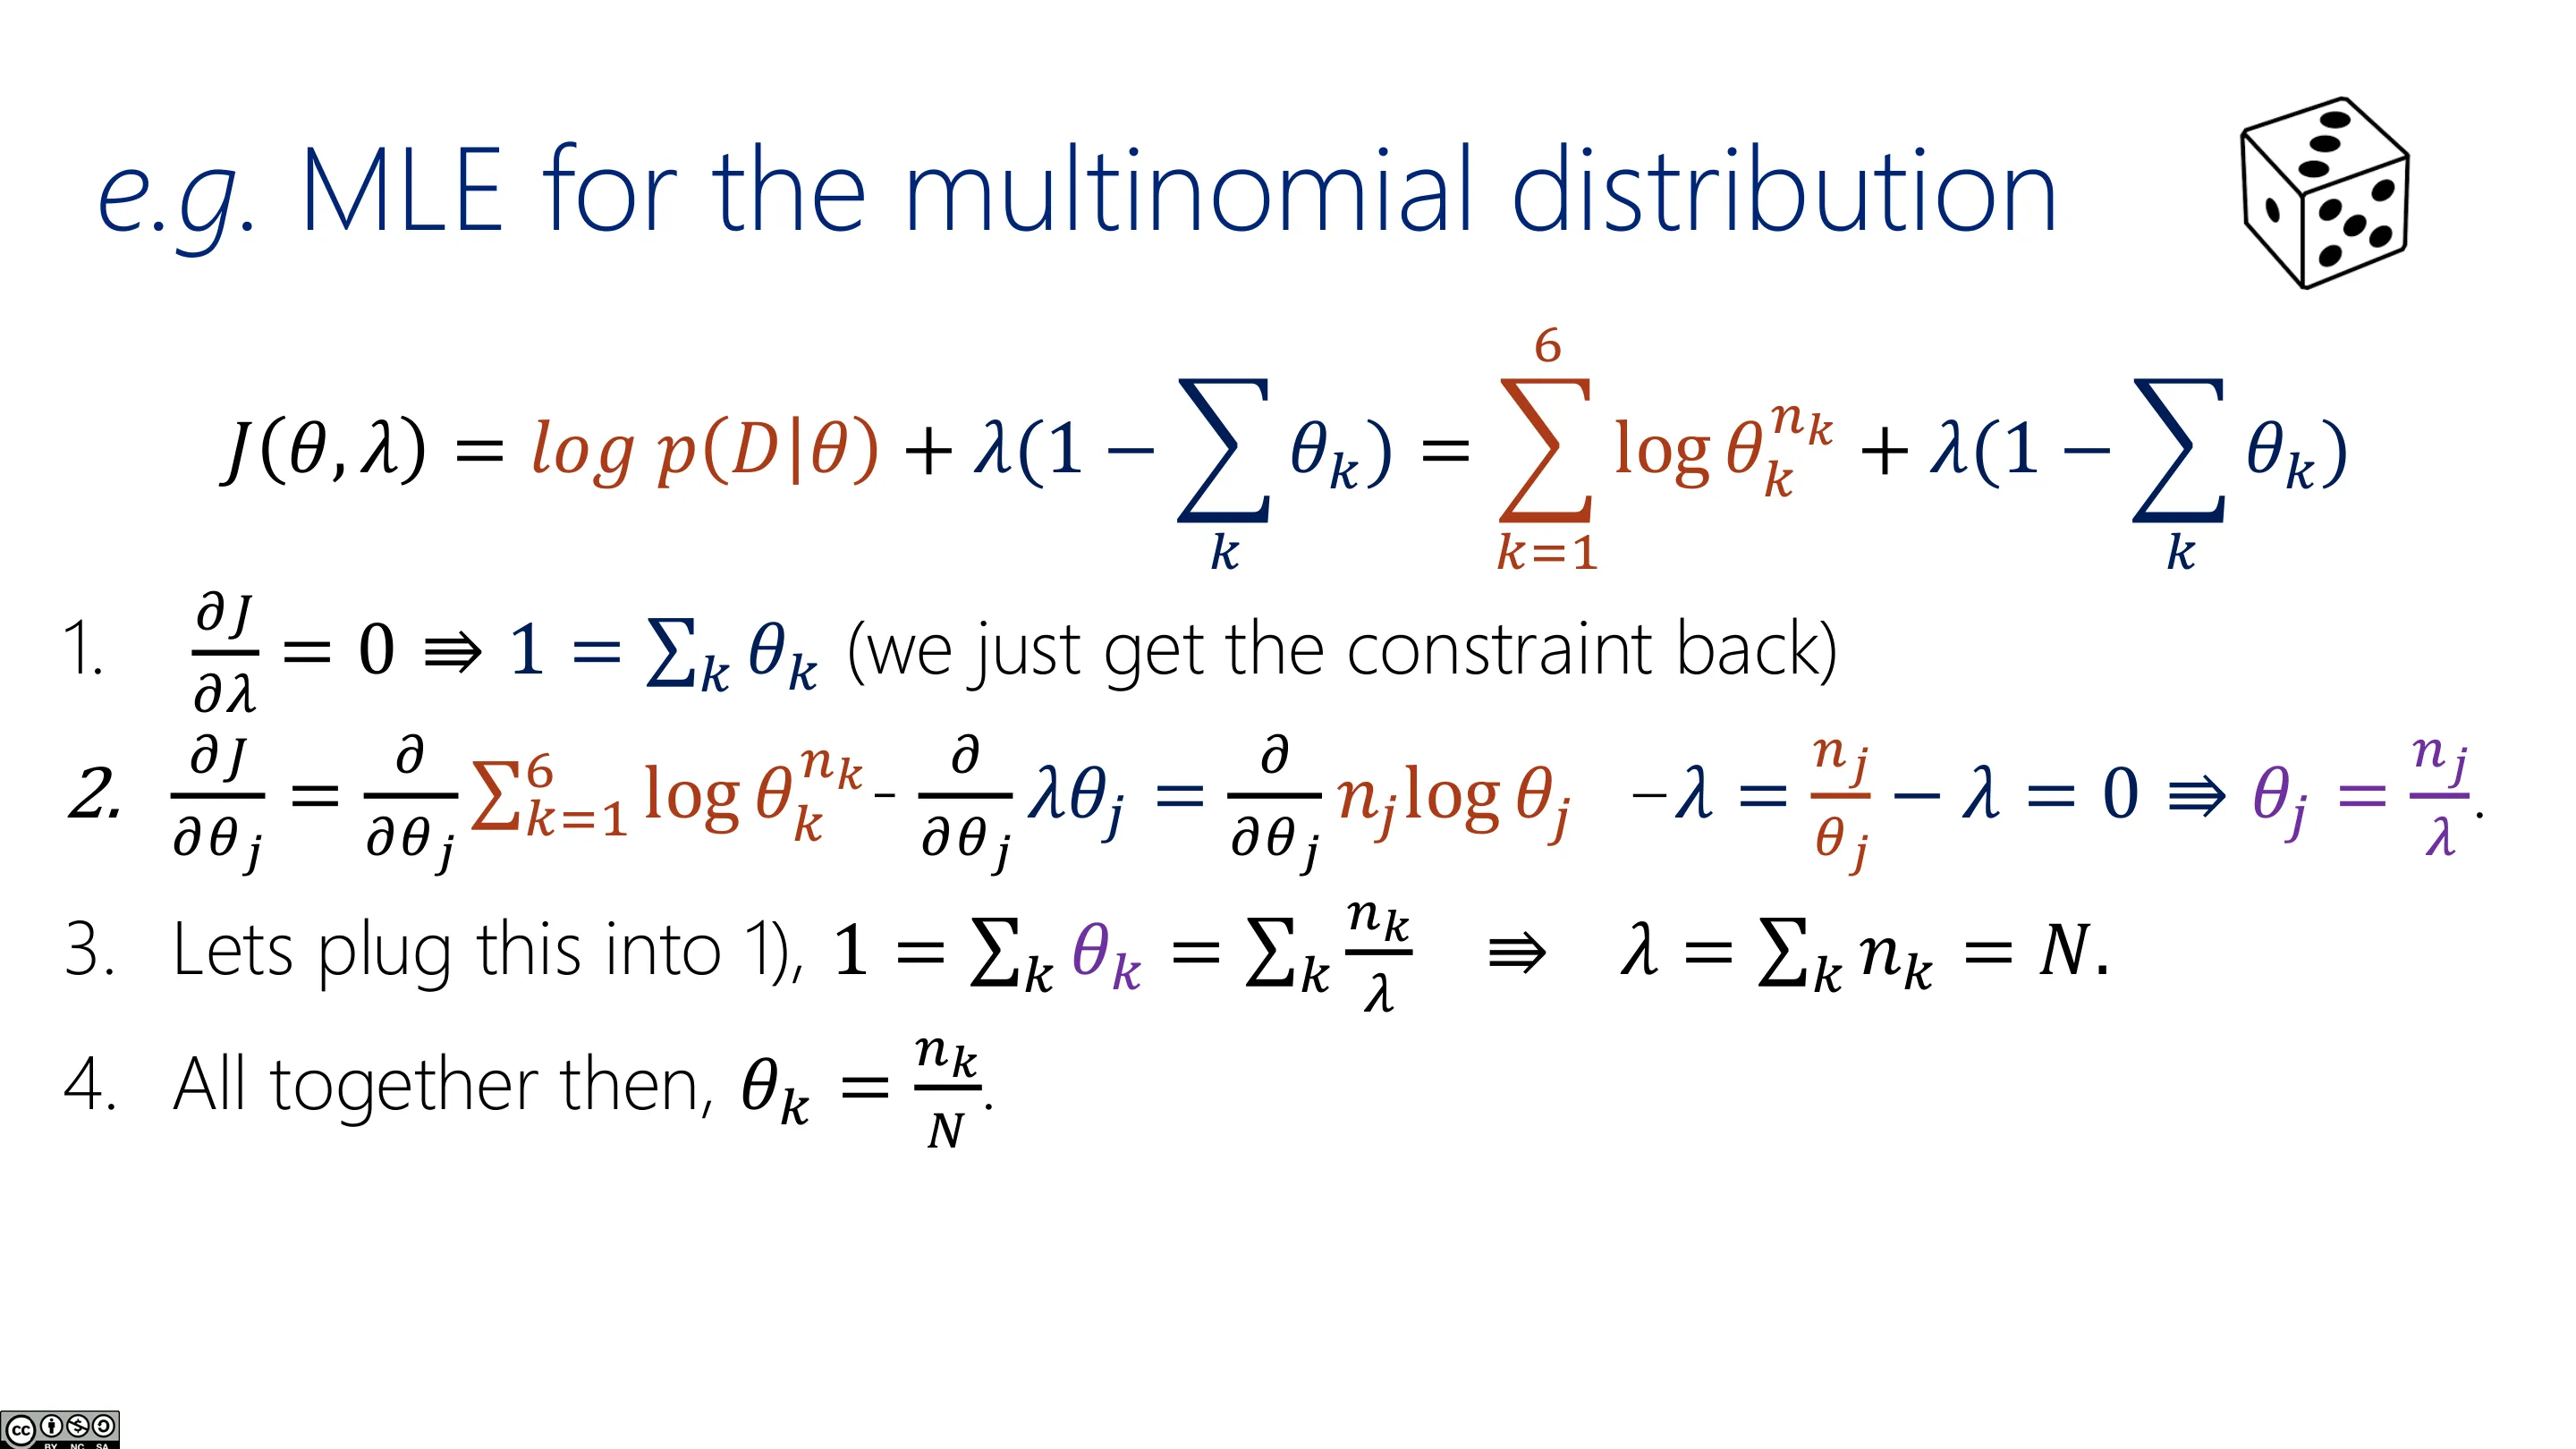
再把 $\theta_j=n_j/\lambda$ 代回约束 $1=\sum_k\theta_k=\sum_k n_k/\lambda$,解出
$$ \lambda=\sum_k n_k=N \;\Longrightarrow\; \hat{\theta}_k=\frac{n_k}{N} $$
直觉结论:第 $k$ 面的概率 = 看到第 $k$ 面的次数 ÷ 试验总次数。这正是我们「本来就知道」的答案,而 MLE 把它推导了出来。
📷 代回约束求 λ
回到原视频 (00:11:18)
📷 结论:θ = n_k / N
回到原视频 (00:12:50)
编者说明:讲师提醒——很多常见分布在 MLE 下都会给出这种「符合直觉」的结果,但并不总是。做题时不要机械套公式,而应像这样推一遍、再用直觉做合理性检查。
1.4 预告:MLE 常常需要迭代优化
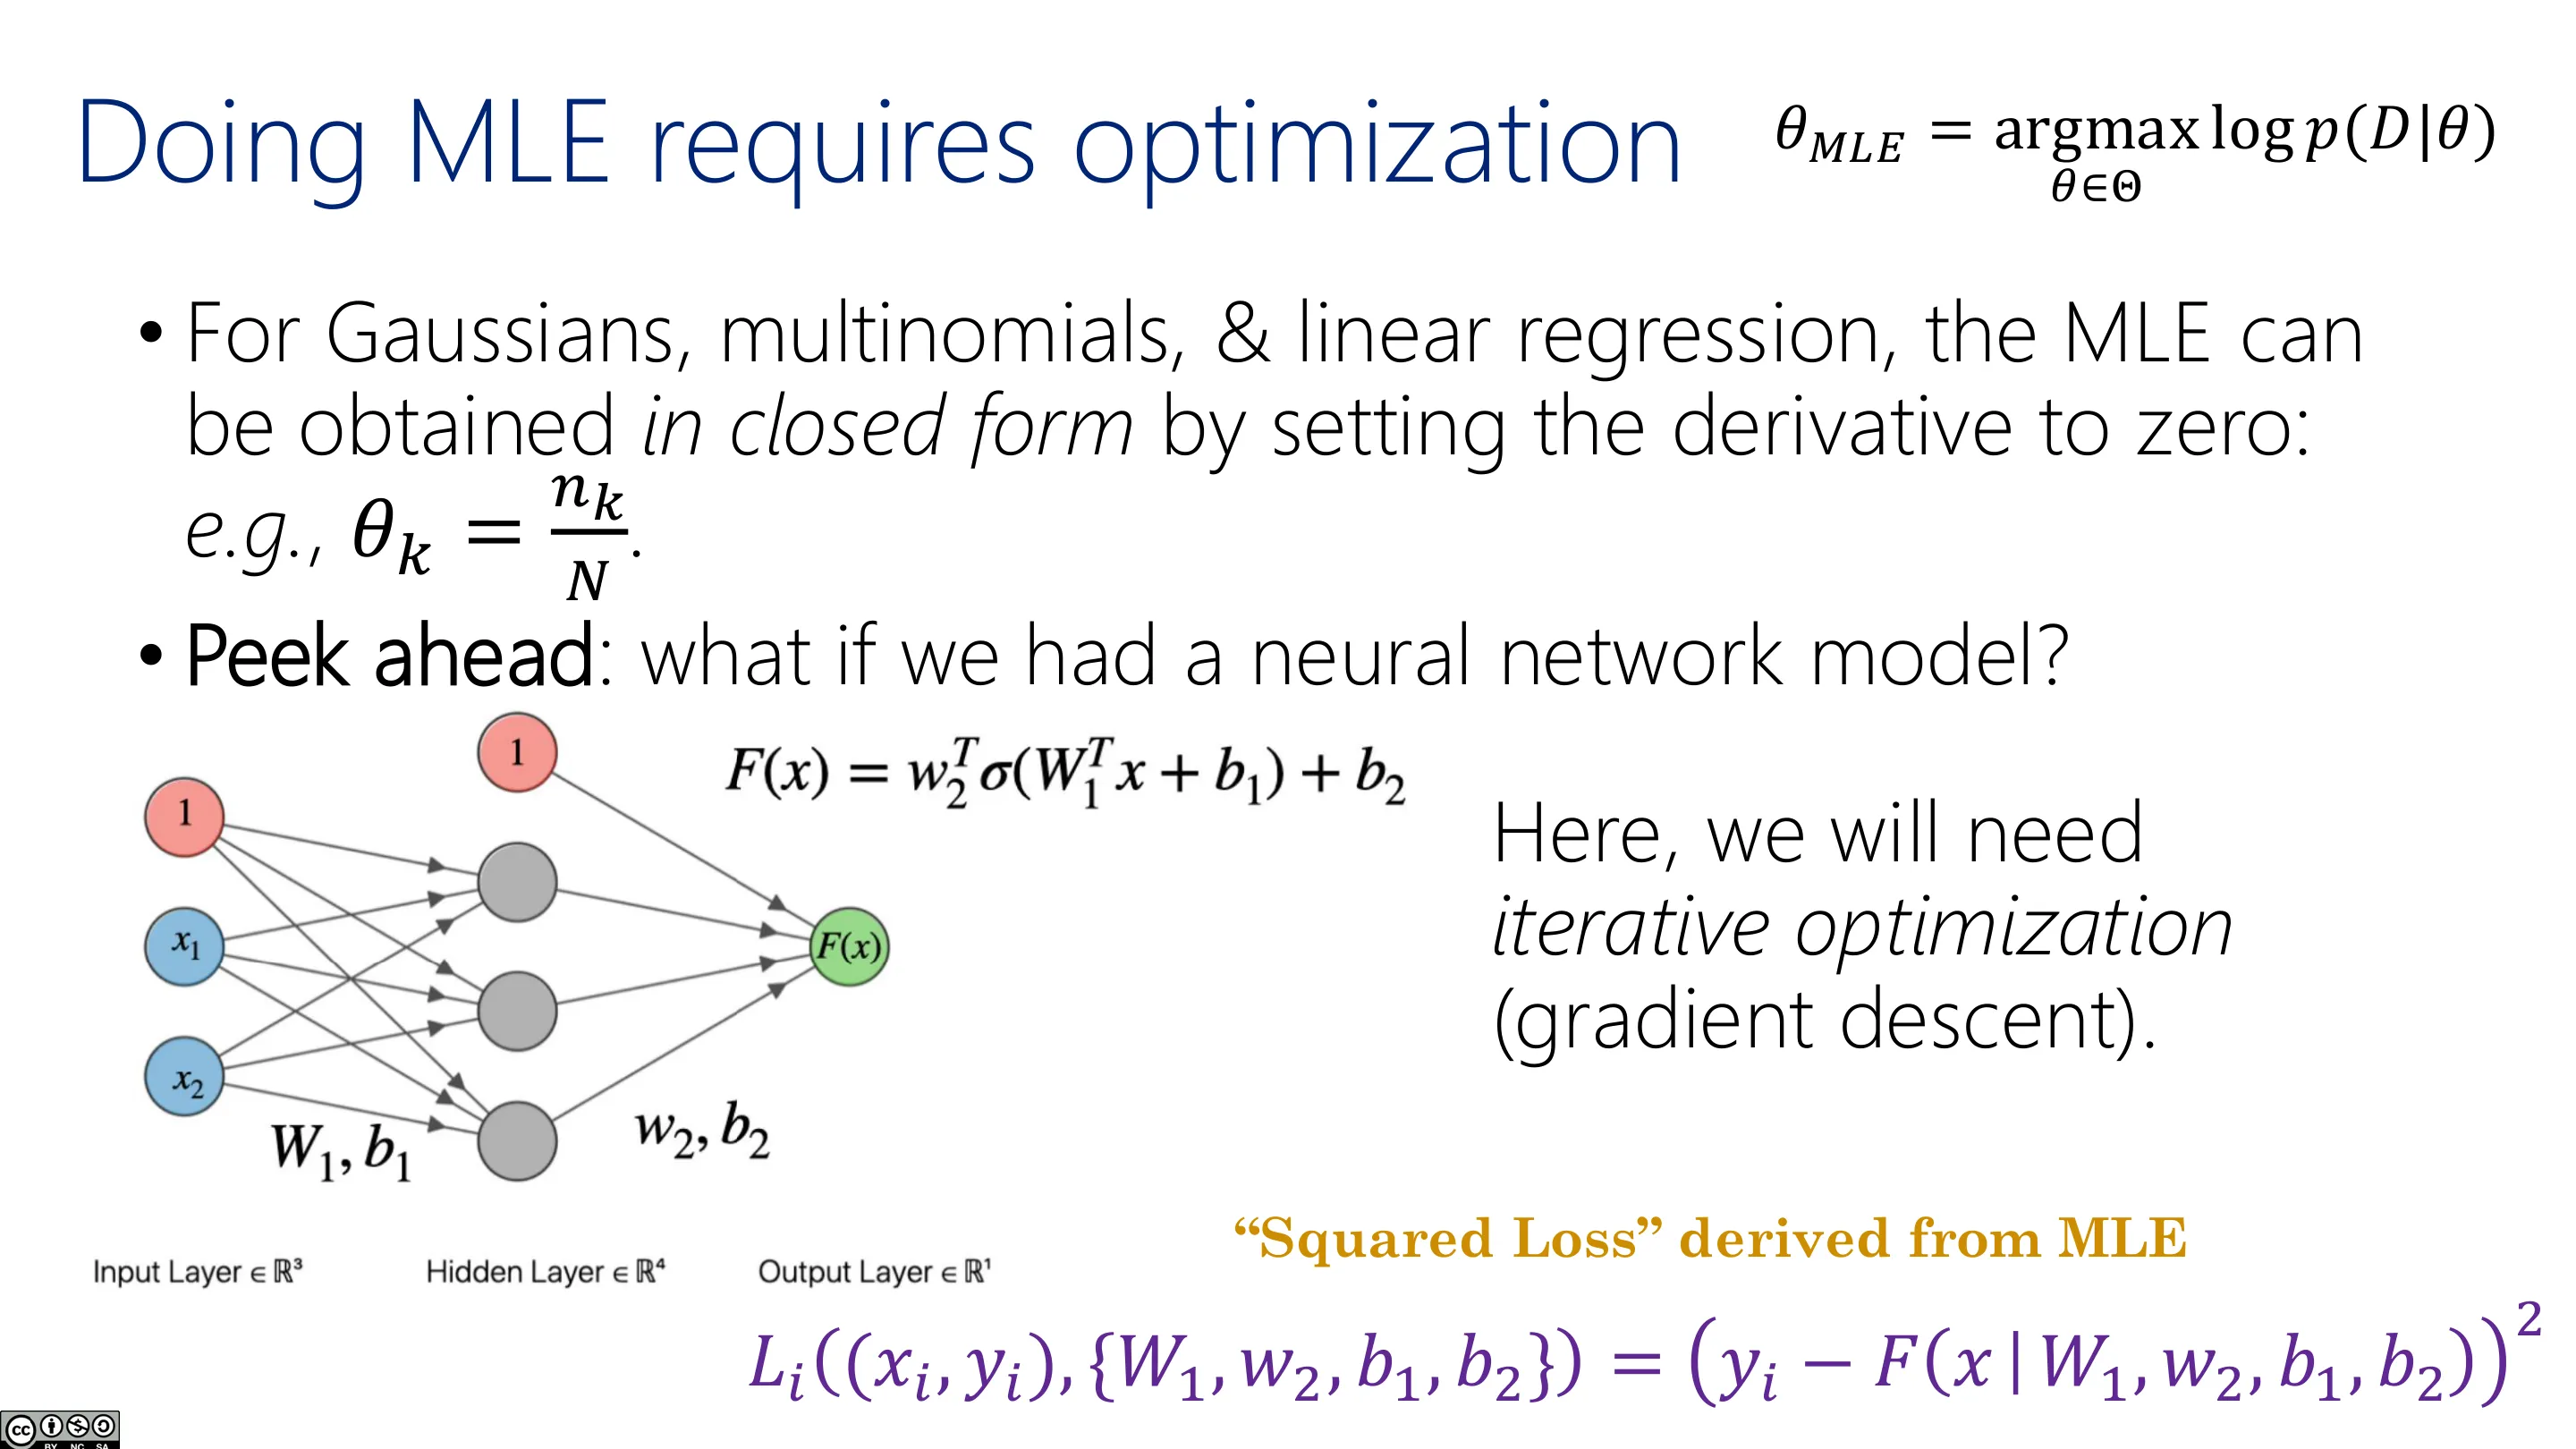
对高斯、多项分布、线性回归,MLE 都能用「令导数为零」得到闭式解(closed form)。但神经网络等模型把参数相互耦合(这个参数通过非线性依赖那个参数),无法再分离求解——此时需要迭代优化(梯度下降,gradient descent)。
编者说明:这也是本课重排后的动机——「既然要用统计方式建模,就用 MLE 来拟合;而统计模型(如高斯混合)本身又需要迭代优化」,于是自然引出后续的梯度下降。
📷 做 MLE 需要优化
回到原视频 (00:17:25)
📷 路线图(三)
回到原视频 (00:20:33)
二、多元高斯分布(MVG)
2.1 从单变量到多变量
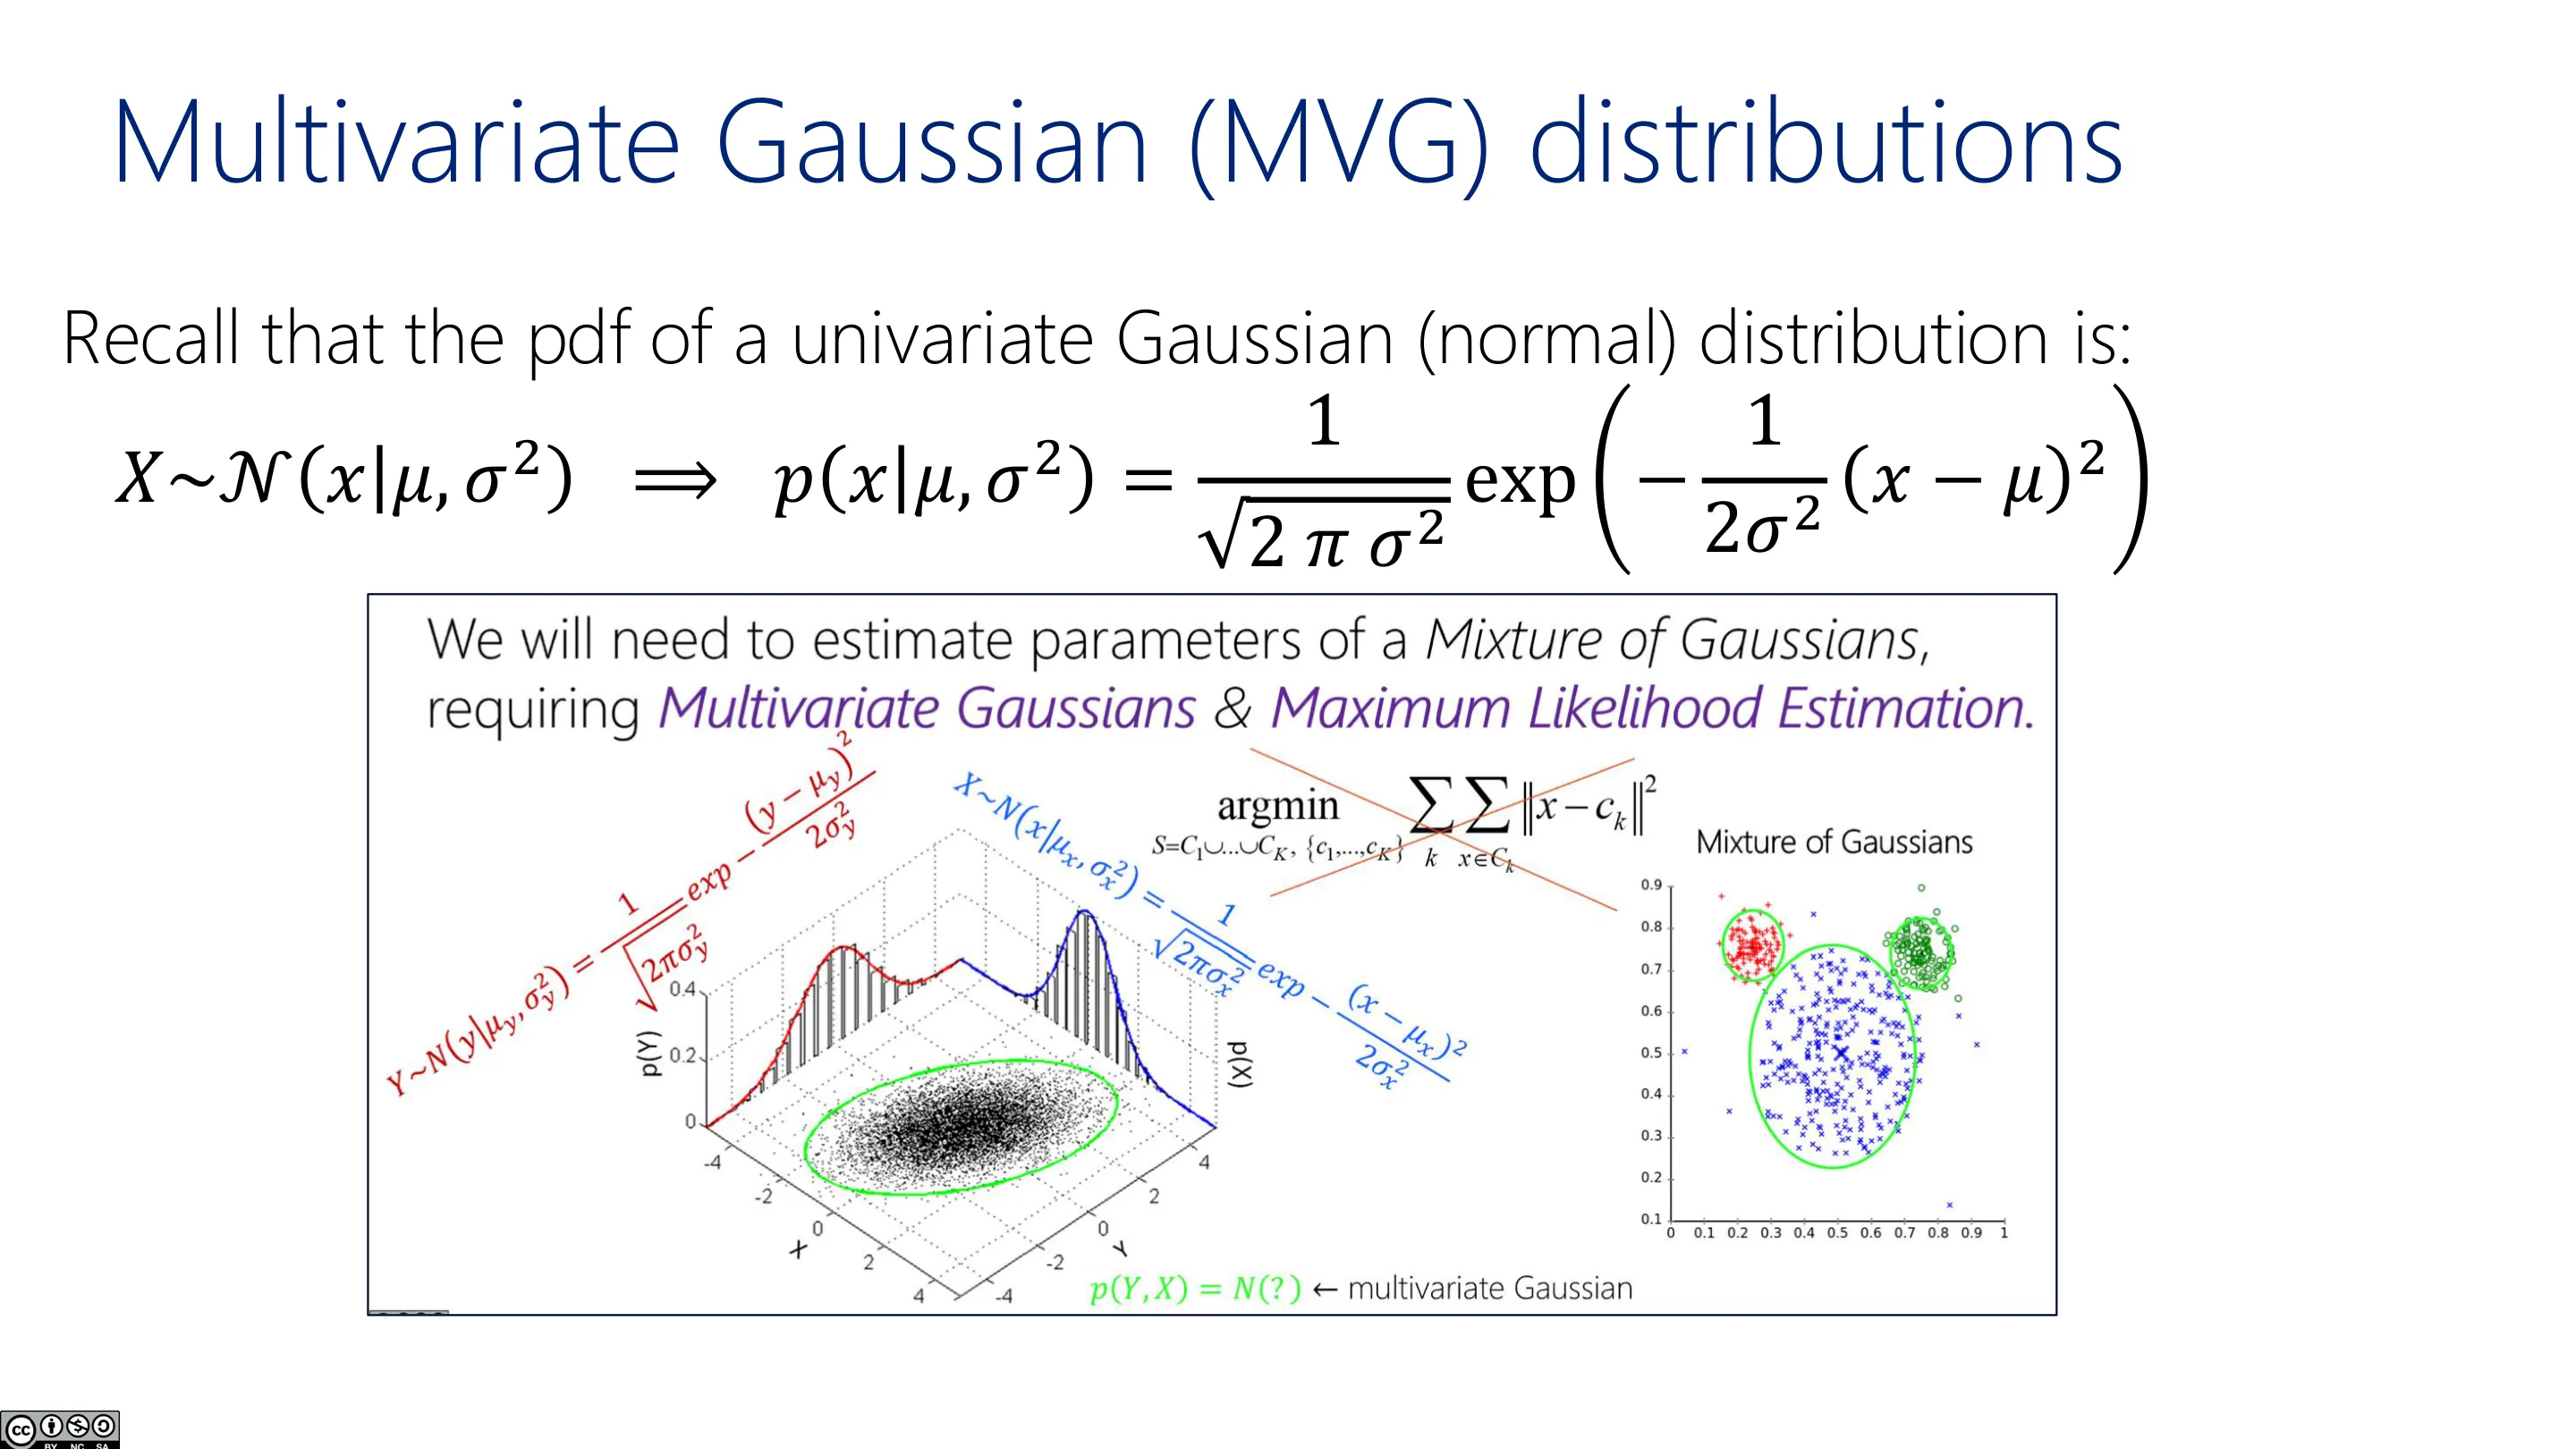
单变量高斯(pdf):
$$ X\sim\mathcal{N}(x\mid\mu,\sigma^2)\;\Longrightarrow\; p(x\mid\mu,\sigma^2)=\frac{1}{\sqrt{2\pi\sigma^2}}\exp\!\Big(-\frac{1}{2\sigma^2}(x-\mu)^2\Big) $$
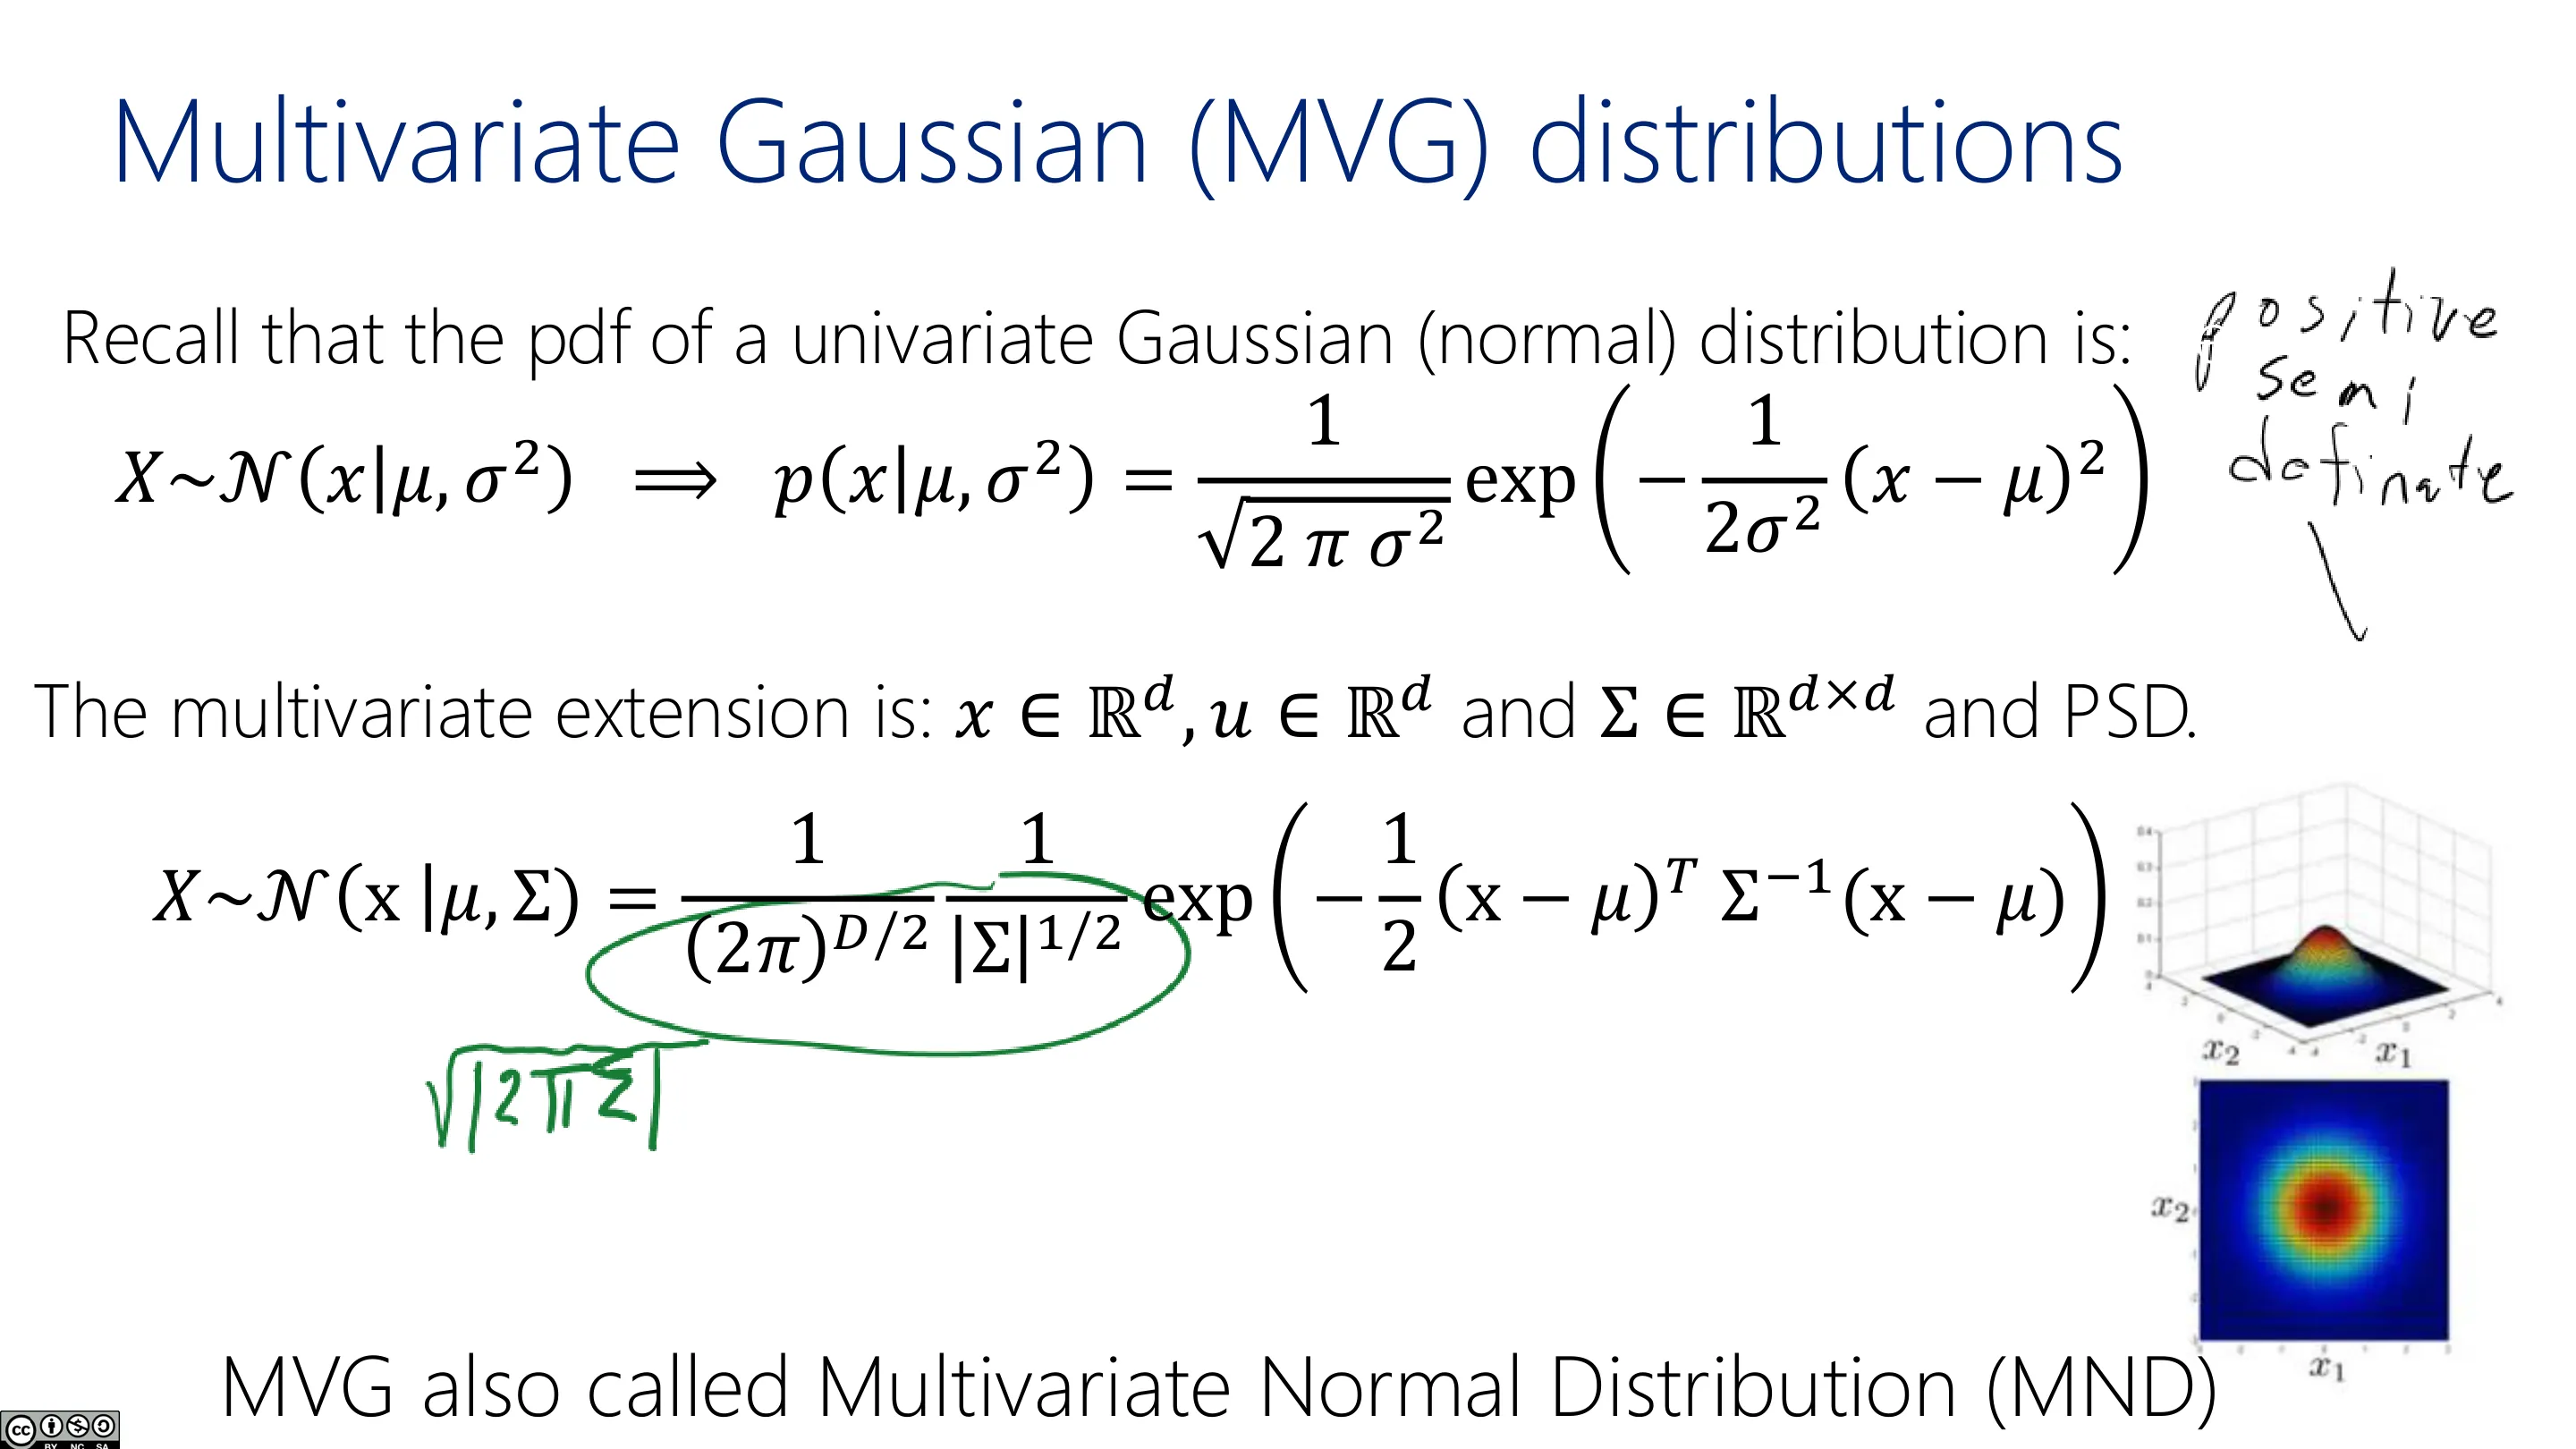
多元推广:对 $x\in\mathbb{R}^d$、$\mu\in\mathbb{R}^d$、$\Sigma\in\mathbb{R}^{d\times d}$(半正定,PSD):
$$ X\sim\mathcal{N}(\mathbf{x}\mid\mu,\Sigma)=\frac{1}{(2\pi)^{D/2}}\frac{1}{|\Sigma|^{1/2}}\exp\!\Big(-\tfrac12(\mathbf{x}-\mu)^\top\Sigma^{-1}(\mathbf{x}-\mu)\Big) $$
其中 $\top$ 表示转置(一维时标量的转置就是它自己)。MVG 也叫多元正态分布(MND)。
📷 单变量高斯(回顾)
回到原视频 (00:21:41)
📷 多元高斯定义
回到原视频 (00:22:26)
📷 (过渡页)
回到原视频 (00:23:46)
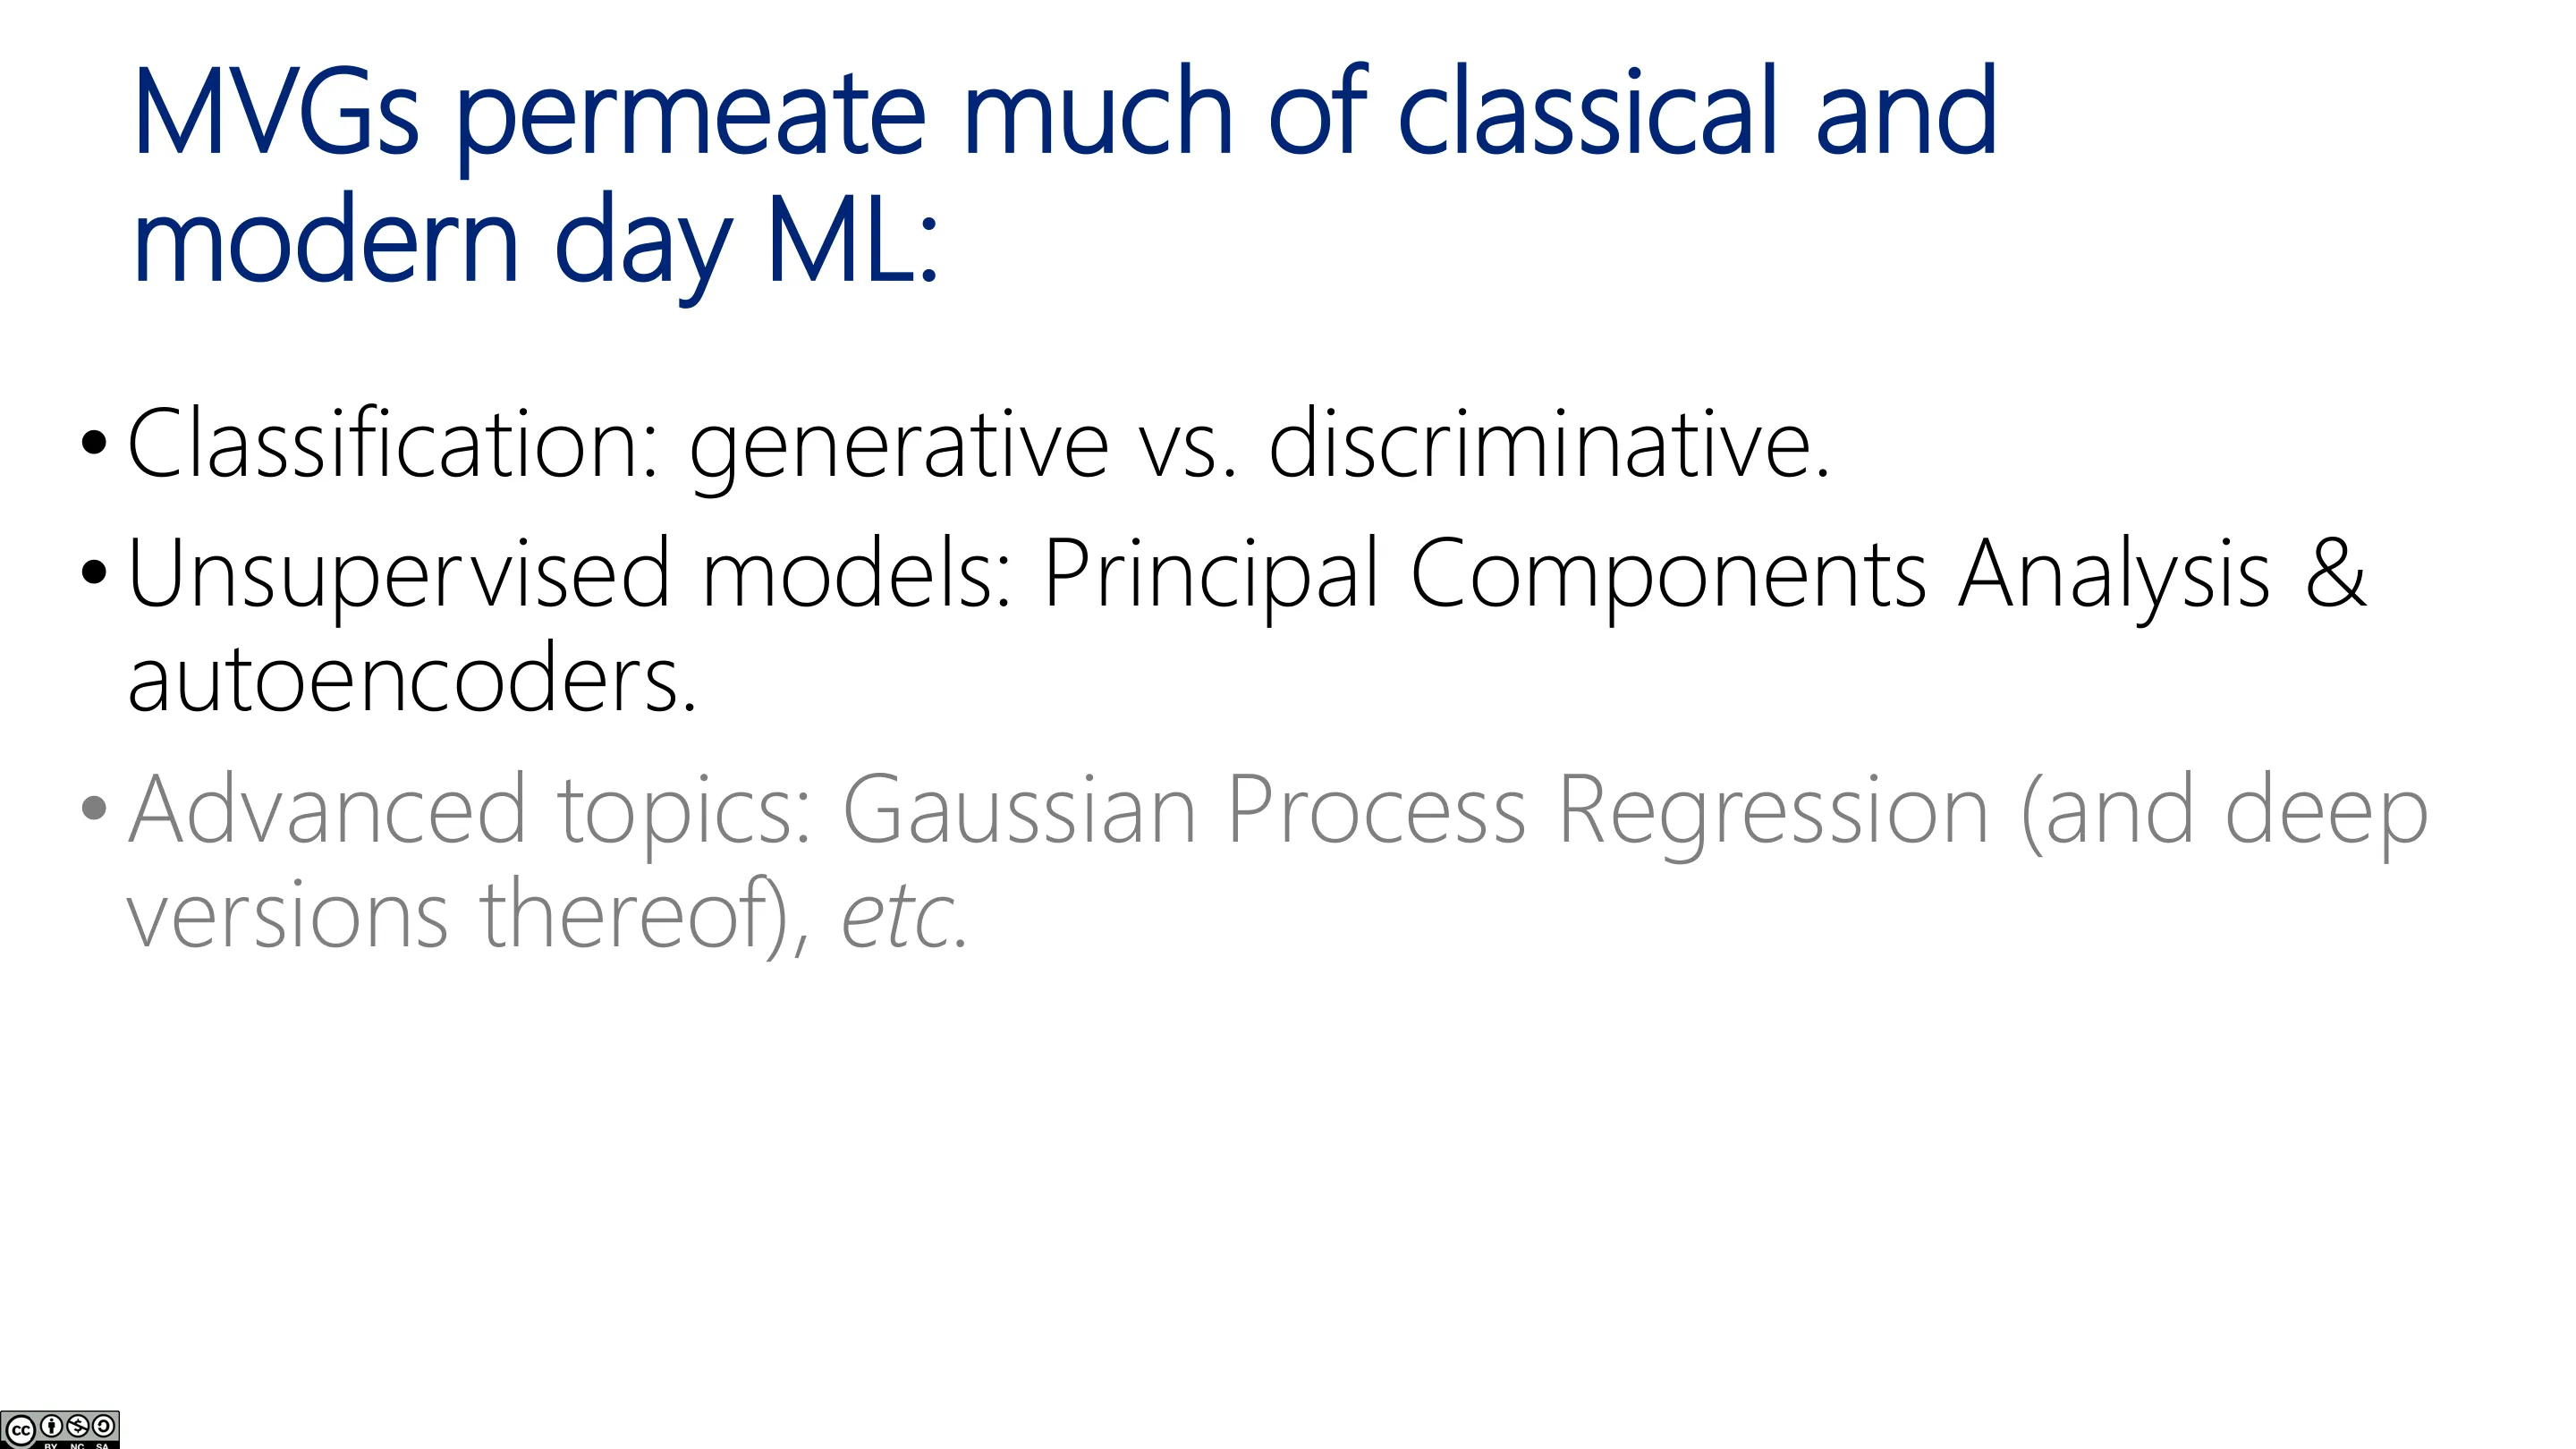
多元高斯在机器学习中无处不在:分类(生成式 vs 判别式)、无监督模型(PCA、自编码器)、高级主题(高斯过程回归)等。
📷 MVG 无处不在
回到原视频 (00:26:22)
2.2 身高与体重:联合分布
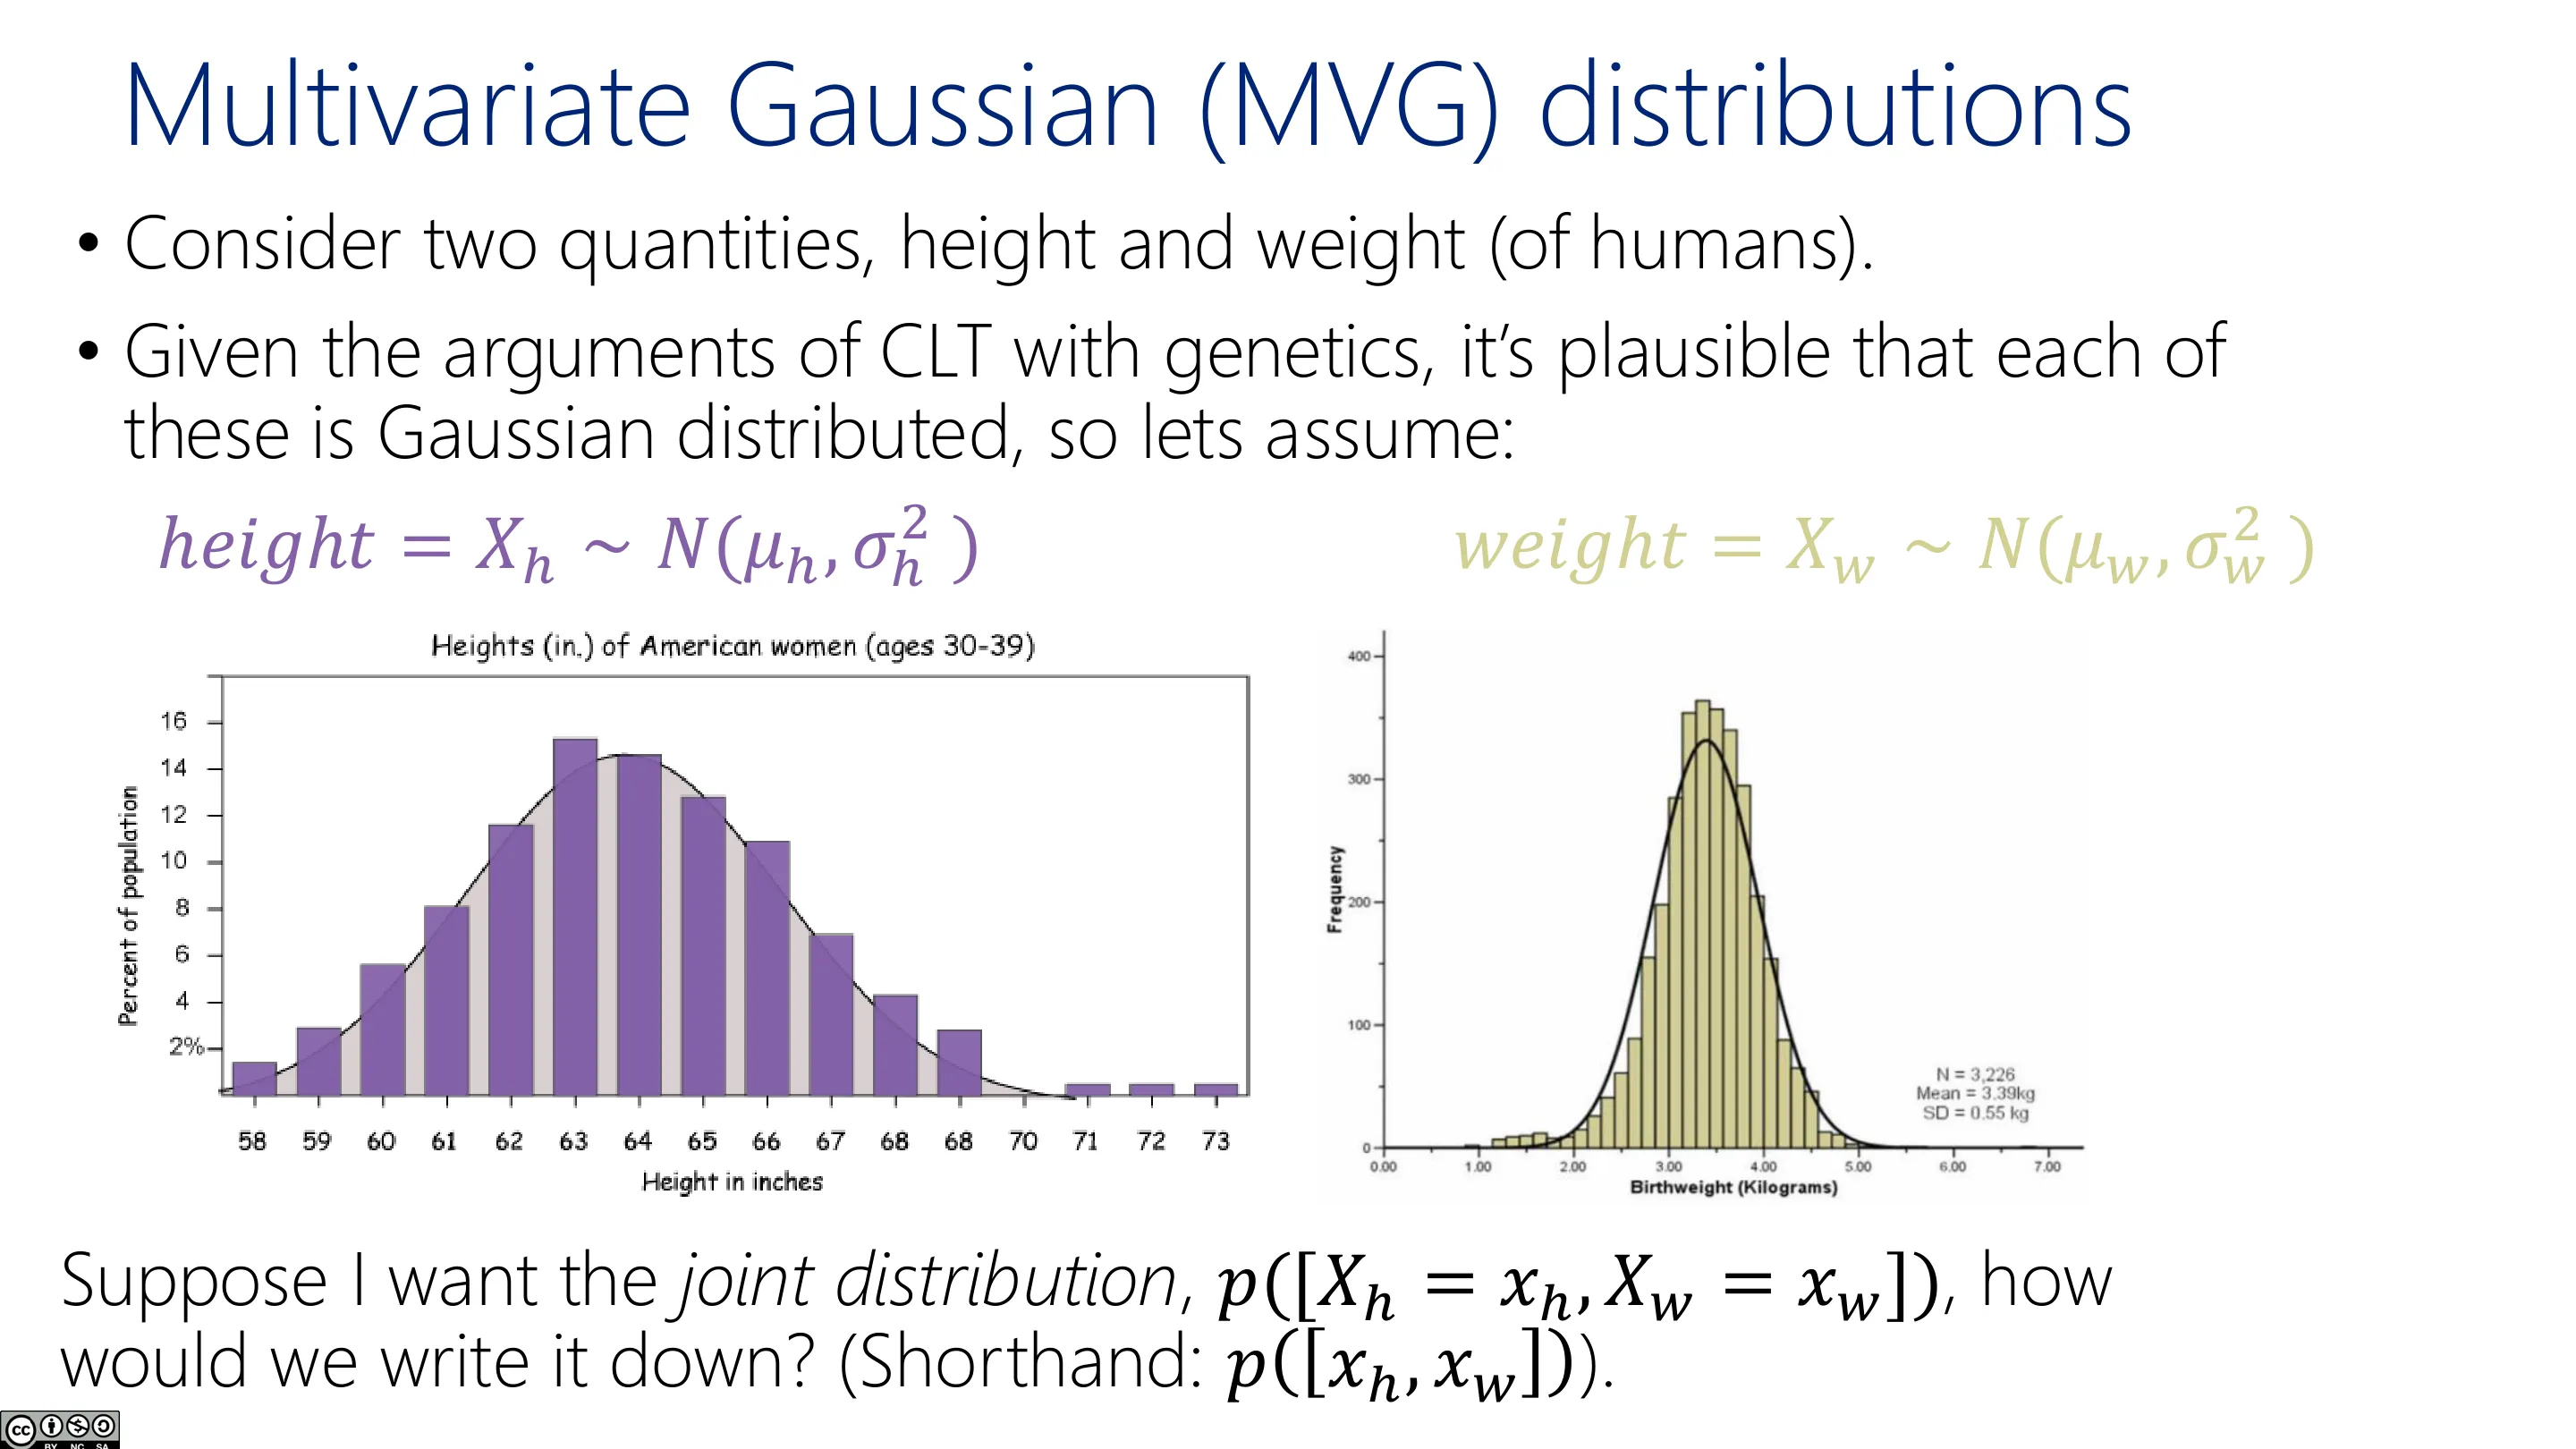
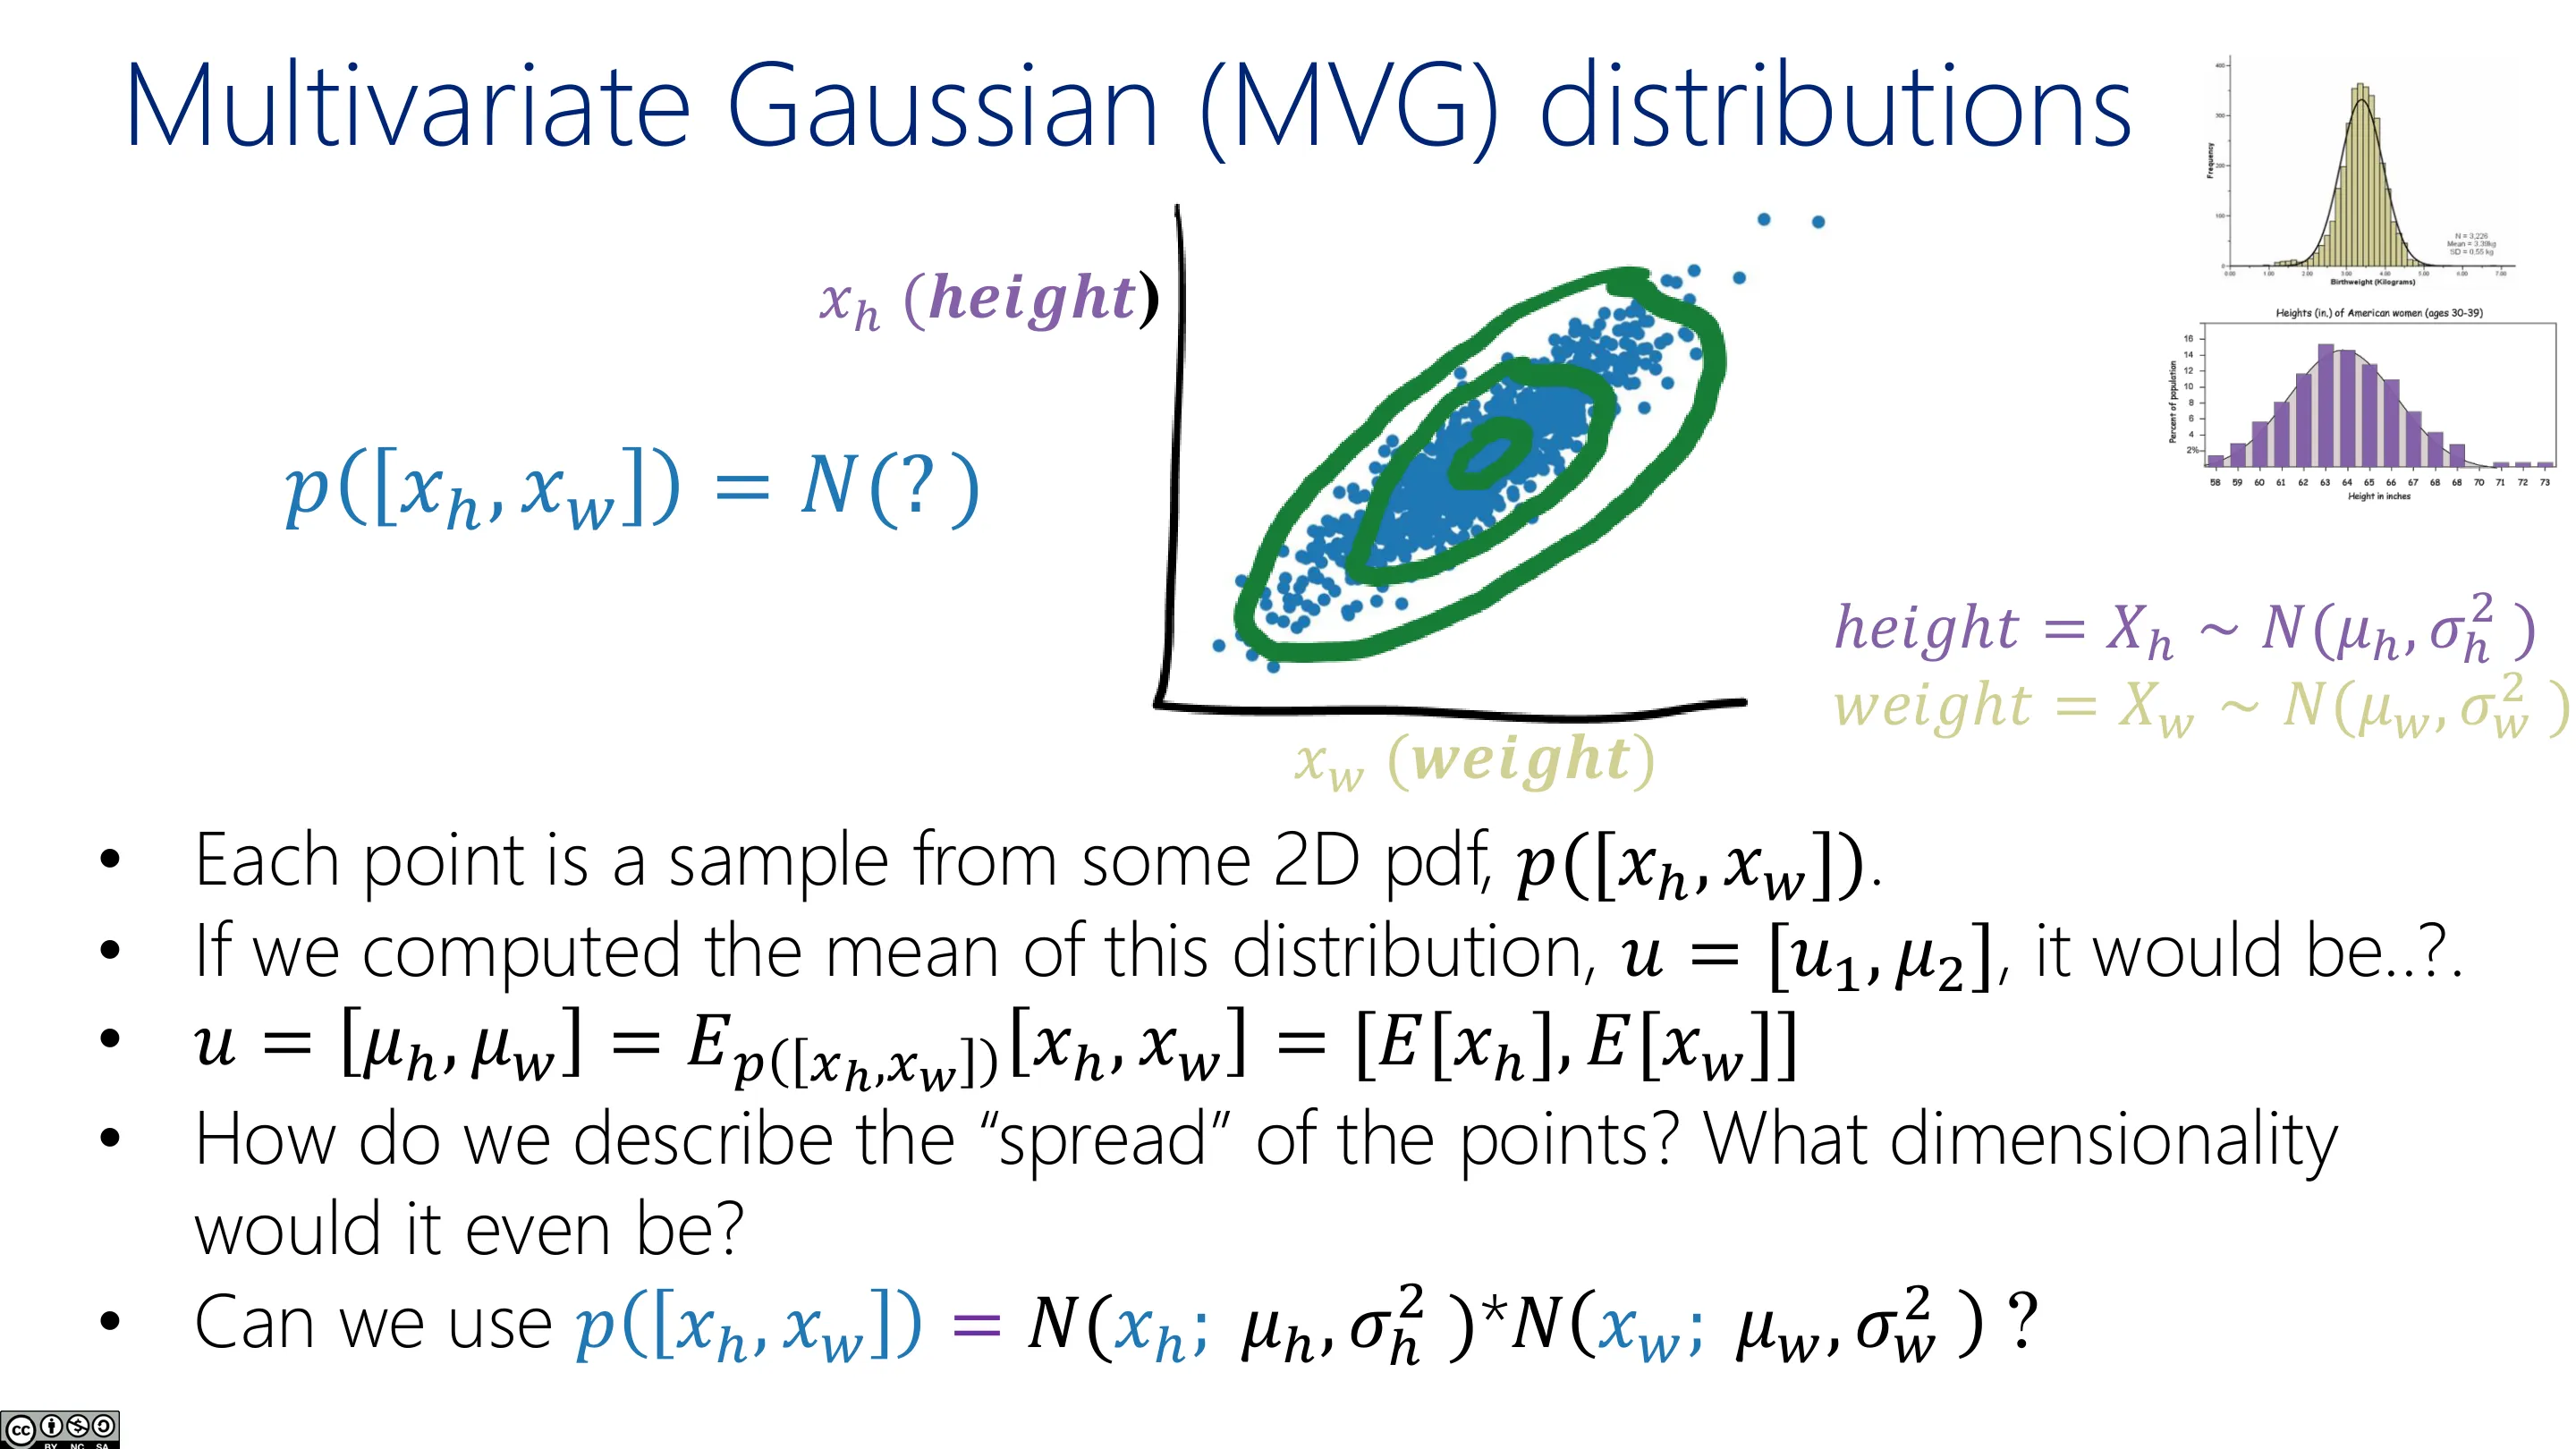
假设身高 $X_h\sim\mathcal{N}(\mu_h,\sigma_h^2)$、体重 $X_w\sim\mathcal{N}(\mu_w,\sigma_w^2)$(用中心极限定理 + 遗传学论证它们近似高斯)。我们想要联合分布 $p(x_h,x_w)$——它该怎么写?
📷 身高与体重
回到原视频 (00:27:27)
- 均值:二维向量,$\mu=[\mu_h,\mu_w]=[\mathbb{E}[x_h],\mathbb{E}[x_w]]$(期望的线性性);
- 「散布」怎么描述?一维用方差,二维还够用吗?
📷 联合分布的均值
回到原视频 (00:29:32)
关键判断:
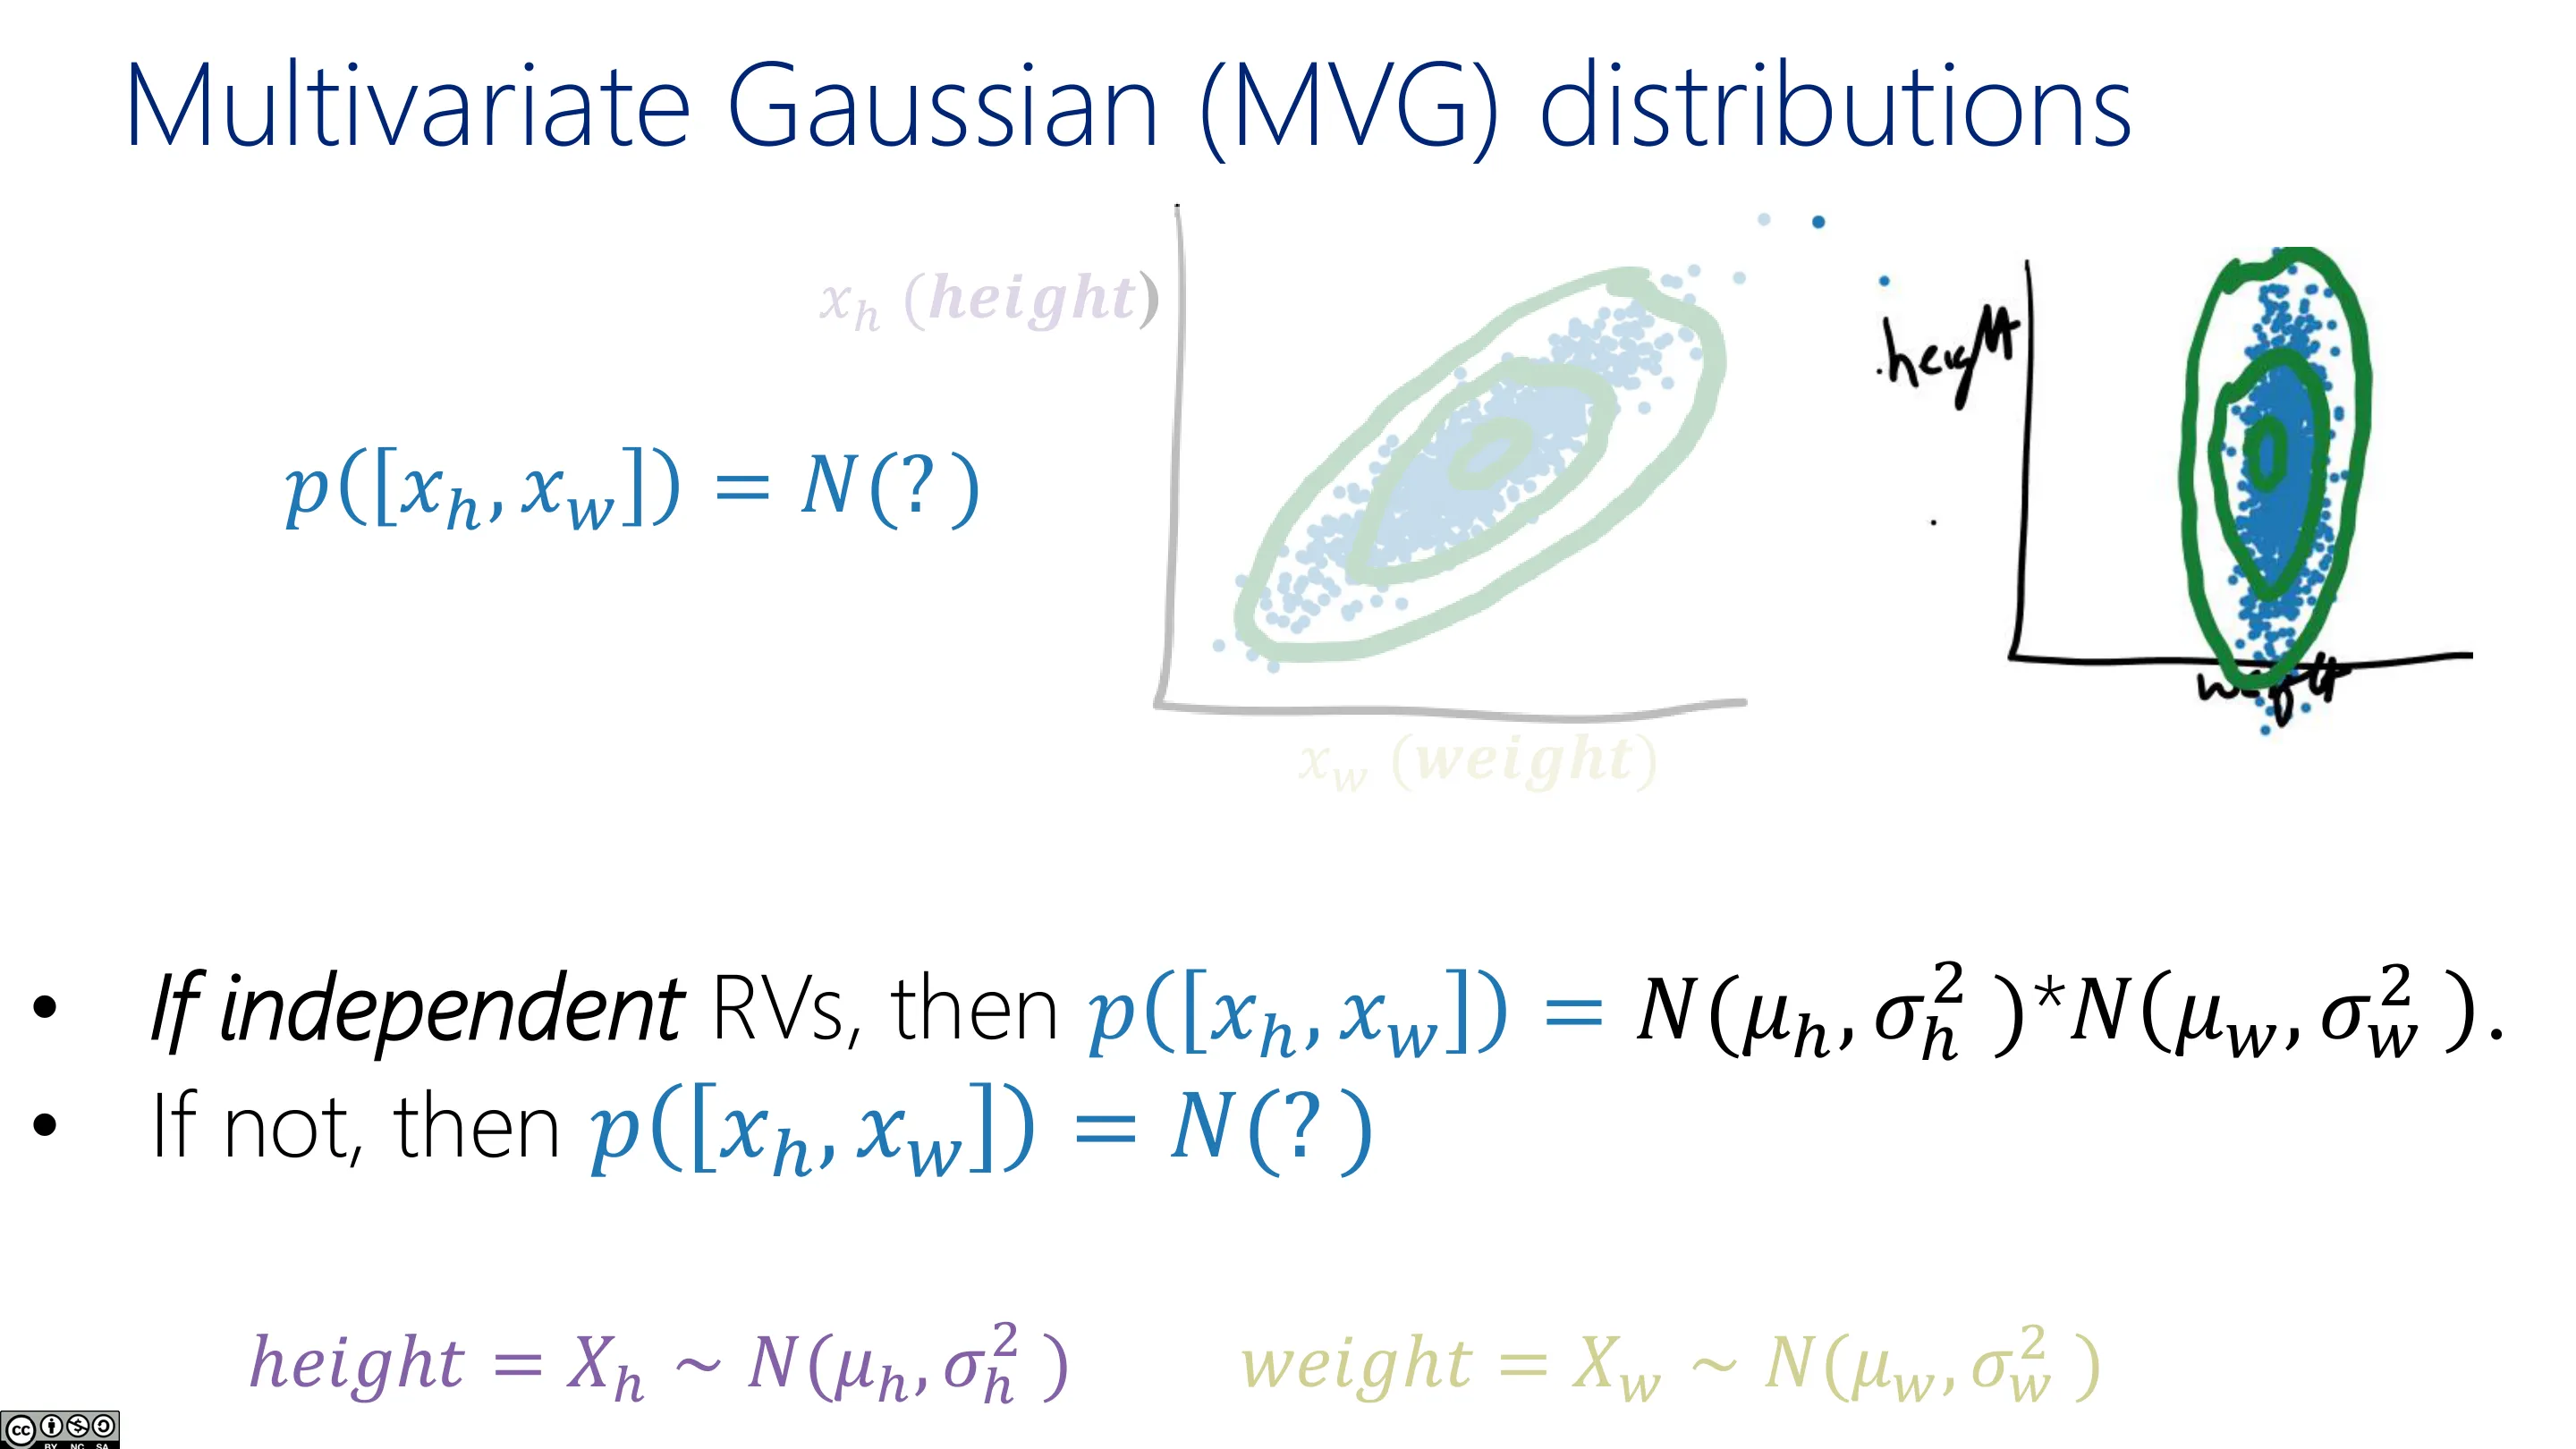
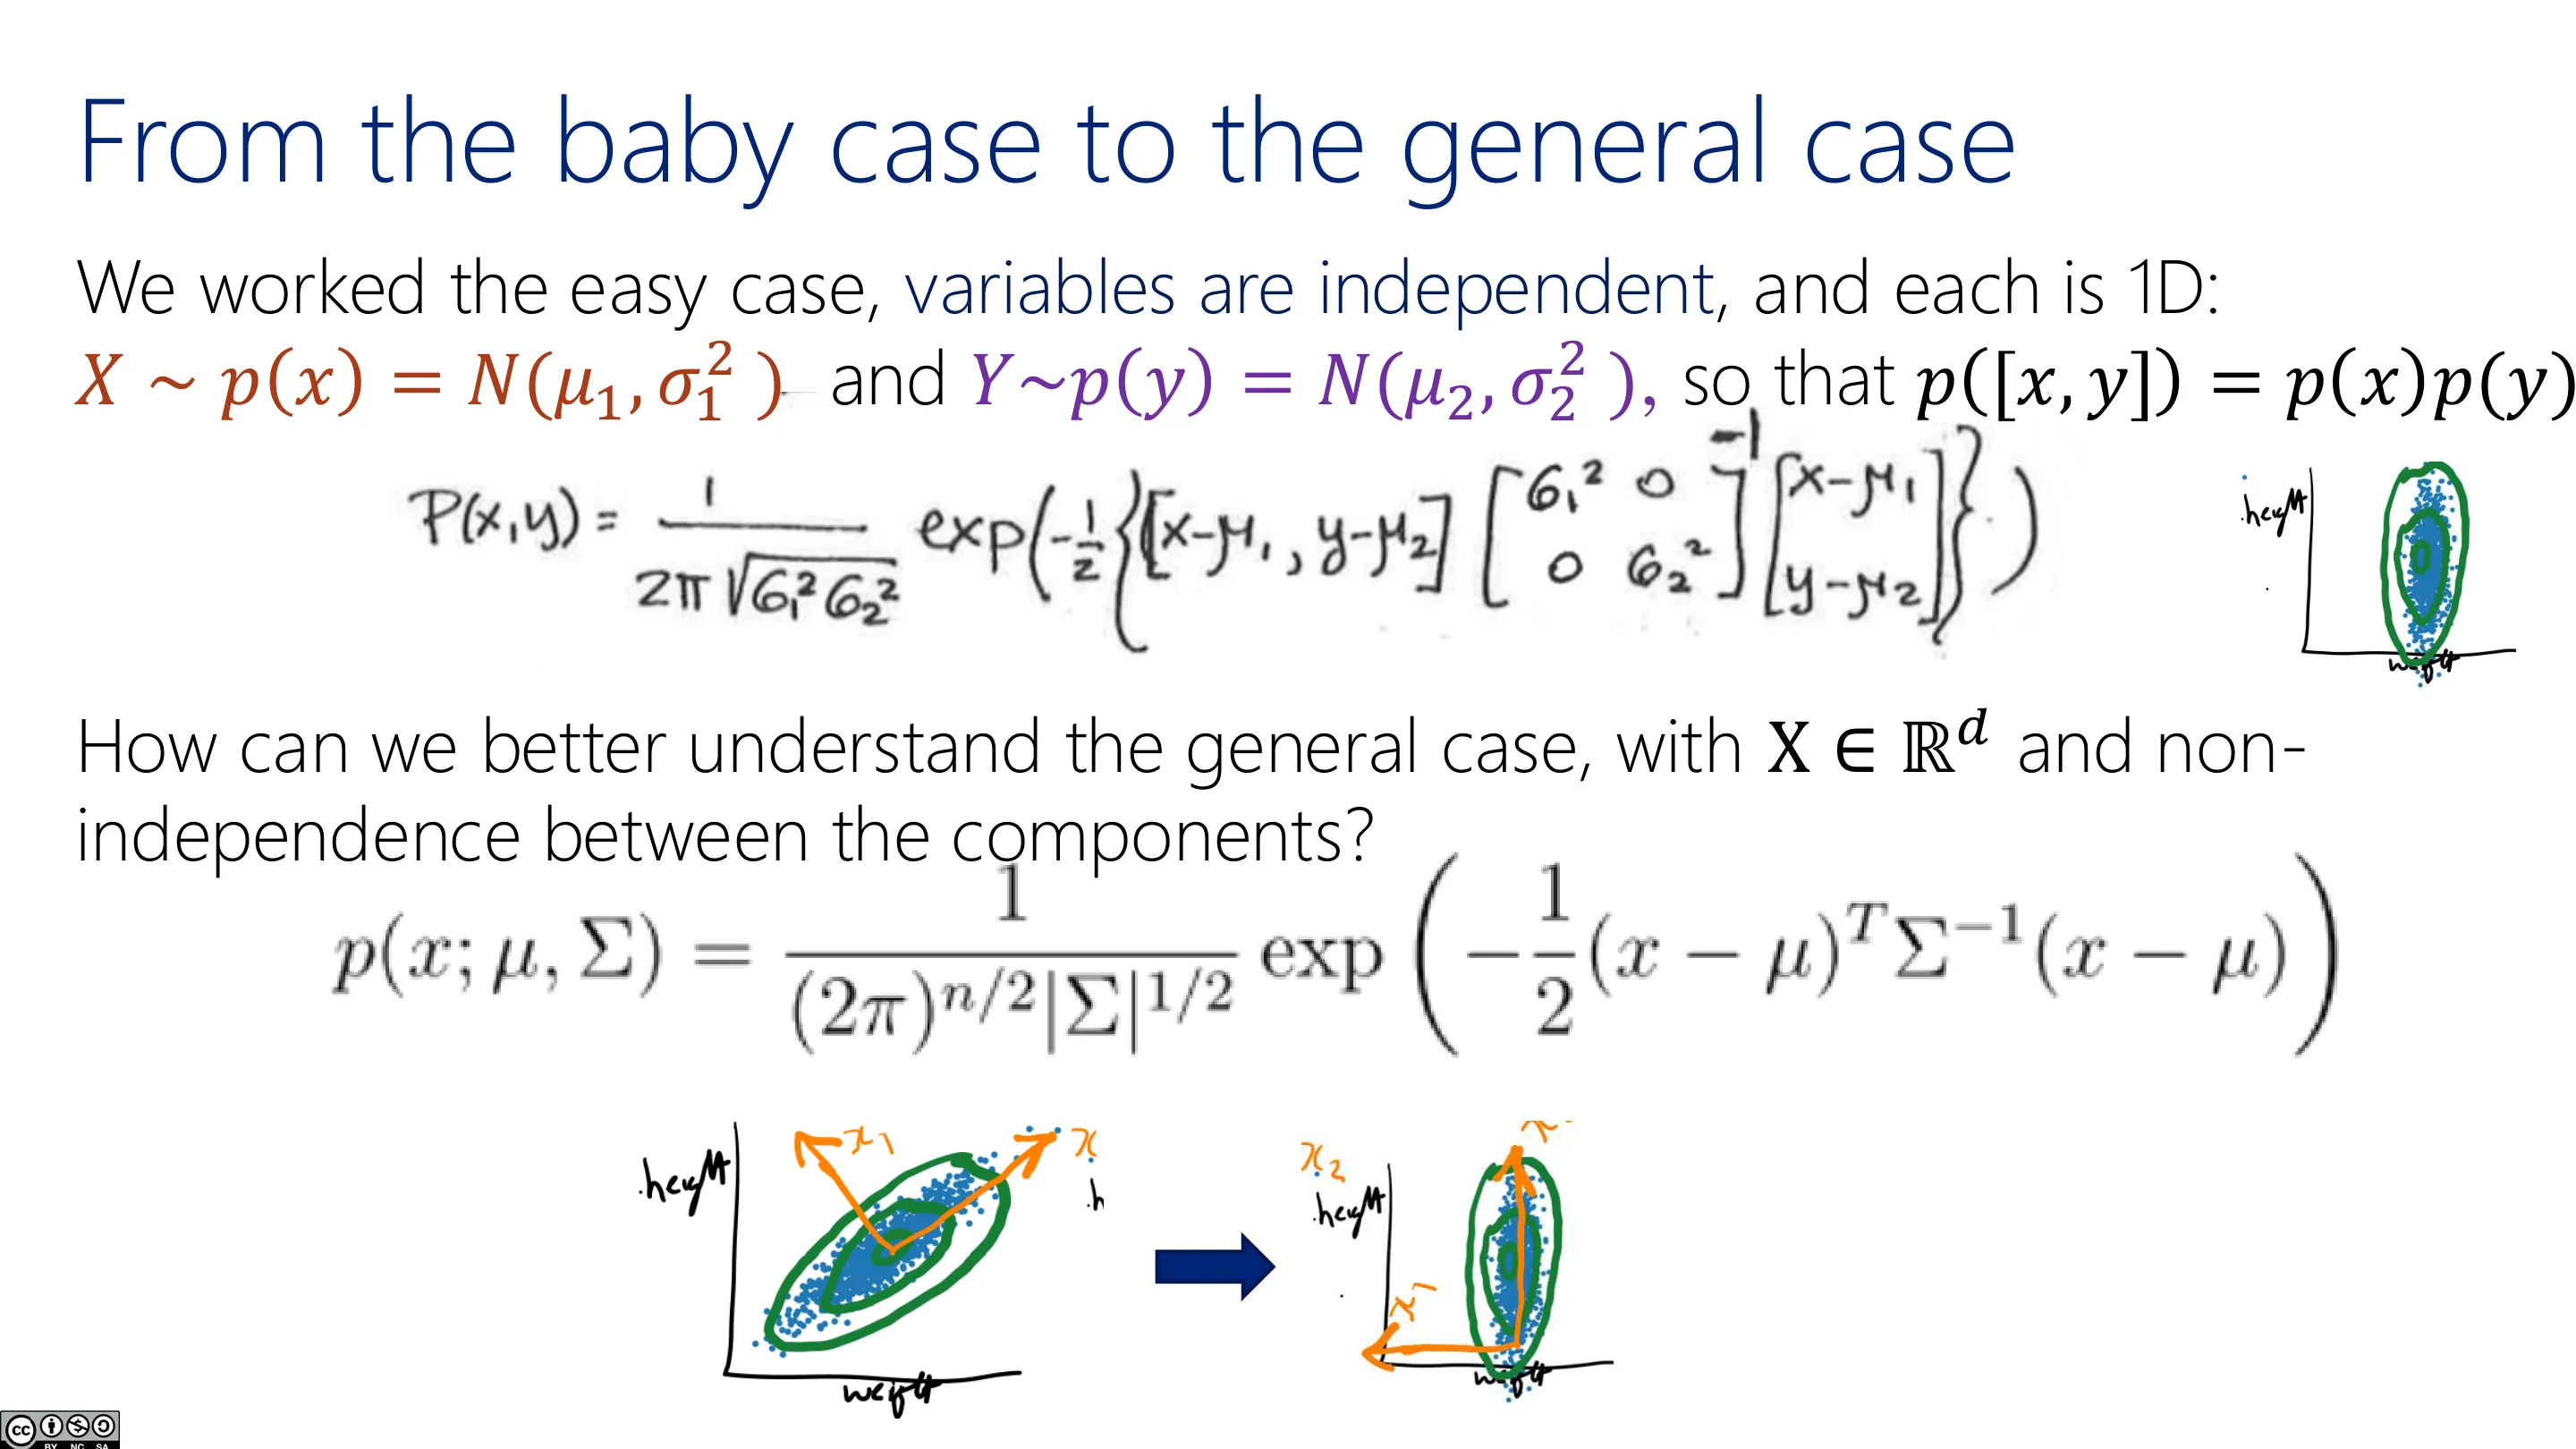
- 若两个变量独立,则 $p(x_h,x_w)=\mathcal{N}(x_h;\mu_h,\sigma_h^2)\cdot\mathcal{N}(x_w;\mu_w,\sigma_w^2)$——两个标量方差就够了;
- 若不独立,就不能简单相乘,必须引入协方差矩阵。
📷 独立 vs 不独立
回到原视频 (00:30:25)
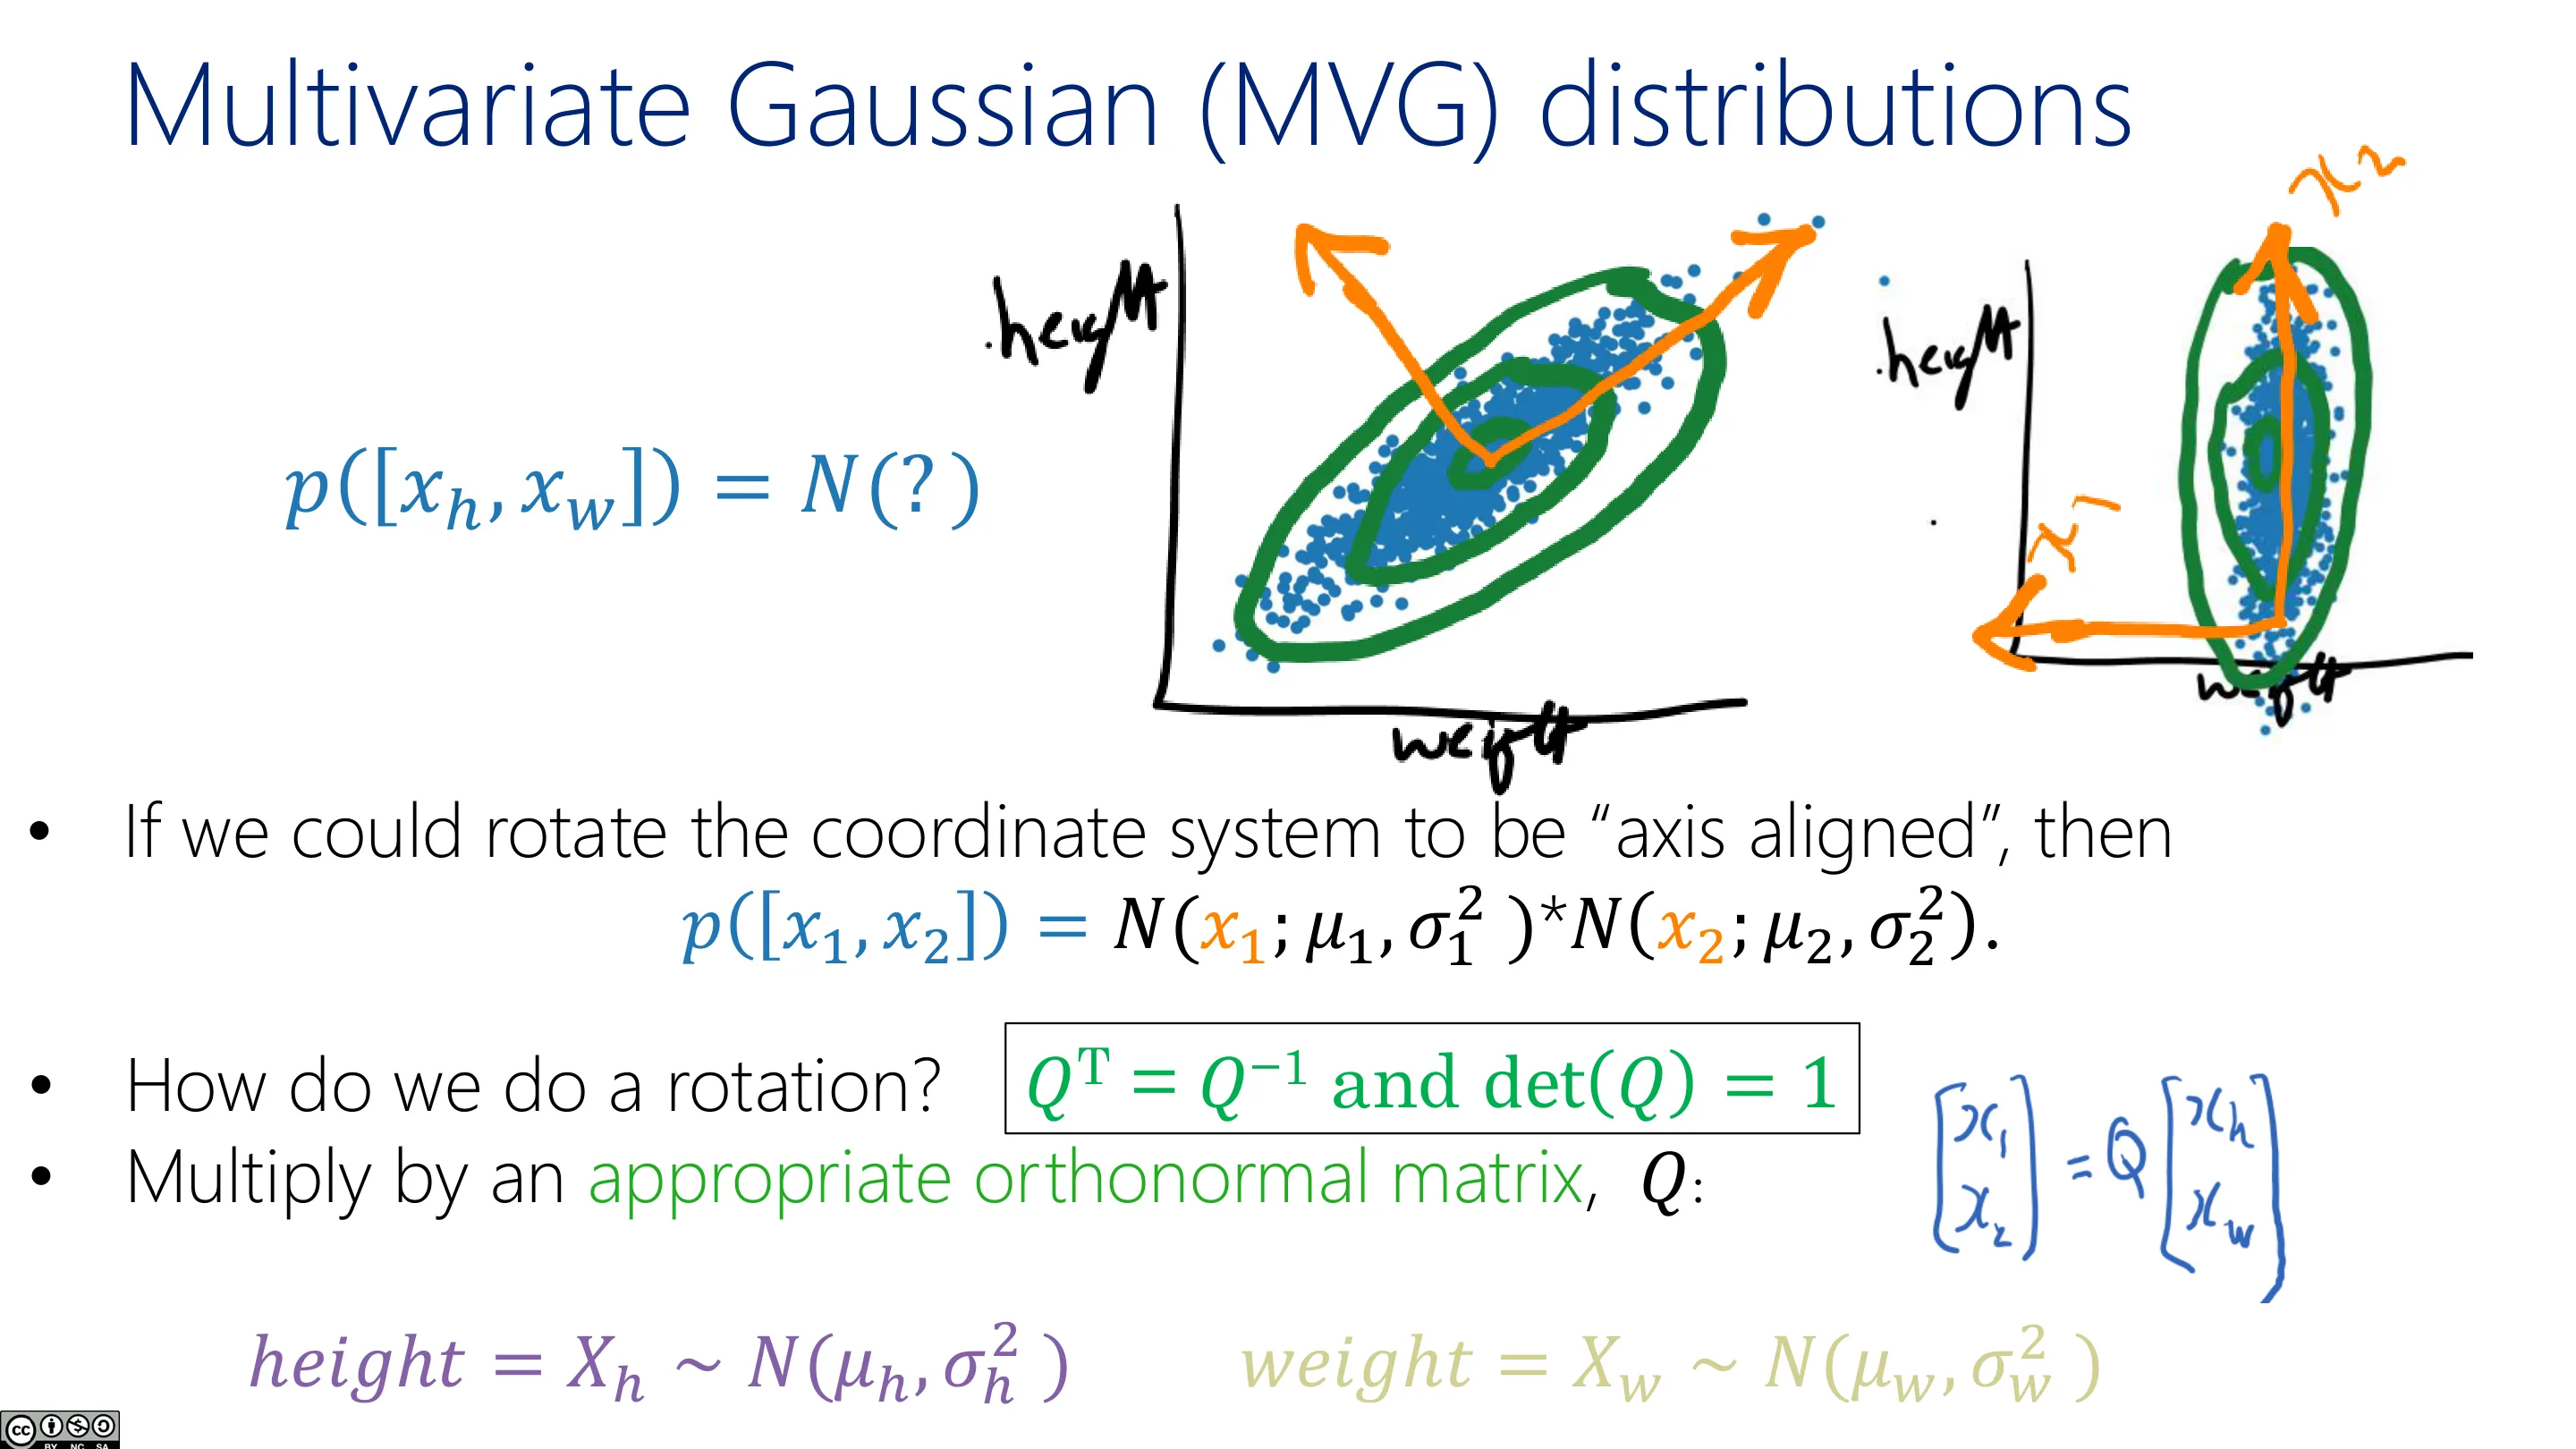
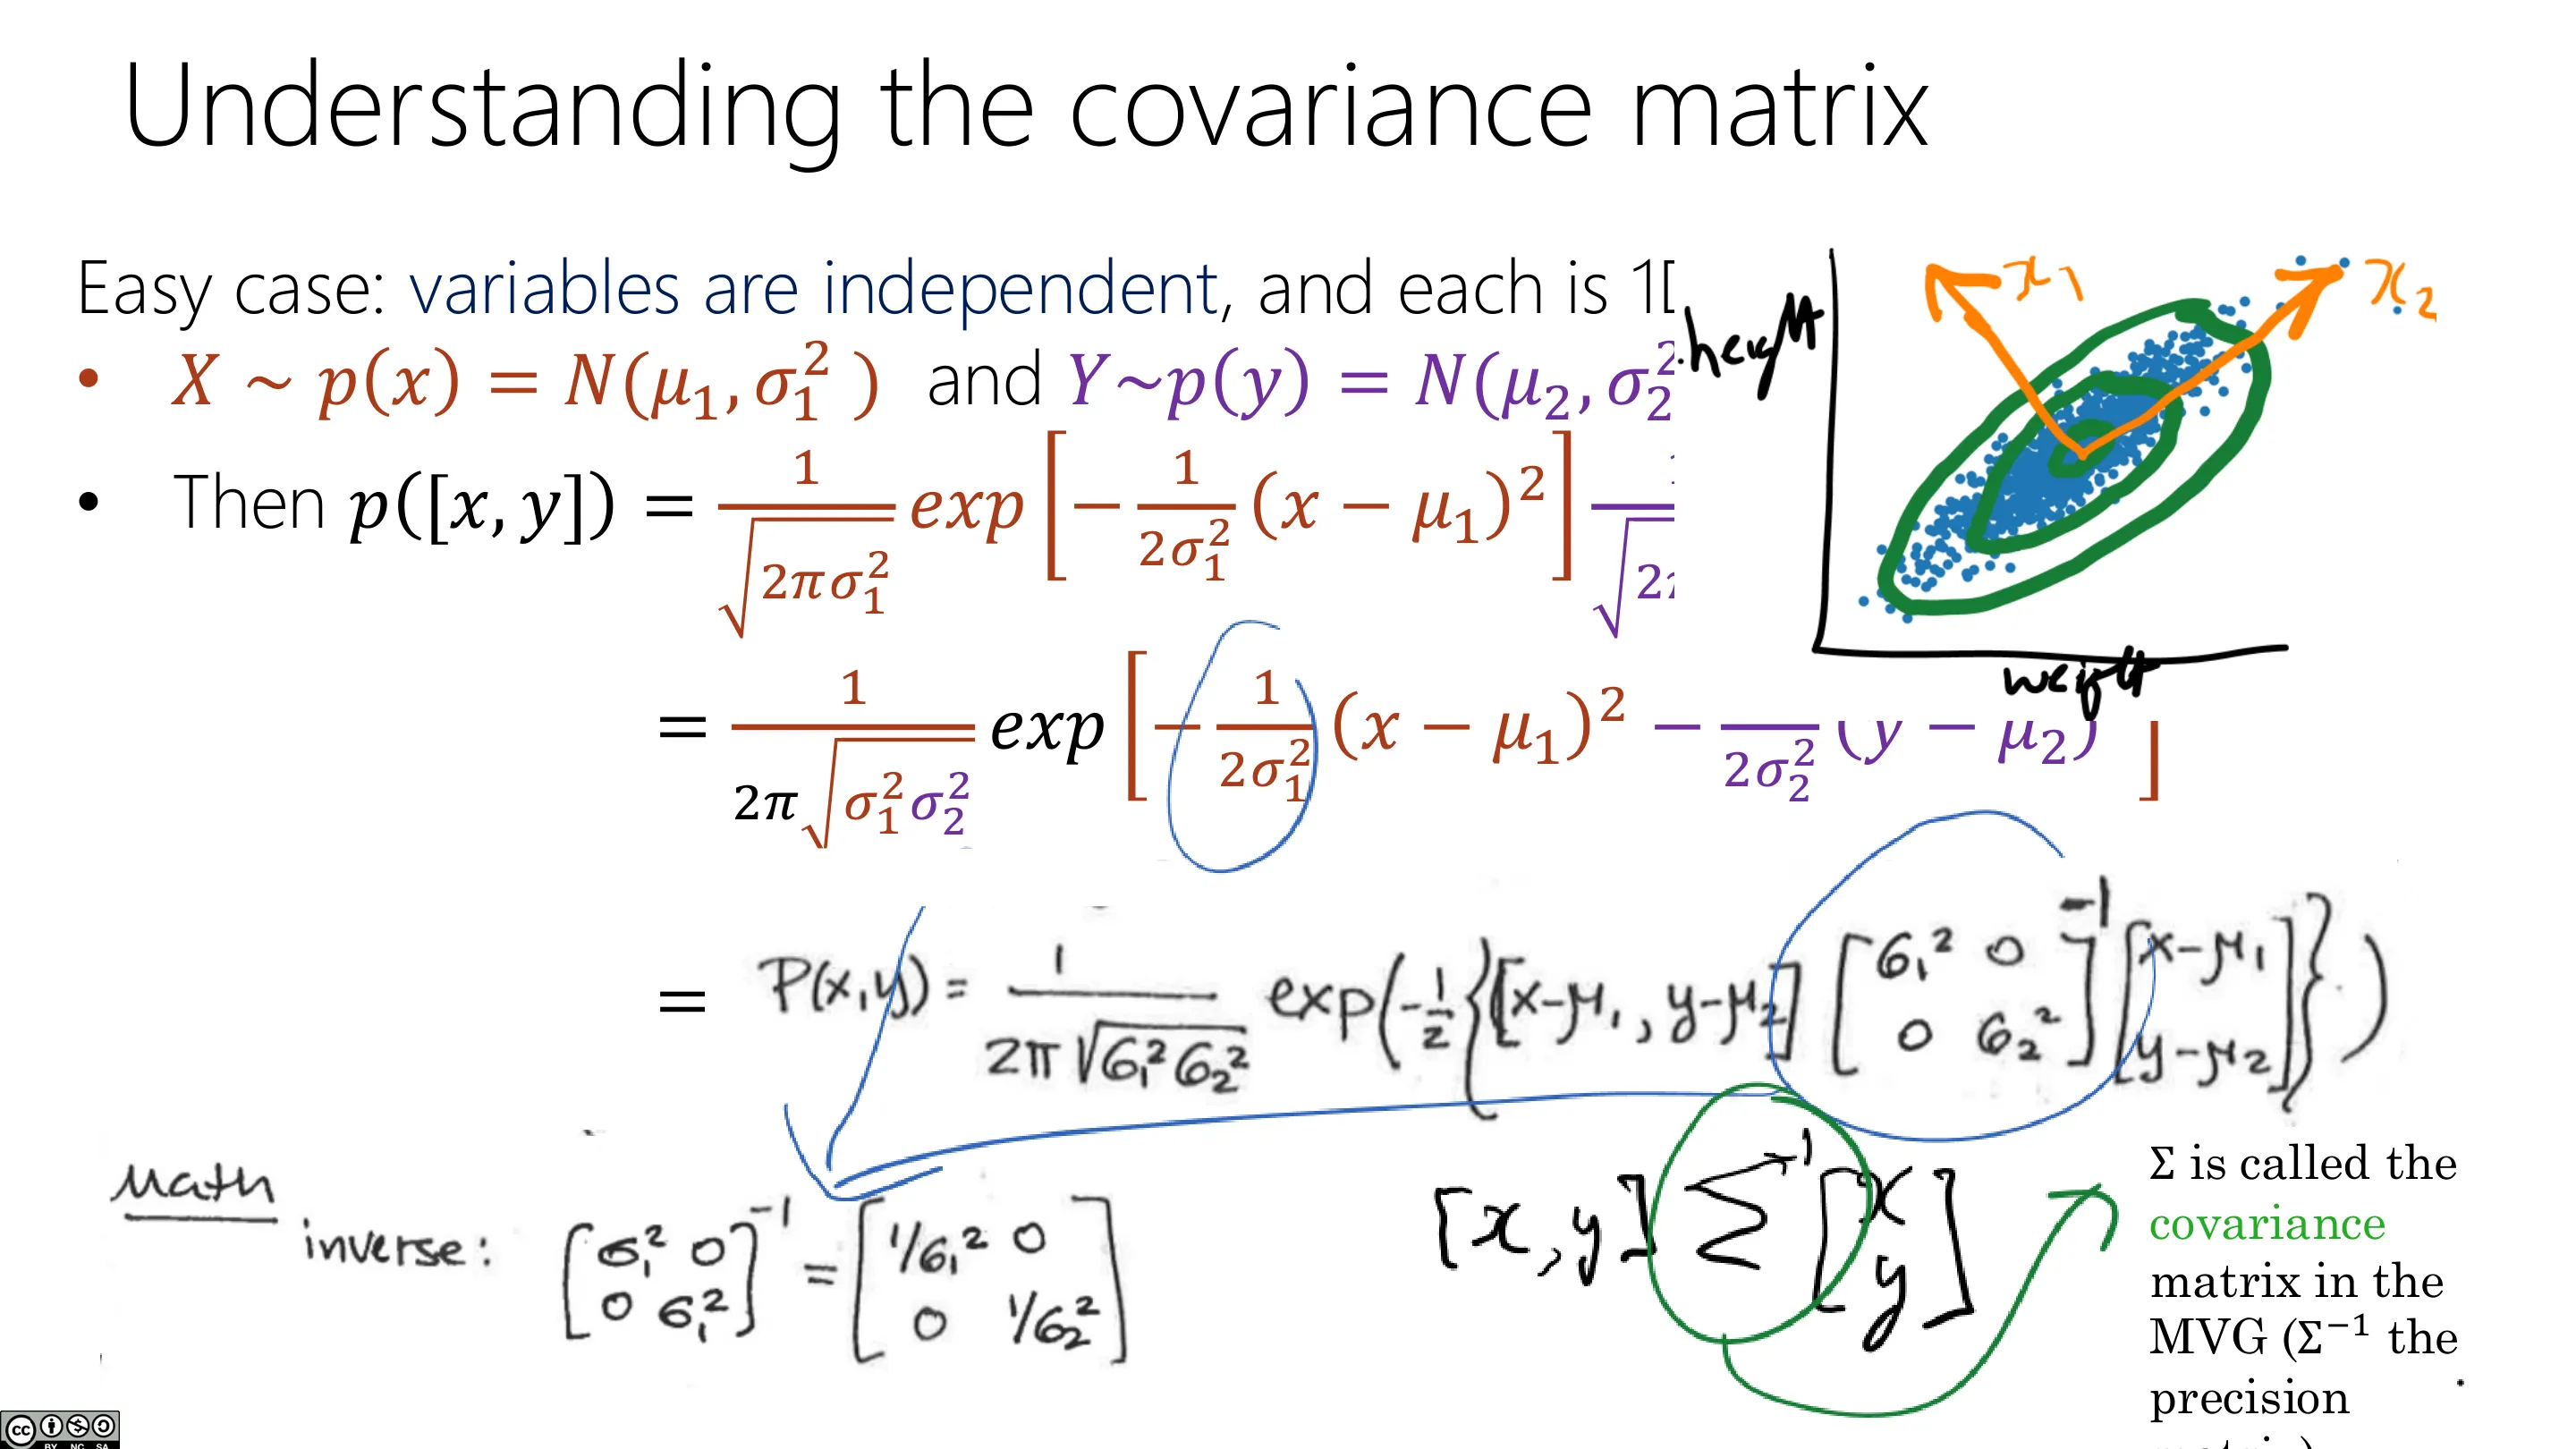
一个漂亮的视角:如果能把坐标系旋转到与数据「轴对齐」,就能在新坐标系里把它们相乘、得到对角协方差矩阵。旋转用正交矩阵 $Q$:$Q^\top=Q^{-1}$、$\det Q=1$。
📷 旋转坐标系到轴对齐
回到原视频 (00:31:26)
2.3 简单情形:独立的两个一维高斯
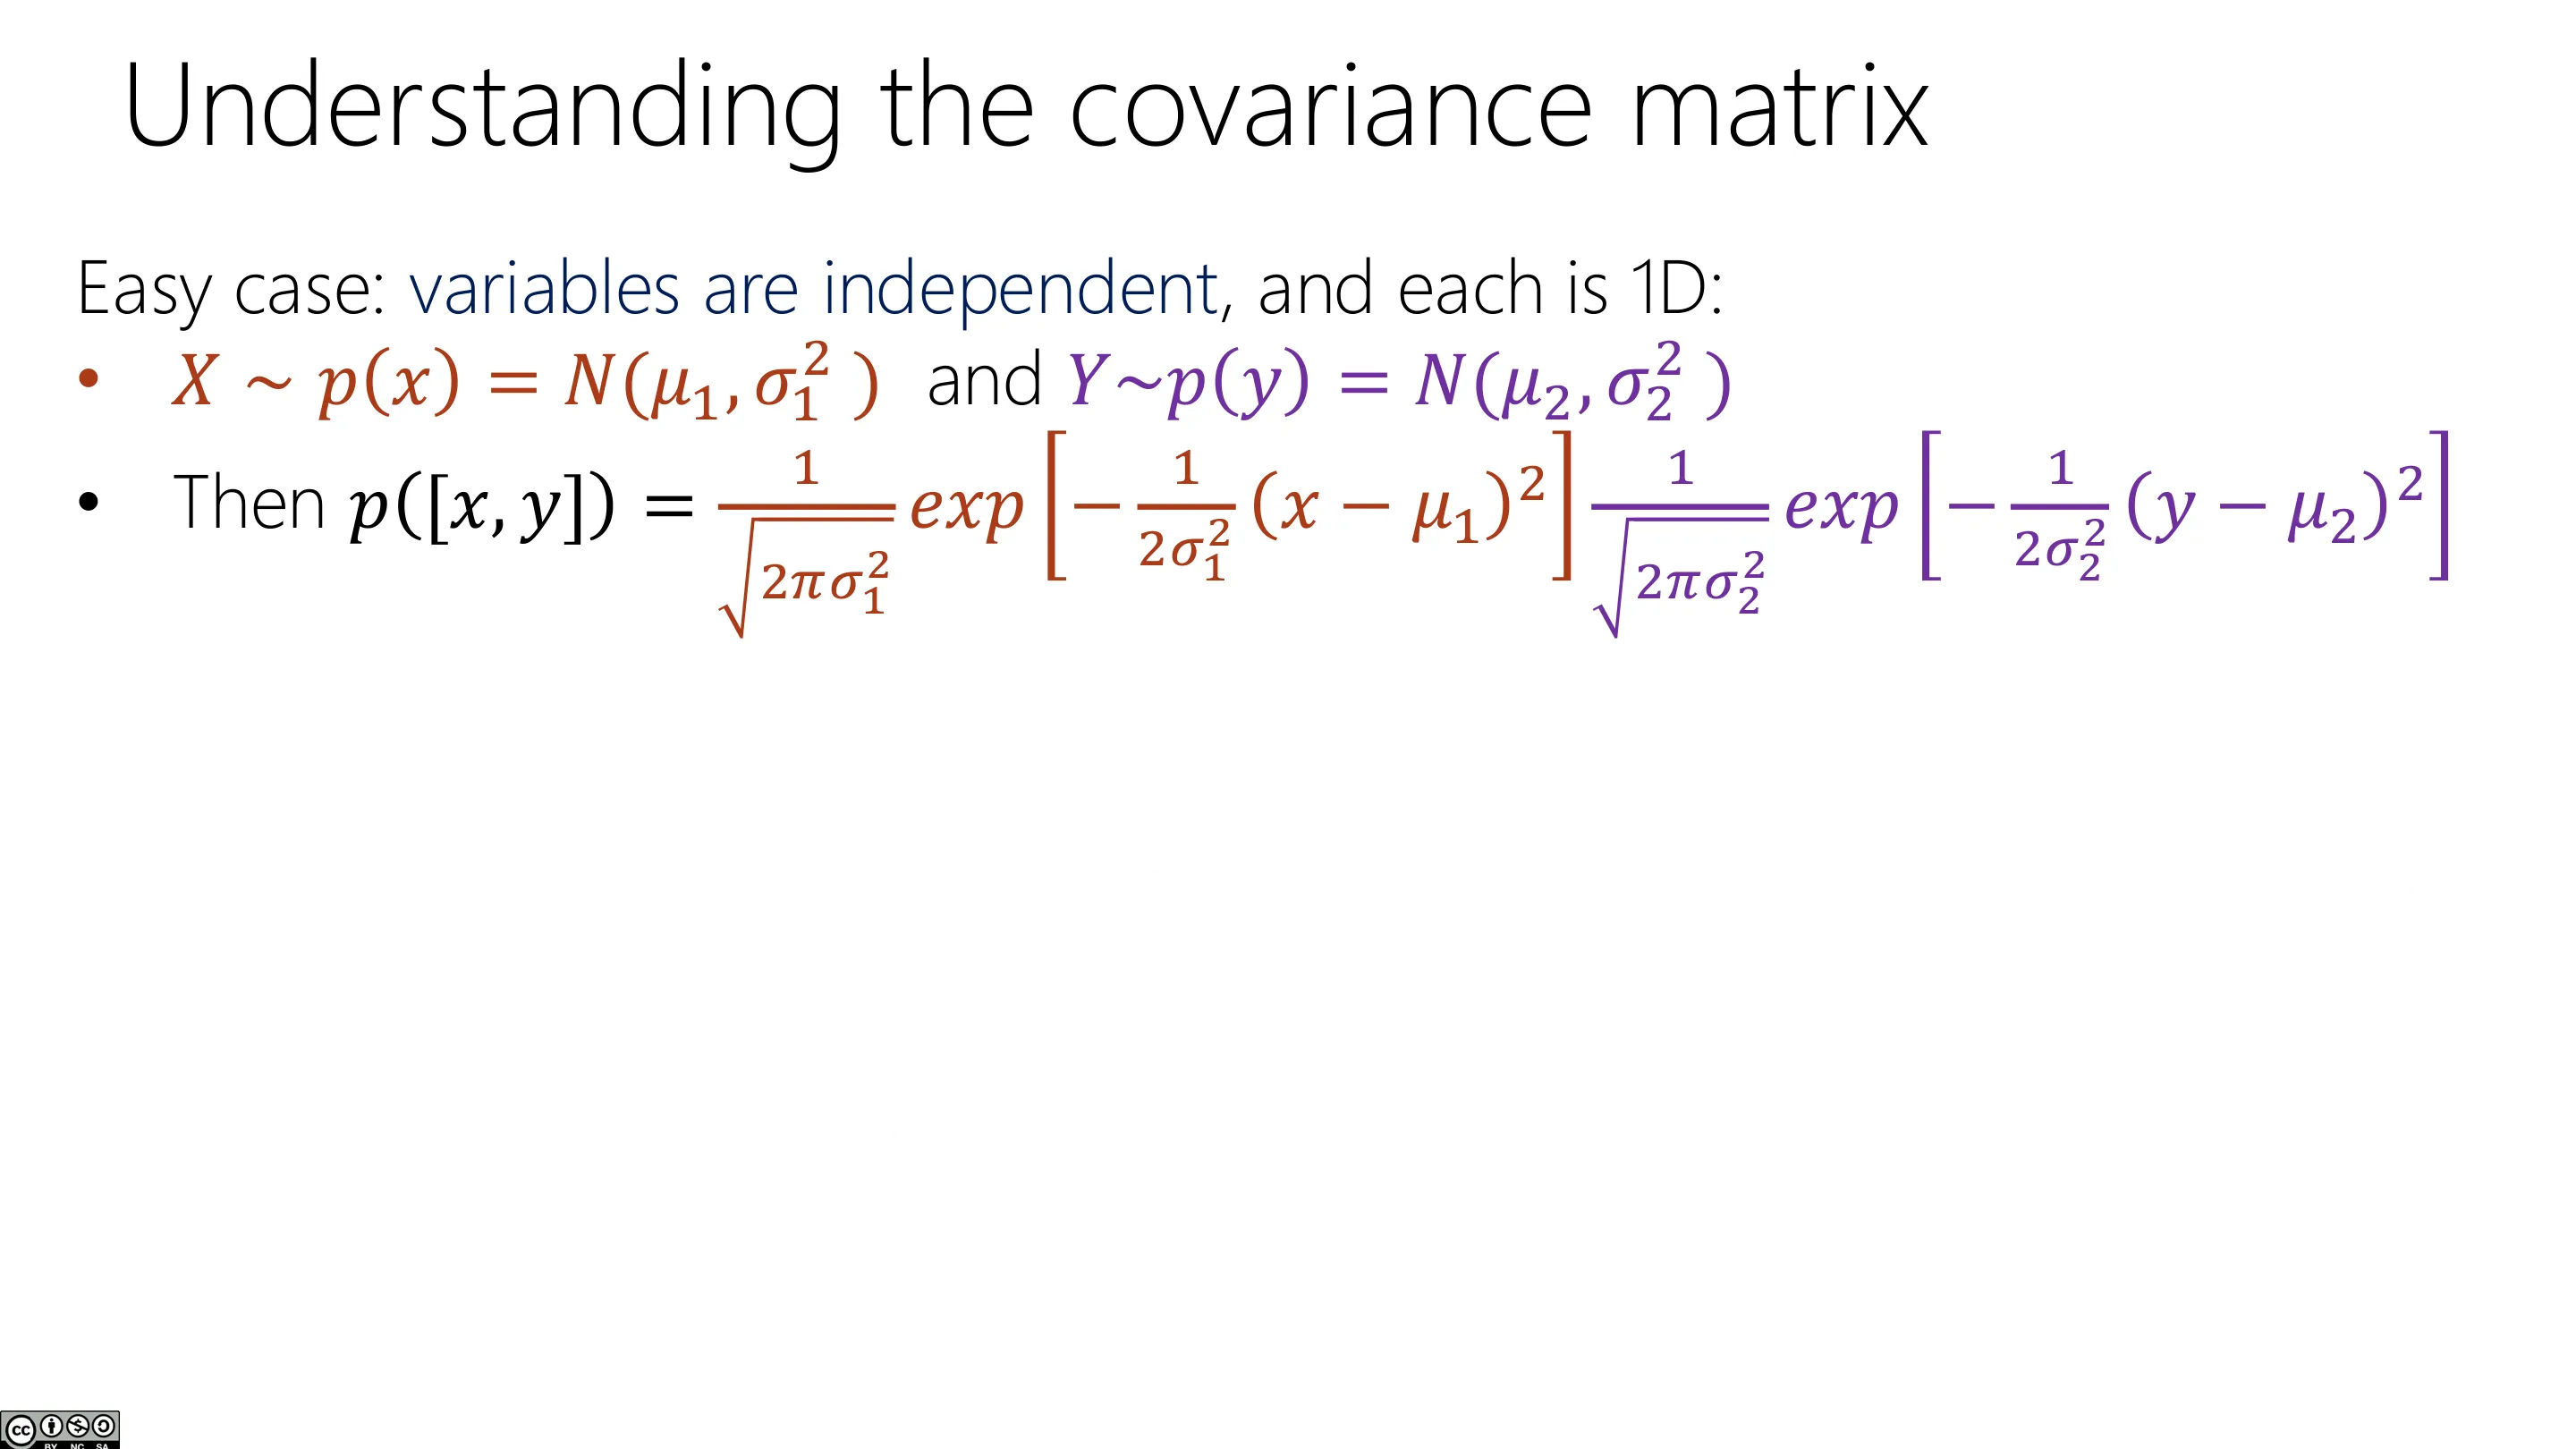
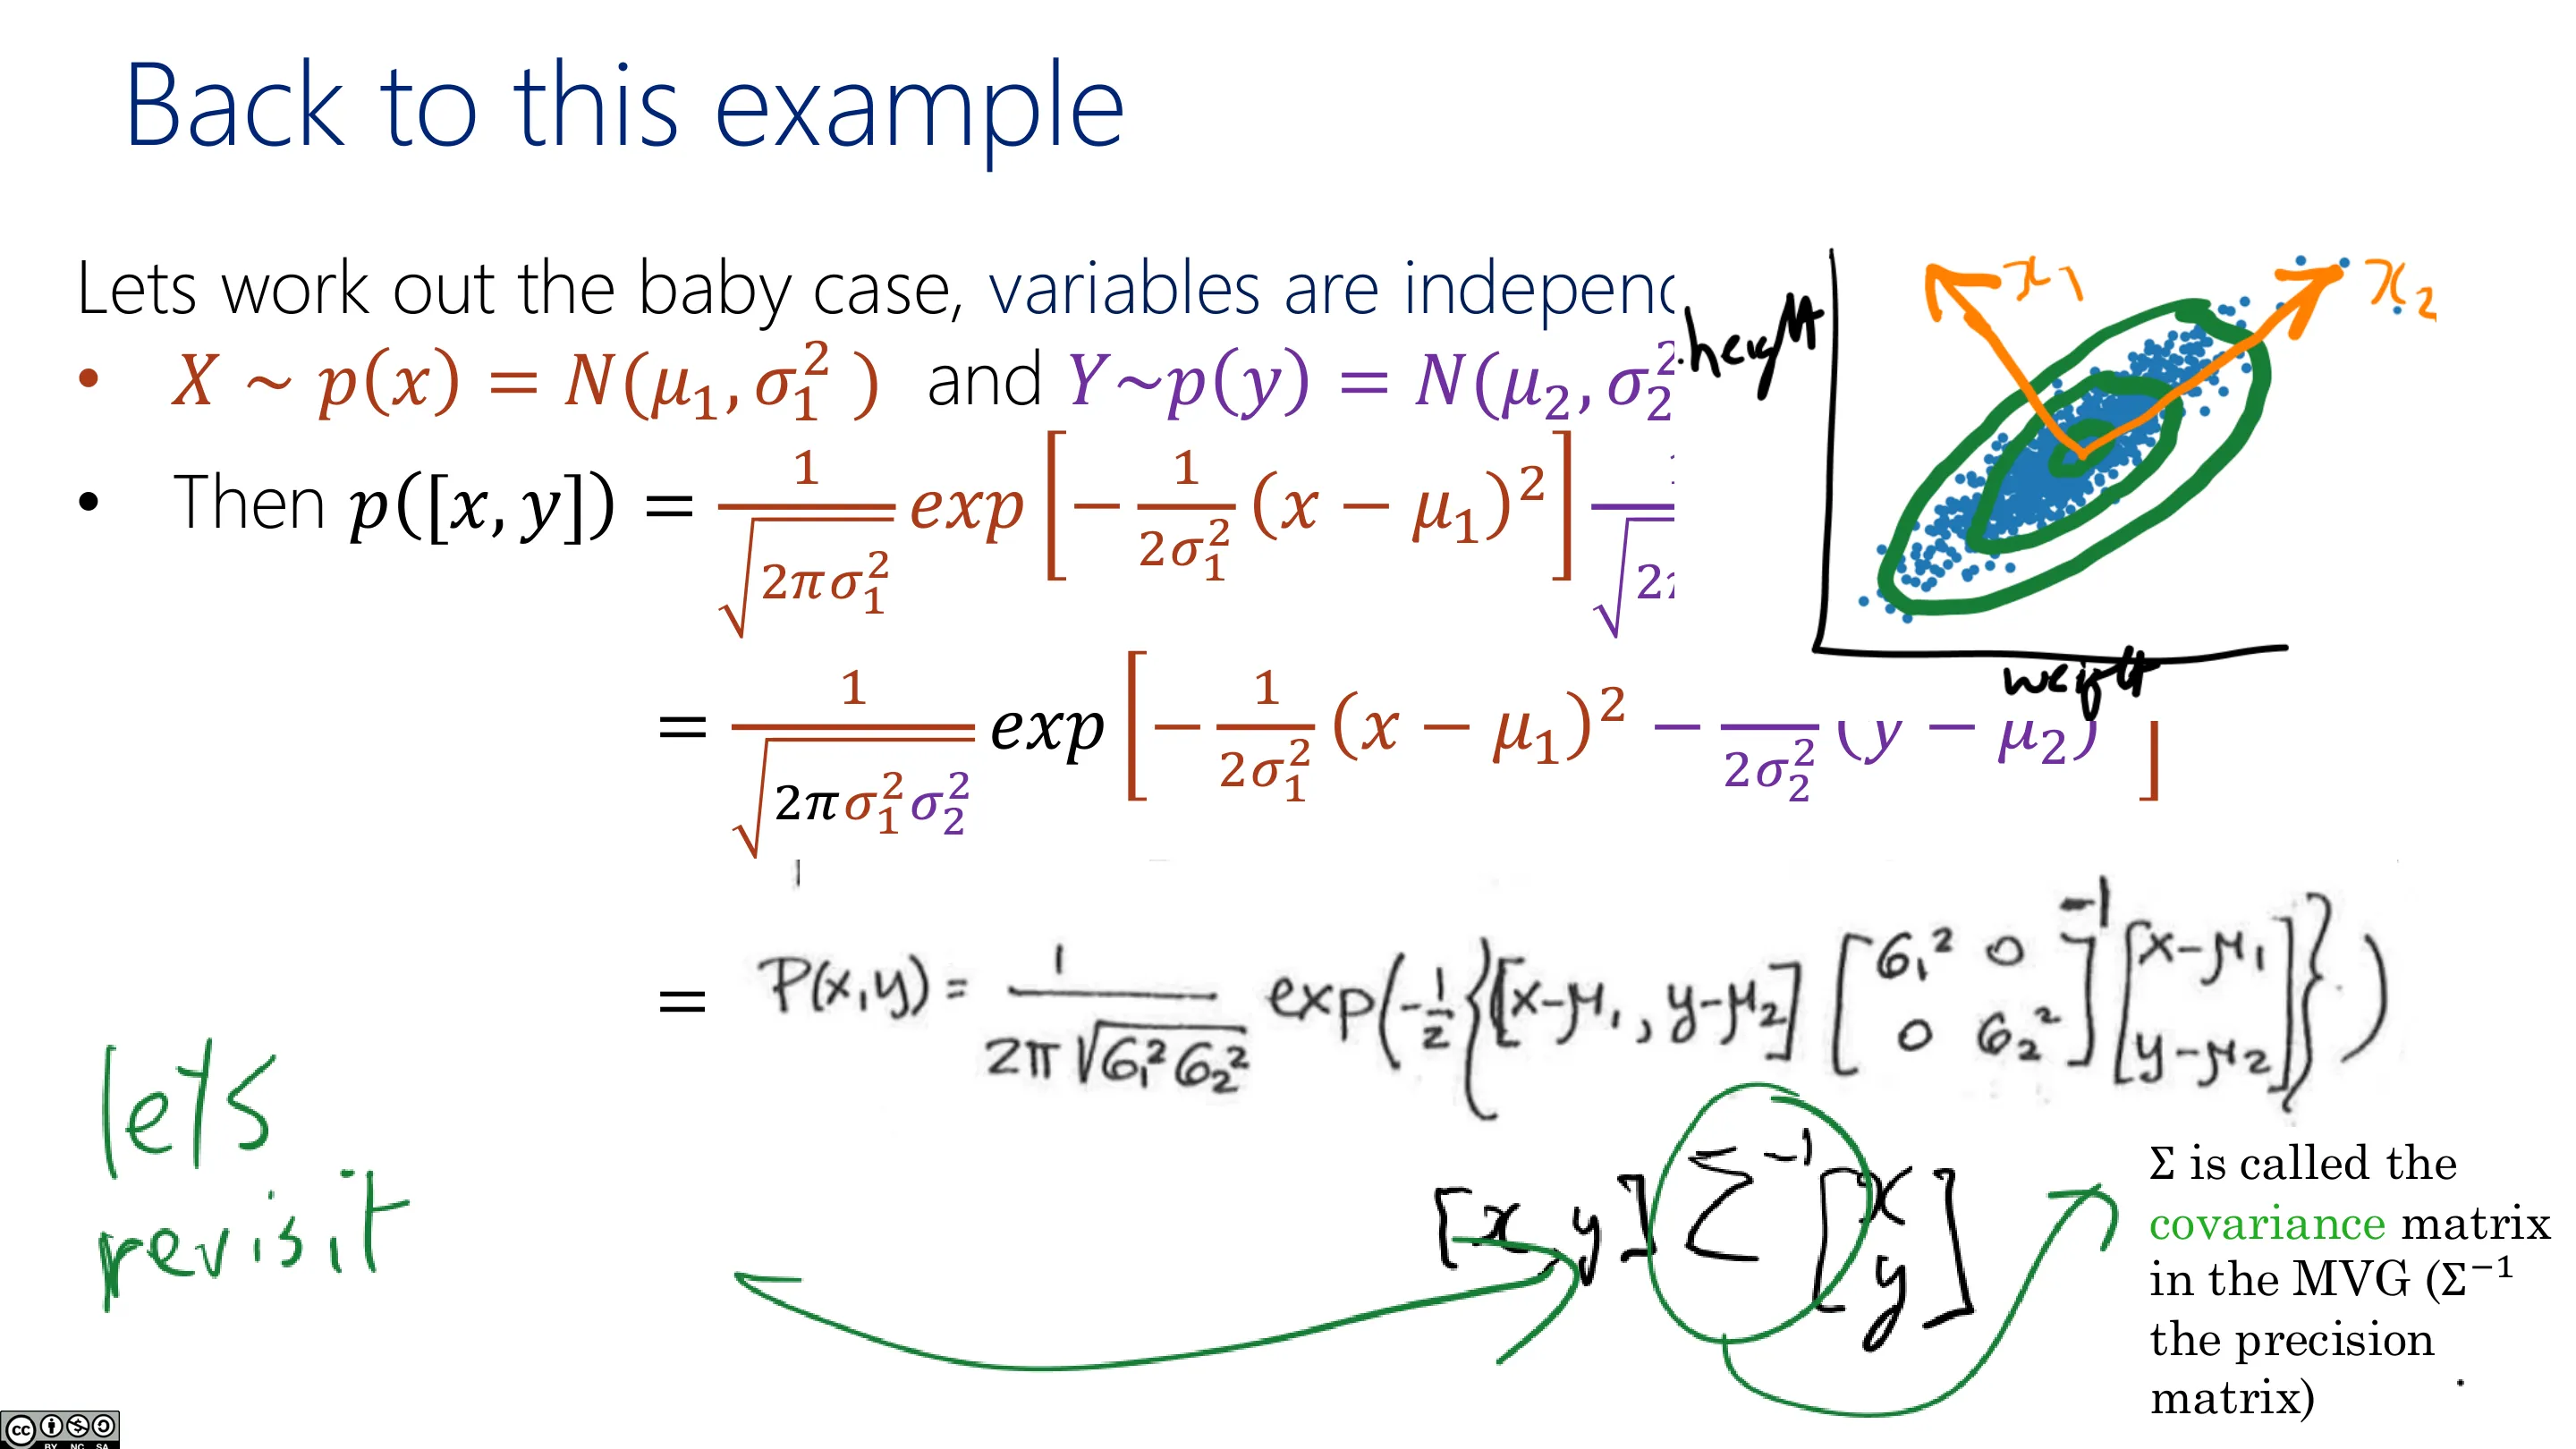
设 $X\sim\mathcal{N}(\mu_1,\sigma_1^2)$、$Y\sim\mathcal{N}(\mu_2,\sigma_2^2)$ 且独立,则
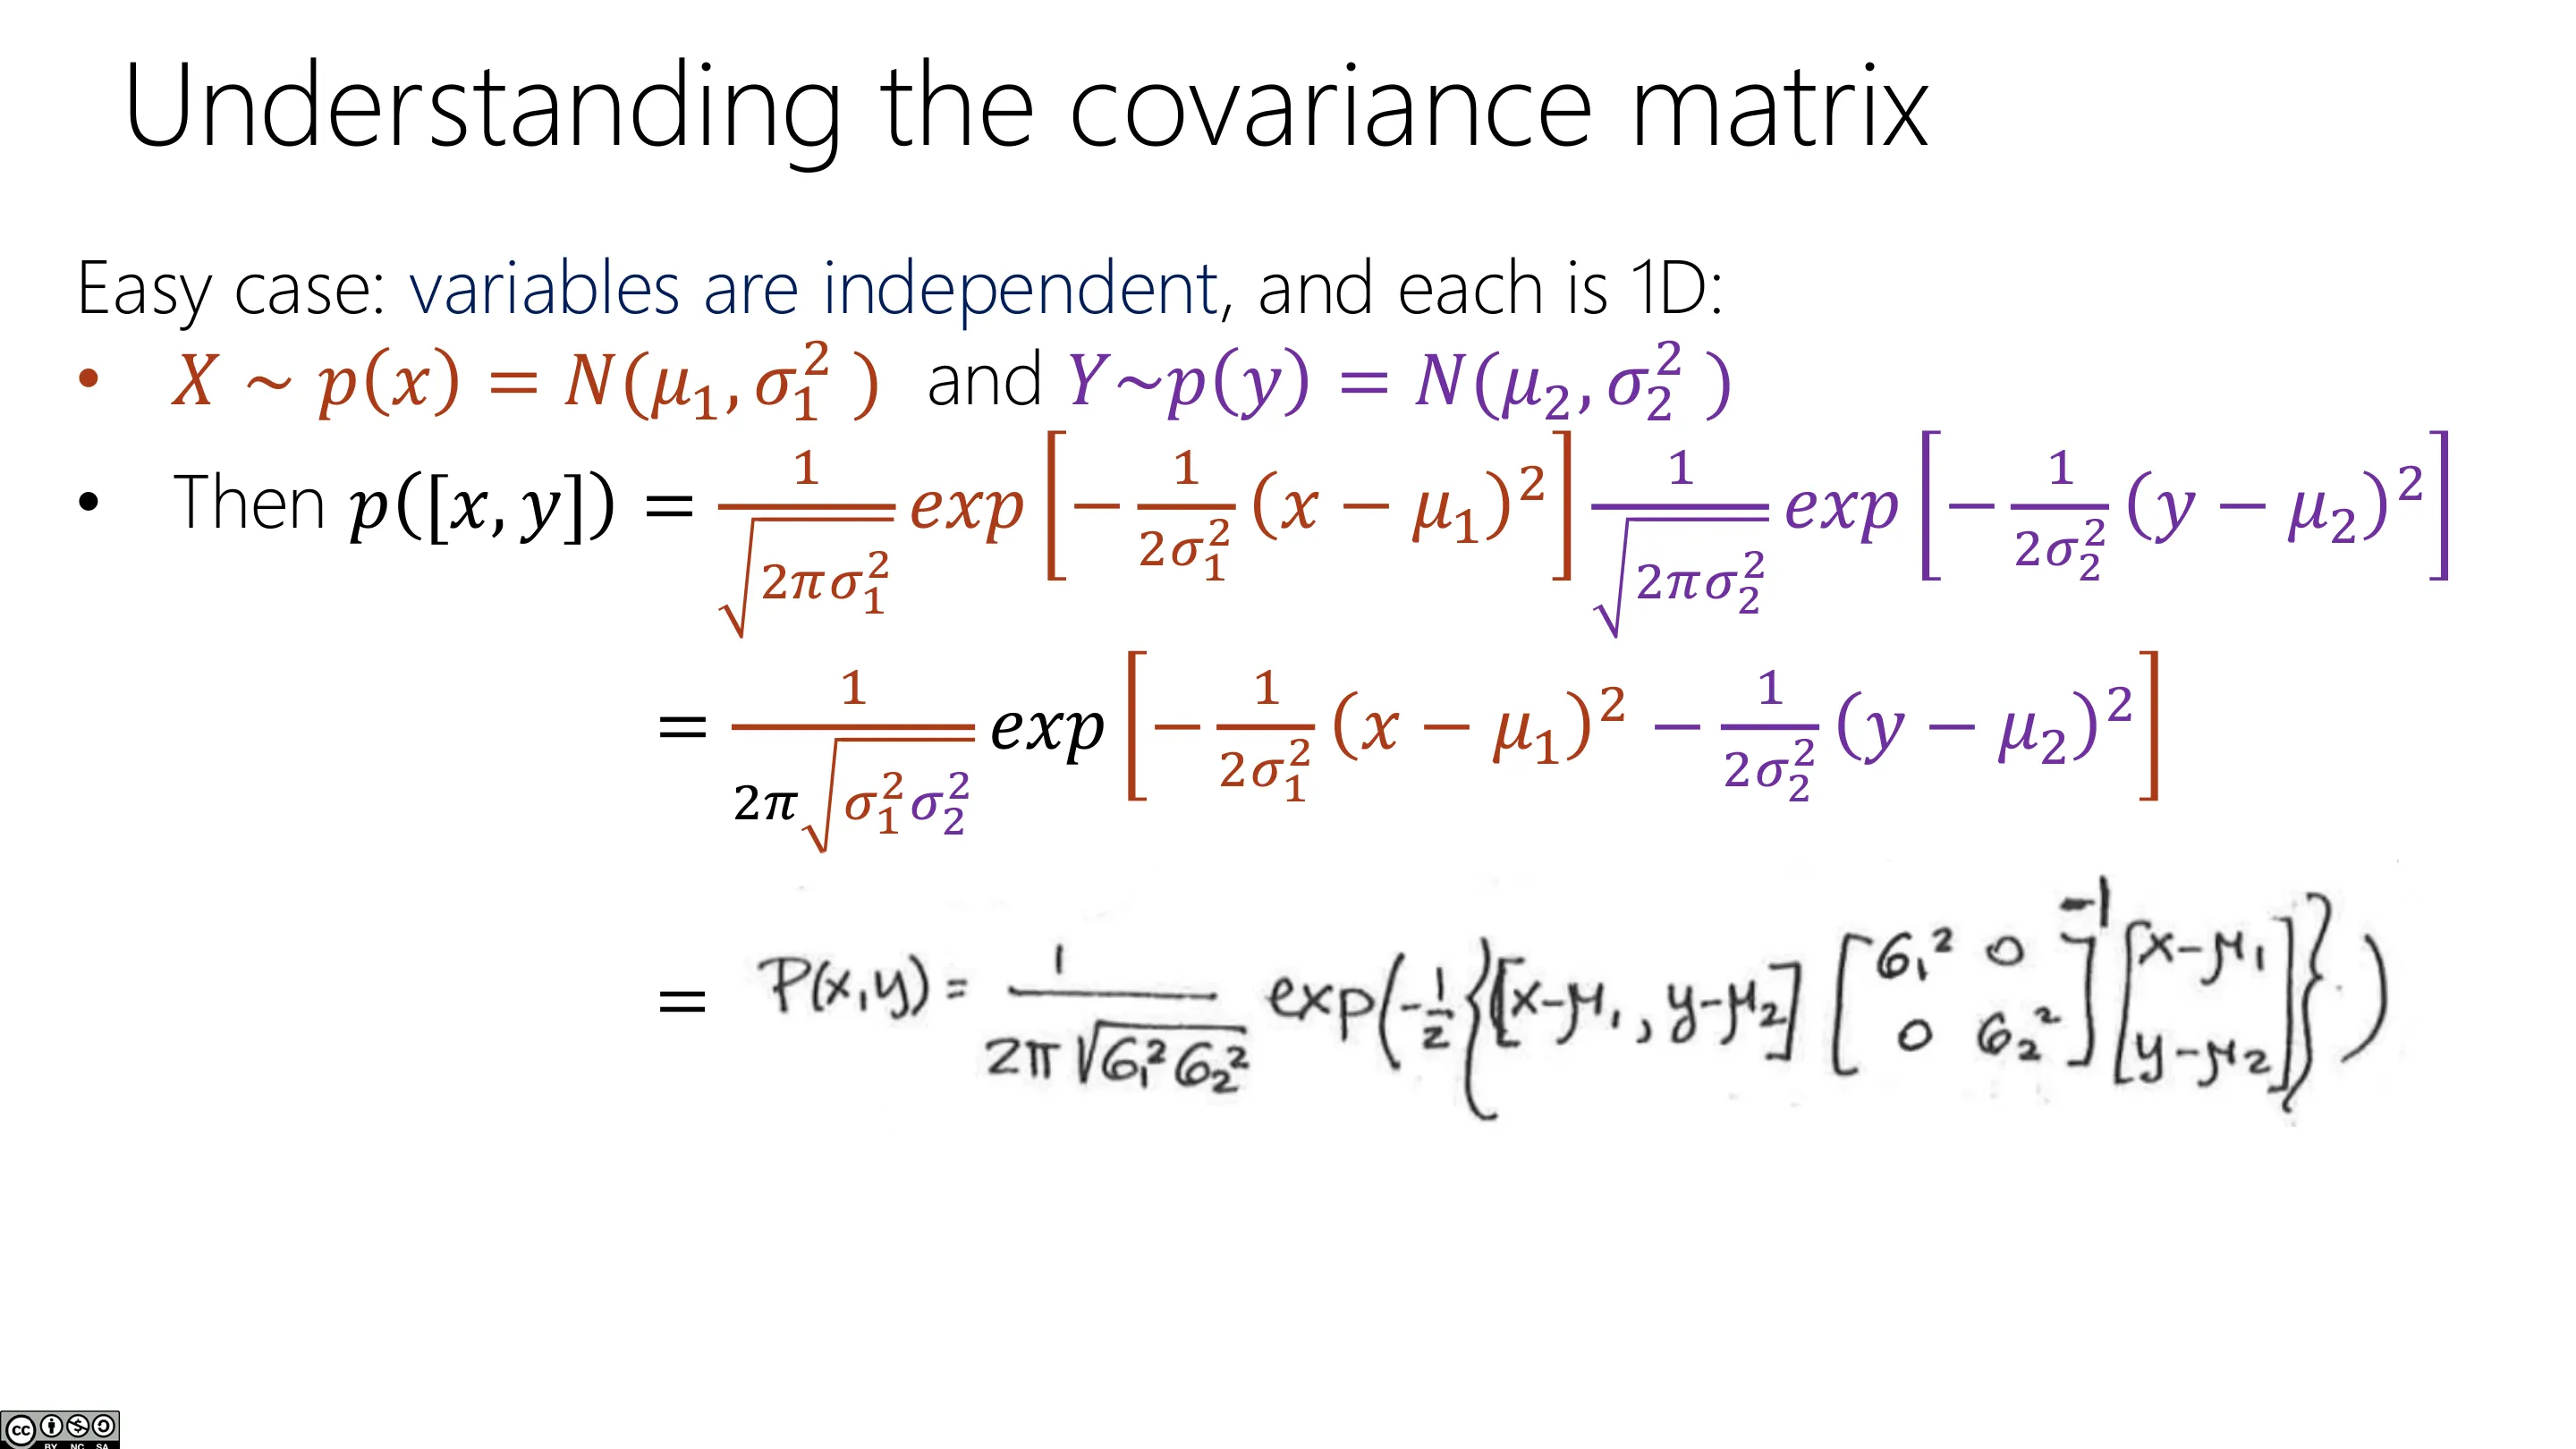
$$ p([x,y])=\frac{1}{\sqrt{2\pi\sigma_1^2}}e^{-\frac{(x-\mu_1)^2}{2\sigma_1^2}}\cdot\frac{1}{\sqrt{2\pi\sigma_2^2}}e^{-\frac{(y-\mu_2)^2}{2\sigma_2^2}}=\frac{1}{2\pi\sqrt{\sigma_1^2\sigma_2^2}}\exp\!\Big(-\tfrac12\frac{(x-\mu_1)^2}{\sigma_1^2}-\tfrac12\frac{(y-\mu_2)^2}{\sigma_2^2}\Big) $$
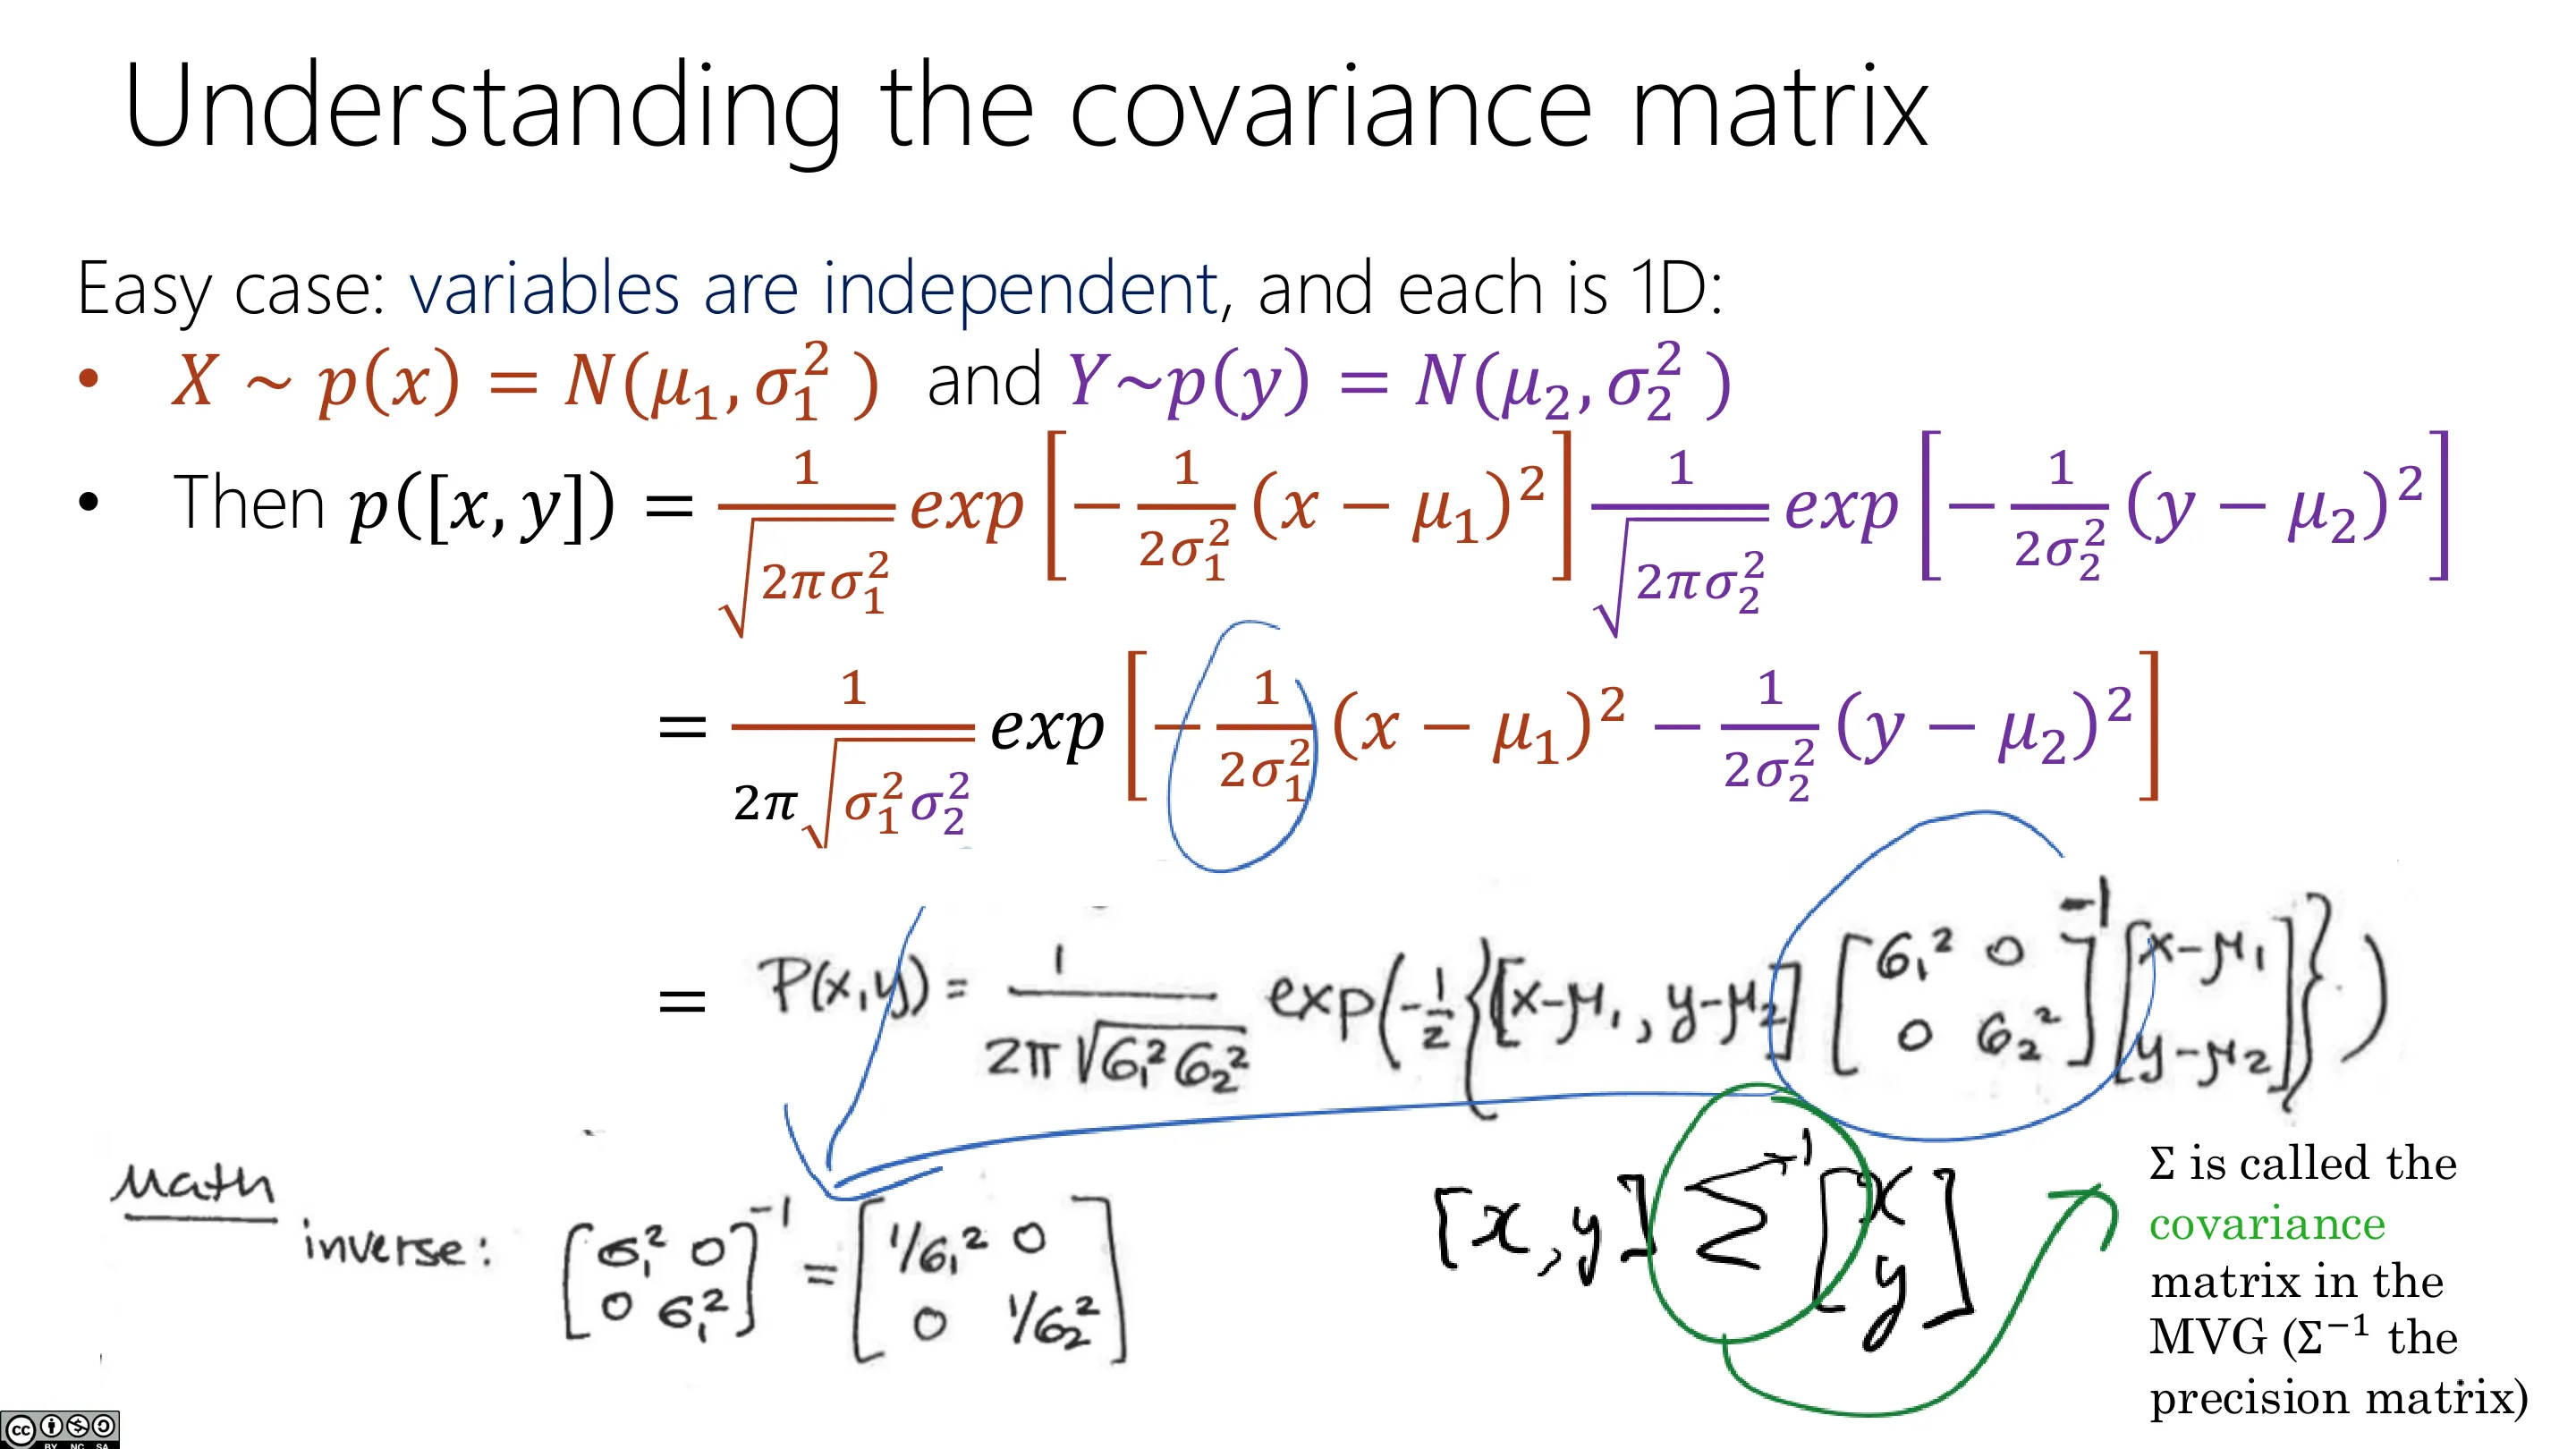
把它整理成向量—矩阵形式,就得到只有一个均值和一个协方差矩阵 $\Sigma$ 的多元高斯:
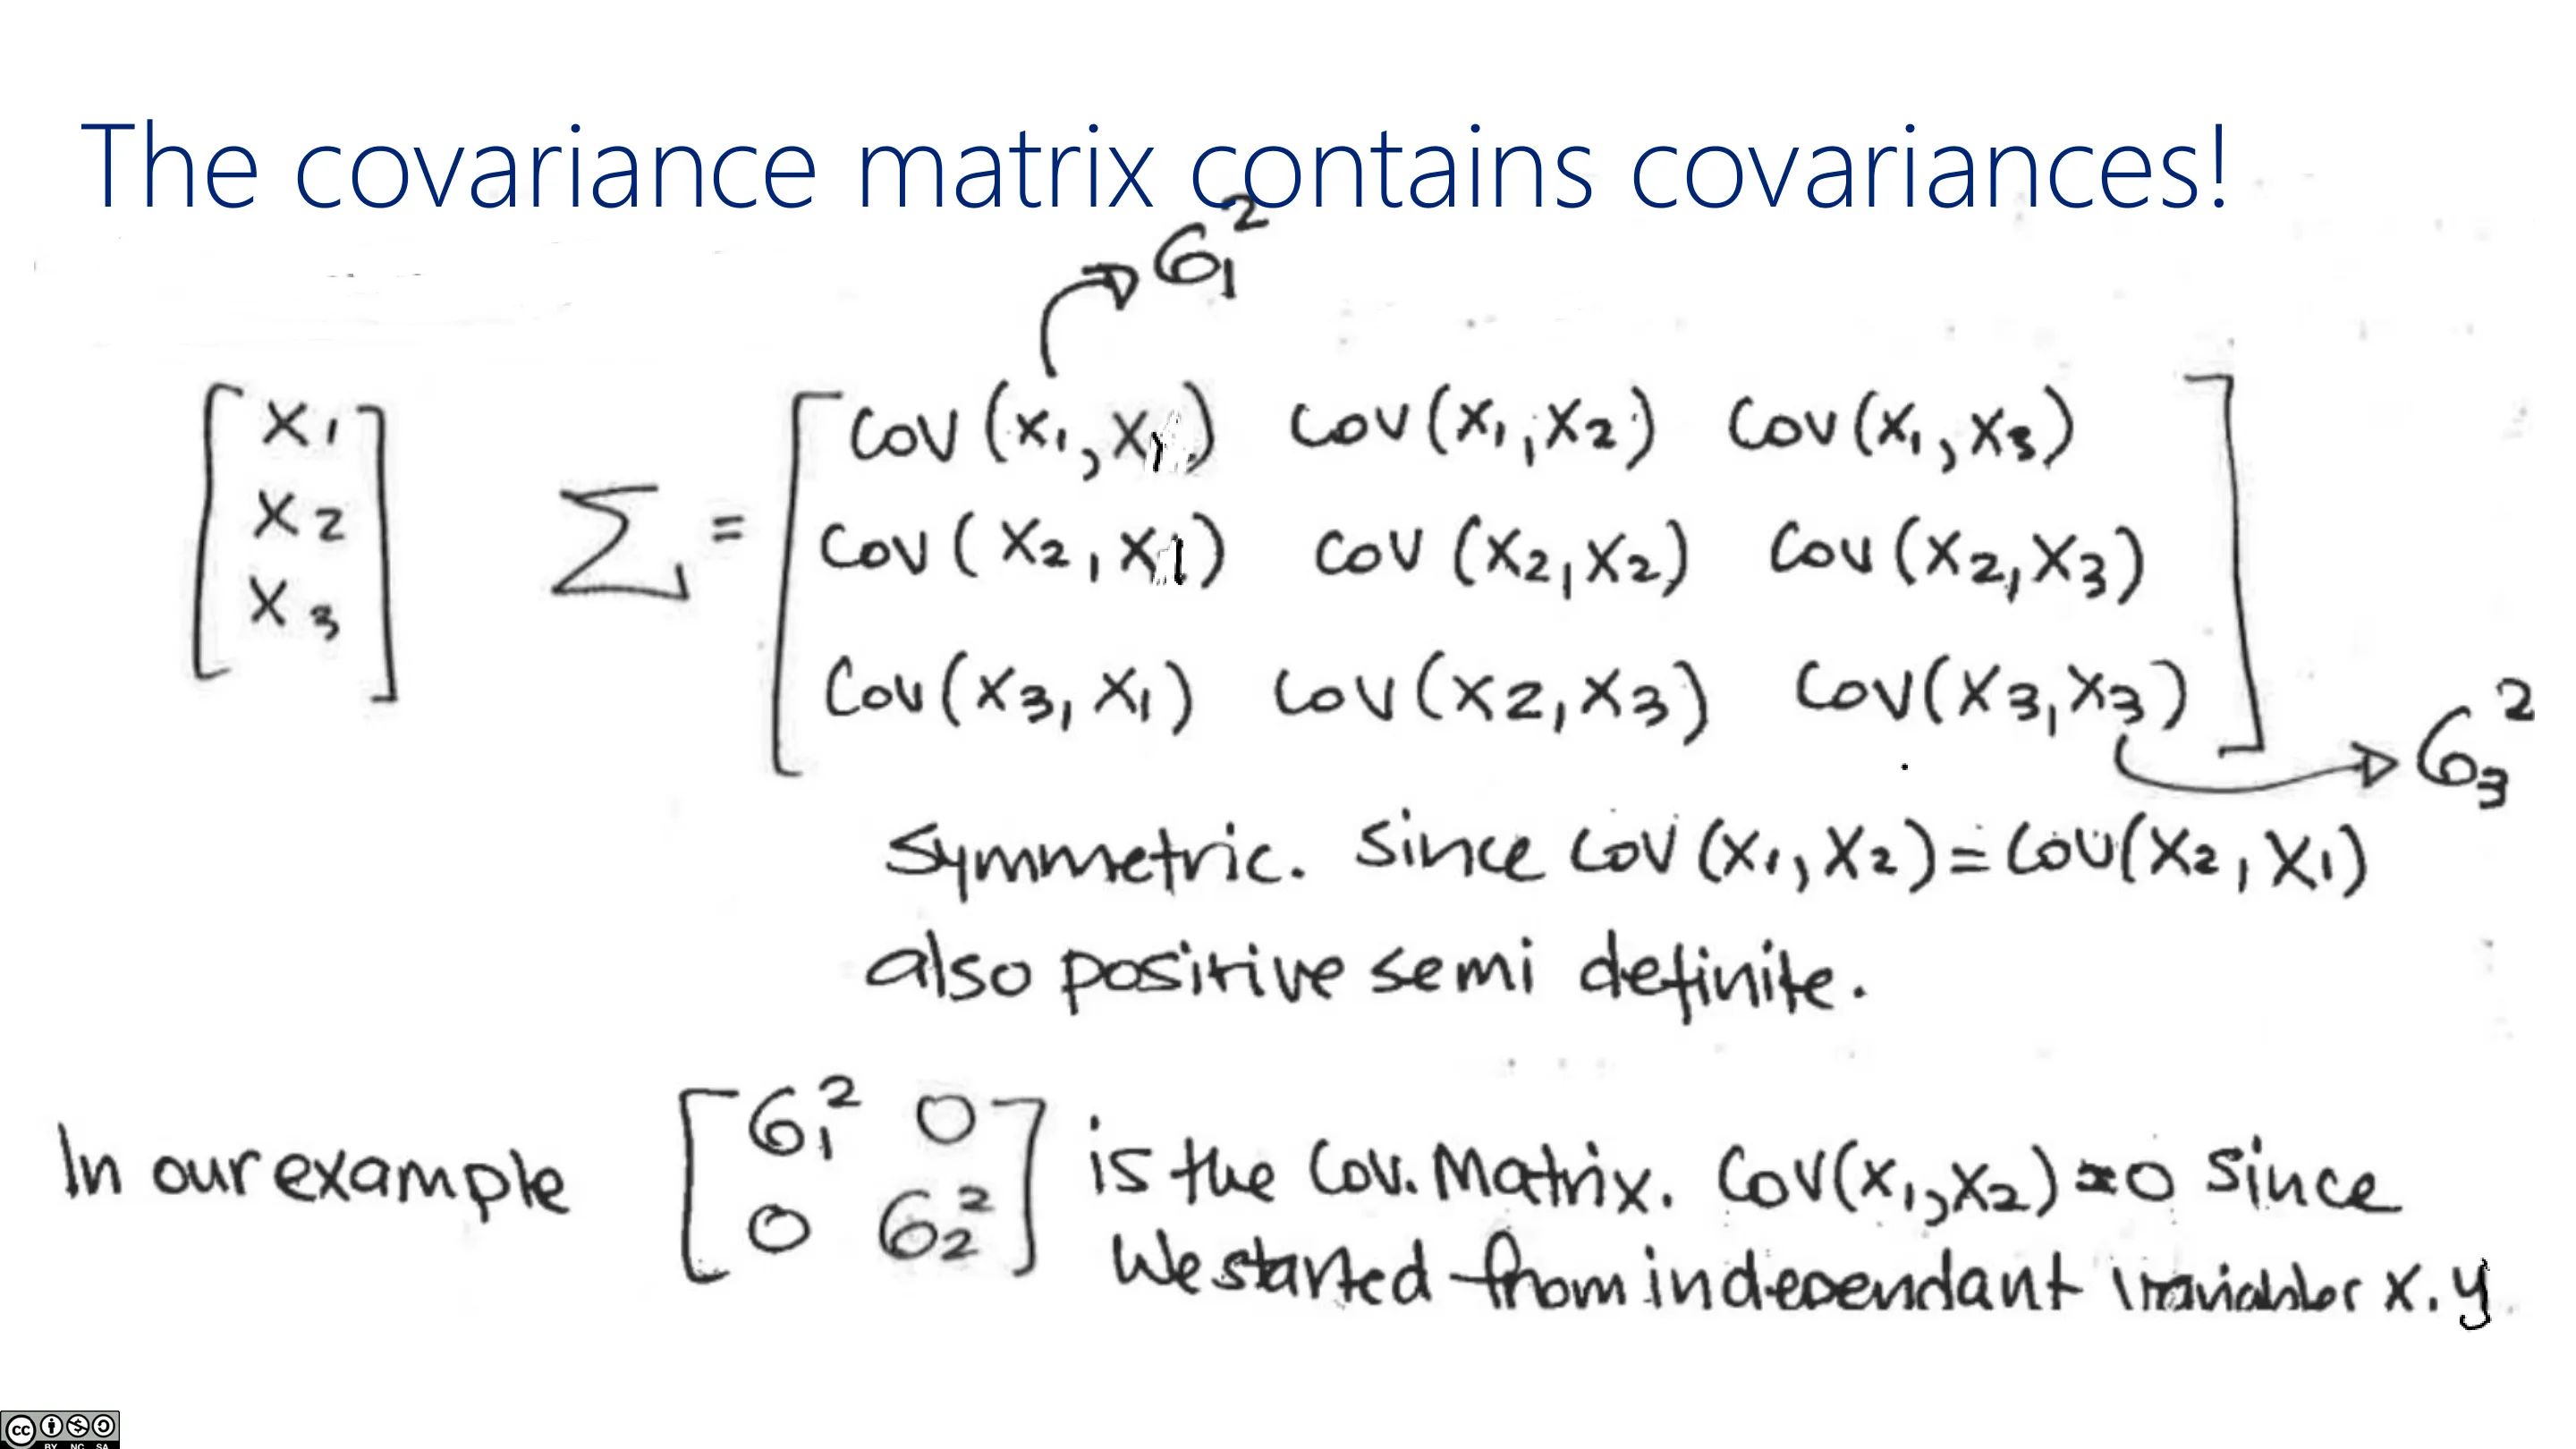
$$ \Sigma=\begin{pmatrix}\sigma_1^2&0\\0&\sigma_2^2\end{pmatrix},\qquad \Sigma^{-1}=\begin{pmatrix}1/\sigma_1^2&0\\0&1/\sigma_2^2\end{pmatrix} $$
$\Sigma$ 称为协方差矩阵,$\Sigma^{-1}$ 称为精度矩阵(precision matrix)。独立 ⇒ 对角矩阵,两个标量就足以描述分布——这与直觉完全吻合。
📷 独立的简单情形(一)
回到原视频 (00:33:39)
📷 独立的简单情形(二)
回到原视频 (00:34:00)
📷 独立的简单情形(三):整理成矩阵形式
回到原视频 (00:36:24)
📷 独立的简单情形(四):对角协方差矩阵
回到原视频 (00:38:24)
编者说明:讲师强调一个通用的合理性检查——因为整个式子是由标量拼出来的,最后一定还是标量;做作业/考试时检查维度是发现错误的好办法。另外,对角矩阵求逆只需把对角元取倒数,遇到时应该高兴。
2.4 复习:期望、方差、协方差
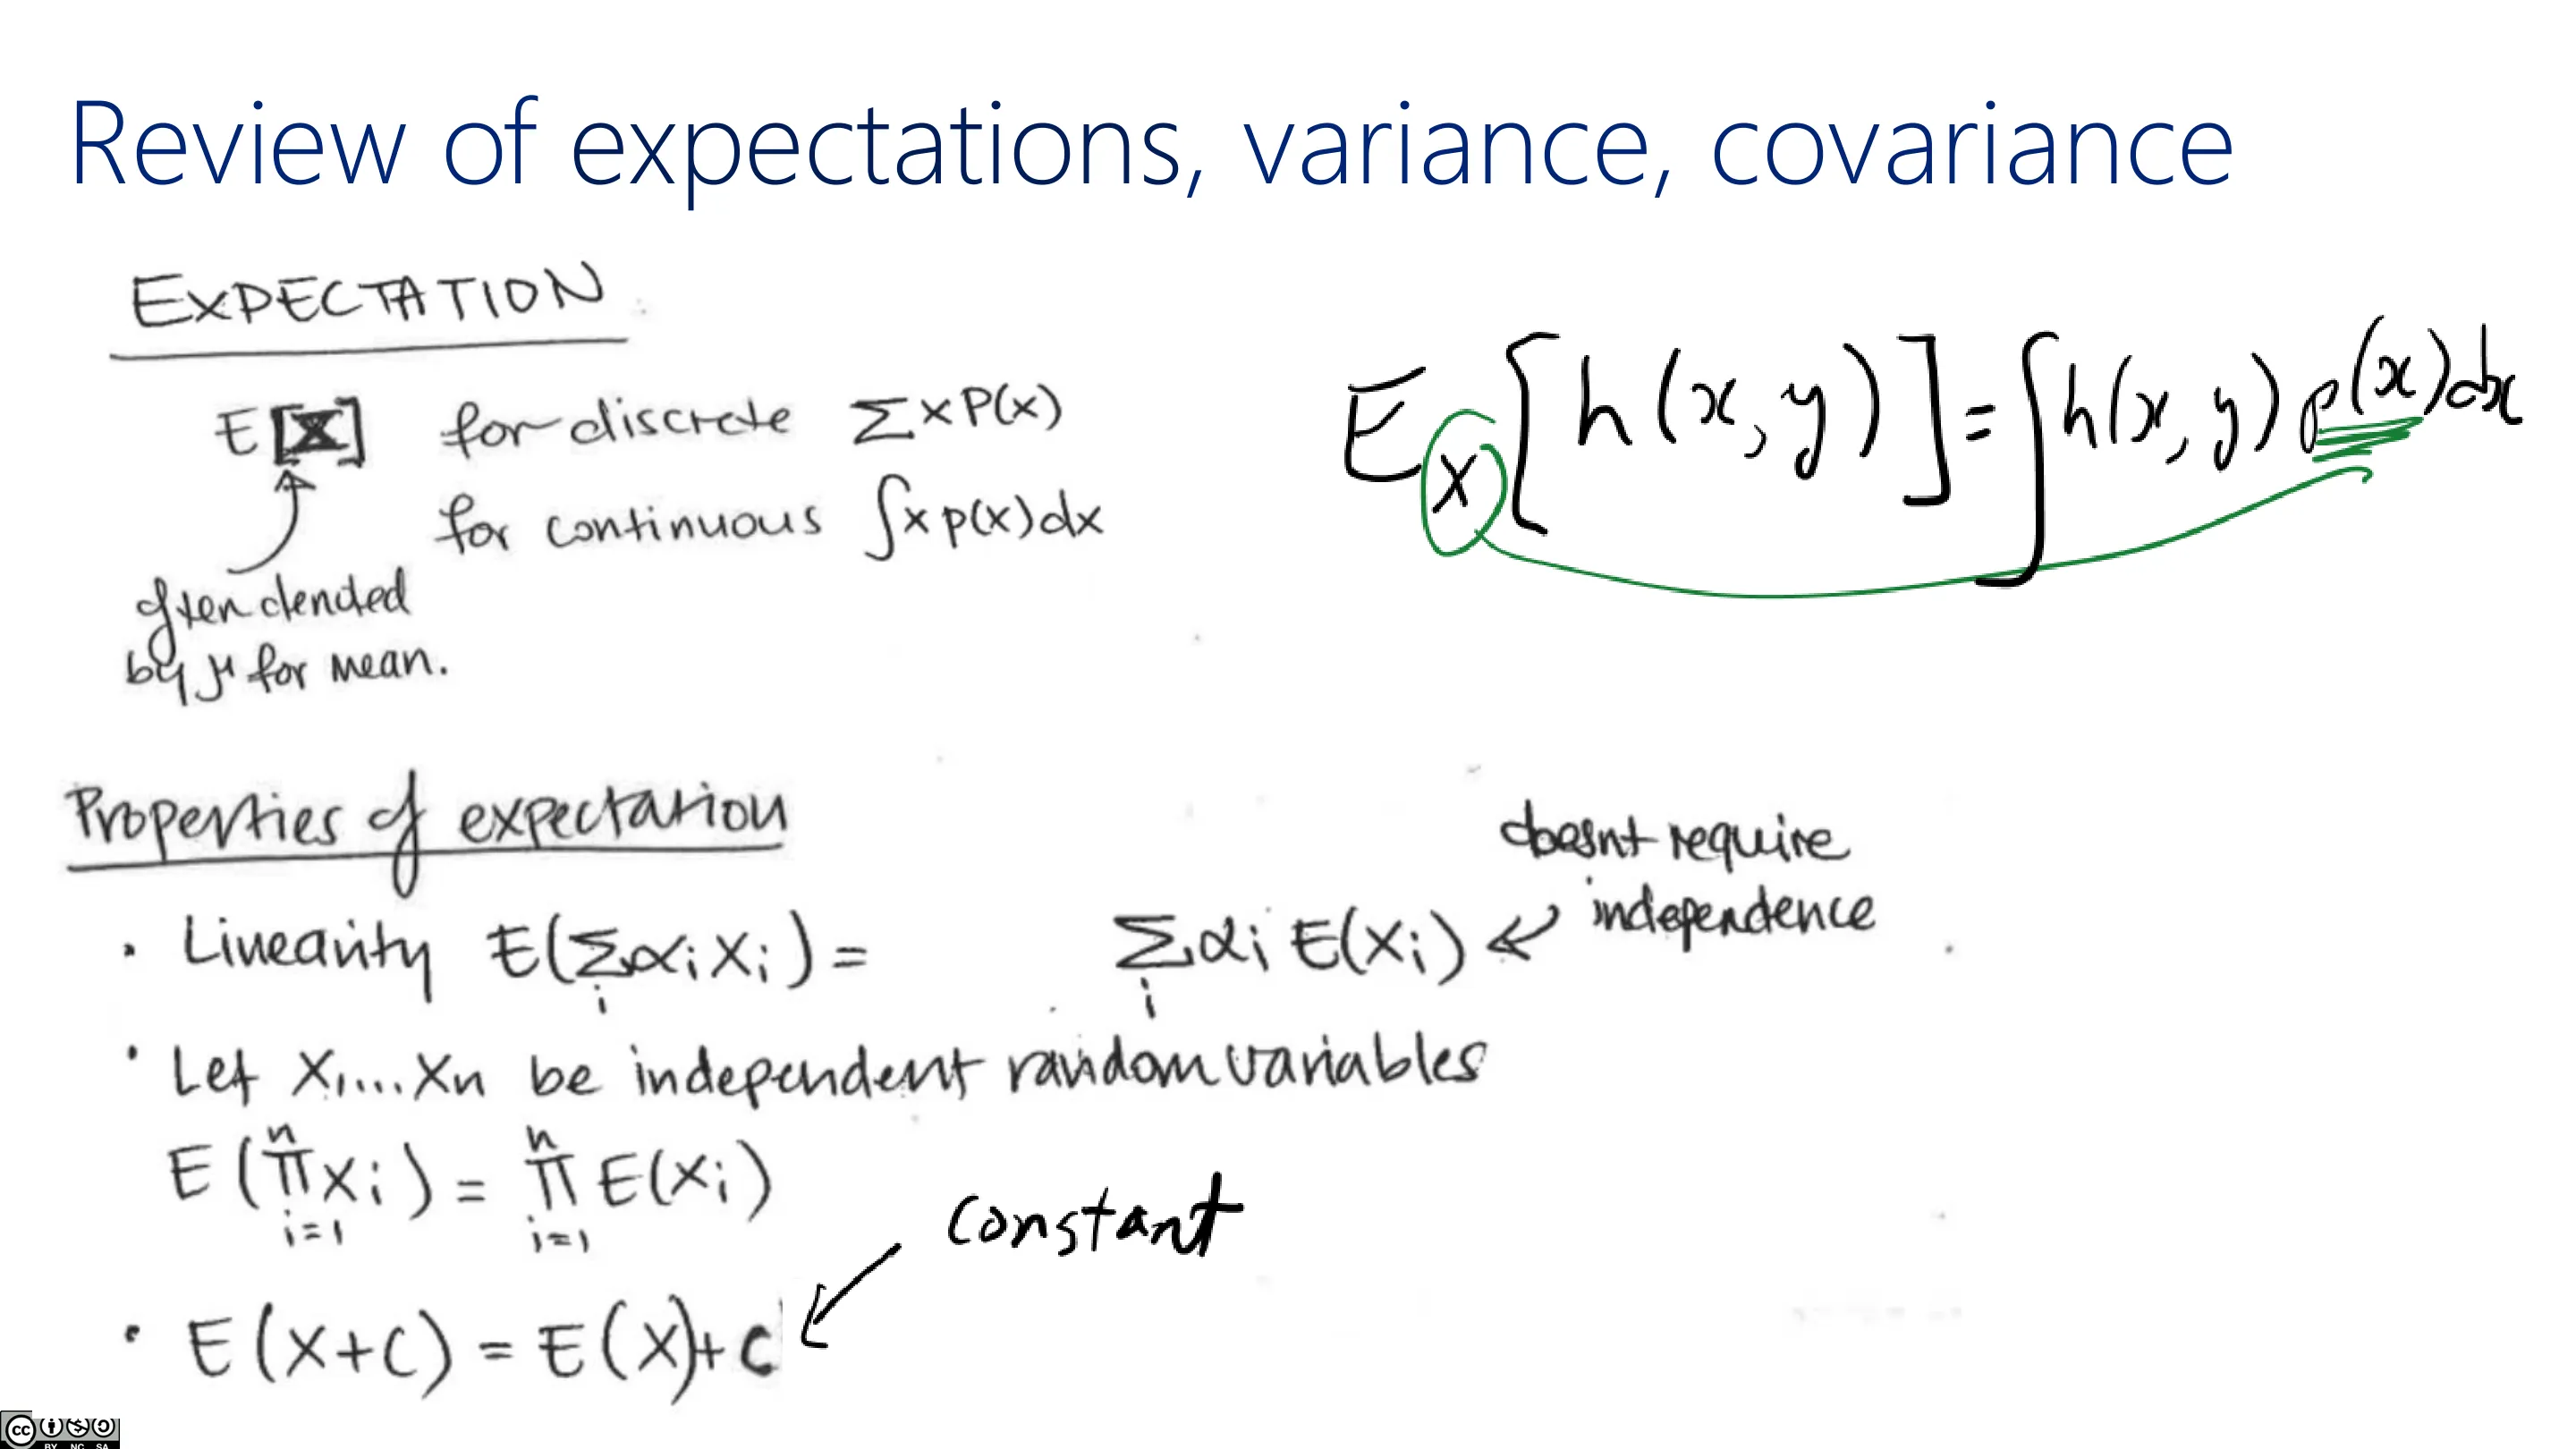
期望(离散求和、连续积分):$\mathbb{E}[X]=\sum_x x\,p(x)$(连续为 $\int x\,p(x)dx$)。性质:线性(不要求独立)、独立时可把期望「拉进」乘积、$\mathbb{E}[X+c]=\mathbb{E}[X]+c$。
📷 期望、方差、协方差复习(一)
回到原视频 (00:46:18)
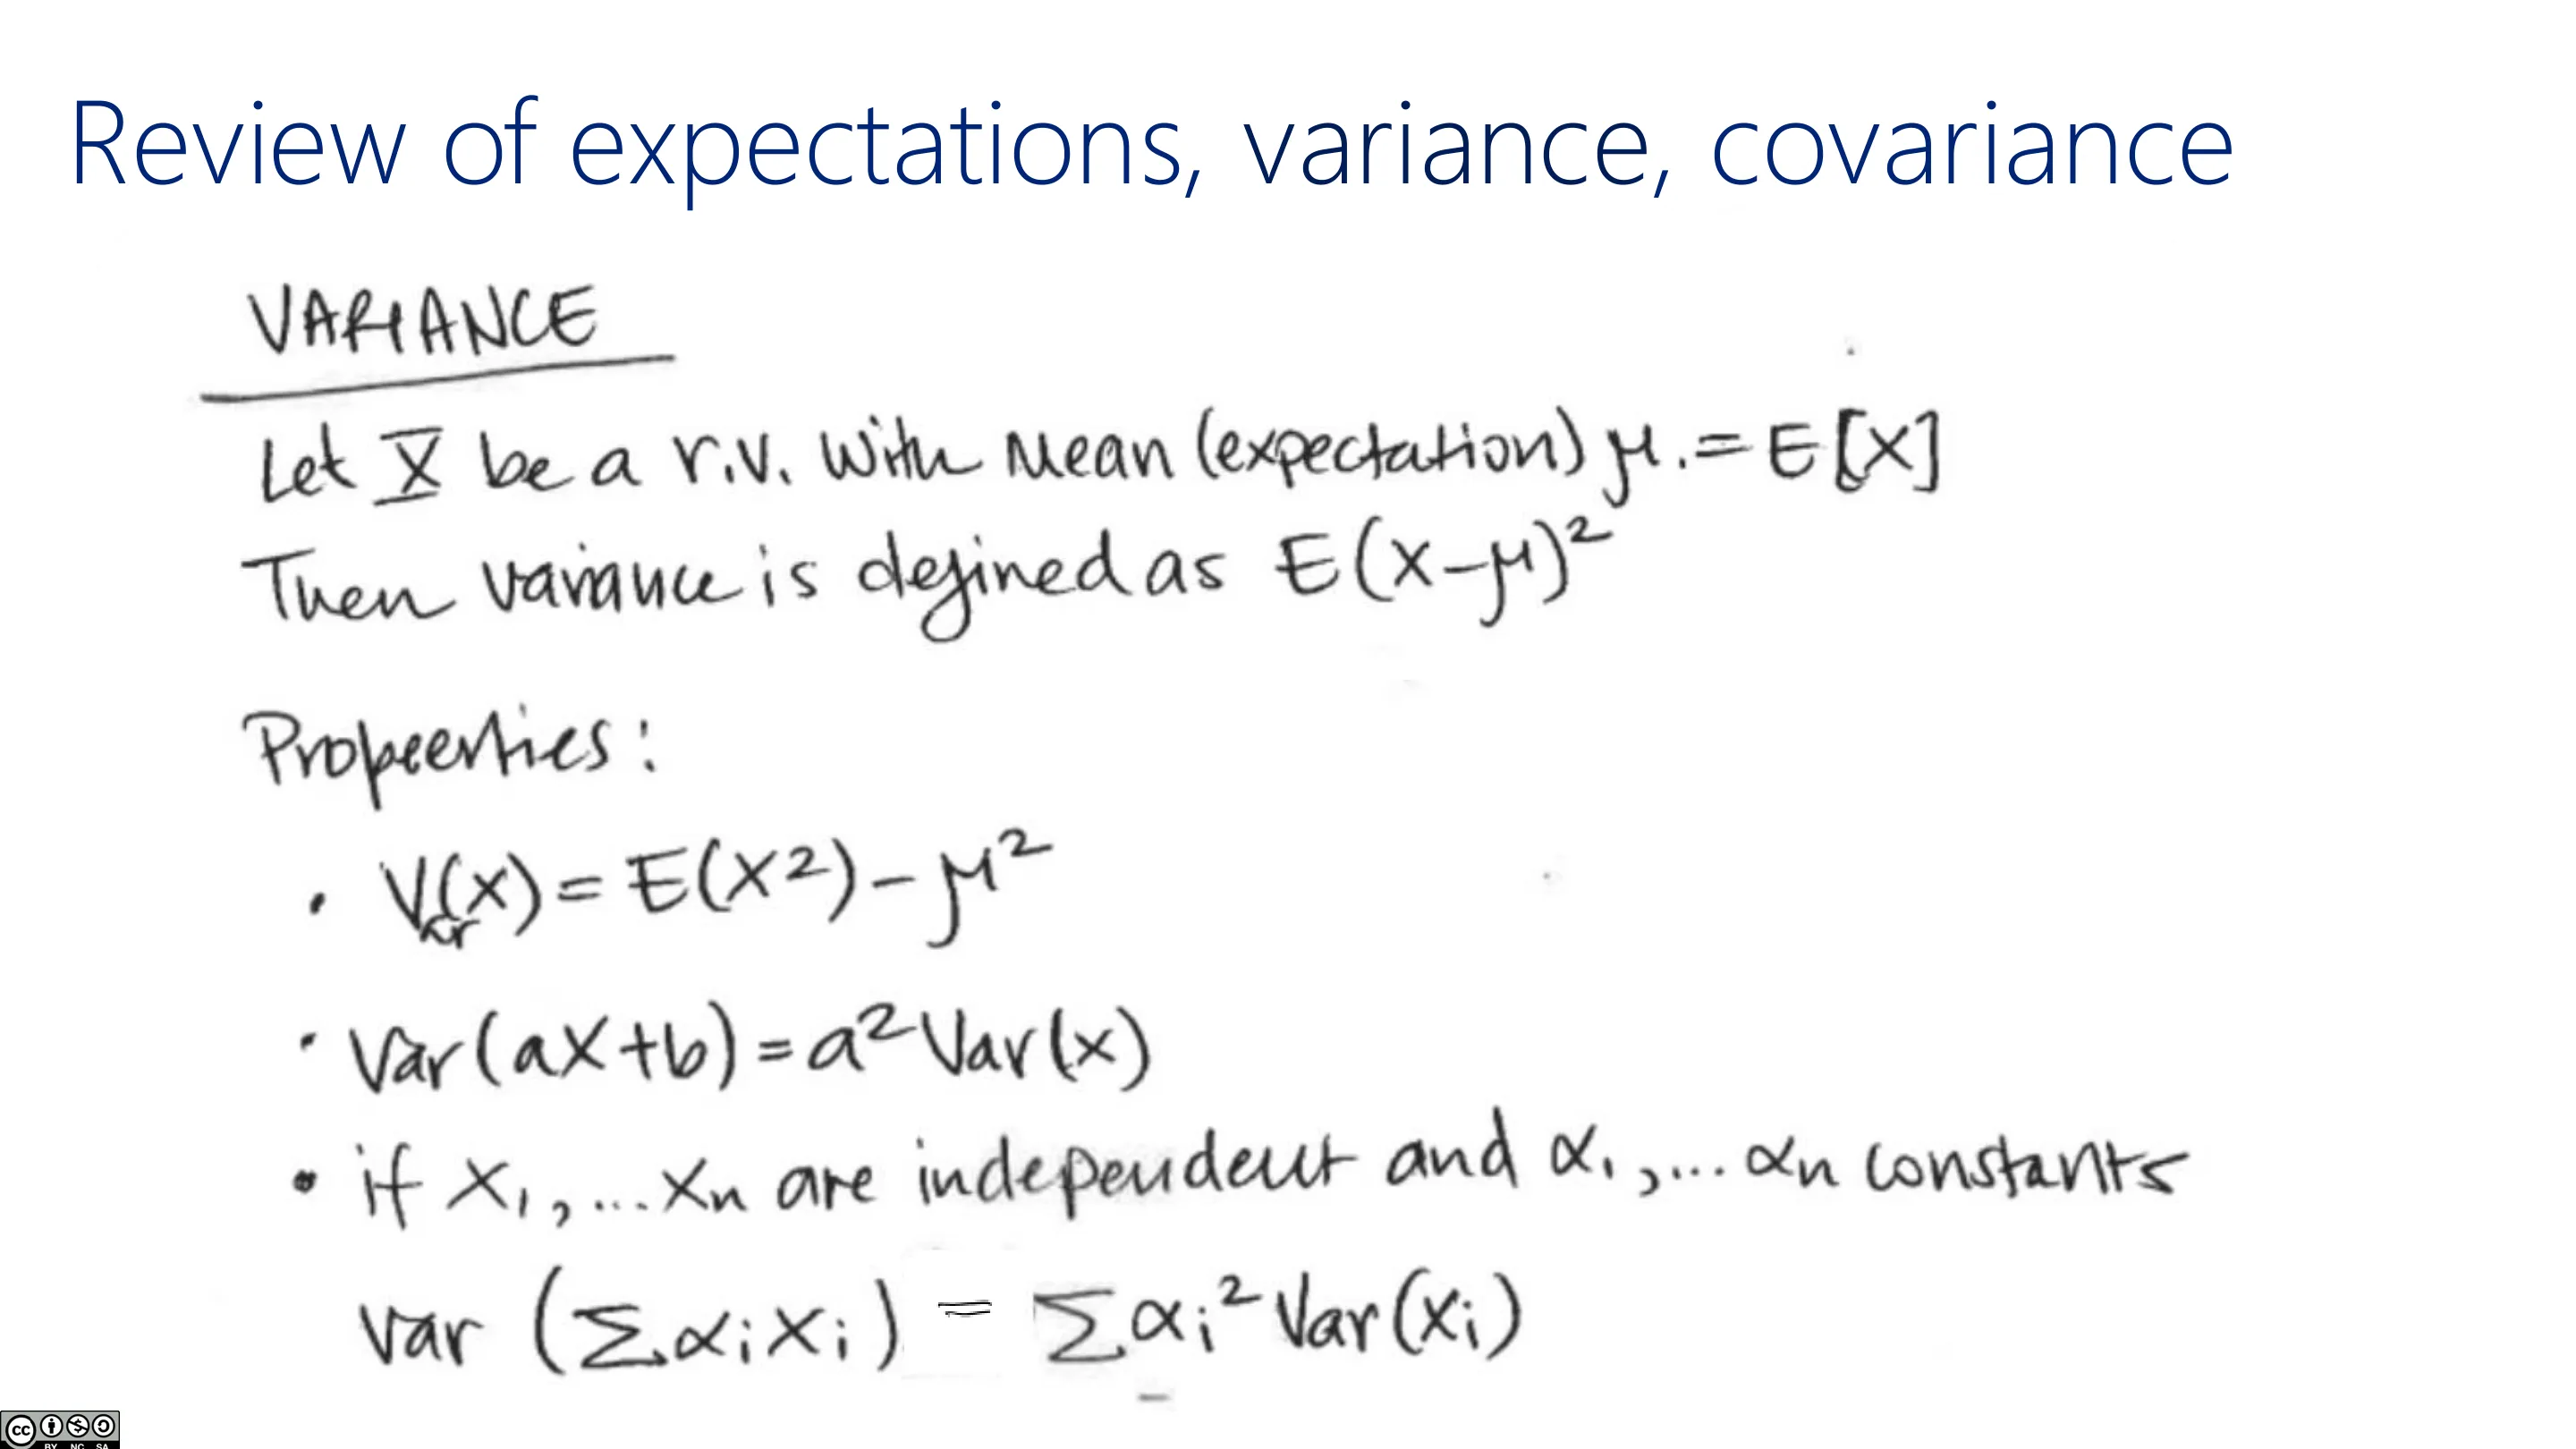
方差:$\mathrm{Var}(X)=\mathbb{E}[(X-\mathbb{E}[X])^2]=\mathbb{E}[X^2]-(\mathbb{E}[X])^2$。性质:加常数不影响方差,乘常数 $a$ 则方差乘 $a^2$;独立变量线性组合的方差是各方差(系数平方后)之和。
📷 期望、方差、协方差复习(二)
回到原视频 (00:47:28)
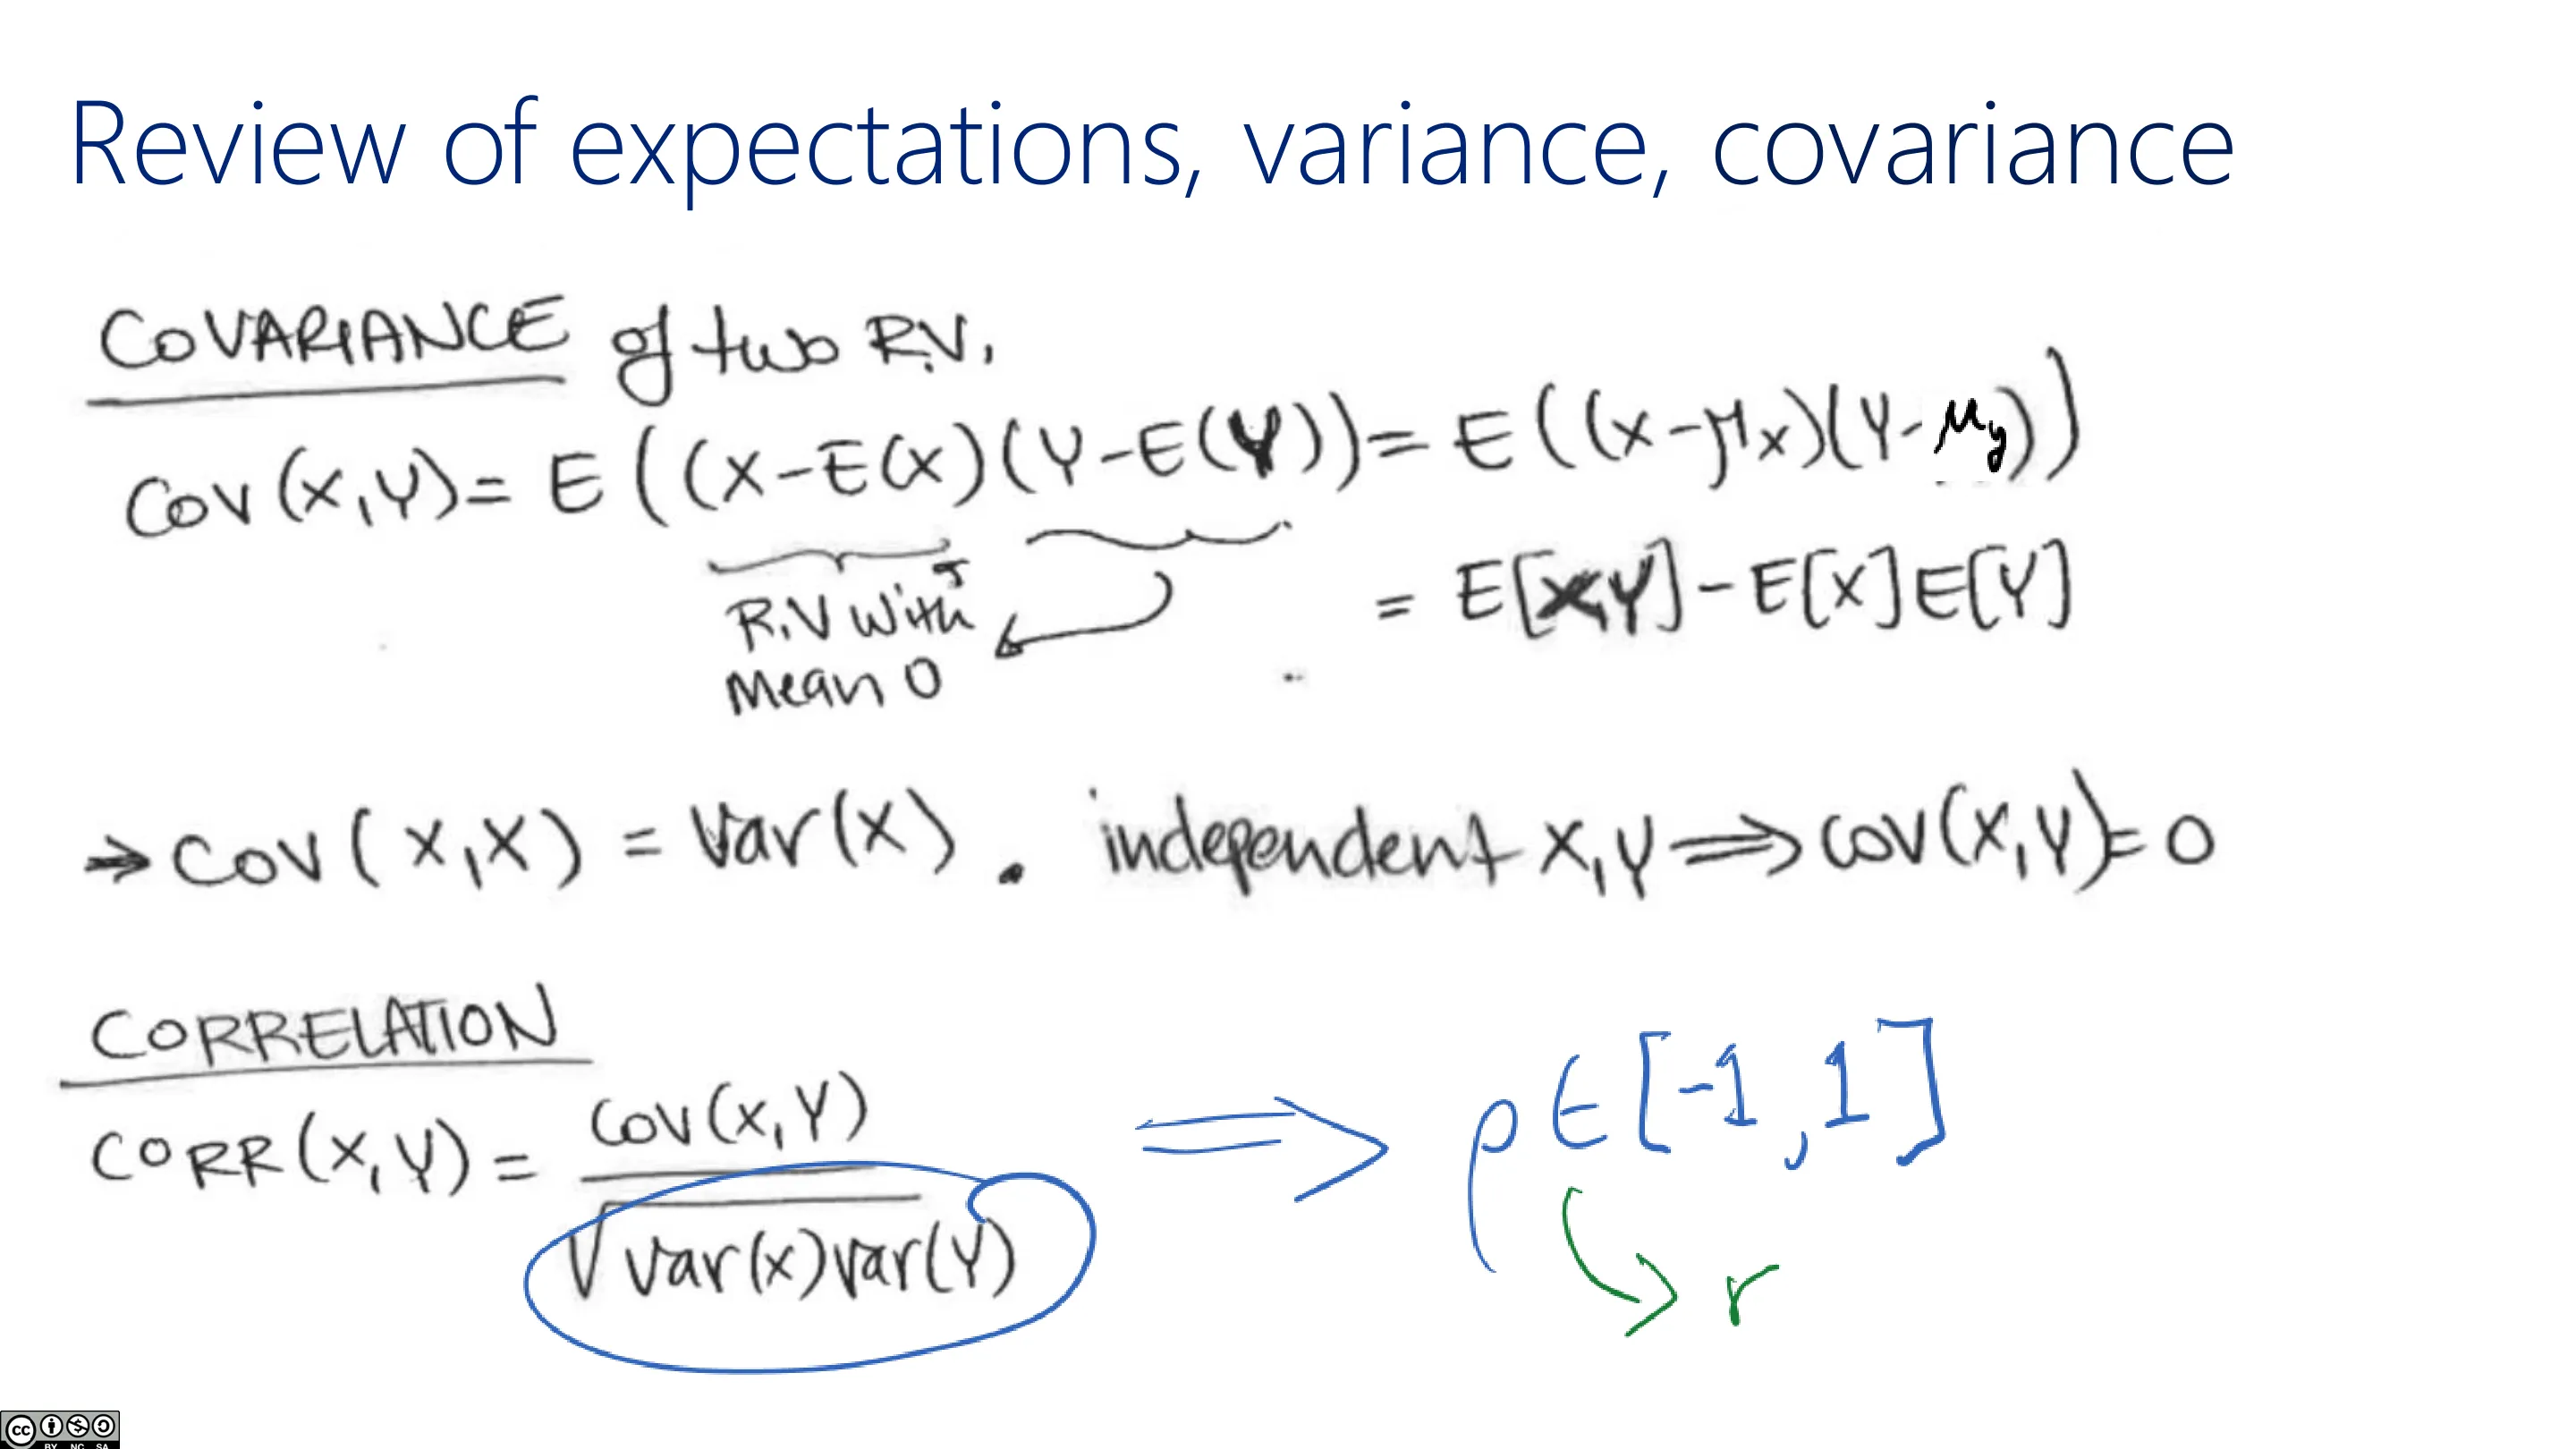
📷 期望、方差、协方差复习(三)
回到原视频 (00:52:01)
协方差:$\mathrm{Cov}(X,Y)=\mathbb{E}[(X-\mathbb{E}X)(Y-\mathbb{E}Y)]=\mathbb{E}[XY]-\mathbb{E}[X]\mathbb{E}[Y]$。要点:
- $X$ 与自身的协方差就是方差;
- 若 $X,Y$ 独立,则协方差为 0(但反之不一定,除非联合高斯——见下);
- 相关系数(correlation)$r=\mathrm{Cov}(X,Y)/\sqrt{\mathrm{Var}(X)\mathrm{Var}(Y)}\in[-1,1]$,是有界的归一化版本(协方差本身无界)。
📷 回到简单情形
回到原视频 (00:56:25)
📷 协方差矩阵里装的正是协方差
回到原视频 (00:57:18)
2.5 一个重要事实:协方差为零 ⇔ 独立(仅对联合高斯)
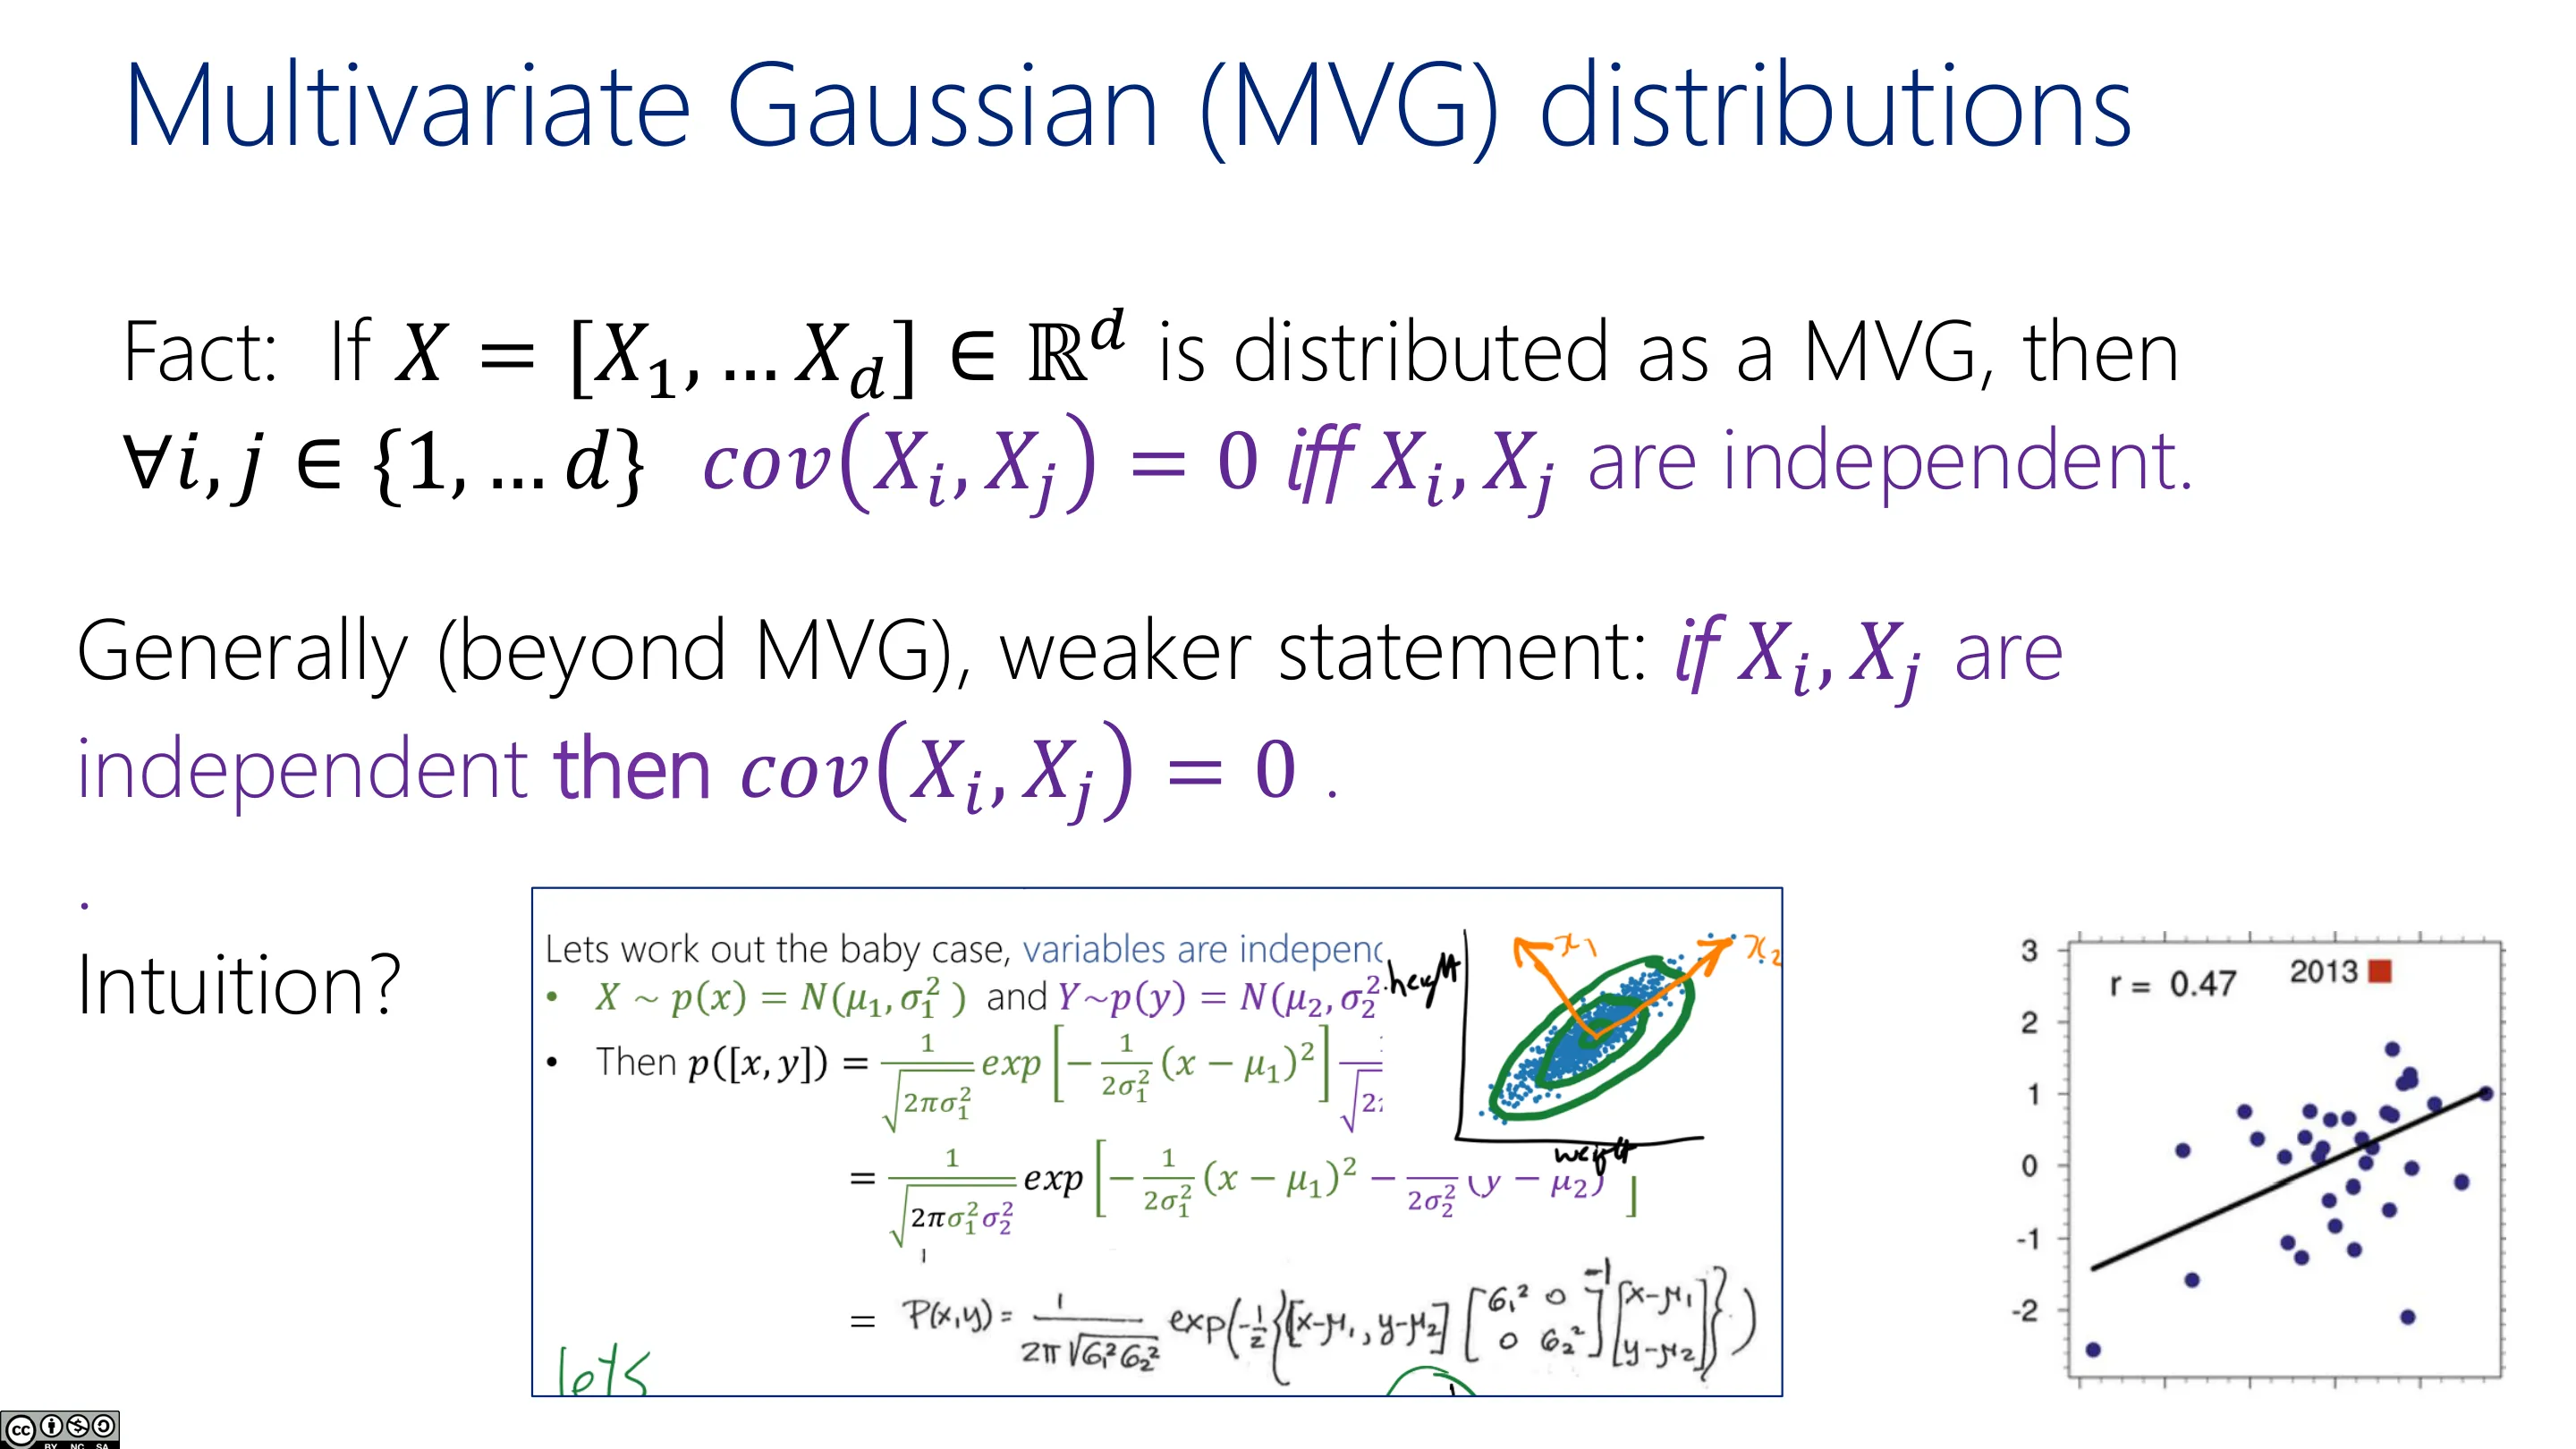
若 $X=[X_1,\dots,X_d]$ 联合服从 MVG,则对任意 $i,j$:$\mathrm{Cov}(X_i,X_j)=0 \iff X_i,X_j$ 独立。
而对一般(非联合高斯)的分布,只能得到较弱的单向结论:若独立,则协方差为 0(反之不成立)。
直觉:协方差只捕捉线性依赖。非高斯变量完全可能以非线性方式相互依赖,却仍有零协方差——所以「不相关」不等于「独立」。而高斯具有这种本质的「线性性」,才让二者几乎等价。
📷 MVG 中协方差为零 ⇔ 独立
回到原视频 (00:58:59)
2.6 一般情形:二次型与椭圆水平集
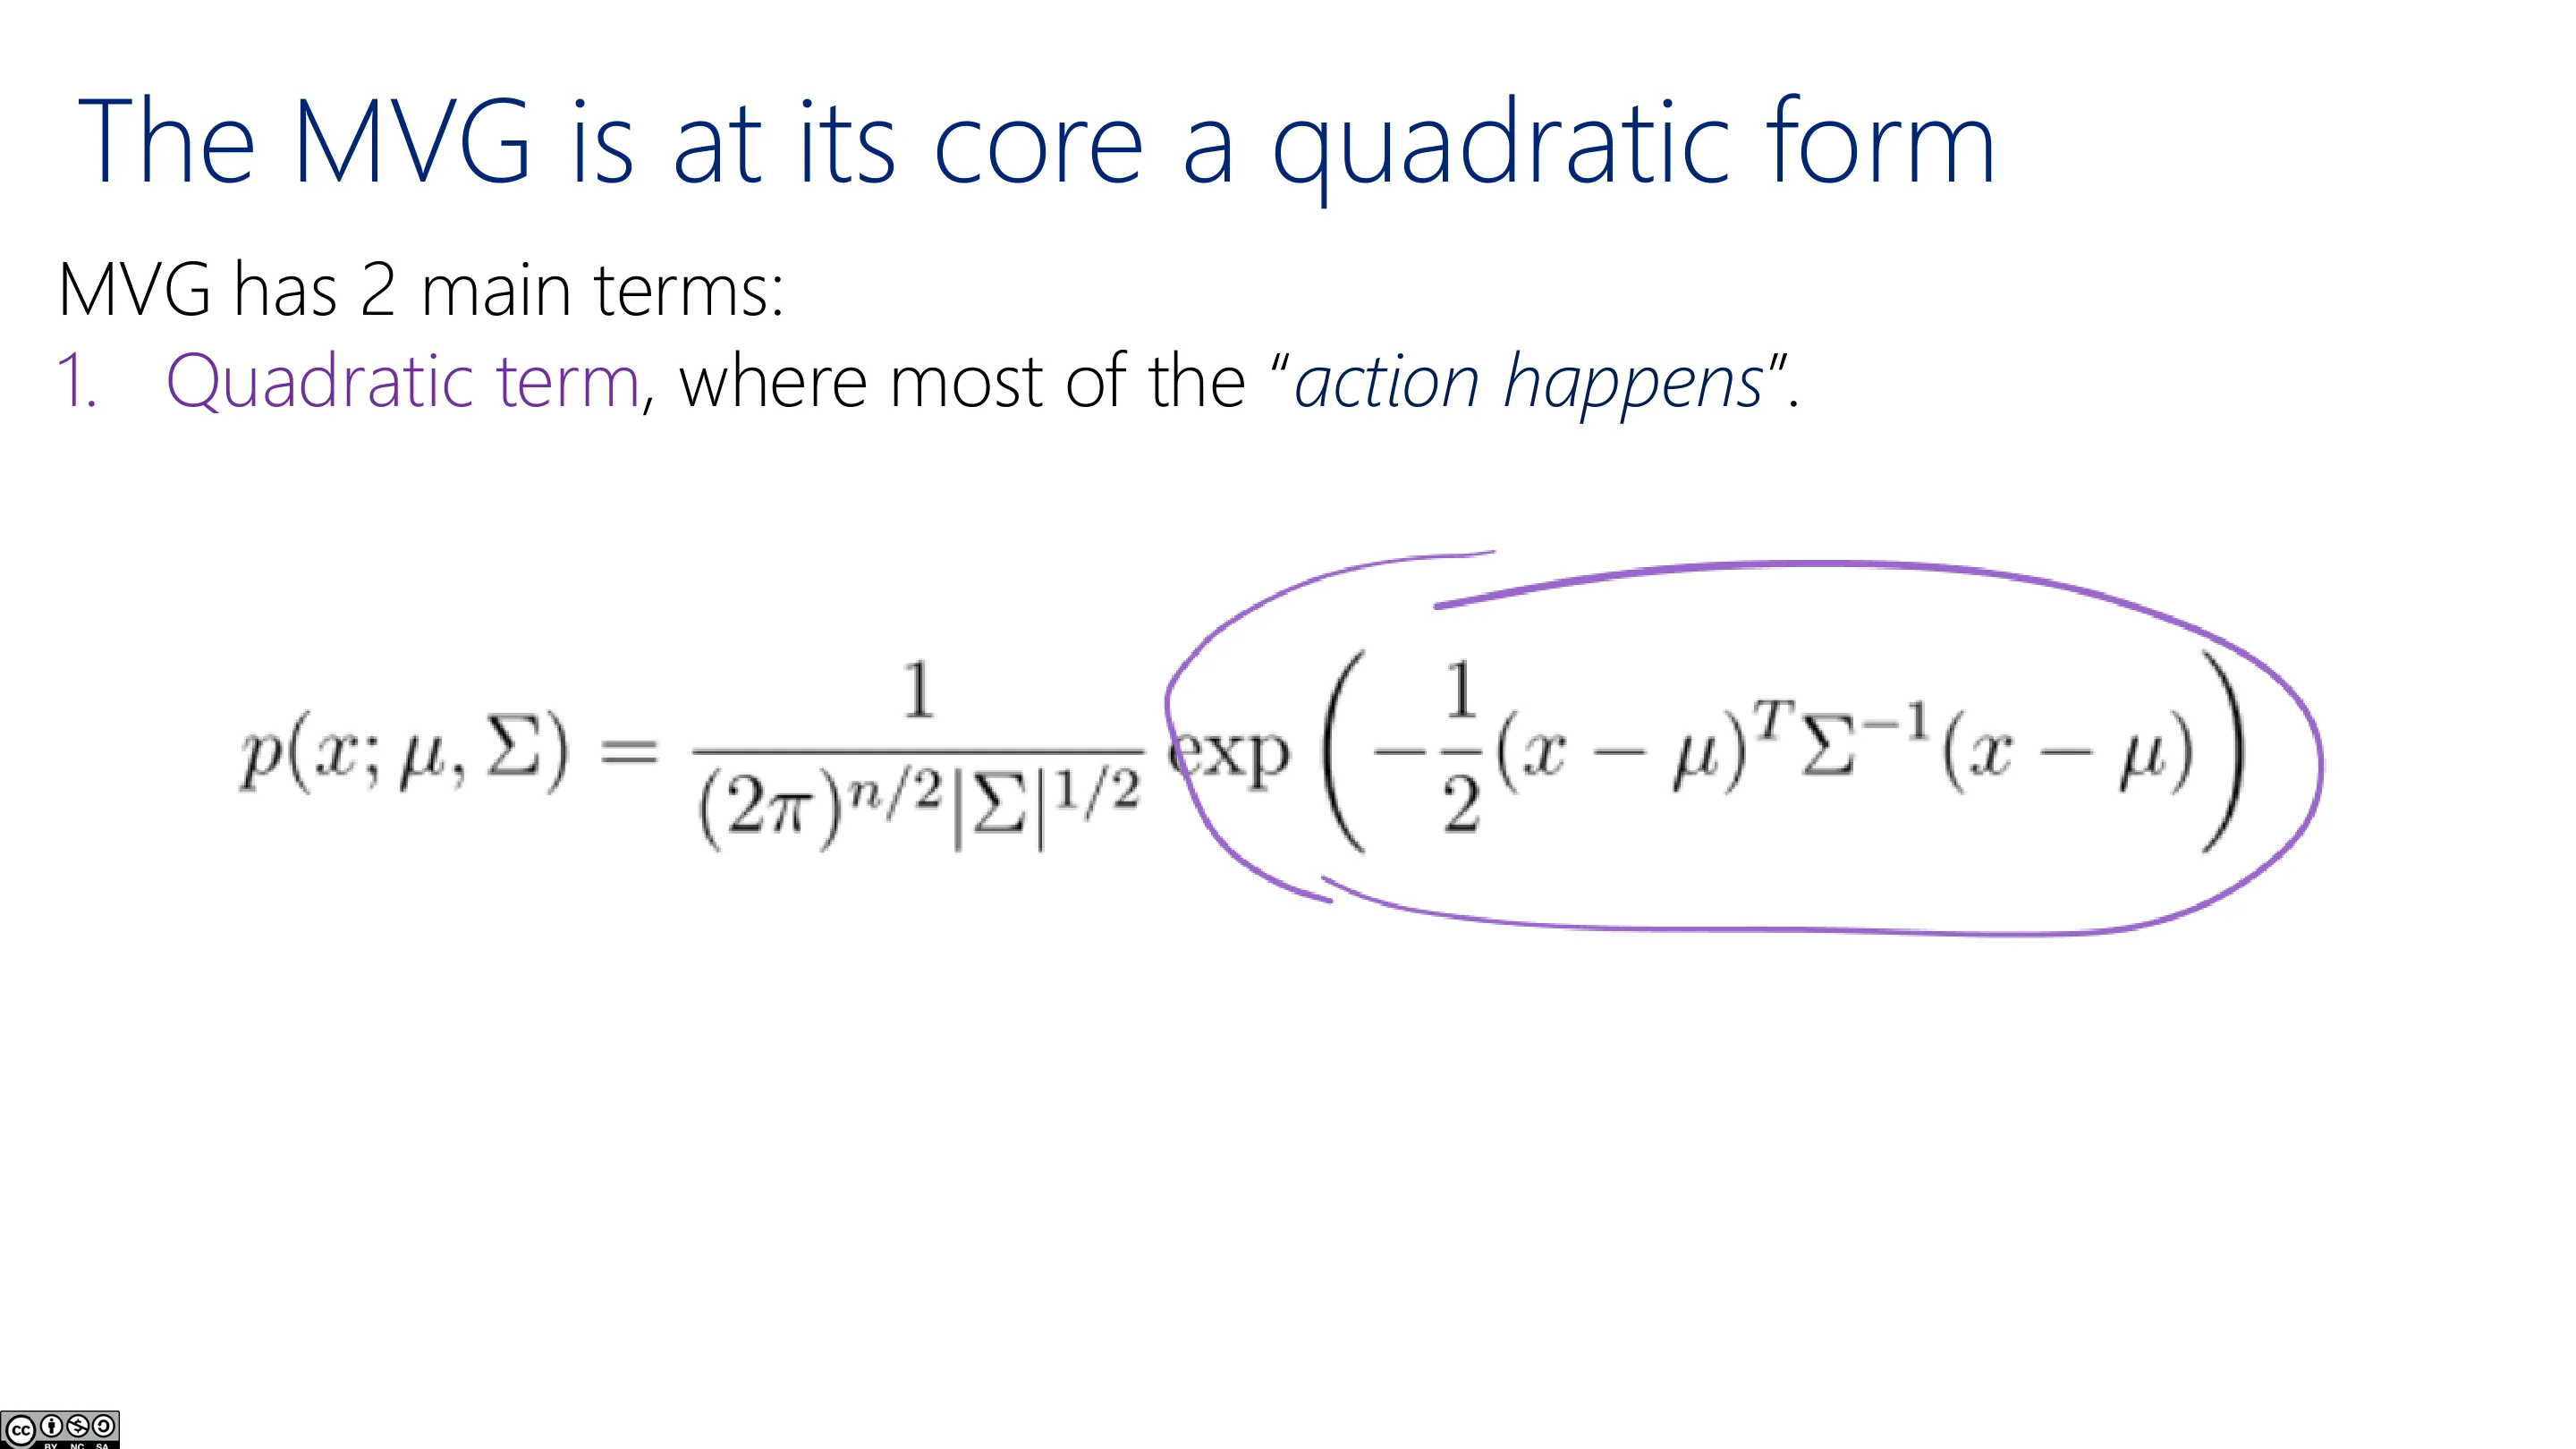
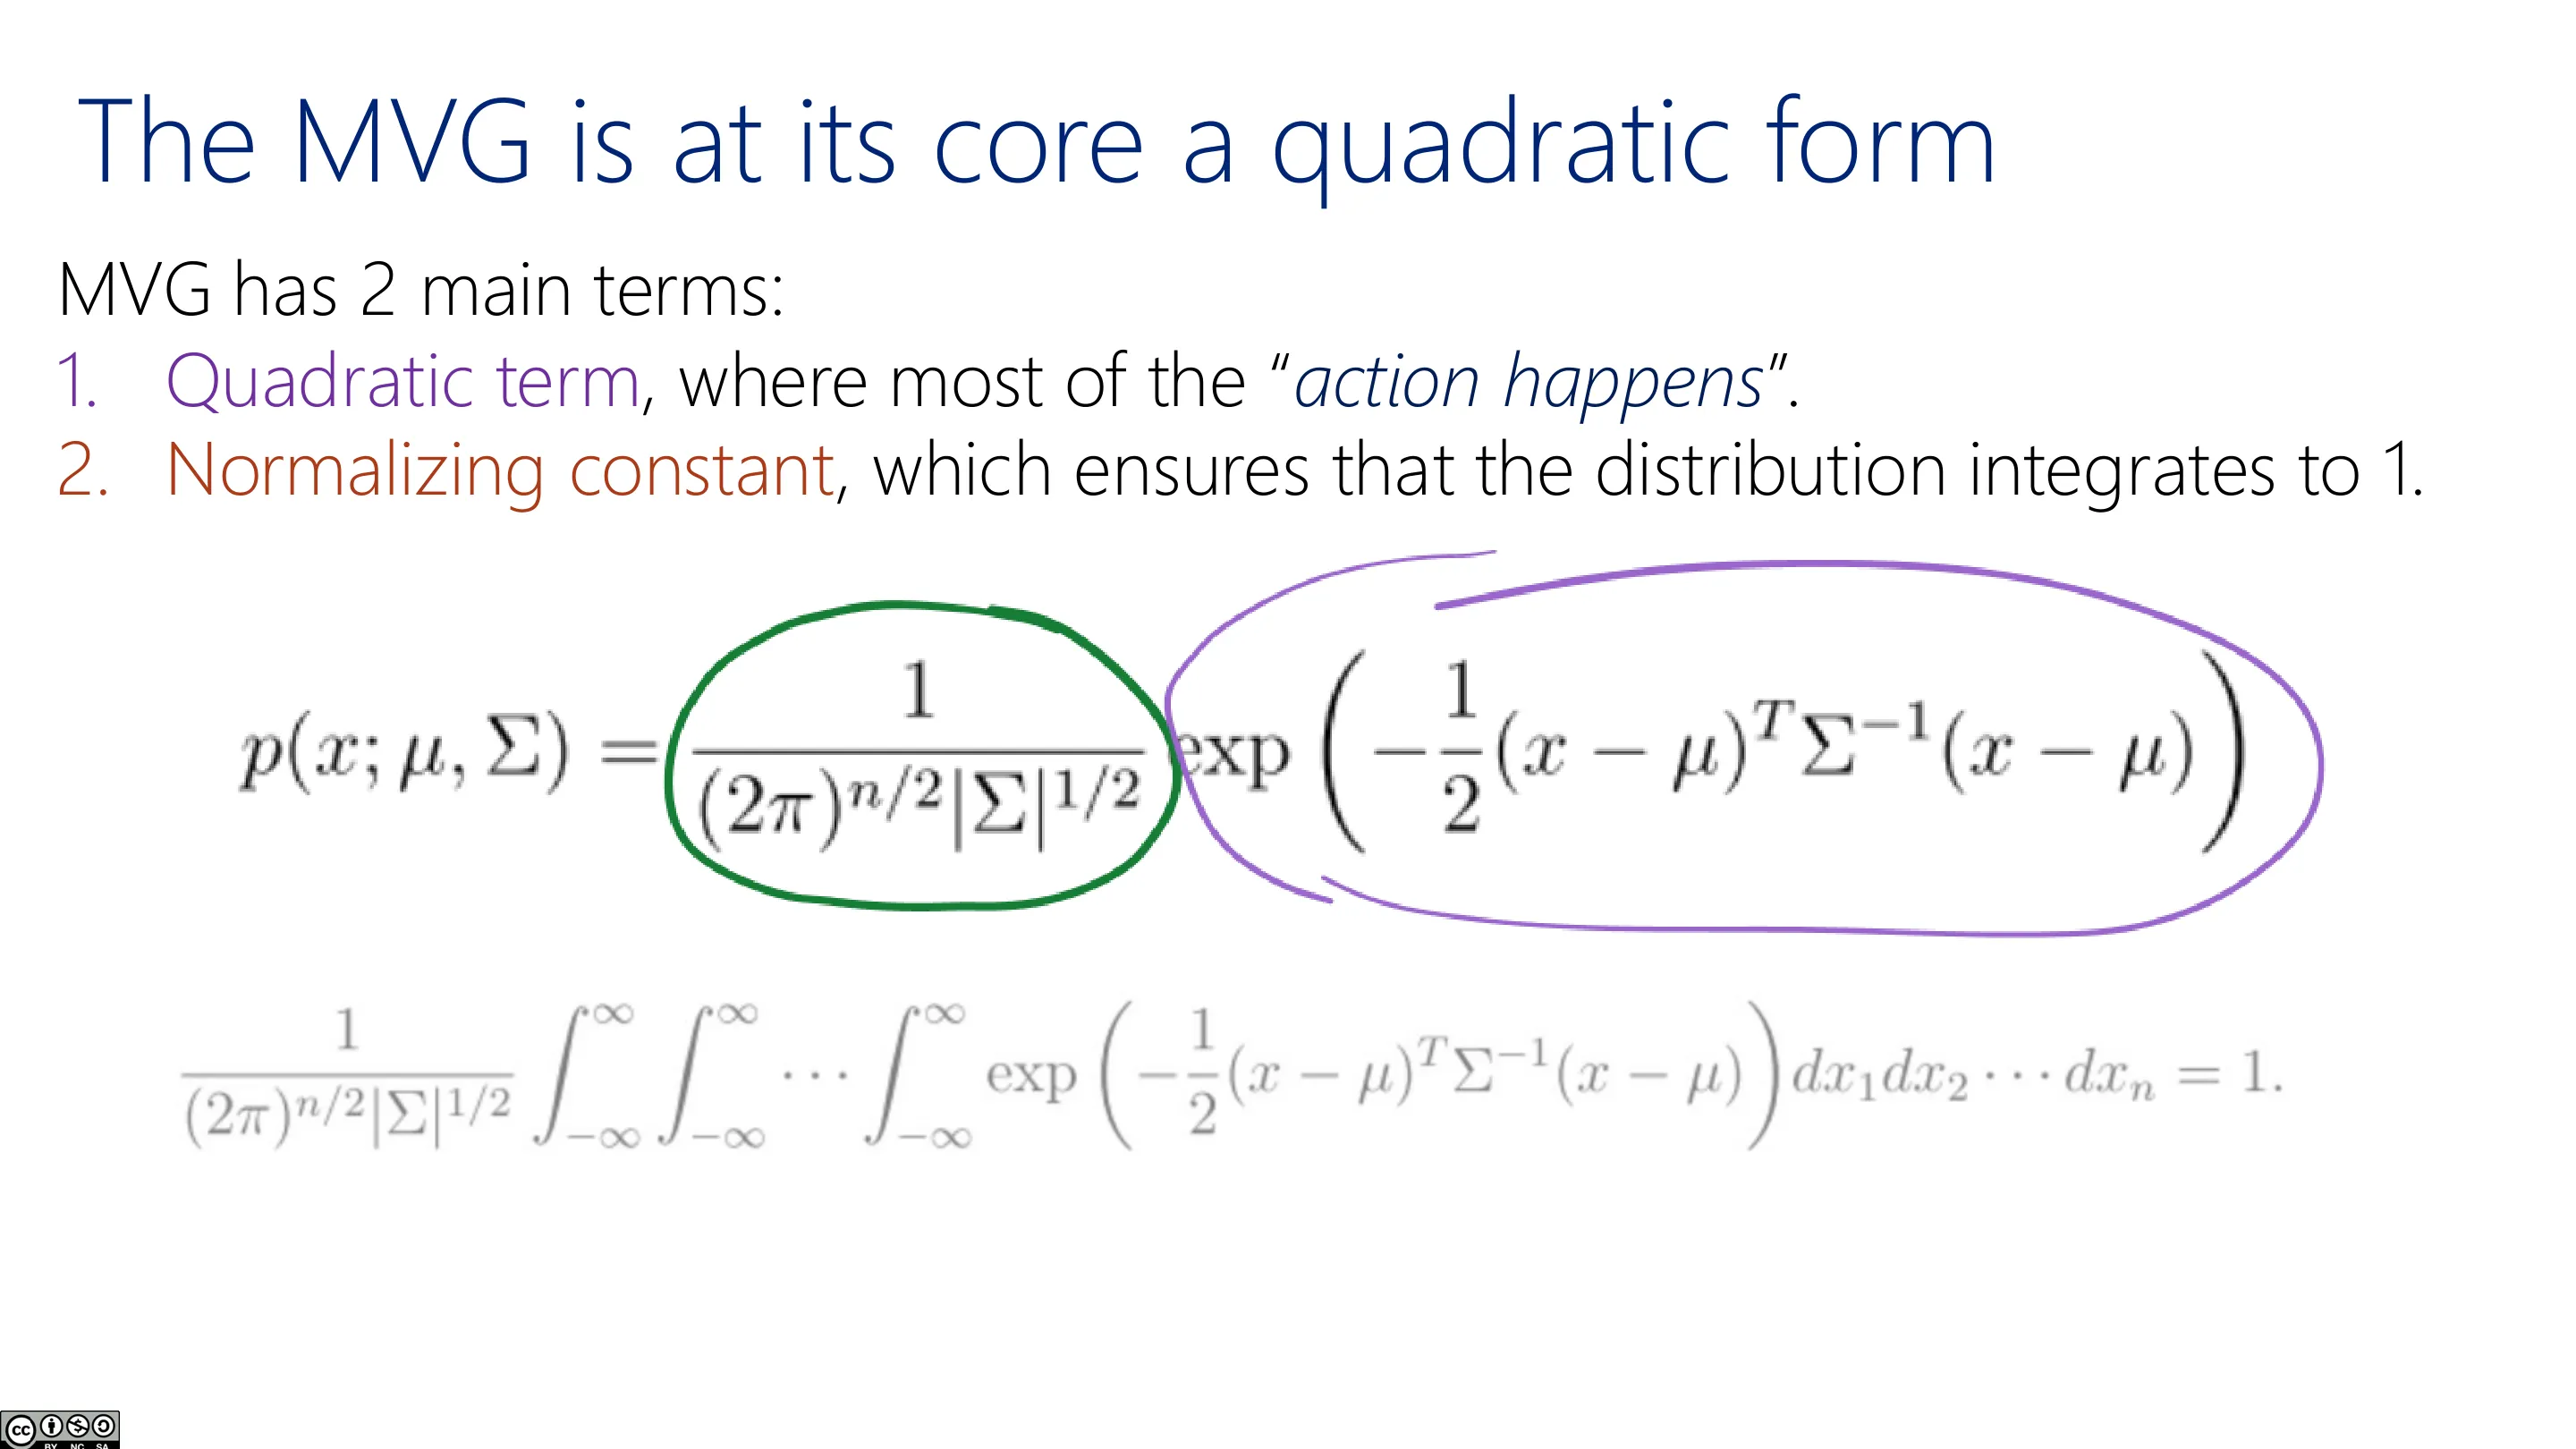
从简单情形走向一般情形($X\in\mathbb{R}^d$、分量间不独立):MVG 有两大项——① 二次型(「戏都在这里」)与 ② 归一化常数(保证积分为 1)。
📷 从简单情形到一般情形
回到原视频 (01:04:02)
📷 MVG 本质是一个二次型(一)
回到原视频 (01:05:14)
📷 MVG 本质是一个二次型(二)
回到原视频 (01:05:57)
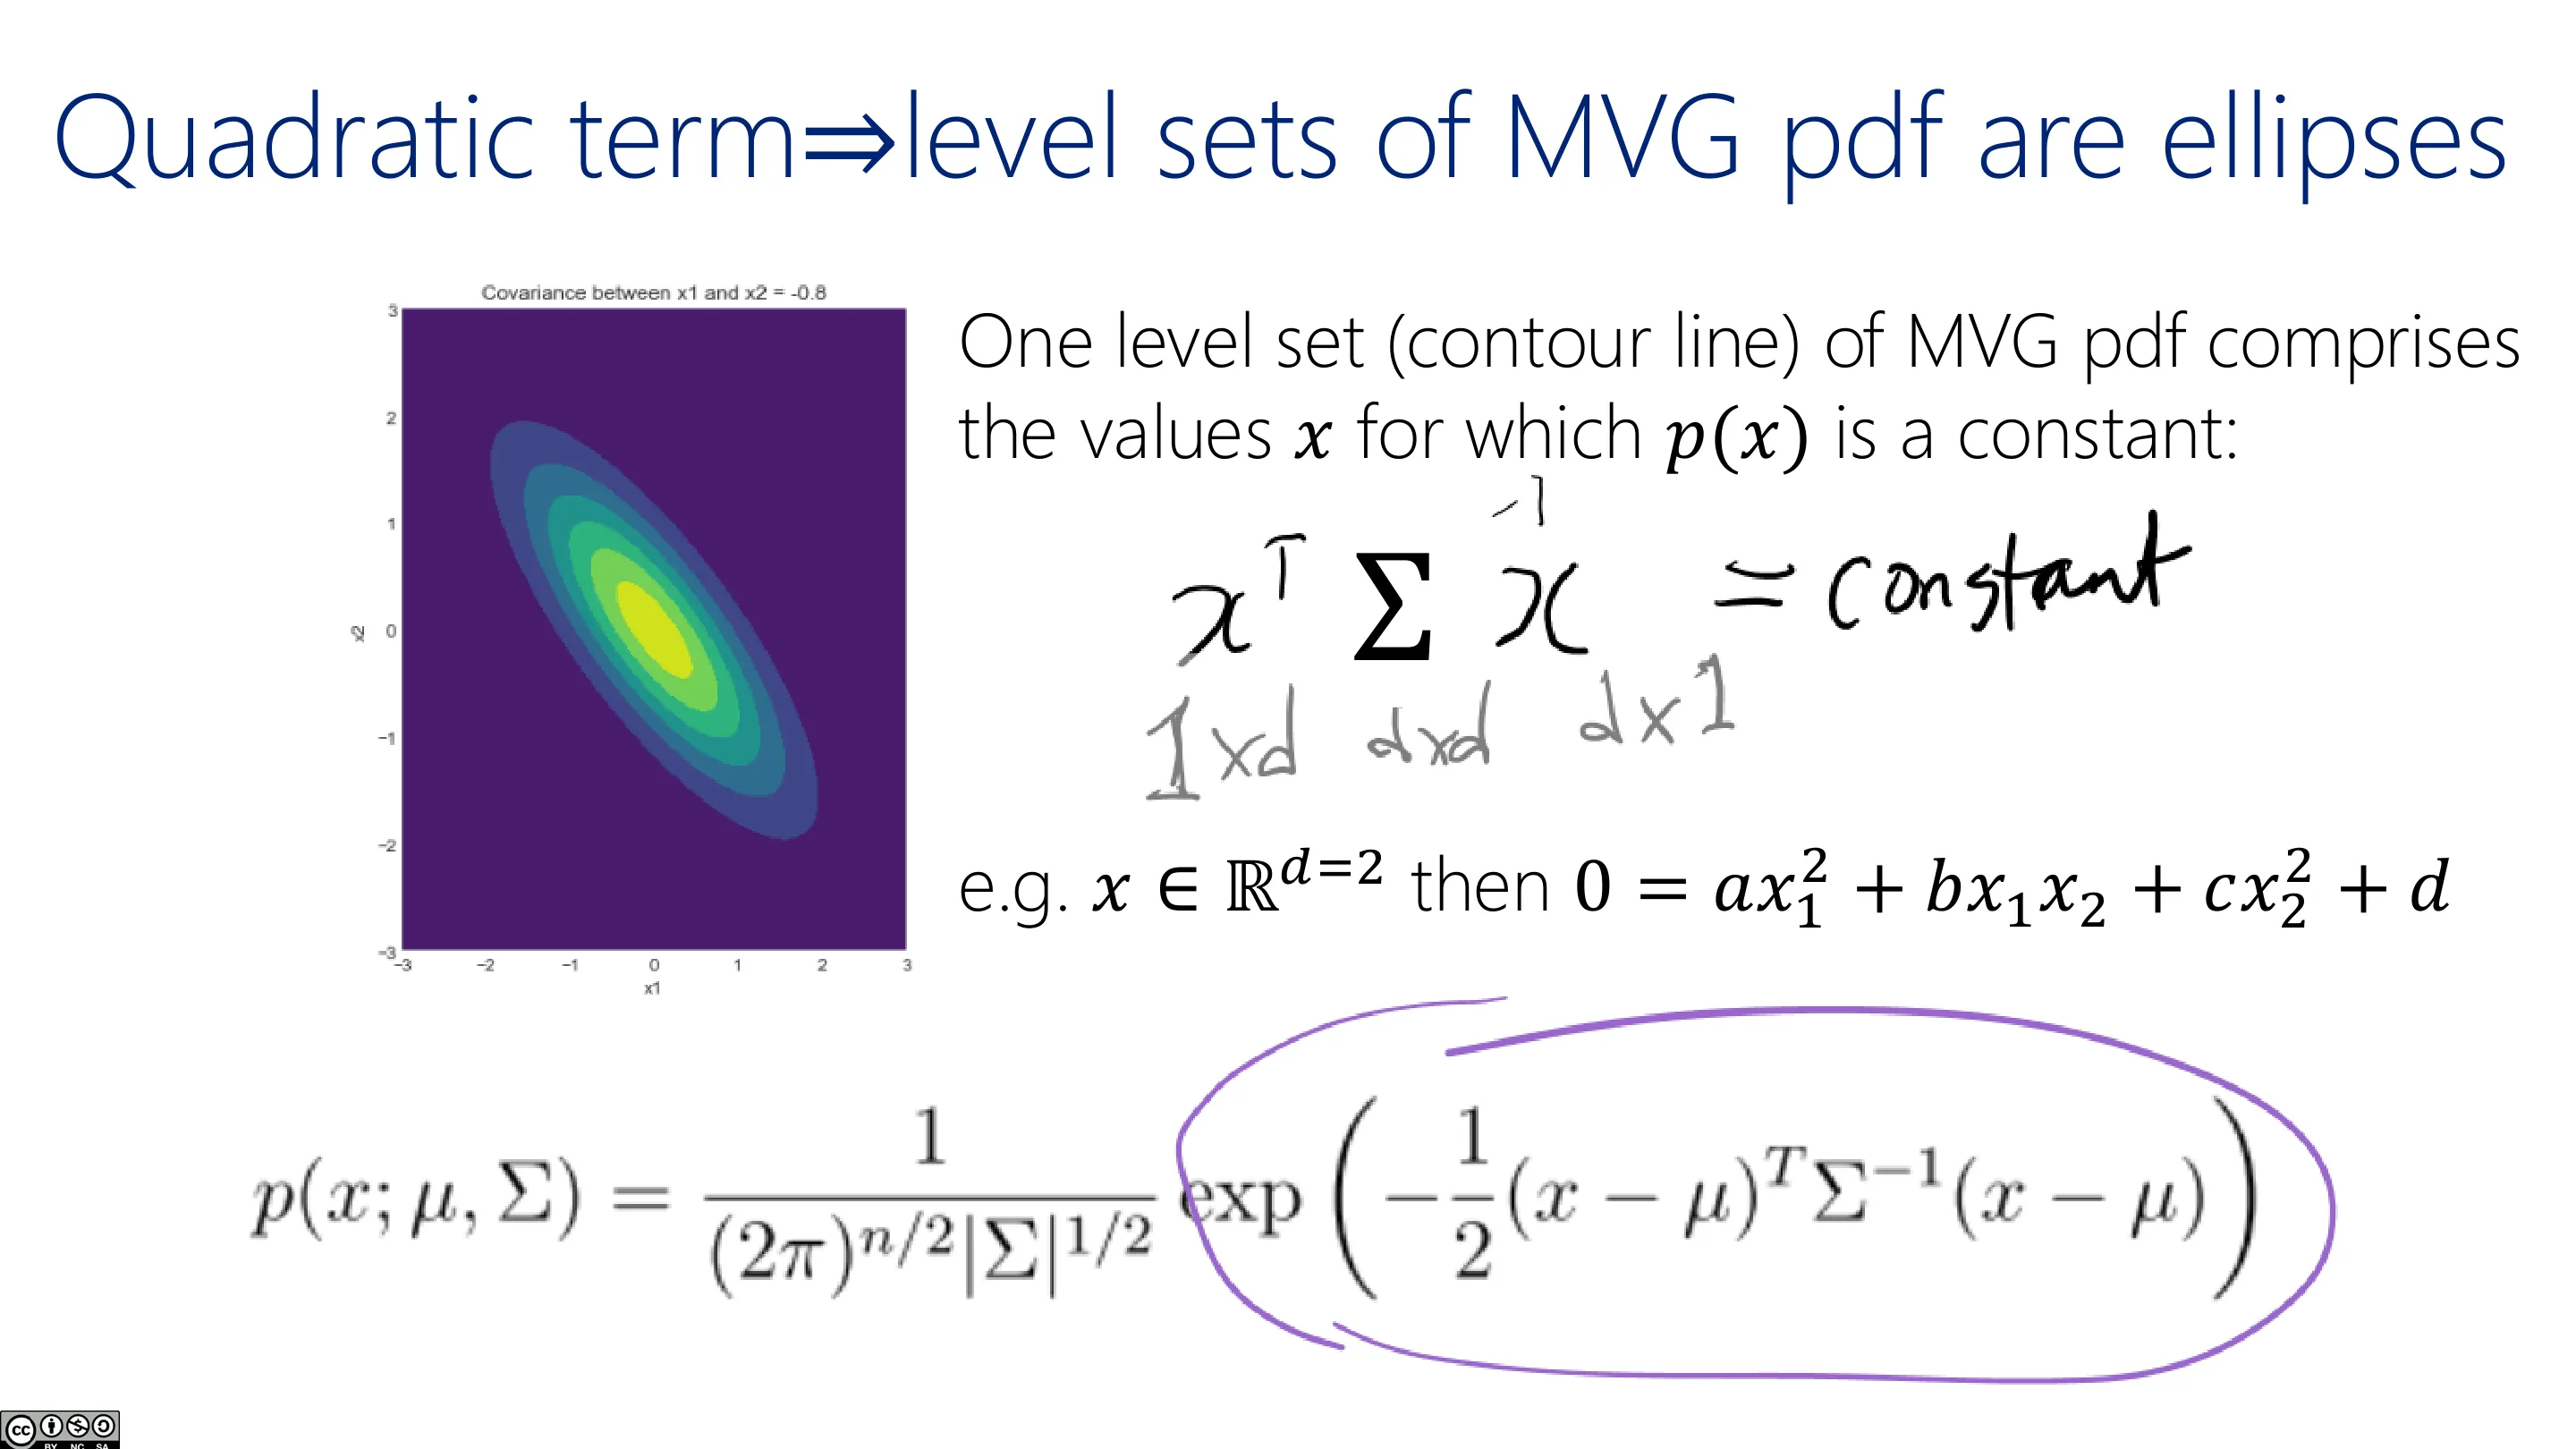
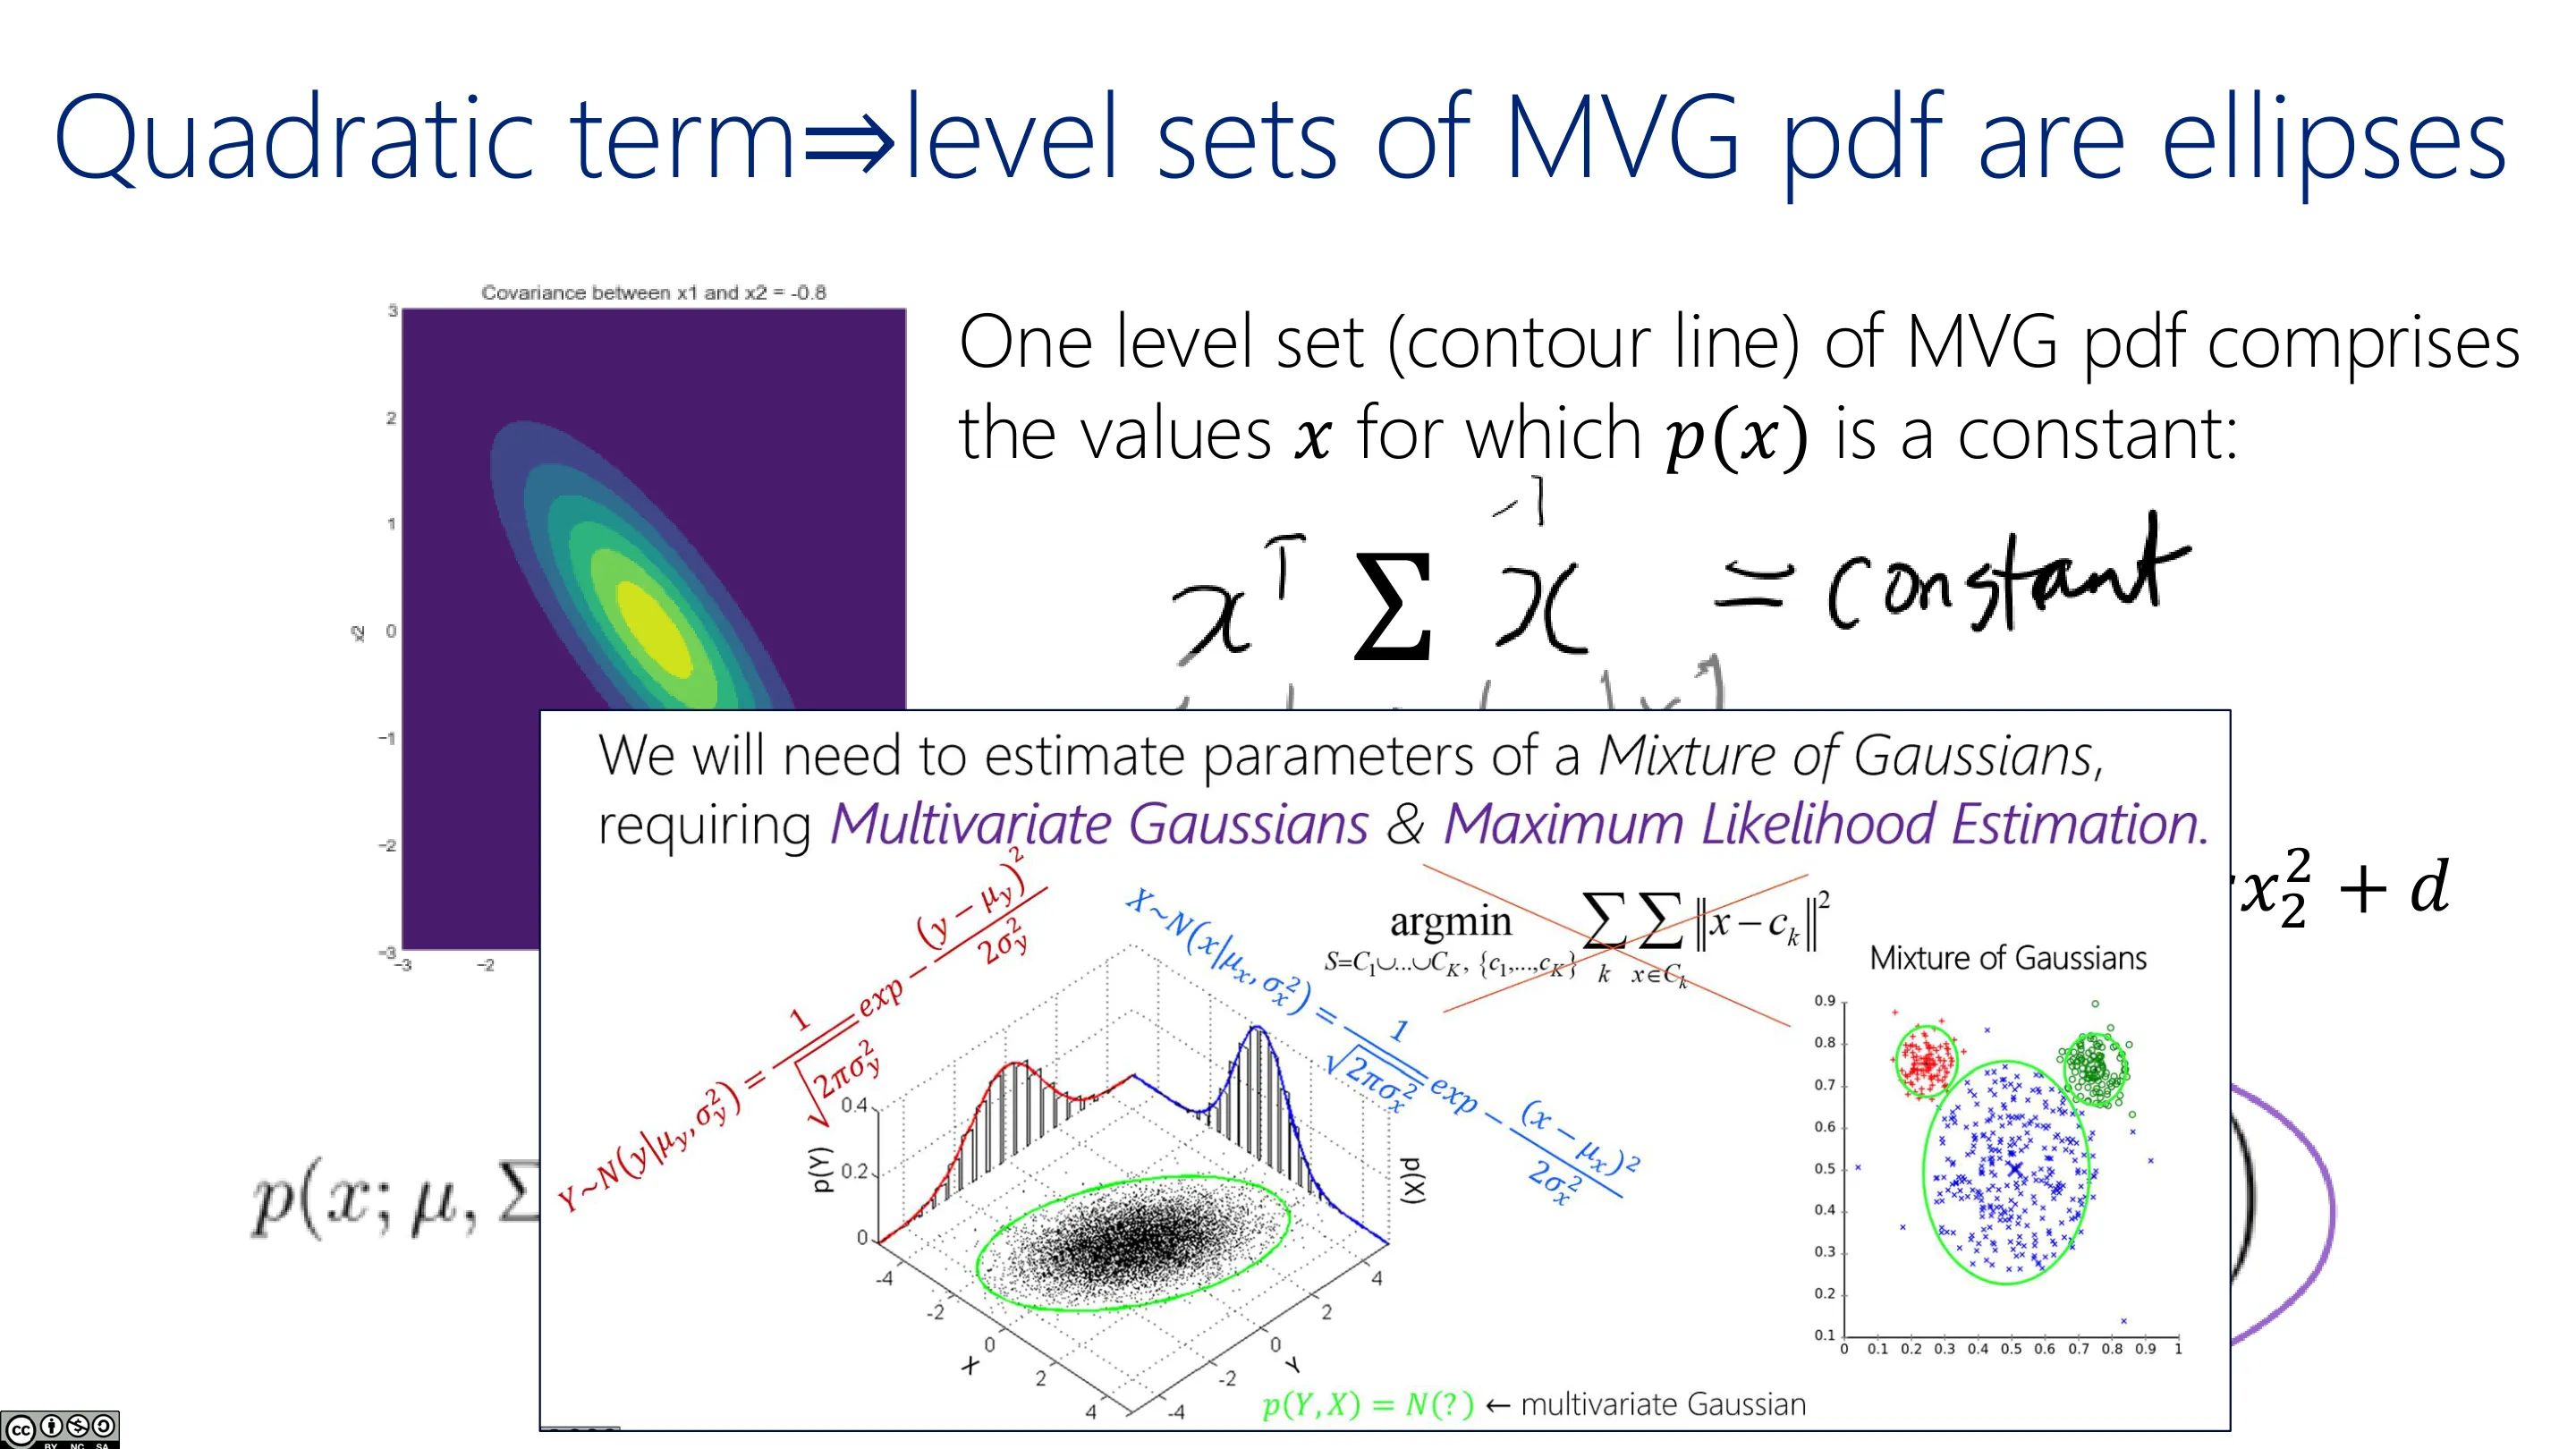
水平集(level set)就是椭圆:固定 $\mu,\Sigma$,令 $p(x)$ 为常数,等价于令二次项为常数:
$$ 0=a x_1^2 + b x_1 x_2 + c x_2^2 + d $$
这正是椭圆的方程。椭圆的方向由 $\Sigma$ 决定:若水平集与坐标轴对齐,说明变量独立;否则存在(正/负)相关。
📷 二次型 ⇒ 水平集是椭圆(一)
回到原视频 (01:06:12)
📷 二次型 ⇒ 水平集是椭圆(二)
回到原视频 (01:08:20)
2.7 高维直觉
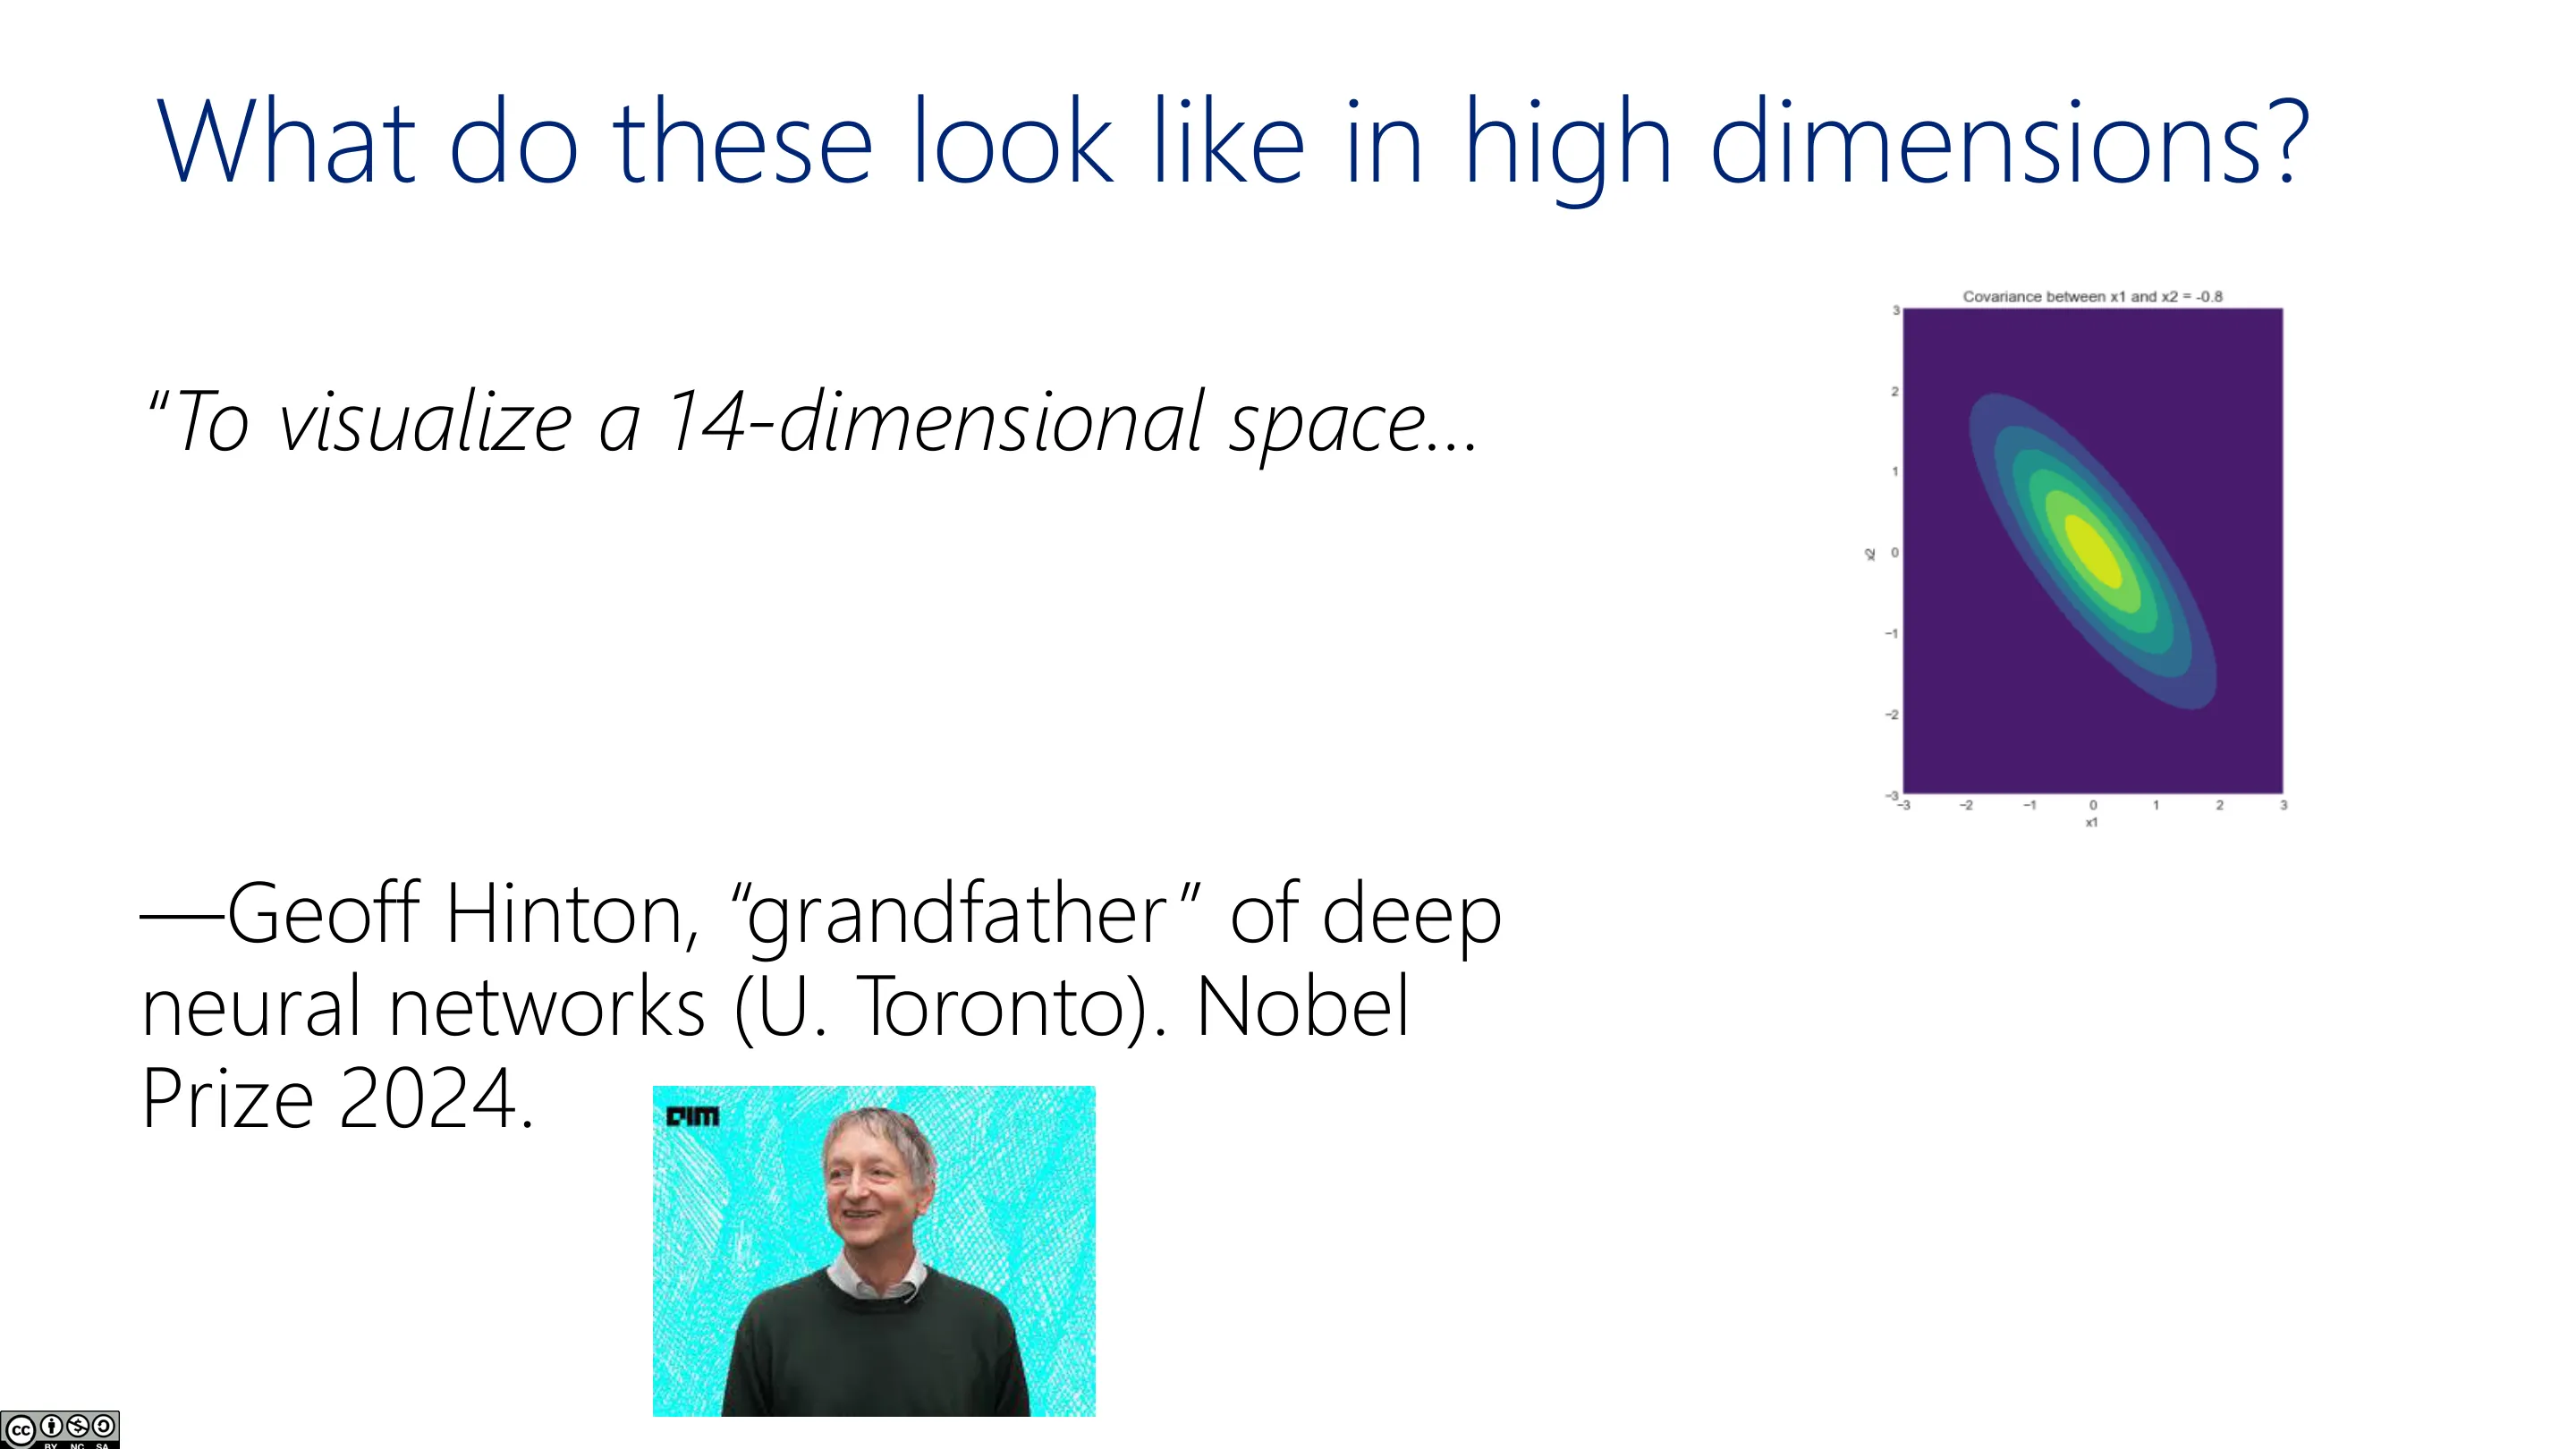
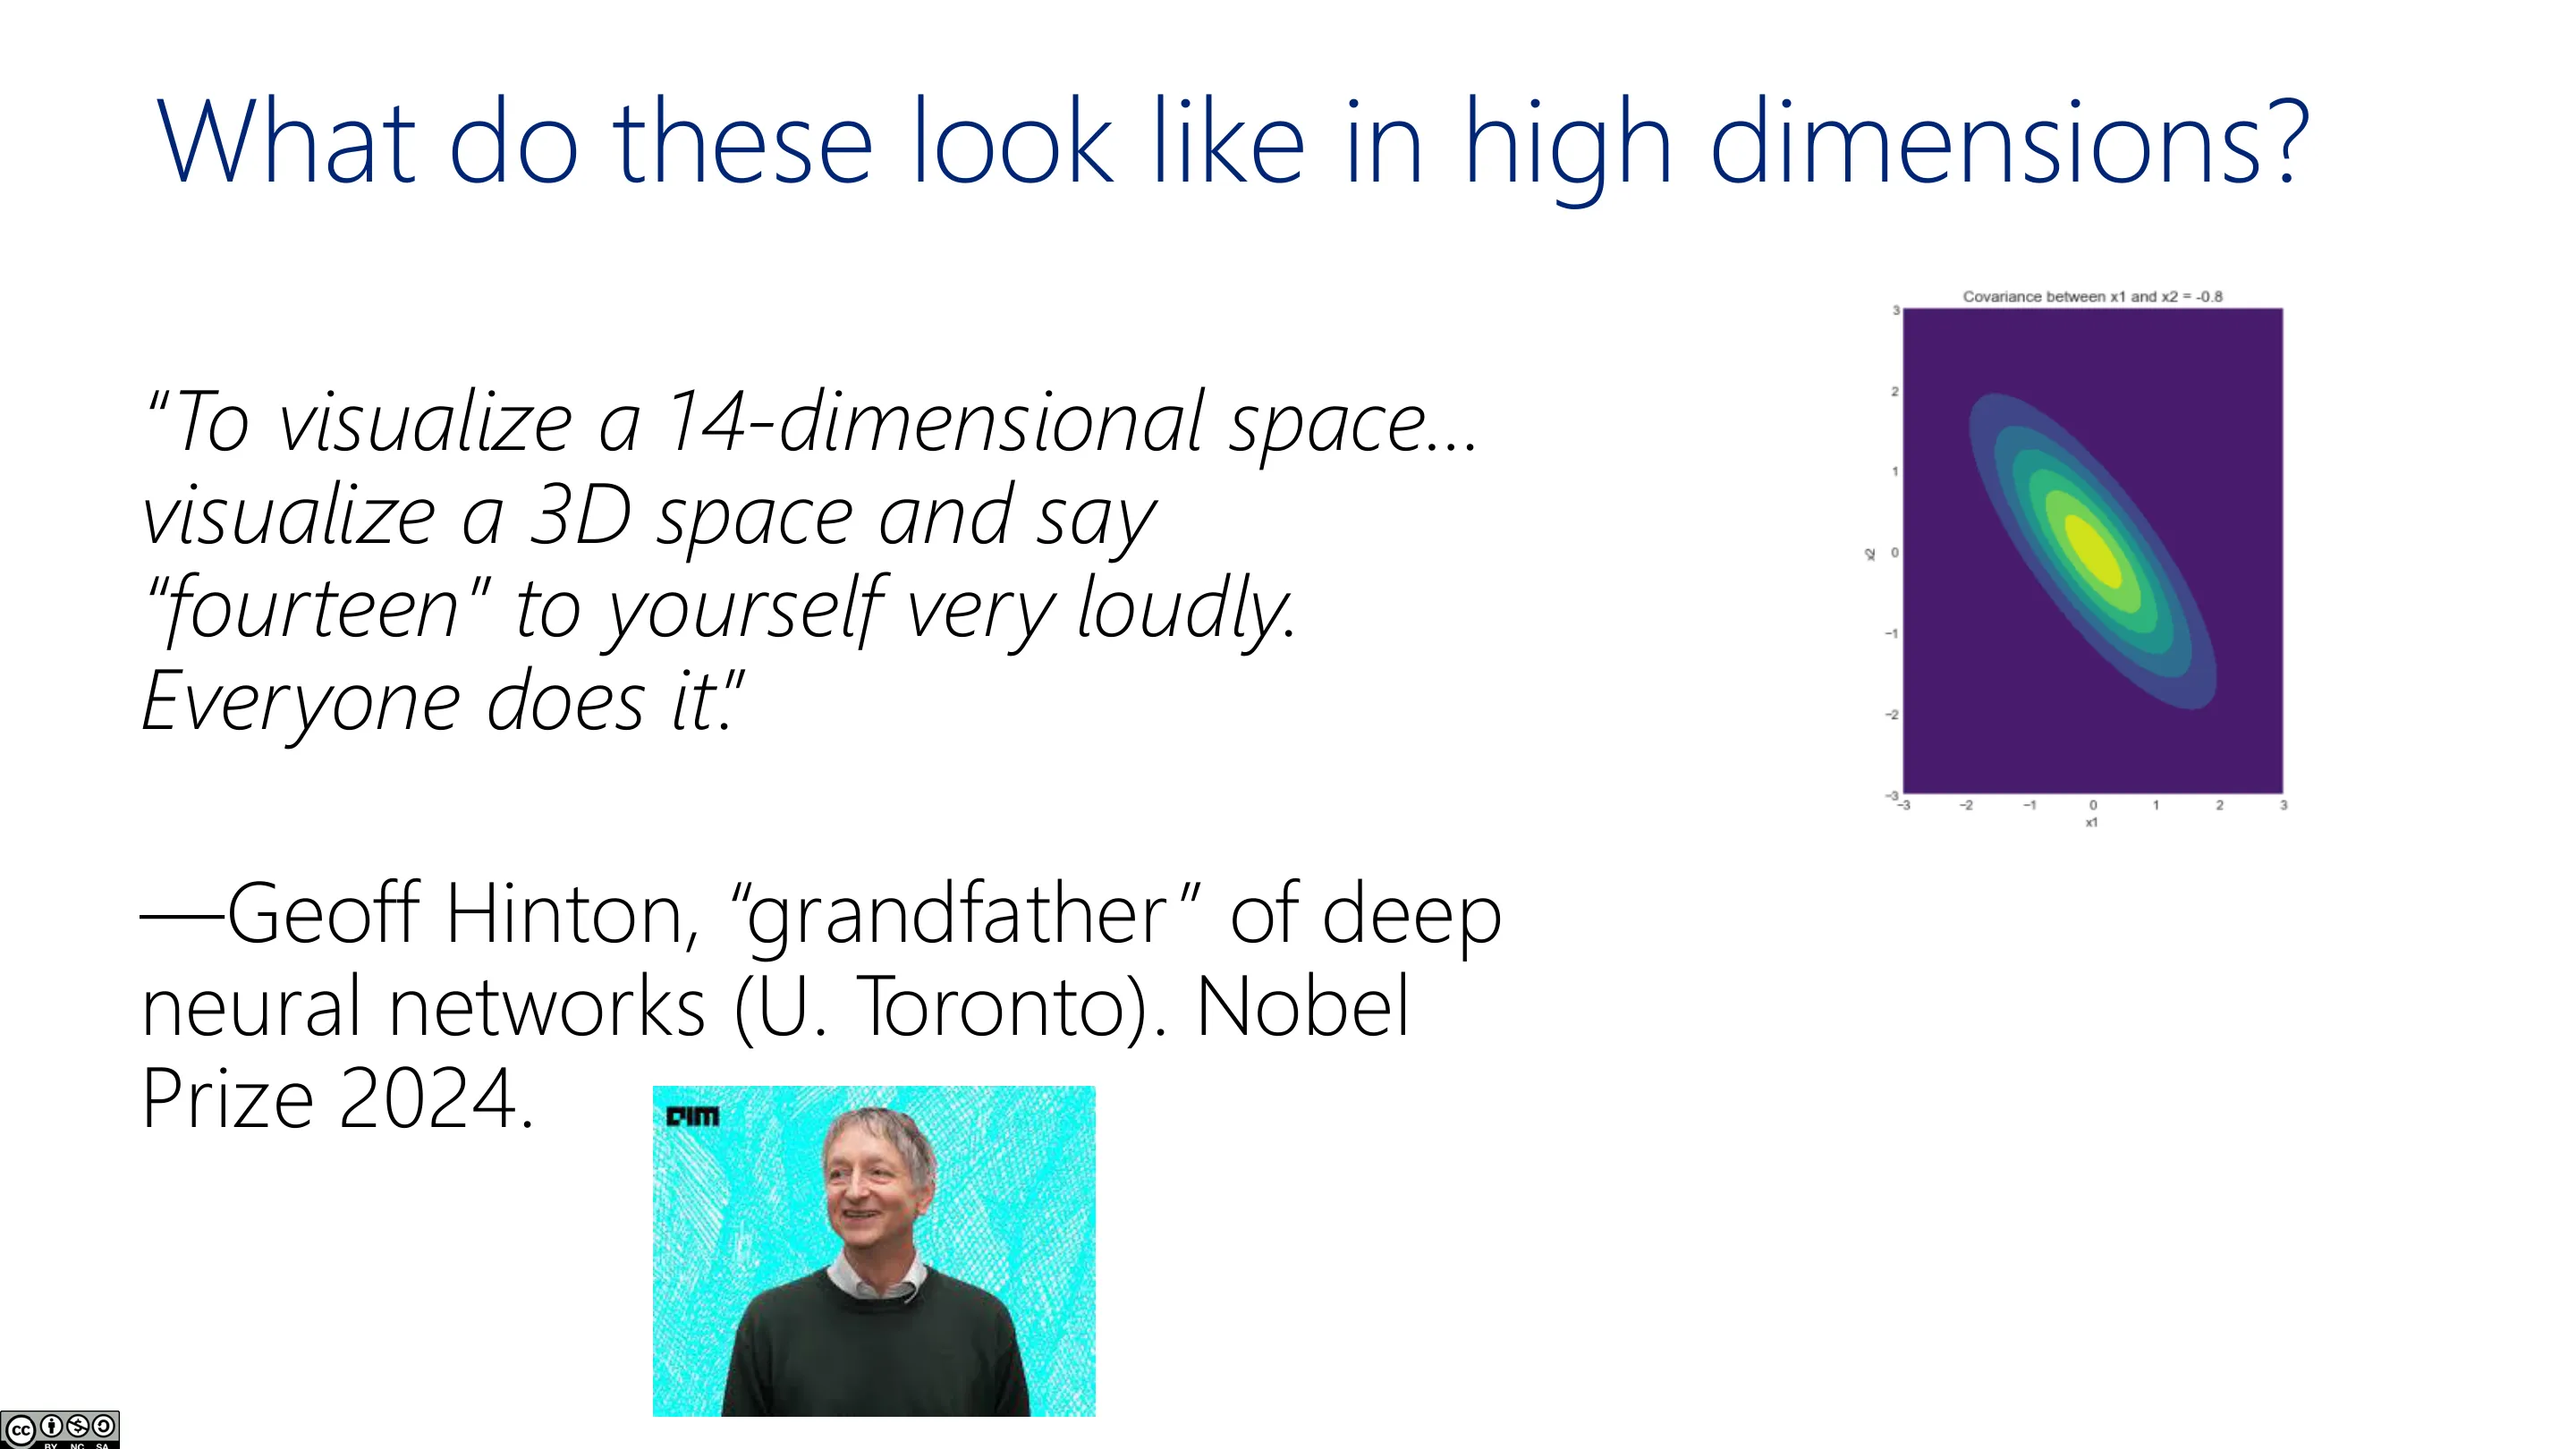
「要想象一个 14 维空间……就想象一个 3 维空间,然后在心里大声喊『十四』。大家都这么干。」——Geoff Hinton
📷 高维空间:Hinton 的话(一)
回到原视频 (01:11:48)
📷 高维空间:Hinton 的话(二)
回到原视频 (01:13:08)
高维下无法直接可视化,但可以逐对变量画水平集来获得直觉。一般而言,$d$ 维高斯的协方差矩阵是 $d\times d$ 的对称半正定矩阵:对角线是各变量的方差,非对角线是两两协方差($d$ 维有 $\binom{d}{2}$ 对)。
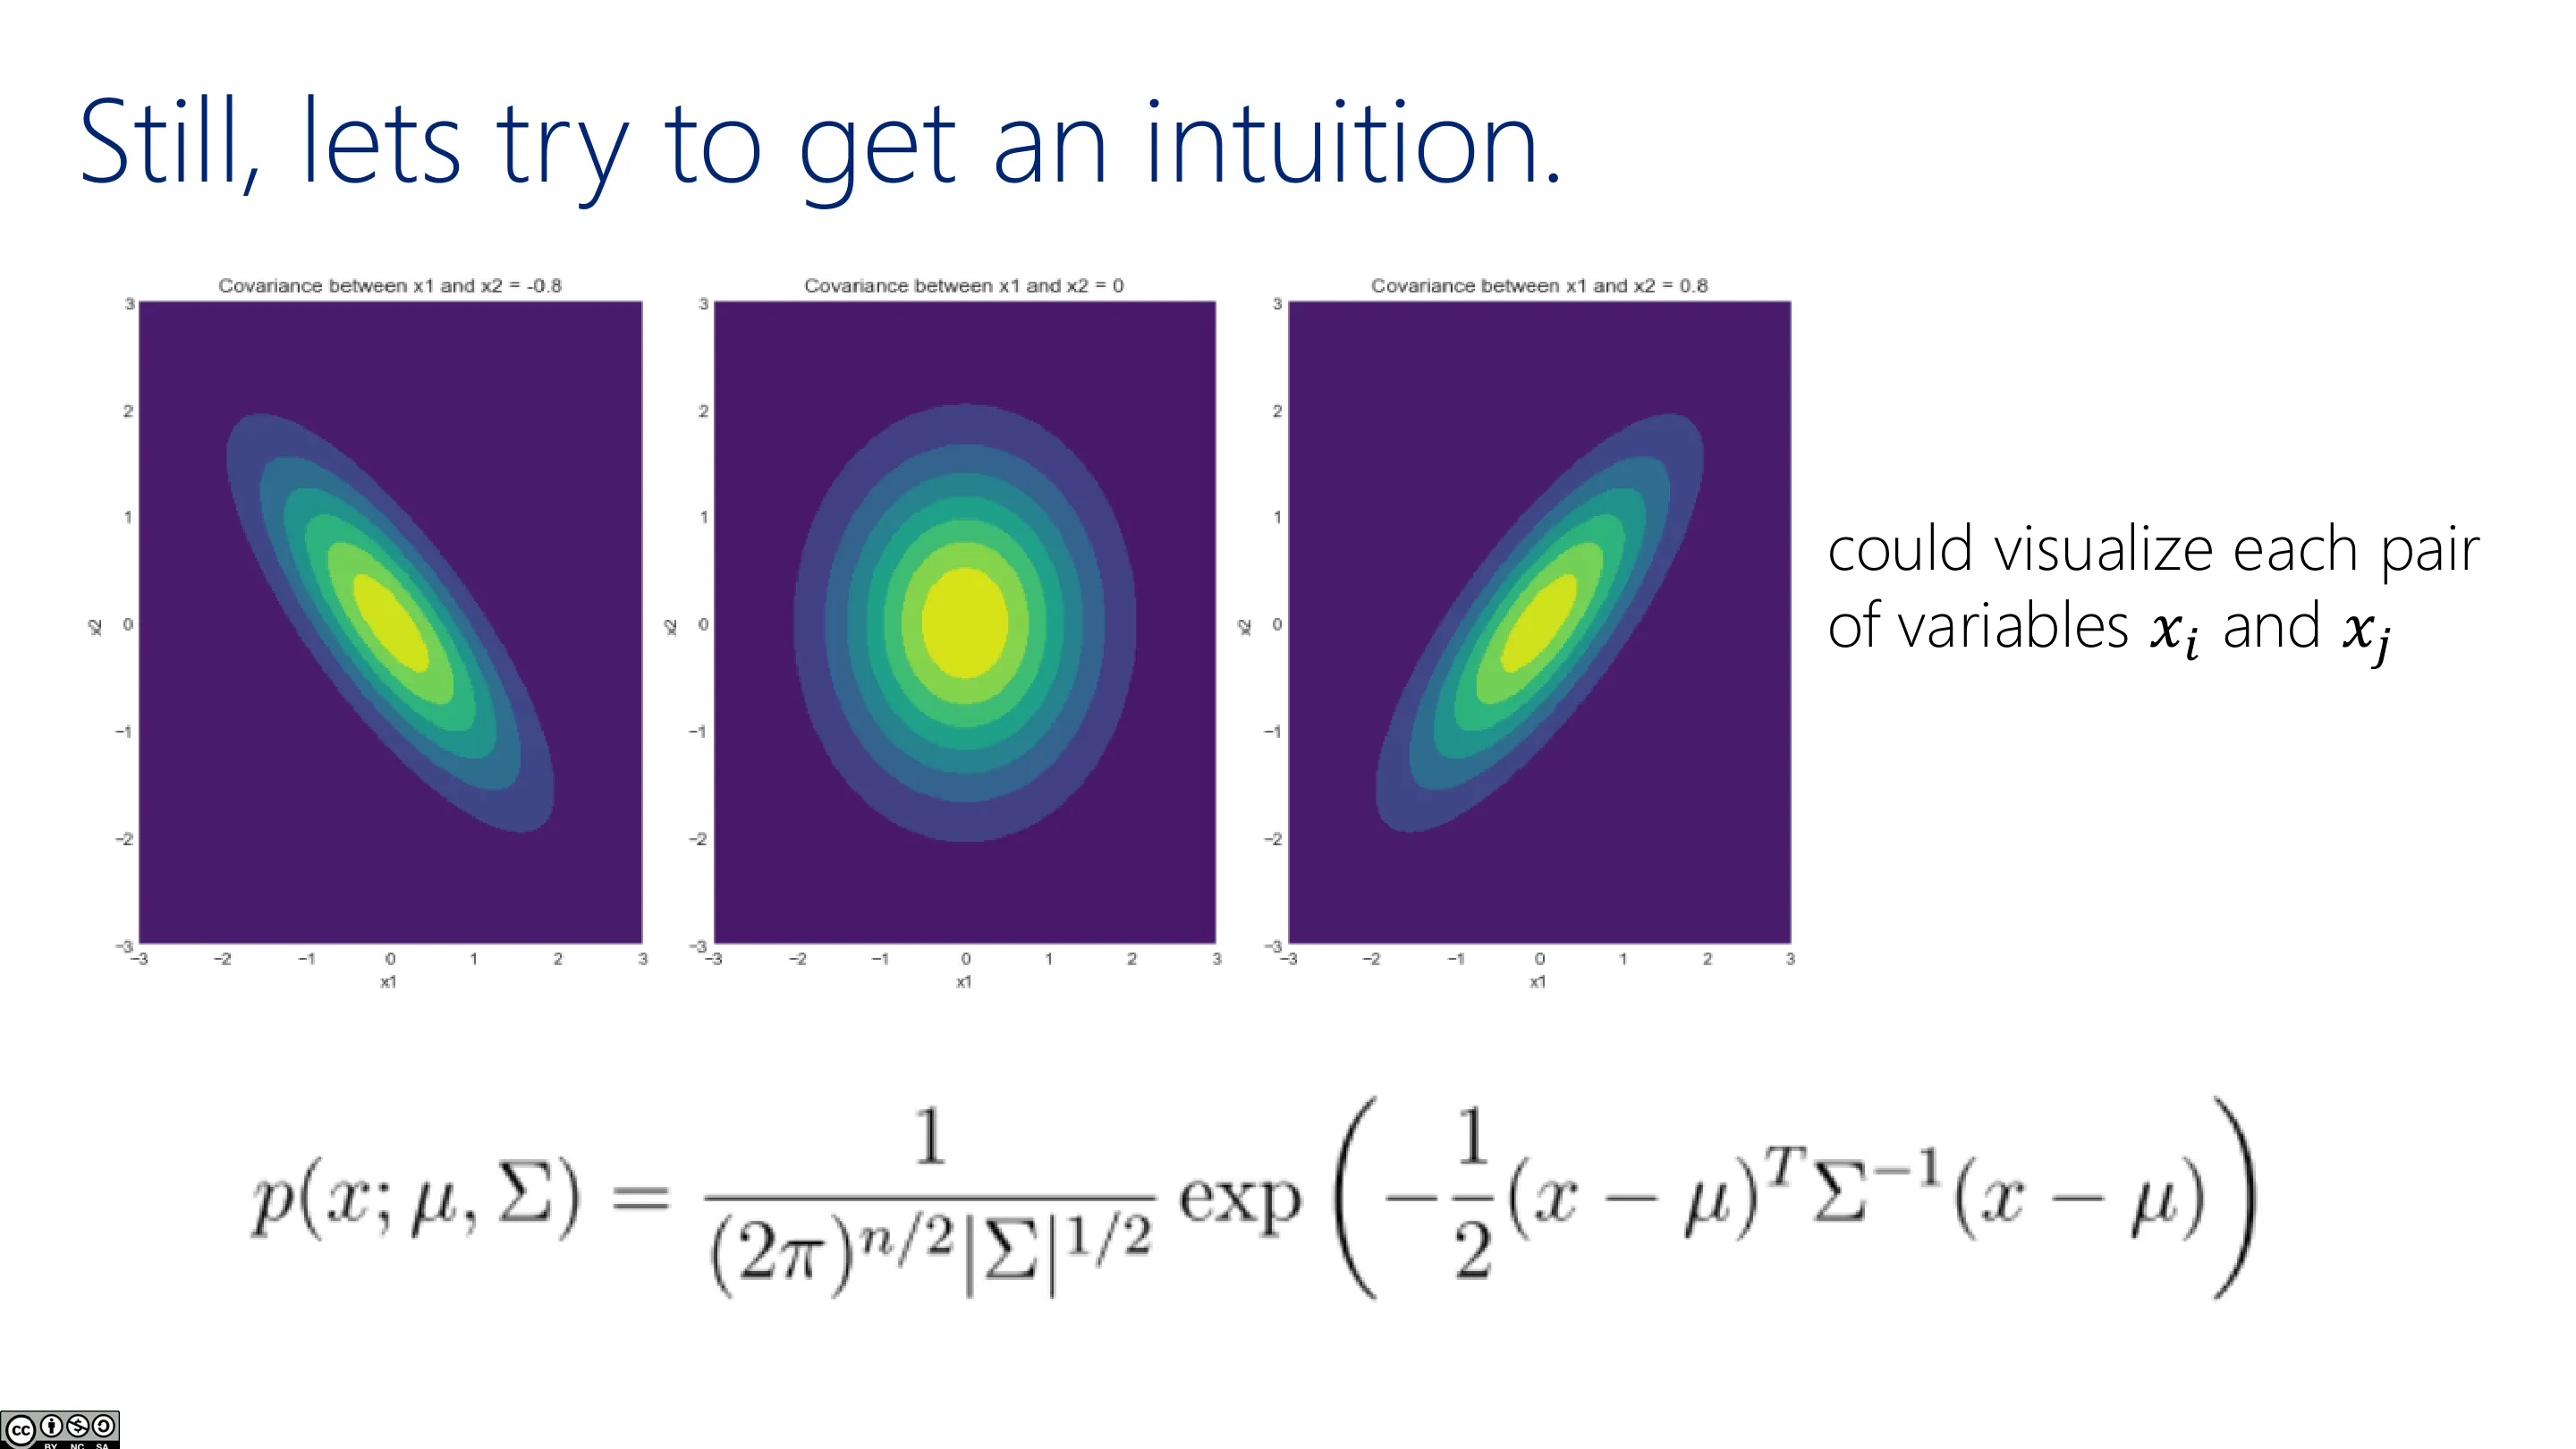
📷 逐对变量获得直觉
回到原视频 (01:13:28)
三、高斯混合模型(GMM / MoG)
(参考时间: 01:14)
📷 路线图(四)
回到原视频 (01:13:57)
📷 回顾
回到原视频 (01:14:49)
3.1 动机:把 K 均值「概率化」
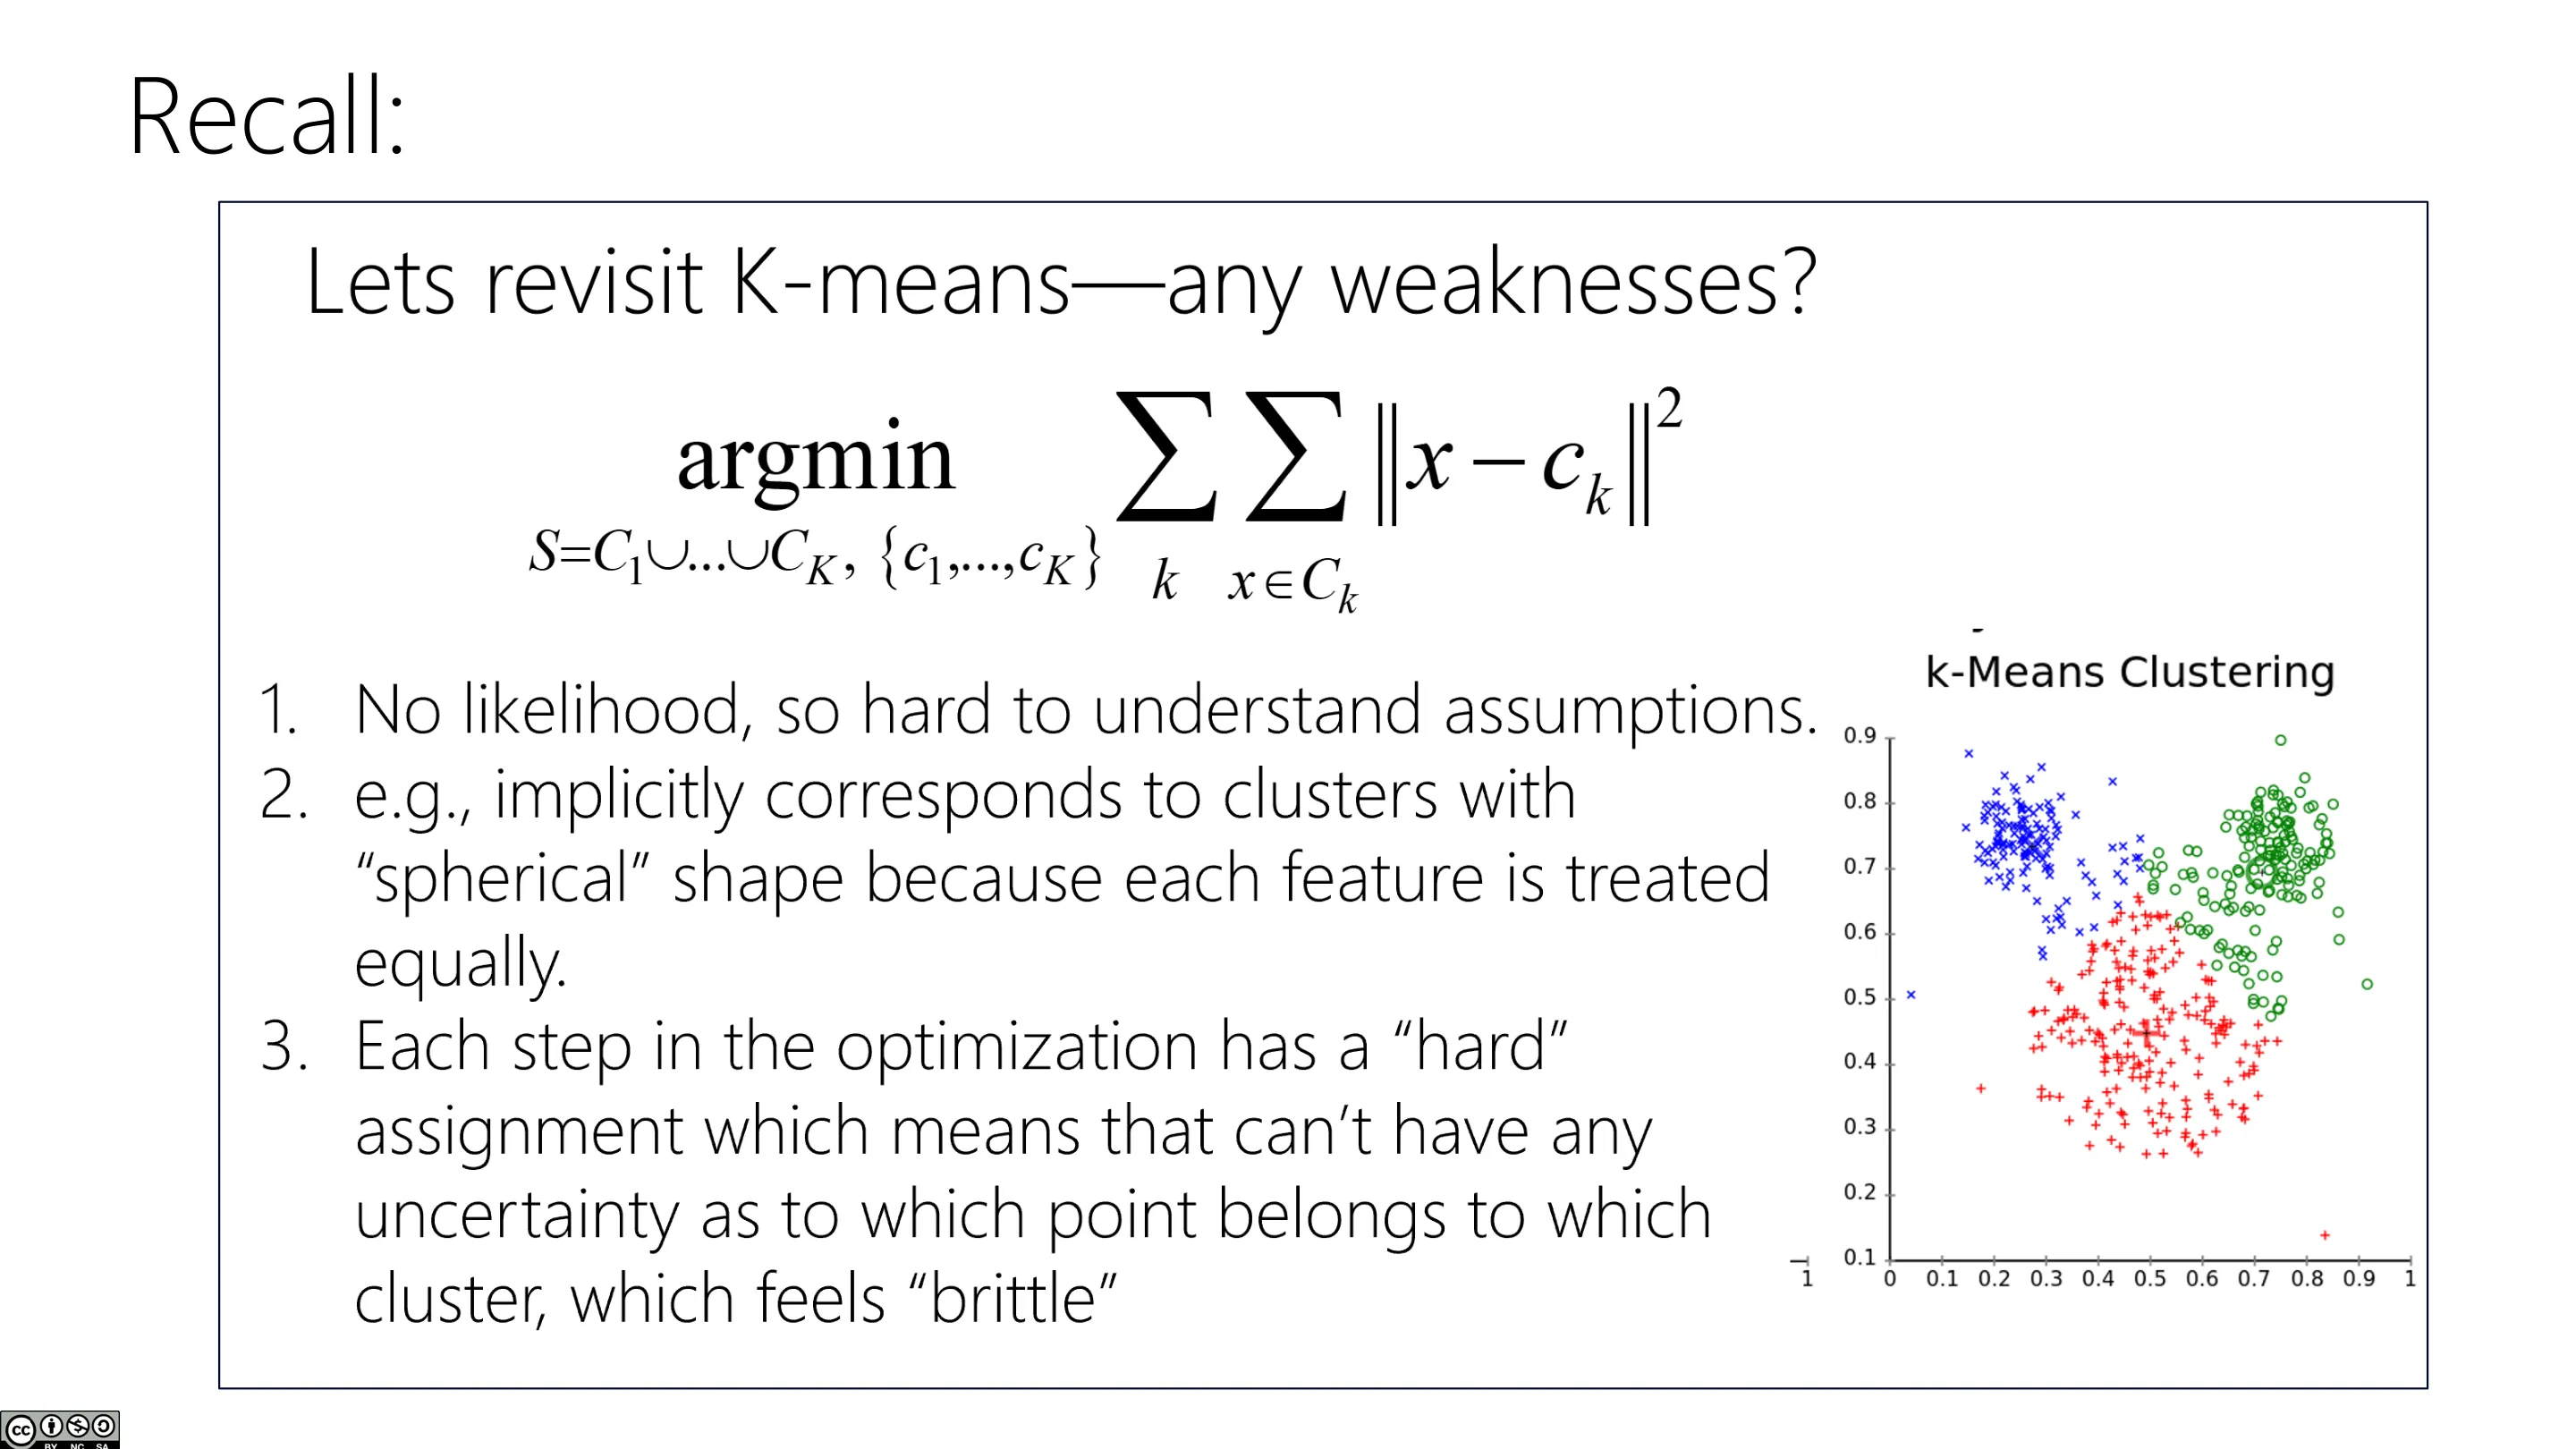
K 均值隐含假设每个簇体积相同、近似球形,并且每步做硬分配(非红即蓝),因此脆弱:稍微扰动数据,某点可能突然改变归属。
概率模型的优势在于):
- 用统计分布显式表达假设(更易理解、更易推广);
- 允许软分配(一个点可以 80% 属于蓝、20% 属于红),从而更稳健;
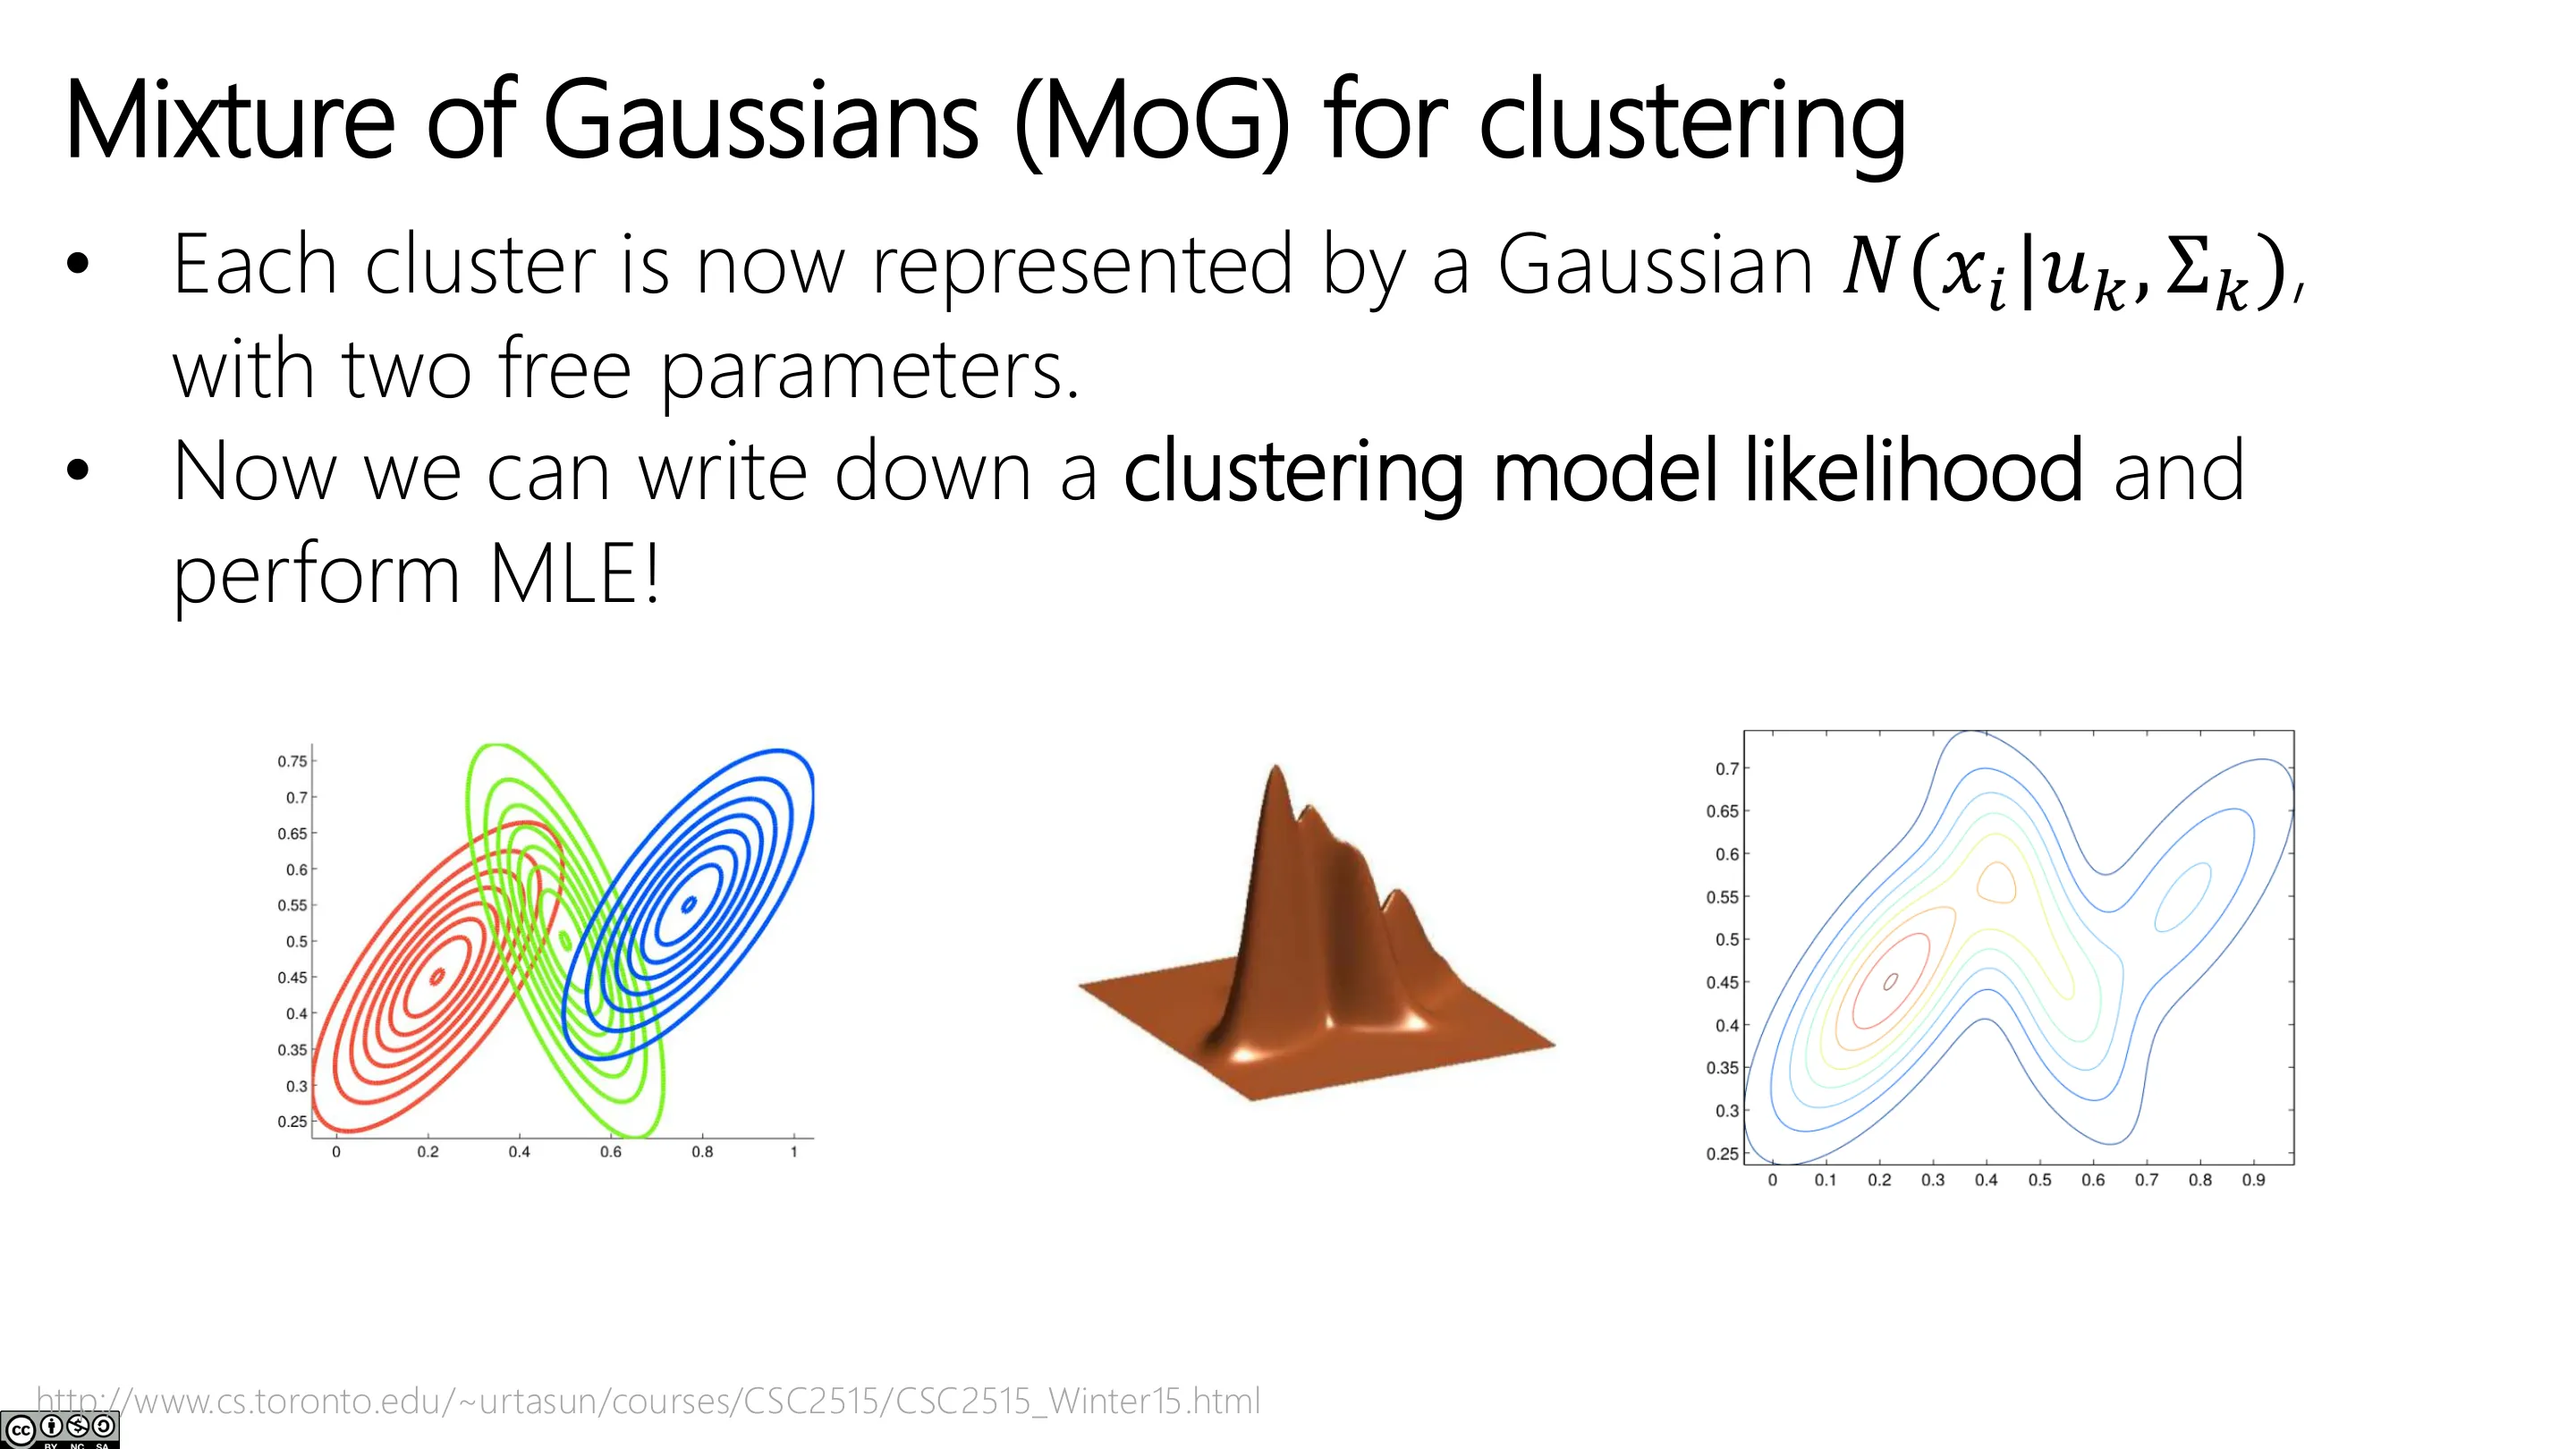
- 每个簇可以有自己的协方差矩阵(各自的形状/大小),水平集有机可调。
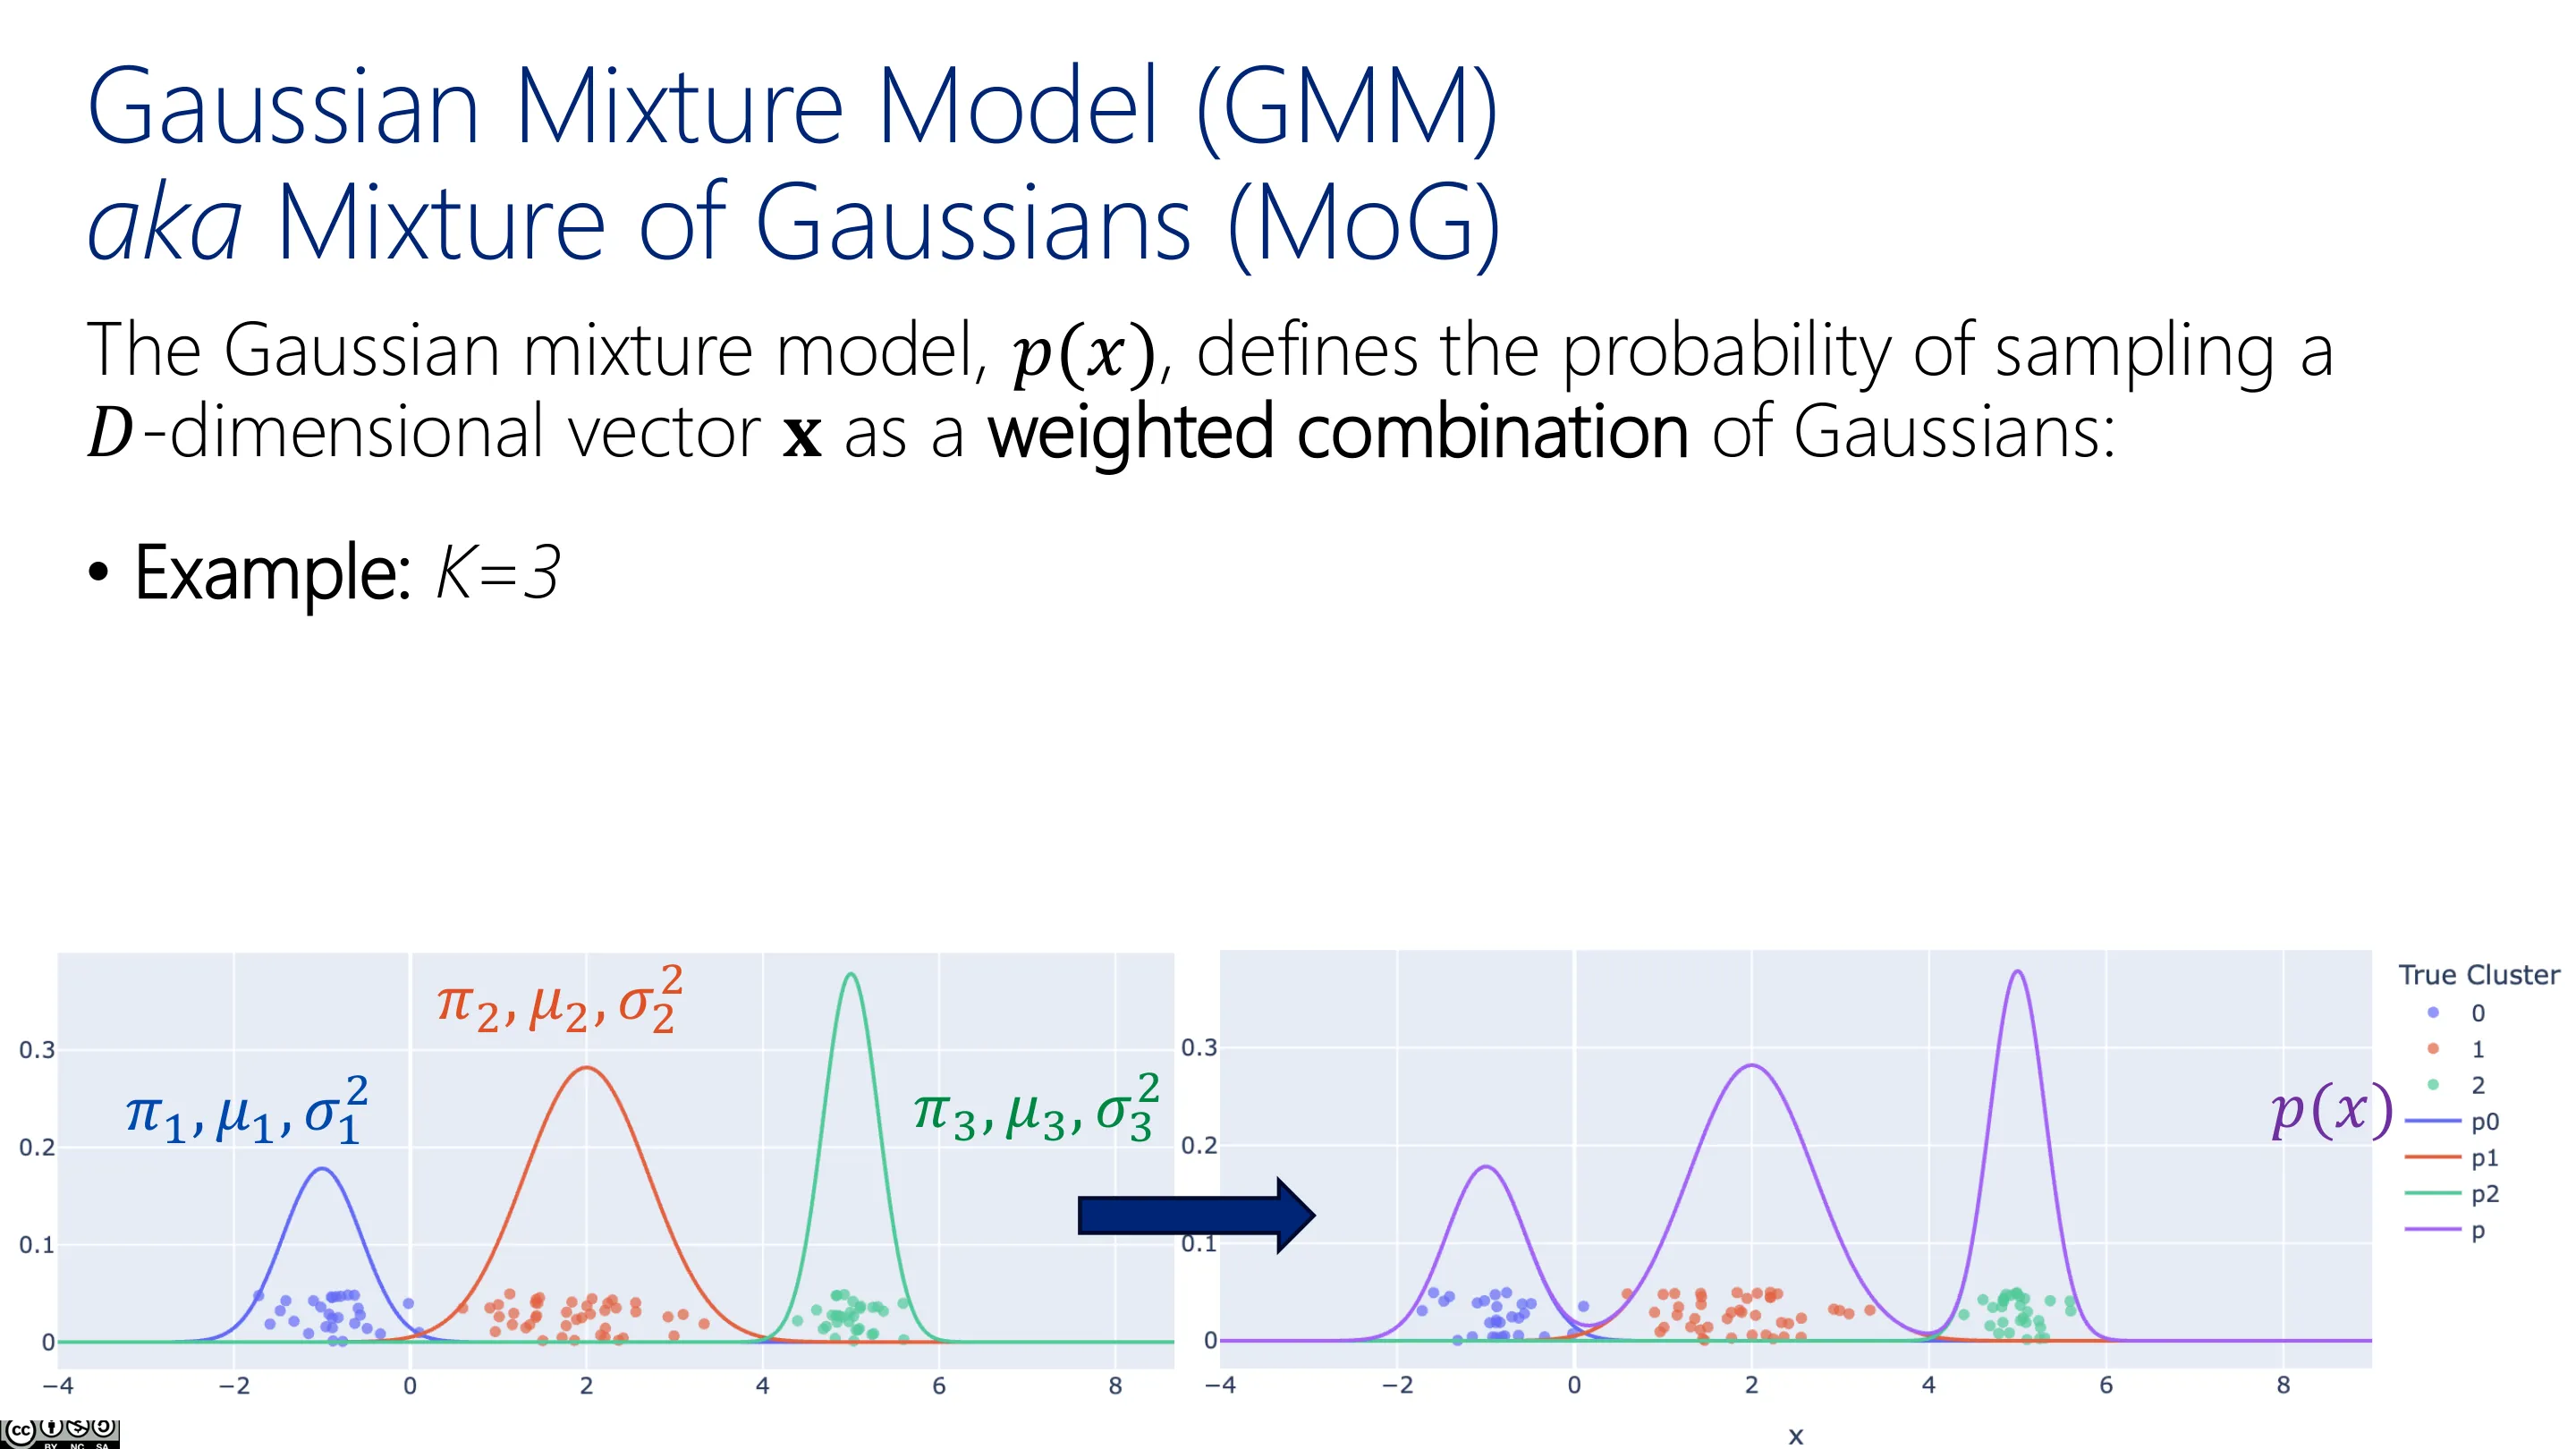
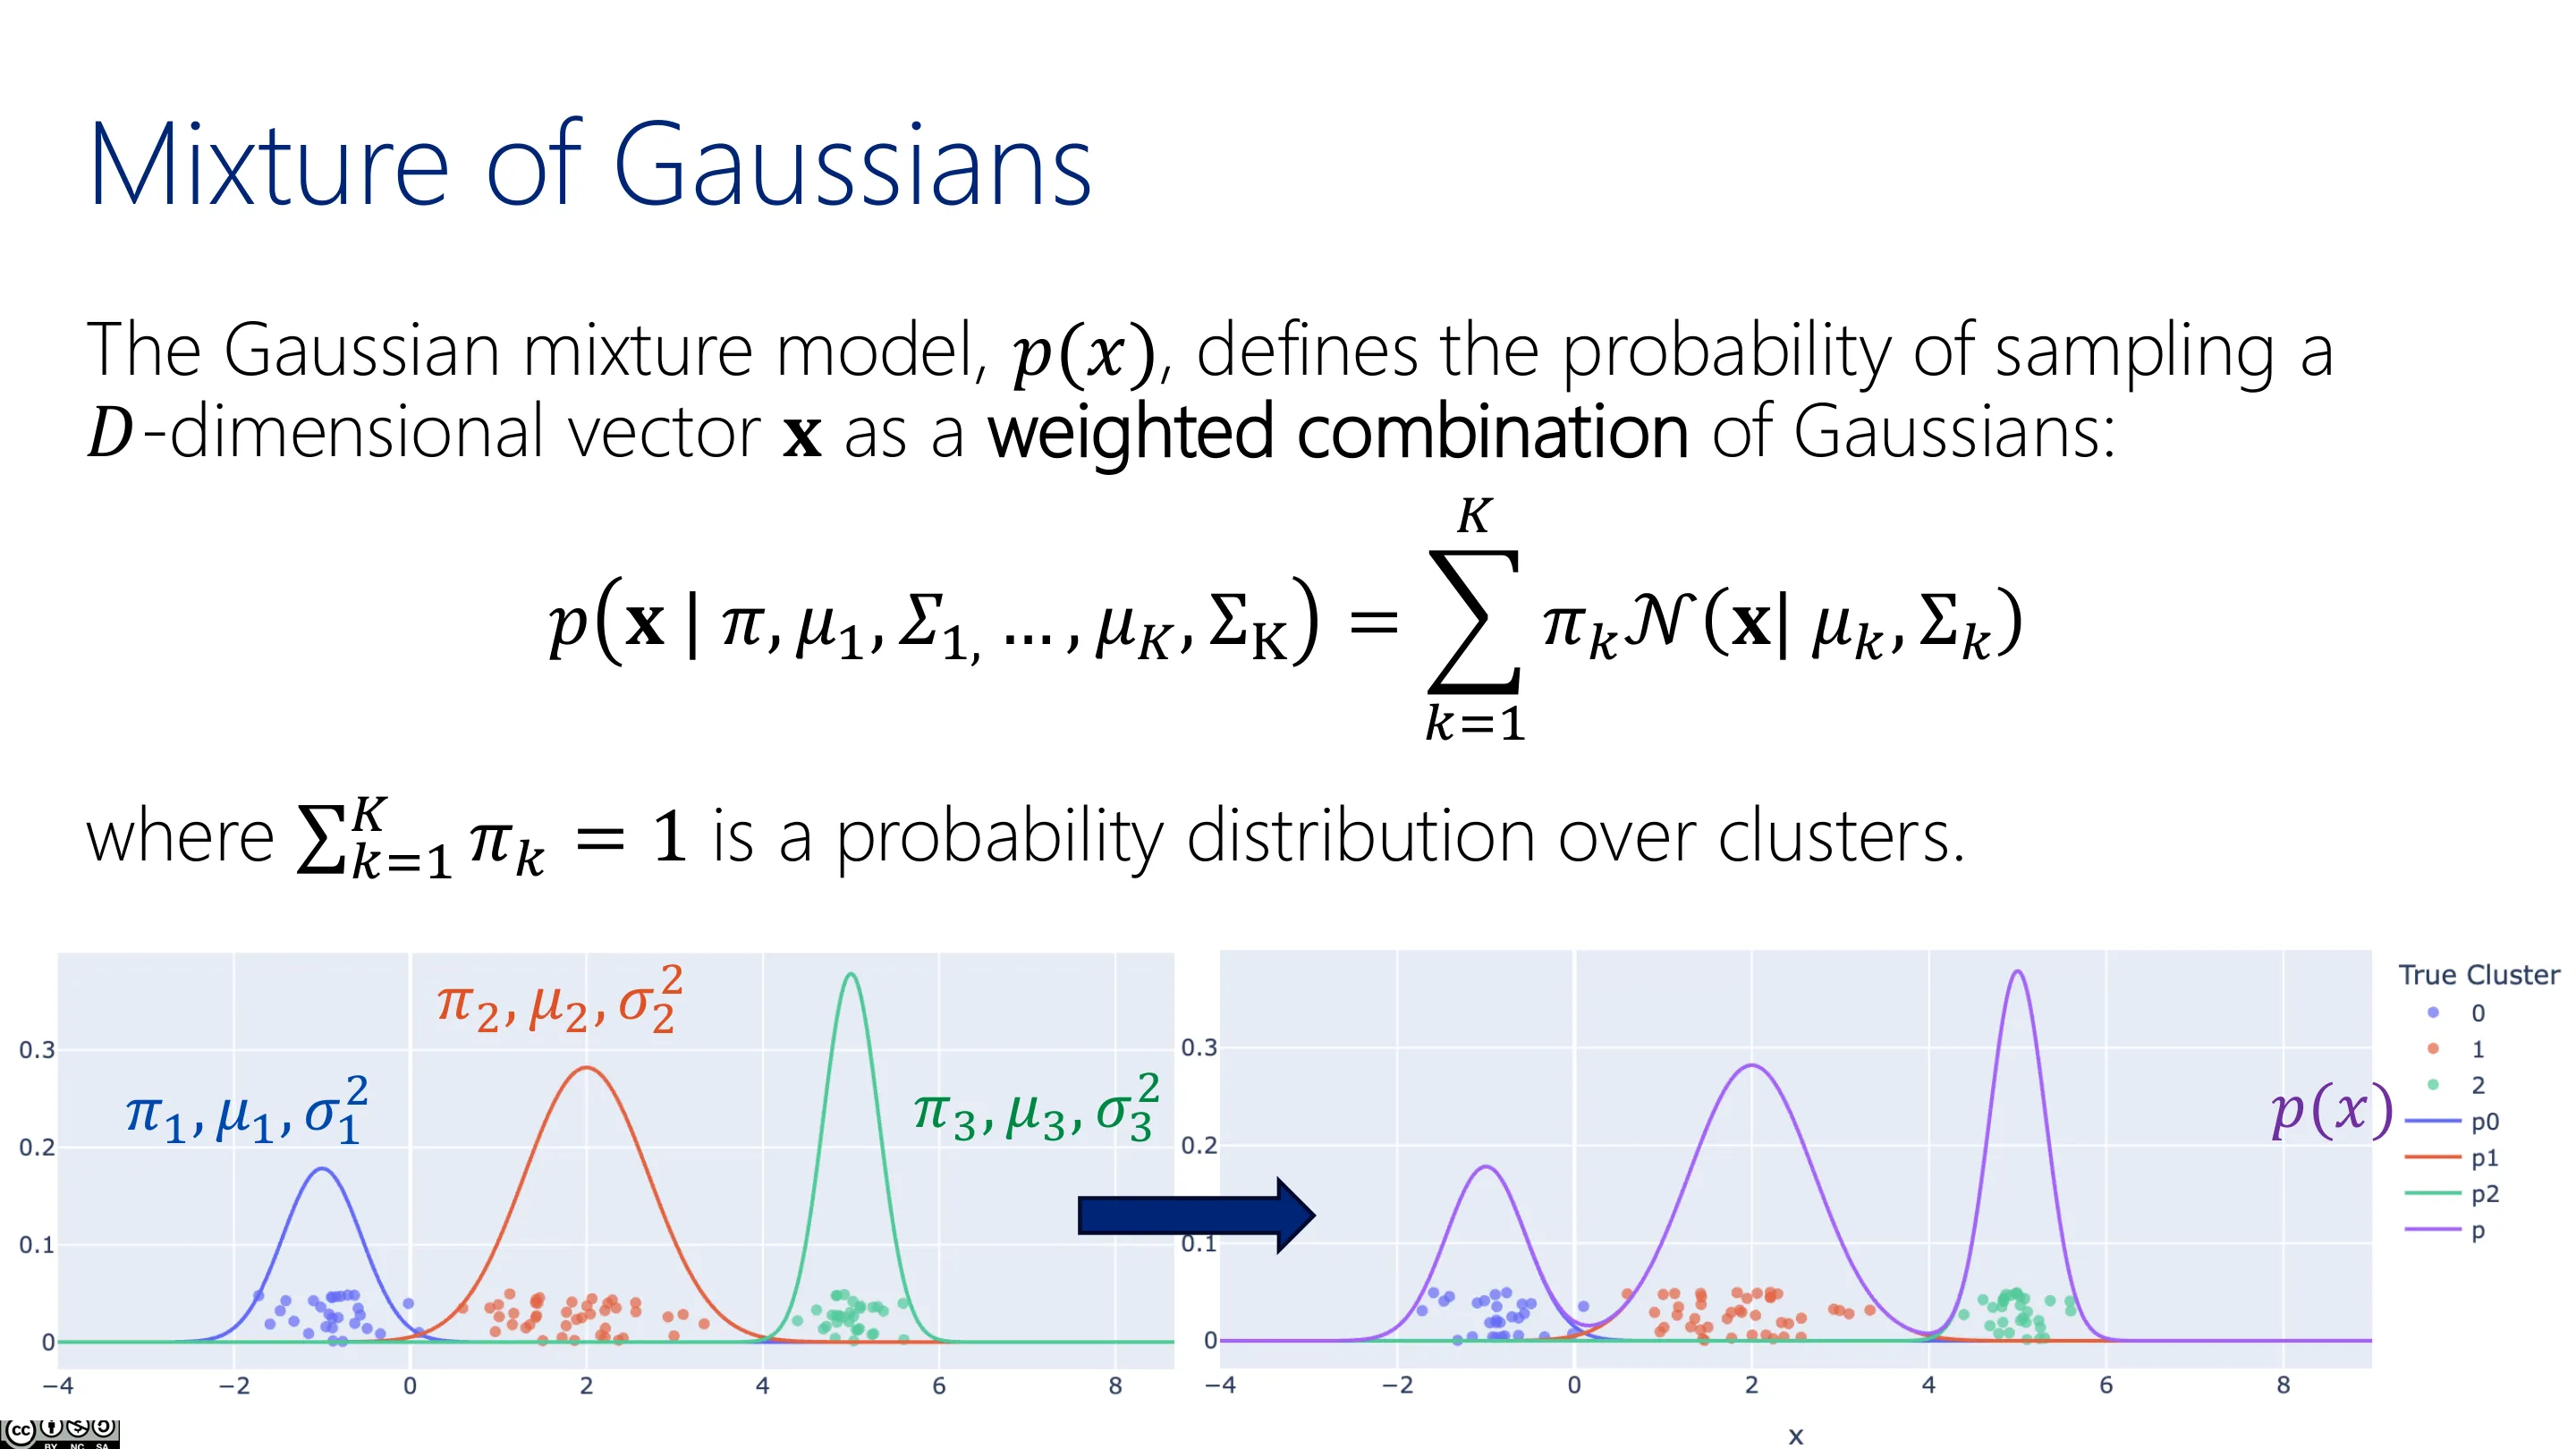
高斯混合模型(Gaussian Mixture Model, GMM)即用若干个高斯的加权和作为密度:
$$ p(\mathbf{x}\mid\pi,\mu_1,\Sigma_1,\dots,\mu_K,\Sigma_K)=\sum_{k=1}^{K}\pi_k\,\mathcal{N}(\mathbf{x}\mid\mu_k,\Sigma_k),\qquad \sum_{k=1}^{K}\pi_k=1 $$
其中 $\pi_k$ 是混合权重(mixing weights),$\sum_k\pi_k=1$ 保证整体仍是一个归一化的概率分布。
📷 高斯混合模型(一)
回到原视频 (01:16:02)
📷 高斯混合模型(二):加权组合
回到原视频 (01:17:30)
3.2 用 MoG 做聚类:隐变量与似然
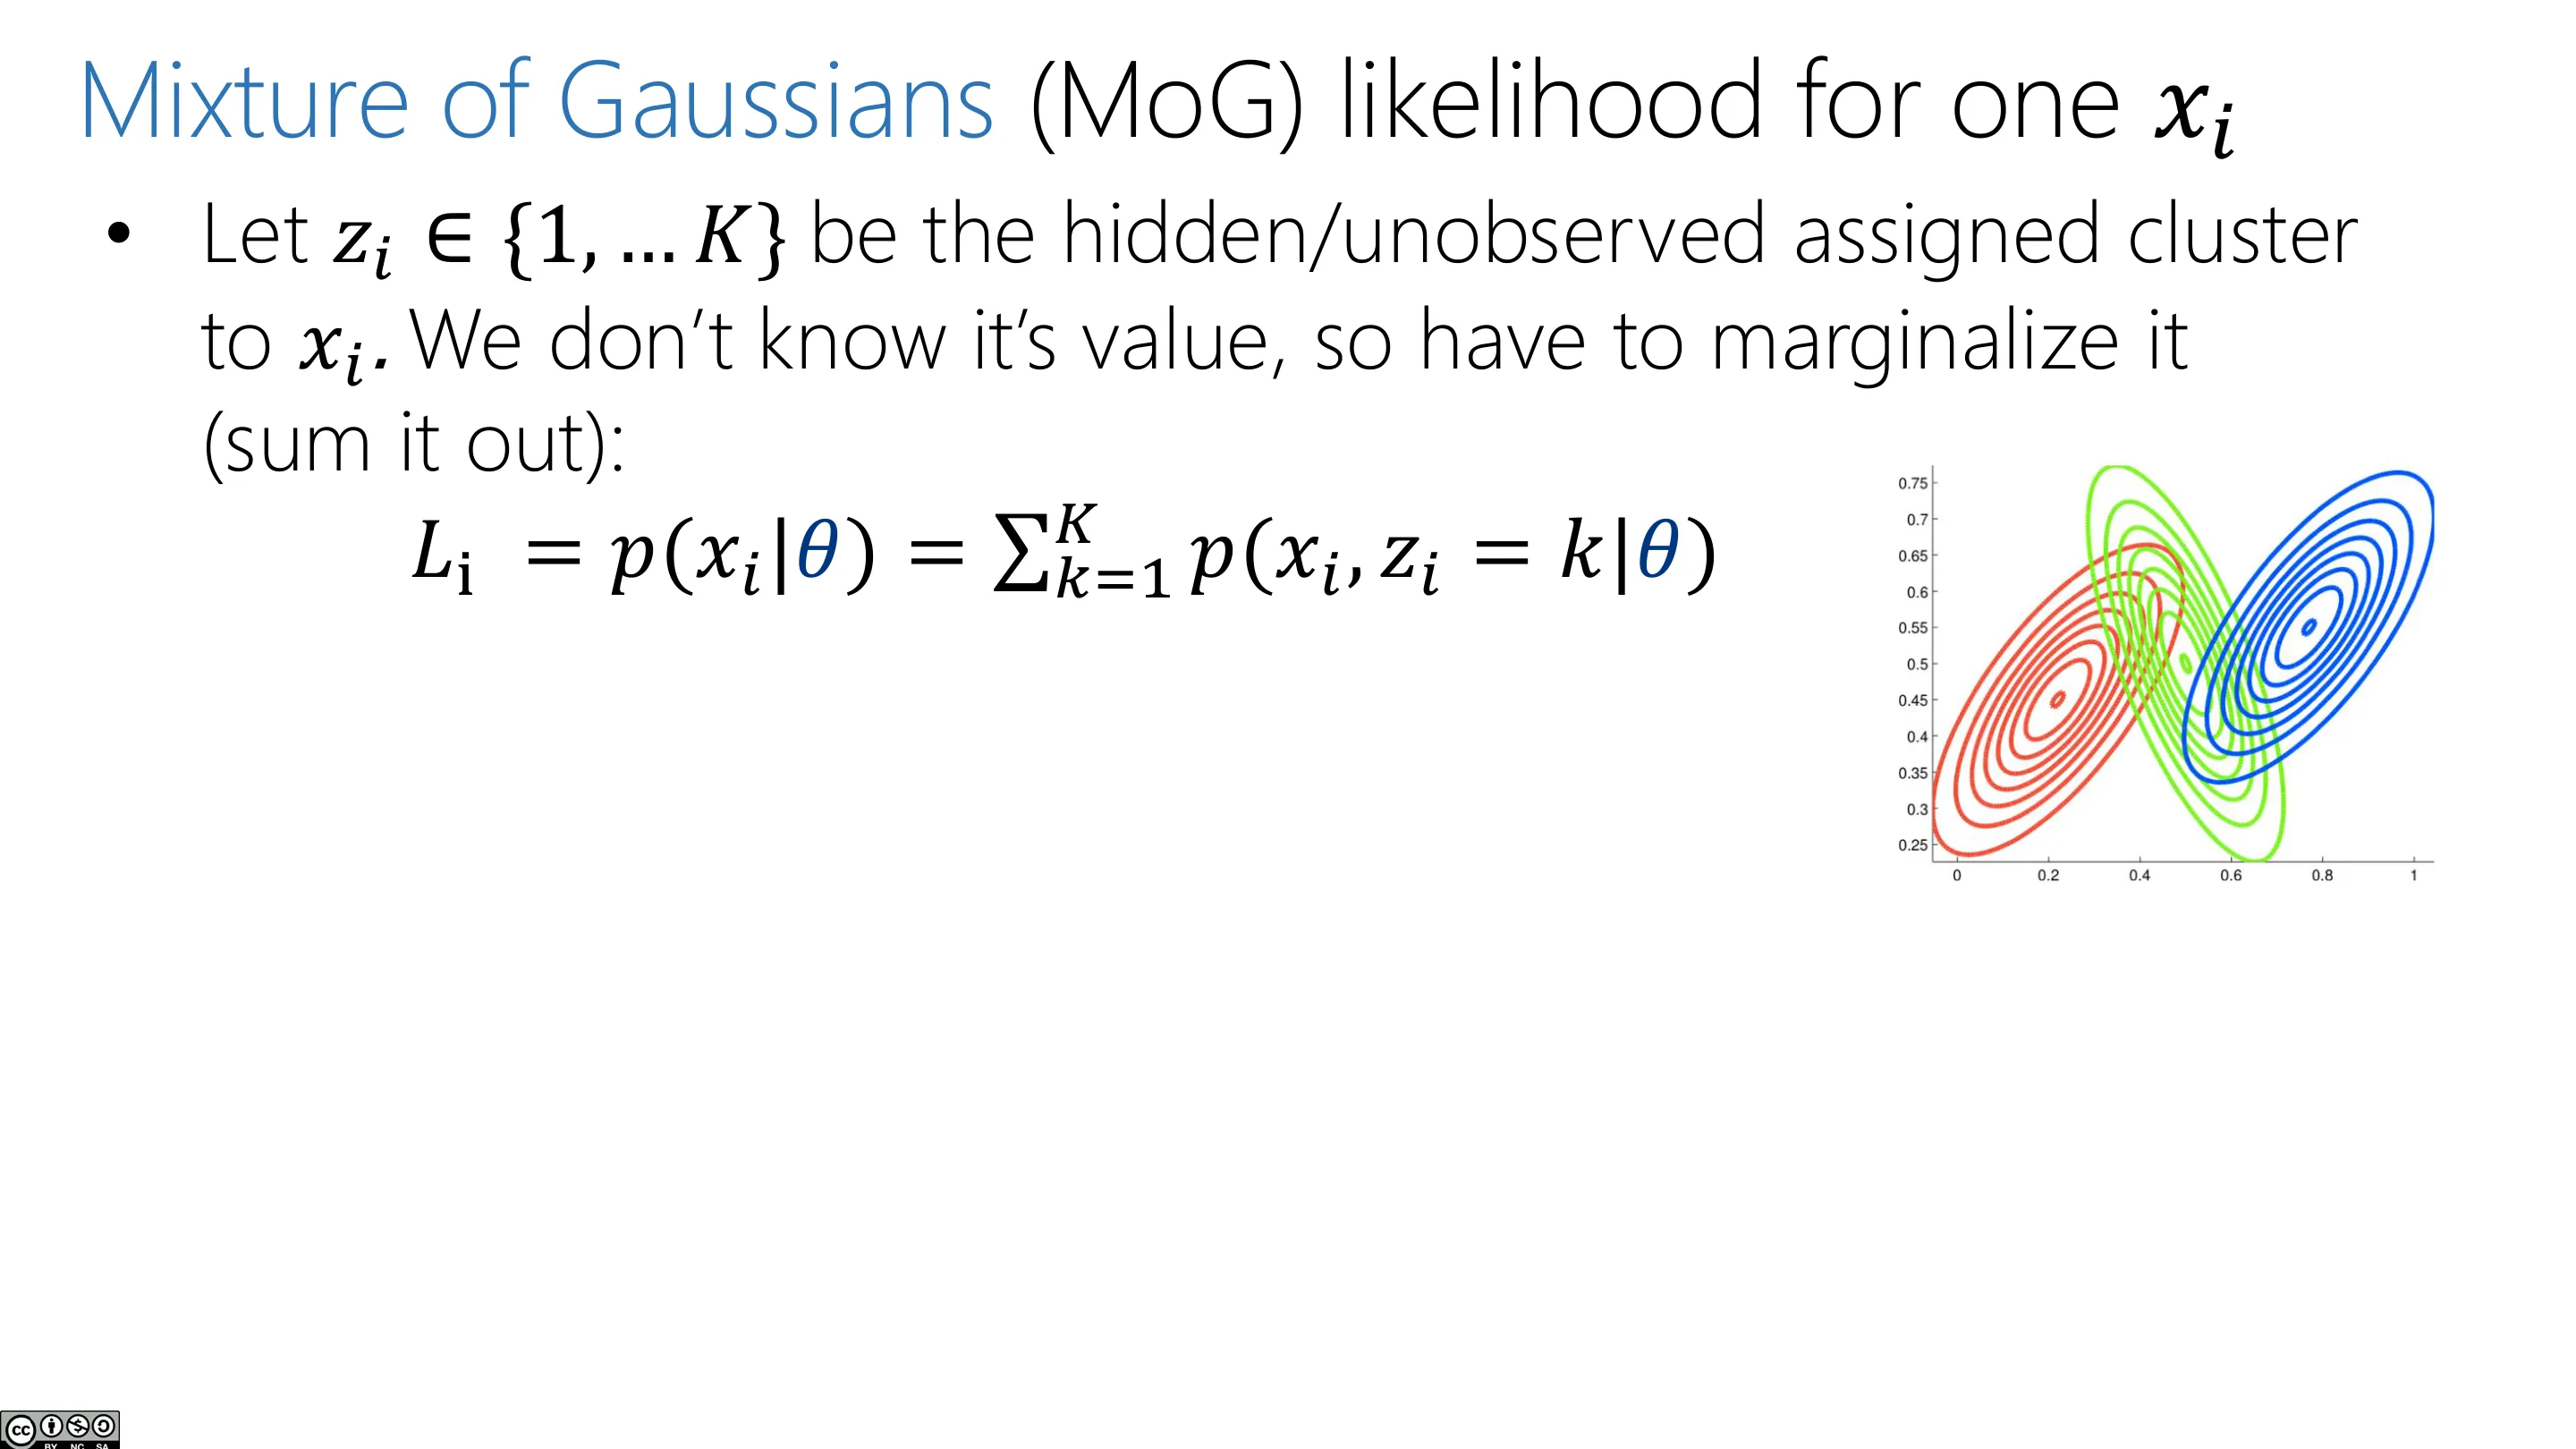
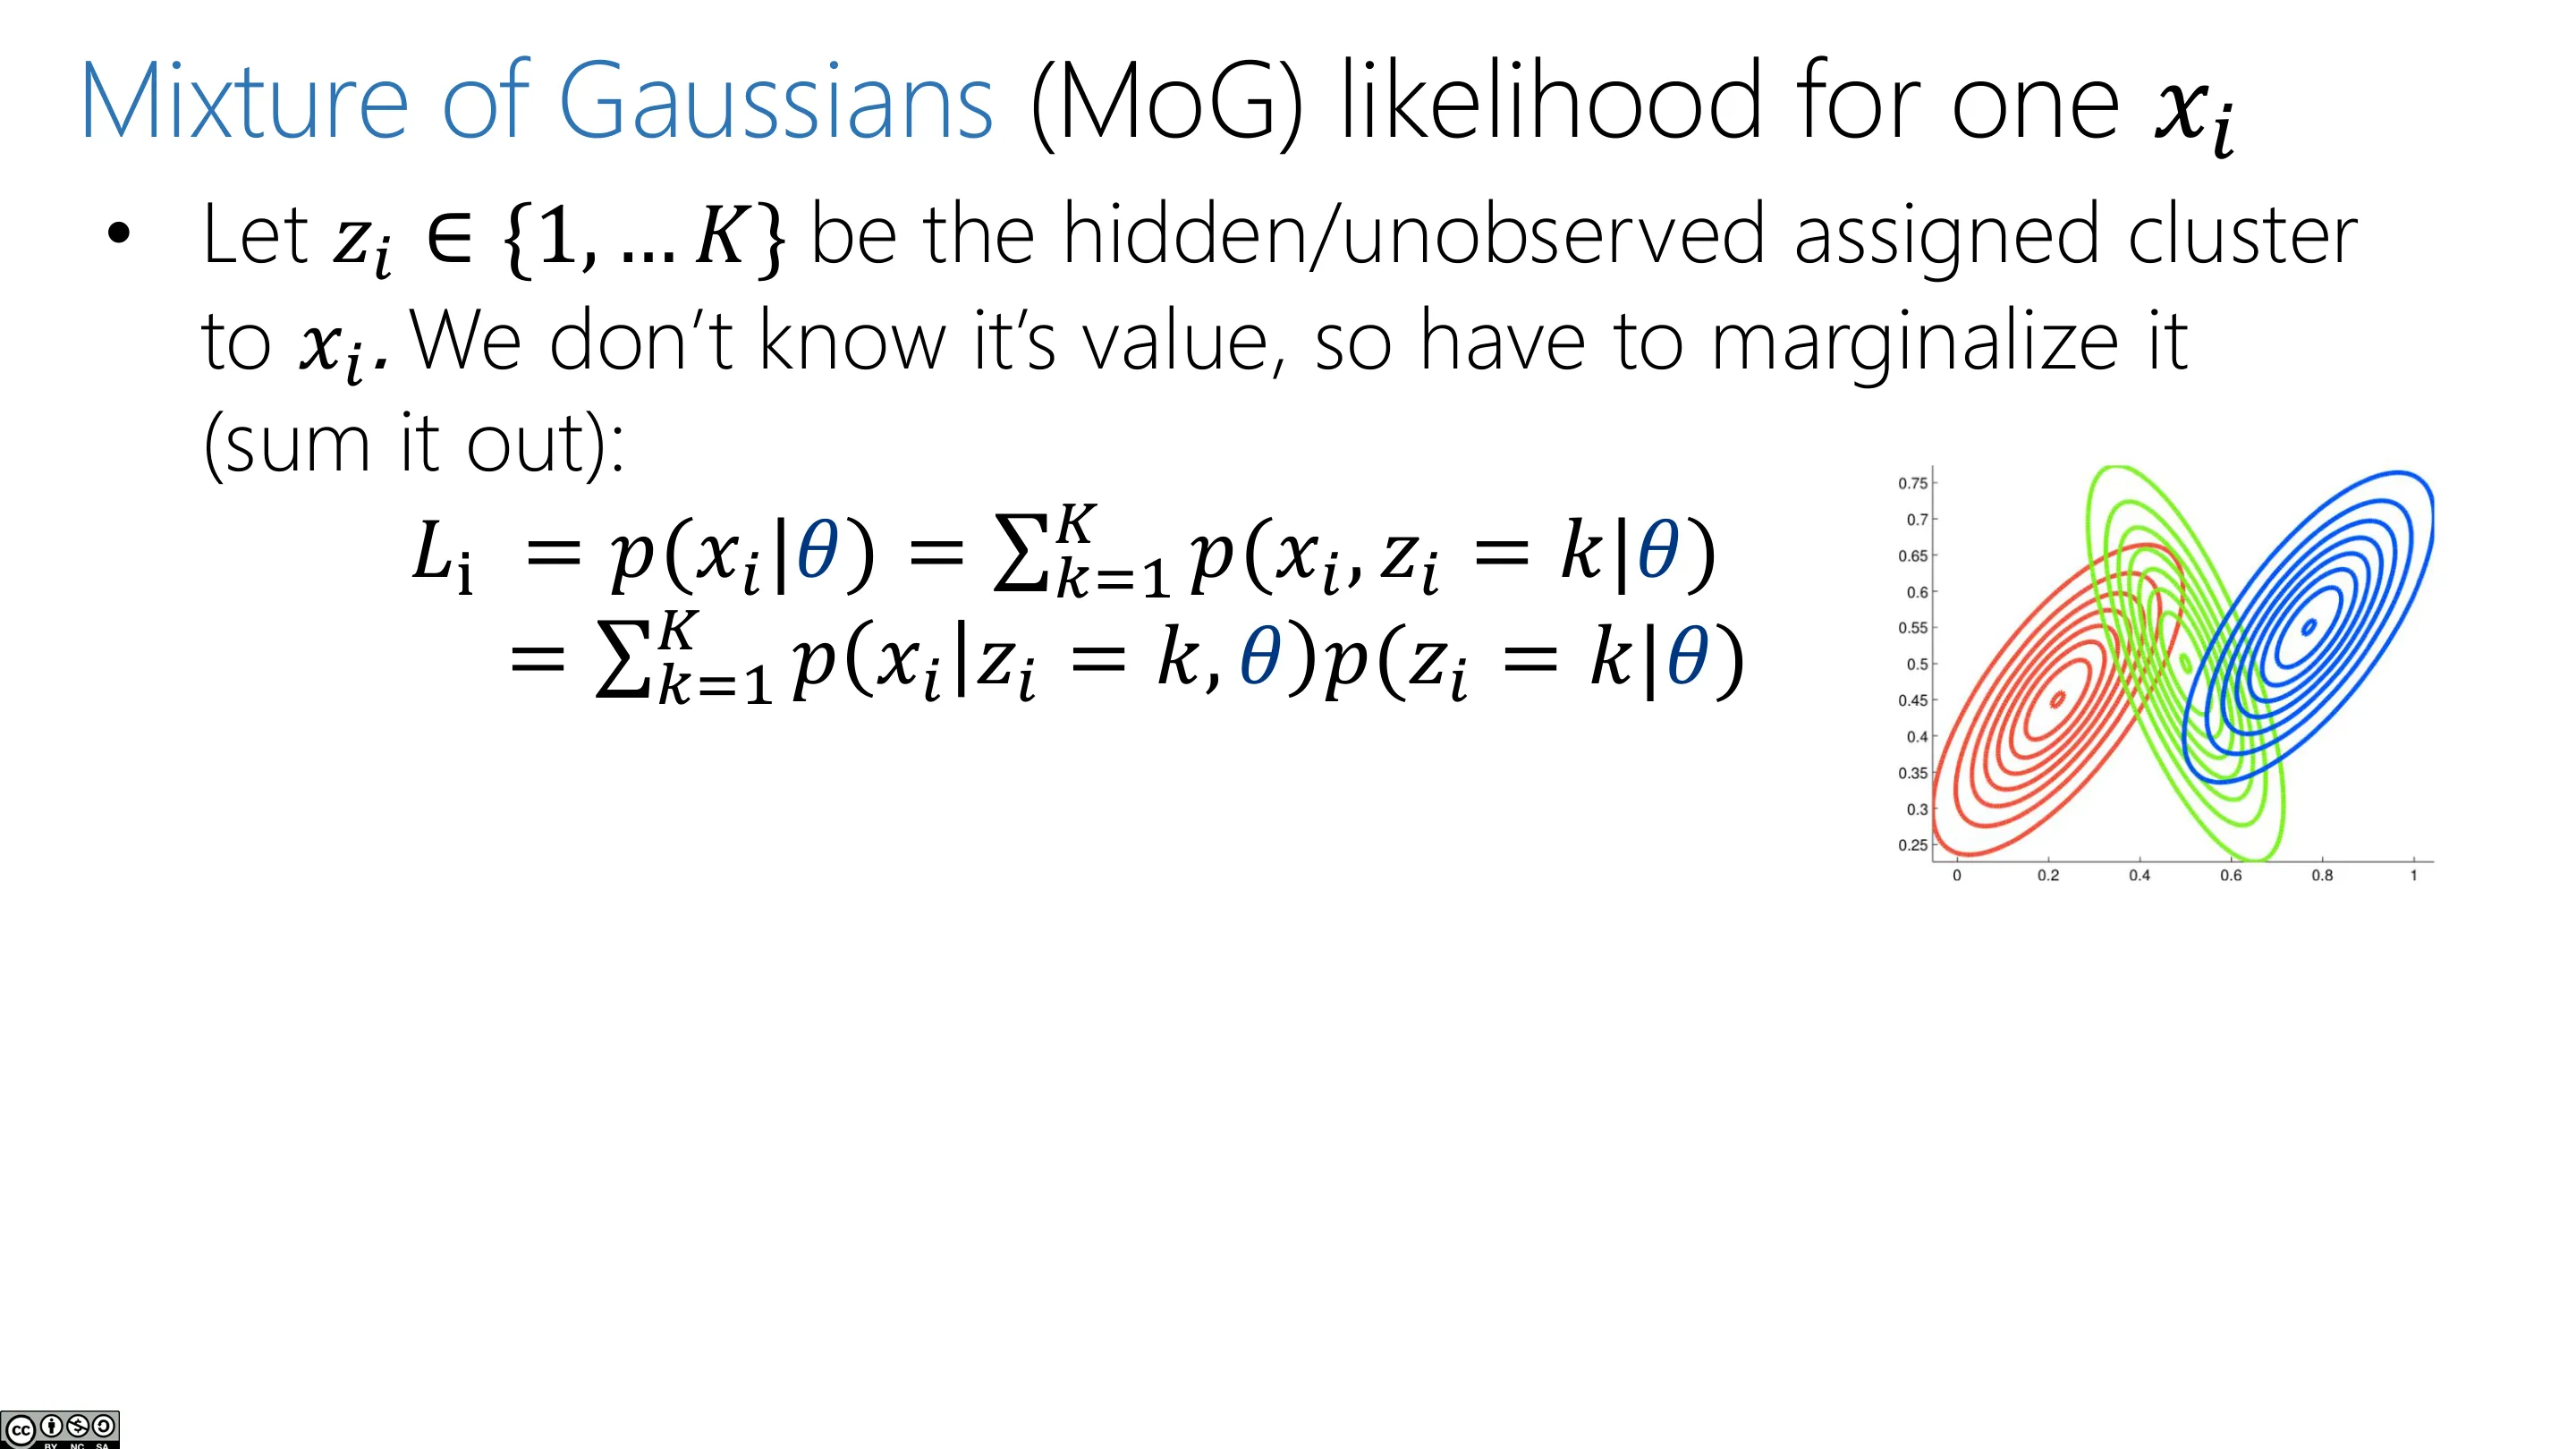
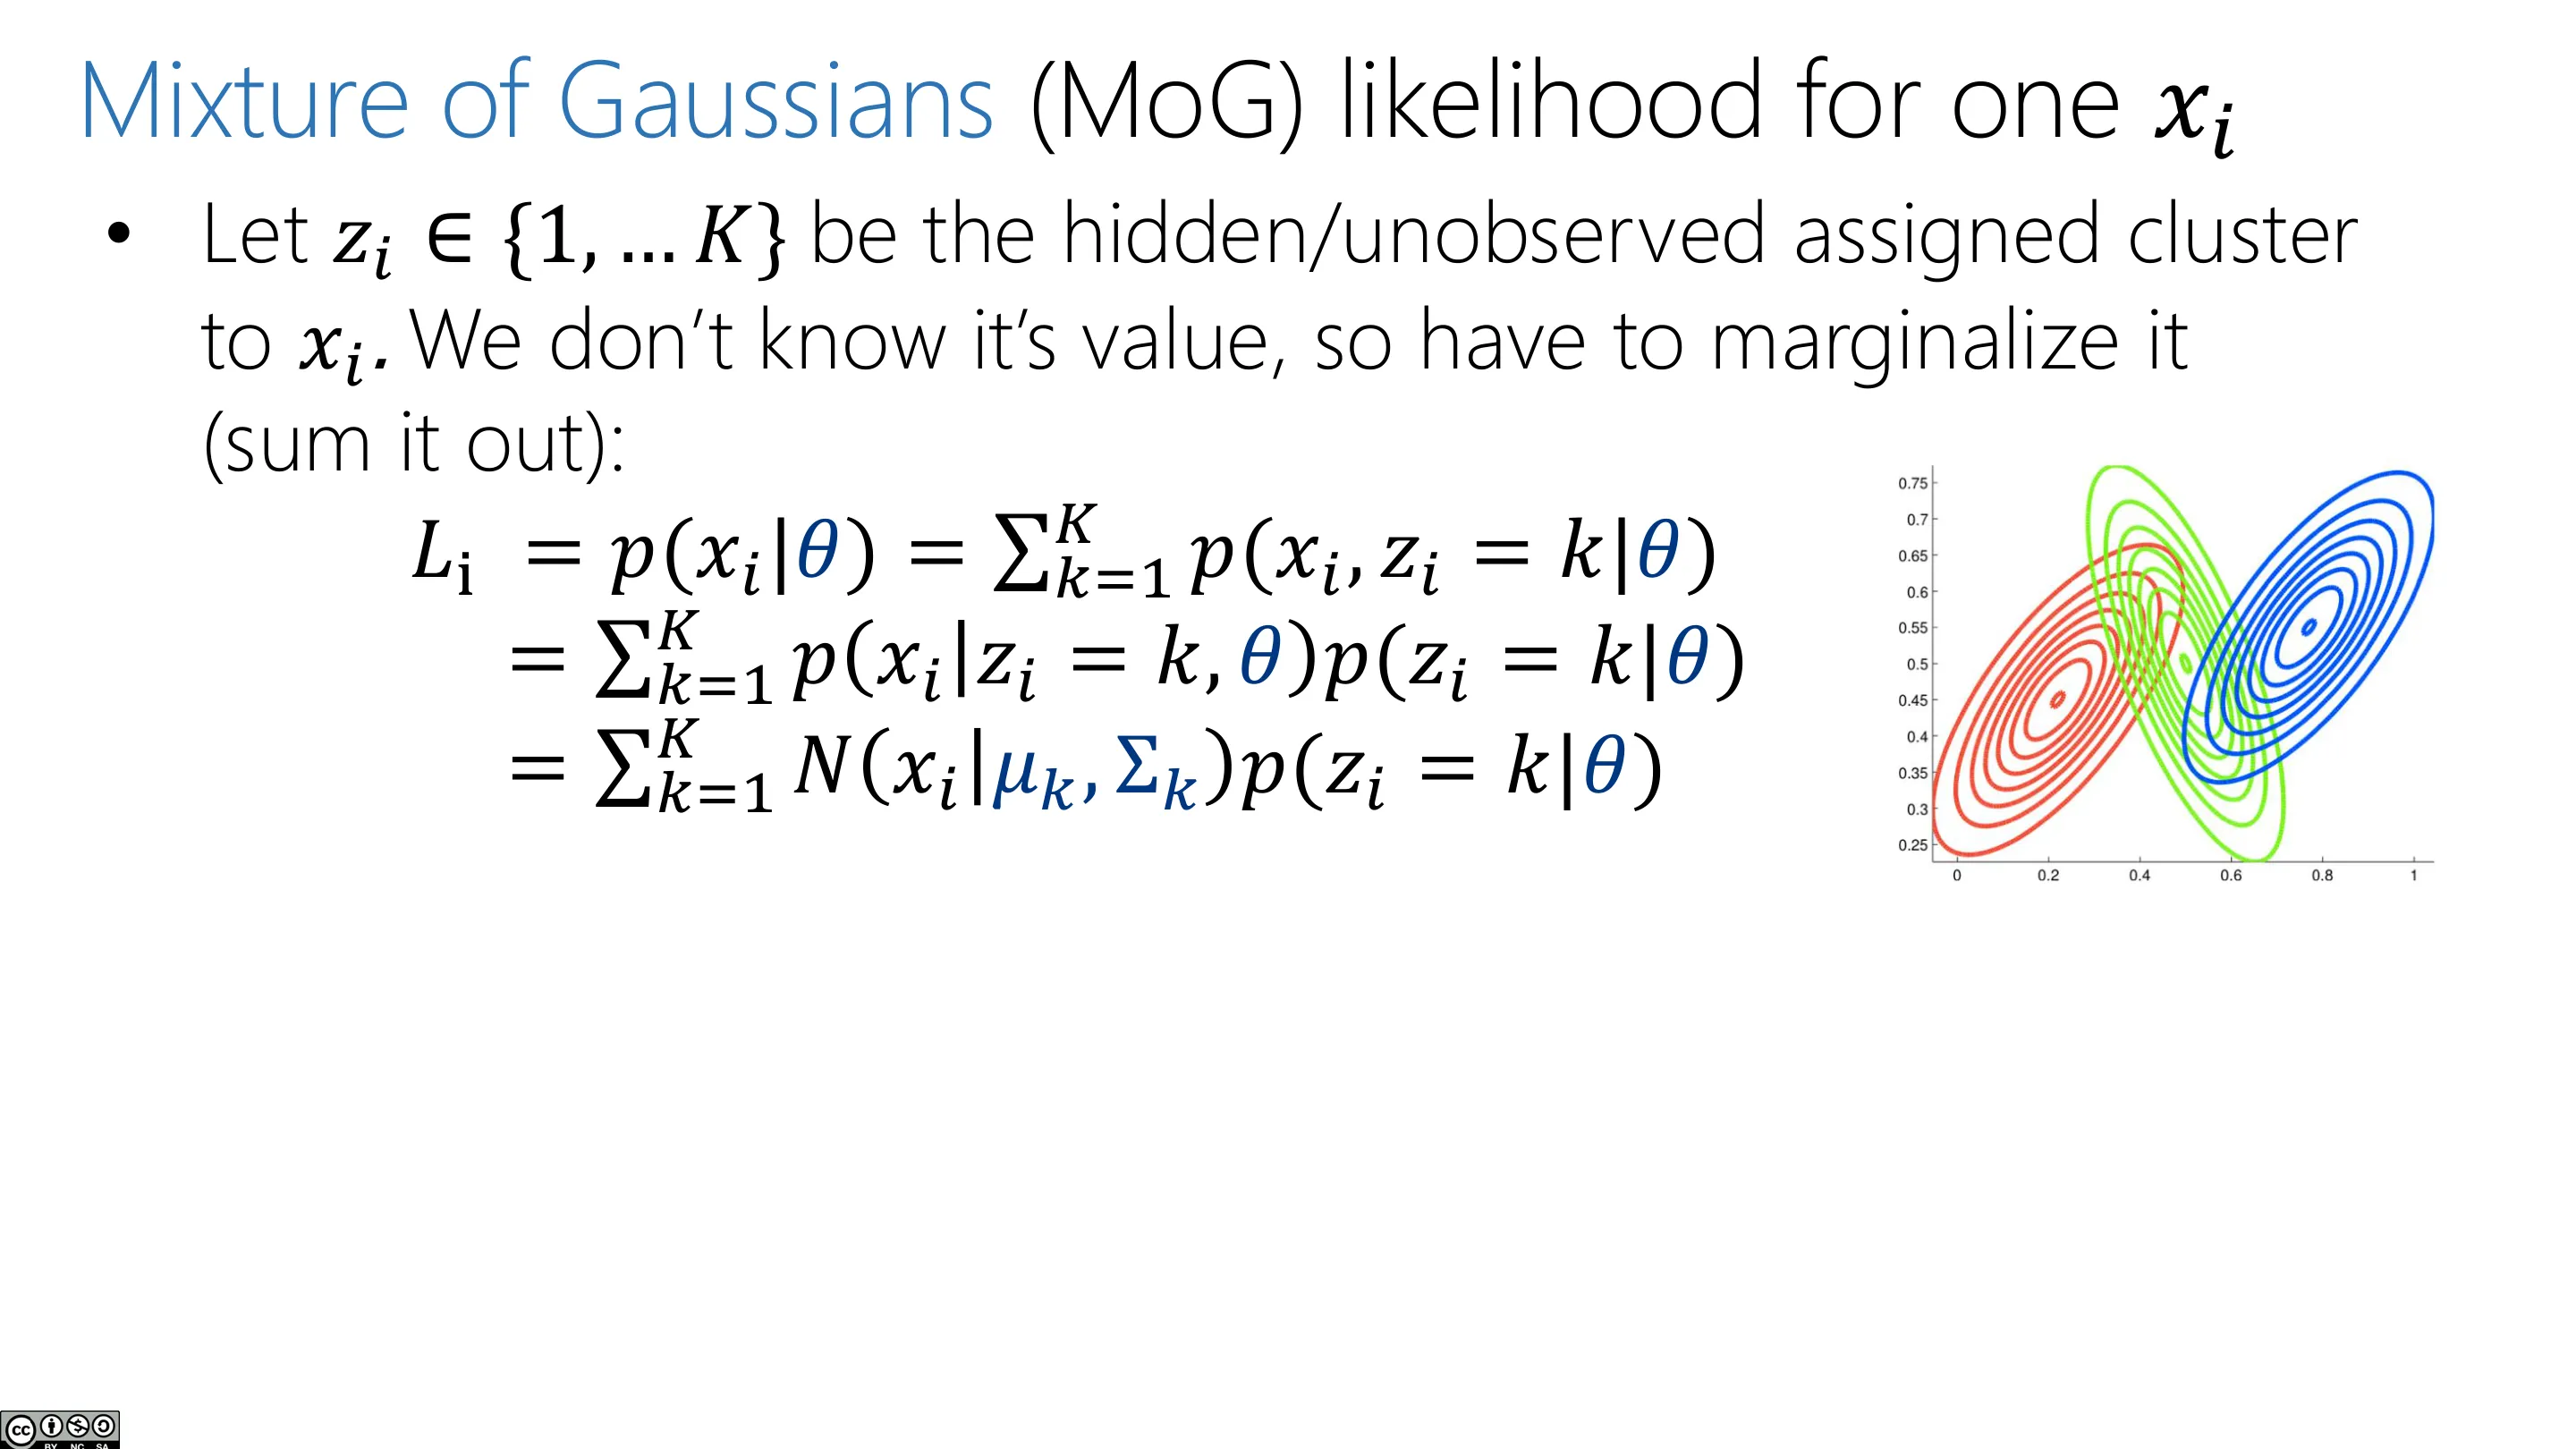
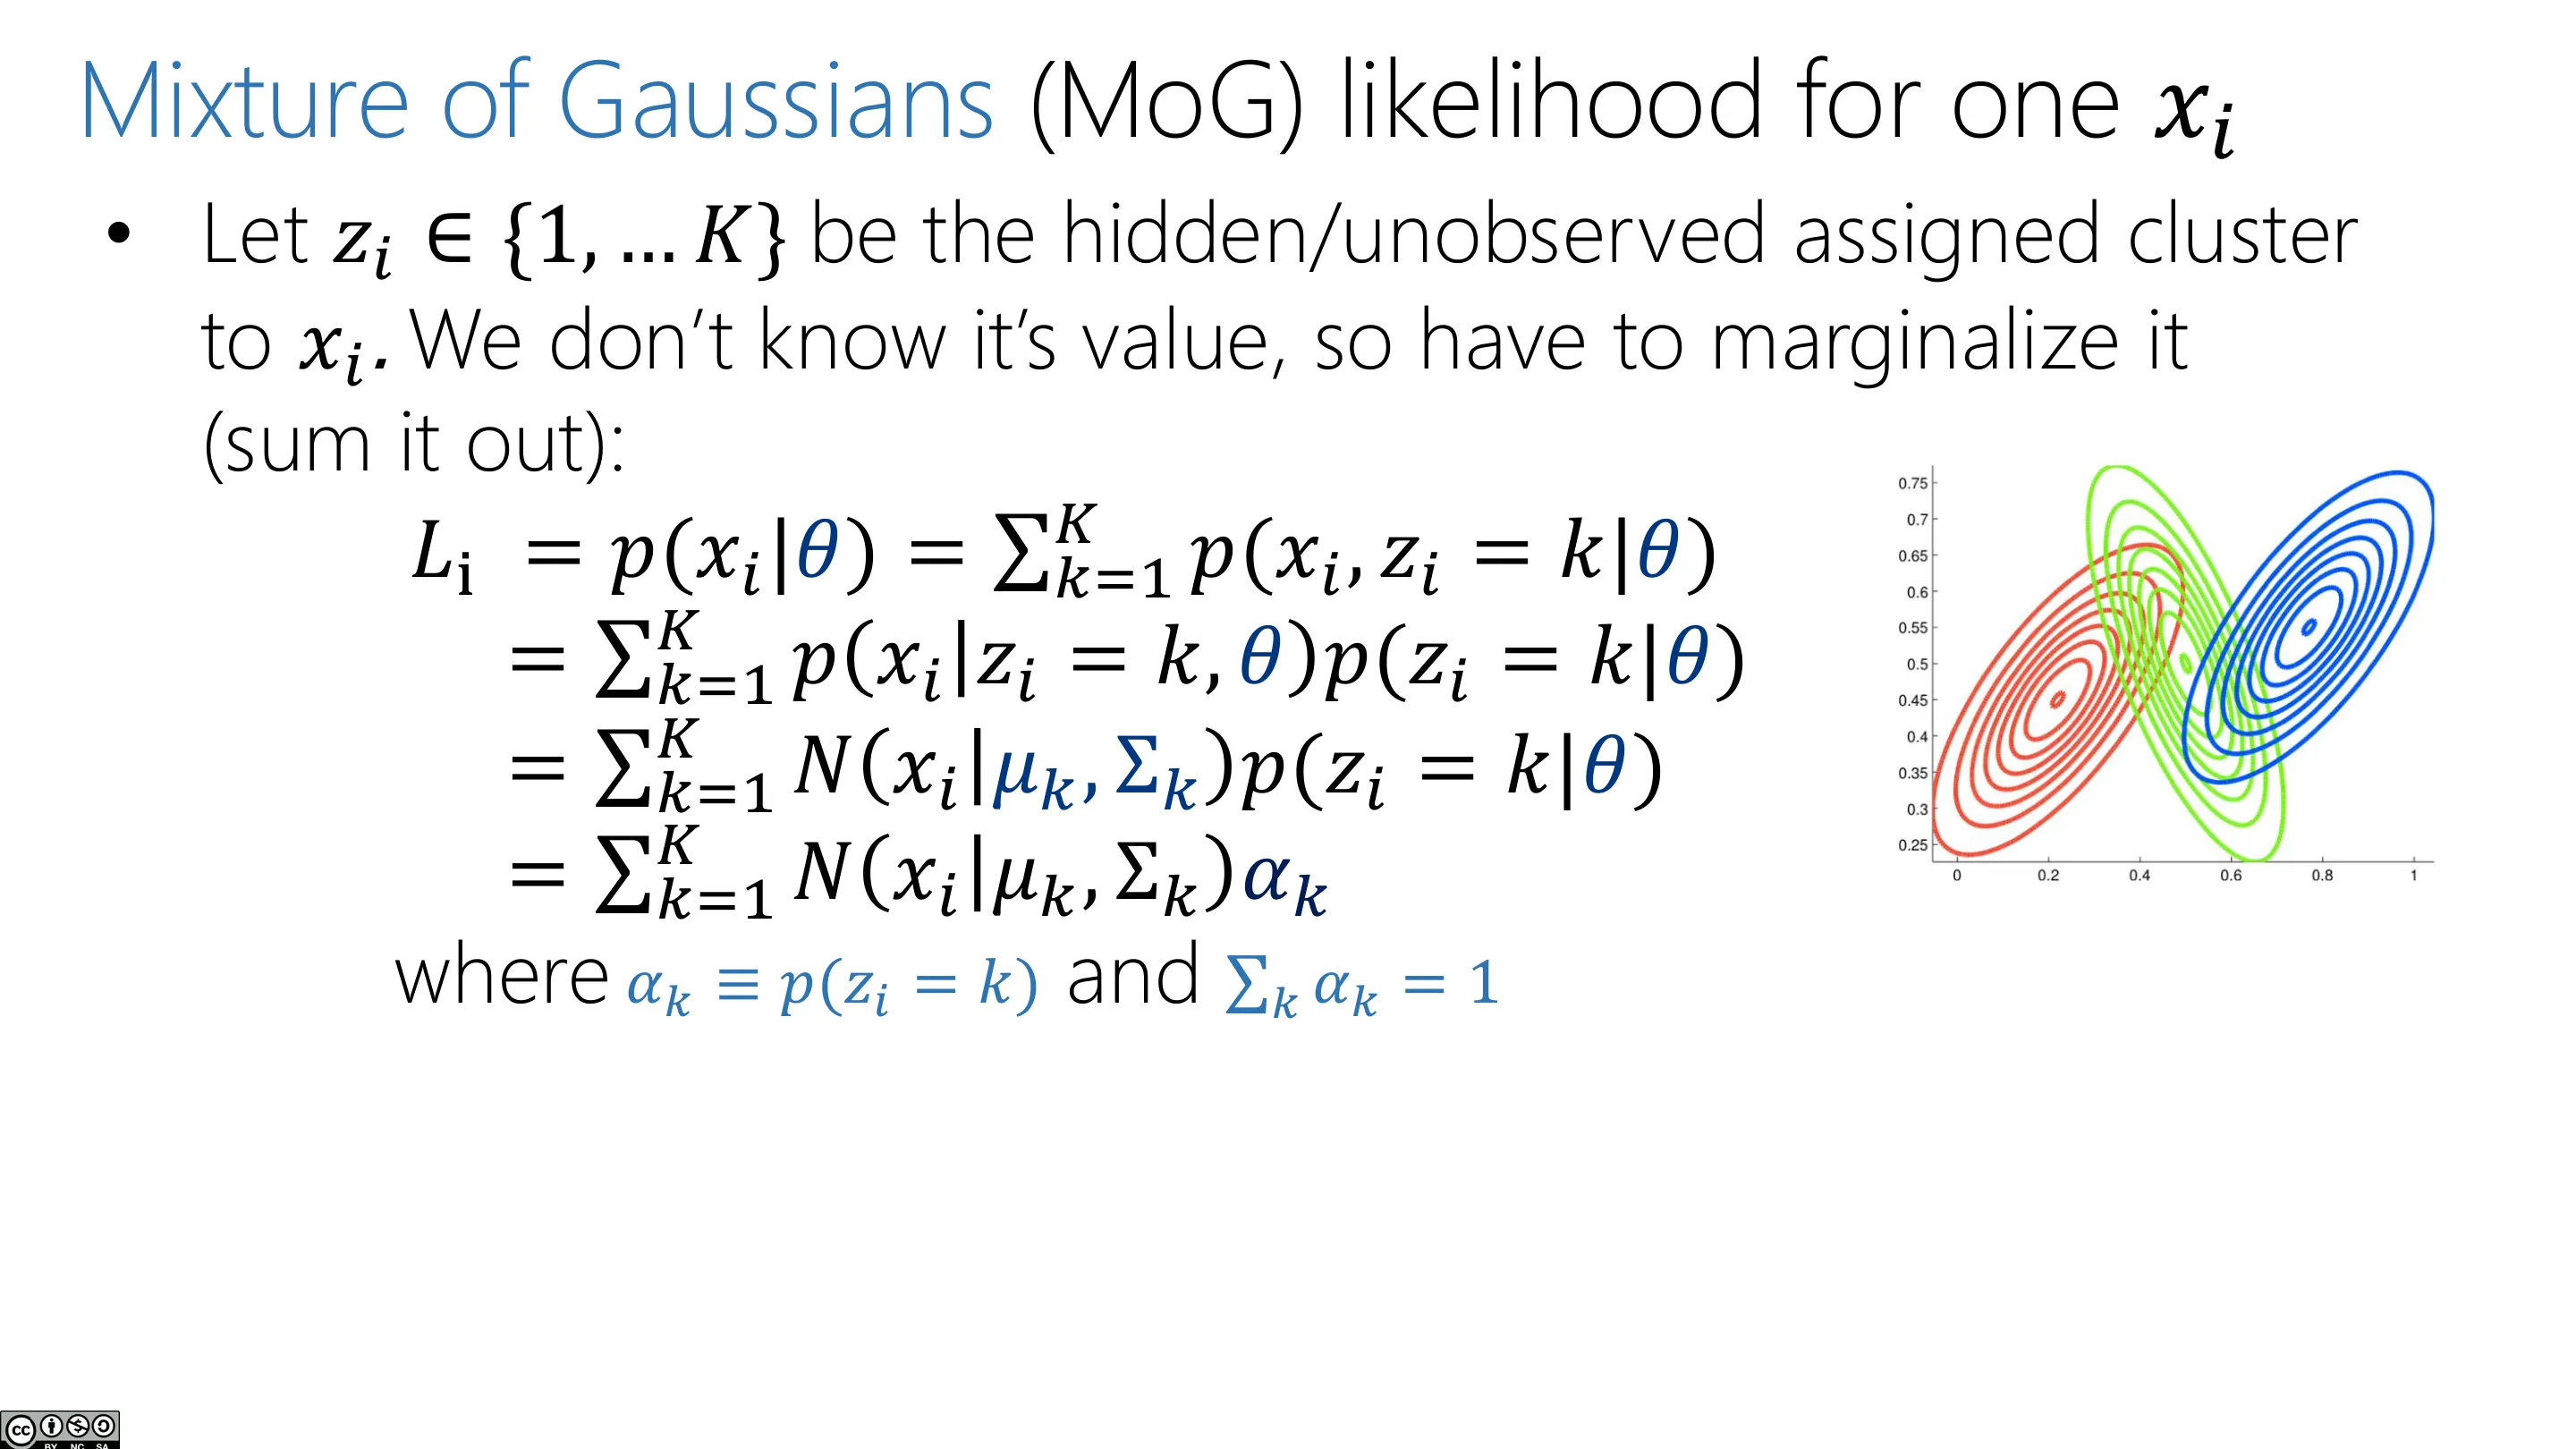
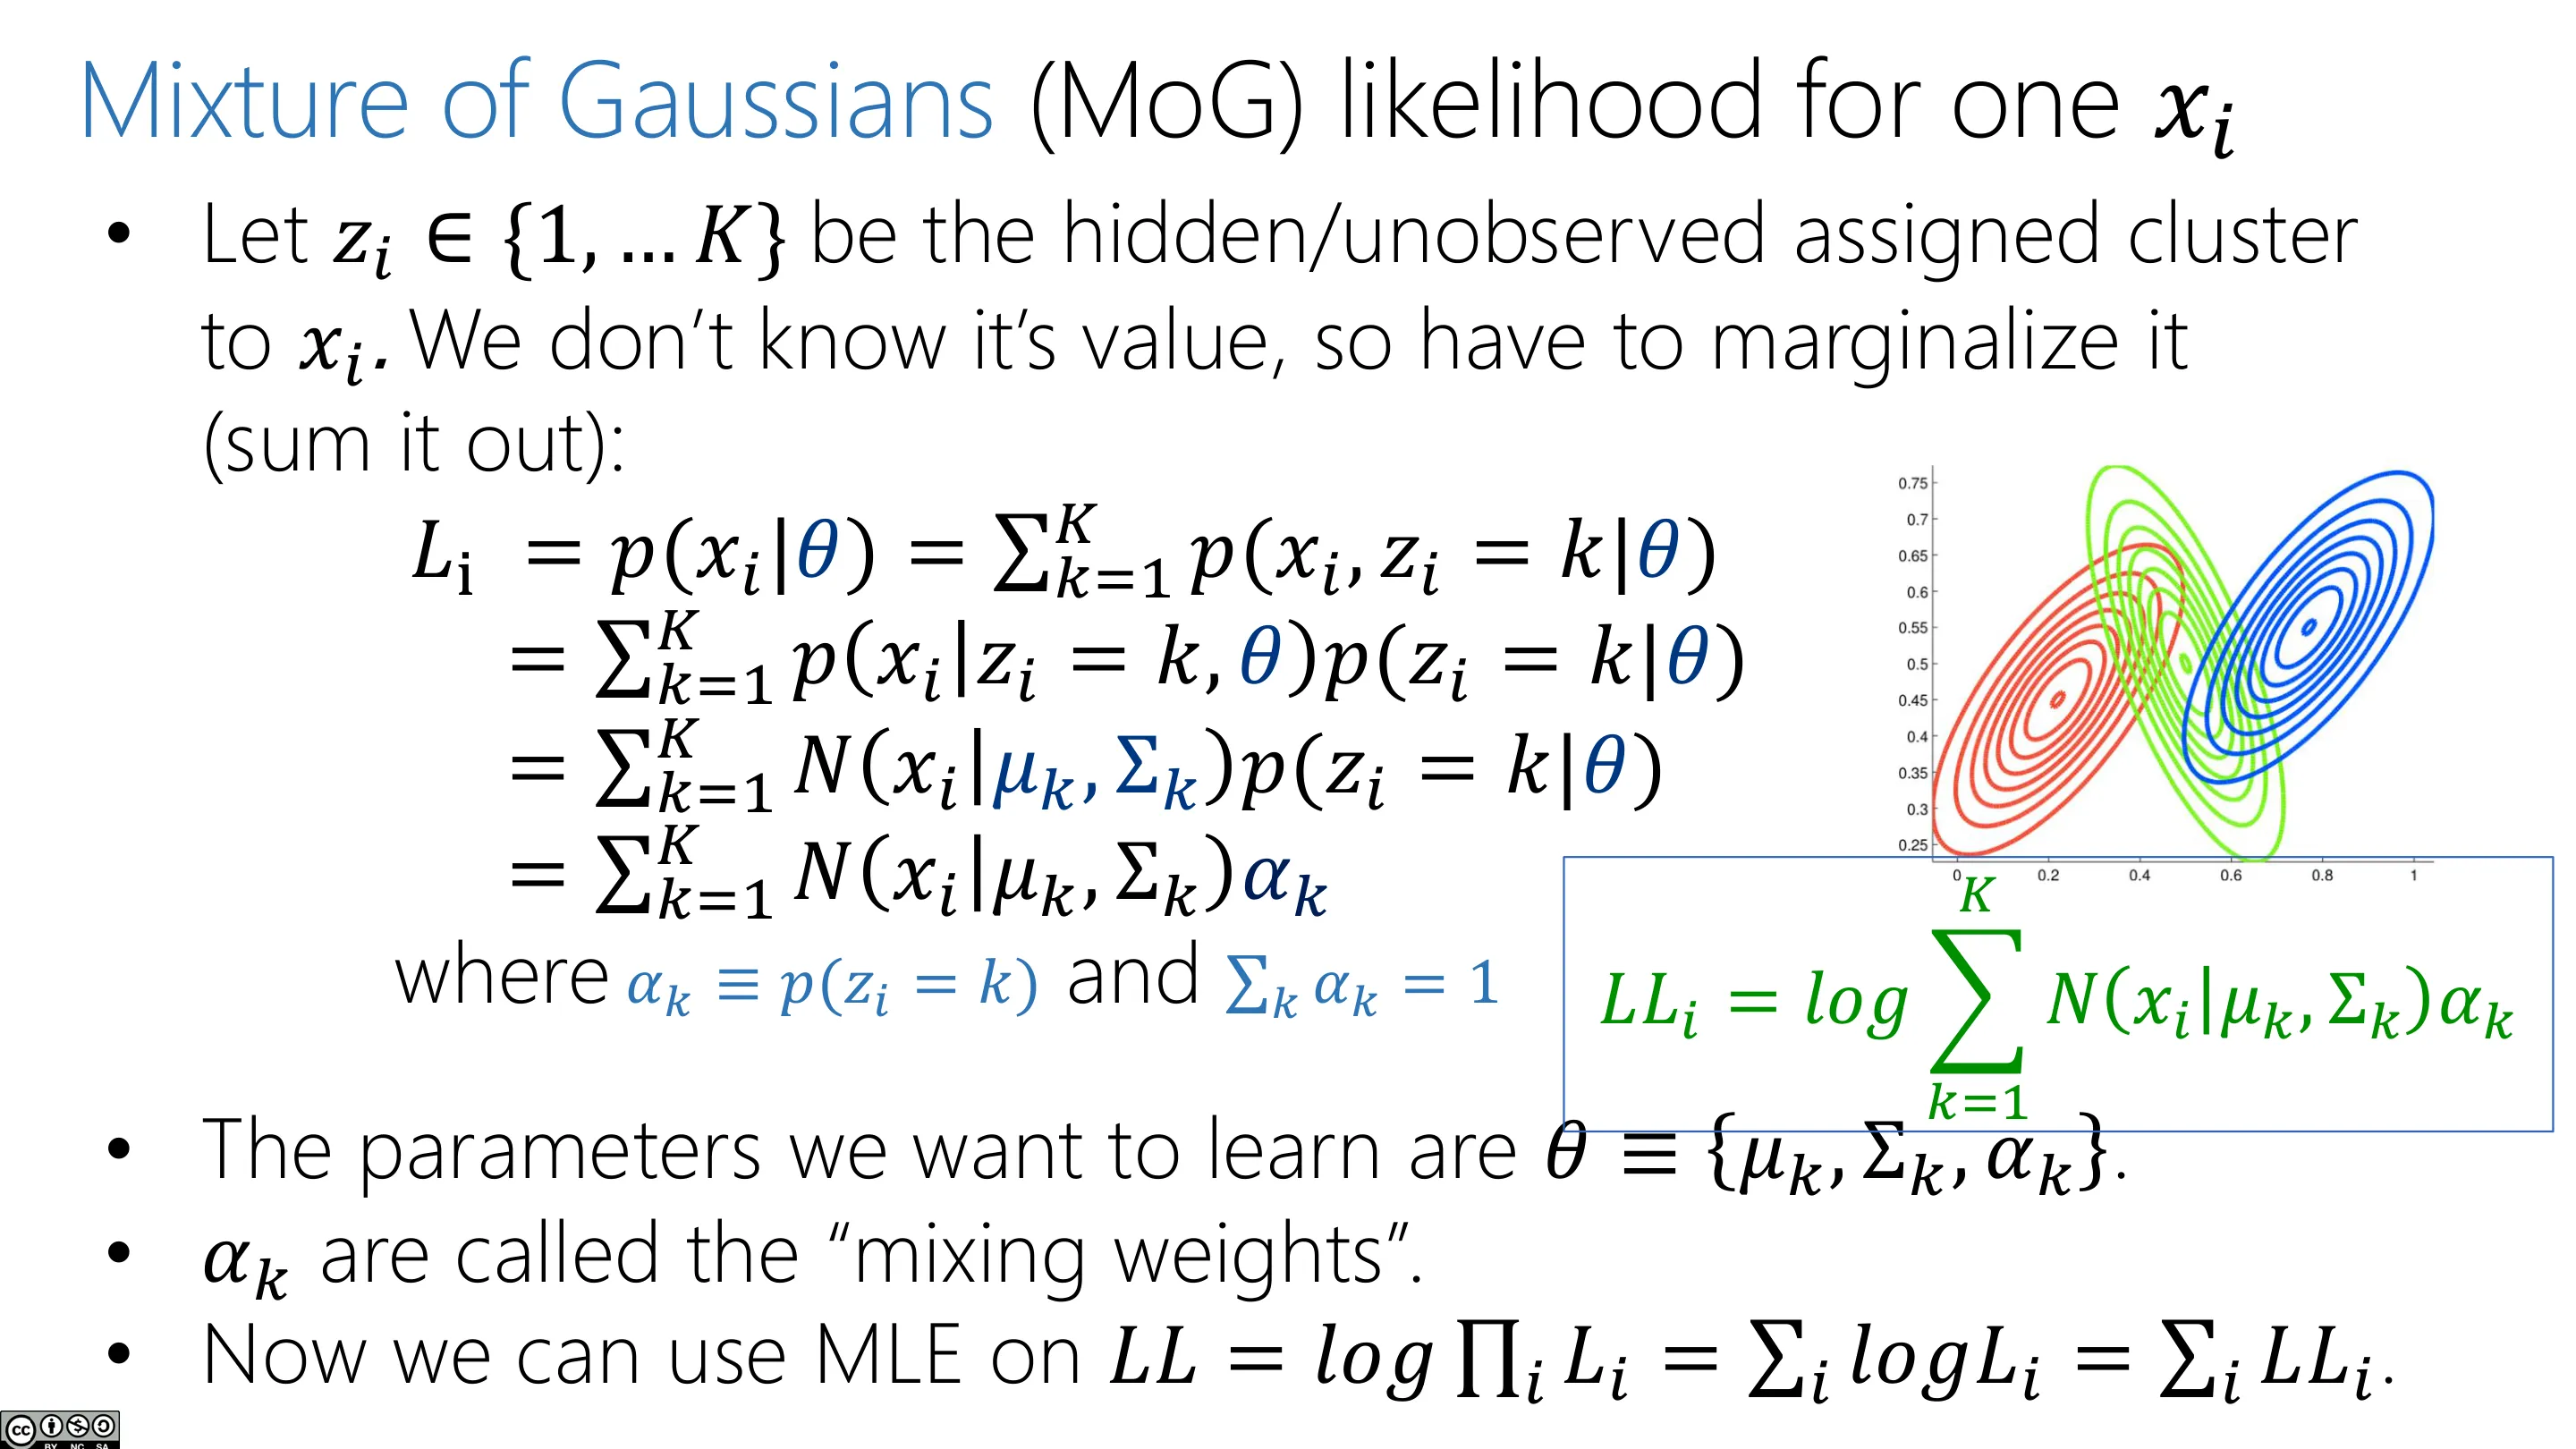
每个簇现在由一个高斯 $\mathcal{N}(x_i\mid\mu_k,\Sigma_k)$ 表示(两个自由参数:均值与协方差)。引入隐变量(latent variable) $z_i\in\{1,\dots,K}$ 表示「$x_i$ 属于哪个簇」——它不可观测,因此要对它边缘化(求和消去):
$$ L_i=p(x_i\mid\theta)=\sum_{k=1}^{K}p(x_i,z_i=k\mid\theta)=\sum_{k=1}^{K}p(x_i\mid z_i=k,\theta)\,p(z_i=k\mid\theta)=\sum_{k=1}^{K}\mathcal{N}(x_i\mid\mu_k,\Sigma_k)\,\alpha_k $$
其中 $\alpha_k\equiv p(z_i=k)$ 即混合权重,$\sum_k\alpha_k=1$。要学的参数是 $\theta\equiv\{\mu_k,\Sigma_k,\alpha_k\}$。
📷 MoG 用于聚类
回到原视频 (01:15:06)
📷 MoG 单个样本的似然(一)
回到原视频 (01:16:51)
📷 MoG 单个样本的似然(二)
回到原视频 (01:17:10)
📷 MoG 单个样本的似然(三)
回到原视频 (01:17:20)
📷 MoG 单个样本的似然(四)
回到原视频 (01:17:40)
📷 MoG 单个样本的似然(五):参数为 μₖ, Σₖ, αₖ
回到原视频 (01:17:50)
3.3 难点:没有闭式解,需要迭代优化
对整个数据集做 MLE:$\arg\max_\theta LL=\arg\max_\theta\sum_i\log L_i$,其中 $LL_i=\log\sum_{k=1}^K\mathcal{N}(x_i\mid\mu_k,\Sigma_k)\alpha_k$。
难点在于:
- 没有闭式解(对数里套着求和);
- 需要迭代优化(如下讲会讲的梯度下降,以及针对隐变量的 EM 算法,教材 15.3)。
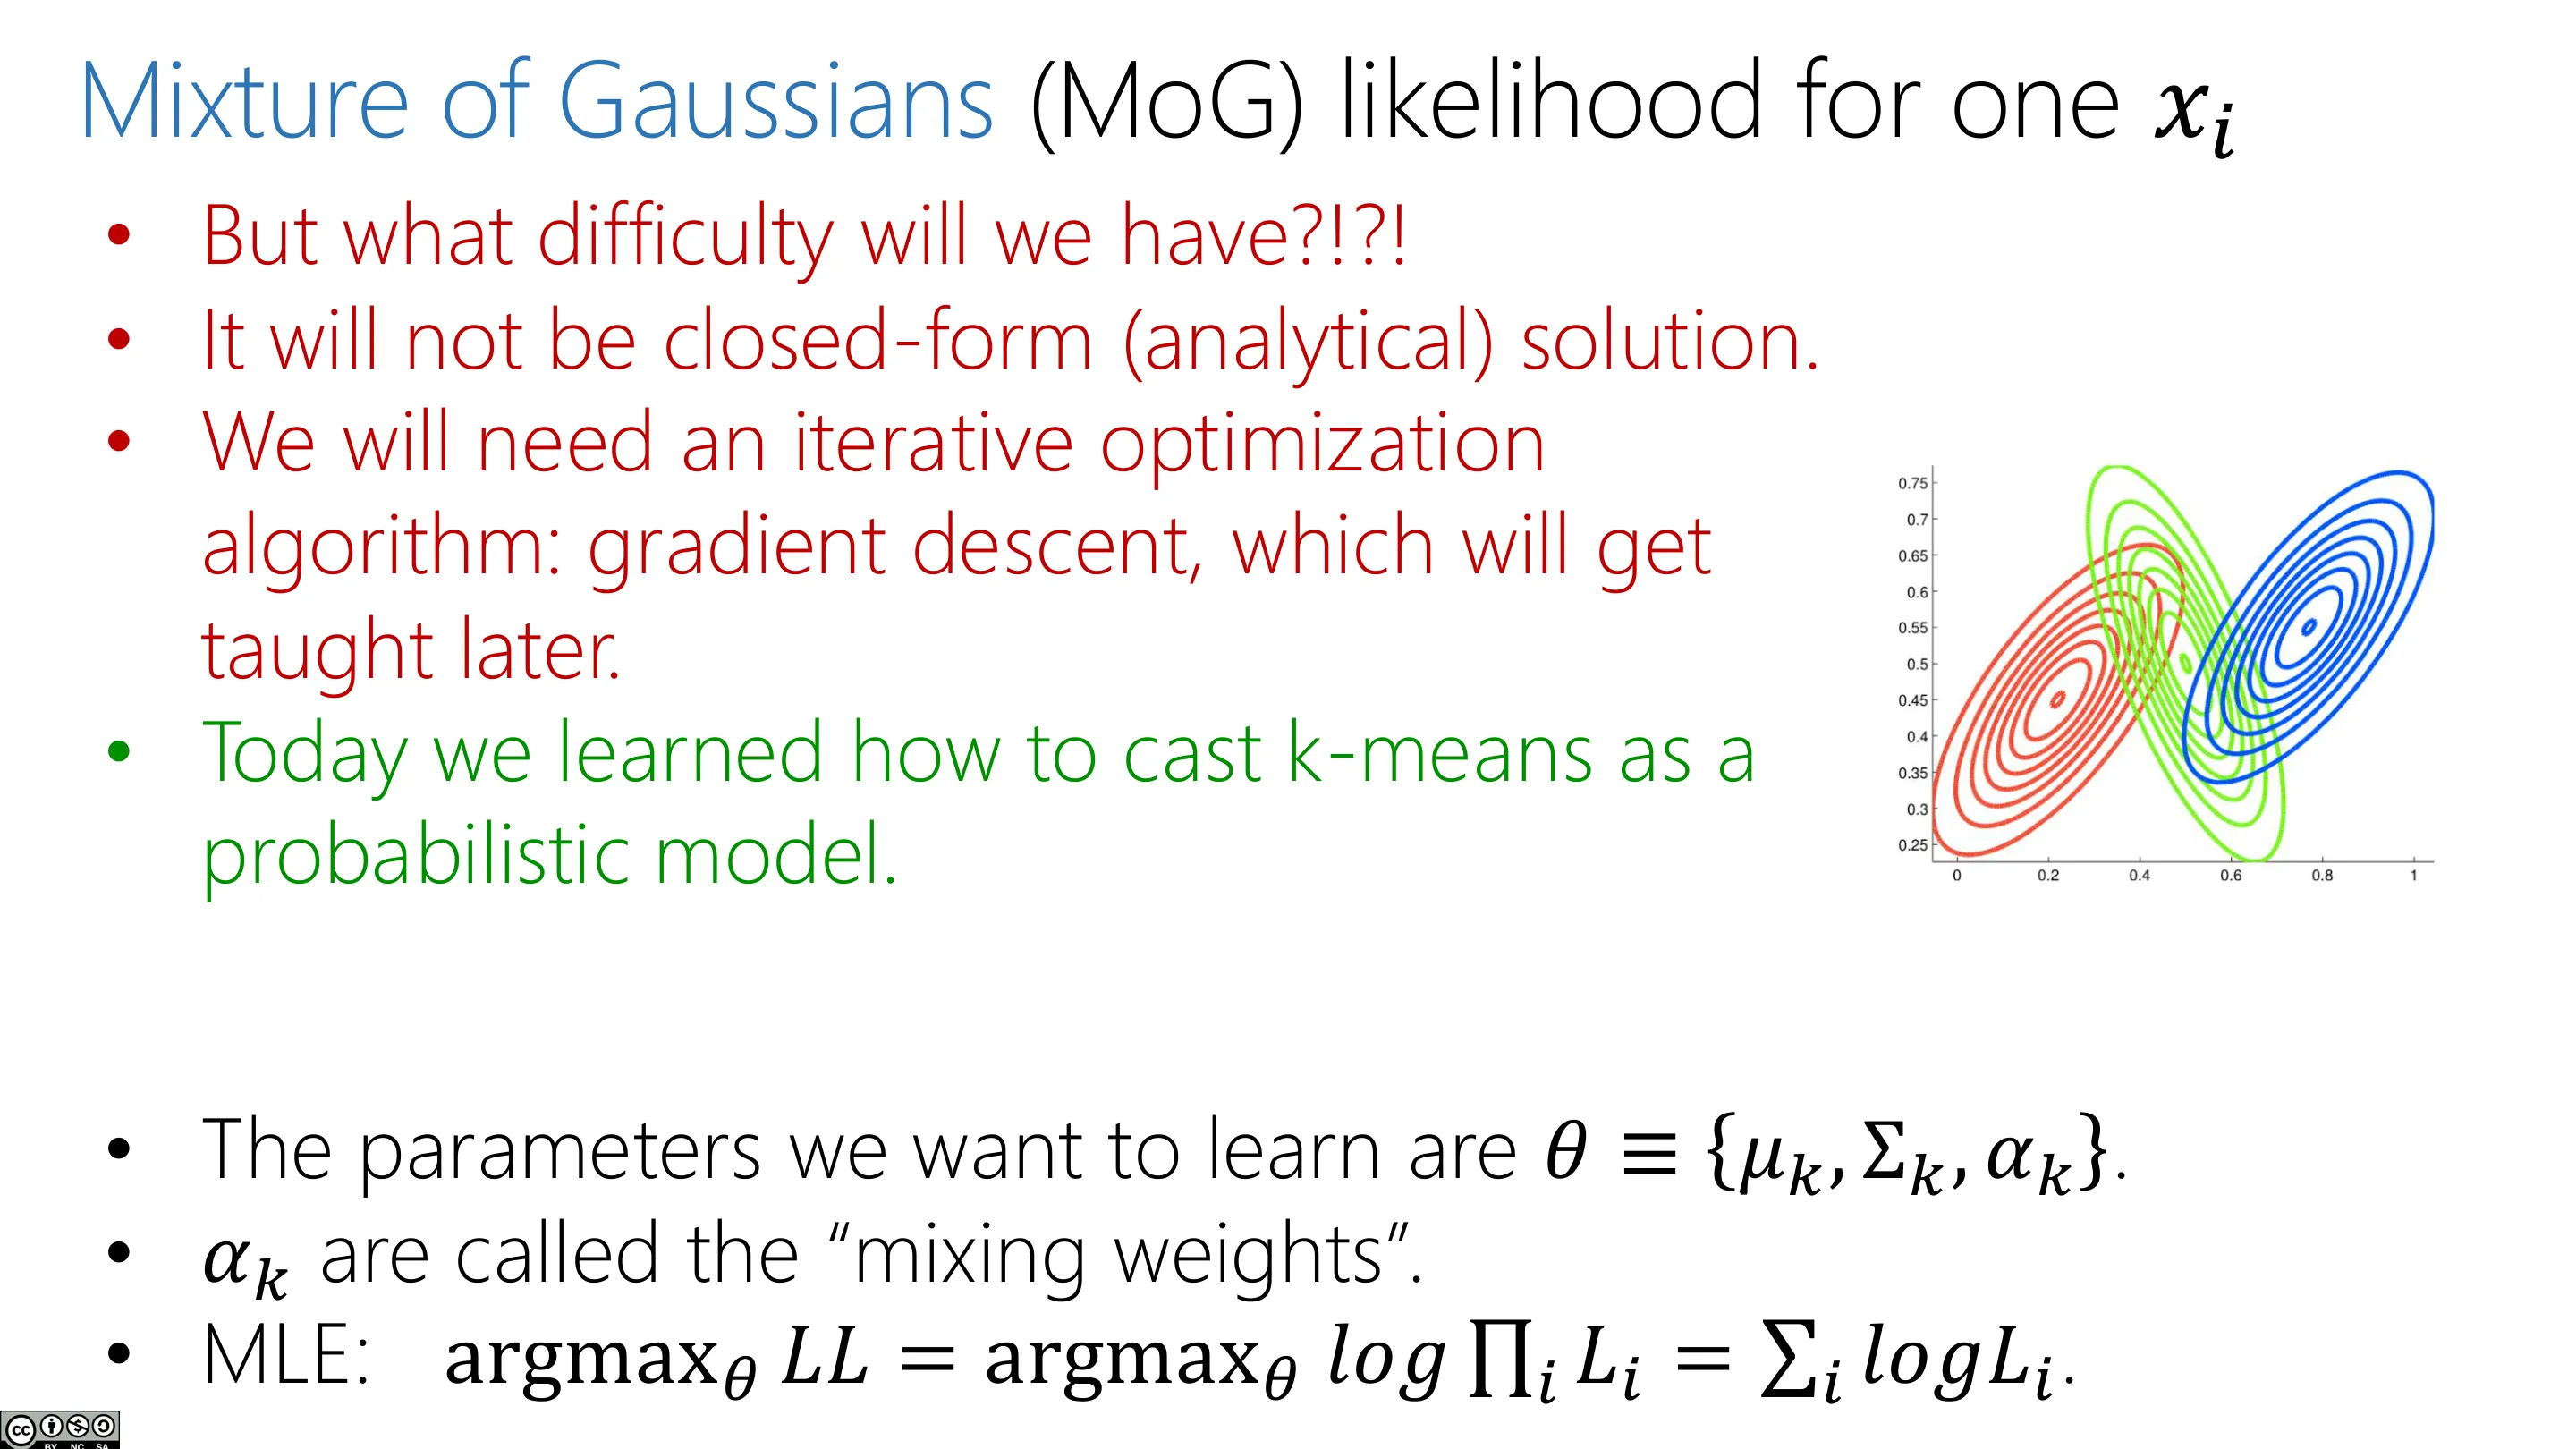
📷 难点:需要迭代优化
回到原视频 (01:18:10)
3.4 MoG 的其他用途与对比
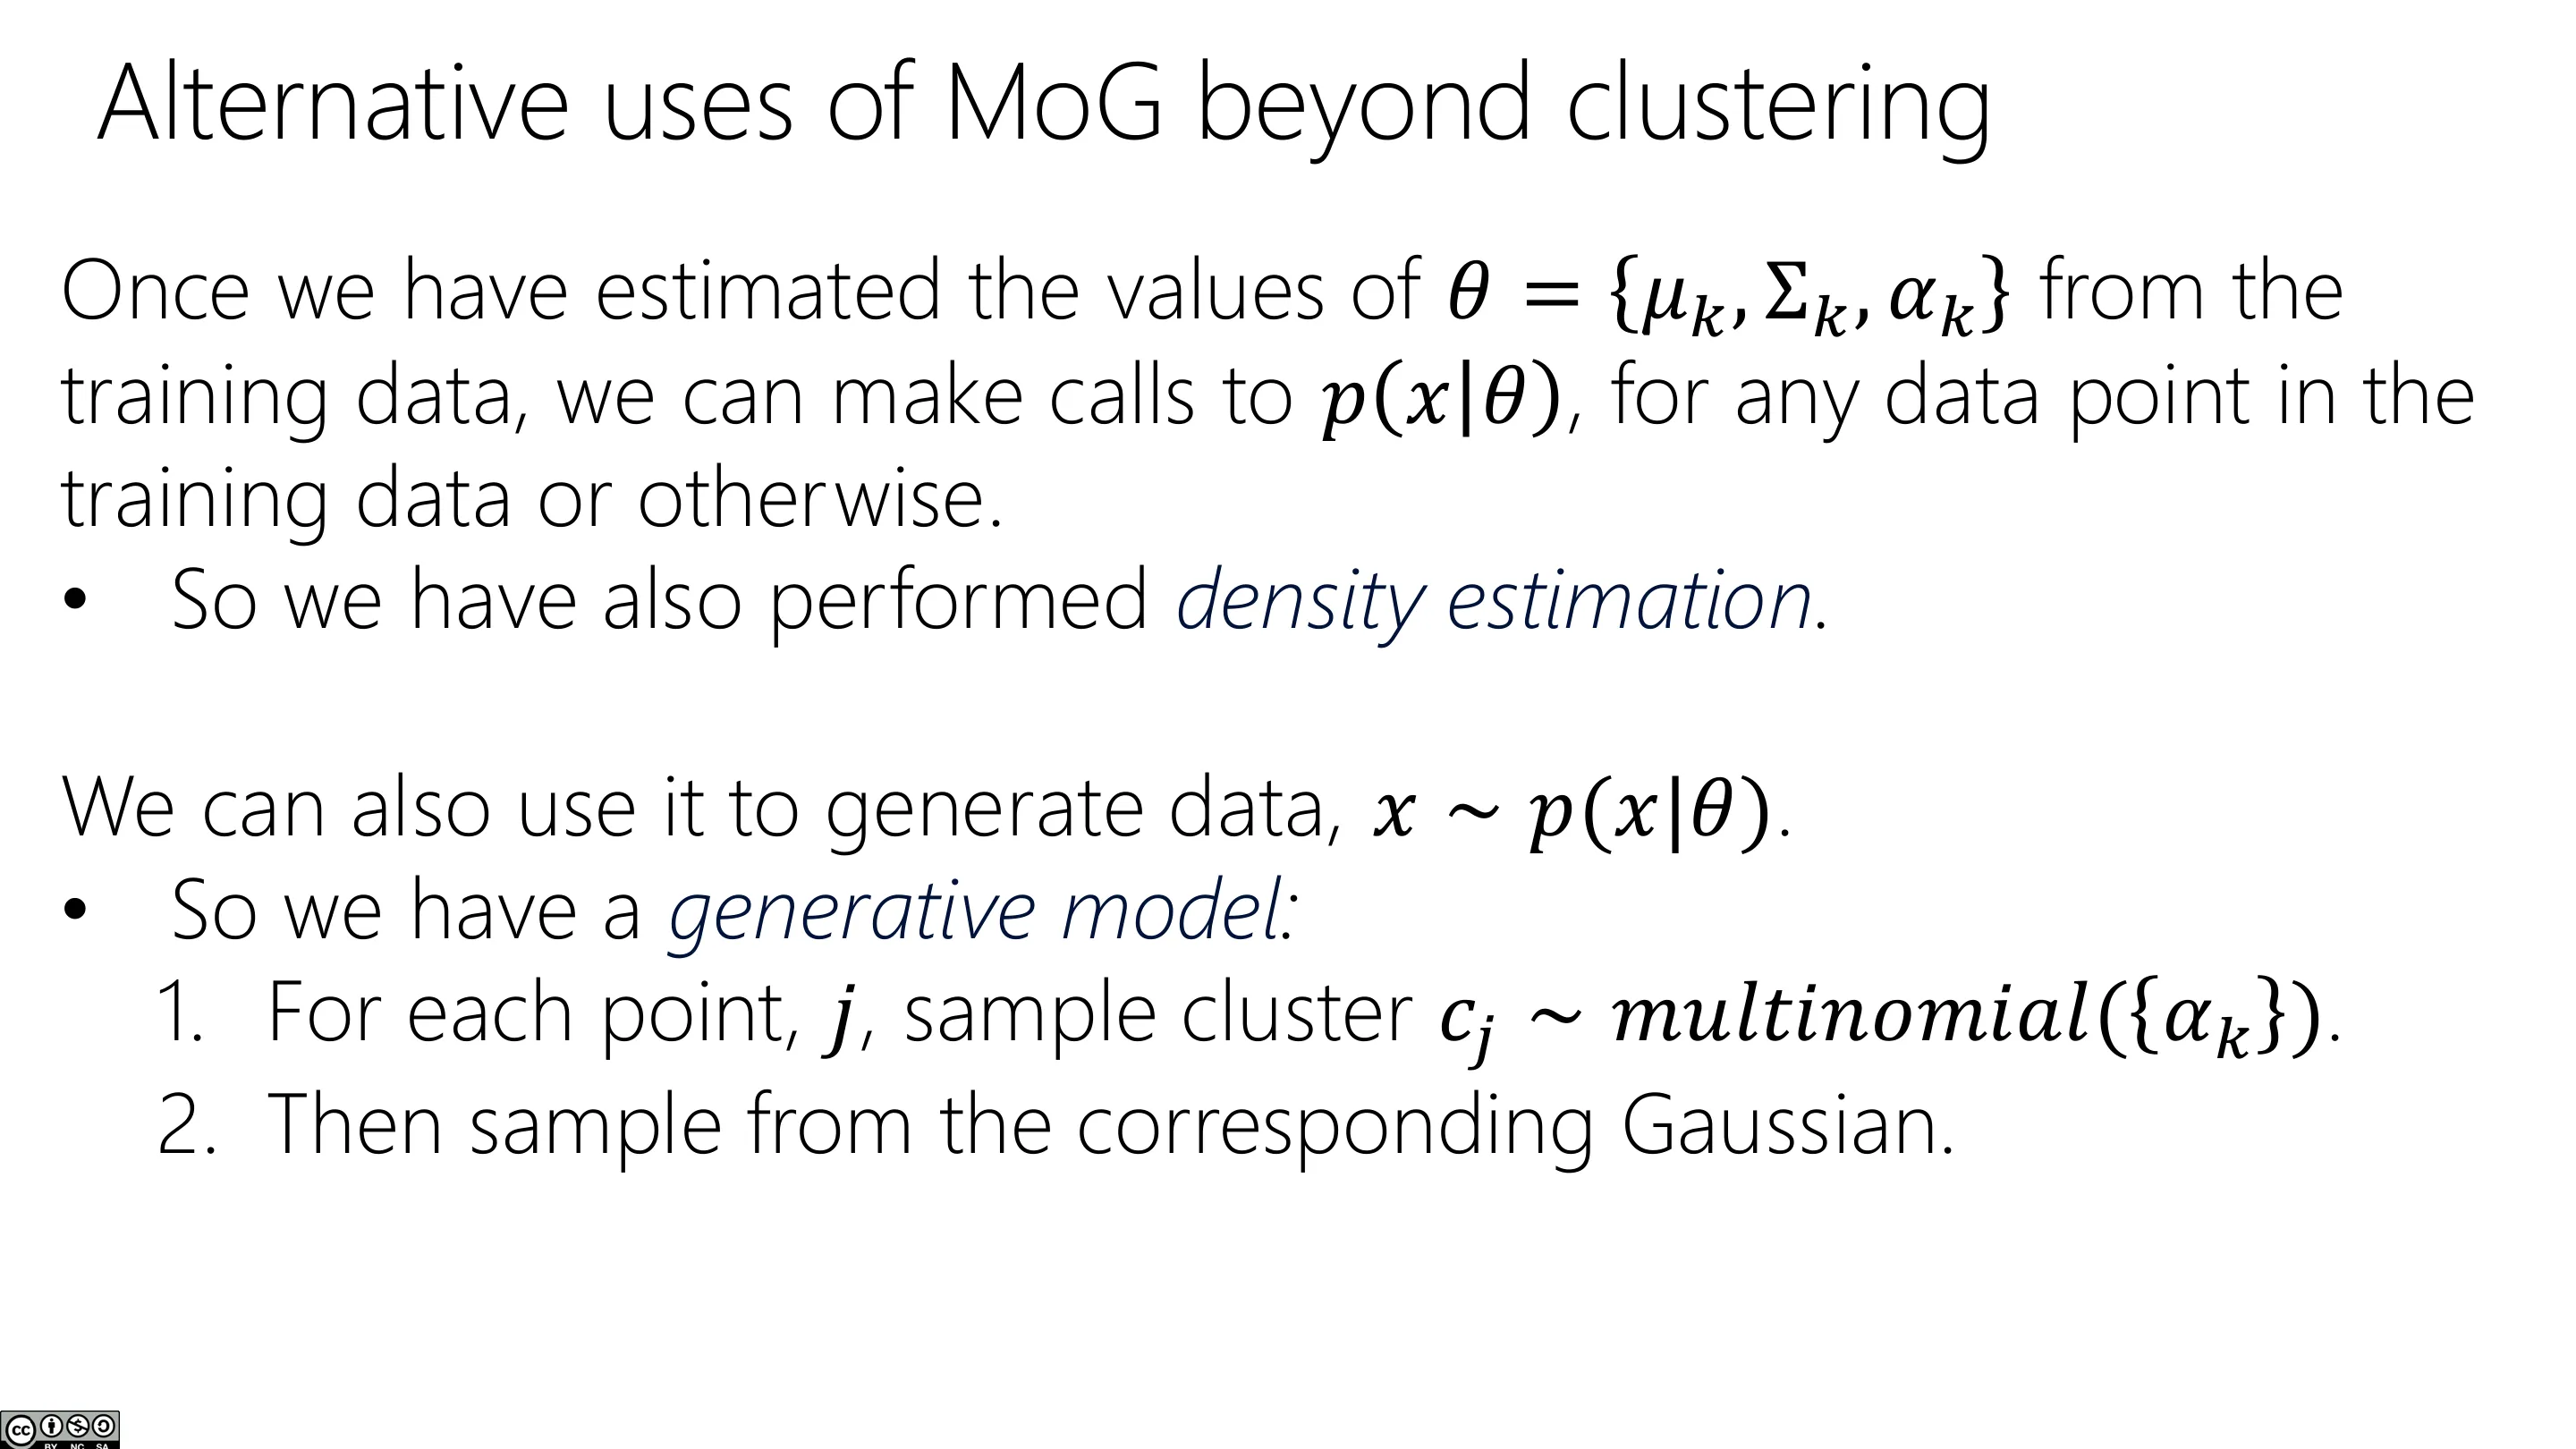
超出聚类:一旦估出 $\theta$,既能对任意点求密度 $p(x\mid\theta)$(密度估计),也能生成数据 $x\sim p(x\mid\theta)$(生成模型):
- 先按 $\alpha_k$ 抽一个簇 $c_j\sim\text{multinomial}(\alpha_k)$;
- 再从对应高斯采样。
📷 MoG 的其他用途
回到原视频 (01:18:25)
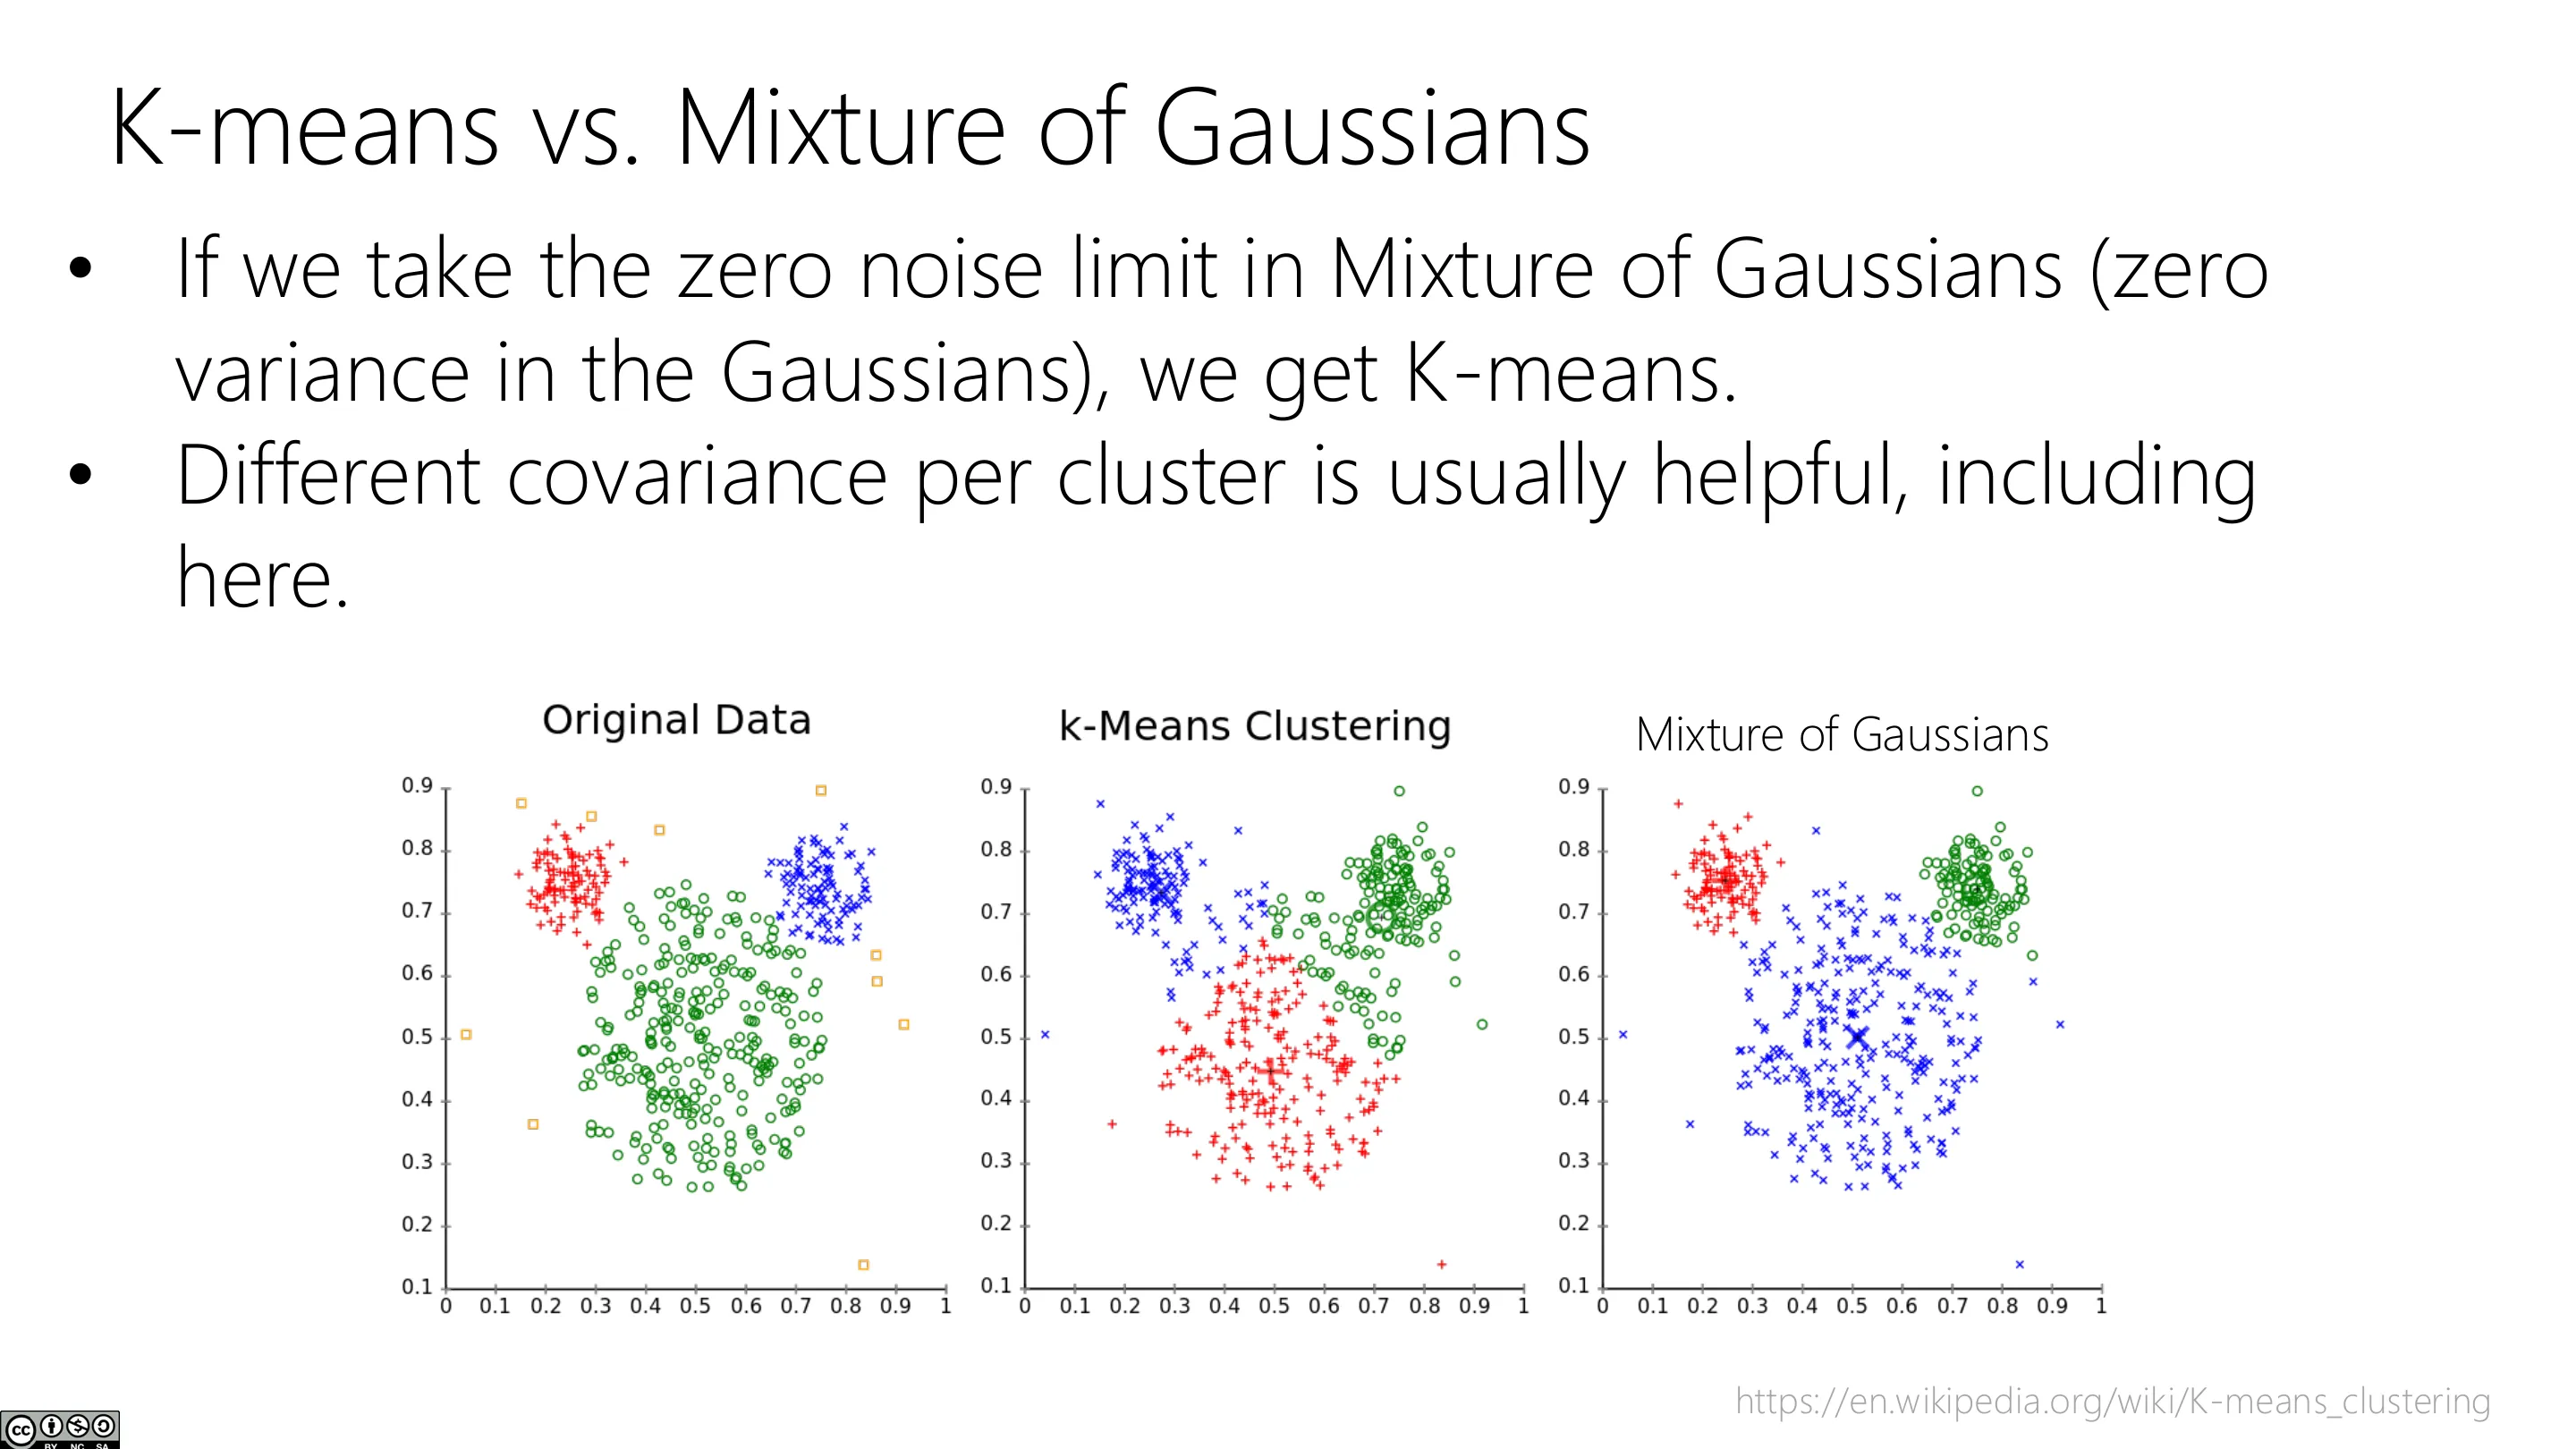
与 K 均值的关系:若把 MoG 中的高斯方差趋于零(零噪声极限),就退化为 K 均值。实践中,每个簇用各自的协方差通常更有利——这正是 MoG 相对 K 均值的核心改进。
📷 K 均值 vs MoG(一)
回到原视频 (01:16:55)
MoG 的优点:假设以统计分布显式给出,因此更易推广、更易理解;可推导出有原则的目标(似然),其中包含对隐变量的边缘化;针对这类隐变量存在专门的 MLE 形式——期望最大化(EM)。
📷 K 均值 vs MoG(二)
回到原视频 (01:18:30)
总结(Takeaways)
- 多项分布的 MLE:需要带约束优化,用拉格朗日乘子处理 $\sum_k\theta_k=1$,结果 $\hat\theta_k=n_k/N$;而高斯因内建归一化常数,无需约束。
- MLE 不总有闭式解:高斯/多项/线性回归可闭式求解;神经网络等参数耦合的模型需要迭代优化。
- 多元高斯(MVG):均值是向量、散布由协方差矩阵 $\Sigma$ 描述($\Sigma^{-1}$ 为精度矩阵);$\Sigma$ 对角 ⇔ 分量独立。
- 关键事实:对联合高斯,协方差为零 ⇔ 独立;一般分布只有「独立 ⇒ 协方差为零」这一单向结论(协方差只捕捉线性依赖)。
- 几何直觉:MVG 的水平集是椭圆,其形状/朝向由 $\Sigma$ 决定。
- 高斯混合模型(GMM/MoG):用加权高斯和建模,引入隐变量 $z_i$ 并边缘化;参数 $\{\mu_k,\Sigma_k,\alpha_k\}$;它把 K 均值概率化,允许软分配与各簇不同的协方差;拟合需迭代优化(EM,见下讲)。
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=JzlMrqaa_-A |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 6) | Google Drive PDF |
| 教材 Machine Learning: A First Course for Engineers and Scientists | 概率 2.[1-3]、分布 3.1/3.2.1、聚类 15.1/15.2/15.3 · https://doi.org/10.1017/9781108919371 |
| CSC2515(聚类/MoG 幻灯片来源) | http://www.cs.toronto.edu/~urtasun/courses/CSC2515/CSC2515_Winter15.html |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。