第7讲 · EECS 189:高斯混合模型与线性回归
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | Mixture of Gaussians & Linear Regression |
| 视频 | https://www.youtube.com/watch?v=0YLmbbERr0g |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 7) | Google Drive PDF |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第7讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
本讲路线图
(参考时间: 00:00)
- 完成高斯混合模型(MoG):隐变量视角、用 MLE 拟合的困难、零噪声极限给出 K 均值;
- 线性回归:从「估计条件分布 $p(y\mid x)$」出发,用 MLE 导出最小二乘;
- 基函数展开与设计矩阵的向量化。
📷 标题页
回到原视频 (00:00:11)
📷 路线图(一)
回到原视频 (00:00:30)
📷 路线图(二)
回到原视频 (00:00:40)
一、高斯混合模型(MoG)回顾与完成
1.1 回顾:多元高斯与水平集
(参考时间: 00:00)
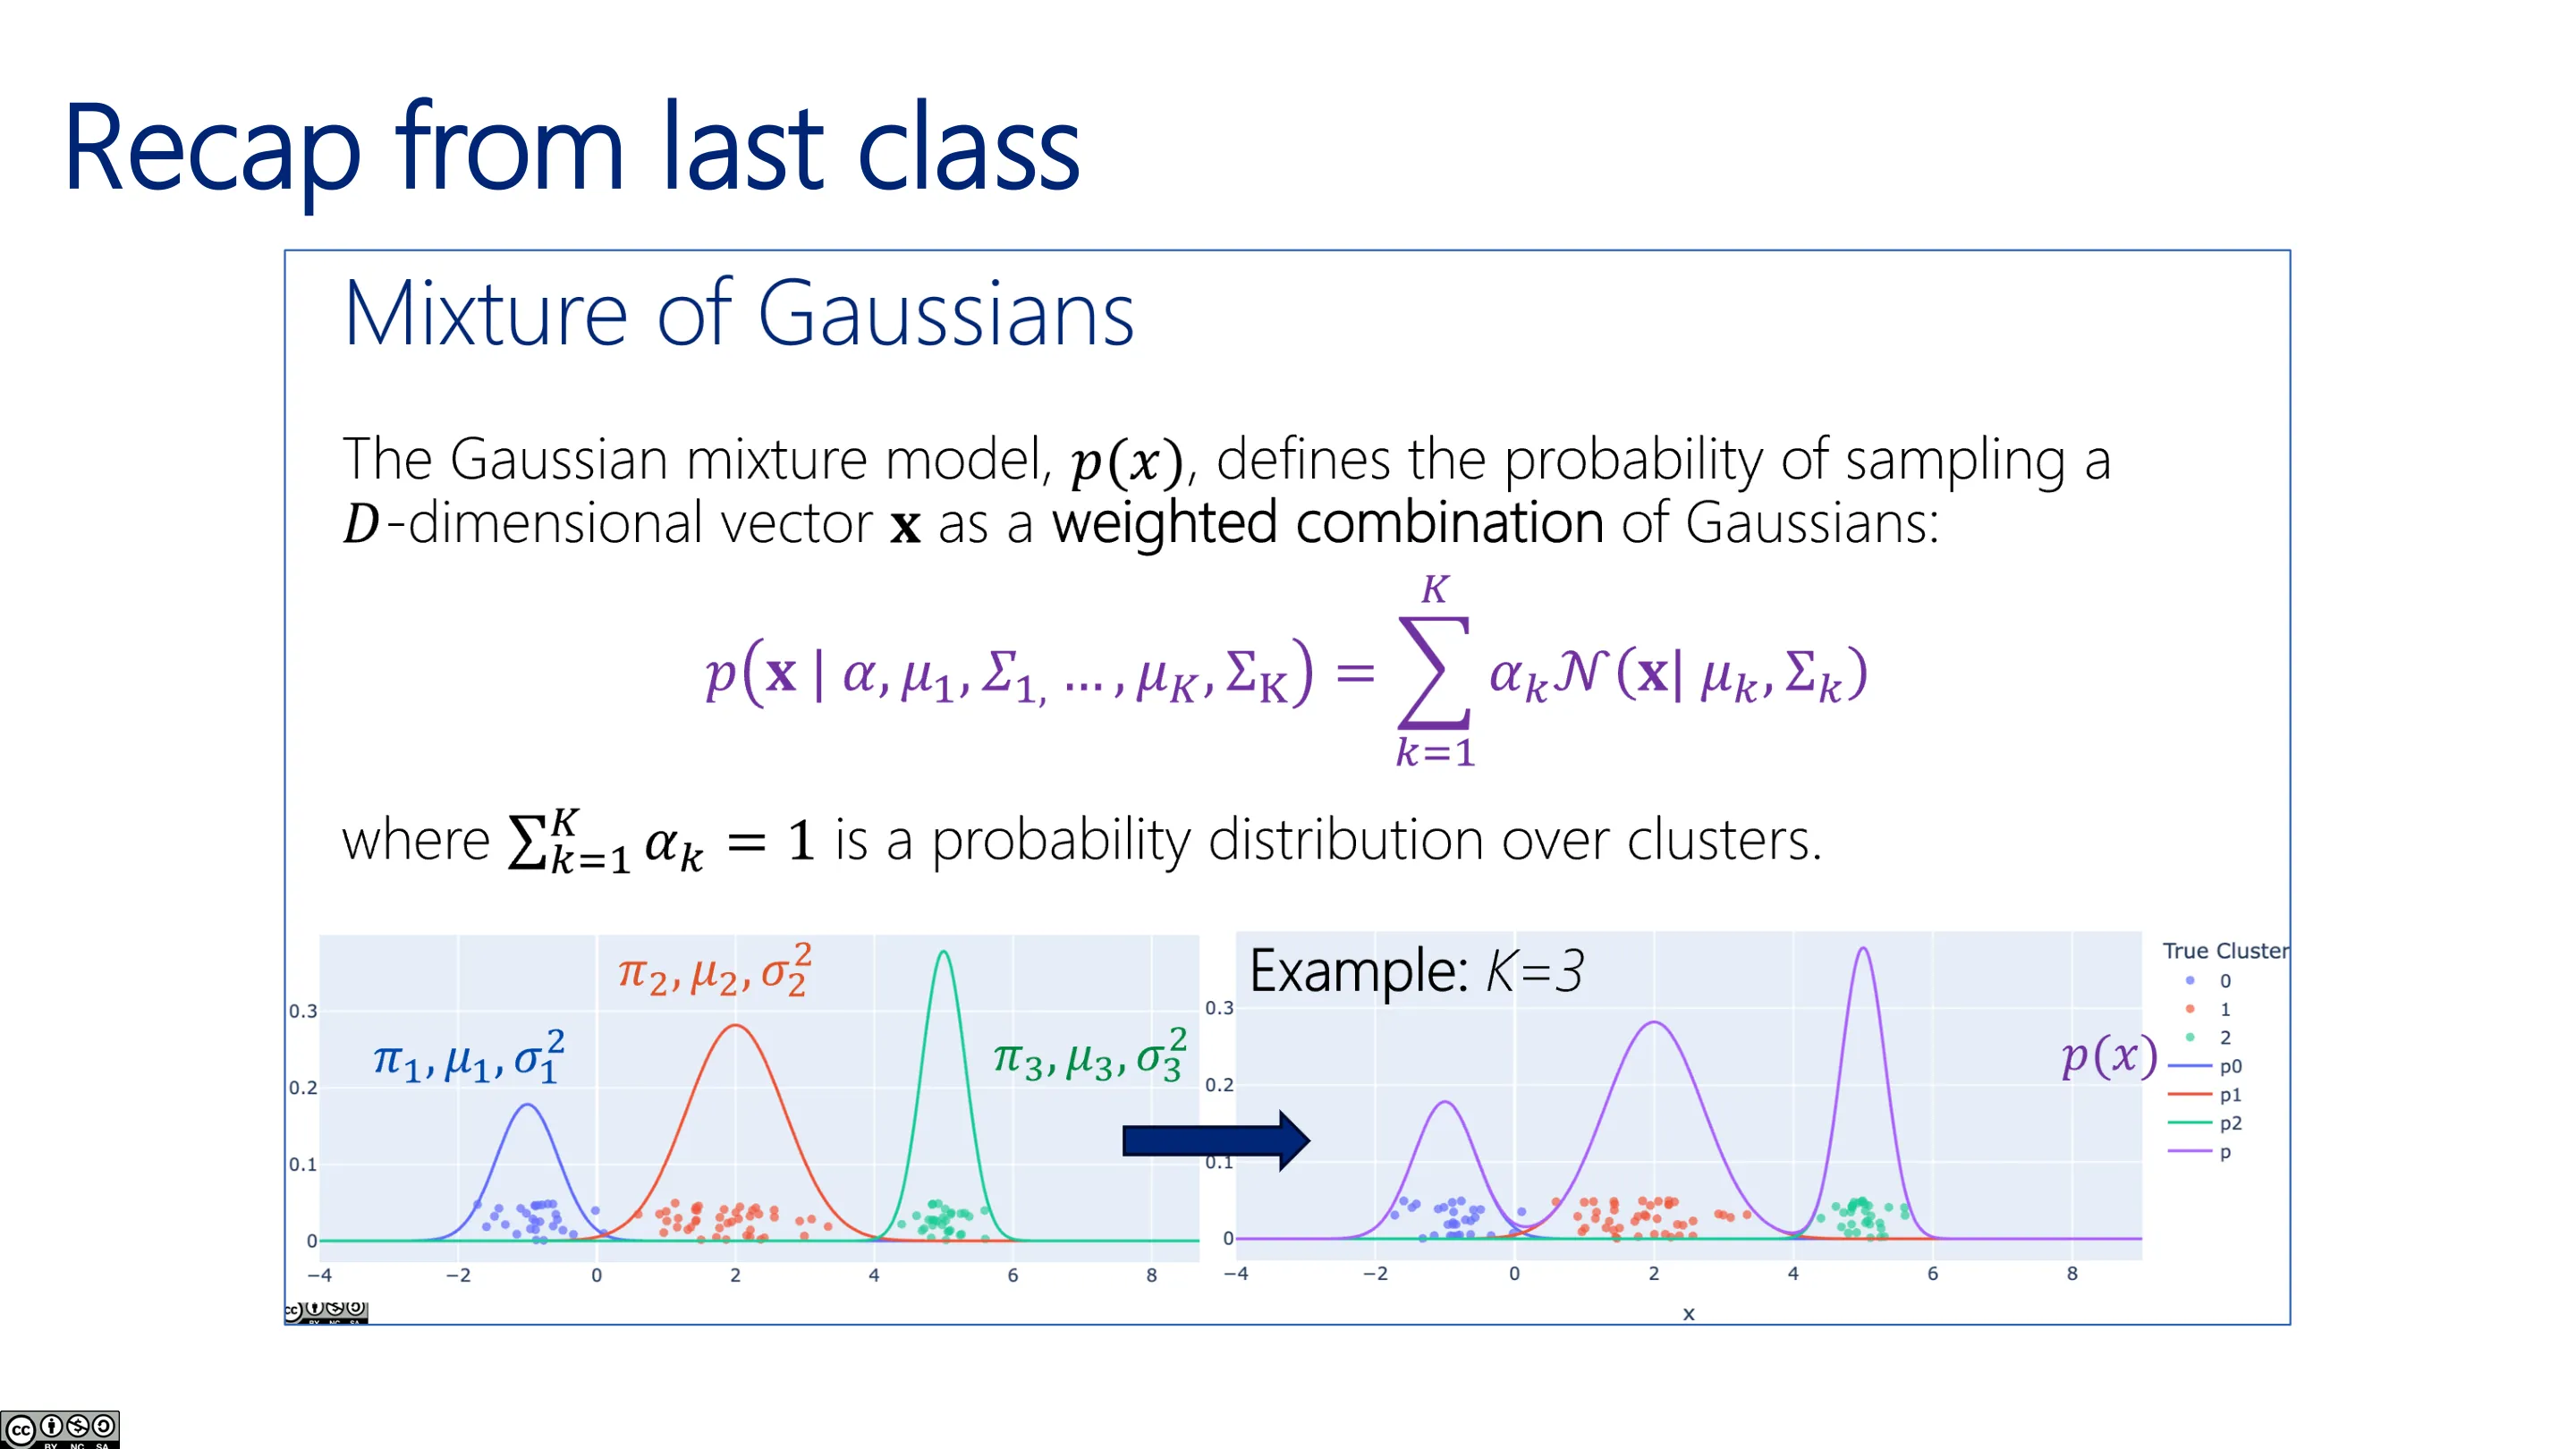
上一讲我们学习了多元高斯分布:均值是向量,散布由协方差矩阵编码;把二次项设为常数,就得到椭圆形的水平集(等密度线)。随后引入高斯混合模型——把若干高斯线性混合(权重之和为 1),作为概率版的 K 均值。
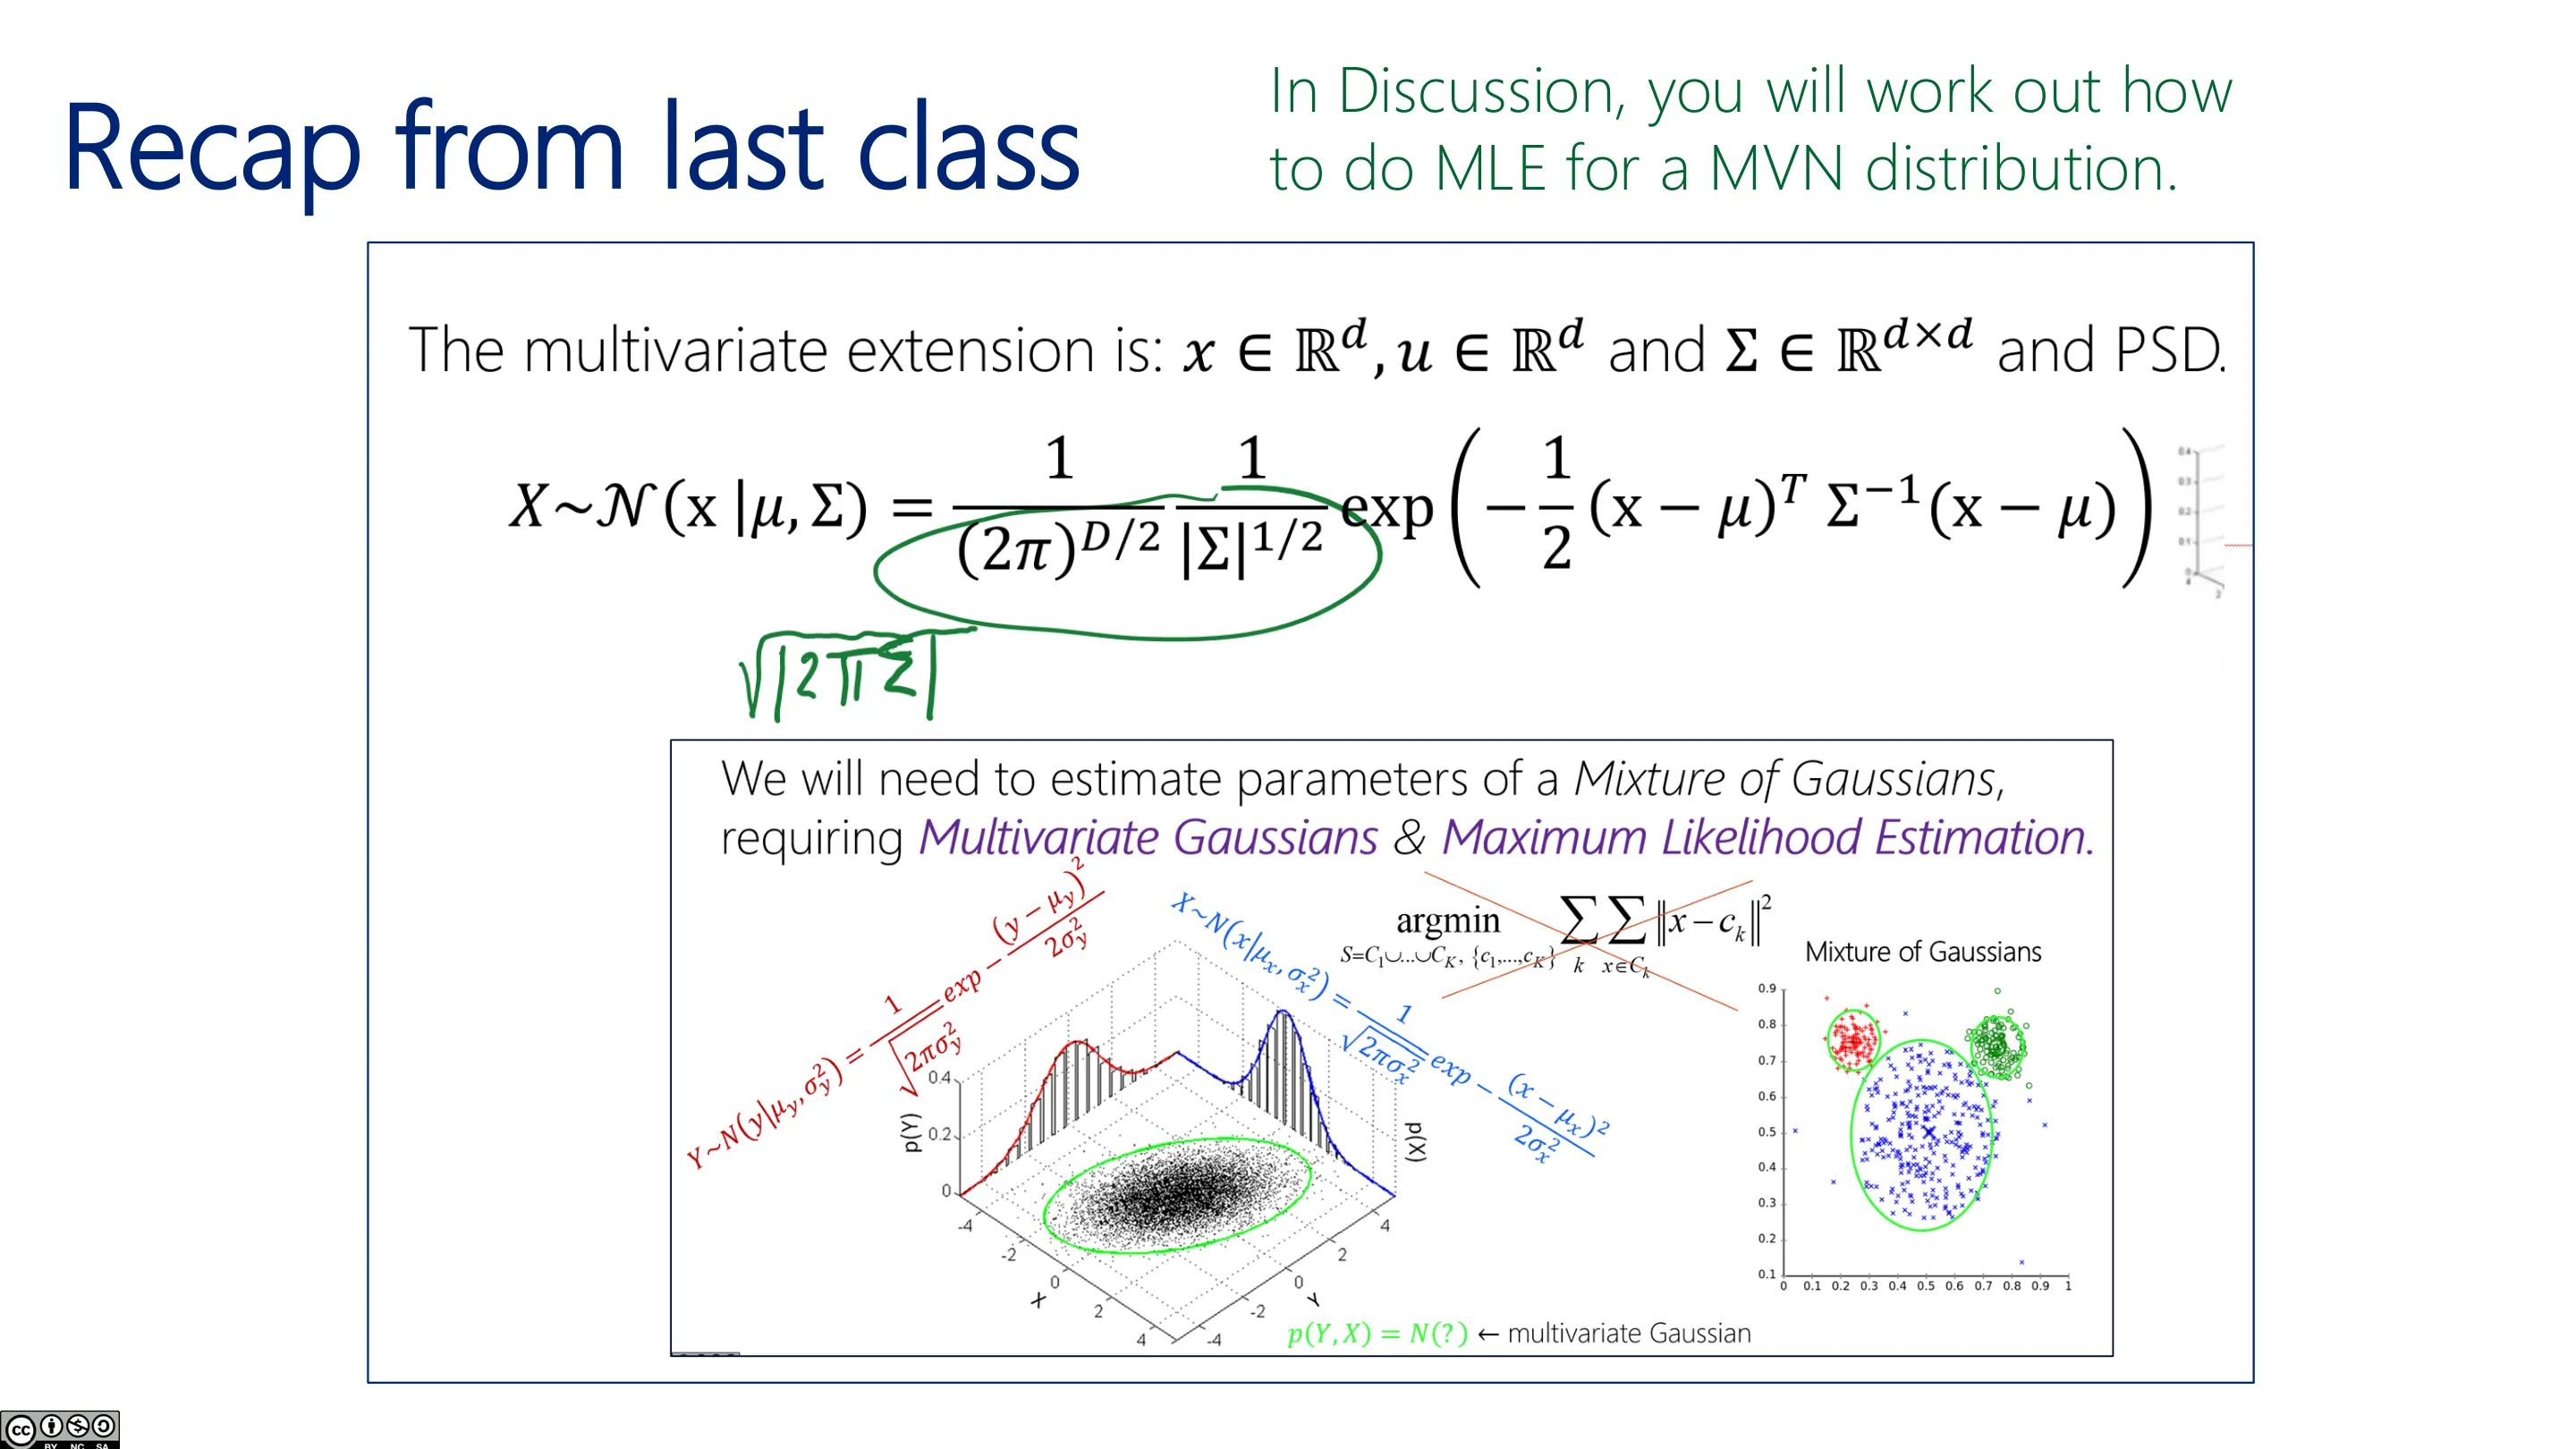
📷 上节课回顾(一)
回到原视频 (00:00:50)
📷 上节课回顾(二)
回到原视频 (00:01:05)
每条紫色曲线是一个高斯,混合系数之和为 1,保证整体仍是归一化的概率密度(积分为 1)。
📷 MoG:混合的归一化
回到原视频 (00:01:20)
1.2 每个簇现在是「一个高斯」
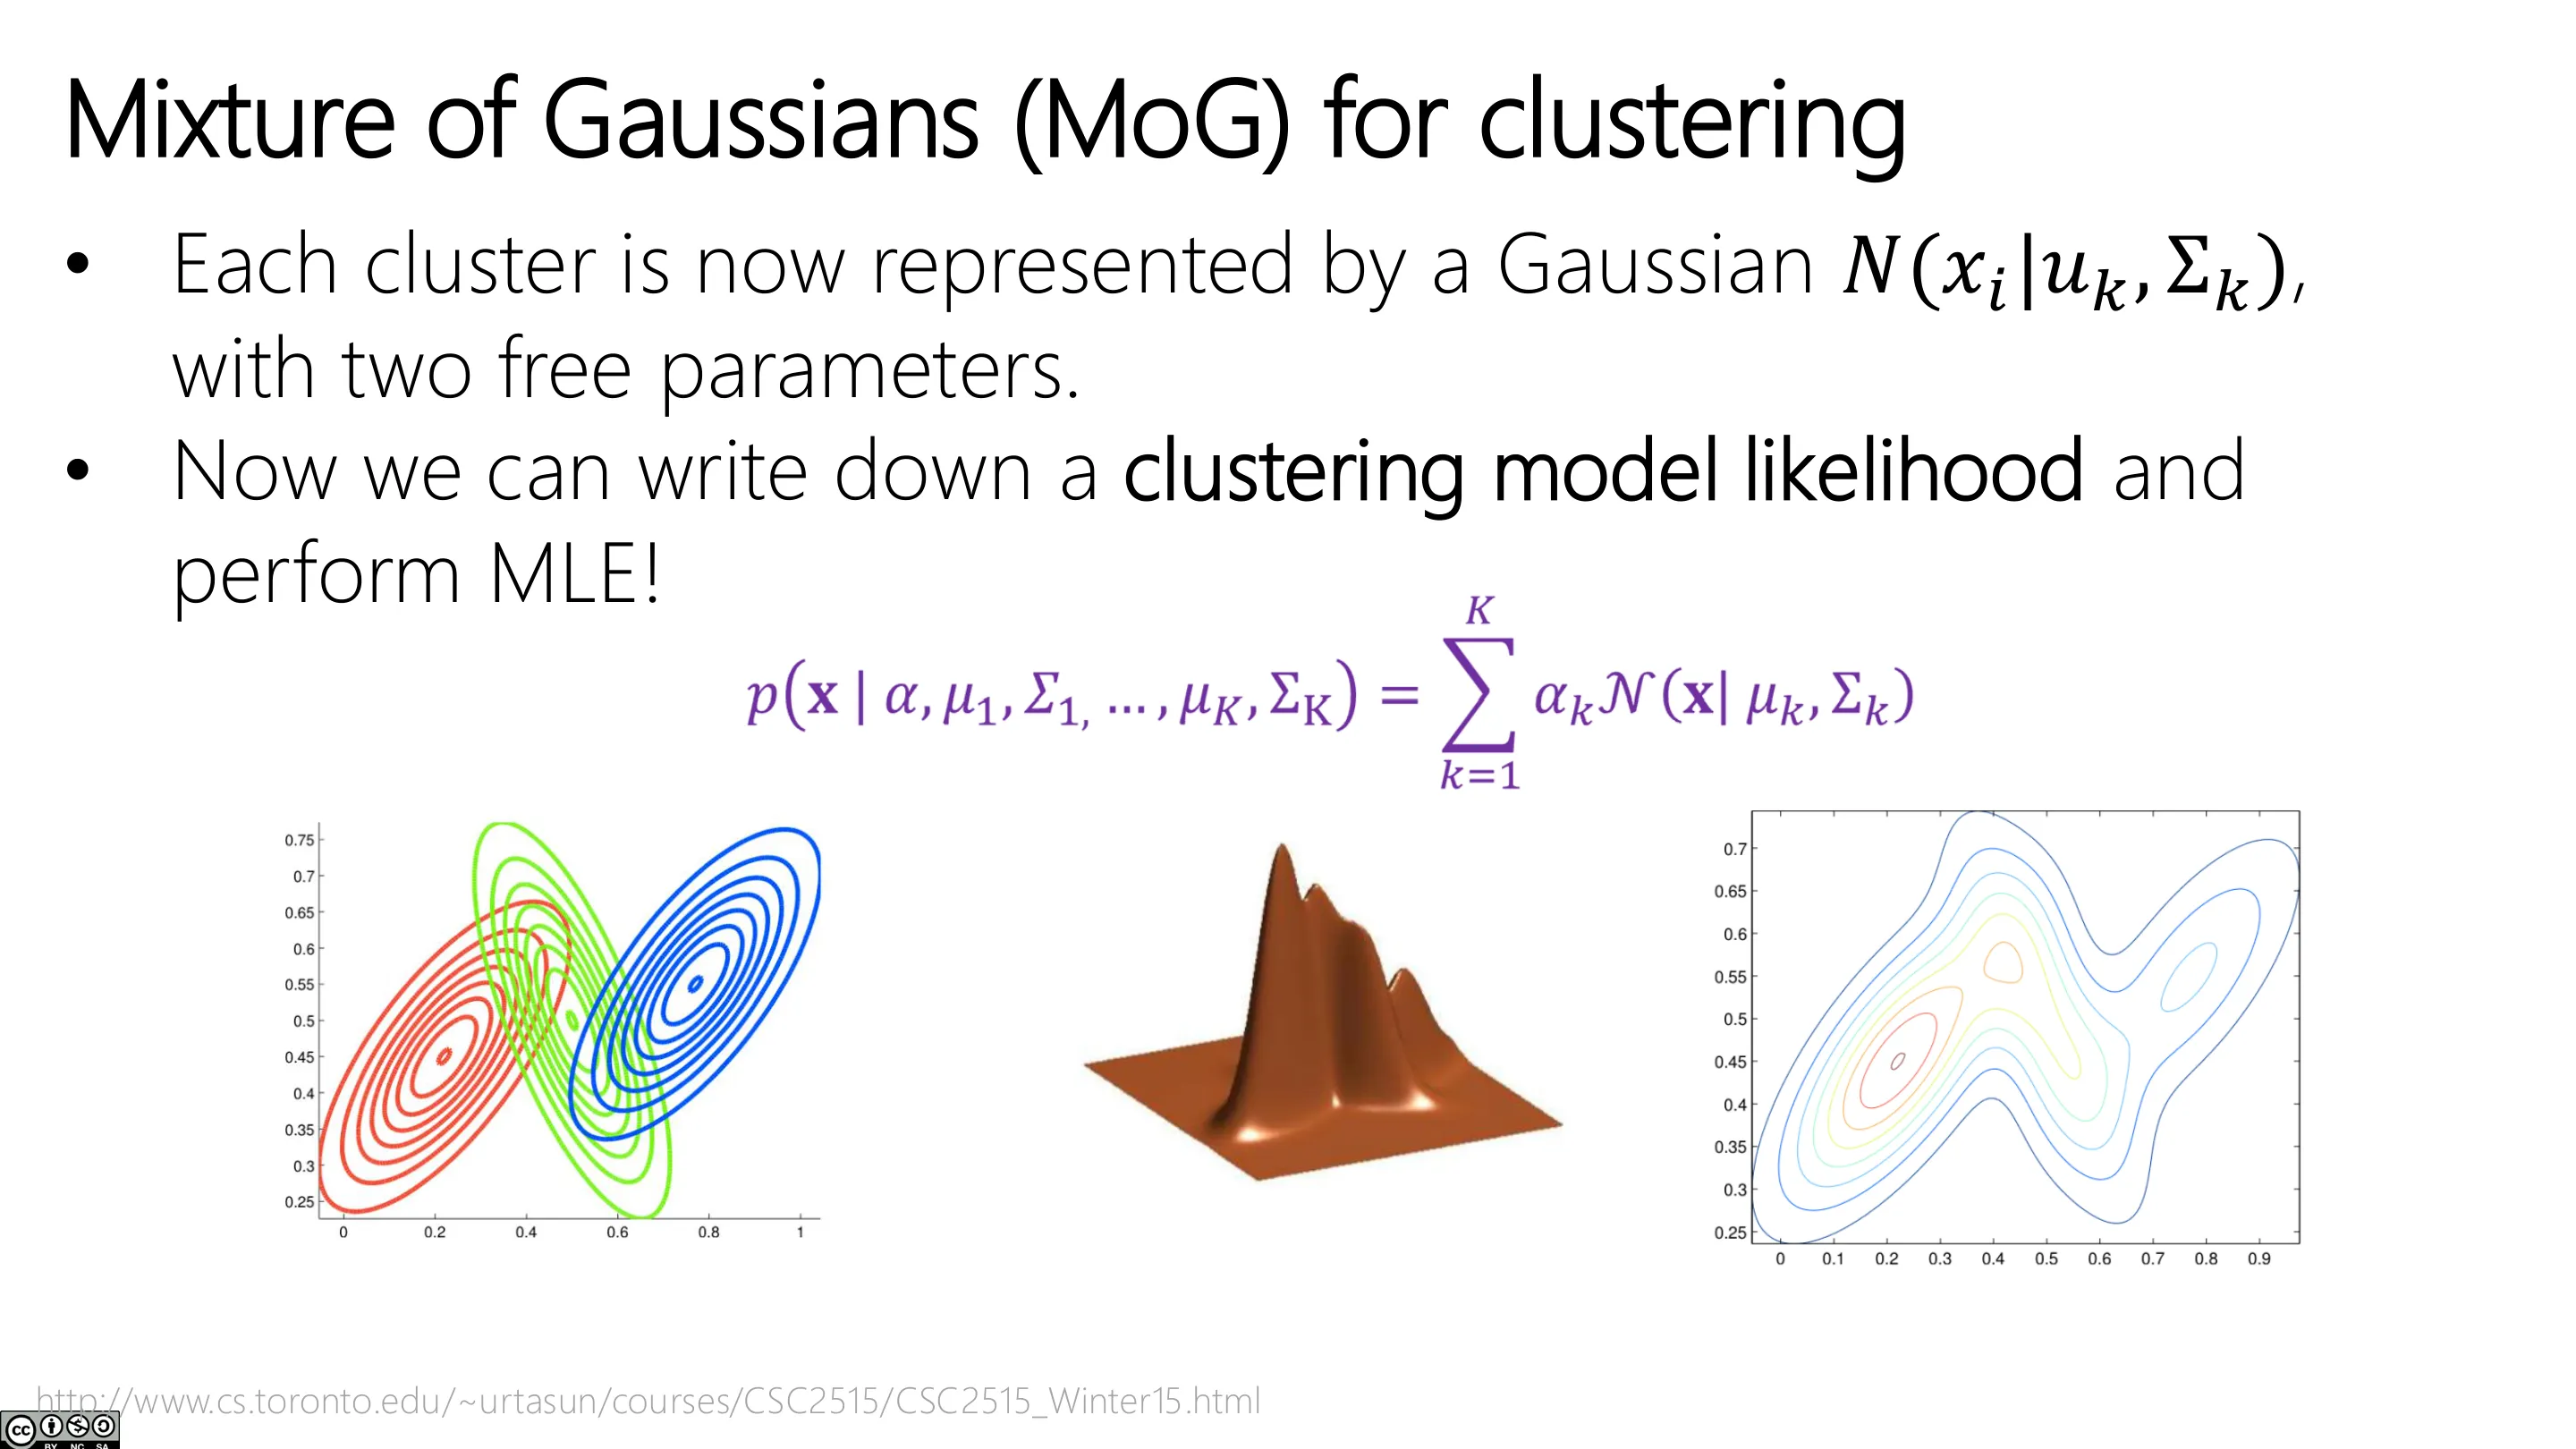
K 均值中每个簇只有一个中心点;概率版本里,每个簇由一个高斯表示——除了均值(类似中心点),还多了协方差矩阵来建模簇的形状:
- 协方差矩阵可看作 K 均值距离度量的推广;强行把它约束成「球形」就退化回 K 均值;
- 现在每个簇可以各自拉伸、旋转,形成细长的椭圆。
📷 MoG:每个簇是一个高斯
回到原视频 (00:02:10)
📷 MoG:协方差带来形状自由度
回到原视频 (00:03:00)
📷 MoG 与 K 均值的对照
回到原视频 (00:04:00)
1.3 隐变量(latent variable)视角
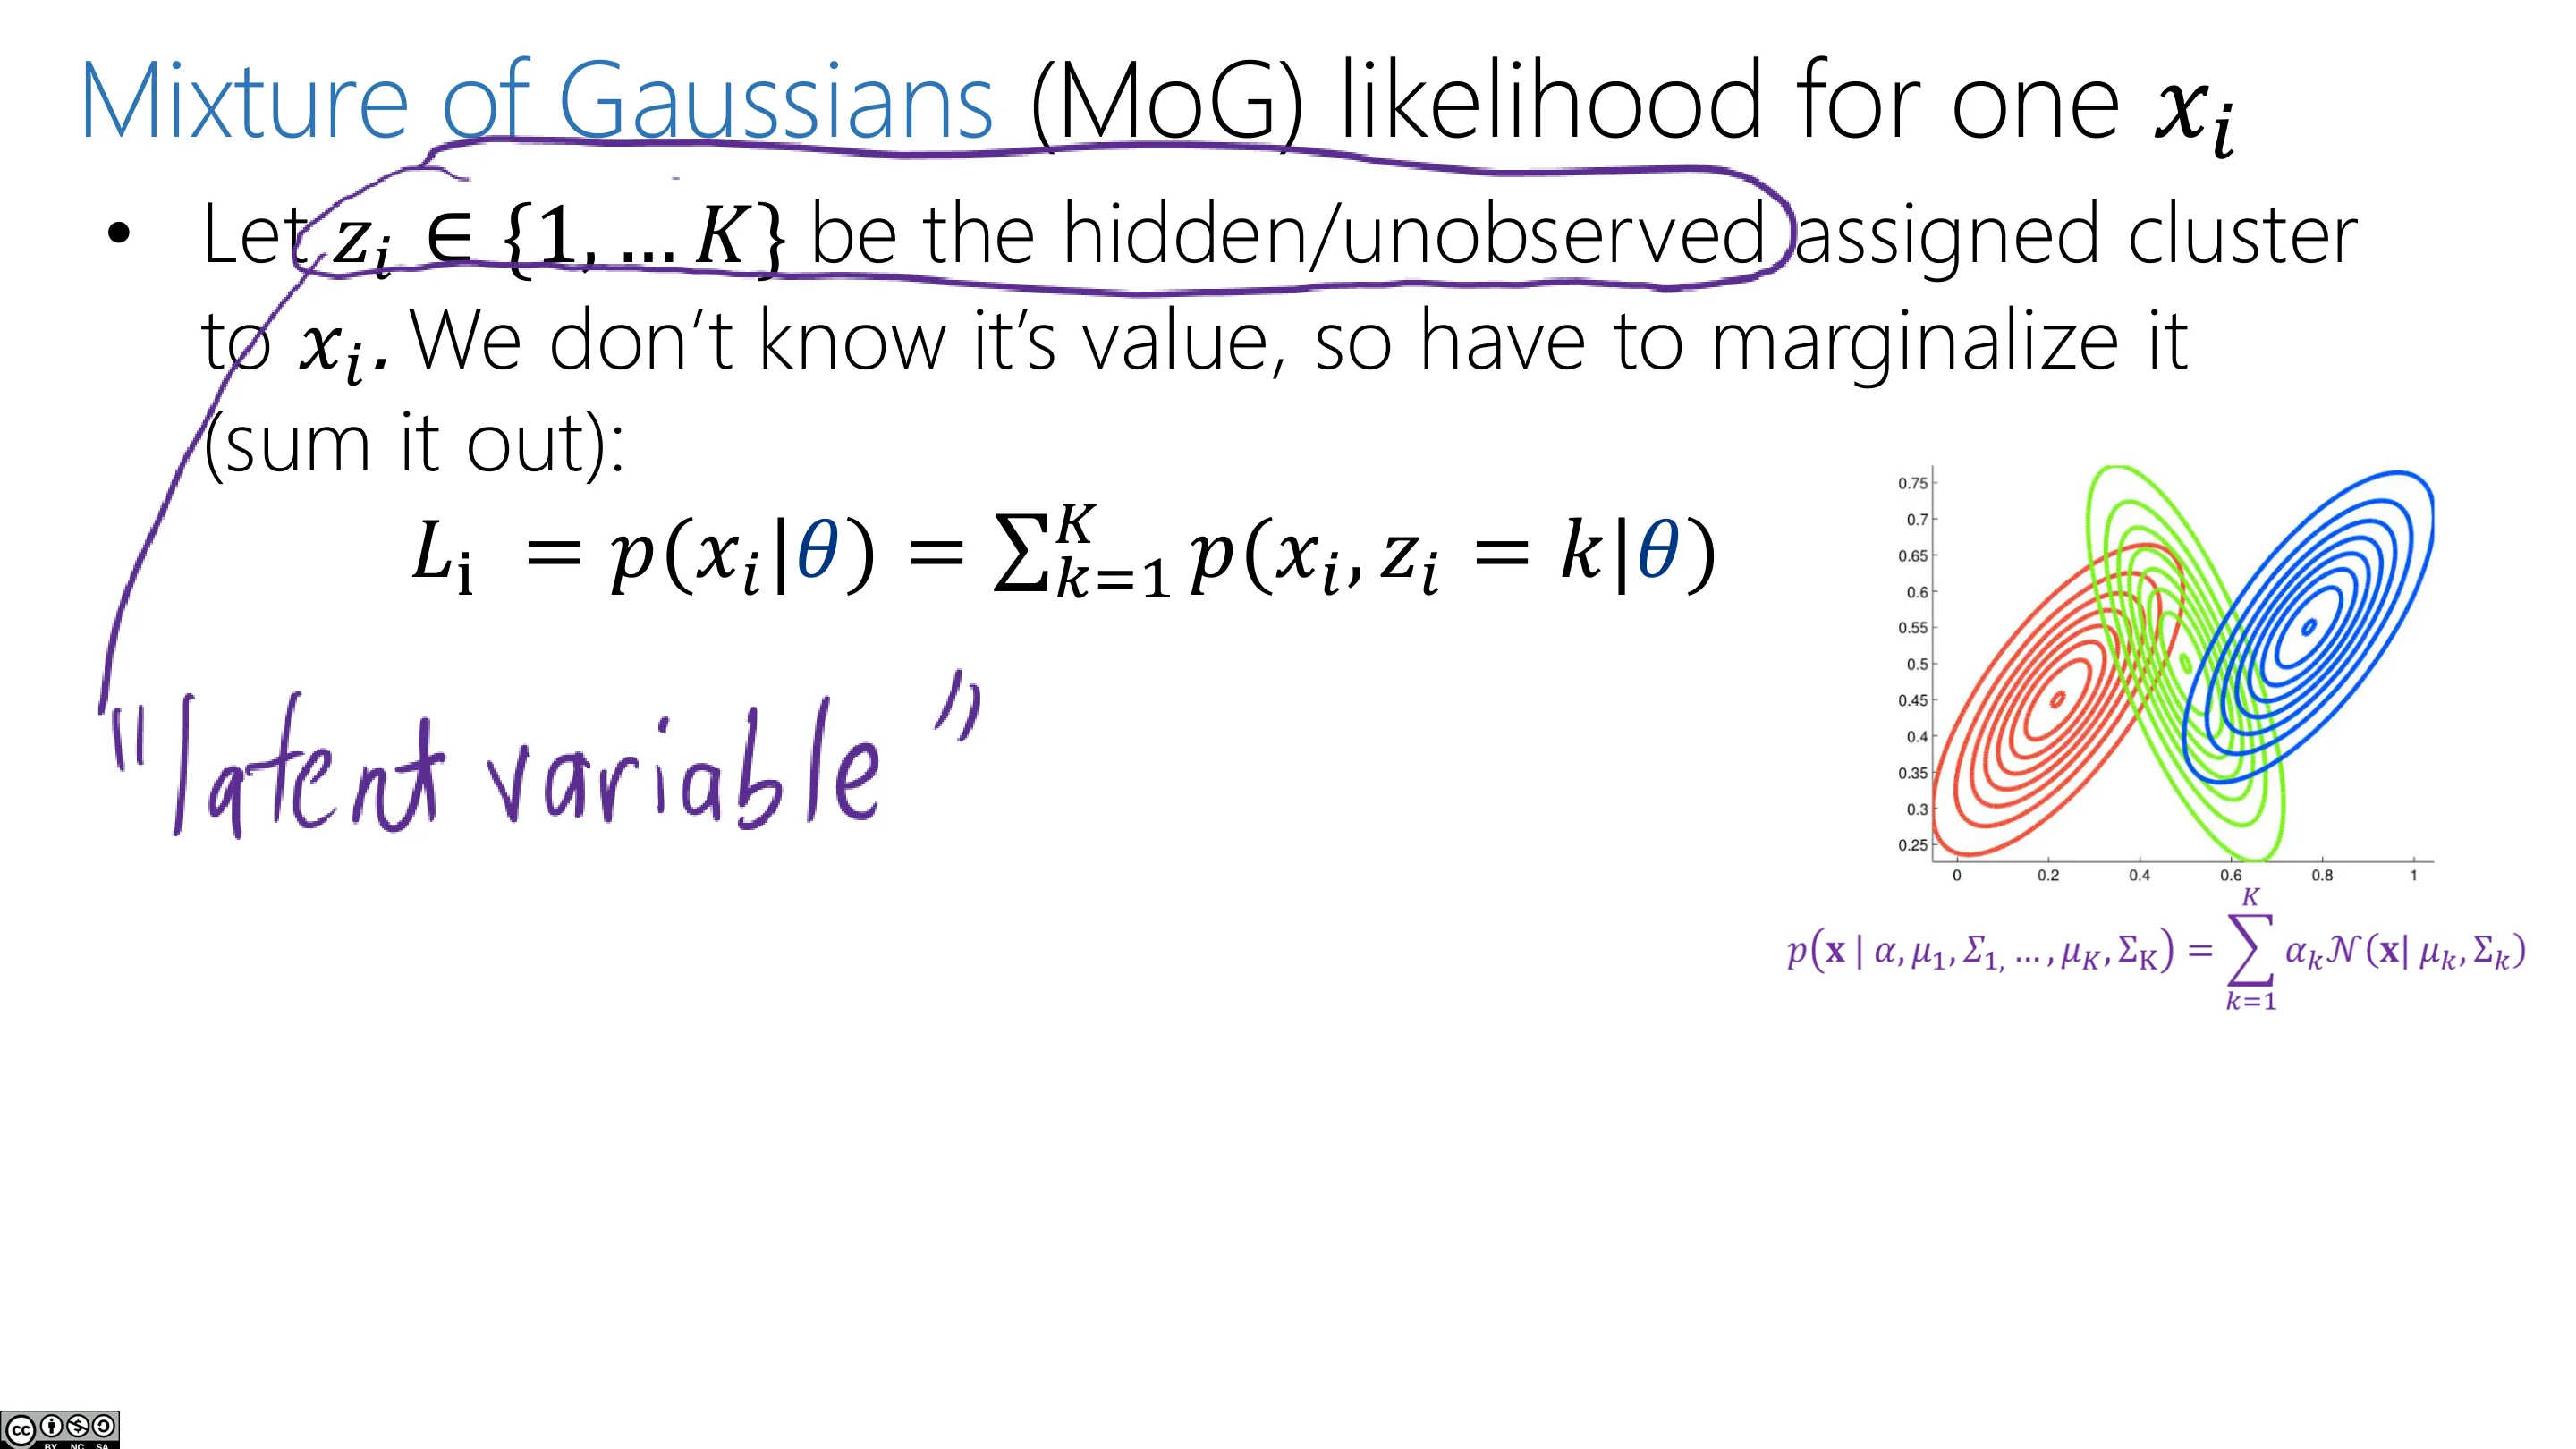
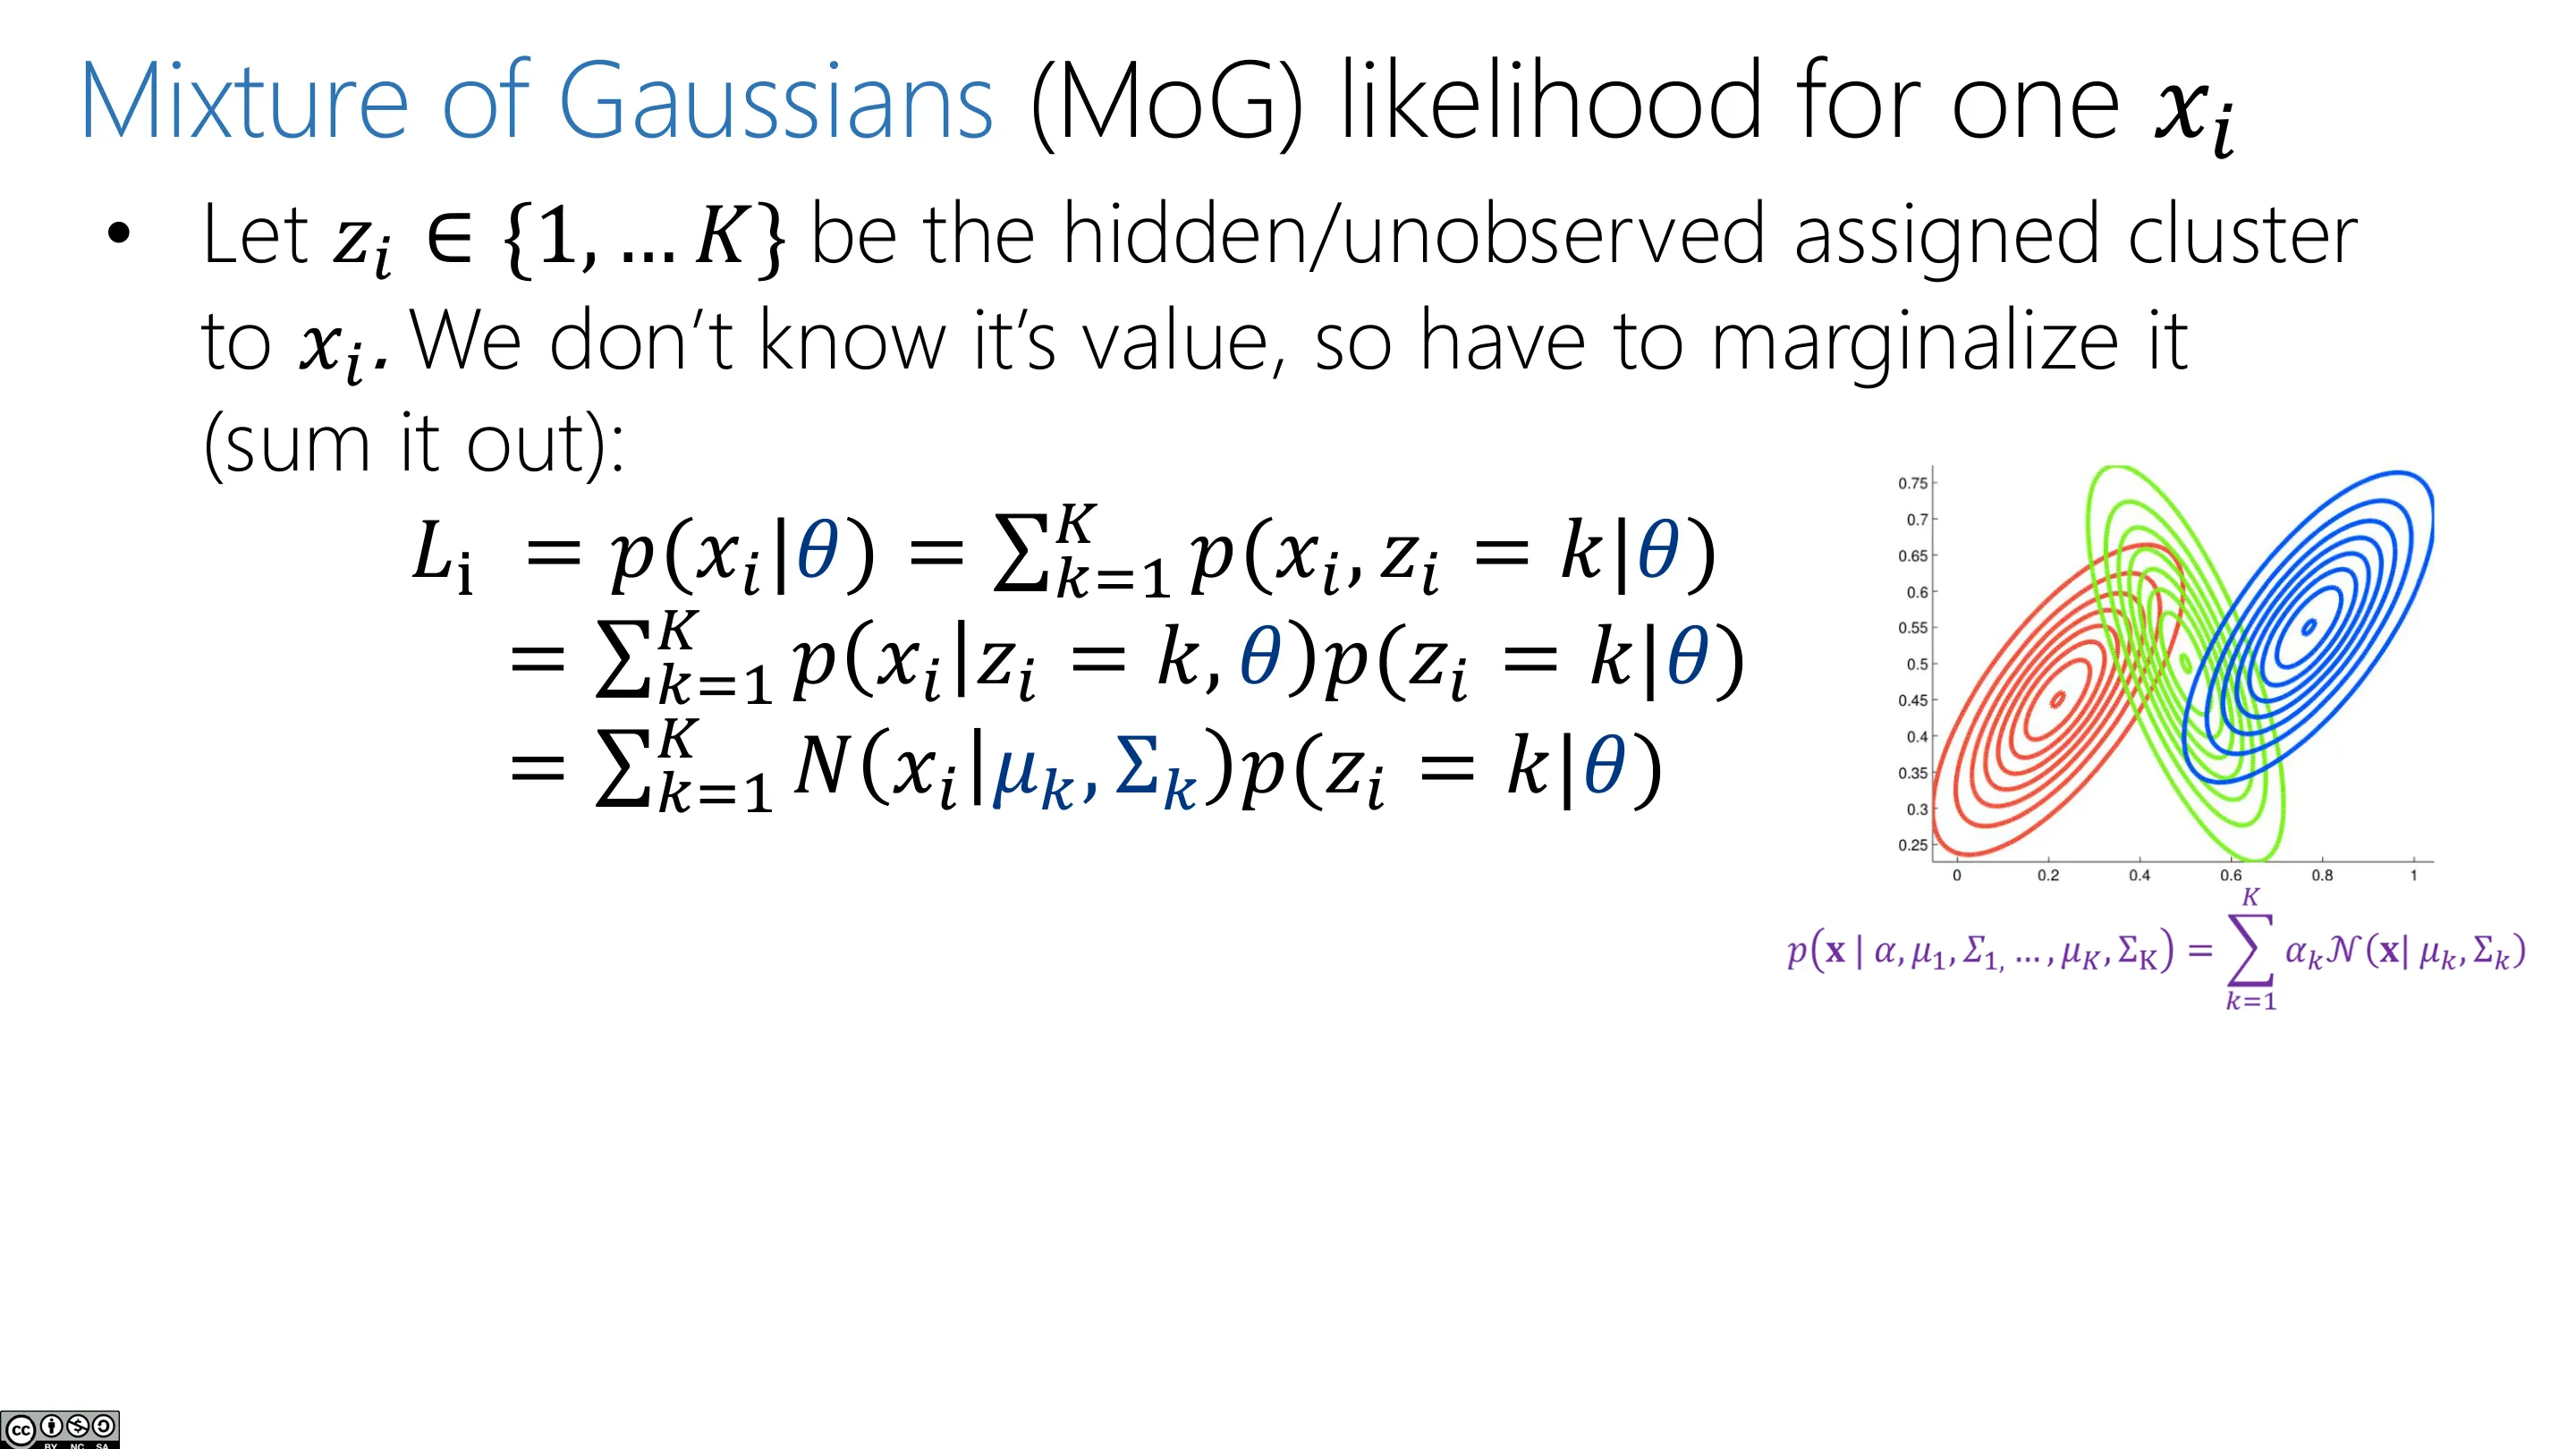
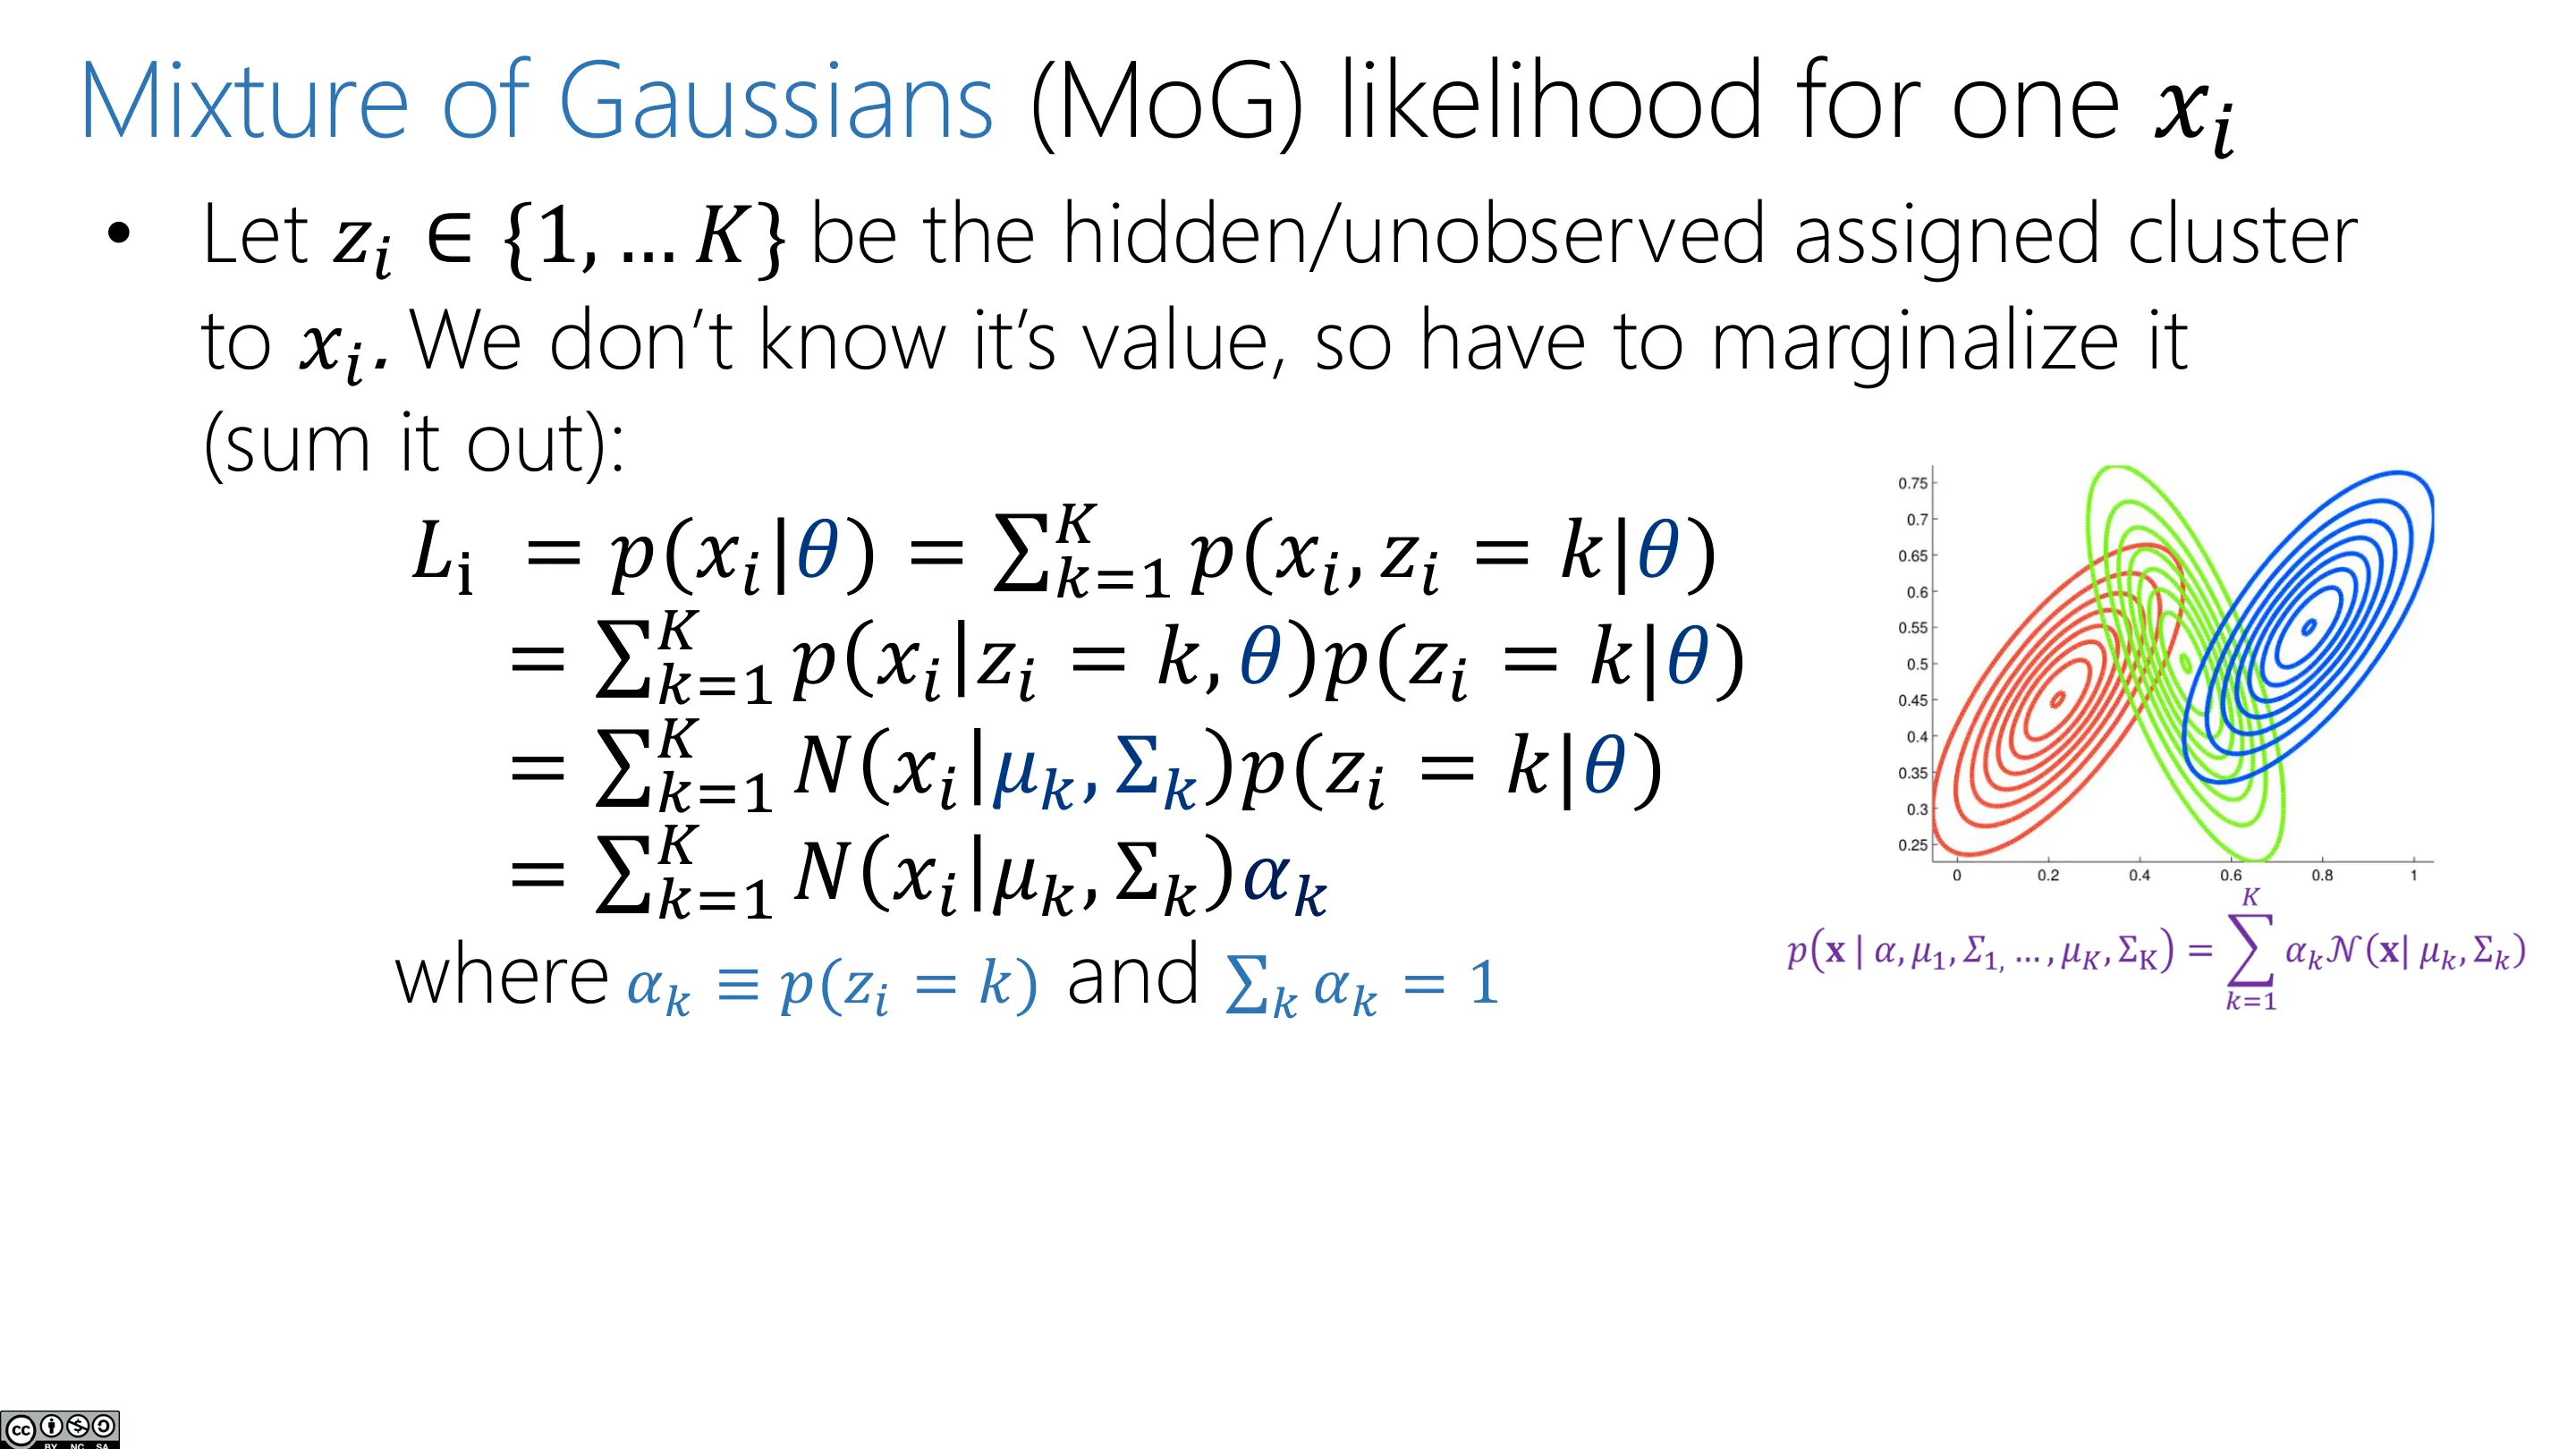
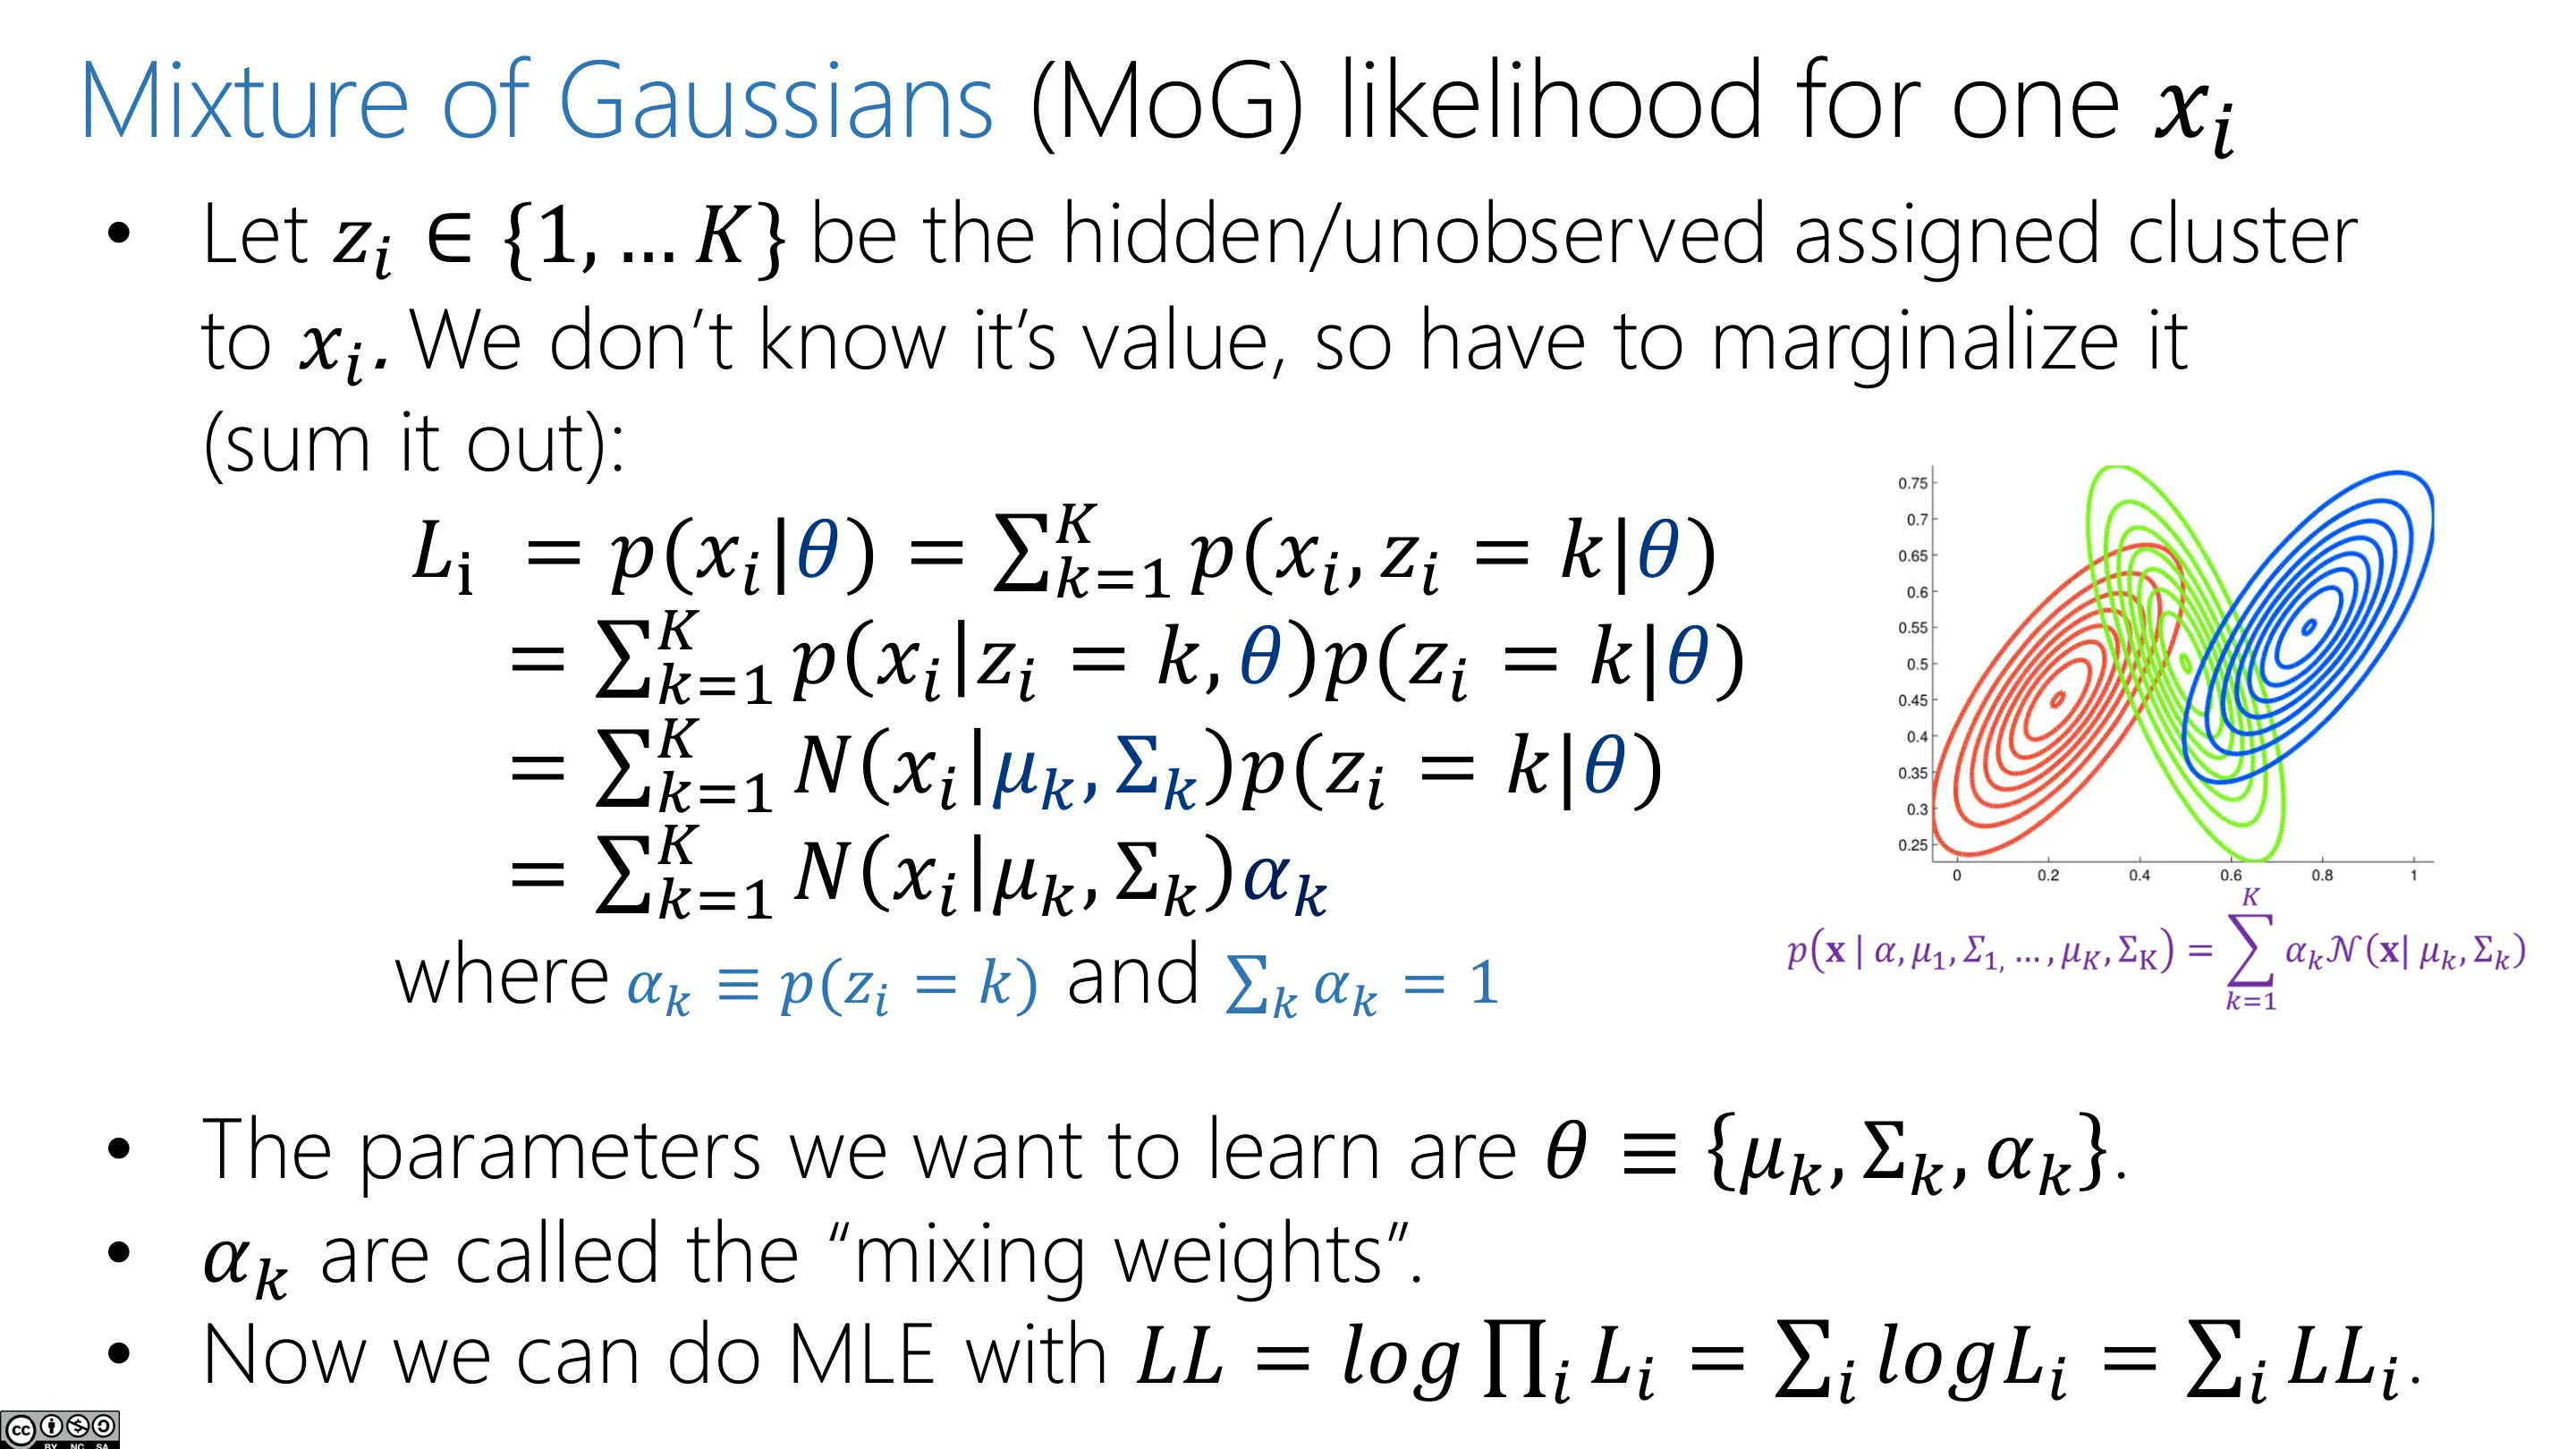
用隐变量 / 潜变量(latent / hidden / unobserved variable) $z_i\in\{1,\dots,K}$ 表示「$x_i$ 属于哪个簇」。它是我们人为引入的随机变量,因为这样做在数学上方便;但我们没有观测到它的取值。
对单个点:
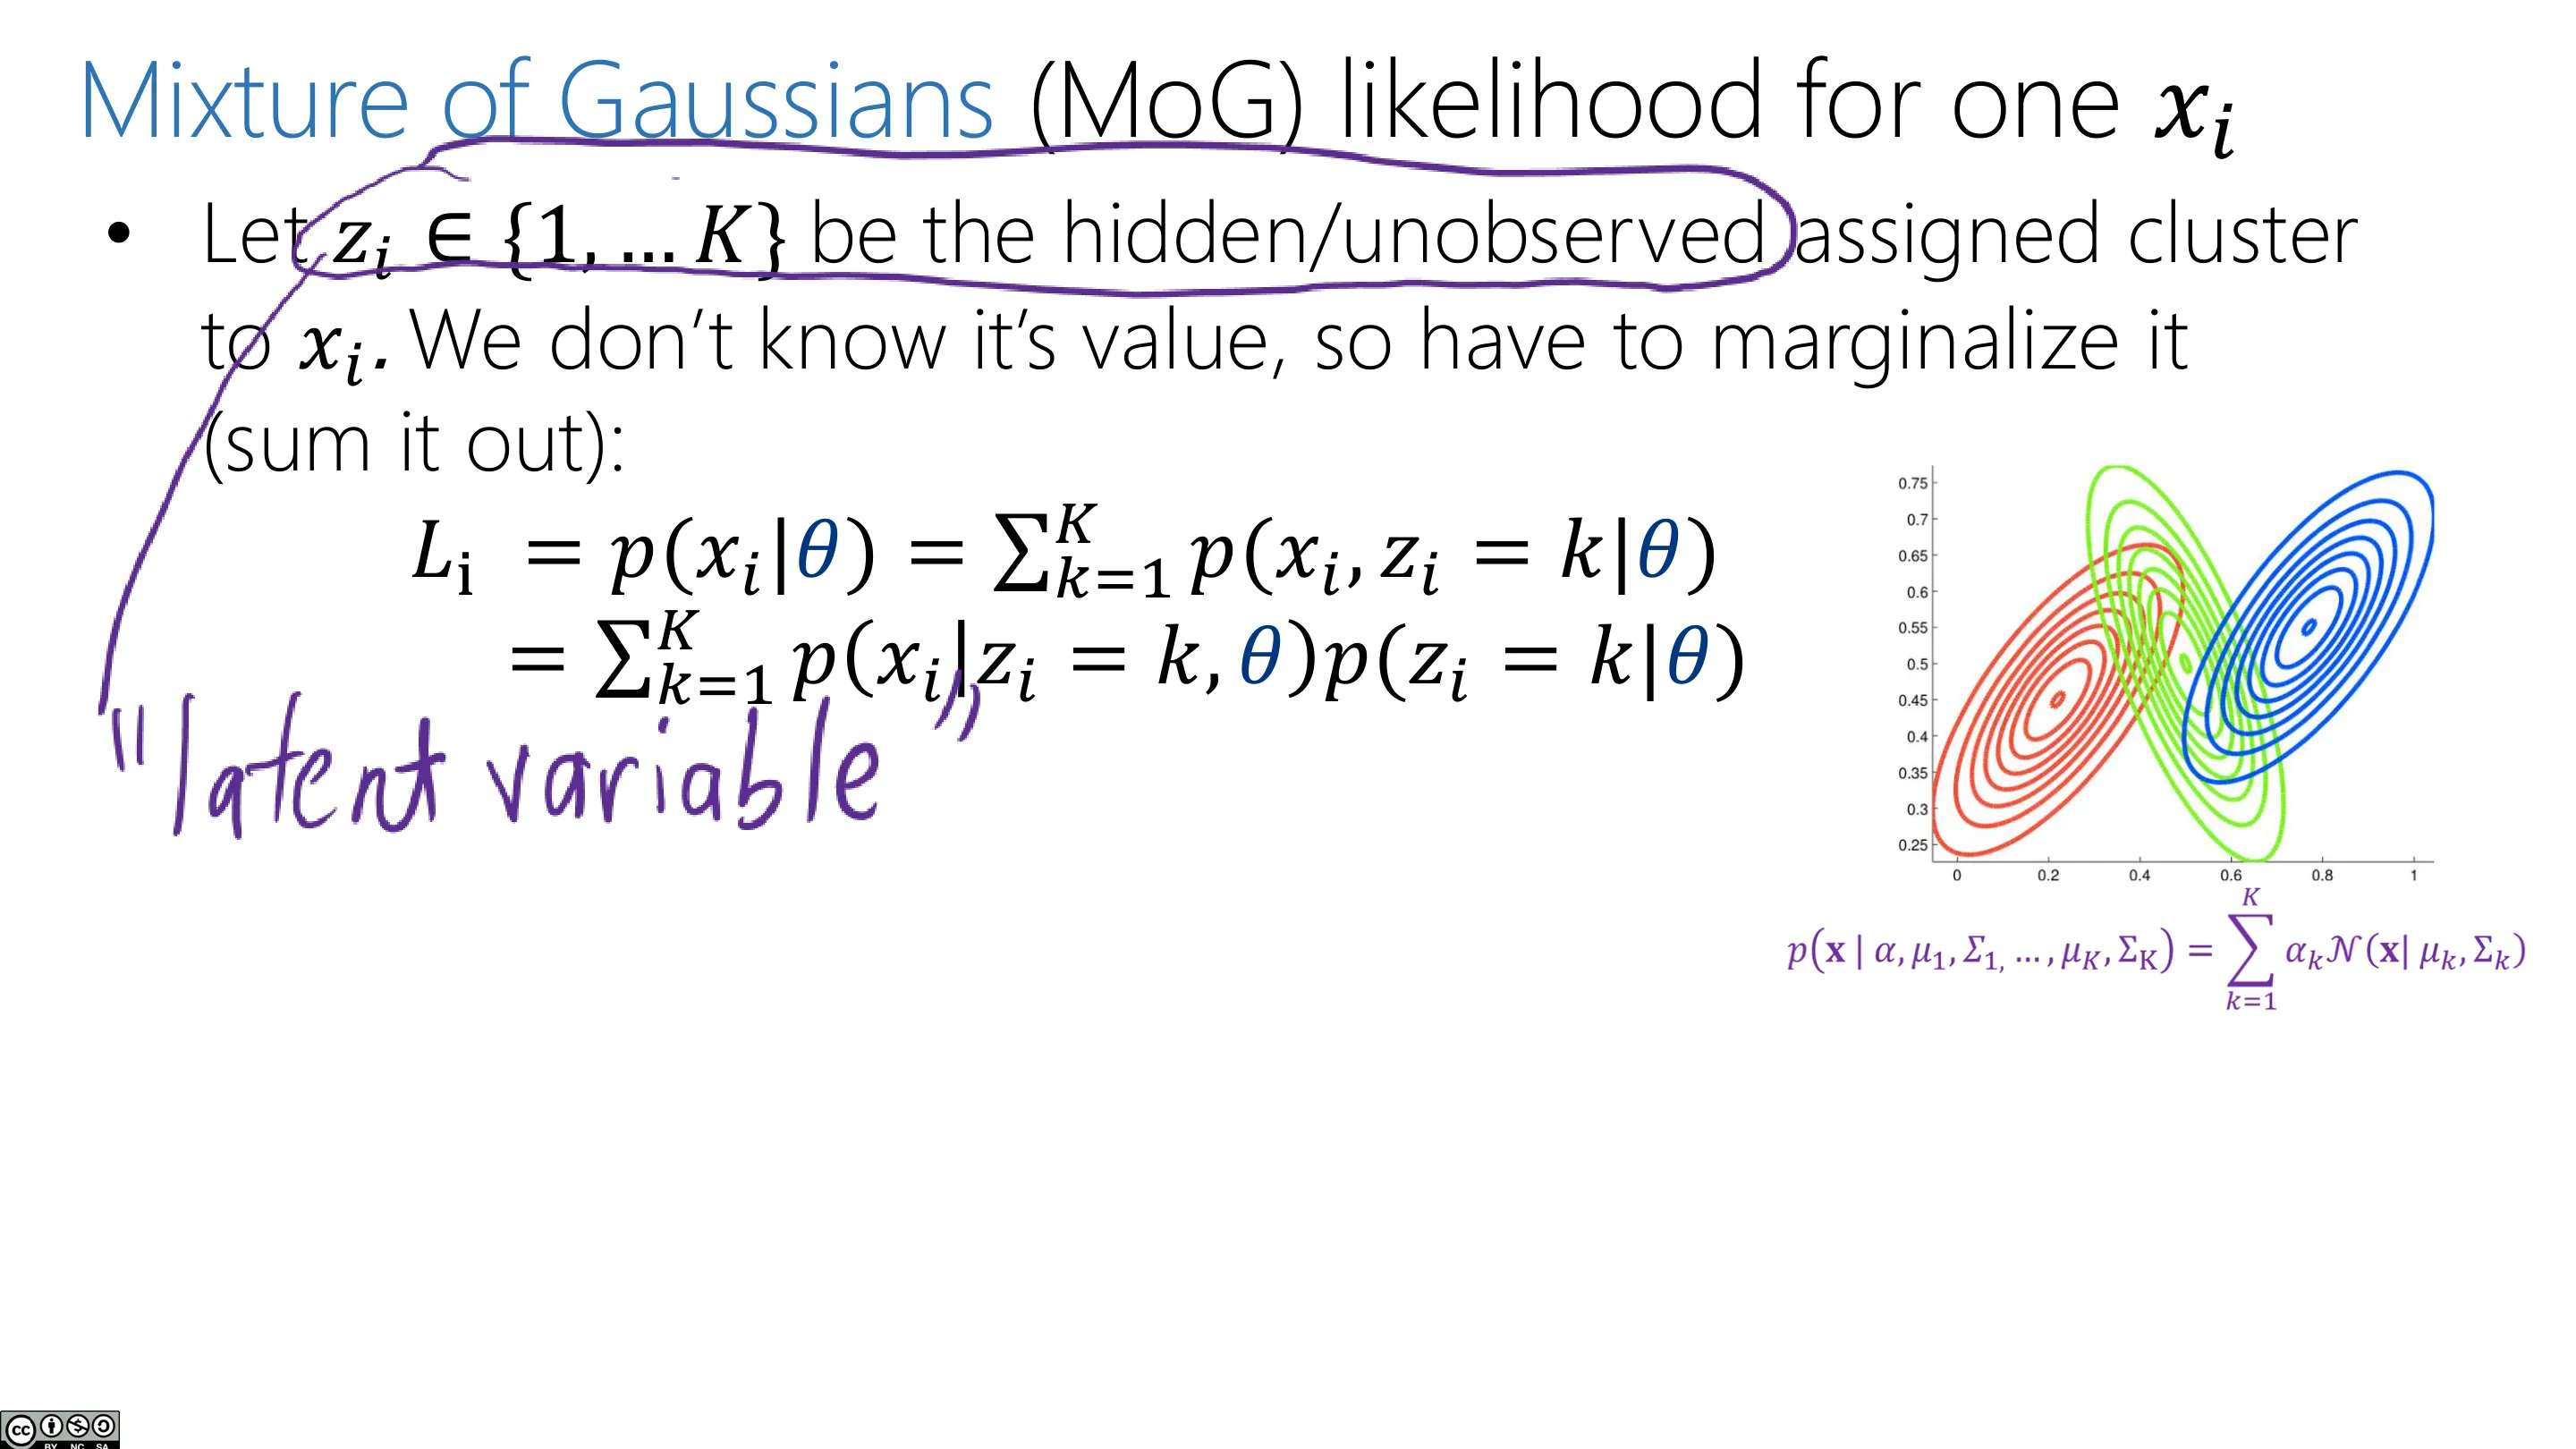
$$ L_i=p(x_i\mid\theta)=\sum_{k=1}^{K}p(x_i,z_i=k\mid\theta)=\sum_{k=1}^{K}\underbrace{p(x_i\mid z_i=k,\theta)}_{\text{第 }k\text{ 个高斯}}\underbrace{p(z_i=k\mid\theta)}_{\alpha_k} $$
- 若知道 $z_i=k$,似然就是第 $k$ 个高斯密度;
- 既然不知道,就对 $z_i$ 边缘化(求和消去);
- 用链式法则把联合密度分解为「条件 × 先验」;
- $\alpha_k\equiv p(z_i=k)$ 即混合系数(mixing weights),$\sum_k\alpha_k=1$。
关键区别:一个点可以部分属于某个簇——这种「软分配」表达了我们对归属的不确定性,正是它比 K 均值的硬分配更稳健。
📷 隐变量与 MoG 似然(一)
回到原视频 (00:05:00)
📷 隐变量与 MoG 似然(二)
回到原视频 (00:06:10)
📷 隐变量与 MoG 似然(三)
回到原视频 (00:07:10)
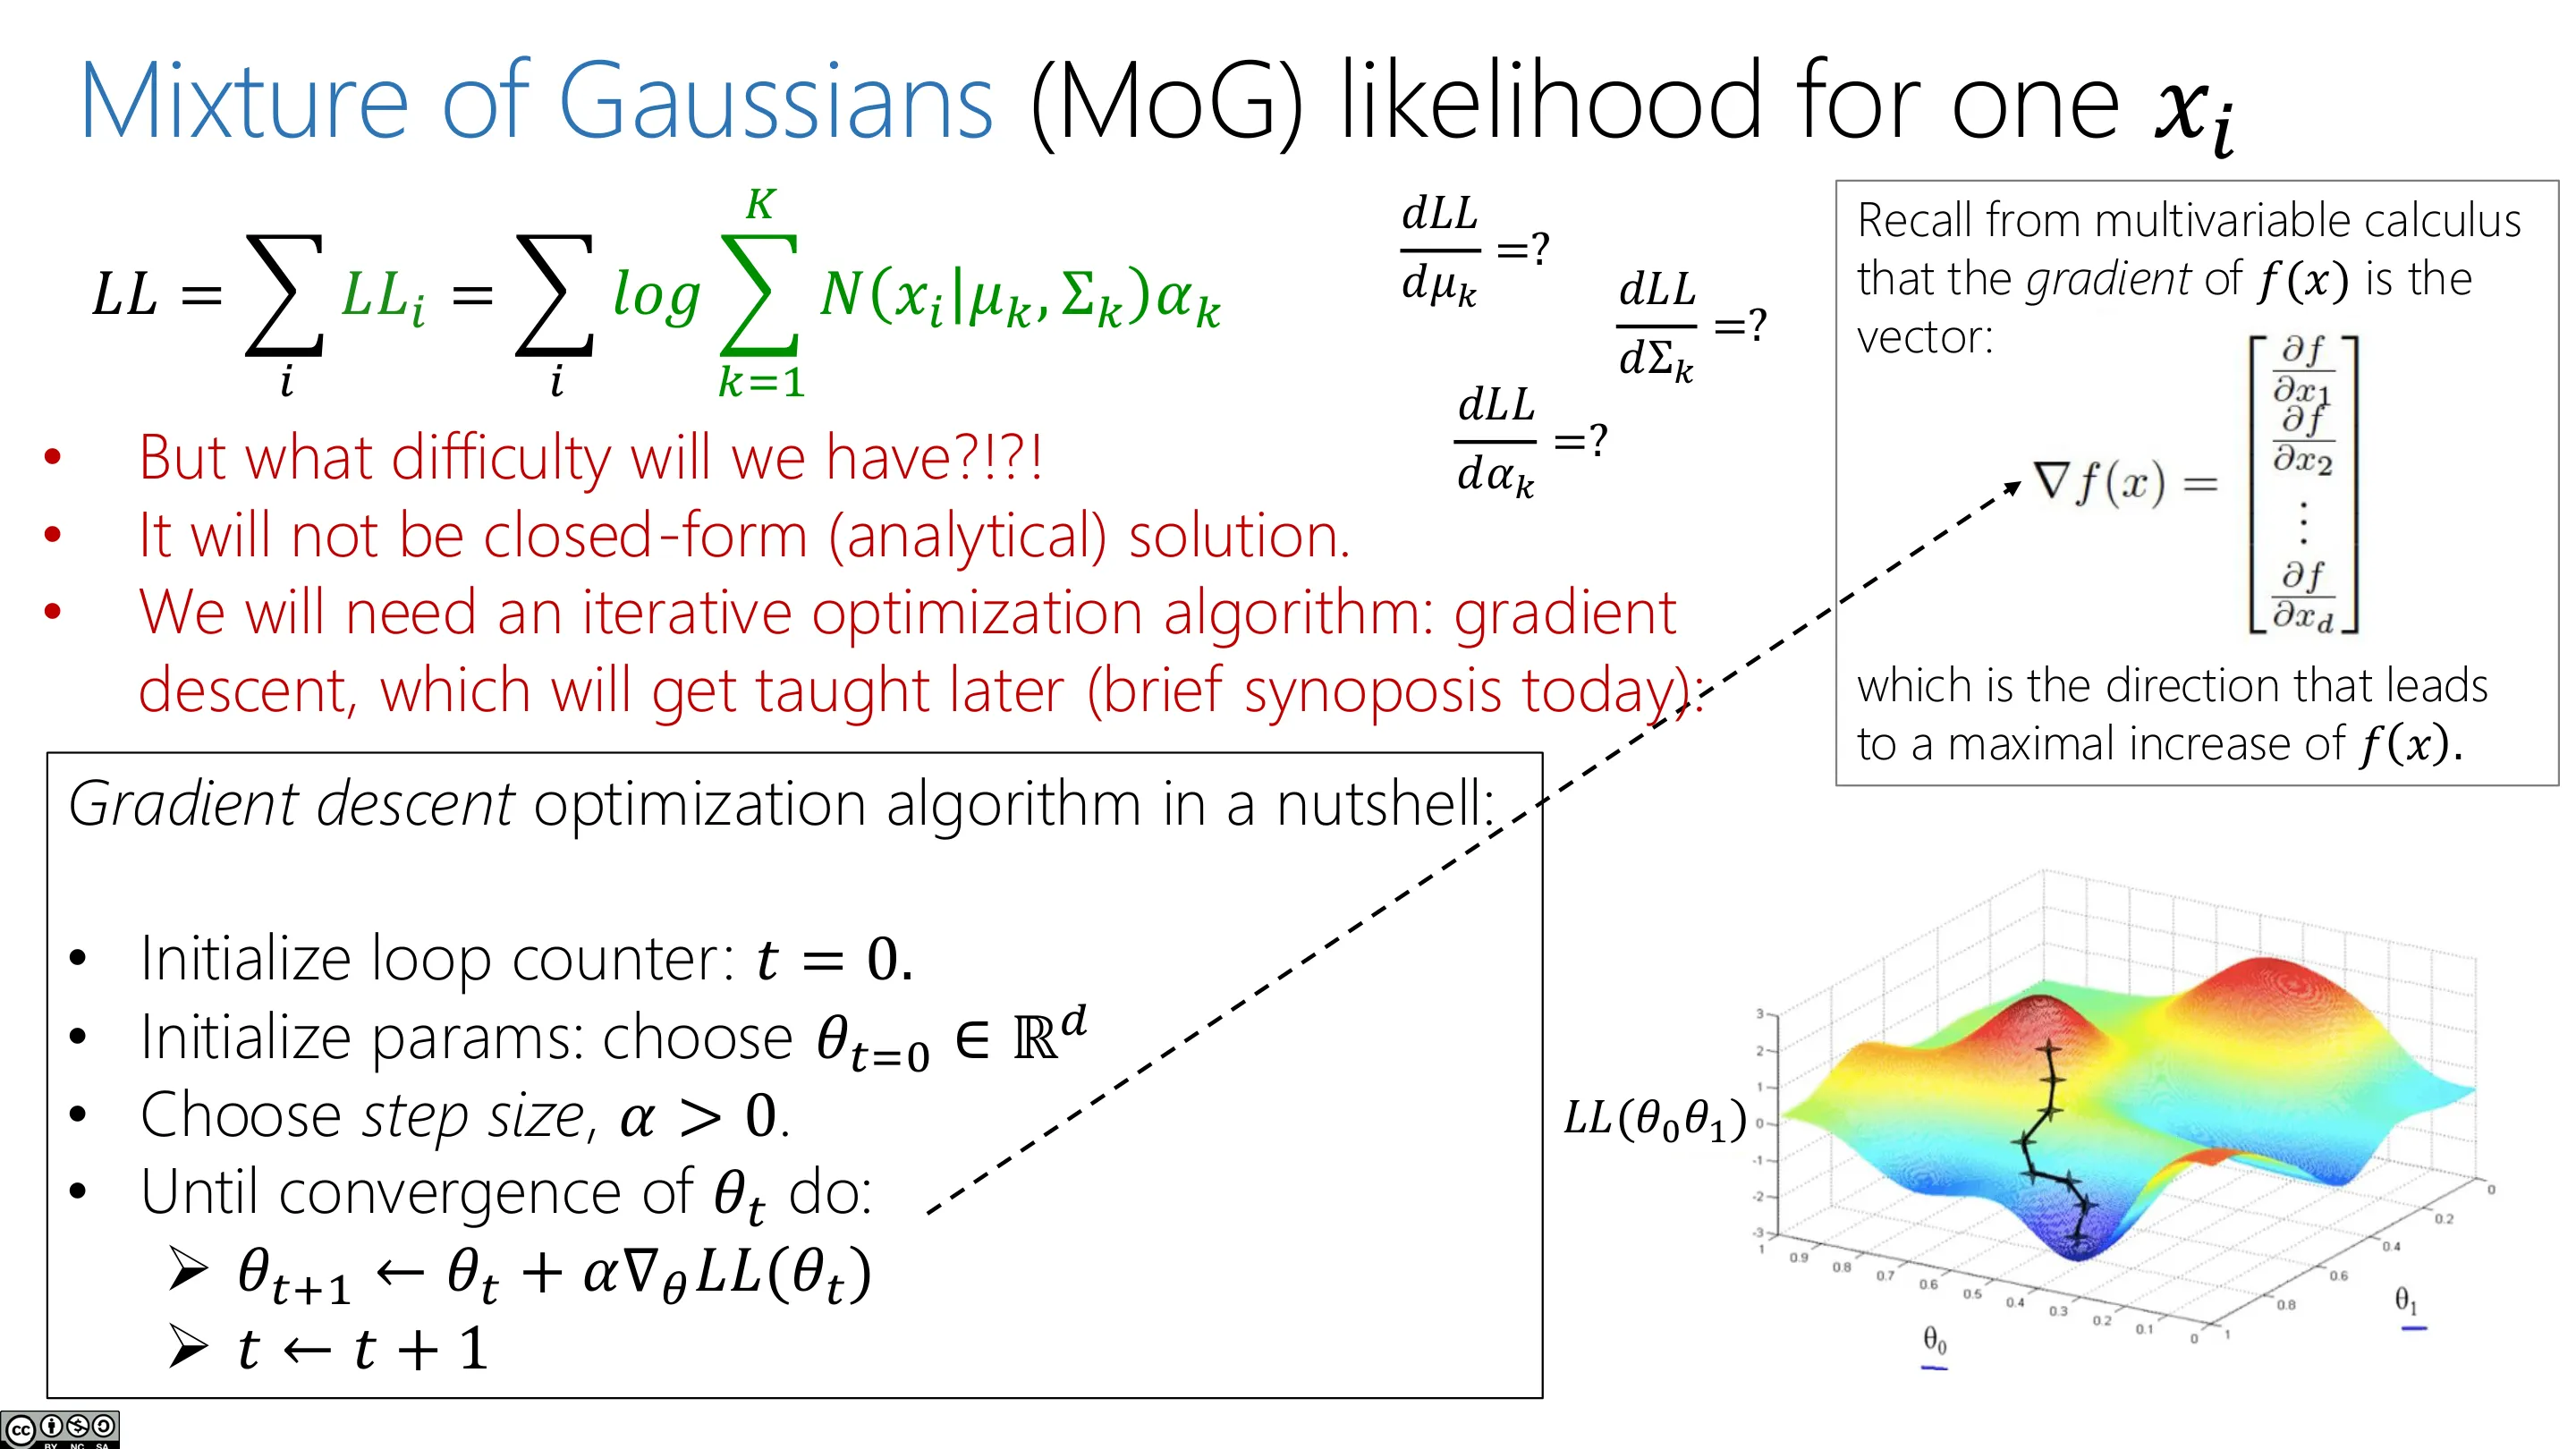
📷 单个点的 MoG 似然
回到原视频 (00:08:55)
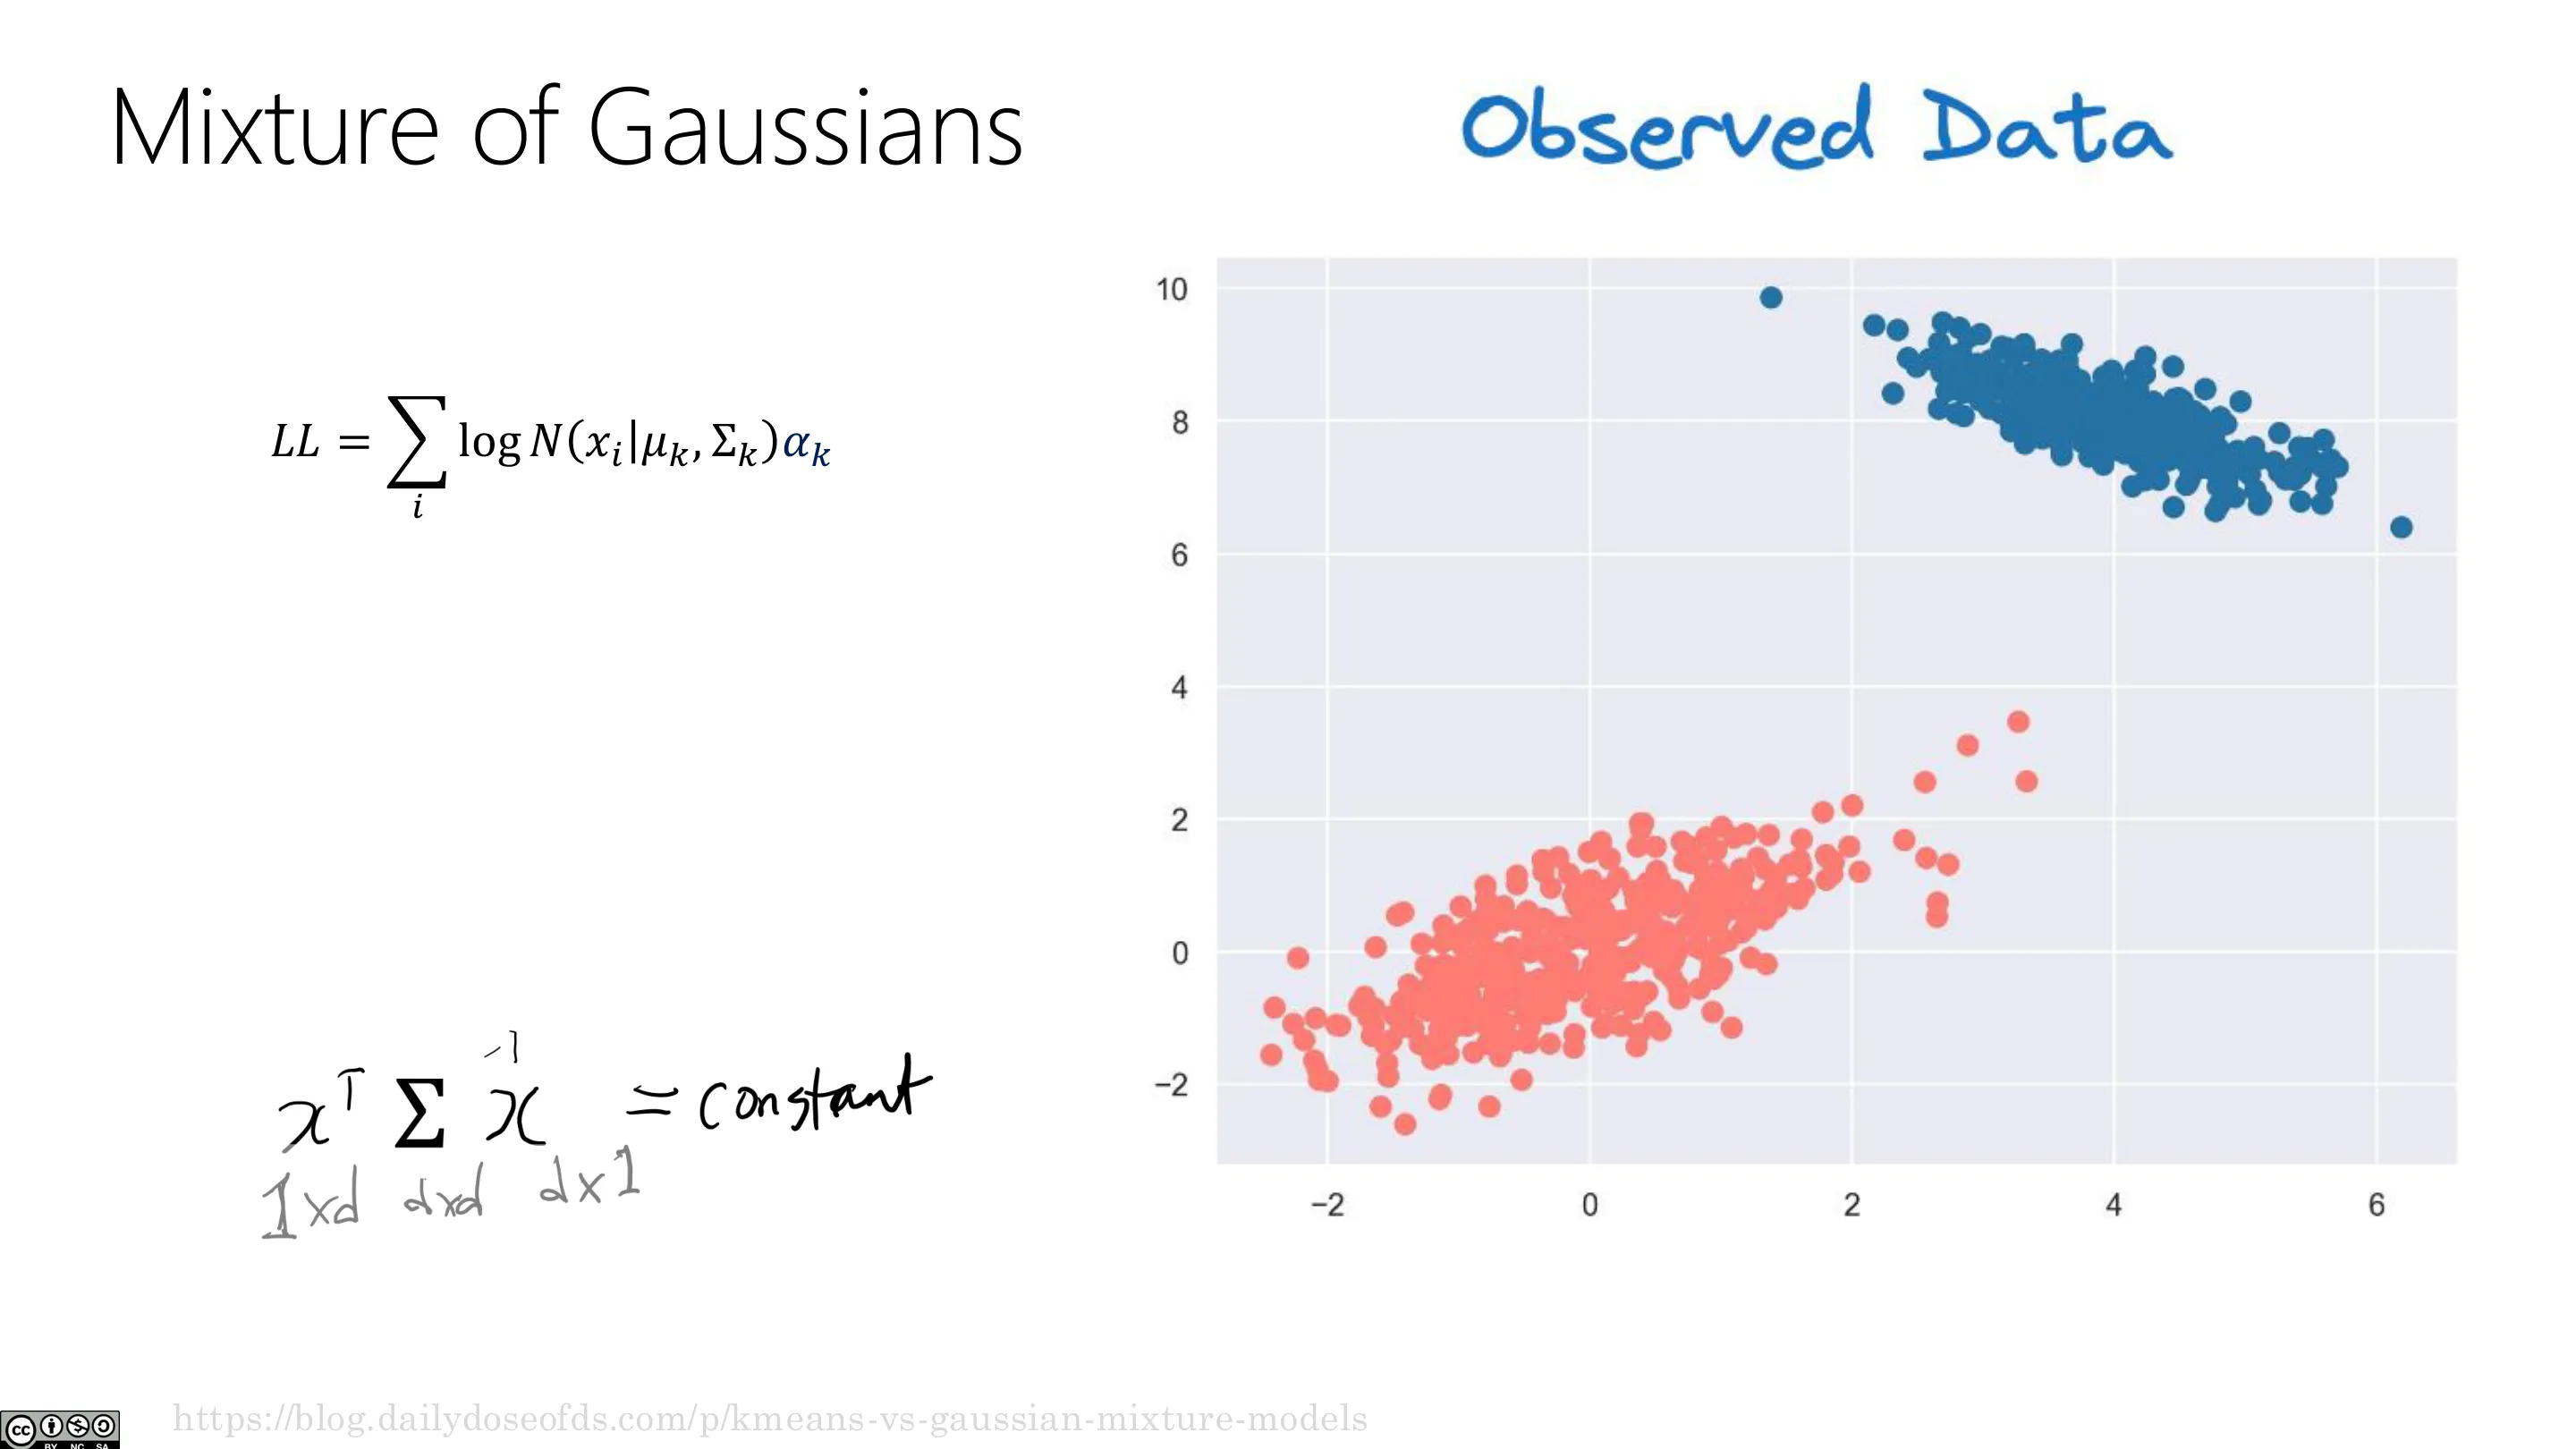
📷 MoG 的隐变量表述
回到原视频 (00:09:30)
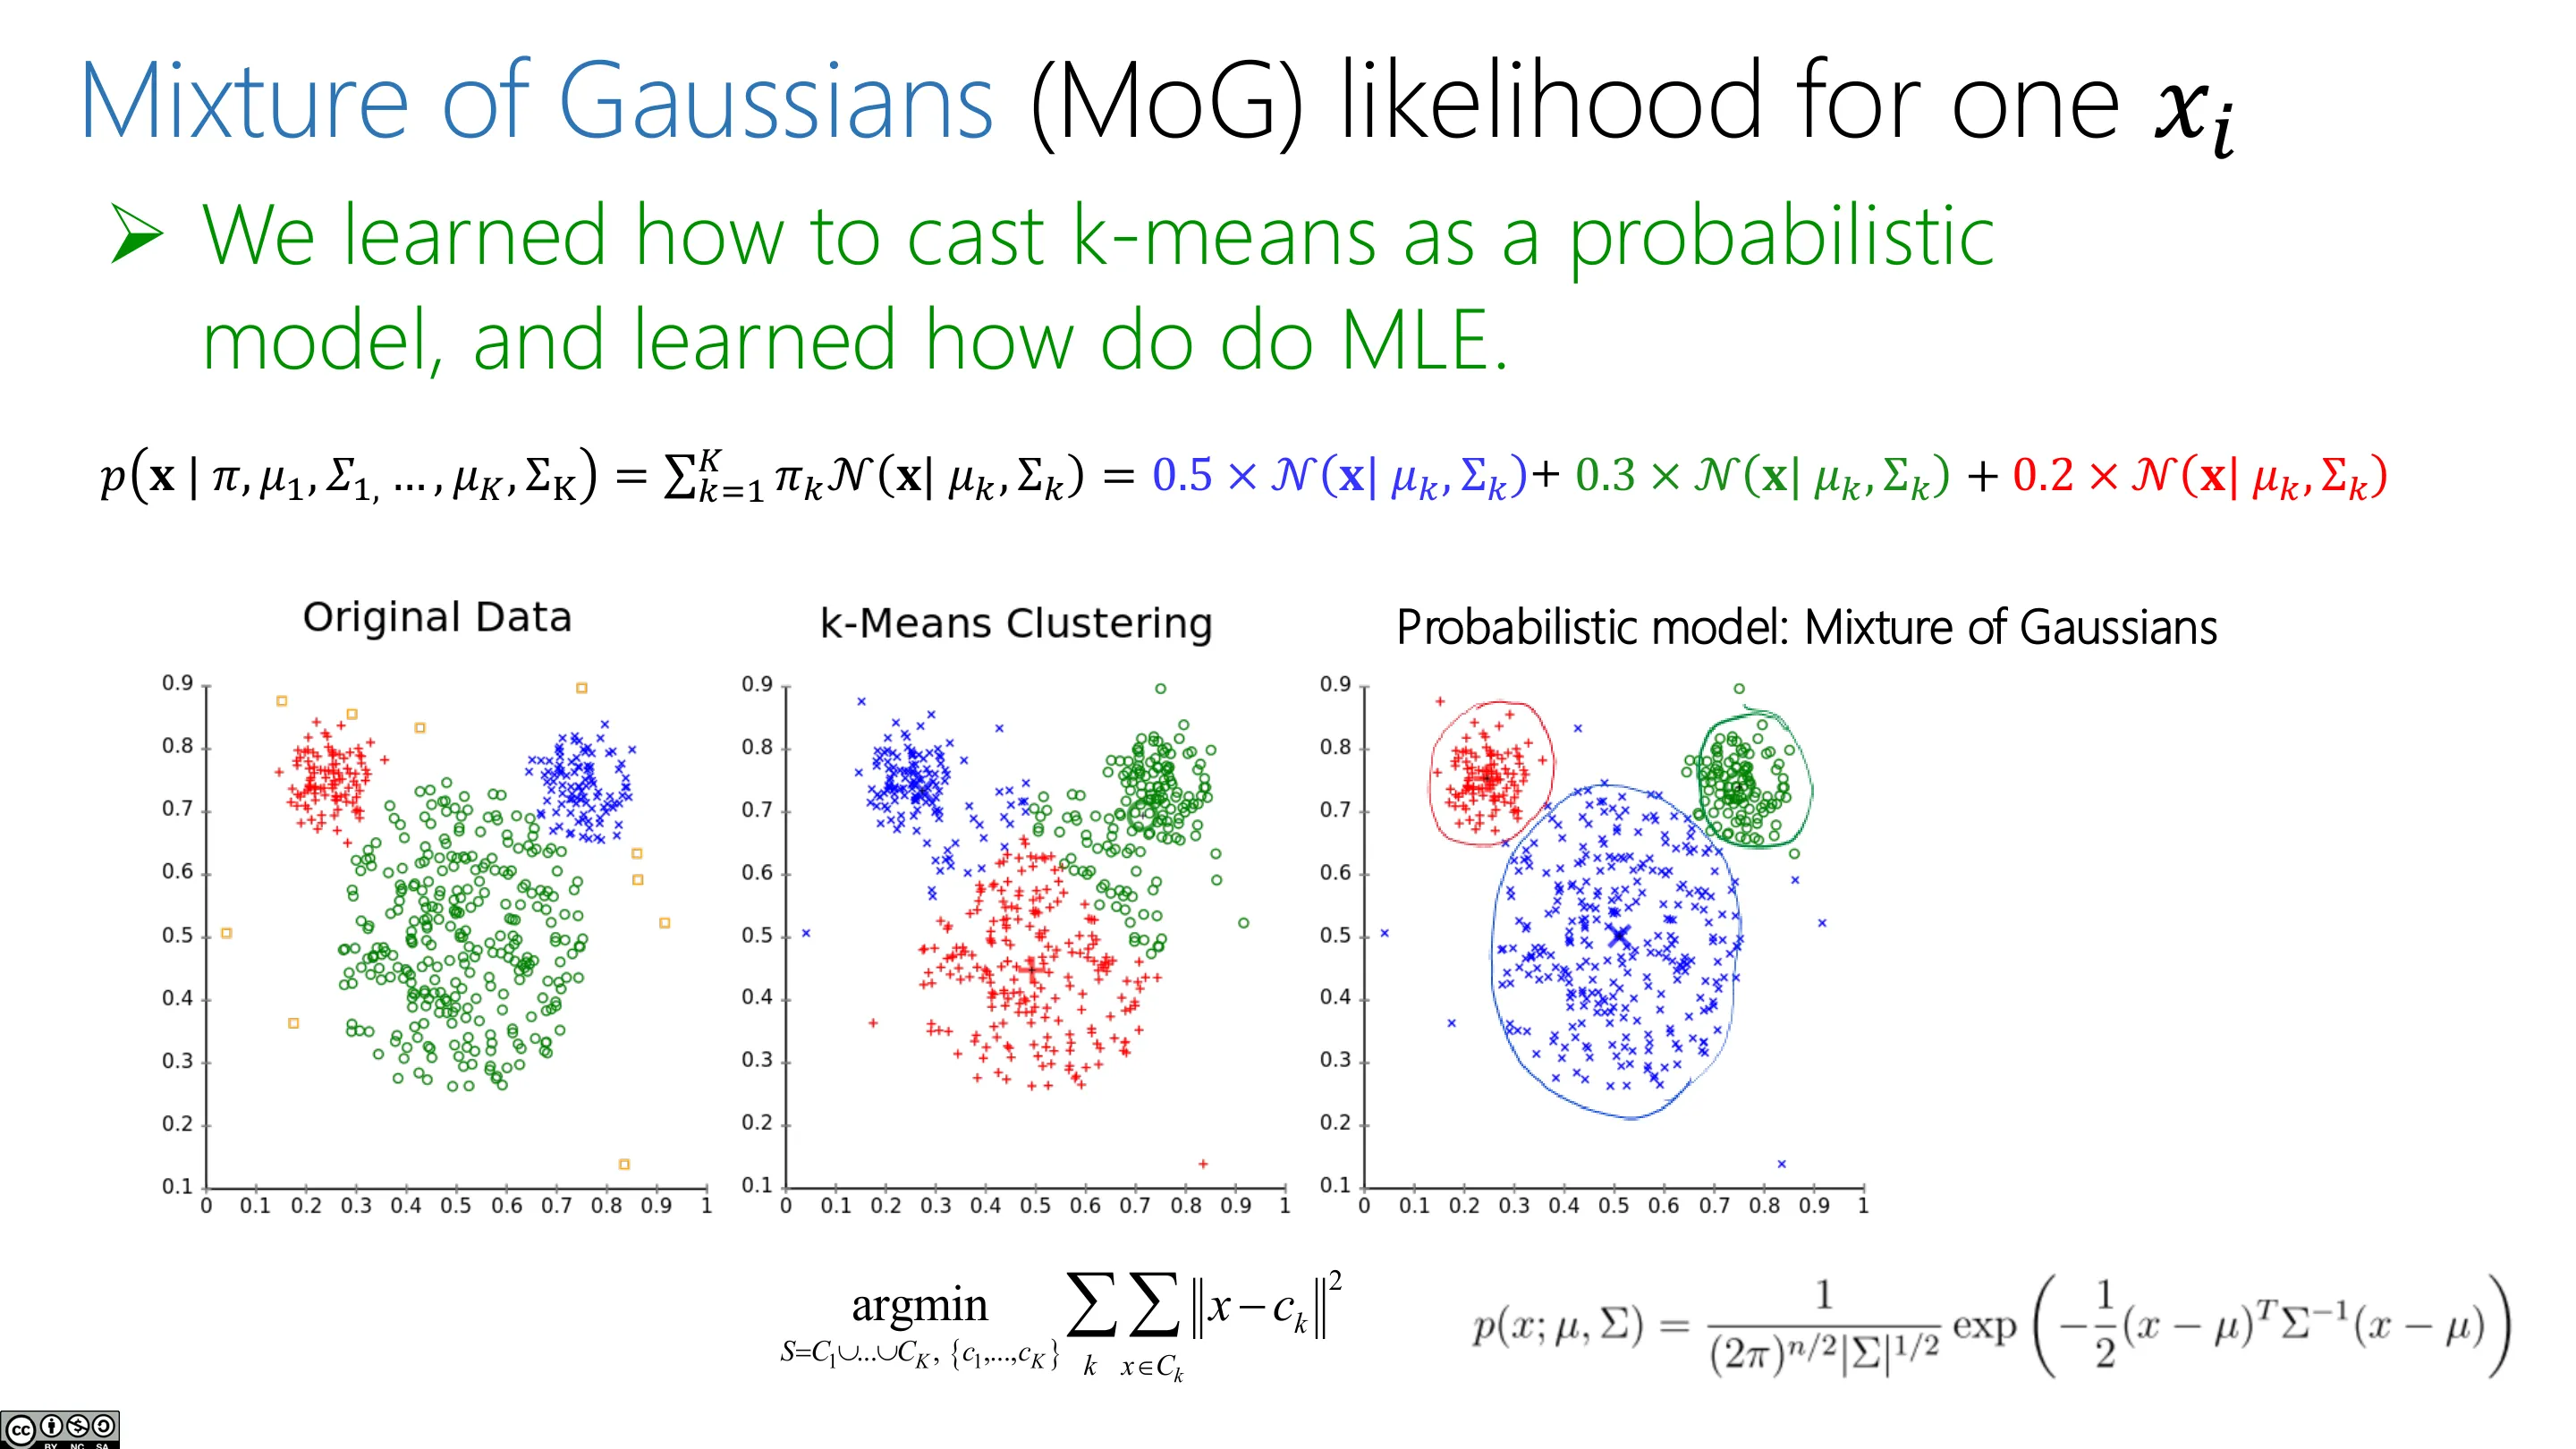
📷 K 均值的概率化
回到原视频 (00:10:00)
编者说明:讲师提醒参数数量——三个一维高斯,每个有一个均值与一个方差,再加上三个混合系数,共 9 个自由参数($\alpha_k$ 受和为 1 的约束)。
1.4 为什么难:对数里套着求和
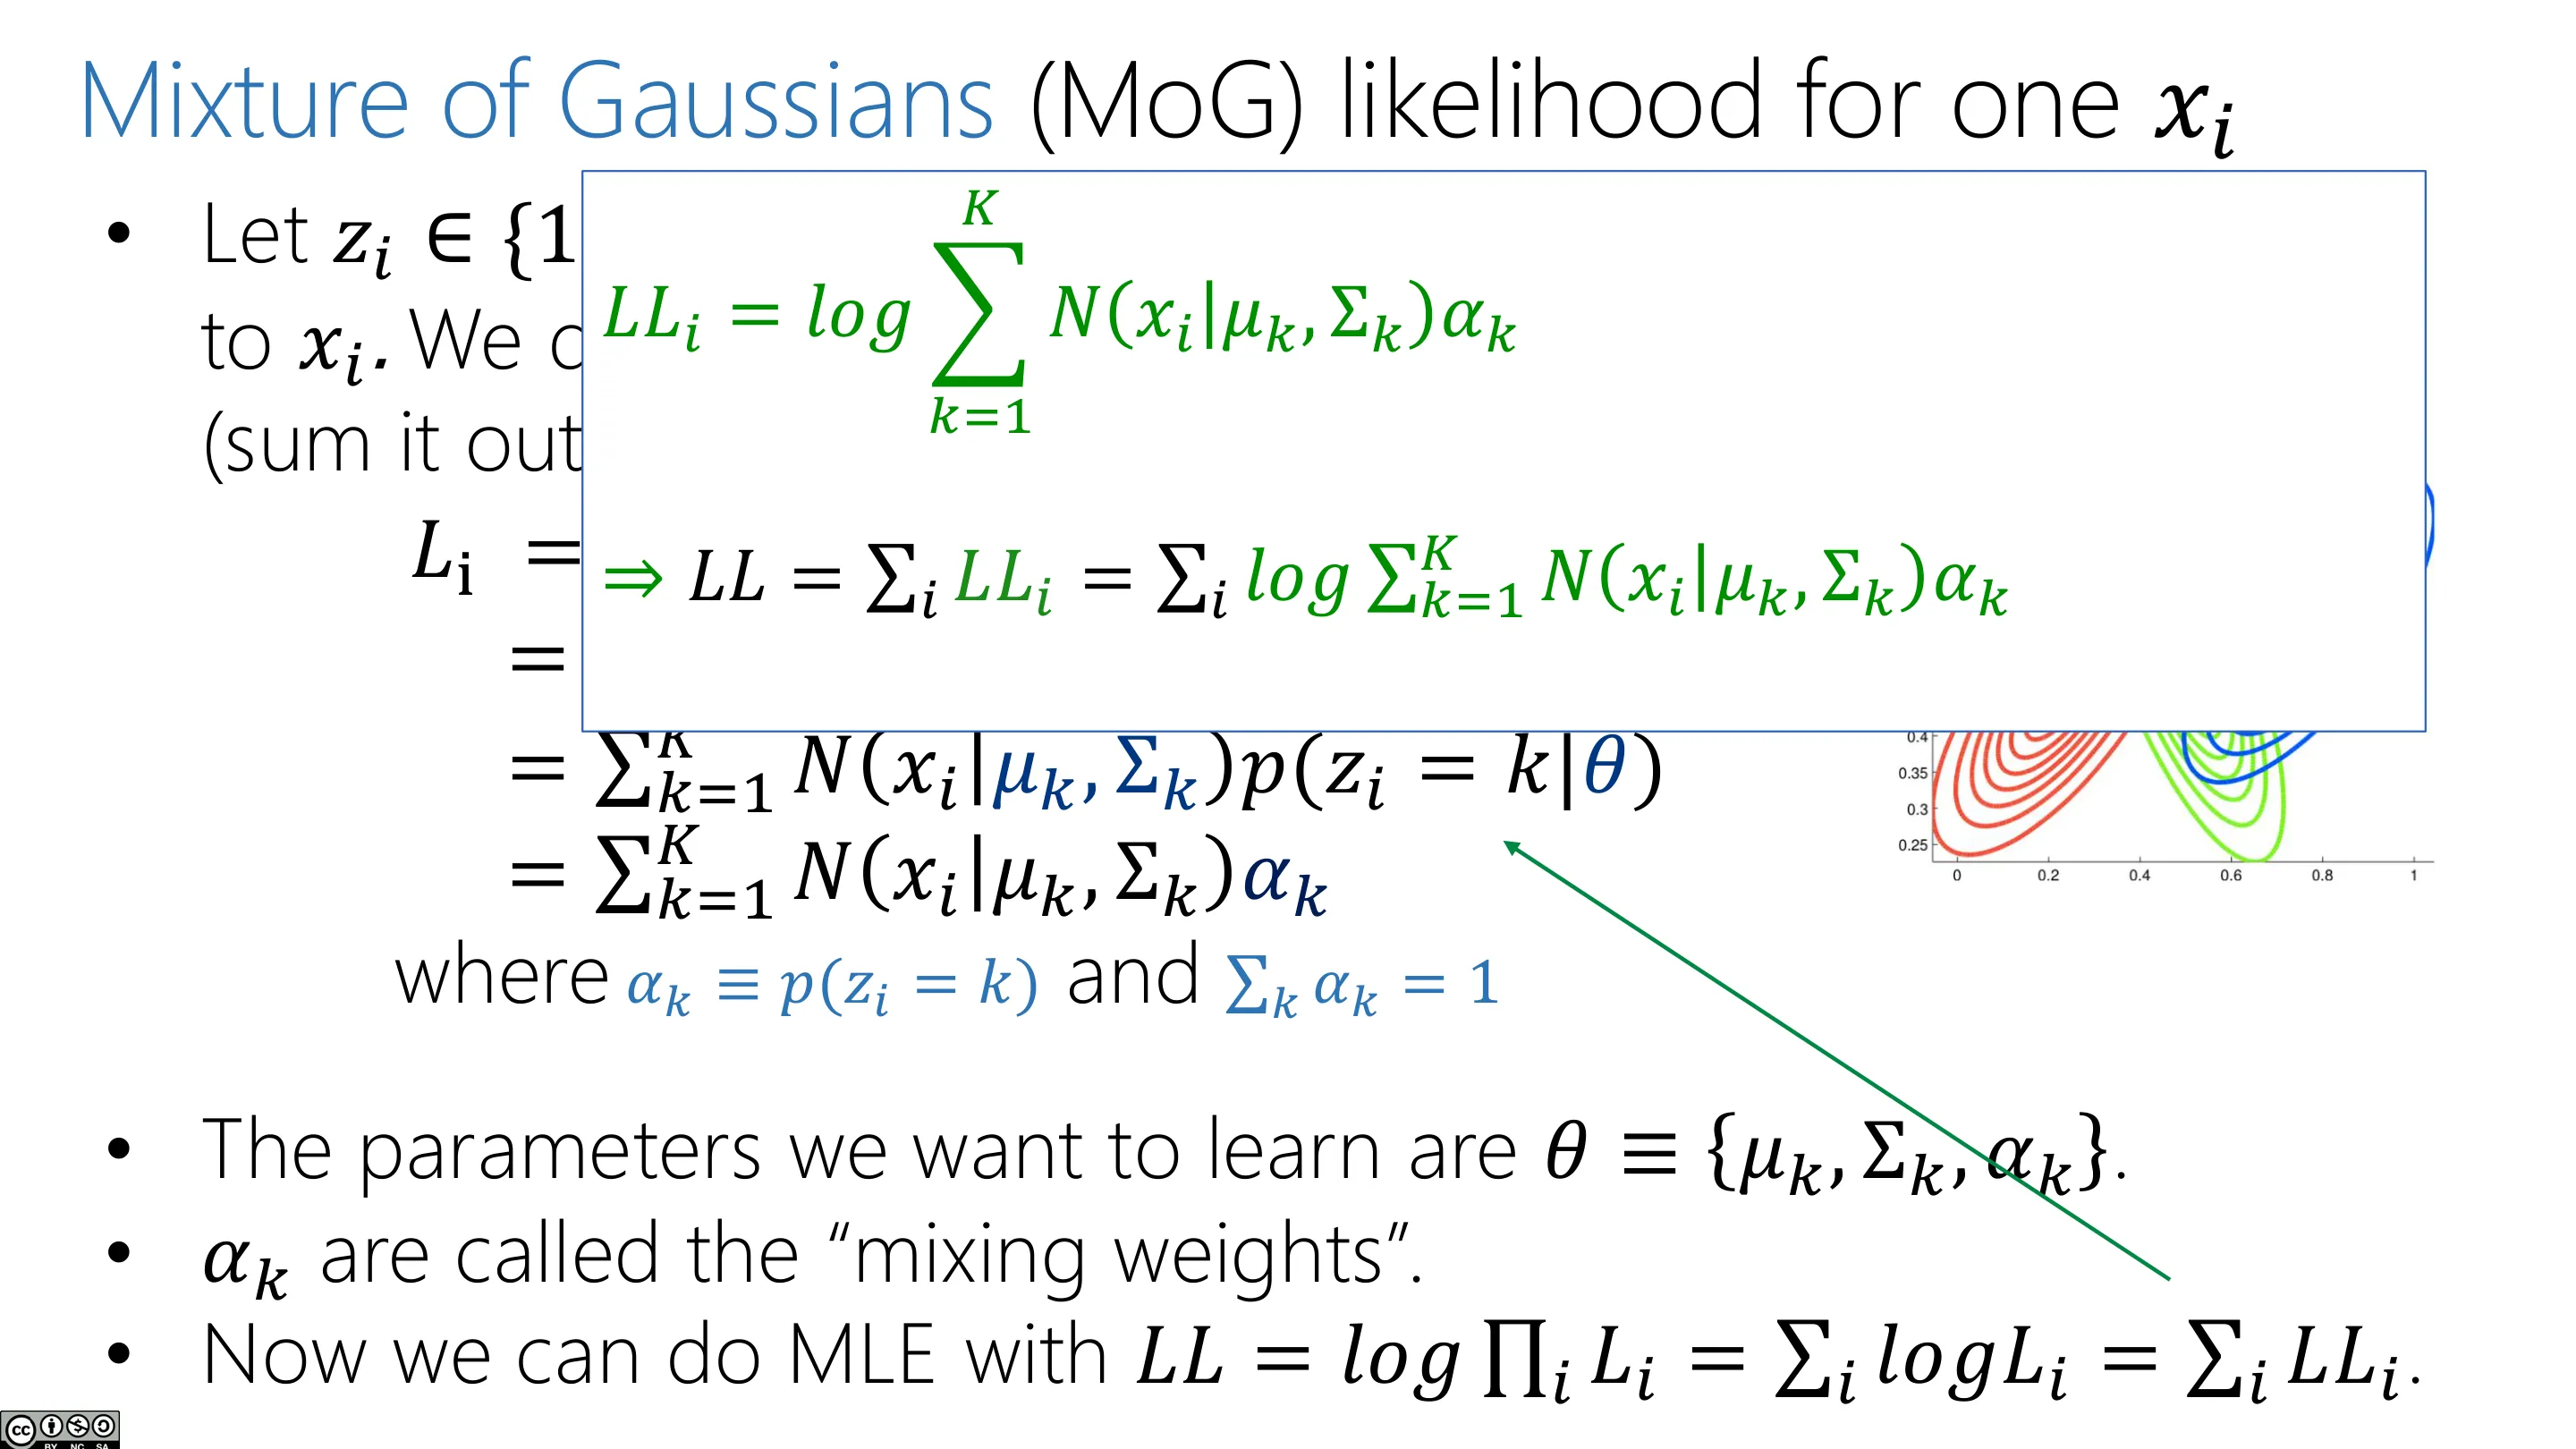
对整个数据集的对数似然:$LL=\sum_i \log L_i$,其中
$$ LL_i=\log\sum_{k=1}^{K}\mathcal{N}(x_i\mid\mu_k,\Sigma_k)\,\alpha_k $$
麻烦在于:对乘积取对数会变成漂亮的和,但对和取对数无法化简——这让闭式解(令导数为零)变得极其笨拙。因此需要迭代优化:对隐变量模型,有一个专门的算法叫期望最大化(EM)(本课不深入),更普适的是梯度下降。
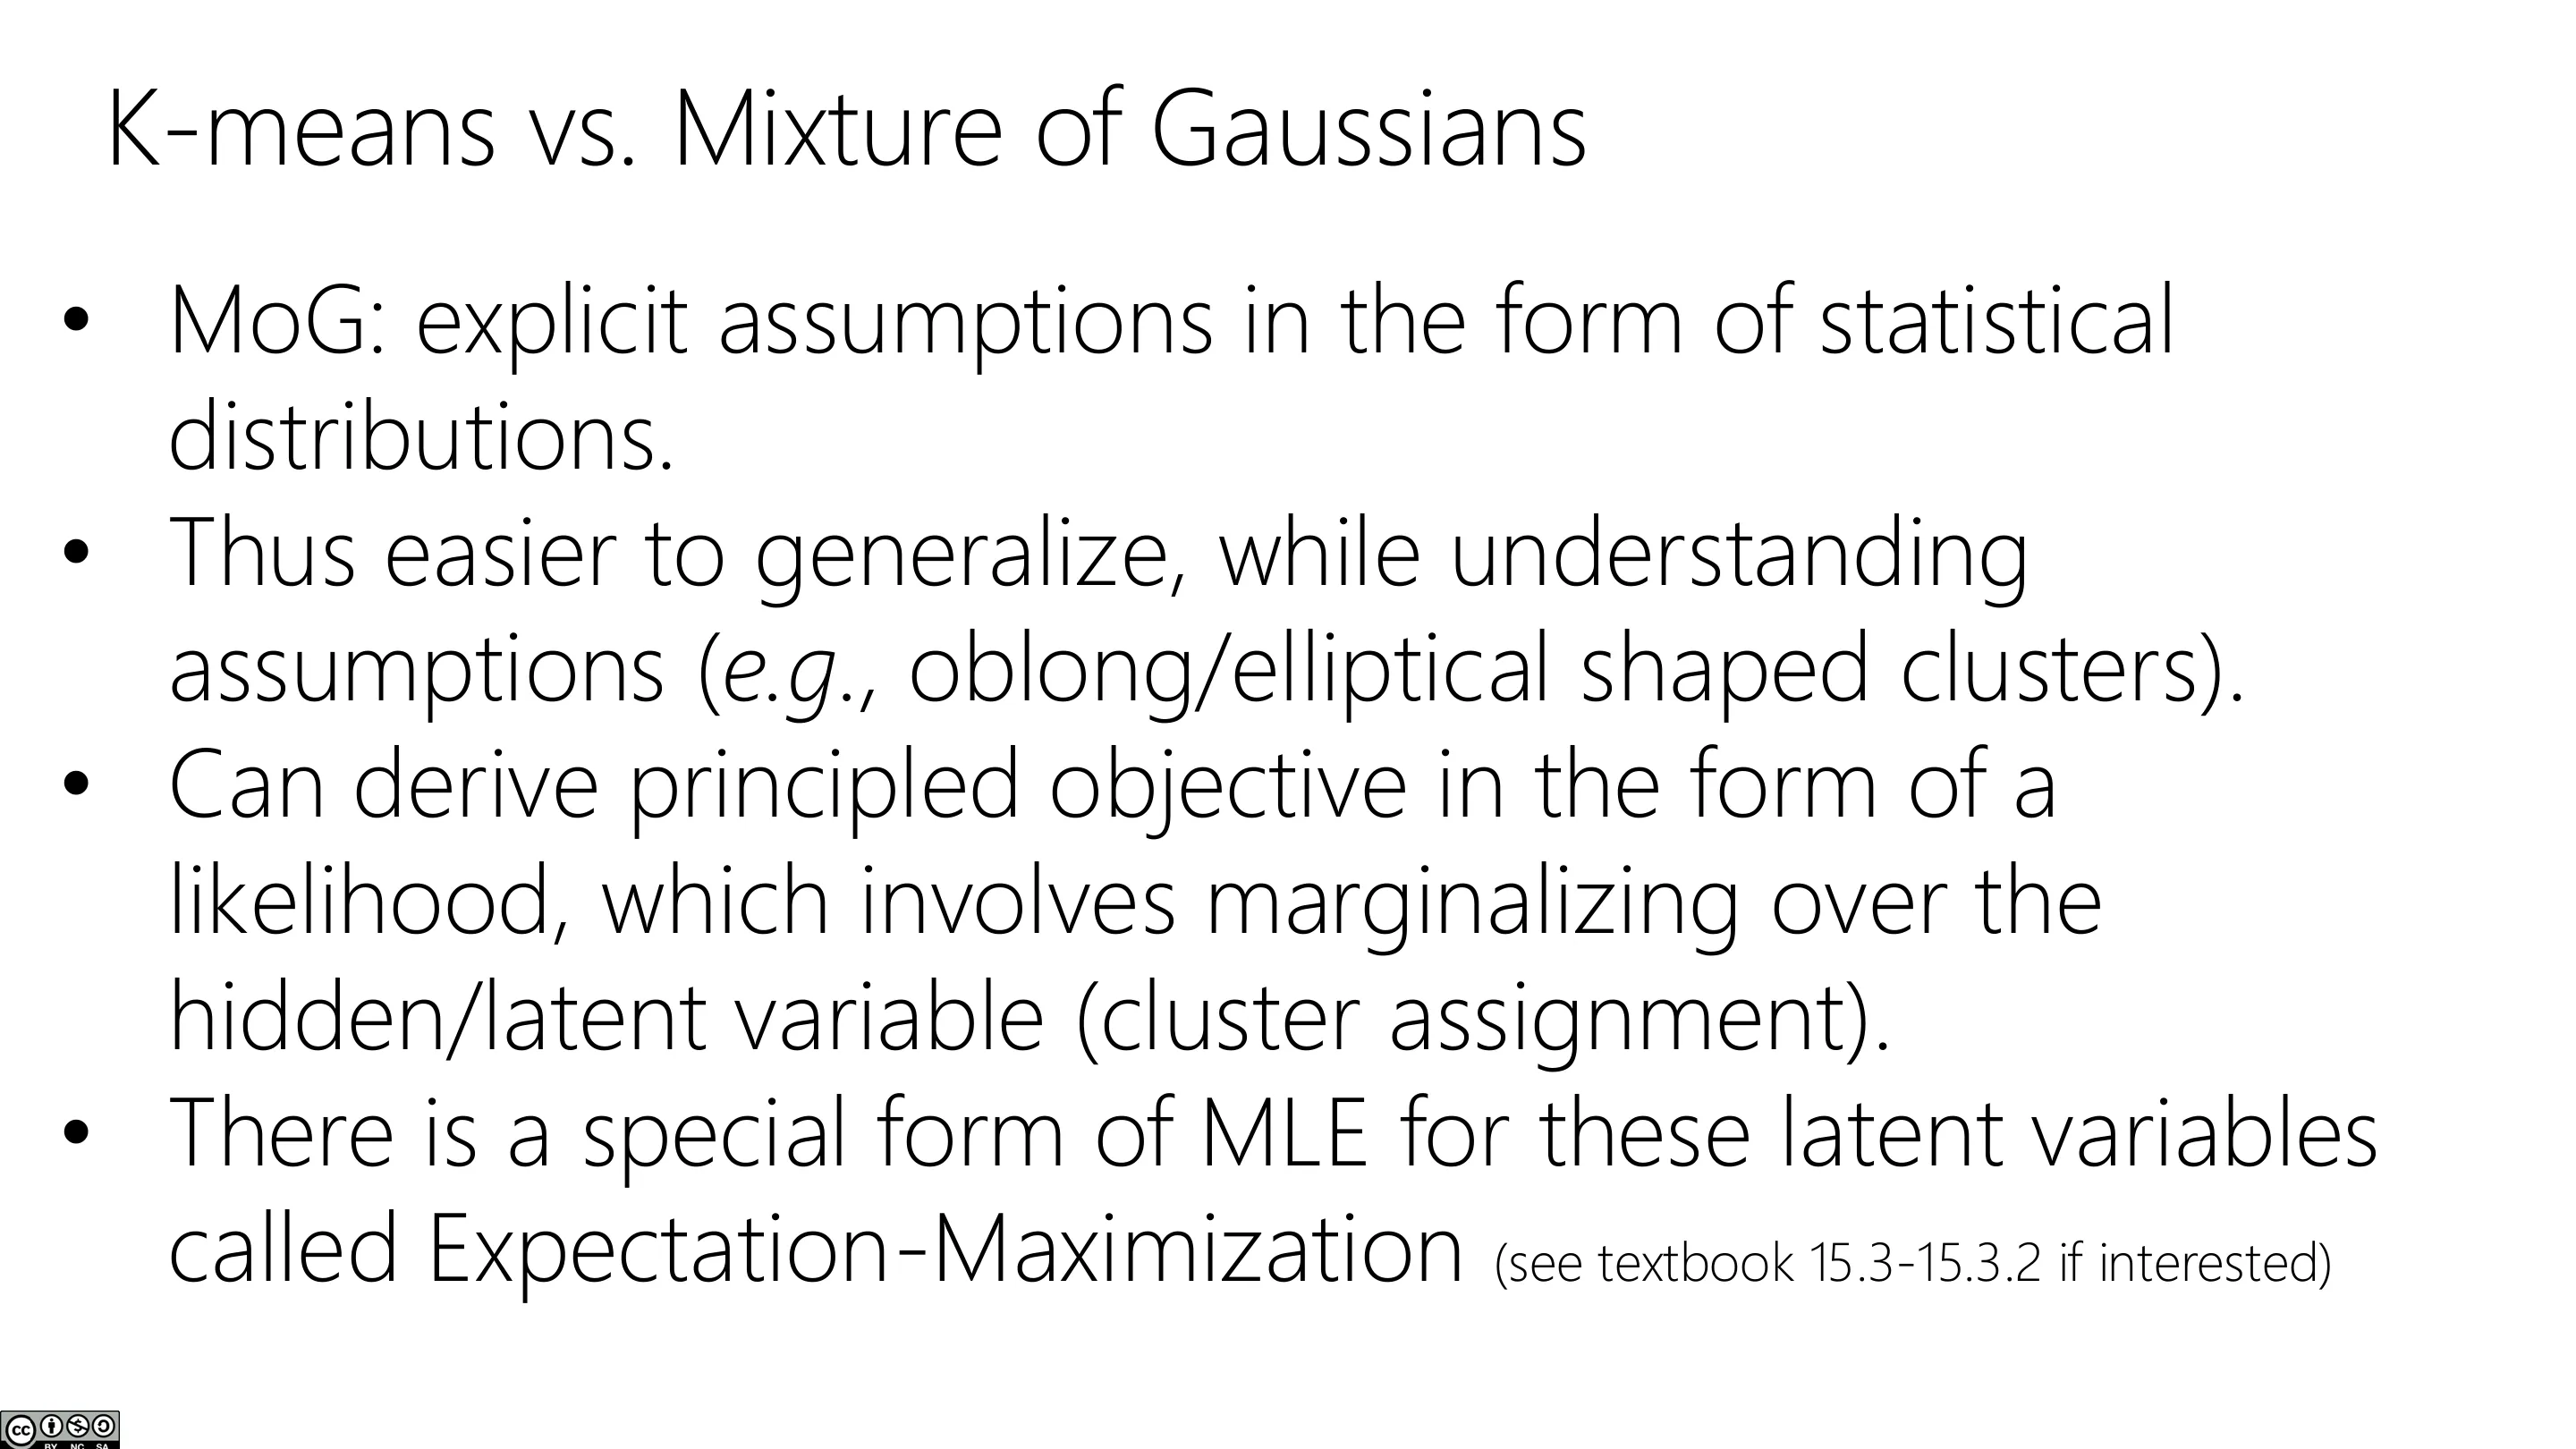
📷 MoG 的显式统计假设
回到原视频 (00:24:30)
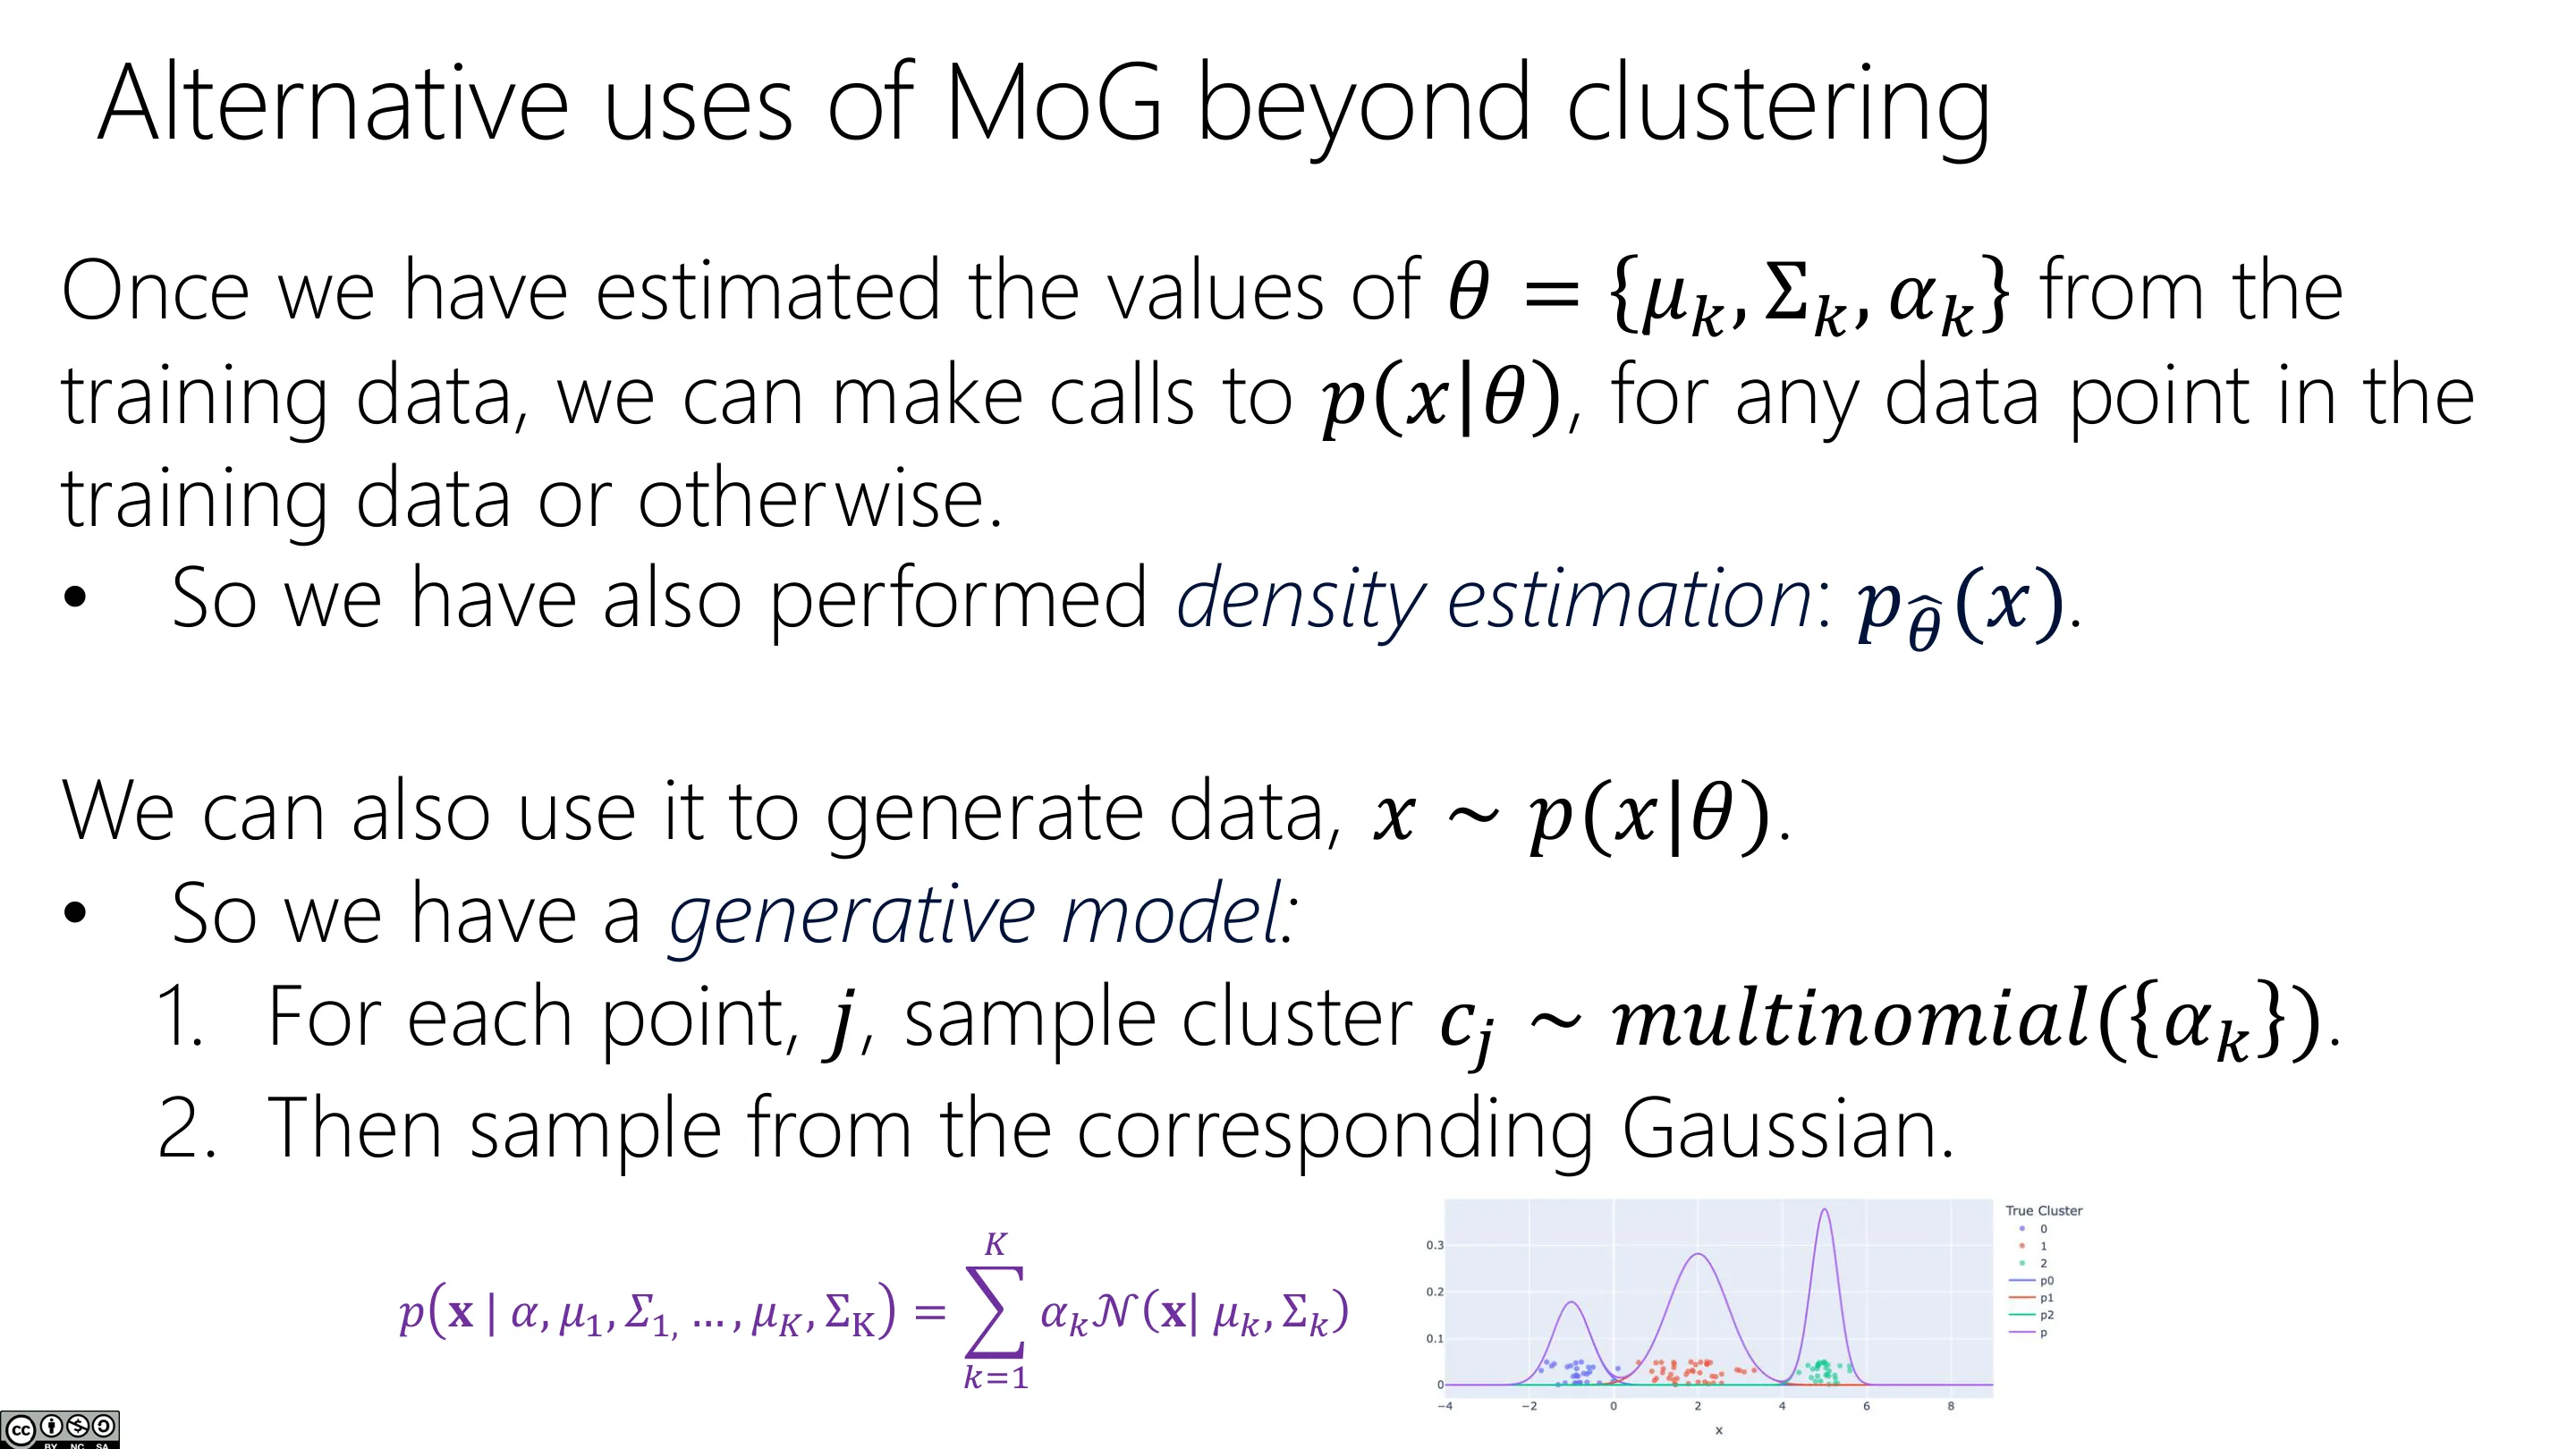
编者说明:讲师用随机初始化 + 沿梯度小步迭代的动画预告了梯度下降:初始化所有均值/协方差/混合权重 → 选步长 → 沿梯度方向反复更新,直到梯度为零(收敛)。这就是现代机器学习的主力优化方法。
📷 MoG 估计完成后可做的事
回到原视频 (00:26:30)
📷 路线图(三)
回到原视频 (00:29:50)
1.5 MoG 的三种用途与零噪声极限
- 聚类:簇由高斯表示,协方差决定形状/大小/朝向,混合系数决定「分给每个簇多少个点」(允许严重不均衡);
- 密度估计:对任意新点评估 $p(x\mid\theta)$ → 可用于异常检测(讲师提到在蛋白质工程中用它推断功能);
- 生成模型:从密度采样——先按 $\alpha_k$ 抽簇,再从对应高斯采样(过程简单,Python 能从均匀/标准高斯采样即可实现)。
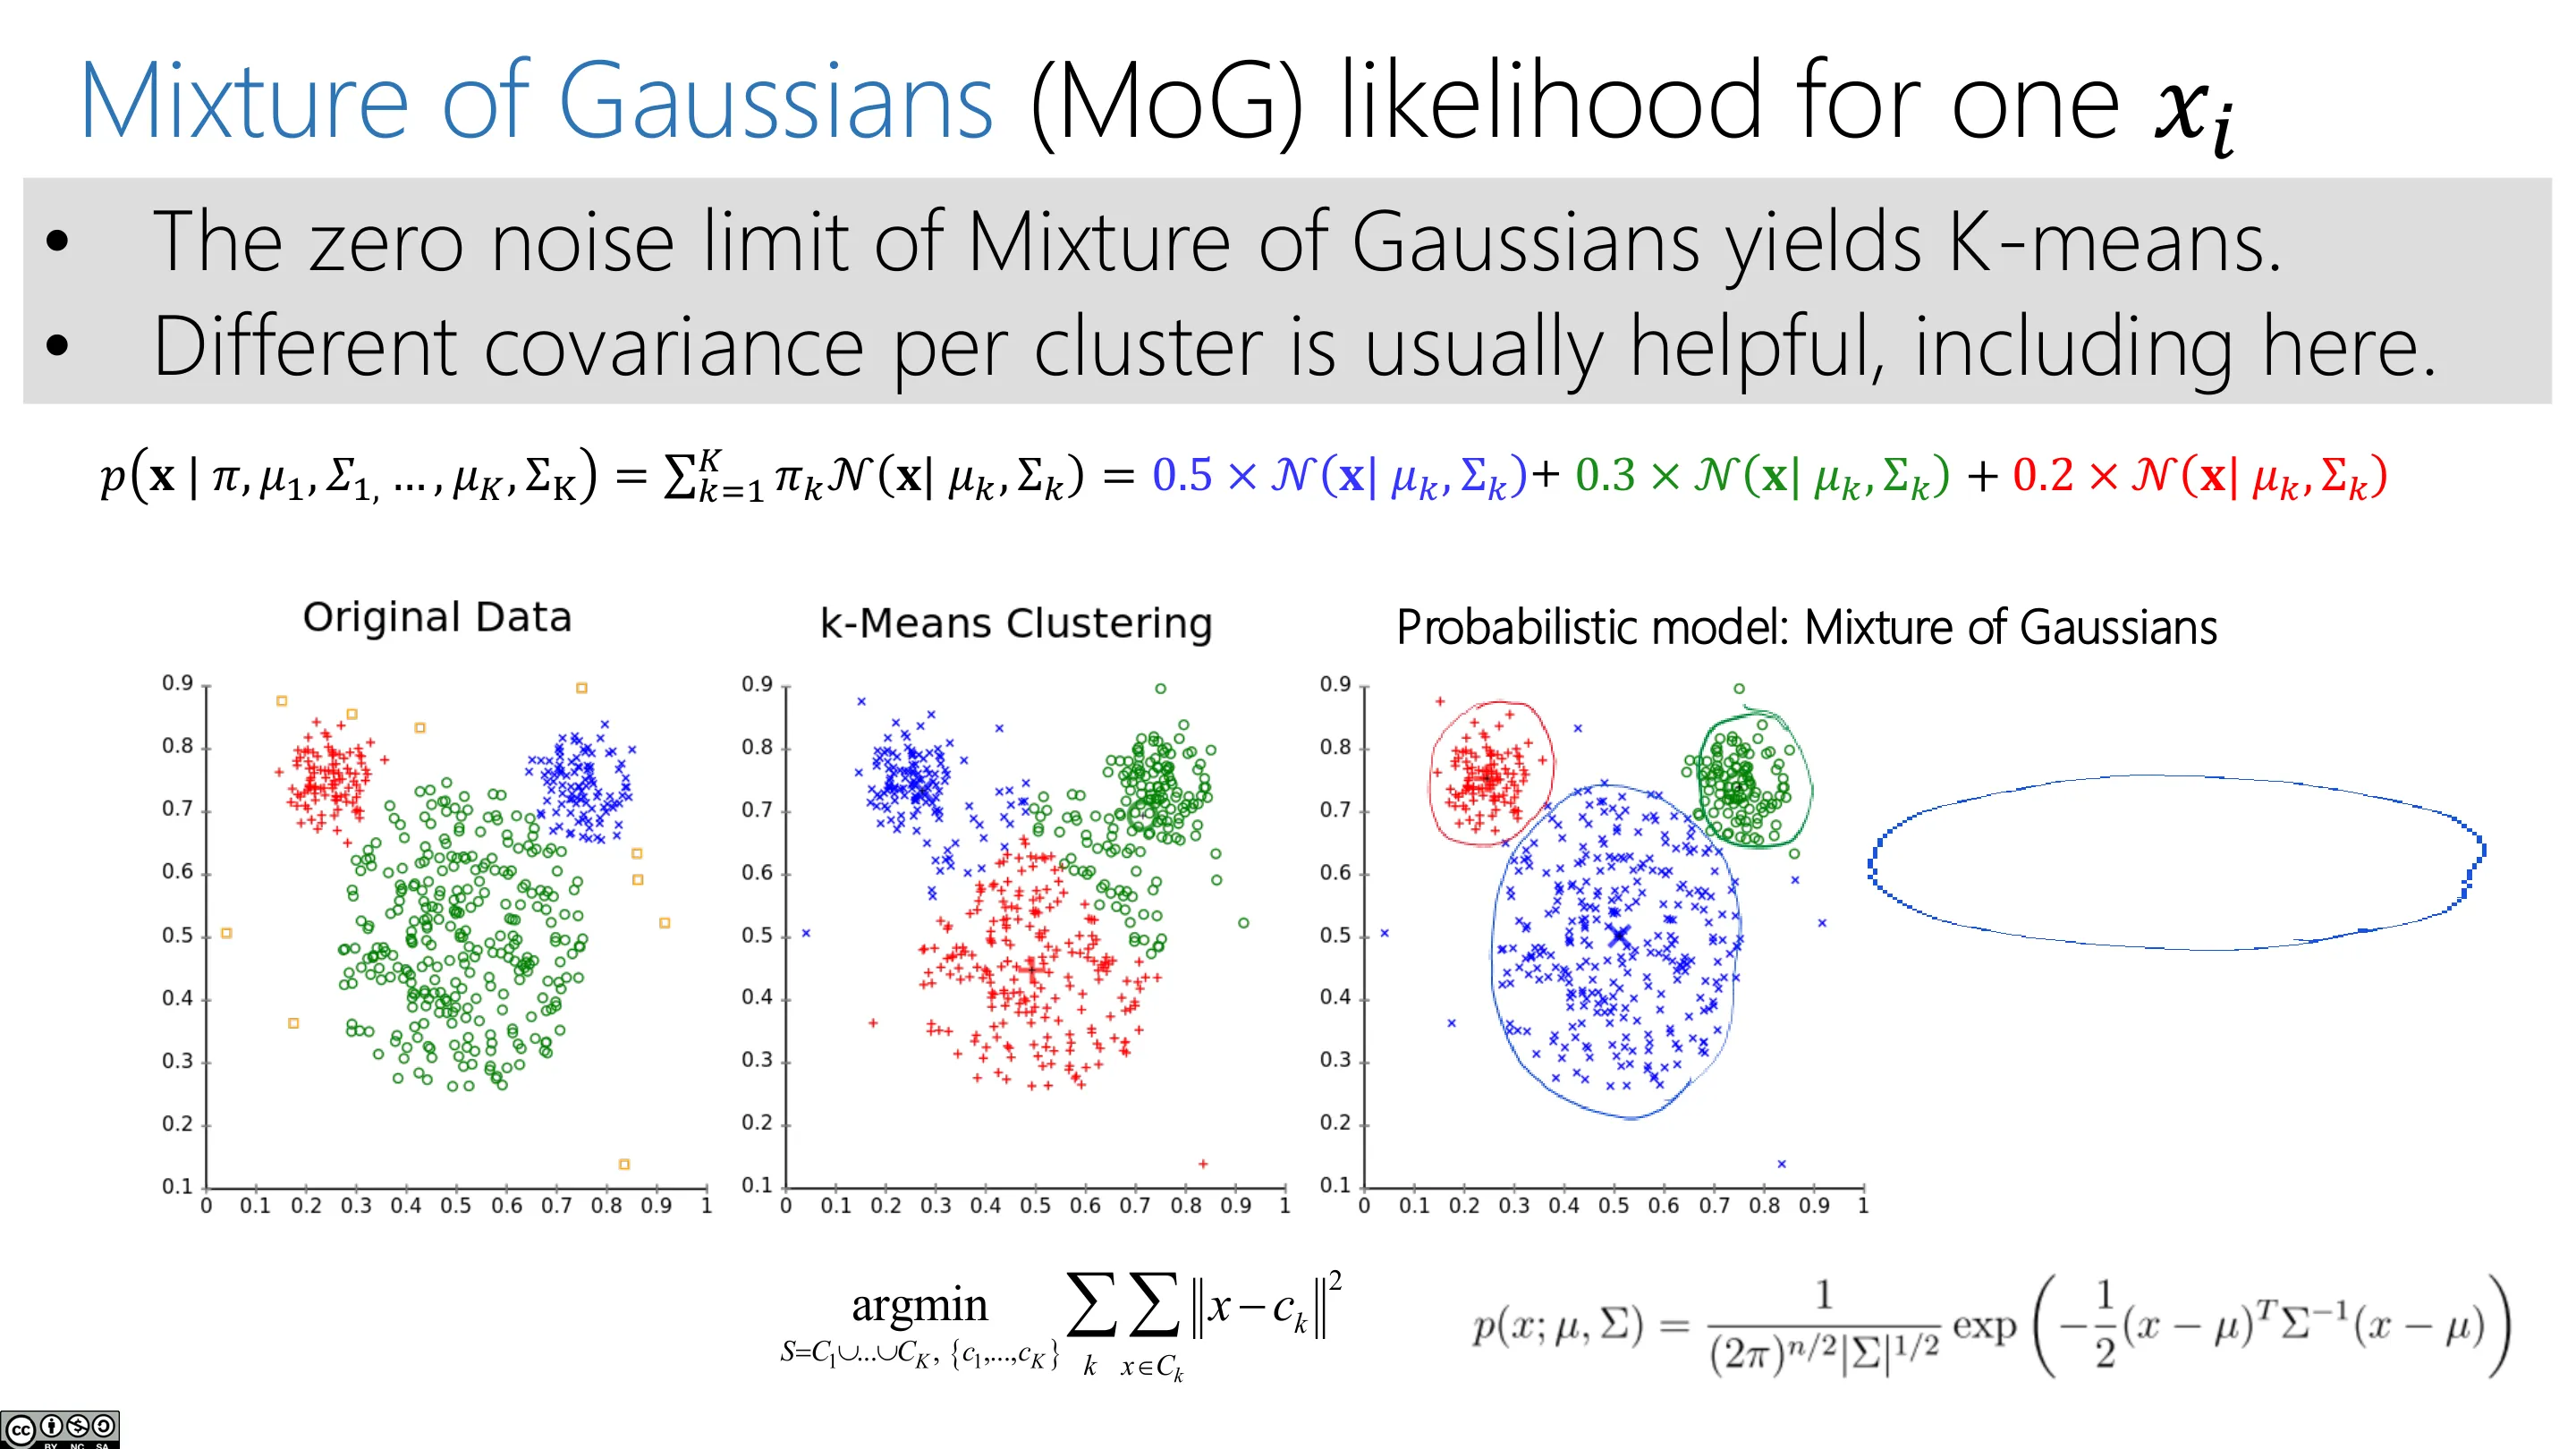
零噪声极限:把 MoG 中高斯的方差趋于零、系数取等,就退化为 K 均值。
优点:假设以统计分布显式给出,因此更易理解与推广;可写出有原则的似然目标(含对隐变量的边缘化);针对隐变量有专门的 MLE 形式 EM。
📷 MoG 的其他用途
回到原视频 (00:11:00)
📷 K 均值 vs MoG(一)
回到原视频 (01:11:10)
二、回归(Regression)
2.1 「回归」一词的来历
(参考时间: 00:30)
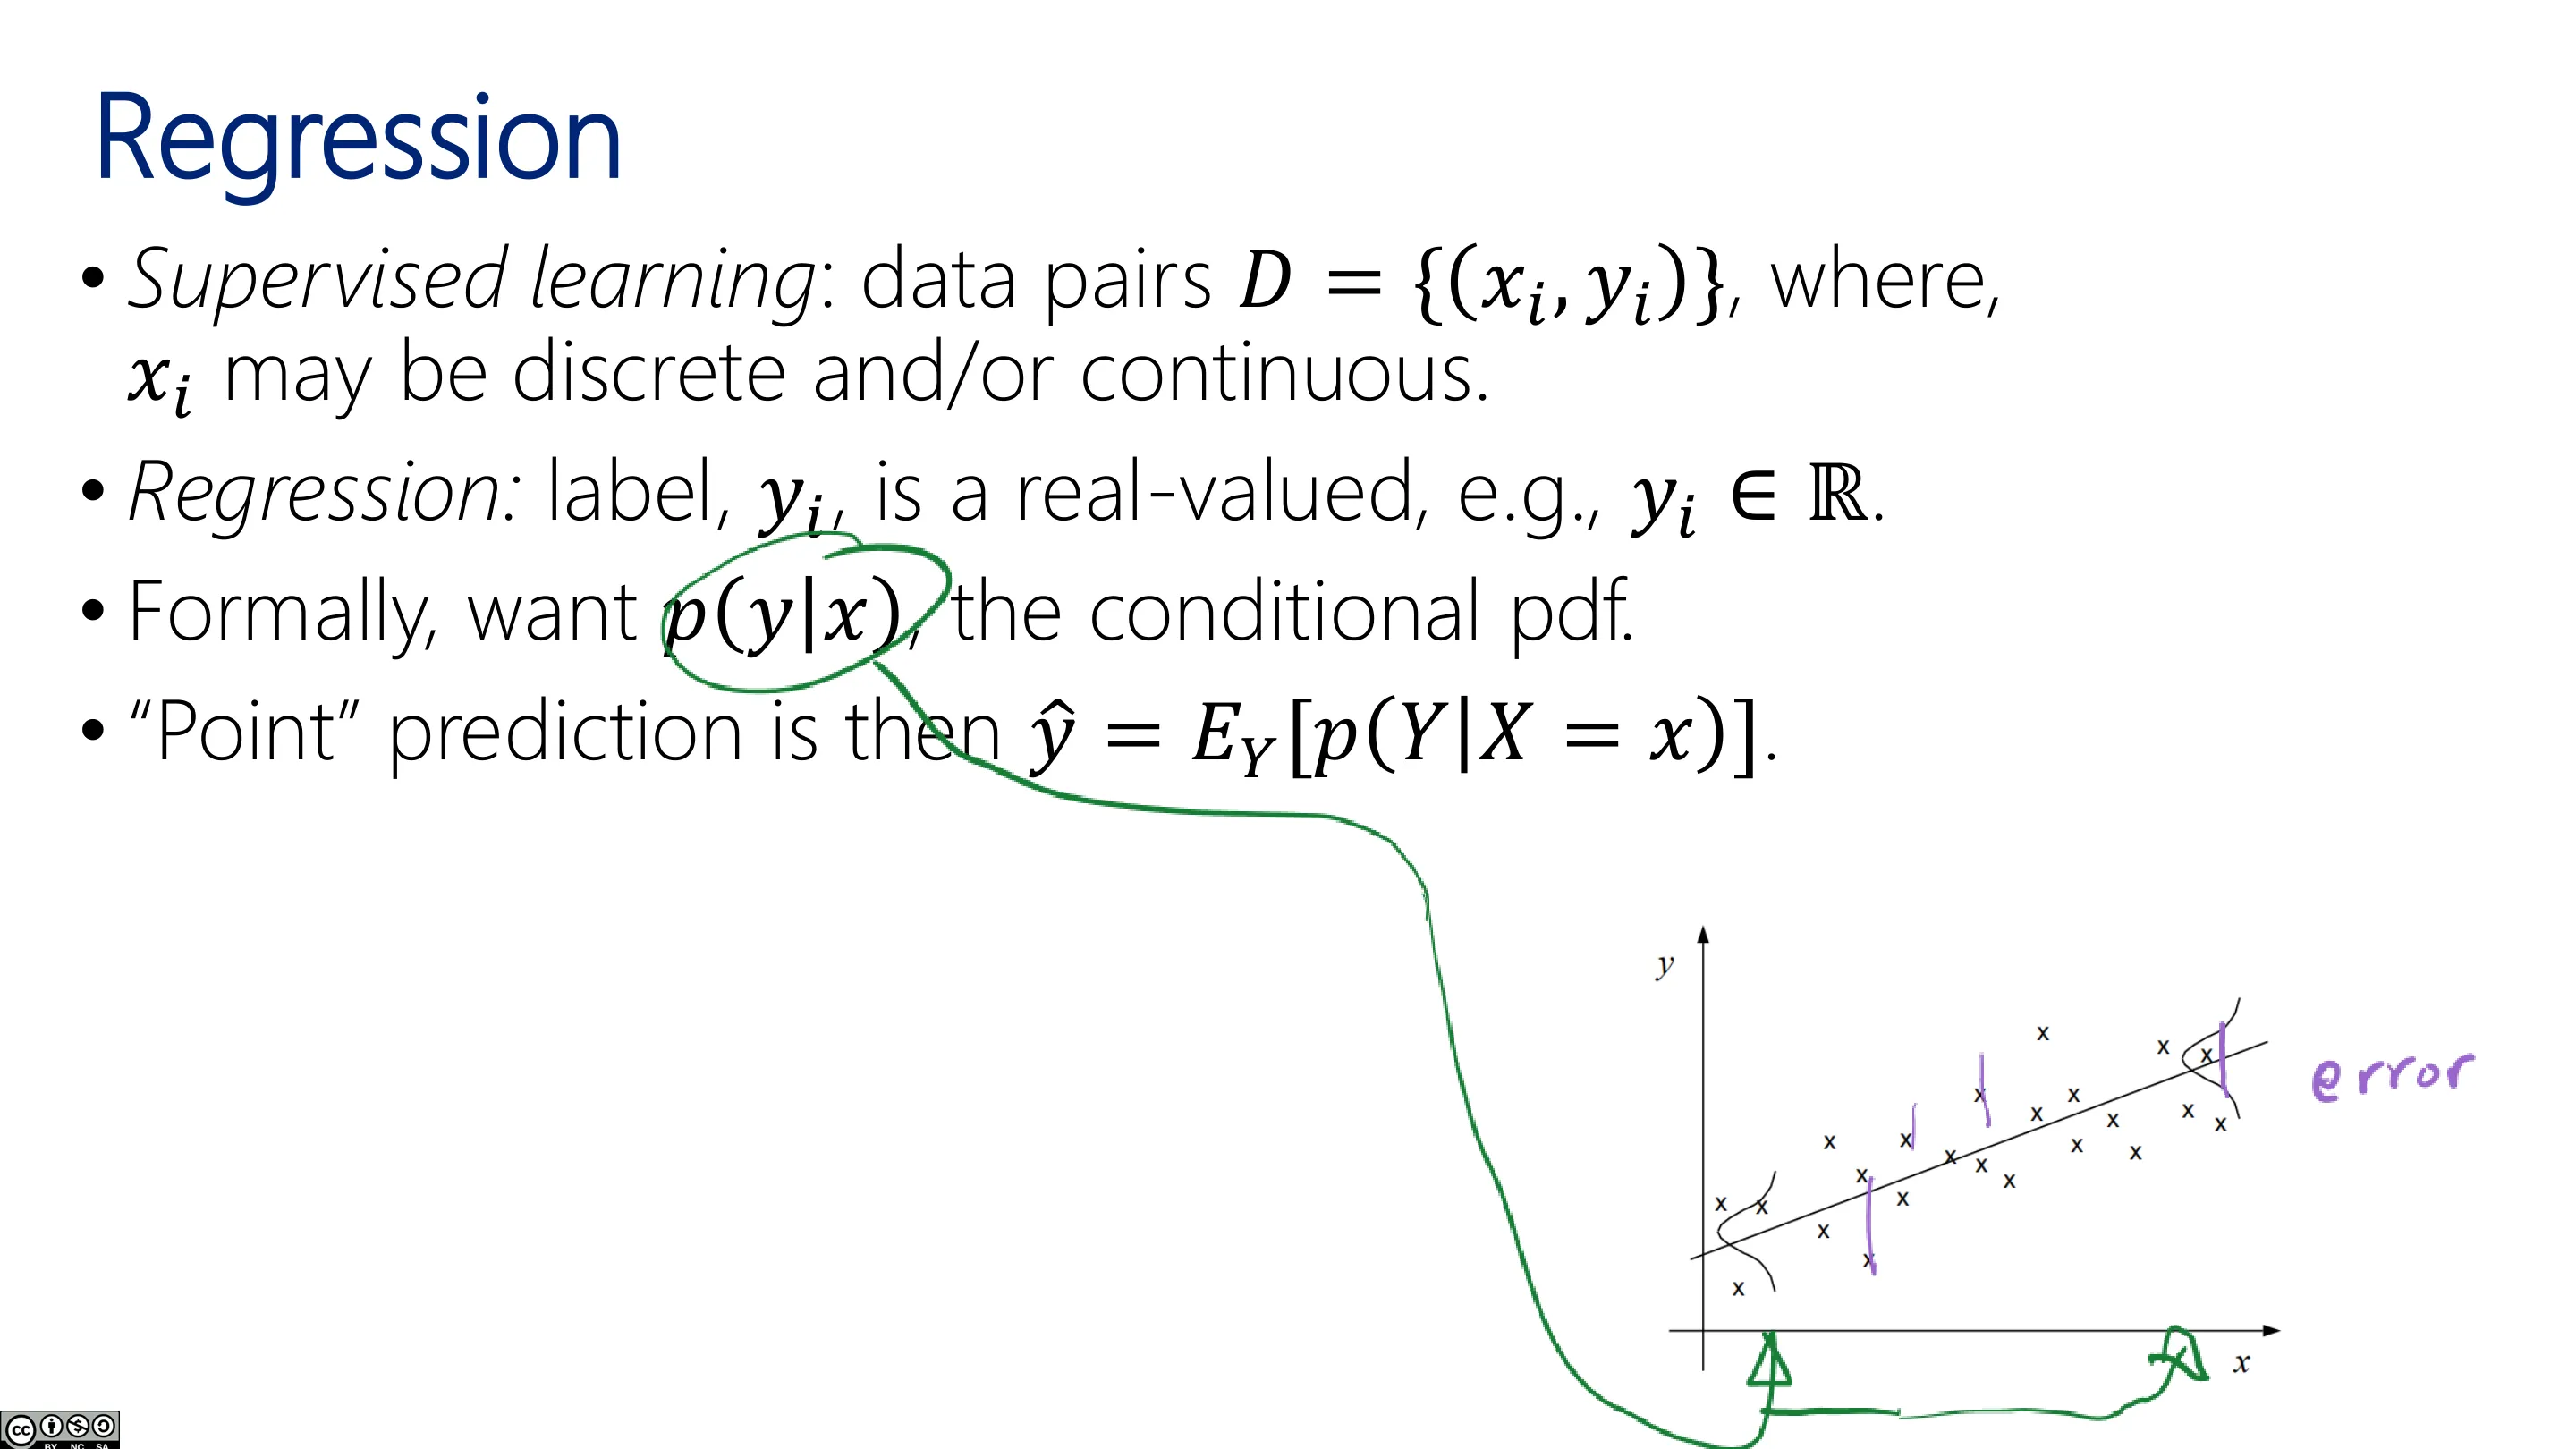
📷 路线图(四)
回到原视频 (00:30:25)
回归分析可追溯到 1805 年,高斯与勒让德用它估计天体绕日轨道——这是一门非常古老的技术;可以说现代机器学习就是「打了兴奋剂的线性回归」。
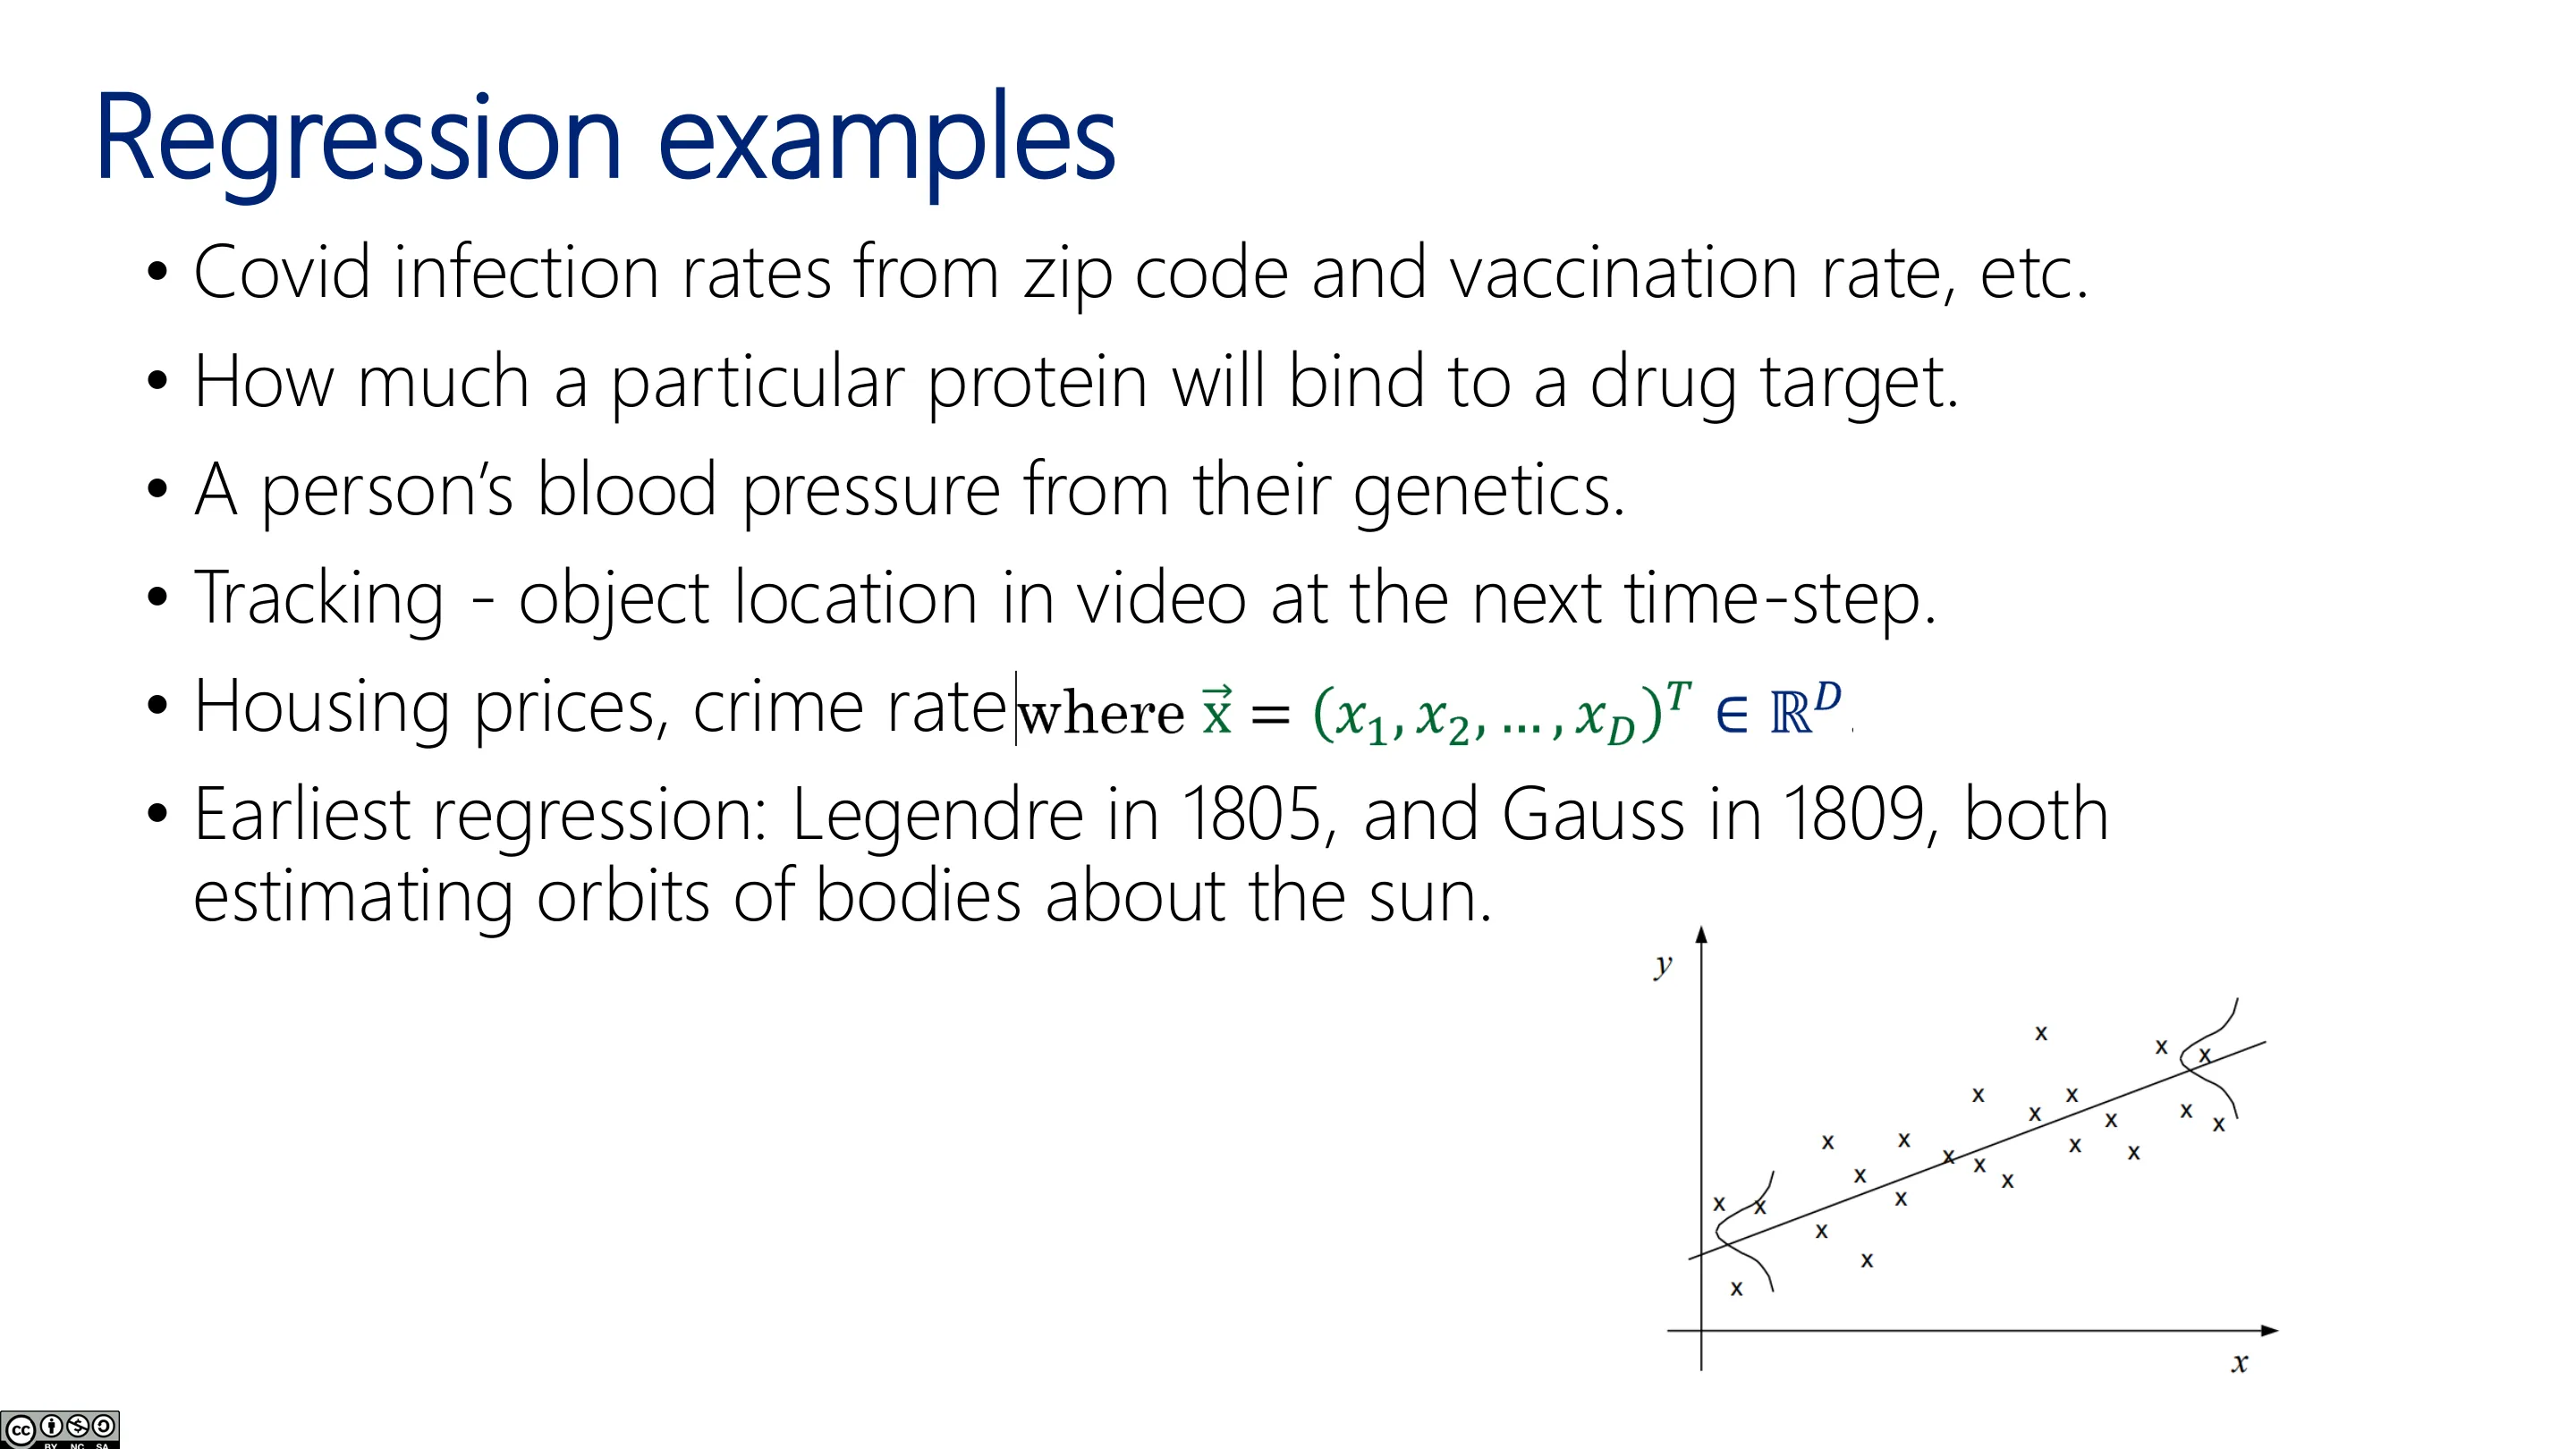
📷 回归的例子
回到原视频 (00:33:35)
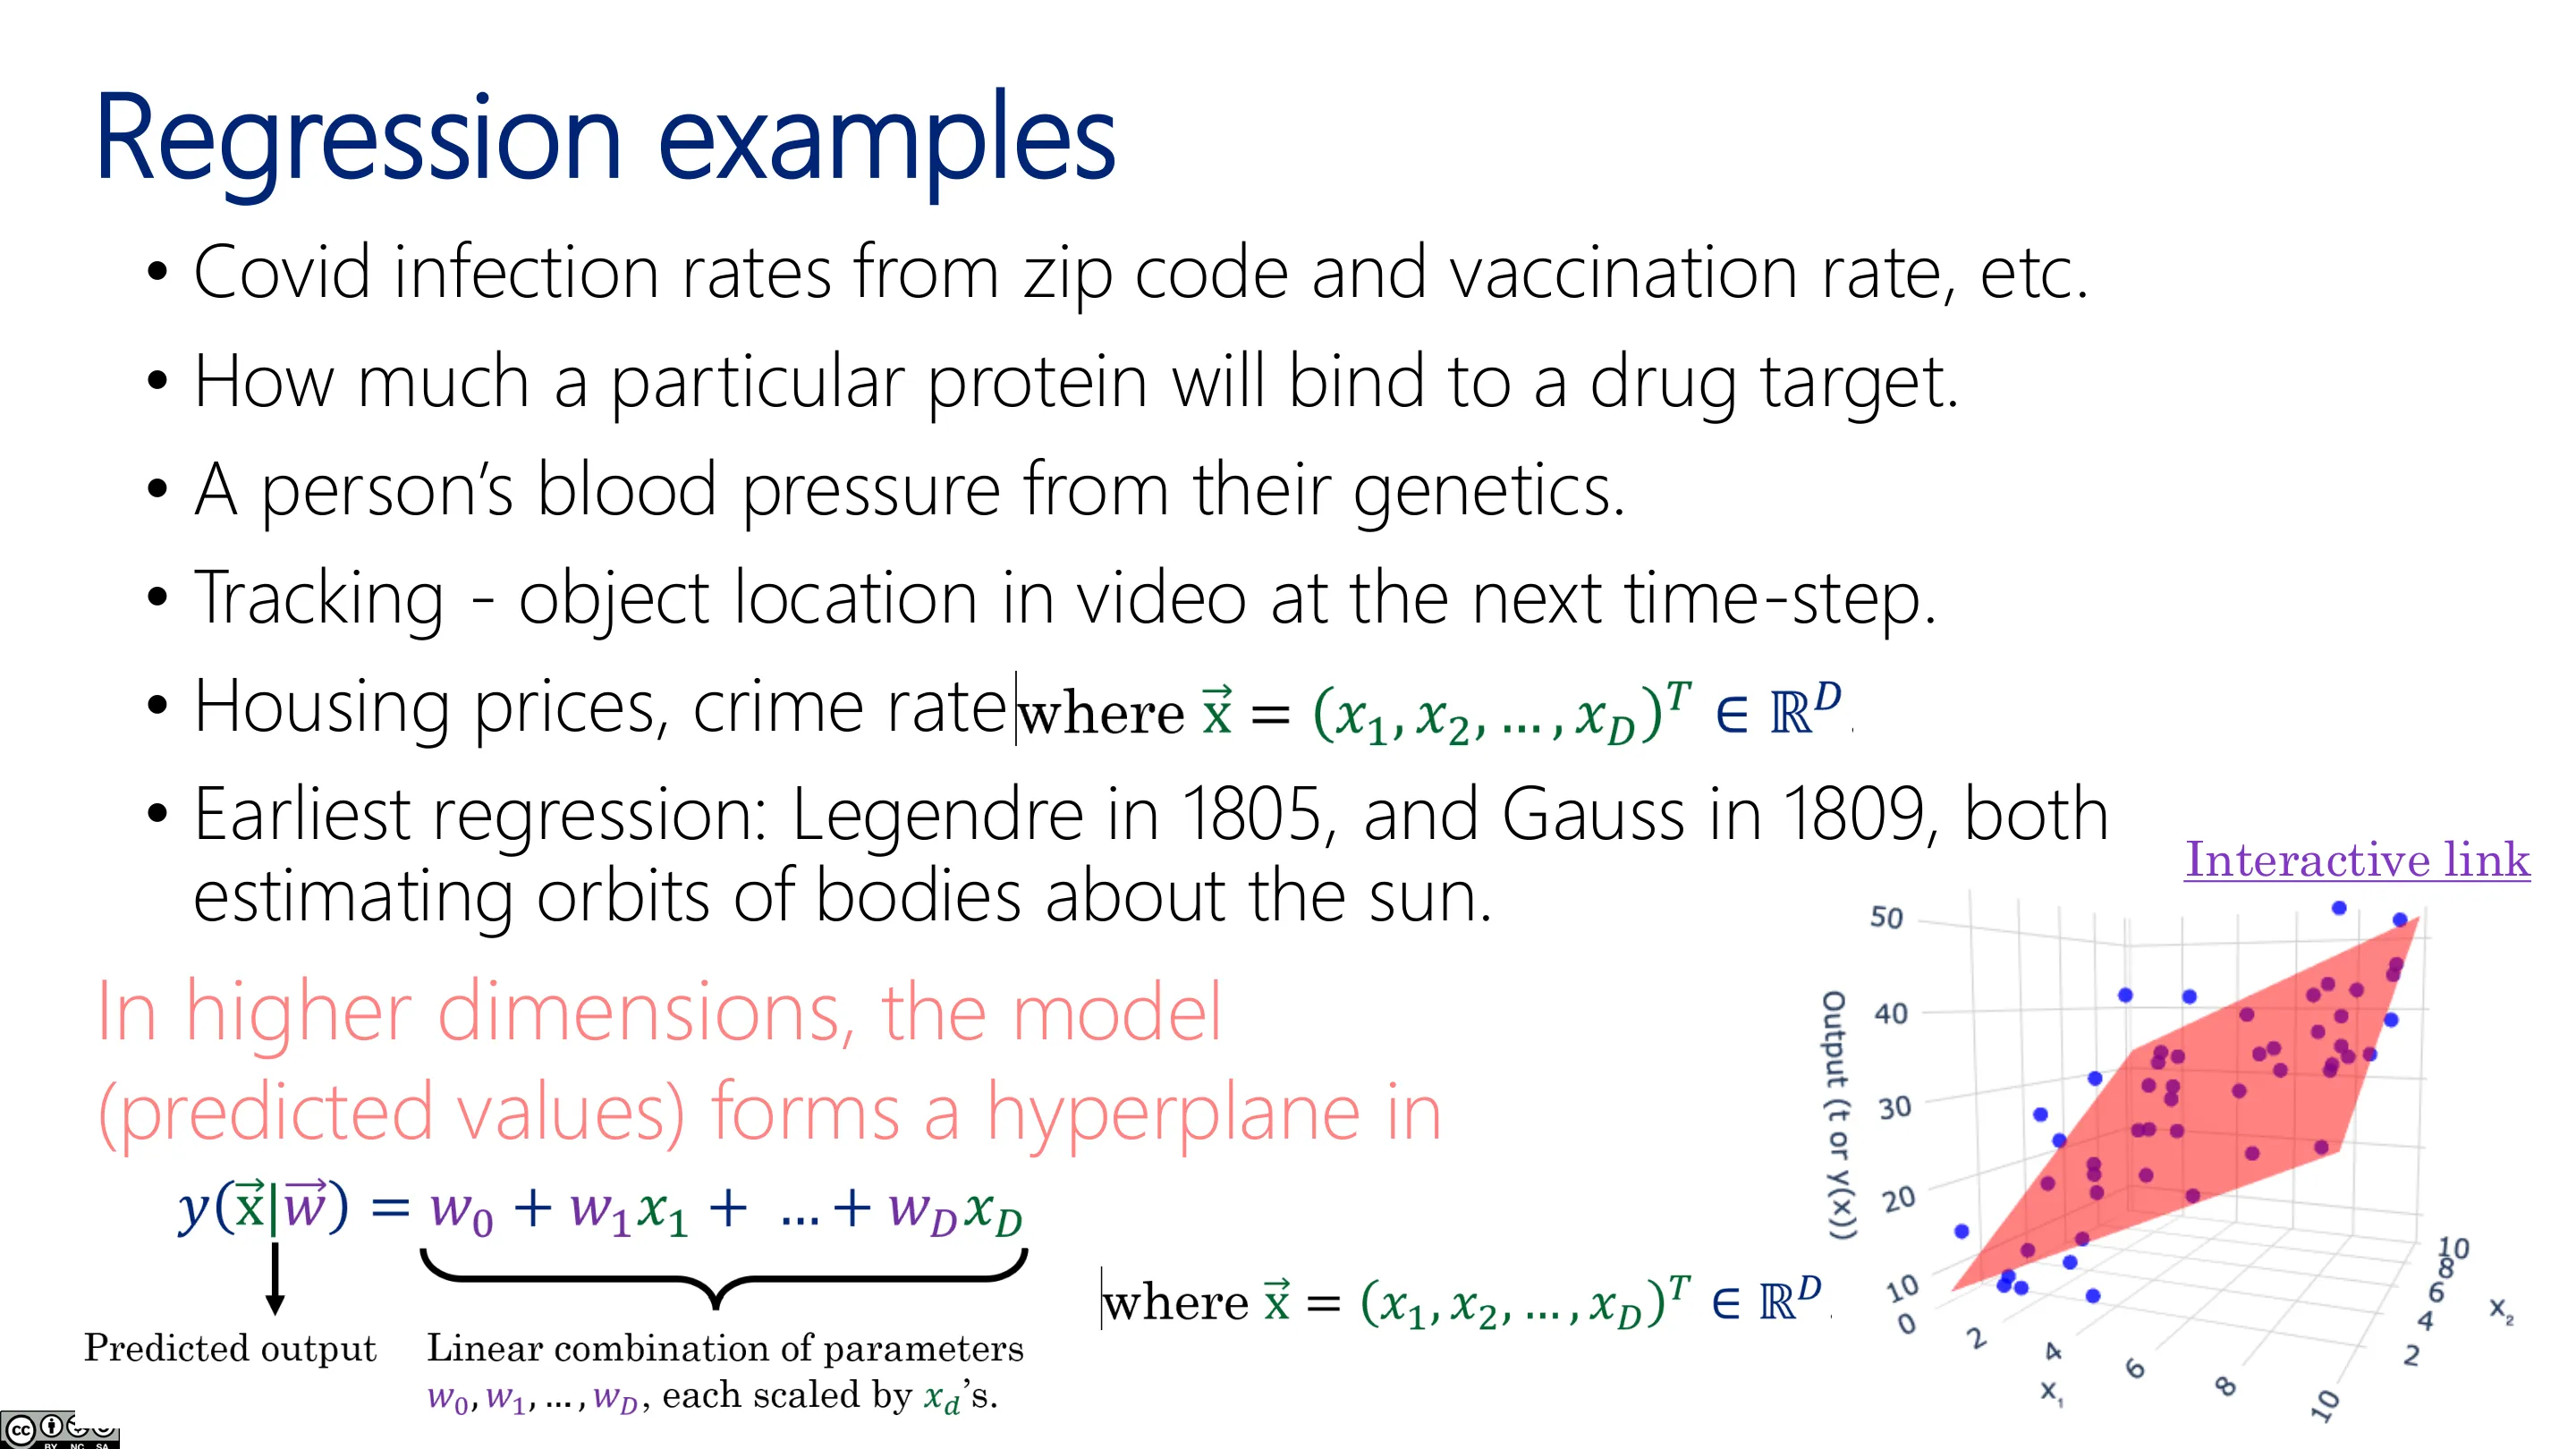
📷 更多回归场景
回到原视频 (00:33:50)
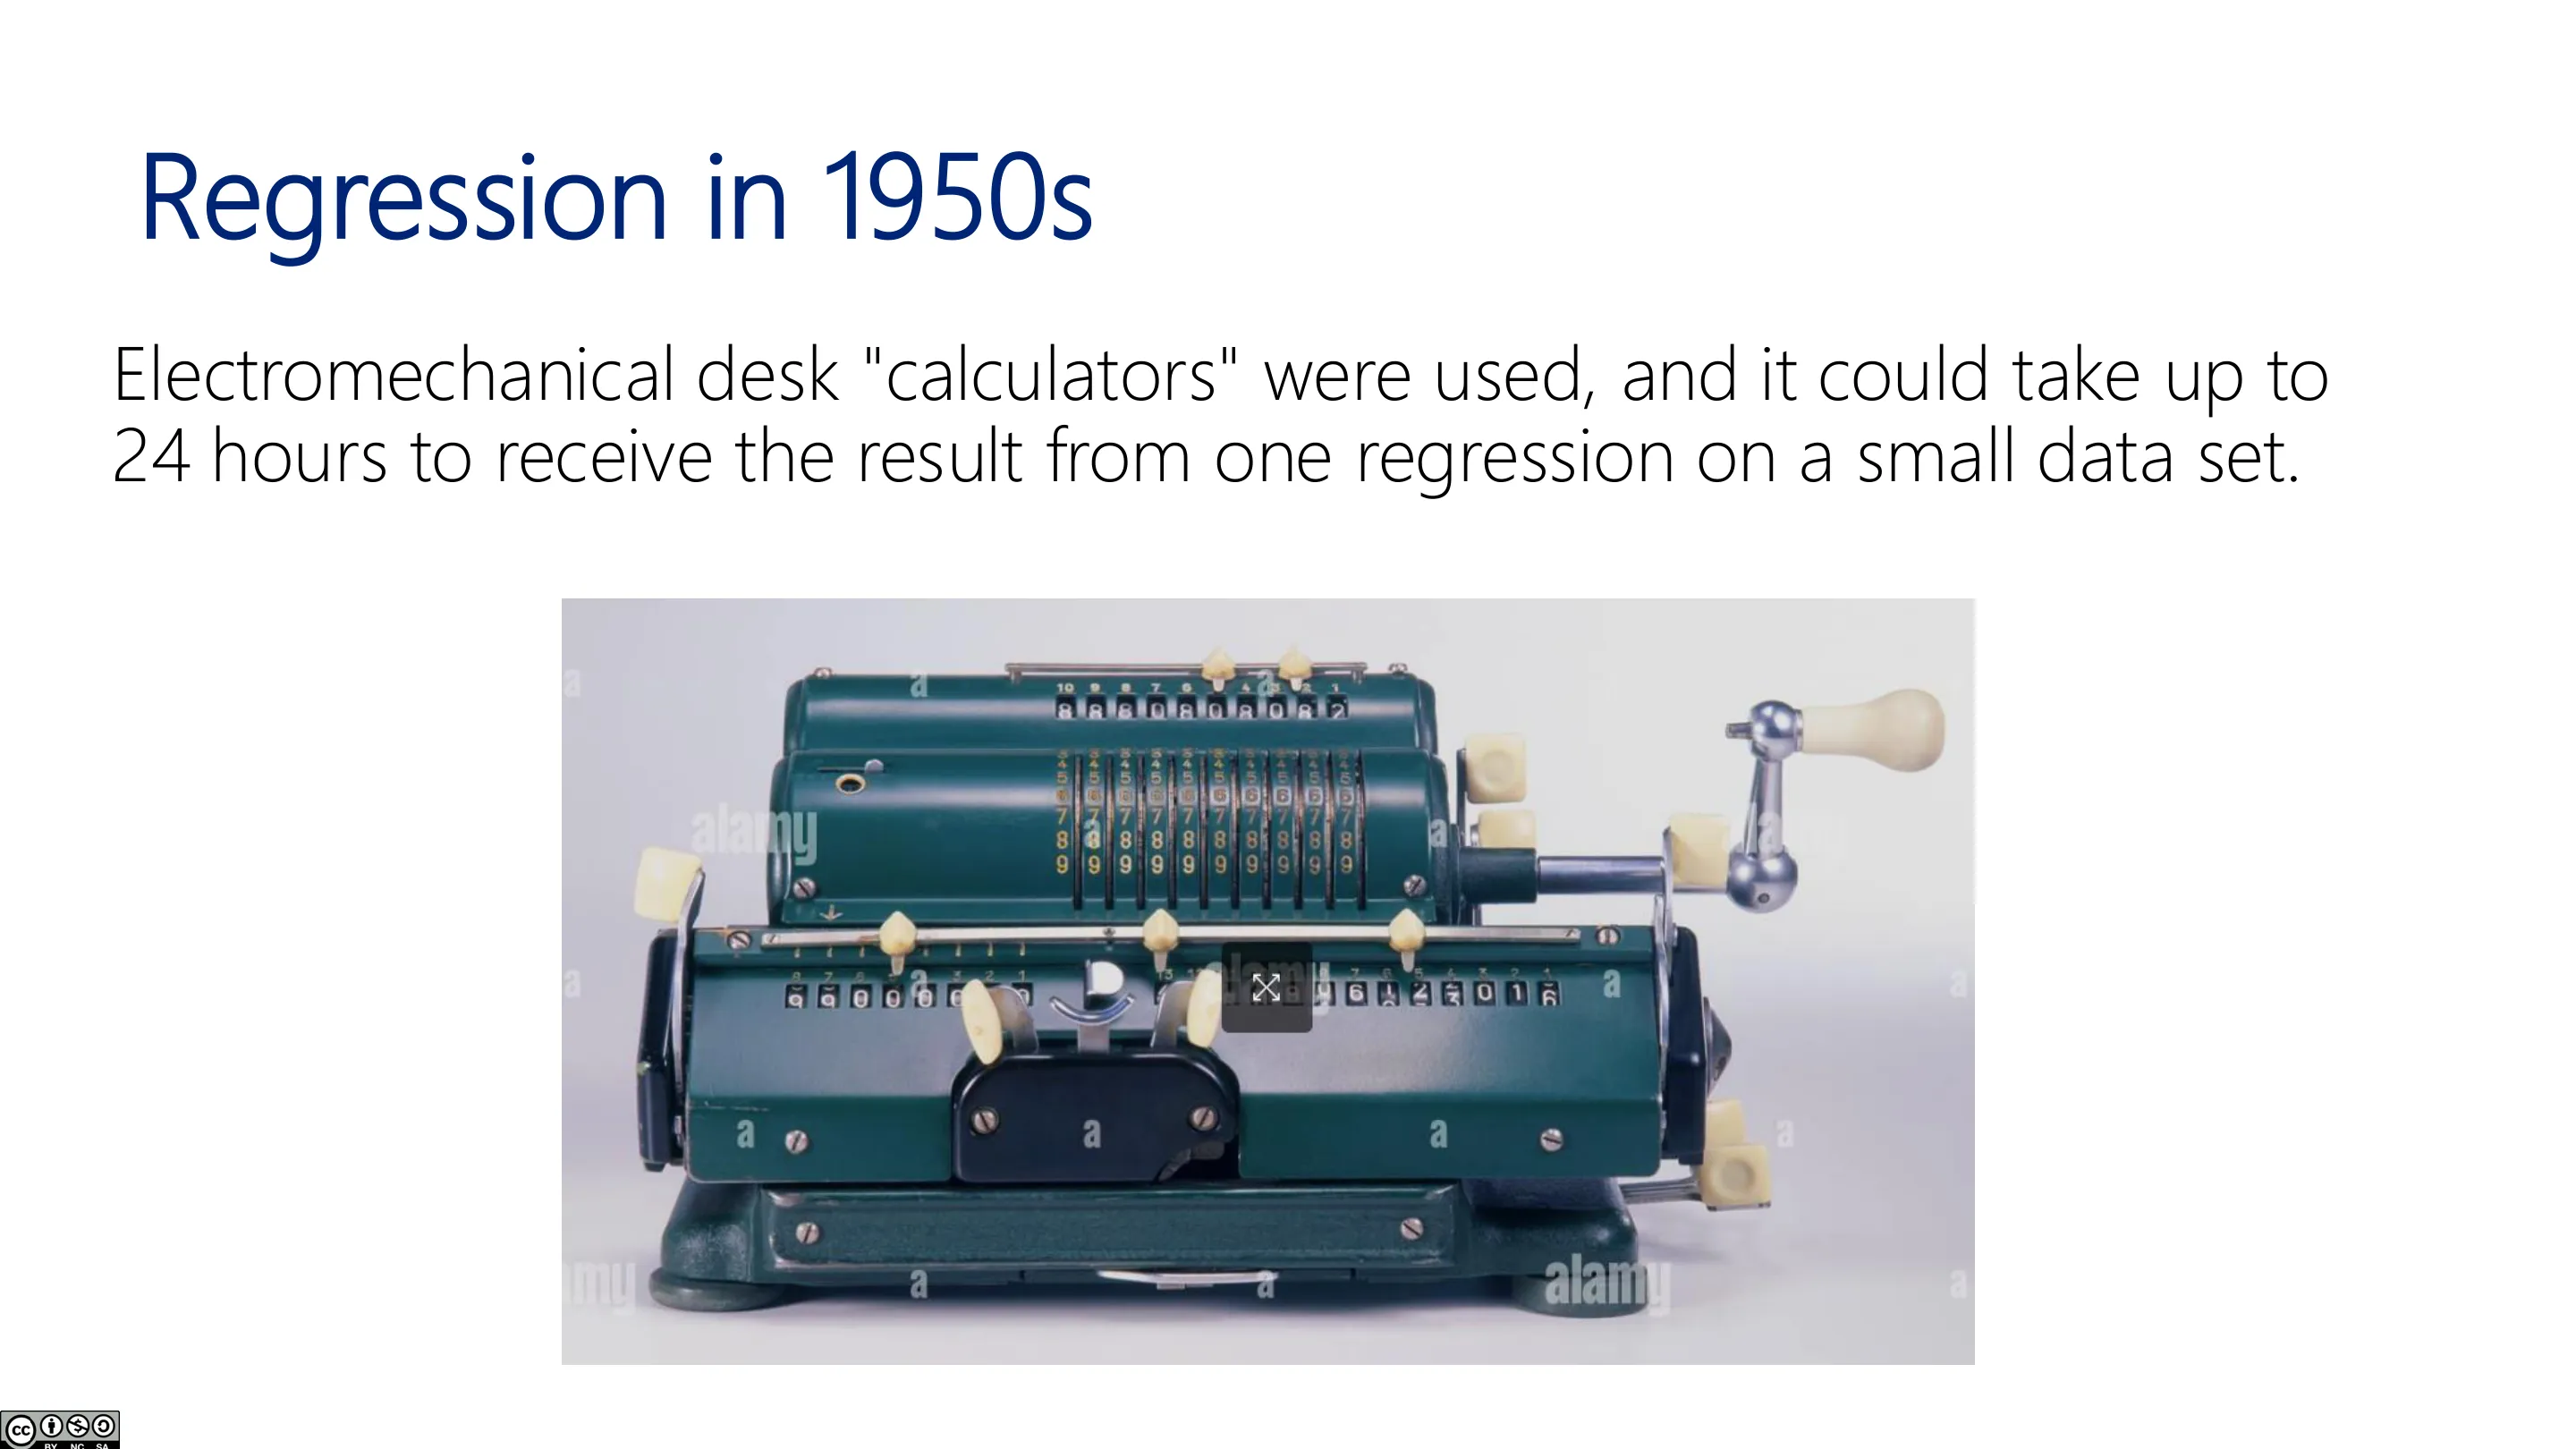
📷 回归在 1950 年代
回到原视频 (00:34:25)
术语提醒(重要):Galton 的 「回归到均值」(regression to the mean)是最早的「回归」含义——身高会向群体均值靠拢,与今天的线性回归毫无关系;而 「逻辑回归」既不是线性回归也不是这种回归。听「回归」一词时务必分清语境。
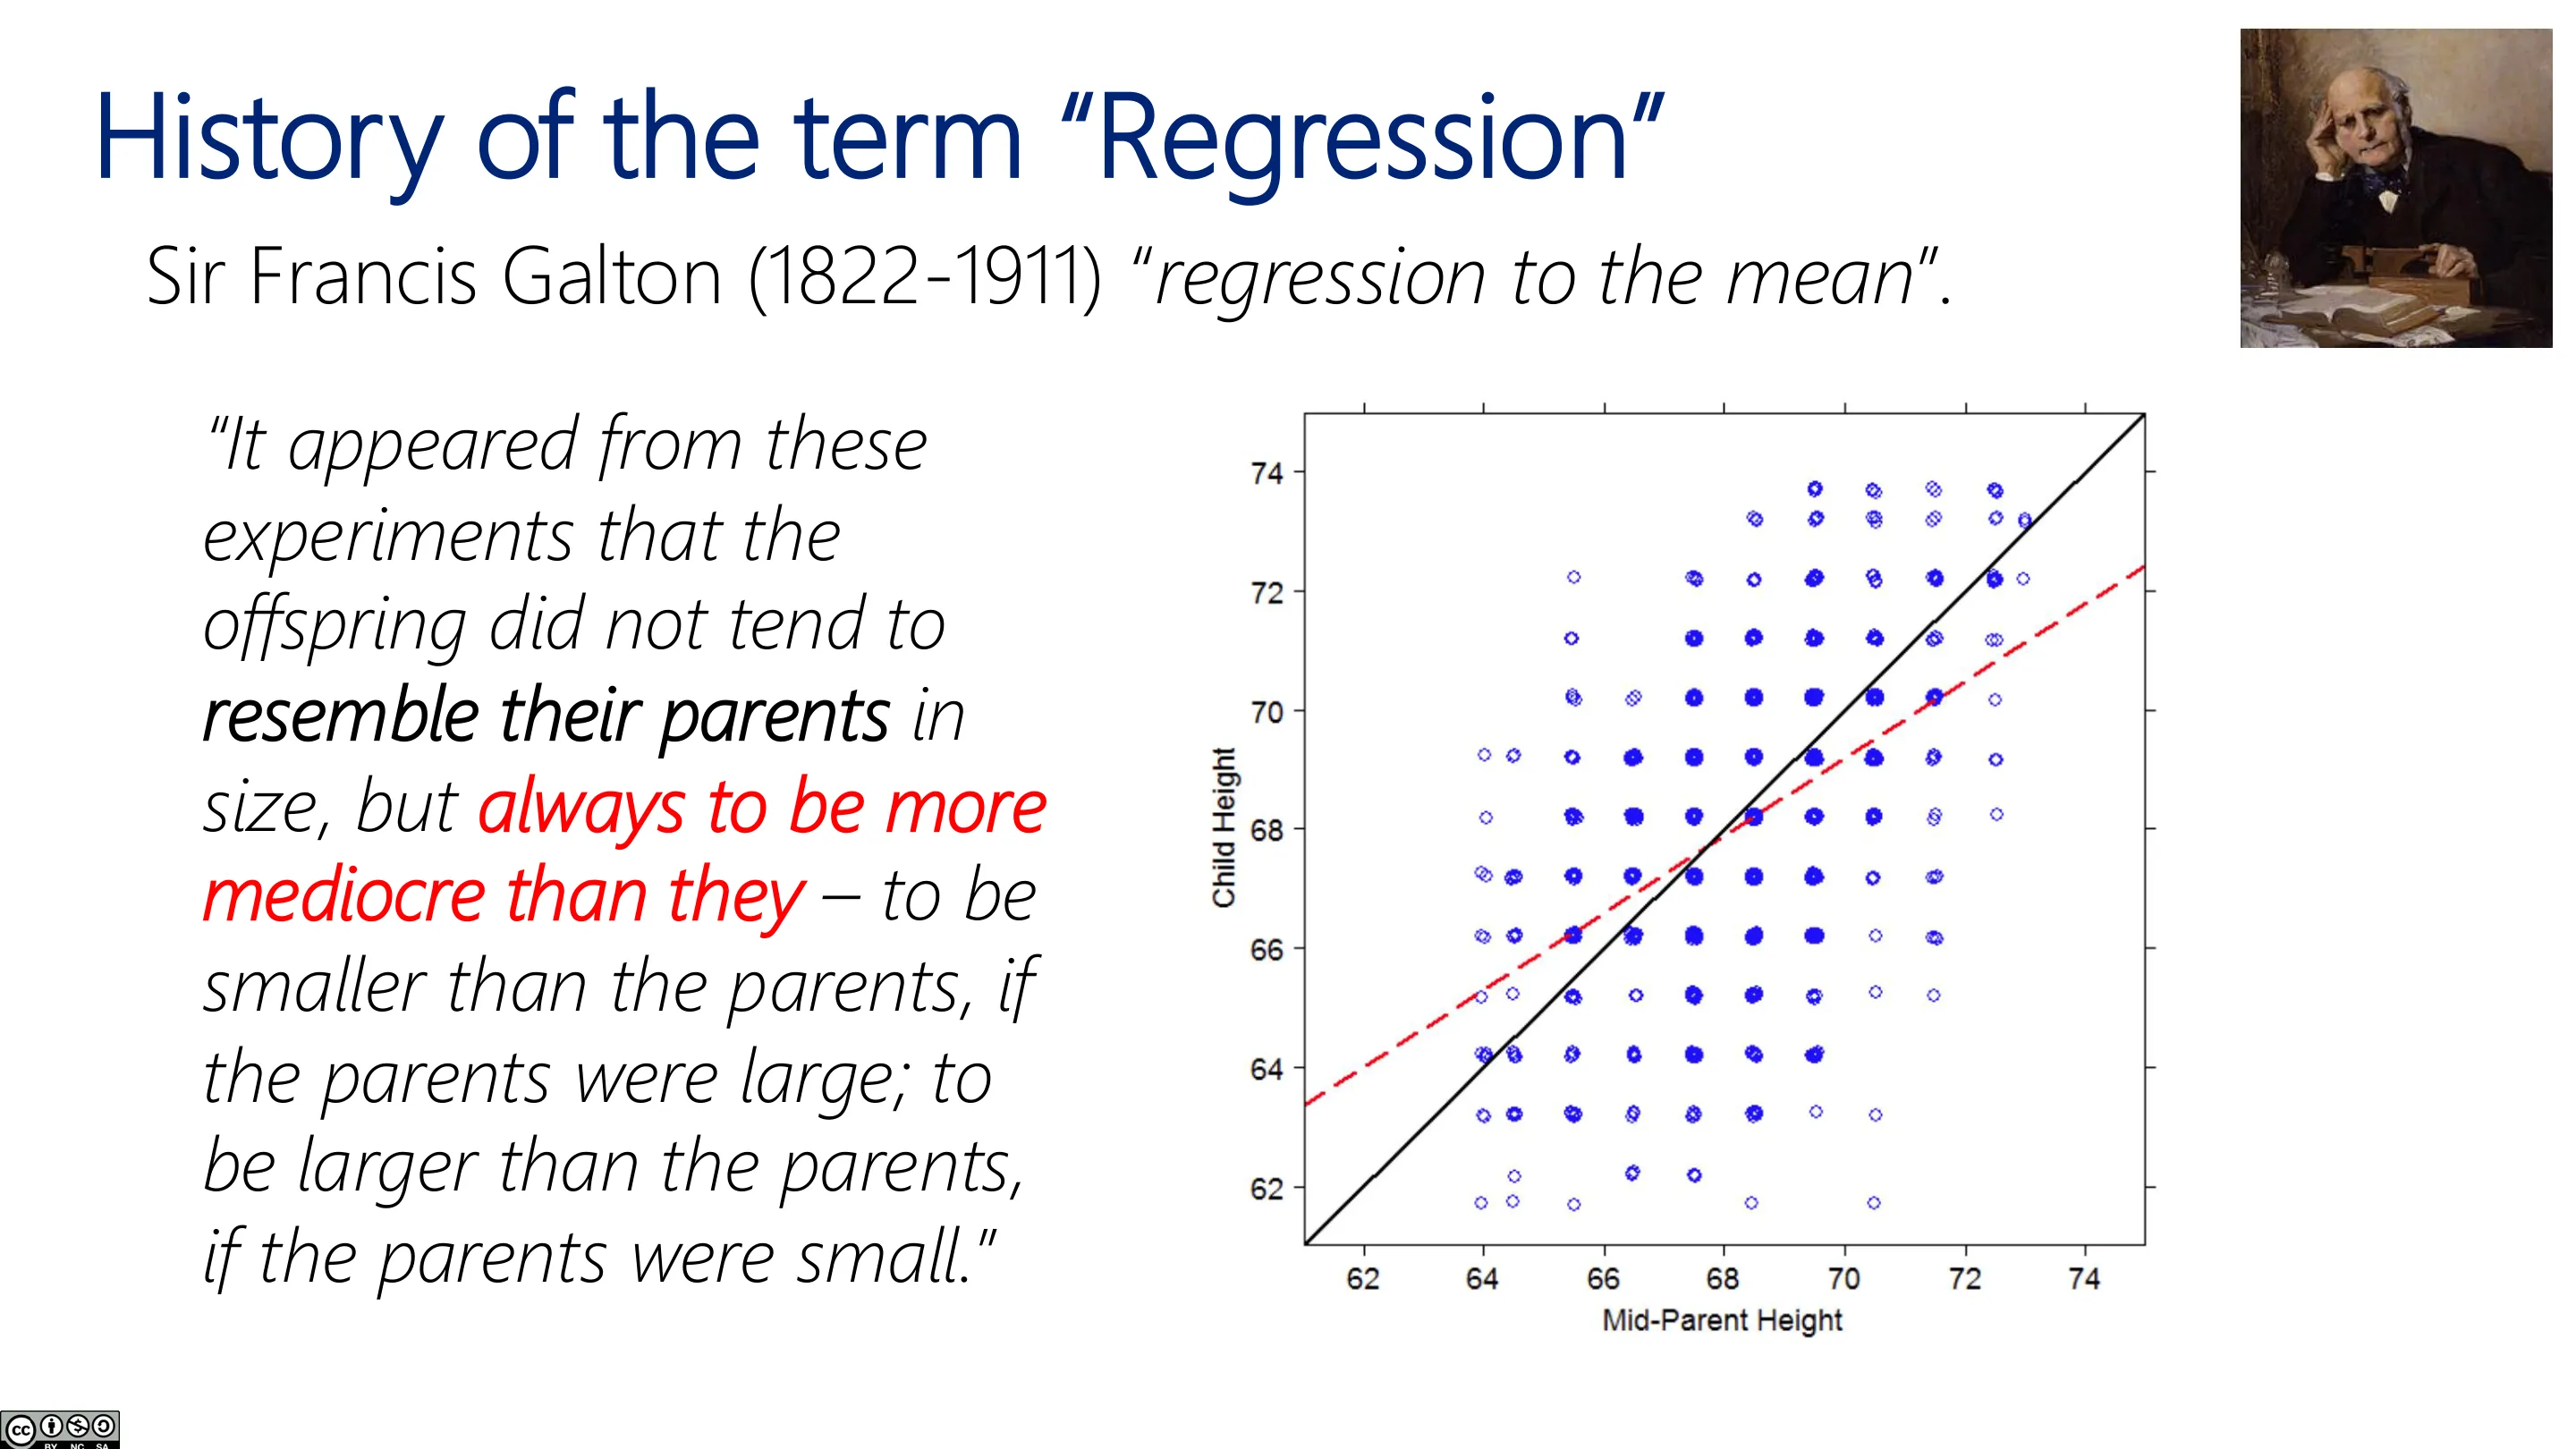
📷 Galton 与「回归到均值」(一)
回到原视频 (00:36:30)
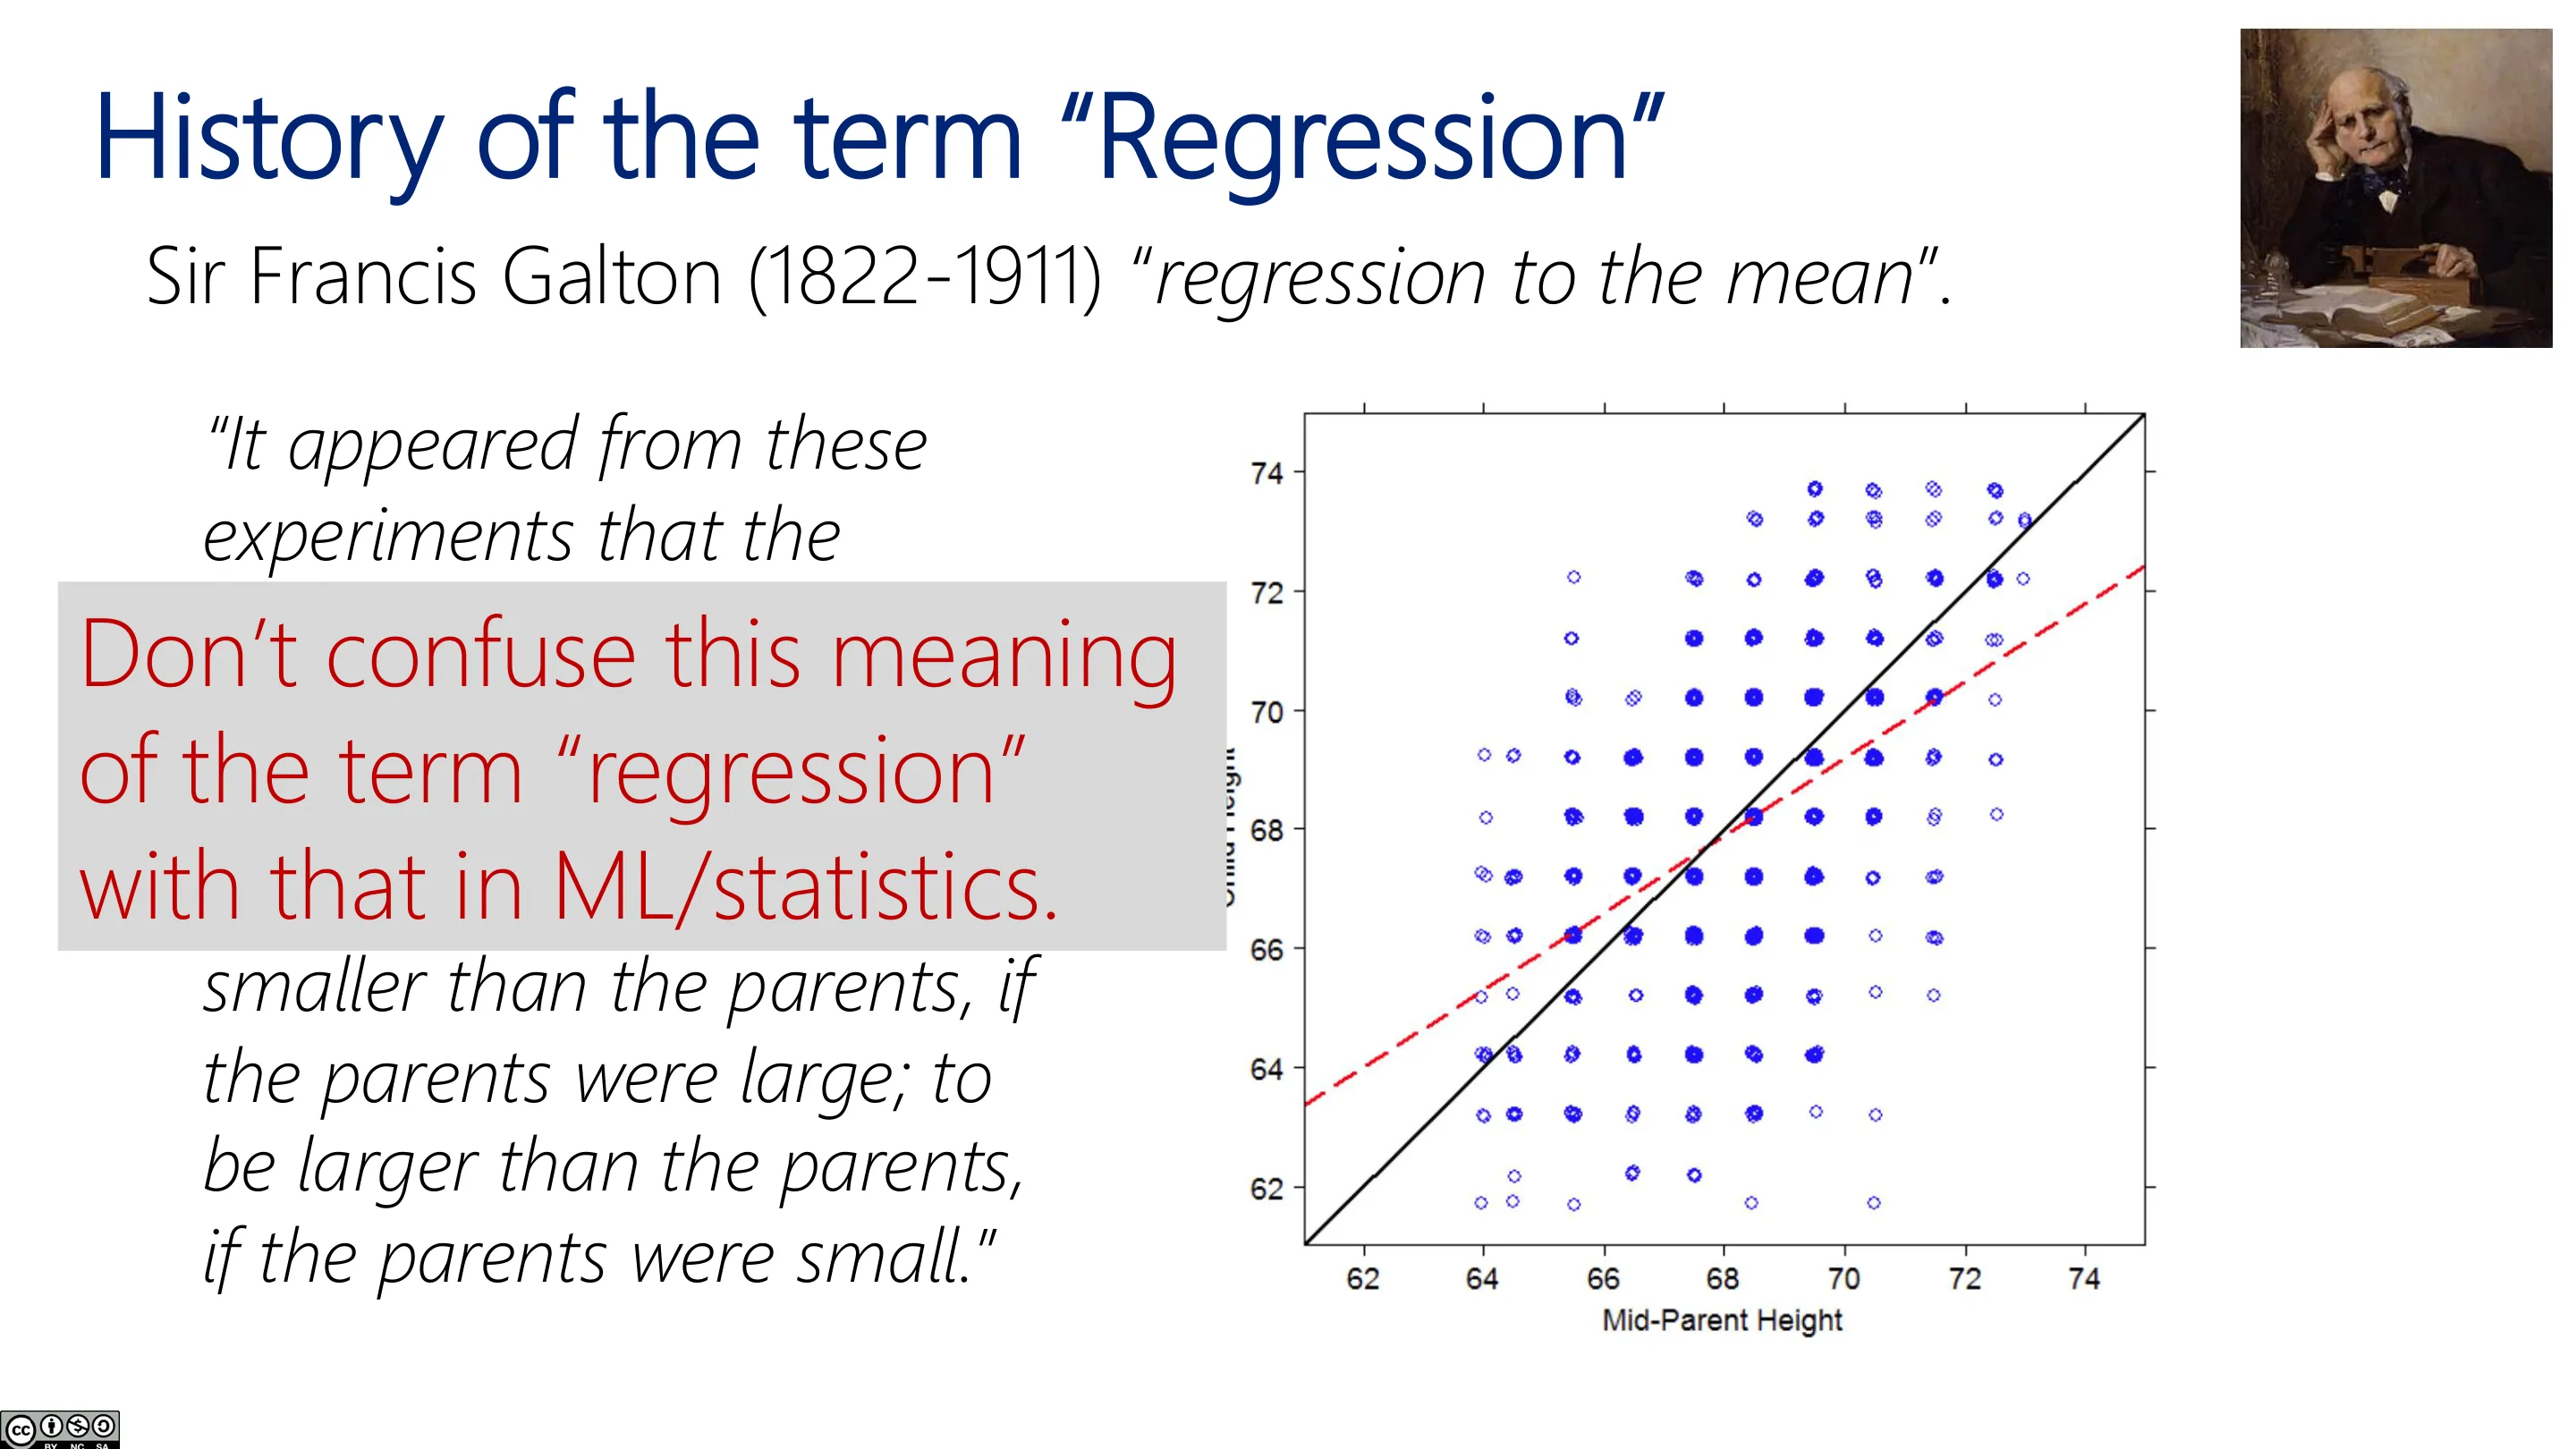
📷 Galton 与「回归到均值」(二)
回到原视频 (00:37:30)
2.2 回归的目标:估计条件分布 $p(y\mid x)$
(参考时间: 00:39)
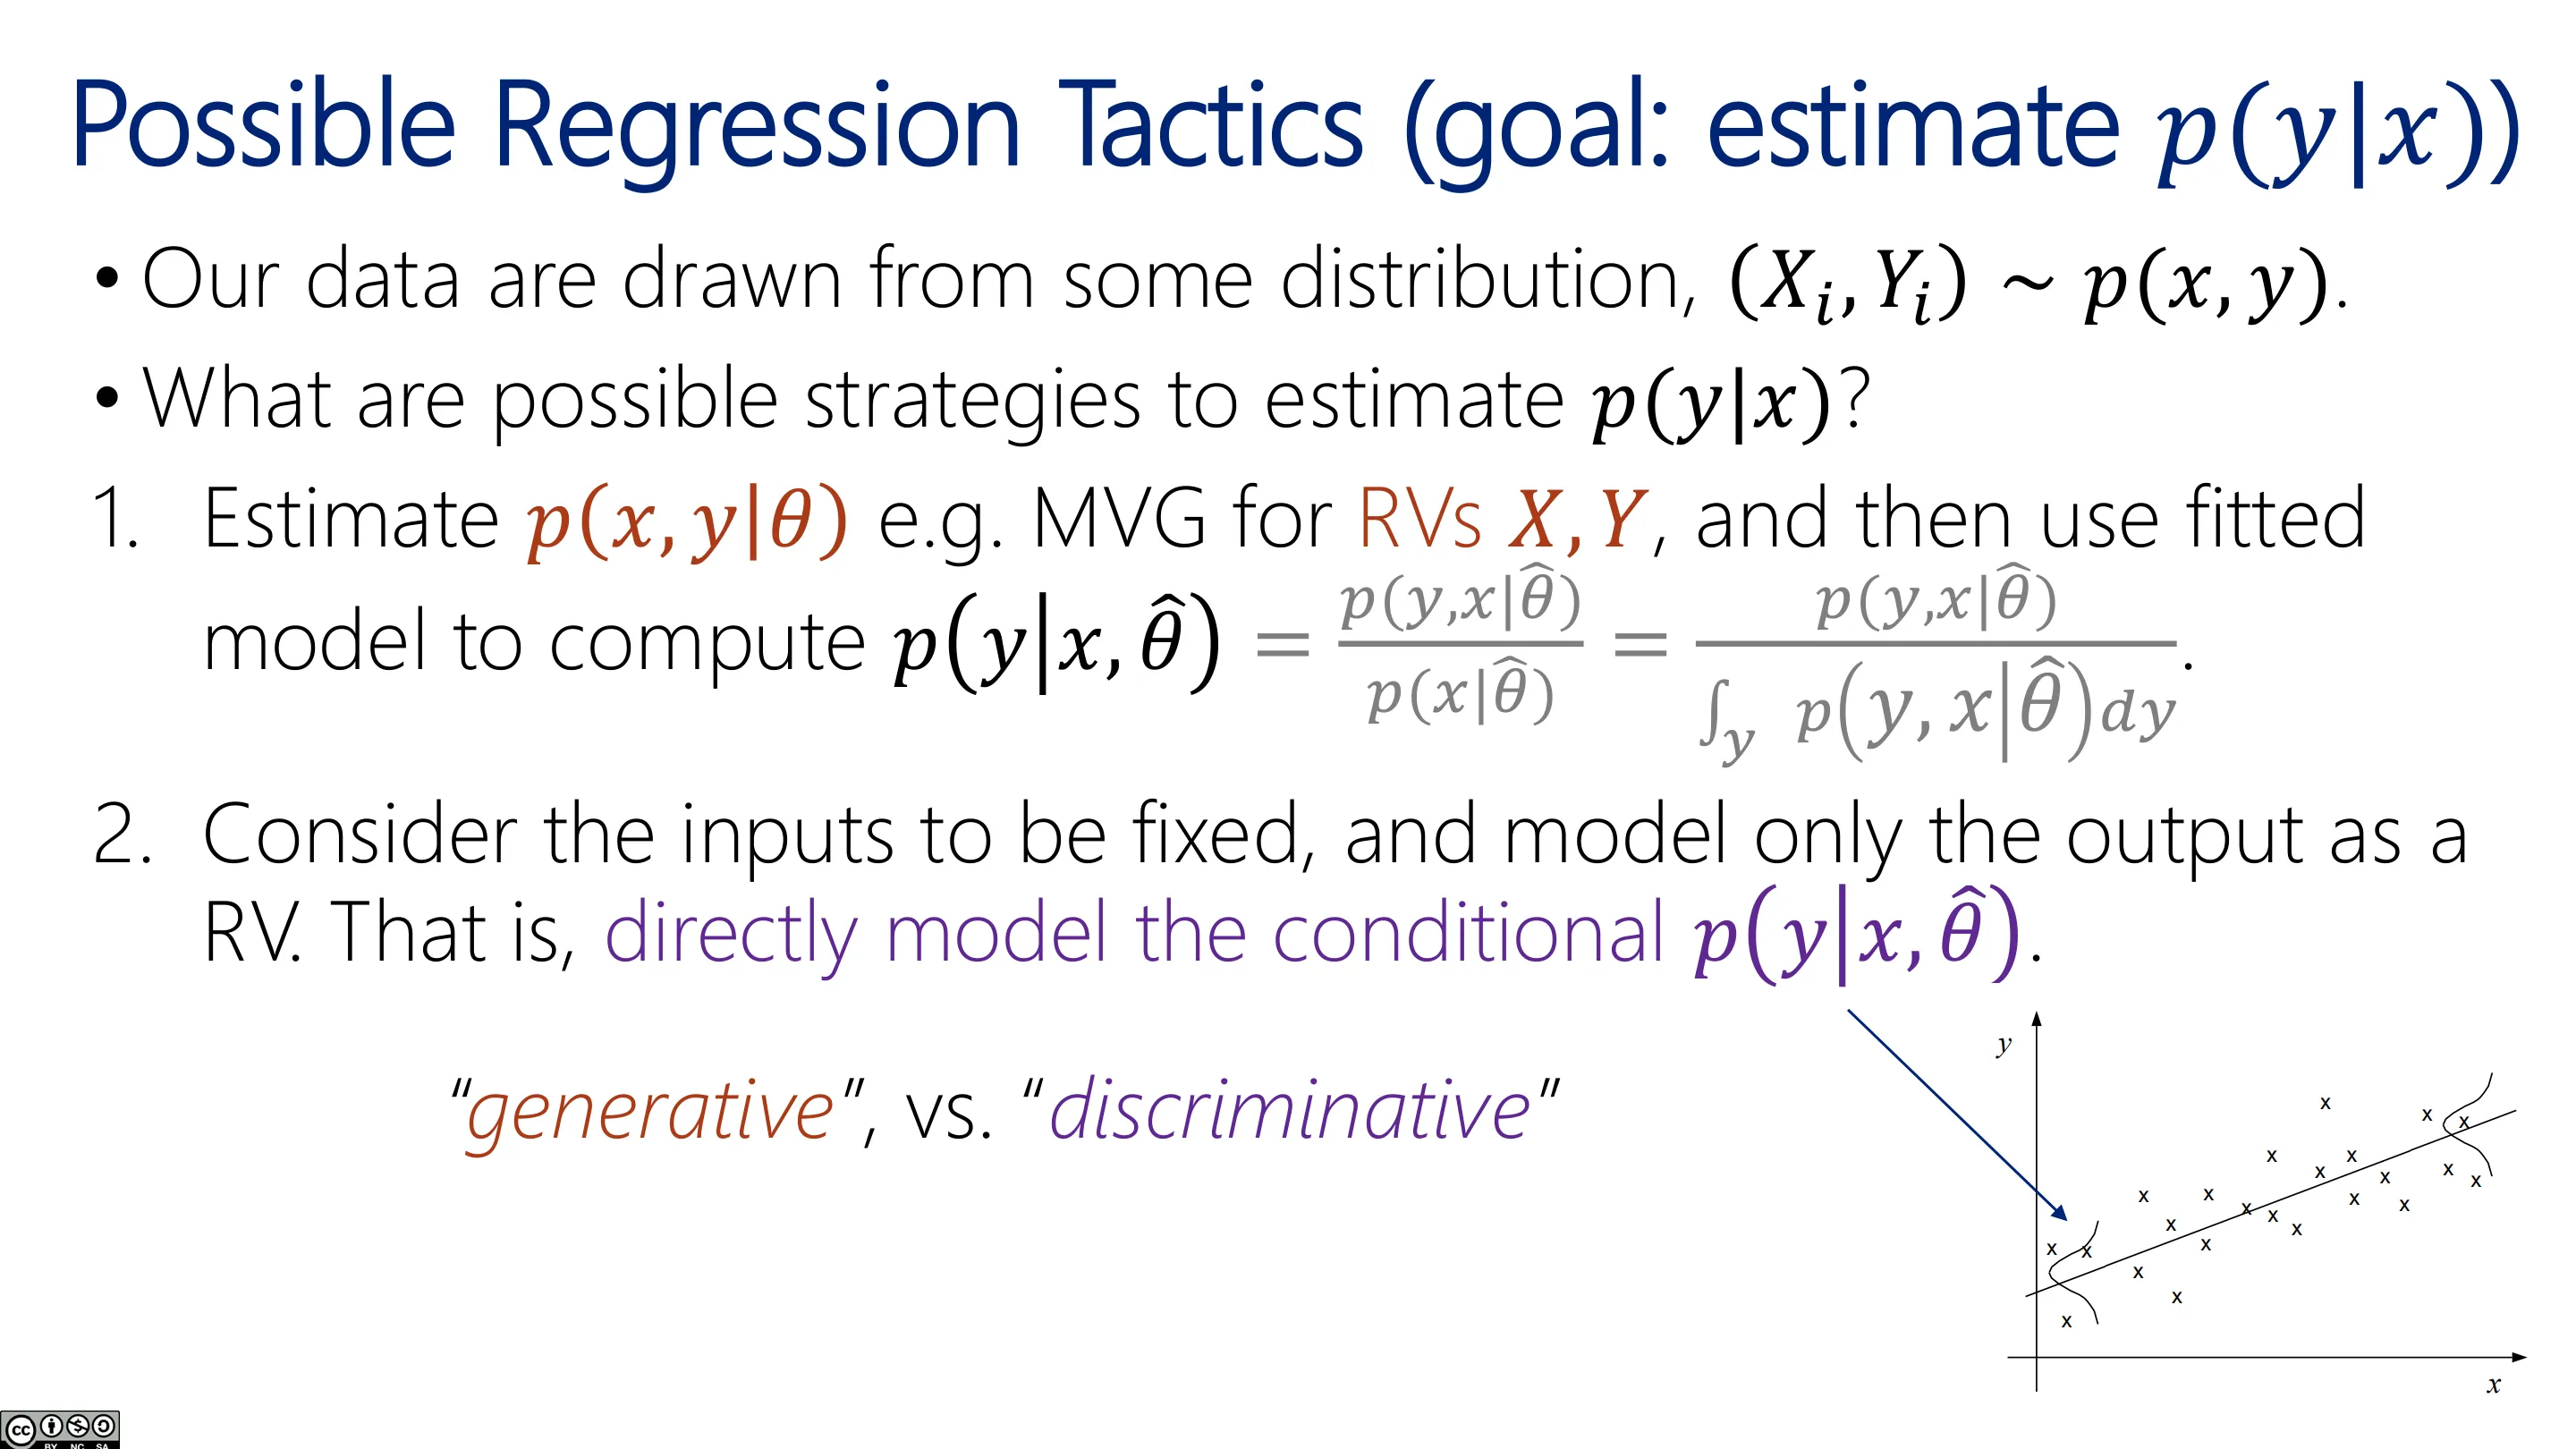
数据是带标签的:每个对象有特征向量 $x$ 与实数标签 $y$,来自联合分布 $(X,Y)\sim p(x,y)$。我们想要一个预测模型——给定 $x$,得到 $y$ 的条件分布 $p(y\mid x)$;若只想要一个点预测,就取该分布的期望。
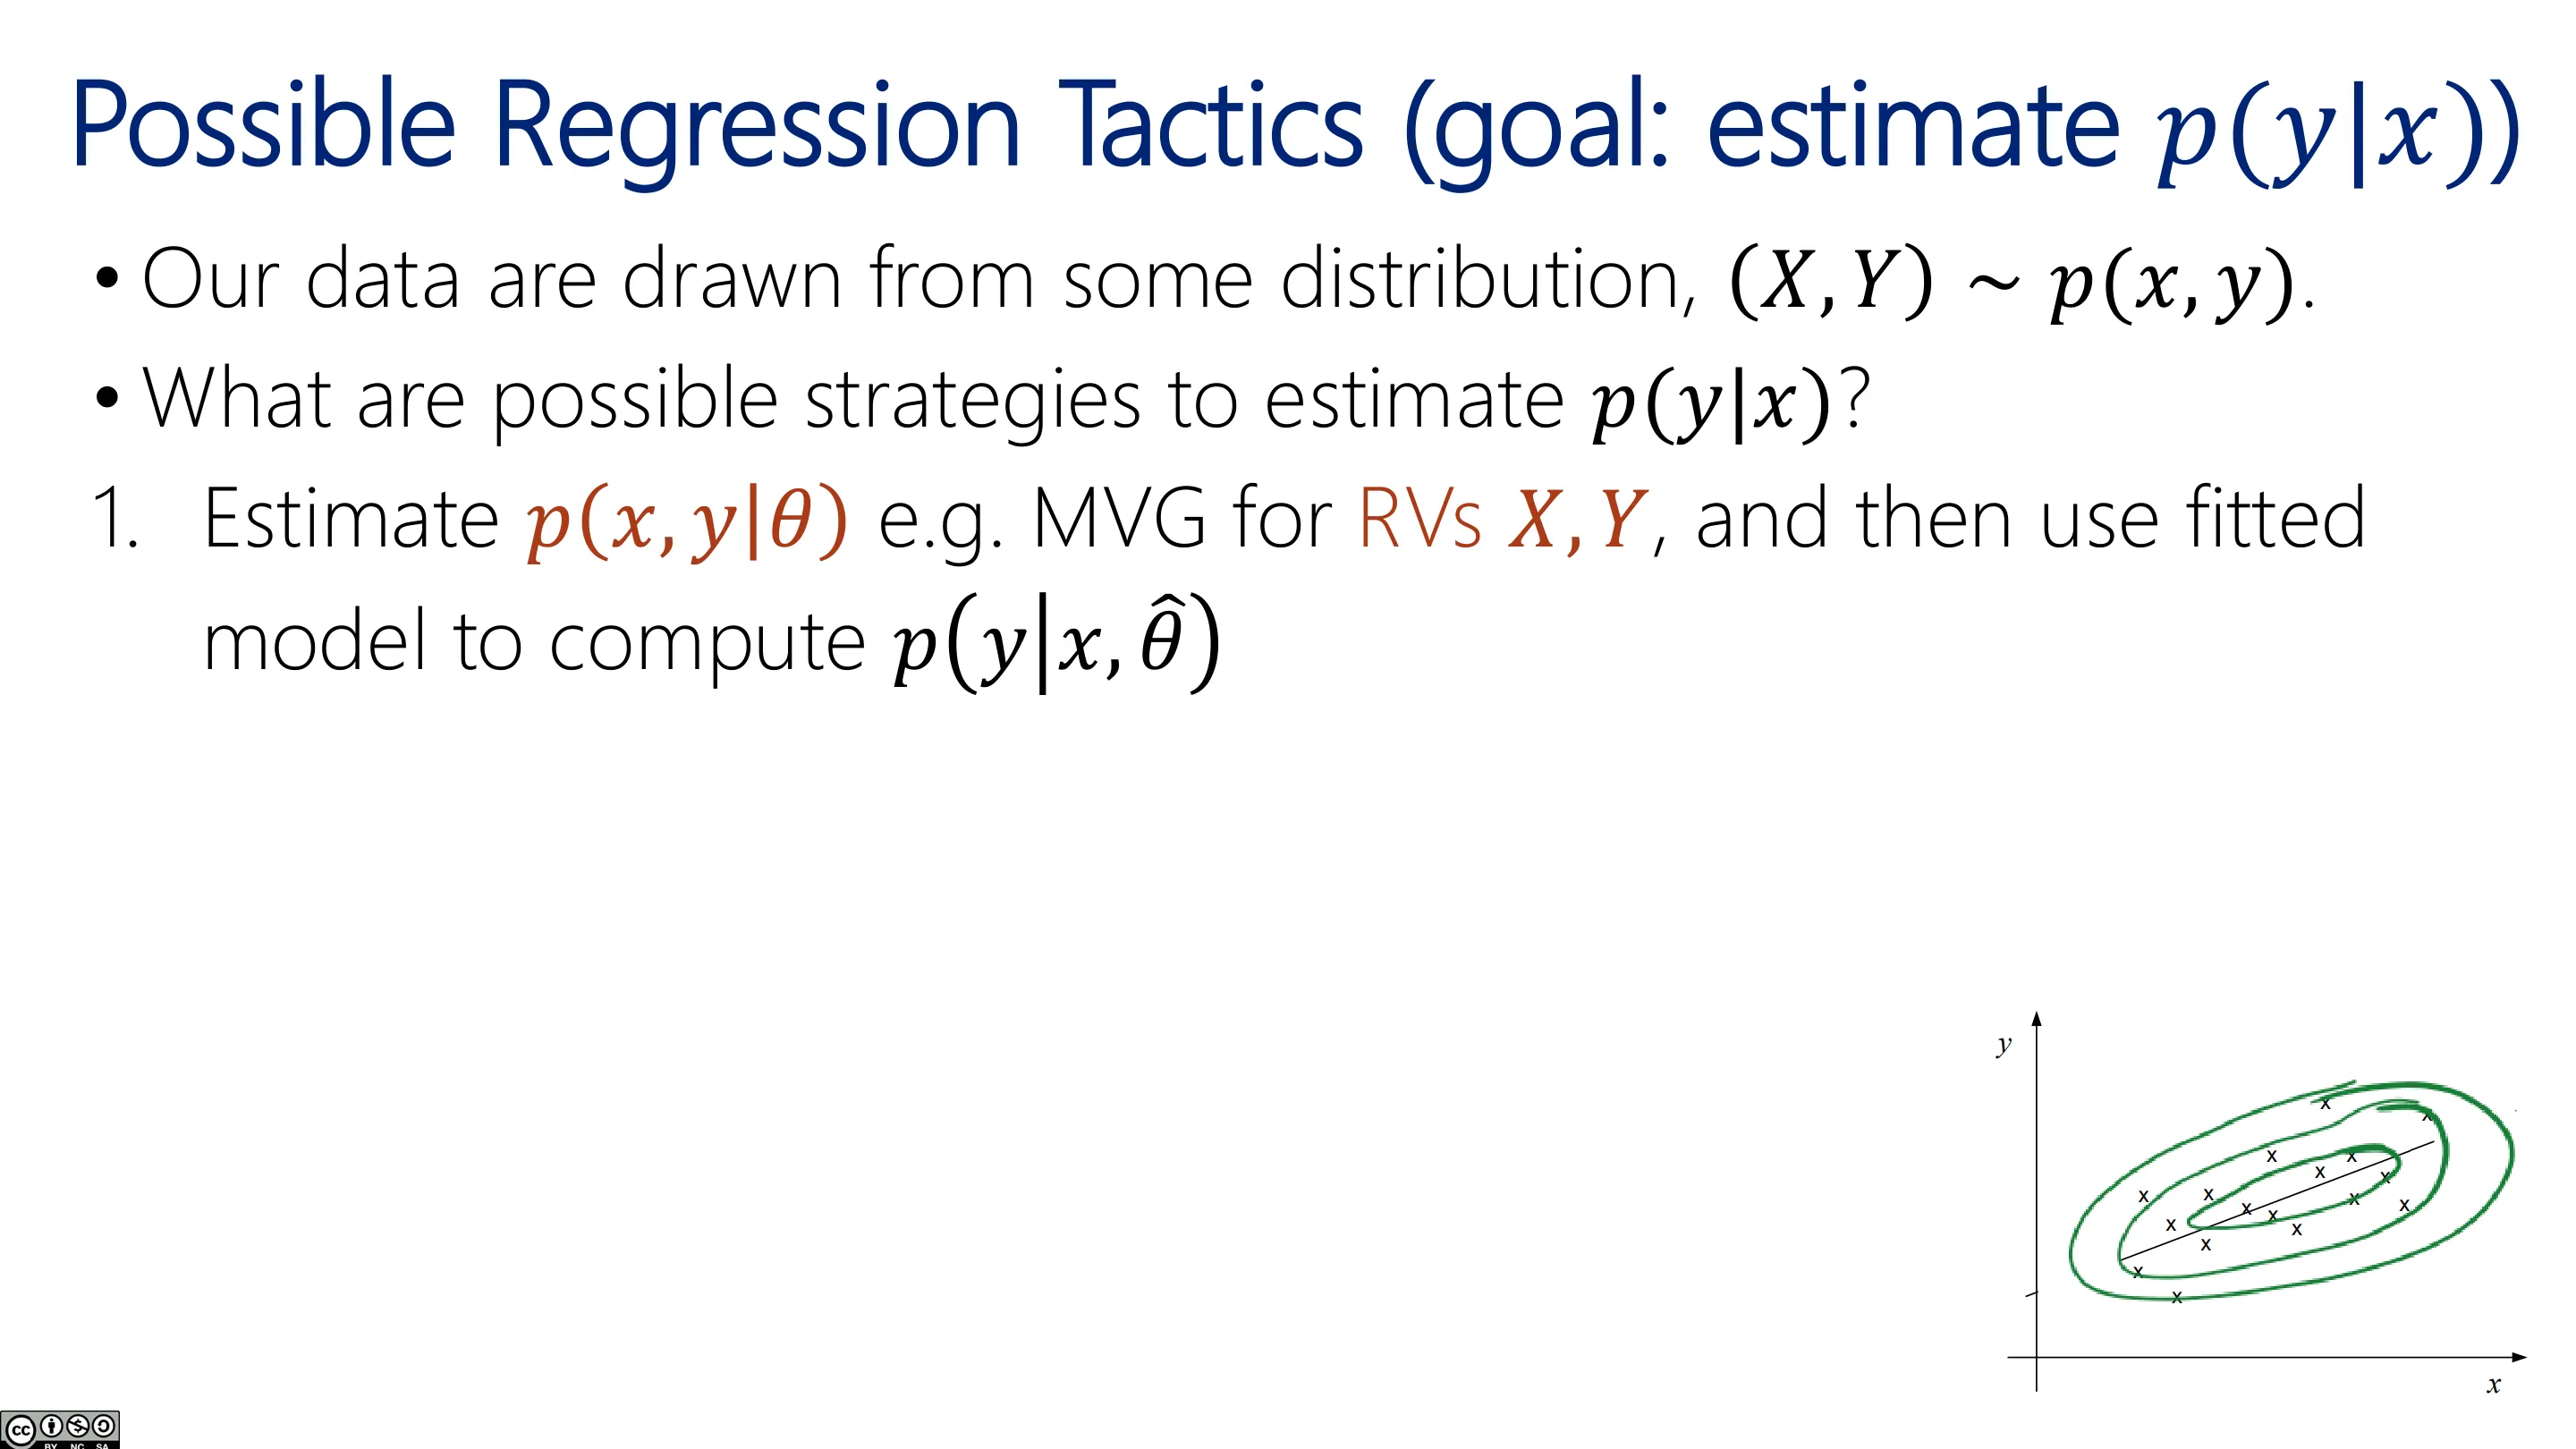
📷 数据来自联合分布 p(x,y)(一)
回到原视频 (00:39:10)
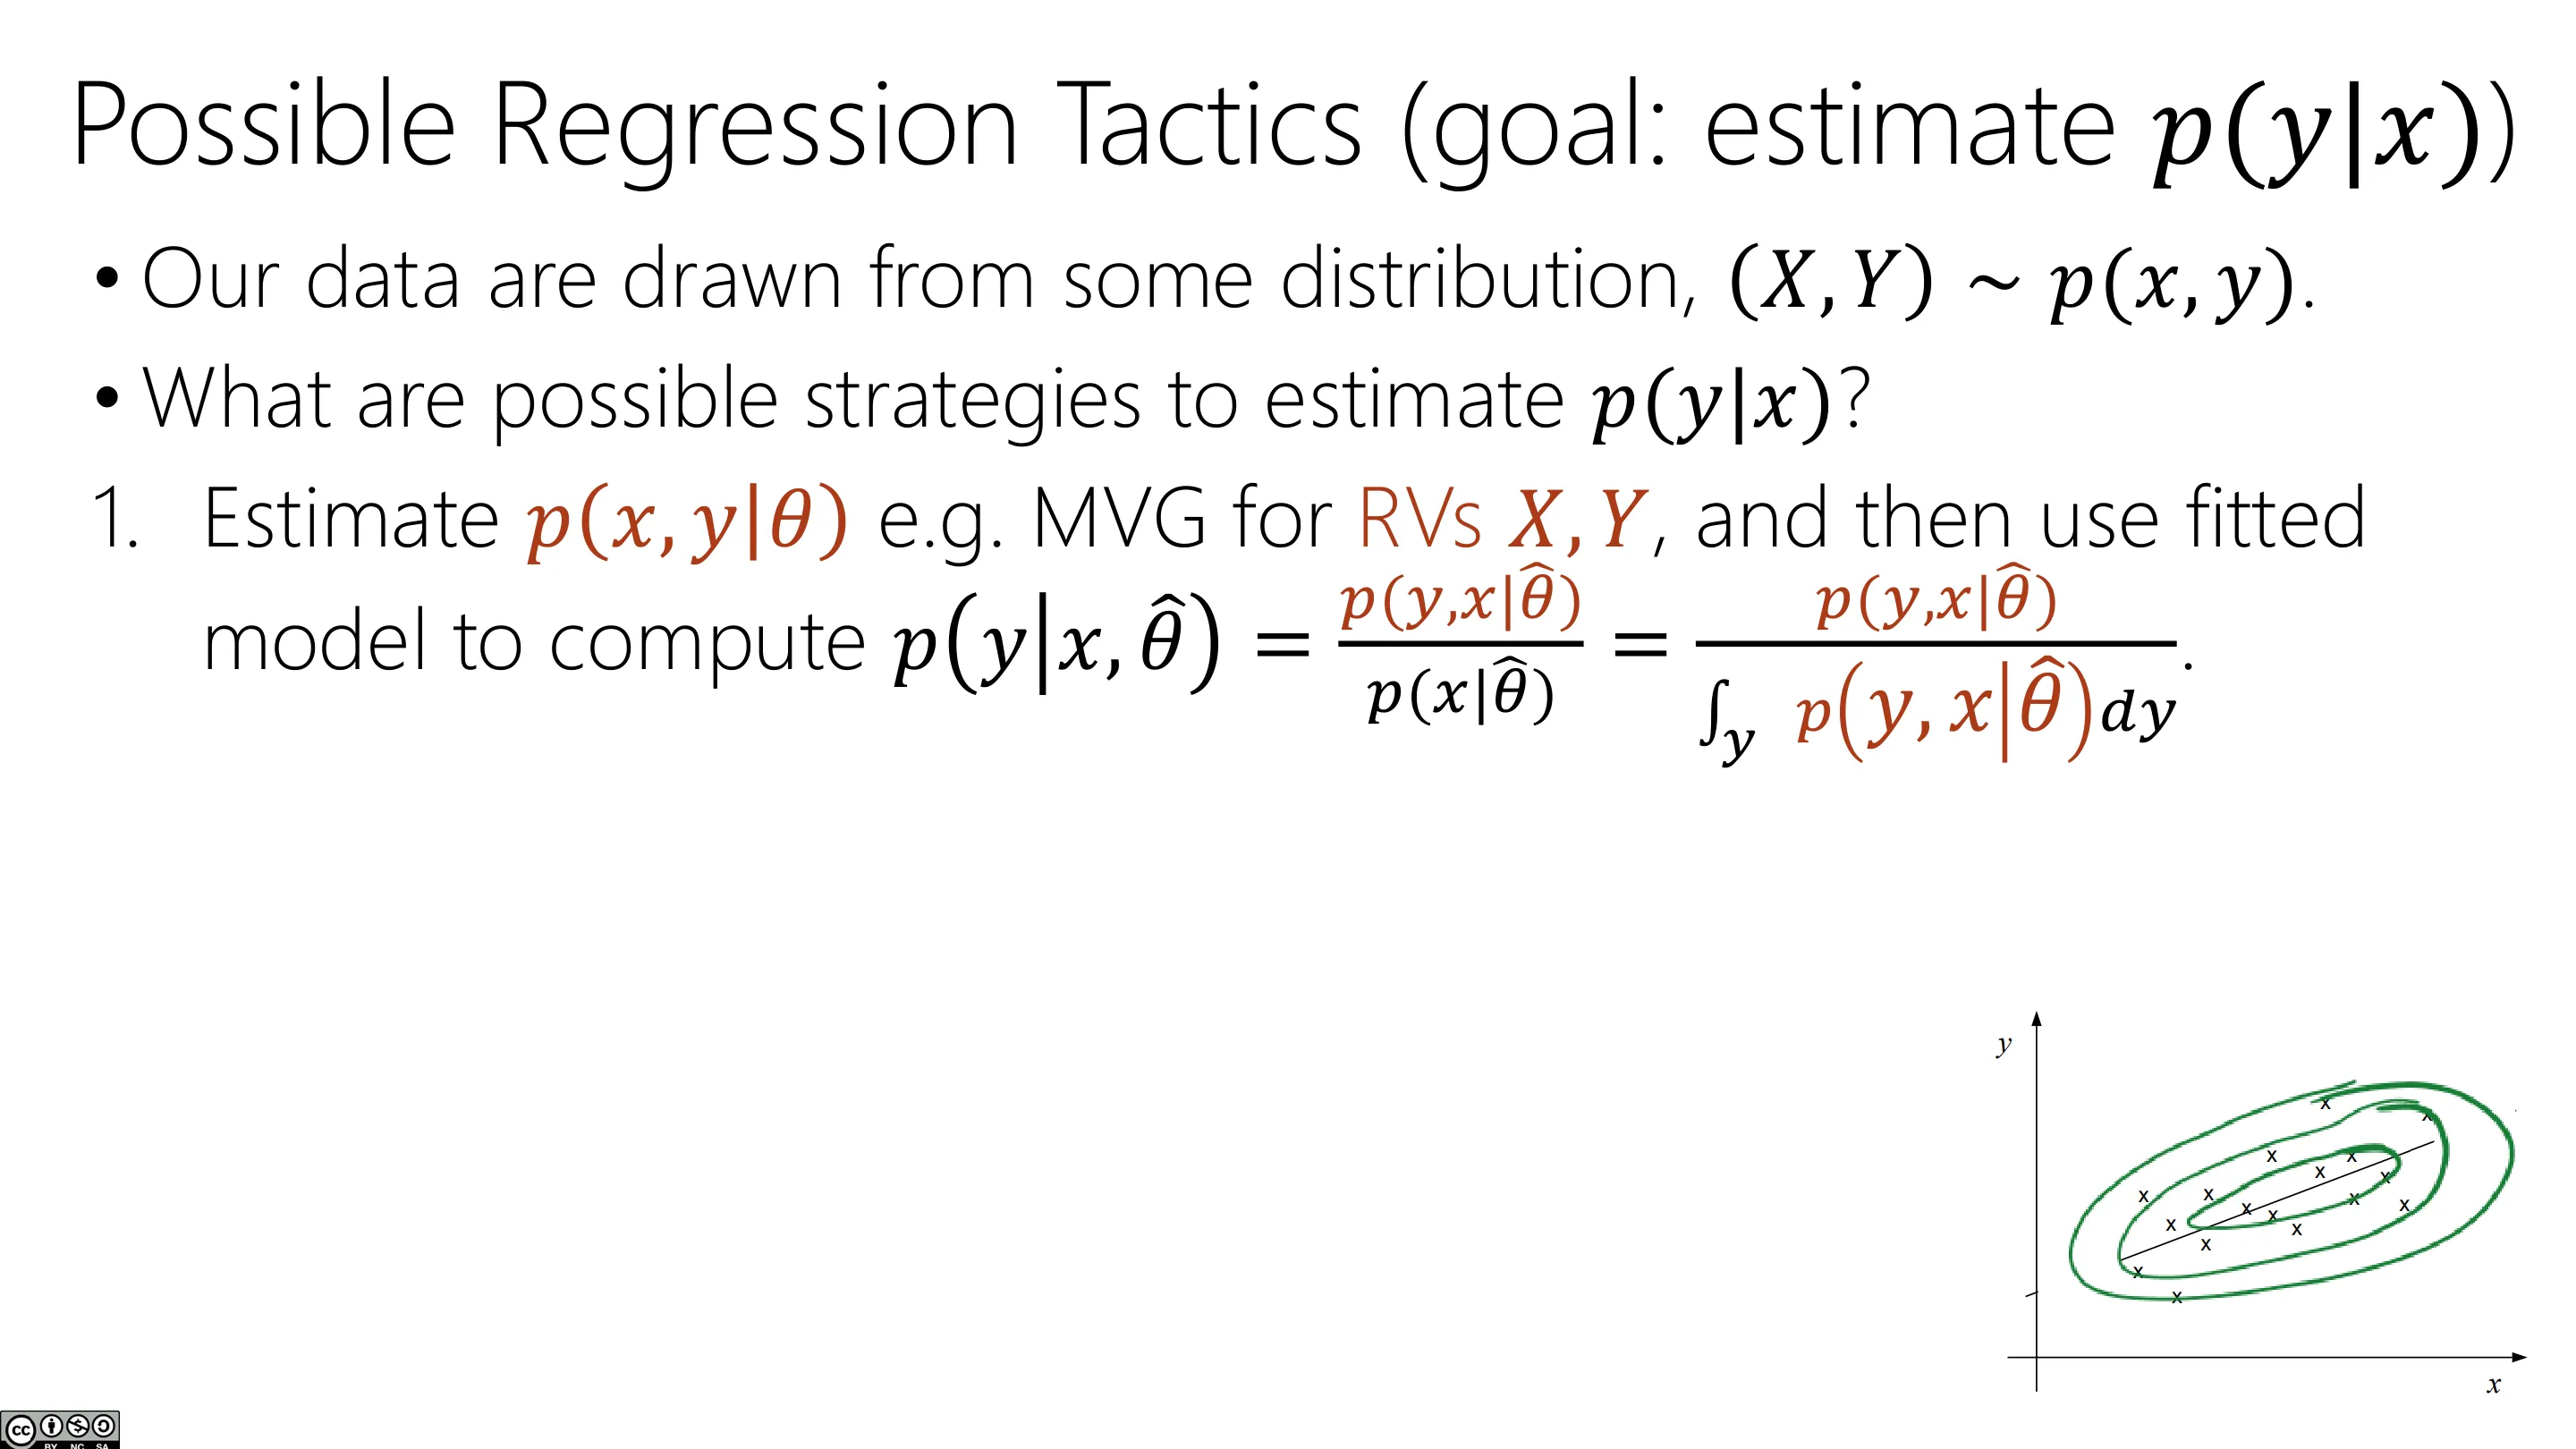
📷 数据来自联合分布 p(x,y)(二)
回到原视频 (00:40:00)
两条路线(生成式 vs 判别式):
- 生成式:假设 $(X,Y)$ 联合服从多元高斯,估计联合密度,再用概率规则 $p(y\mid x)=p(x,y)/p(x)$ 得到条件分布;它能生成新的 $X$(能把 $X$ 当随机变量),但通常不是我们要做的;
- 判别式(本课采用):直接对 $p(y\mid x)$ 建模——只以 $X$ 为条件,因此无法生成新的 $X$,只能「给一个 $x$,产出 $y$」。
📷 回归的两种策略
回到原视频 (00:41:30)
2.3 线性回归
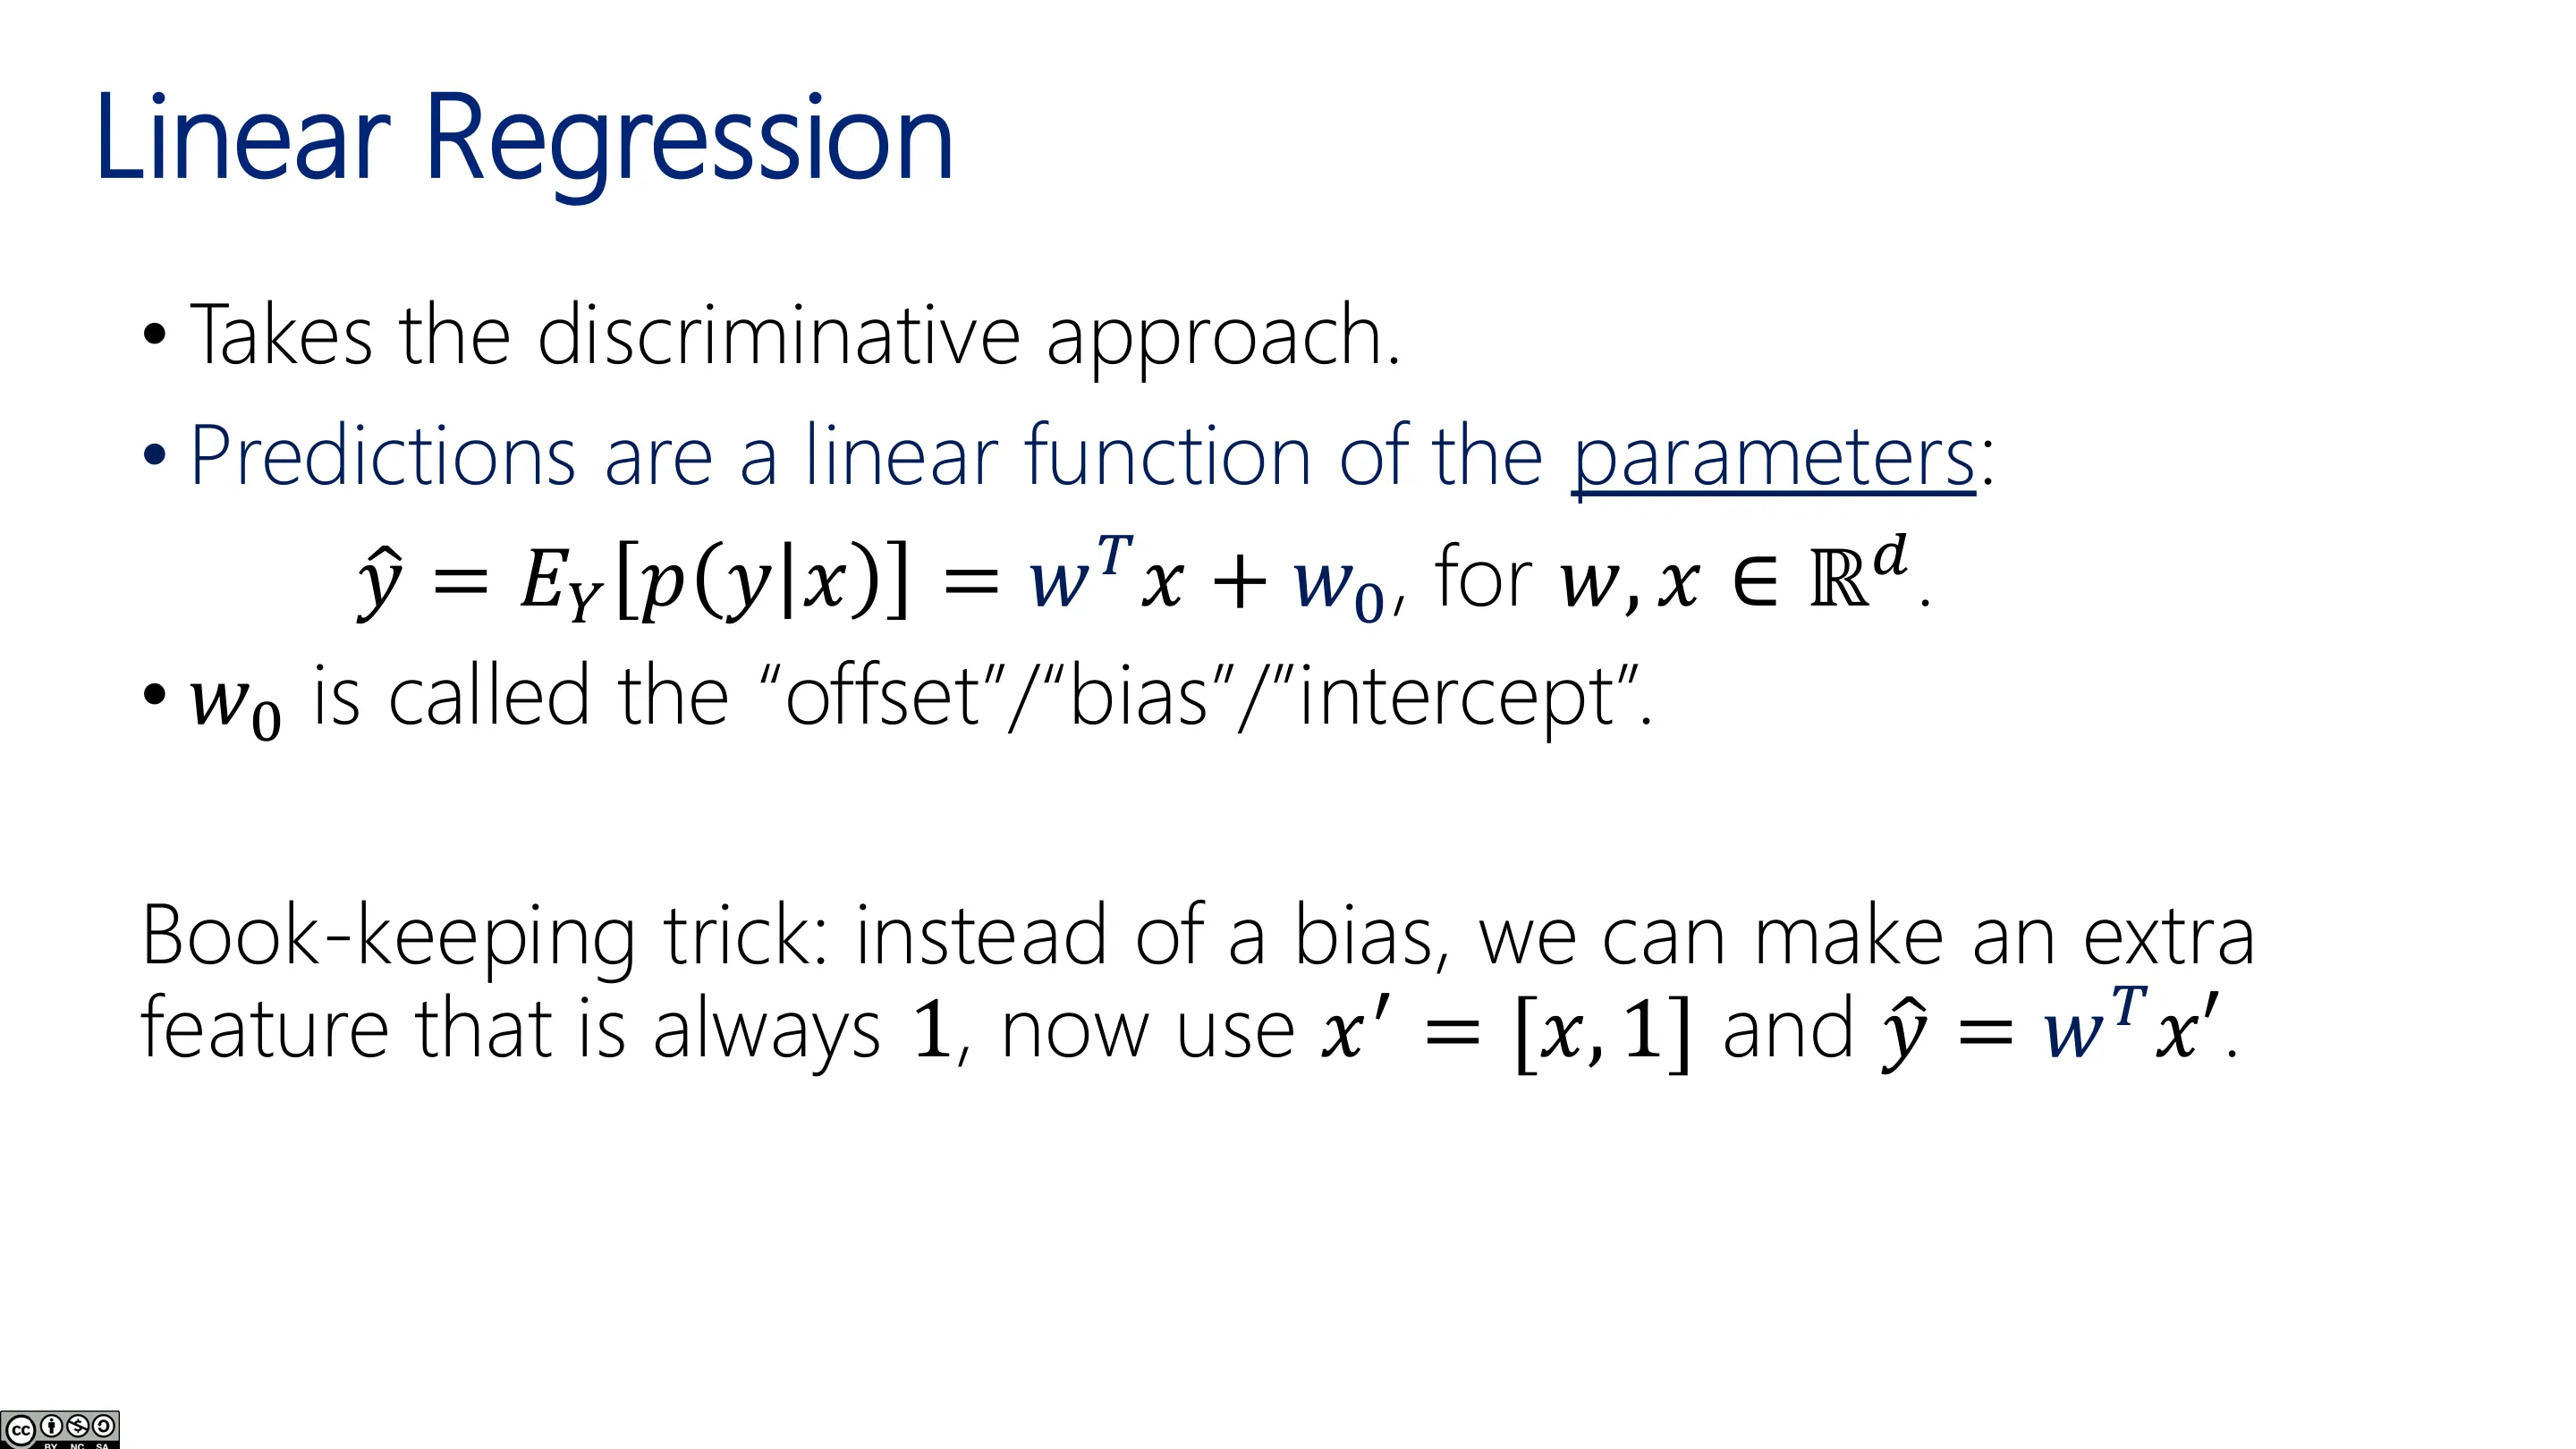
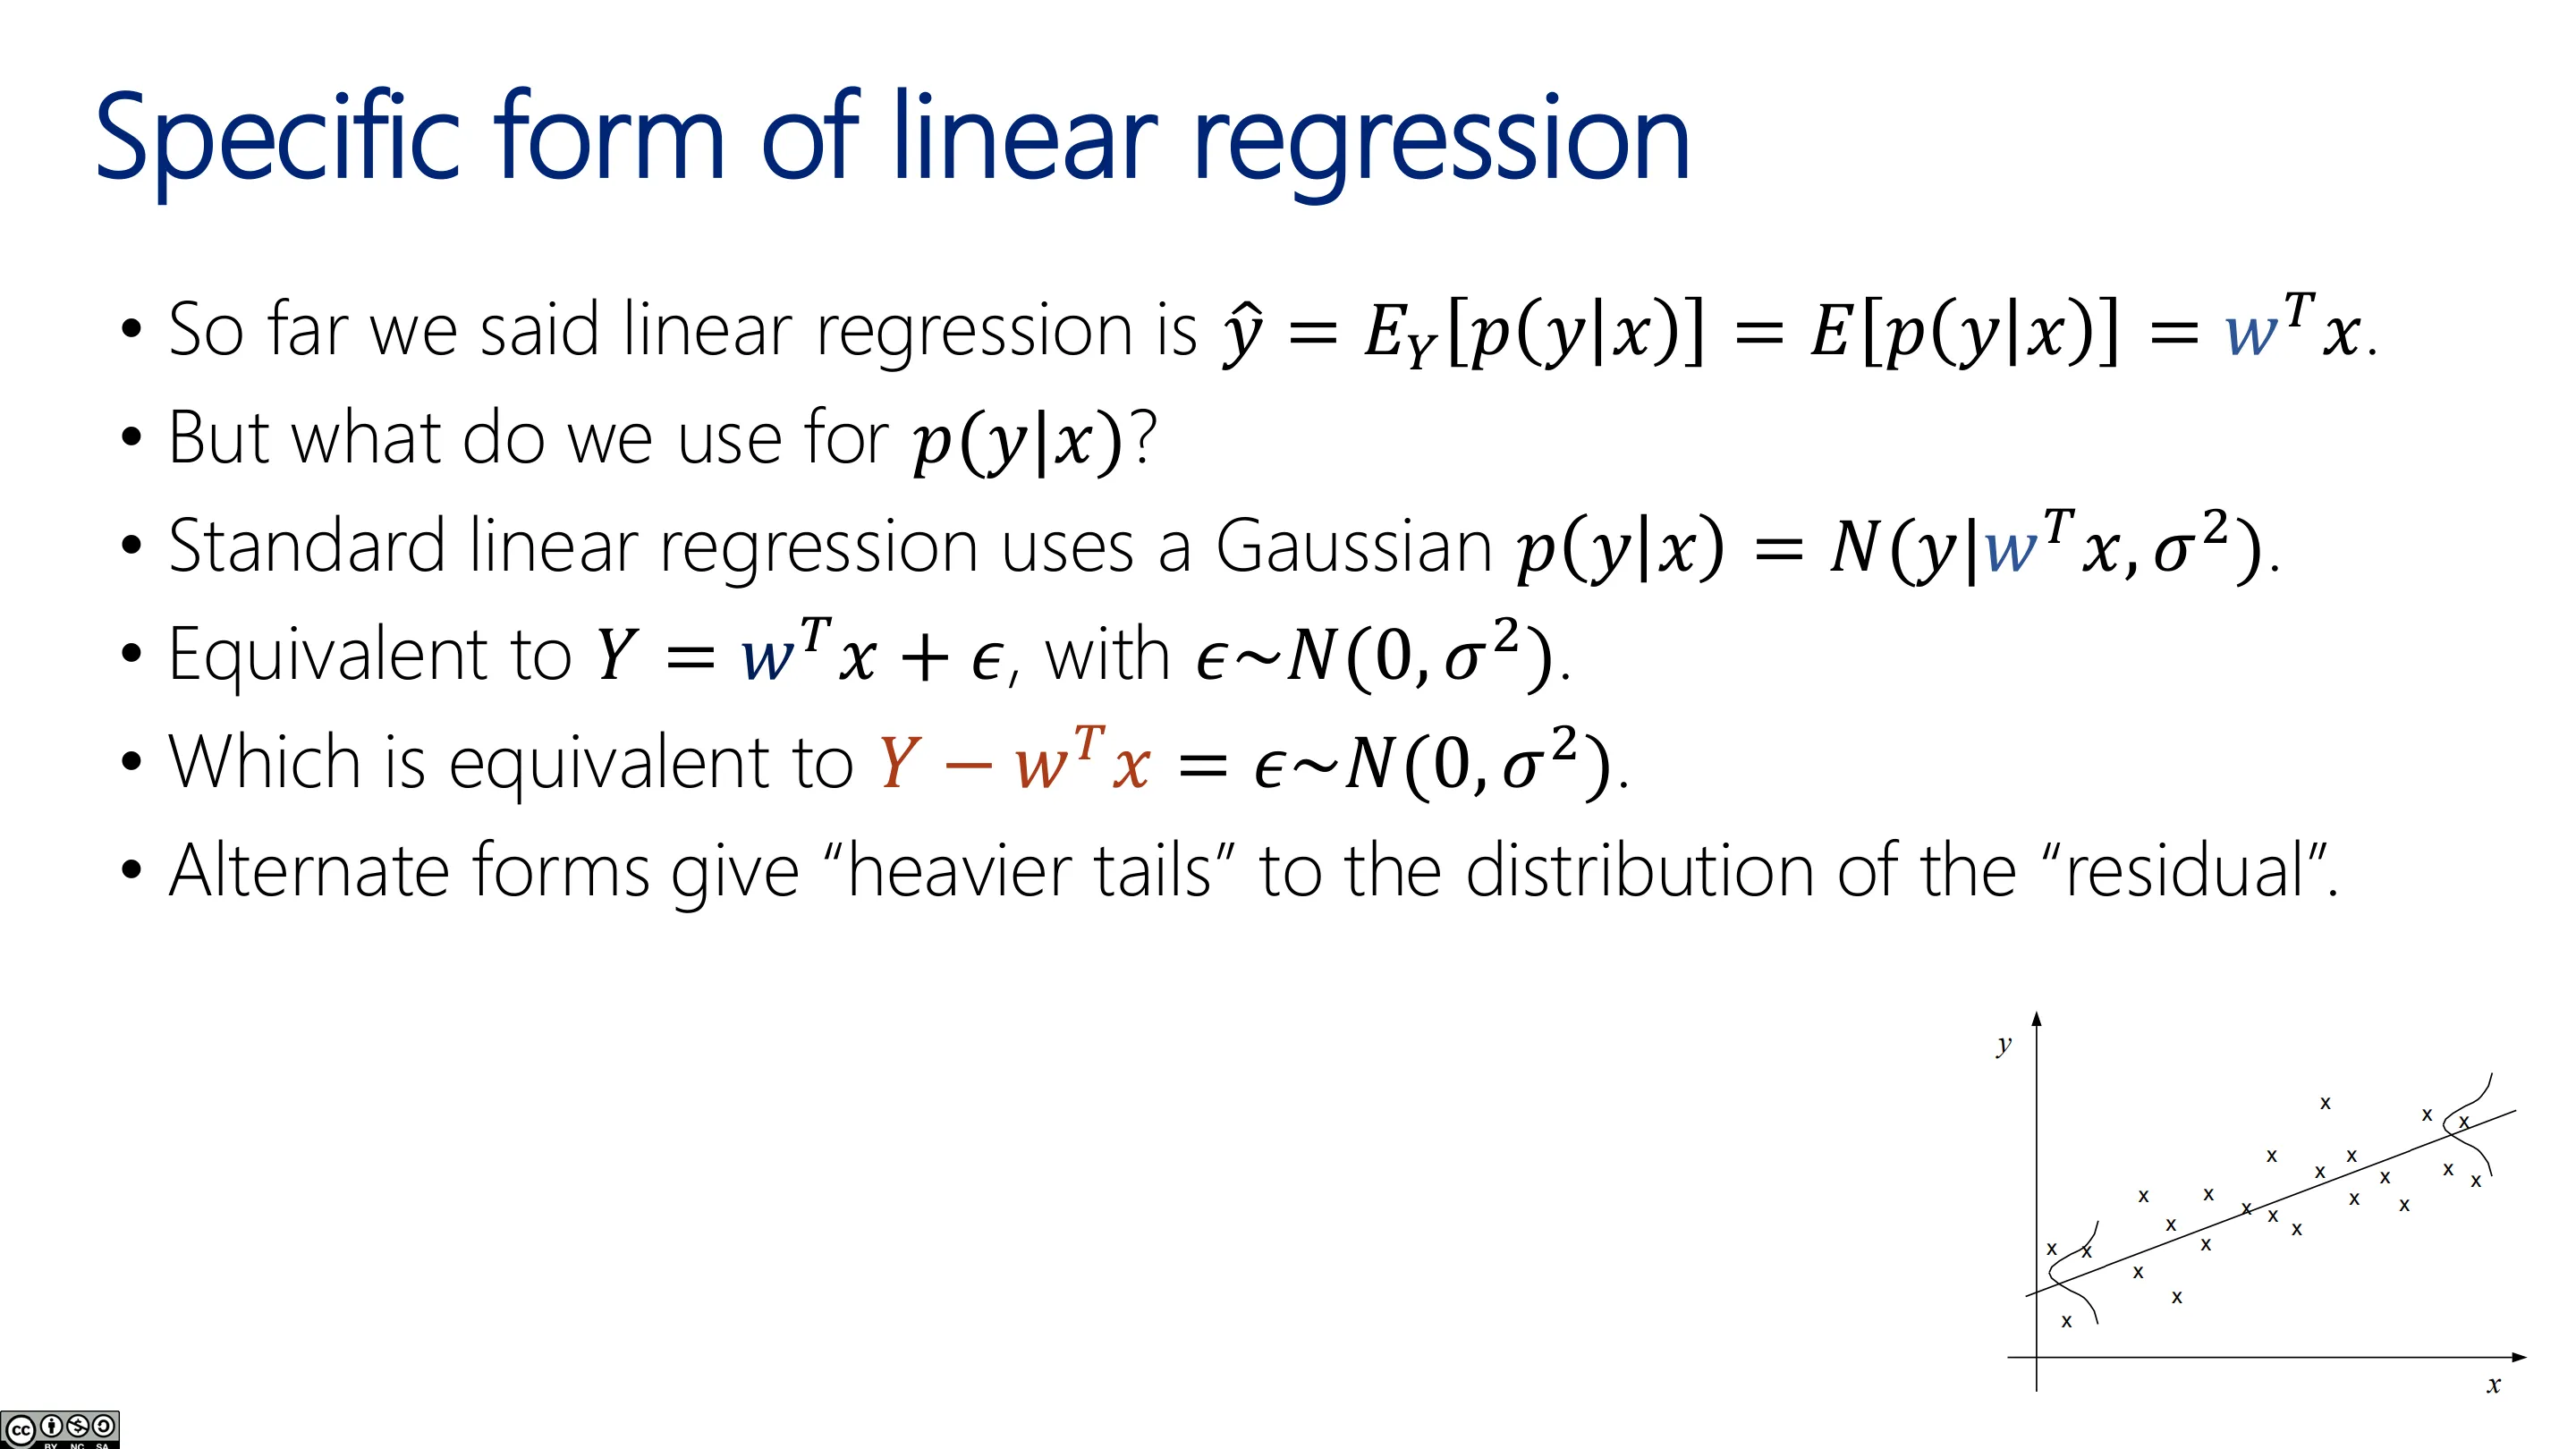
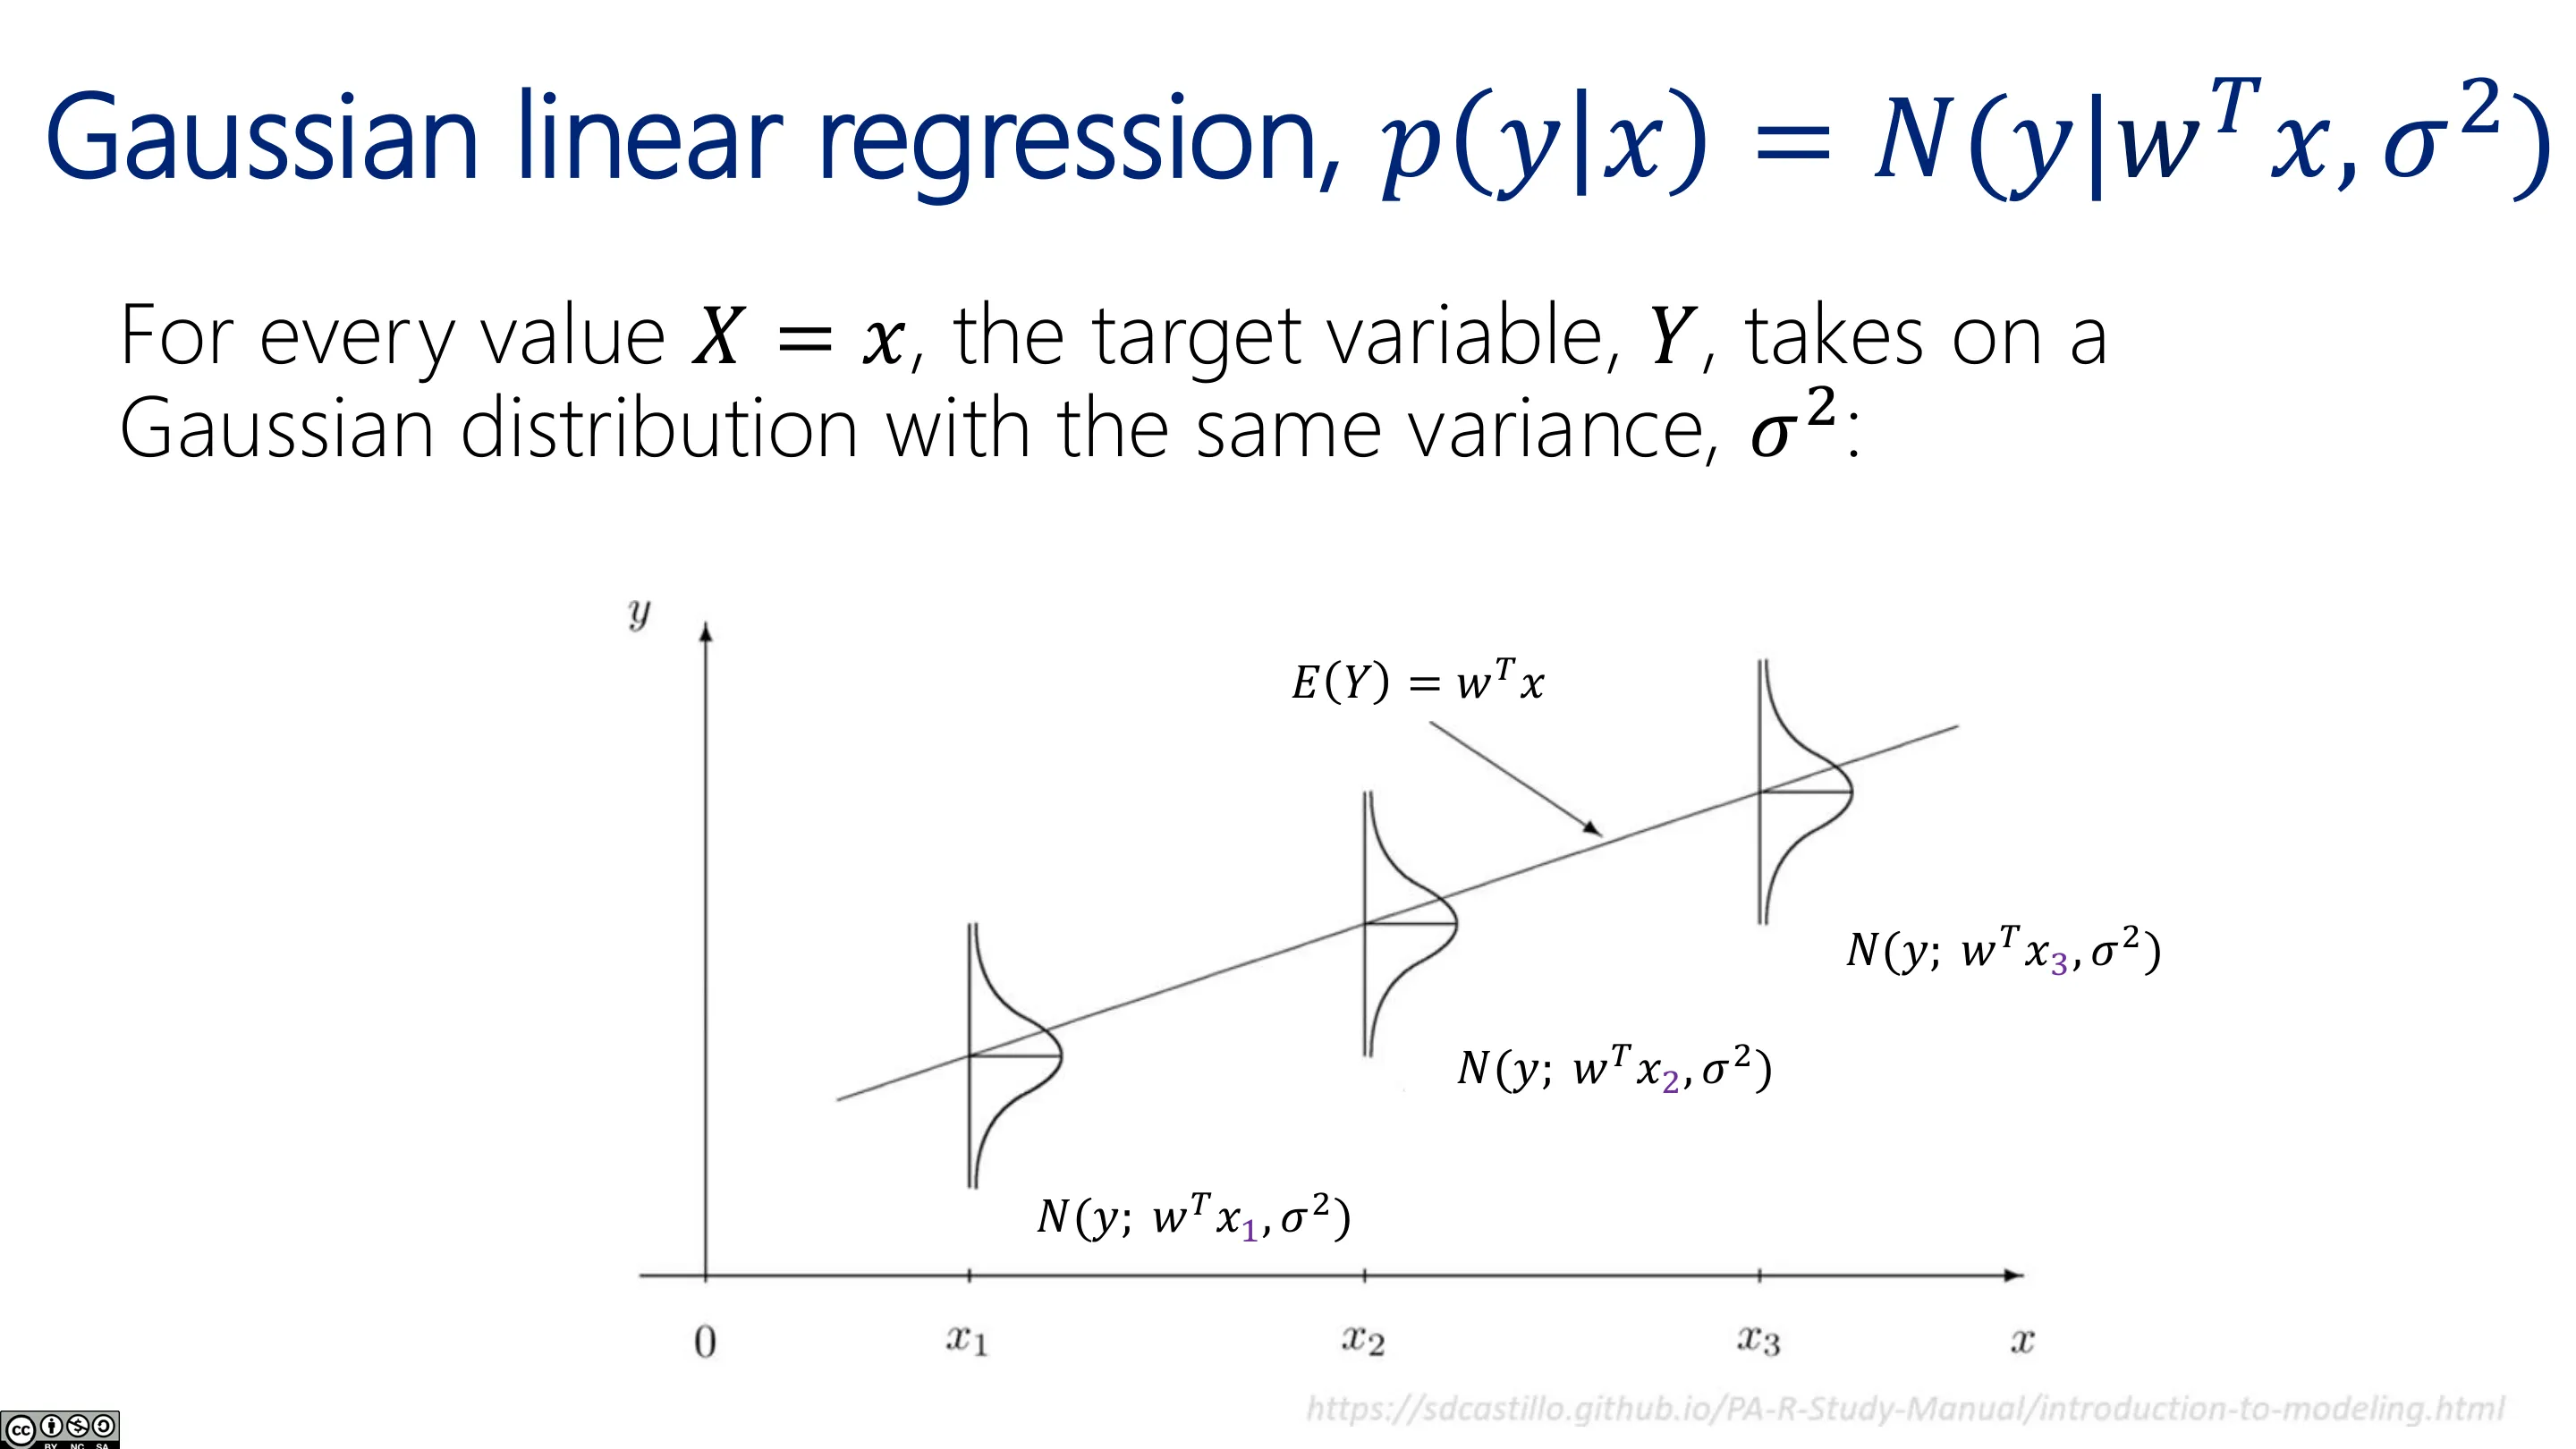
线性回归的定义:点预测(预测分布的期望)是参数的线性函数。高斯线性回归则取预测分布为
$$ p(y\mid x)=\mathcal{N}\!\left(y\mid w^\top x,\ \sigma^2\right) $$
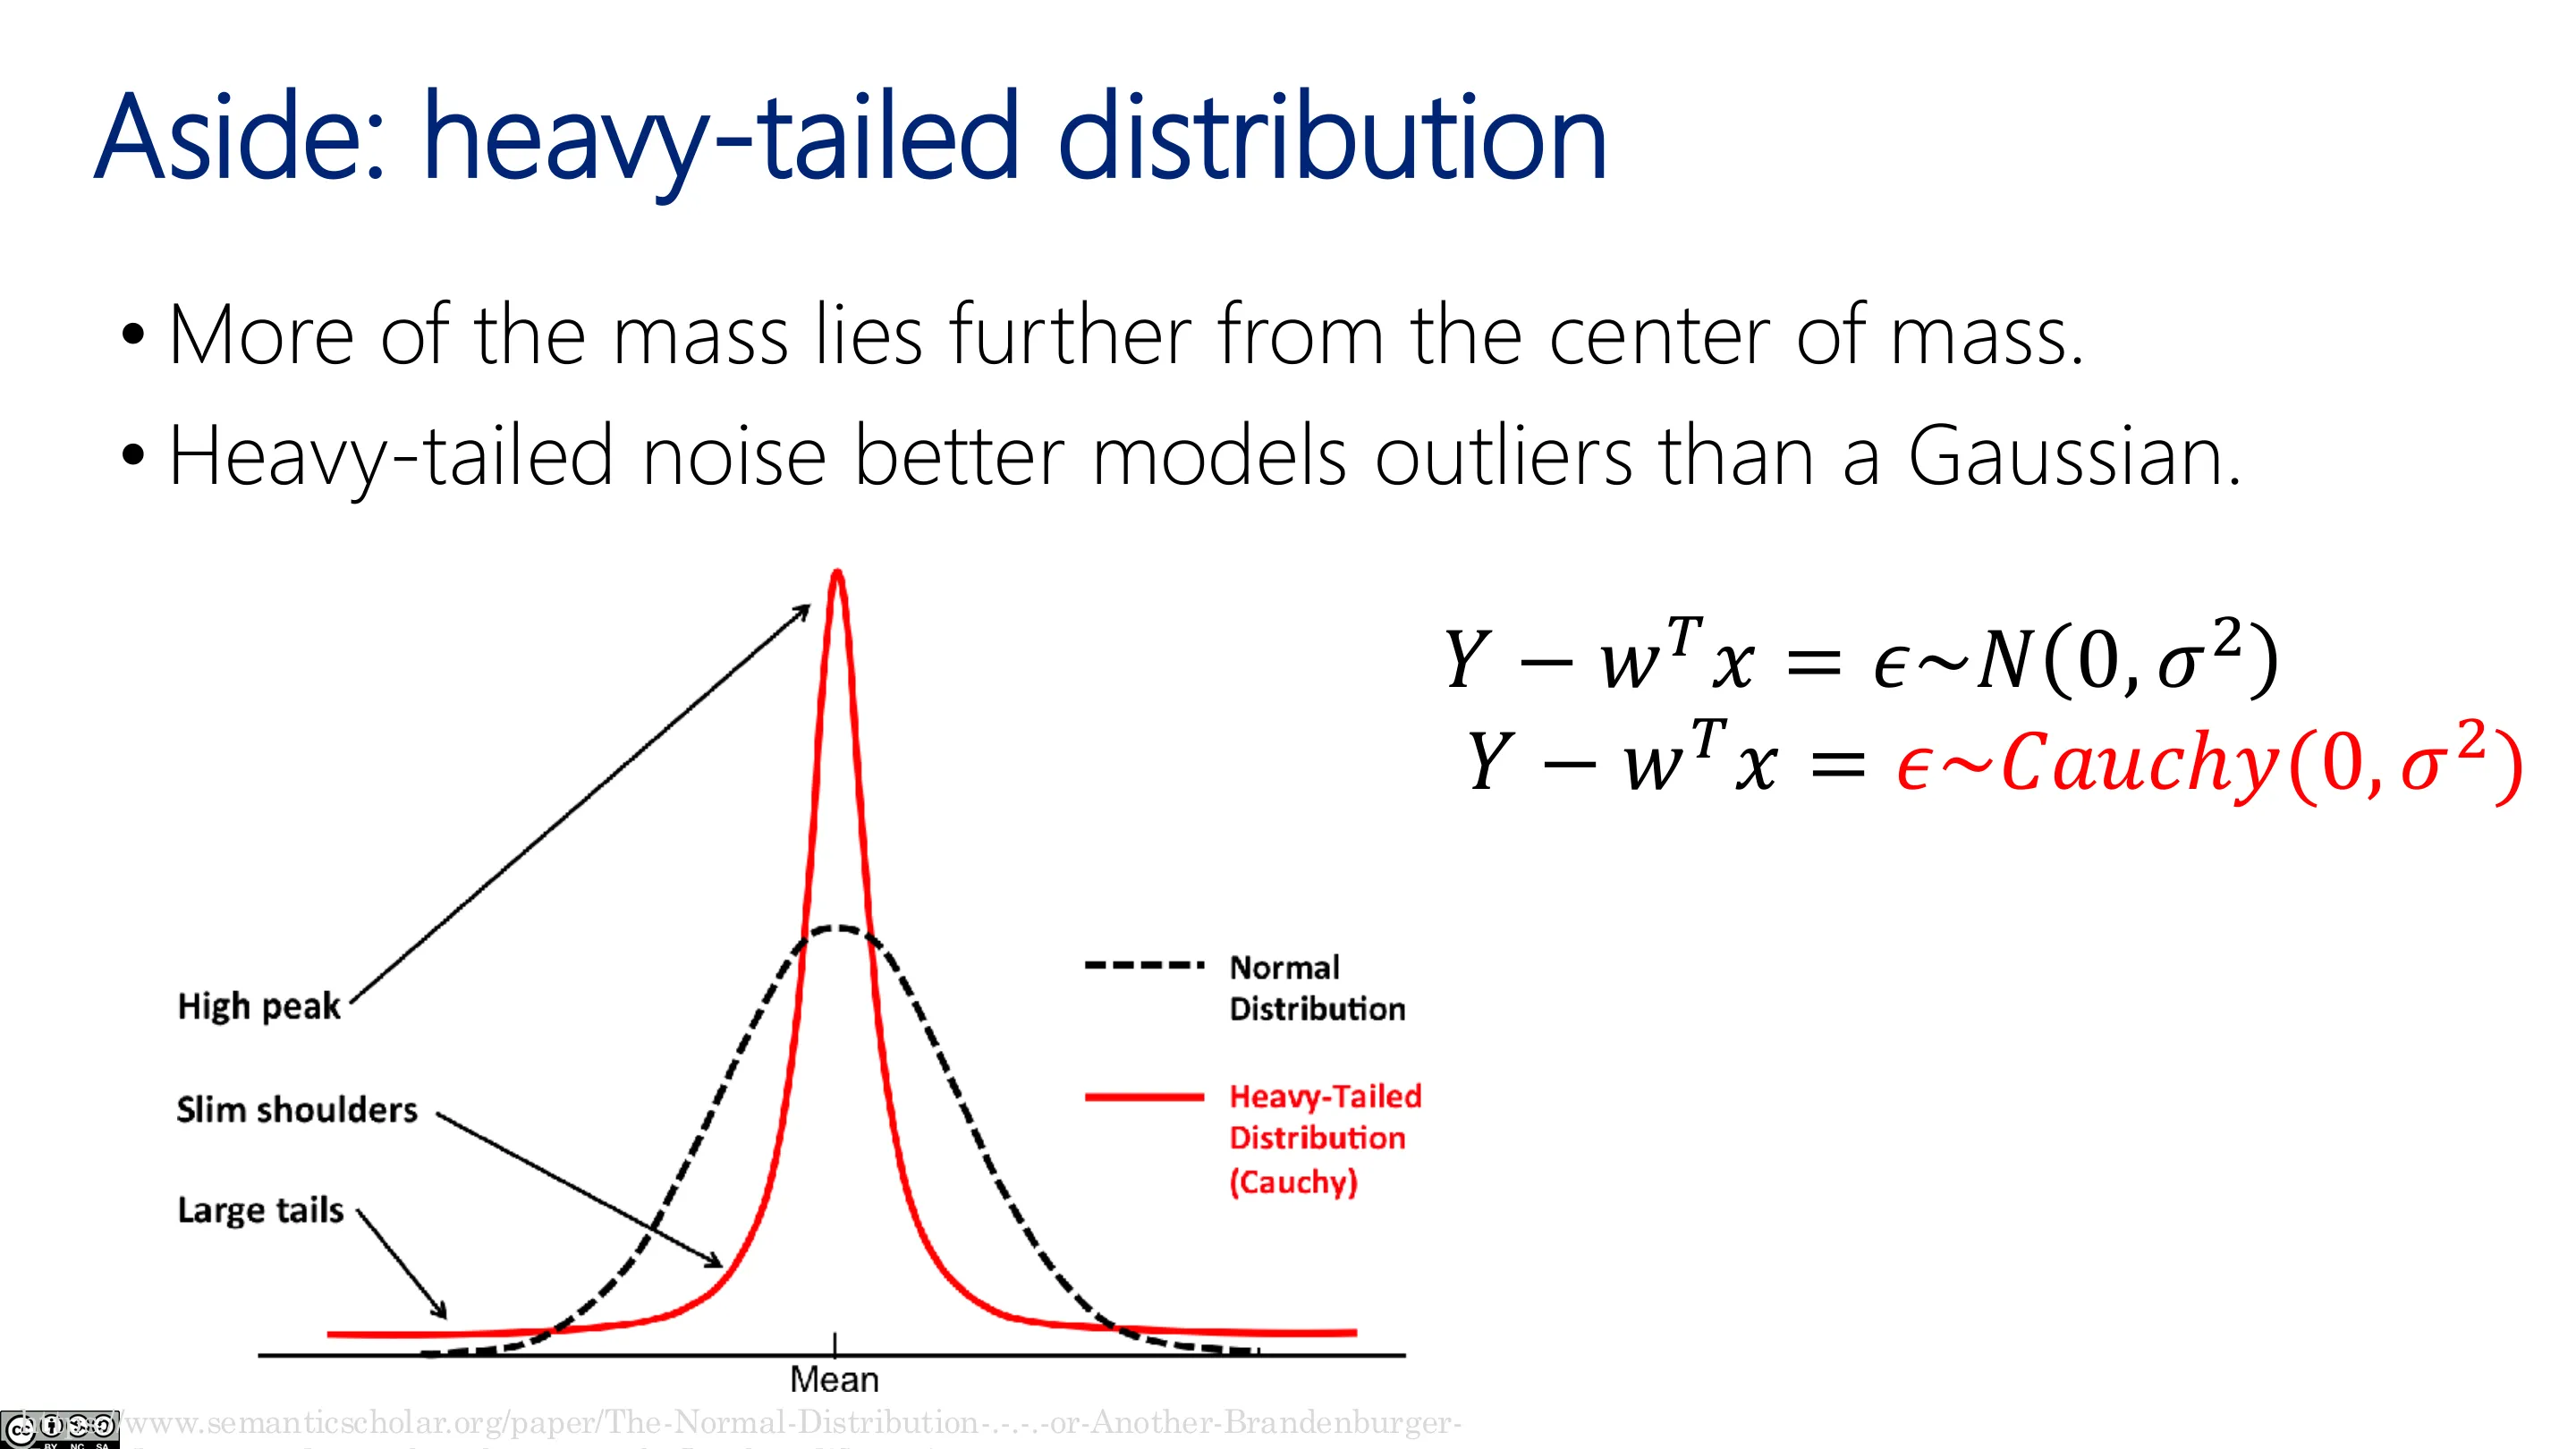
等价写法(统计学家偏好):$y=w^\top x+\epsilon$,$\epsilon\sim\mathcal{N}(0,\sigma^2)$——即「残差服从高斯」。也存在重尾版本(如 t 分布、柯西分布),但本课只讲高斯线性回归。
📷 线性回归
回到原视频 (00:41:50)
📷 线性回归的几何视角
回到原视频 (00:30:55)
📷 线性模型能有多大用?
回到原视频 (00:42:55)
📷 线性回归的定义
回到原视频 (00:43:35)
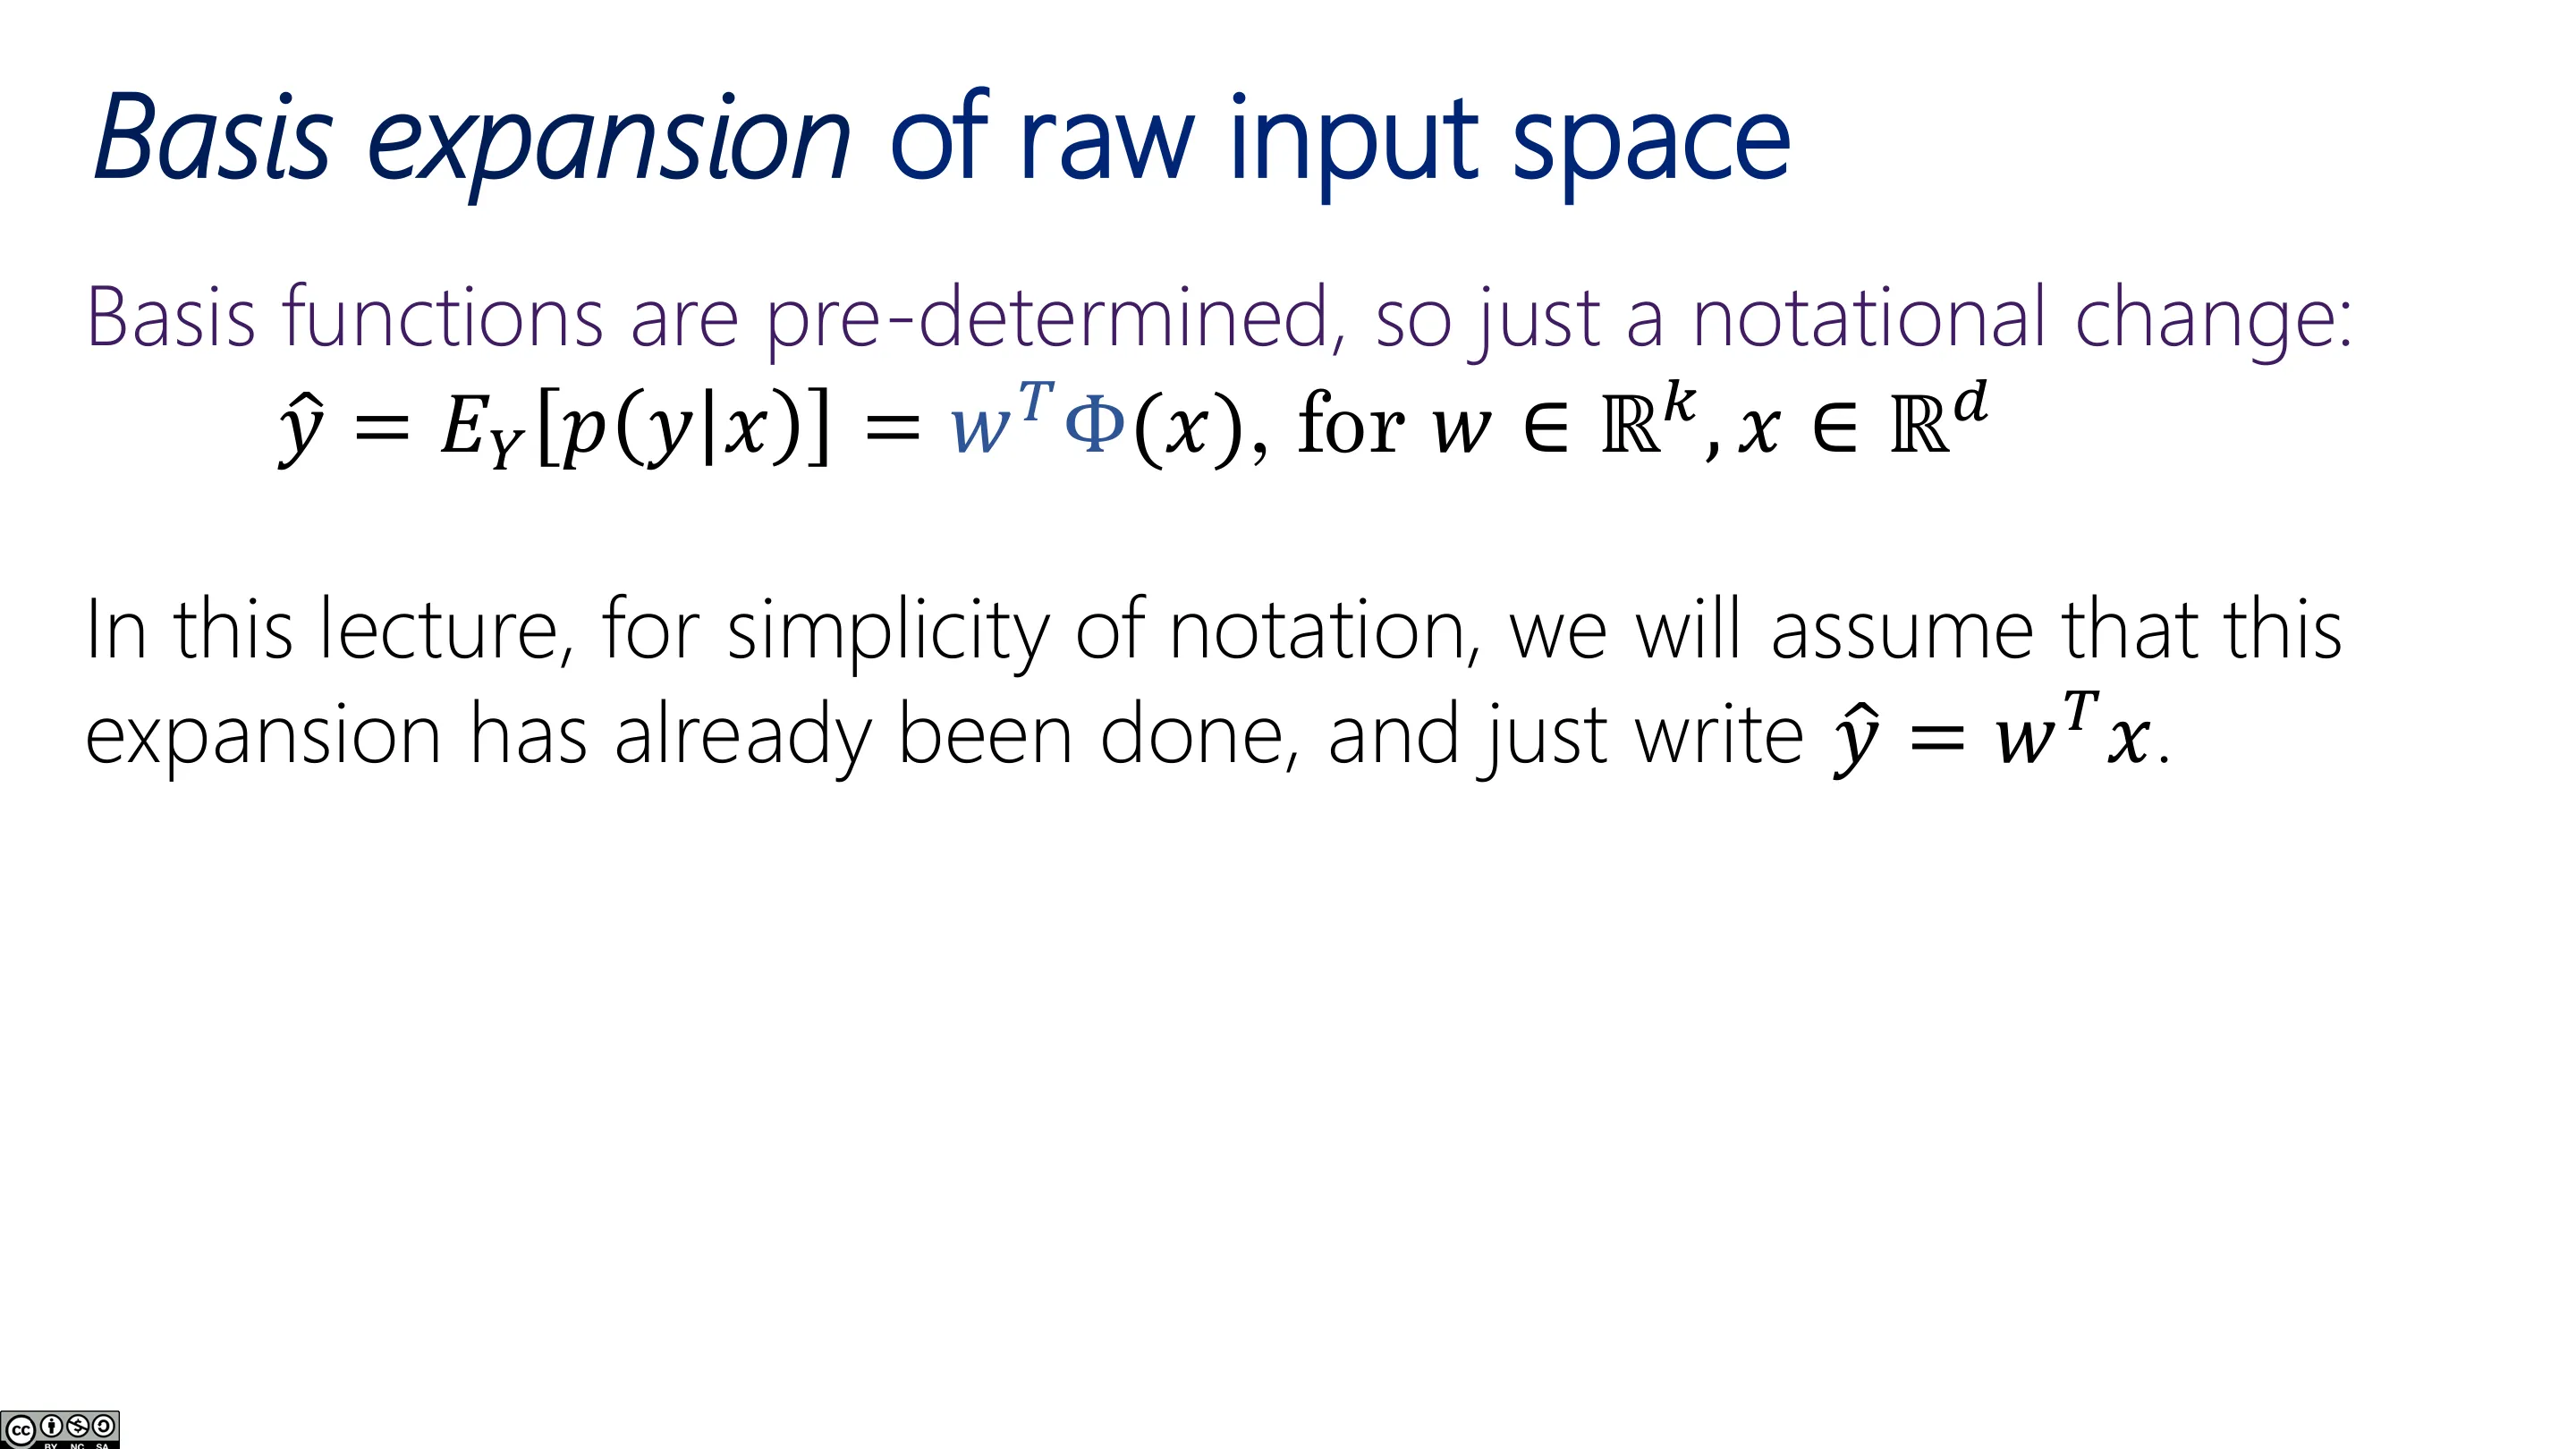
编者说明:偏置项 $w_0$ 可以通过增广特征(加一个恒为 1 的特征)隐藏进 $w^\top x$,这样公式更简洁。
2.4 基函数展开:让「线性」变得非常灵活
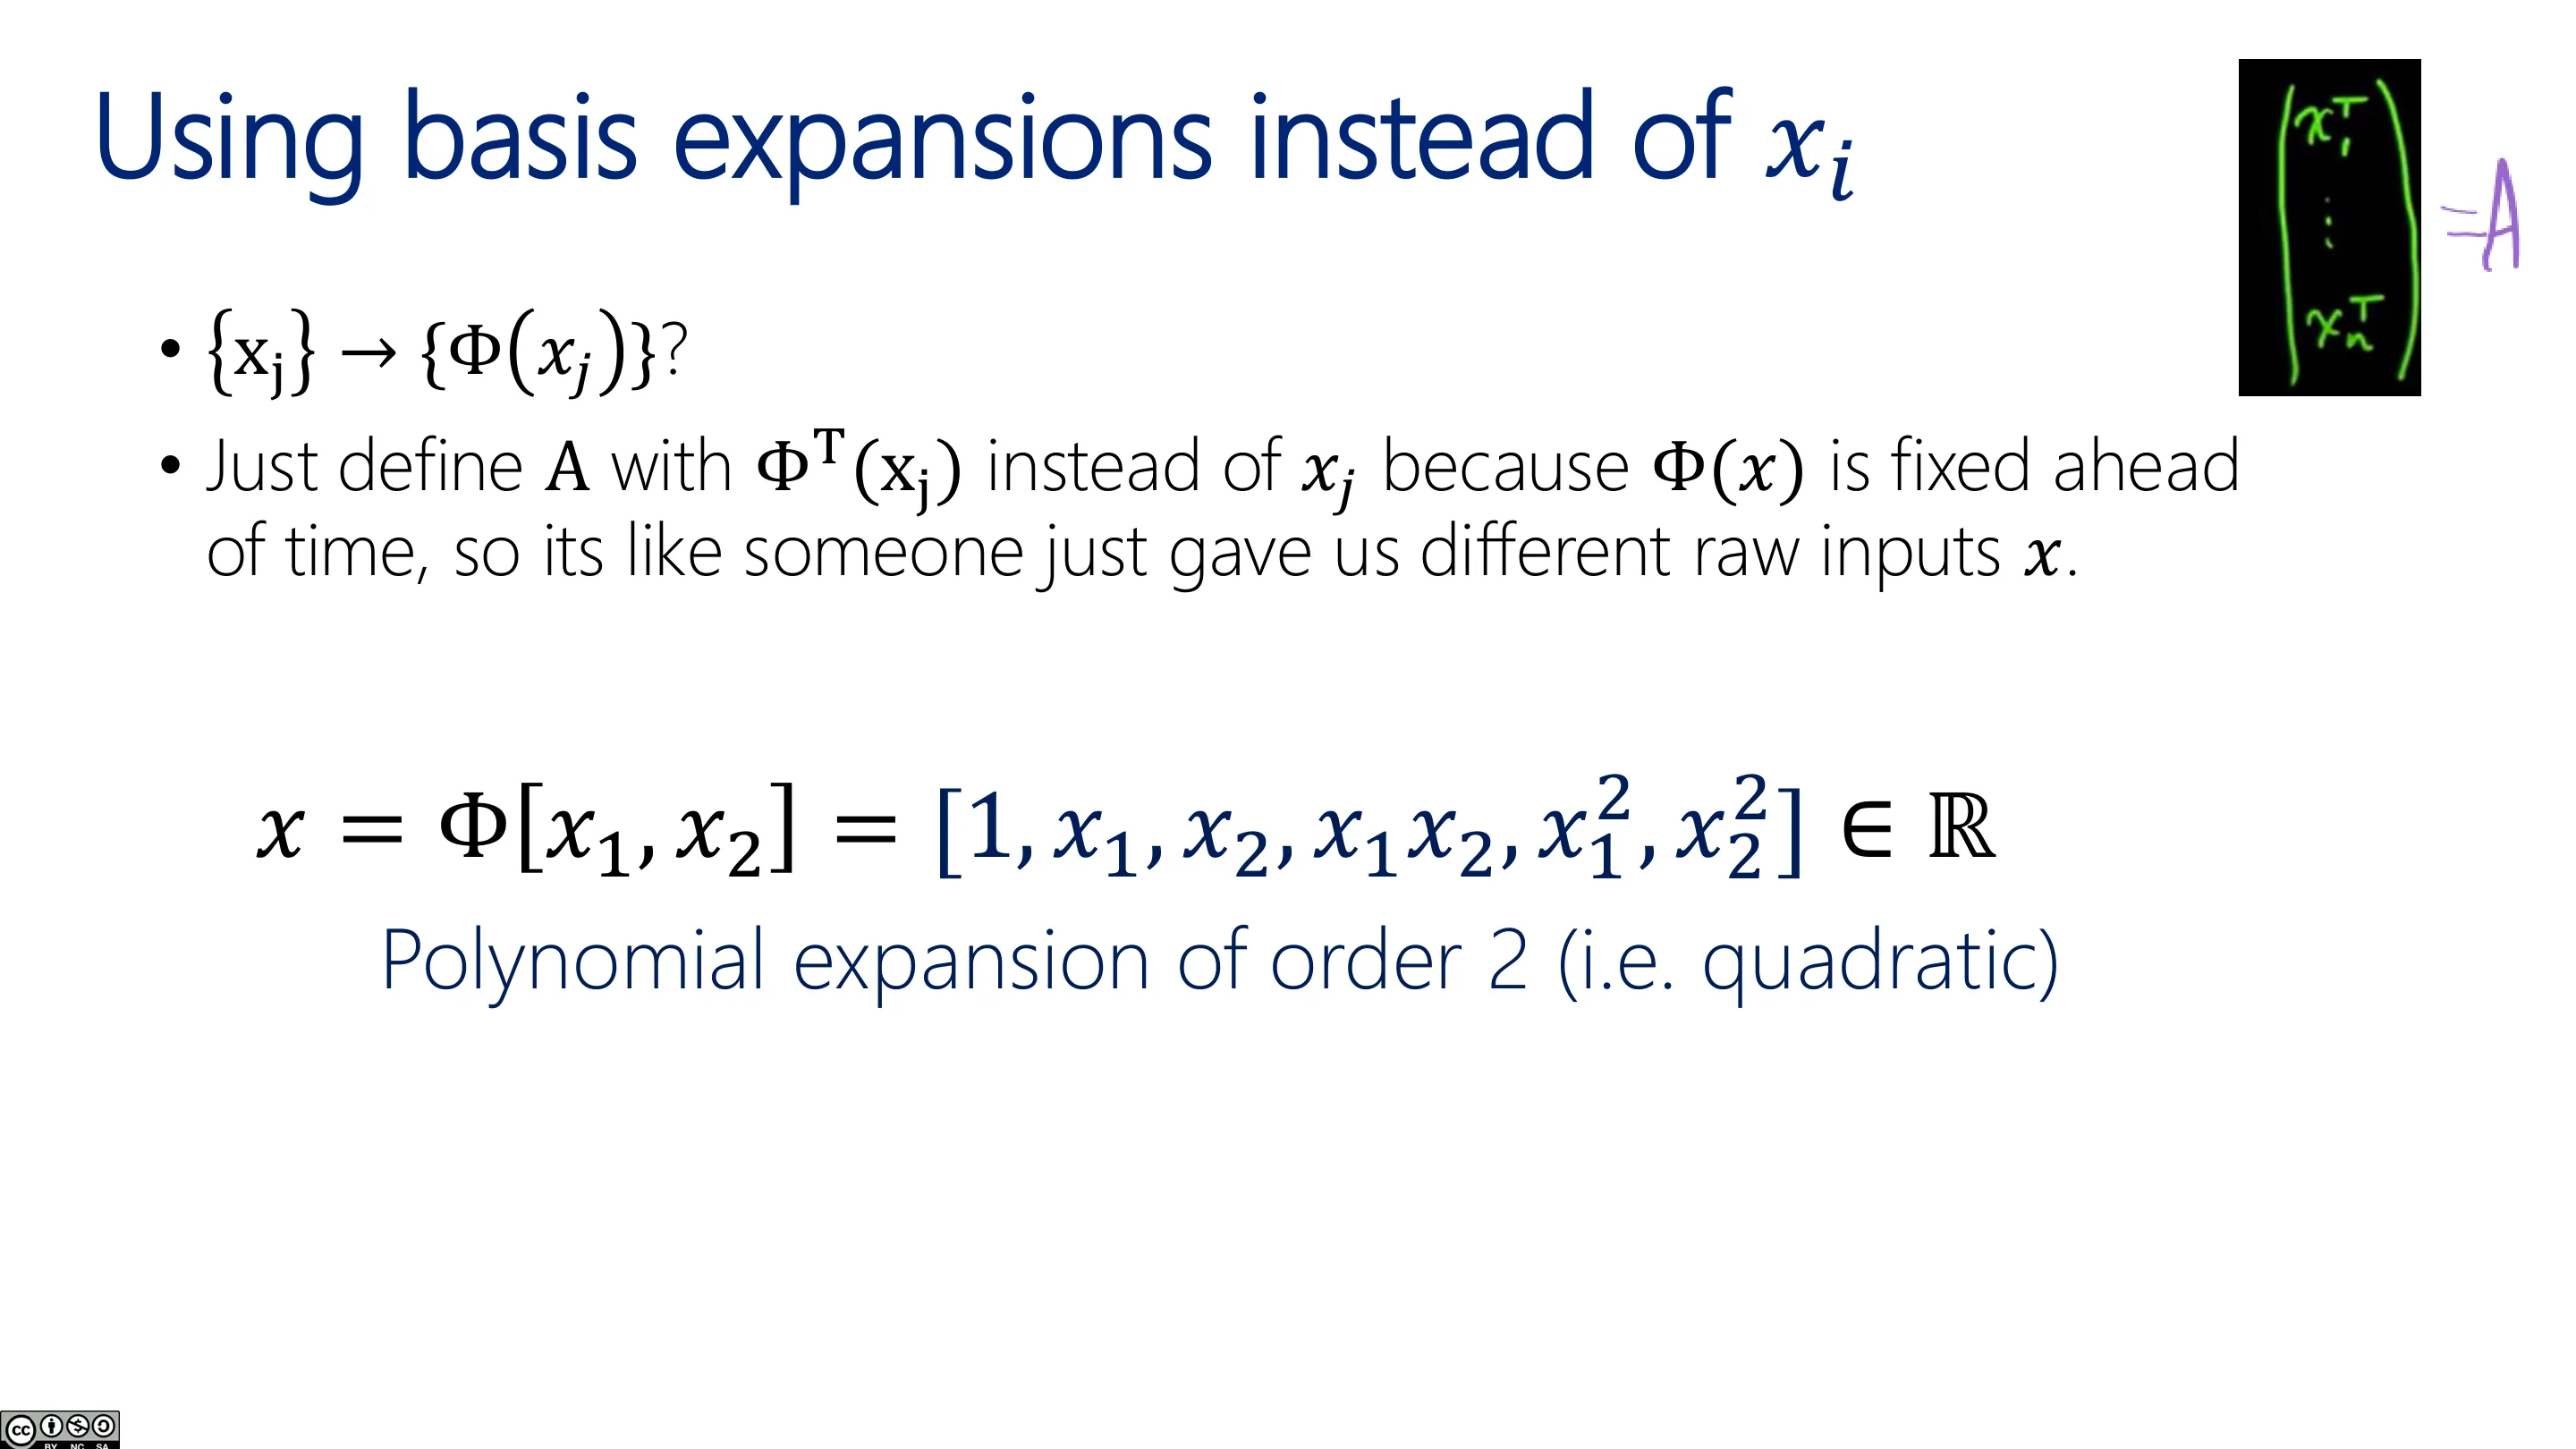
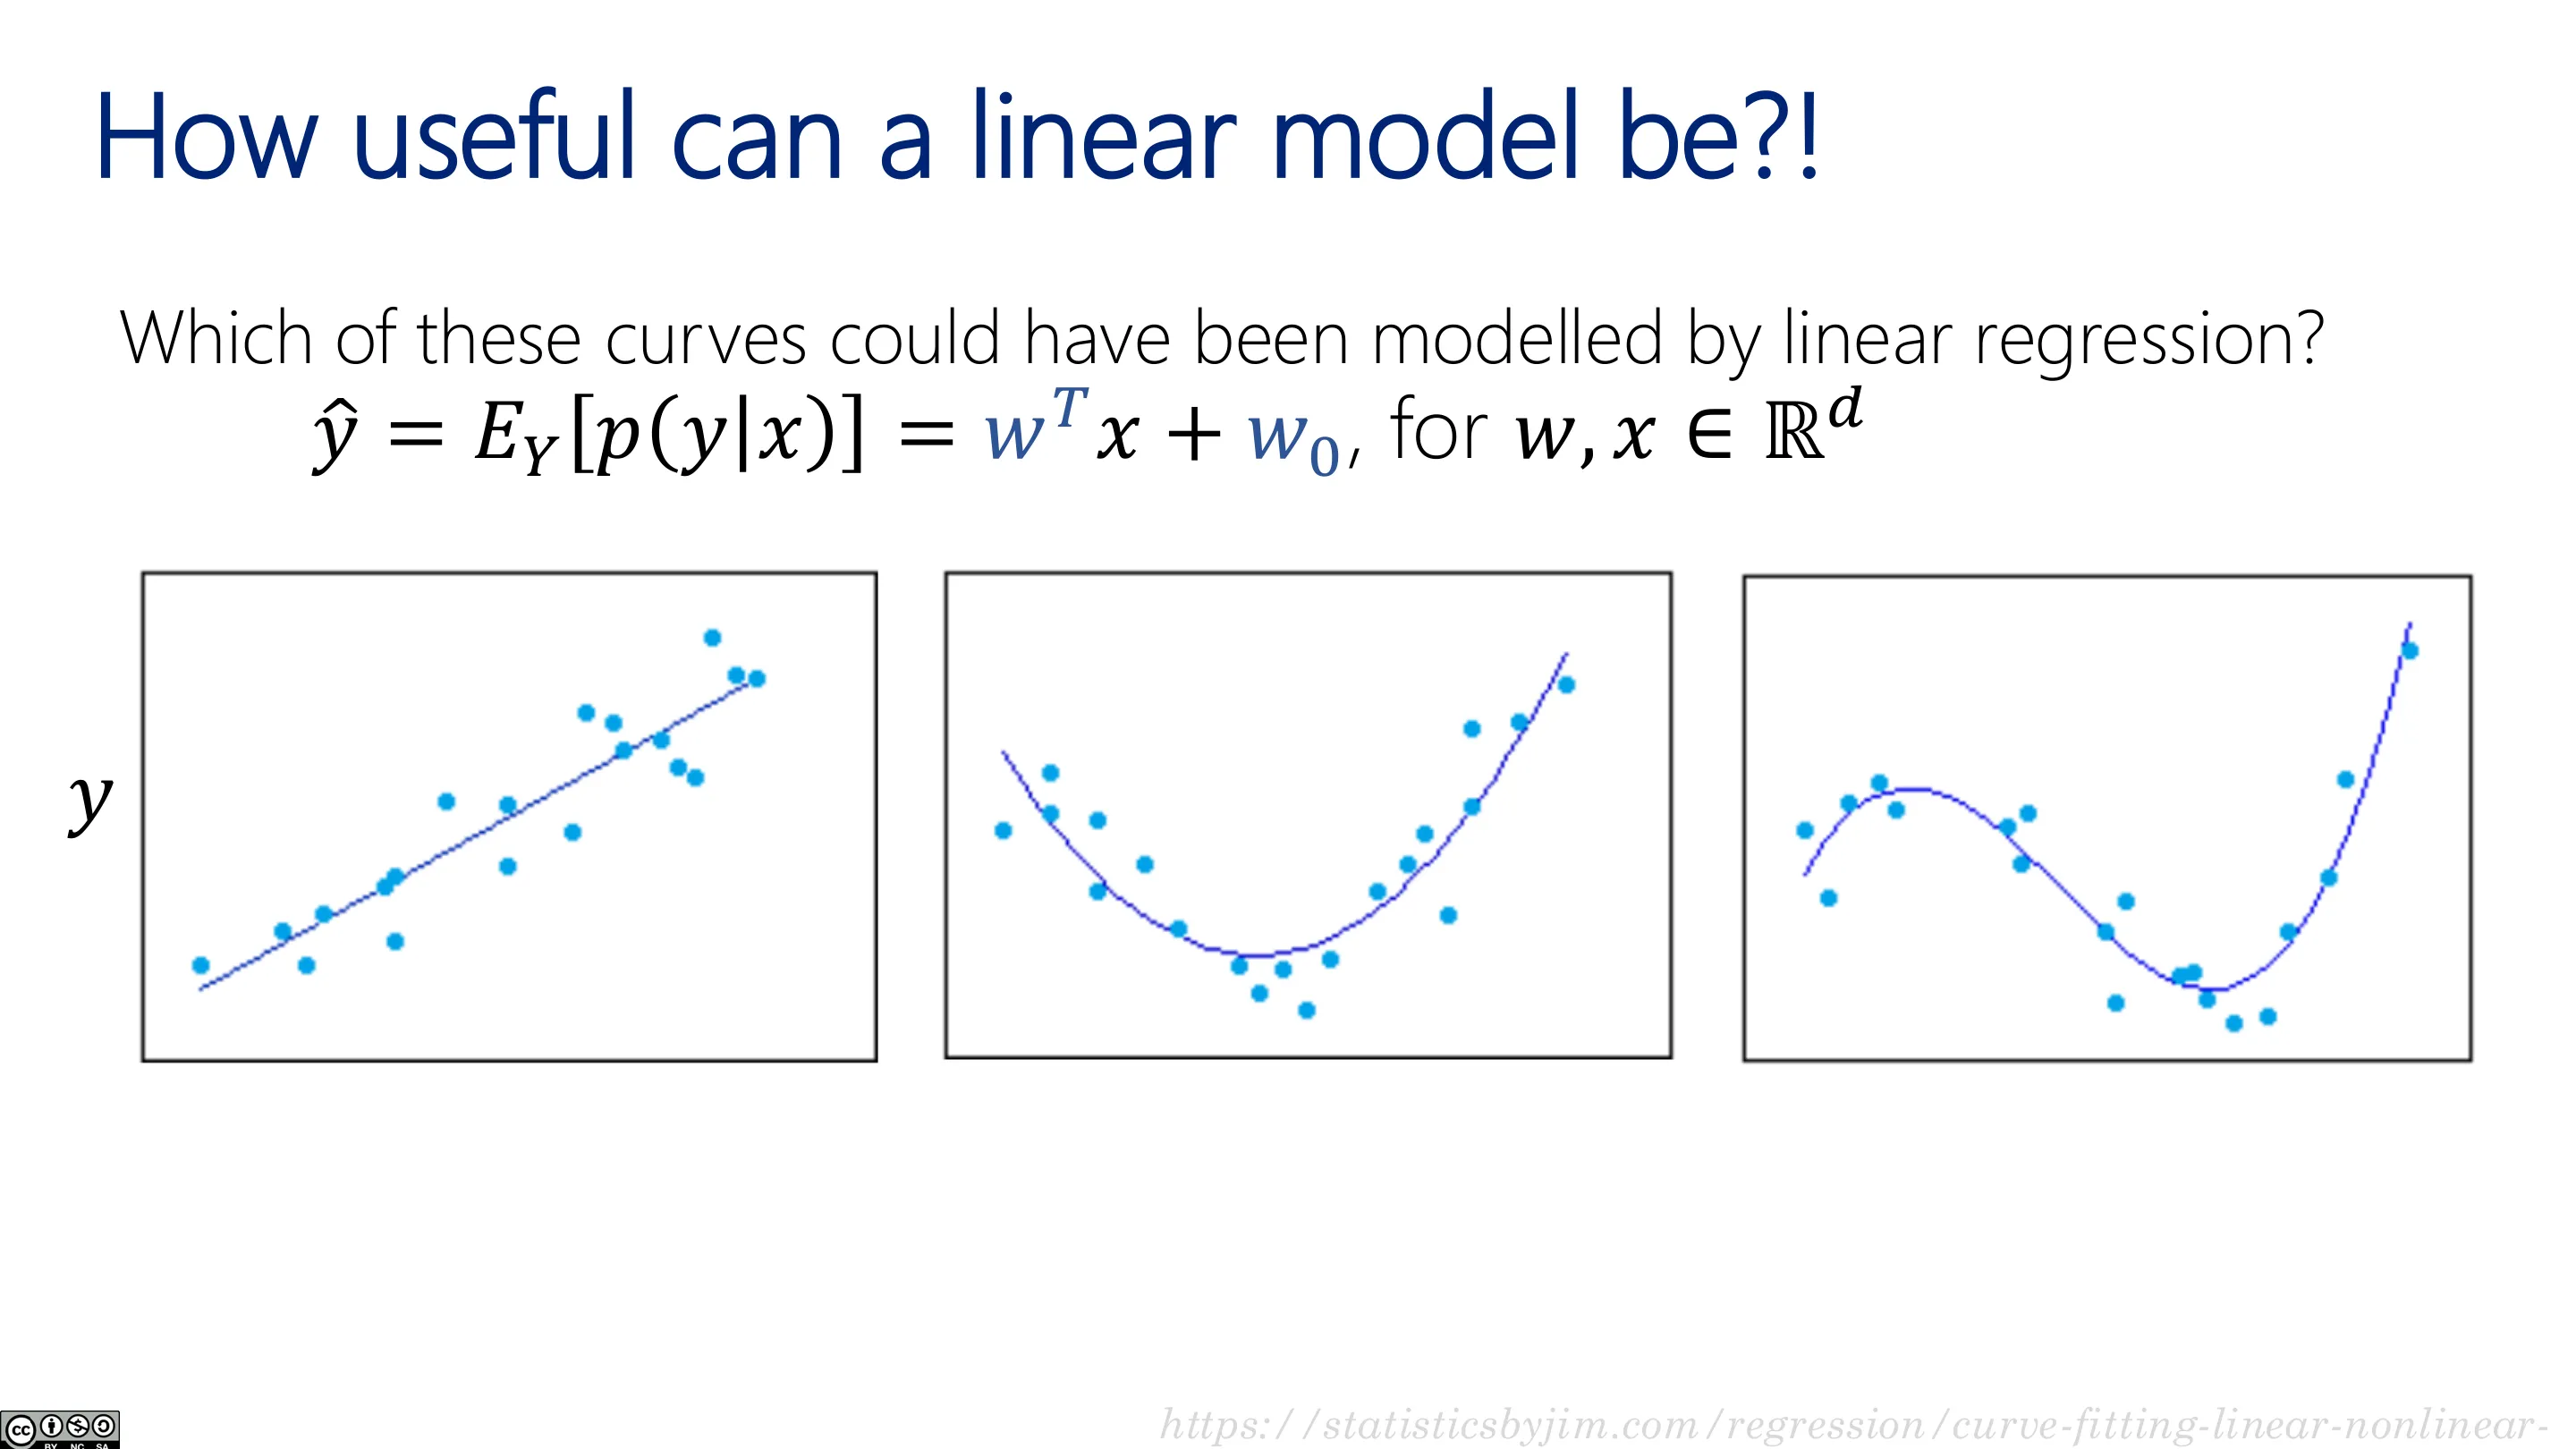
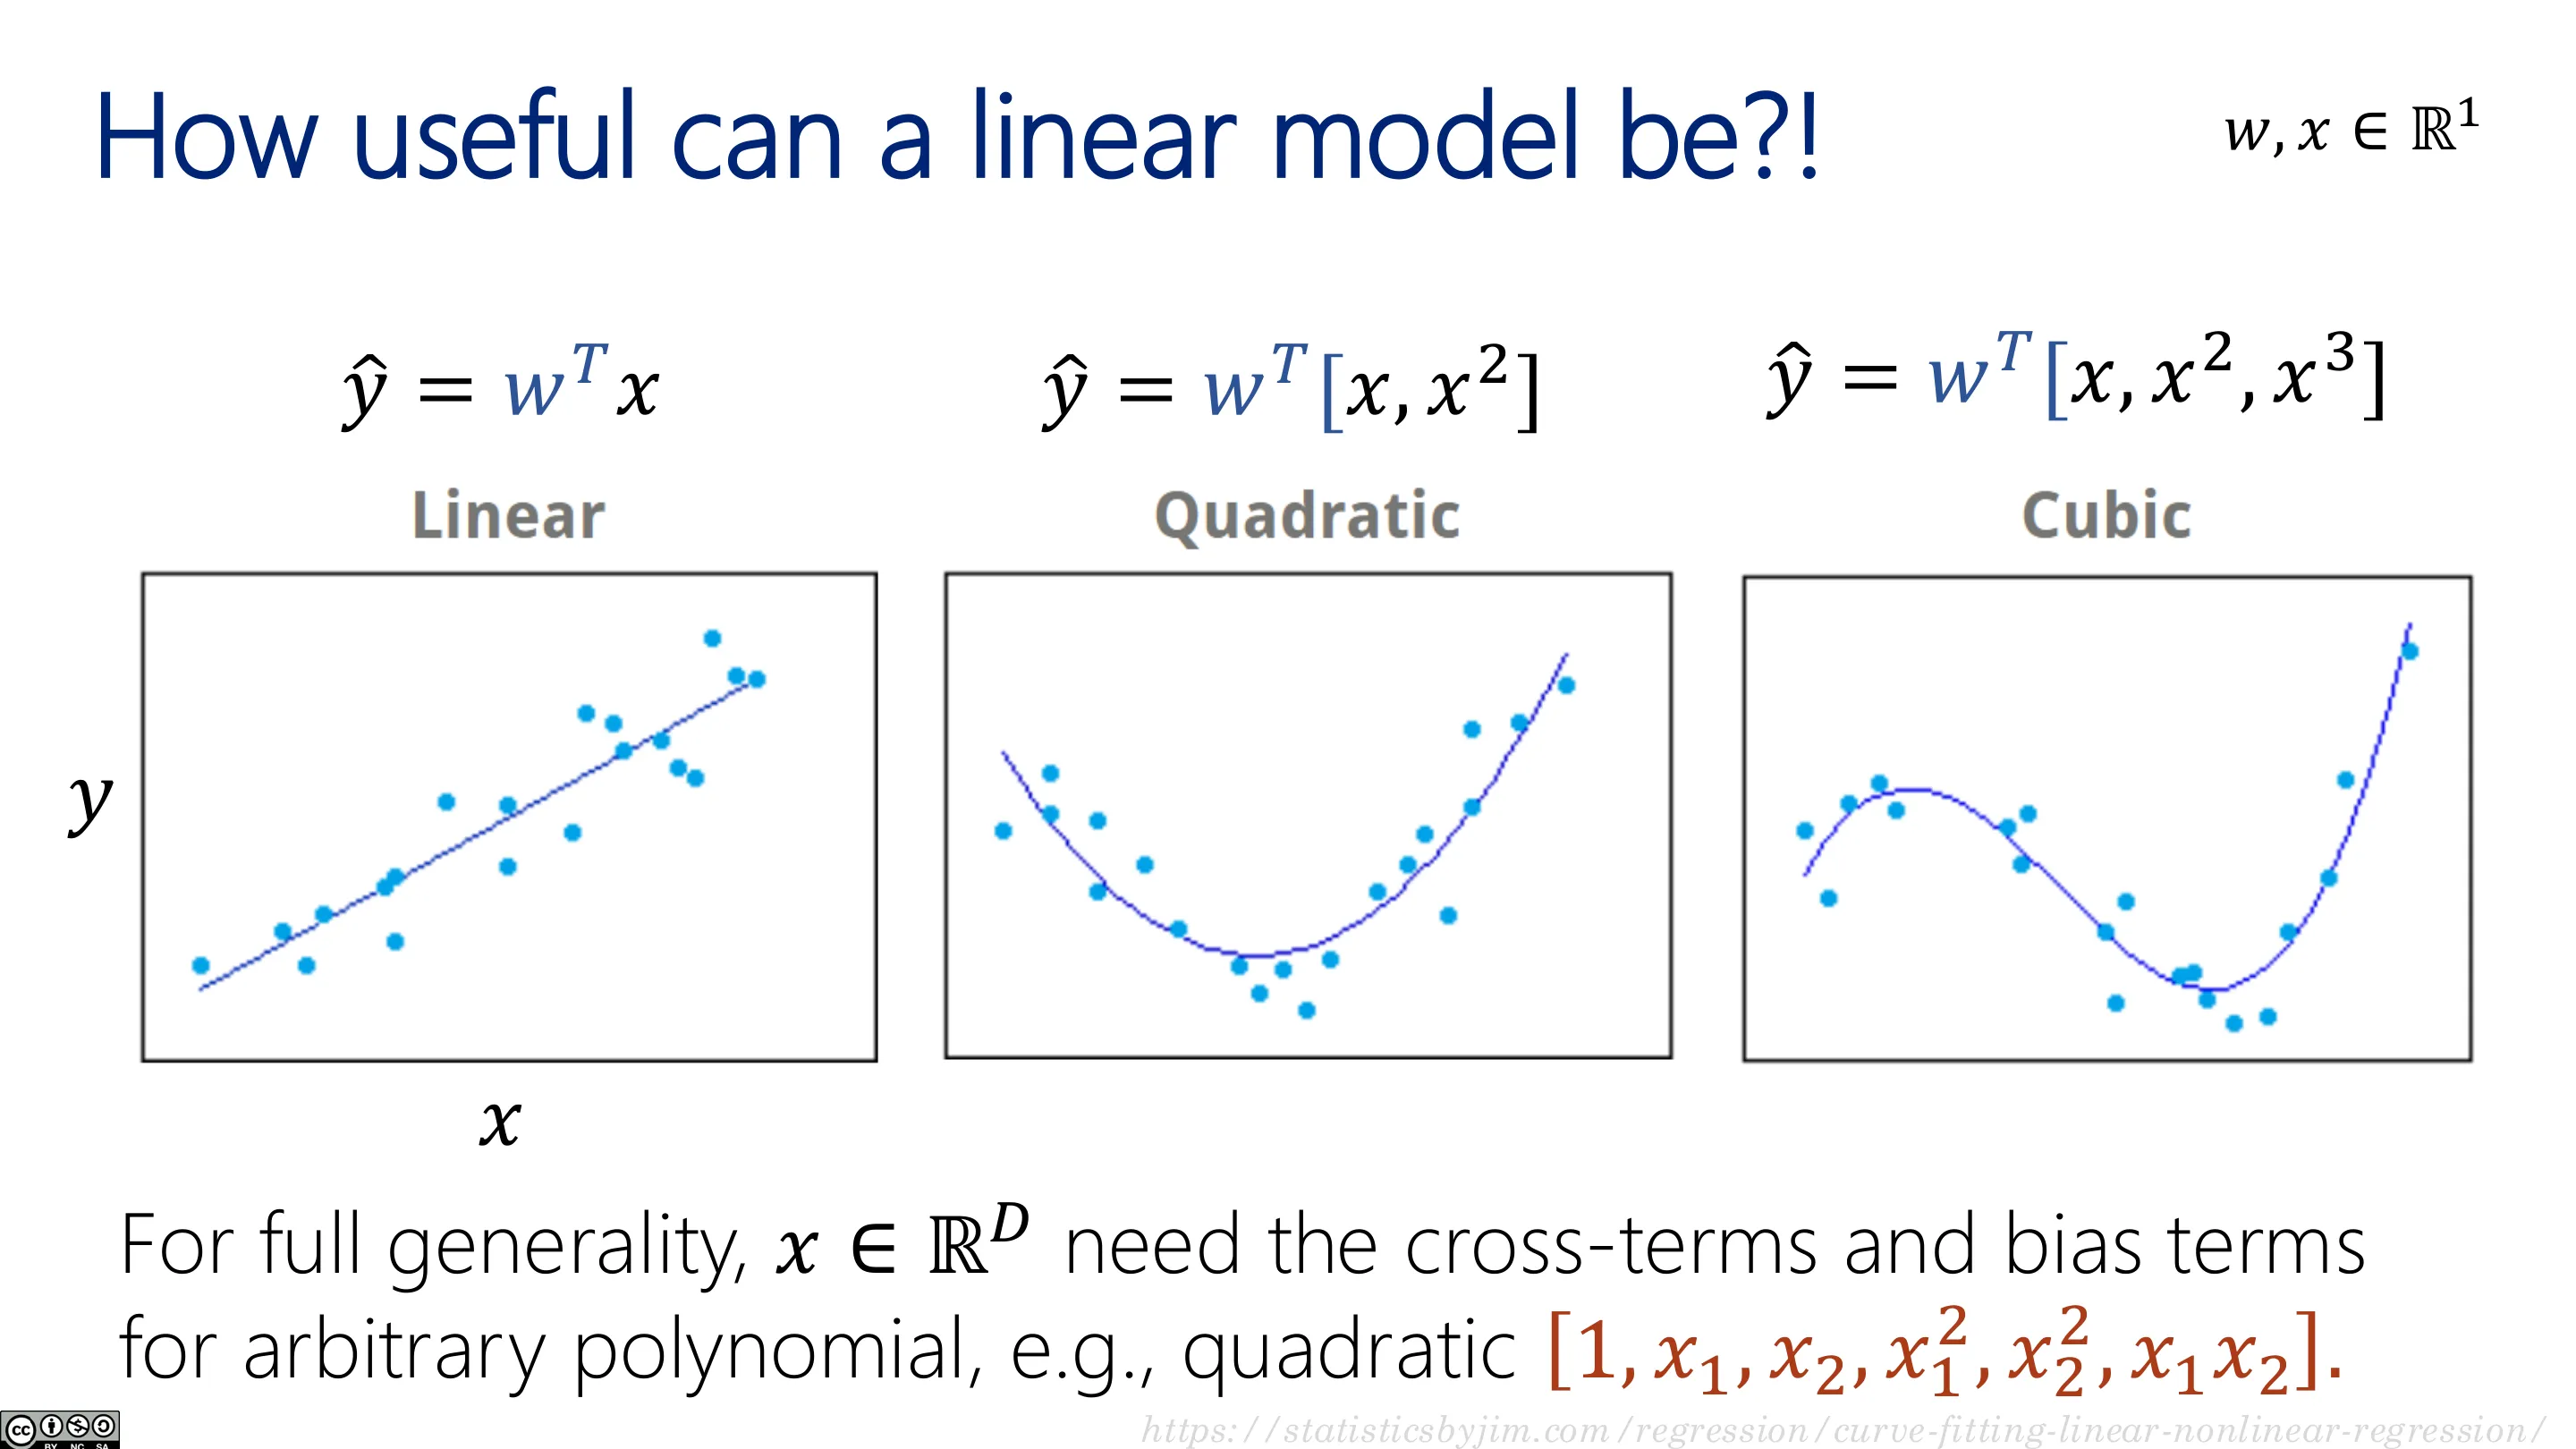
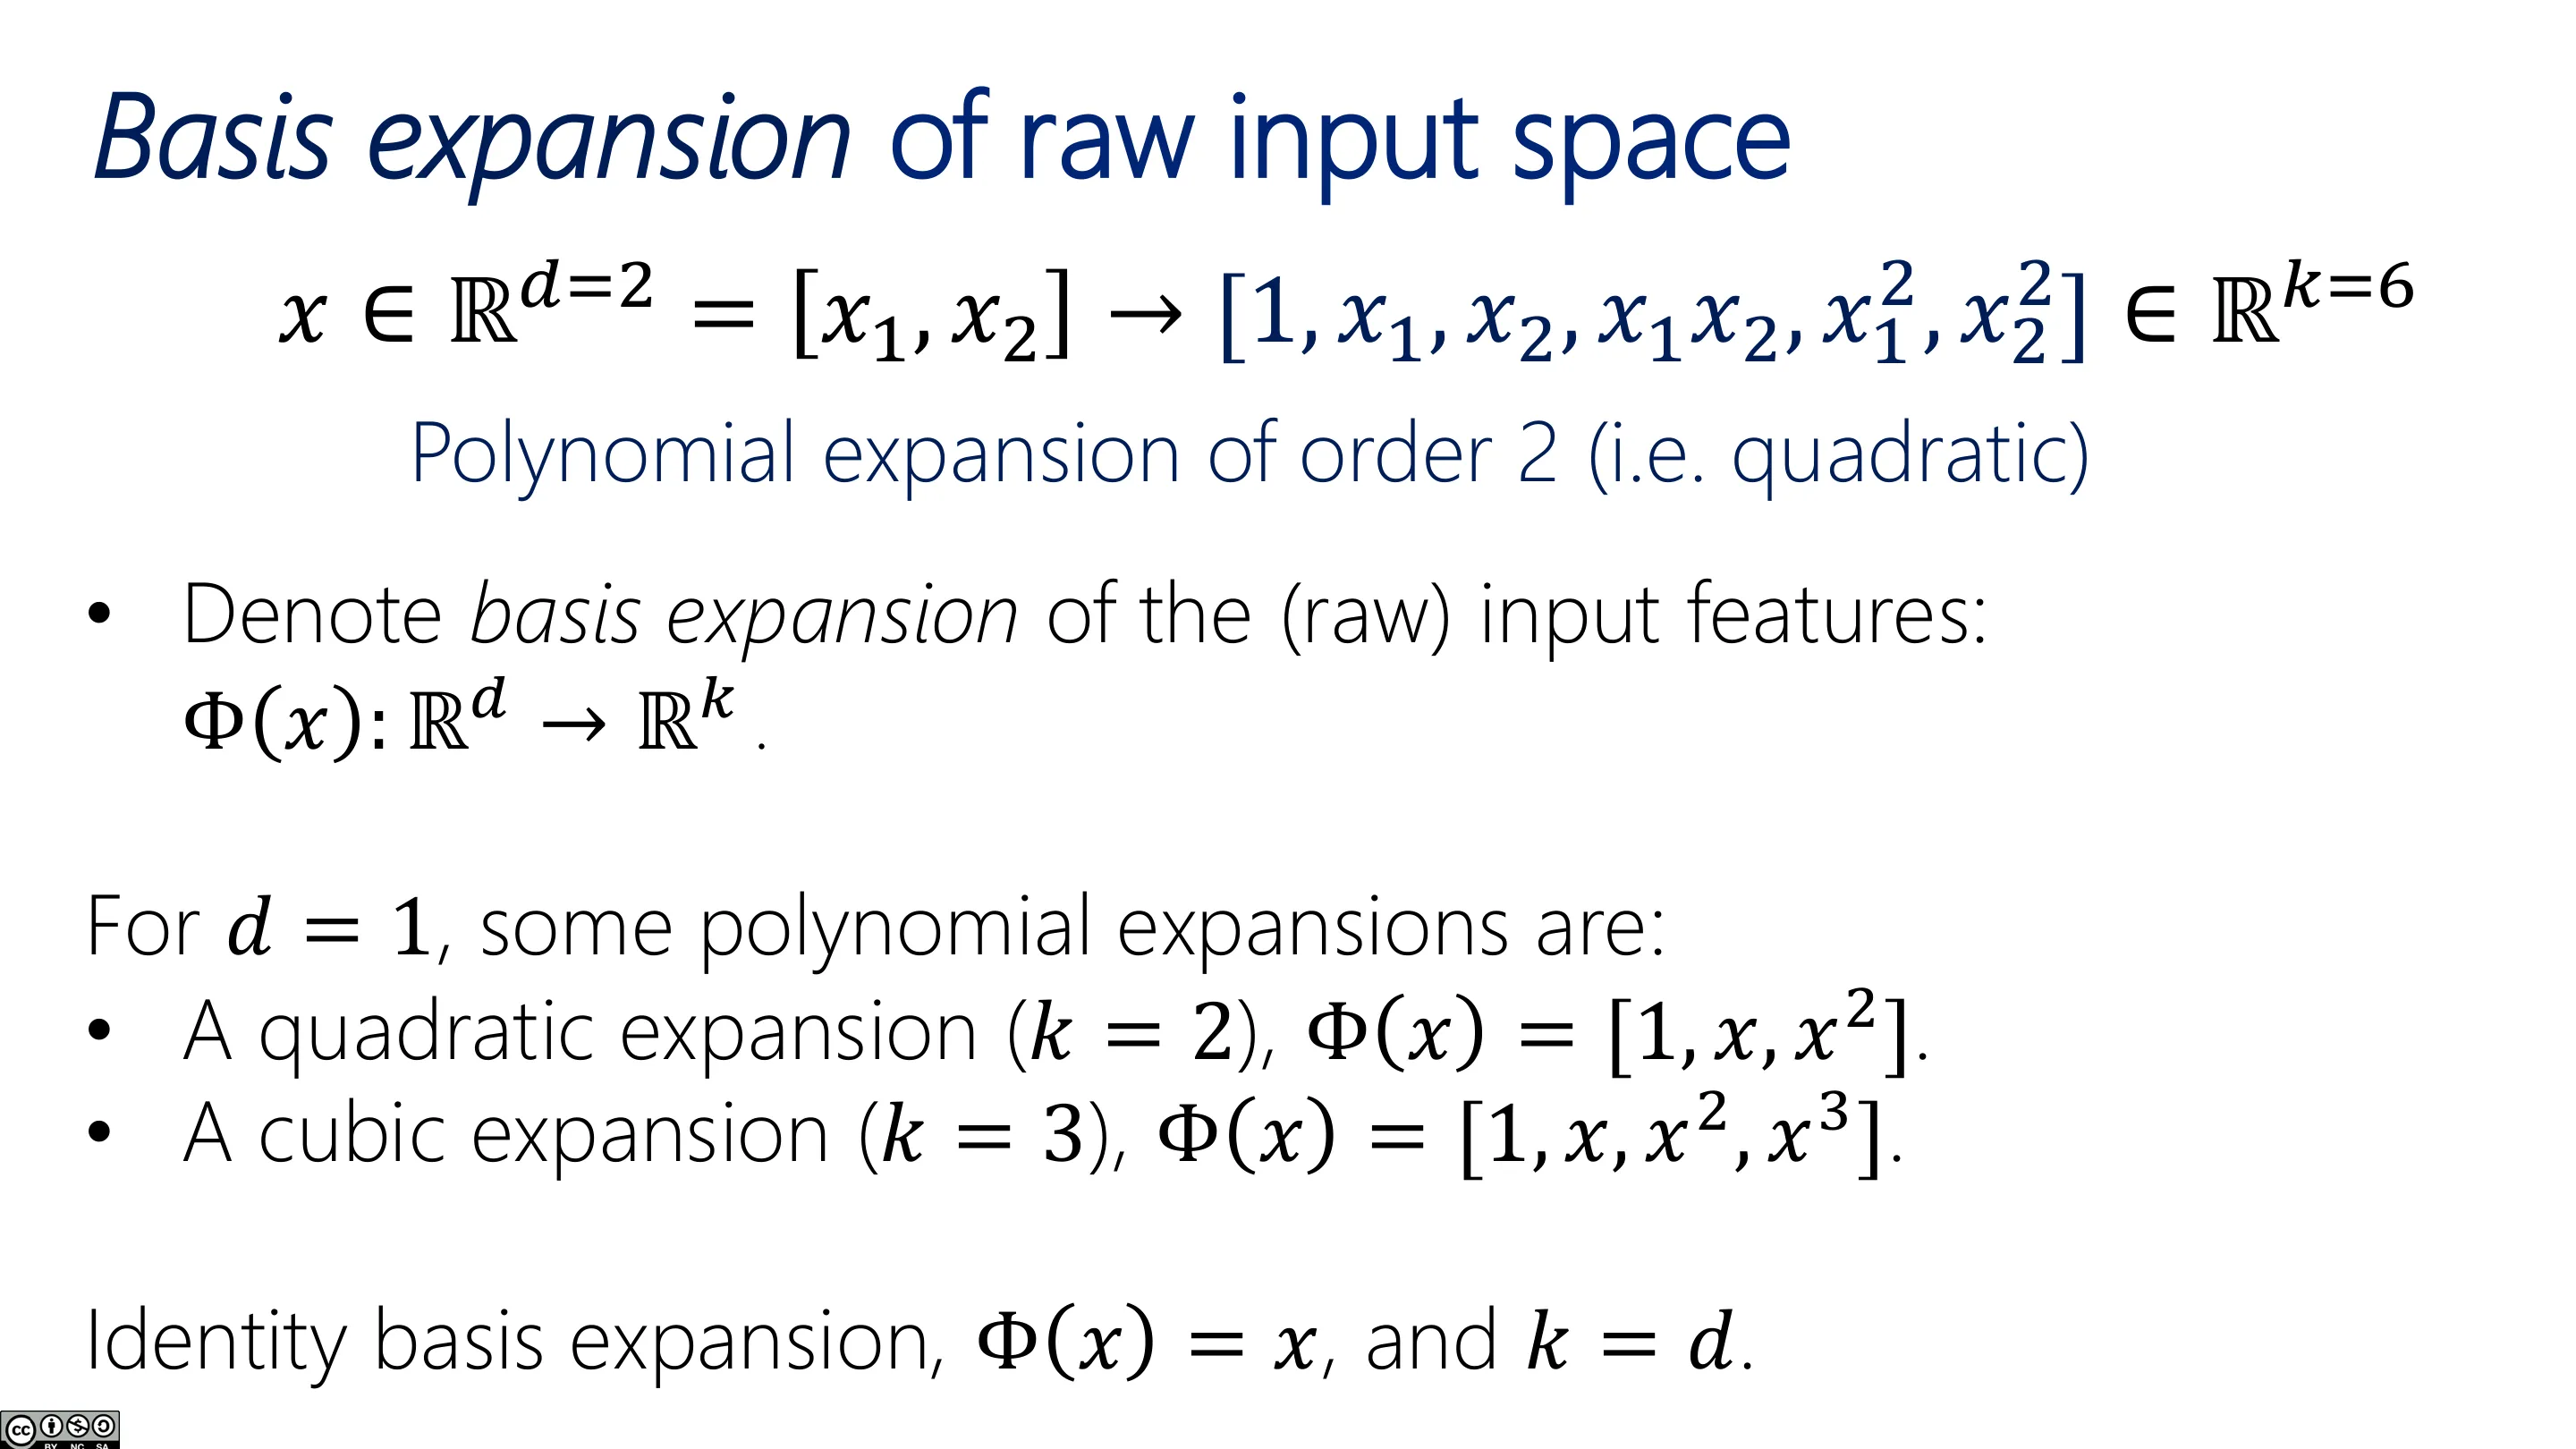
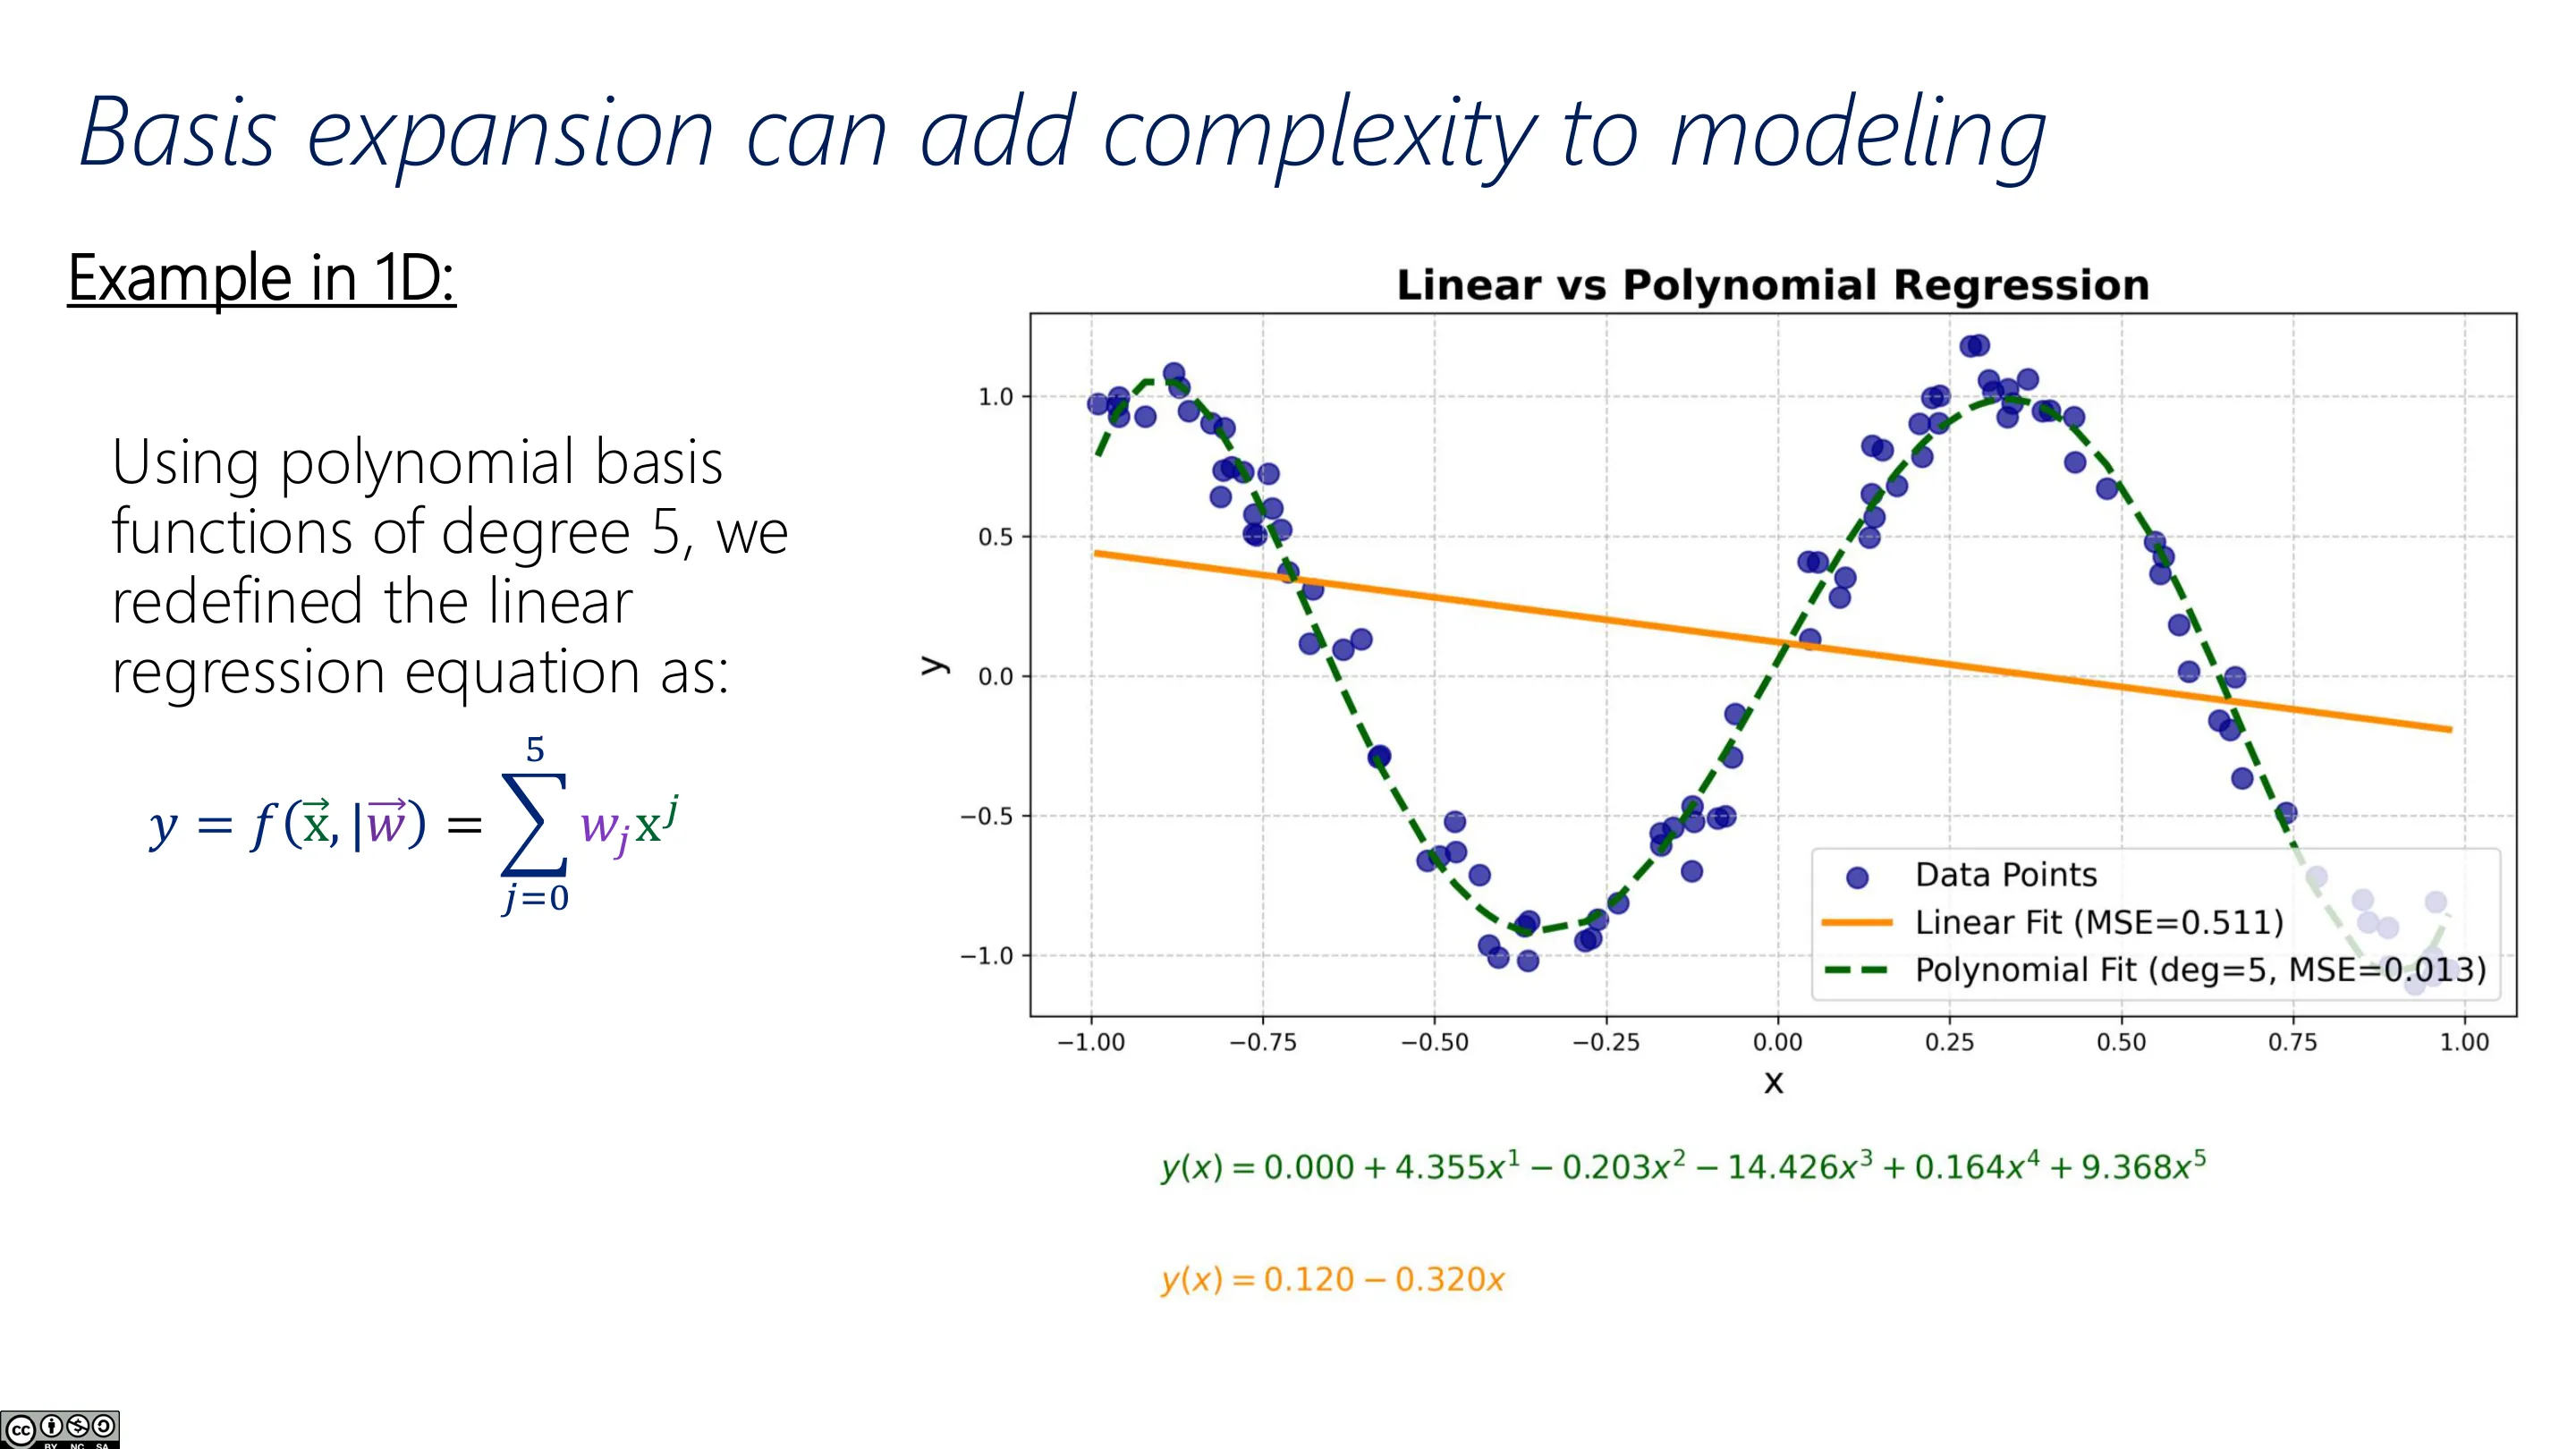
How useful can a linear model be?!——非常有用!关键技巧是基函数展开(basis expansion):把原始 $x$ 替换为 $\phi(x)$(如 $[1, x, x^2, x^3]$),再对其做线性回归。在增强特征空间里它仍是线性的,但在原始 $x$ 空间里它看起来是弯曲的曲线。
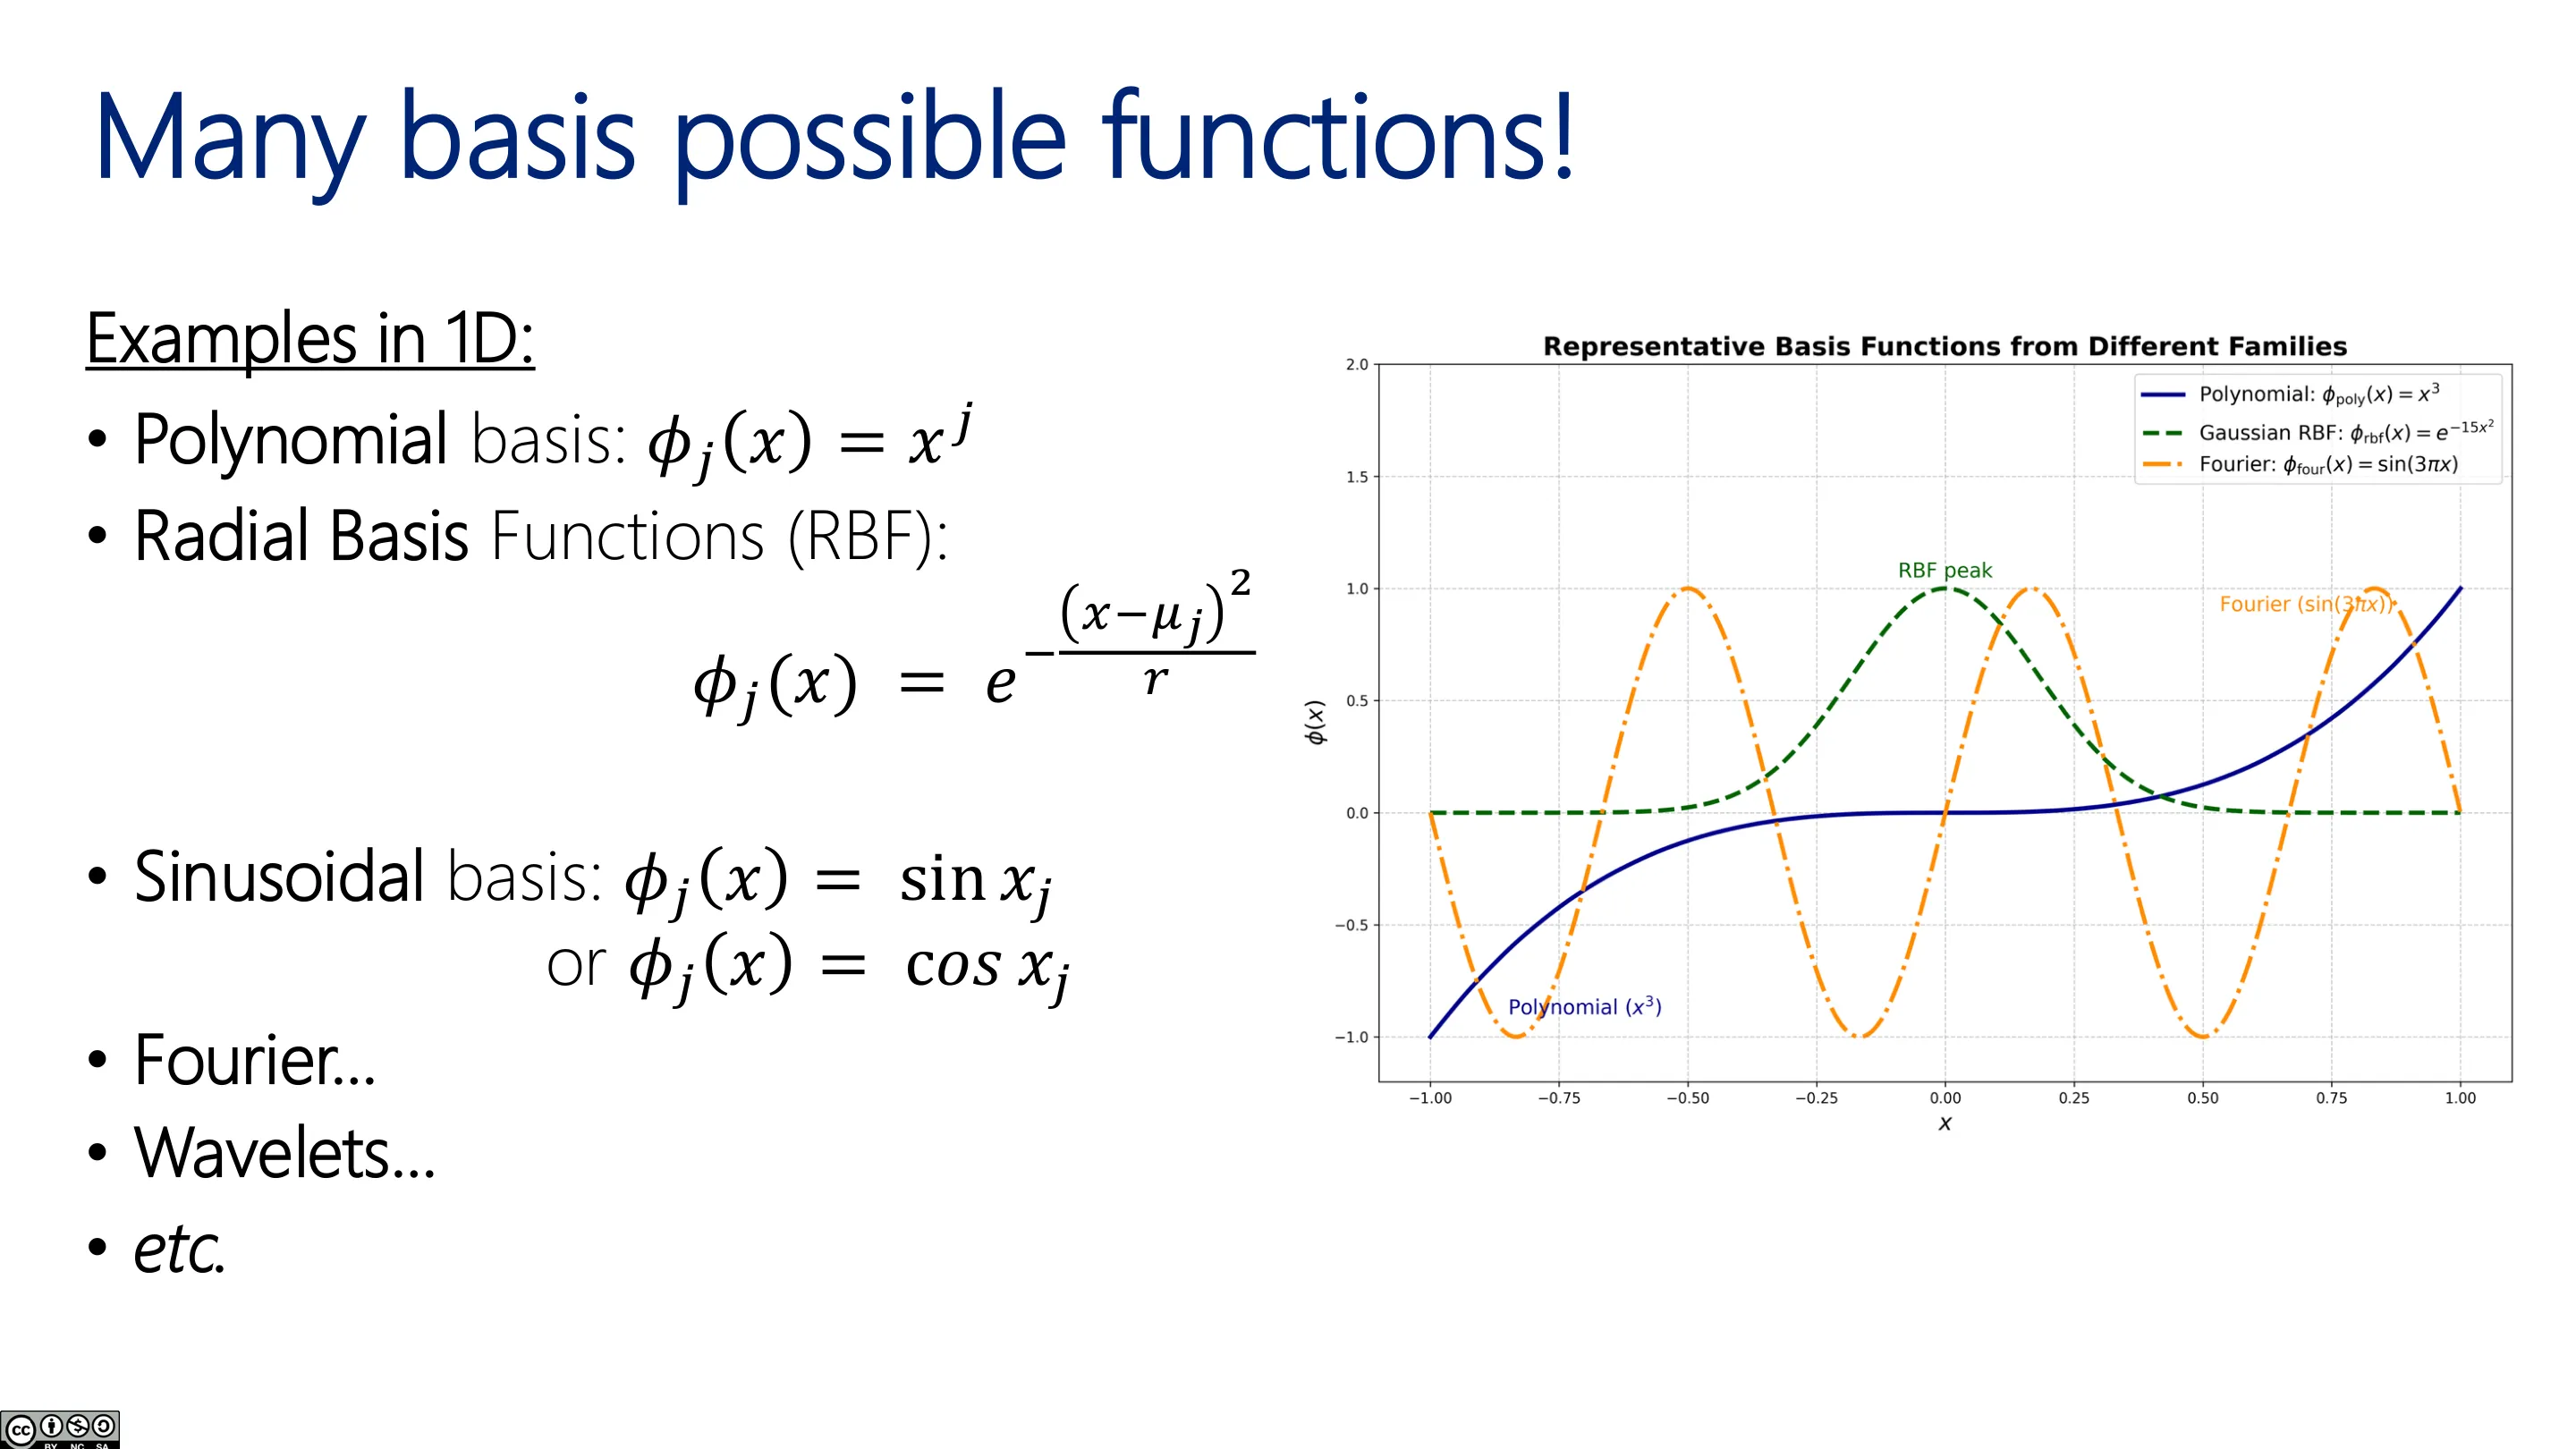
- 一维 多项式基:$k$ 阶展开得到 $k+1$ 个特征;
- 二维 完全多项式展开:加入交叉项、平方项……如 $d=2$ 的二阶展开得到 6 维特征 $\{1, x_1, x_2, x_1^2, x_1x_2, x_2^2\}$;
- 还有 径向基函数(RBF)(带均值/半径超参数)、傅里叶展开、小波等;
- 理论上可扩展到无限维(核学习)。
更多特征 ⇒ 更多自由参数 ⇒ 模型更灵活,但也需要更多数据来估计。现代深度学习(神经网络)的威力之一,就是自适应地学习有用的基函数,而不必手工设计。
📷 基函数展开
回到原视频 (00:48:45)
📷 原始输入空间的基展开
回到原视频 (00:49:45)
📷 一维例子
回到原视频 (00:50:30)
📷 多项式基
回到原视频 (00:51:20)
📷 线性回归的具体形式
回到原视频 (00:52:30)
📷 重尾分布(旁注)
回到原视频 (01:00:50)
📷 高斯线性回归
回到原视频 (00:59:55)
三、训练:用 MLE 导出最小二乘
(参考时间: 01:03)
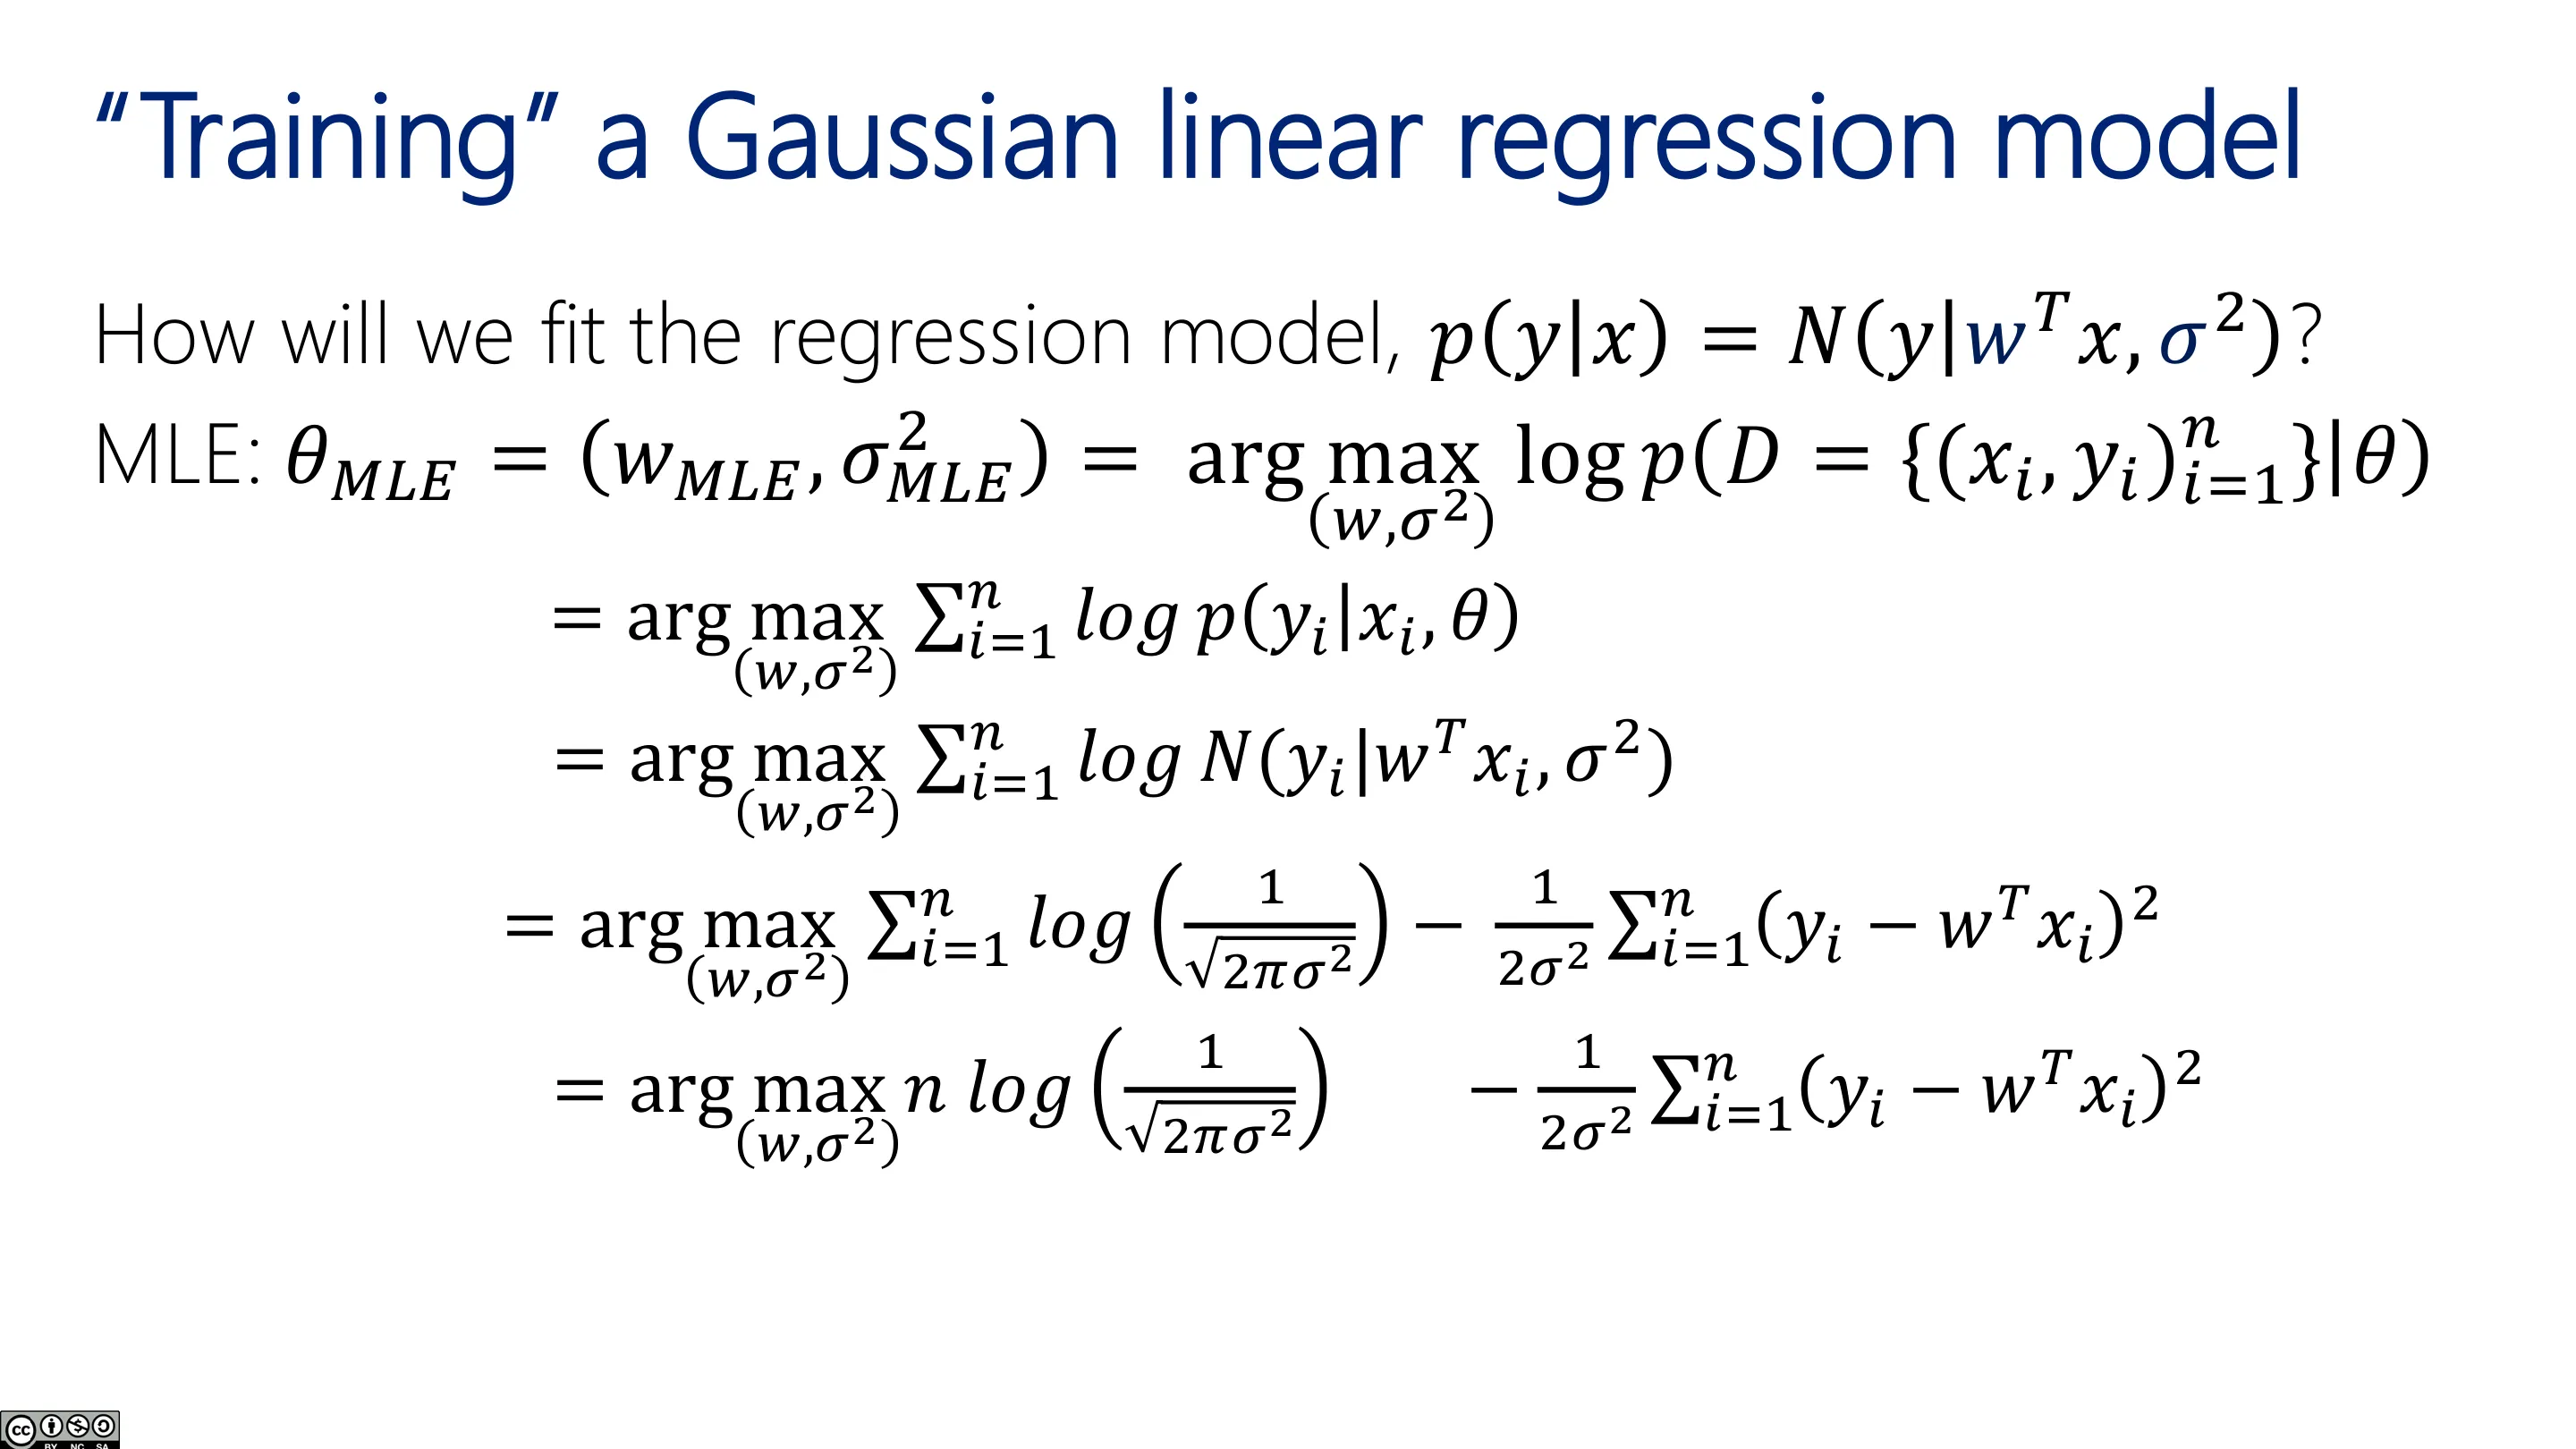
高斯线性回归中,预测分布的均值随 $x$ 变化(就是 $w^\top x$),而方差 $\sigma^2$ 在所有位置相同(统计学家称为同方差性 homoscedasticity)。
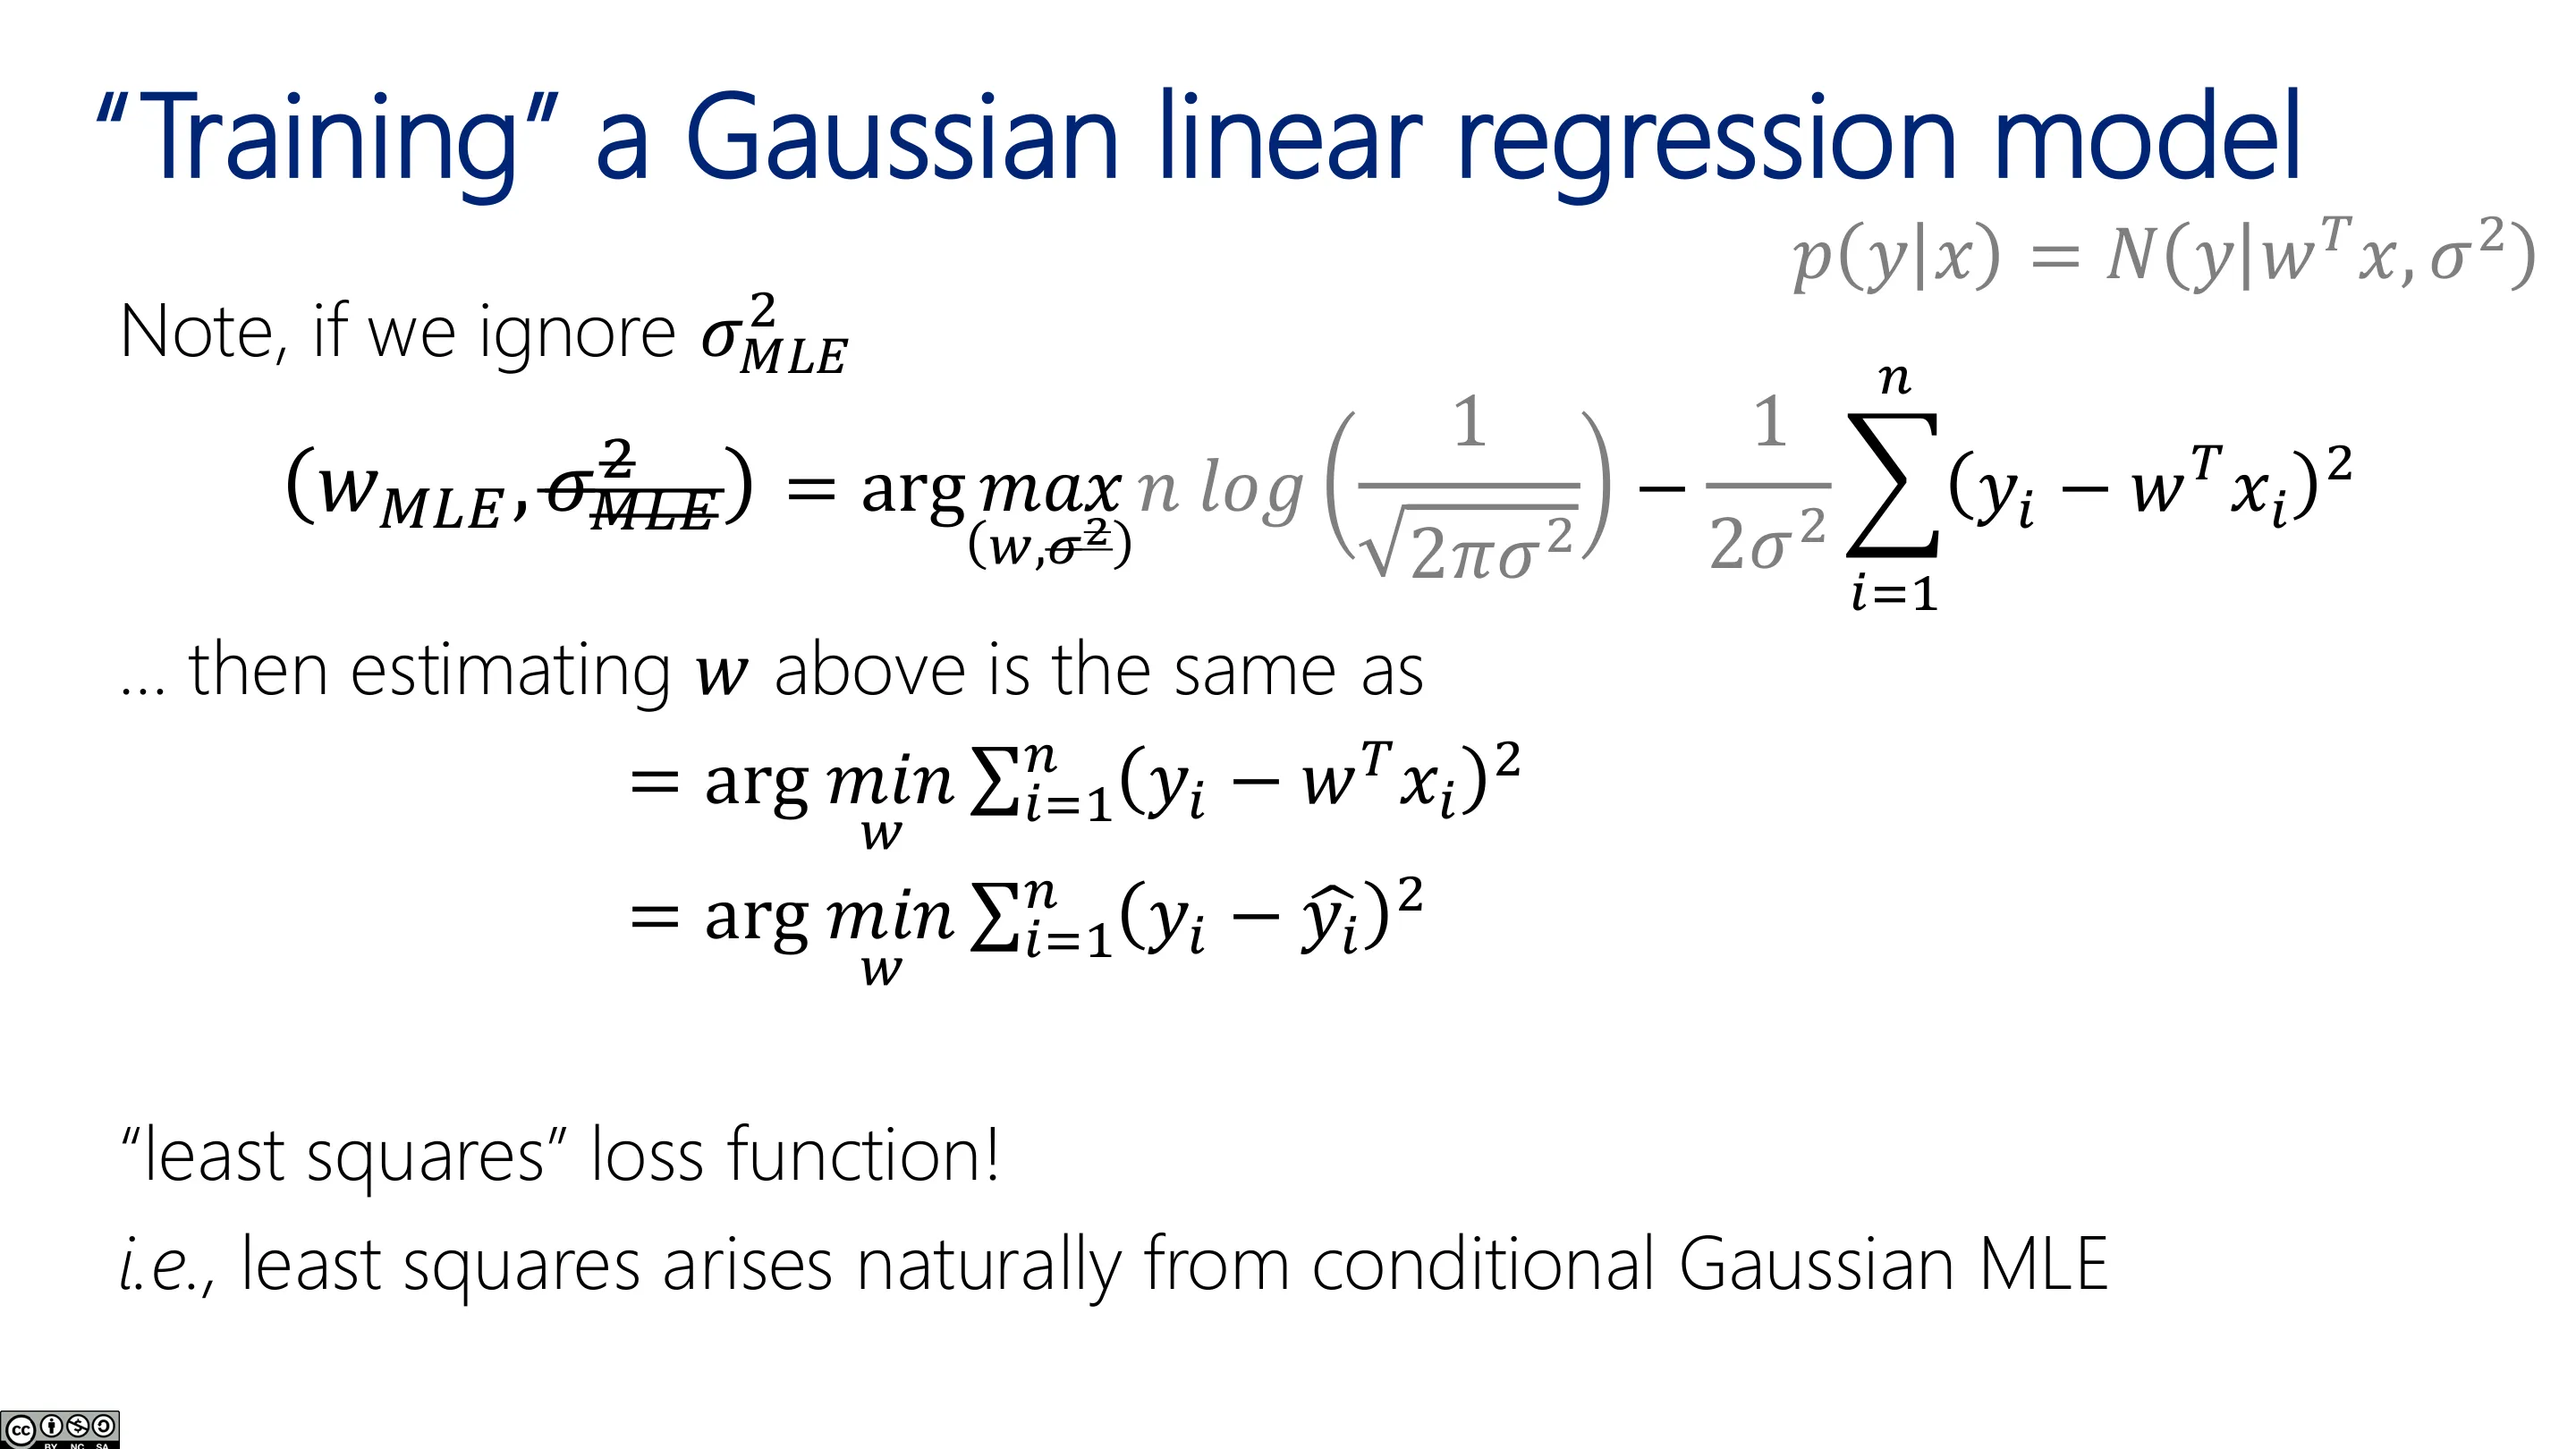
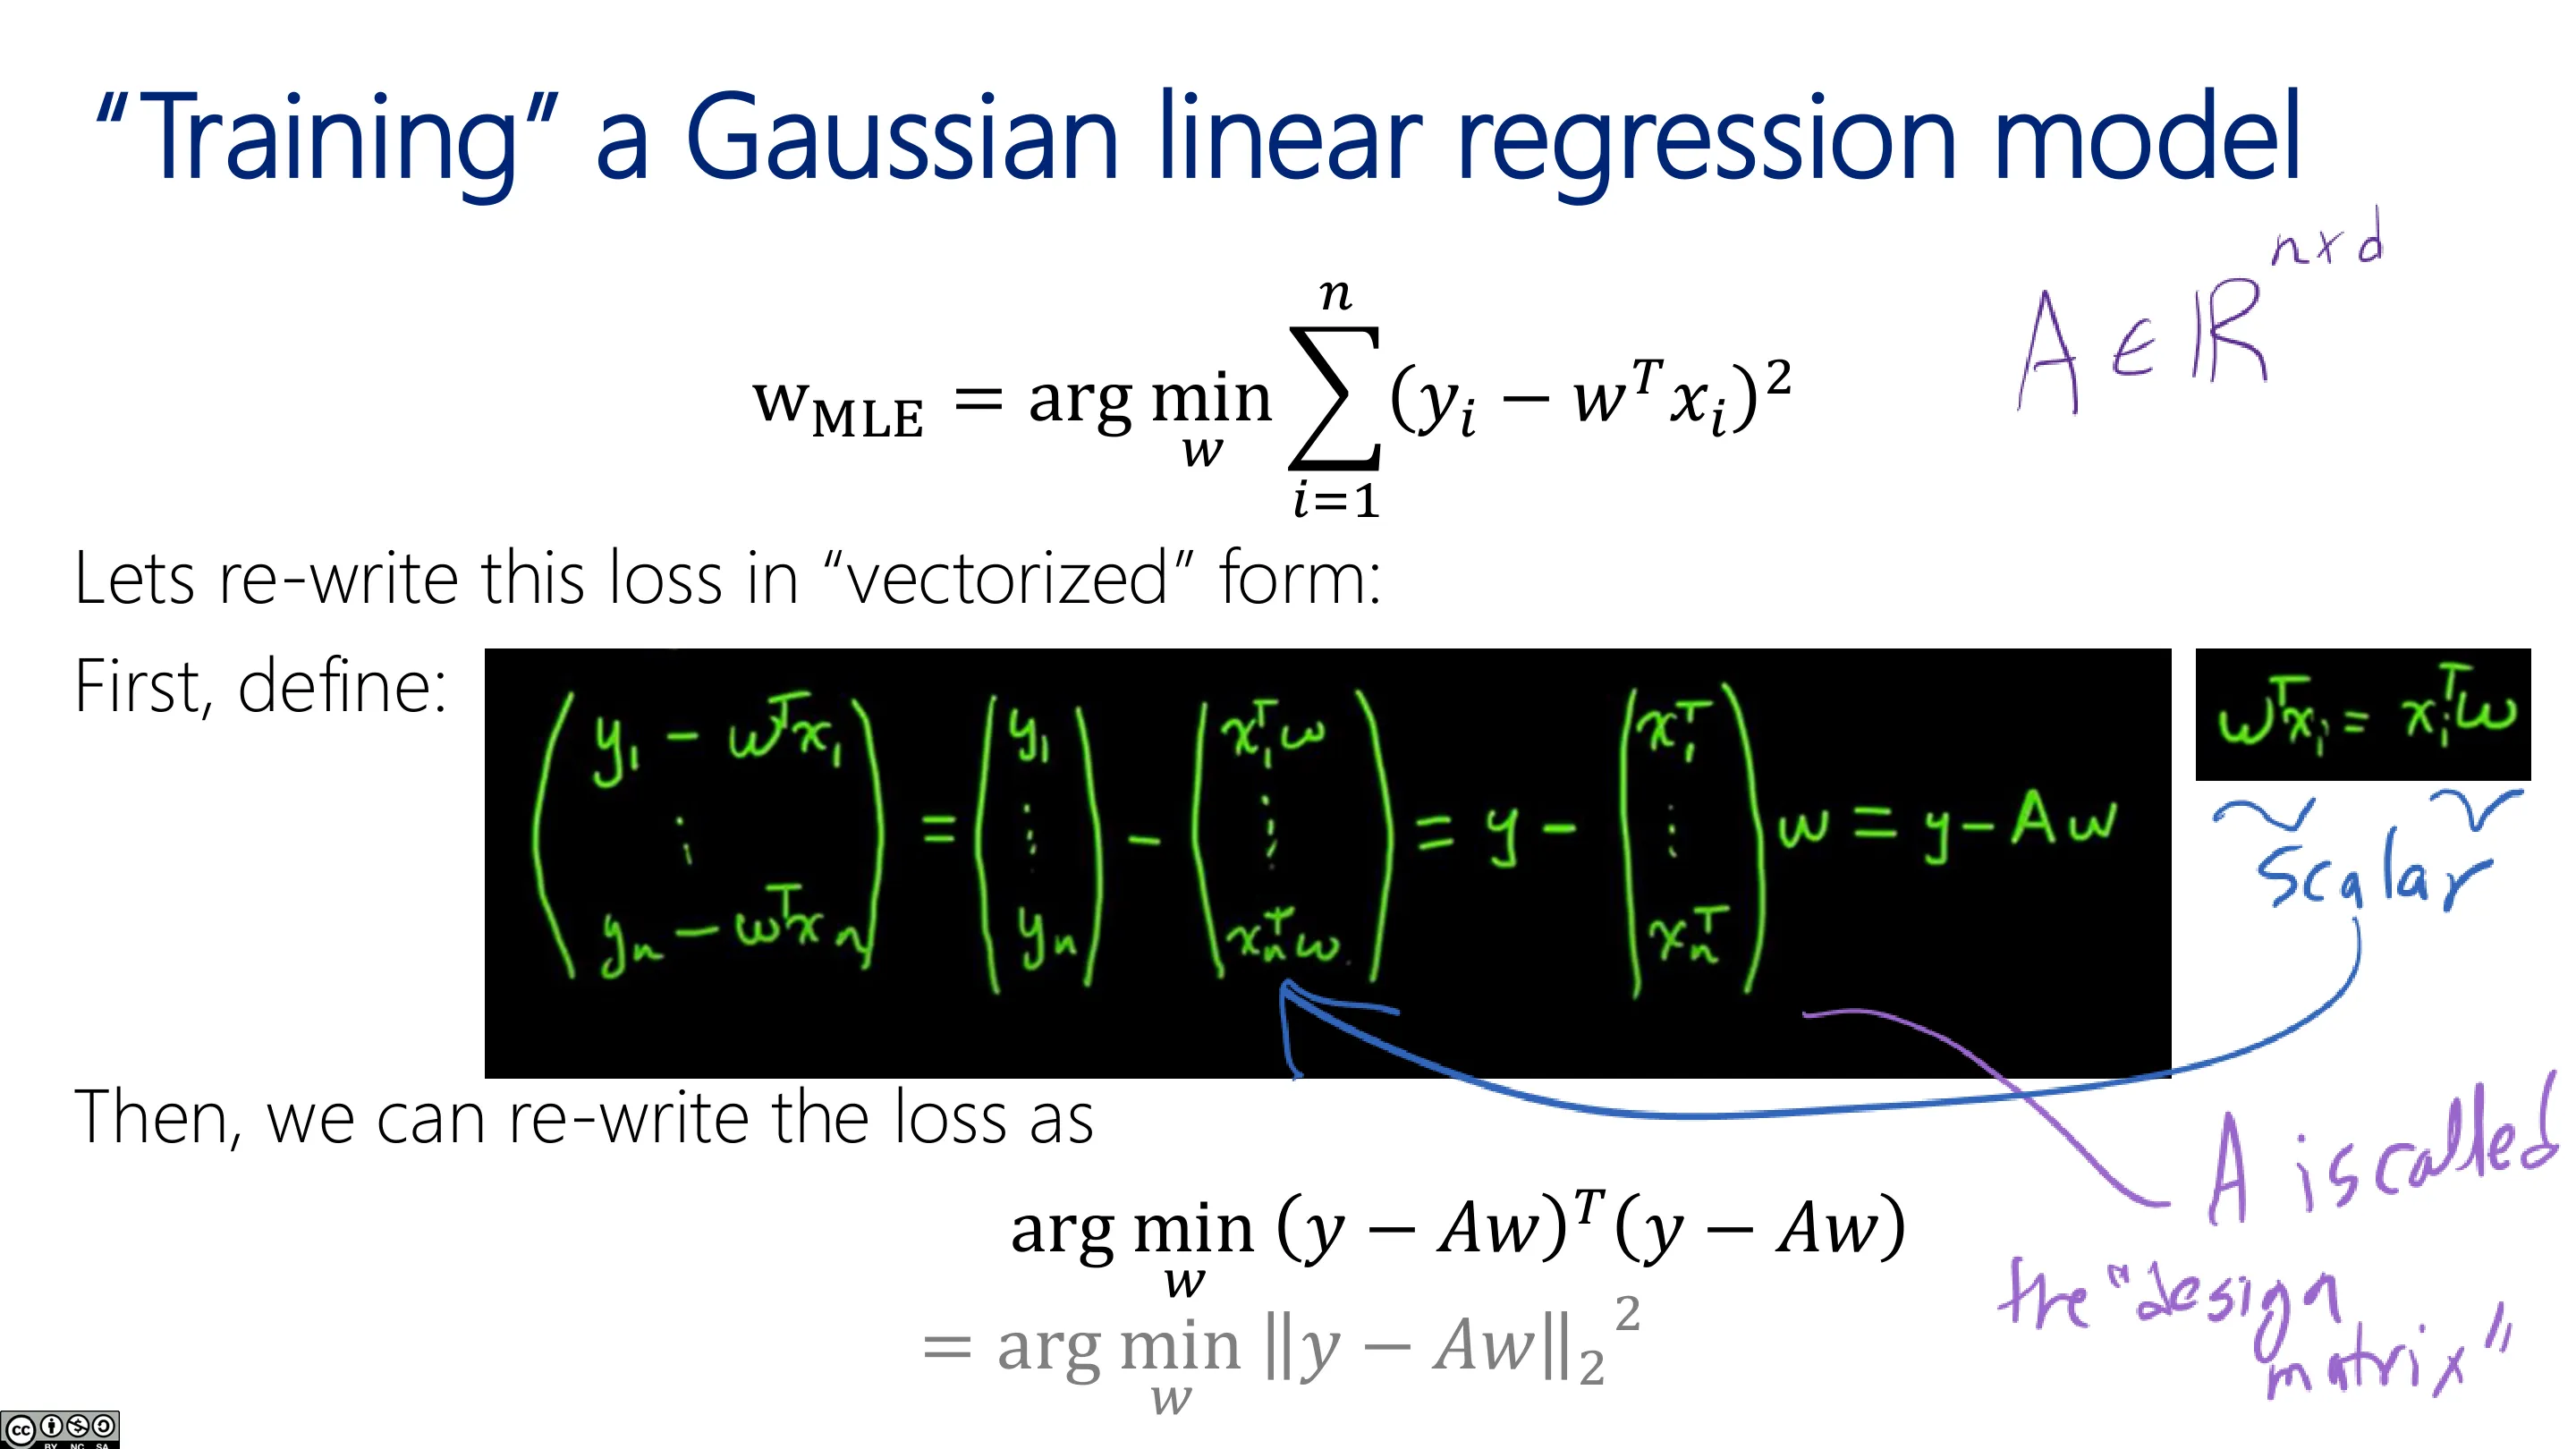
训练 = 用 MLE 估计 $w$ 和 $\sigma^2$:最大化对数似然(IID ⇒ 乘积 → 取对数 → 求和)。把高斯代入并对 $w$ 求导、令其为零,$\sigma$ 的项不含 $w$,于是从优化中消失,只剩下
$$ \hat w_{\text{MLE}}=\arg\min_w \sum_{i=1}^{N}\big(y_i-w^\top x_i\big)^2 $$
——这正是最小二乘 / 均方误差损失!这印证了第 3 讲的说法:平方损失可以从最大似然原理推导出来。
📷 训练高斯线性回归(一)
回到原视频 (01:03:30)
📷 训练高斯线性回归(二)
回到原视频 (01:04:10)
📷 训练高斯线性回归(三)
回到原视频 (01:05:20)
📷 训练高斯线性回归(四)
回到原视频 (01:06:10)
📷 训练高斯线性回归(五)
回到原视频 (01:07:20)
📷 训练高斯线性回归(六)
回到原视频 (01:08:45)
3.1 向量化:设计矩阵
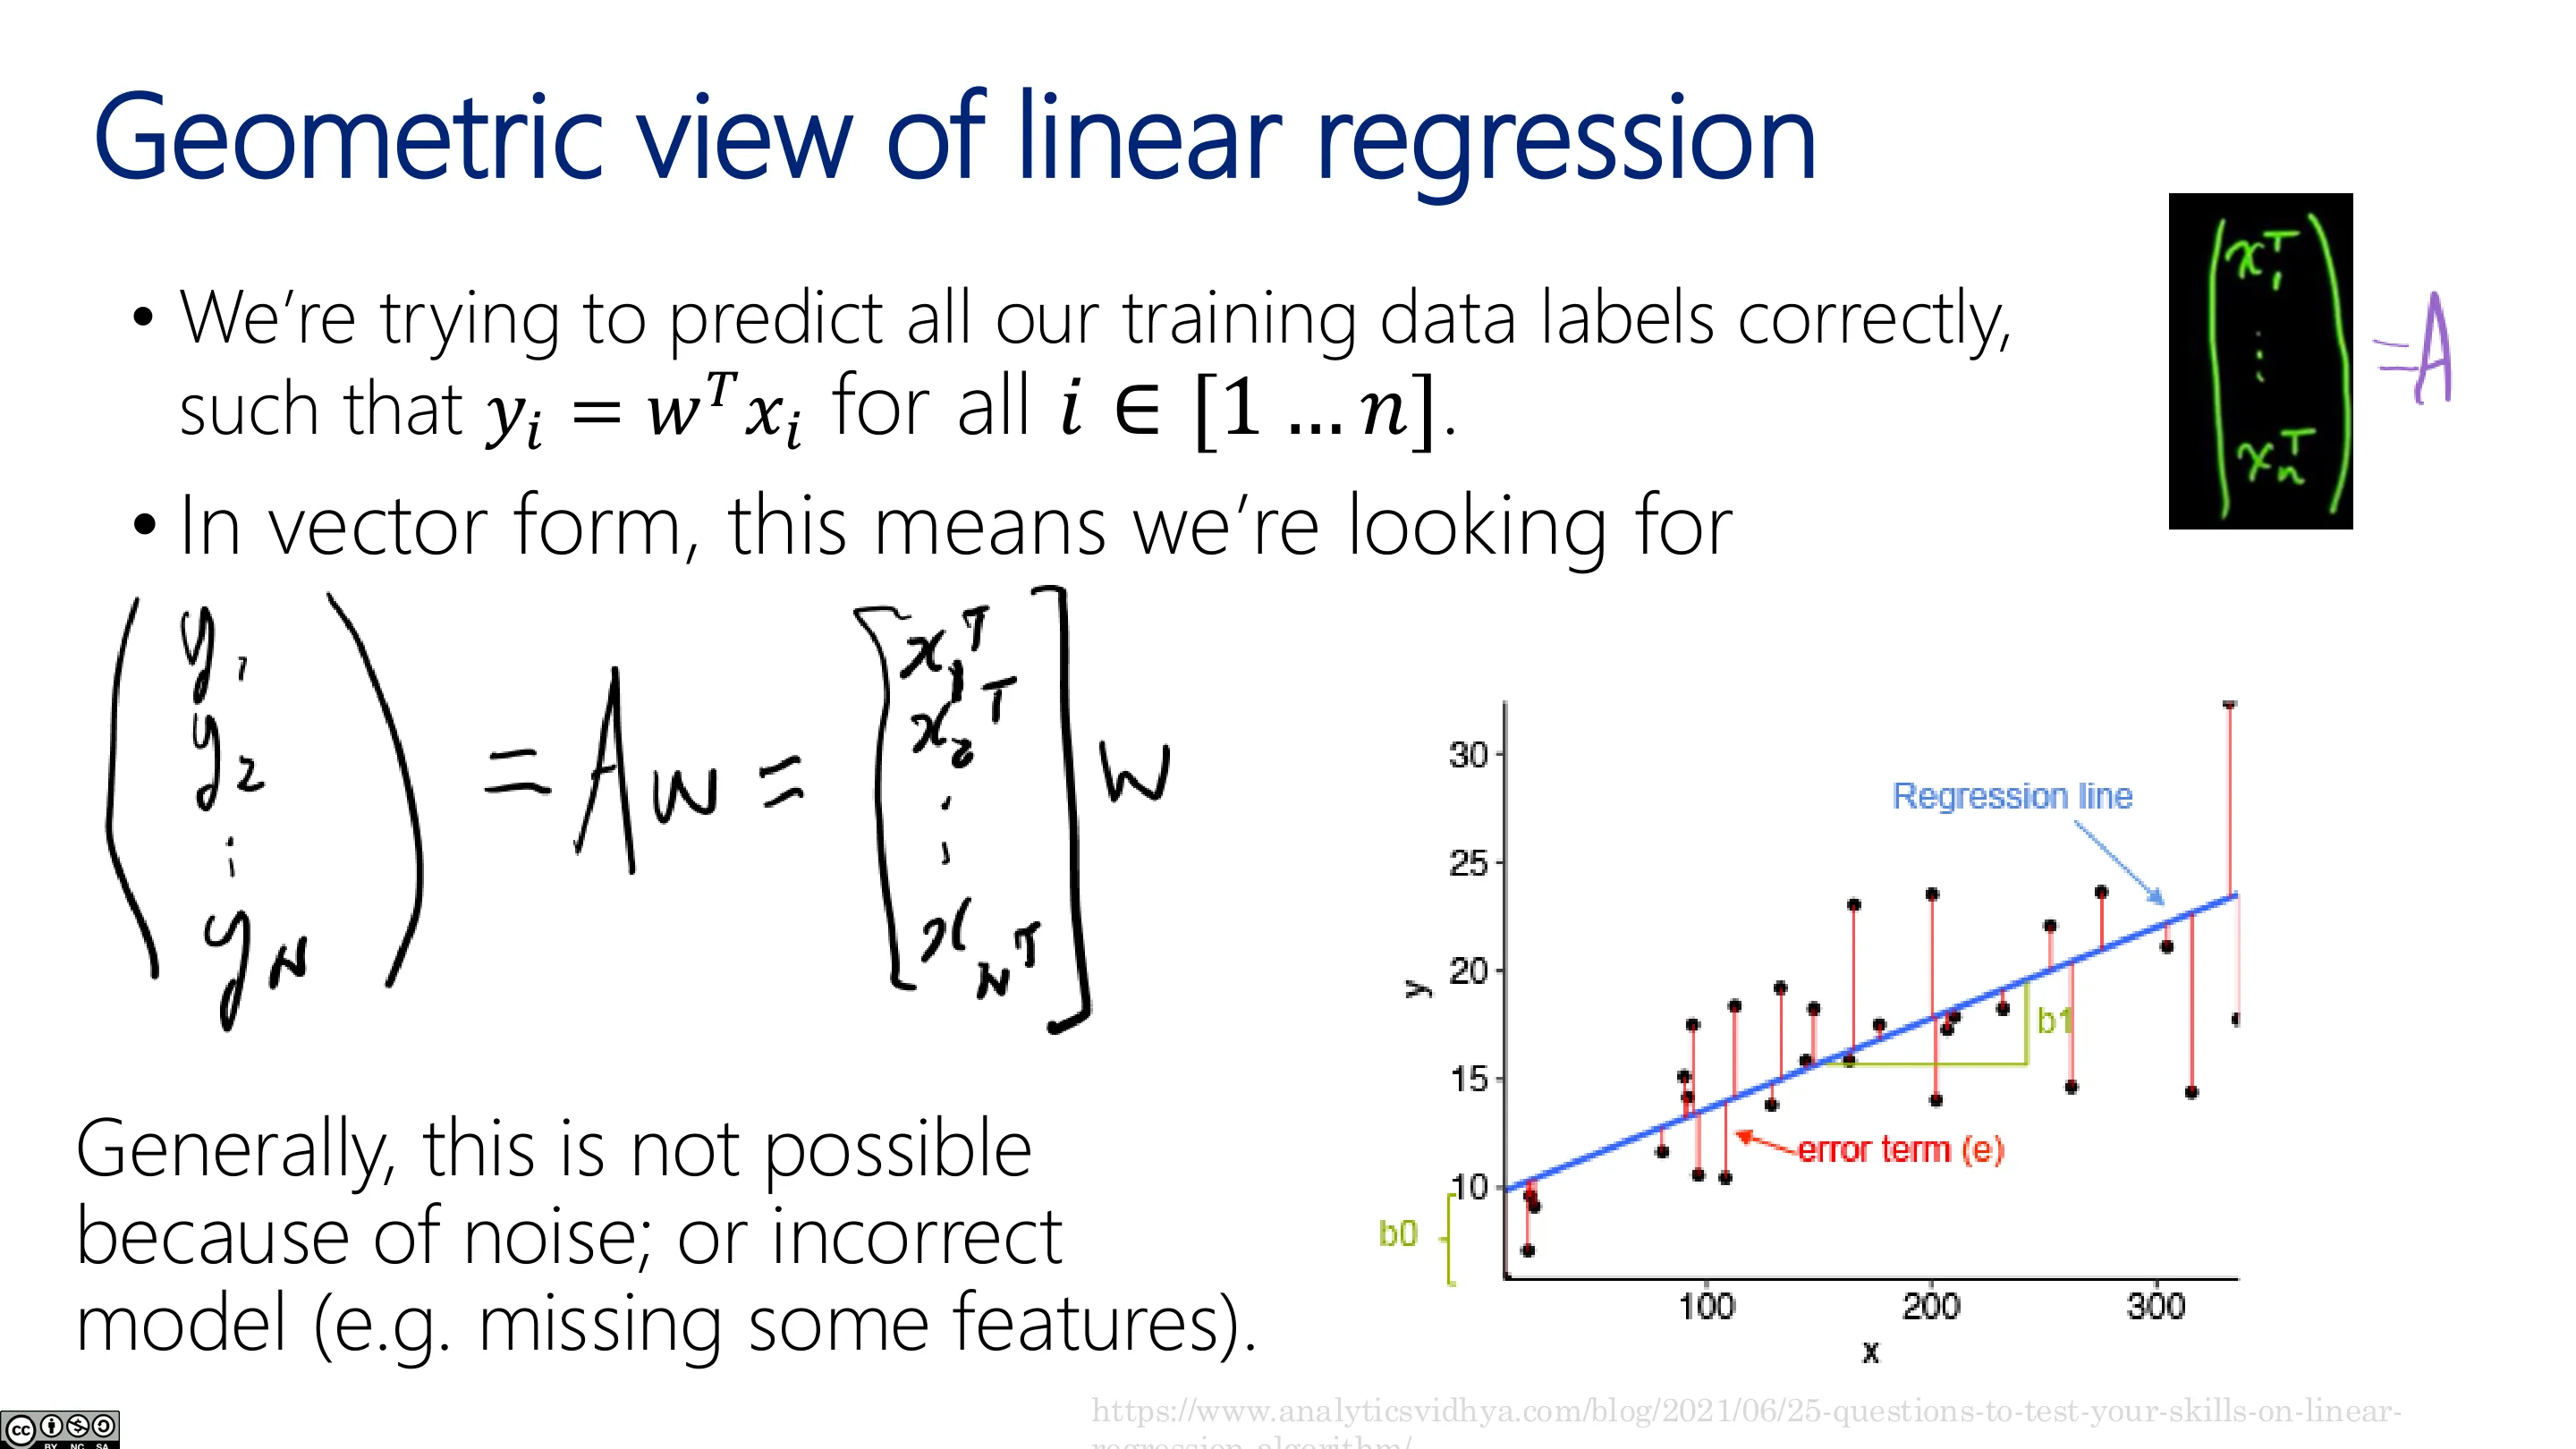
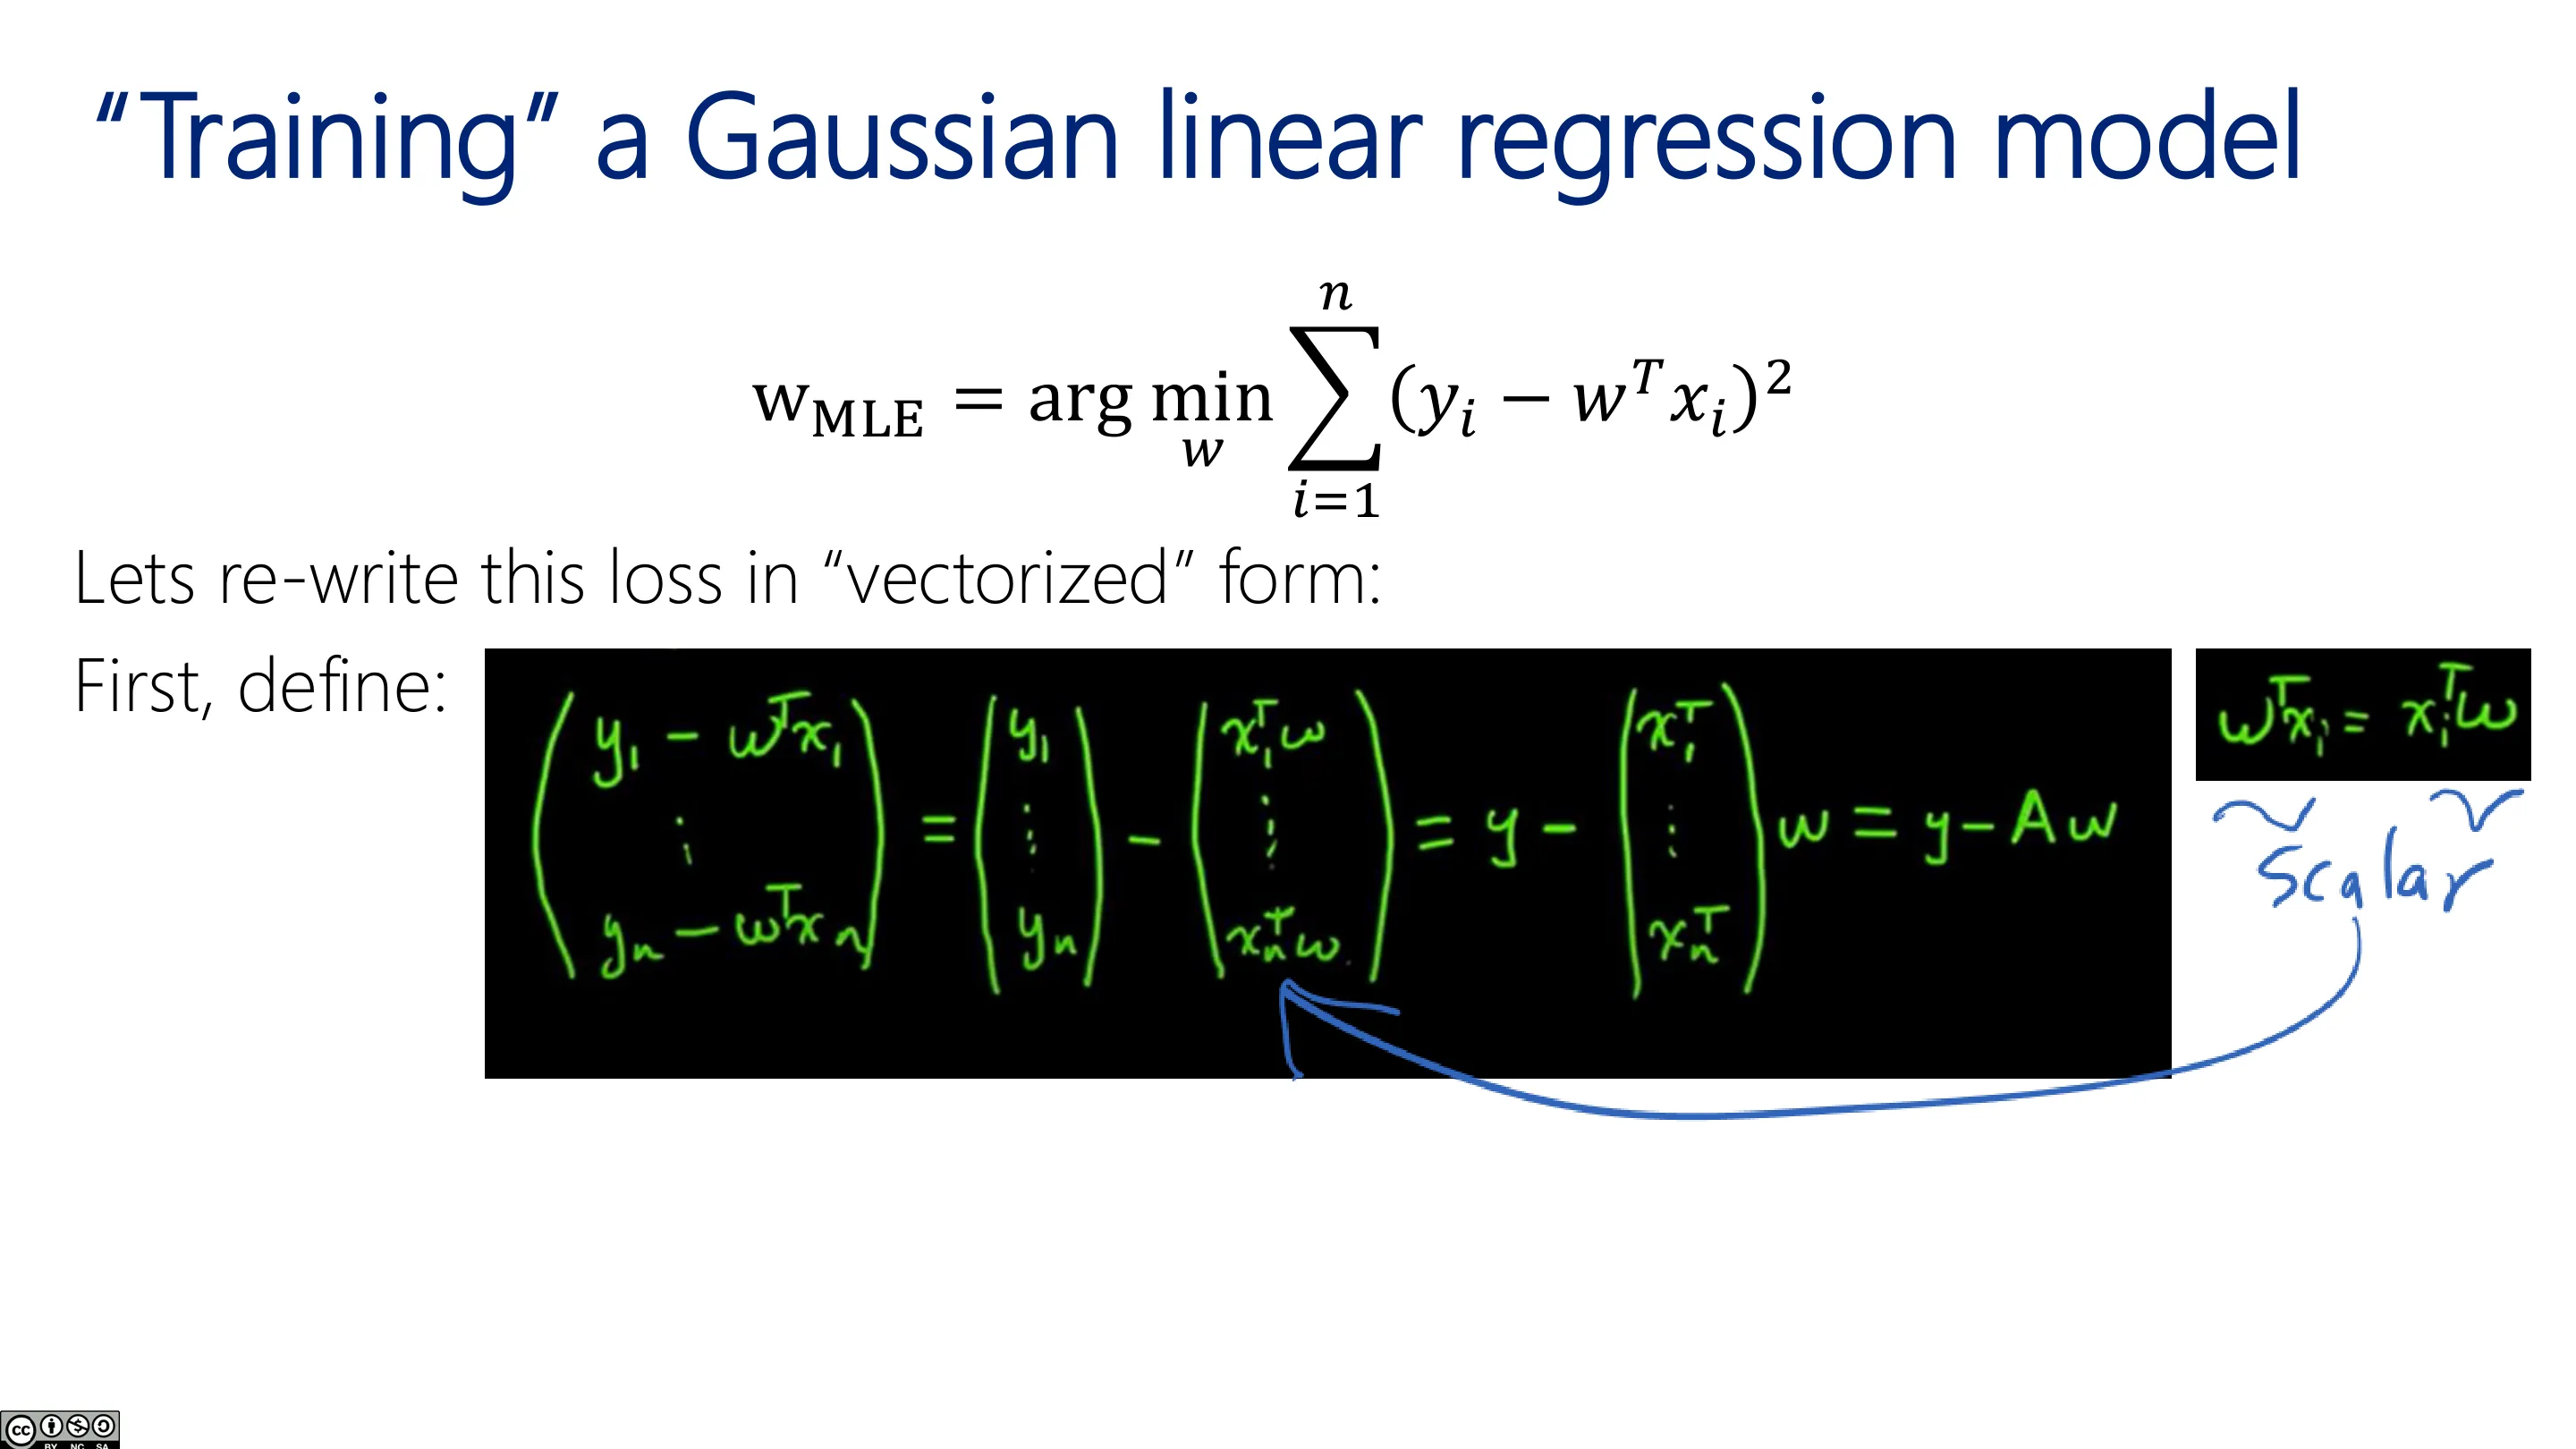
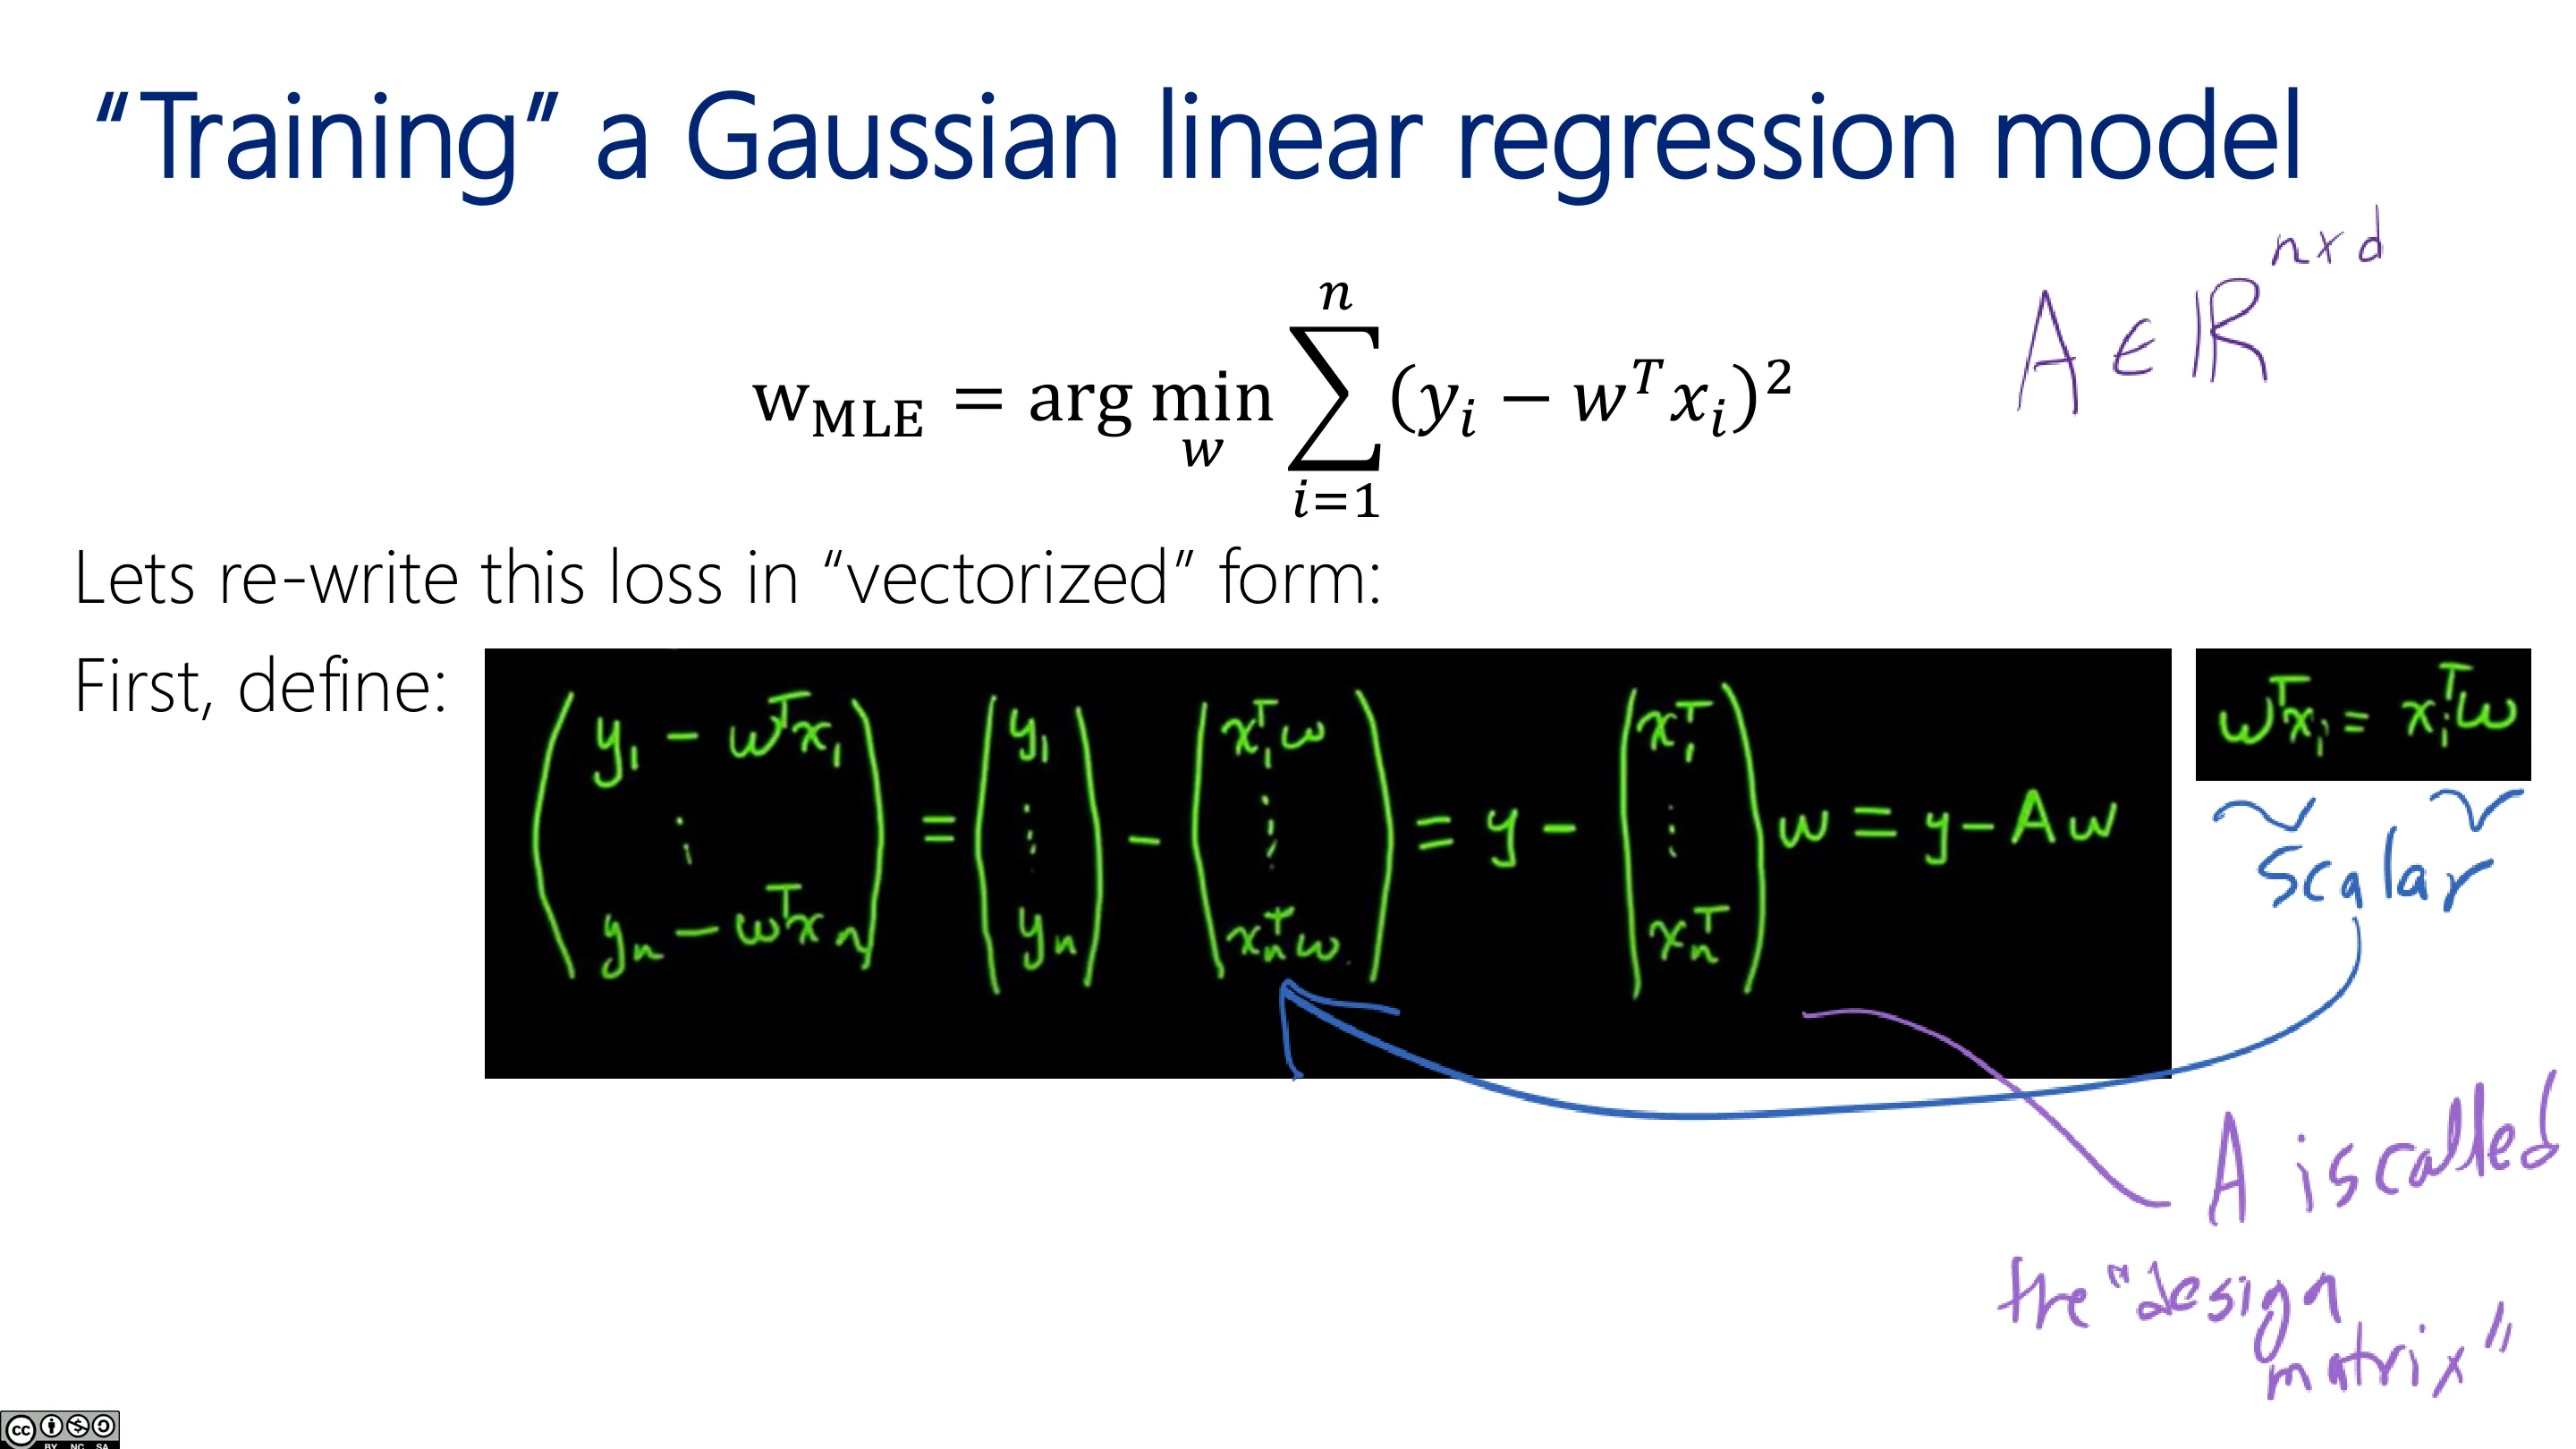
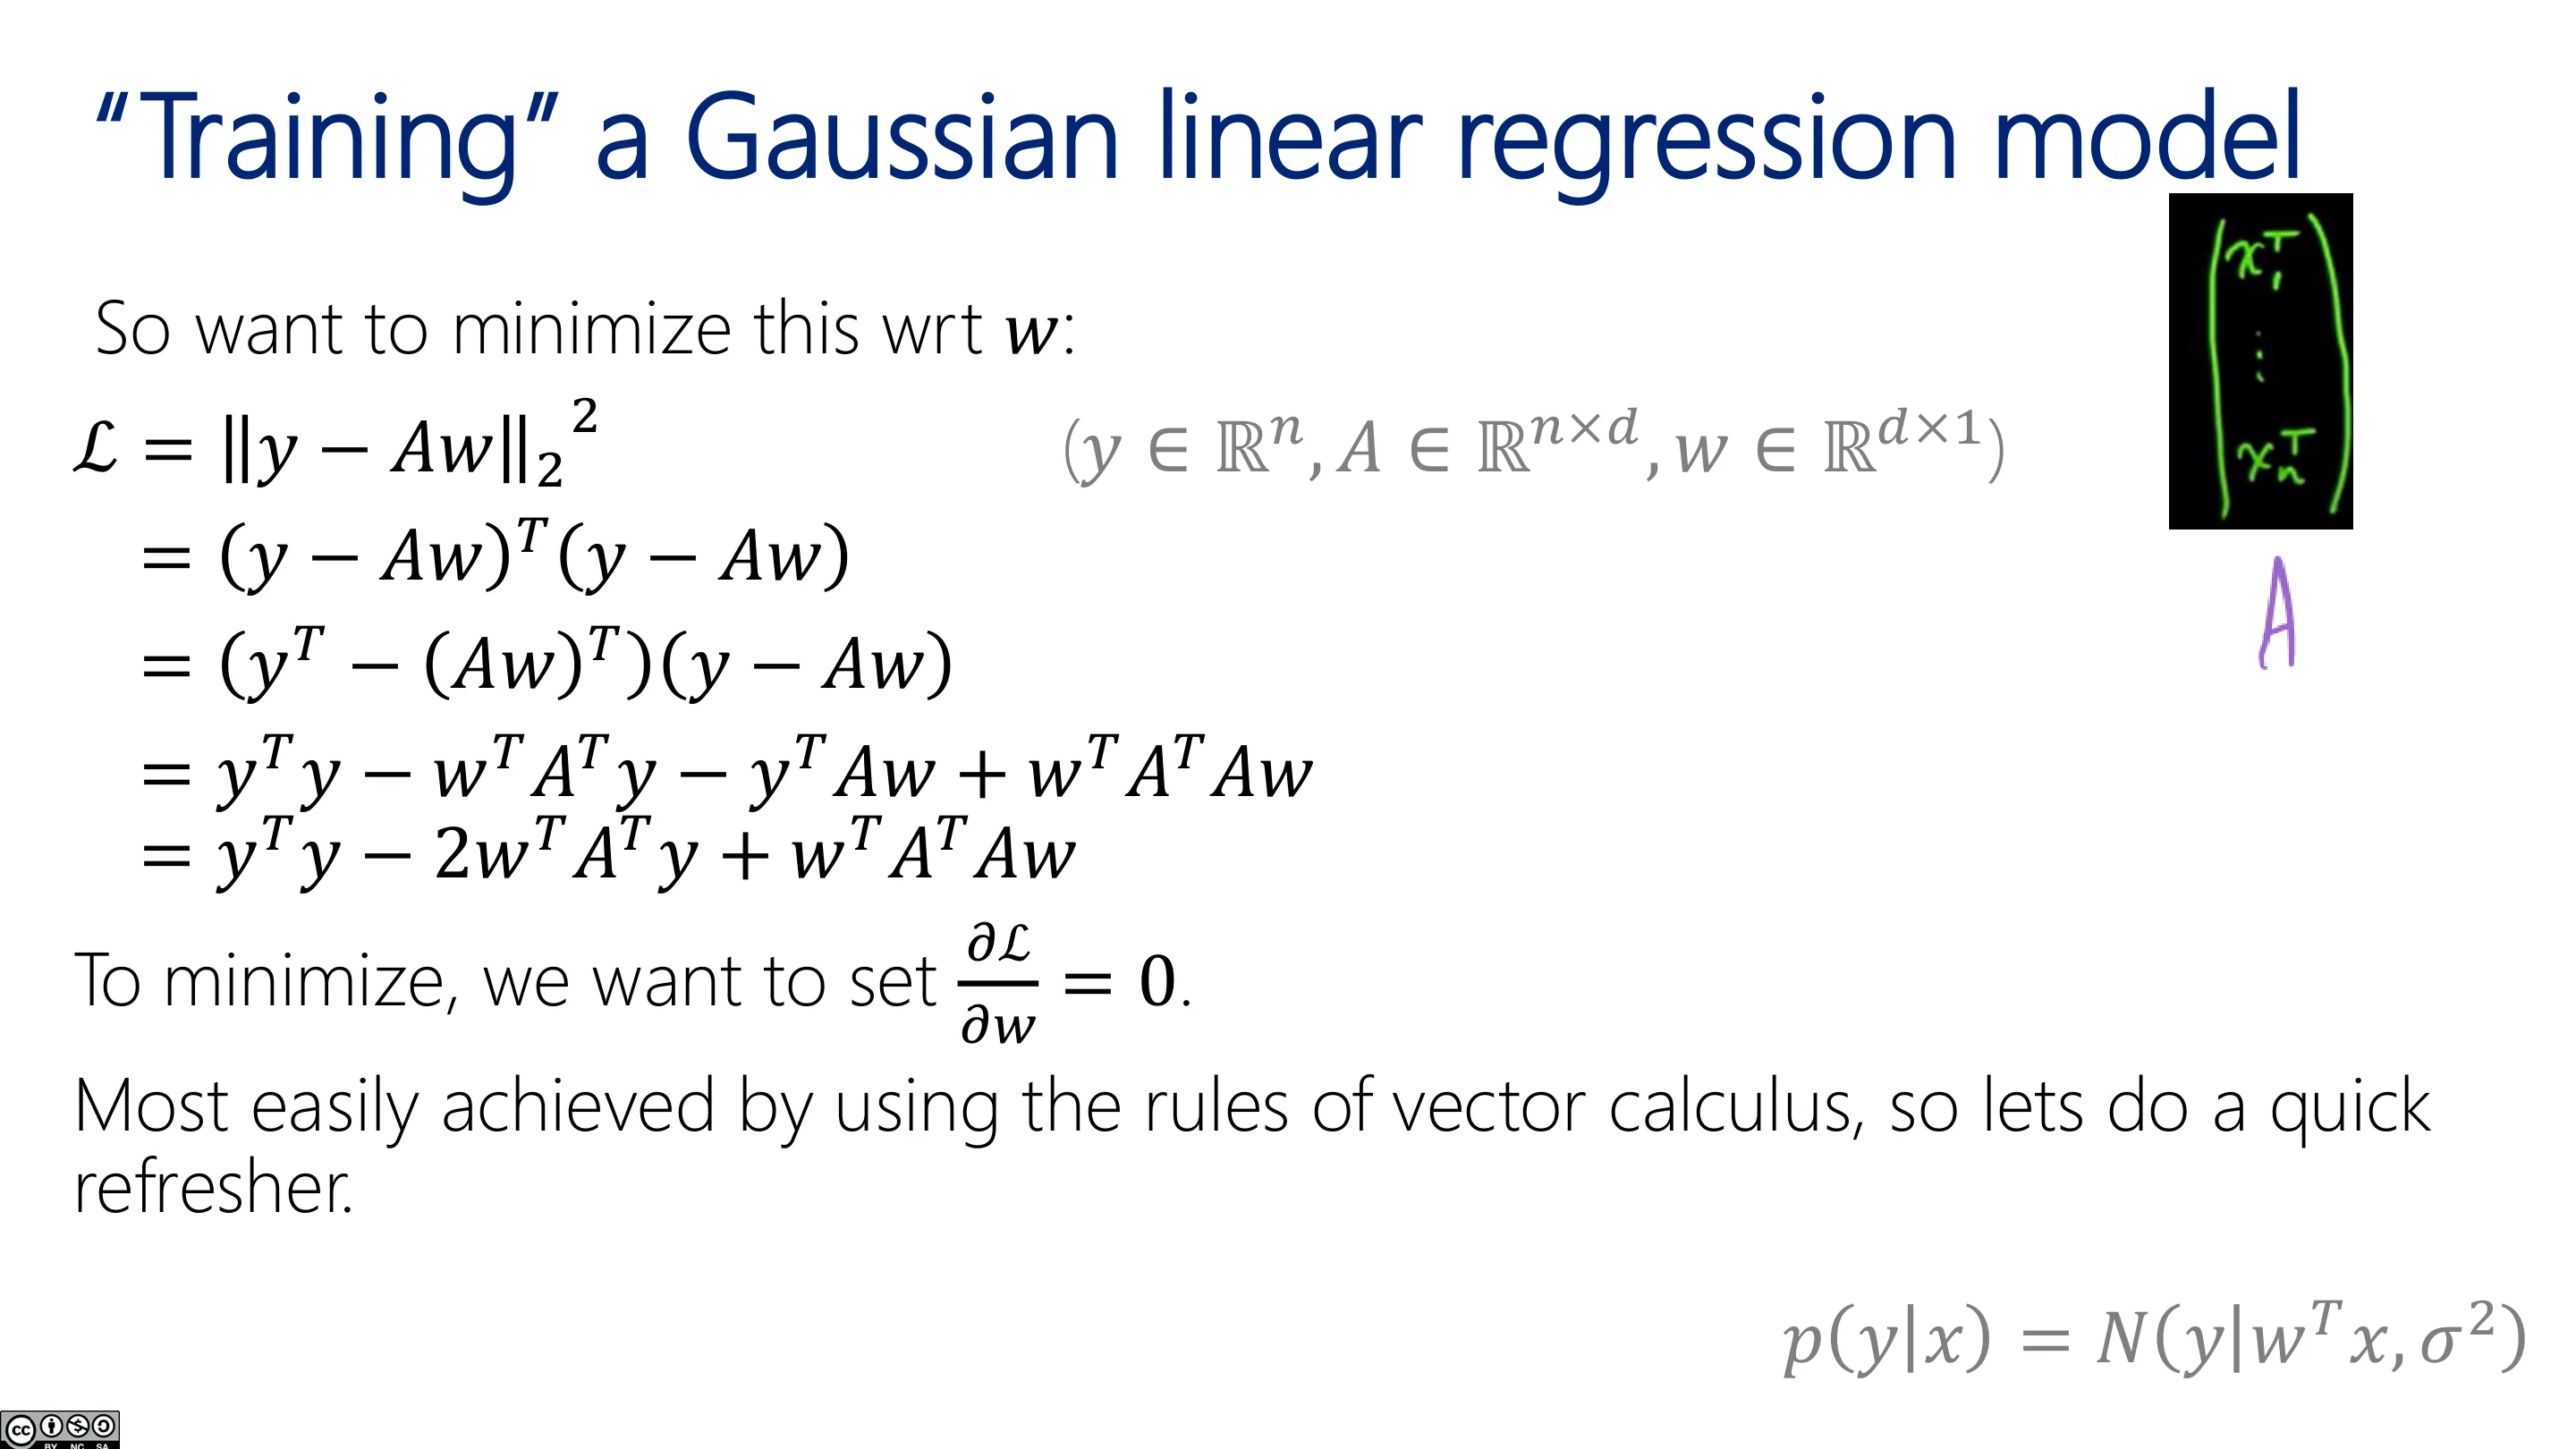
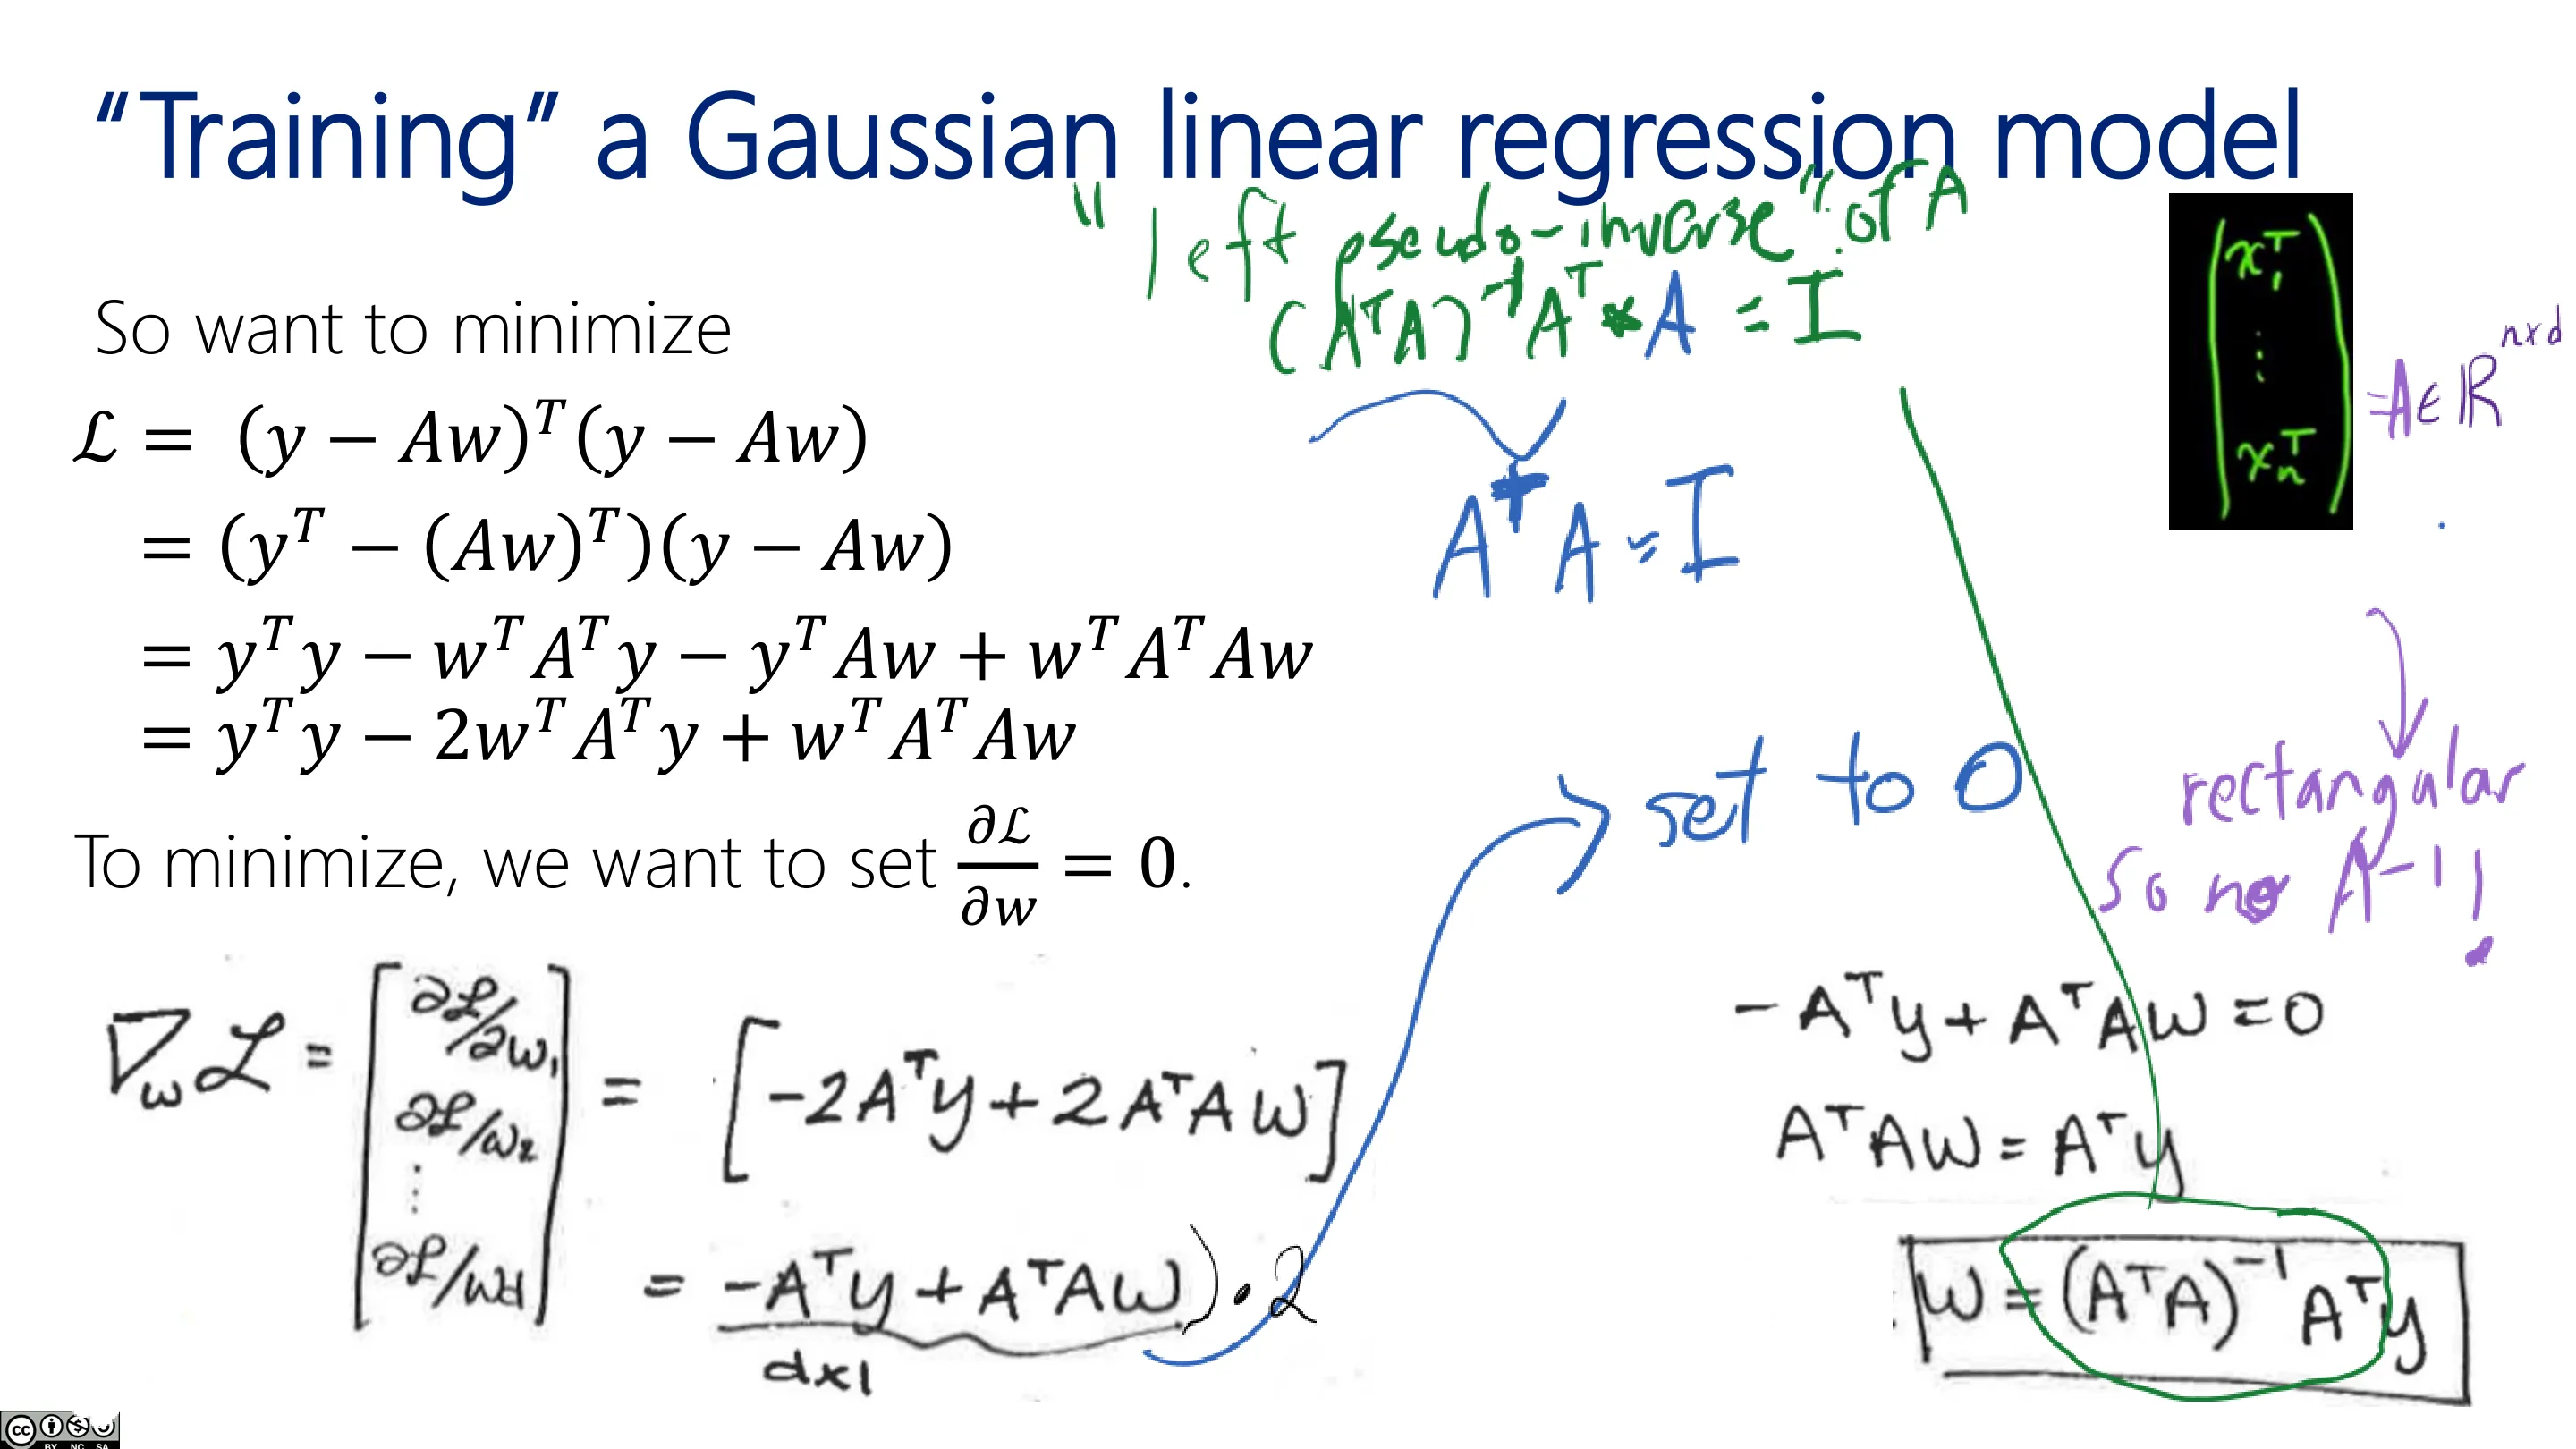
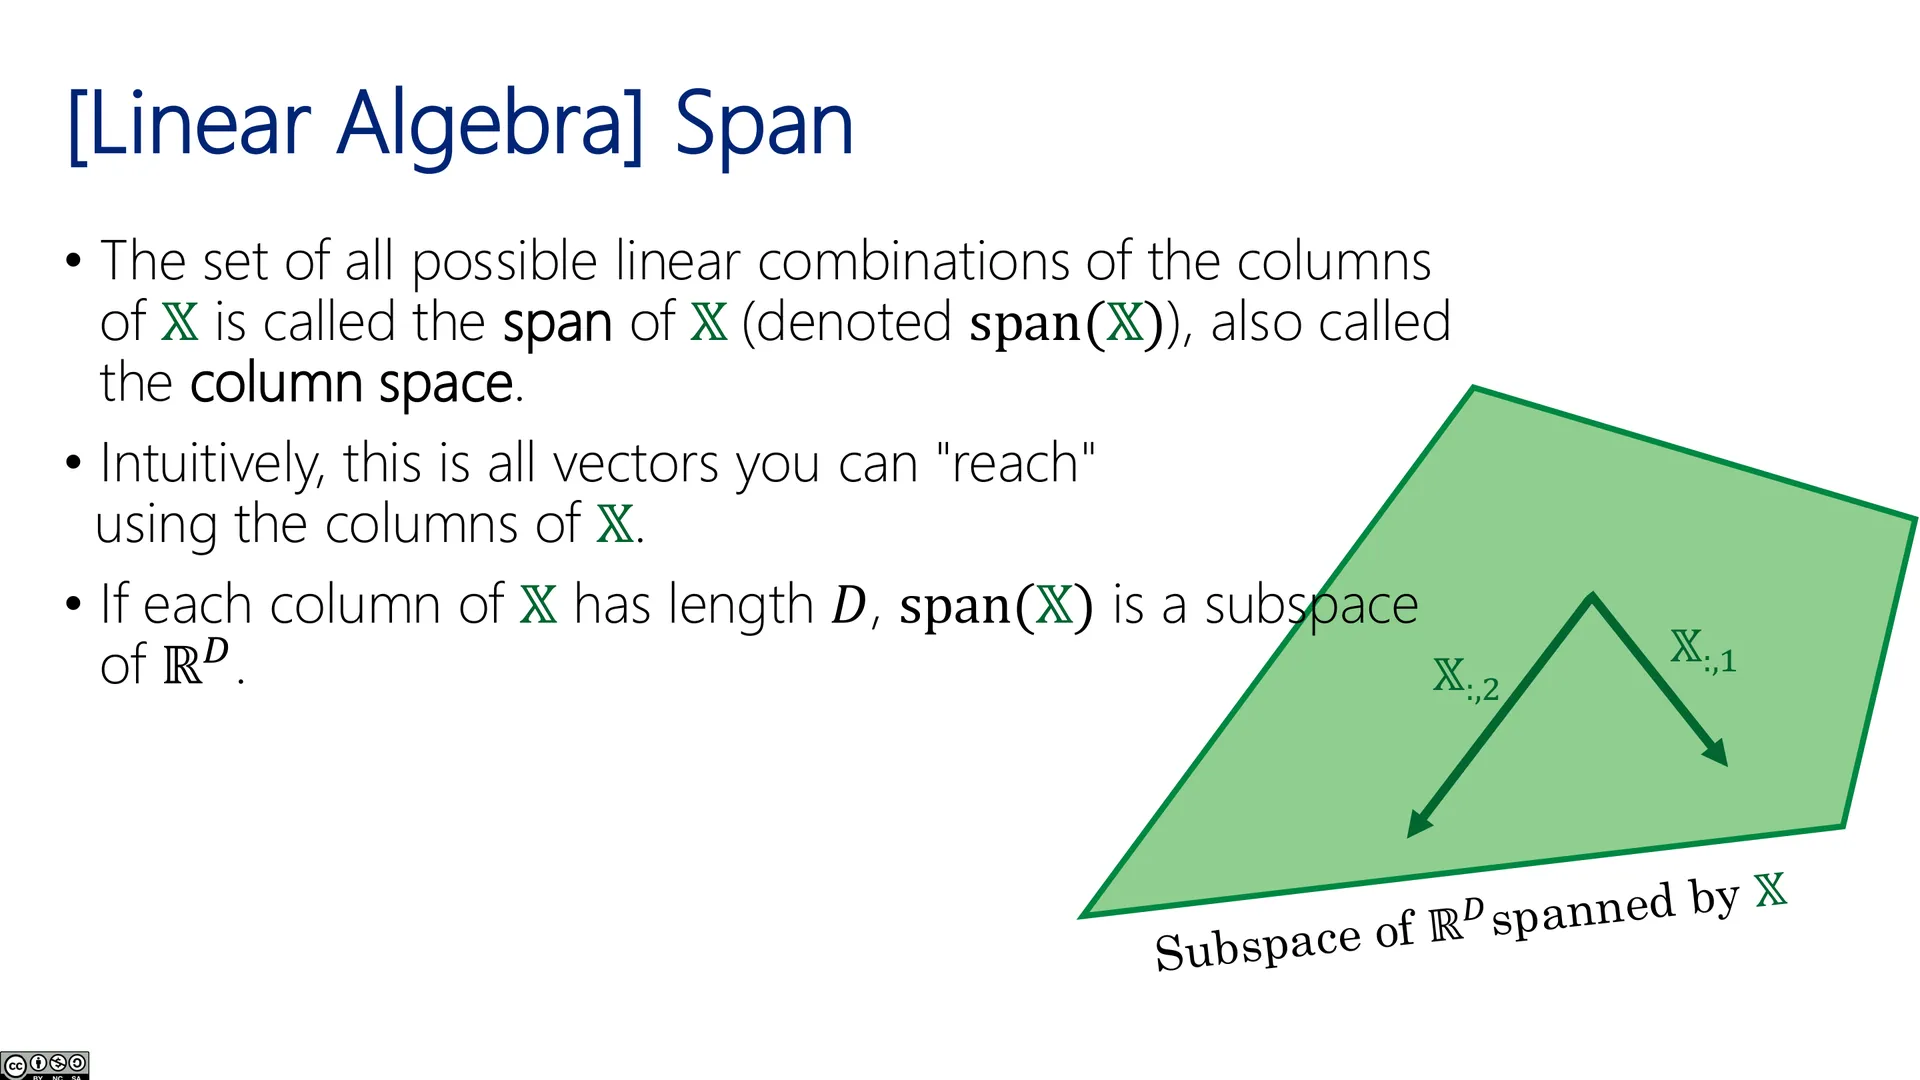
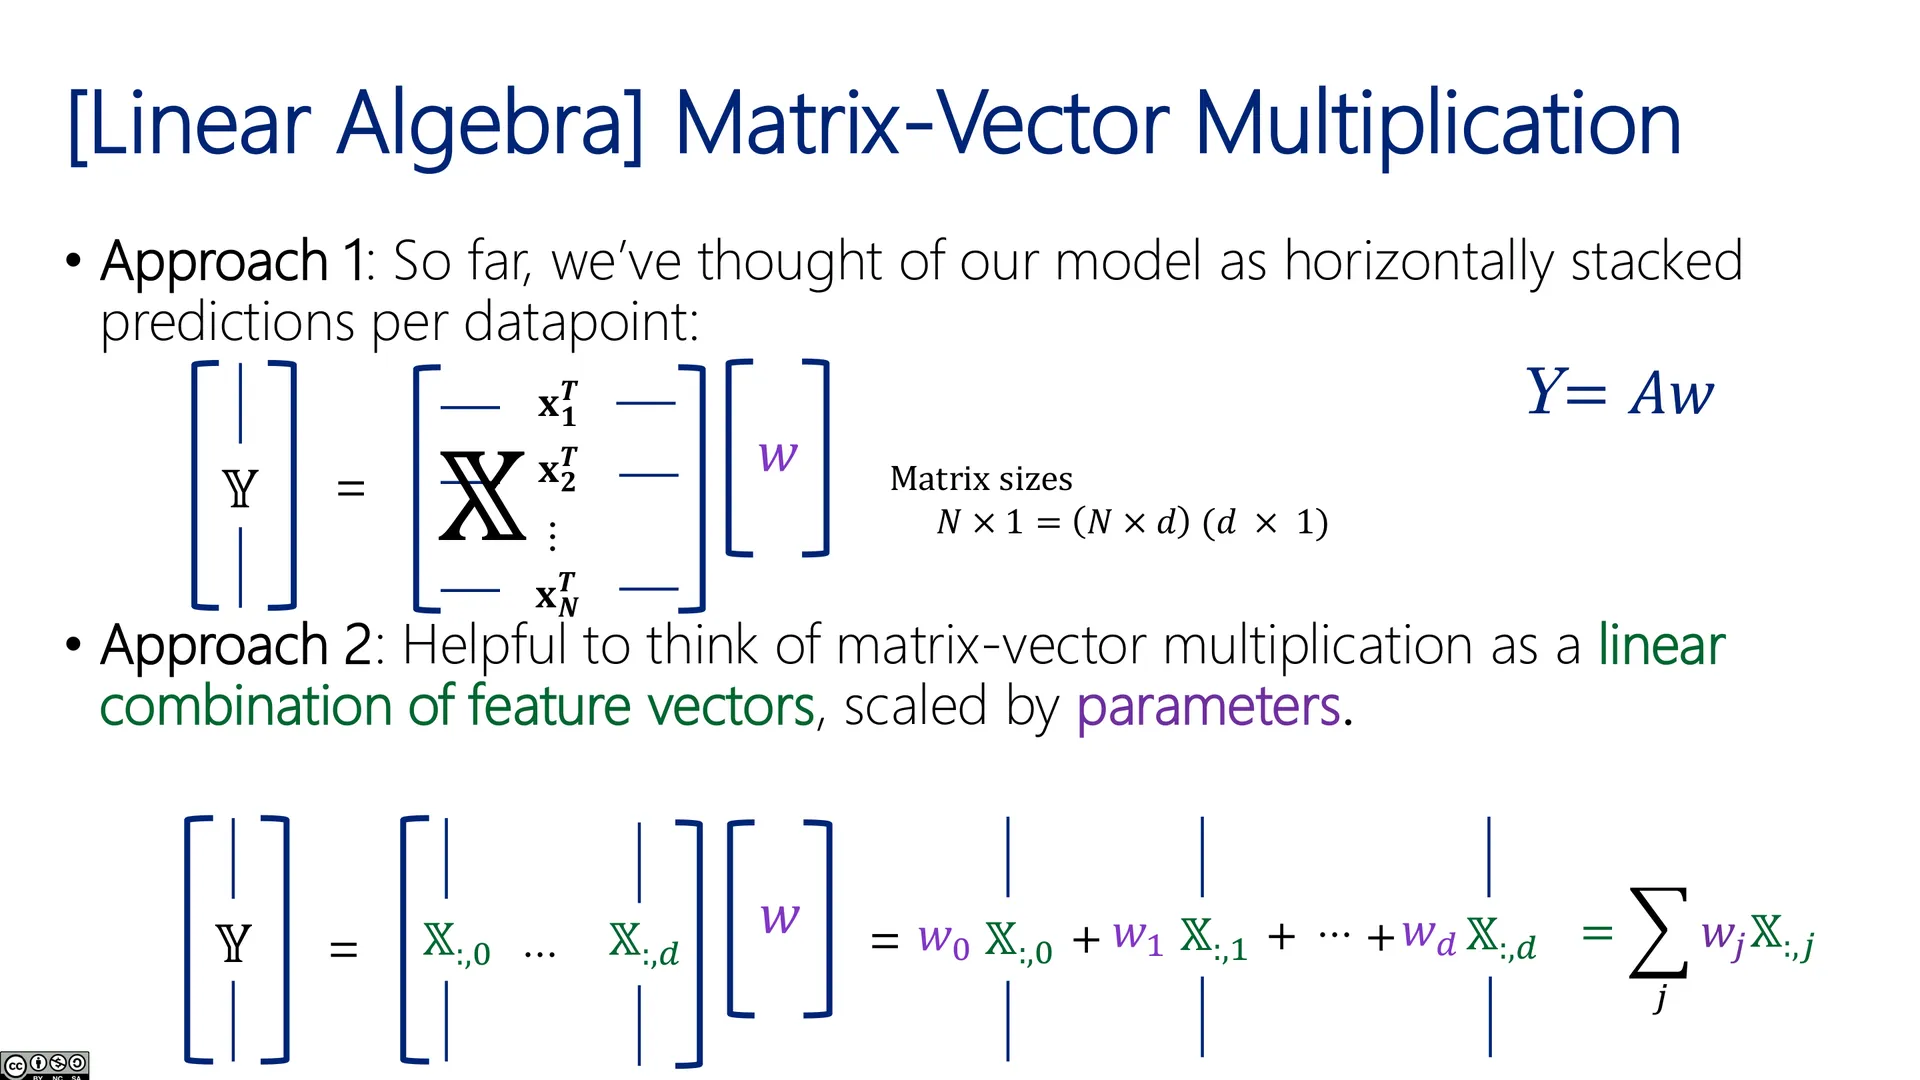
把平方损失写成向量/矩阵形式:令 $y$ 为 $N\times1$ 的标签向量,$A$(设计矩阵,$N\times D$)每一行是一个样本的特征 $x_i^\top$,$w$ 为 $D\times1$ 参数向量,则
$$ \sum_{i=1}^{N}(y_i-w^\top x_i)^2=\lVert y-Aw\rVert_2^2 $$
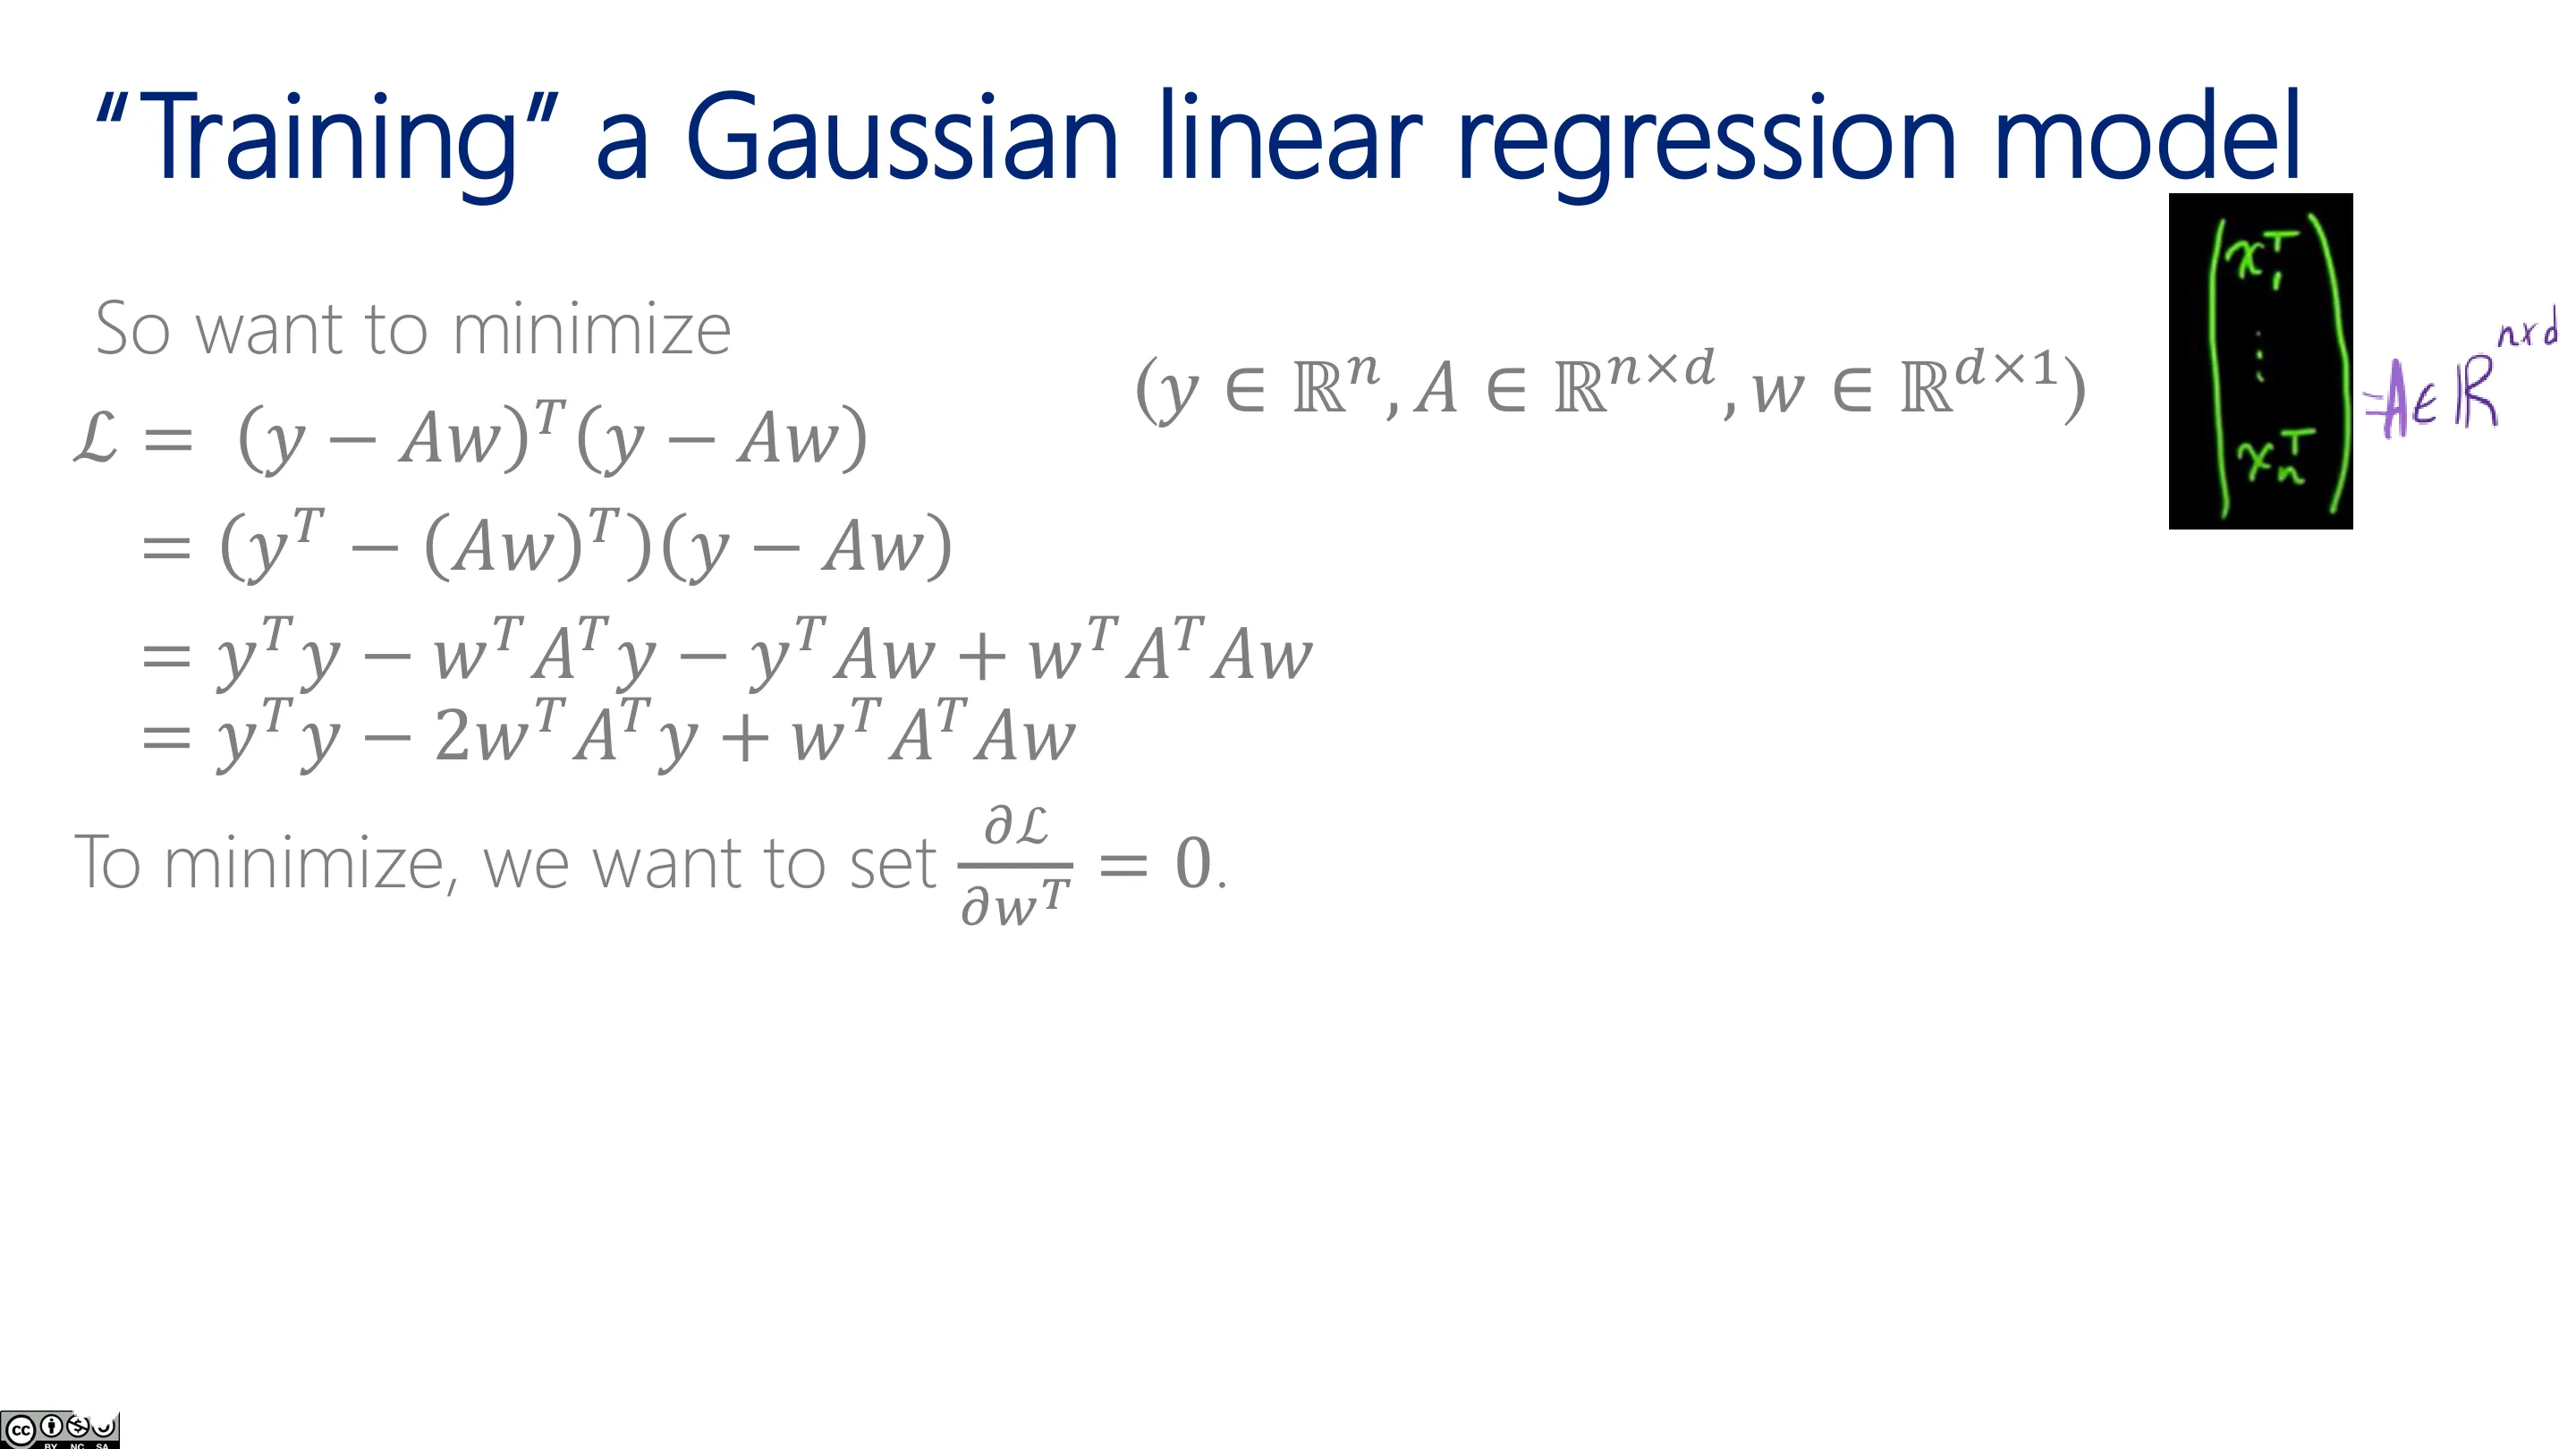
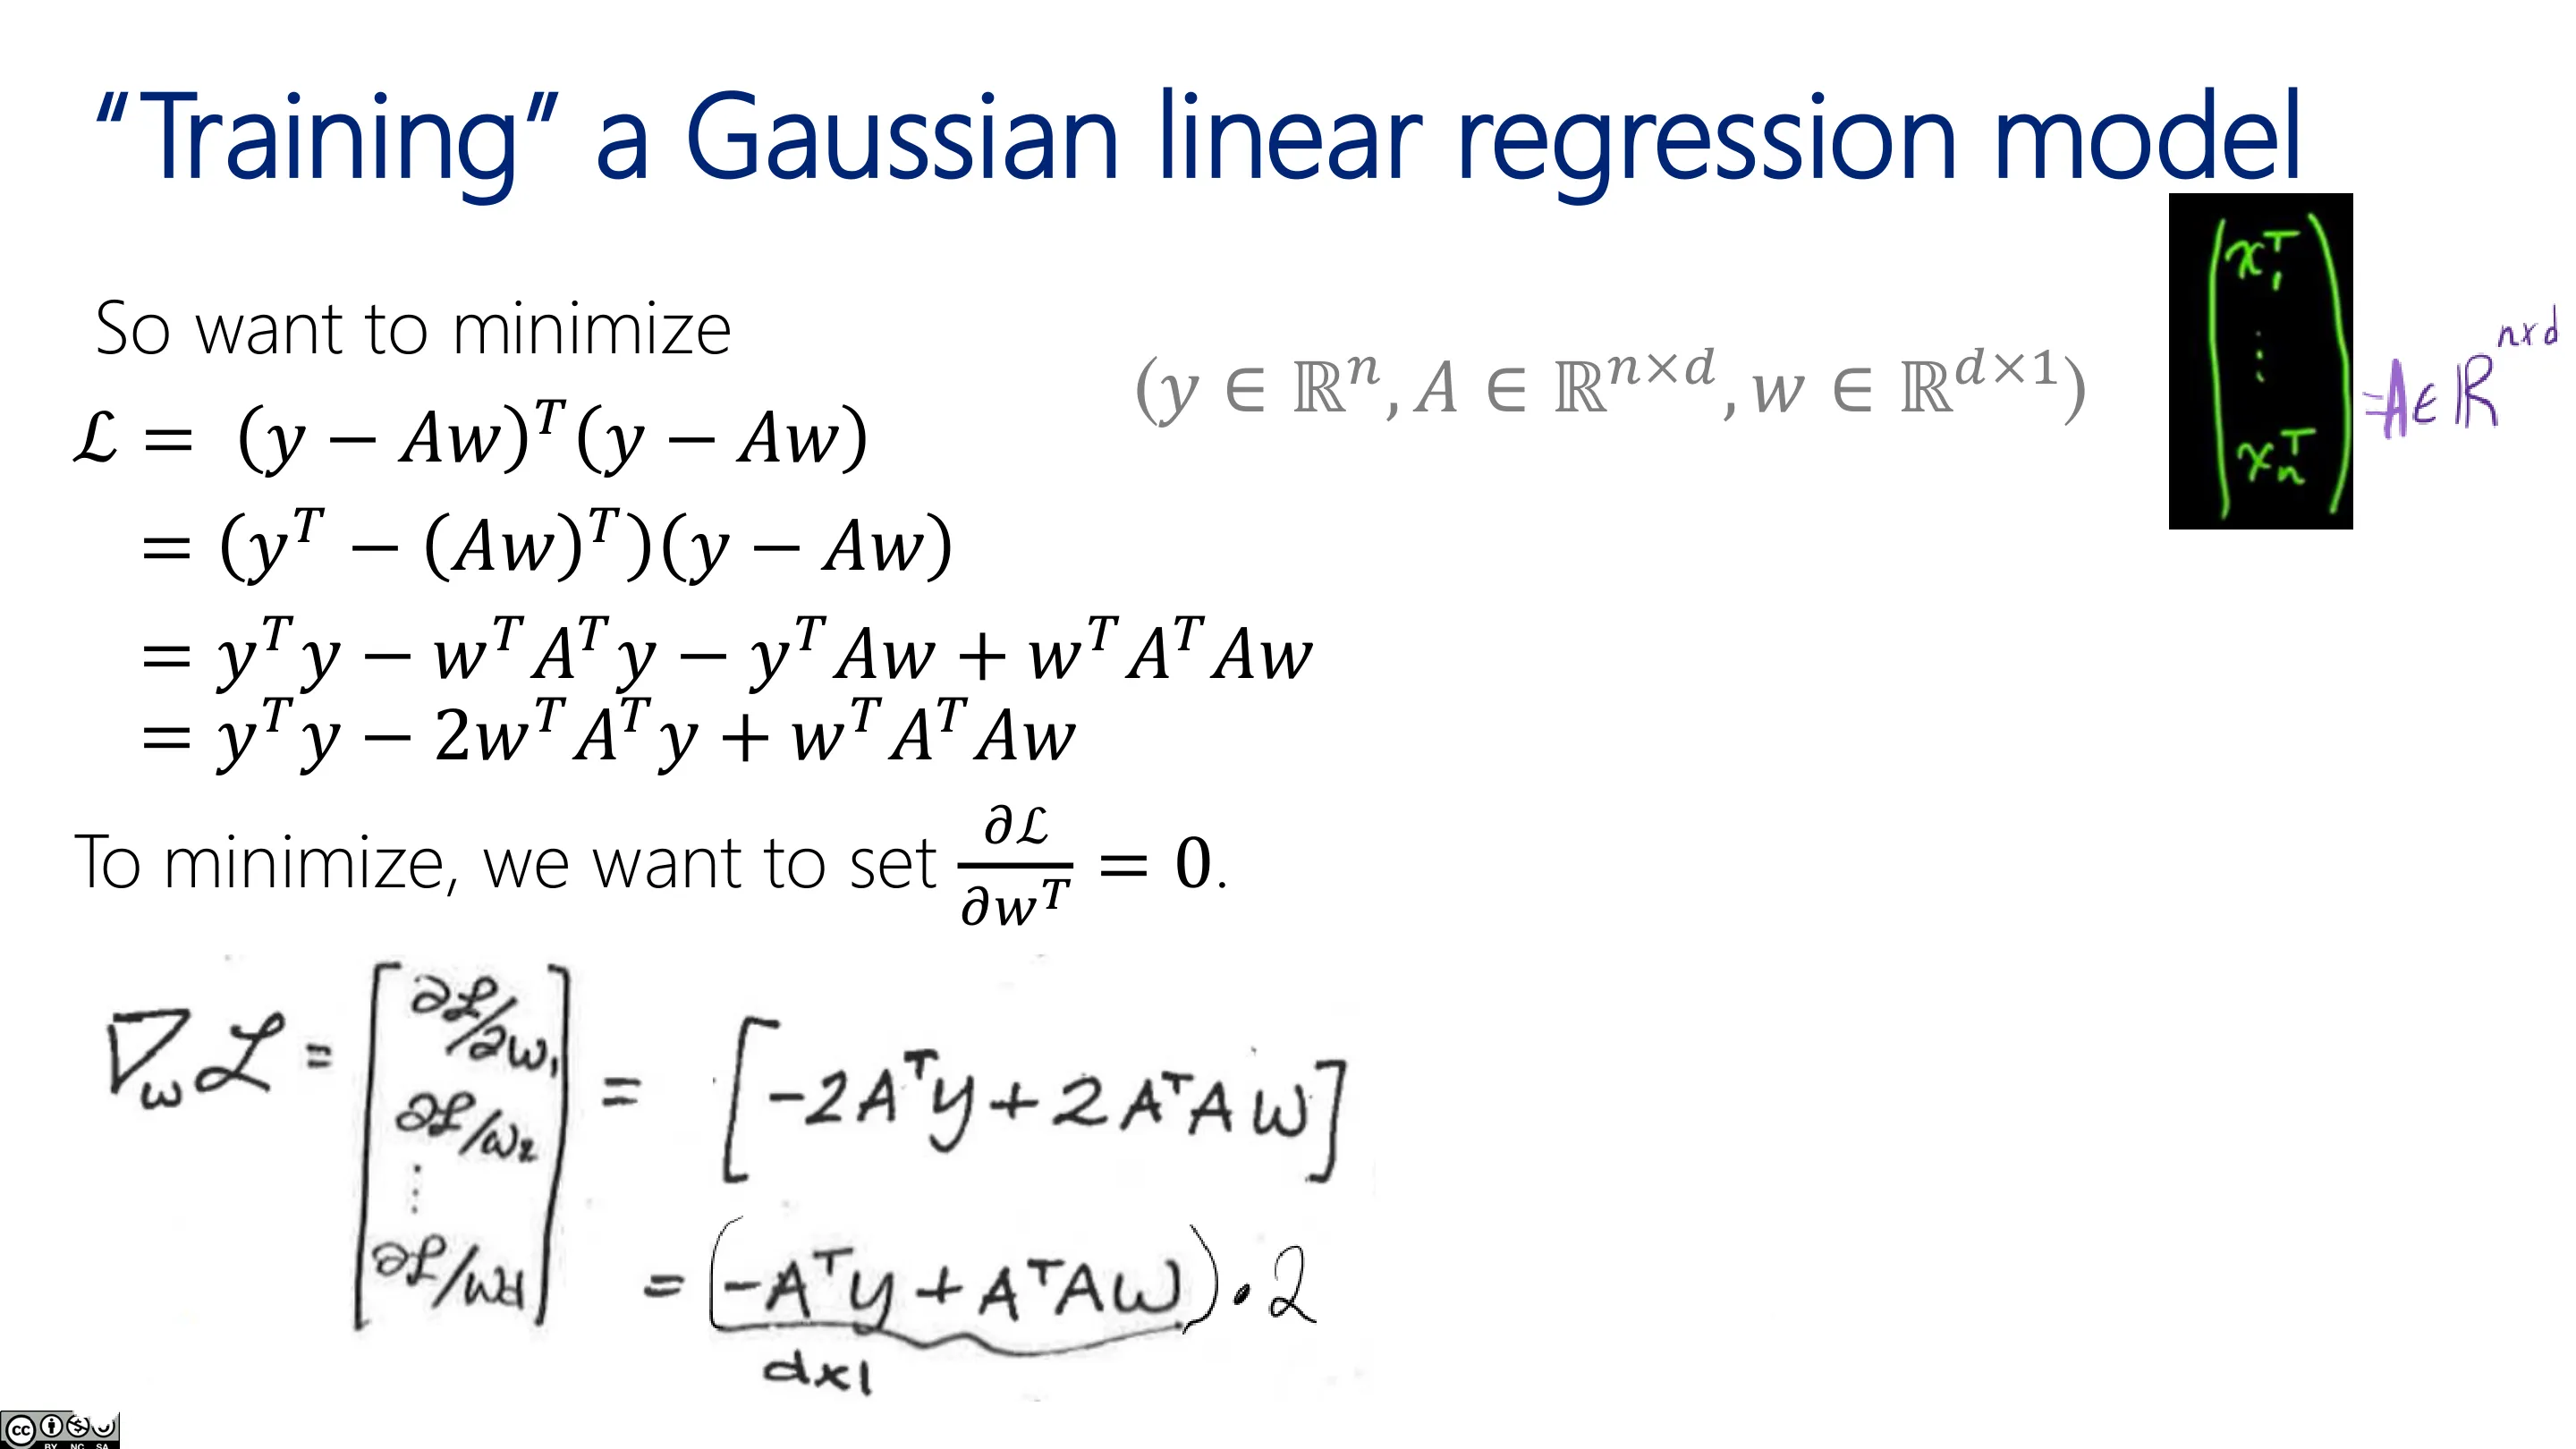
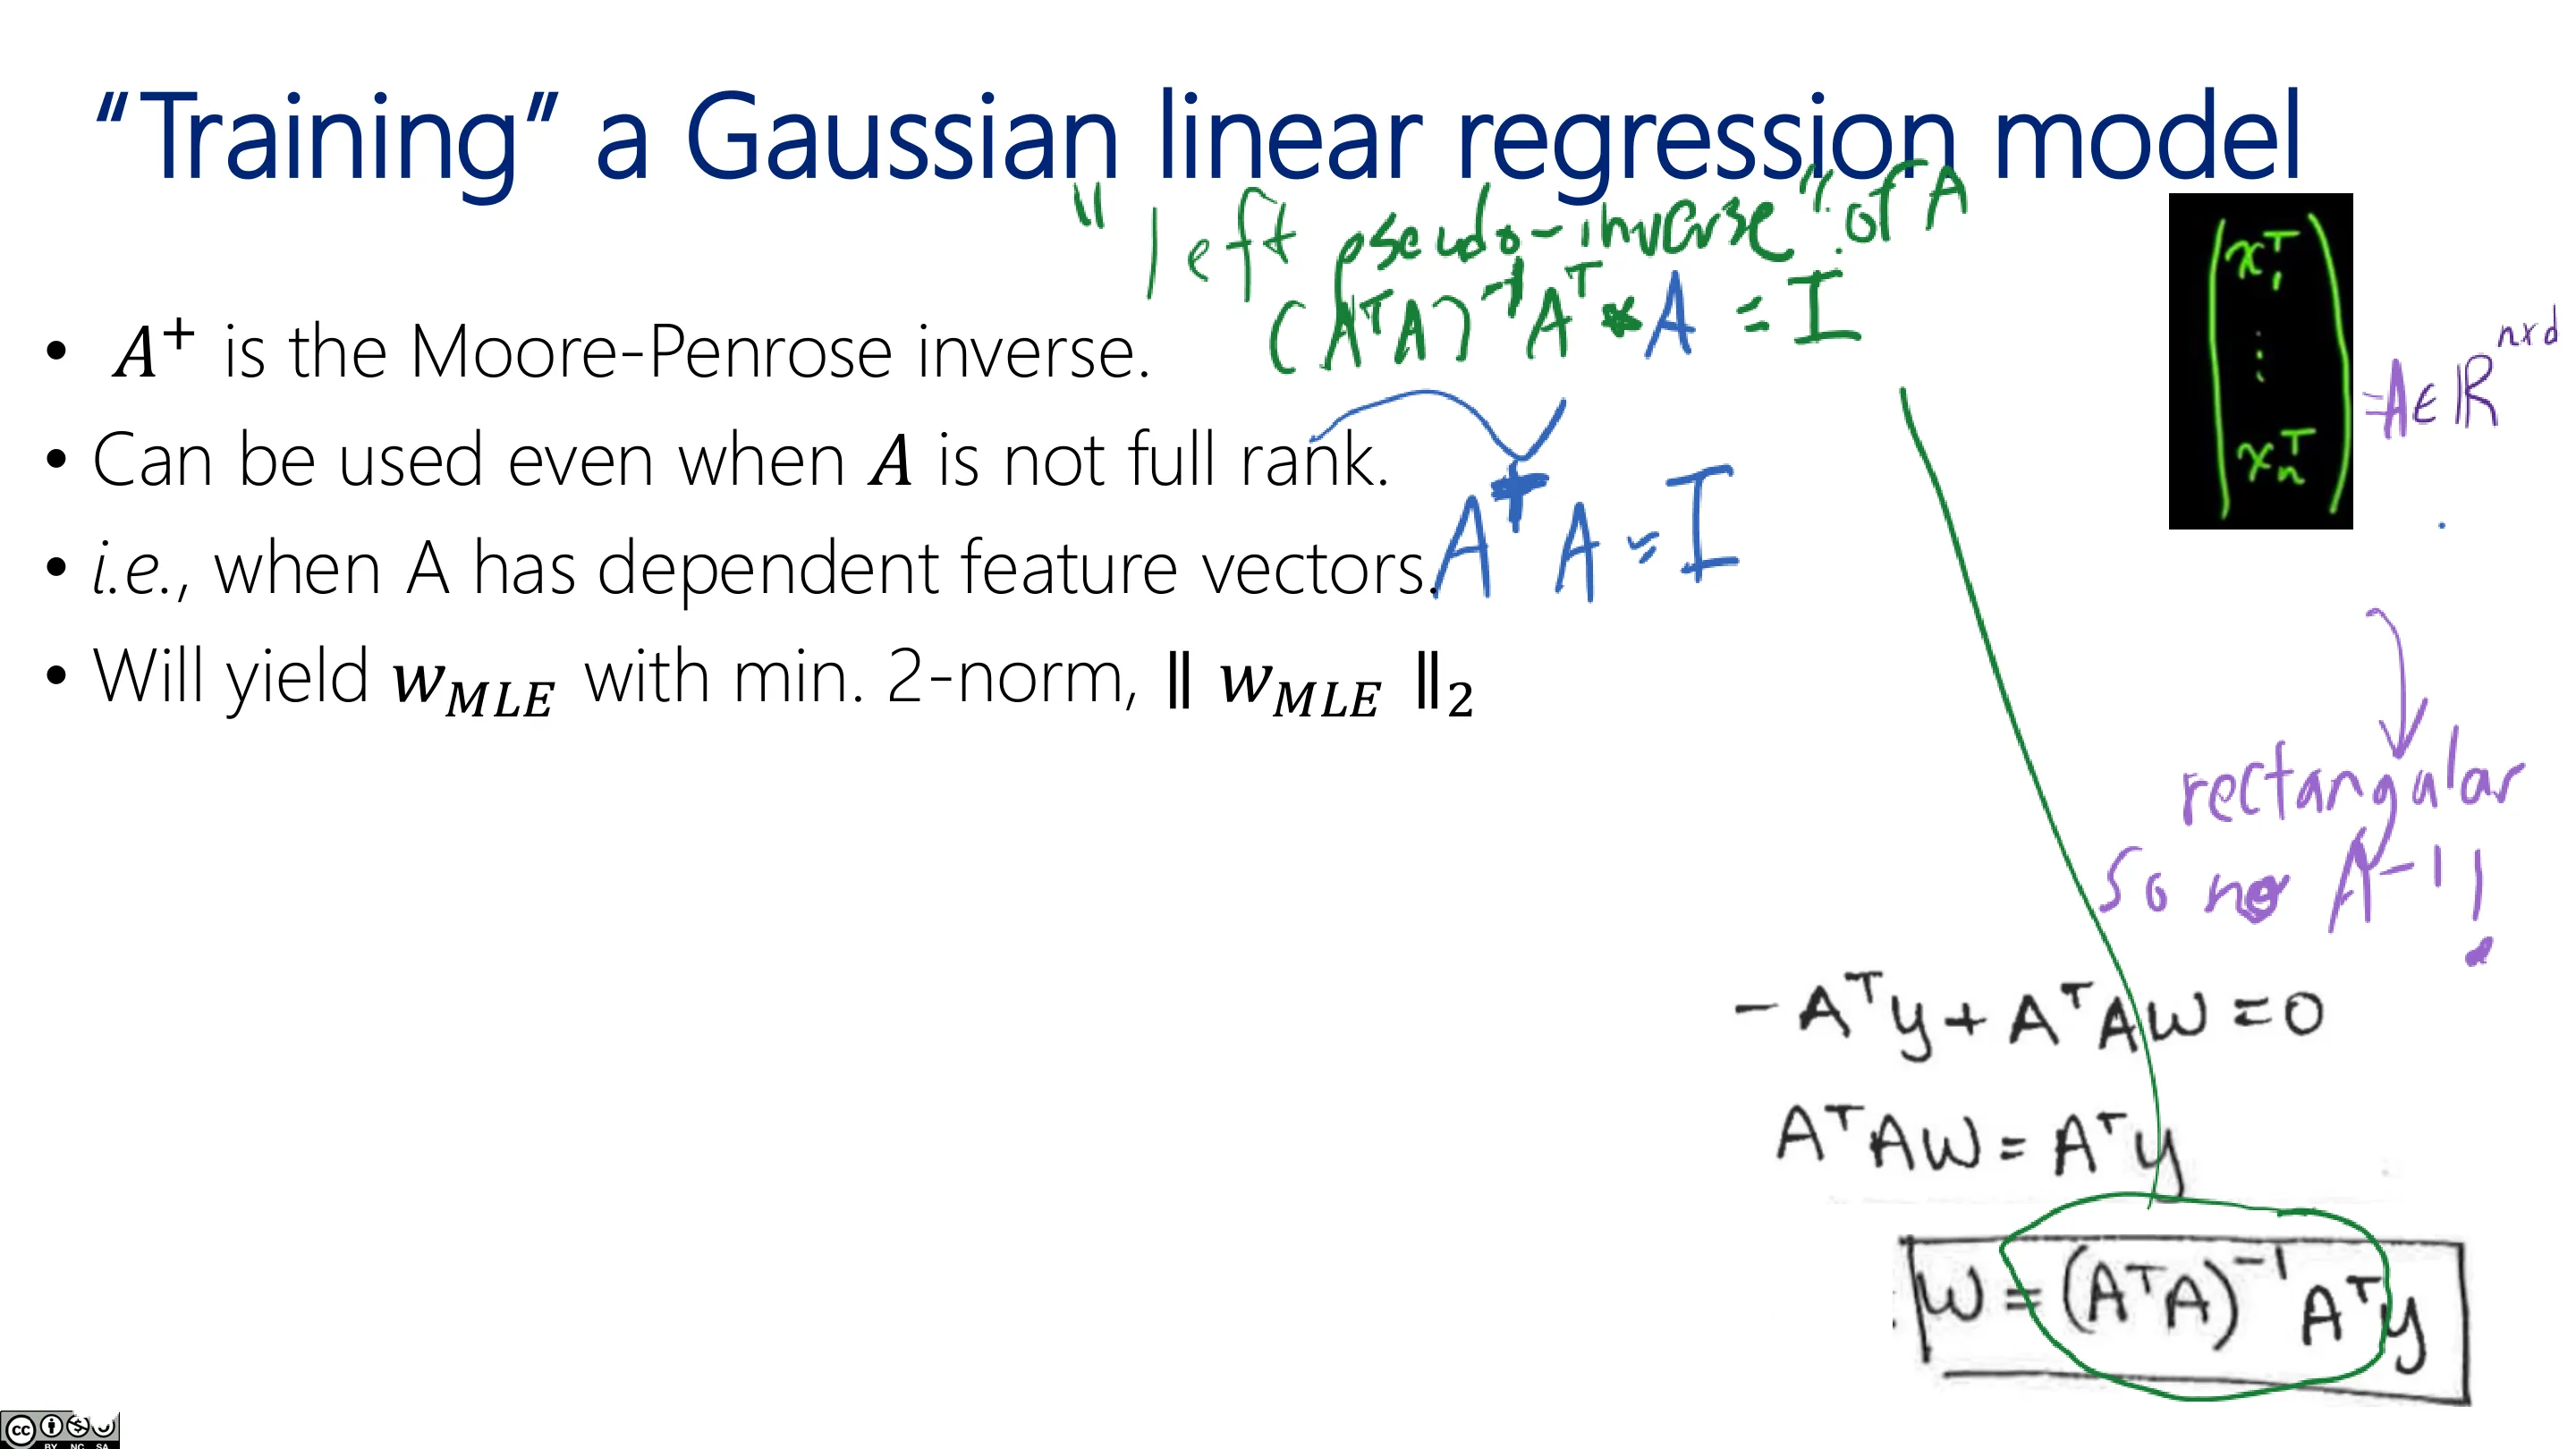
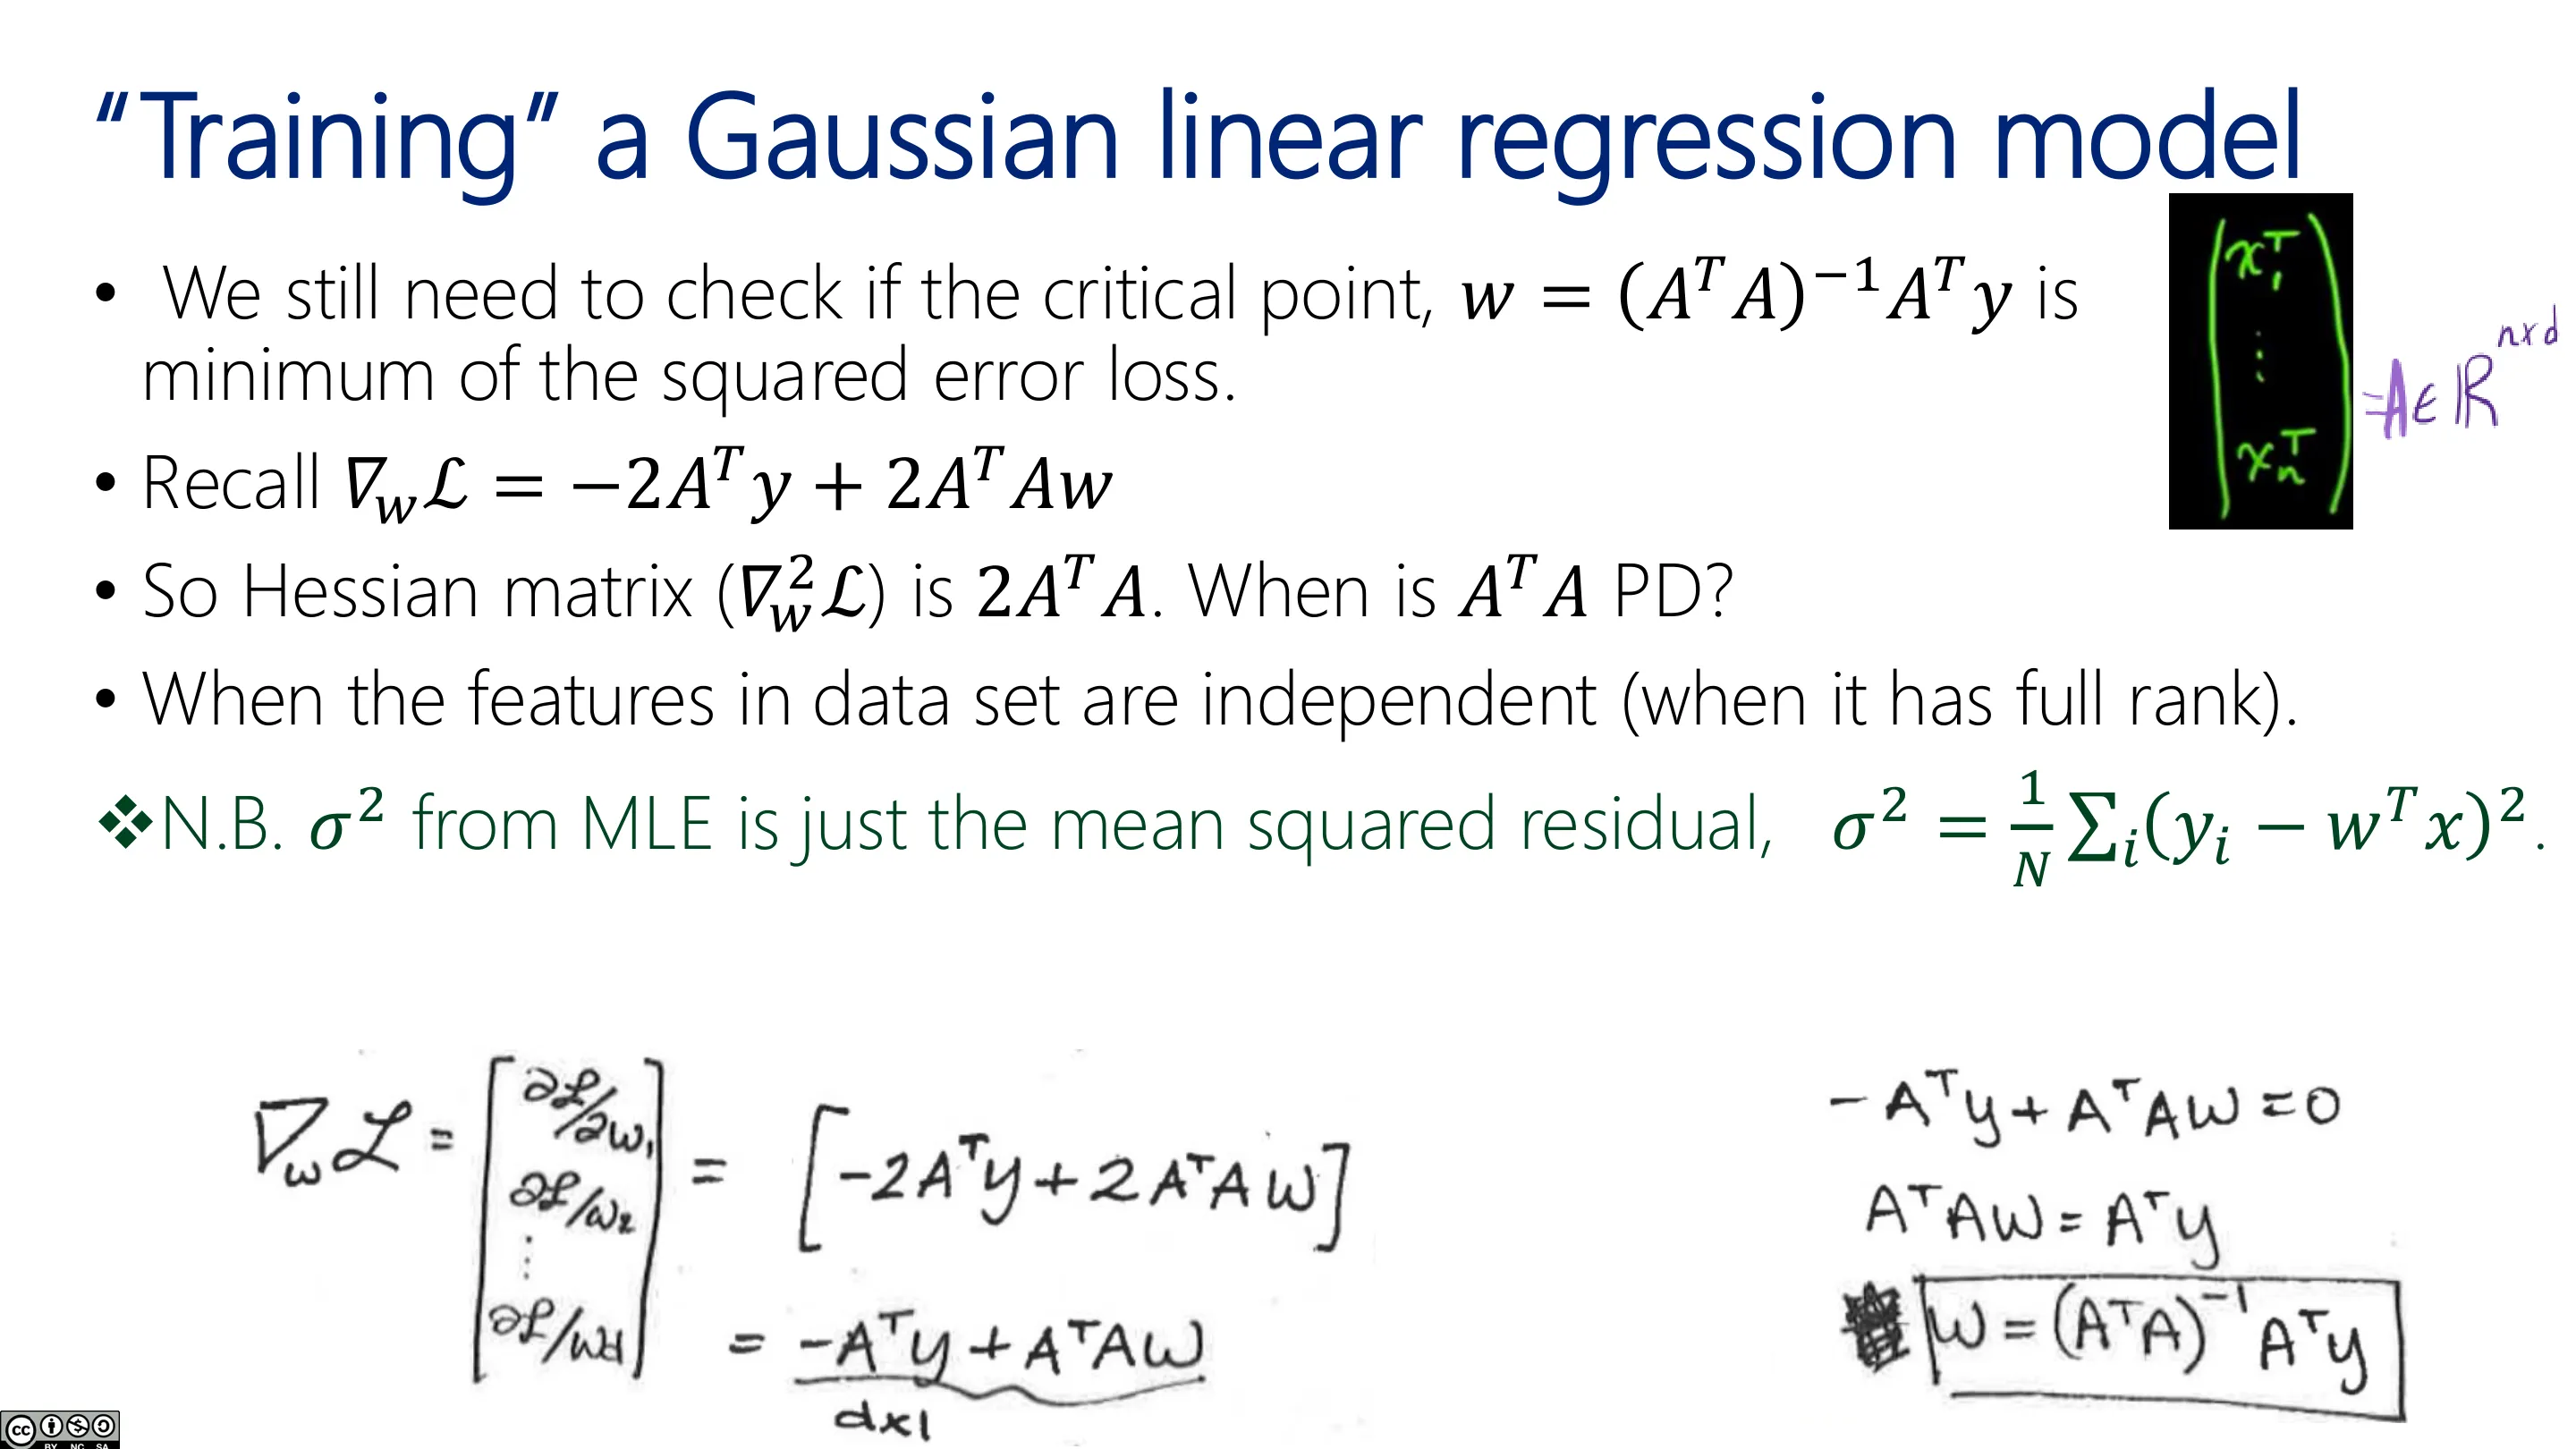
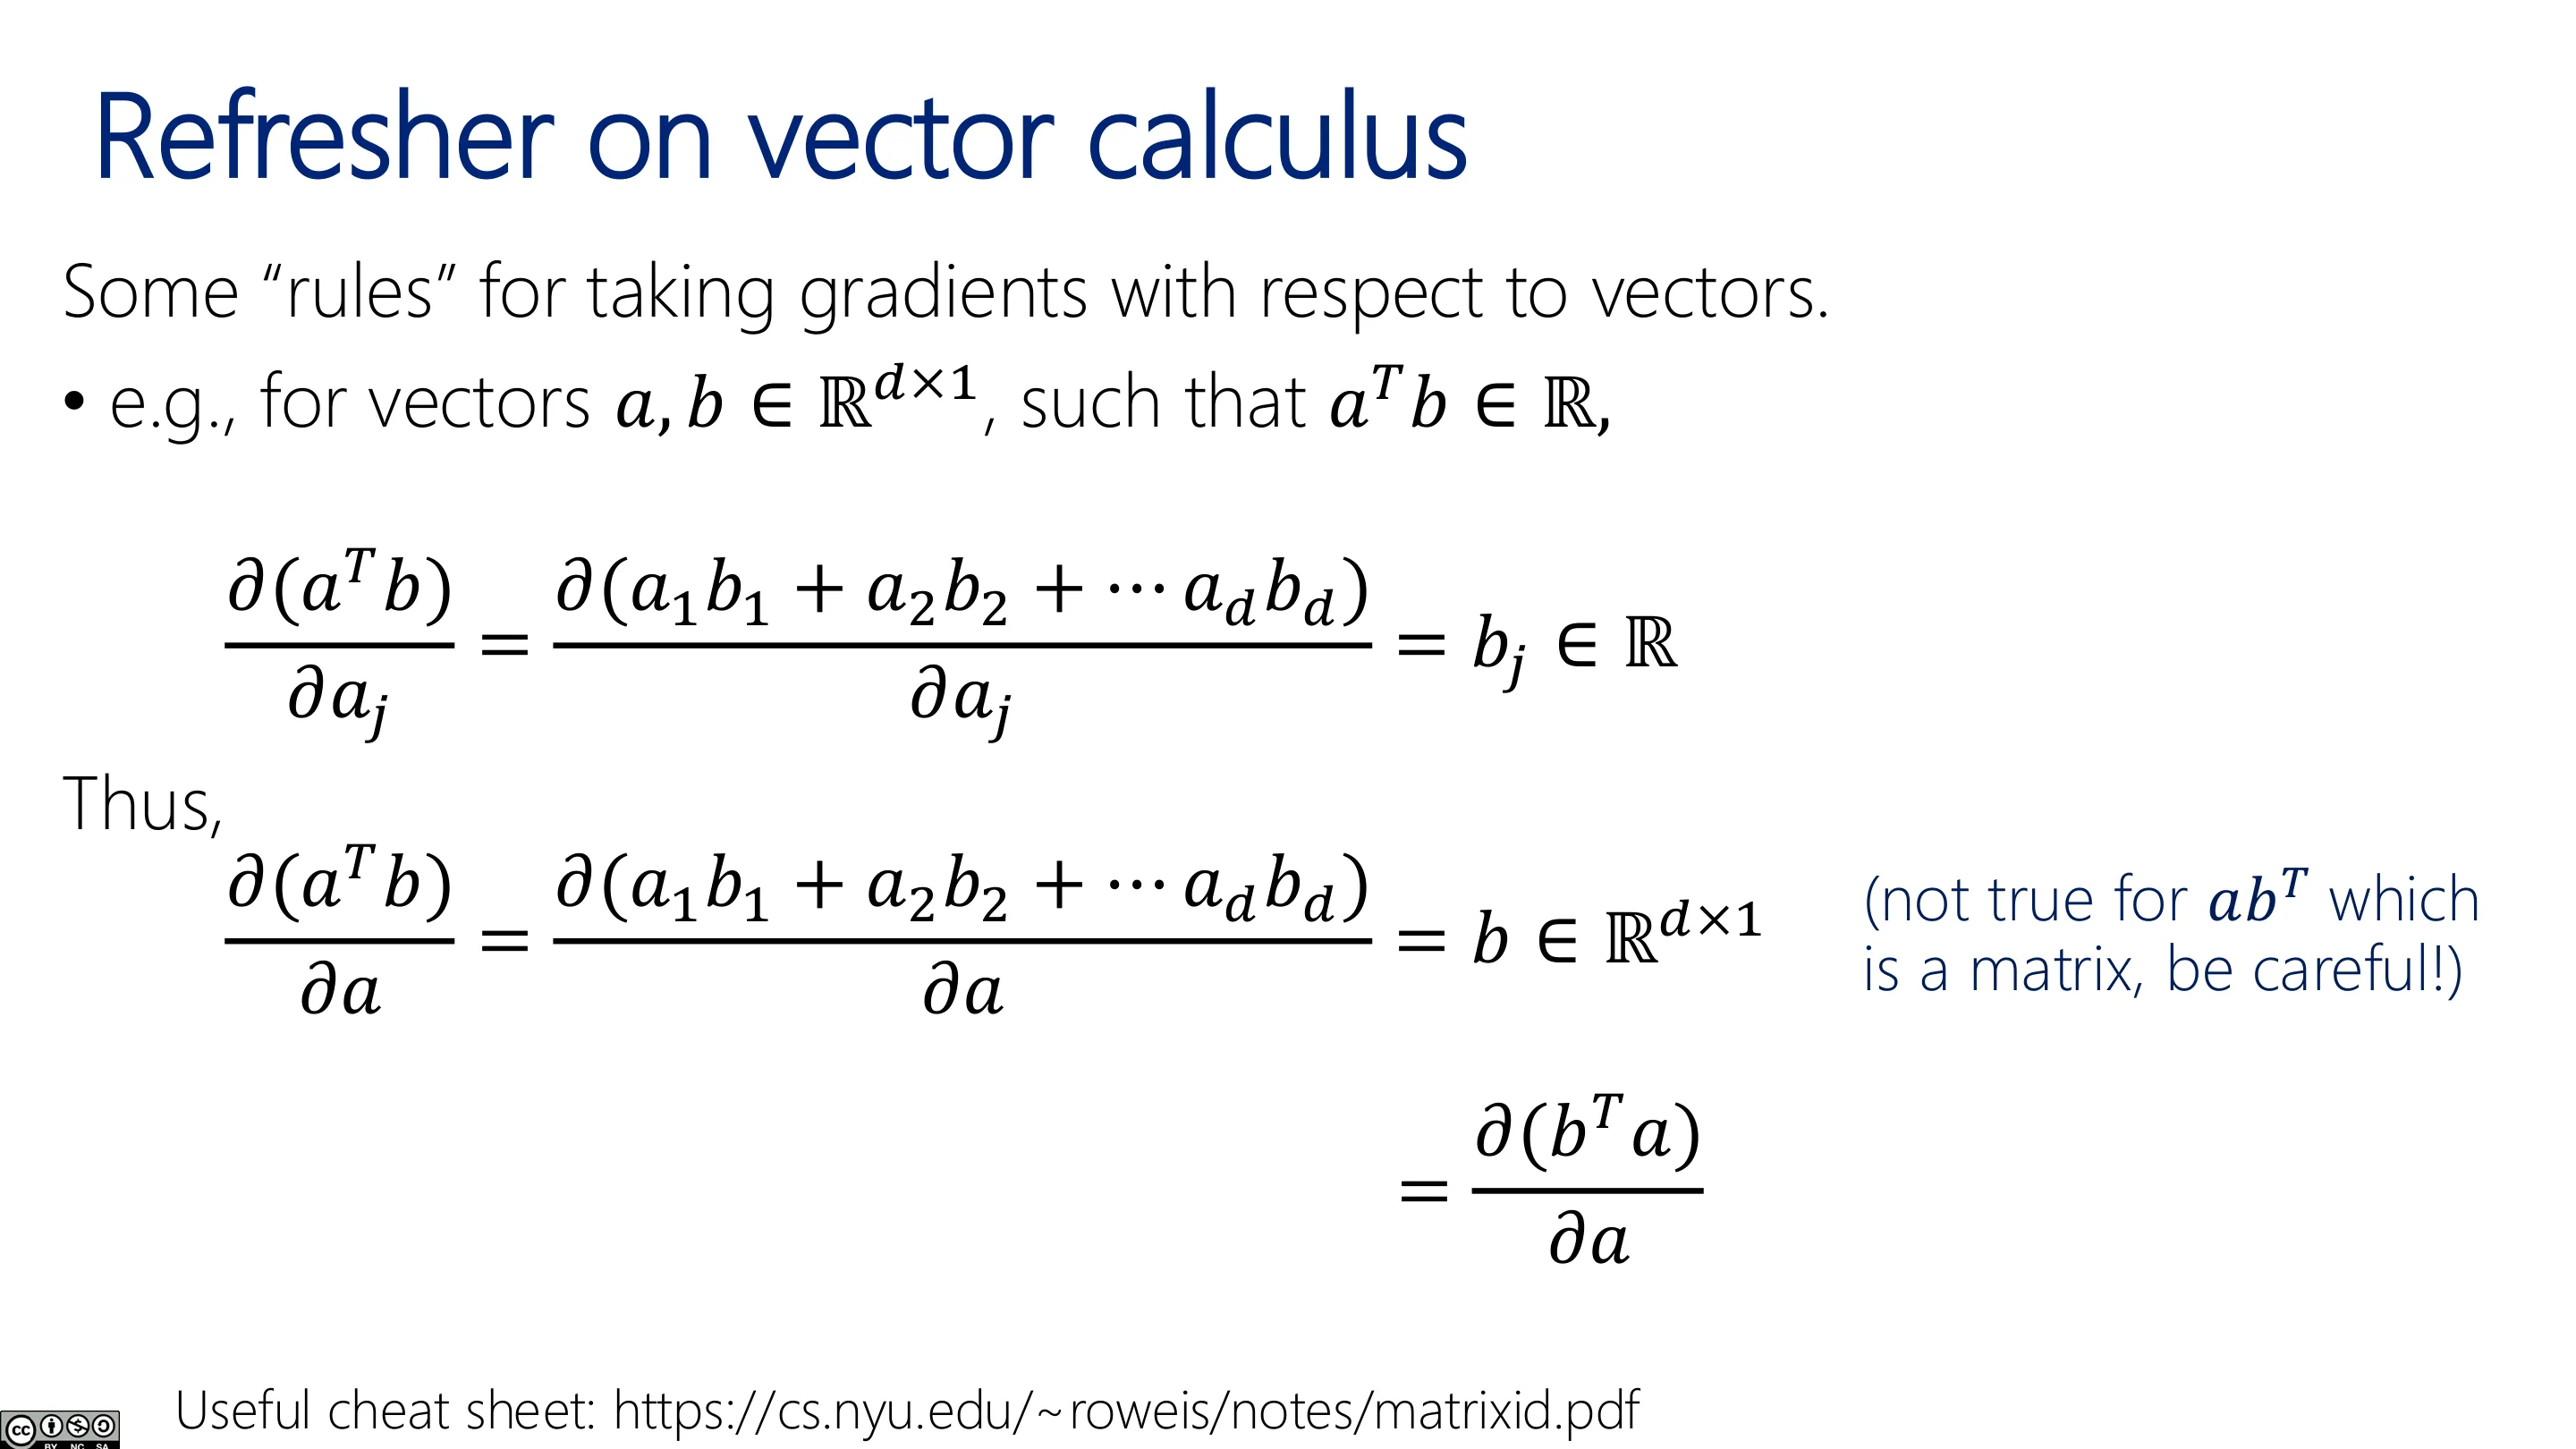
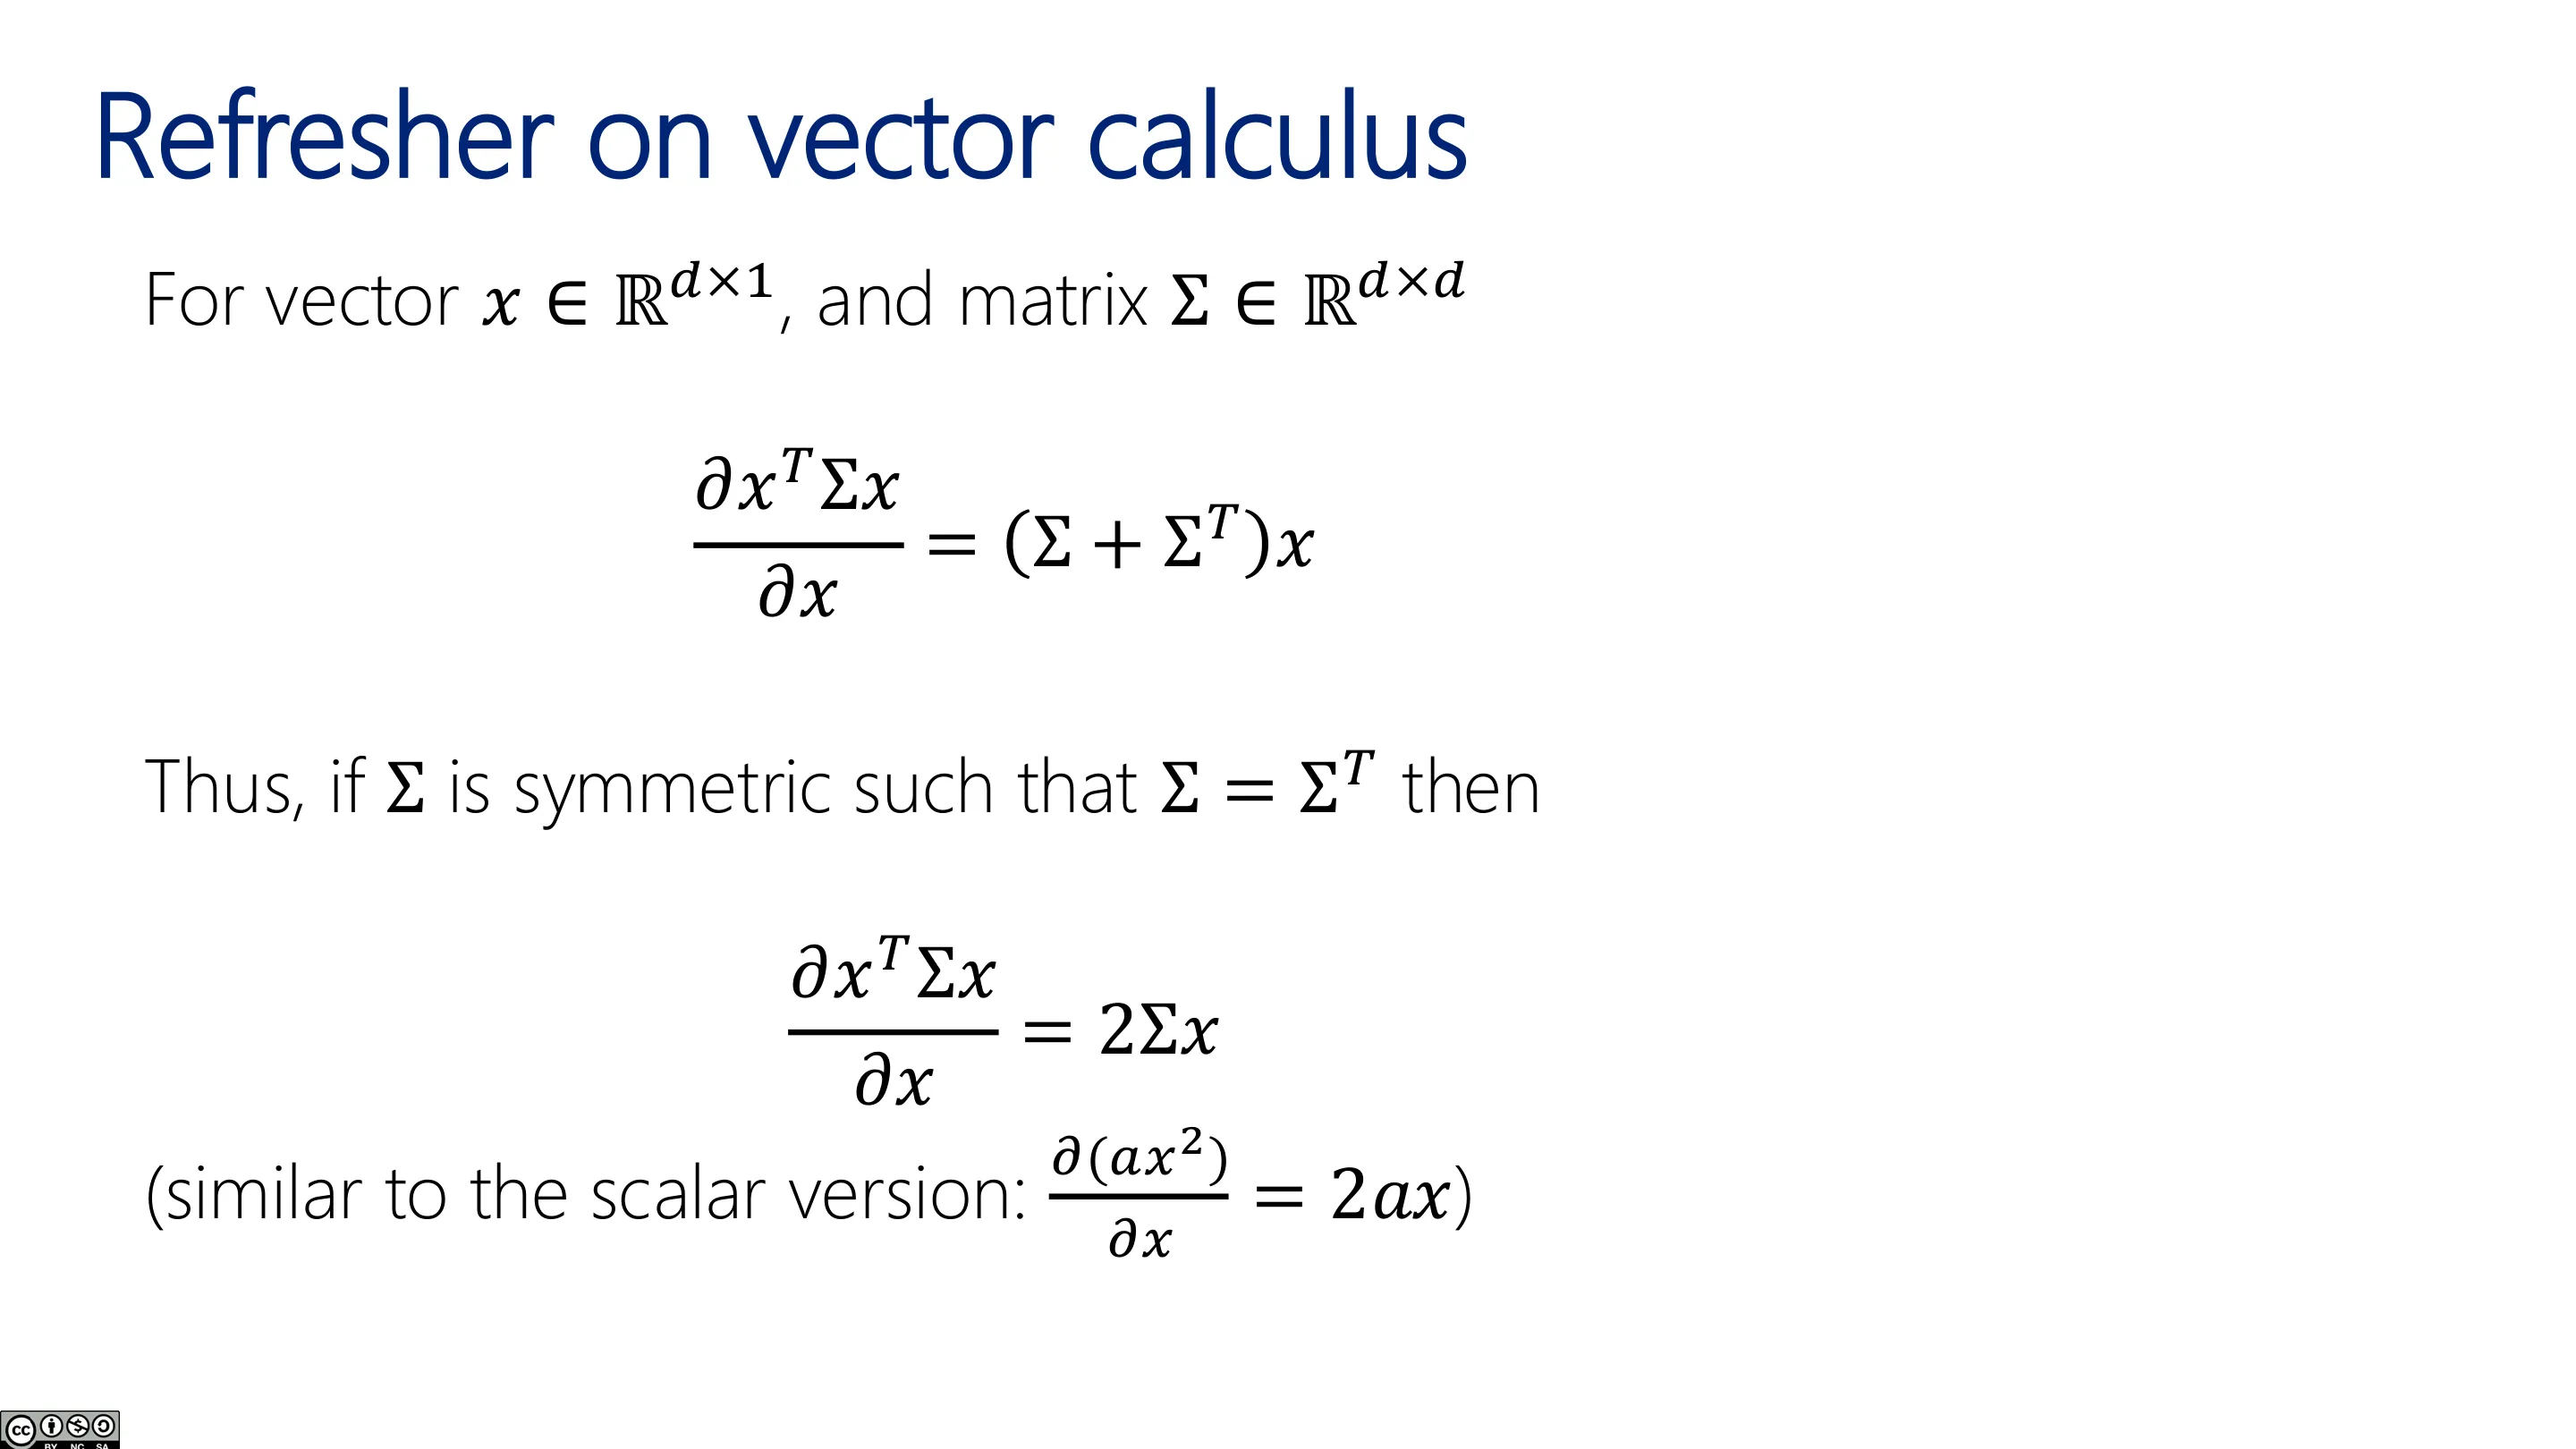
展开 $\lVert y-Aw\rVert^2=(y-Aw)^\top(y-Aw)$,对 $w$ 求导并令其为零,即可得正规方程(下节课继续):
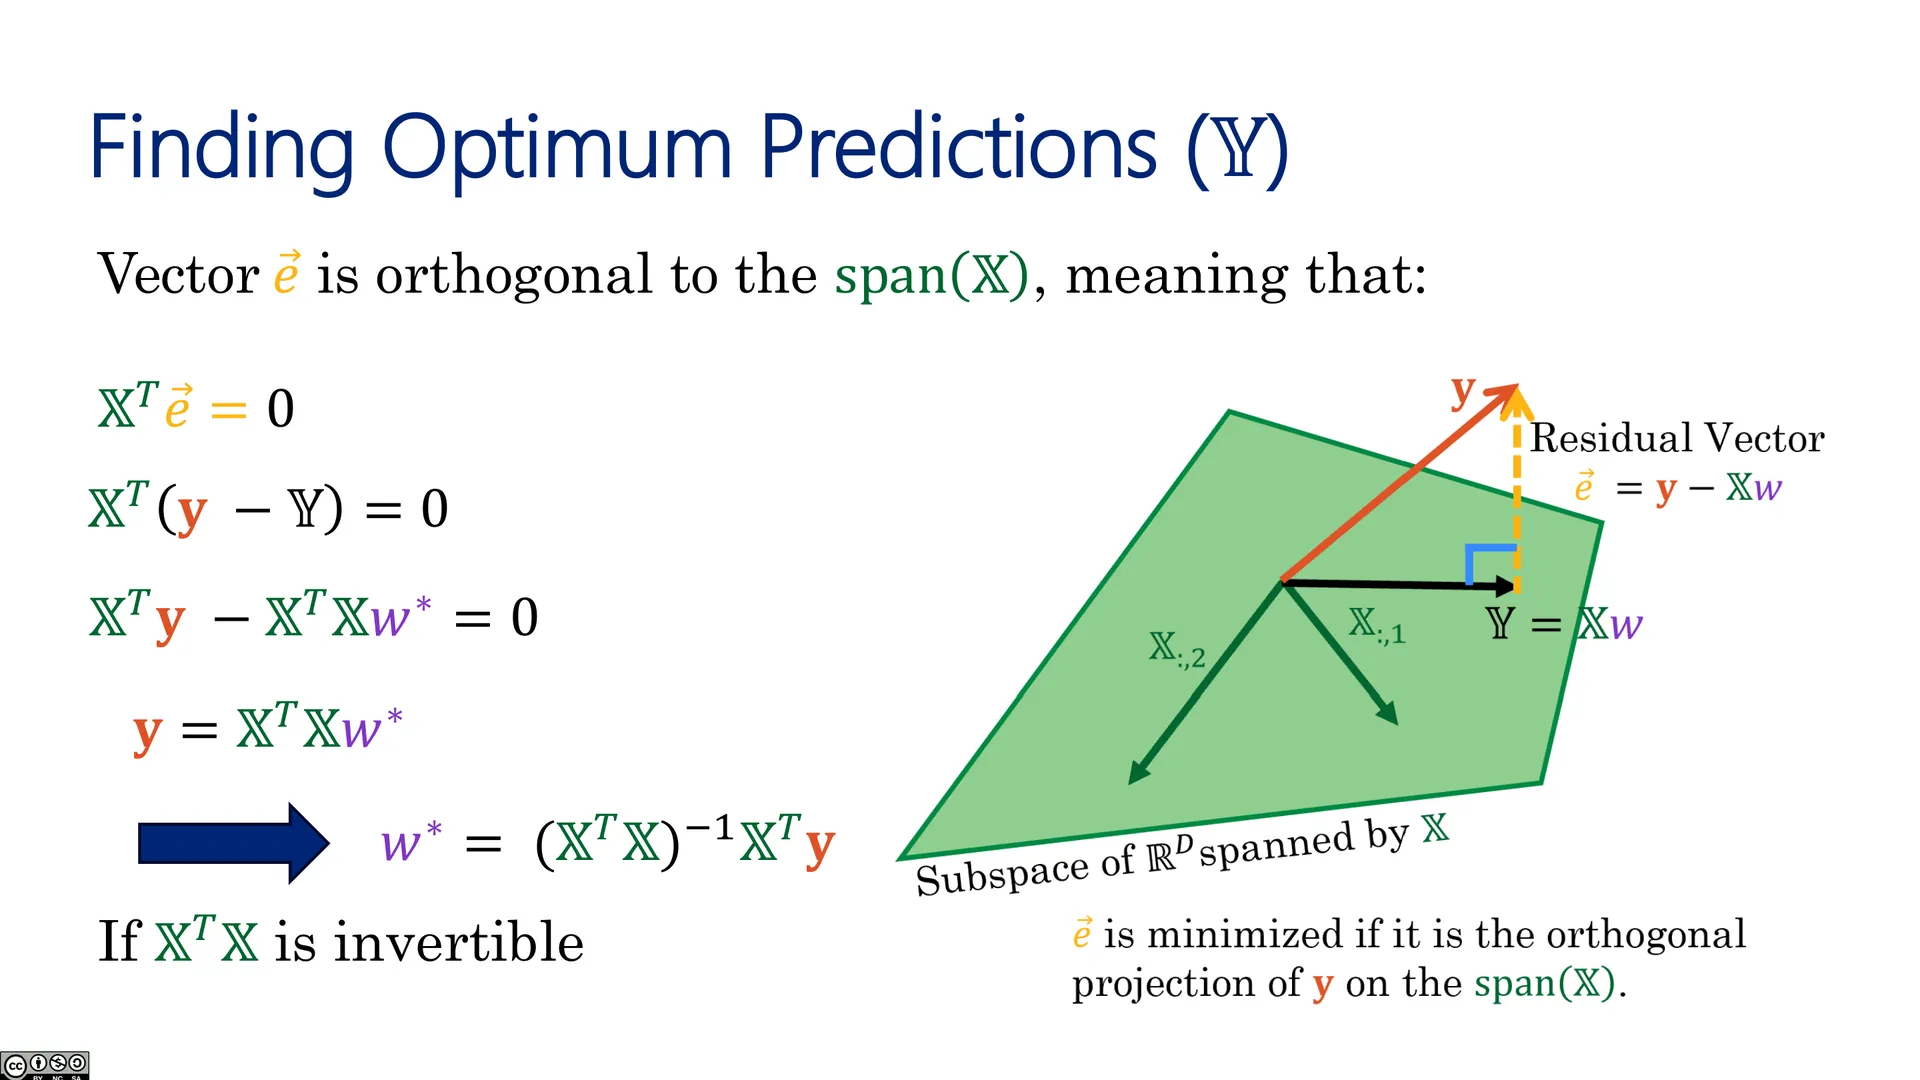
$$ -2A^\top y+2A^\top A w=0 \;\Longrightarrow\; \hat w=(A^\top A)^{-1}A^\top y $$
📷 向量化损失与设计矩阵
回到原视频 (01:09:20)
📷 用矩阵微积分求解
回到原视频 (01:10:05)
📷 展开平方项
回到原视频 (01:11:05)
📷 对 w 求导
回到原视频 (01:11:30)
📷 得到正规方程
回到原视频 (01:12:30)
📷 向量微积分复习(一)
回到原视频 (01:19:10)
📷 向量微积分复习(二)
回到原视频 (01:19:20)
总结(Takeaways)
- MoG 用隐变量 $z_i$ 与边缘化写似然 $L_i=\sum_k \mathcal{N}(x_i\mid\mu_k,\Sigma_k)\alpha_k$;对数里套求和导致无闭式解,需迭代优化(EM / 梯度下降)。
- 零噪声极限下 MoG 退化为 K 均值;MoG 的协方差给出形状自由度,混合系数决定各簇规模。
- MoG 可用于聚类、密度估计、生成采样,并用统计假设换来了更好的可理解性与可推广性。
- 回归的目标是估计 $p(y\mid x)$;判别式(直接建模条件的)vs 生成式(建模联合再推条件)。
- 高斯线性回归 $p(y\mid x)=\mathcal{N}(y\mid w^\top x,\sigma^2)$,用 MLE 训练即得最小二乘。
- 基函数展开让线性模型极度灵活;设计矩阵把最小二乘写成 $\lVert y-Aw\rVert^2$,正规解 $\hat w=(A^\top A)^{-1}A^\top y$。
附录:课堂未展示的幻灯片(几何与线性代数视角)
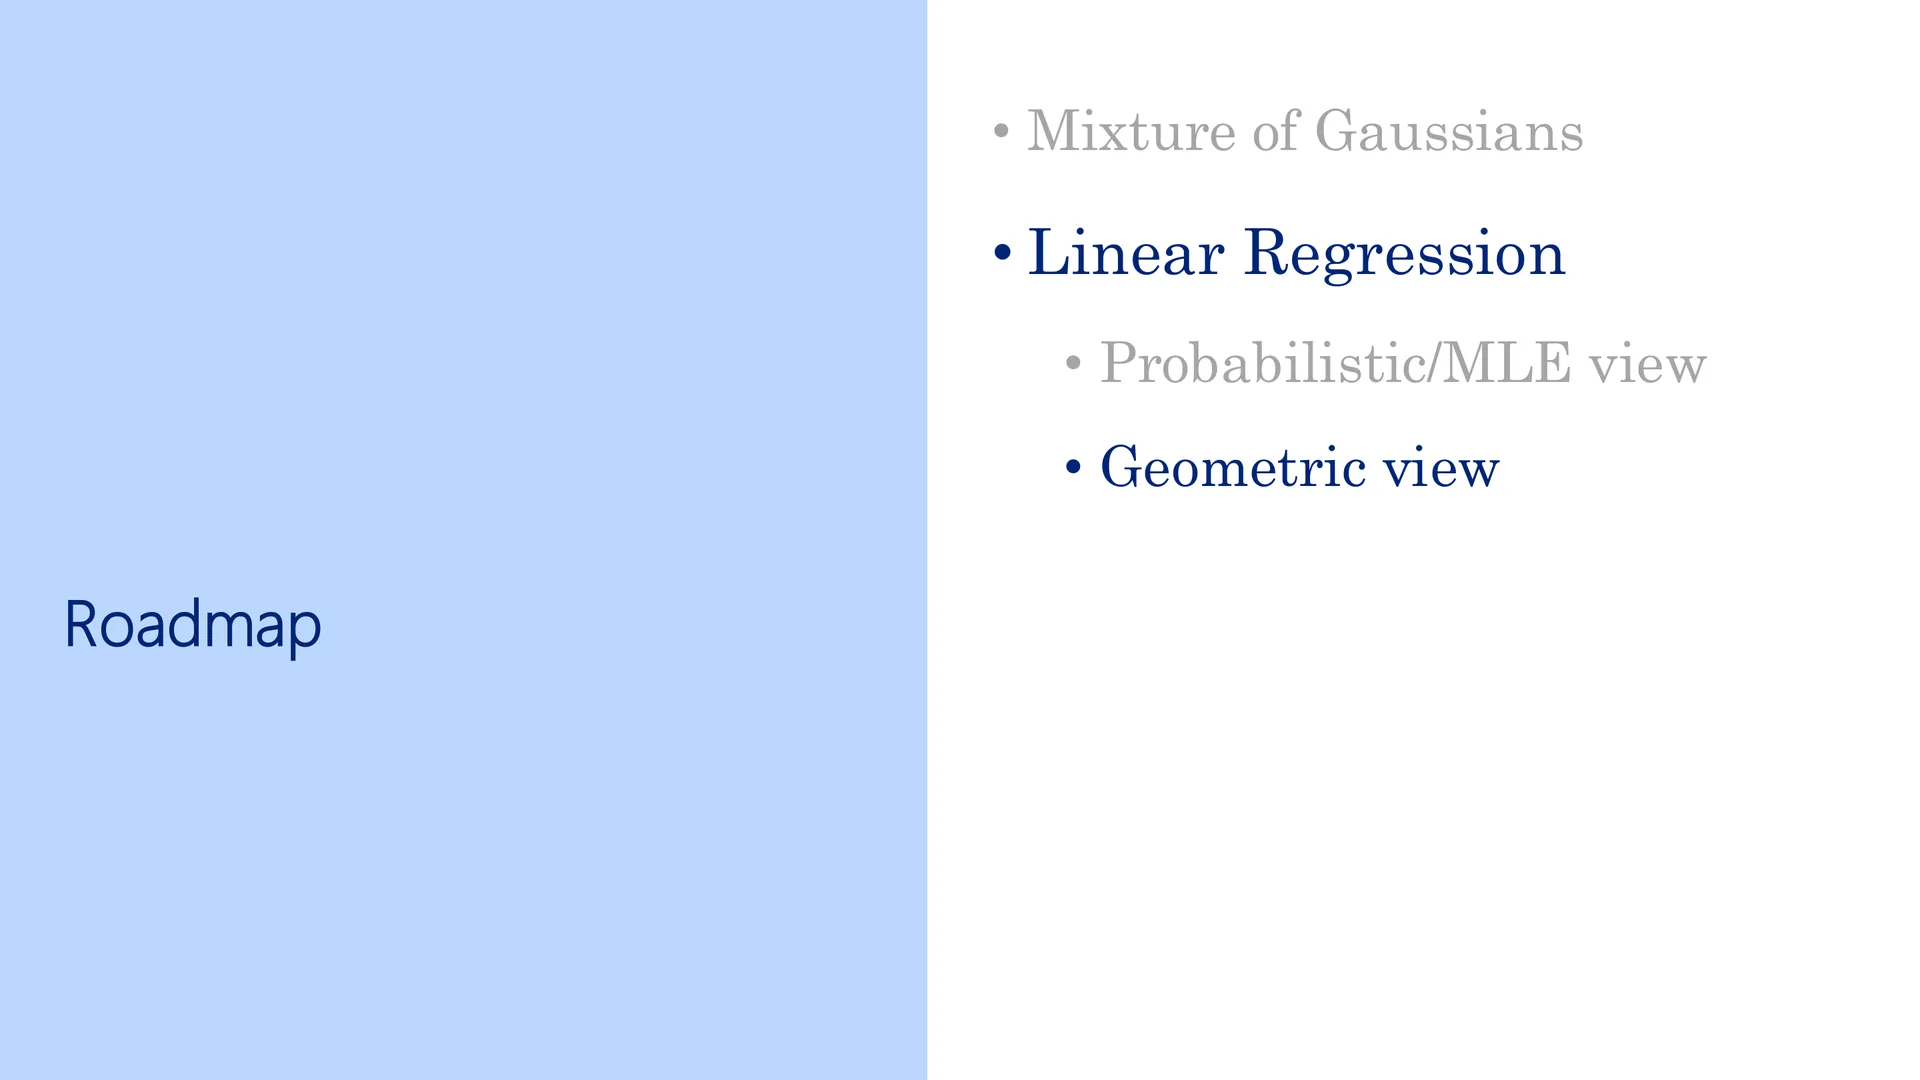
以下幻灯片属于本讲 deck 的几何视角 / 线性代数复习 / 线性回归的陷阱部分,本次录像未展开,作为延伸阅读收录。
🖼️ 线代:张成(Span)
🖼️ 线代:矩阵—向量乘法(一)
🖼️ 线代:矩阵—向量乘法(二)
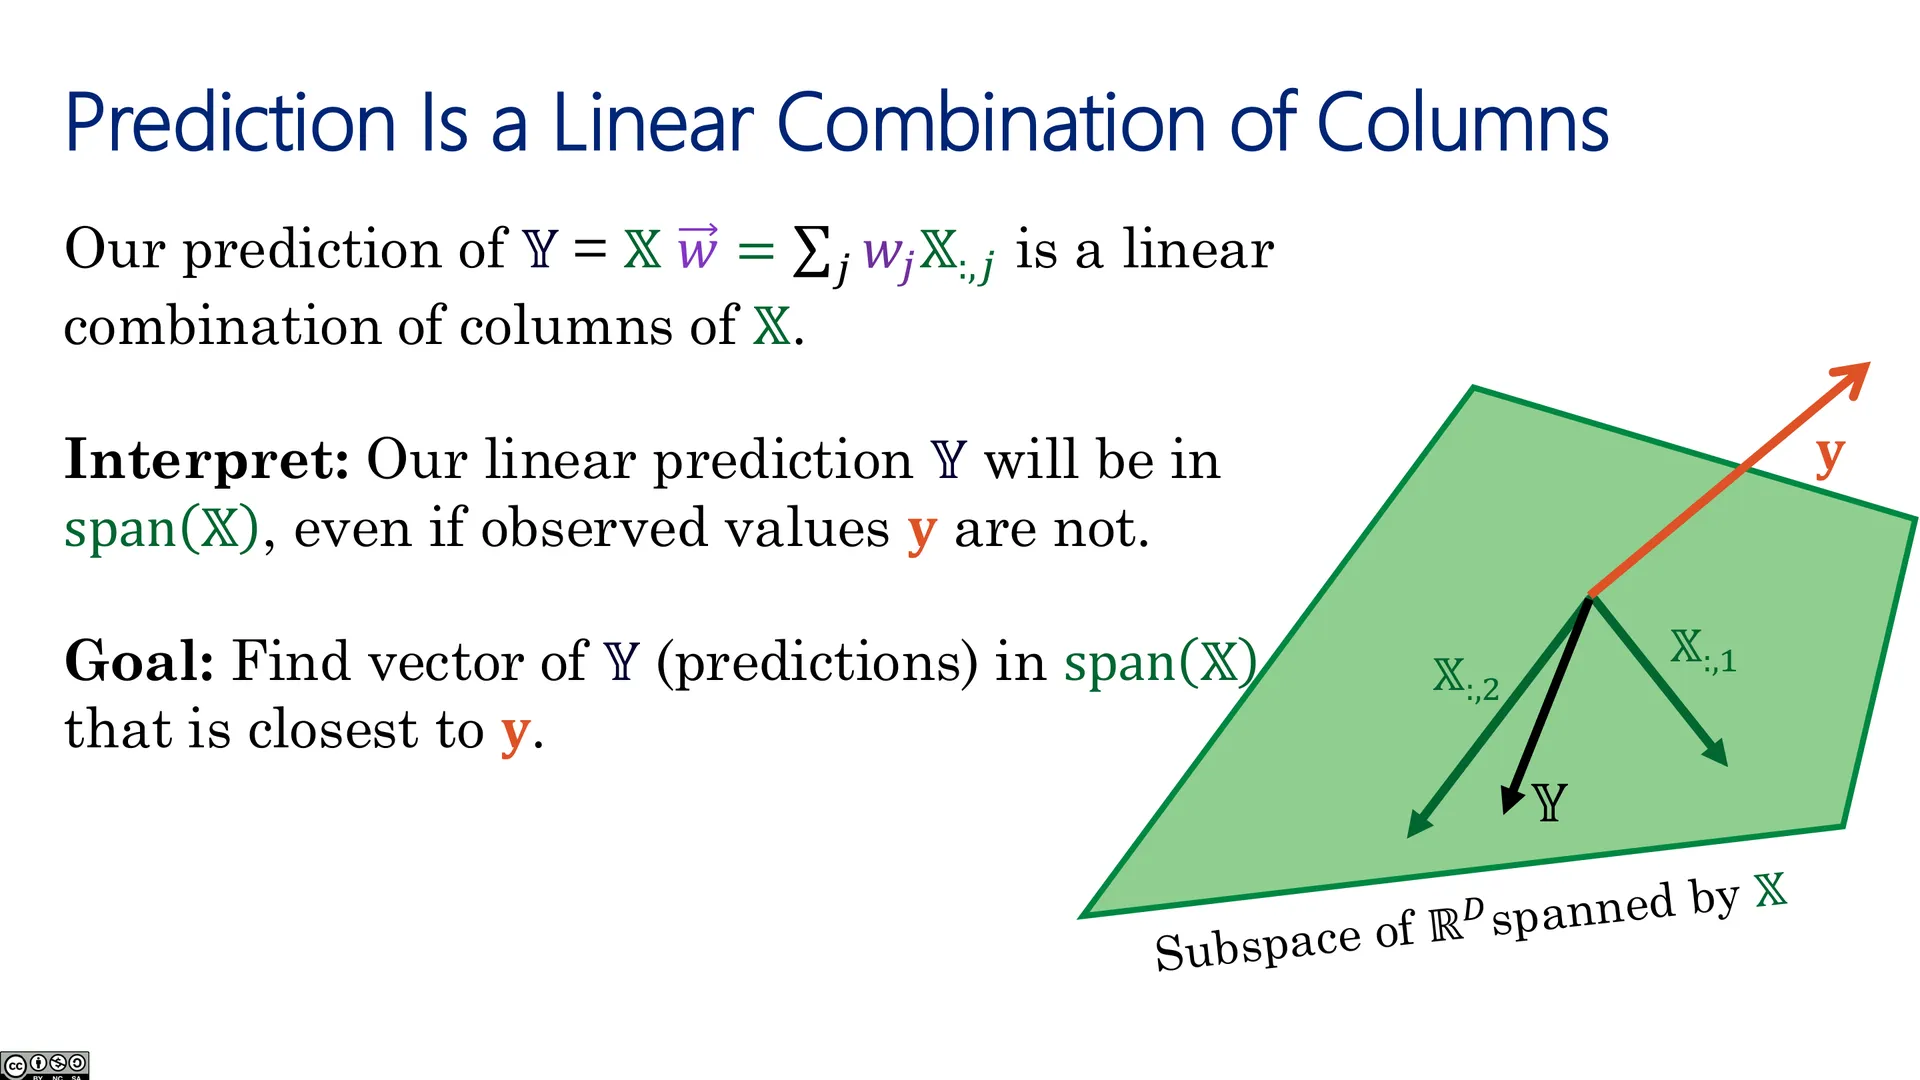
🖼️ 预测是各列向量的线性组合
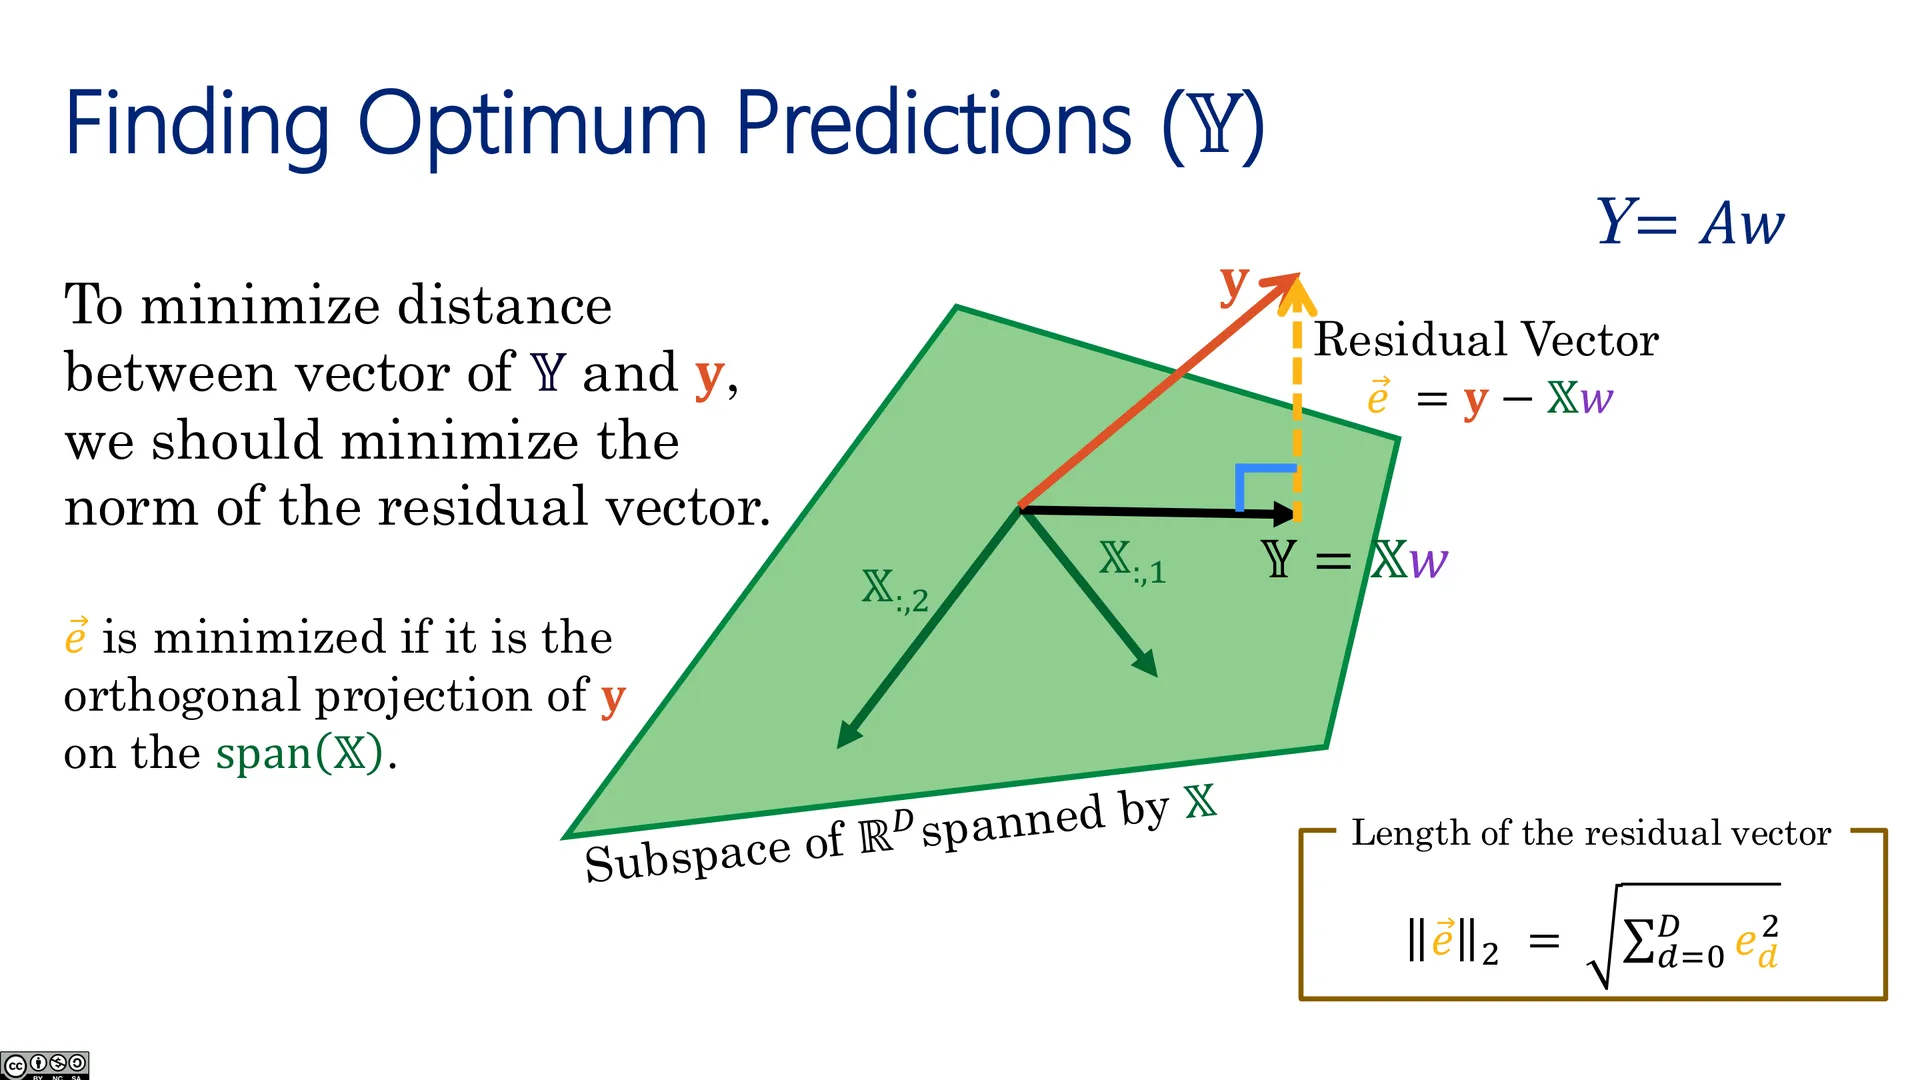
🖼️ 寻找最优预测
🖼️ 残差向量正交于张成空间
🖼️ 几何视角(一)
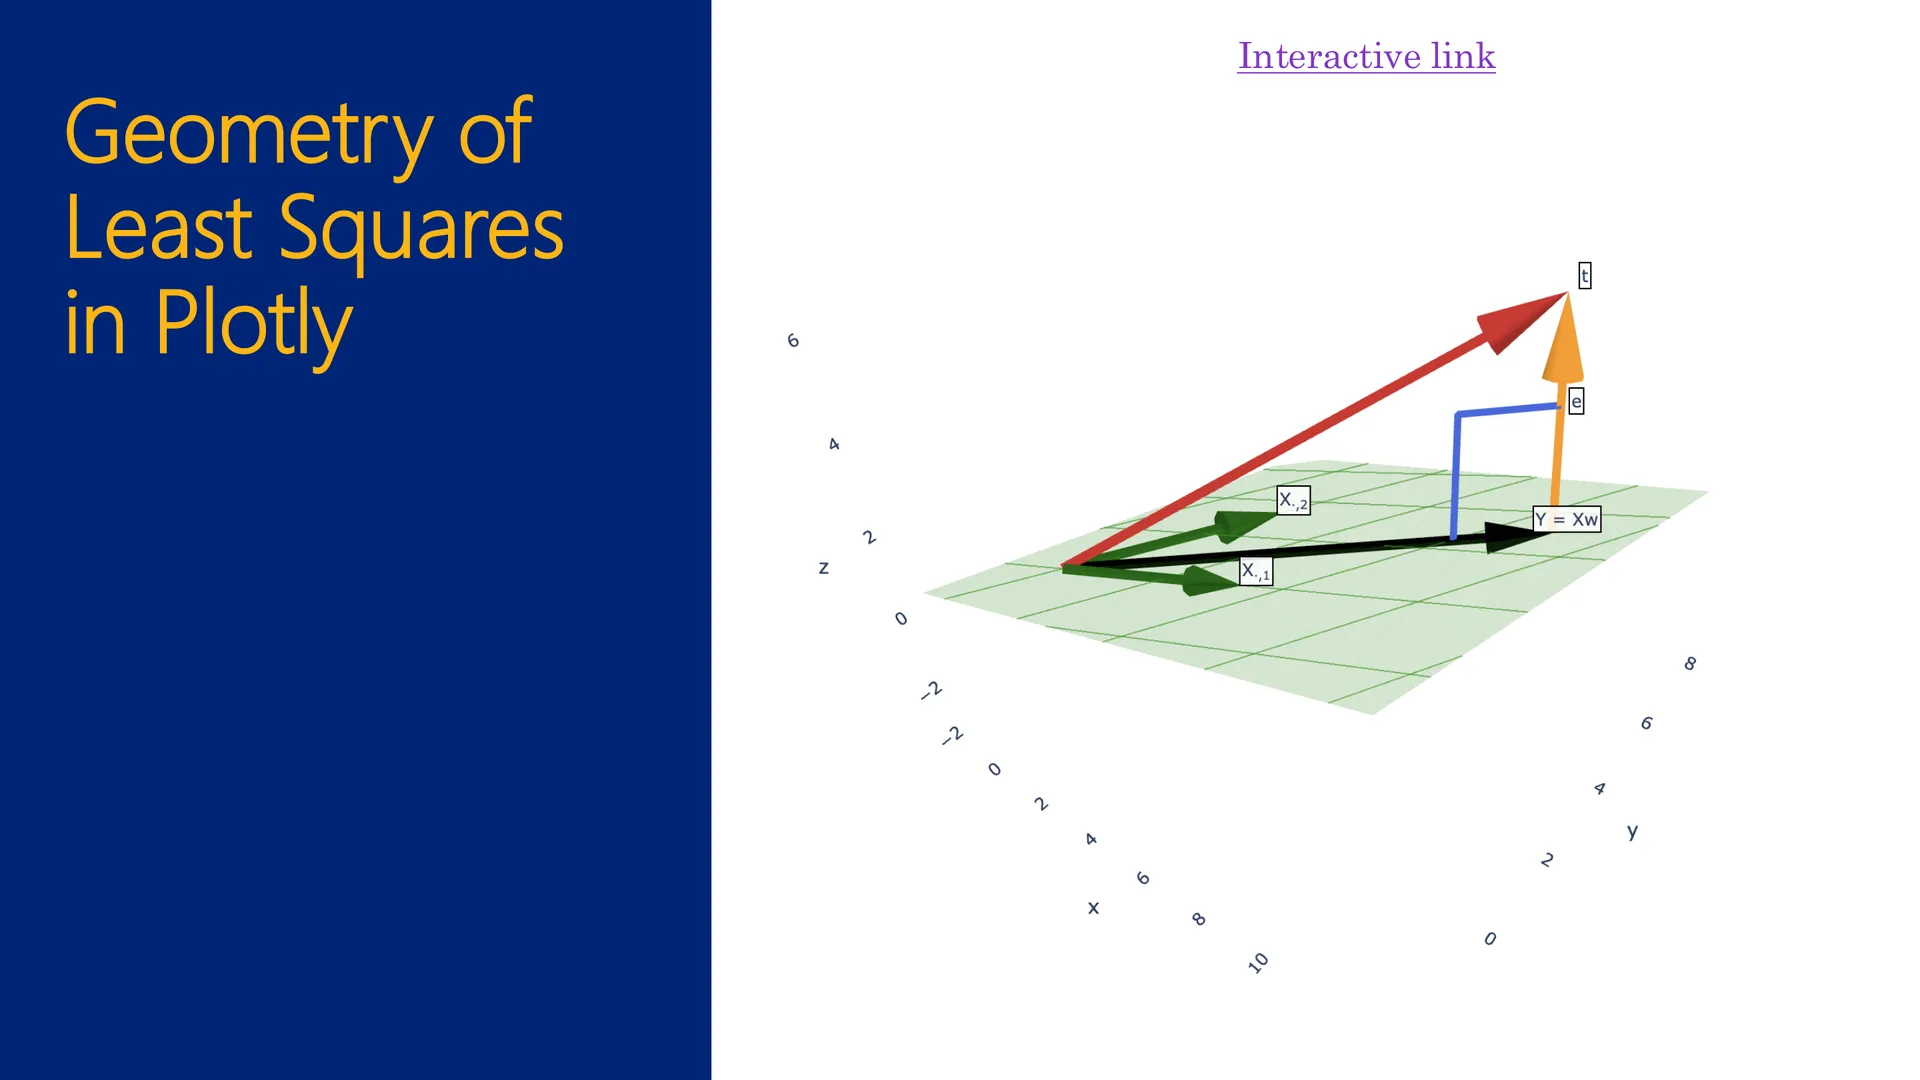
🖼️ 几何视角(二)
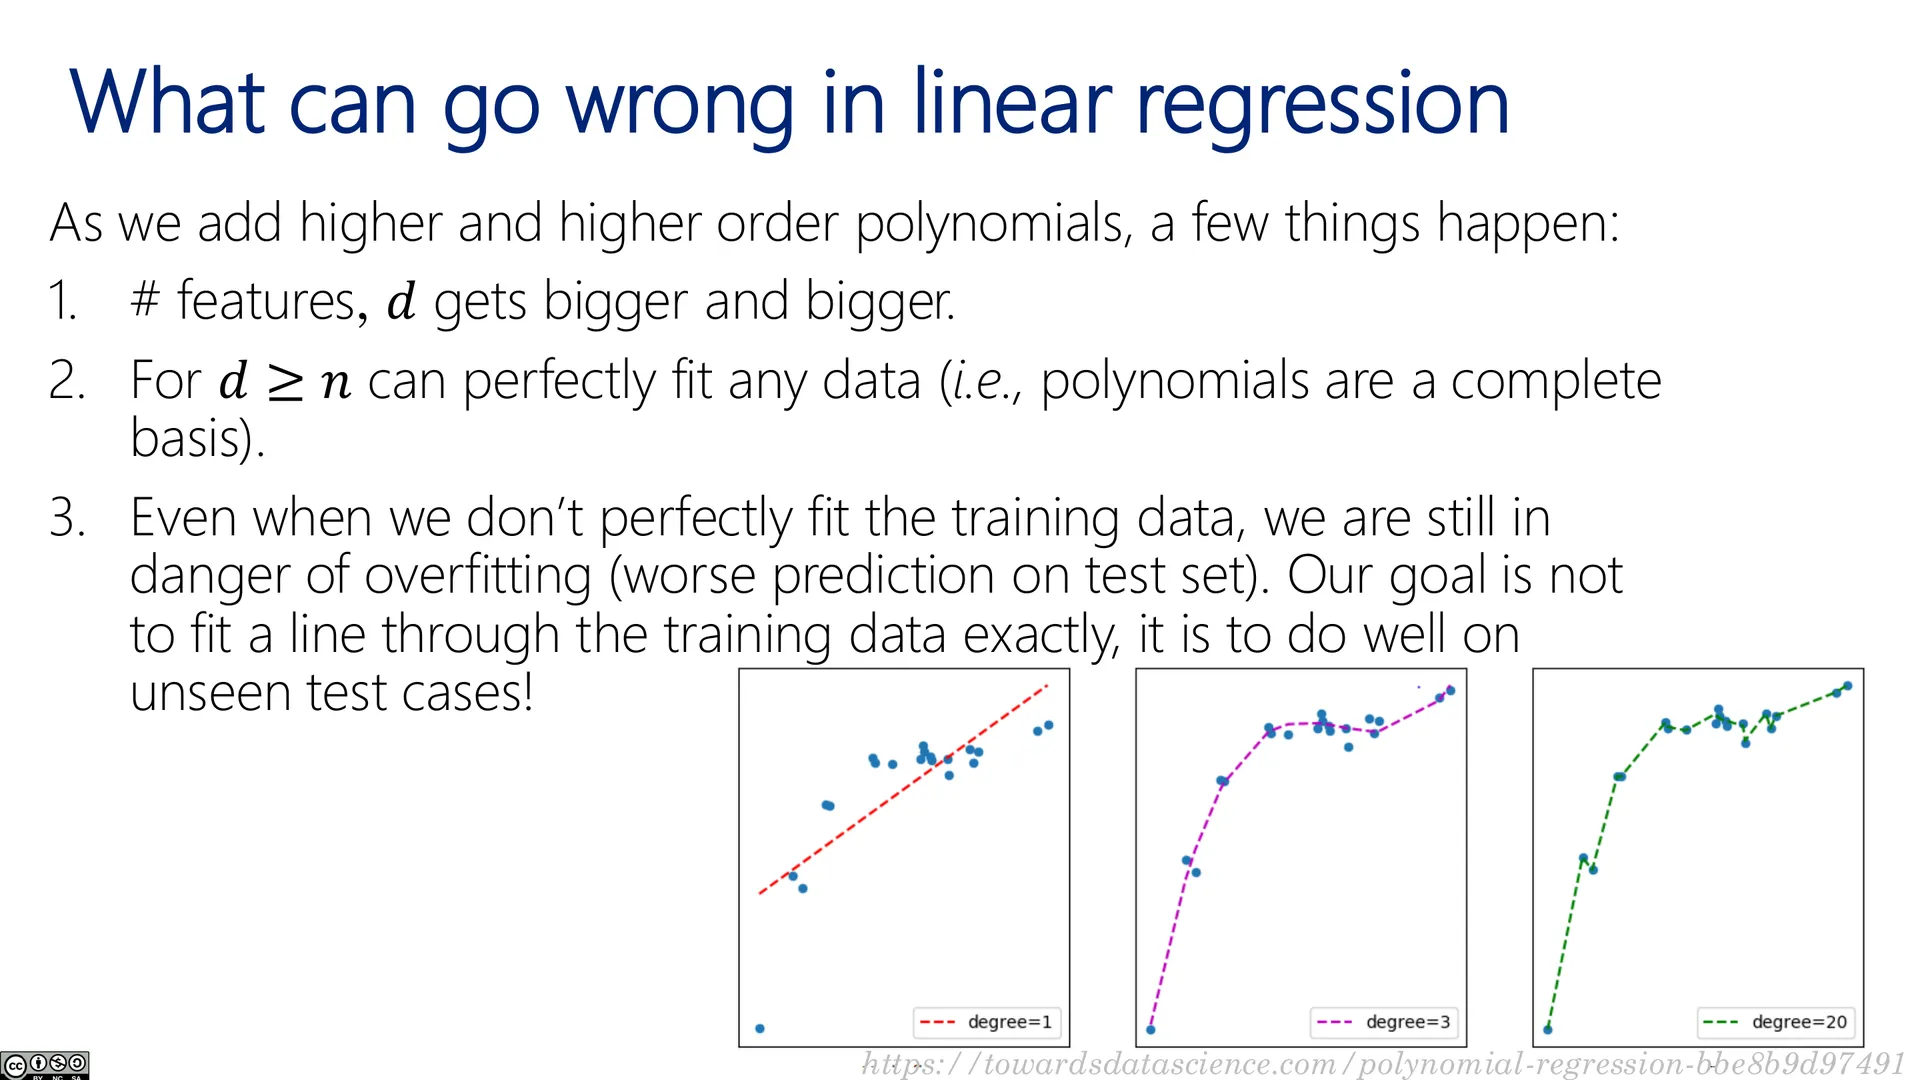
🖼️ 线性回归可能出的问题(一)
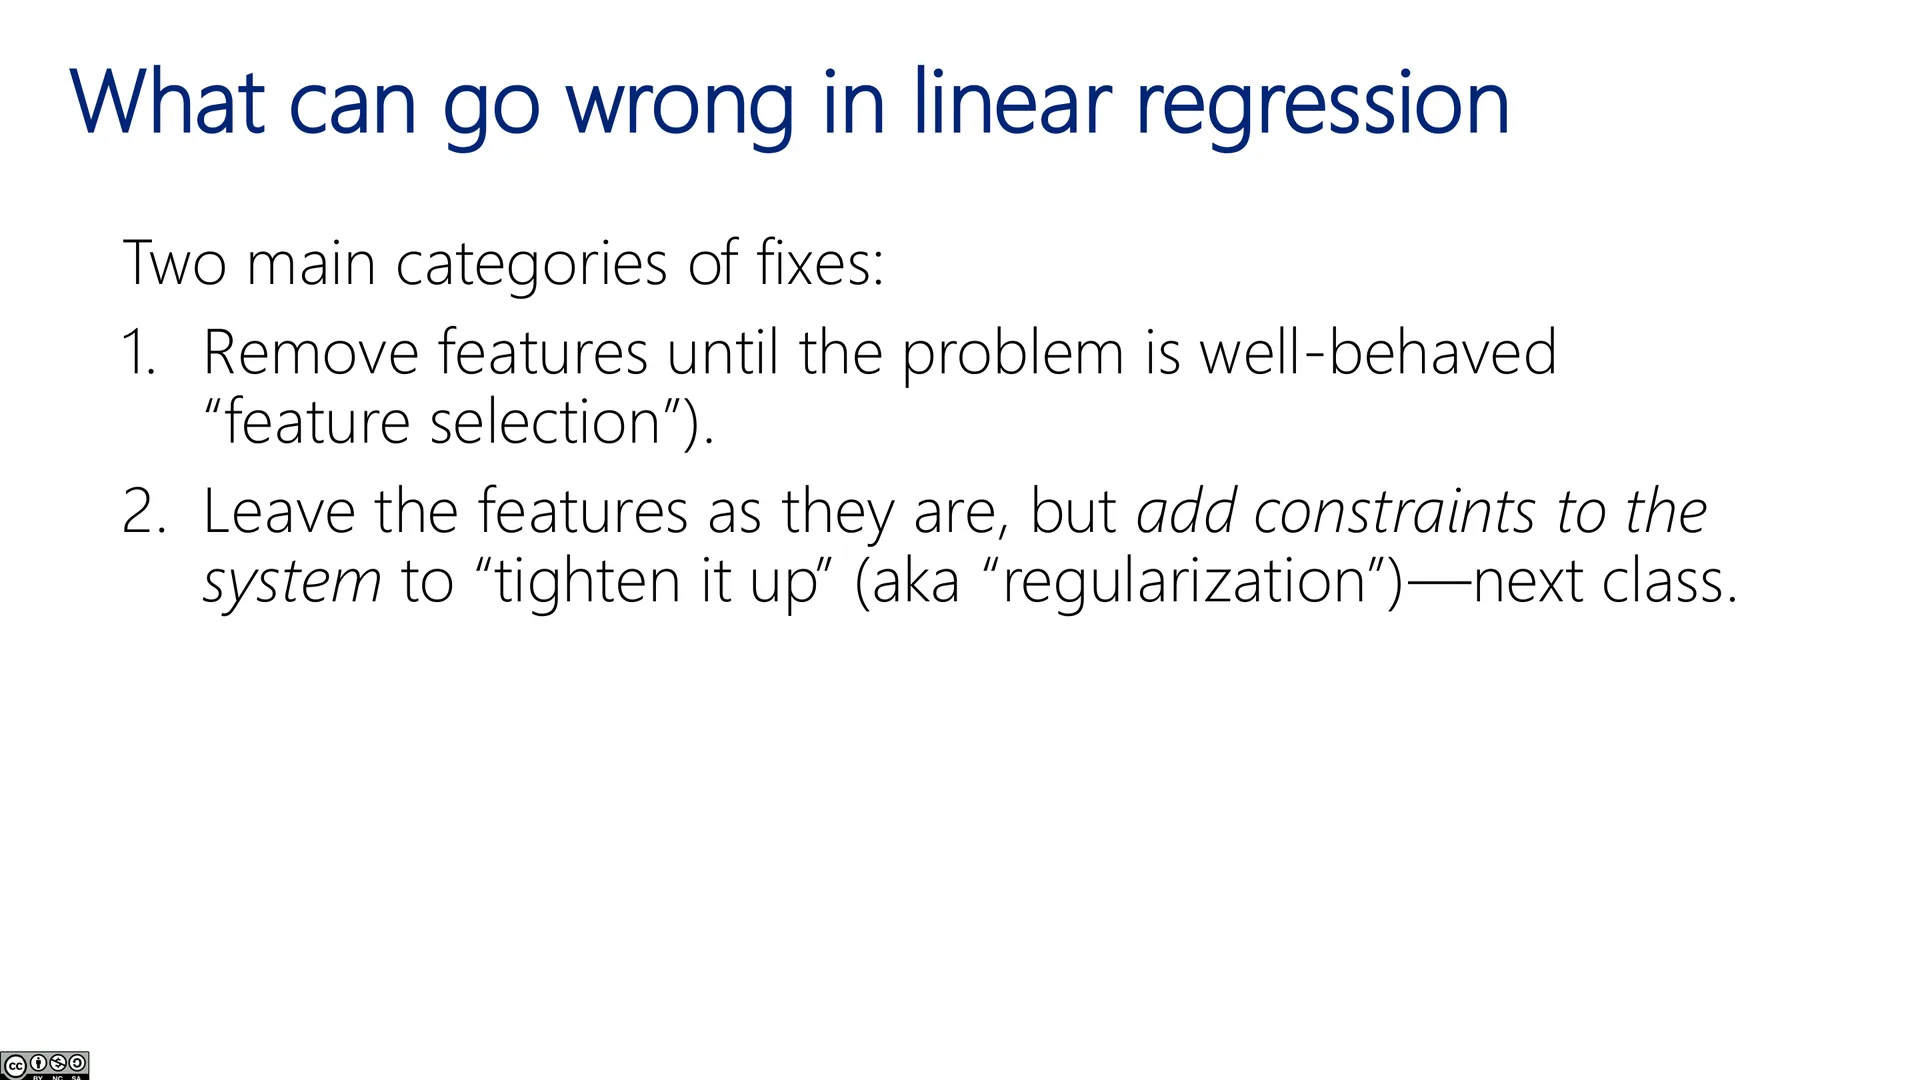
🖼️ 线性回归可能出的问题(二)
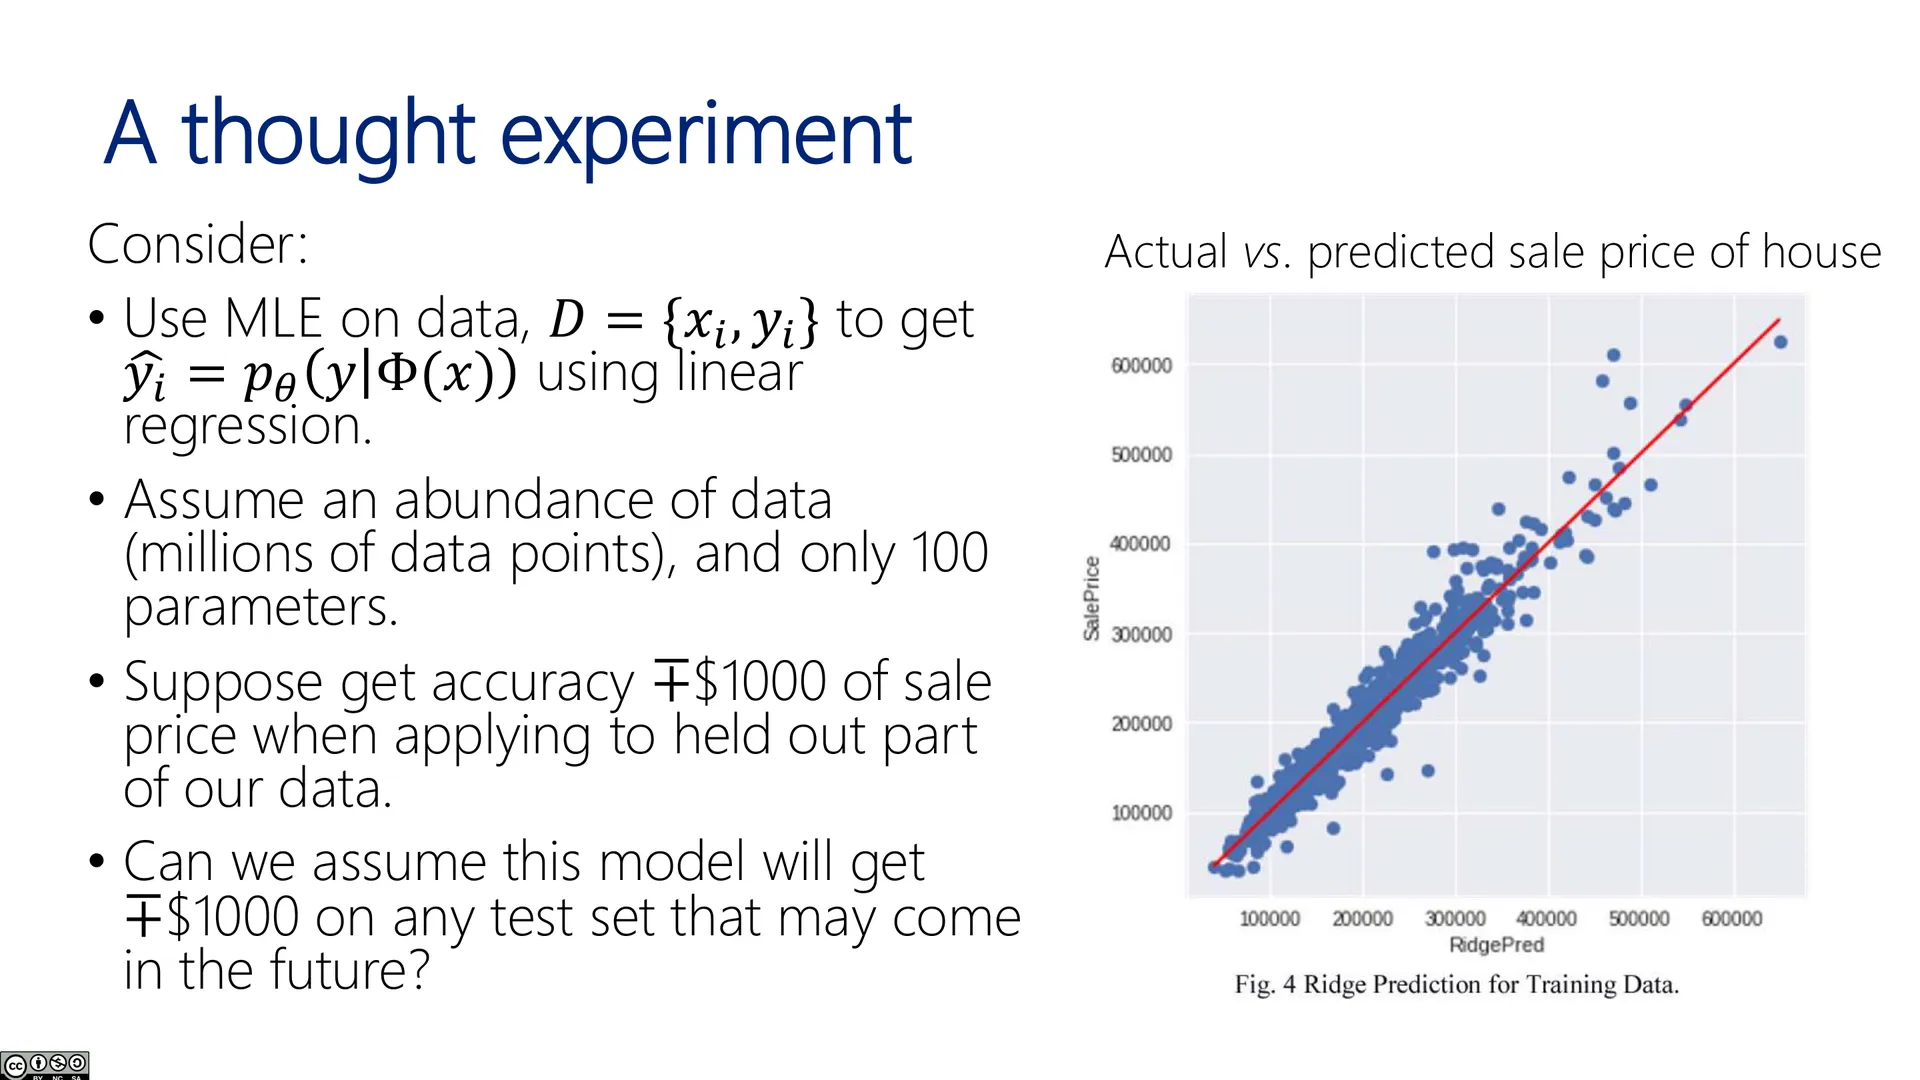
🖼️ 一个思想实验
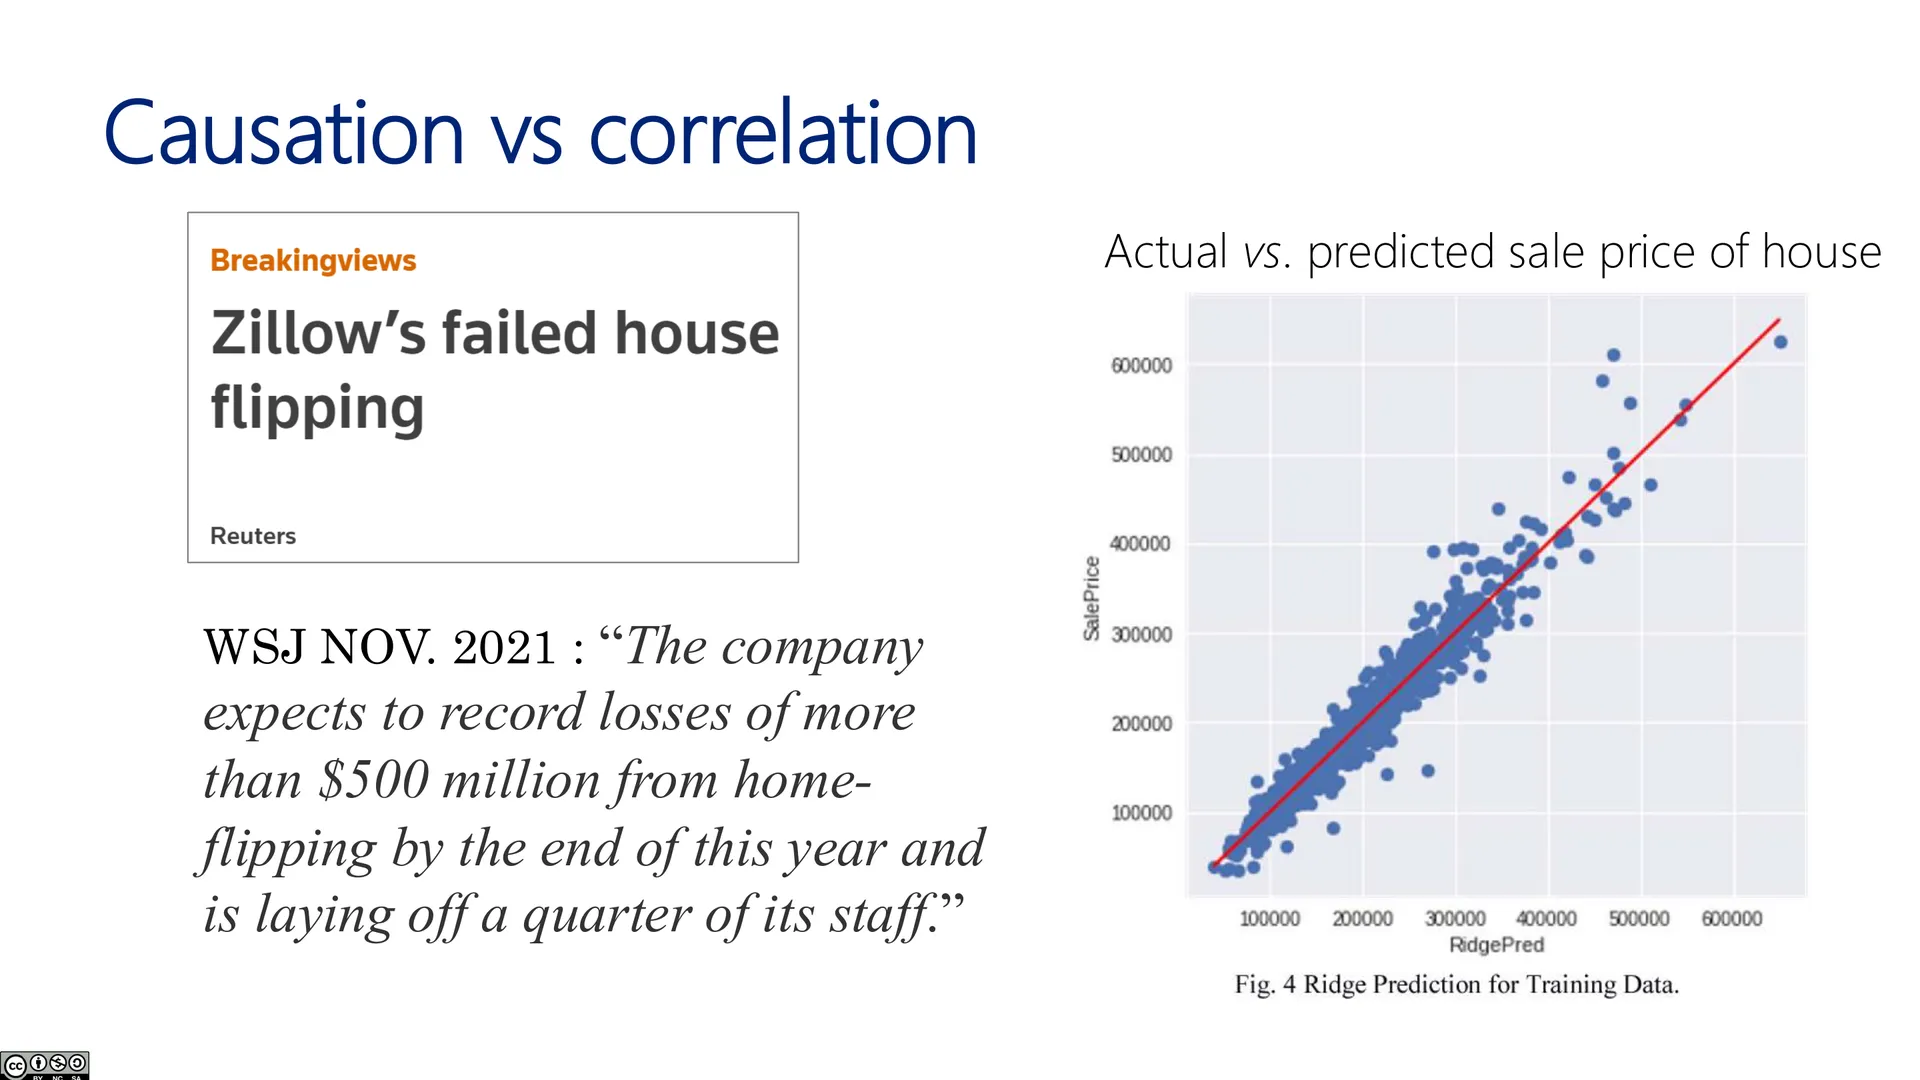
🖼️ 因果 vs 相关
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=0YLmbbERr0g |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 7) | Google Drive PDF |
| 教材 Machine Learning: A First Course for Engineers and Scientists | 回归、基函数展开、MoG/EM 相关章节 · https://doi.org/10.1017/9781108919371 |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。