第8讲 · EECS 189:线性回归
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | Linear Regression |
| 视频 | https://www.youtube.com/watch?v=202aSB1p8do |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 8) | Google Drive PDF |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第8讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
本讲路线图
(参考时间: 00:00)
本讲从两个完全不同的视角推导同一个结论——参数的最大似然估计:
- 概率视角:完成高斯线性回归的 MLE,用矩阵微积分得到闭式解;
- 几何视角:把问题变成「把标签向量投影到特征张成空间」,用线性代数得到同样的正规方程;
- 讨论秩亏 / 过拟合,并引出正则化(L2/L1、MAP)。
📷 标题页
回到原视频 (00:00:11)
📷 路线图(一)
回到原视频 (00:00:30)
📷 路线图(二)
回到原视频 (00:00:40)
一、回顾:高斯线性回归的 MLE
(参考时间: 00:00)
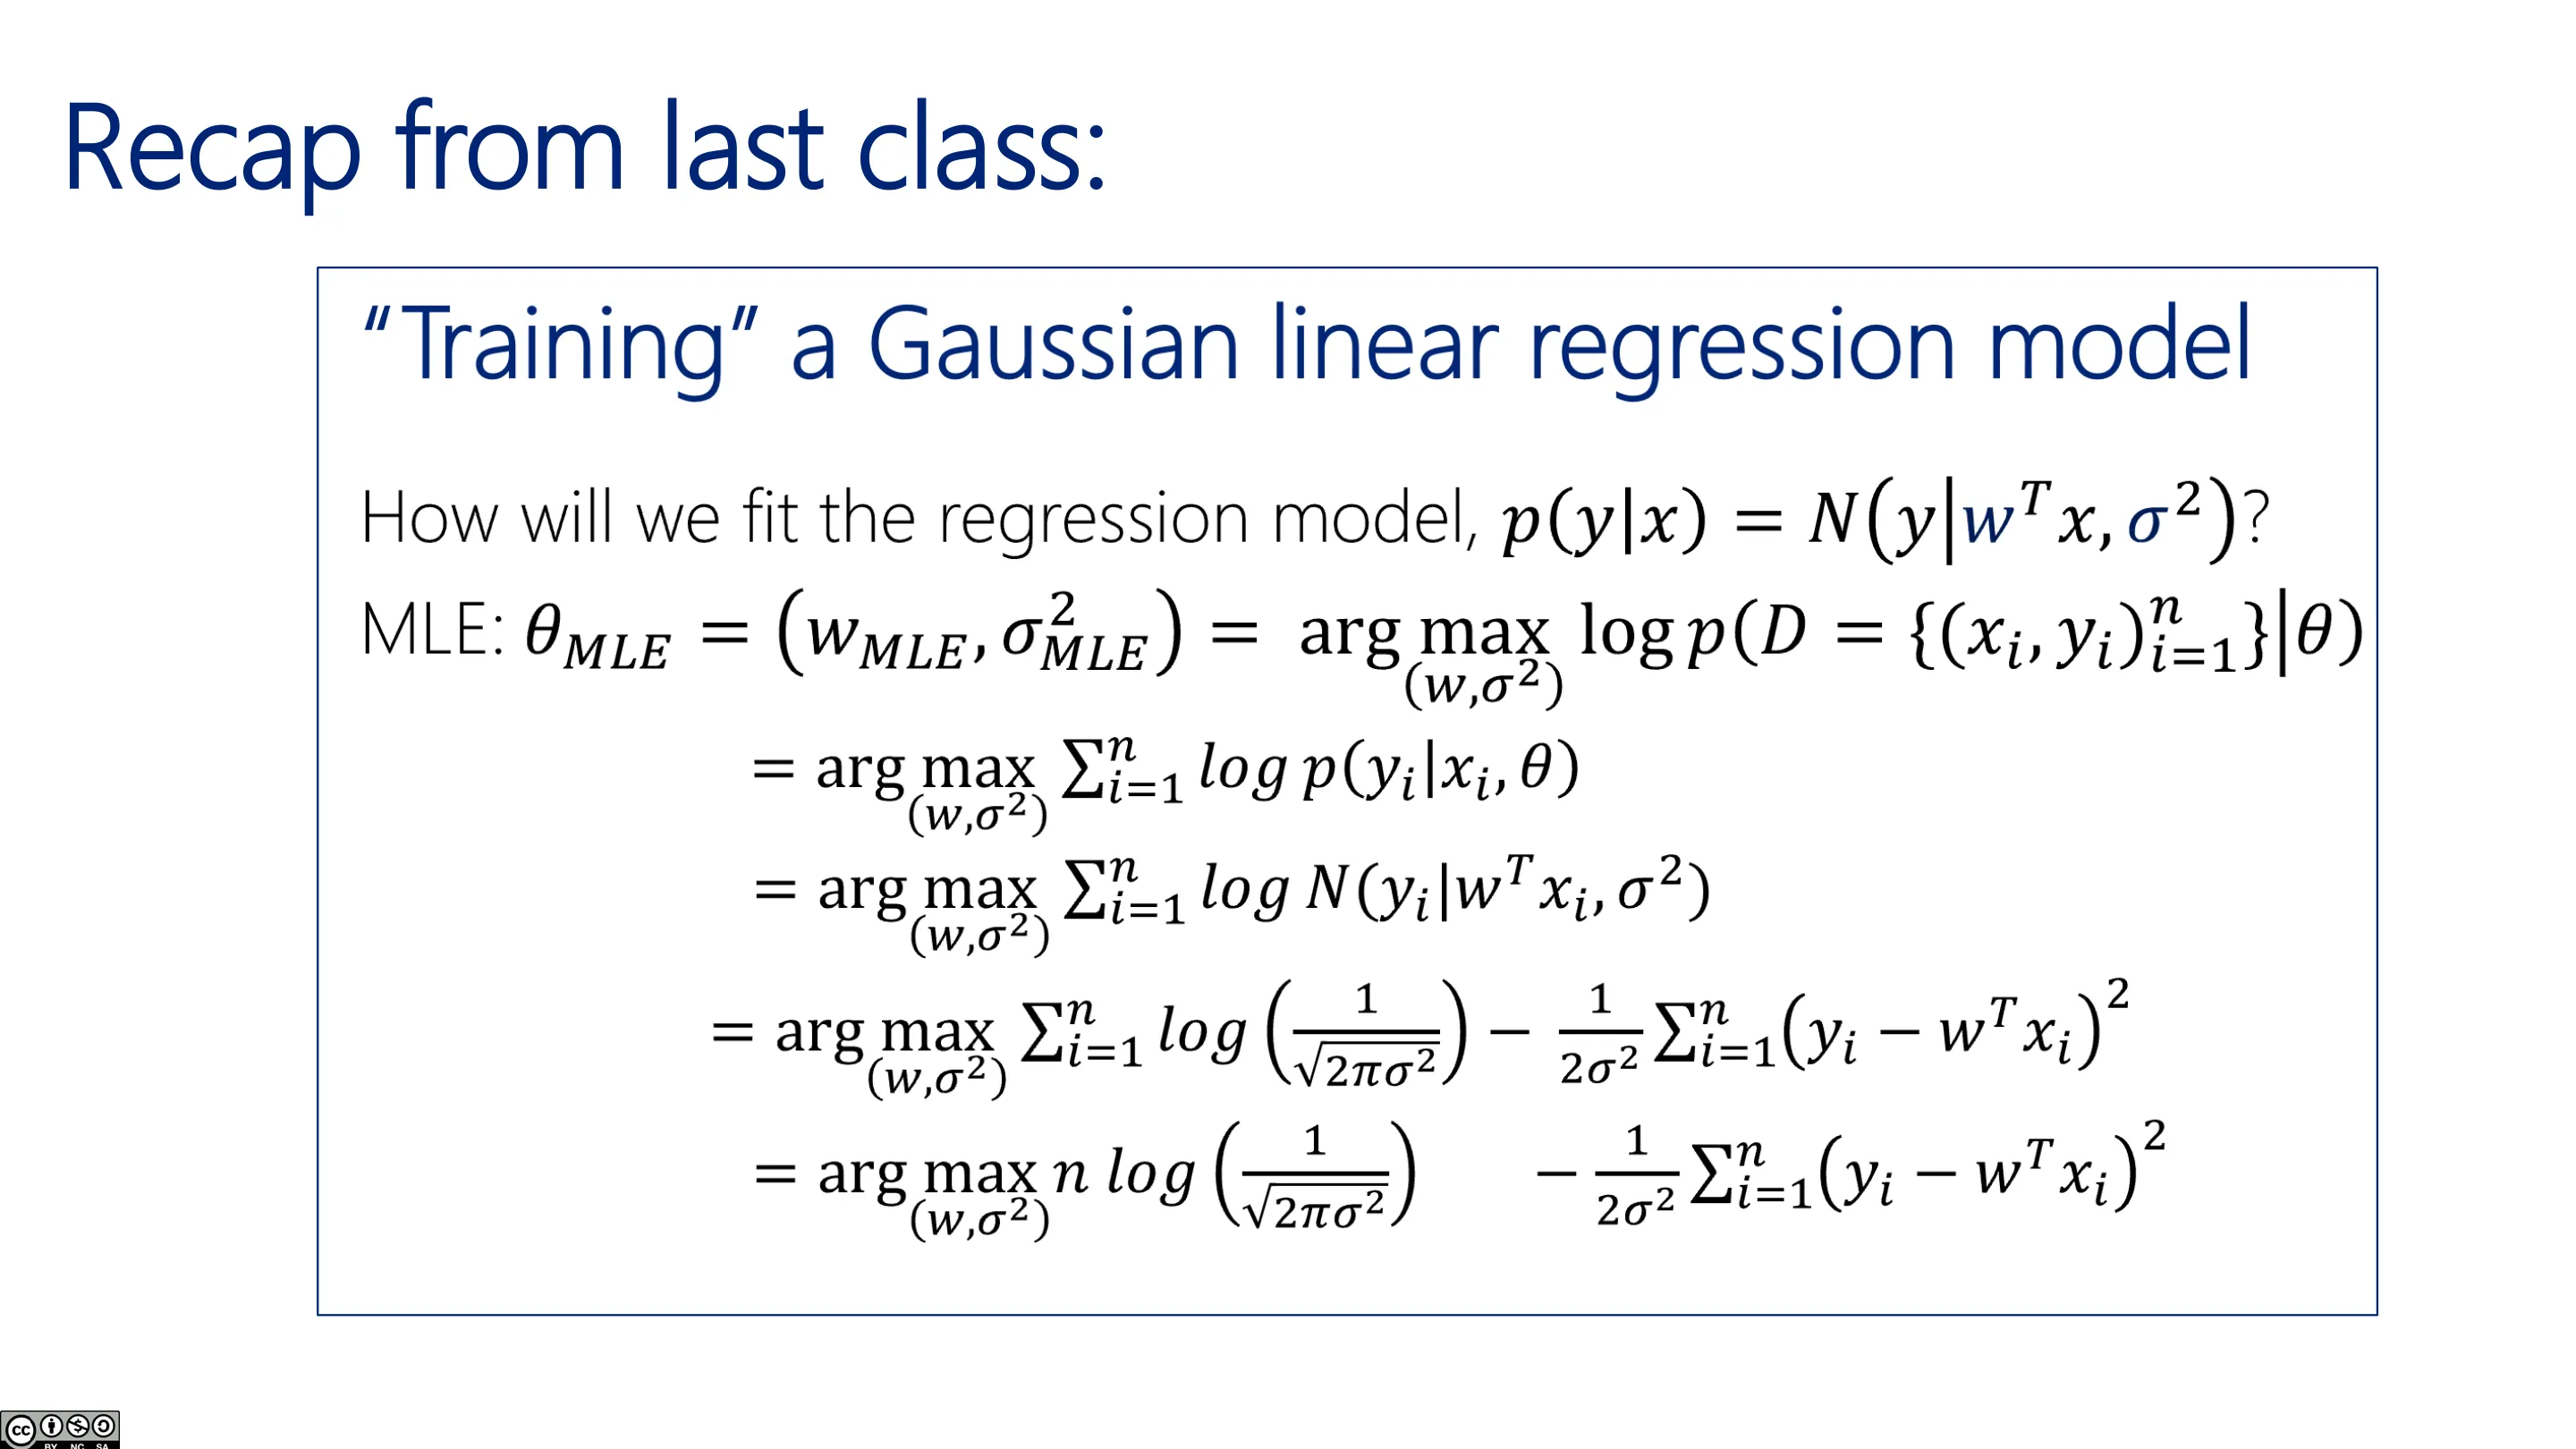
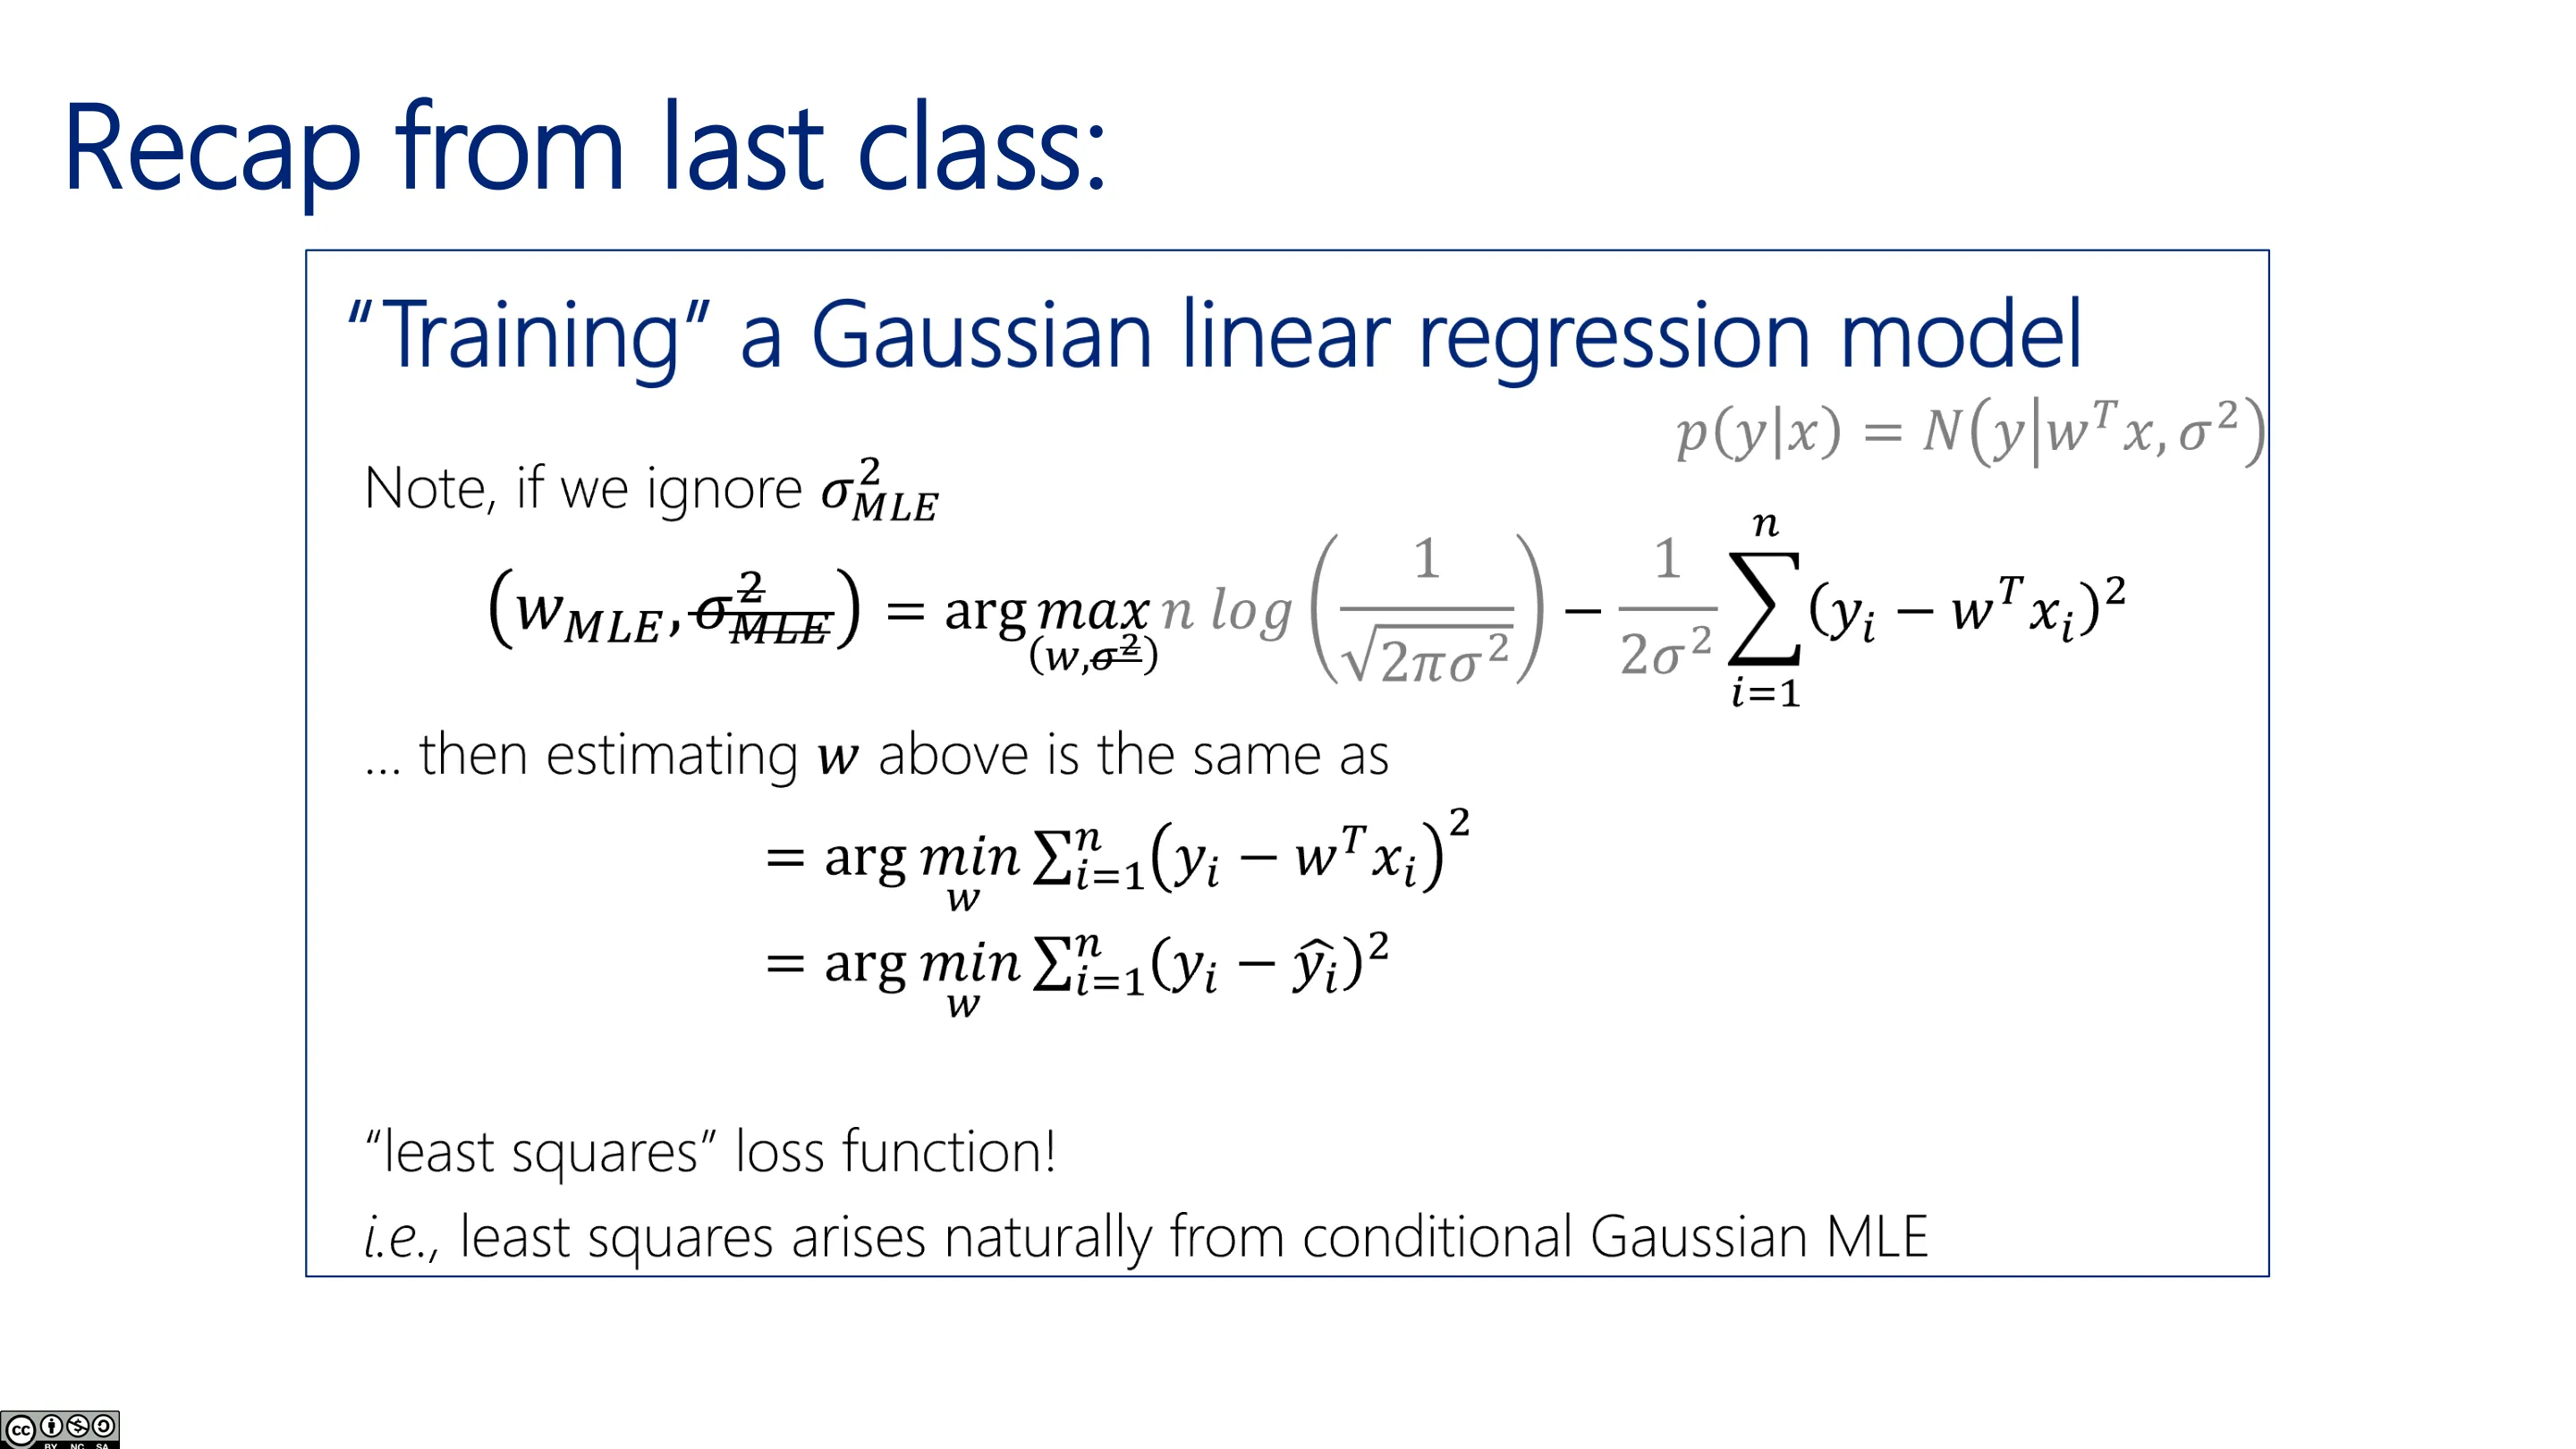
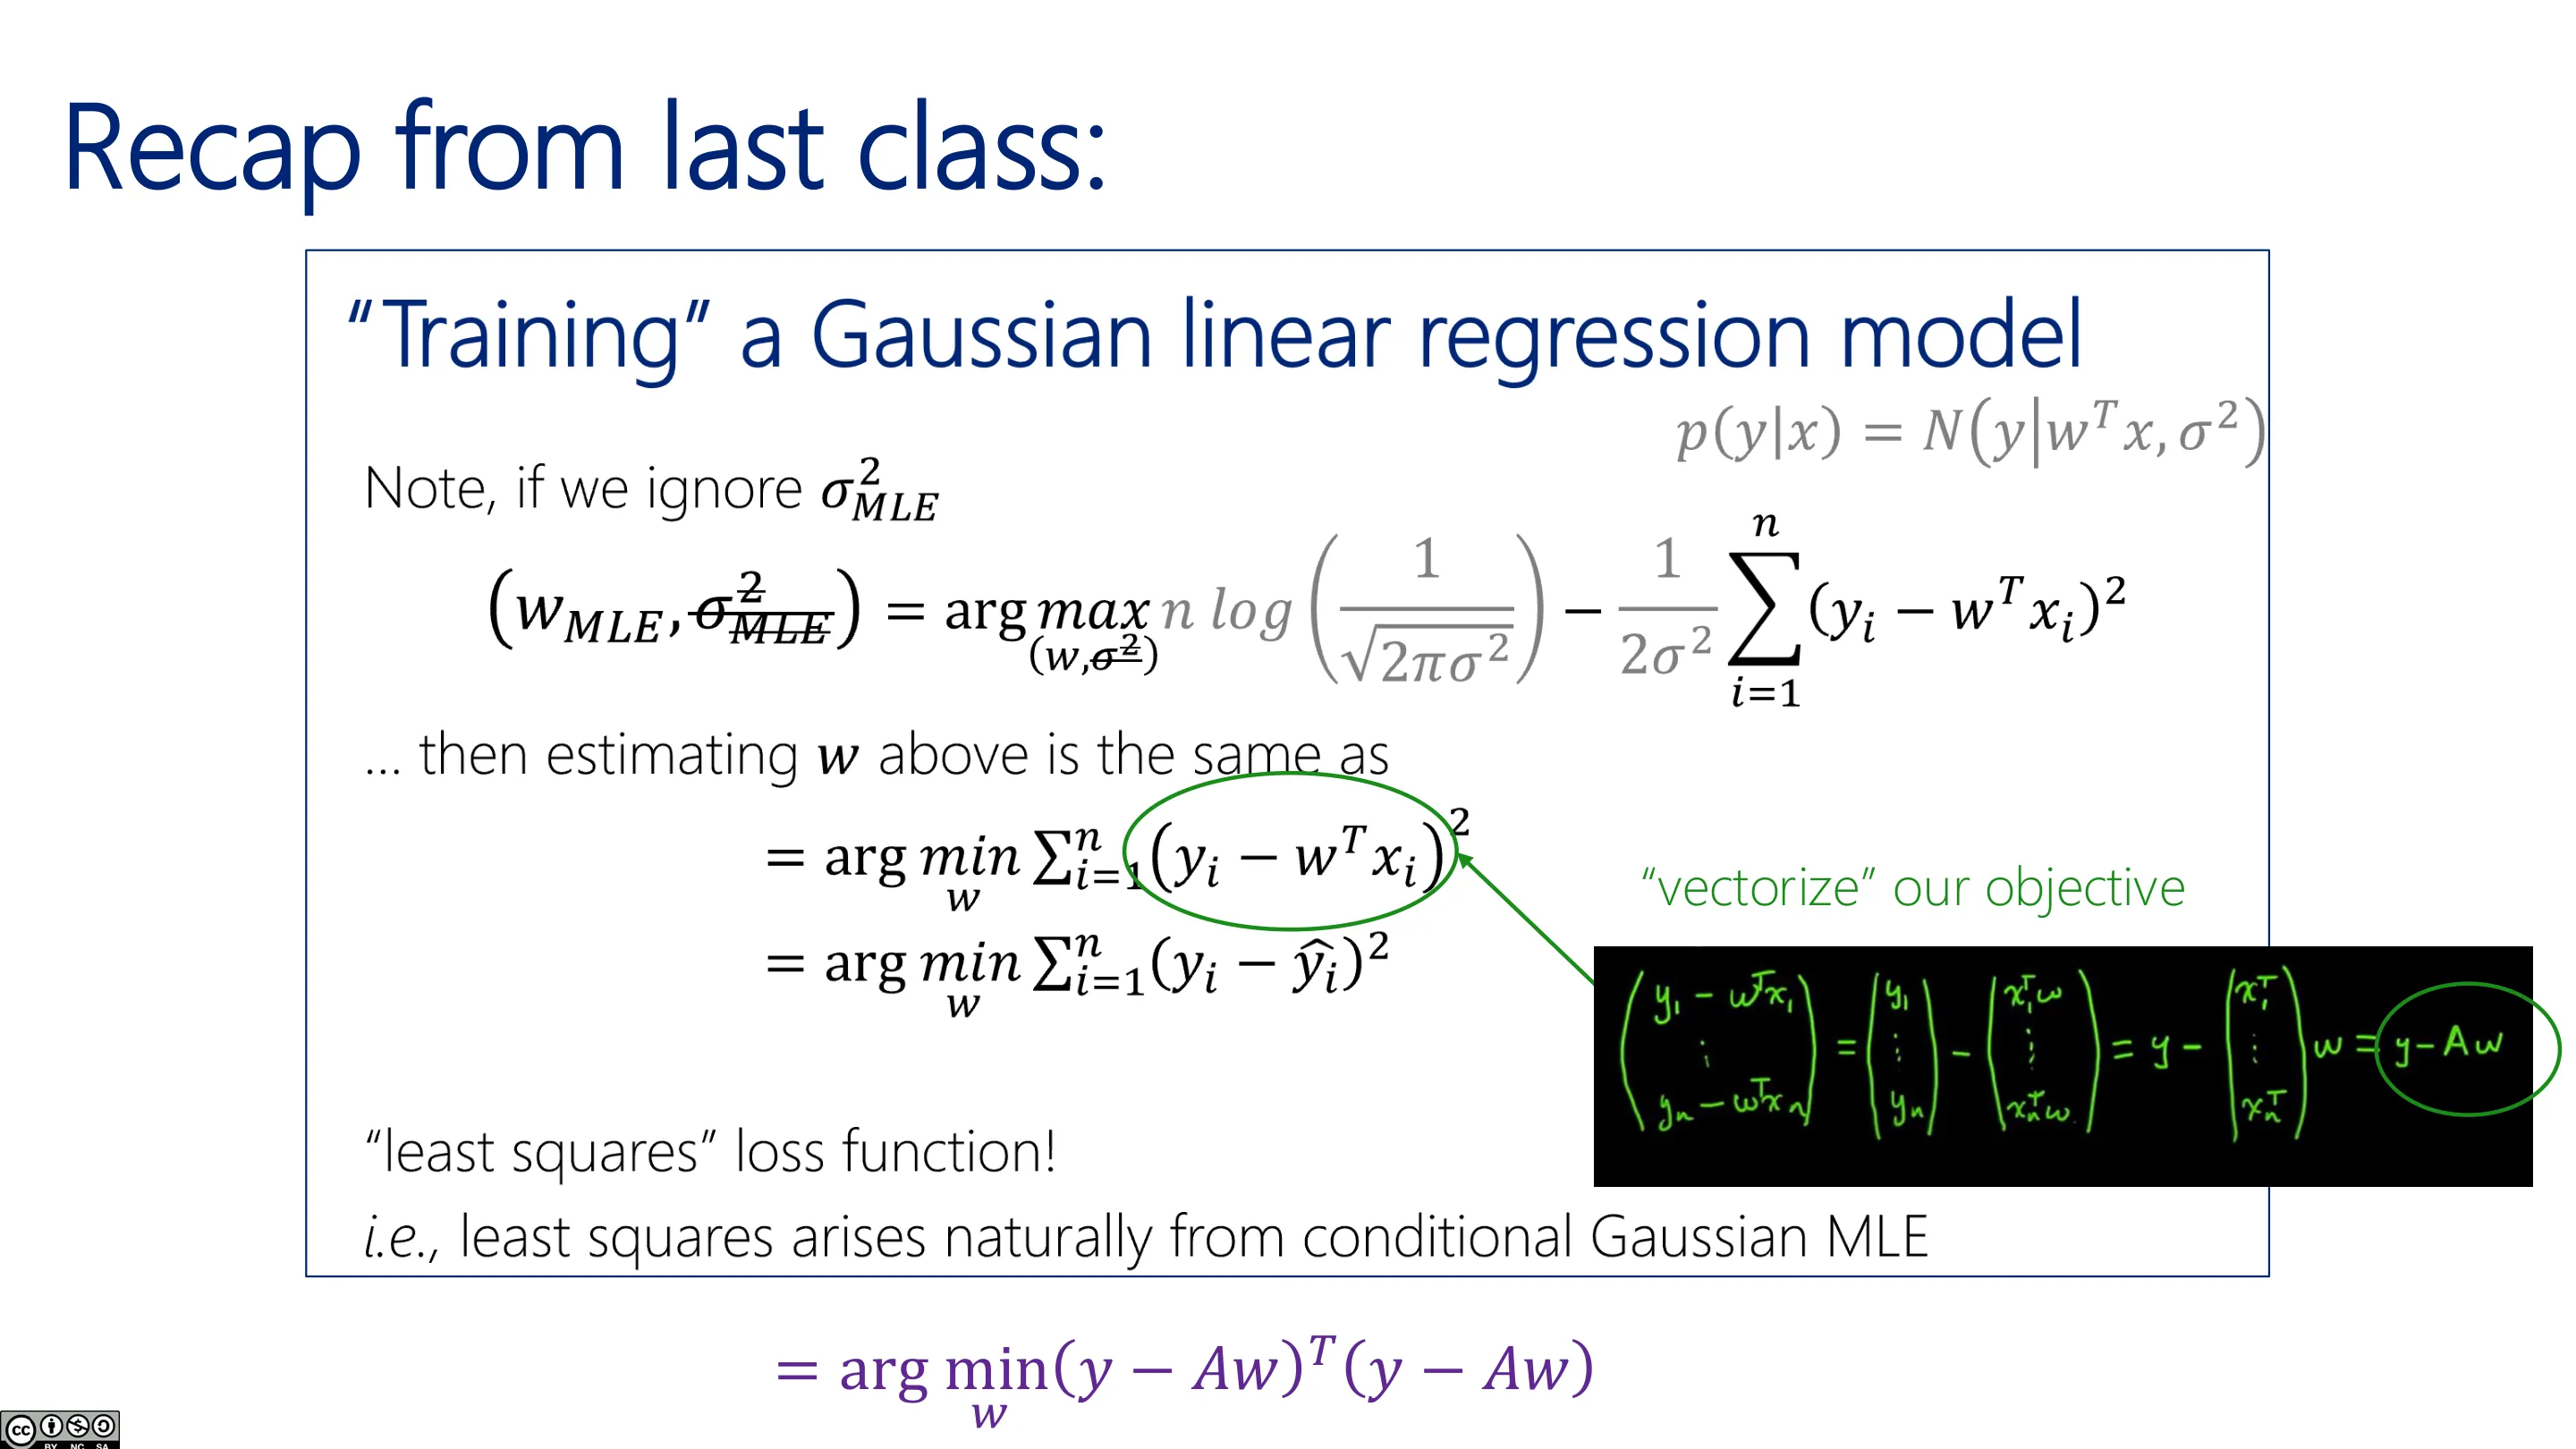
上一讲我们建立了高斯线性回归:预测分布是 $p(y\mid x)=\mathcal{N}(y\mid w^\top x,\sigma^2)$,所有预测分布共享同一个标量方差。用 MLE 拟合时,对数似然里含 $w$ 的项恰好是平方损失($\sigma^2$ 的项不含 $w$,从优化中消失)。
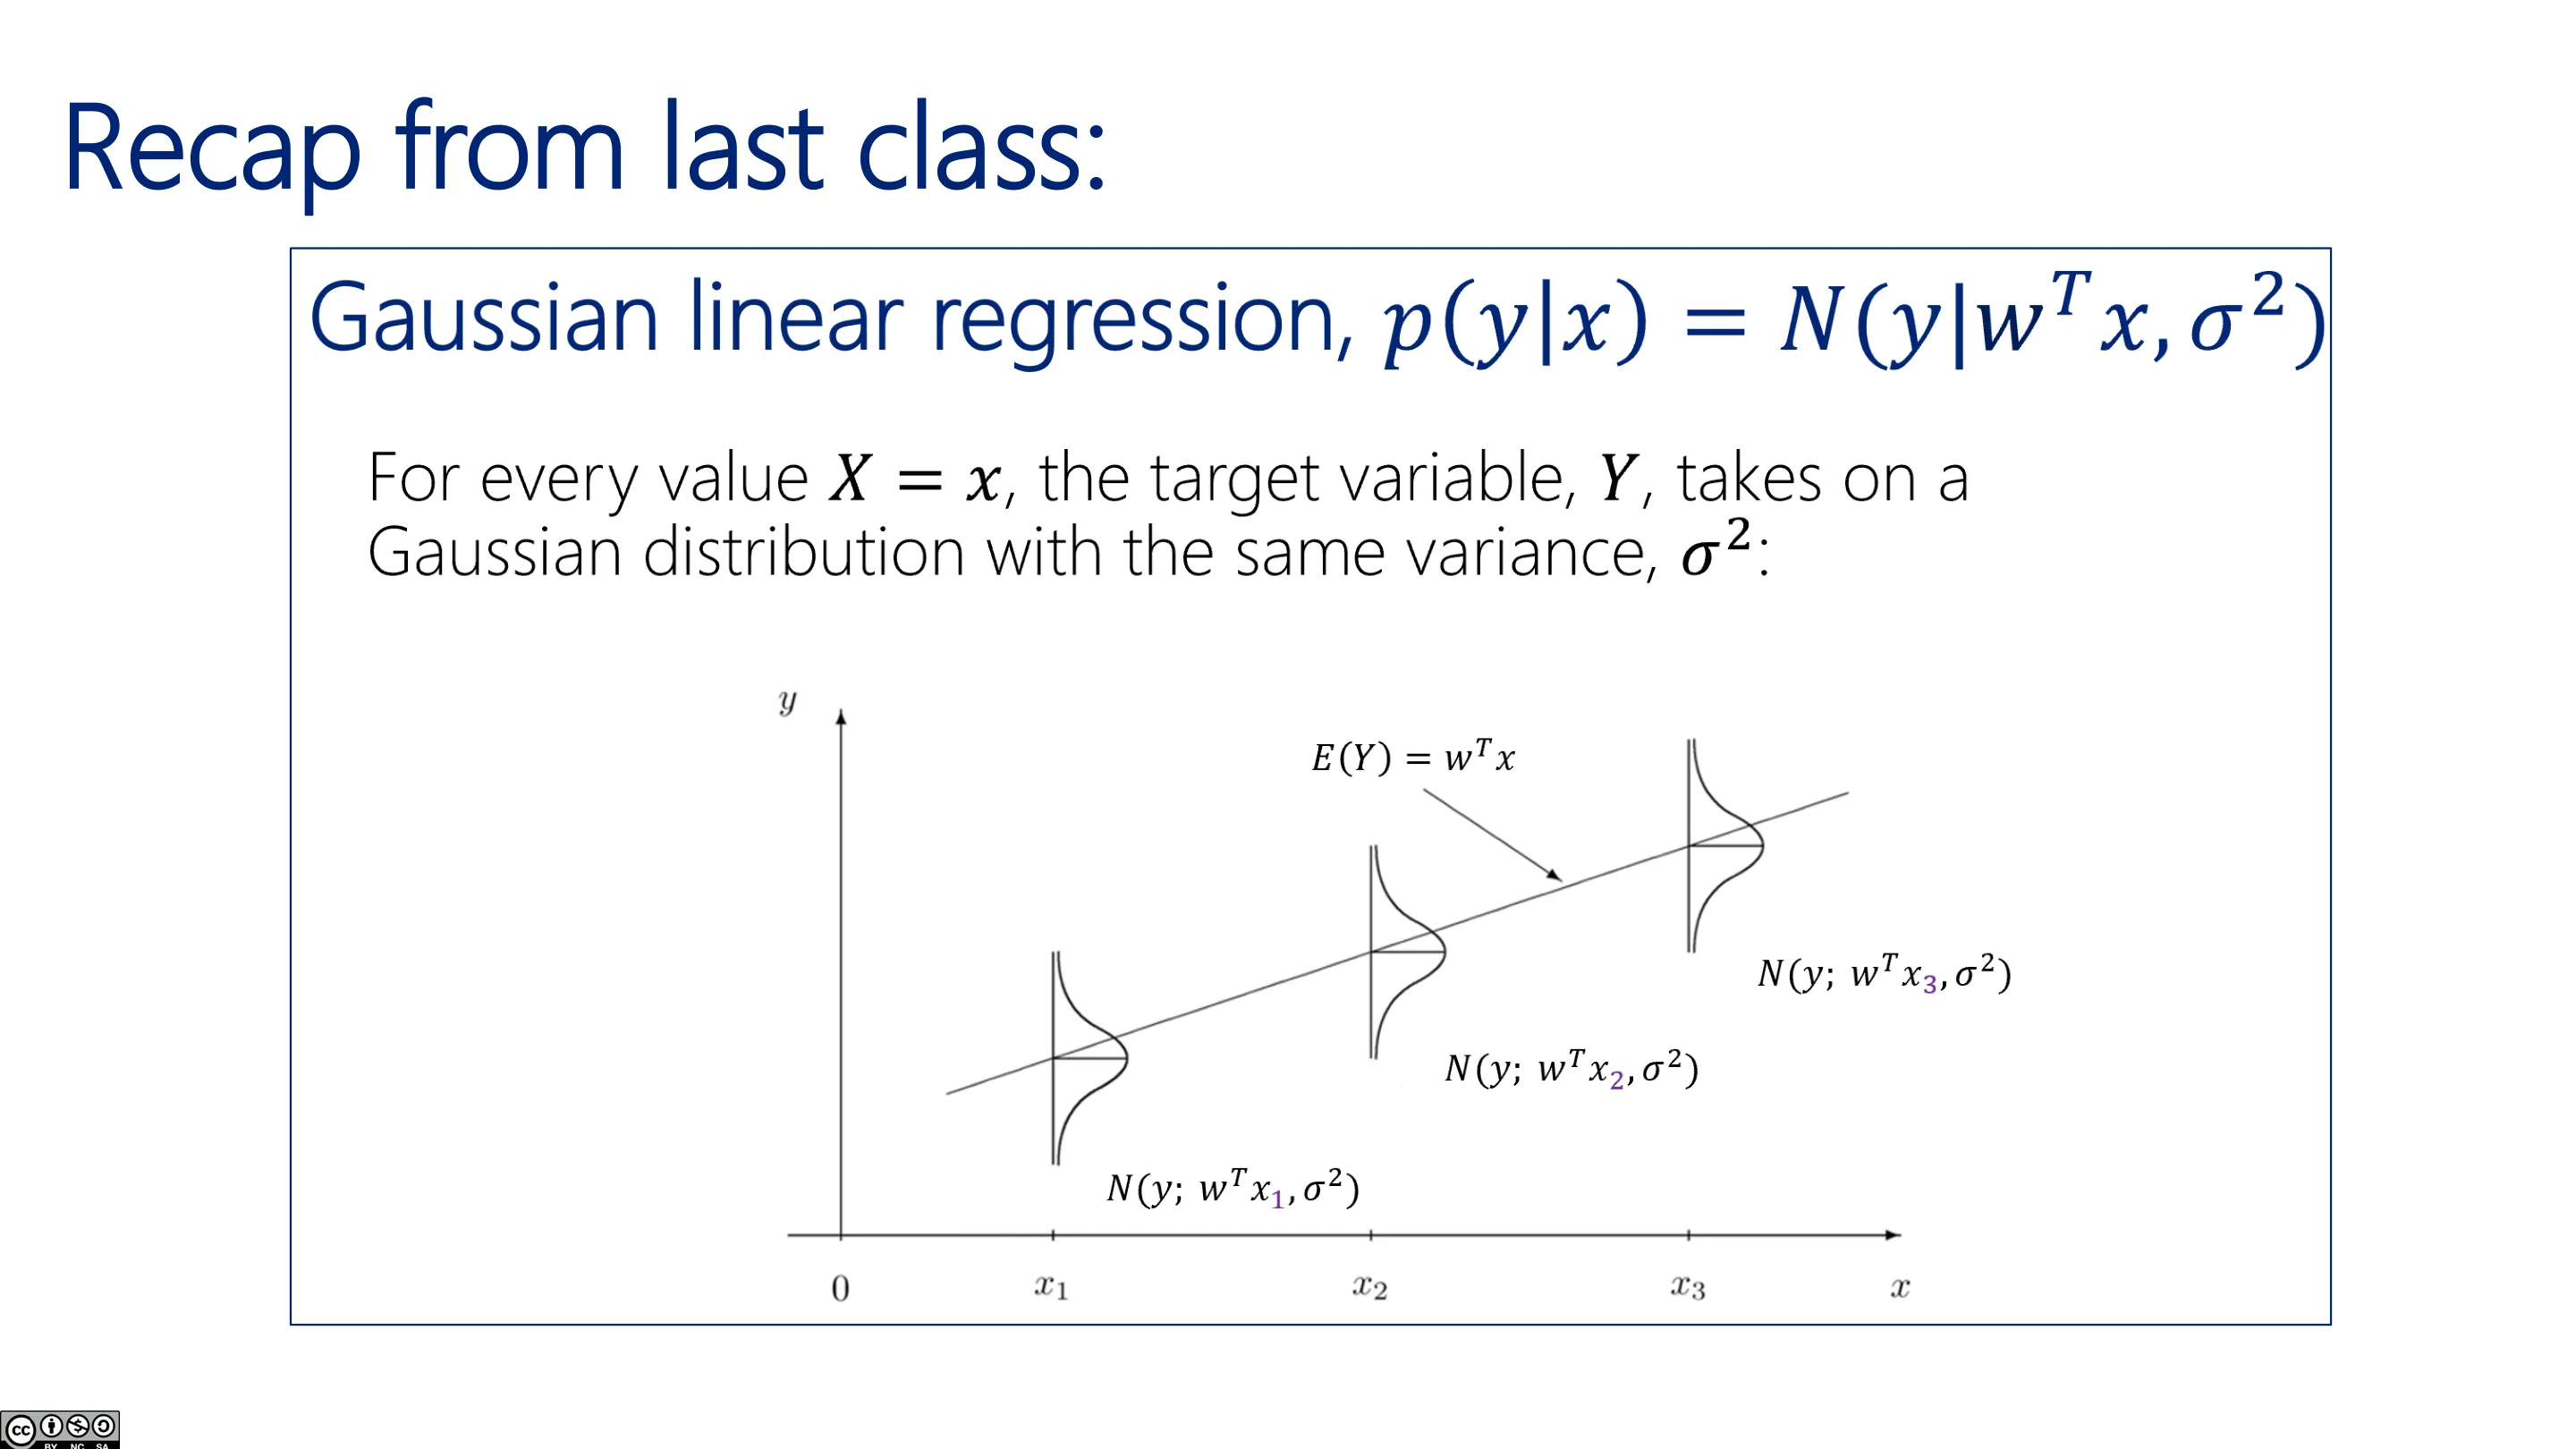
📷 上节课回顾(一)
回到原视频 (00:00:50)
📷 上节课回顾(二)
回到原视频 (00:01:05)
📷 上节课回顾(三)
回到原视频 (00:01:15)
📷 上节课回顾(四):最小二乘
回到原视频 (00:01:51)
📷 上节课回顾(五):矩阵形式
回到原视频 (00:02:48)
二、矩阵微积分:把 MLE 一次算出来
2.1 向量梯度复习
(参考时间: 00:05)
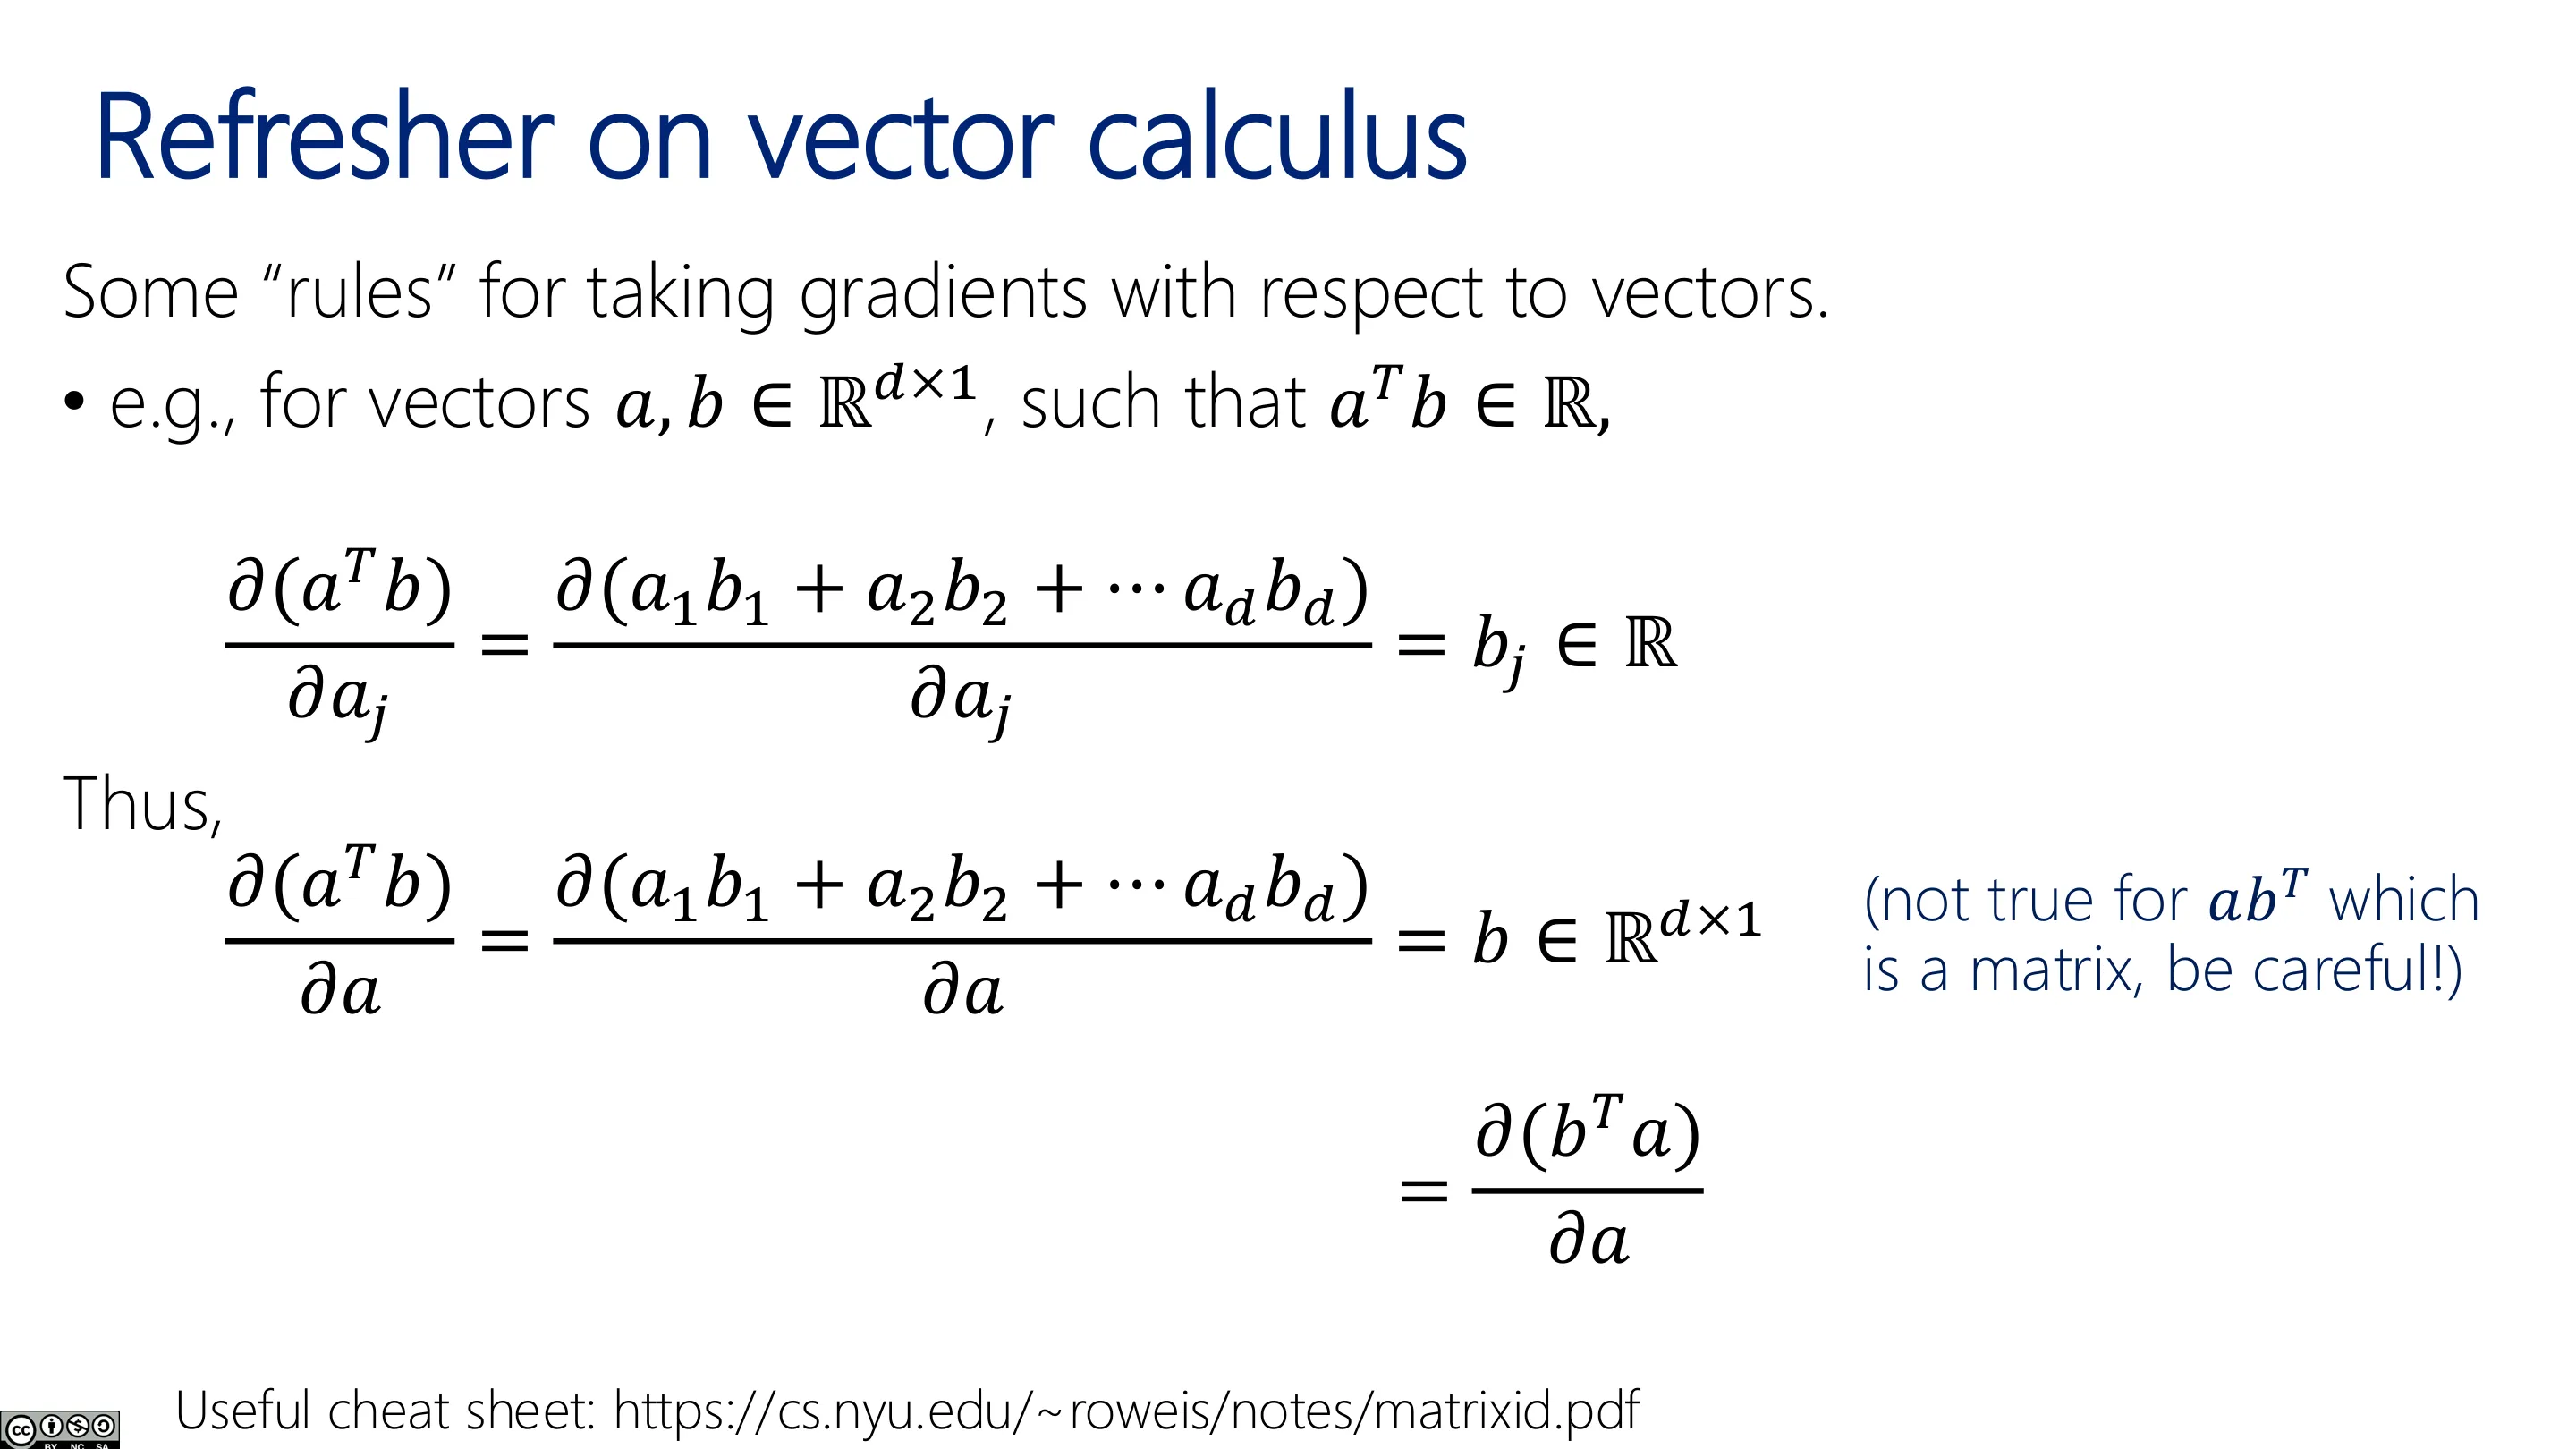
令 $a,b\in\mathbb{R}^d$。$\dfrac{\partial (a^\top b)}{\partial a}=b$(对向量求导得到向量)。注意:由于 $a^\top b$ 是标量,交换顺序不影响值;但一旦出现转置且不再是标量,就不能随意交换——永远检查维度。
📷 向量梯度(一)
回到原视频 (00:05:09)
📷 向量梯度(二)
回到原视频 (00:07:35)
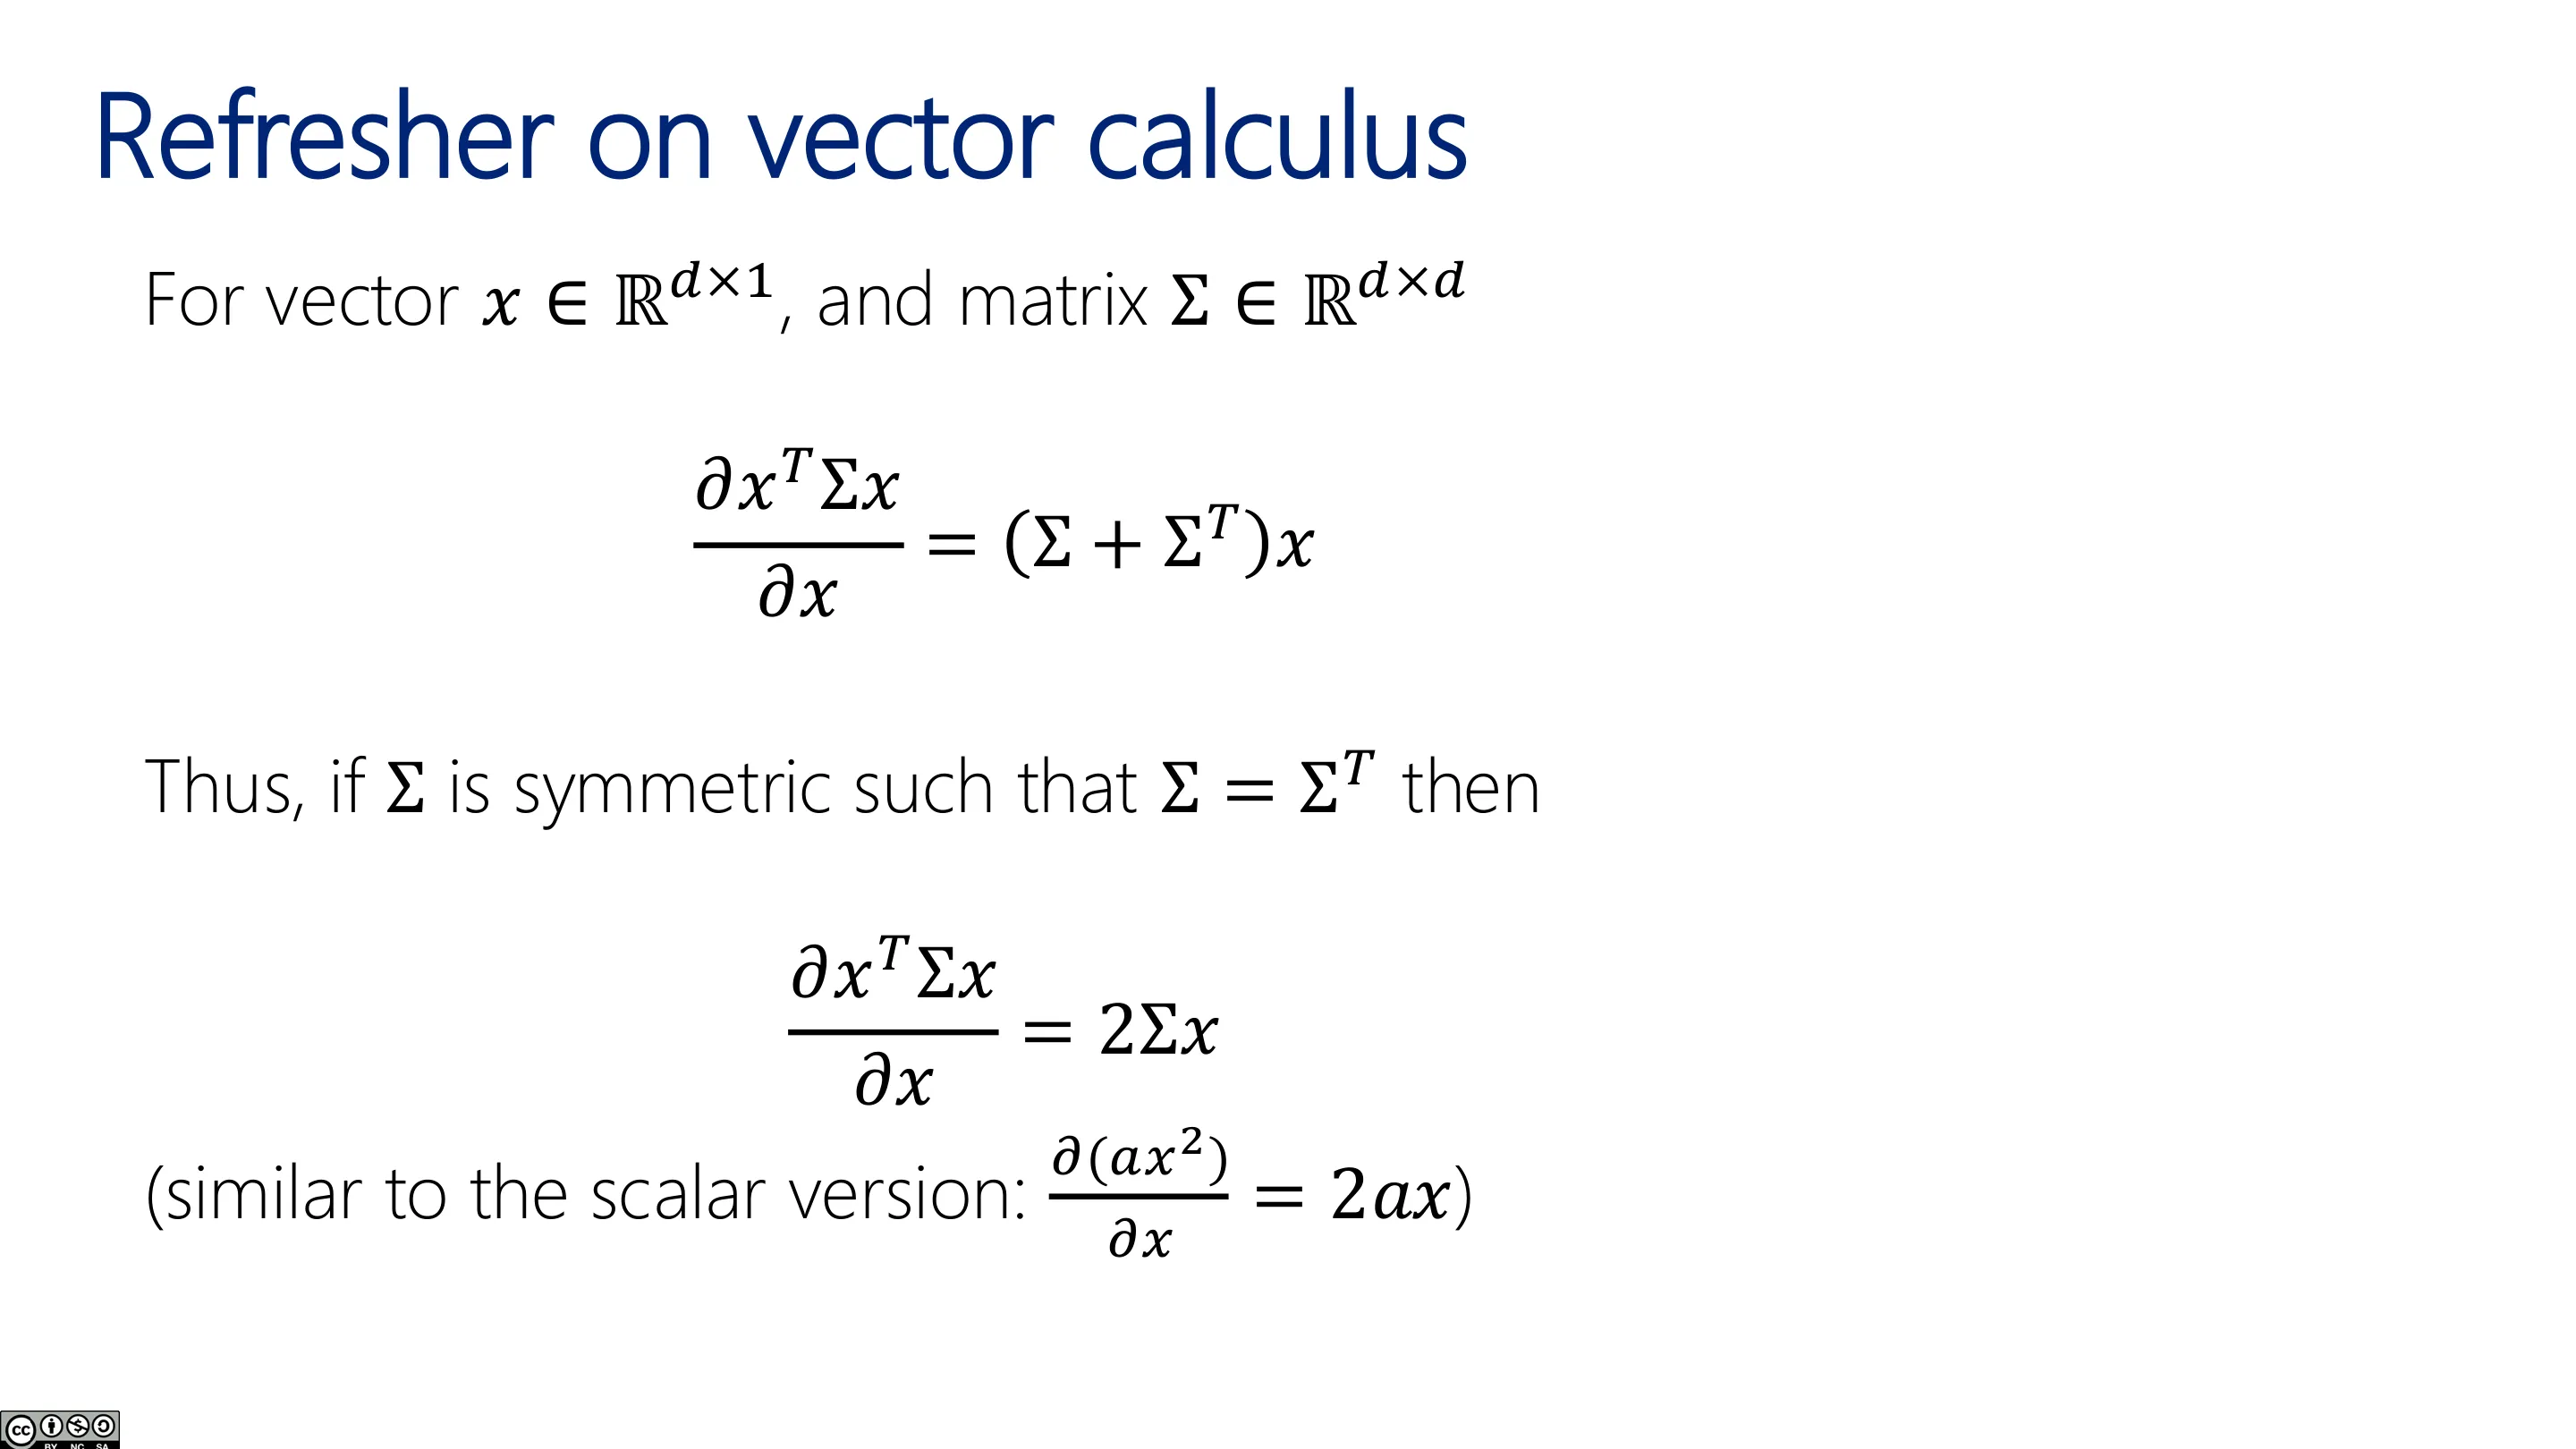
一个常用的二次型导数:对 $x^\top \Sigma x$(标量)关于 $x$ 求导,得到 $\Sigma x+\Sigma^\top x$;若 $\Sigma$ 对称,则为 $2\Sigma x$(与标量 $\frac{d}{dx}(ax^2)=2ax$ 对应),这是很好的助记。
2.2 用矩阵微积分求 $\hat w$
(参考时间: 00:09)
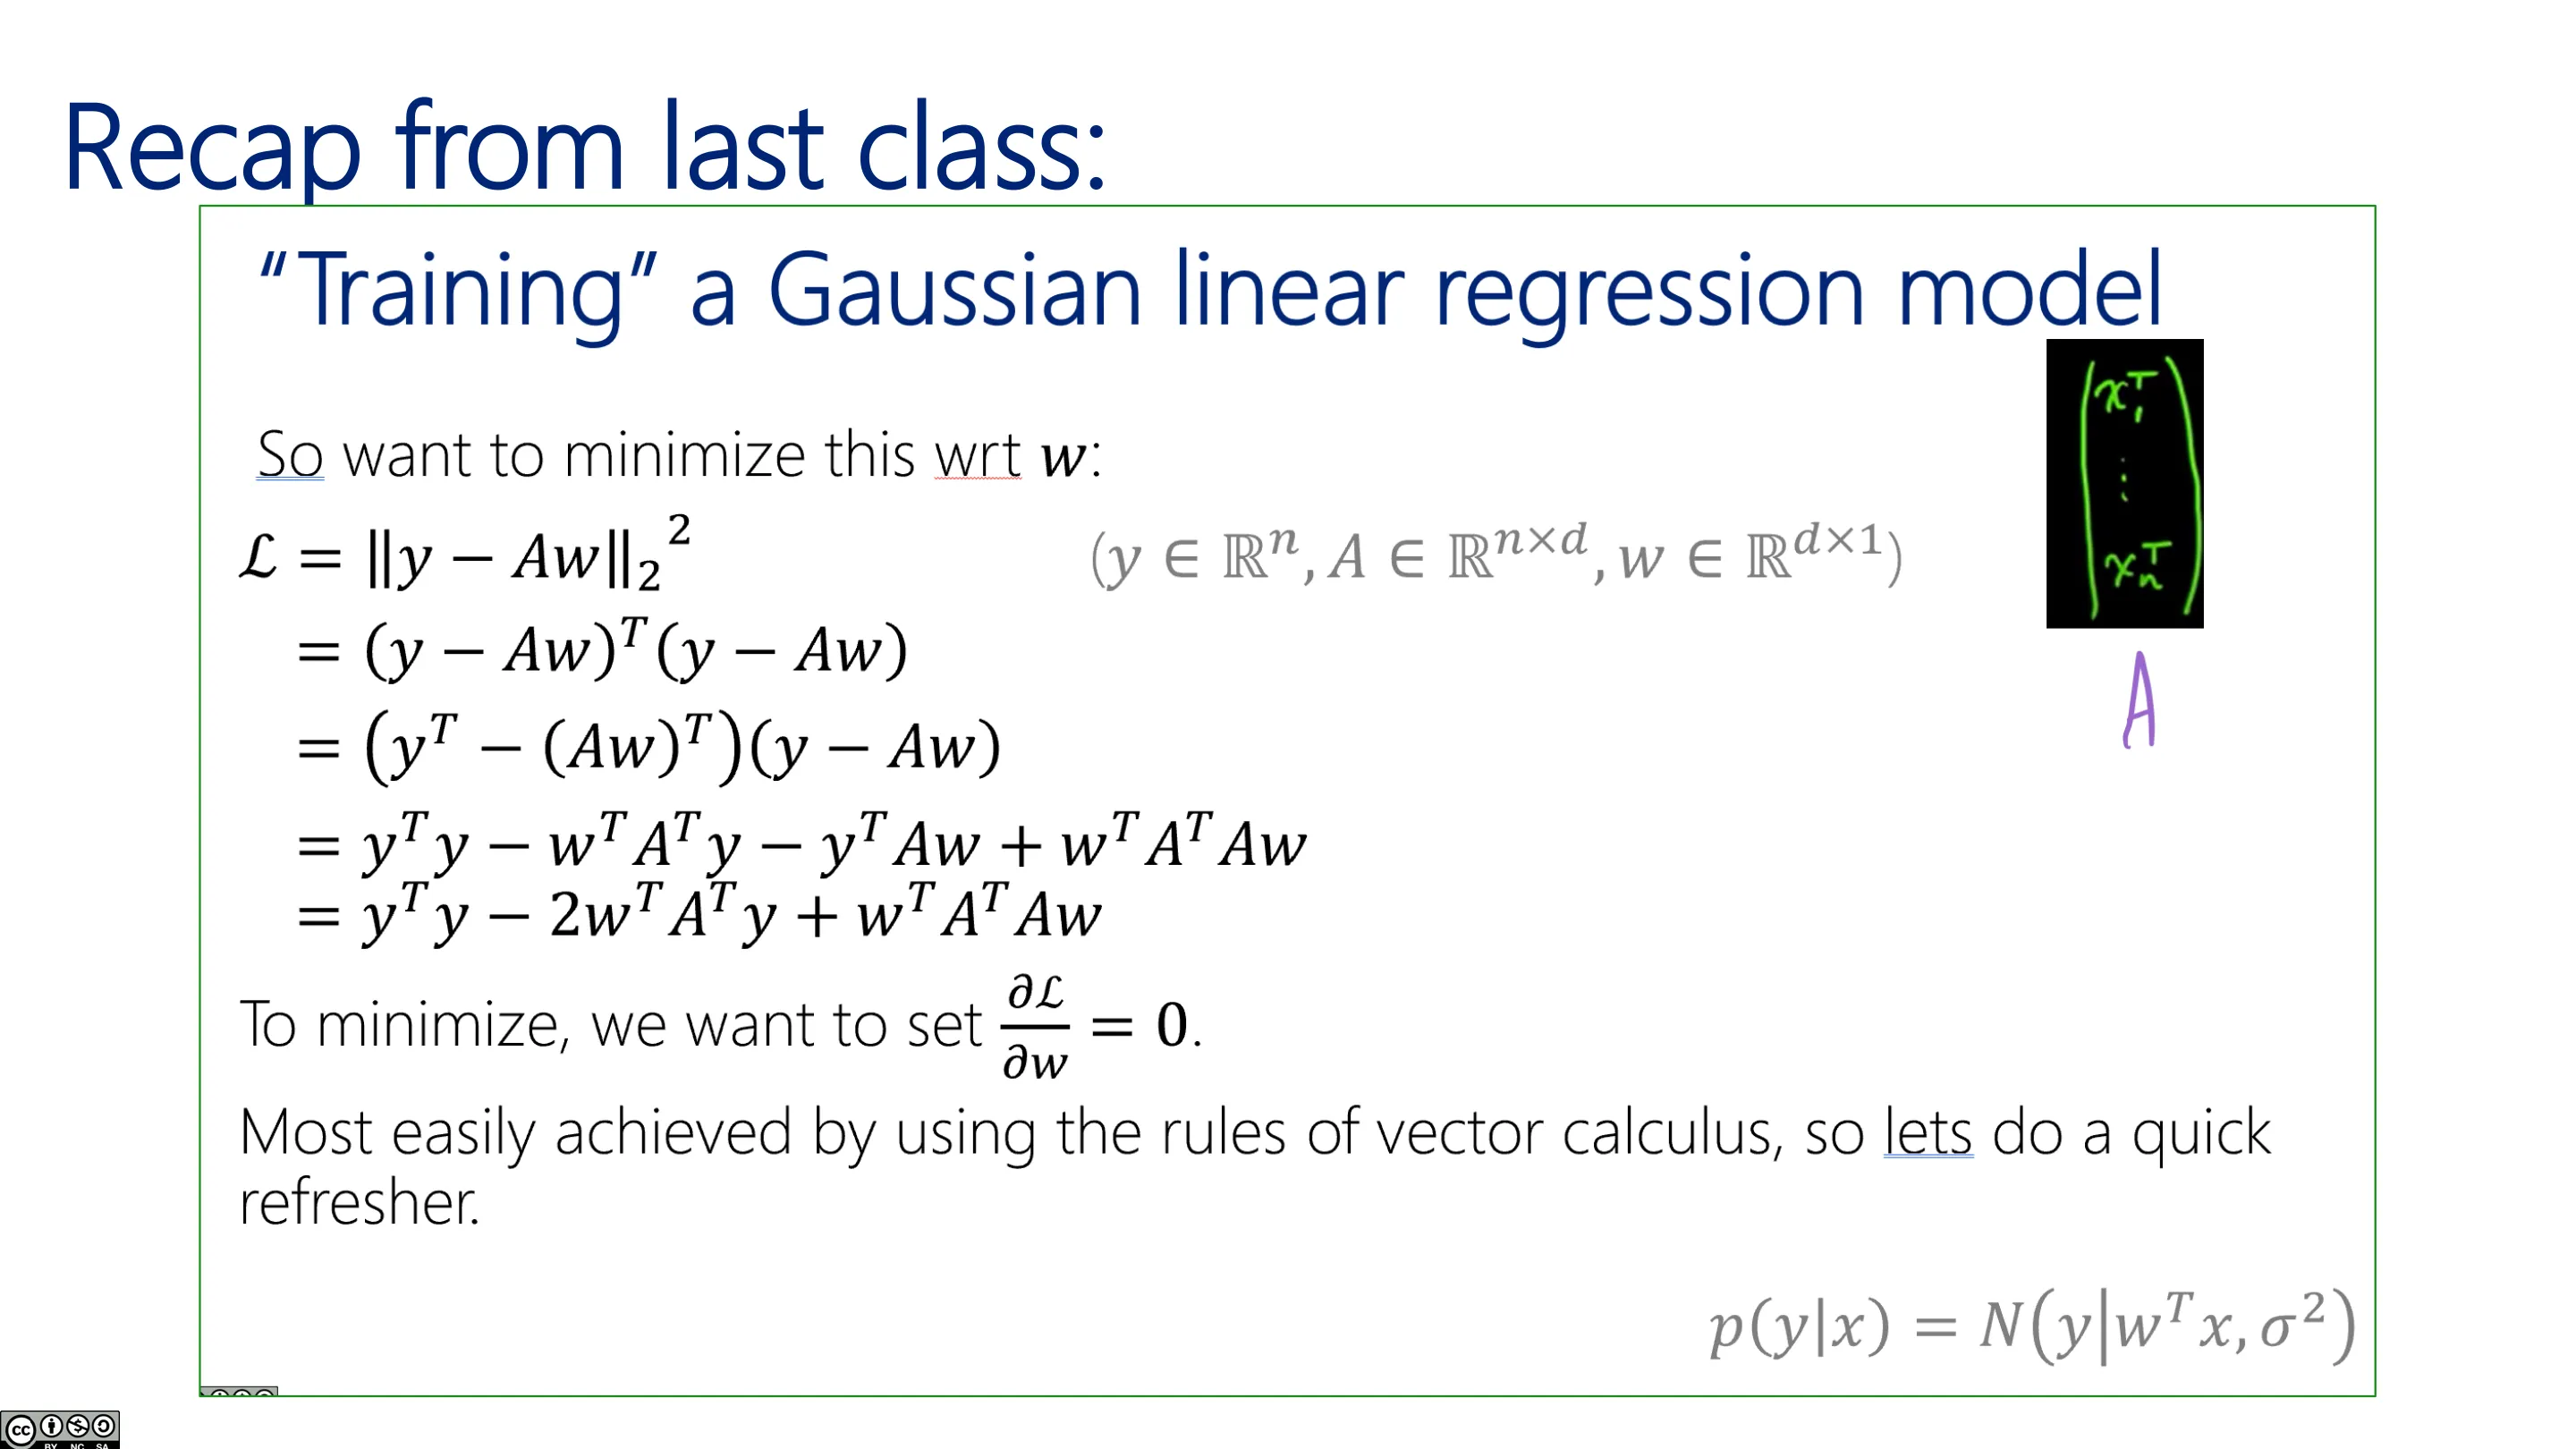
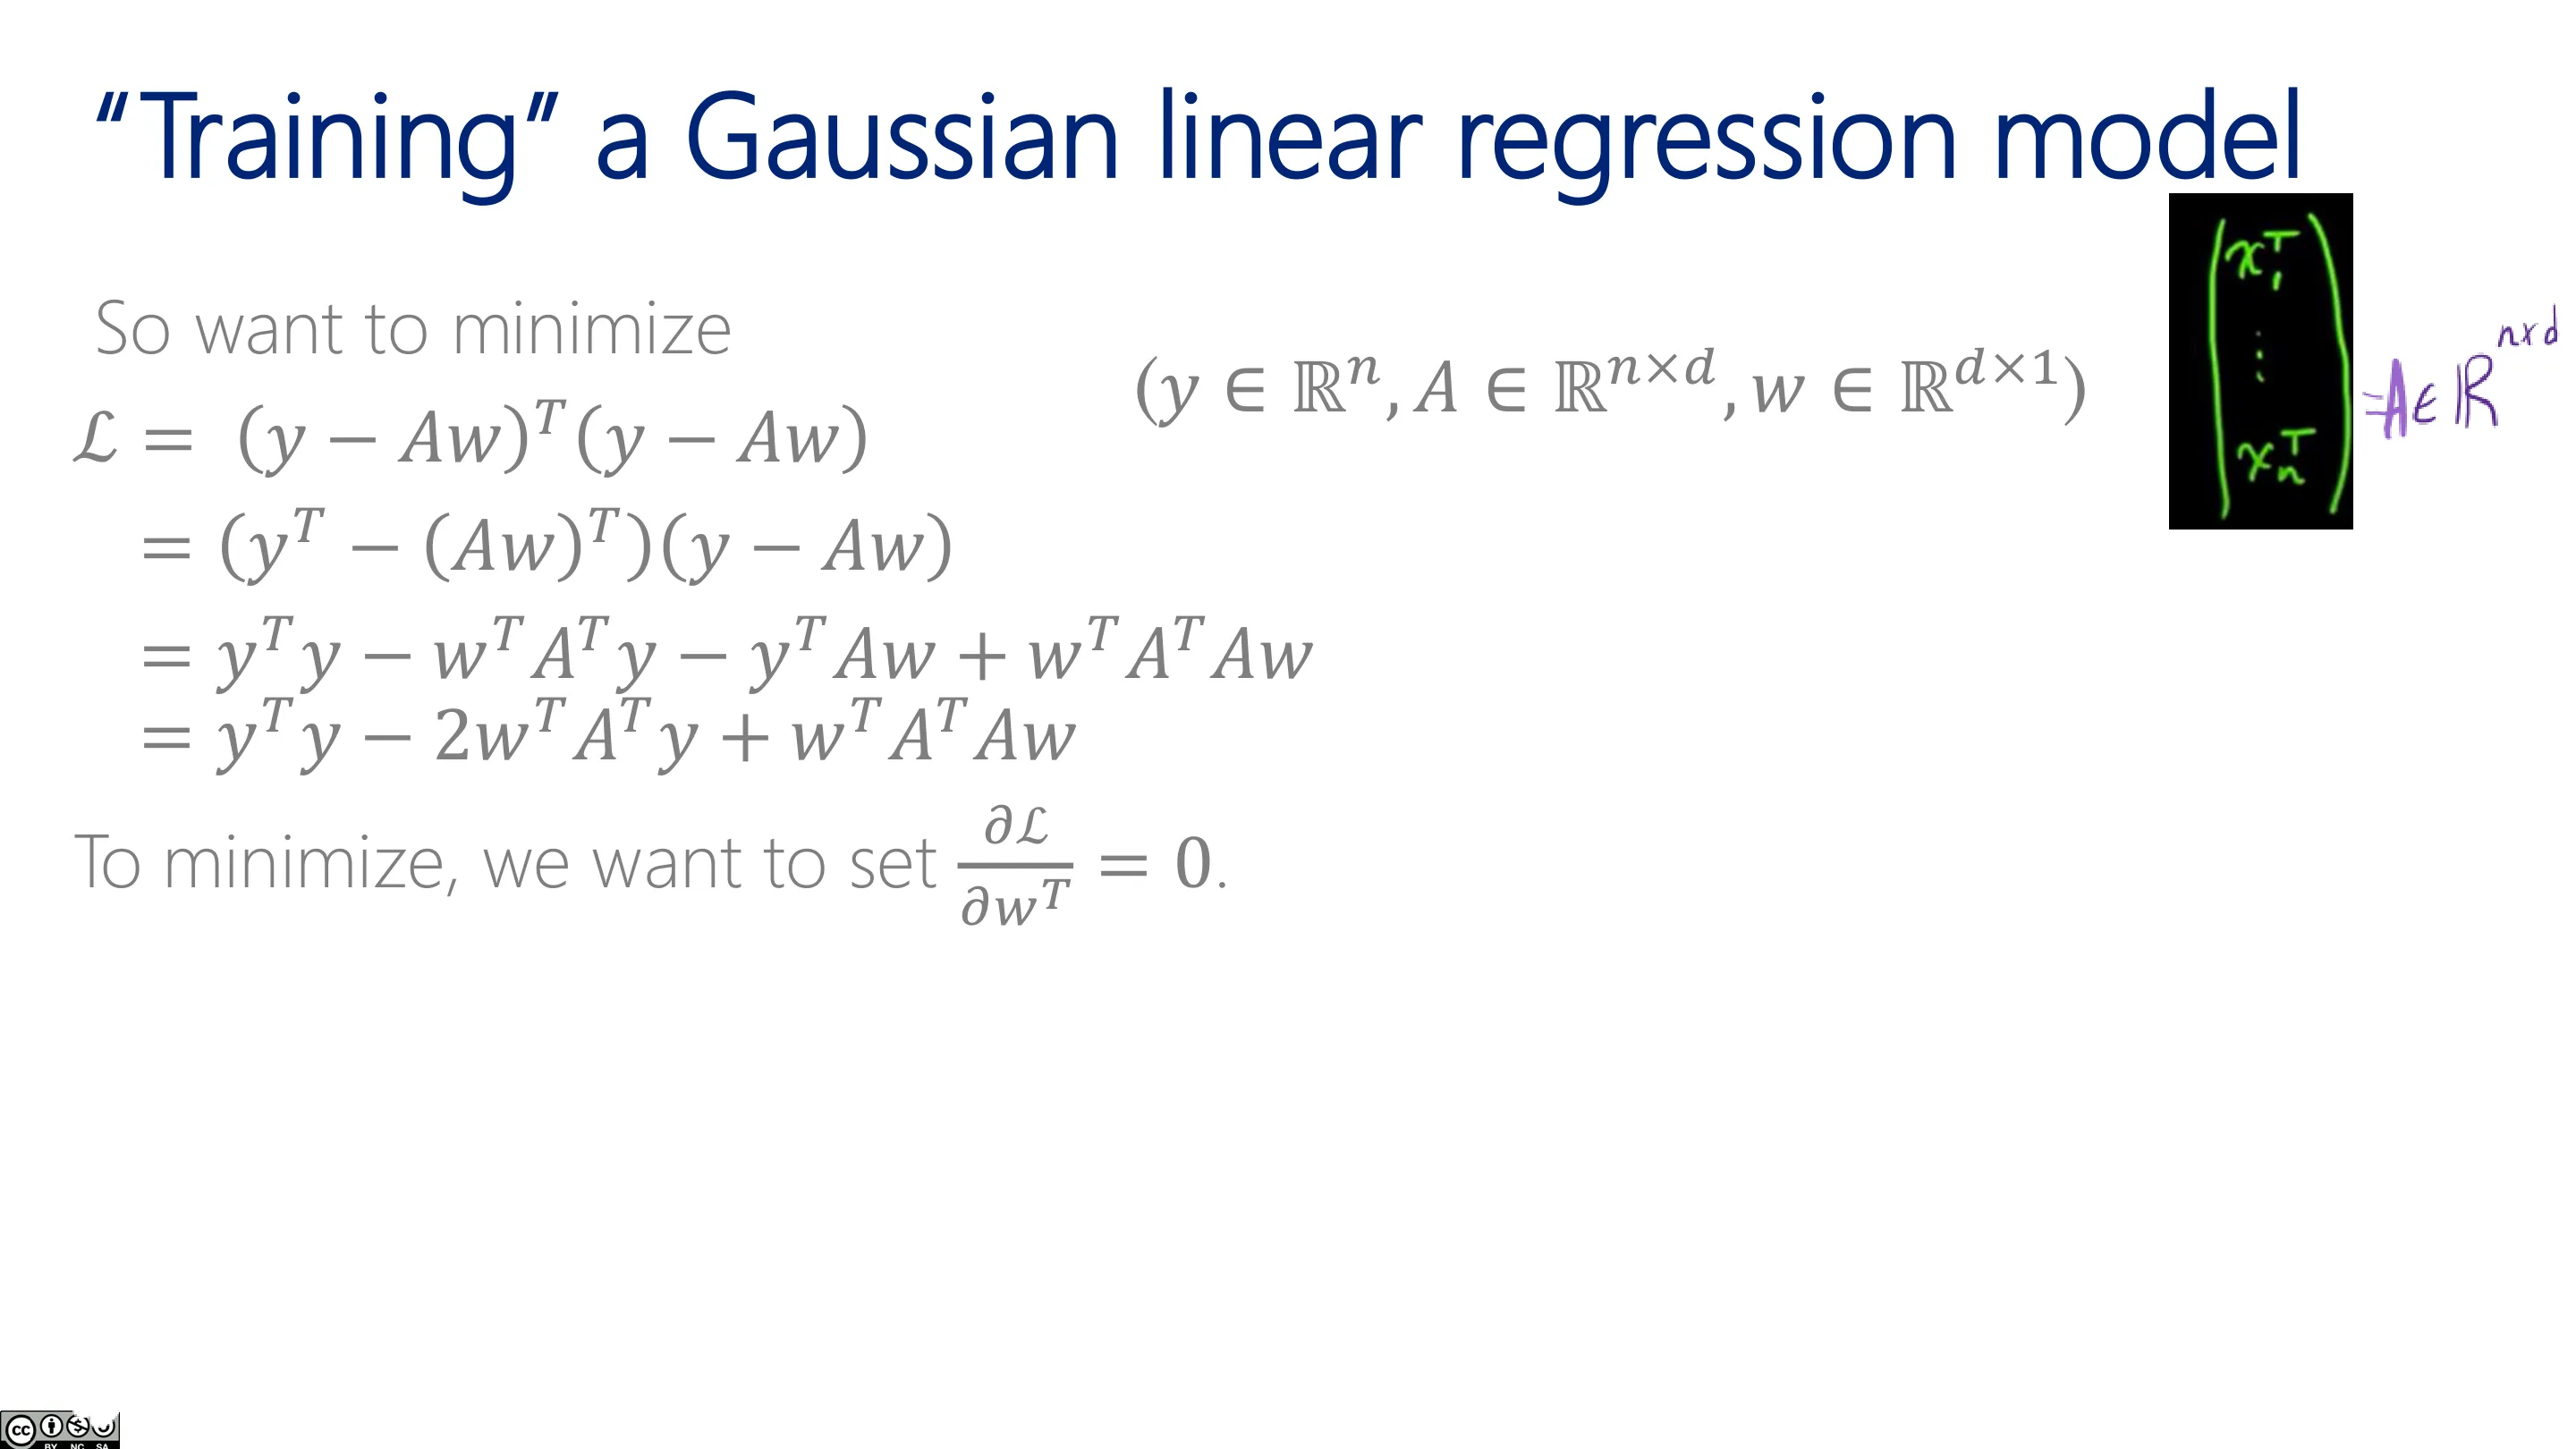
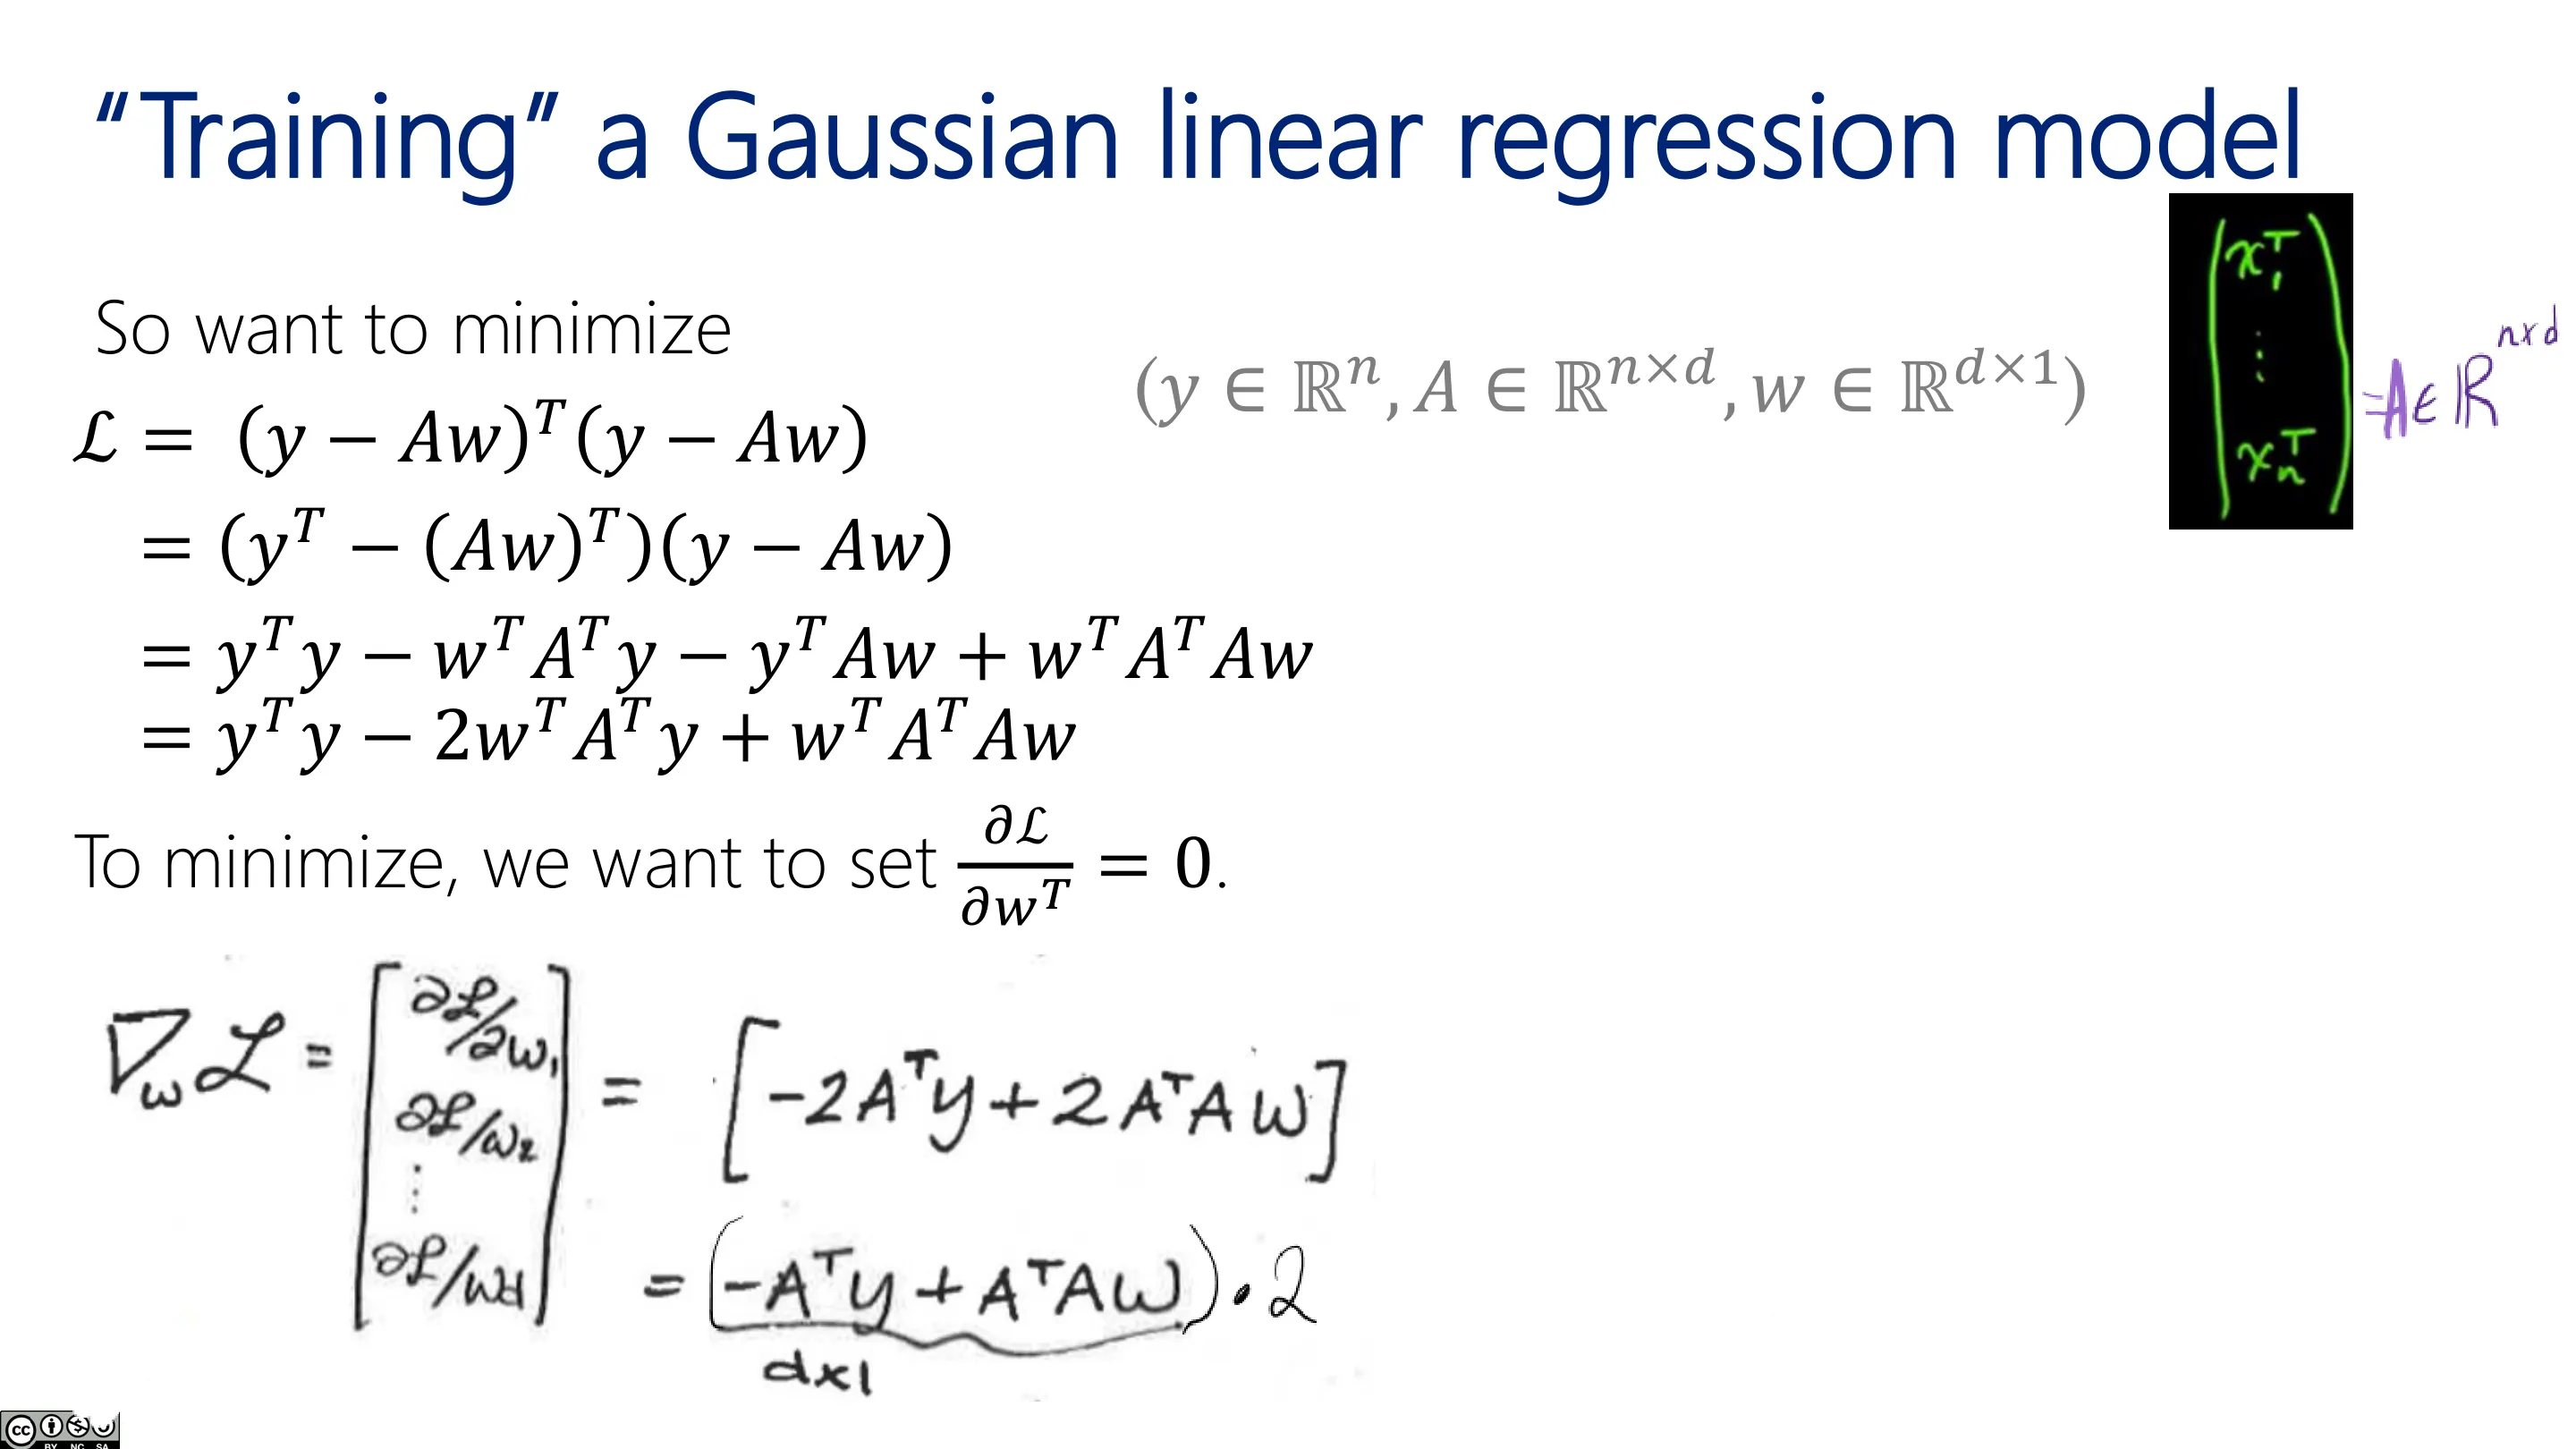
损失(平方损失,矩阵形式):$\lVert y-Aw\rVert_2^2=(y-Aw)^\top(y-Aw)$,其中 $A$(又称 $X$)是 $N\times D$ 设计矩阵,$y$ 是 $N\times1$,$w$ 是 $D\times1$。
展开并求梯度($A^\top A$ 对称,用上面的规则):
$$ \nabla_w \lVert y-Aw\rVert^2 = -2A^\top y + 2A^\top A w = 0 $$
📷 训练高斯线性回归(矩阵形式)
回到原视频 (00:09:19)
📷 目标:最小化平方损失
回到原视频 (00:10:06)
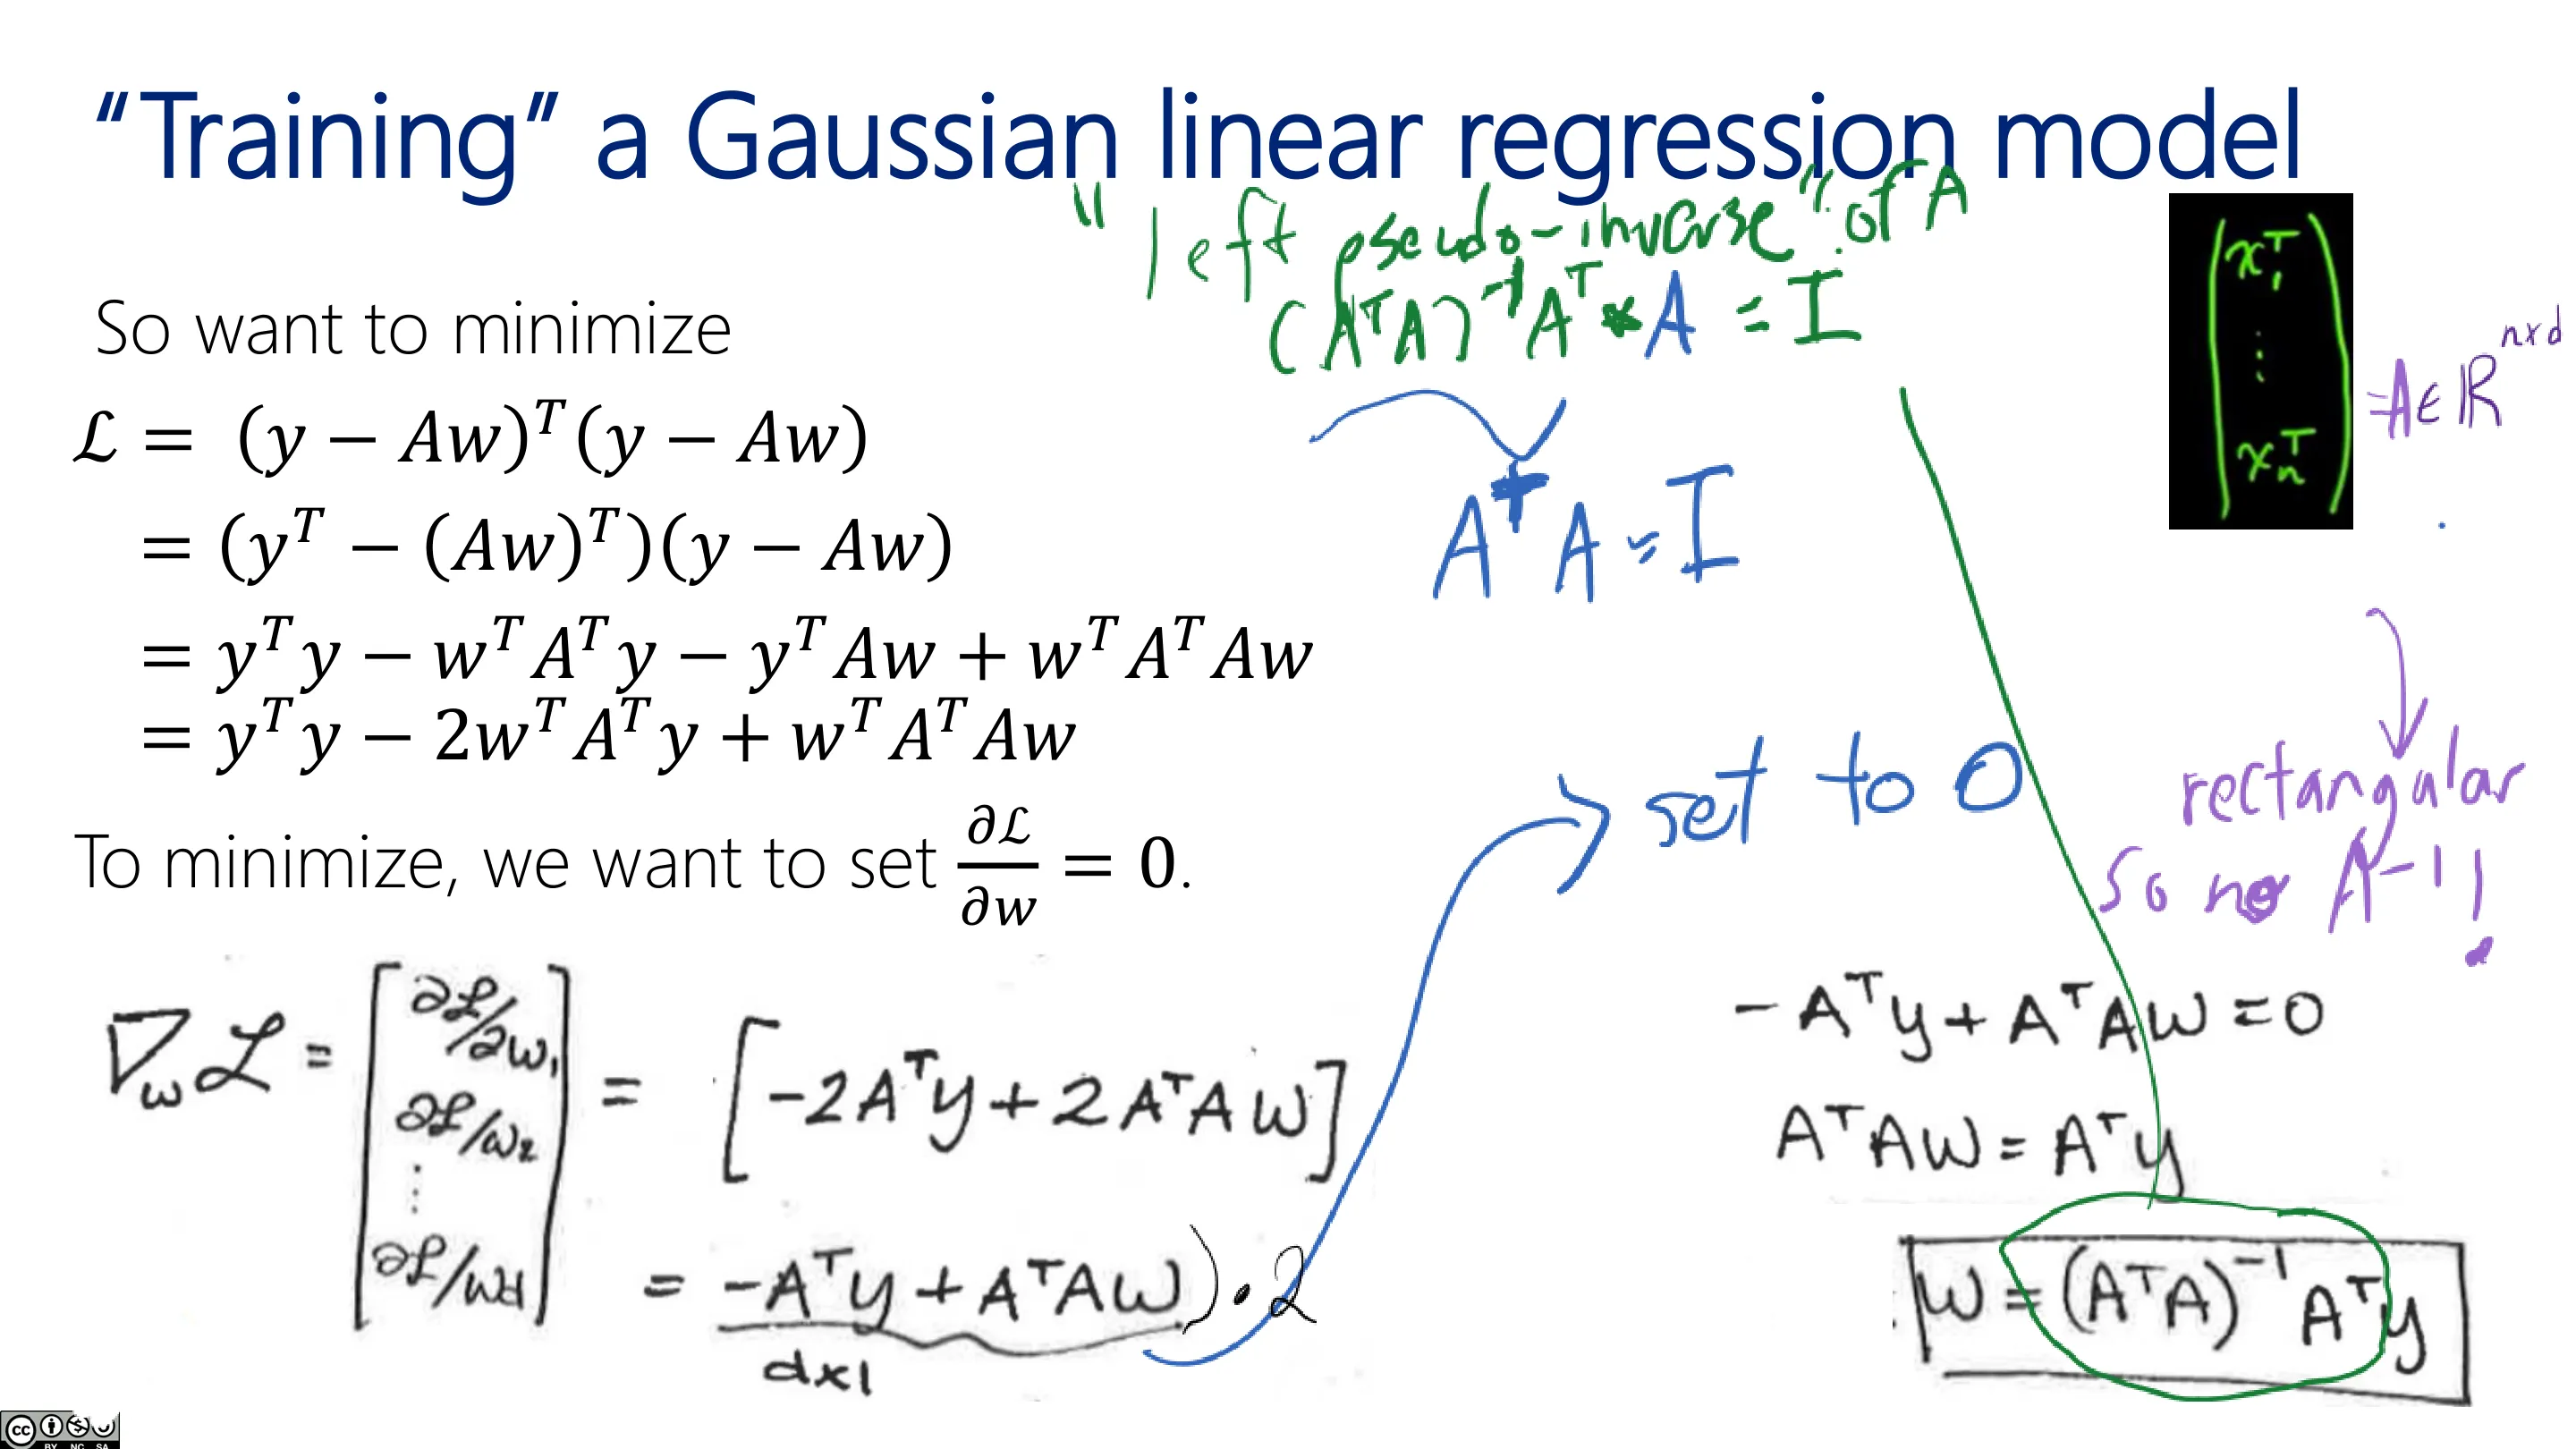
📷 对 w 求导
回到原视频 (00:11:05)
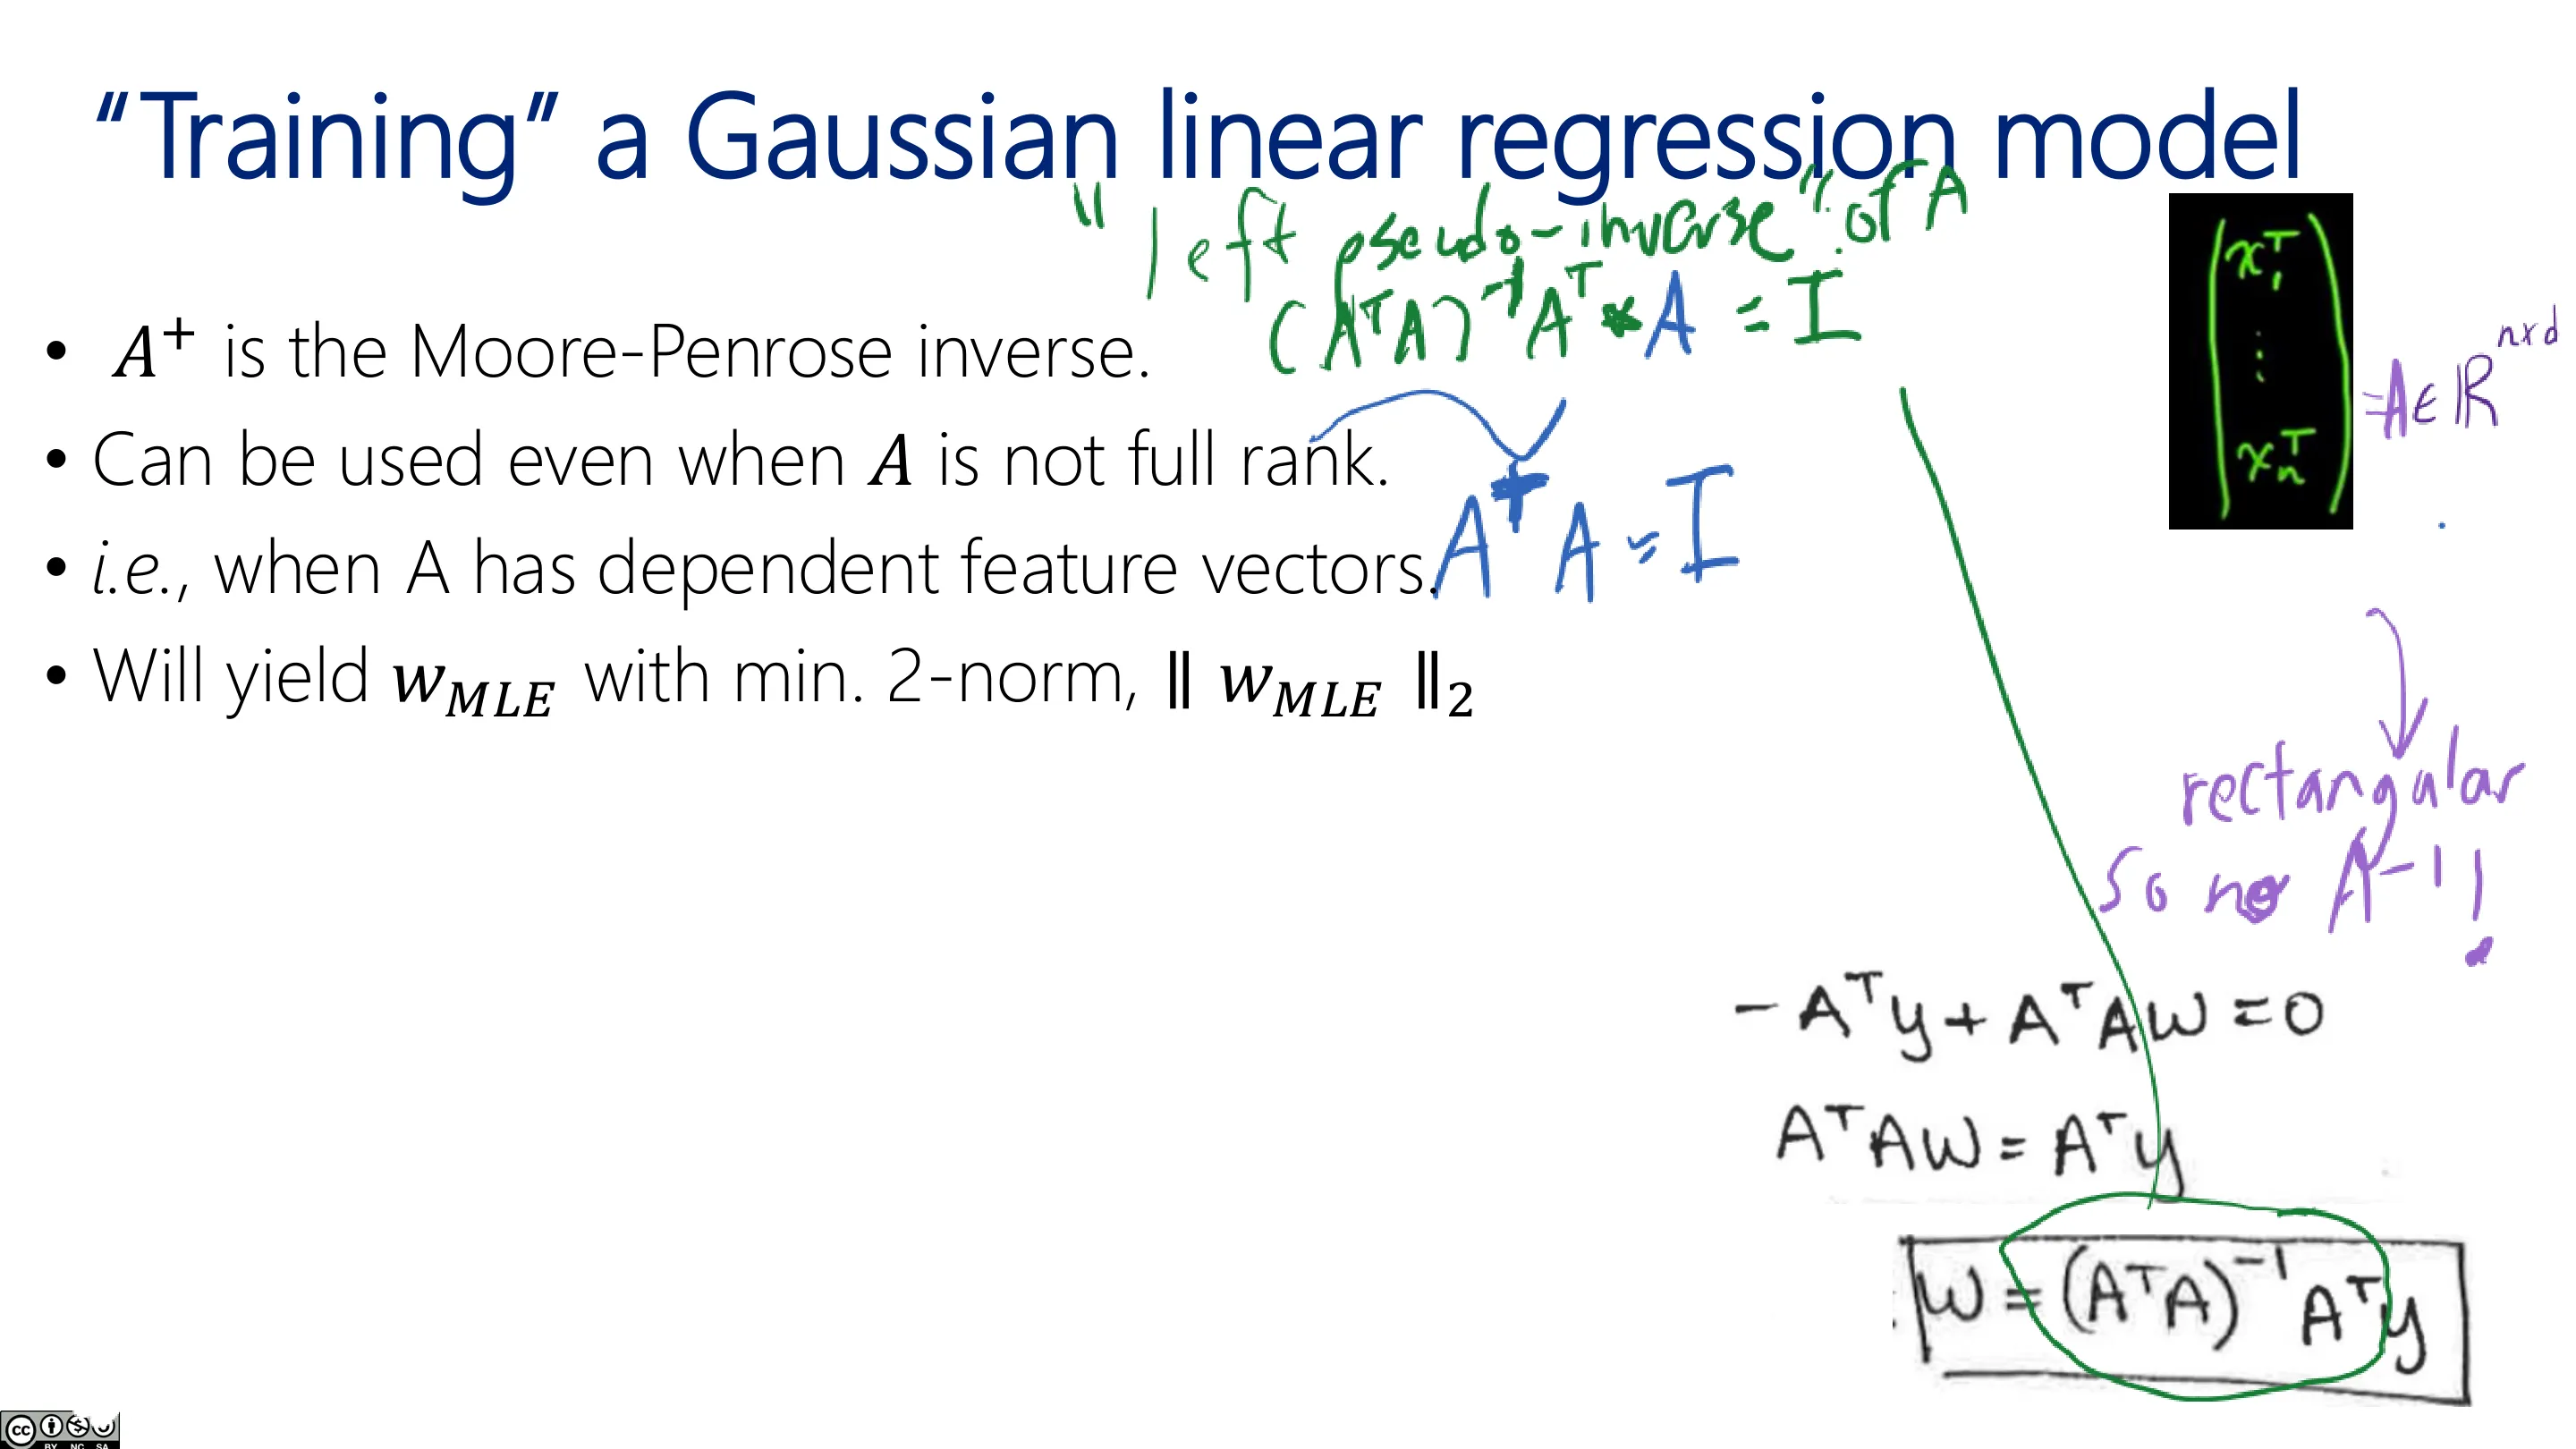
📷 化简
回到原视频 (00:12:33)
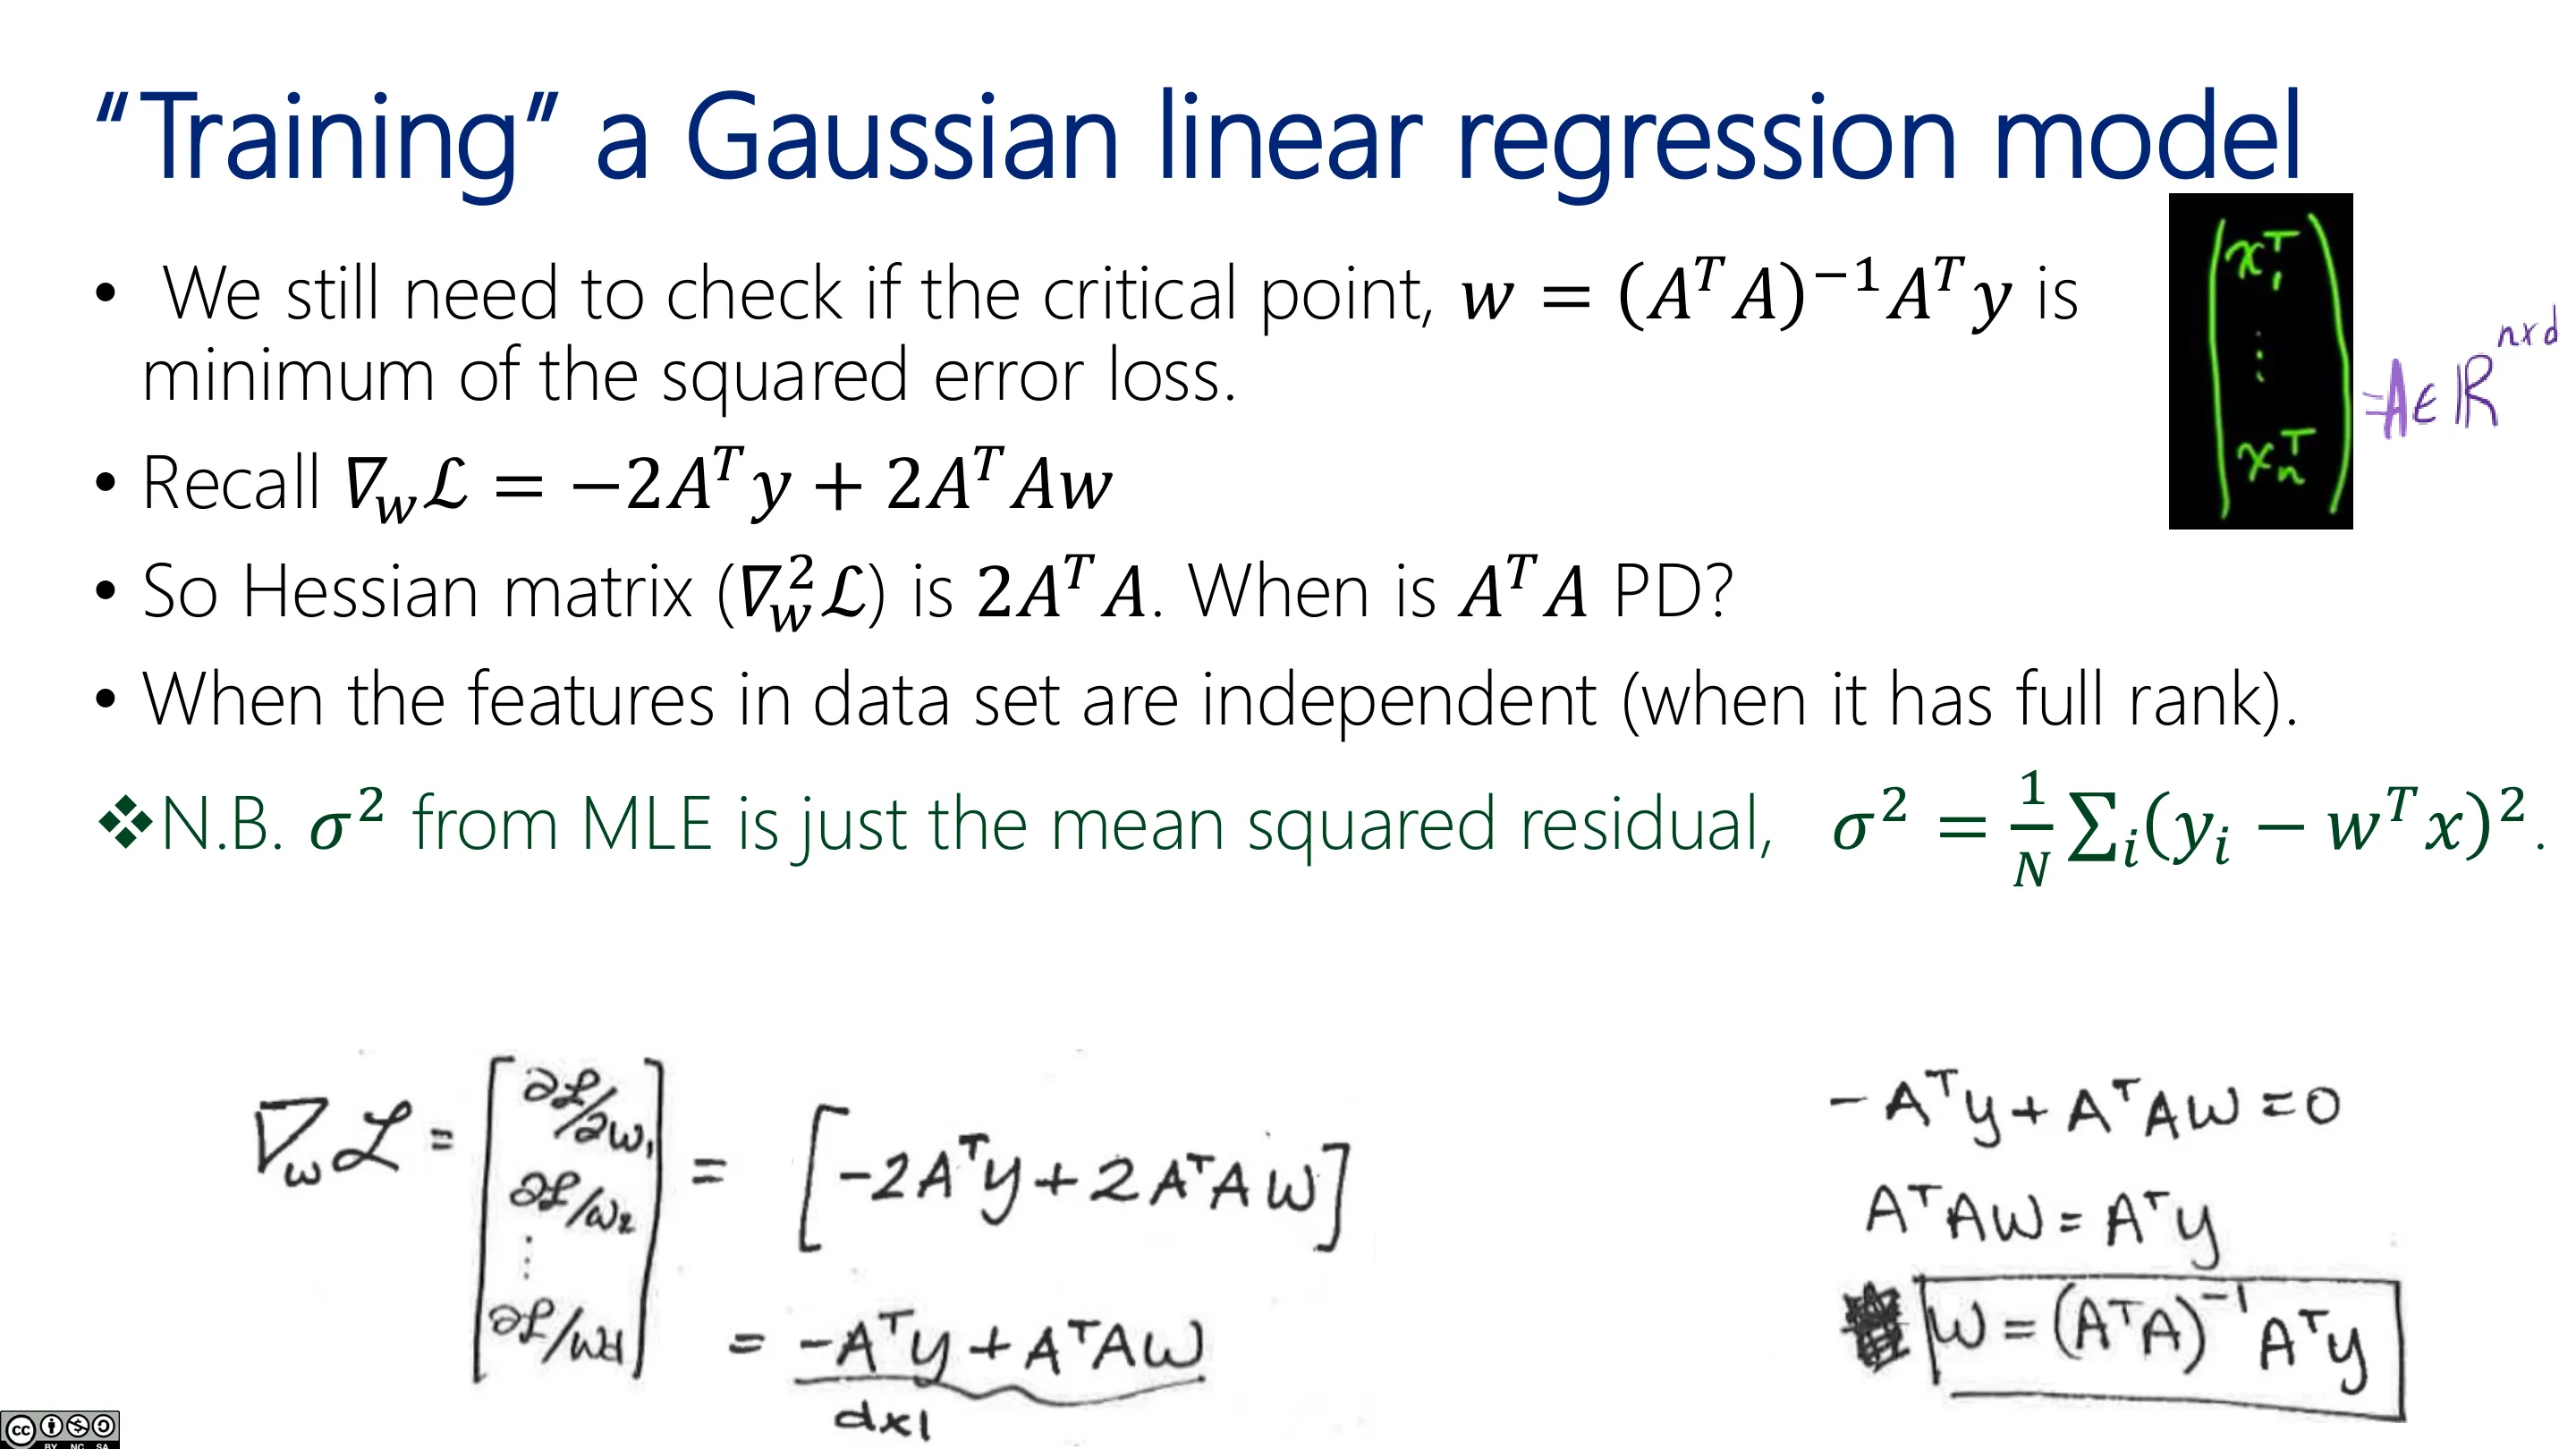
📷 整理
回到原视频 (00:13:56)
于是得到 正规方程(normal equations):
$$ A^\top A\,\hat w = A^\top y \;\Longrightarrow\; \hat w = (A^\top A)^{-1}A^\top y $$
其中 $(A^\top A)^{-1}A^\top$ 是 $A$ 的左伪逆(Moore–Penrose 伪逆)——因为 $A$ 不是方阵($N\times D$),通常不可逆;伪逆在任意 $A$ 上都可用。实践中一般不解显式逆,而是用线性求解器。
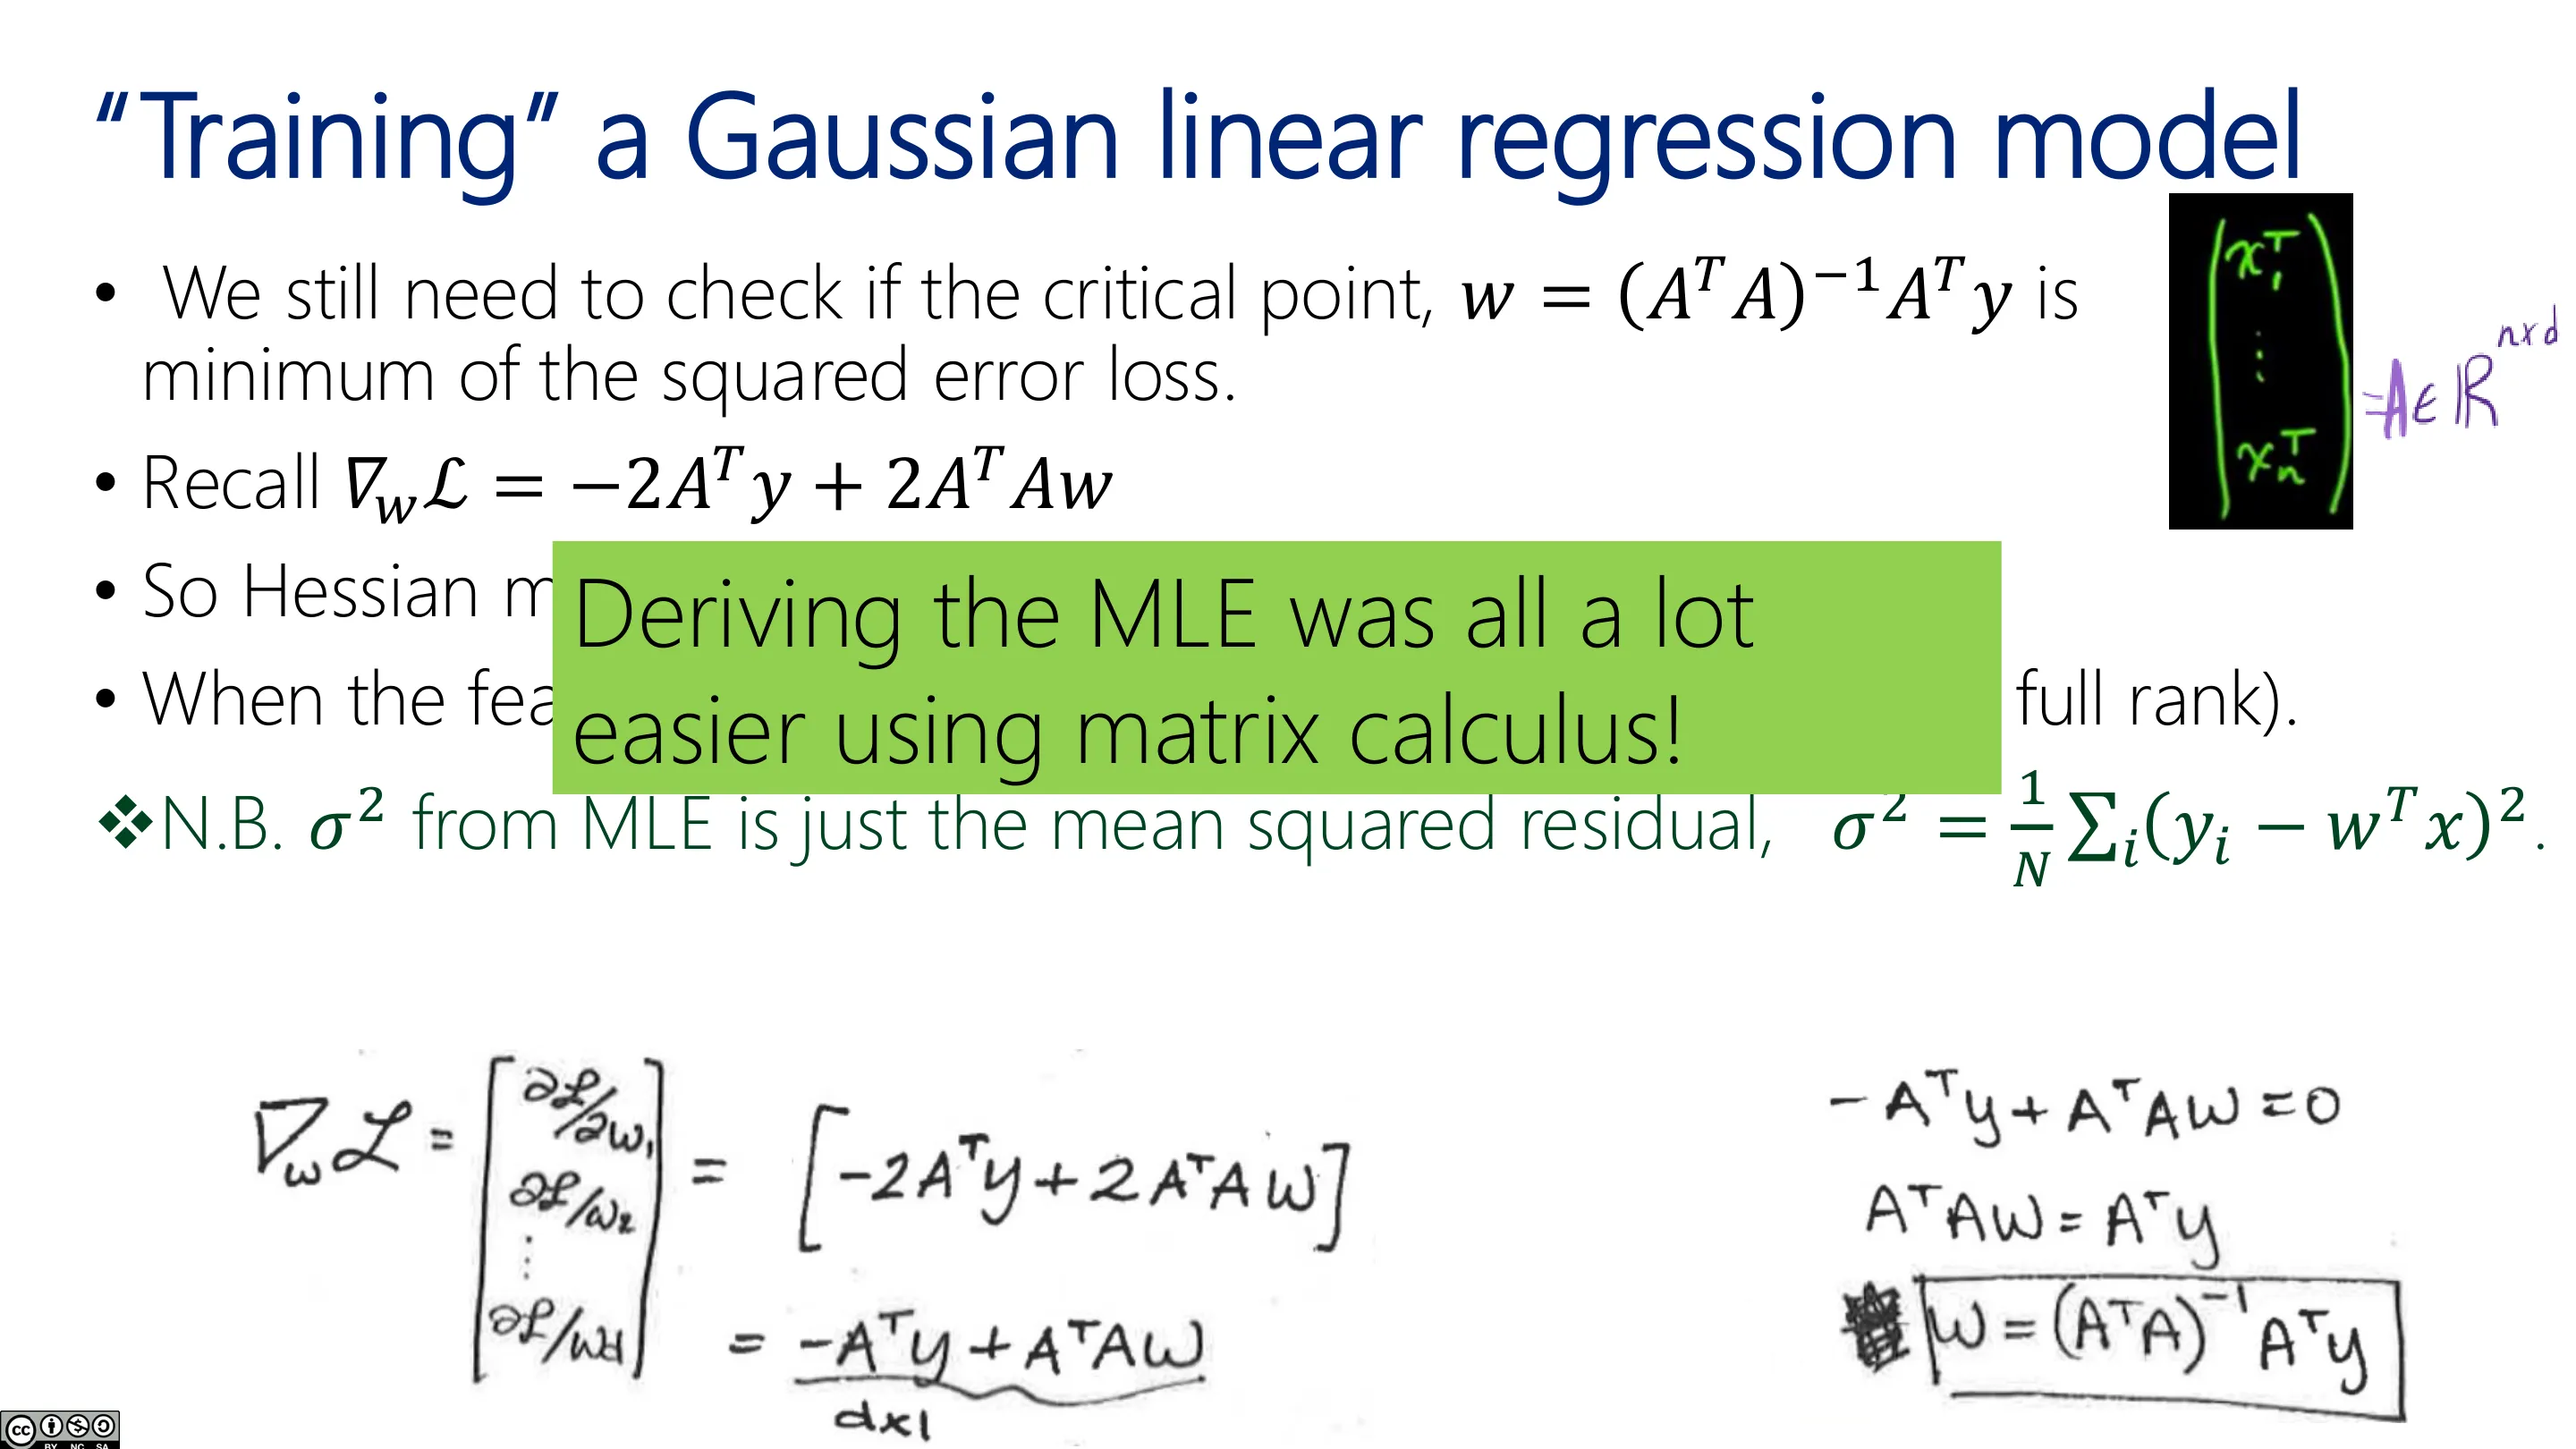
📷 解出 w(左伪逆)
回到原视频 (00:21:08)
编者说明: - 为什么要用矩阵形式? 因为更紧凑、更不易出错,而且几乎所有步骤都能一步到位;逐元素求 $w_i$ 当然也行,但繁琐。 - 何时 $A^\top A$ 可逆? 当特征线性无关(设计矩阵满秩)时,$A^\top A$ 正定、可逆,驻点是最小值(Hessian 为正定即可判定最小)。若特征线性相关或特征数多于样本数,则 $A^\top A$ 半正定、秩亏。 - 同样可推导 $\sigma^2$ 的 MLE(留作练习),结果与单变量高斯方差一致。
2.3 基函数展开:一切照旧
(参考时间: 00:24)
若把原始特征 $x$ 换成基展开 $\phi(x)$(如多项式 $[1,x,x^2,x^3]$、RBF、傅里叶、小波……),求解过程完全不变——只是把设计矩阵的每一行从 $x_i^\top$ 换成 $\phi(x_i)^\top$,$w$ 的维度随之增大。这只是「记账」,不涉及新的数学。
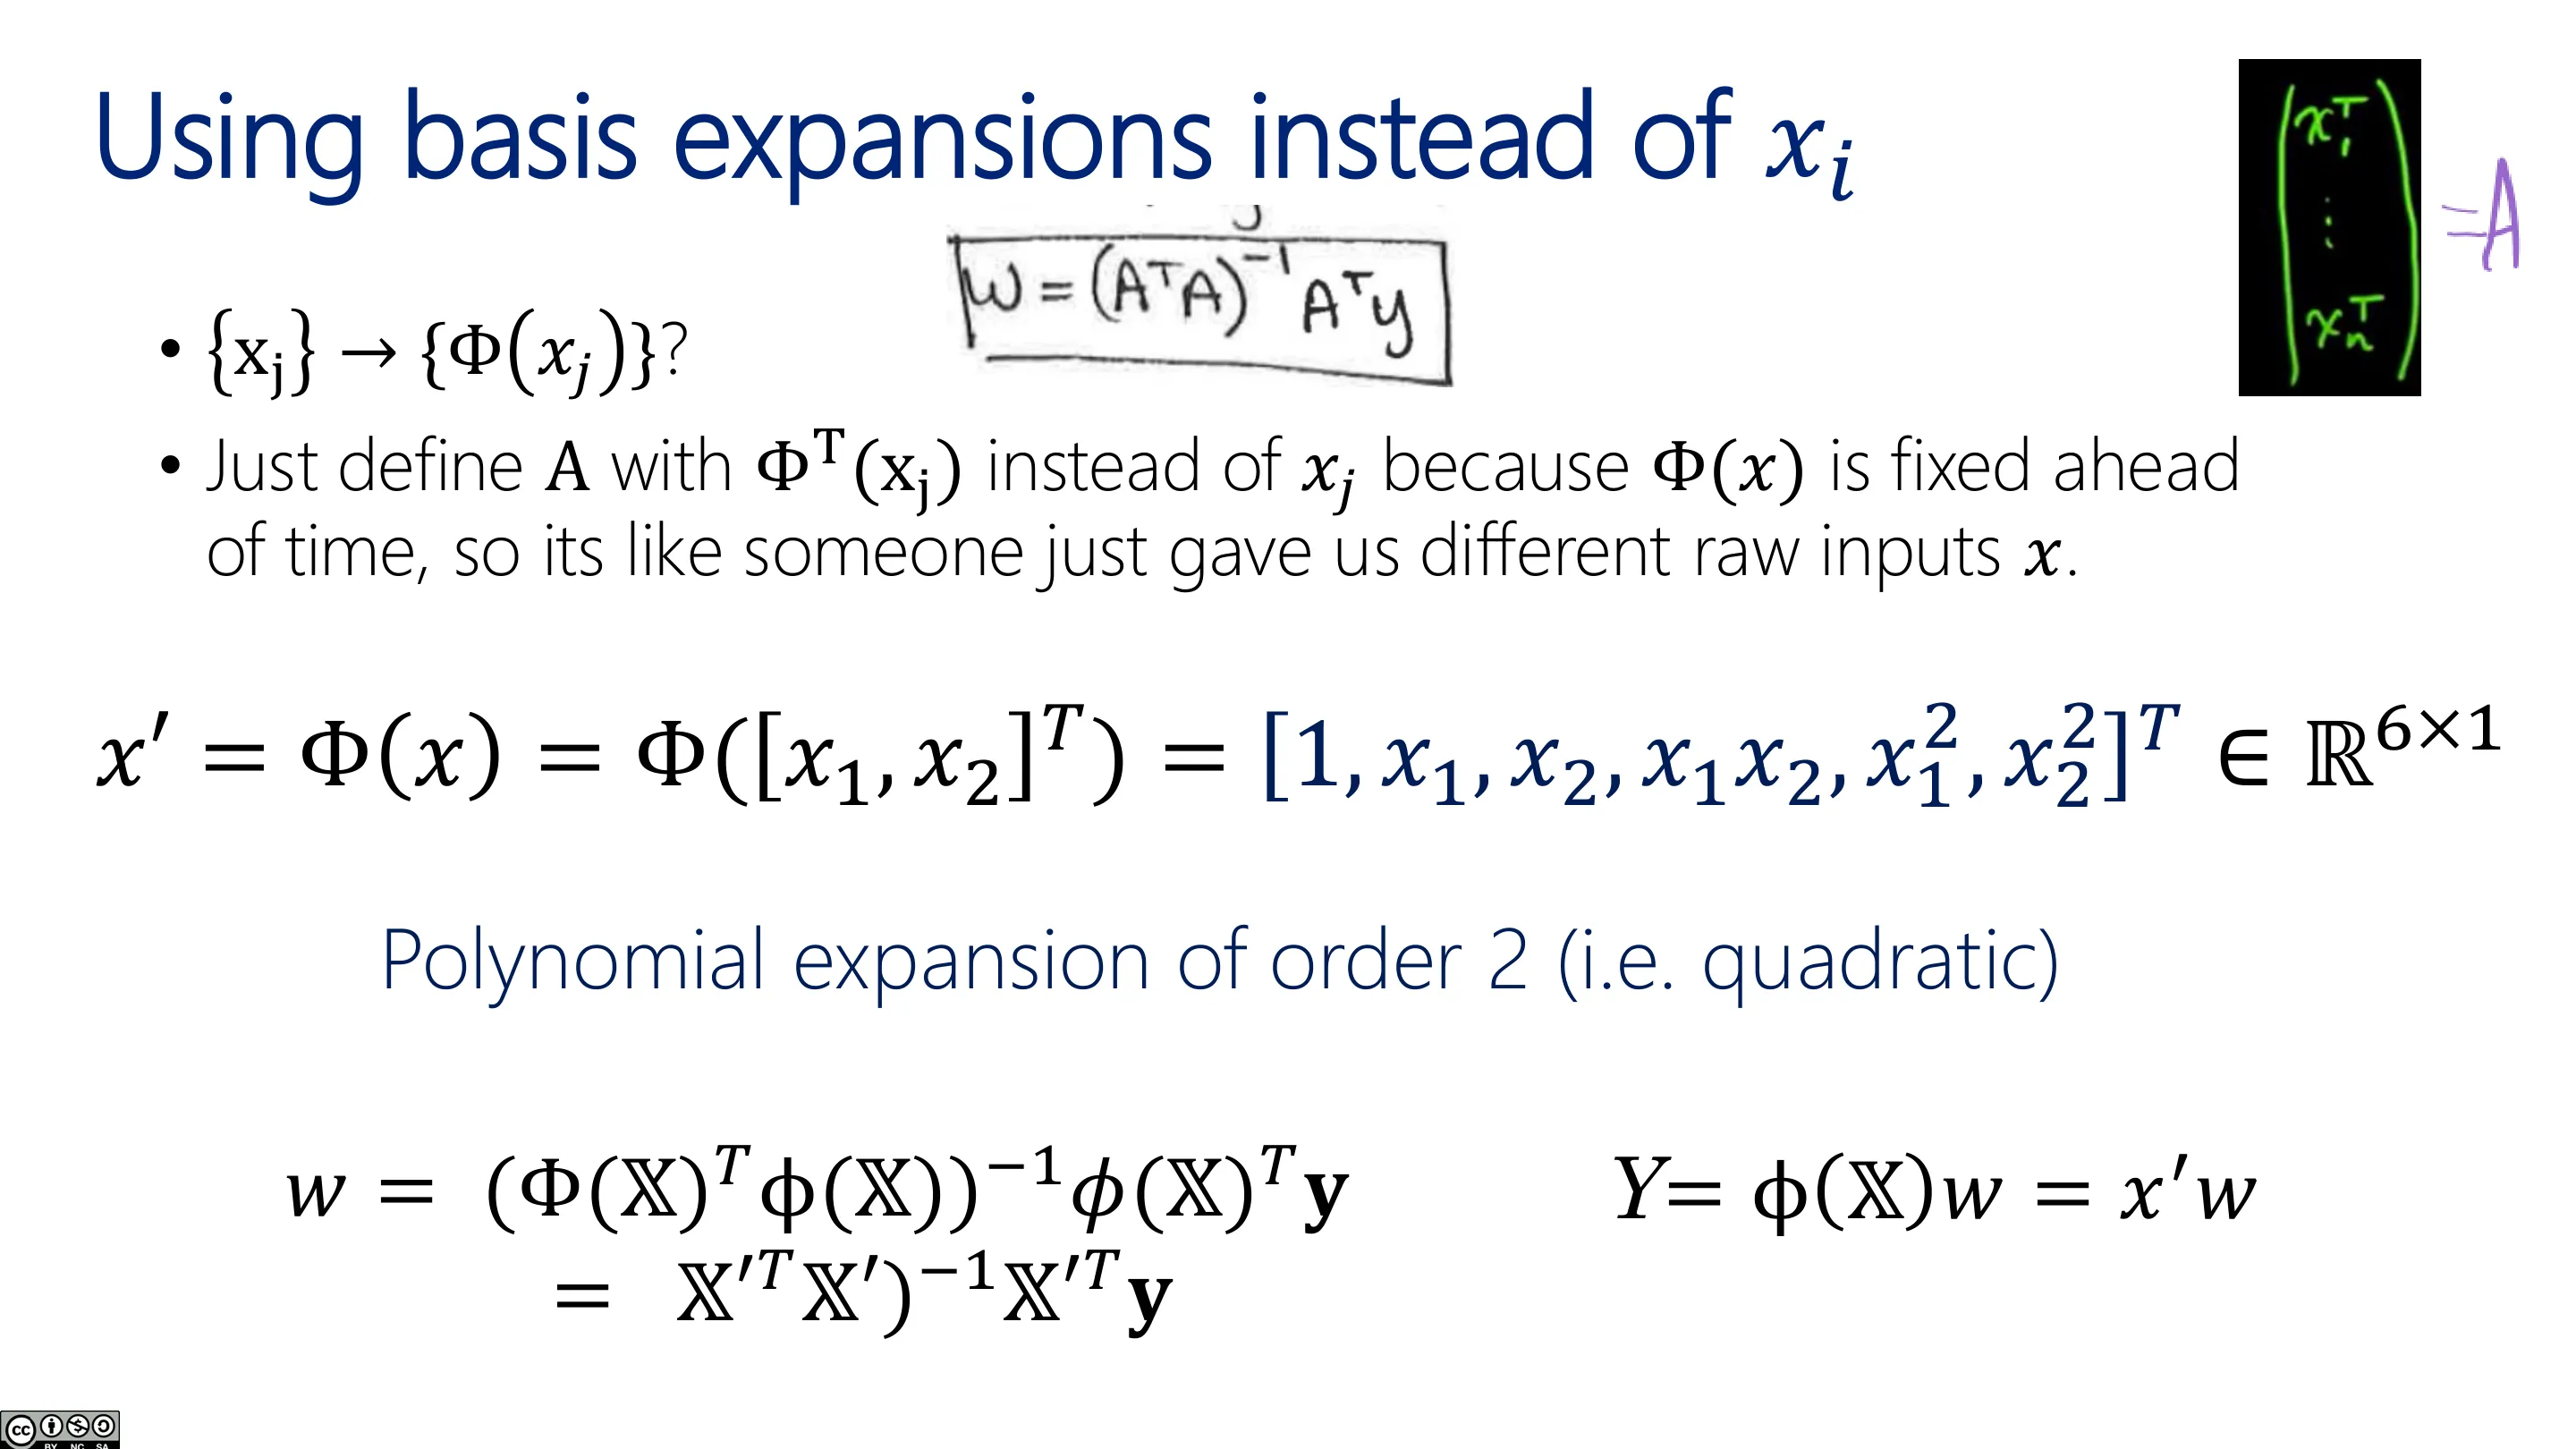
📷 基函数展开
回到原视频 (00:24:10)
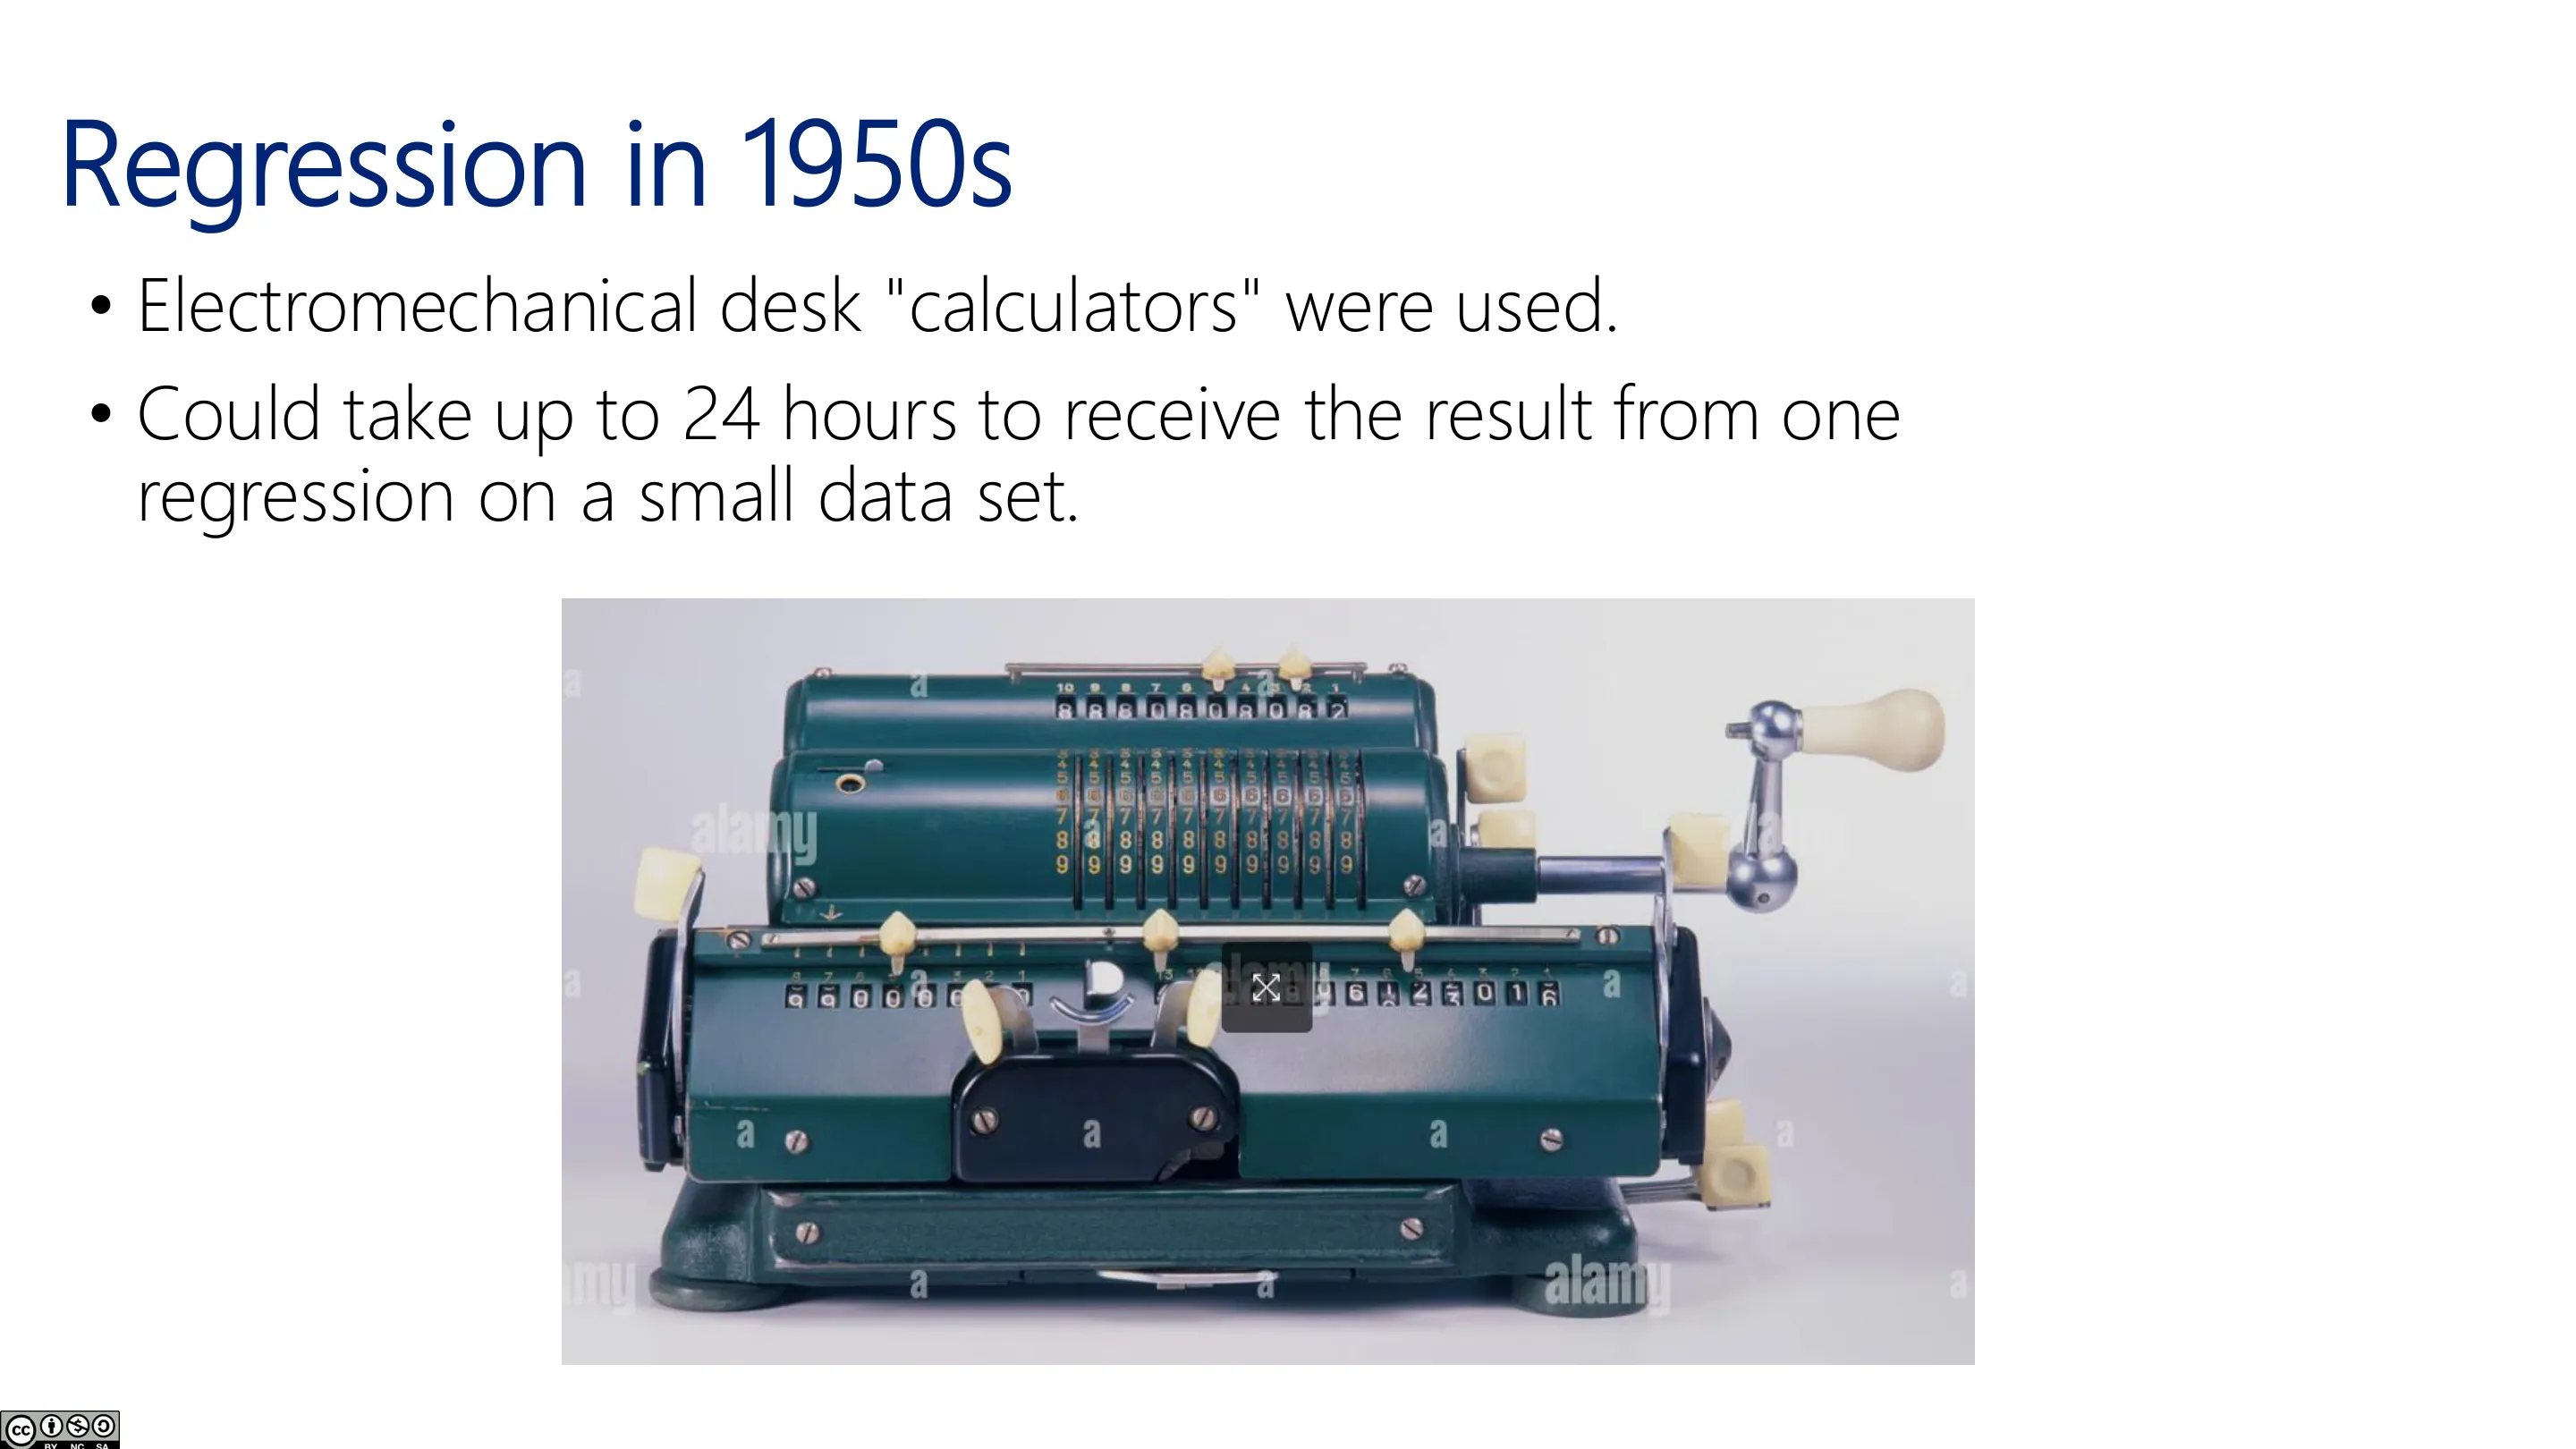
回归的历史:1805 年高斯与勒让德用它估计天体轨道;1950 年代人们用机械计算机做回归,一个很小的回归要算一天。
📷 1950 年代的回归
回到原视频 (00:28:59)
📷 路线图(三)
回到原视频 (00:30:30)
三、几何视角:投影
(参考时间: 00:30)
3.1 张成空间与「矩阵乘法 = 列的线性组合」
📷 线性代数:张成(Span)
回到原视频 (00:30:58)
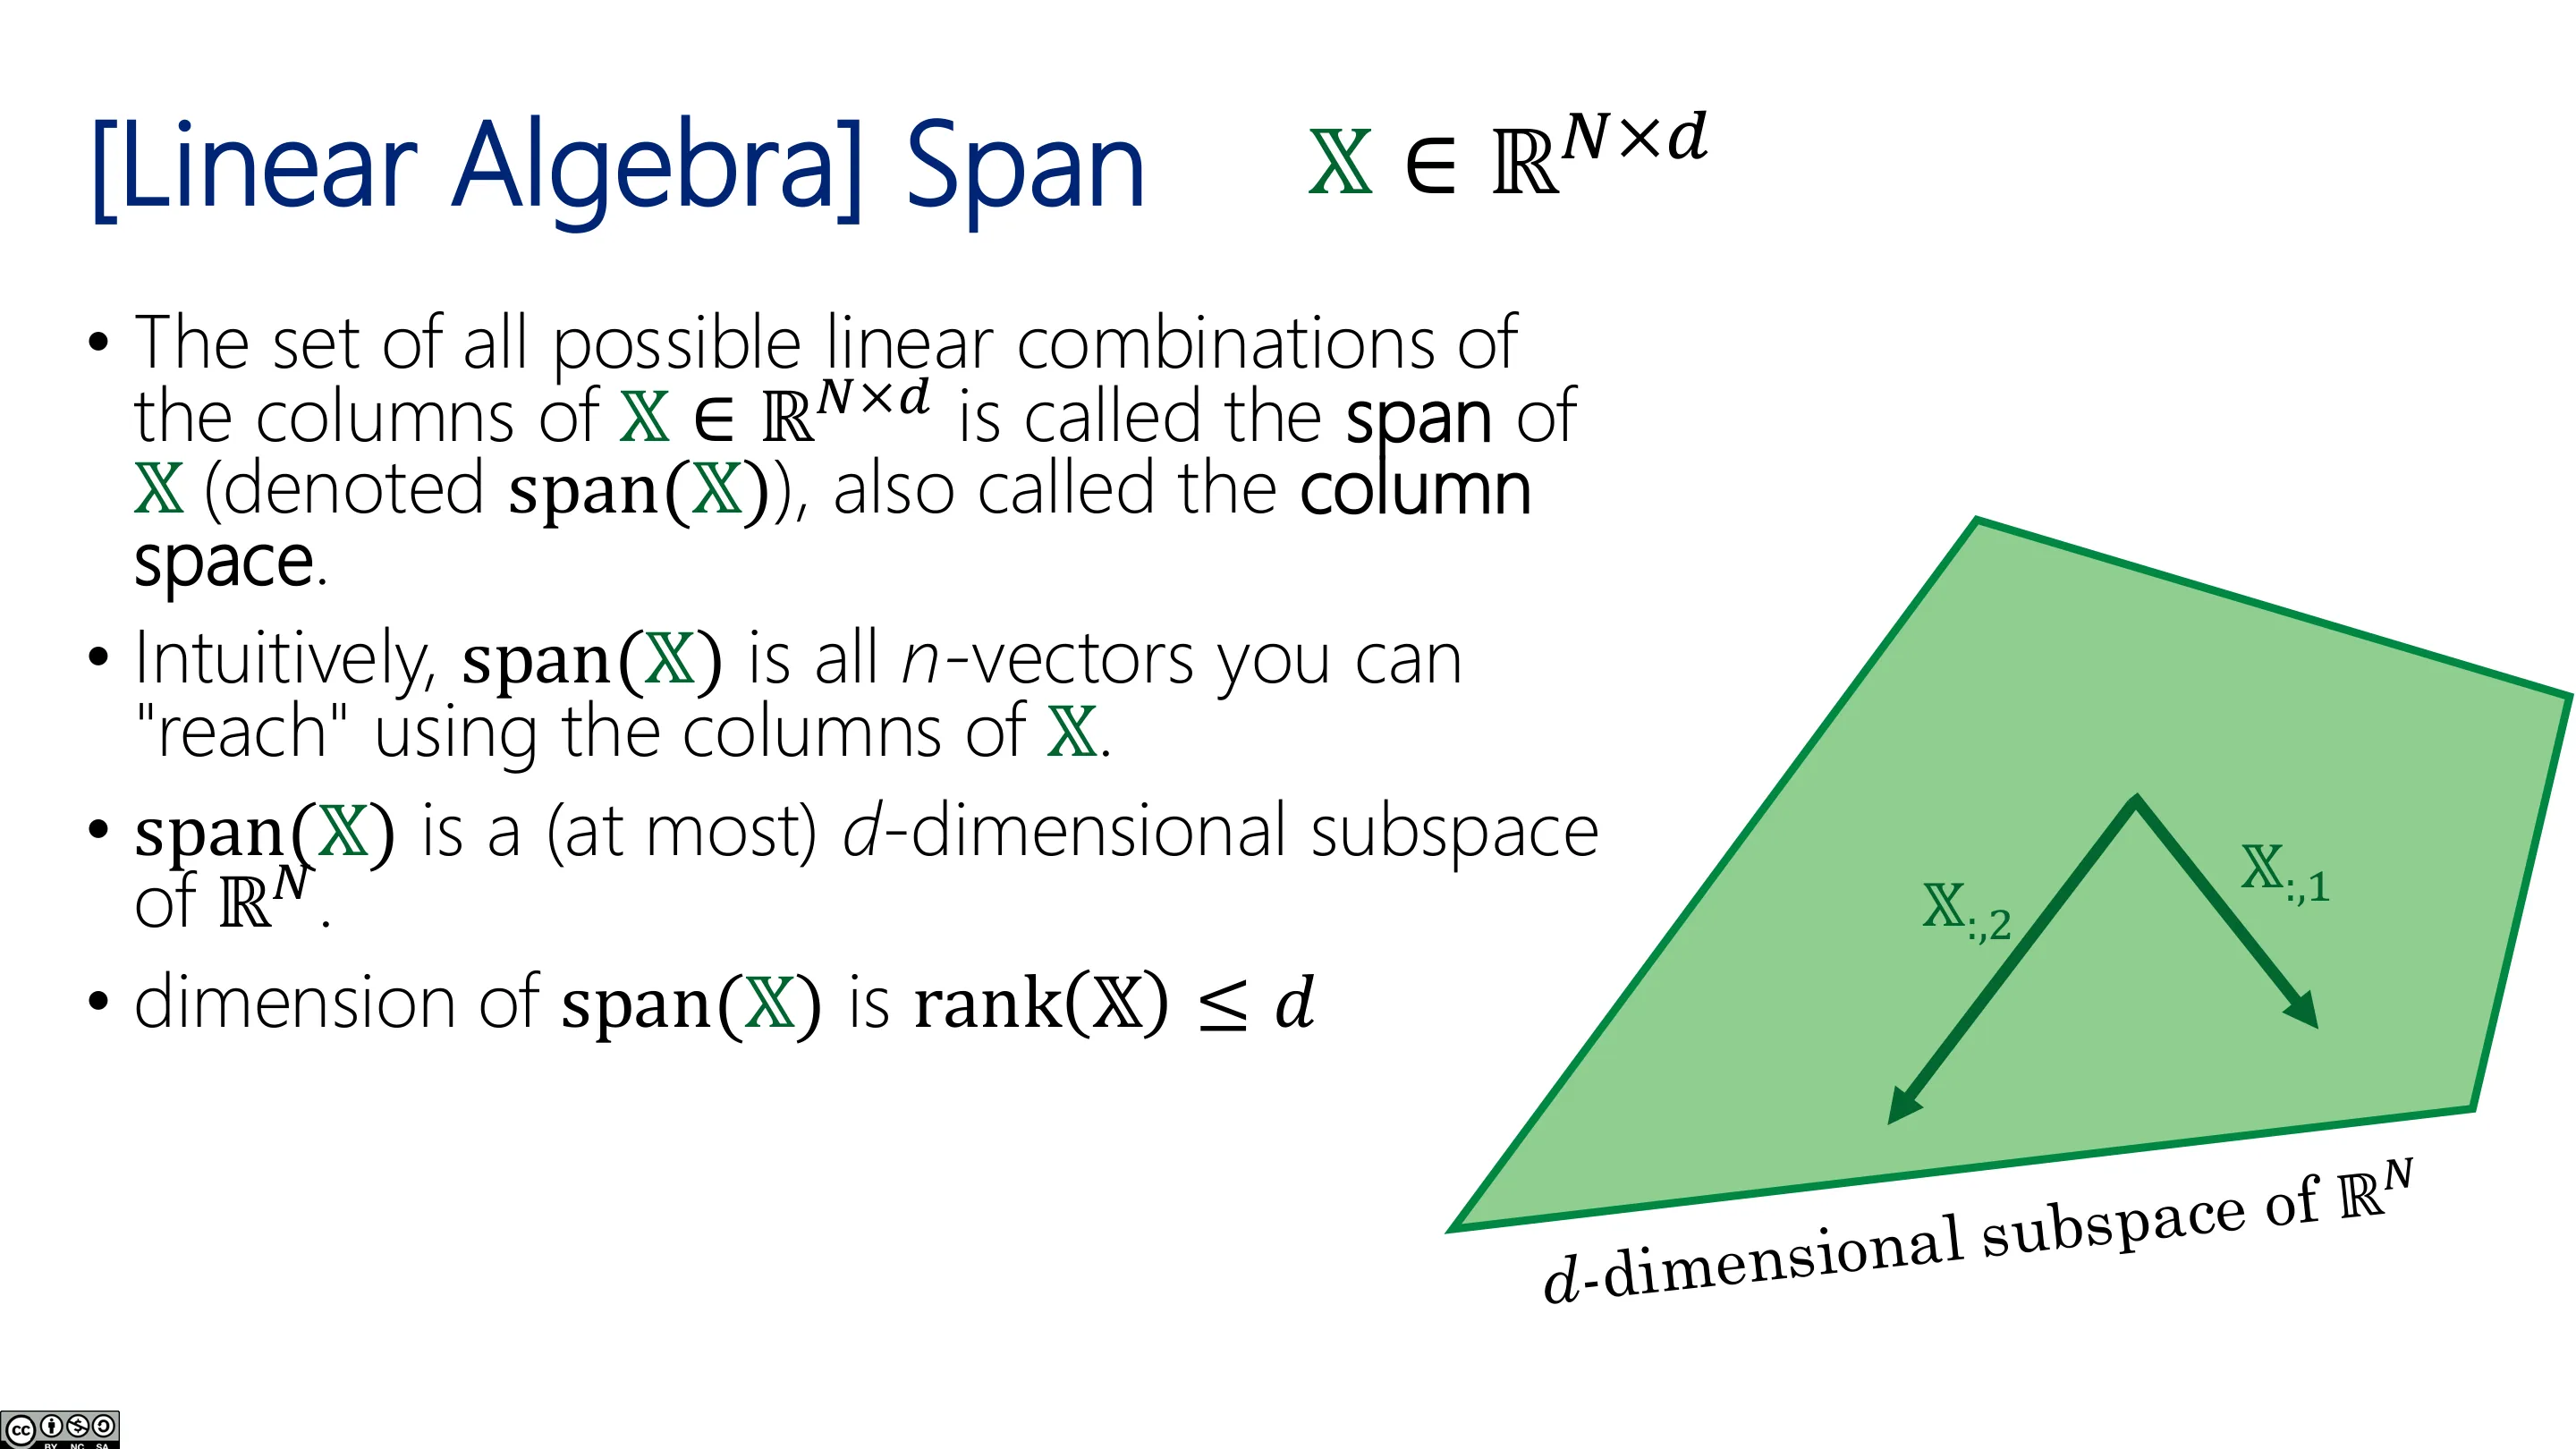
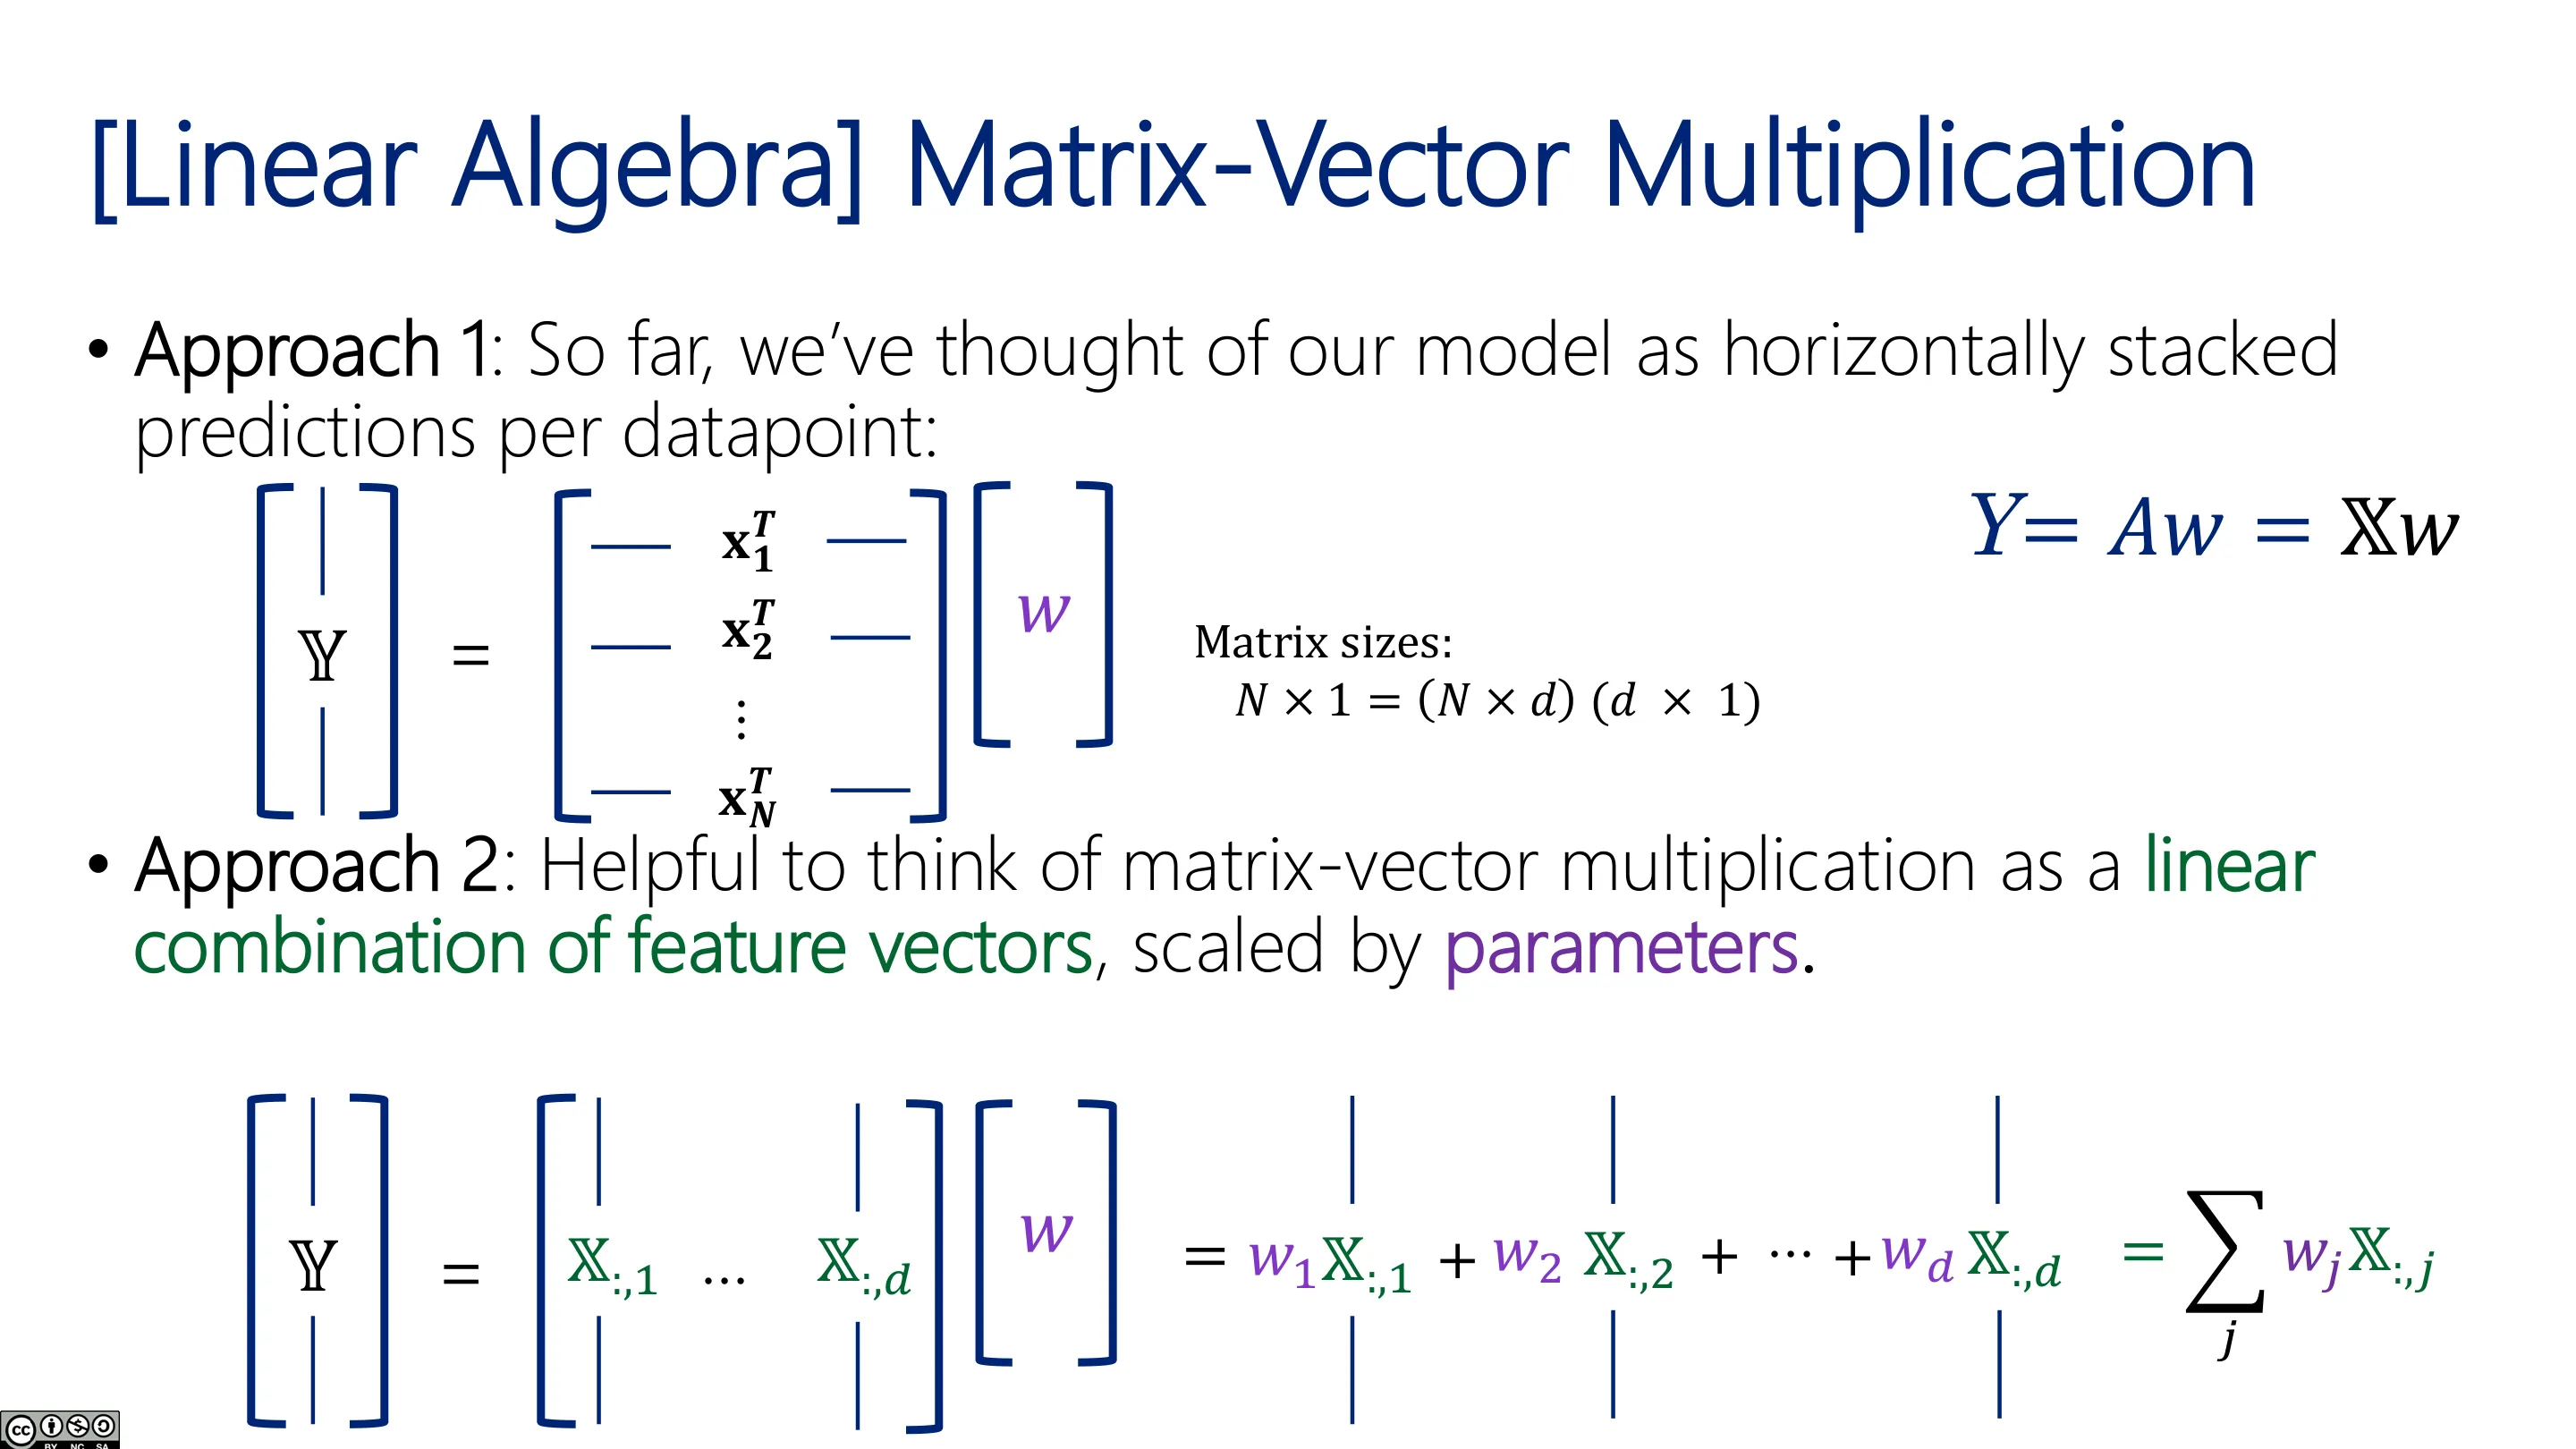
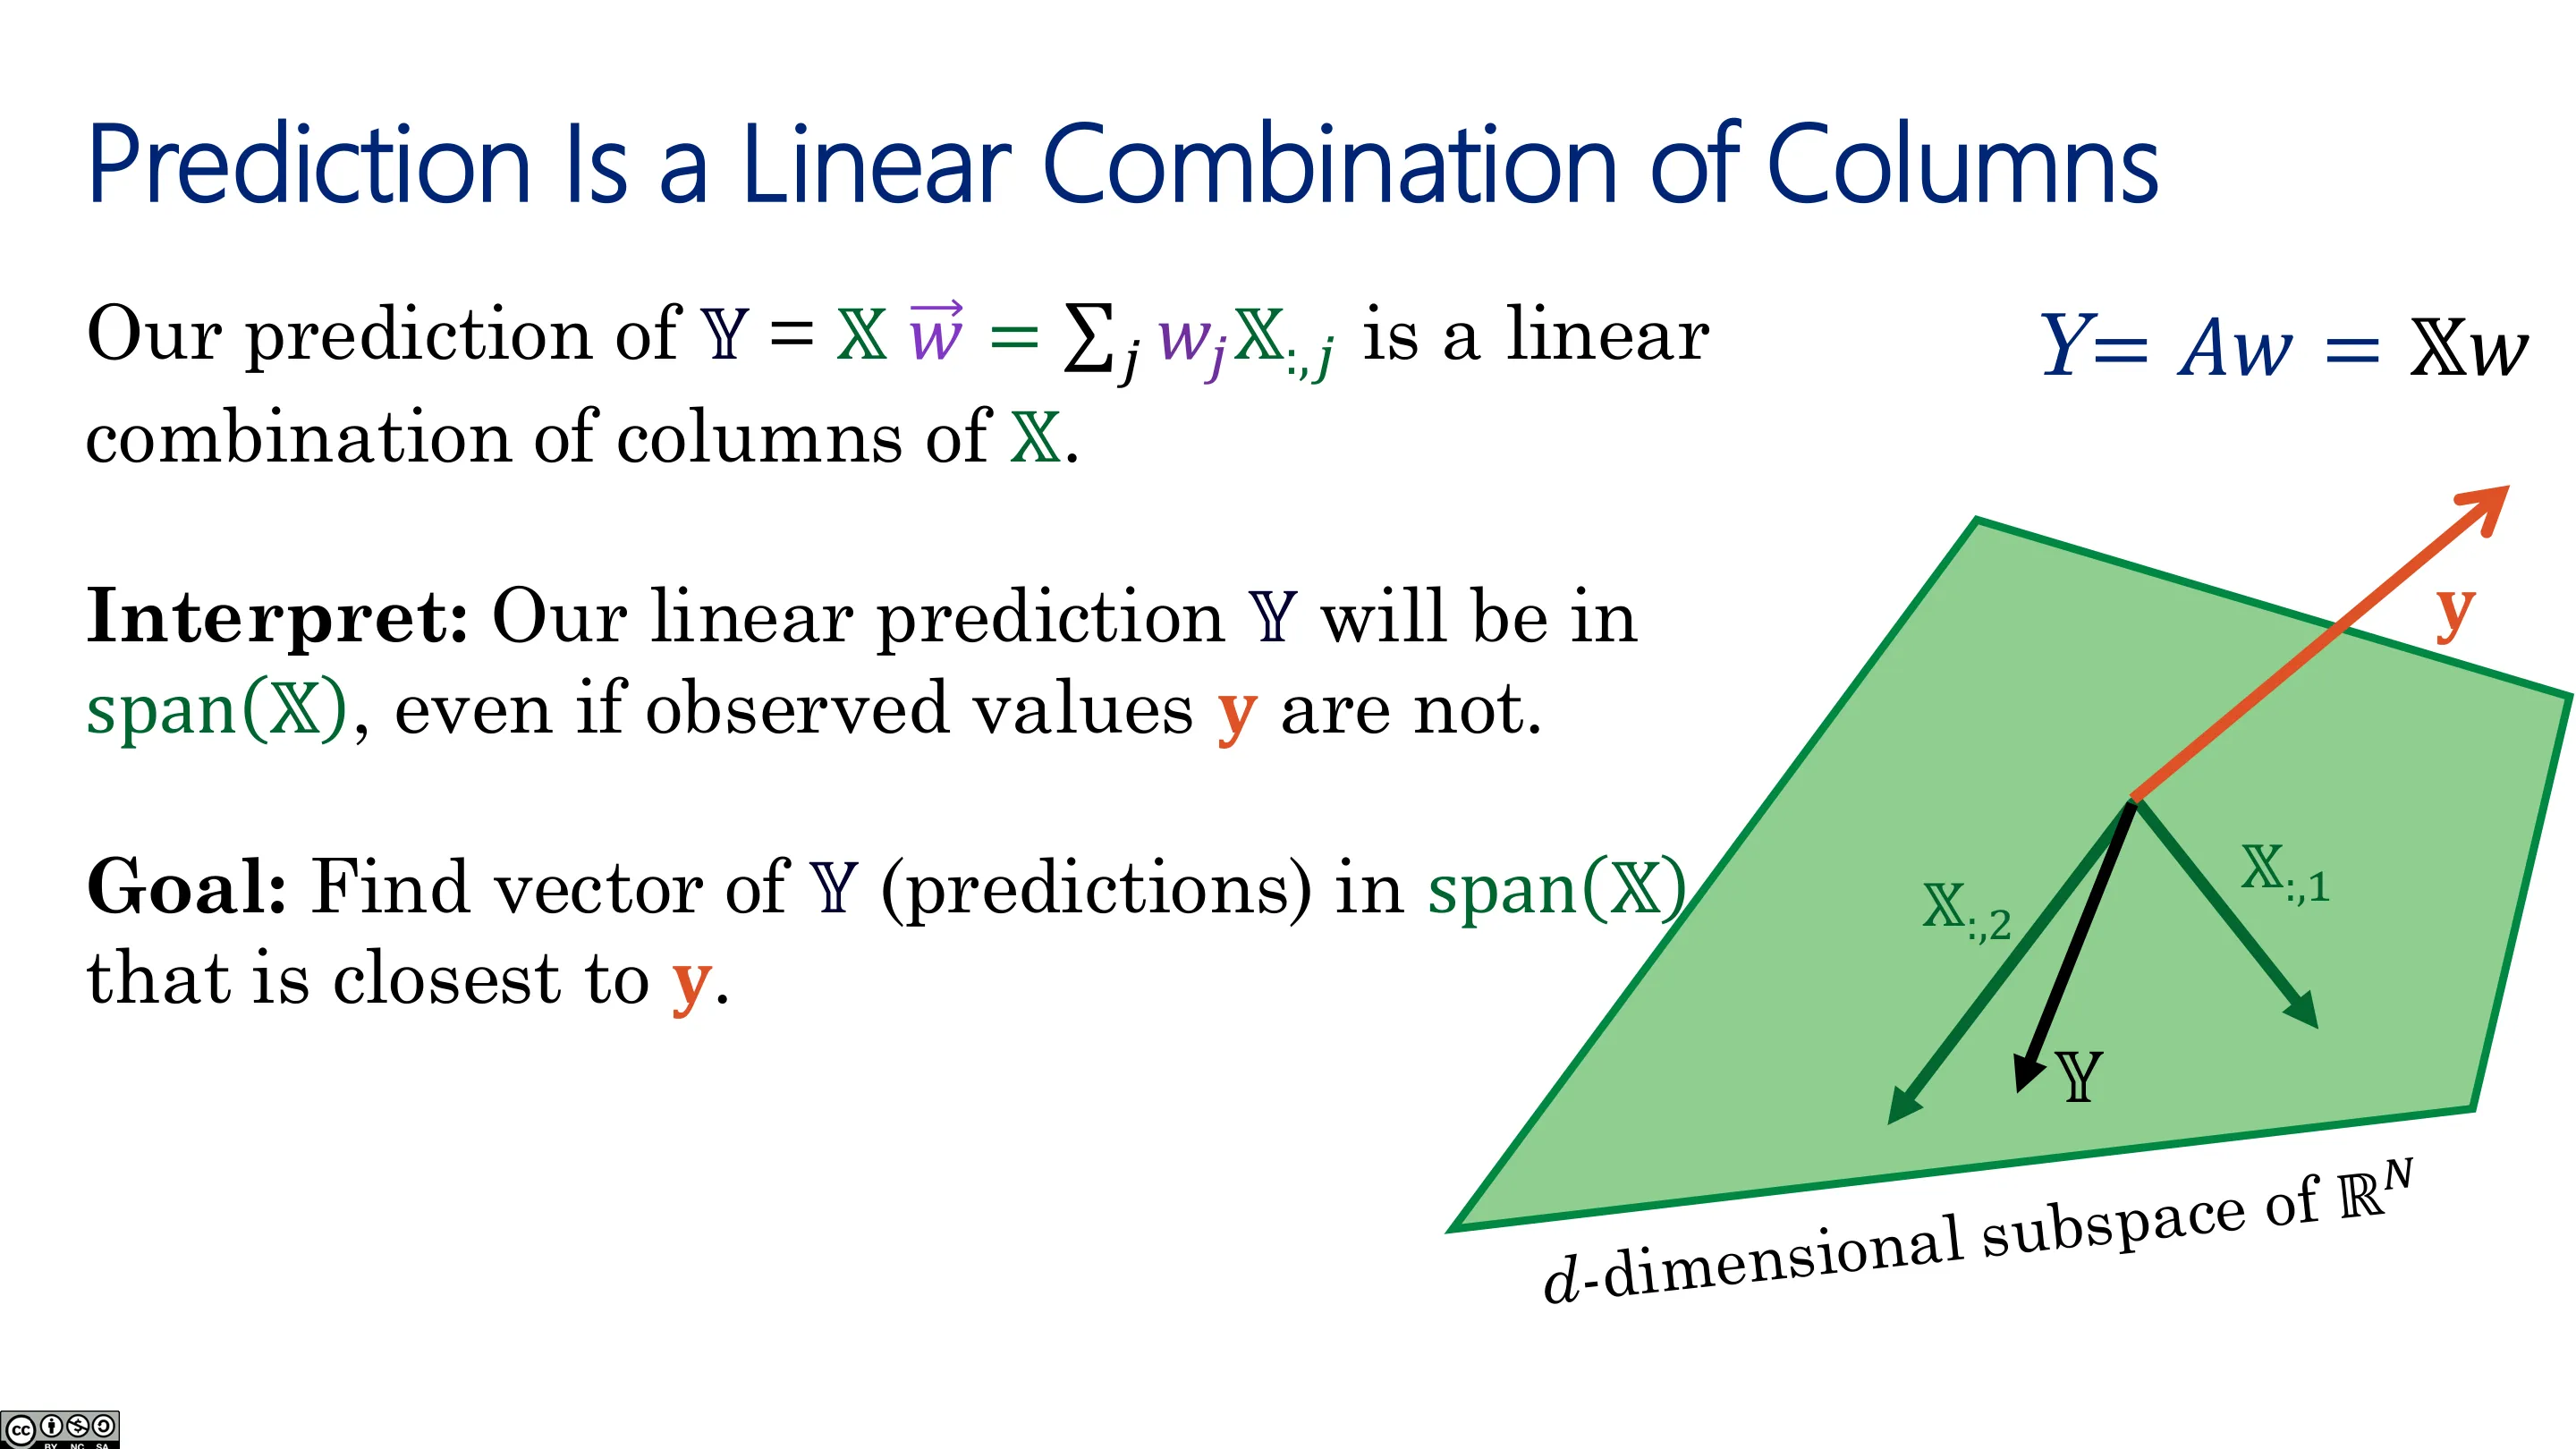
$X$ 的列空间(column span) = 所有可以由 $X$ 的列线性组合得到的向量集合,记 $\mathrm{span}(X)\subseteq\mathbb{R}^N$($N$ 个样本,$D$ 个特征 ⇒ 是 $\mathbb{R}^N$ 中的 $D$ 维子空间)。
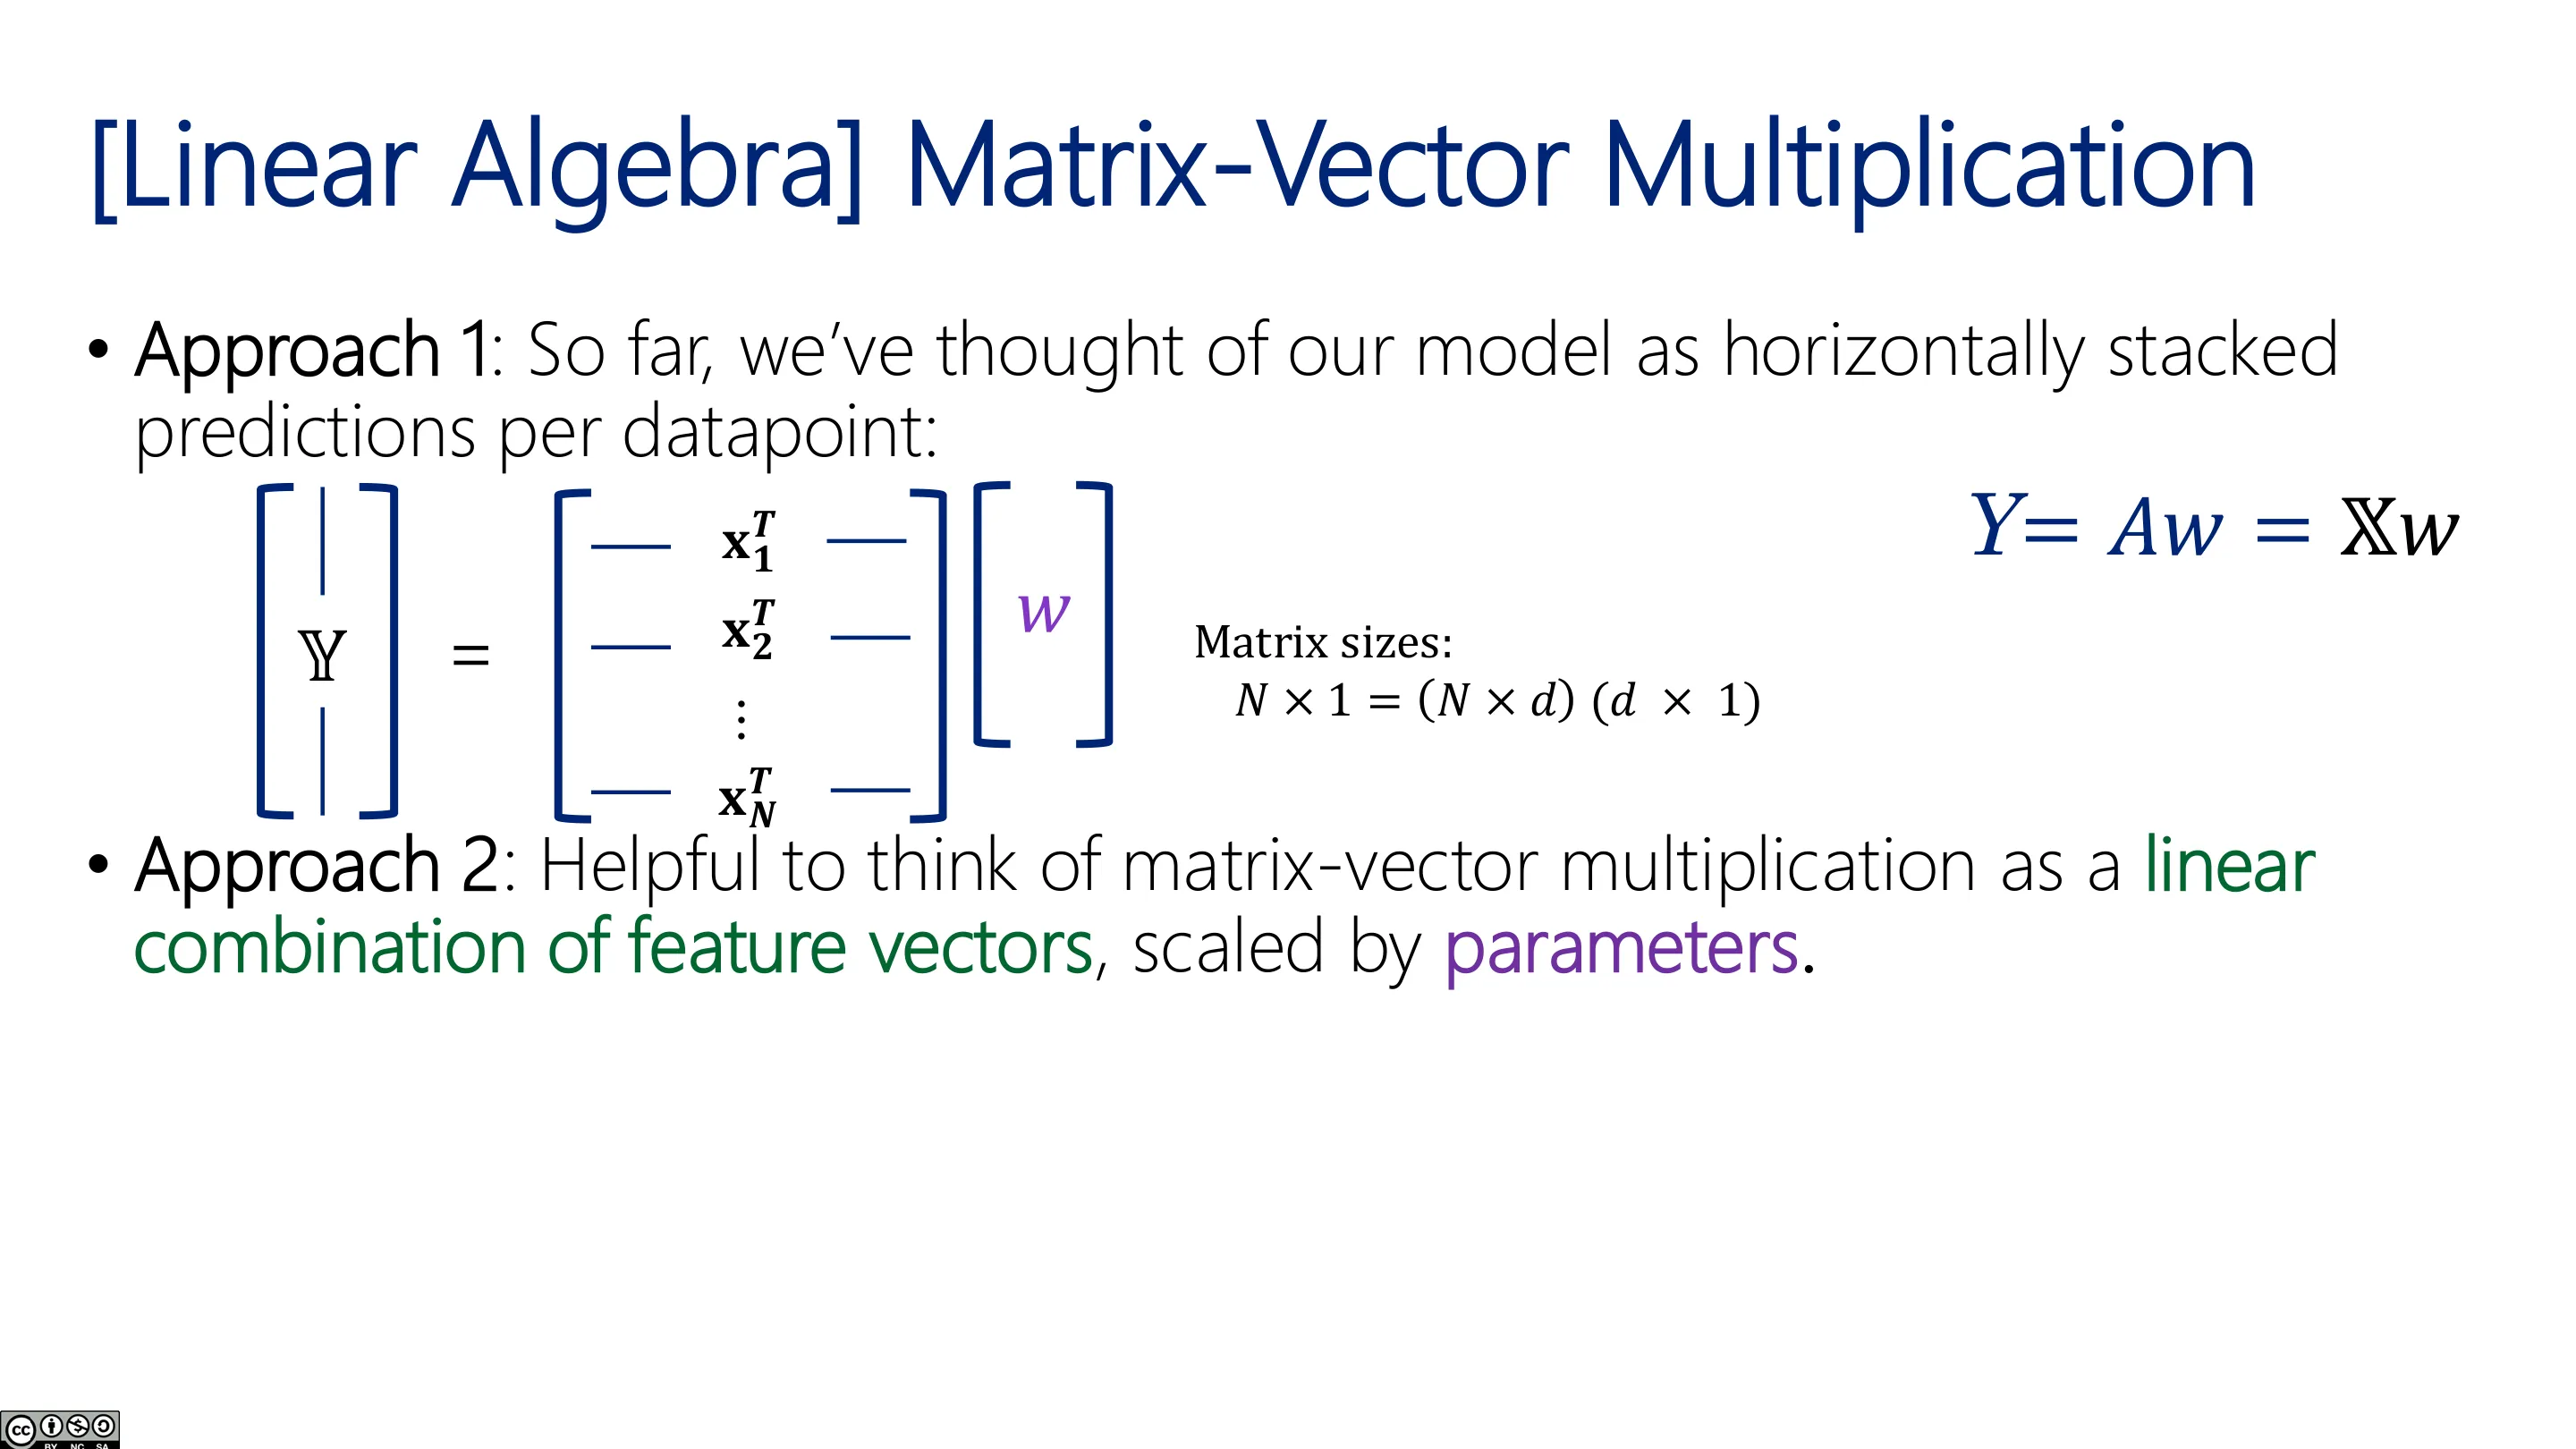
矩阵乘法有两种读法:
- 按行:每一行与向量点积;
- 按列:$Xw = \sum_{d} w_d\,(\text{第 }d\text{ 列})$——即预测是特征列向量的线性组合。
第二种读法正是几何视角的关键。
📷 矩阵—向量乘法(一)
回到原视频 (00:31:55)
📷 矩阵—向量乘法(二)
回到原视频 (00:32:13)
📷 预测是列的线性组合
回到原视频 (00:33:04)
3.2 把标签投影到张成空间
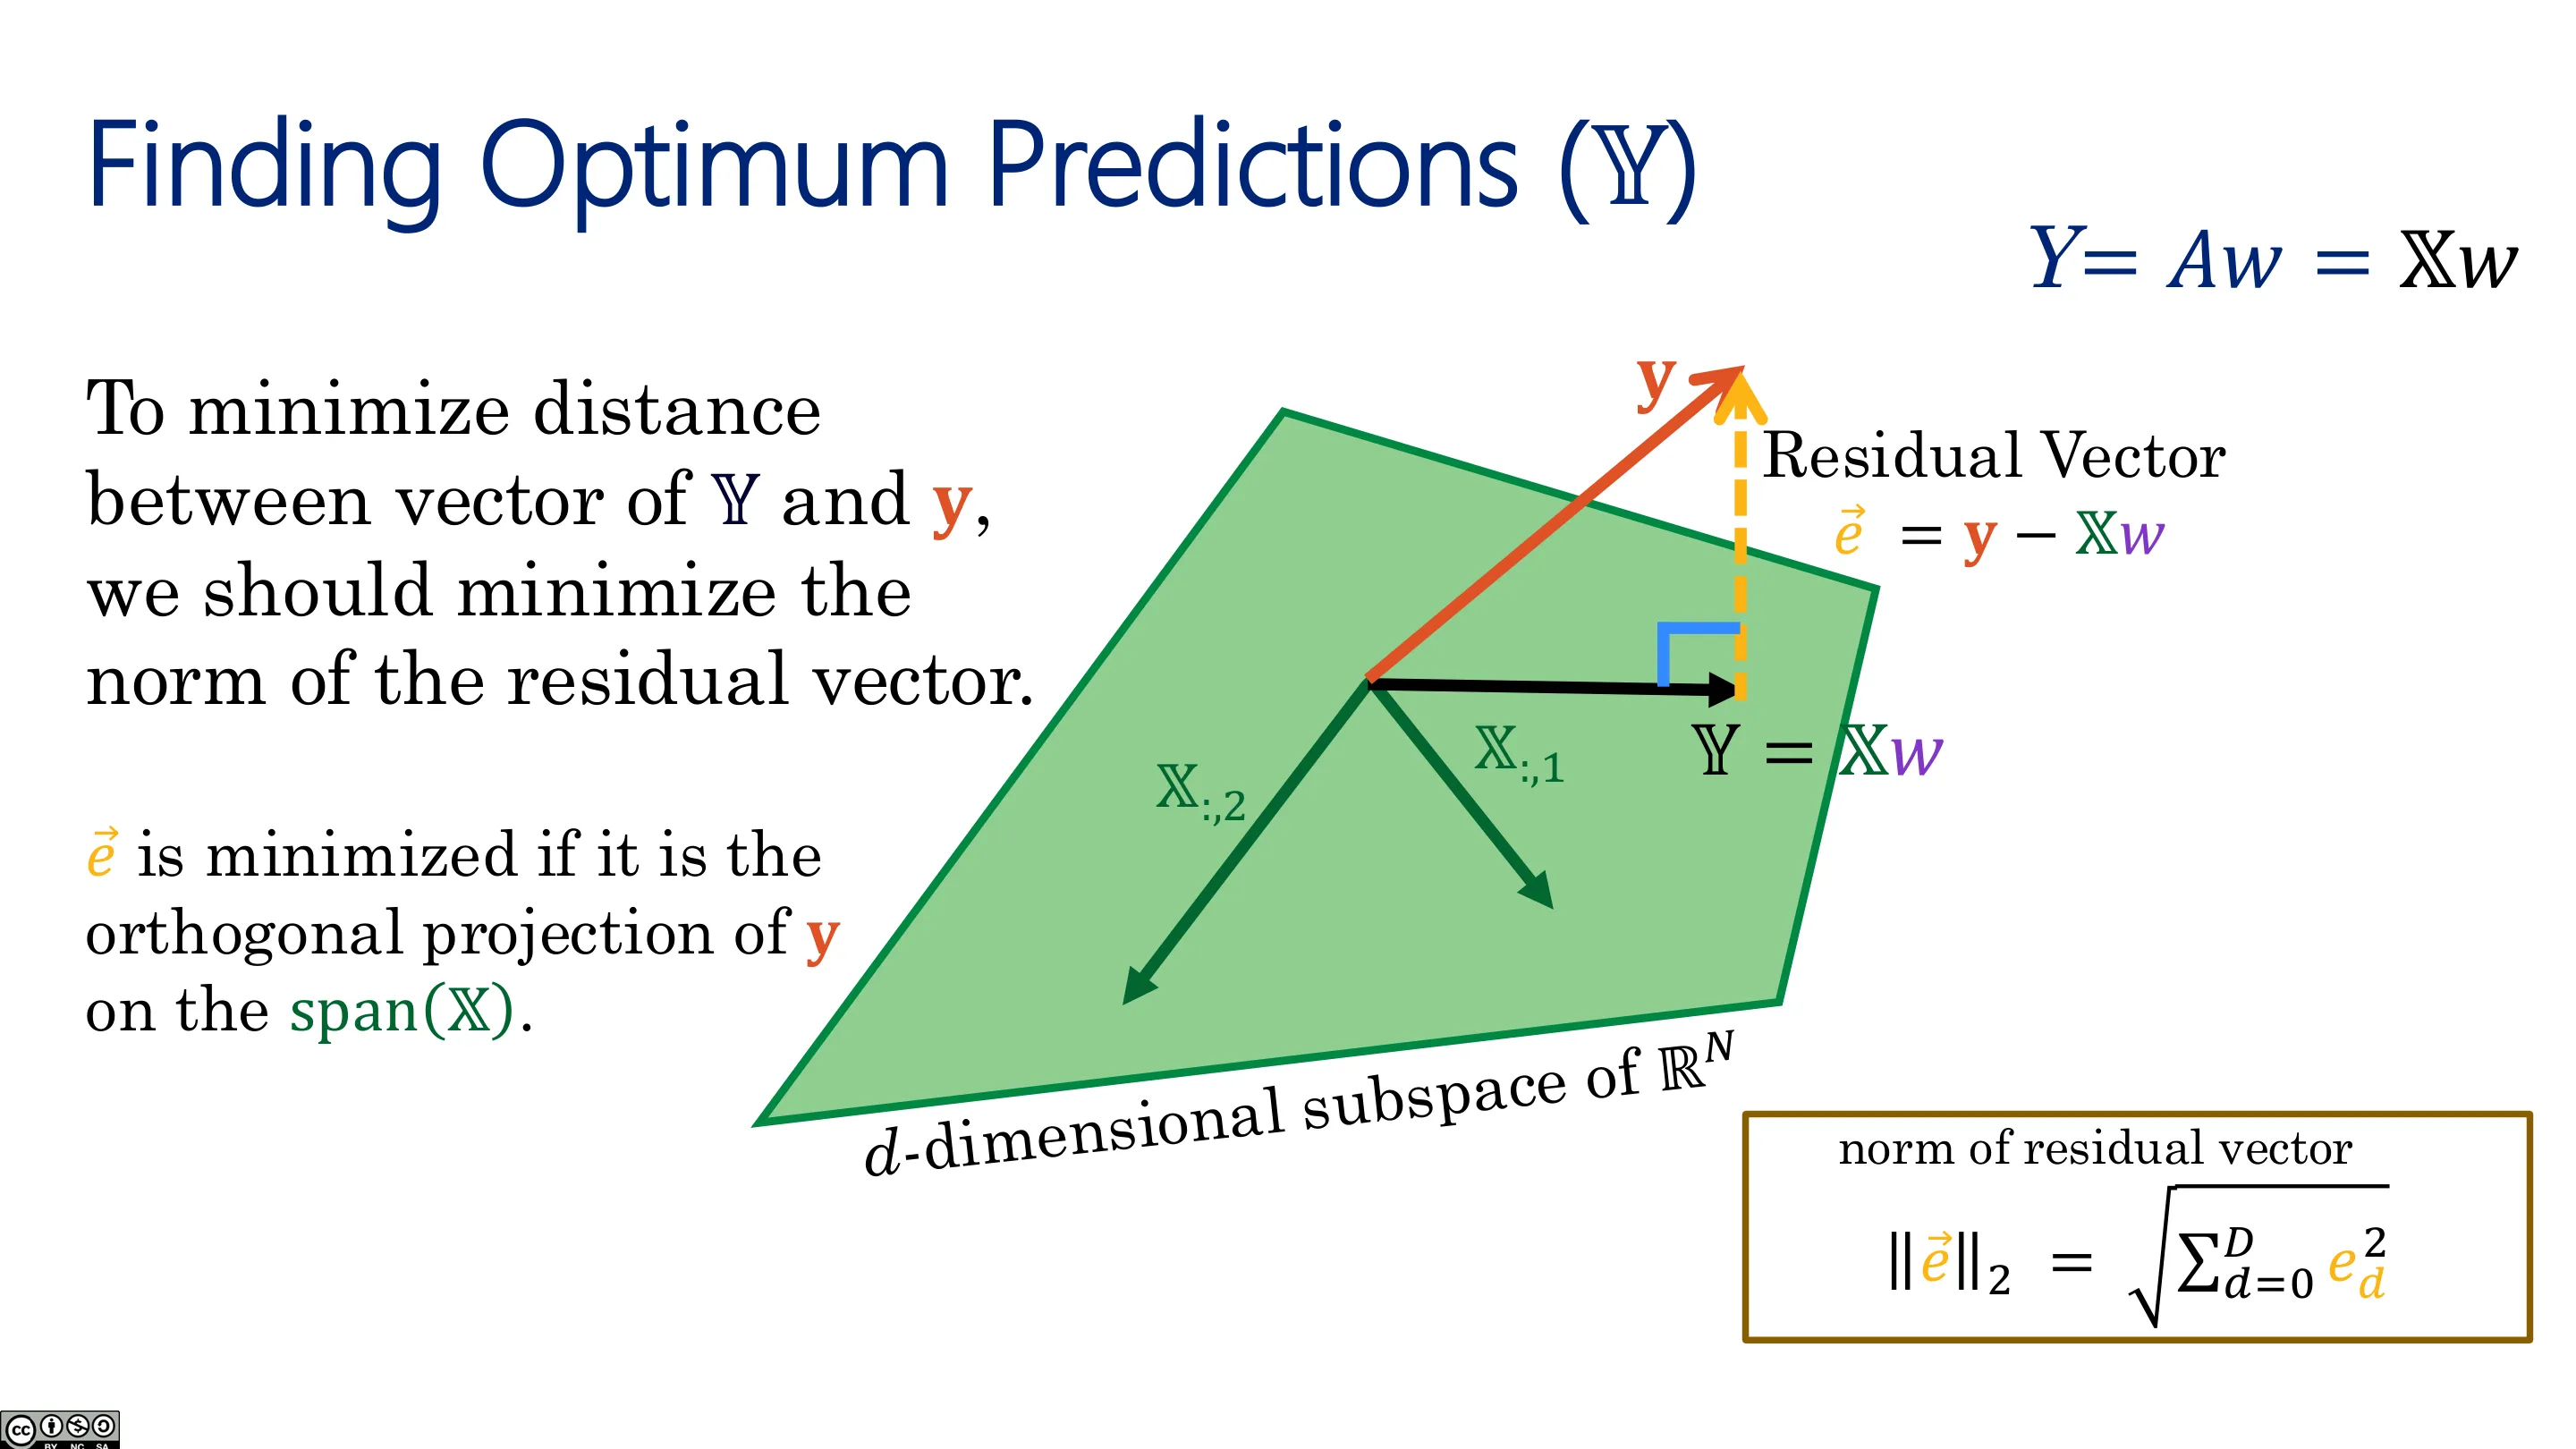
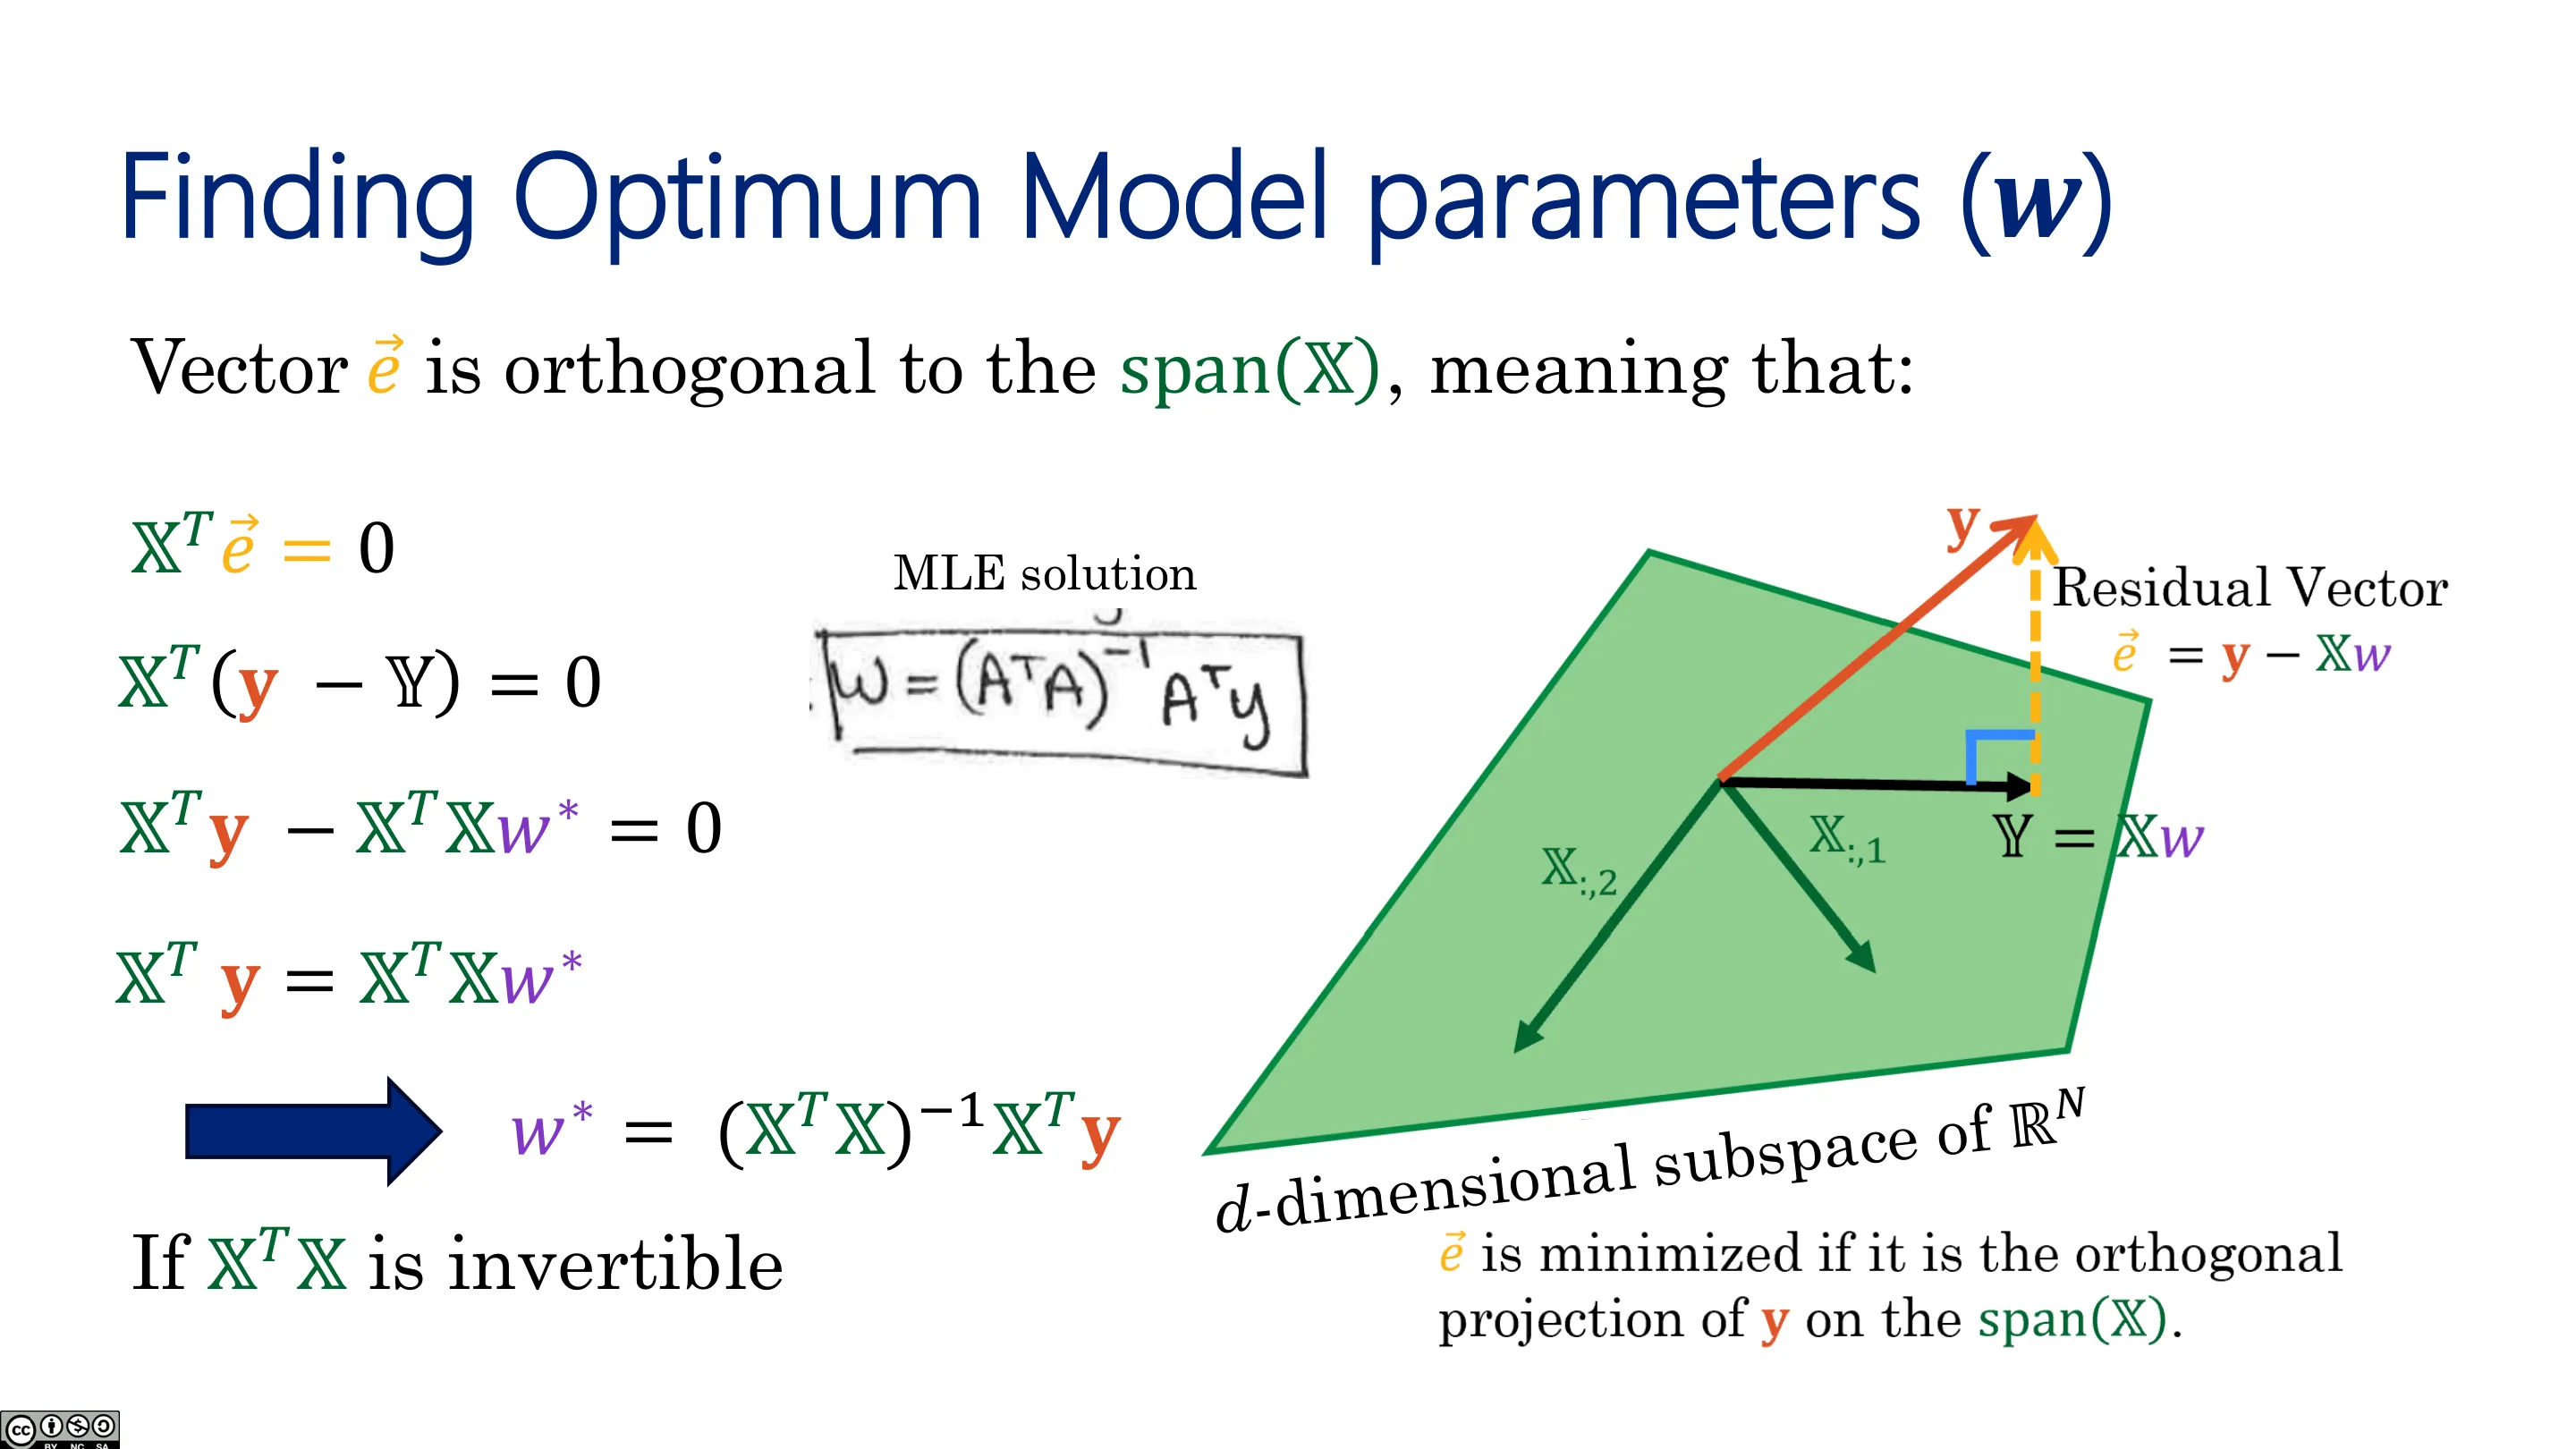
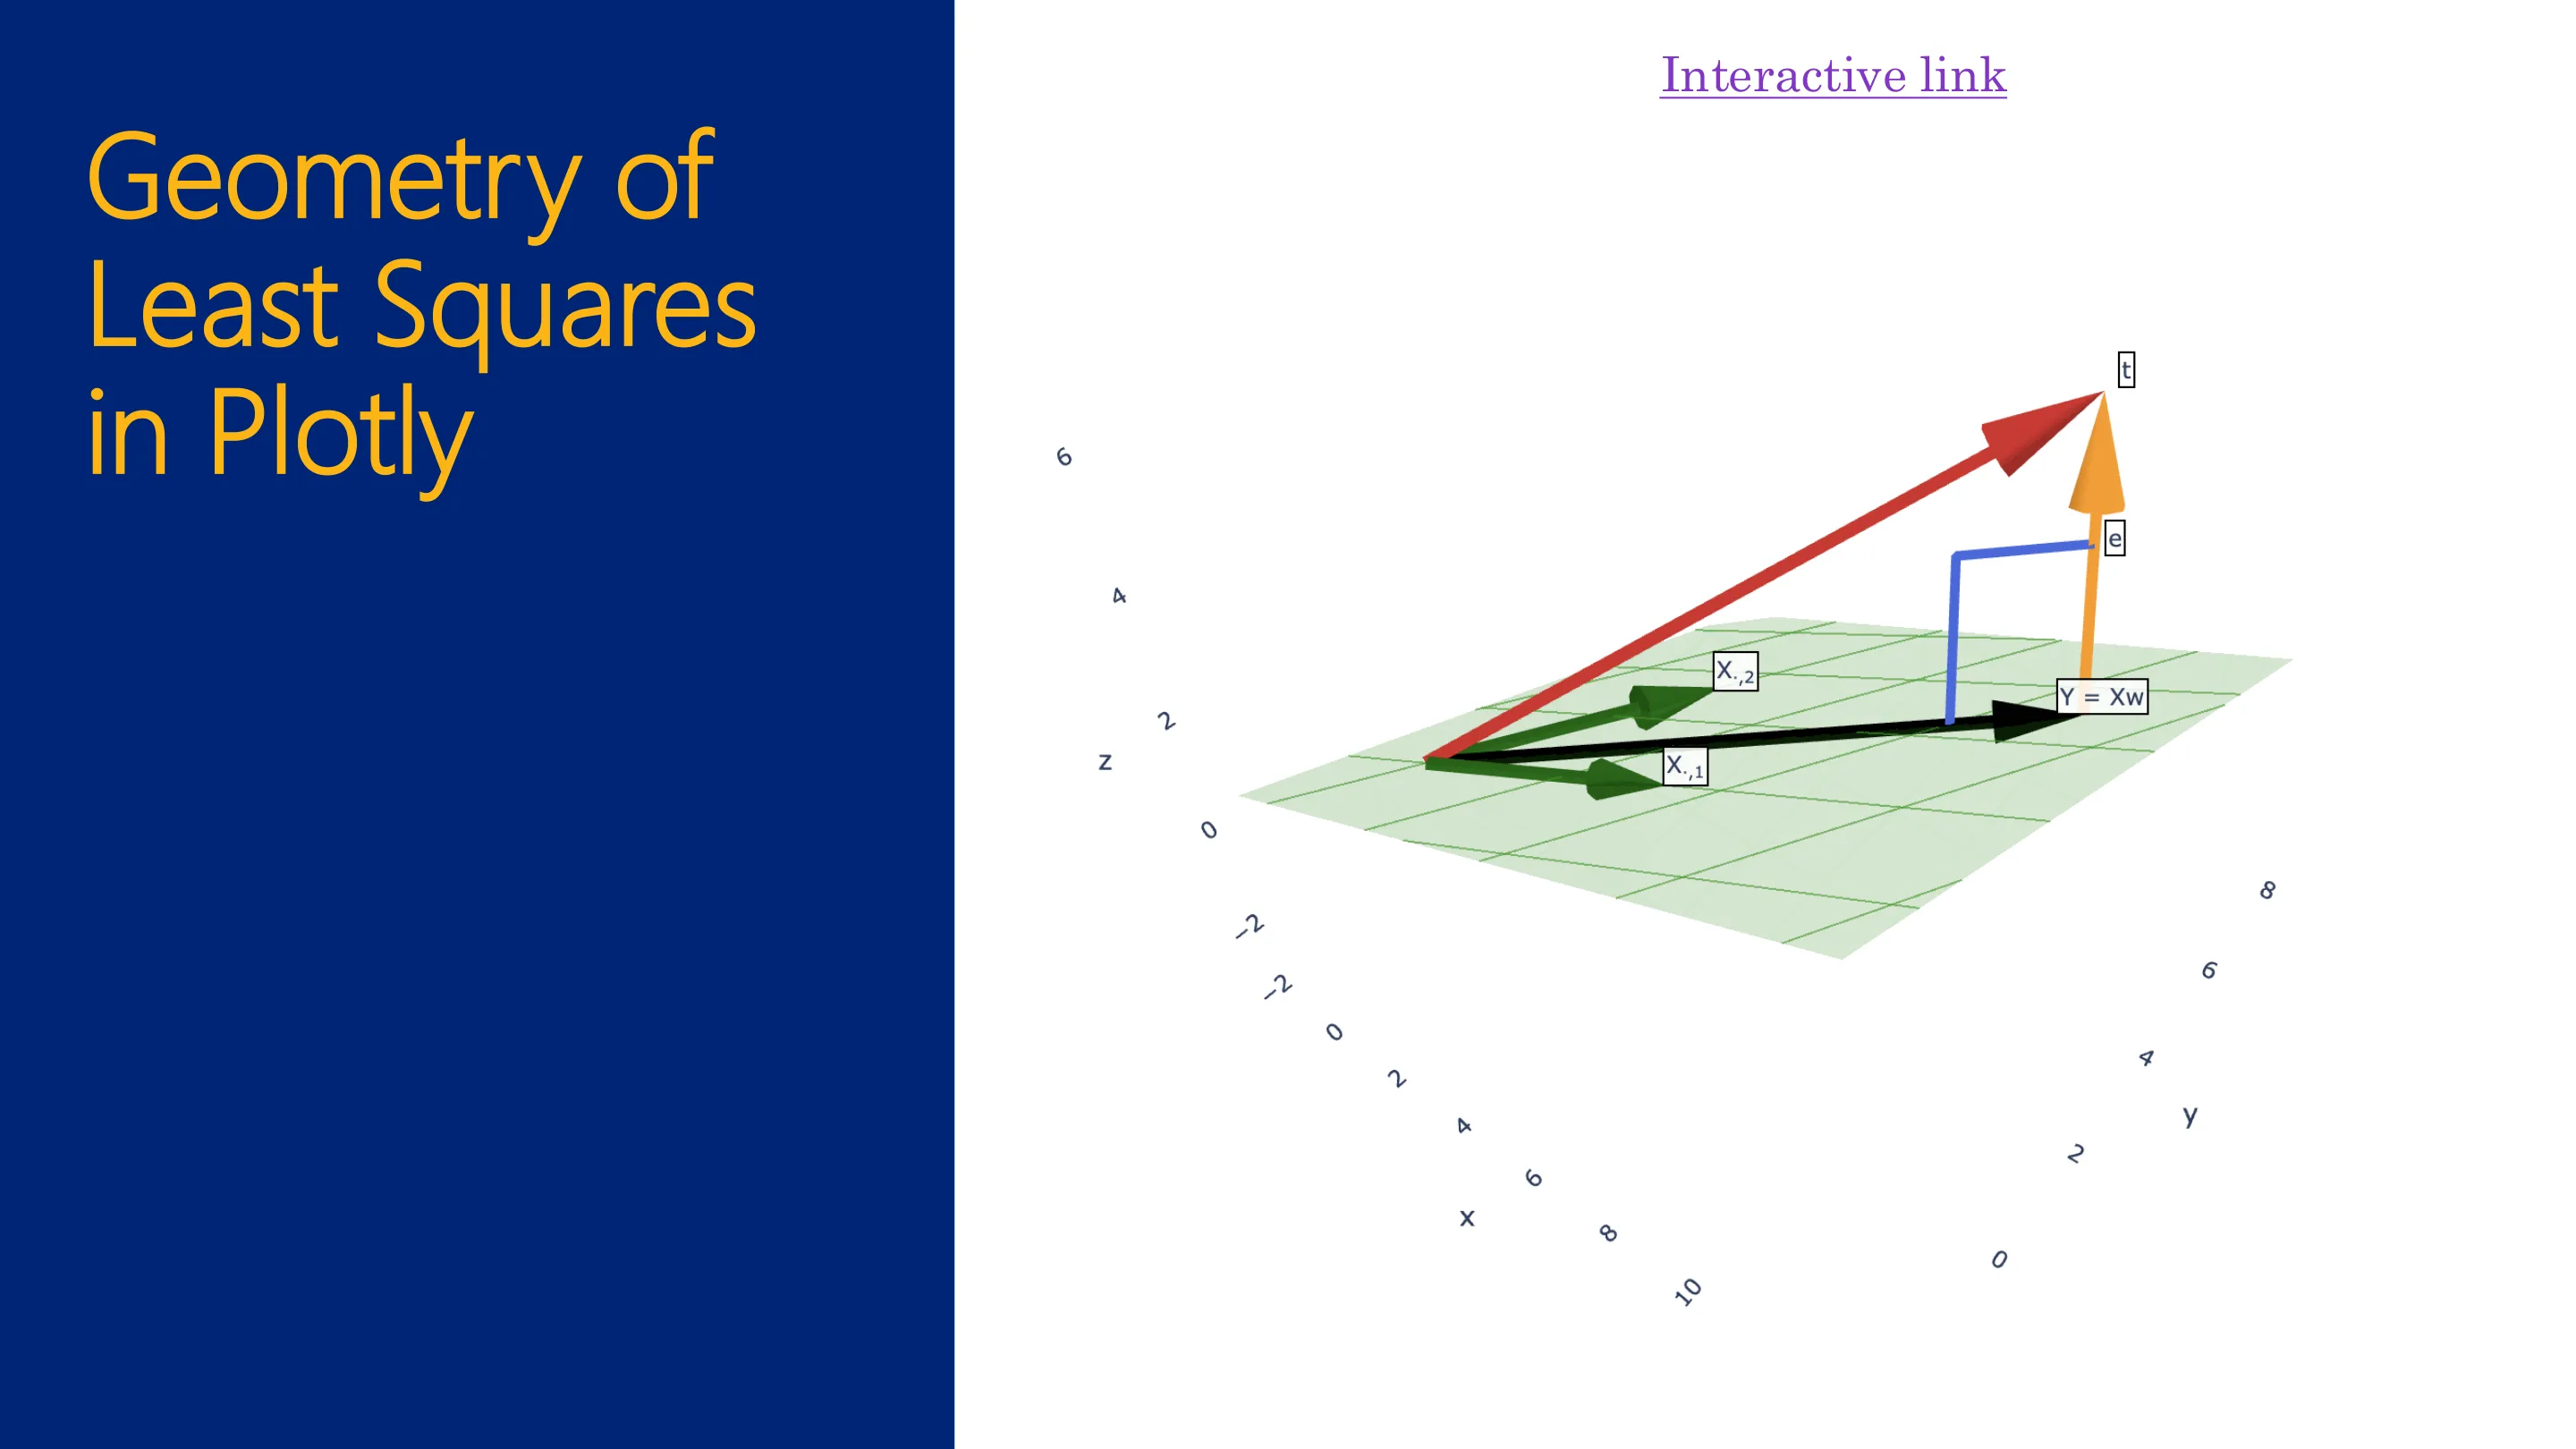
真实标签 $y$ 一般不落在 $\mathrm{span}(X)$ 里(因为噪声、模型不完美)。但预测 $\hat y=Xw$ 一定落在 $\mathrm{span}(X)$ 里。于是「找最好的 $w$」就等价于:在 $\mathrm{span}(X)$ 里找离 $y$ 最近的那个向量——也就是 $y$ 在 $\mathrm{span}(X)$ 上的正交投影。
📷 寻找最优预测
回到原视频 (00:34:06)
残差 $e = y-Xw$ 必须与张成空间正交,即对每一列 $X_j$:$X_j^\top e=0$,写成矩阵形式:
$$ X^\top (y-Xw)=0 \;\Longrightarrow\; X^\top X w = X^\top y \;\Longrightarrow\; \hat w=(X^\top X)^{-1}X^\top y $$
与 MLE 得到的结果完全一致——但不使用任何概率论或微积分,只用了「残差在欧氏距离下最小」这一条几何假设。
📷 残差与张成空间正交
回到原视频 (00:40:07)
📷 几何推导(一)
回到原视频 (00:41:18)
编者说明:讲师说这是数学与统计学最美的地方之一——用两种完全不同的方式看待同一个问题,得到相同的答案。不过,统计(概率)视角更容易推广(例如改成各簇不同协方差、加先验),而纯几何视角难以自然推广。
3.3 线性回归可能出的问题
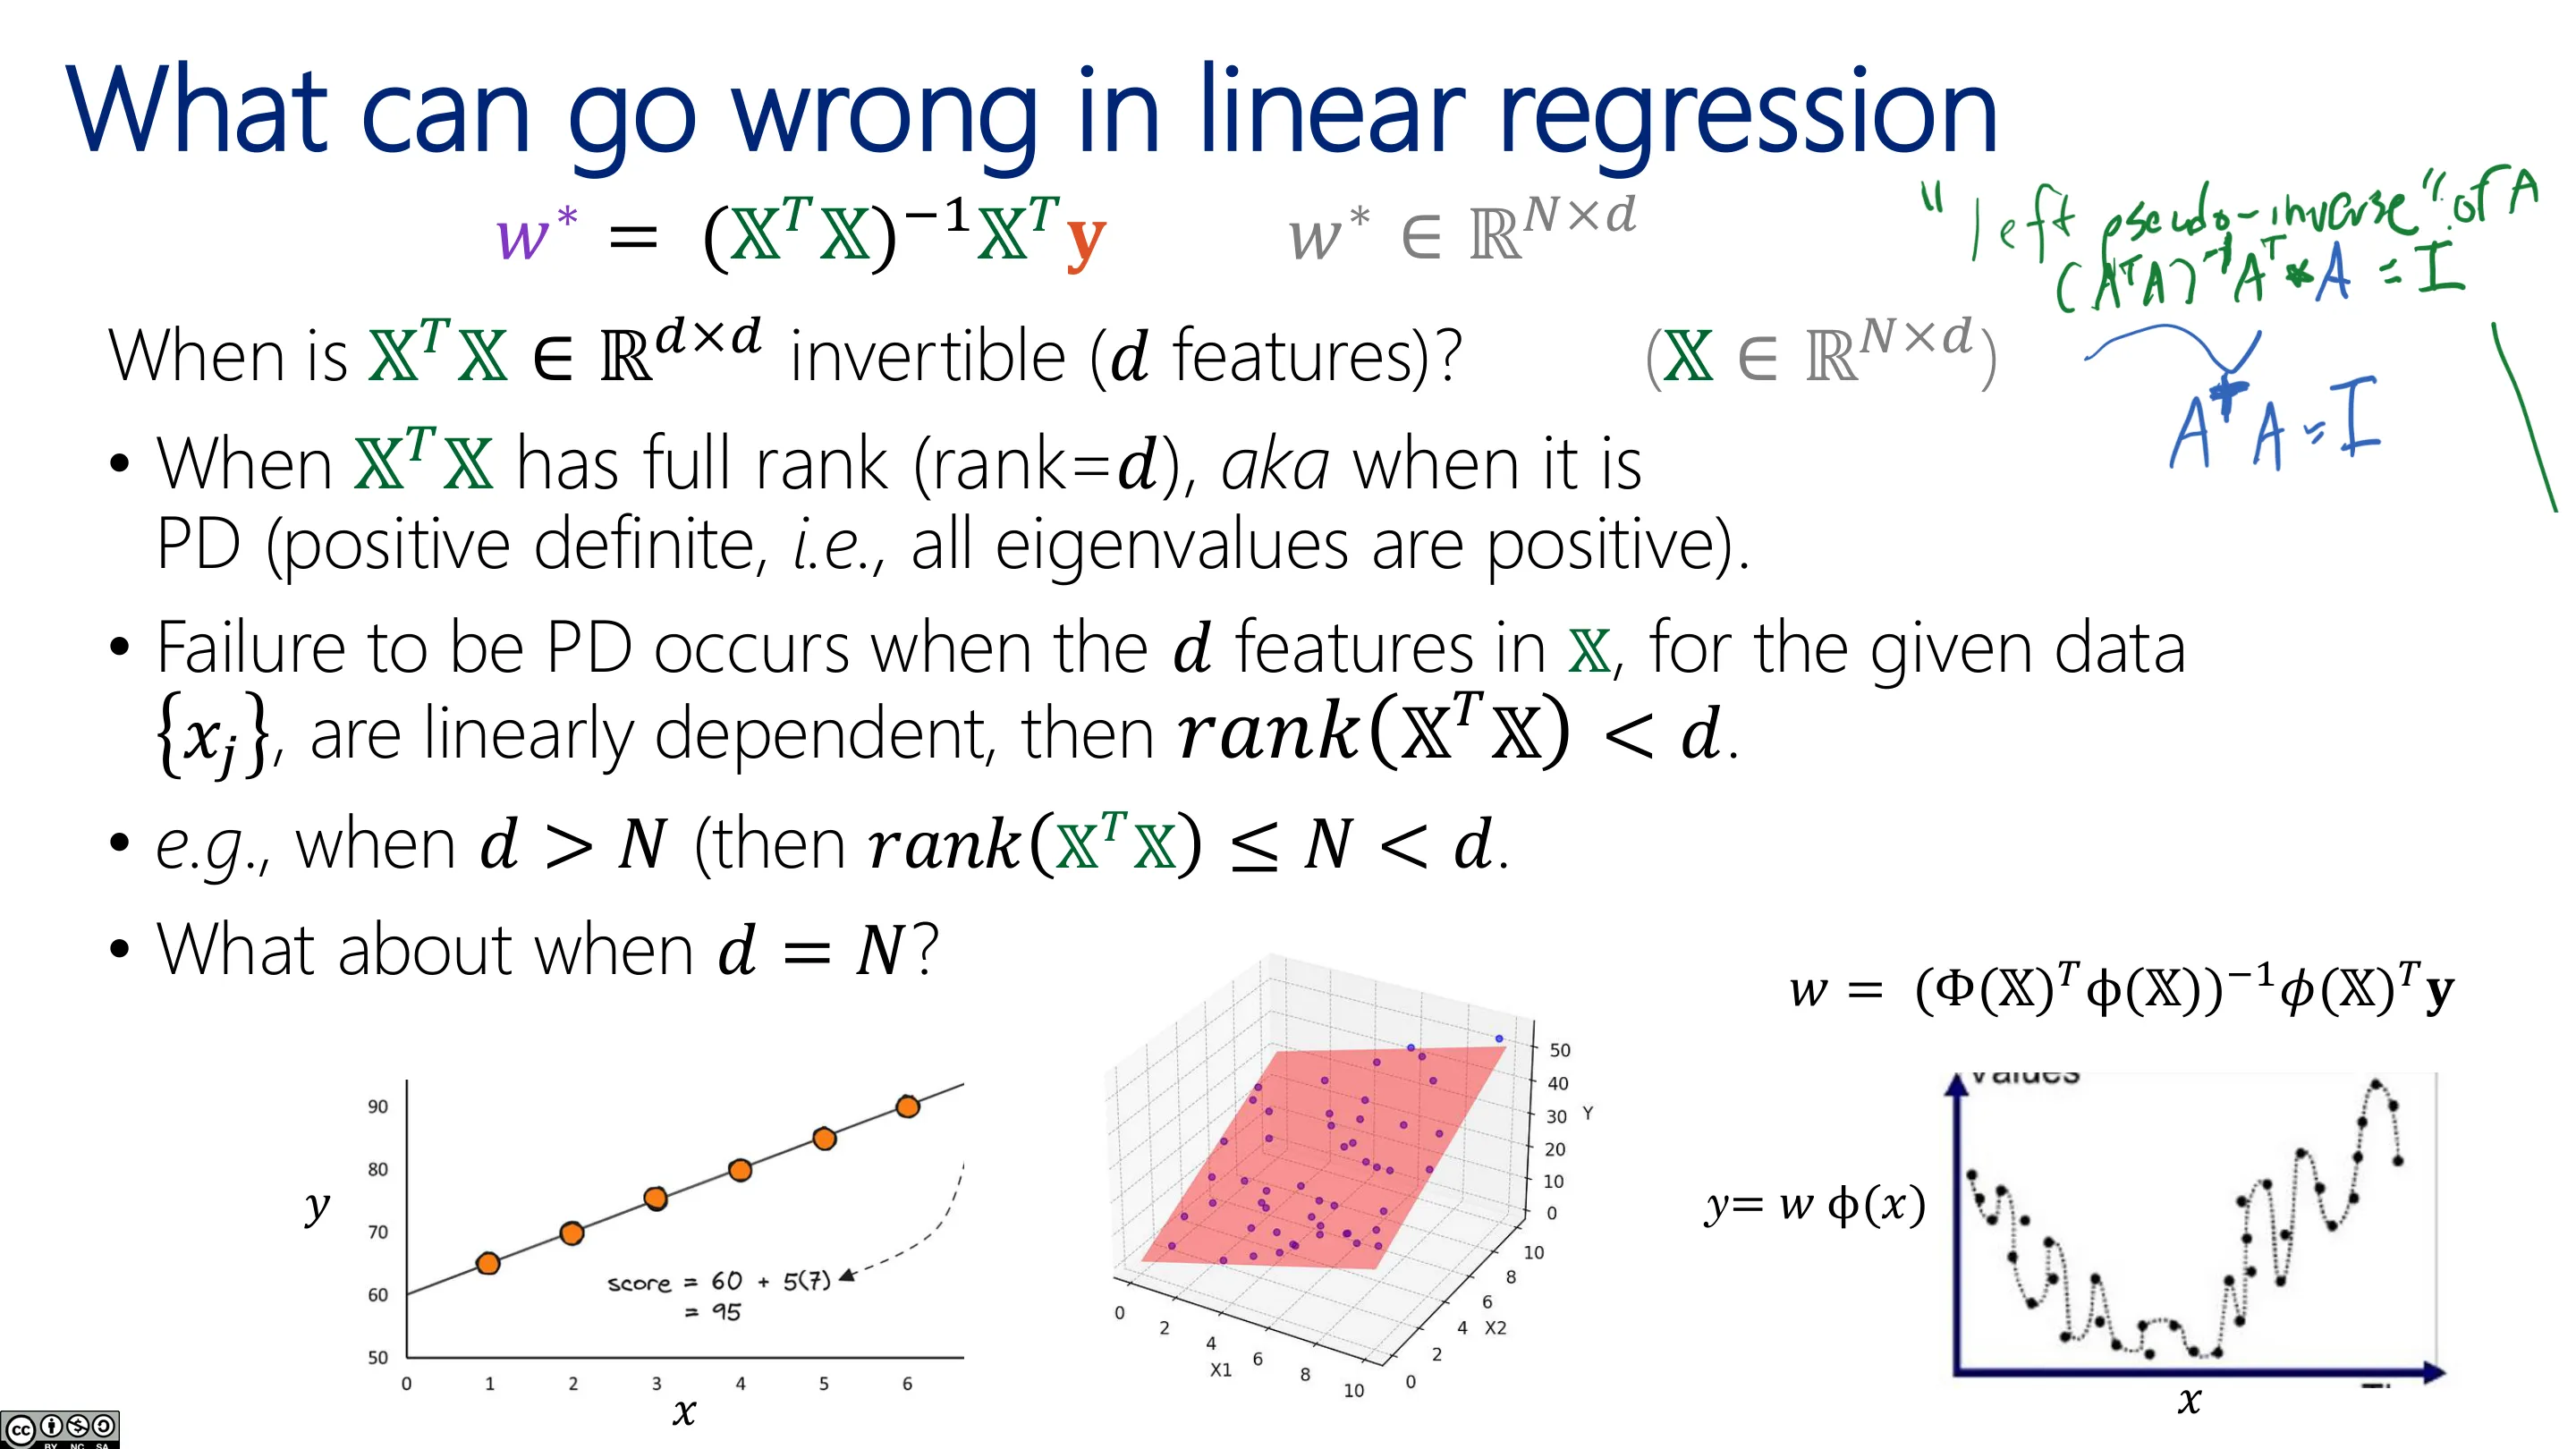
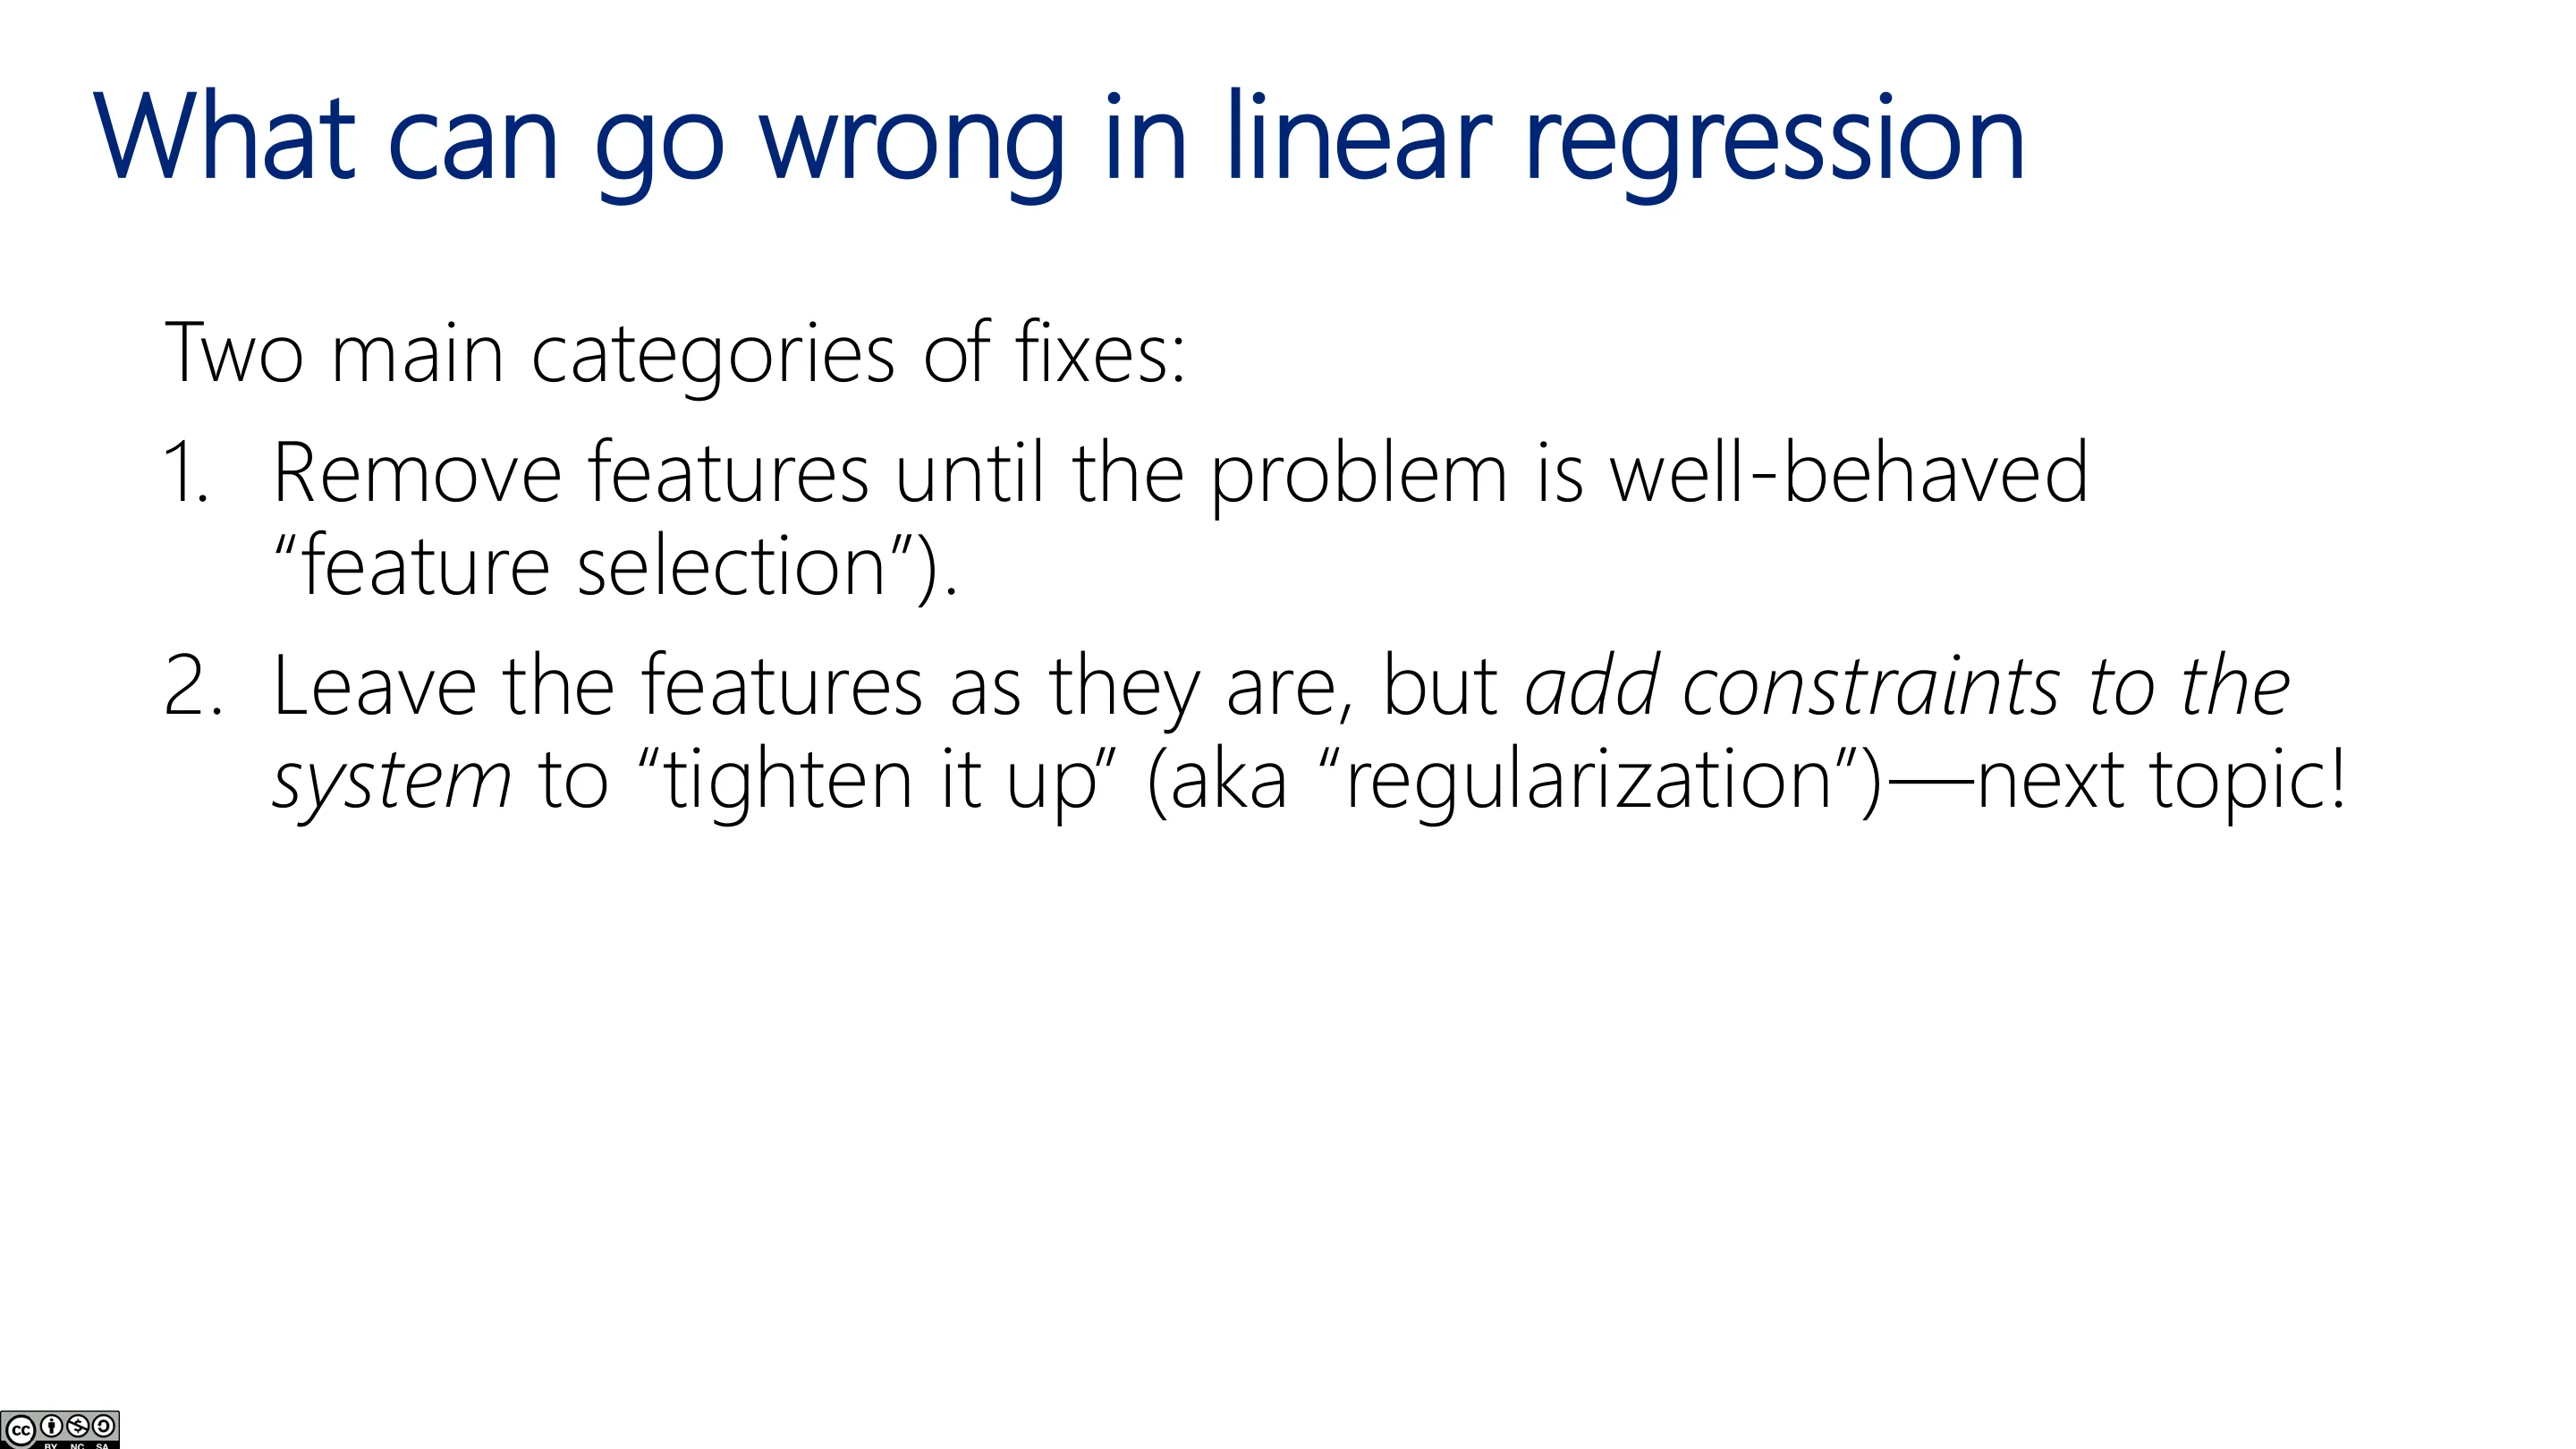
秩亏 = 特征线性相关,或特征数 $D$ 大于样本数 $N$。此时 $X^\top X$ 不可逆:
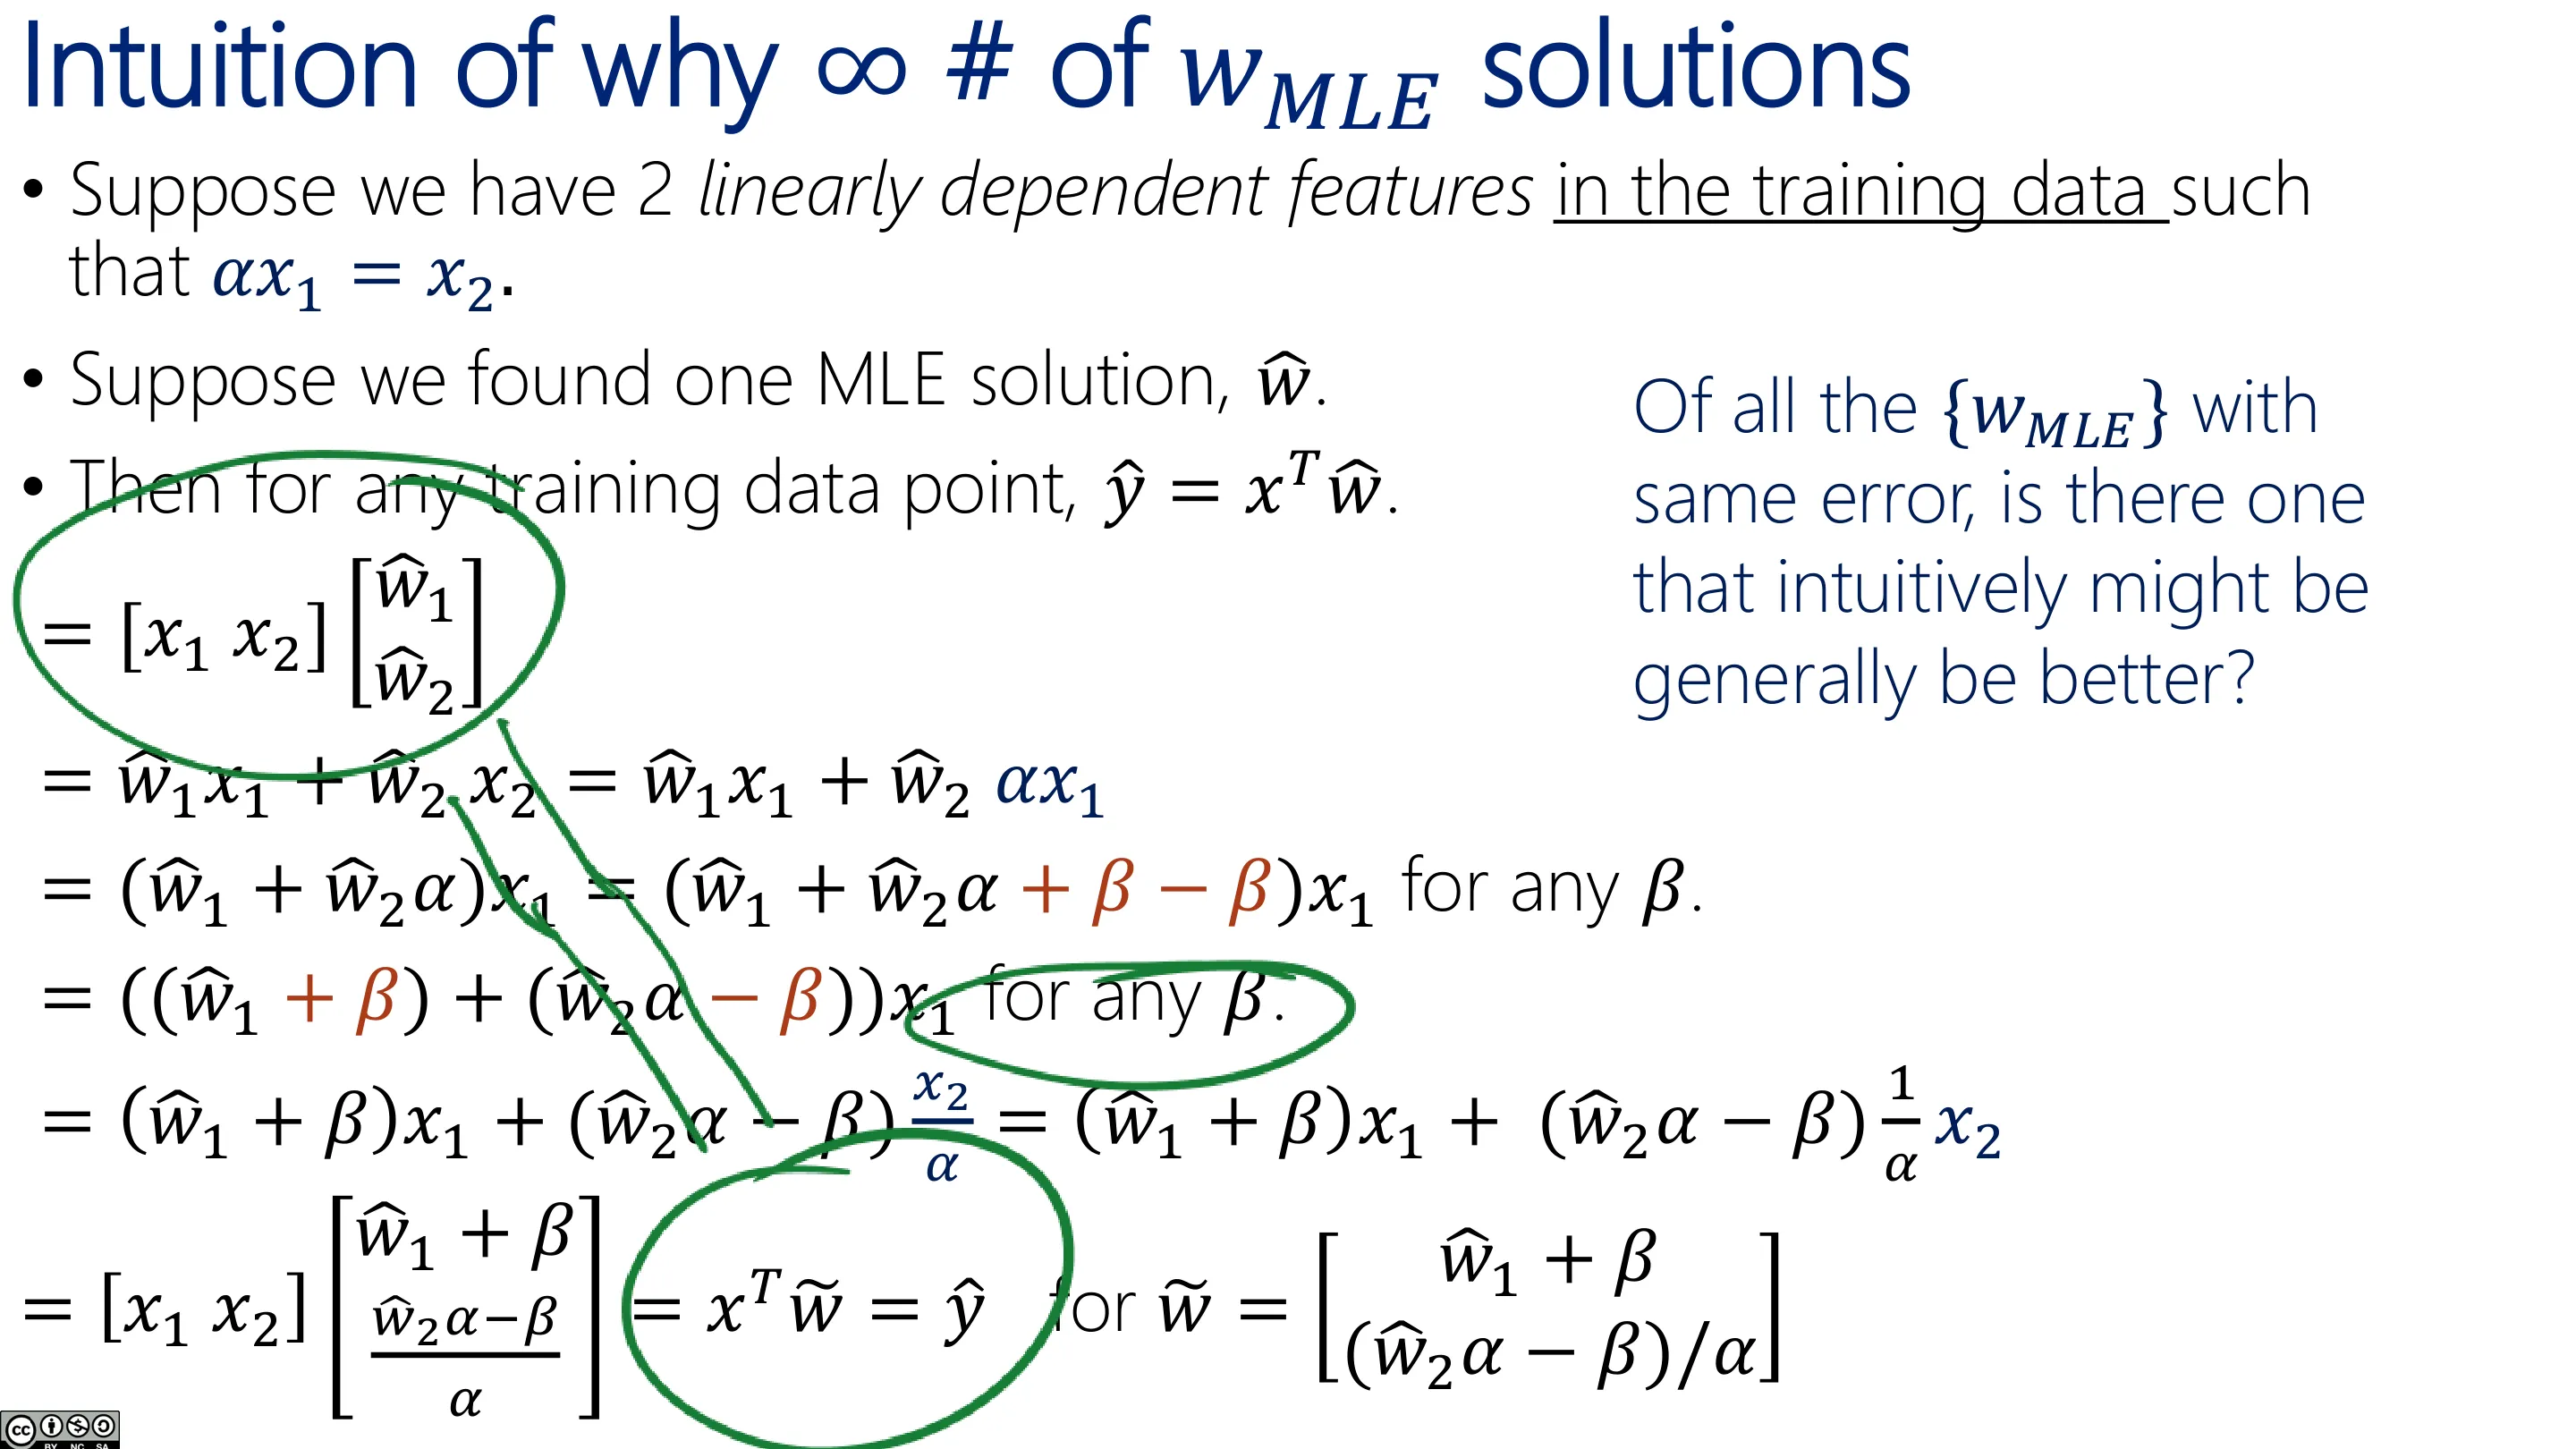
- 若特征线性相关(例:$x_2=\alpha x_1$),则存在无穷多个 $w$ 给出完全相同的预测与损失(讲师用一个含参数的构造证明了这一点);
- 若 $D>N$,则 $X^\top X$ 秩最多为 $N
- 若 $D=N$,一般恰好一个精确拟合解。
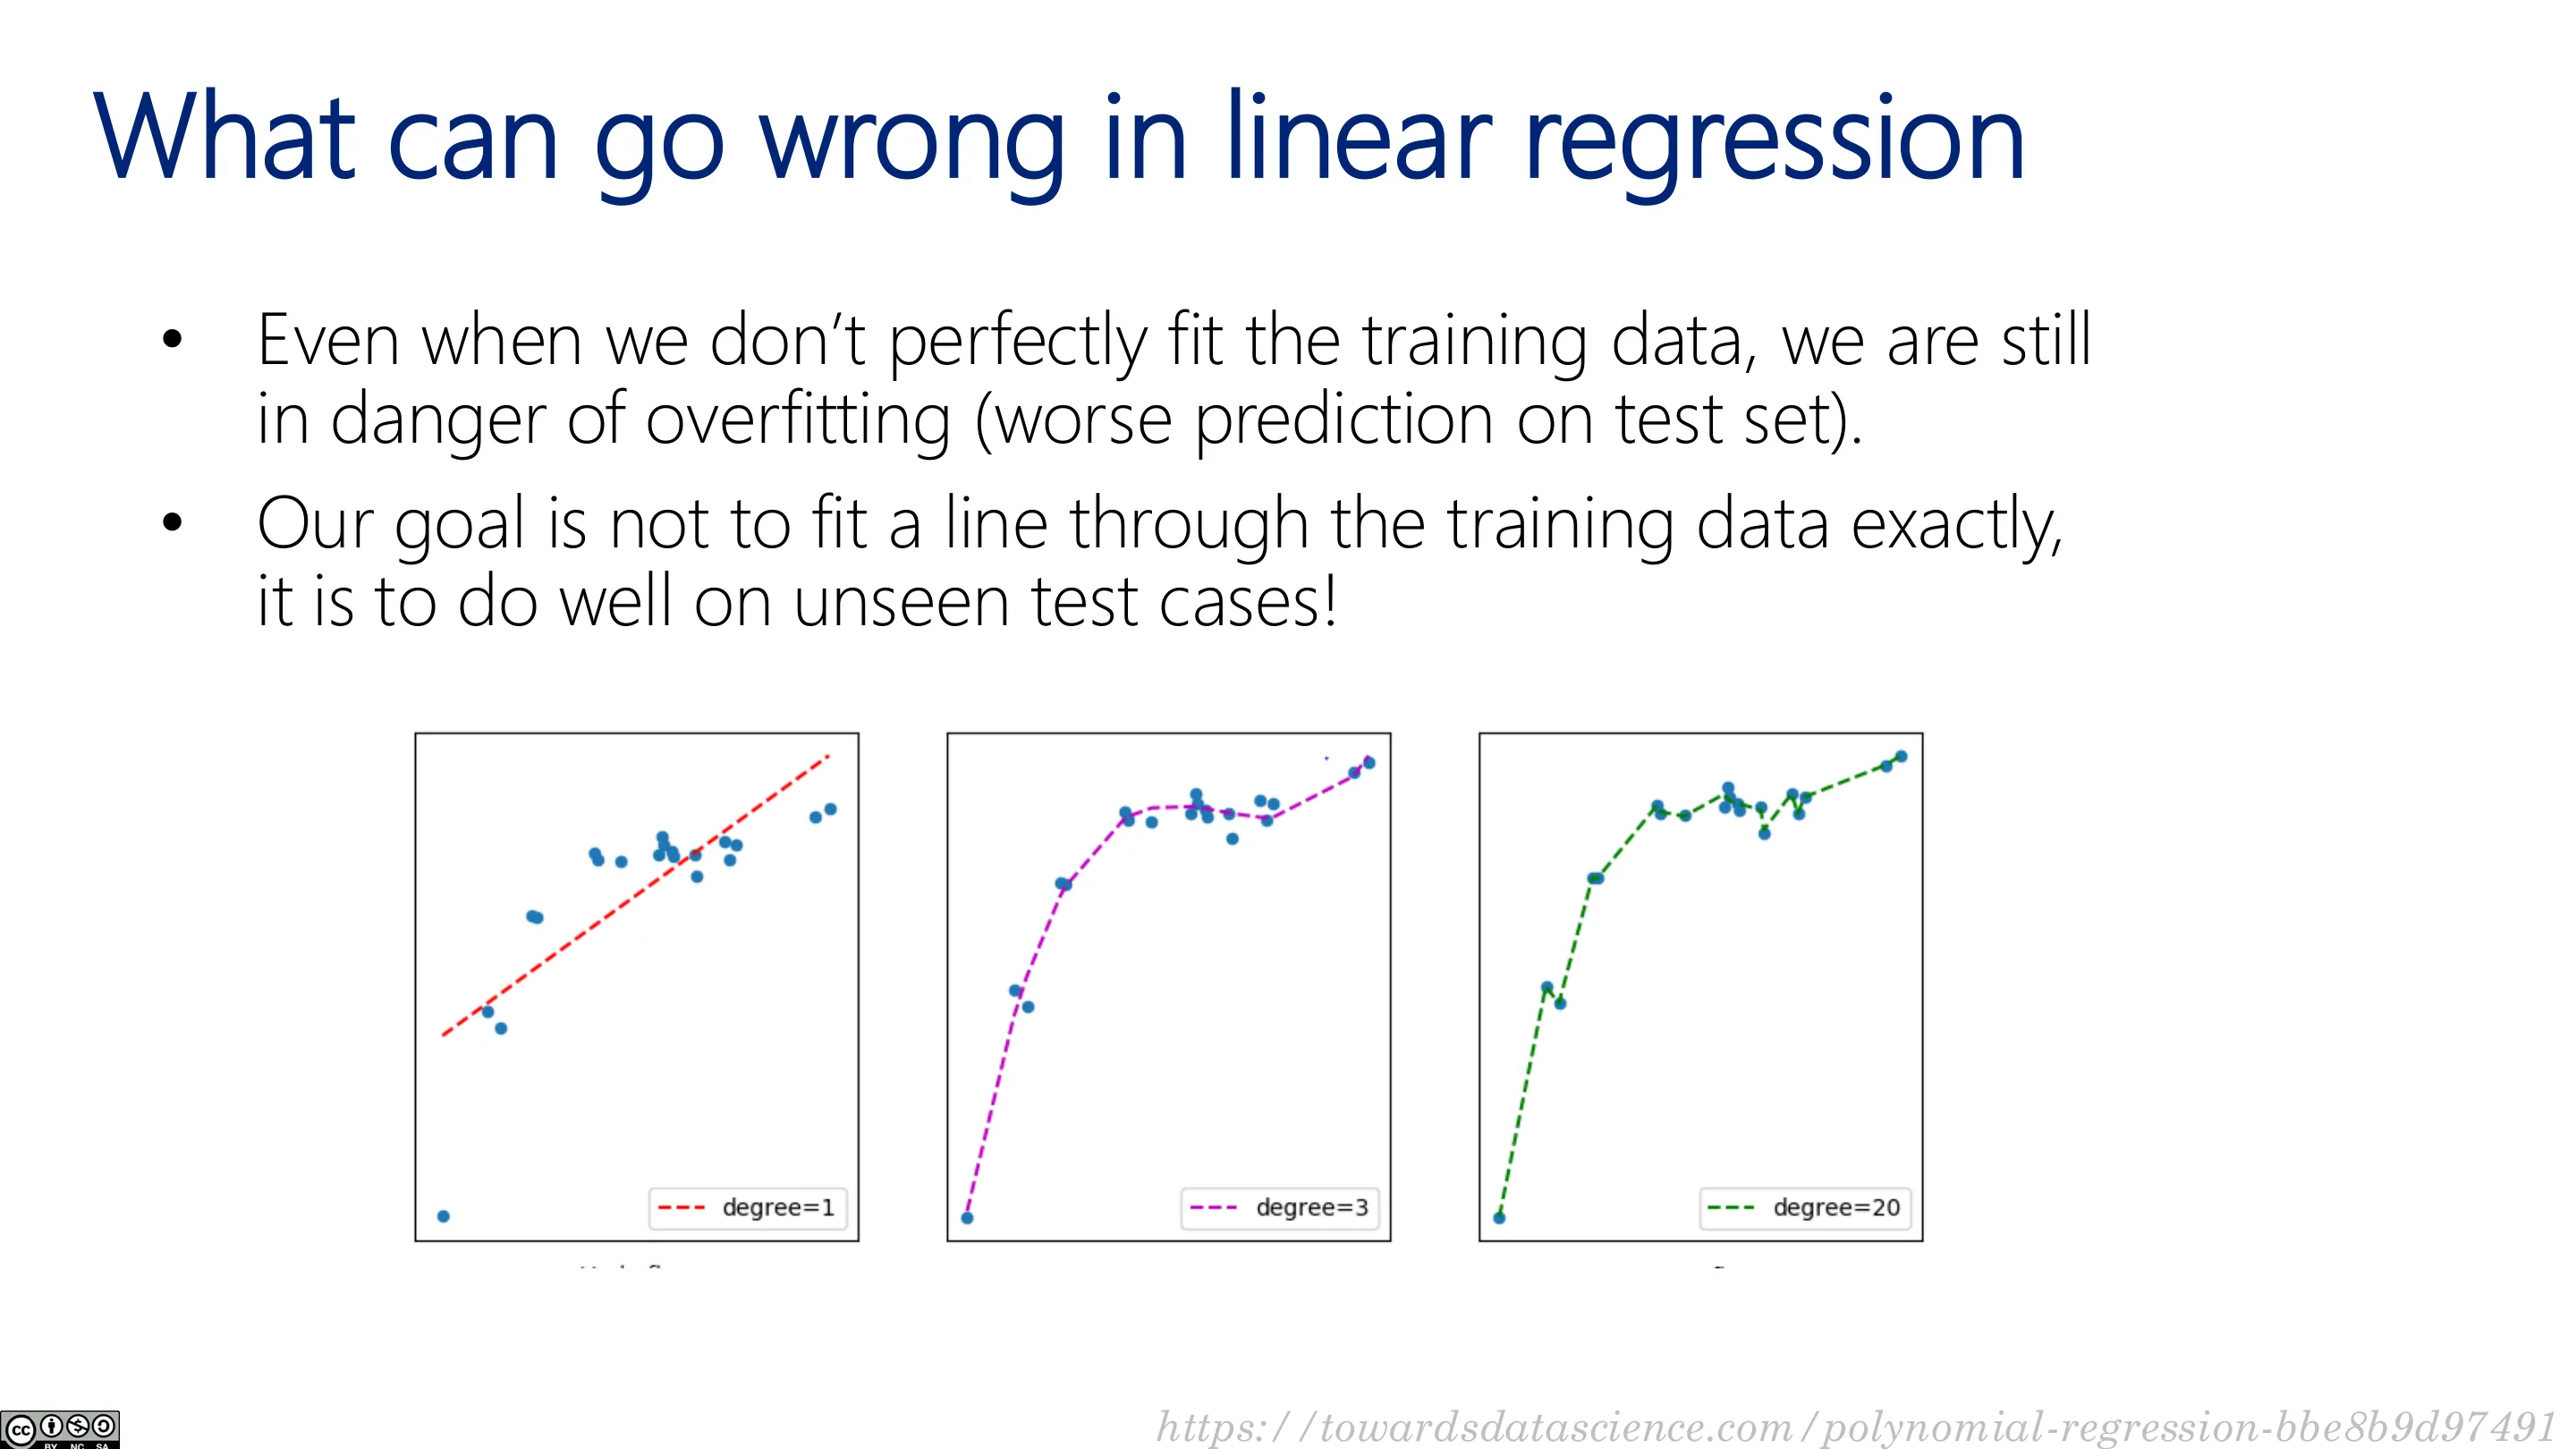
几何上,即使你用高次多项式基,只要独立特征数 = 数据点数,曲线就能穿过每一个数据点——但这是在拟合噪声,预测新点时很差。
📷 线性回归可能出的问题(一)
回到原视频 (00:48:31)
📷 线性回归可能出的问题(二)
回到原视频 (00:49:42)
📷 线性回归可能出的问题(三)
回到原视频 (00:52:40)
📷 路线图(四)
回到原视频 (00:53:20)
📷 为什么可能有无穷多个 w 解
回到原视频 (01:01:00)
3.4 该选哪一个?最小范数
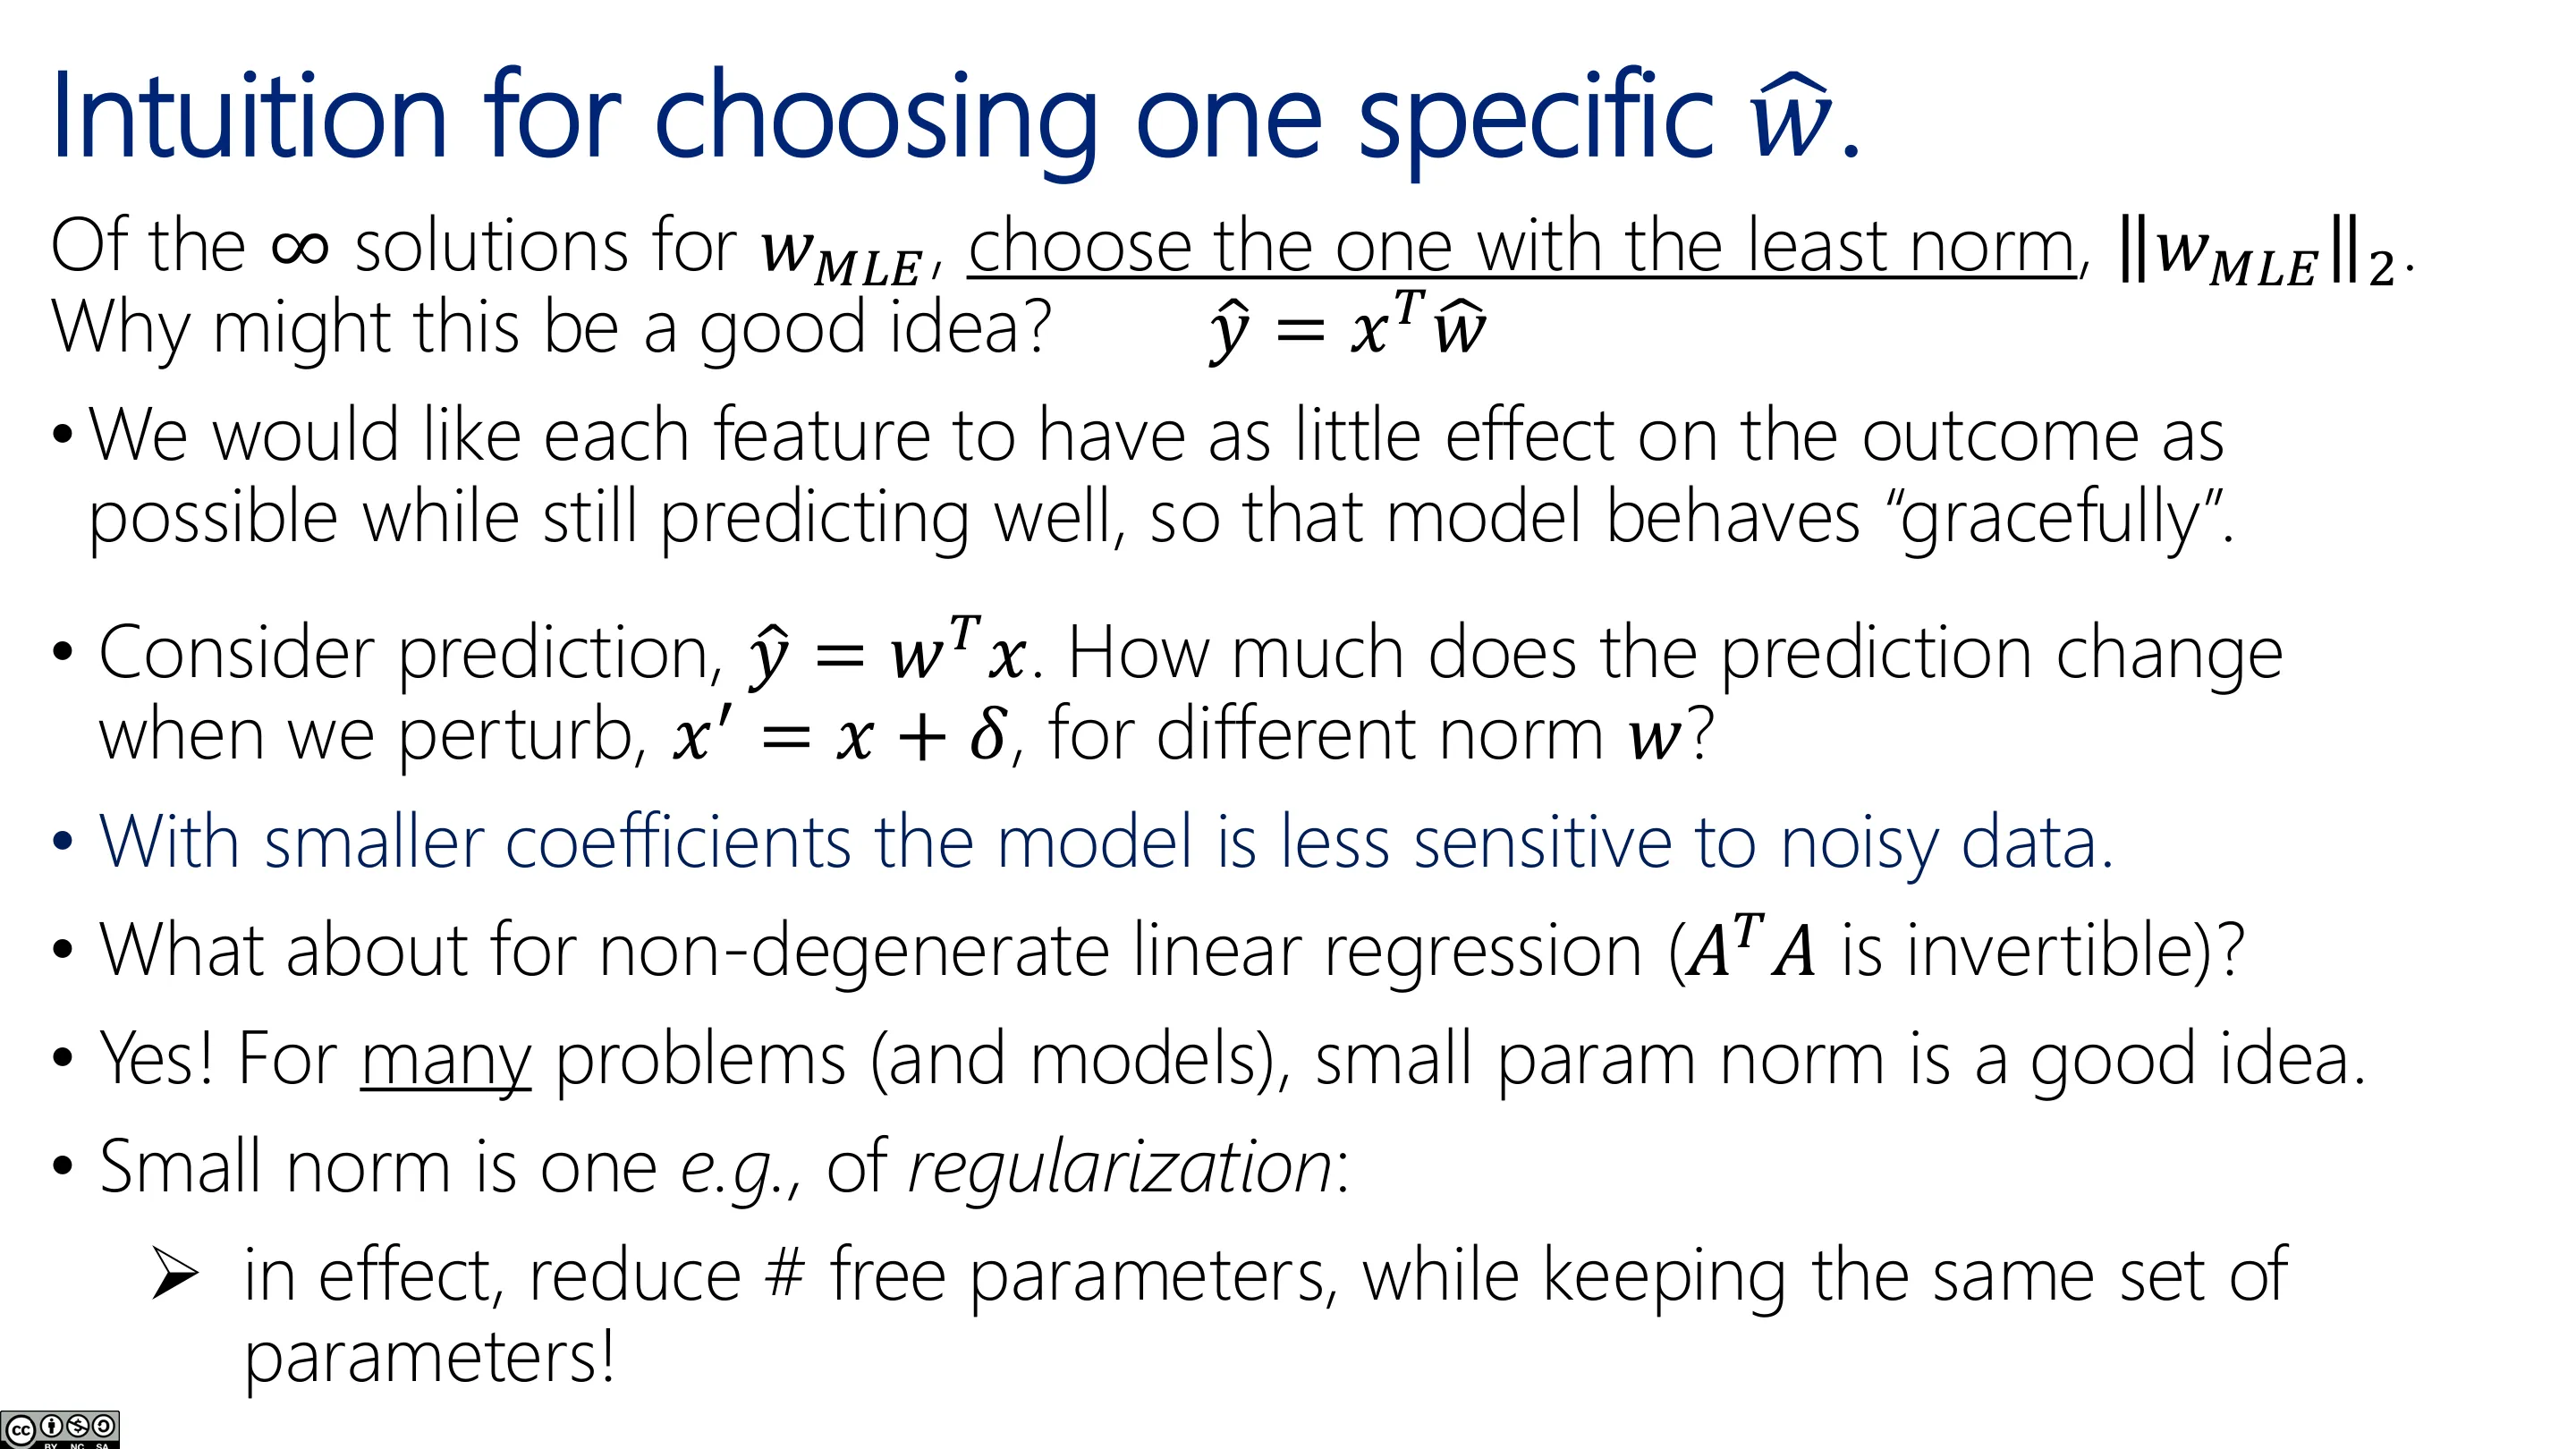
当有无穷多个 $w$ 给出相同预测时,选范数 $\lVert w\rVert$ 最小的那个。直觉:
- 越小 ⇒ 对数据扰动越鲁棒:小扰动下参数变化小,预测更稳定;
- 「模型越简单越好」(奥卡姆剃刀的优化版本);
- 事实上,Moore–Penrose 伪逆返回的正是最小范数解——所以它确实做了件好事,但伪逆不能推广到神经网络/逻辑回归(那些要用迭代梯度下降)。
📷 如何选一个具体的 w
回到原视频 (01:08:47)
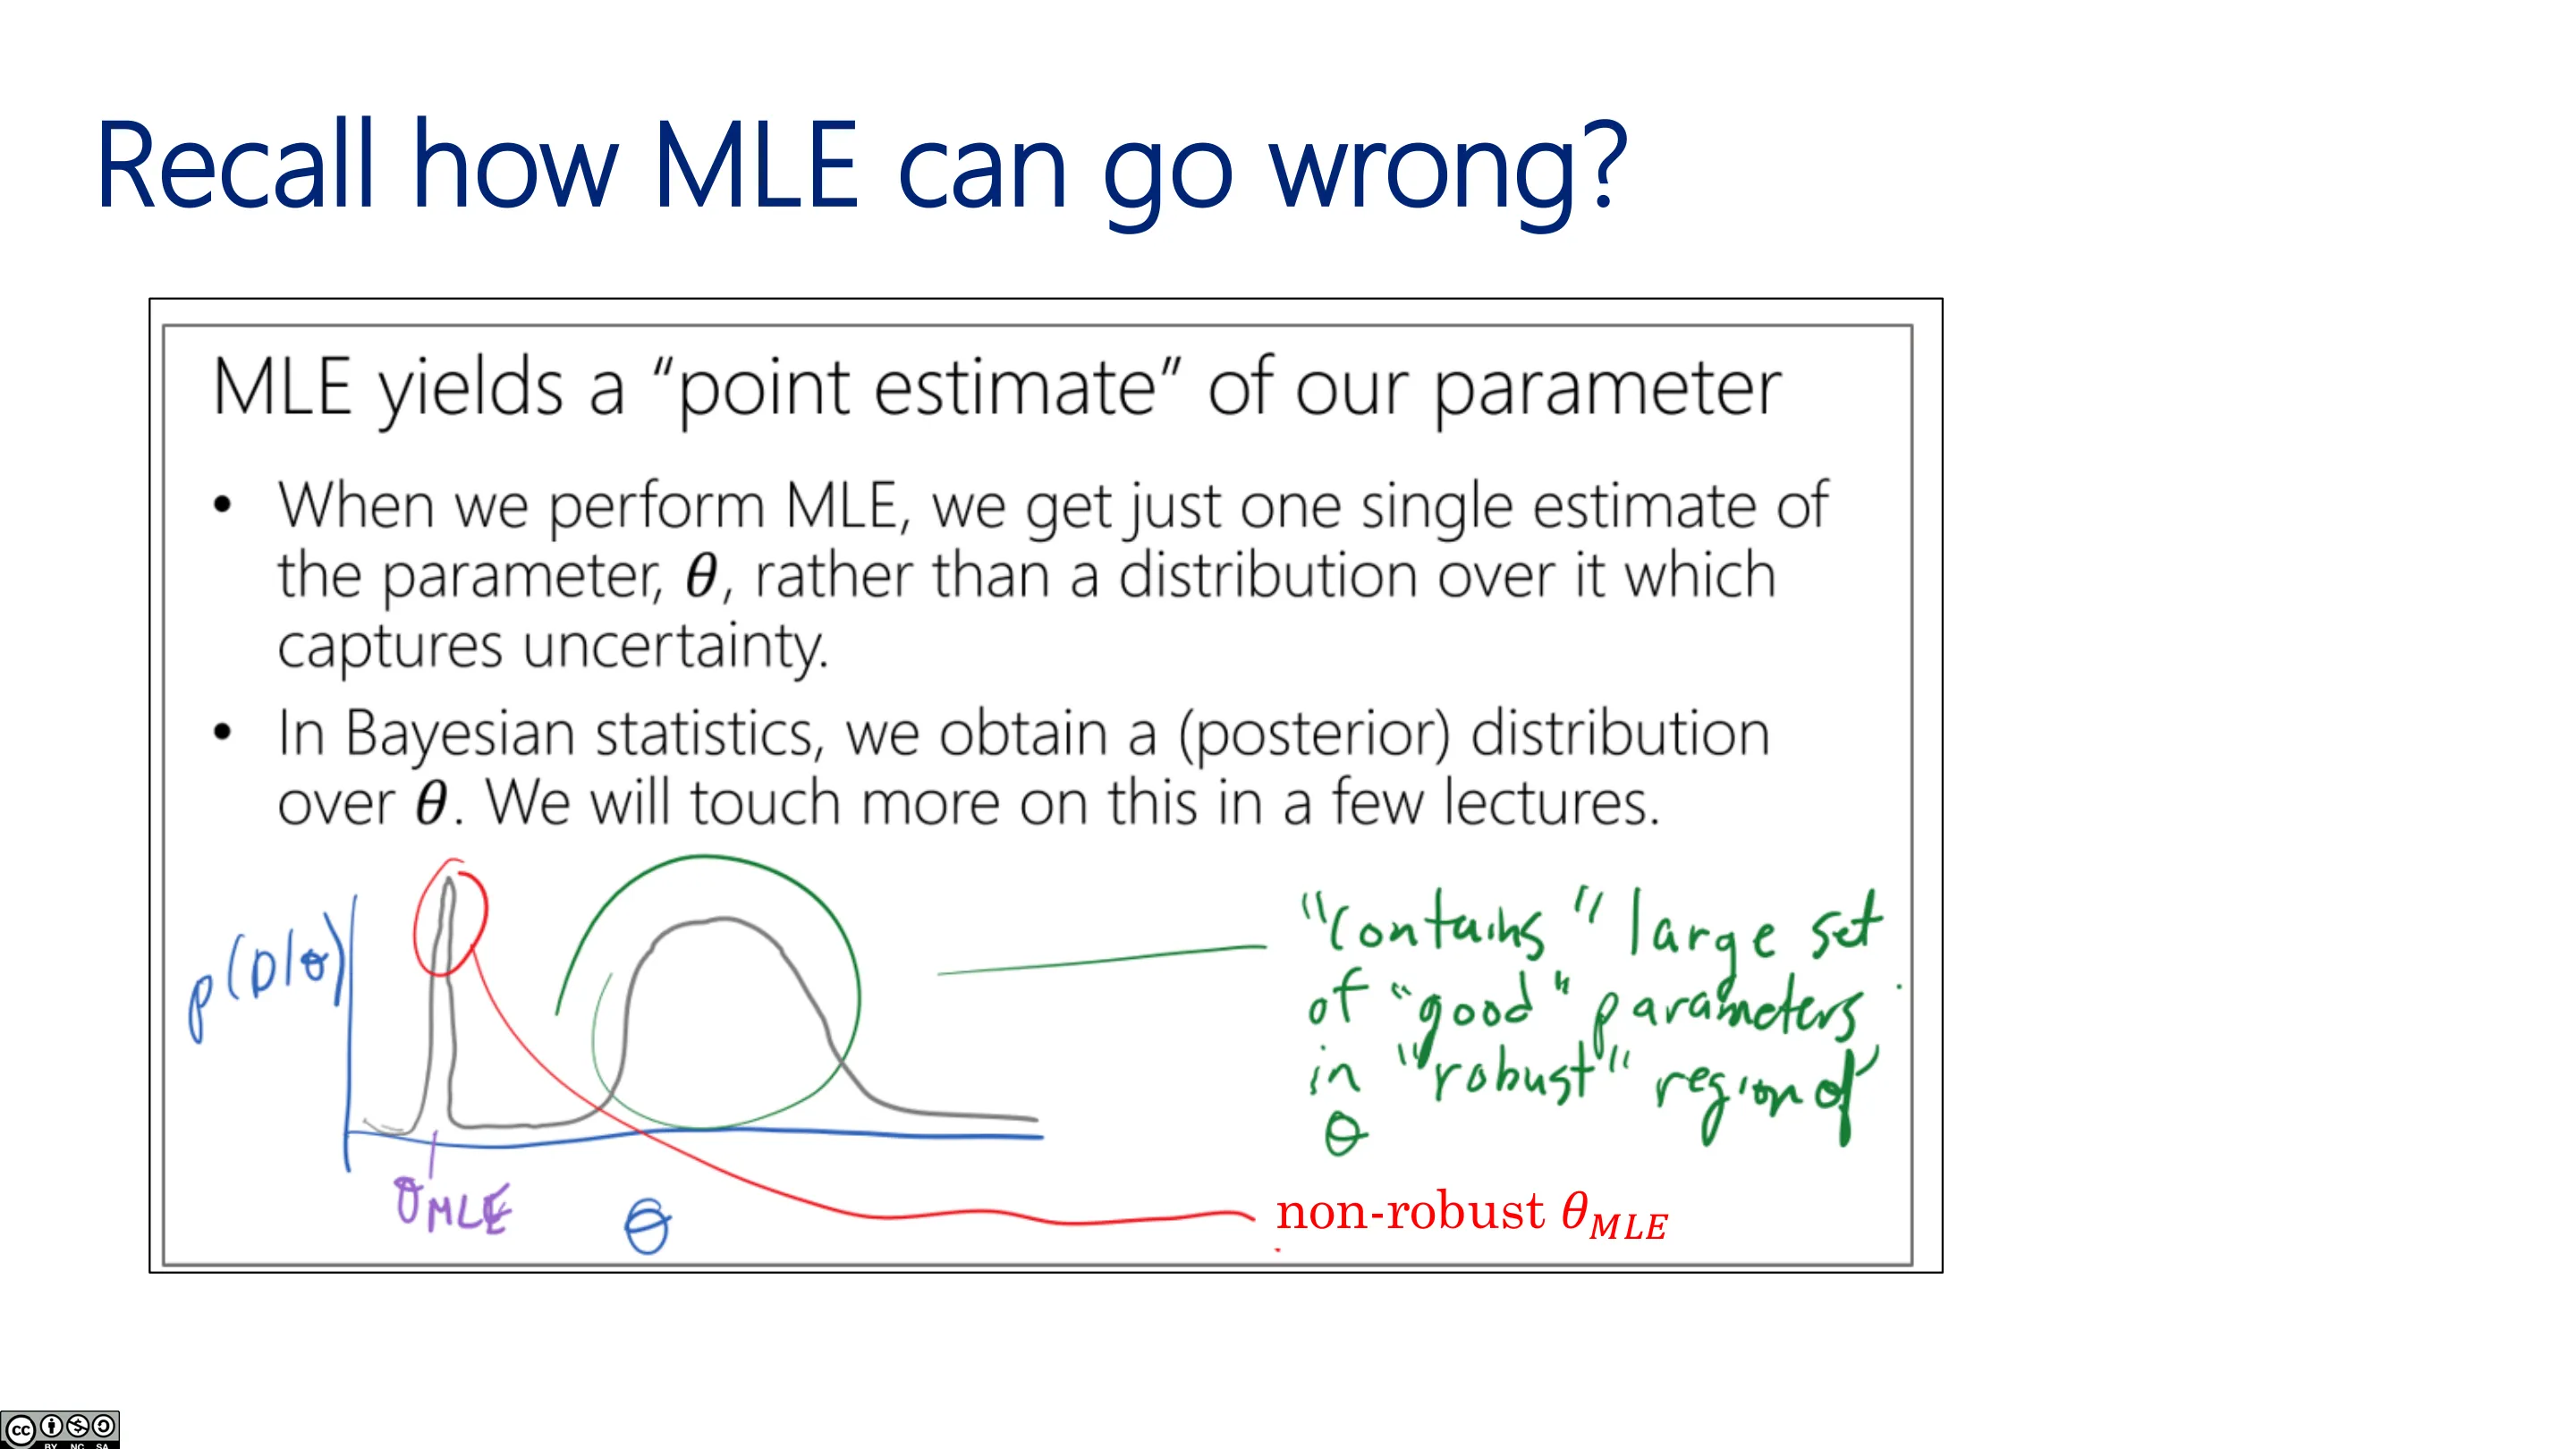
📷 MLE 何时会出错
回到原视频 (01:14:20)
四、正则化(引入)
(参考时间: 01:14)
即使系统非退化($X^\top X$ 可逆、唯一解),我们仍然希望控制参数范数——因为它能减少有效自由度、改善泛化。做法是在损失里加惩罚项:
$$ \hat w=\arg\min_w\ \lVert y-Xw\rVert^2 + \lambda\lVert w\rVert^2 \quad(\text{L2 / Ridge}) $$
- L2 惩罚:对应岭回归(Ridge);
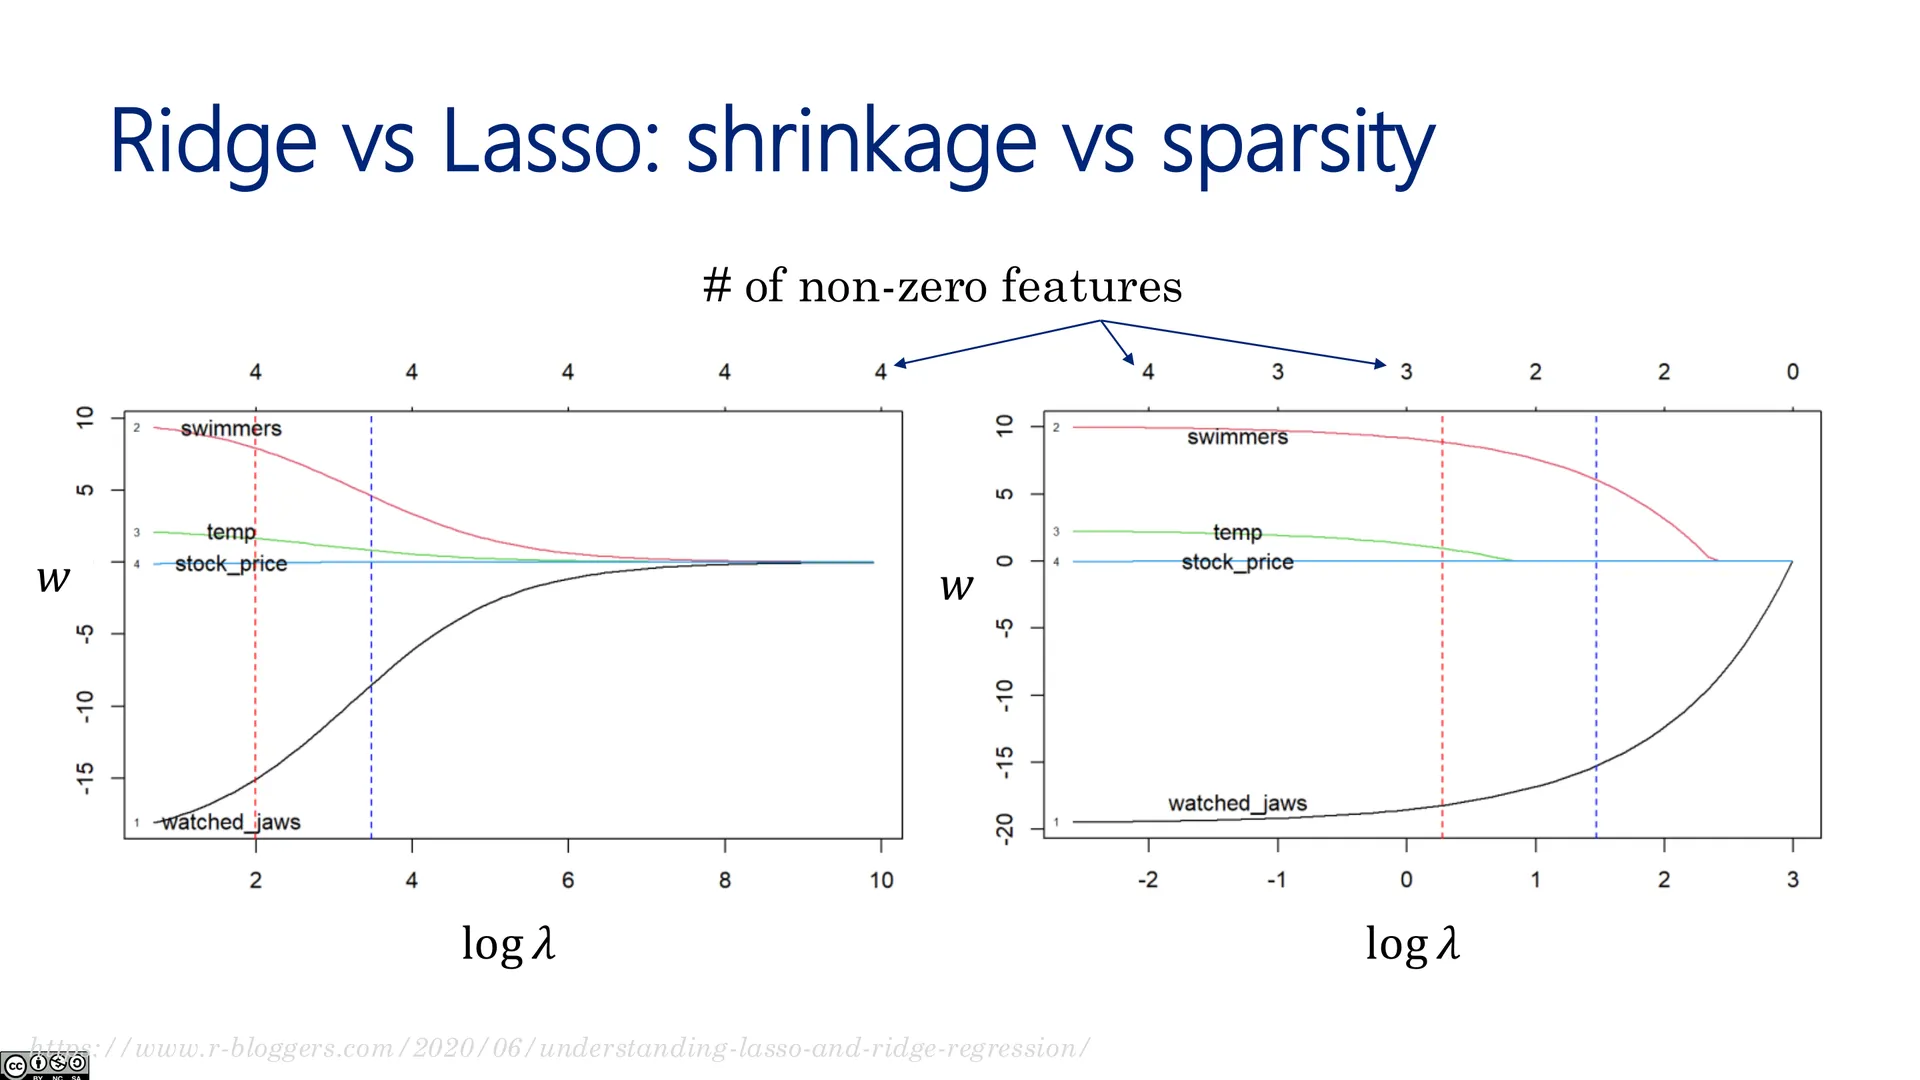
- L1 惩罚:对应 Lasso,会产生稀疏解(自动「删特征」);
- 从贝叶斯/MAP看:「对权重的先验」自然导出 L2 正则化;
- 也可以把 L1 与 L2 组合。
编者说明:讲师在此收尾,把 L2/L1 的具体推导、MAP、交叉验证等留到下一讲。因此这些幻灯片收录于文末附录。
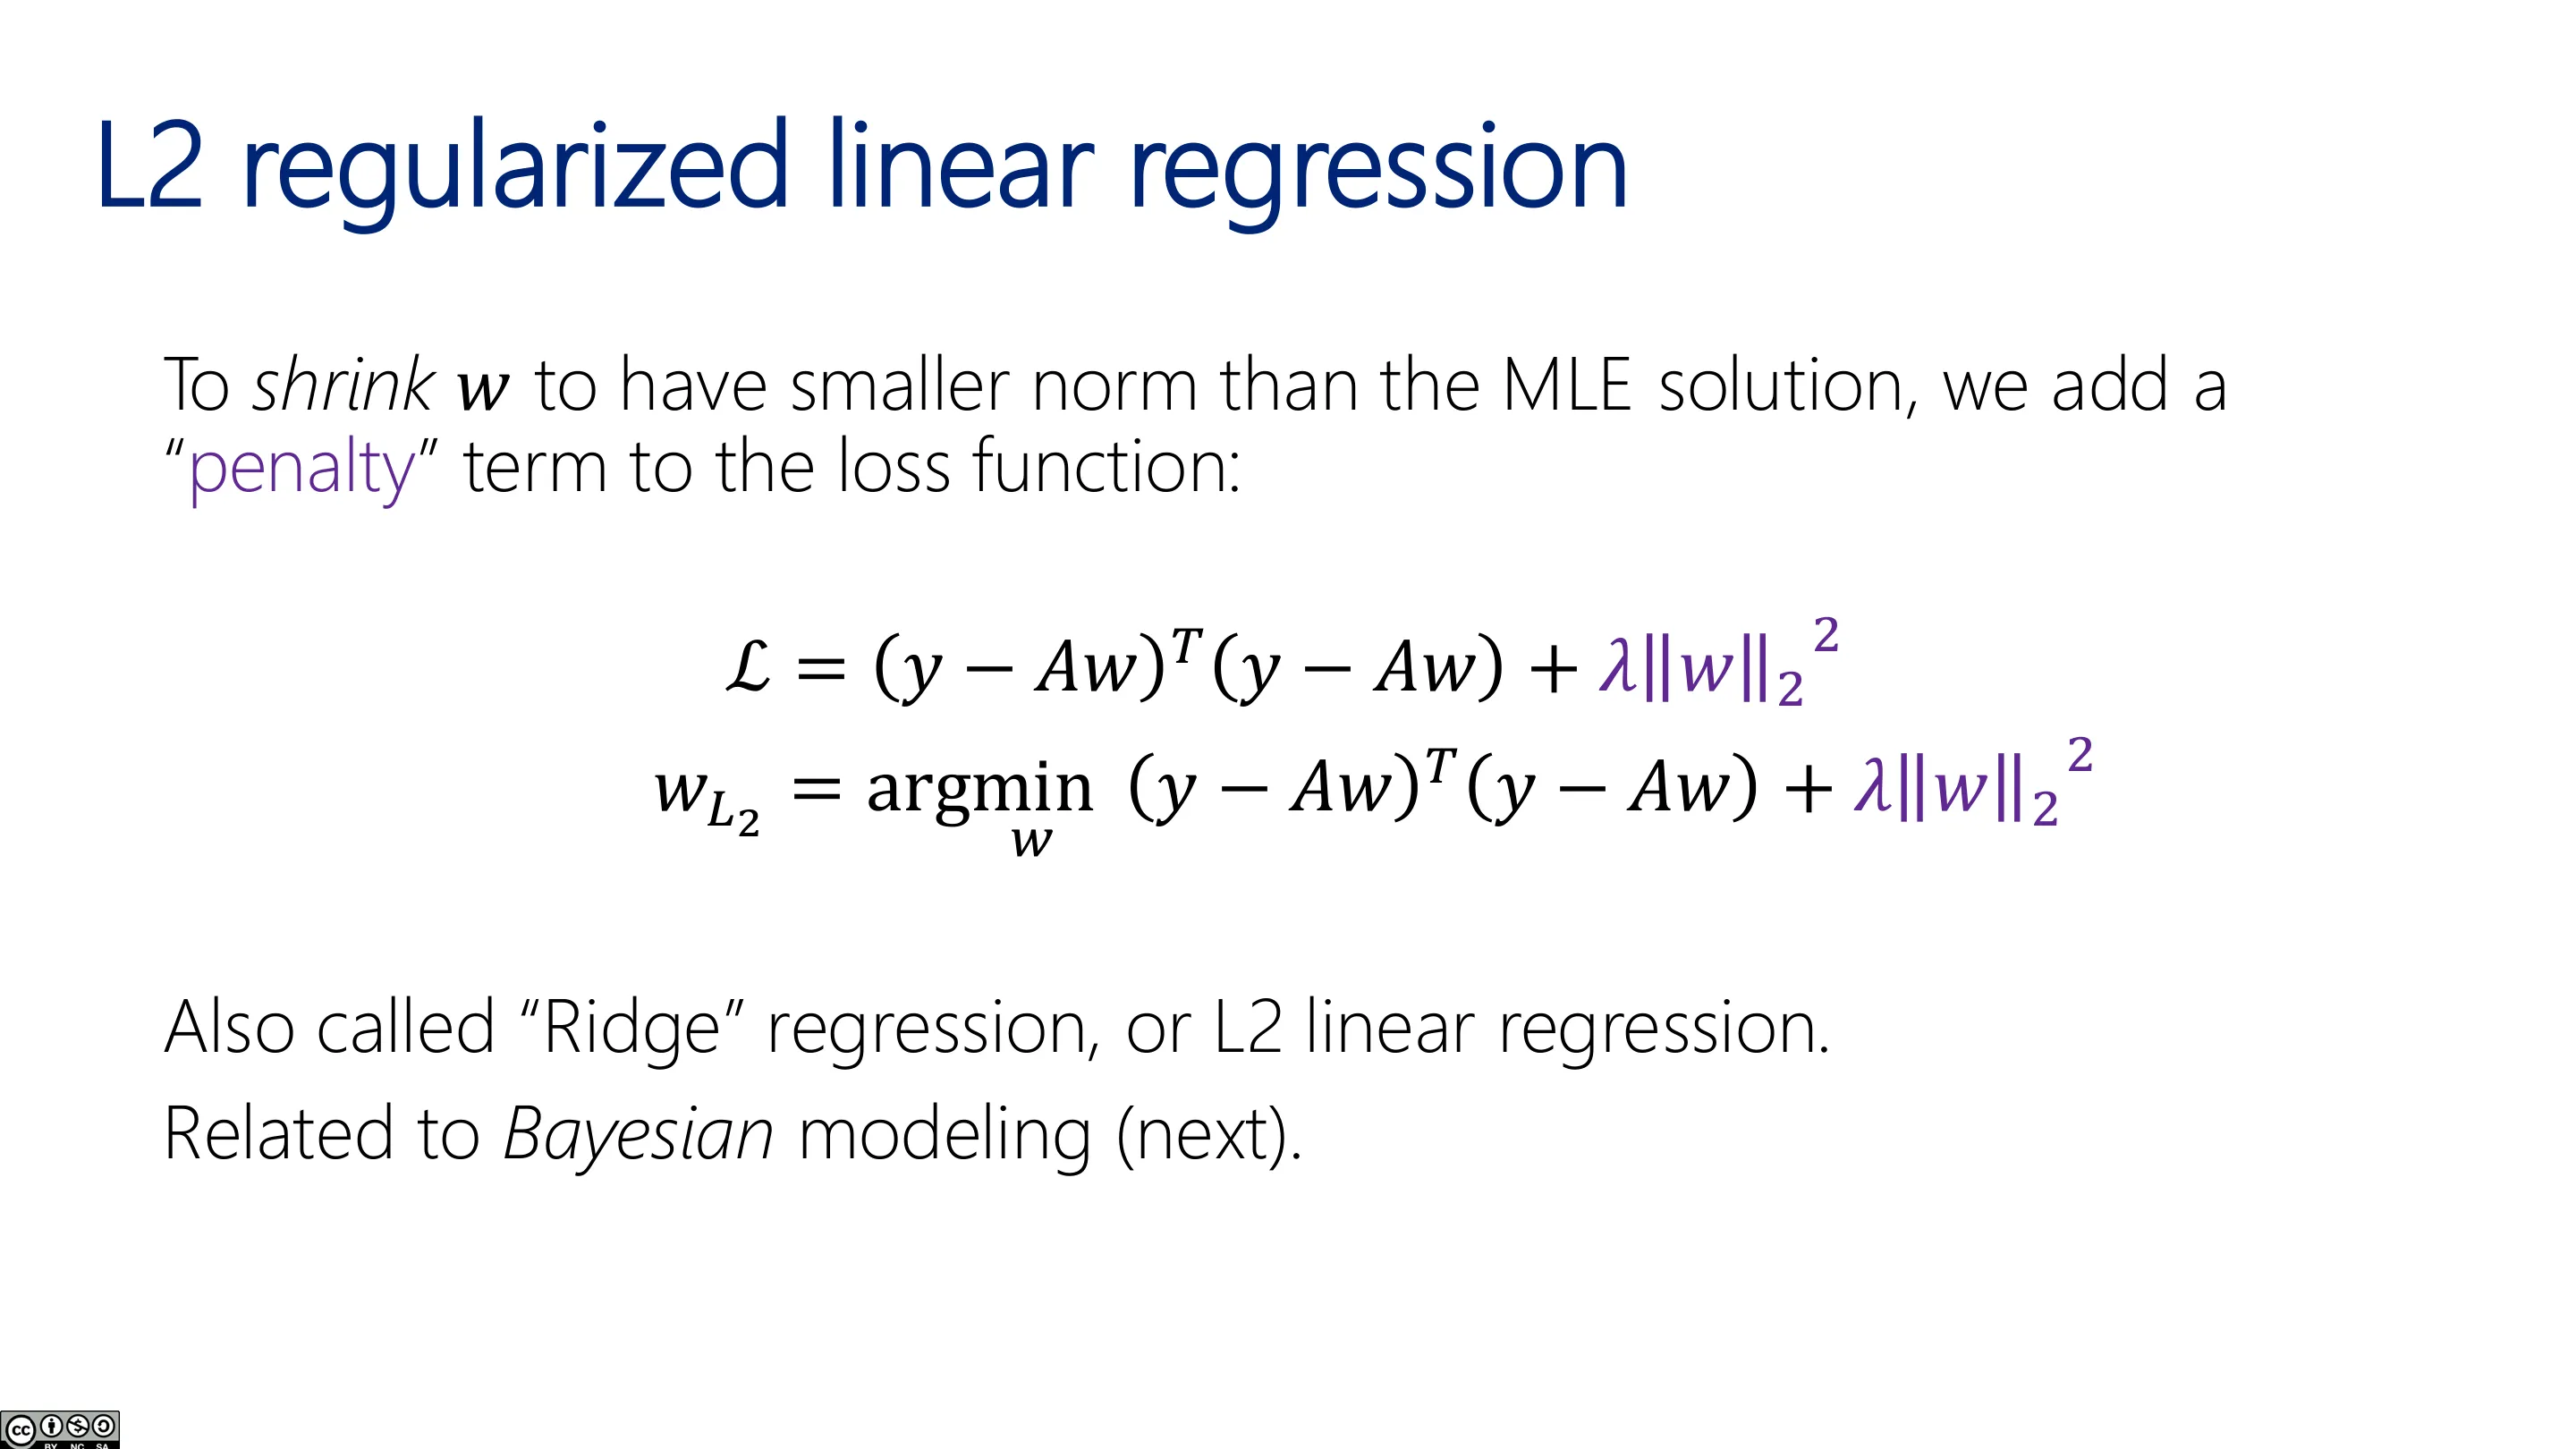
📷 L2 正则化线性回归
回到原视频 (01:16:12)
总结(Takeaways)
- 高斯线性回归的 MLE:对数似然 ⇒ 平方损失;用矩阵微积分求导 ⇒ 正规方程 $\hat w=(A^\top A)^{-1}A^\top y$(左伪逆)。
- 驻点是极小值的条件:设计矩阵满秩(特征线性无关)⇒ $A^\top A$ 正定。
- 基函数展开不改变求解过程,只改变设计矩阵的特征。
- 几何视角:预测落在列的张成空间里,最优 $w$ 使残差与张成空间正交 ⇒ 同样的正规方程。
- 何时出问题:特征线性相关或 $D>N$ ⇒ 秩亏、无穷多解、可用伪逆得最小范数解。
- 正则化:在损失中加 $\lVert w\rVert$ 惩罚(L2=岭回归、L1=Lasso),控制有效自由度、改善泛化;可由贝叶斯先验/MAP导出。
附录:课堂未展示的幻灯片(正则化细节与延伸)
以下幻灯片属于本讲 deck 的L2/L1 正则化推导、贝叶斯/MAP、交叉验证与延伸应用部分,本次录像未展开,作为延伸阅读收录。
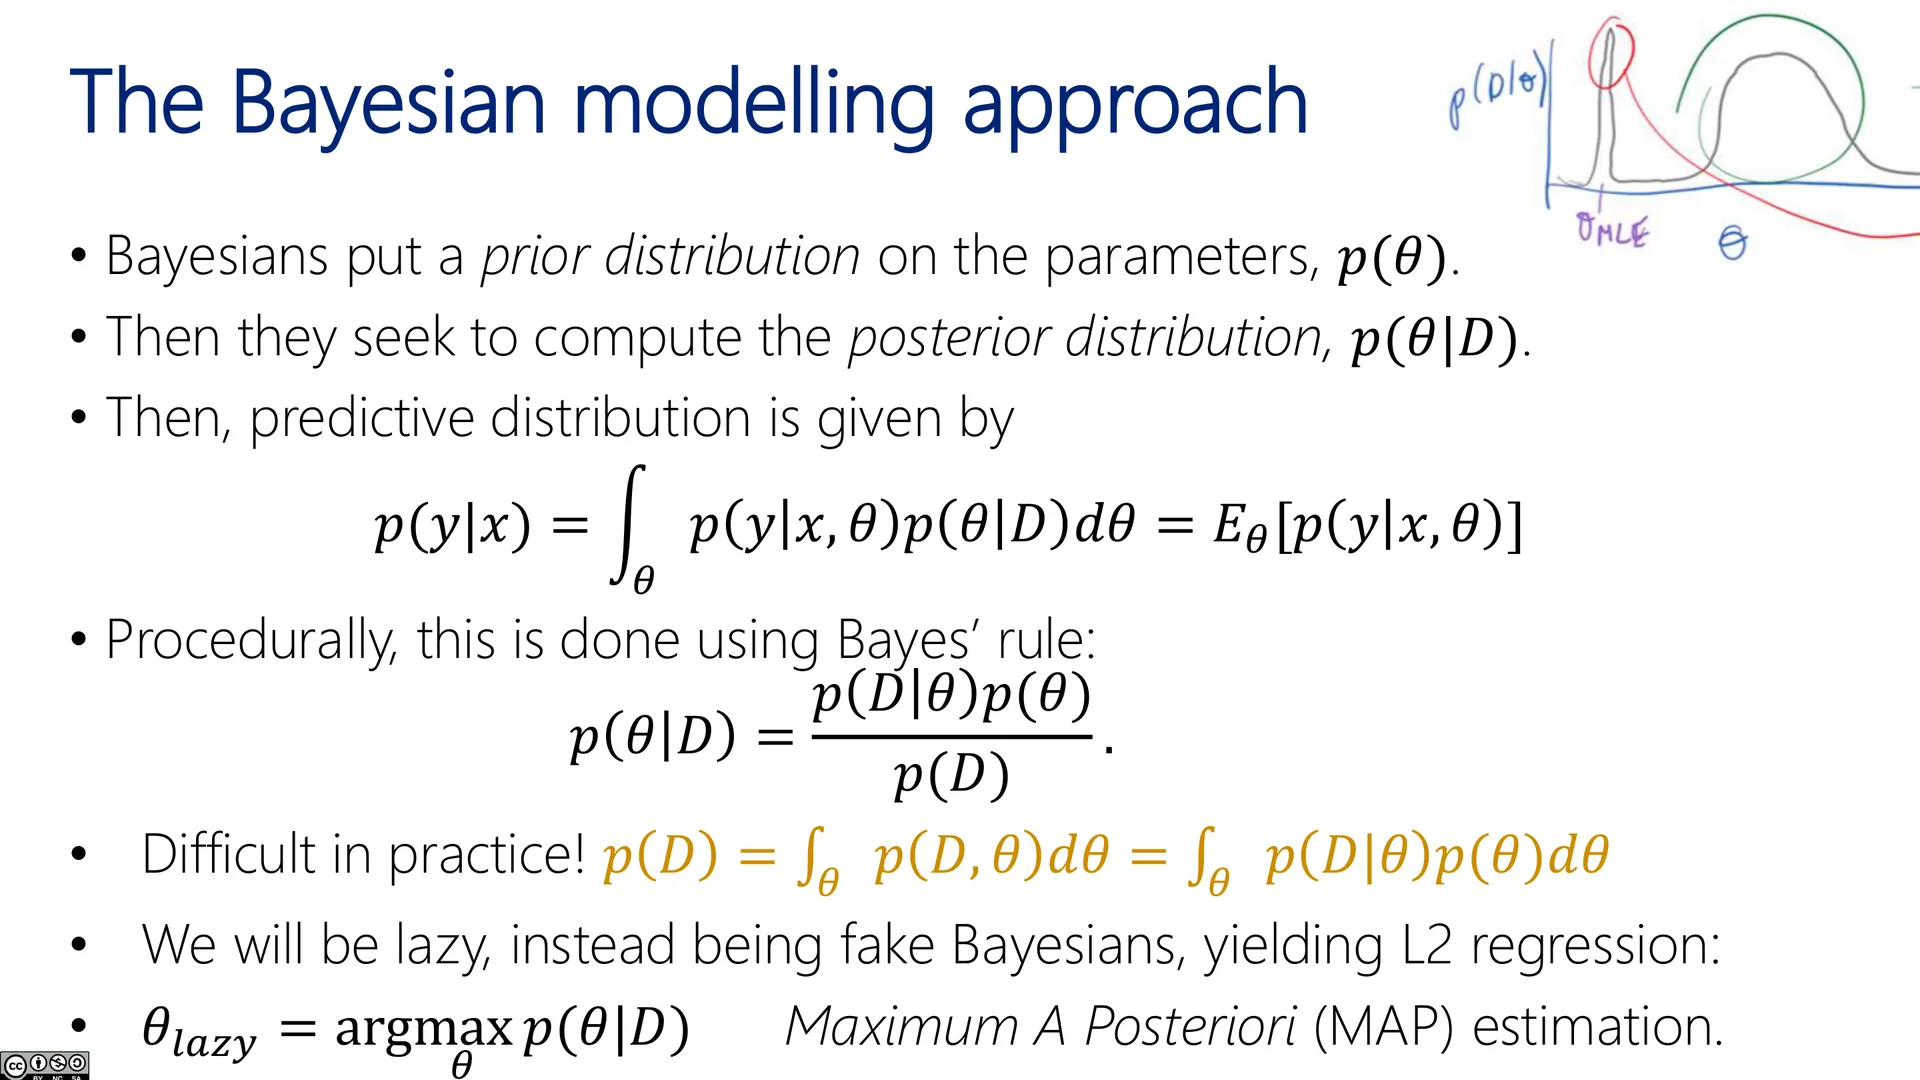
🖼️ 贝叶斯建模视角
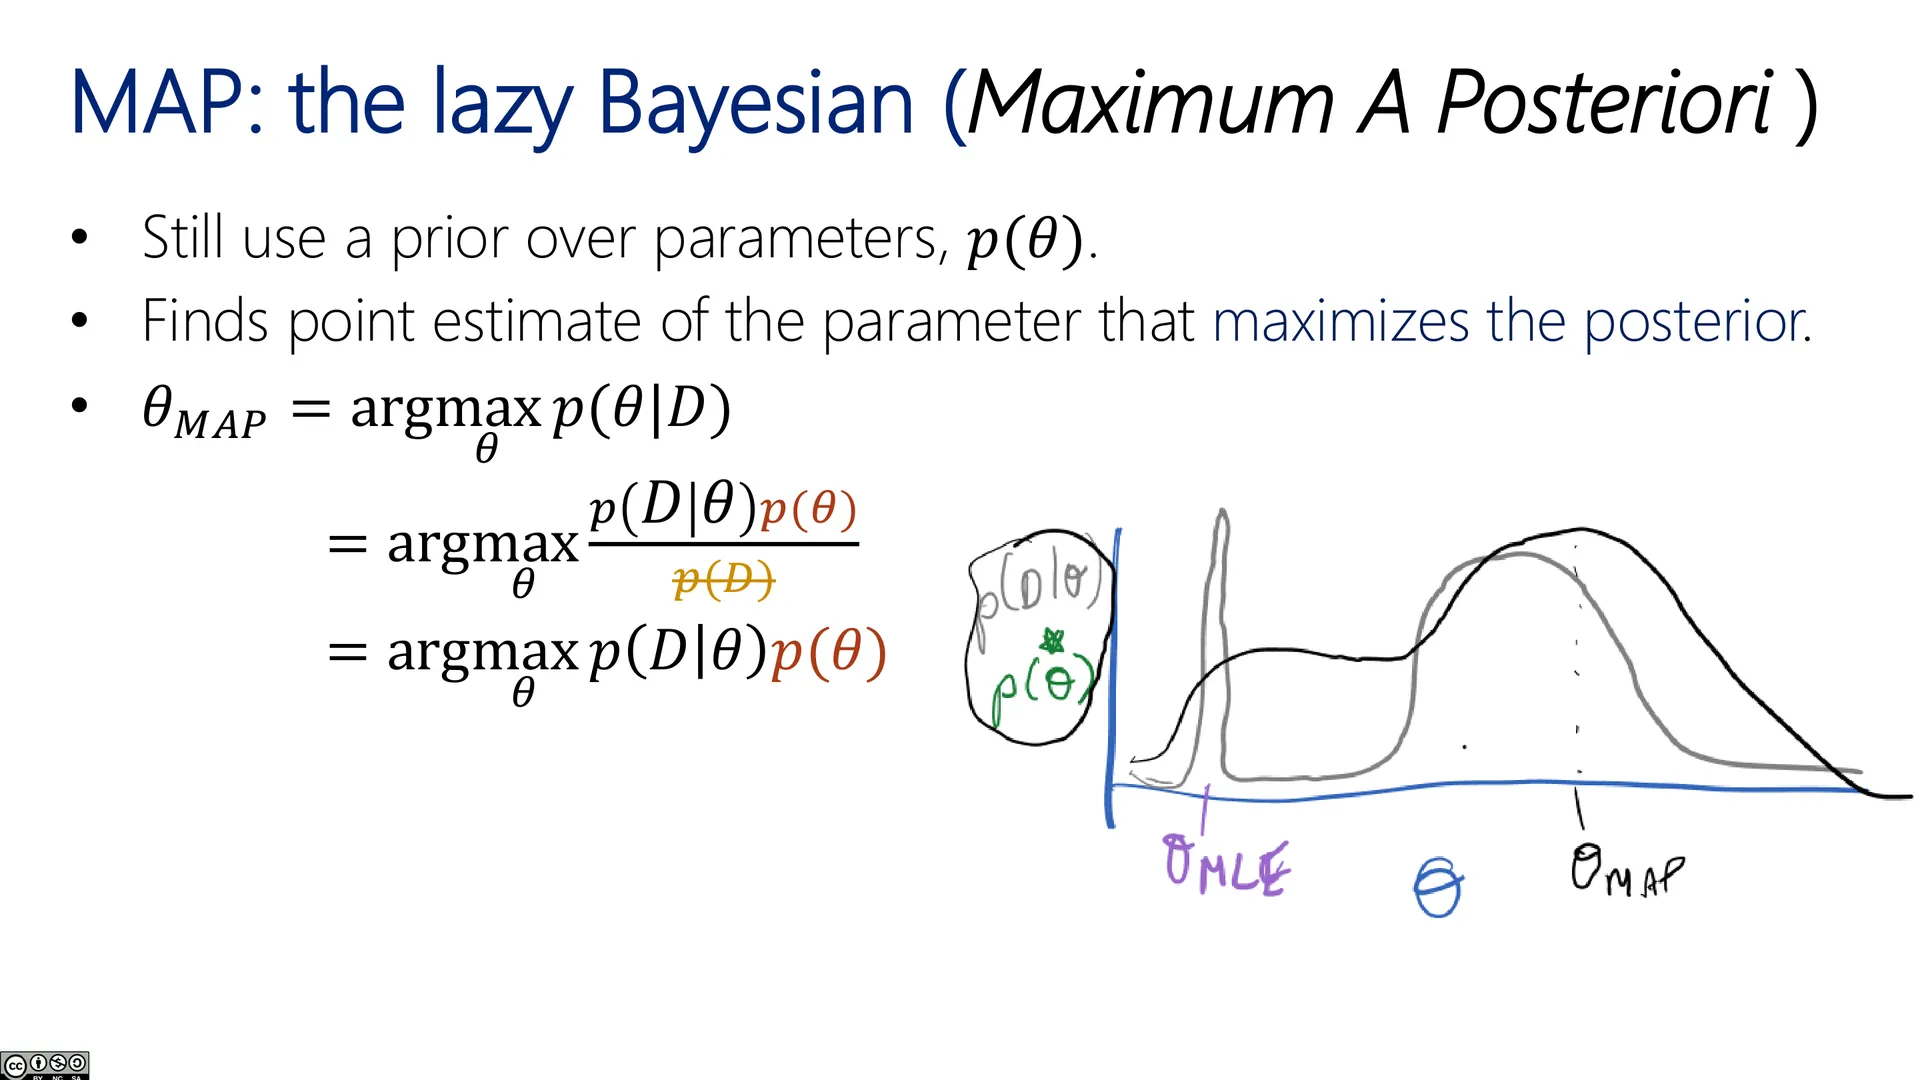
🖼️ 先验与权重
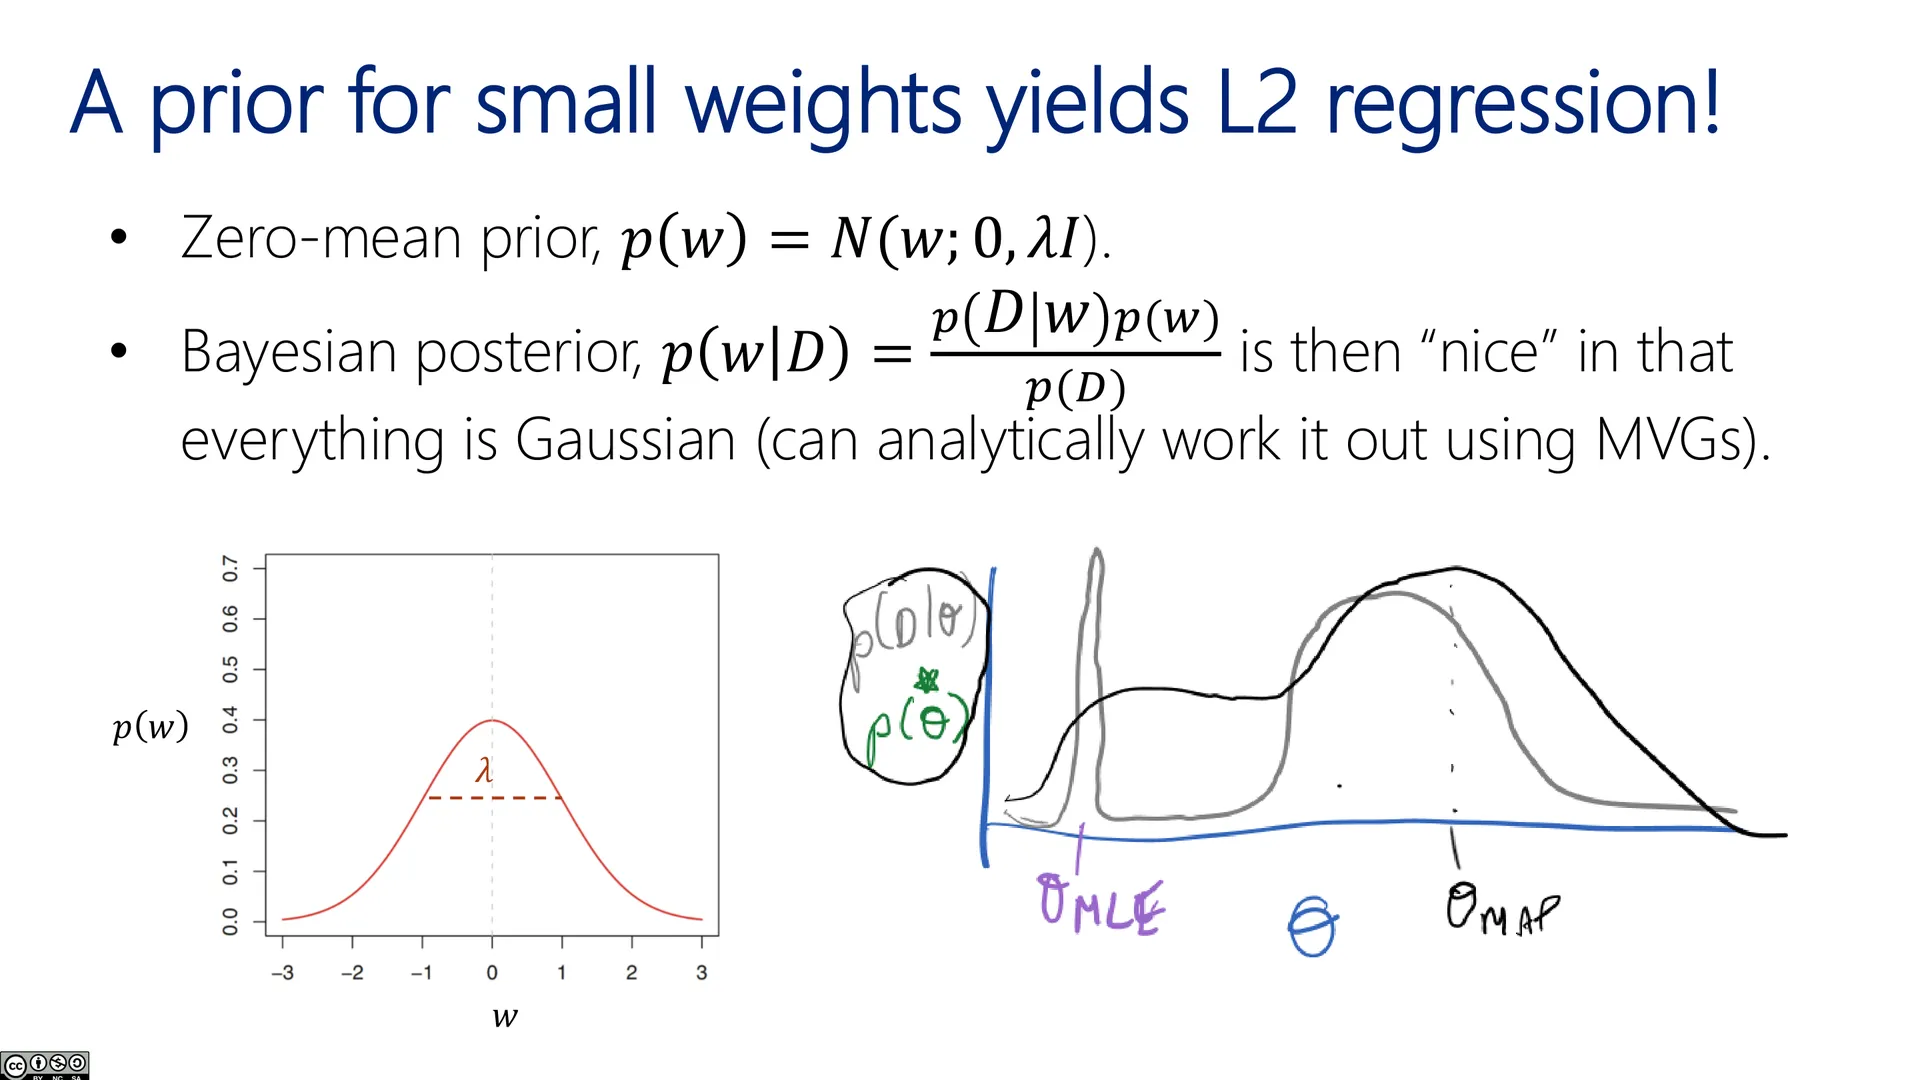
🖼️ 小权重先验 ⇒ L2 回归
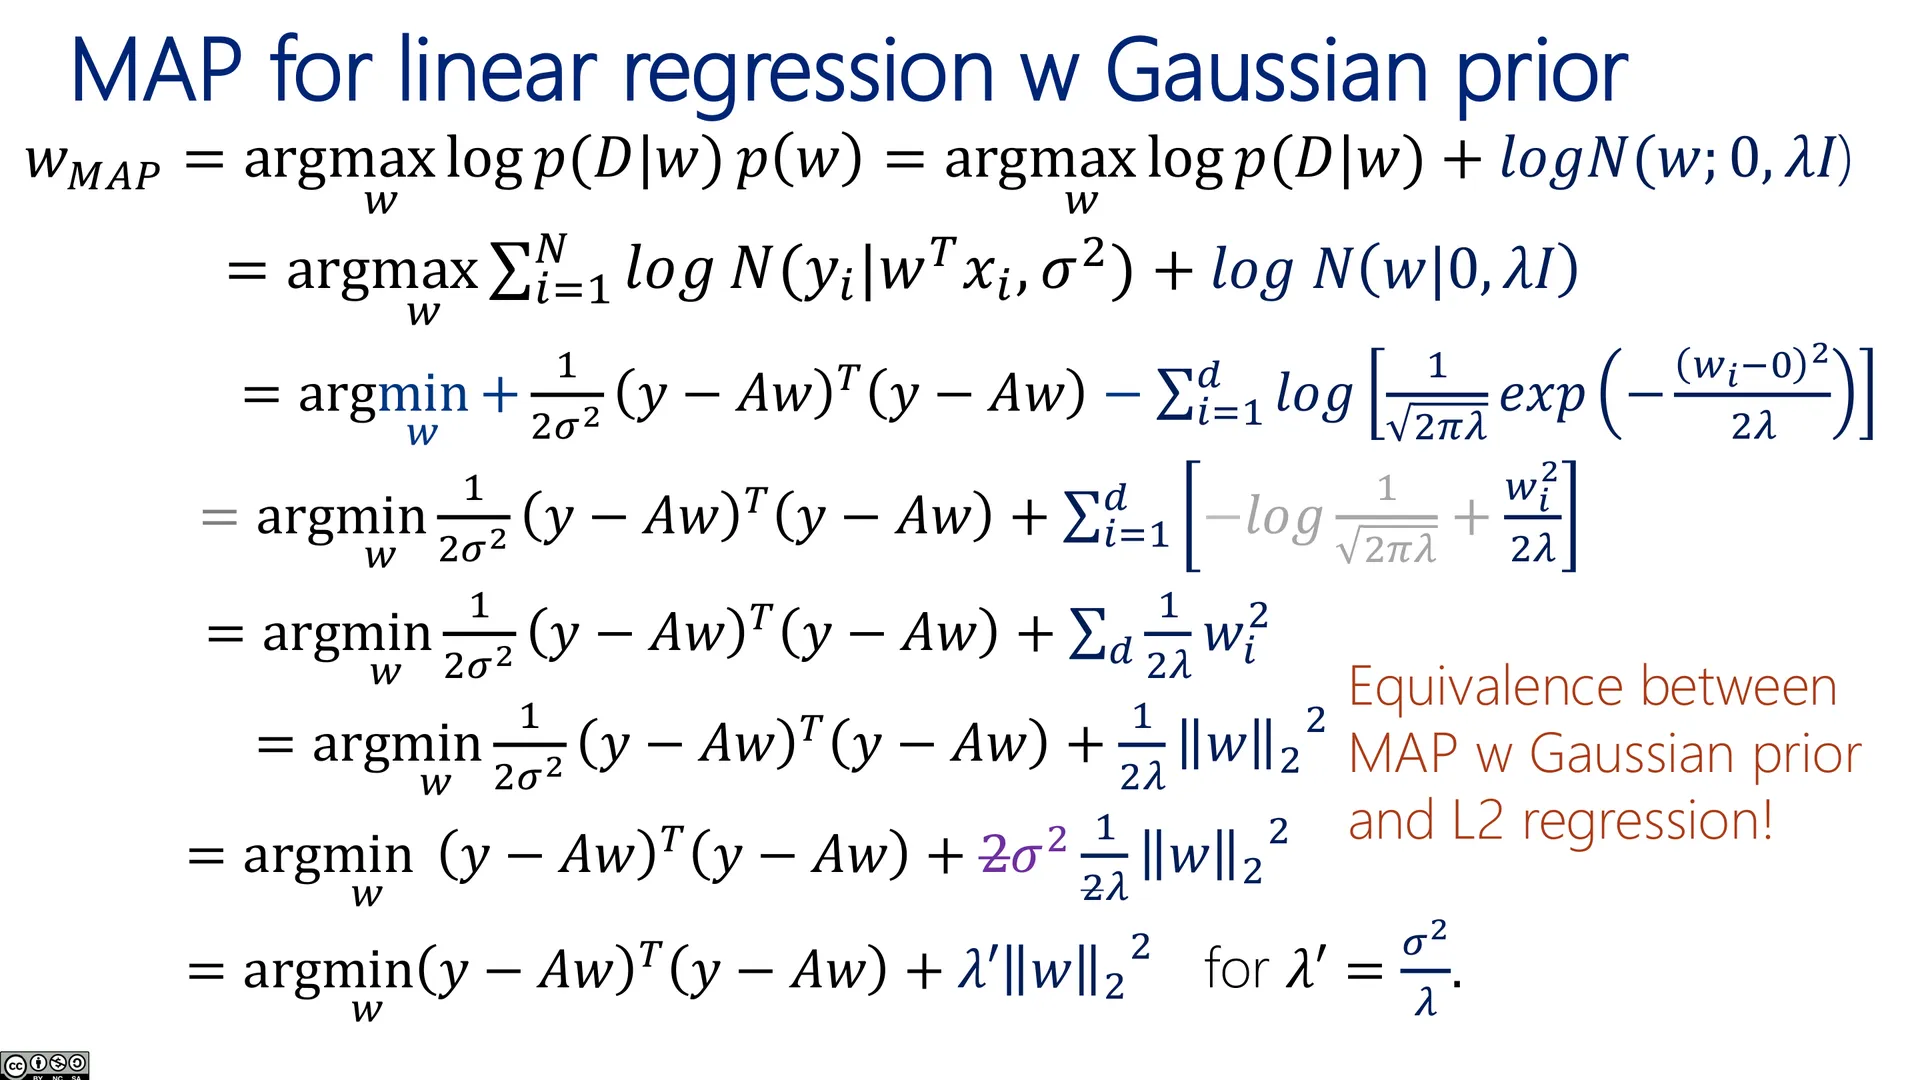
🖼️ 高斯先验下的 MAP
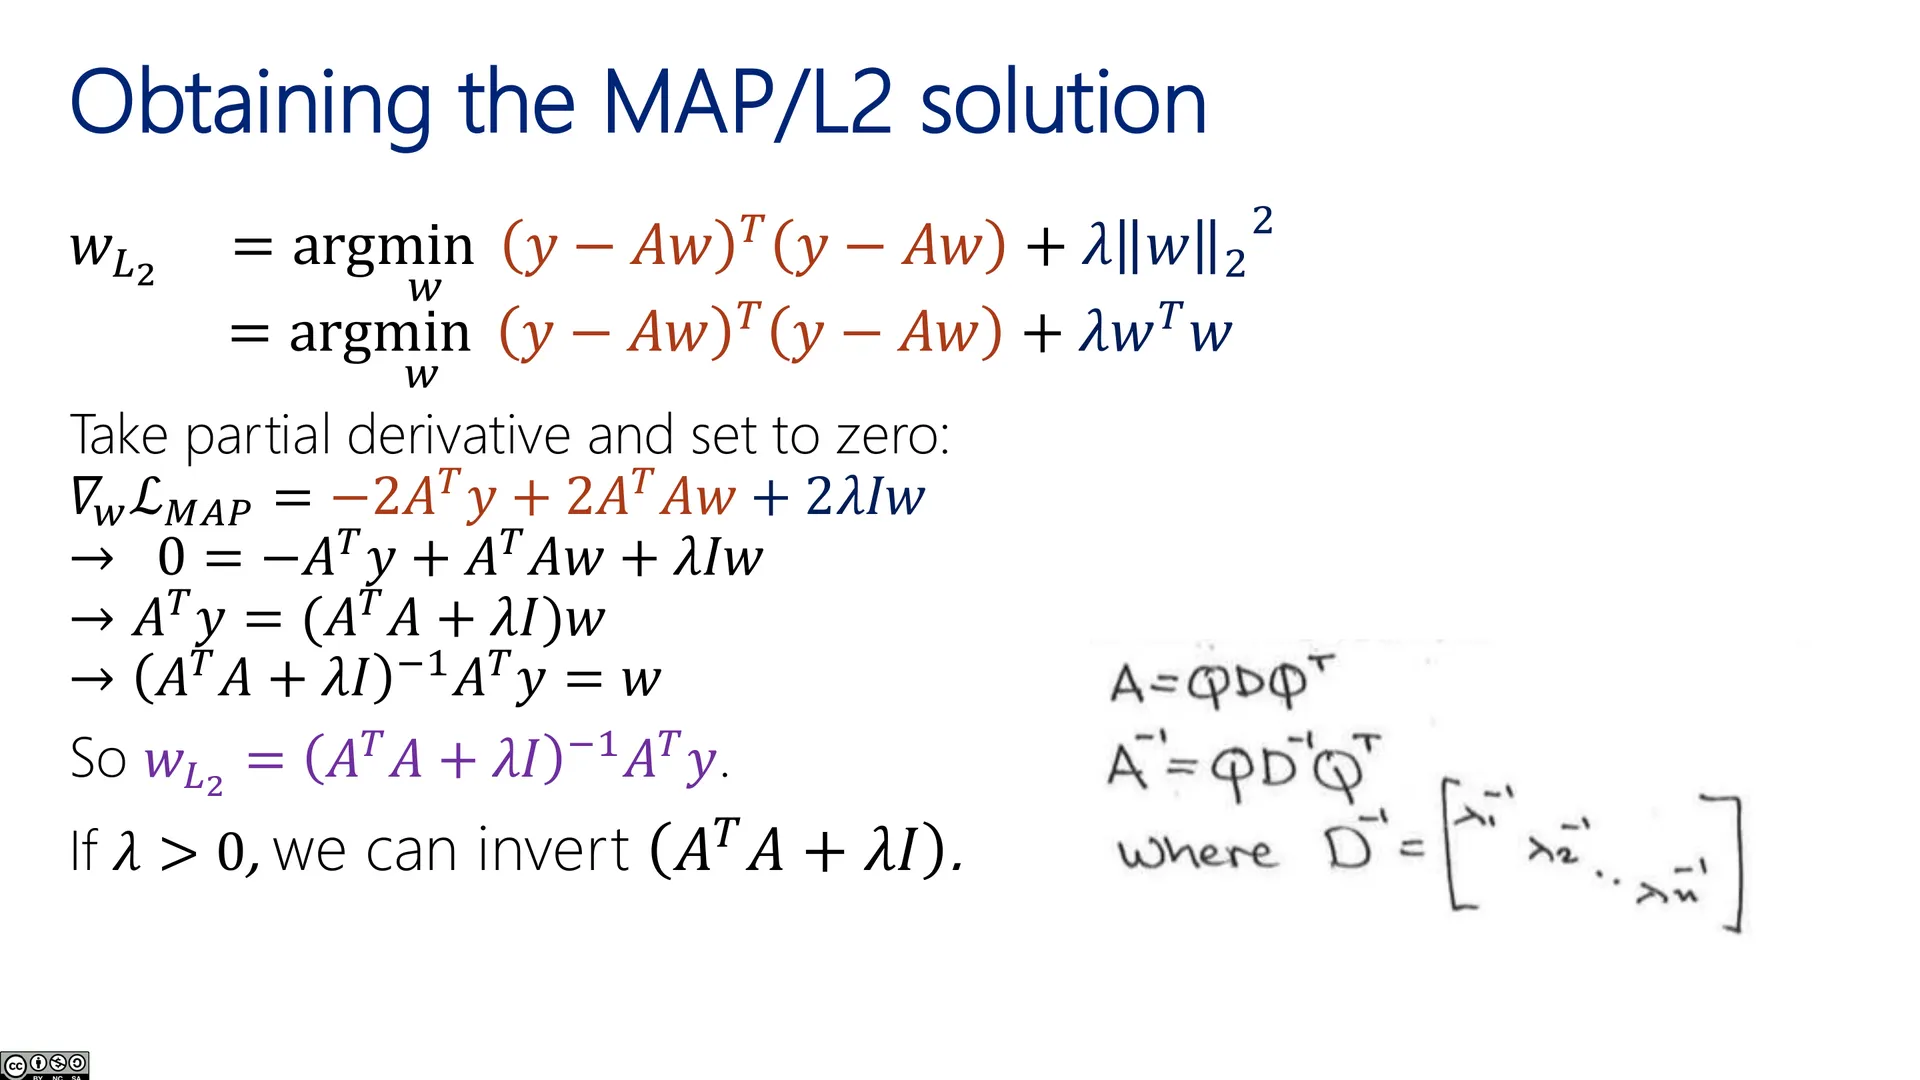
🖼️ MAP/L2 解的推导
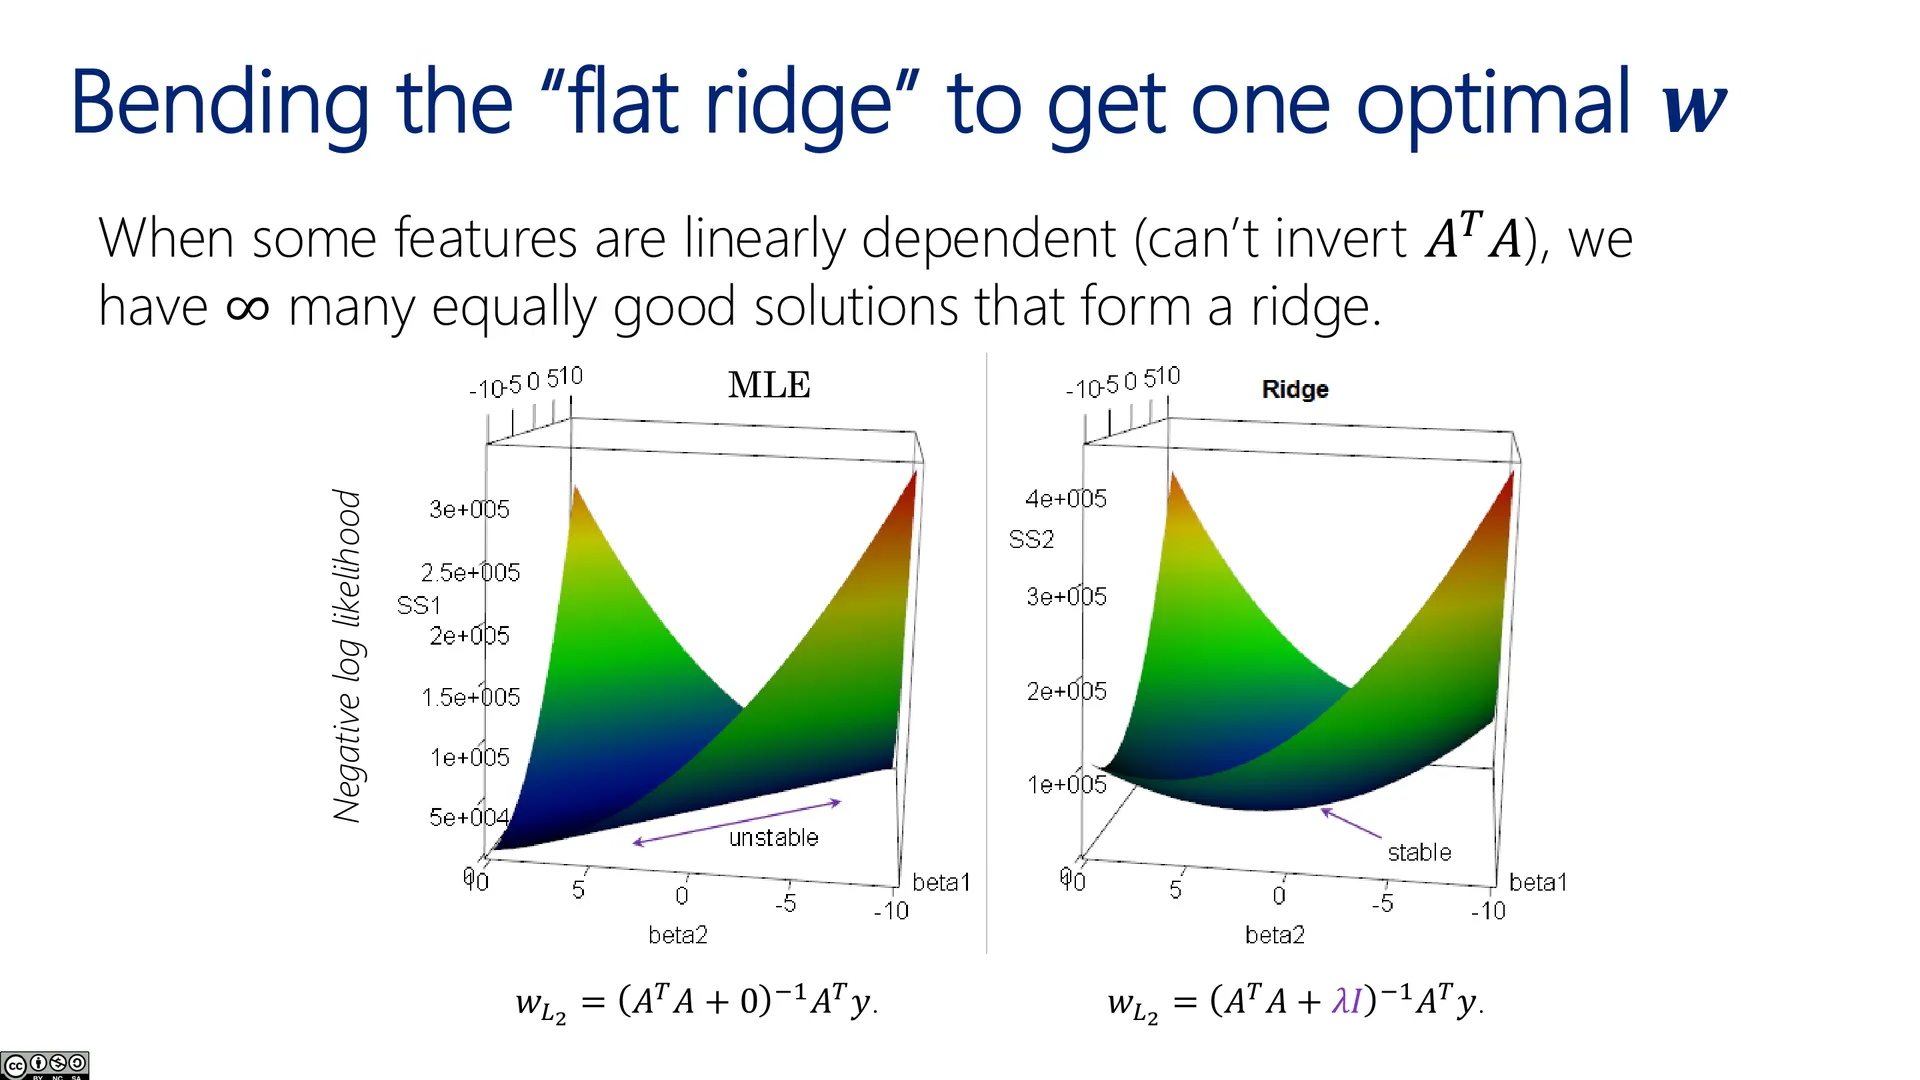
🖼️ 把「平坦山脊」弯出唯一最优 w
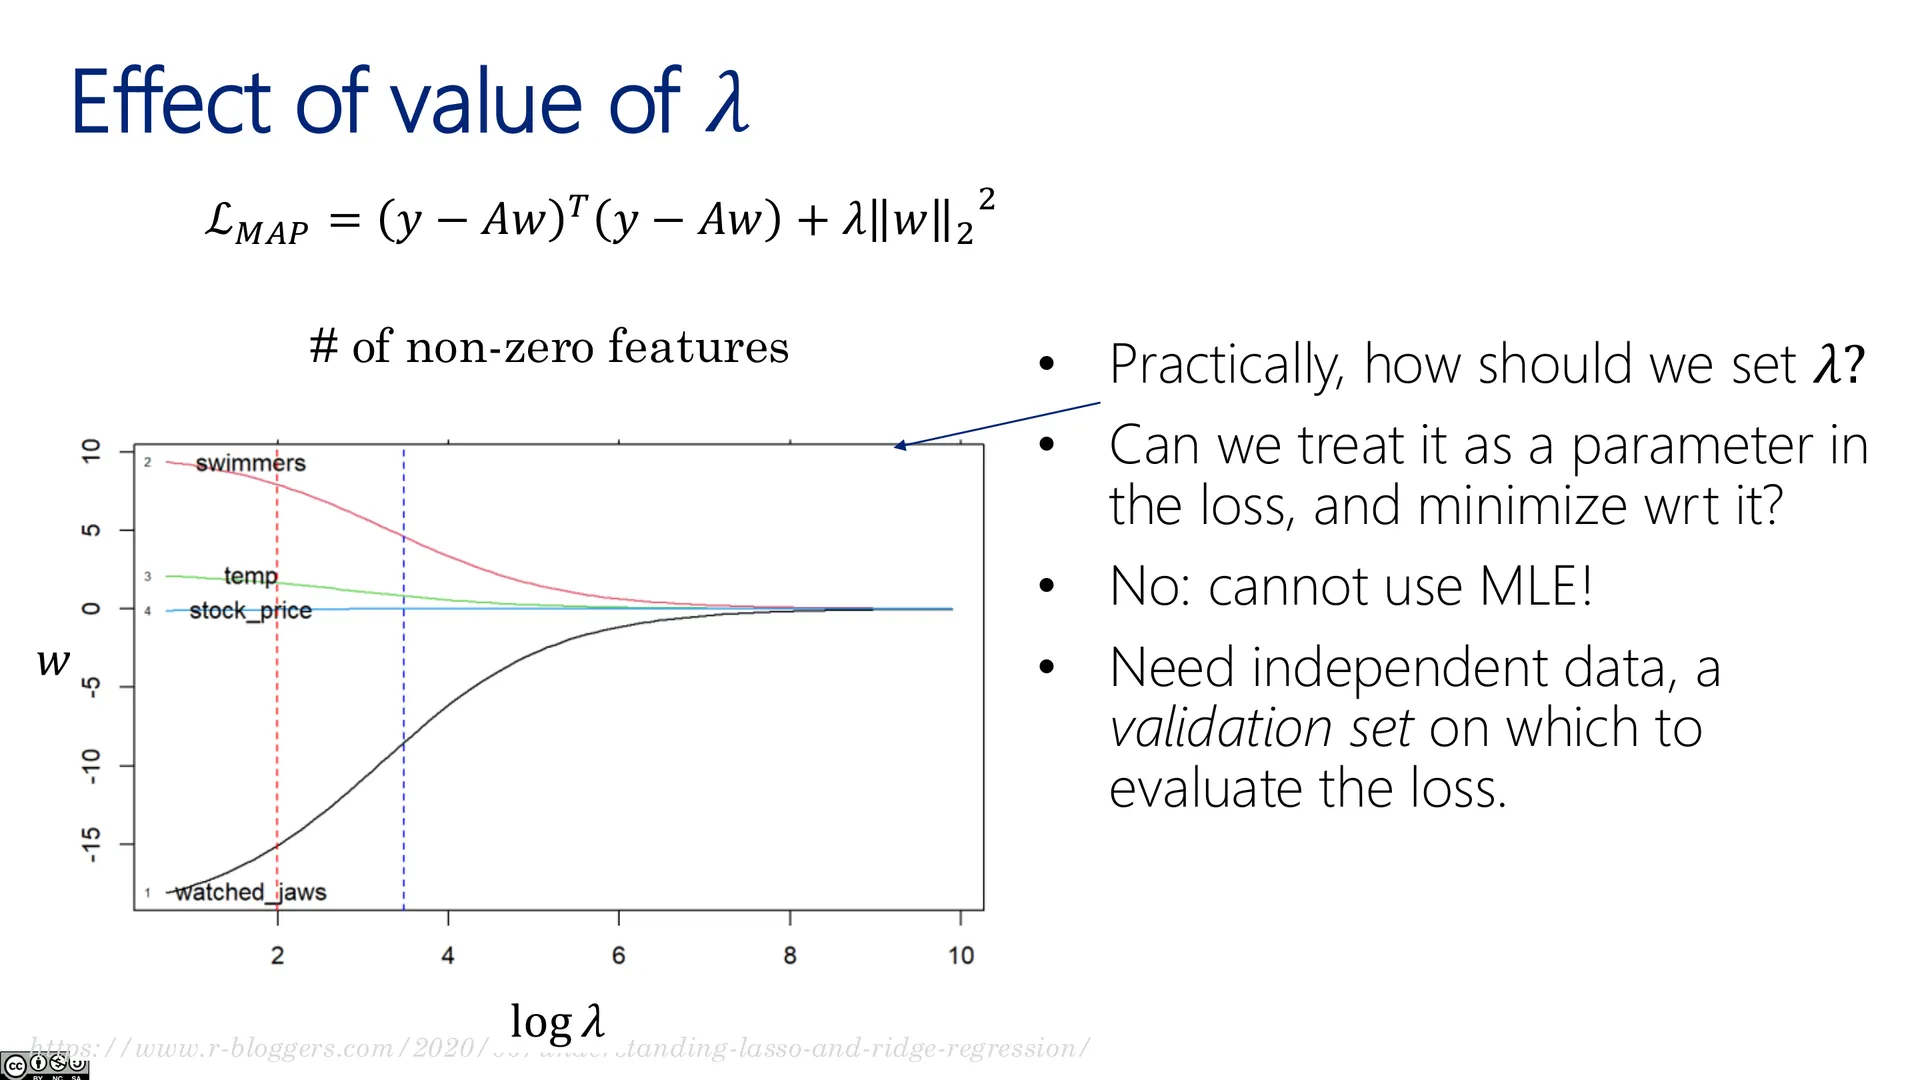
🖼️ 正则化路径
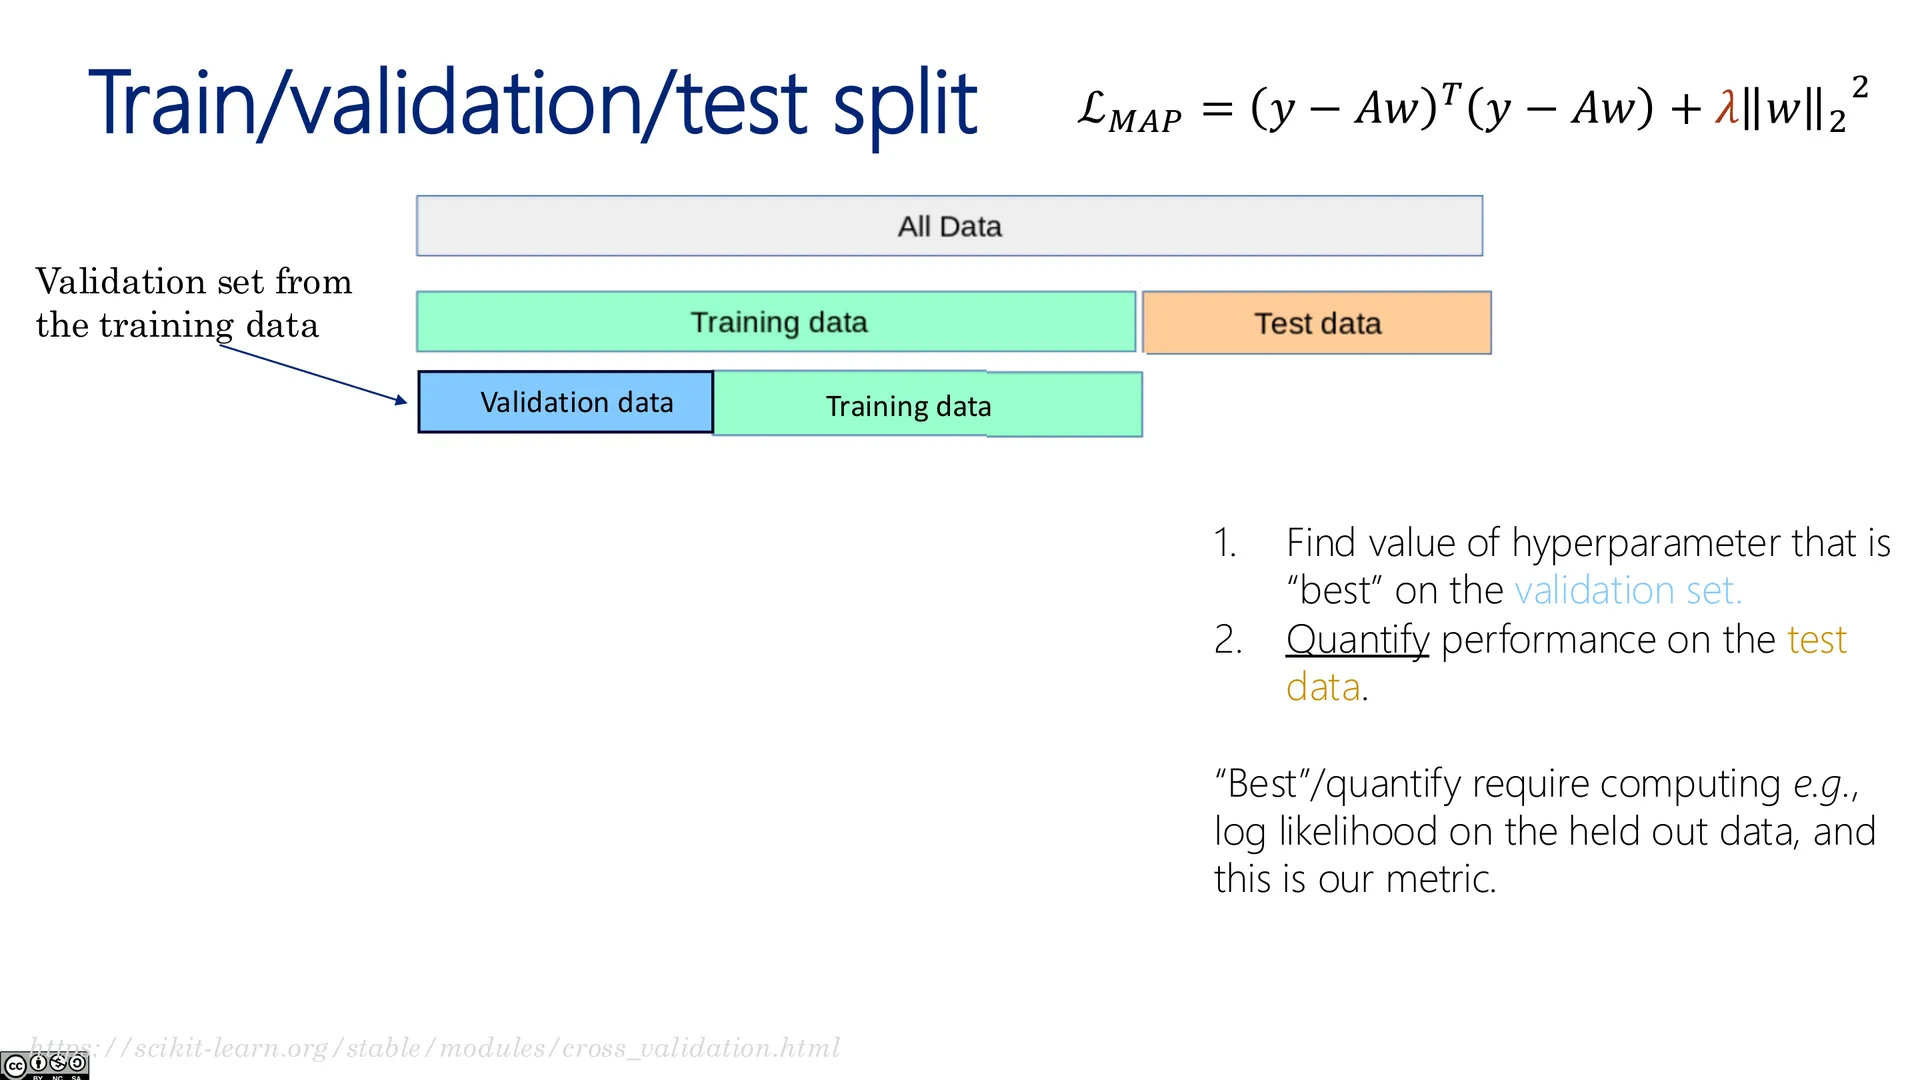
🖼️ 训练/验证/测试划分(一)
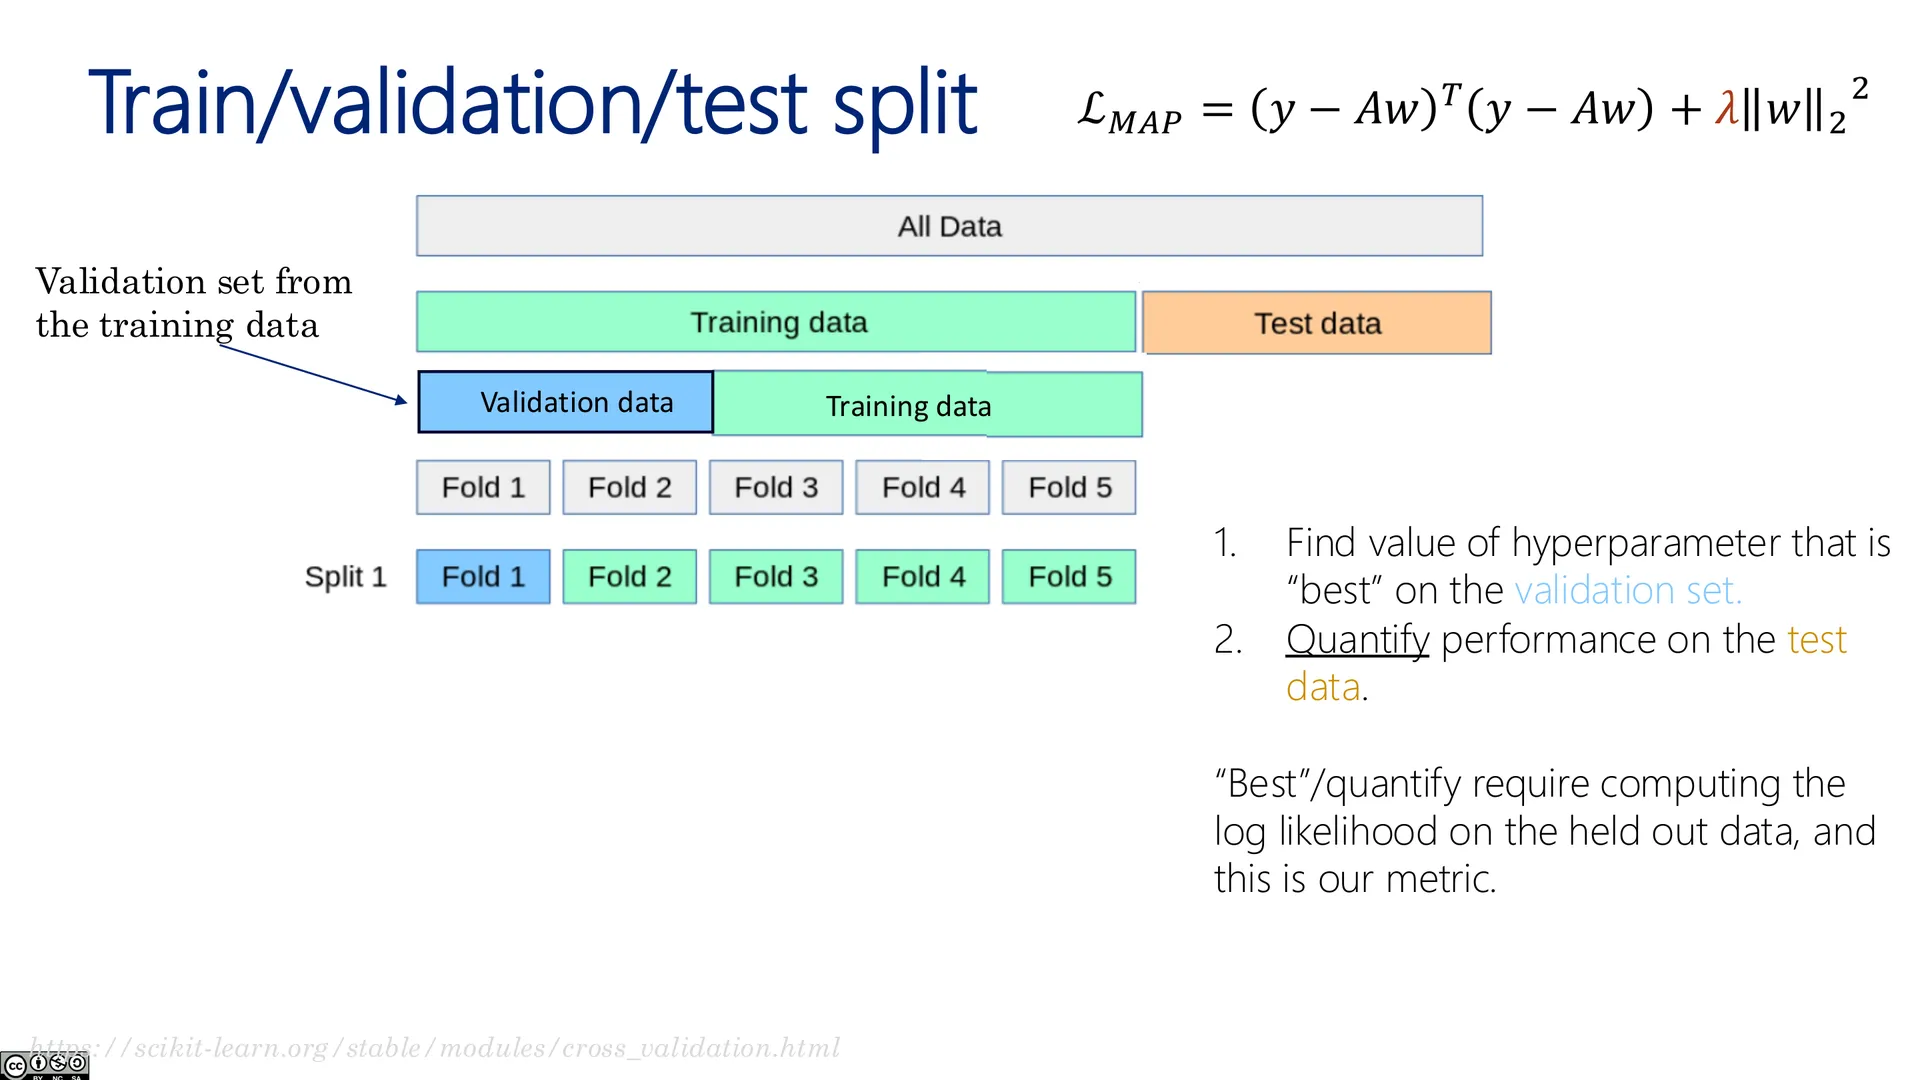
🖼️ 训练/验证/测试划分(二)
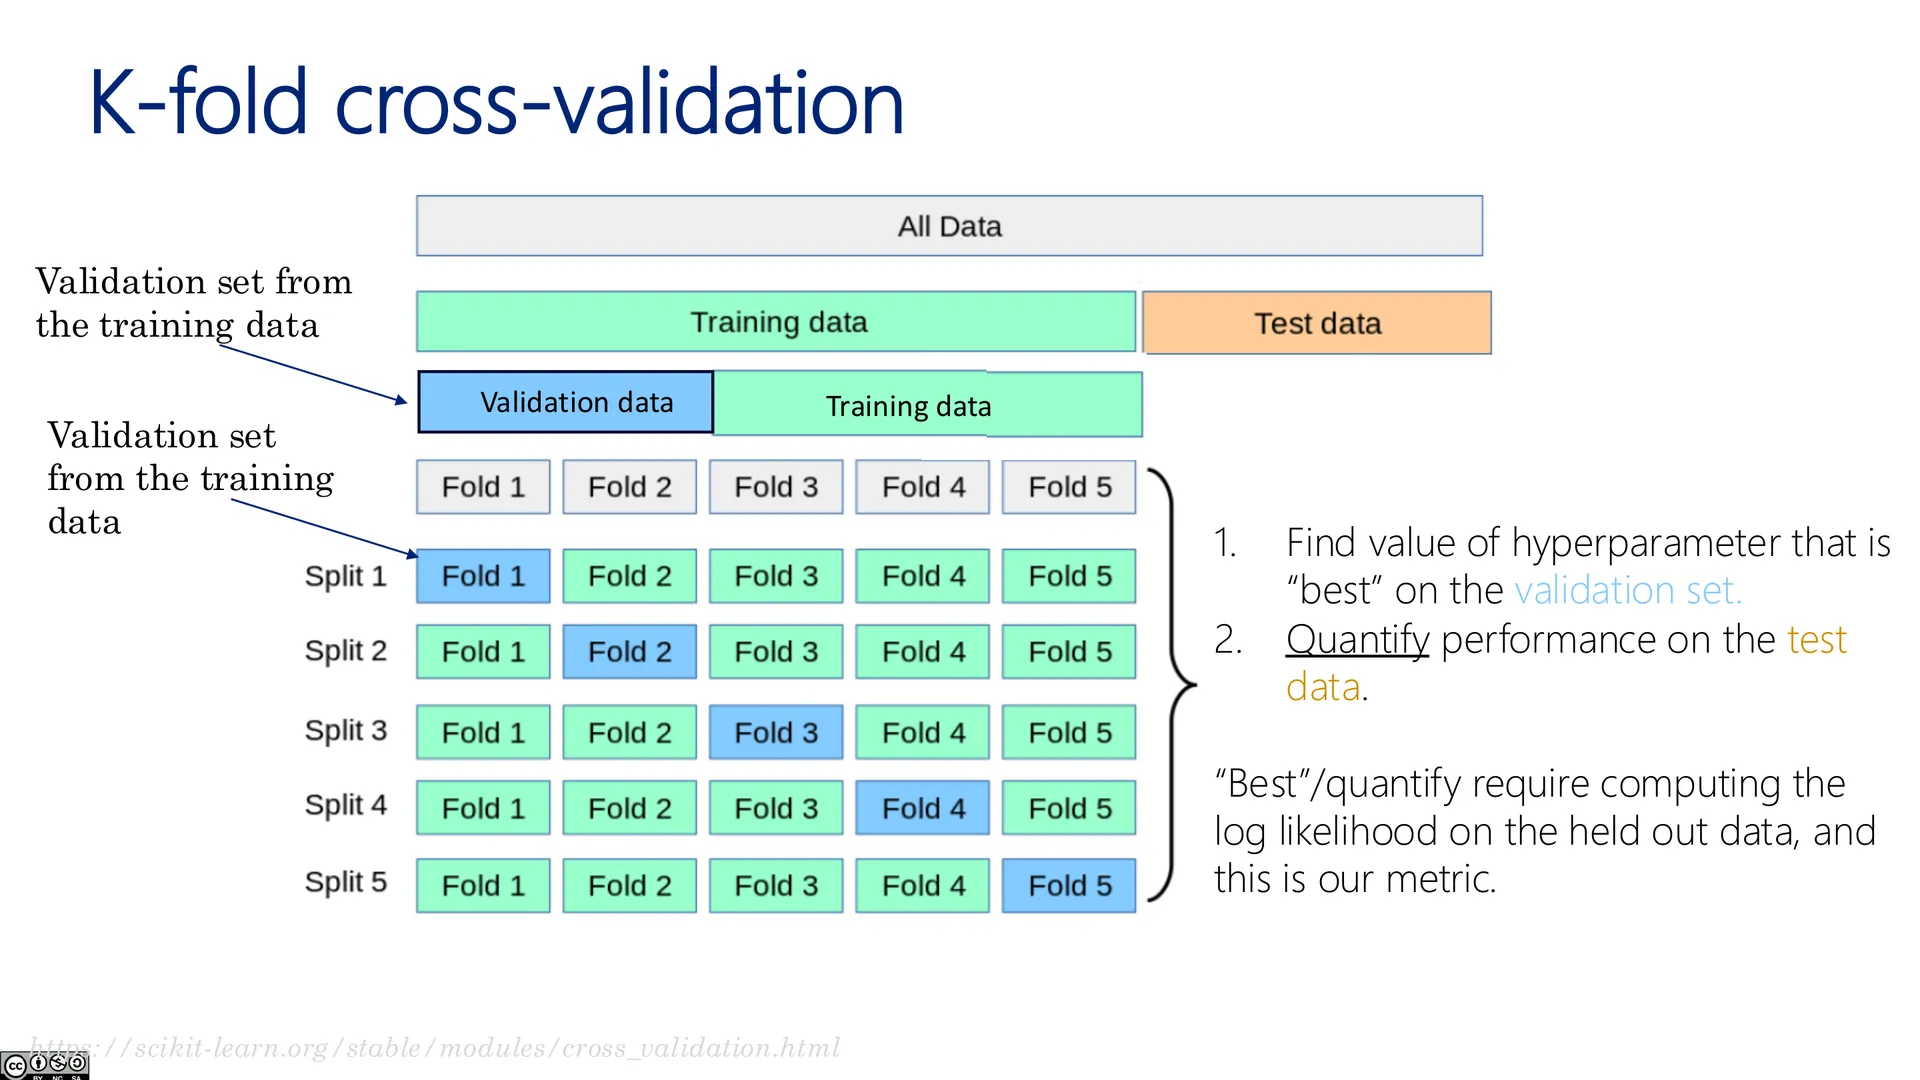
🖼️ K 折交叉验证
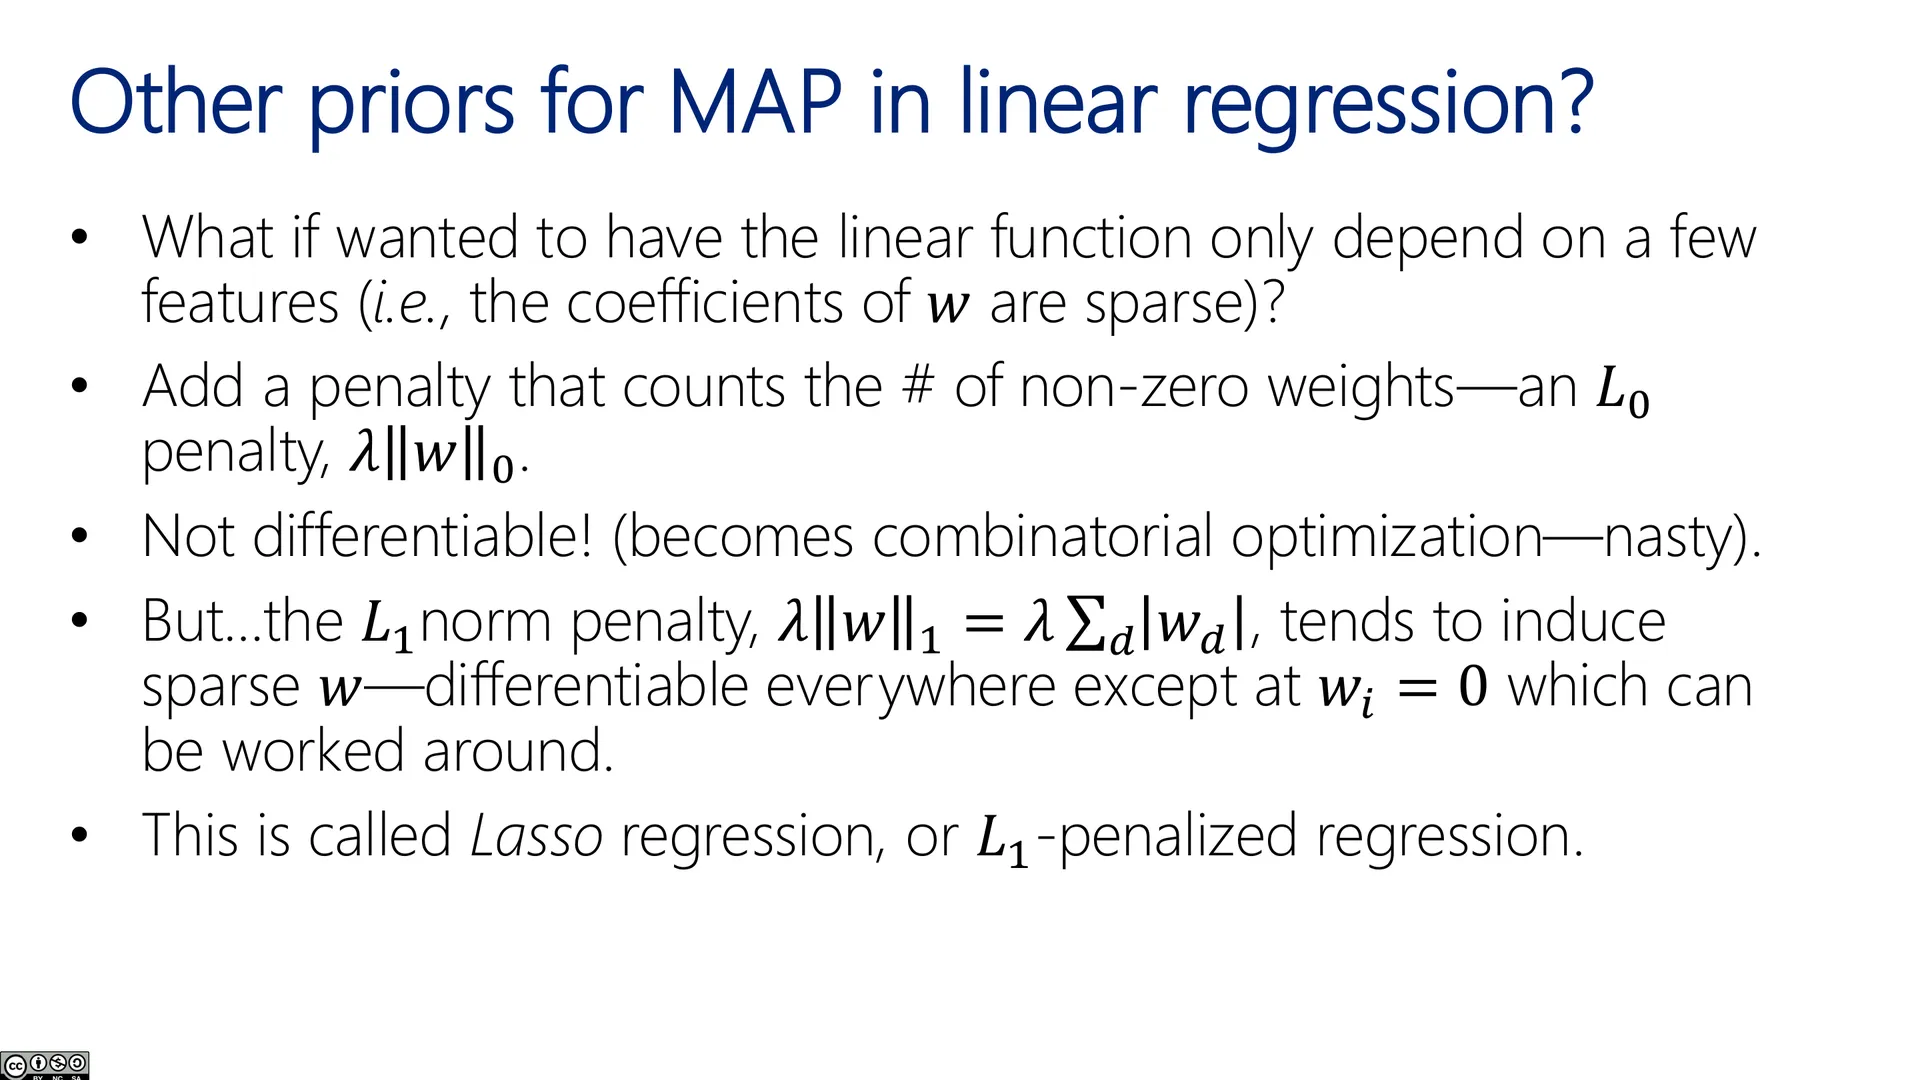
🖼️ 线性回归的其他先验
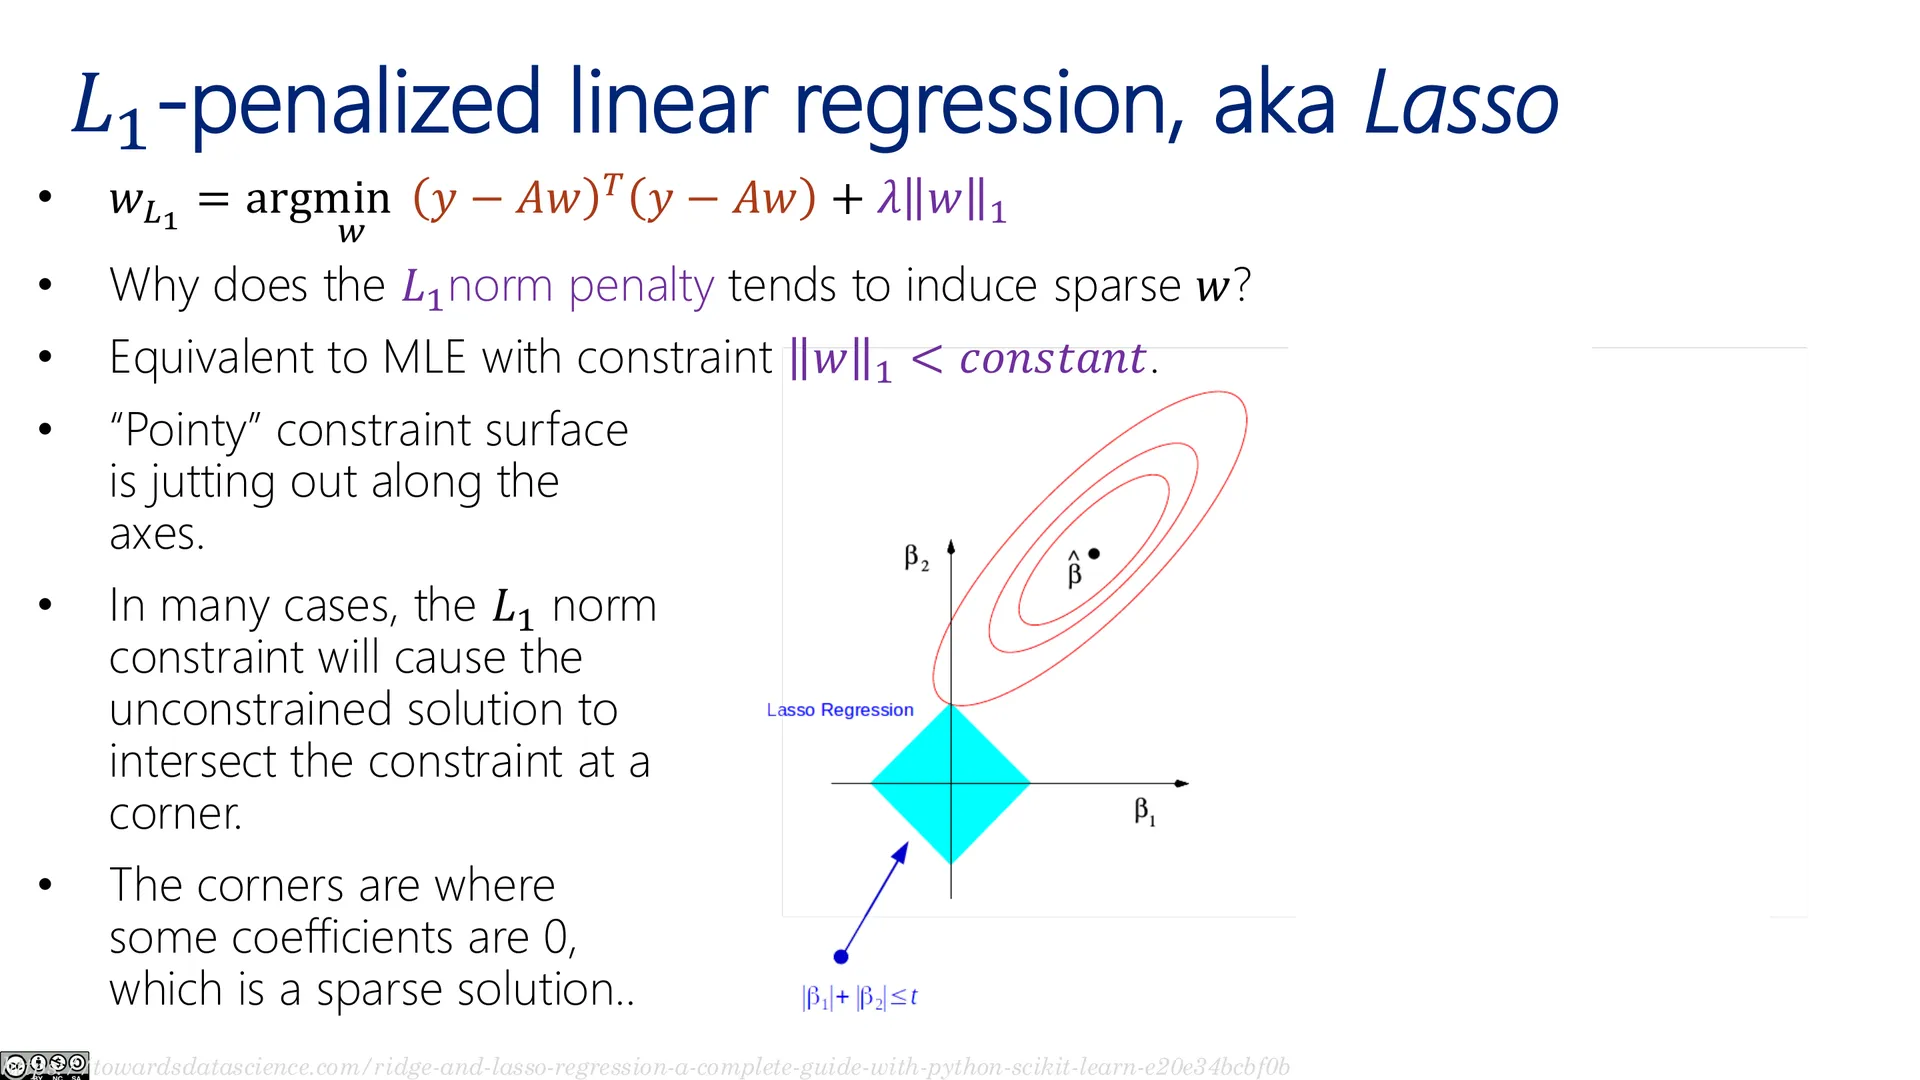
🖼️ L1 惩罚线性回归(Lasso)(一)
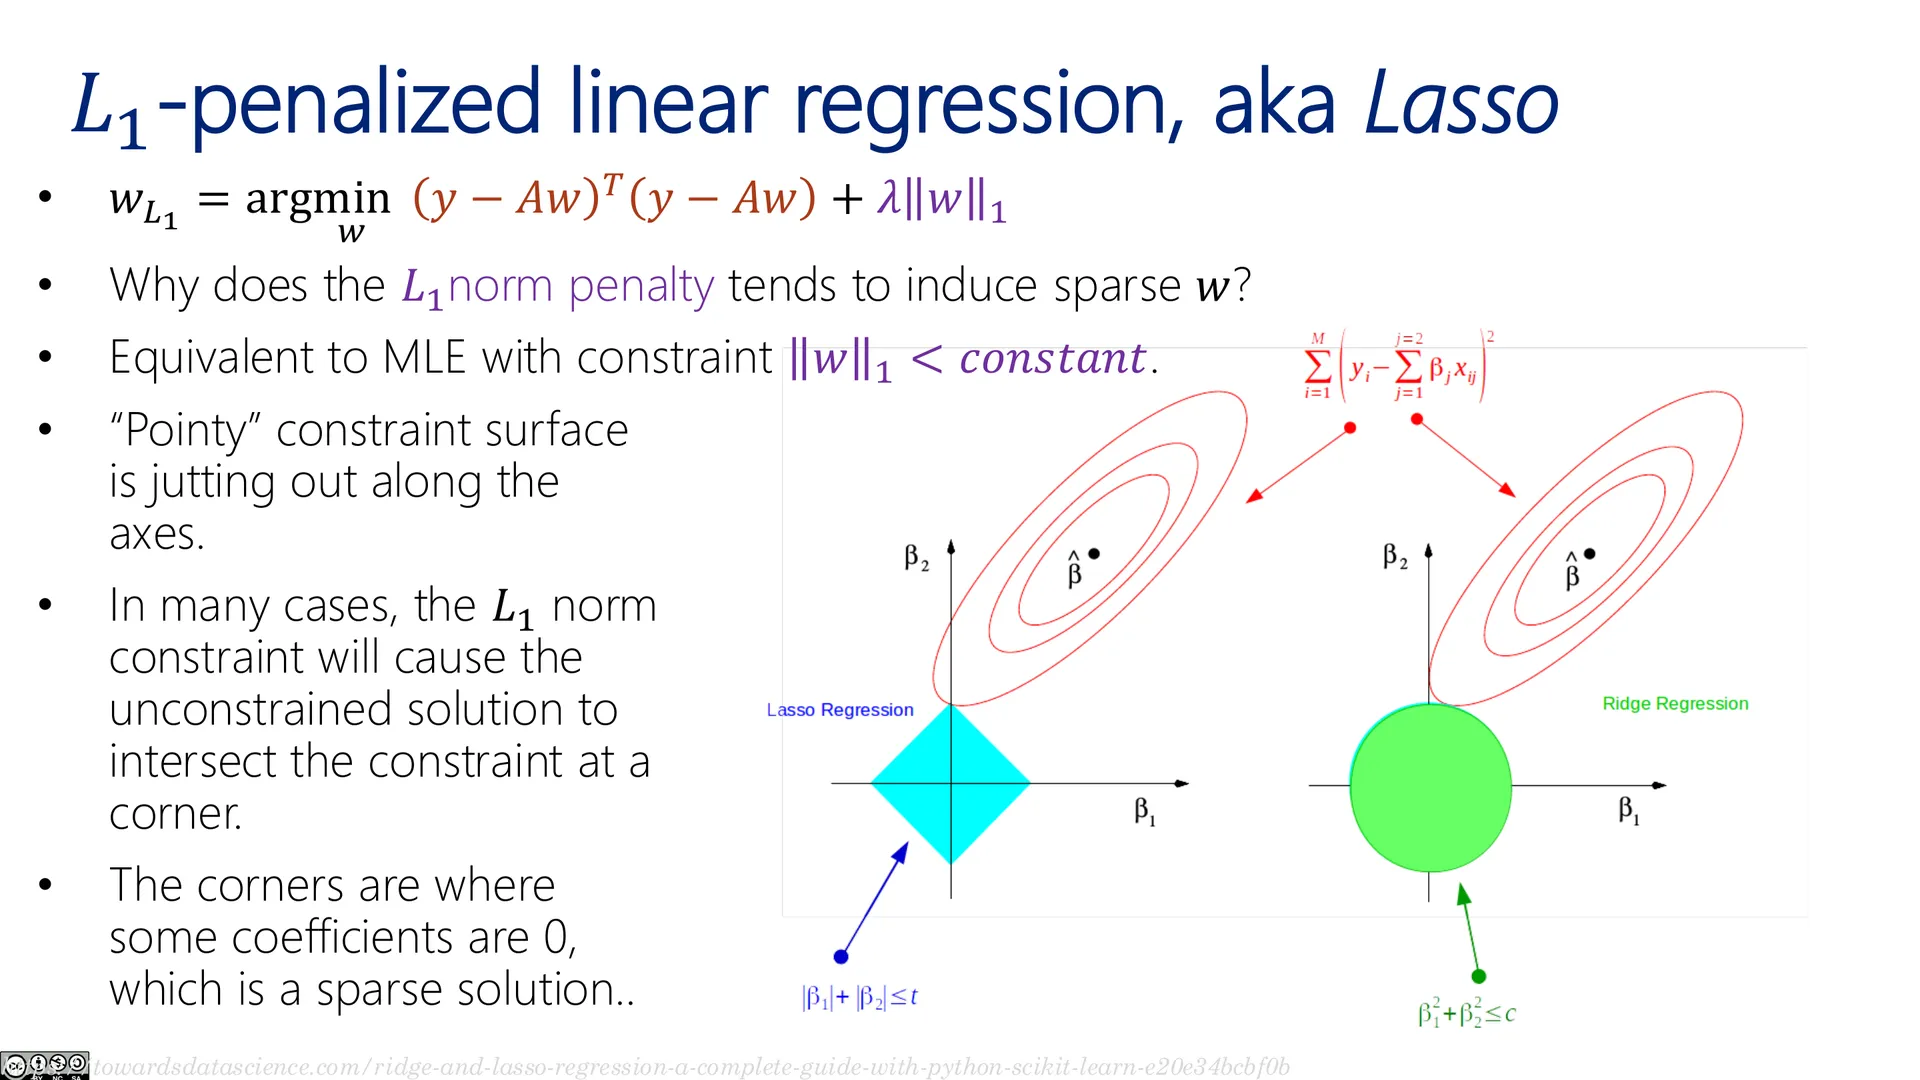
🖼️ L1 惩罚线性回归(Lasso)(二)
🖼️ Lasso 的几何
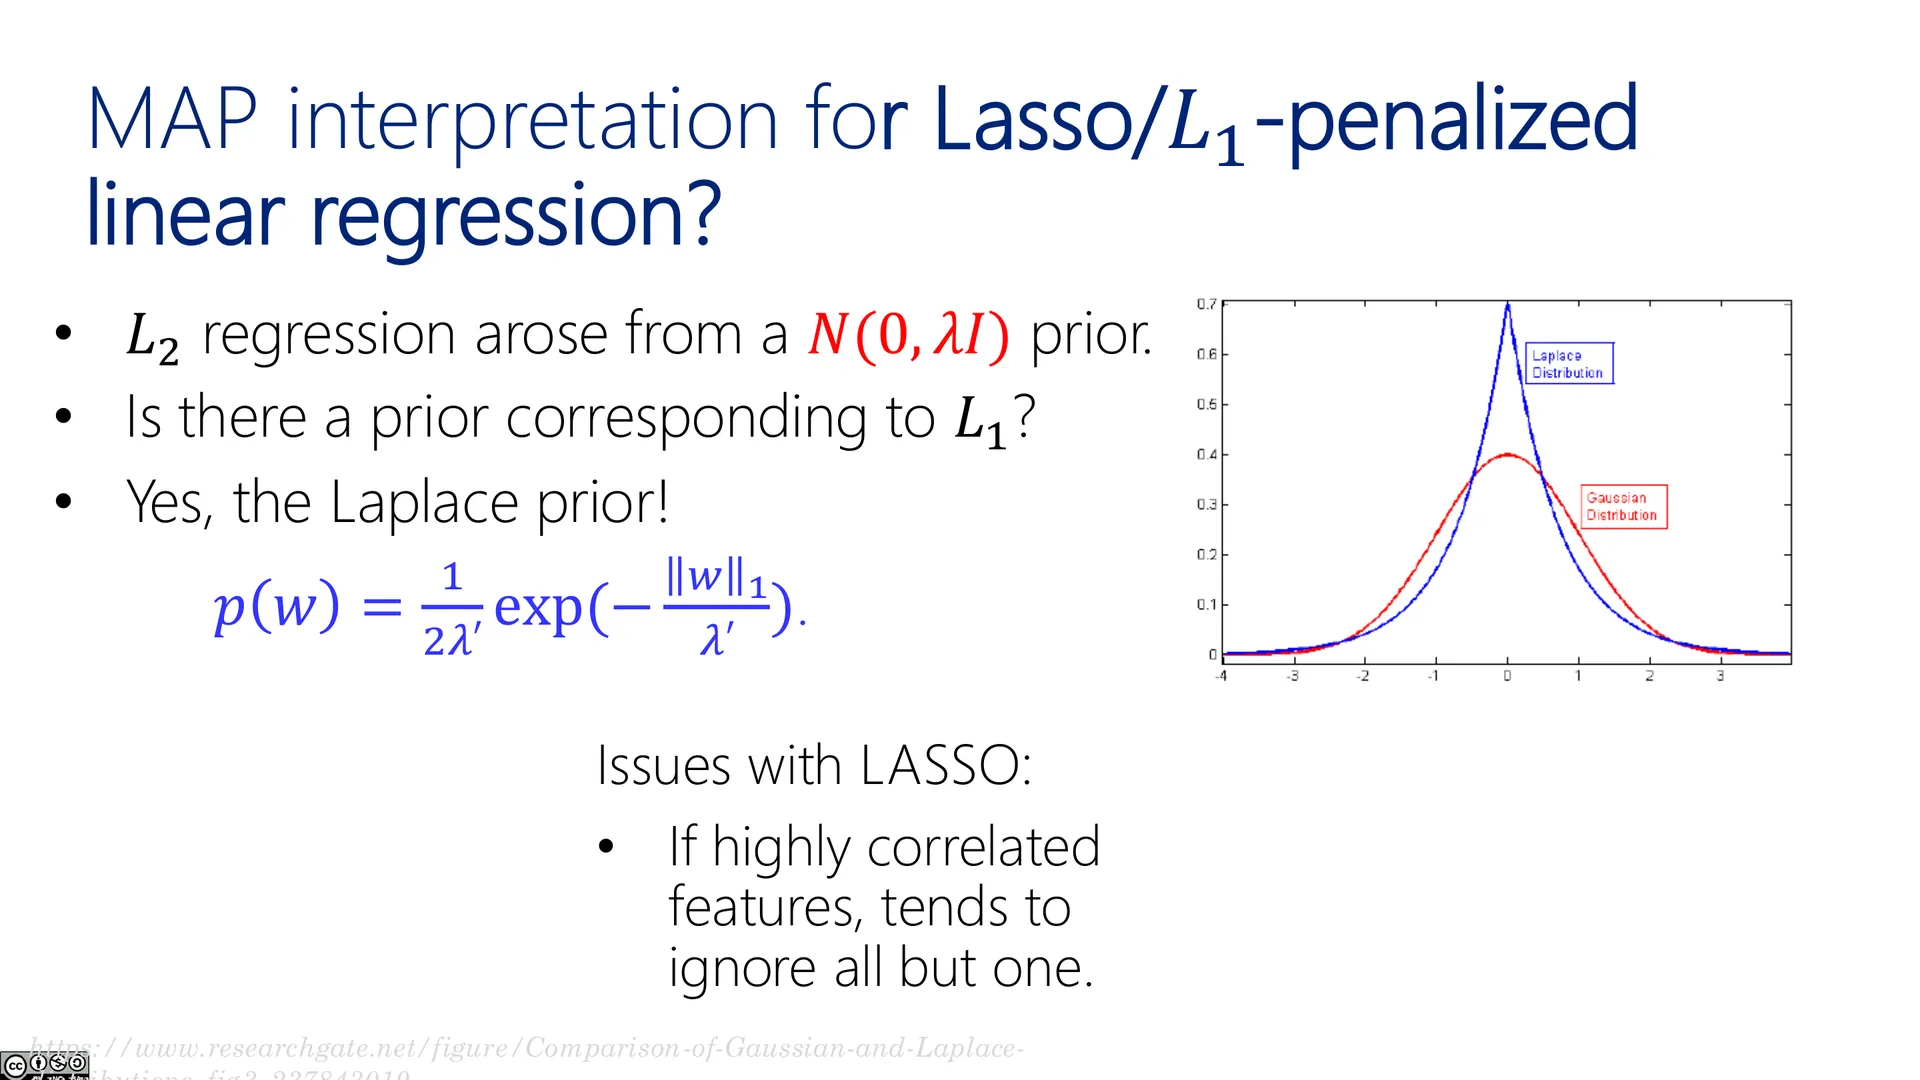
🖼️ Lasso/L1 的 MAP 解释
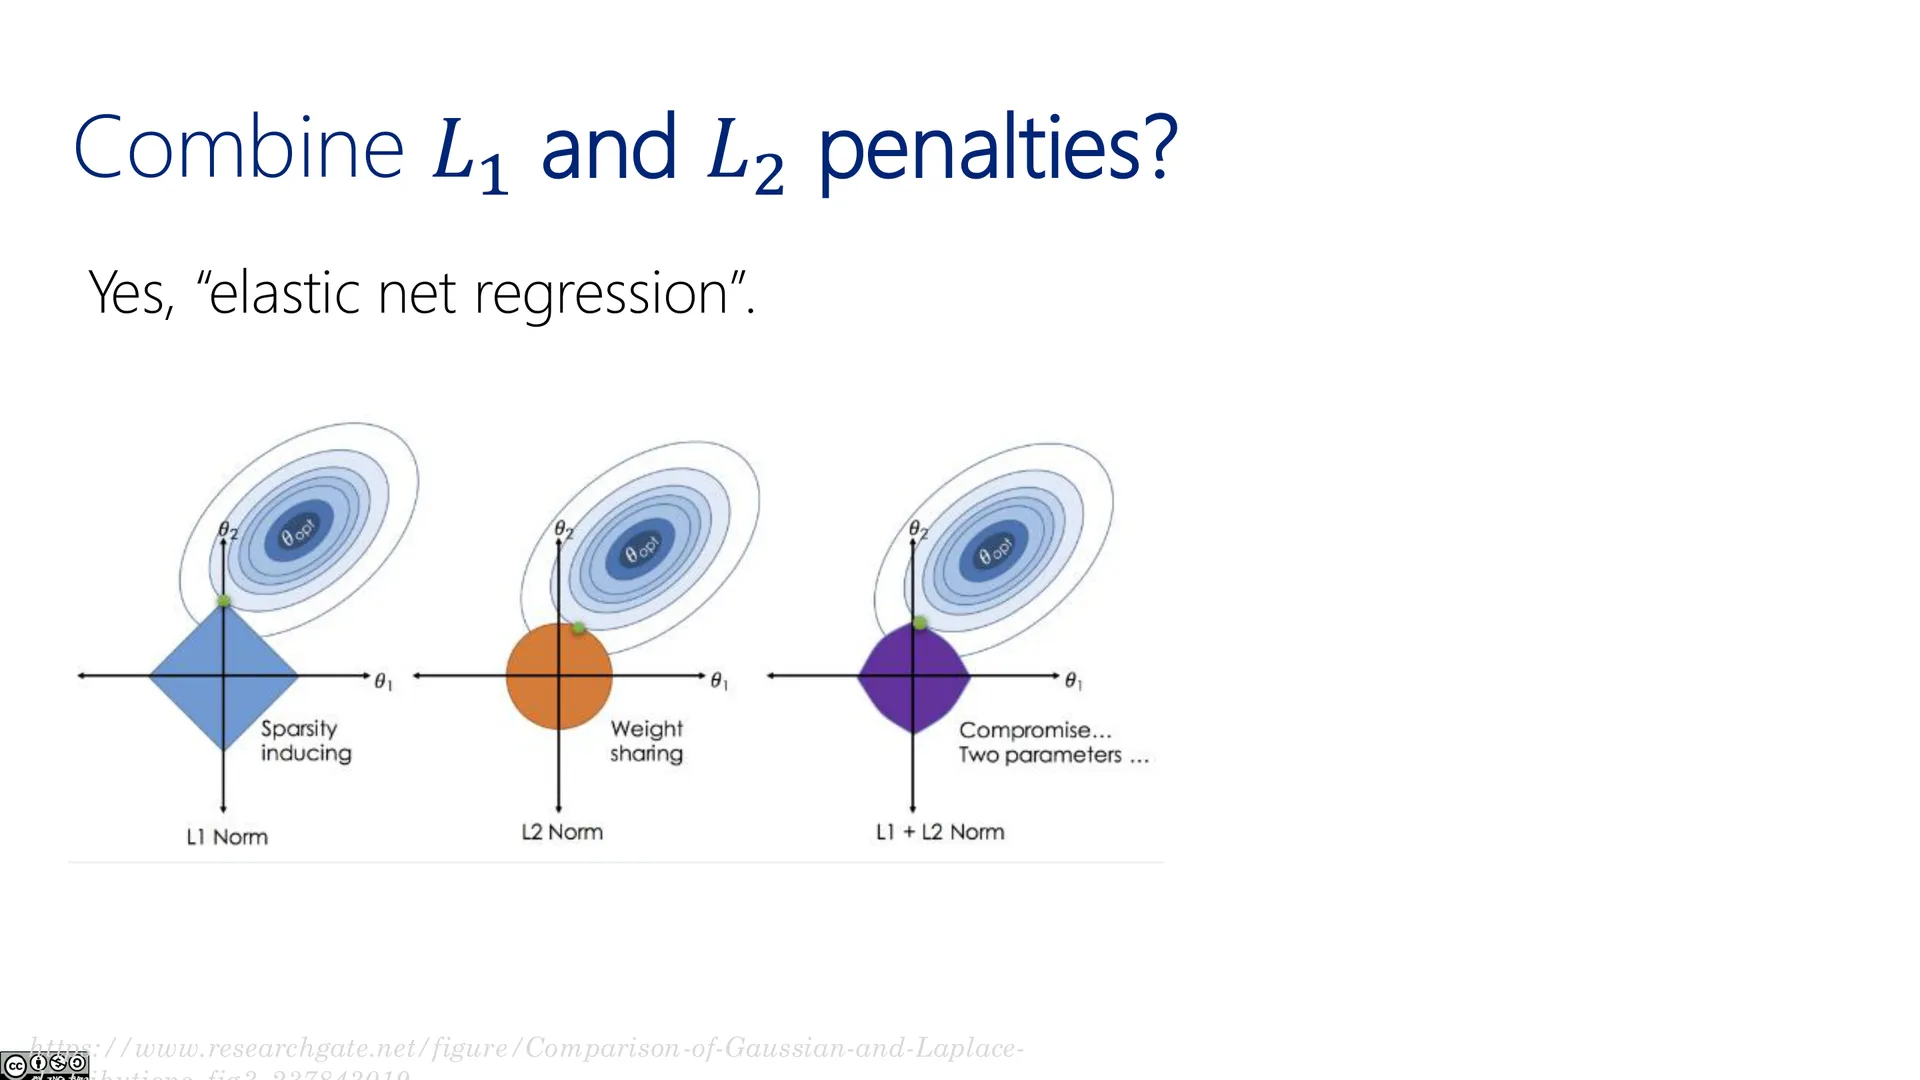
🖼️ 组合 L1 与 L2 惩罚
🖼️ 延伸阅读幻灯片
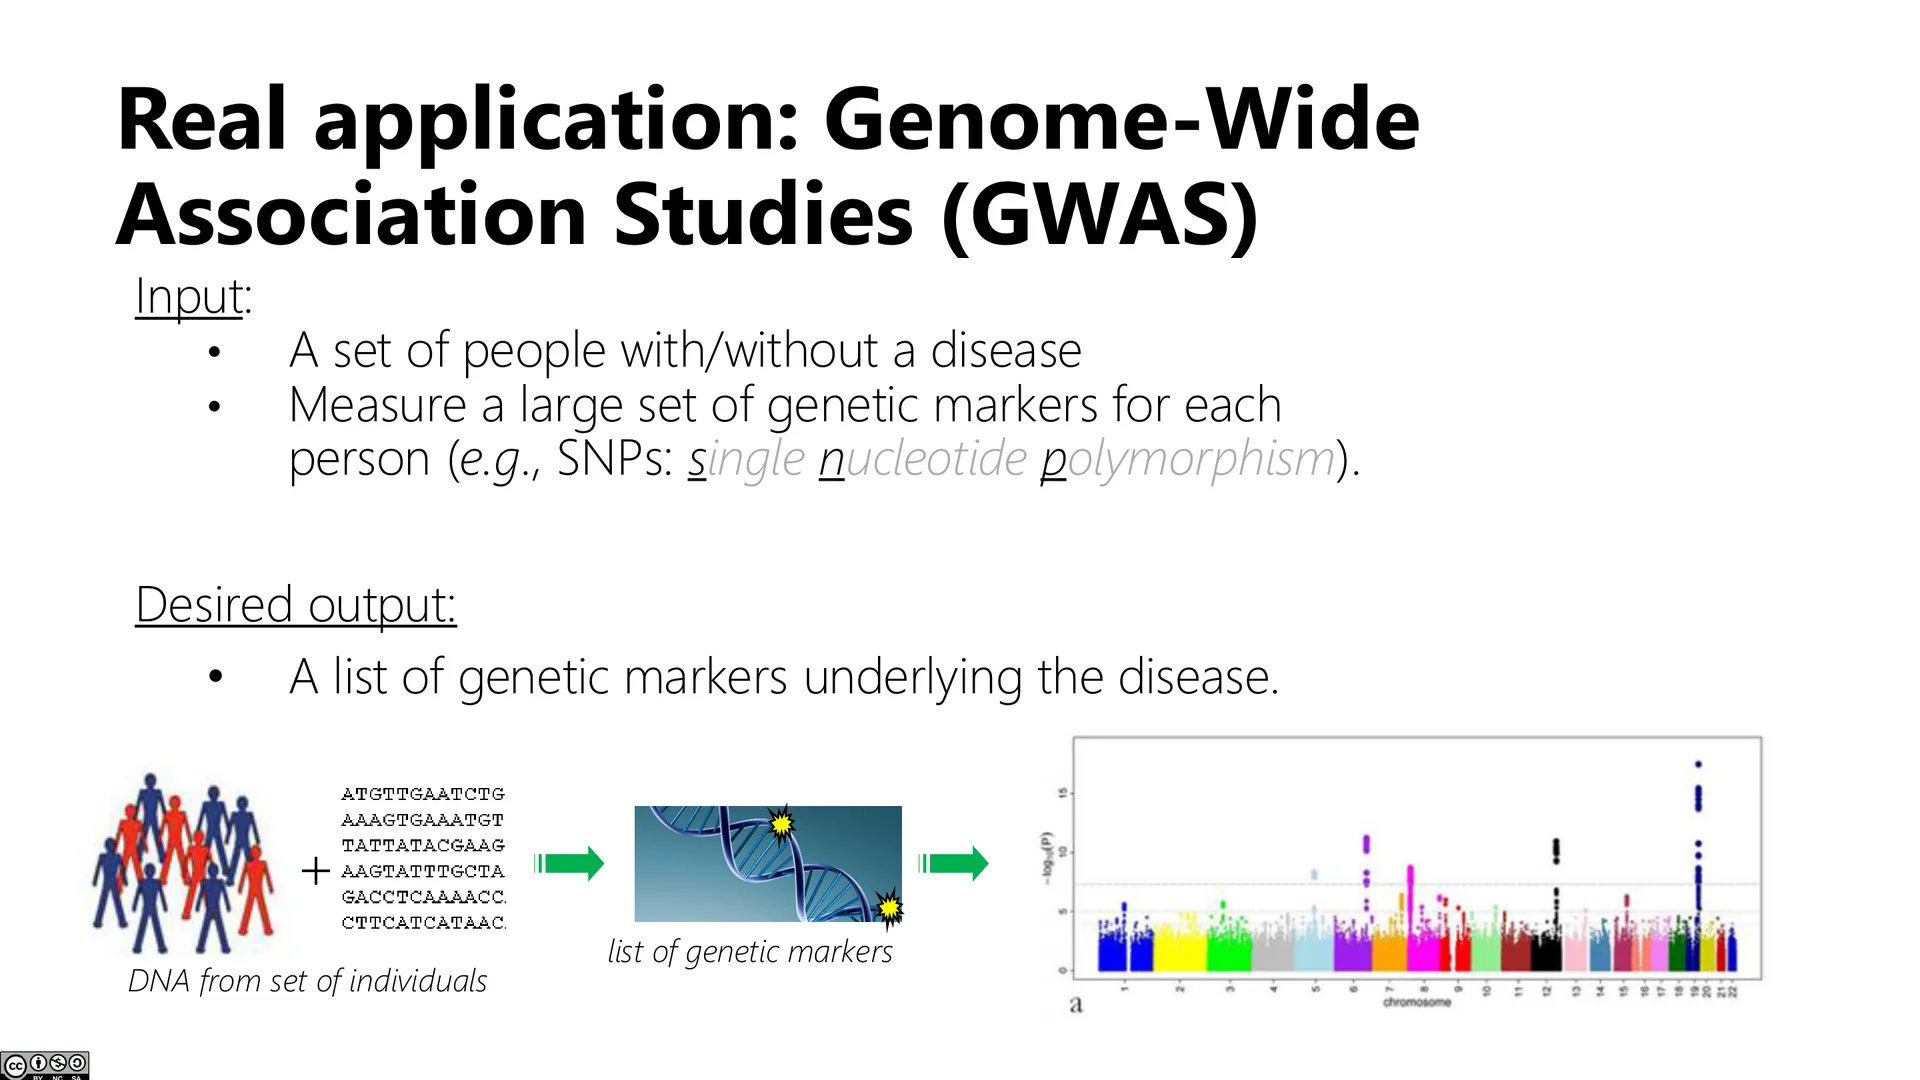
🖼️ 真实应用:全基因组关联分析
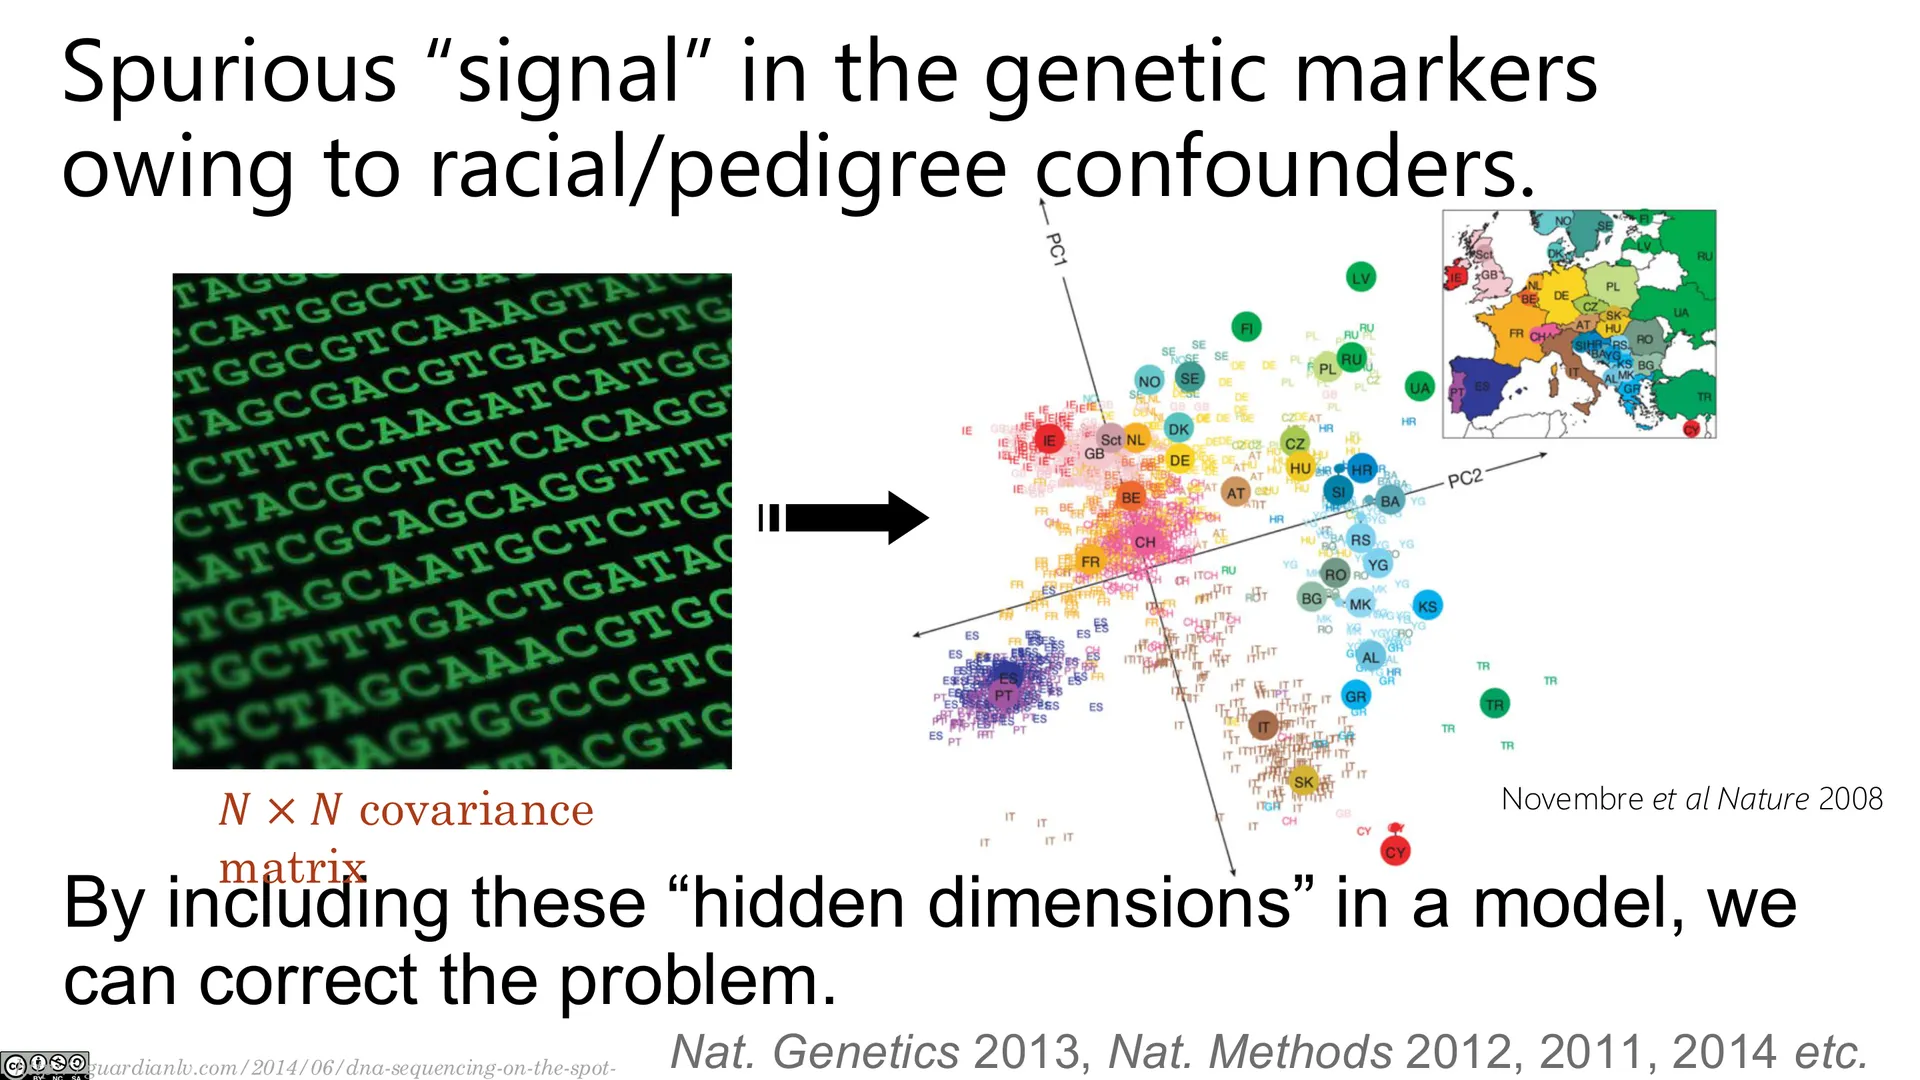
🖼️ Novembre et al., Nature 2008
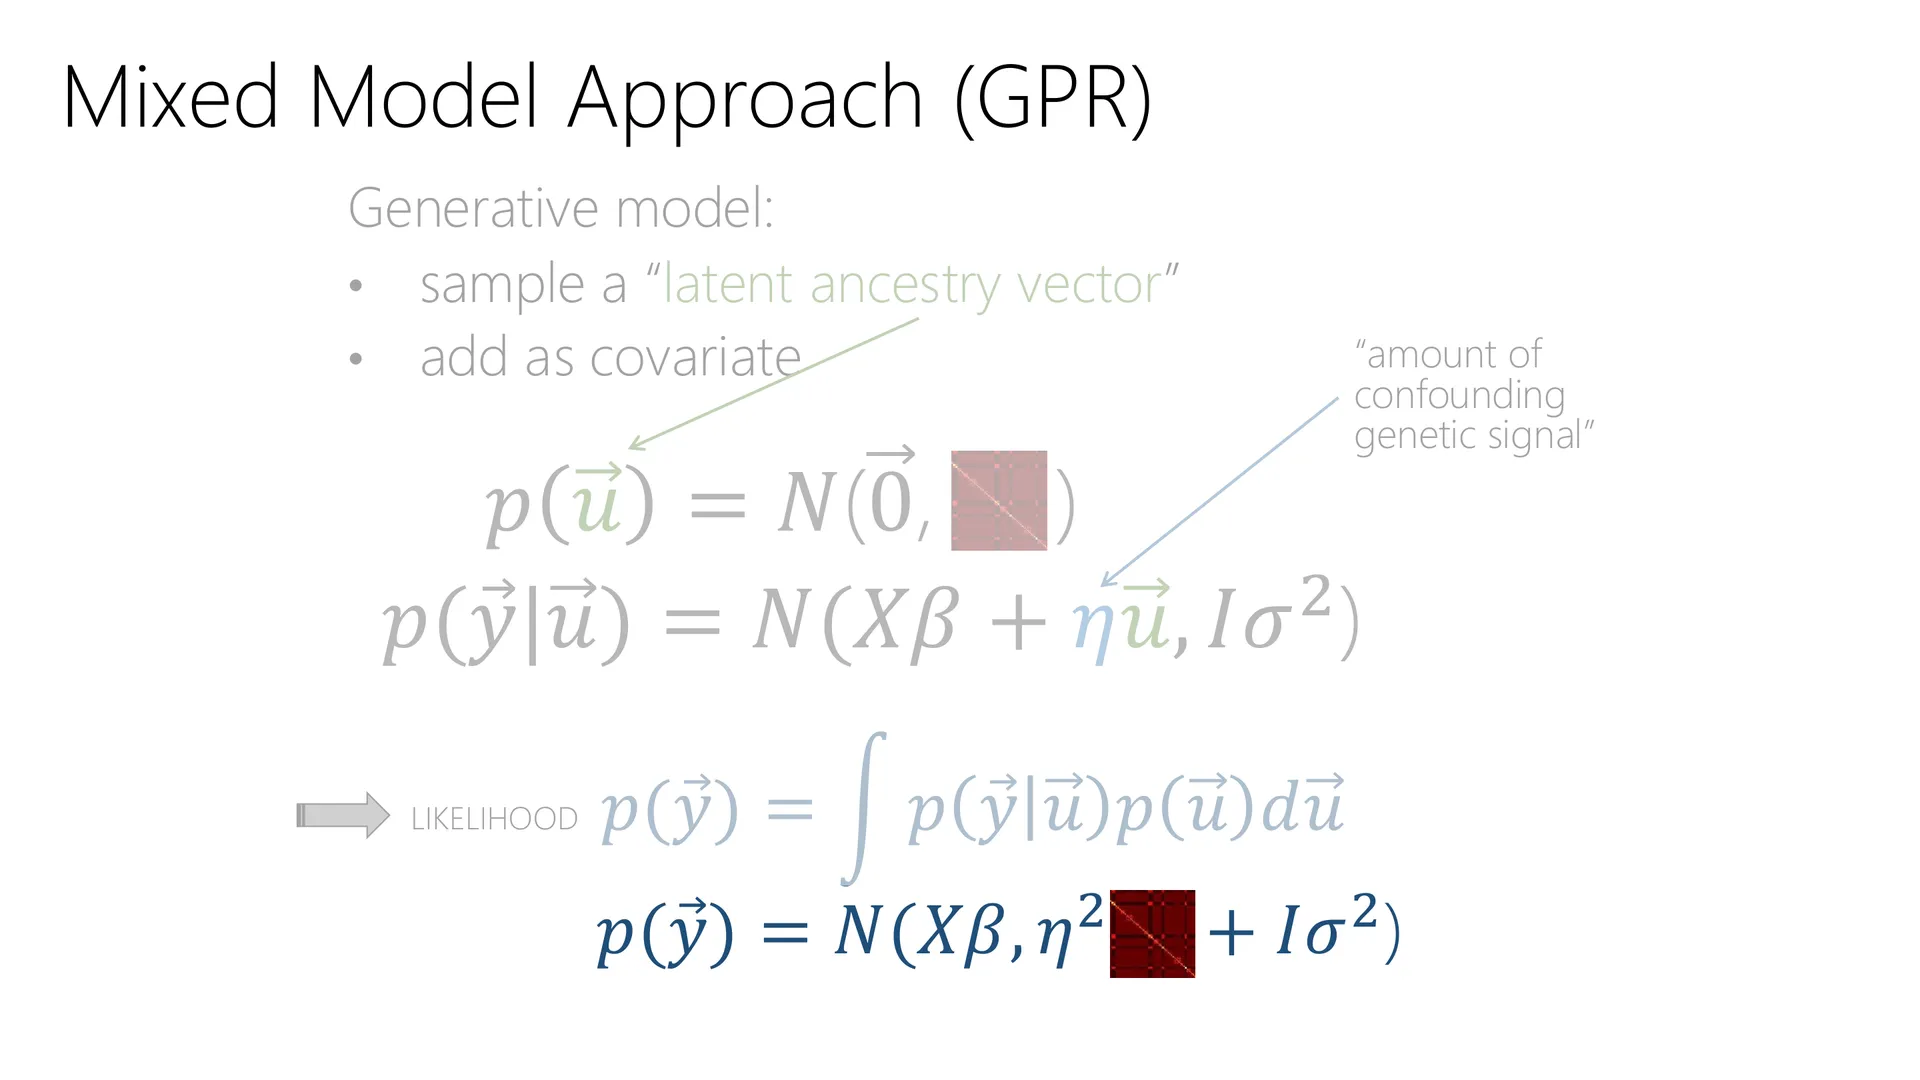
🖼️ 生成模型
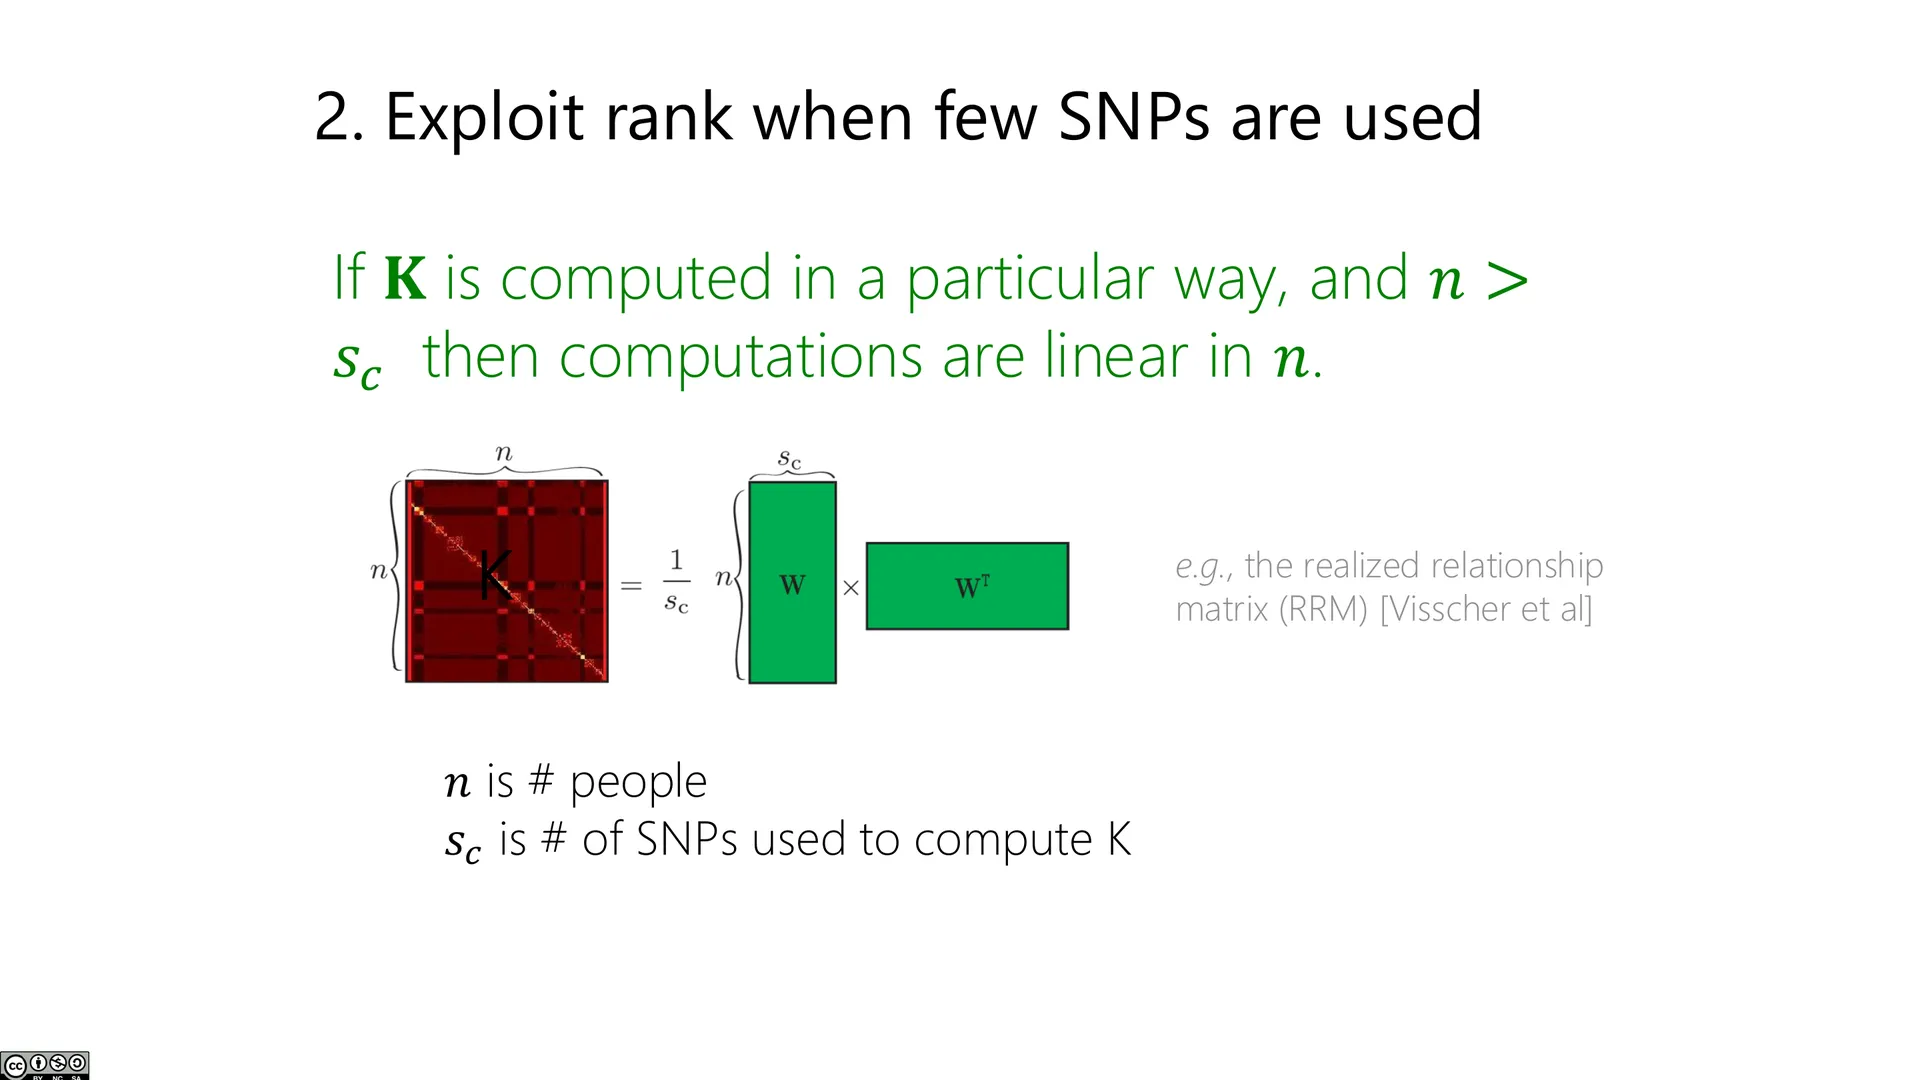
🖼️ 实现的相关矩阵
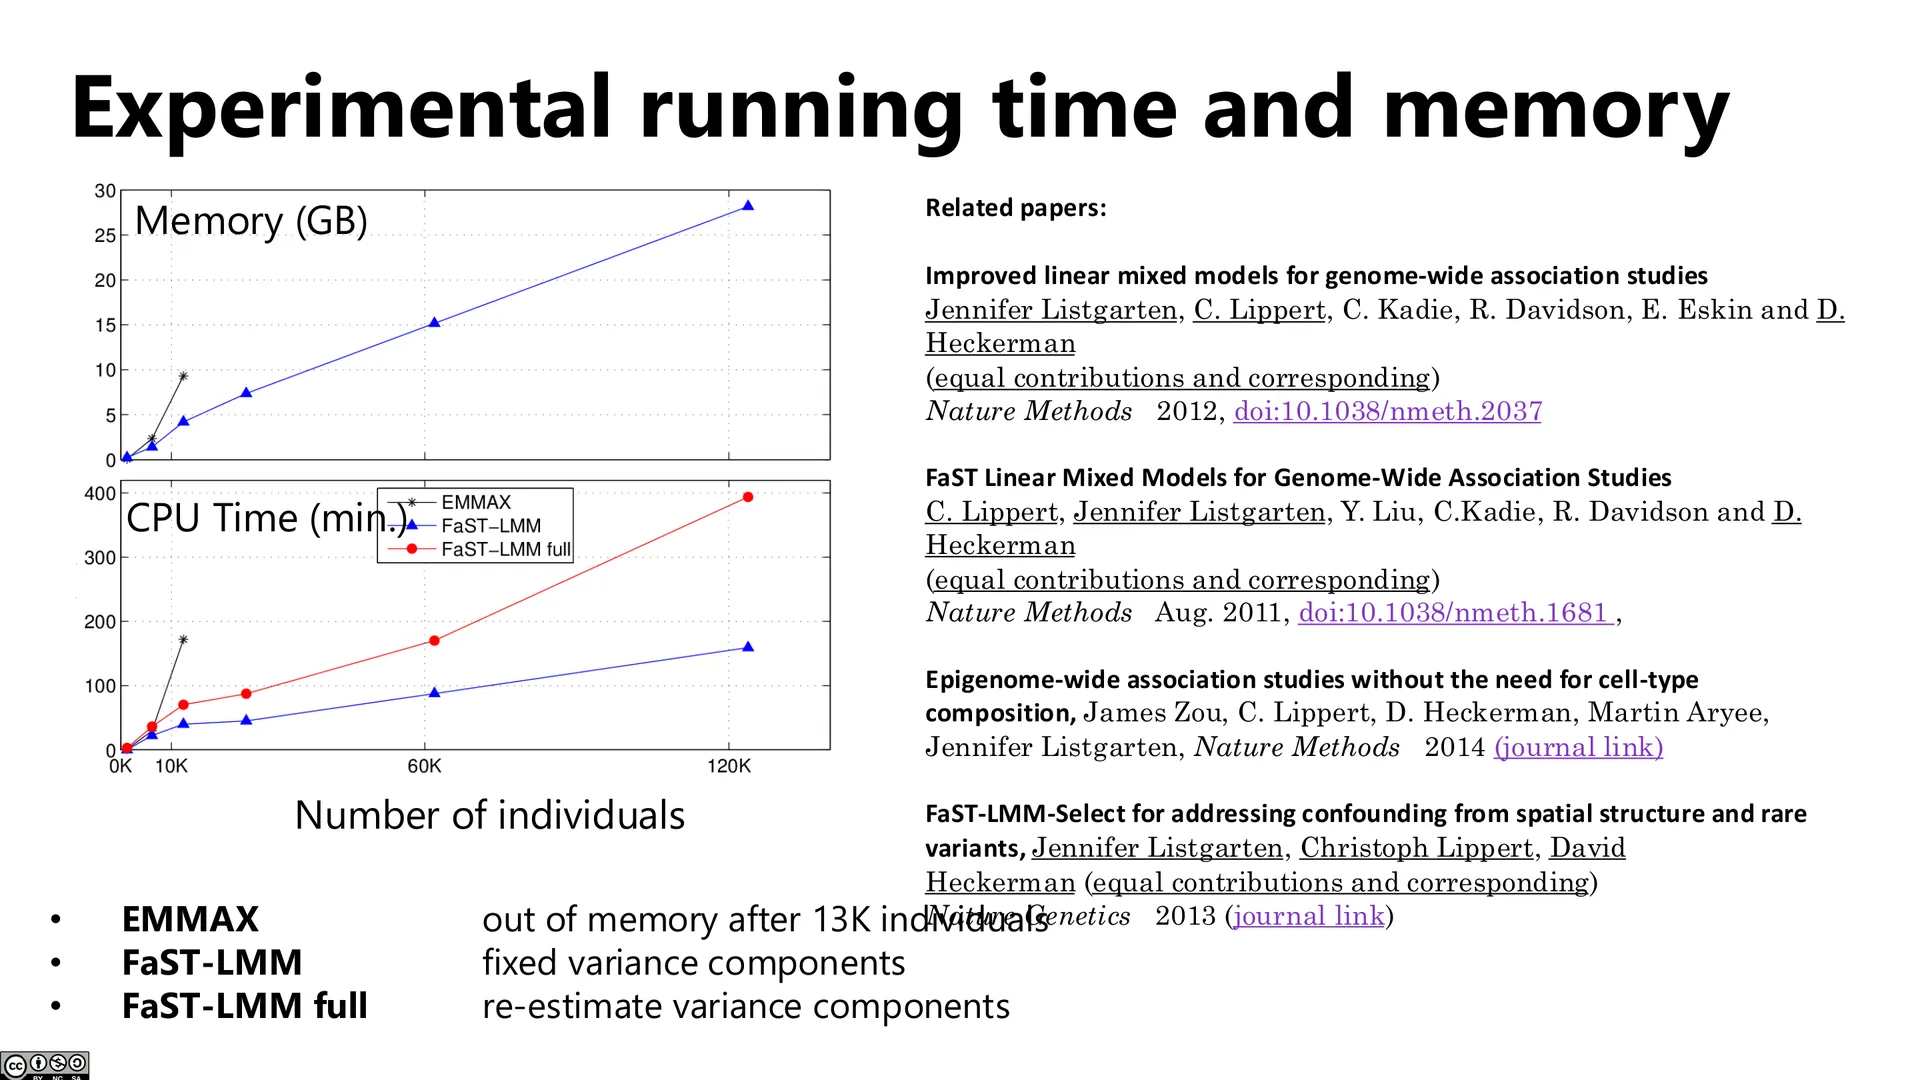
🖼️ 实验运行时间与内存
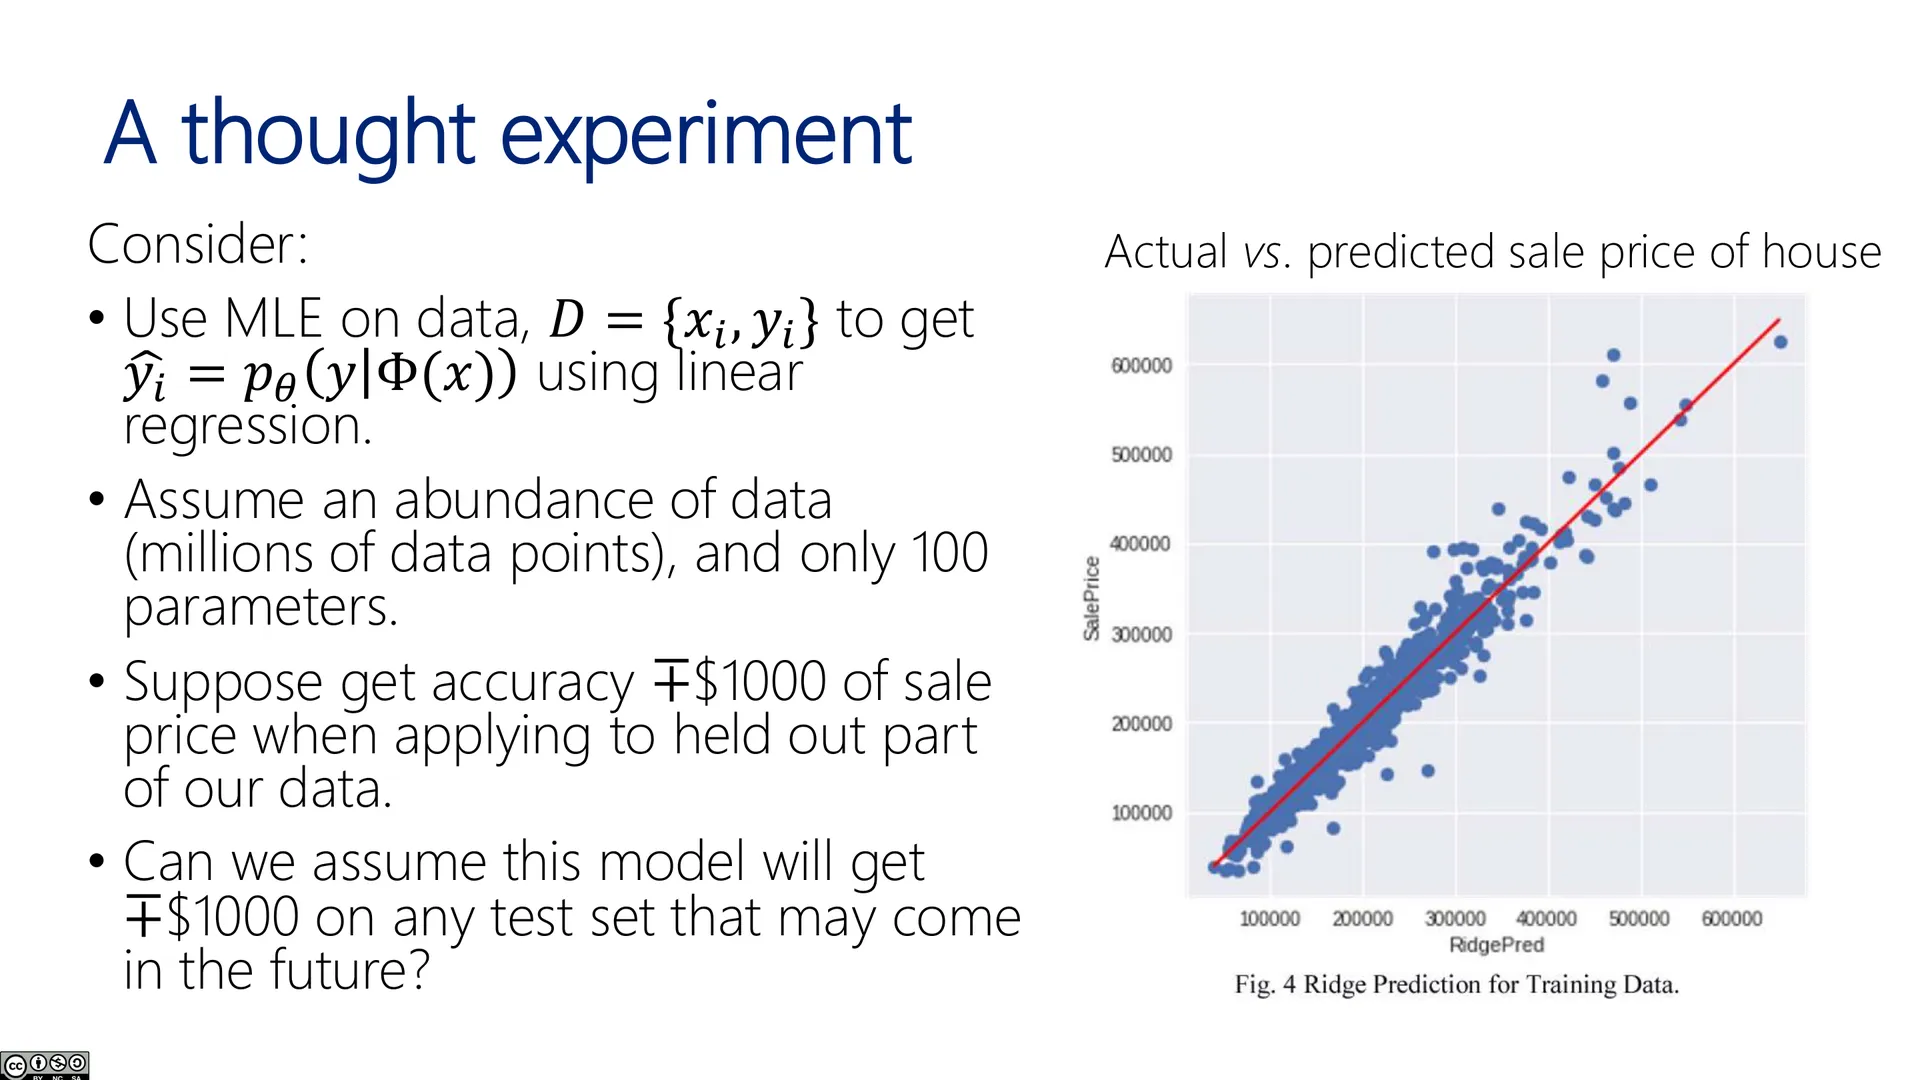
🖼️ 一个思想实验
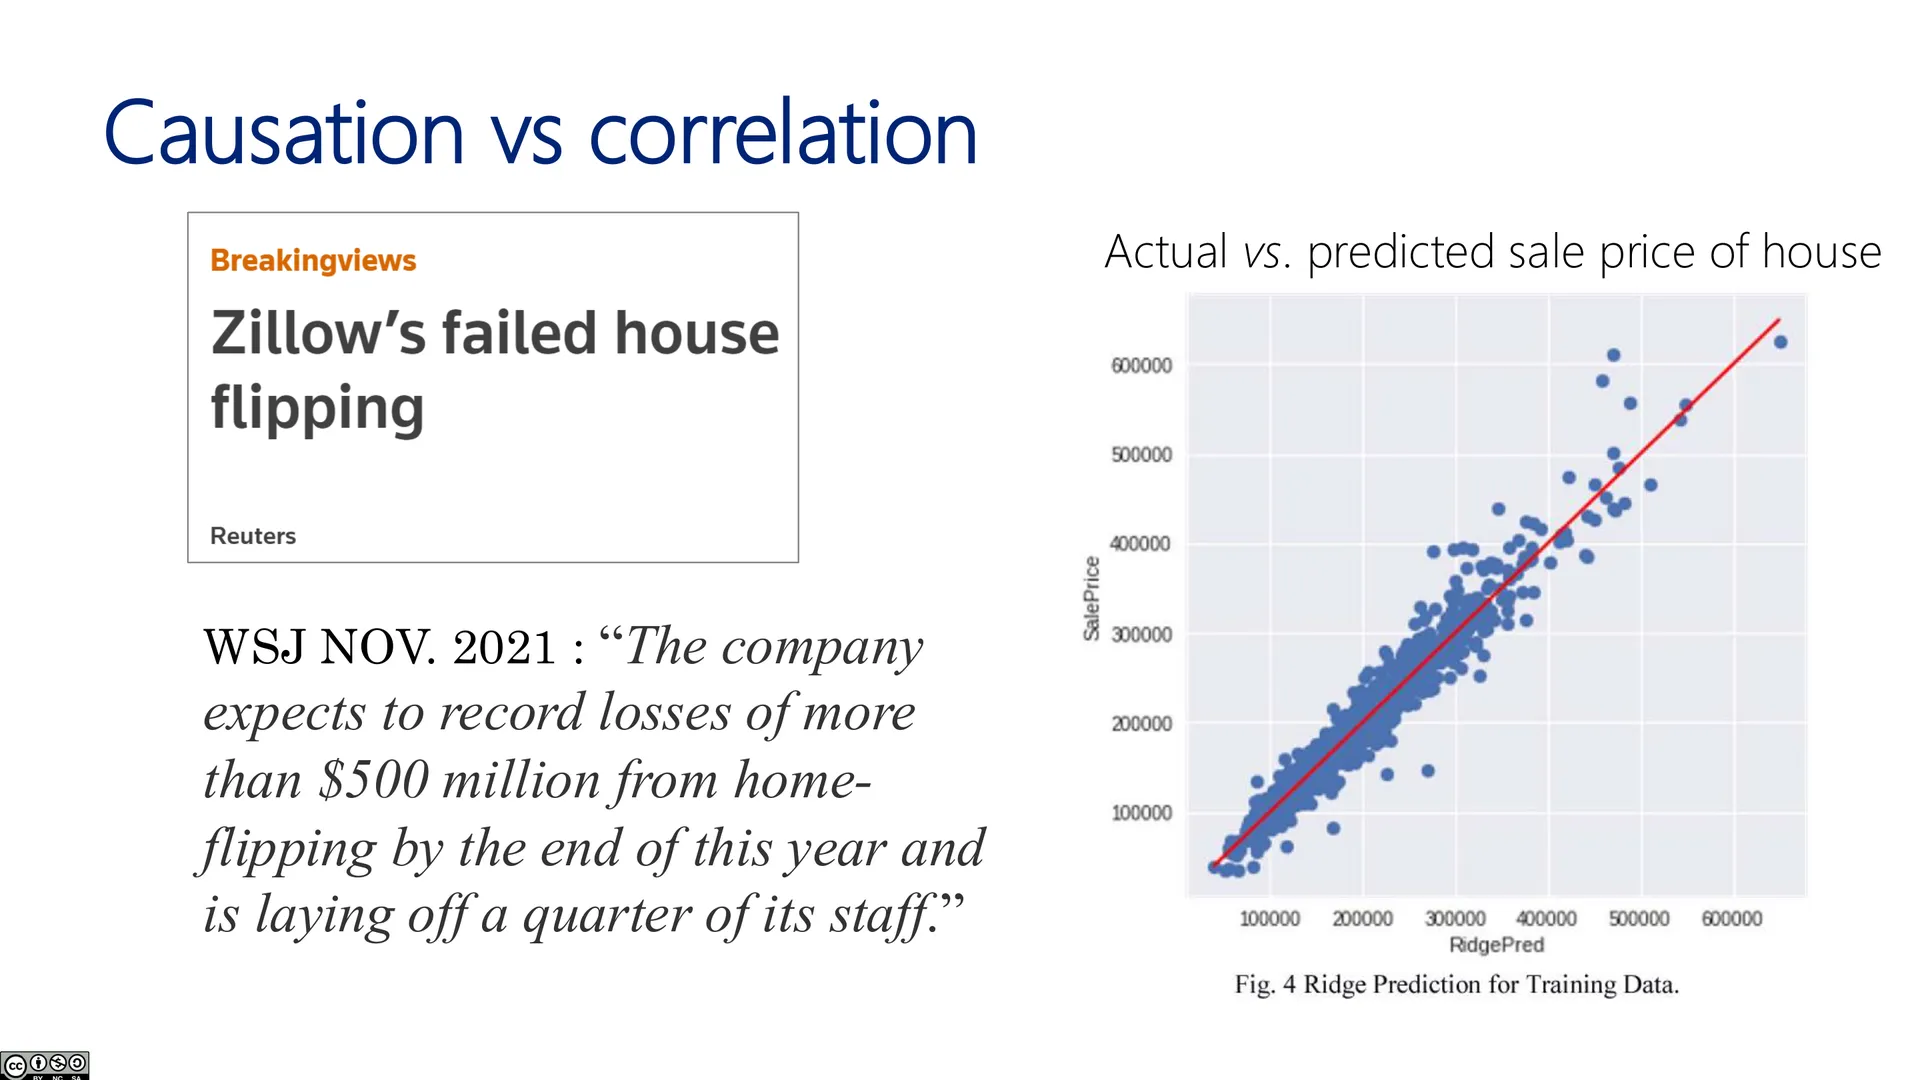
🖼️ 因果 vs 相关
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=202aSB1p8do |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 8) | Google Drive PDF |
| 教材 Machine Learning: A First Course for Engineers and Scientists | 线性回归、基函数、正则化、MAP 相关章节 · https://doi.org/10.1017/9781108919371 |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。