第10讲 · EECS 189:线性回归与正则化(续)
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | Finish Linear Regression & Regularization |
| 视频 | https://www.youtube.com/watch?v=SlkUTrXY60E |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 10) | Google Drive PDF |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第10讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
编者说明:本讲 deck 共 98 页,但课堂在「正则化 / 分布漂移」处结束,分类(Generative vs Discriminative、Gaussian Discriminant Analysis、LDA vs Logistic)部分(第 26–98 页)留到后续讲次,全部收录于文末附录。
本讲路线图
(参考时间: 00:00)
- 完成正则化:条件数视角、L1/Lasso 与稀疏性;
- 讨论评估度量(似然、MSE/RMSE/R²/MAE)与训练/验证/测试;
- 一个关于分布漂移与因果的思想实验。
📷 标题页
回到原视频 (00:00:10)
📷 路线图
回到原视频 (00:00:50)
一、复杂度与过拟合
(参考时间: 00:01)
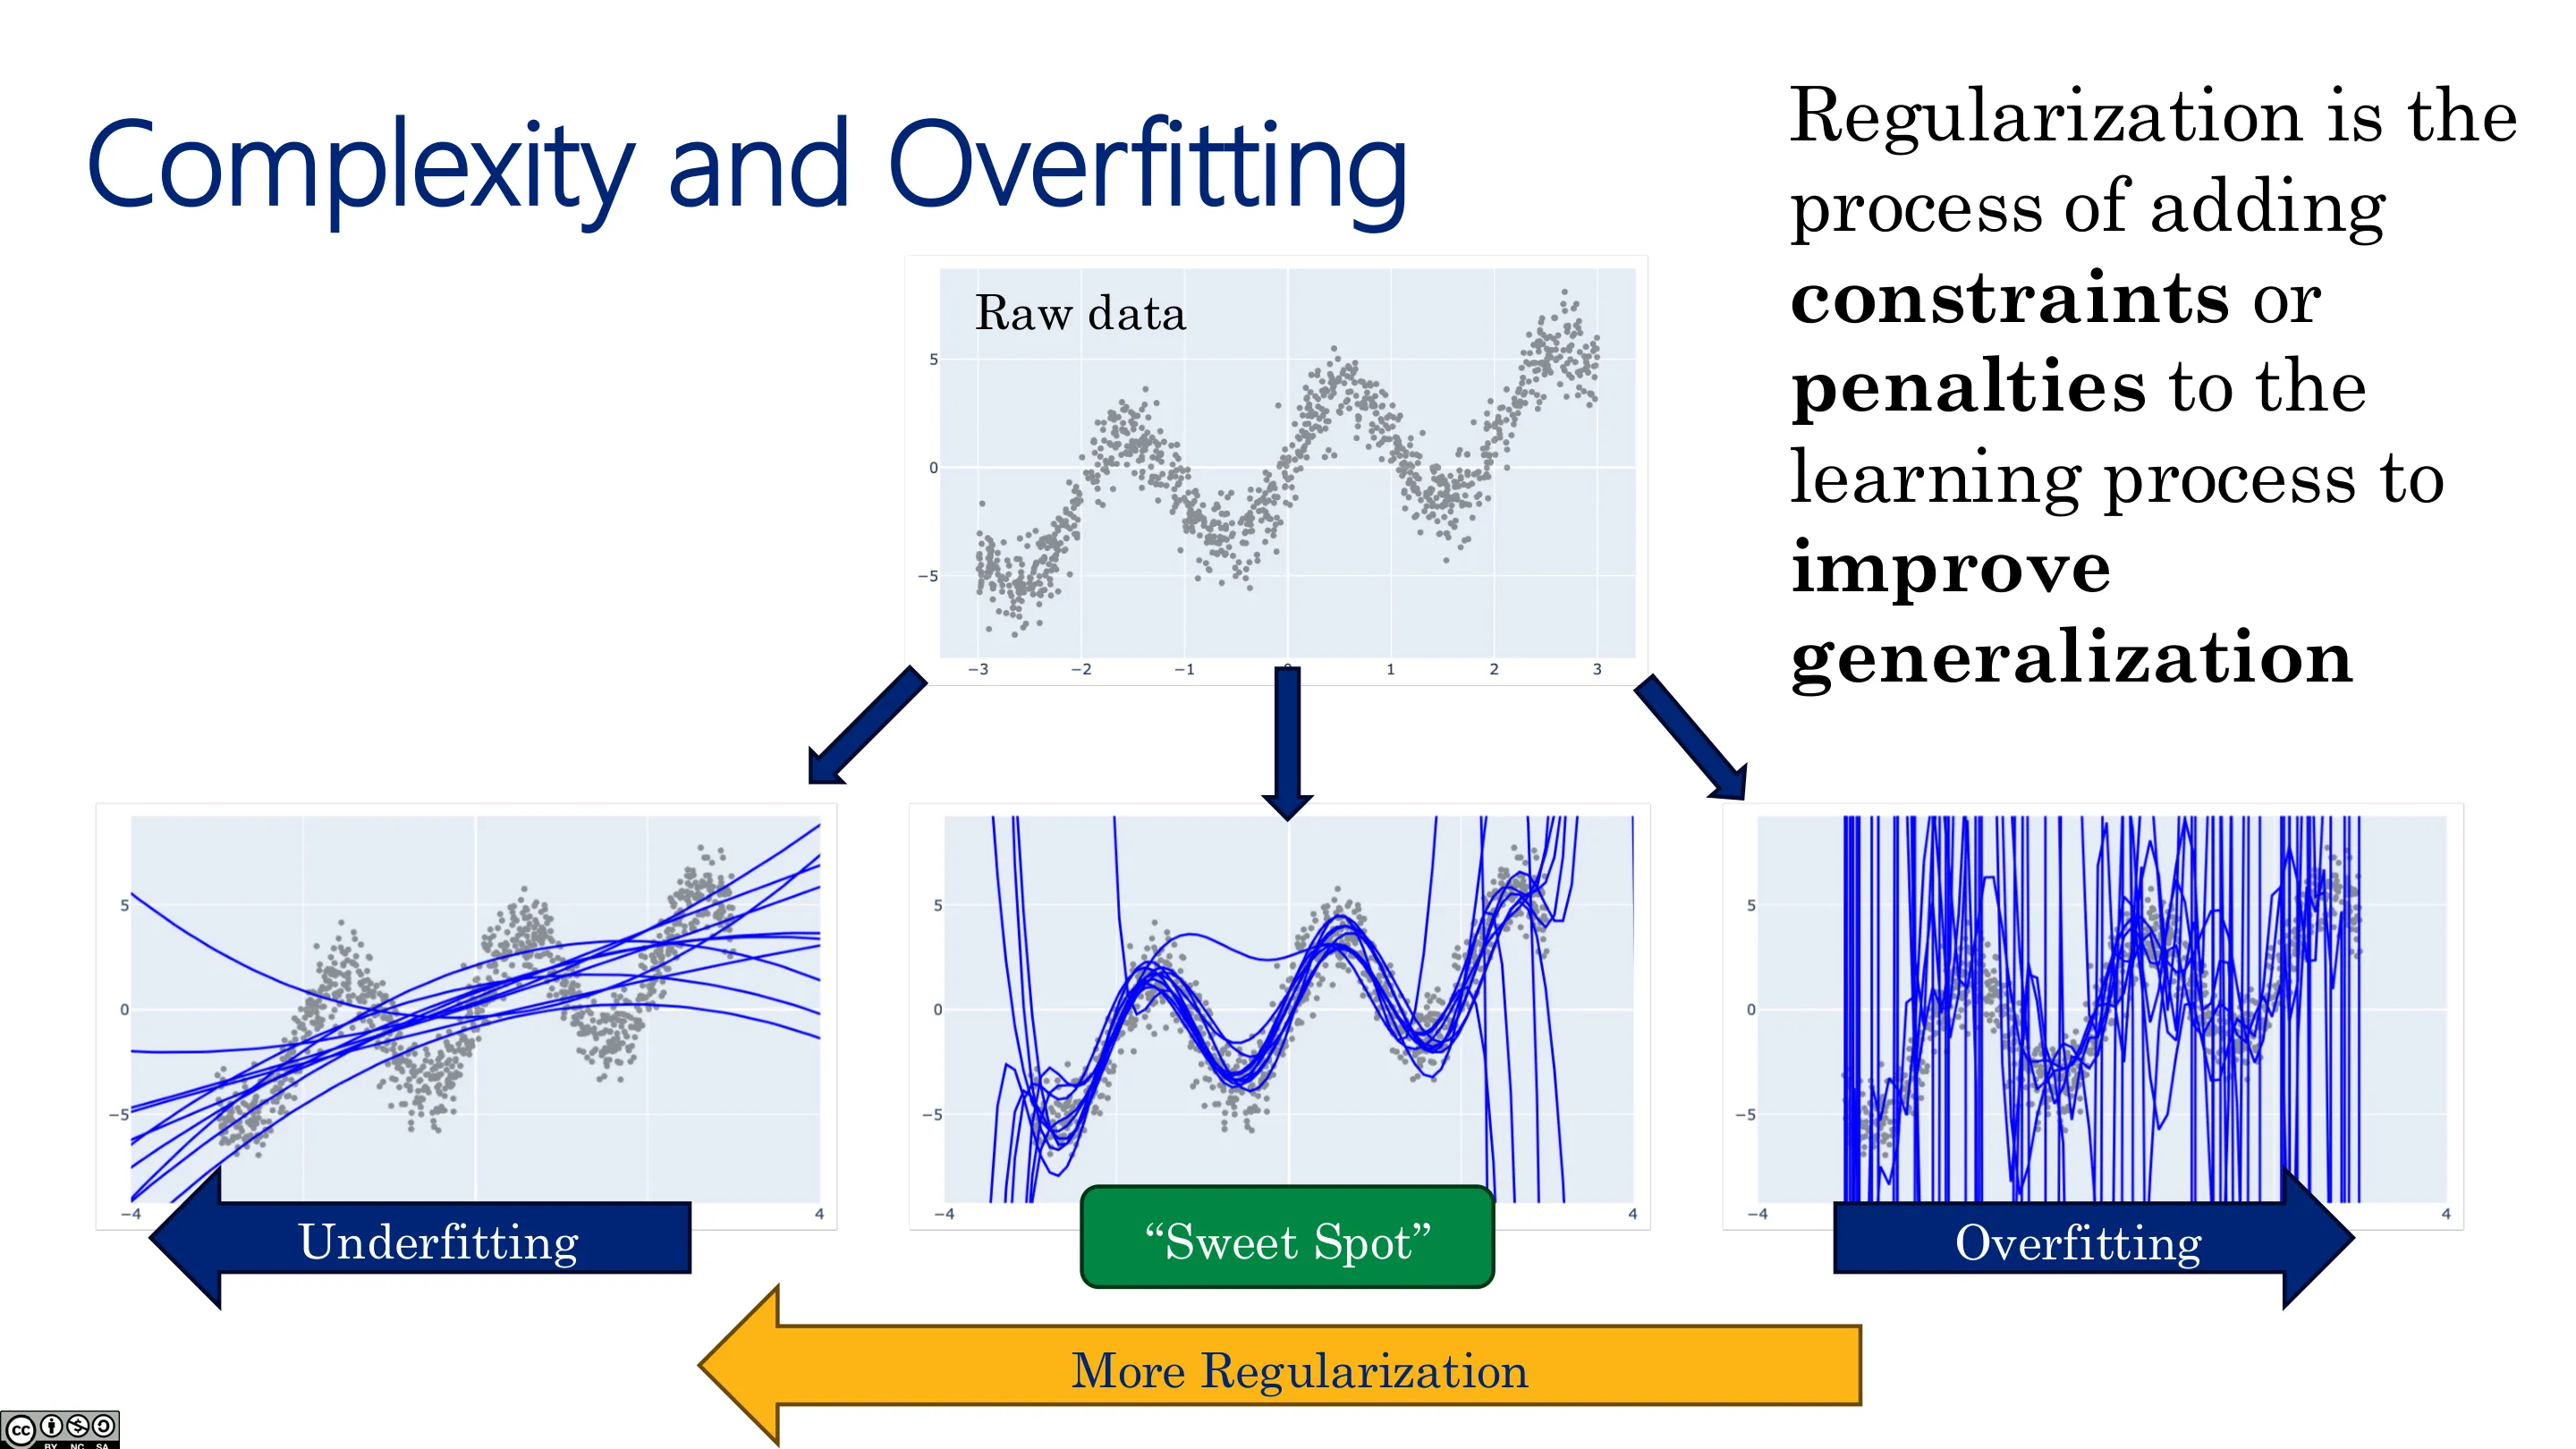
线性回归模型的复杂度取决于特征扩展的方式(如多项式展开的阶数);神经网络里则取决于宽度与深度。所有模型都有一个「容量 / 丰富度(capacity)」的概念——模型能有多弯曲。容量过大 ⇒ 弯曲到穿过每个带噪声的点(过拟合)。
📷 复杂度与过拟合
回到原视频 (00:01:00)
📷 上节回顾(一)
回到原视频 (00:04:17)
📷 上节回顾(二):正则化减少自由度
回到原视频 (00:05:19)
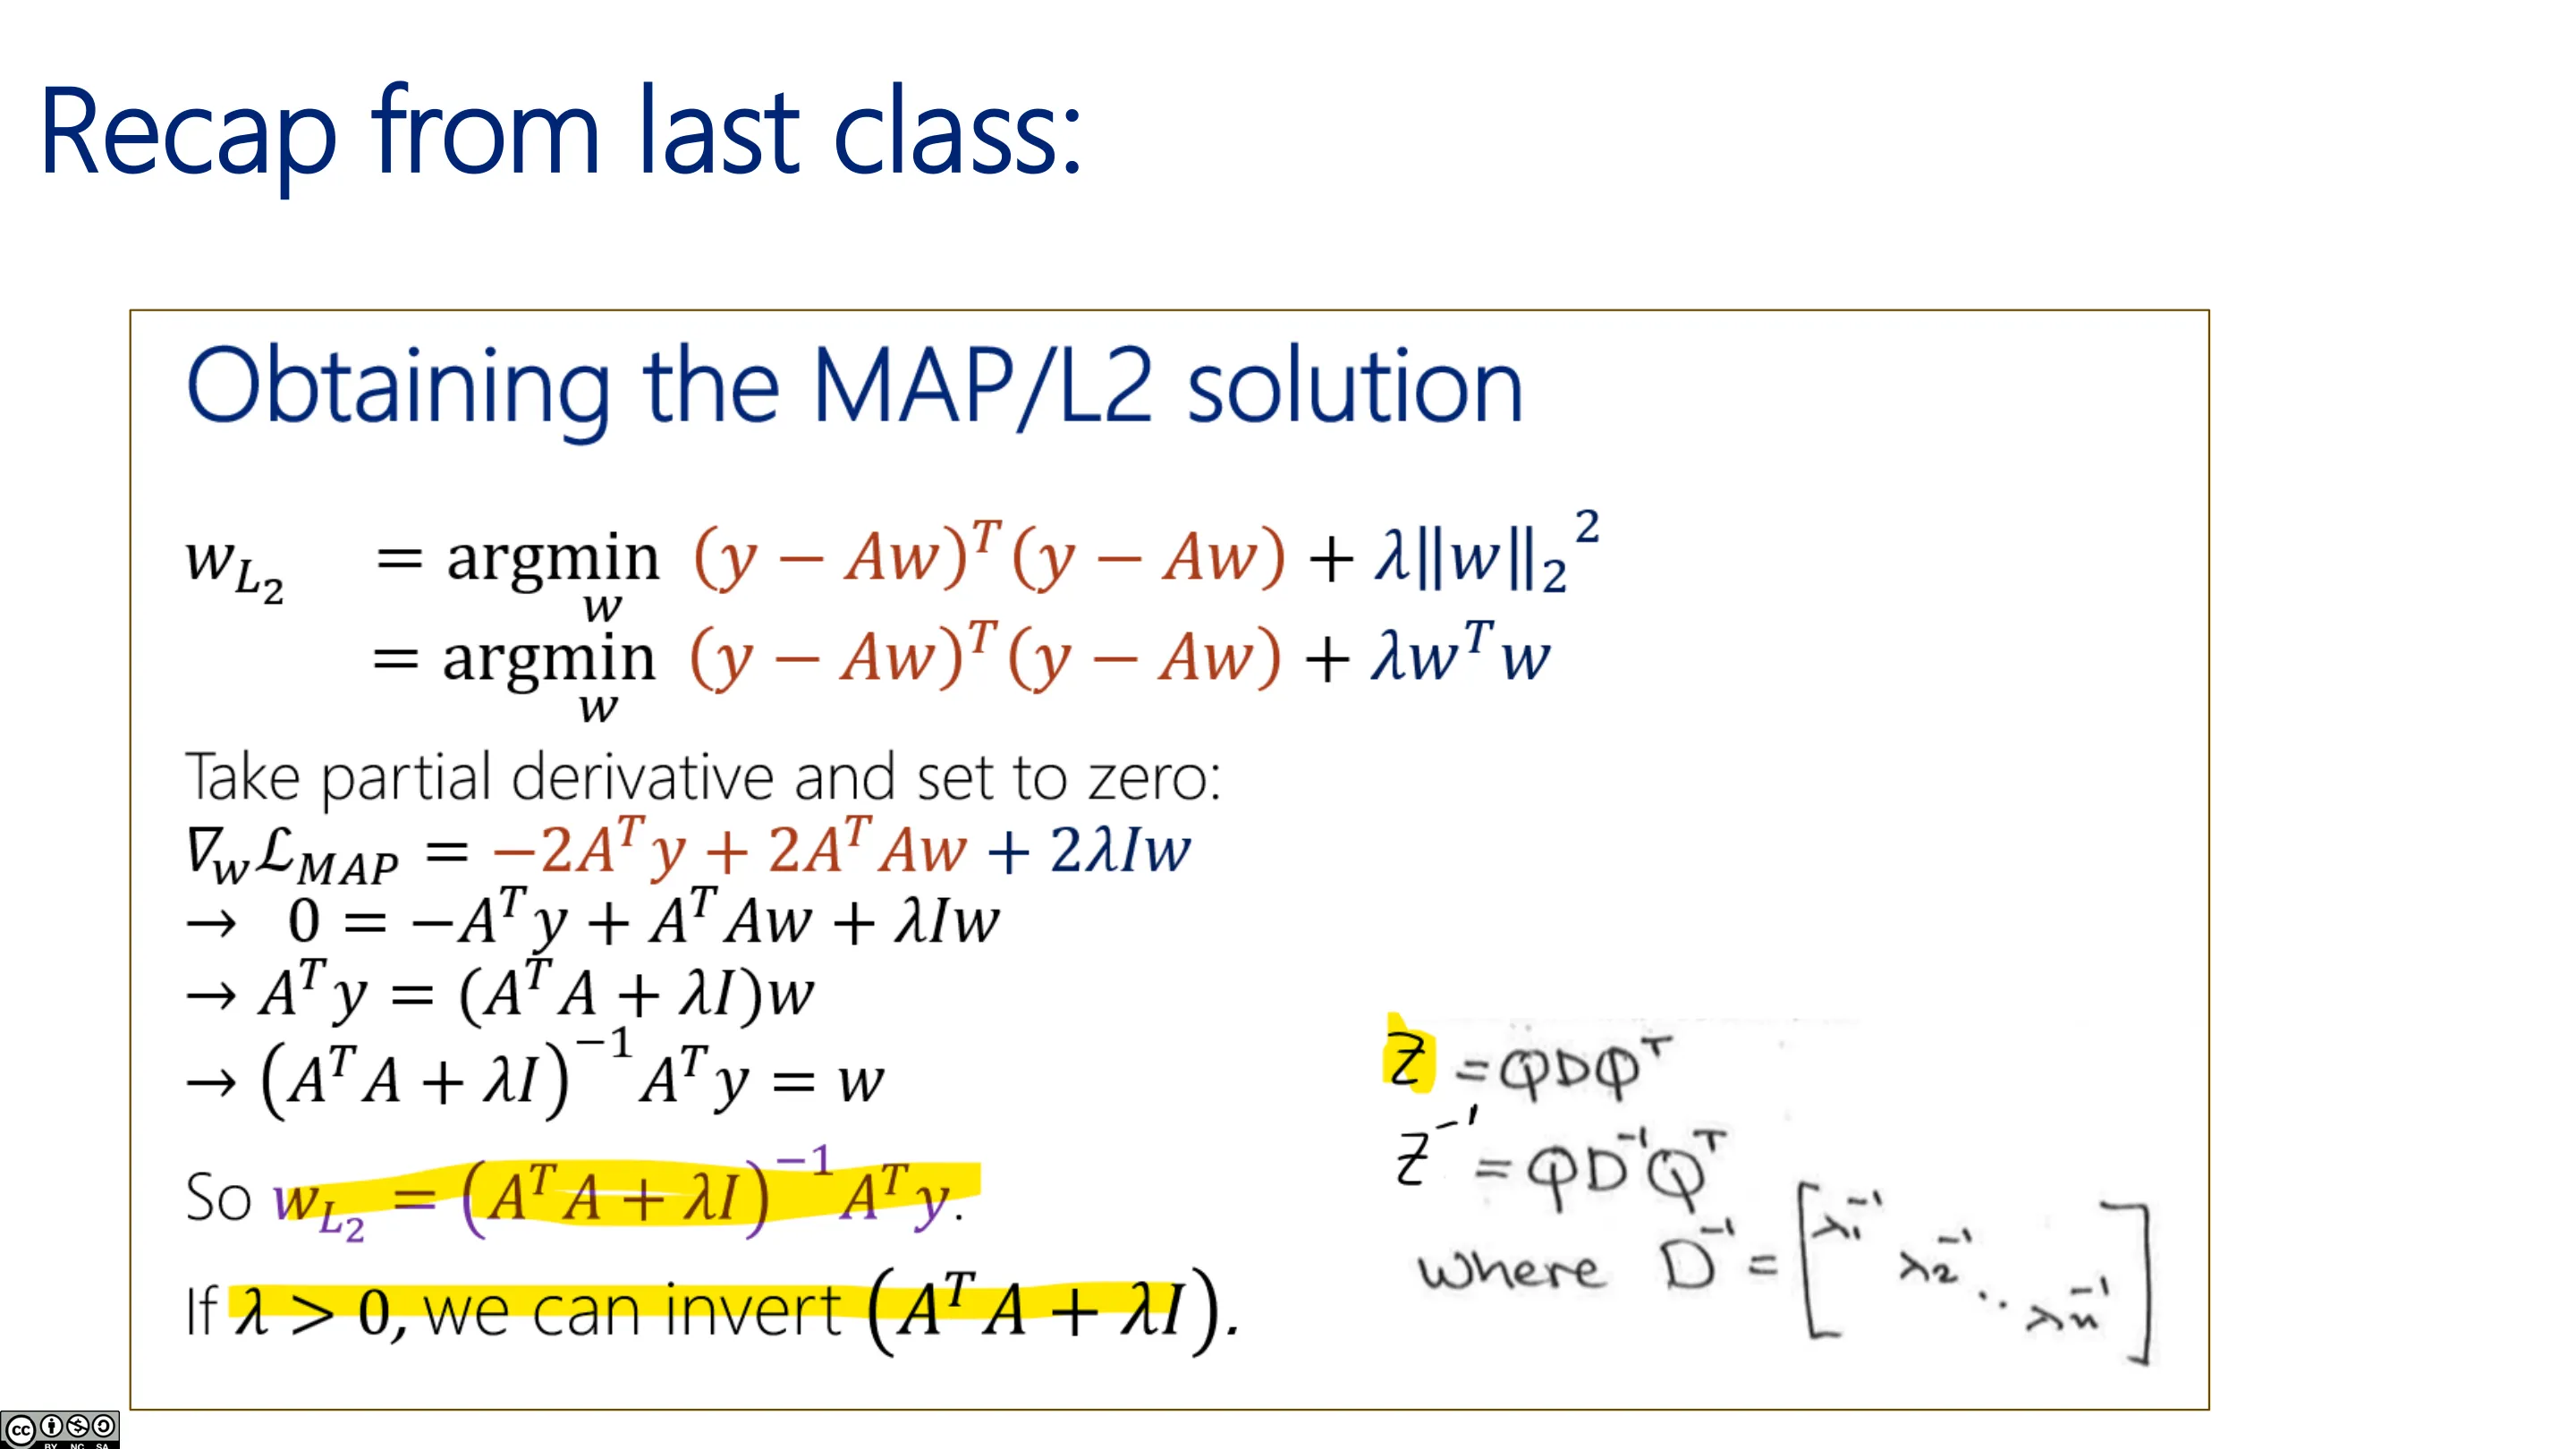
📷 上节回顾(三):岭回归与先验
回到原视频 (00:06:27)
📷 上节回顾(四):Ridge 解
回到原视频 (00:07:09)
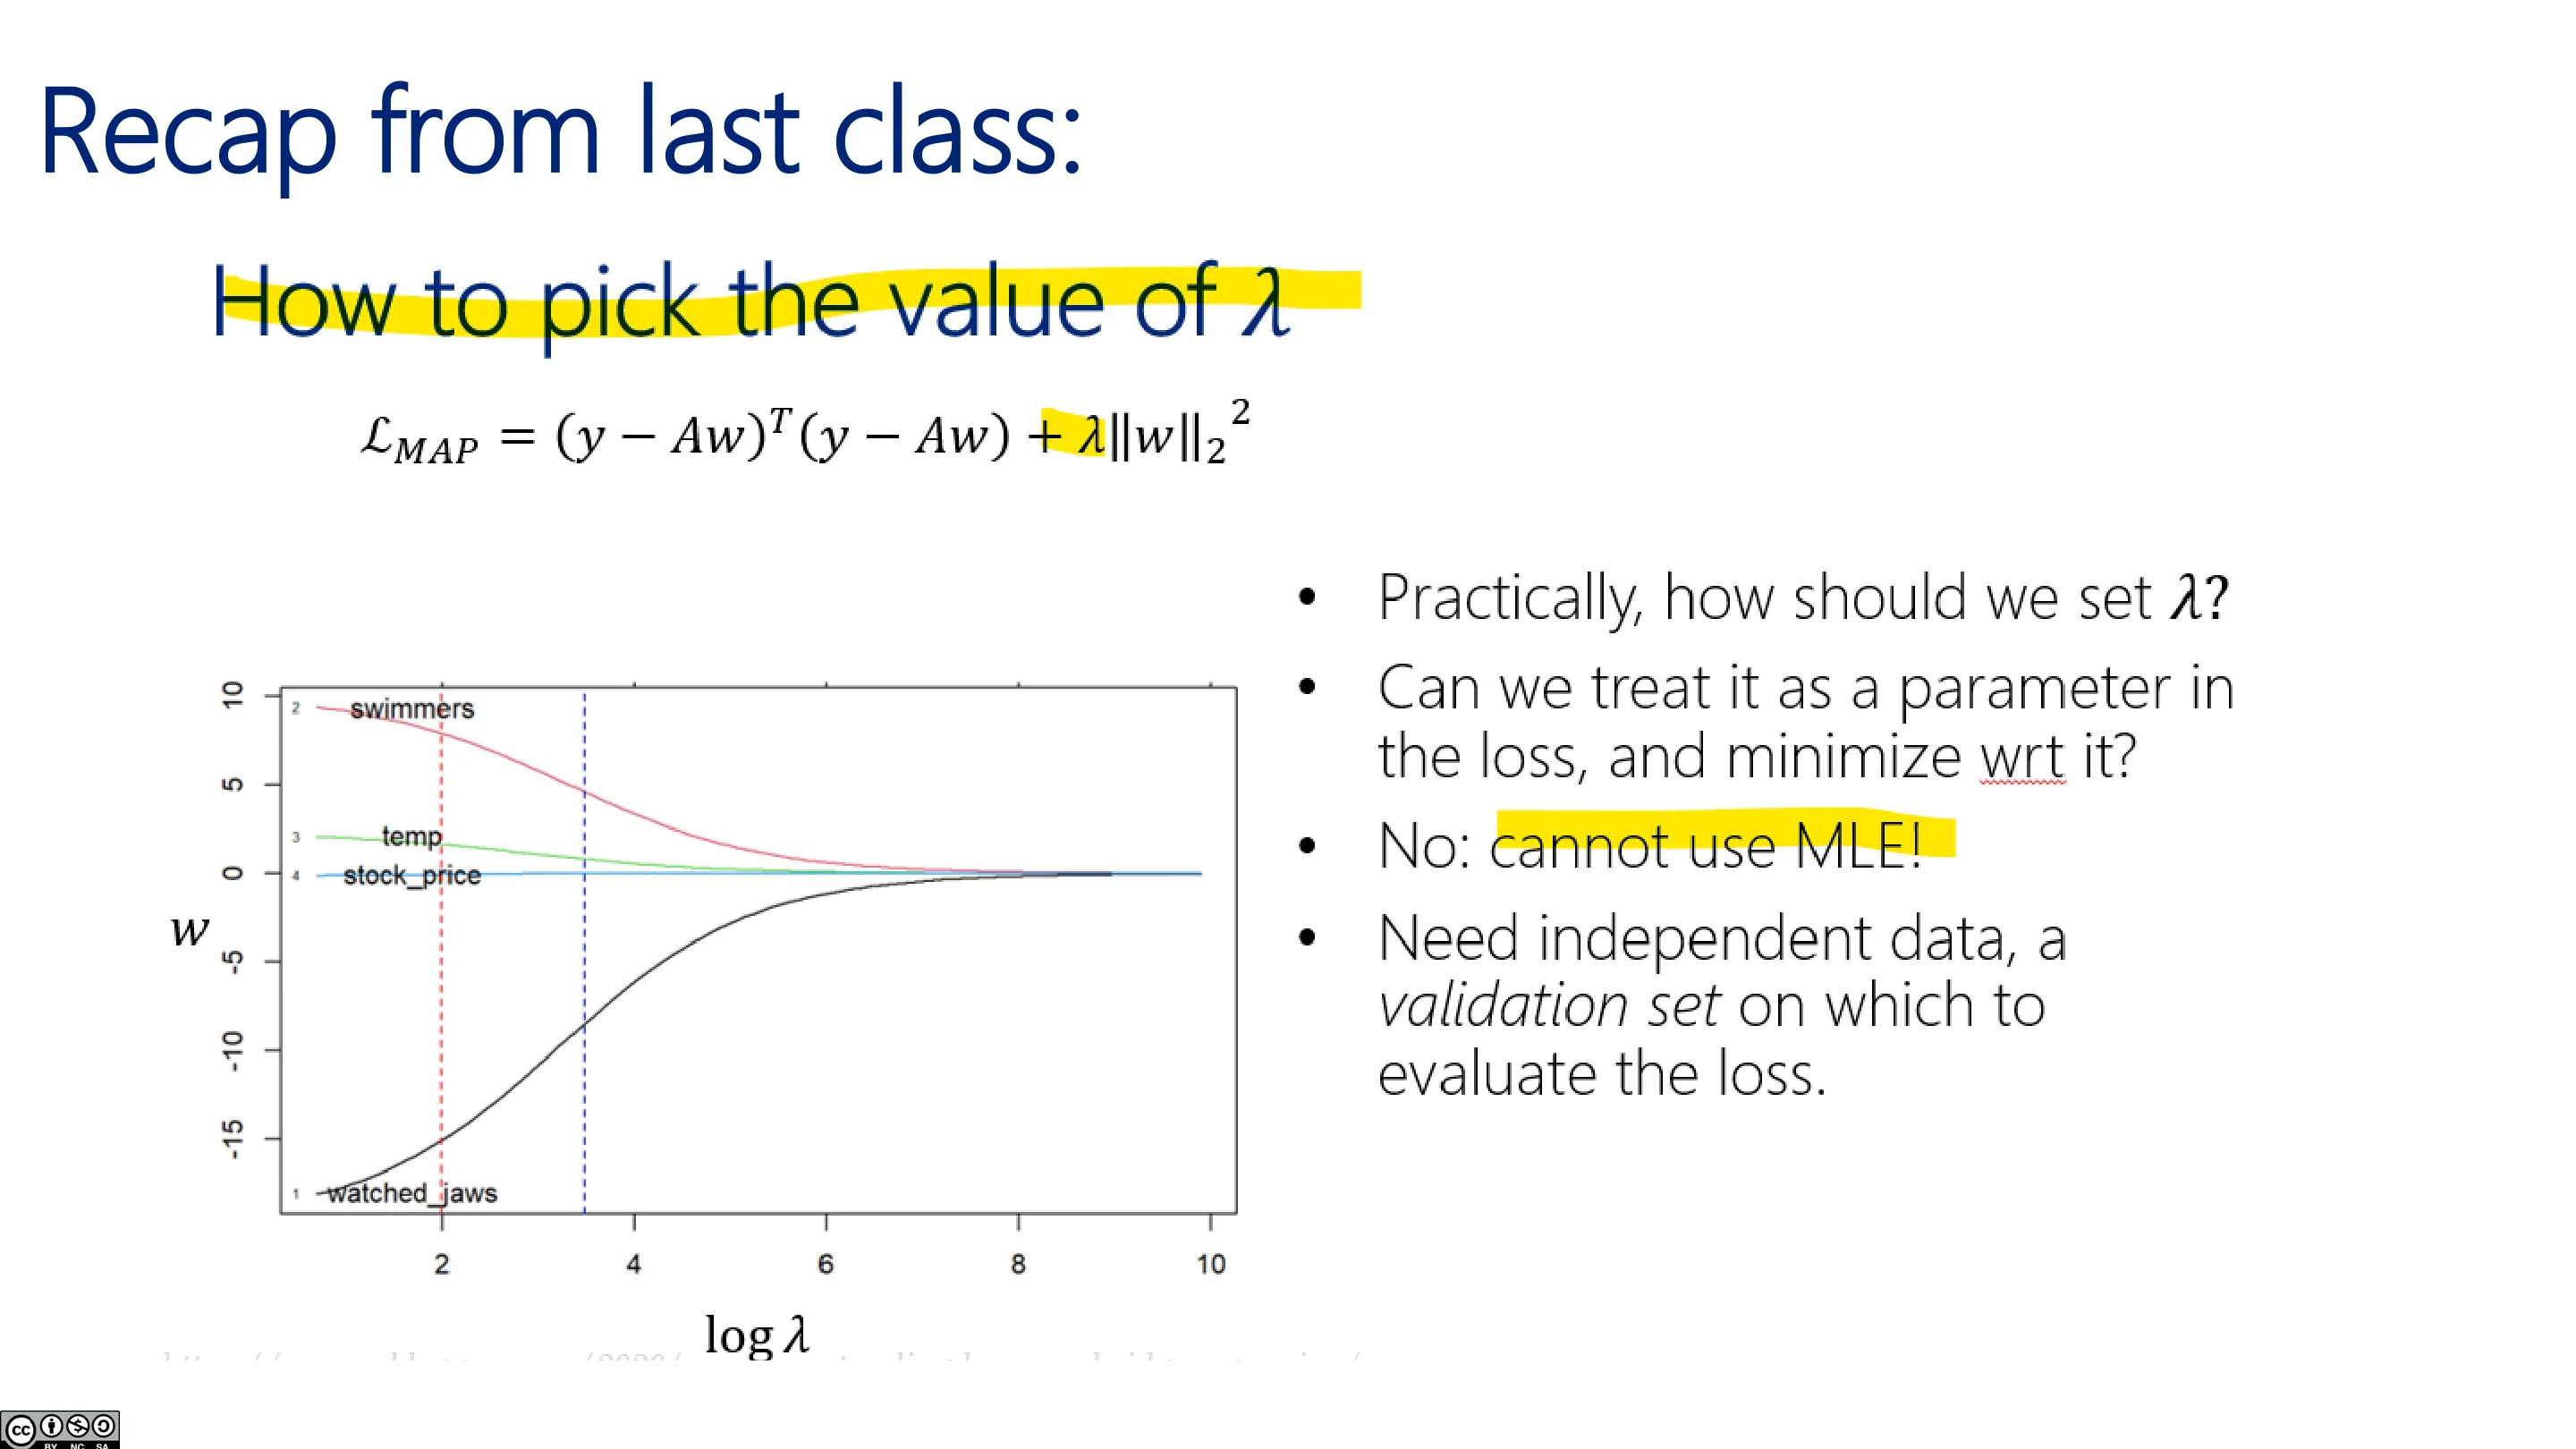
📷 上节回顾(五)
回到原视频 (00:07:30)
1.1 条件数(condition number):为什么岭回归更数值稳定
(参考时间: 00:07)
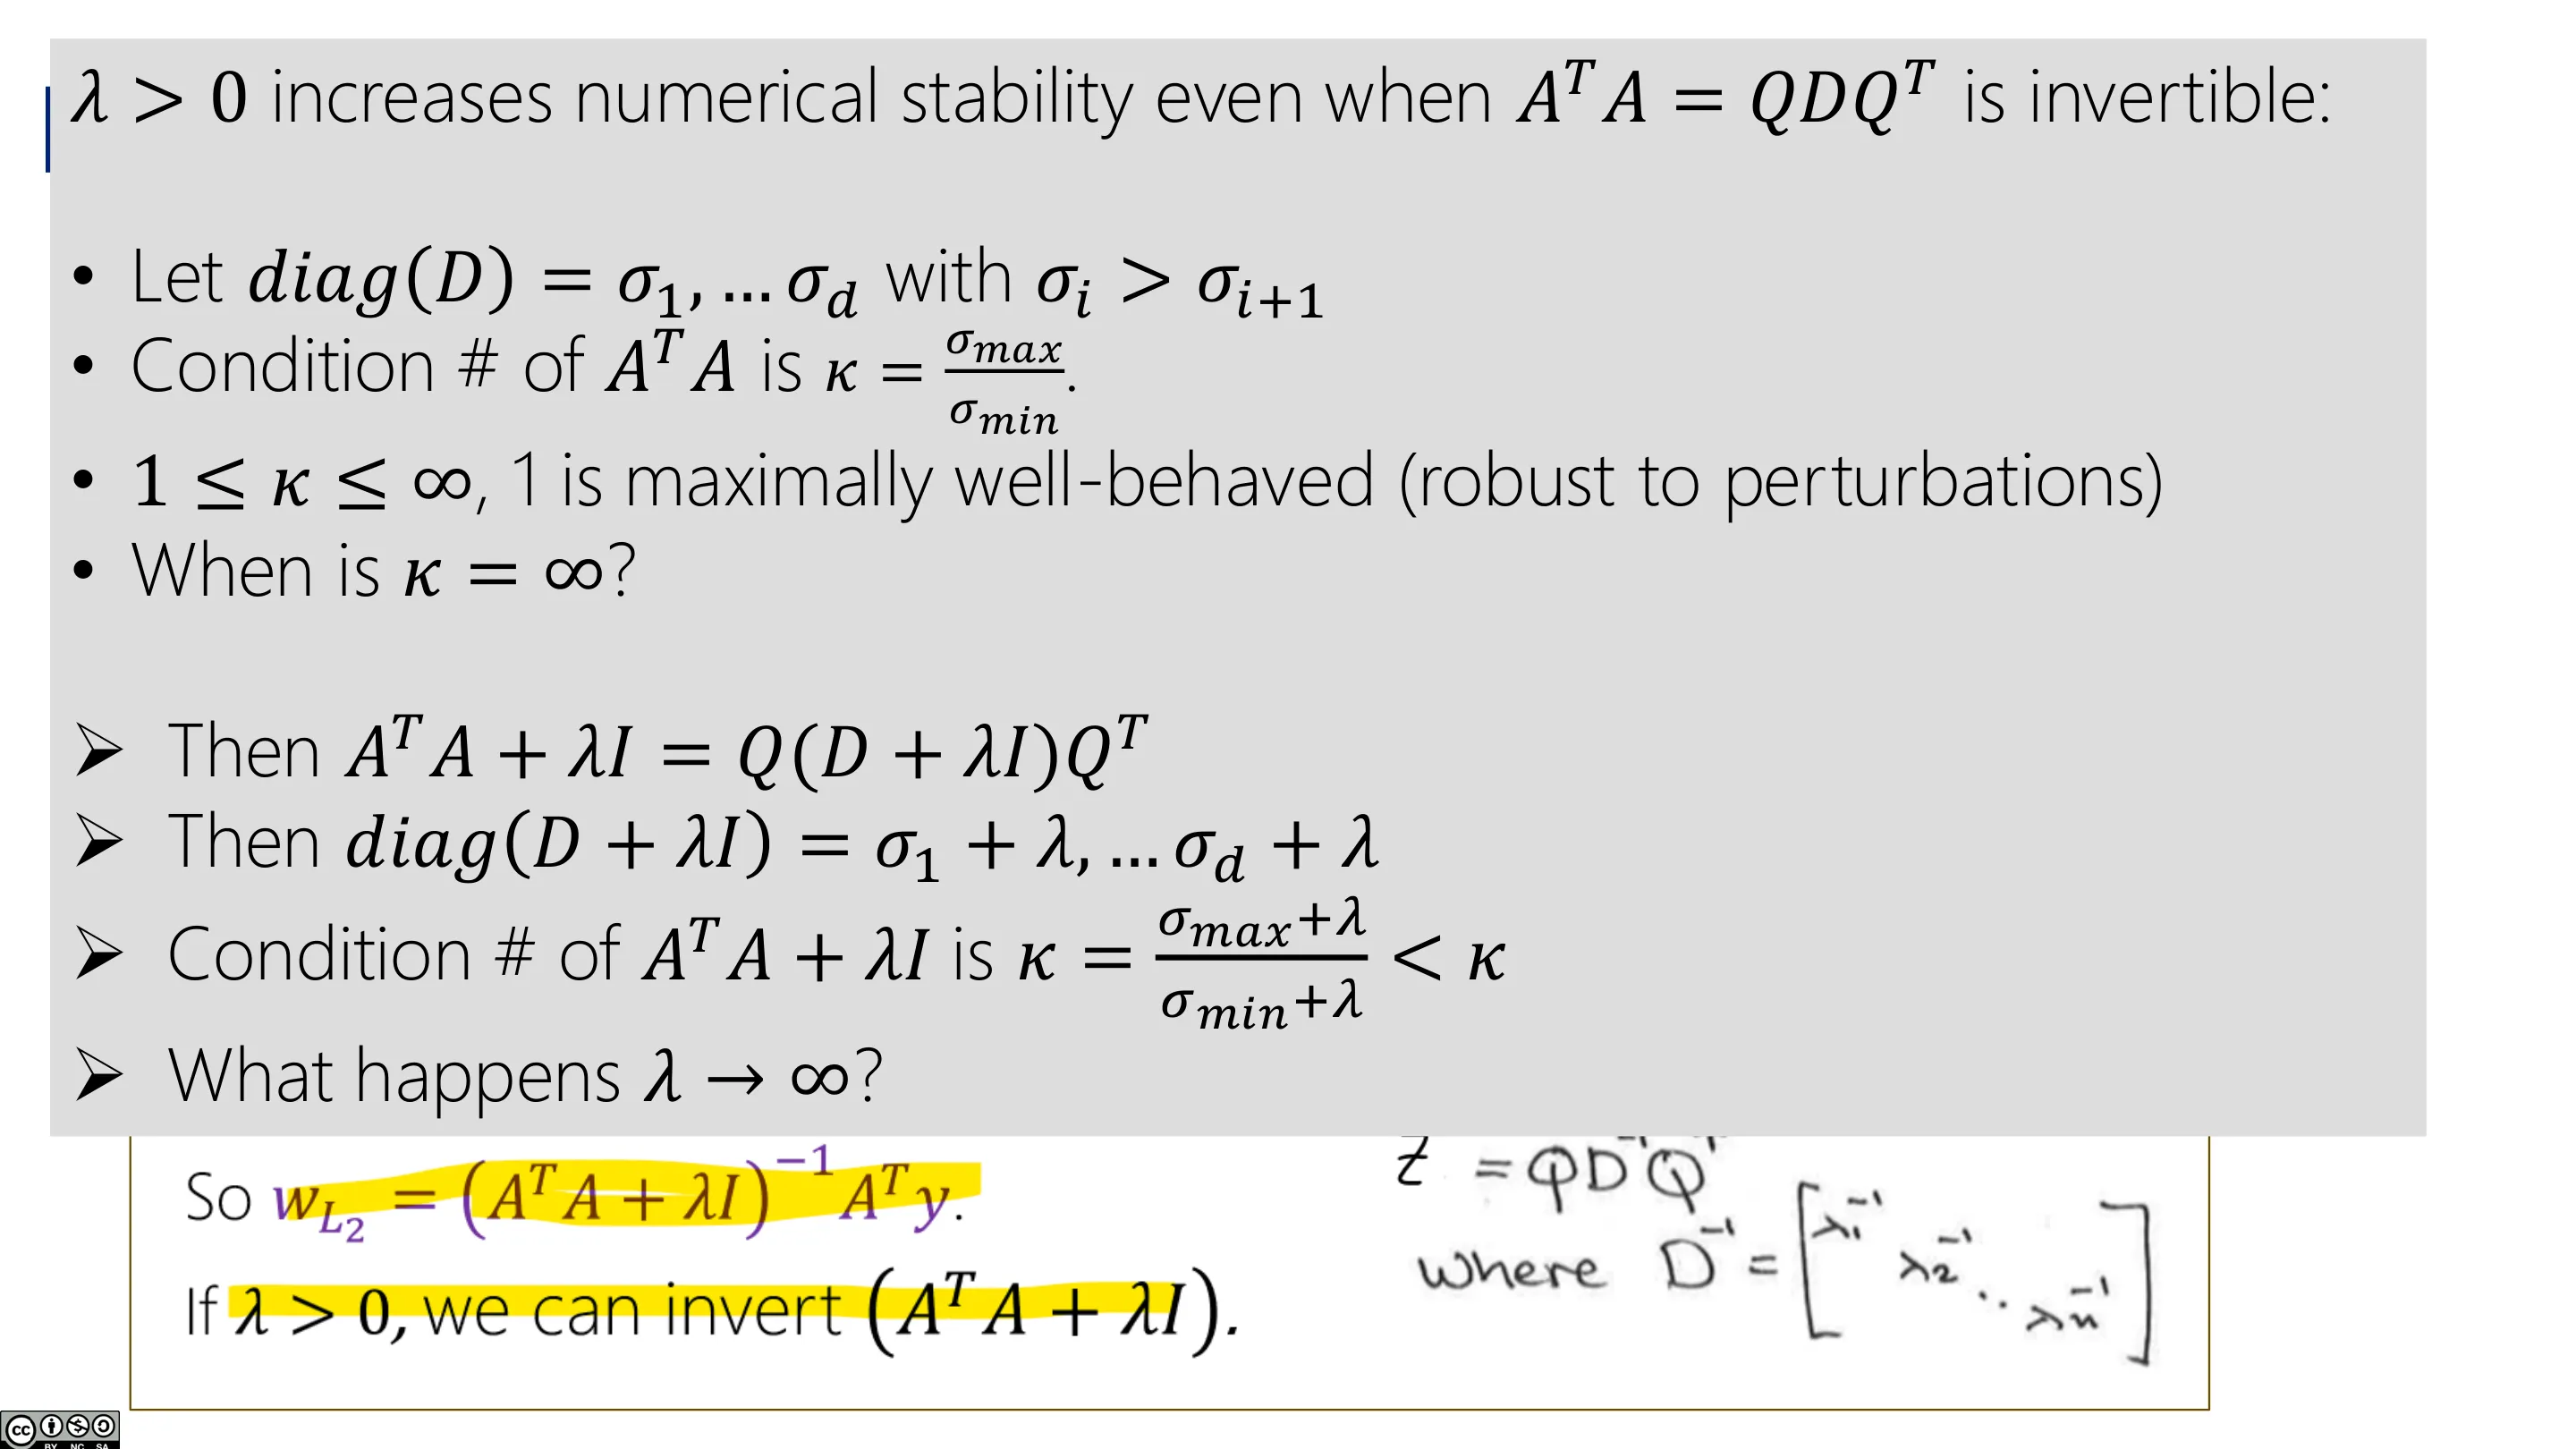
由 SVD,$X^\top X$ 的特征值就是奇异值的平方;条件数 = 最大奇异值 / 最小奇异值,衡量「反演这个线性映射有多不稳」:
- 条件数越大 ⇒ 系统越病态:对 $w$ 的微小扰动会被放大;
- 若某特征线性相关 ⇒ 有零奇异值 ⇒ 条件数 = ∞(完全不可逆);
- 岭回归把 $\lambda$ 加到对角线上 ⇒ 对角元变成 $\sigma_i^2+\lambda$ ⇒ 条件数下降;$\lambda\to\infty$ 时条件数 → 1(最稳定)。
📷 条件数(一)
回到原视频 (00:09:32)
📷 条件数(二)
回到原视频 (00:10:47)
📷 岭回归改善条件数
回到原视频 (00:12:28)
但 λ 不能无限大:$\lambda$ 越大,损失越被惩罚项主导、逐渐忽略数据。于是存在张力——既要数值稳定、又不要忽视数据。
📷 条件数的权衡
回到原视频 (00:14:00)
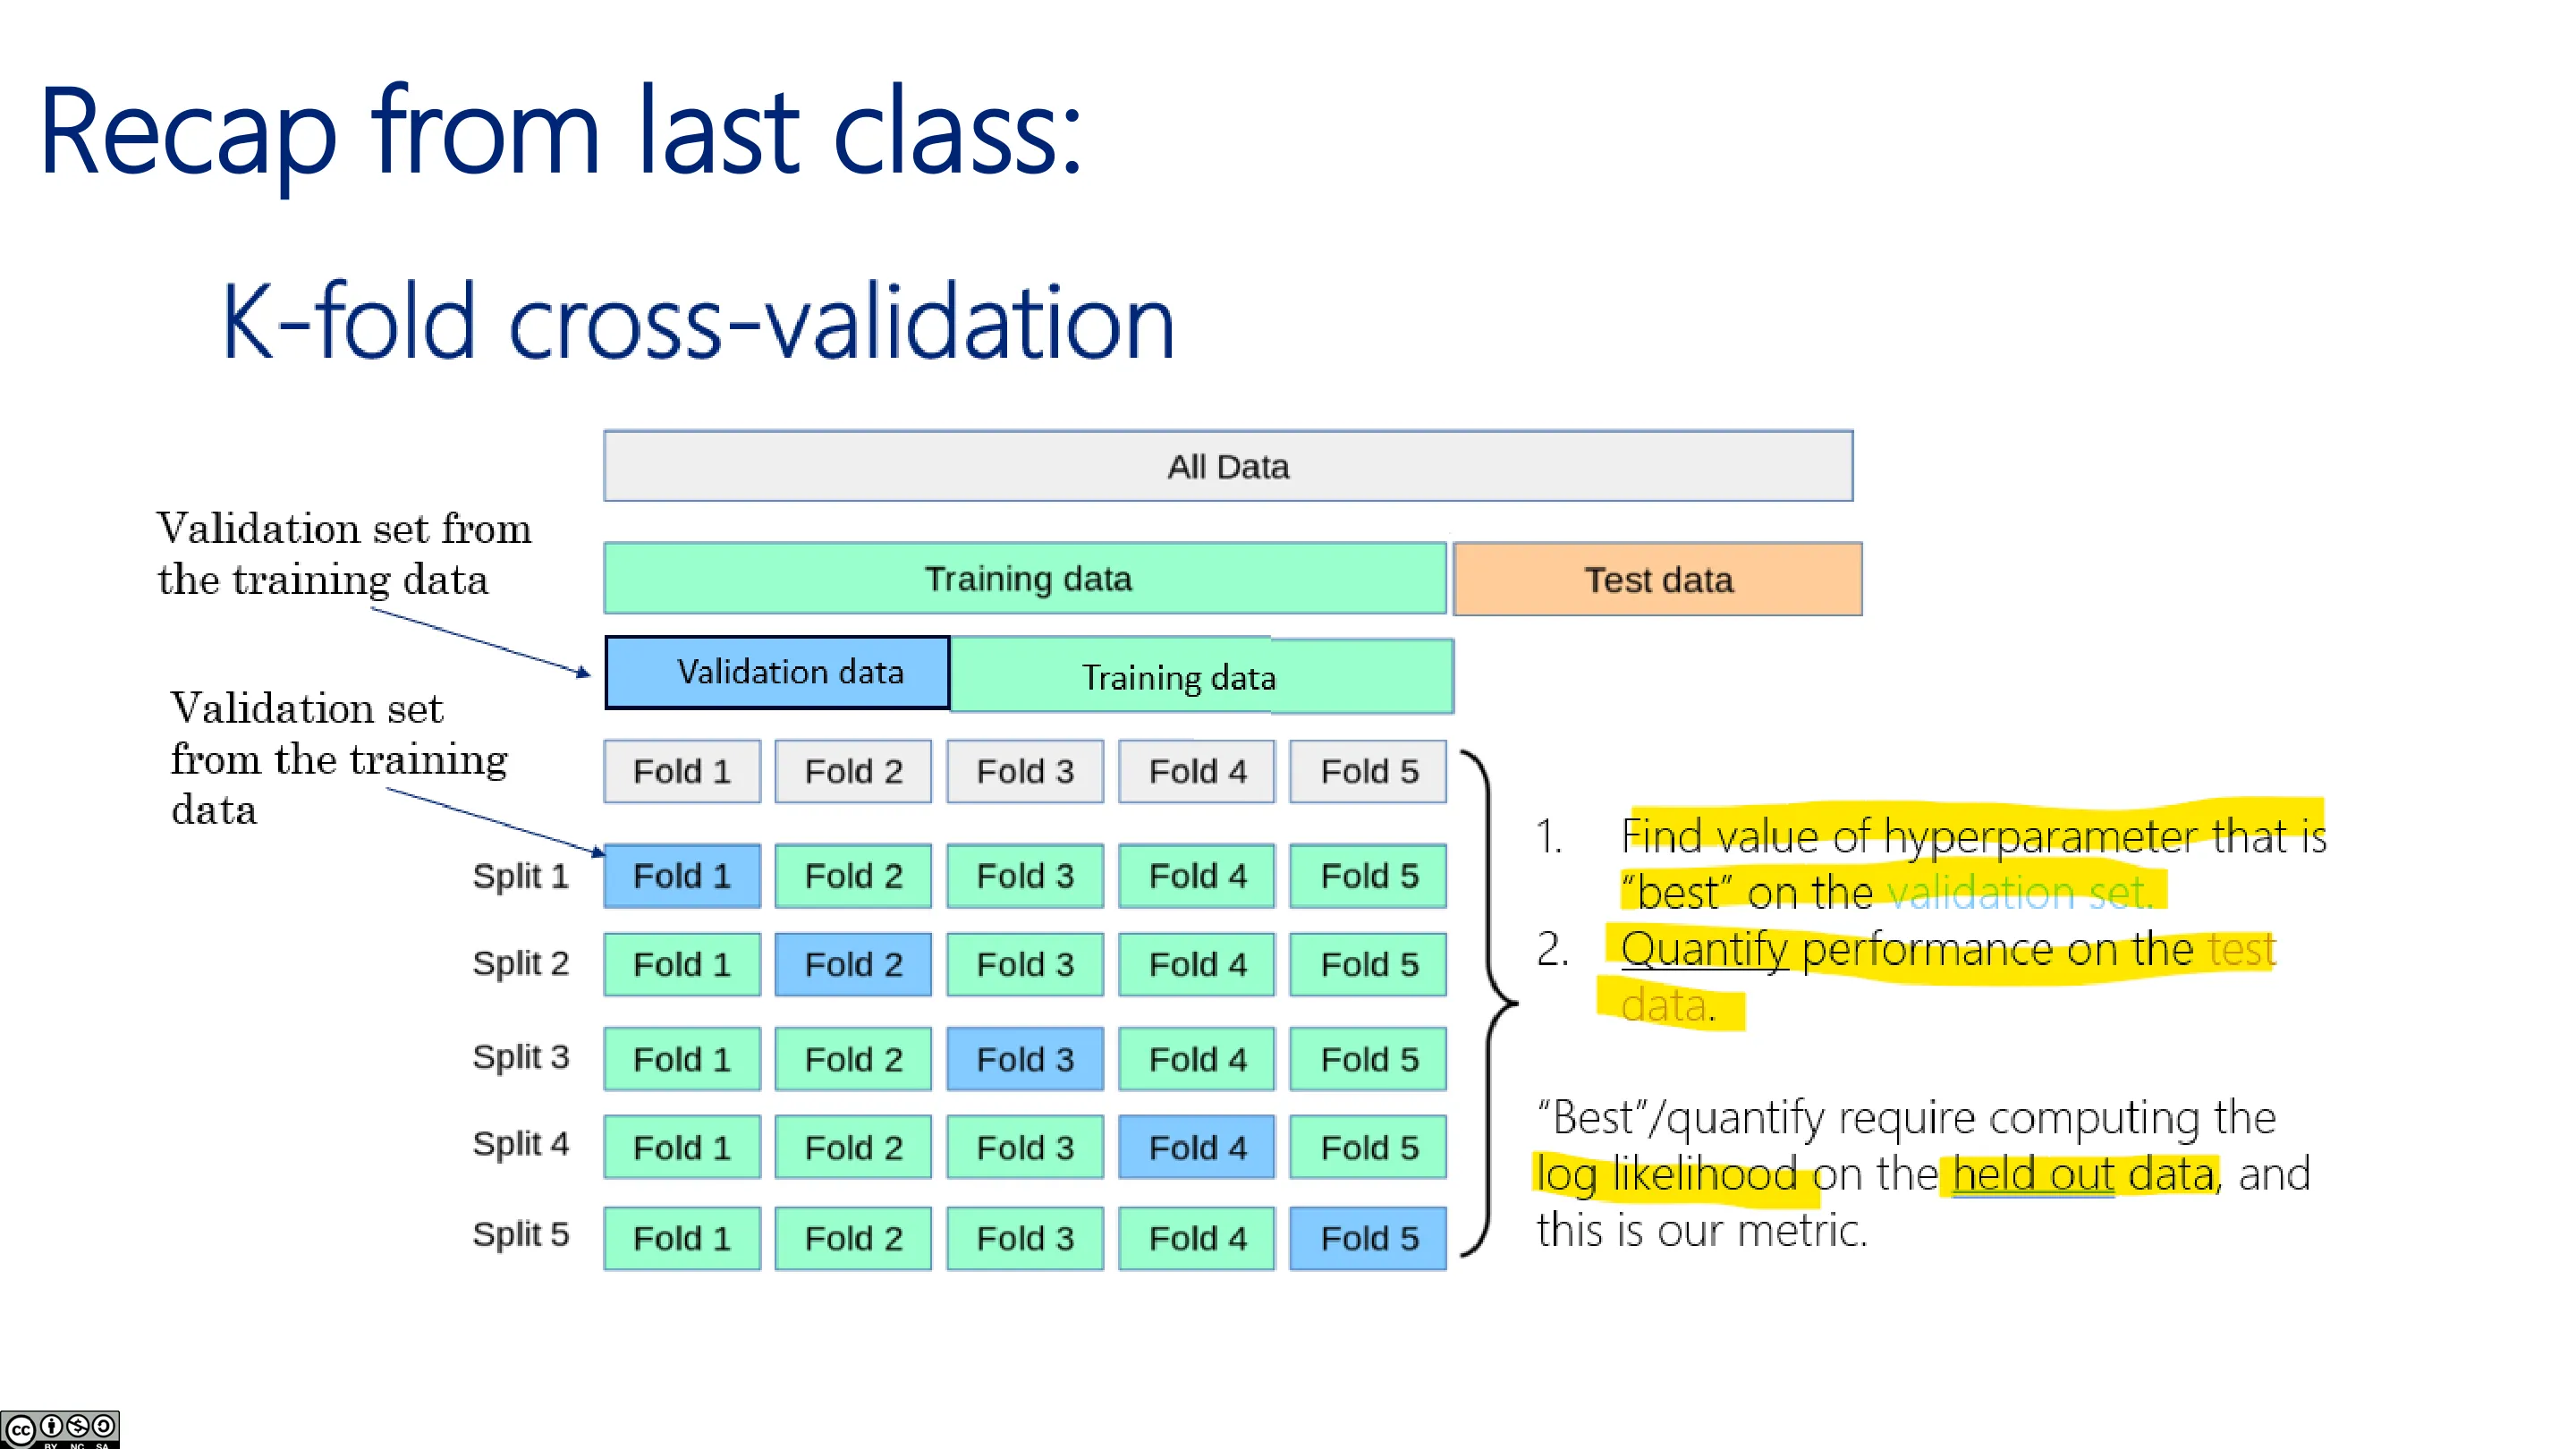
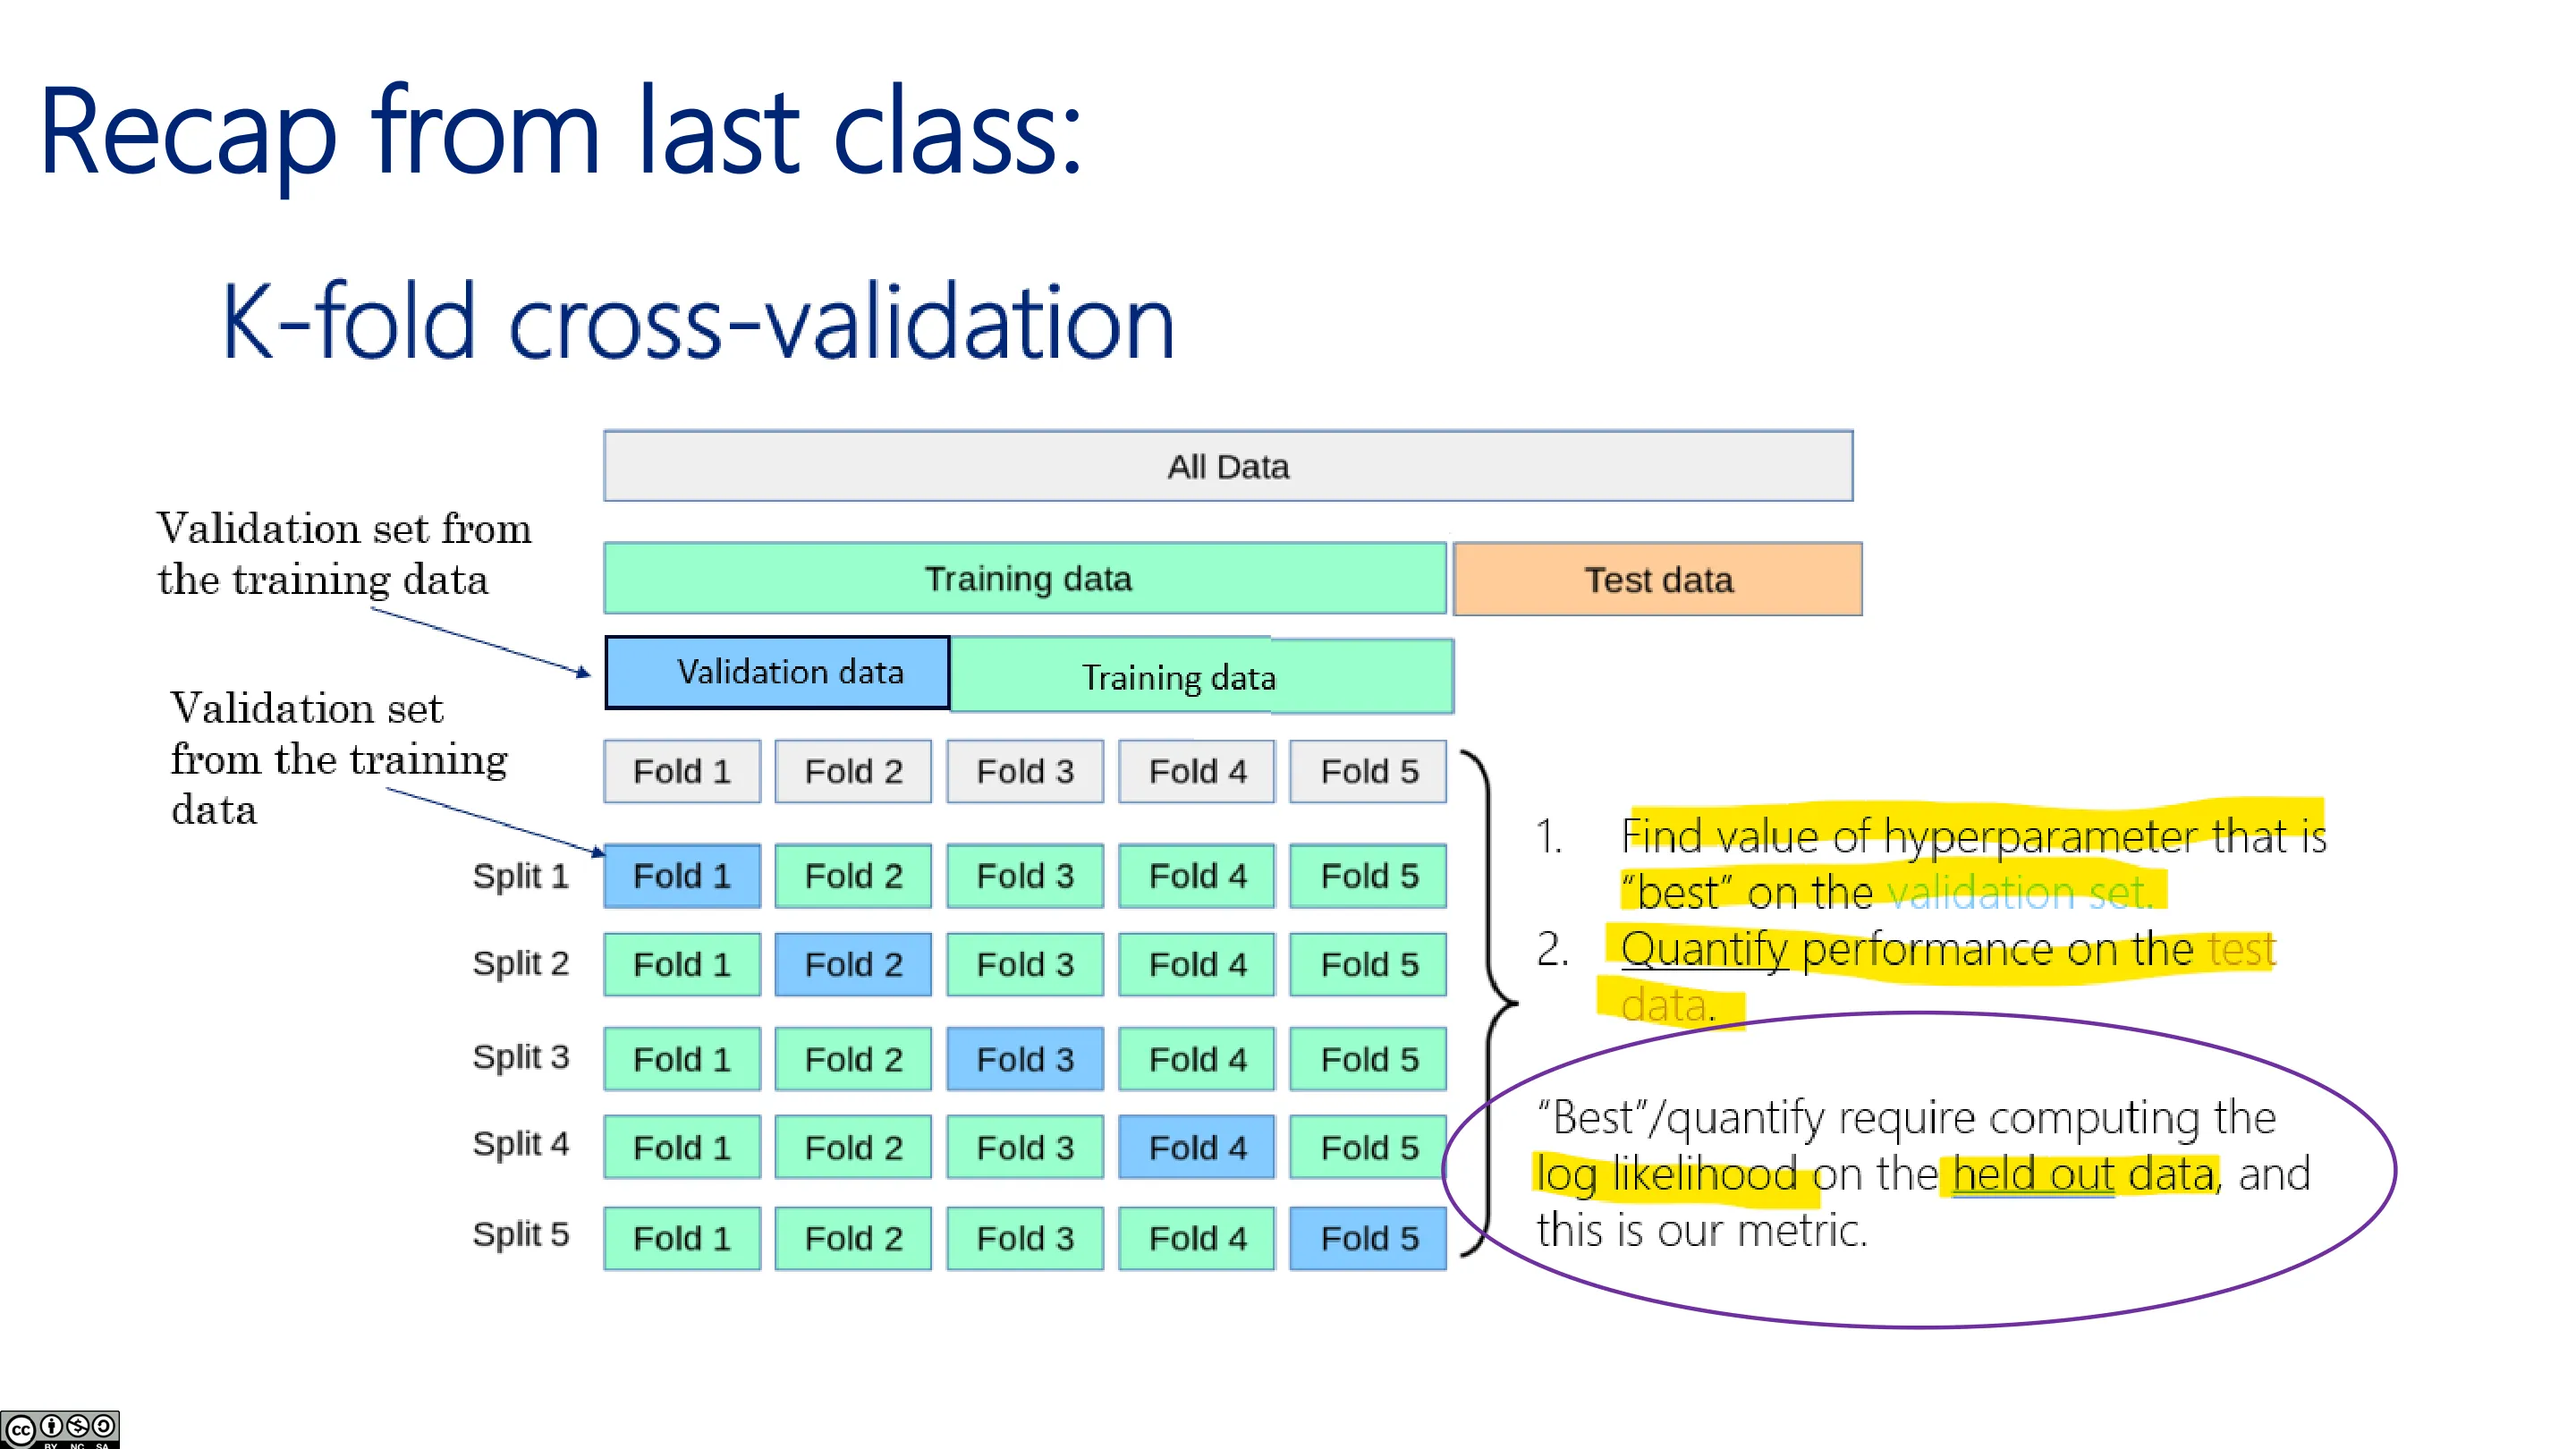
📷 回顾:如何设置超参数
回到原视频 (00:16:00)
📷 回顾:训练/验证划分
回到原视频 (00:16:50)
二、评估度量与数据划分
(参考时间: 00:19)
2.1 用什么度量?
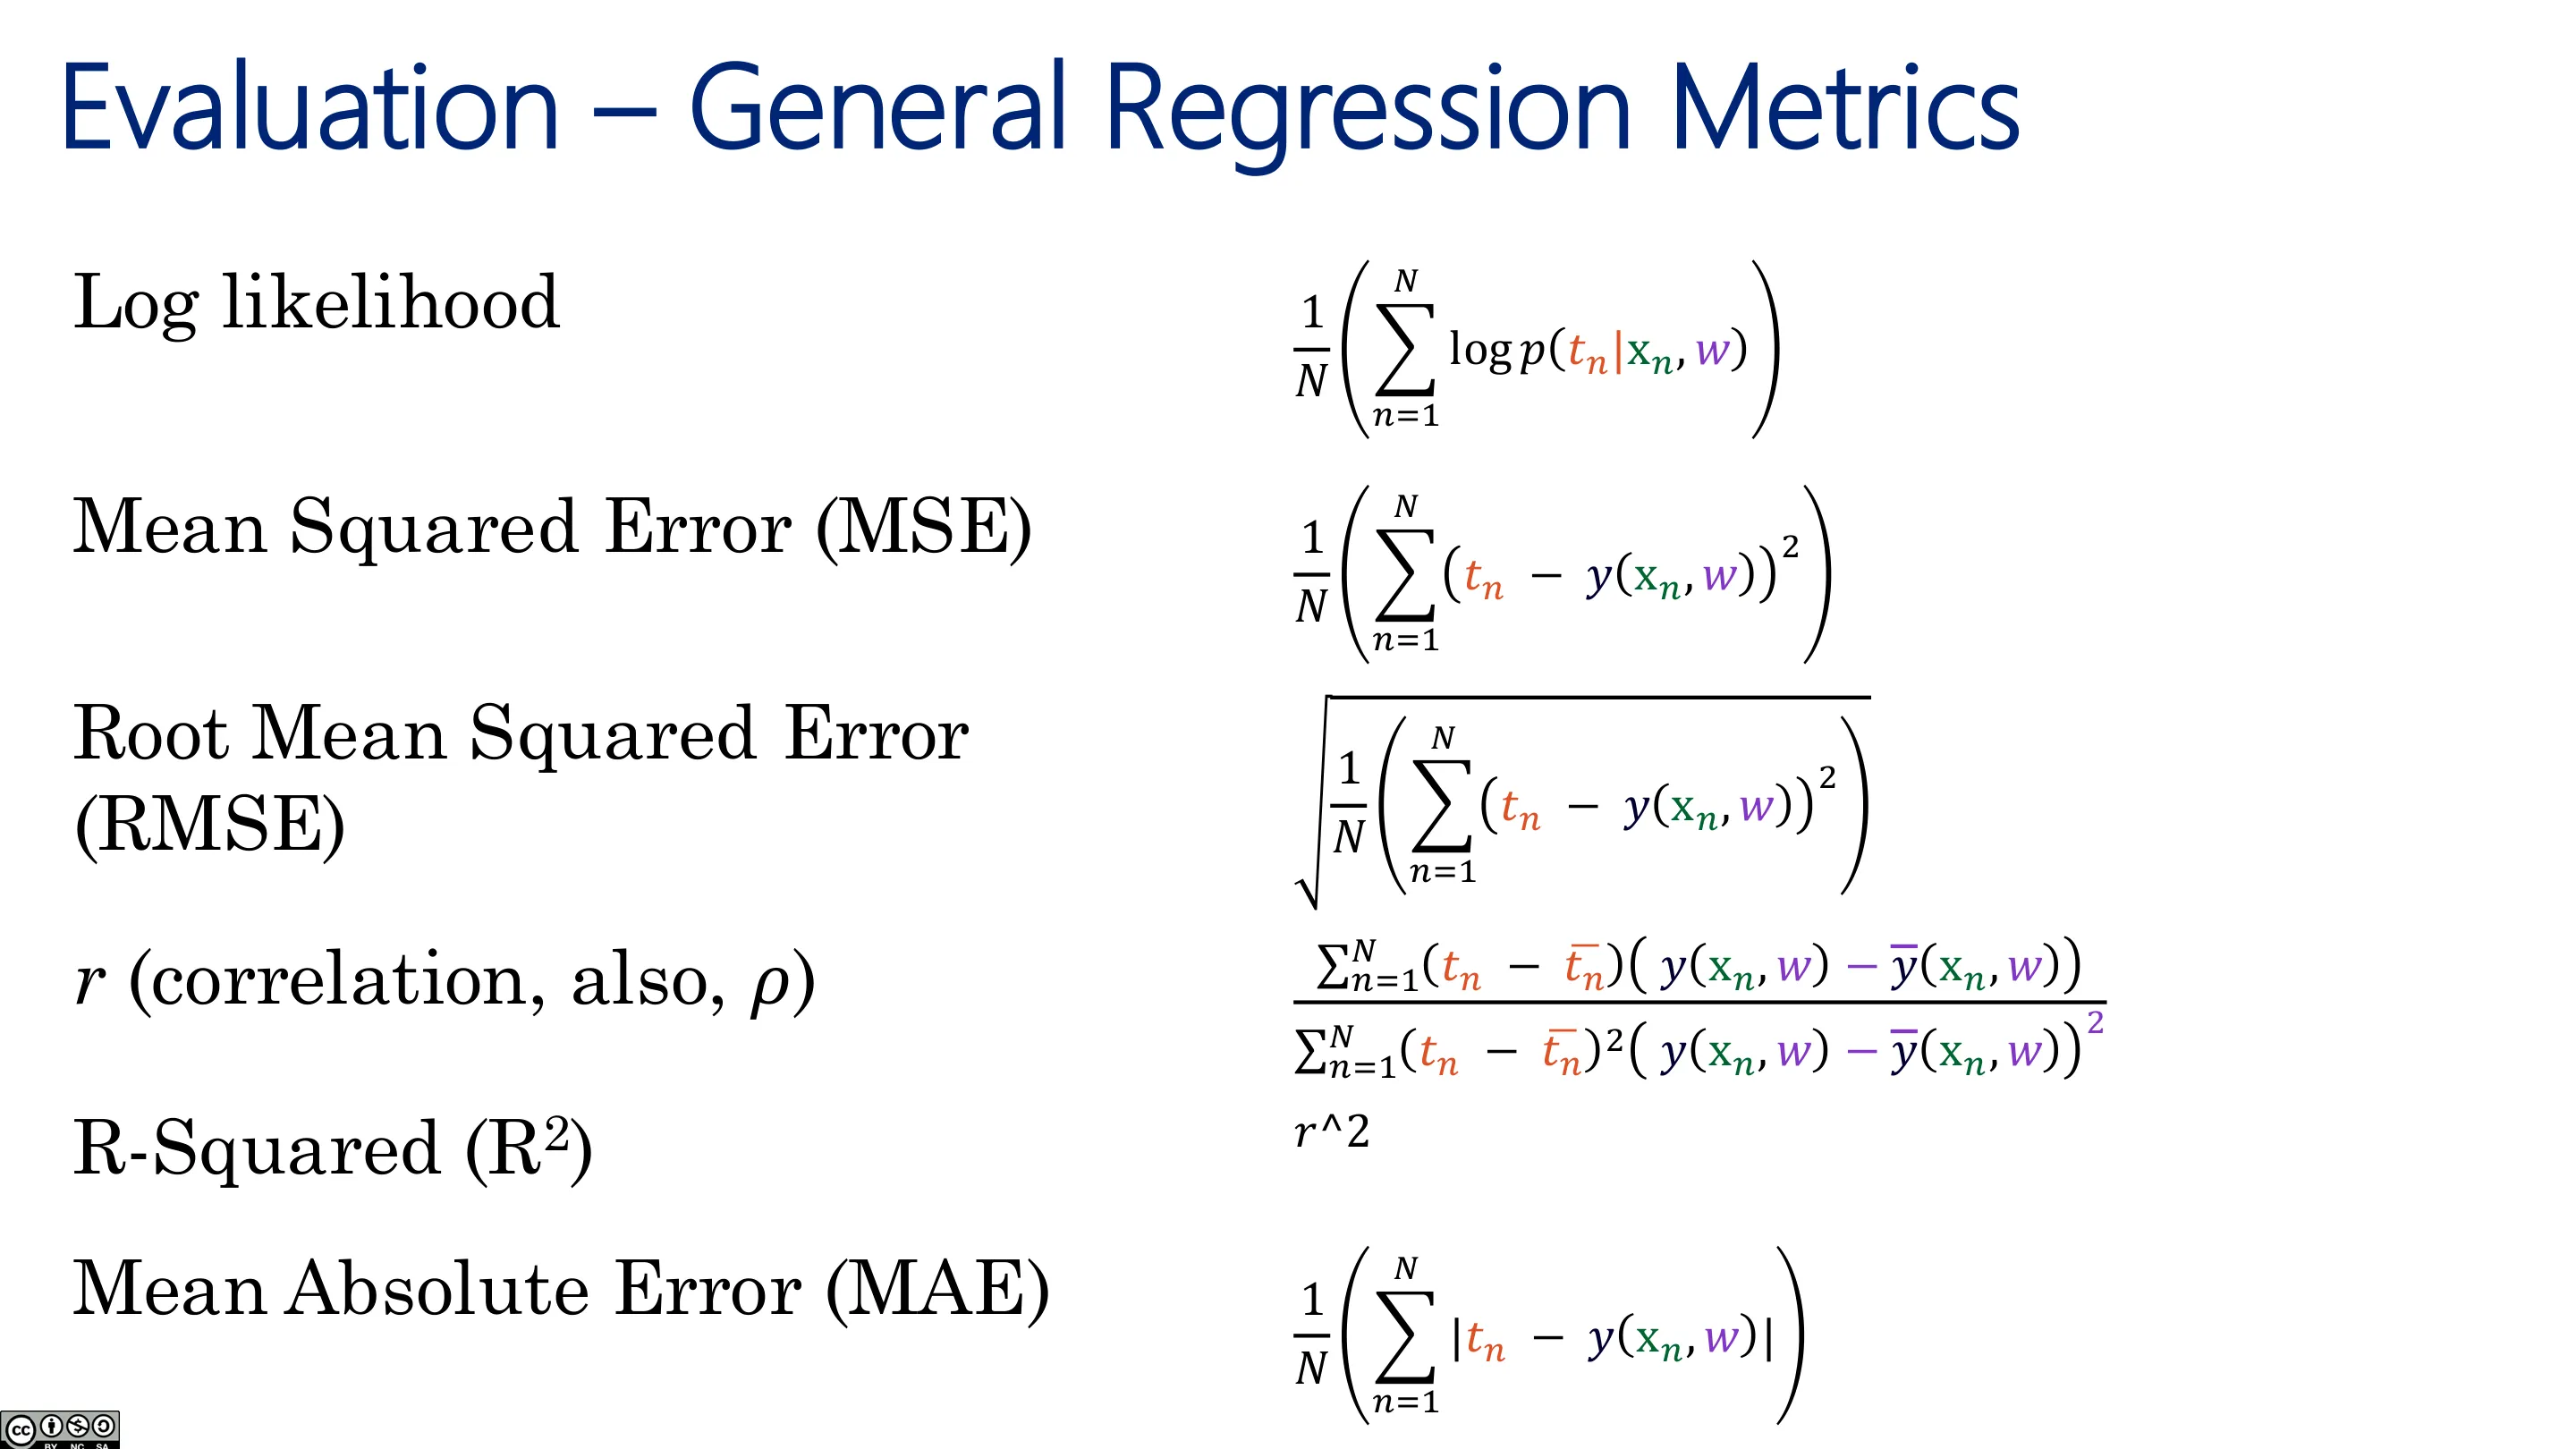
- 保留数据的似然(held-out likelihood):一个通用原则;
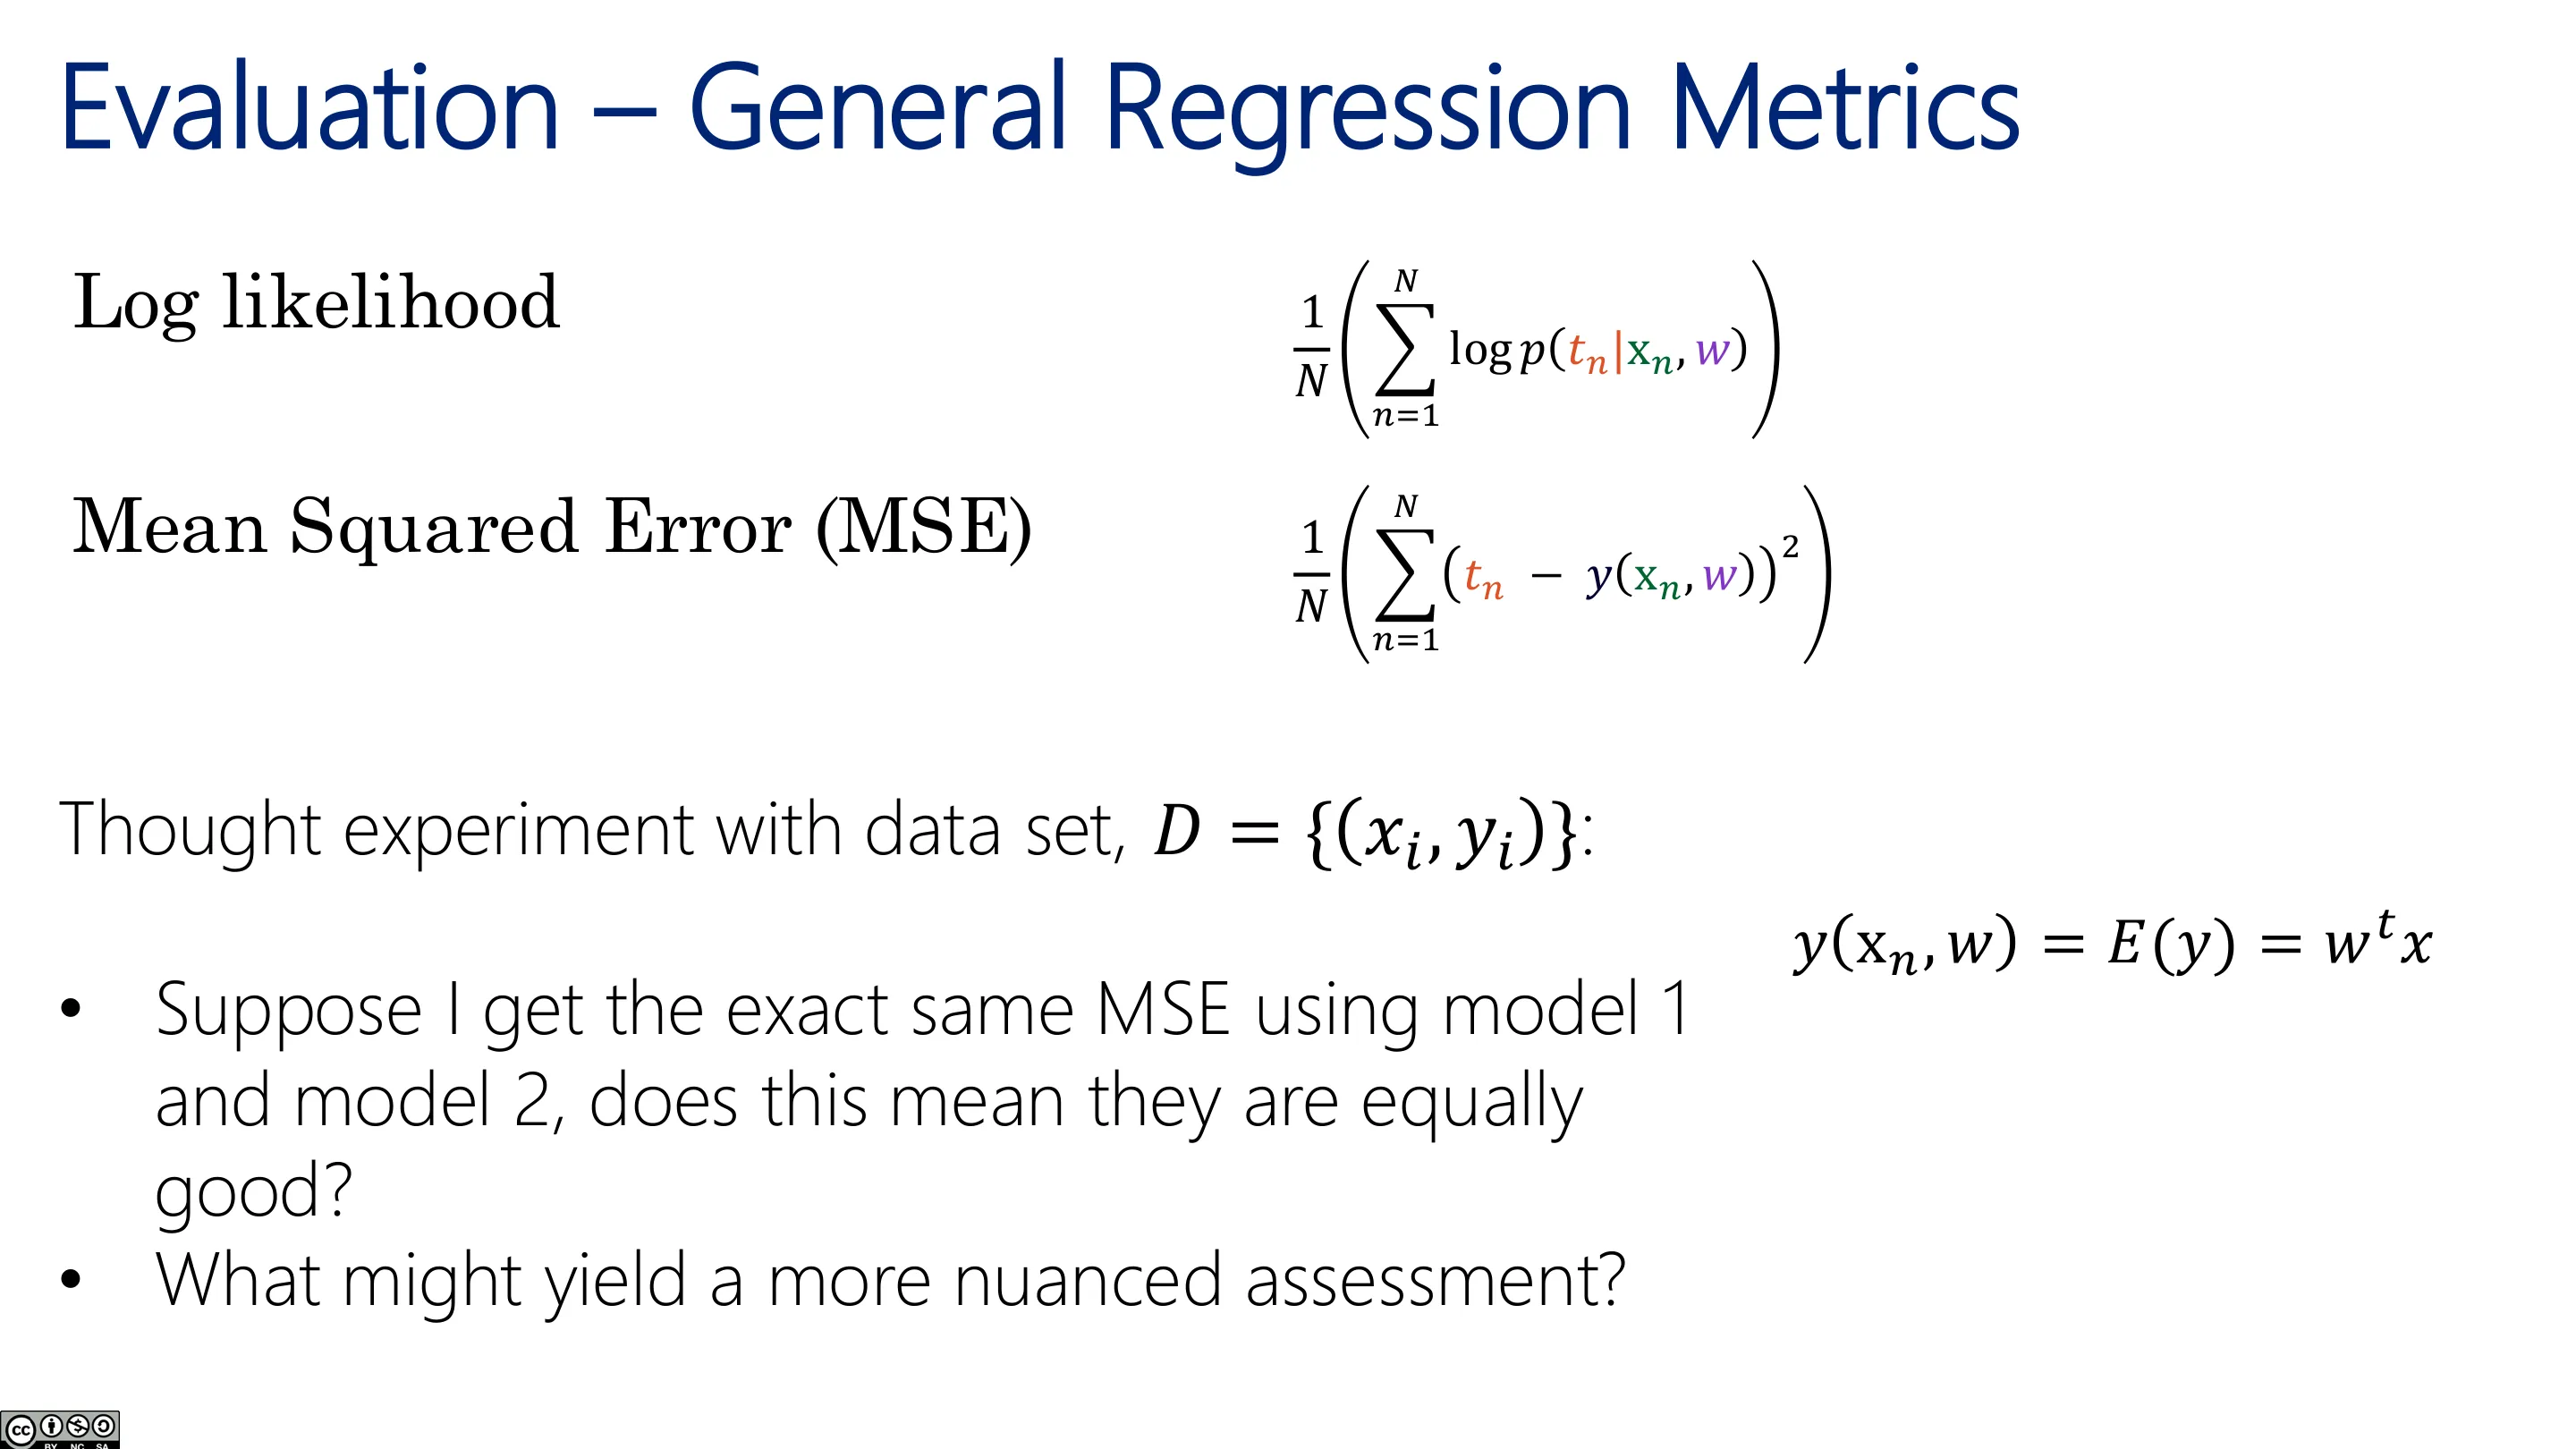
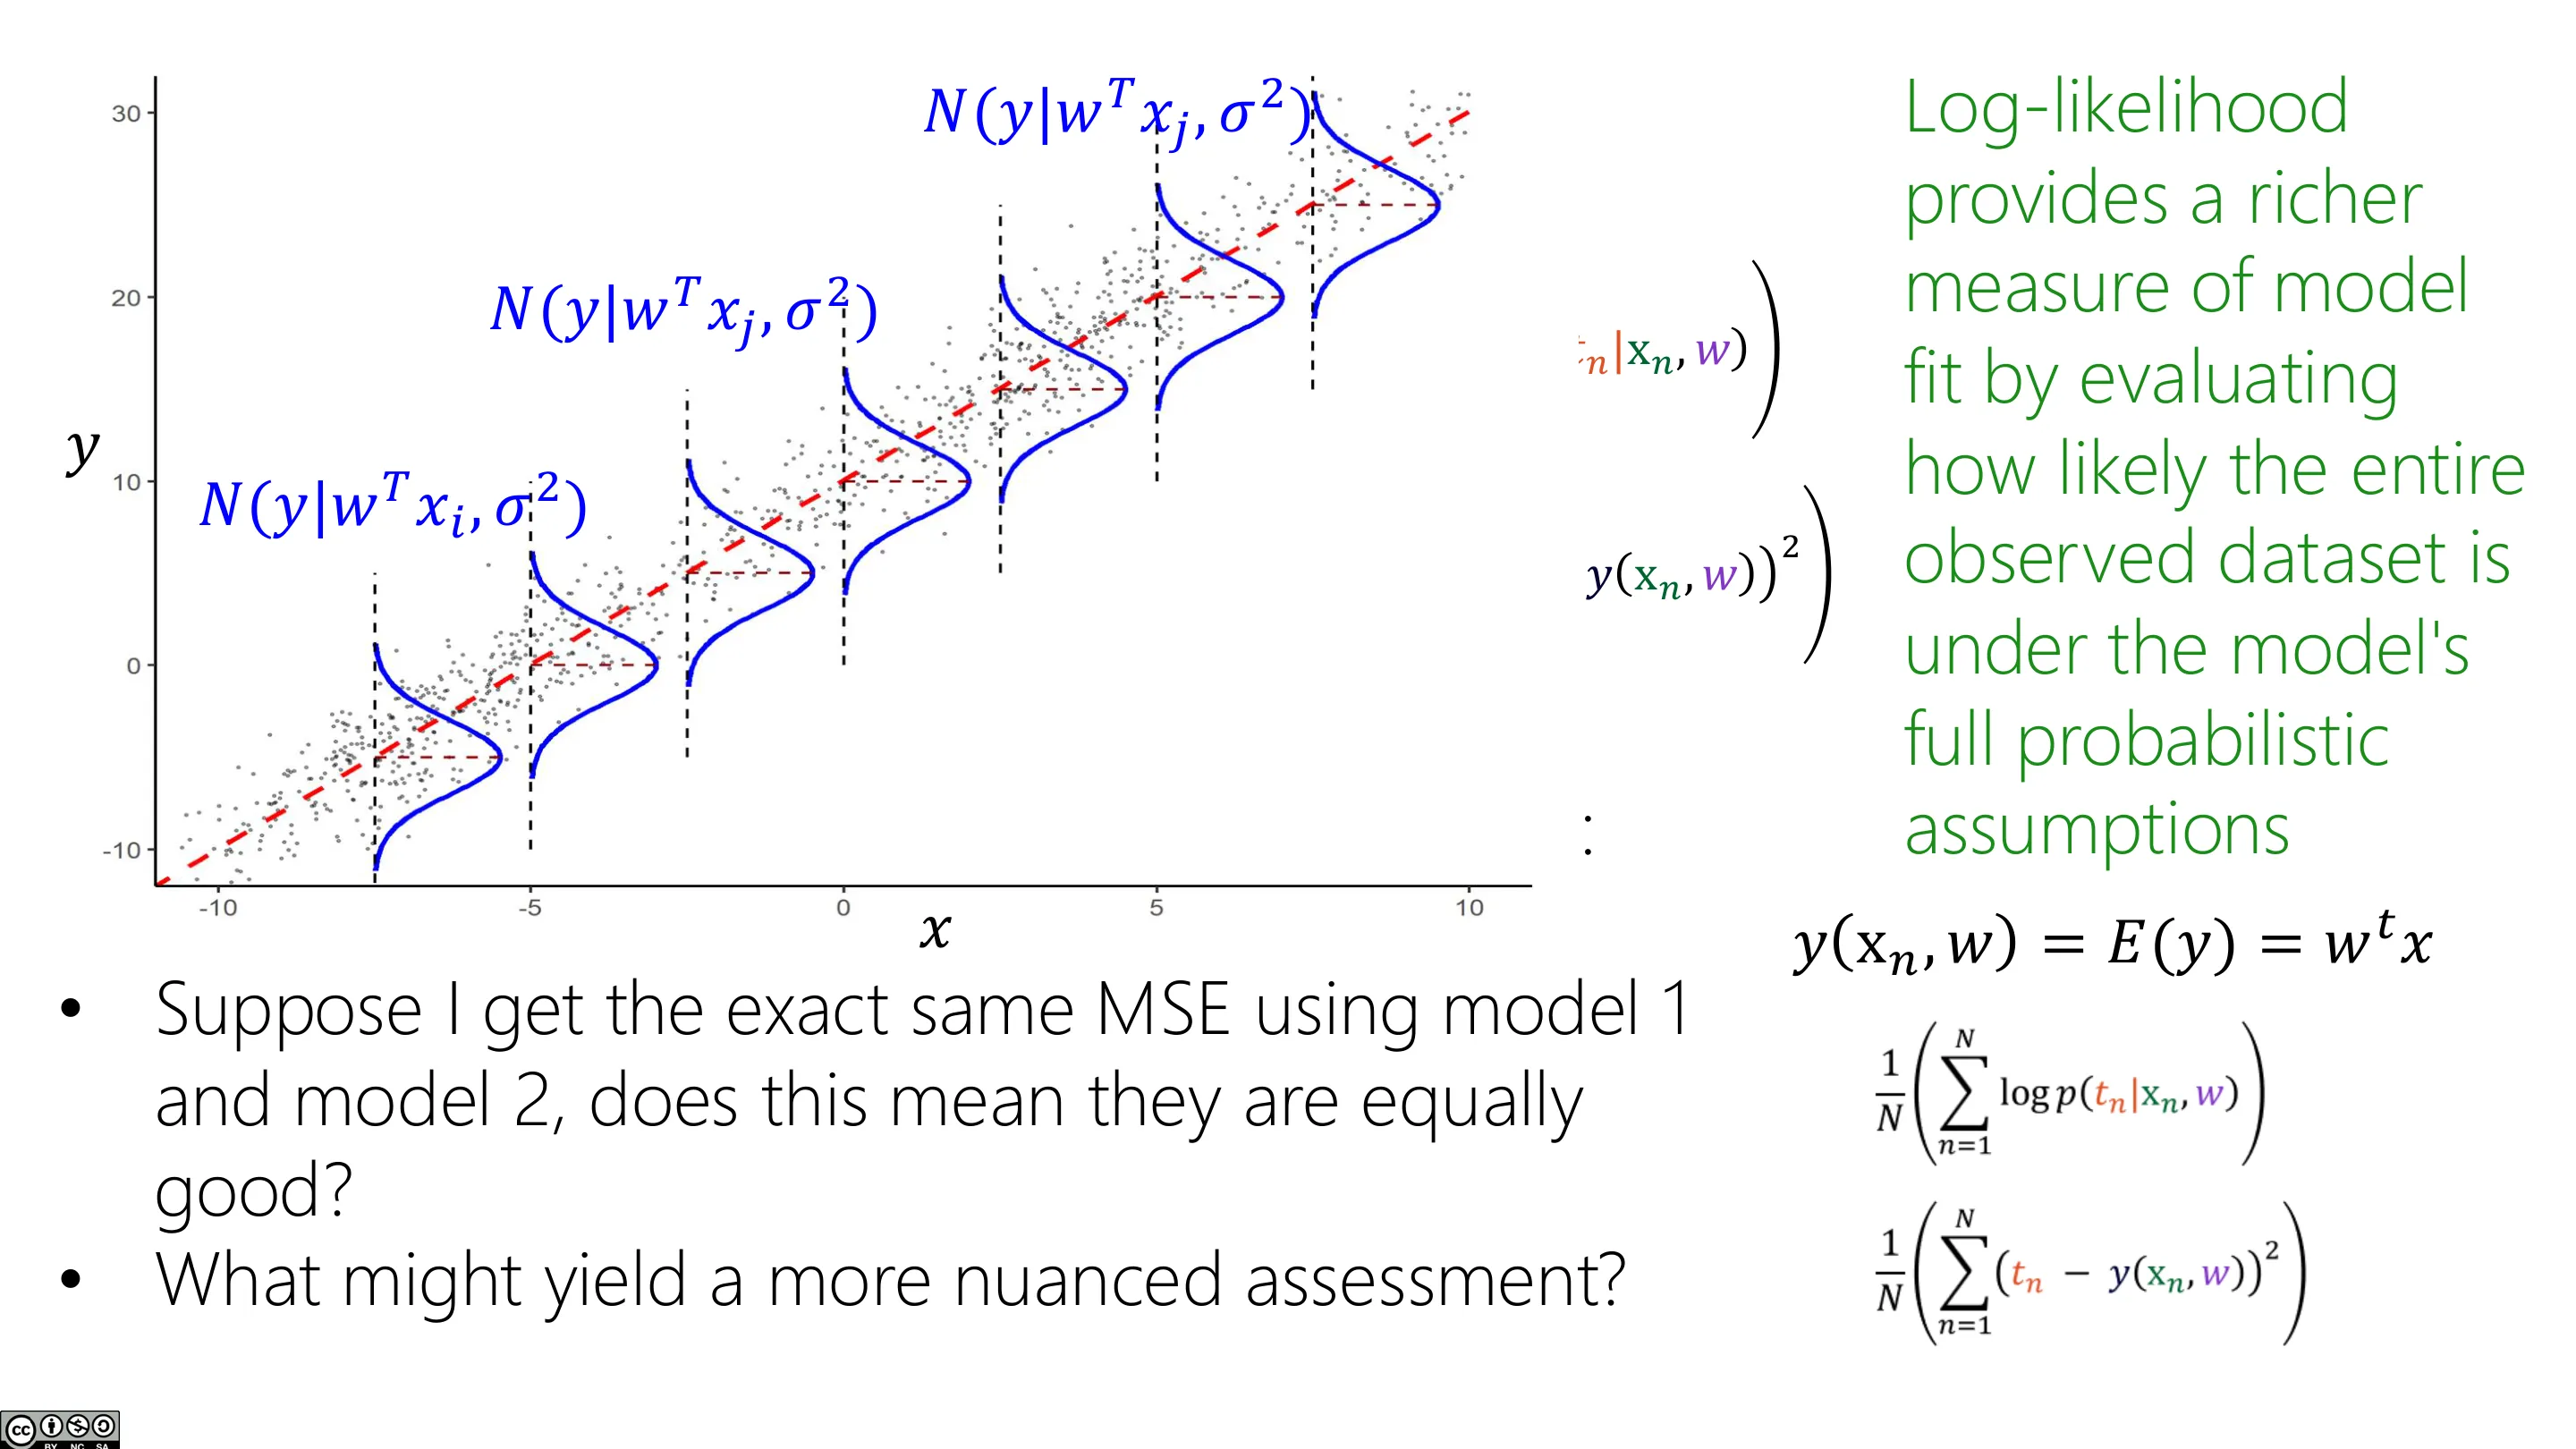
- 均方误差(MSE):$\frac1n\sum(\hat y_i-y_i)^2$——对线性回归,最小化 MSE ≡ 最大化含 $w$ 的似然;
- 均方根误差(RMSE)、相关 $r$、$R^2$(= $r^2$,可解释为「模型解释的方差比例」)、平均绝对误差(MAE)(对异常值更鲁棒)。
📷 评估:一般回归度量(一)
回到原视频 (00:19:18)
📷 评估:一般回归度量(二)
回到原视频 (00:22:03)
📷 评估:度量
回到原视频 (00:29:06)
2.2 似然 vs MSE:一个思想实验
两个模型可能有相同的点预测、相同的 MSE,但方差不同 ⇒ 似然不同。因为 MSE 只看预测分布的均值,而似然看的是整个分布(包含不确定性)。当你做模型比较/选择时,似然通常比只盯点预测更有信息量。
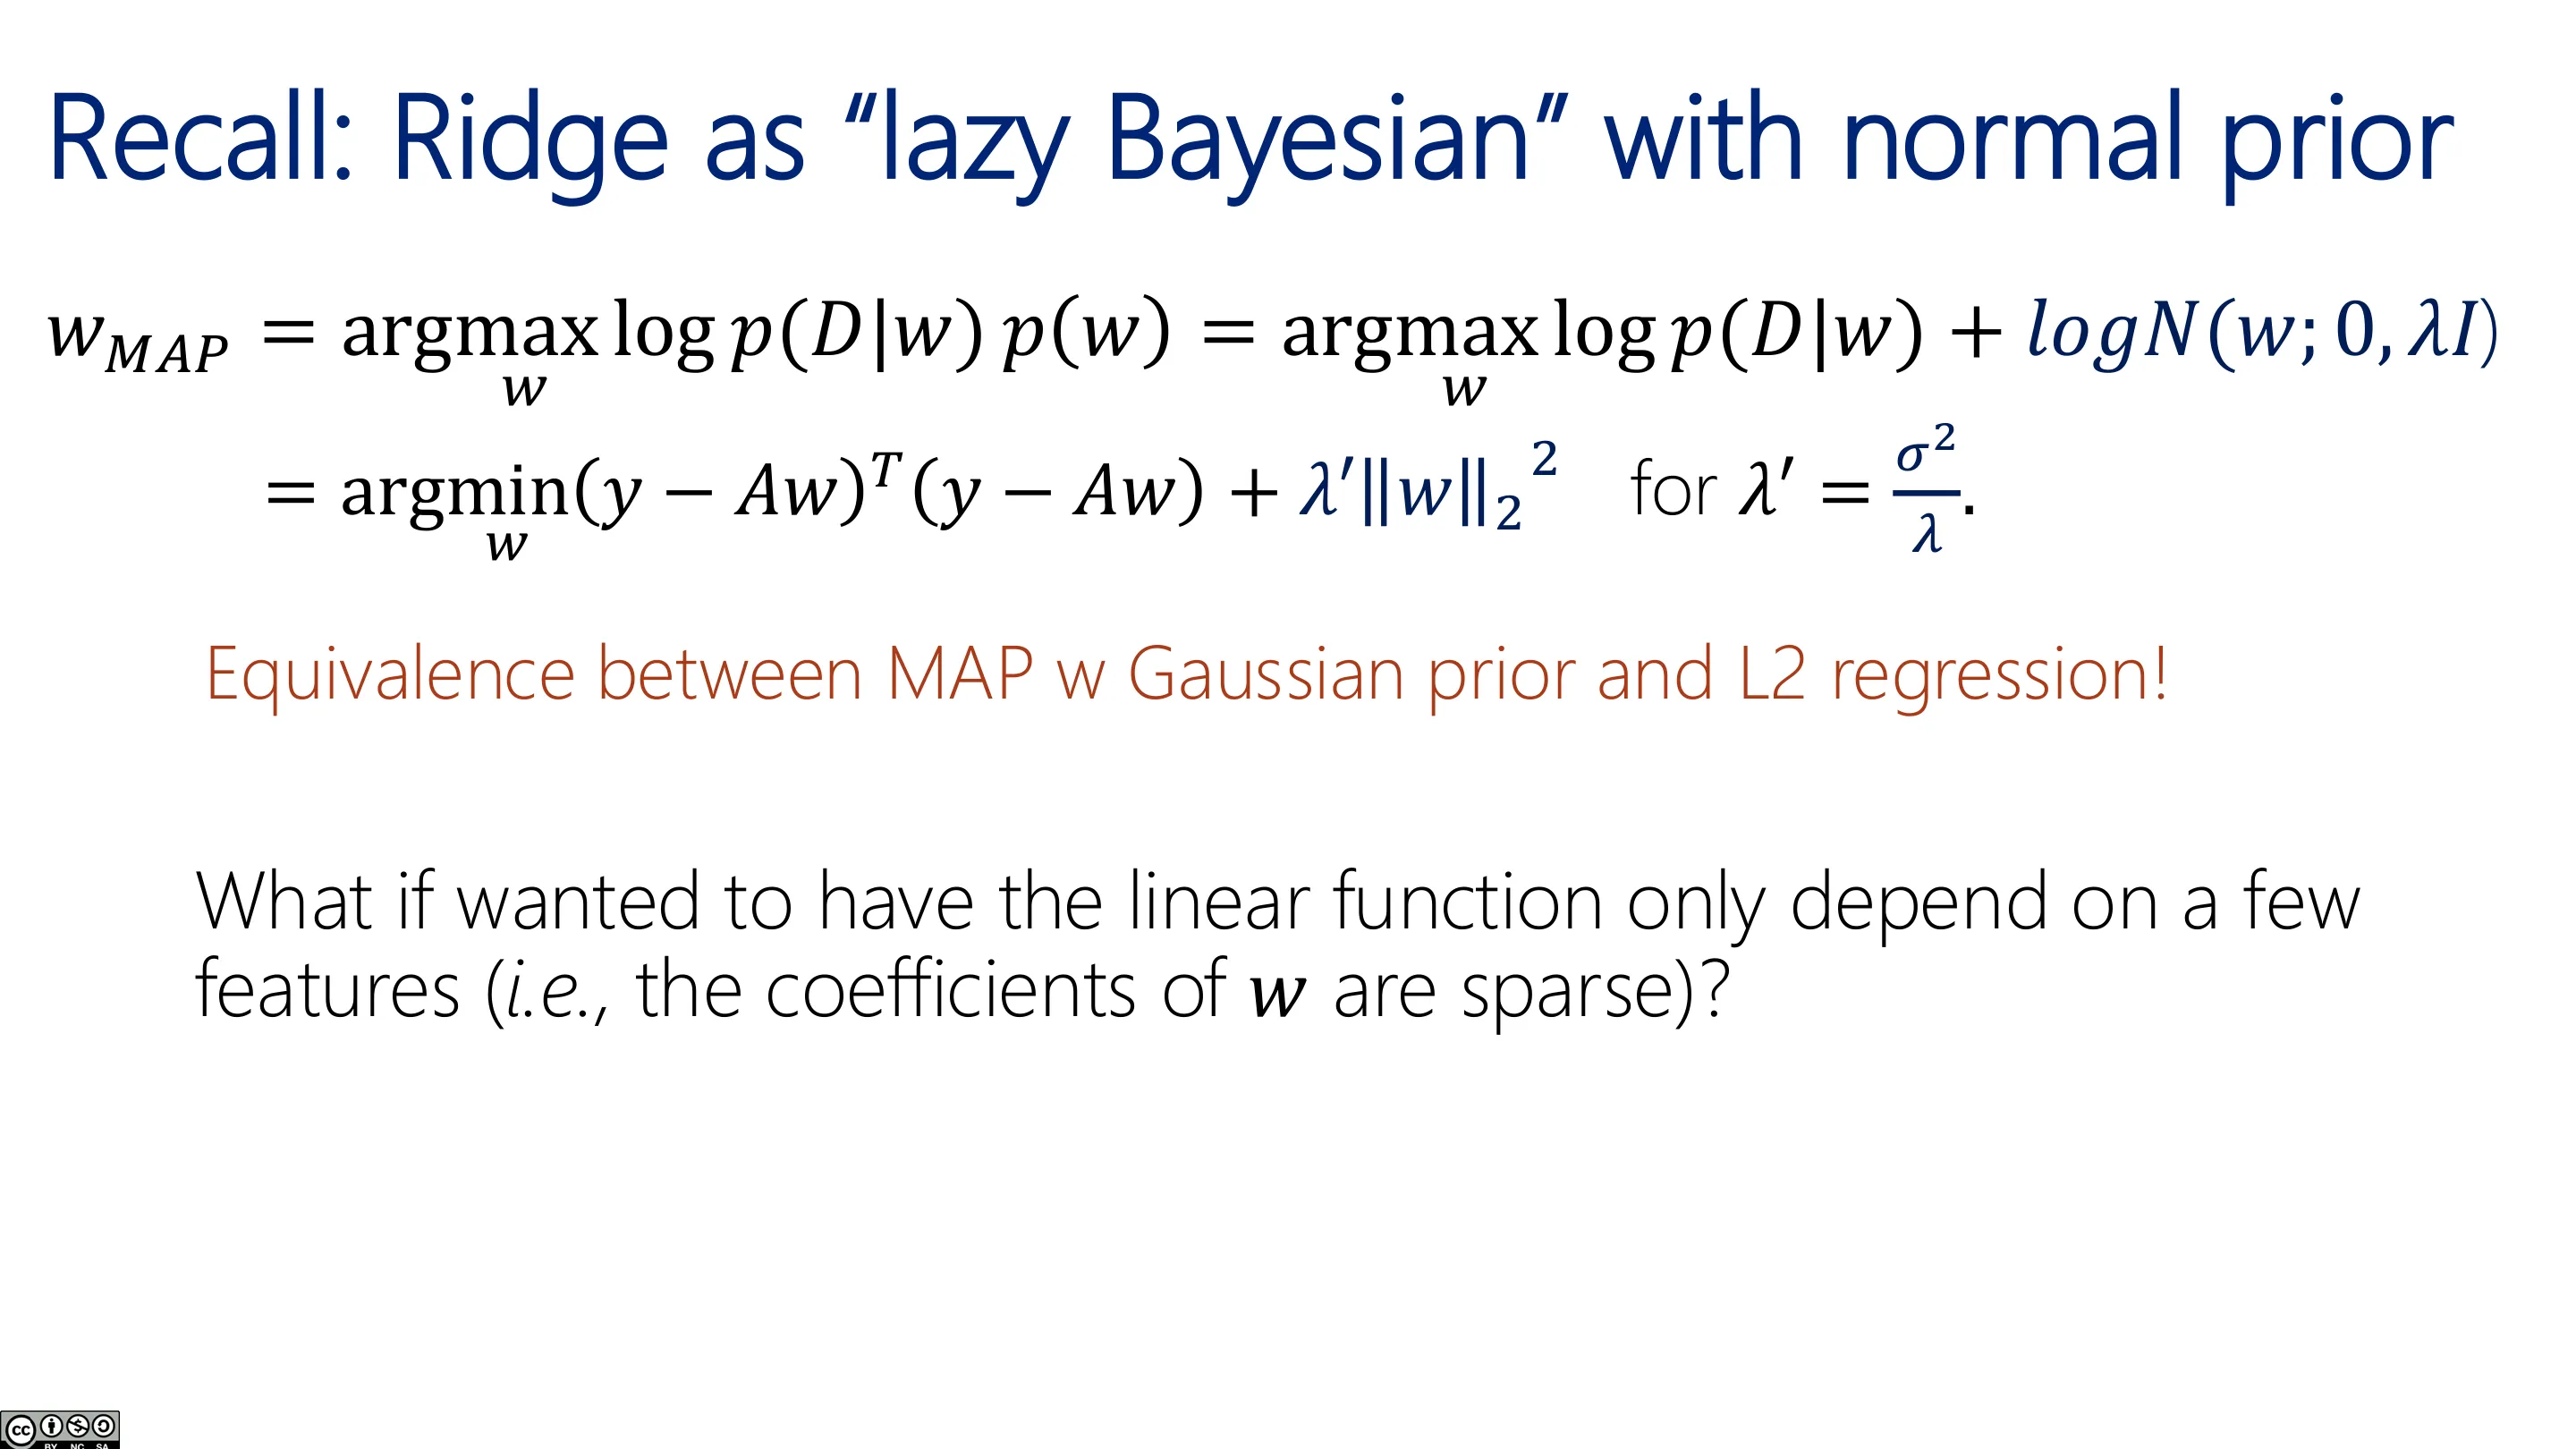
📷 回顾:Ridge 是「偷懒的贝叶斯」
回到原视频 (00:41:25)
📷 其他先验?
回到原视频 (00:45:40)
2.3 测试集与「赢家诅咒」
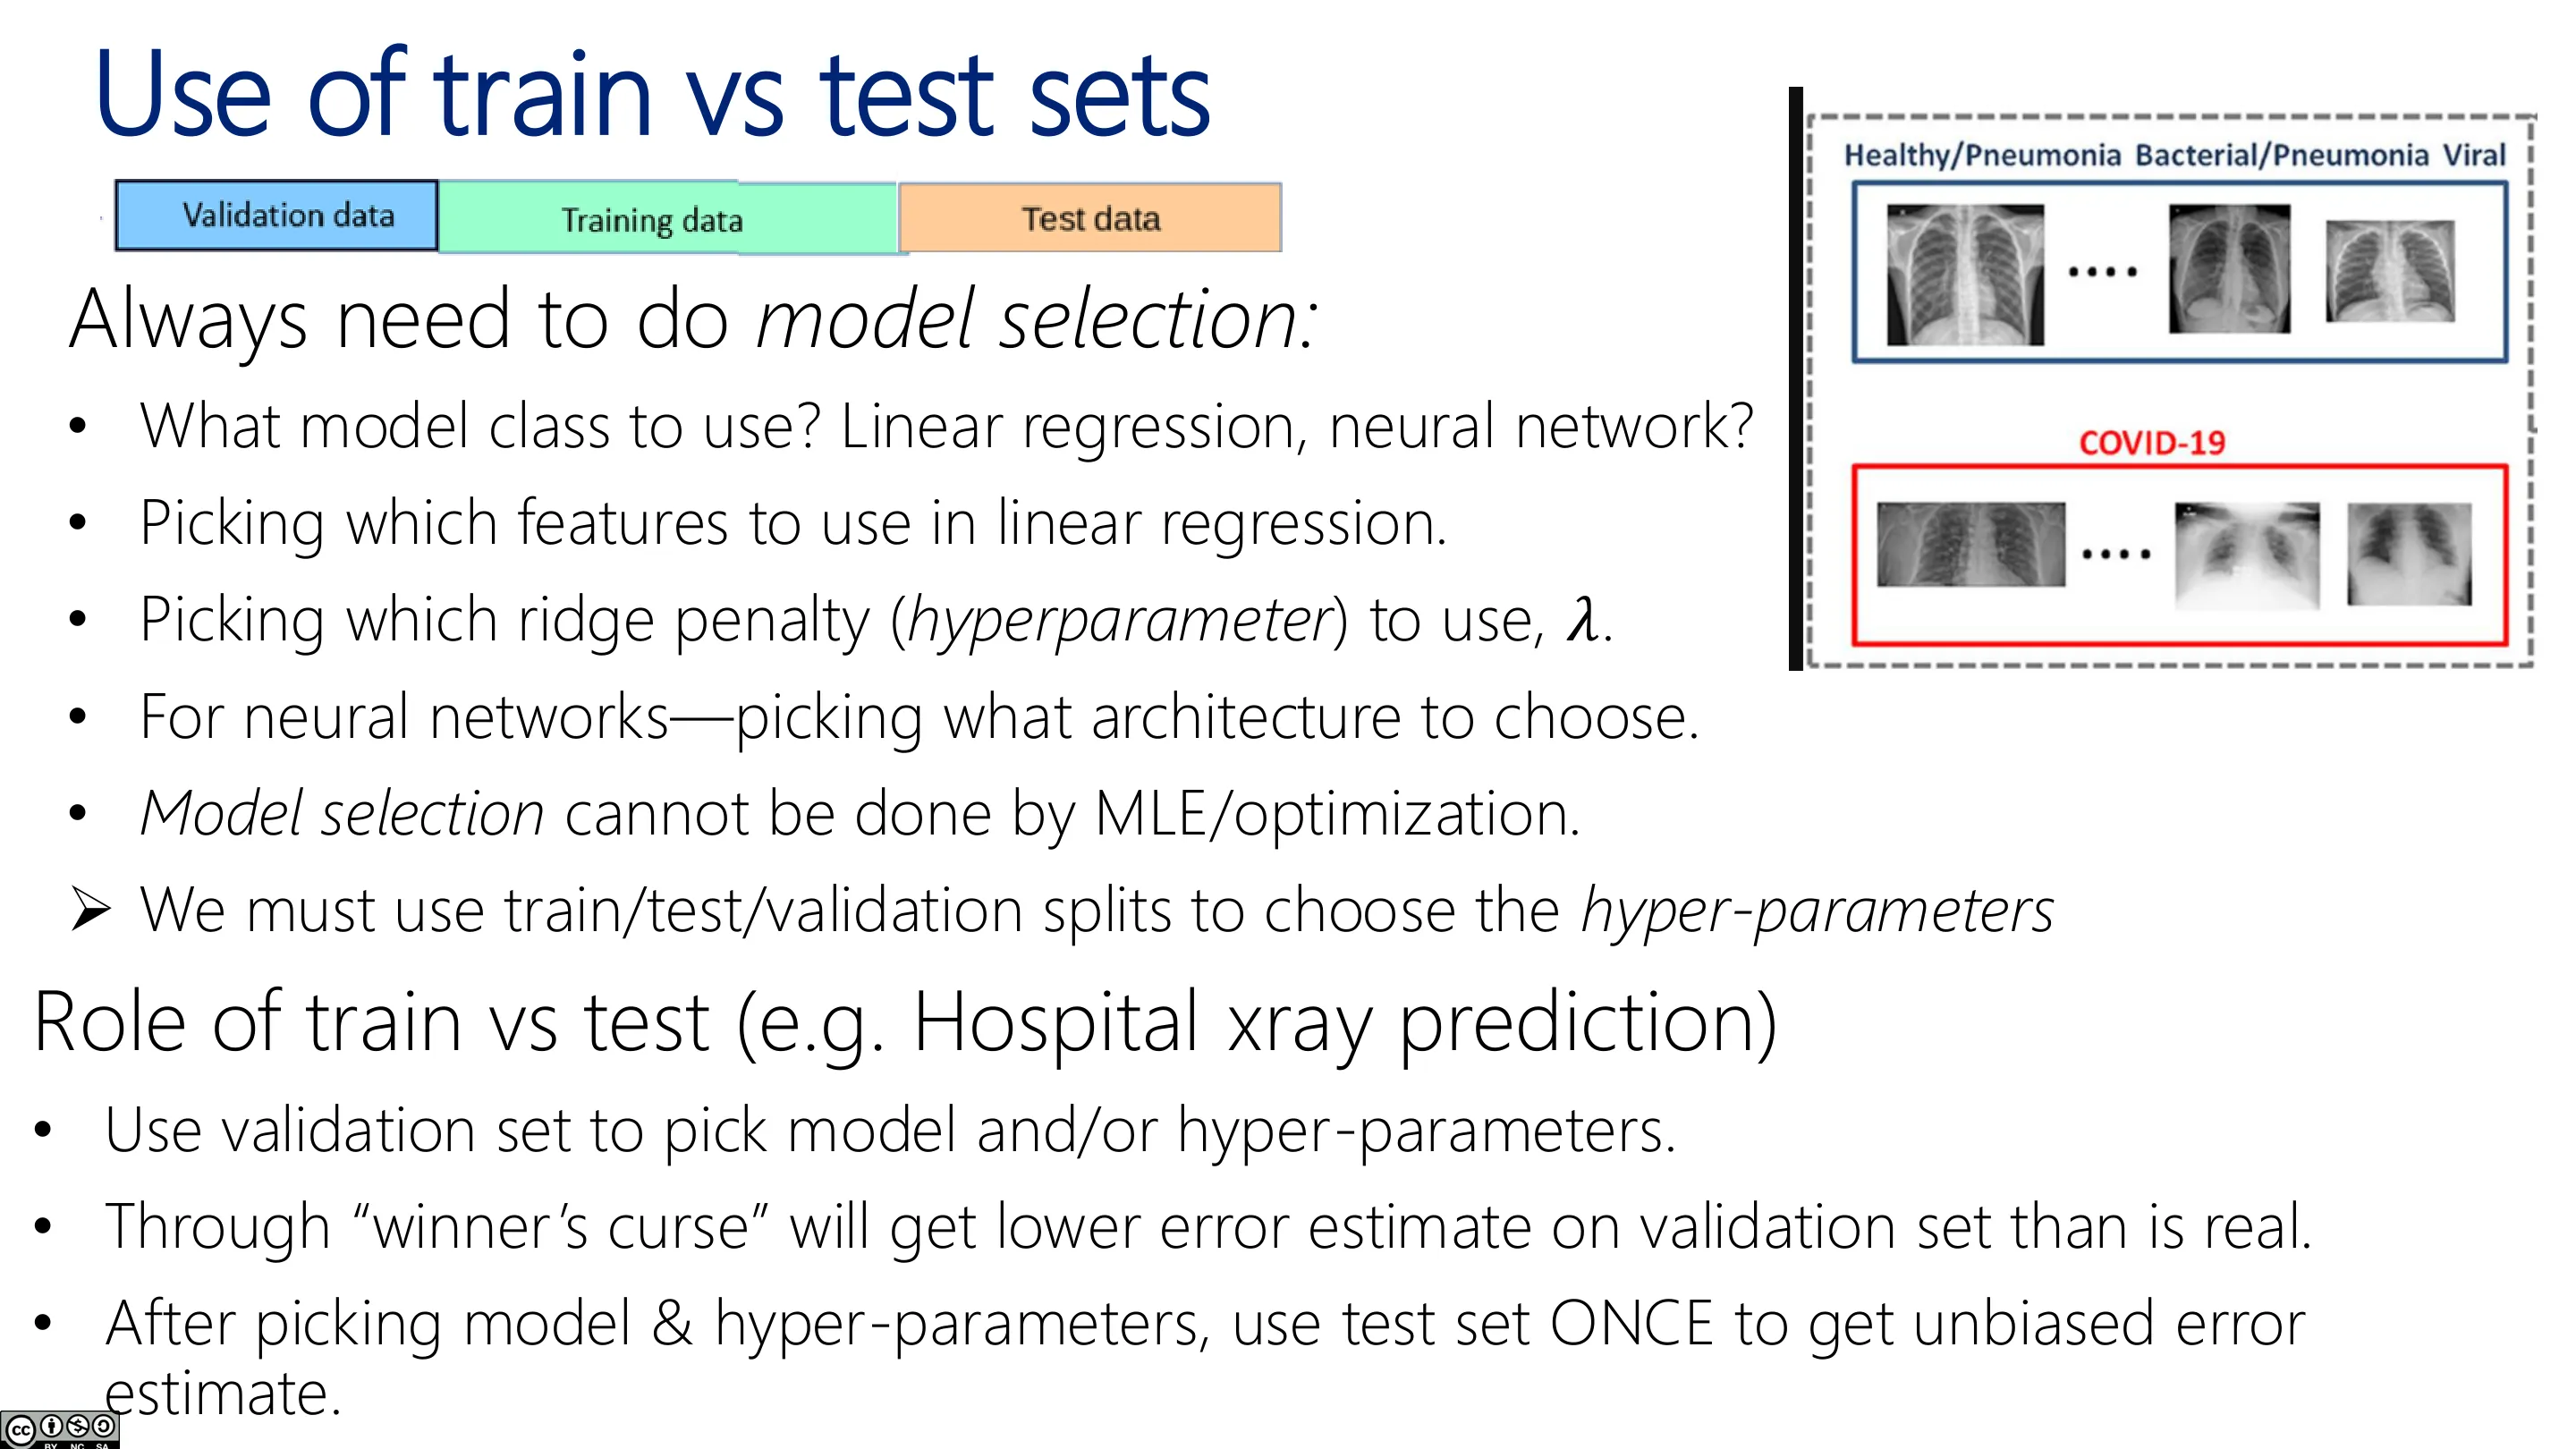
- 只需训练集 + 验证集即可做模型选择(超参数、特征、甚至模型类型);
- 测试集的作用:选定模型后,获得一个无偏的泛化误差估计;
- 规则:测试集只能用一次。若你尝试成百上千个超参数,总有一个在验证集上「碰巧」很好——这是多重假设检验问题(机器学习里叫 赢家诅咒 winner's curse),验证误差会被低估,所以必须用独立的测试集确认;
- 现实中很多人(甚至论文)违反了这一点——所以「读到别人的结果要谨慎」。
📷 L1 惩罚线性回归(Lasso)
回到原视频 (00:46:33)
三、L1 正则化(Lasso)与稀疏性
(参考时间: 00:41)
3.1 从 Ridge 到 Lasso
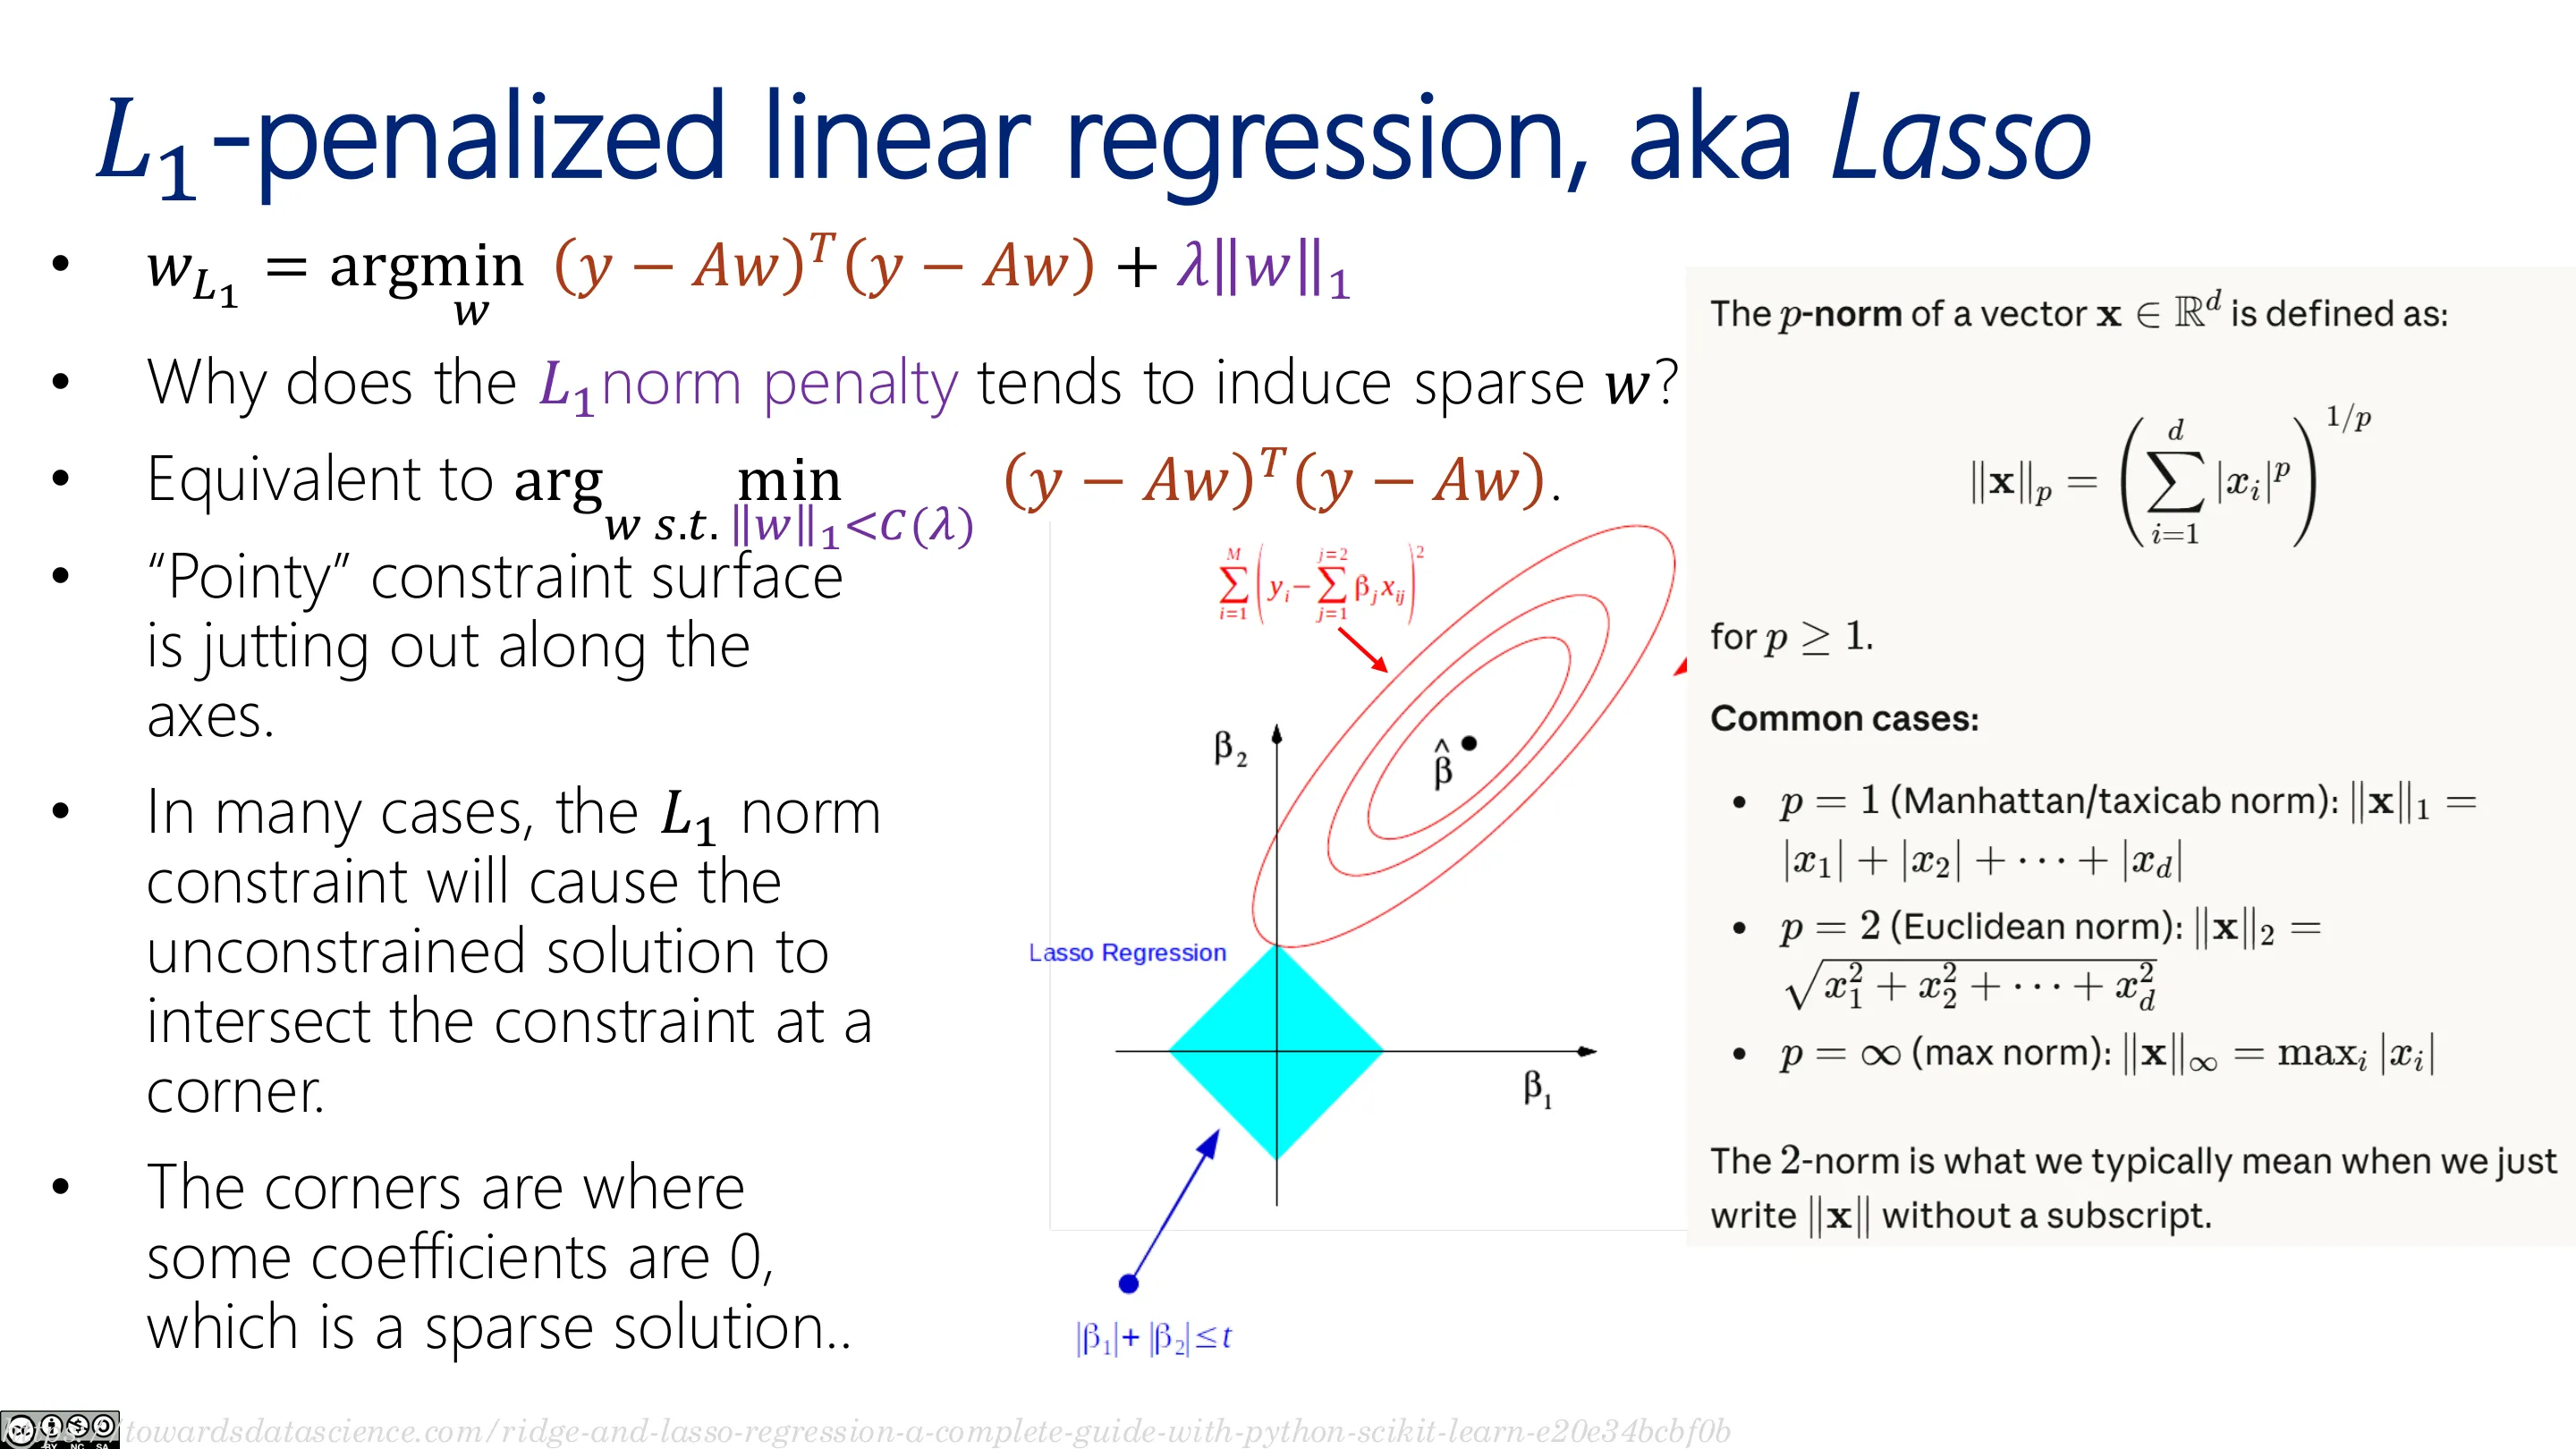
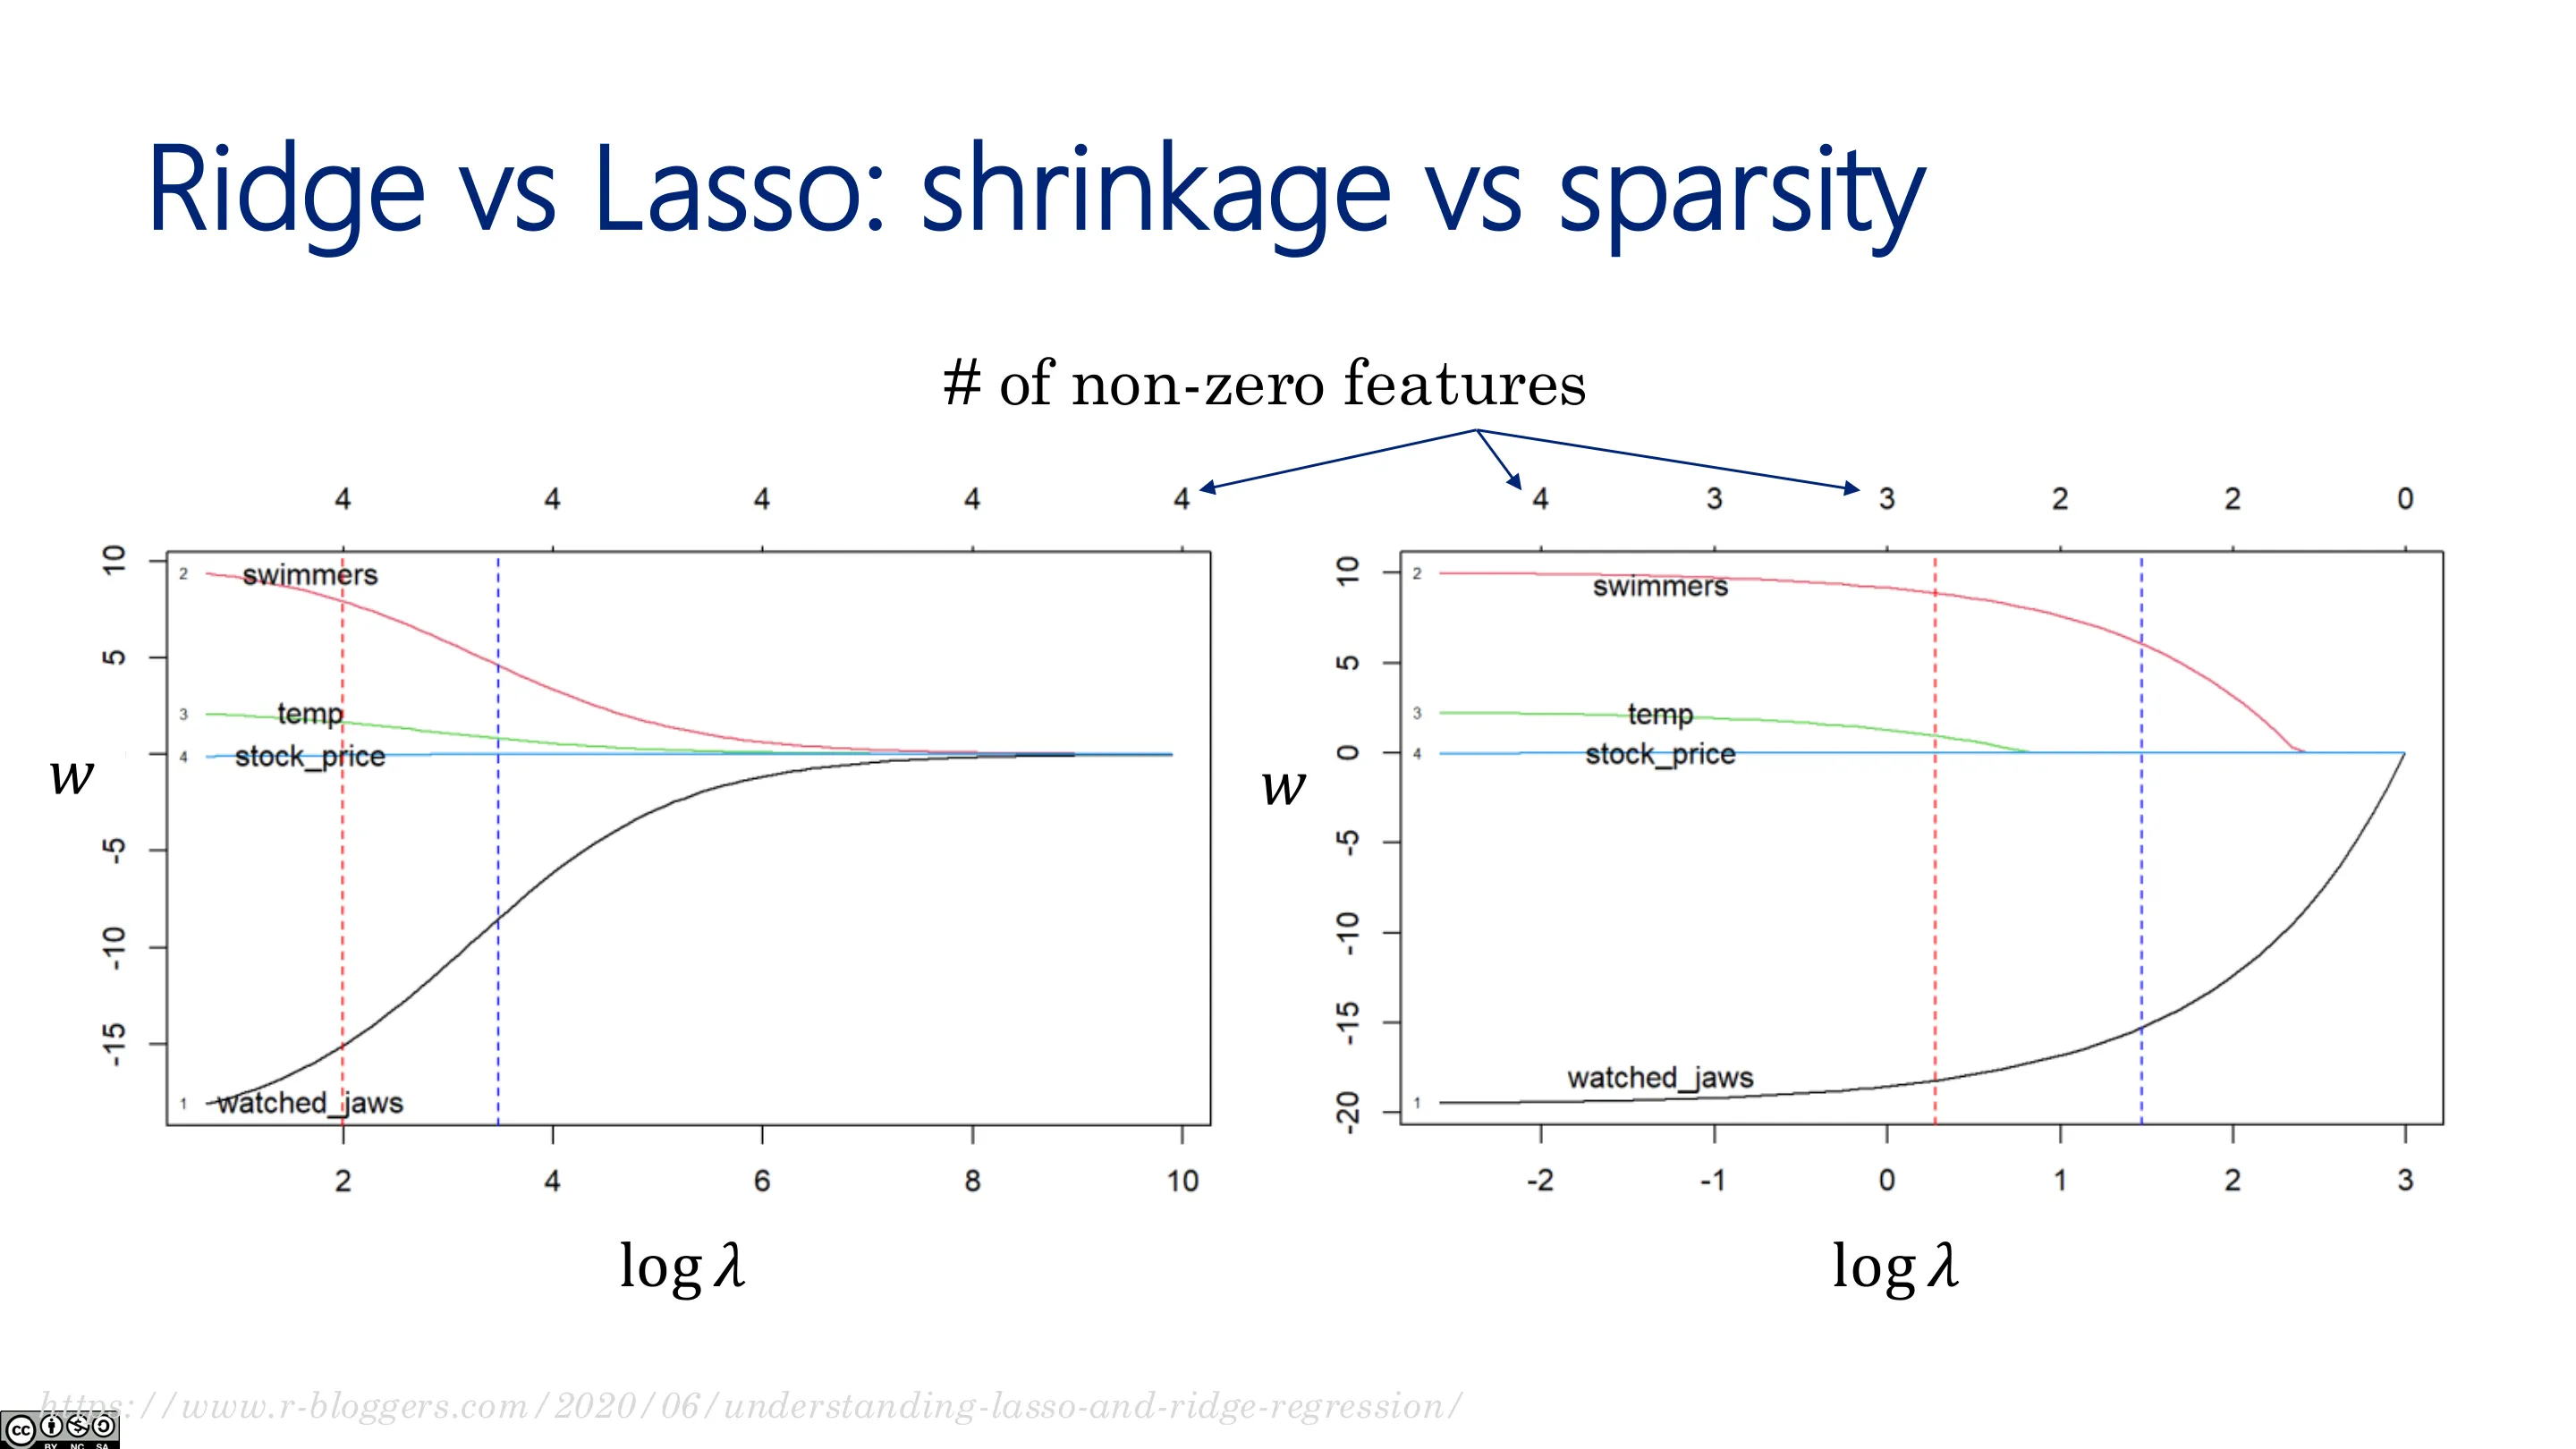
Ridge(L2)会把参数优雅地缩小但一般不为 0。但我们常常想要真正去掉无关特征(让某些 $w_j$ 恰为 0)。于是用 L1 惩罚:
$$ \hat w=\arg\min_w\ \lVert y-Xw\rVert^2+\lambda\lVert w\rVert_1,\qquad \lVert w\rVert_1=\sum_j|w_j| $$
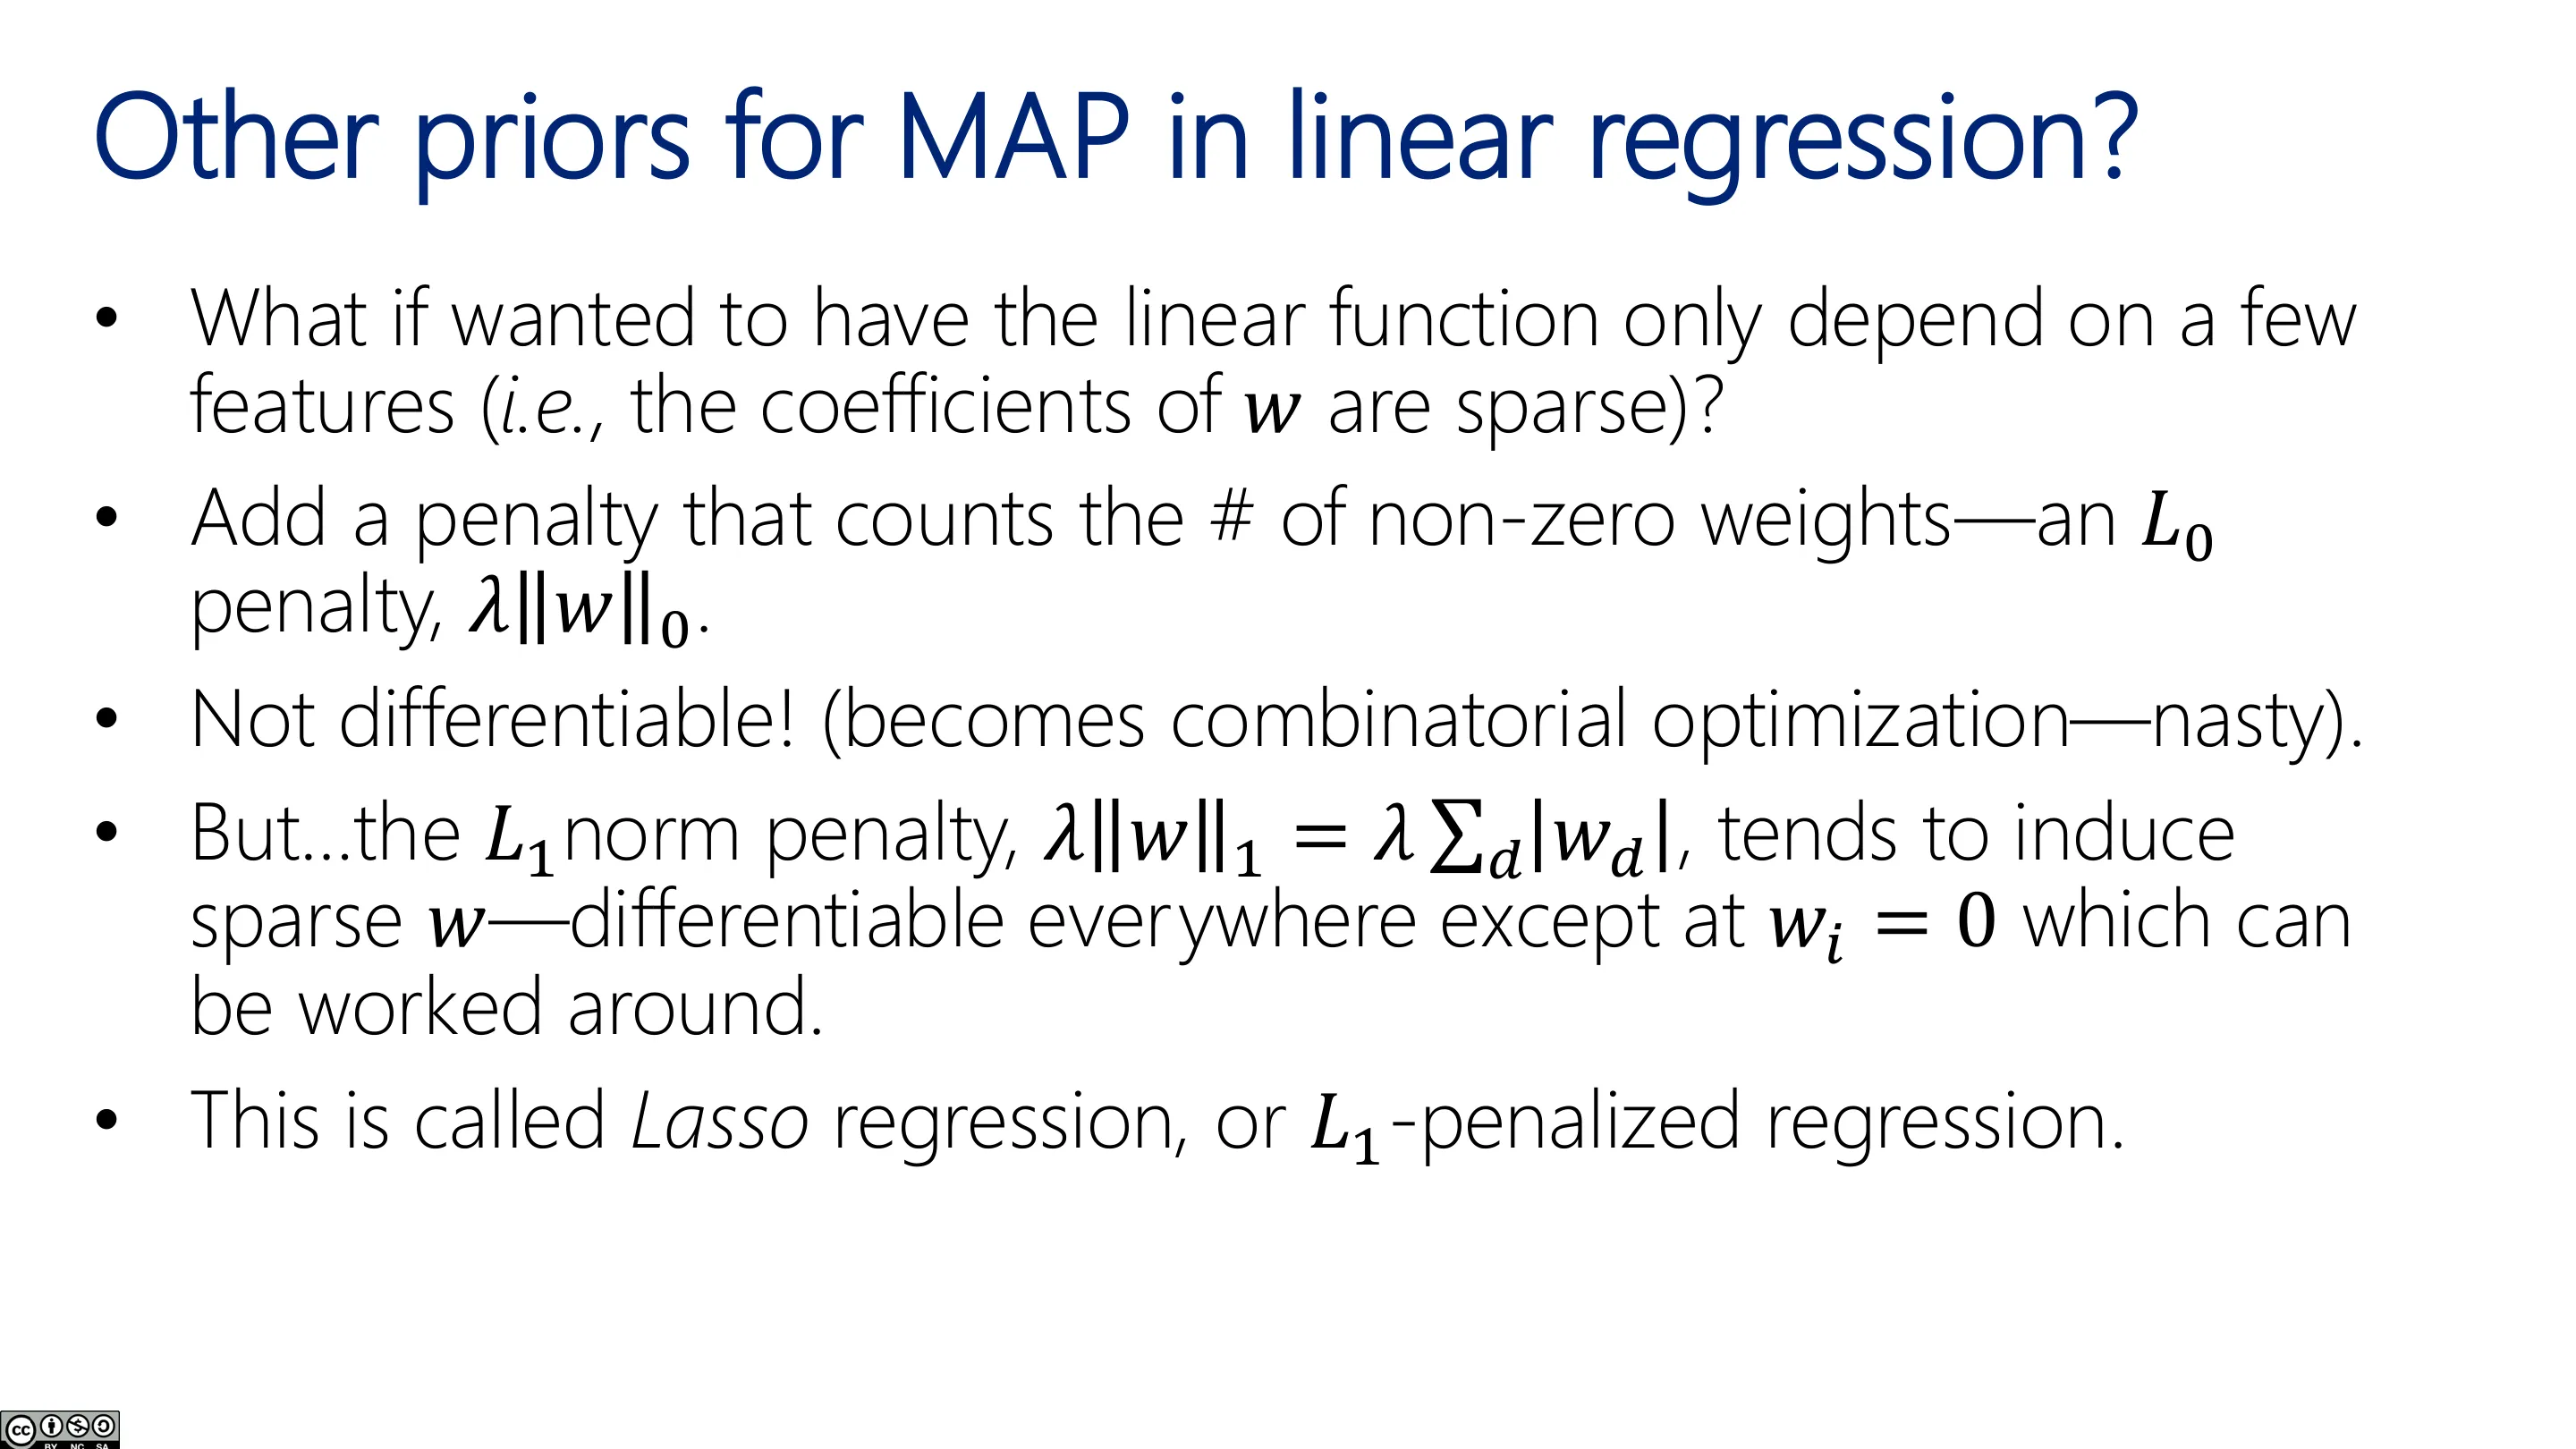
- 想直接惩罚「非零参数个数」(L0)会得到不可微、组合优化的问题;
- L1 是可微(除原点外)的近似,会产生稀疏解。
📷 Lasso(一)
回到原视频 (00:41:56)
📷 Lasso(二)
回到原视频 (00:43:38)
3.2 几何直觉:为什么 L1 产生稀疏
(参考时间: 00:49)
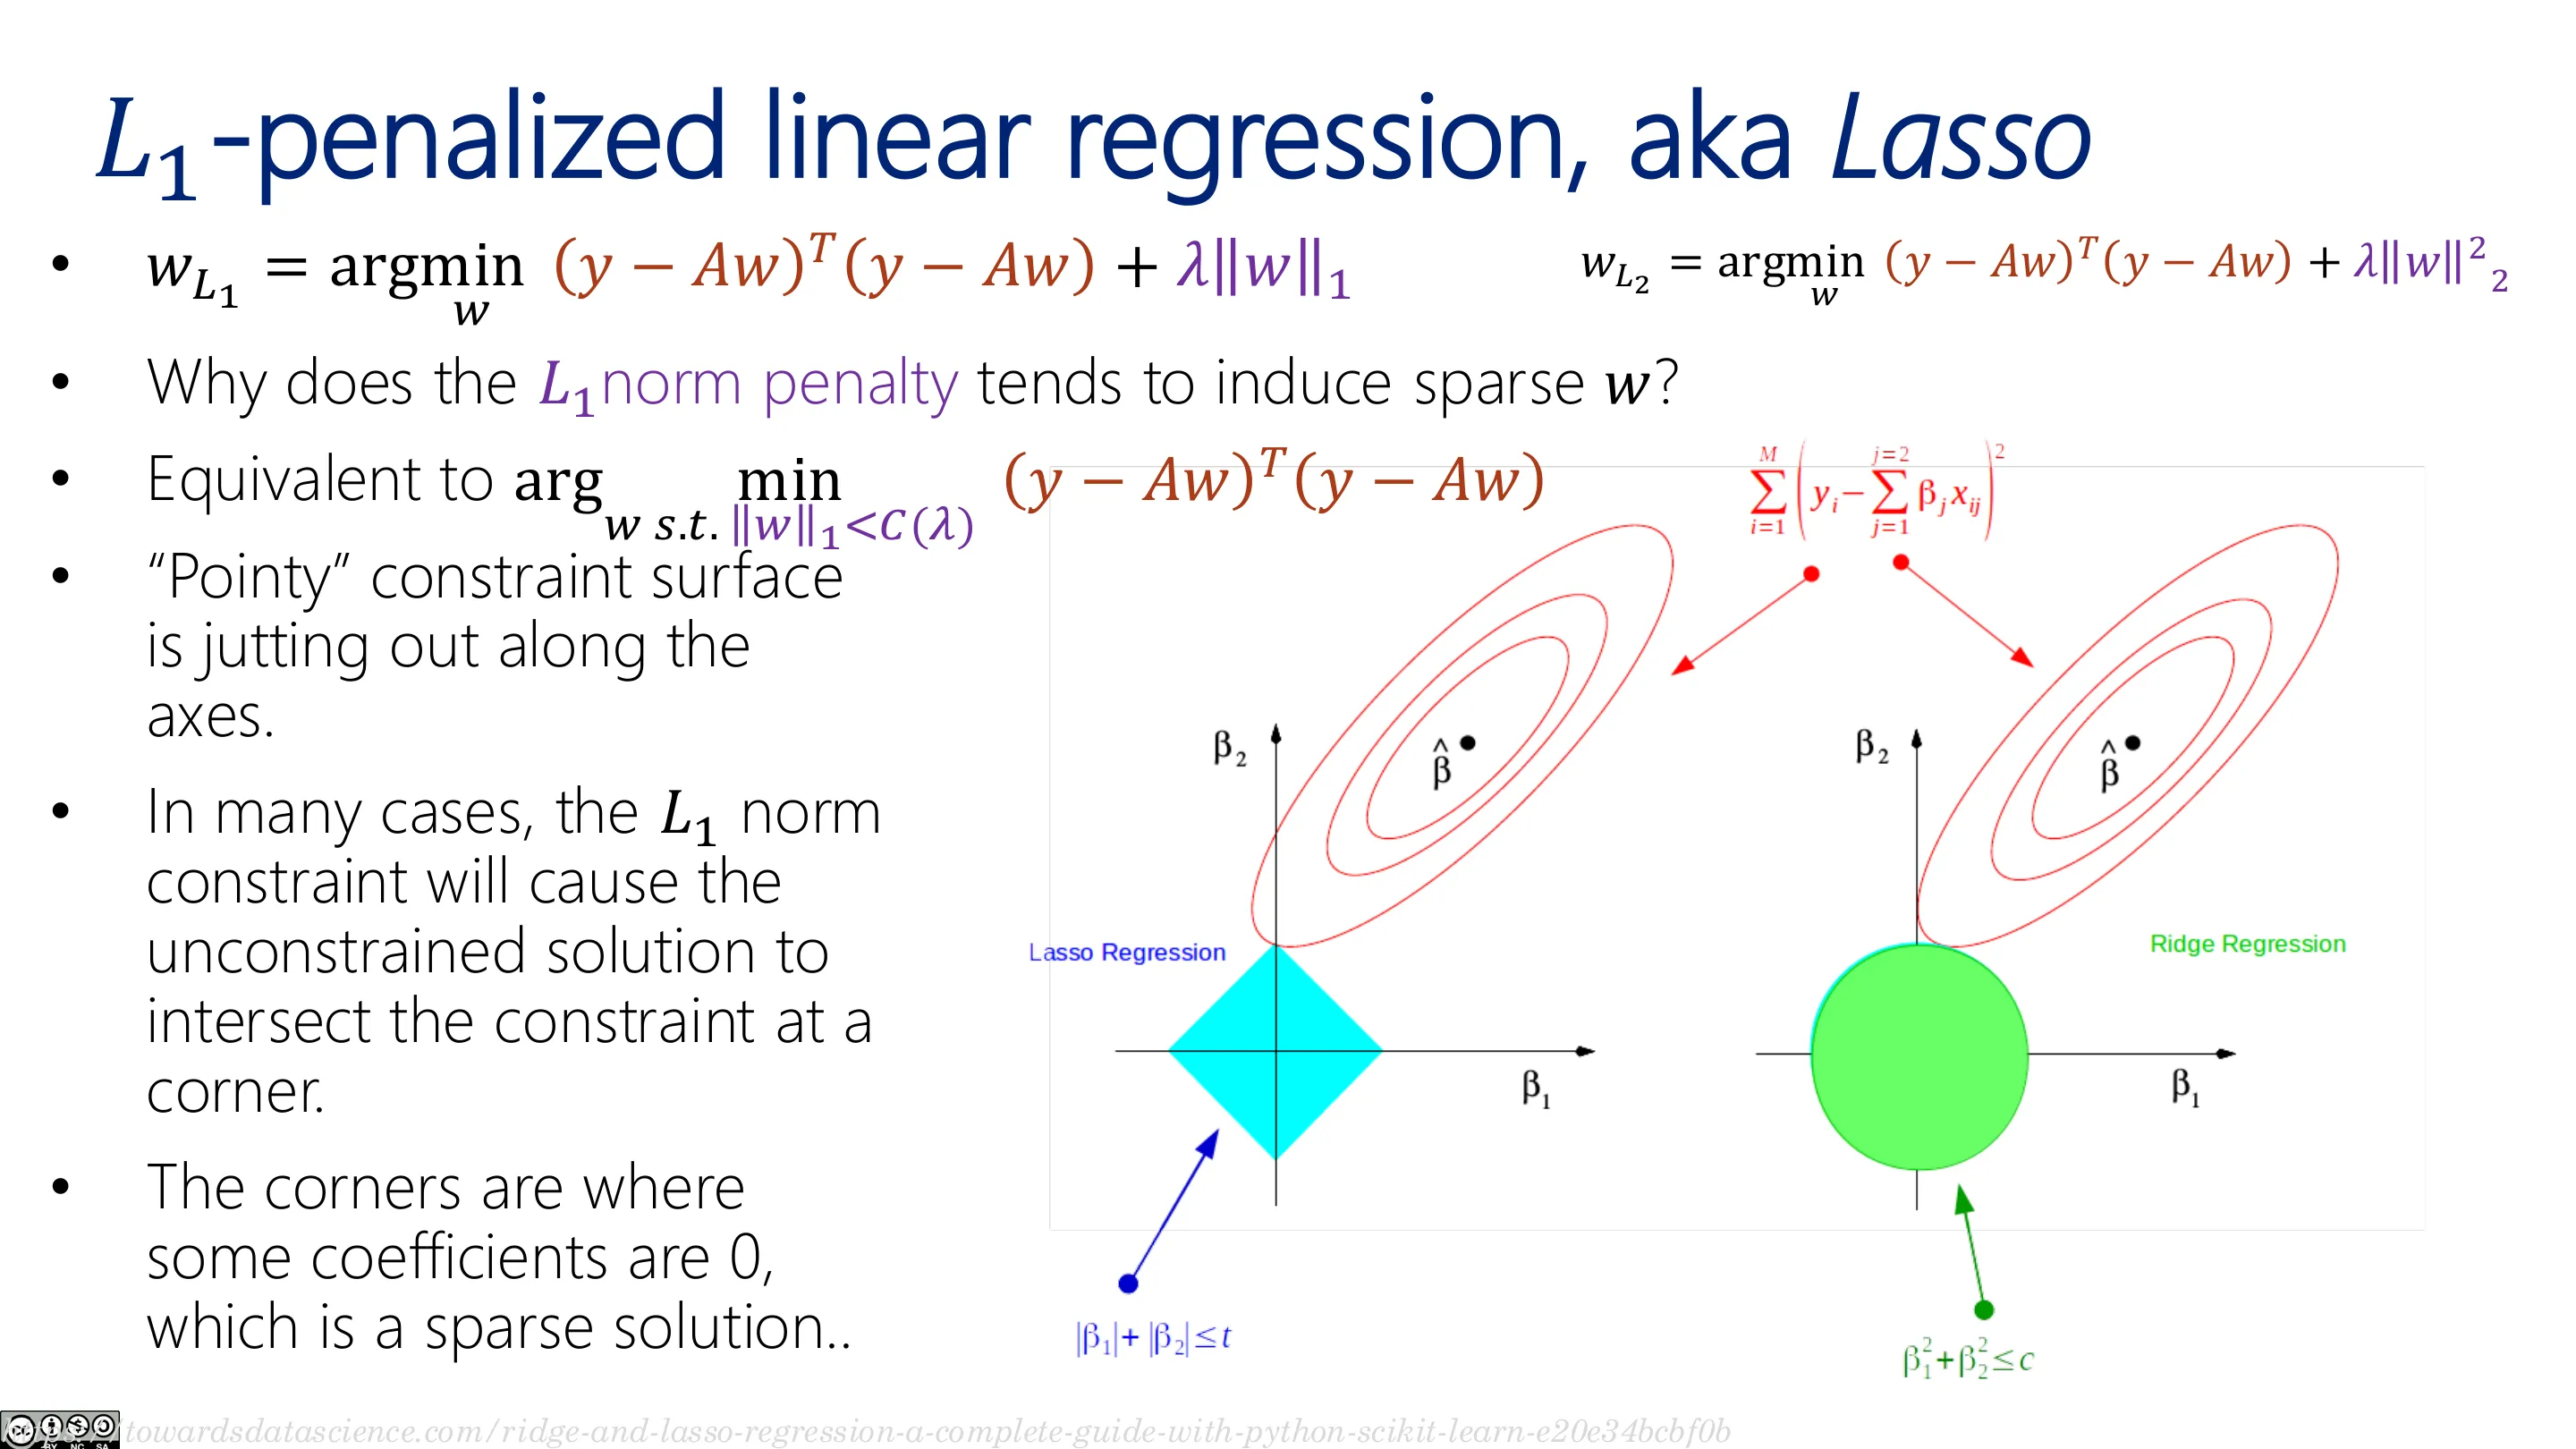
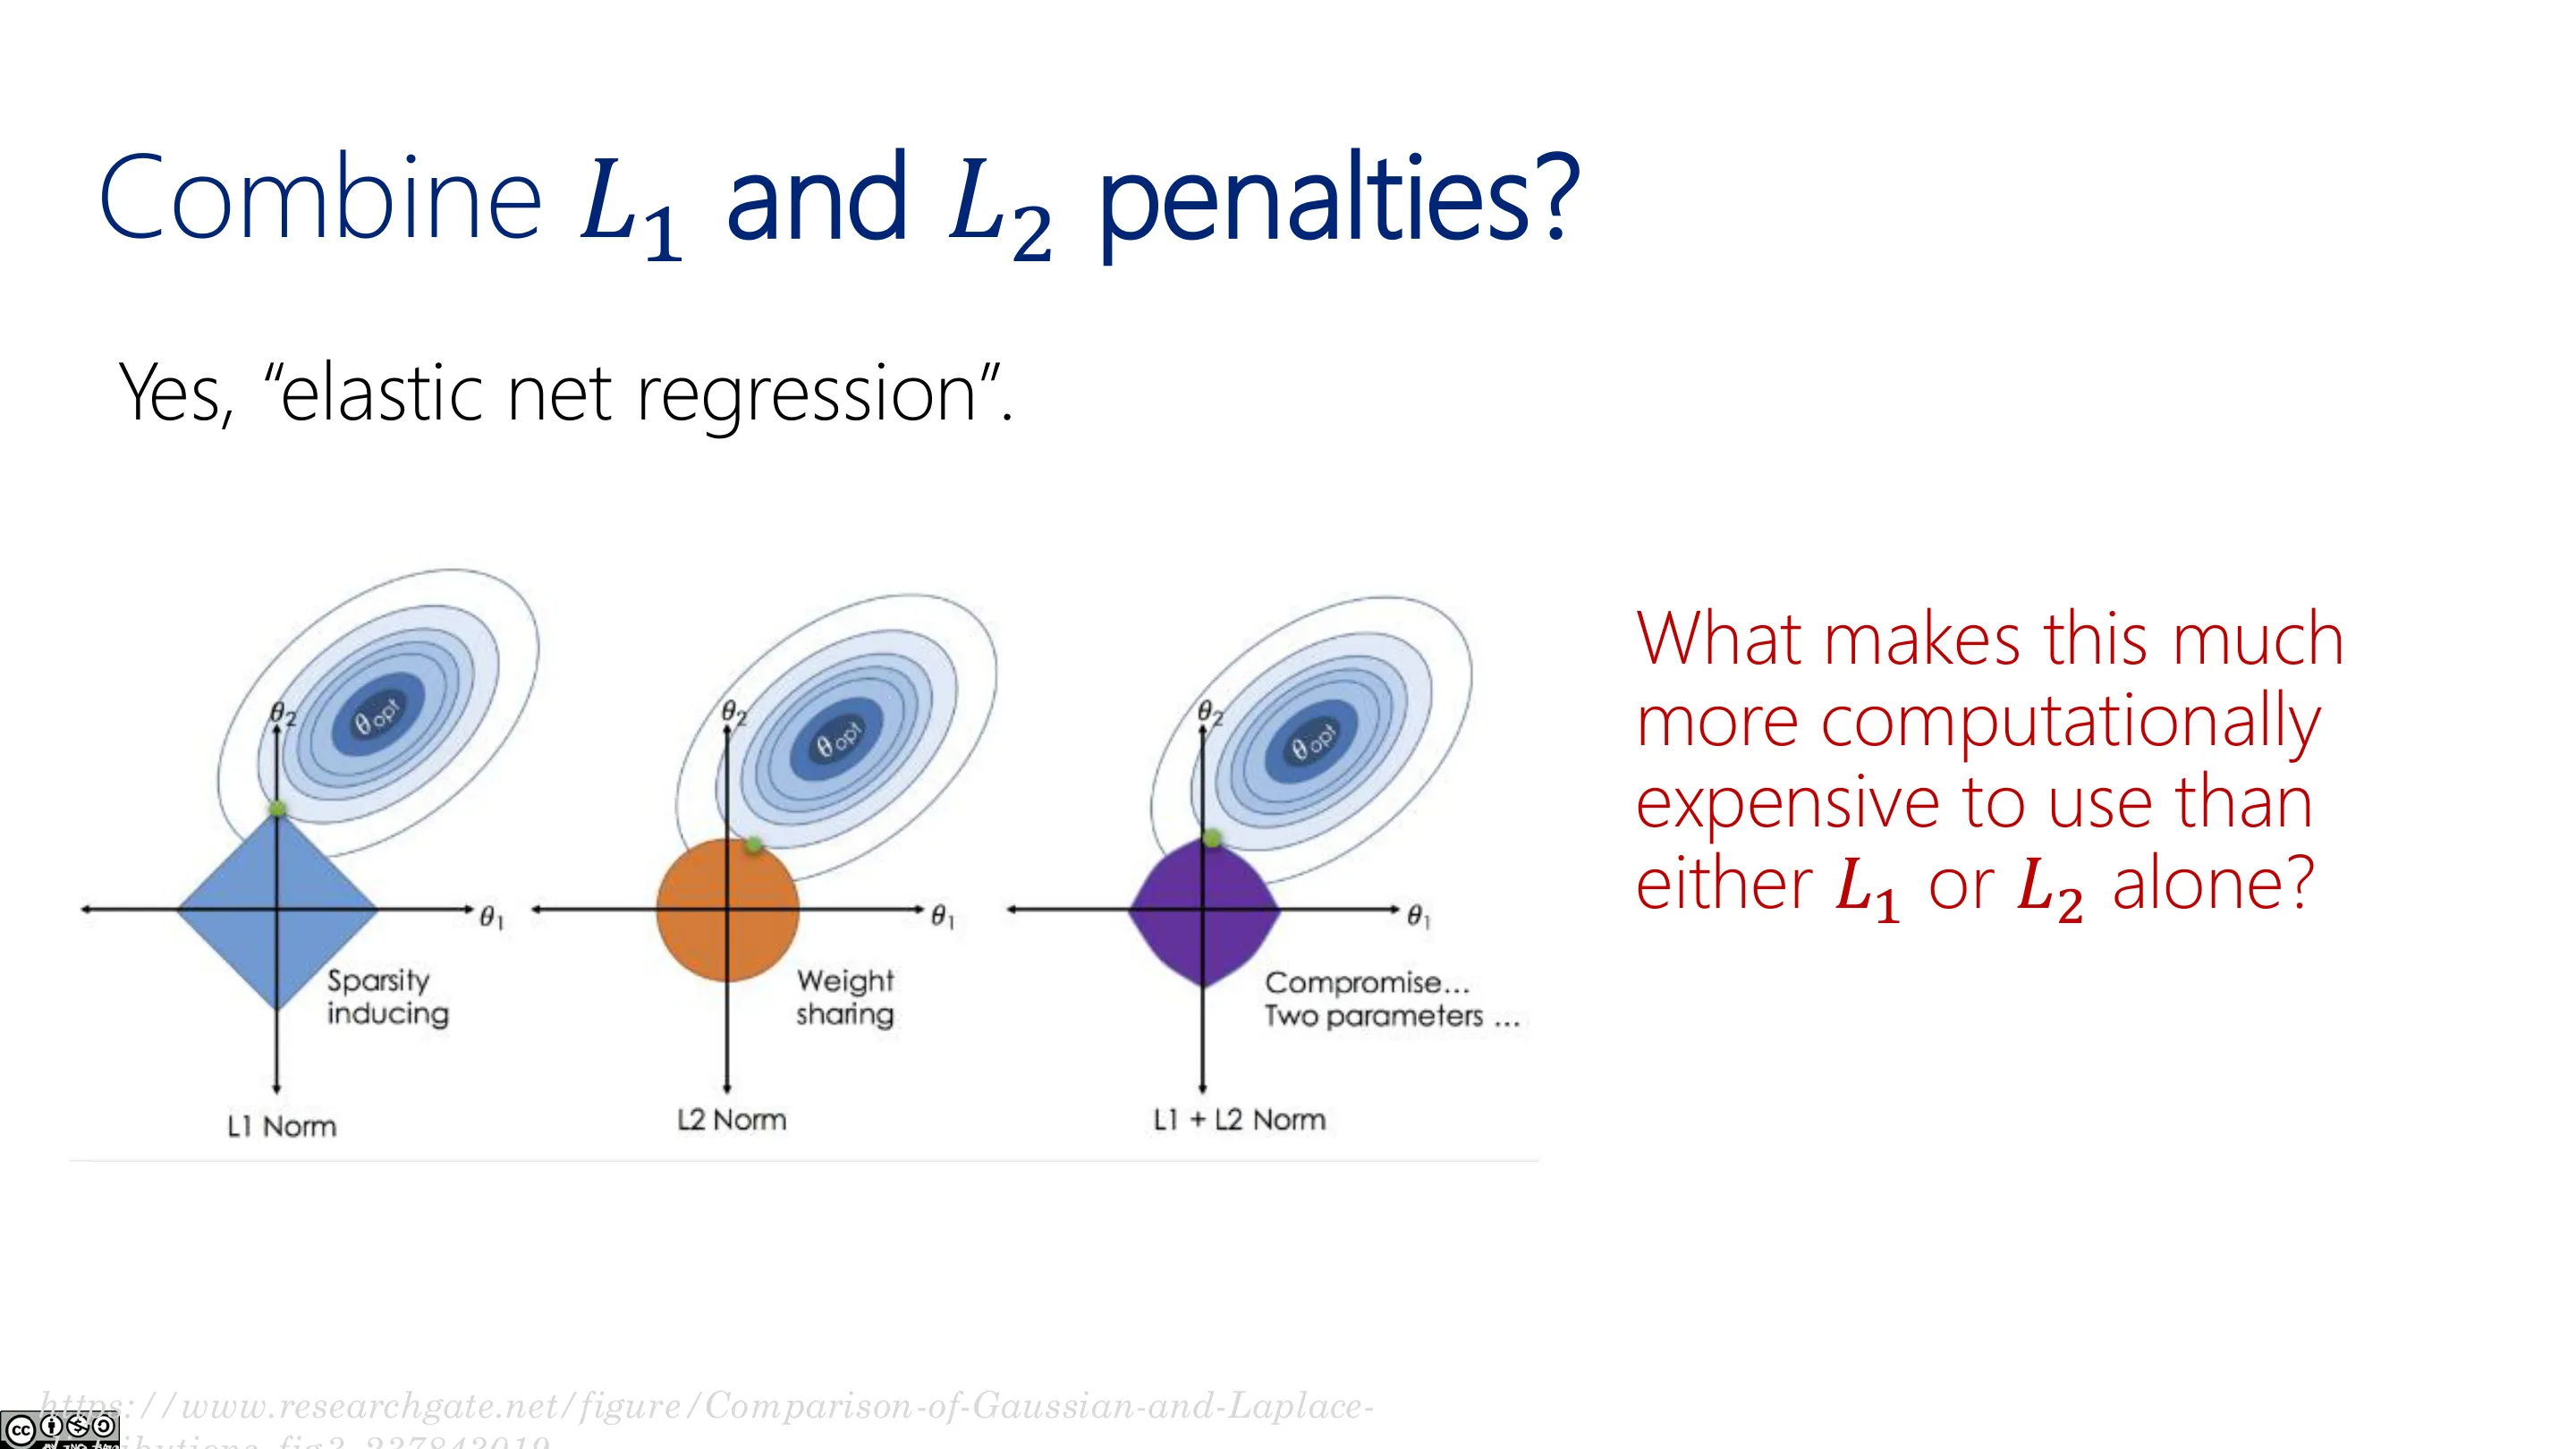
在二维参数空间,约束区域:
- L2 / Ridge:$\lVert w\rVert_2^2\le C$ ⇒ 一个圆(球);
- L1 / Lasso:$|w_1|+|w_2|\le C$ ⇒ 一个菱形(有尖角在对角线上)。
约束优化中,解出现在似然水平集首次与约束区域相切处。由于菱形有尖角落在坐标轴上,切点很可能正好落在坐标轴上 ⇒ 某个参数恰好为 0。球没有尖角 ⇒ 几乎不可能恰好相切于轴 ⇒ Ridge 一般不给稀疏解。
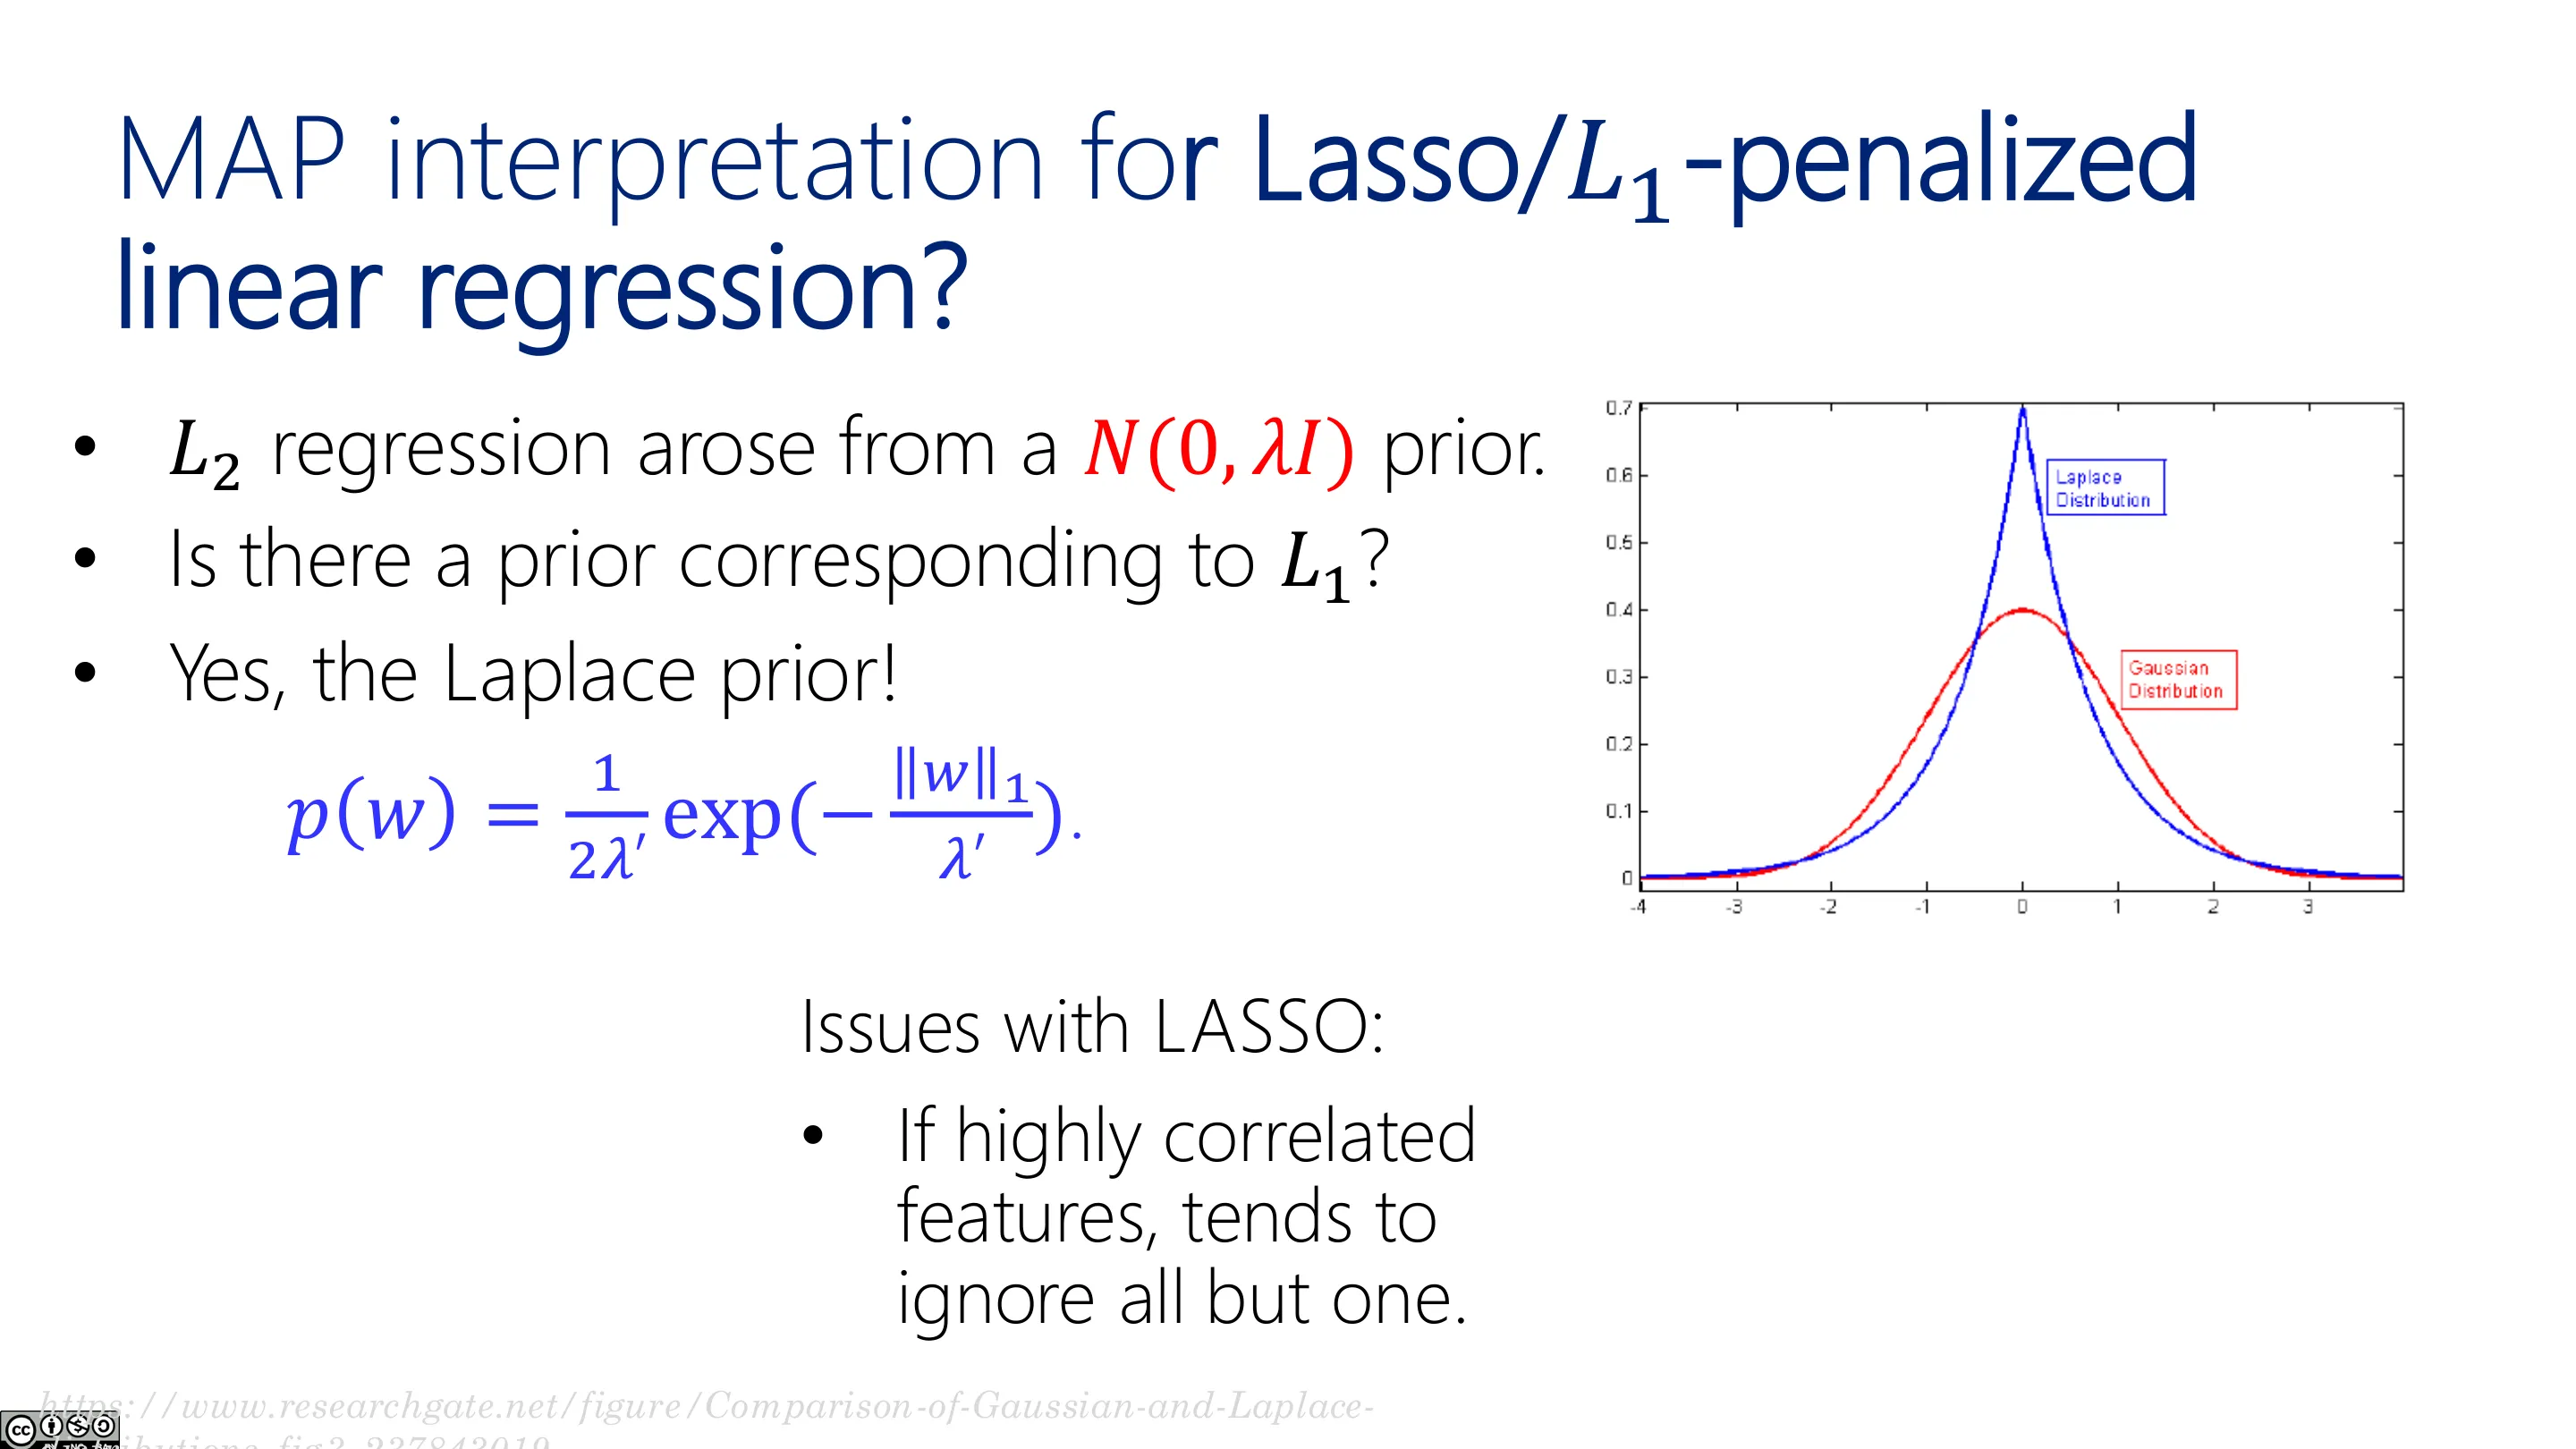
📷 Lasso 的 MAP 解释(Laplace 先验)
回到原视频 (00:54:01)
📷 L1 与 L2 的对比
回到原视频 (00:55:01)
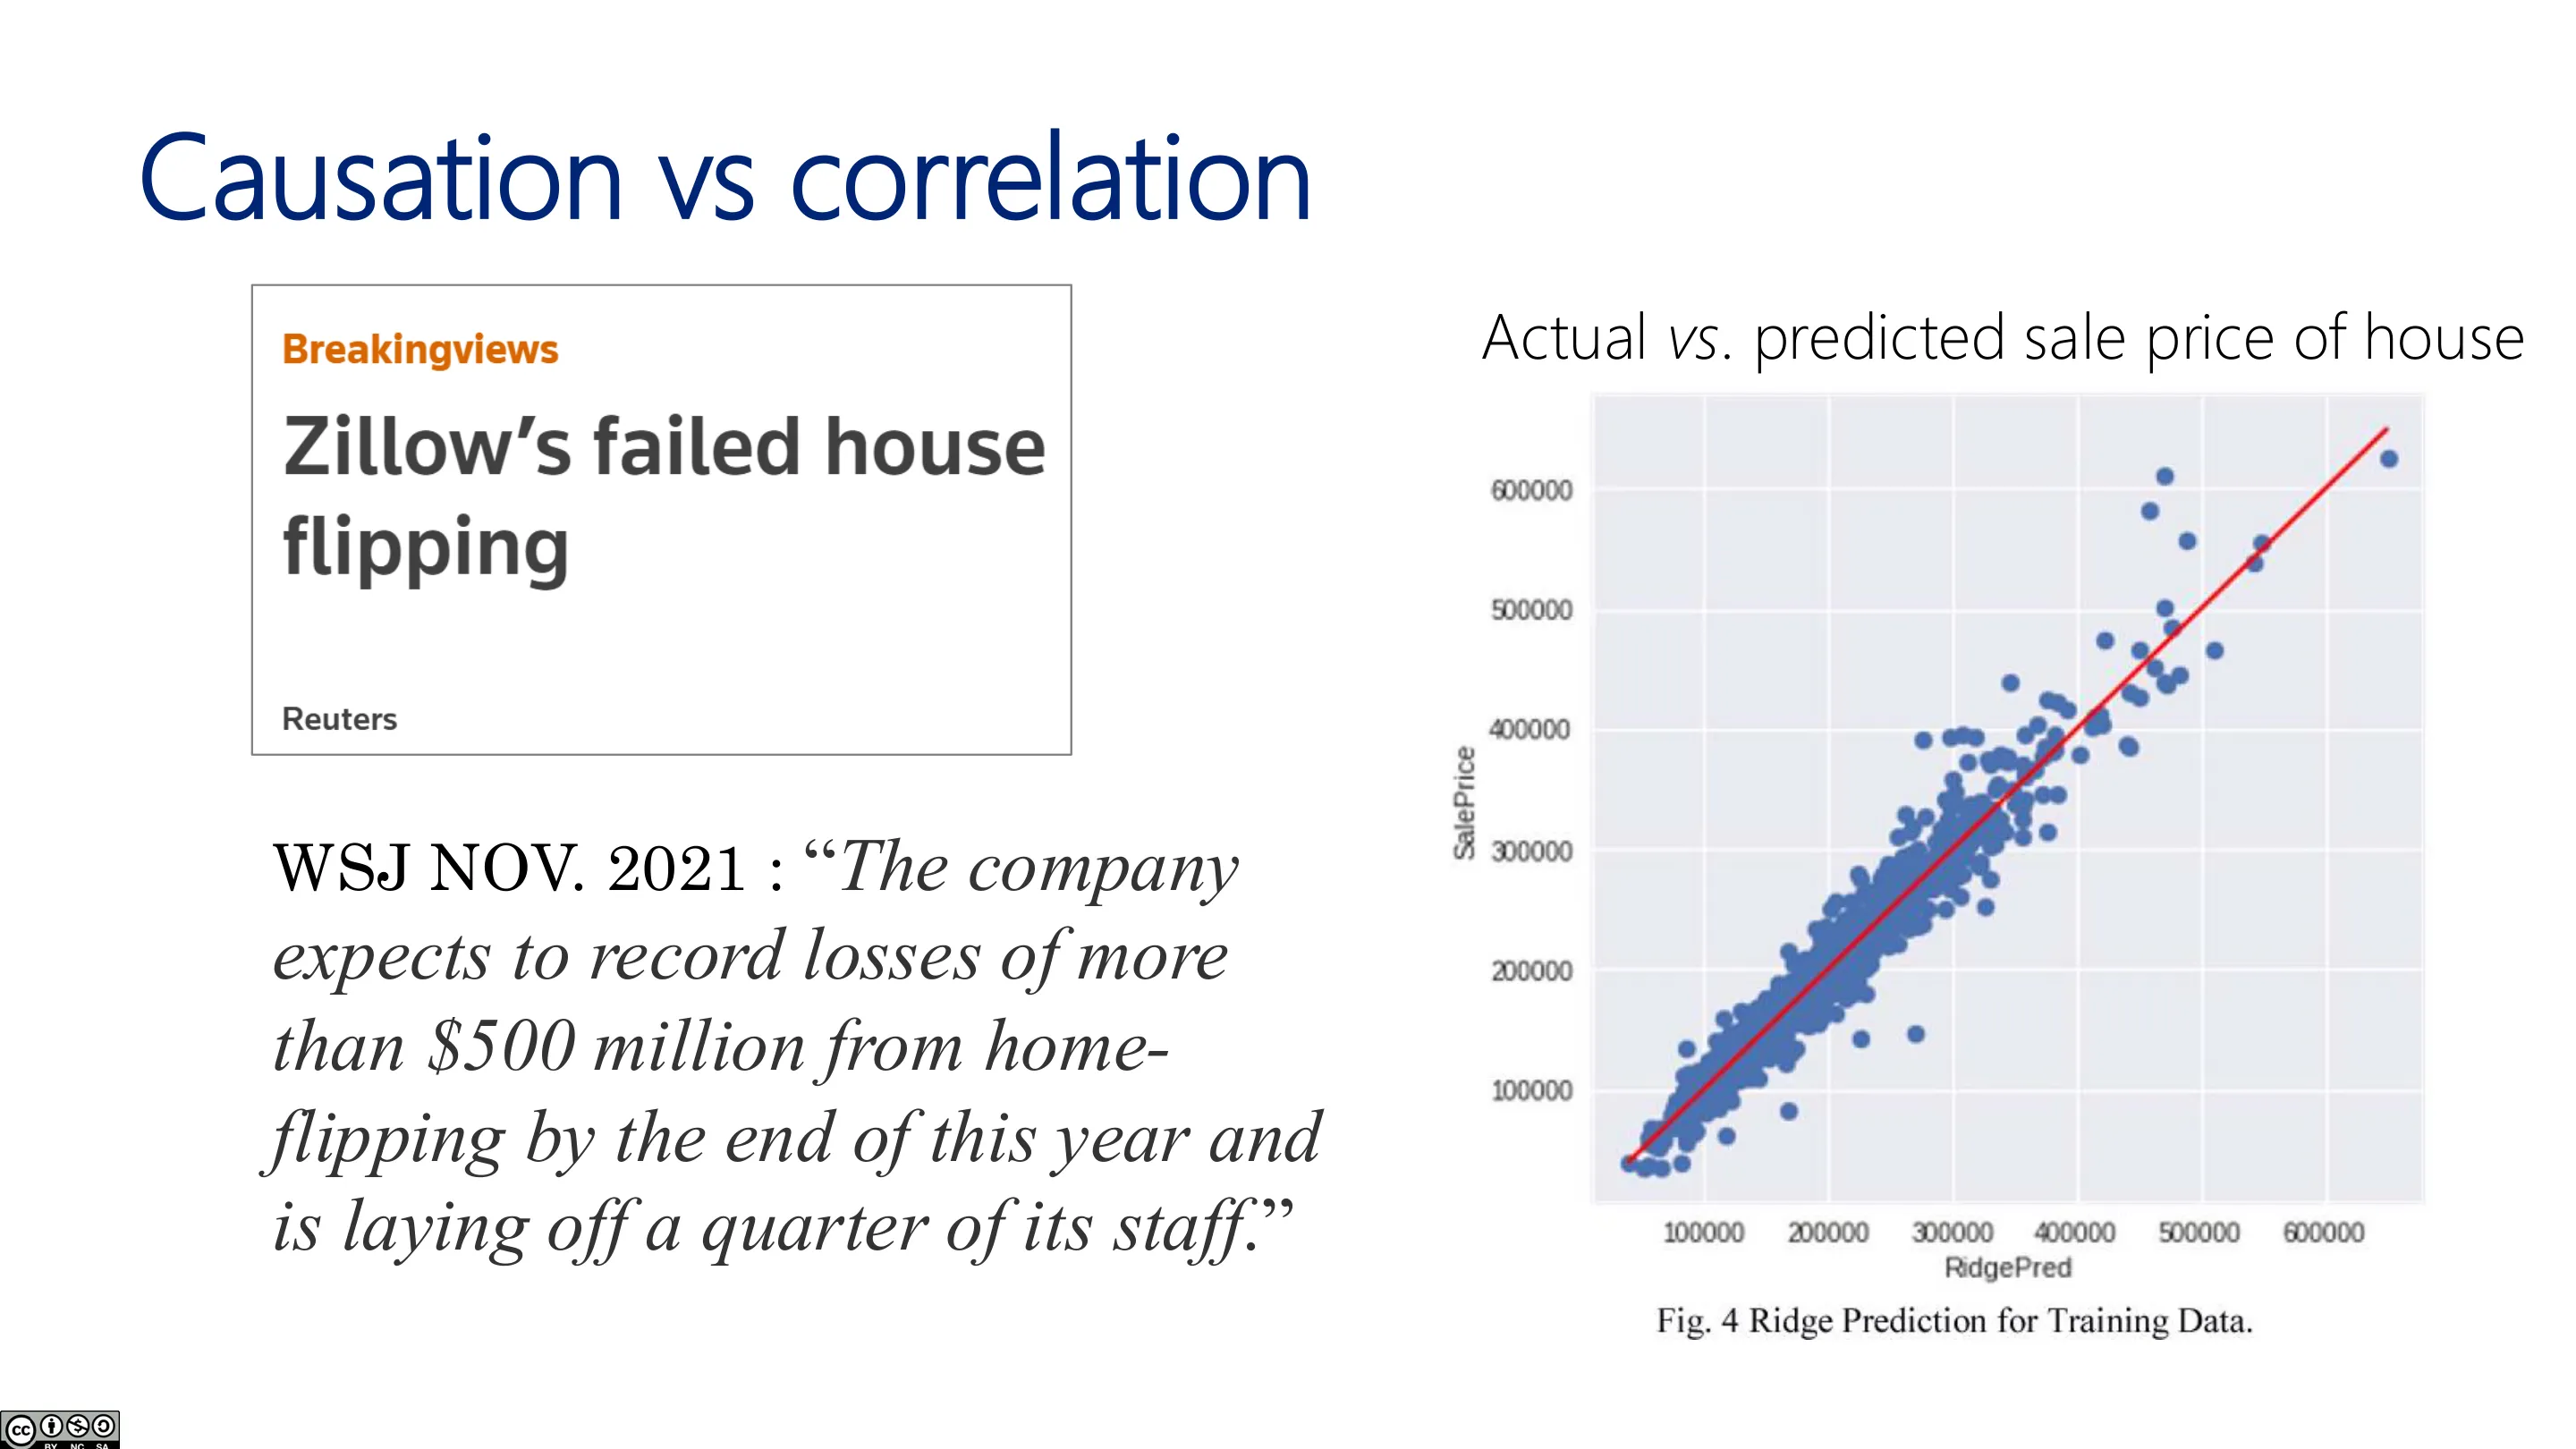
📷 稀疏化过程(λ 增大,参数逐个精确归零)
回到原视频 (00:57:30)
编者说明: - MAP 解释:Ridge 对应高斯先验,Lasso 对应拉普拉斯(Laplace)先验(在 0 处有尖峰、尾部更重,故更「喜欢」精确的 0)。 - Lasso 的陷阱:当特征高度相关时(如邮政编码、经纬度),Lasso 会任意地保留一个、丢掉另一个,从而丢掉有用信息;此时把相关特征「平摊」的 Ridge 反而更好。因此 Lasso 不总是优于 Ridge(反之亦然)。 - 可以组合 L1+L2(弹性网):但这会带来两个超参数,搜索空间从 1 维网格变成 2 维网格(10×10=100 个组合而非 20),训练成本急剧上升——这正是现代机器学习昂贵的原因之一,也催生了 AutoML(智能搜索超参数空间)。 - 条件数视角(讲师补充):Ridge 把 $\lambda$ 加到 $X^\top X$ 对角线上,等价于对奇异值加 $\lambda$,从而降低条件数、提升数值稳定性。
四、思想实验:分布漂移与因果
(参考时间: 01:12)
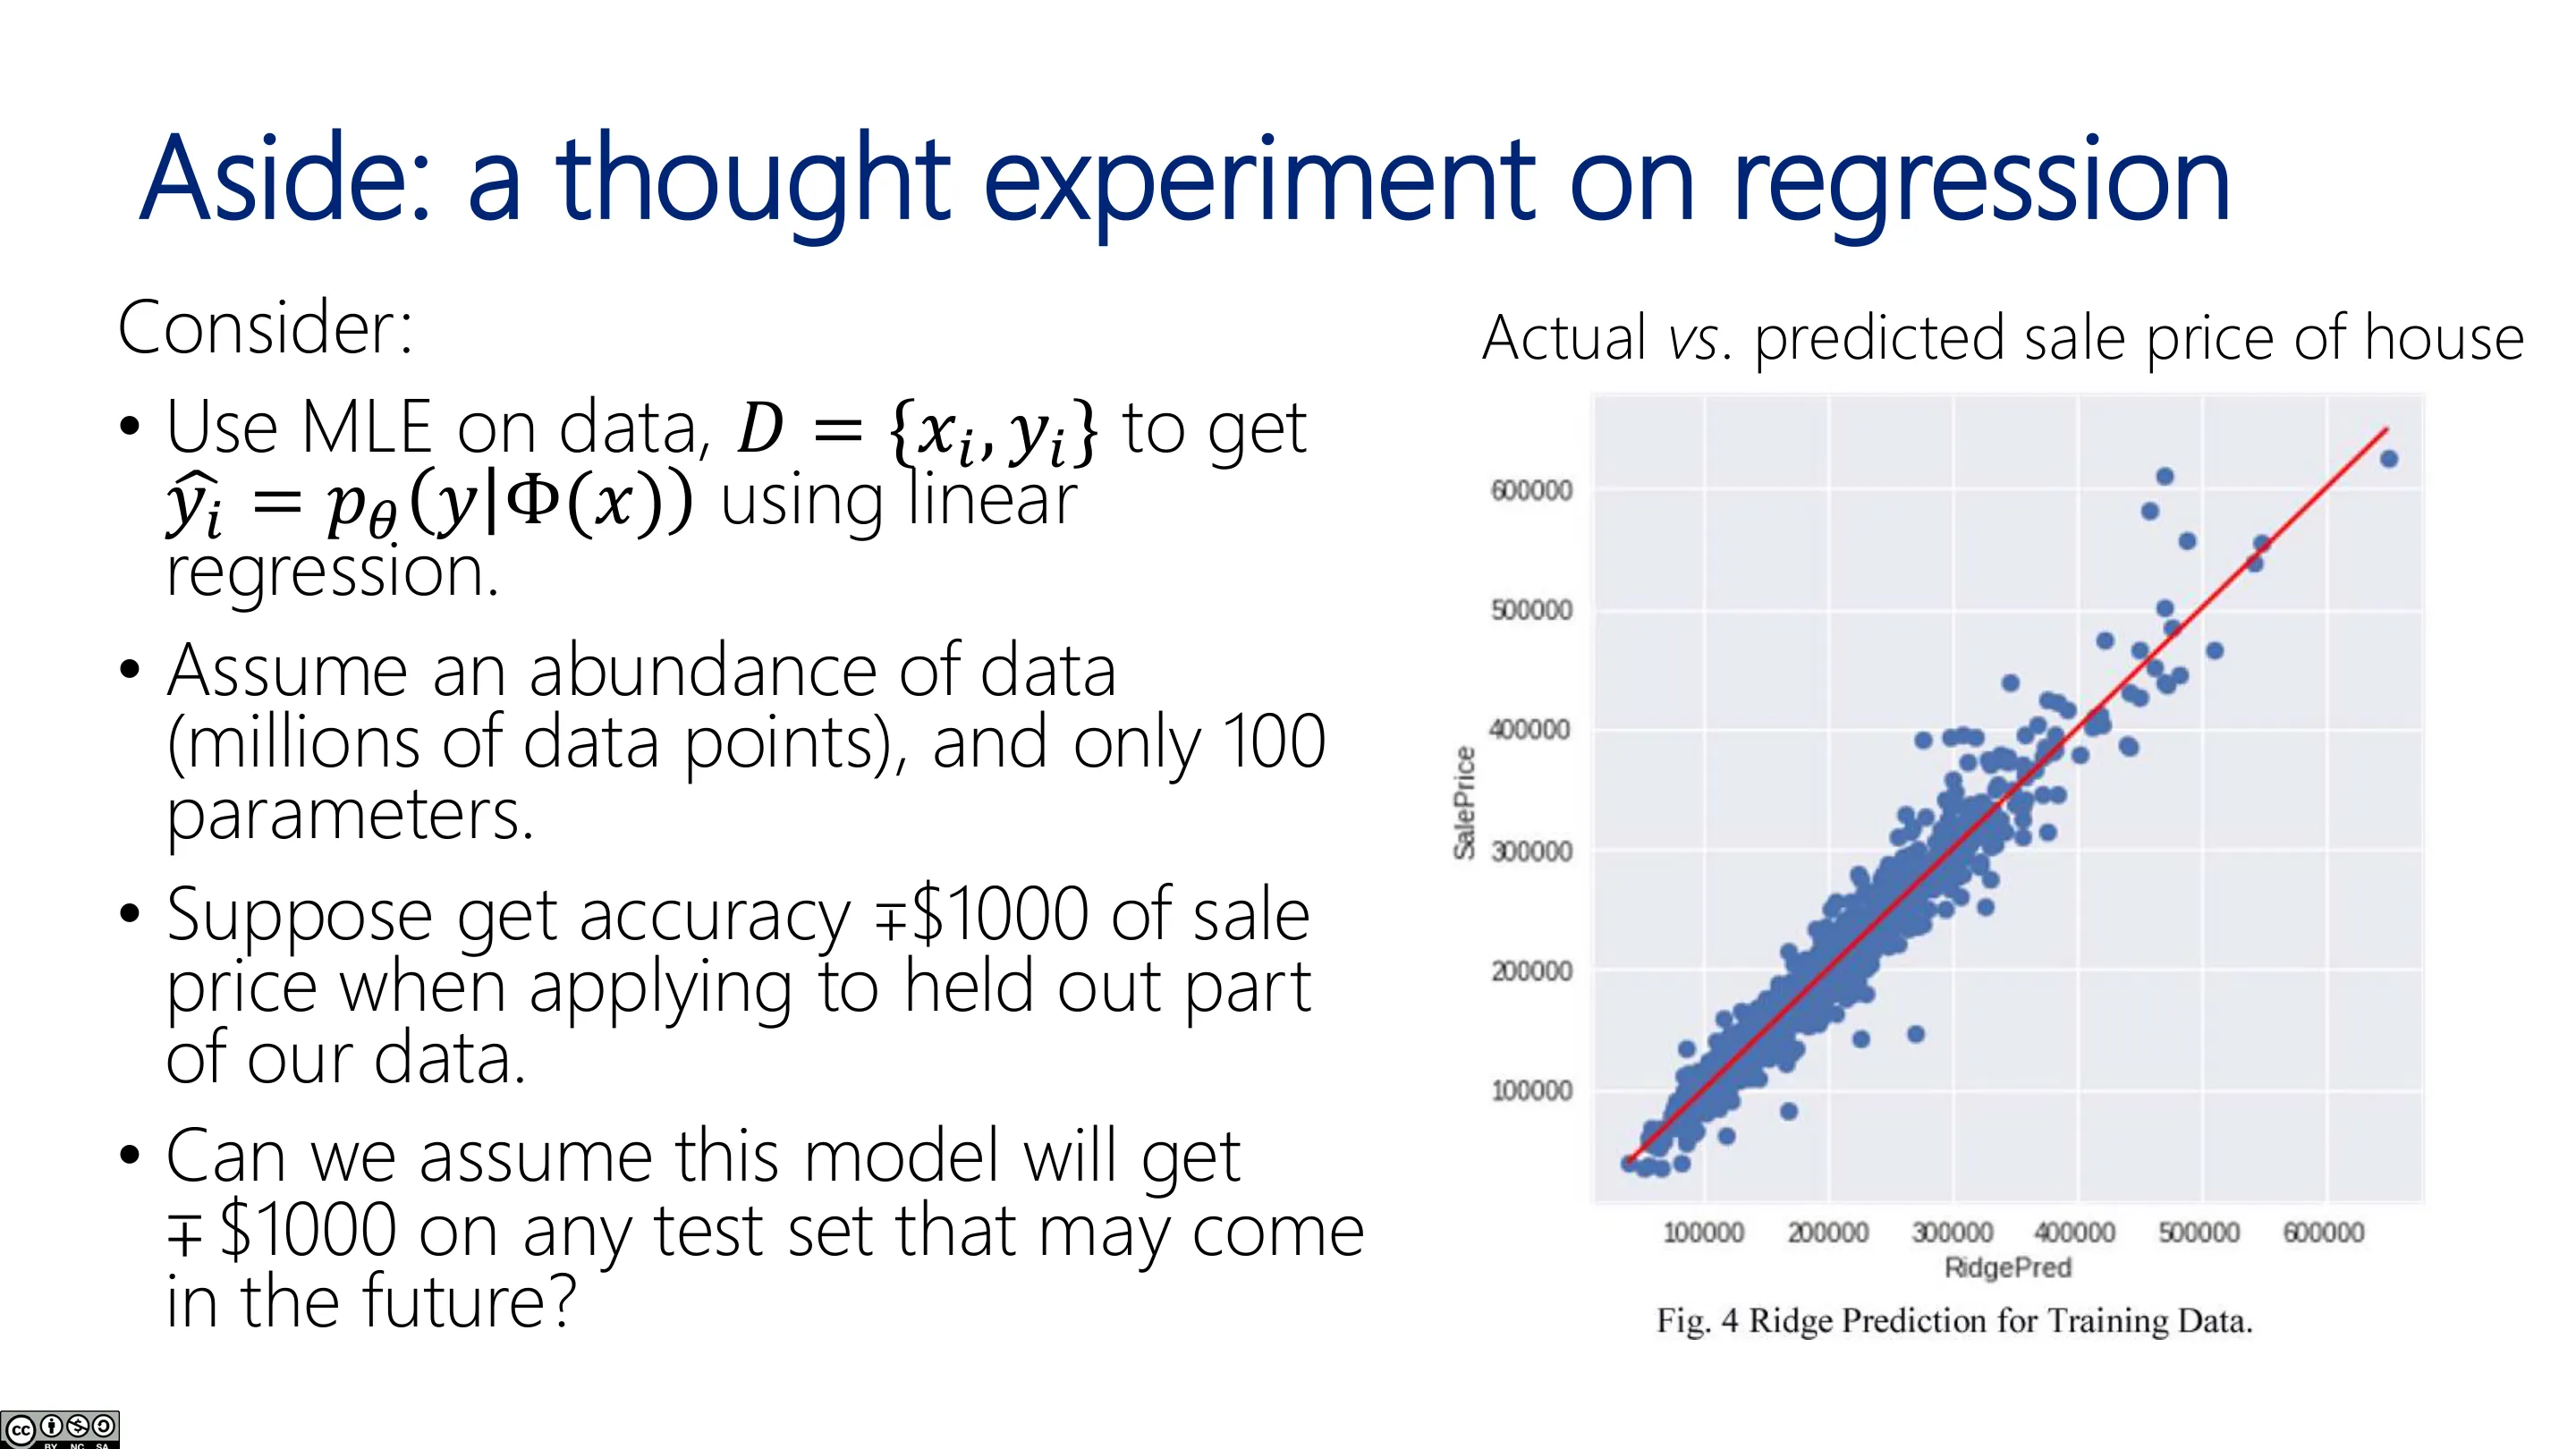
设想:你在 Zillow 实习,用过去五年的房价数据训练了一个好模型(误差 < \$1000)。你做了训练/验证/测试,测试集误差很好。它能用吗?
陷阱在于:你做测试集估计时,隐含假设了所有数据同分布。但未来经济与房市会变 ⇒ 分布漂移(distribution shift) ⇒ 之前的一切都失效。这背后的根本问题是 相关 vs 因果。
真实案例:Zillow 的房屋翻新业务因超过 \$5 亿的损失而关停——很可能就是把相关模型误当成因果模型、没有察觉测试数据来自不同的分布。
缓解思路:
- 把导致分布变化的因素(如通货膨胀)作为协变量/特征纳入,以「控制」它;
- 更高级的主题:在目标医院(B)采样以了解其特征分布,再对源模型(A)做纠偏。
总结(Takeaways)
- 条件数衡量反演的稳定性;岭回归通过给对角线加 $\lambda$ 降低条件数,但 $\lambda$ 太大会忽视数据。
- 评估要有保留数据;似然 > 仅看 MSE(后者忽略方差);常见度量:MSE/RMSE/R²/MAE。
- 模型(含超参数)选择只需训练+验证;测试集只能用一次,否则遇「赢家诅咒」,误差估计有偏。
- L1(Lasso)产生稀疏解(几何上是菱形;MAP 上是 Laplace 先验),适合「挑特征」;但相关特征会被任意丢弃。
- L1+L2 可组合,但引入更多超参数,搜索组合爆炸。
- 分布漂移会让「同分布」假设失效,测试误差不再可信;相关 ≠ 因果。
附录:课堂未展示的幻灯片(分类:生成式 vs 判别式、GDA)
以下 73 页是本讲 deck 中尚未讲授的分类部分(在后续讲次展开),作为延伸阅读收录。
🖼️ 路线图:进入分类
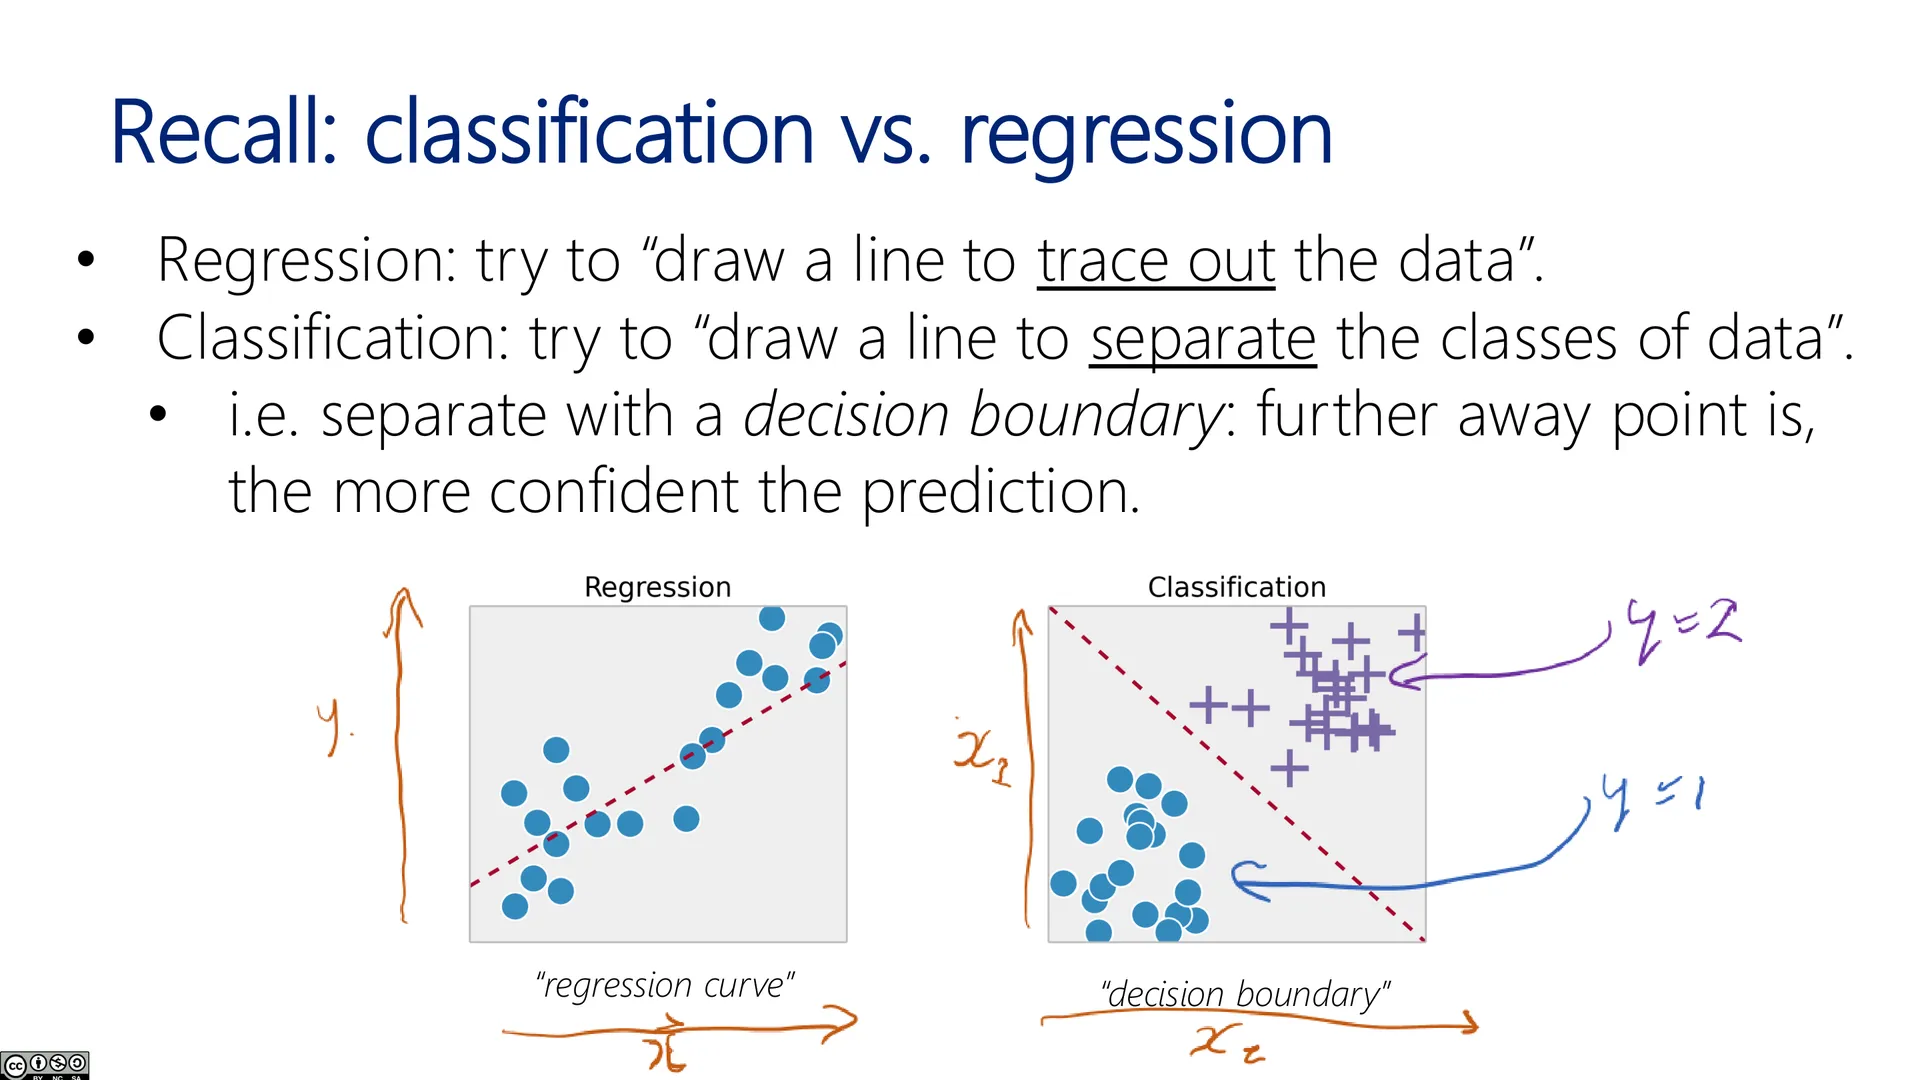
🖼️ 回顾:分类 vs 回归
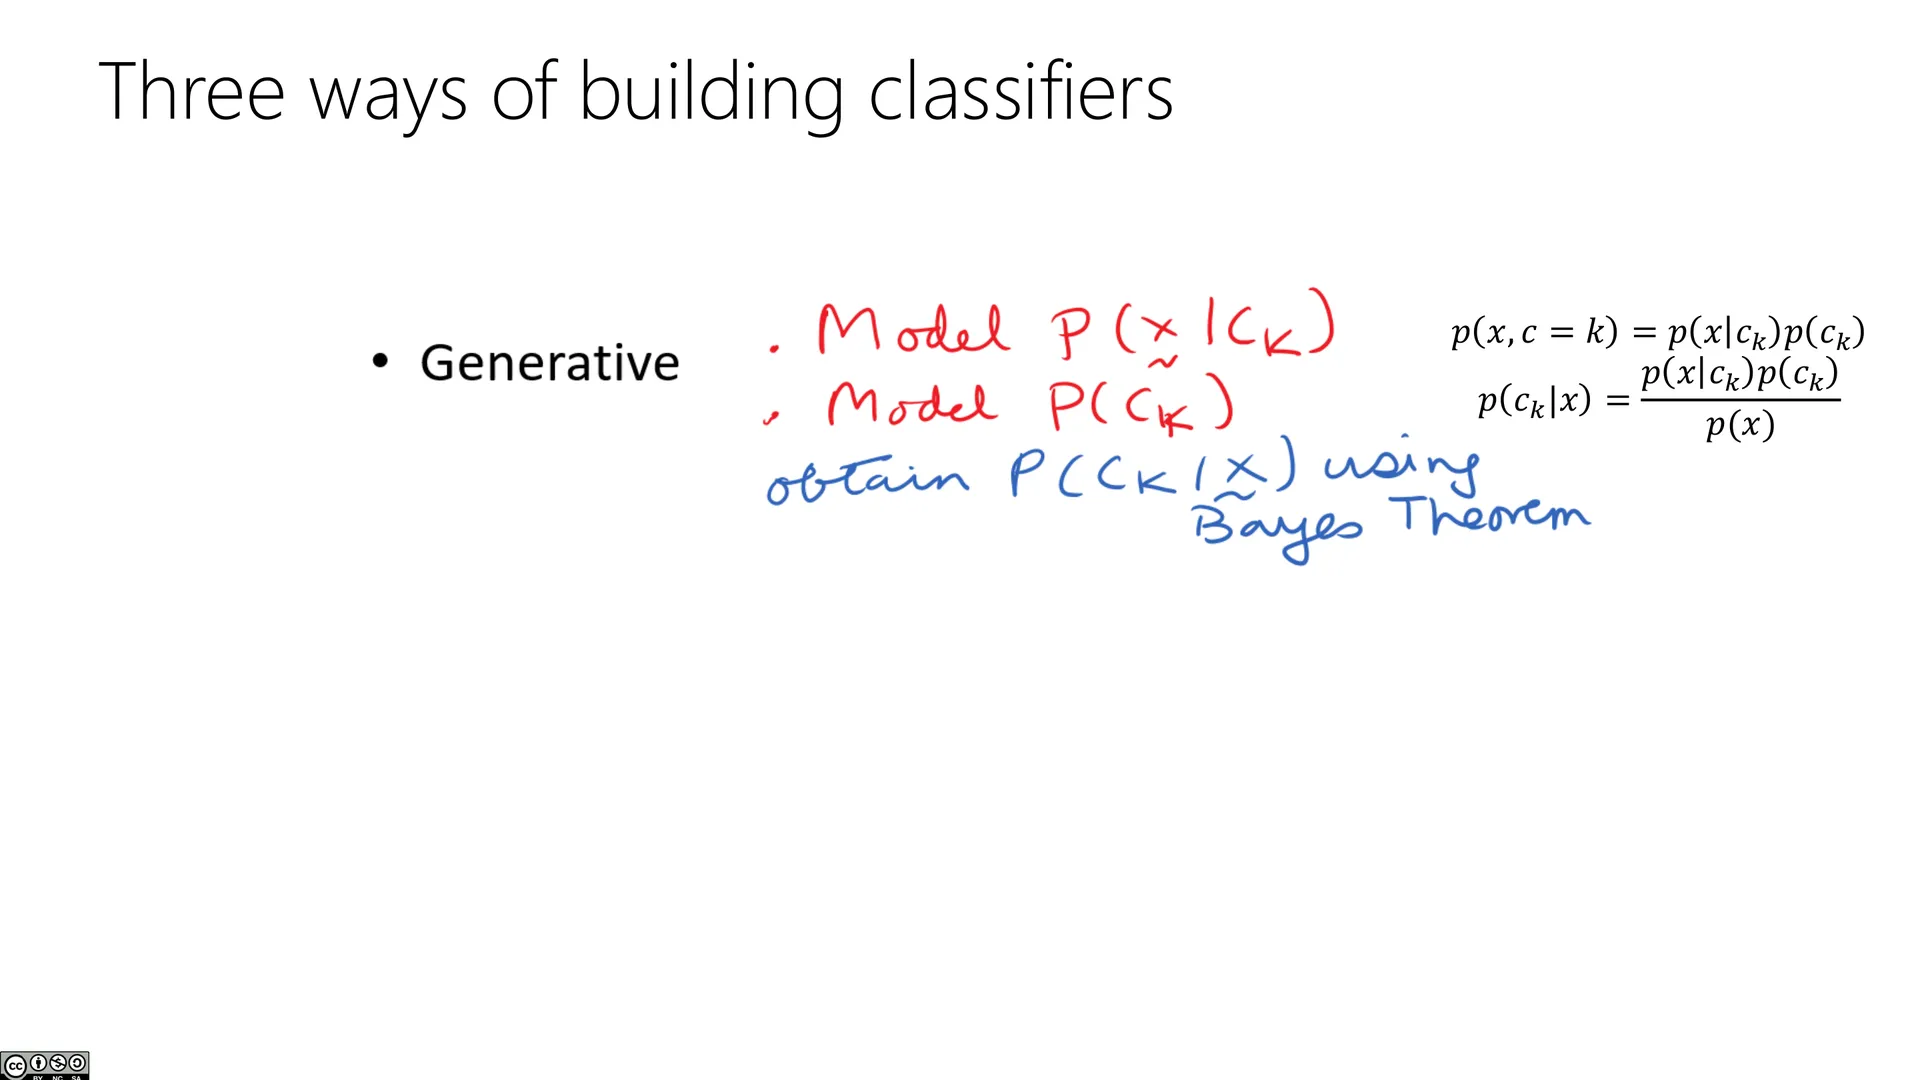
🖼️ 构建分类器的三种方式(一)
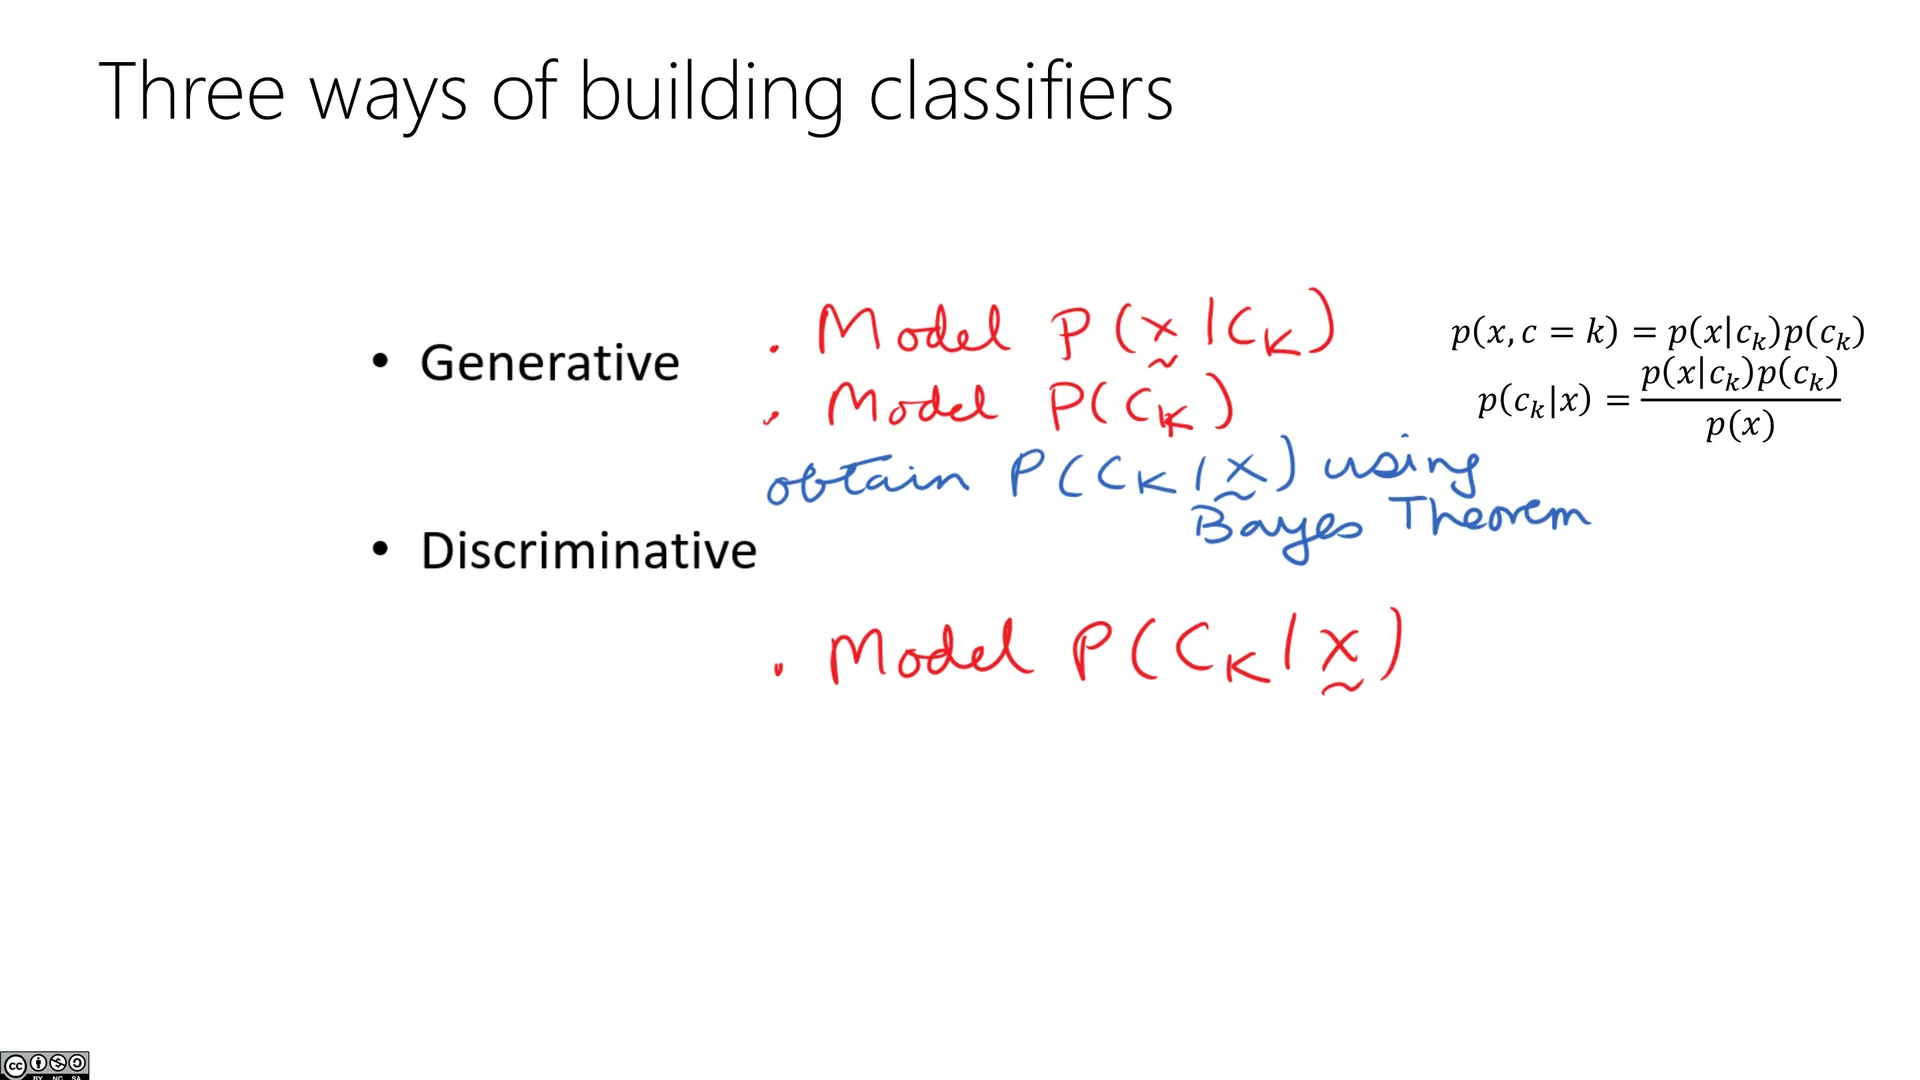
🖼️ 构建分类器的三种方式(二)
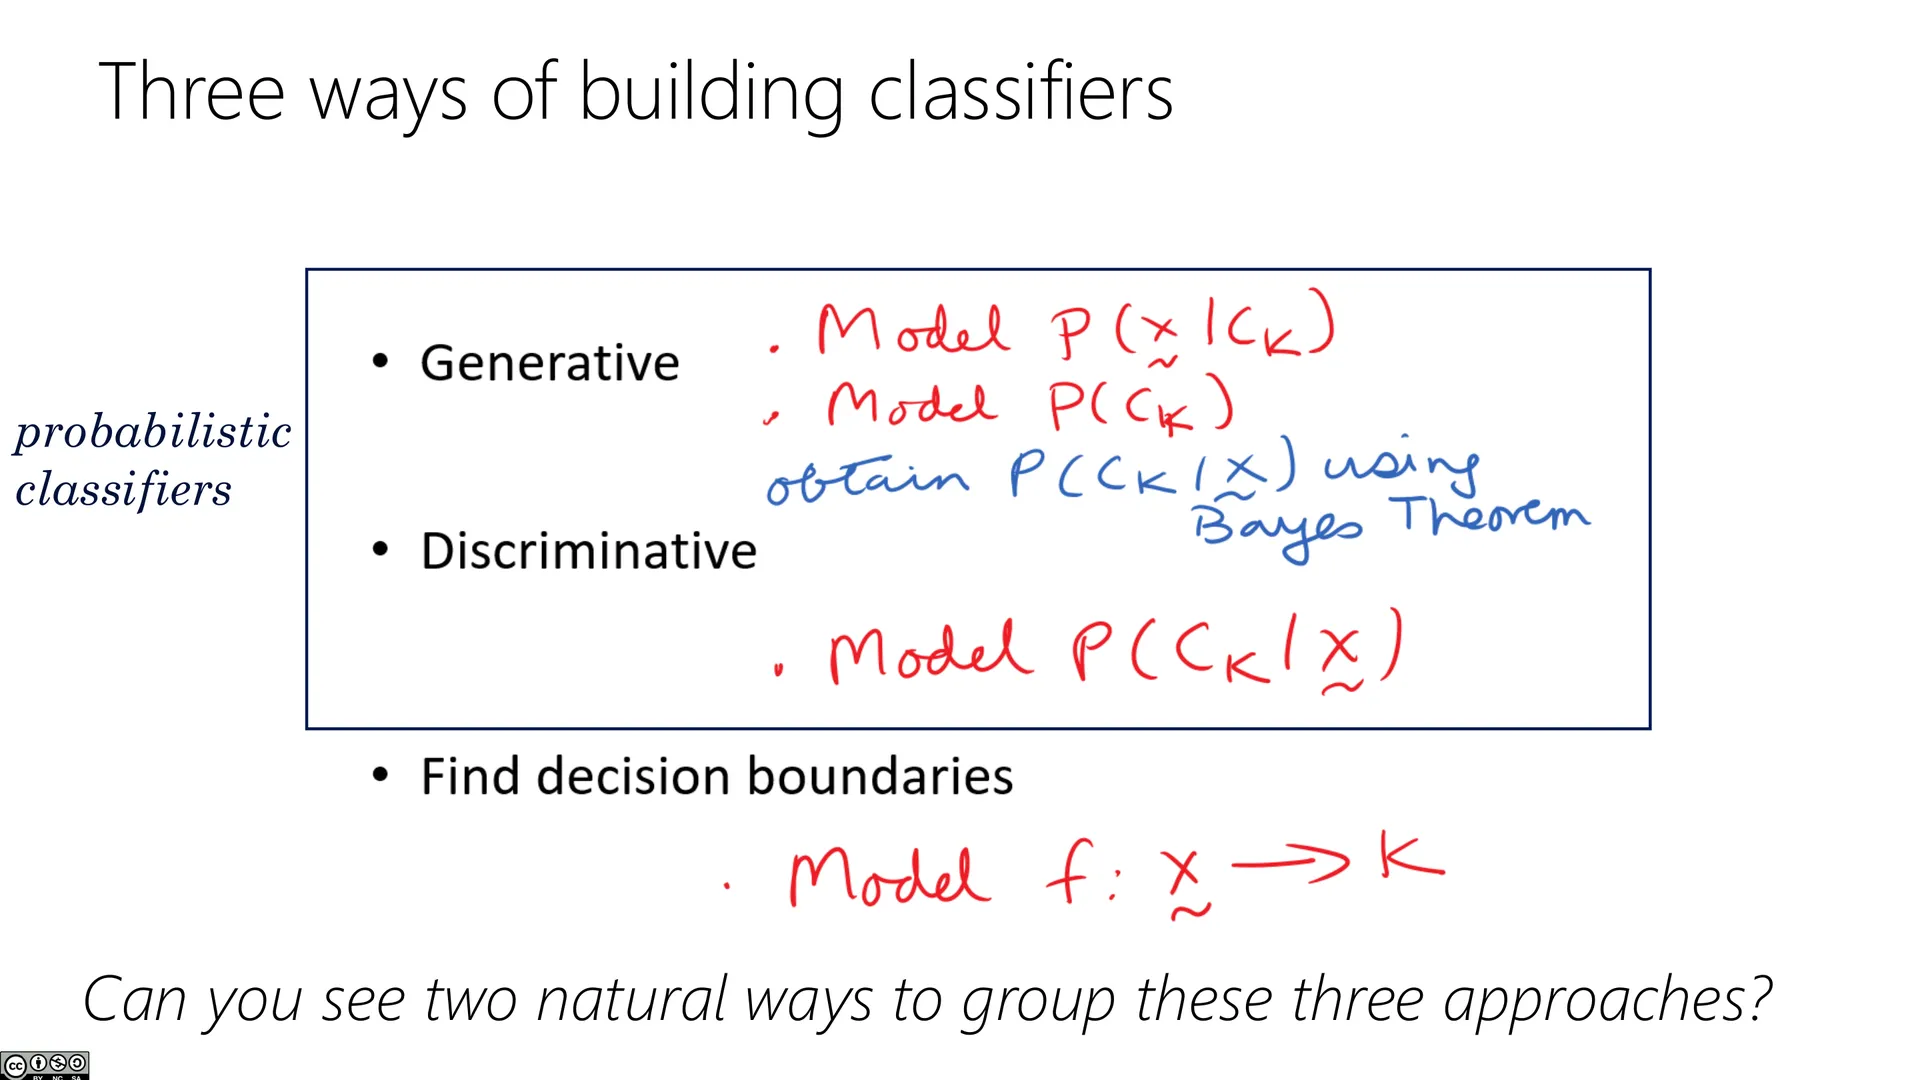
🖼️ 构建分类器的三种方式(三)
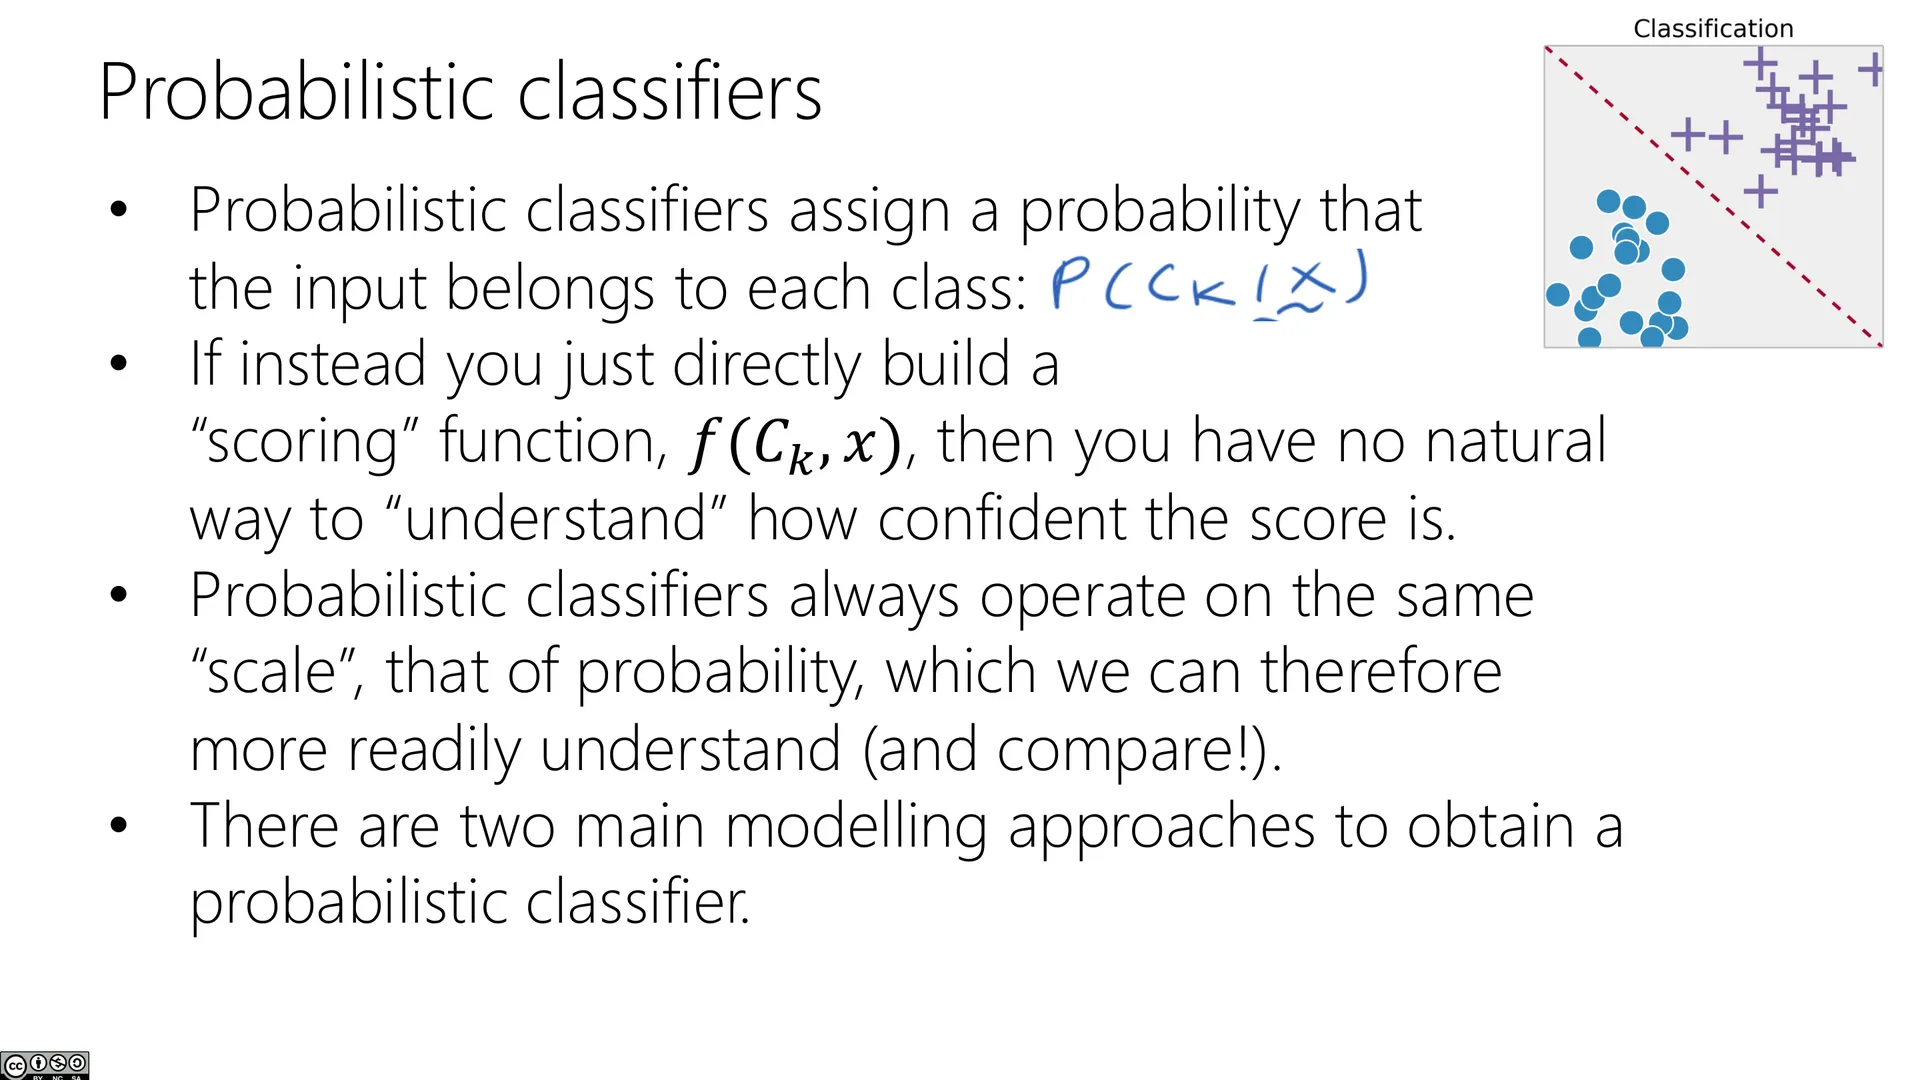
🖼️ 概率分类器
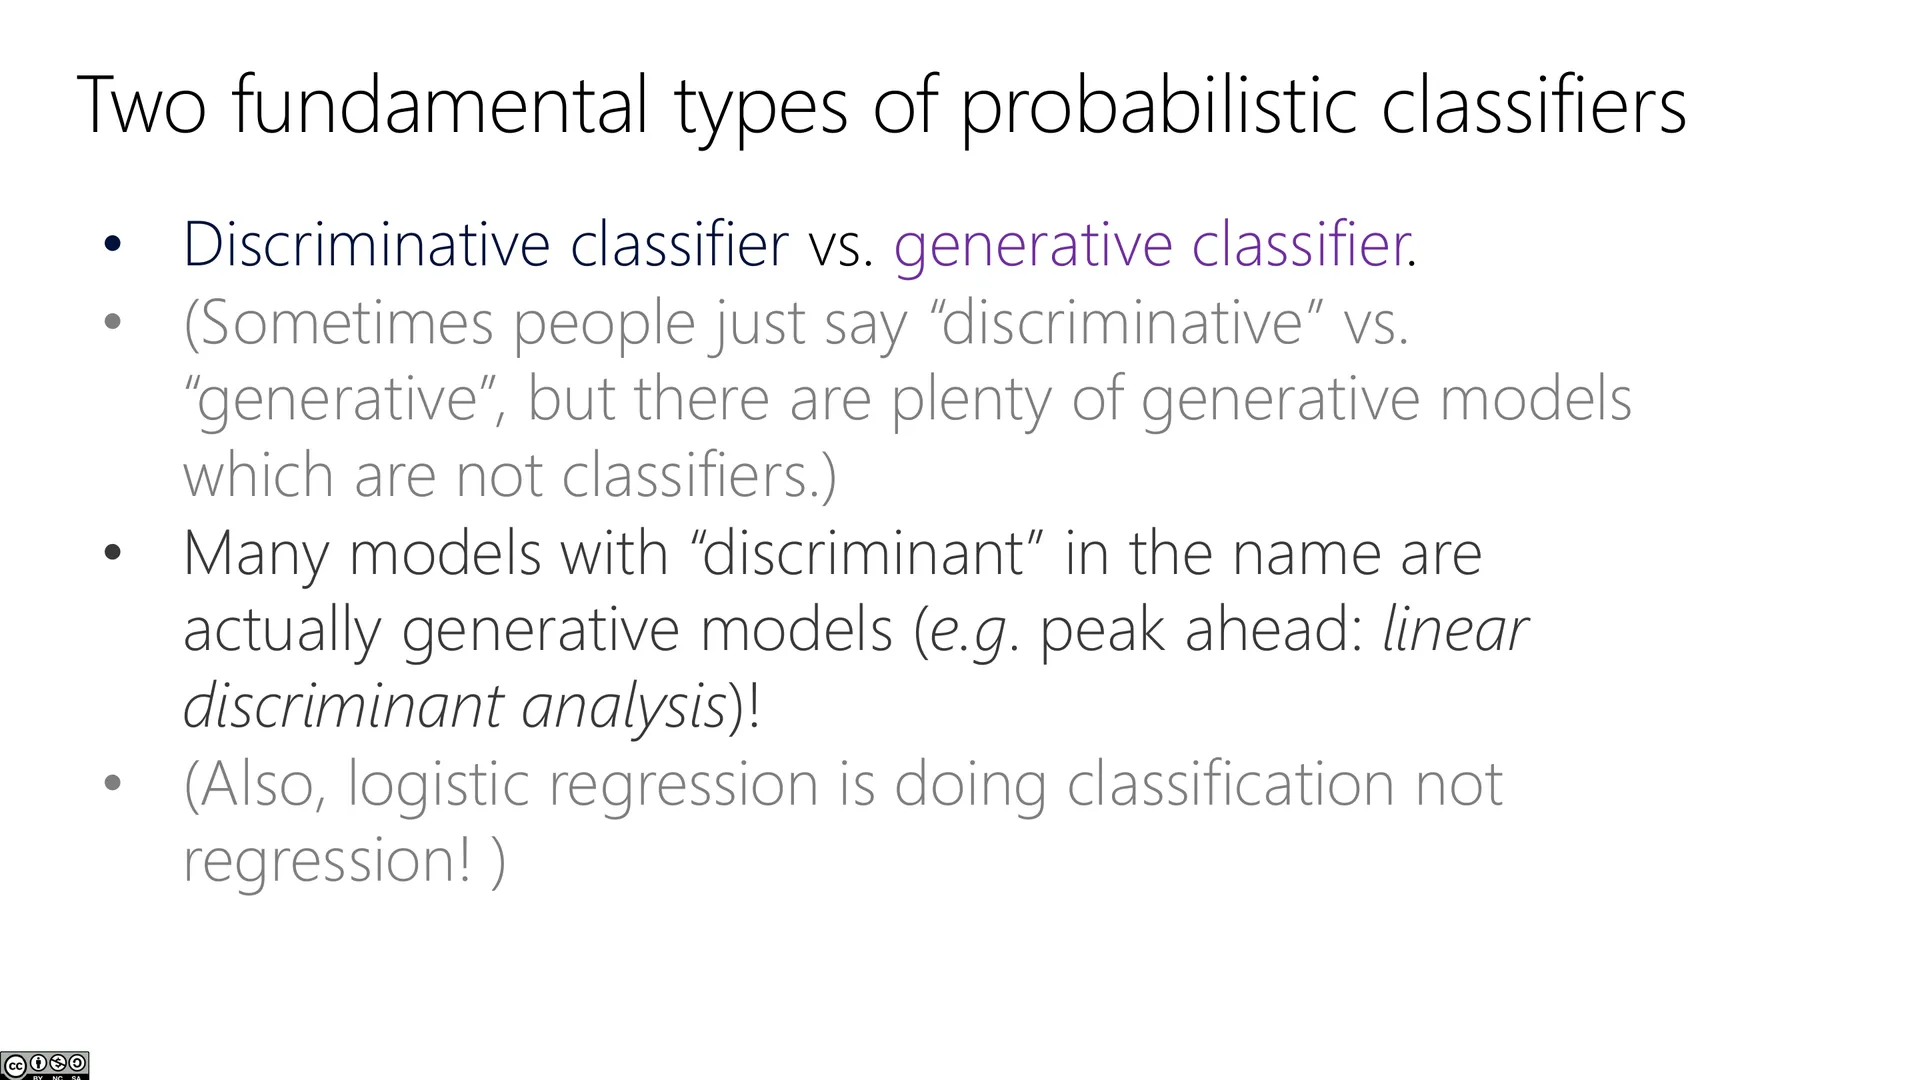
🖼️ 两类概率分类器
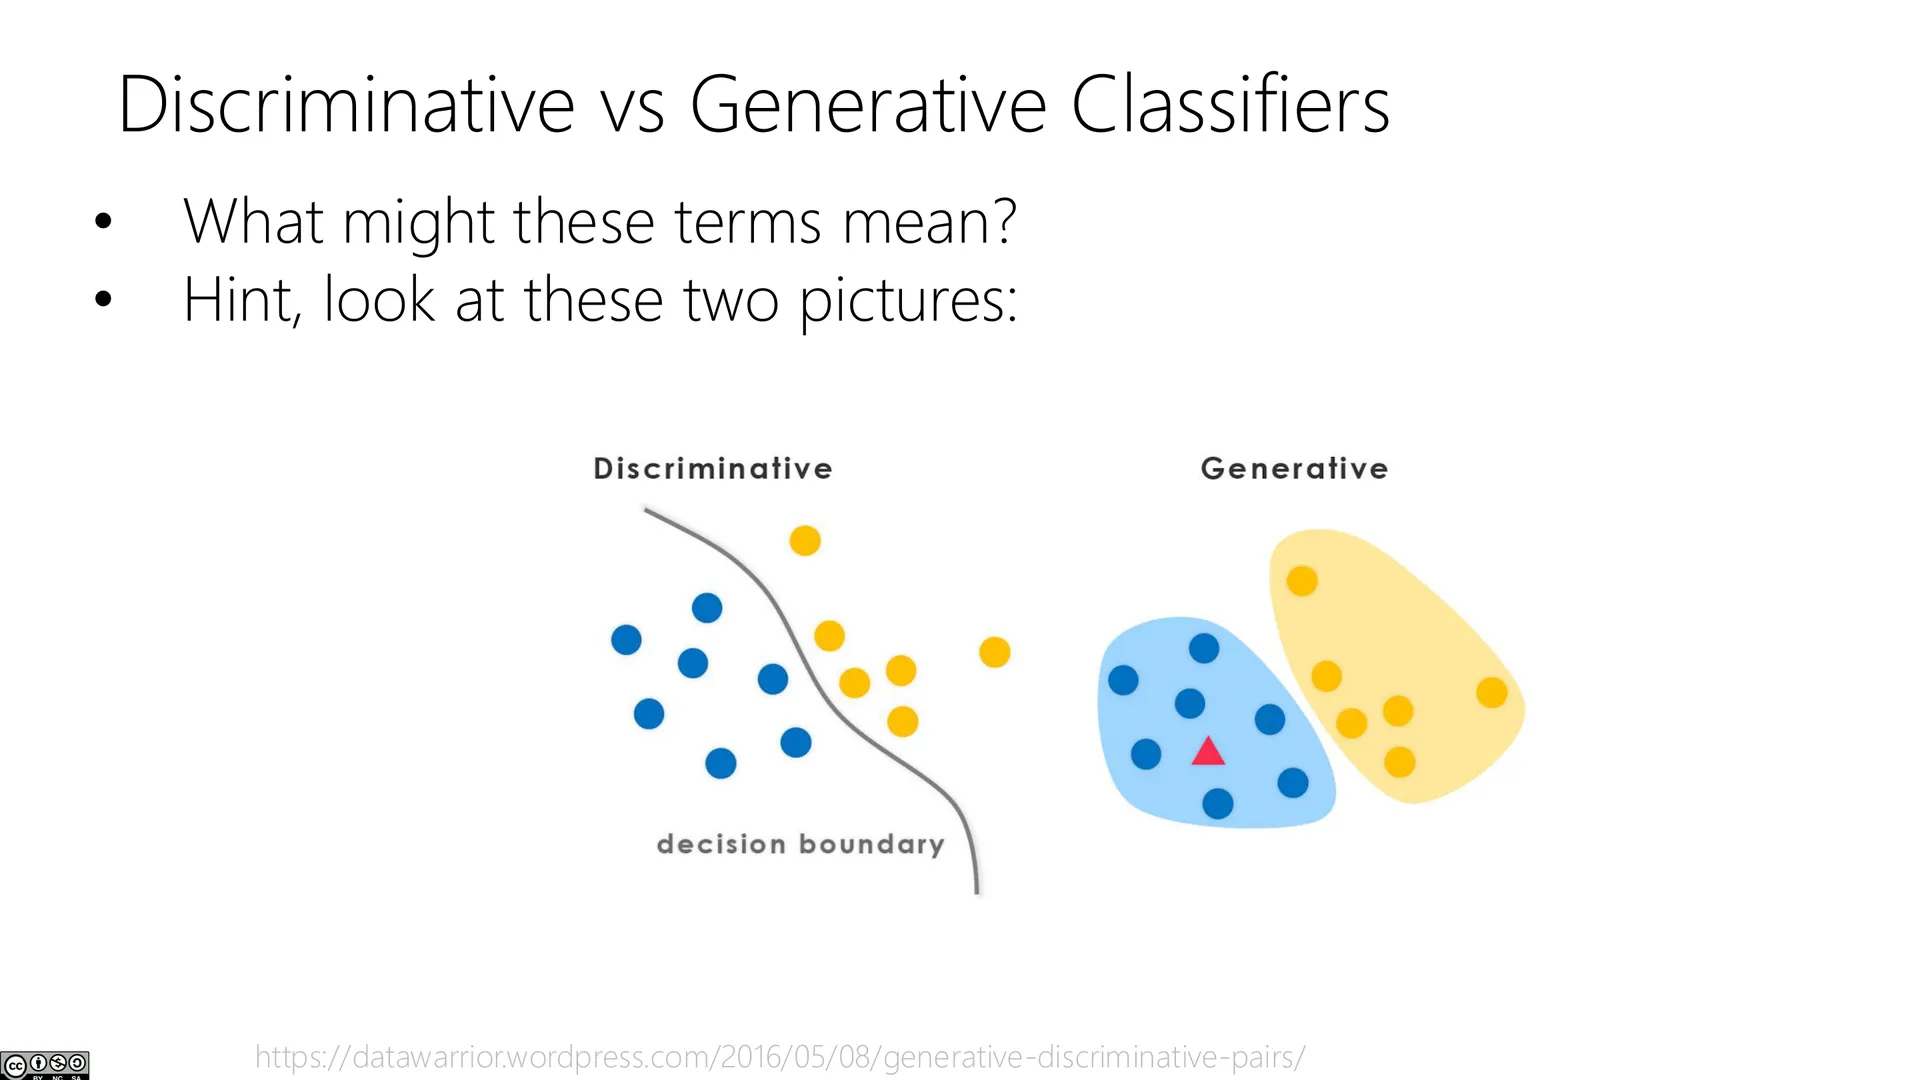
🖼️ 判别式 vs 生成式分类器(一)
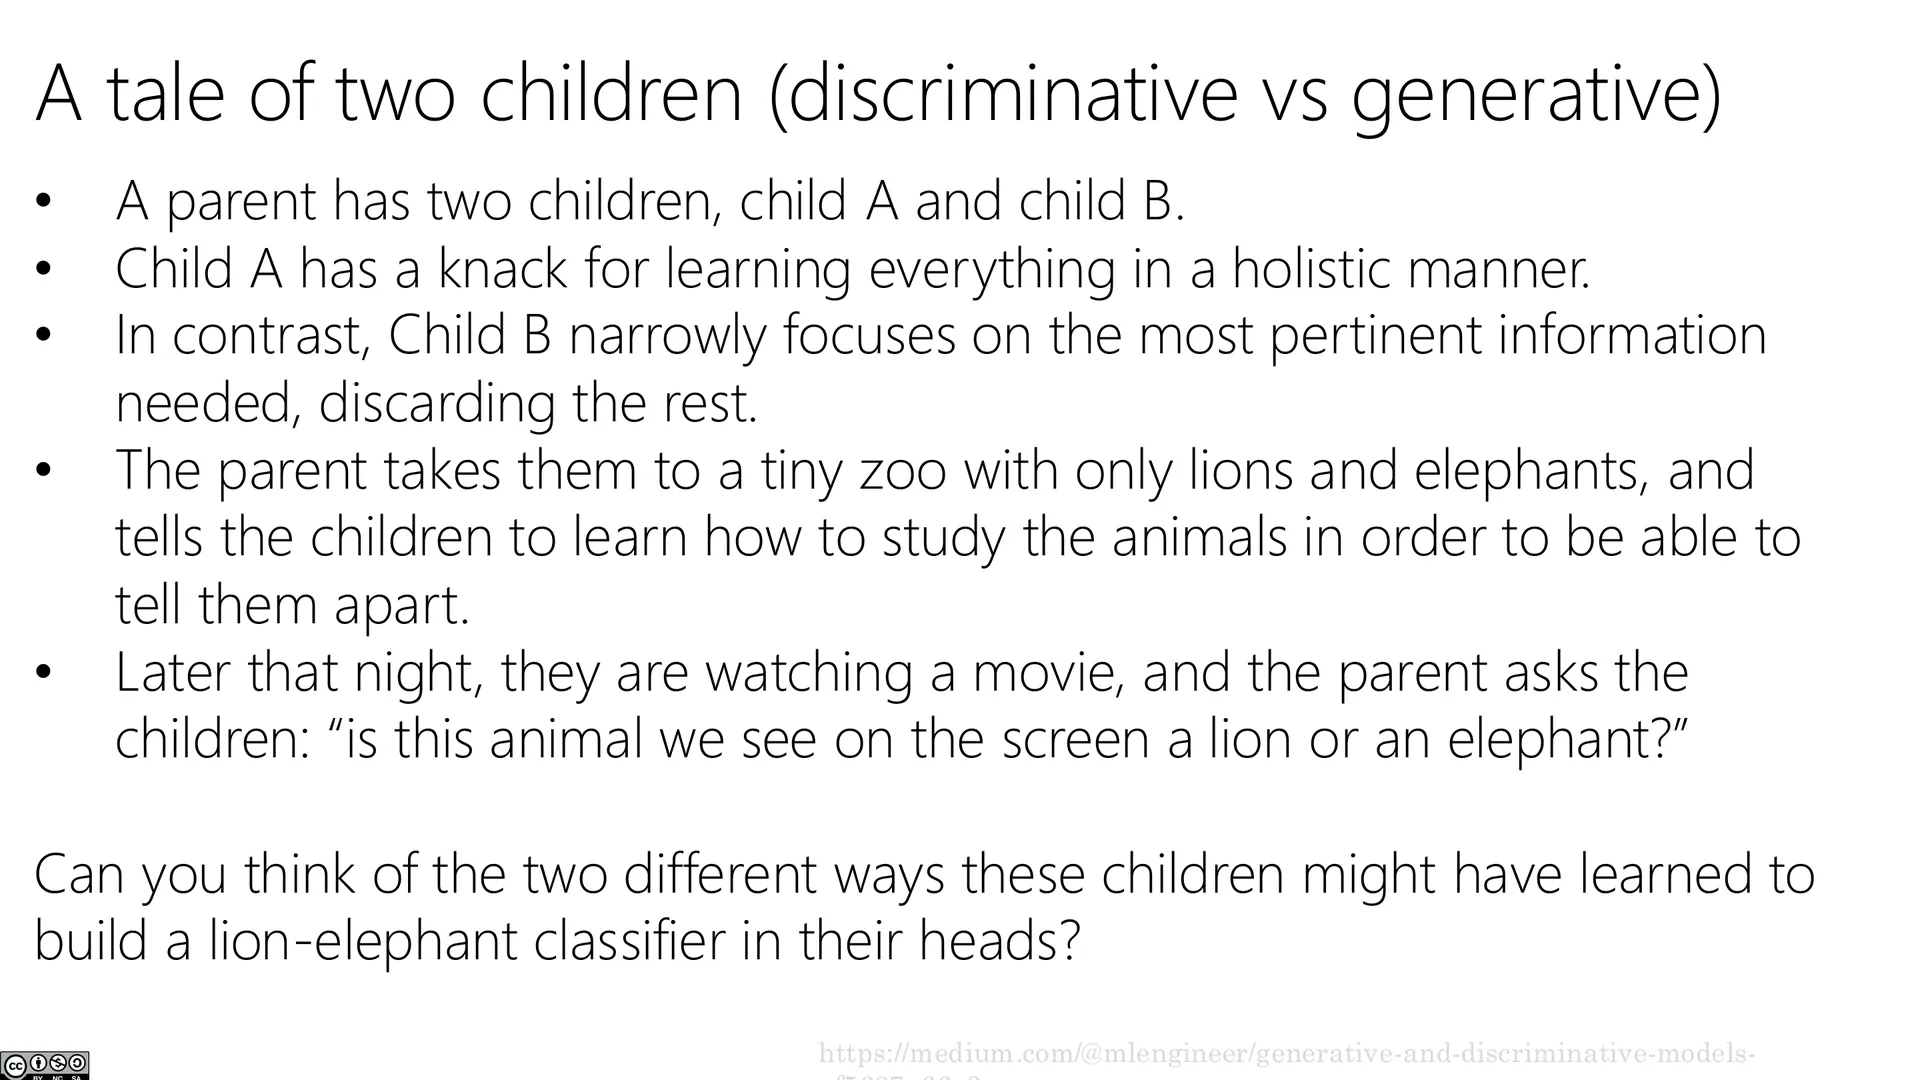
🖼️ 两个孩子的故事(一)
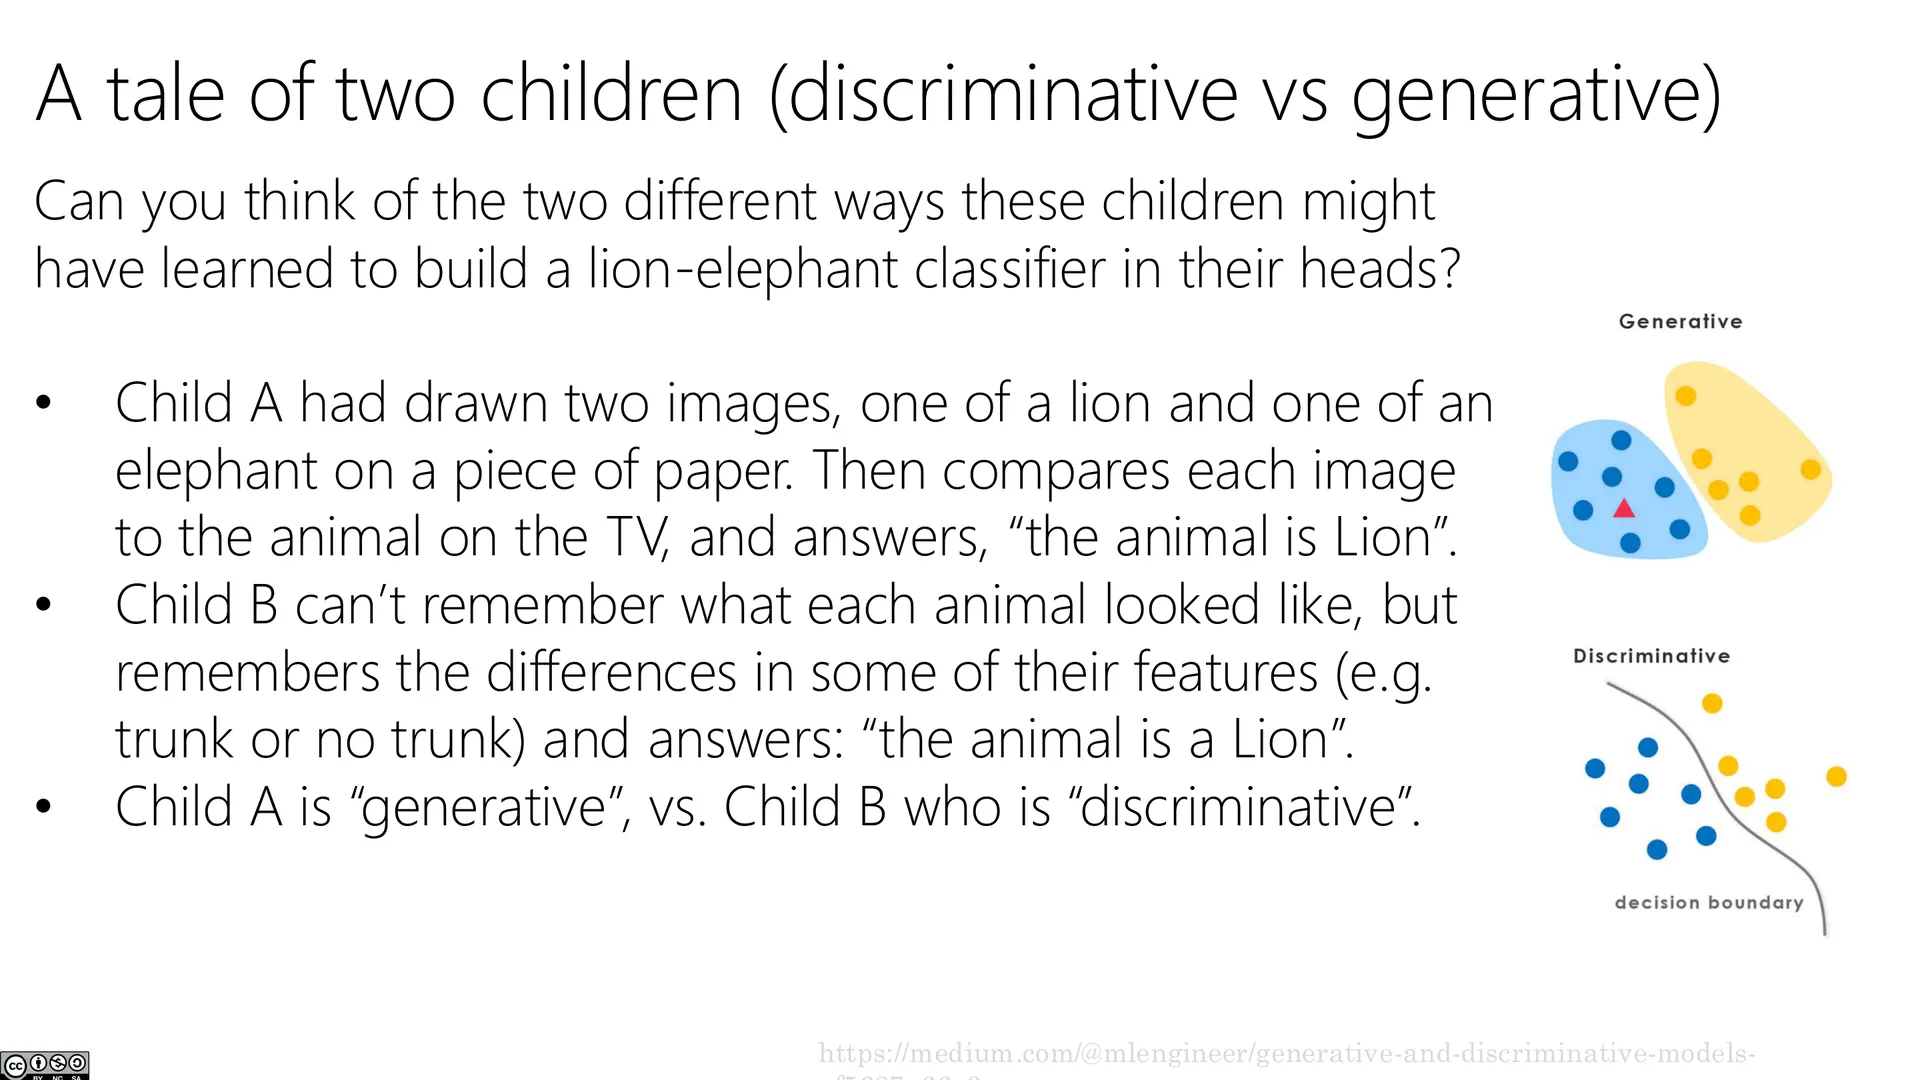
🖼️ 两个孩子的故事(二)
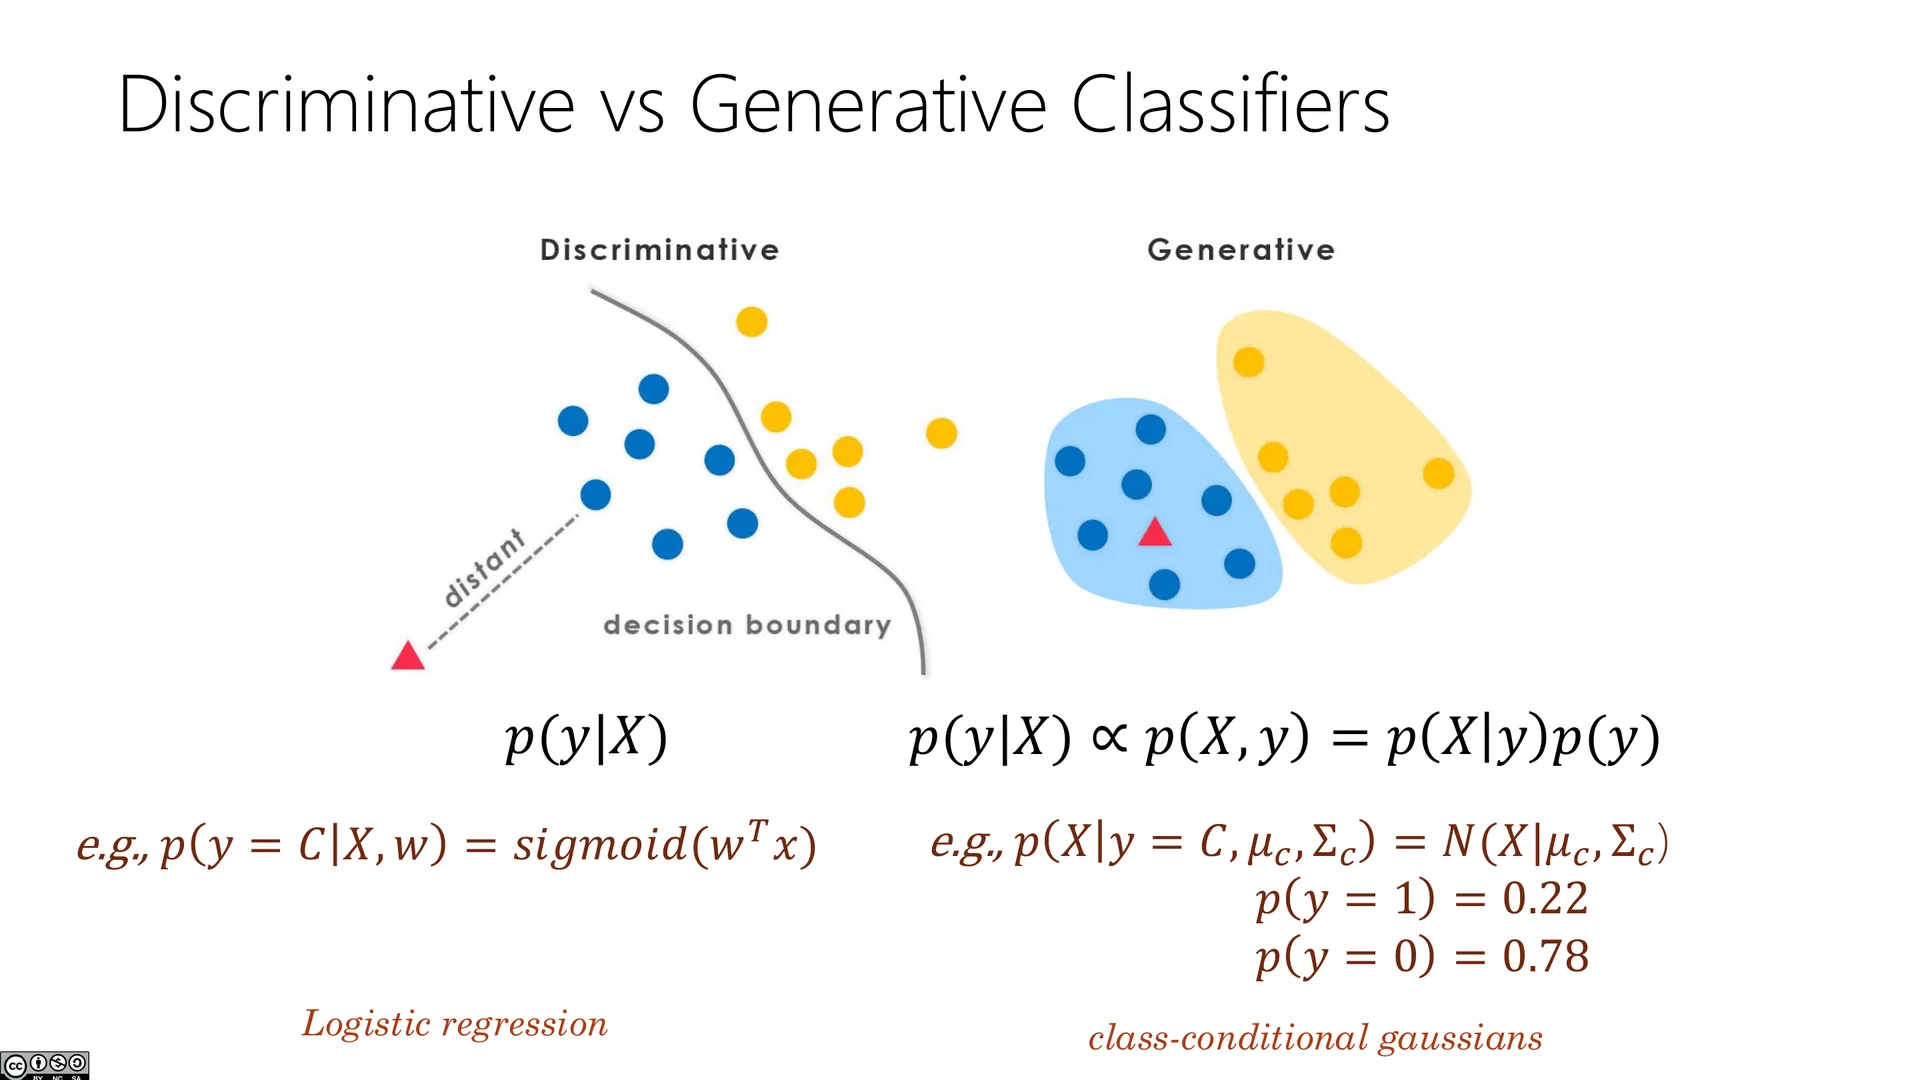
🖼️ 贝叶斯公式
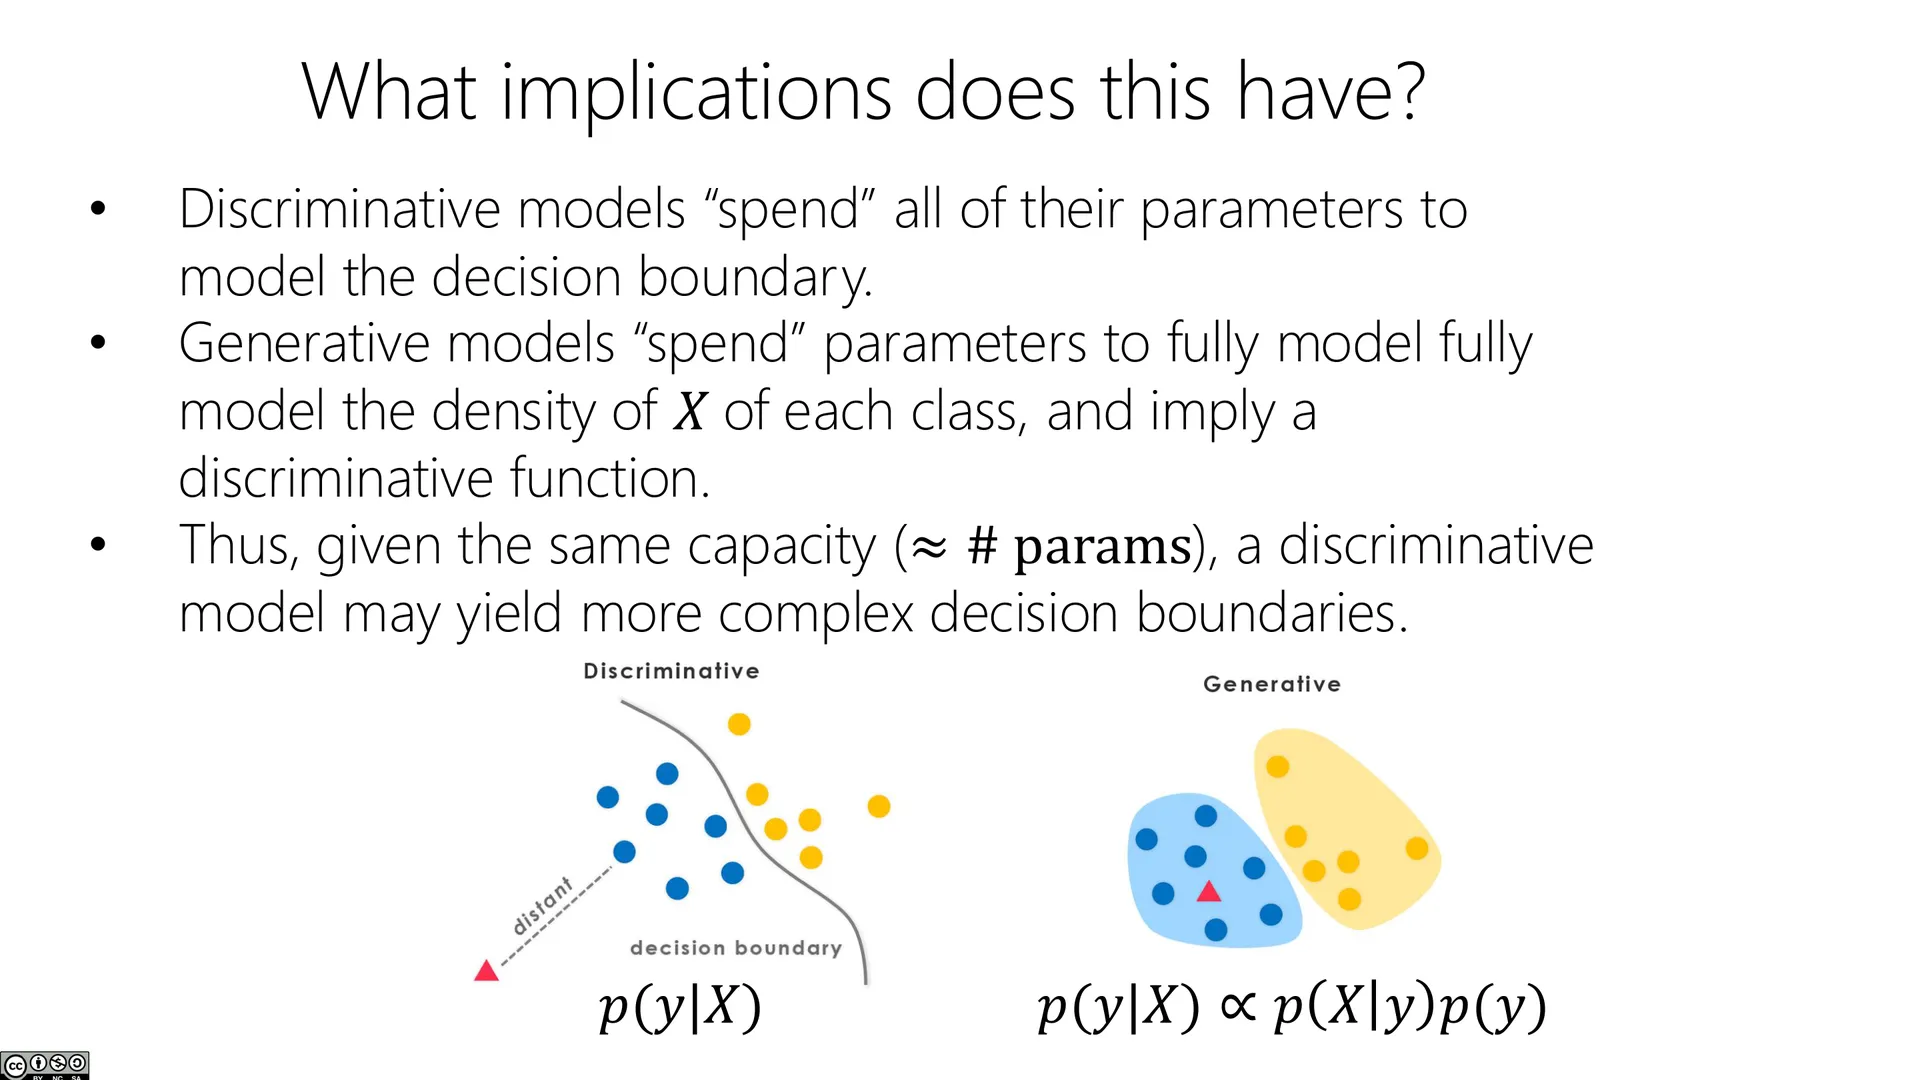
🖼️ 这意味着什么
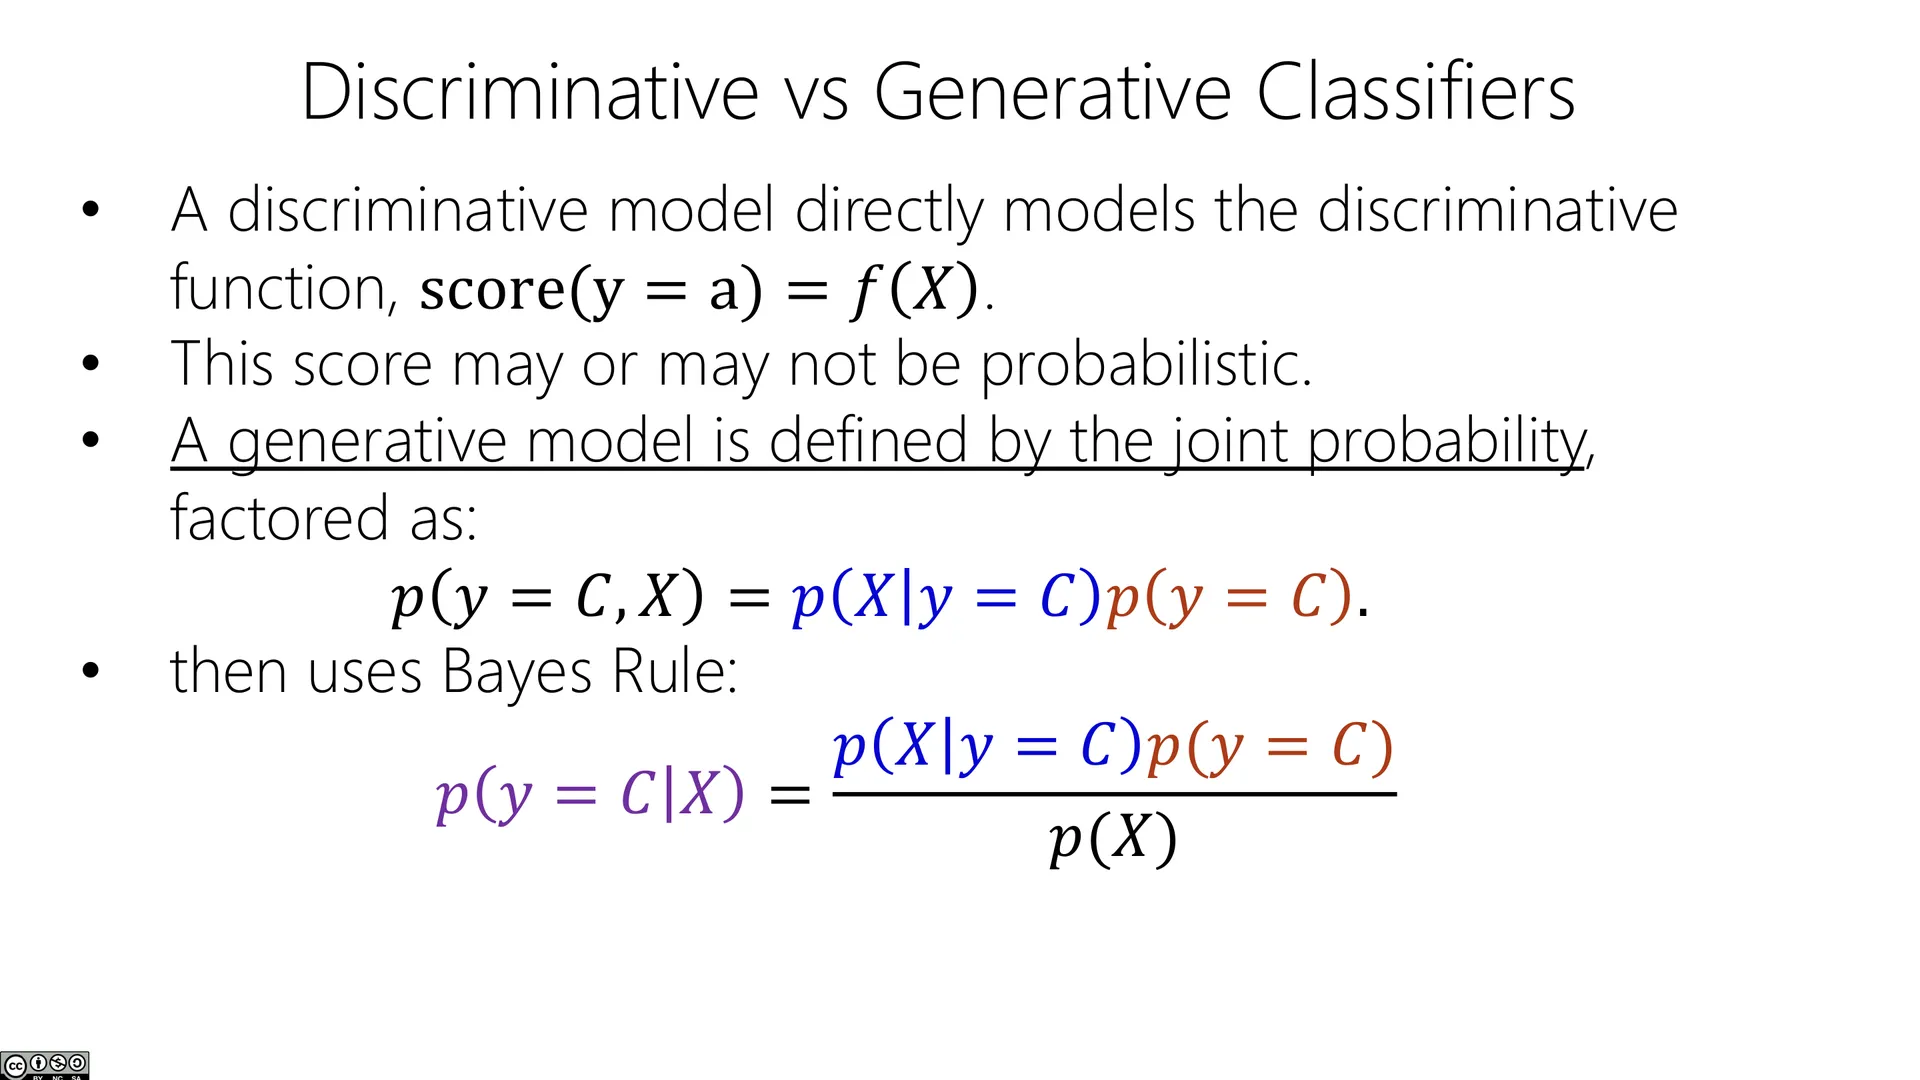
🖼️ 判别式 vs 生成式(二)
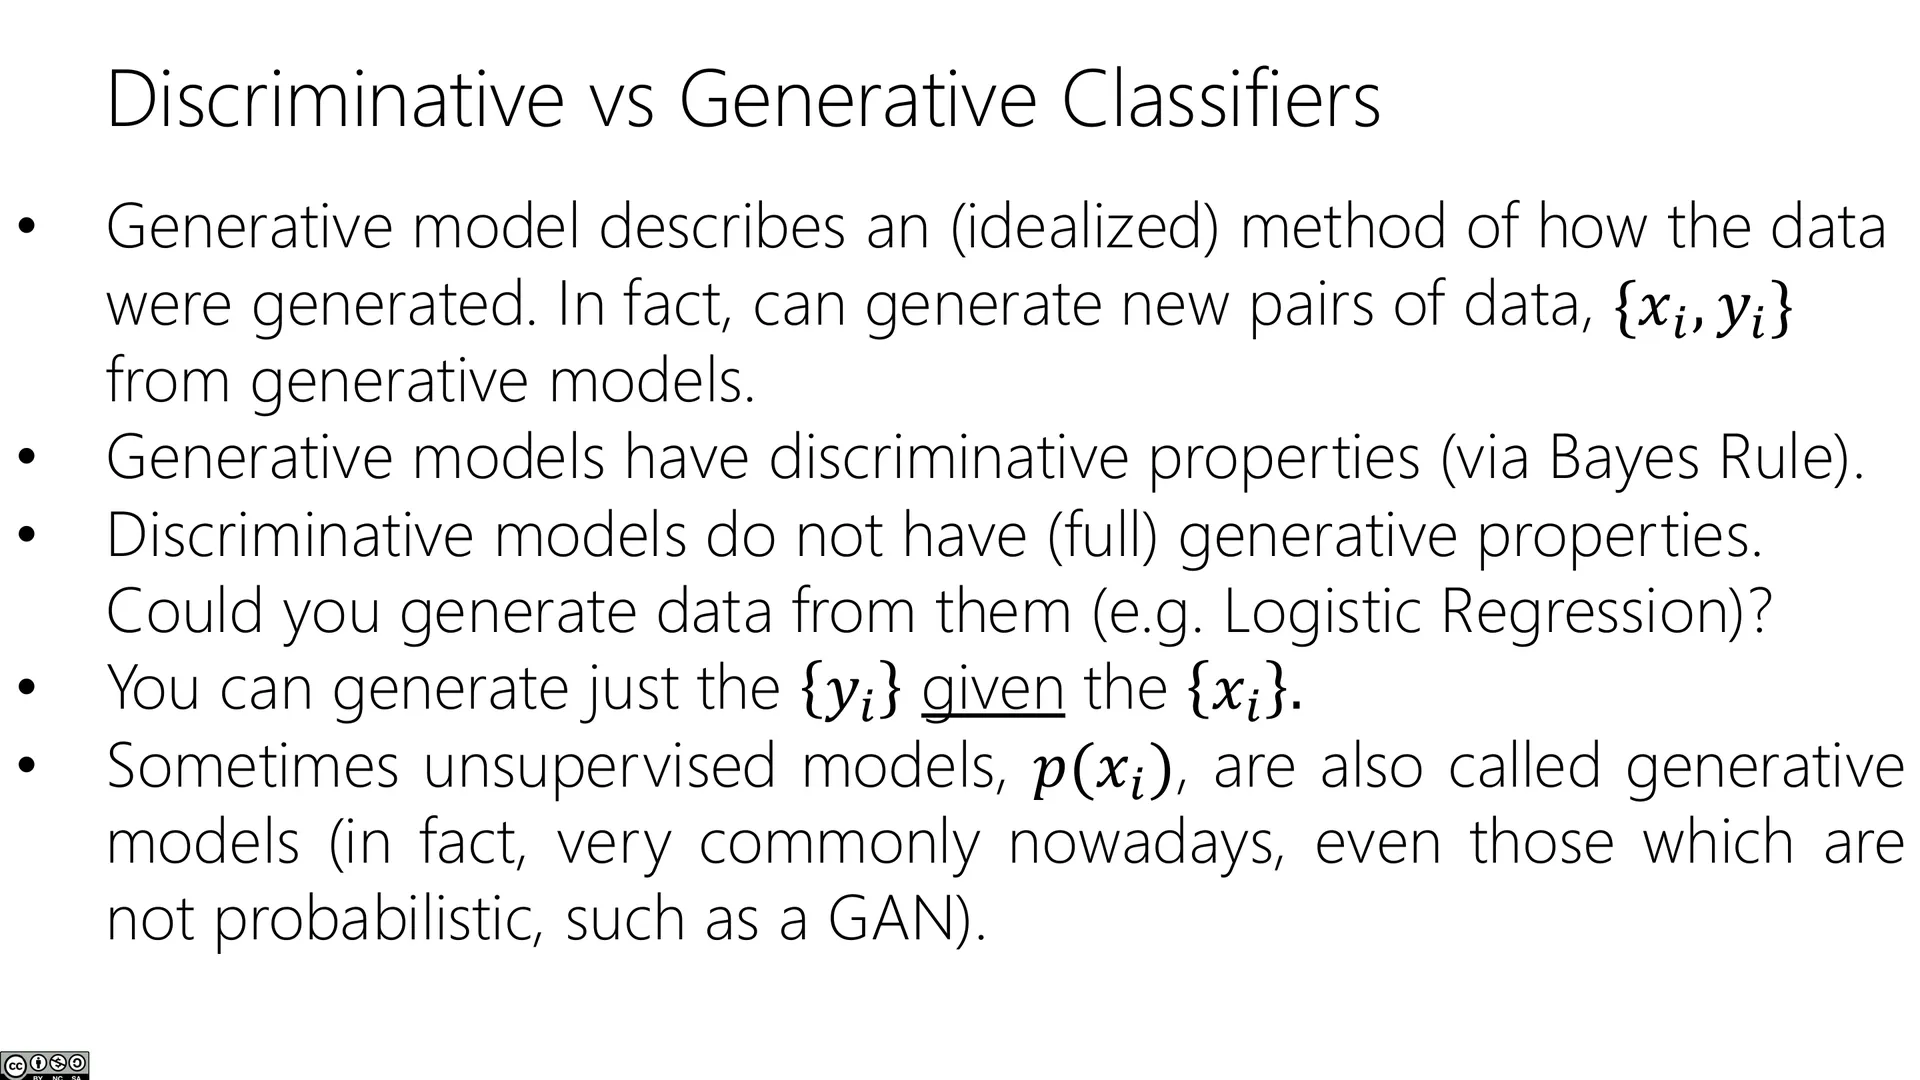
🖼️ 判别式 vs 生成式(三)
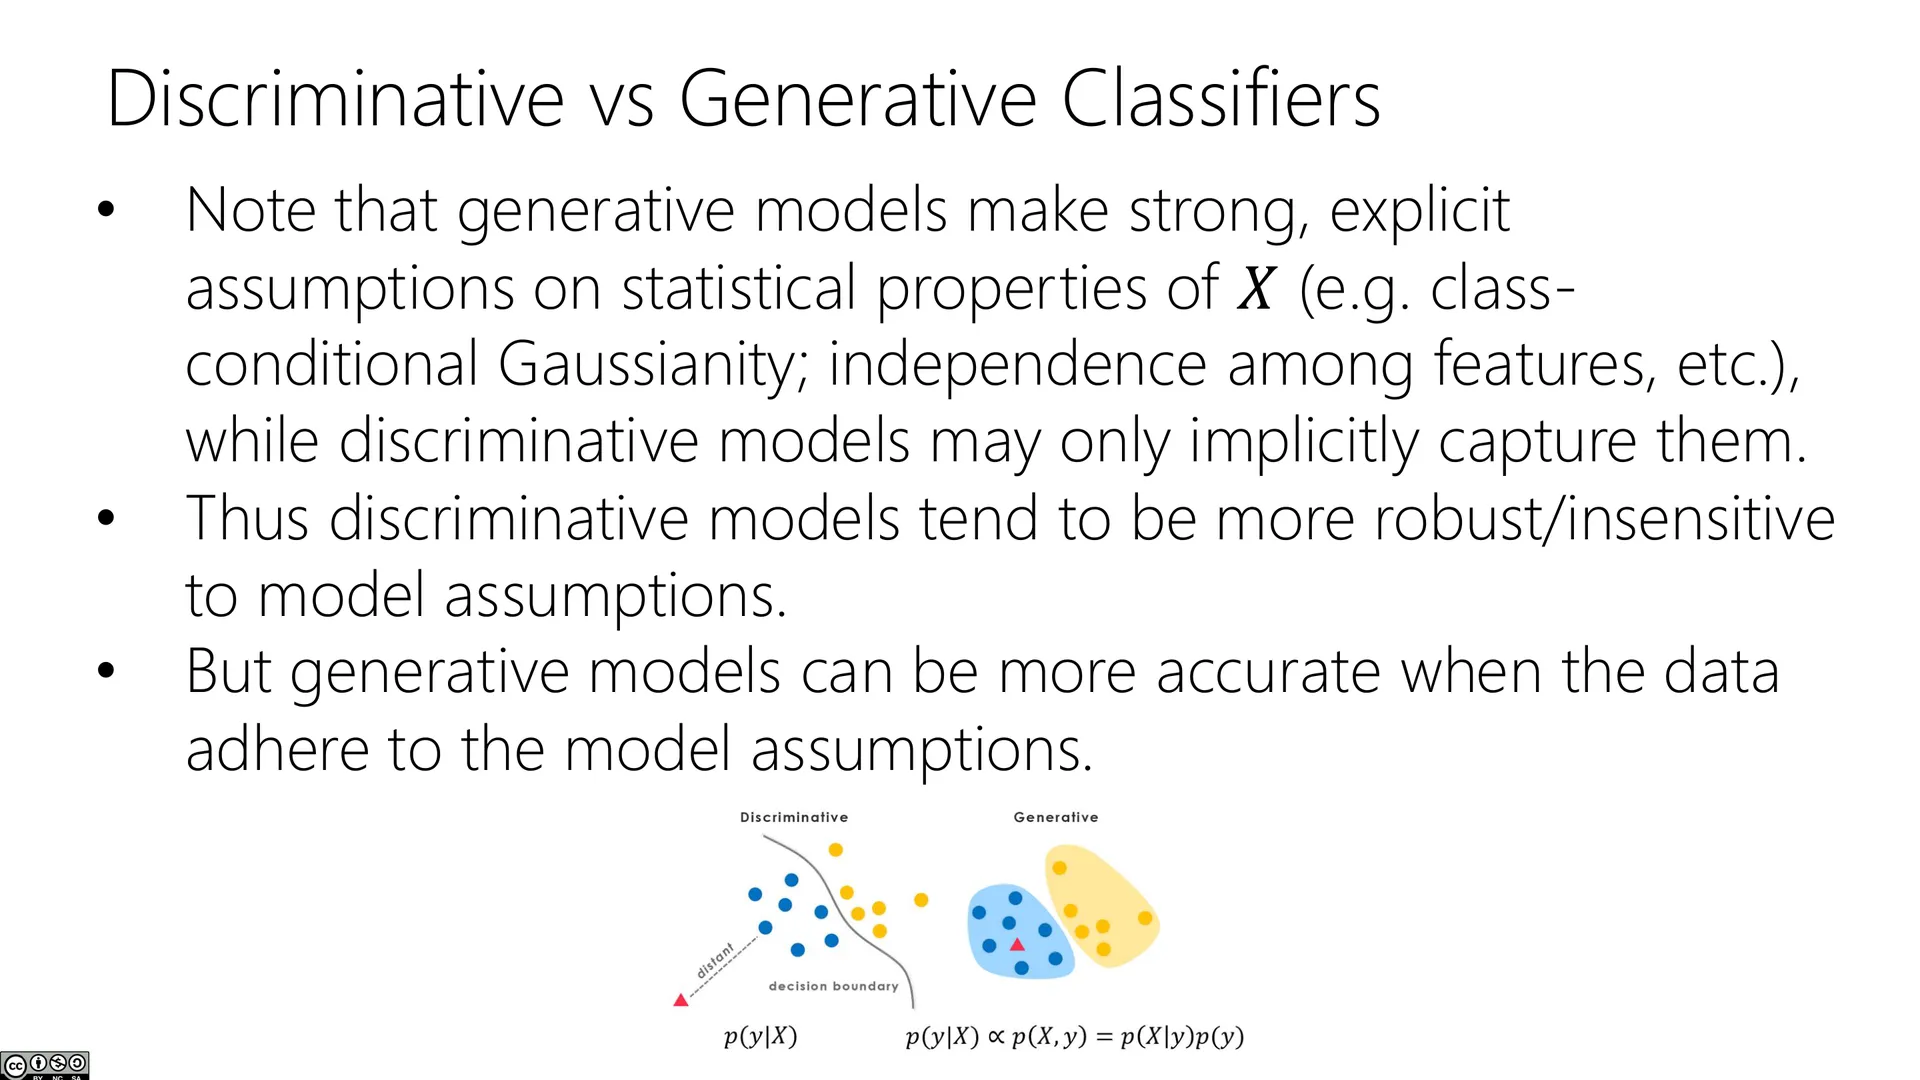
🖼️ (过渡)
🖼️ CS 189/289
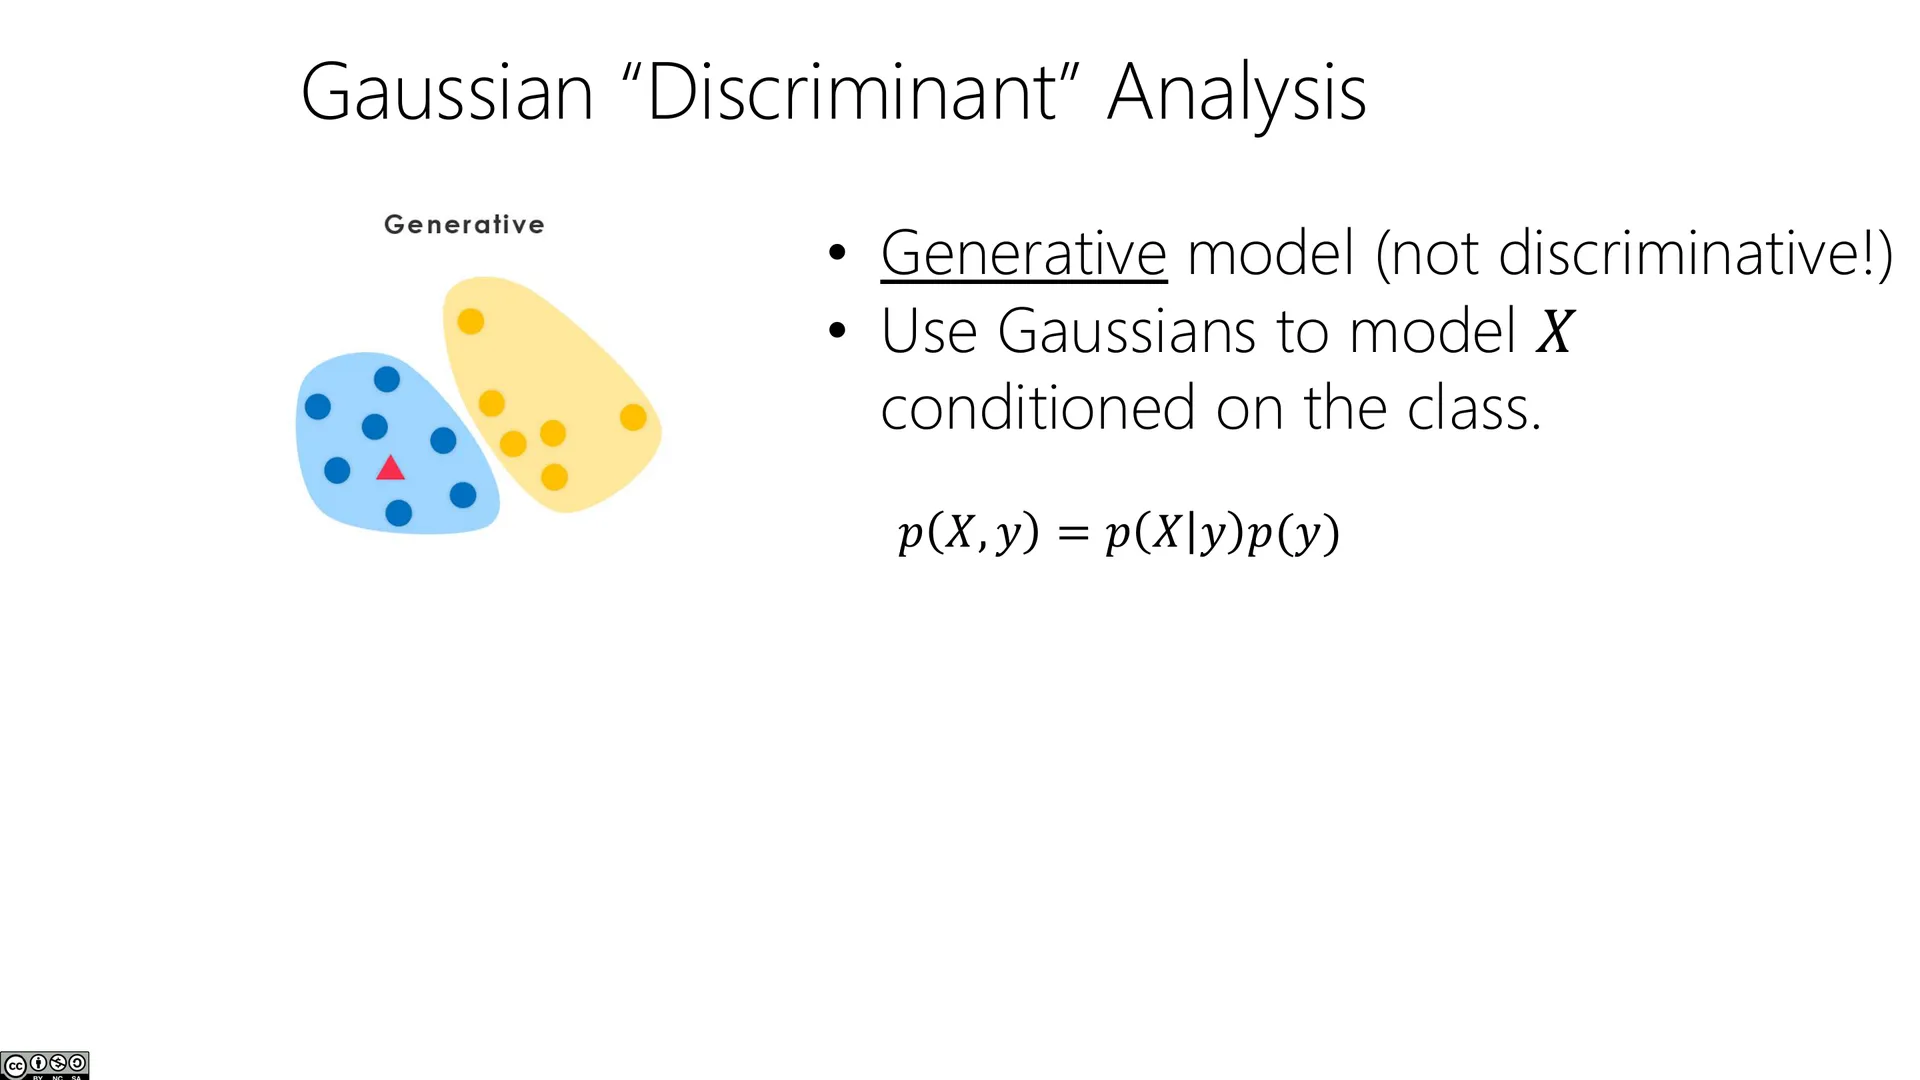
🖼️ 高斯判别分析(GDA)(01)
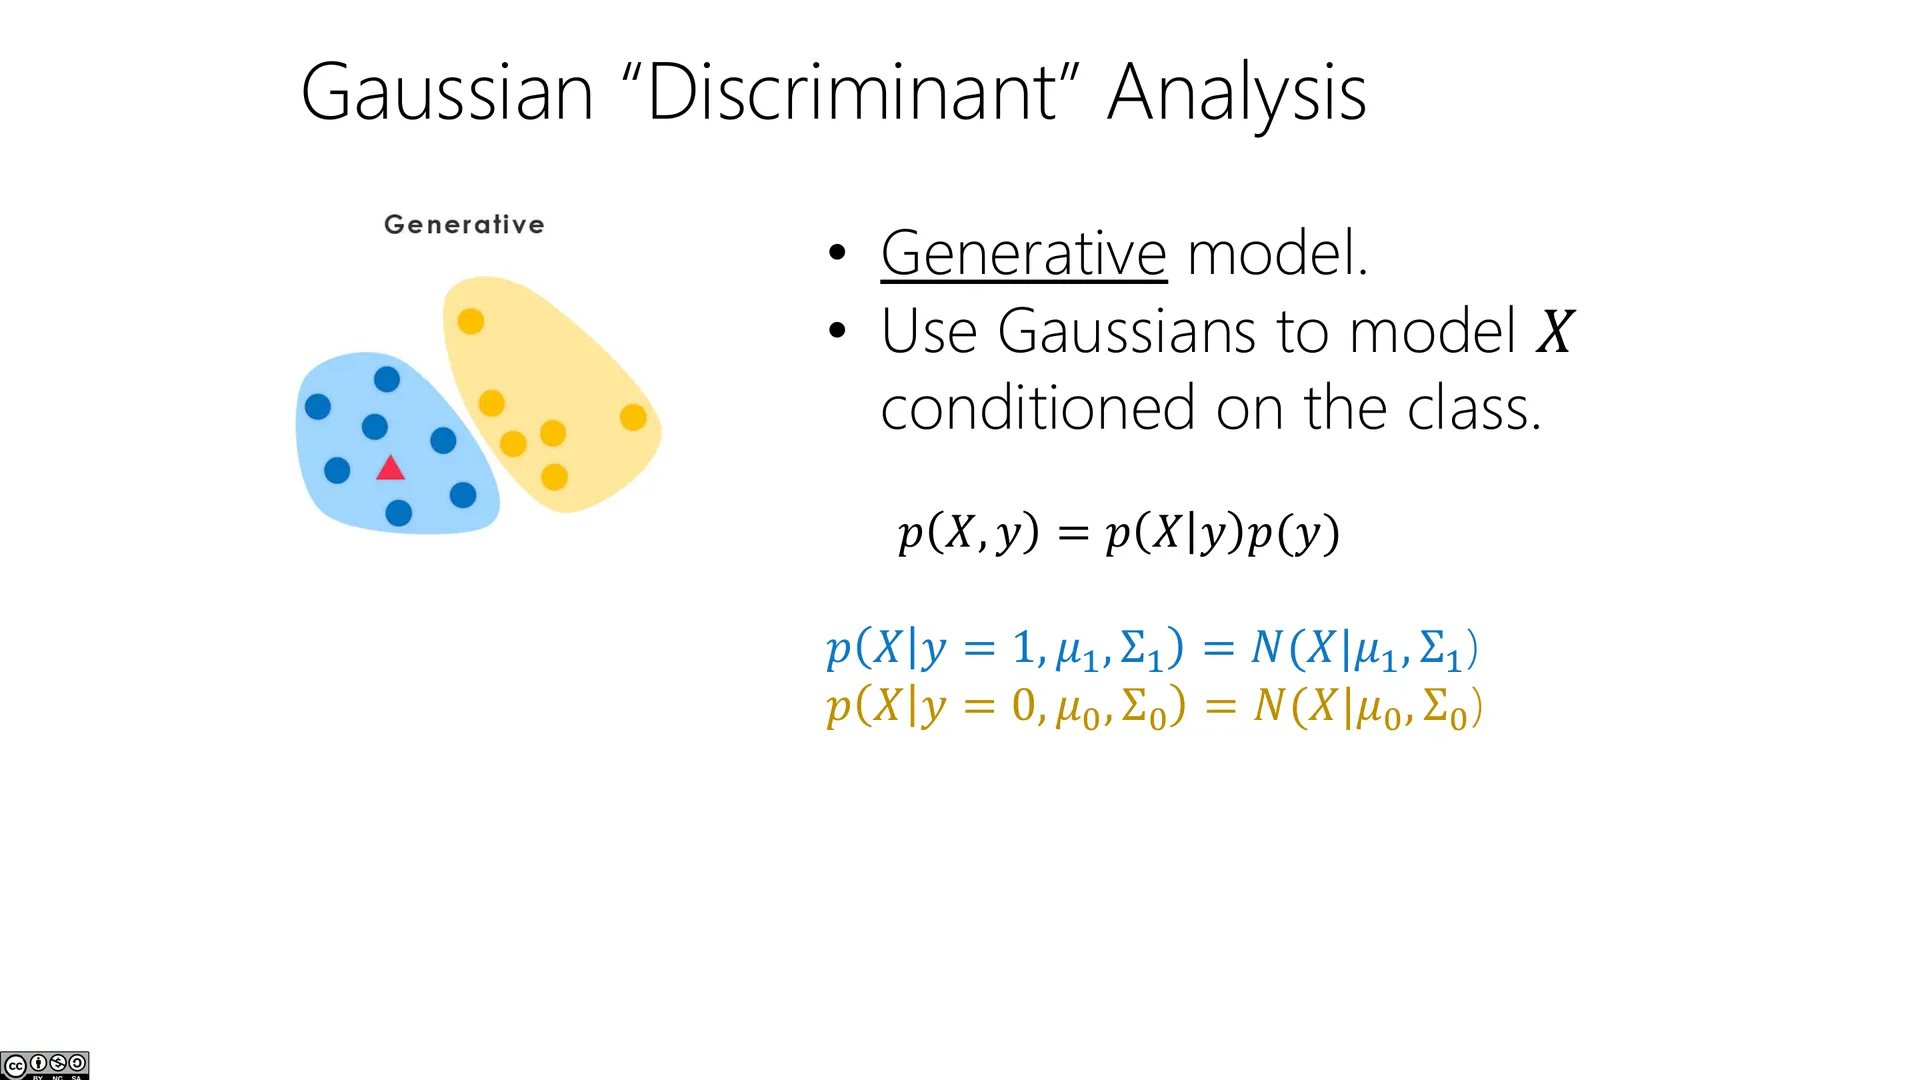
🖼️ GDA(02)
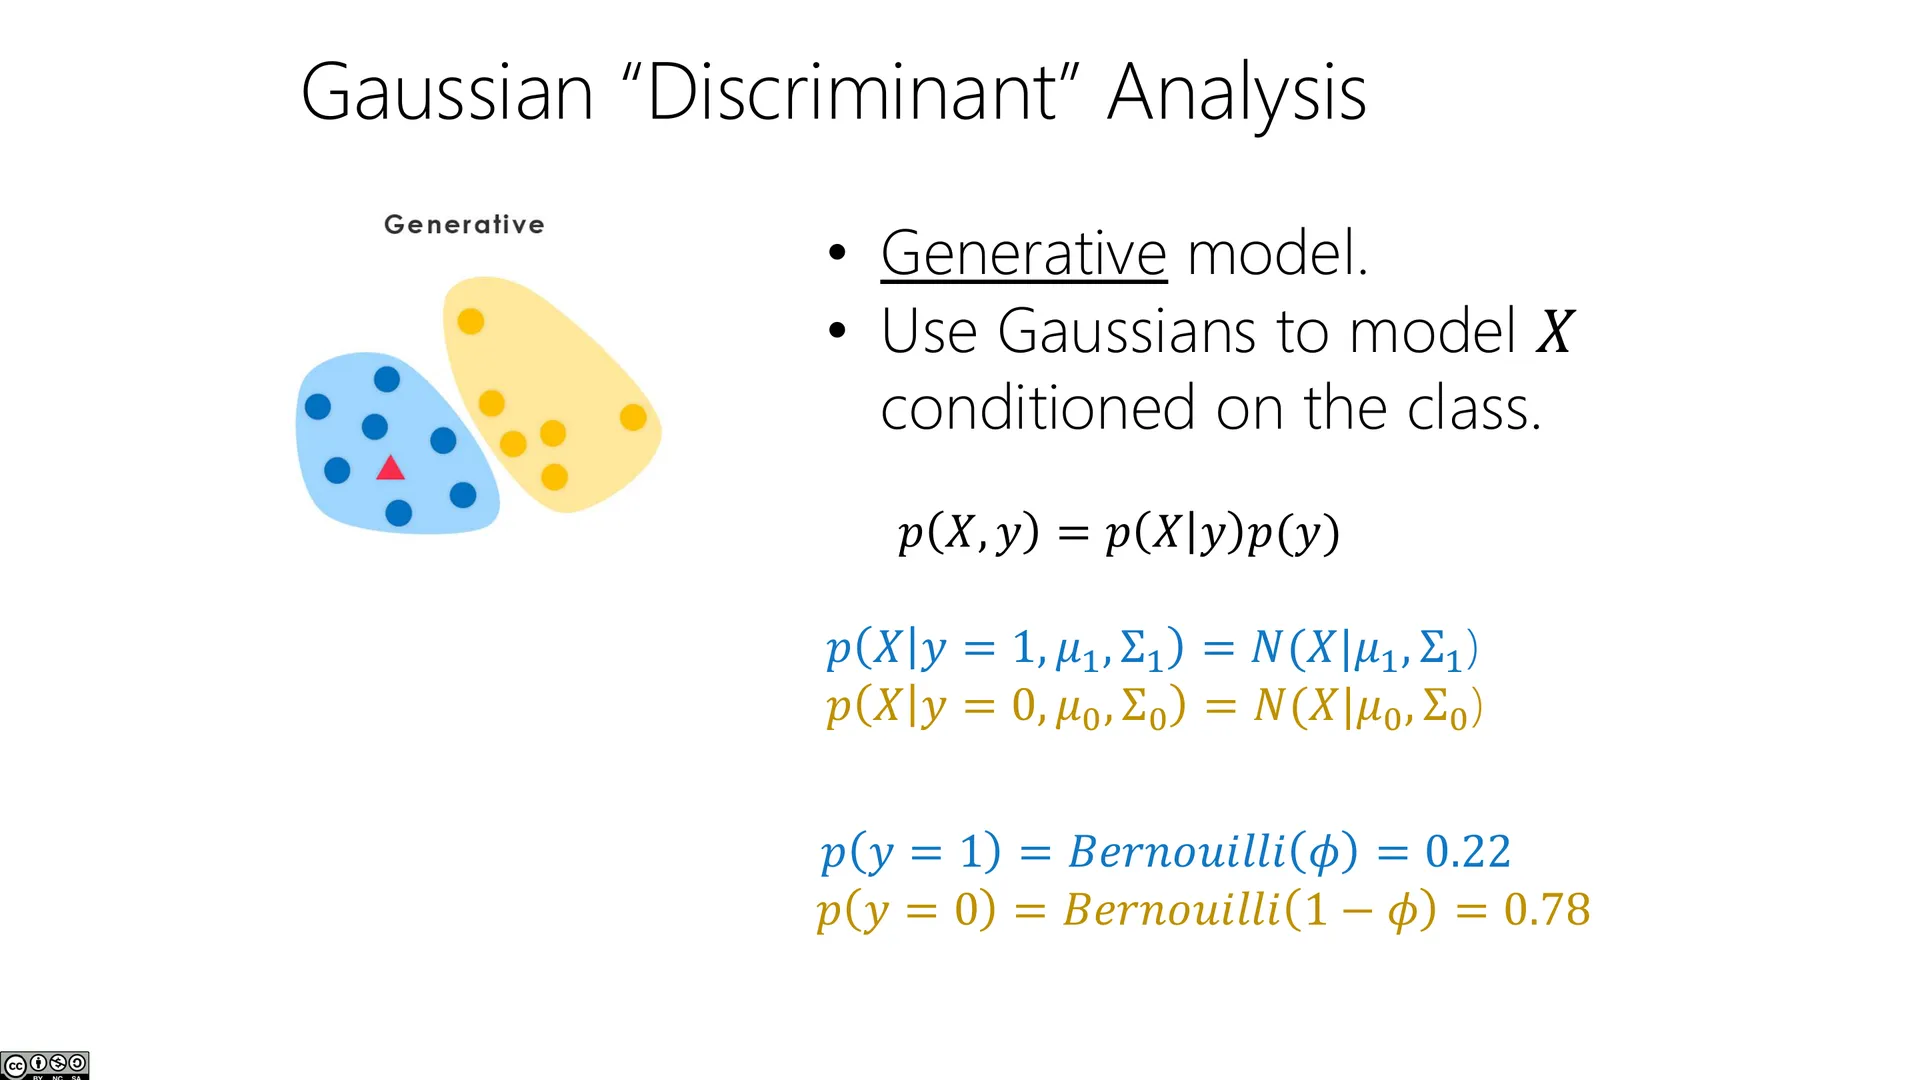
🖼️ GDA(03)
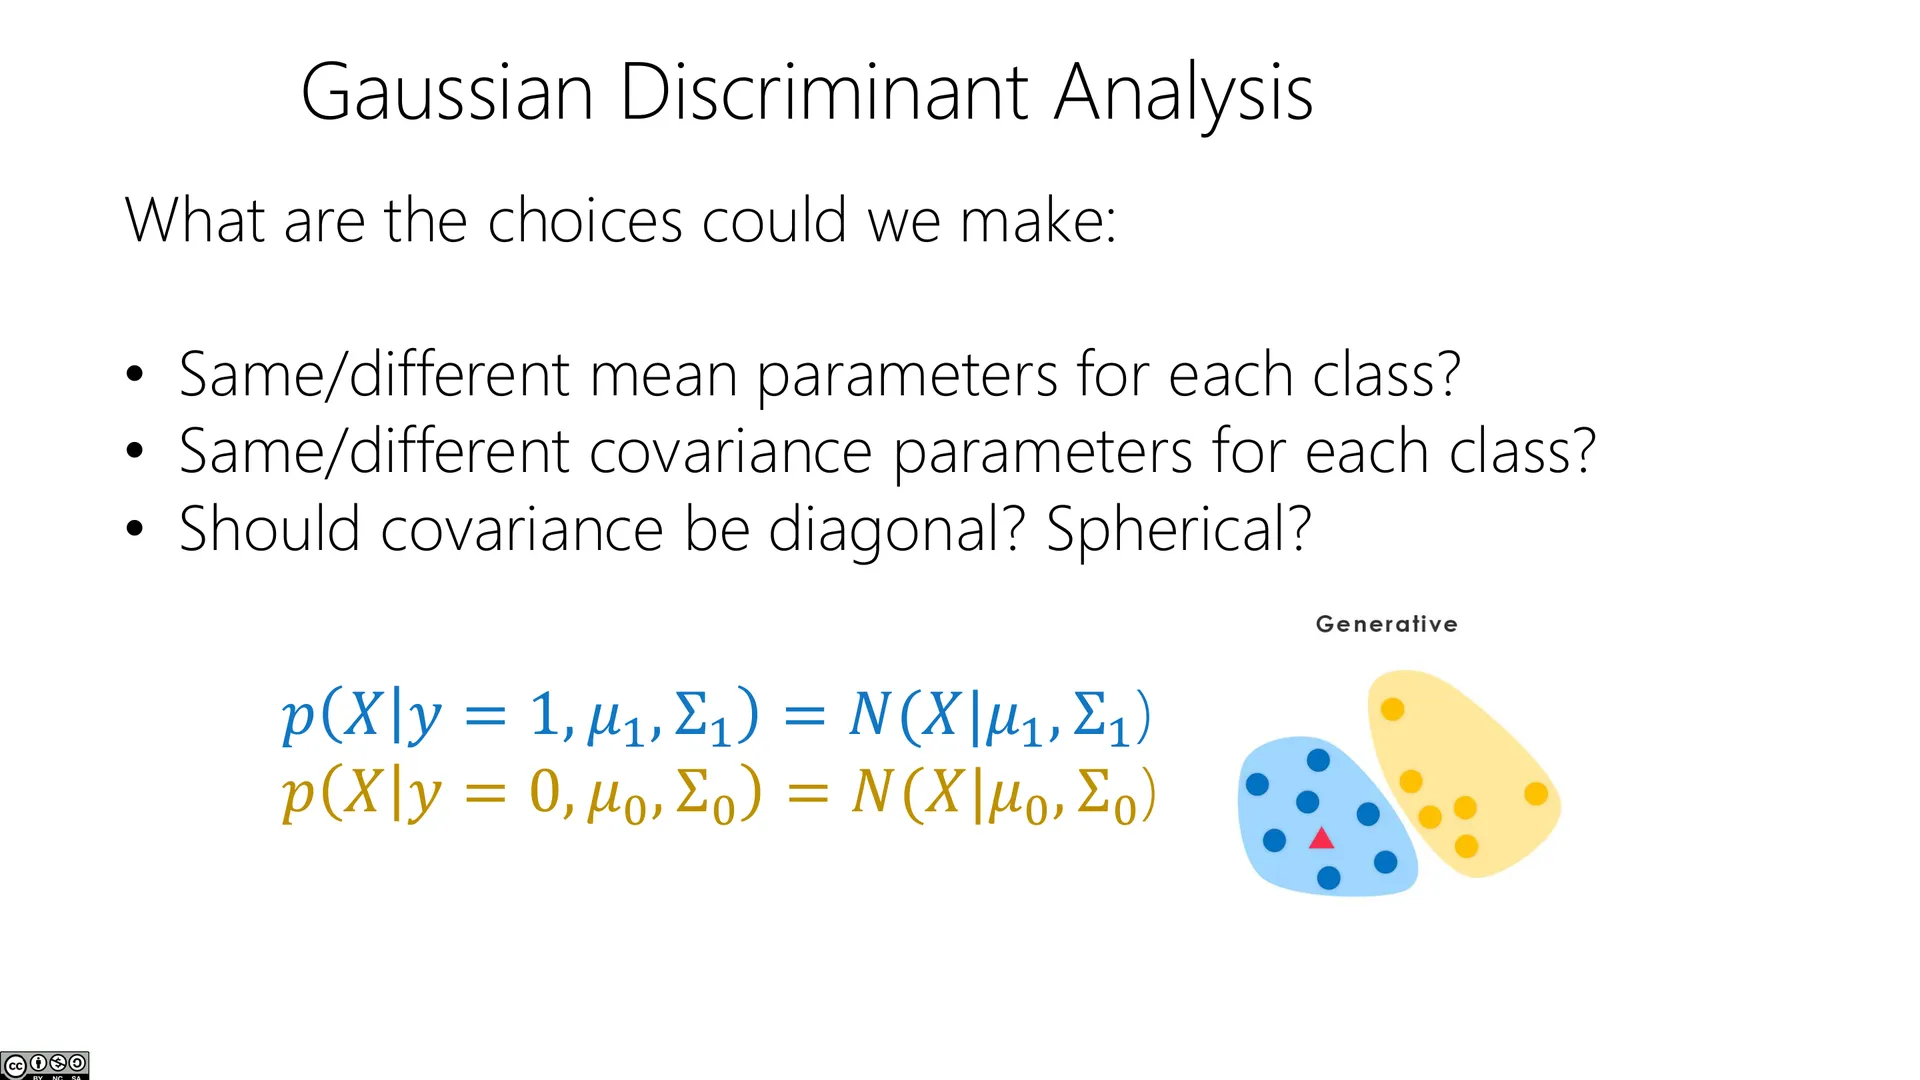
🖼️ GDA(04)
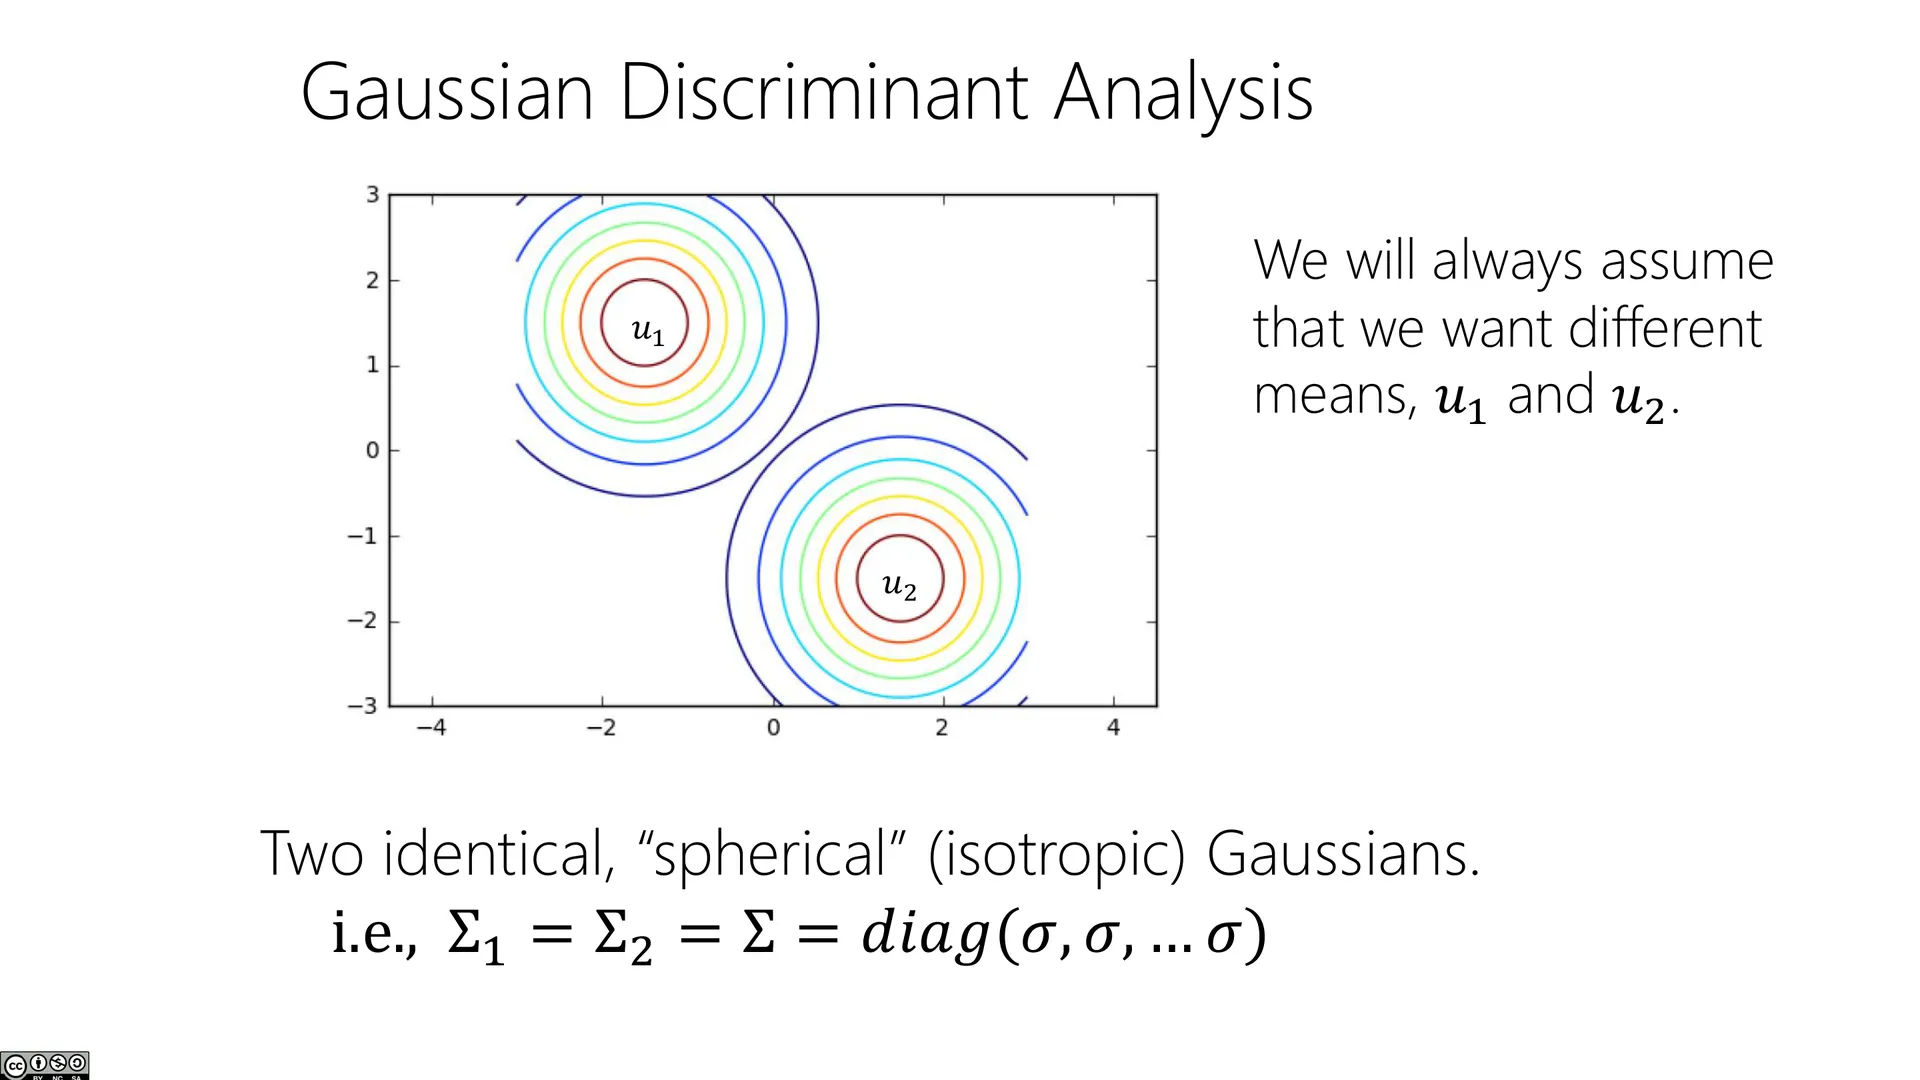
🖼️ GDA(05)
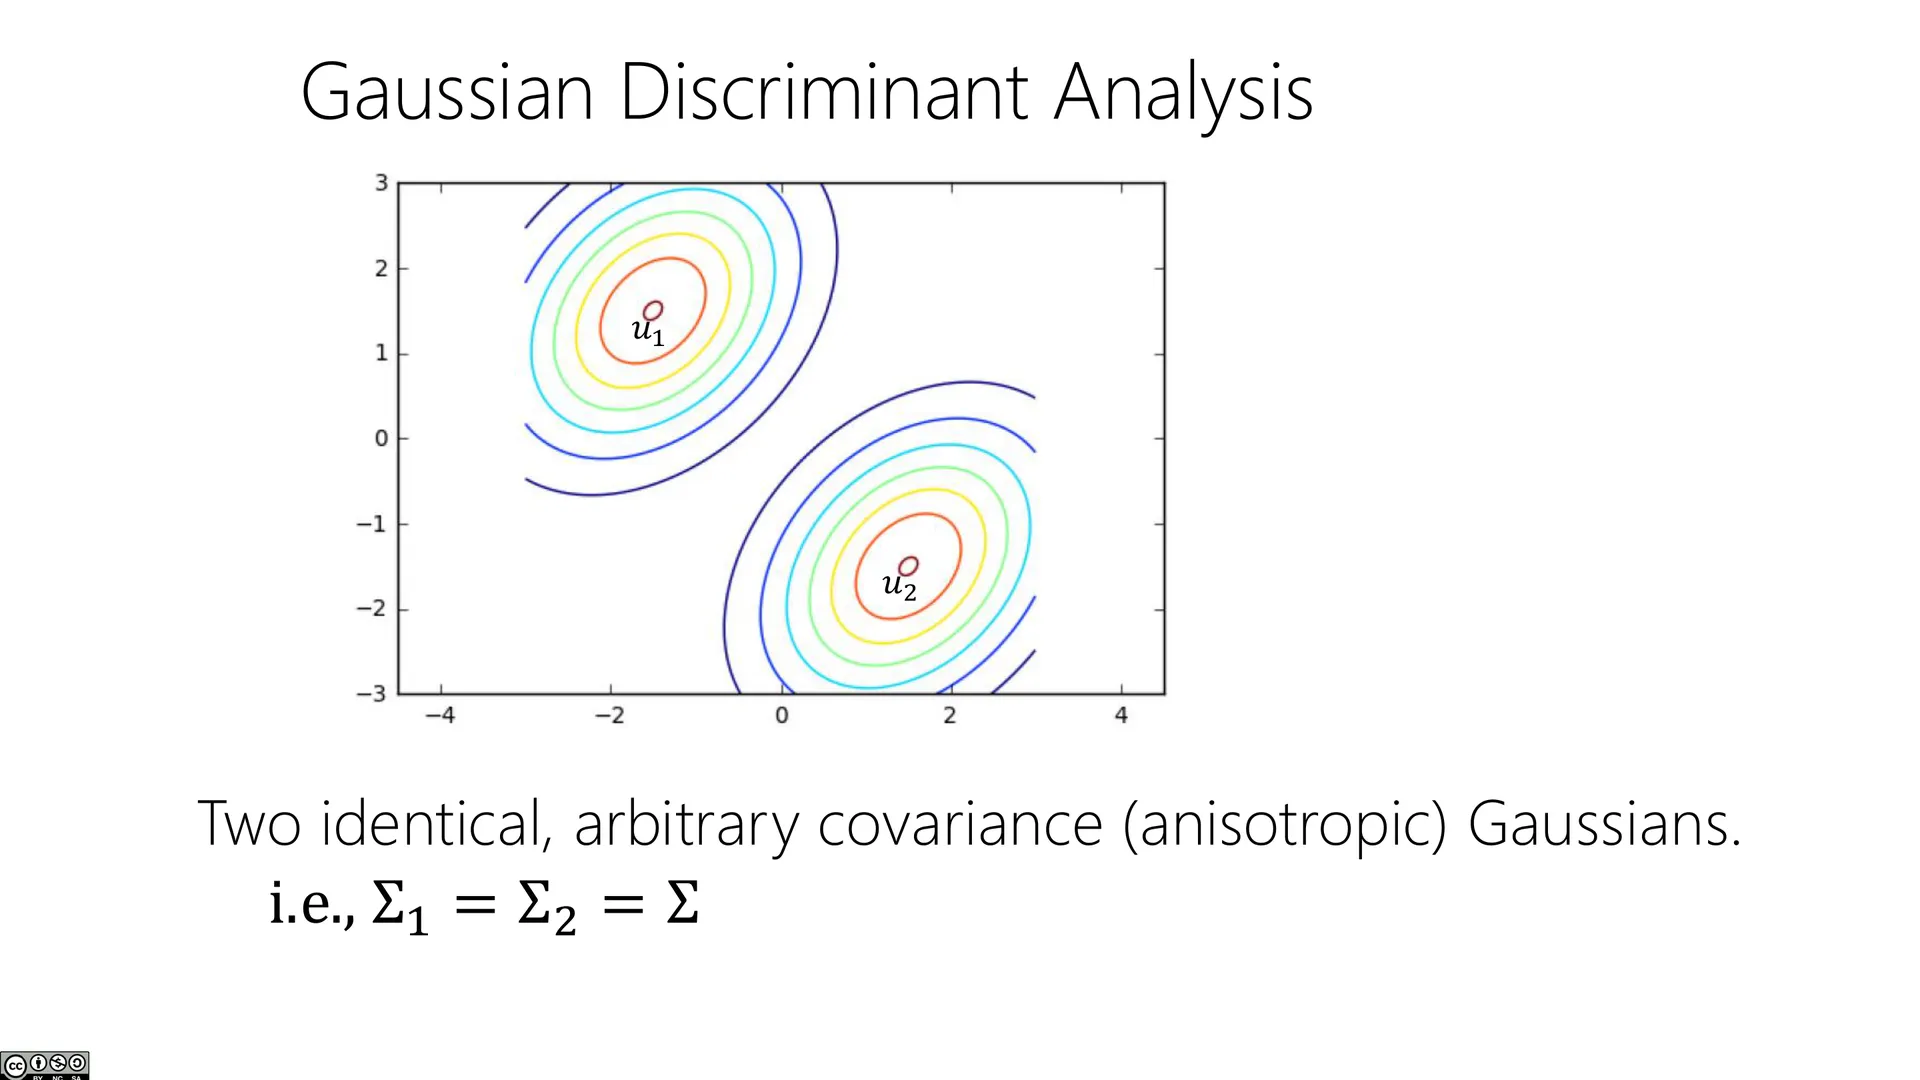
🖼️ GDA(06)
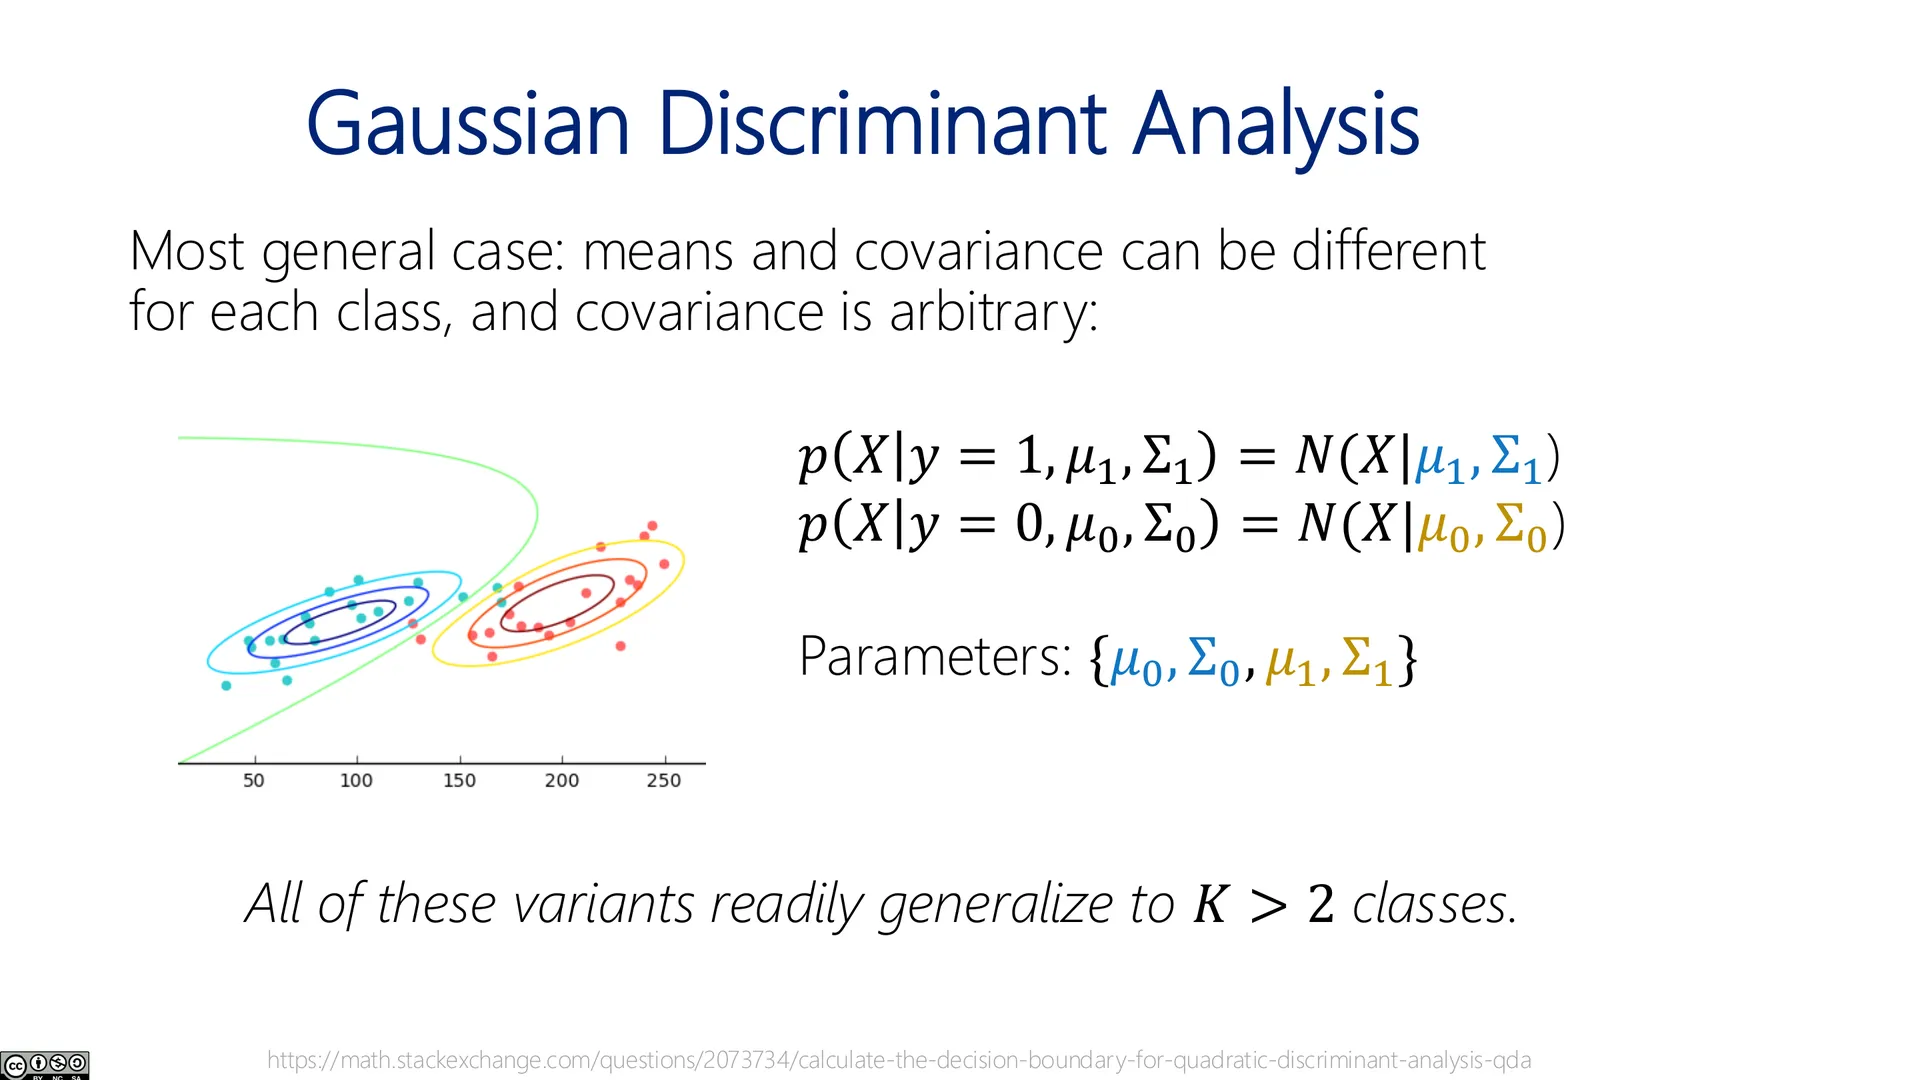
🖼️ GDA(07)
🖼️ GDA(08)
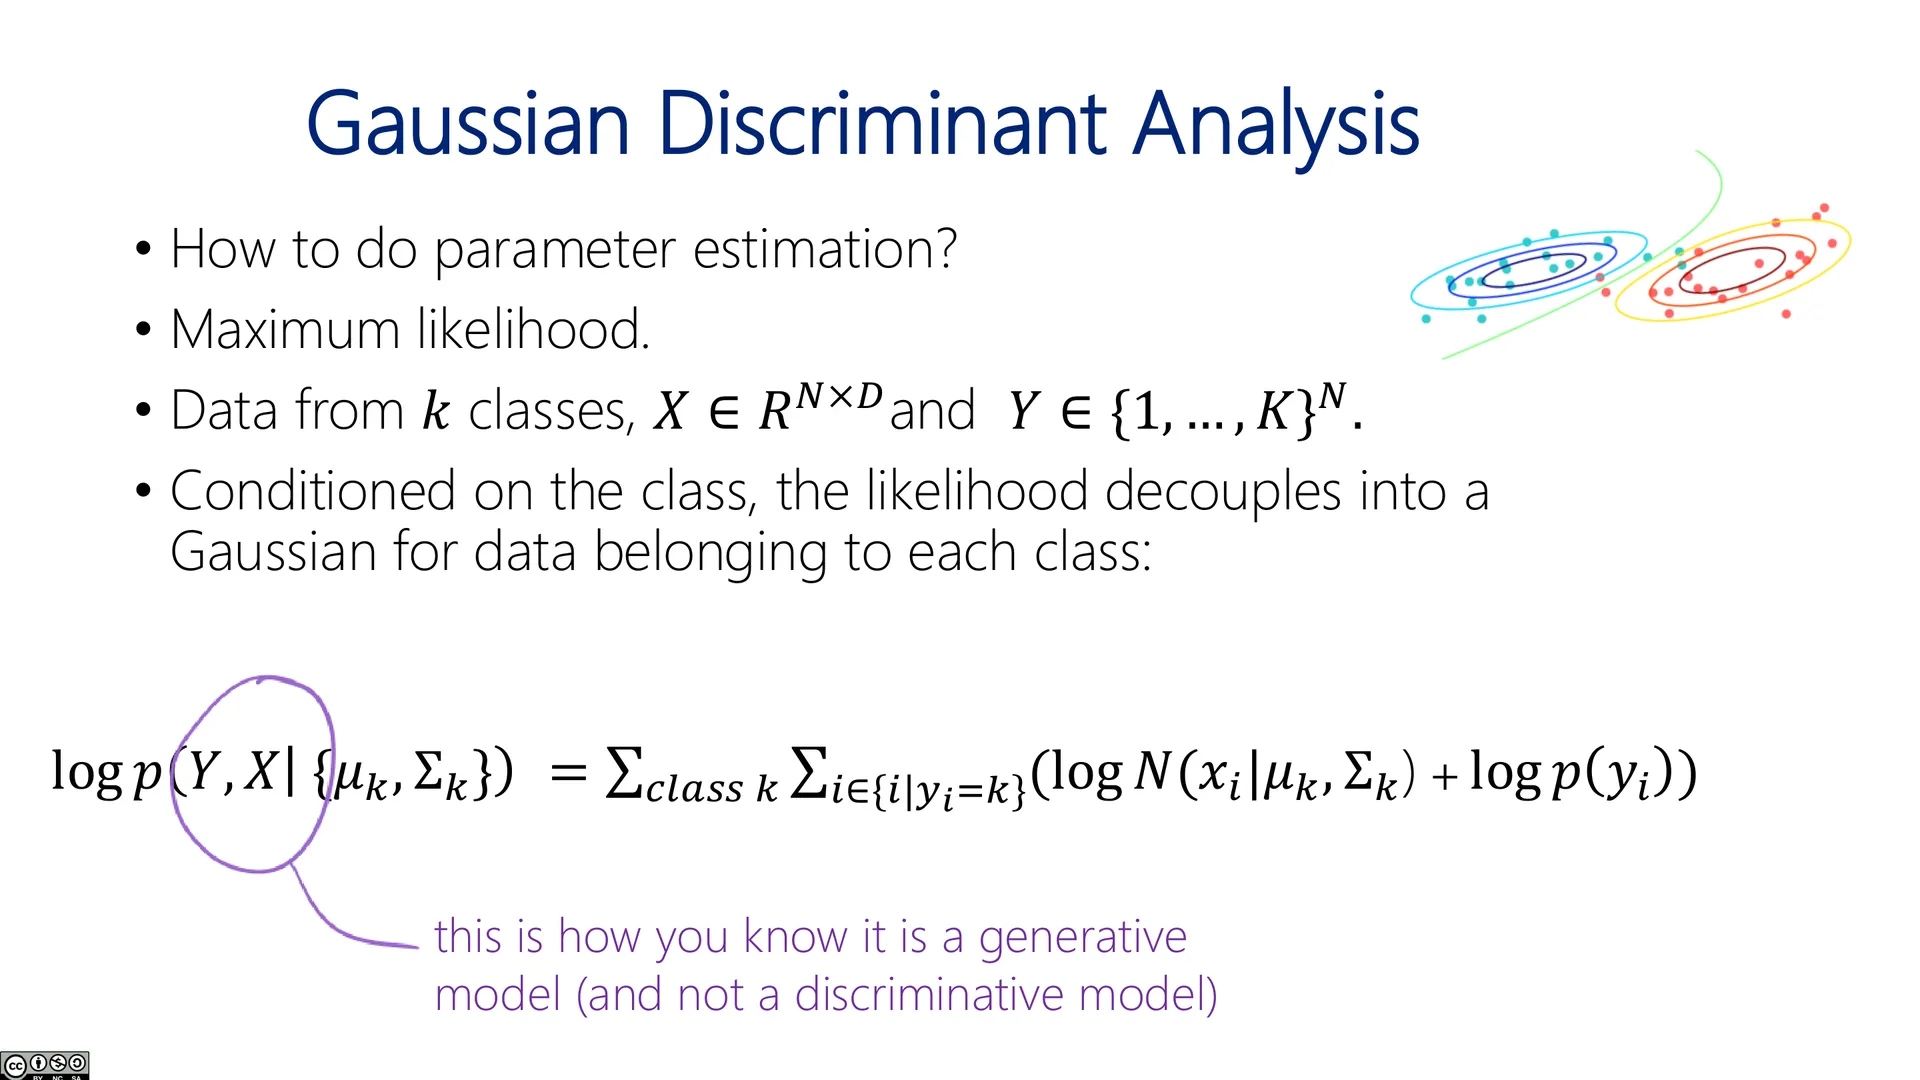
🖼️ GDA(09)
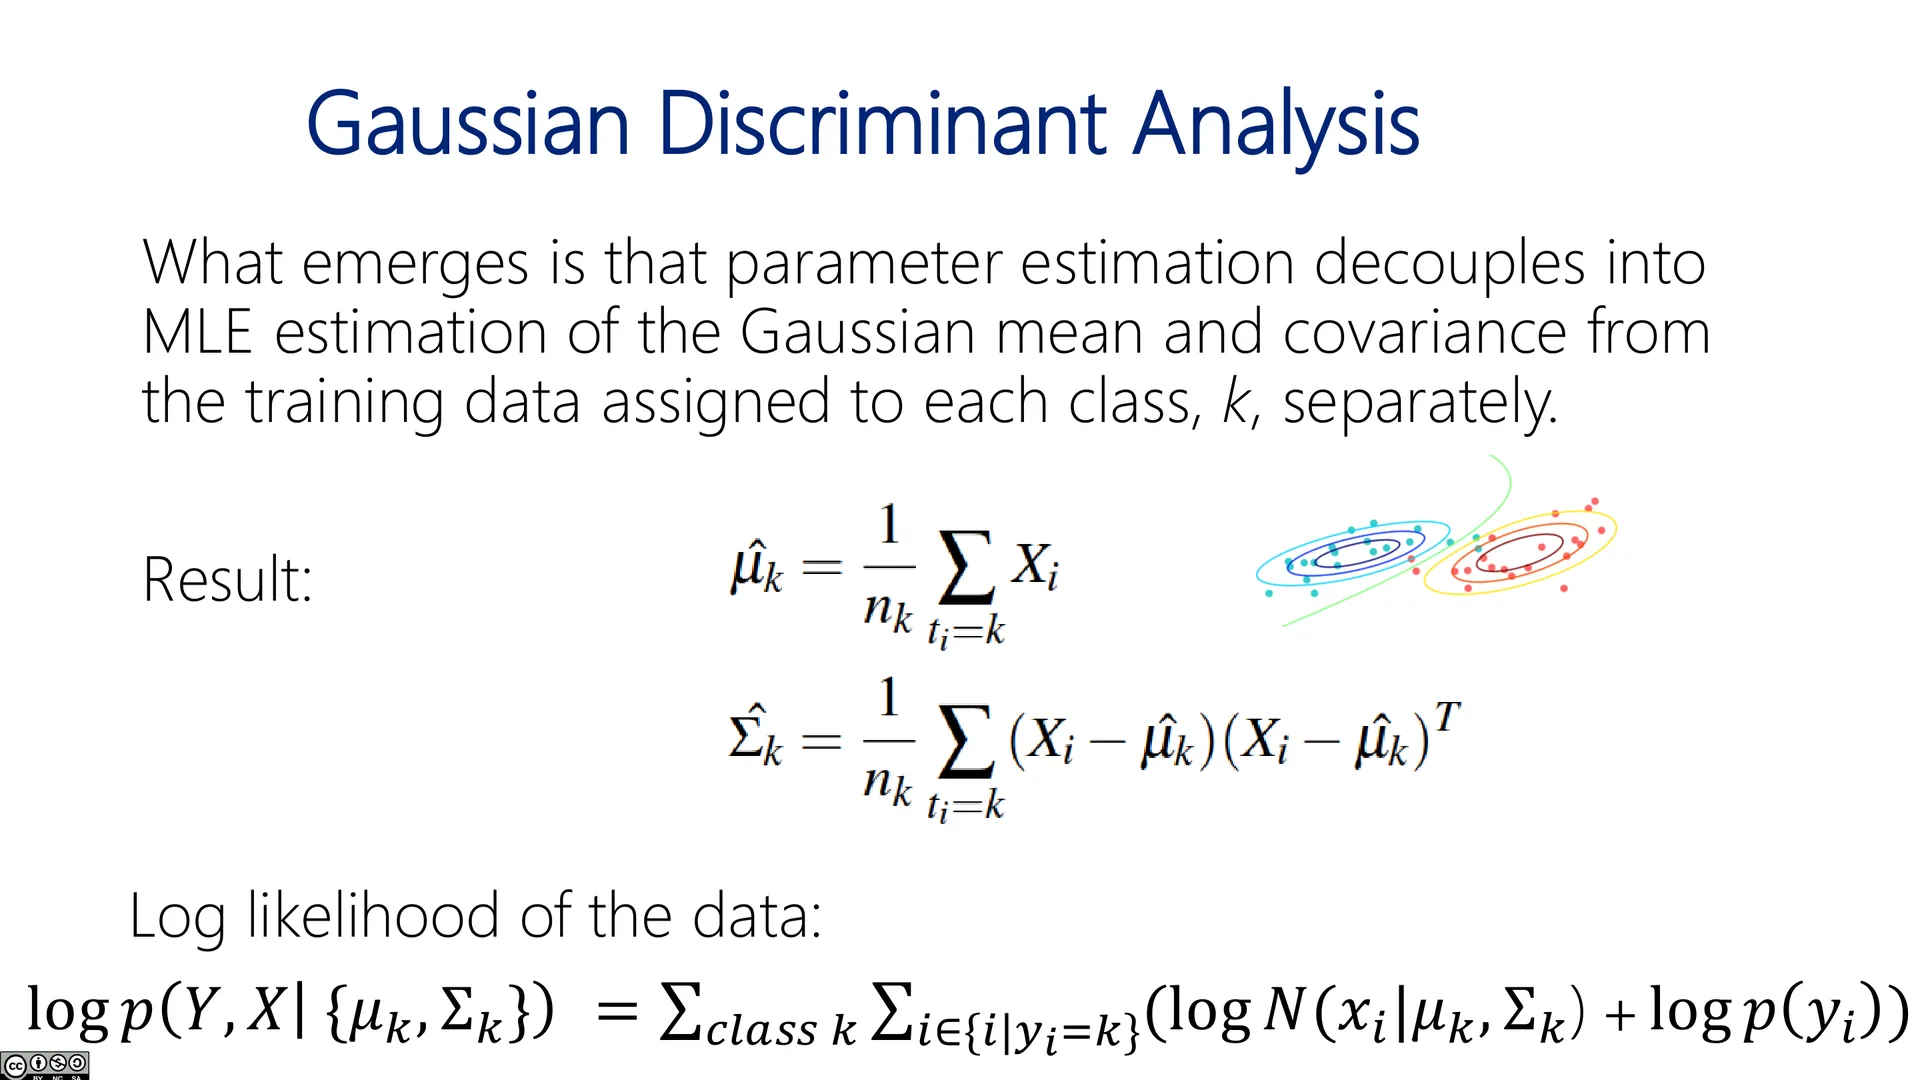
🖼️ GDA(10)
🖼️ GDA(11)
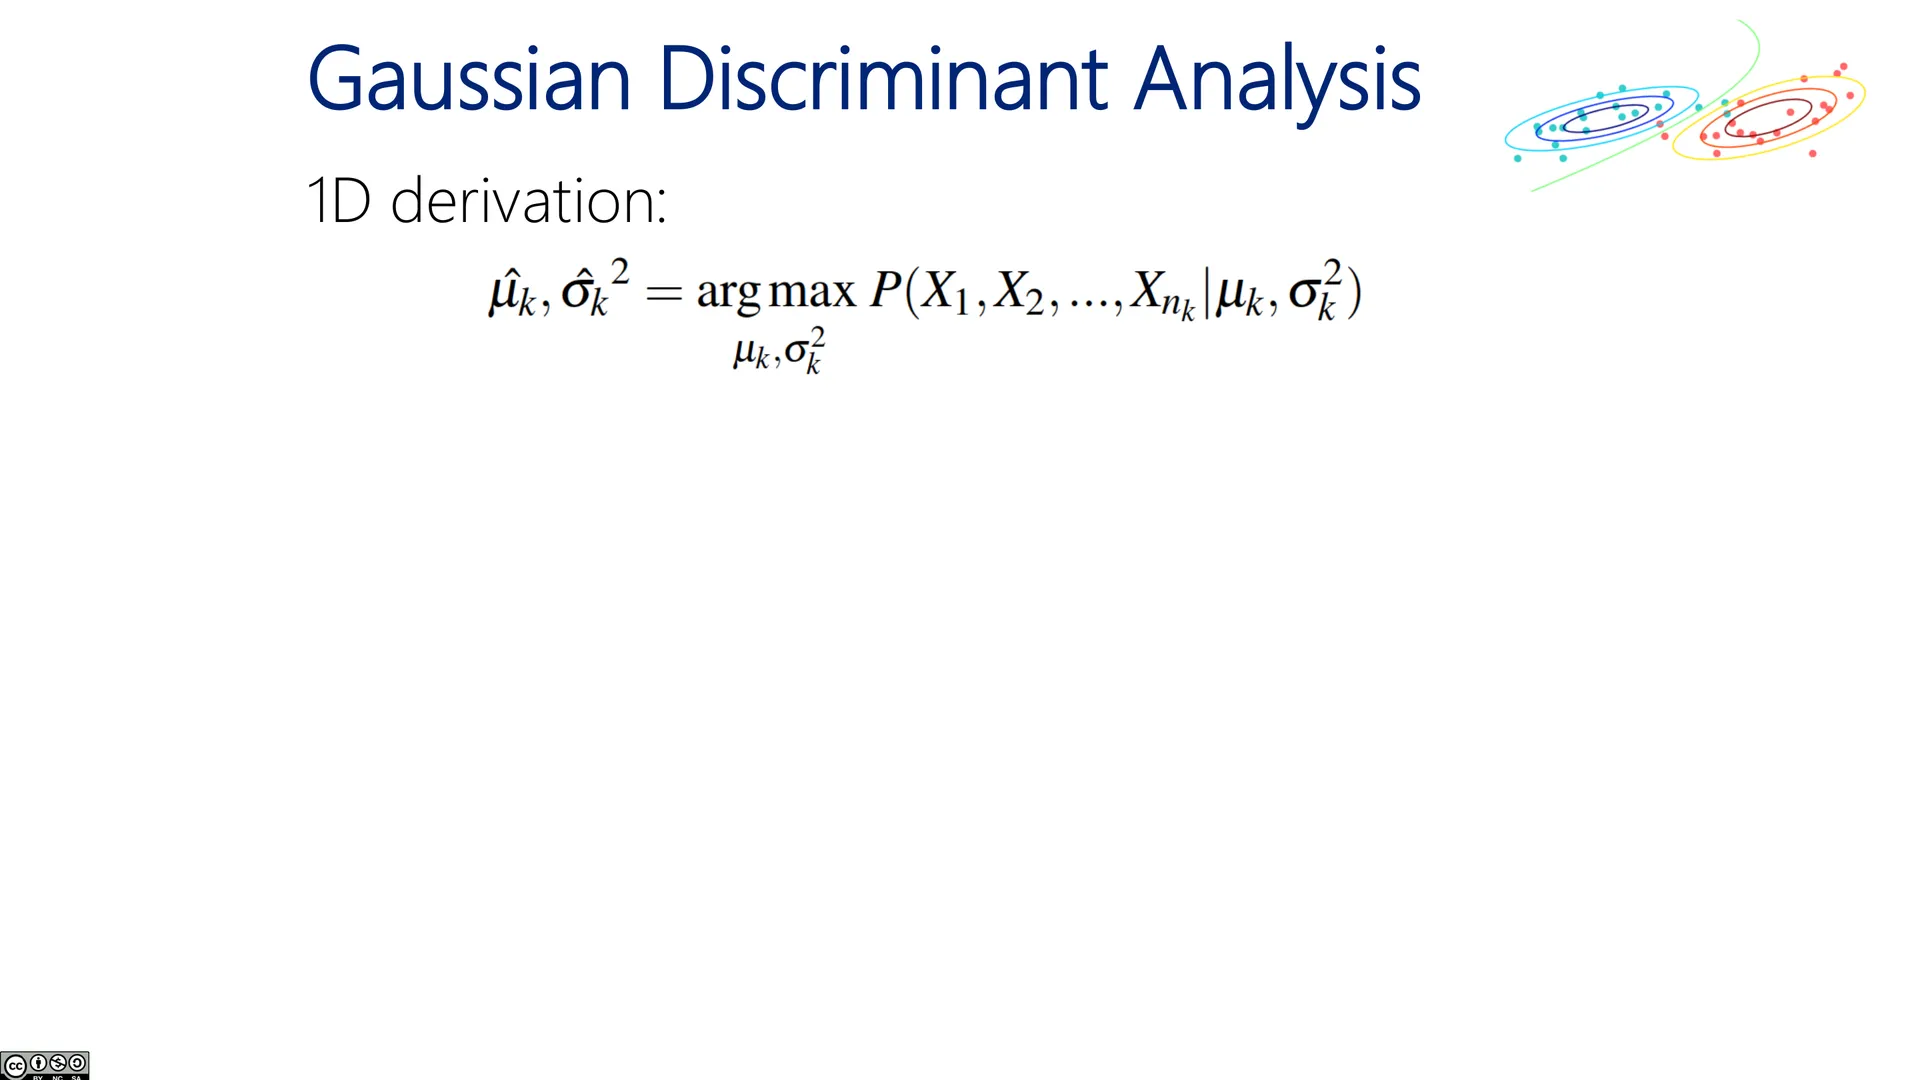
🖼️ GDA(12)
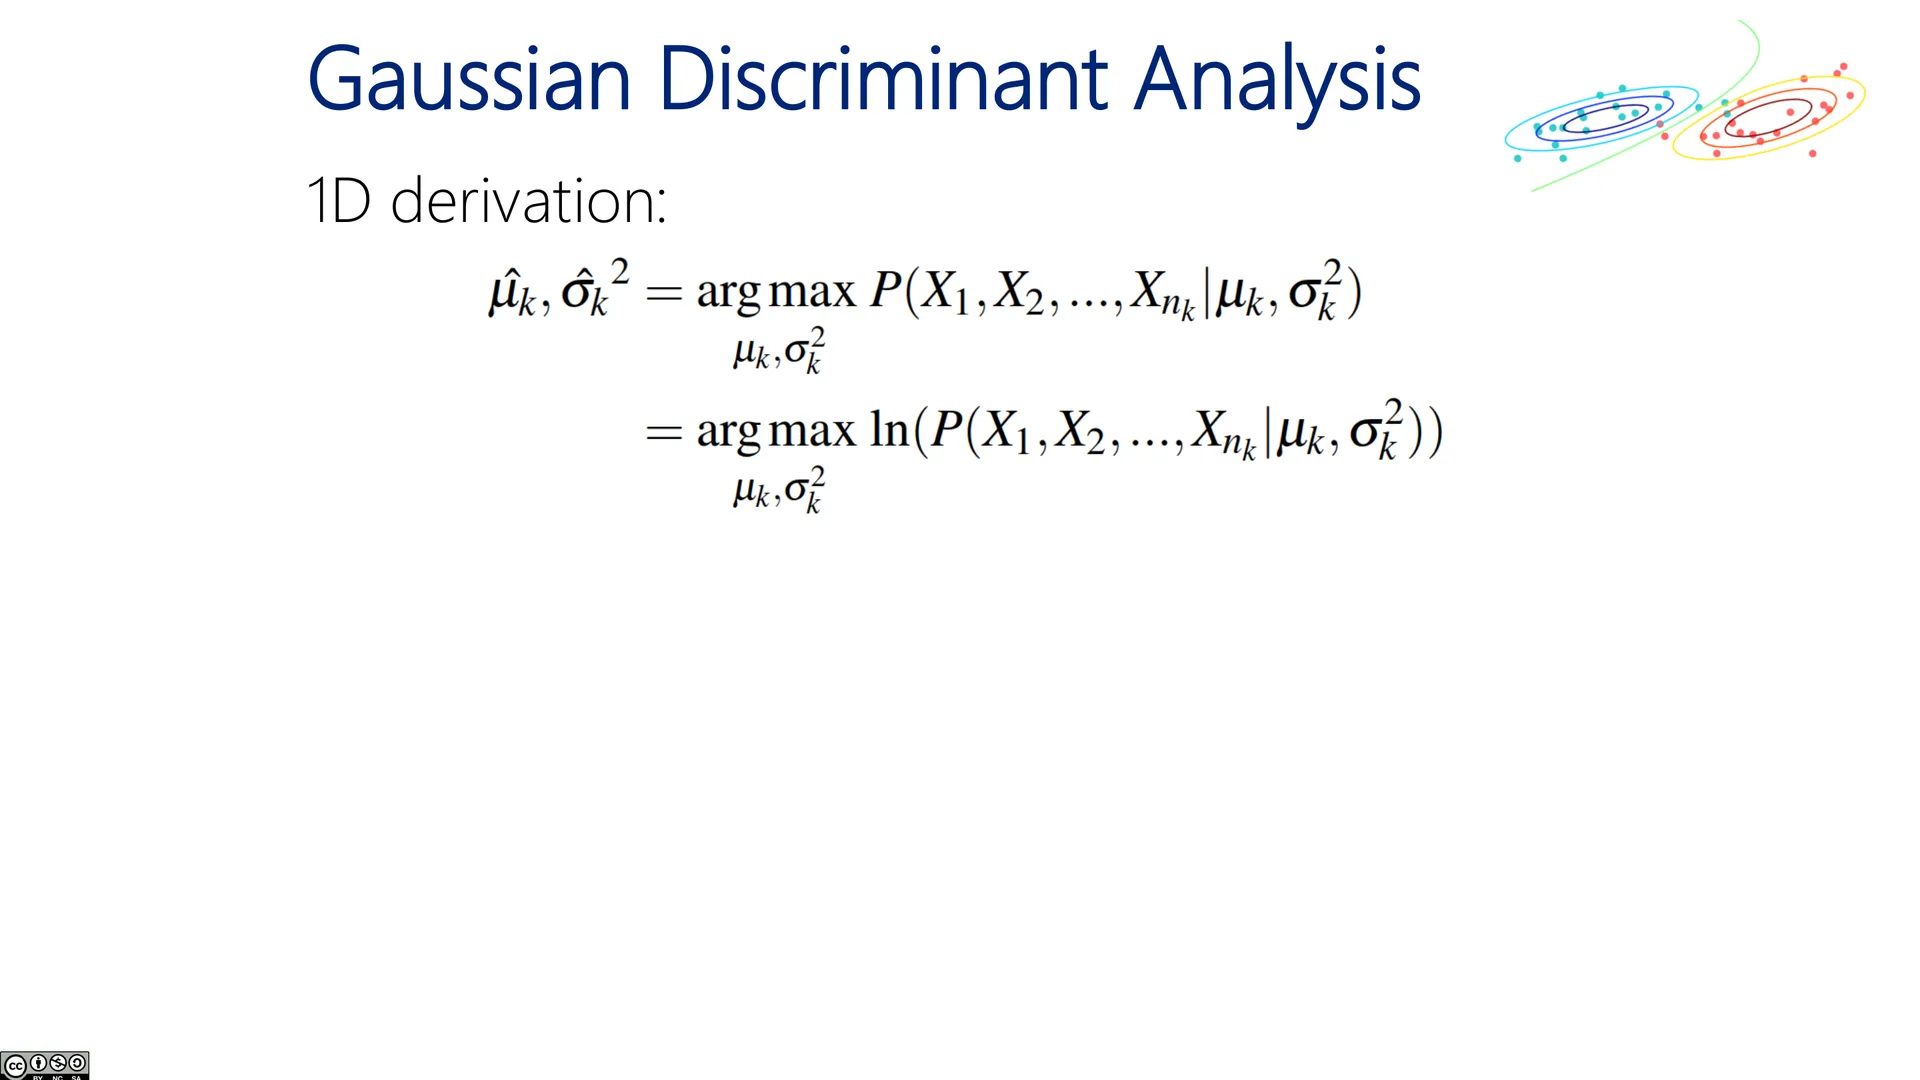
🖼️ GDA(13)
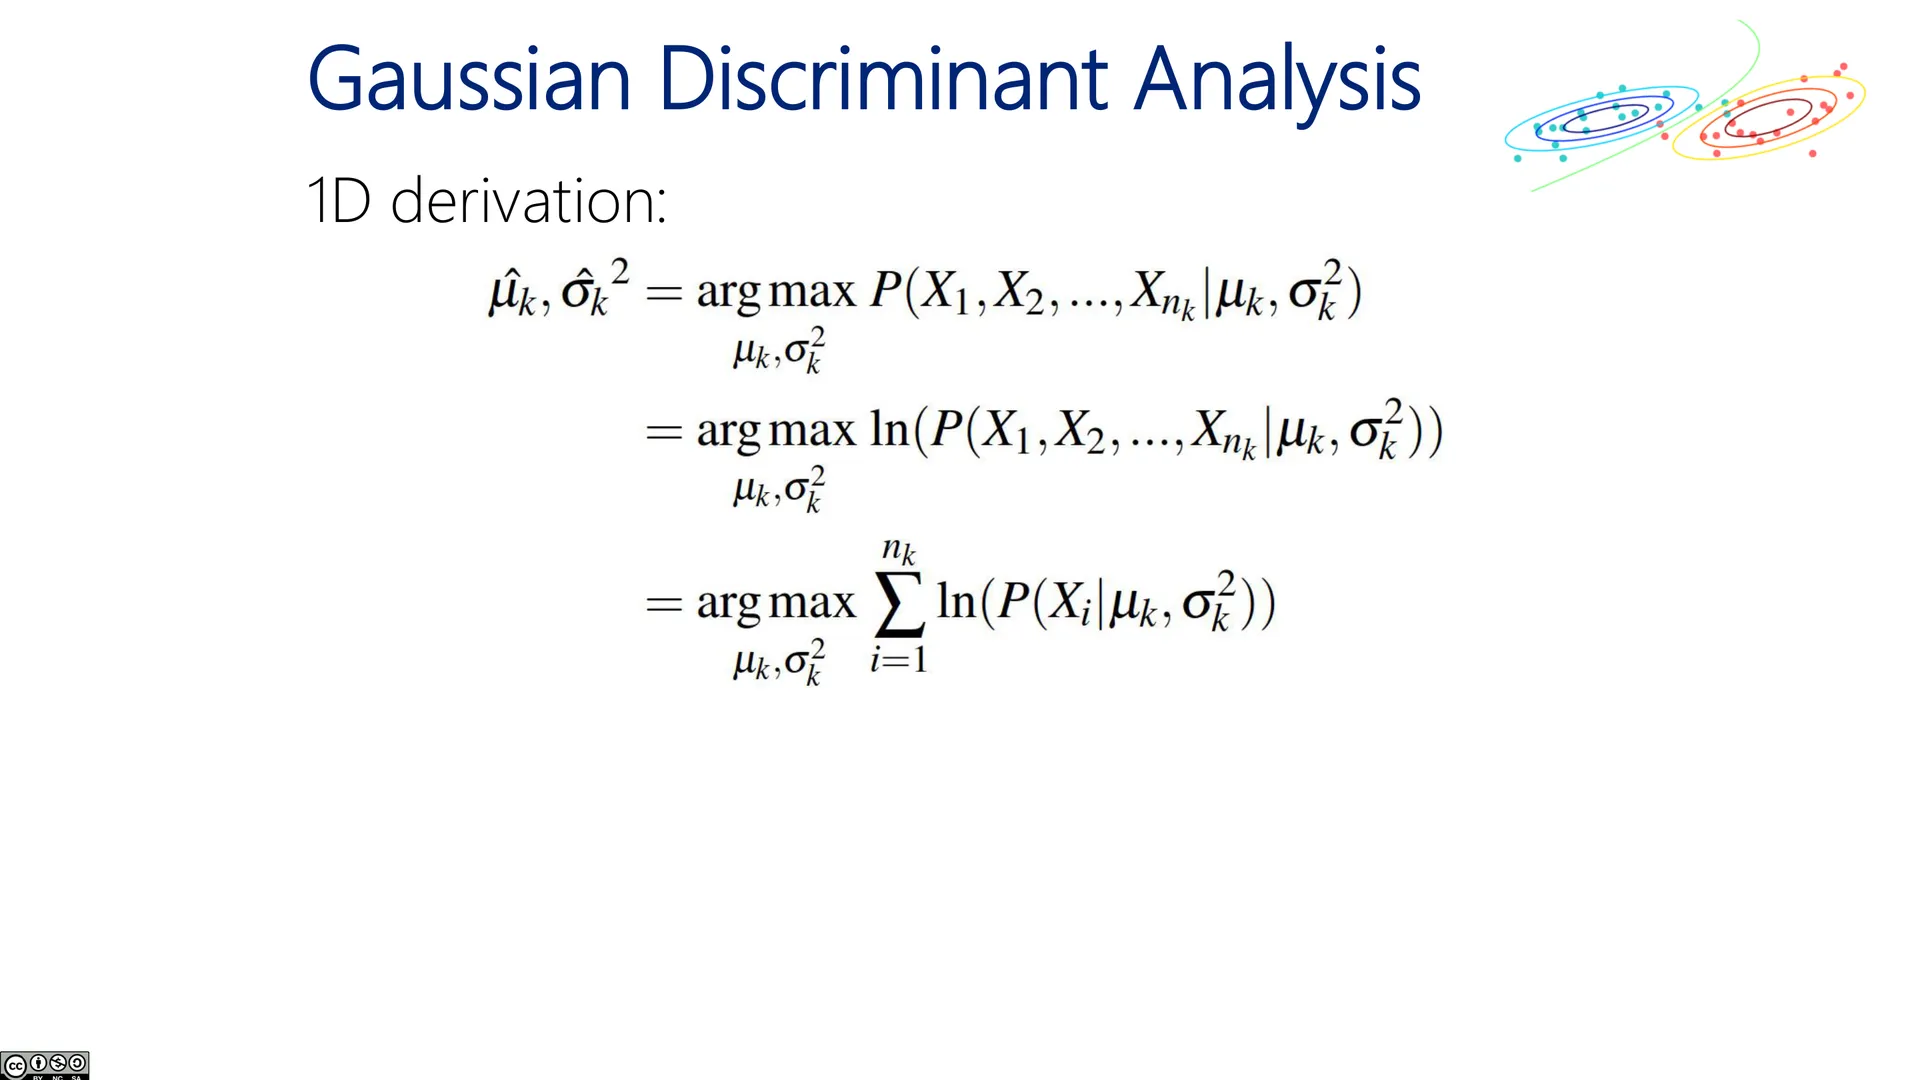
🖼️ GDA(14)
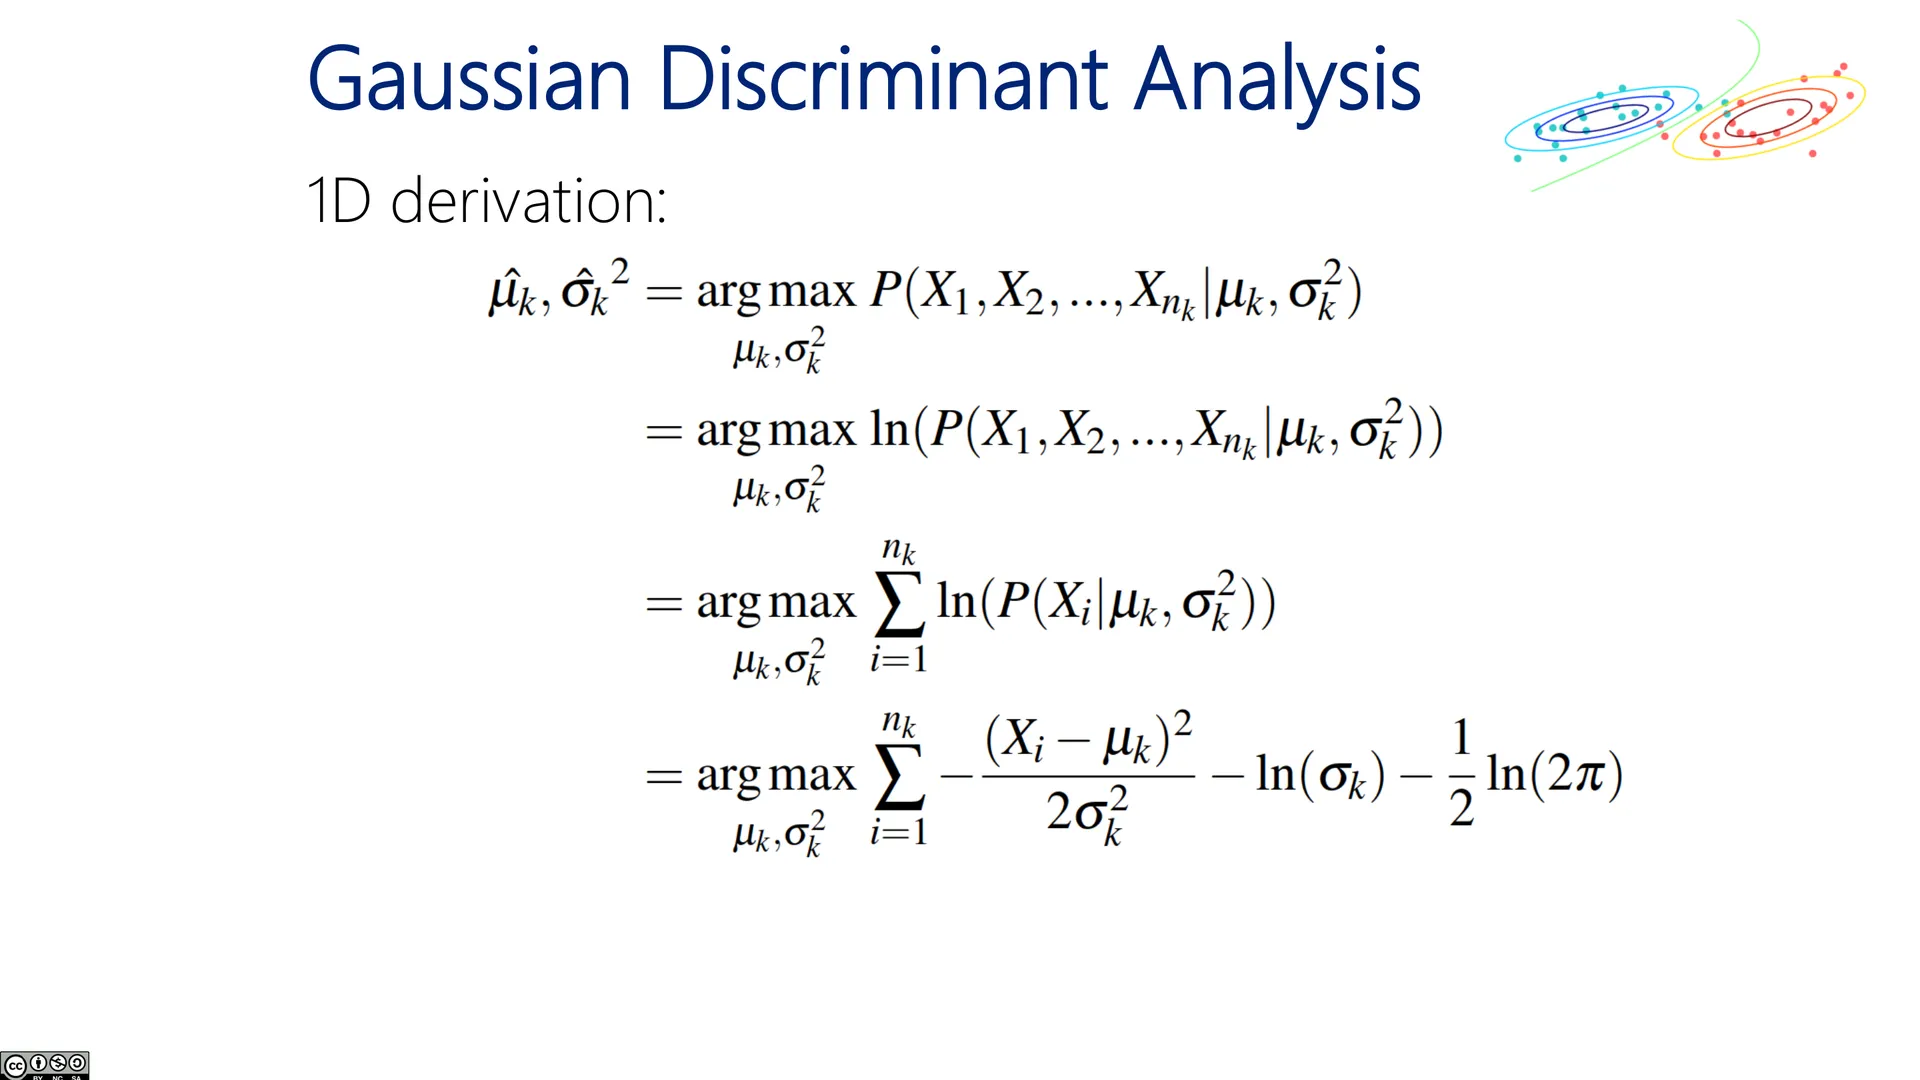
🖼️ GDA(15)
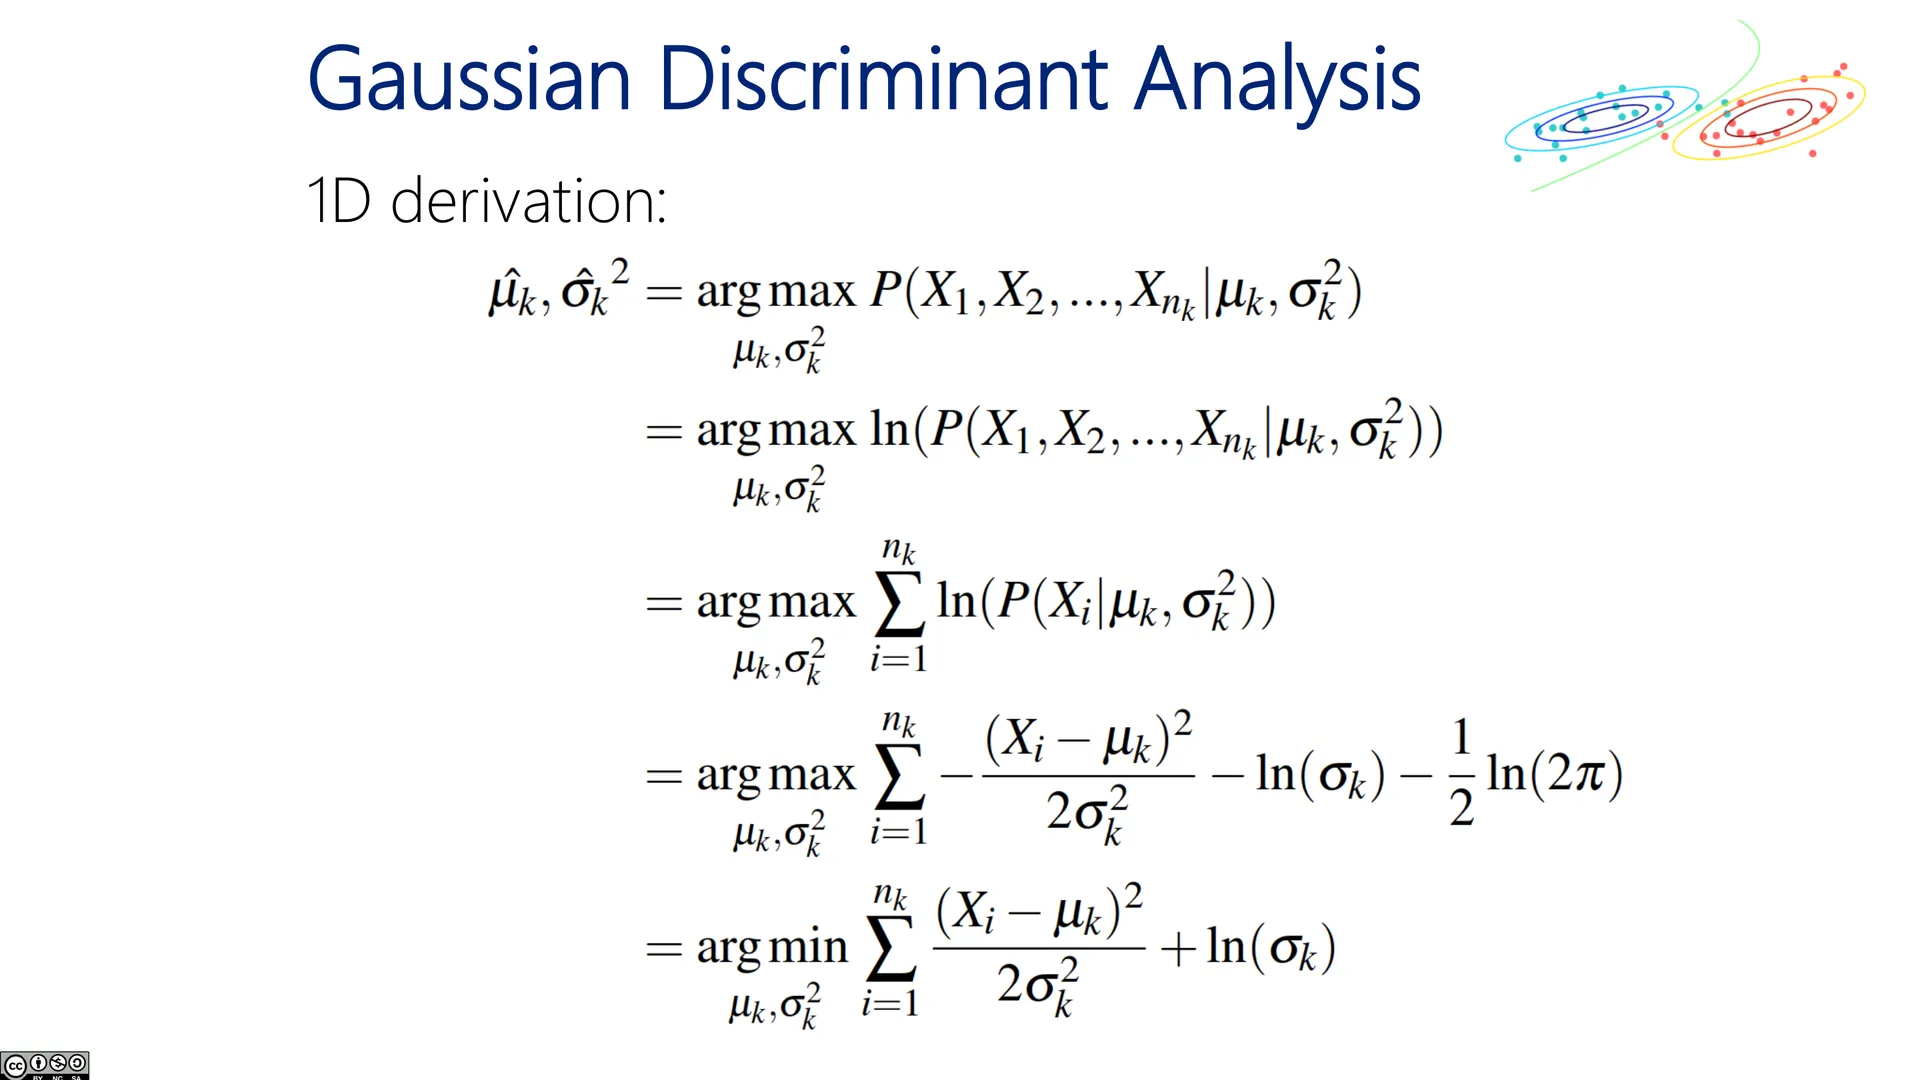
🖼️ GDA(16)
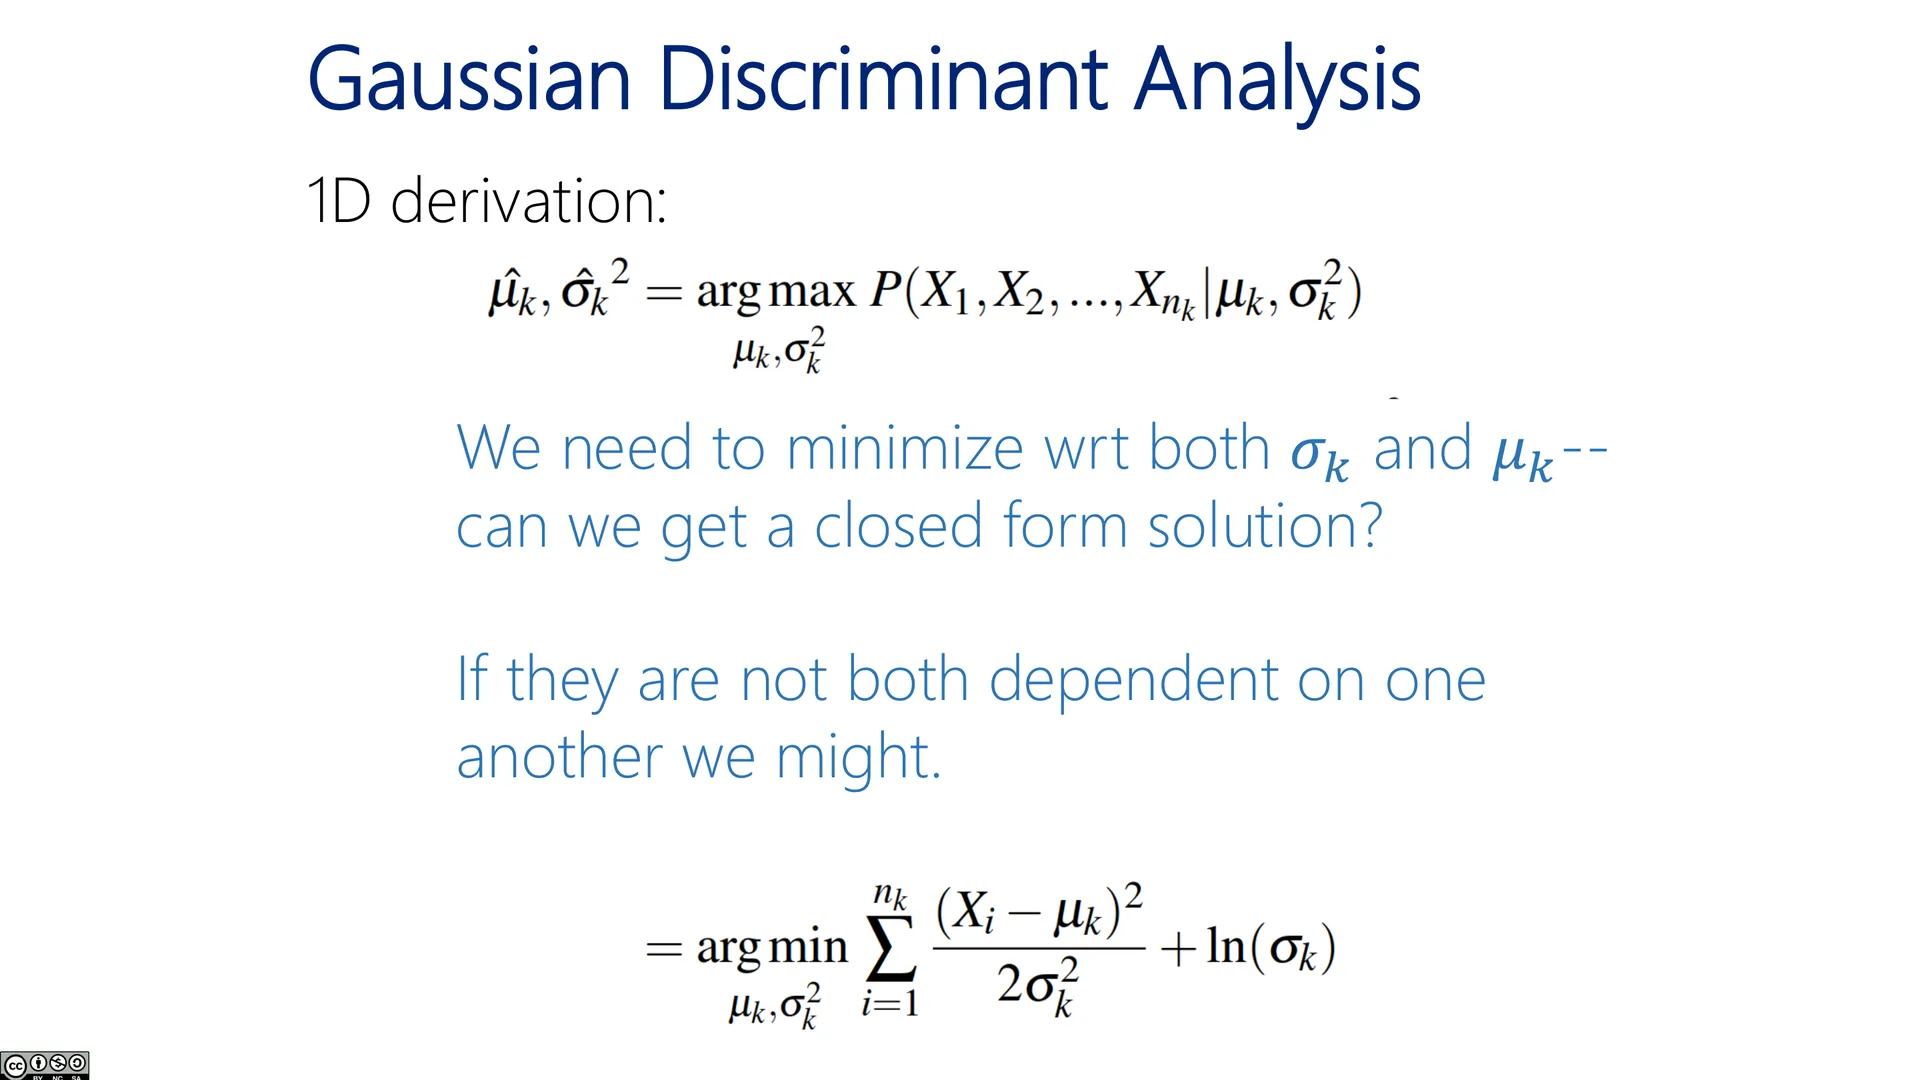
🖼️ GDA(17)
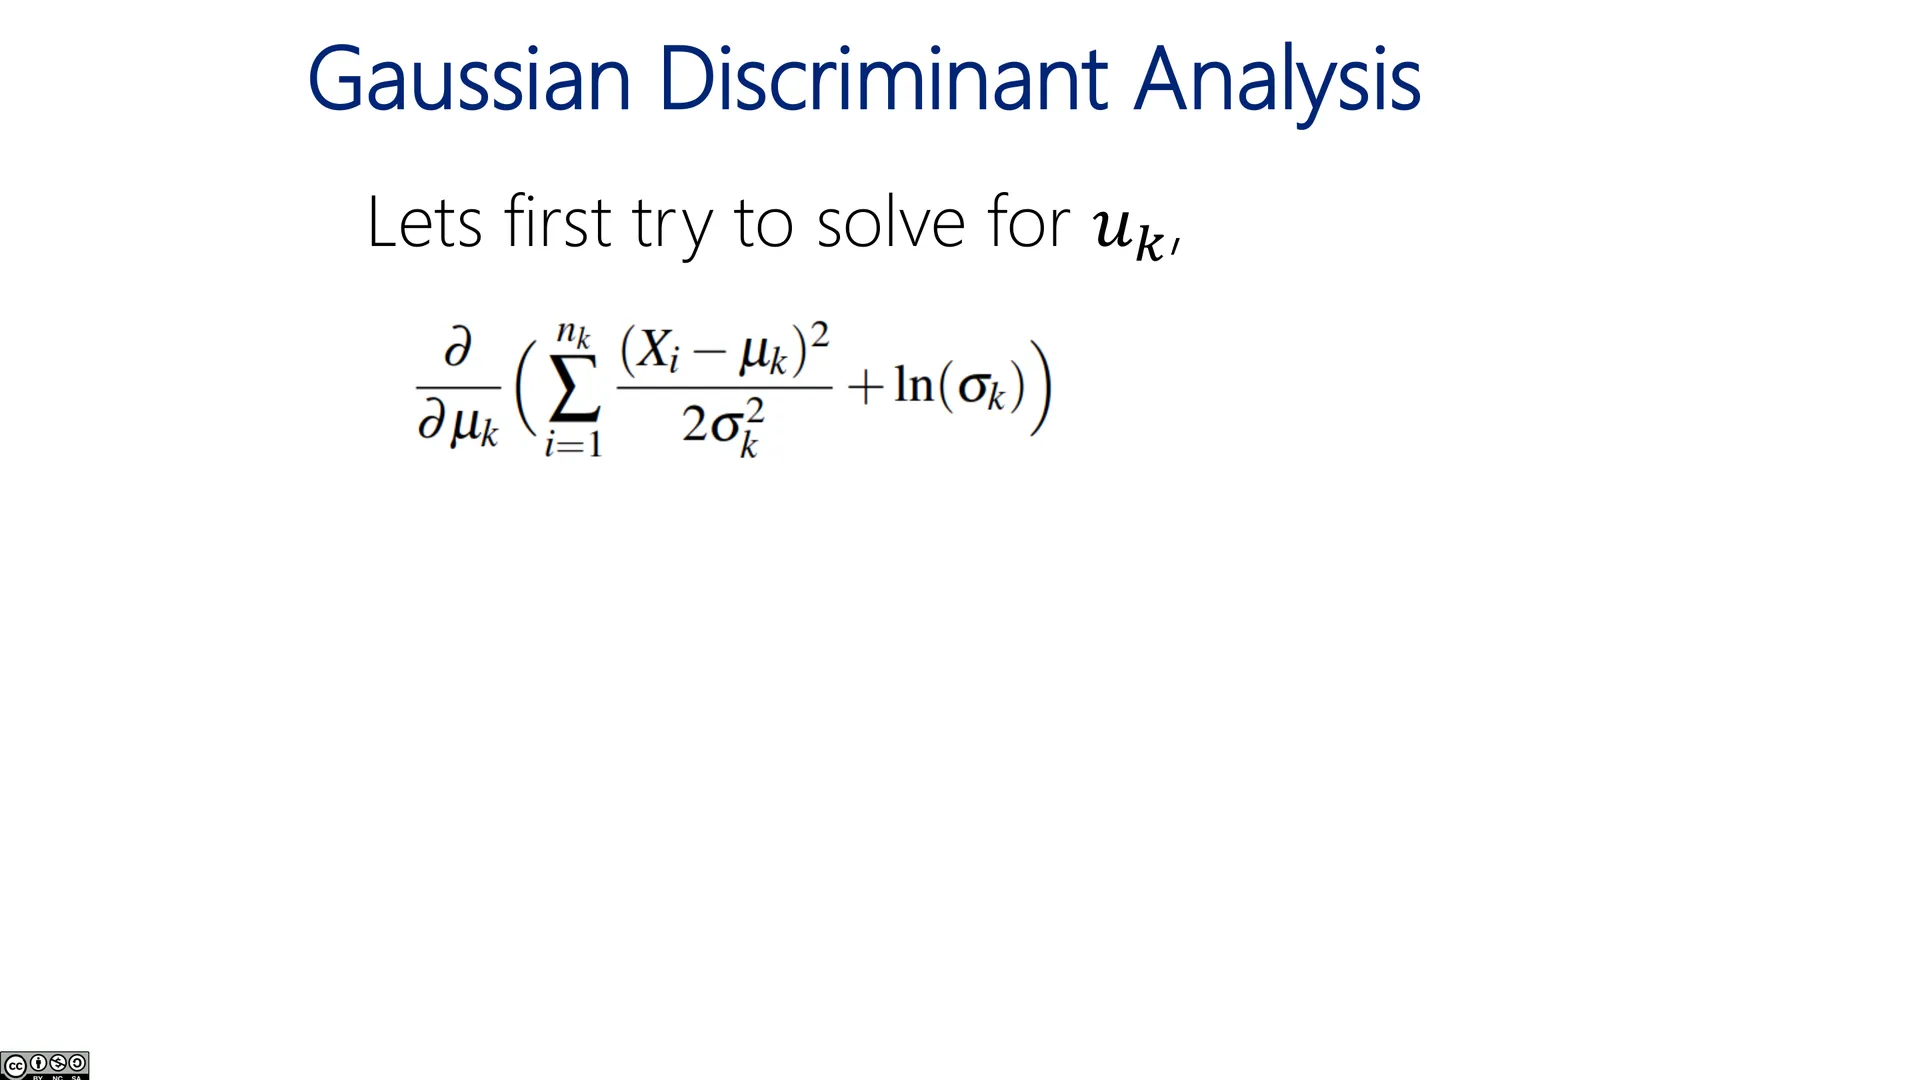
🖼️ GDA(18)
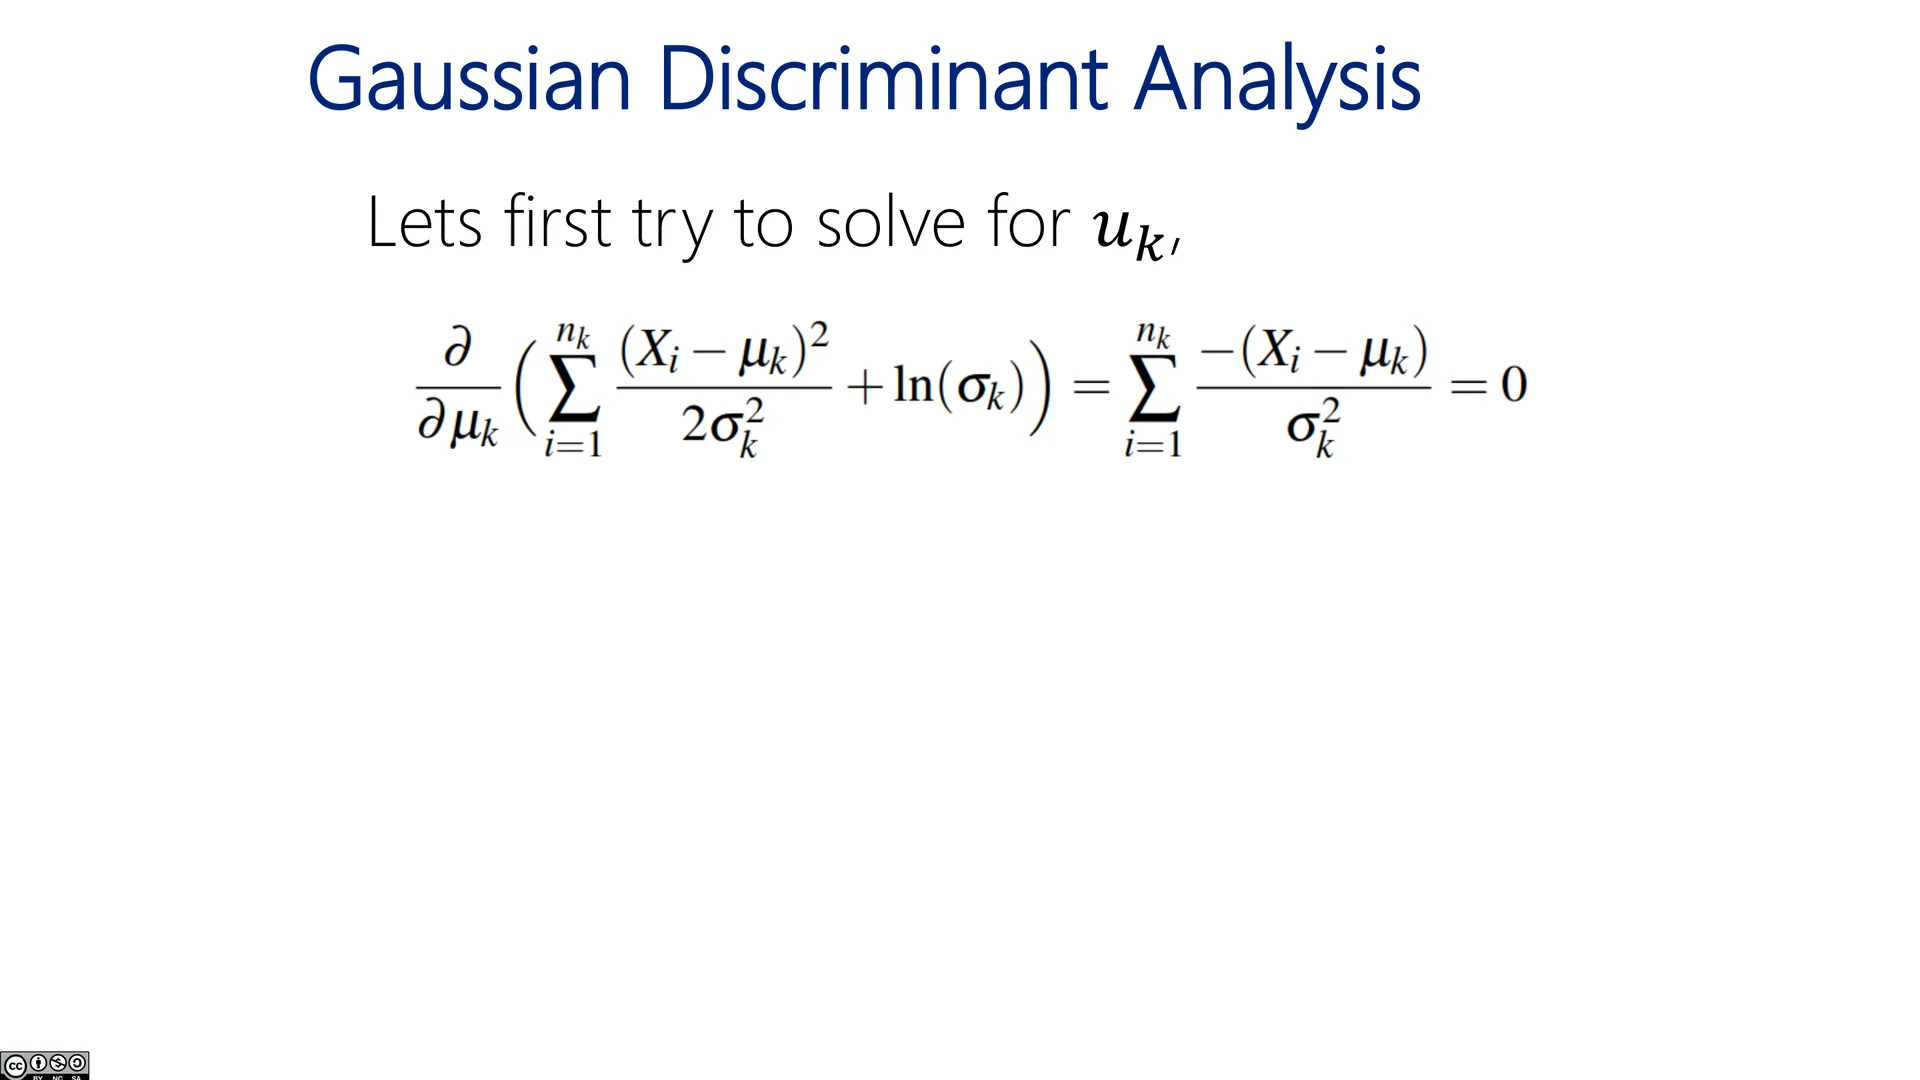
🖼️ GDA(19)
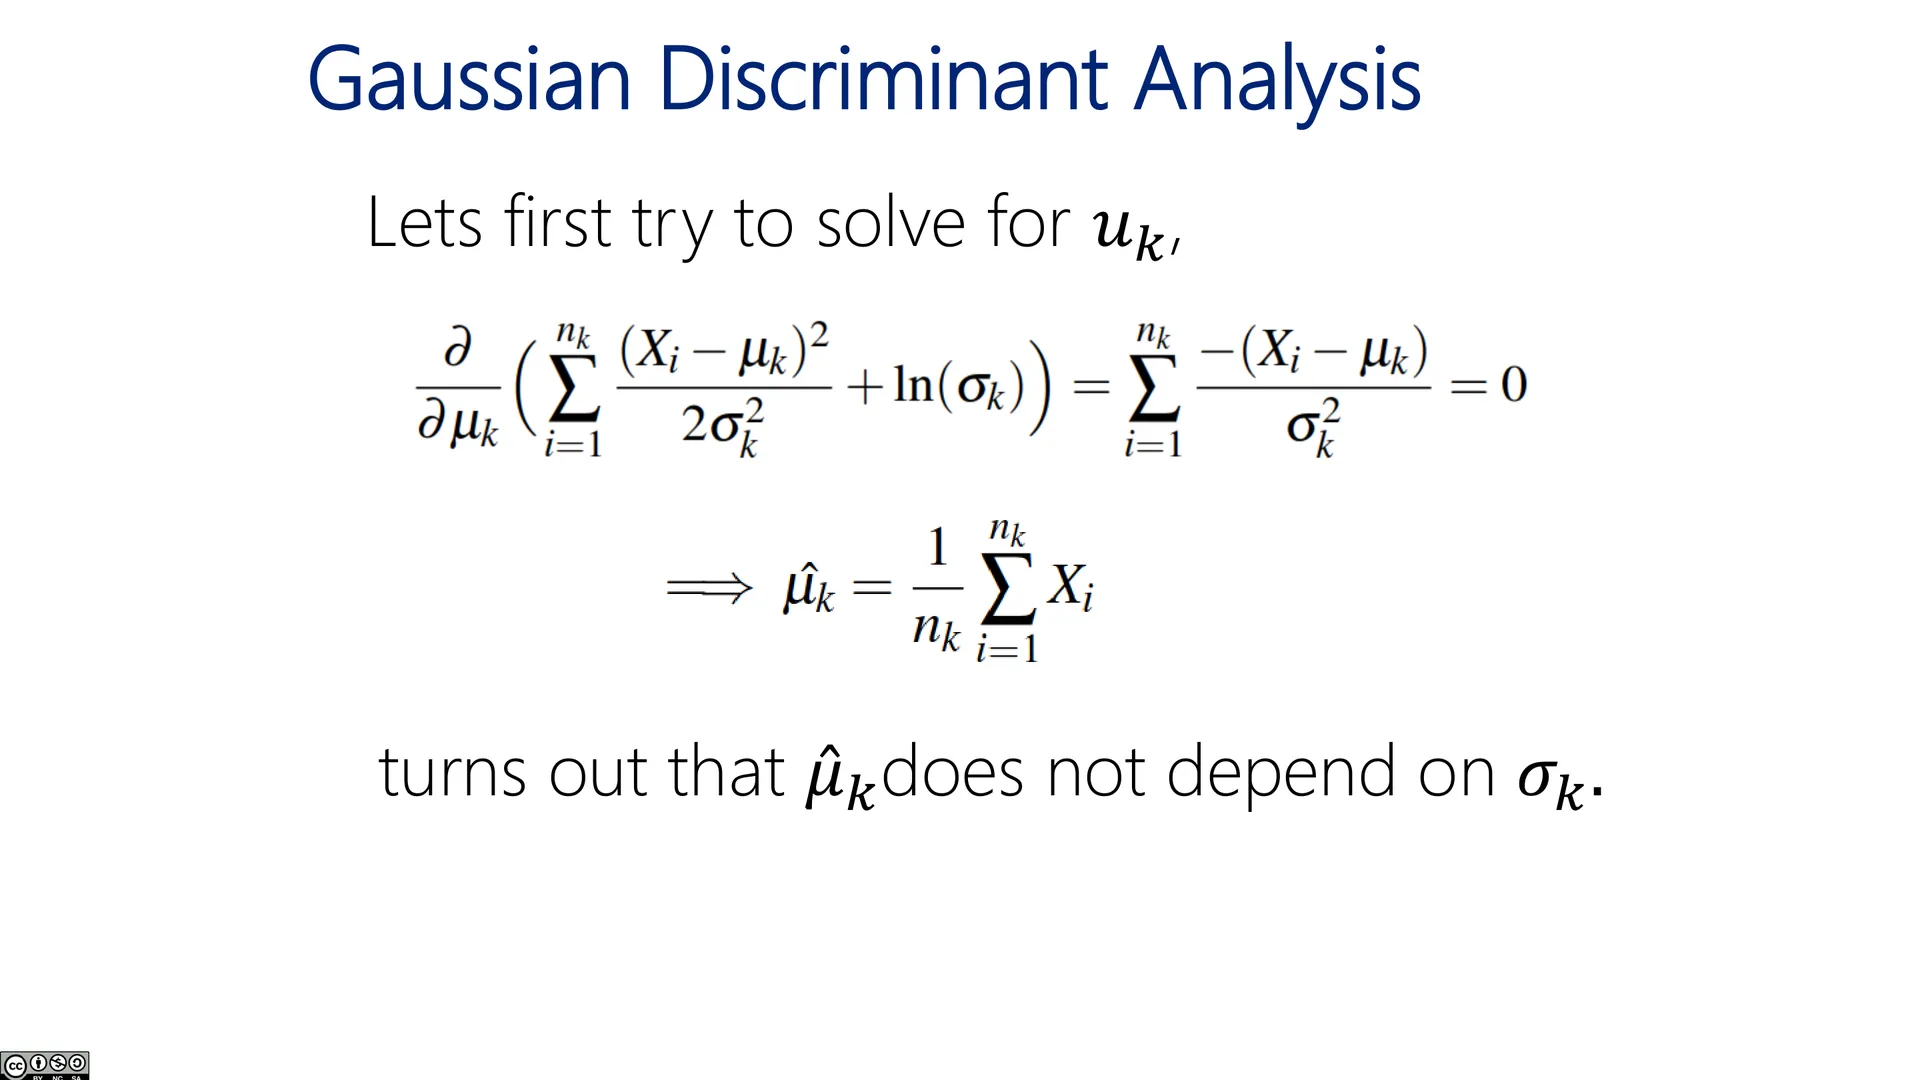
🖼️ GDA(20)
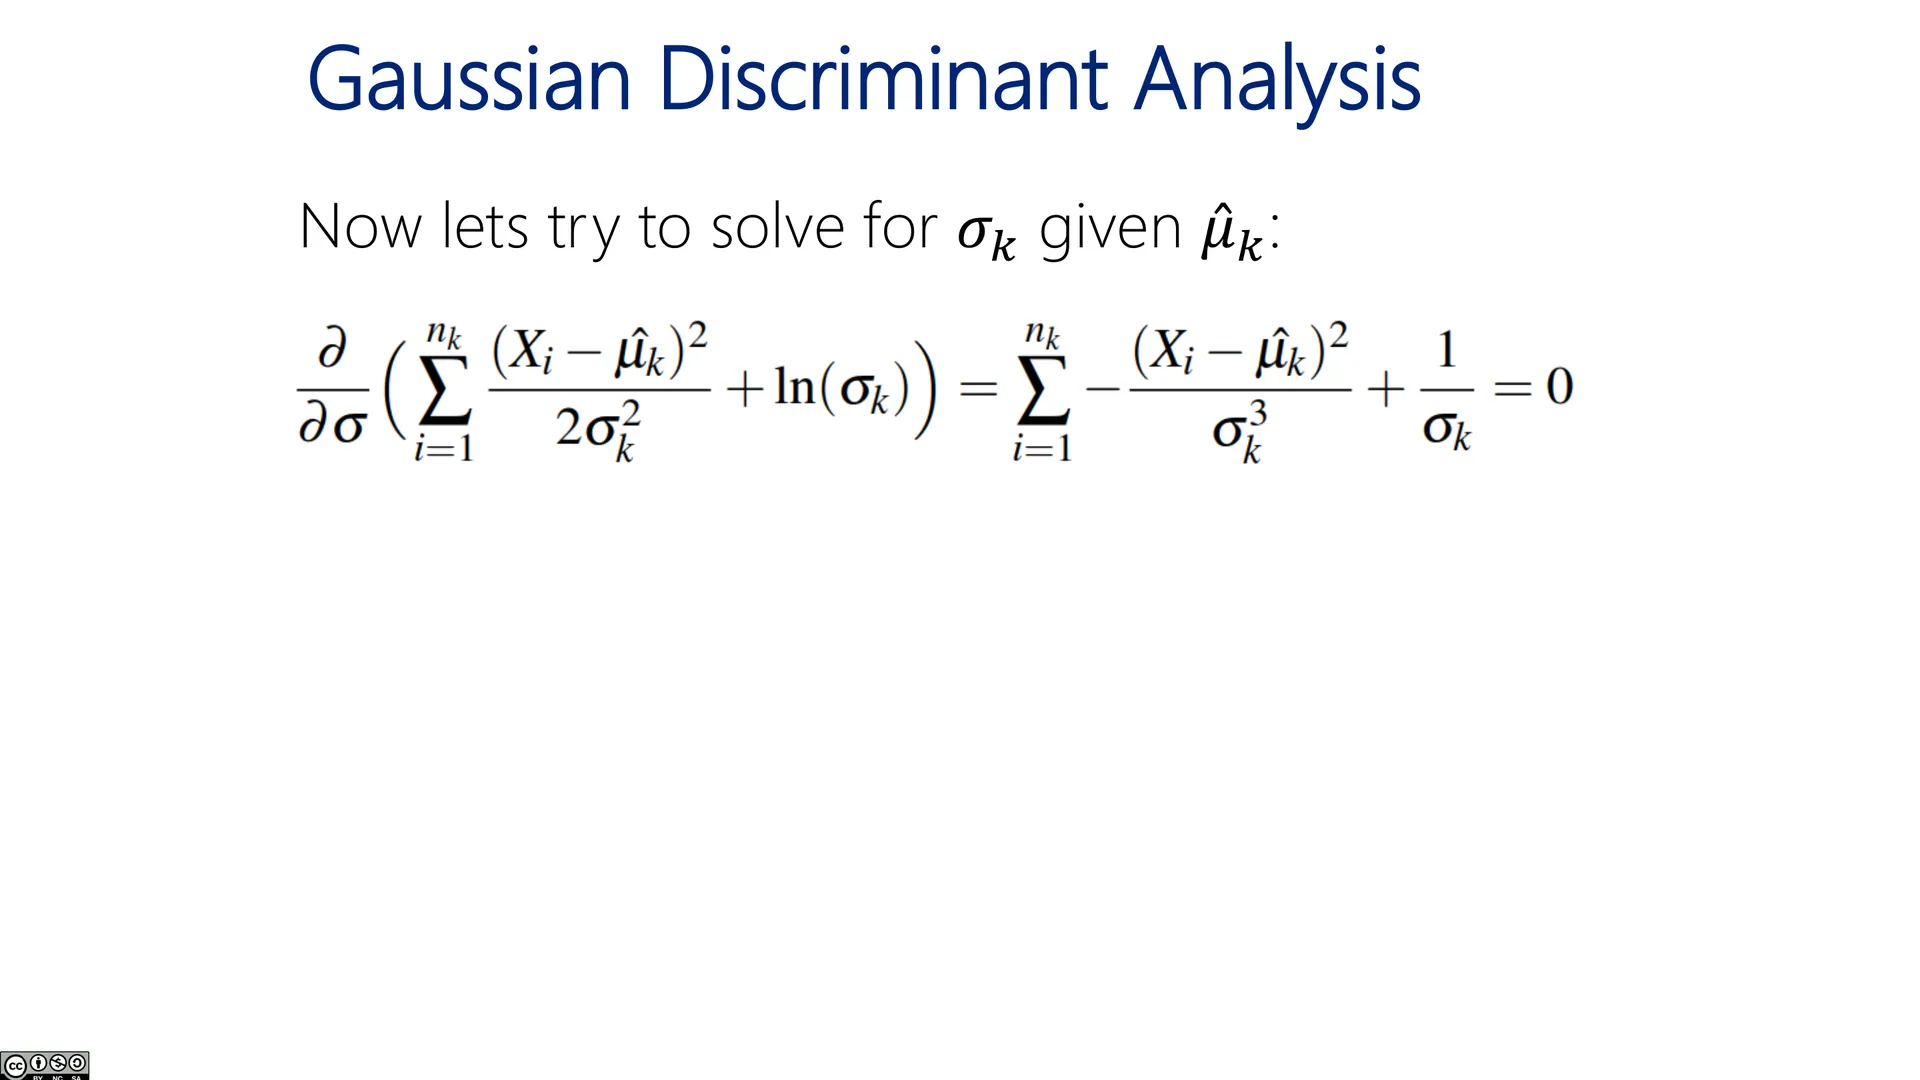
🖼️ GDA(21)
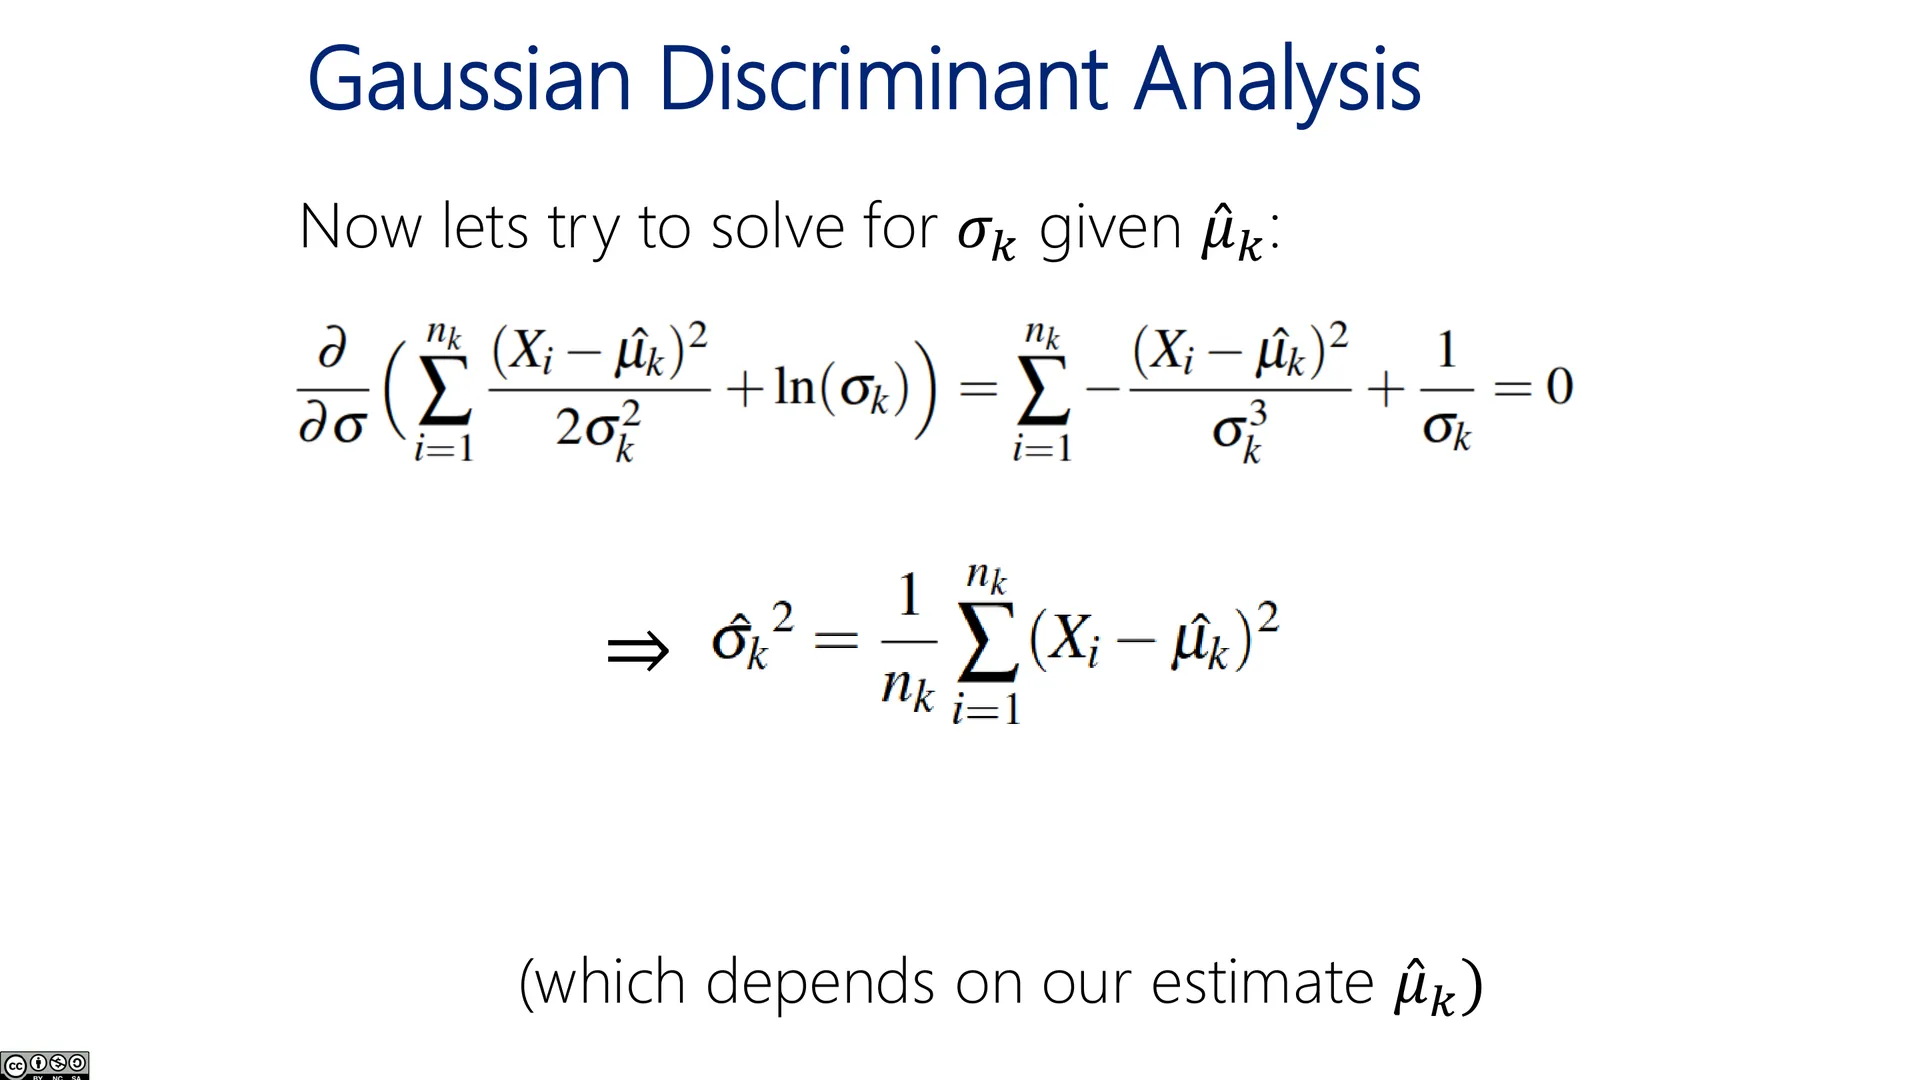
🖼️ GDA(22)
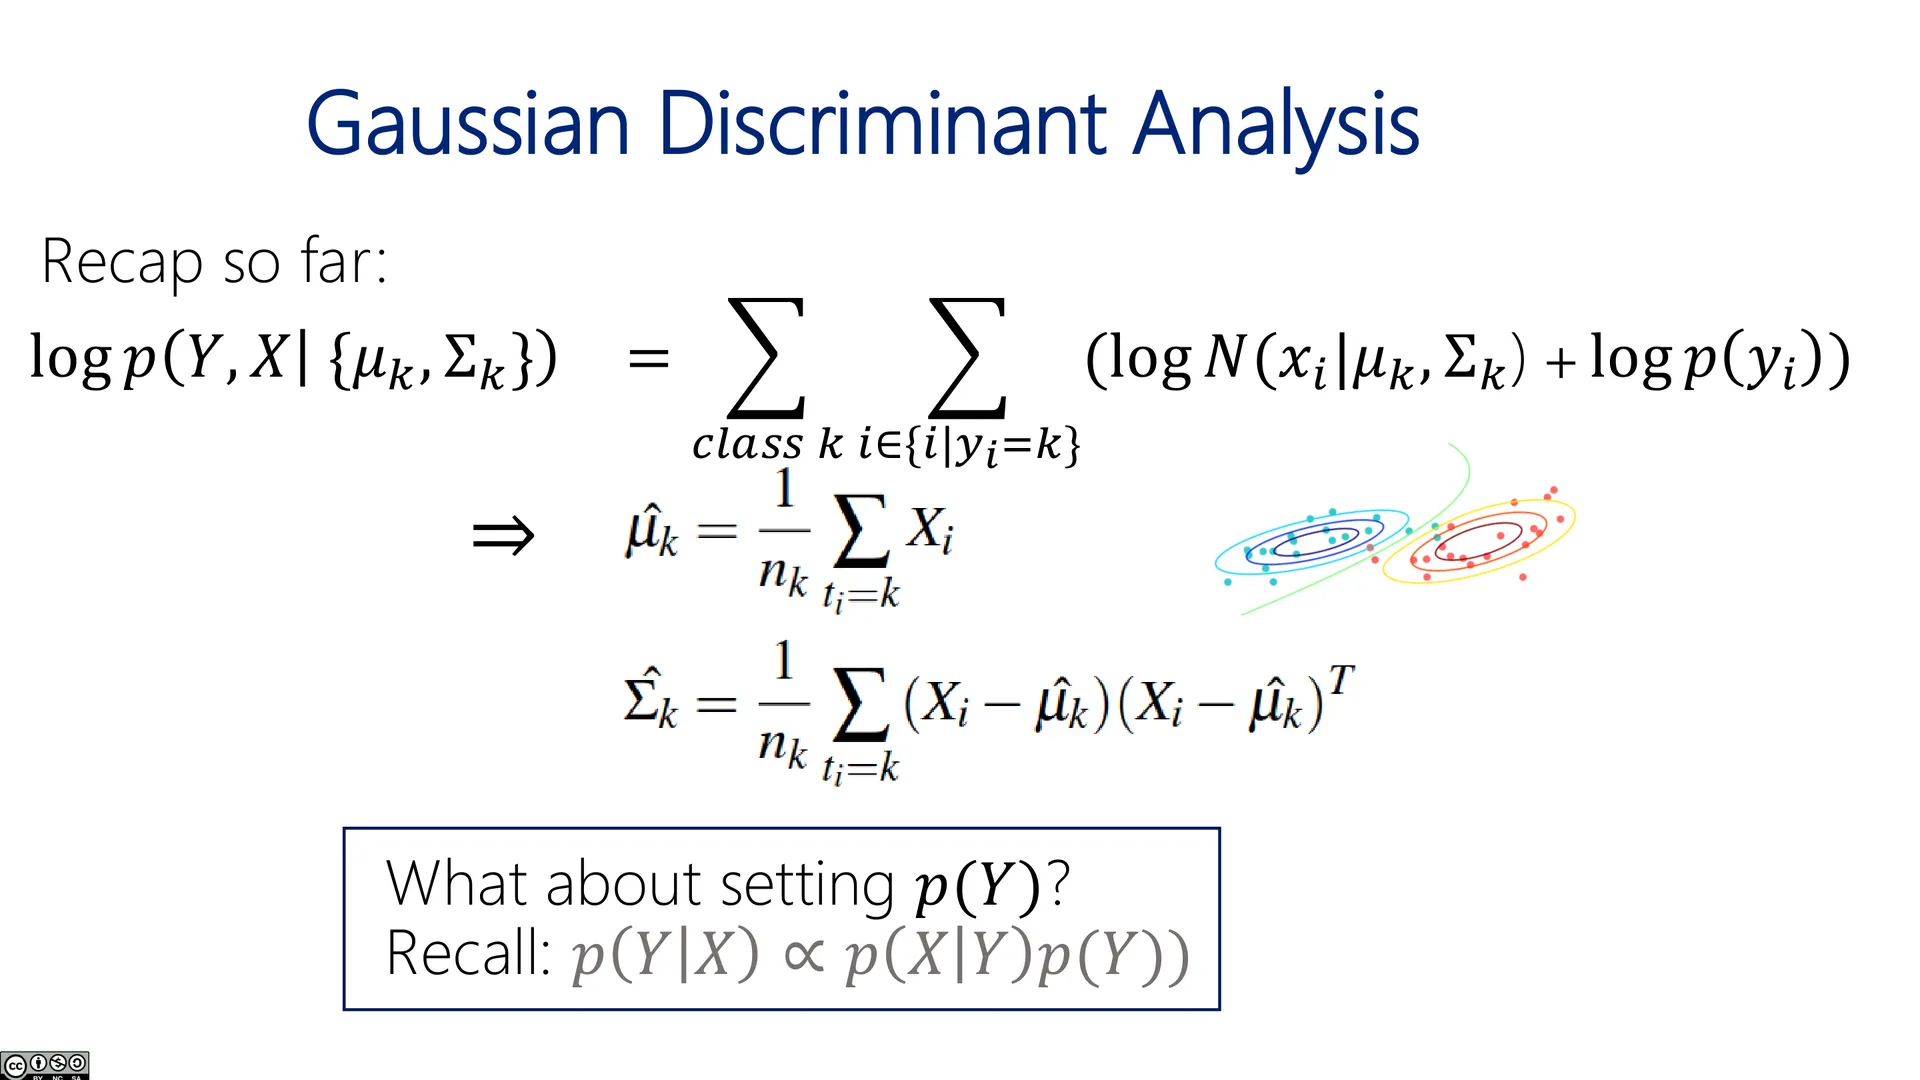
🖼️ GDA(23)
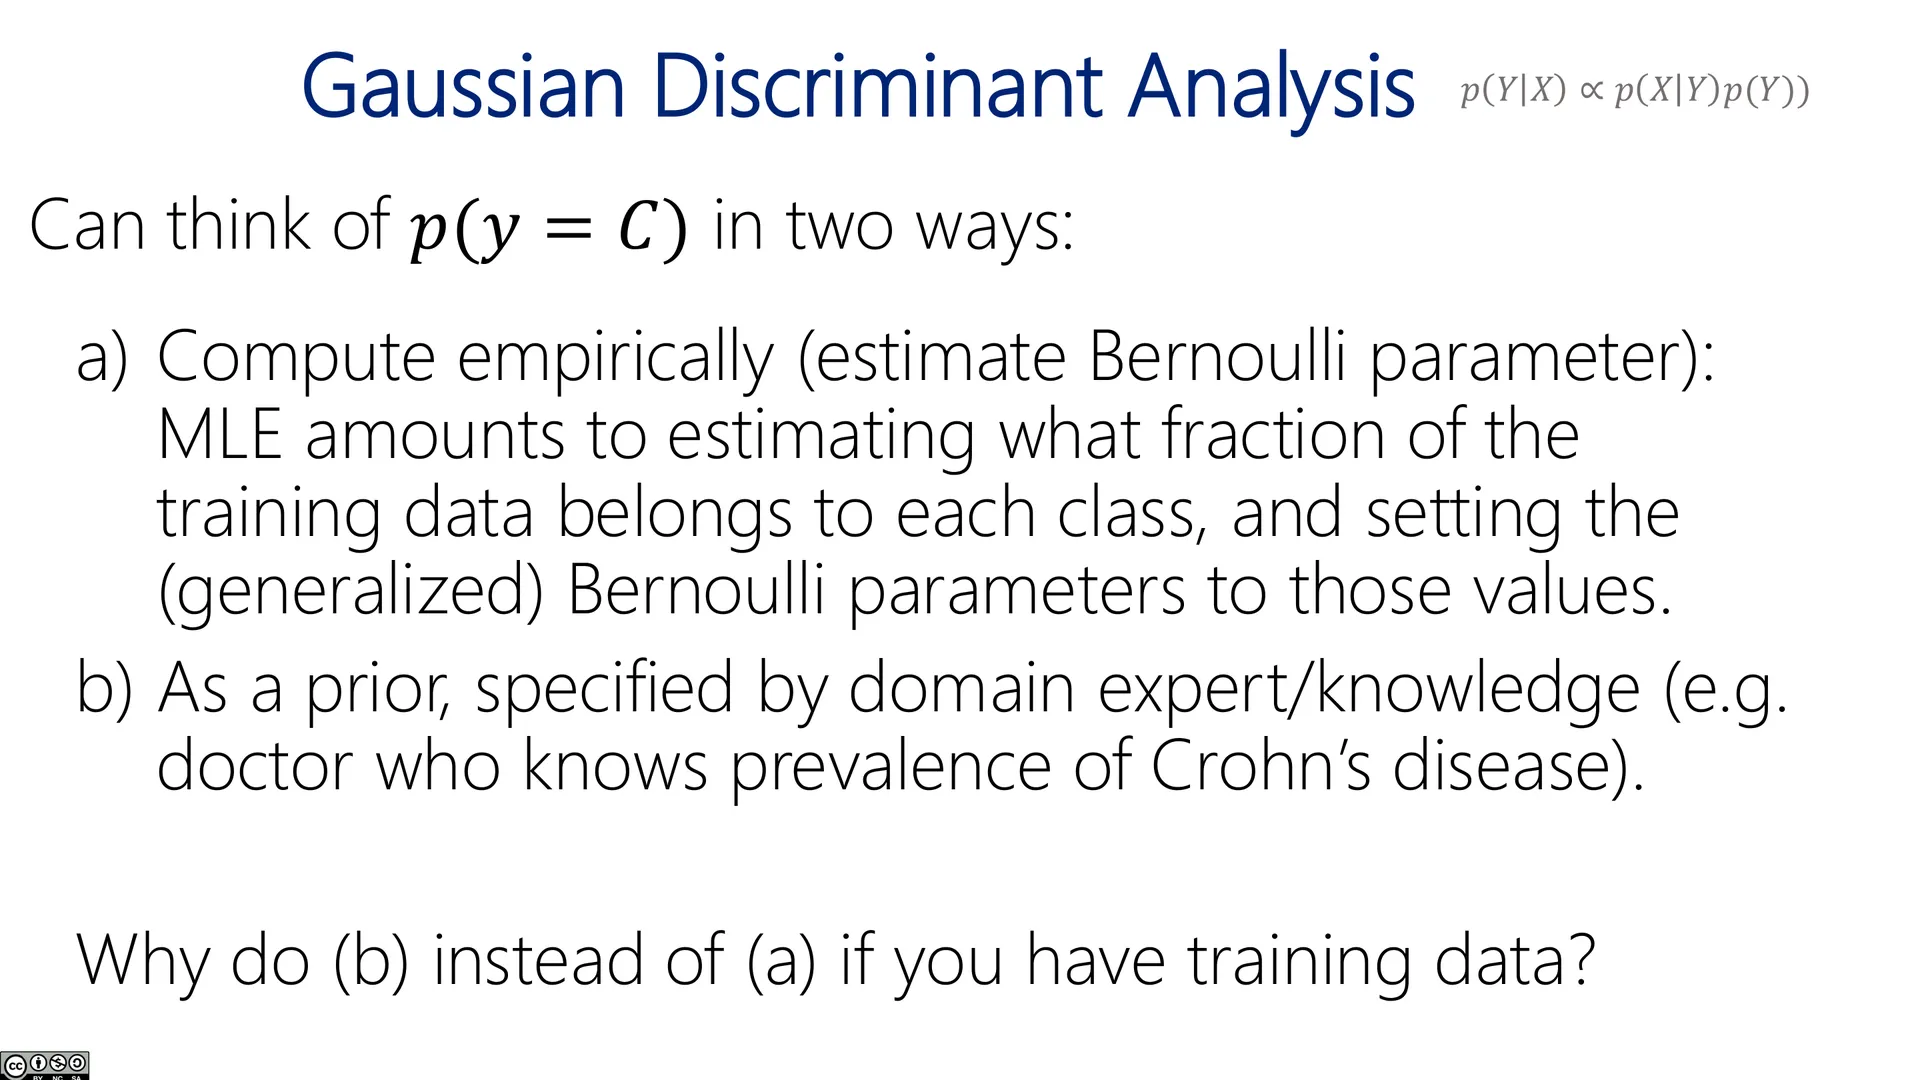
🖼️ GDA(24)
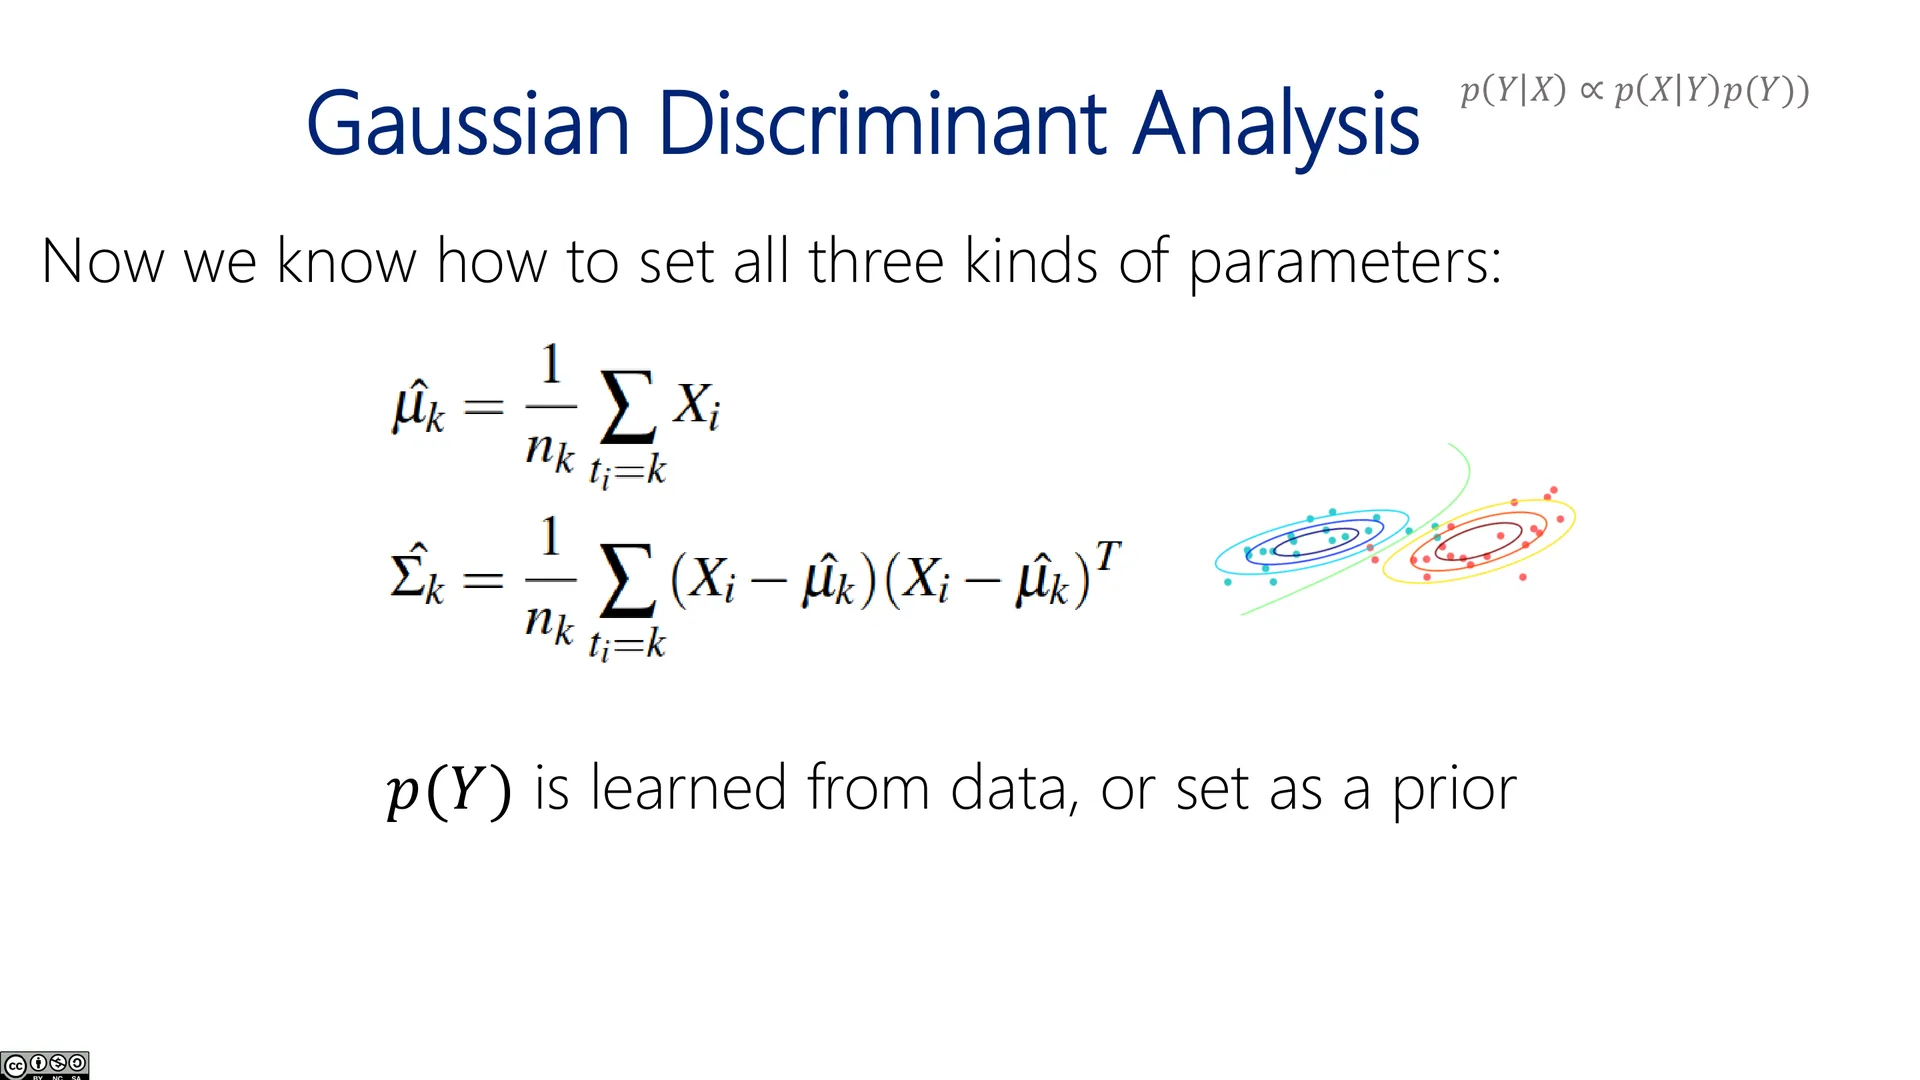
🖼️ GDA(25)
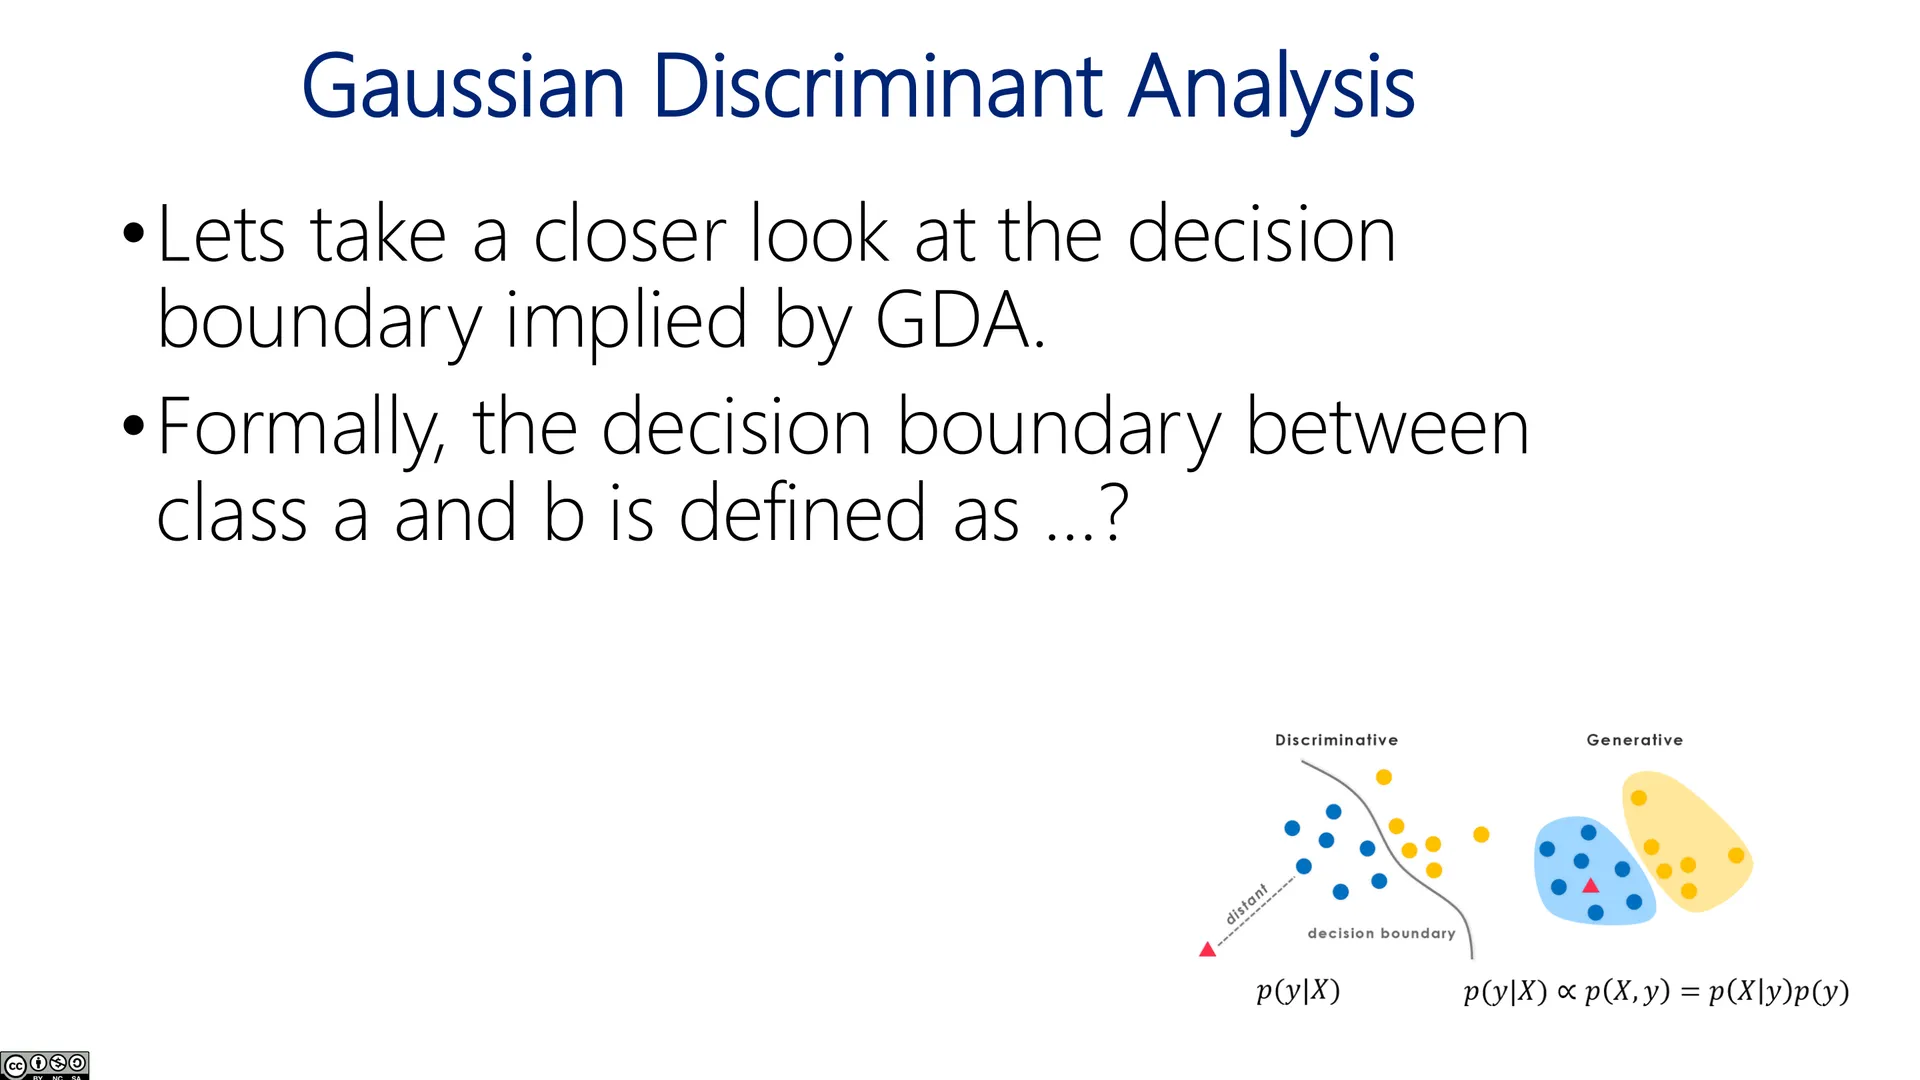
🖼️ GDA(26)
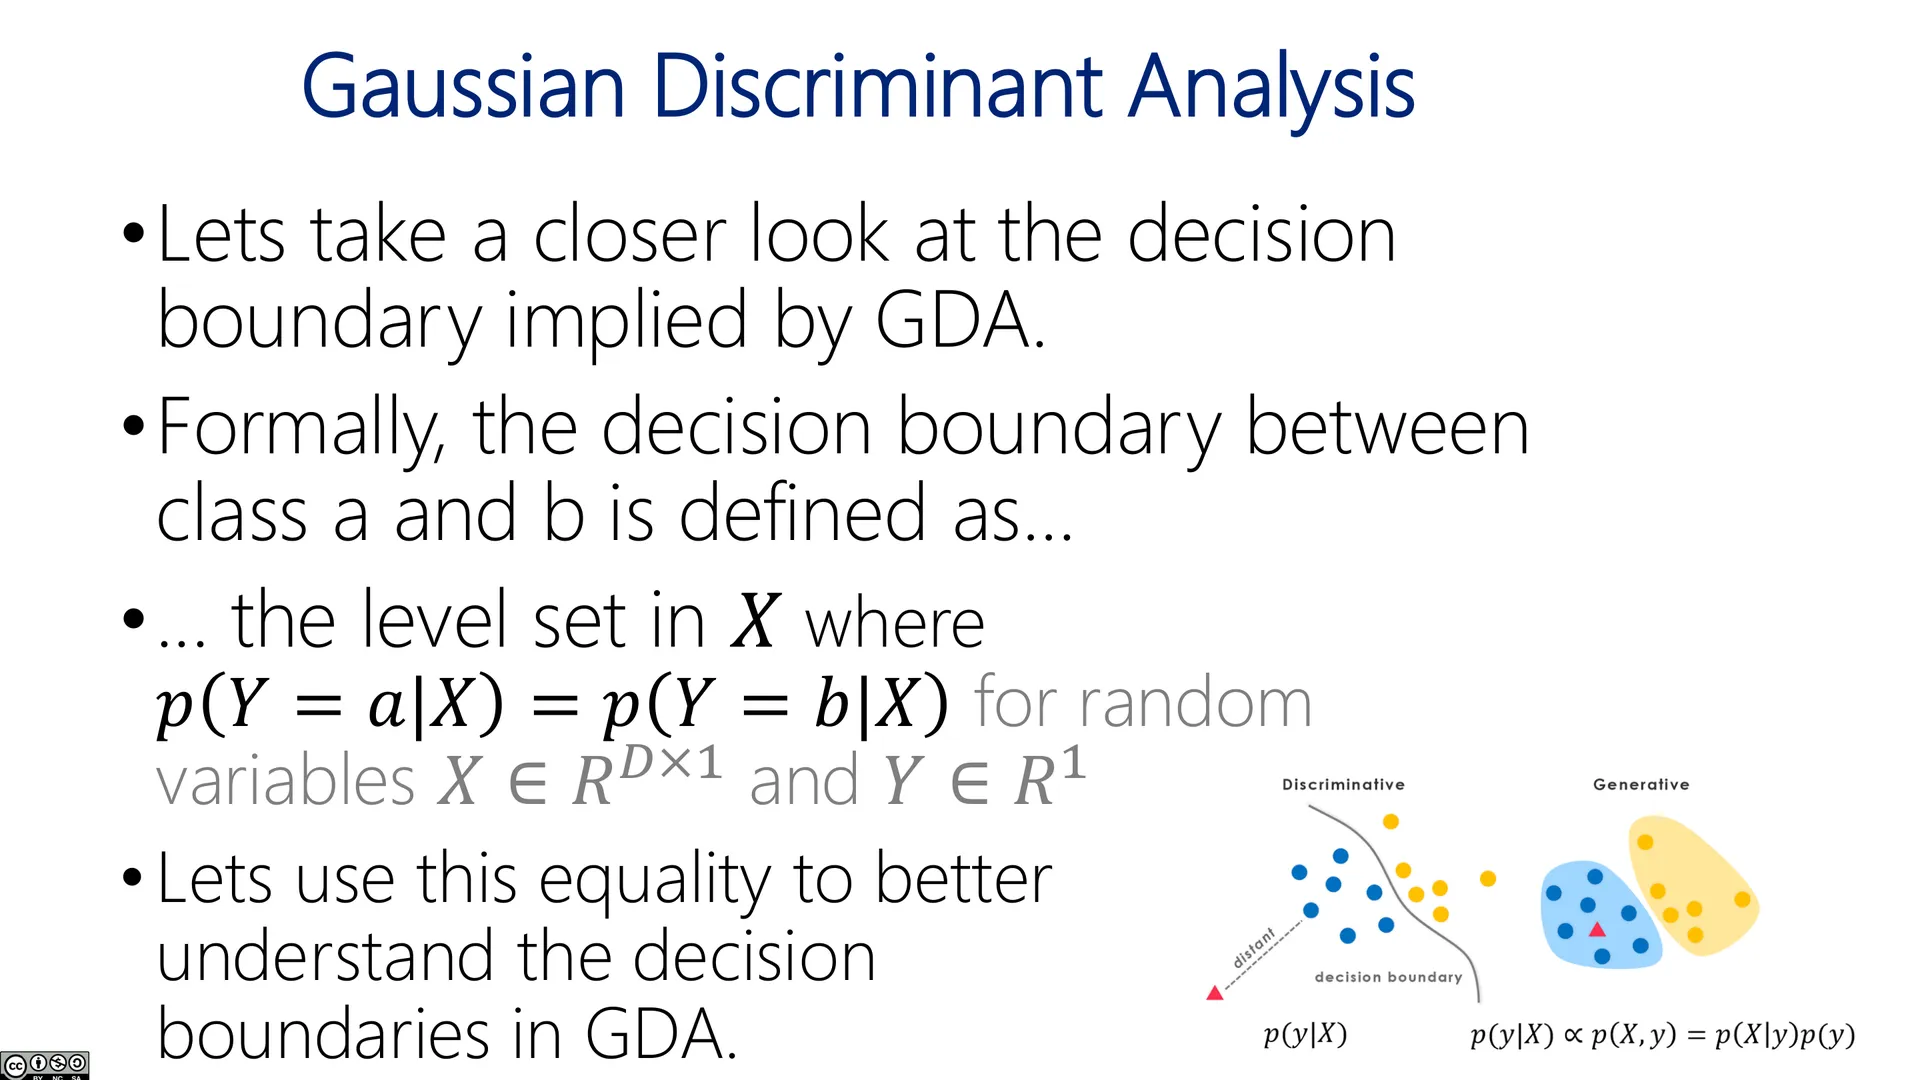
🖼️ GDA(27)
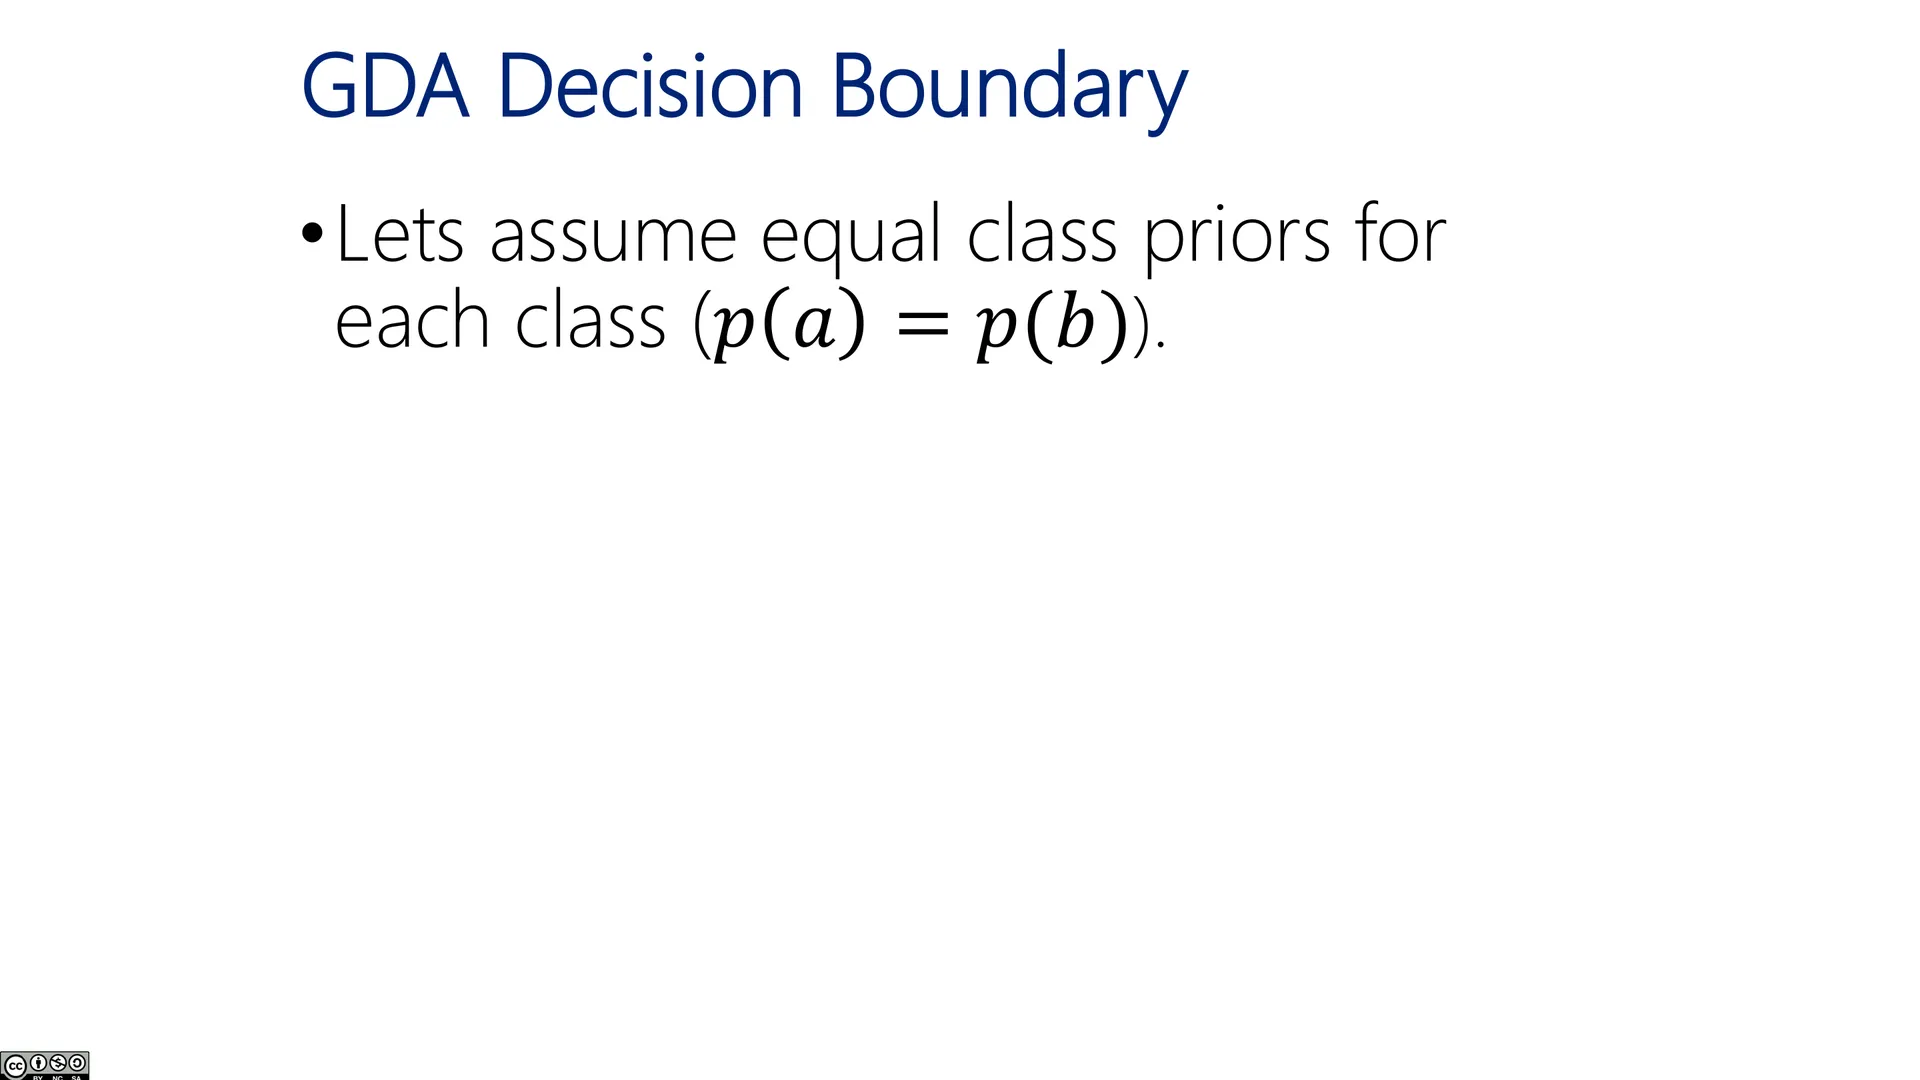
🖼️ GDA 决策边界(01)
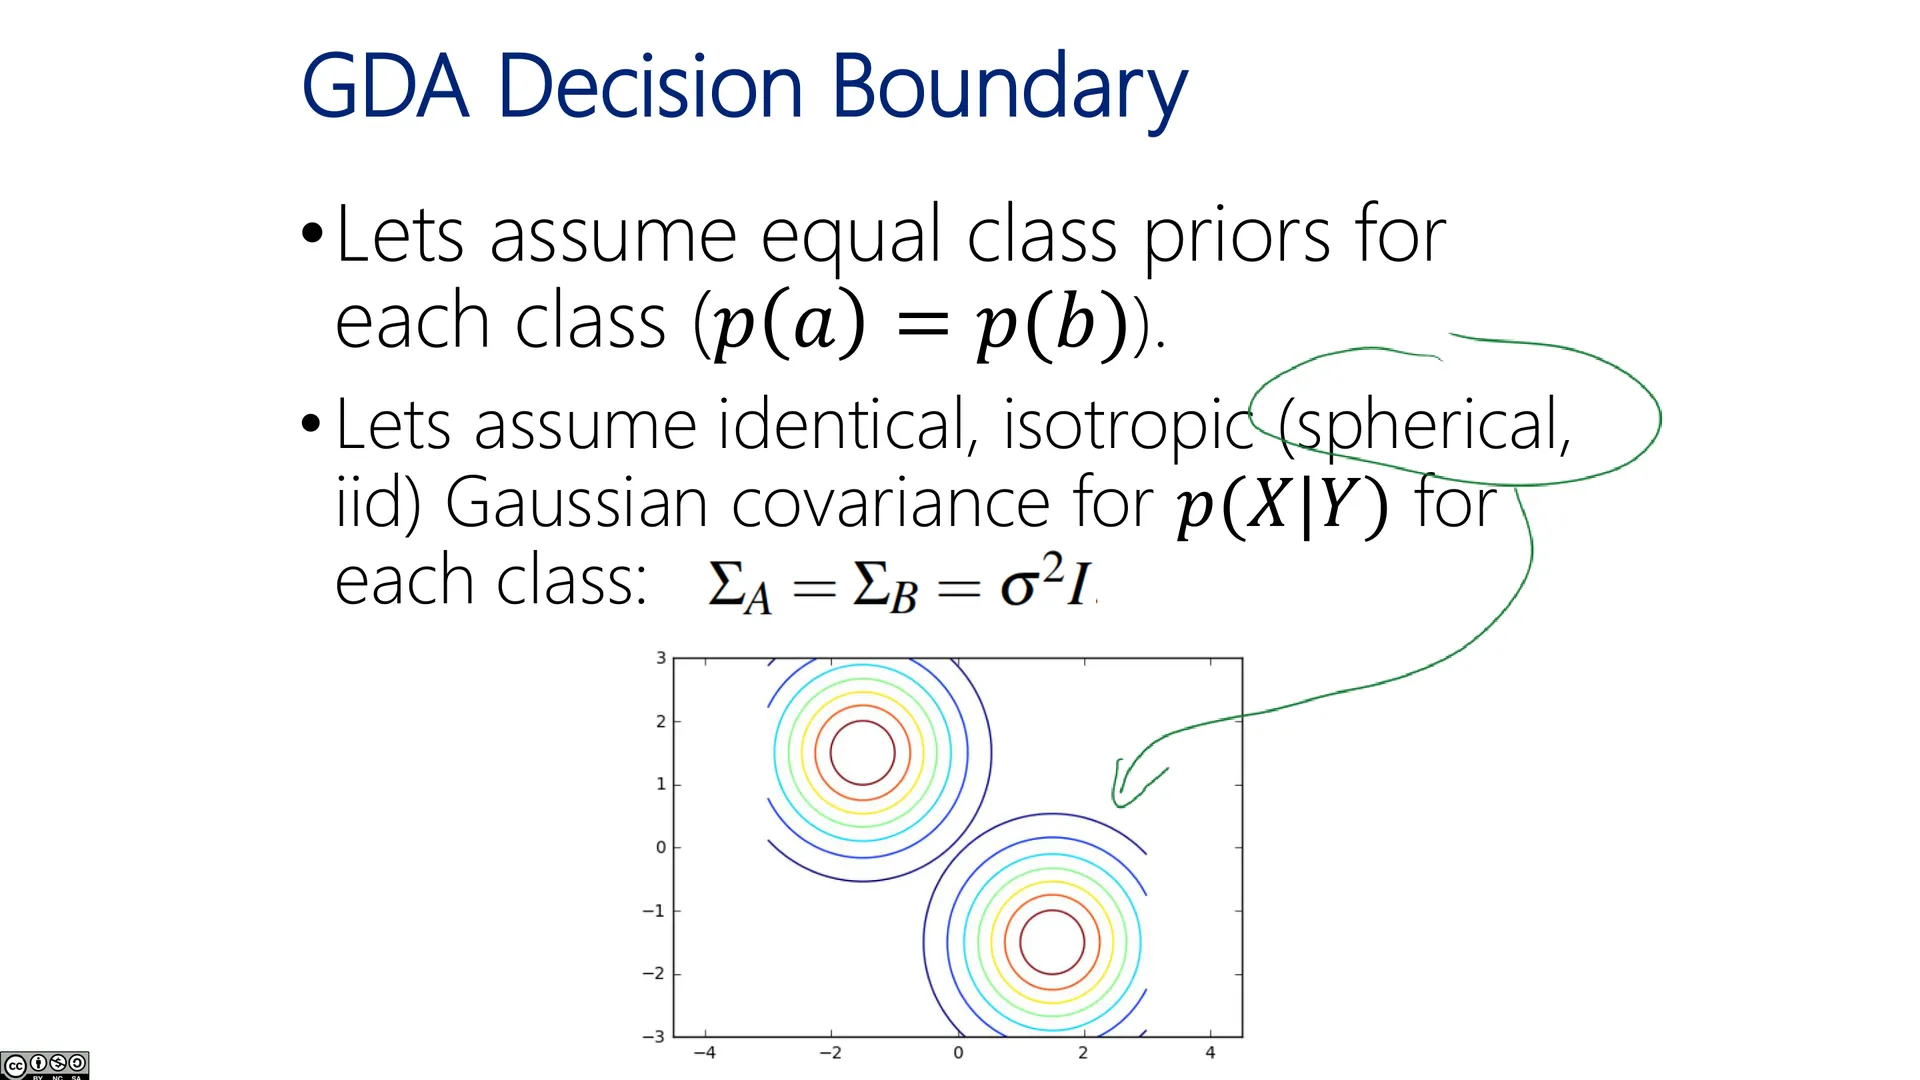
🖼️ GDA 决策边界(02)
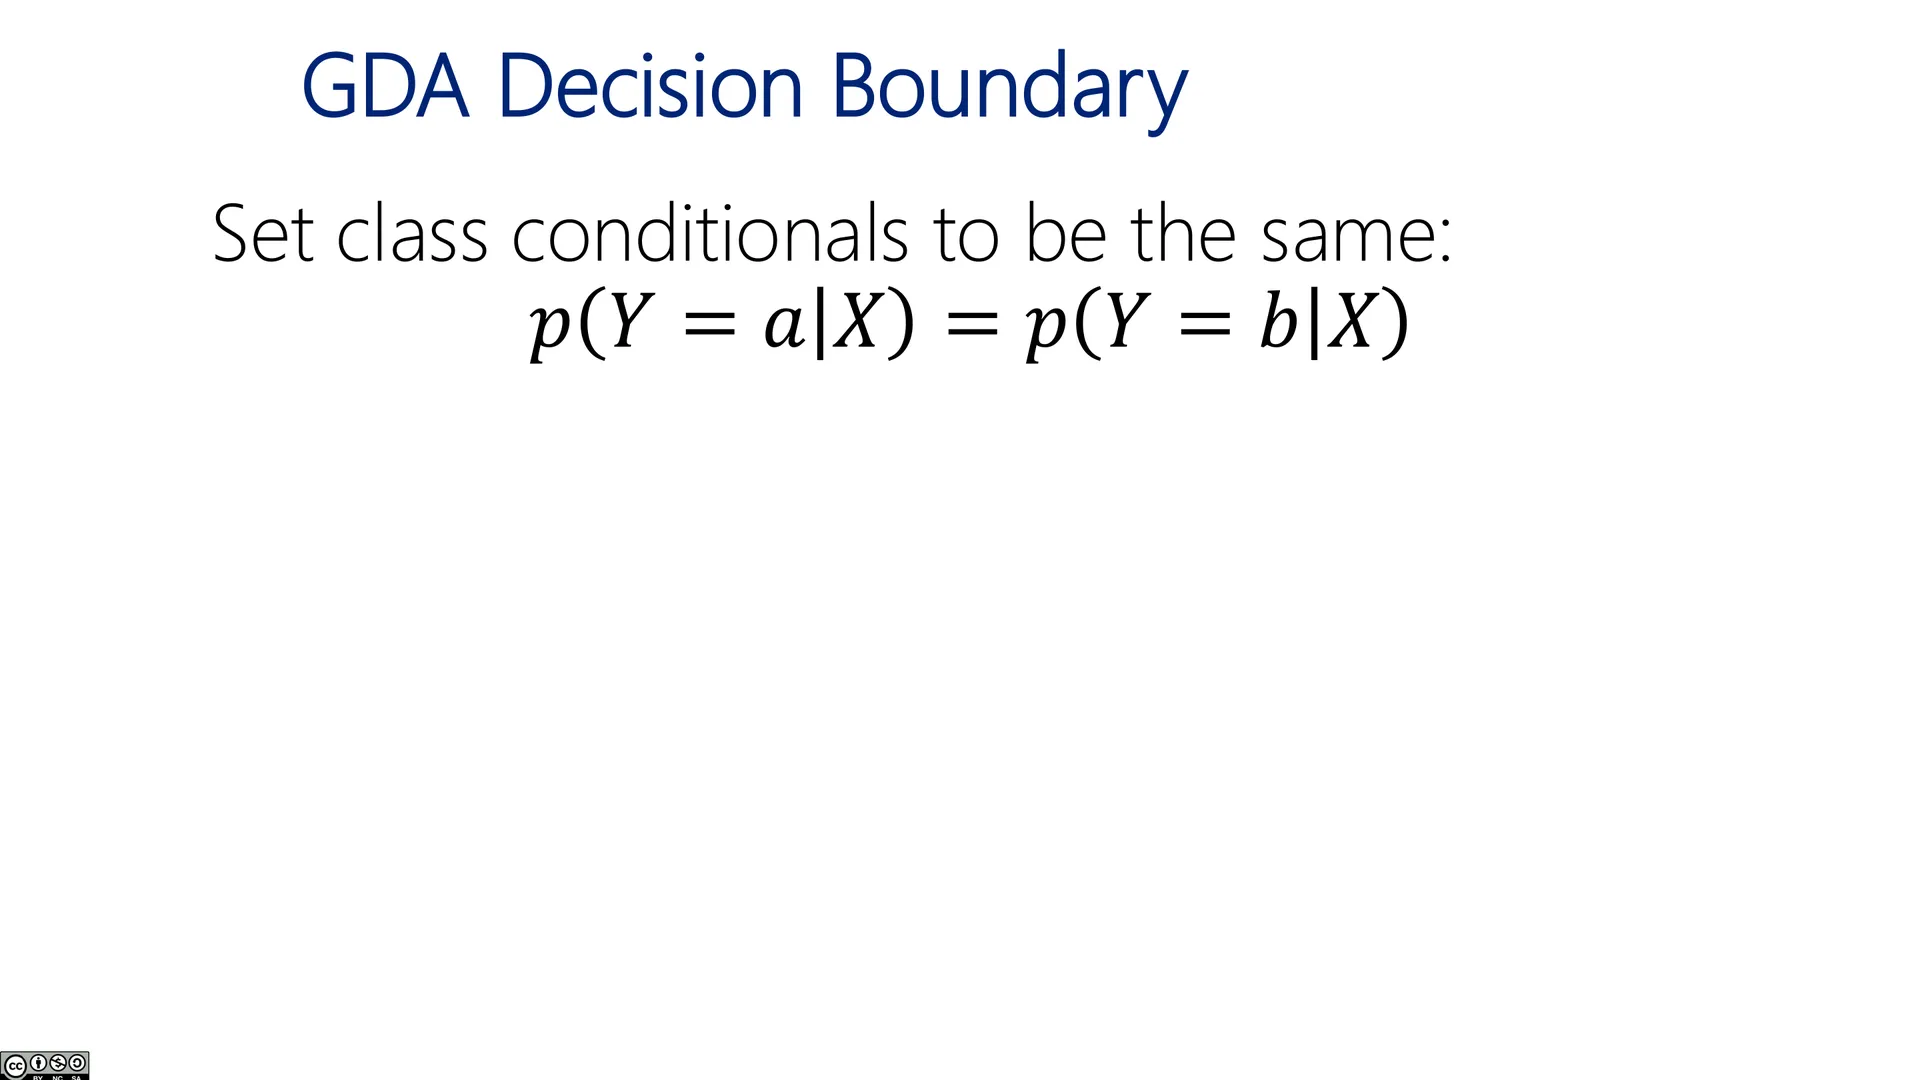
🖼️ GDA 决策边界(03)
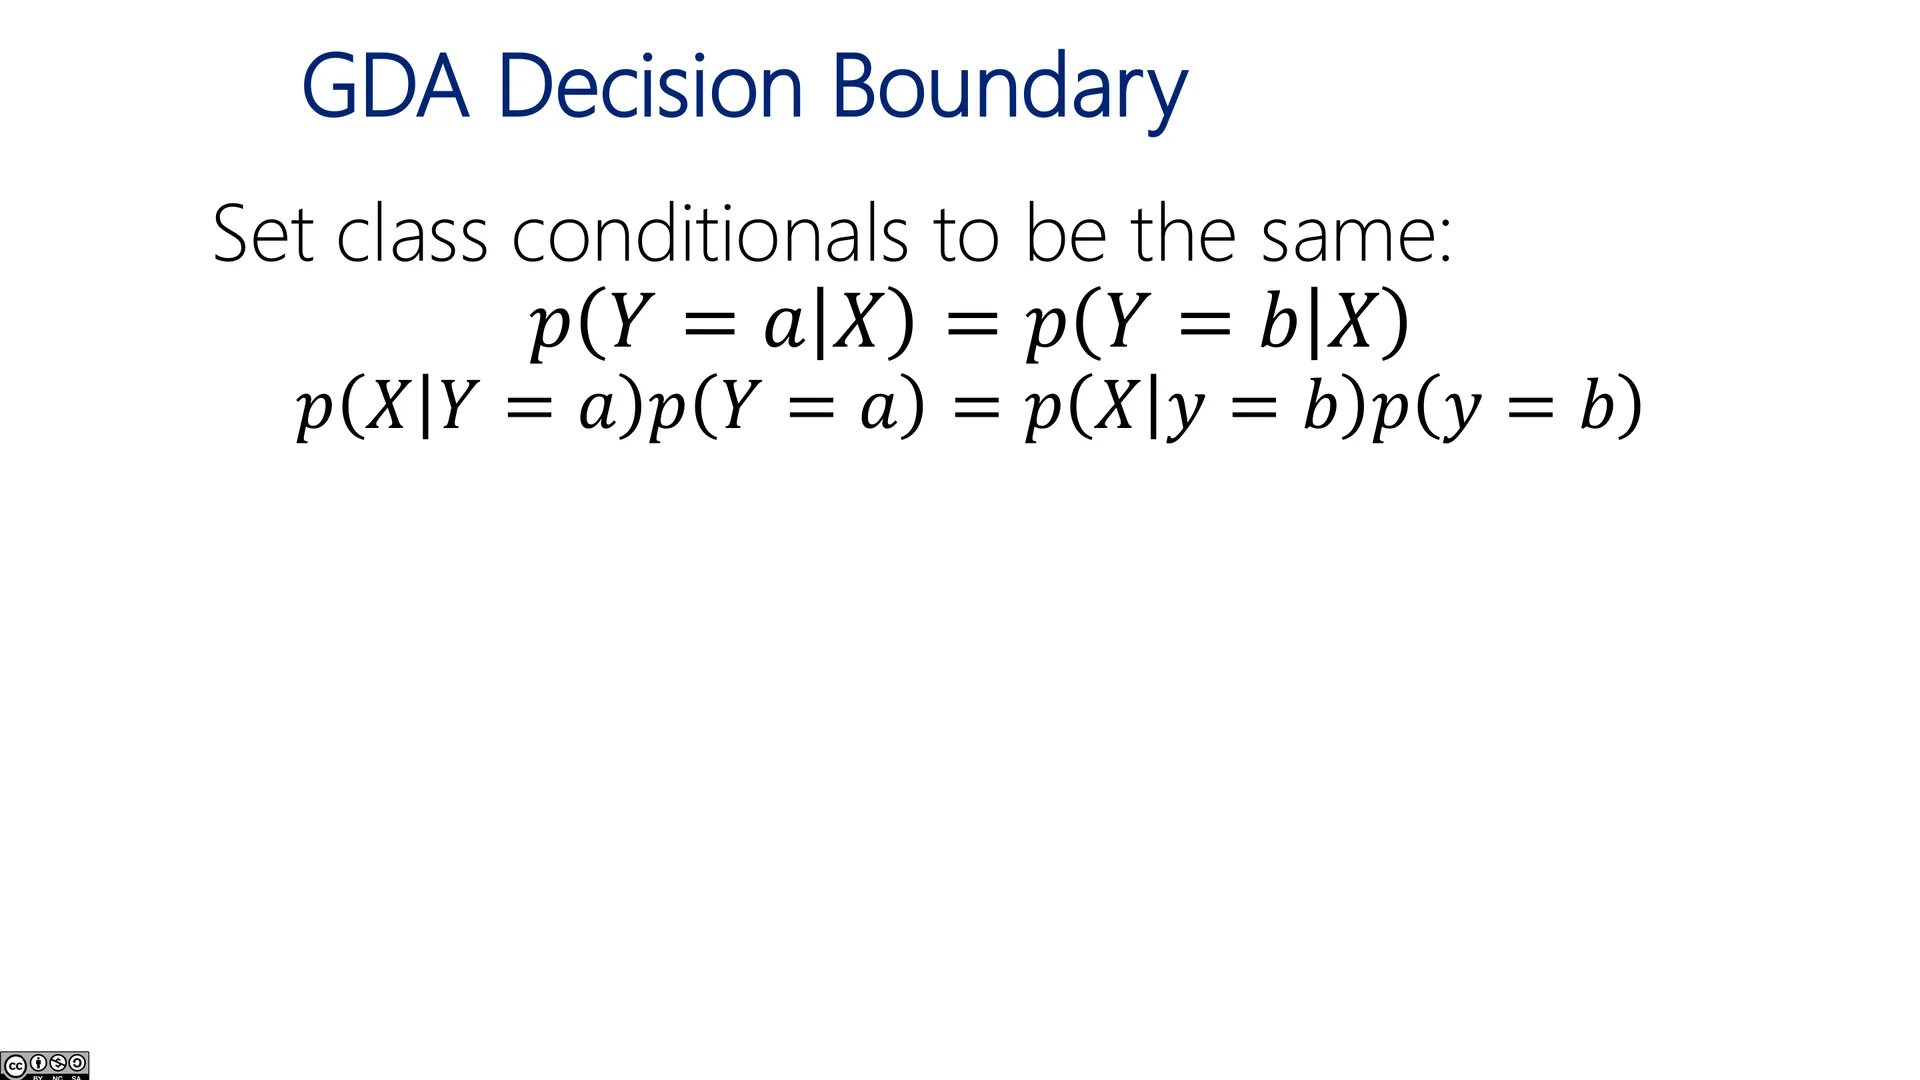
🖼️ GDA 决策边界(04)
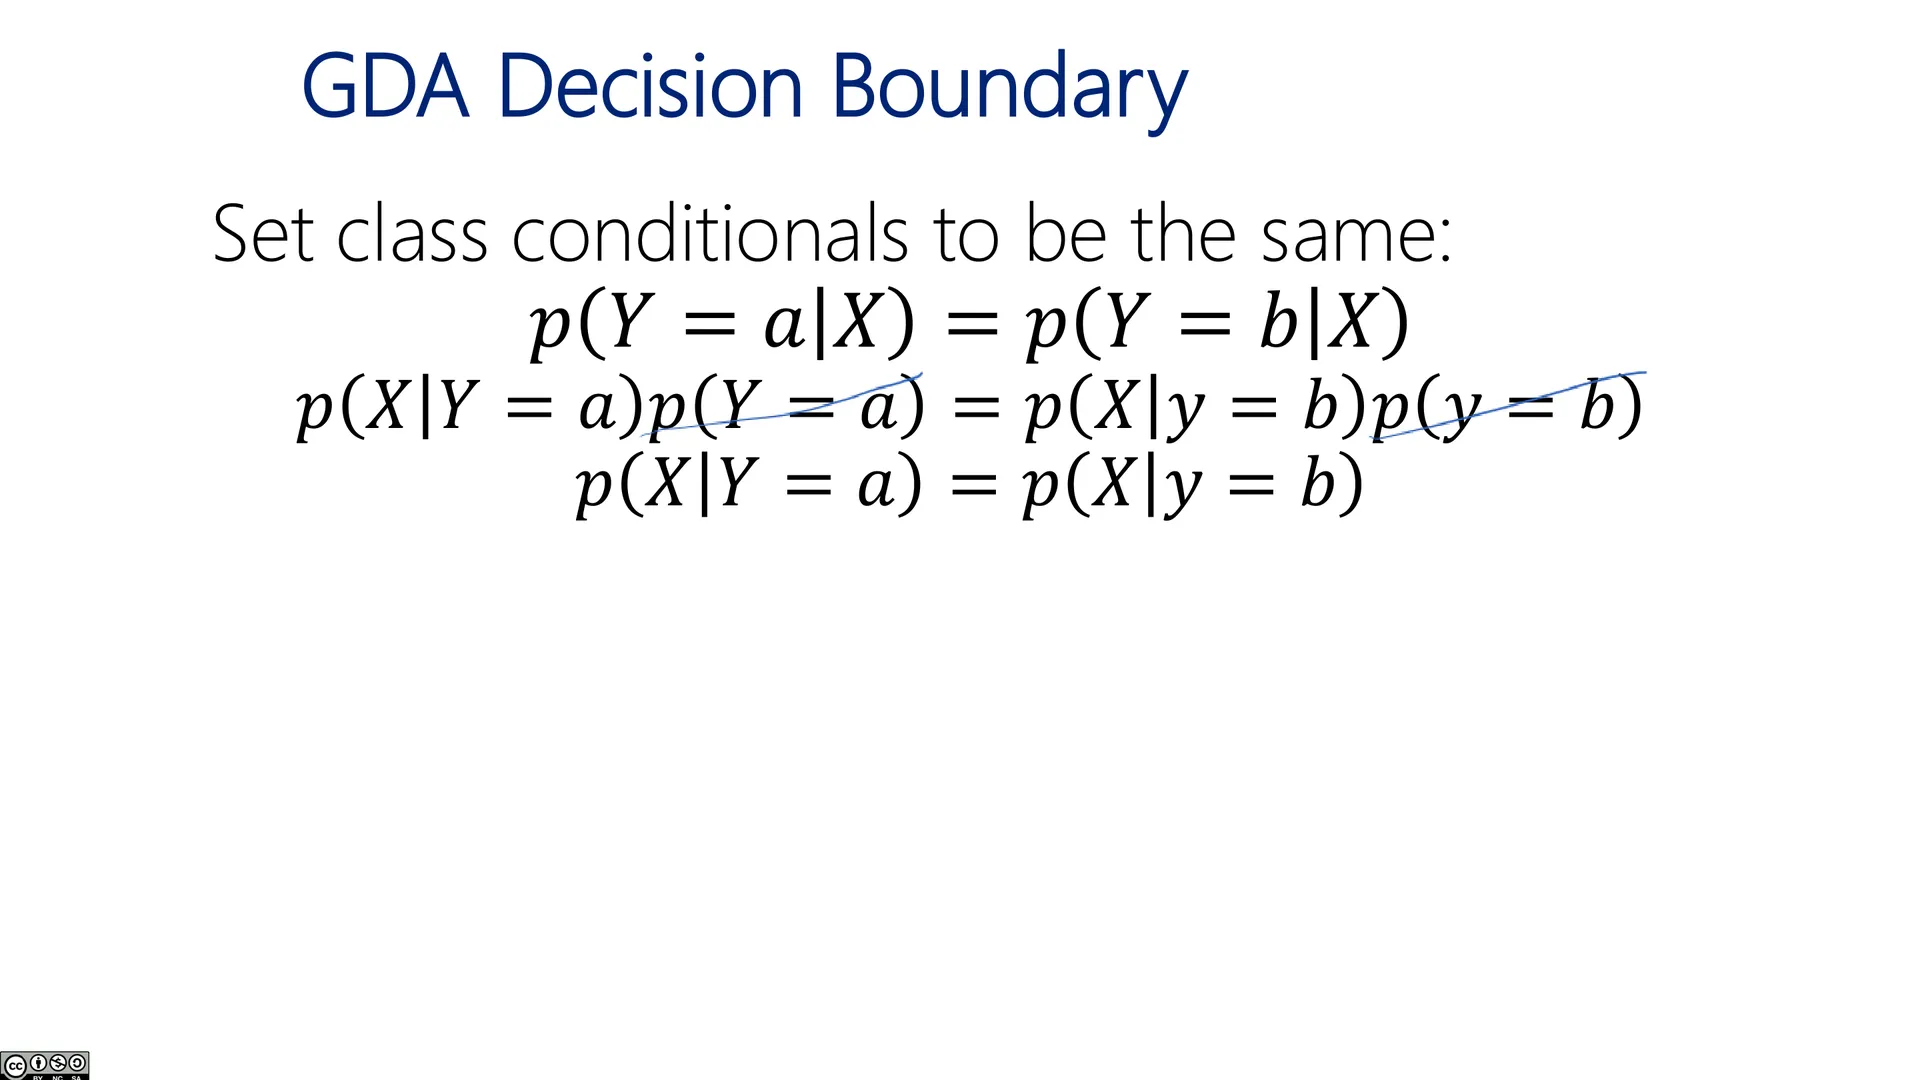
🖼️ GDA 决策边界(05)
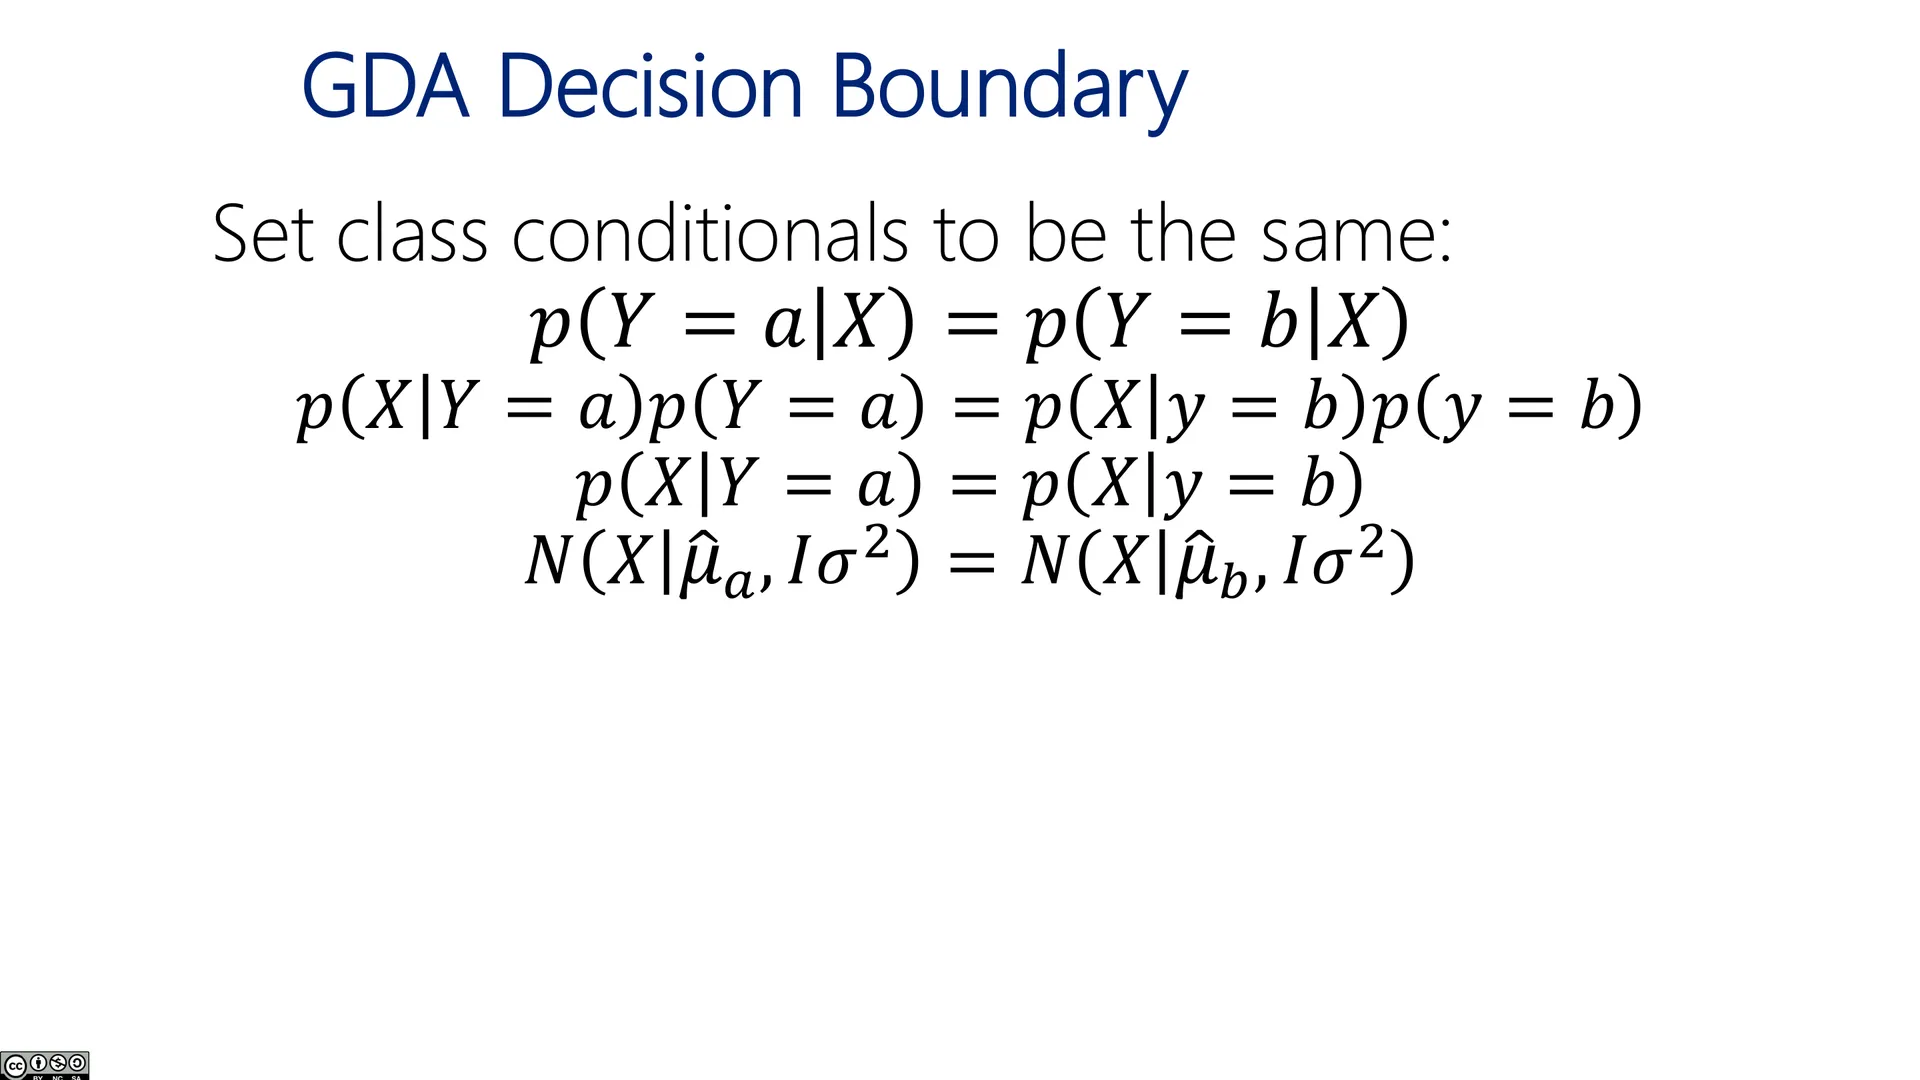
🖼️ GDA 决策边界(06)
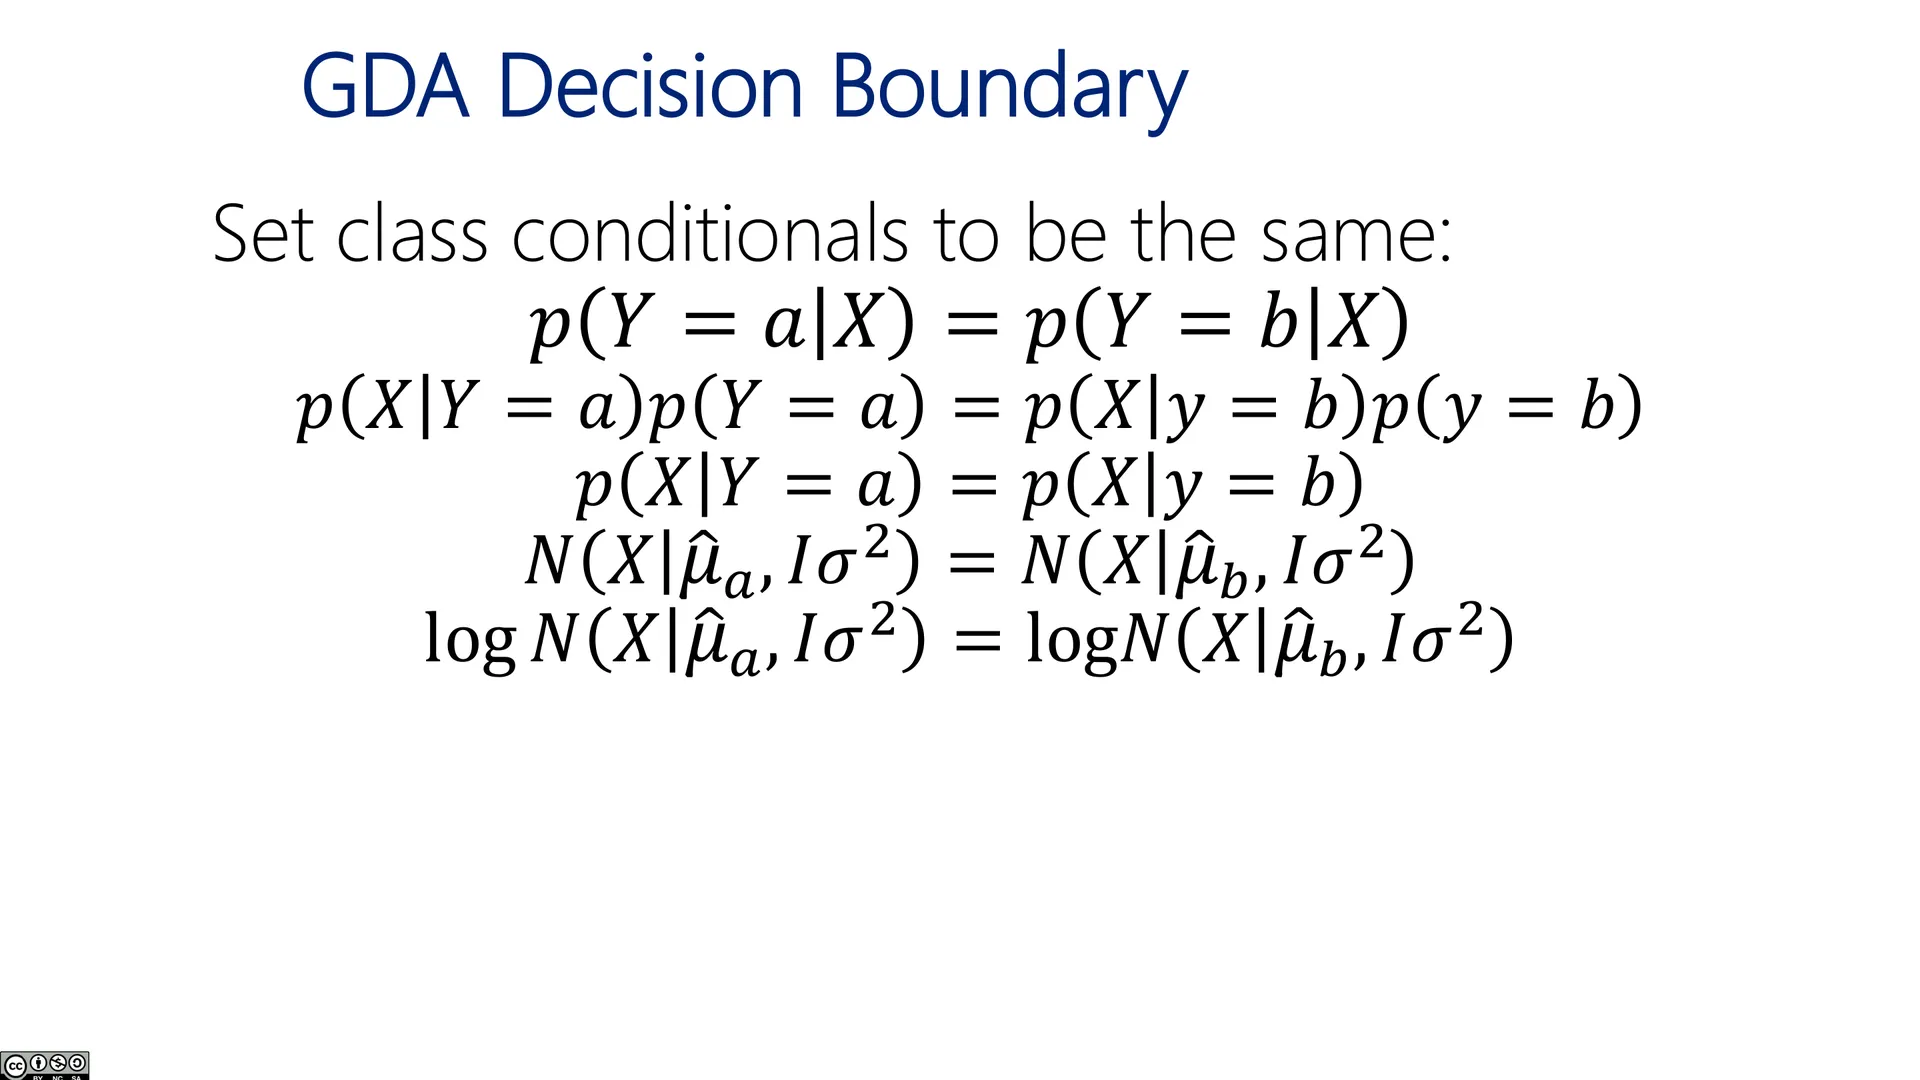
🖼️ GDA 决策边界(07)
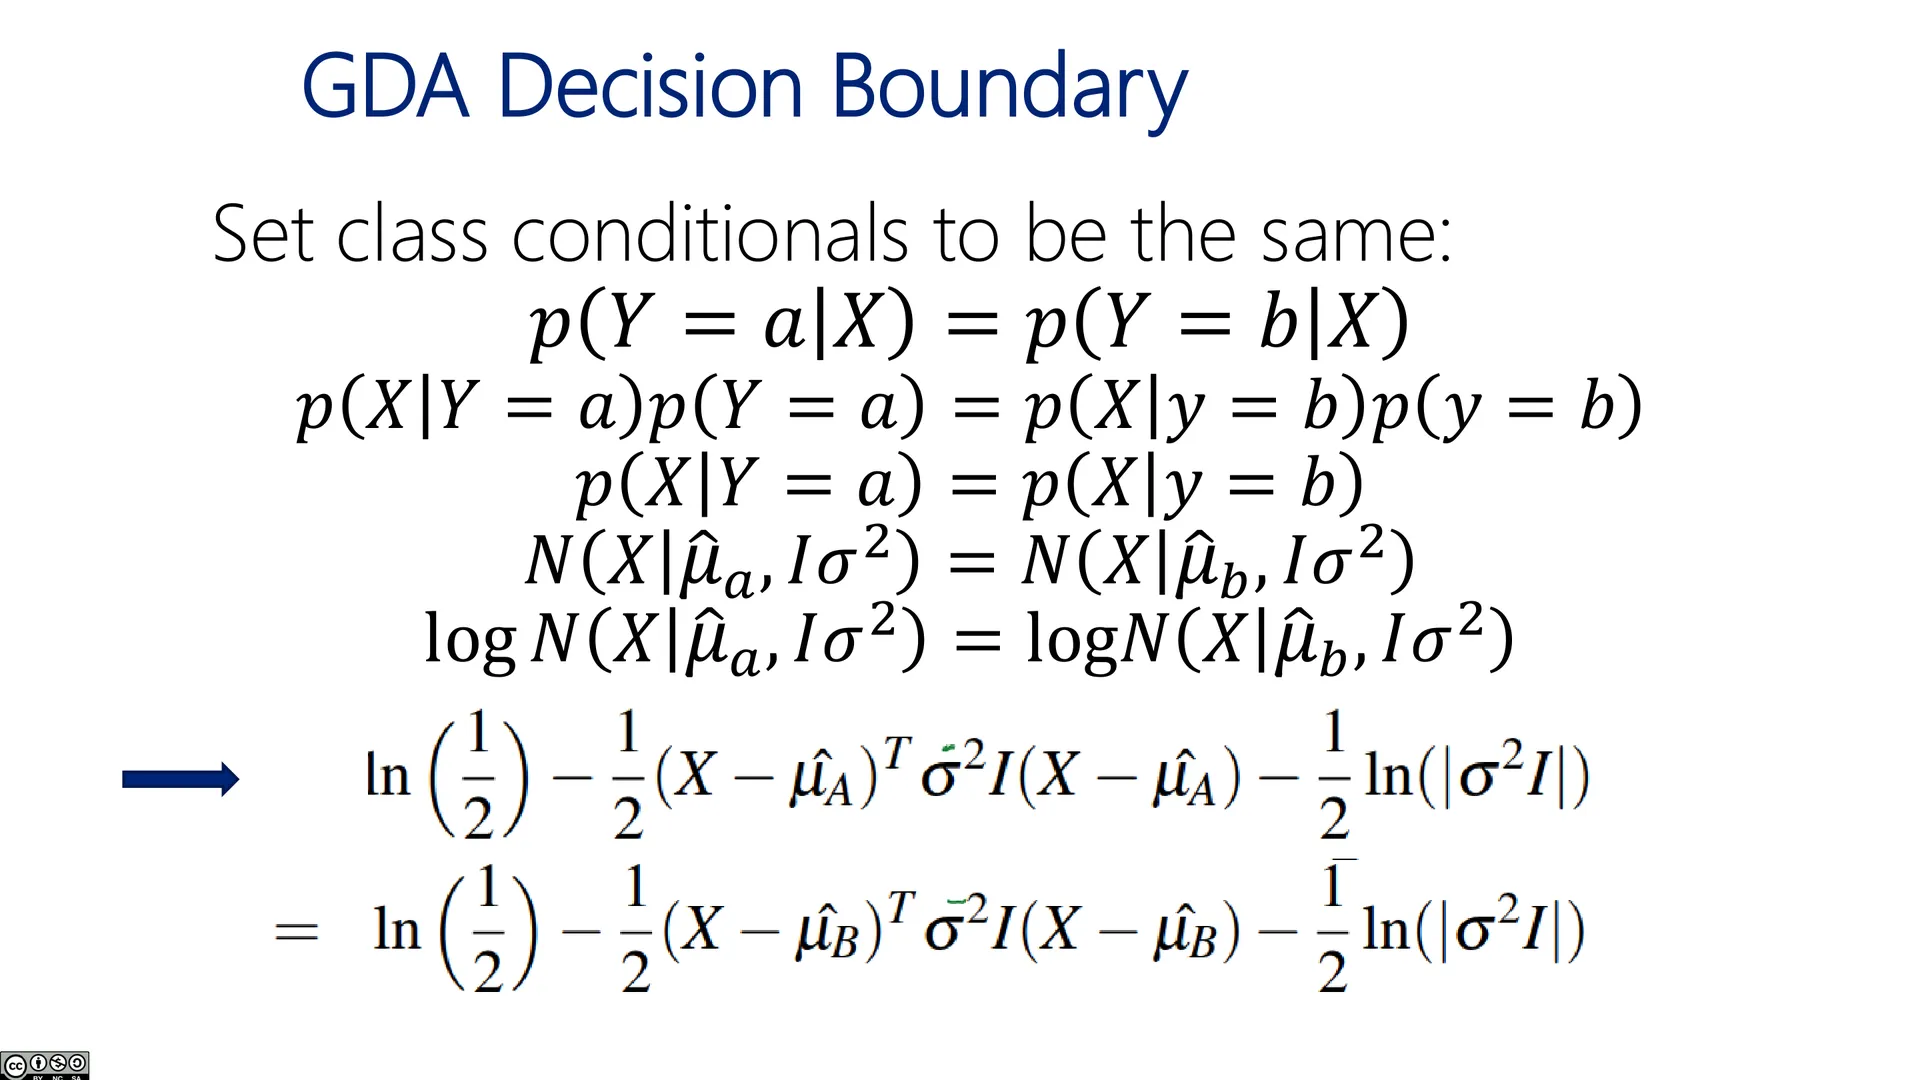
🖼️ GDA 决策边界(08)
🖼️ GDA 决策边界(09)
🖼️ 决策边界由 x 的集合给出
🖼️ GDA 决策边界(10)
🖼️ GDA 决策边界(11)
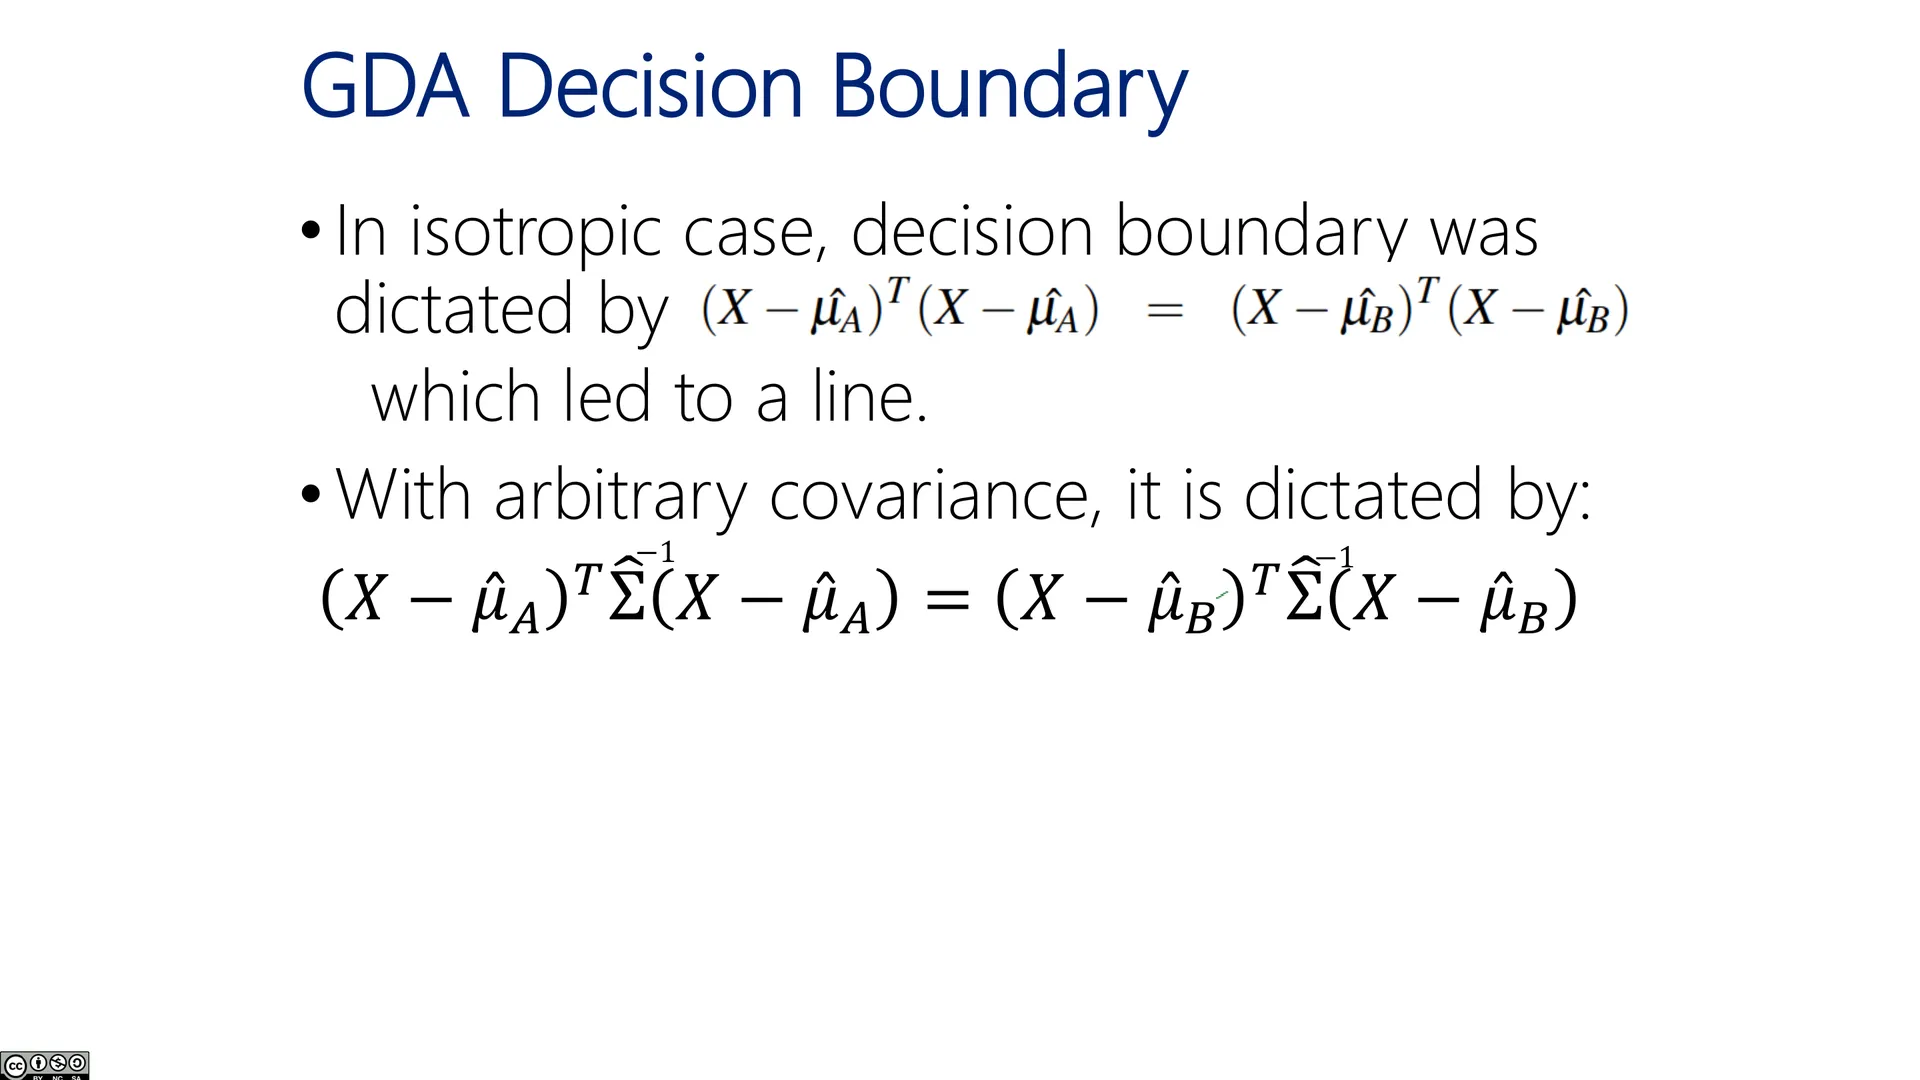
🖼️ GDA 决策边界(12)
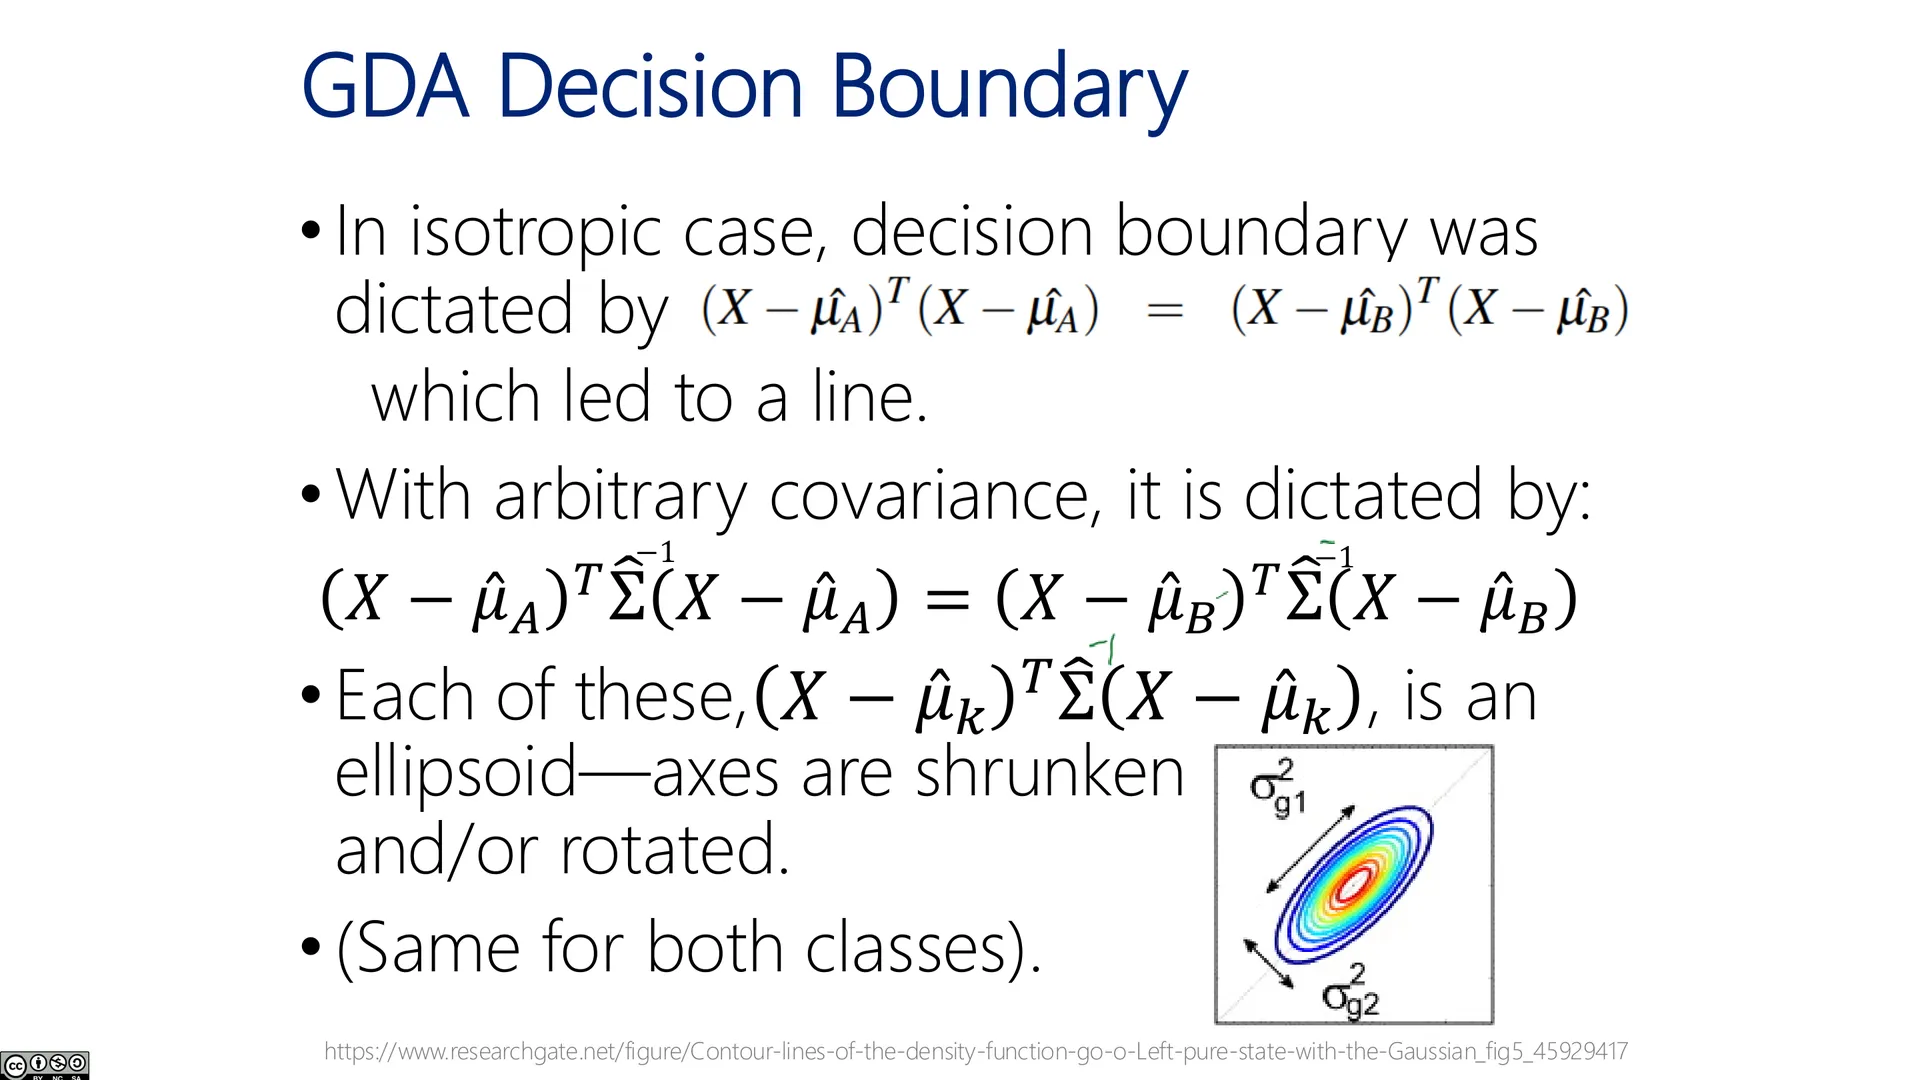
🖼️ GDA 决策边界(13)
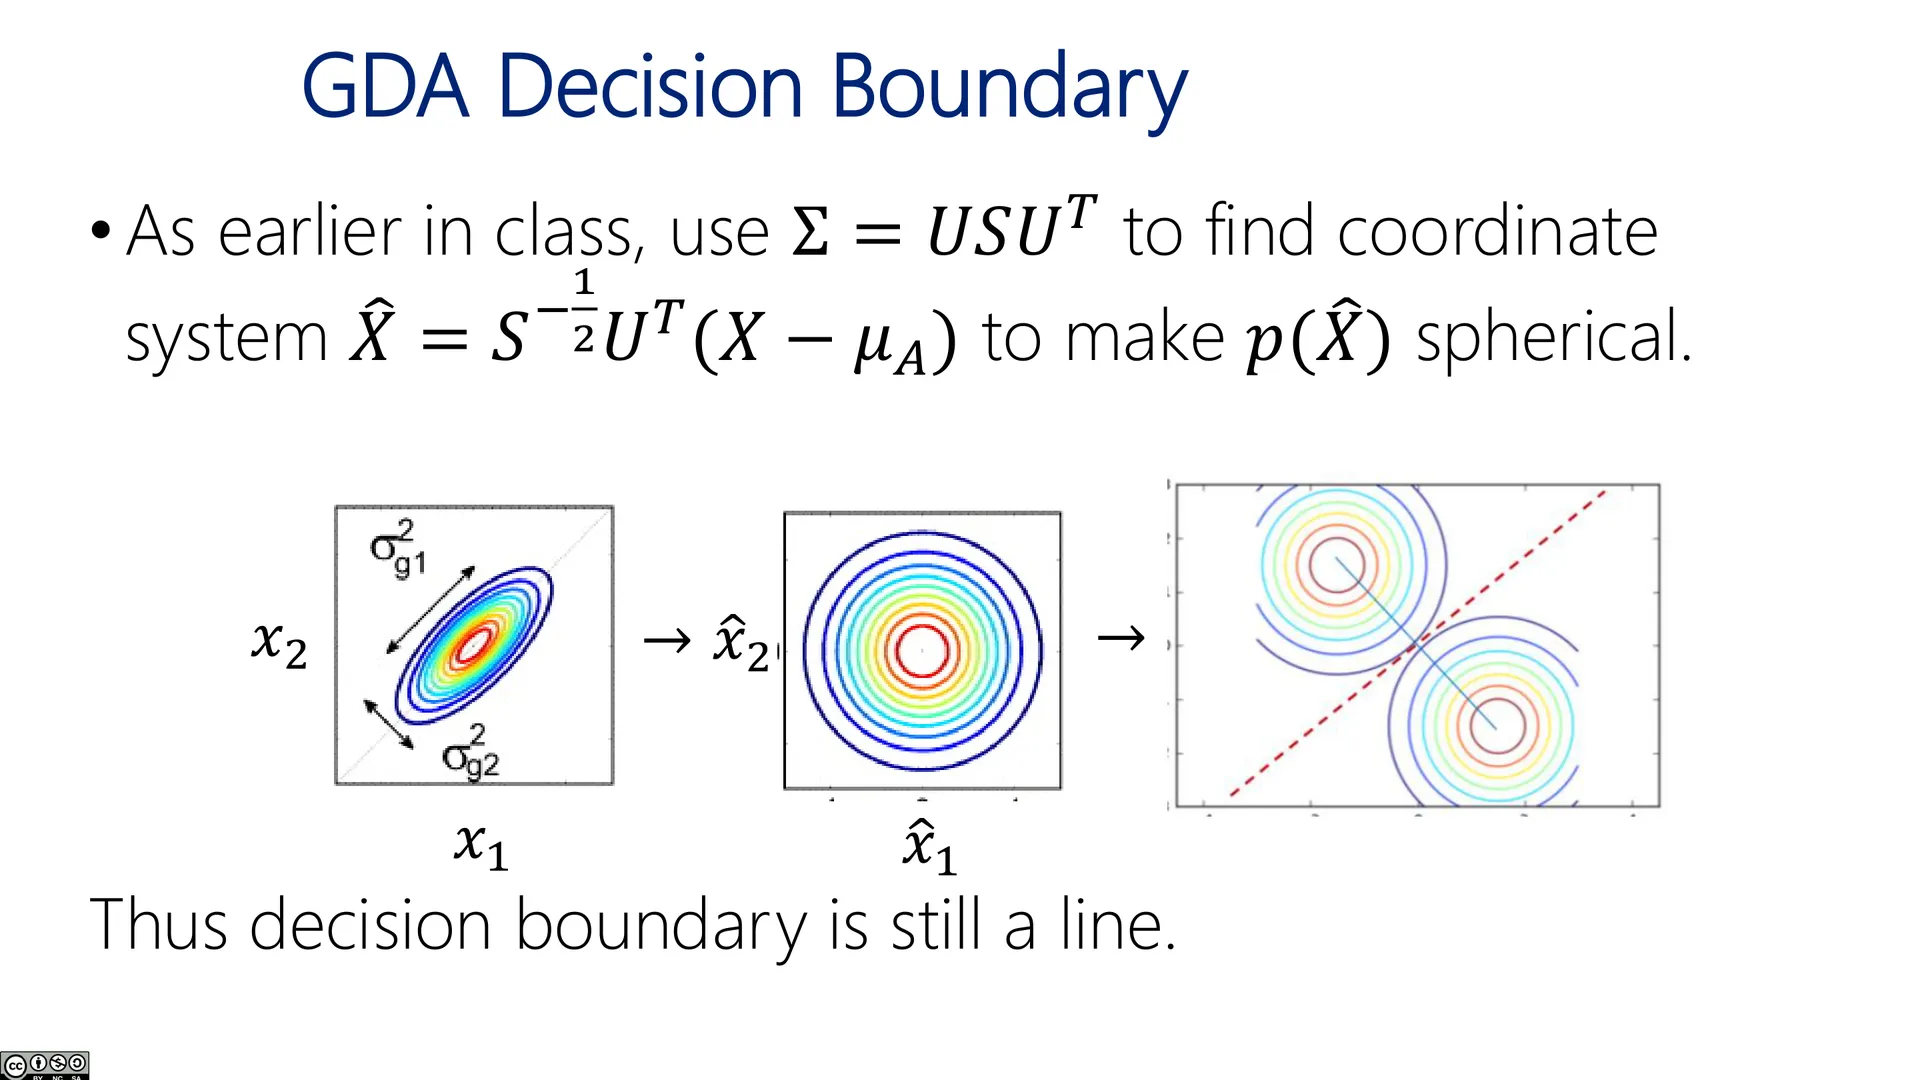
🖼️ GDA 决策边界(14)
🖼️ GDA 决策边界(15)
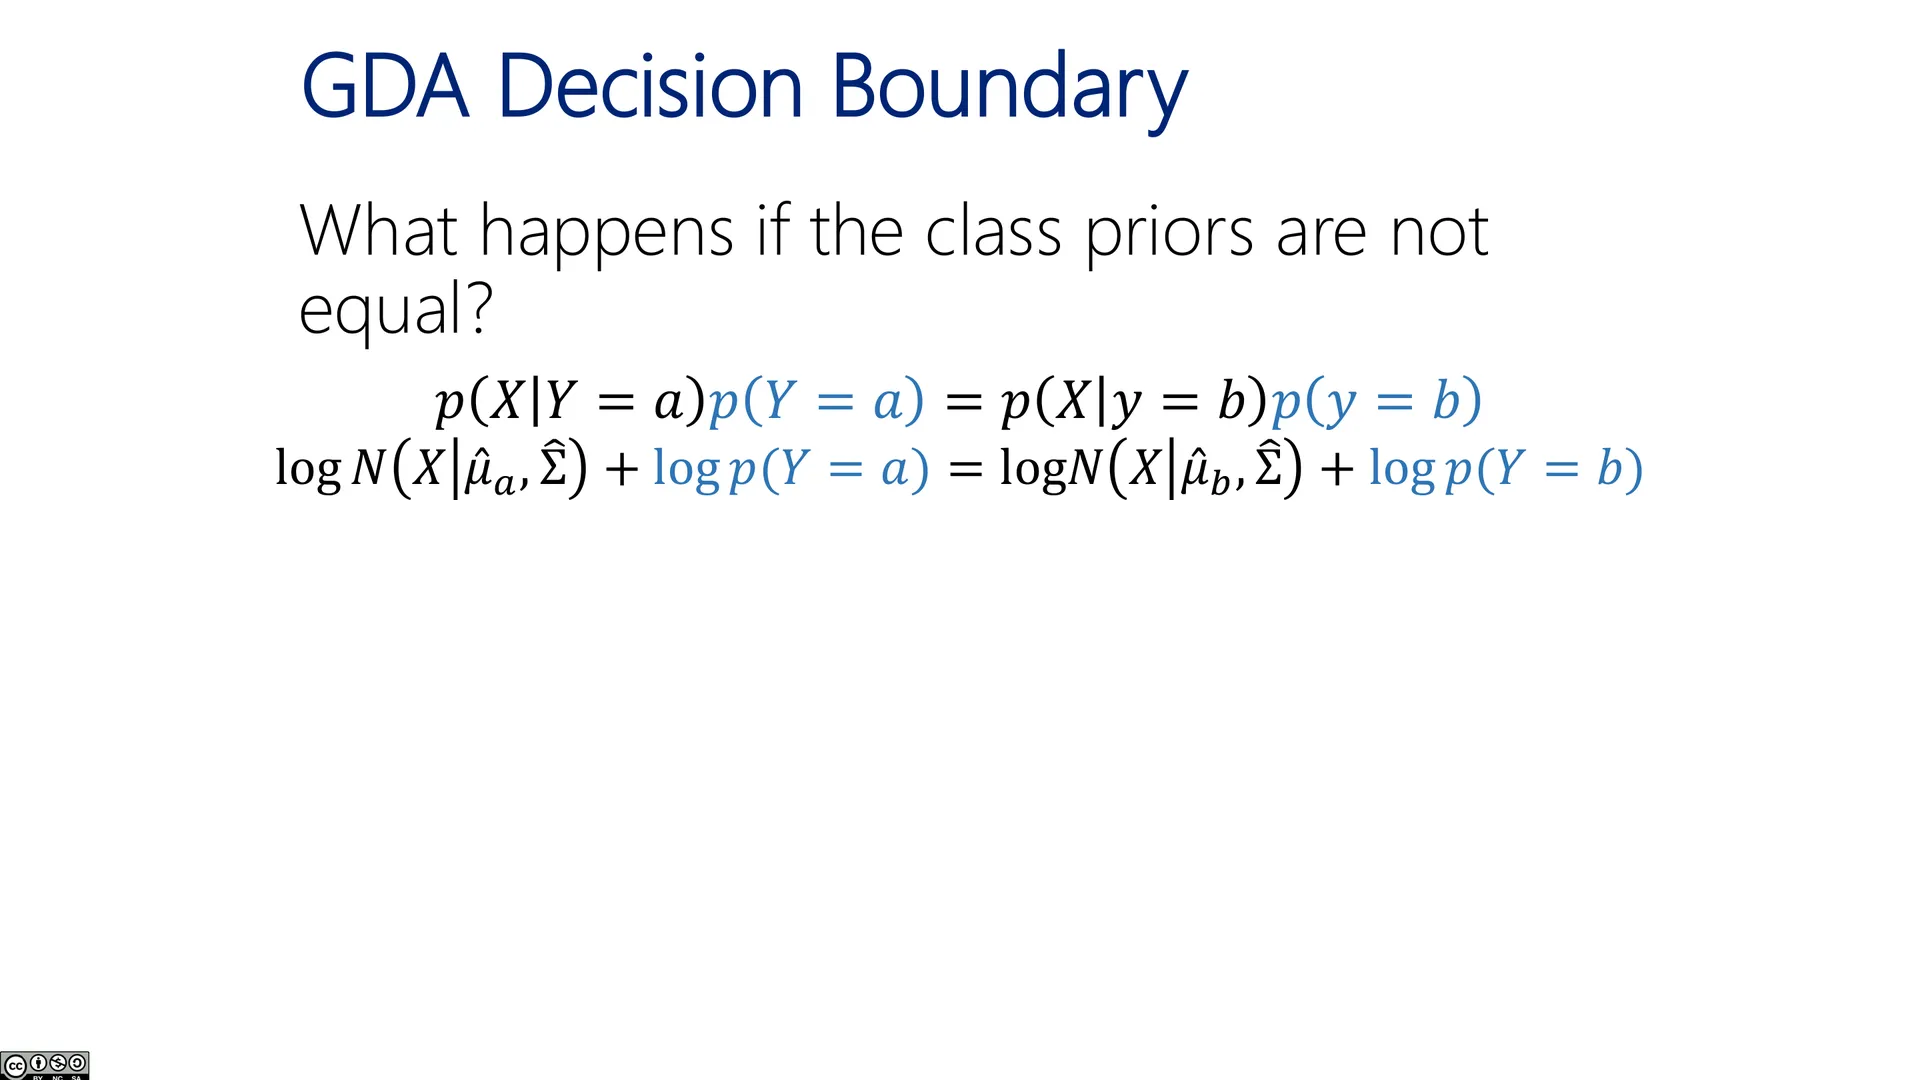
🖼️ GDA 决策边界(16)
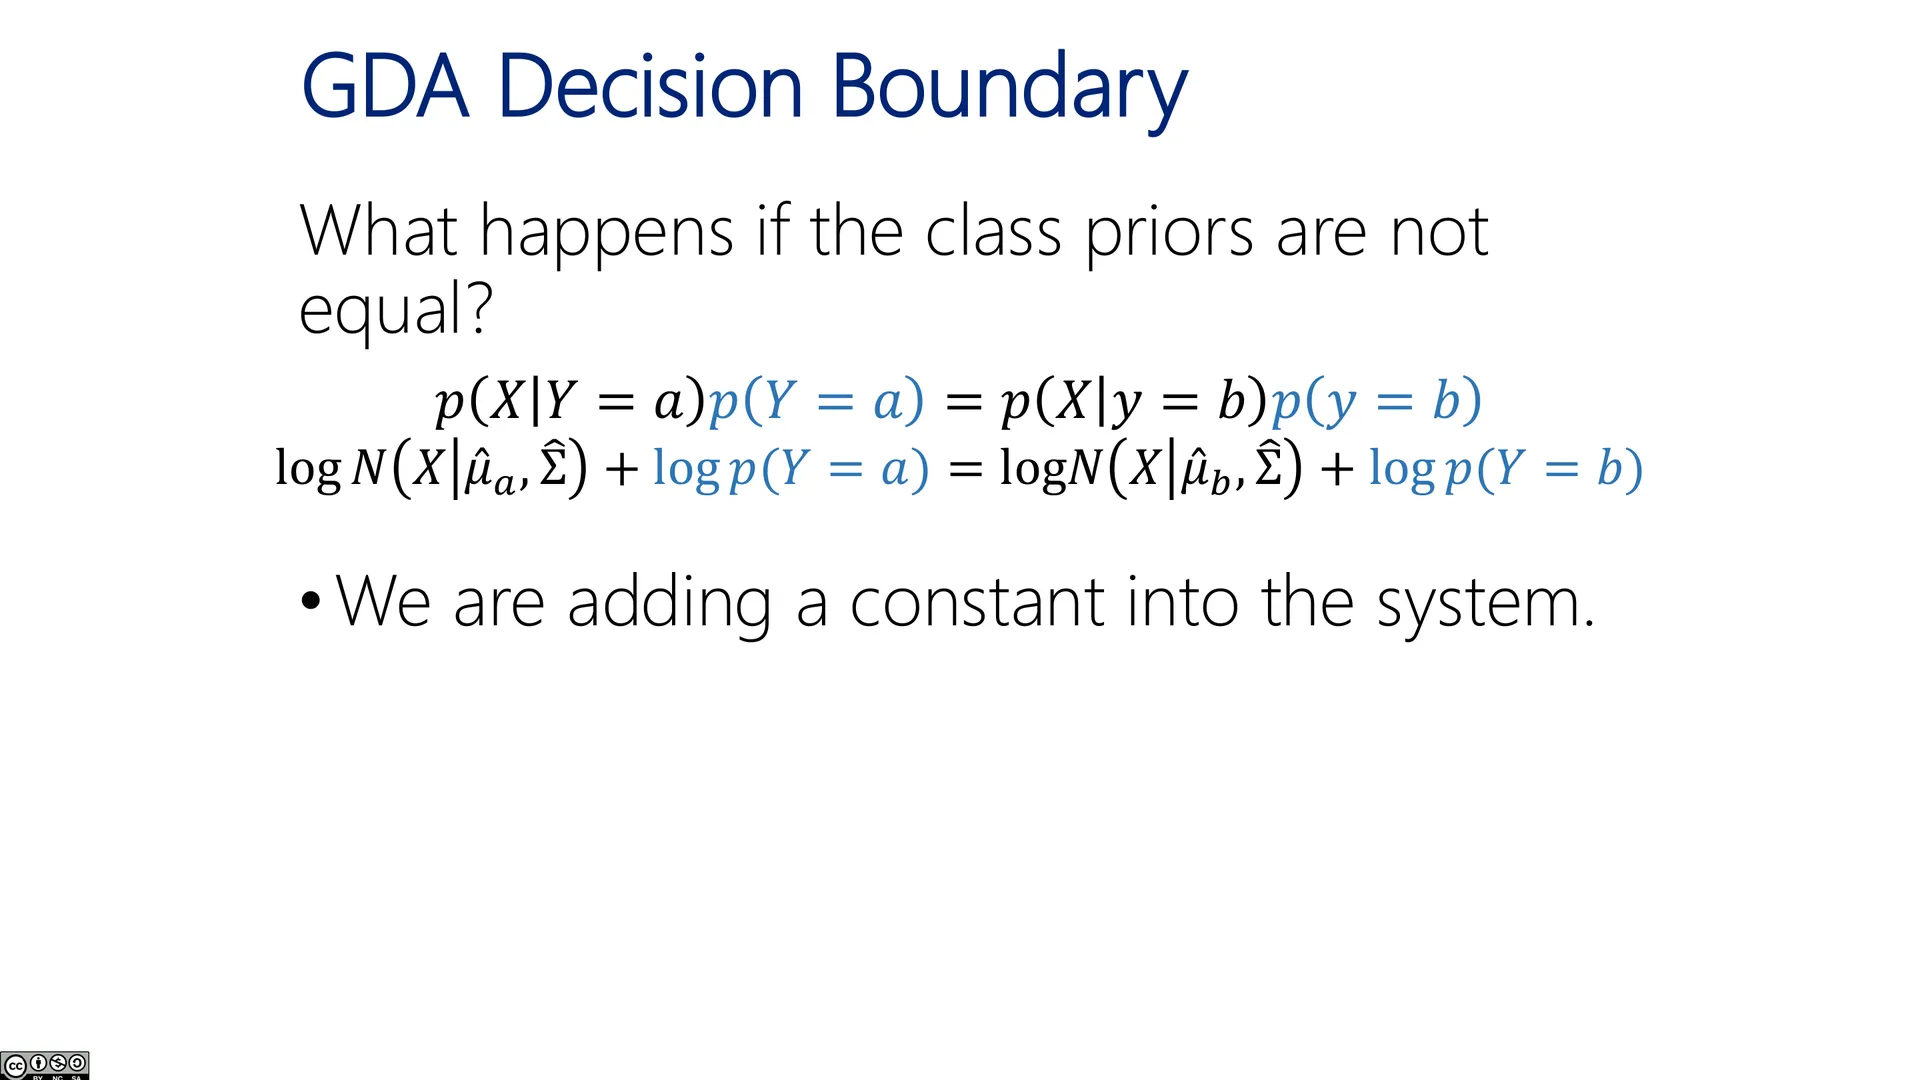
🖼️ GDA 决策边界(17)
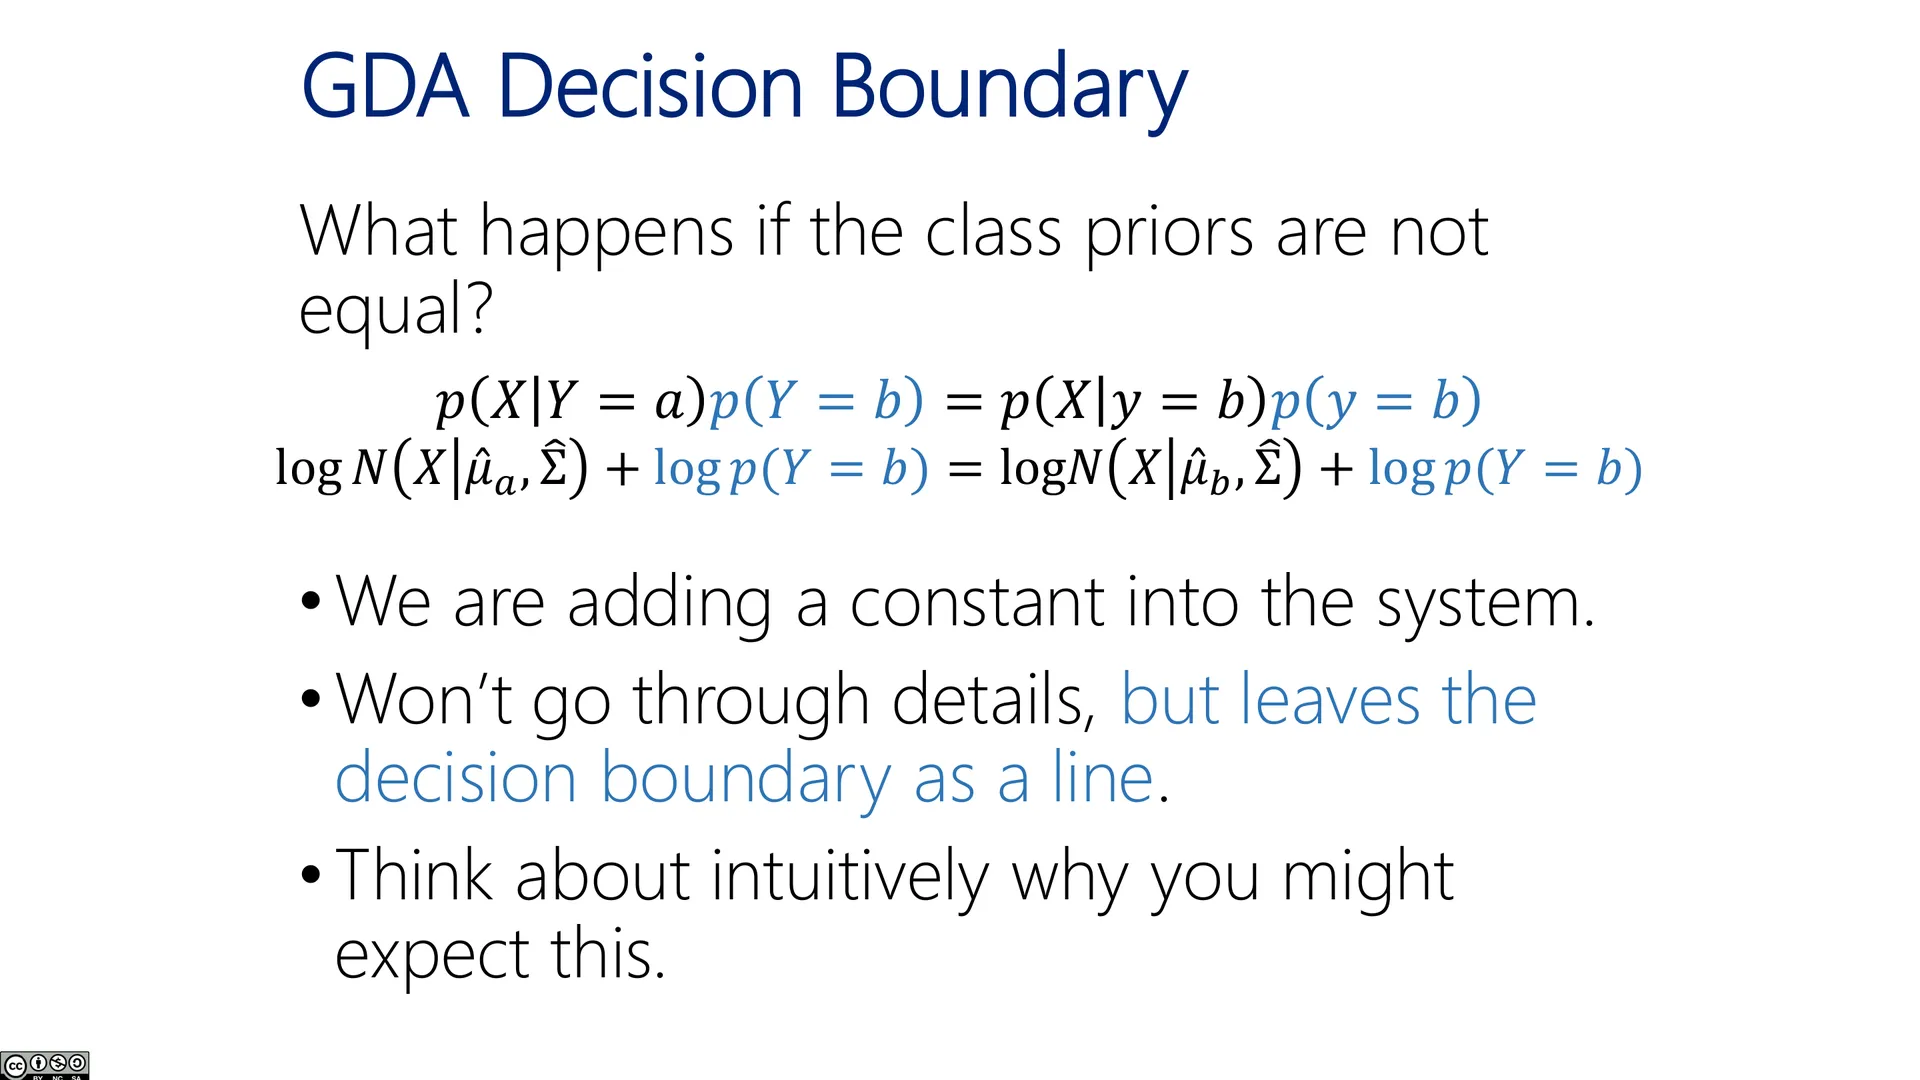
🖼️ GDA 决策边界(18)
🖼️ GDA 决策边界(19)
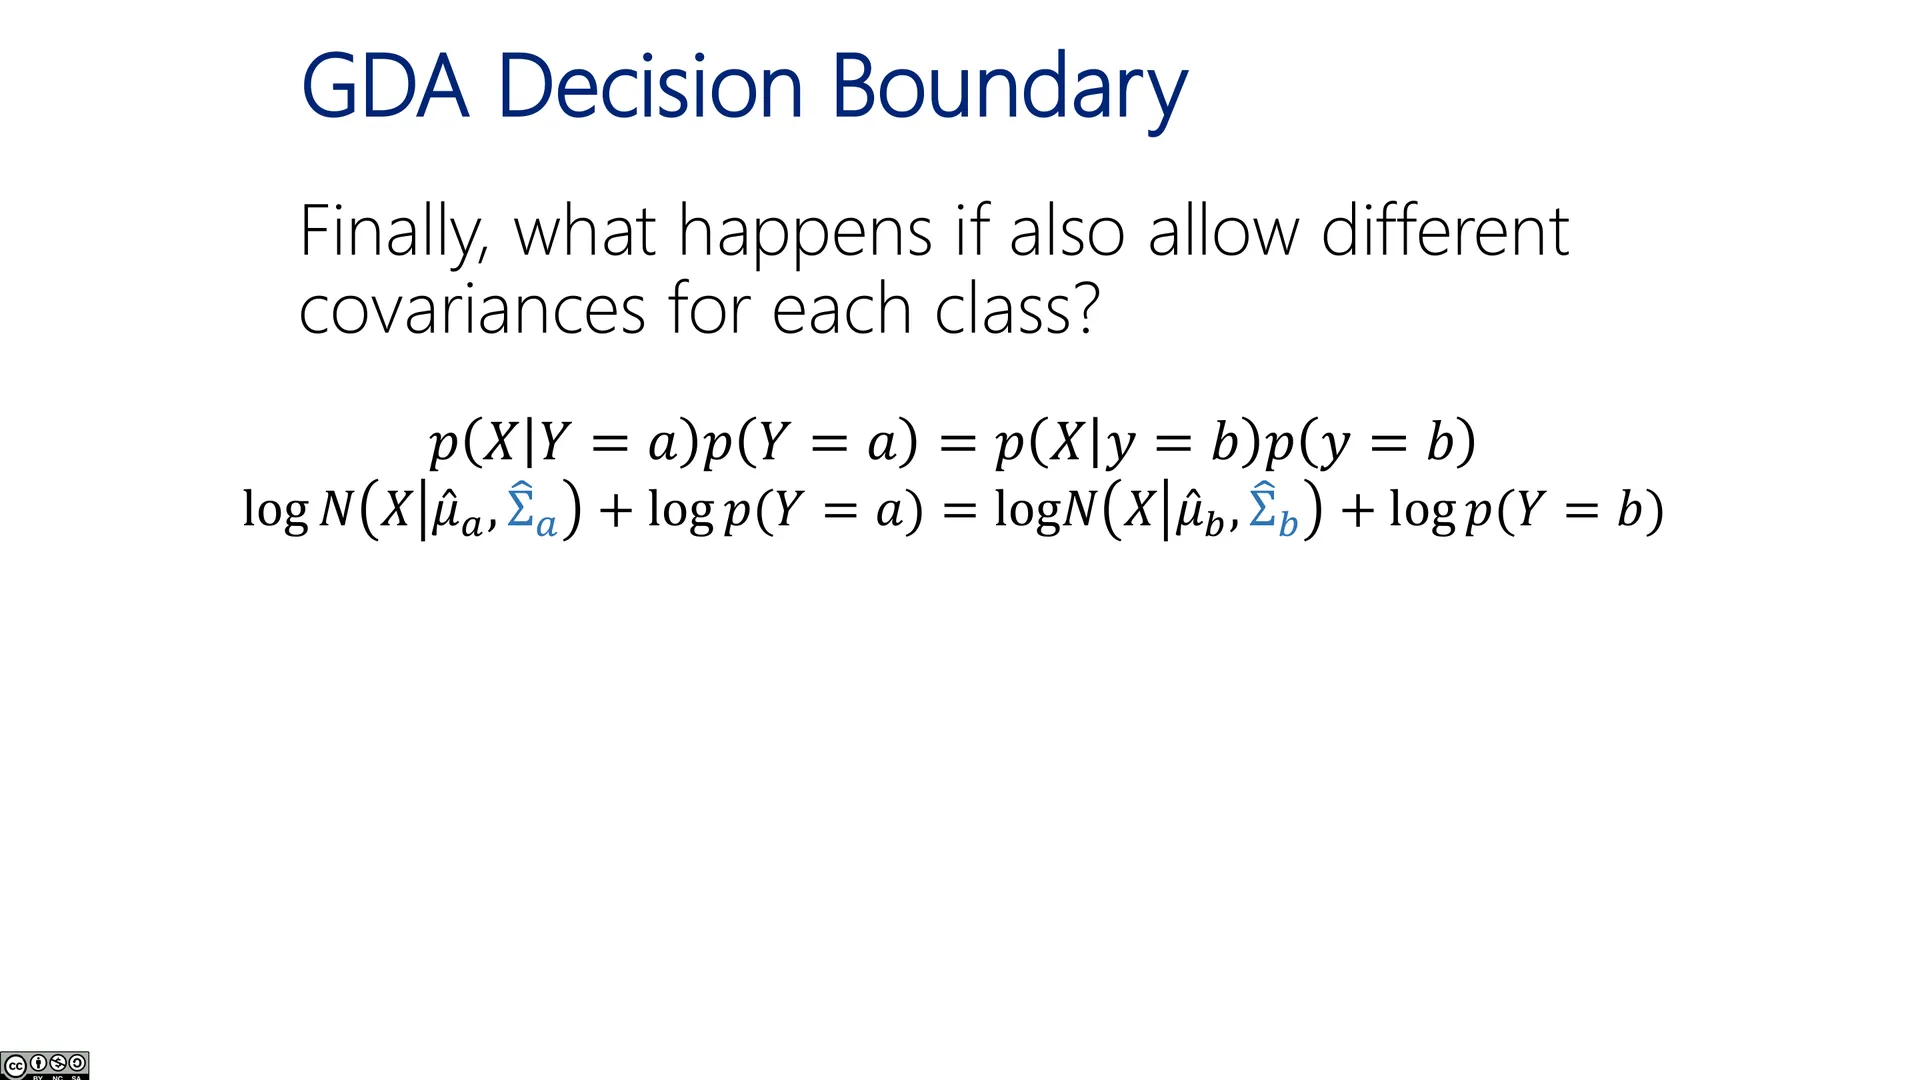
🖼️ GDA 决策边界(20)
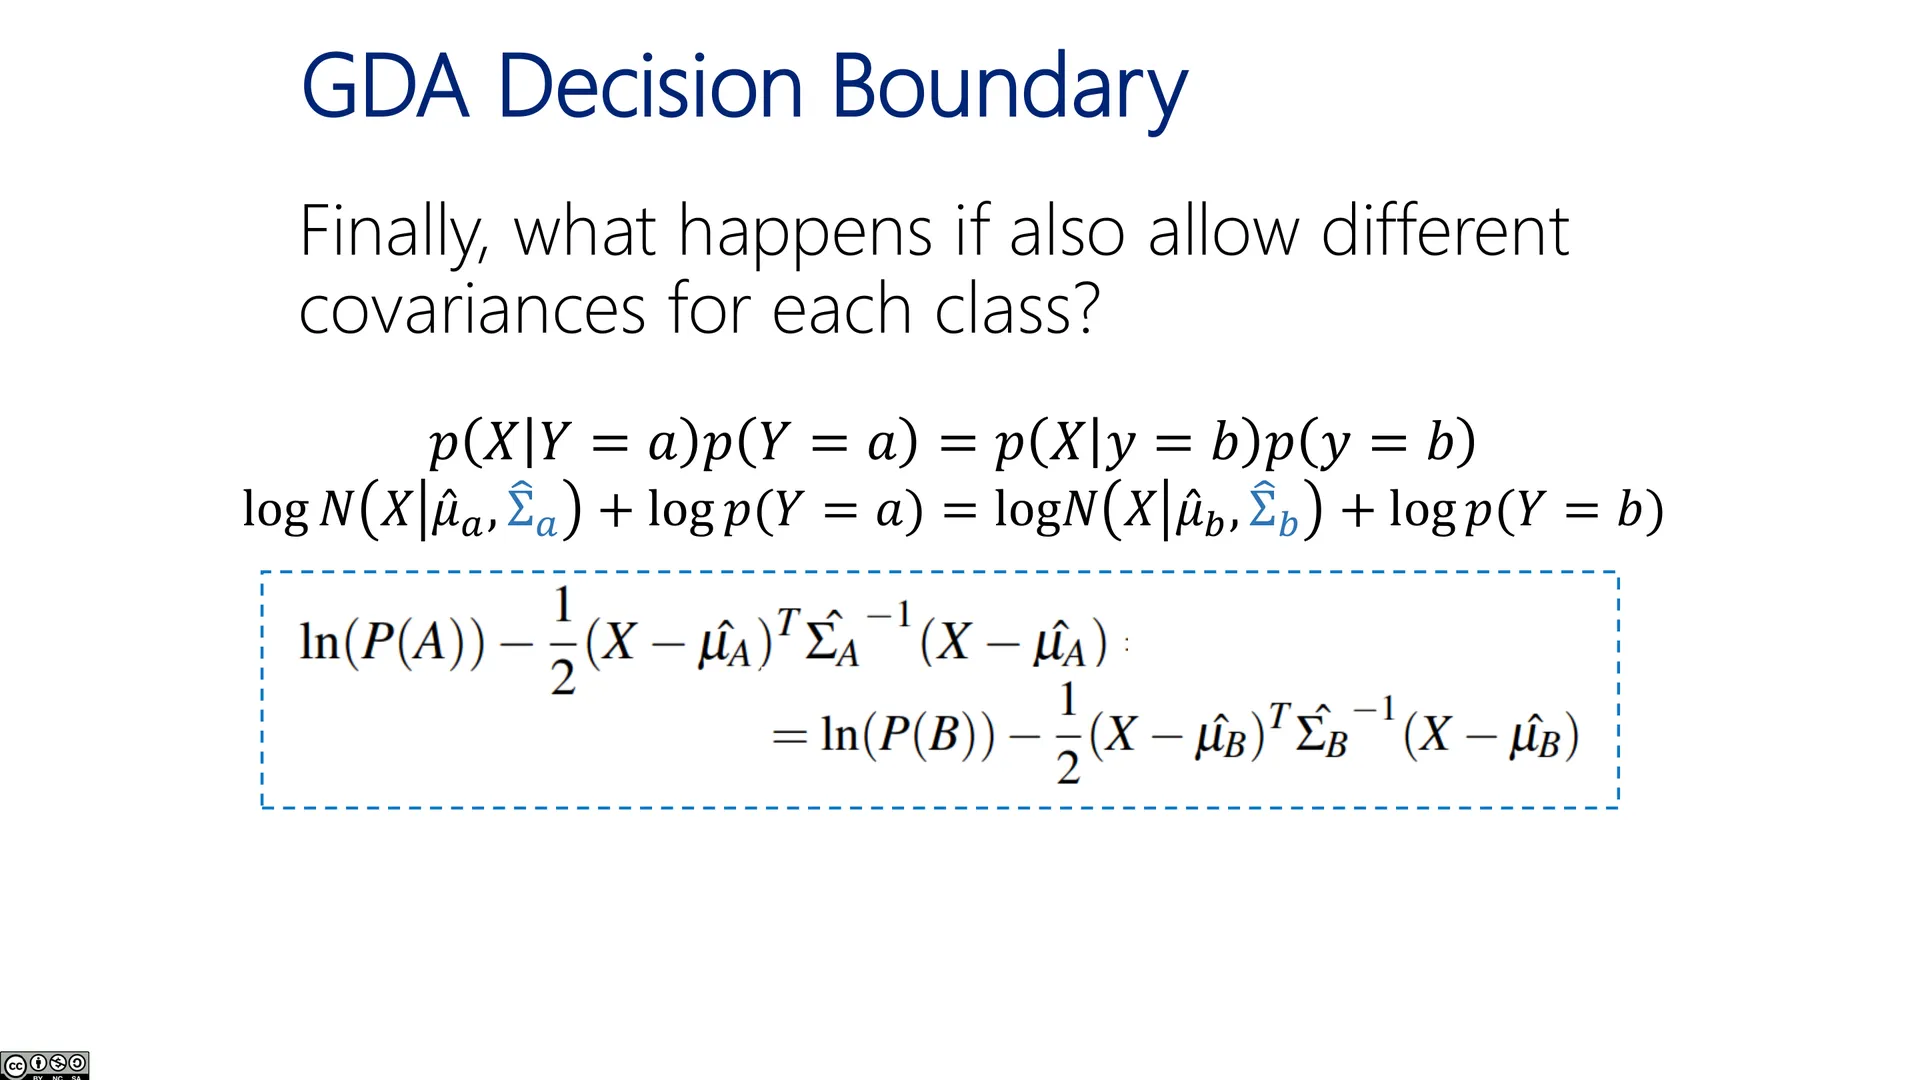
🖼️ GDA 决策边界(21)
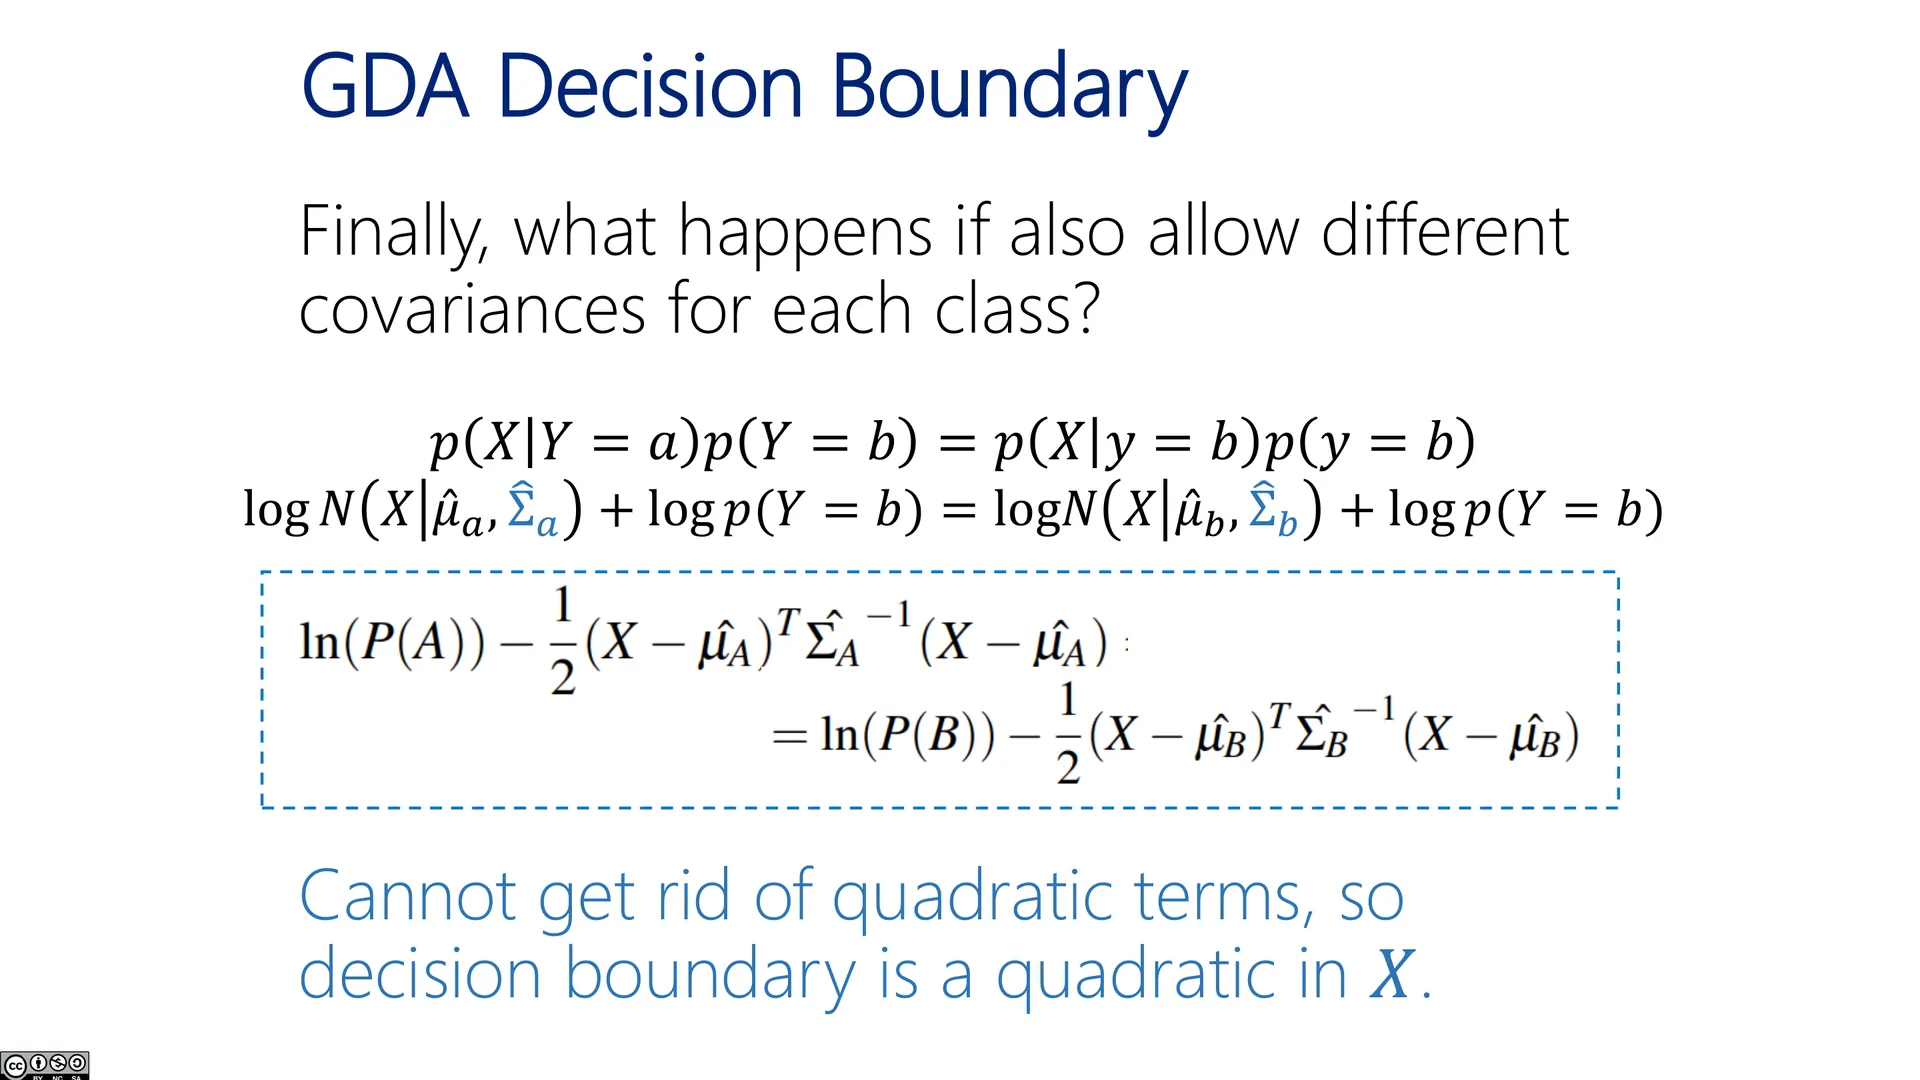
🖼️ GDA 决策边界(22)
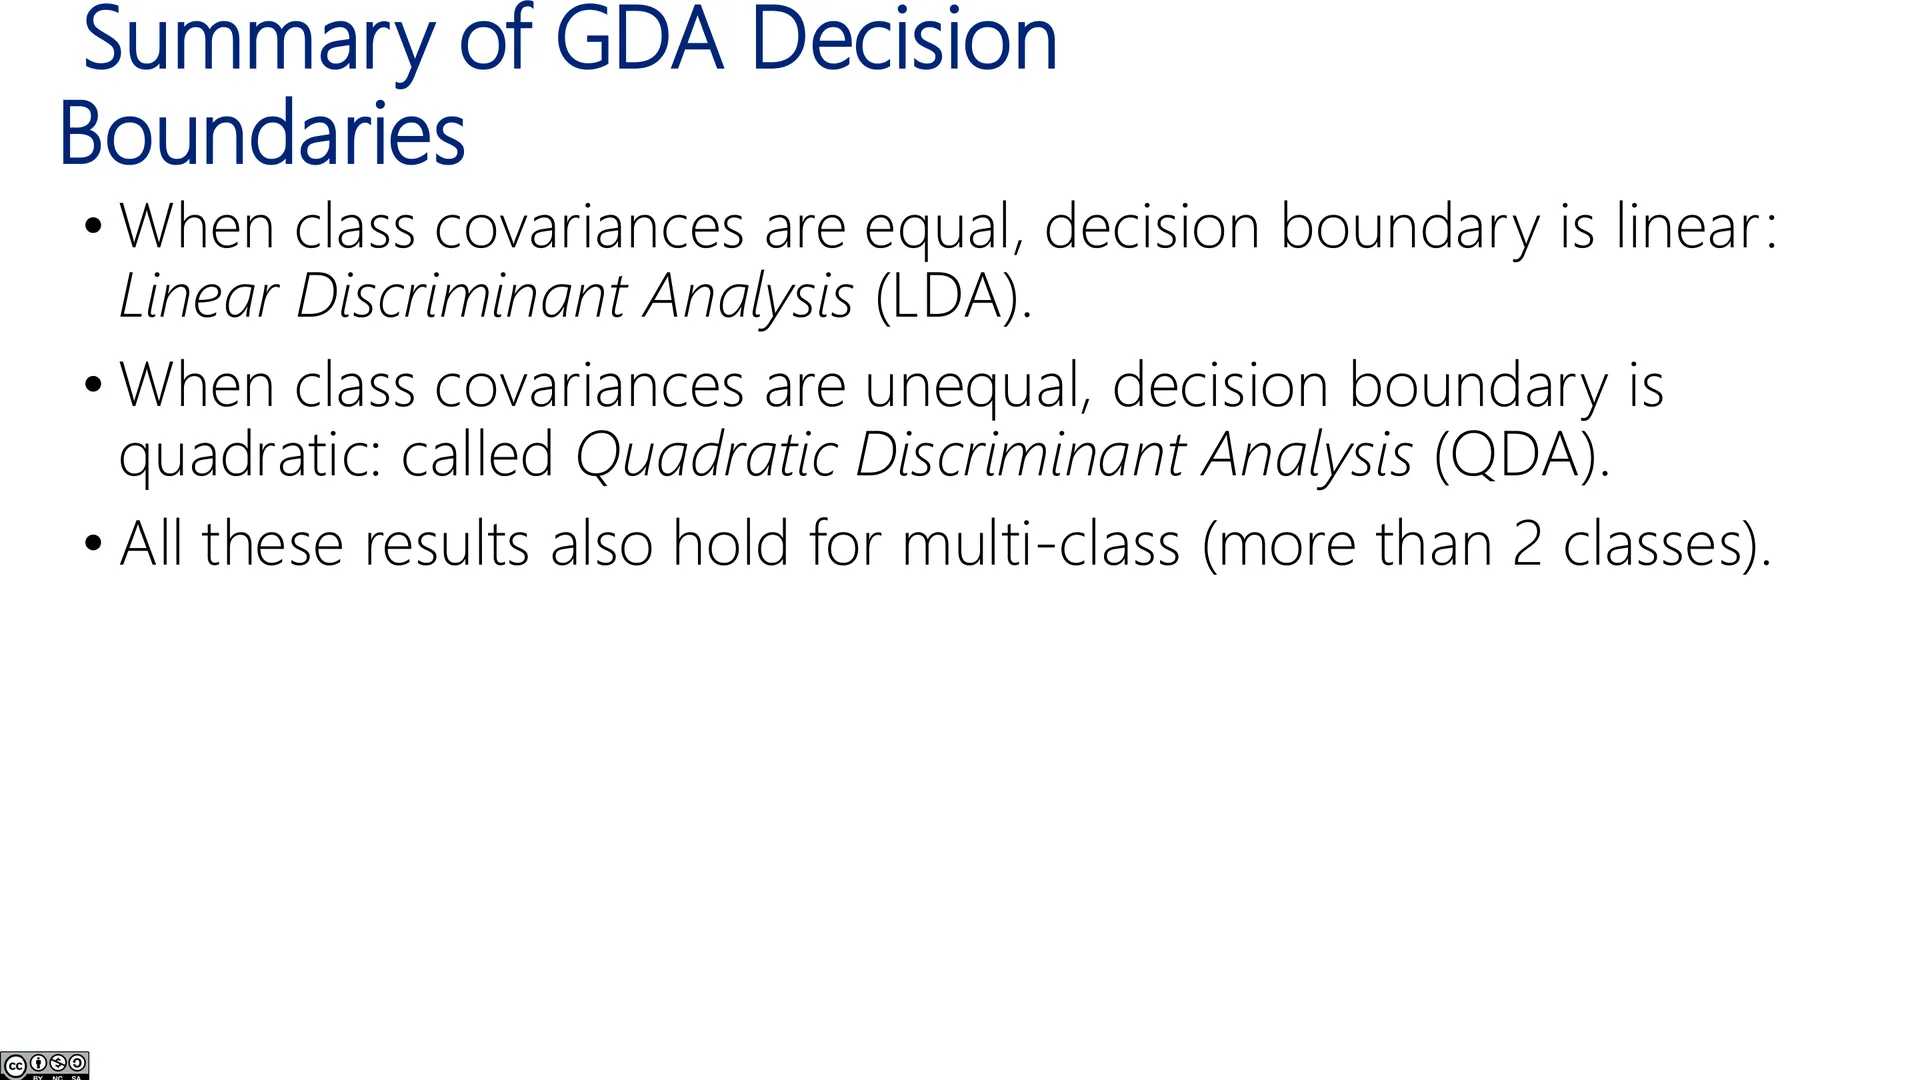
🖼️ GDA 决策总结
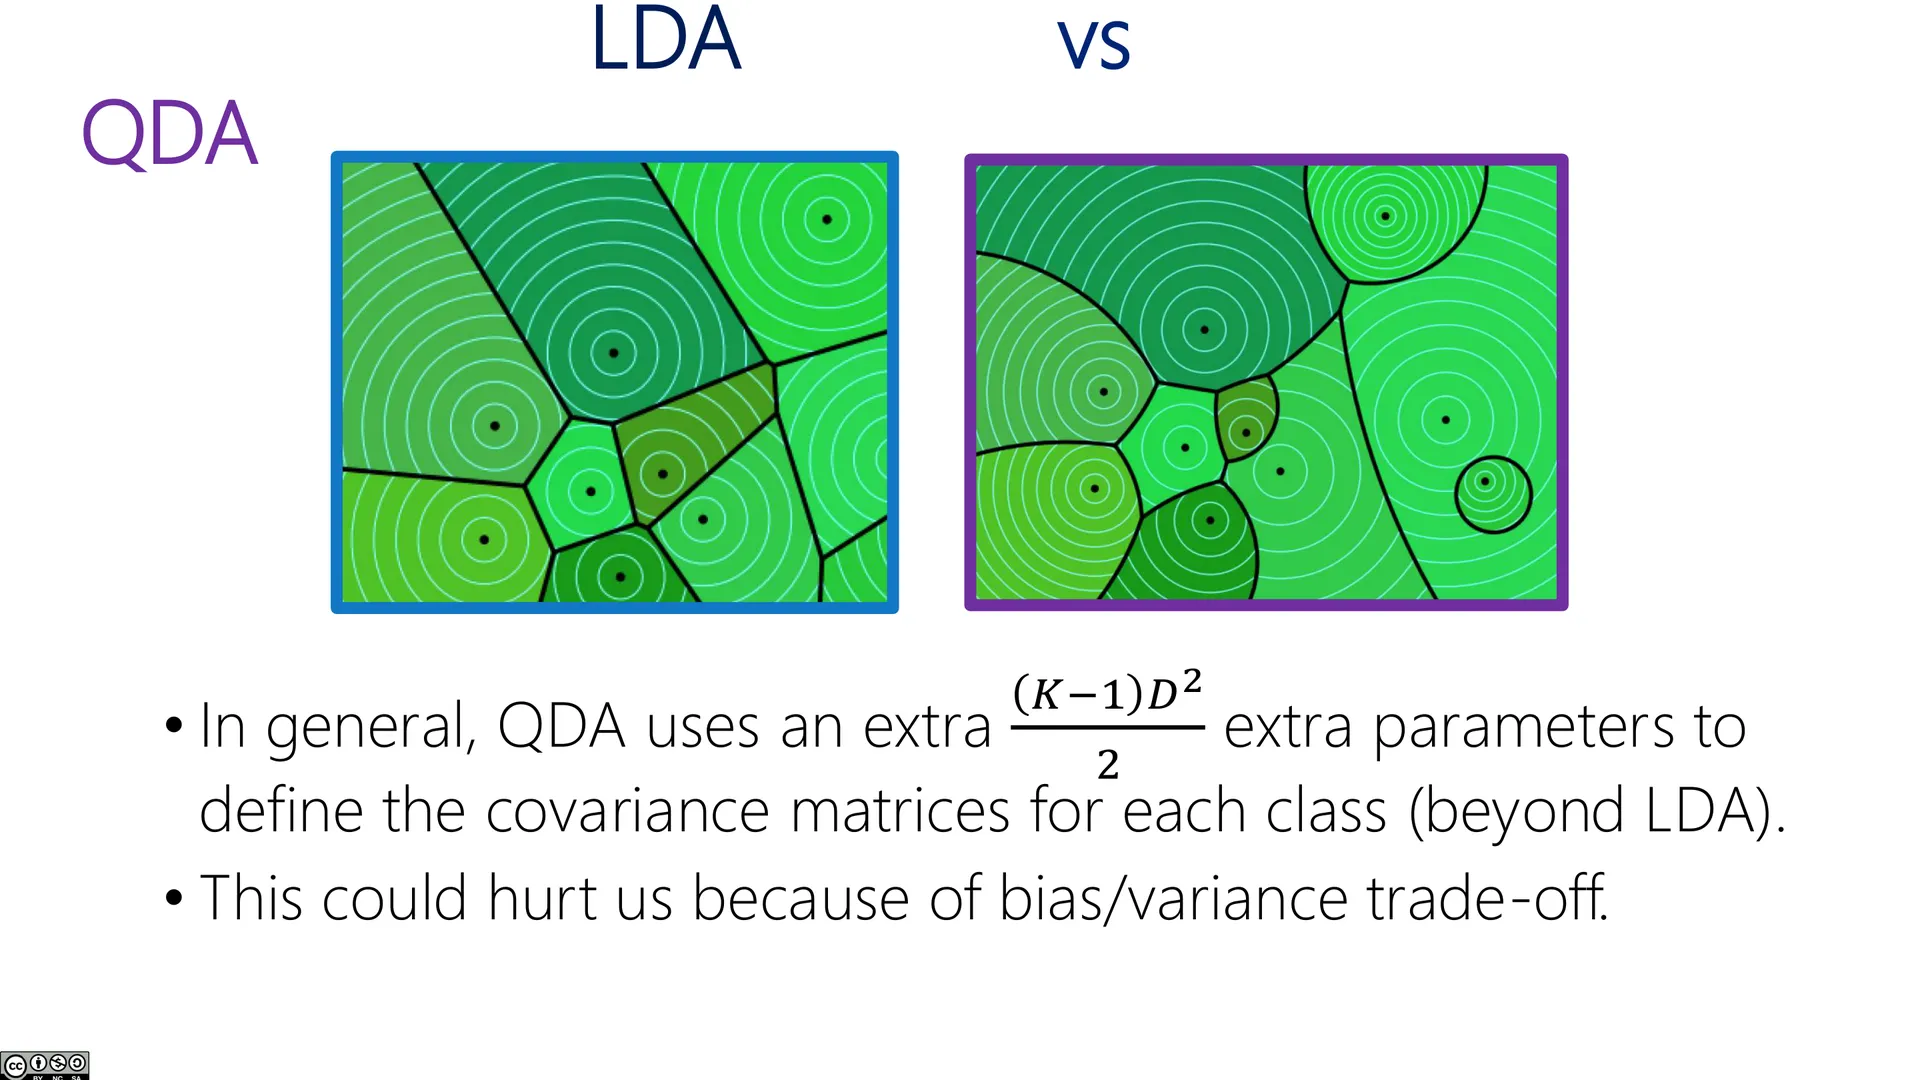
🖼️ LDA vs 其他
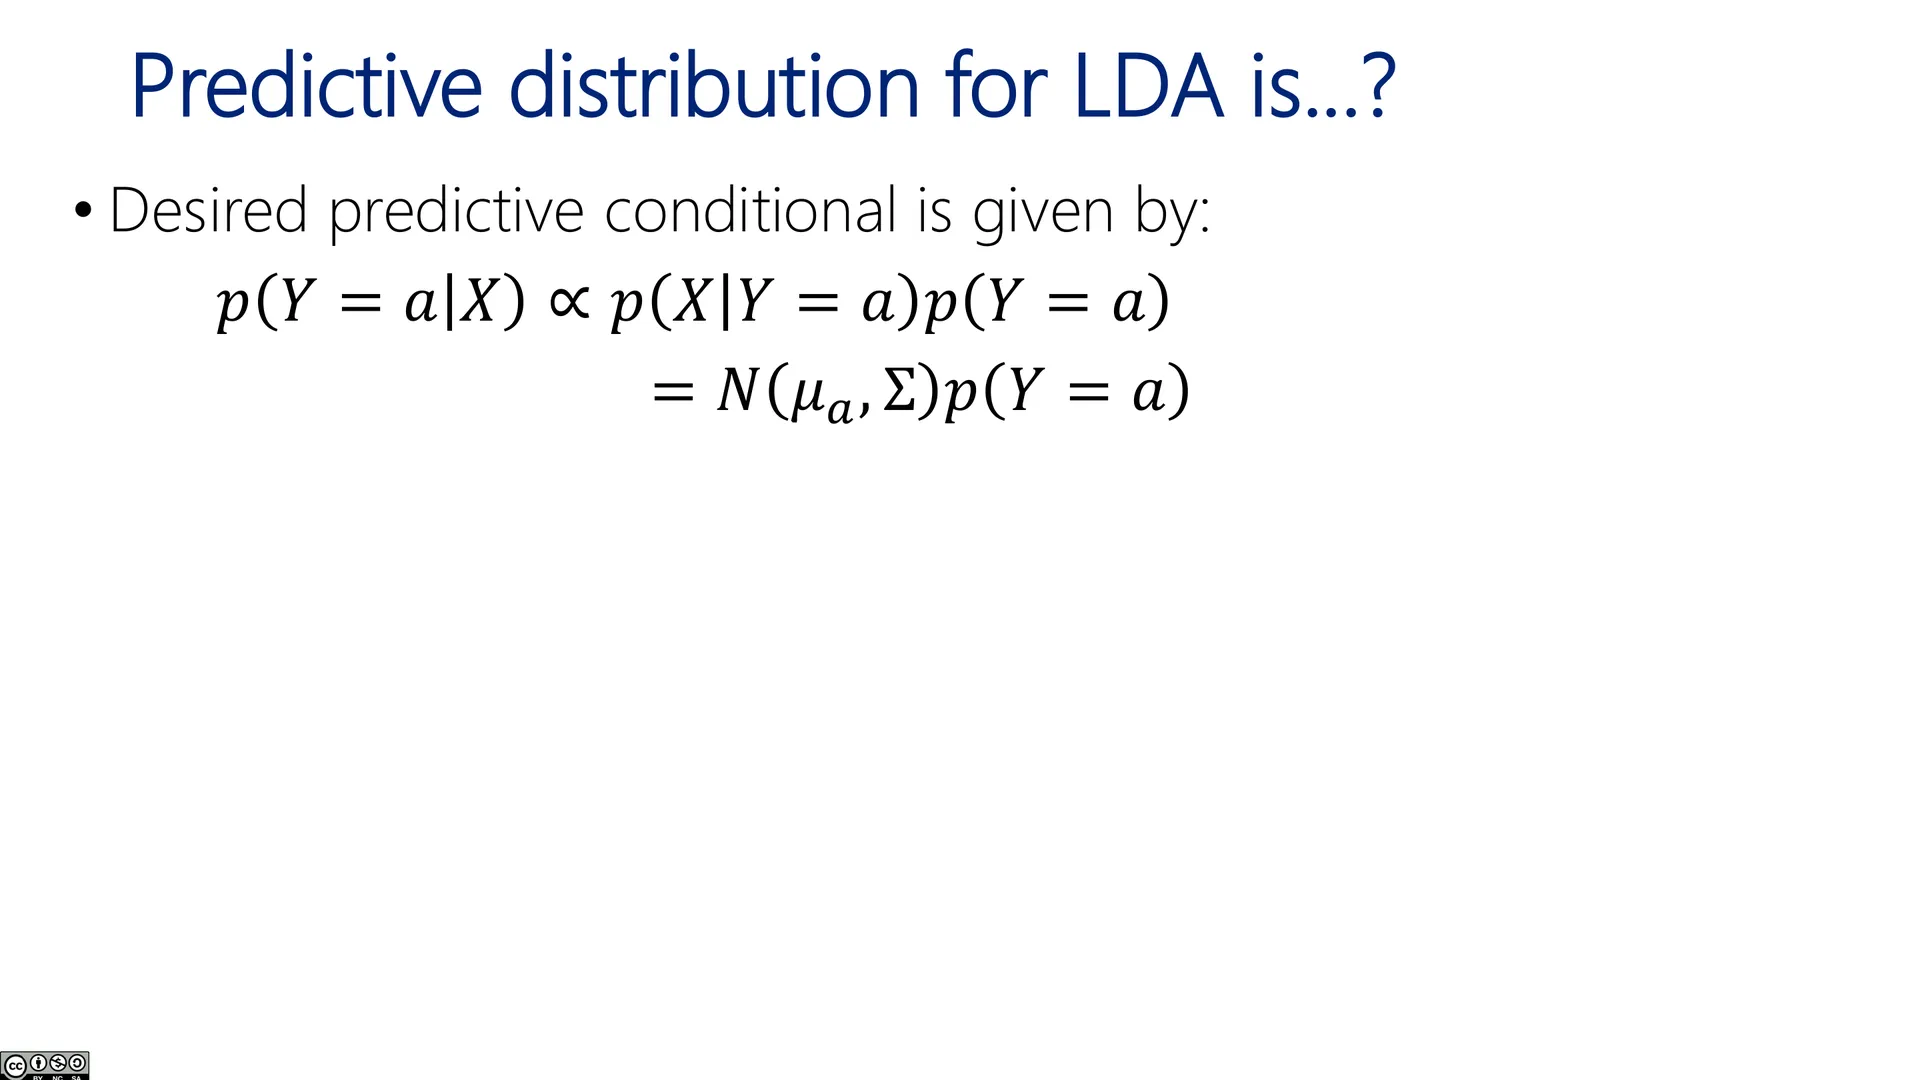
🖼️ LDA 的预测分布
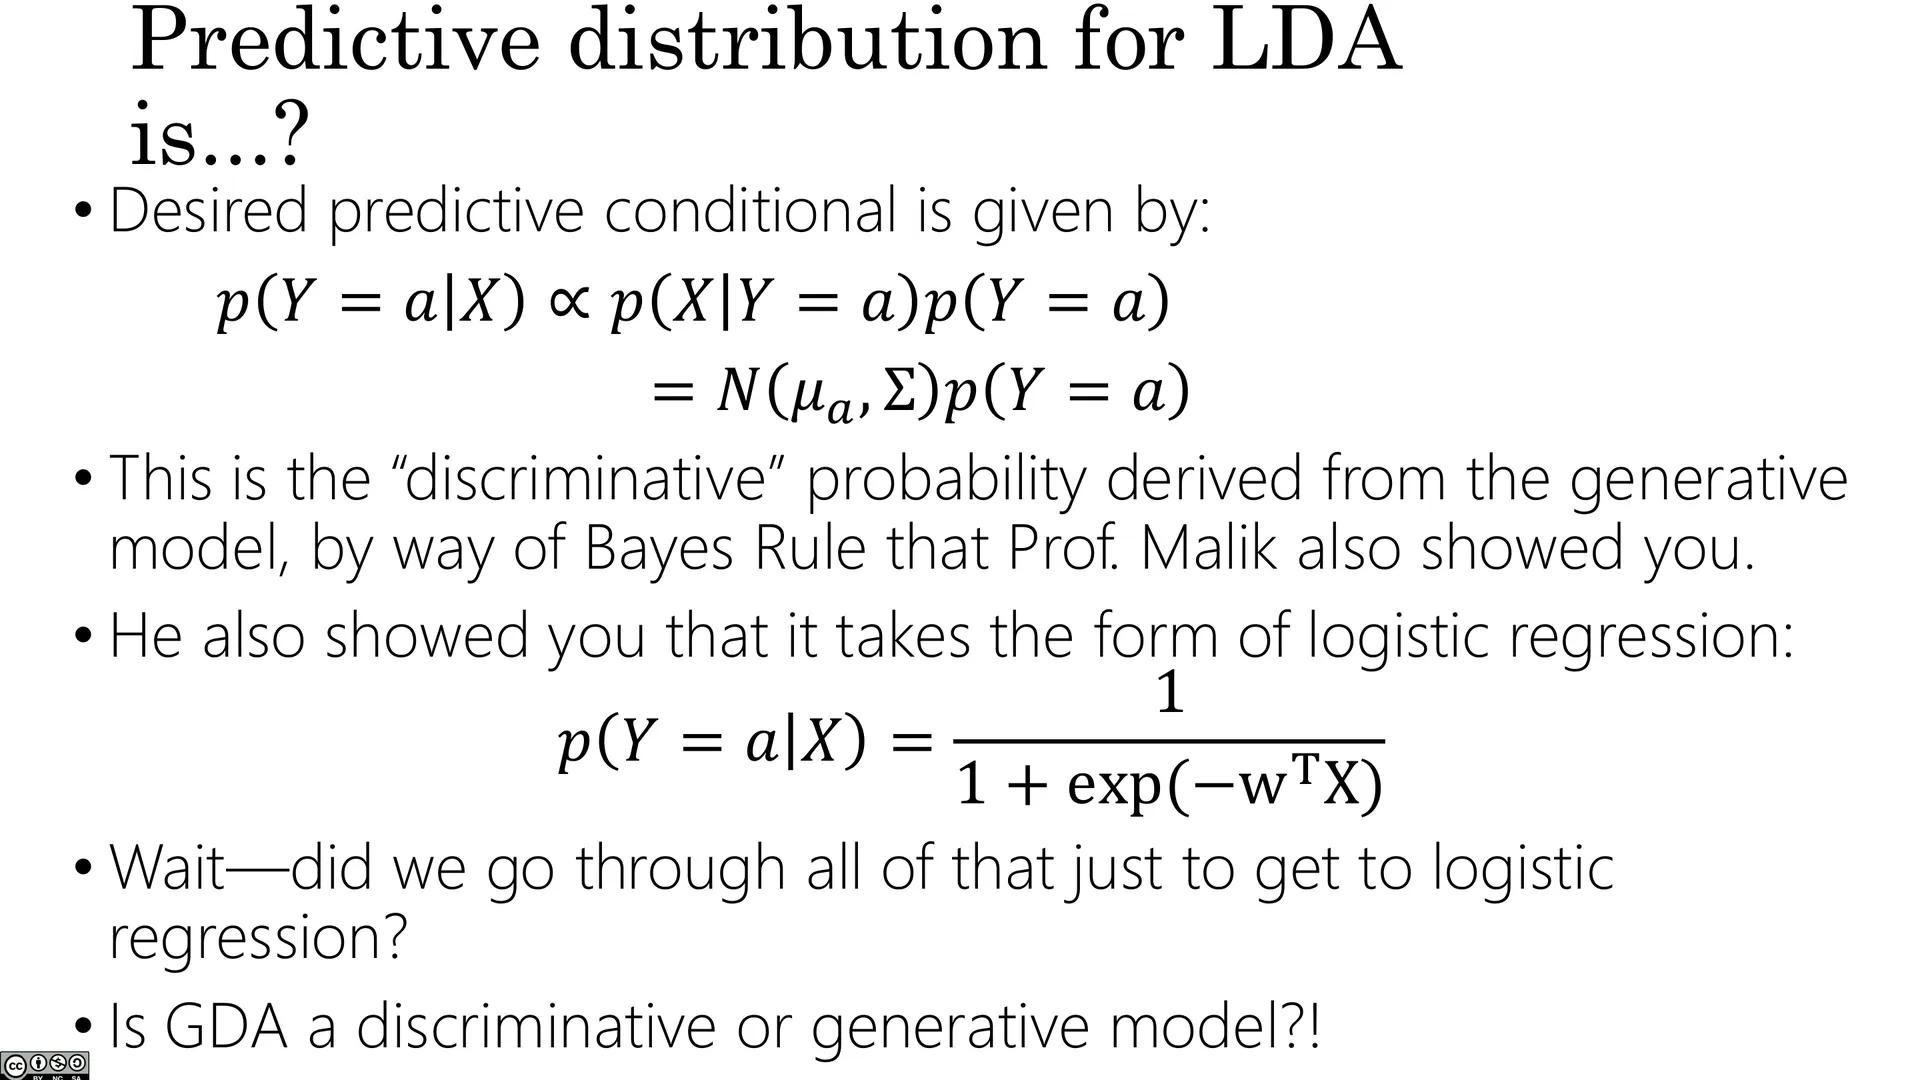
🖼️ 期望的预测条件分布
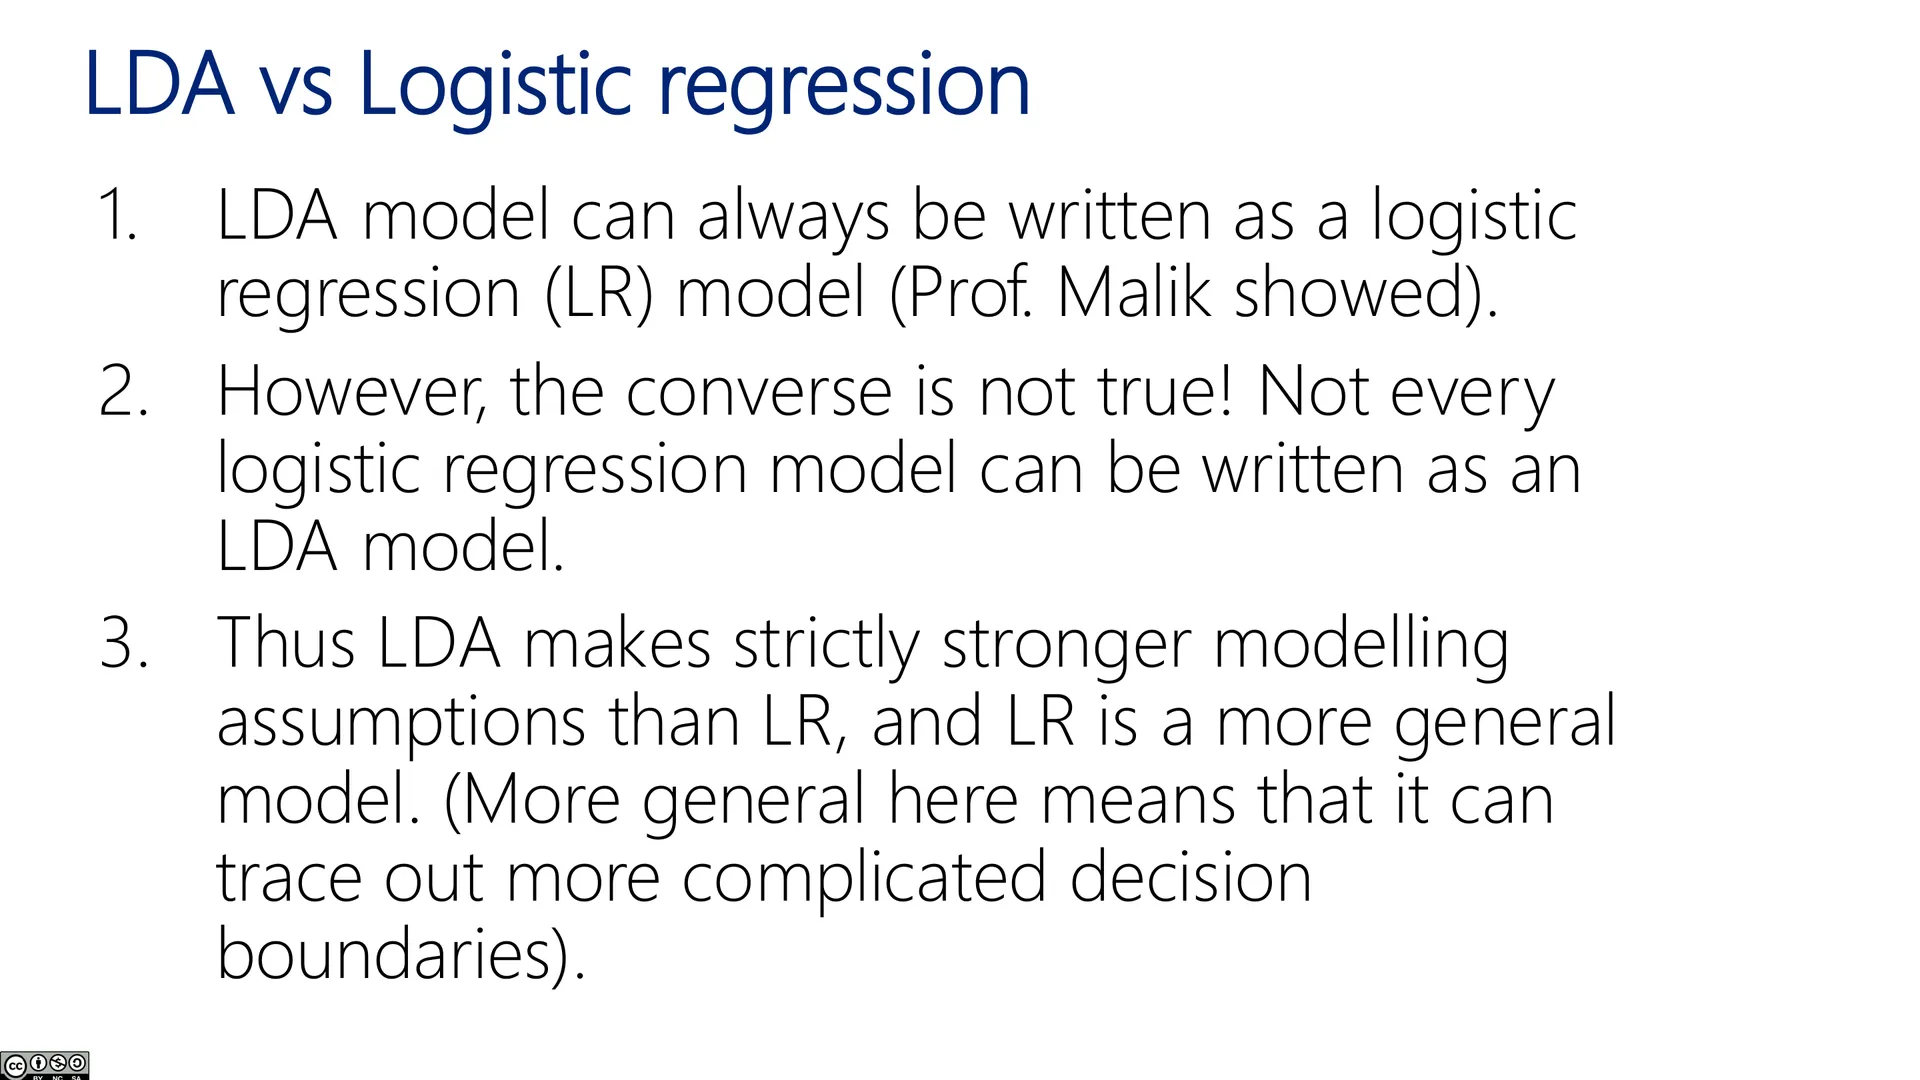
🖼️ LDA vs 逻辑回归
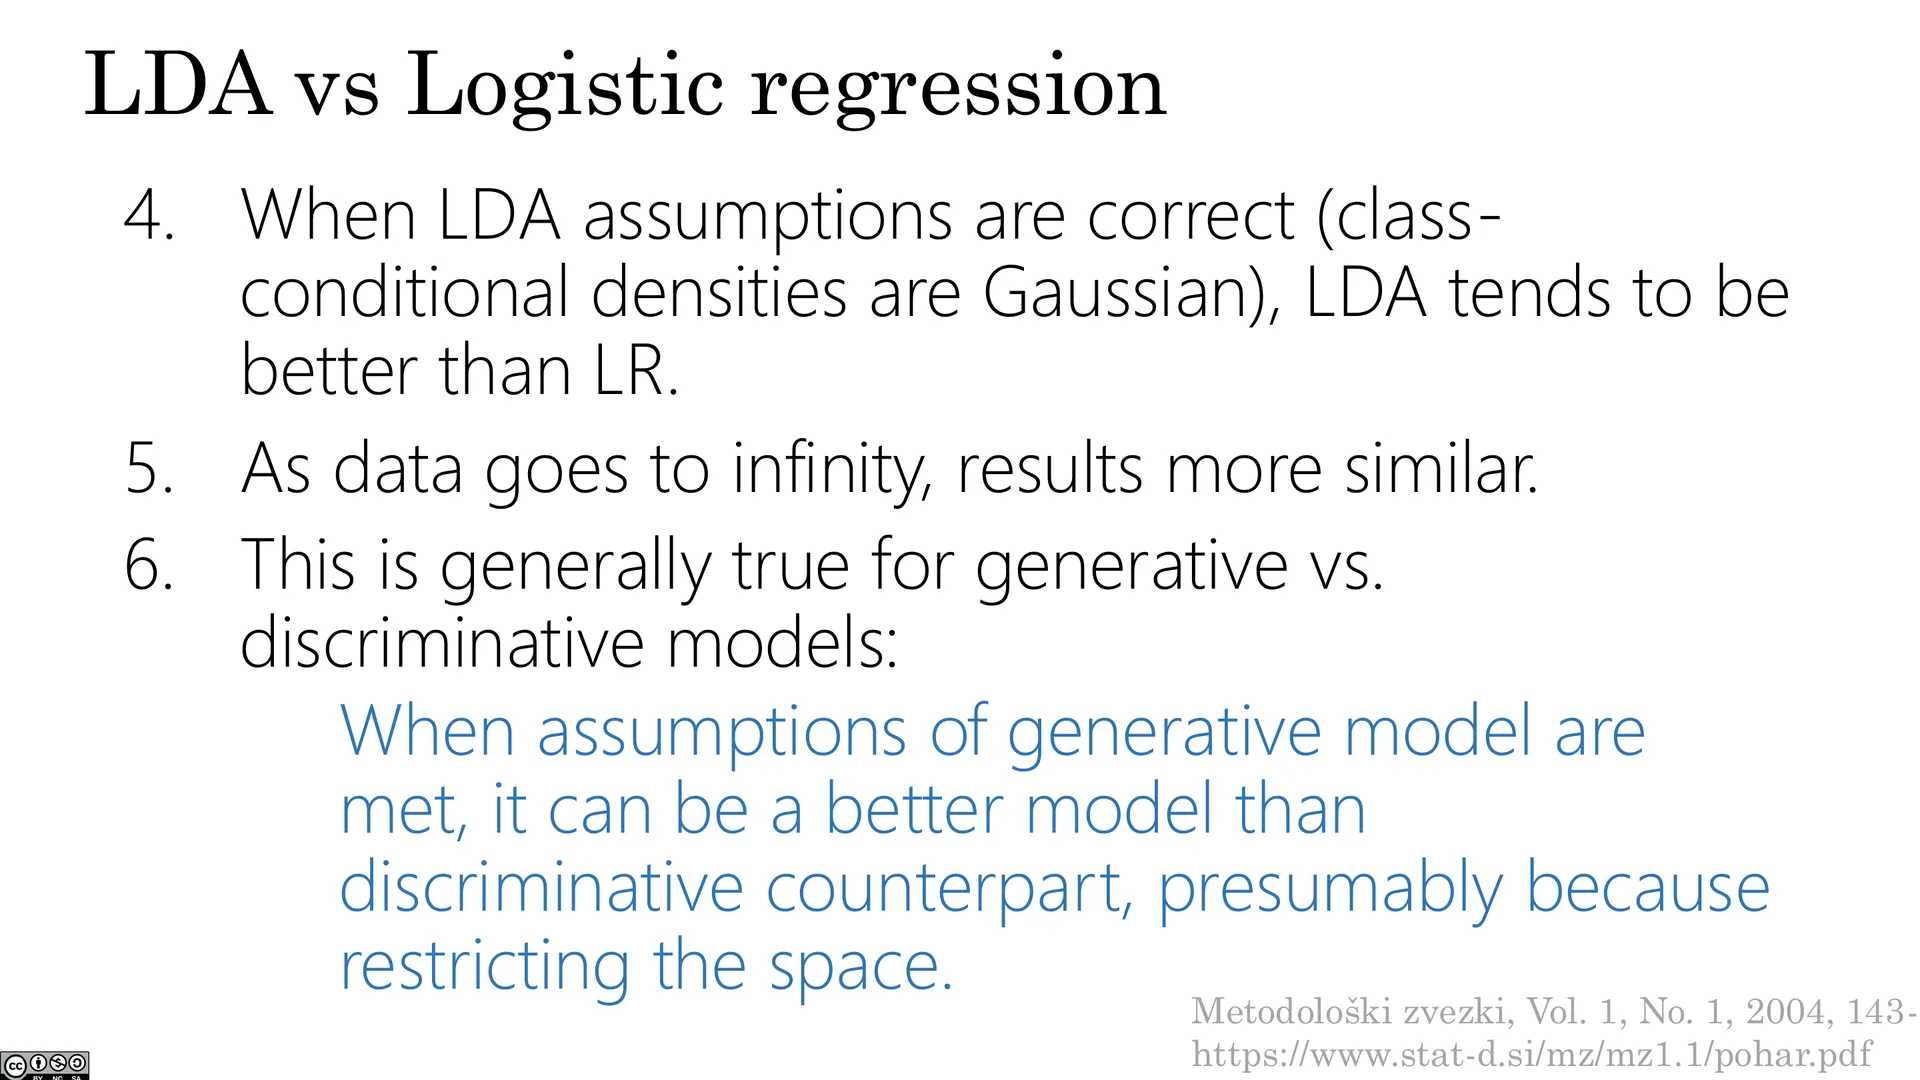
🖼️ (小结)
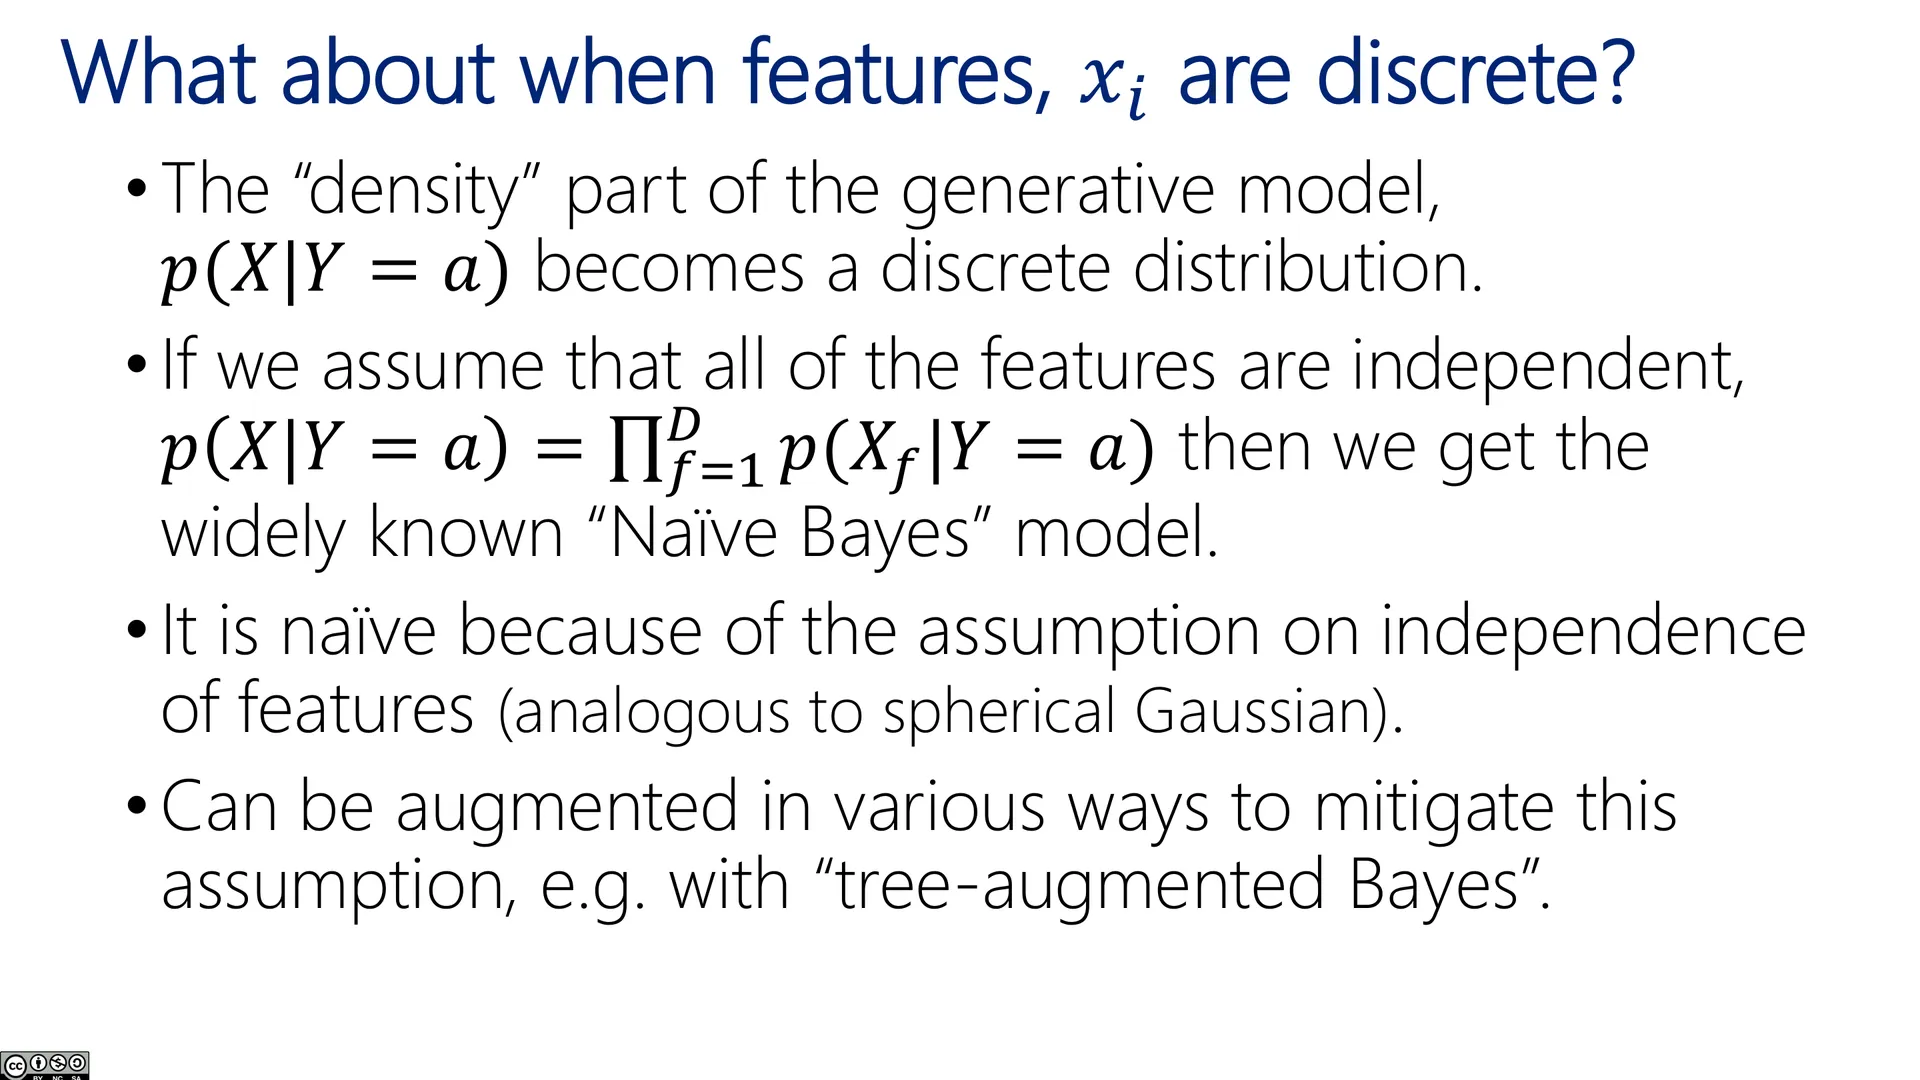
🖼️ 当特征离散时
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=SlkUTrXY60E |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 10) | Google Drive PDF |
| 教材 Machine Learning: A First Course for Engineers and Scientists | 正则化(Ridge/Lasso)、模型选择、分类相关章节 · https://doi.org/10.1017/9781108919371 |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。