第12讲 · EECS 189:逻辑回归与分类器评估
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | Logistic Regression, Classifier Accuracy |
| 视频 | https://www.youtube.com/watch?v=xBCpwQt8A5w |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 12) | Google Drive PDF |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第12讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
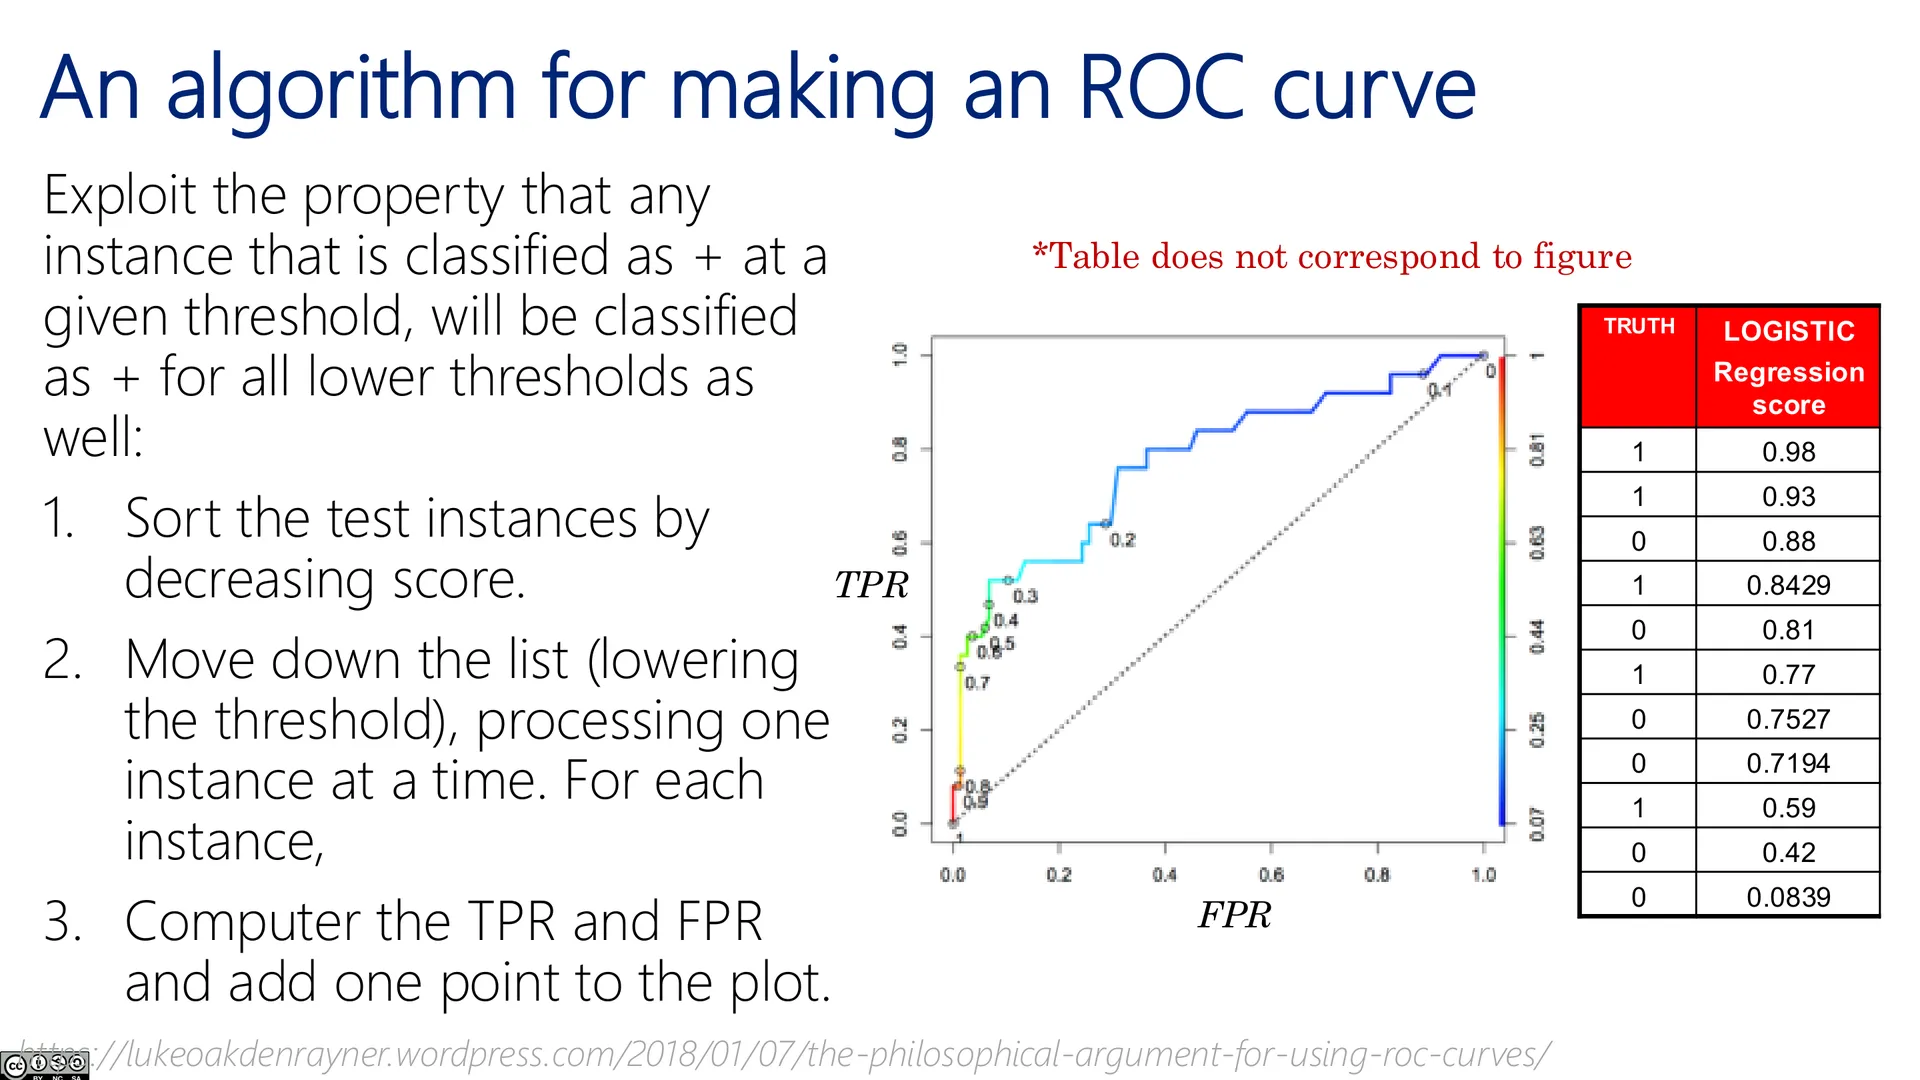
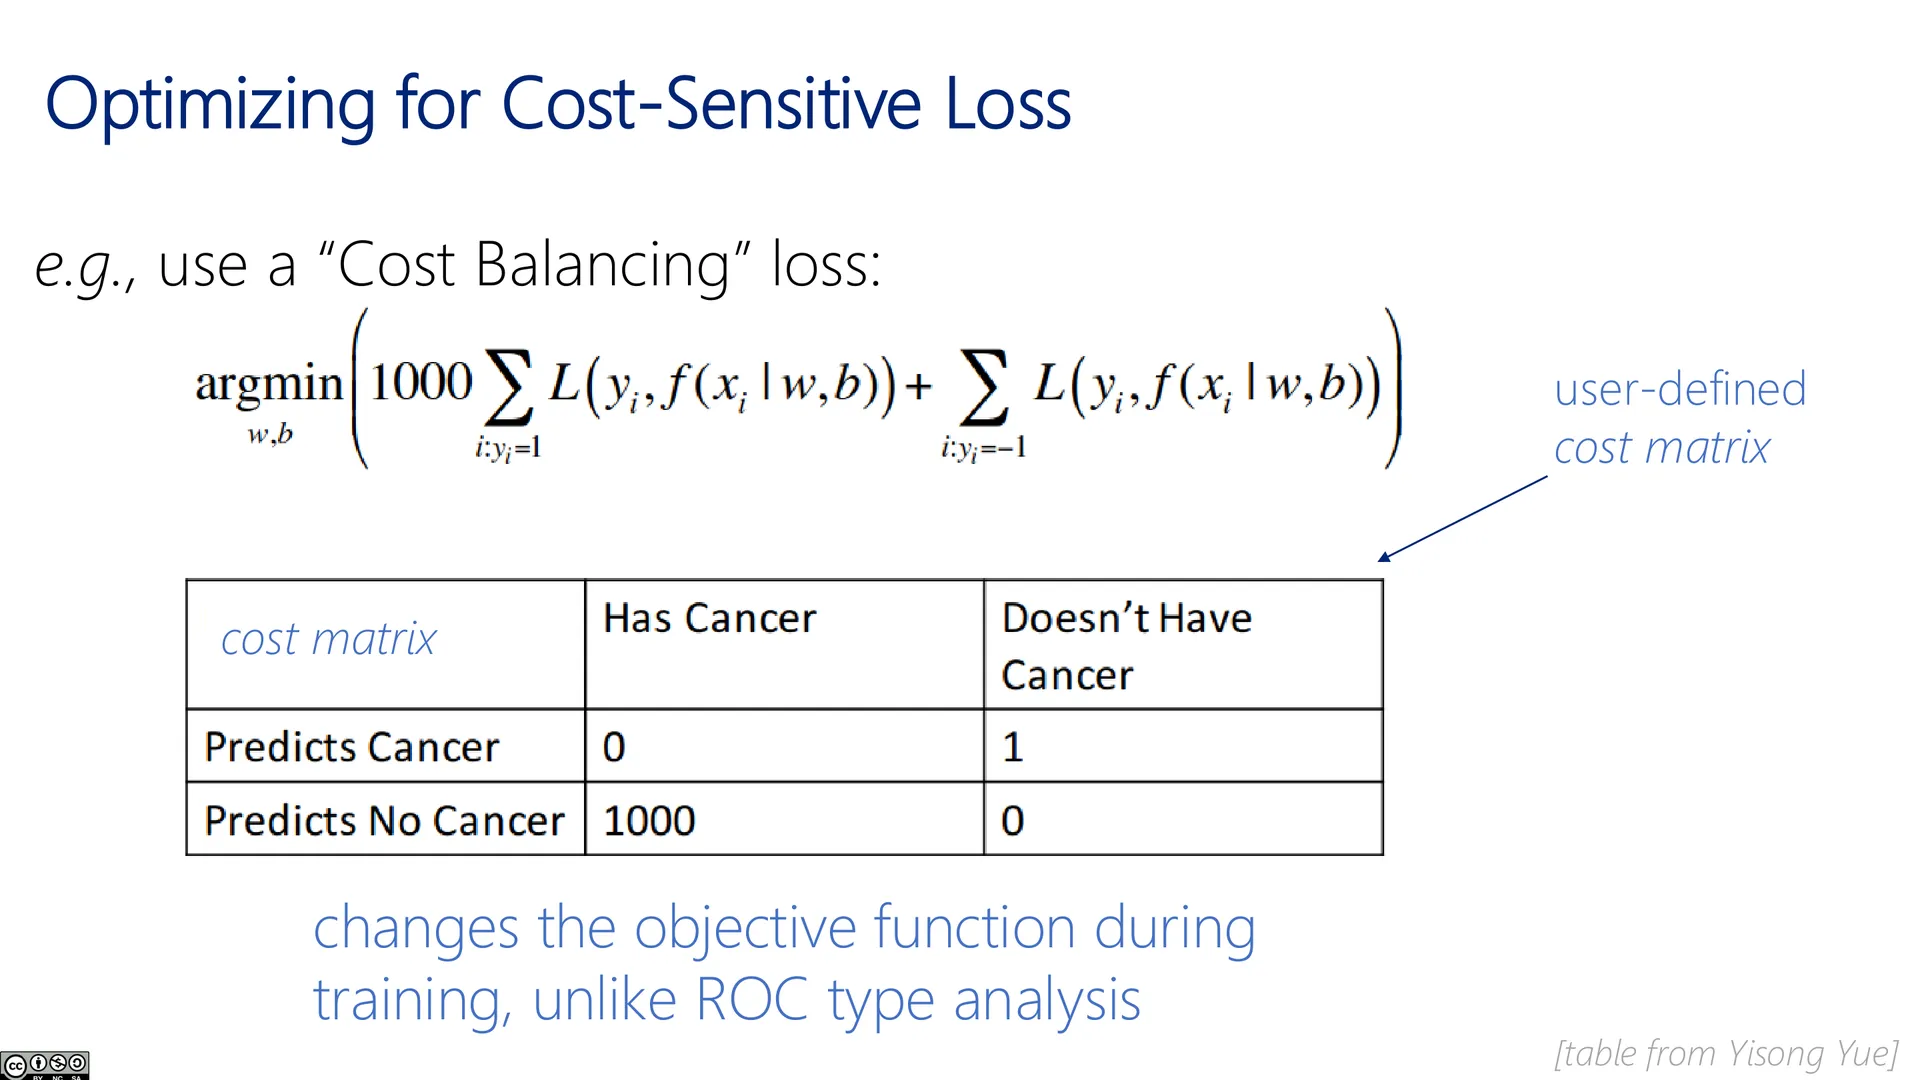
编者说明:本讲 deck 共 61 页,课堂讲到「精确率—召回率曲线」;标注「not responsible」的 ROC 算法细节与代价敏感学习(第 53–61 页)收录于文末附录。
本讲路线图
(参考时间: 00:00)
- 逻辑回归(判别式分类):sigmoid、softmax、MLE(无闭式解 → 梯度下降);
- 分类器评估:校准、混淆矩阵、ROC / AUC、精确率 / 召回率。
📷 标题页
回到原视频 (00:00:17)
一、从生成式到判别式
(参考时间: 00:00)
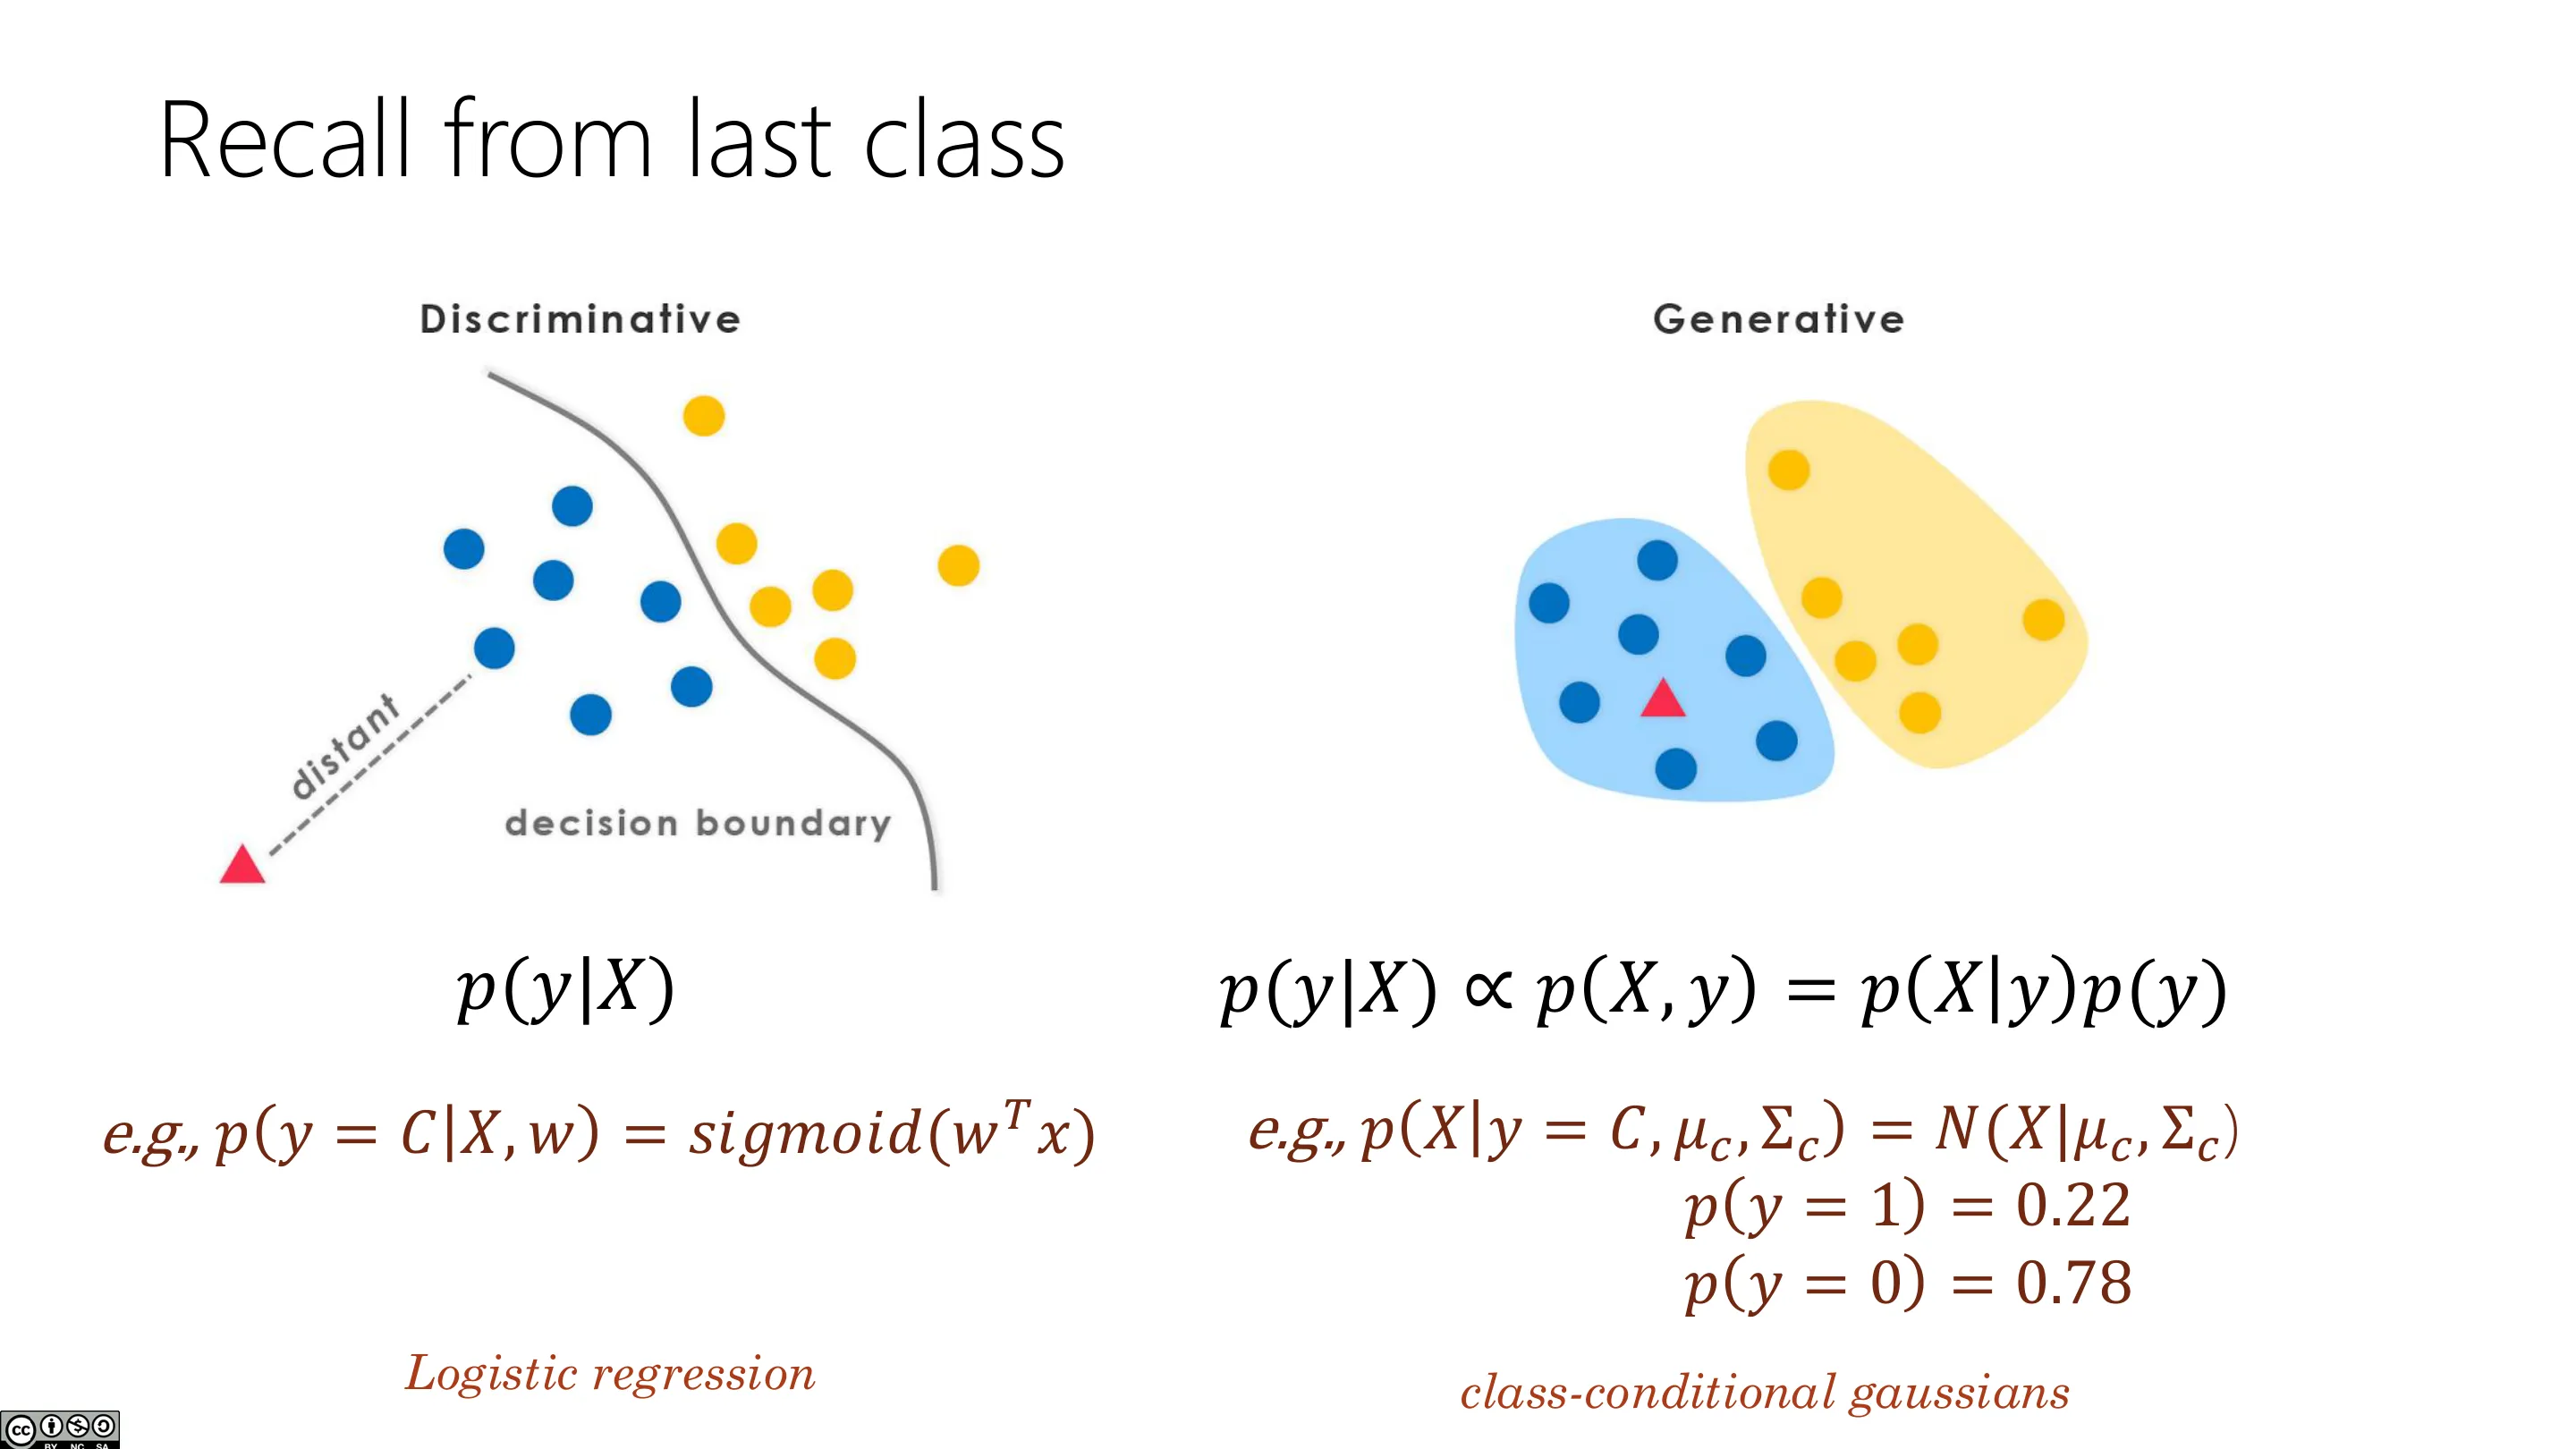
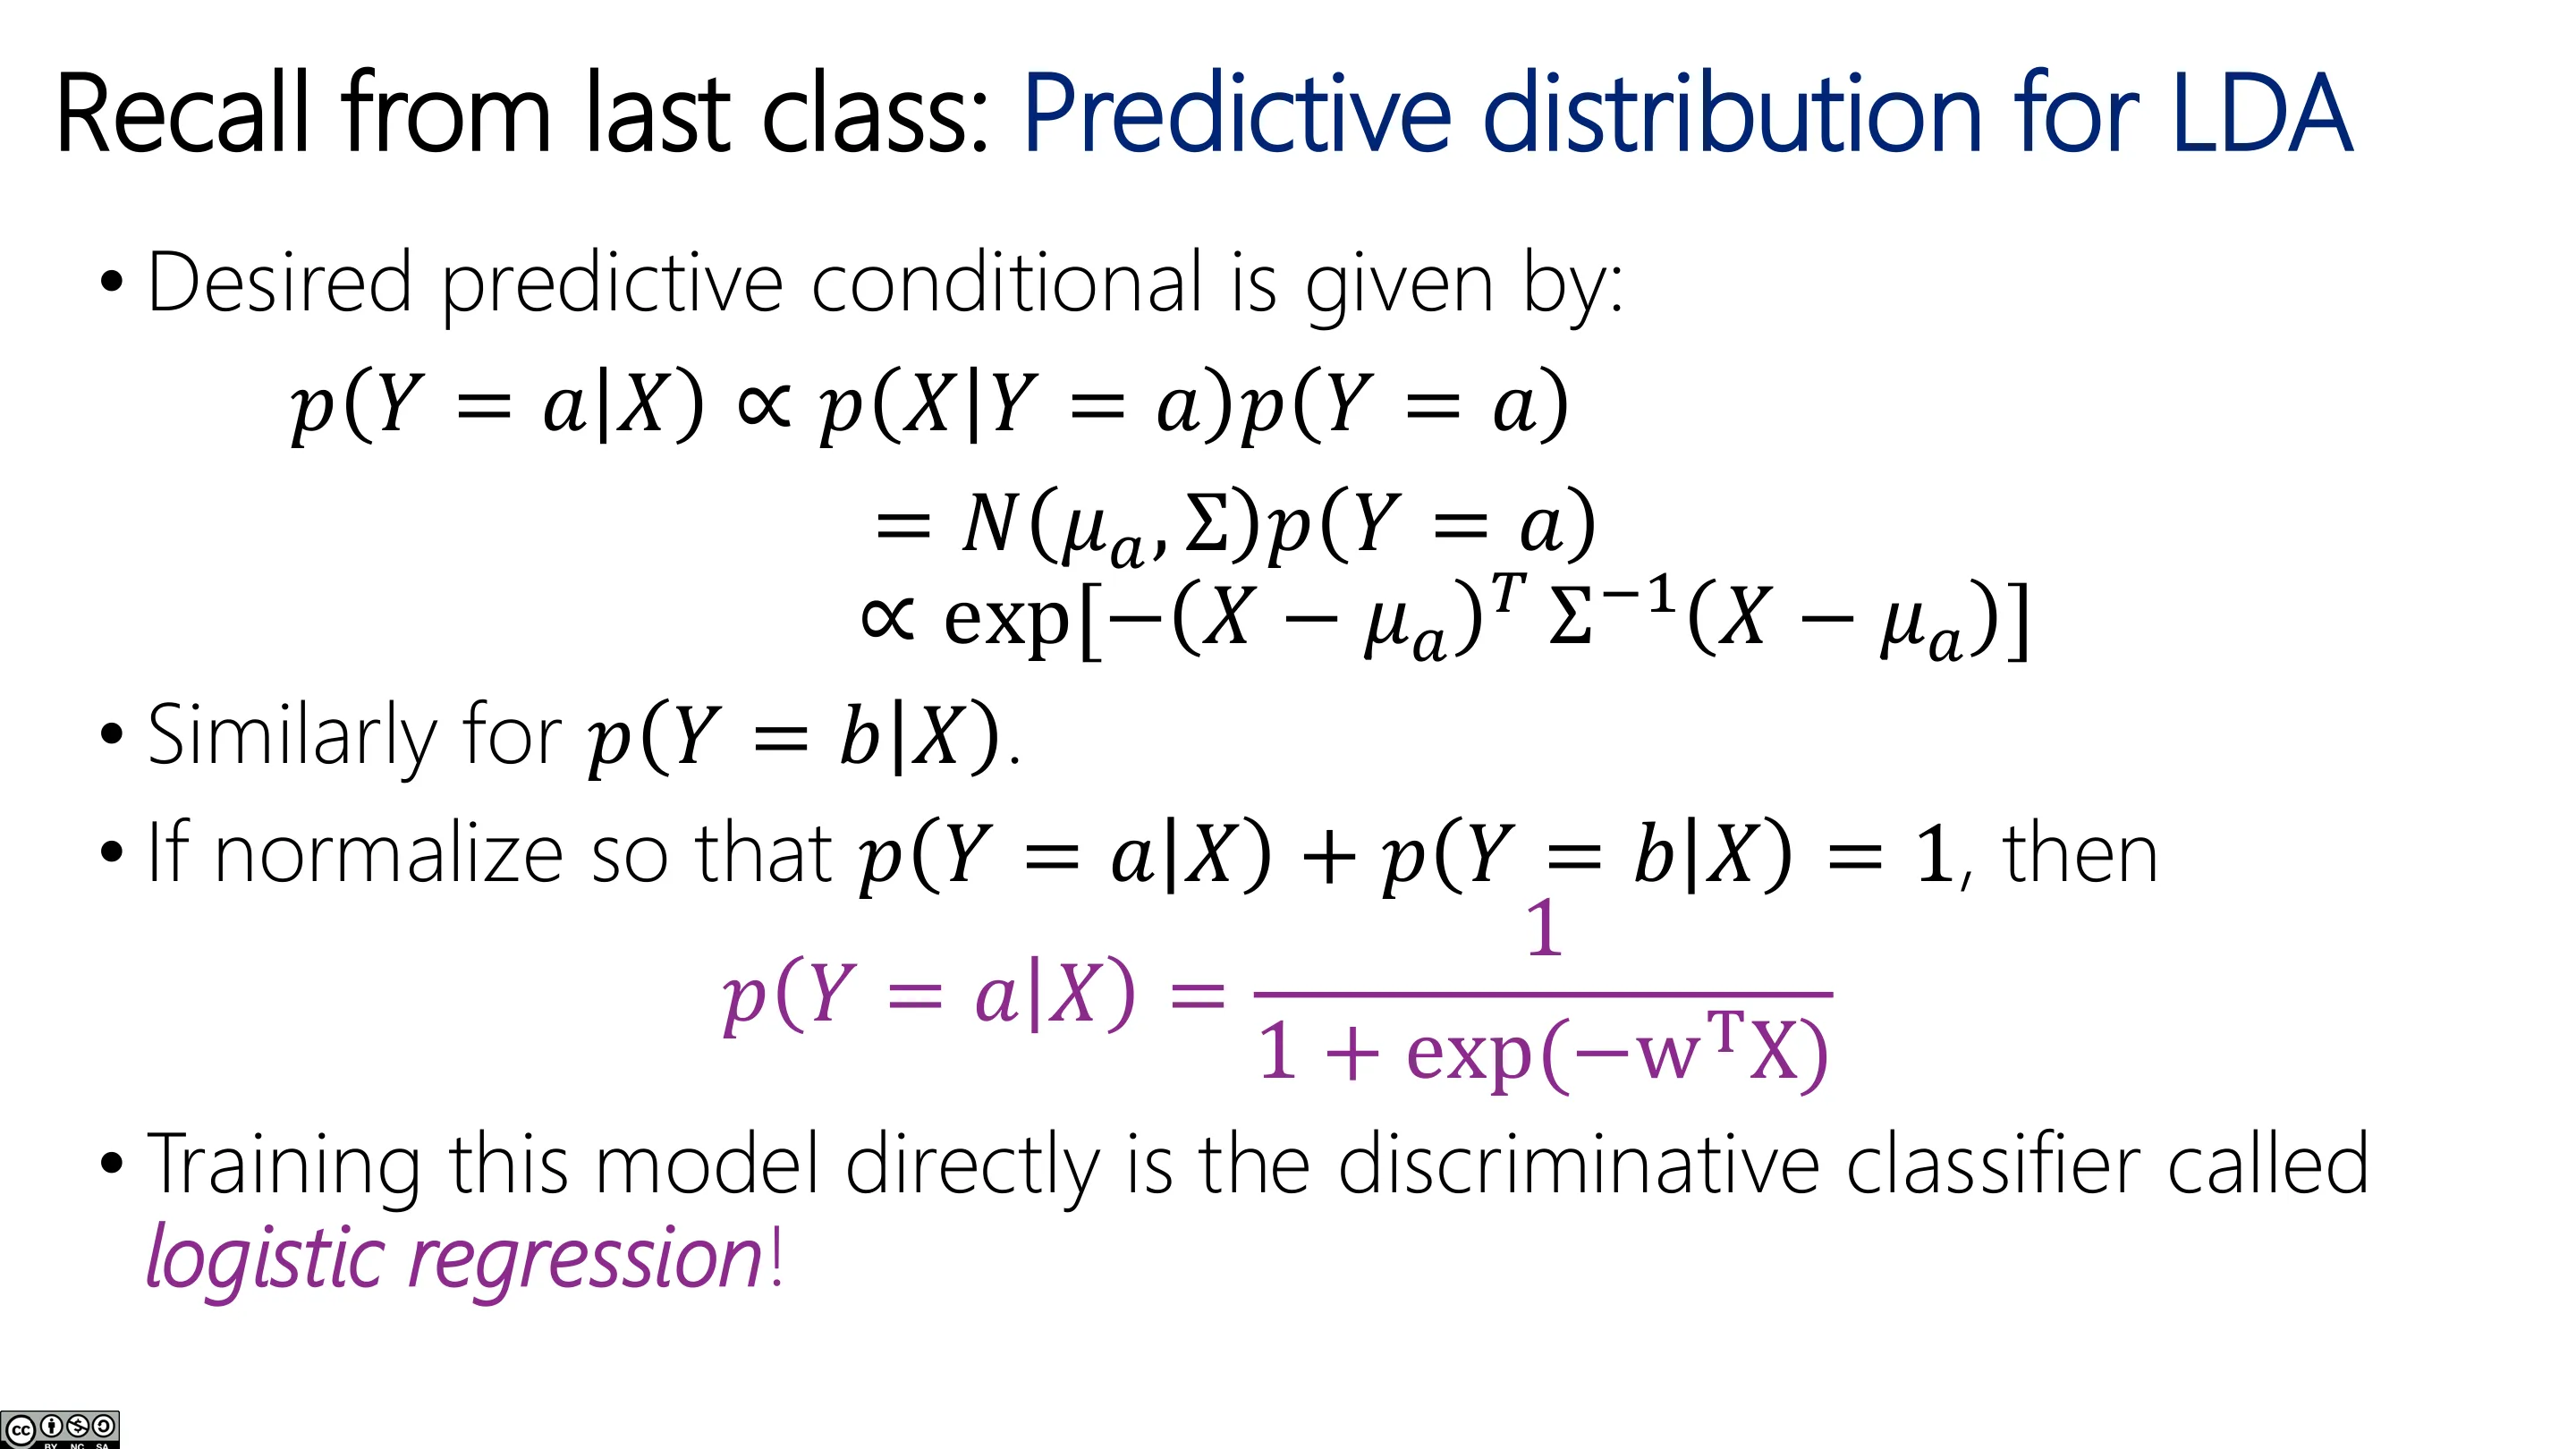
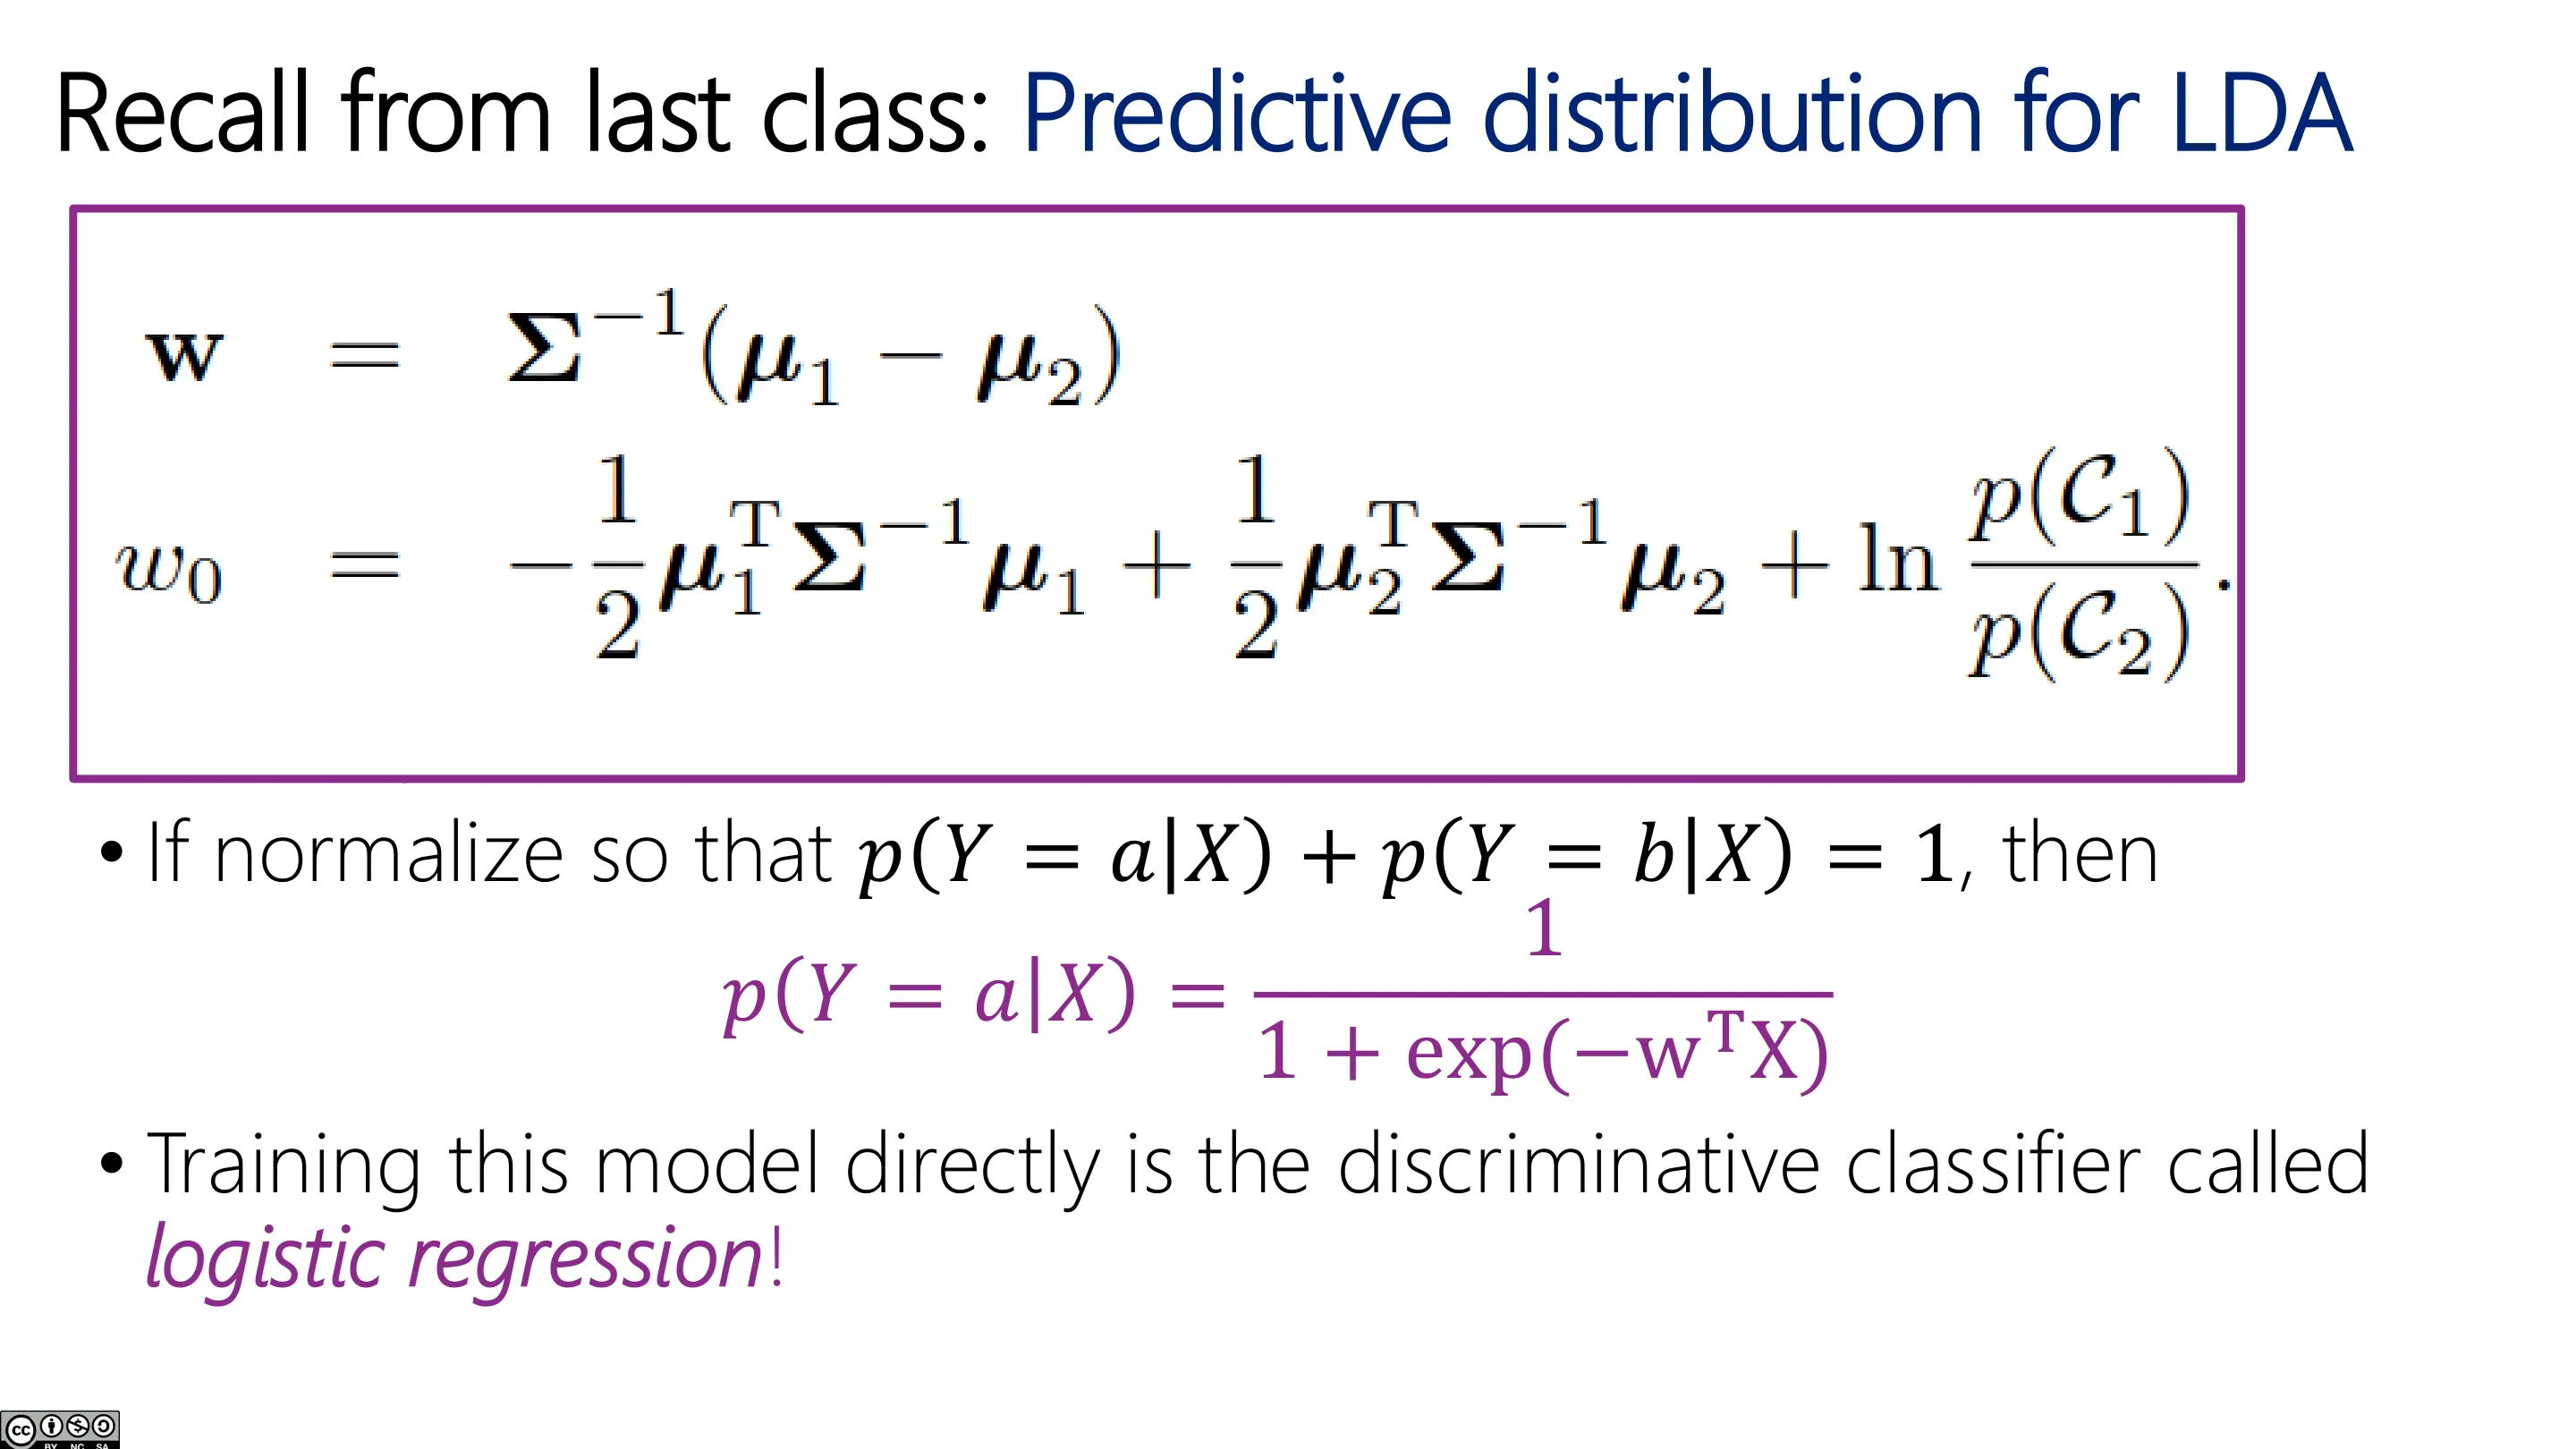
上一讲:高斯判别分析(GDA)是生成式——建模类条件高斯 $p(x\mid y)$ 与先验 $p(y)$,再用贝叶斯规则得到 $p(y\mid x)$。可以证明,这样得到的 $p(y=1\mid x)$ 恰好有 sigmoid 形式,只是 $w$ 被约束成「协方差与均值差的特定函数」。
📷 CS 189/289
回到原视频 (00:00:32)
📷 GDA 导出的 sigmoid 形式
回到原视频 (00:01:05)
📷 p(y|X) ∝ p(X,y)
回到原视频 (00:01:15)
📷 期望的预测条件分布
回到原视频 (00:01:25)
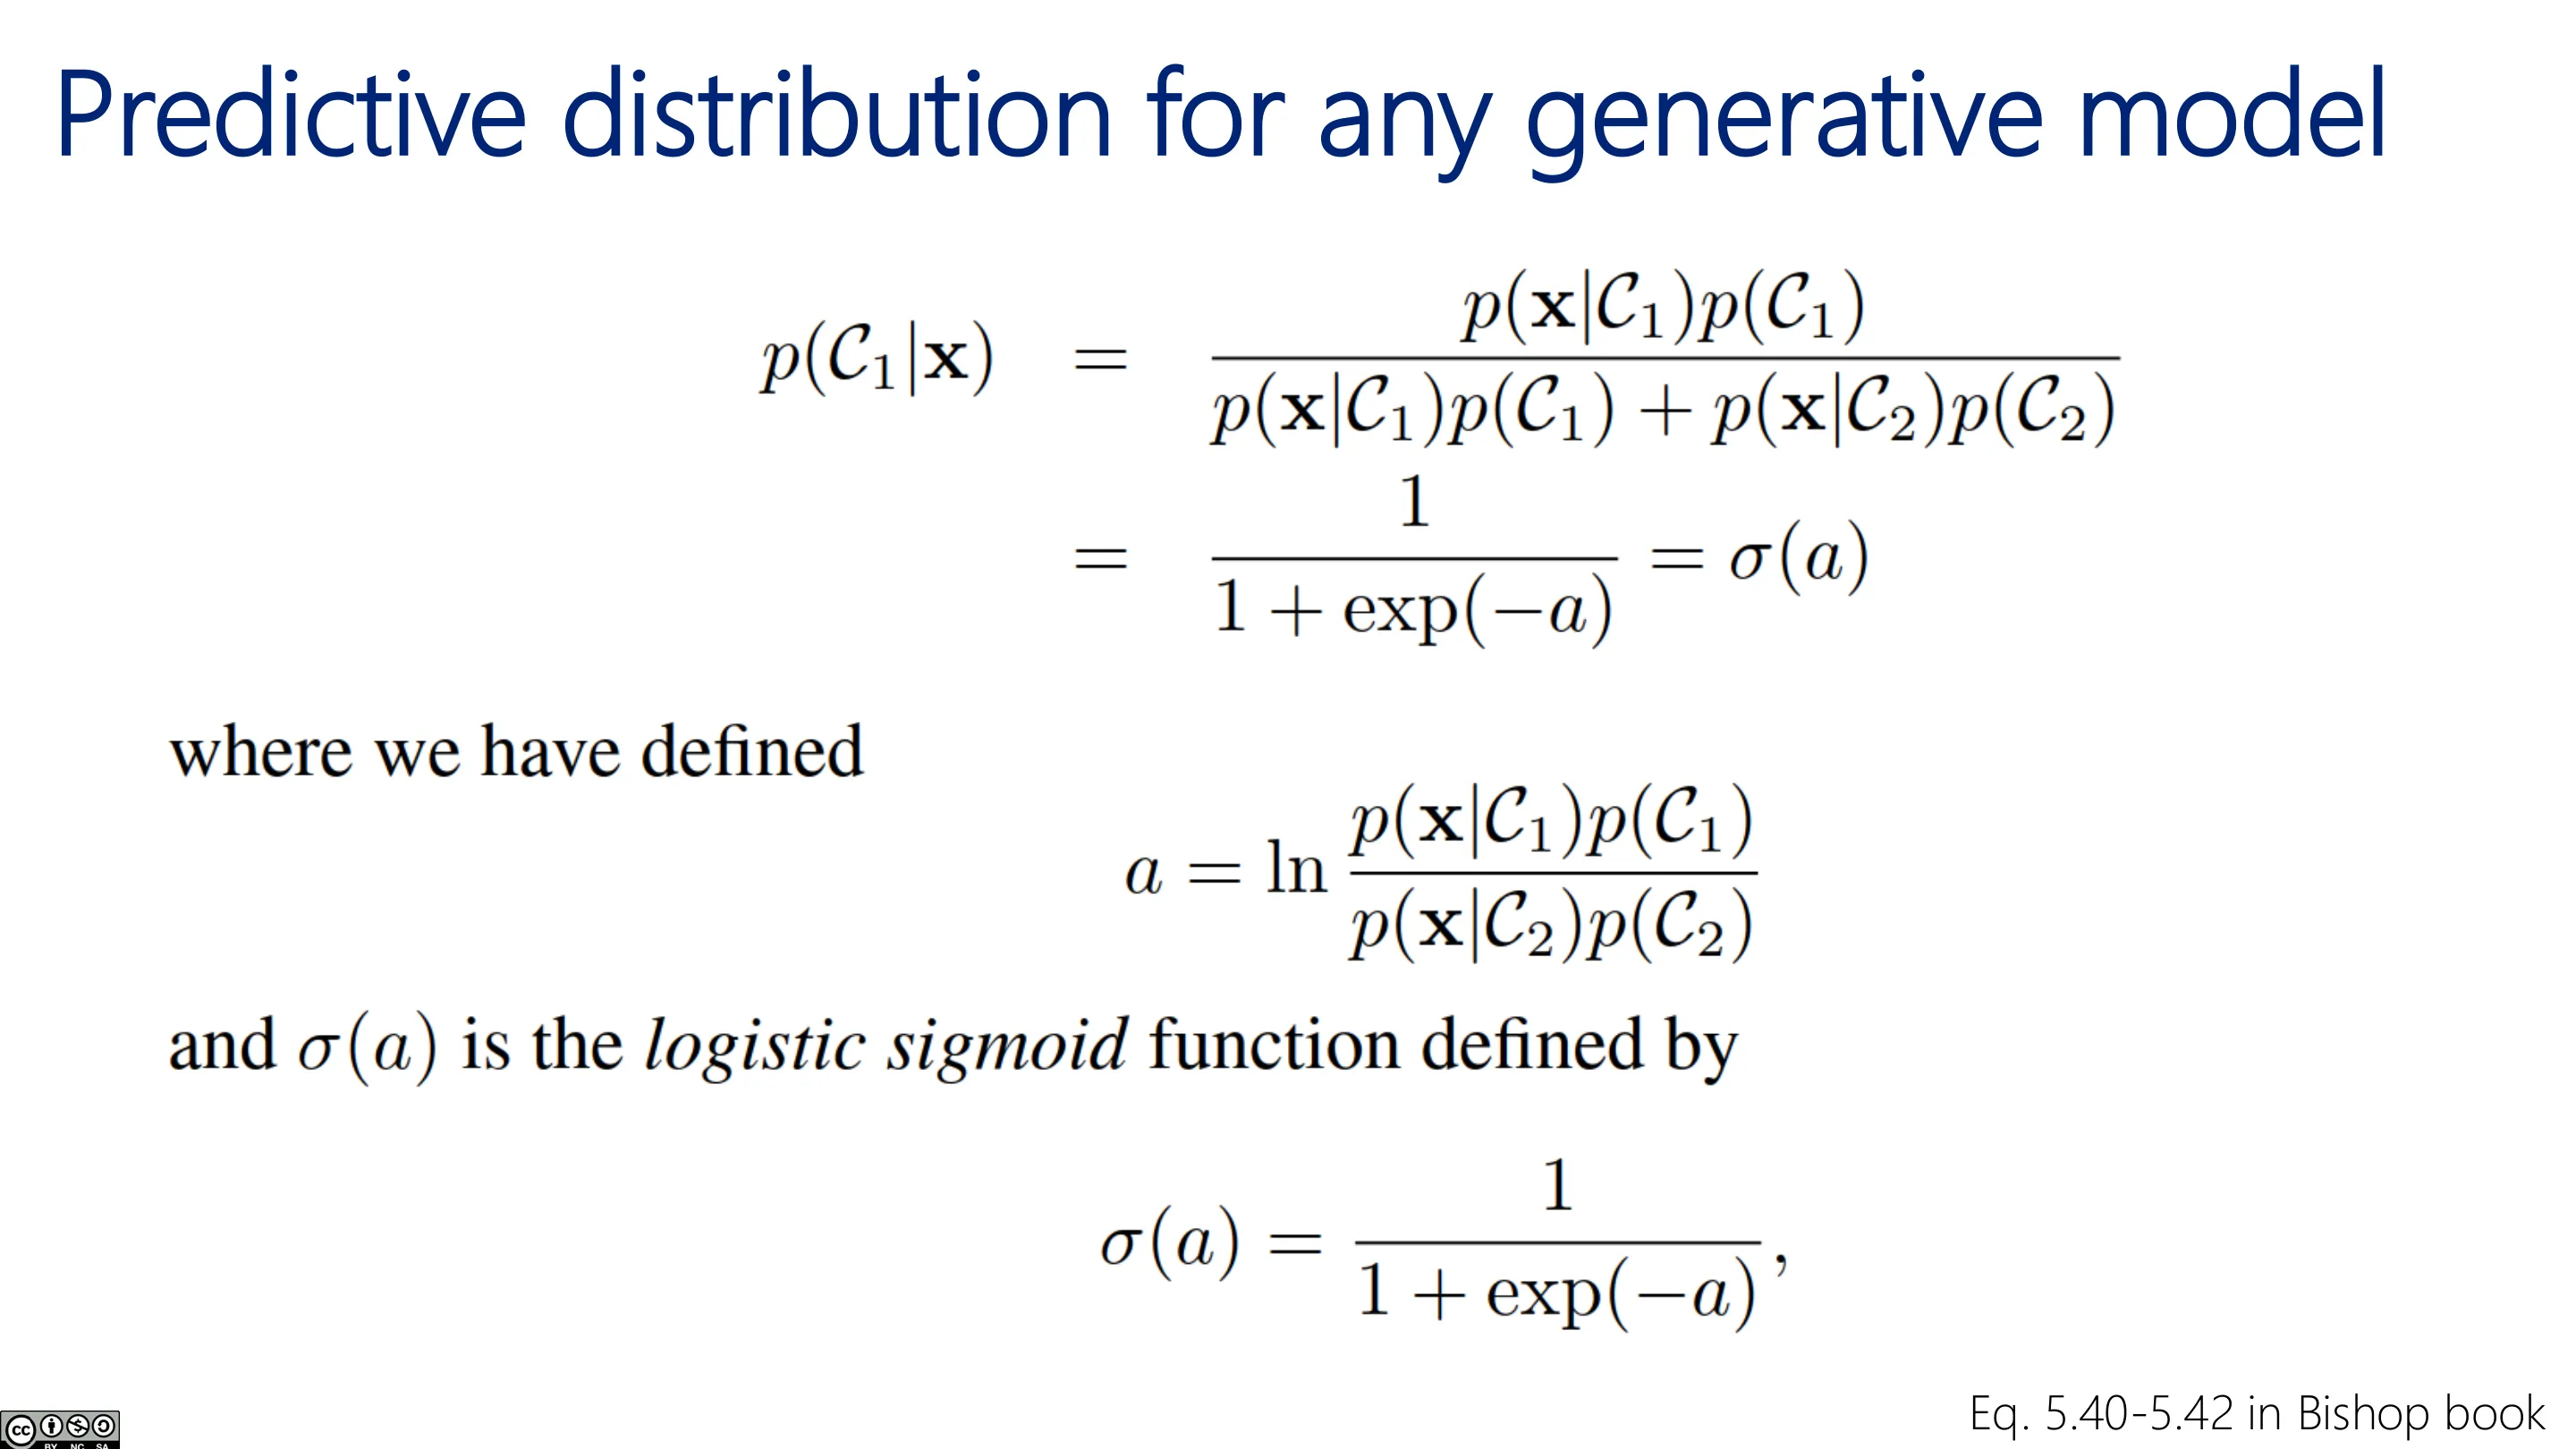
逻辑回归反过来:不假设 X 的分布,直接把 $p(y\mid x)$ 参数化成 sigmoid/softmax,其中 $w$ 可以是任意值(比 GDA 更灵活),再用 MLE 拟合。
📷 任意生成模型的预测分布
回到原视频 (00:02:28)
📷 期望的预测条件分布(续)
回到原视频 (00:03:47)
二、逻辑回归
2.1 Sigmoid
(参考时间: 00:05)
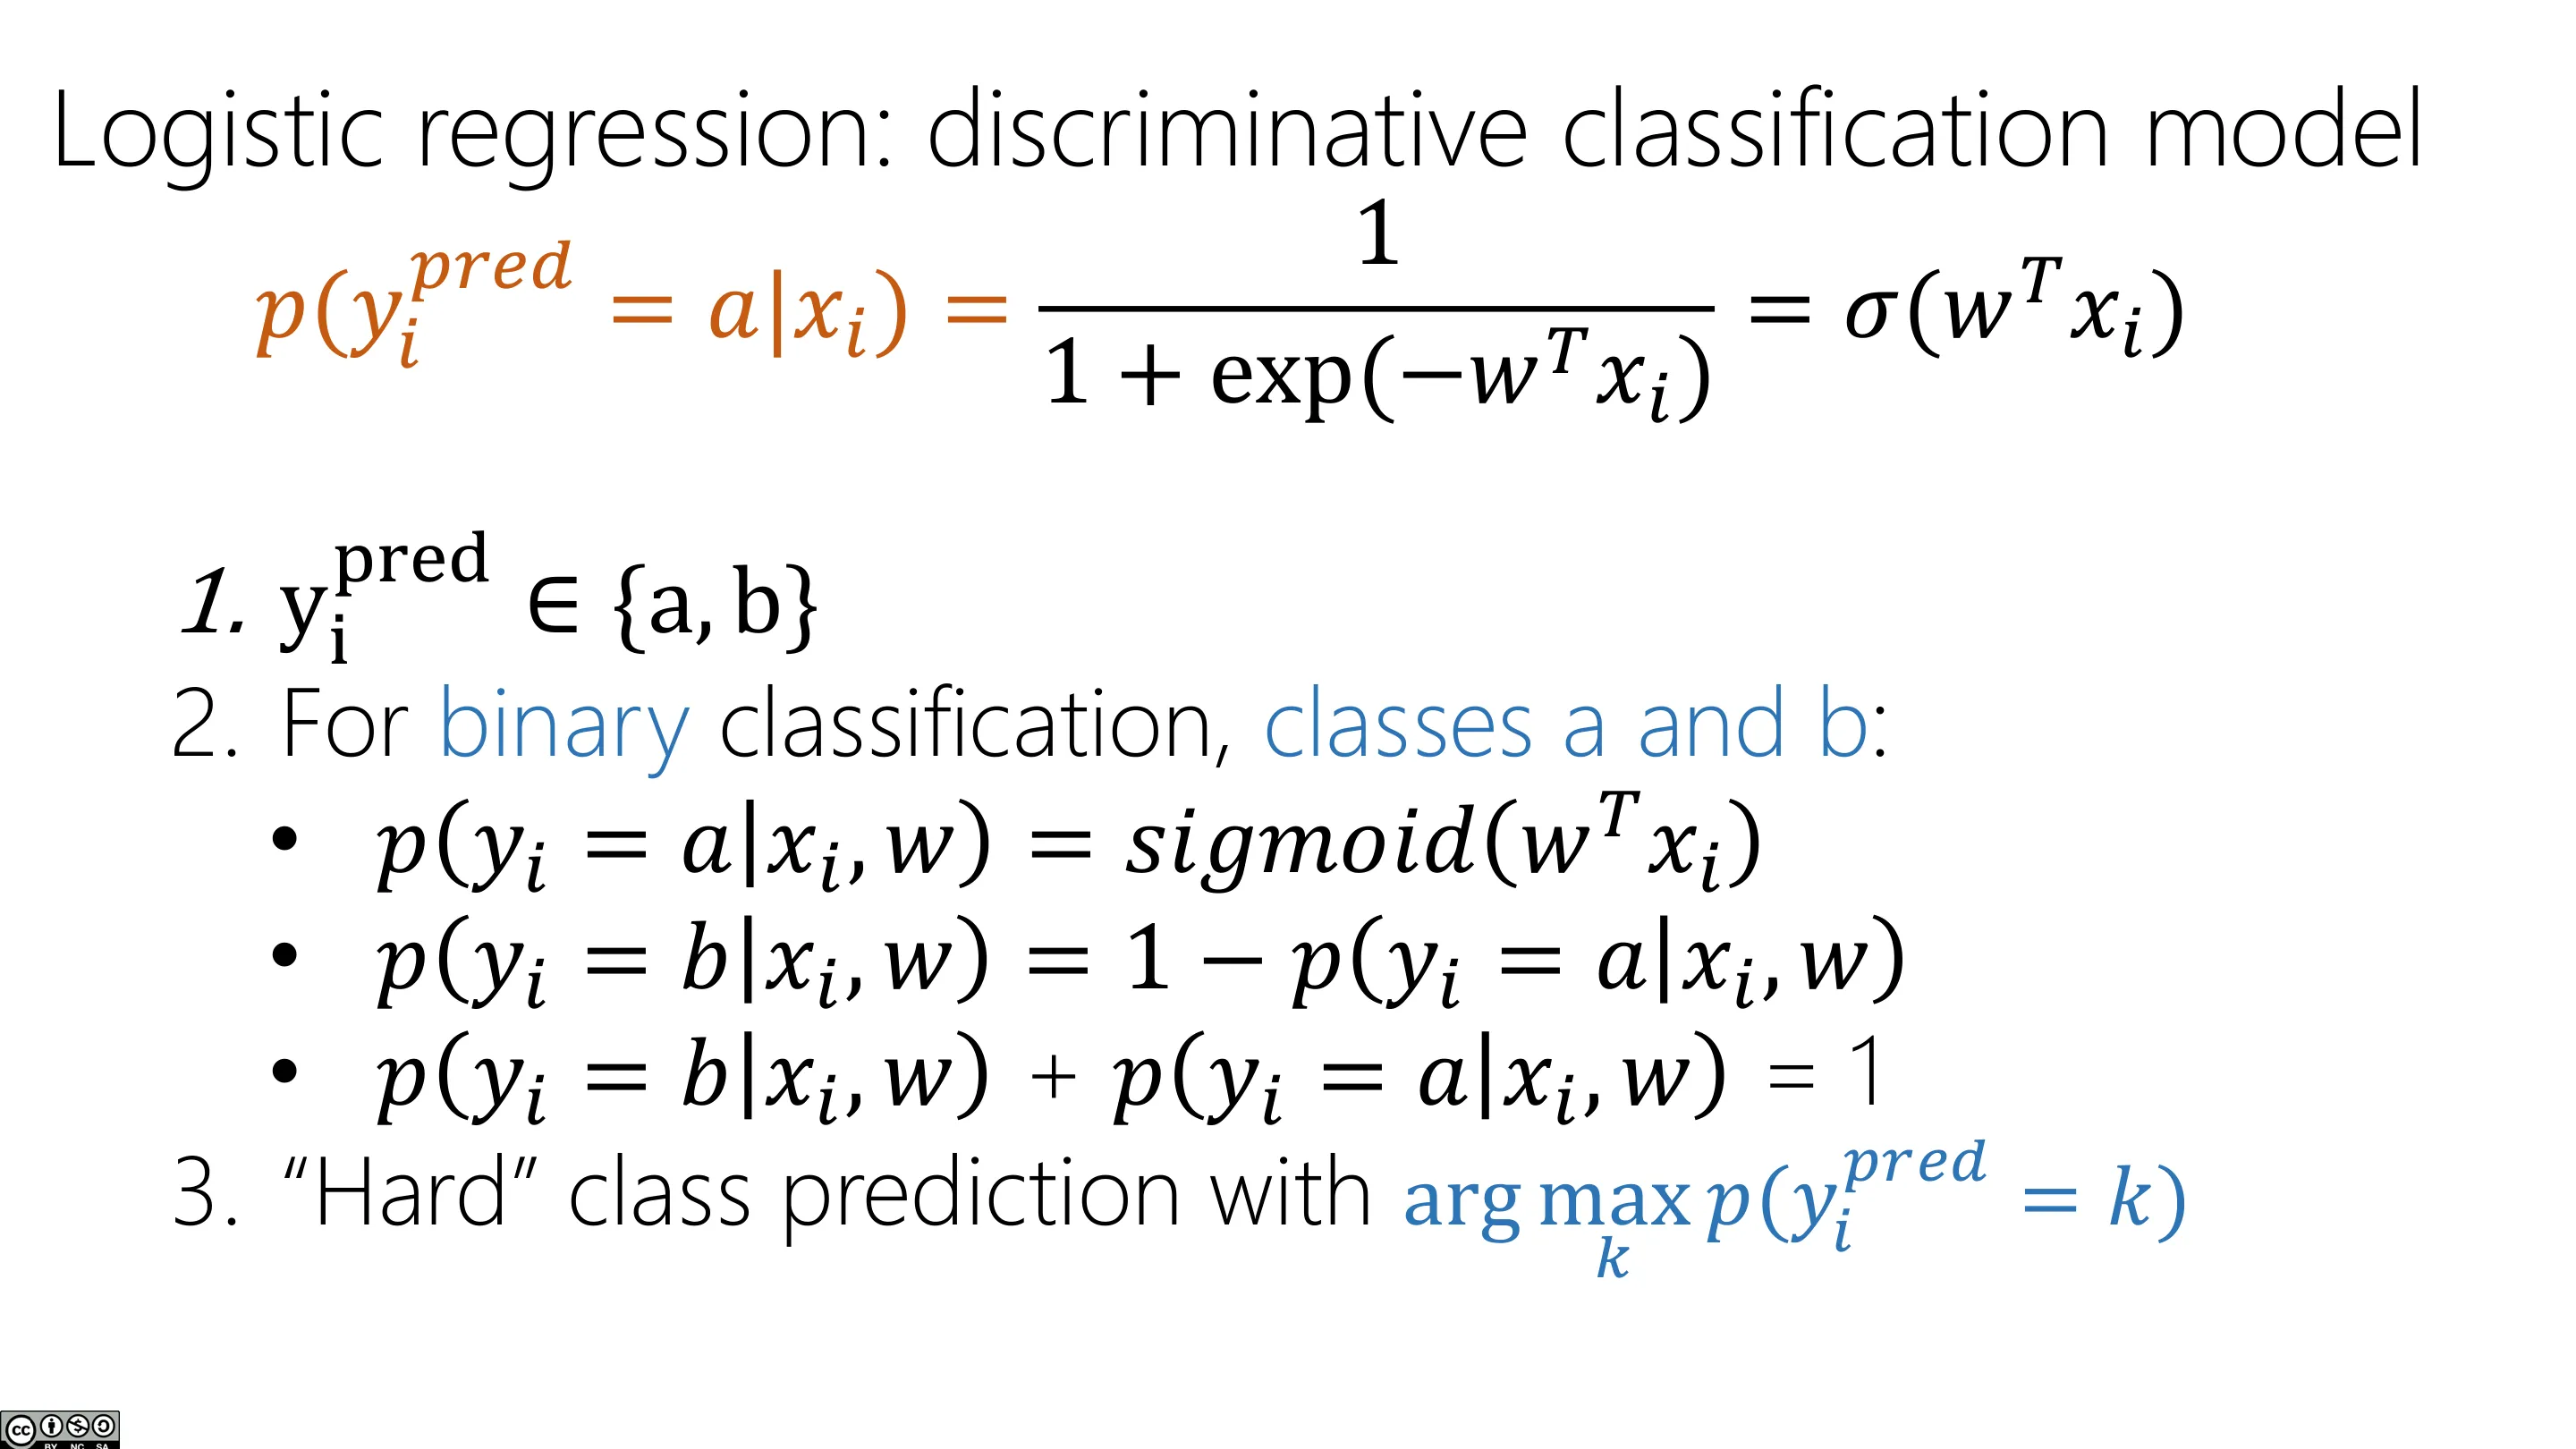
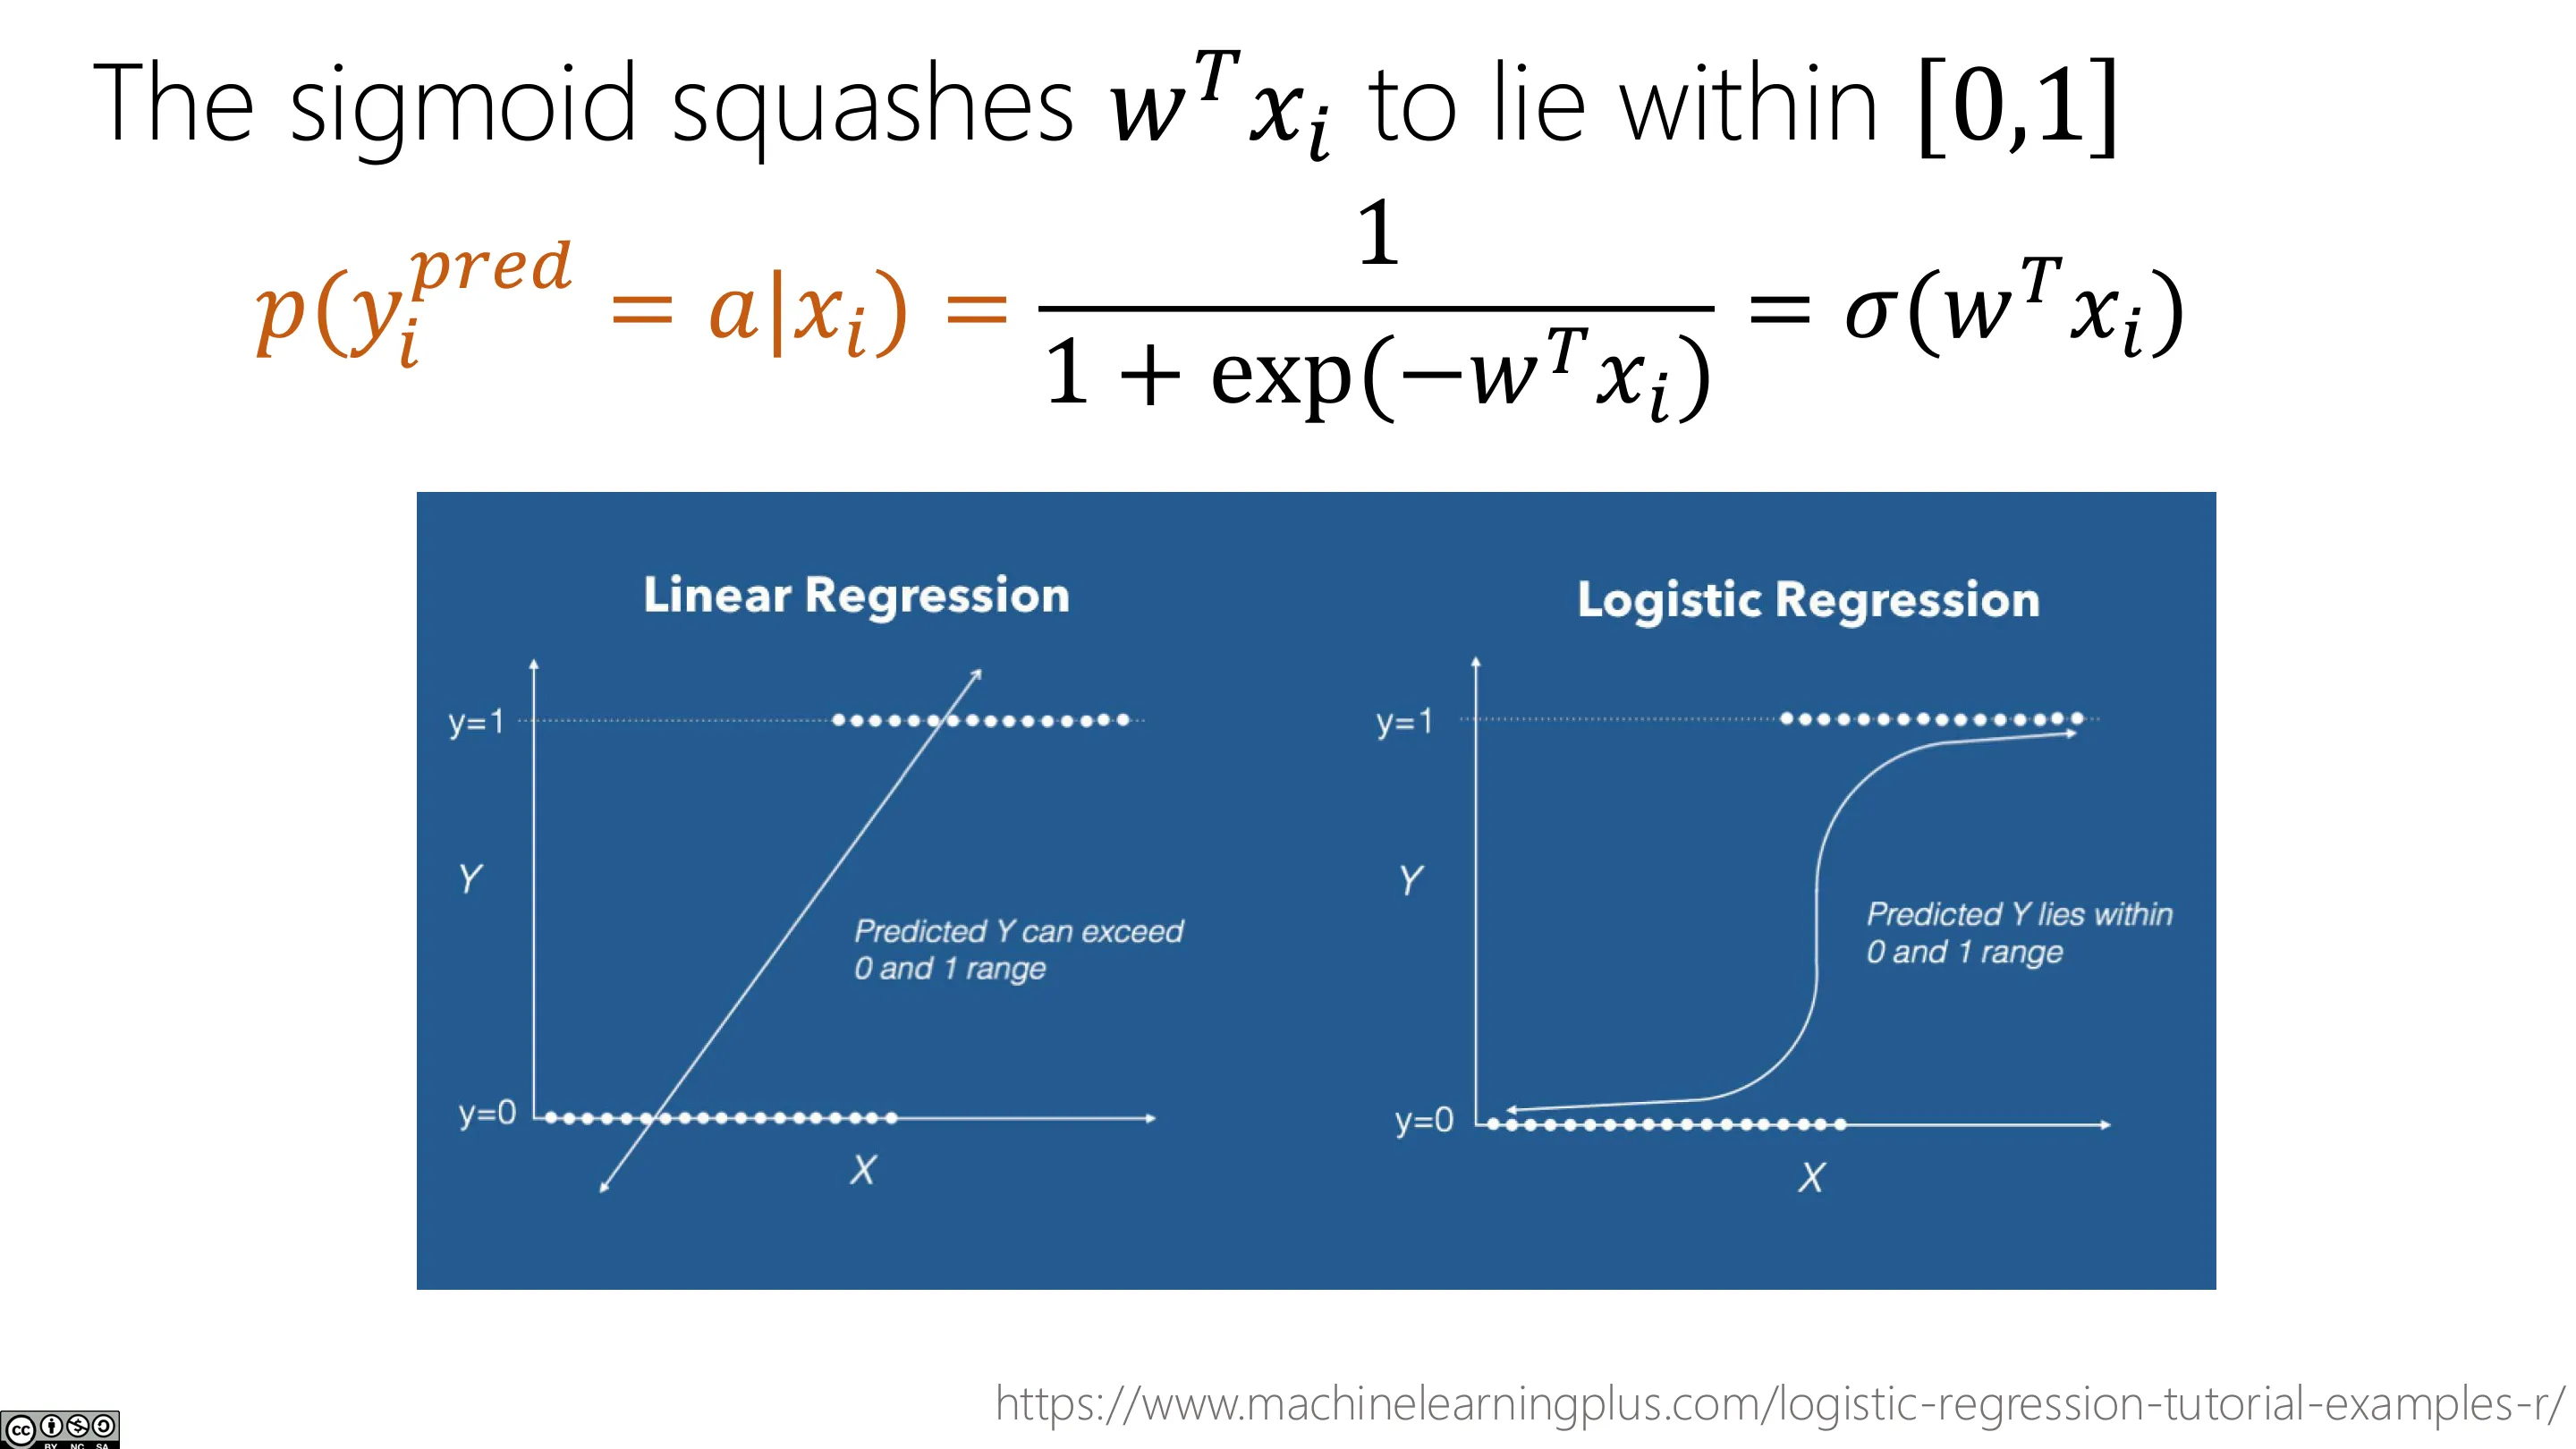
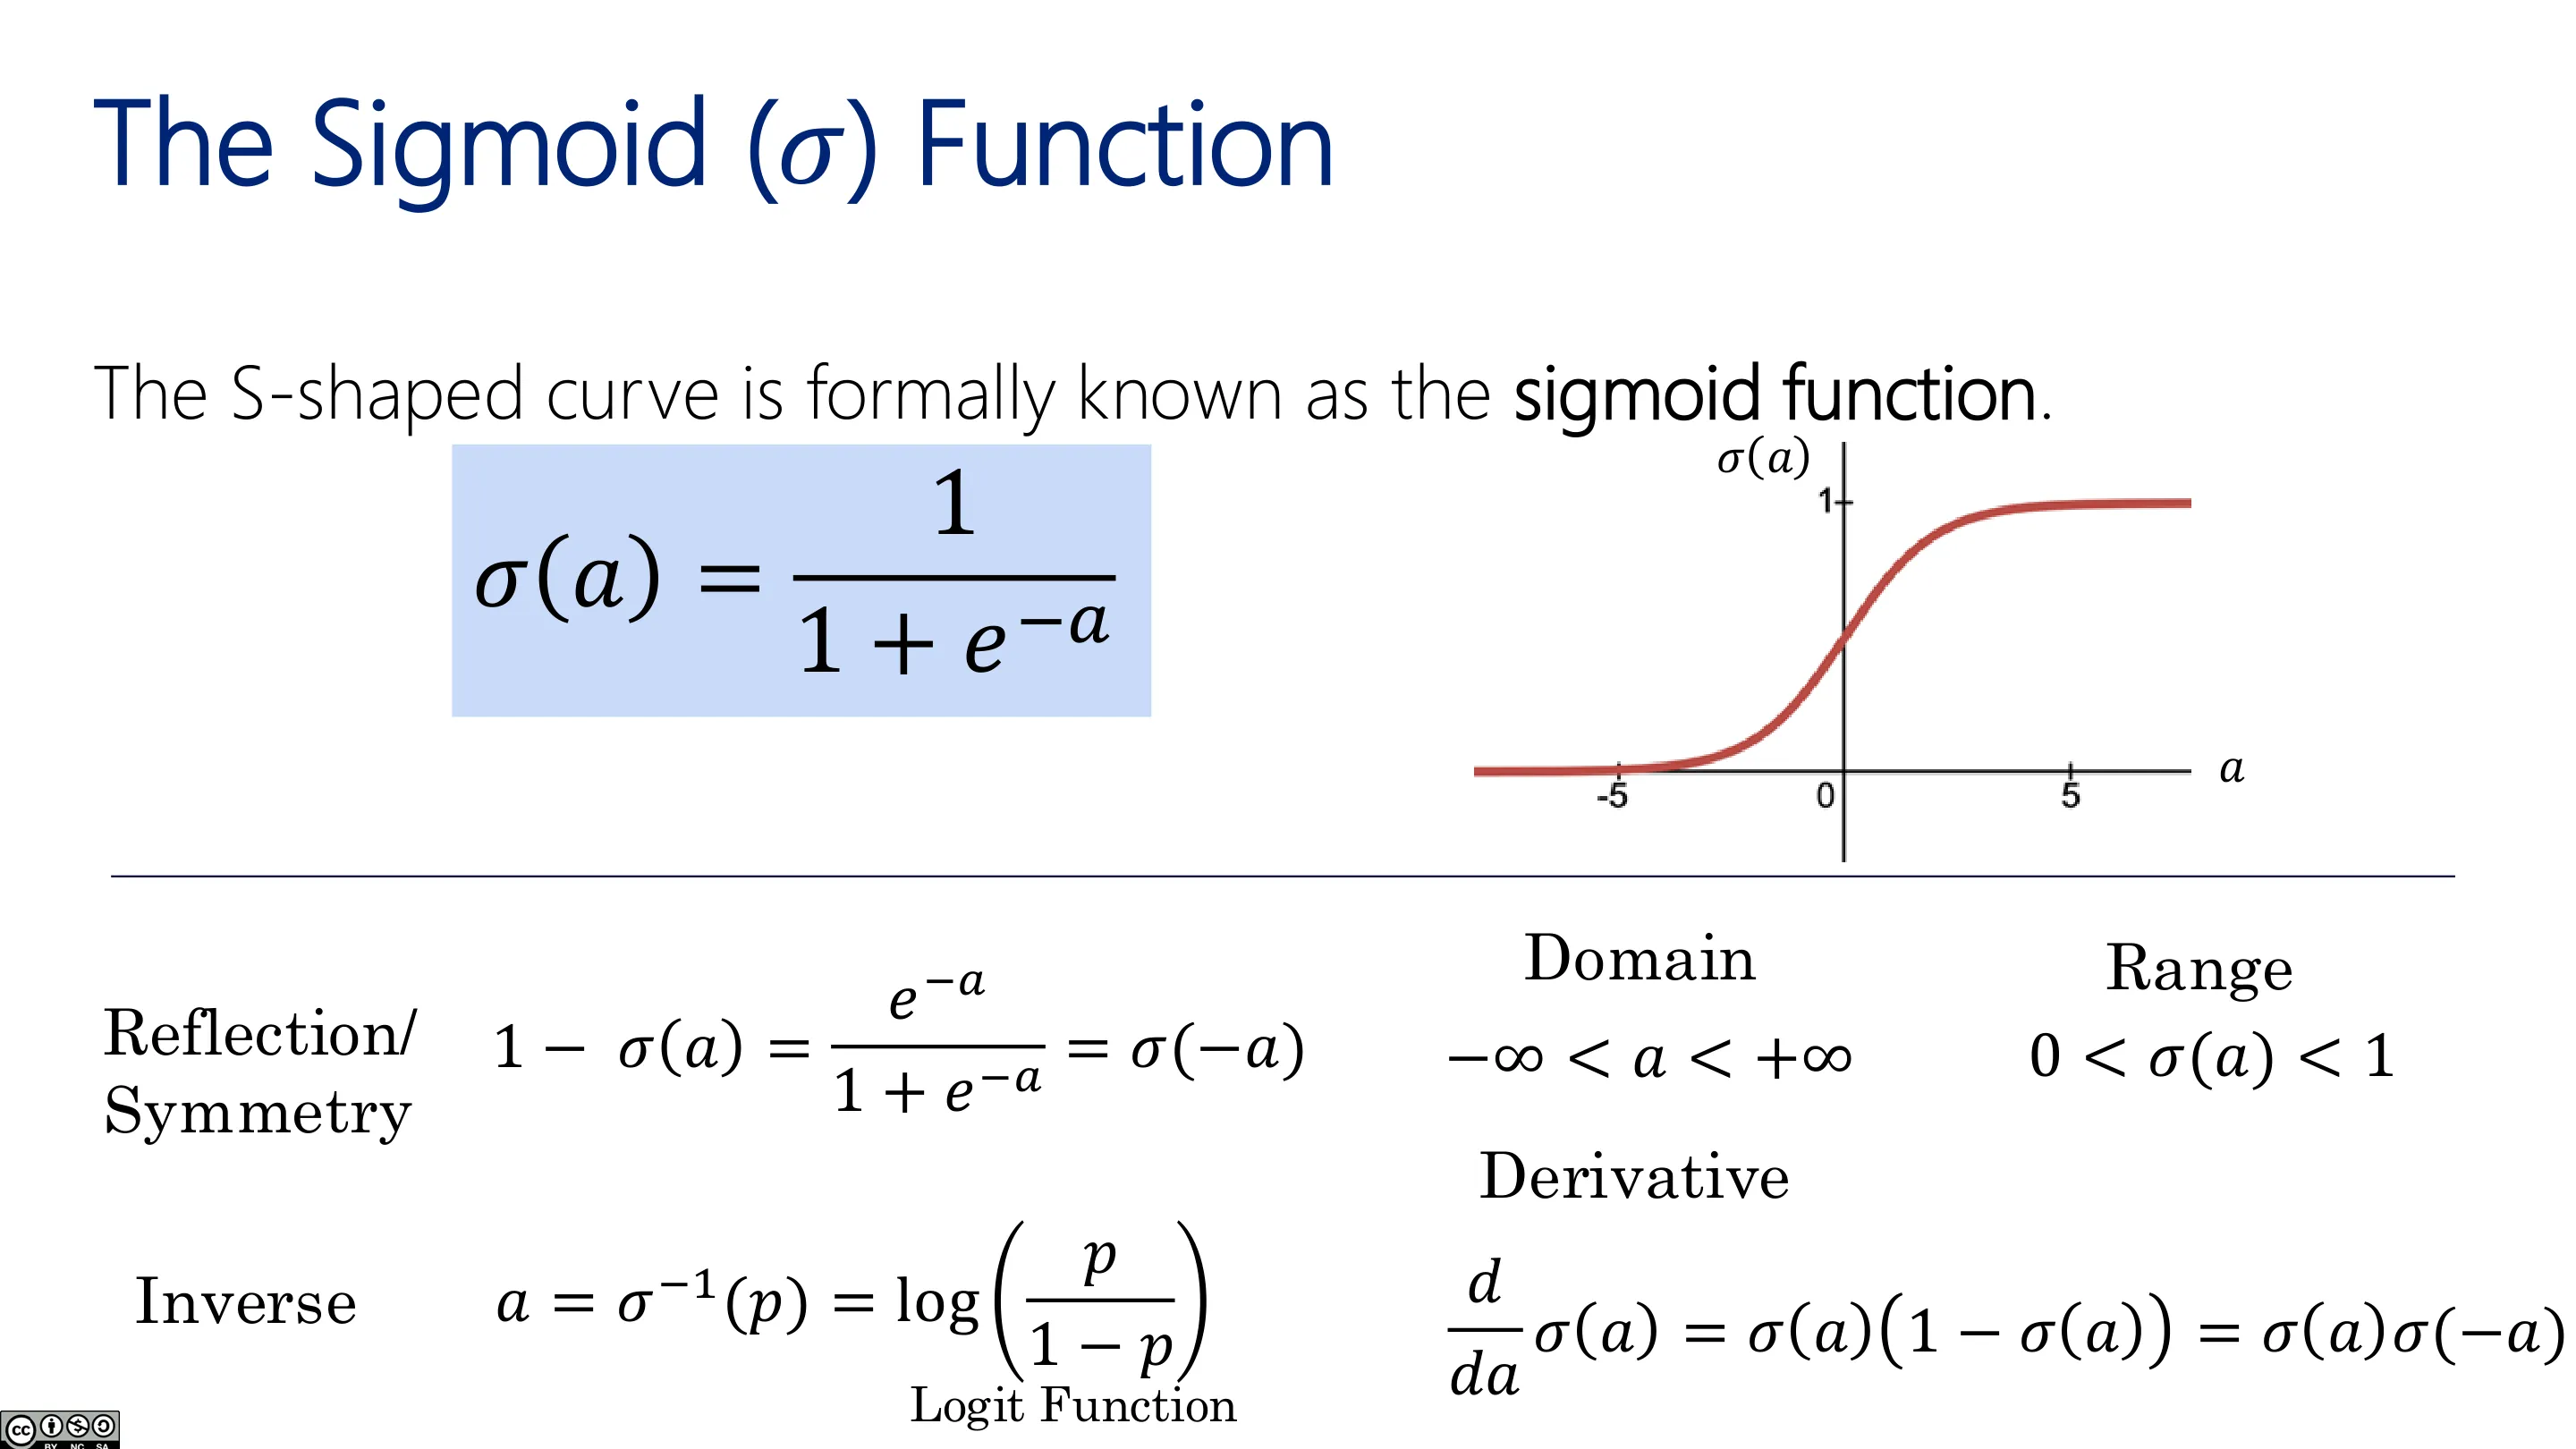
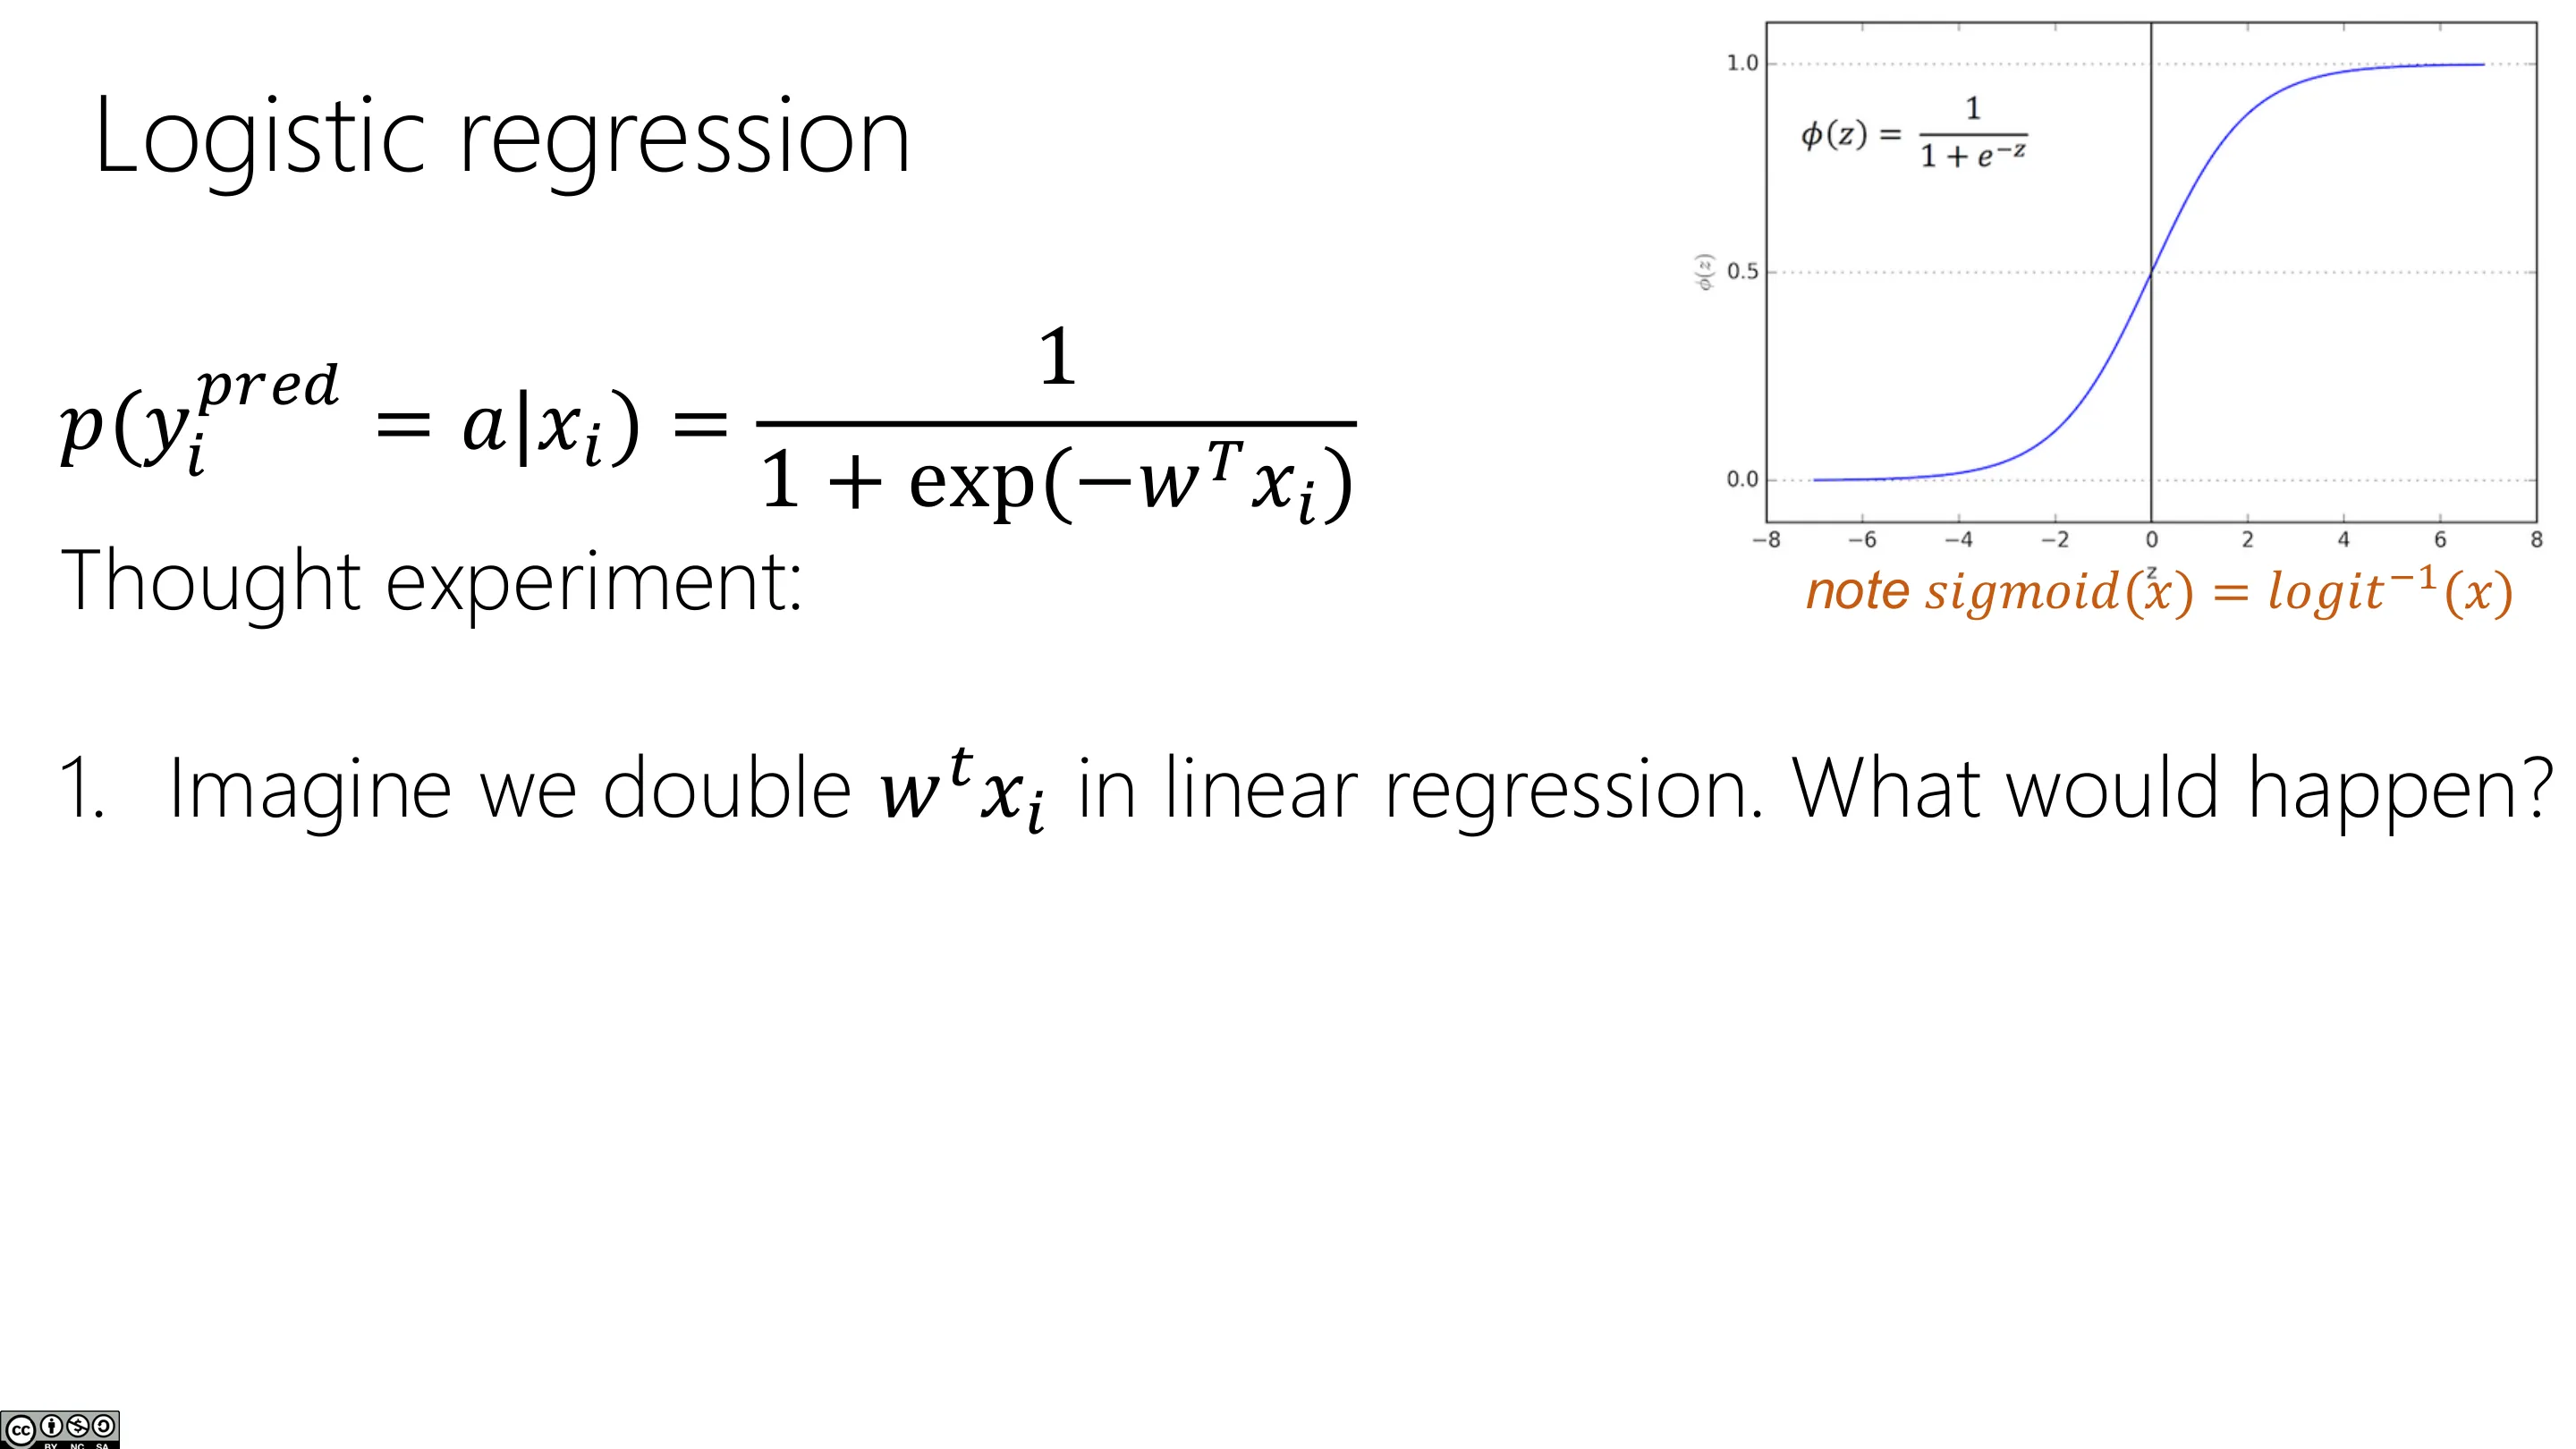
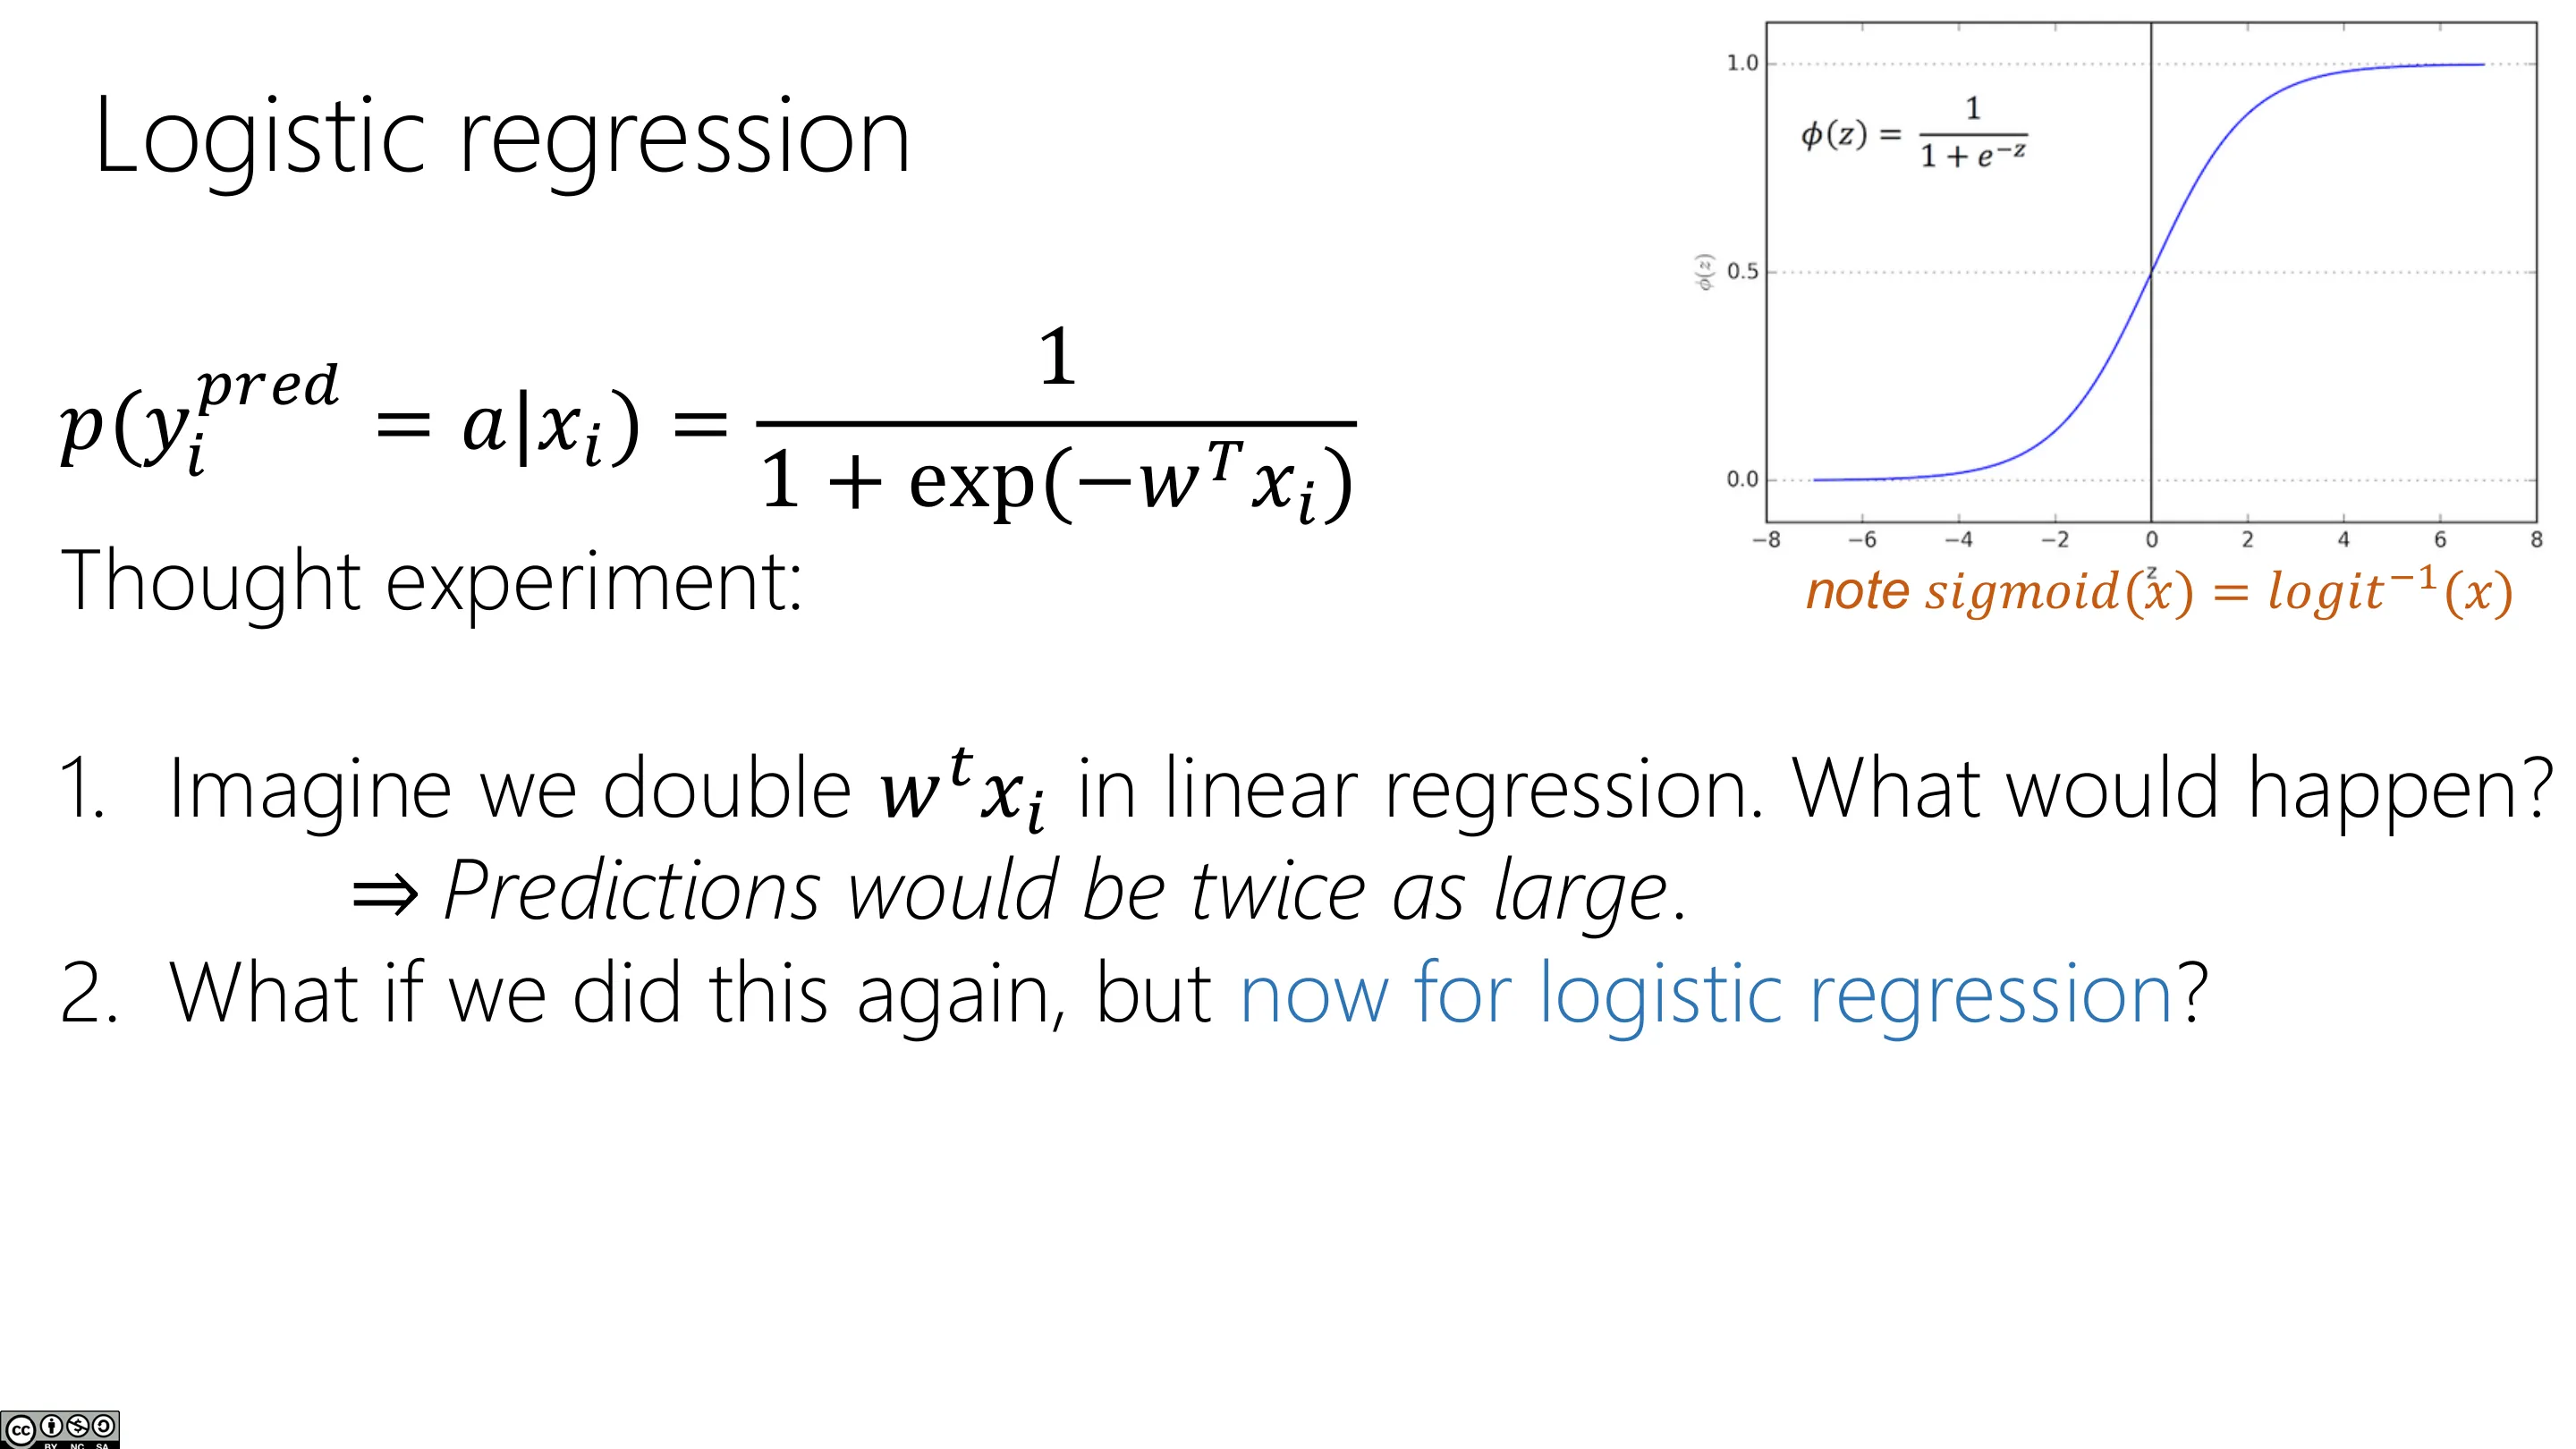
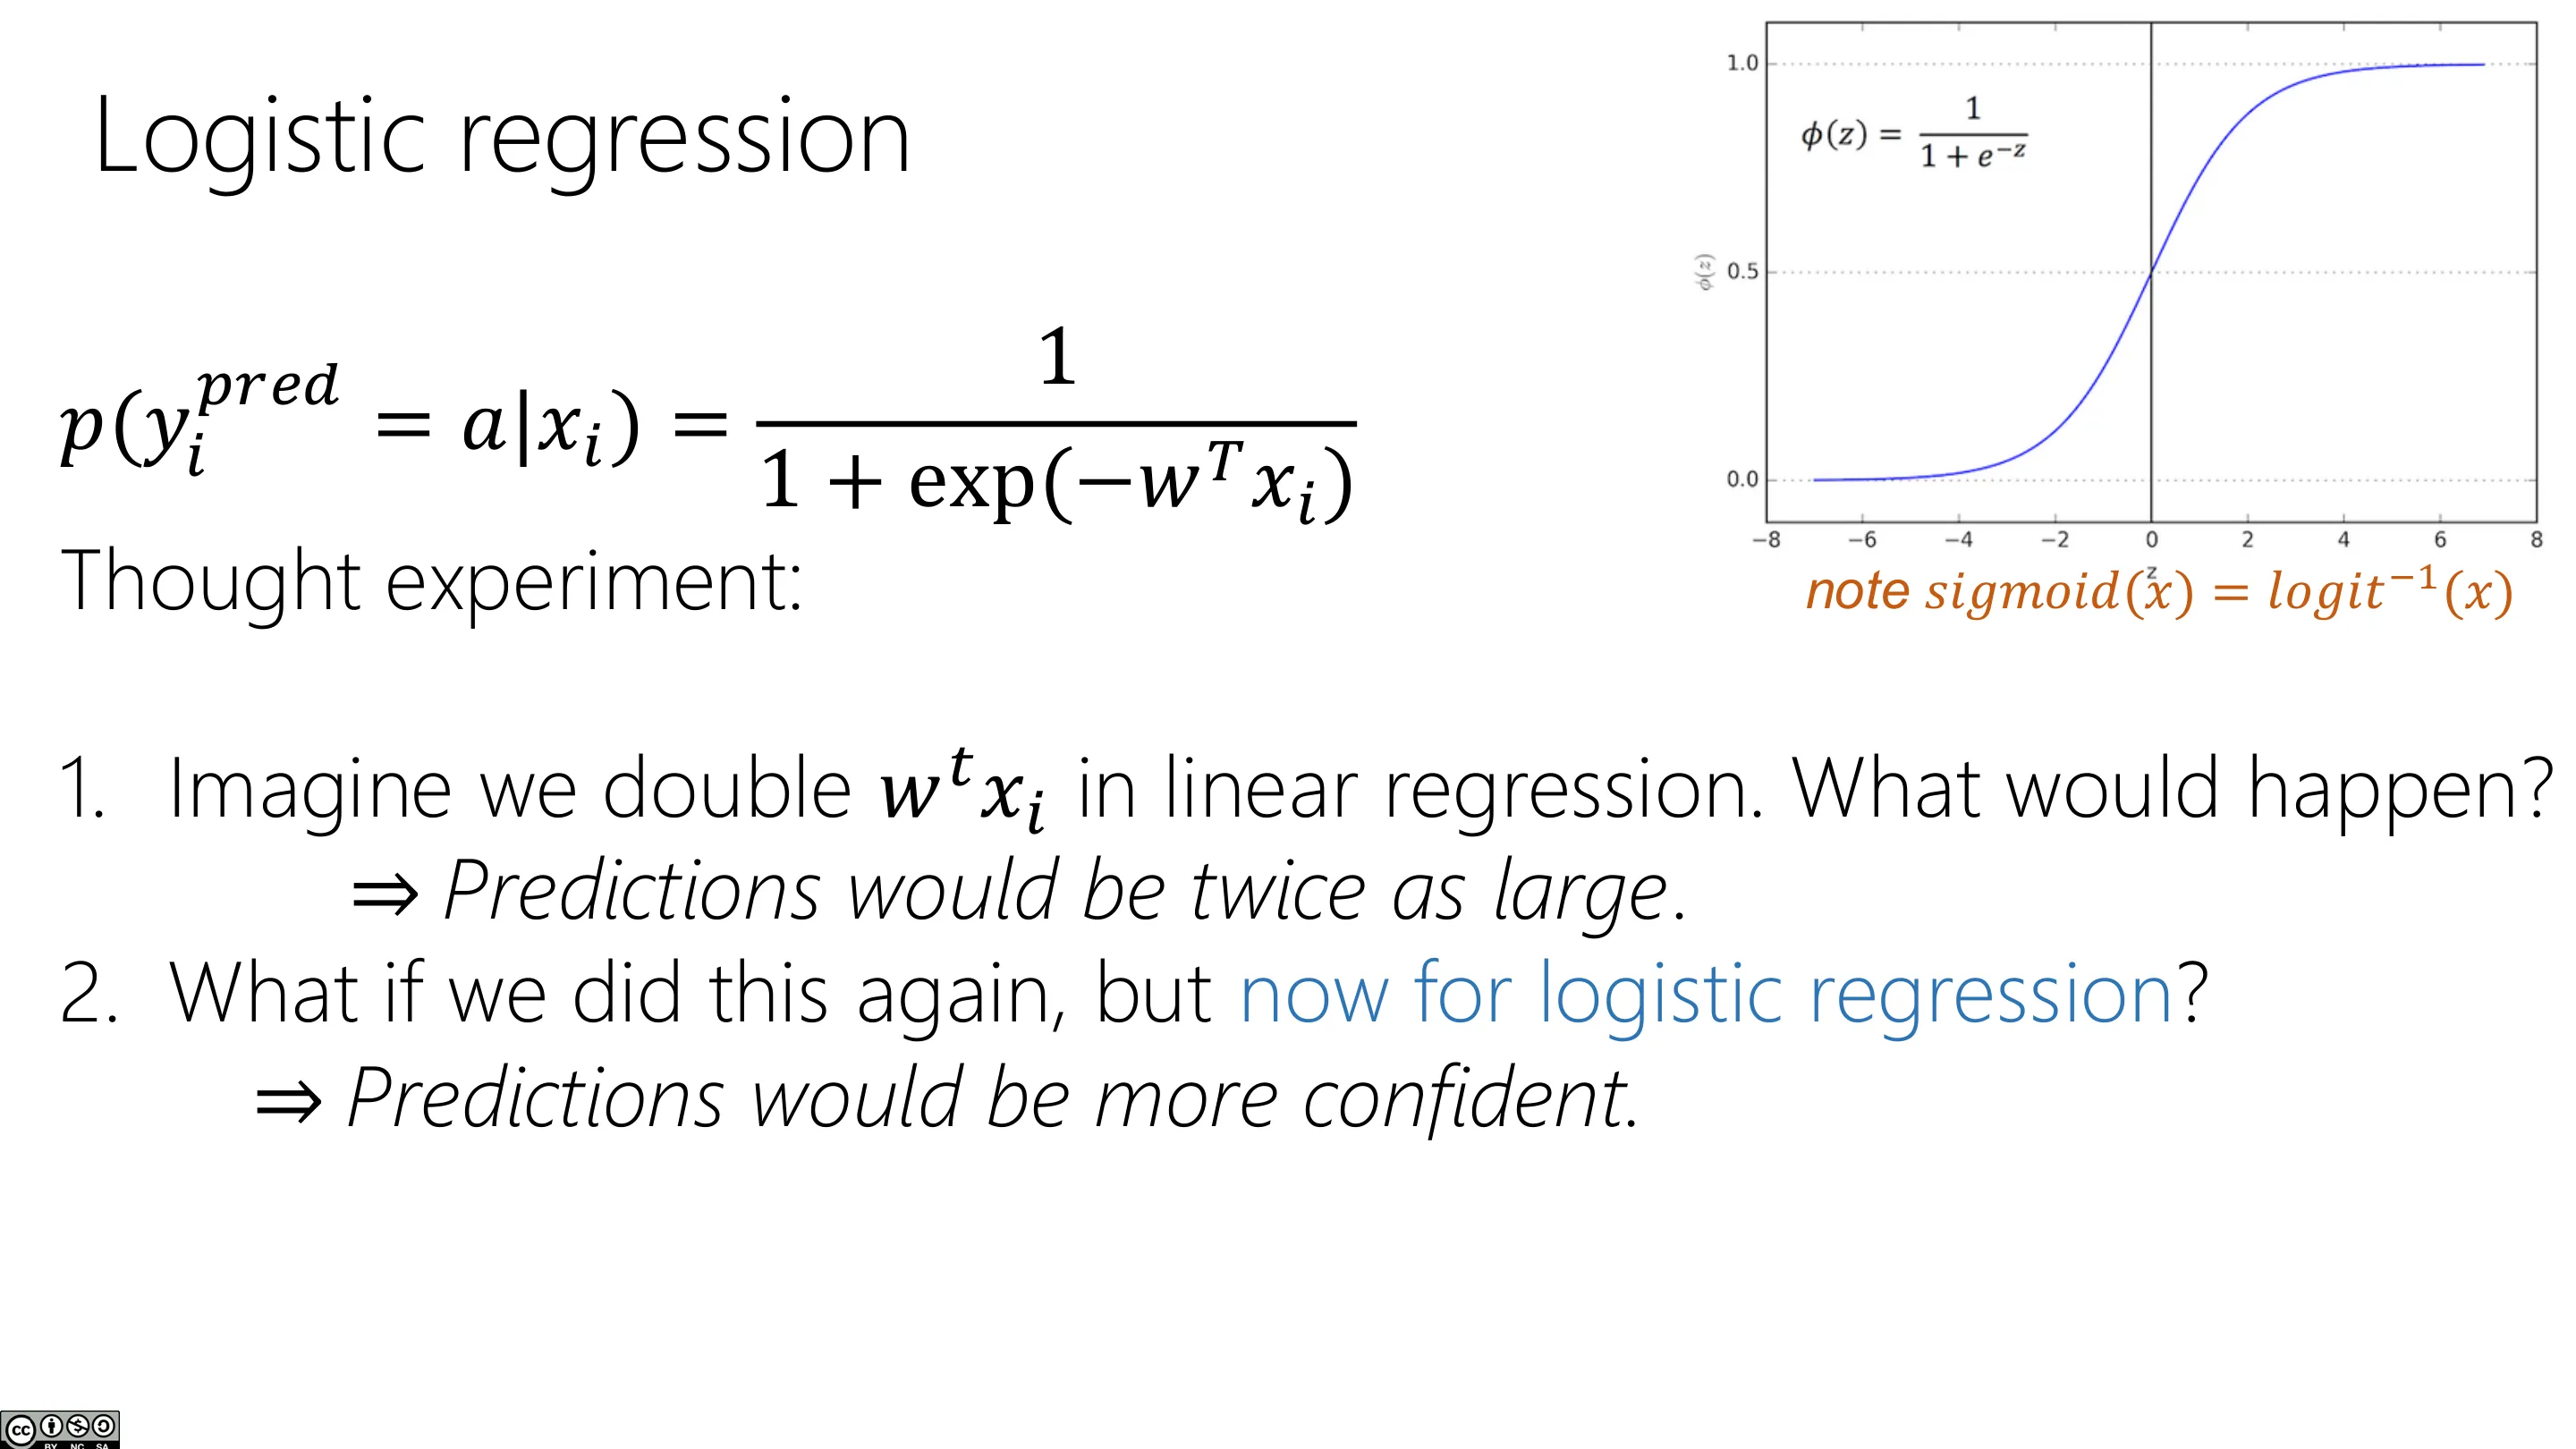
二元逻辑回归:$p(y=1\mid x)=\sigma(w^\top x)$,$p(y=0\mid x)=1-\sigma(w^\top x)$,其中
$$ \sigma(a)=\frac{1}{1+e^{-a}} $$
性质:
- 把 $(-\infty,\infty)$ 压缩到 $(0,1)$,可解释为概率;
- 导数很漂亮:$\sigma'(a)=\sigma(a)\,(1-\sigma(a))$;
- 把 $w^\top x$ 放大,只改变置信度(推向 0/1 的渐近线),不像线性回归那样改变预测均值。
📷 逻辑回归:判别式分类模型
回到原视频 (00:05:25)
📷 sigmoid 把 wᵀx 压缩到 (0,1)
回到原视频 (00:06:24)
📷 Sigmoid 函数
回到原视频 (00:08:48)
📷 逻辑回归(一)
回到原视频 (00:08:54)
📷 逻辑回归(二)
回到原视频 (00:11:56)
📷 逻辑回归(三)
回到原视频 (00:12:30)
2.2 多分类:Softmax
(参考时间: 00:12)
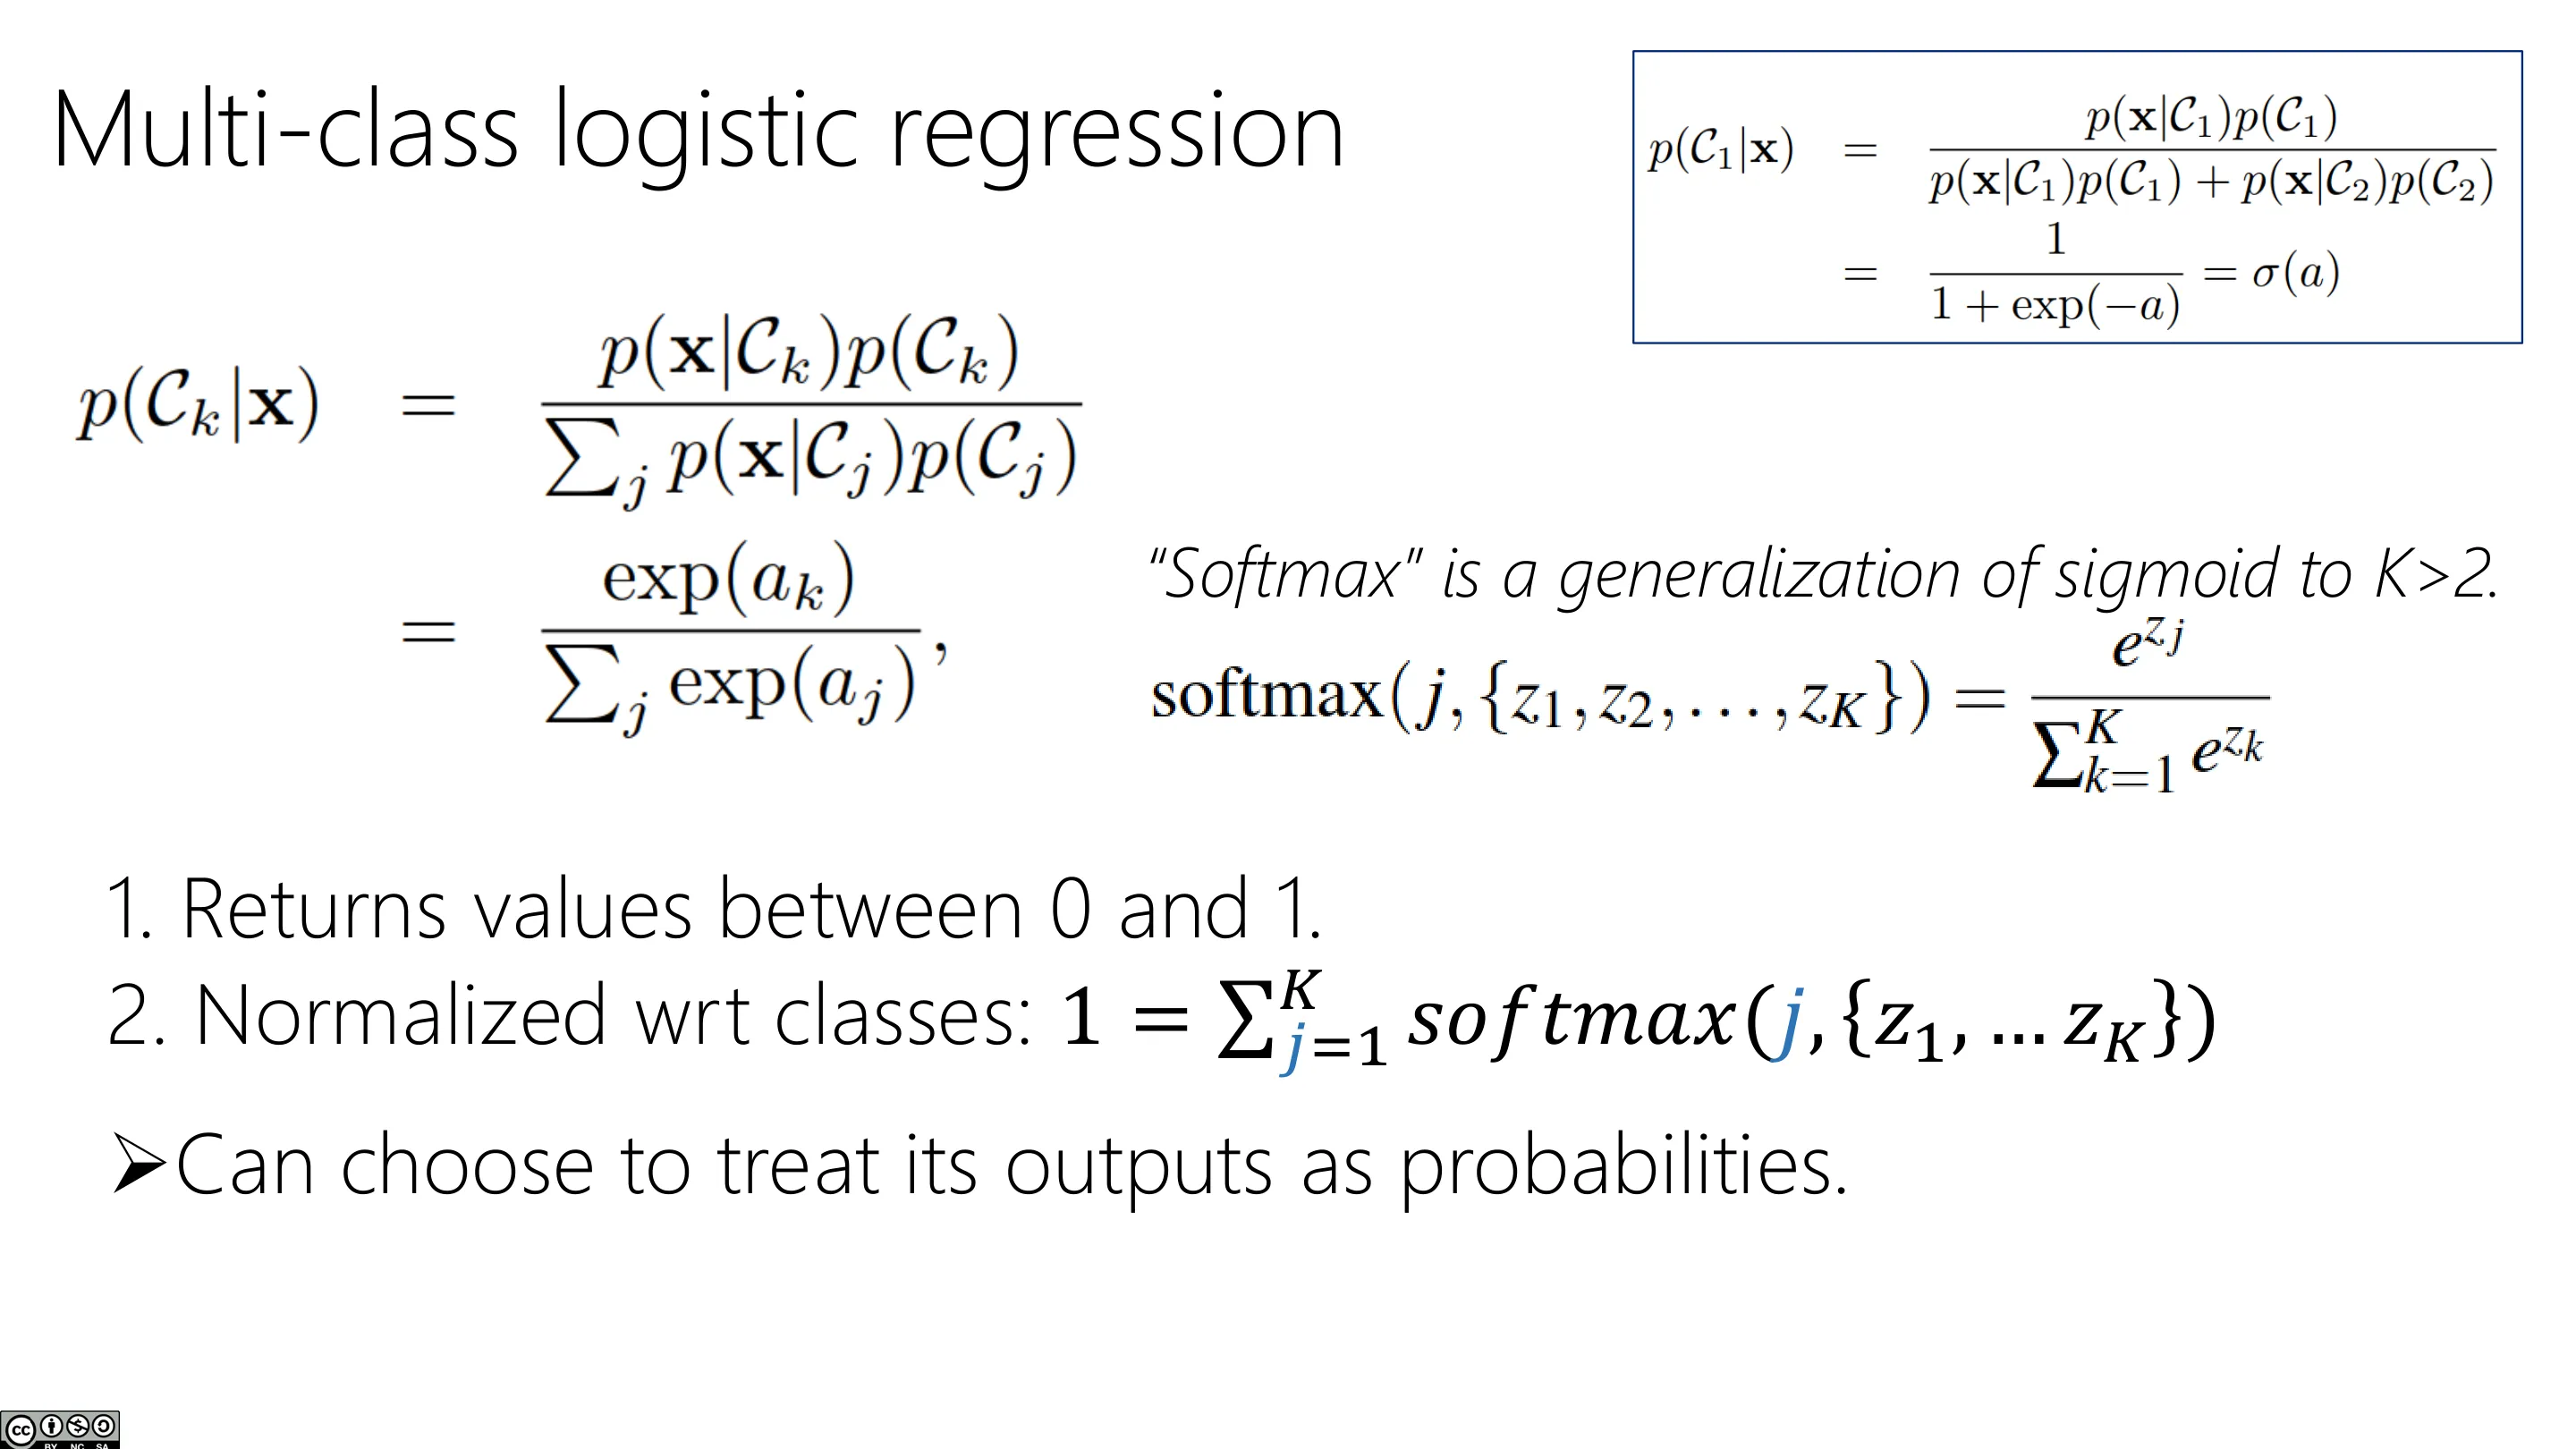
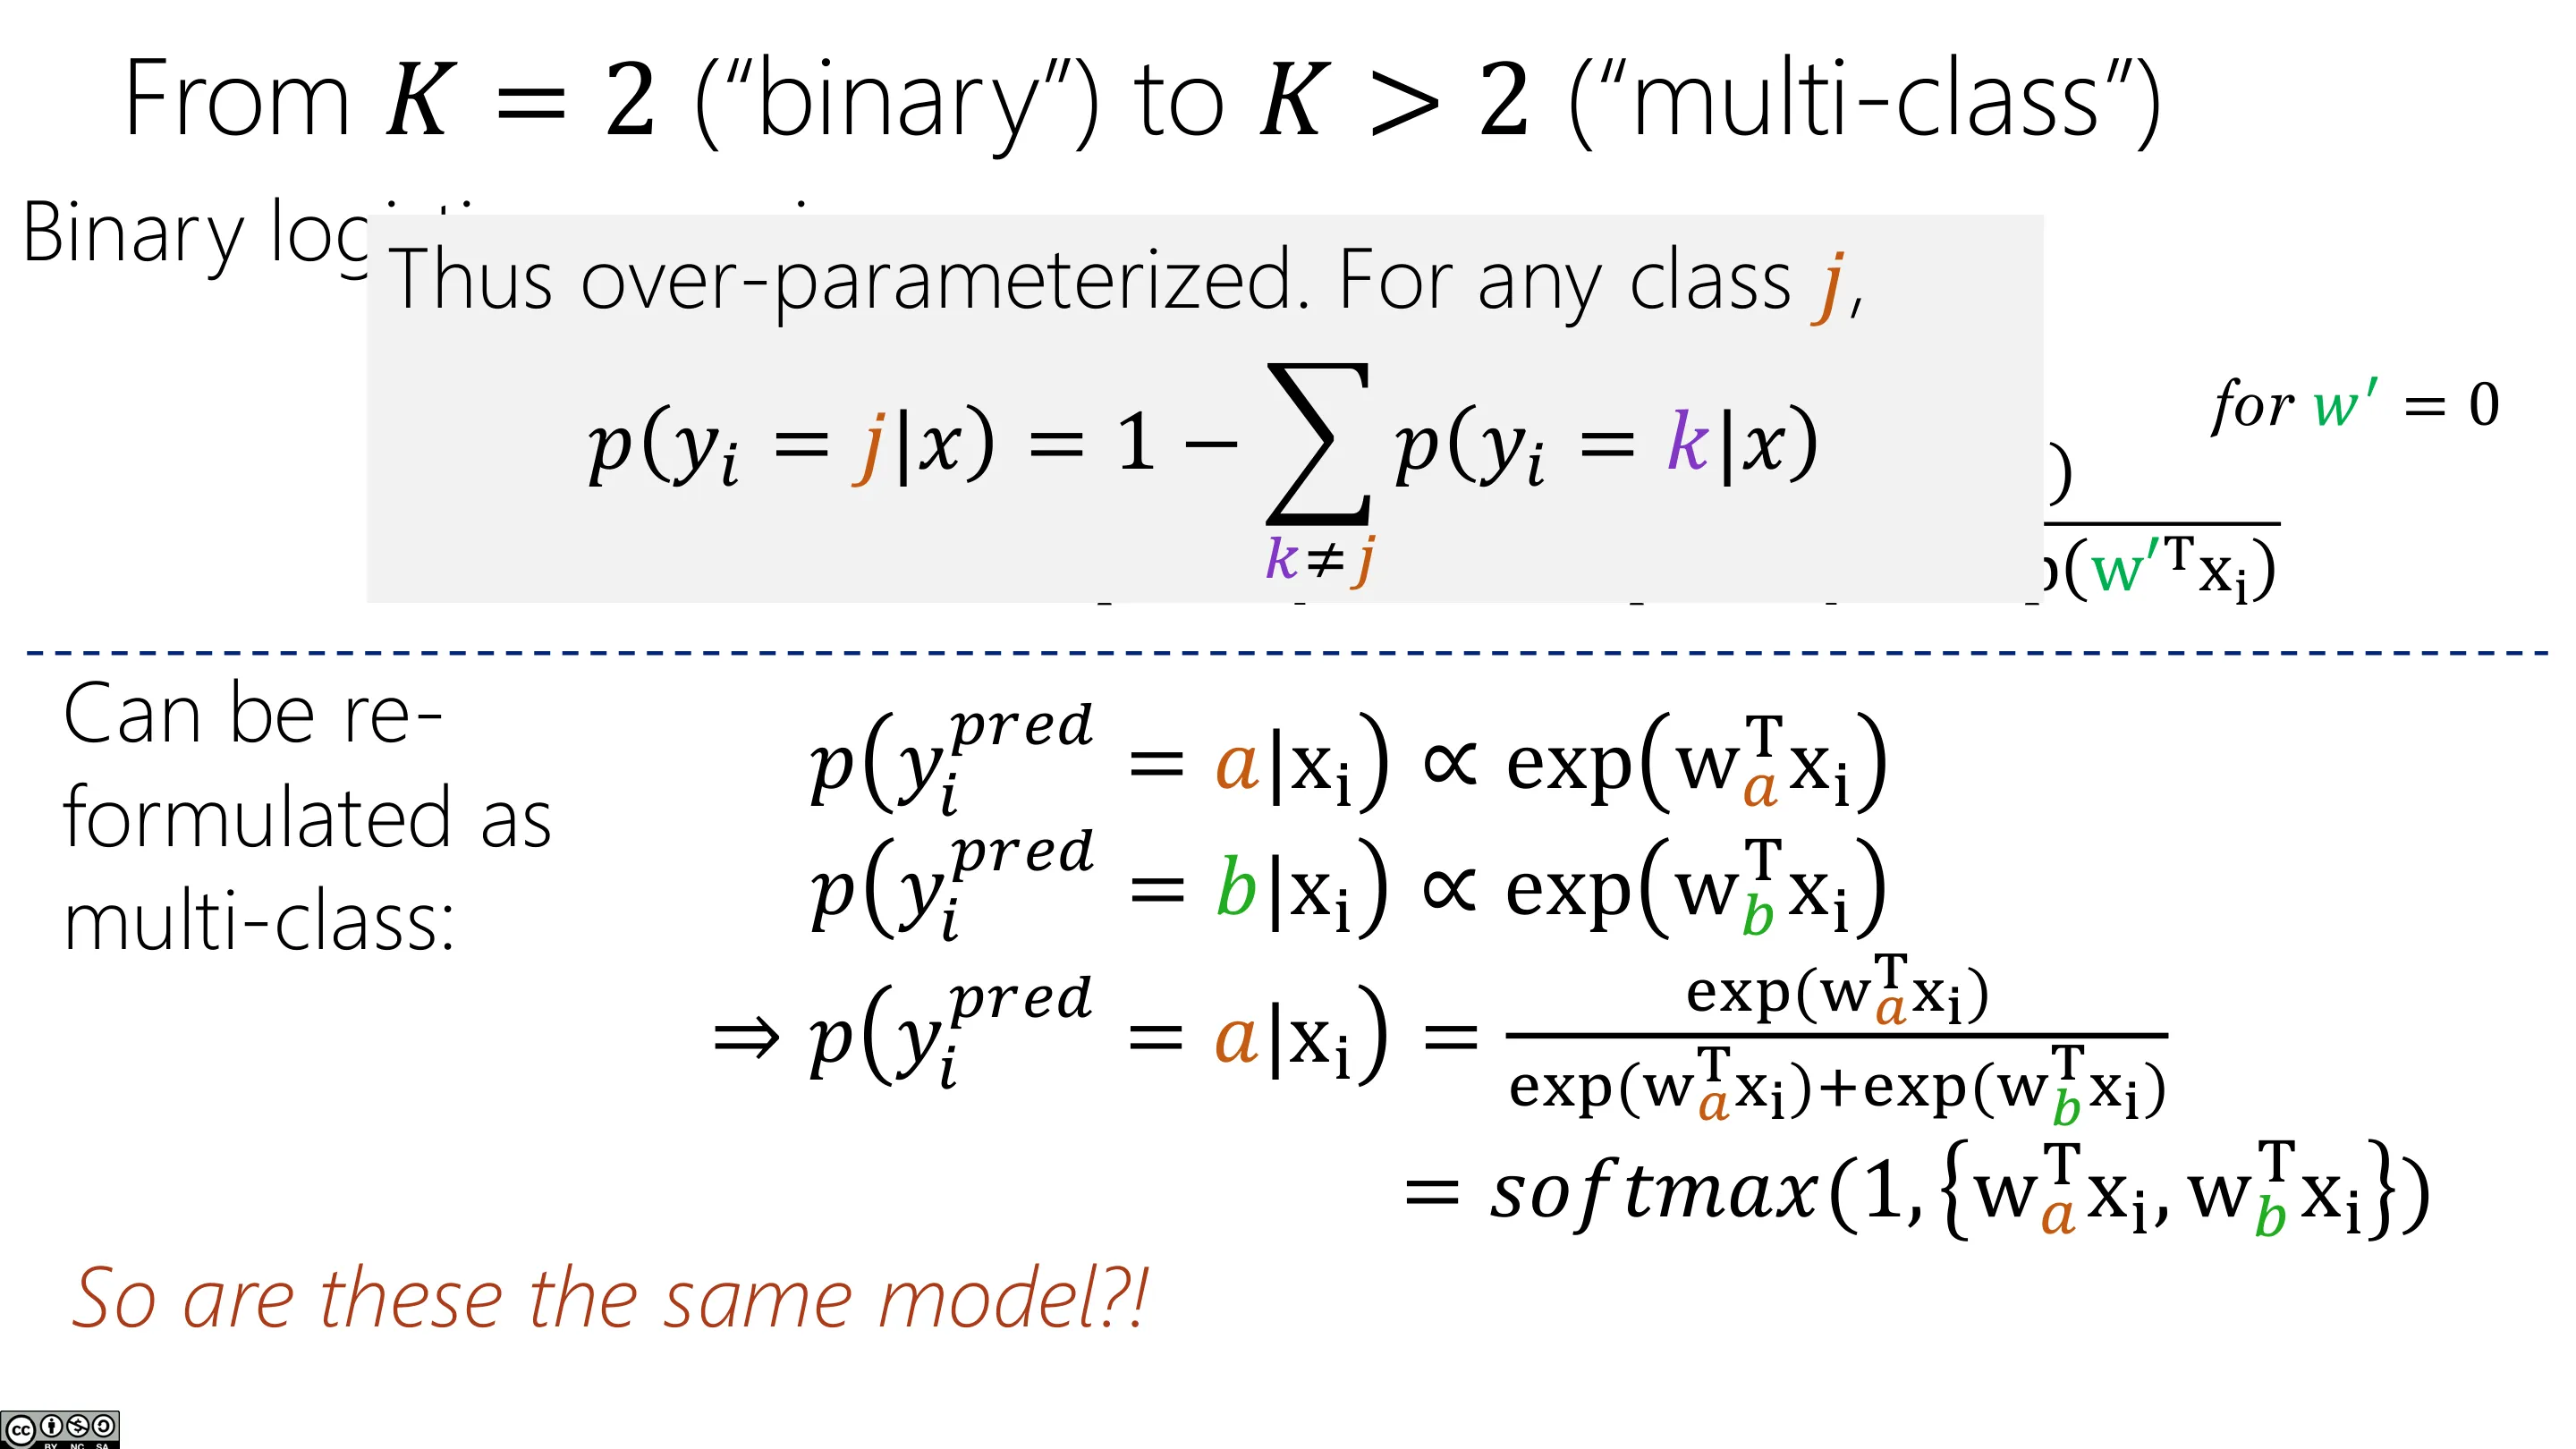
$K>2$ 时,sigmoid 推广为 softmax:
$$ p(y=j\mid x)=\frac{e^{w_j^\top x}}{\sum_{k=1}^{K}e^{w_k^\top x}} $$
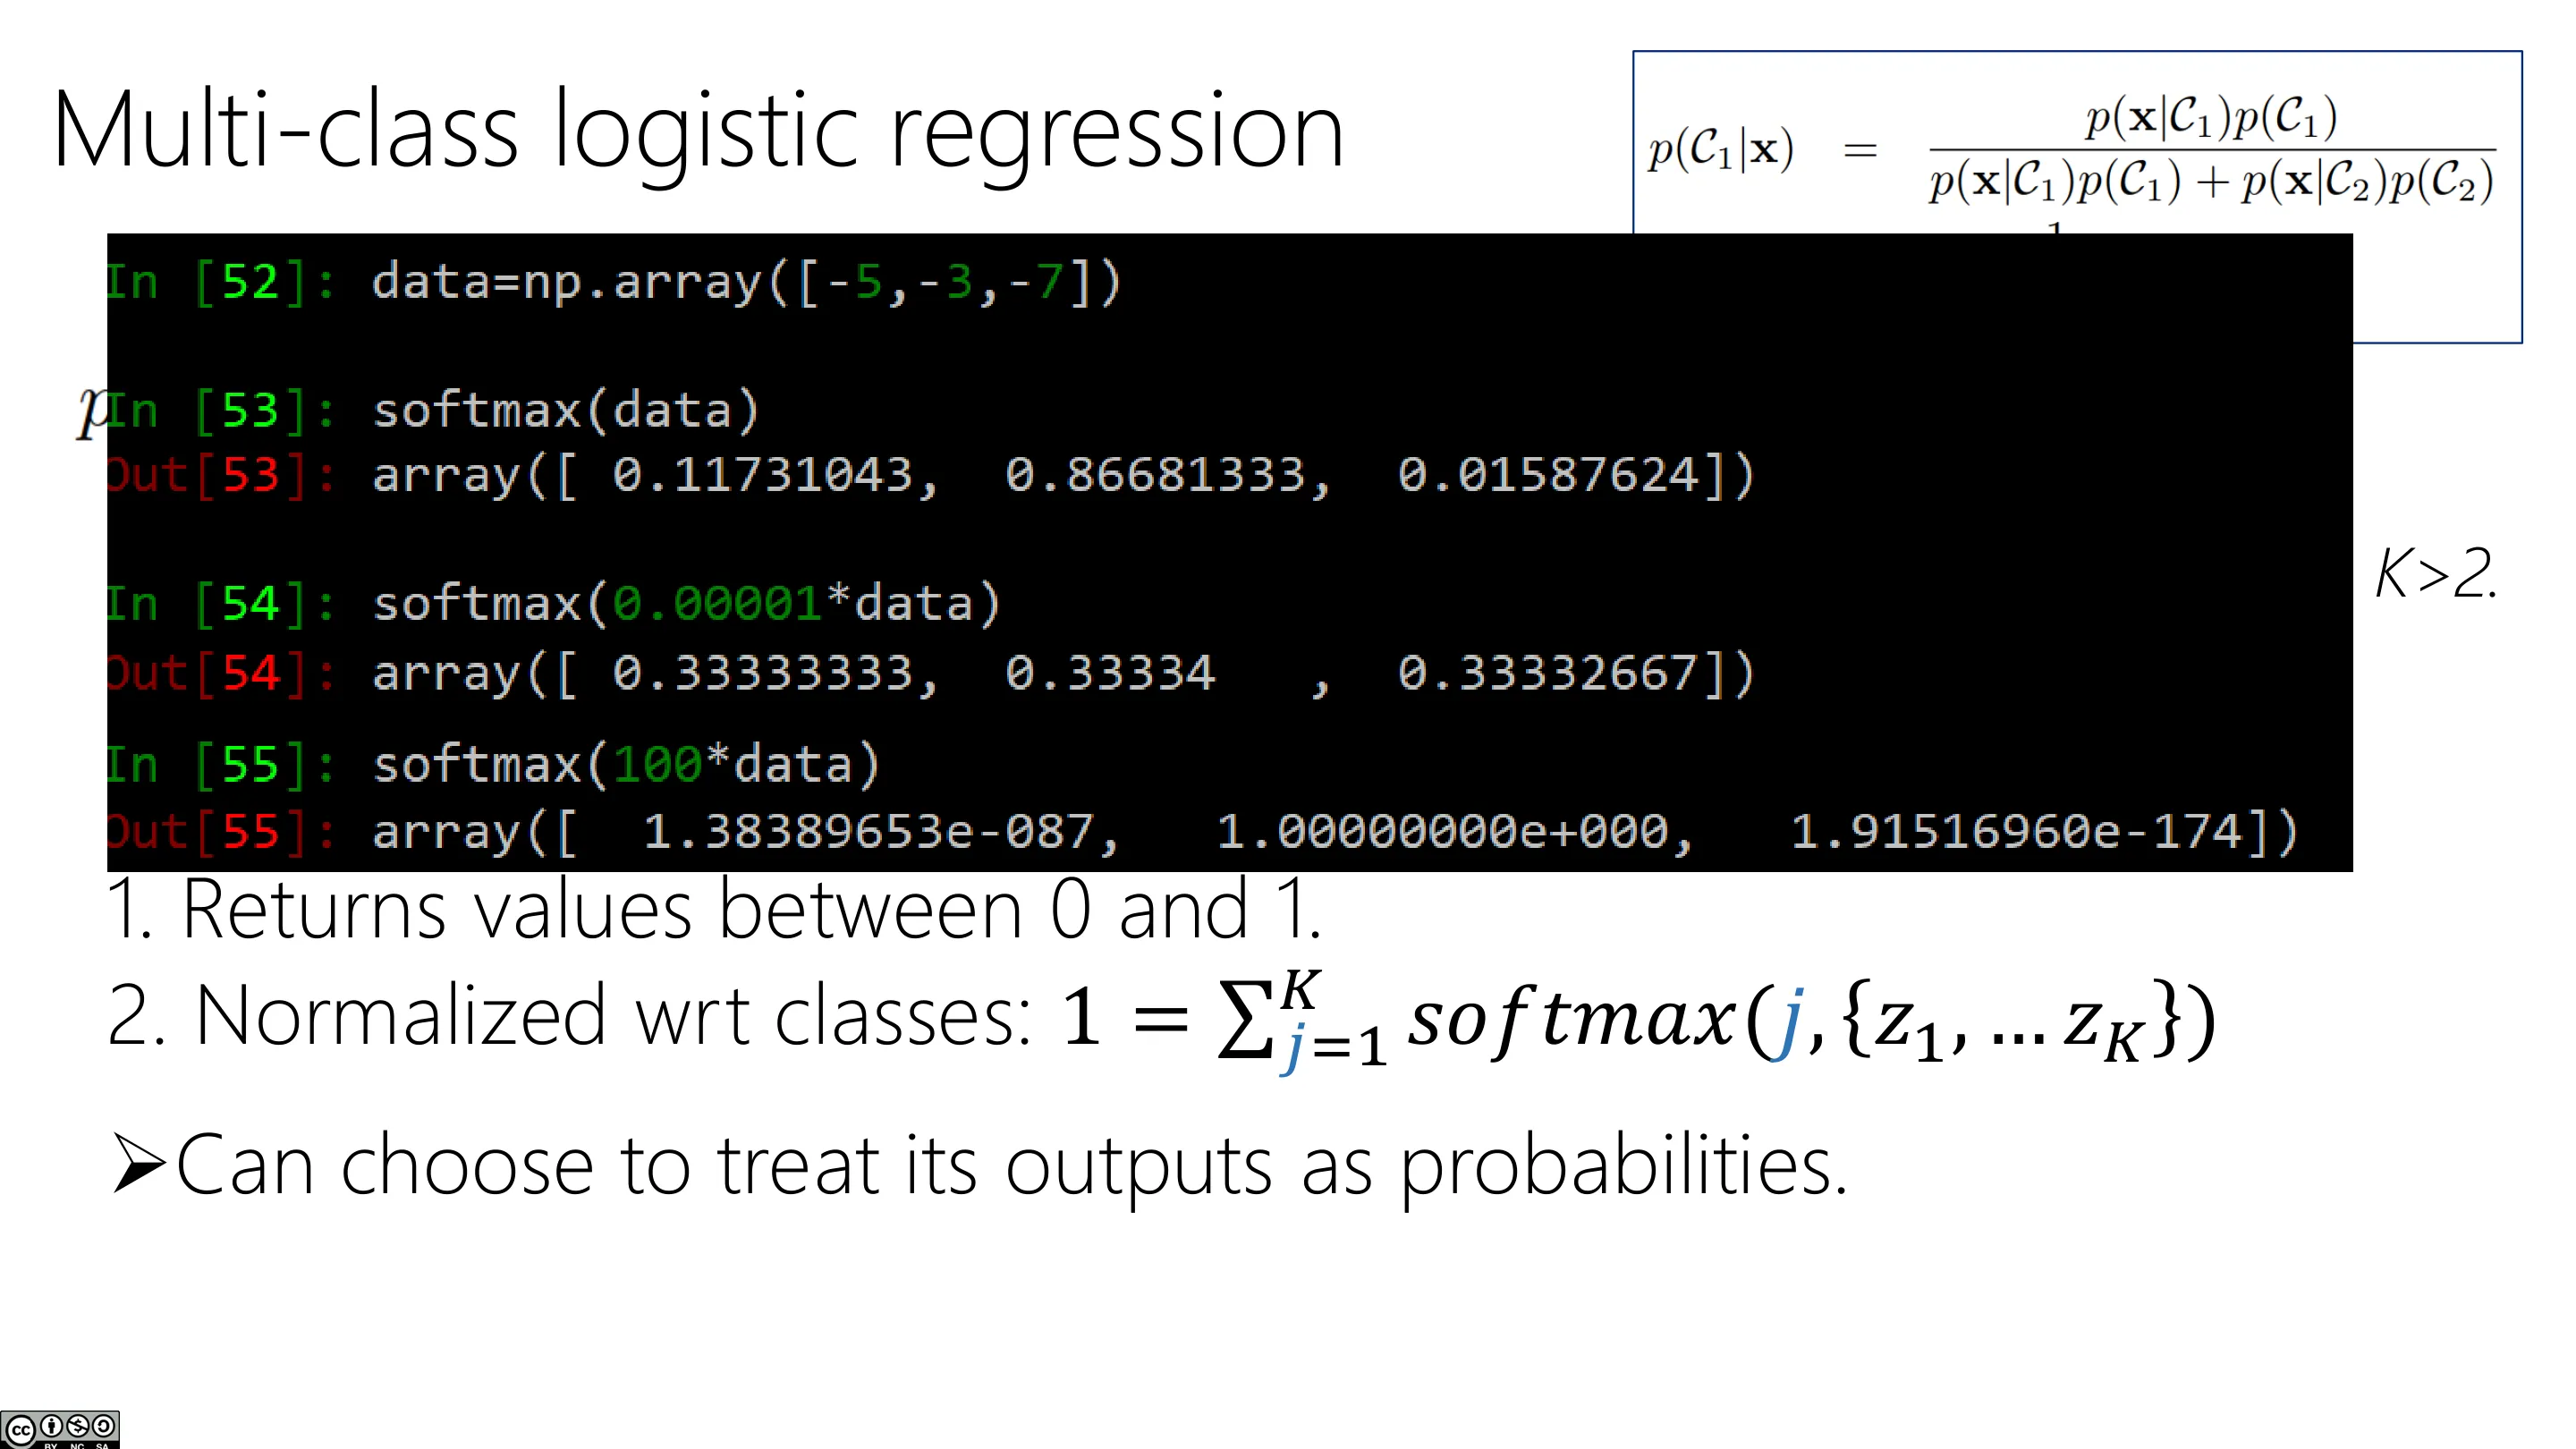
- softmax:「软的最大值」——不是把全部票投给最大值,而是按大小分配概率(值越大票越多),且归一化(求和为 1);
- 温度/缩放:把输入乘很小的数 ⇒ 趋于均匀;乘很大的数 ⇒ 趋于 one-hot 的 max;
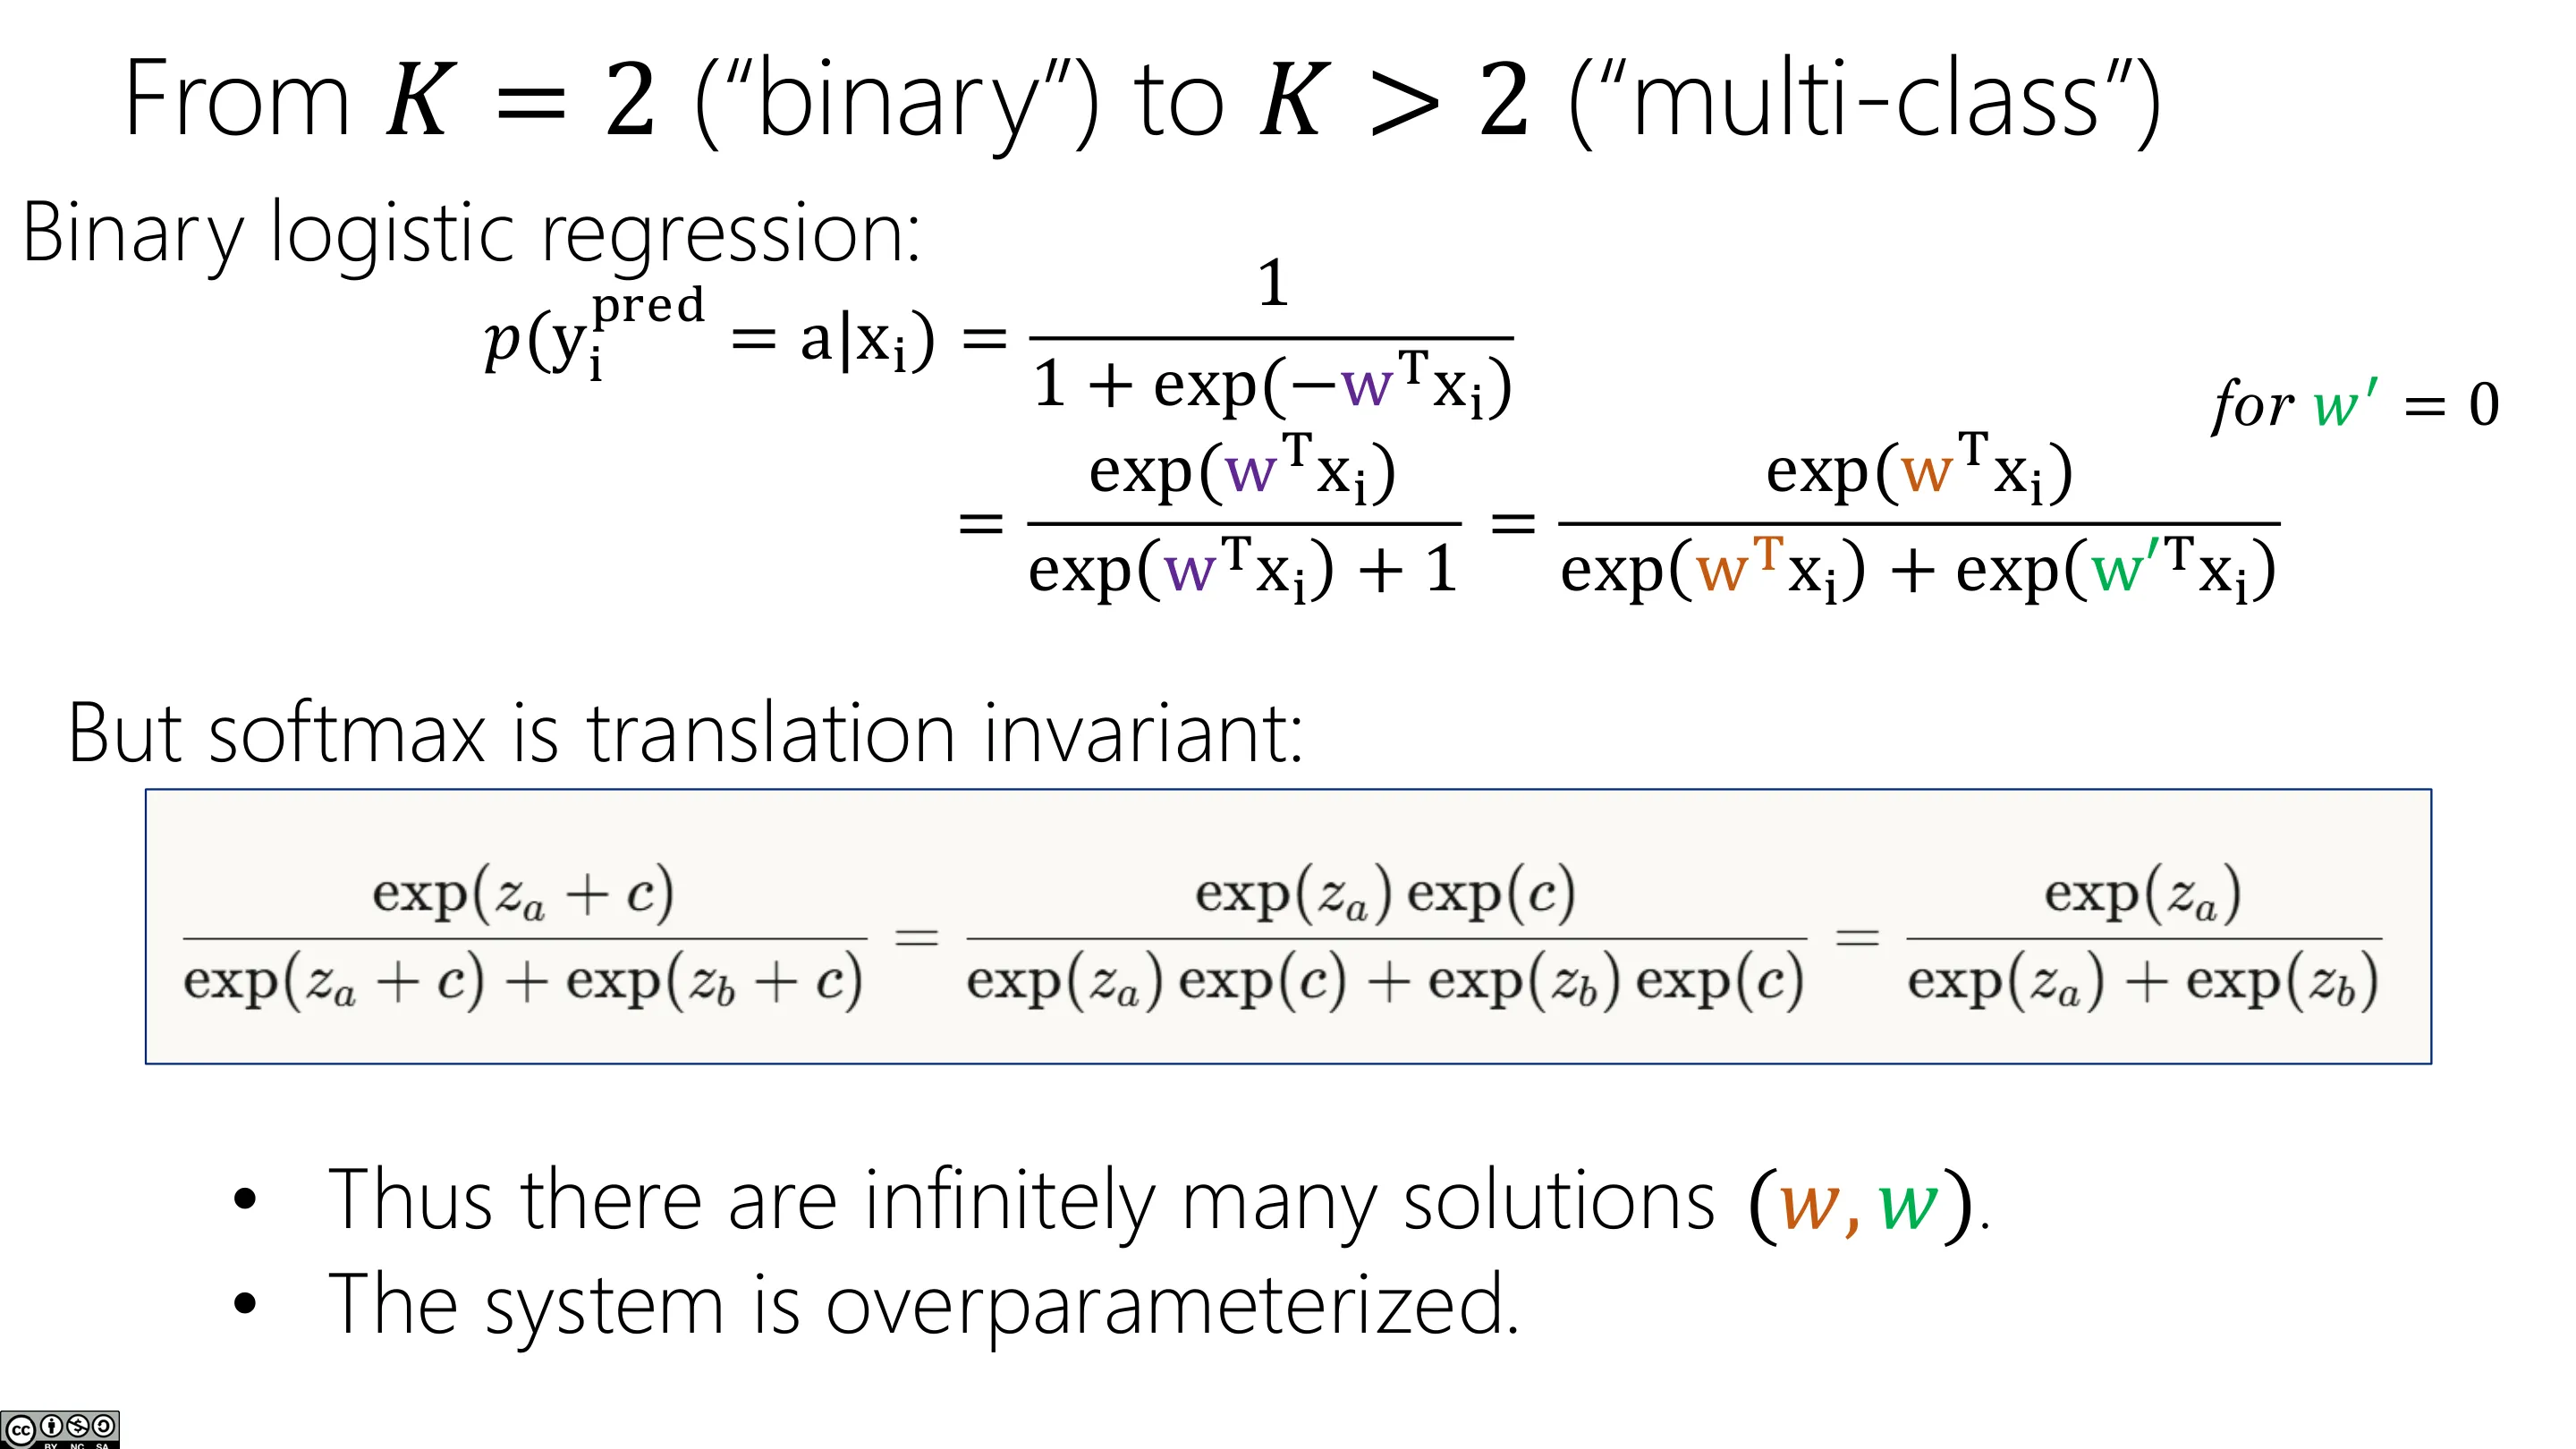
- 平移不变性:给所有类的参数加同一常数不影响输出 ⇒ 系统过参数化,有无穷多组等价解;实践中固定某一类 $w=0$ 即可(二元时 softmax 退化为 sigmoid)。
📷 多分类逻辑回归(一)
回到原视频 (00:12:49)
📷 多分类逻辑回归(二)
回到原视频 (00:13:40)
📷 从二分类到多分类(一)
回到原视频 (00:14:10)
📷 从二分类到多分类(二)
回到原视频 (00:18:44)
📷 softmax 与参数化
回到原视频 (00:18:38)
2.3 基函数展开改变决策边界
(参考时间: 00:31)
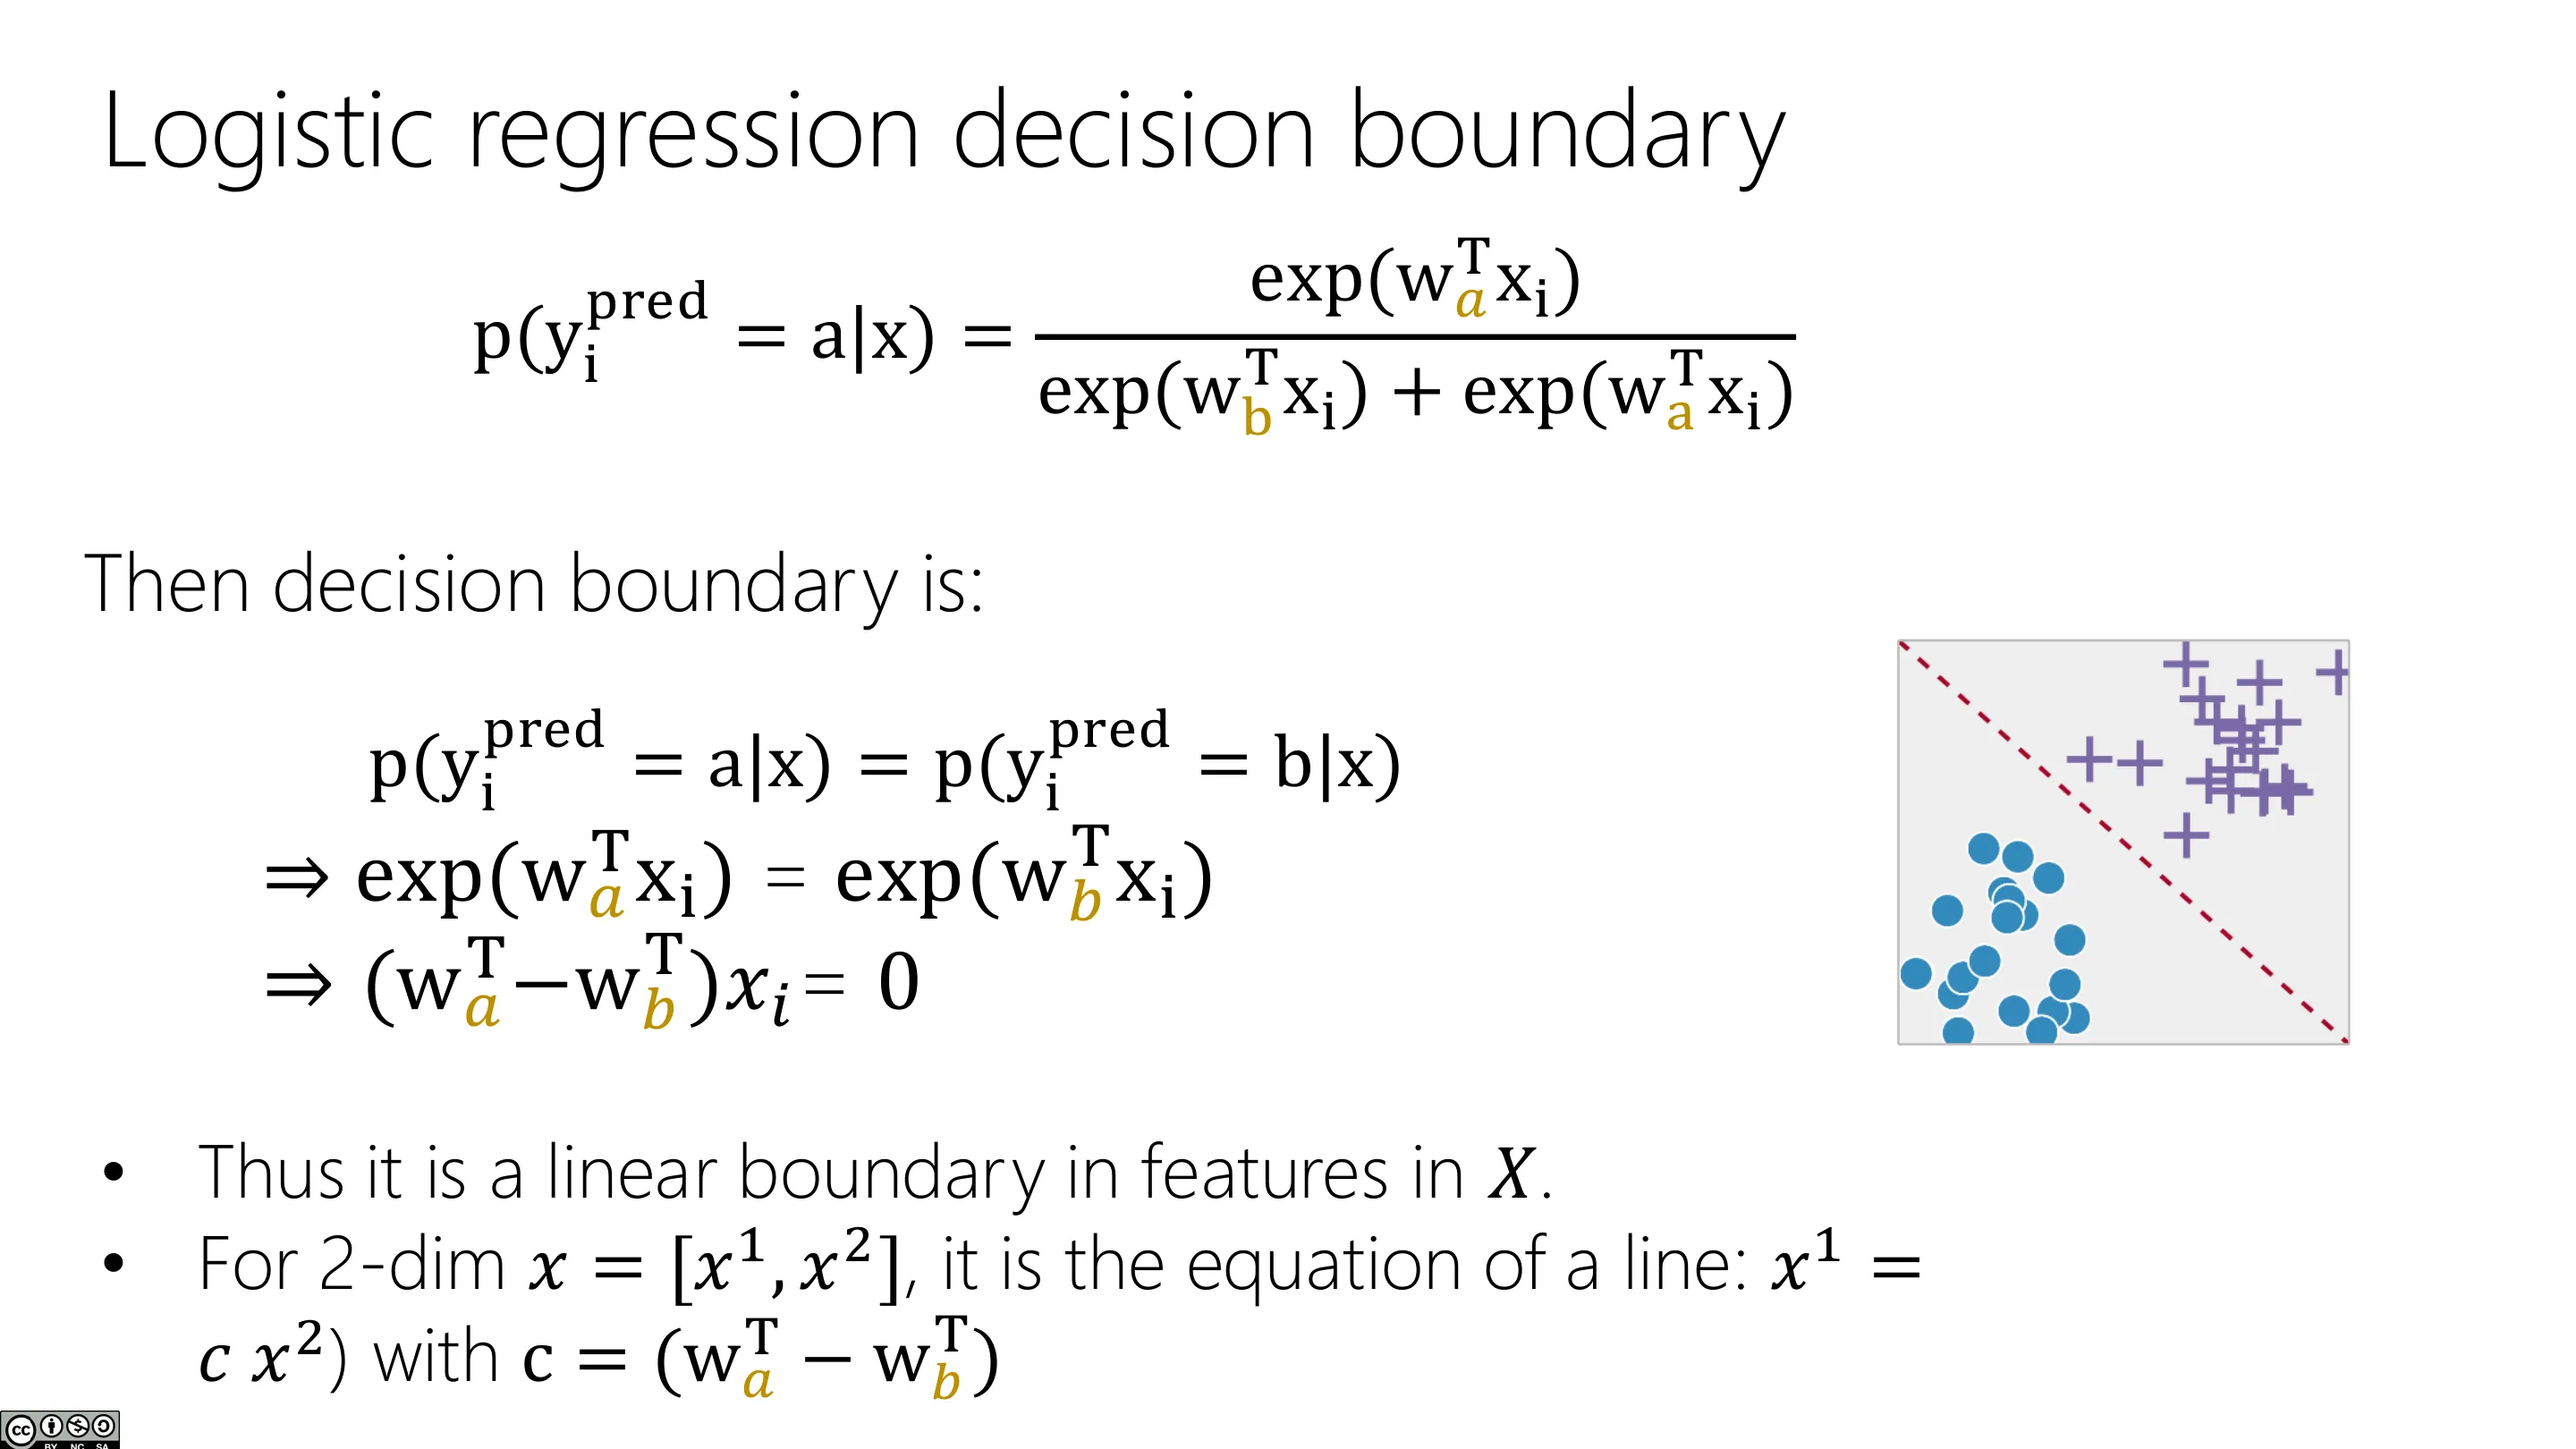
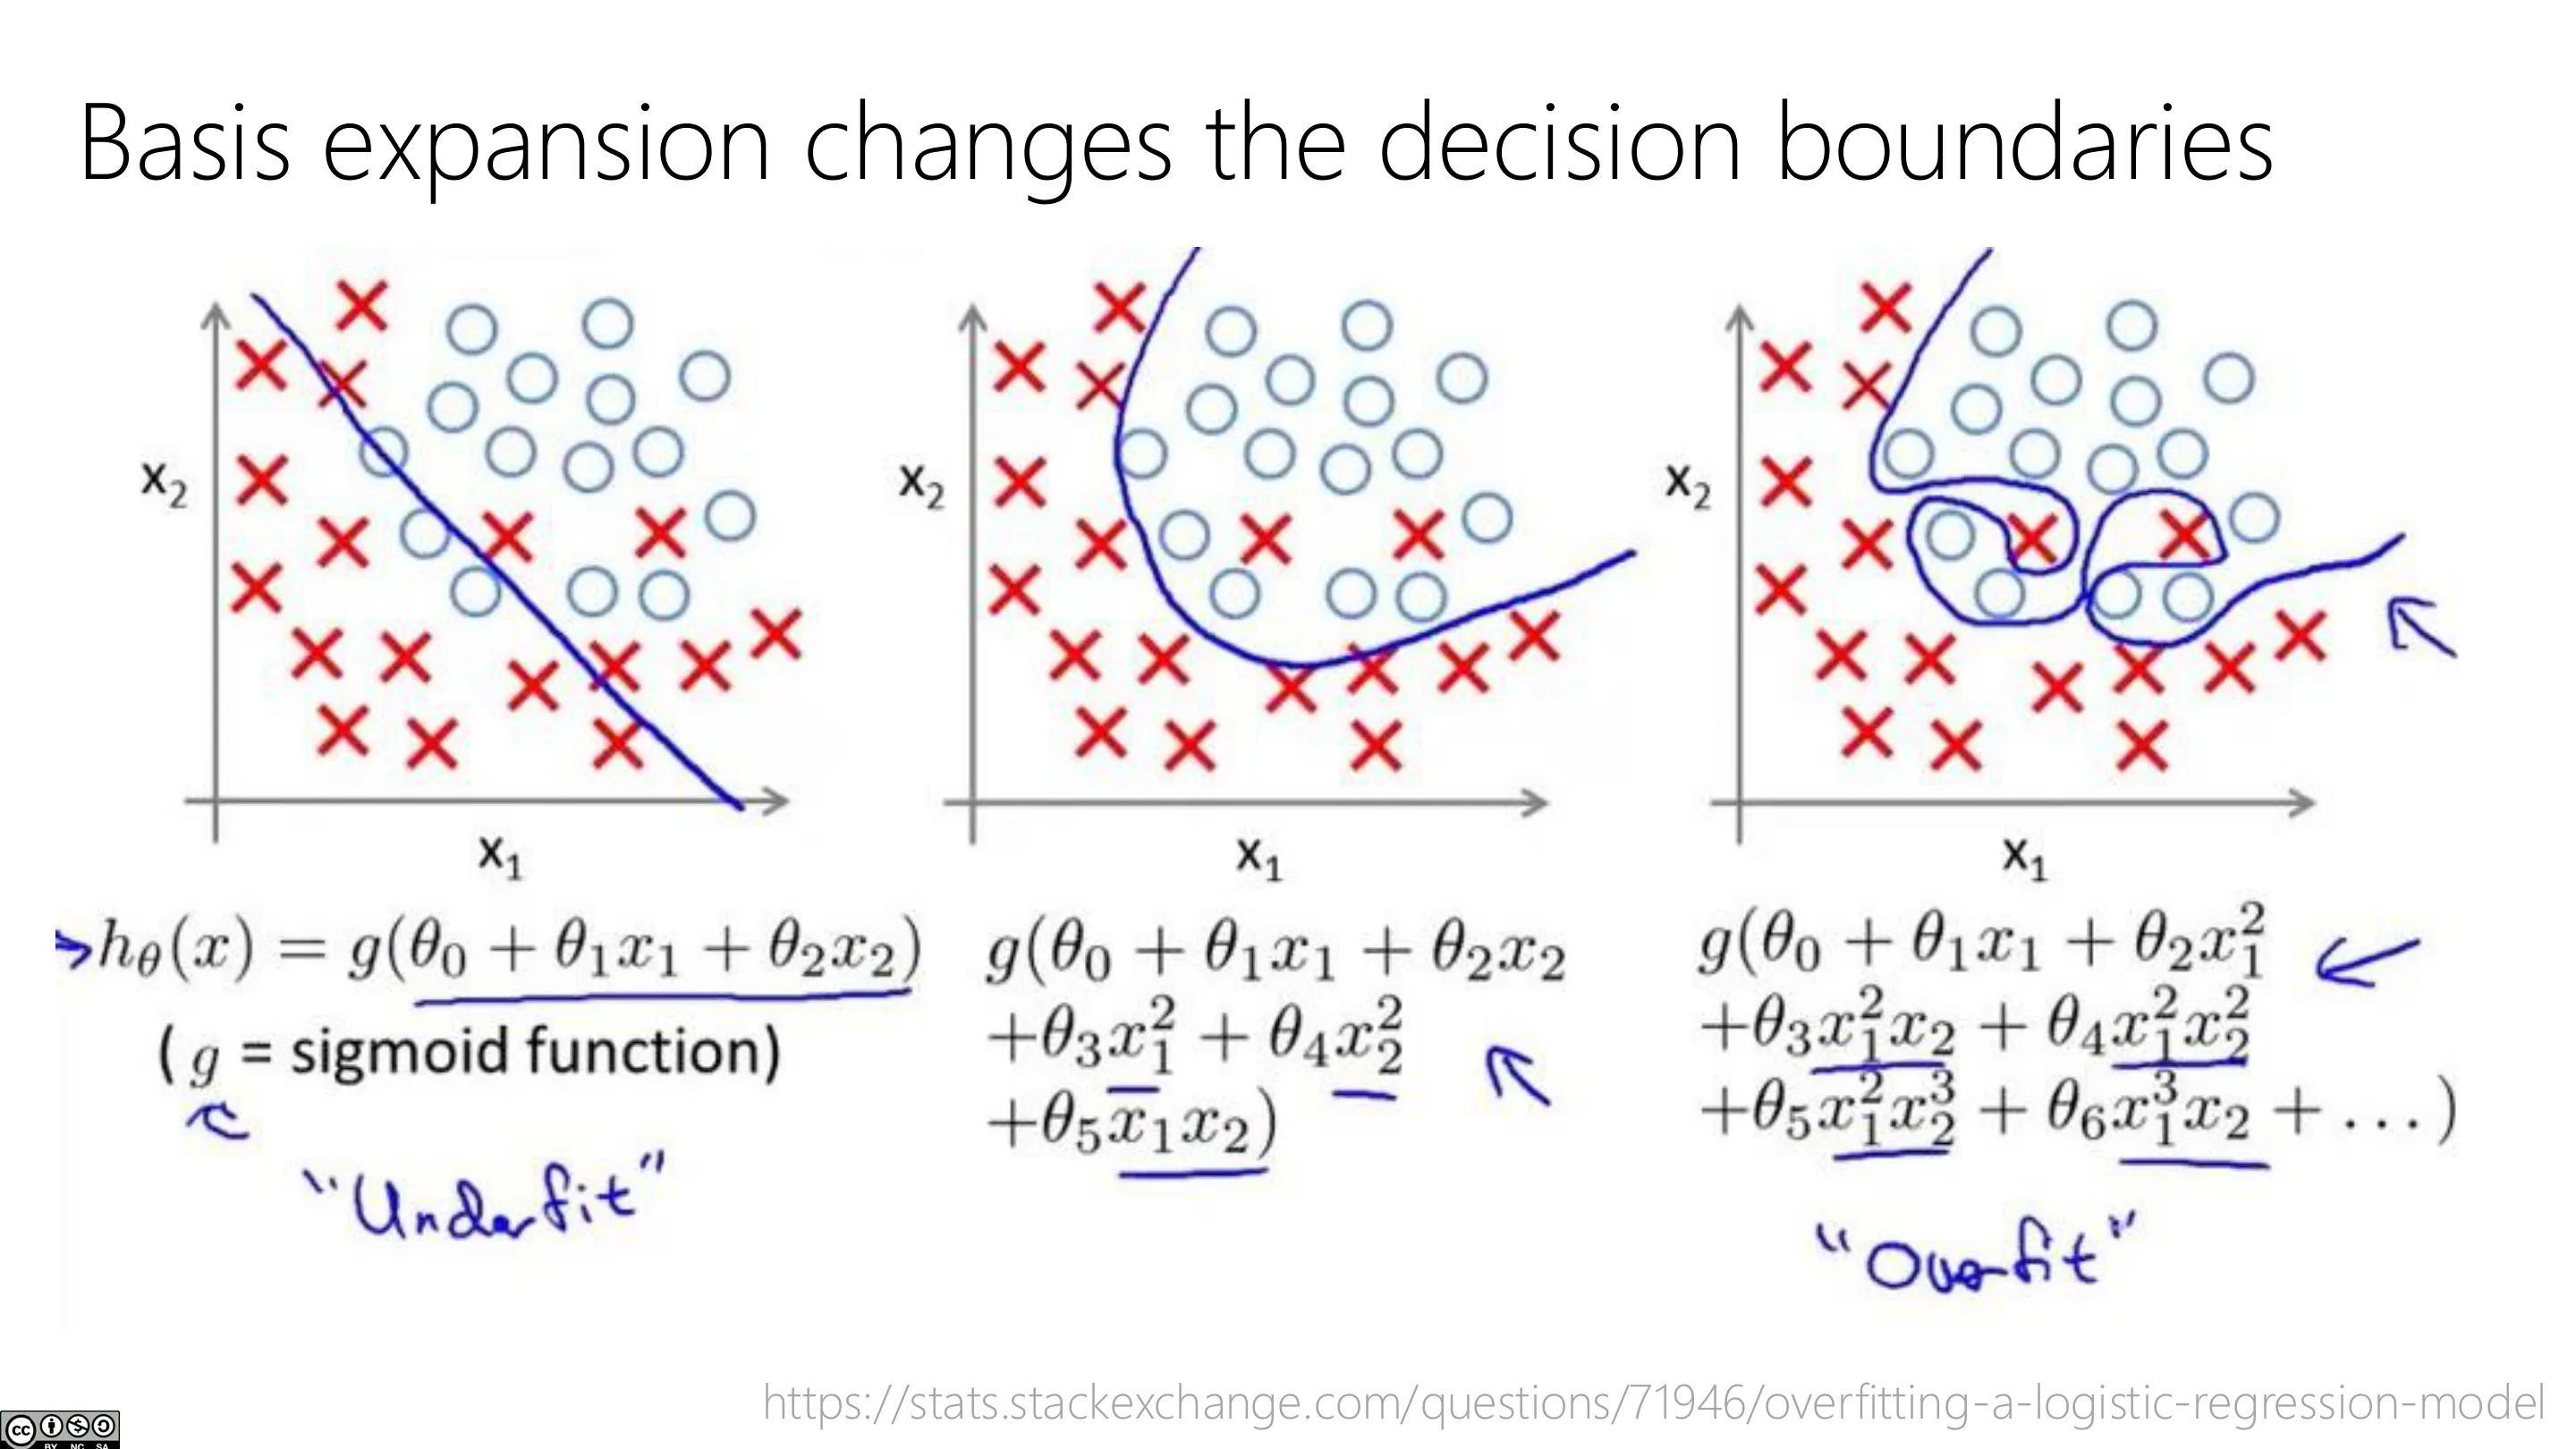
和线性回归一样,把 $x$ 换成基展开 $\phi(x)$(如多项式),逻辑回归的决策边界就从线性变成二次/更高阶。决策边界定义为 $p(y=1\mid x)=p(y=0\mid x)$,对逻辑回归即 $w^\top x=0$ ⇒ 线性边界;基展开后可做复杂边界。
📷 基展开改变决策边界
回到原视频 (00:31:56)
2.4 MLE 与「无闭式解」
(参考时间: 00:34)
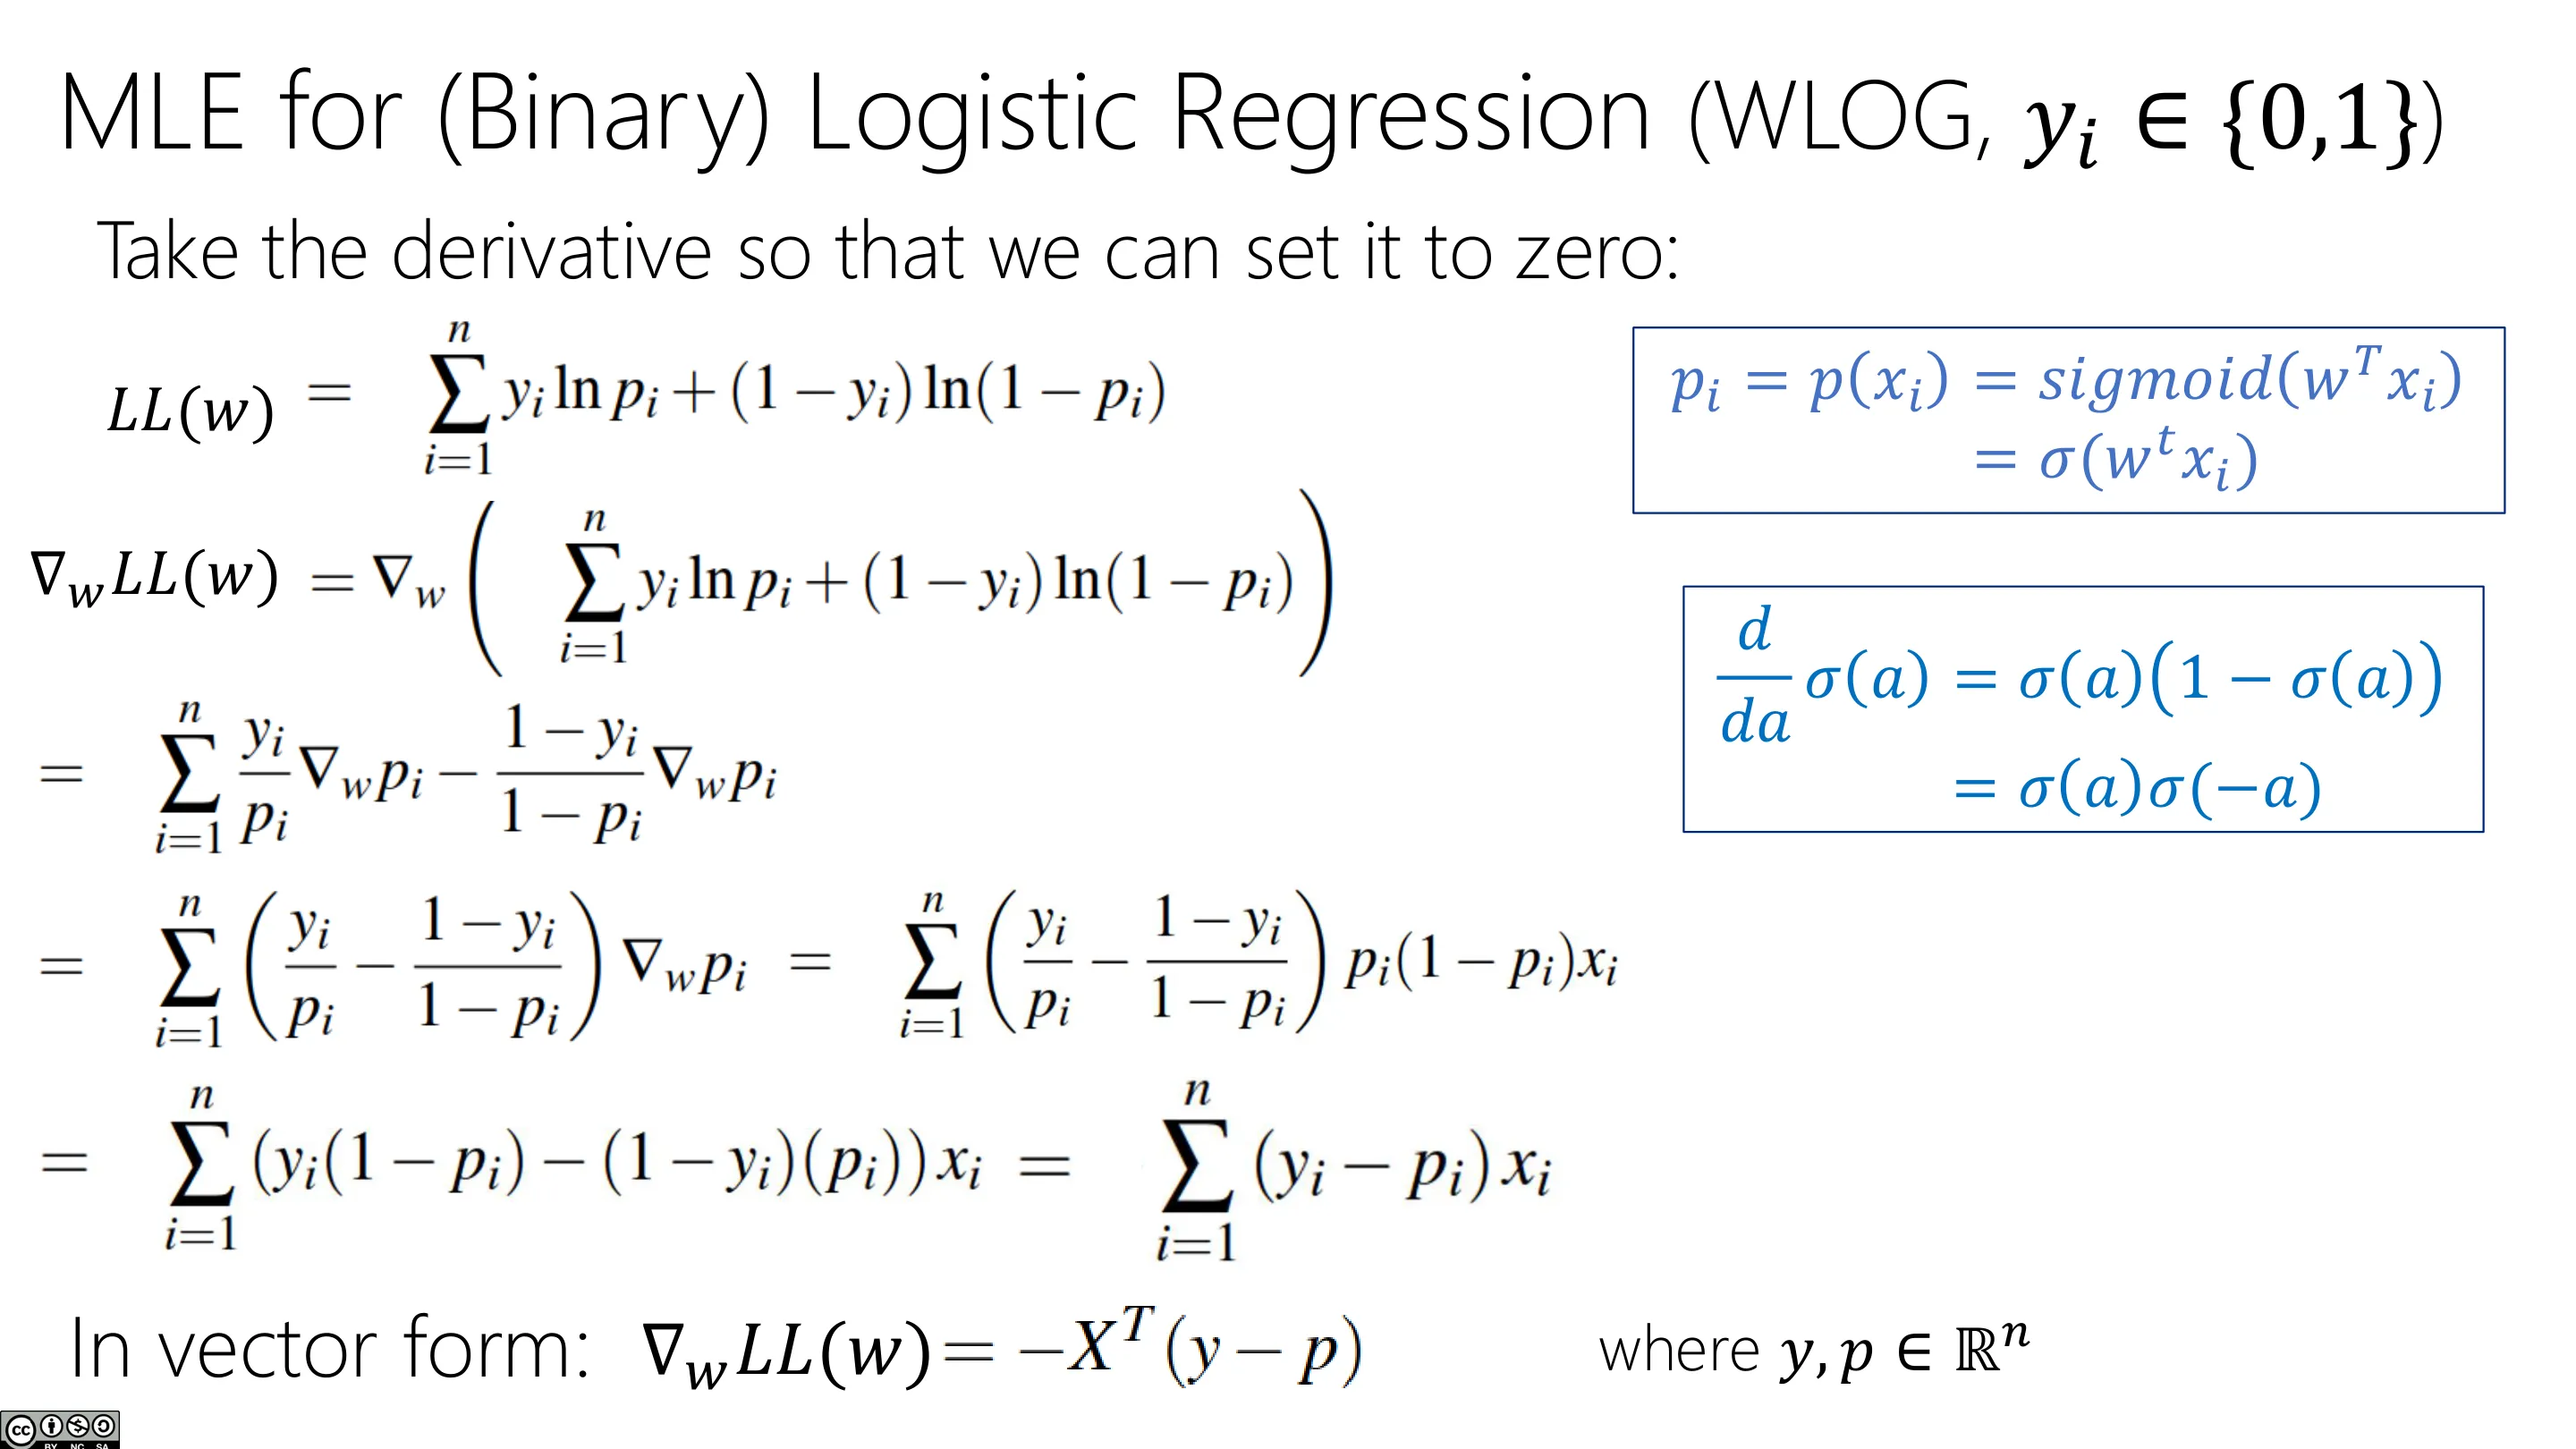
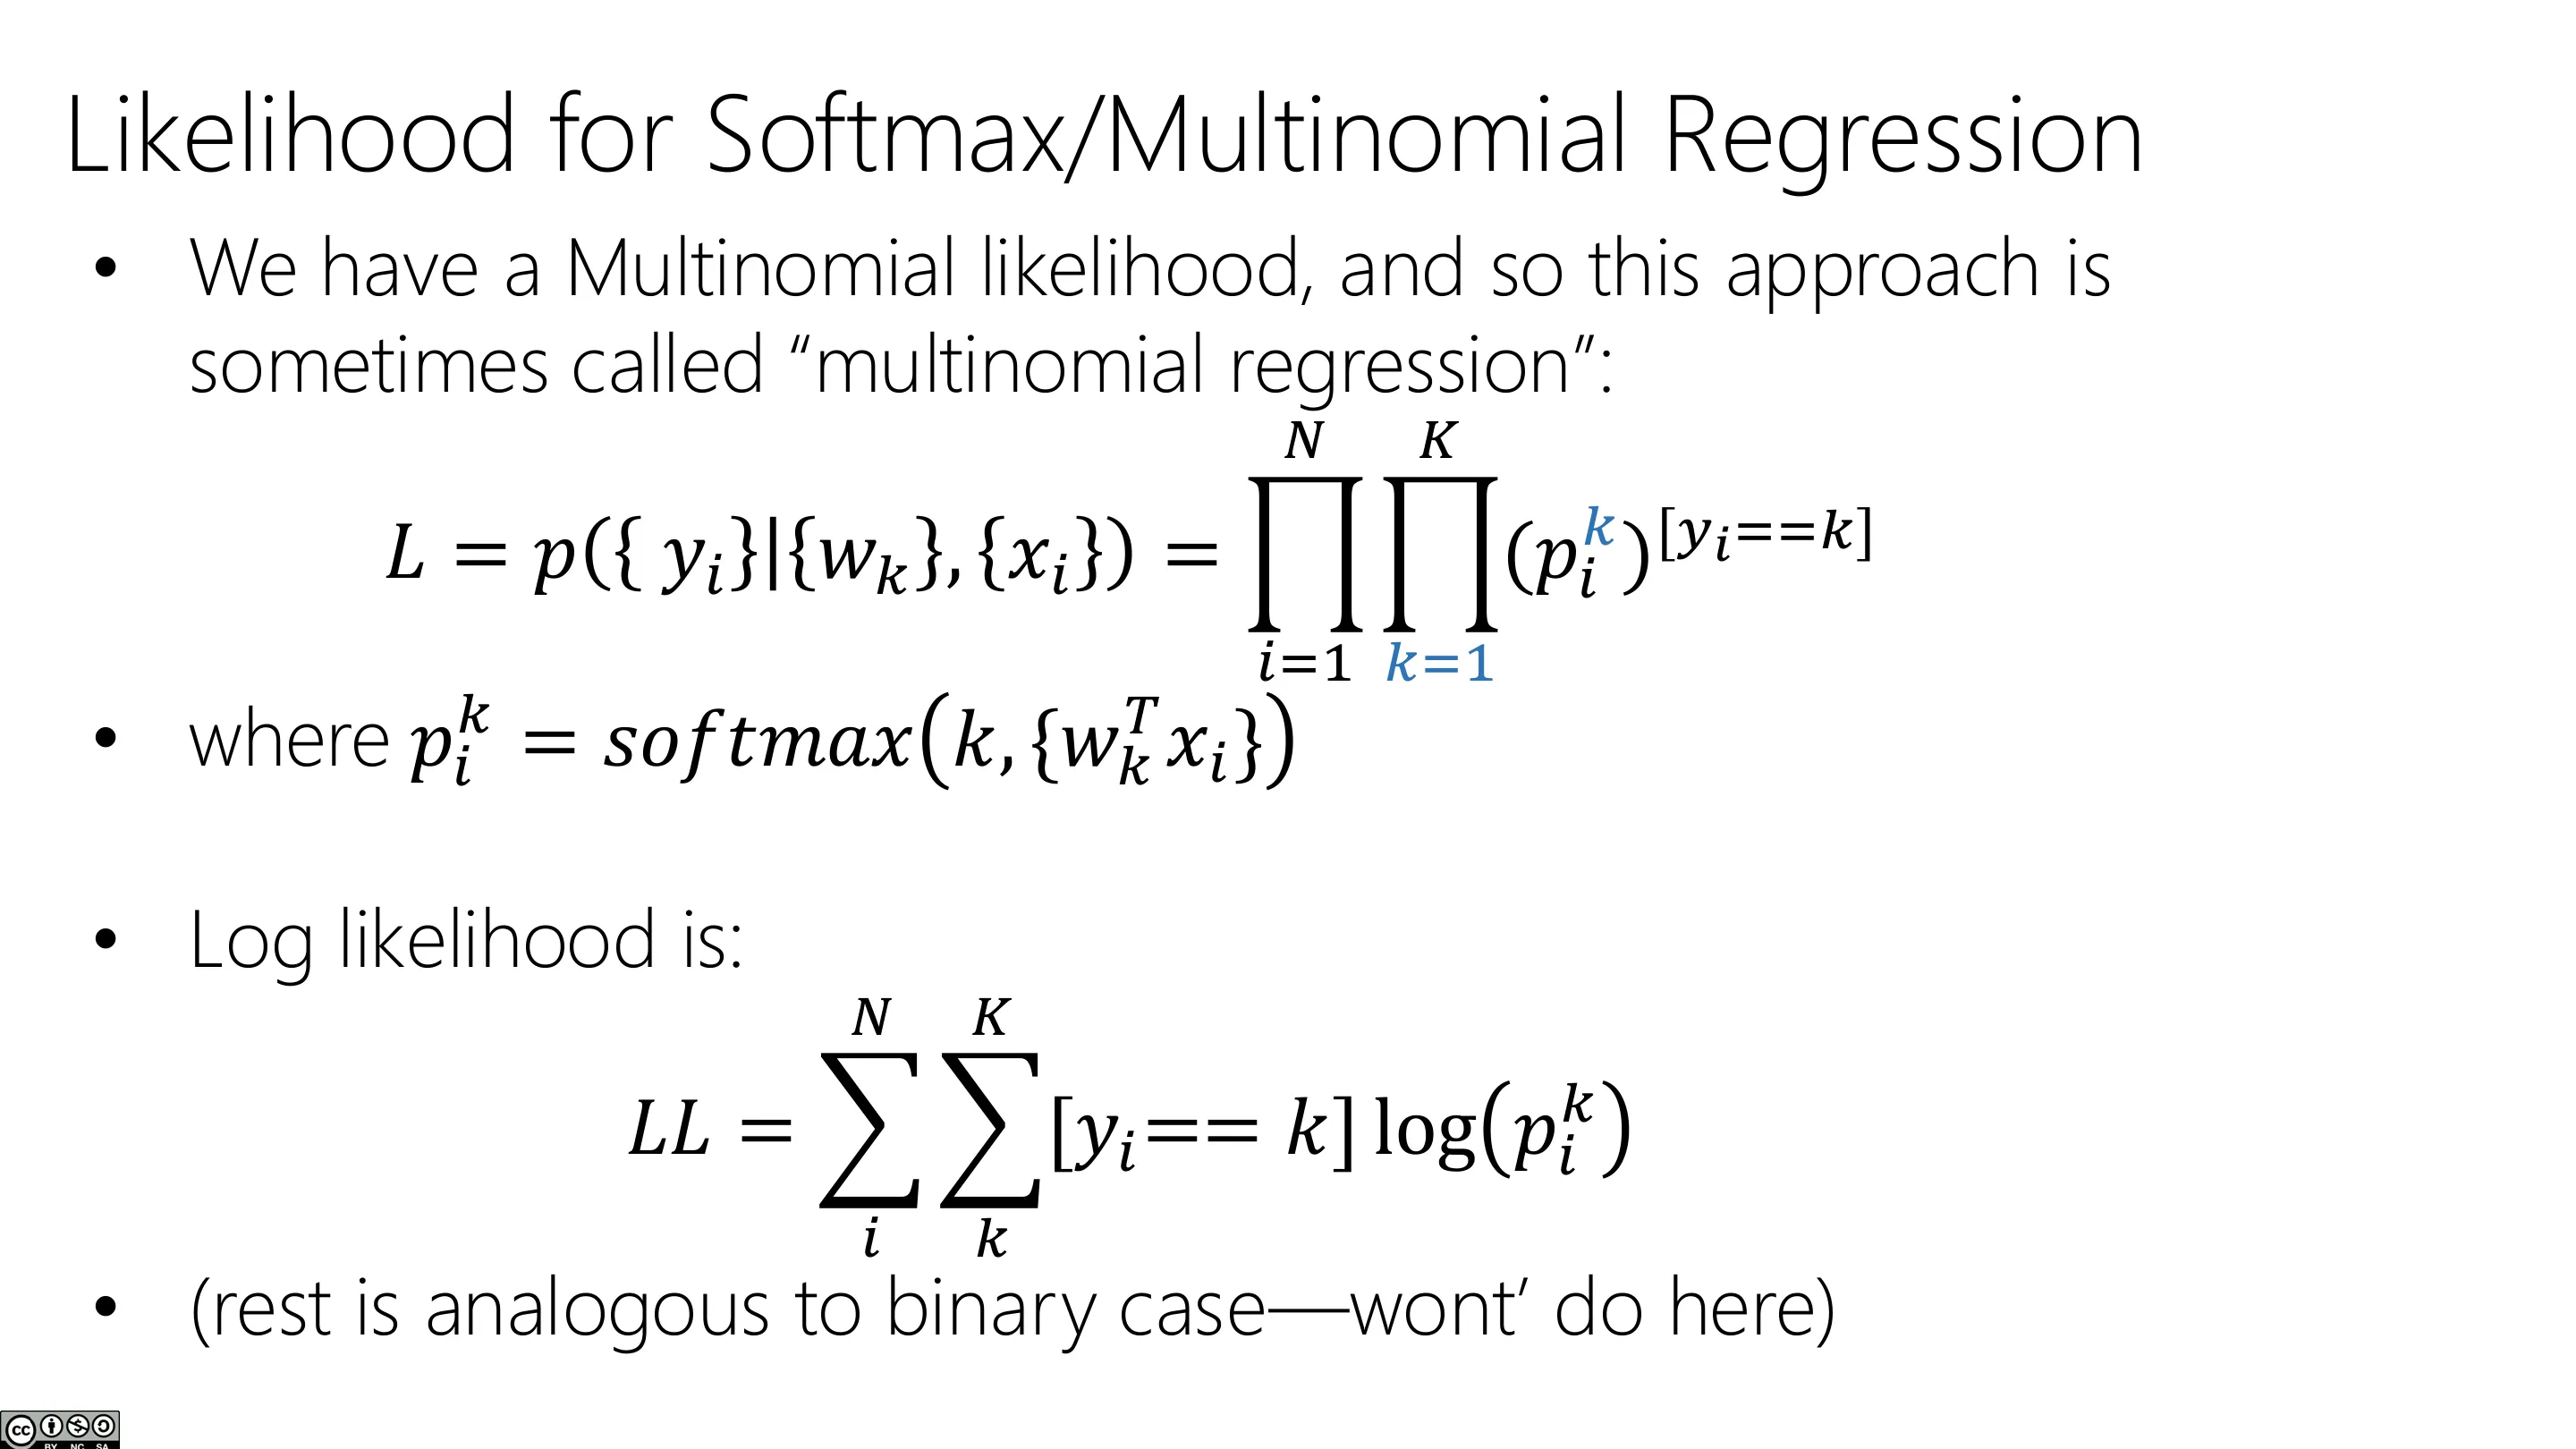
二元逻辑回归的对数似然(用 $y\in\{0,1\}$ 的记账技巧):
$$ LL(w)=\sum_i\Big[y_i\log \sigma(w^\top x_i)+(1-y_i)\log(1-\sigma(w^\top x_i))\Big] $$
即负对数似然(交叉熵)。对其求梯度(用 $\sigma'=\sigma(1-\sigma)$):
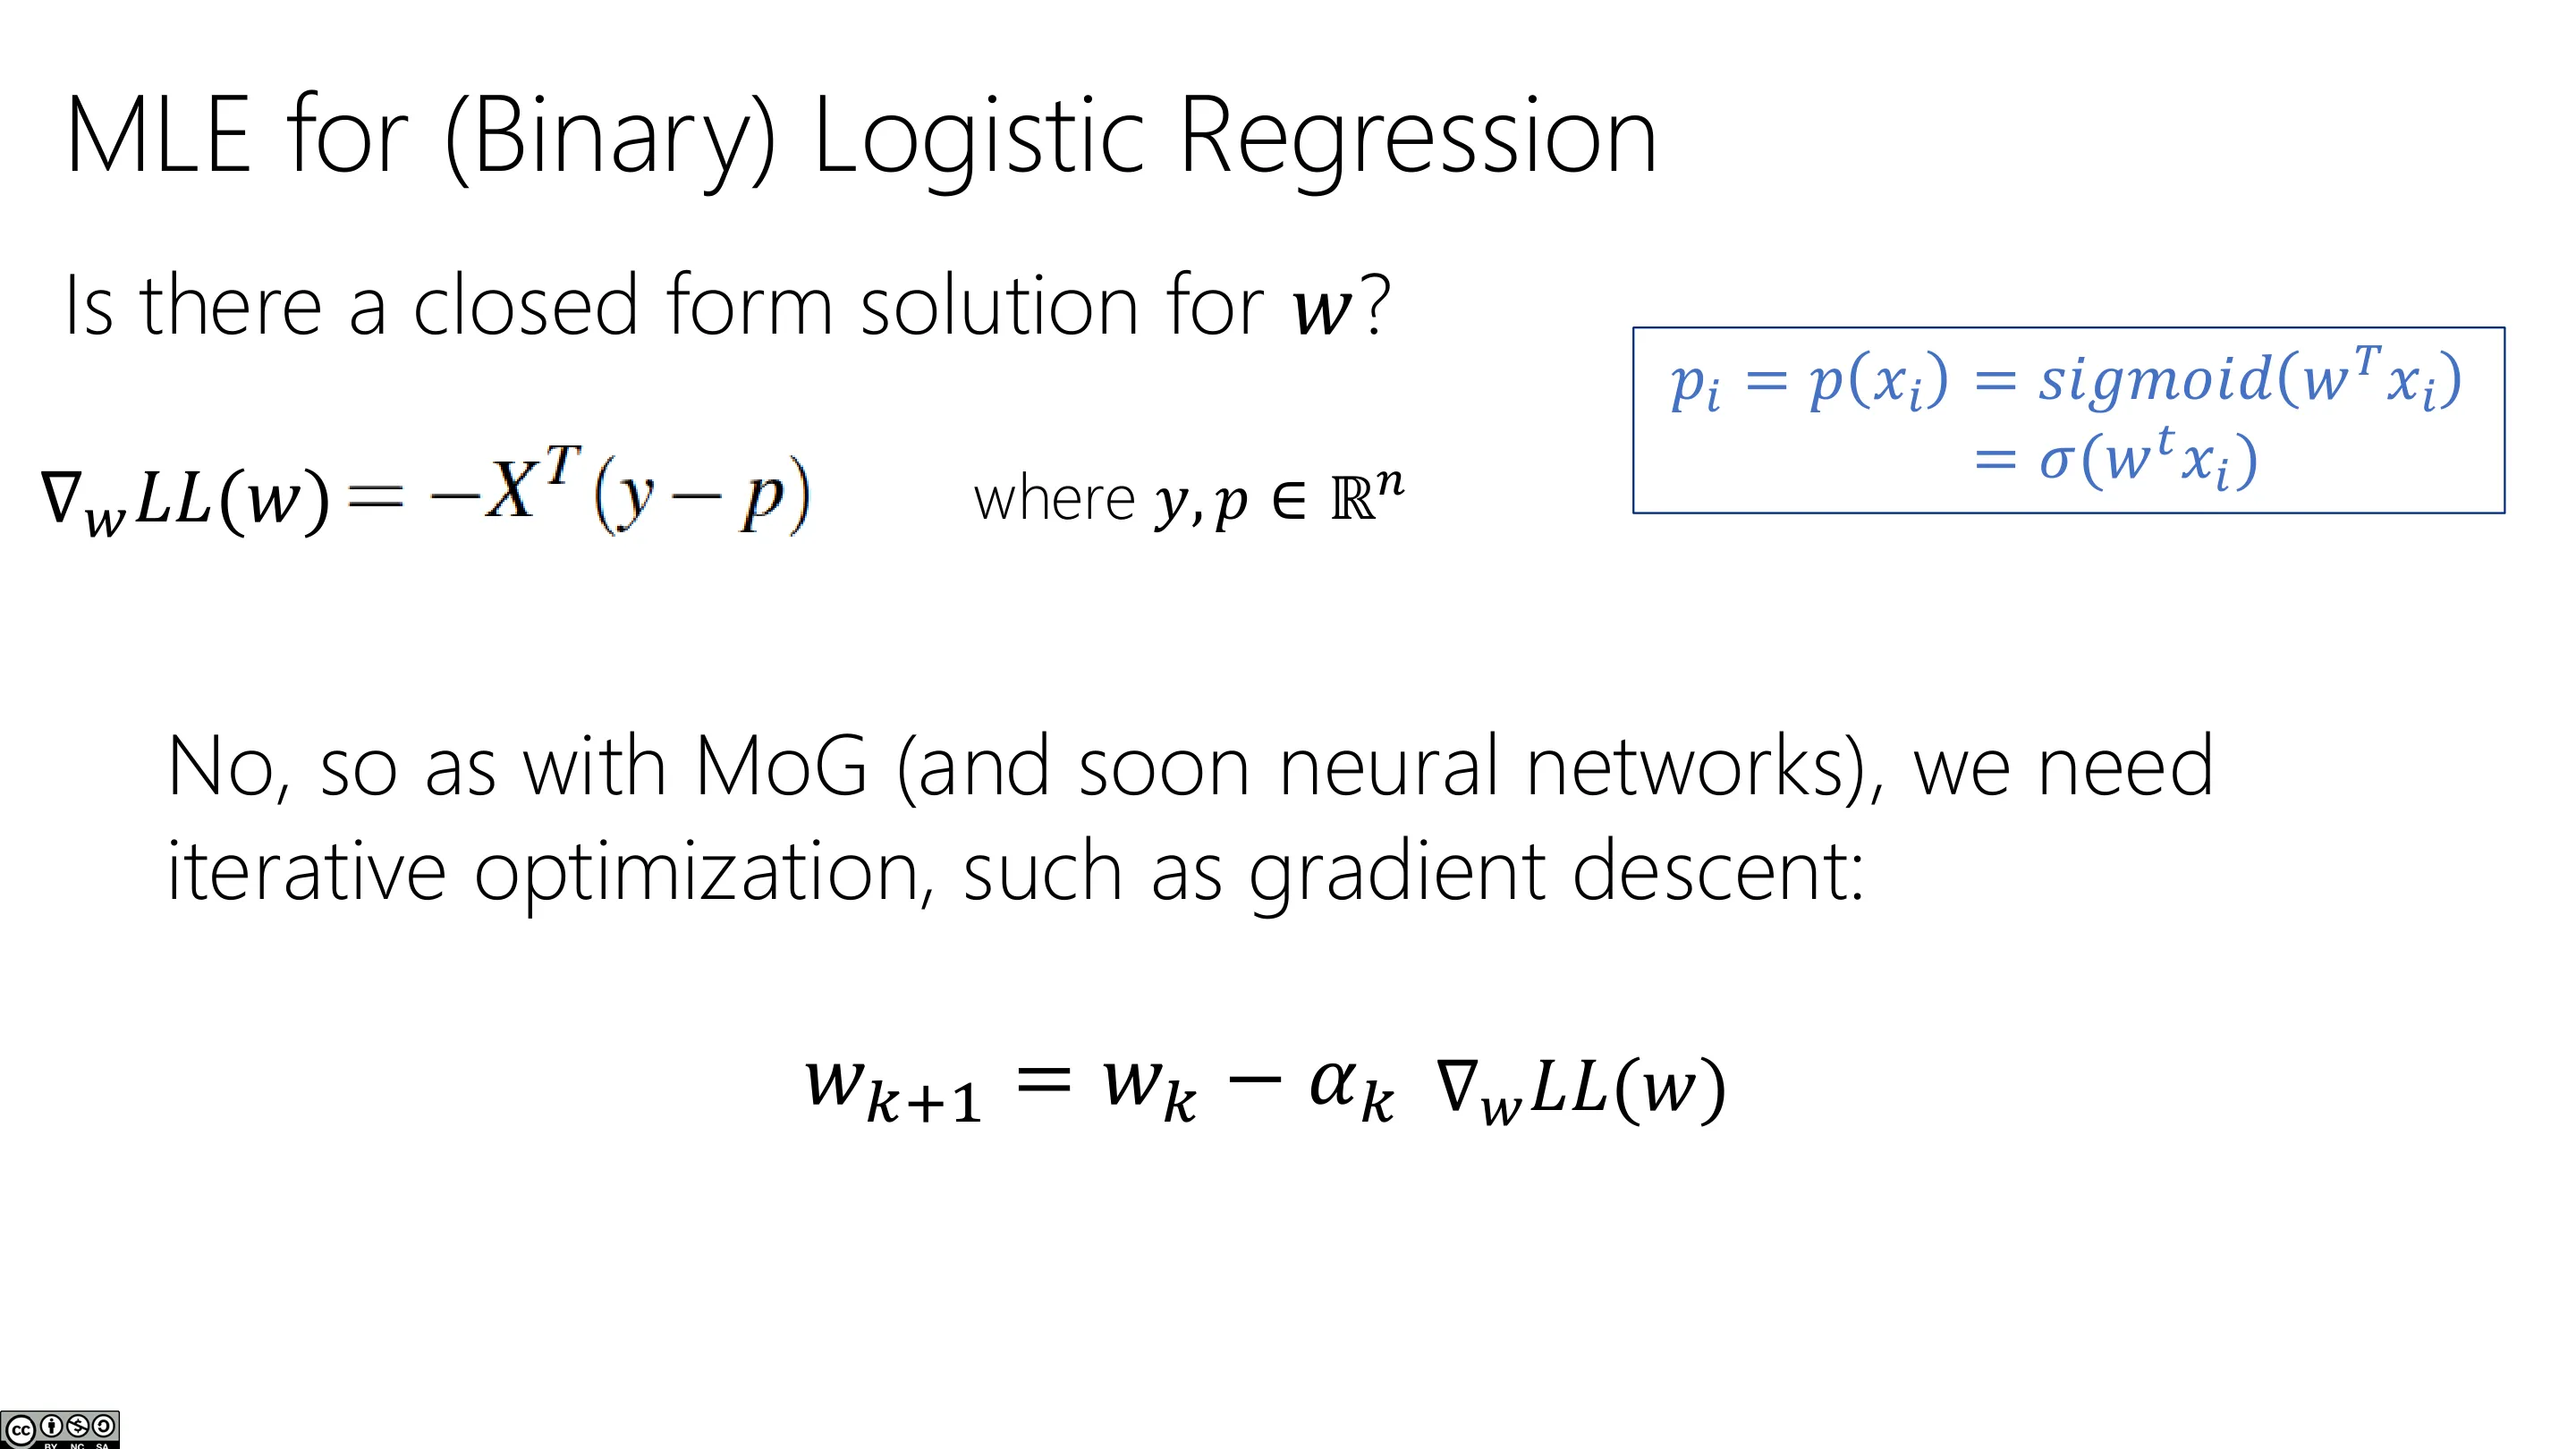
$$ \nabla_w\,(-LL)=\sum_i\big(\sigma(w^\top x_i)-y_i\big)x_i = X^\top(\hat p-y) $$
关键:令其为零无法分离出 $w$(内部还有 sigmoid),因此没有闭式解——必须用迭代优化(梯度下降,下一讲详讲)。这与高斯混合模型一样。
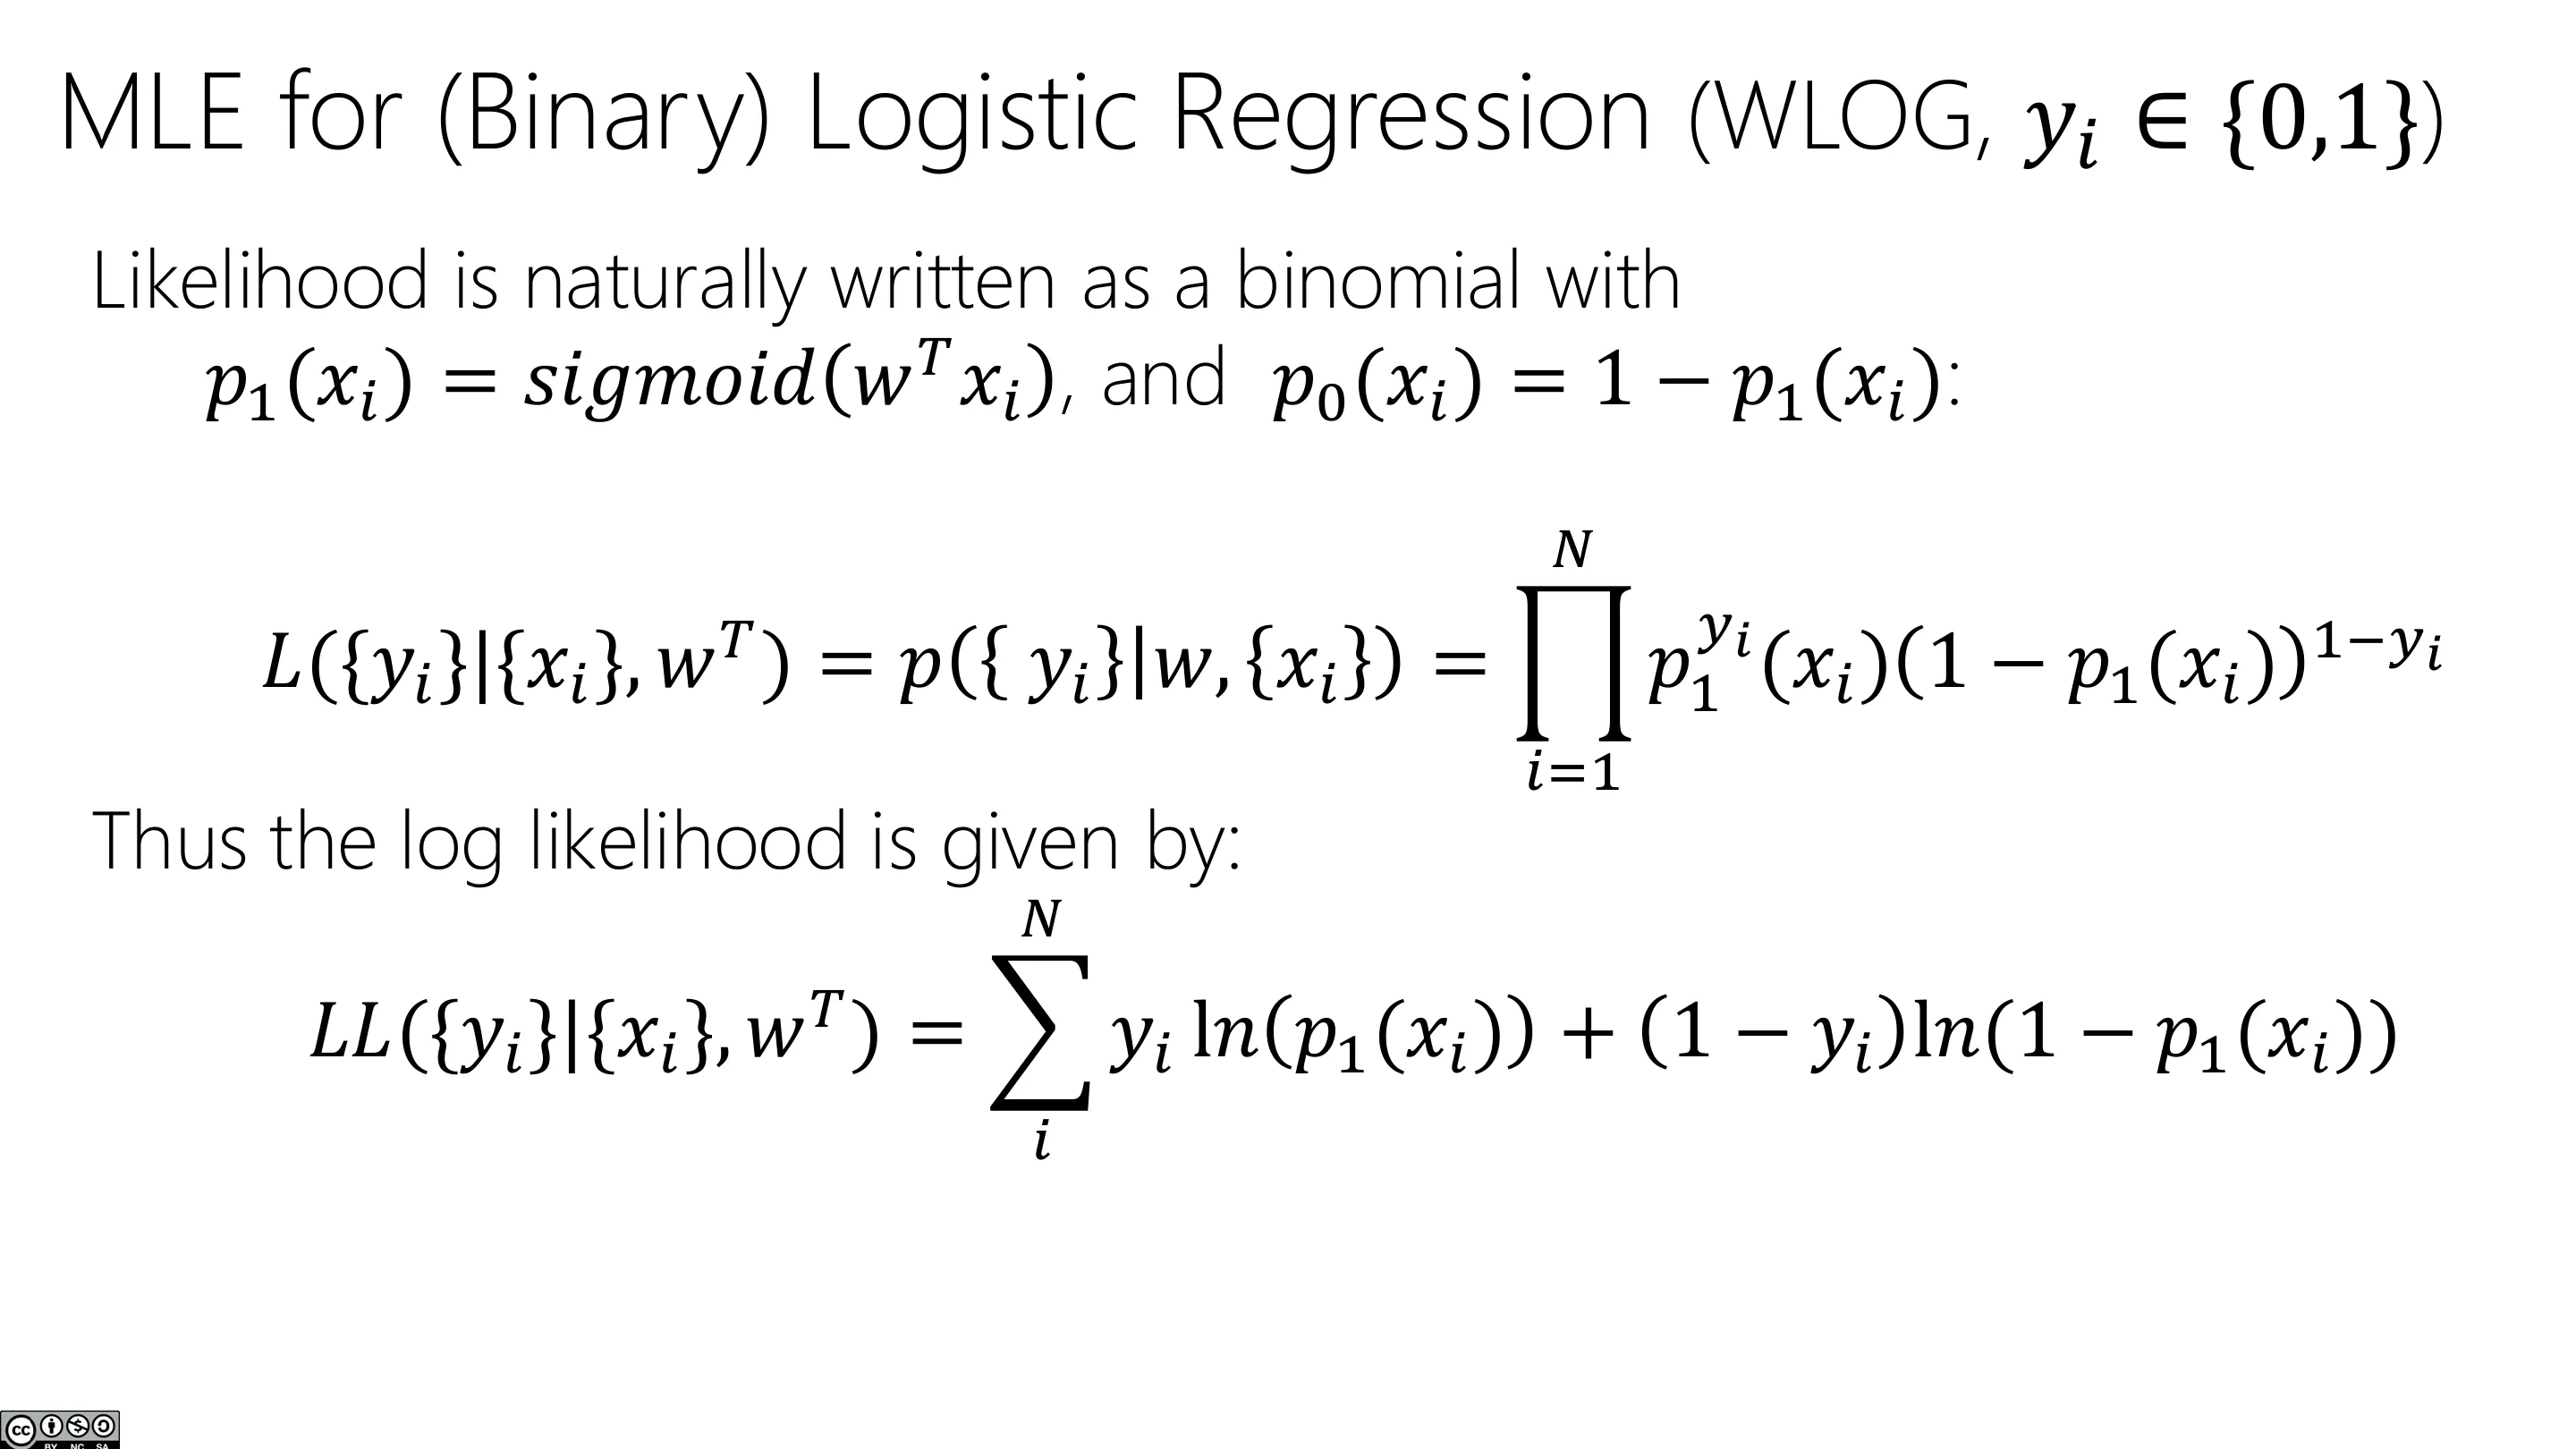
📷 二元逻辑回归的 MLE
回到原视频 (00:34:15)
📷 对参数求导
回到原视频 (00:39:11)
📷 是否存在闭式解?
回到原视频 (00:44:58)
📷 负对数似然与梯度
回到原视频 (00:48:02)
📷 多分类的对数似然(指示函数)
回到原视频 (00:48:53)
编者说明:讲师强调——逻辑回归从未对 $X$ 的分布作任何假设($X$ 不是随机变量),因此不会有「假设错 X 分布」的风险;这正是判别式模型相对生成式的优势。
三、分类器评估
(参考时间: 00:51)
3.1 校准(calibration)与保留似然
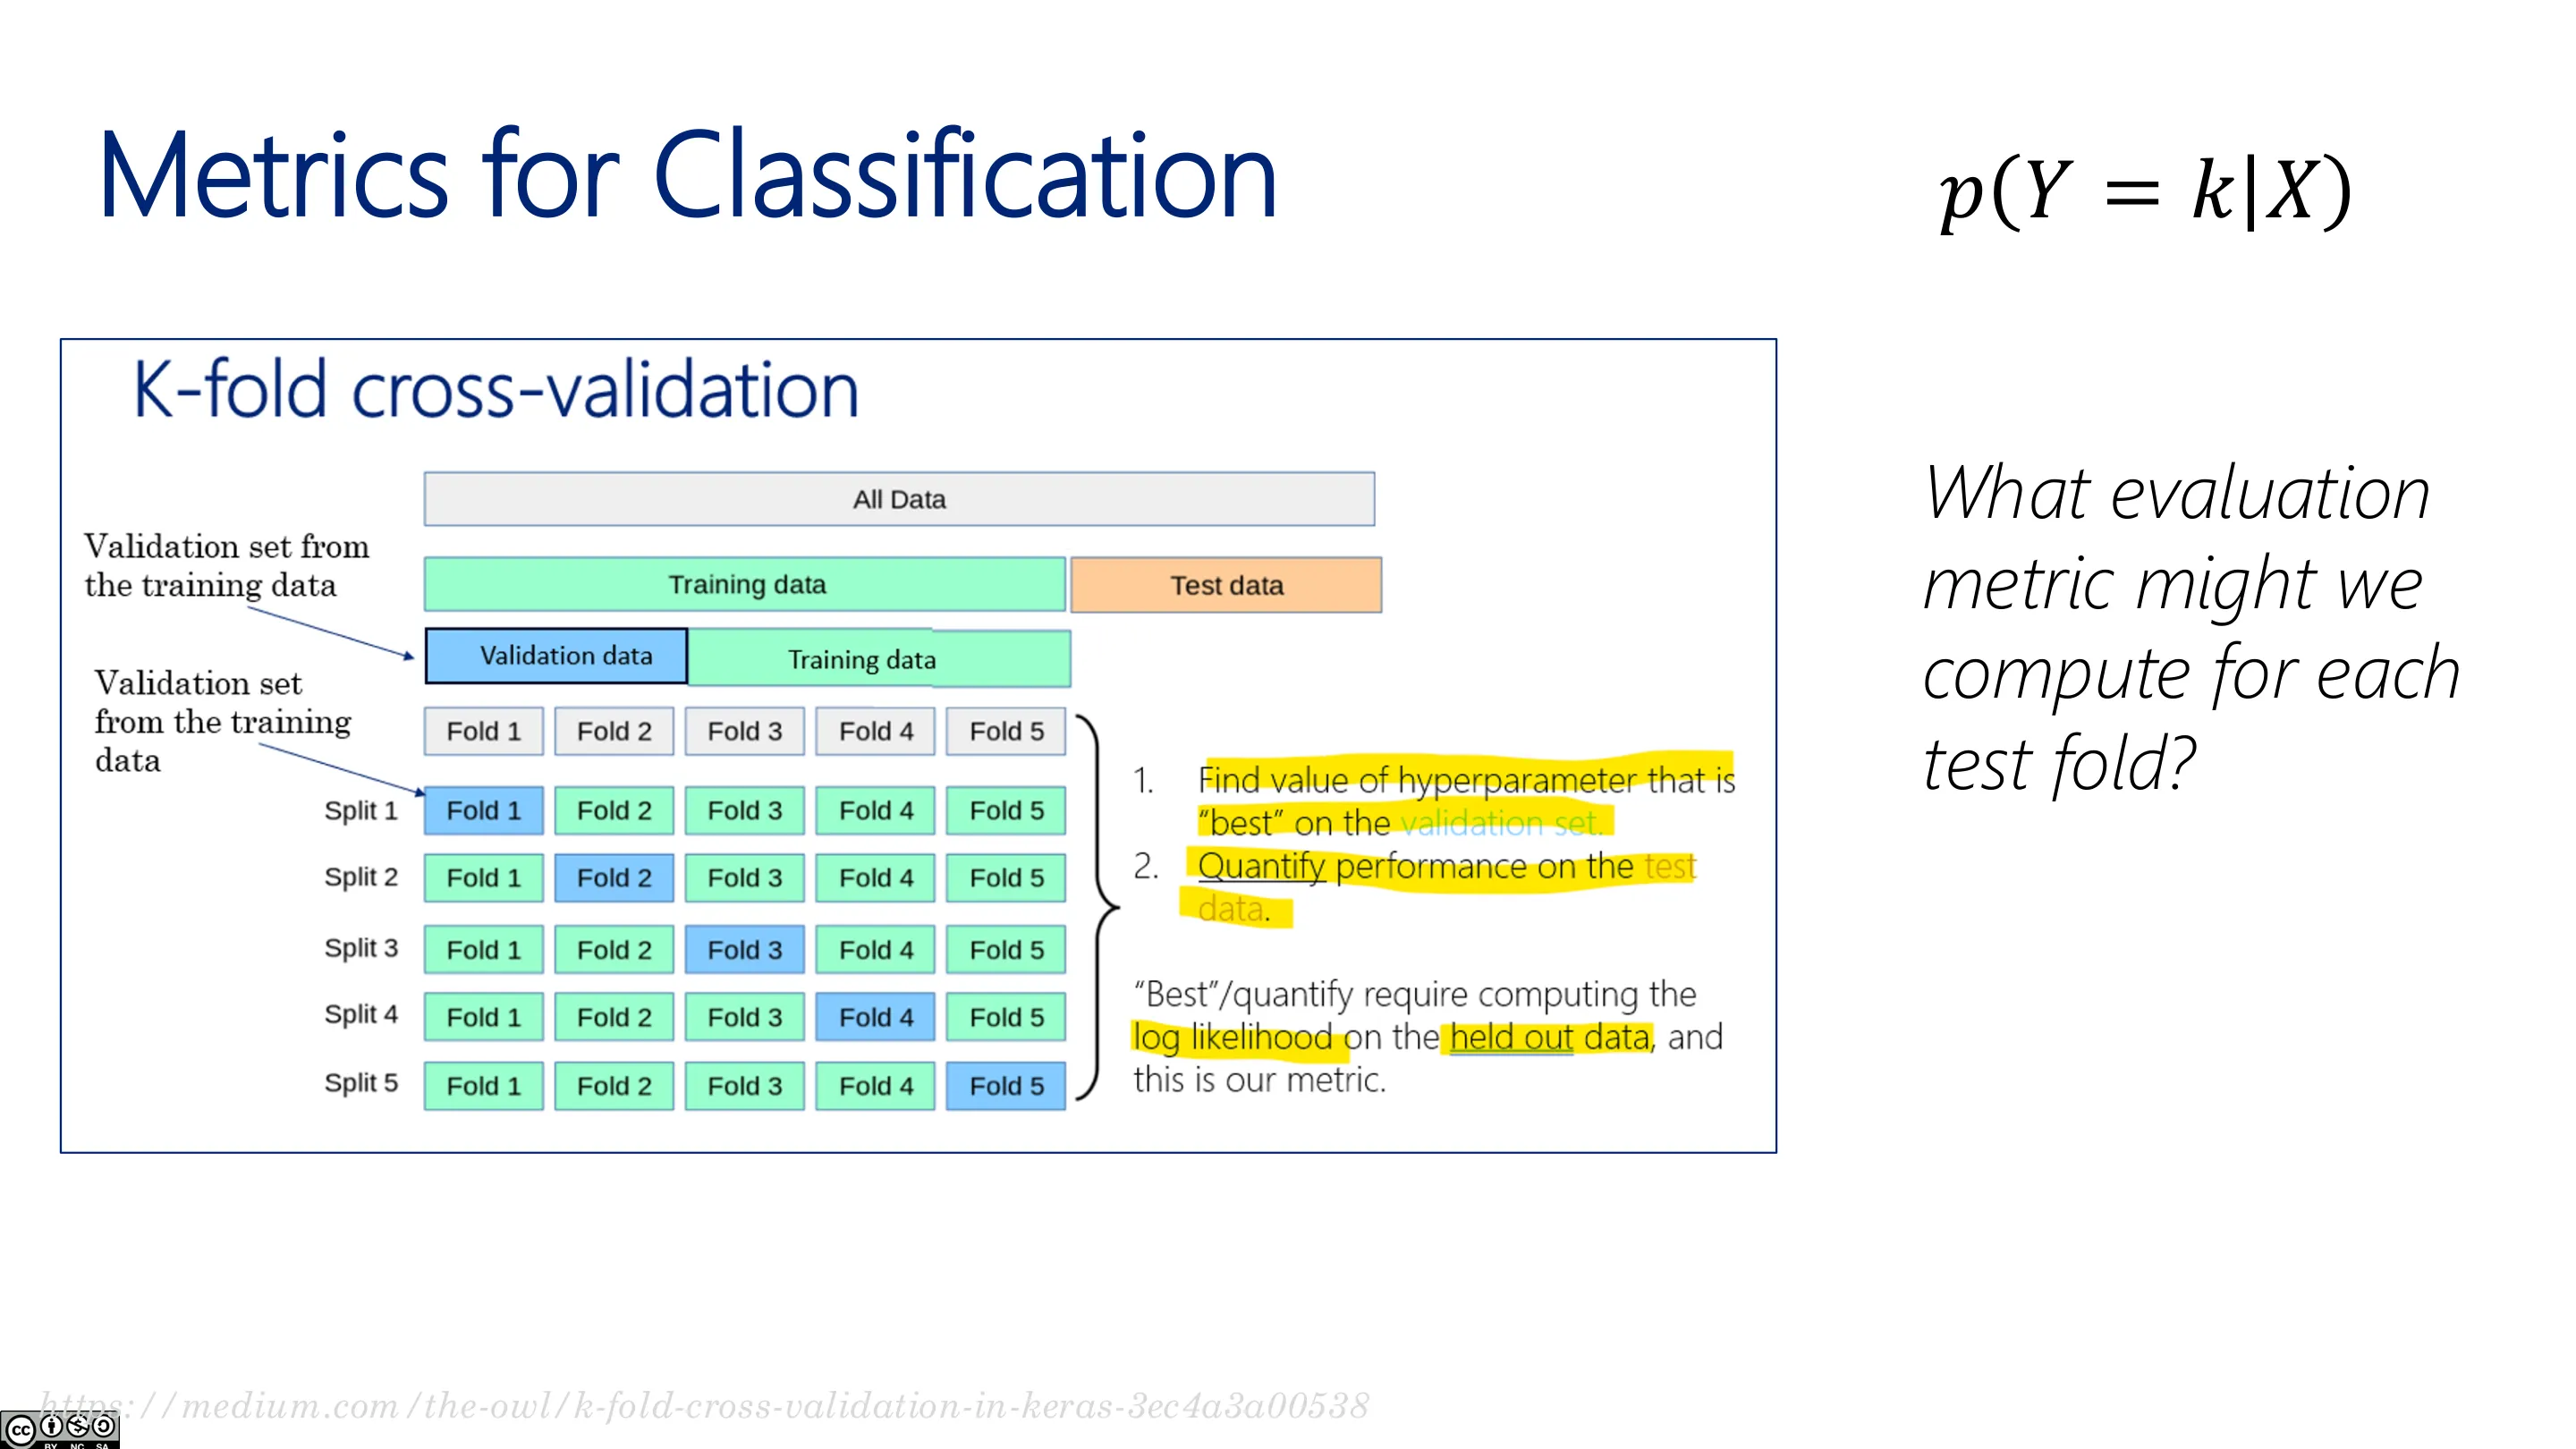
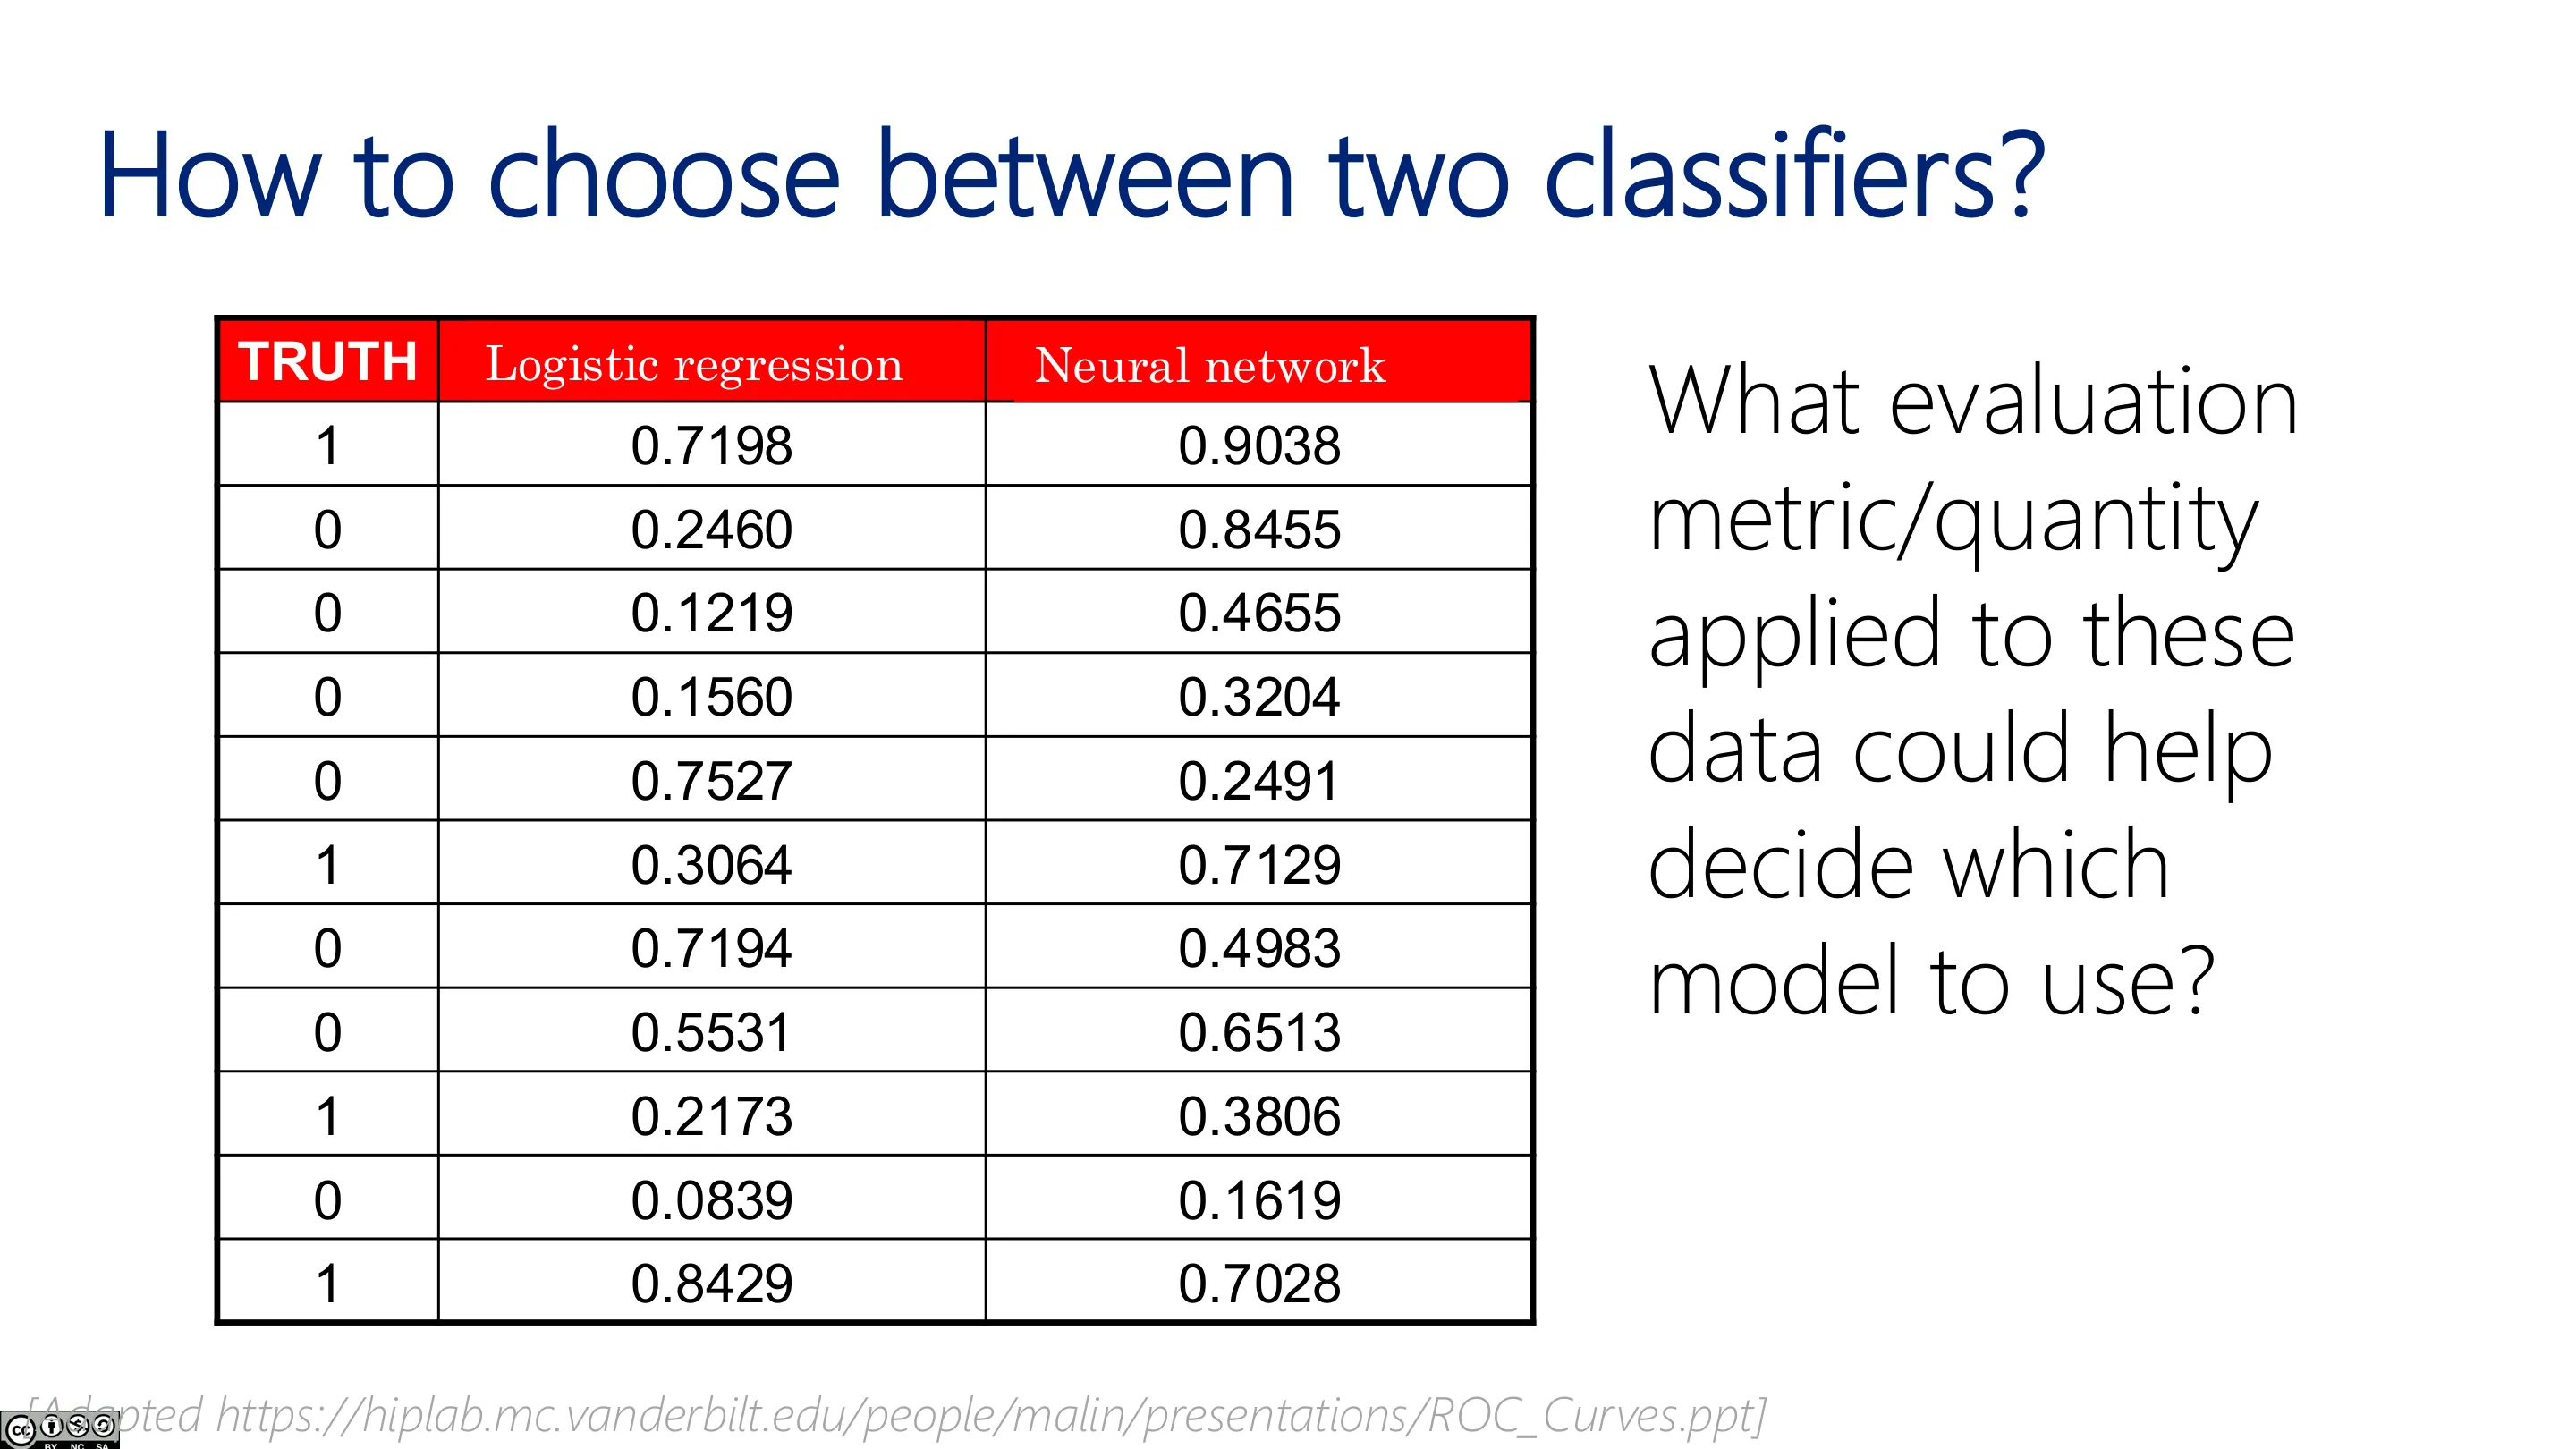
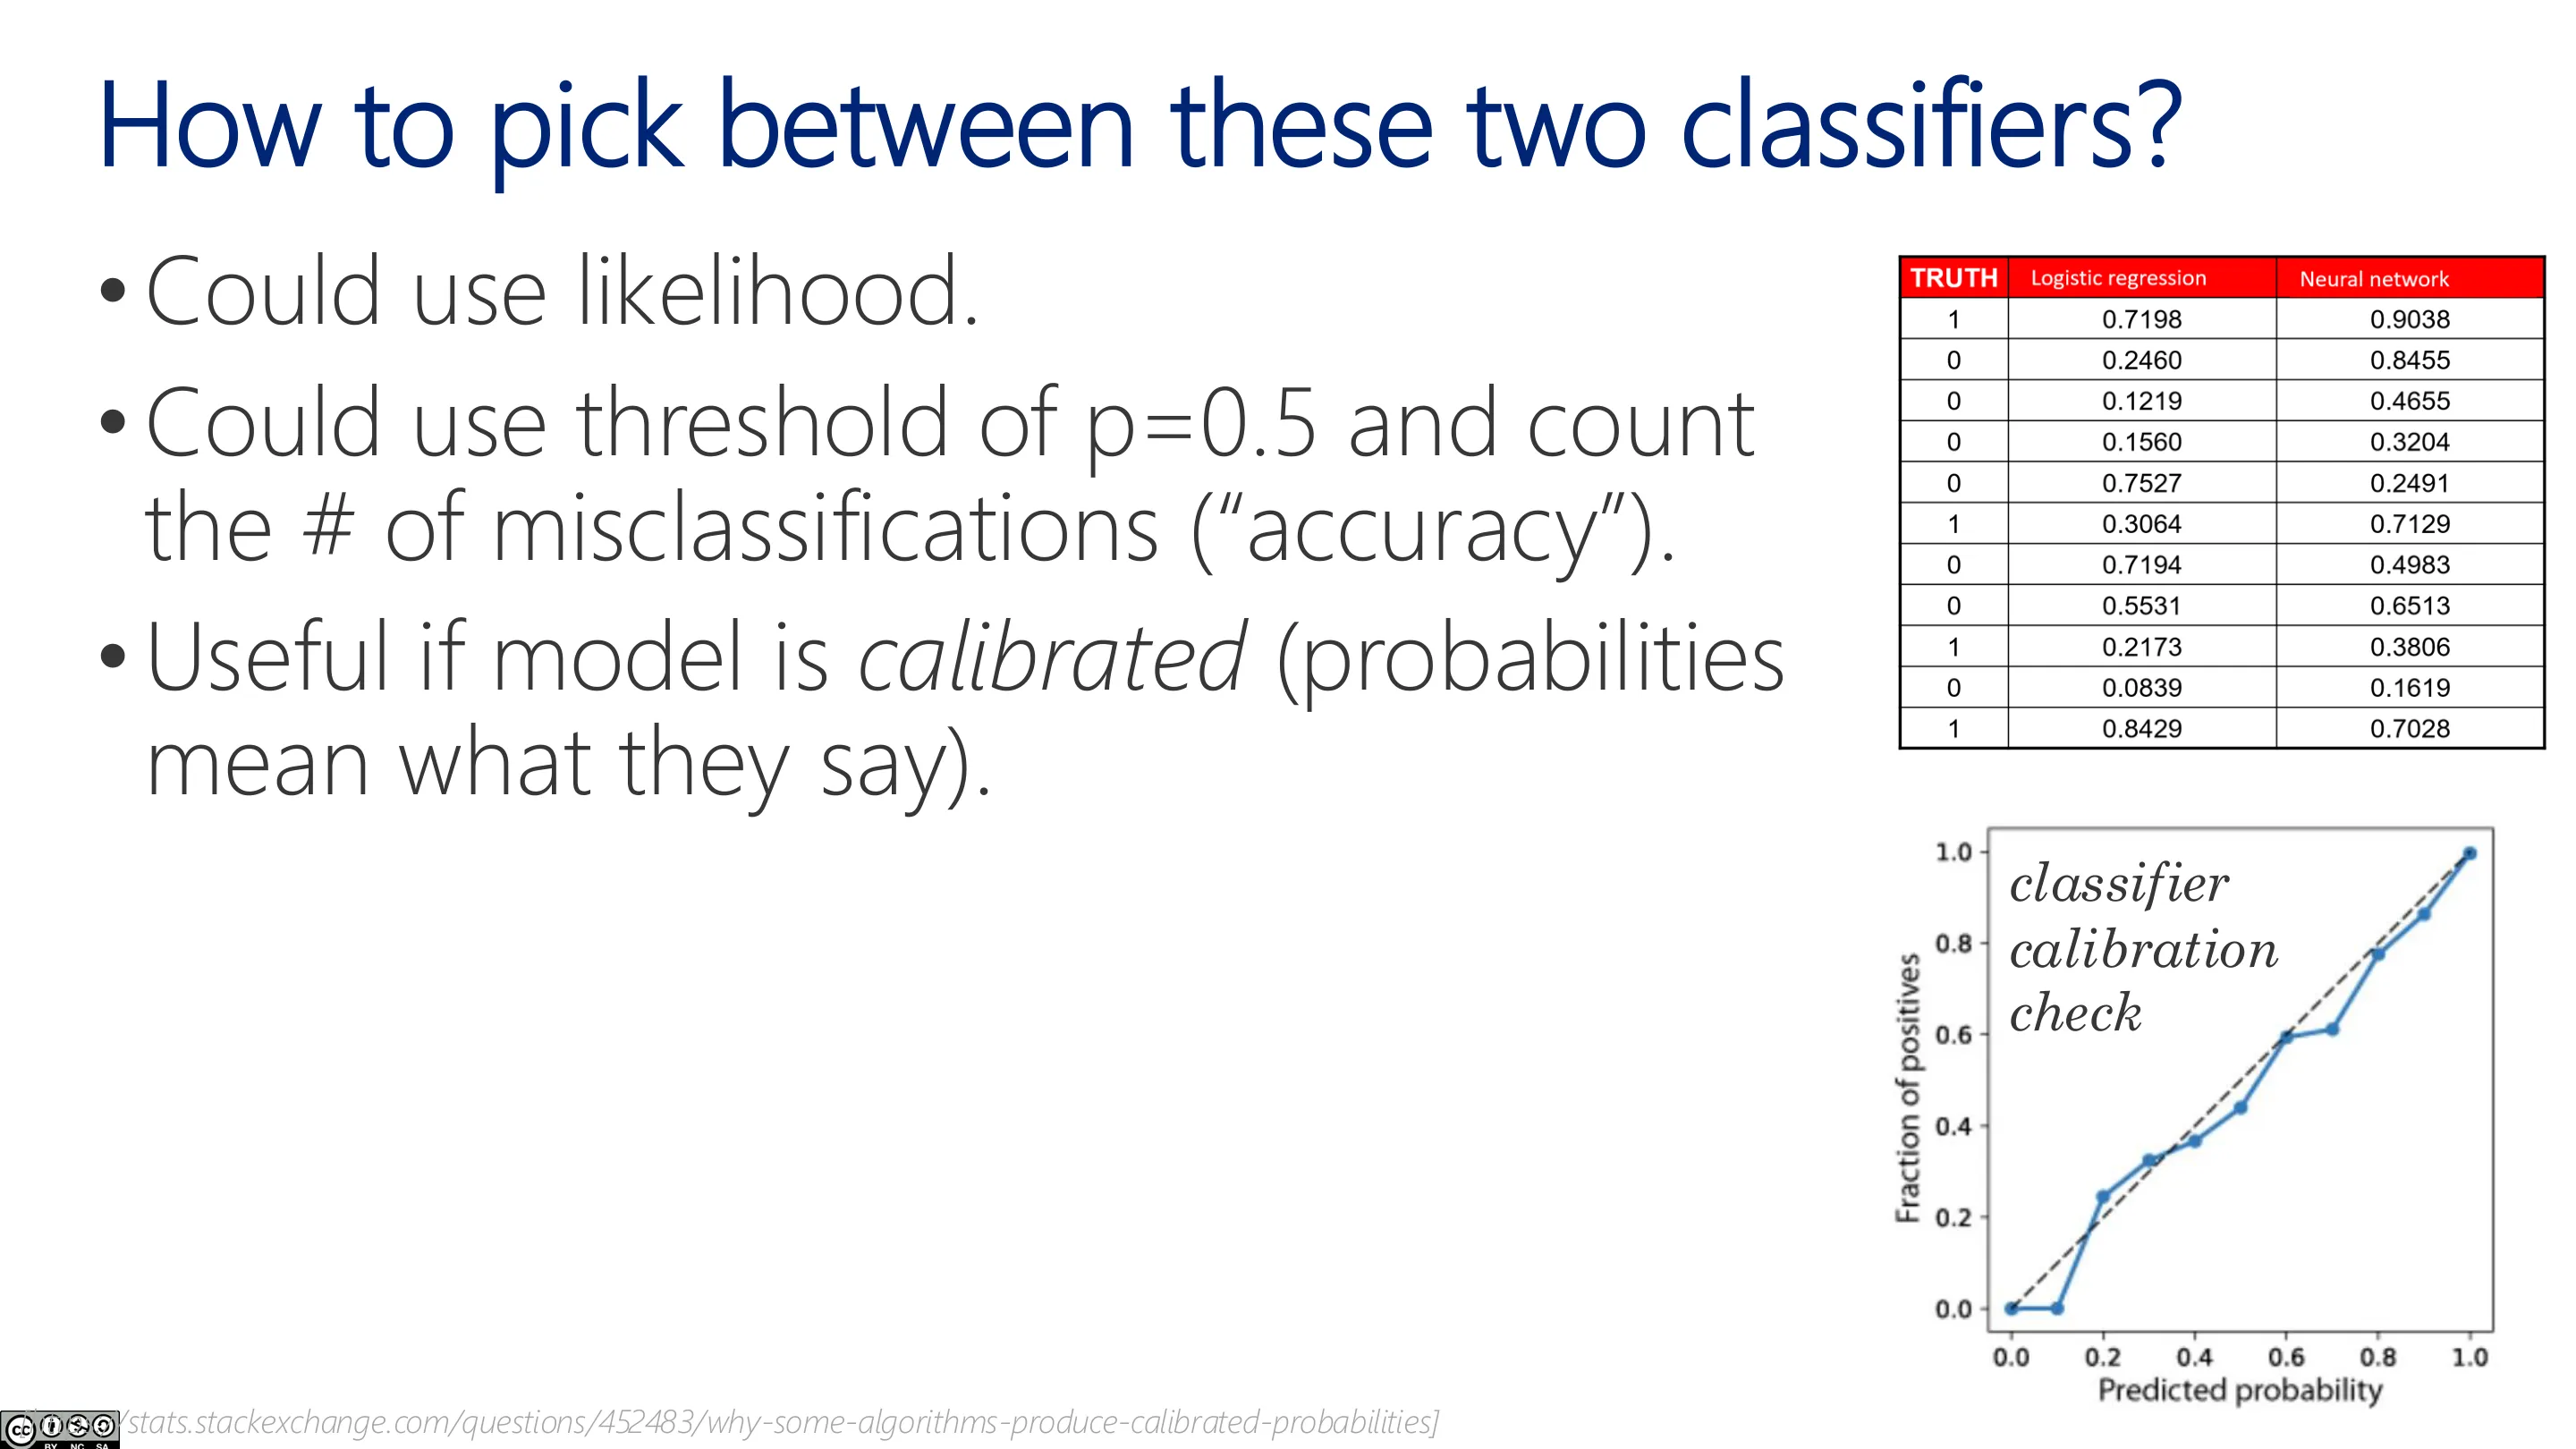
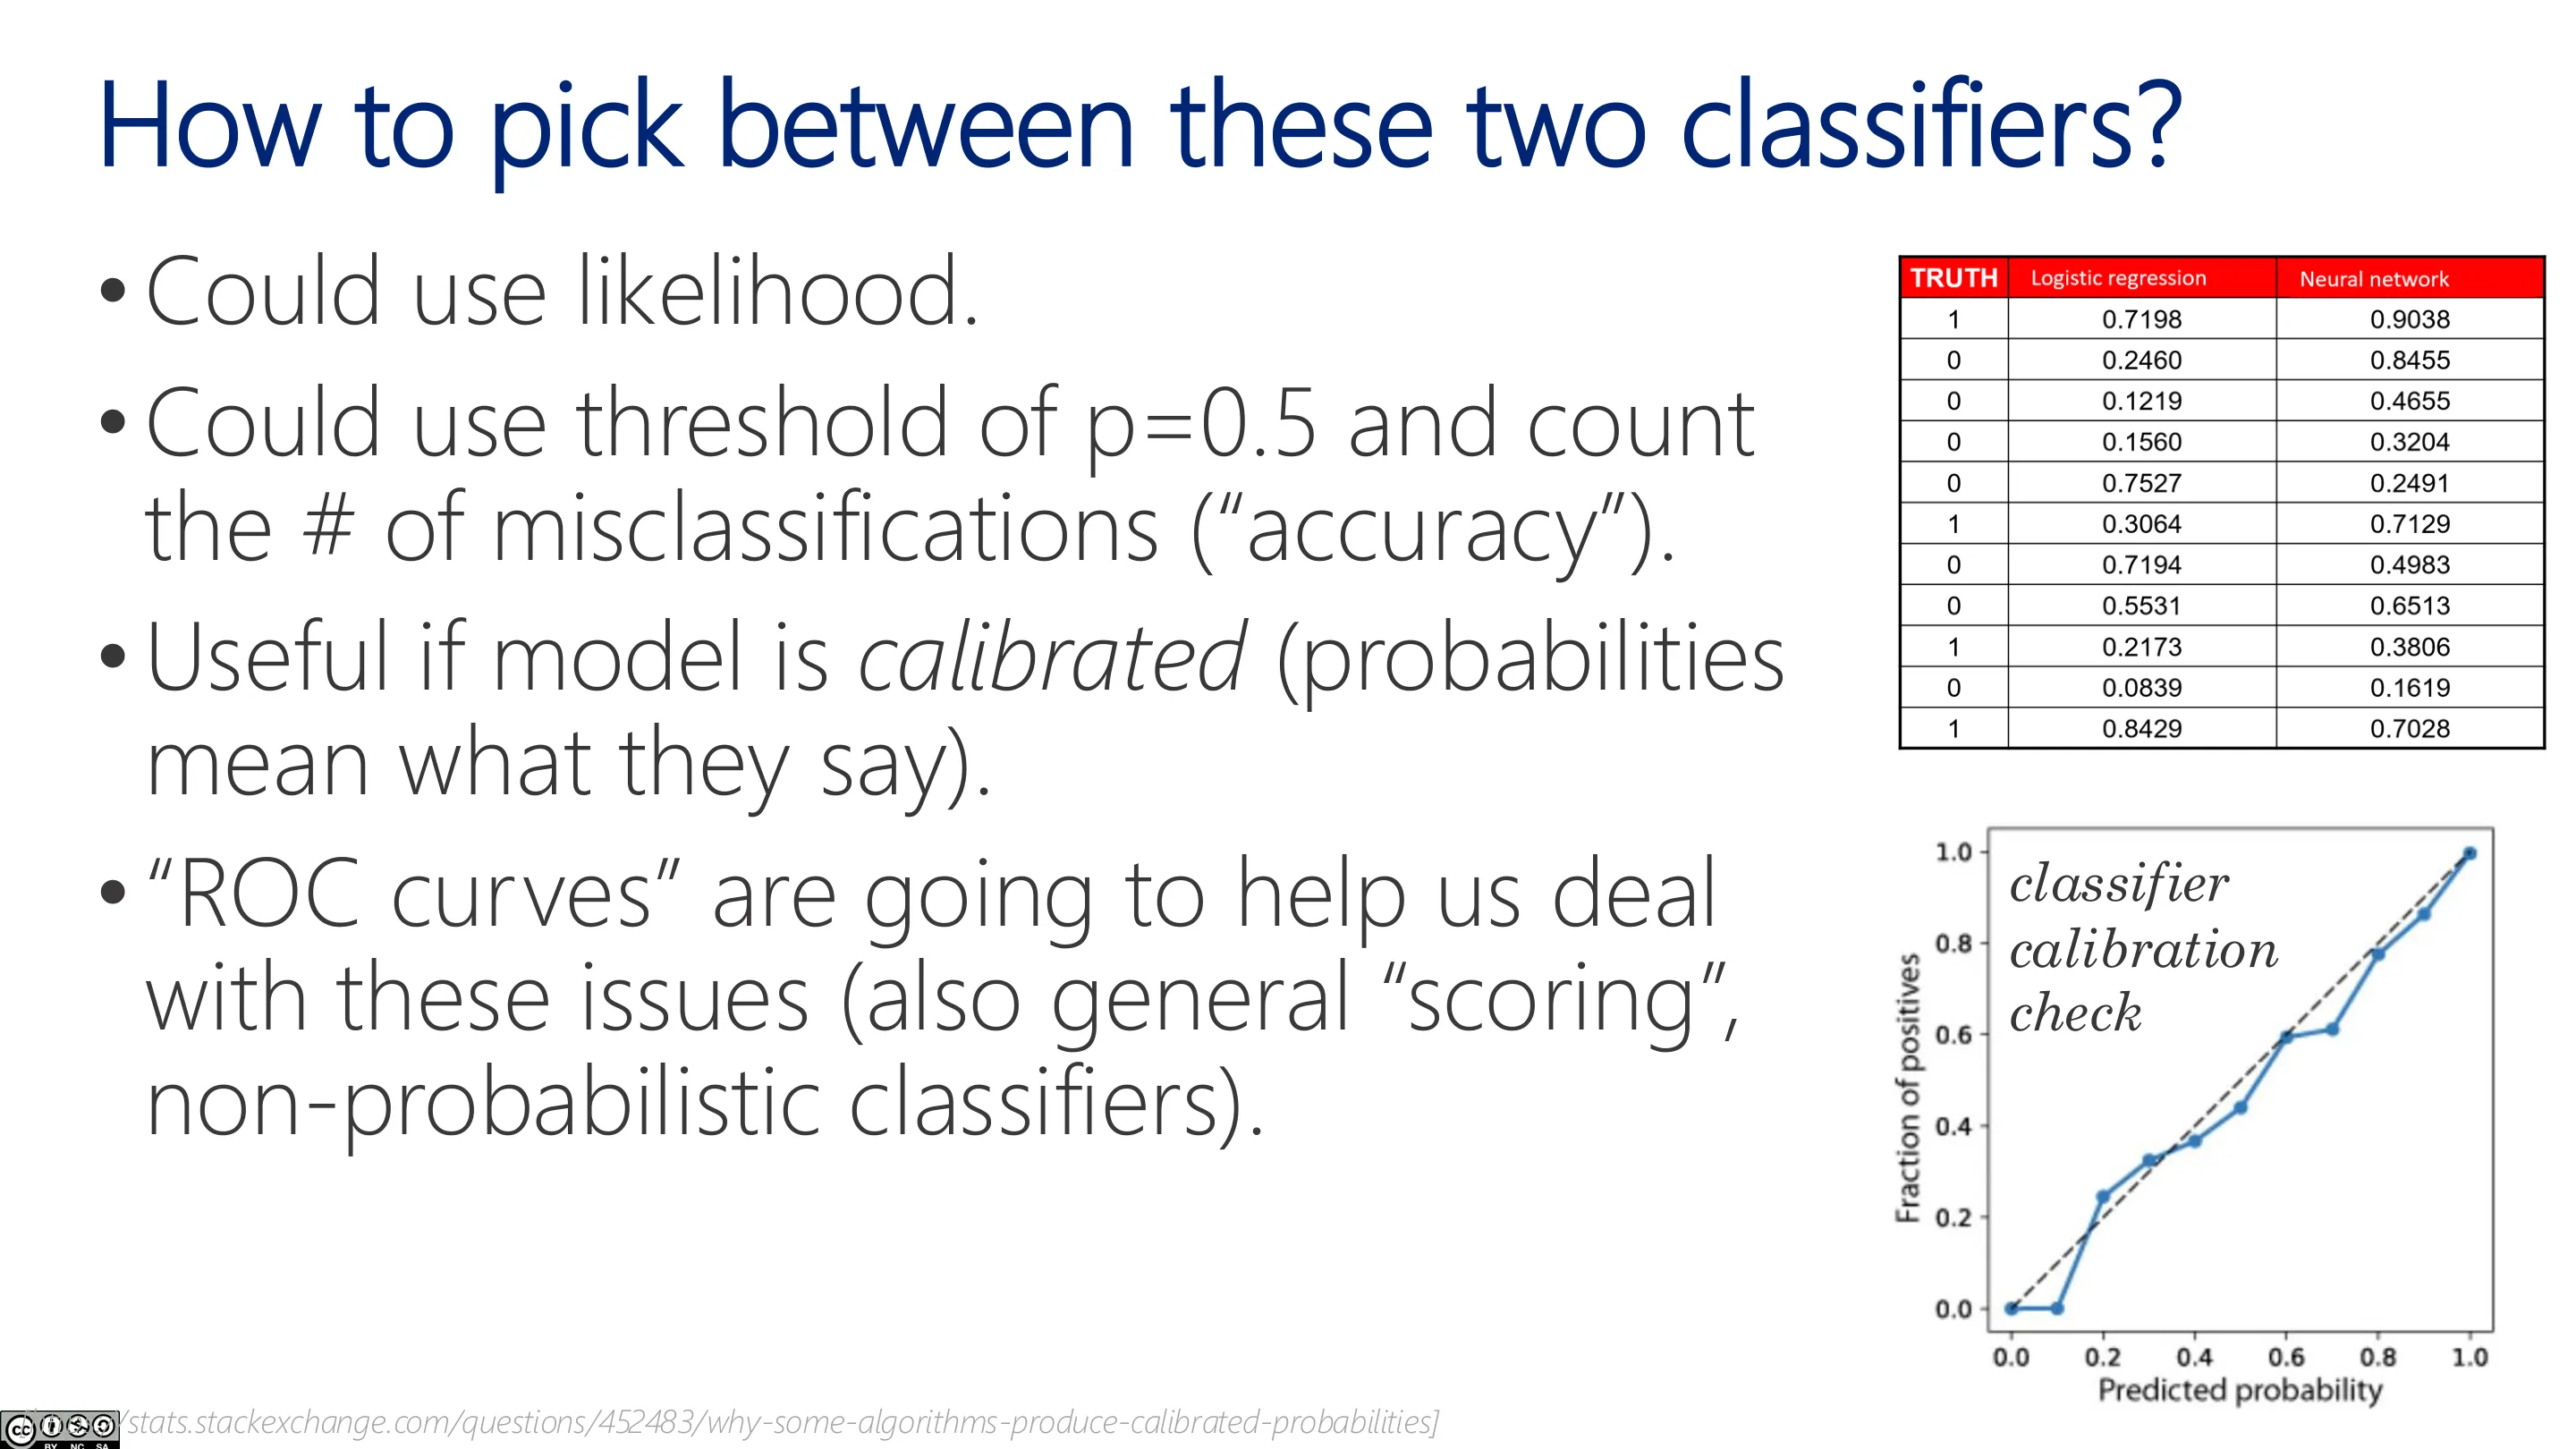
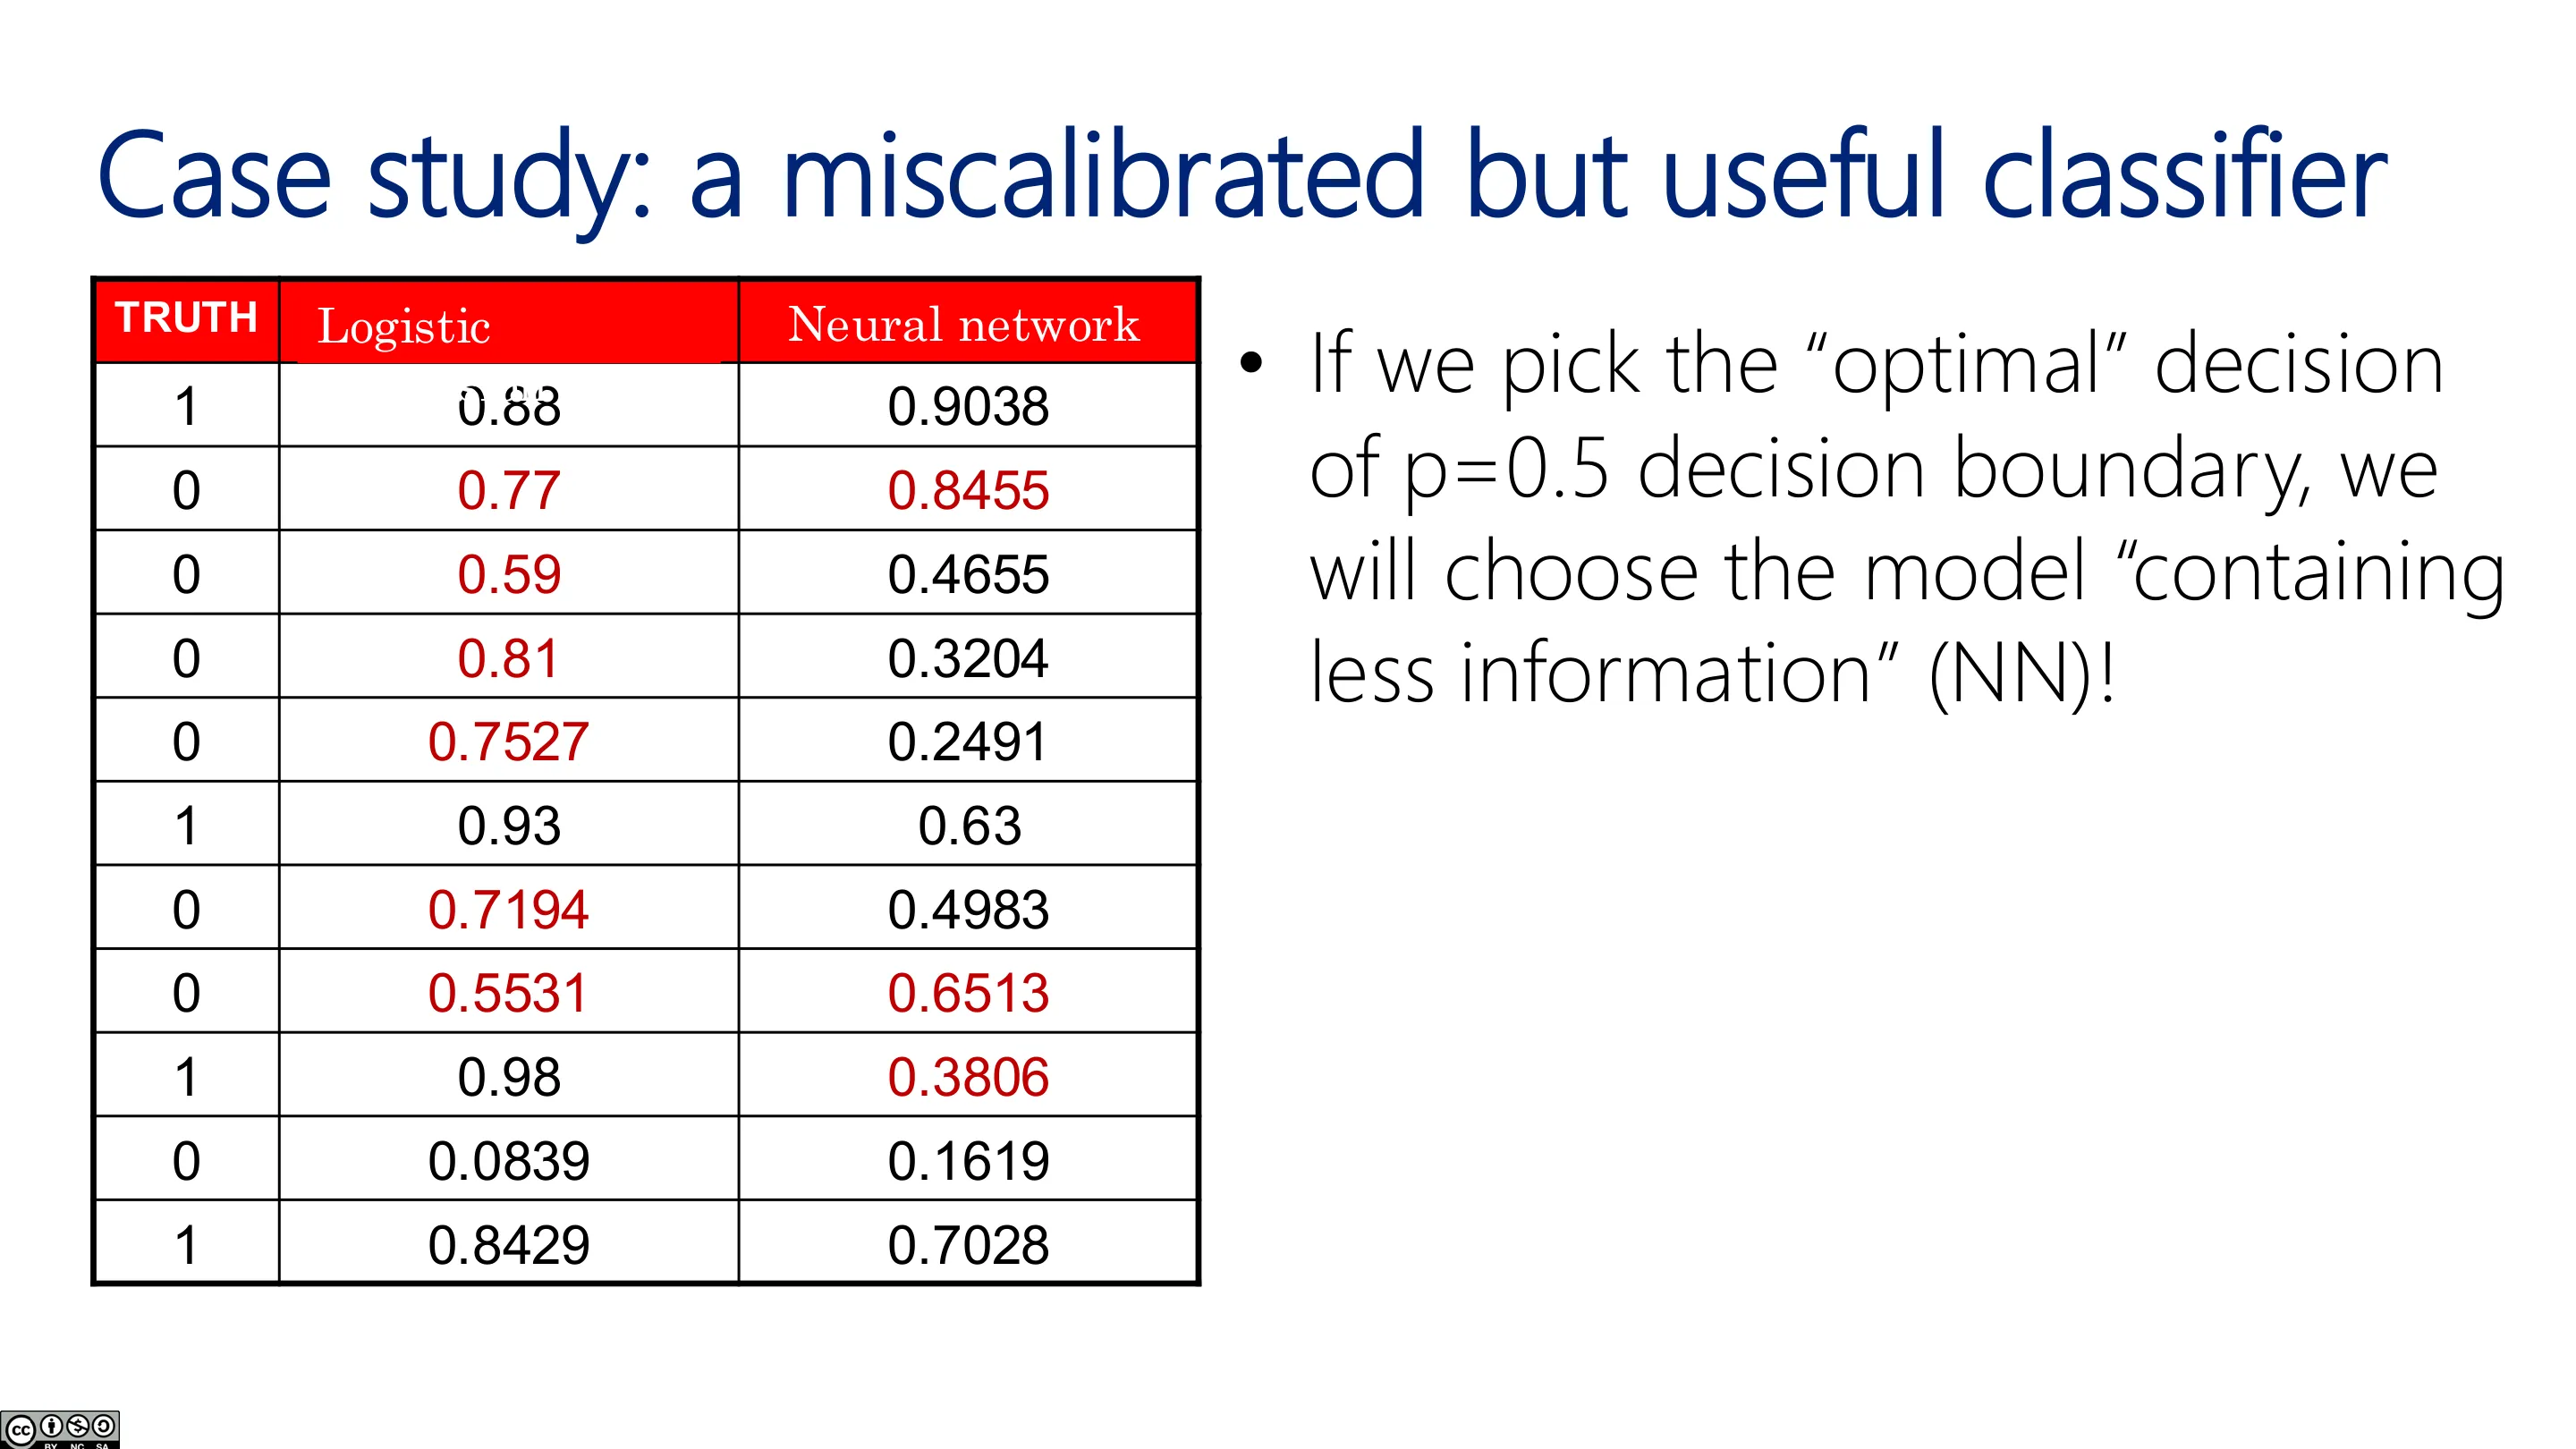
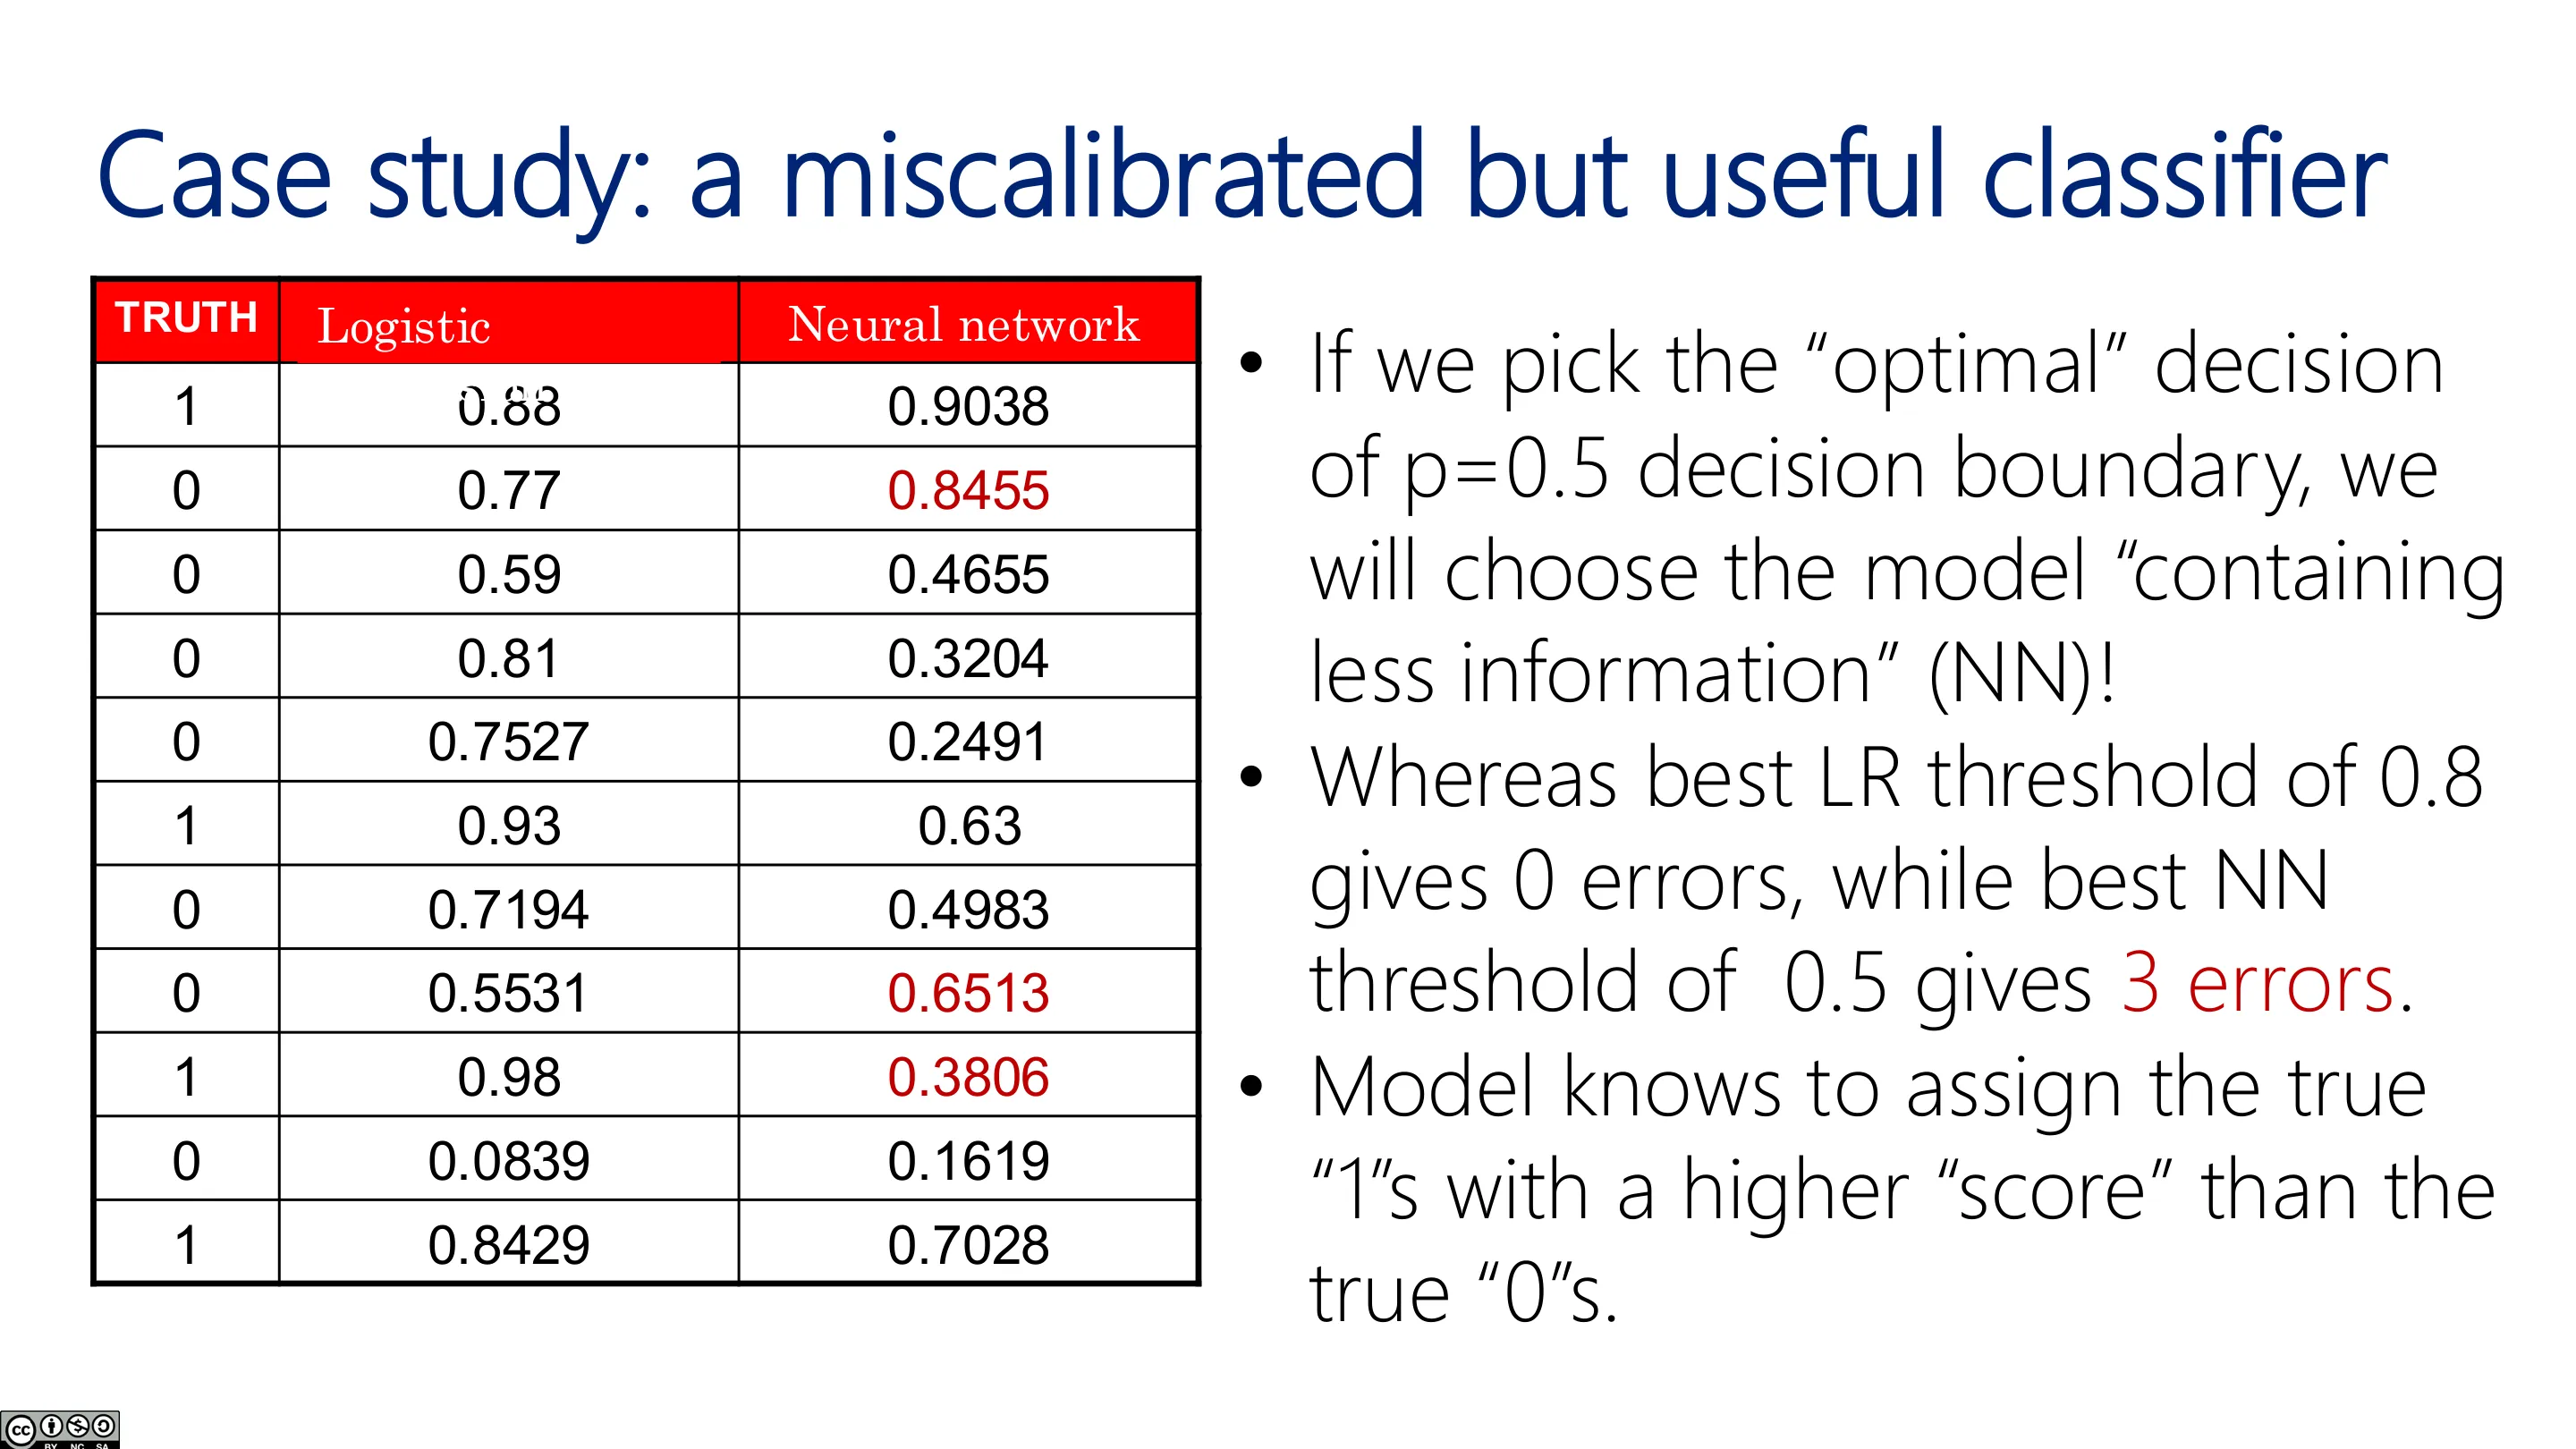
在验证/测试数据上,对数似然是通用指标。但分类器有个微妙之处:它可能似然很差但信息量很大(排序好但概率未校准)。
校准:概率要有「概率」的含义——被预测为「猫的概率 0.8」的样本里,应真有 80% 是猫。逻辑回归是概率模型,可以被阈值化为硬分类(如 >0.5 判为正类),但很多有用的分类器并未校准,套用「0.5 阈值 + 准确率」会出错。
📷 分类的度量
回到原视频 (00:51:47)
📷 如何在两个分类器间选择(一)
回到原视频 (00:52:22)
📷 如何在两个分类器间选择(二)
回到原视频 (00:52:30)
📷 如何在两个分类器间选择(三)
回到原视频 (00:52:38)
📷 案例:一个未校准但有用的分类器(一)
回到原视频 (00:52:52)
📷 案例:一个未校准但有用的分类器(二)
回到原视频 (00:53:18)
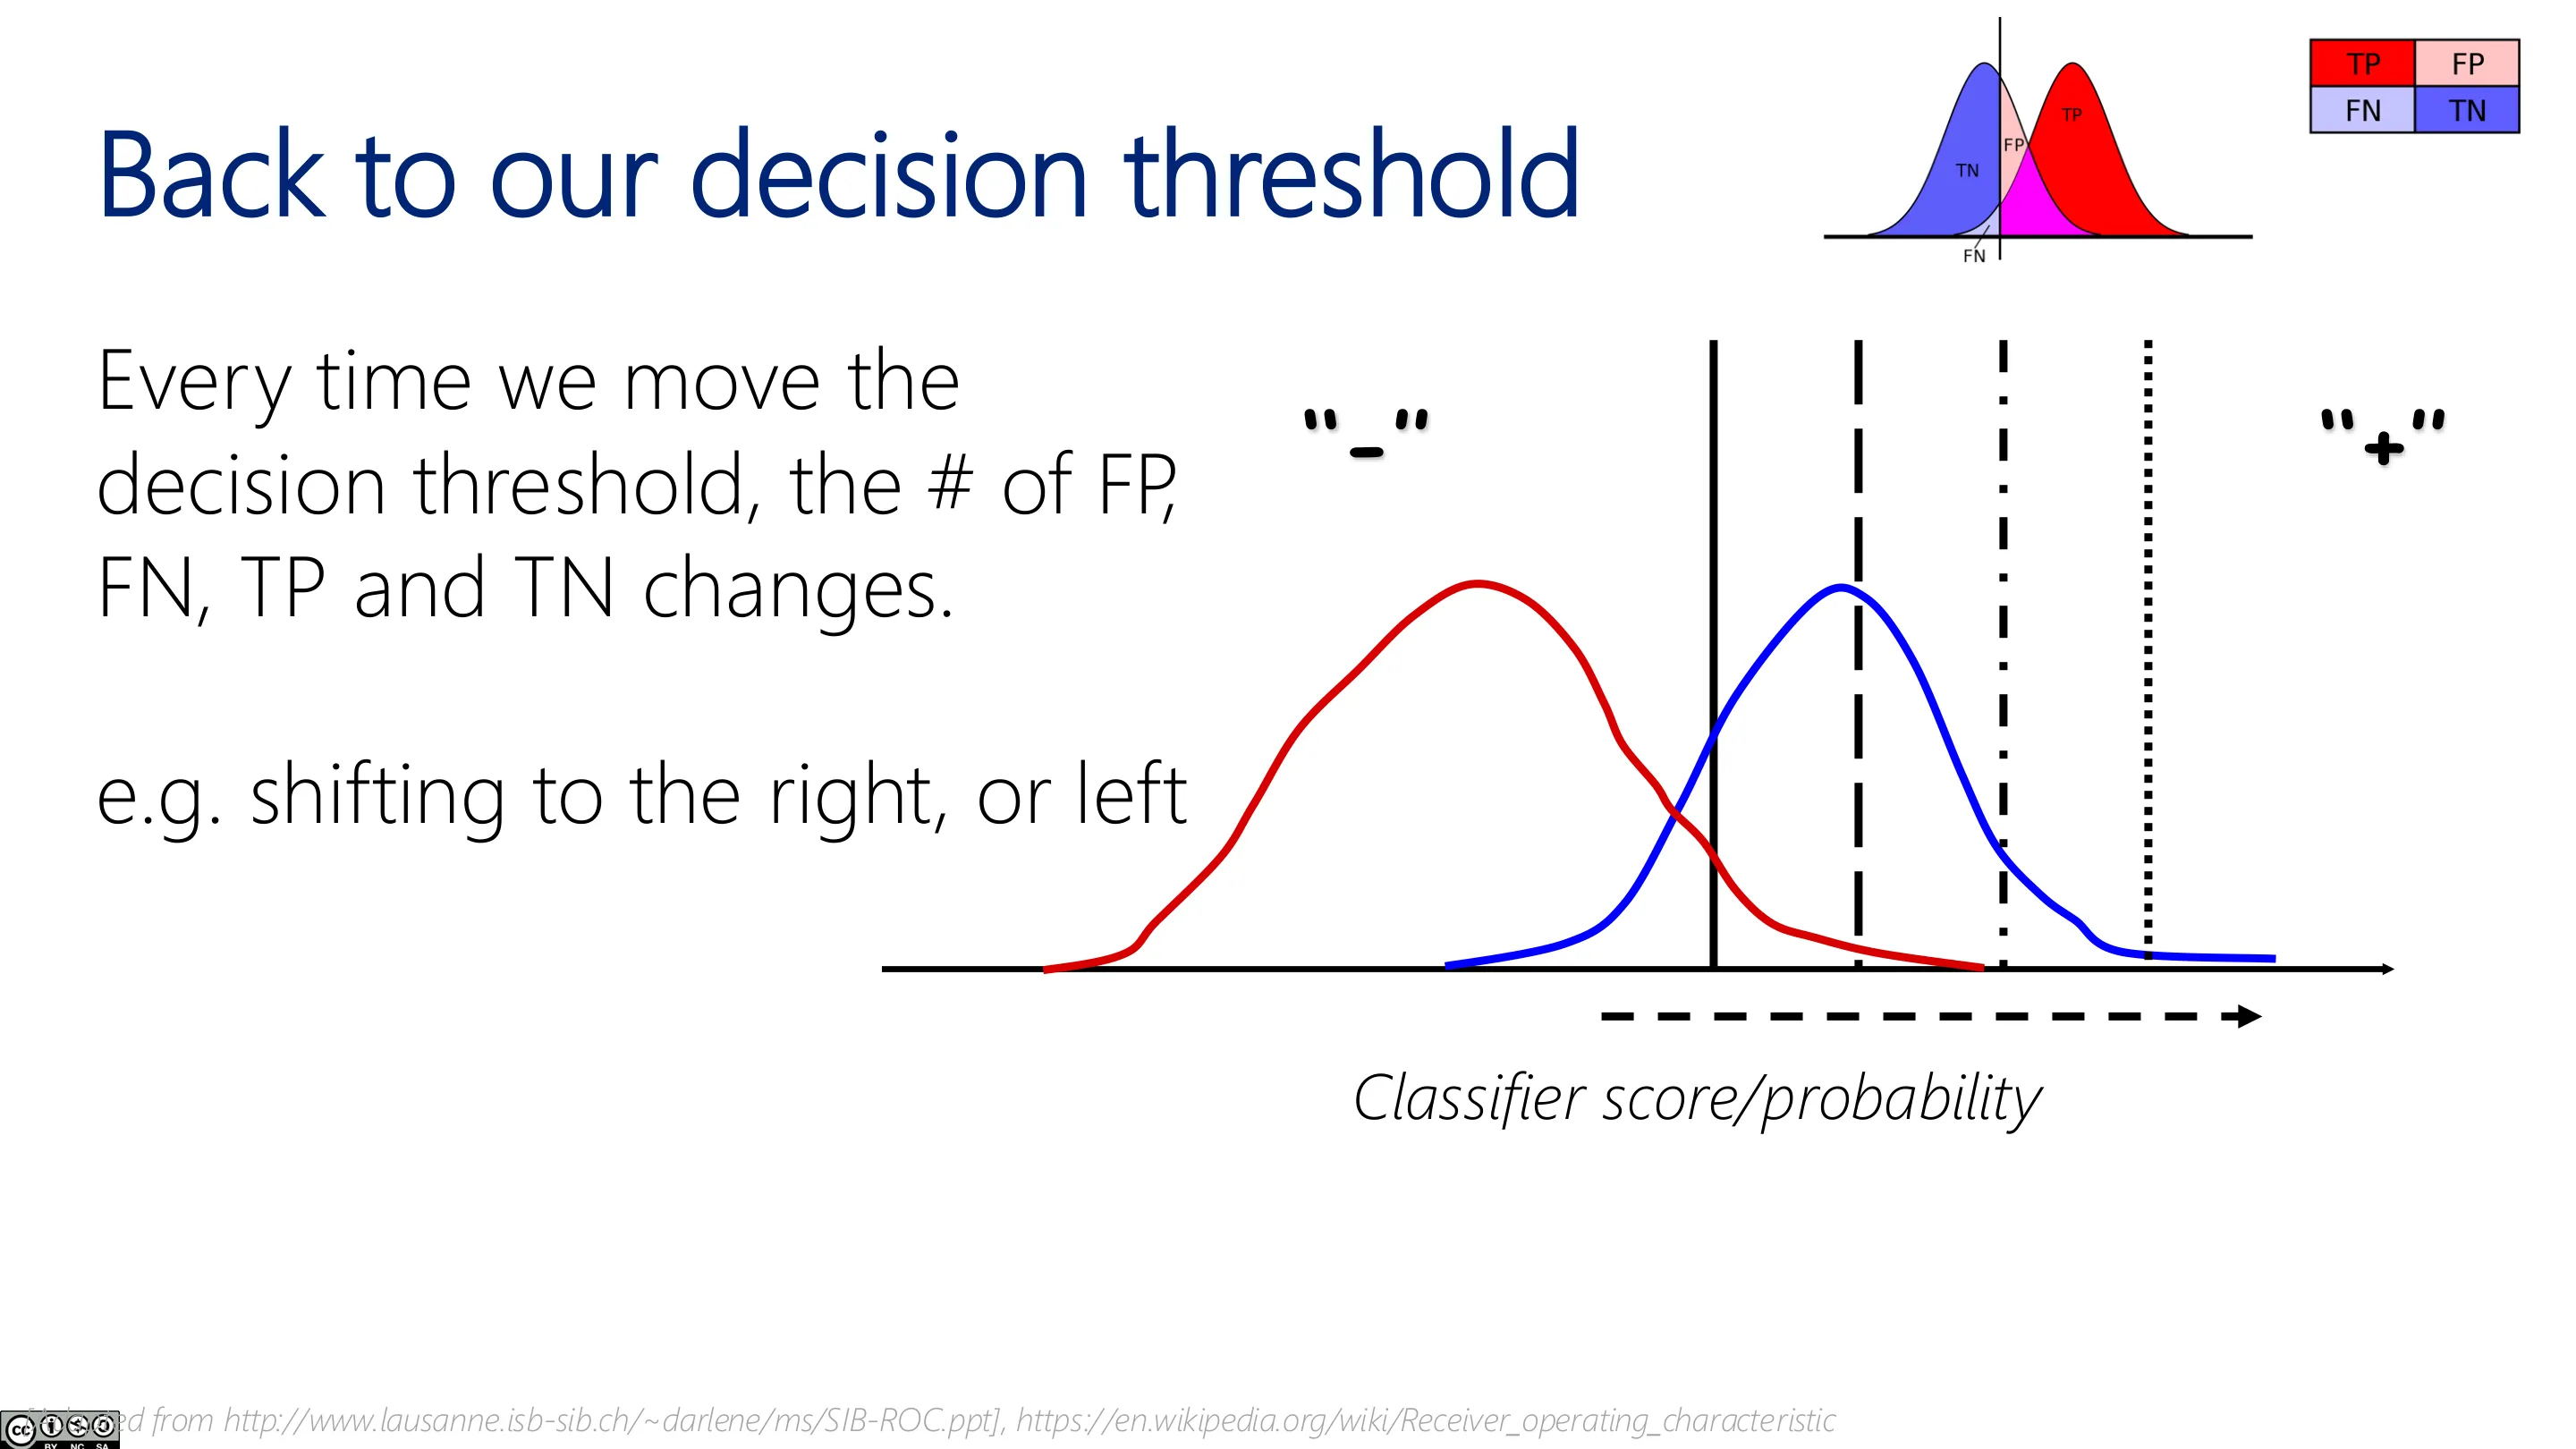
编者说明:讲师用一个例子说明——同一个阈值下「神经网络更好」,但换一个阈值「逻辑回归更好」。这说明:若不关心校准,真正重要的是分类器对样本排序的能力(把正例排得比负例高),而非某个固定阈值下的准确率。
3.2 混淆矩阵
(参考时间: 00:59)
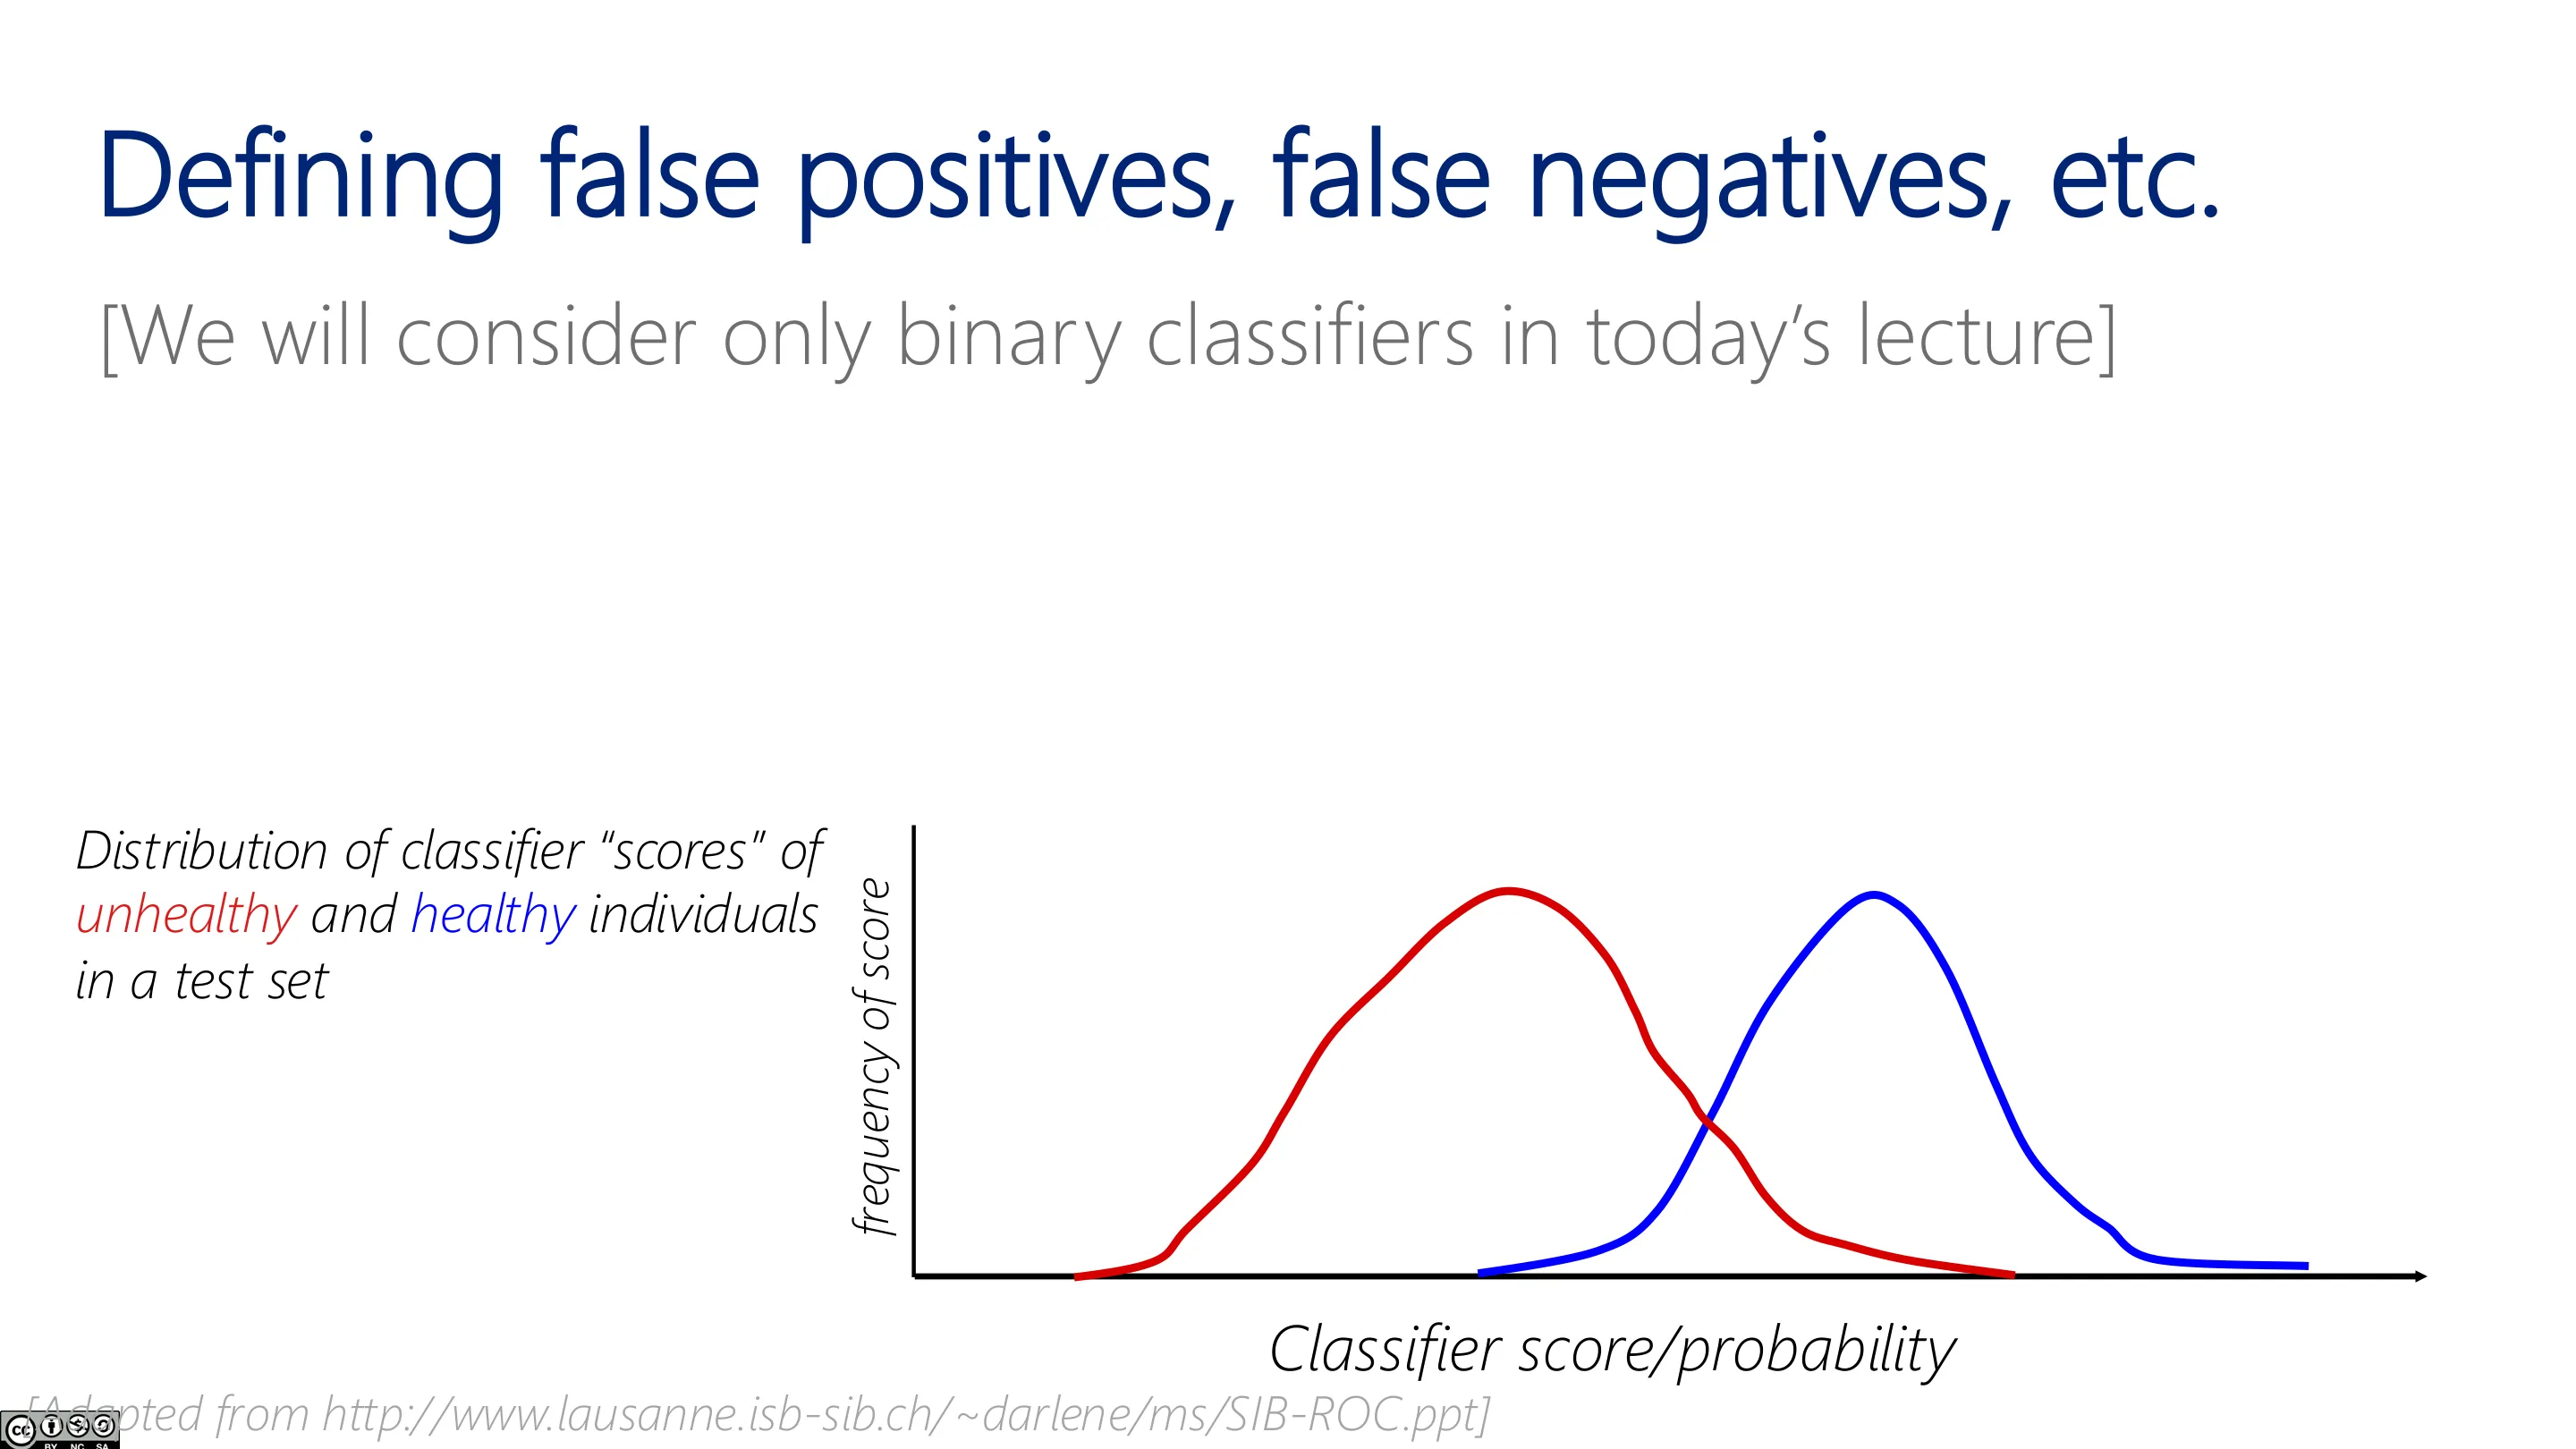
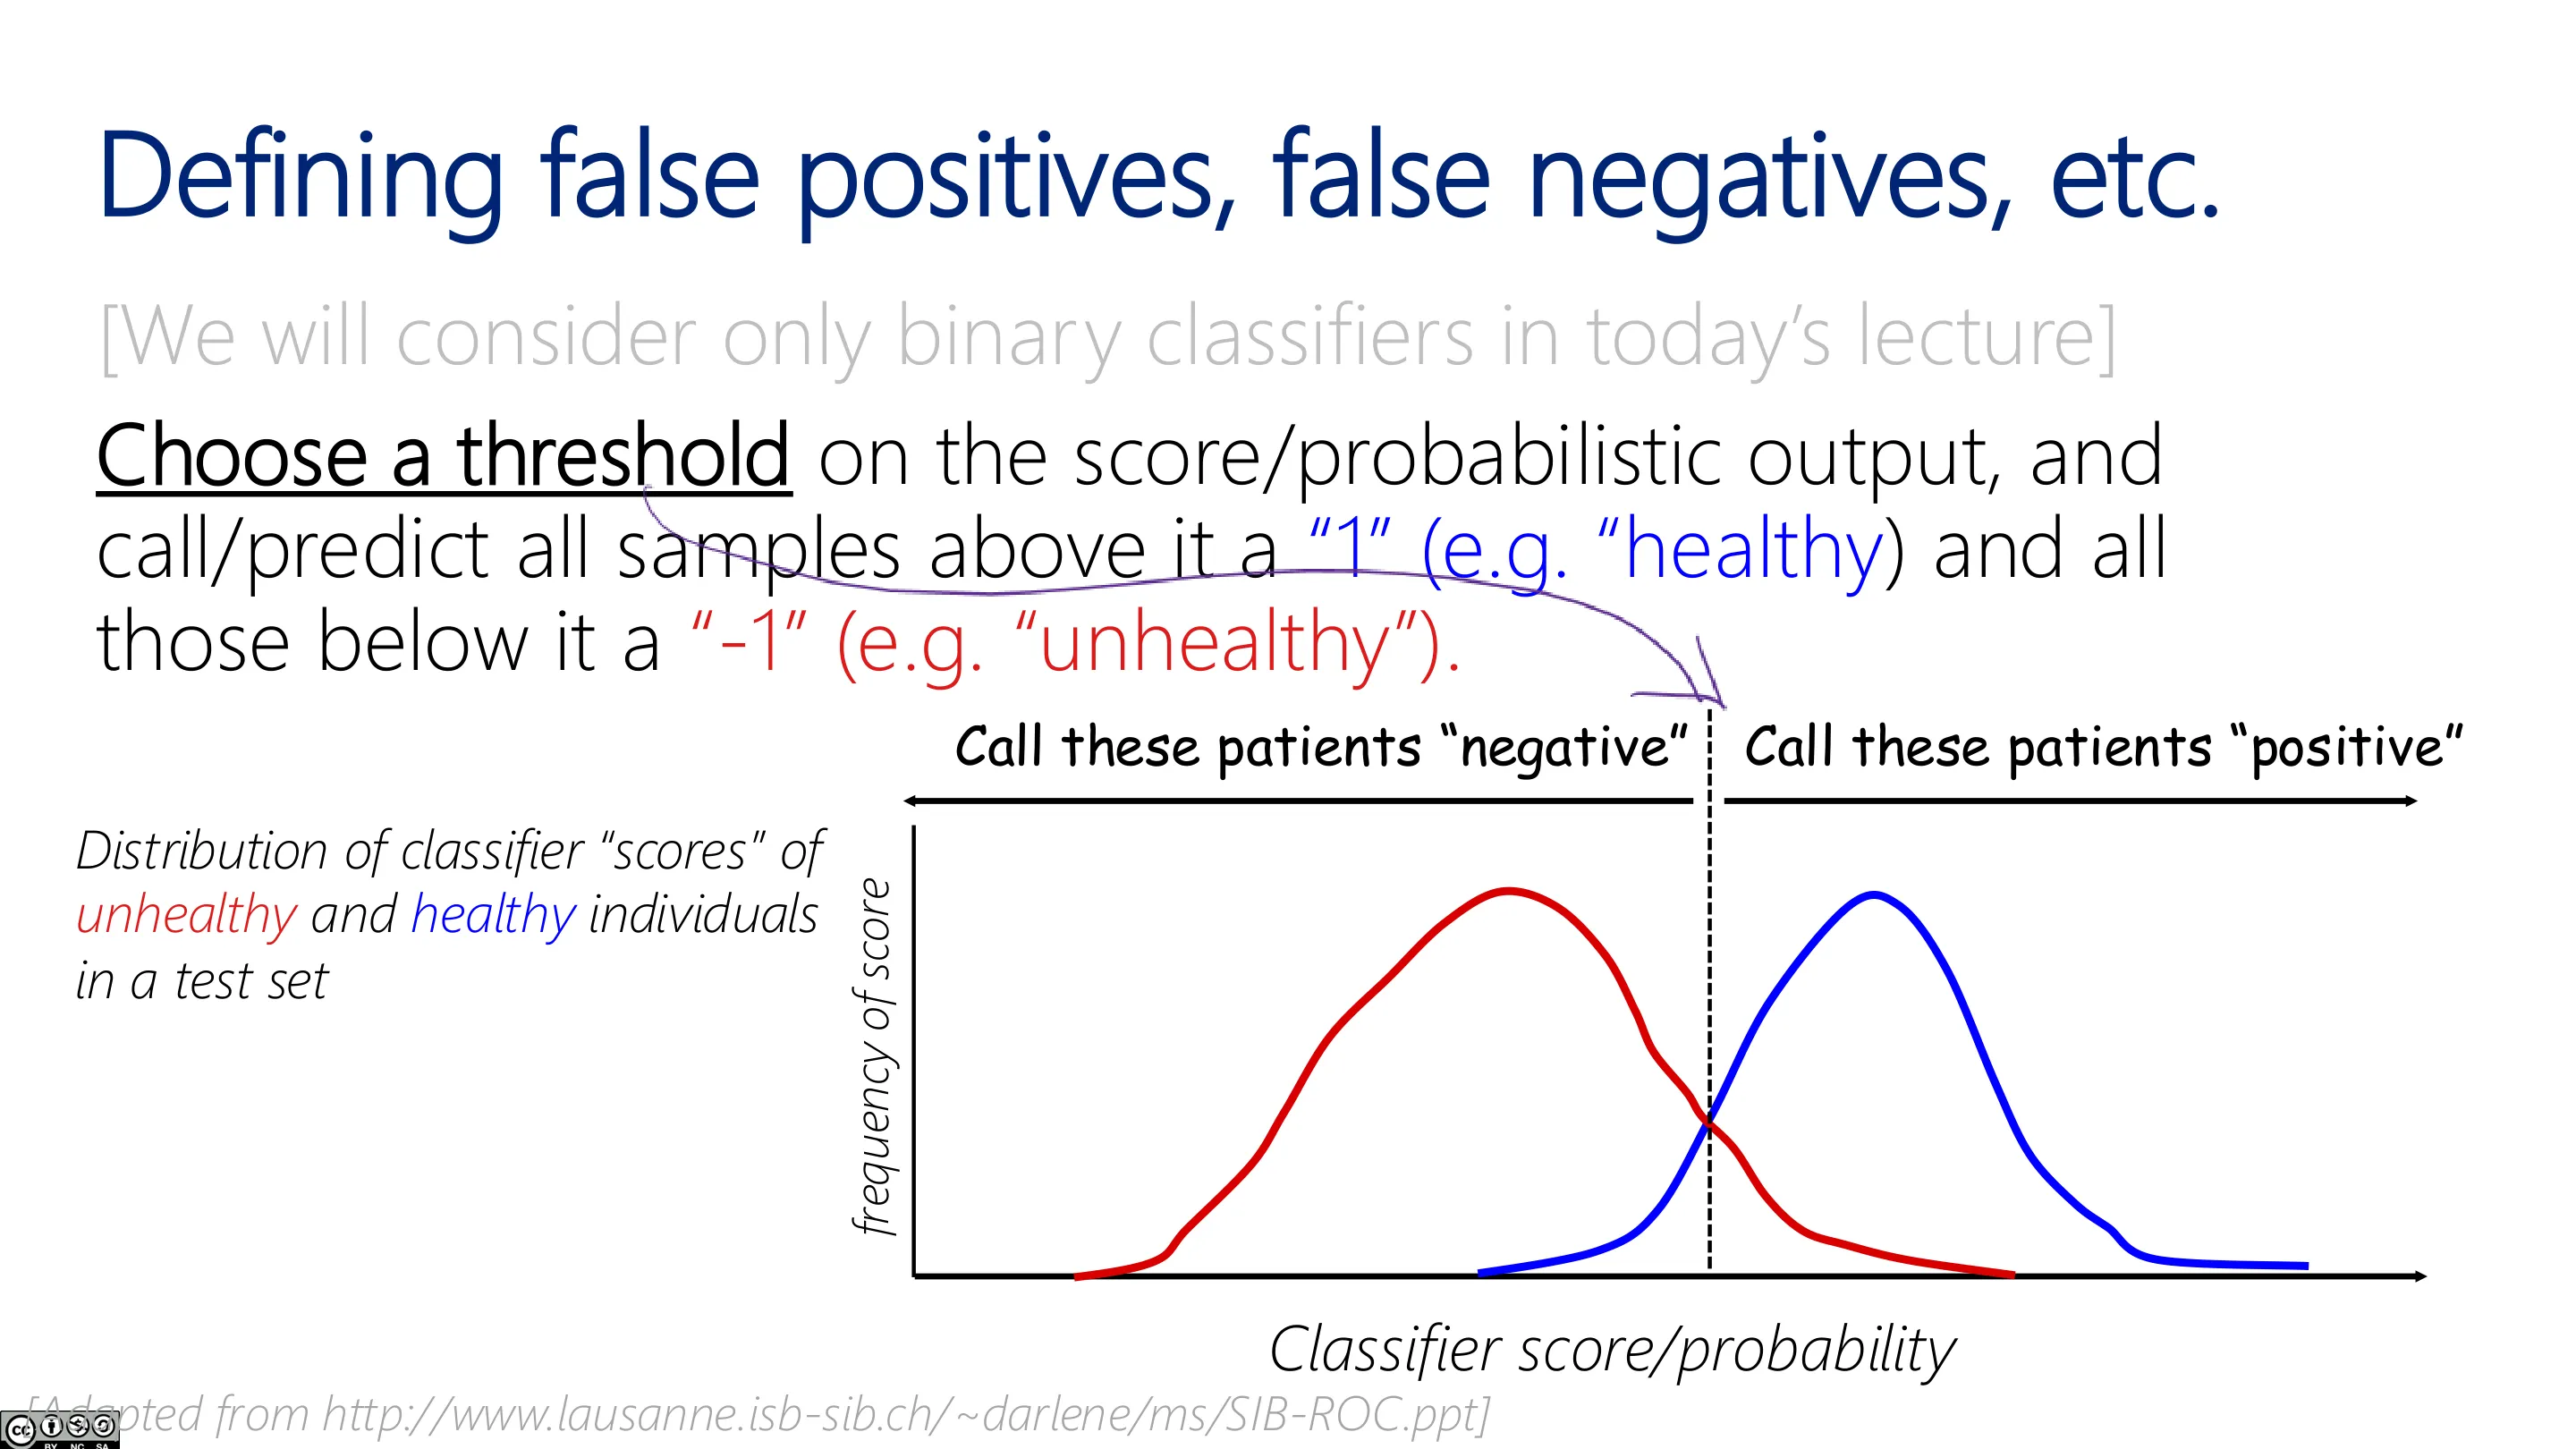
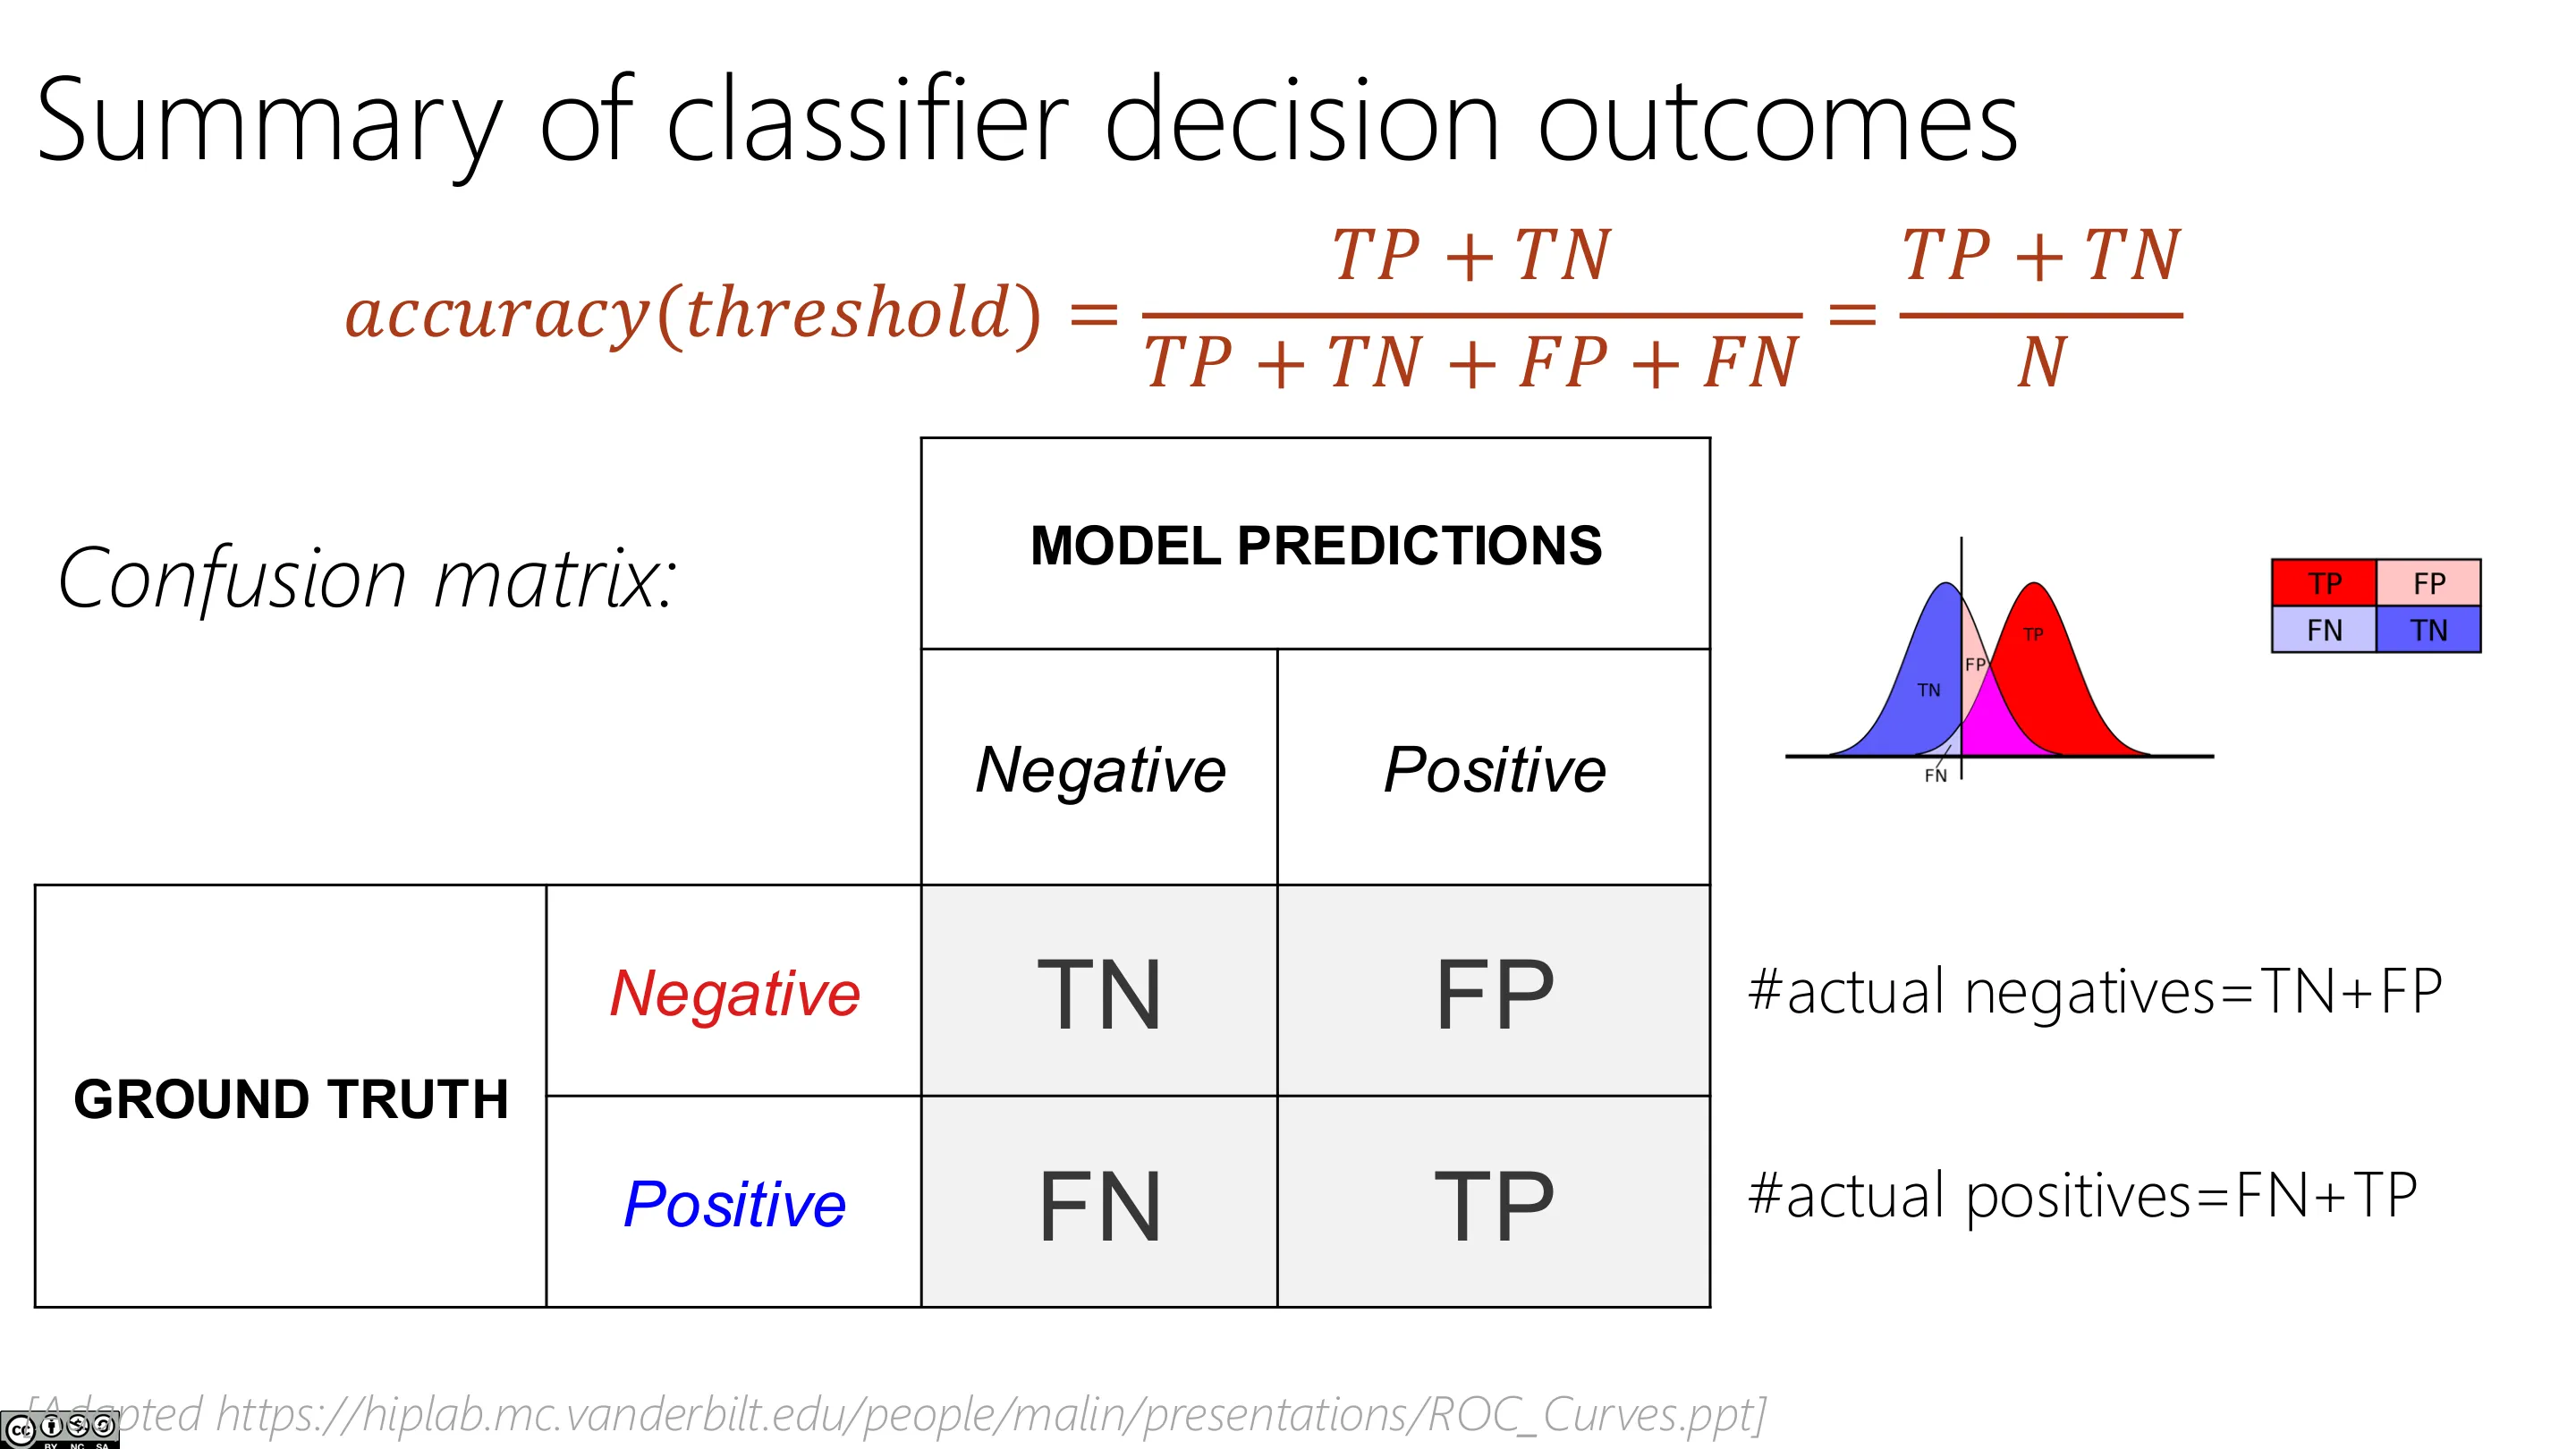
设阈值为 $\tau$,把预测分数高于 $\tau$ 的判为正类:
| 实际正 | 实际负 | |
|---|---|---|
| 预测正 | 真阳性 TP | 假阳性 FP |
| 预测负 | 假阴性 FN | 真阴性 TN |
- TPR / 灵敏度 / 召回率 = TP / (TP+FN);
- FPR = FP / (FP+TN);
- 准确率 = (TP+TN) / 总数。
📷 定义假正例、假负例等
回到原视频 (00:59:06)
📷 (本讲只考虑二分类器)
回到原视频 (00:59:57)
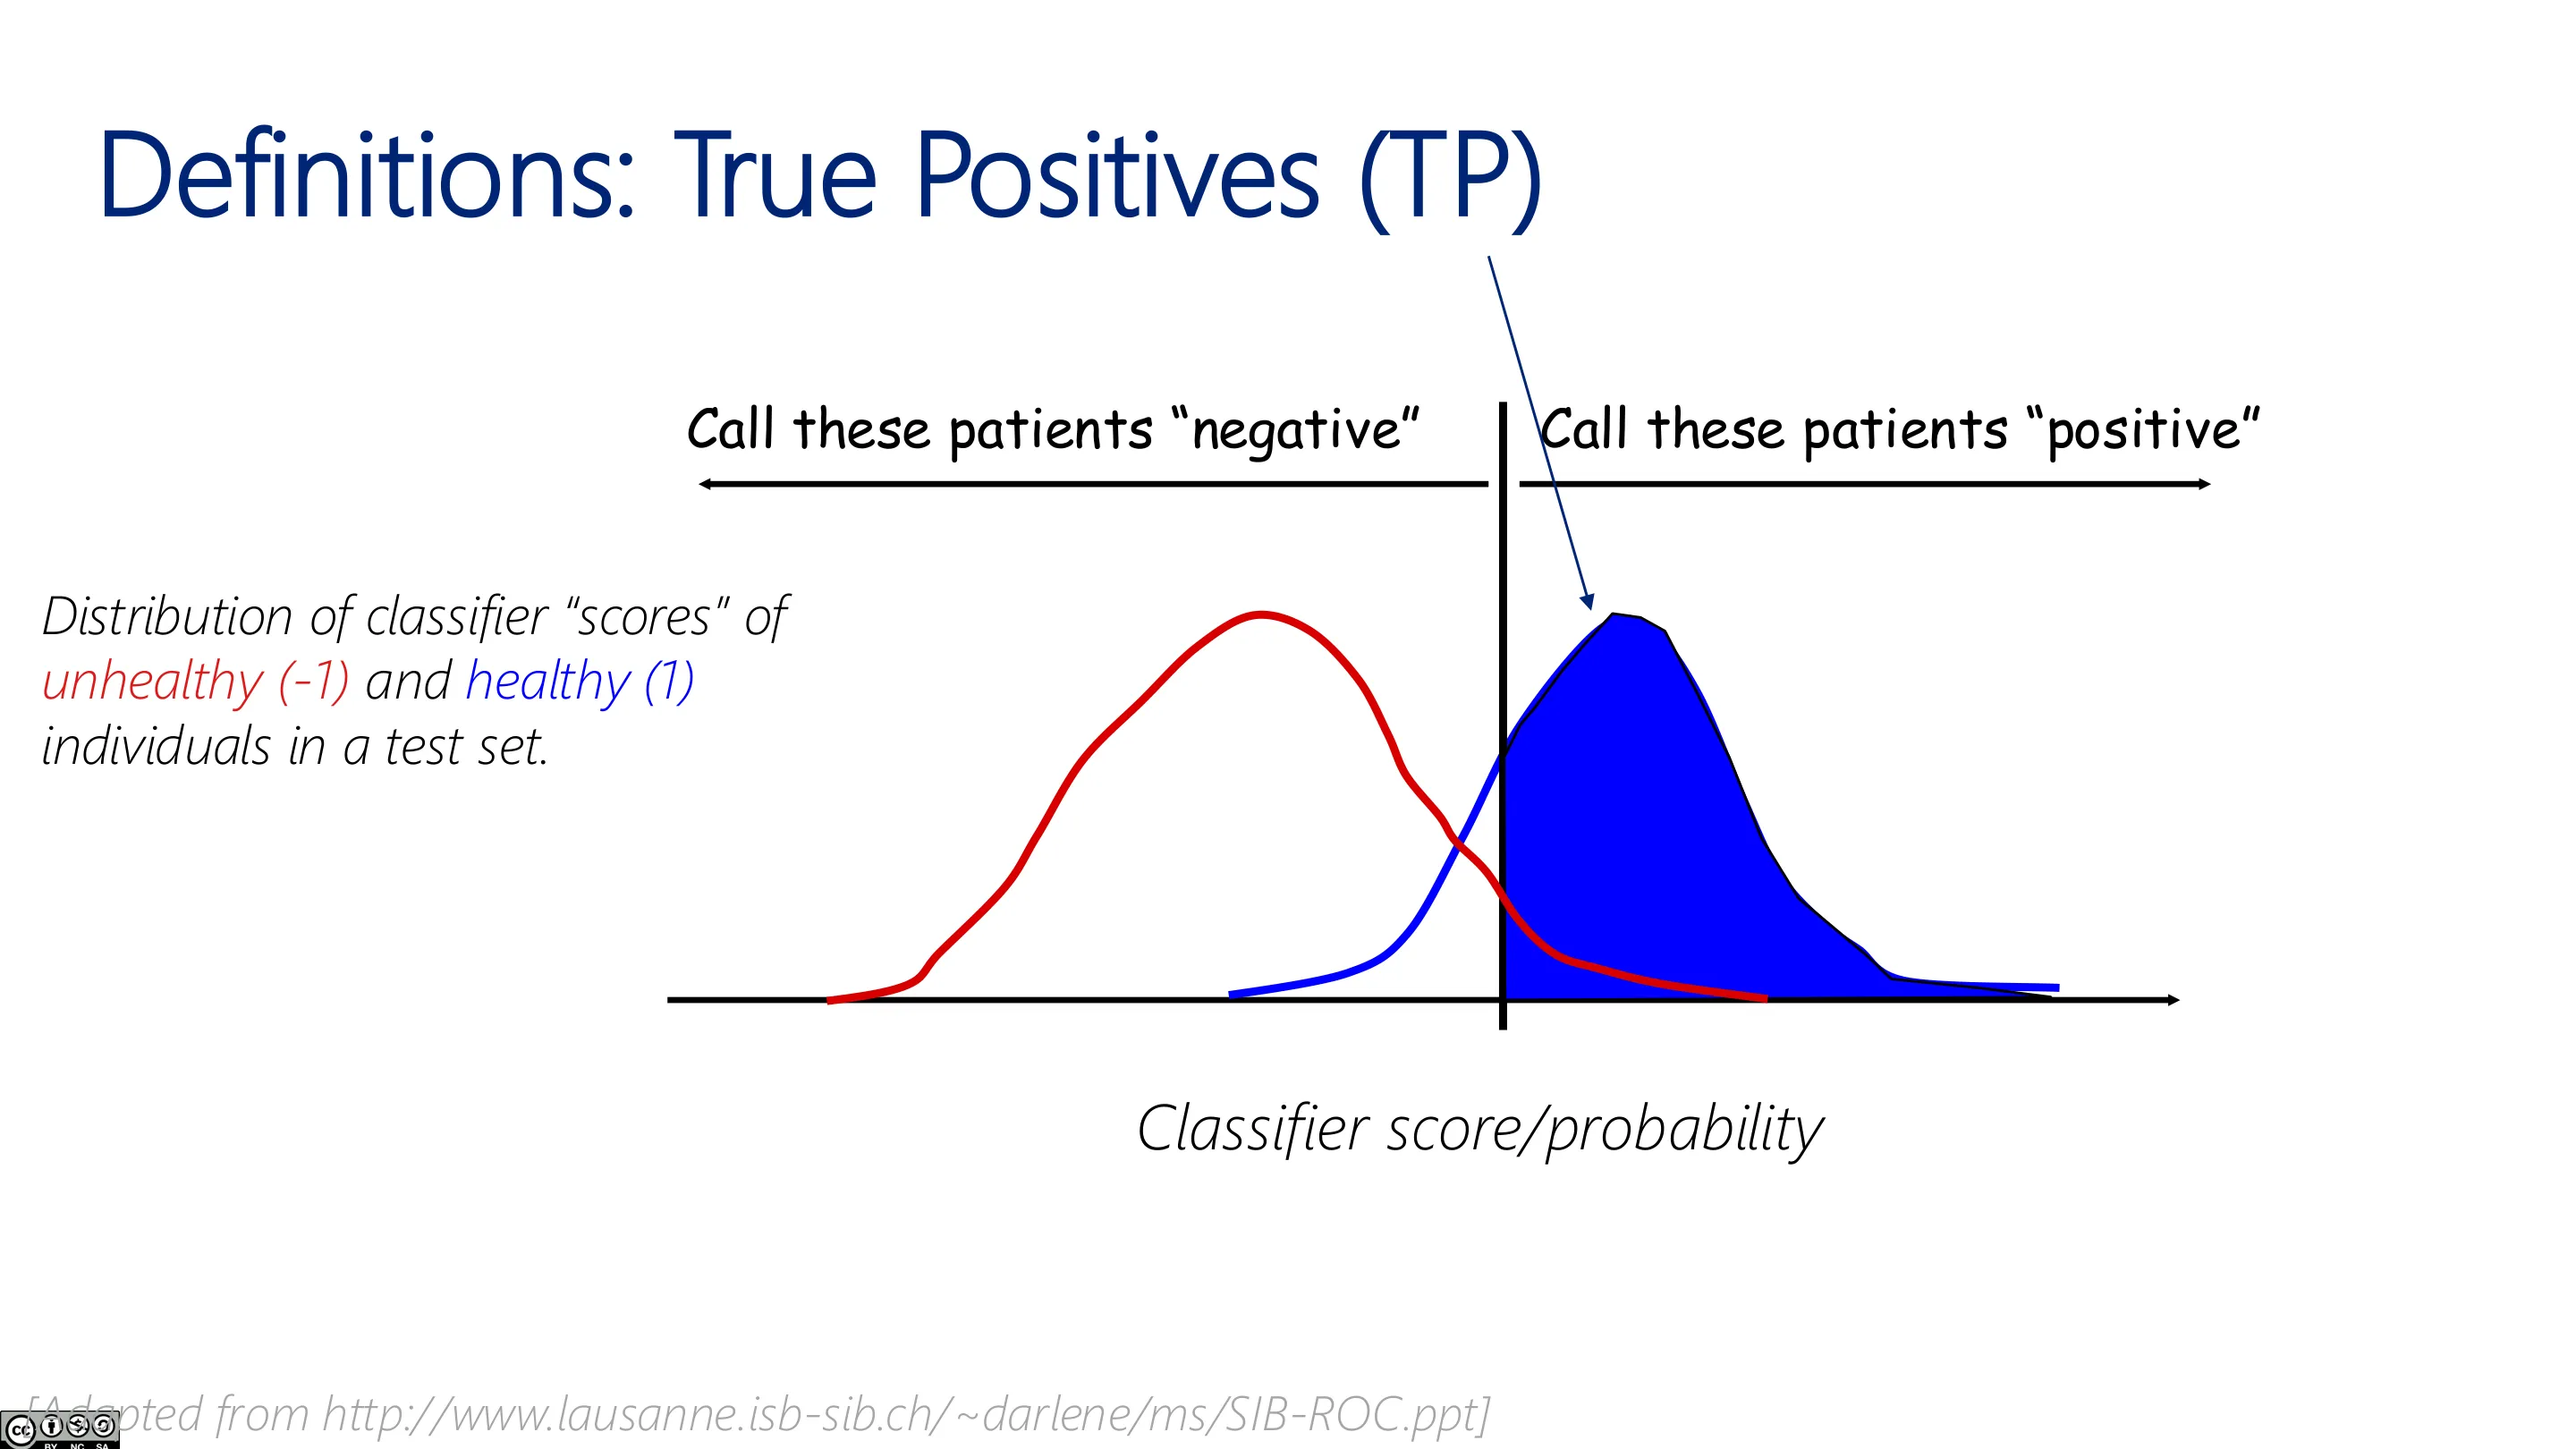
📷 定义:真阳性 TP
回到原视频 (01:00:42)
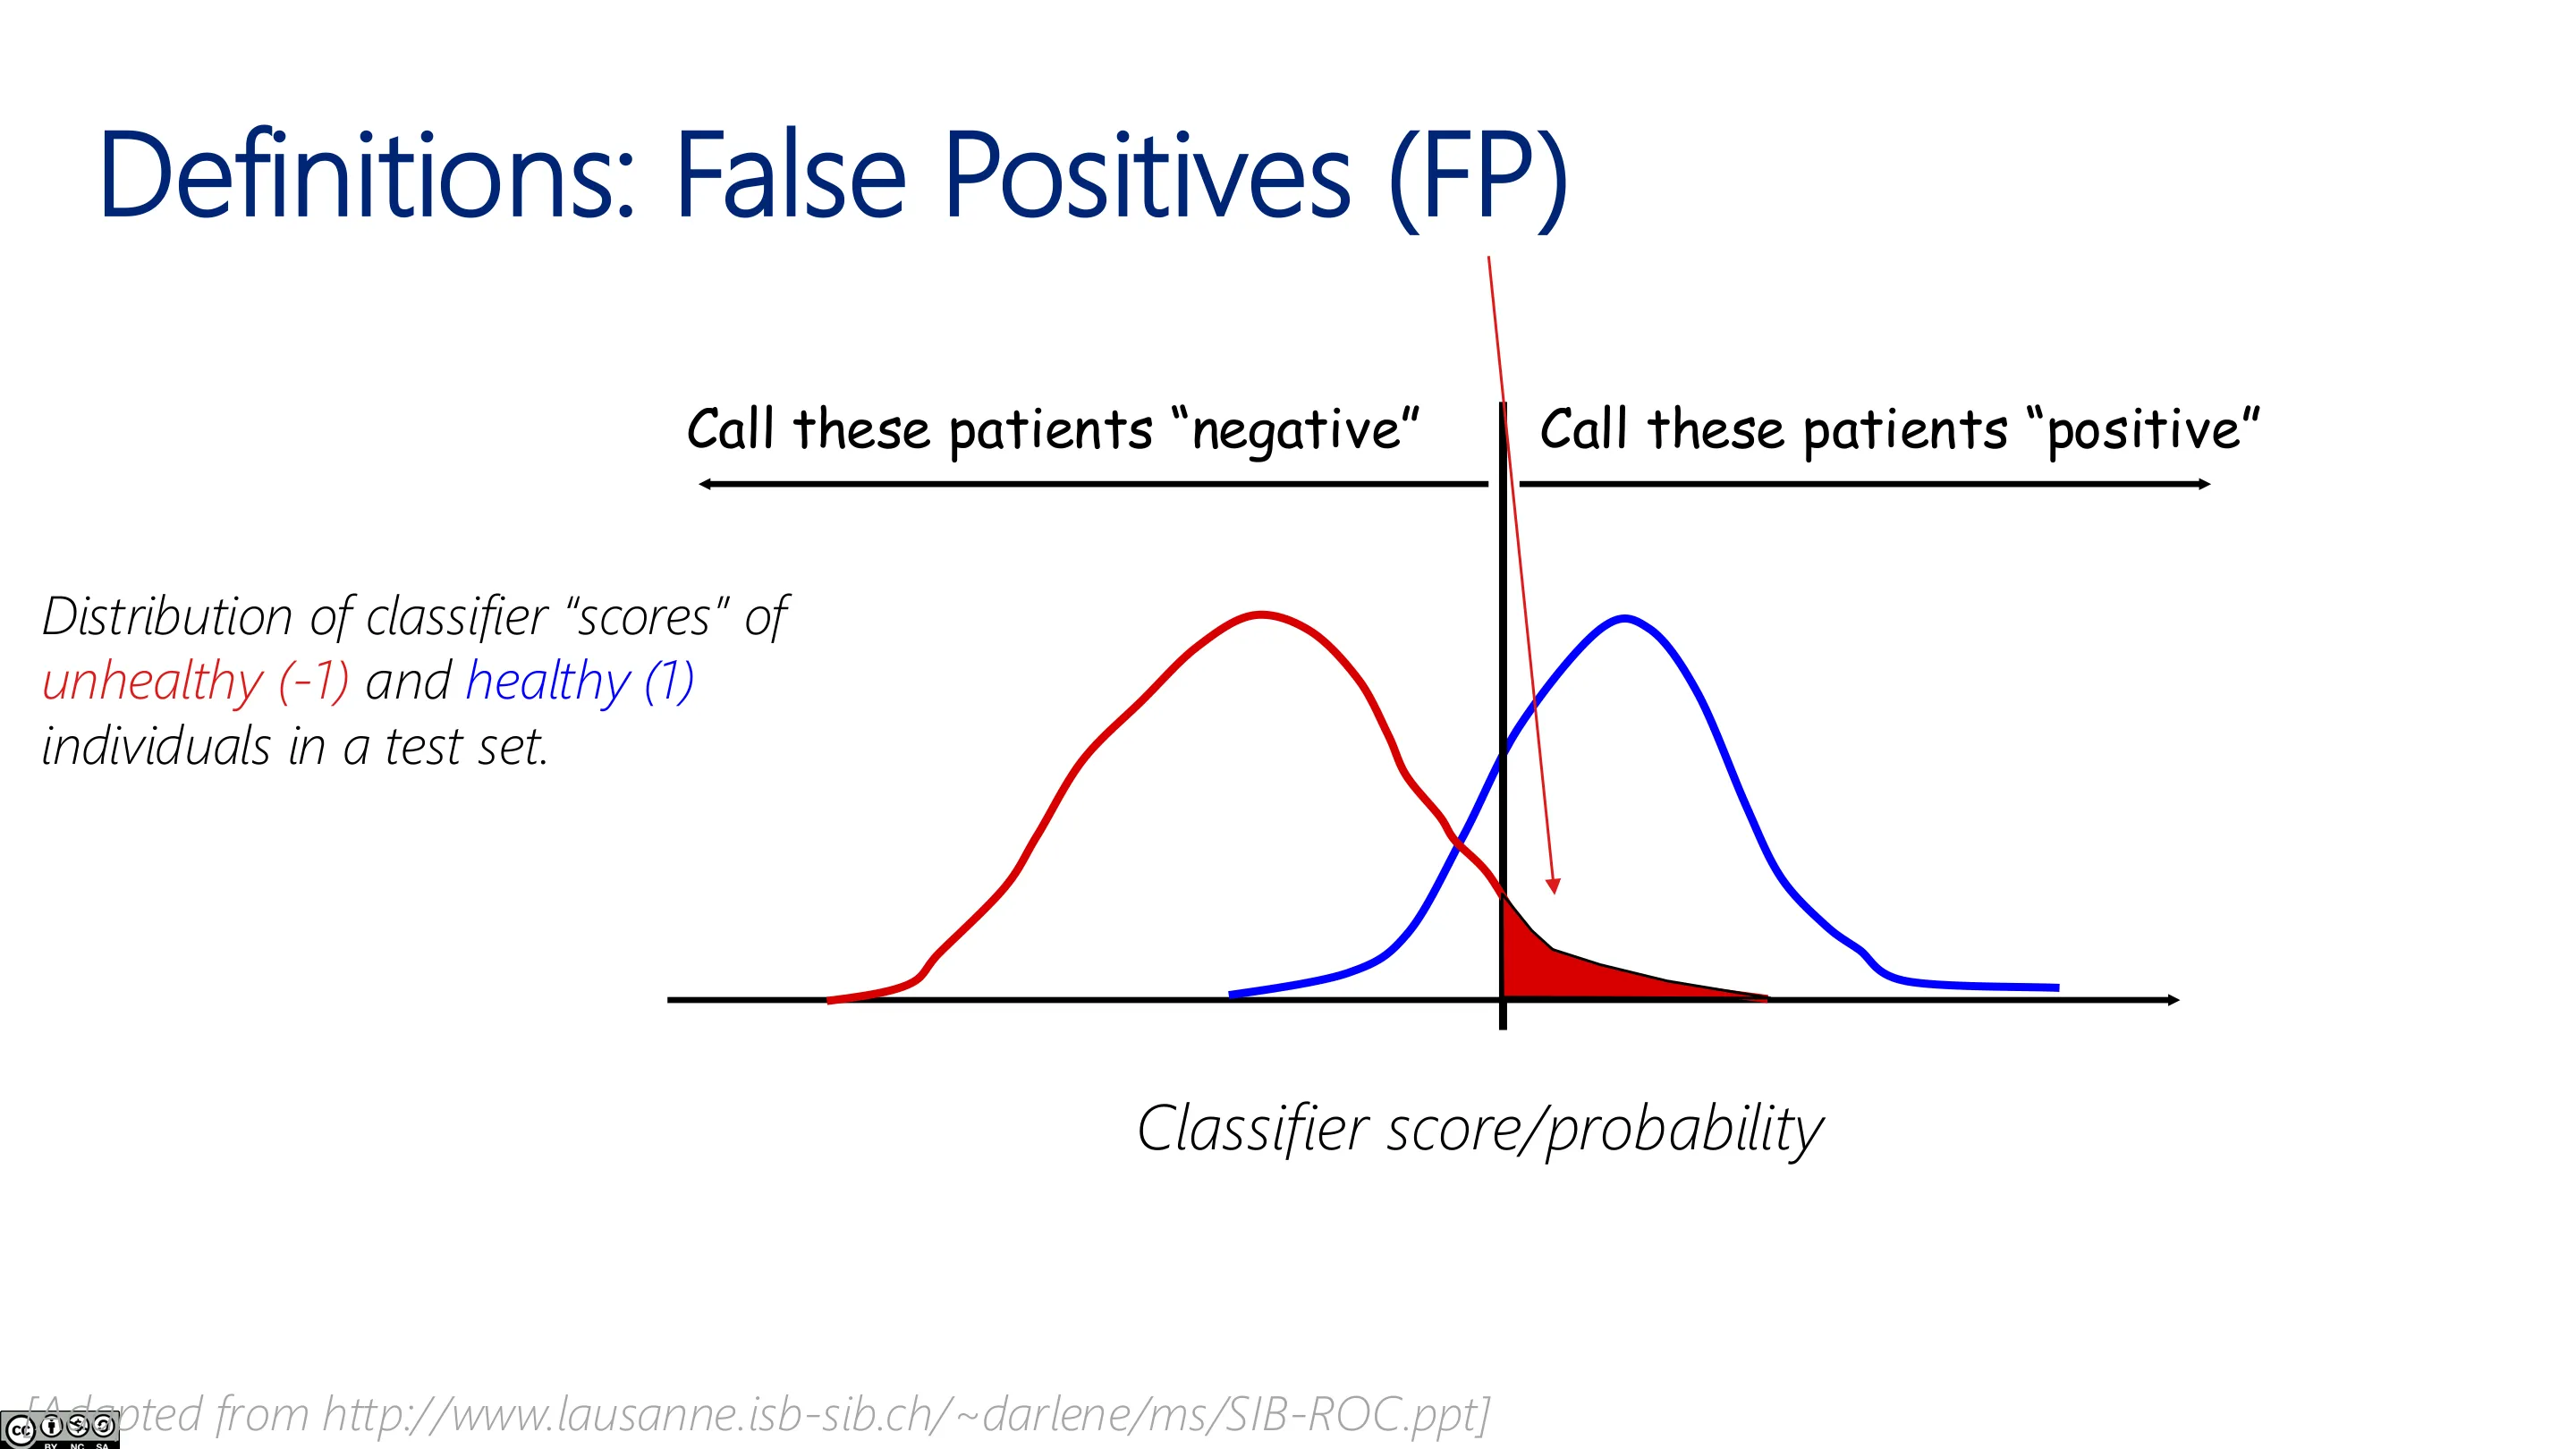
📷 定义:假阳性 FP
回到原视频 (01:01:40)
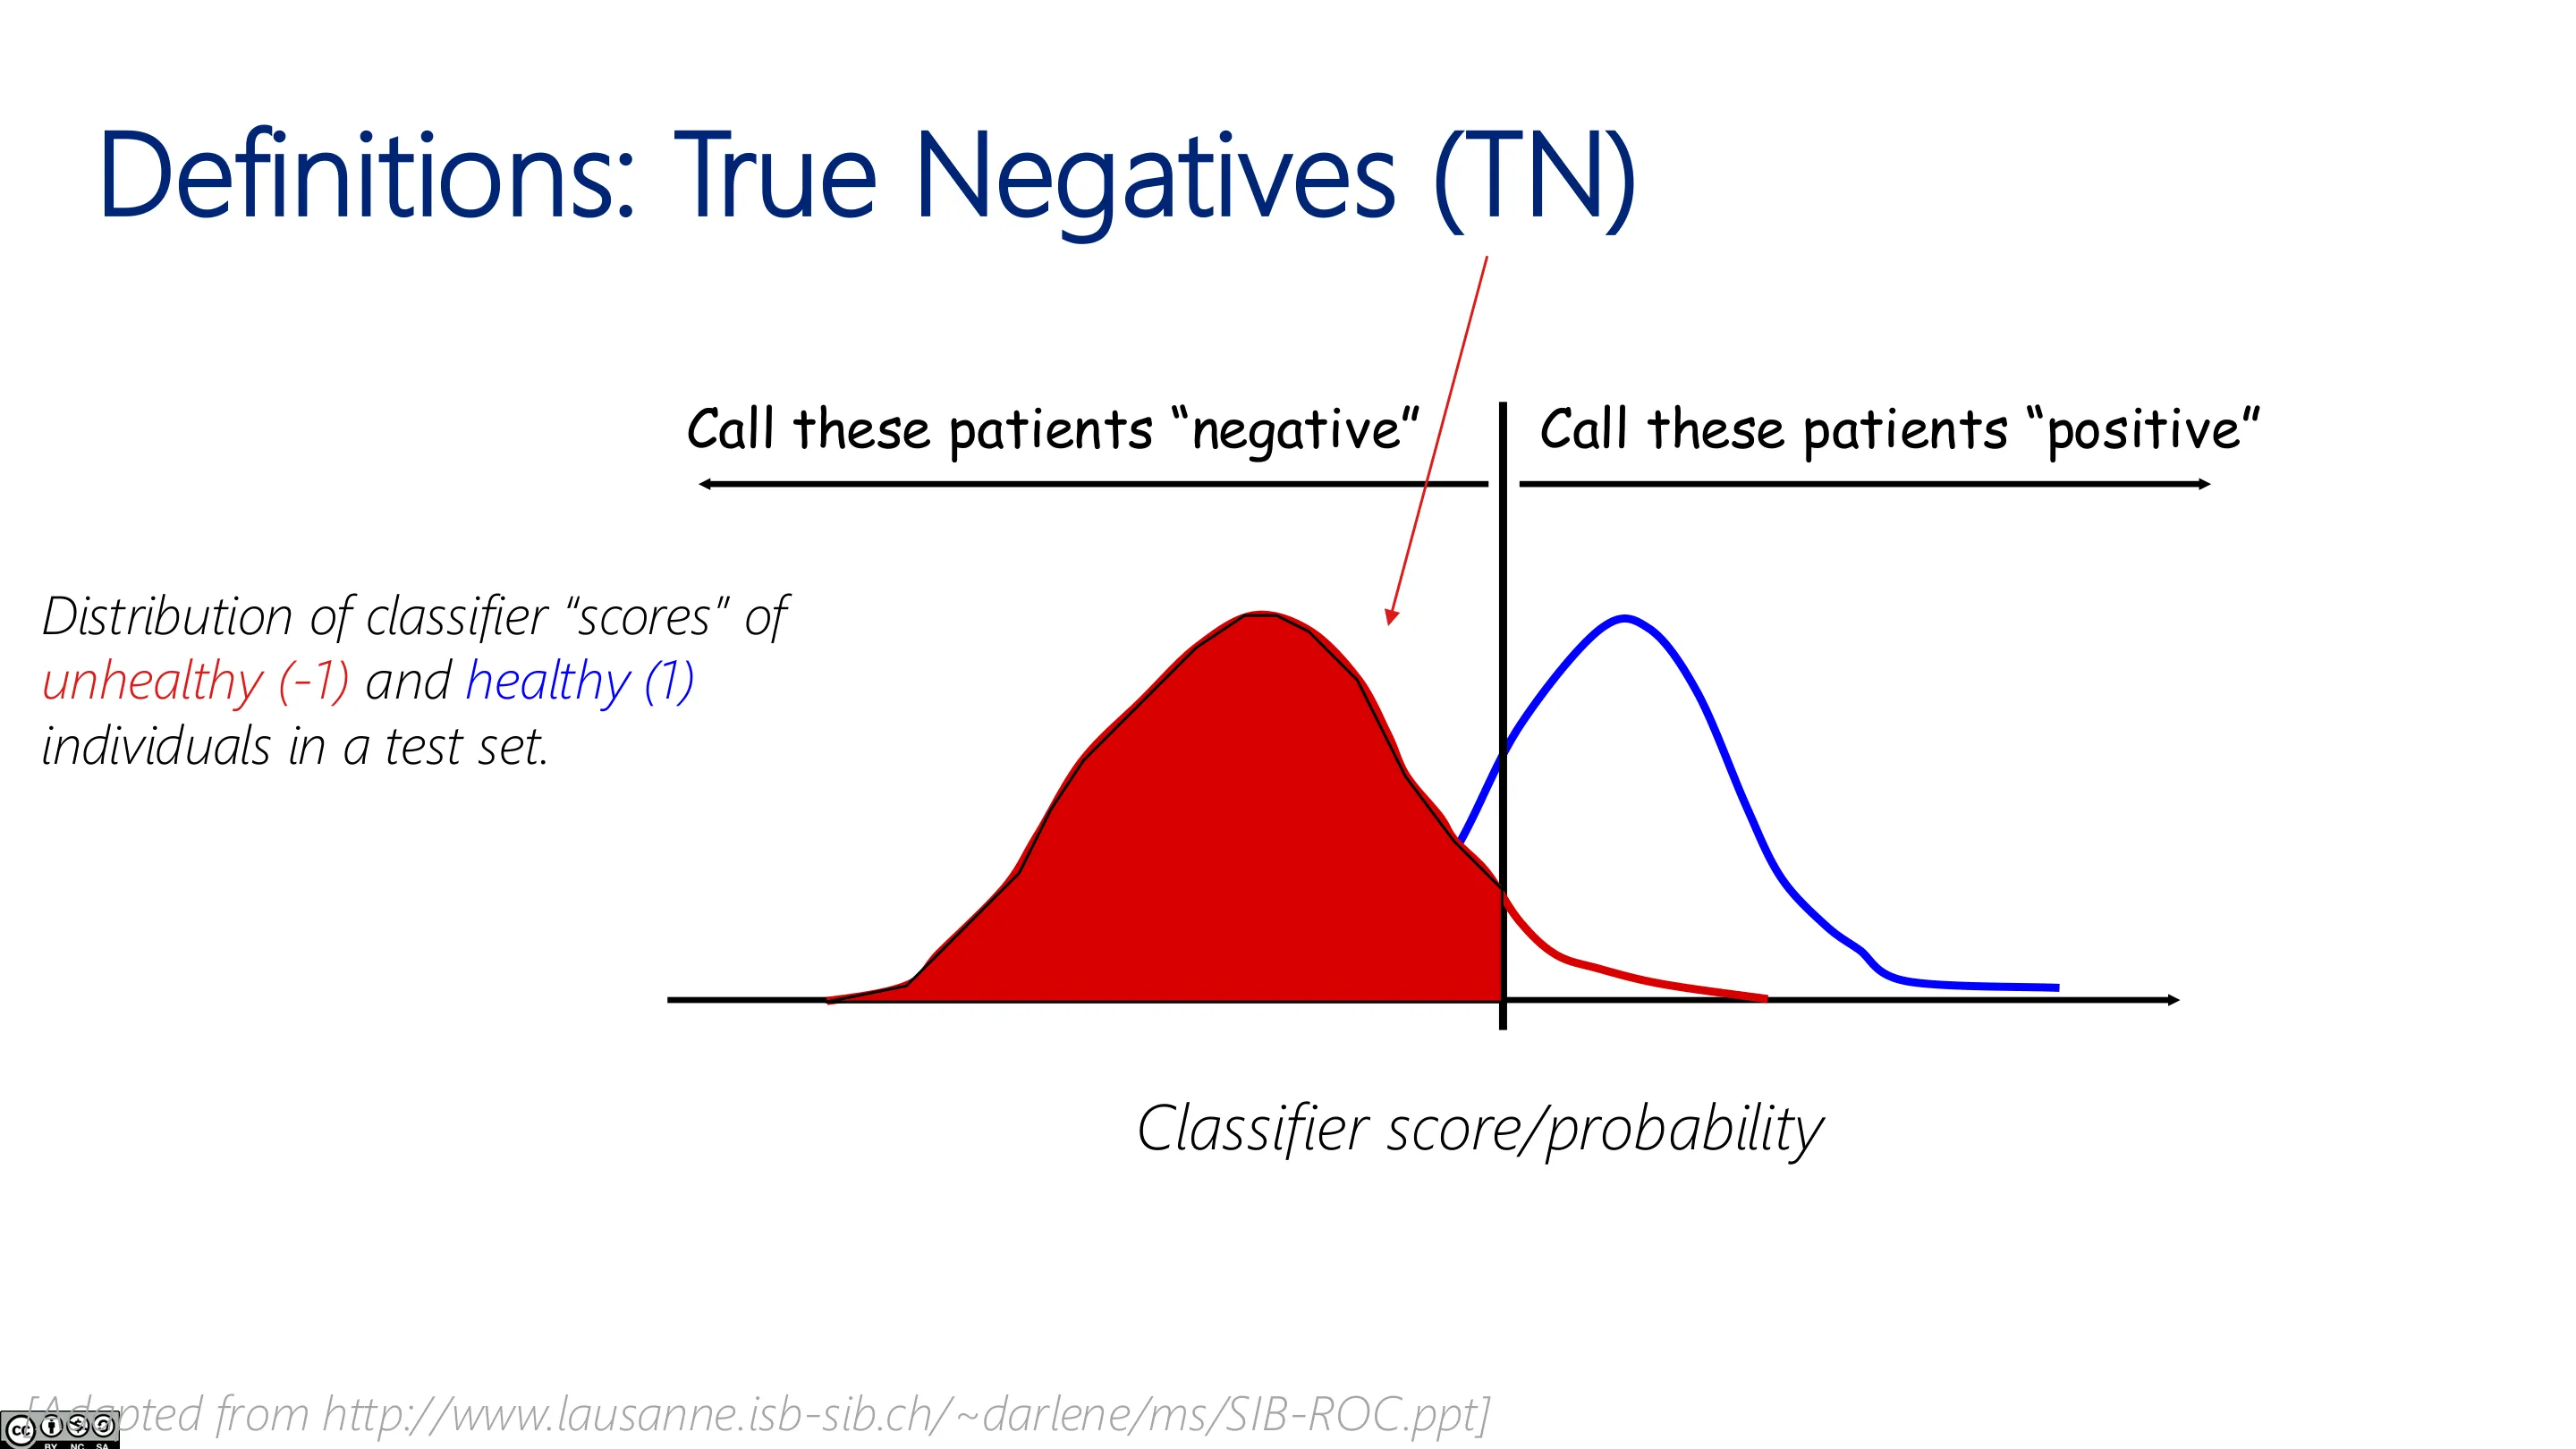
📷 定义:真阴性 TN
回到原视频 (01:02:08)
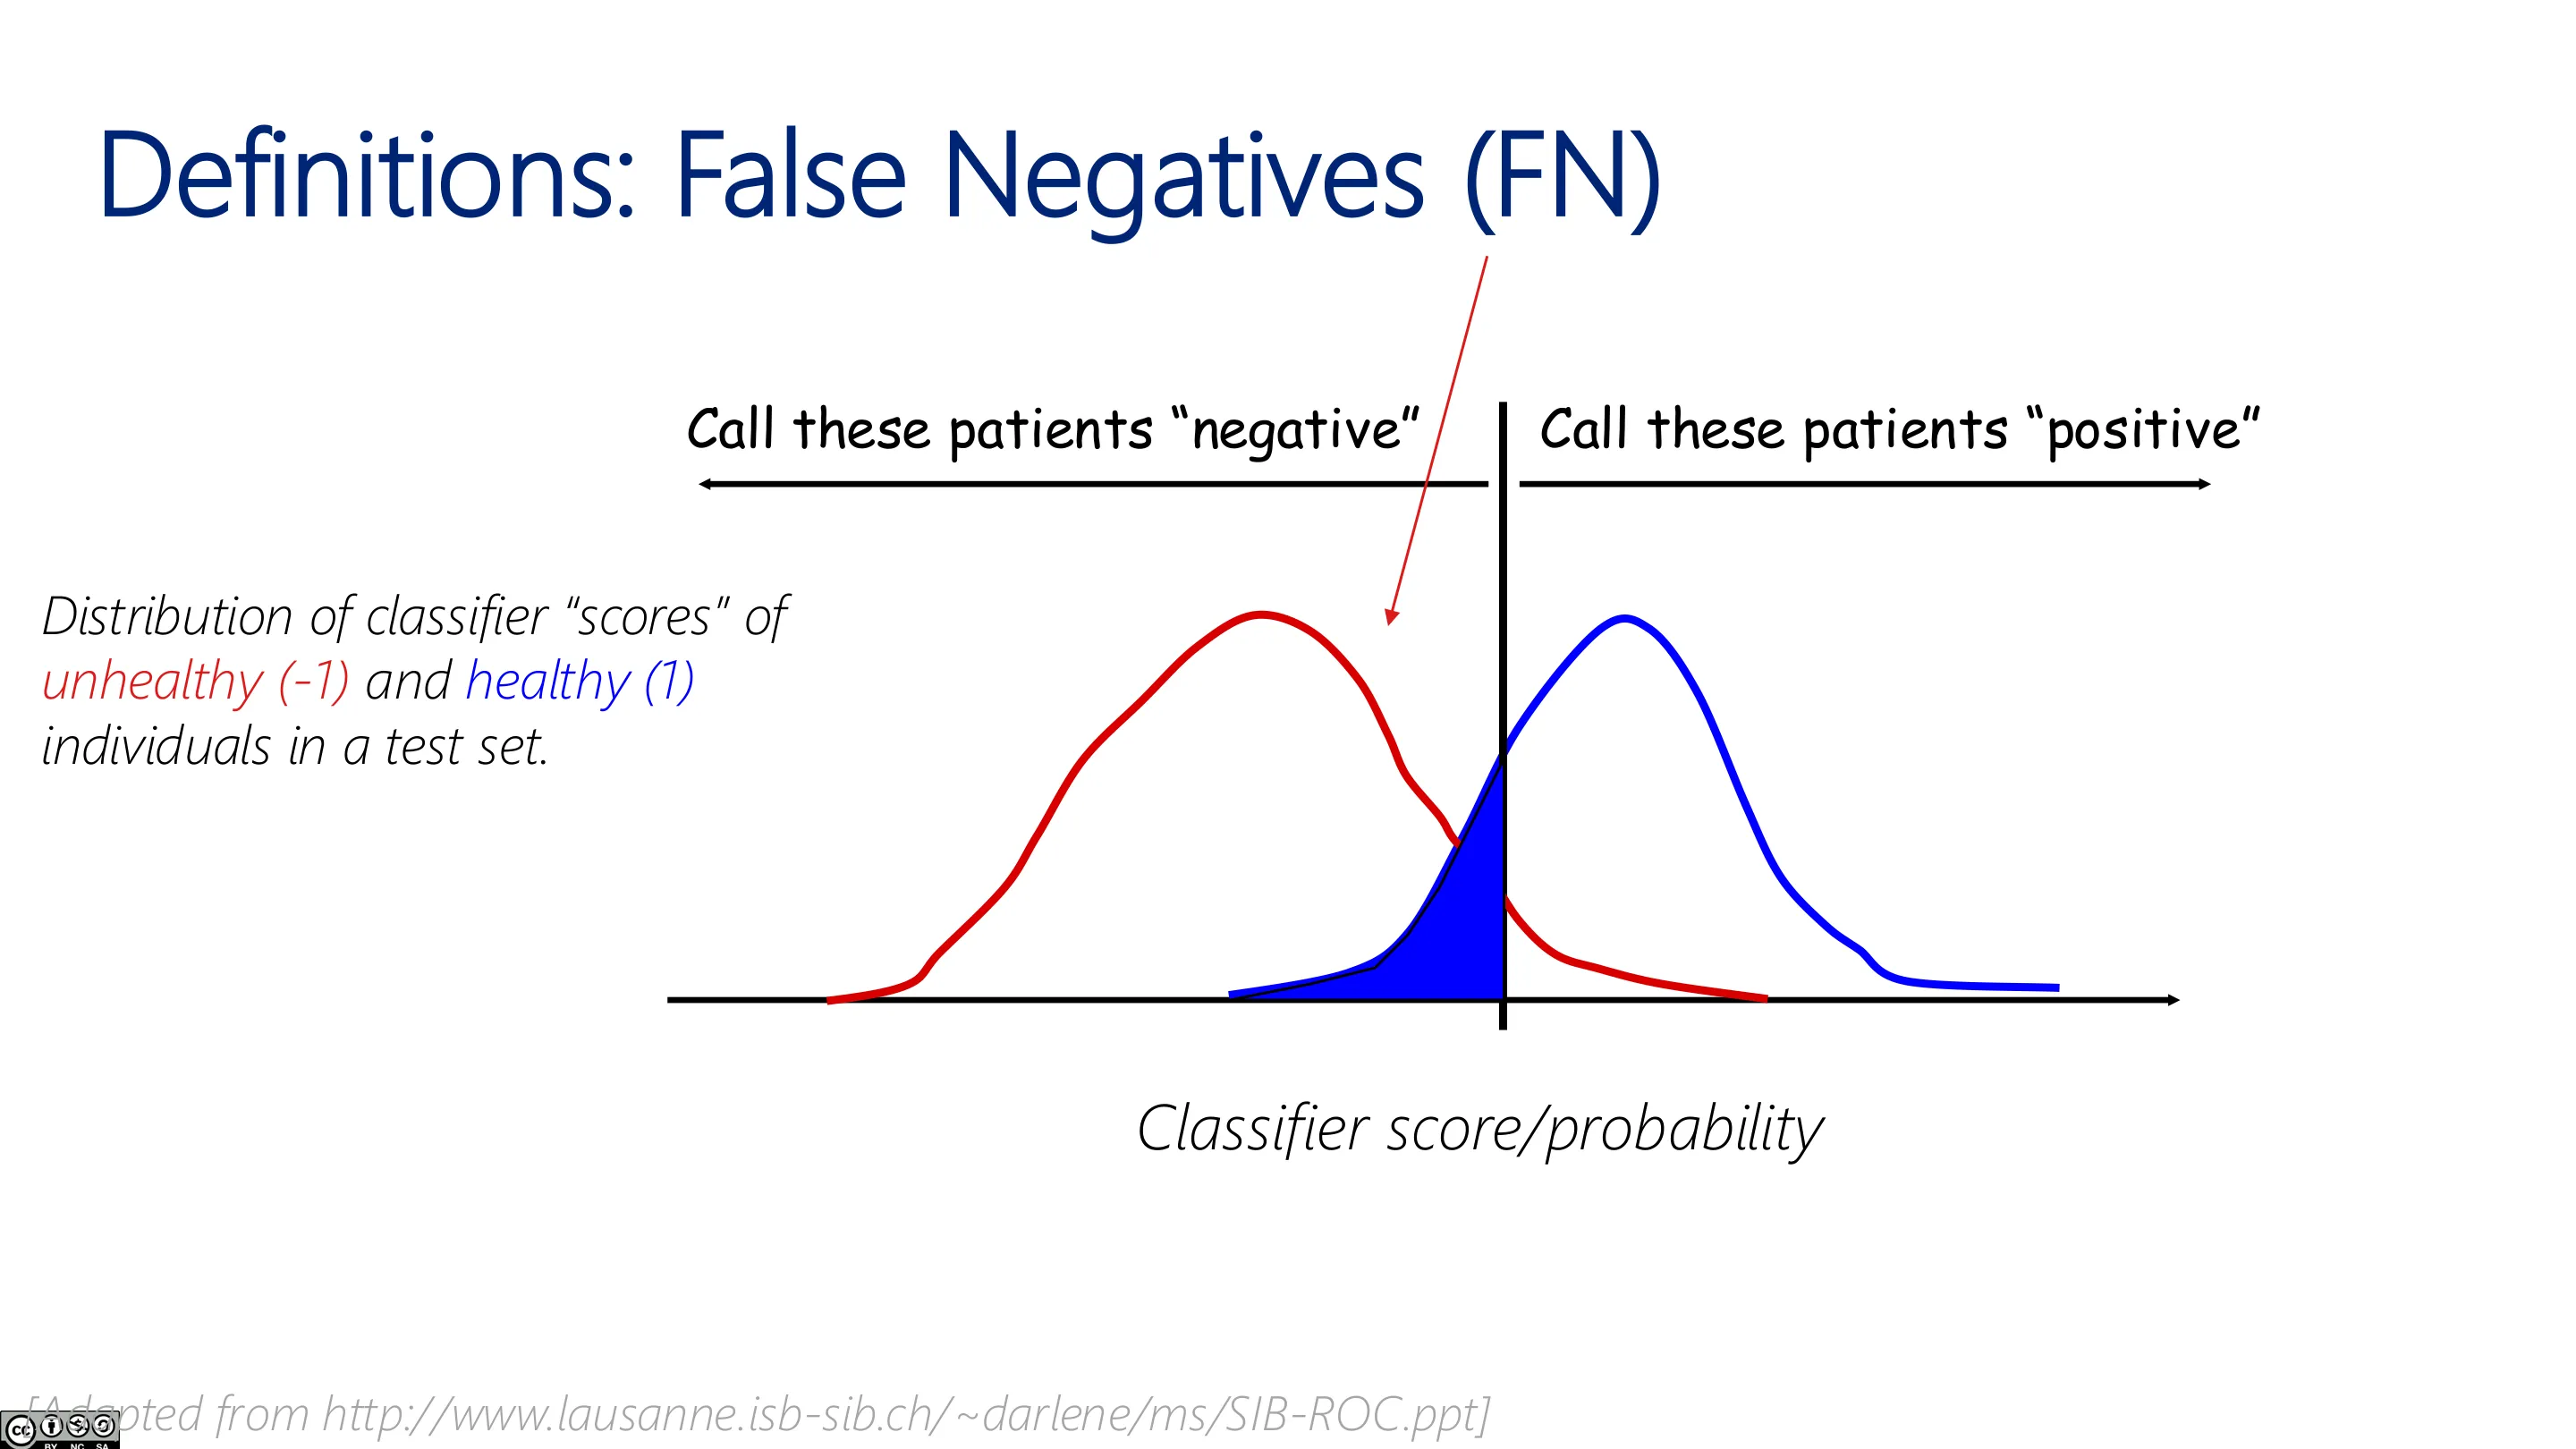
📷 定义:假阴性 FN
回到原视频 (01:02:25)
📷 混淆矩阵
回到原视频 (01:02:47)
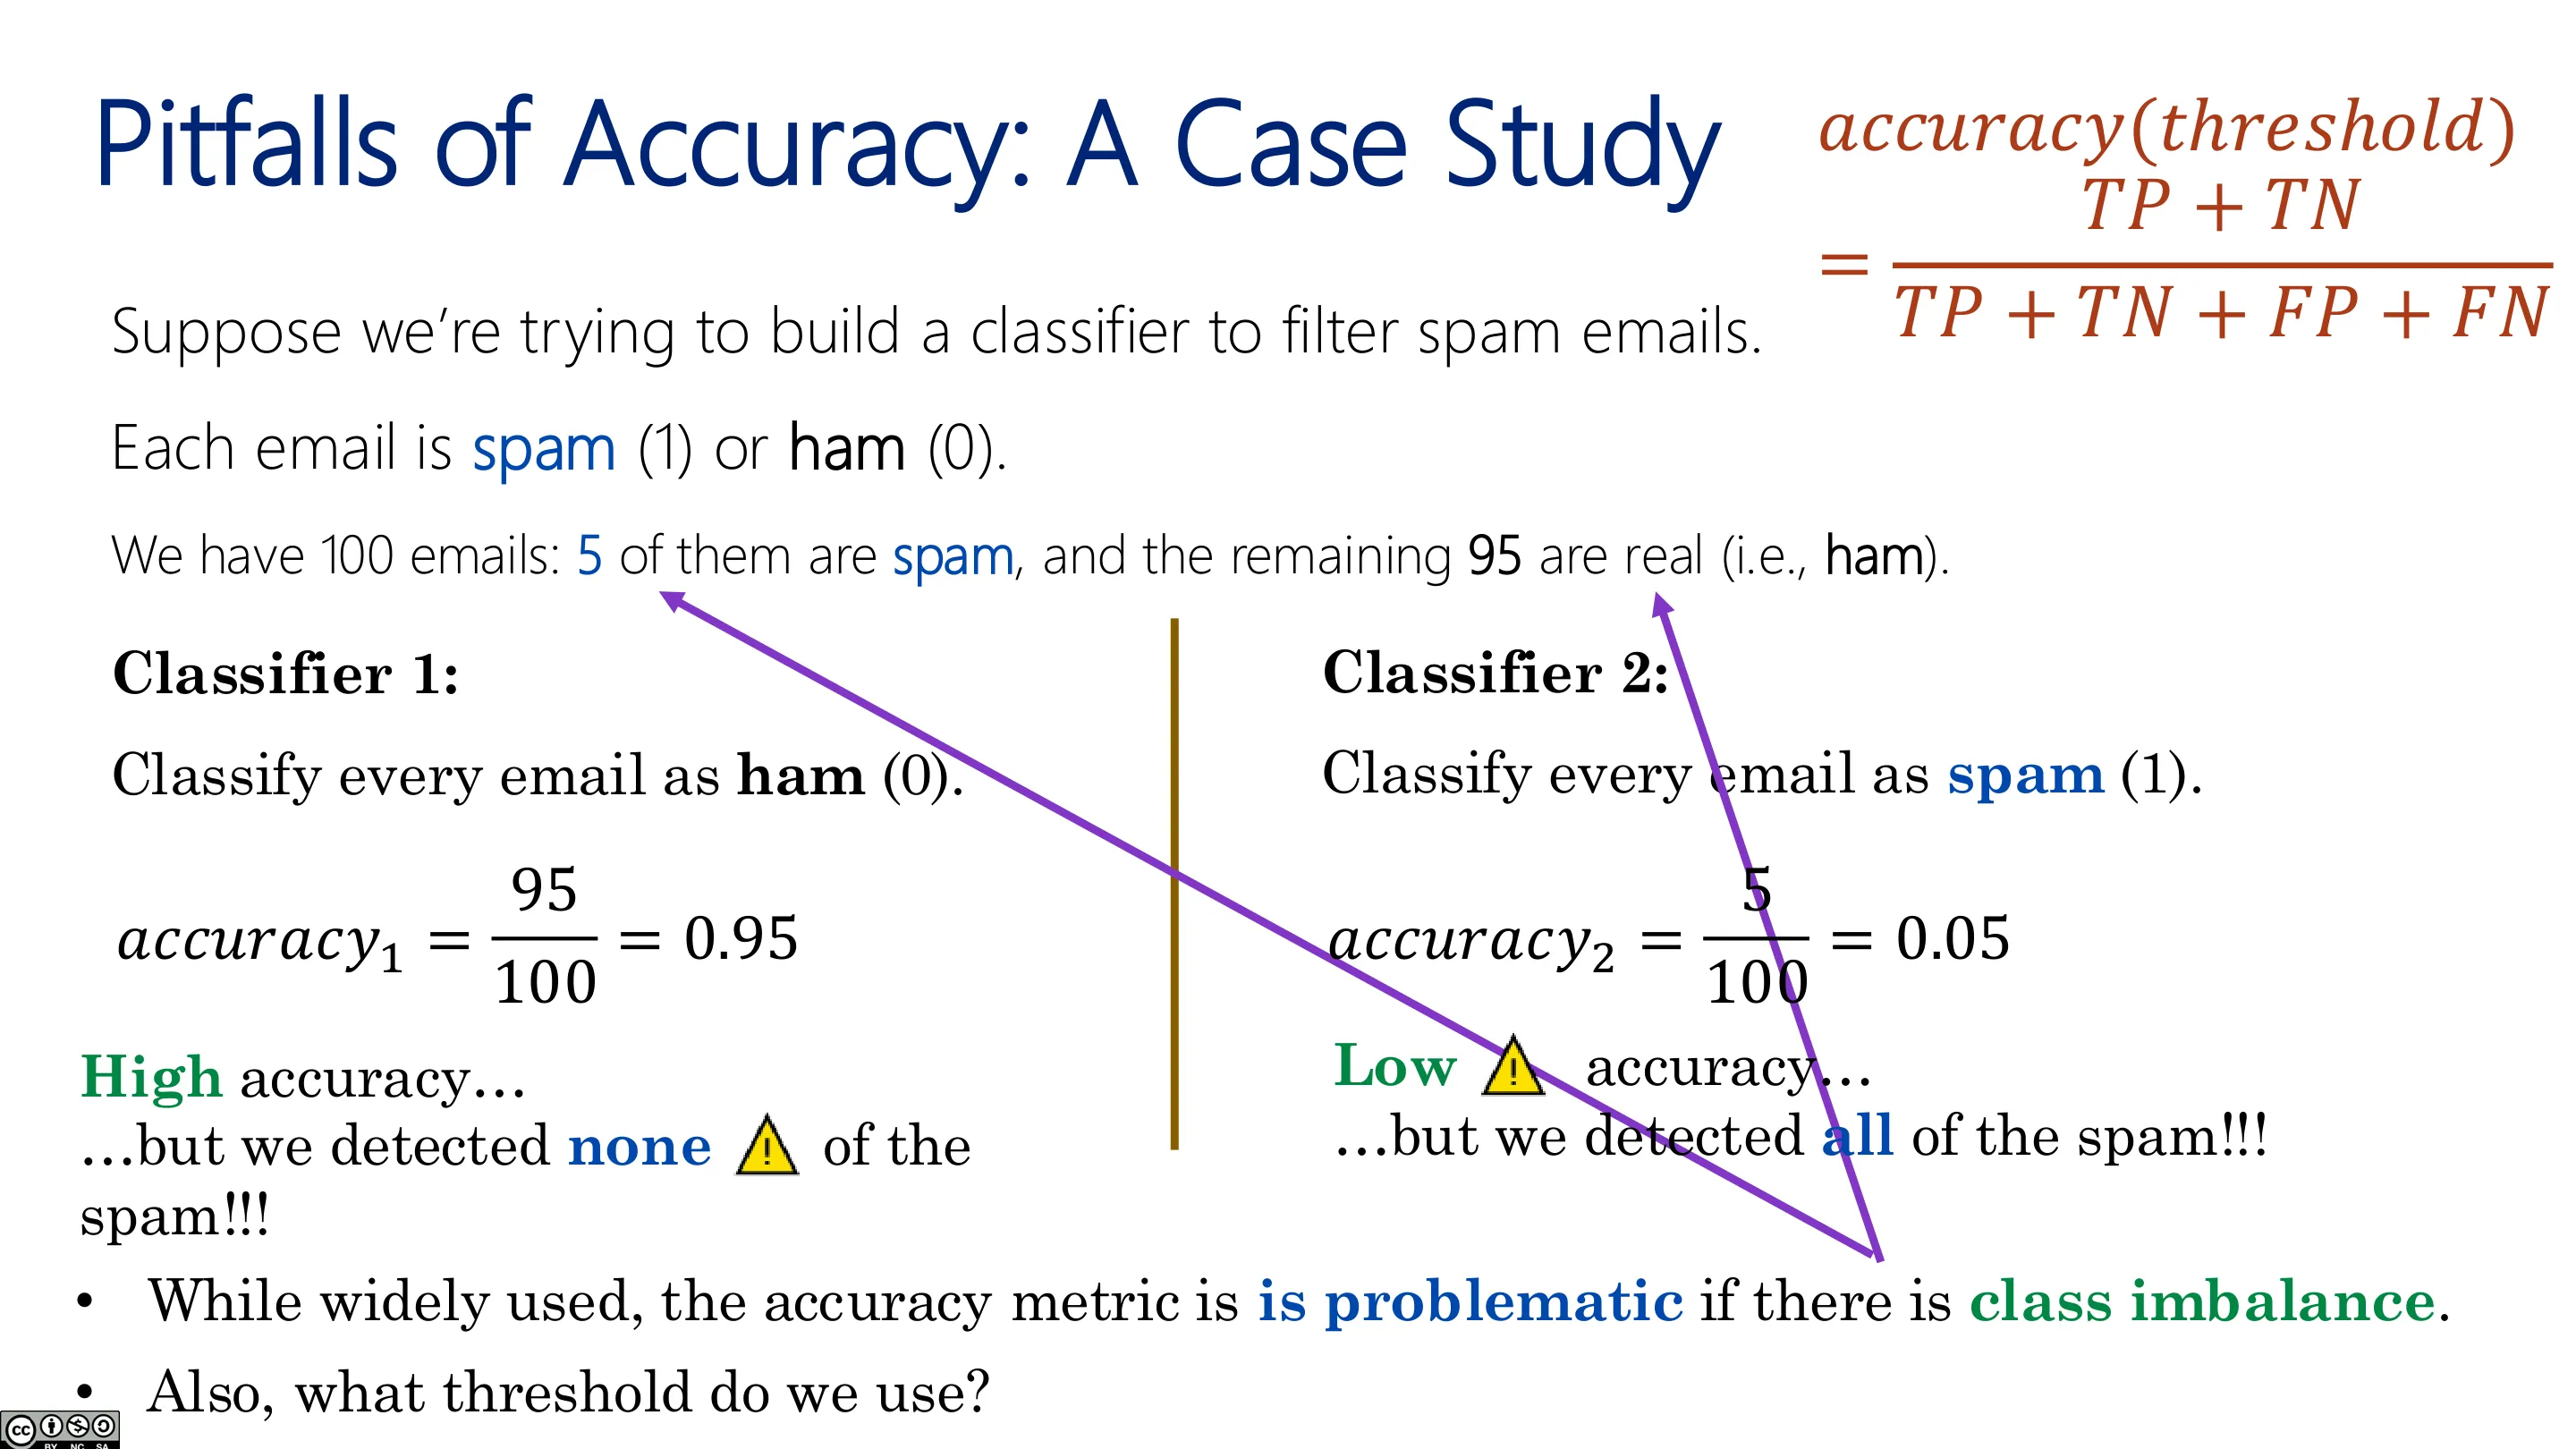
准确率的陷阱(类别不平衡):垃圾邮件过滤器中只有 5 封垃圾邮件、95 封正常邮件;一个「全都判为正常」的最蠢分类器准确率却有 95%——毫无信息量。所以准确率在有类别不平衡时极具误导性,而且报告准确率时往往不告诉你阈值。
📷 准确率的陷阱:案例研究
回到原视频 (01:03:57)
📷 回到决策阈值
回到原视频 (01:03:36)
3.3 ROC 曲线与 AUC
(参考时间: 01:06)
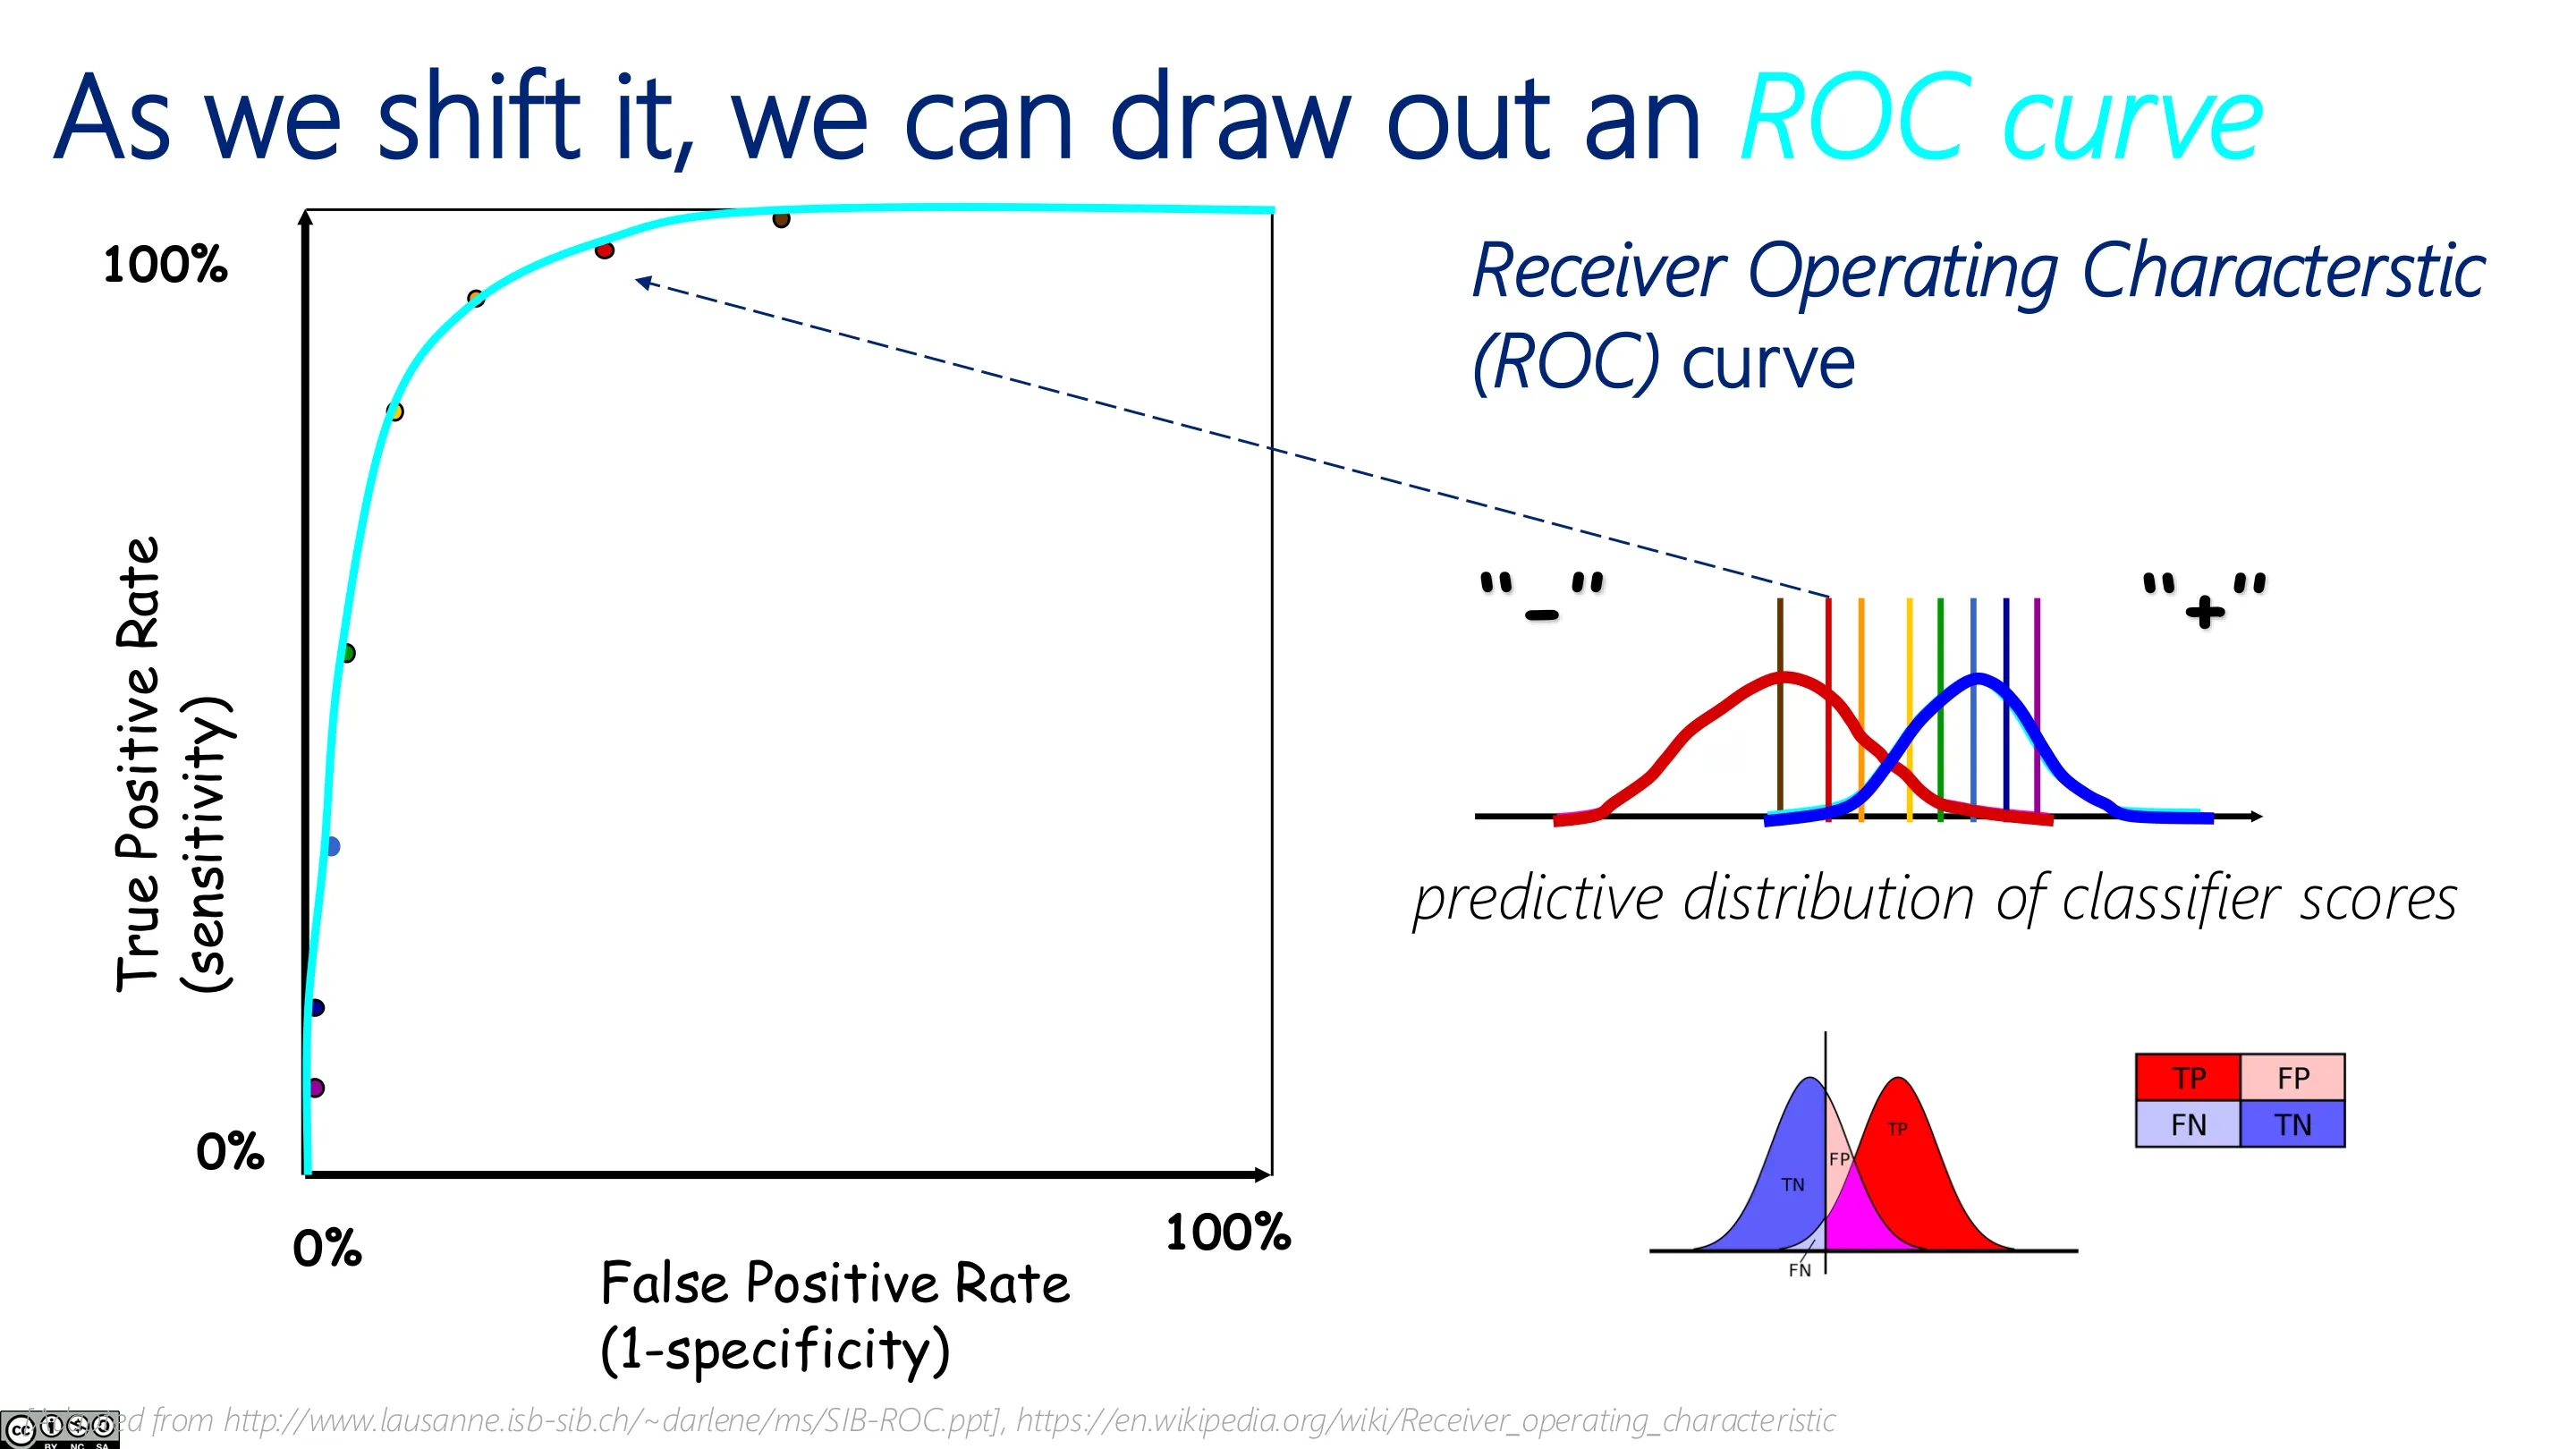
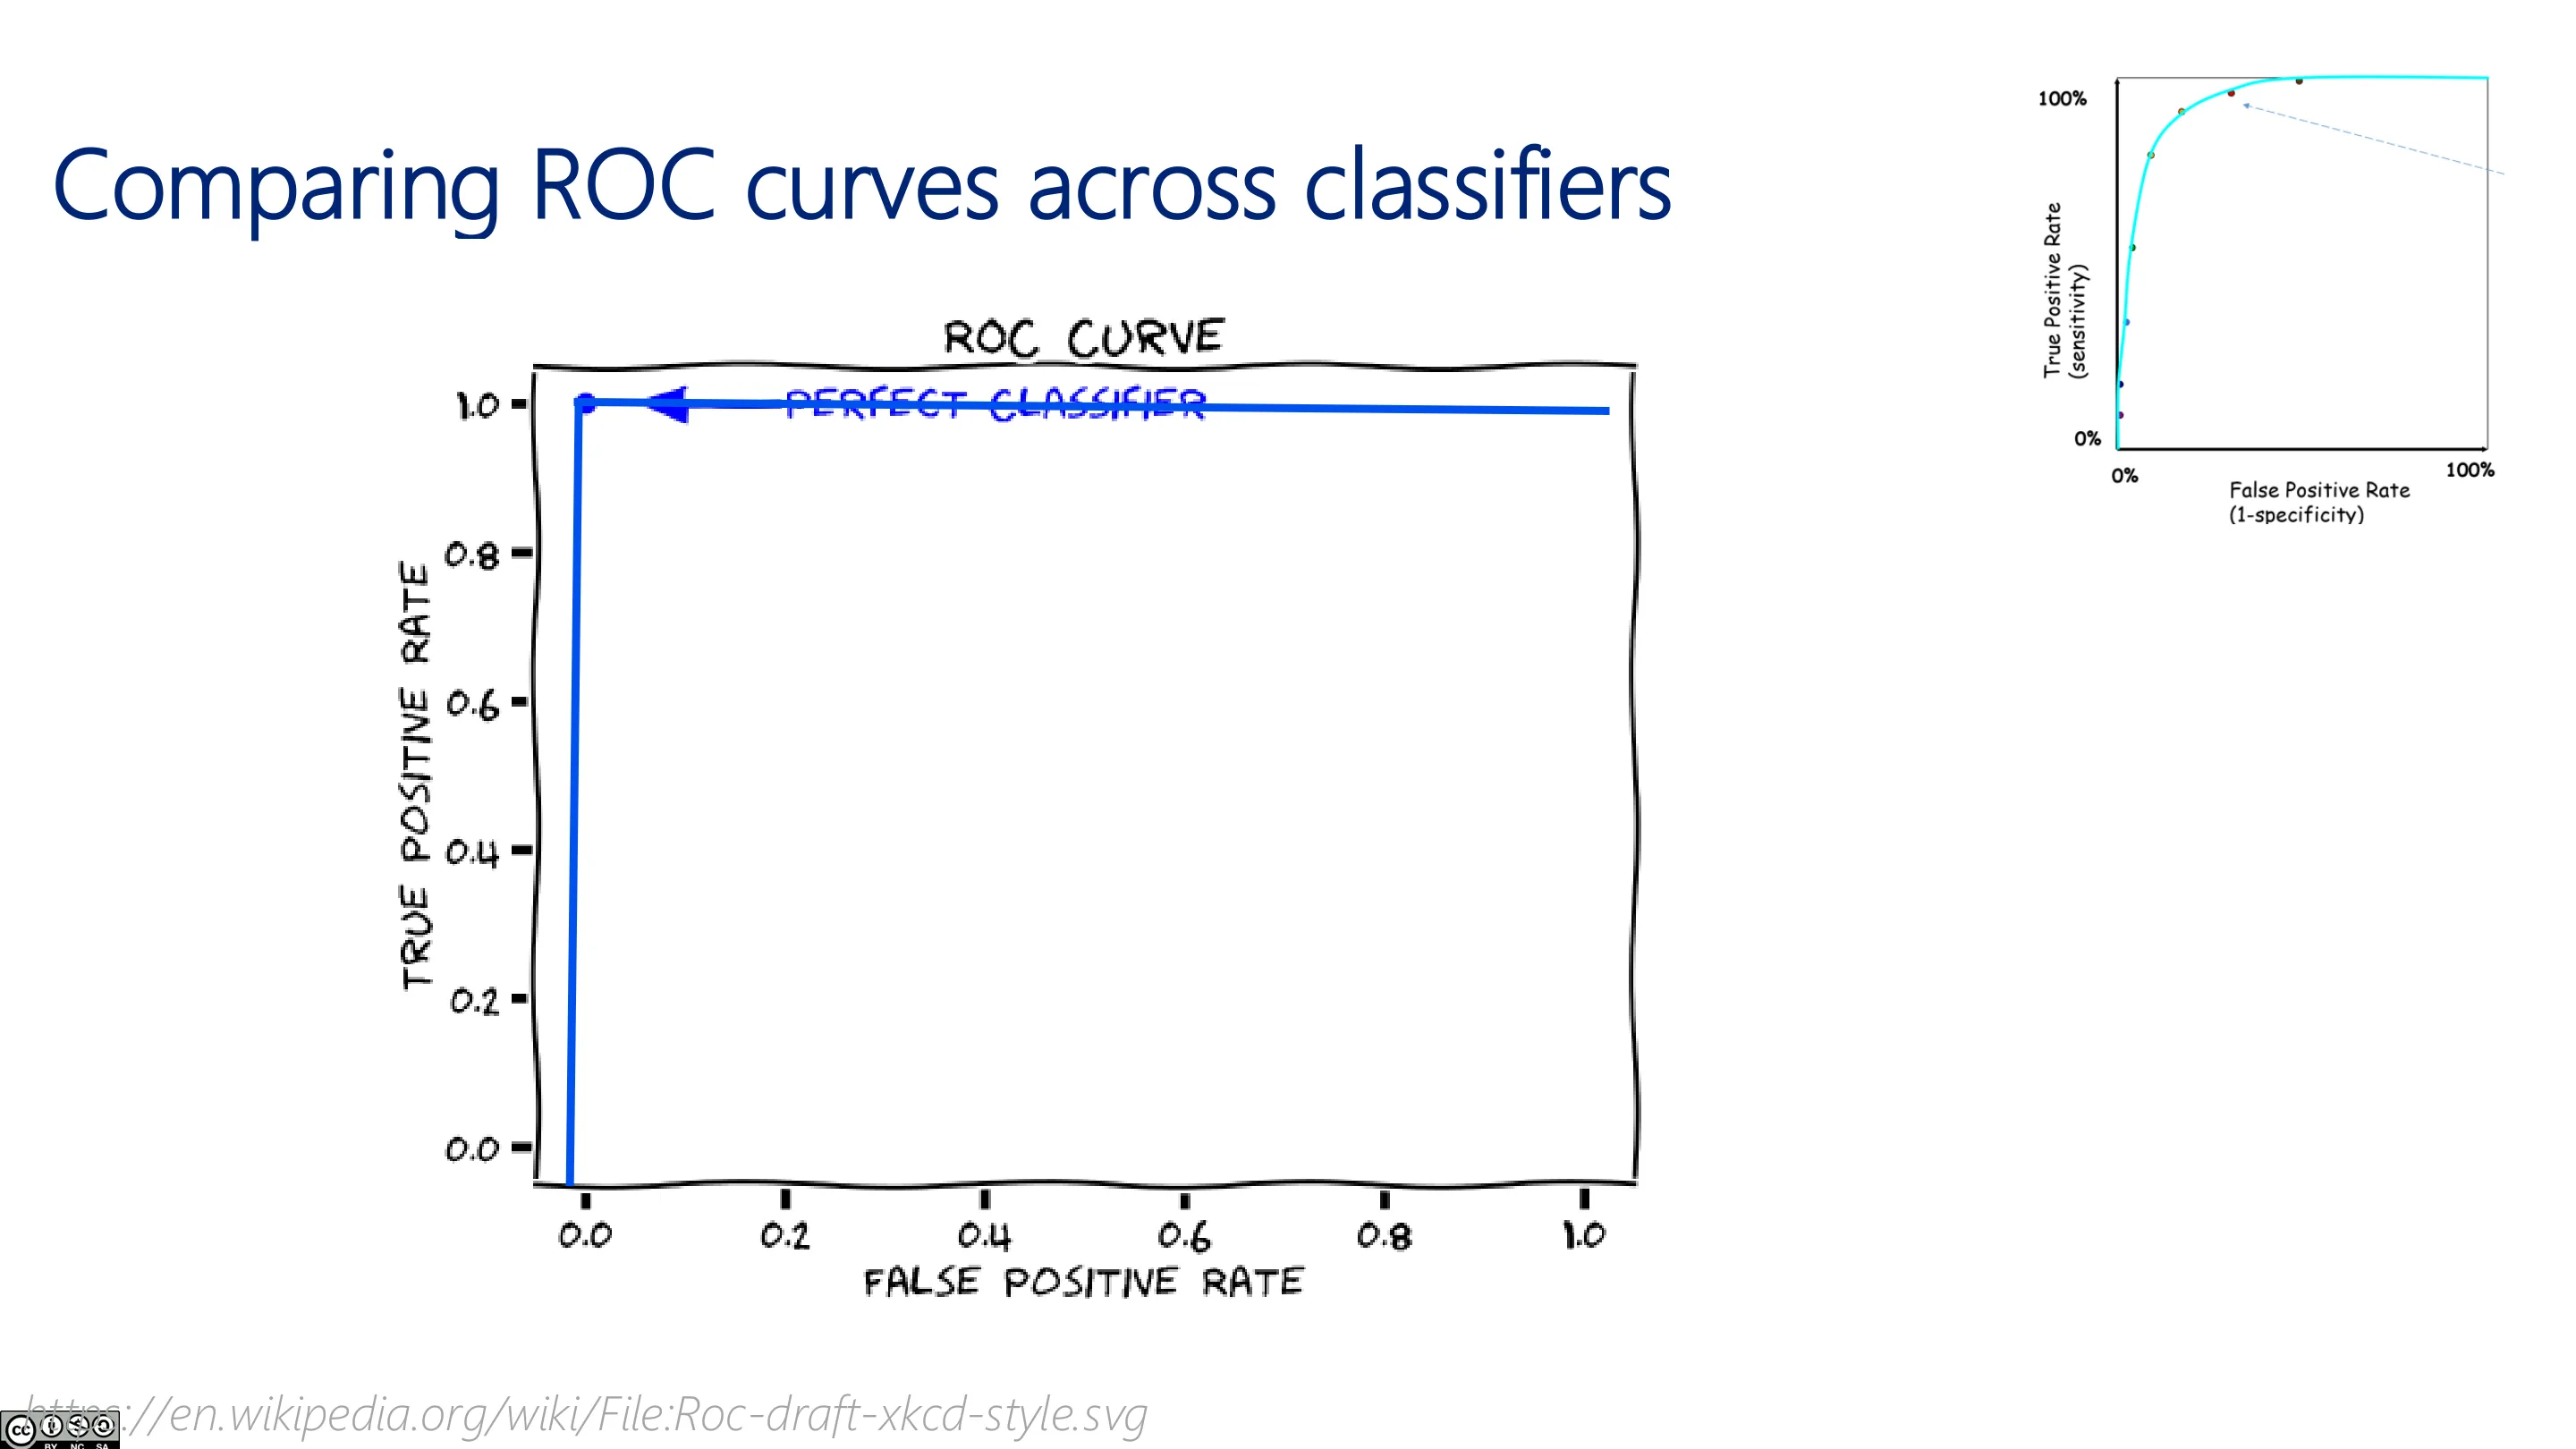
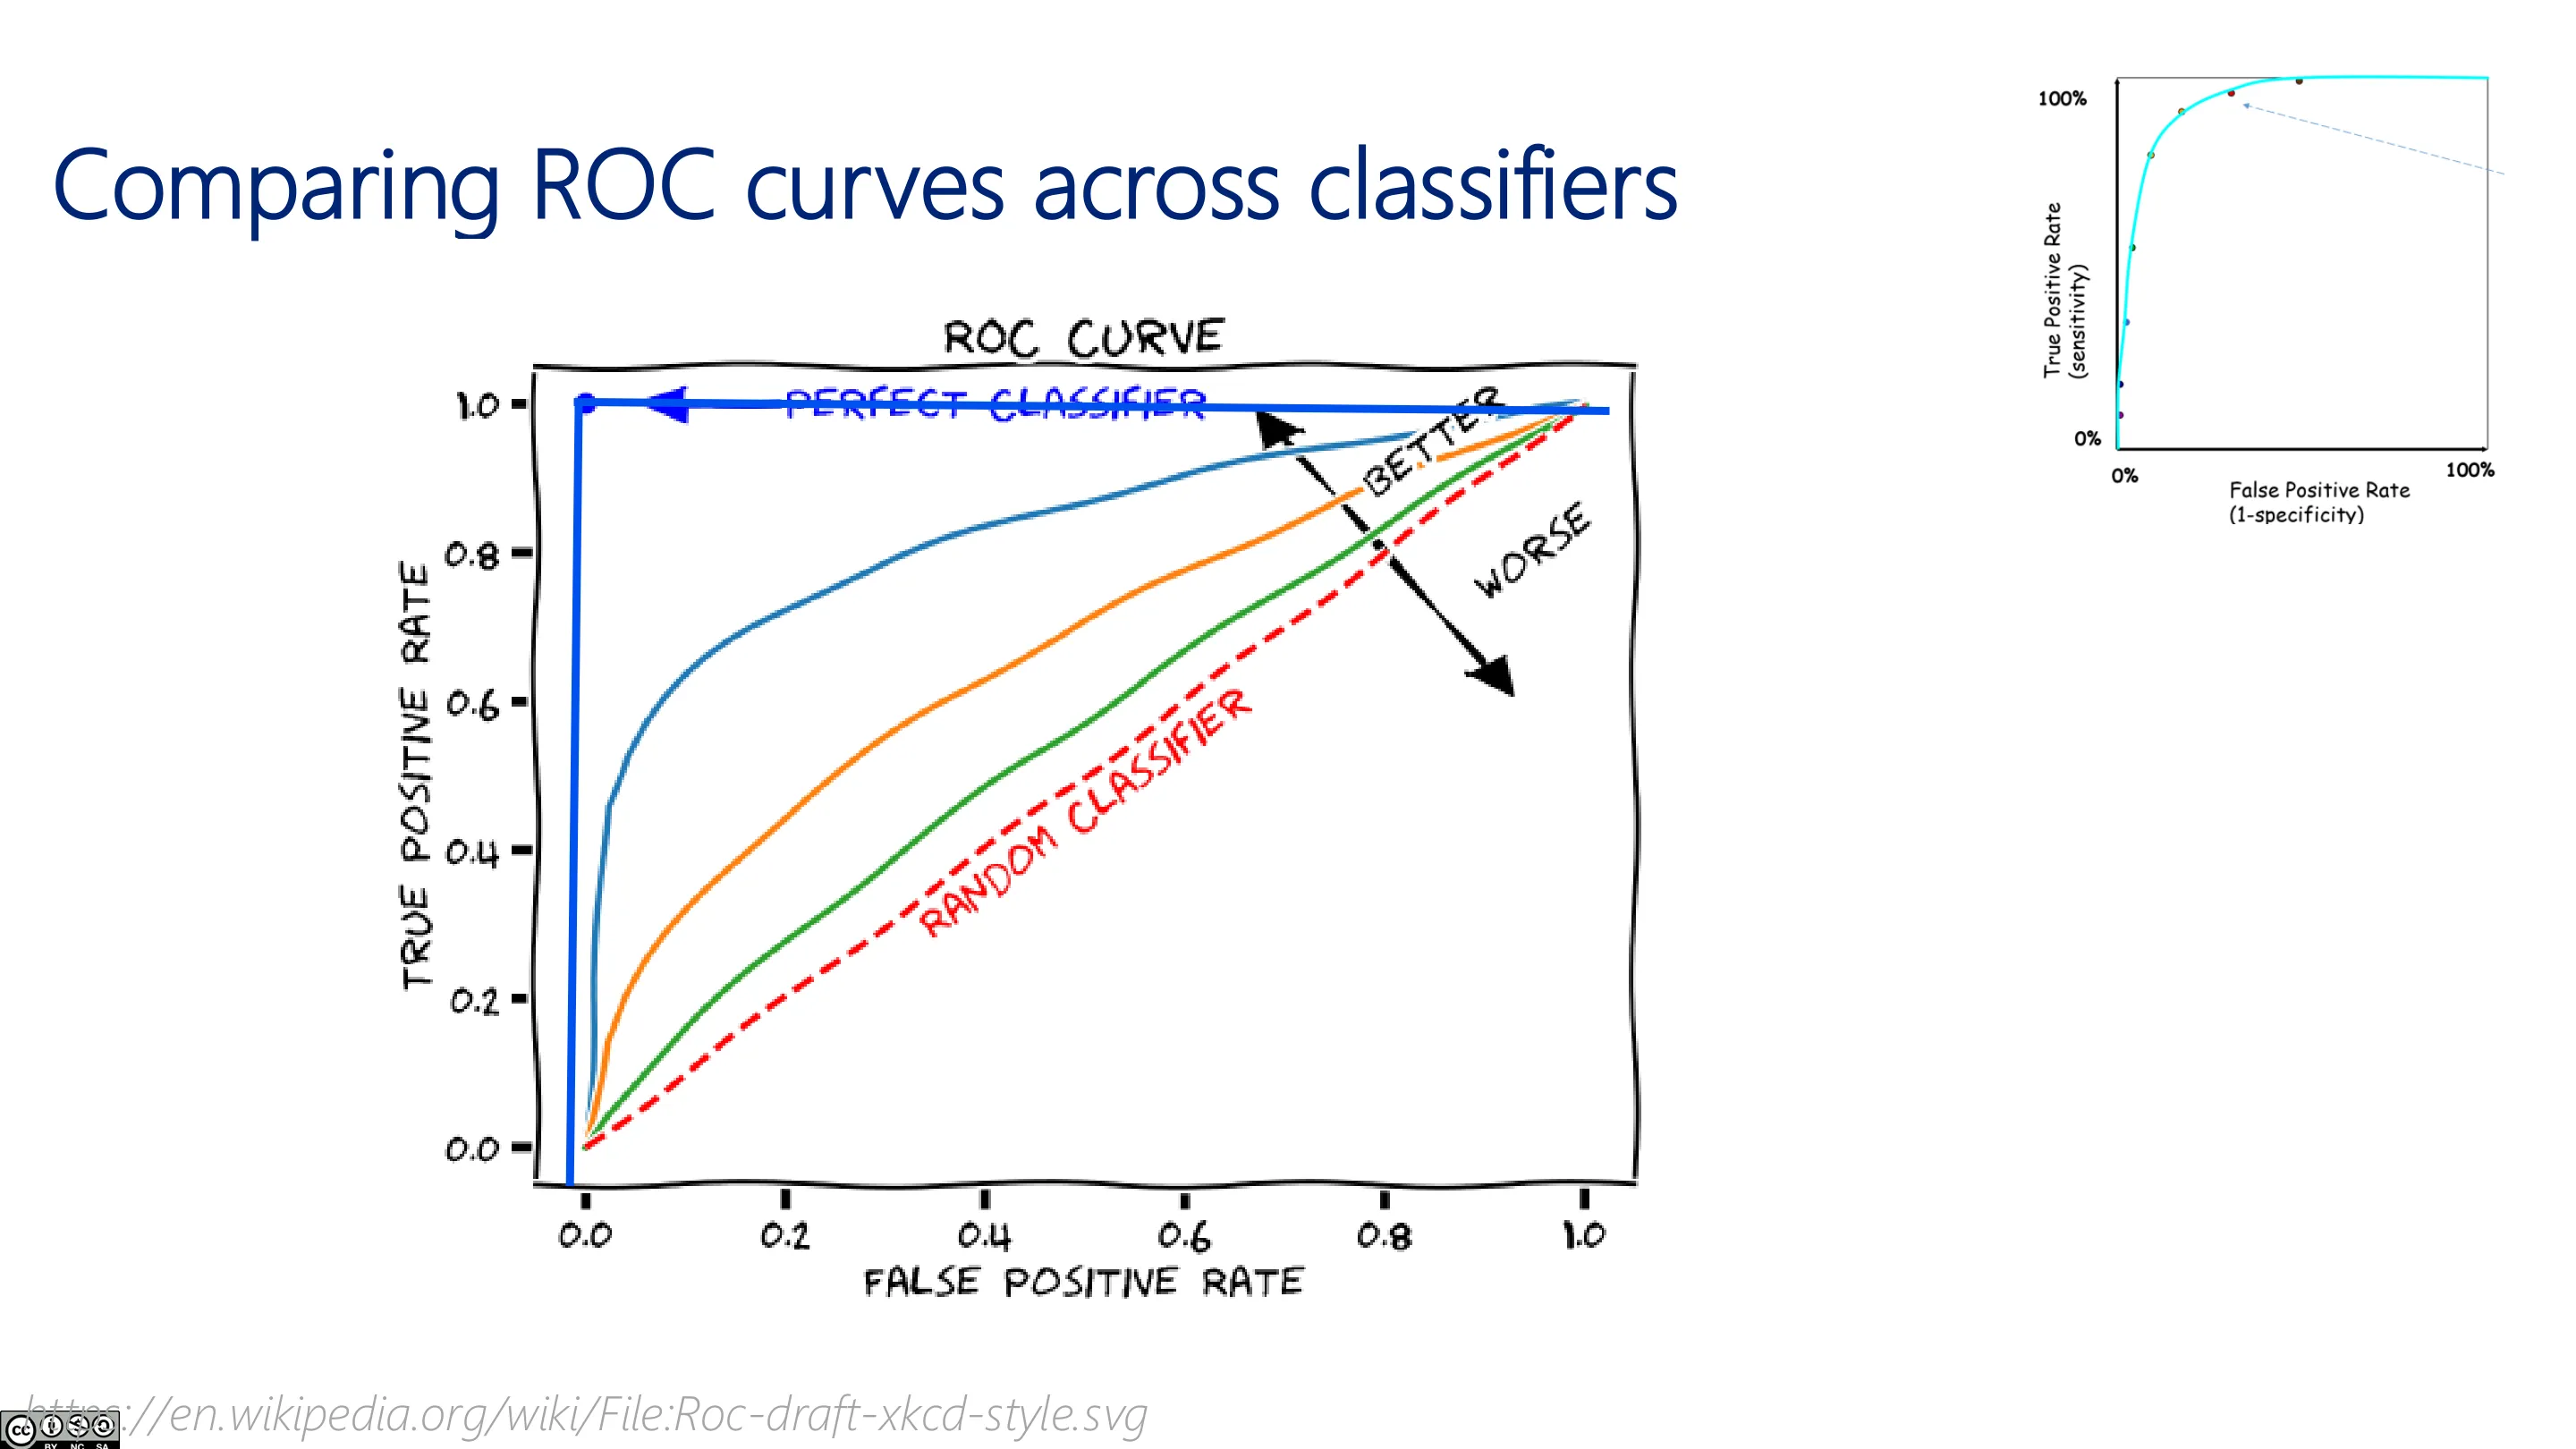
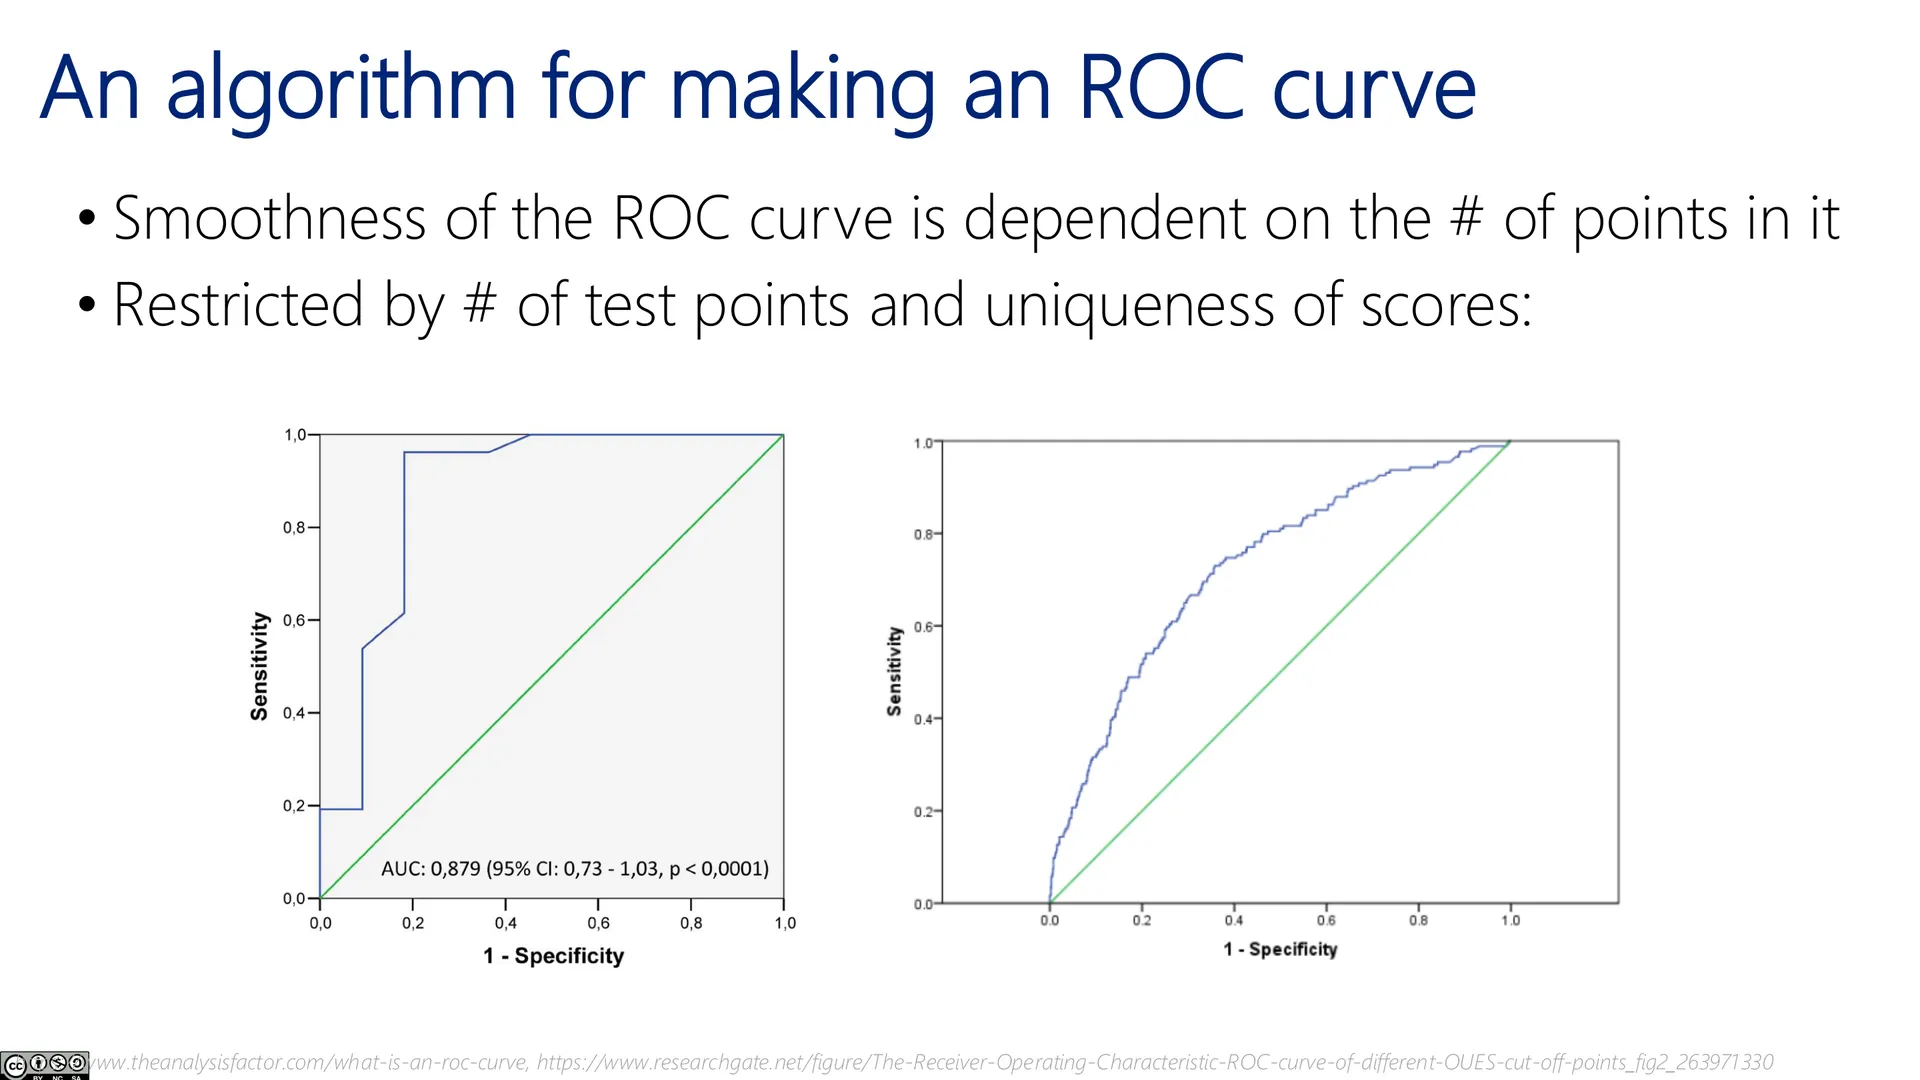
ROC 曲线的构造:遍历所有可能的阈值,对每个阈值算一个 (FPR, TPR) 点,连成曲线。
- 完美分类器:TPR=1、FPR=0(左上角);
- 随机分类器:对角线;
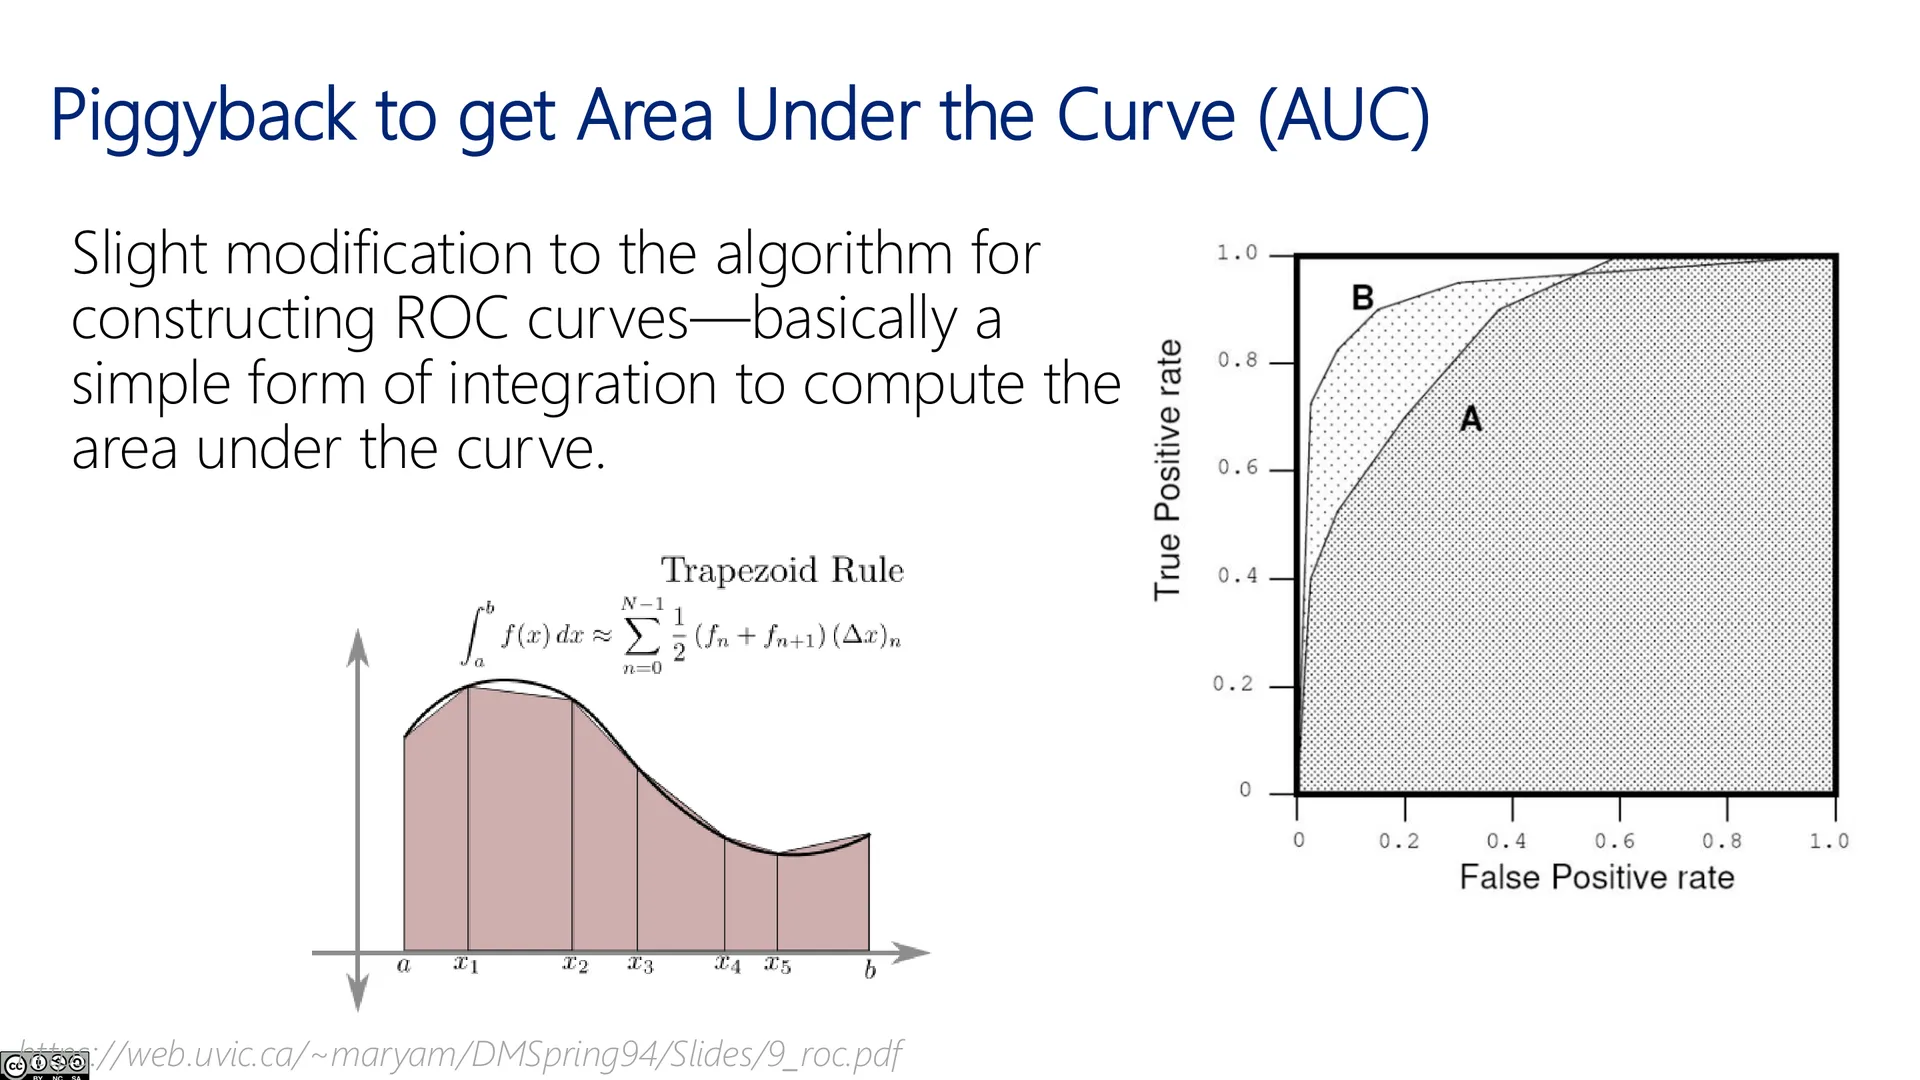
- 曲线下的面积 = AUC ∈ [0.5, 1],越大越好;
- AUC 的含义:随机取一个正例和一个负例,分类器把正例排在负例前面的概率。
📷 移动阈值得到 ROC 曲线
回到原视频 (01:06:13)
📷 如何绘制 ROC 曲线
回到原视频 (01:07:21)
📷 比较不同分类器的 ROC 曲线(一)
回到原视频 (01:12:23)
📷 比较不同分类器的 ROC 曲线(二)
回到原视频 (01:12:51)
📷 ROC 曲线的历史
回到原视频 (01:12:10)
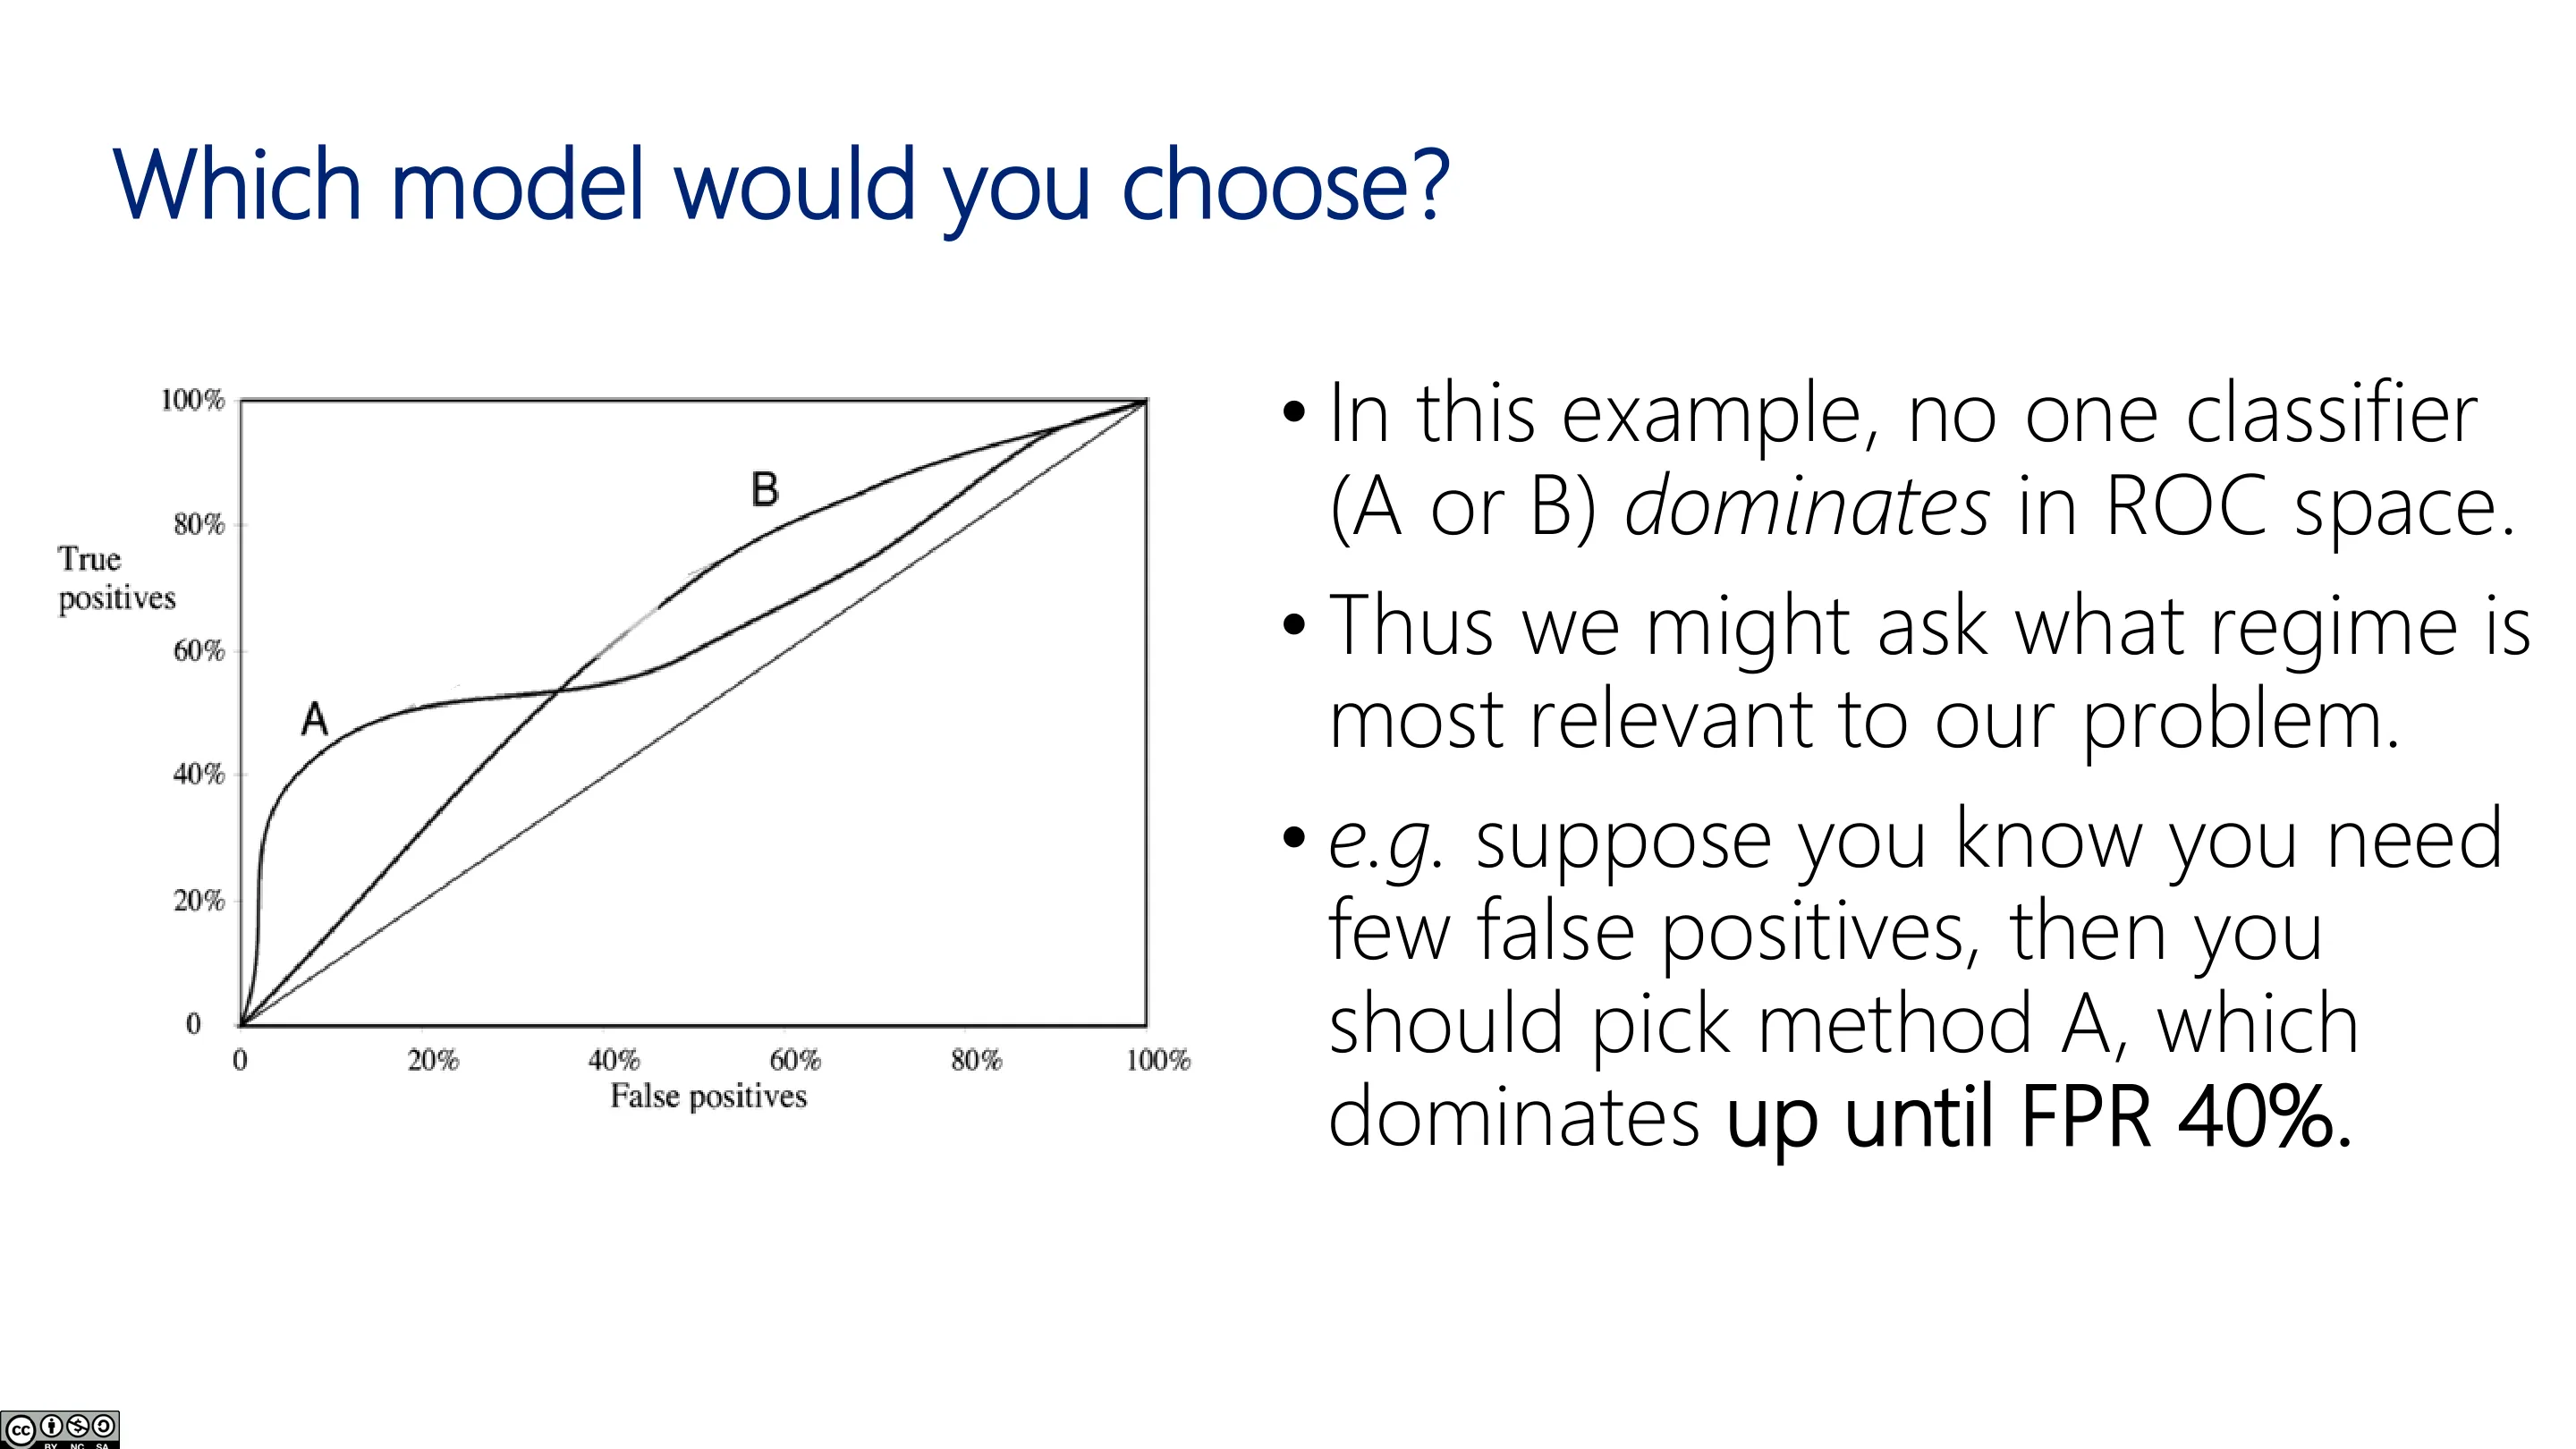
📷 你会选哪个模型
回到原视频 (01:12:55)
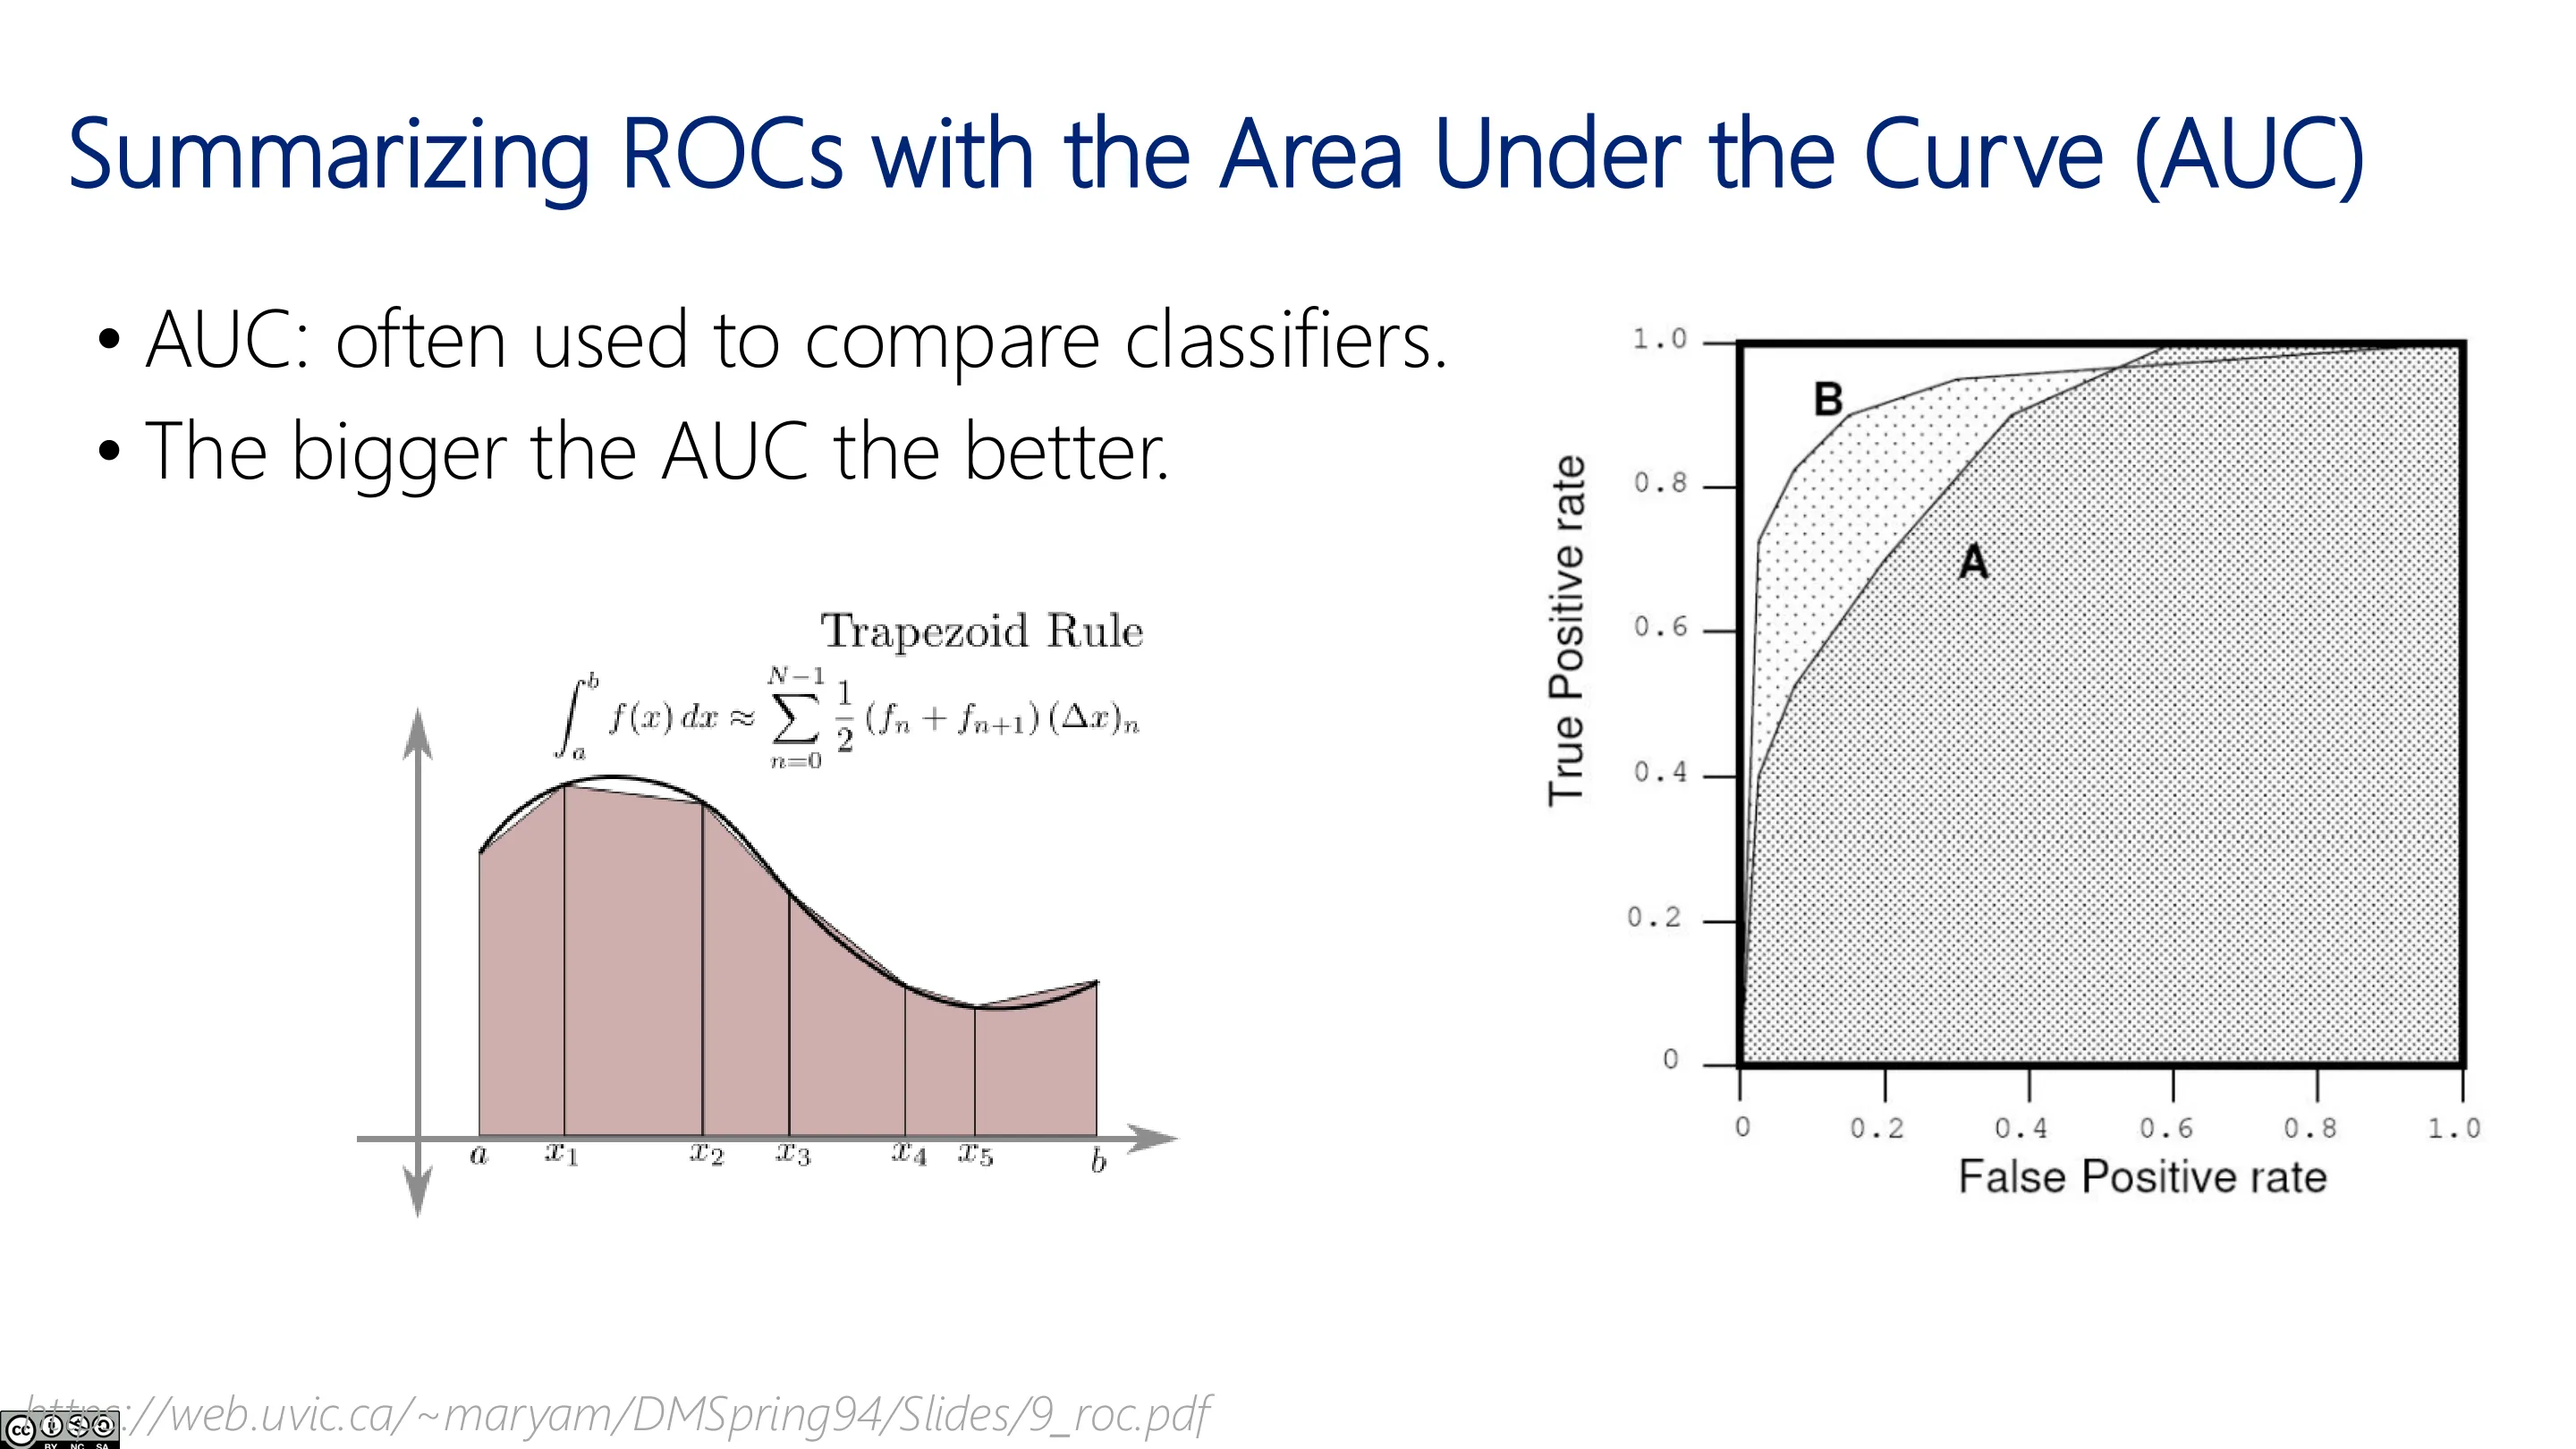
📷 用 AUC 概括 ROC(一)
回到原视频 (01:13:42)
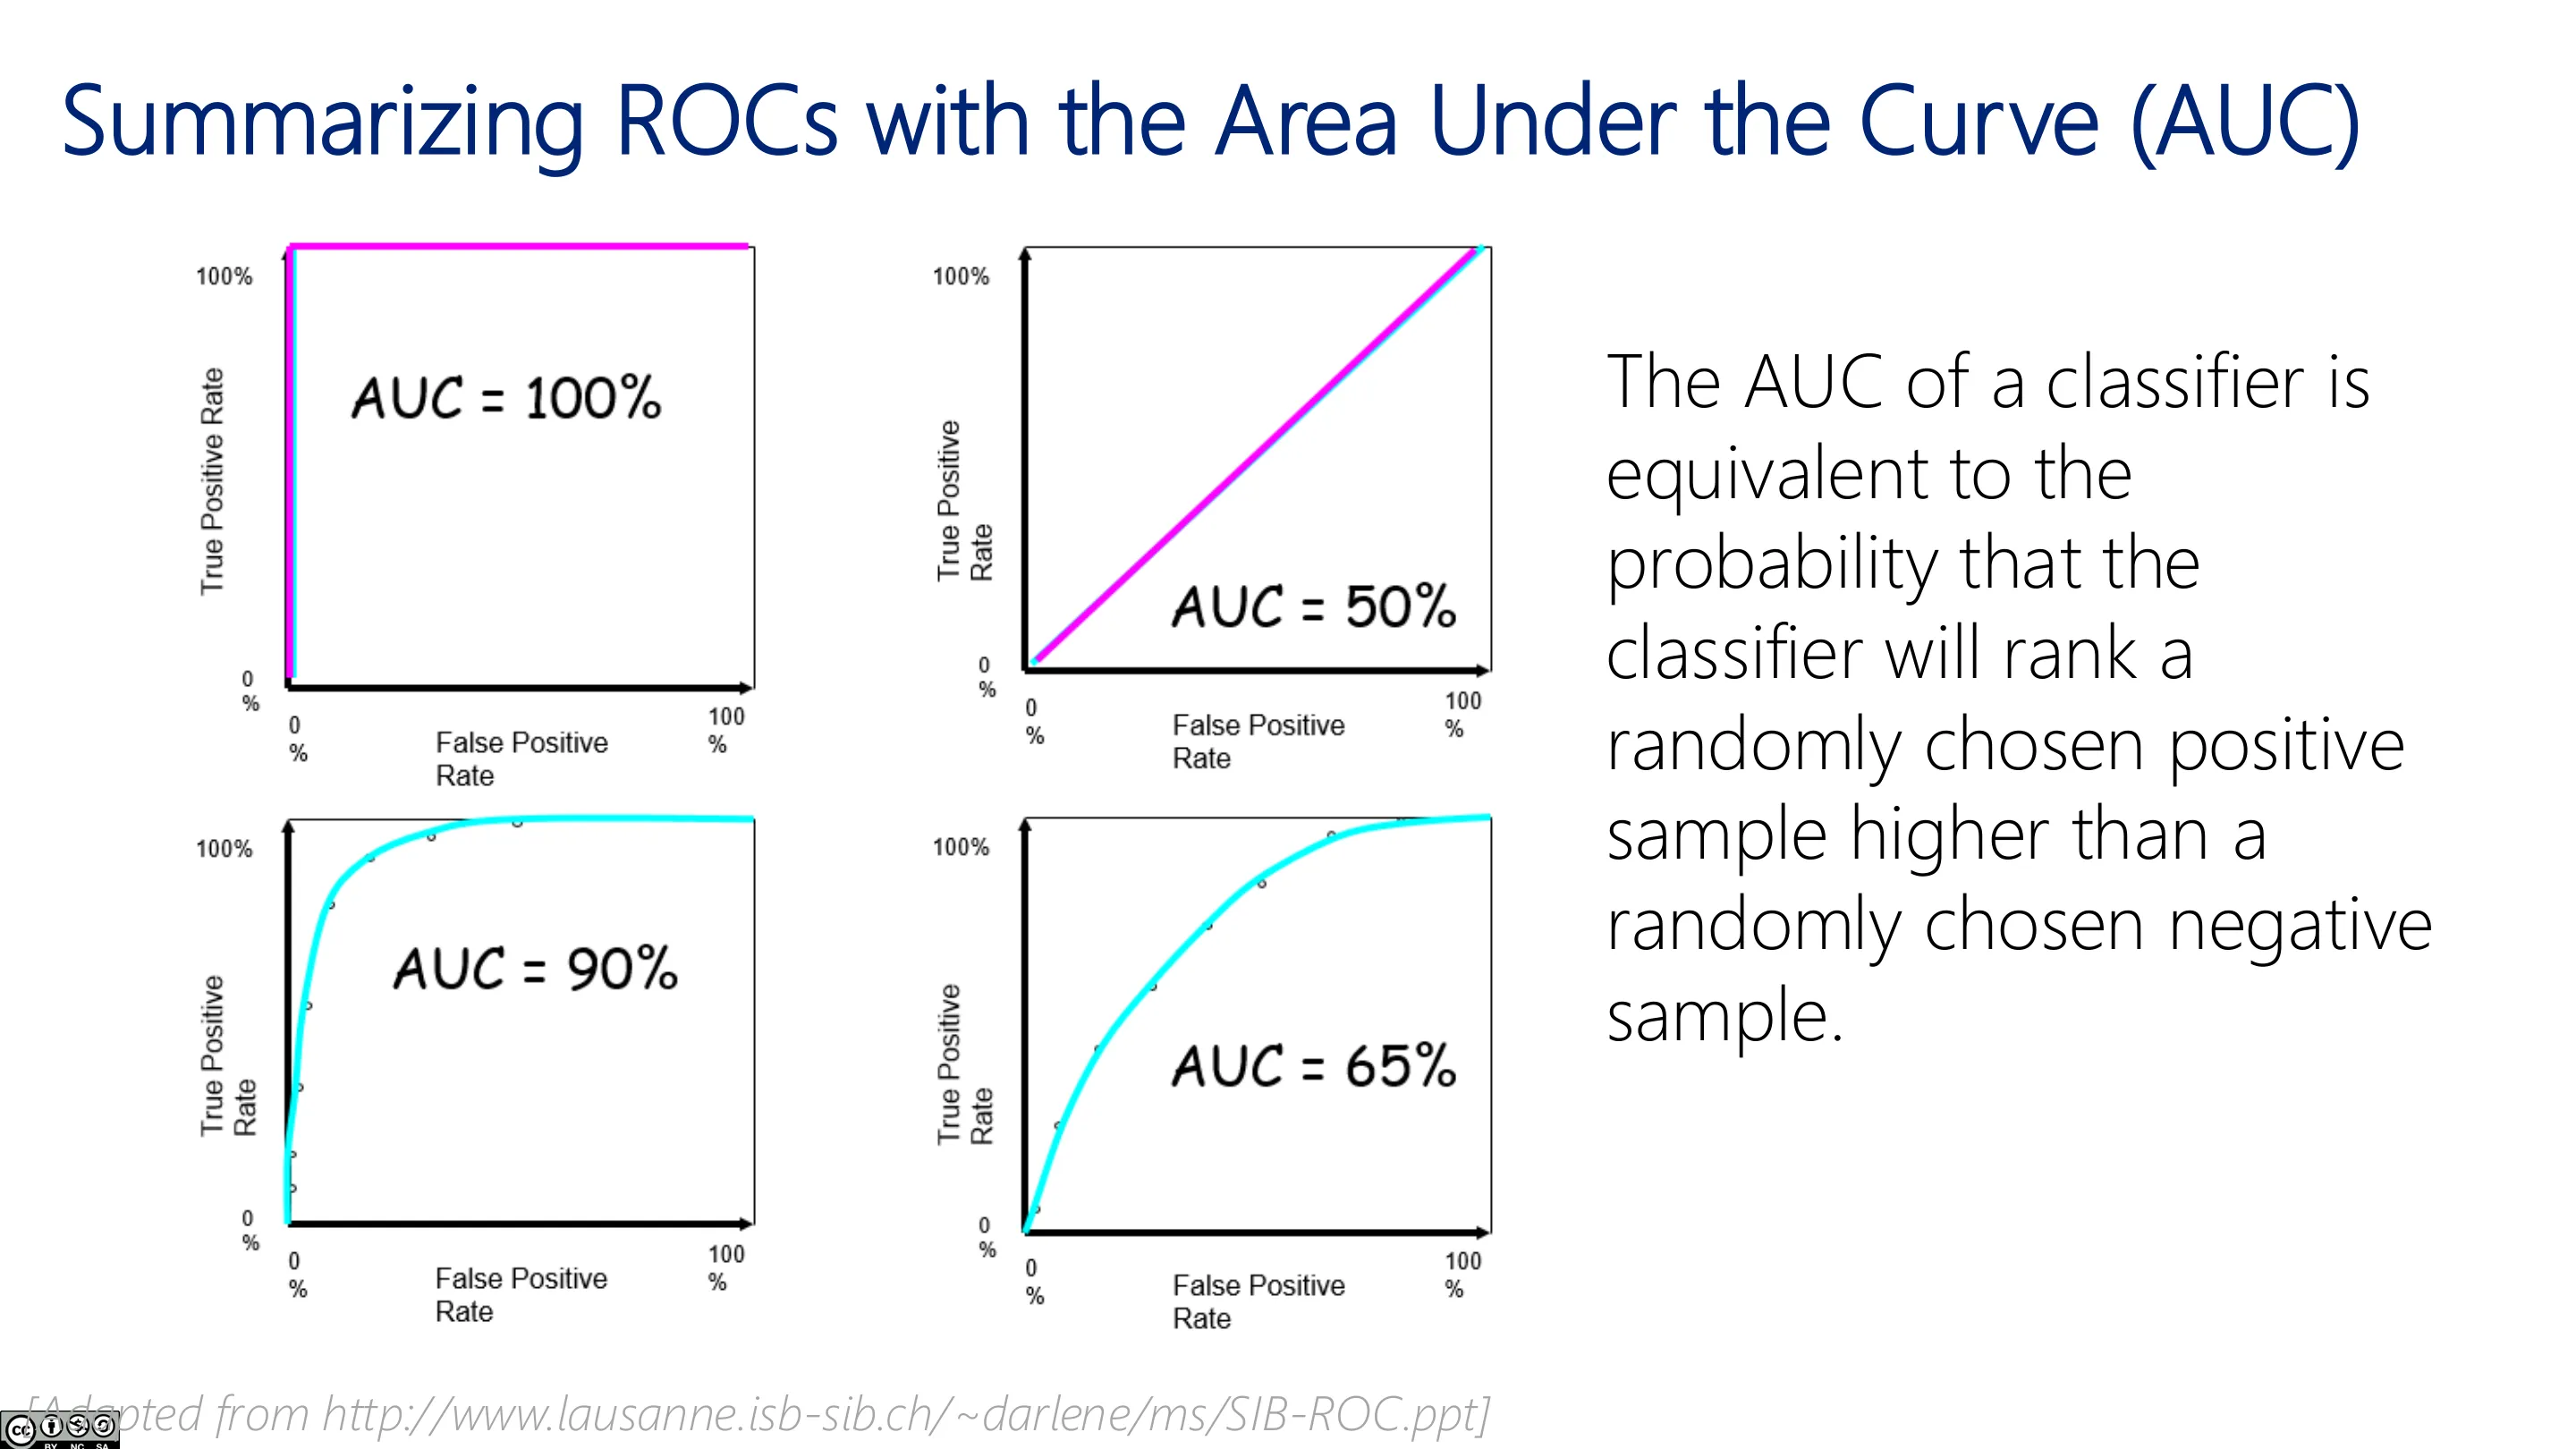
📷 用 AUC 概括 ROC(二)
回到原视频 (01:14:29)
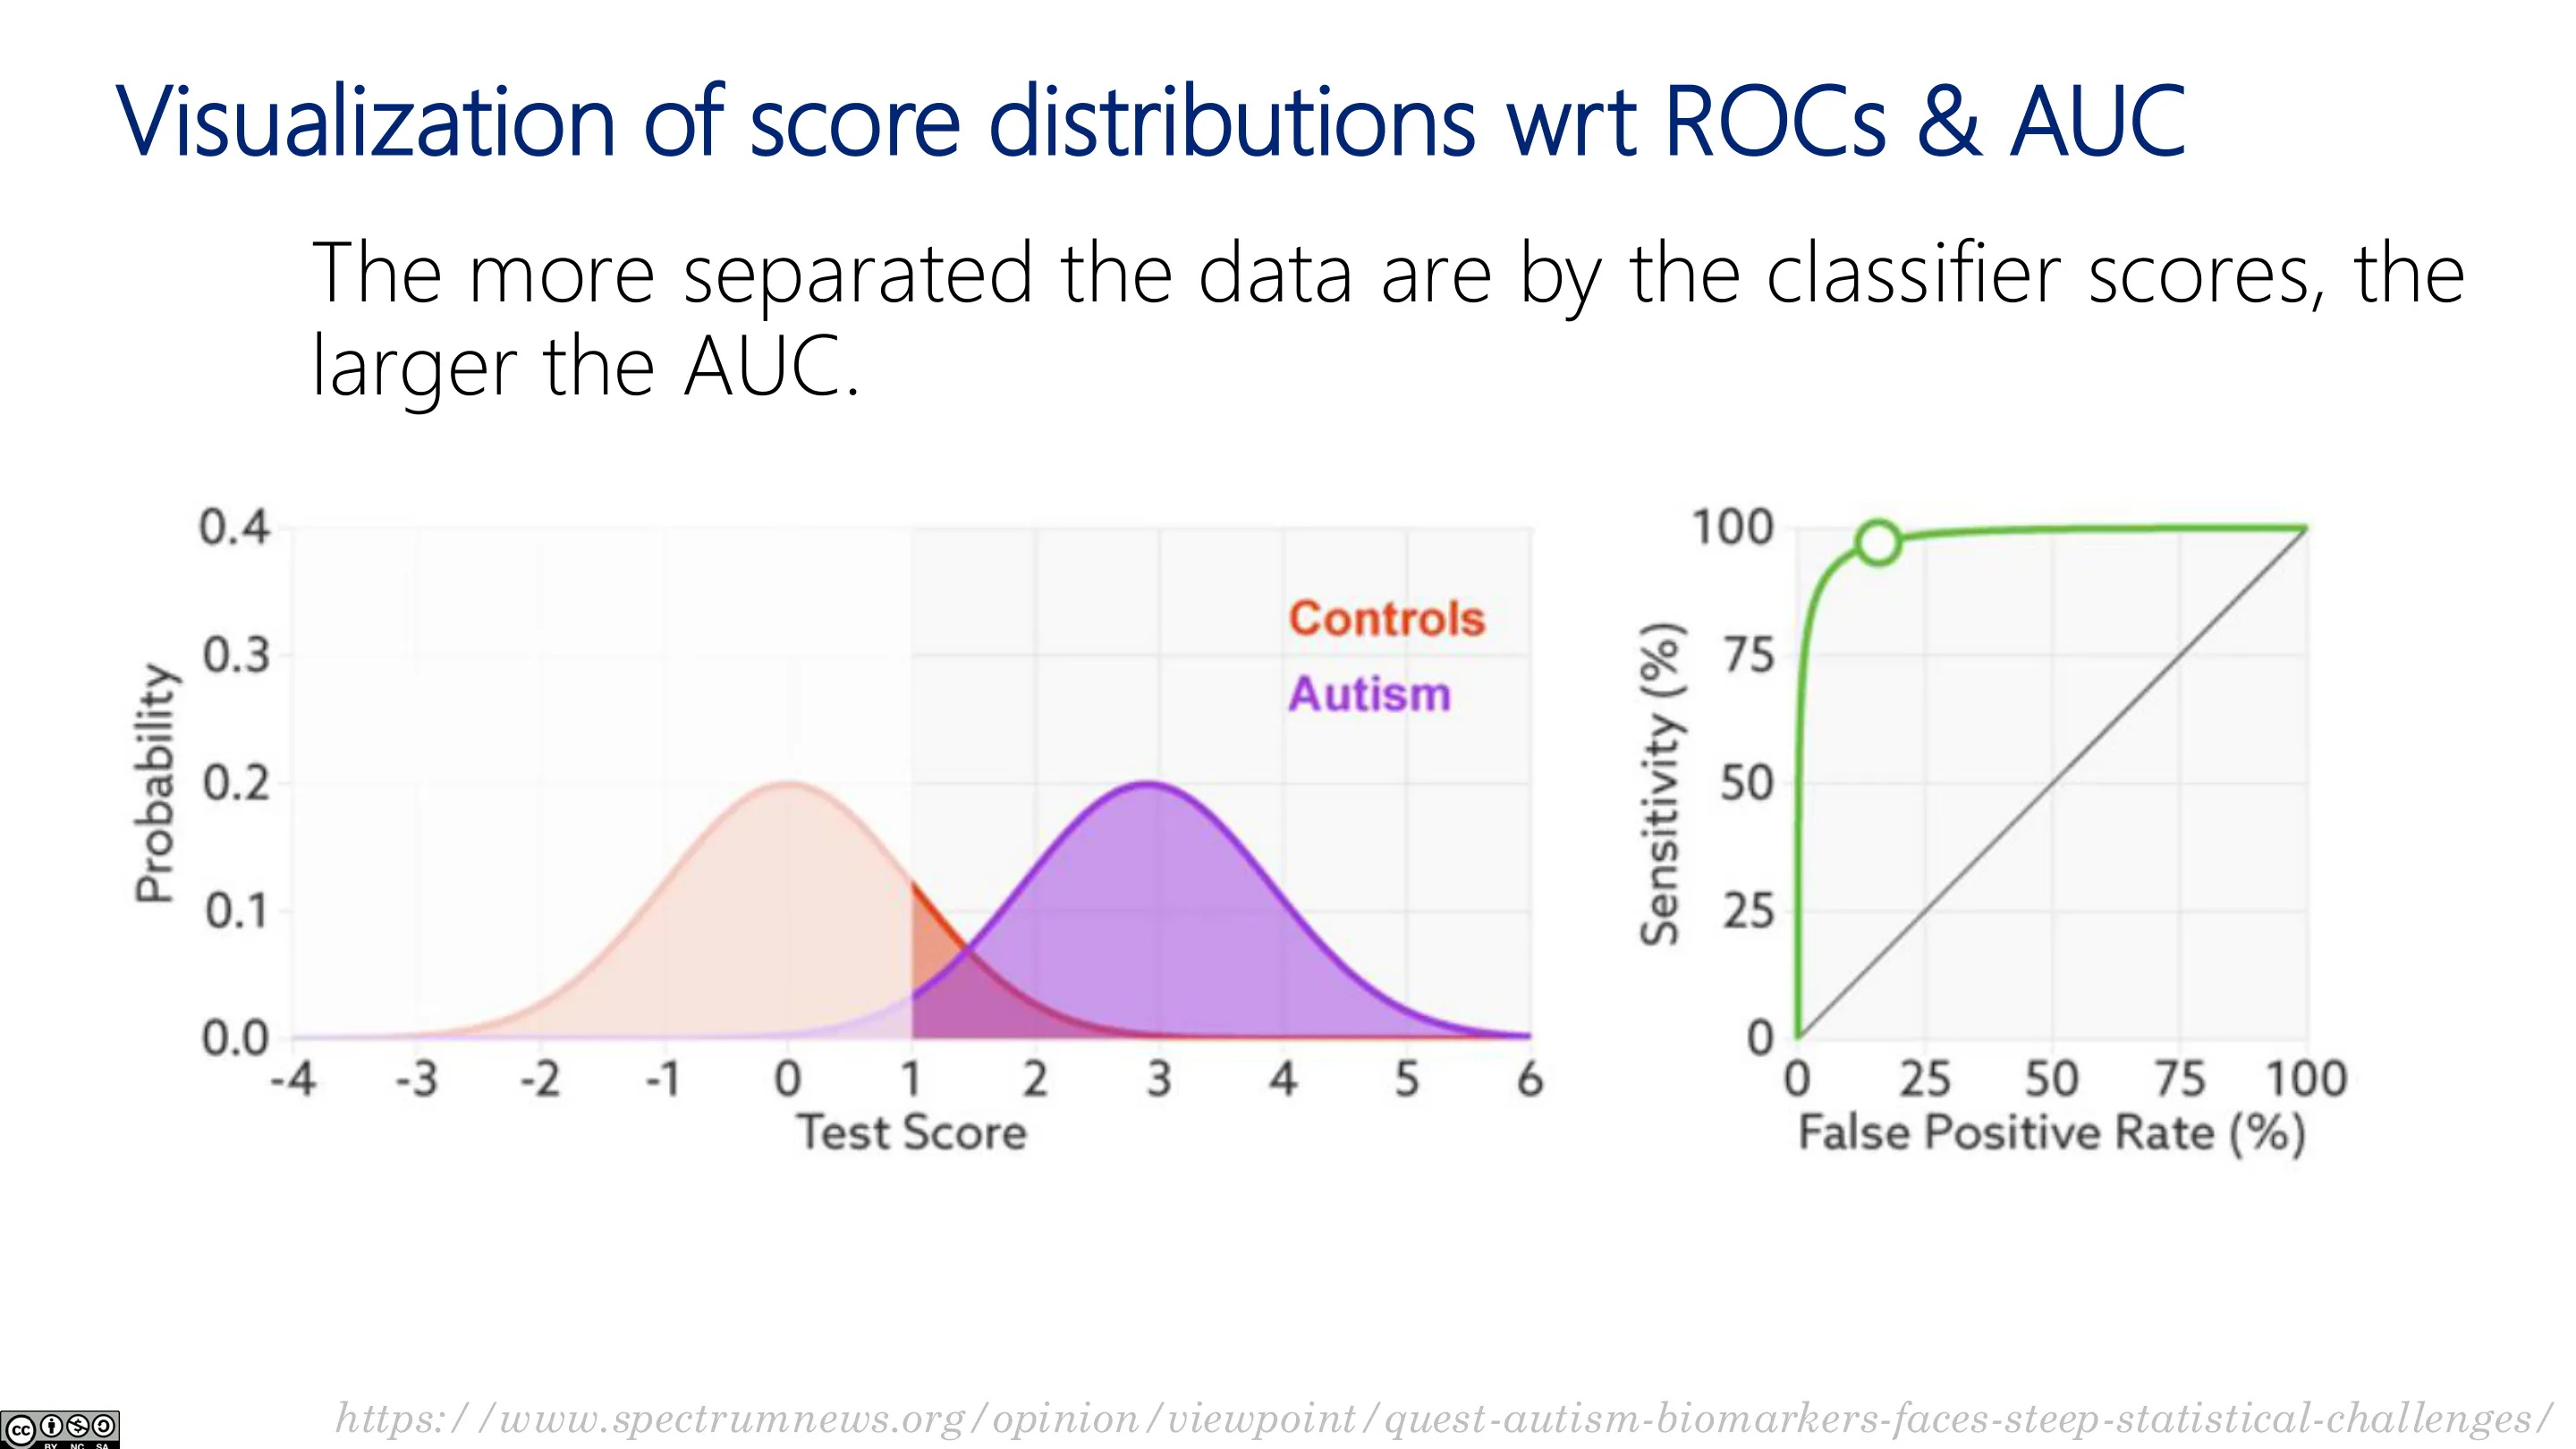
📷 分数分布与 ROC/AUC 可视化
回到原视频 (01:15:45)
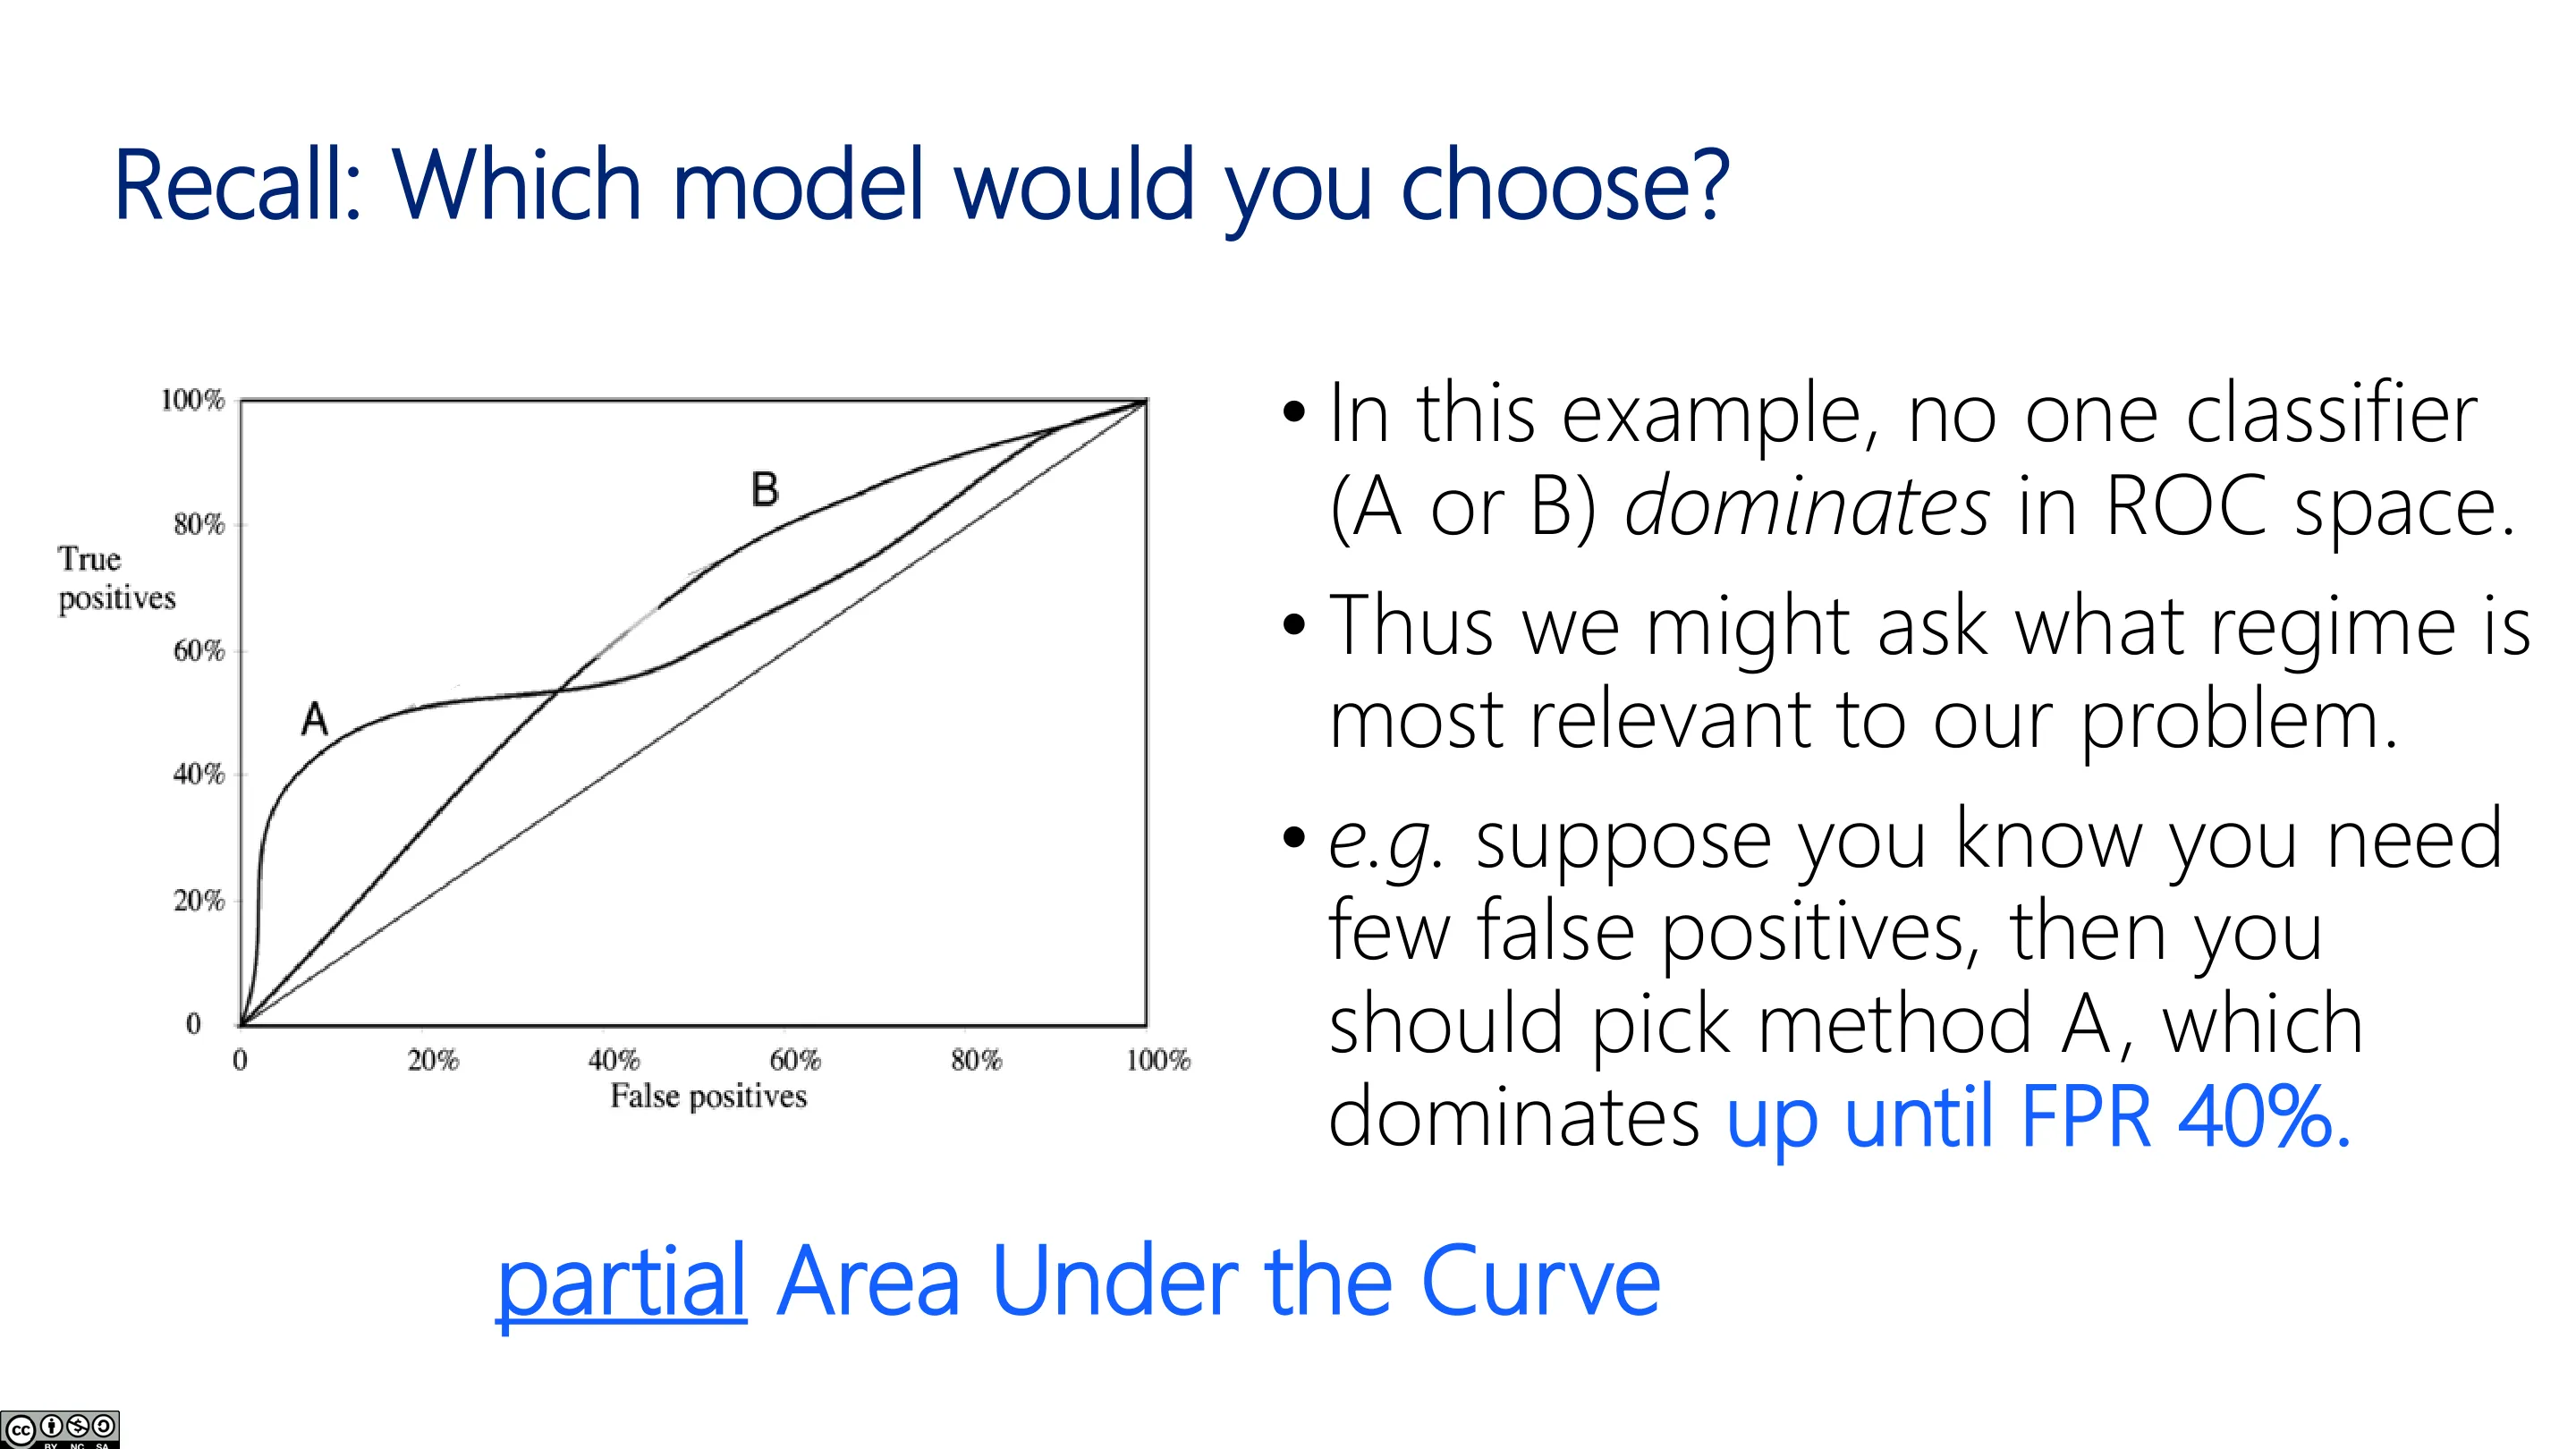
📷 回顾:你会选哪个模型
回到原视频 (01:14:50)
部分 AUC(partial AUC):若你只关心某个 FPR 范围(如医学诊断只允许 FPR ≤ 20%),可只对该区间积分比较。
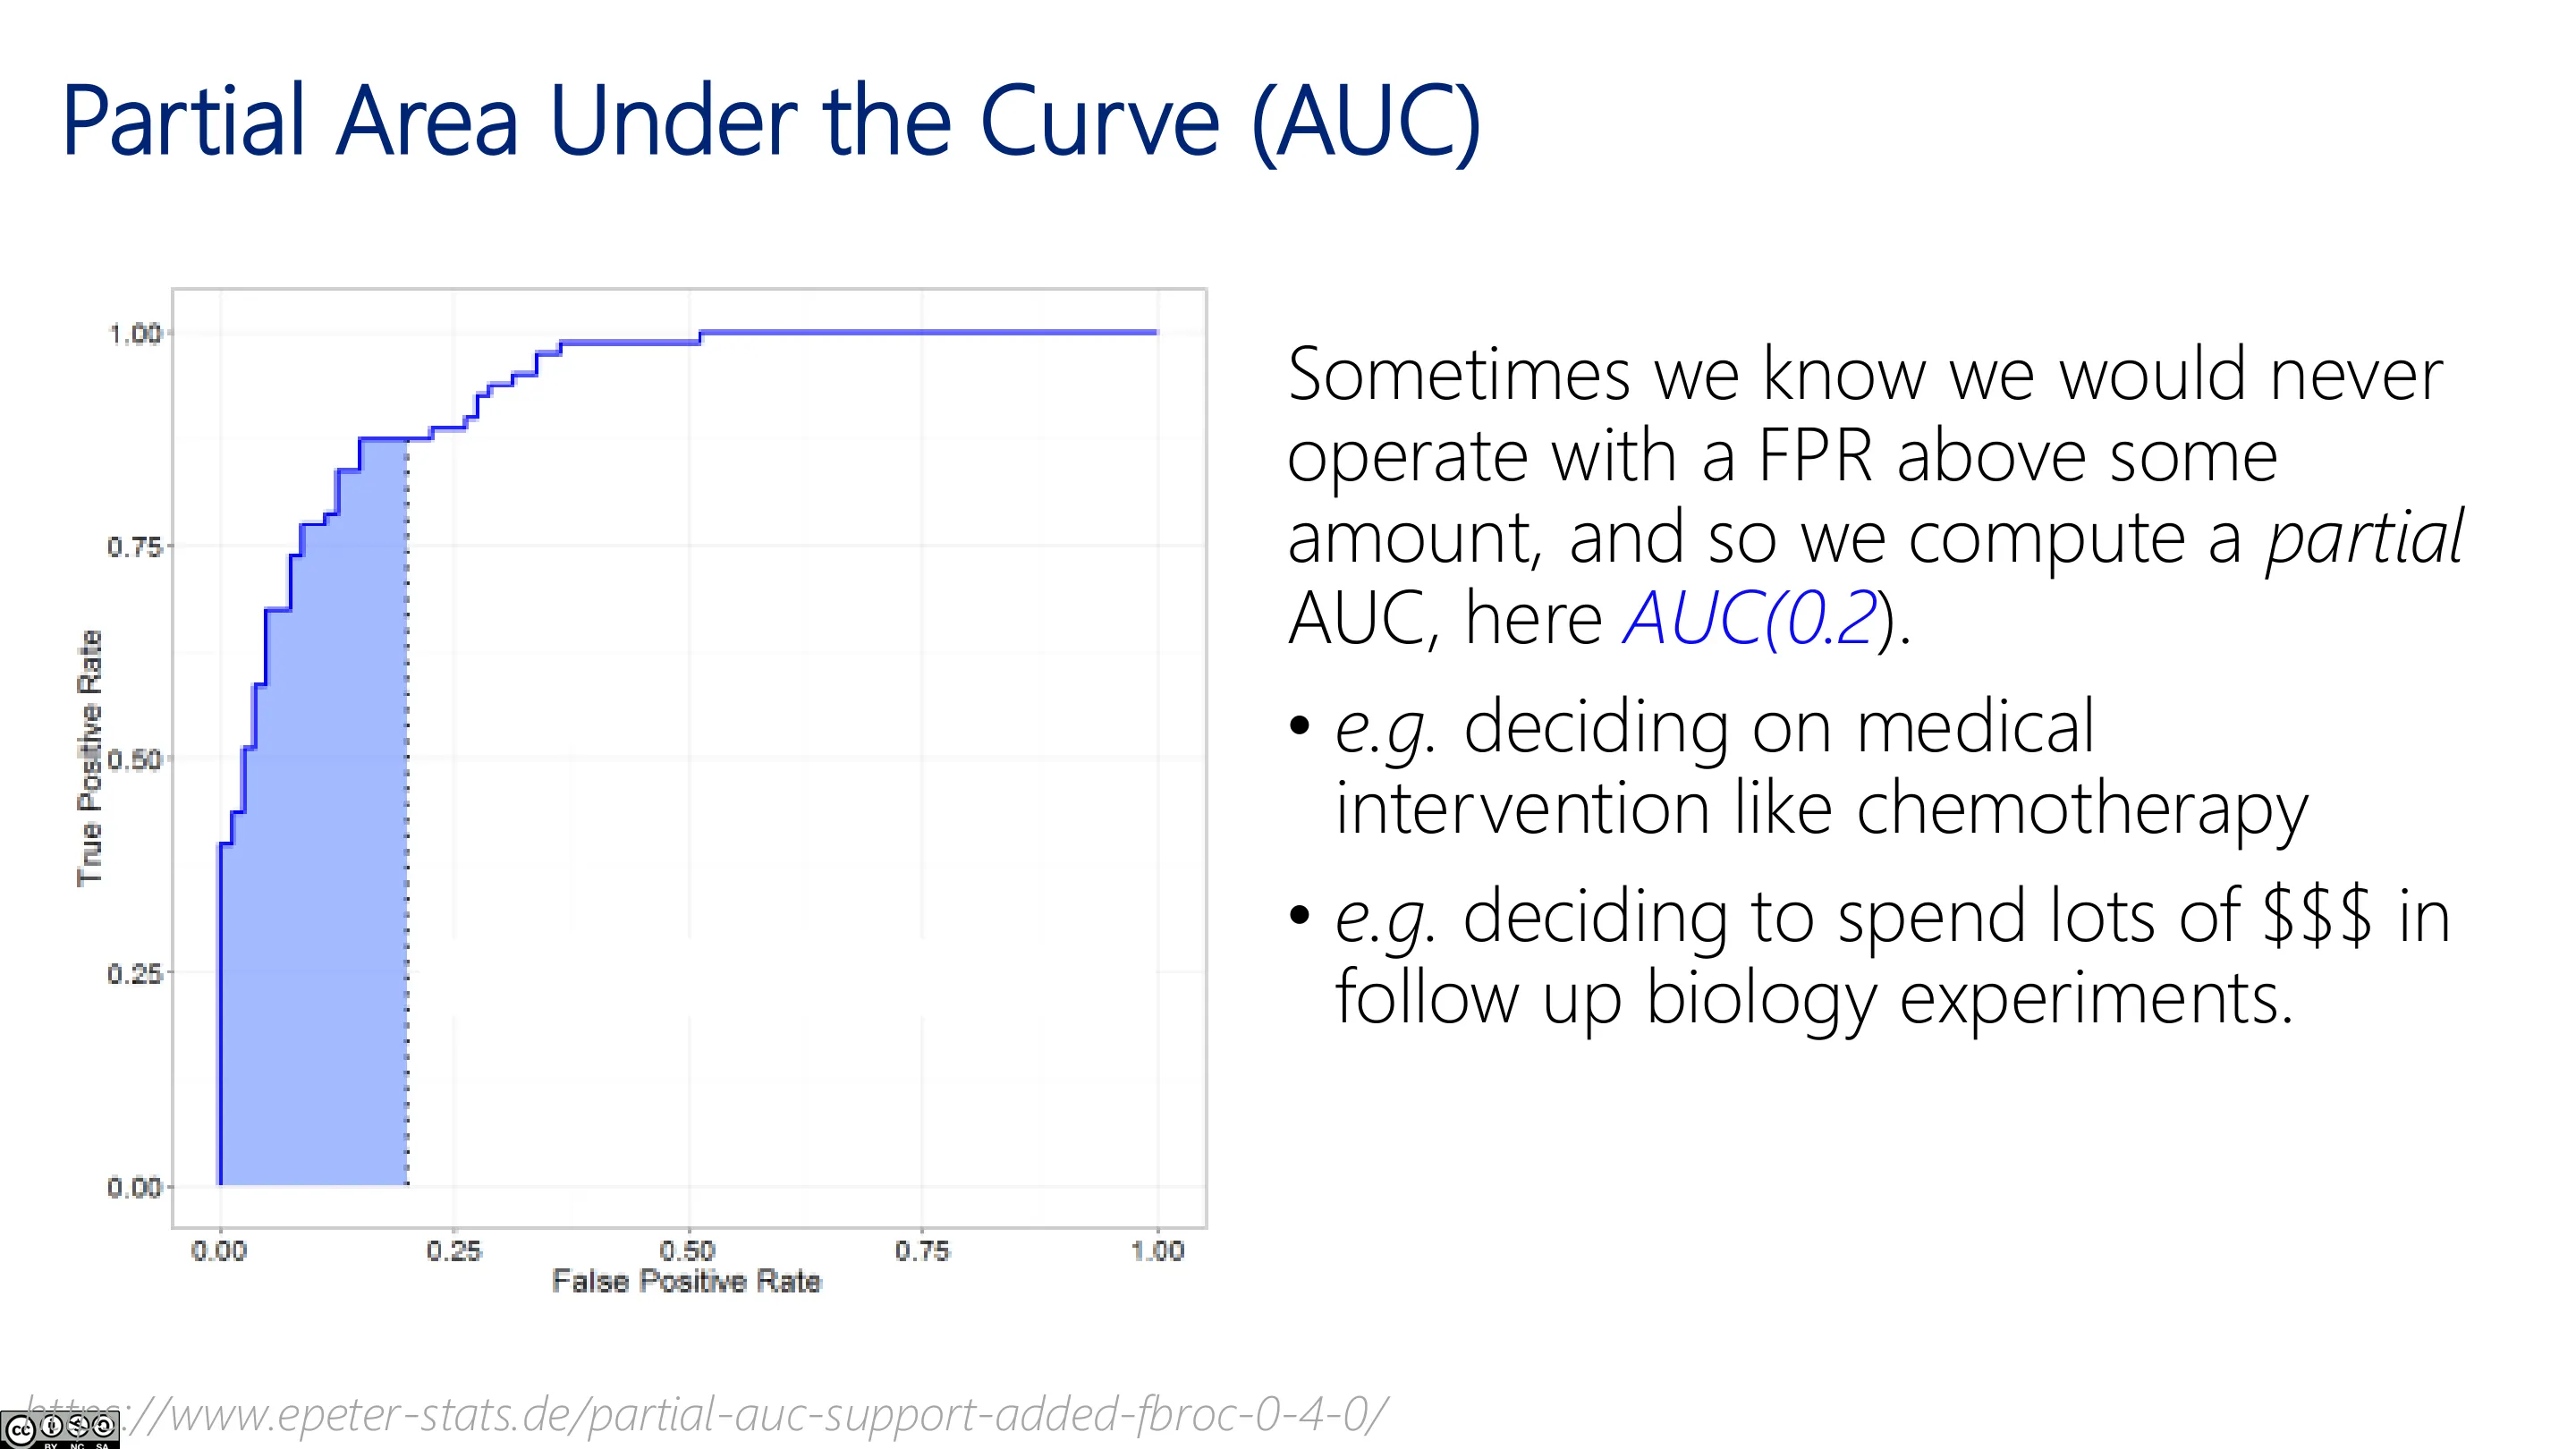
📷 部分 AUC
回到原视频 (01:16:51)
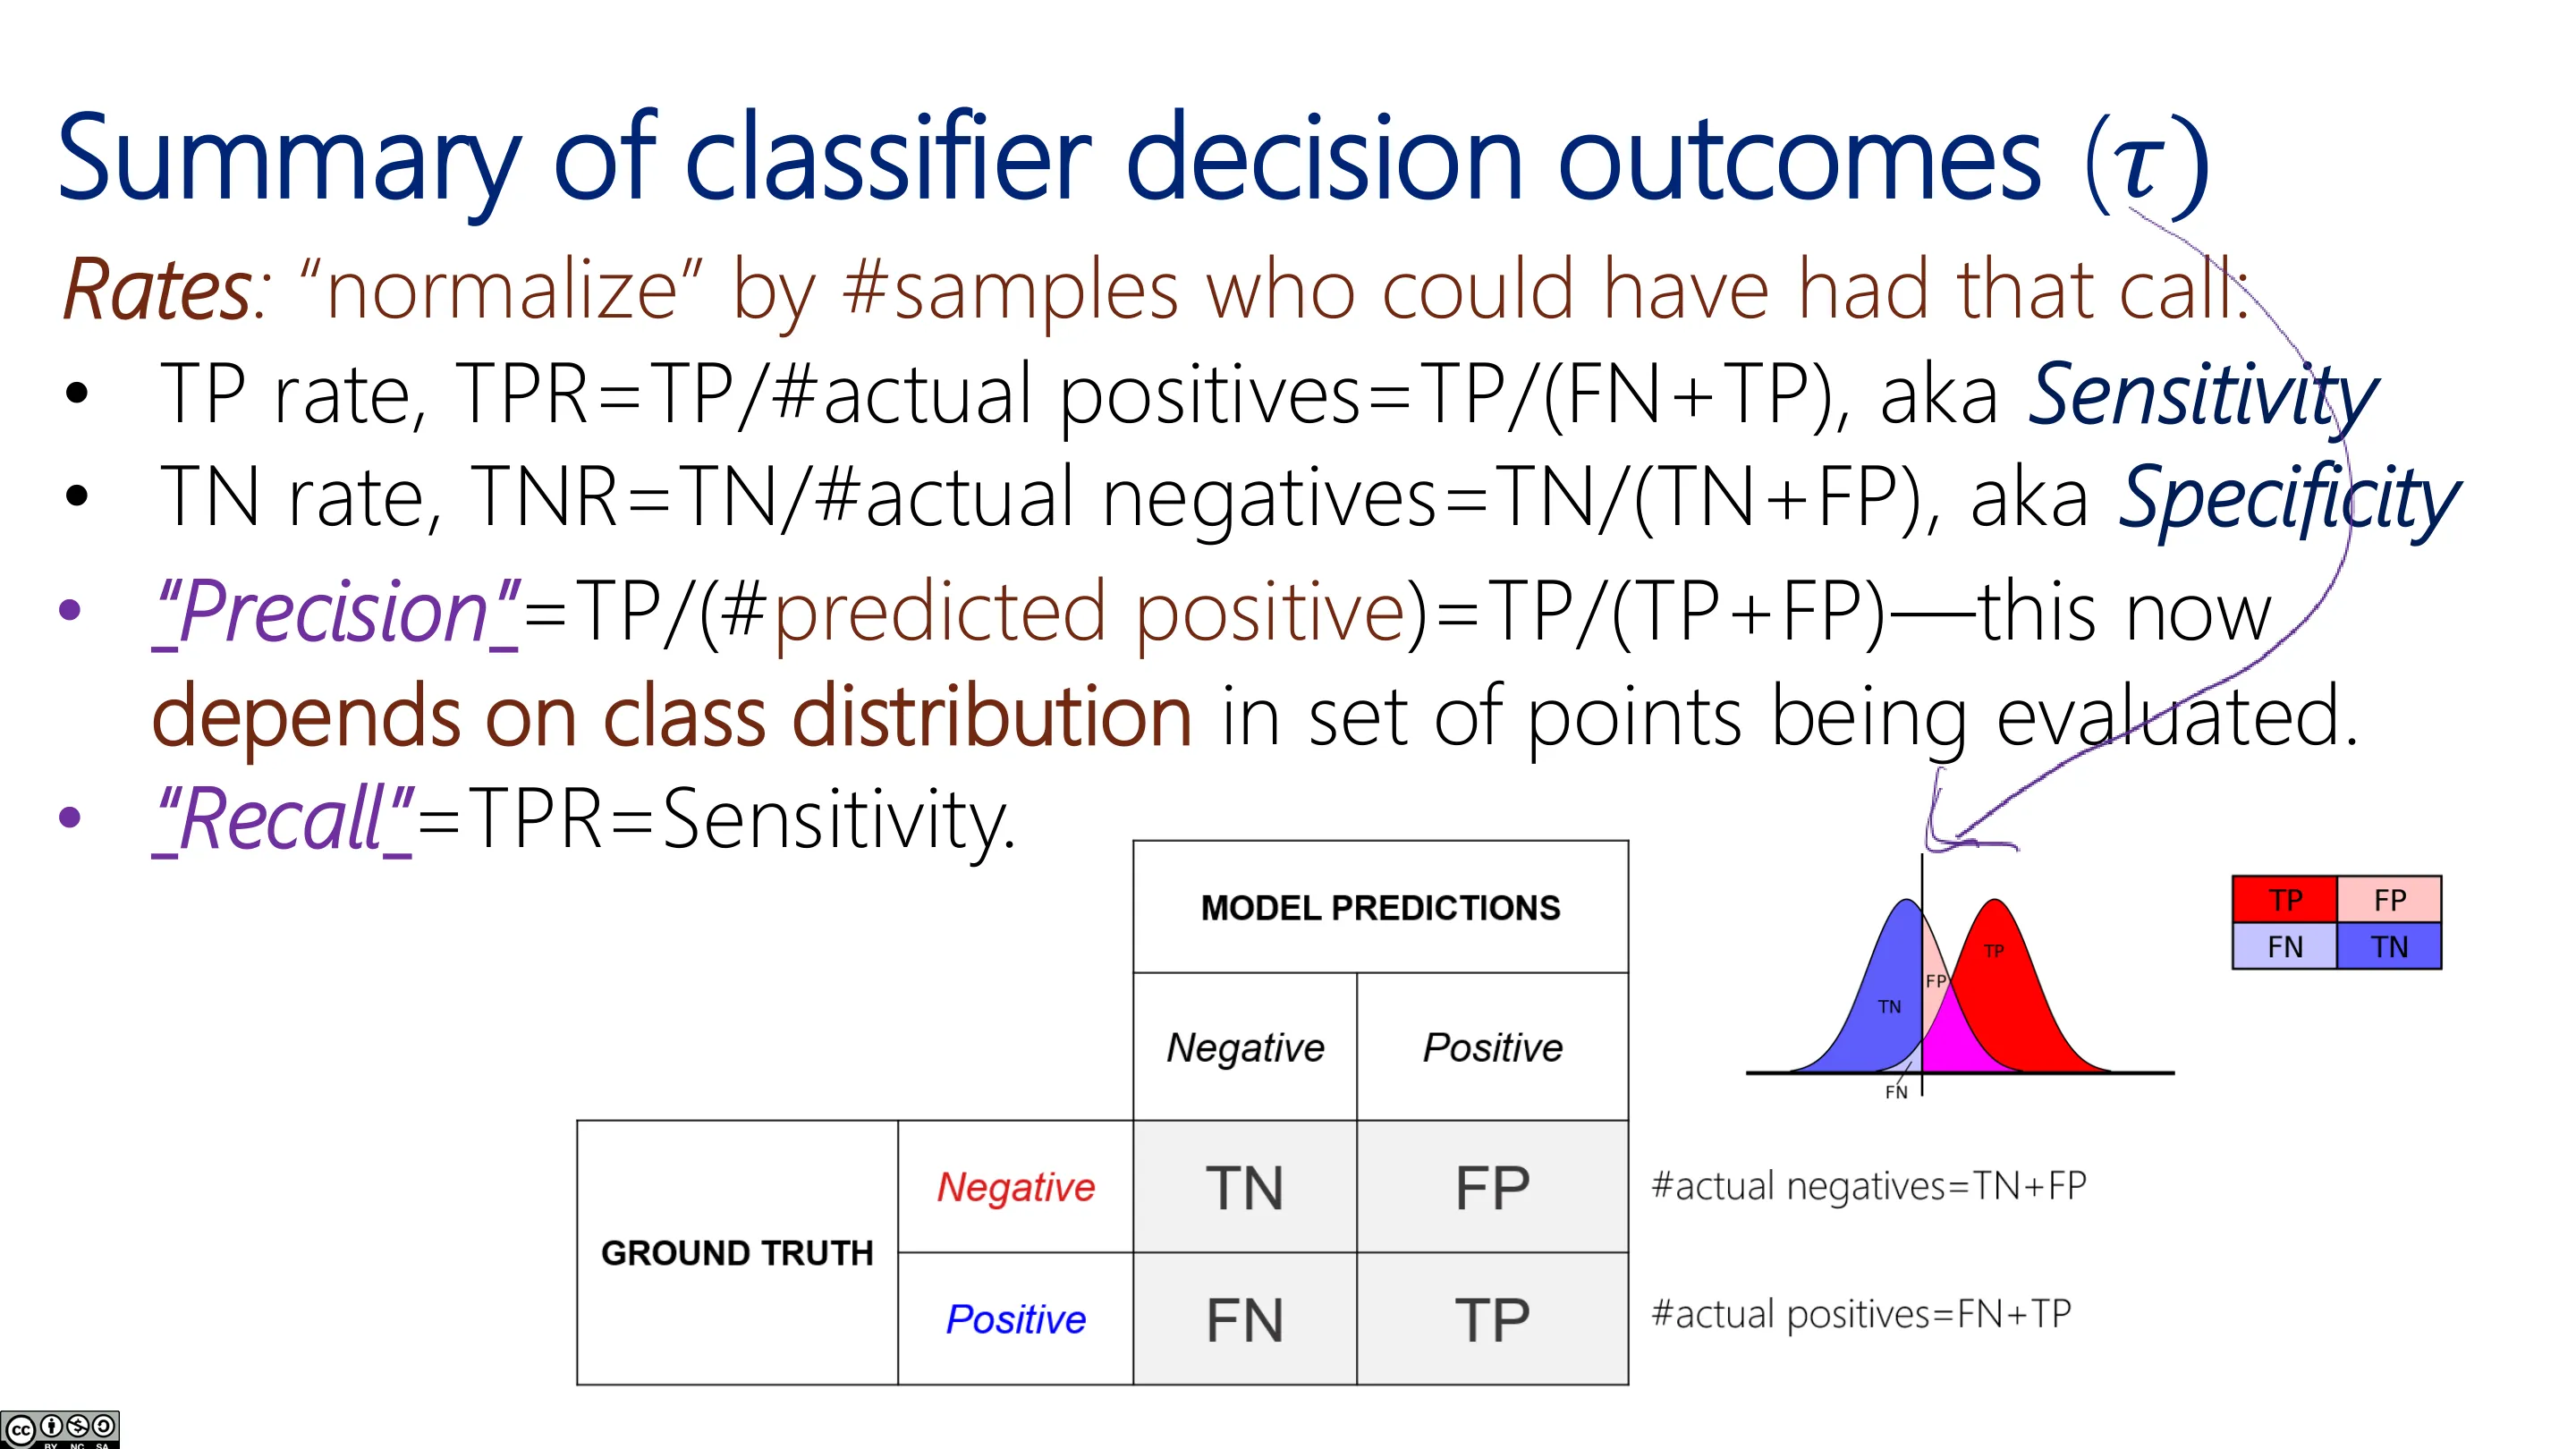
📷 分类决策结果汇总
回到原视频 (01:17:59)
3.4 精确率—召回率曲线
(参考时间: 01:17)
- 精确率(precision) = TP / (TP+FP)(预测为正的里有多少是真例);
- 召回率(recall) = 灵敏度 = TPR;
- PR 曲线把坐标轴换成 (recall, precision),其 AUC 也能概括性能。
与 ROC 的关键区别:PR 曲线对类别不平衡敏感(改变正负比例会改变 PR 曲线),而 ROC 对类别不平衡不敏感。因此,当类别严重不平衡且你关心的是「少数类」时,常用 PR 曲线;否则常用 ROC。实践中两者常一起报告。
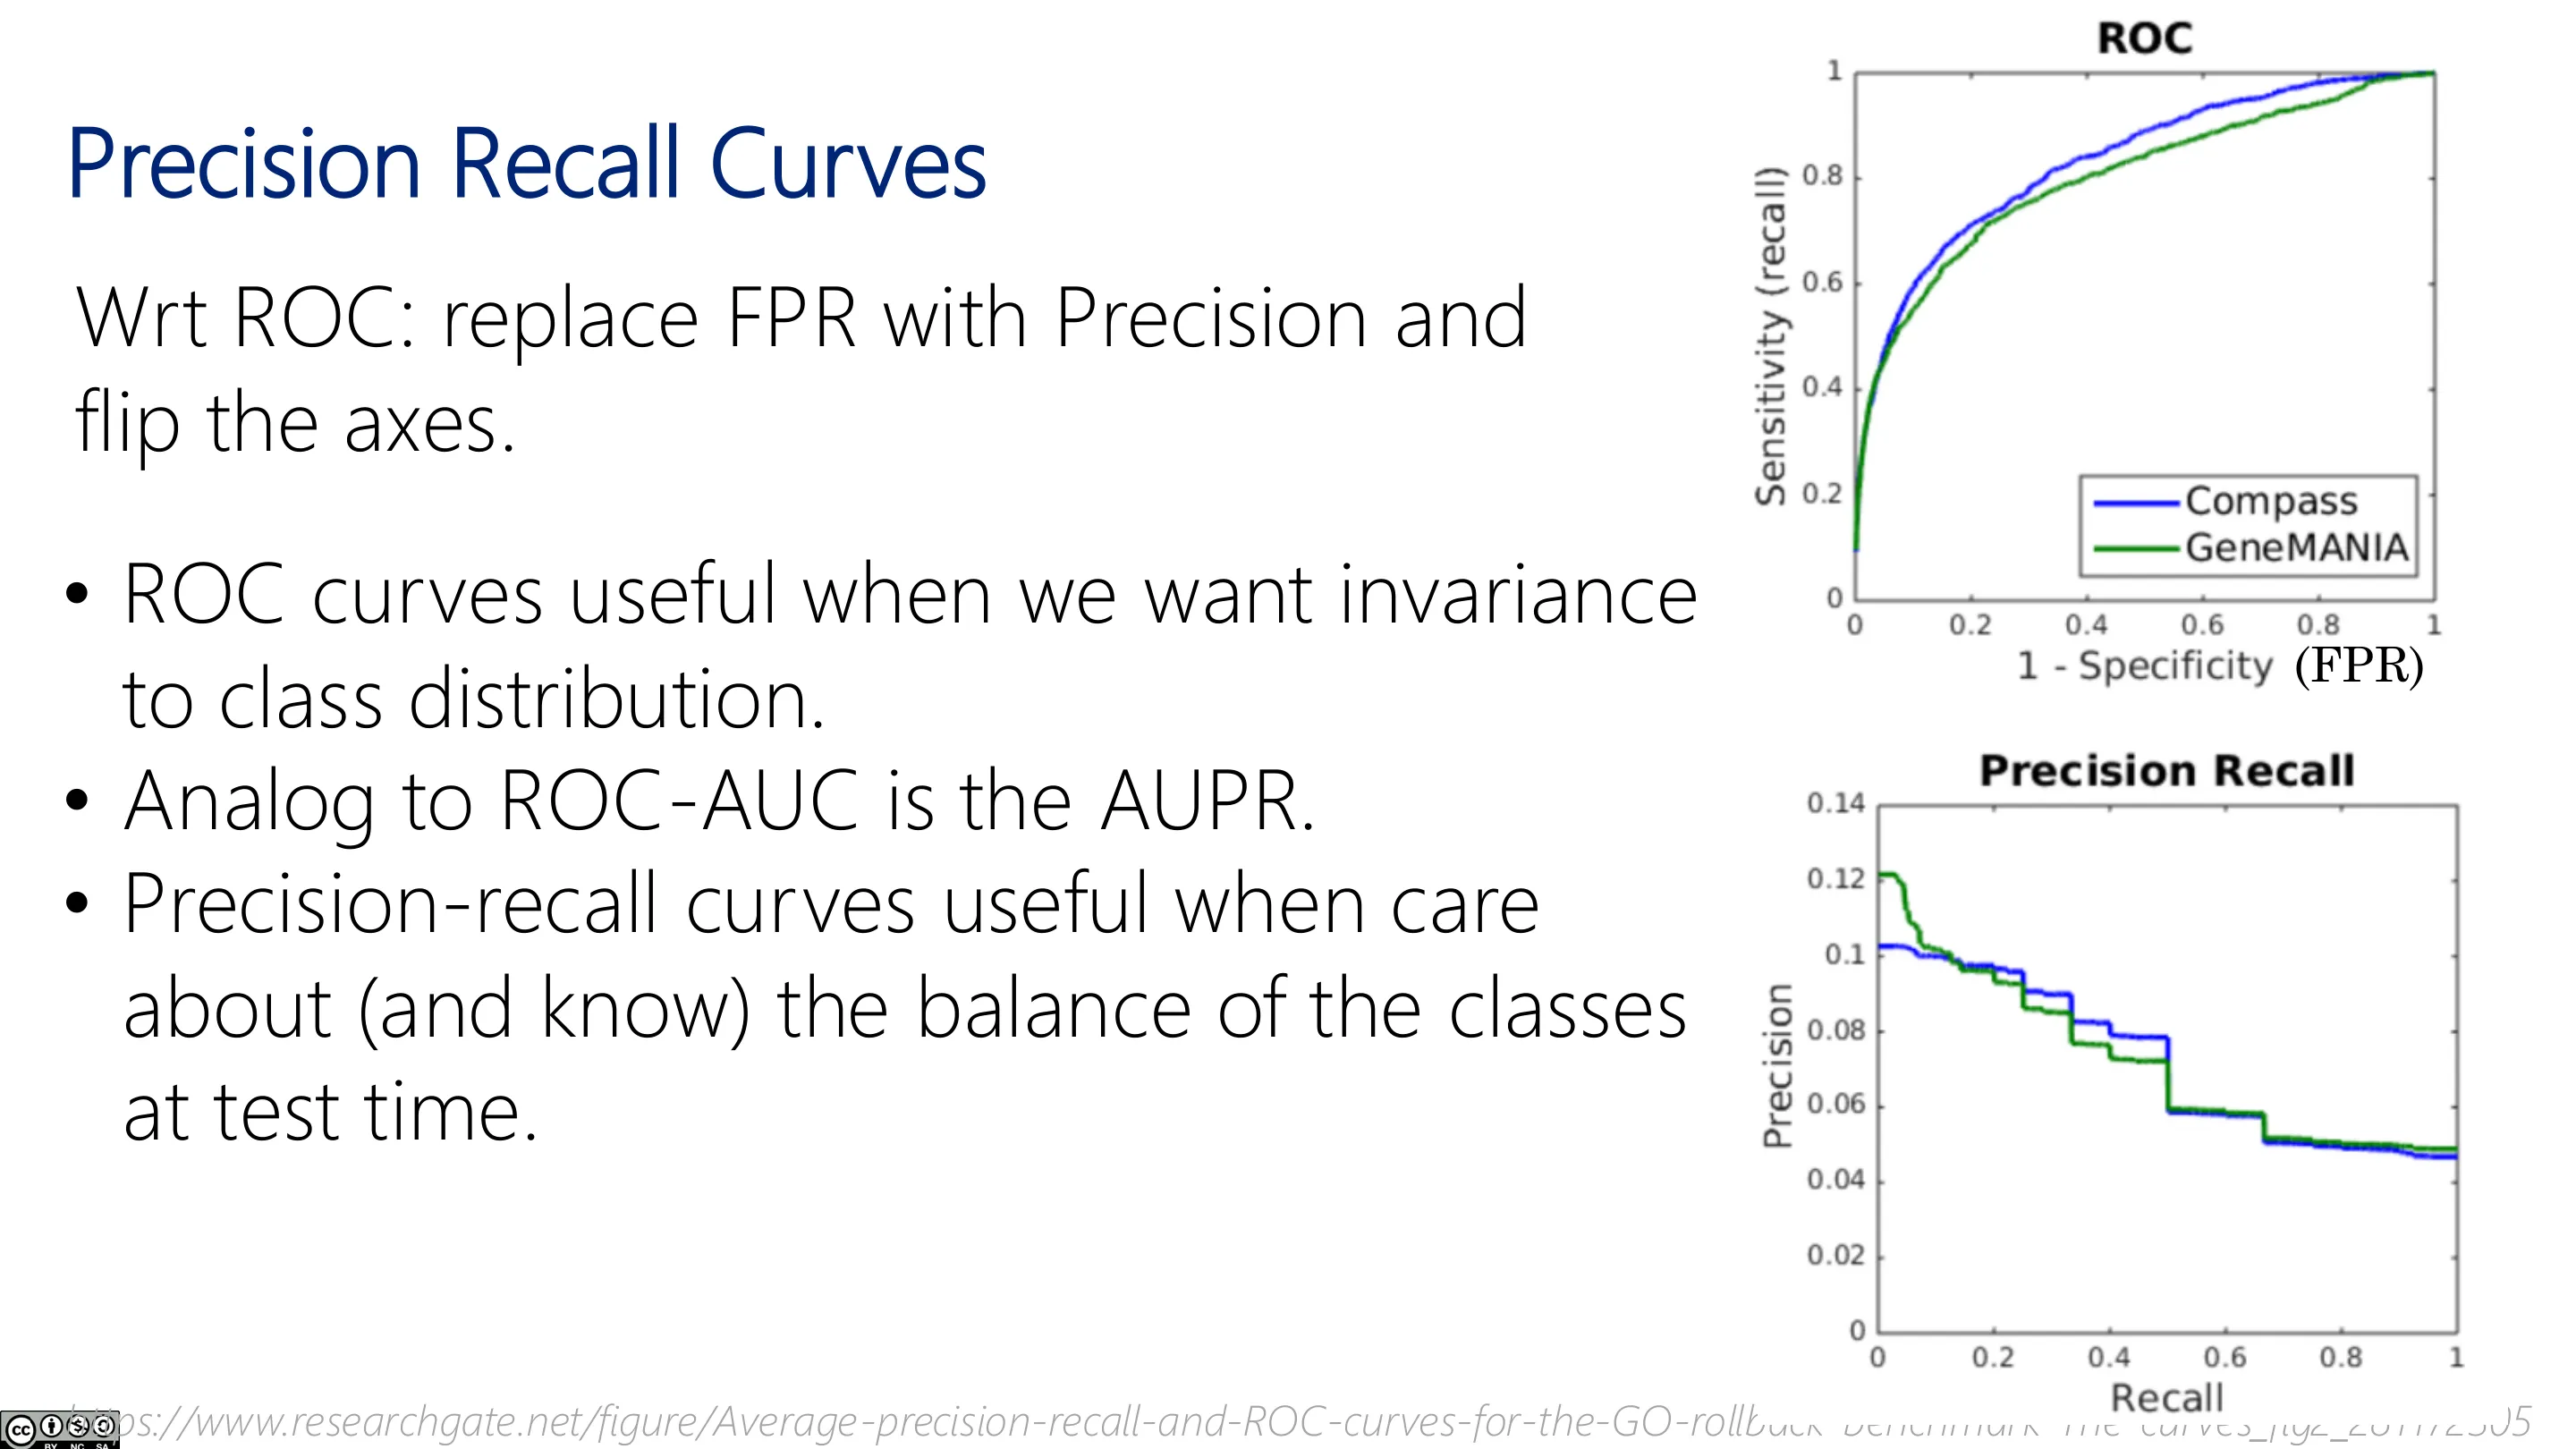
📷 精确率—召回率曲线
回到原视频 (01:18:10)
总结(Takeaways)
- 逻辑回归是判别式分类器:$p(y=1\mid x)=\sigma(w^\top x)$,多分类用 softmax;不对 $X$ 的分布作假设 ⇒ 比 GDA 更灵活。
- sigmoid 导数 $\sigma'=\sigma(1-\sigma)$ 使梯度简洁;MLE 的梯度是 $X^\top(\hat p-y)$,但无闭式解,需迭代优化。
- softmax 有平移不变性 ⇒ 系统过参数化(无穷多等价解)。
- 准确率在类别不平衡下极具误导性;评估应看混淆矩阵及其派生指标。
- ROC / AUC 衡量「排序能力」,对类别不平衡不敏感;PR 曲线则敏感,适合少数类。
- 校准:概率要有概率的含义;未校准的分类器仍可能排序很好、很有用。
附录:课堂未展示的幻灯片(ROC 算法与代价敏感)
🖼️ 更多幻灯片(本讲不考)
🖼️ 绘制 ROC 曲线的算法(一)
🖼️ 绘制 ROC 曲线的算法(二)
🖼️ 顺带得到 AUC
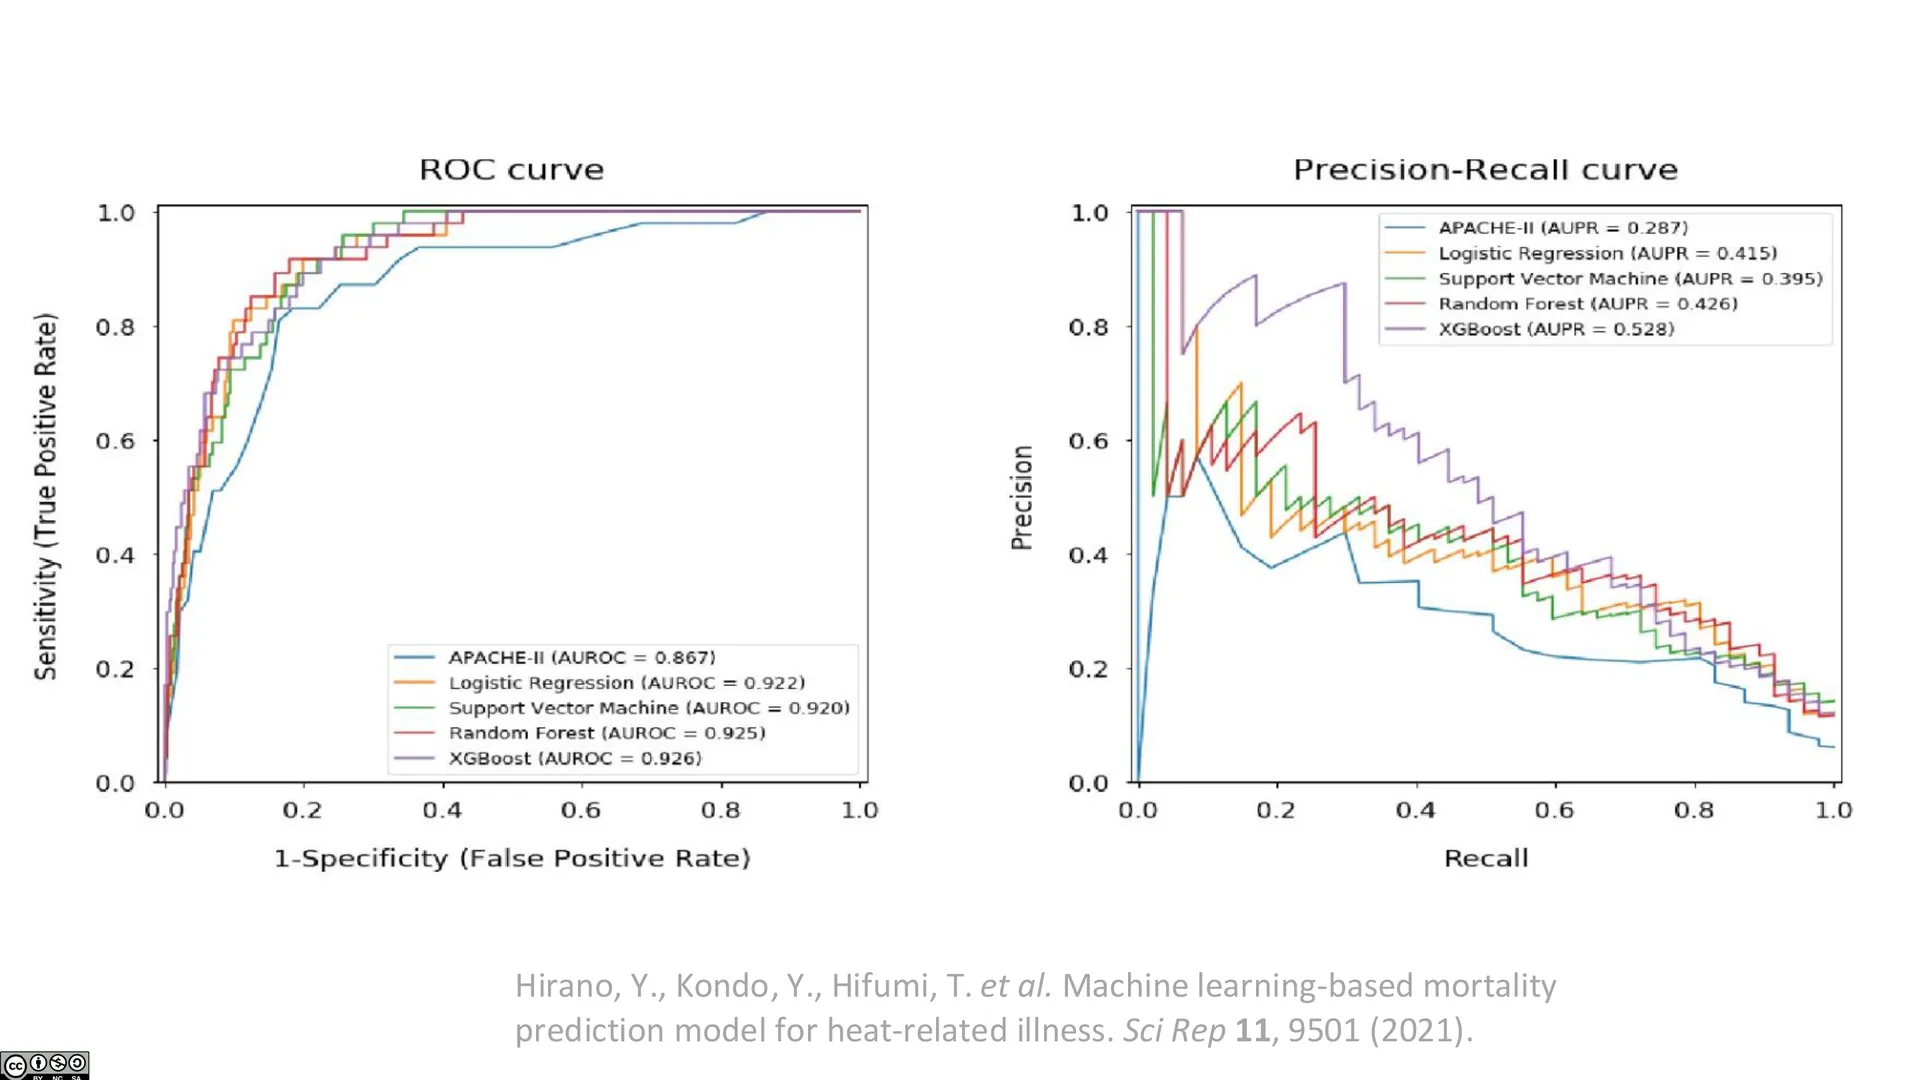
🖼️ 应用论文(死亡率预测)
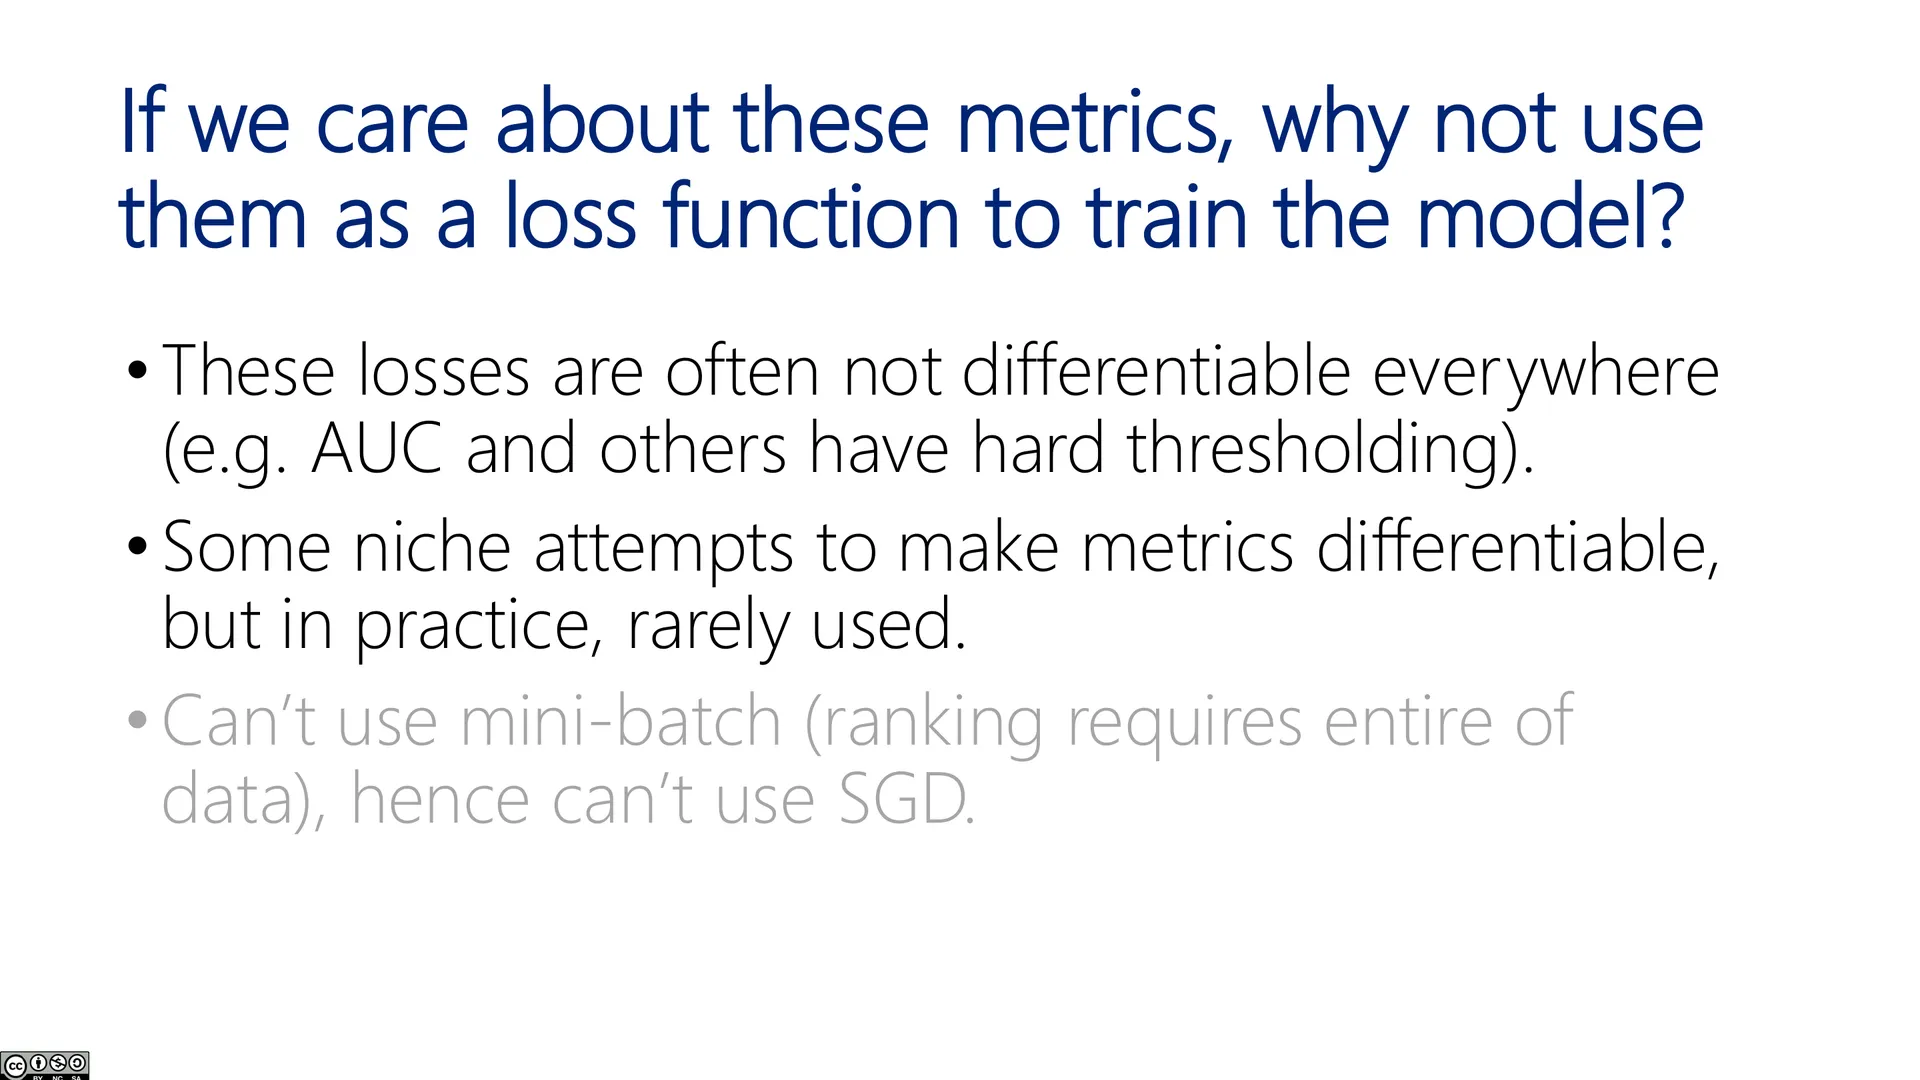
🖼️ 若关心这些指标,为何不直接……
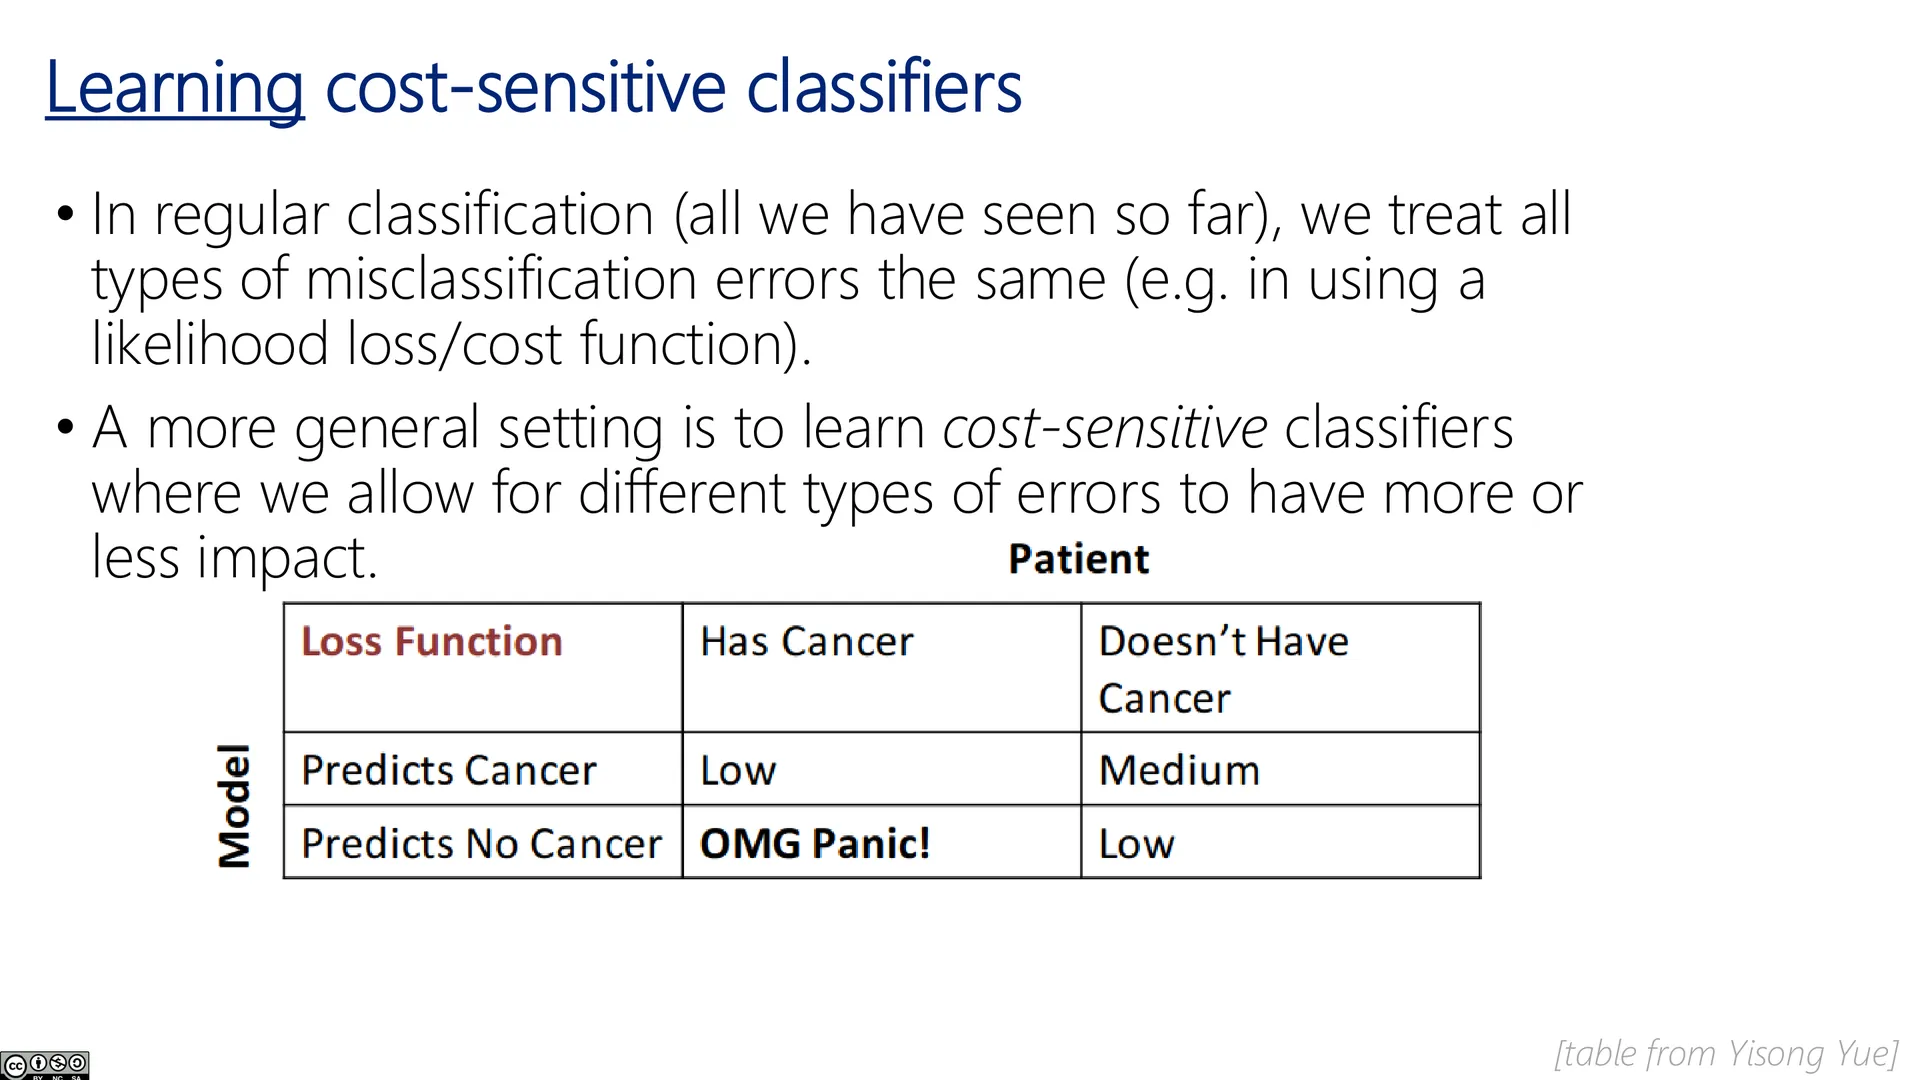
🖼️ 学习代价敏感分类器(一)
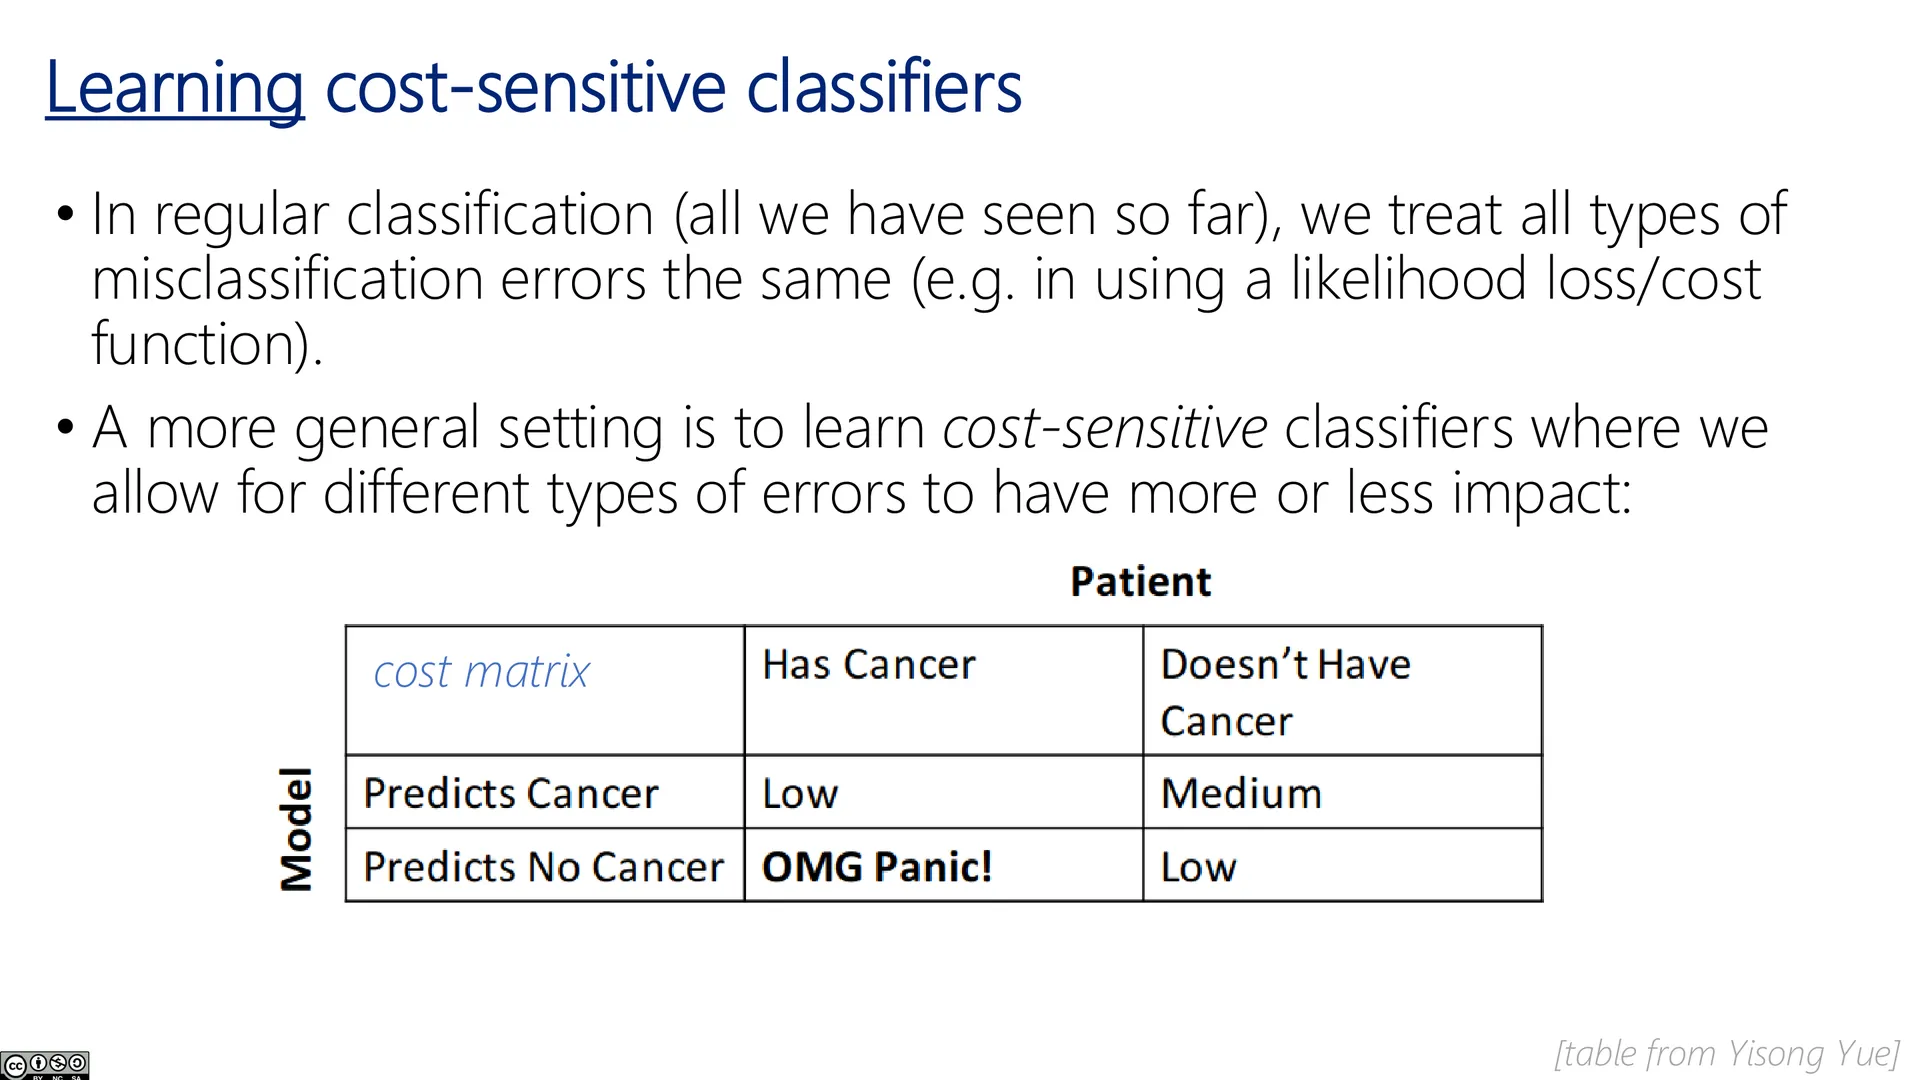
🖼️ 学习代价敏感分类器(二)
🖼️ 面向代价敏感损失优化
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=xBCpwQt8A5w |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 12) | Google Drive PDF |
| 教材 Machine Learning: A First Course for Engineers and Scientists | 逻辑回归、softmax、分类评估相关章节 · https://doi.org/10.1017/9781108919371 |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。