第14讲 · EECS 189:MLE、MAP 与偏差-方差权衡
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | MLE, MAP and Bias-Variance Trade-off |
| 视频 | https://www.youtube.com/watch?v=Z1KuNG9HyiQ |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 14) | Google Drive 文件夹 |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第14讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
本讲路线图
(参考时间: 00:00)
- MLE vs MAP(以「估计硬币的偏差」为例);
- MAP 与岭回归的联系(高斯先验 vs L2 惩罚);
- 偏差-方差权衡(预期测试误差的分解);
- 实践中如何调节复杂度(验证集/测试集)。
📷 标题页
回到原视频 (00:00:44)
📷 路线图
回到原视频 (00:01:54)
一、MLE vs MAP
1.1 硬币偏差的例子
(参考时间: 00:00)
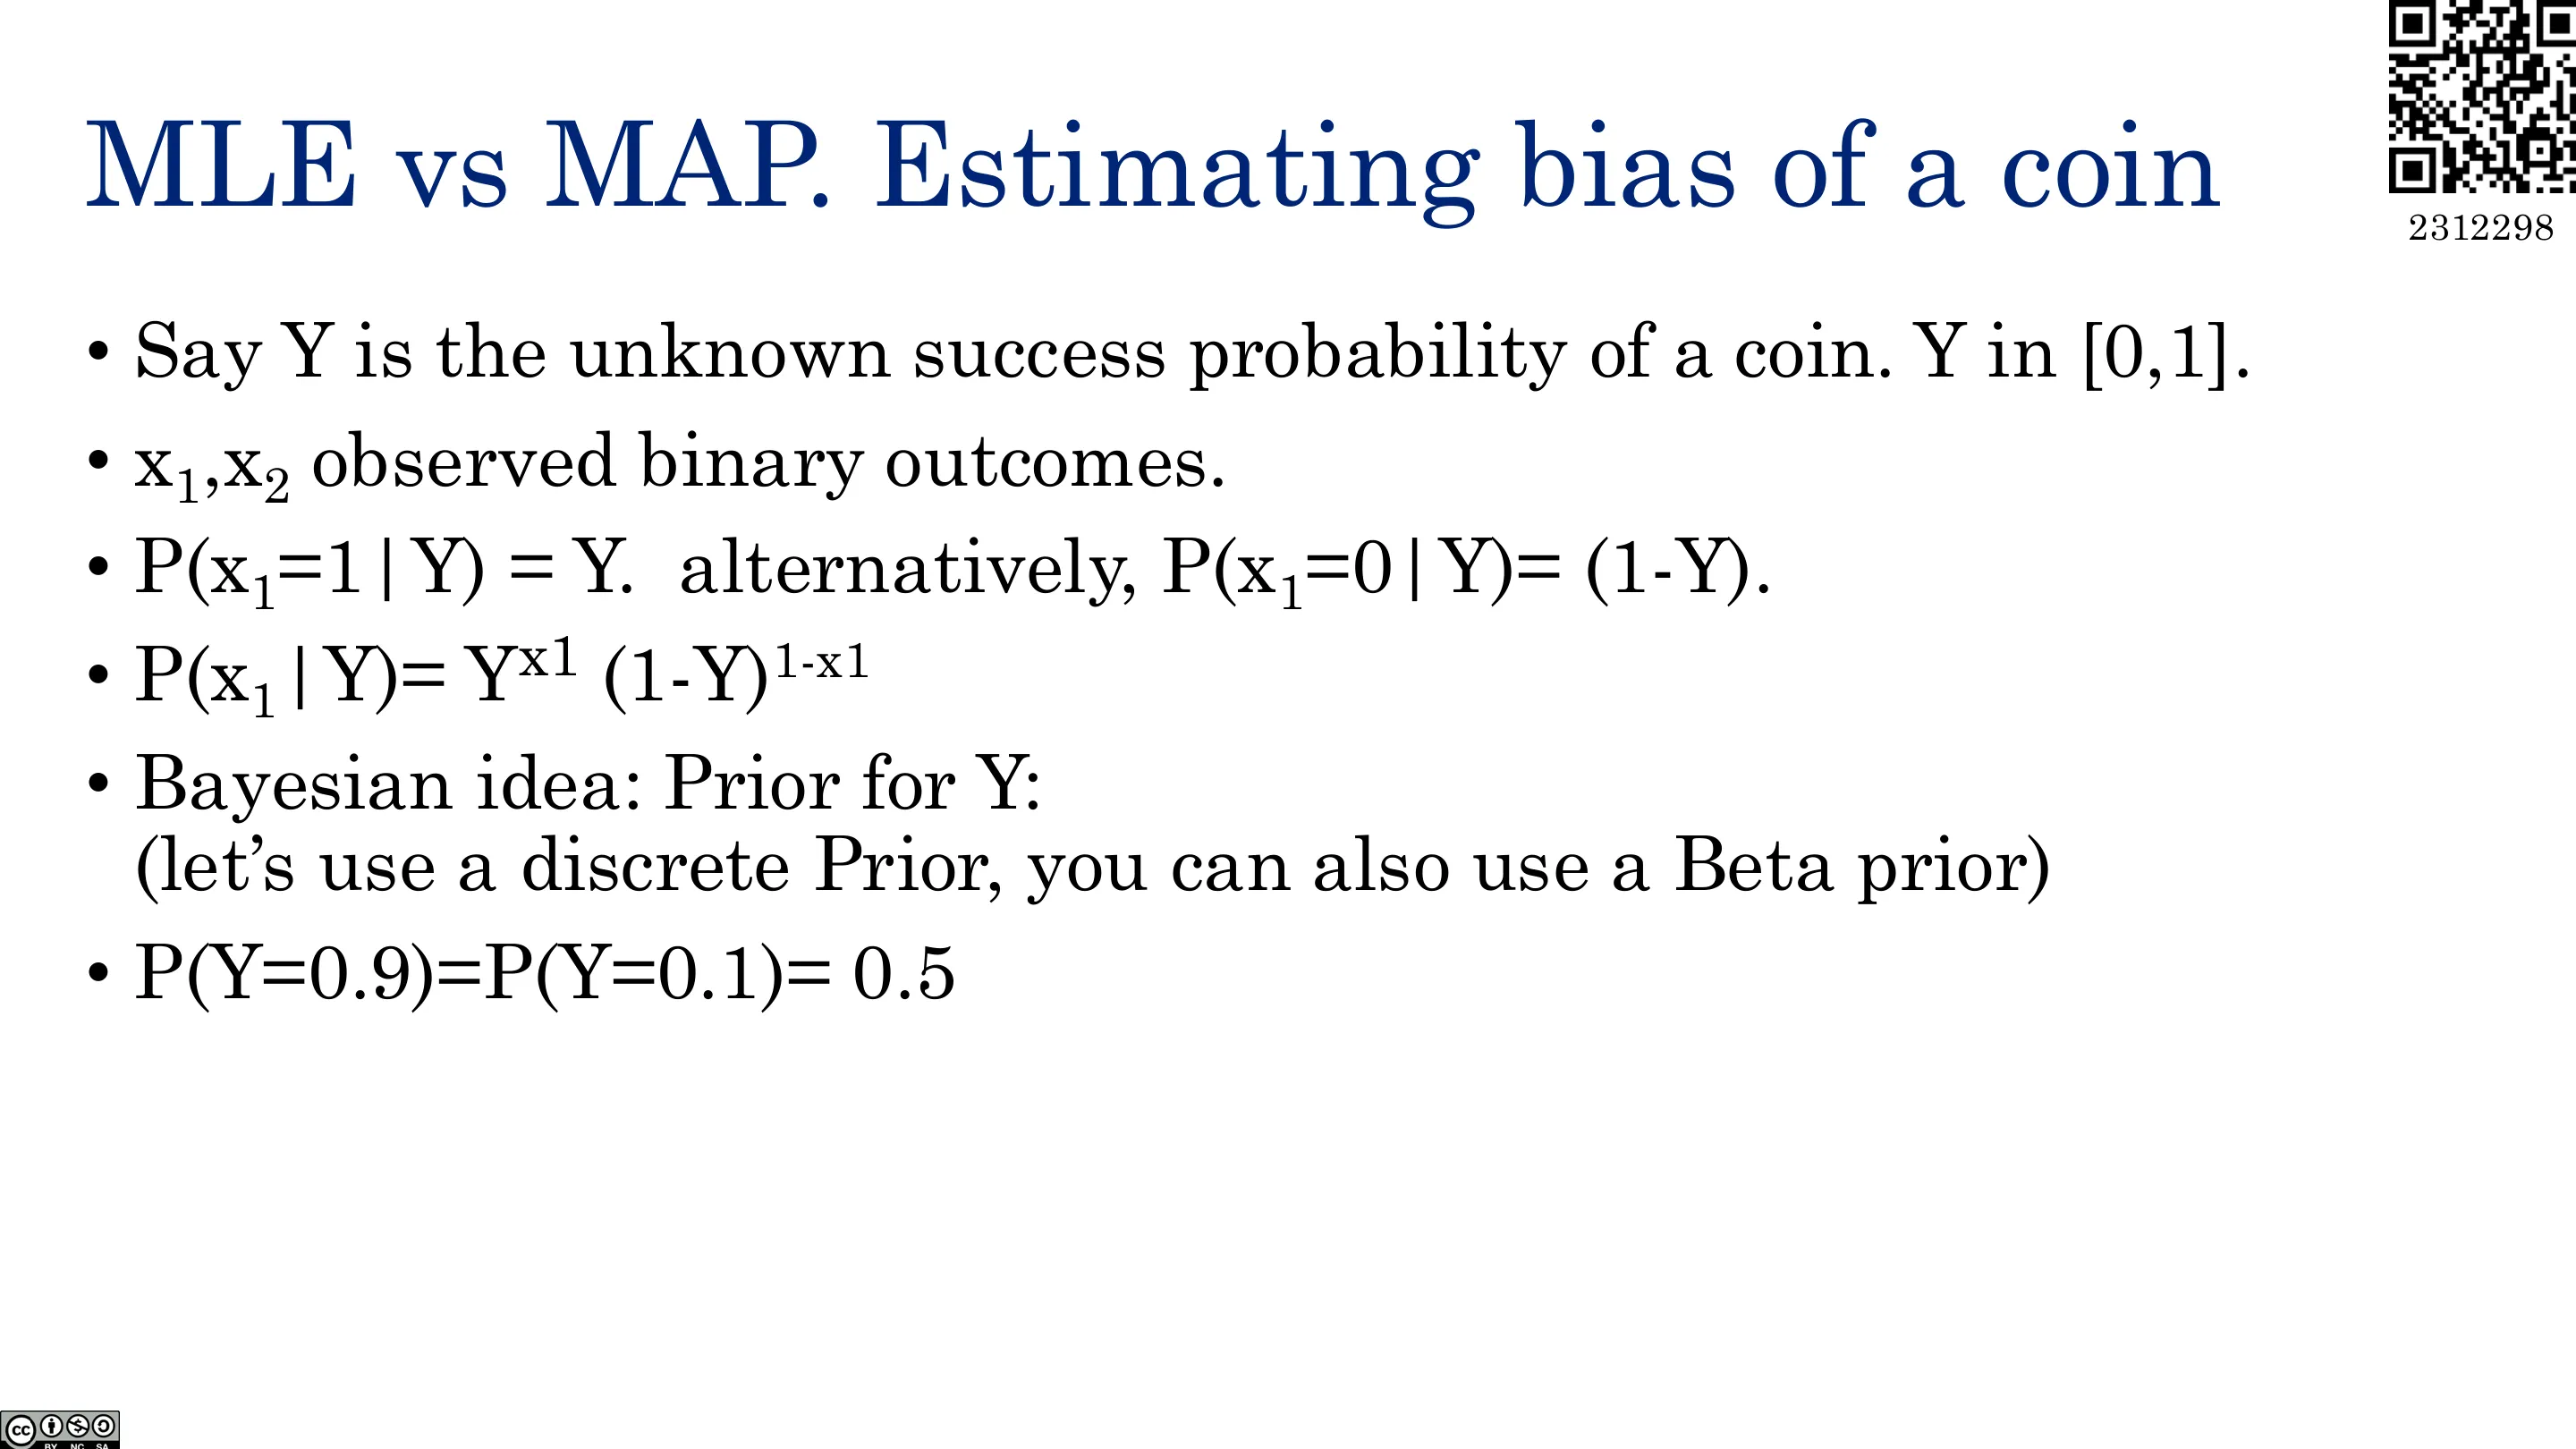
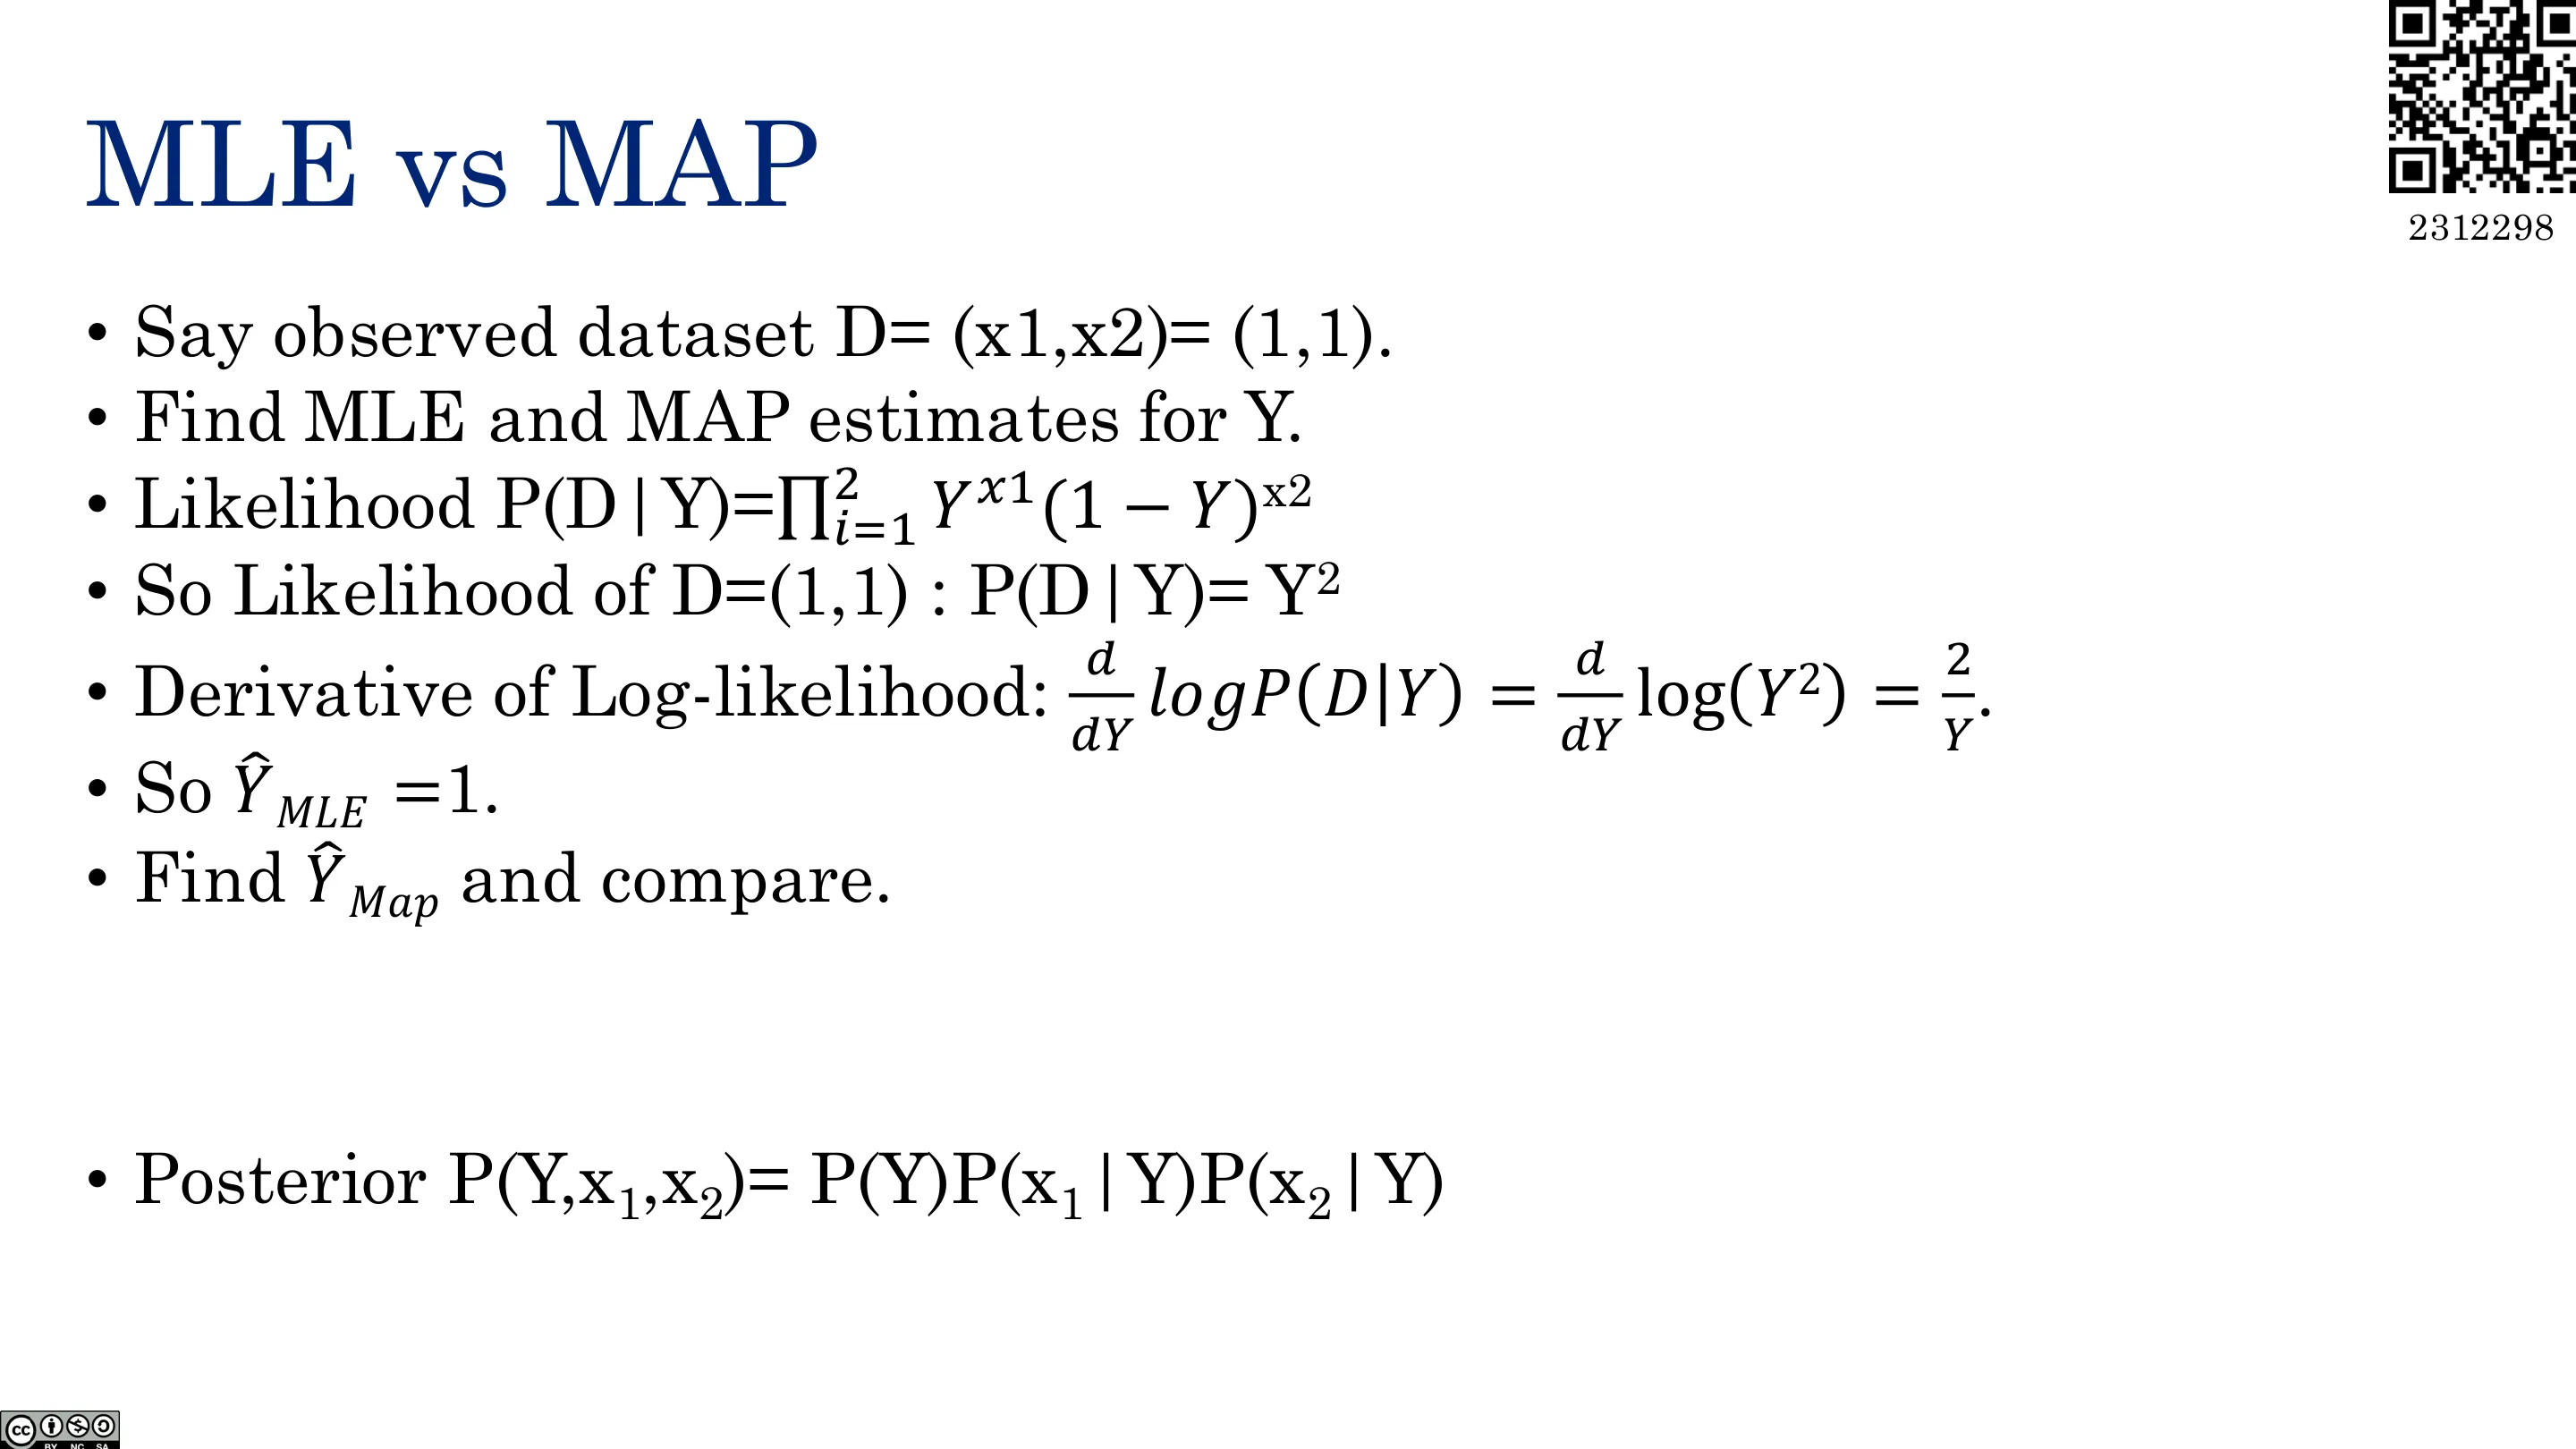
设一枚硬币正面朝上的概率为 $y\in[0,1]$(偏差)。抛两次,都得到正面($x_1=x_2=1$)。用指示函数的记账技巧($y^{x}(1-y)^{1-x}$)并假设独立,似然为
$$ p(D\mid y)=\prod_i y^{x_i}(1-y)^{1-x_i}=y^2 $$
MLE 最大化似然 ⇒ $\hat y_{\text{MLE}}=1$(因为 $y^2$ 在 $[0,1]$ 上单调递增,取边界)。这符合「数据全是正面」的直觉,但也说明 MLE 会过度相信数据。
📷 MLE 回顾
回到原视频 (00:03:04)
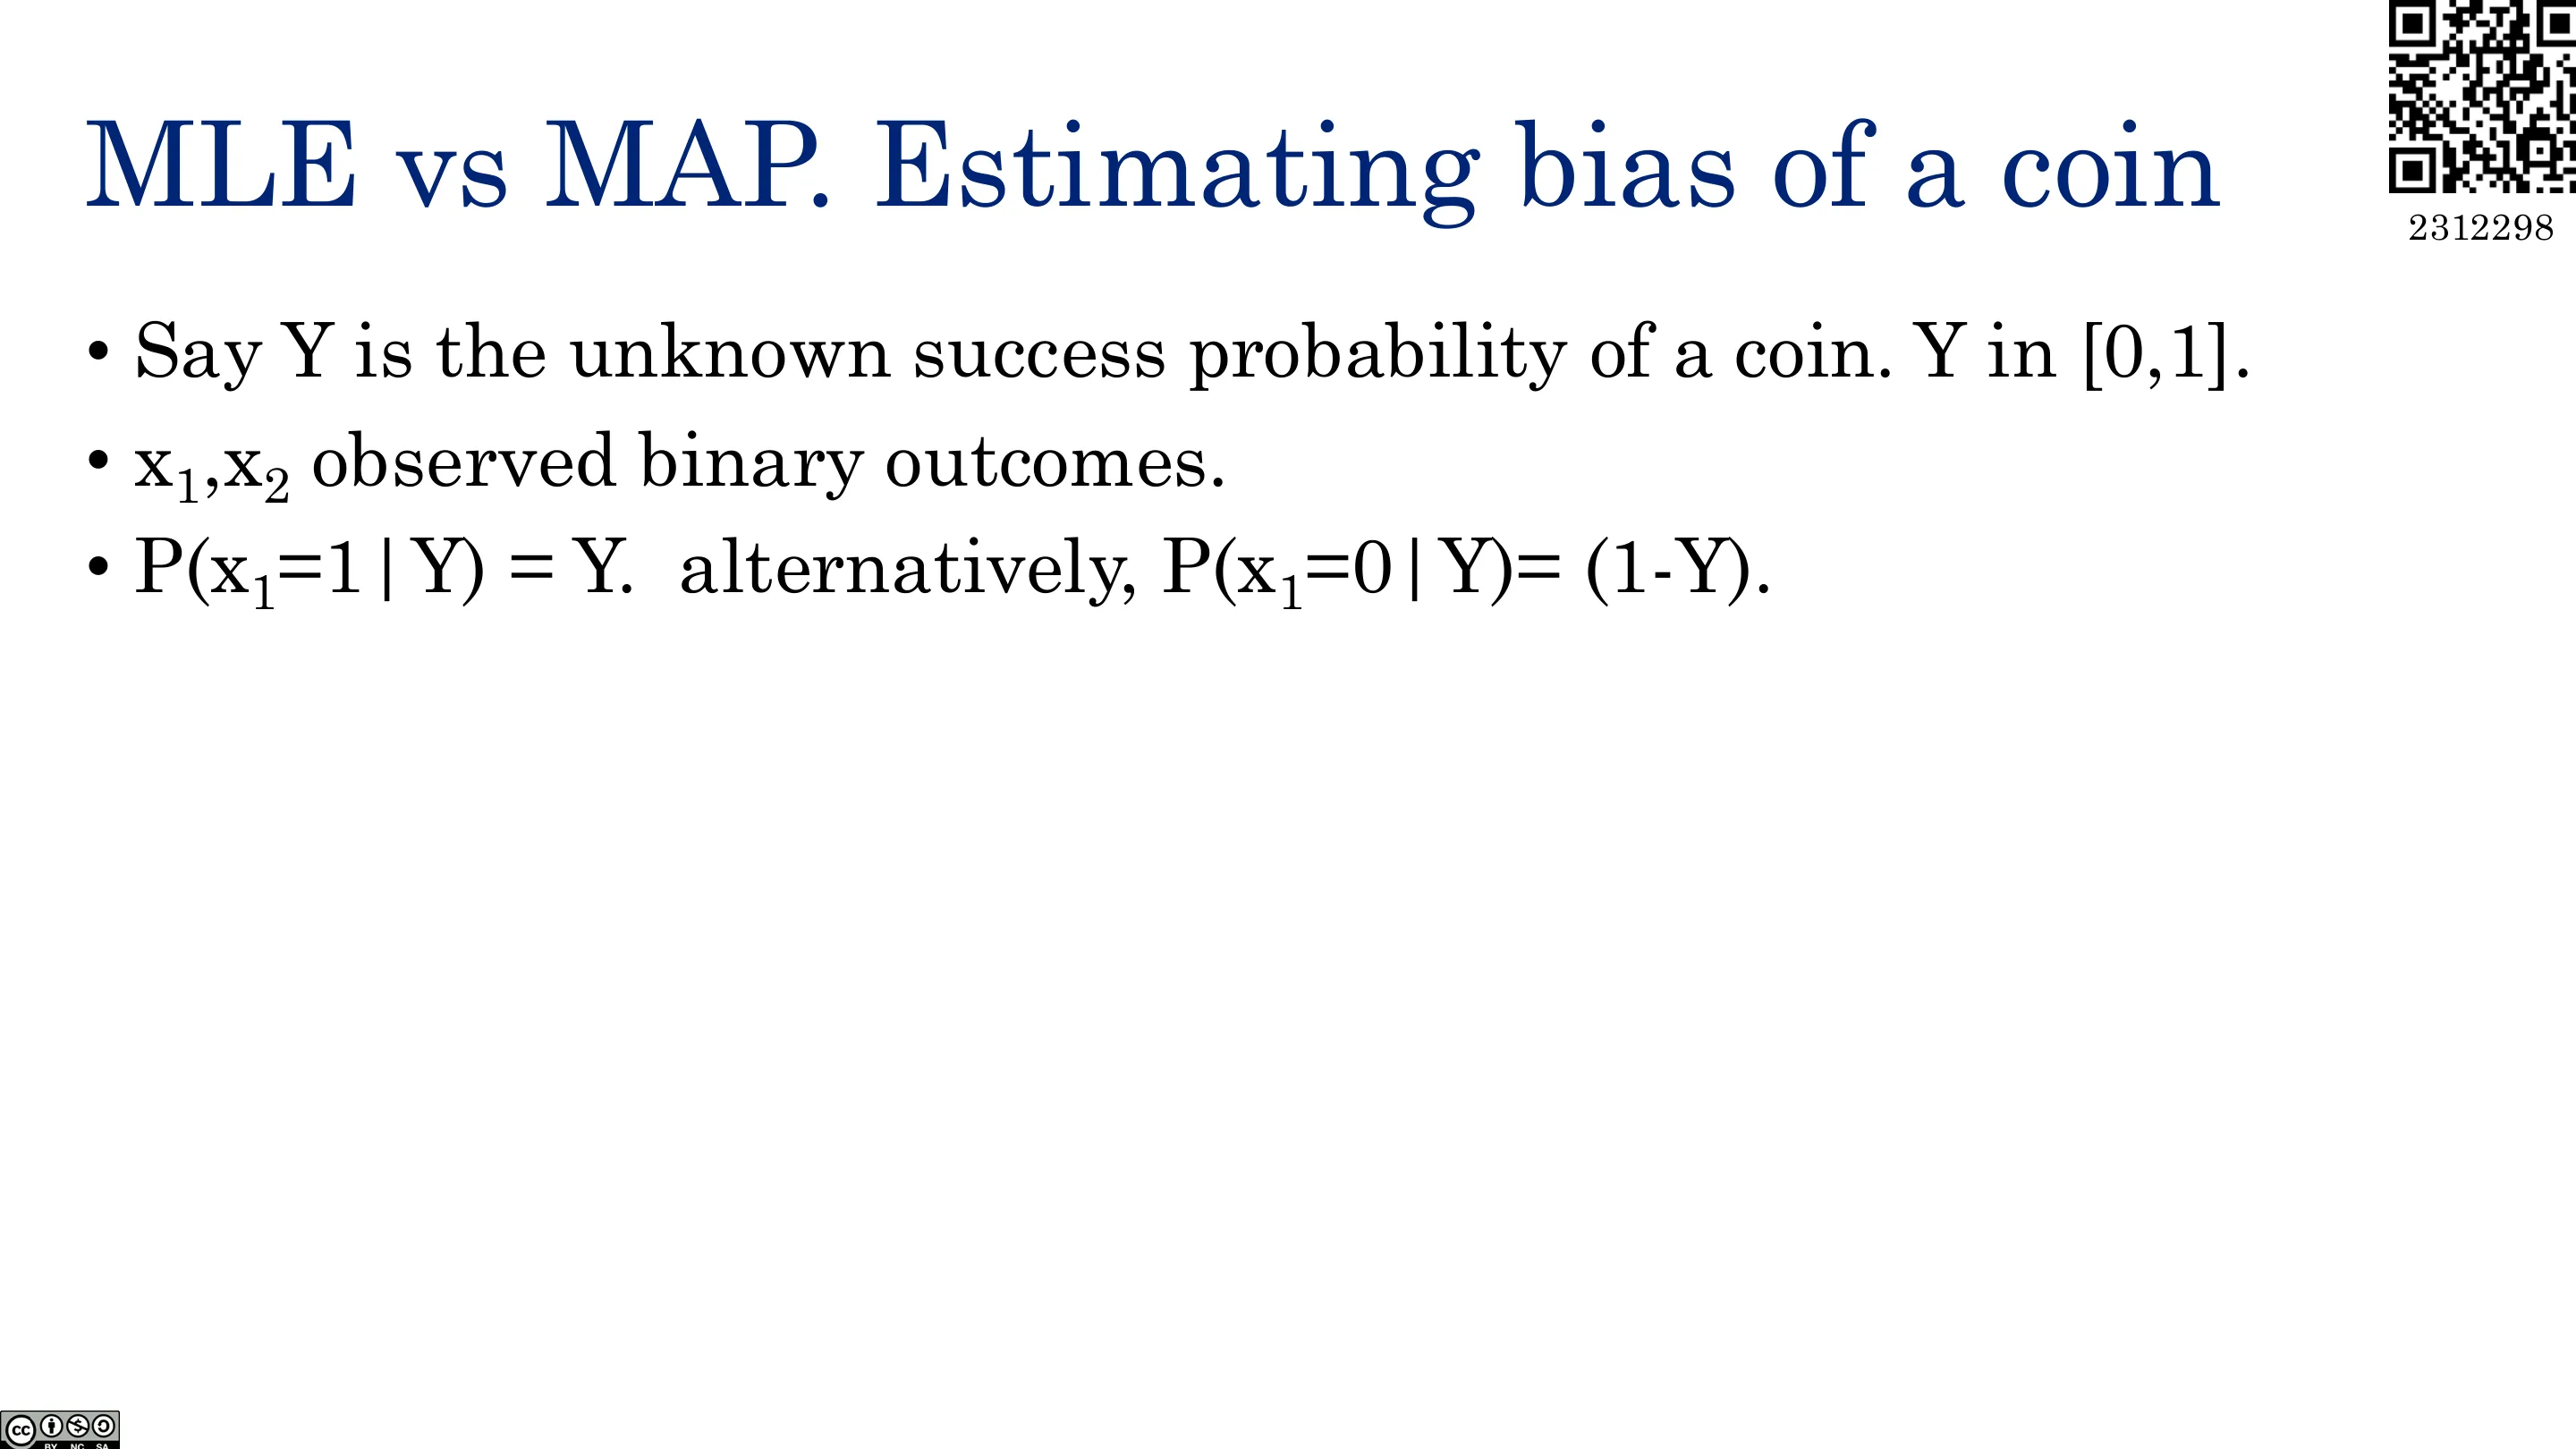
📷 MLE vs MAP:估计硬币偏差(一)
回到原视频 (00:04:14)
📷 MLE vs MAP:估计硬币偏差(二)
回到原视频 (00:05:24)
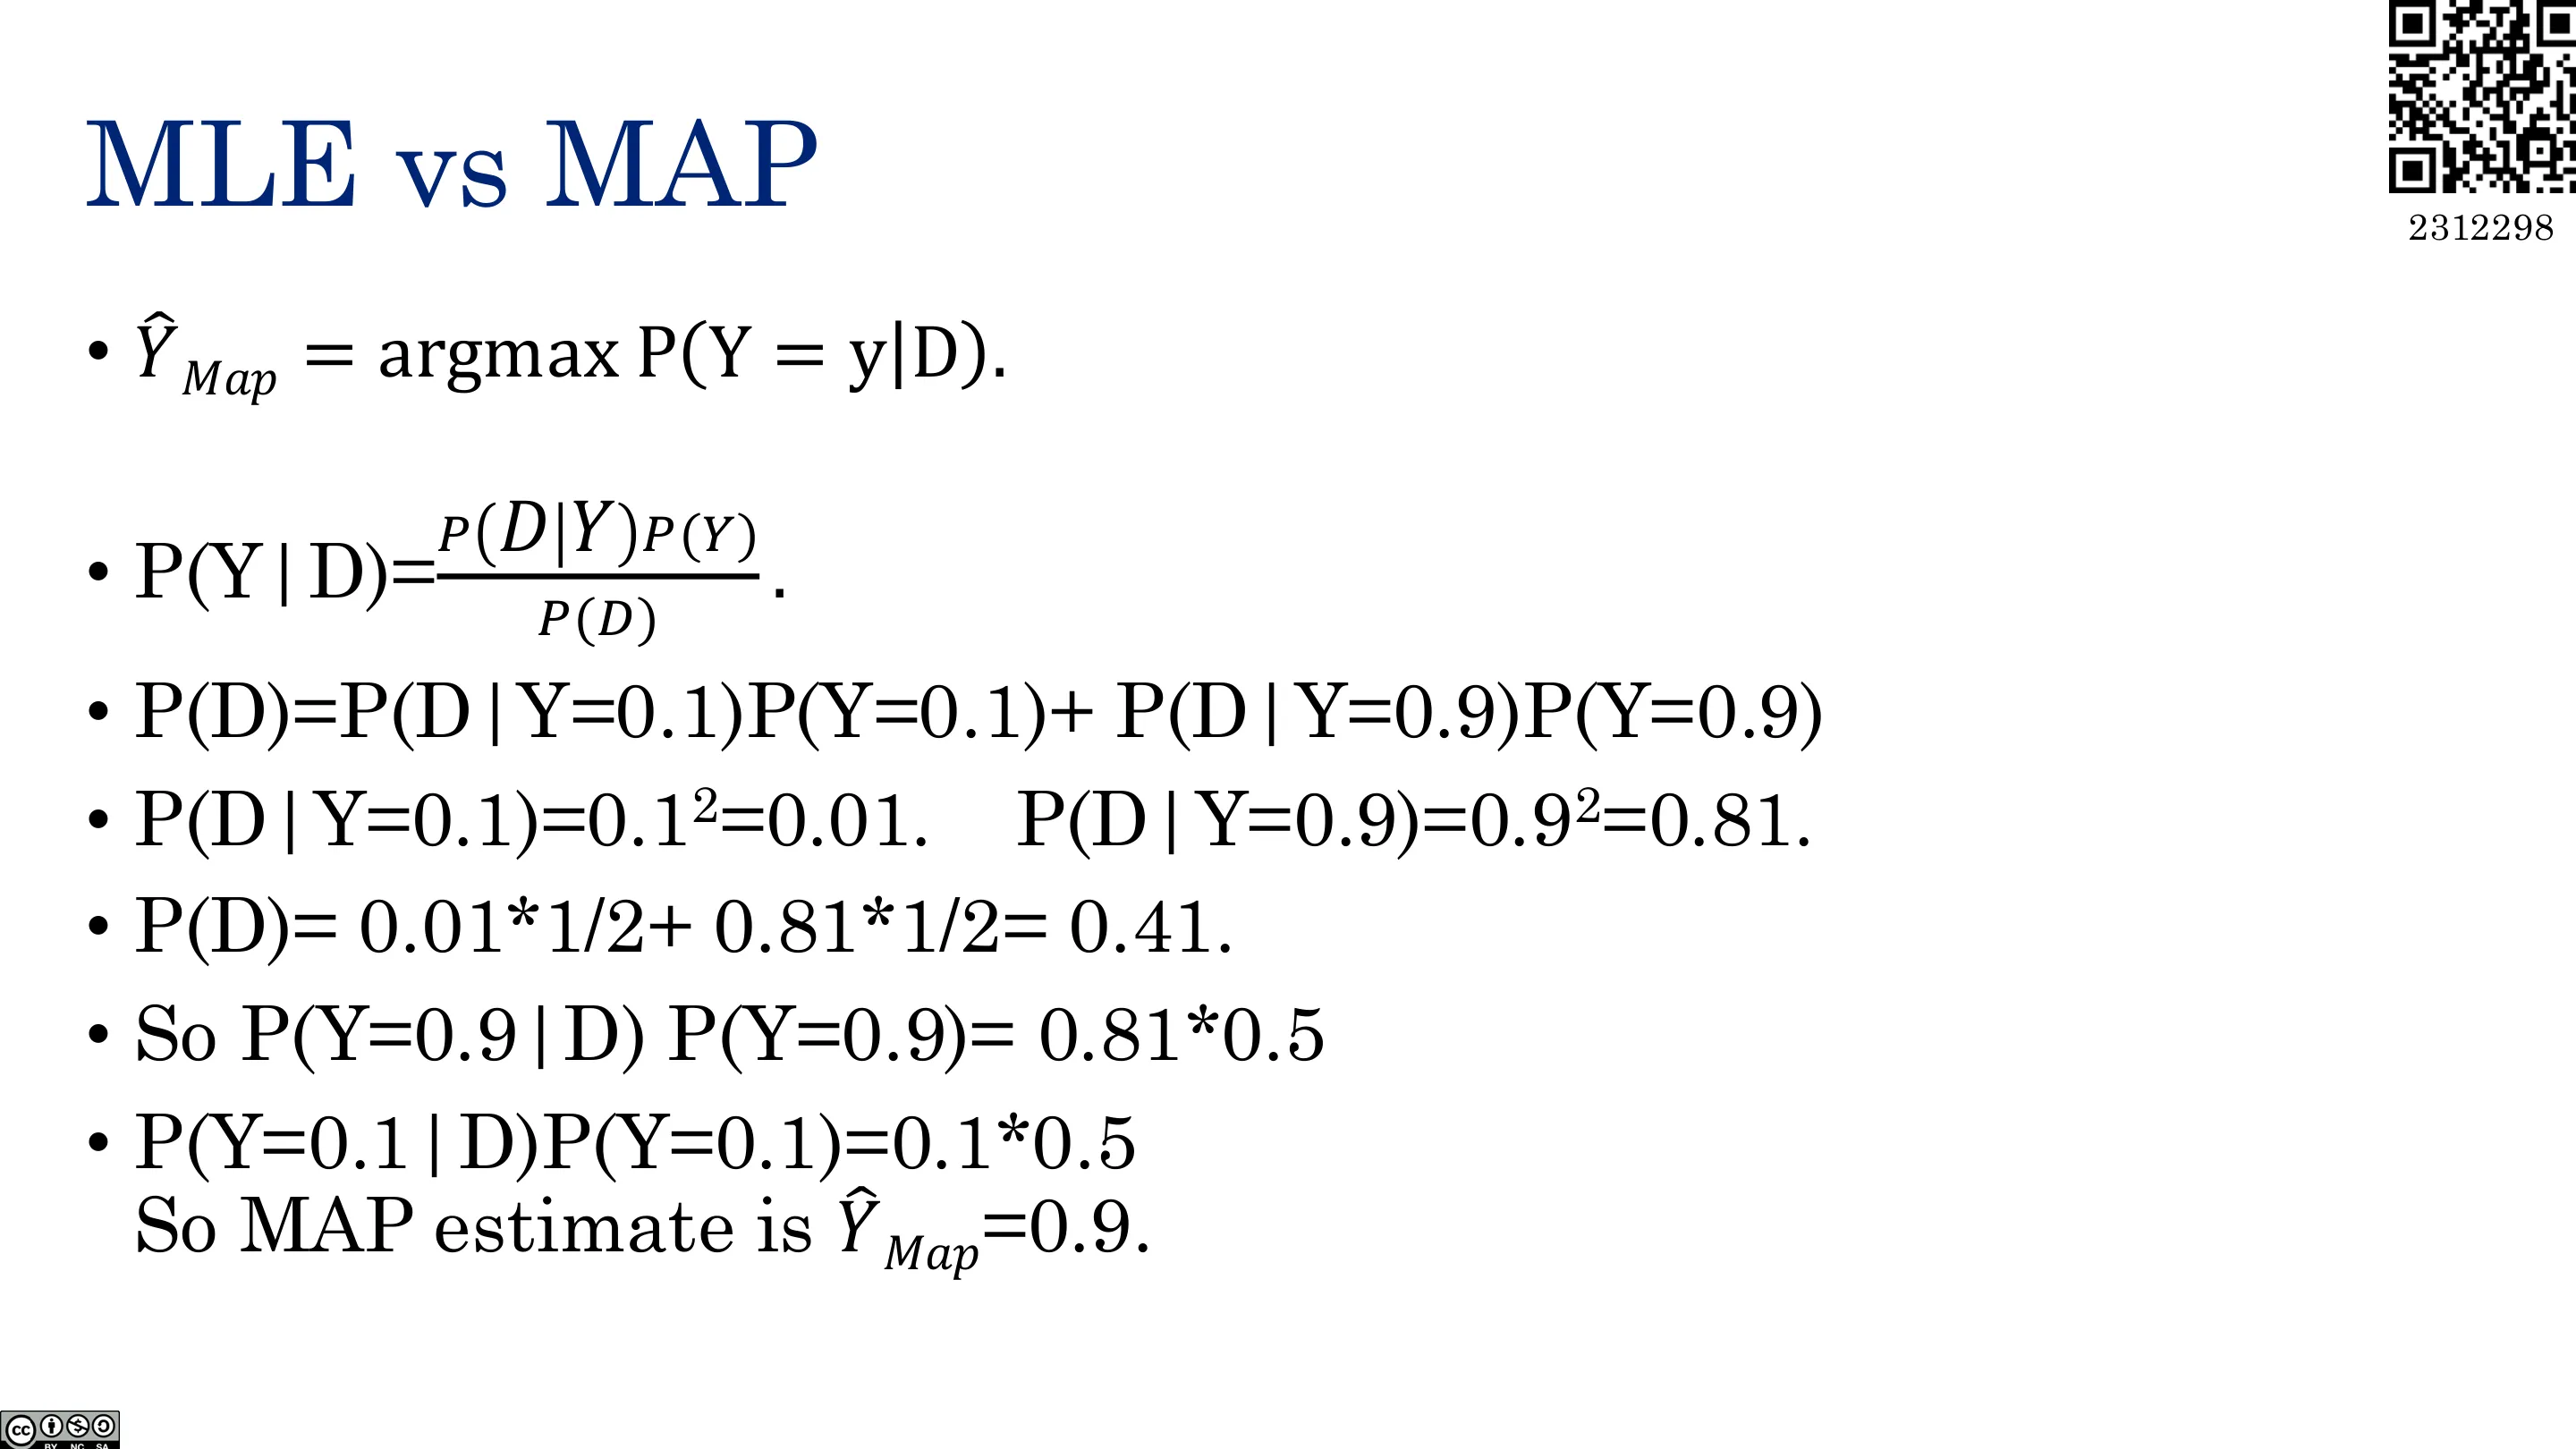
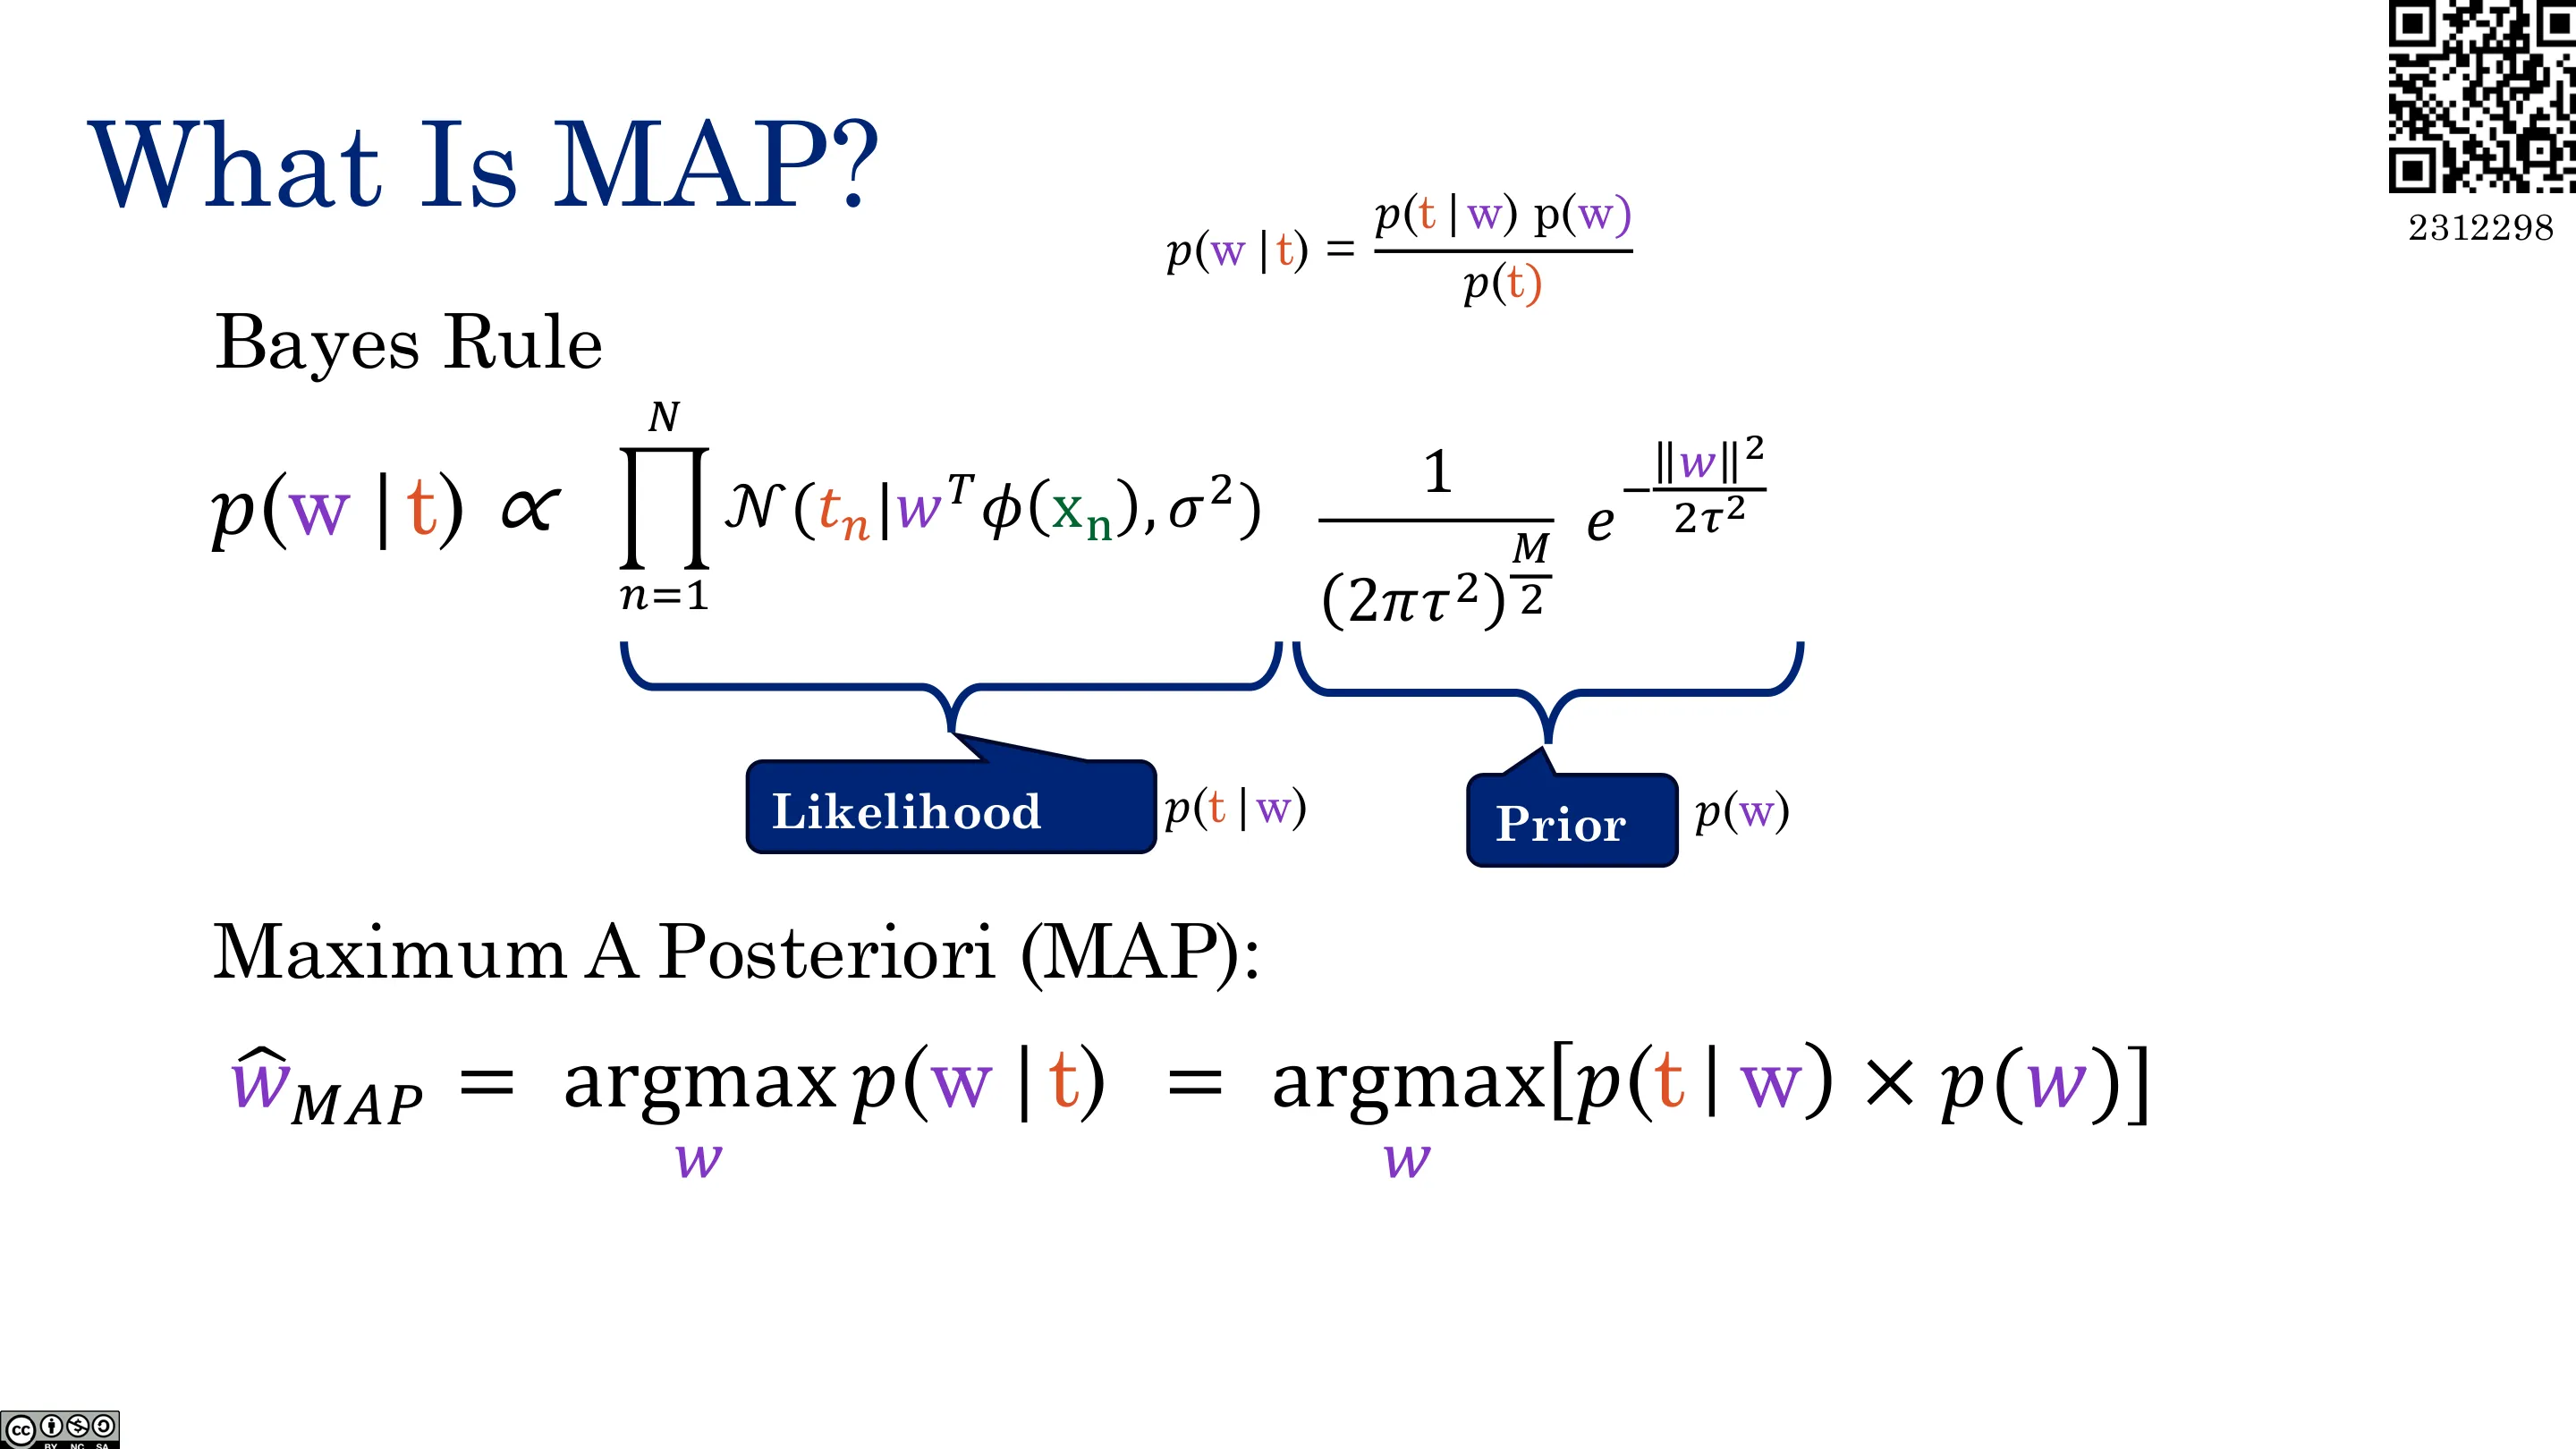
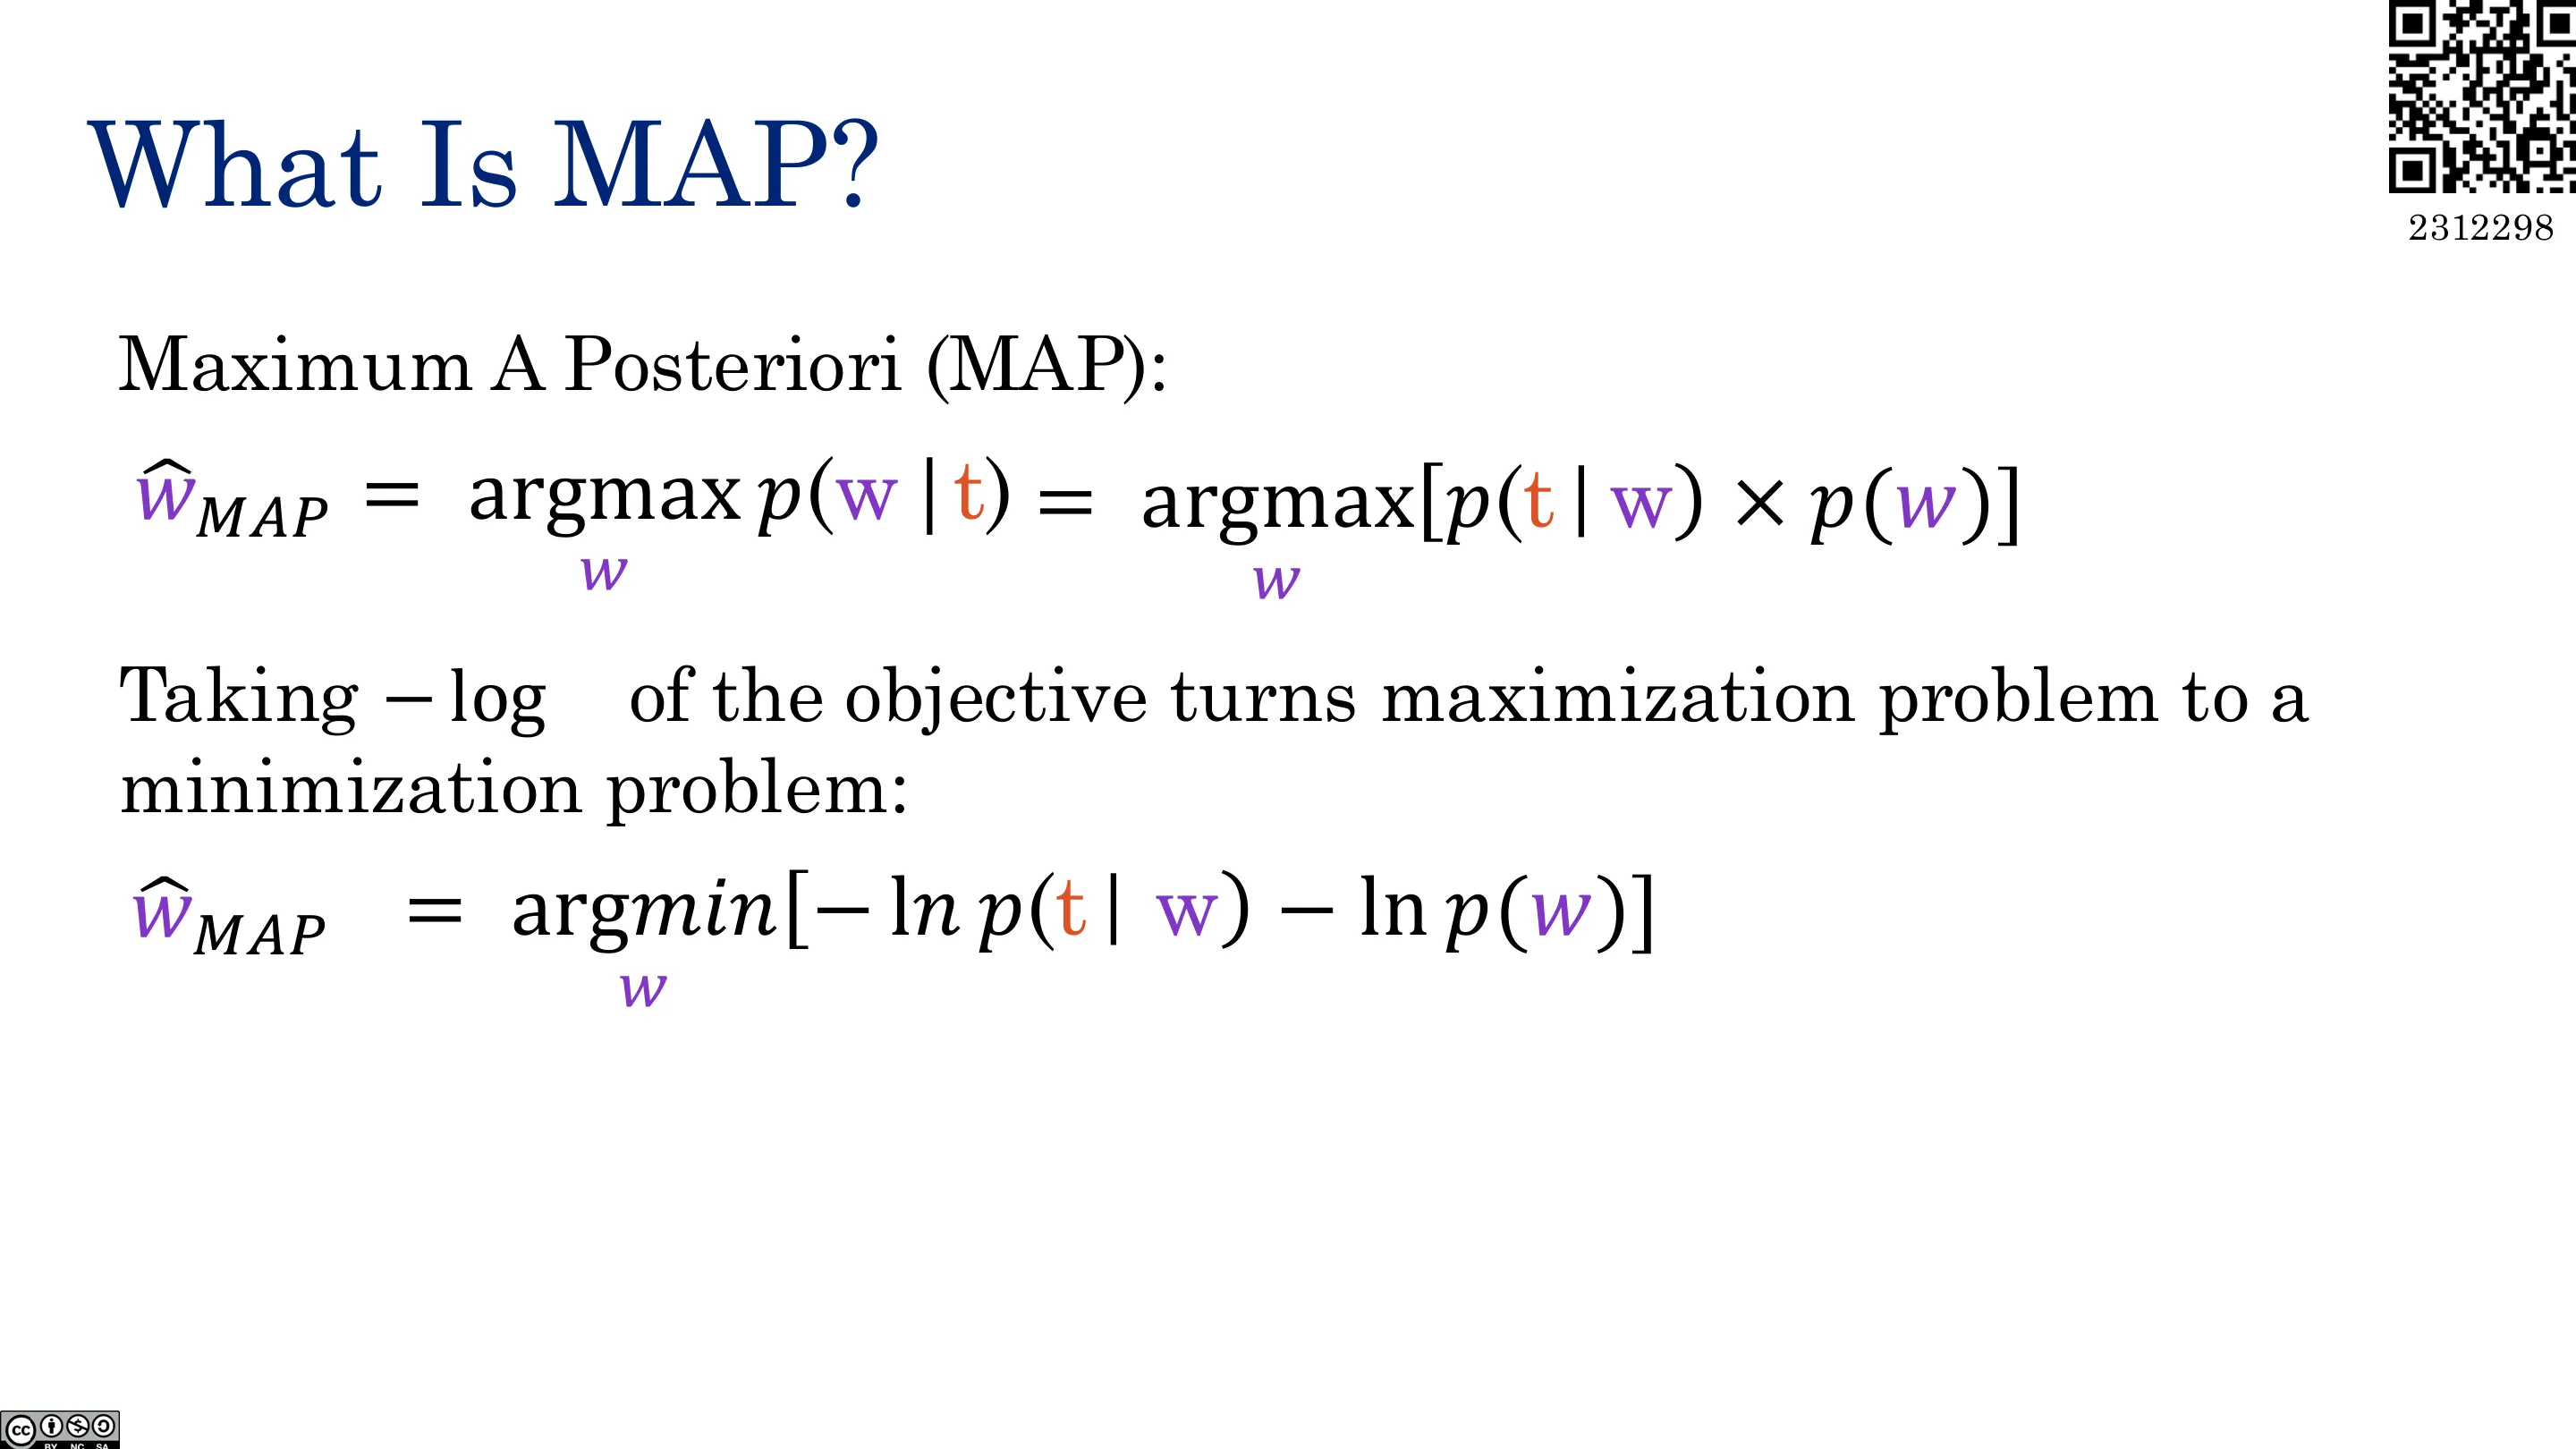
MAP(最大后验) 引入先验信念 $p(y)$:
$$ \hat y_{\text{MAP}}=\arg\max_y\ p(y\mid D)=\arg\max_y\ \frac{p(D\mid y)p(y)}{p(D)} \propto \arg\max_y\ p(D\mid y)\,p(y) $$
分母 $p(D)$ 与 $y$ 无关,可以省略(这正是 MAP 比完整贝叶斯更「偷懒」的地方)。
📷 MLE vs MAP
回到原视频 (00:06:34)
📷 MLE vs MAP(续)
回到原视频 (00:07:44)
关于参数的信念:用离散先验——「世界上的硬币只有两种:正面概率 0.9 或 0.1,各占一半」。两次正面后,后验只在 $\{0.1,0.9\}$ 上非零,且 0.9 的后验更大 ⇒ $\hat y_{\text{MAP}}=0.9$。直觉上任何人都能得出这个结论——数据证据与先验信念相结合。
编者说明:为什么硬币偏差的先验不用高斯?因为 $y\in[0,1]$,而高斯支撑在 $(-\infty,\infty)$,不合法。这里用 Beta 分布 或离散分布更合适。
📷 关于参数的信念
回到原视频 (00:08:54)
📷 什么是 MAP(一)
回到原视频 (00:10:04)
📷 什么是 MAP(二)
回到原视频 (00:11:14)
📷 代入分布(一)
回到原视频 (00:12:24)
📷 代入分布(二)
回到原视频 (00:13:34)
📷 argmin
回到原视频 (00:14:44)
📷 MLE、MAP
回到原视频 (00:15:54)
1.2 MAP 在机器学习中:岭回归
(参考时间: 00:17)
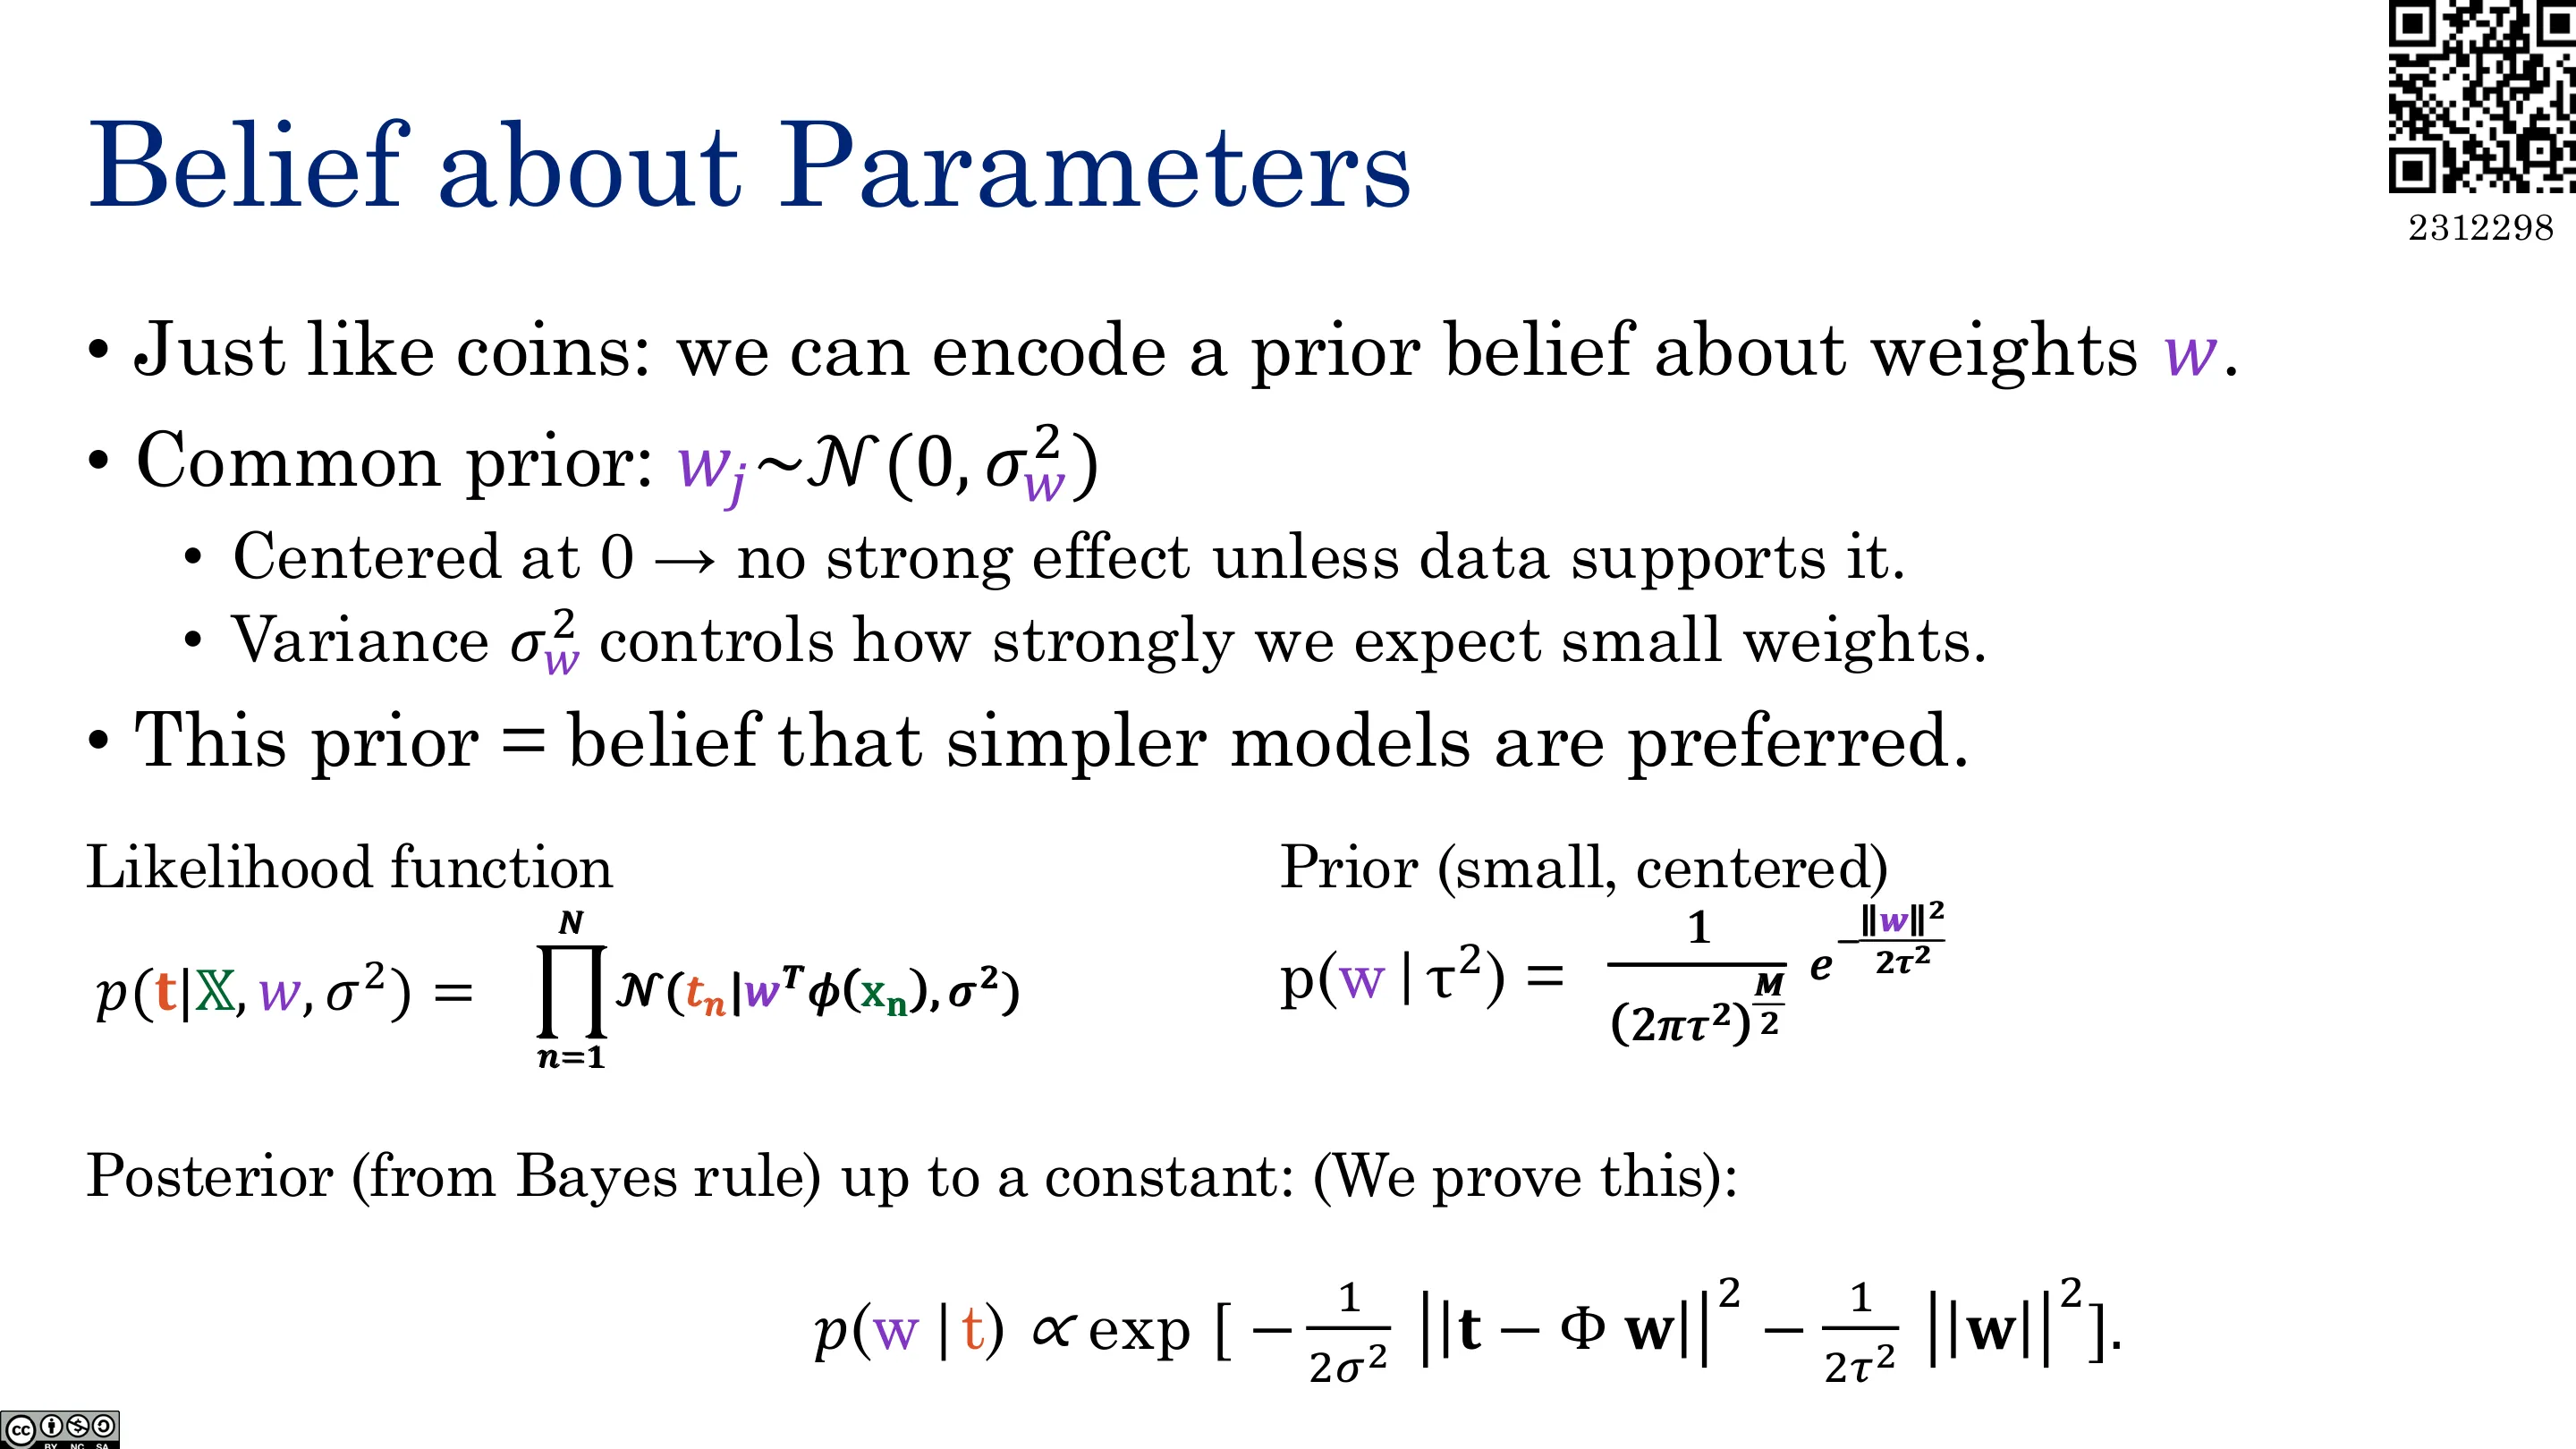
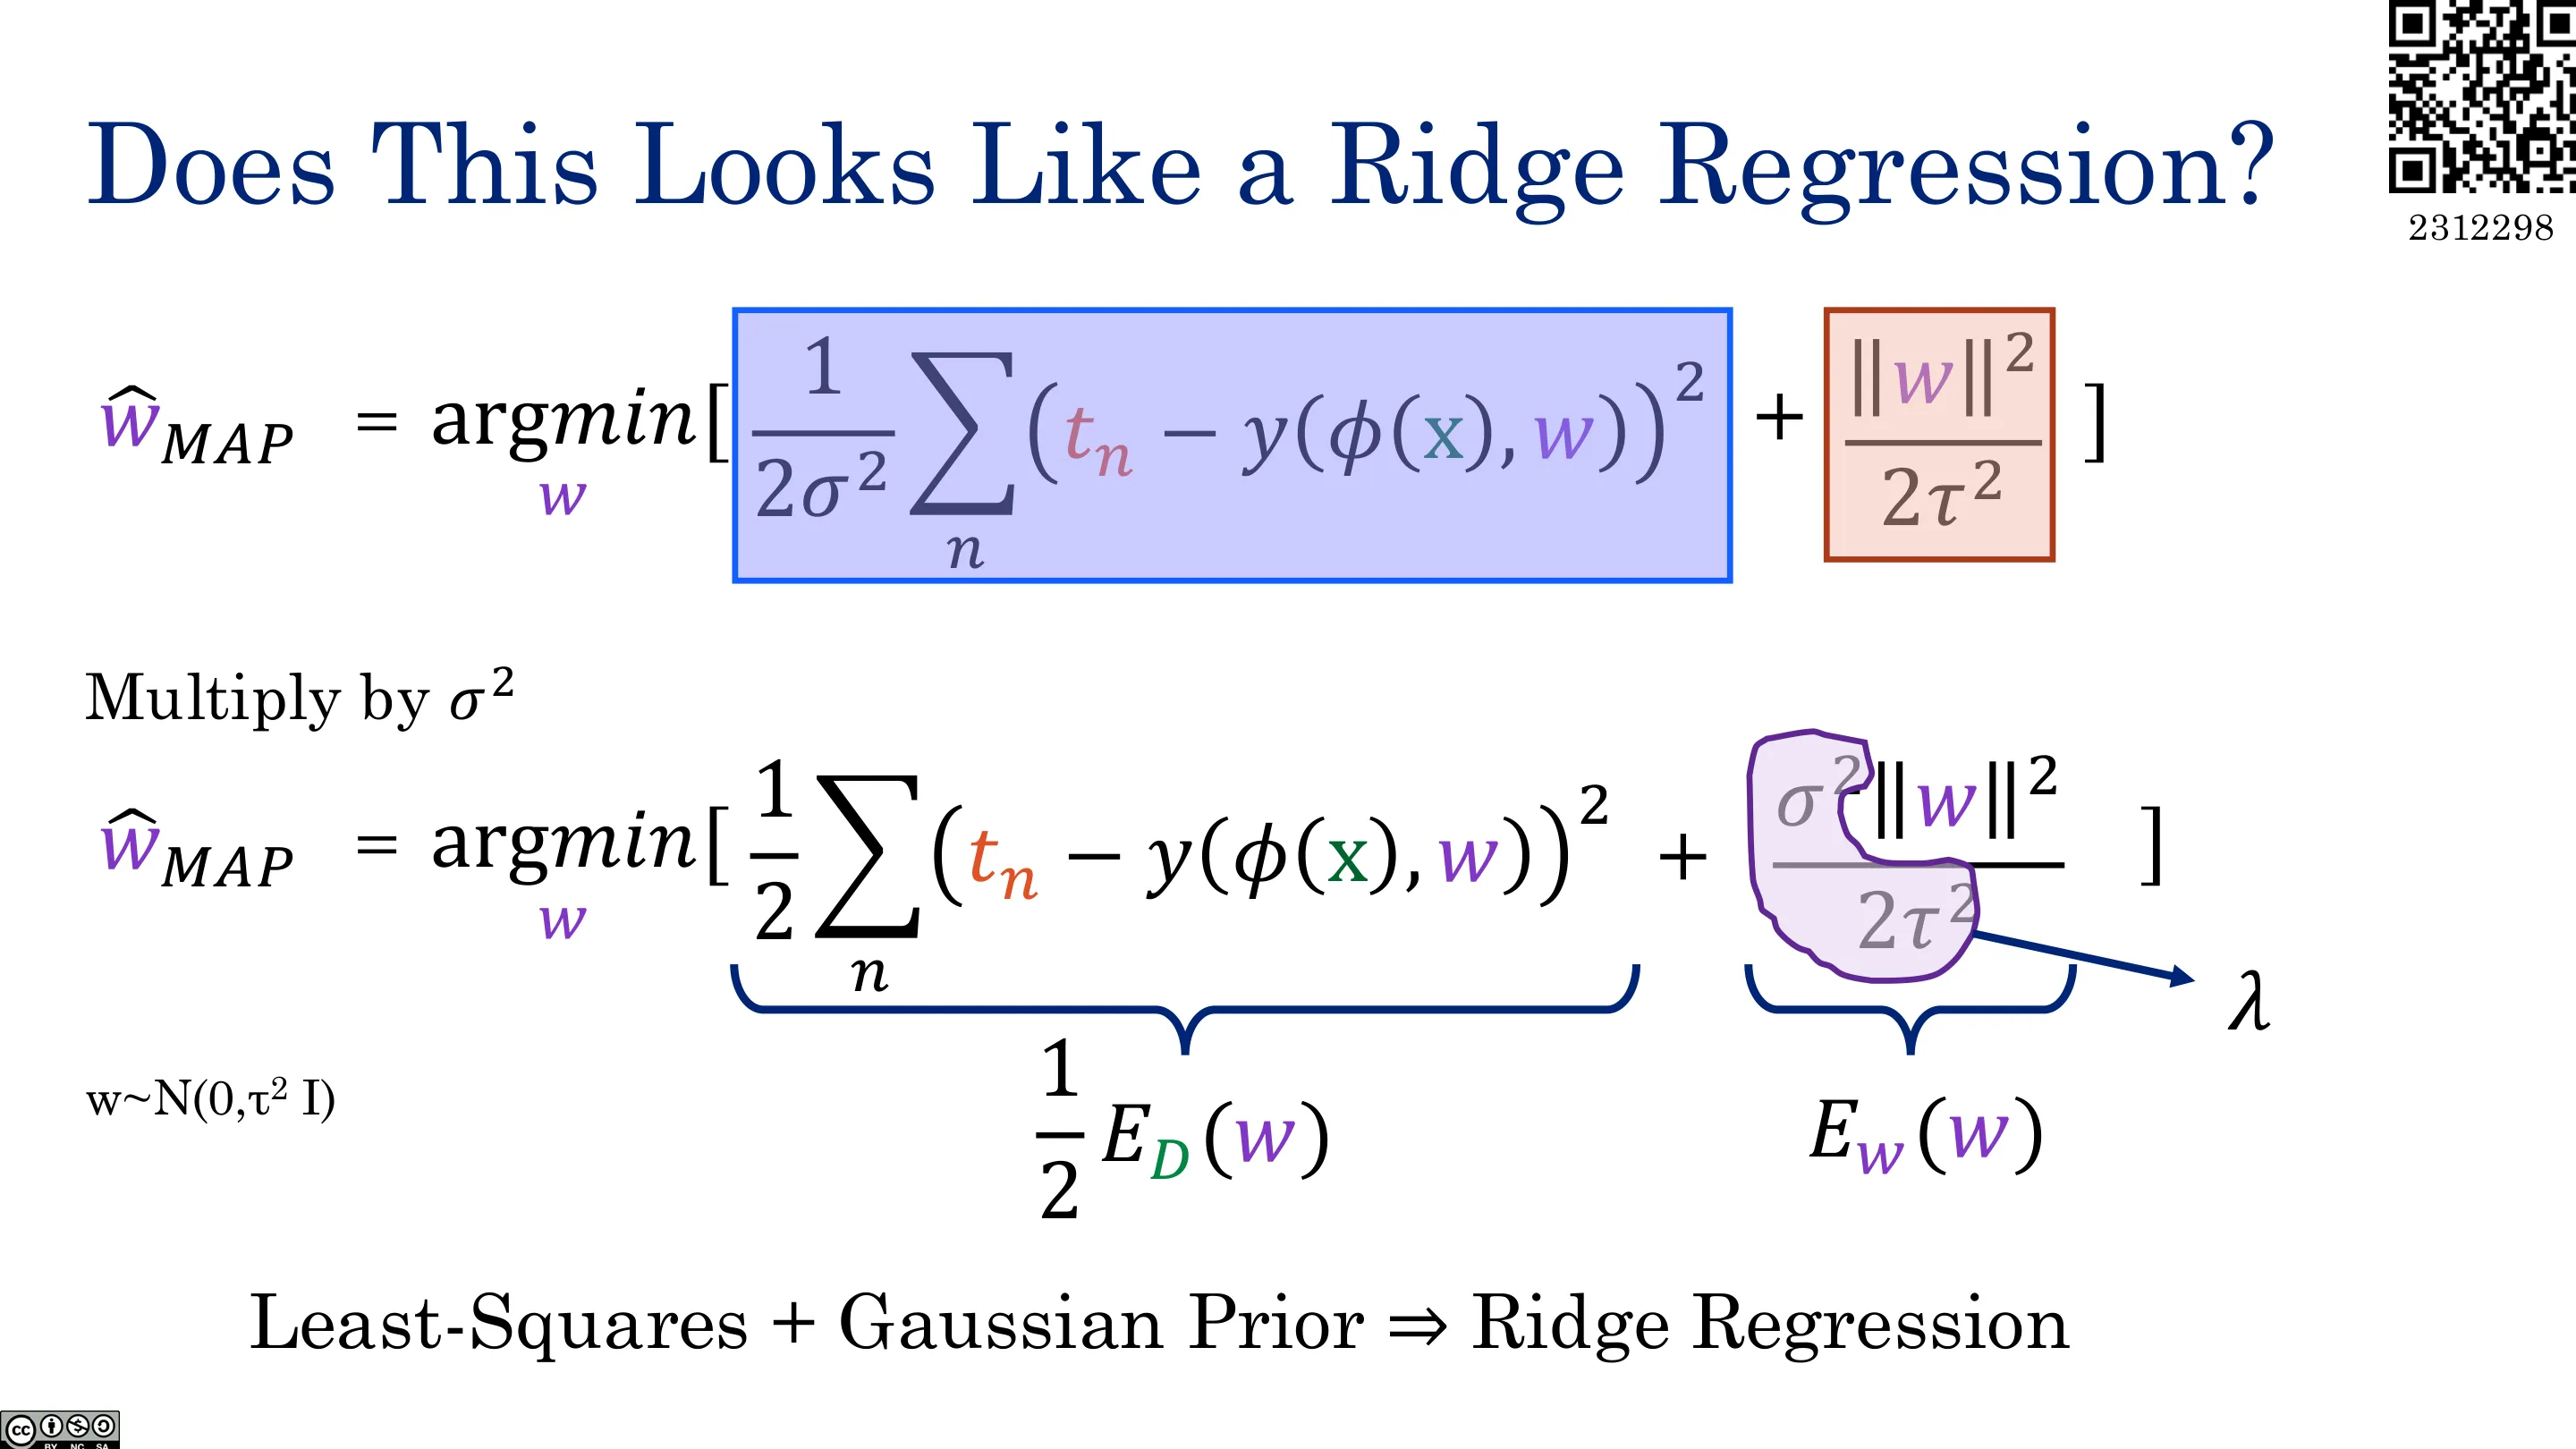
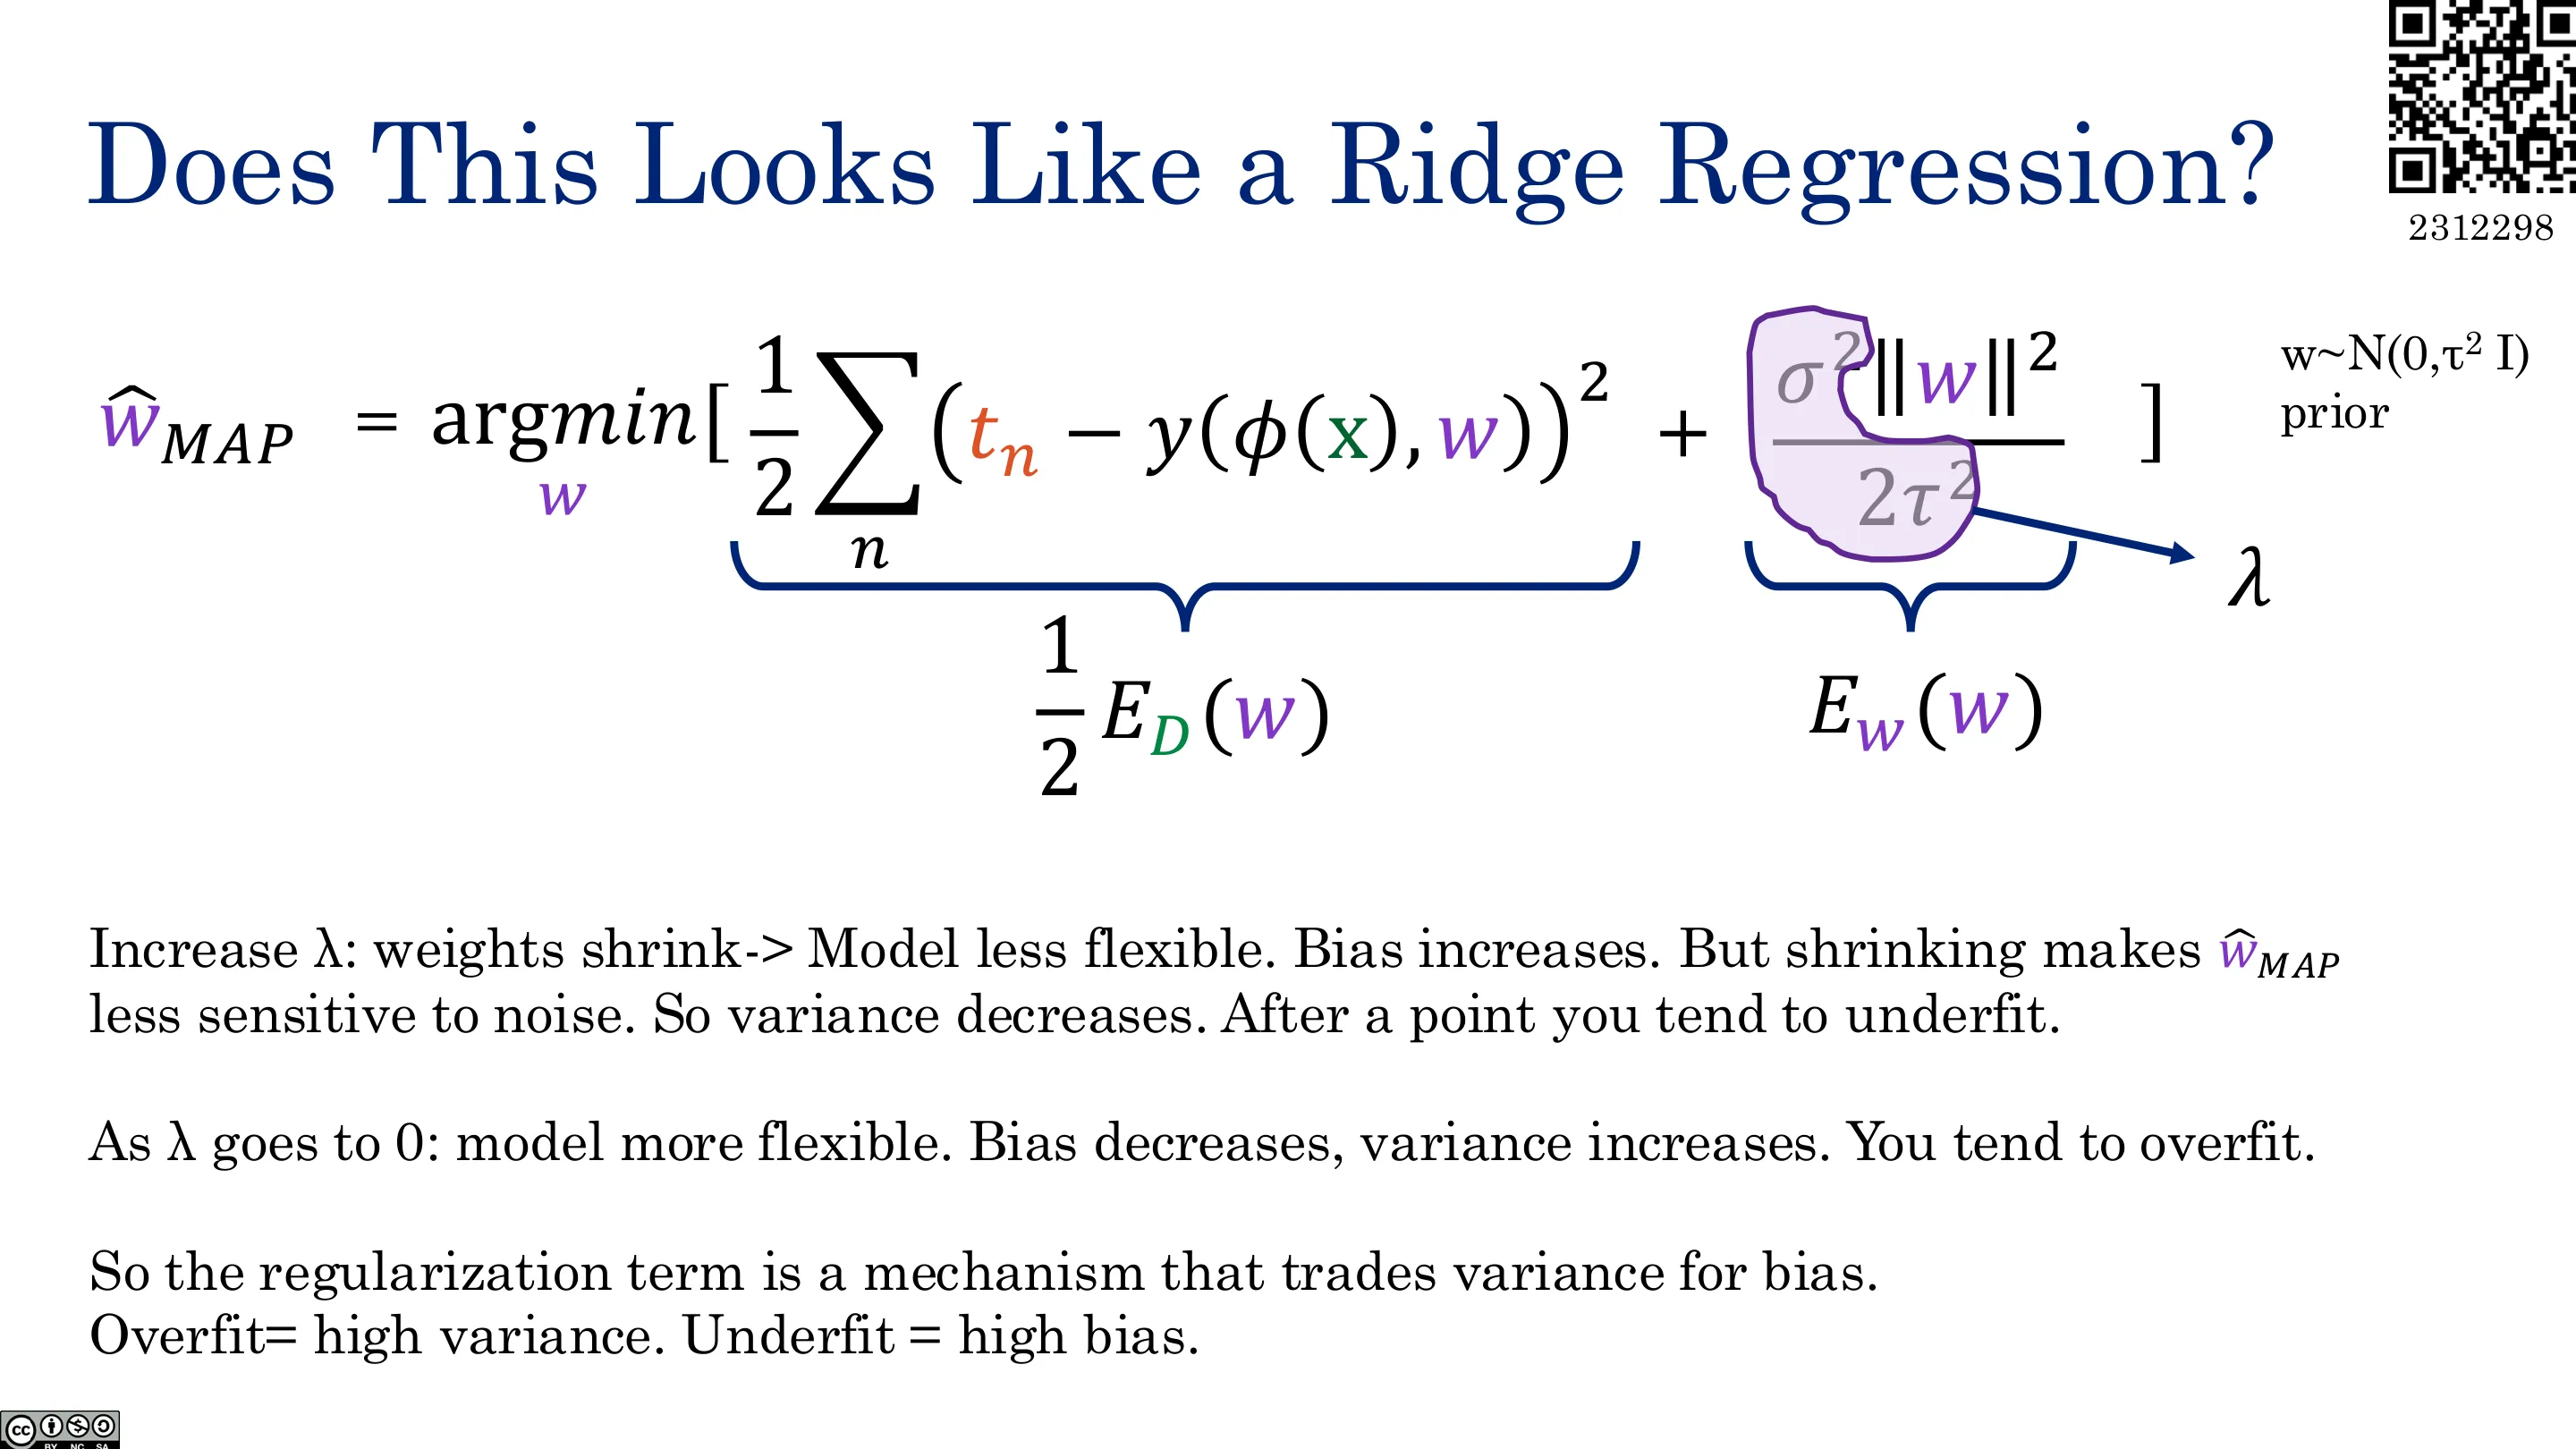
对权重 $w$ 施加零均值高斯先验 $\mathcal{N}(0,\sigma_w^2 I)$(即「偏好小权重」,在神经网络里叫权重衰减 weight decay):
$$ p(w)\propto \exp\!\Big(-\frac{\lVert w\rVert^2}{2\sigma_w^2}\Big) $$
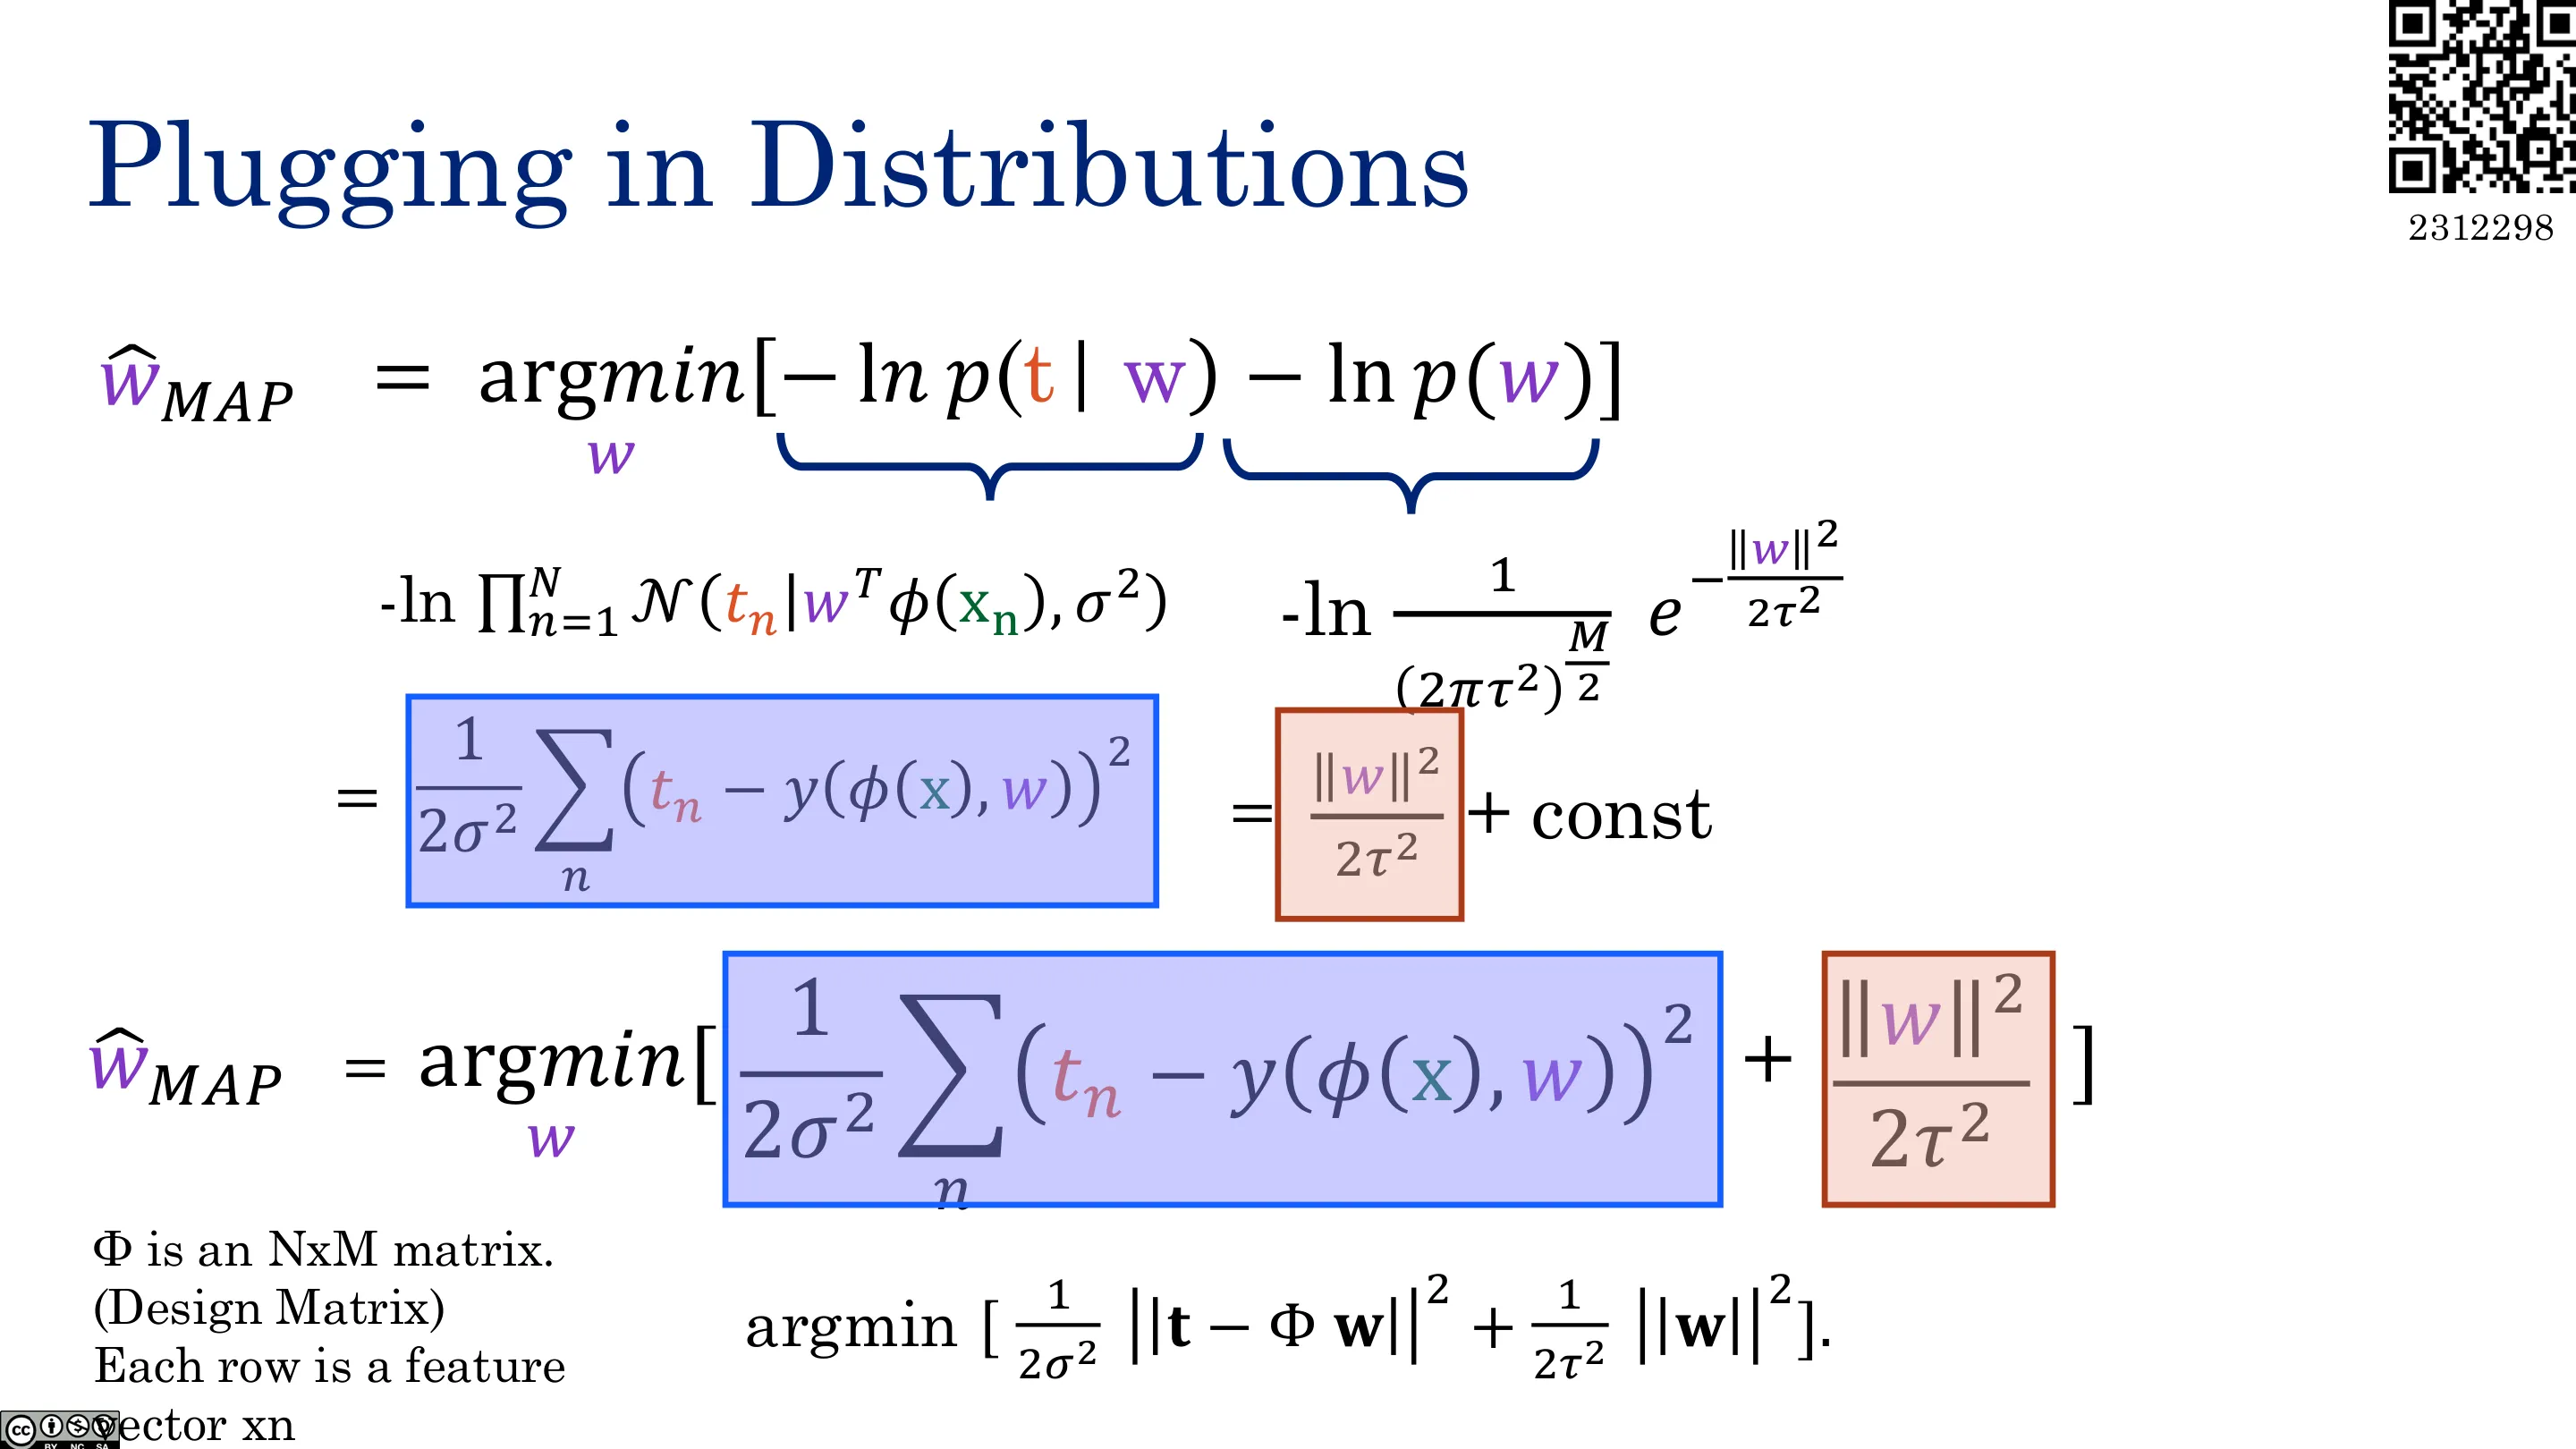
取负对数后:
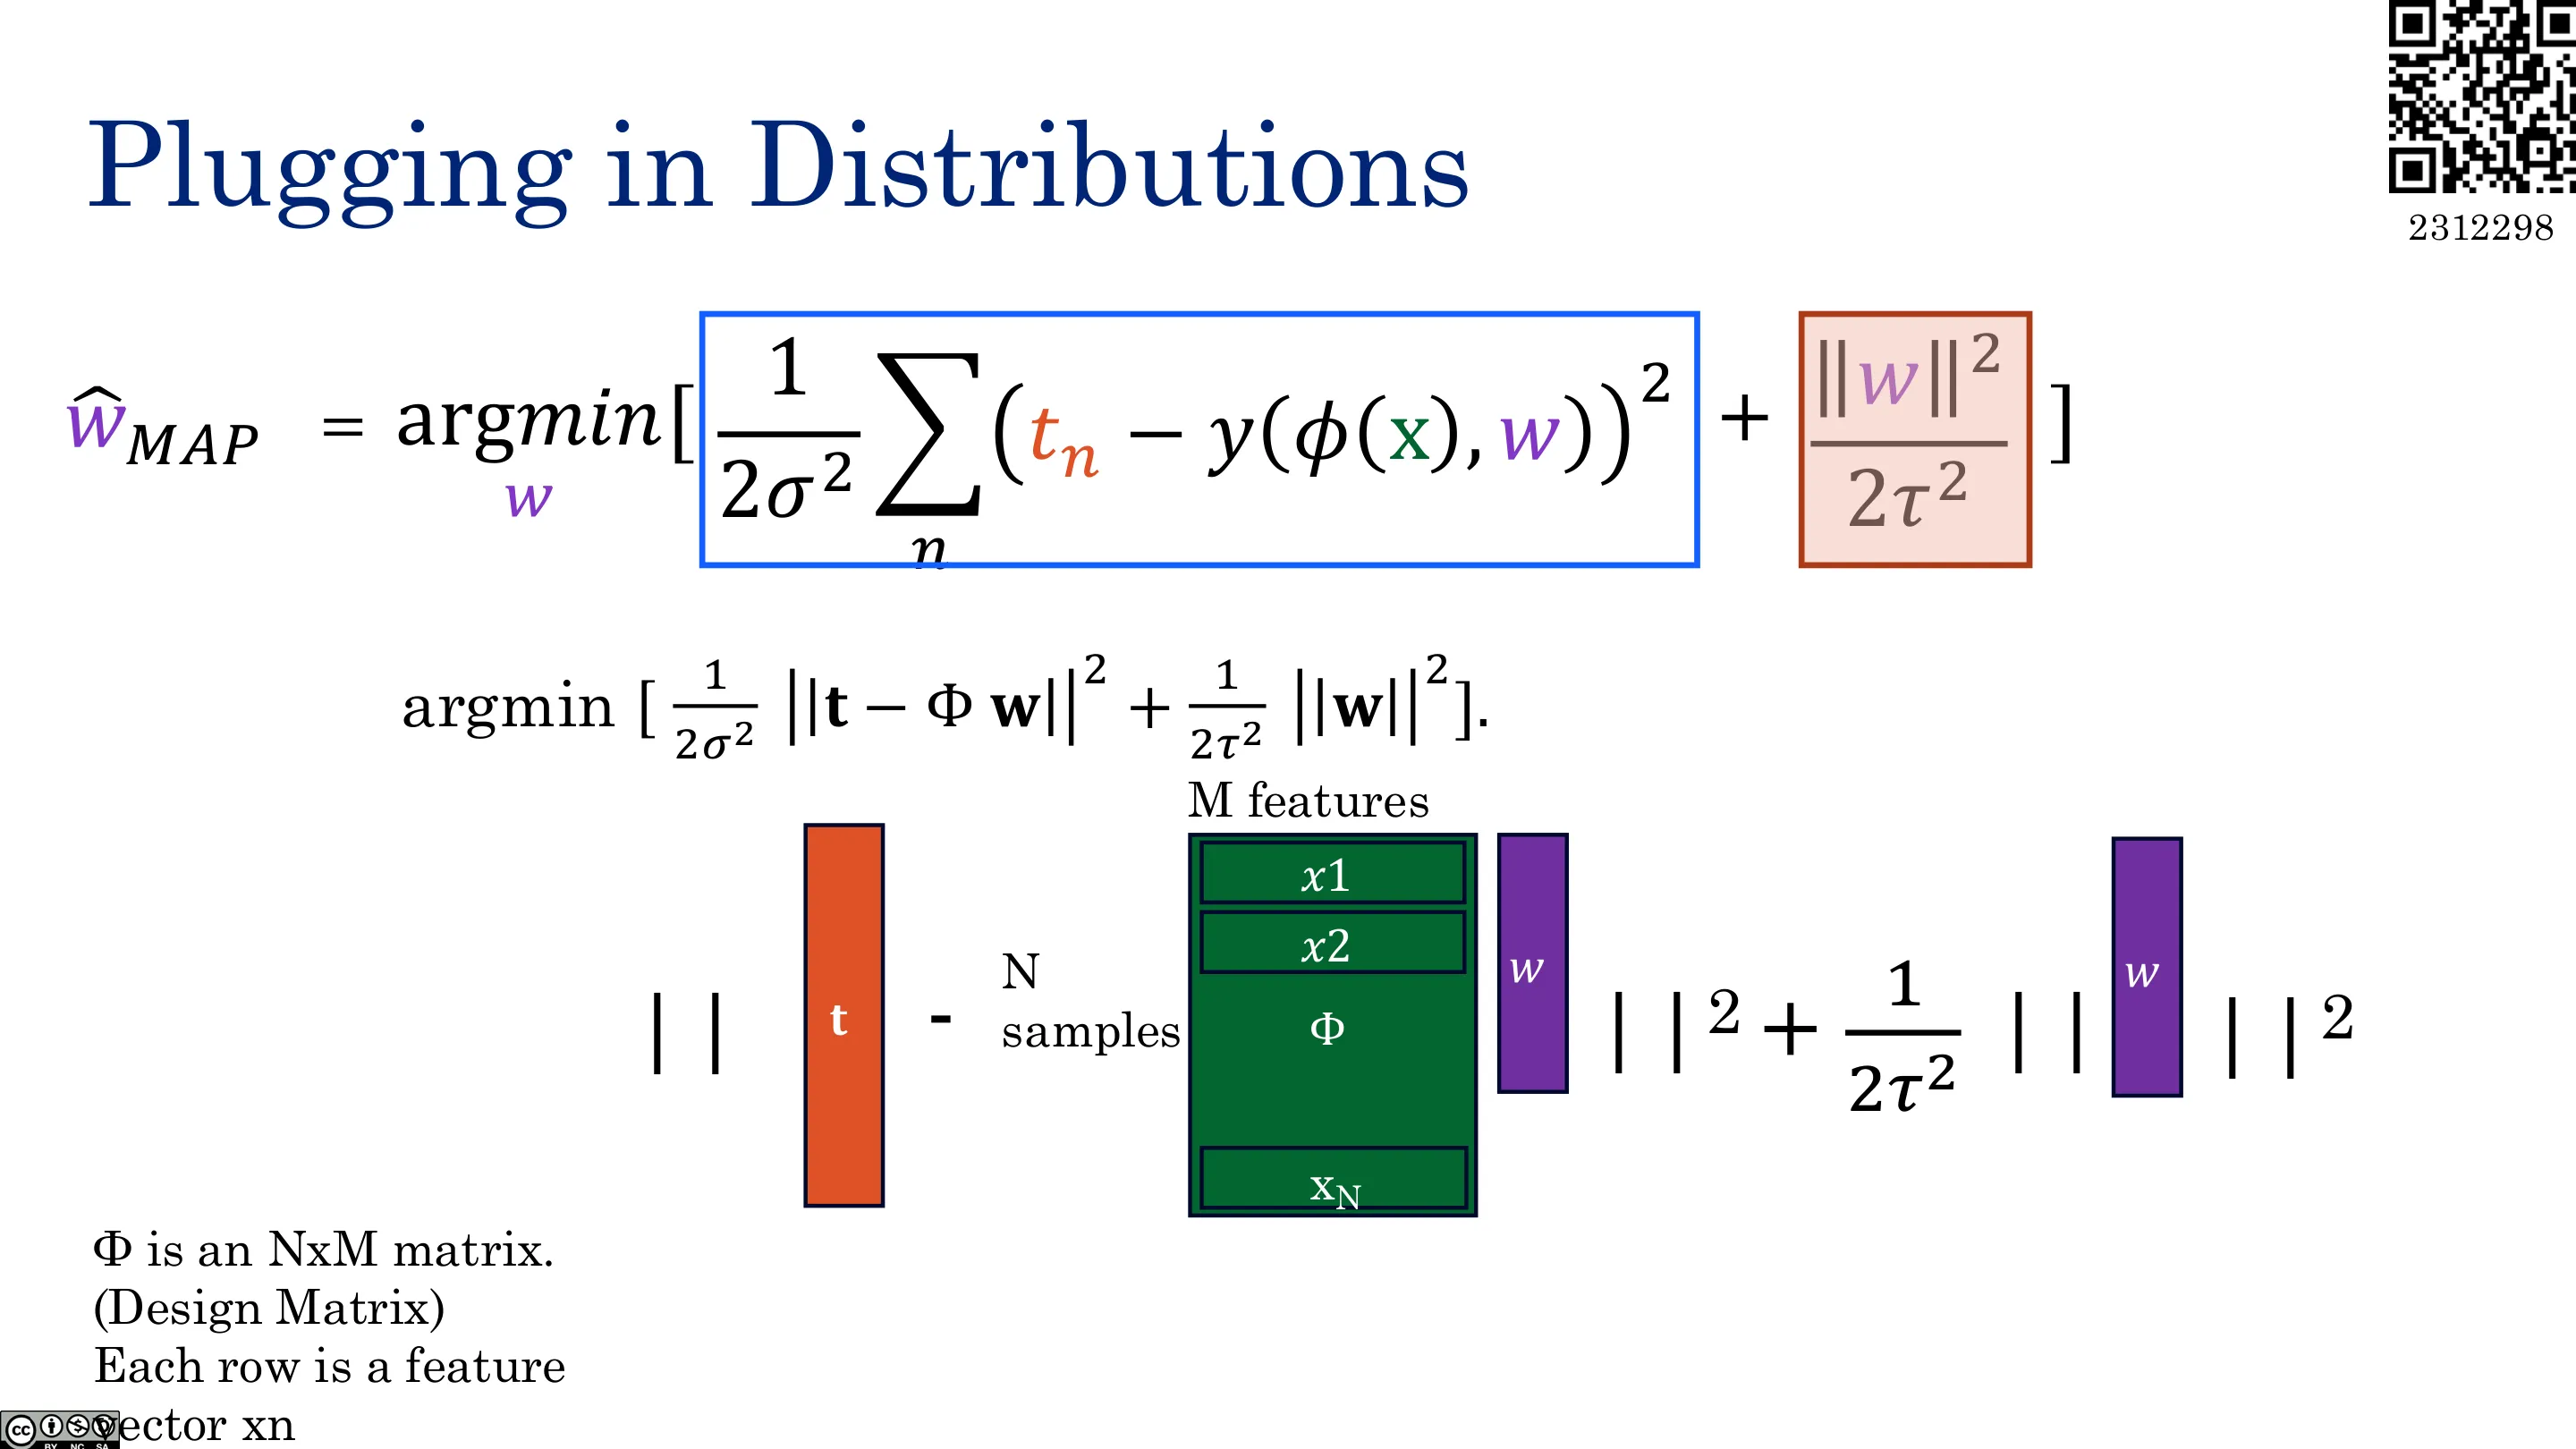
$$ -\log p(w\mid D)\ \propto\ \underbrace{\text{MSE}}_{\text{数据项(似然)}} + \lambda\lVert w\rVert^2,\qquad \lambda\propto \frac{1}{\sigma_w^2} $$
这就是 L2 正则化 / 岭回归! 数据项最小化均方误差,先验项偏好小范数;$\lambda$ 控制你多相信先验。
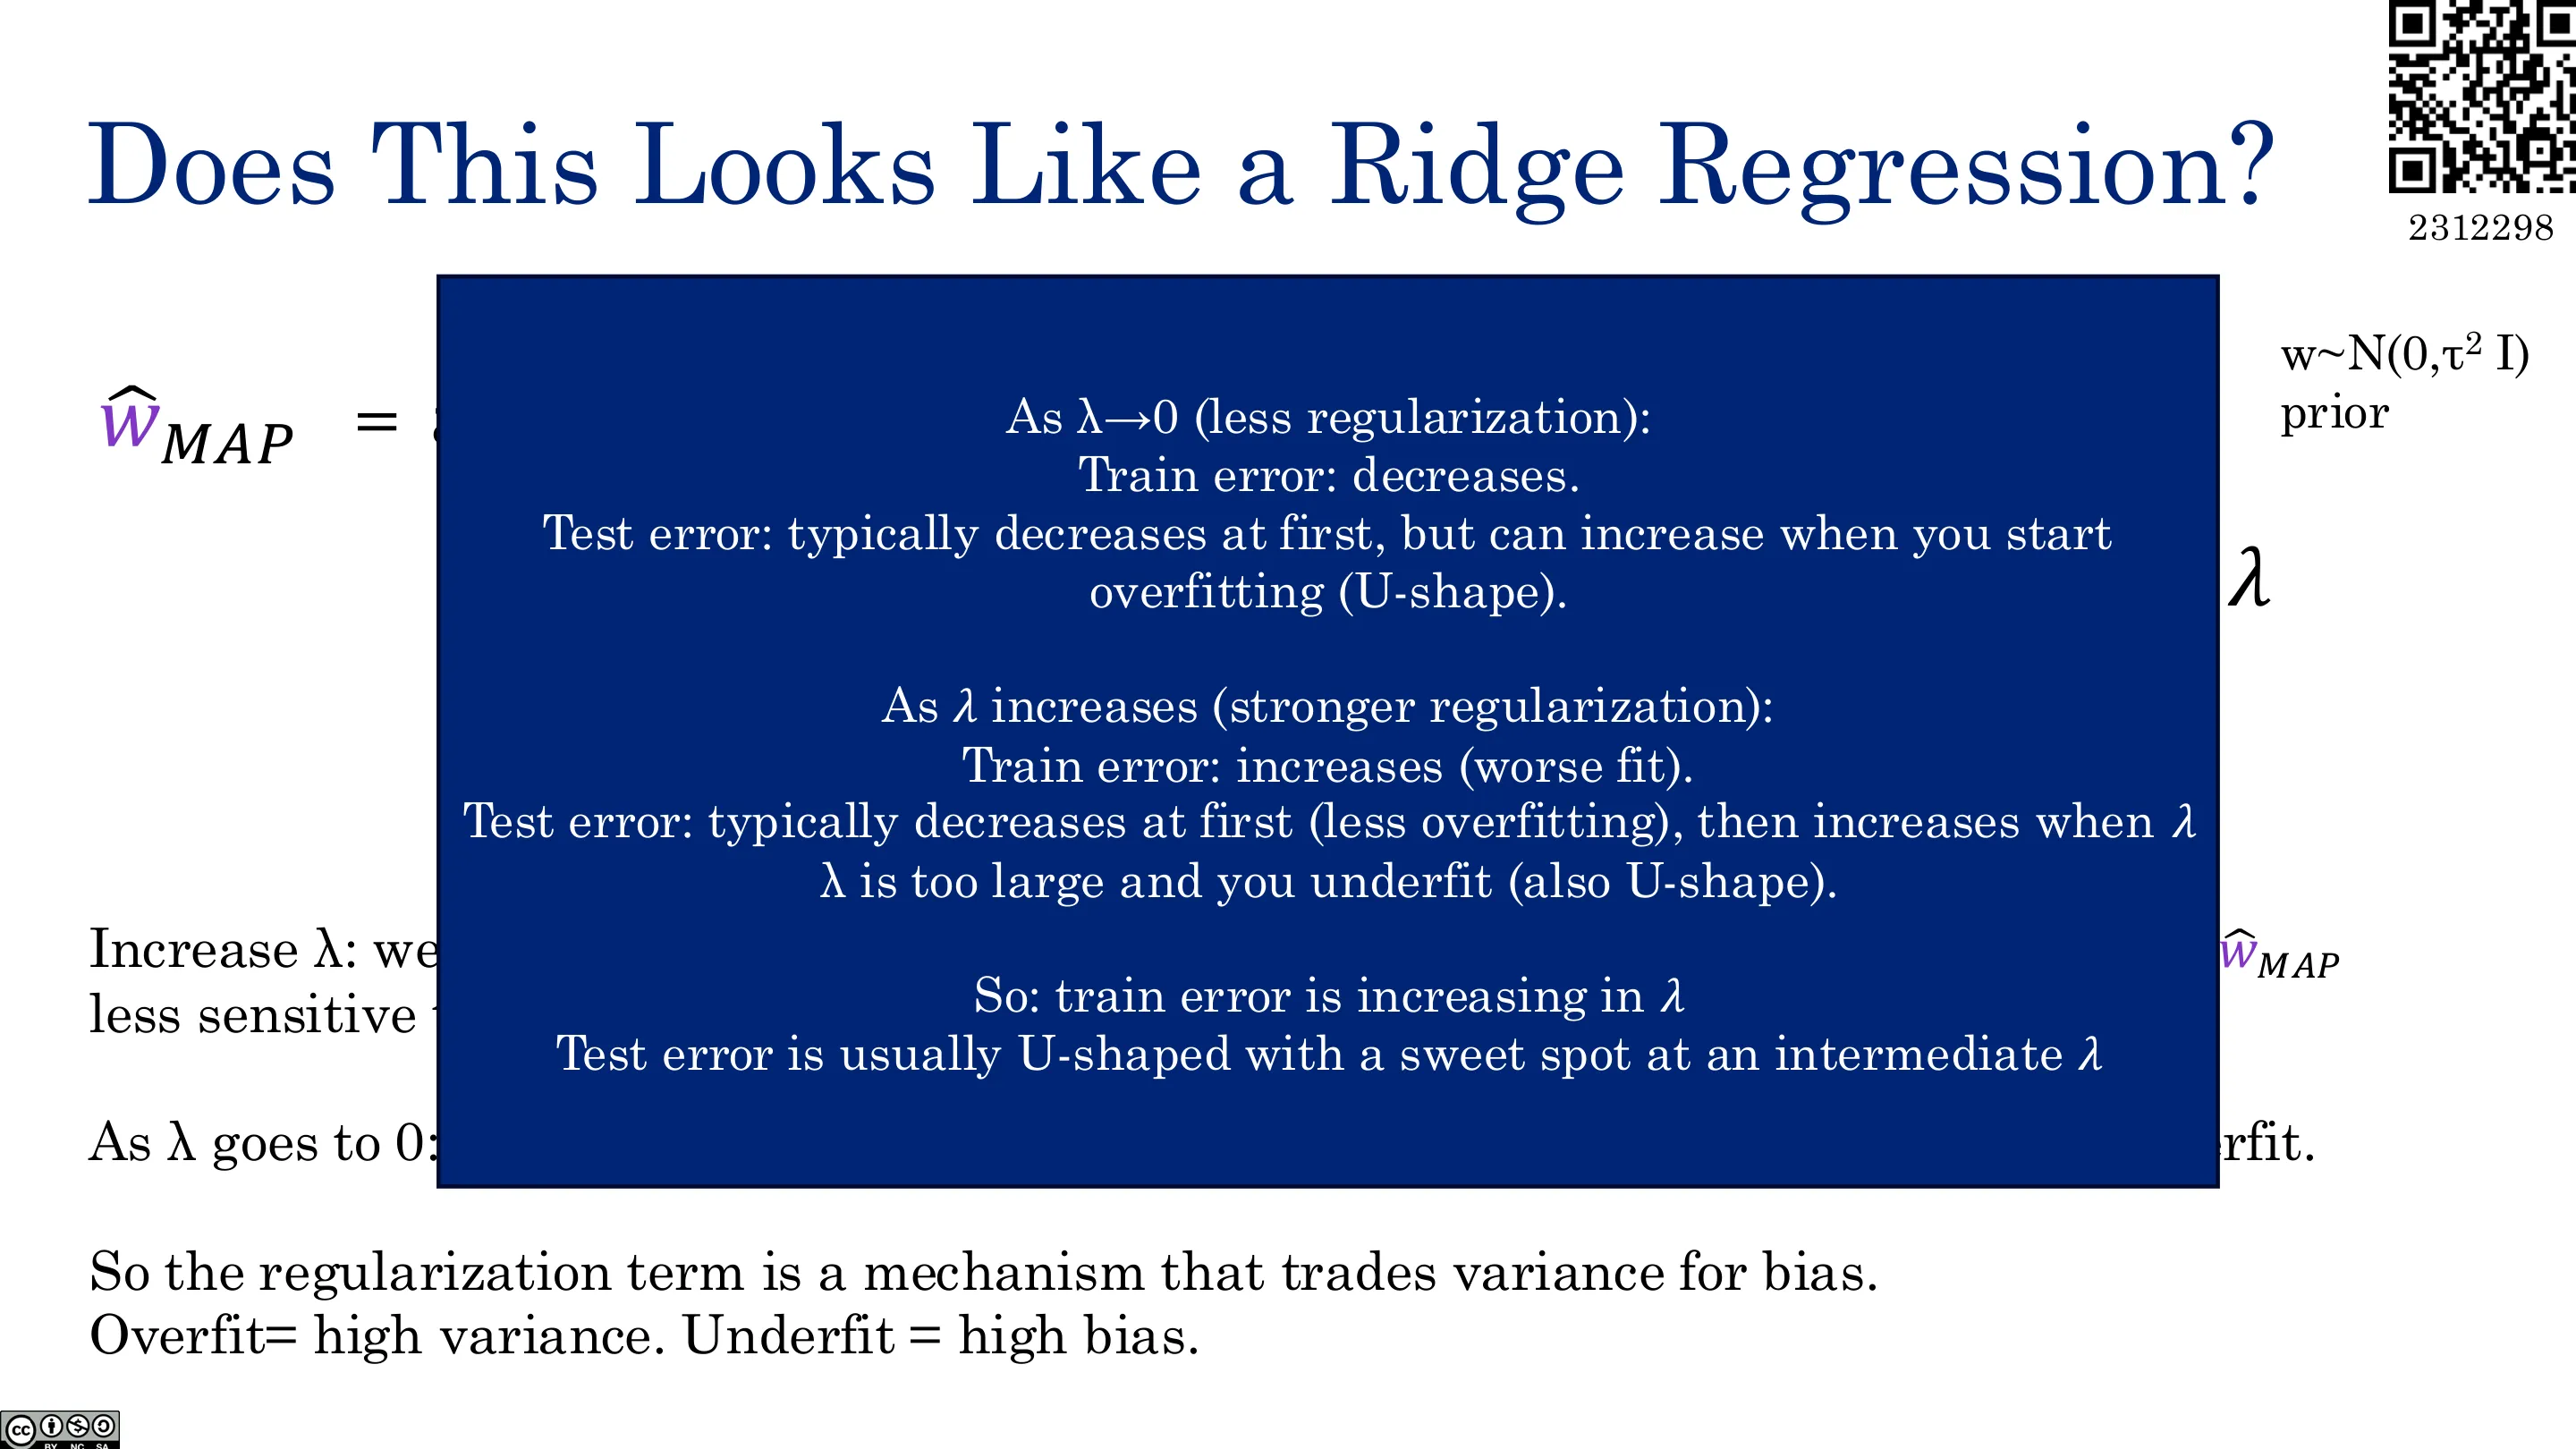
- $\lambda\to0$($\sigma_w^2\to\infty$)⇒ 无先验,退回 MLE;
- $\lambda\to\infty$($\sigma_w^2\to0$)⇒ $w\to0$,模型被极度收缩。
核心联系:「高斯噪声的线性回归 → 平方损失 = MLE」,「再加高斯先验 → 岭回归 = MAP」。
📷 从分布出发
回到原视频 (00:17:04)
📷 机器学习中的根本挑战(一)
回到原视频 (00:18:14)
📷 机器学习中的根本挑战(二)
回到原视频 (00:19:24)
📷 偏差
回到原视频 (00:20:34)
📷 噪声
回到原视频 (00:21:44)
📷 模型方差
回到原视频 (00:22:54)
📷 平方误差分析(一)
回到原视频 (00:24:04)
📷 平方误差分析(二)
回到原视频 (00:25:14)
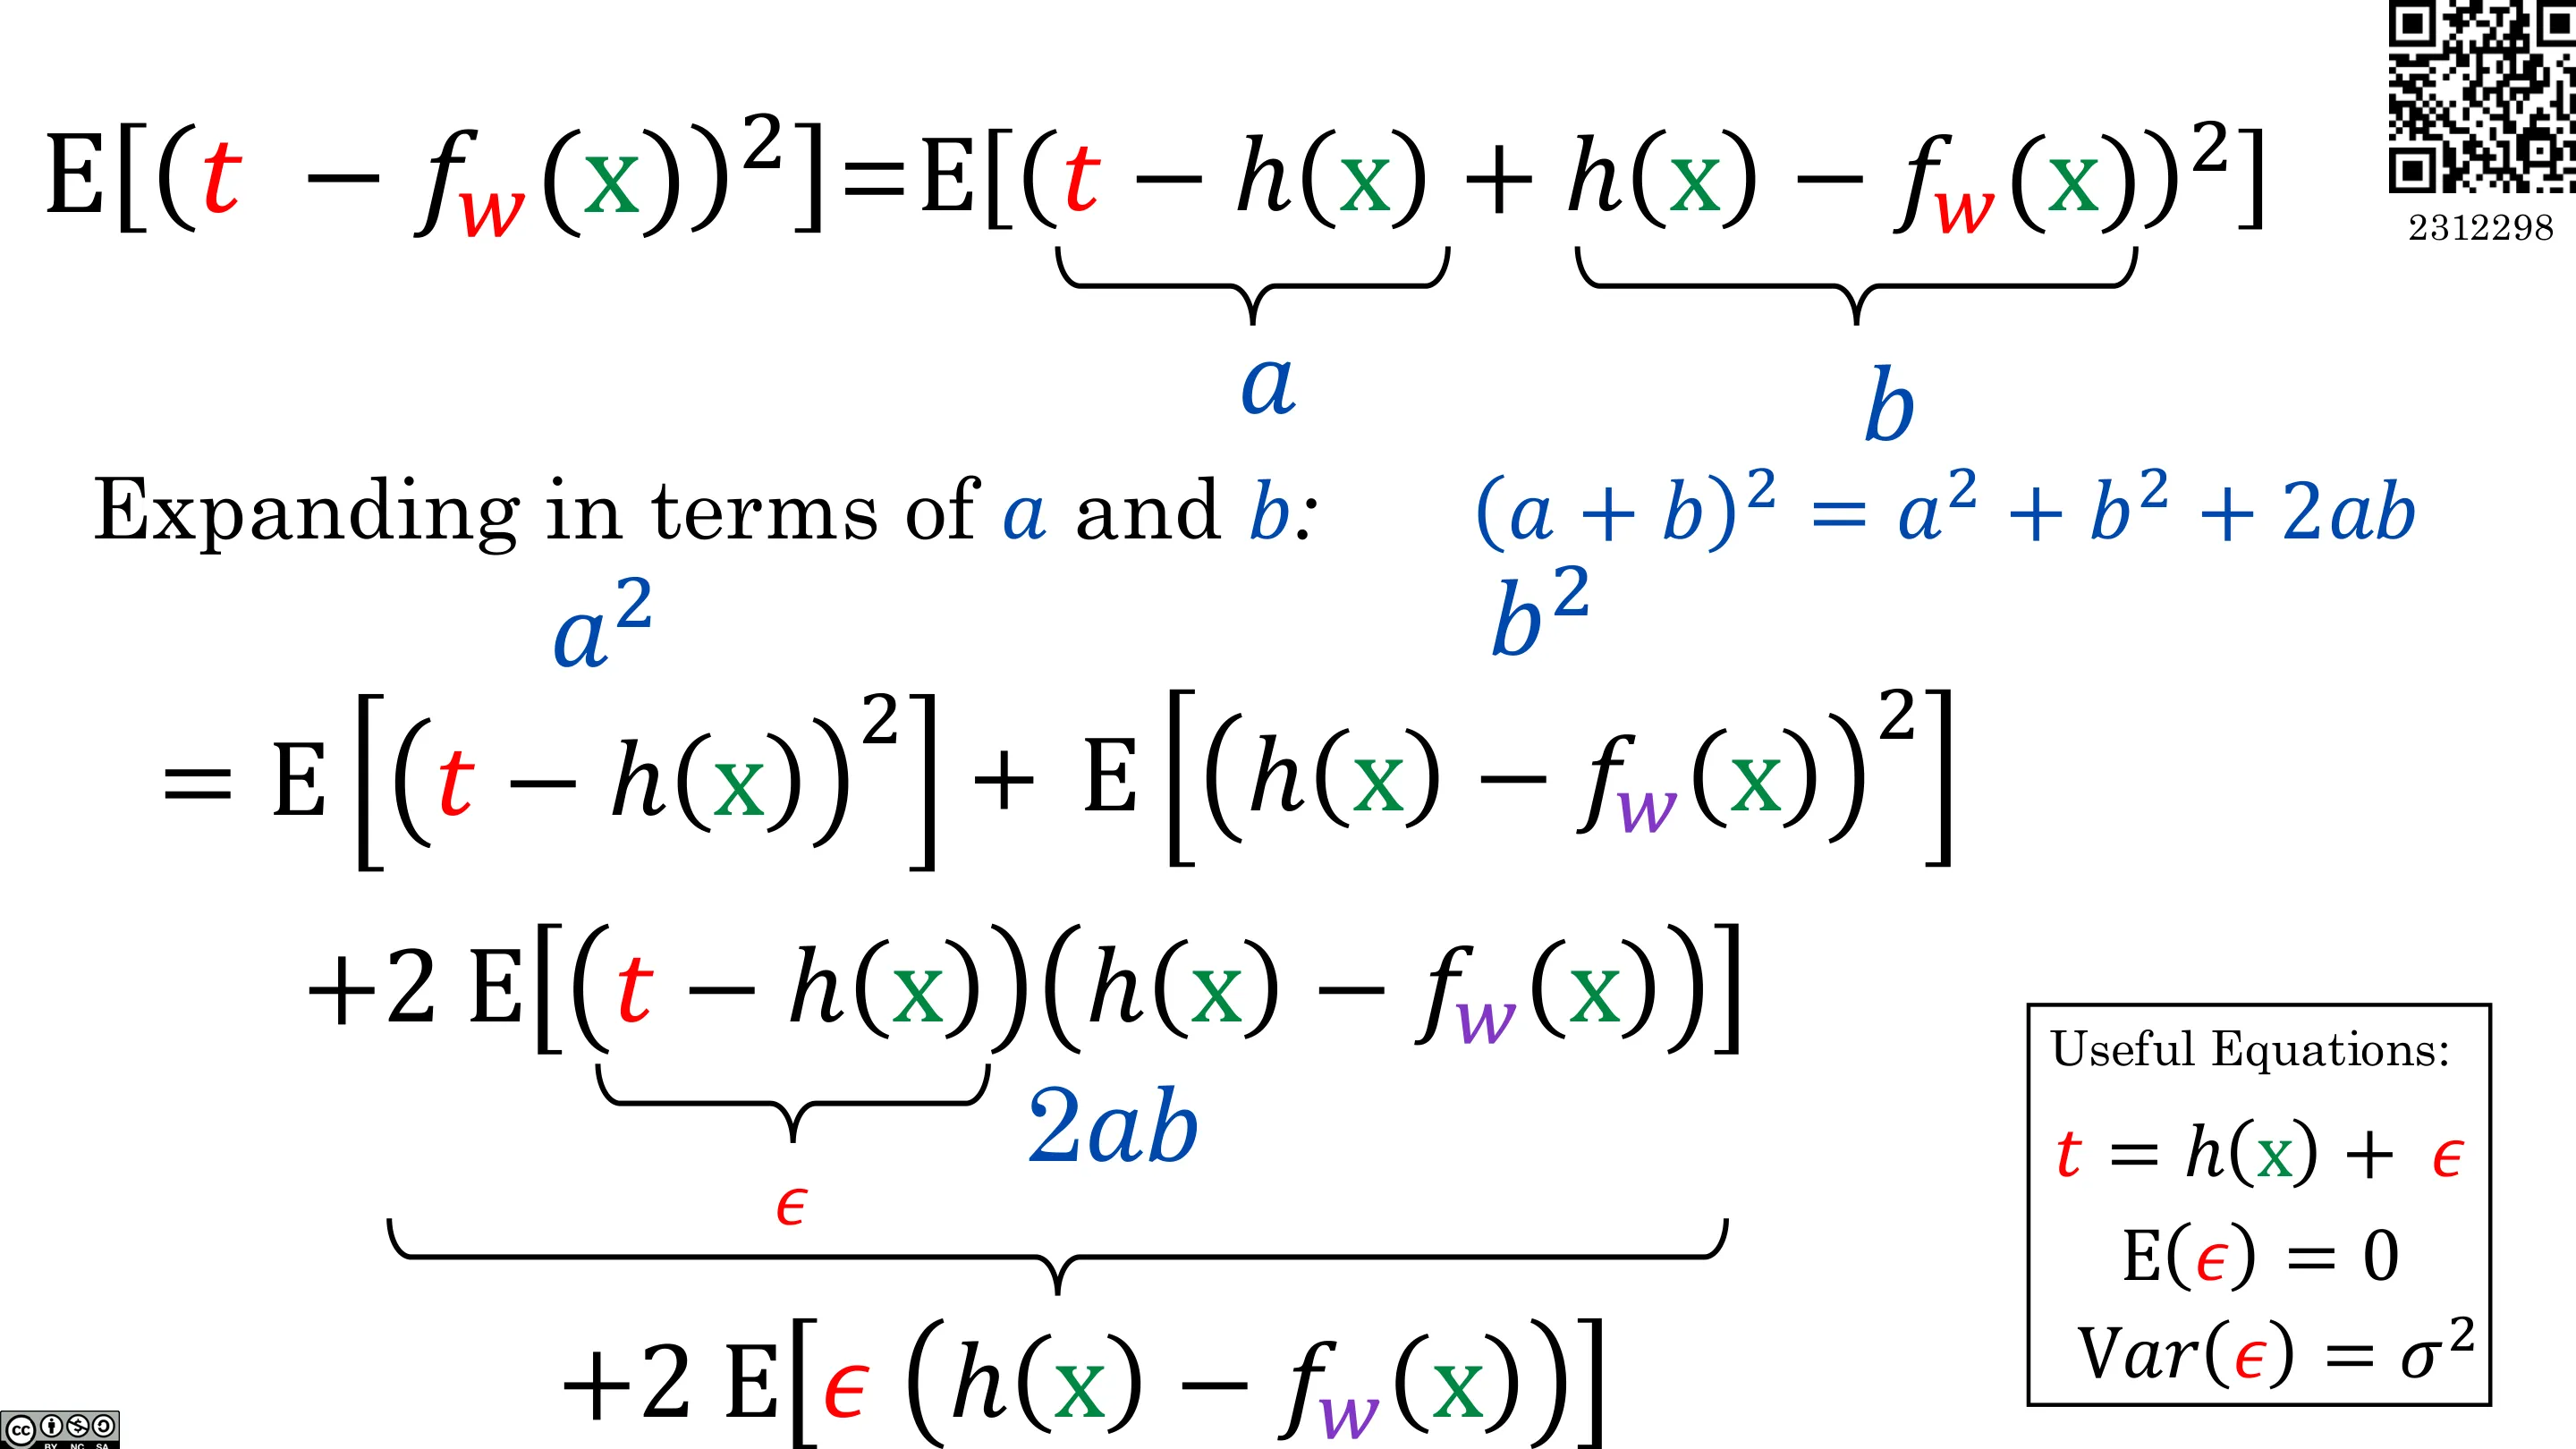
📷 分解(一)
回到原视频 (00:26:24)
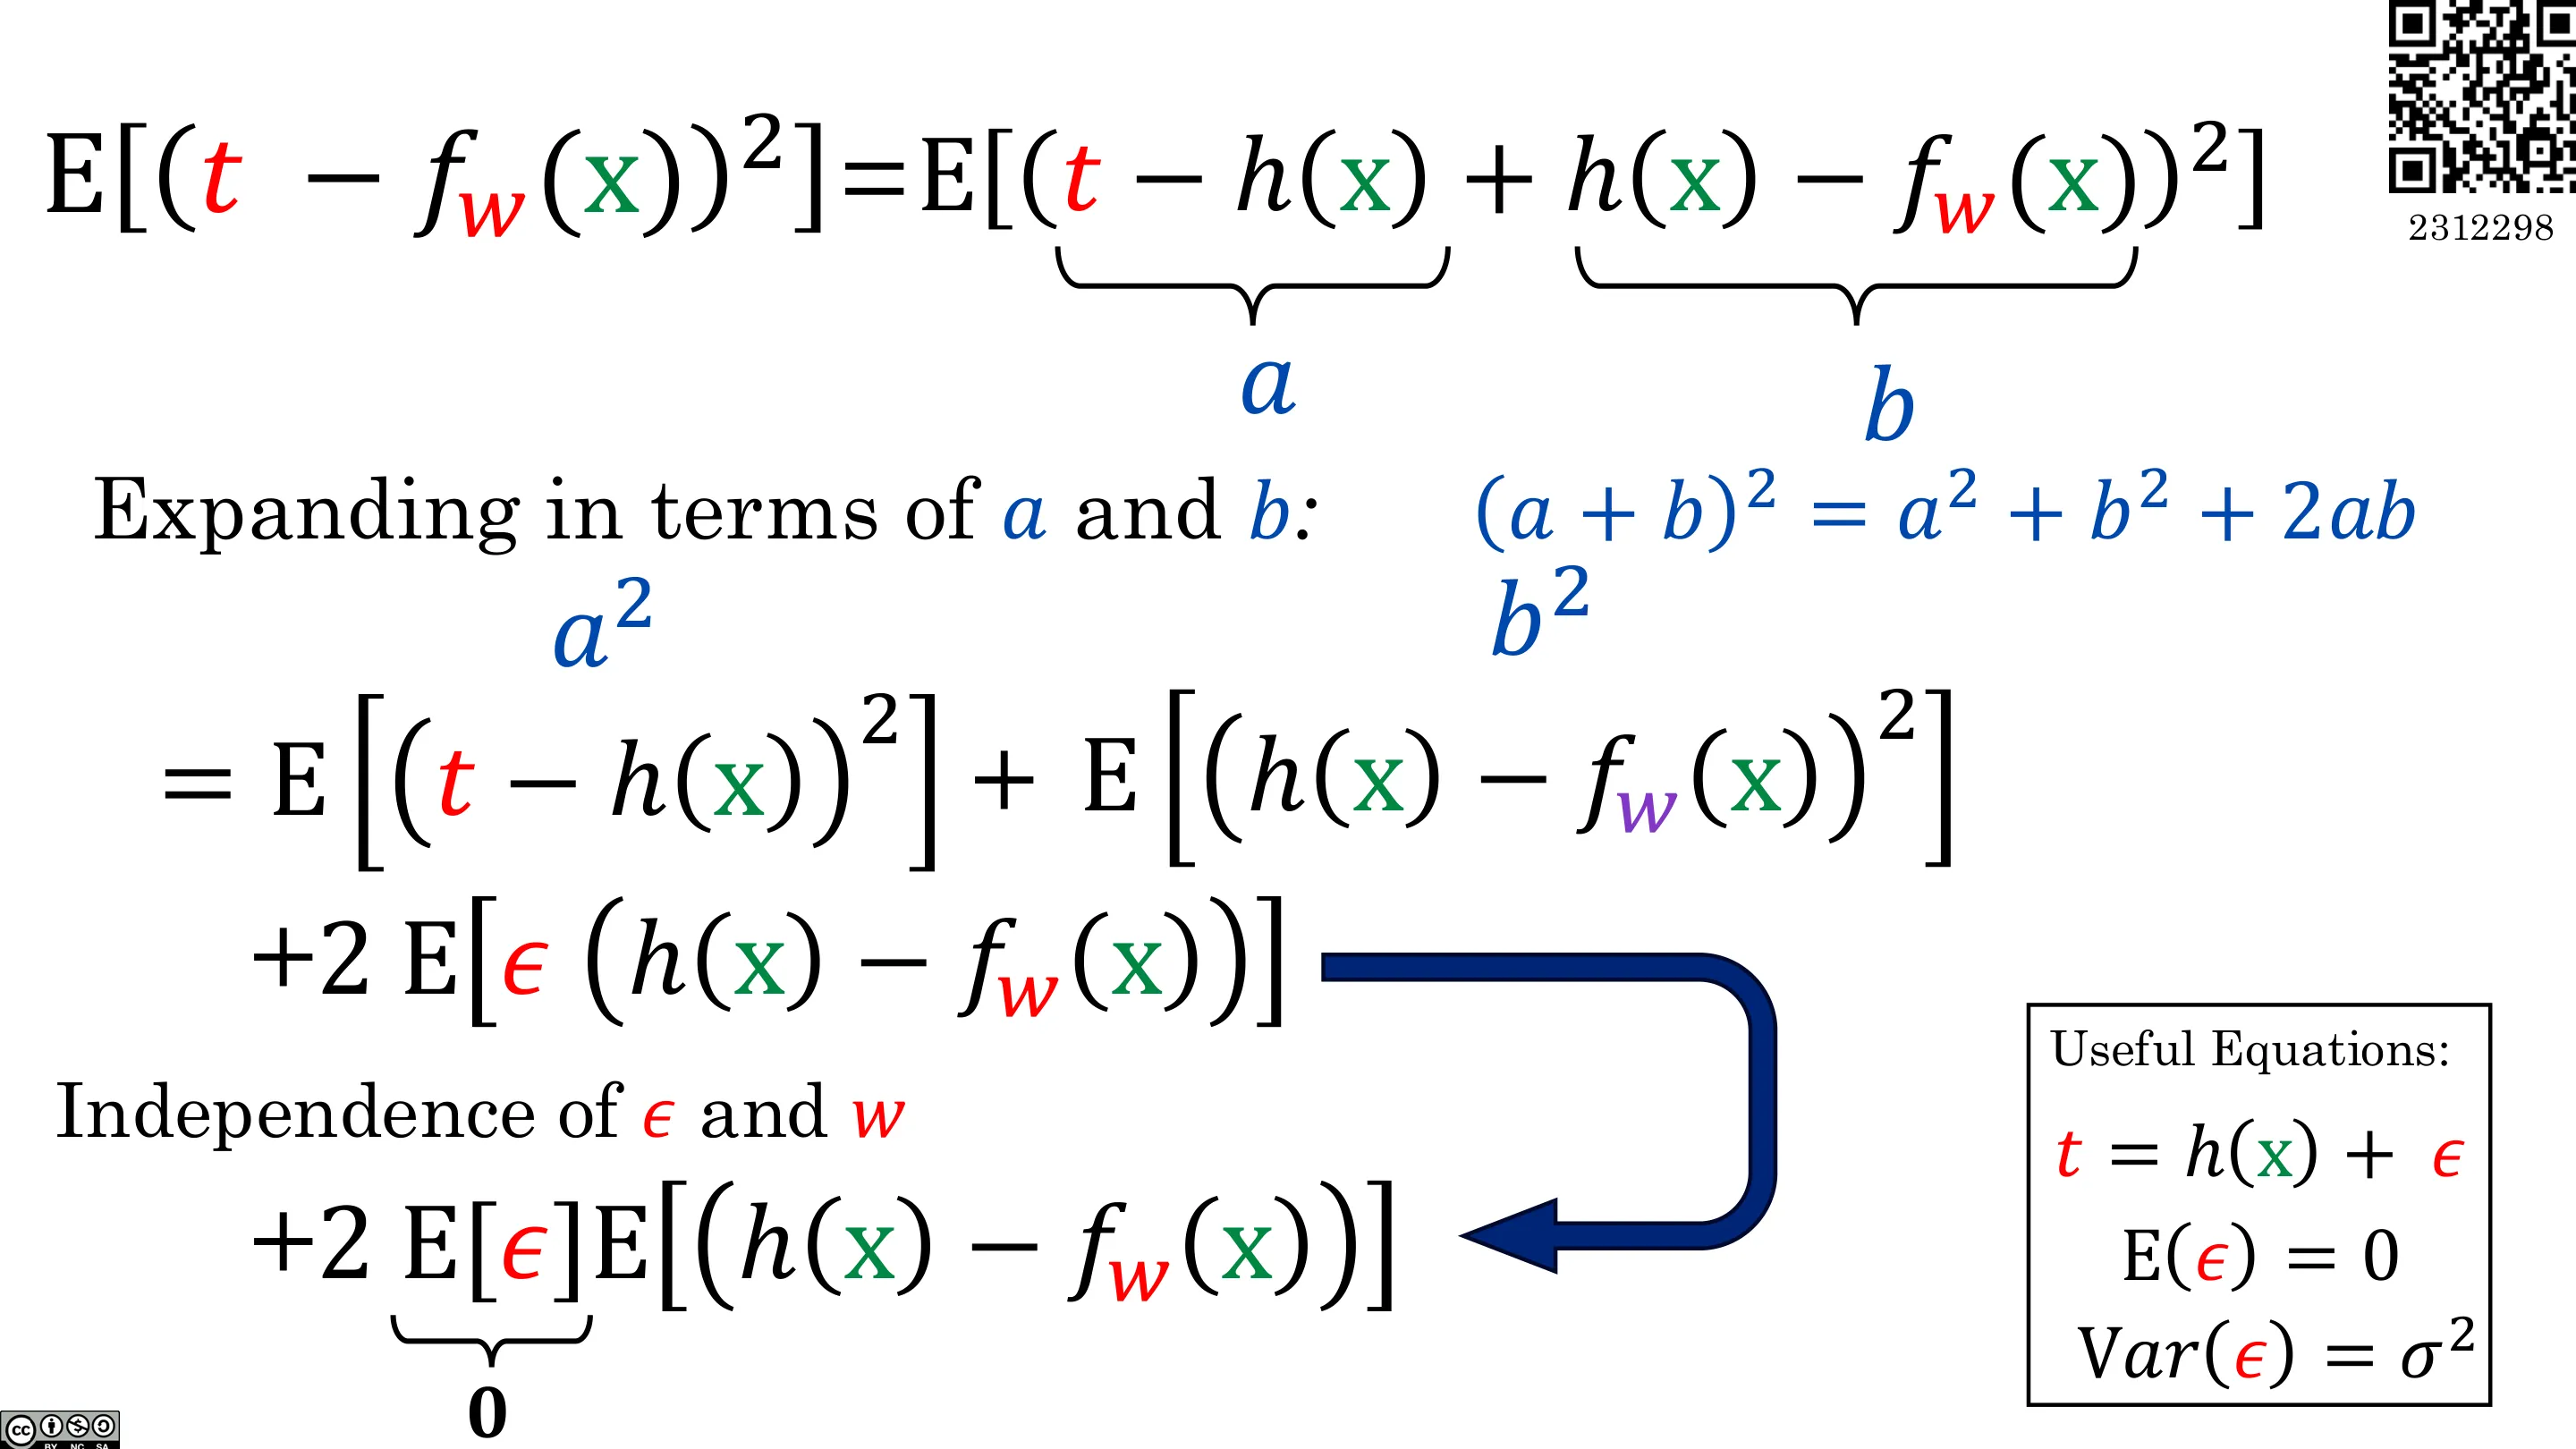
📷 分解(二)
回到原视频 (00:27:34)
📷 有用的恒等式(一)
回到原视频 (00:28:44)
📷 有用的恒等式(二)
回到原视频 (00:29:54)
📷 有用的恒等式(三)
回到原视频 (00:31:04)
📷 期望(一)
回到原视频 (00:32:14)
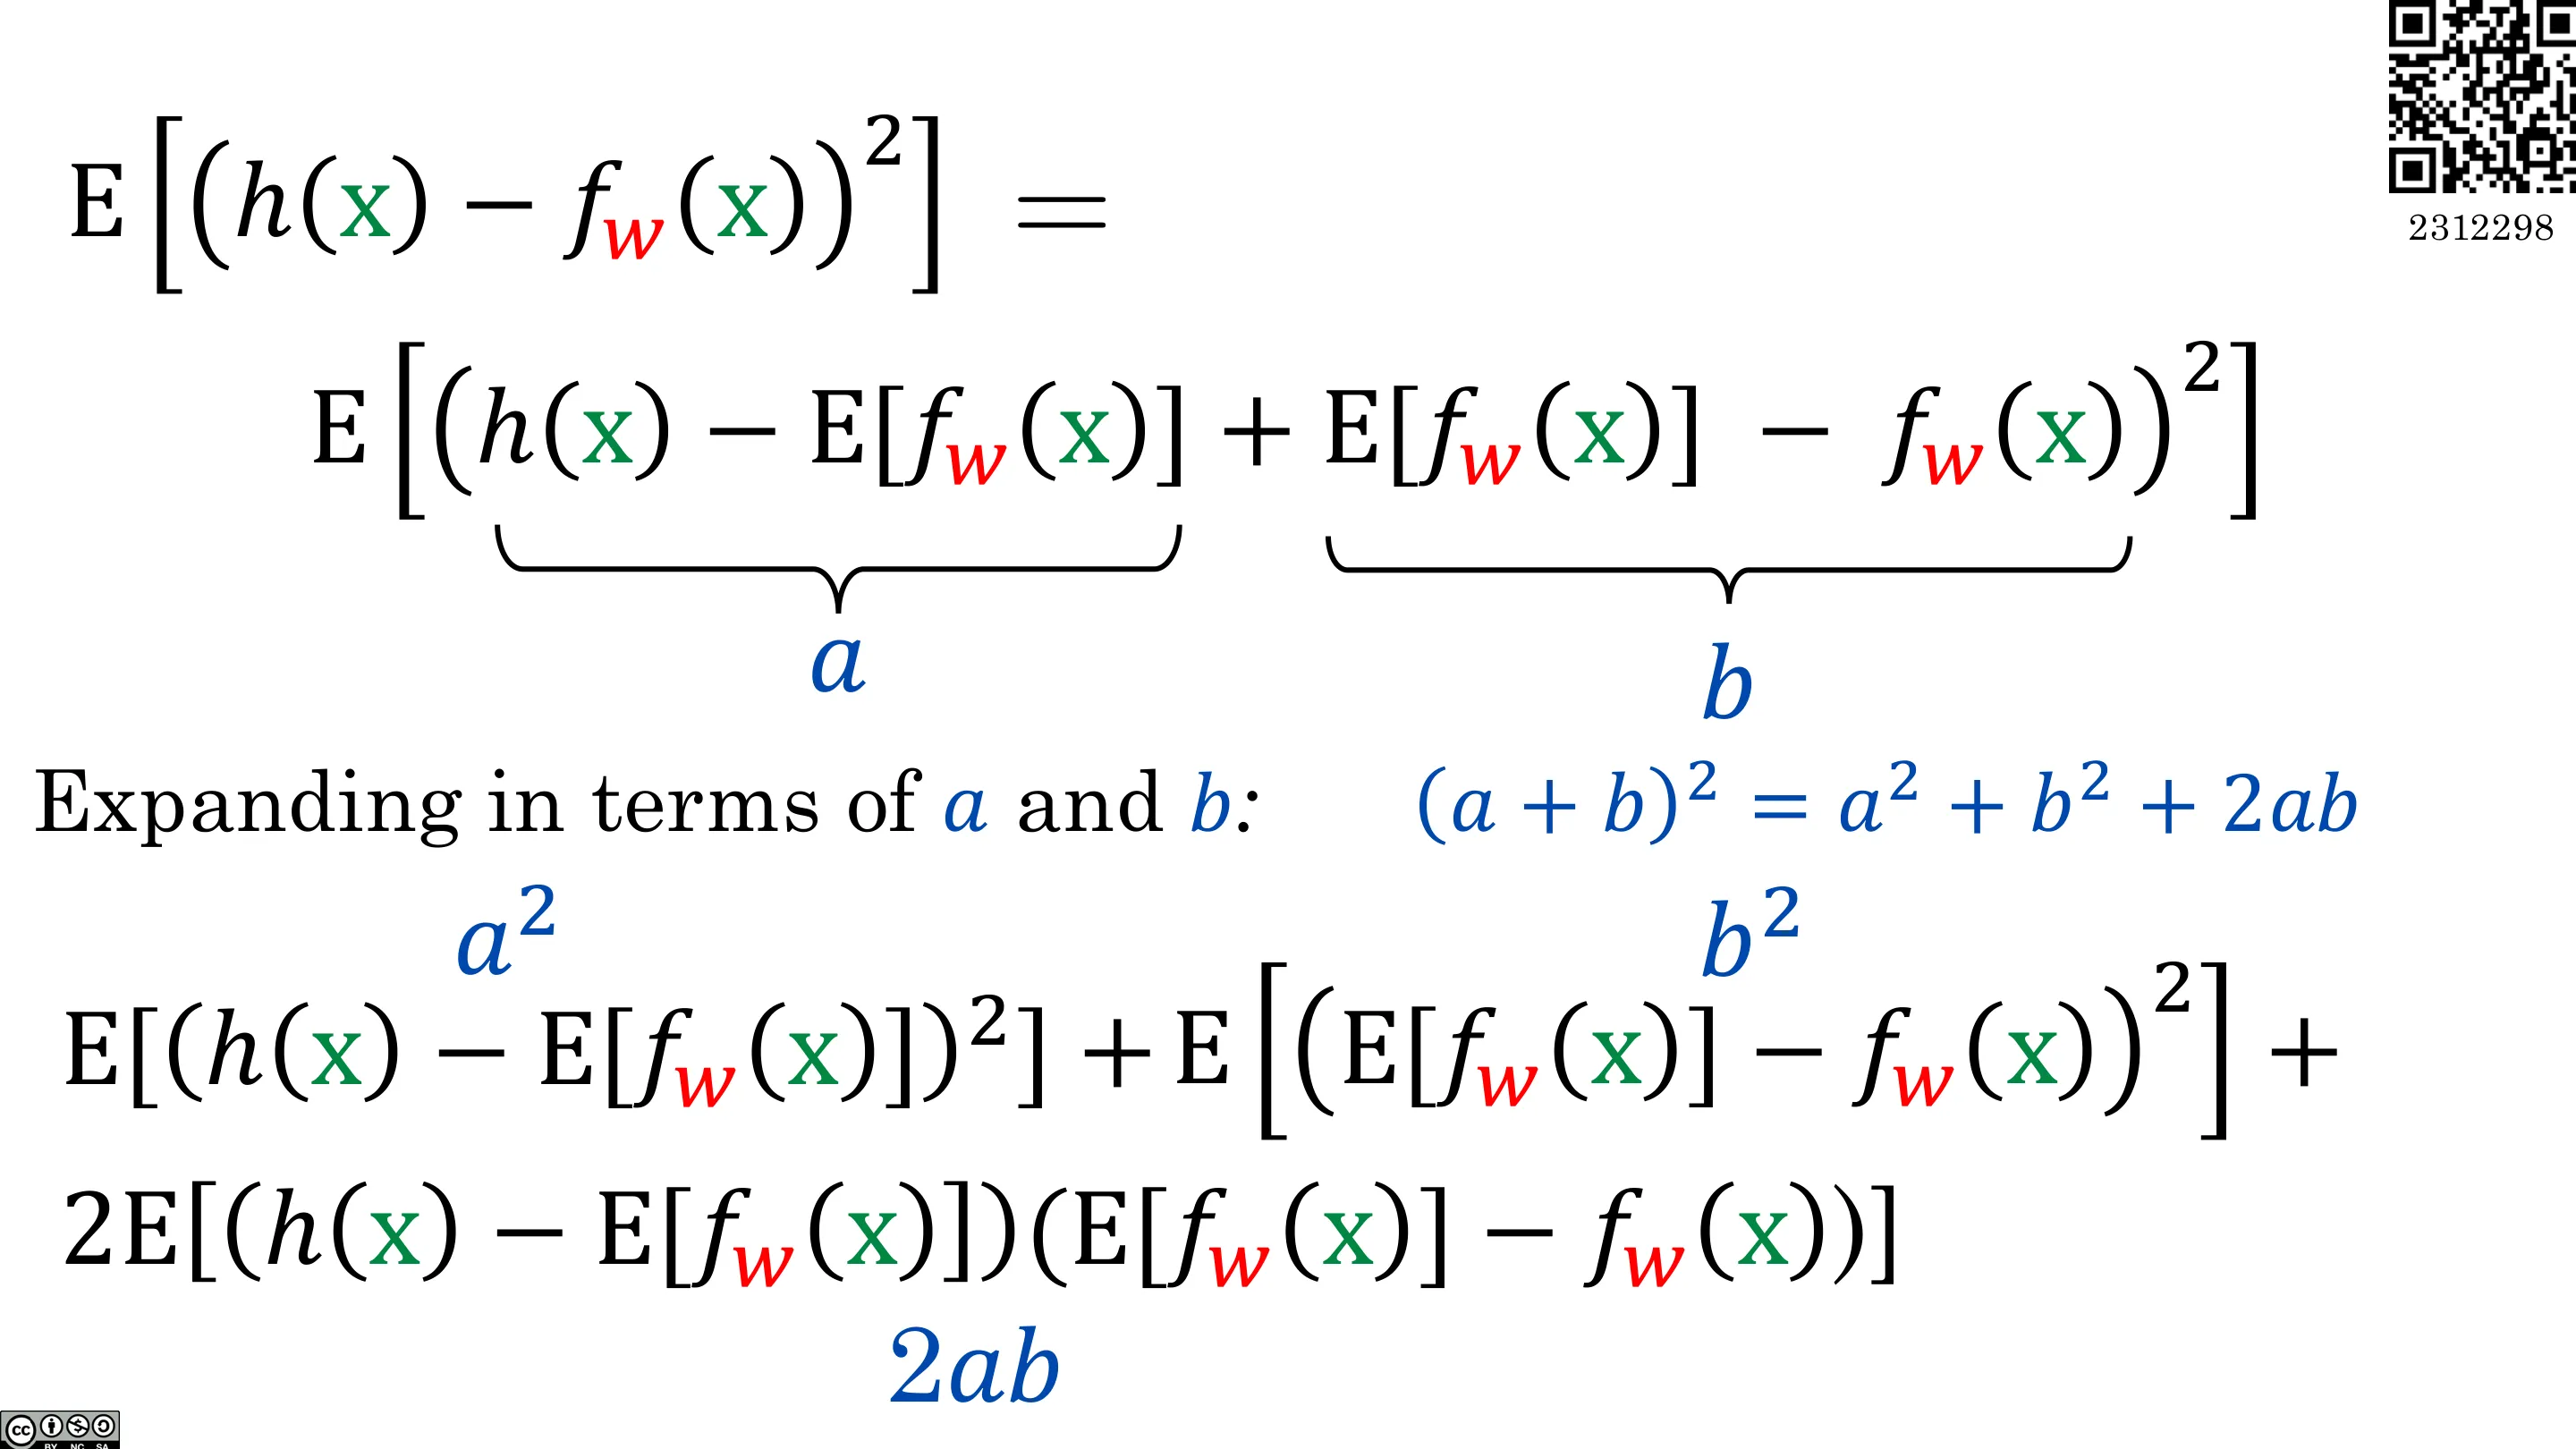
📷 期望(二)
回到原视频 (00:33:24)
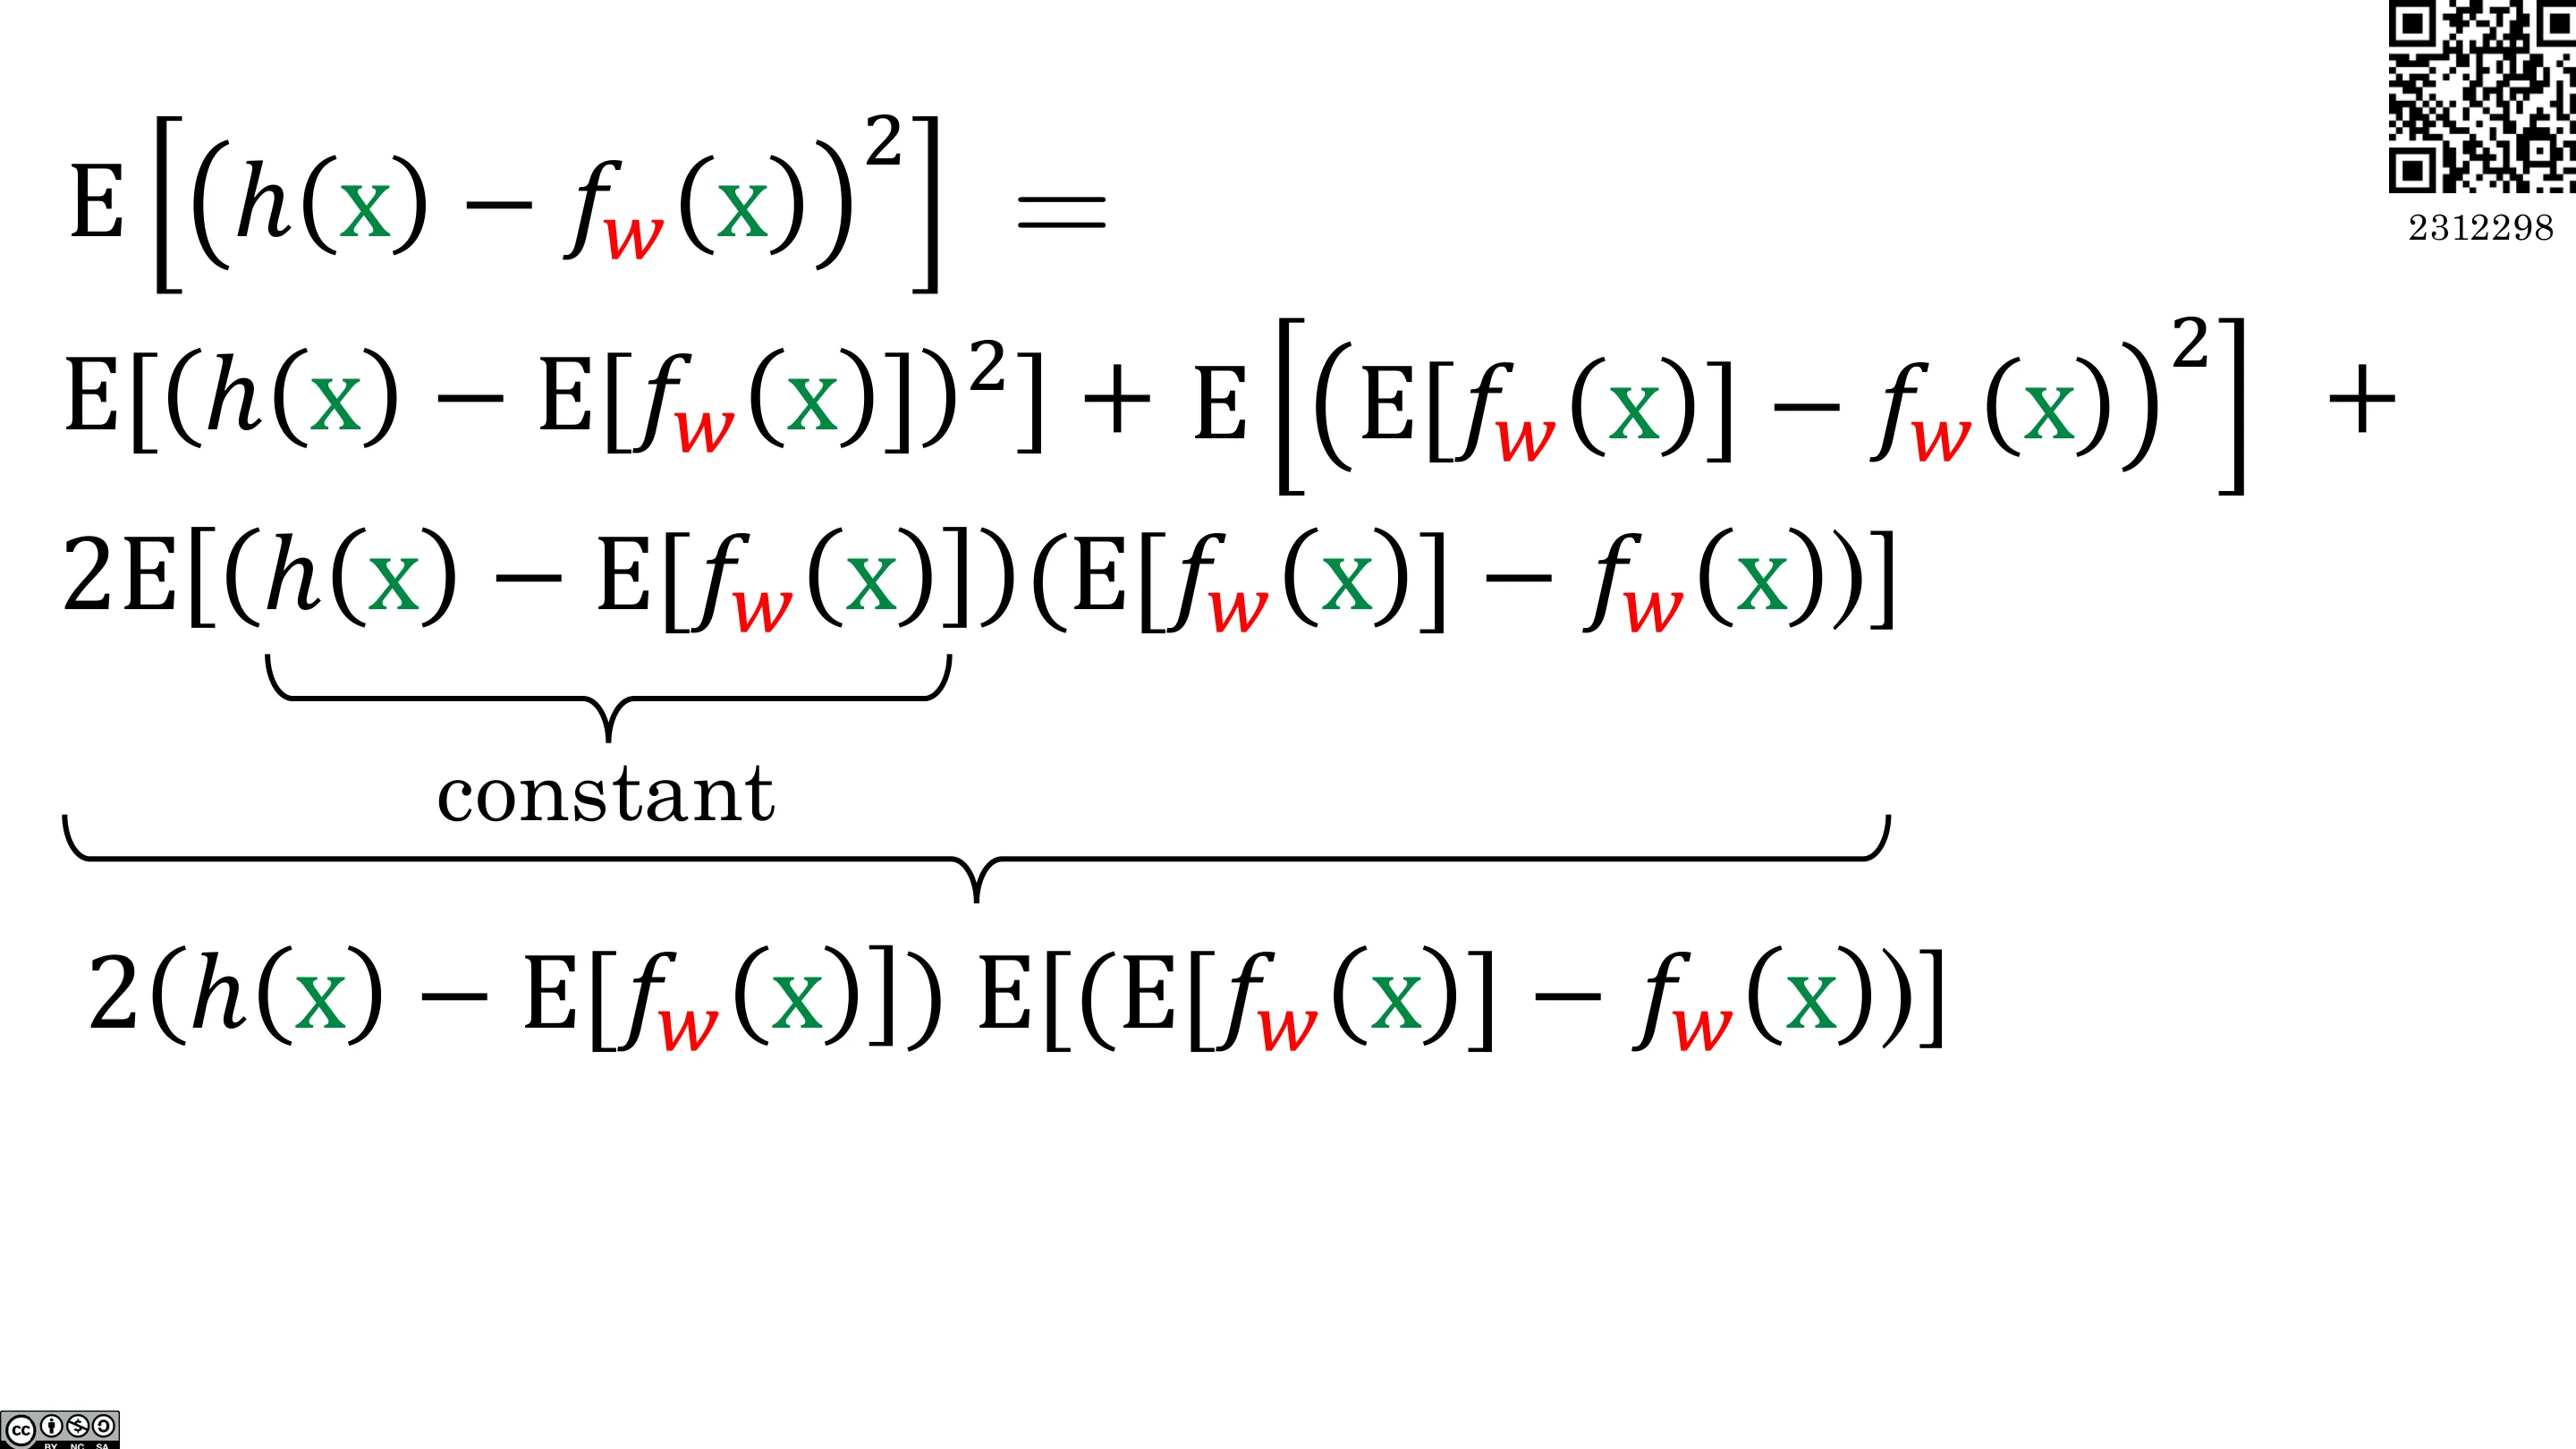
📷 期望(三)
回到原视频 (00:34:34)
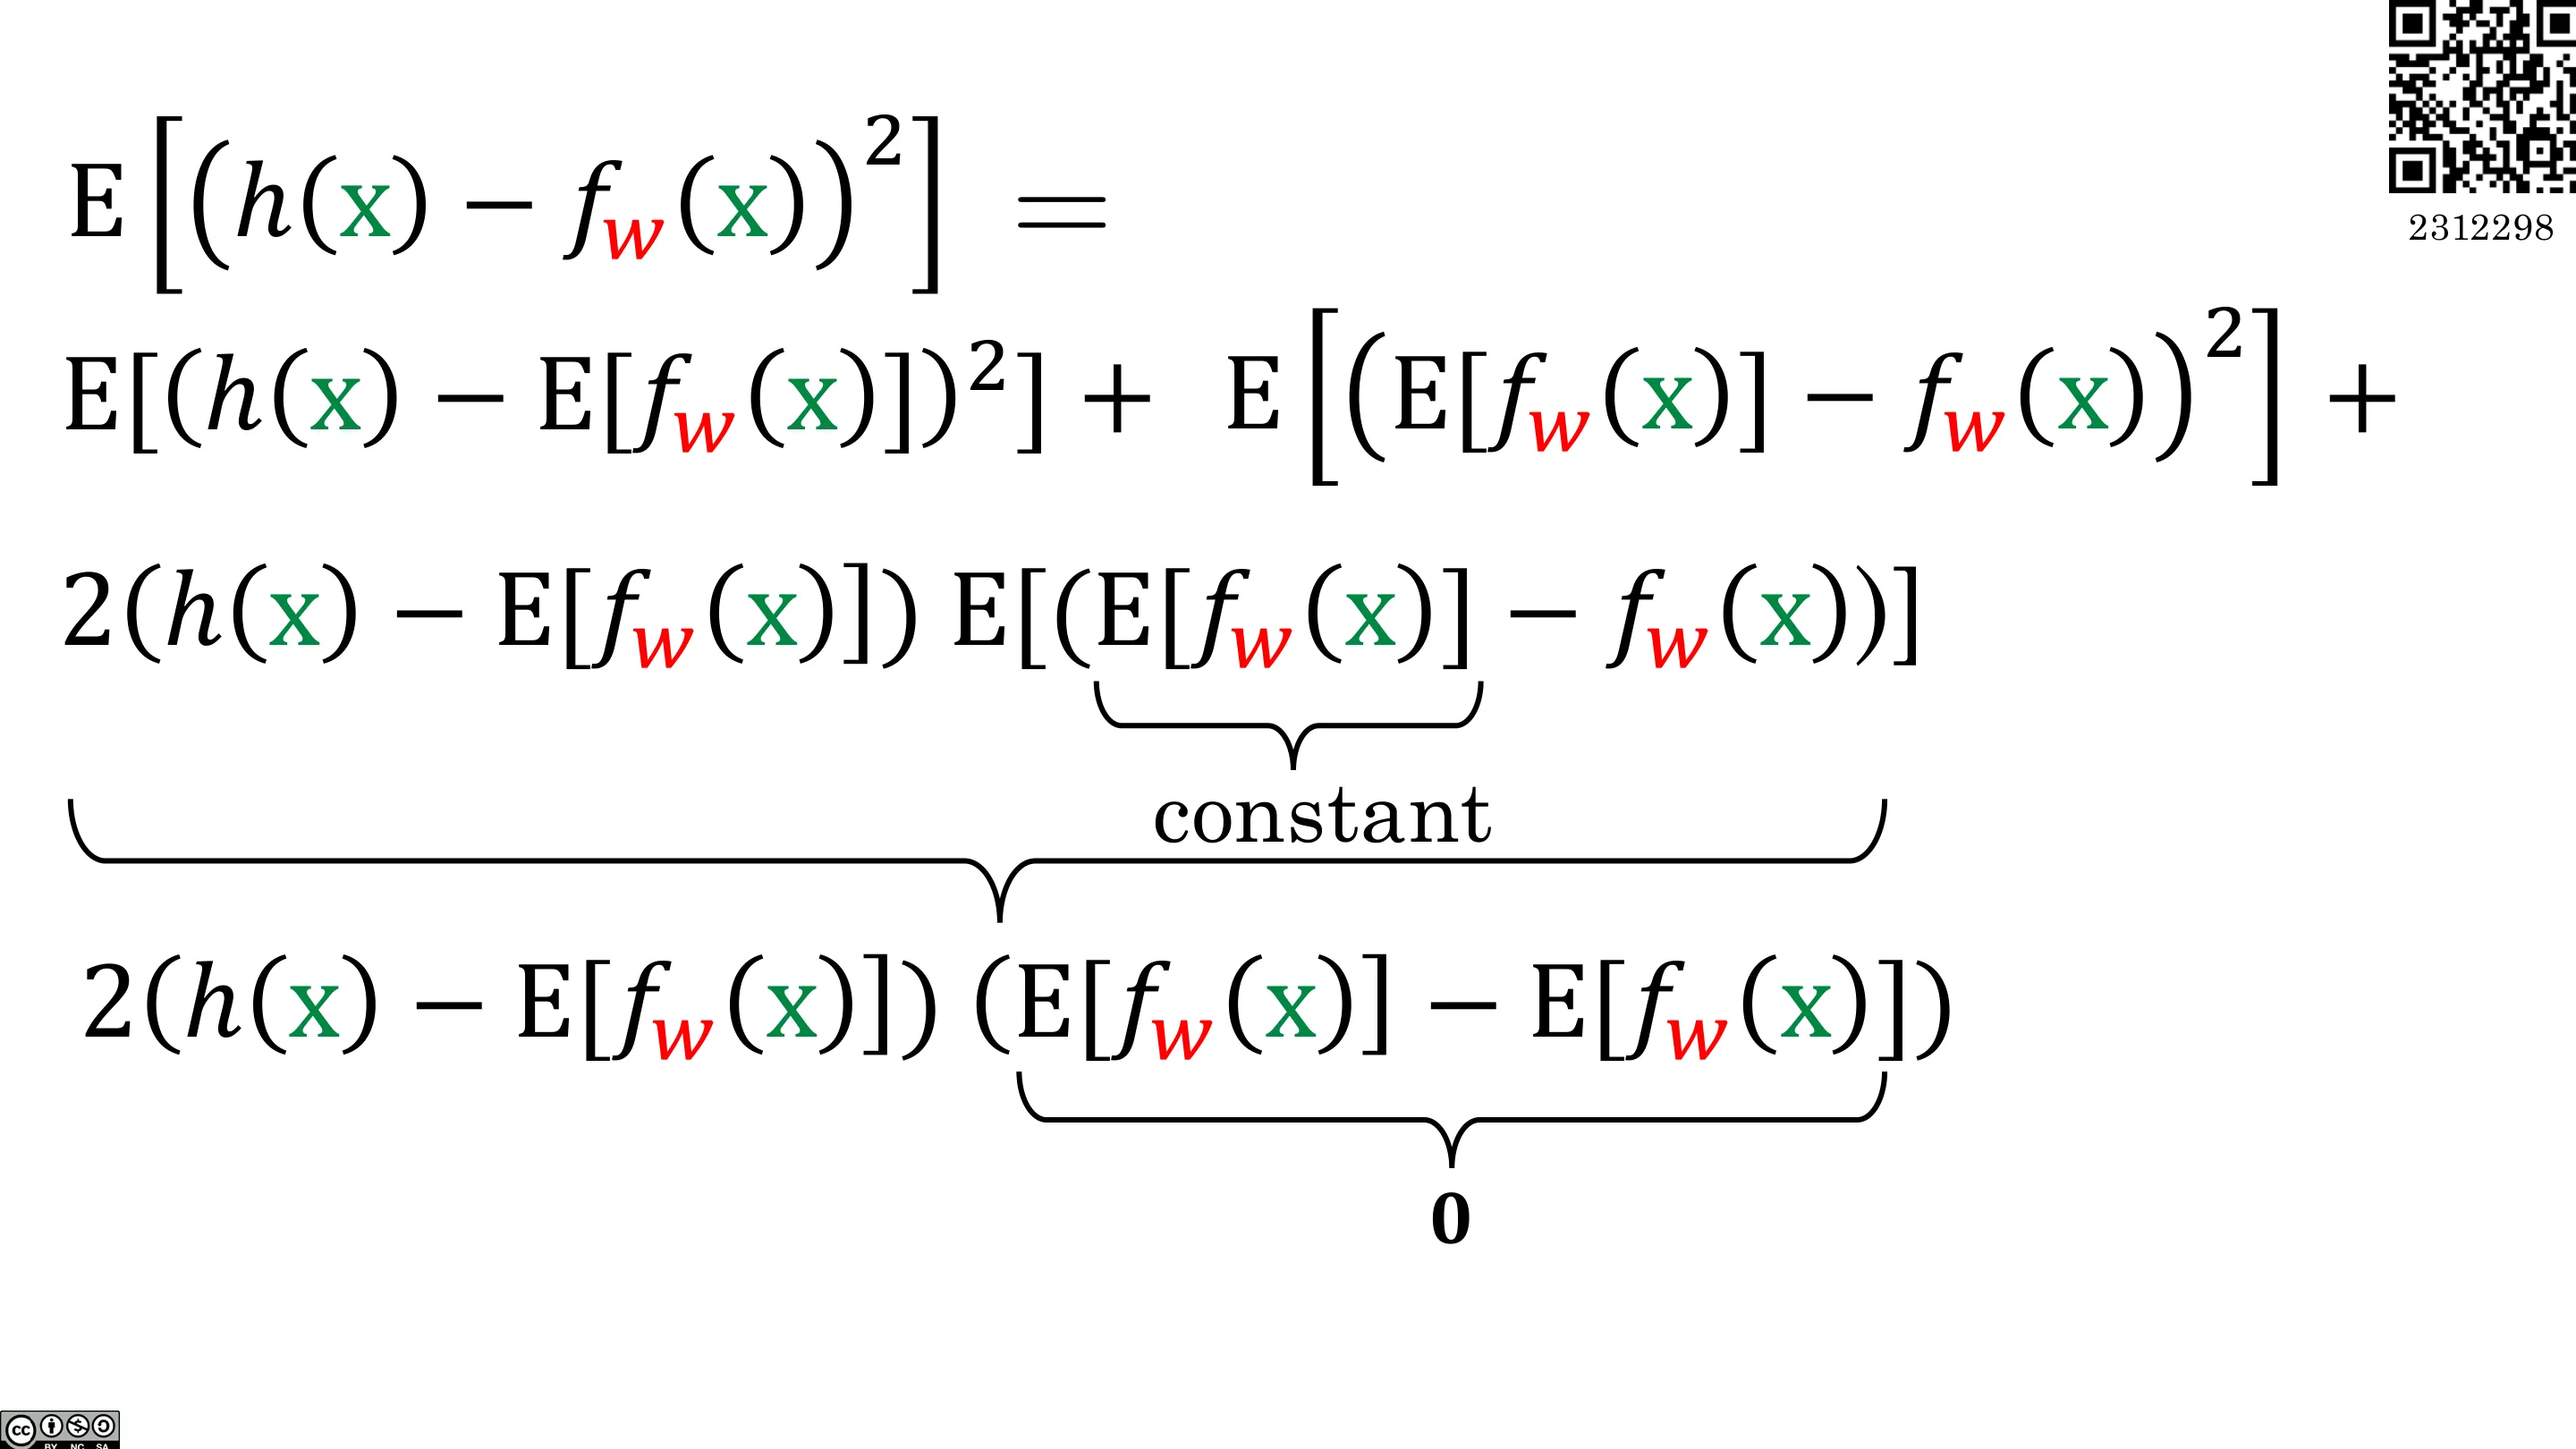
📷 期望(四)
回到原视频 (00:35:44)
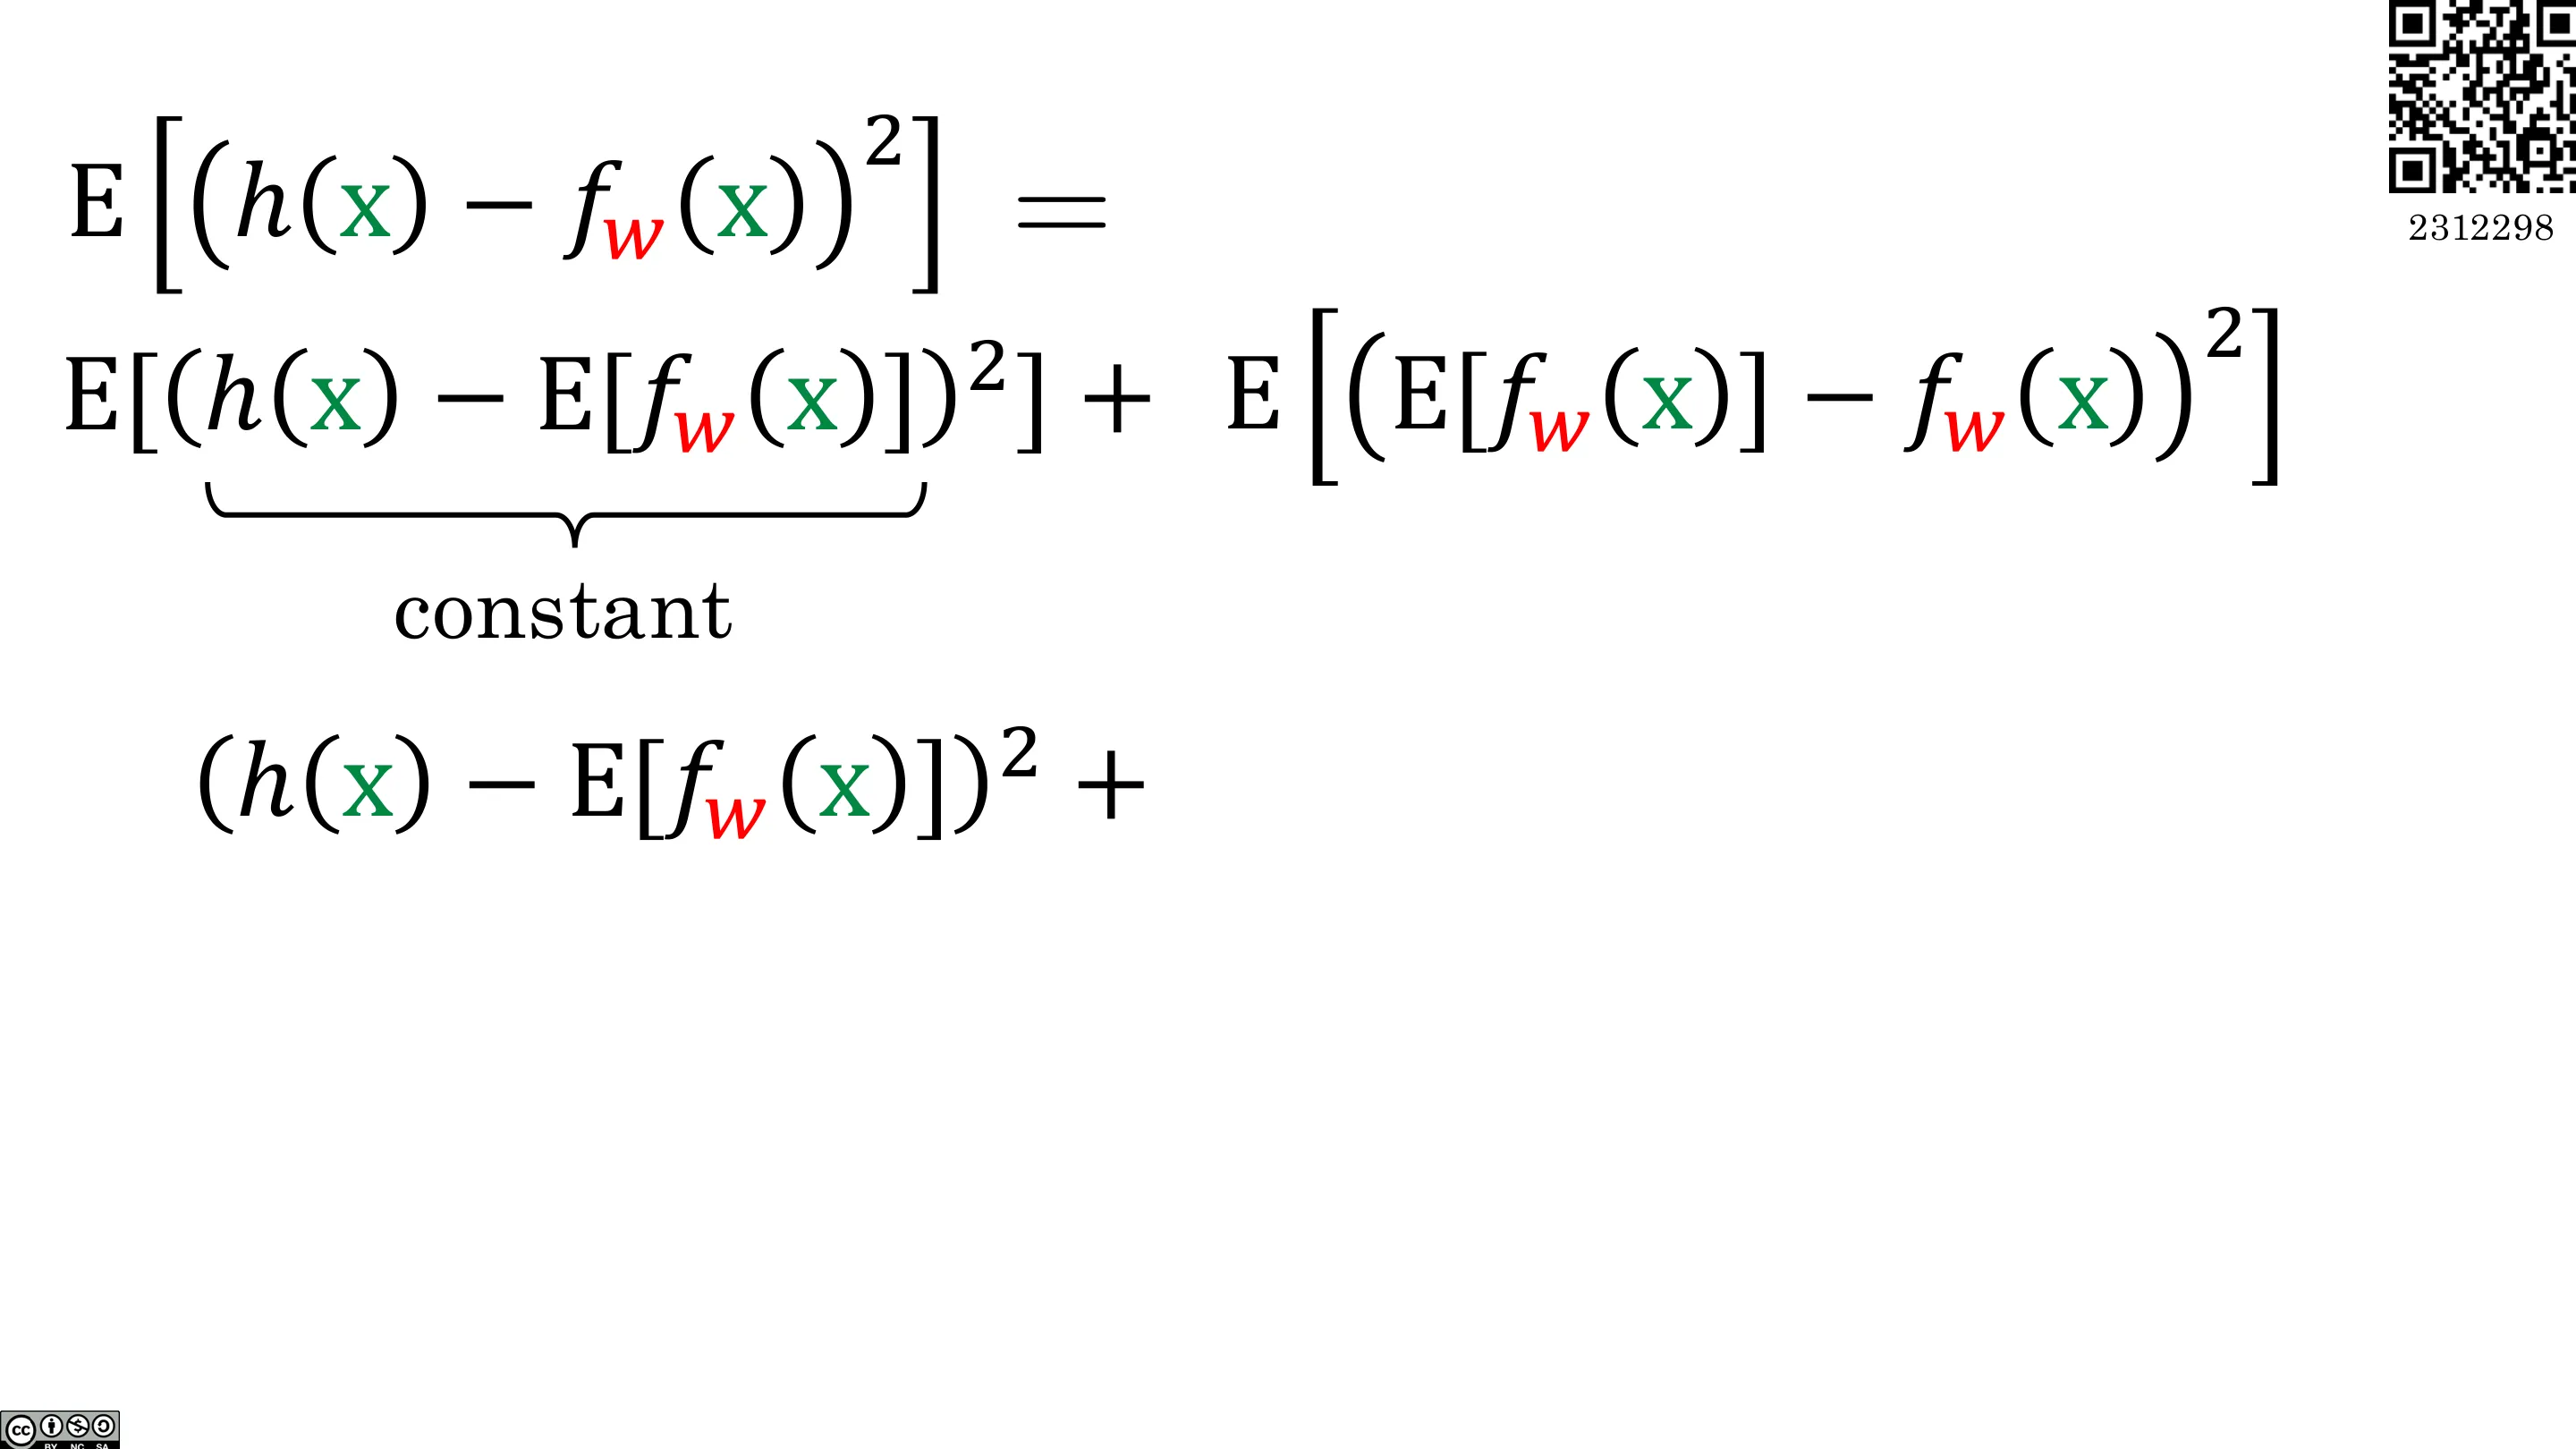
📷 期望(五)
回到原视频 (00:36:54)
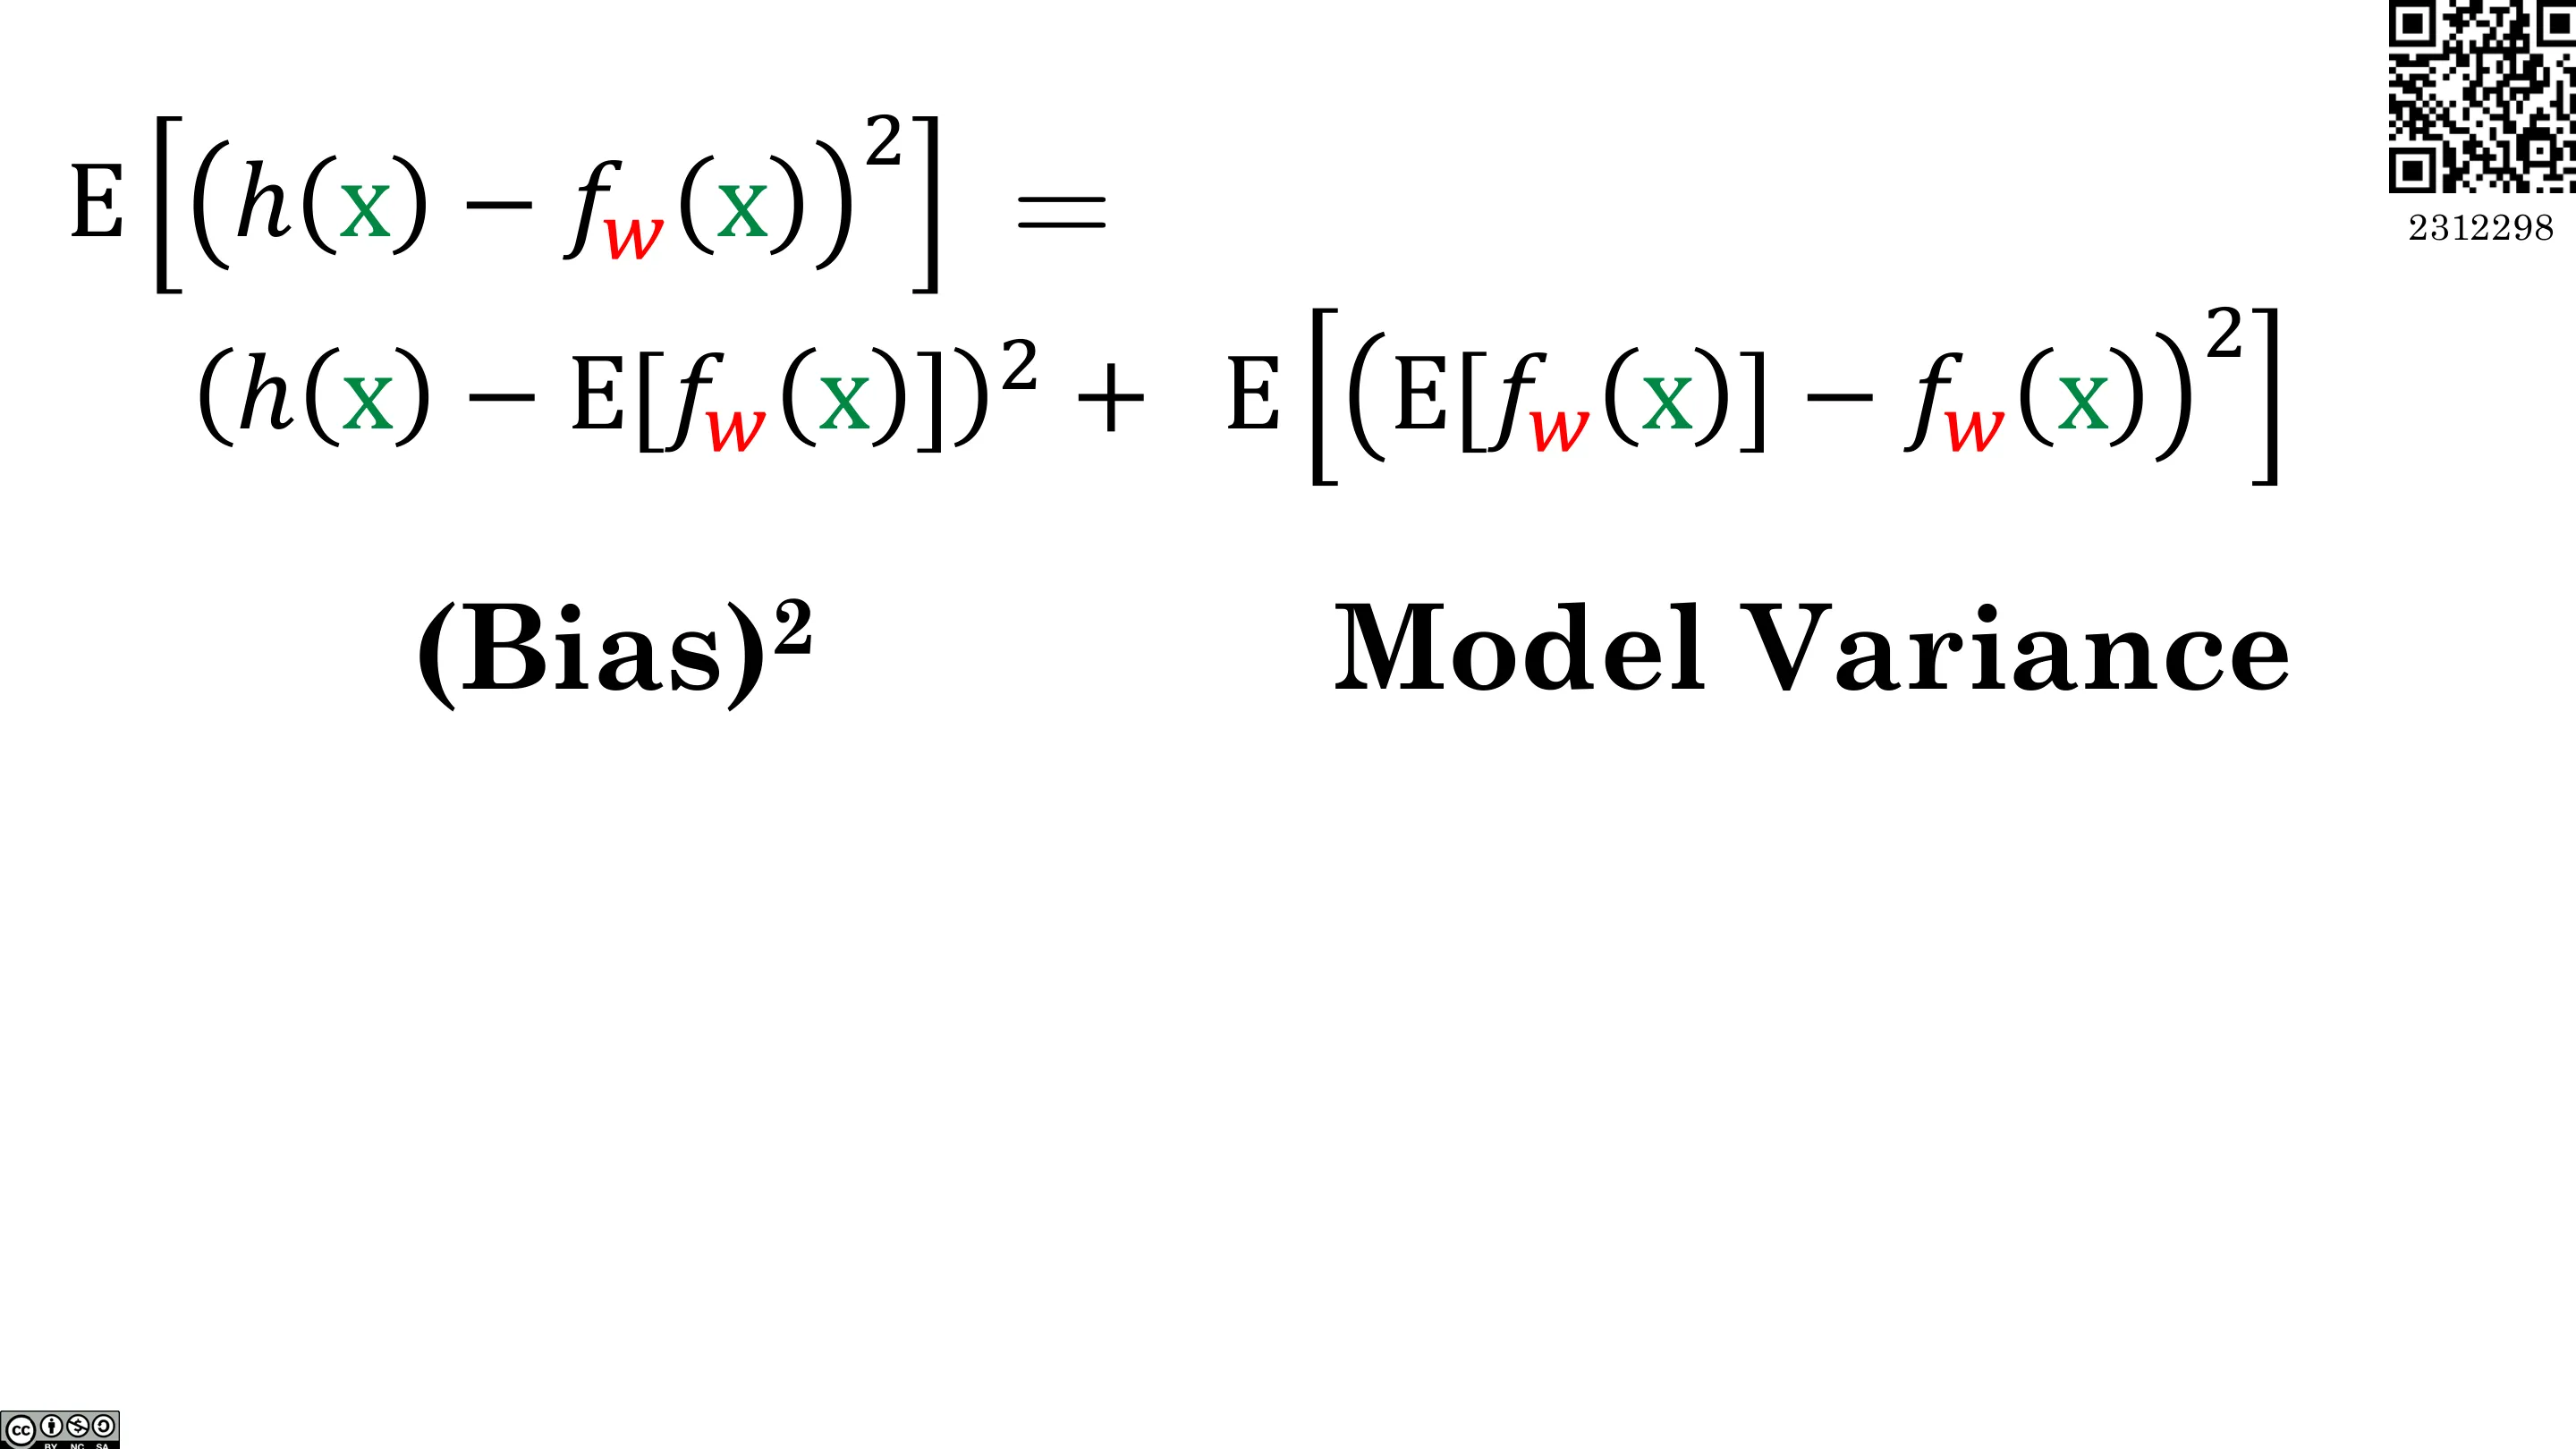
📷 期望(六)
回到原视频 (00:38:04)
📷 有用的恒等式(四)
回到原视频 (00:39:14)
📷 有用的恒等式(五)
回到原视频 (00:40:24)
📷 预期平方误差
回到原视频 (00:41:34)
📷 argmin
回到原视频 (00:42:44)
📷 最优值(一)
回到原视频 (00:43:54)
📷 最优值(二)
回到原视频 (00:45:04)
📷 如何控制模型复杂度
回到原视频 (00:46:14)
📷 确定复杂度
回到原视频 (00:47:24)
📷 数据集示例
回到原视频 (00:48:34)
📷 (过渡)
回到原视频 (00:49:44)
📷 argmin(一)
回到原视频 (00:50:54)
📷 argmin(二)
回到原视频 (00:52:04)
📷 偏差方差推导小测(一)
回到原视频 (00:53:14)
📷 偏差方差推导小测(二)
回到原视频 (00:54:24)
📷 偏差方差推导小测(三)
回到原视频 (00:55:34)
📷 研究
回到原视频 (00:56:44)
📷 在真实世界评估大模型(一)
回到原视频 (00:57:54)
📷 在大模型评估的平台
回到原视频 (00:59:04)
📷 众包用户交互(一)
回到原视频 (01:00:14)
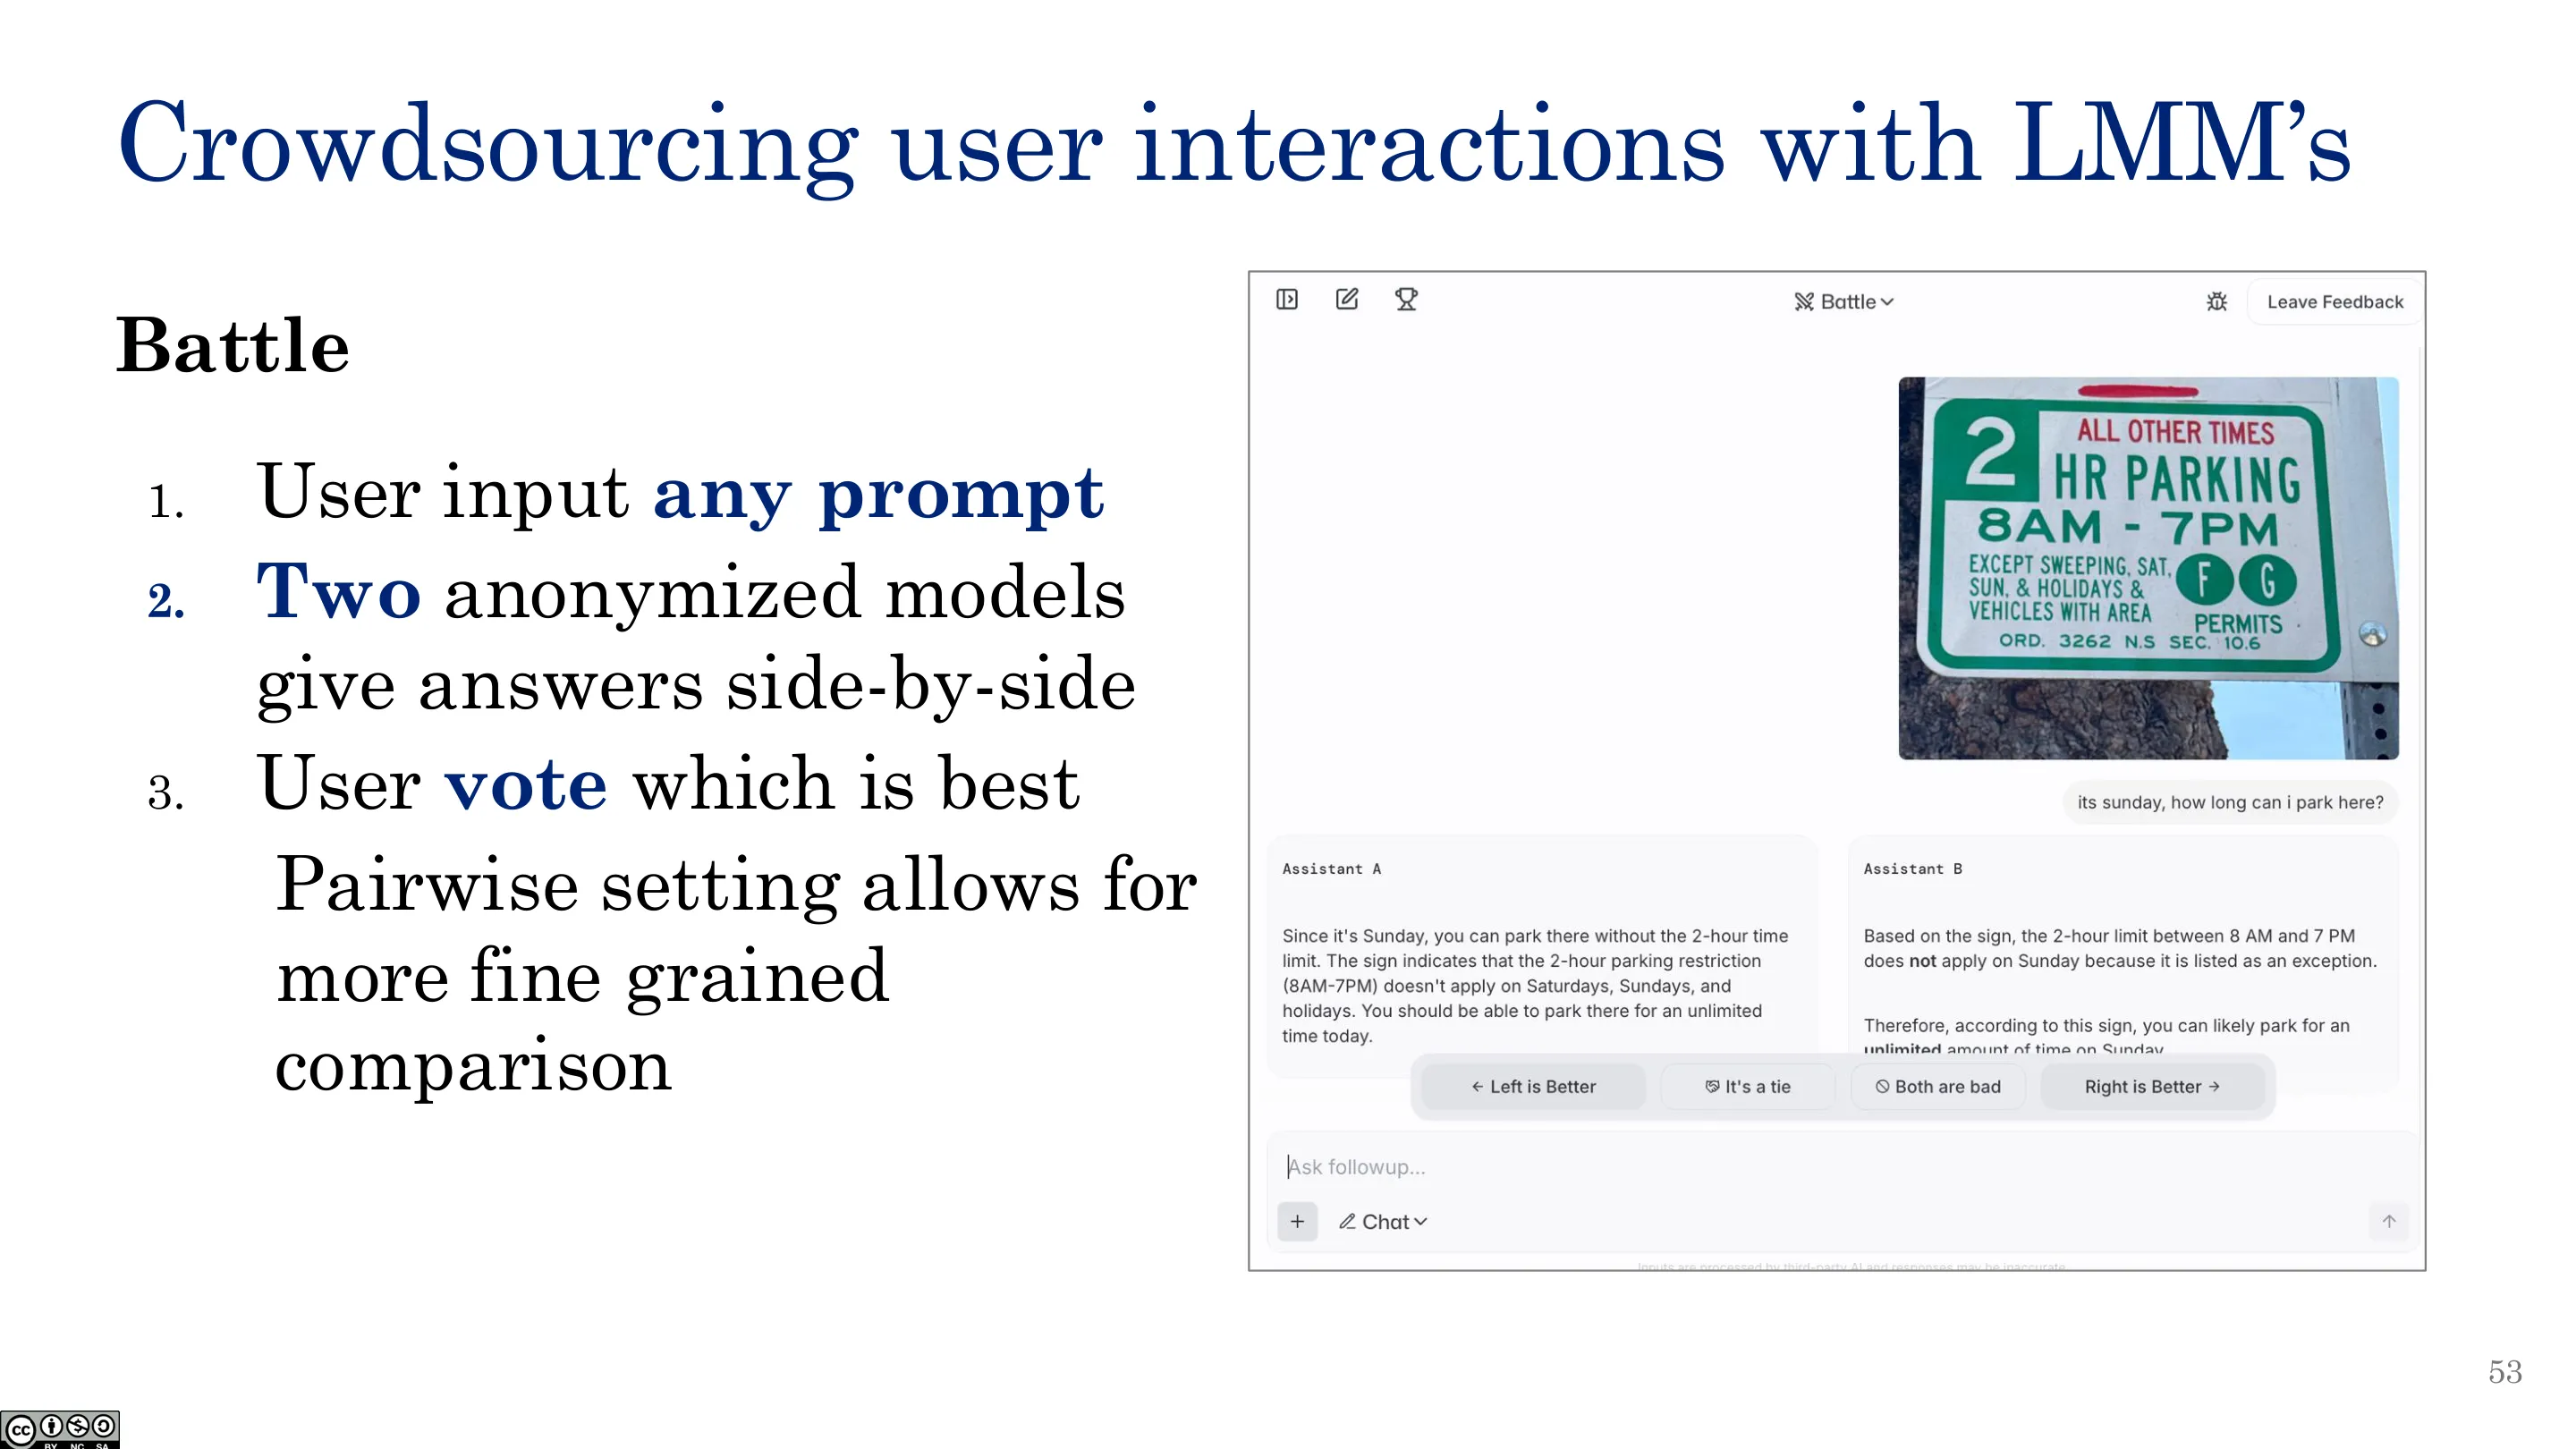
📷 众包用户交互(二)
回到原视频 (01:01:24)
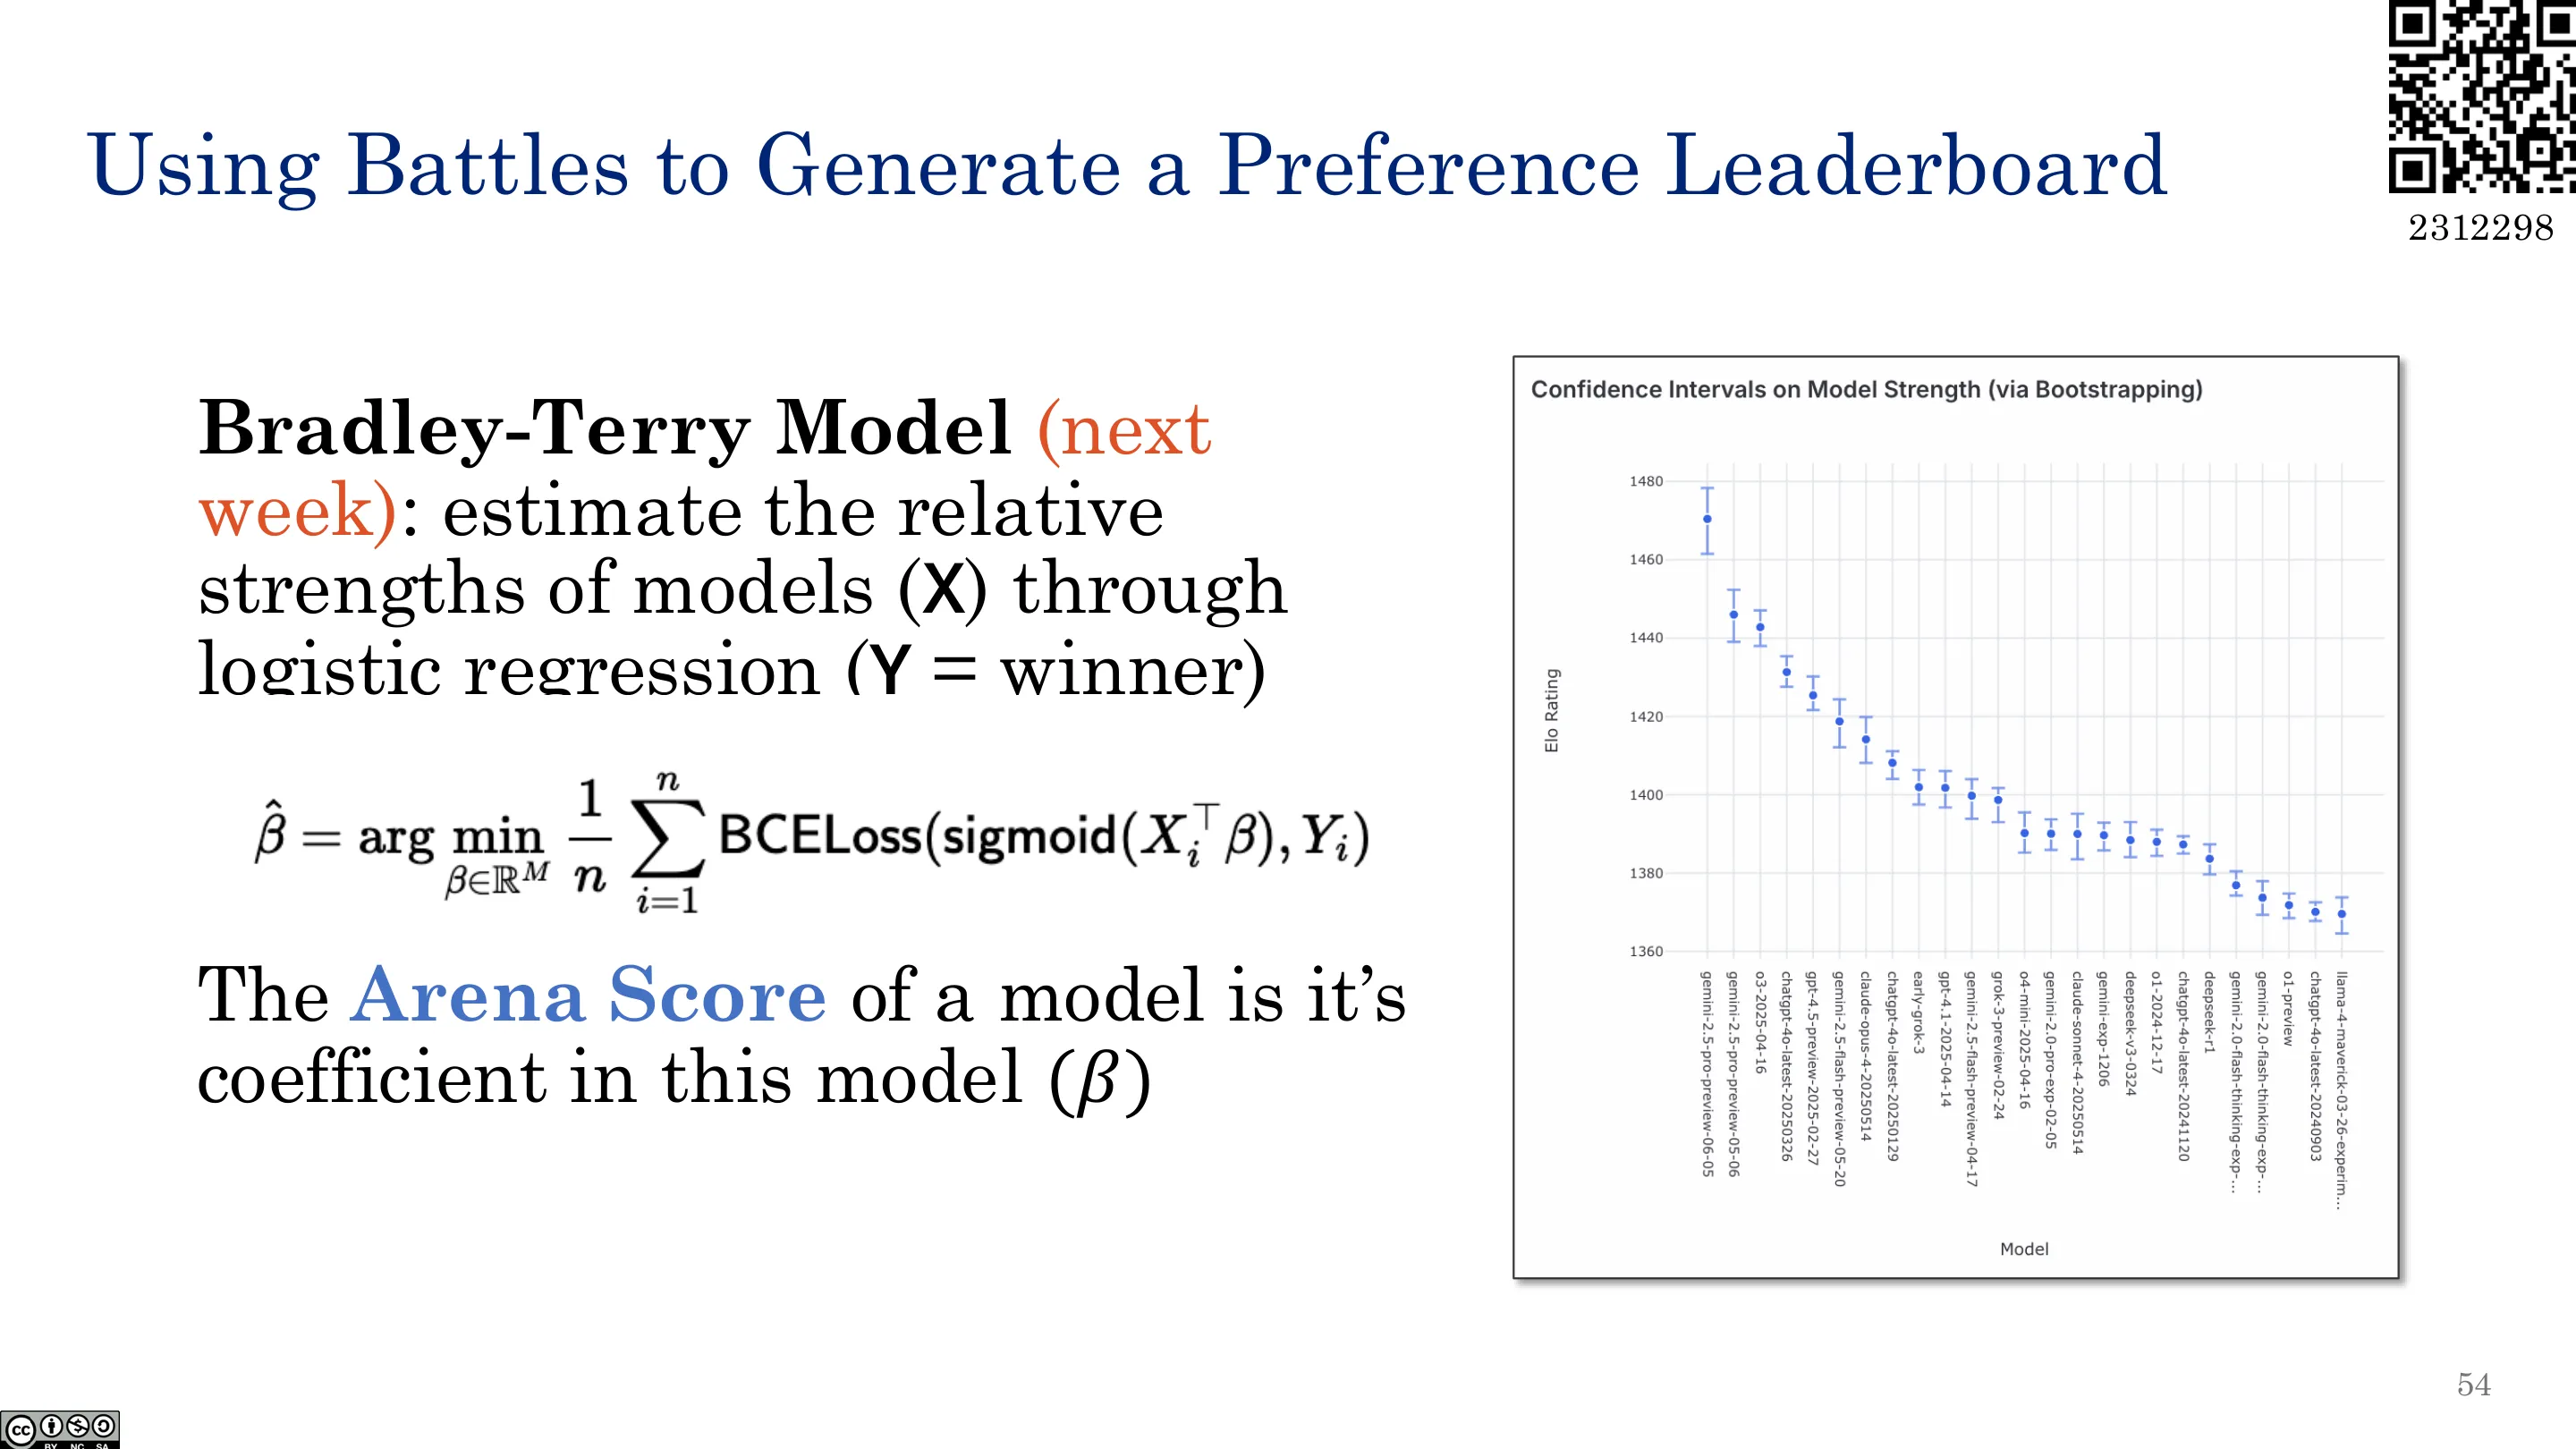
📷 用对战生成偏好排行榜
回到原视频 (01:02:34)
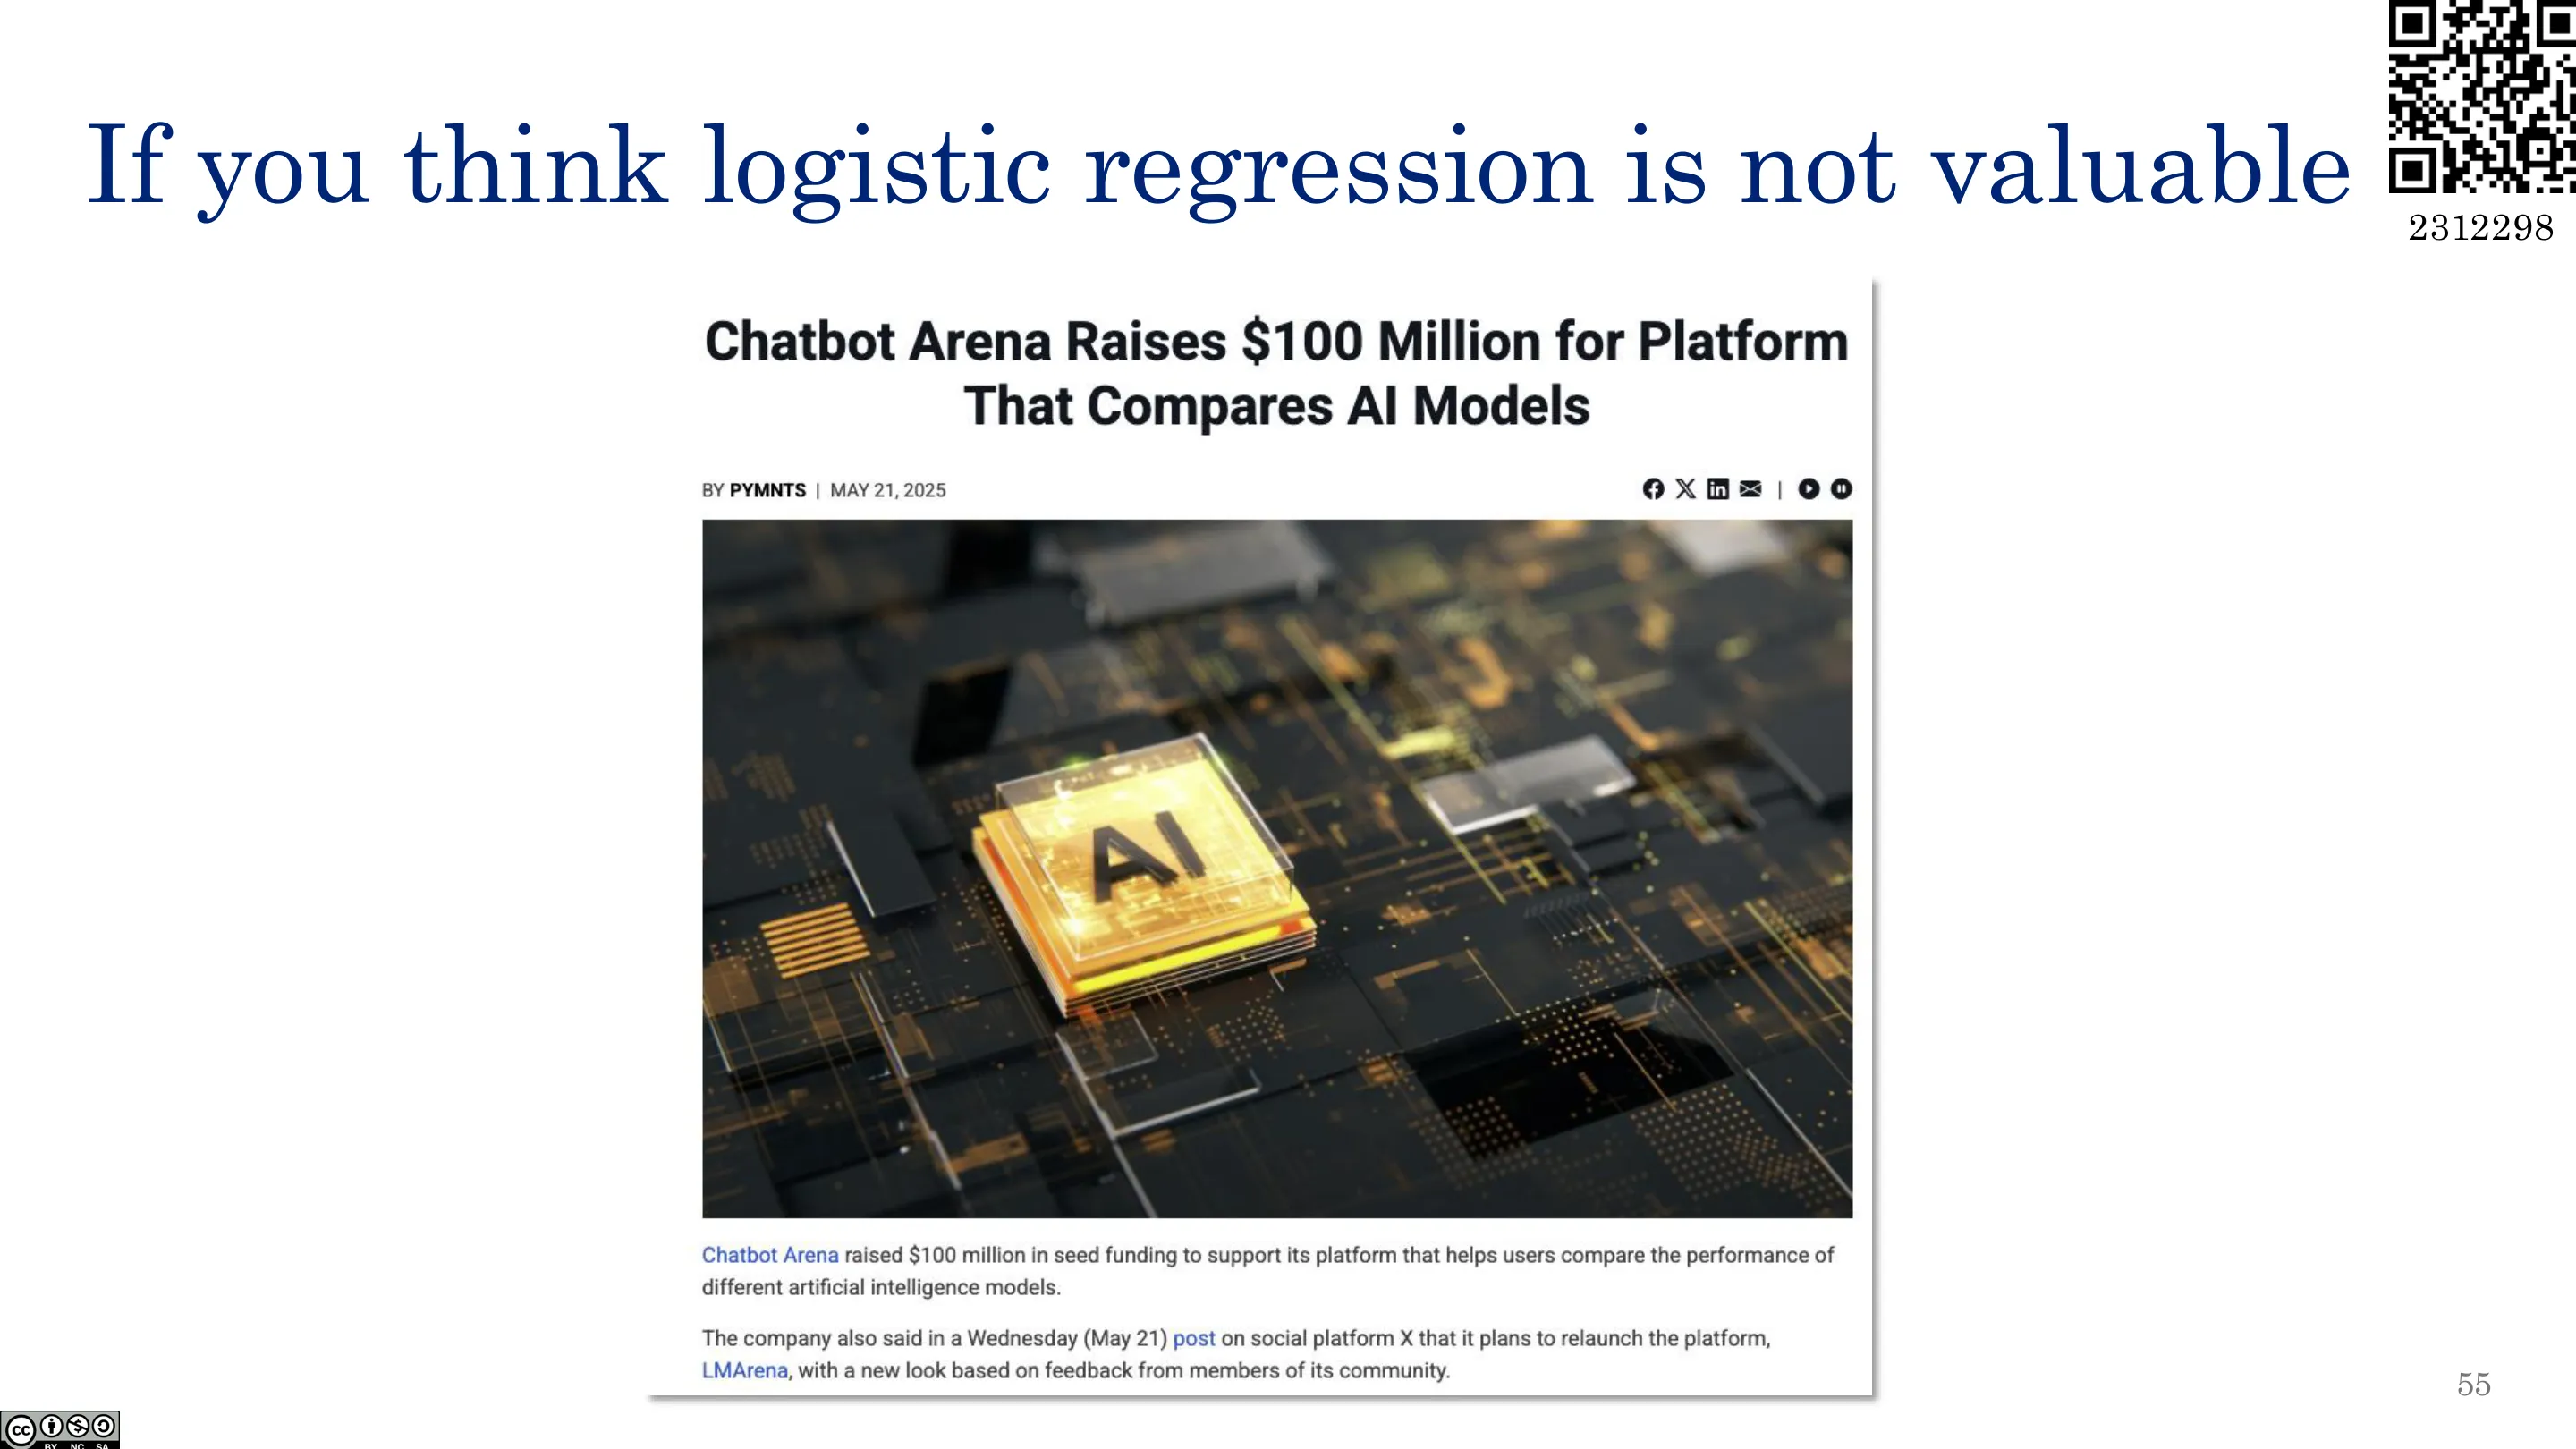
📷 若你觉得逻辑回归没价值
回到原视频 (01:03:44)
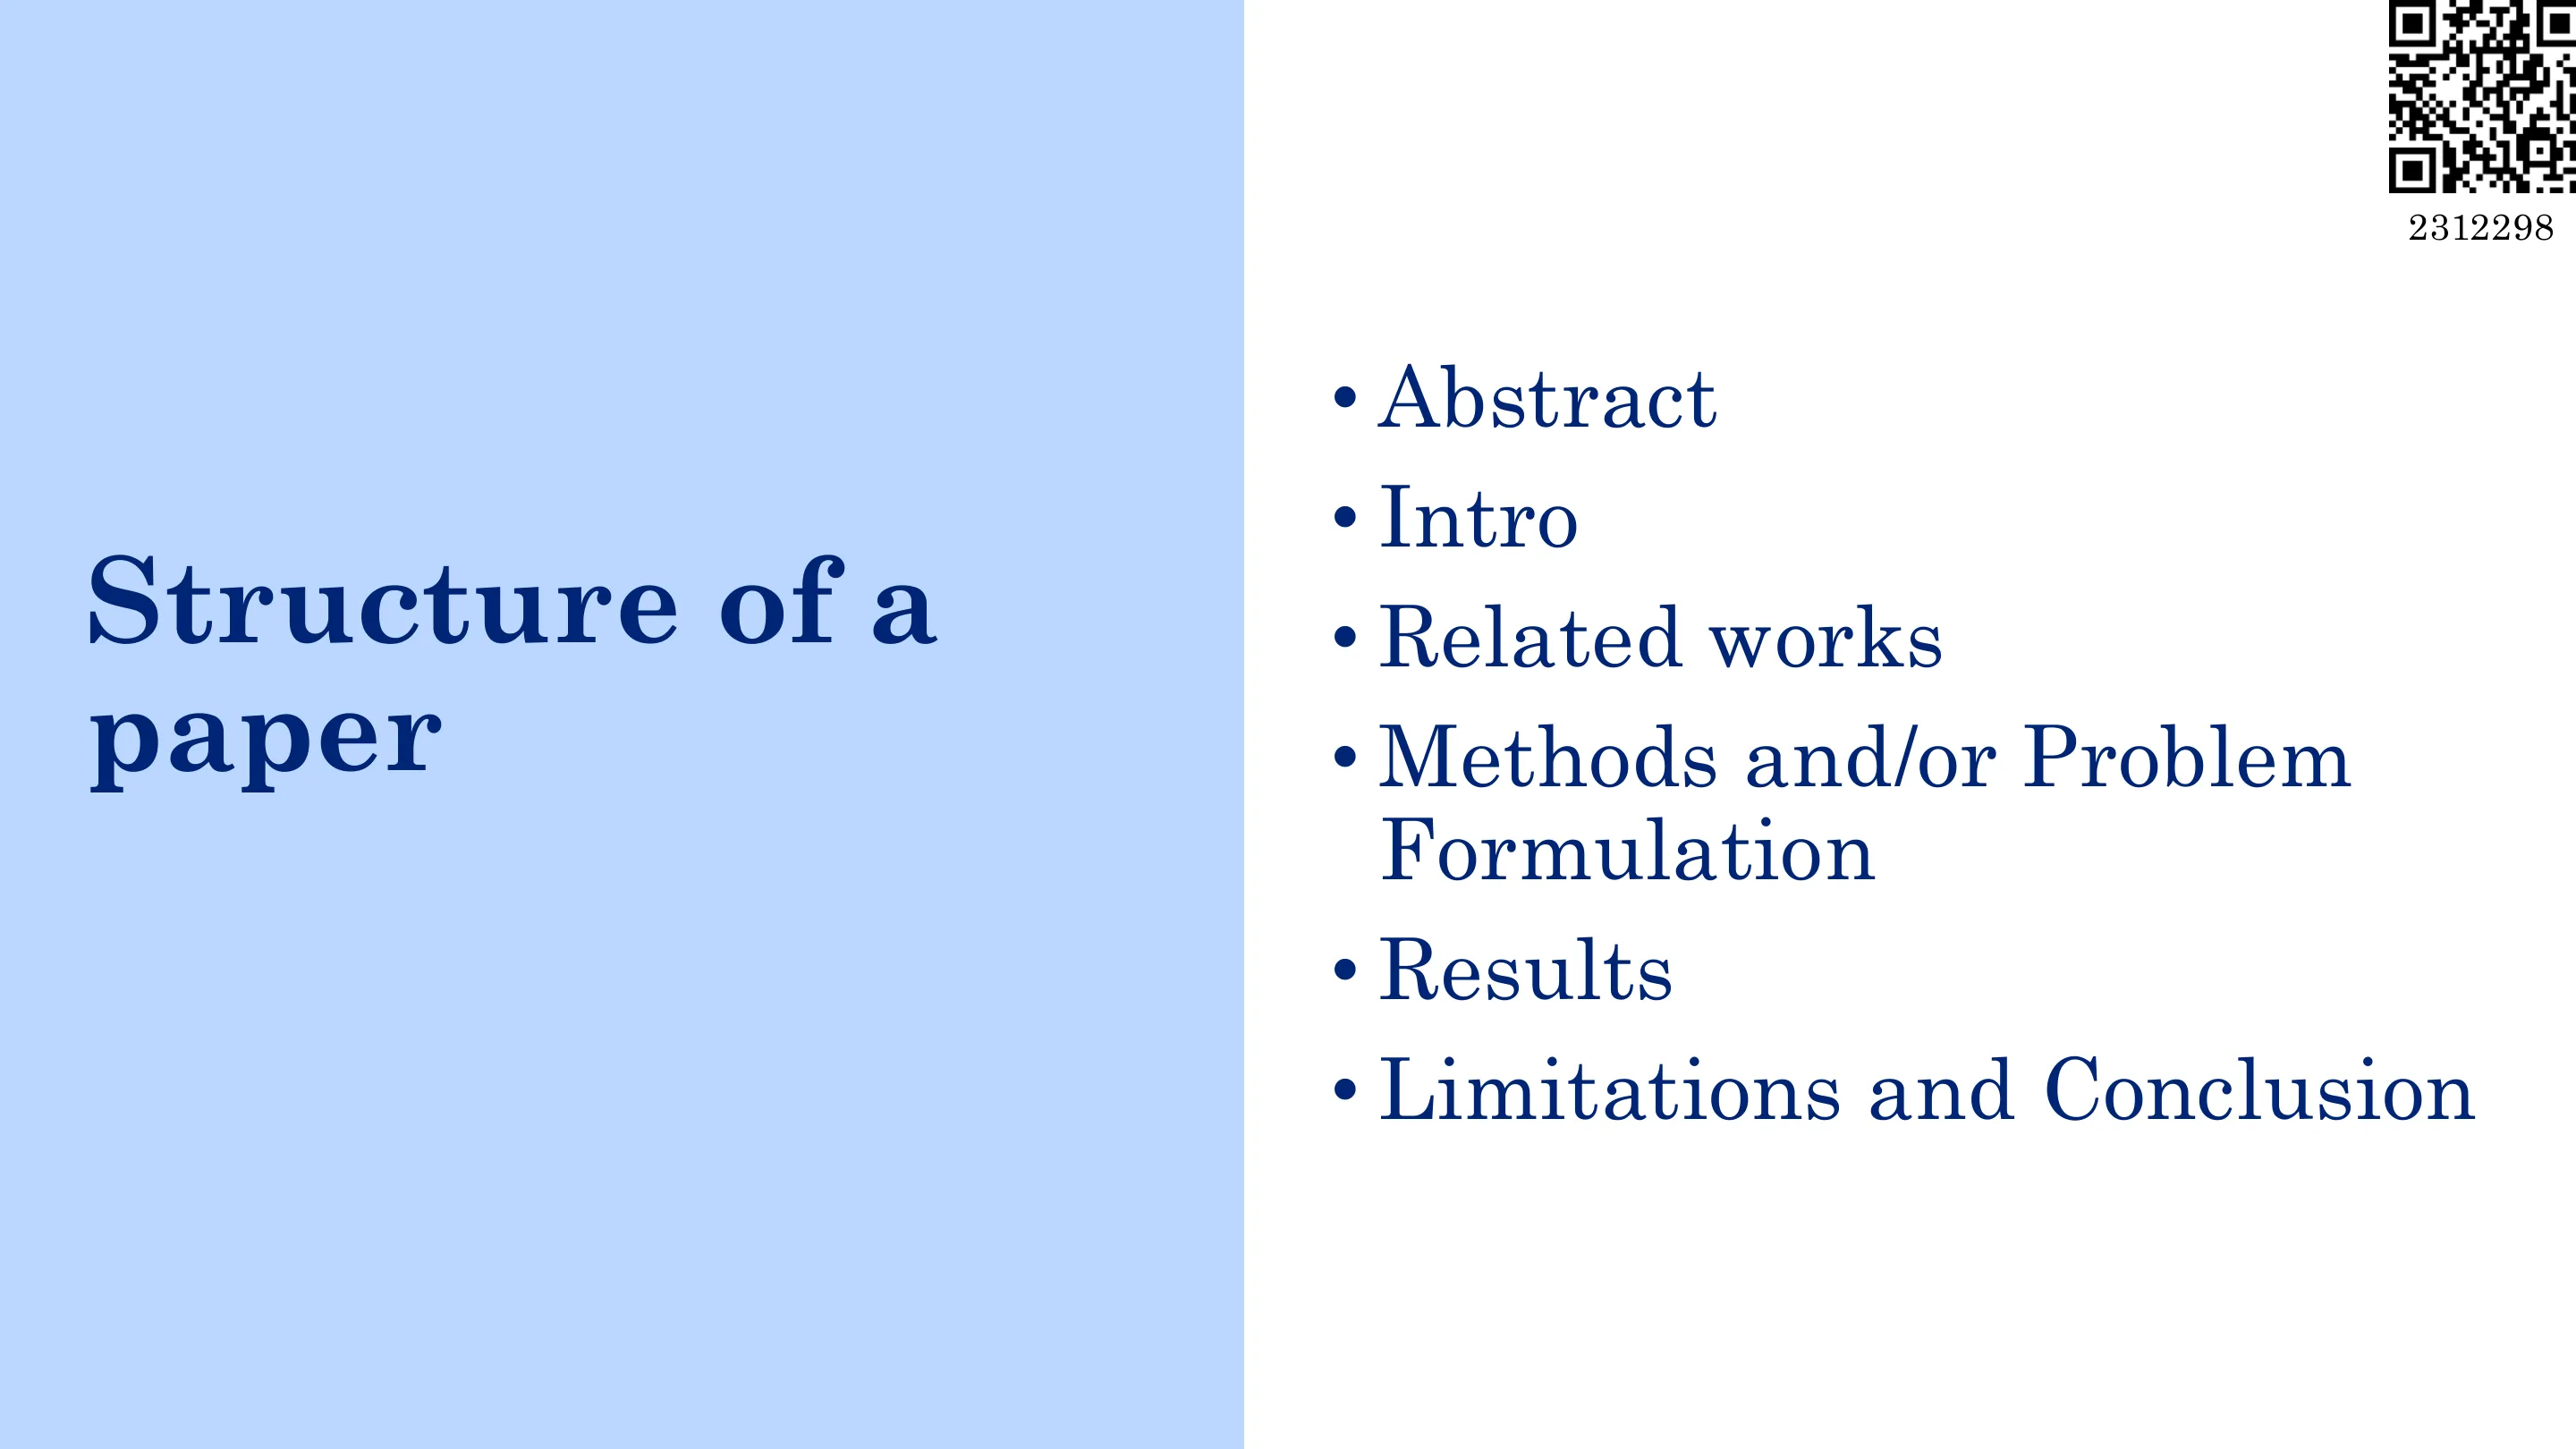
📷 论文的结构
回到原视频 (01:04:54)
📷 每篇论文要回答的问题(一)
回到原视频 (01:06:04)
📷 每篇论文要回答的问题(二)
回到原视频 (01:07:14)
二、偏差-方差权衡
(参考时间: 00:45)
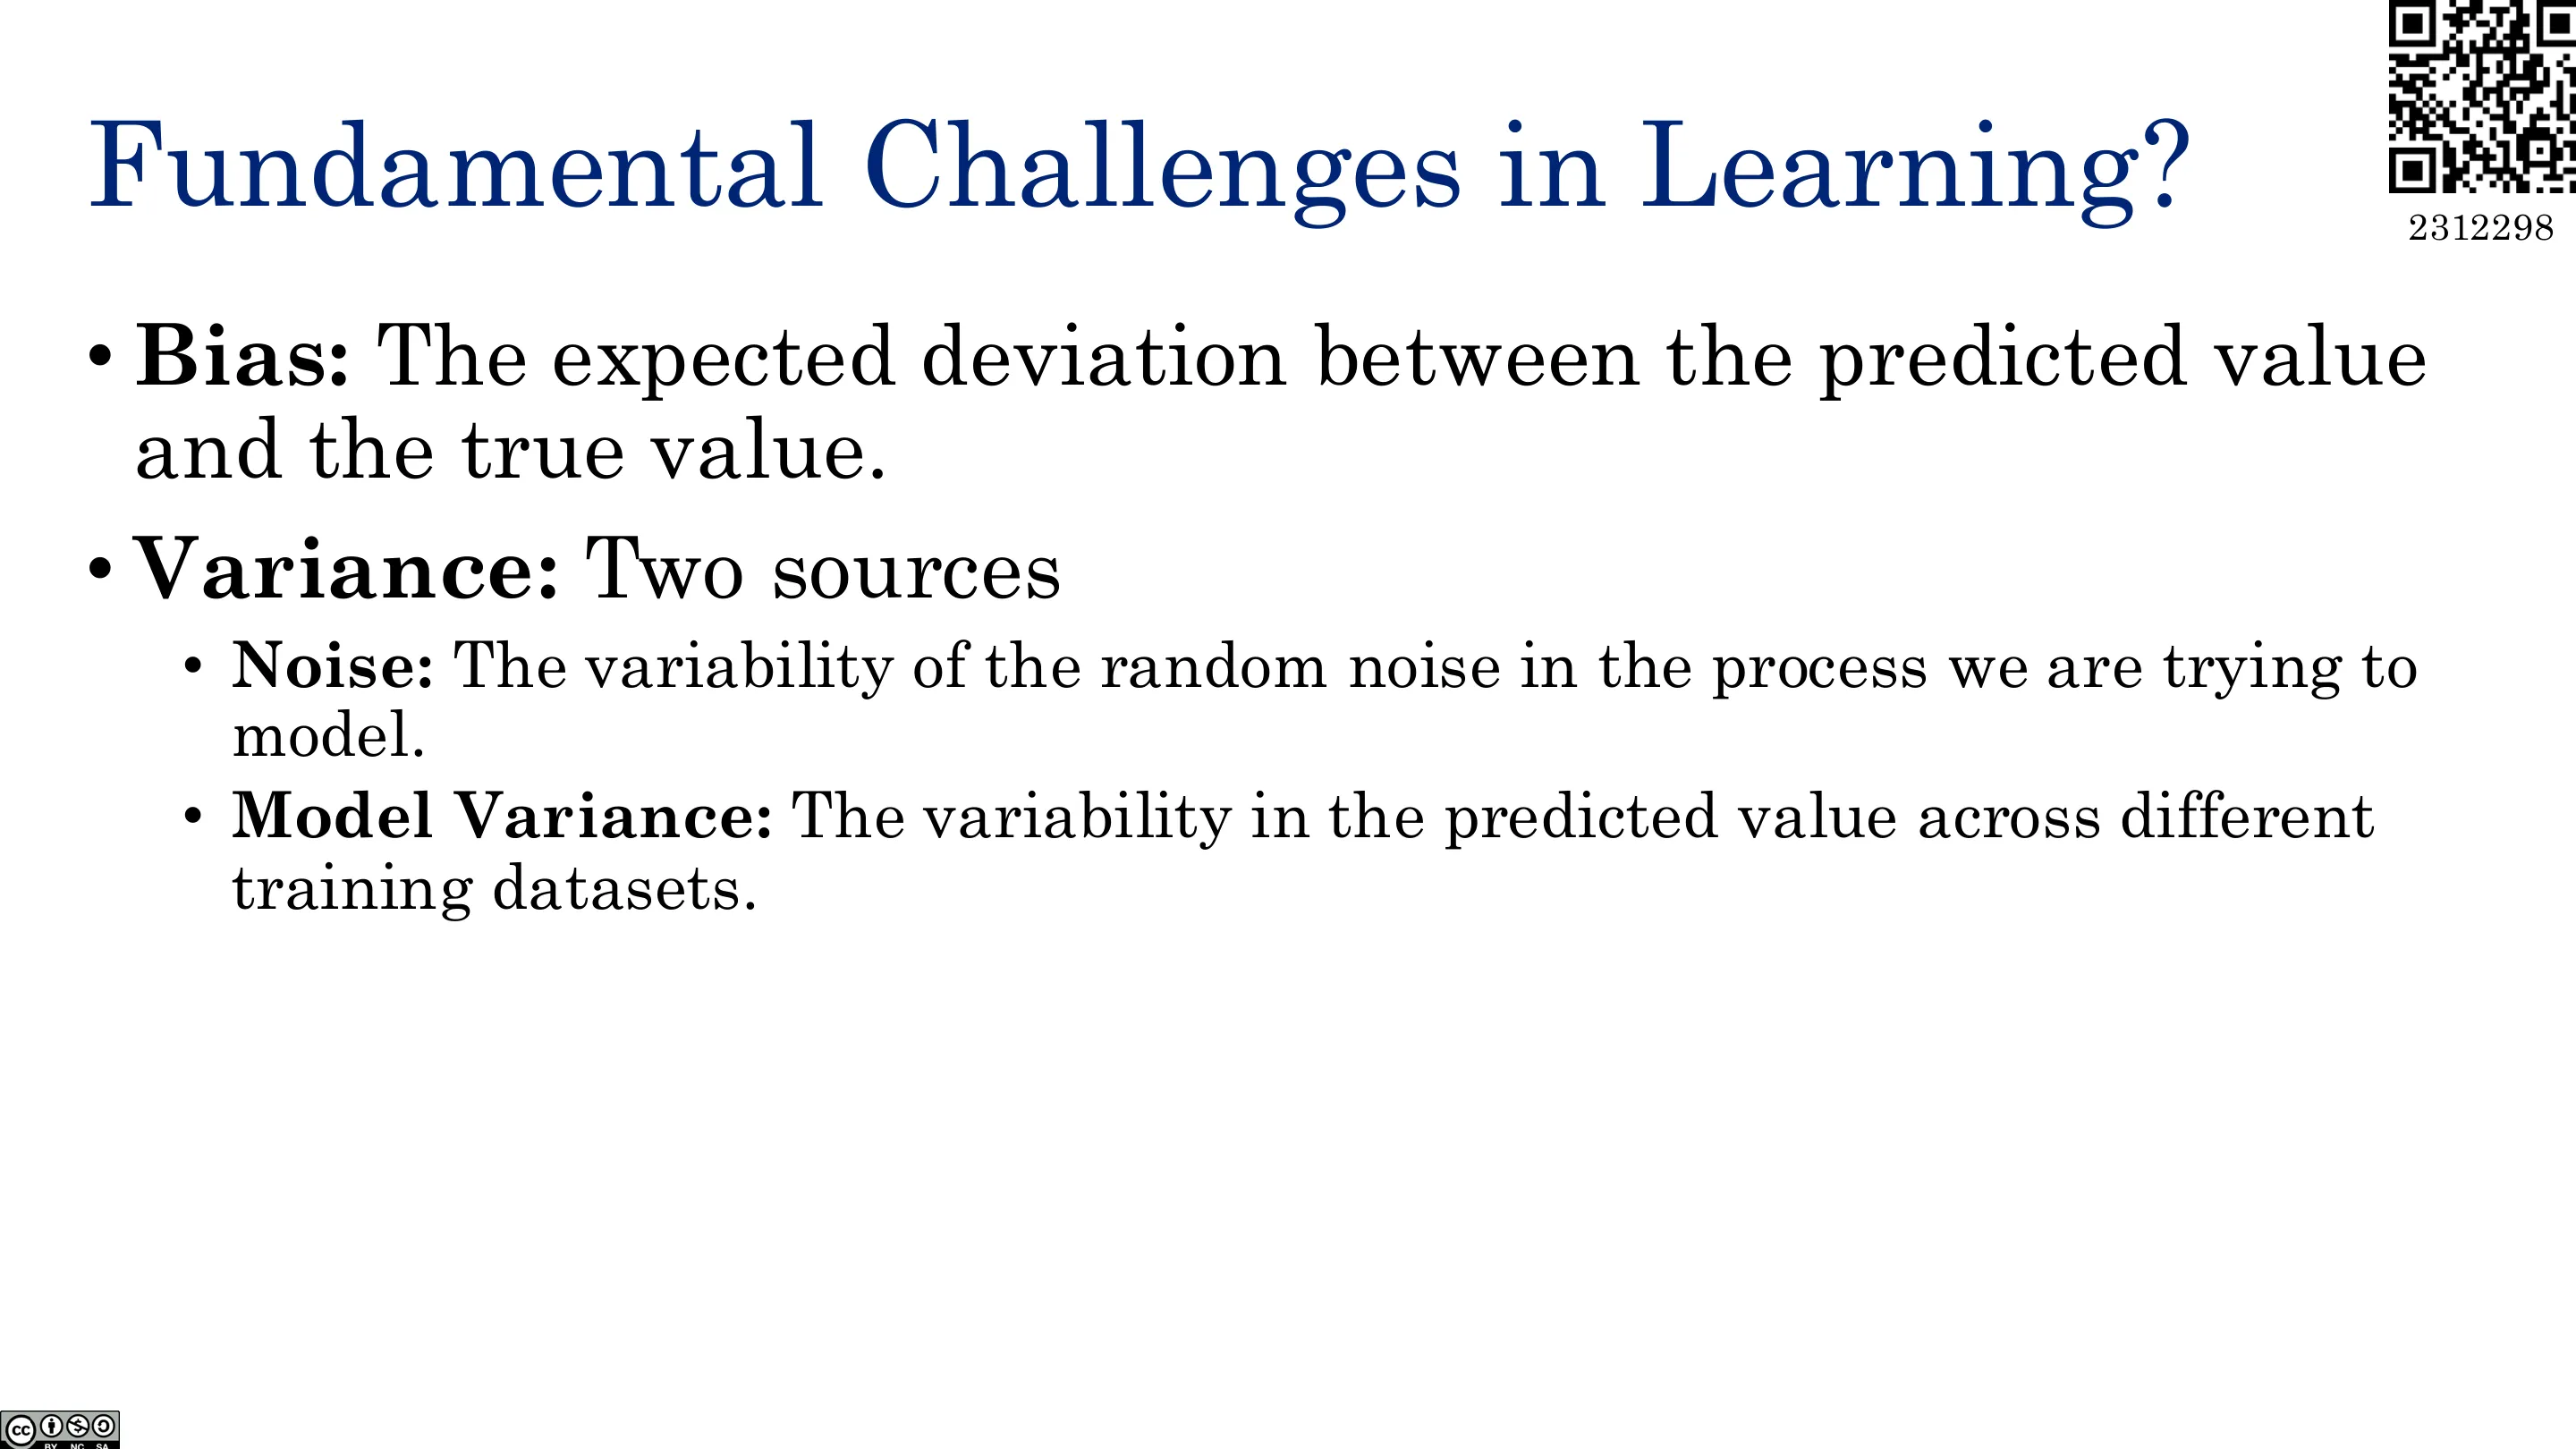
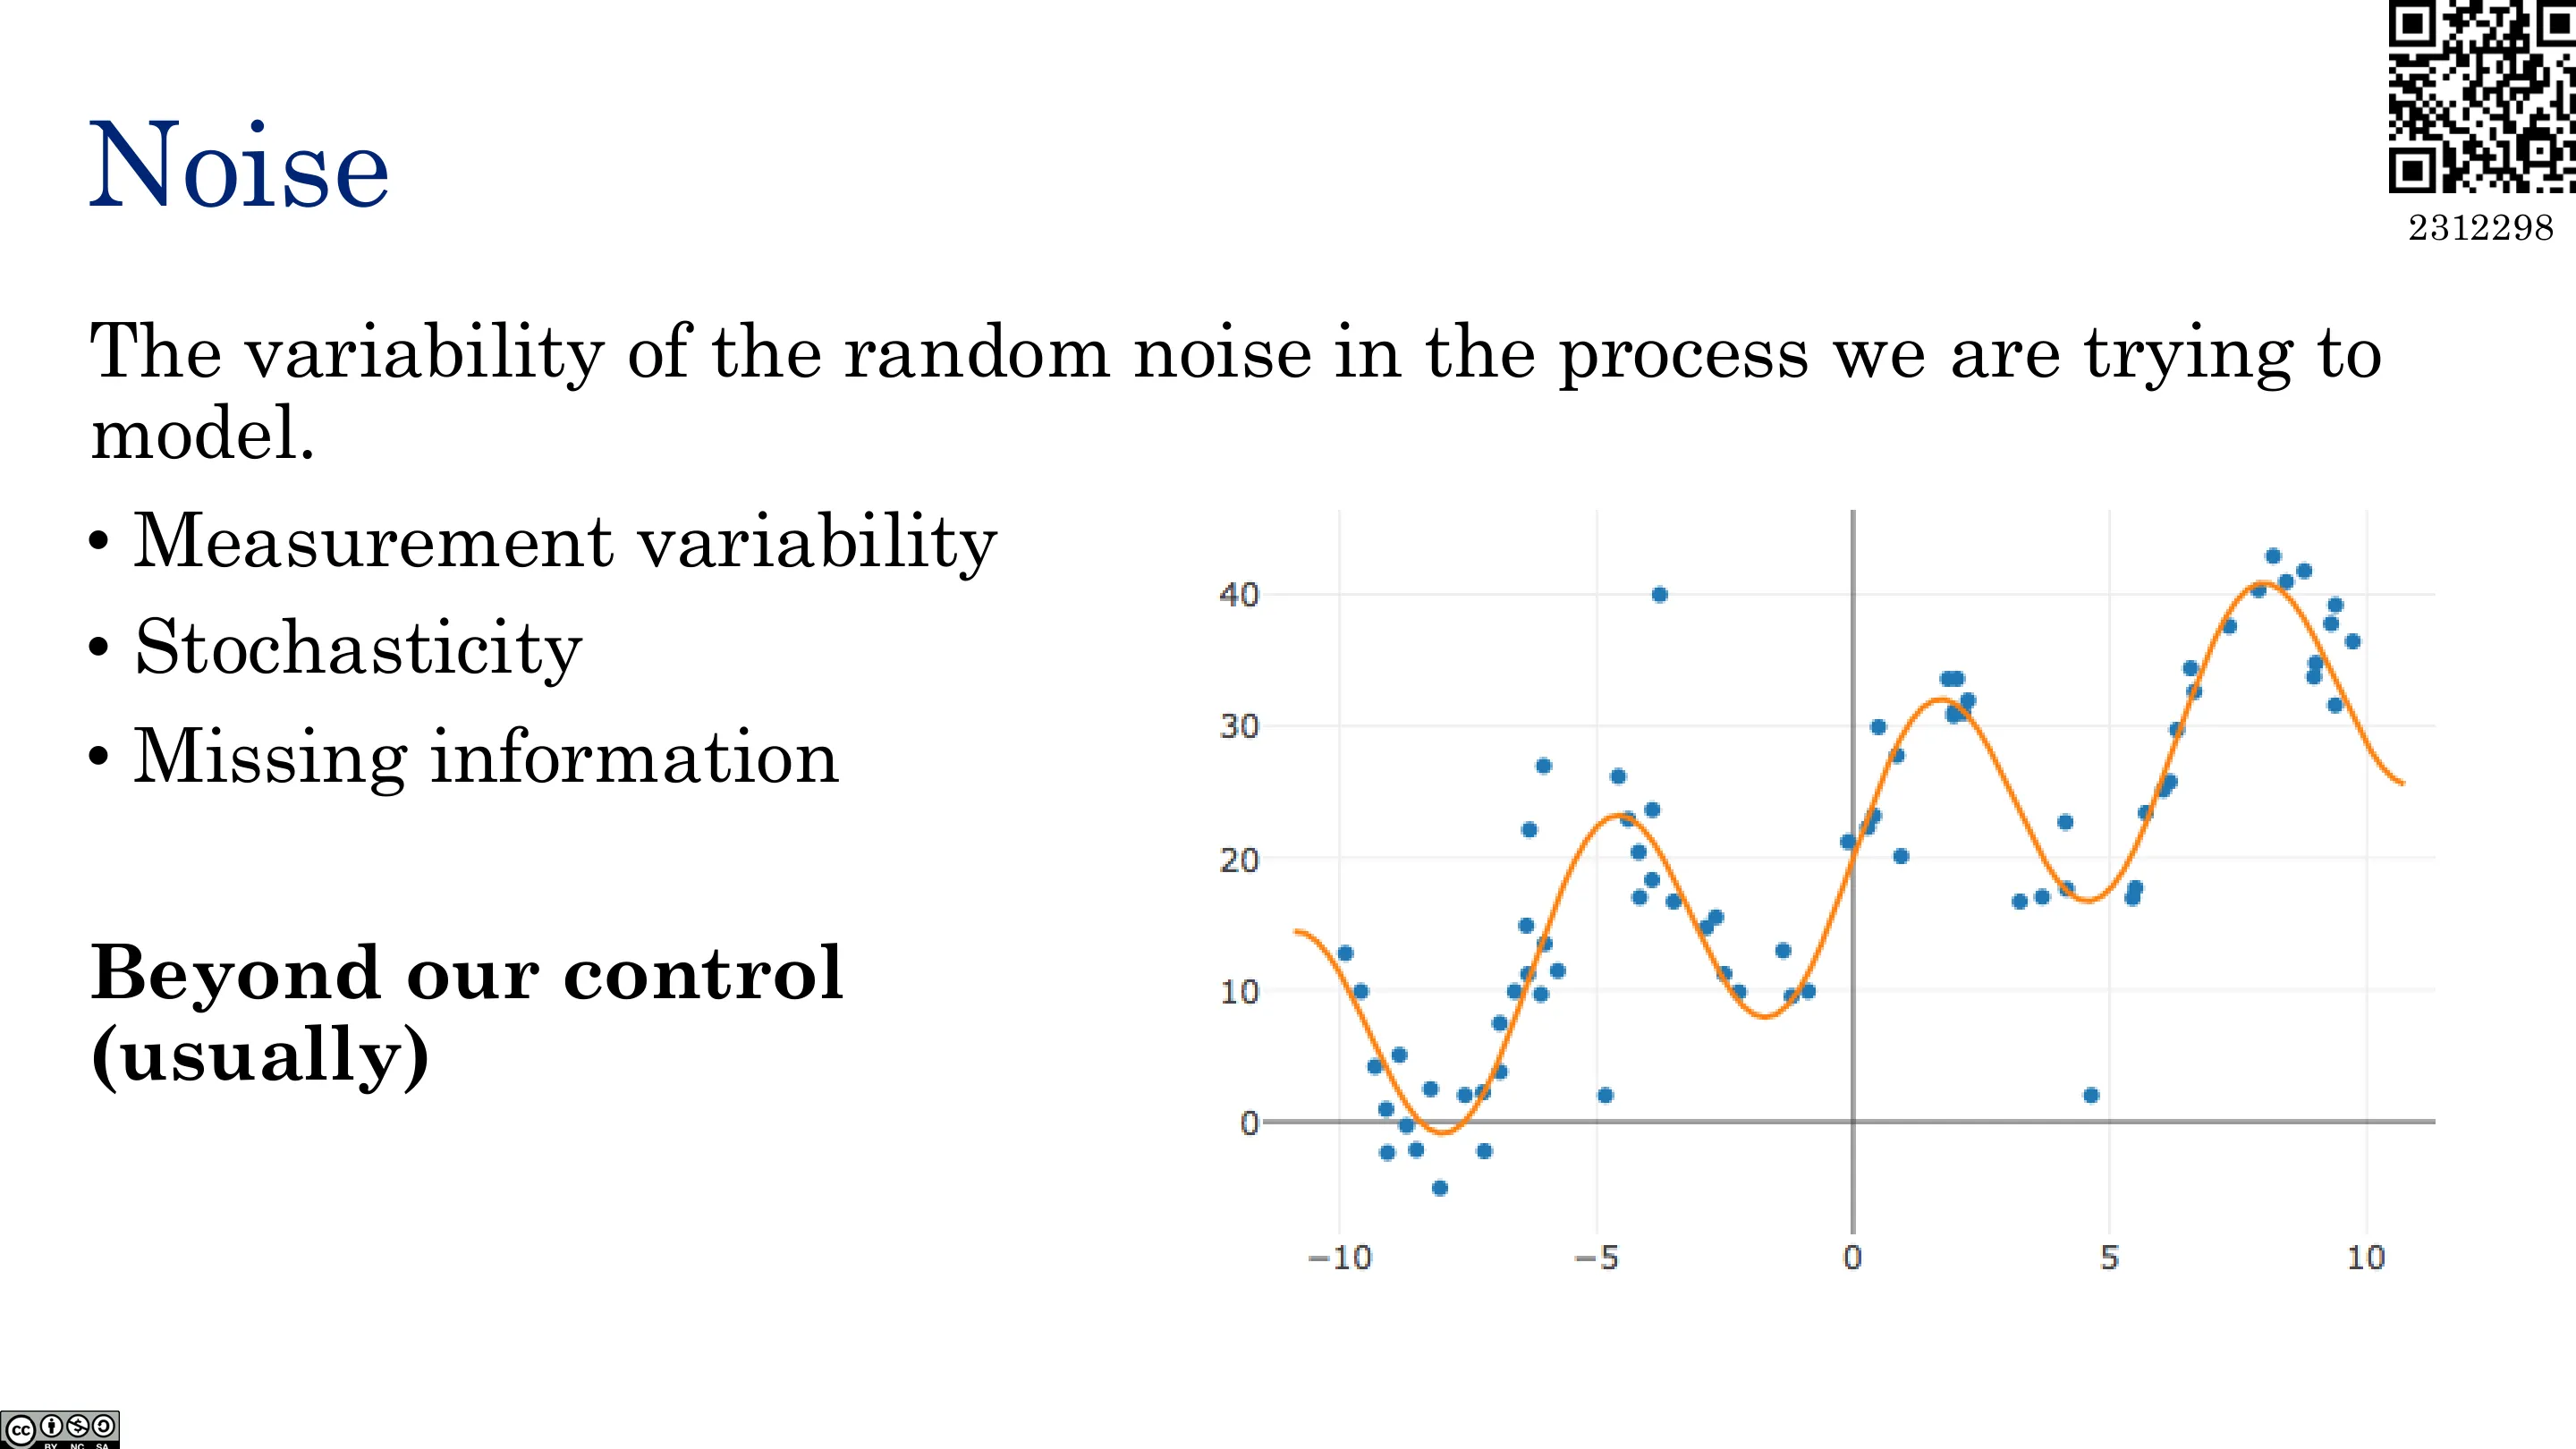
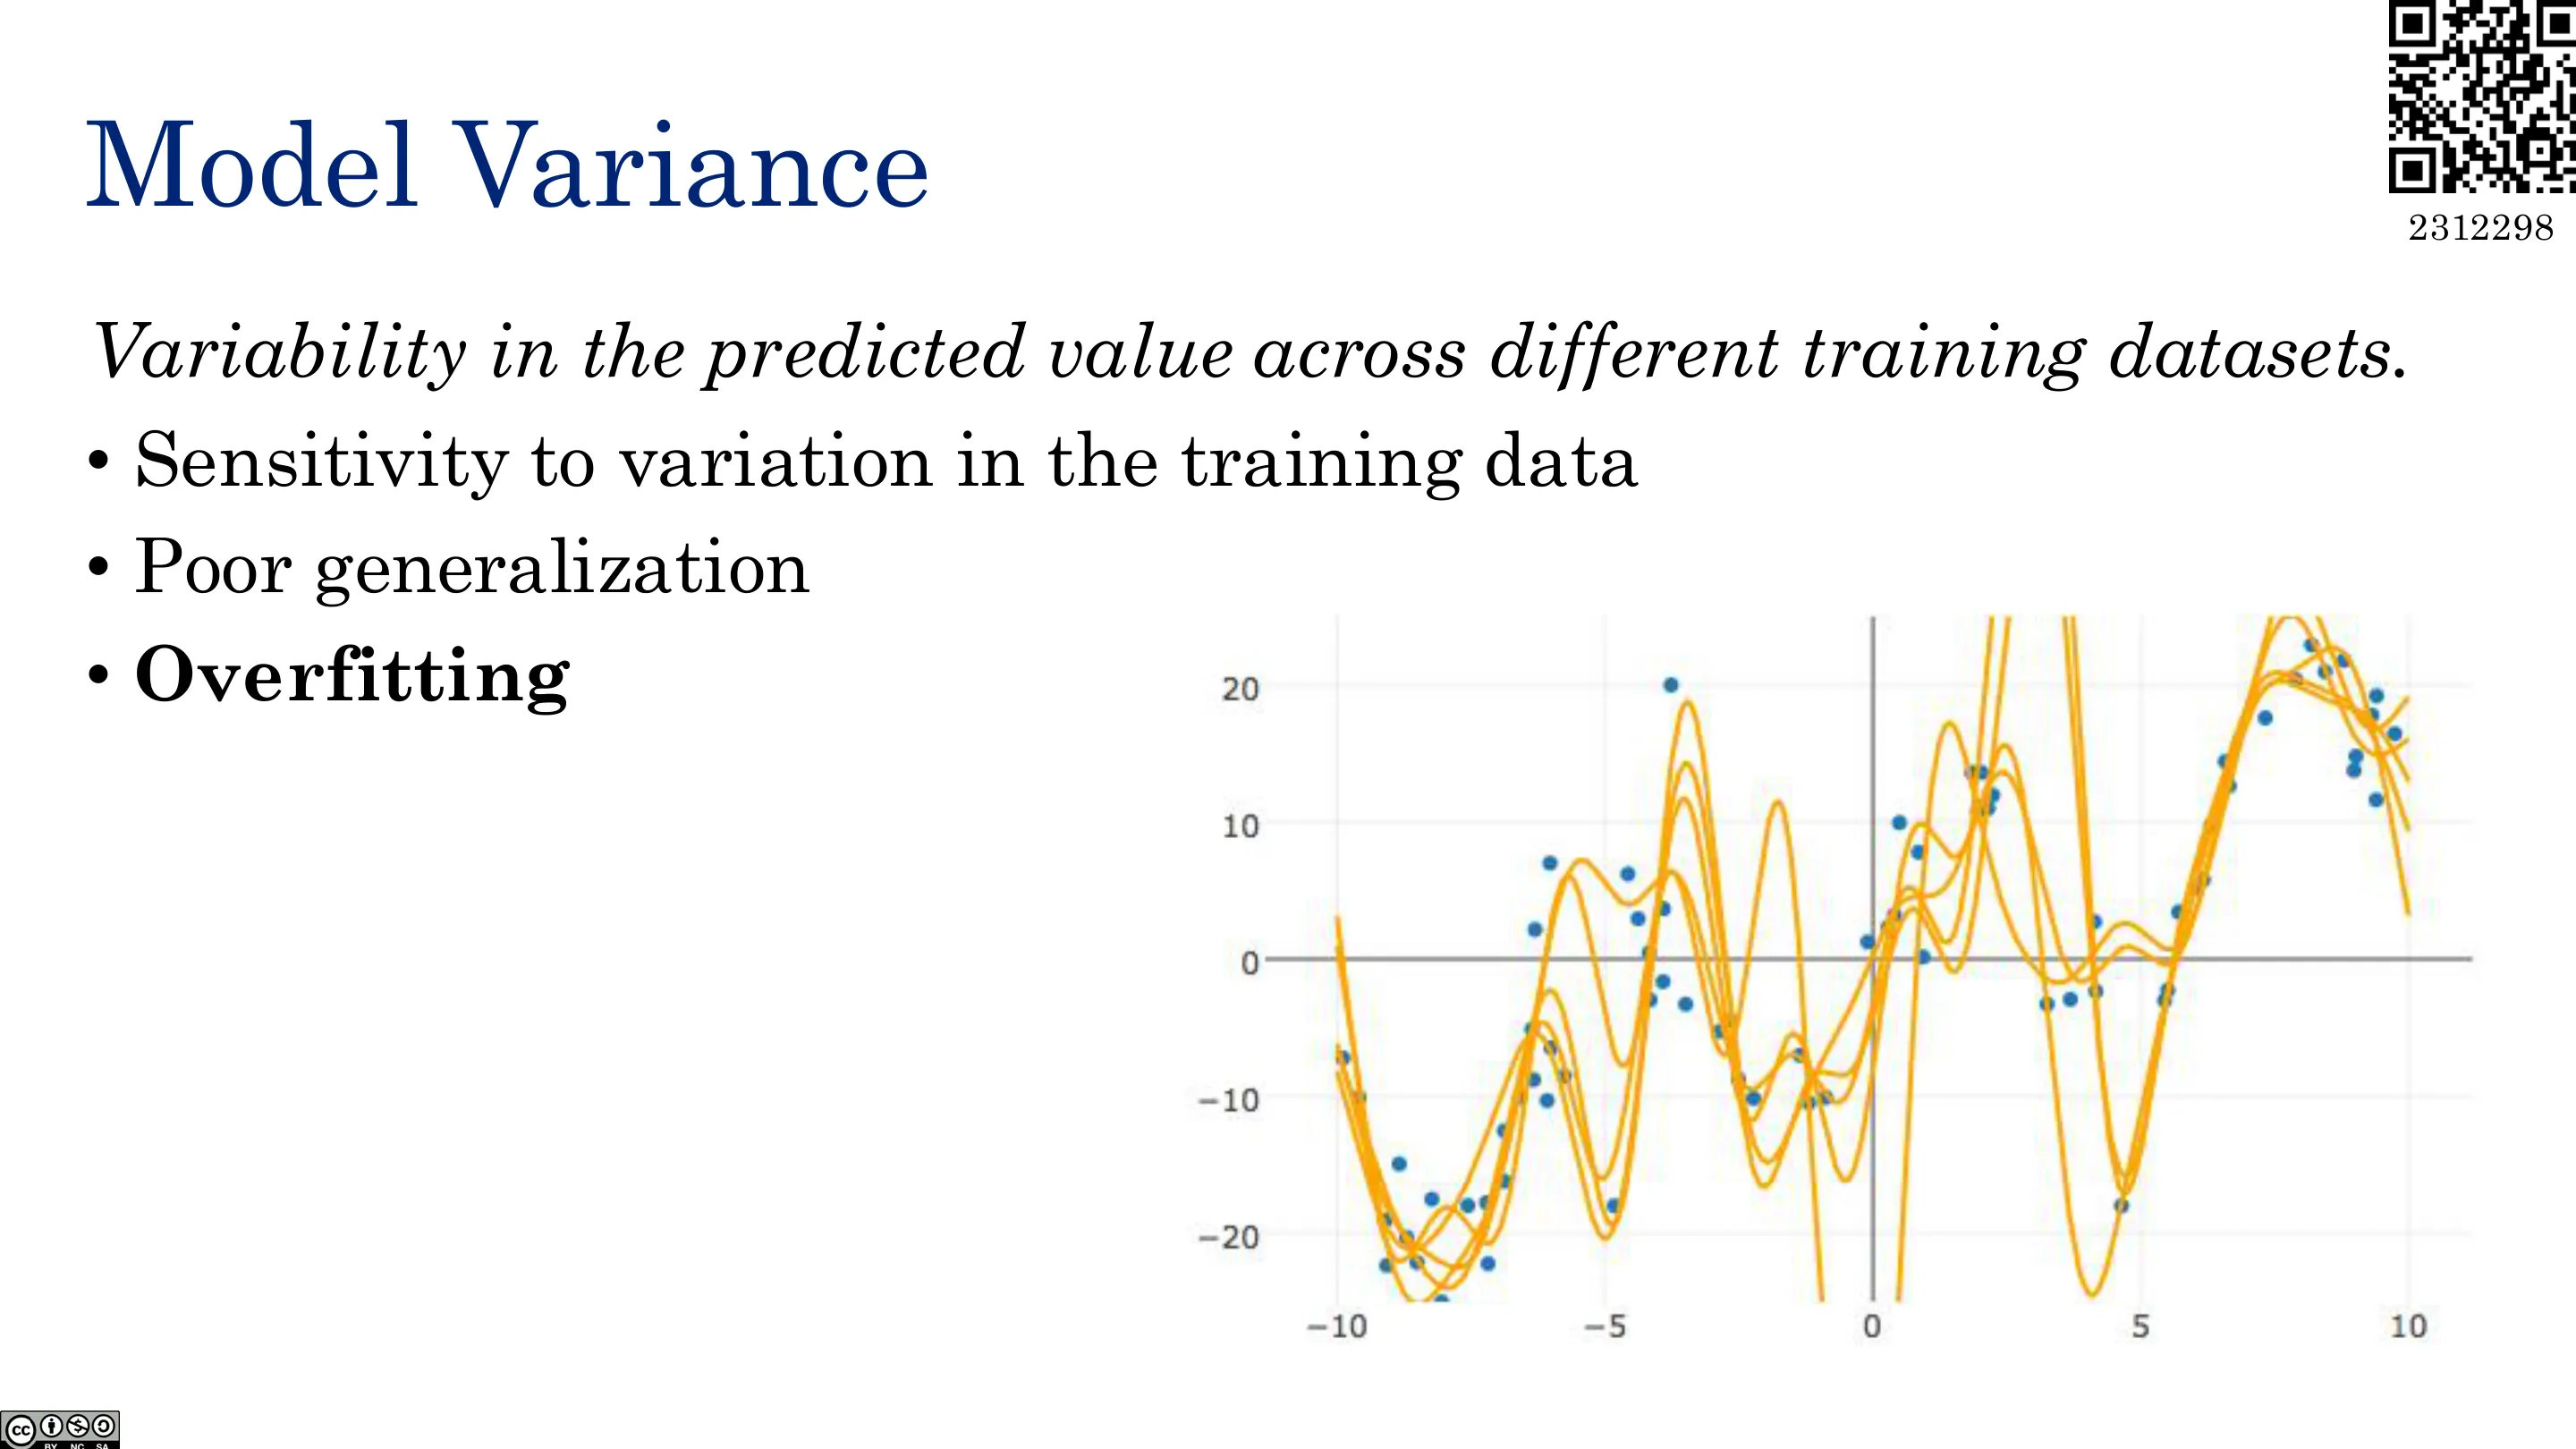
两种误差来源:
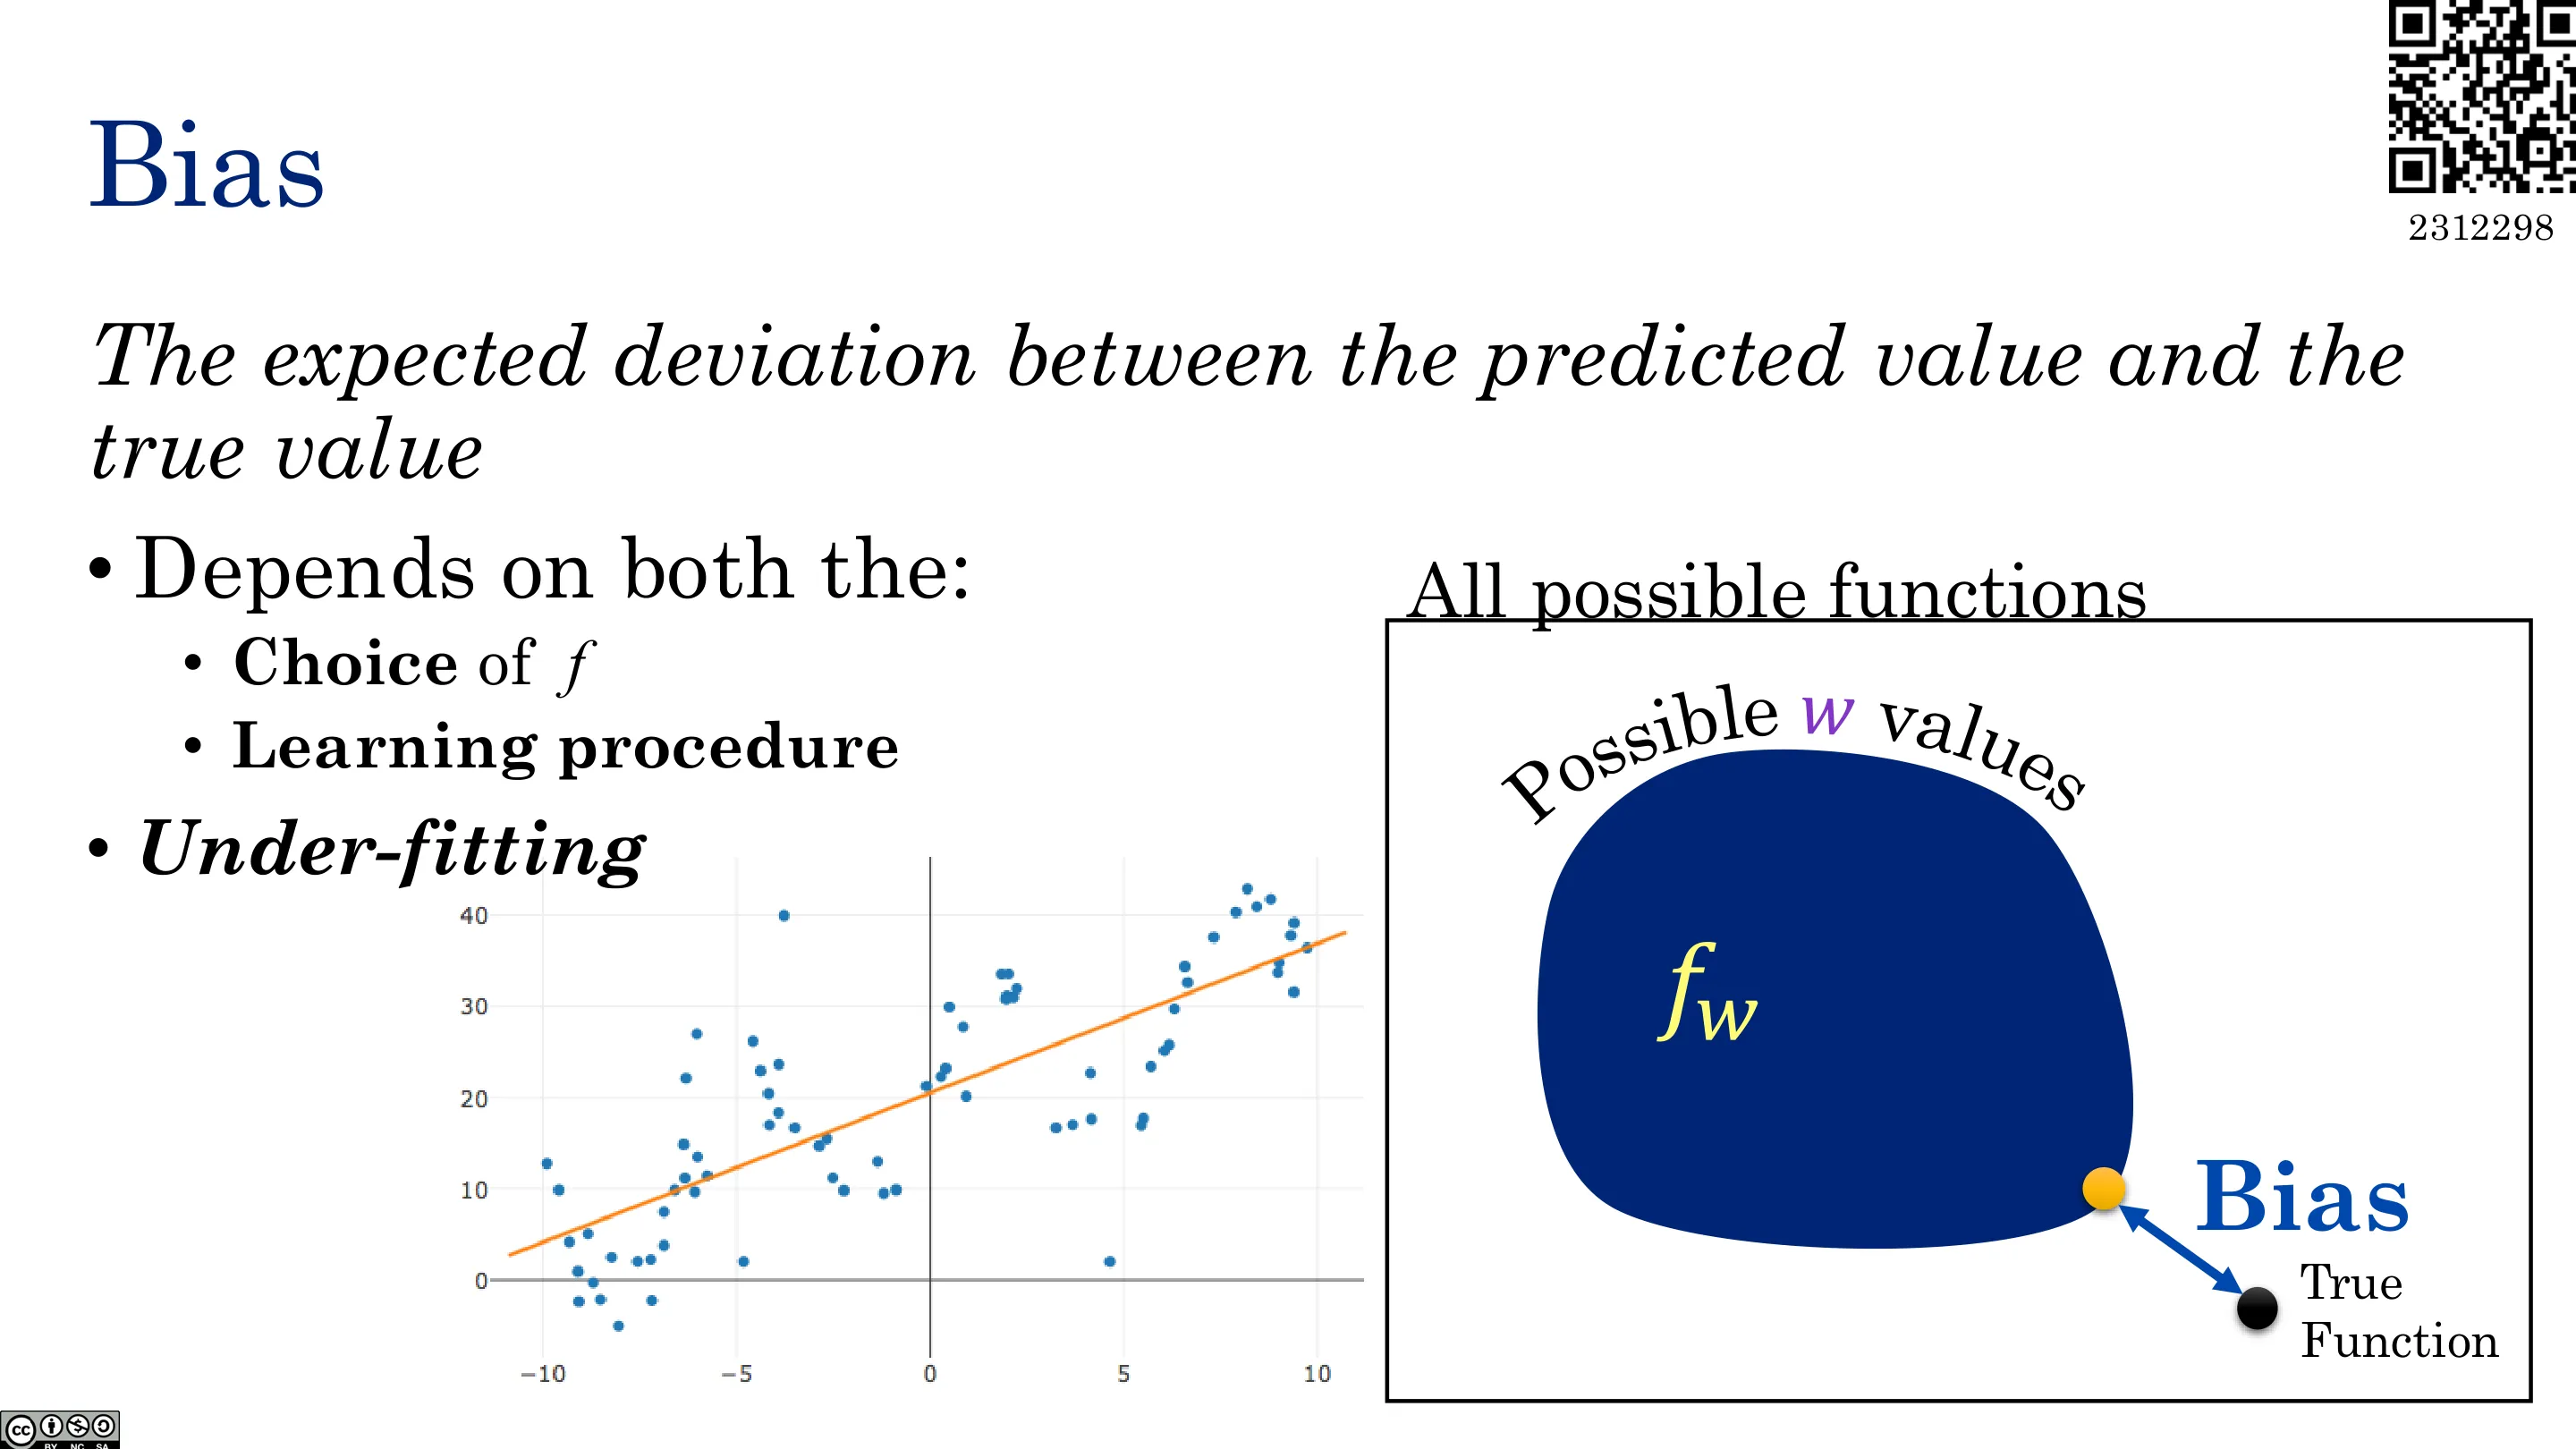
- 偏差(bias):模型本身的系统误差(模型太简单 ⇒ 欠拟合);
- 方差(variance):把数据重新采样、重训一次,模型预测的波动(模型太灵活 ⇒ 过拟合)。
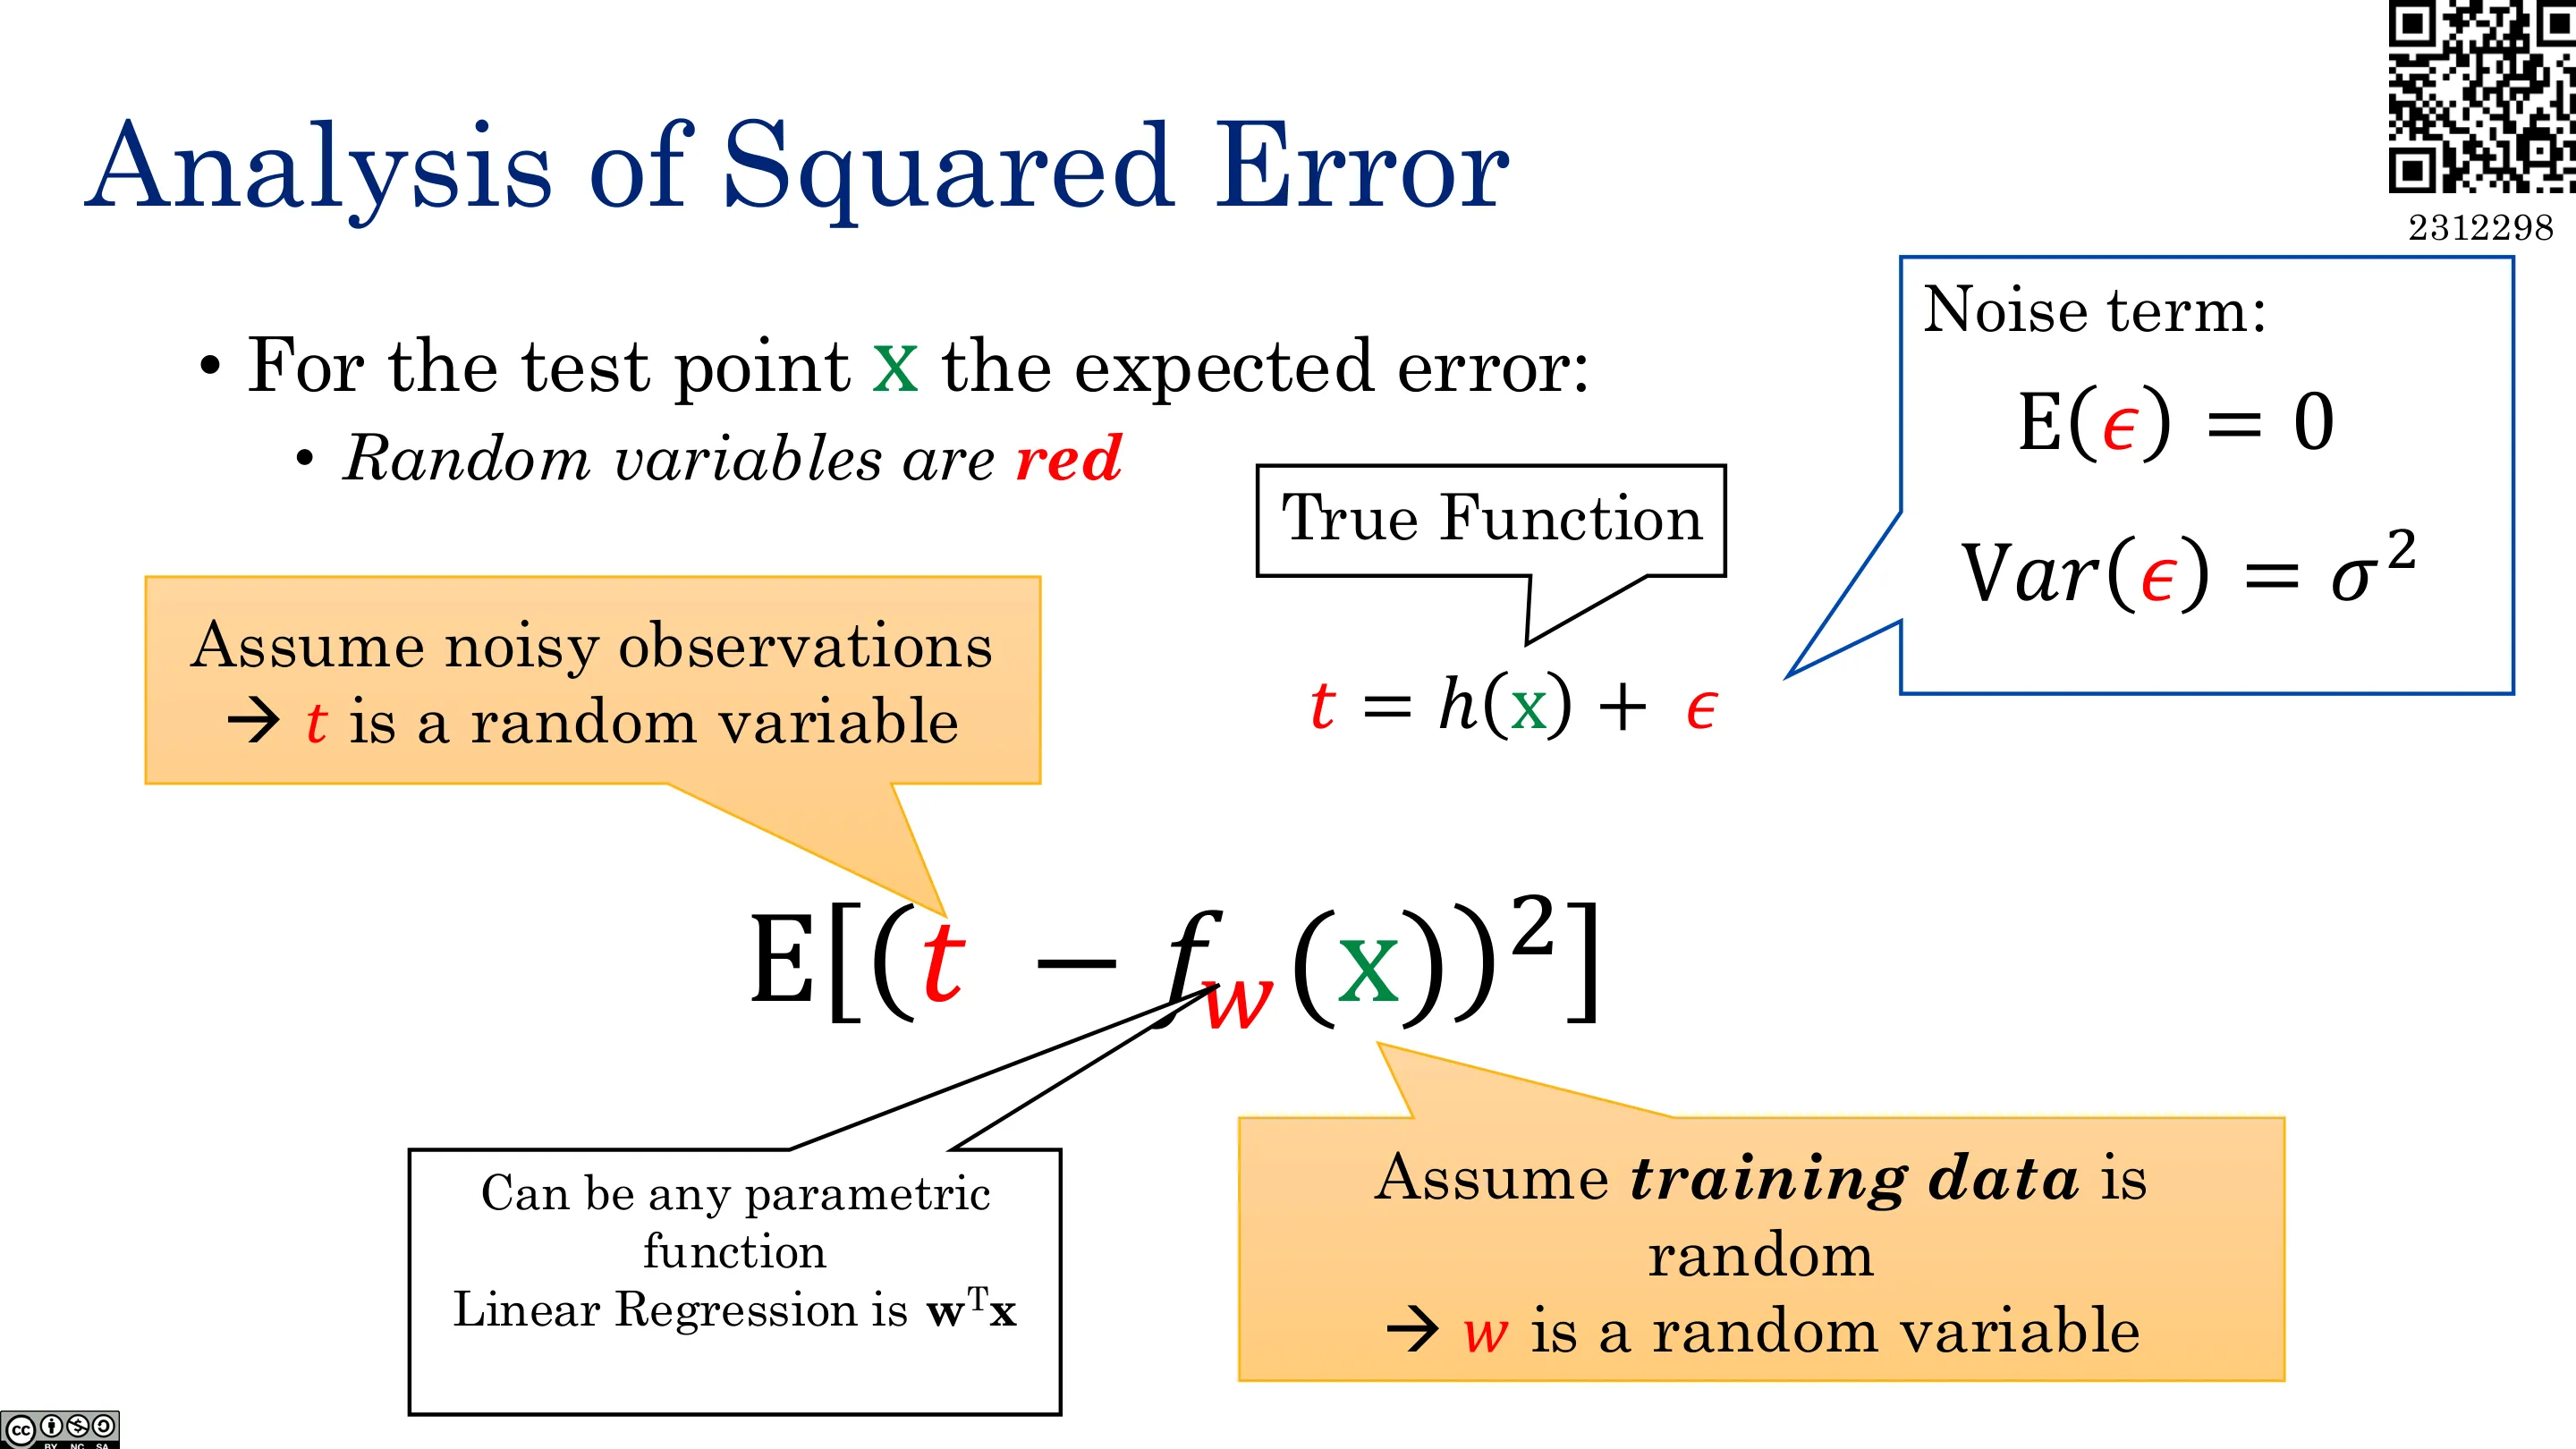
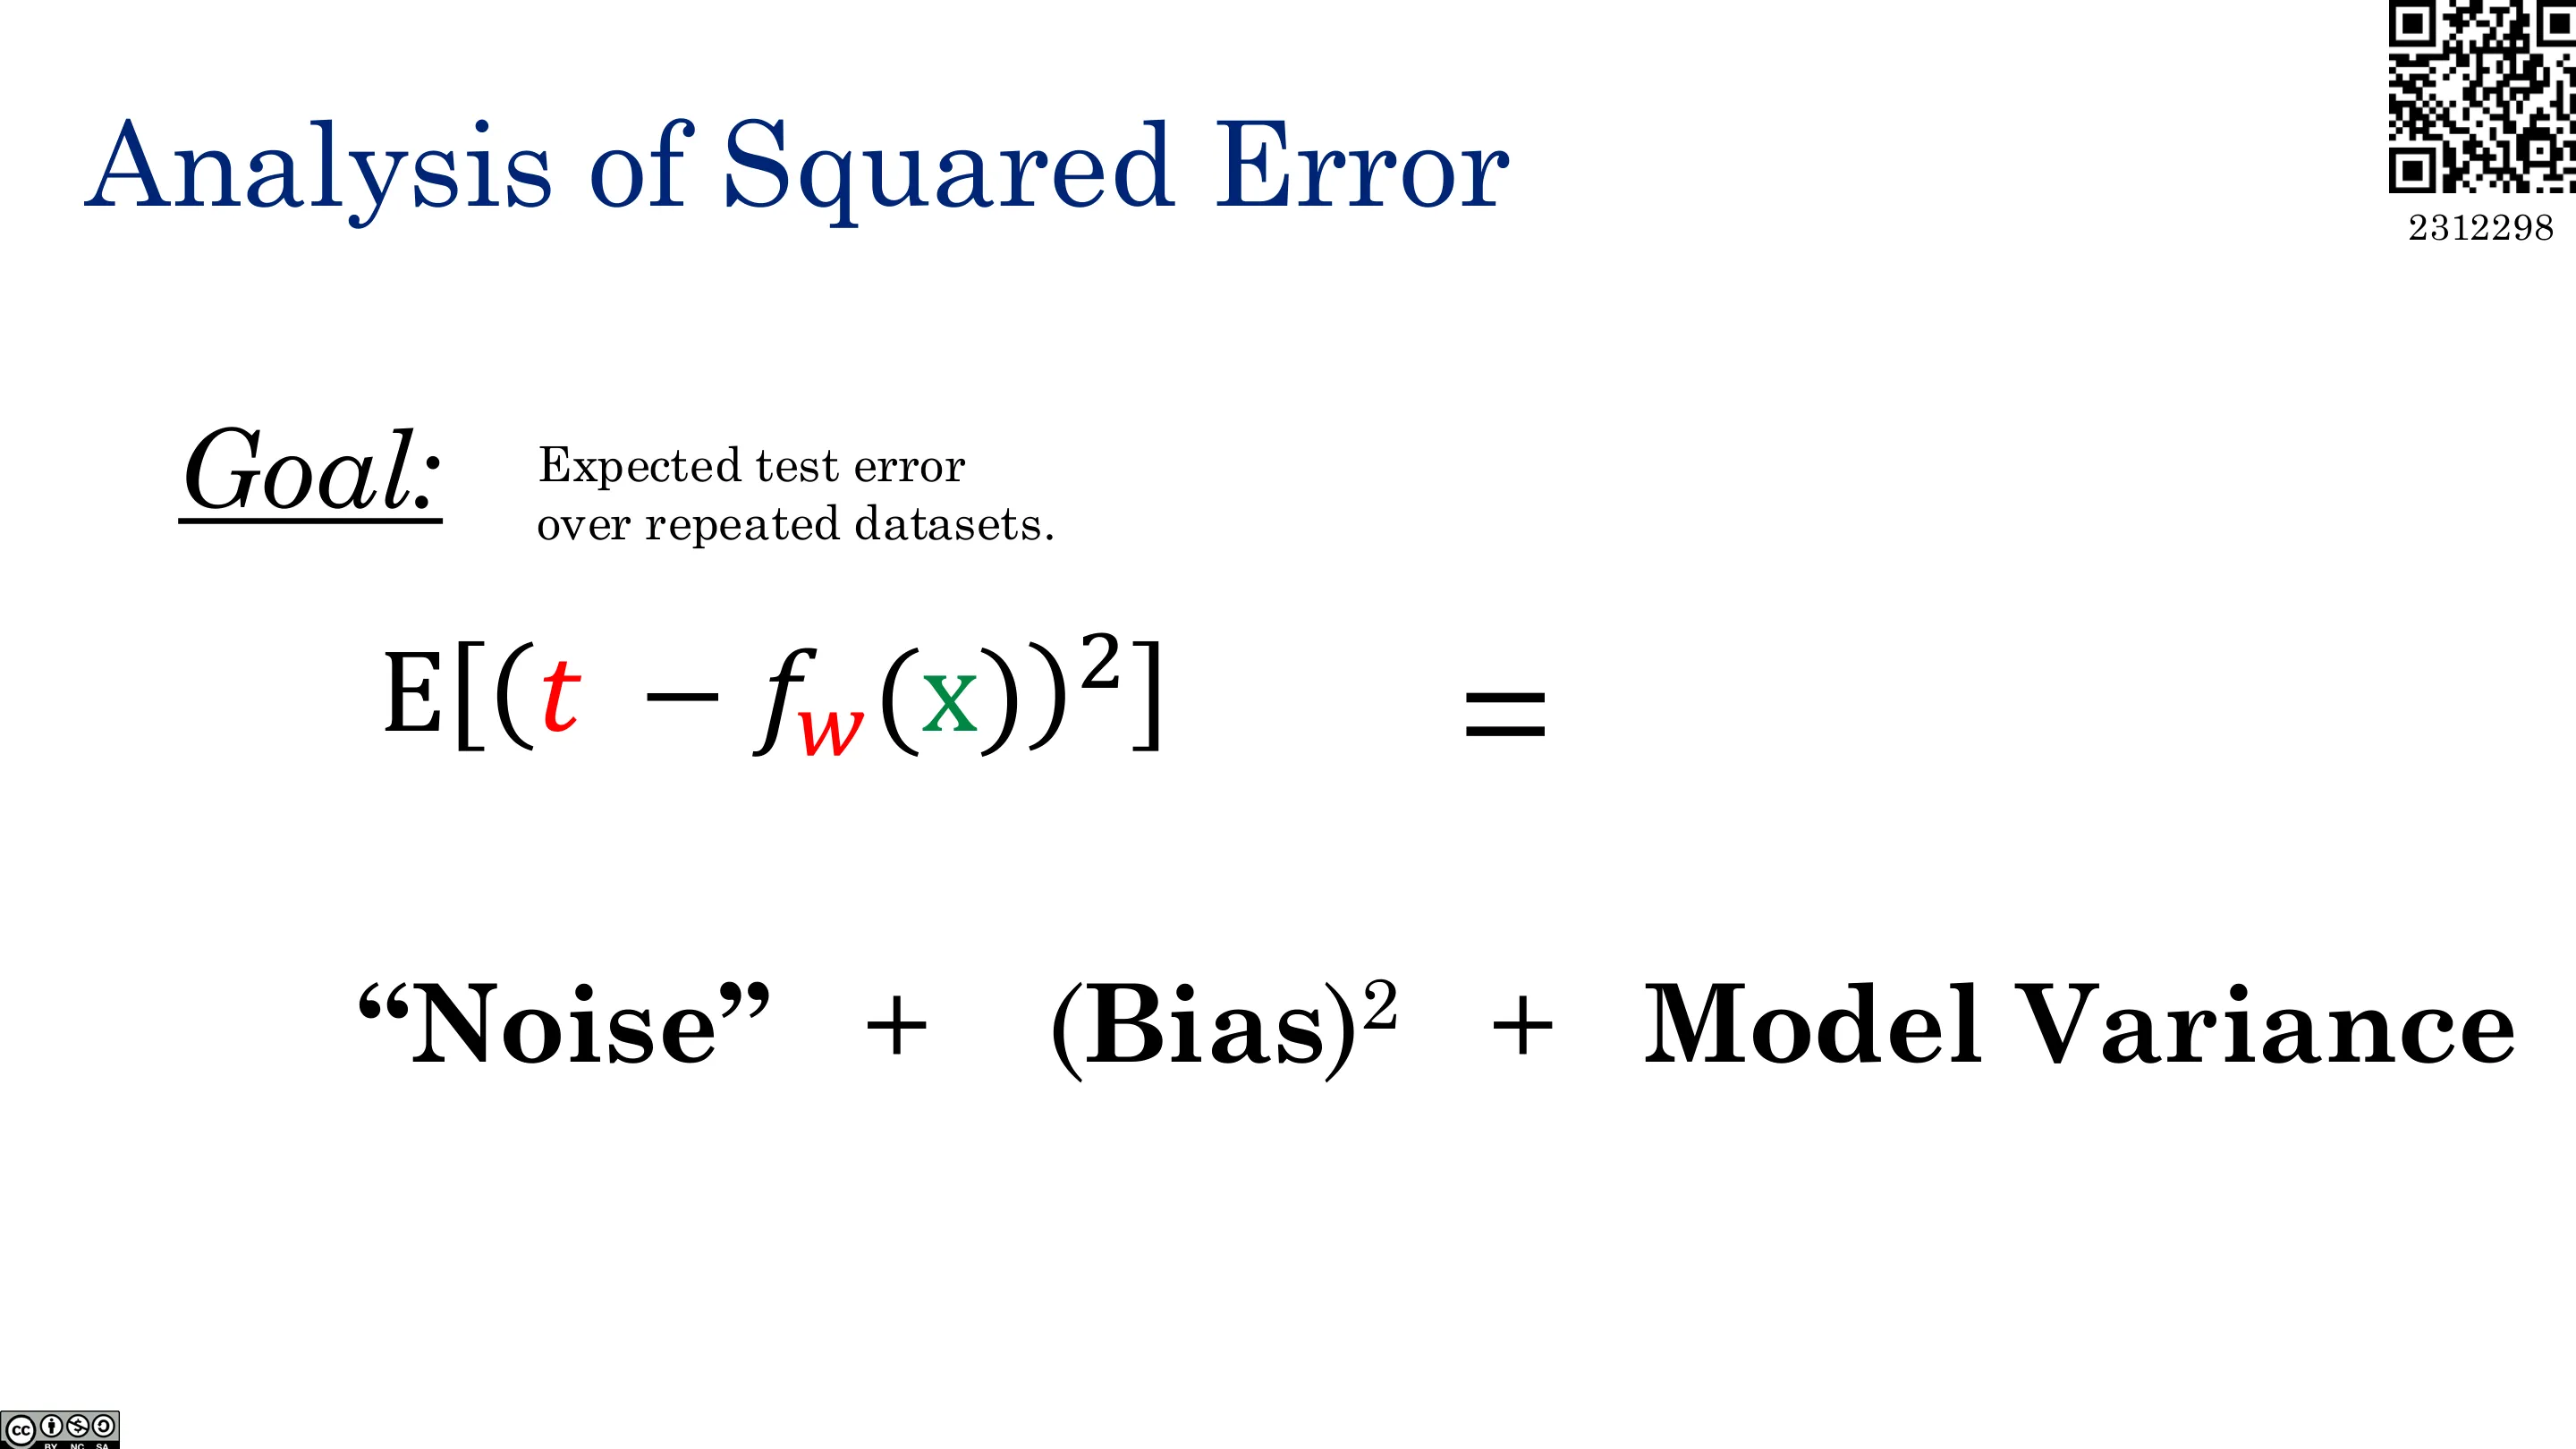
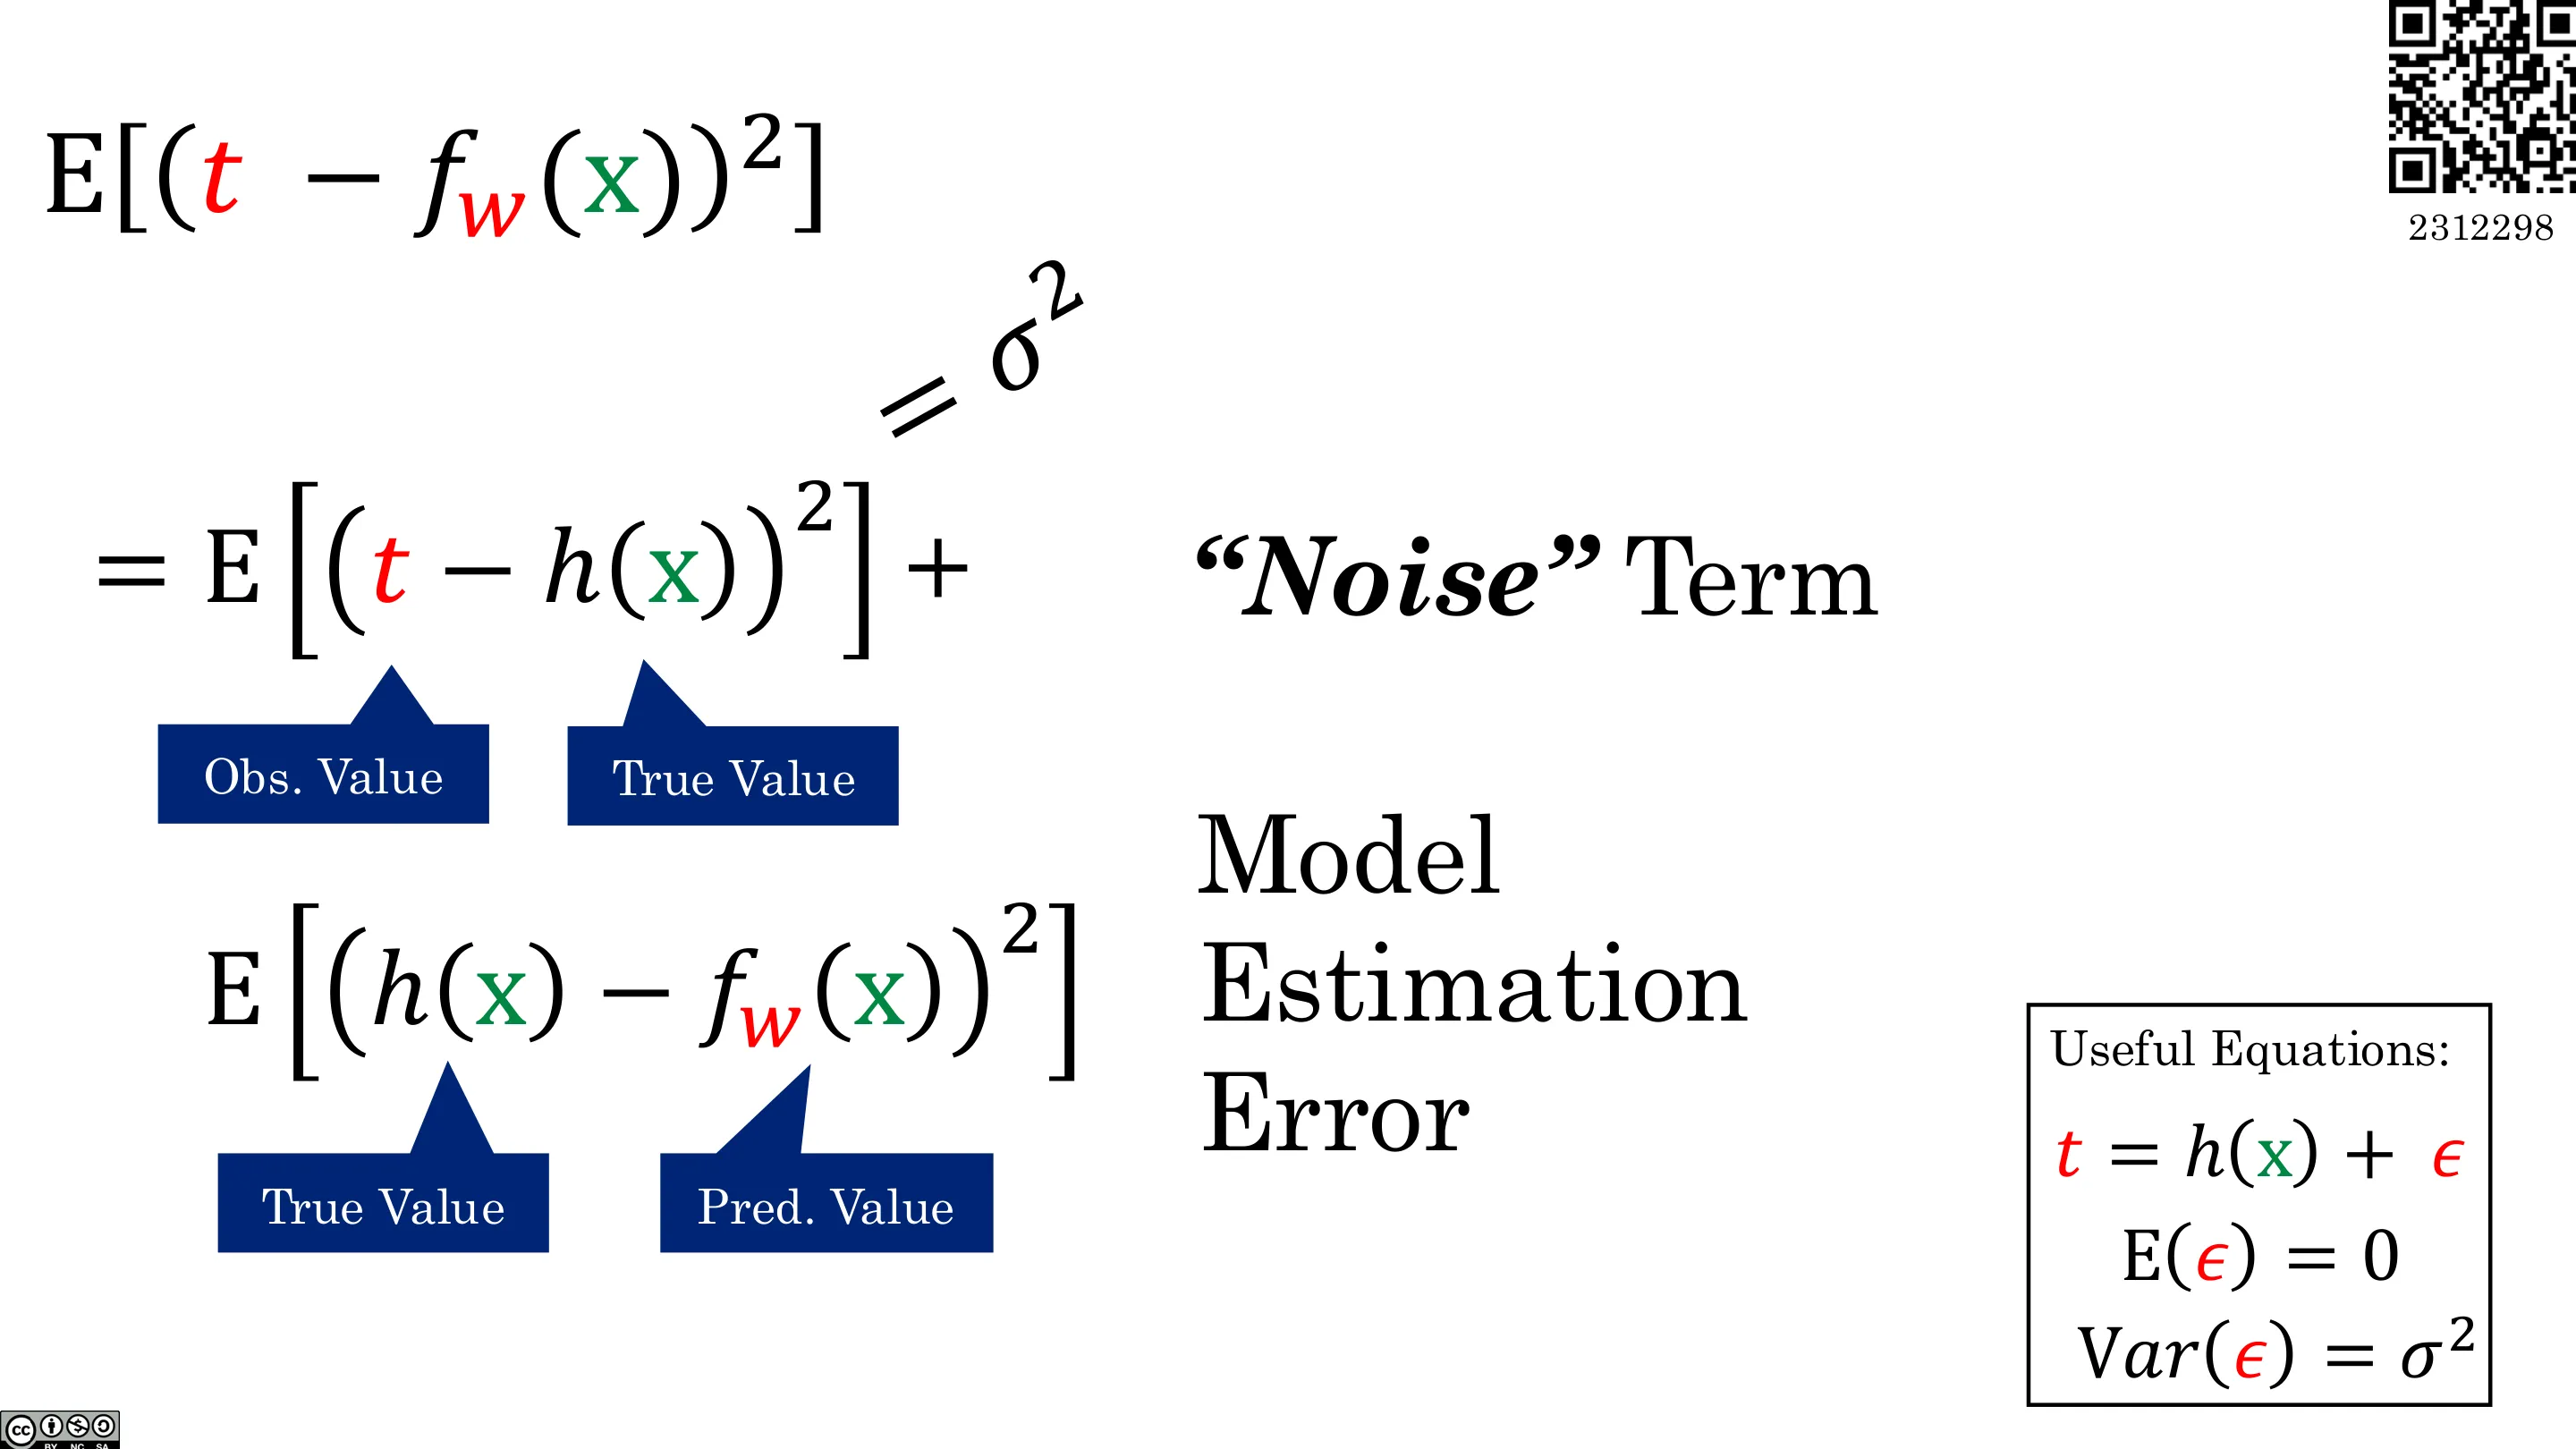
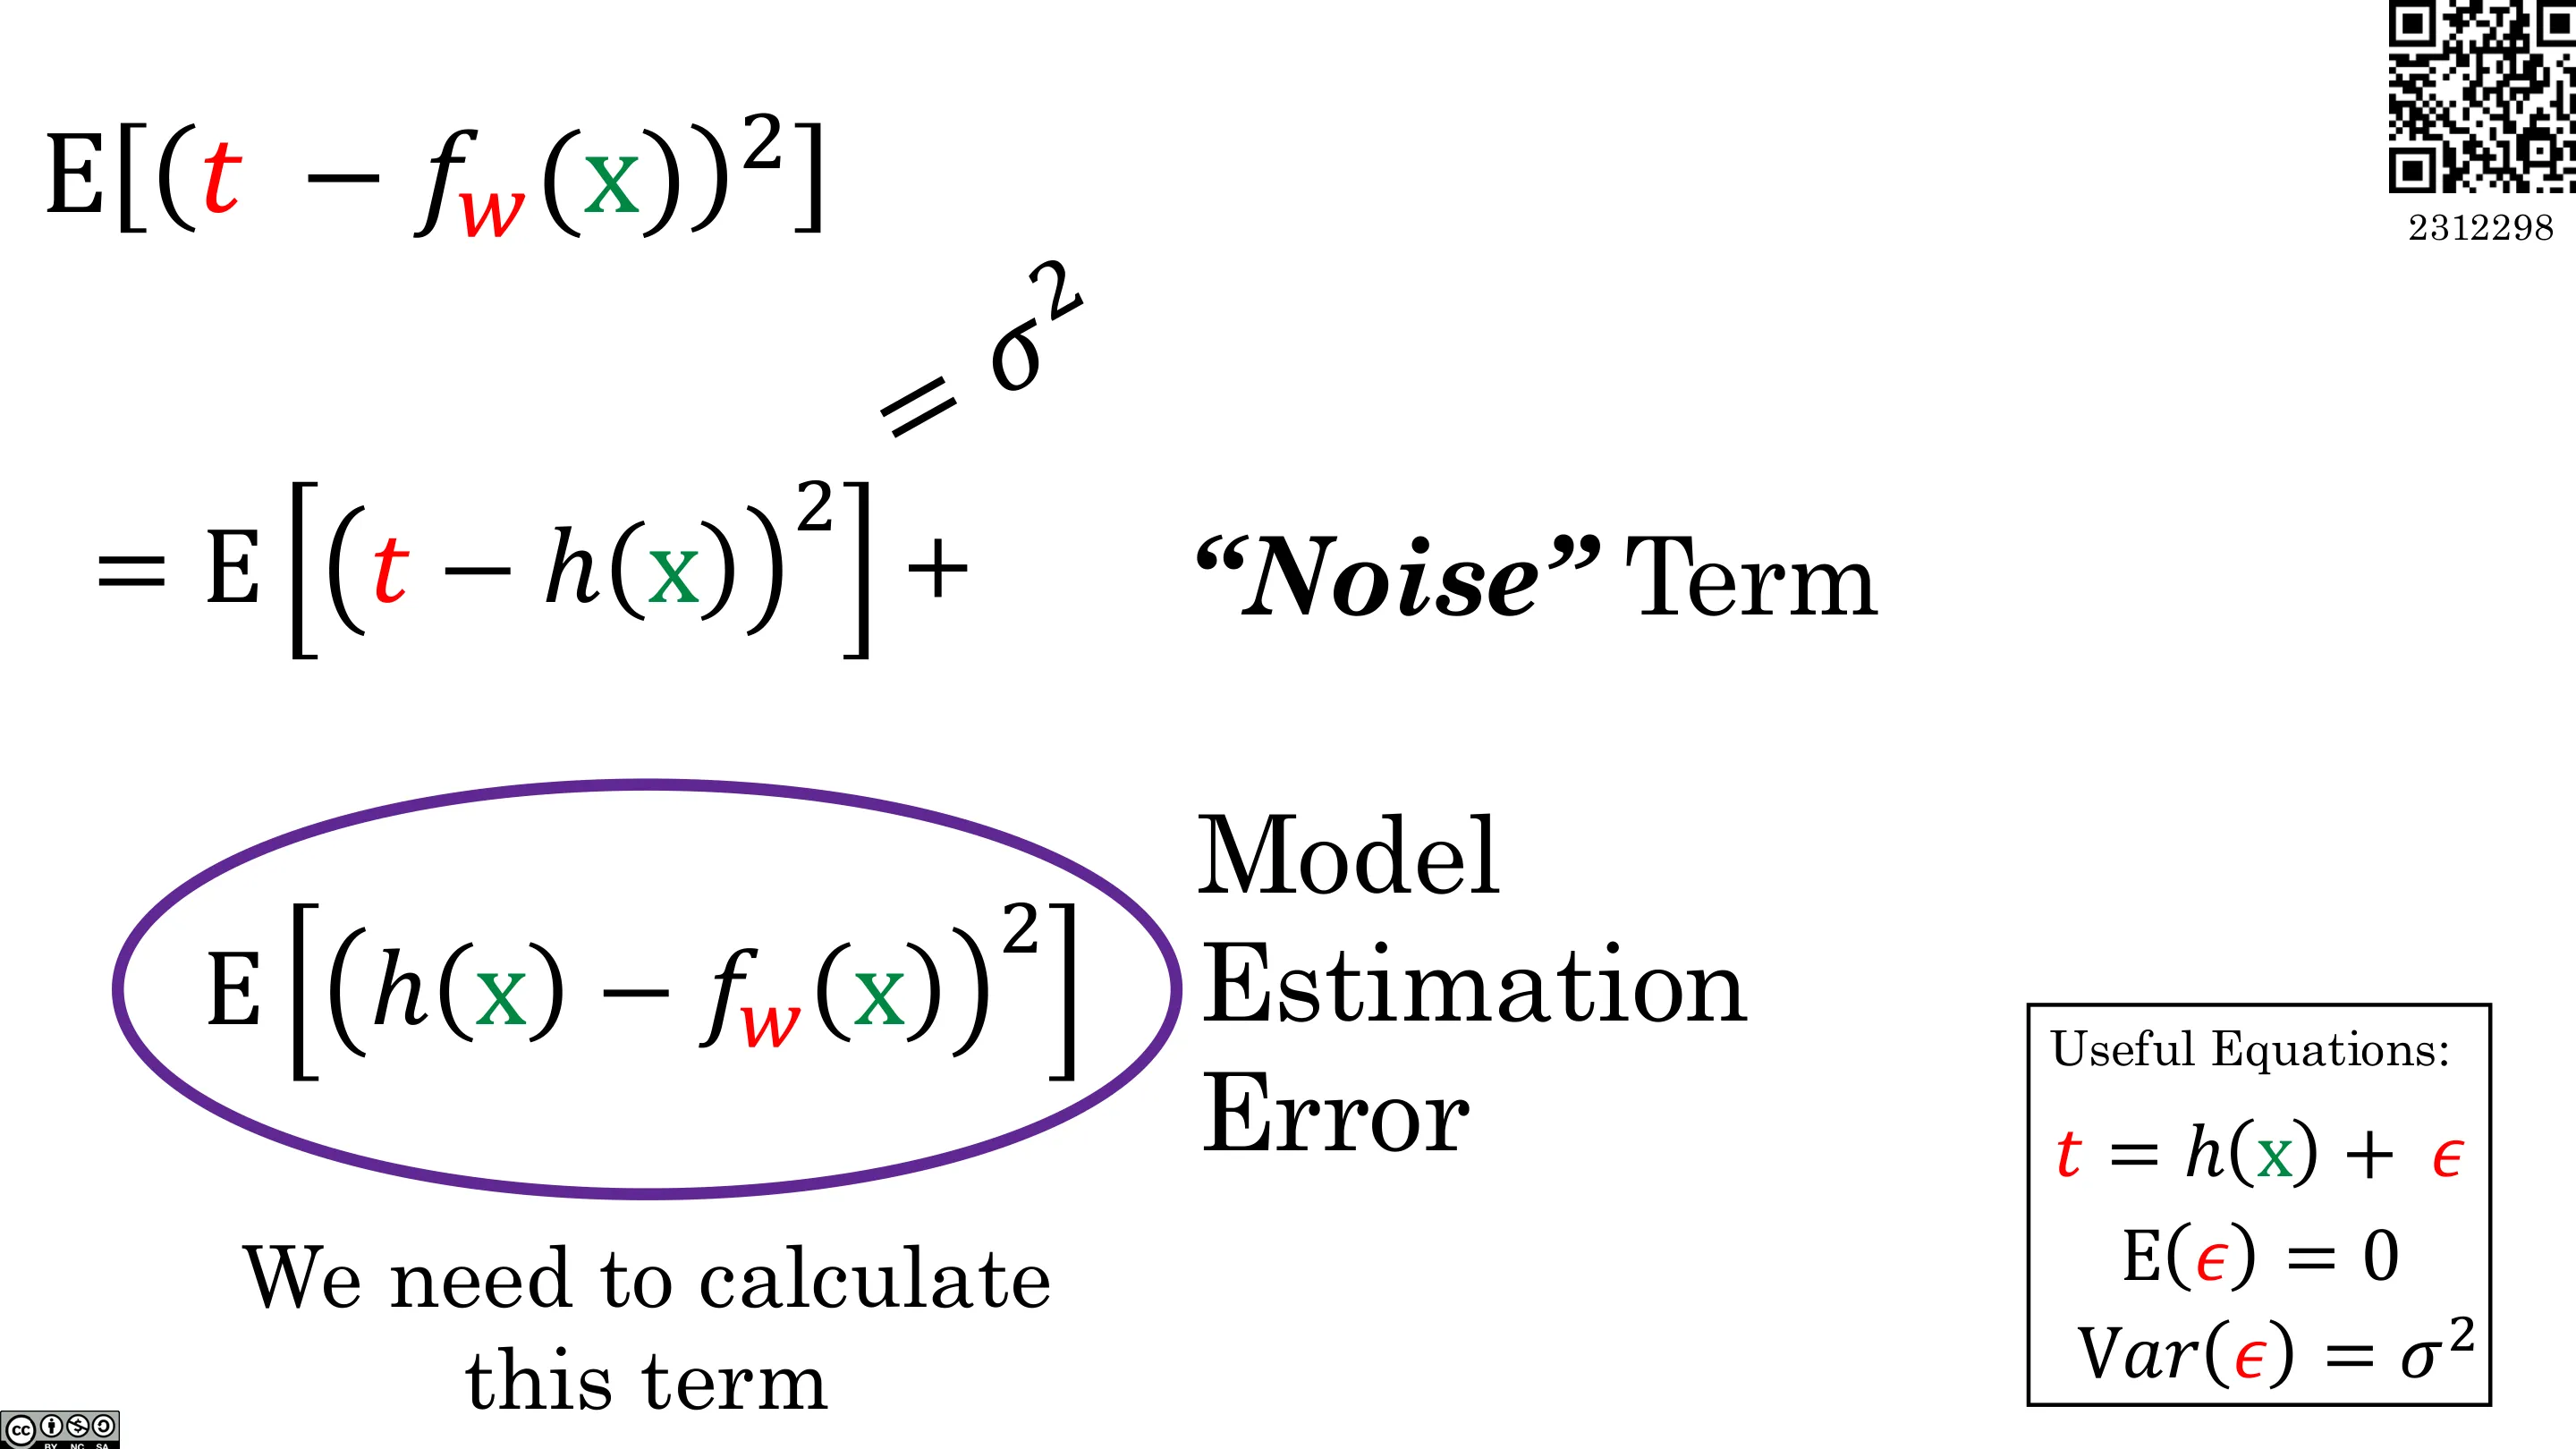
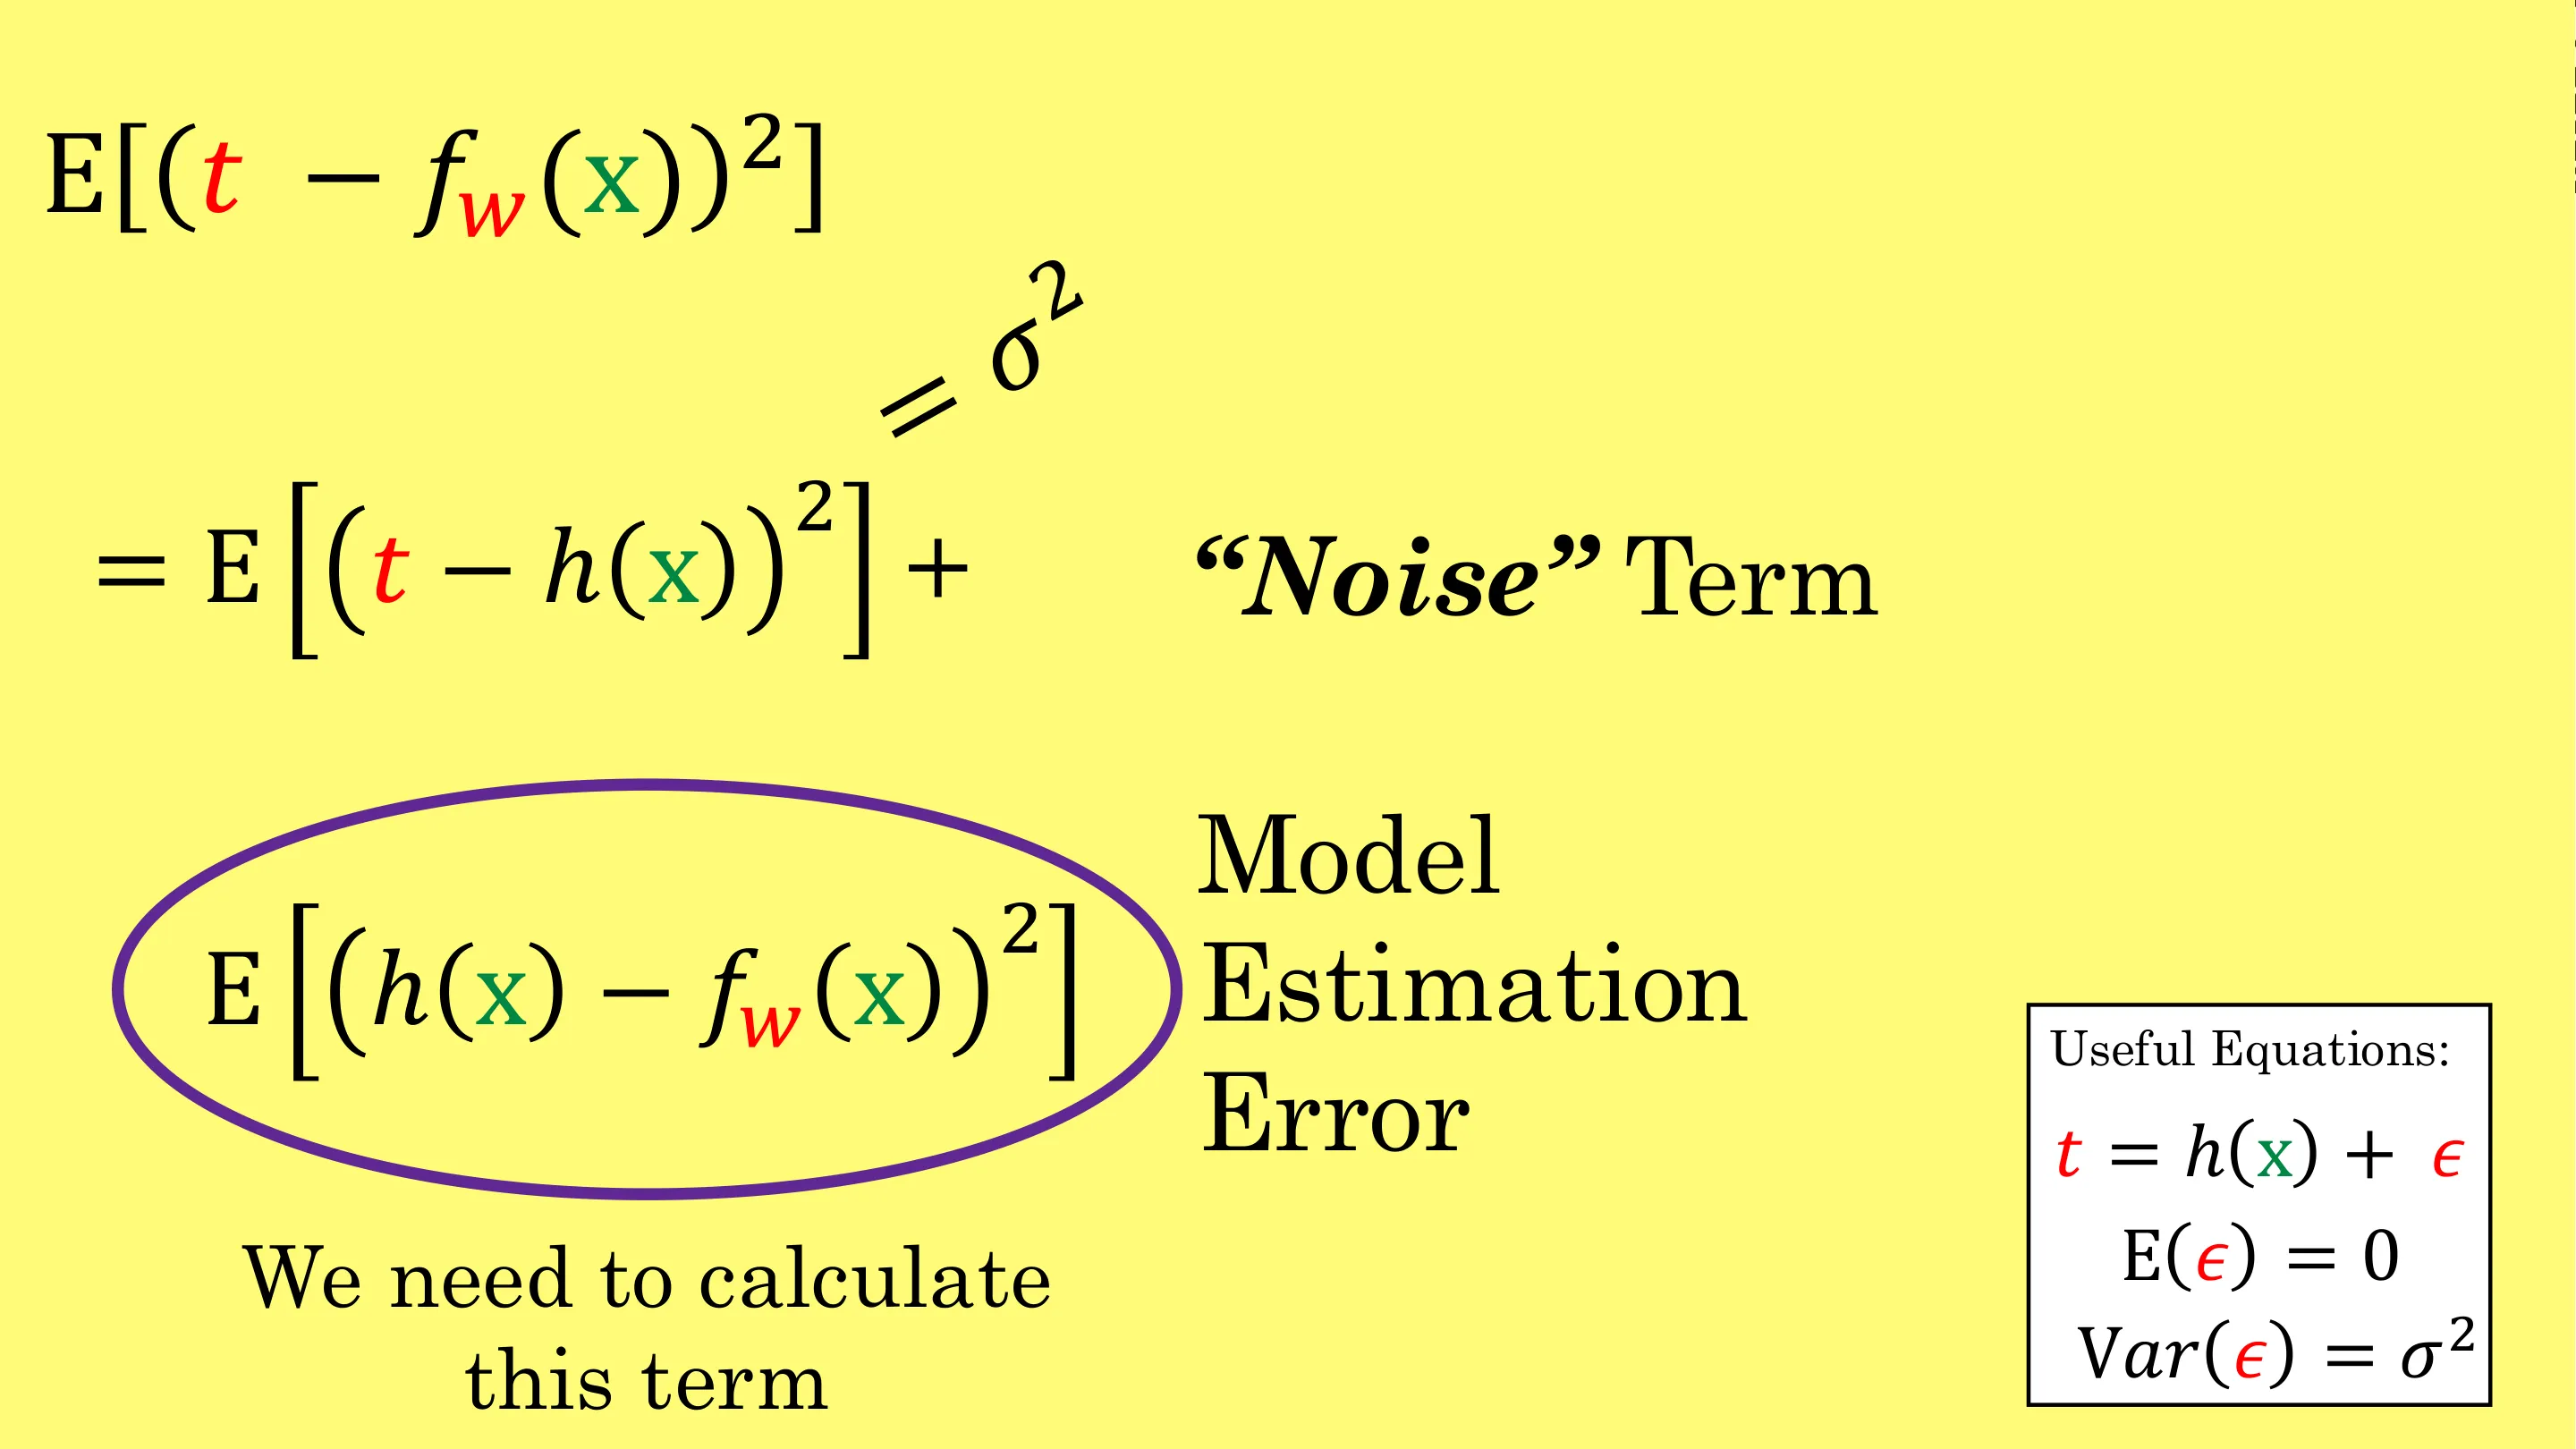
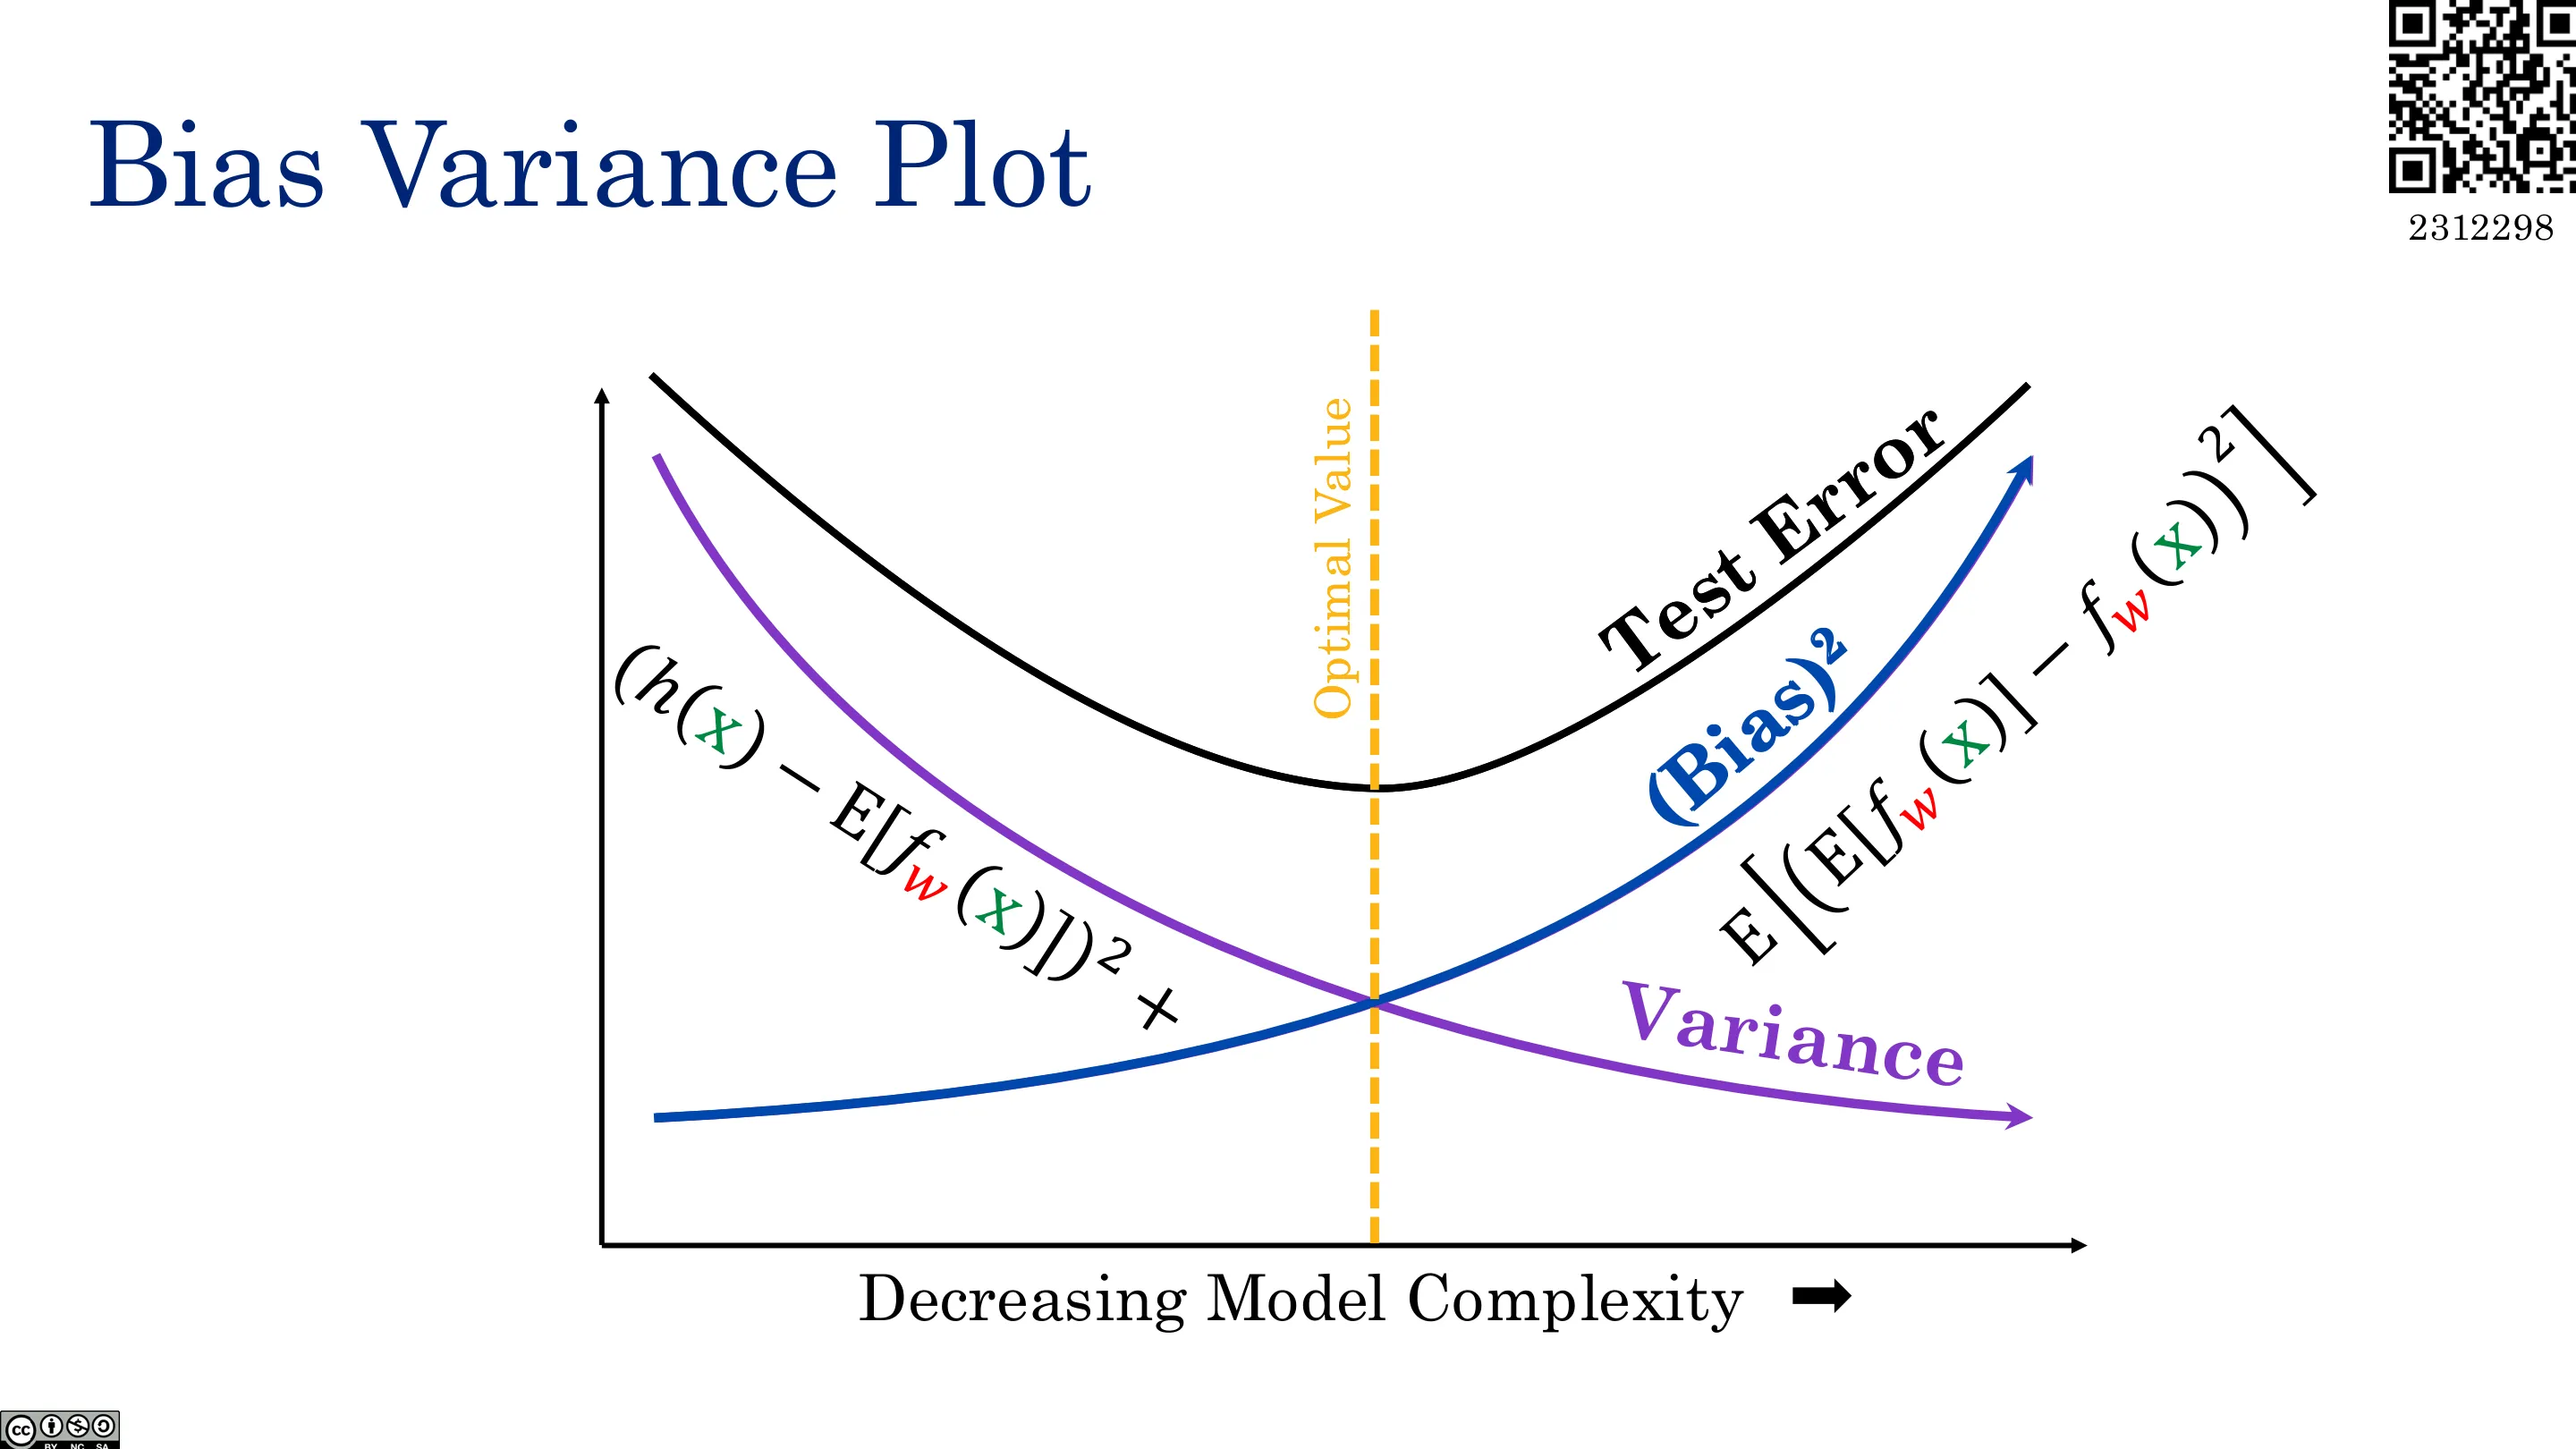
对重复数据集的预期测试误差可以精确分解为三项:
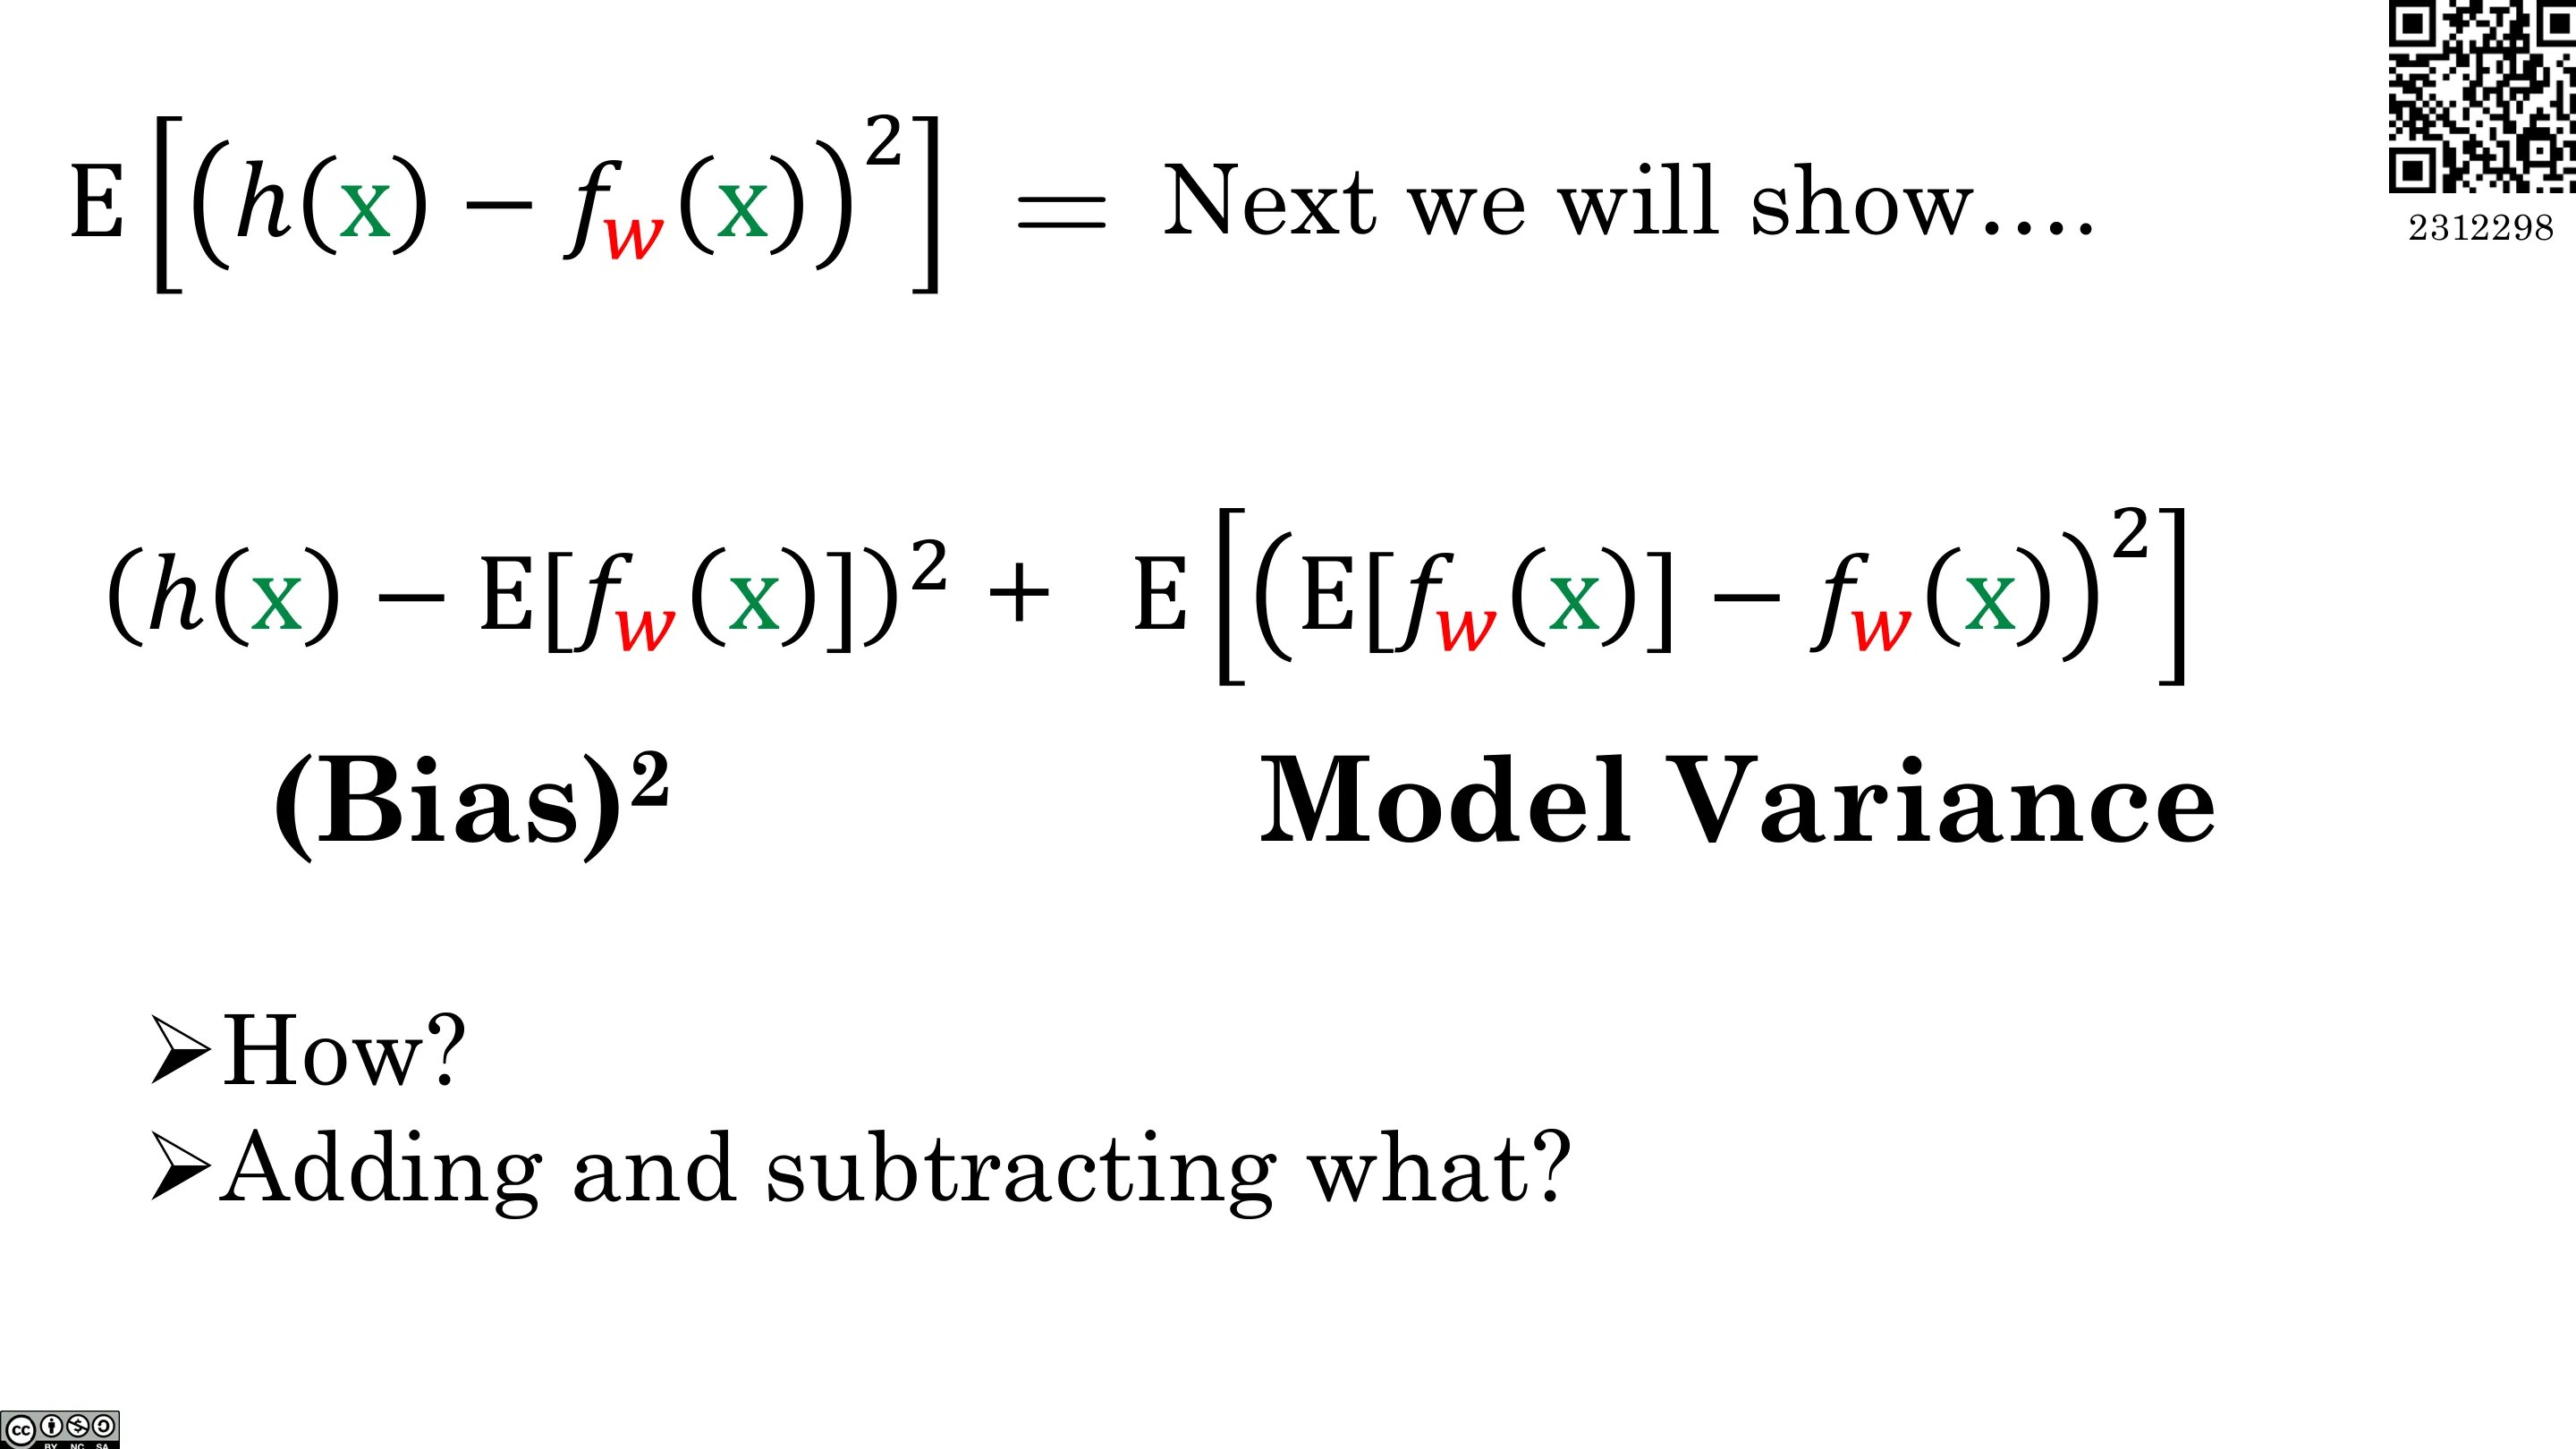
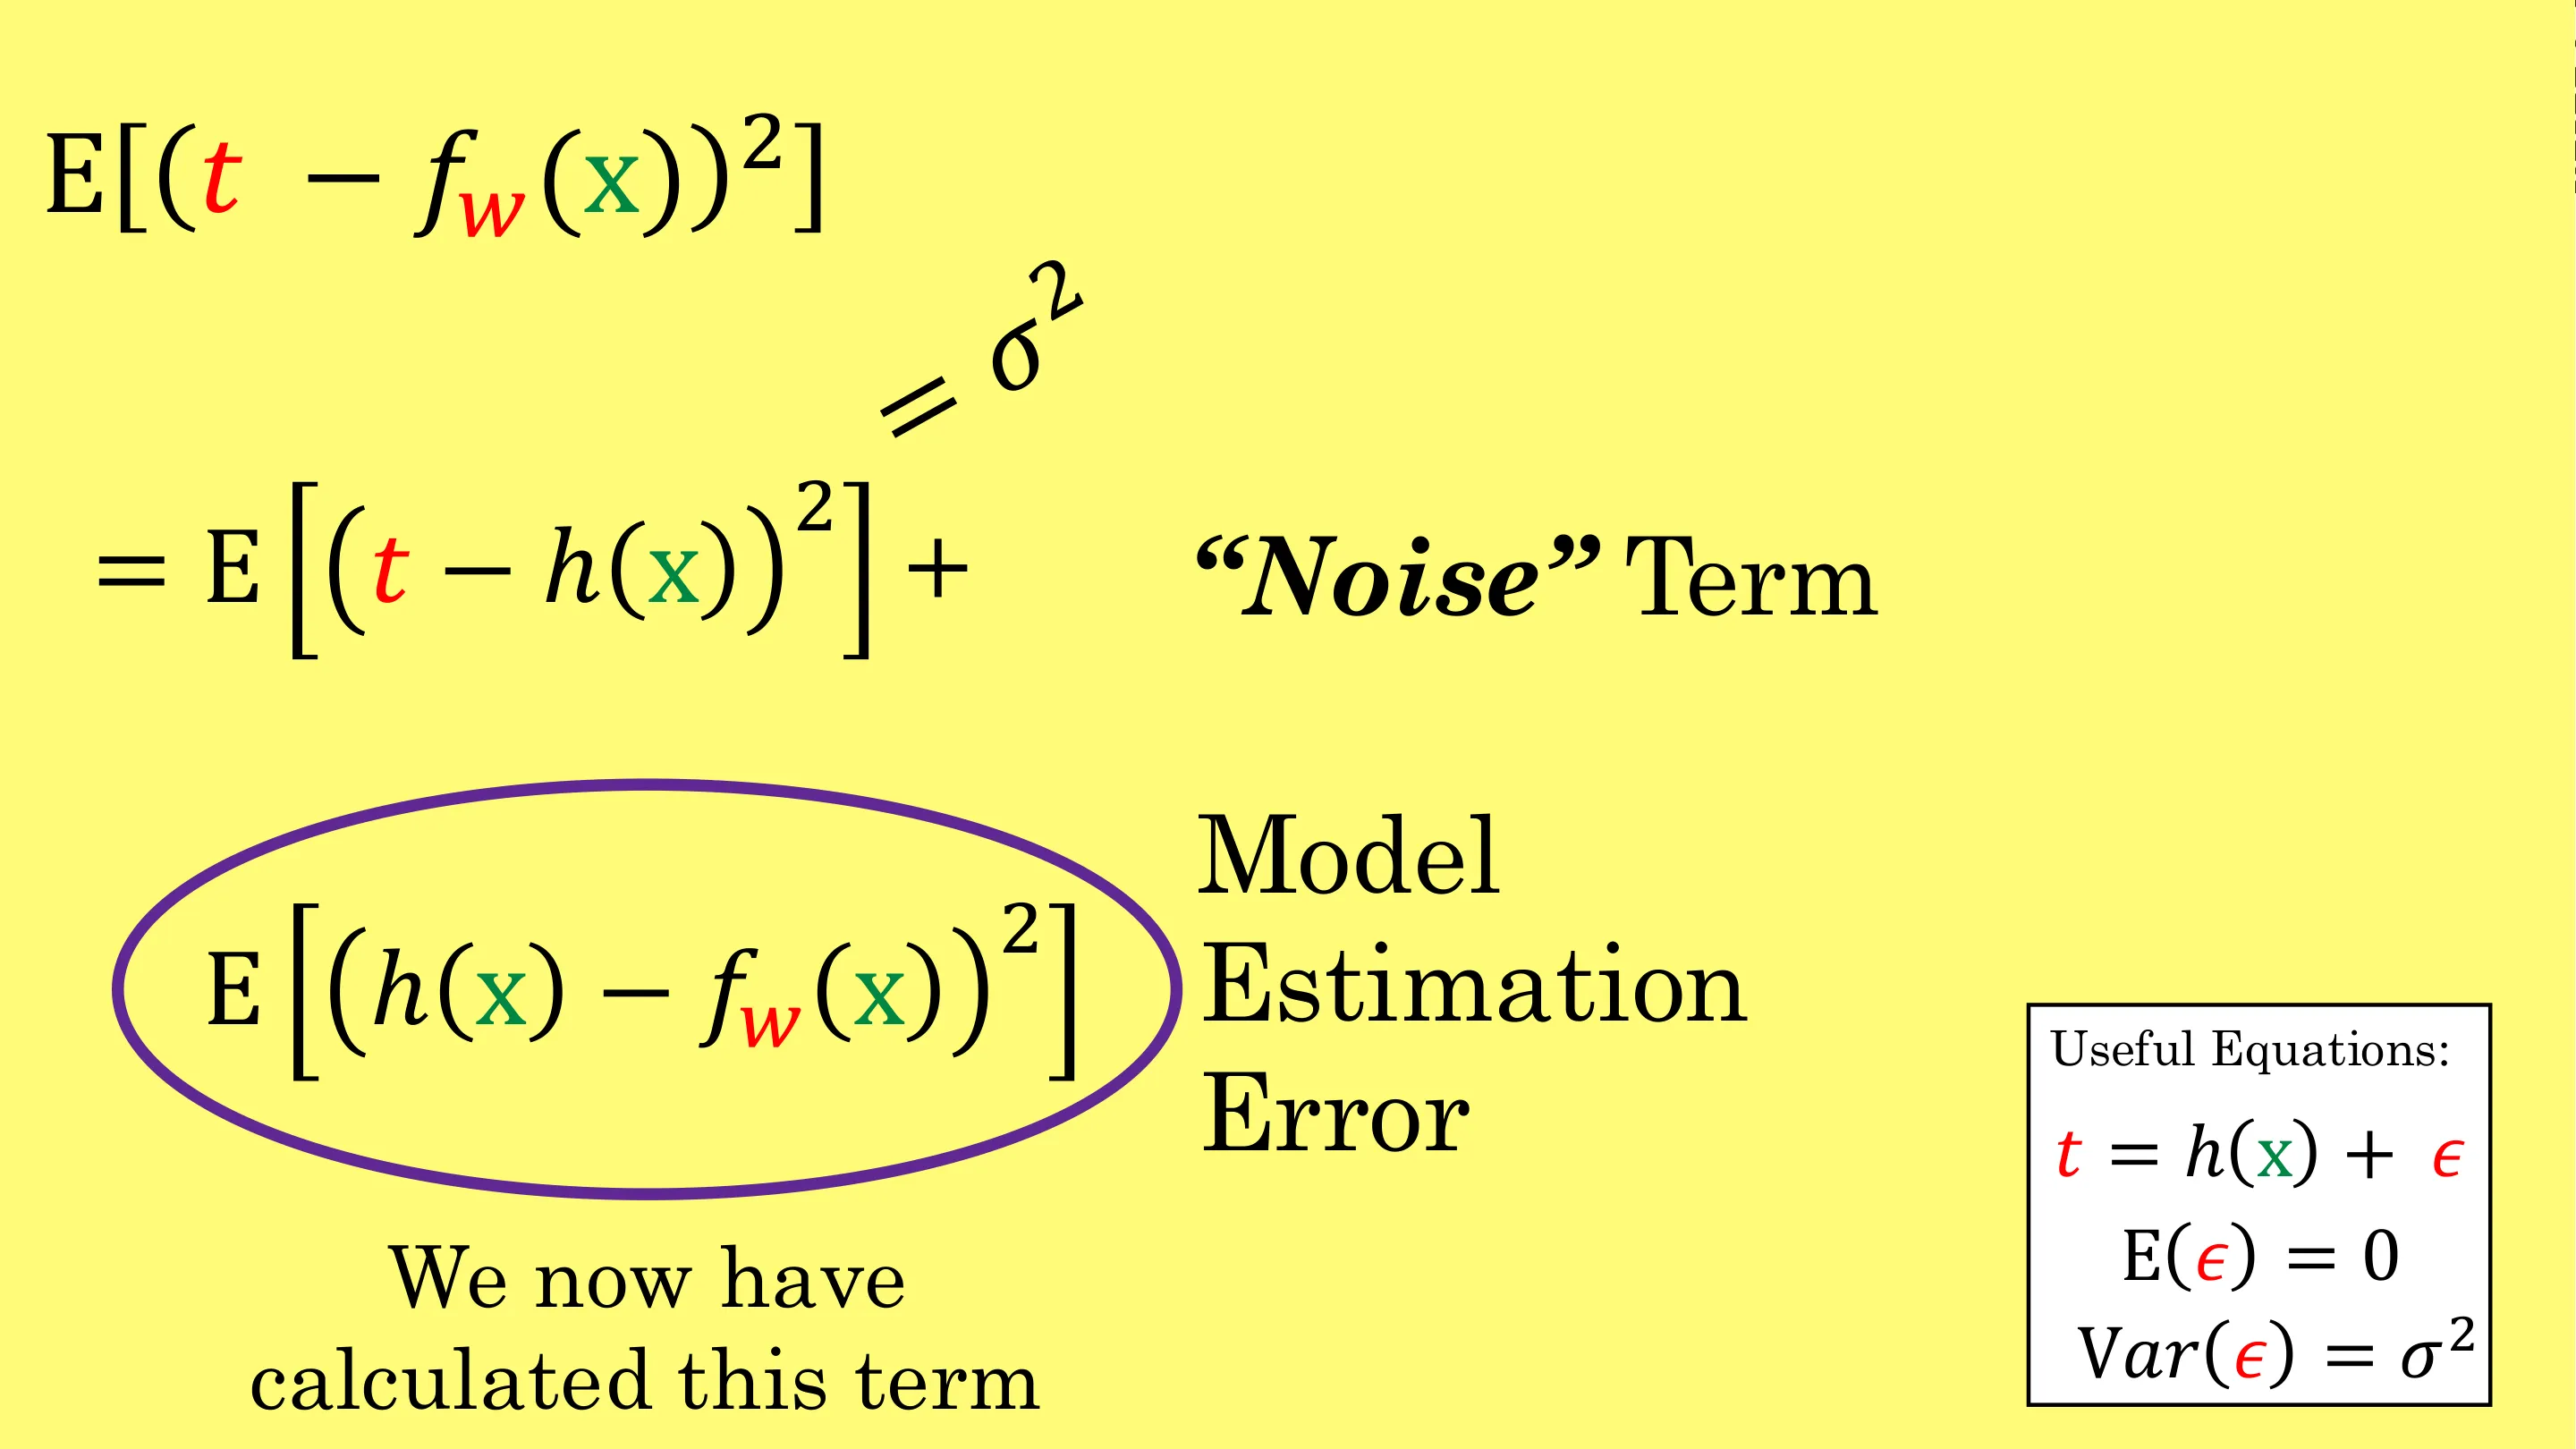
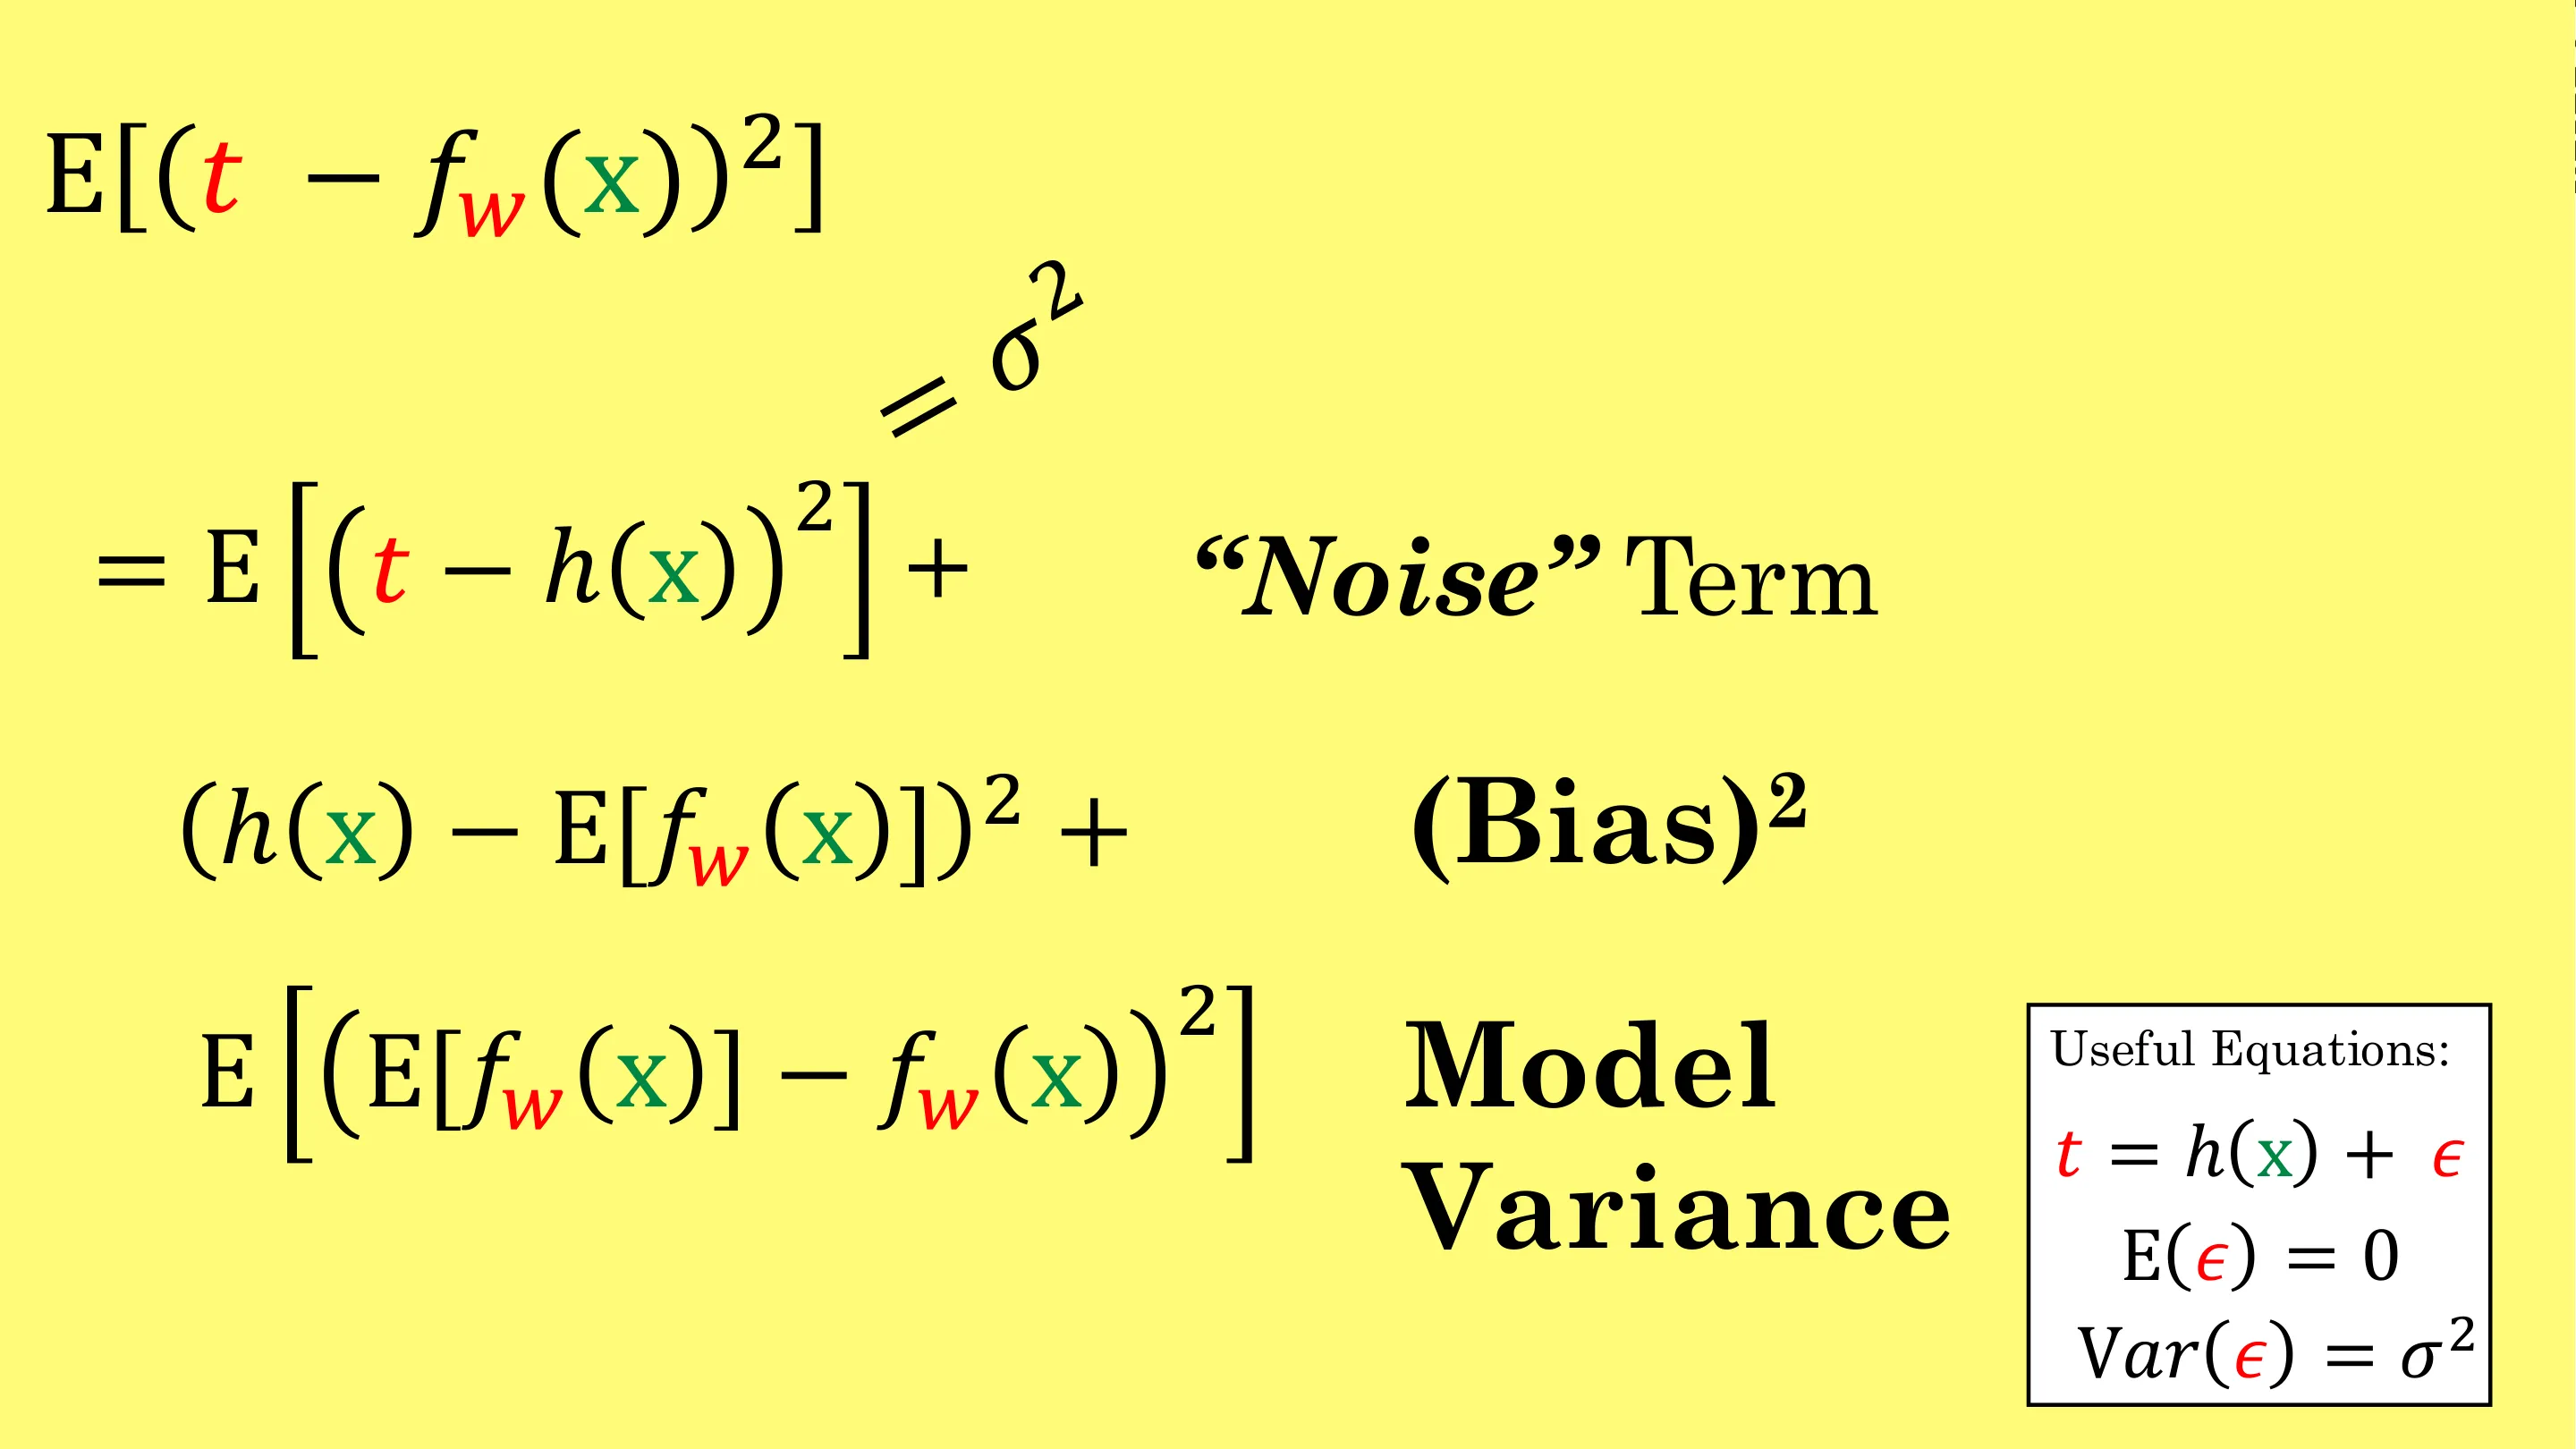
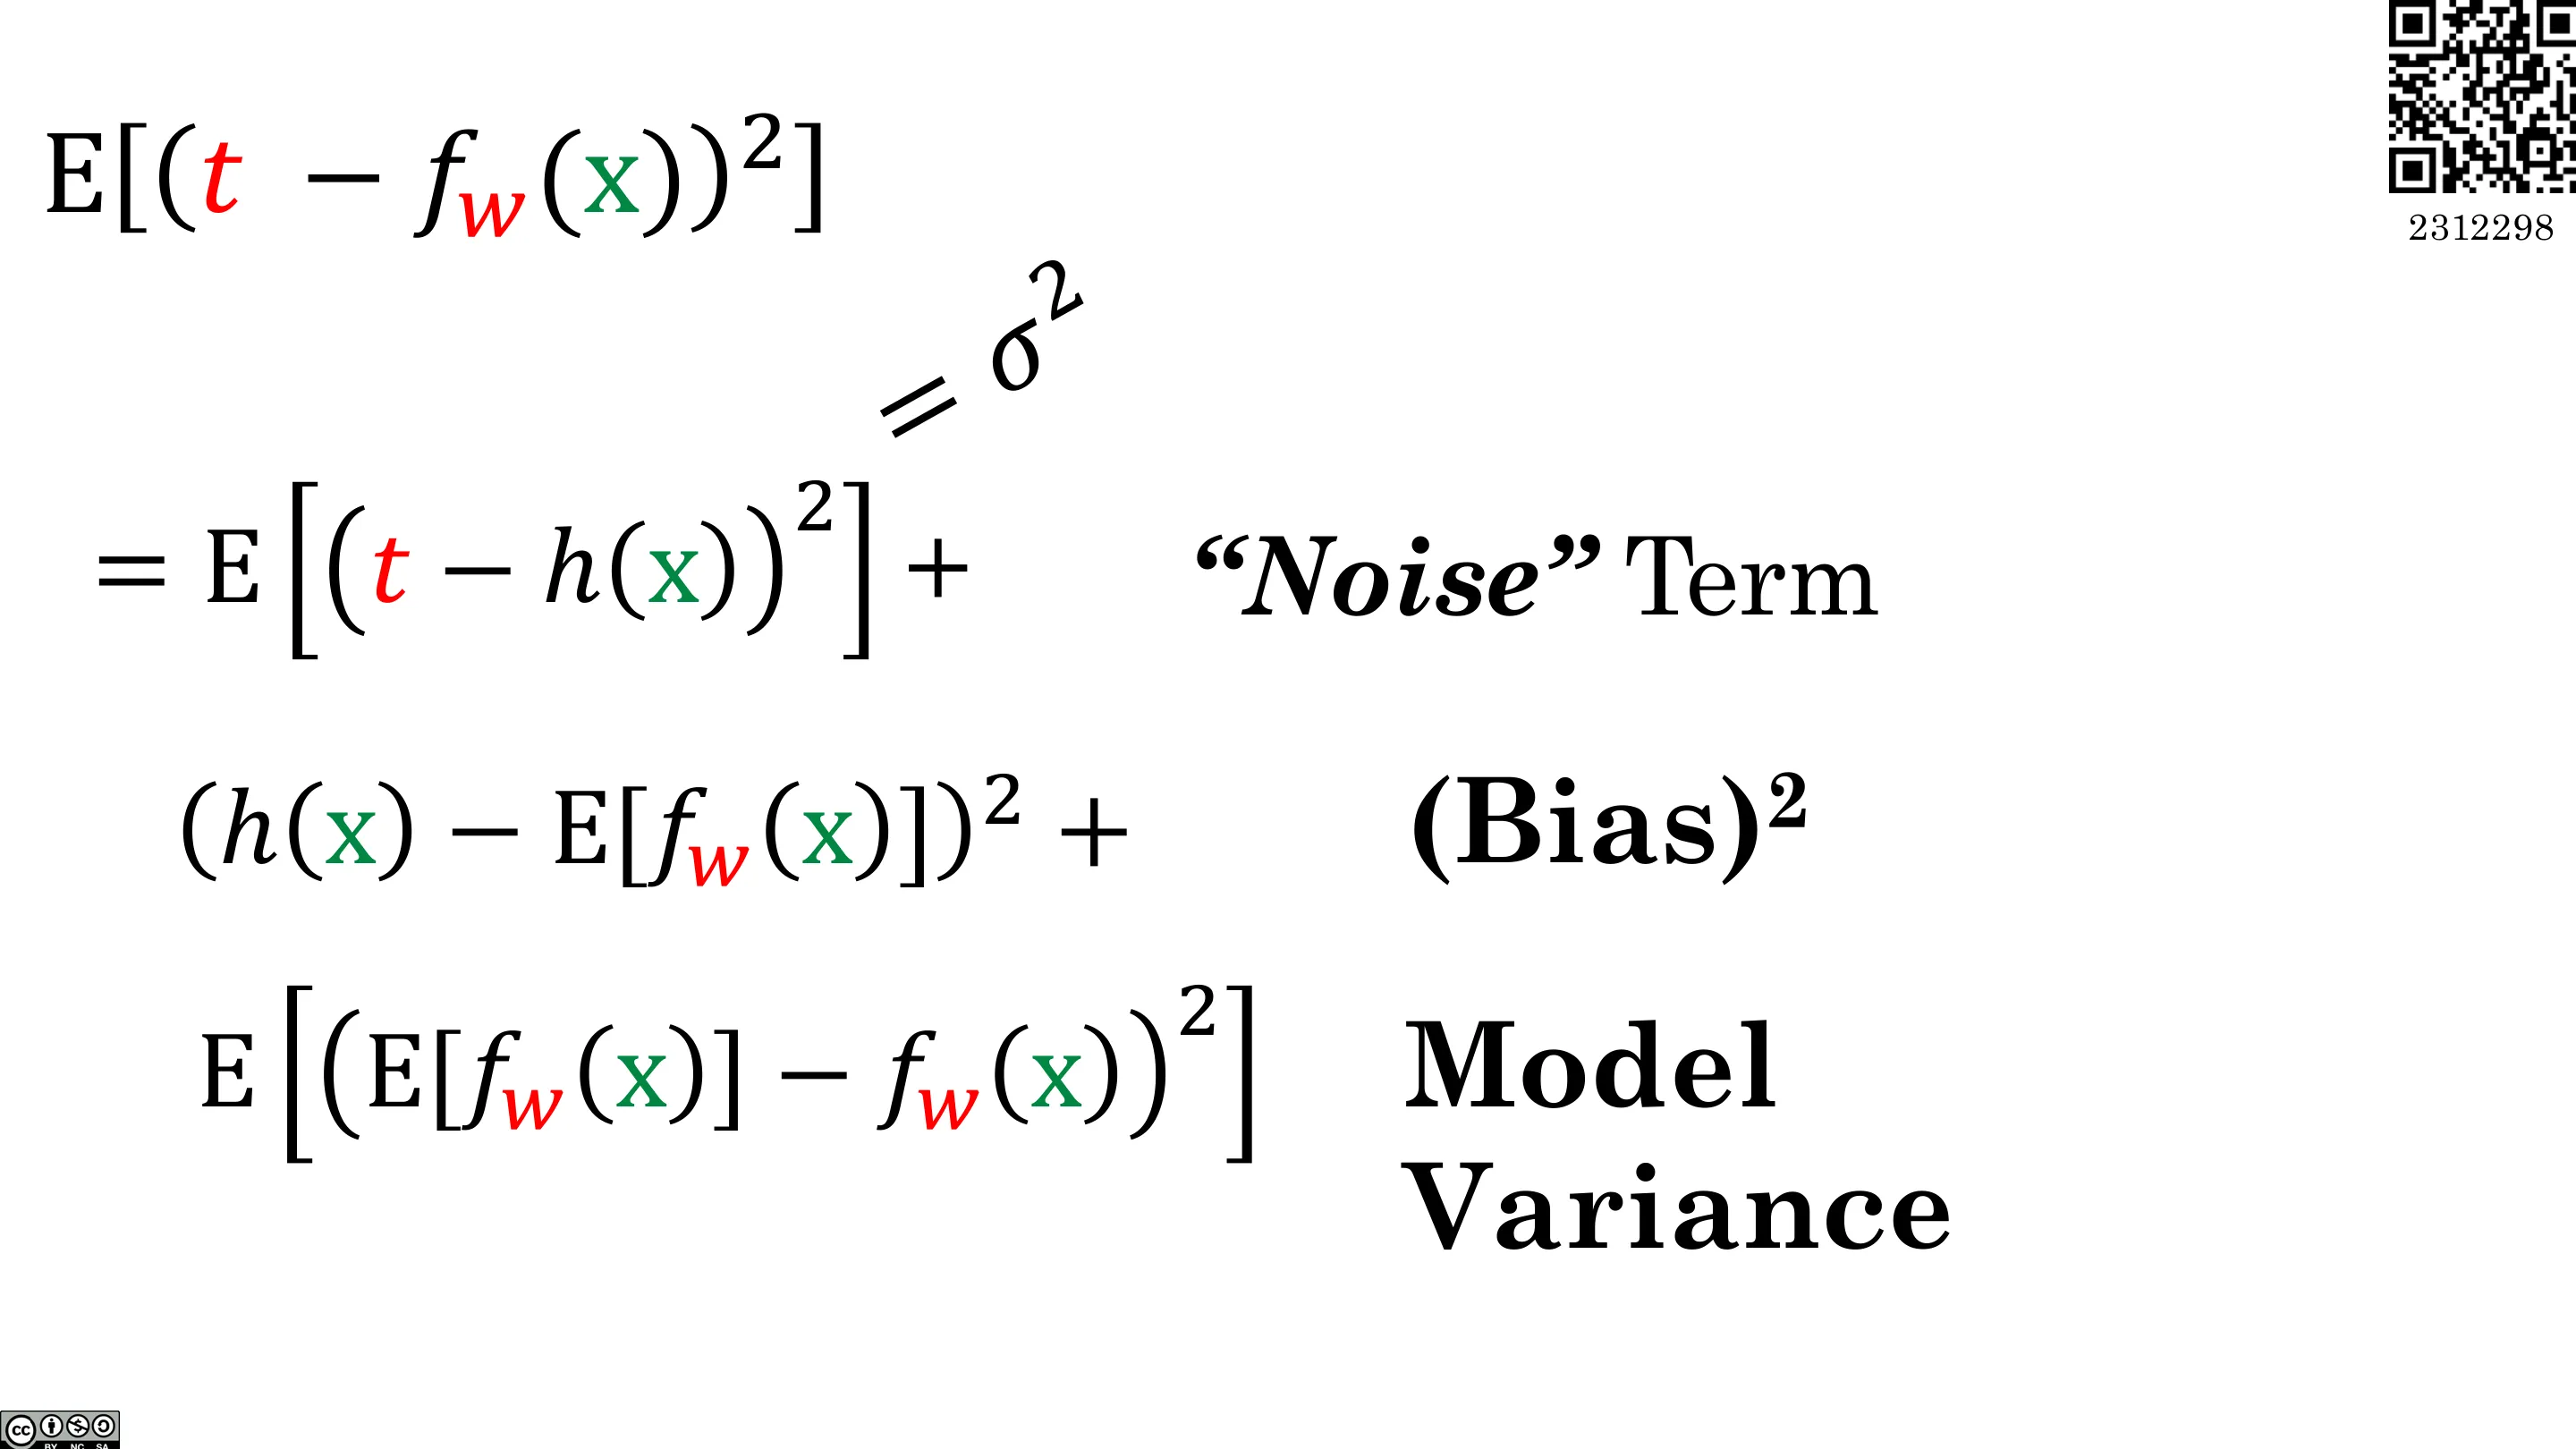
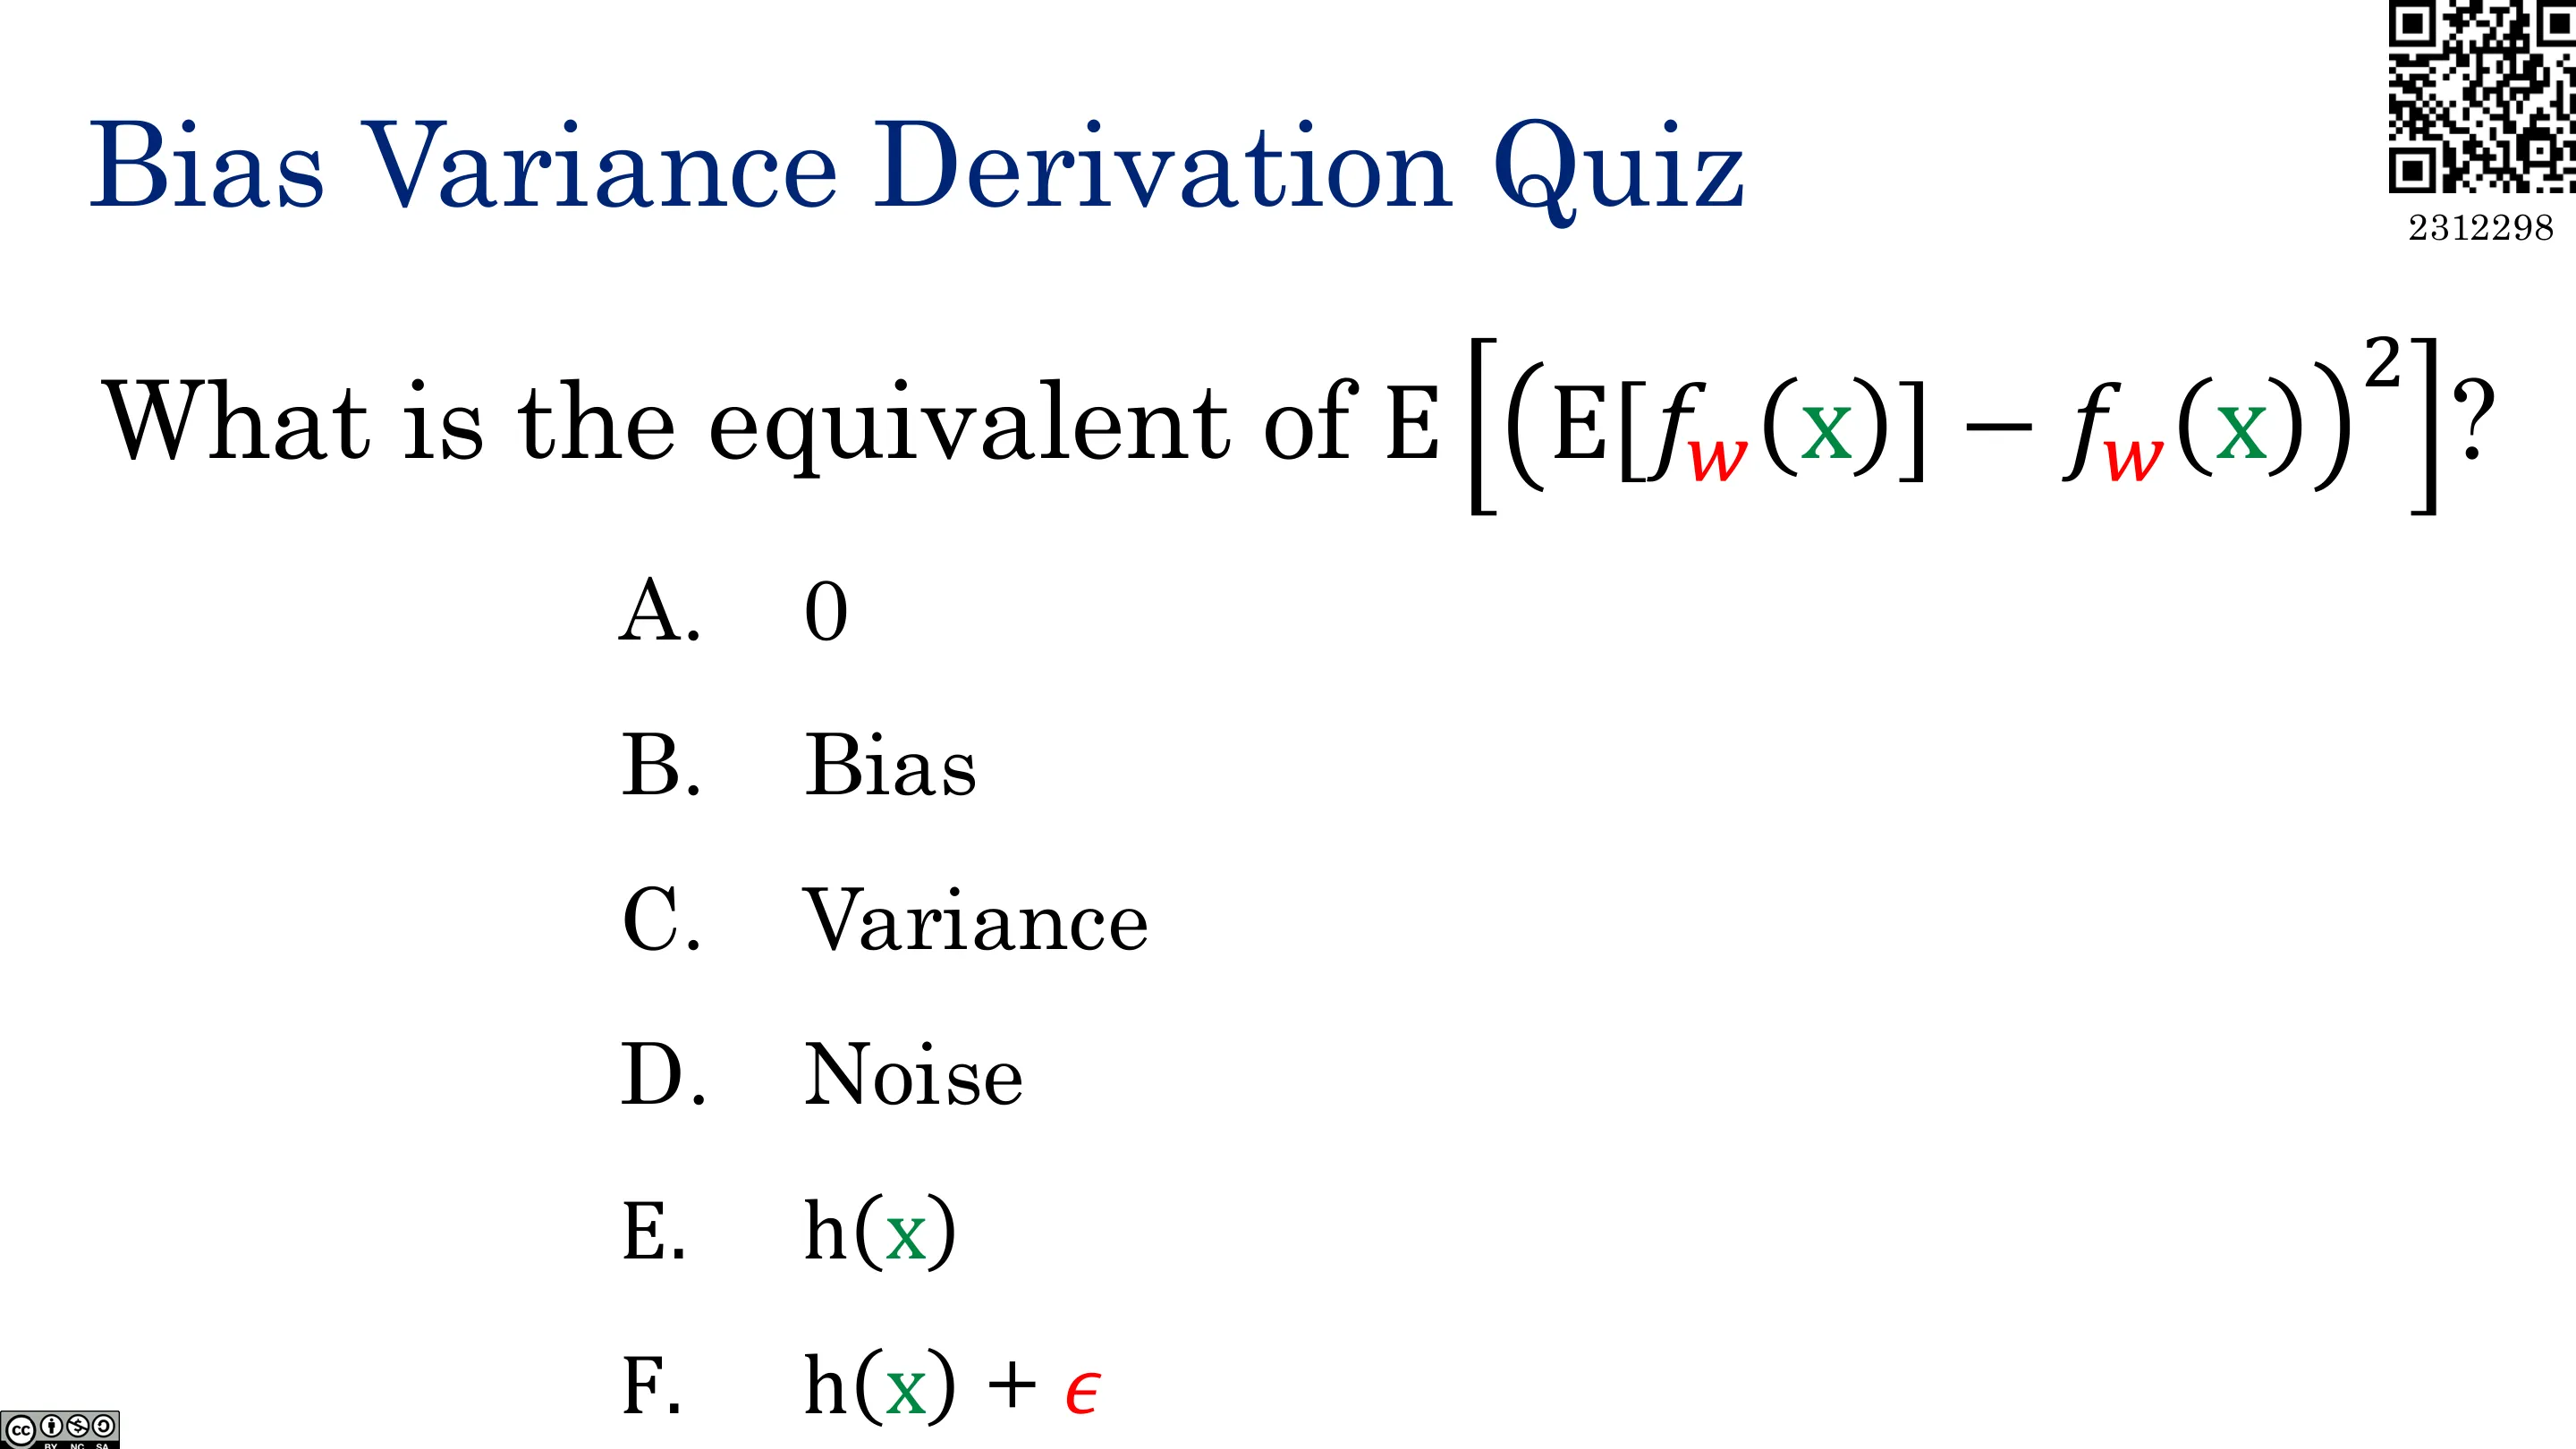
$$ \mathbb{E}\big[(t - f_w(x))^2\big] = \underbrace{\sigma^2}_{\text{不可约噪声}} + \underbrace{\big(f^*(x)-\mathbb{E}[f_w(x)]\big)^2}_{\text{偏差}^2} + \underbrace{\mathbb{E}\big[(f_w(x)-\mathbb{E}[f_w(x)])^2\big]}_{\text{方差}} $$
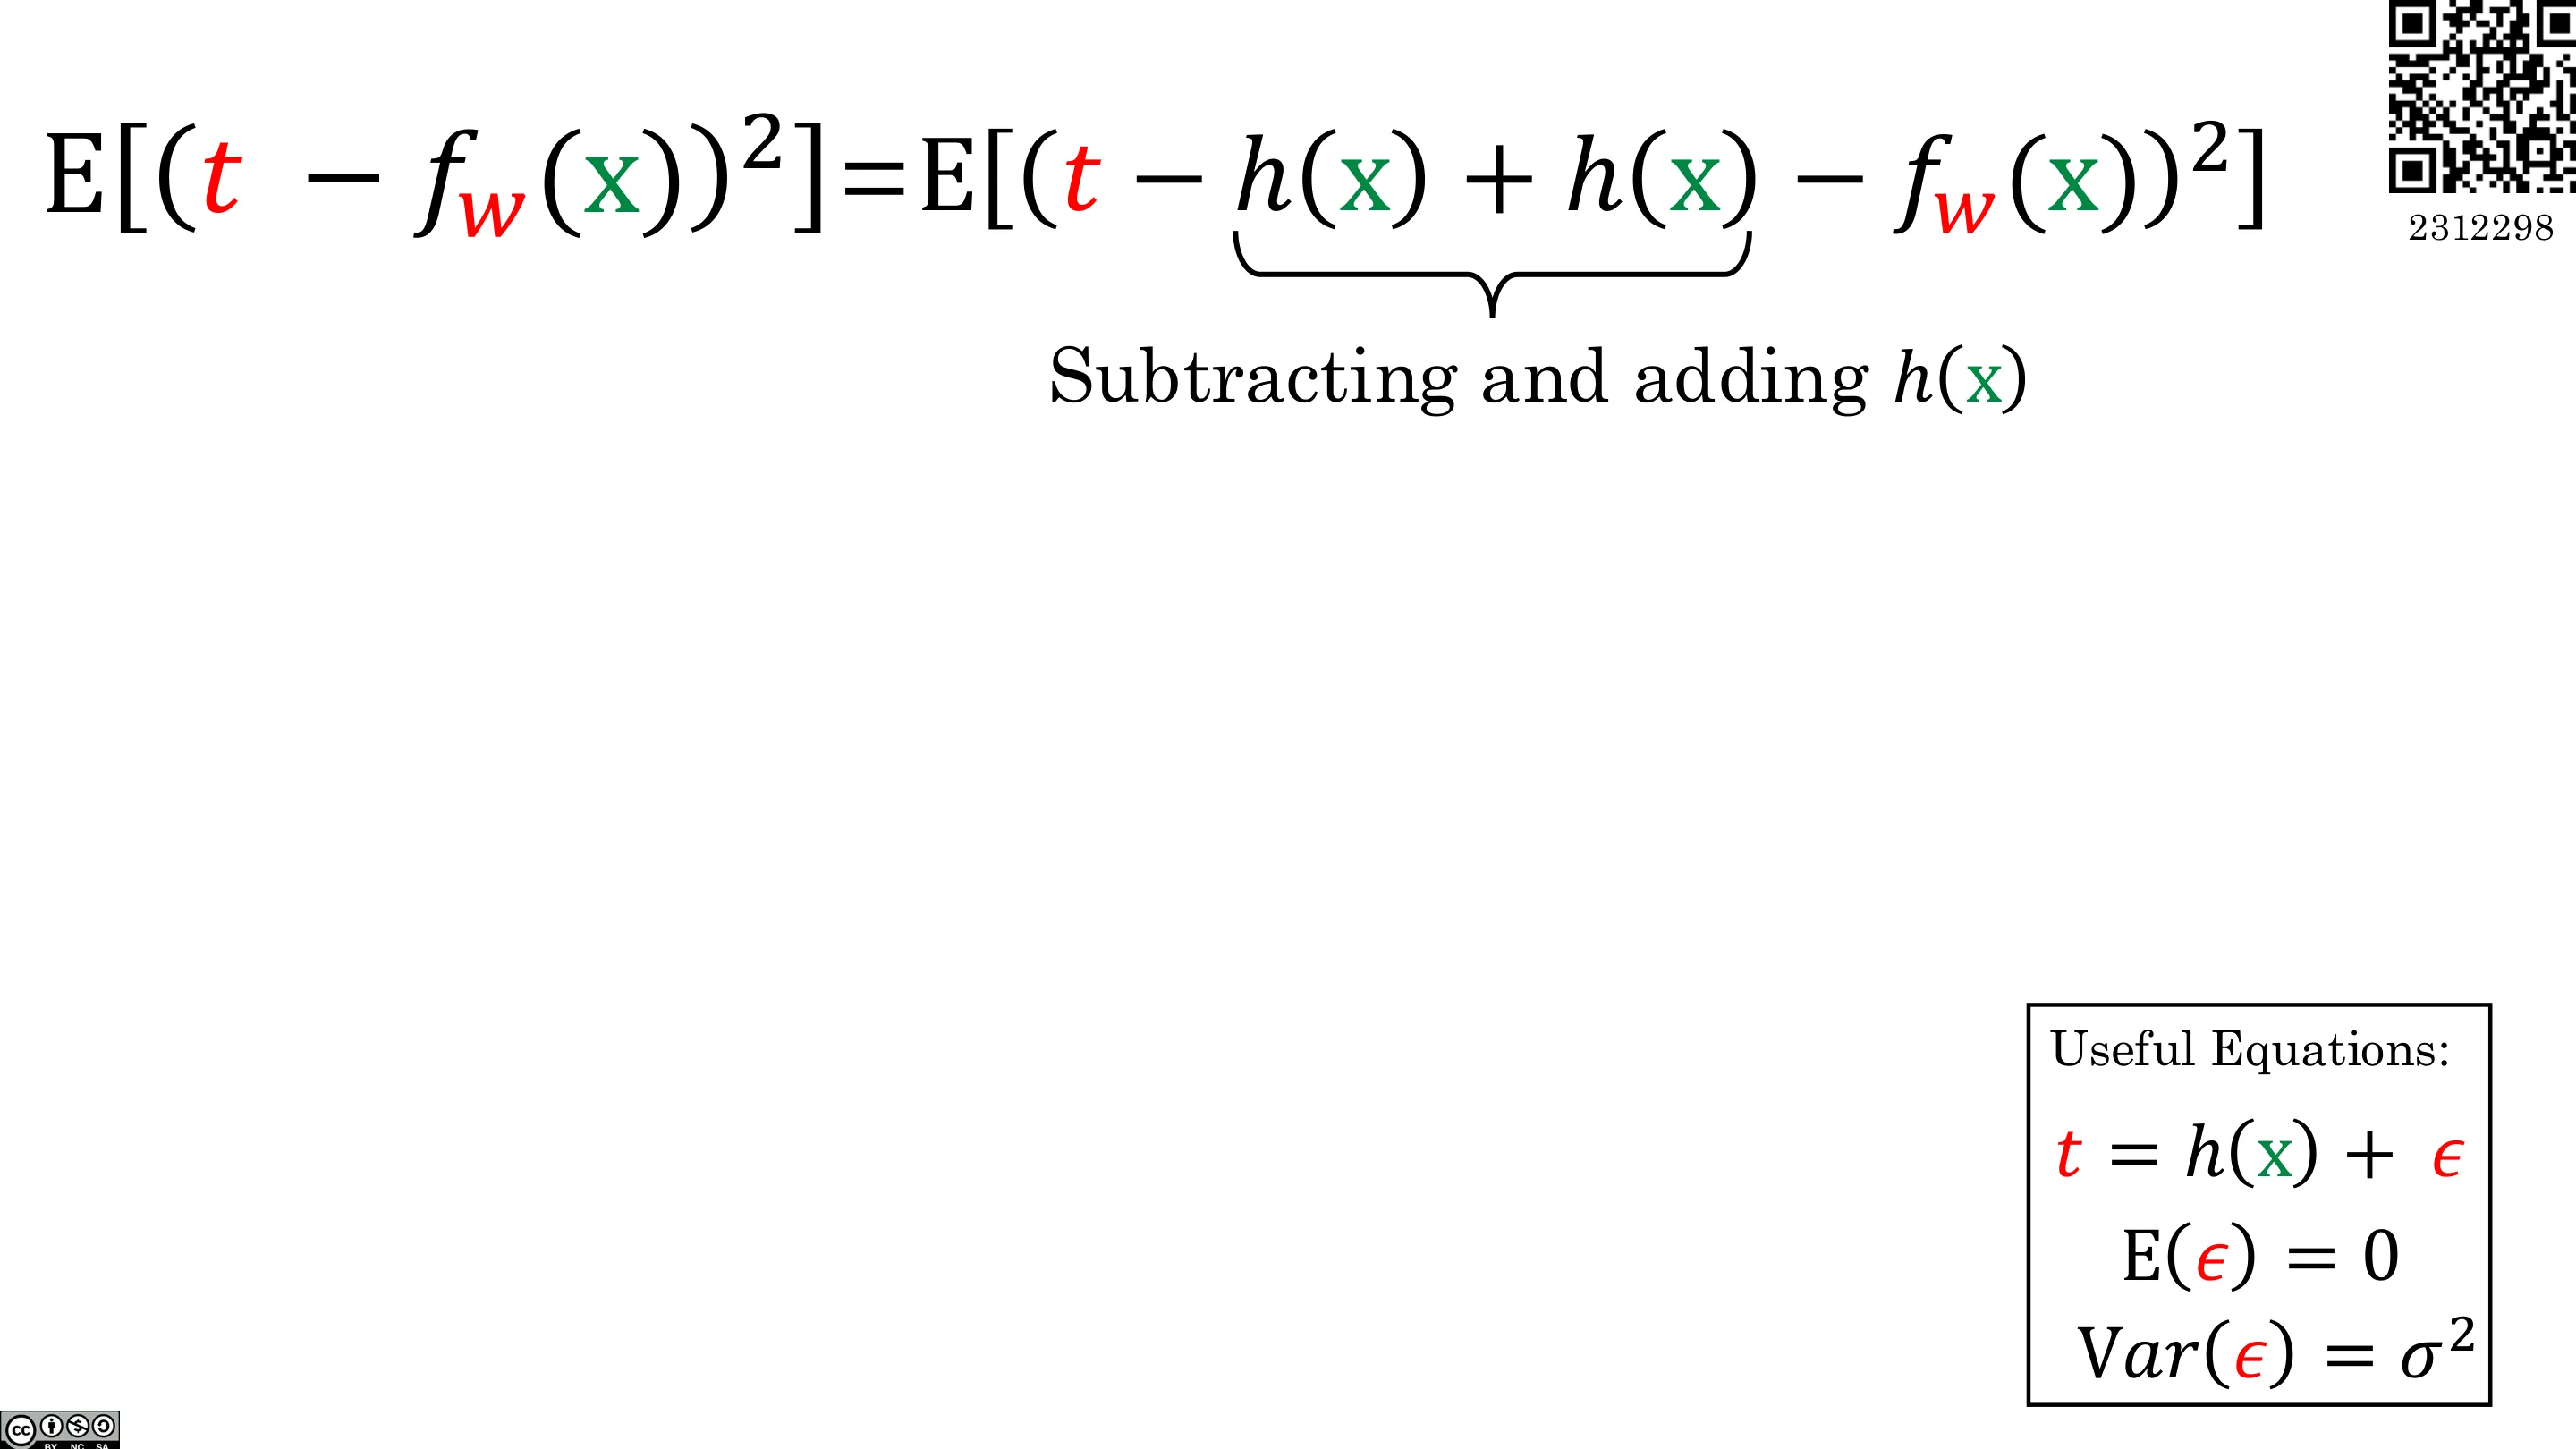
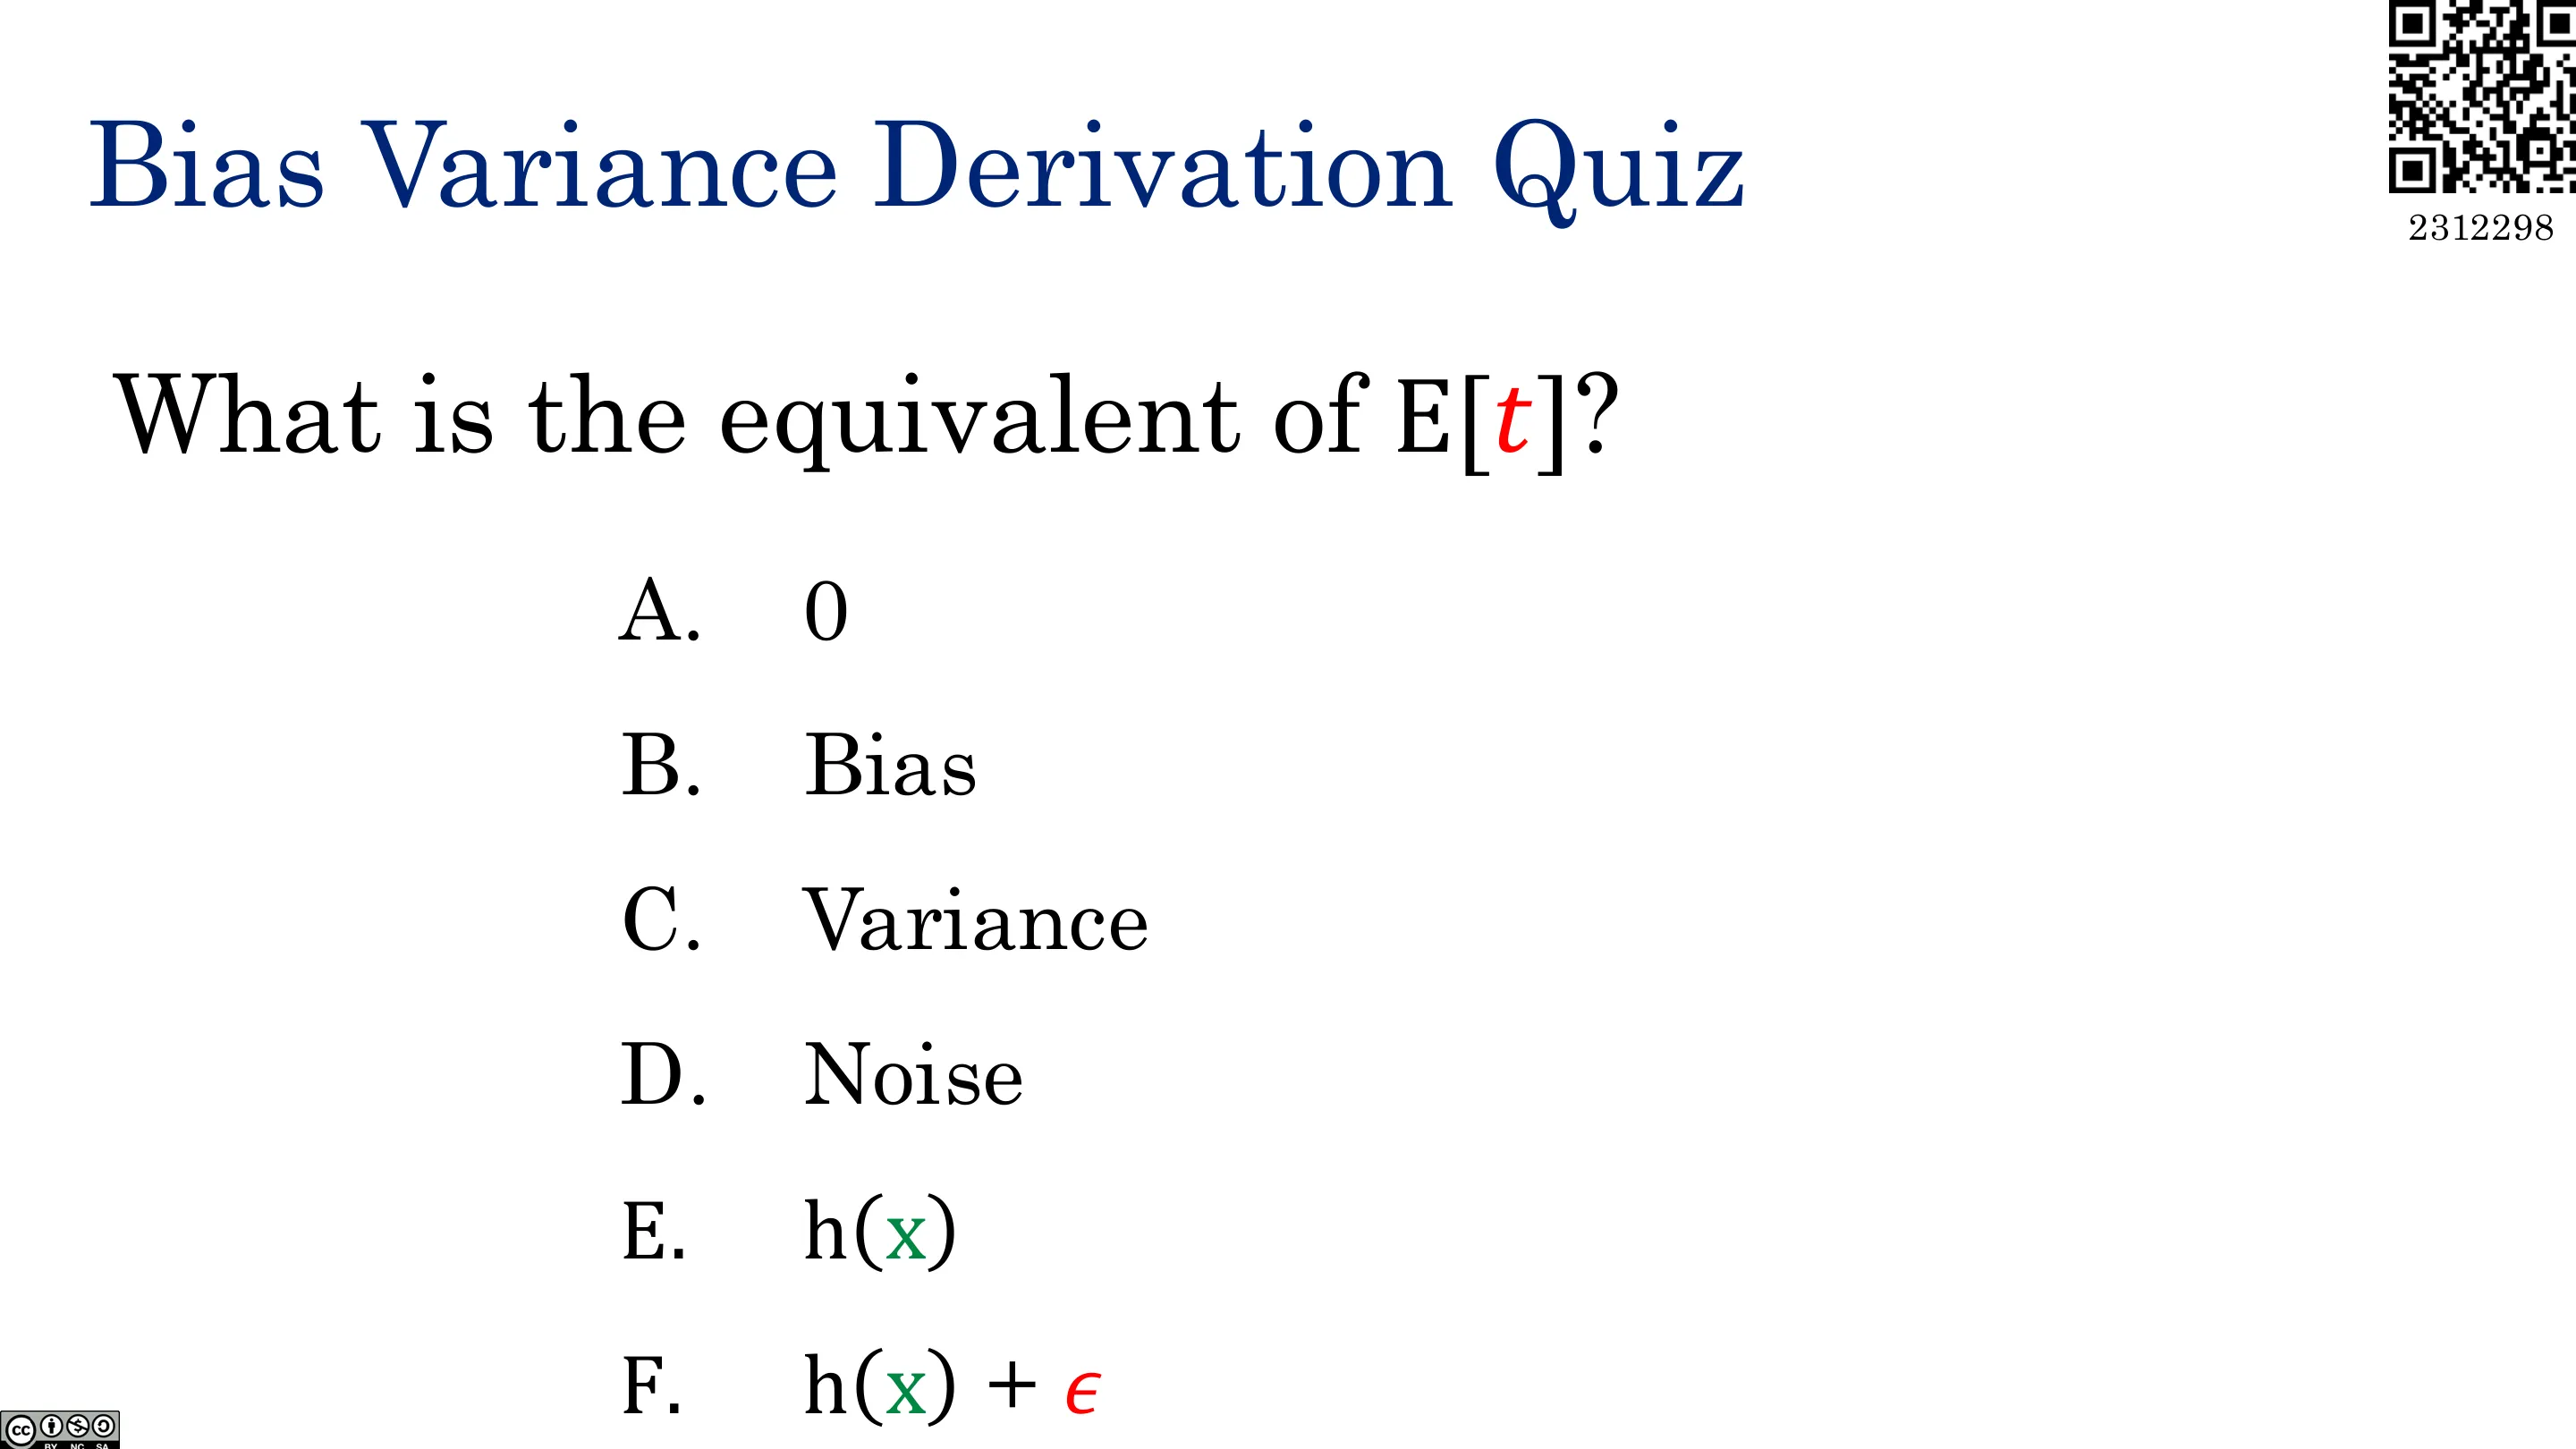
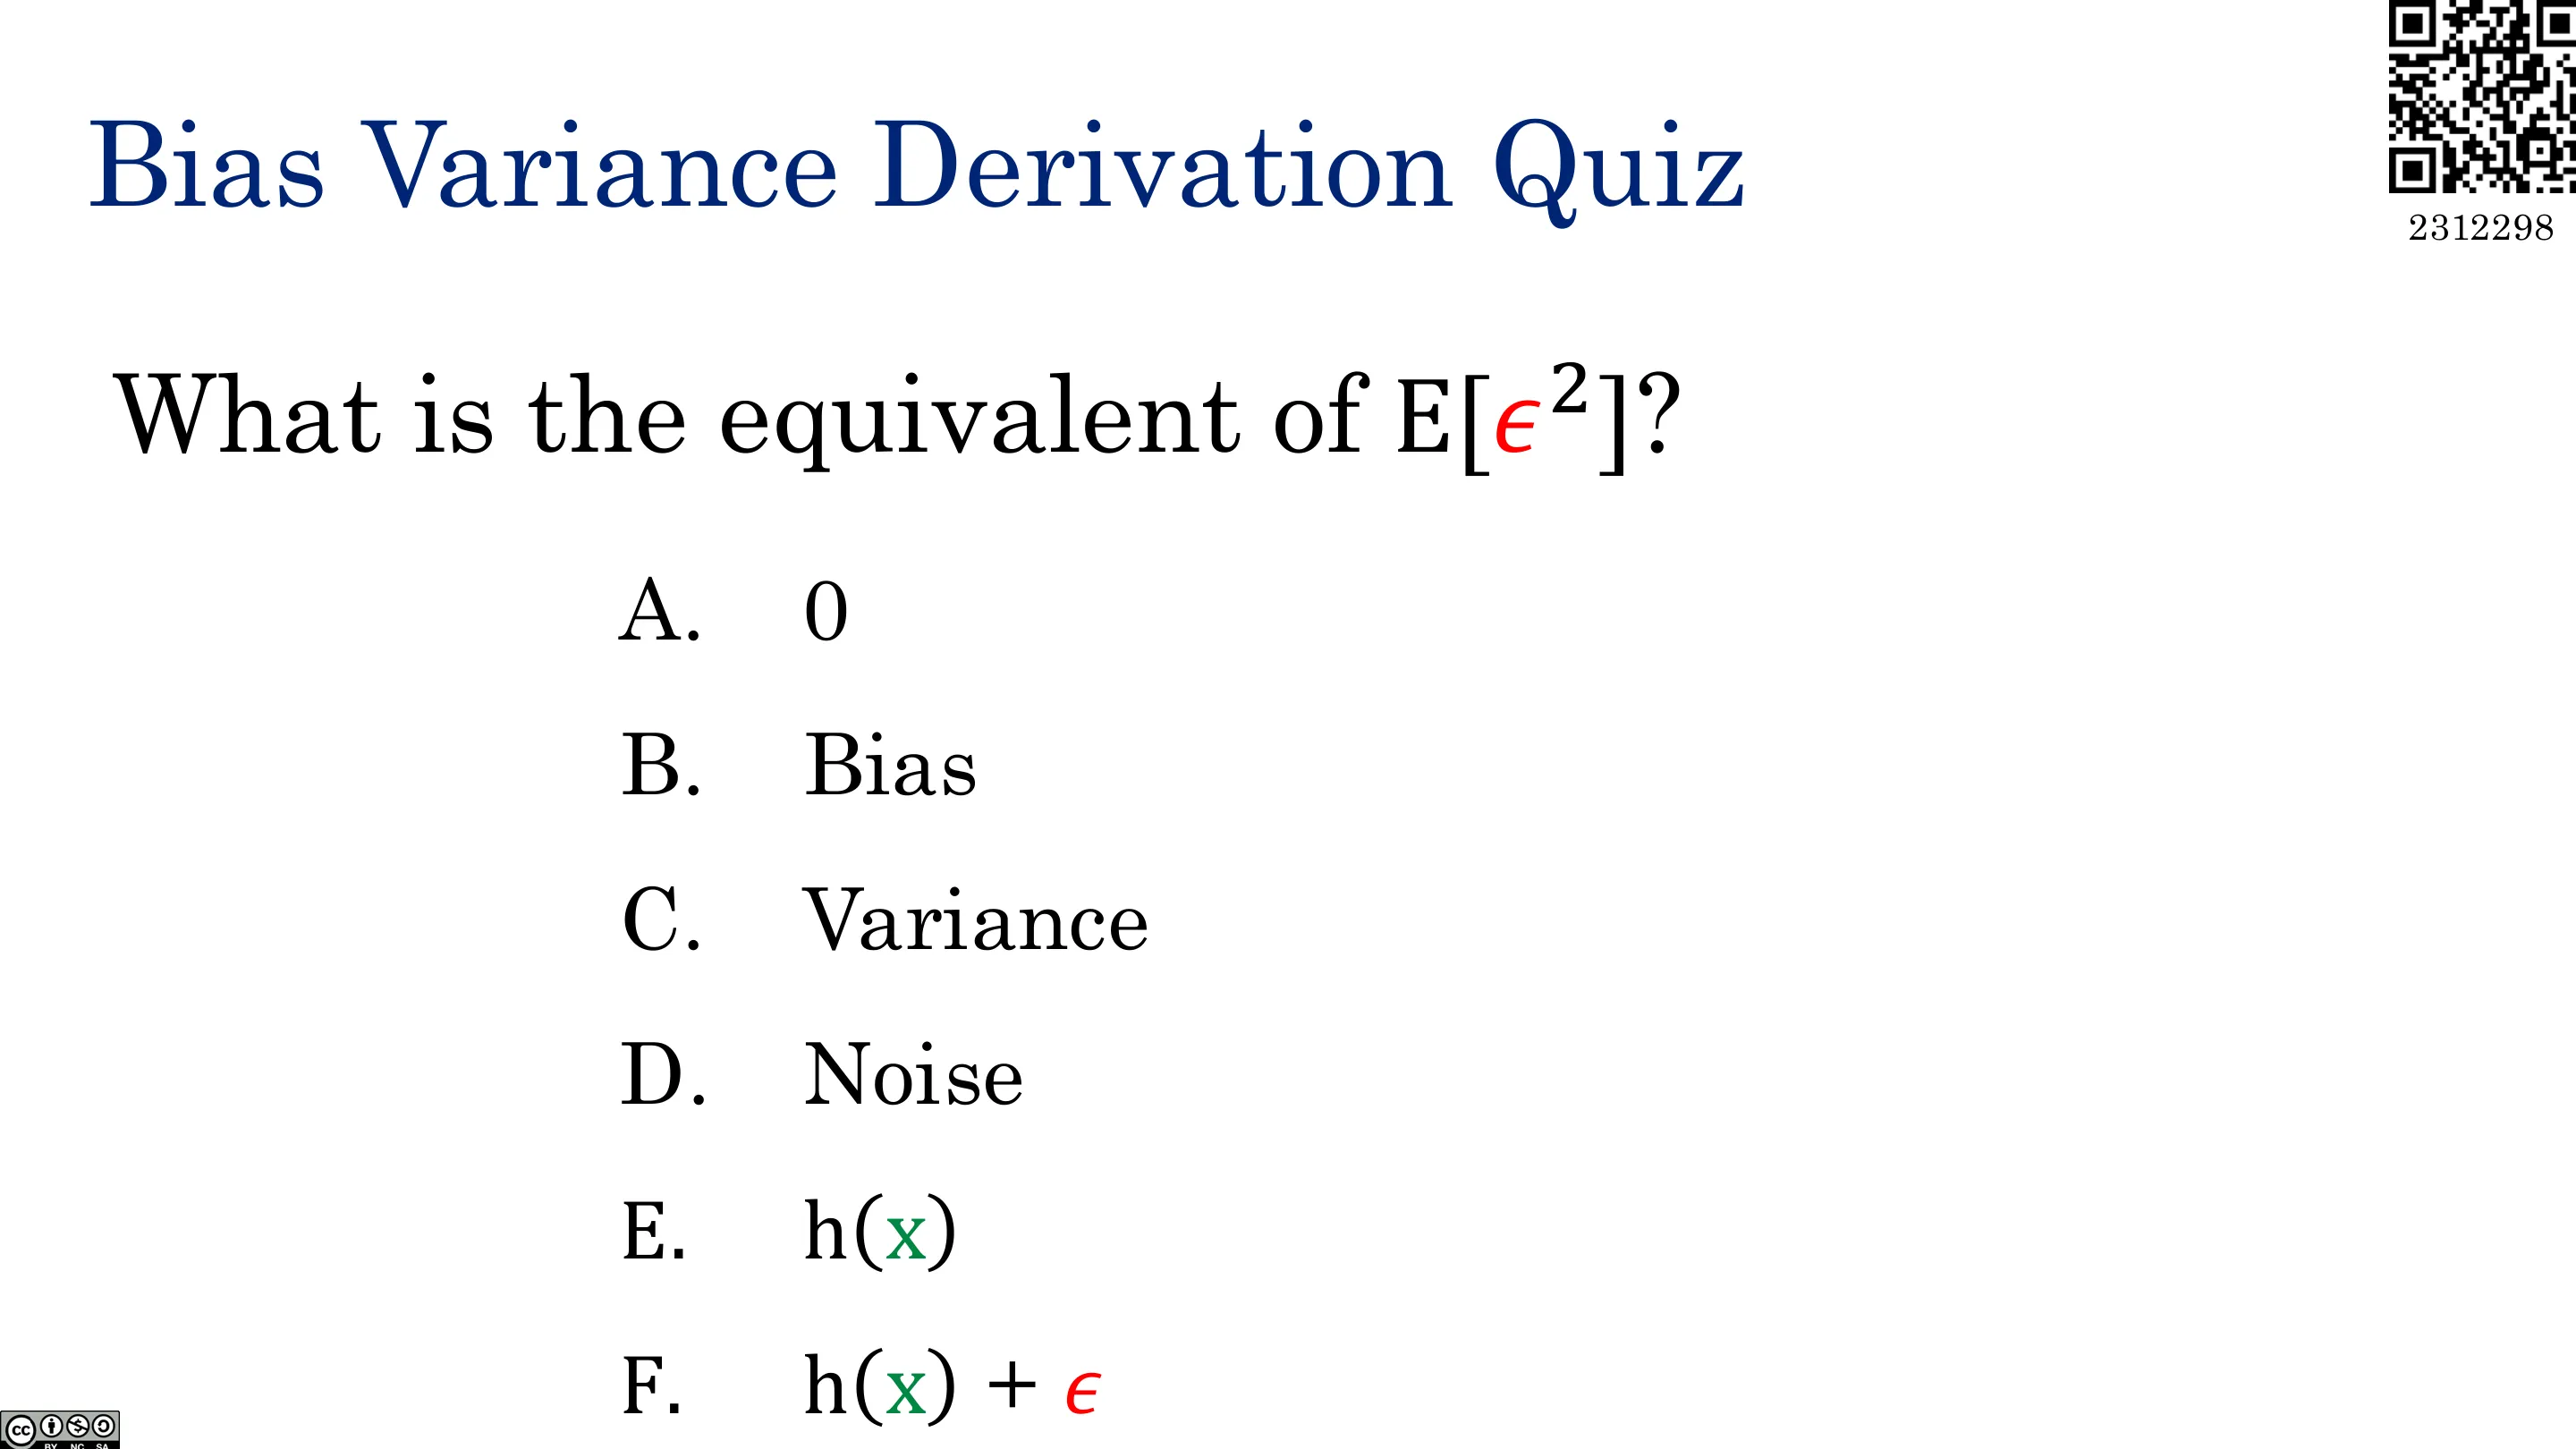
推导思路:观测 $t=f^*(x)+\varepsilon$($\varepsilon$ 零均值、独立);对 $t-f_w(x)$「加减」$\mathbb{E}[f_w(x)]$ 与 $f^*(x)$,展开平方,利用期望线性性与噪声独立、零均值使交叉项消失。结论:
- 噪声项:世界固有的不可预测性,无能为力;
- 偏差项:模型在多次训练上的平均预测与真实函数之差;
- 方差项:单次模型与其平均之差——但该理论量在实践中无法直接计算(因为不知道真实函数 $f^*$),只能靠训练/验证/测试来经验性地调。
2.1 与岭回归的联系
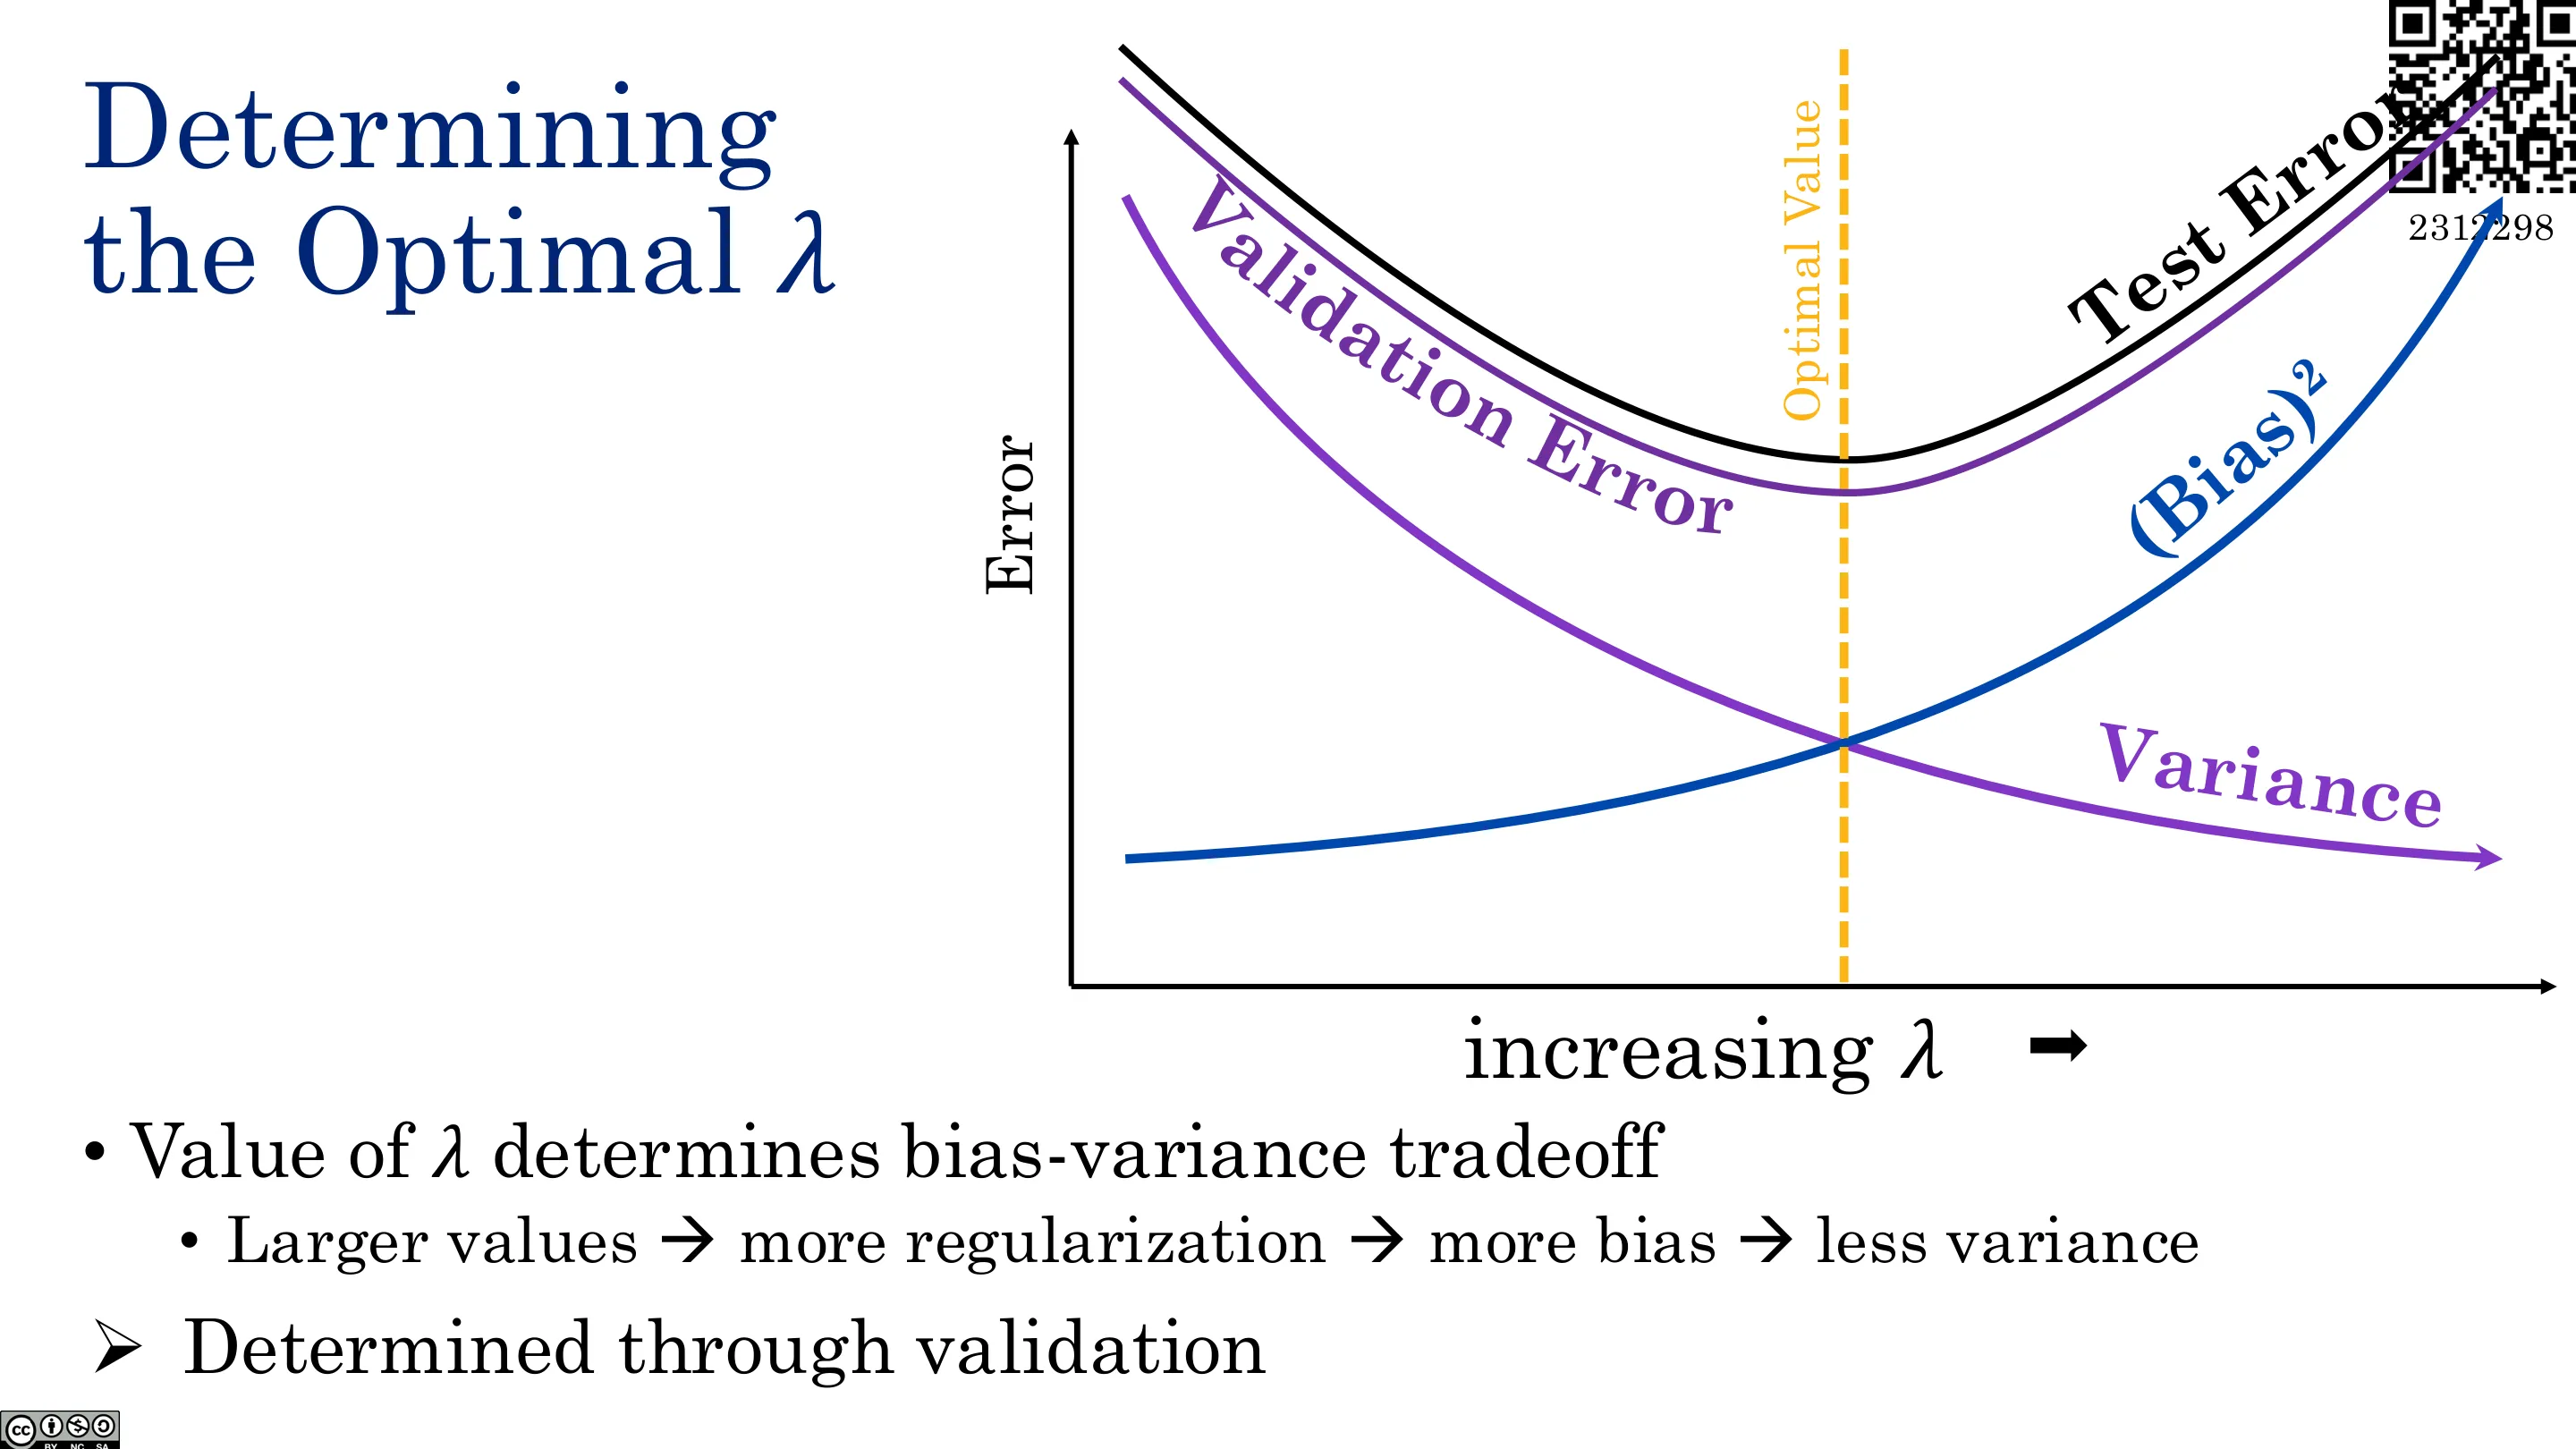
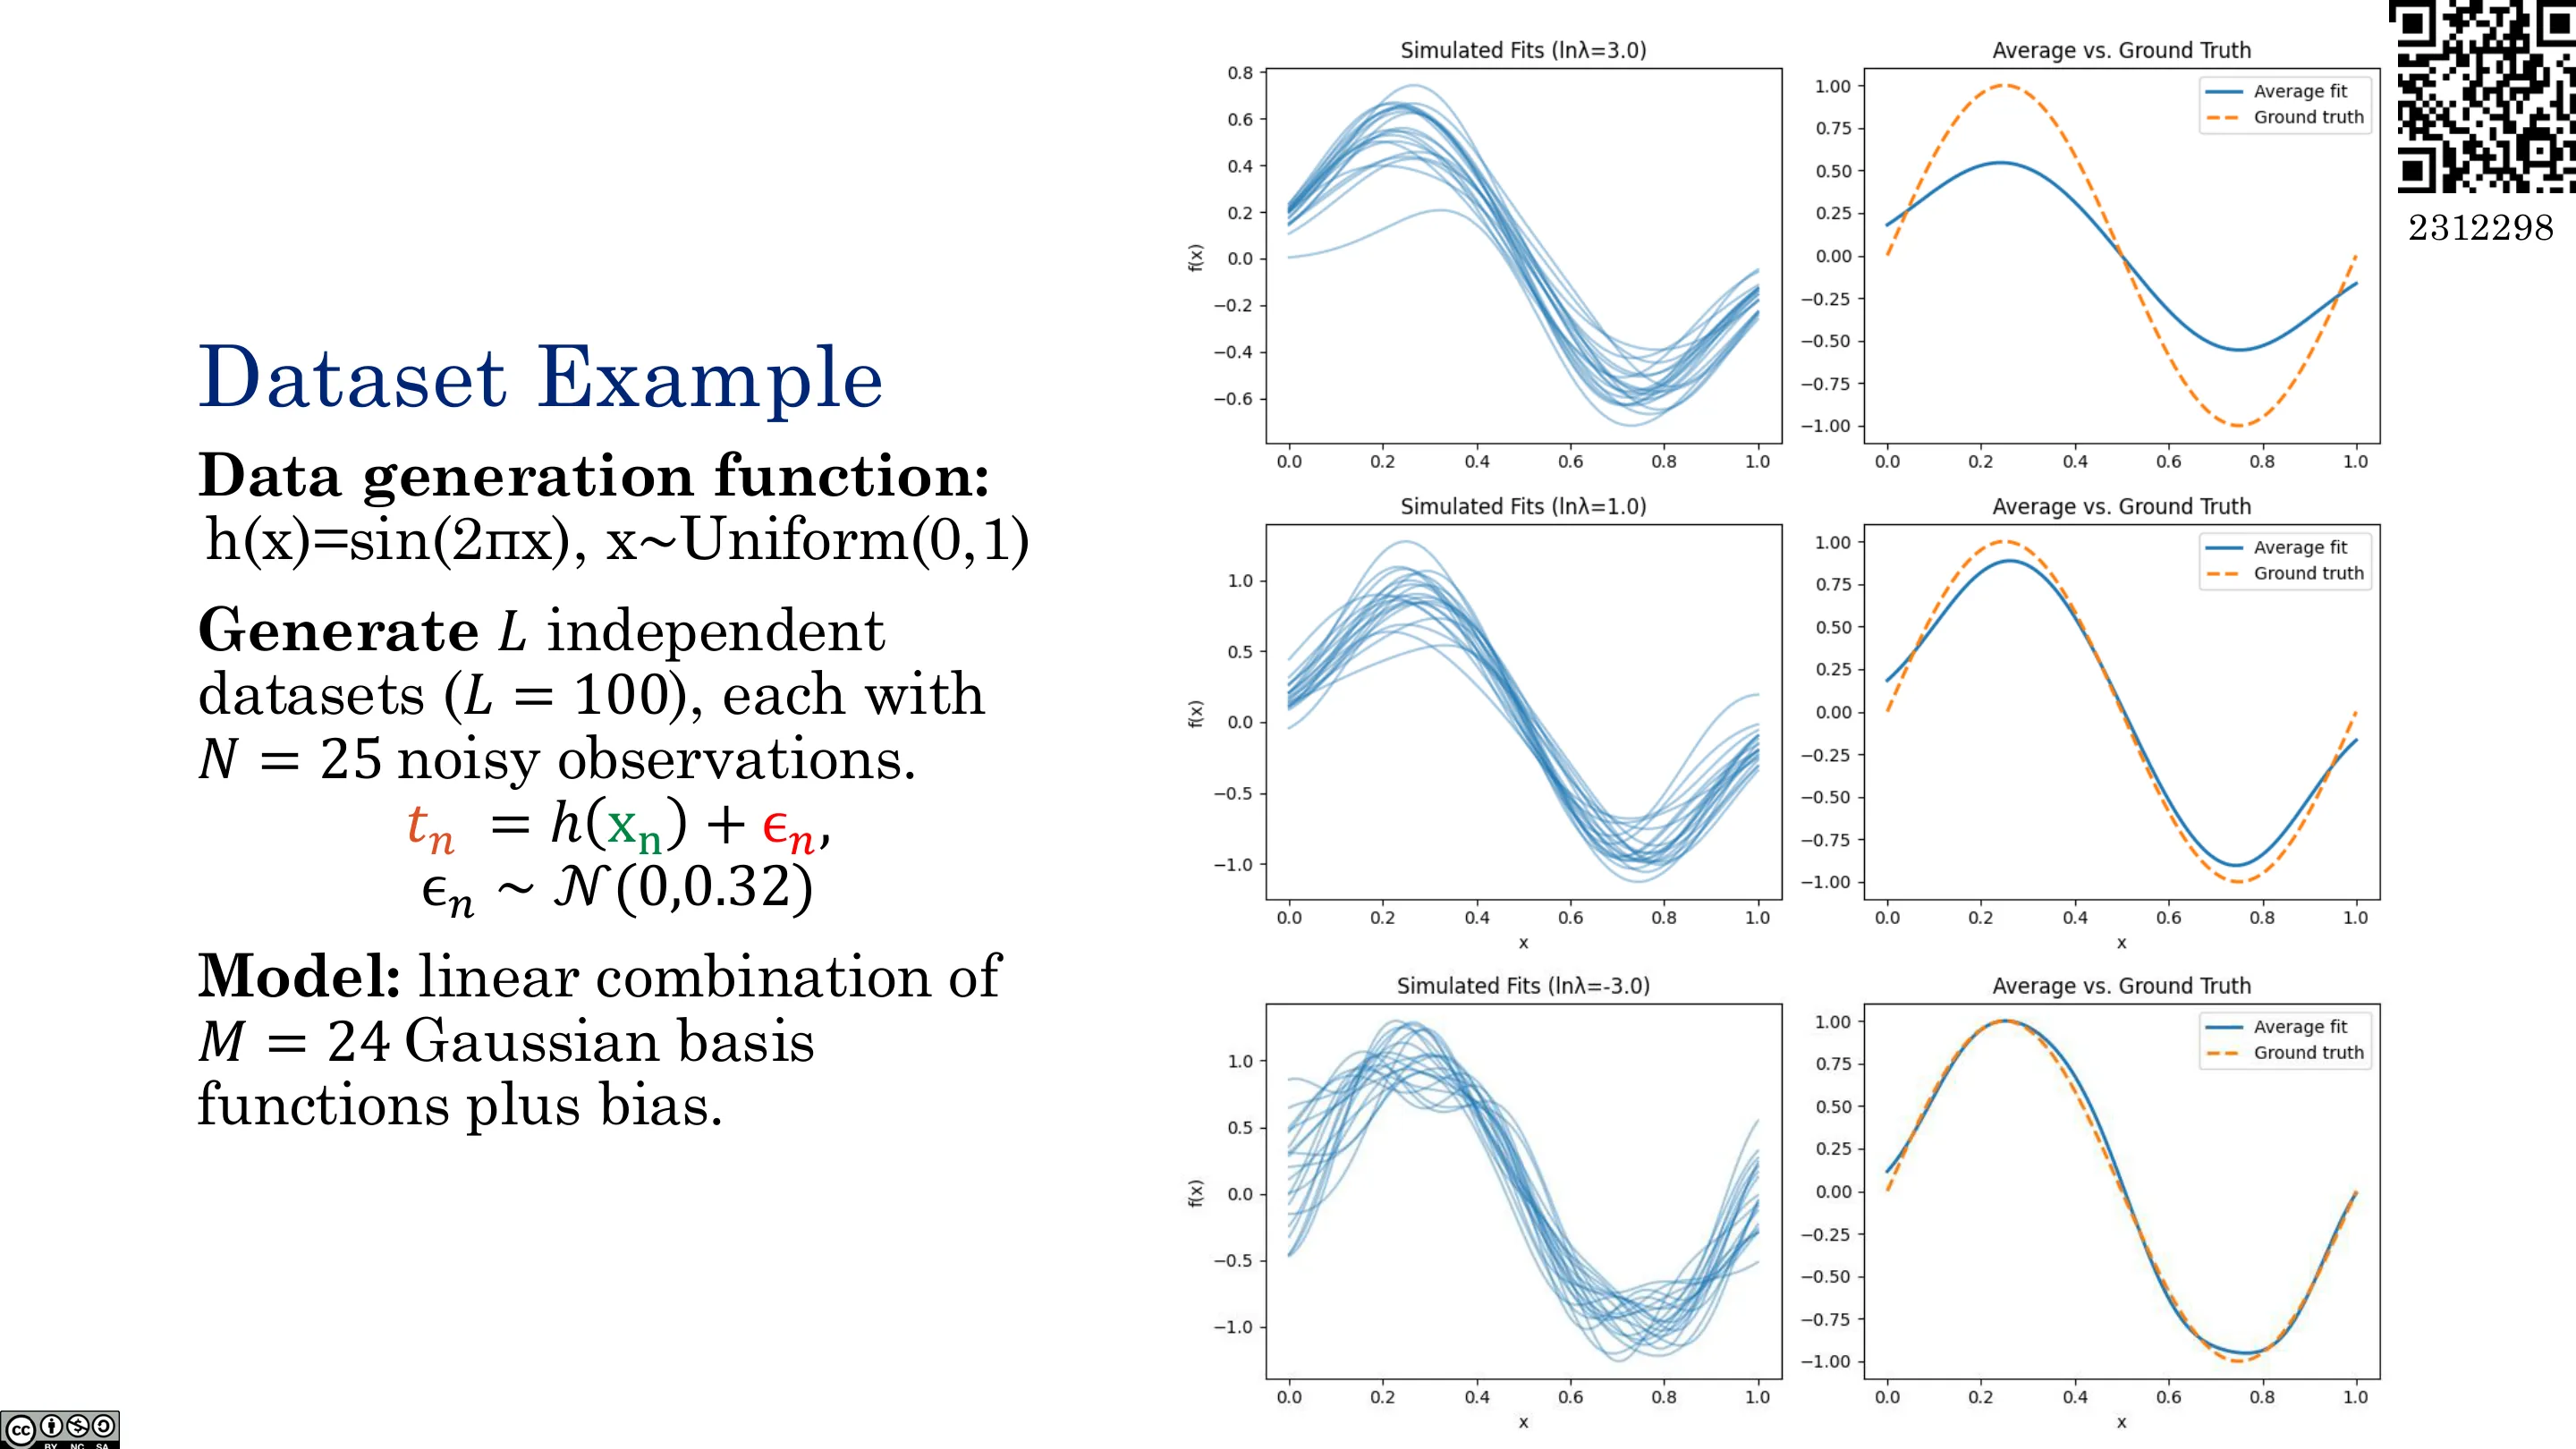
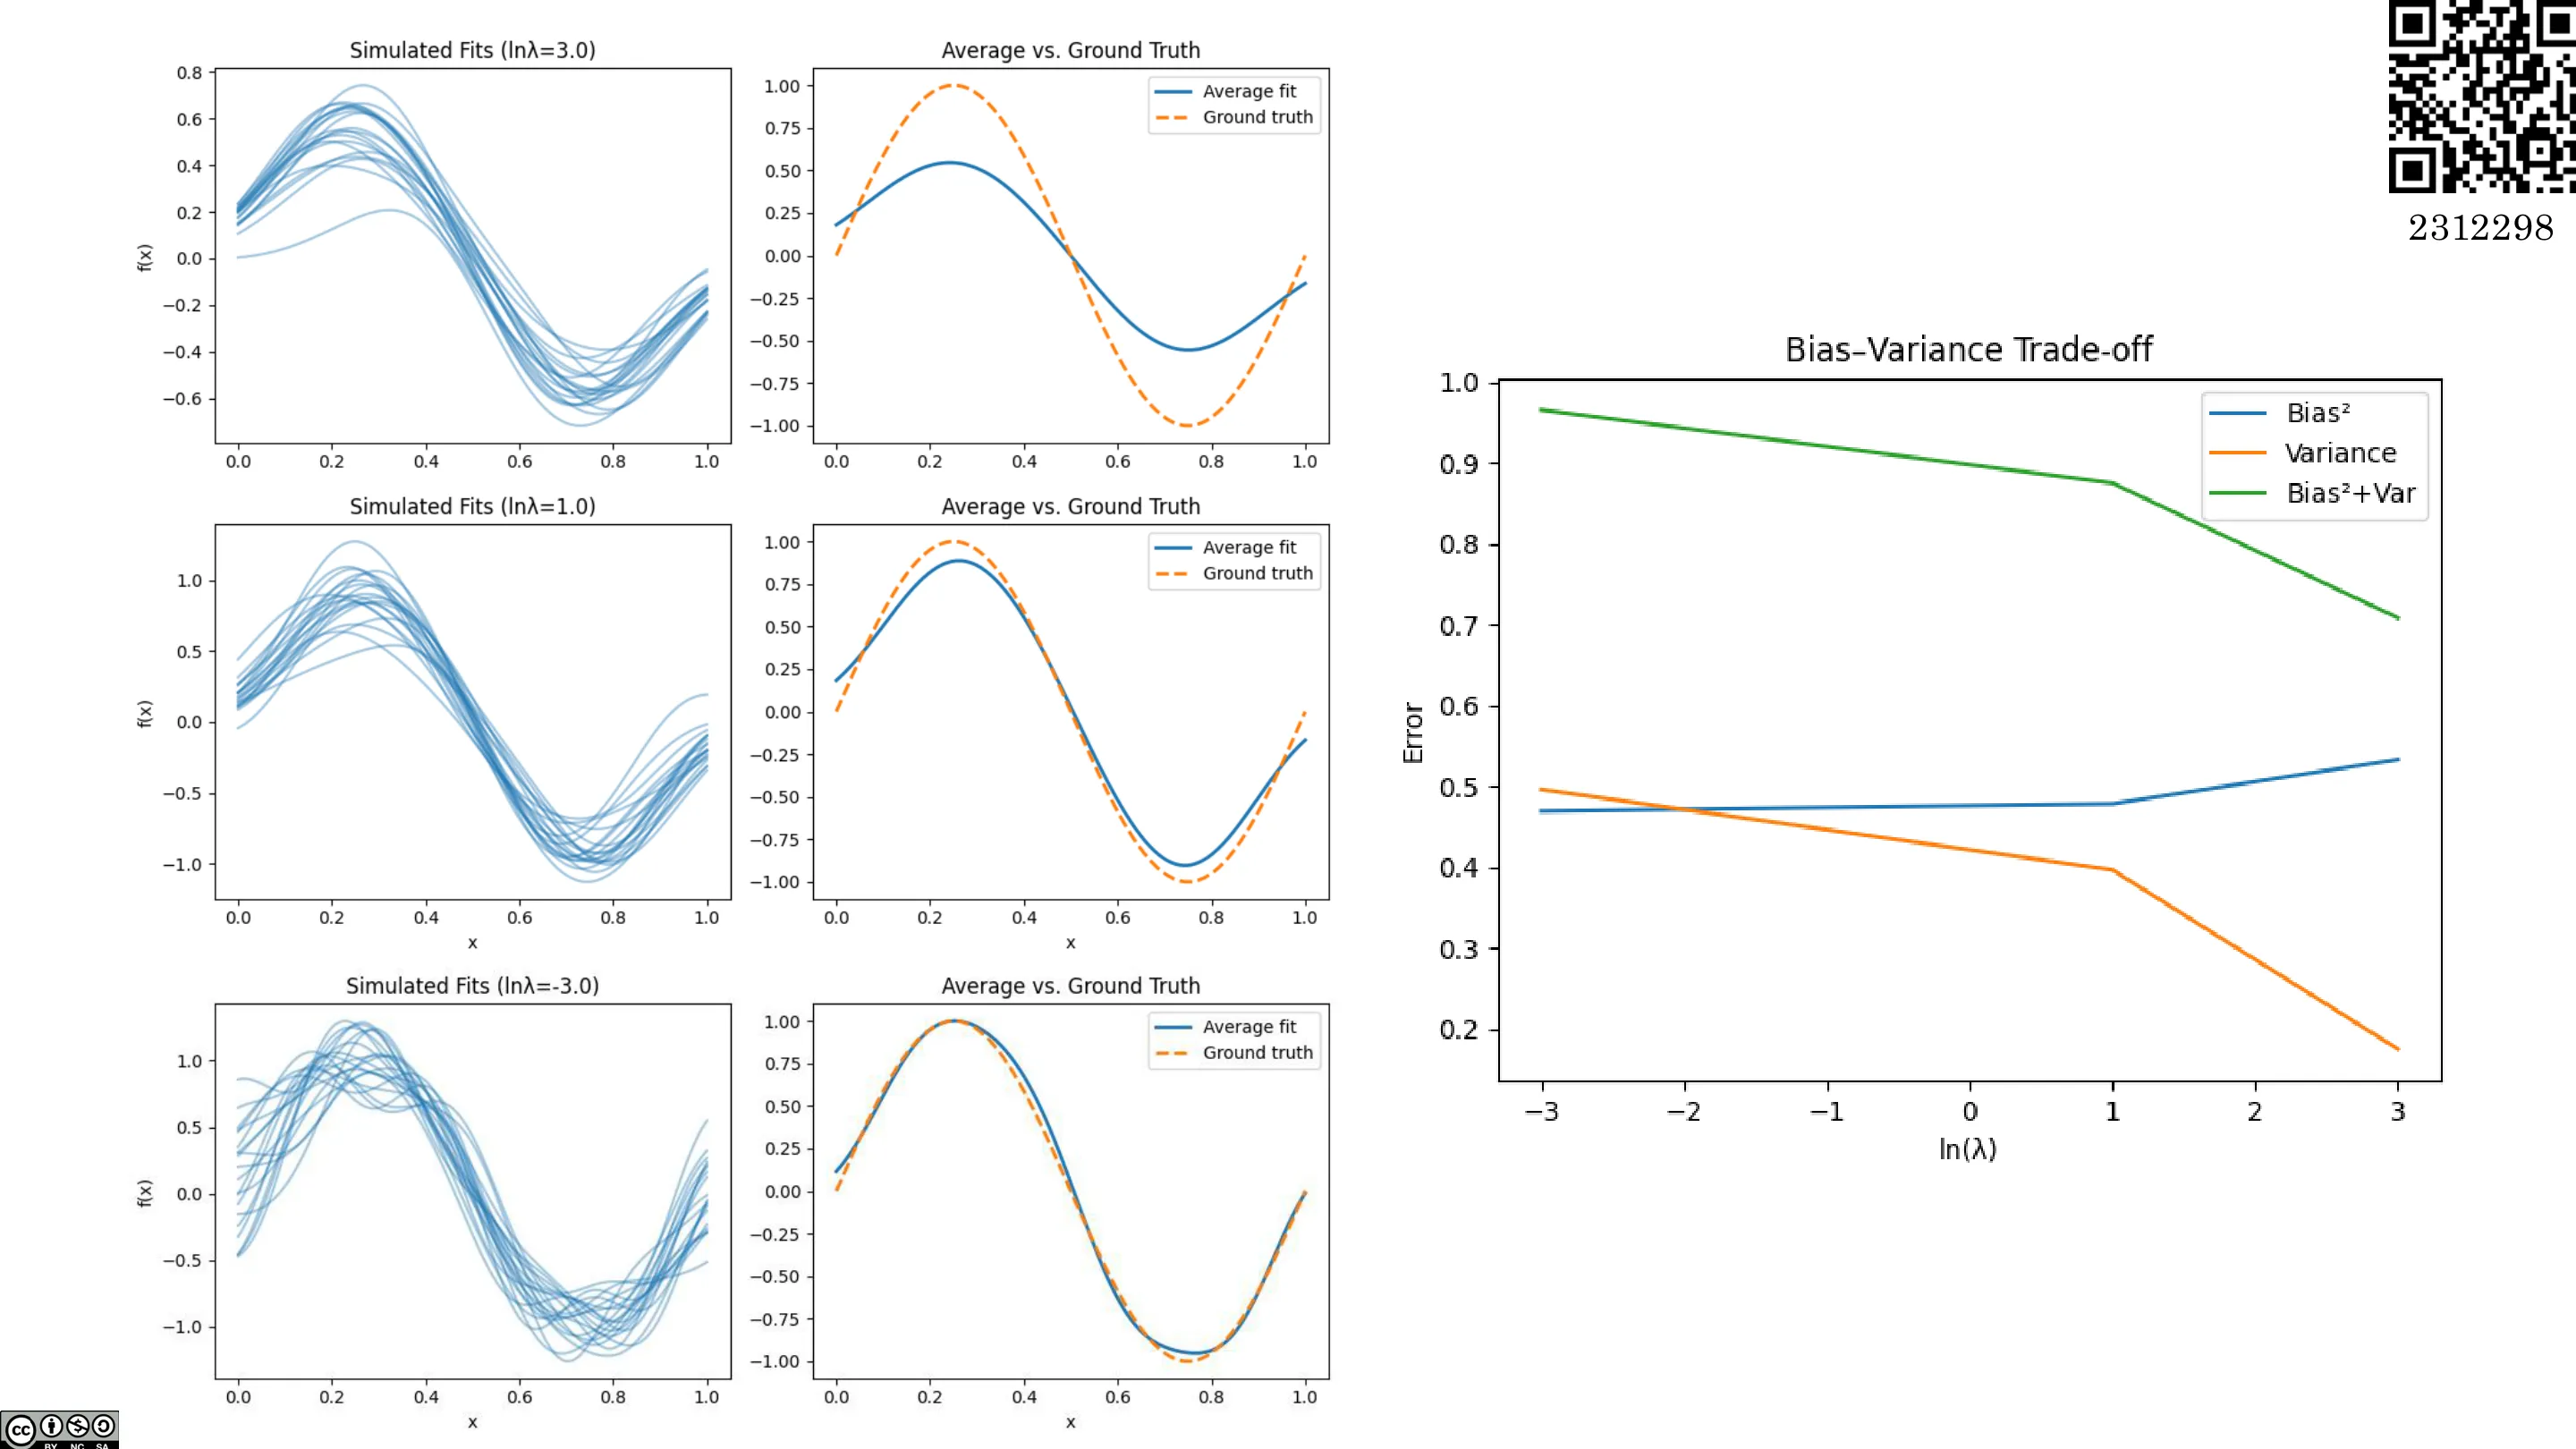
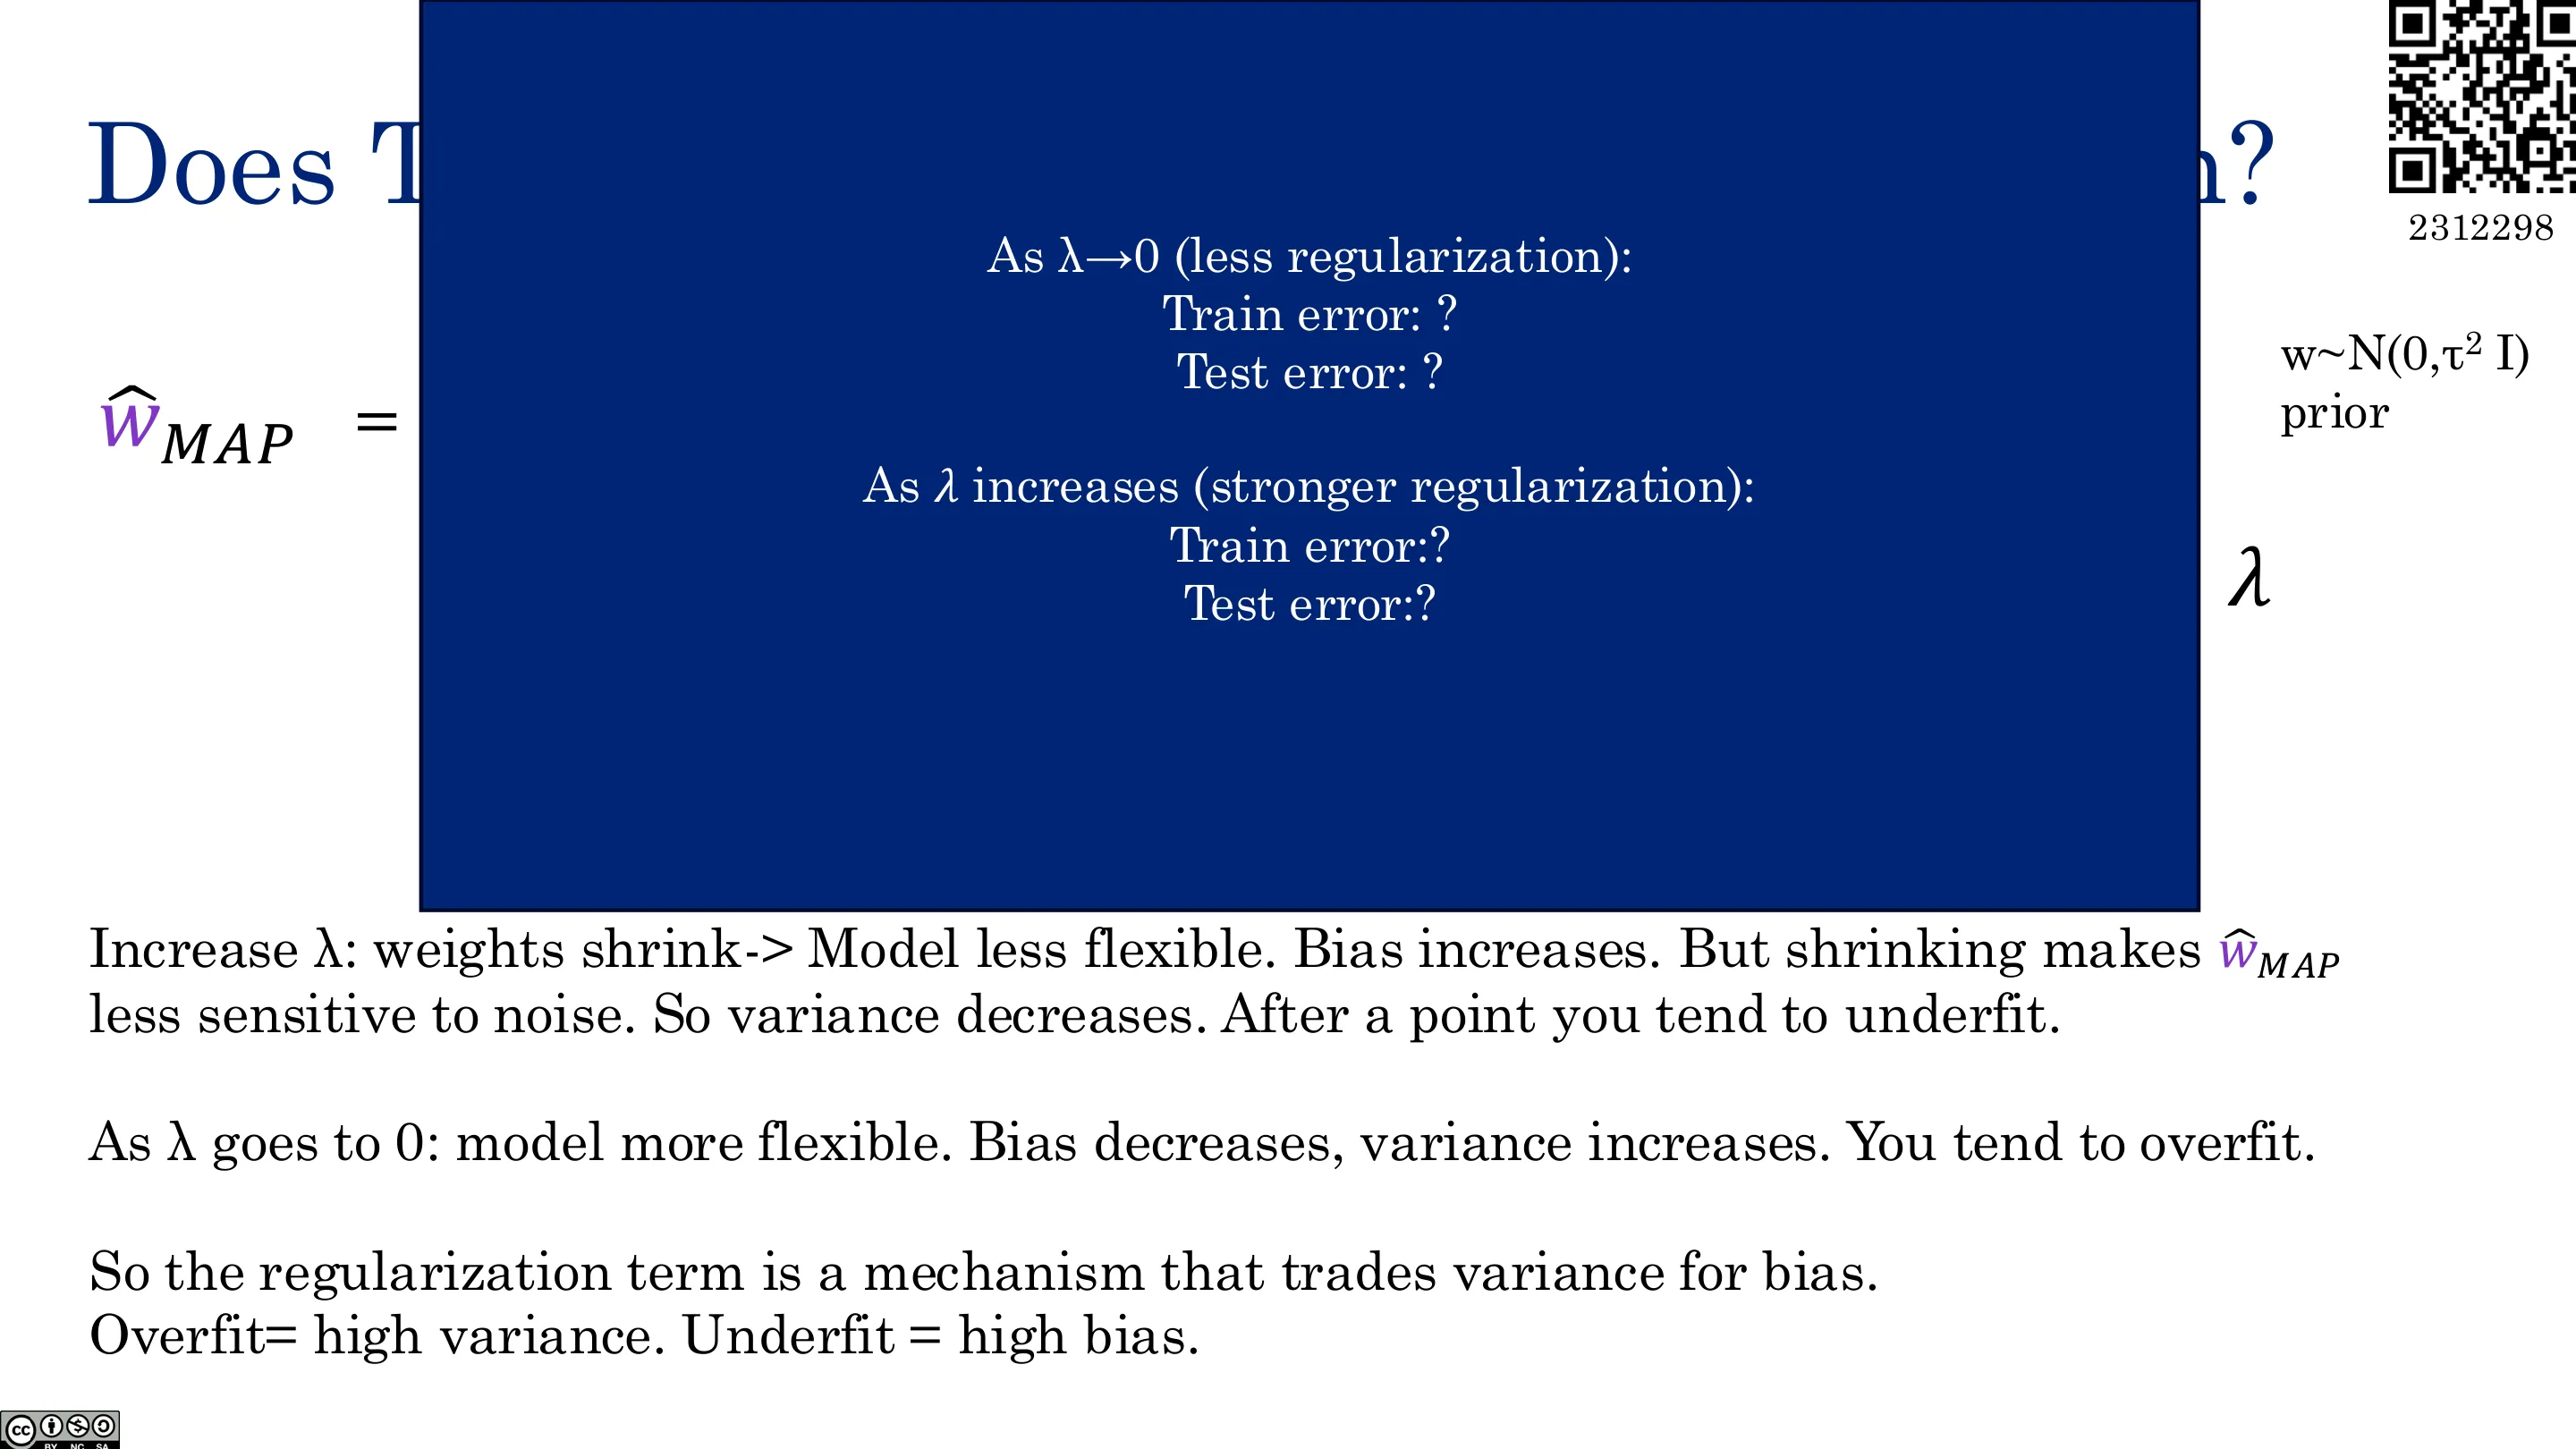
- 正则化越强($\lambda$ 越大)⇒ $w$ 被收缩(shrinkage)、模型更简单 ⇒ 偏差↑、方差↓;
- $\lambda\to\infty$ ⇒ $w=0$(对一切预测为 0)⇒ 方差→0、偏差巨大(严重欠拟合);
- $\lambda\to0$ ⇒ MLE ⇒ 偏差最小、方差最大(过拟合)。
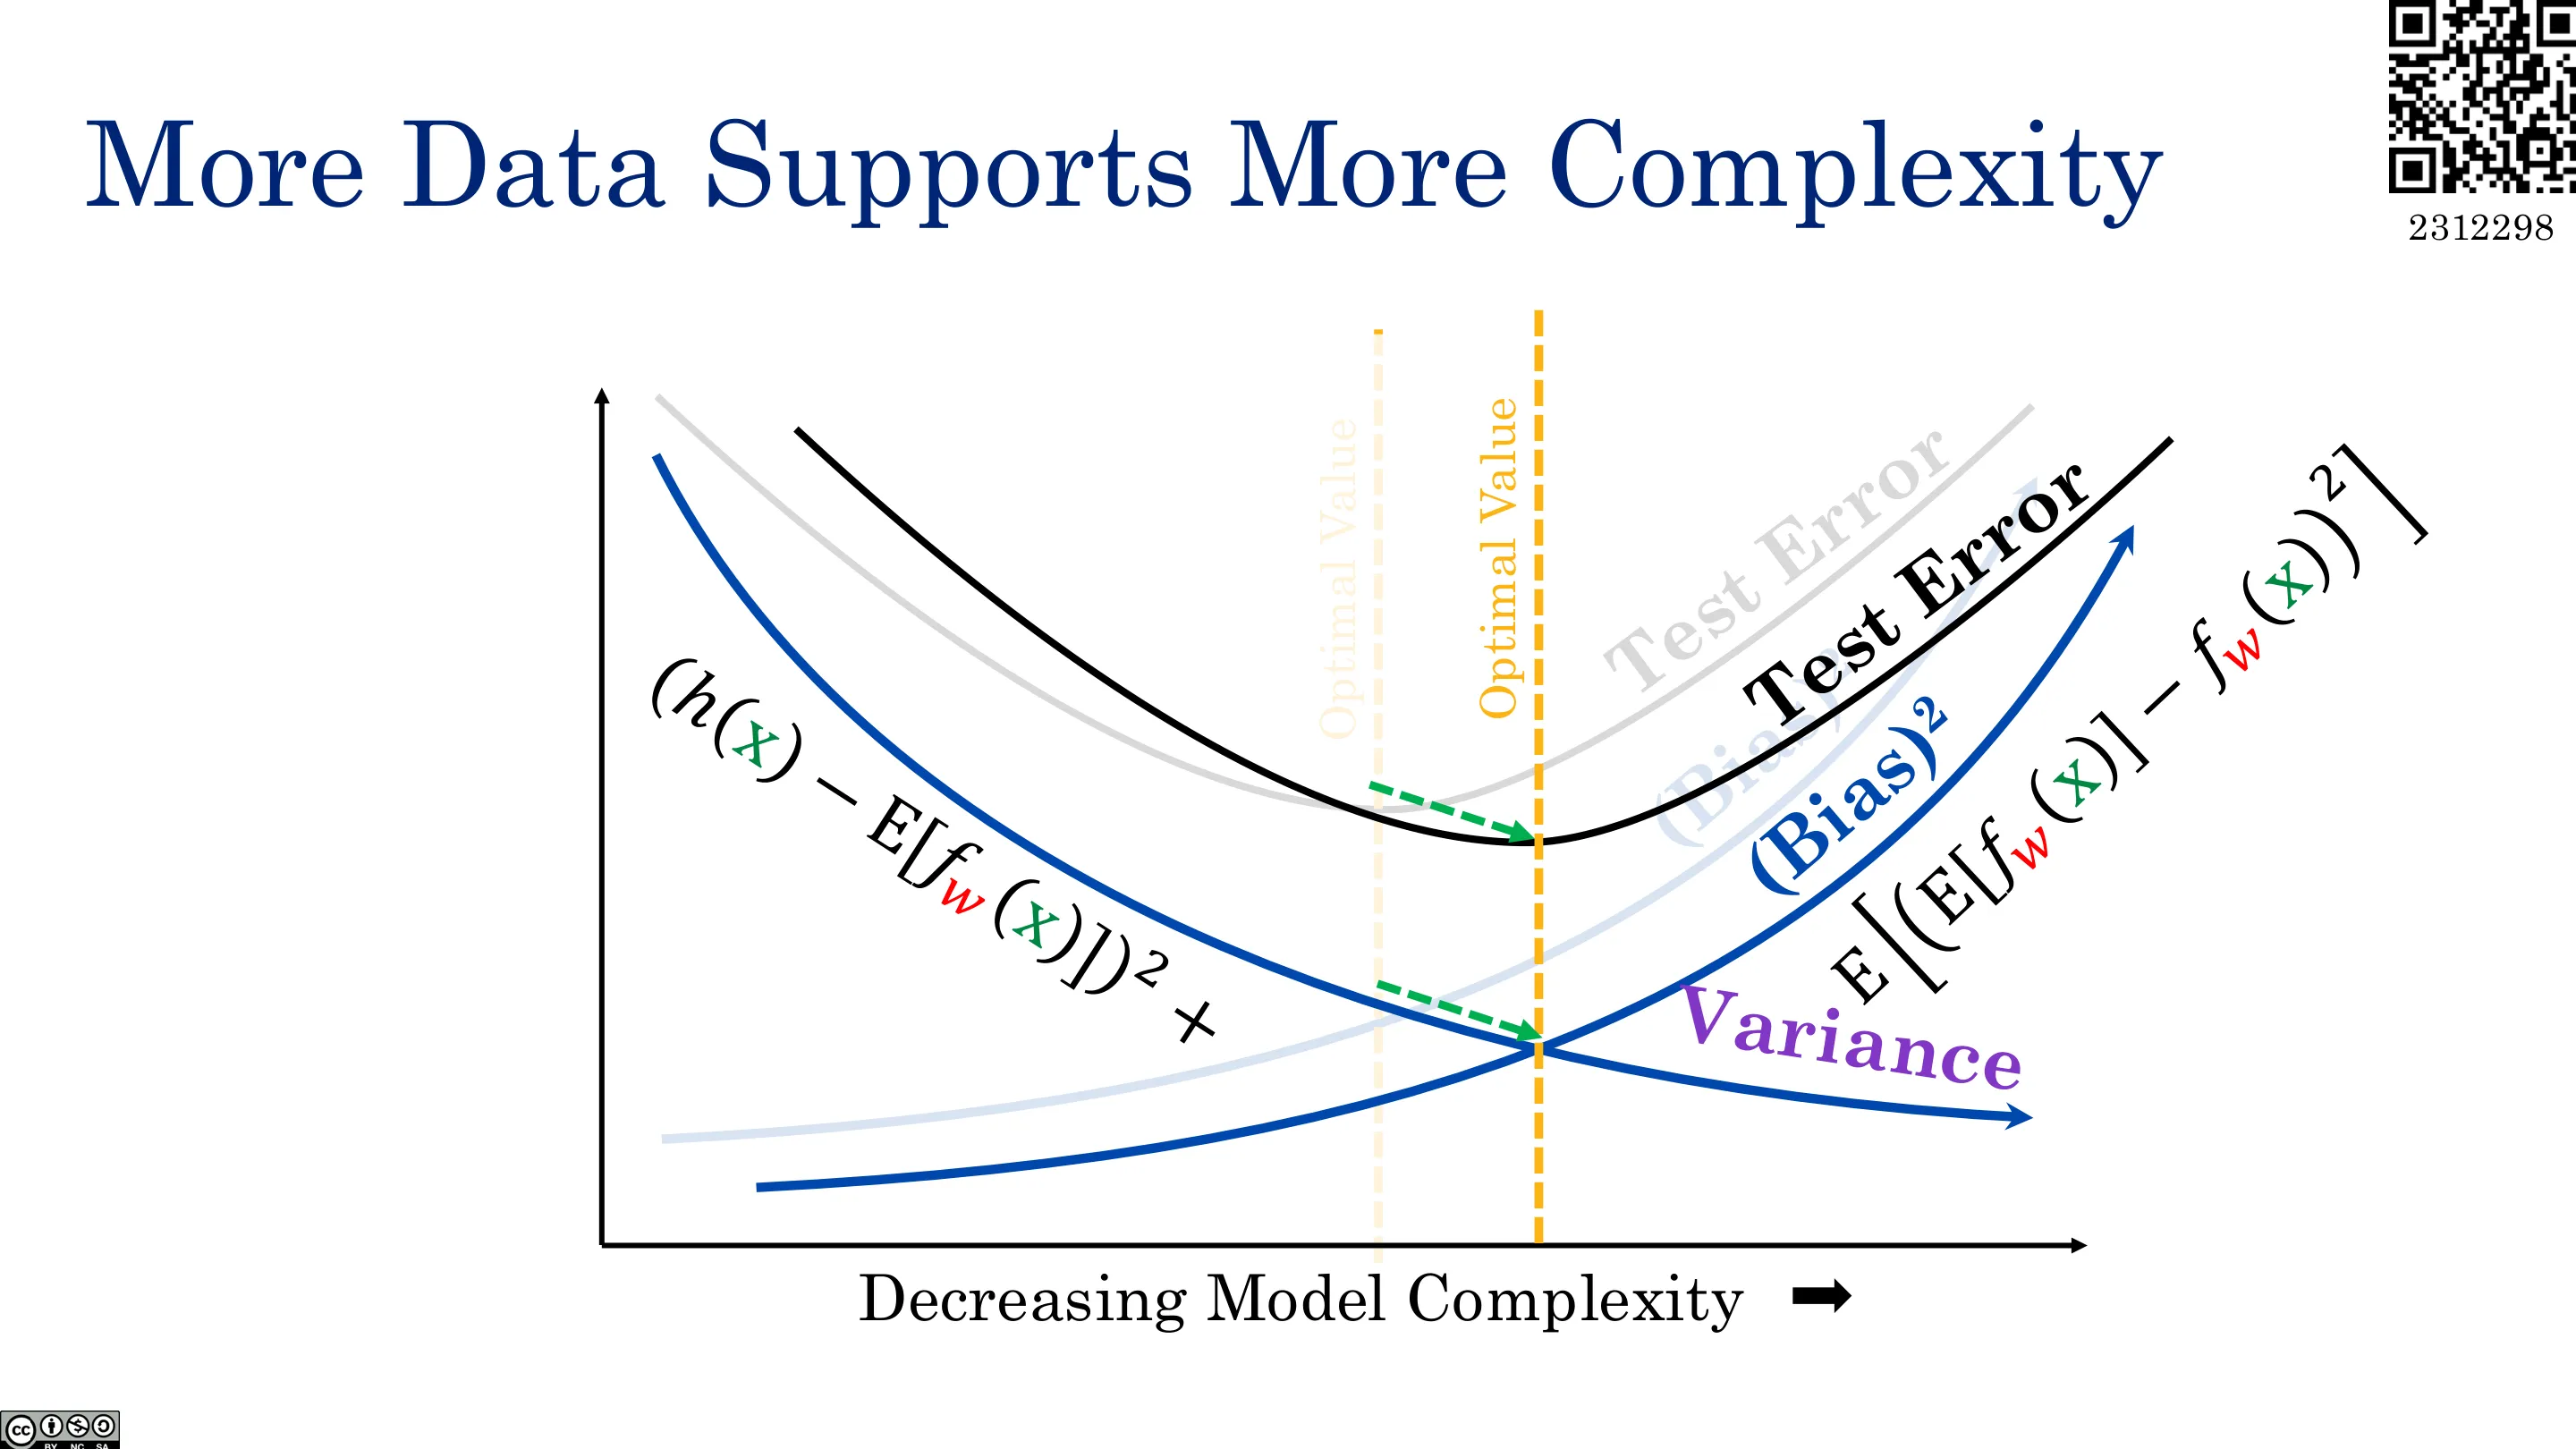
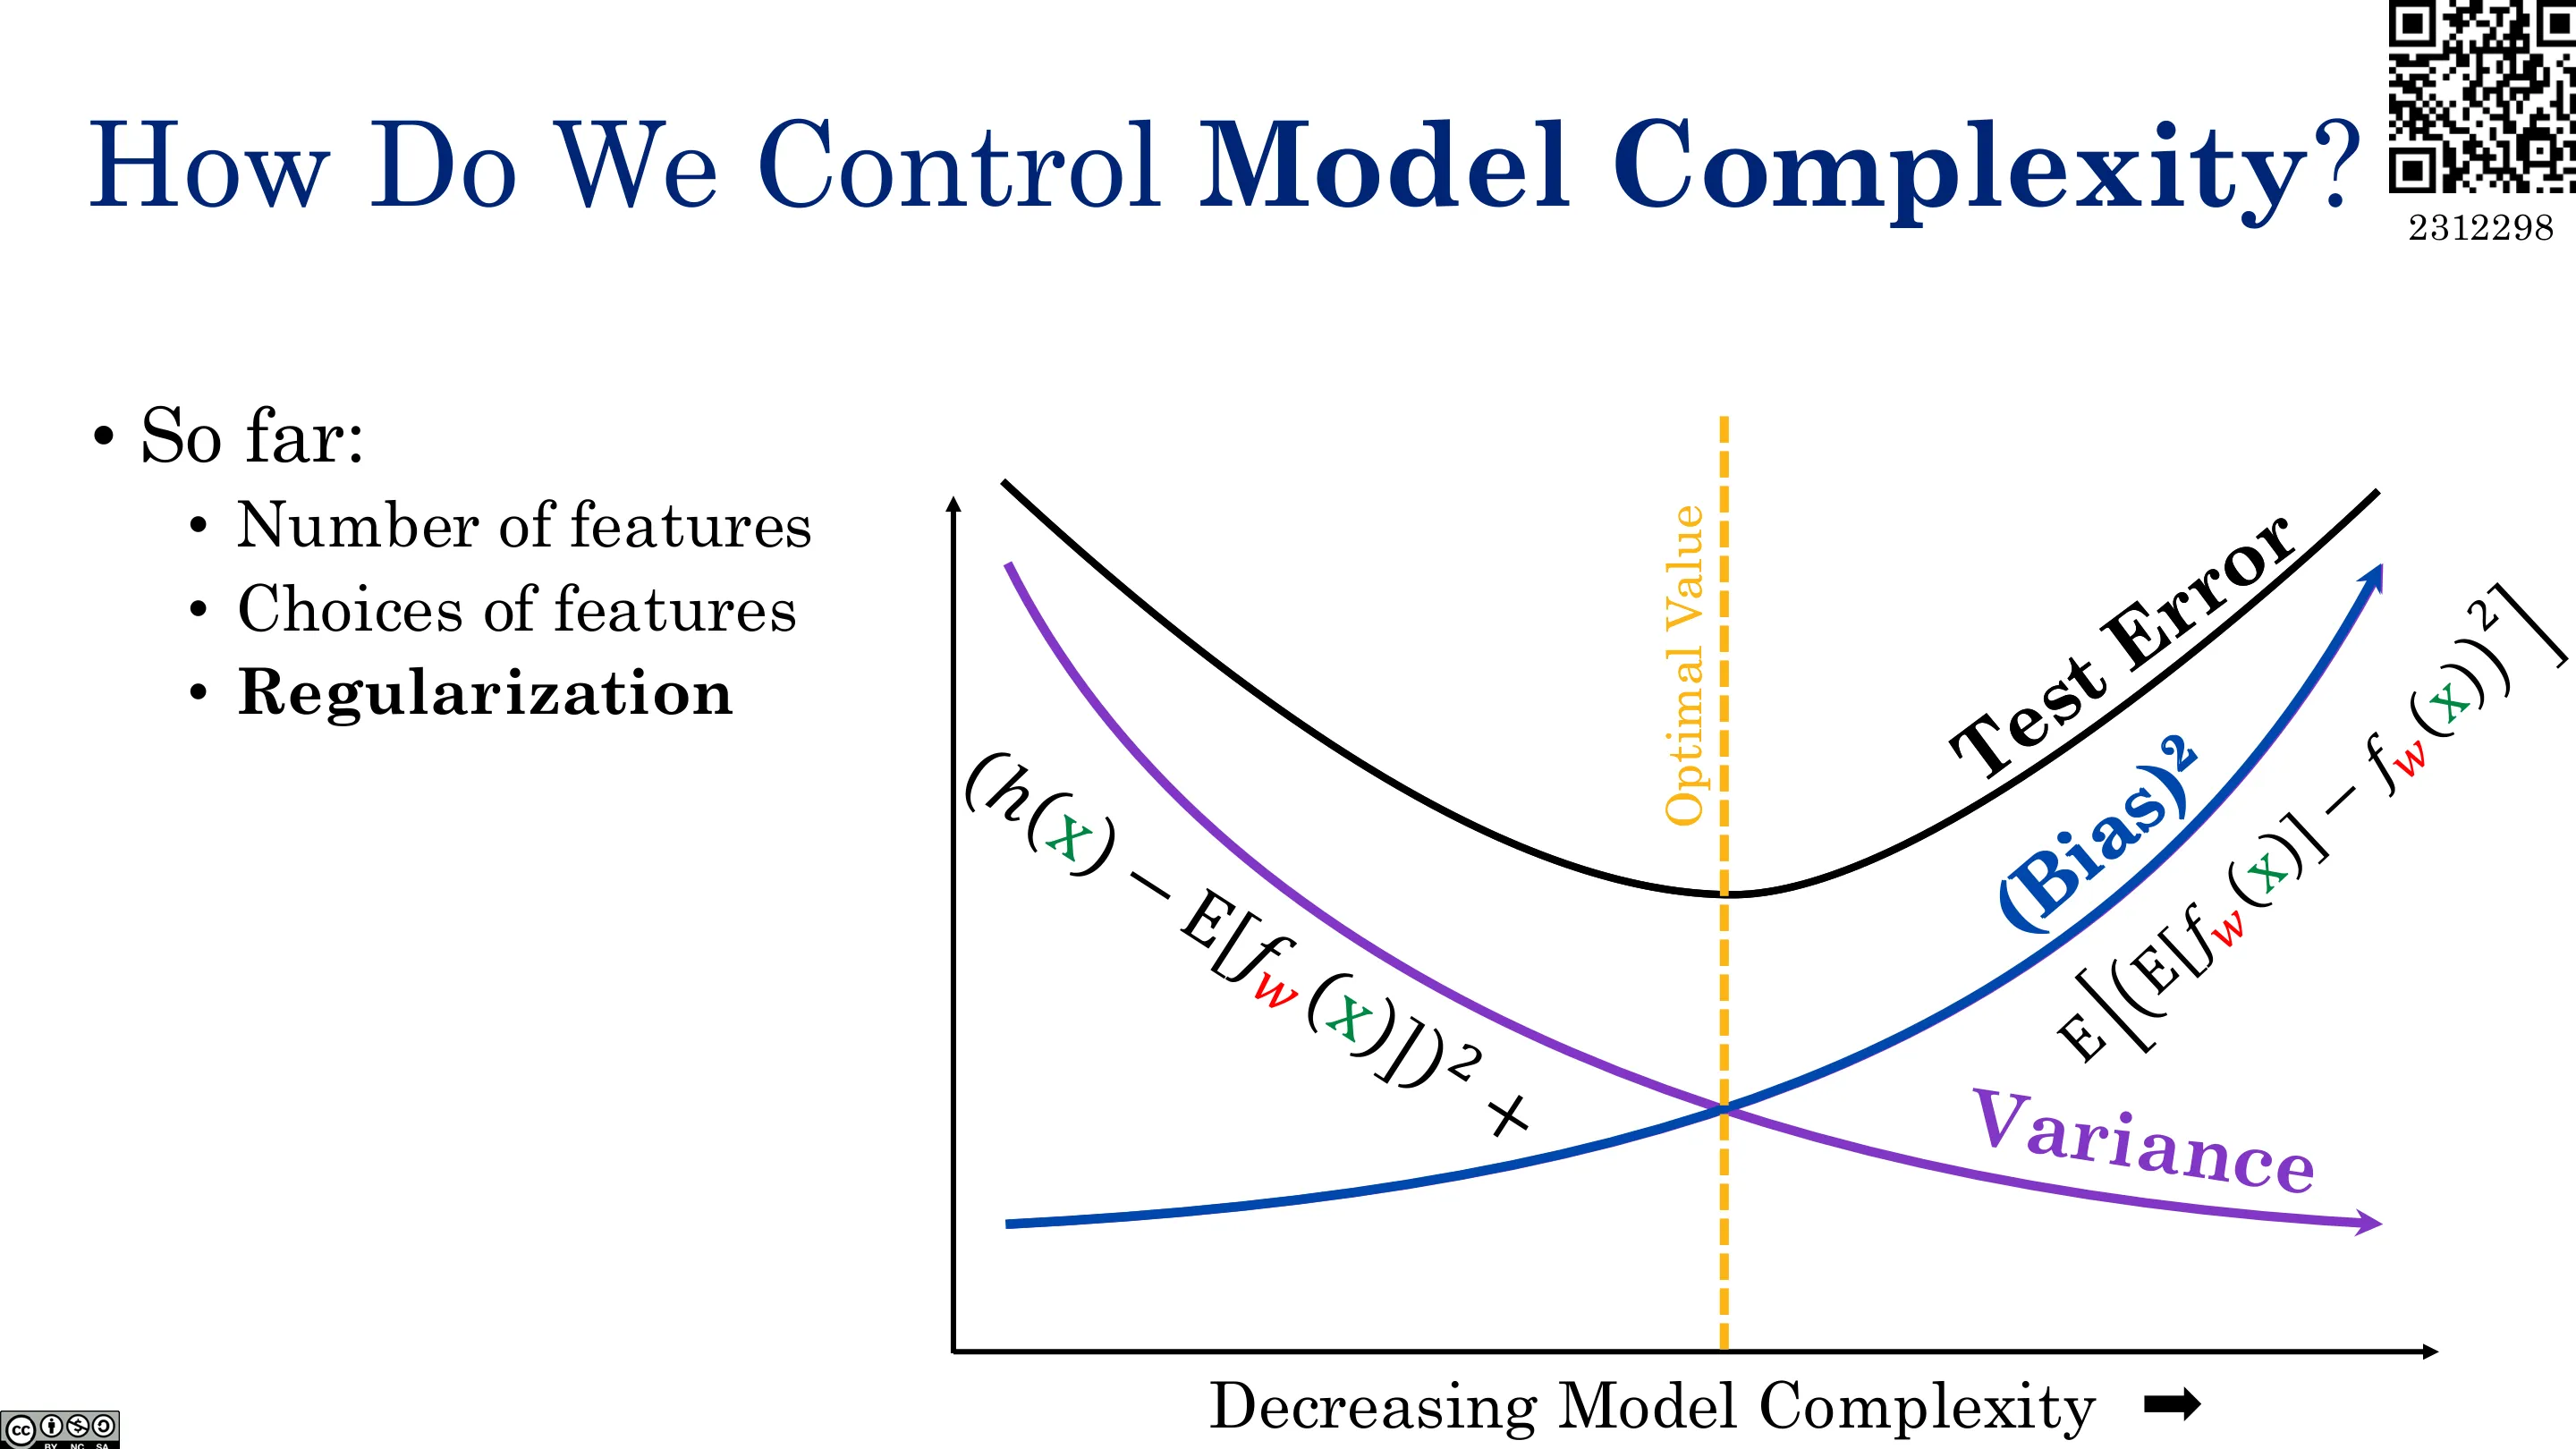
存在一个最优 $\lambda$:让测试误差最小,正好是复杂度与「自然复杂度」匹配的甜点区。现实中你把训练数据再分成训练集 + 验证集:用验证集选 $\lambda$,再用从未用过的测试集做最终评估。
编者说明:讲师在课堂上做了一个合成实验——真实函数是正弦曲线加高斯噪声,用高斯(RBF)基做线性组合去拟合;随着正则化强度变化,方差下降、偏差上升,而「偏差² + 方差」在某个 λ 处最小。这正是调节超参数的依据。实践中 $\lambda$ 越大 → 训练误差上升、测试误差呈 U 形。
总结(Takeaways)
- MLE 只看数据(硬币抛两次正面 ⇒ $\hat y=1$);MAP 把先验也纳入(⇒ $\hat y=0.9$),且因分母与参数无关而无需计算 $p(D)$。
- MAP = MLE + 先验;对权重加高斯先验 ⇒ L2 / 岭回归,$\lambda\propto 1/\sigma_w^2$;$\lambda\to0$ 退回 MLE。
- 预期测试误差 = 不可约噪声 + 偏差² + 方差;正则化把「方差」换成「偏差」。
- 过拟合对应高方差,欠拟合对应高偏差;存在最优复杂度。
- 上述理论量在实践中不可计算,只能用训练/验证/测试划分去经验性地选择超参数。
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=Z1KuNG9HyiQ |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 14) | Google Drive 文件夹 |
| 教材 Machine Learning: A First Course for Engineers and Scientists | MLE/MAP、岭回归、偏差-方差相关章节(另参见第 2.[1-2]、5.4、9.1 等) · https://doi.org/10.1017/9781108919371 |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。