第15讲 · EECS 189:用梯度下降学习
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | Learning with Gradient Descent |
| 视频 | https://www.youtube.com/watch?v=6zV_GGgUa0Y |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 15) | Google Drive 文件夹 |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第15讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
本讲路线图
(参考时间: 00:00)
本讲把上一讲的优化理论落到一个可以手算的例子上,再深入收敛性,最后引向 SGD / mini-batch / 动量 / Adam:
- 一个三参数线性模型的完整梯度下降(写出损失 → 求梯度 → 走一步);
- 收敛分析:Taylor 二次近似、Hessian、特征值、临界点(极小/极大/鞍点);
- 学习率与条件数:为什么 $\eta$ 受最大曲率限制、收敛速度受最小曲率拖慢;
- SGD / mini-batch、动量与自适应方法(AdaGrad/RMSProp/Adam)。
📷 标题页
回到原视频 (00:00:20)
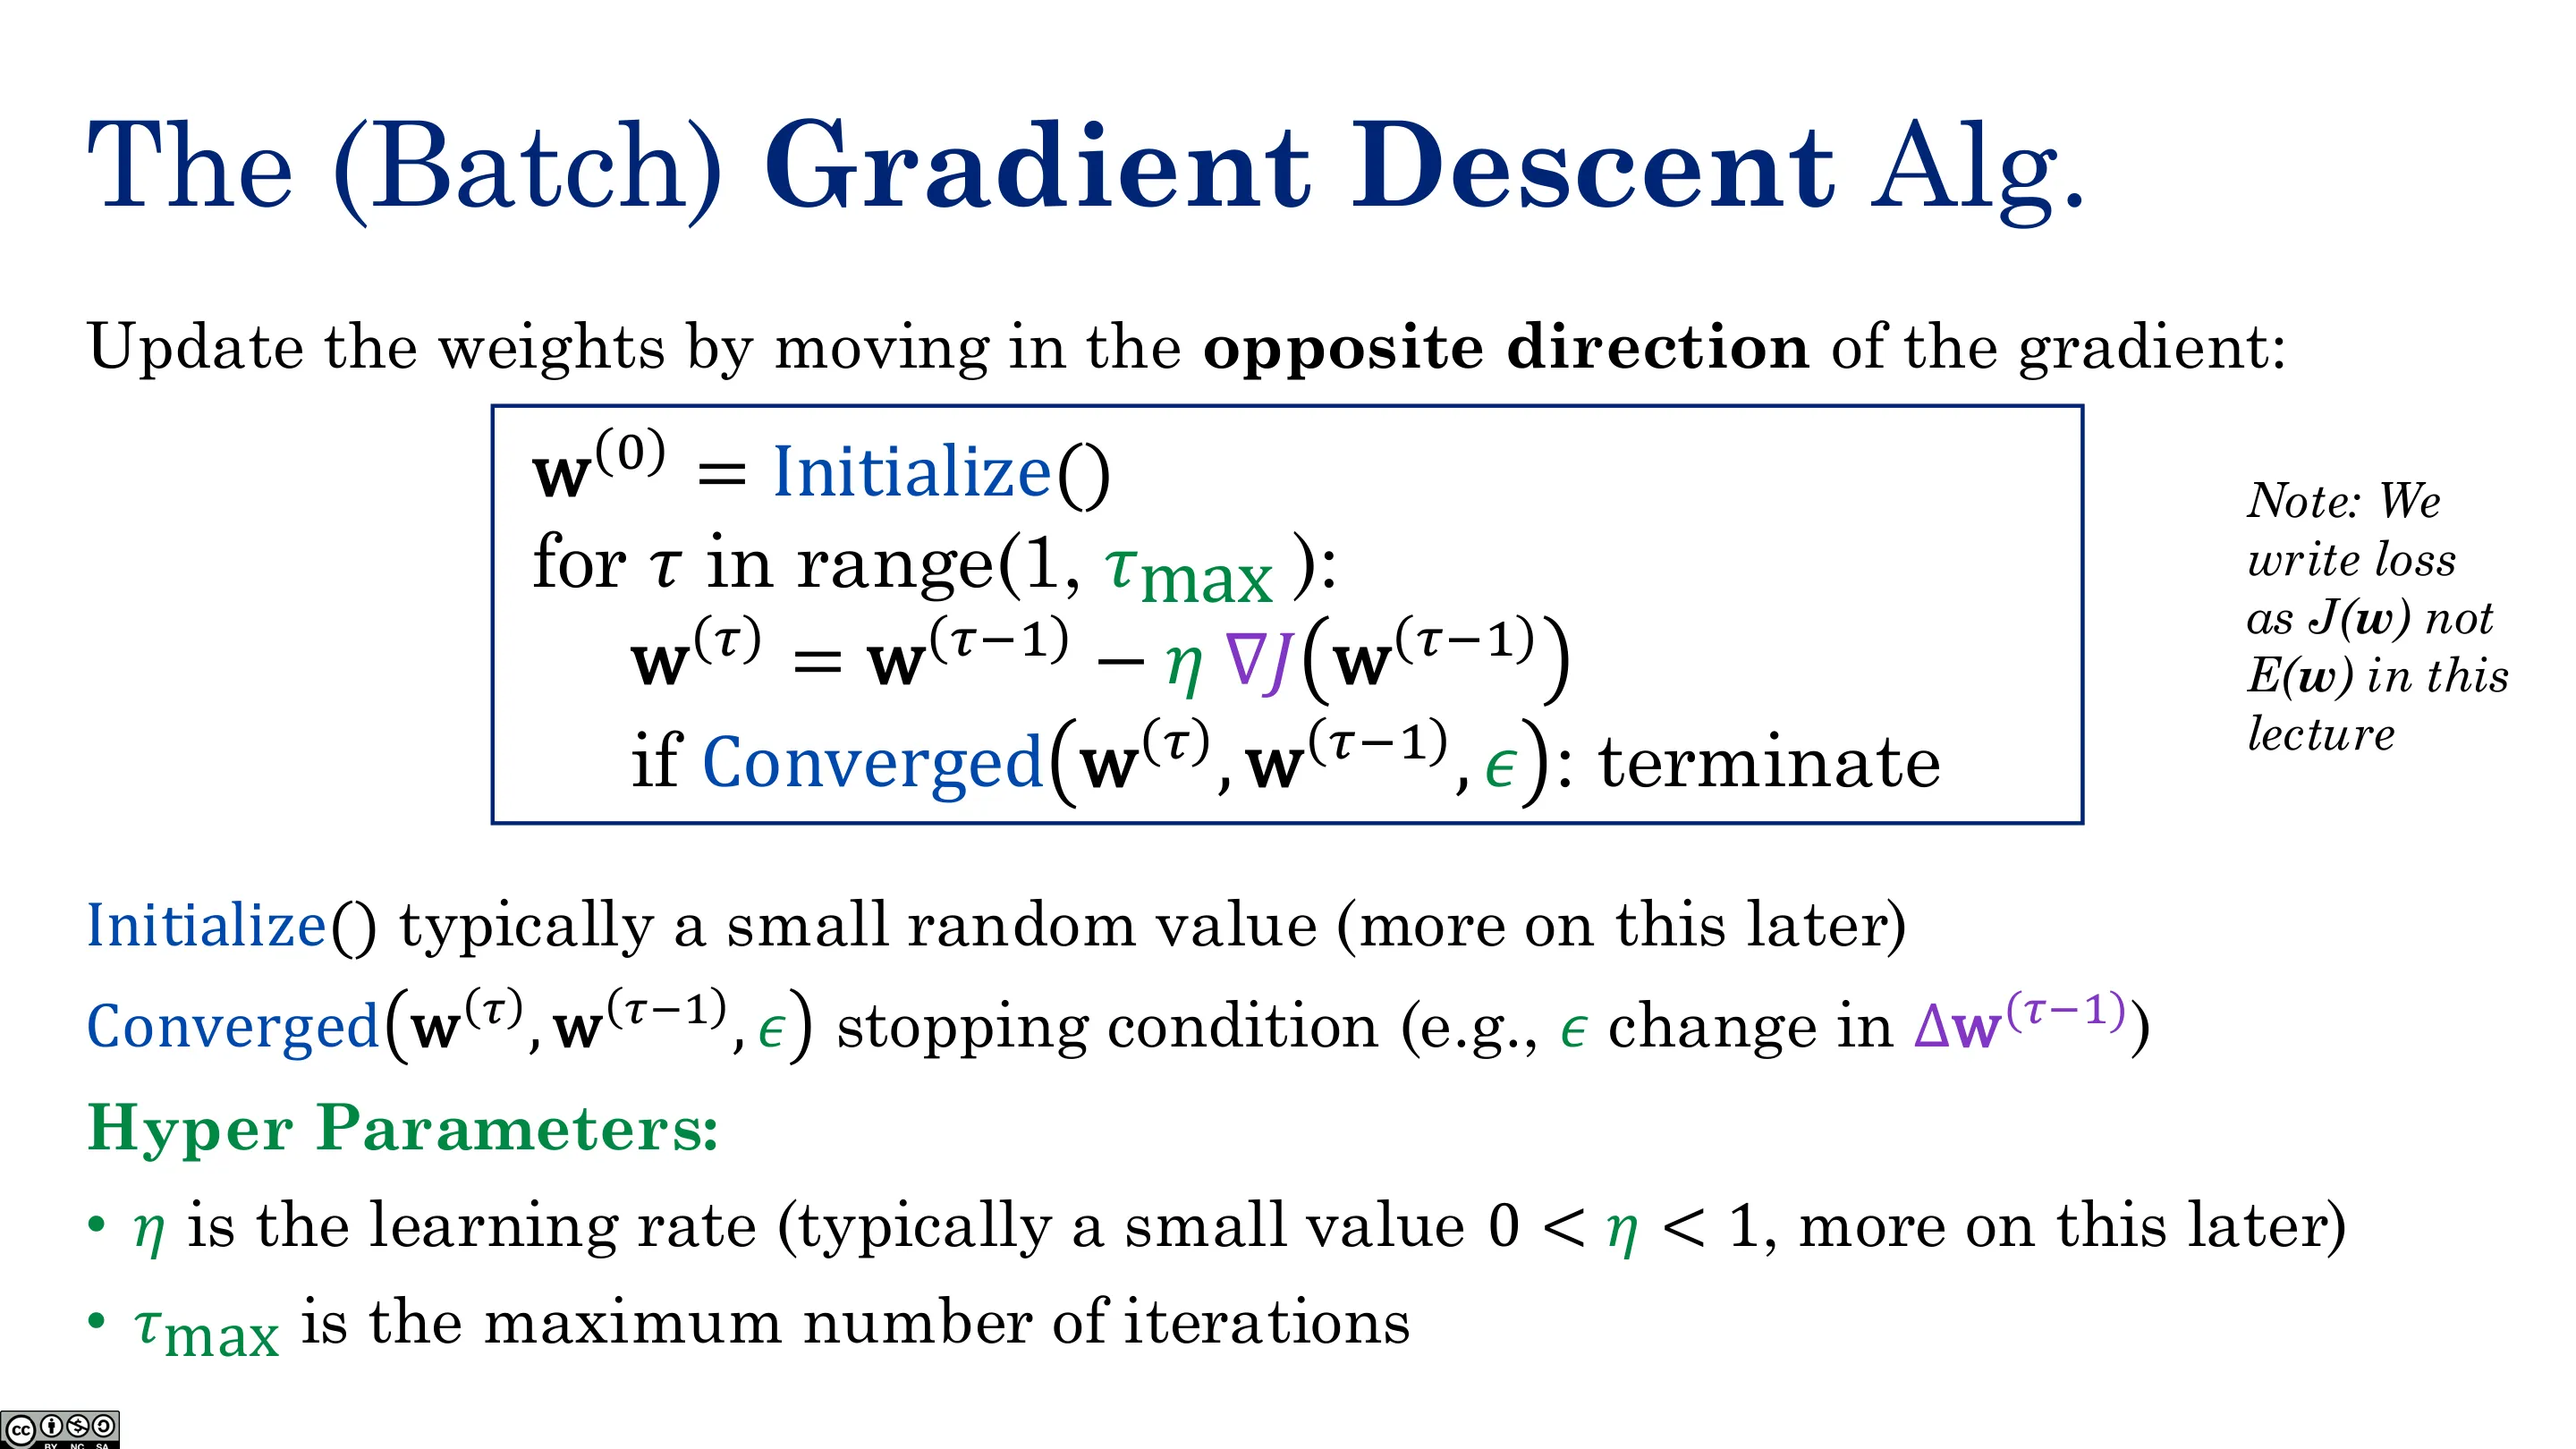
📷 批量梯度下降算法
回到原视频 (00:01:33)
一、一个可以手算的梯度下降例子
(参考时间: 00:03)
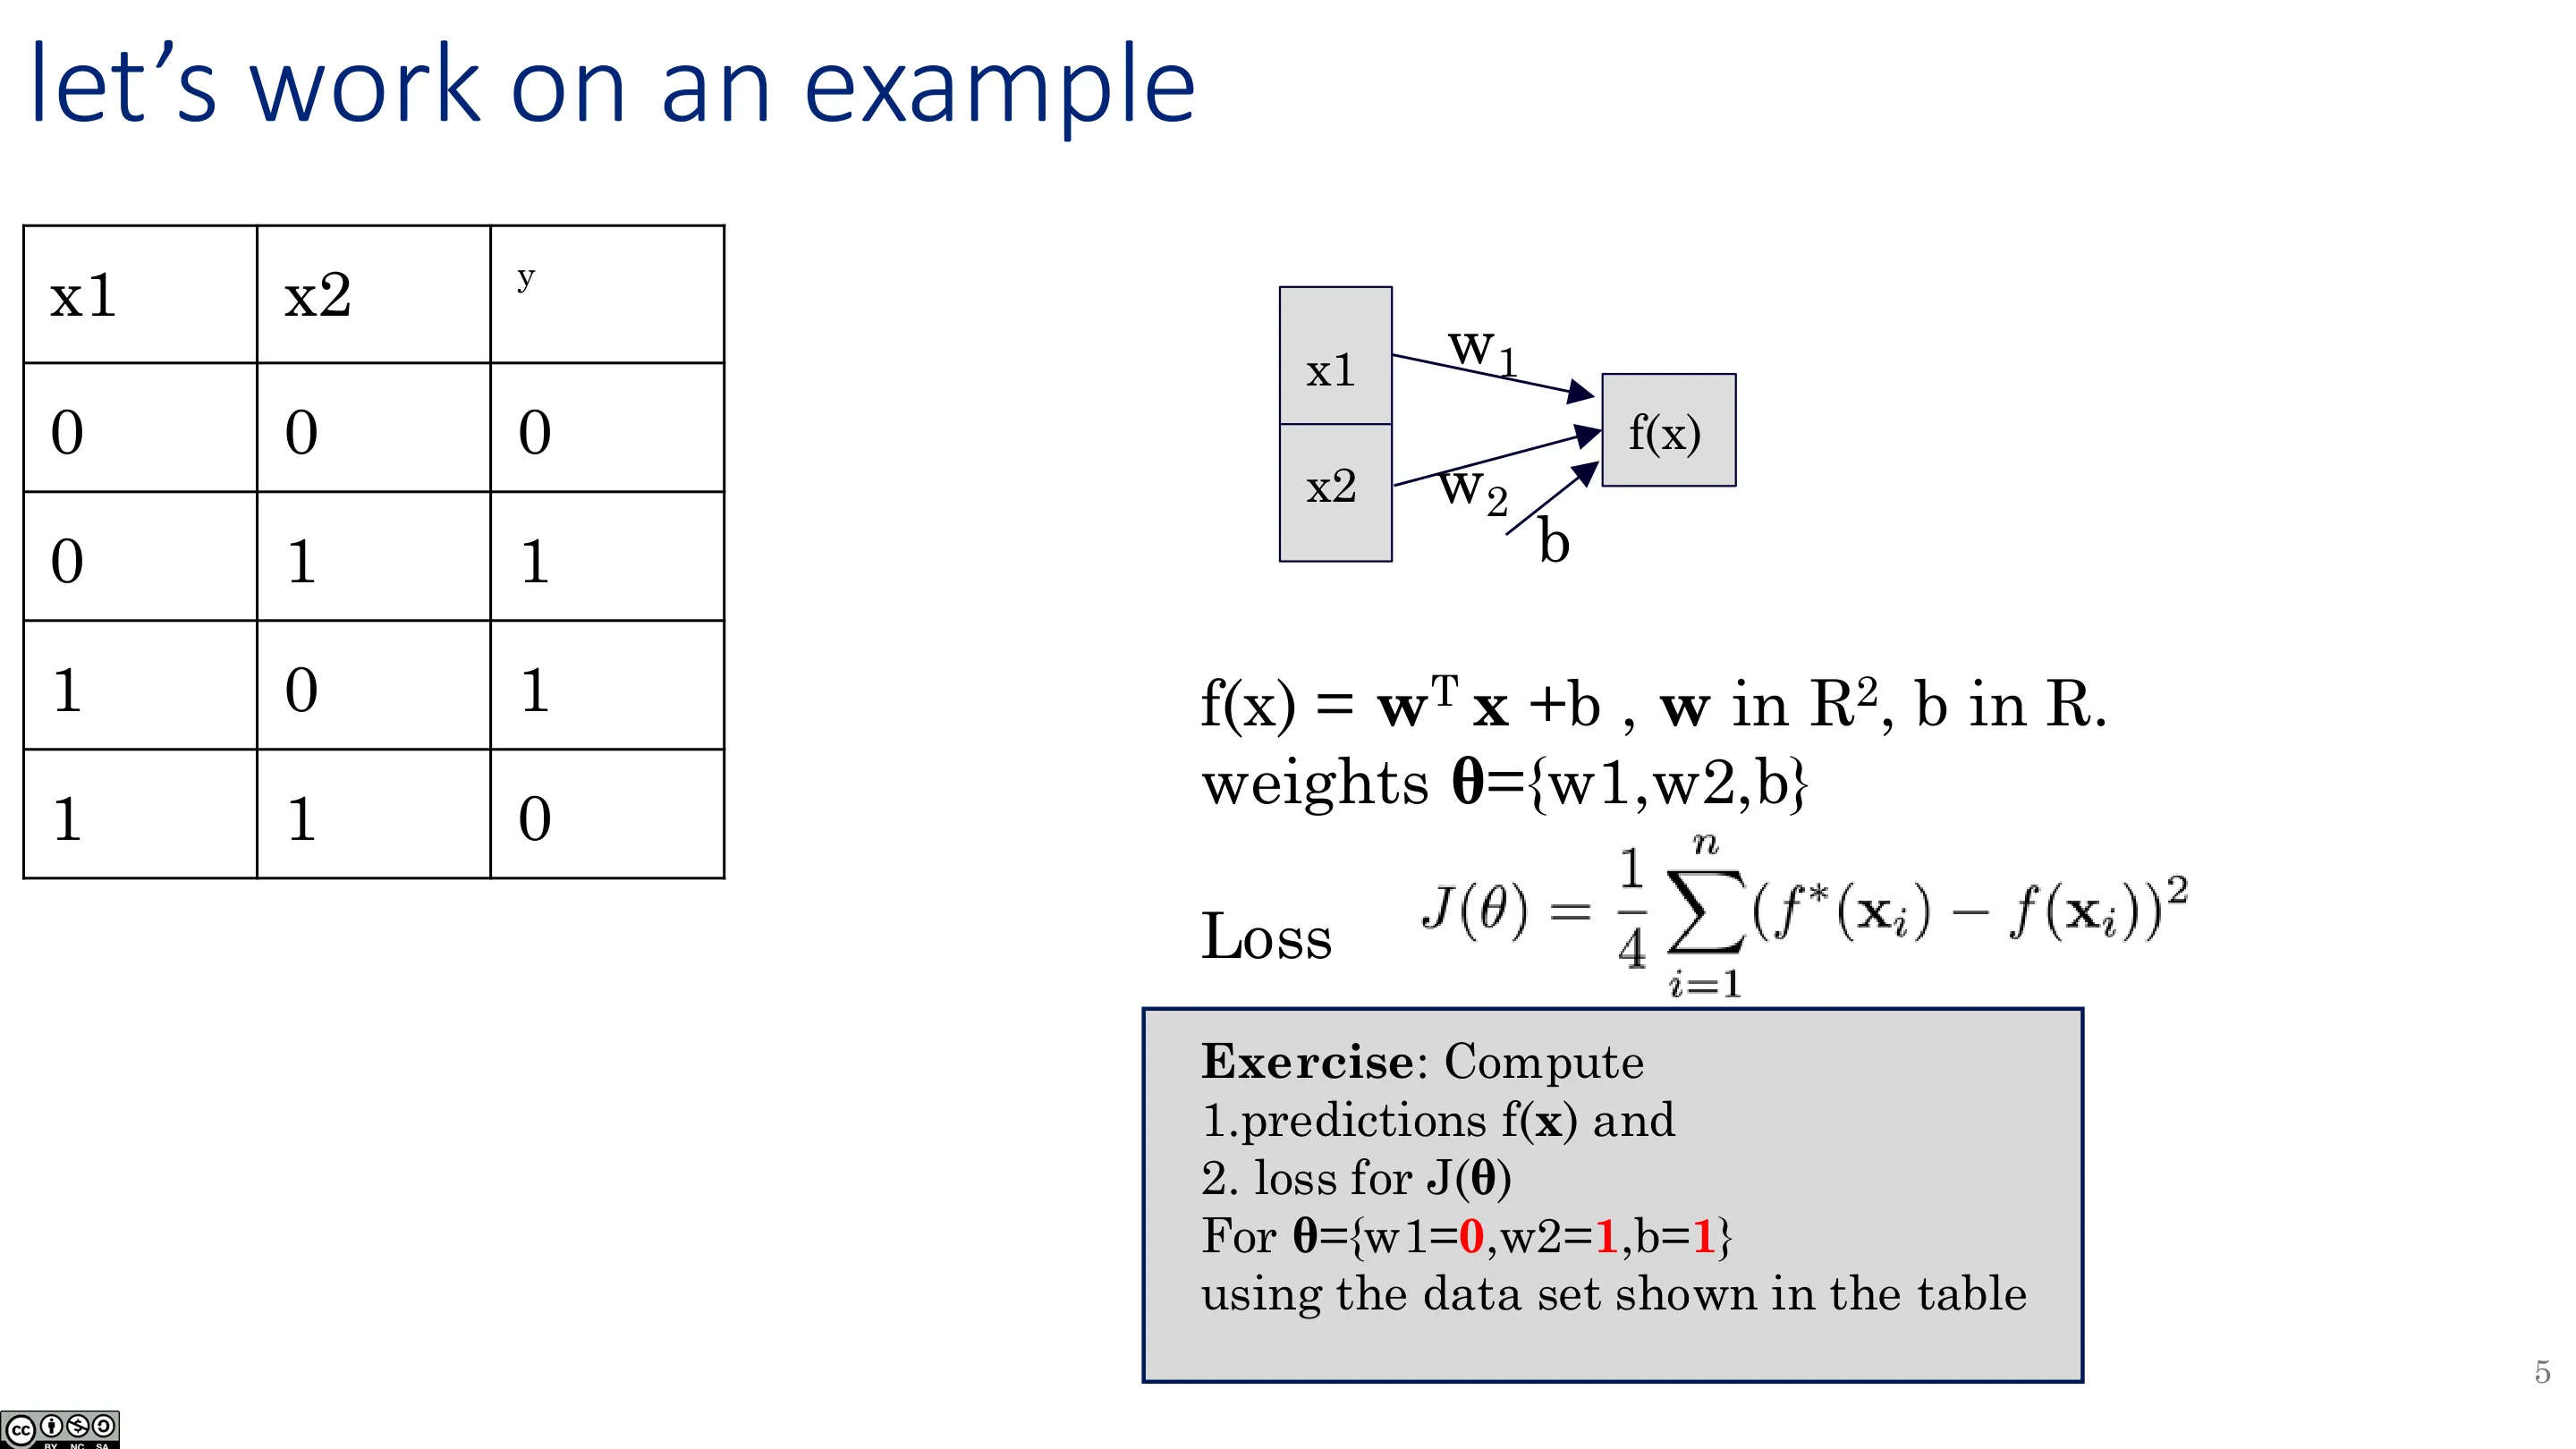
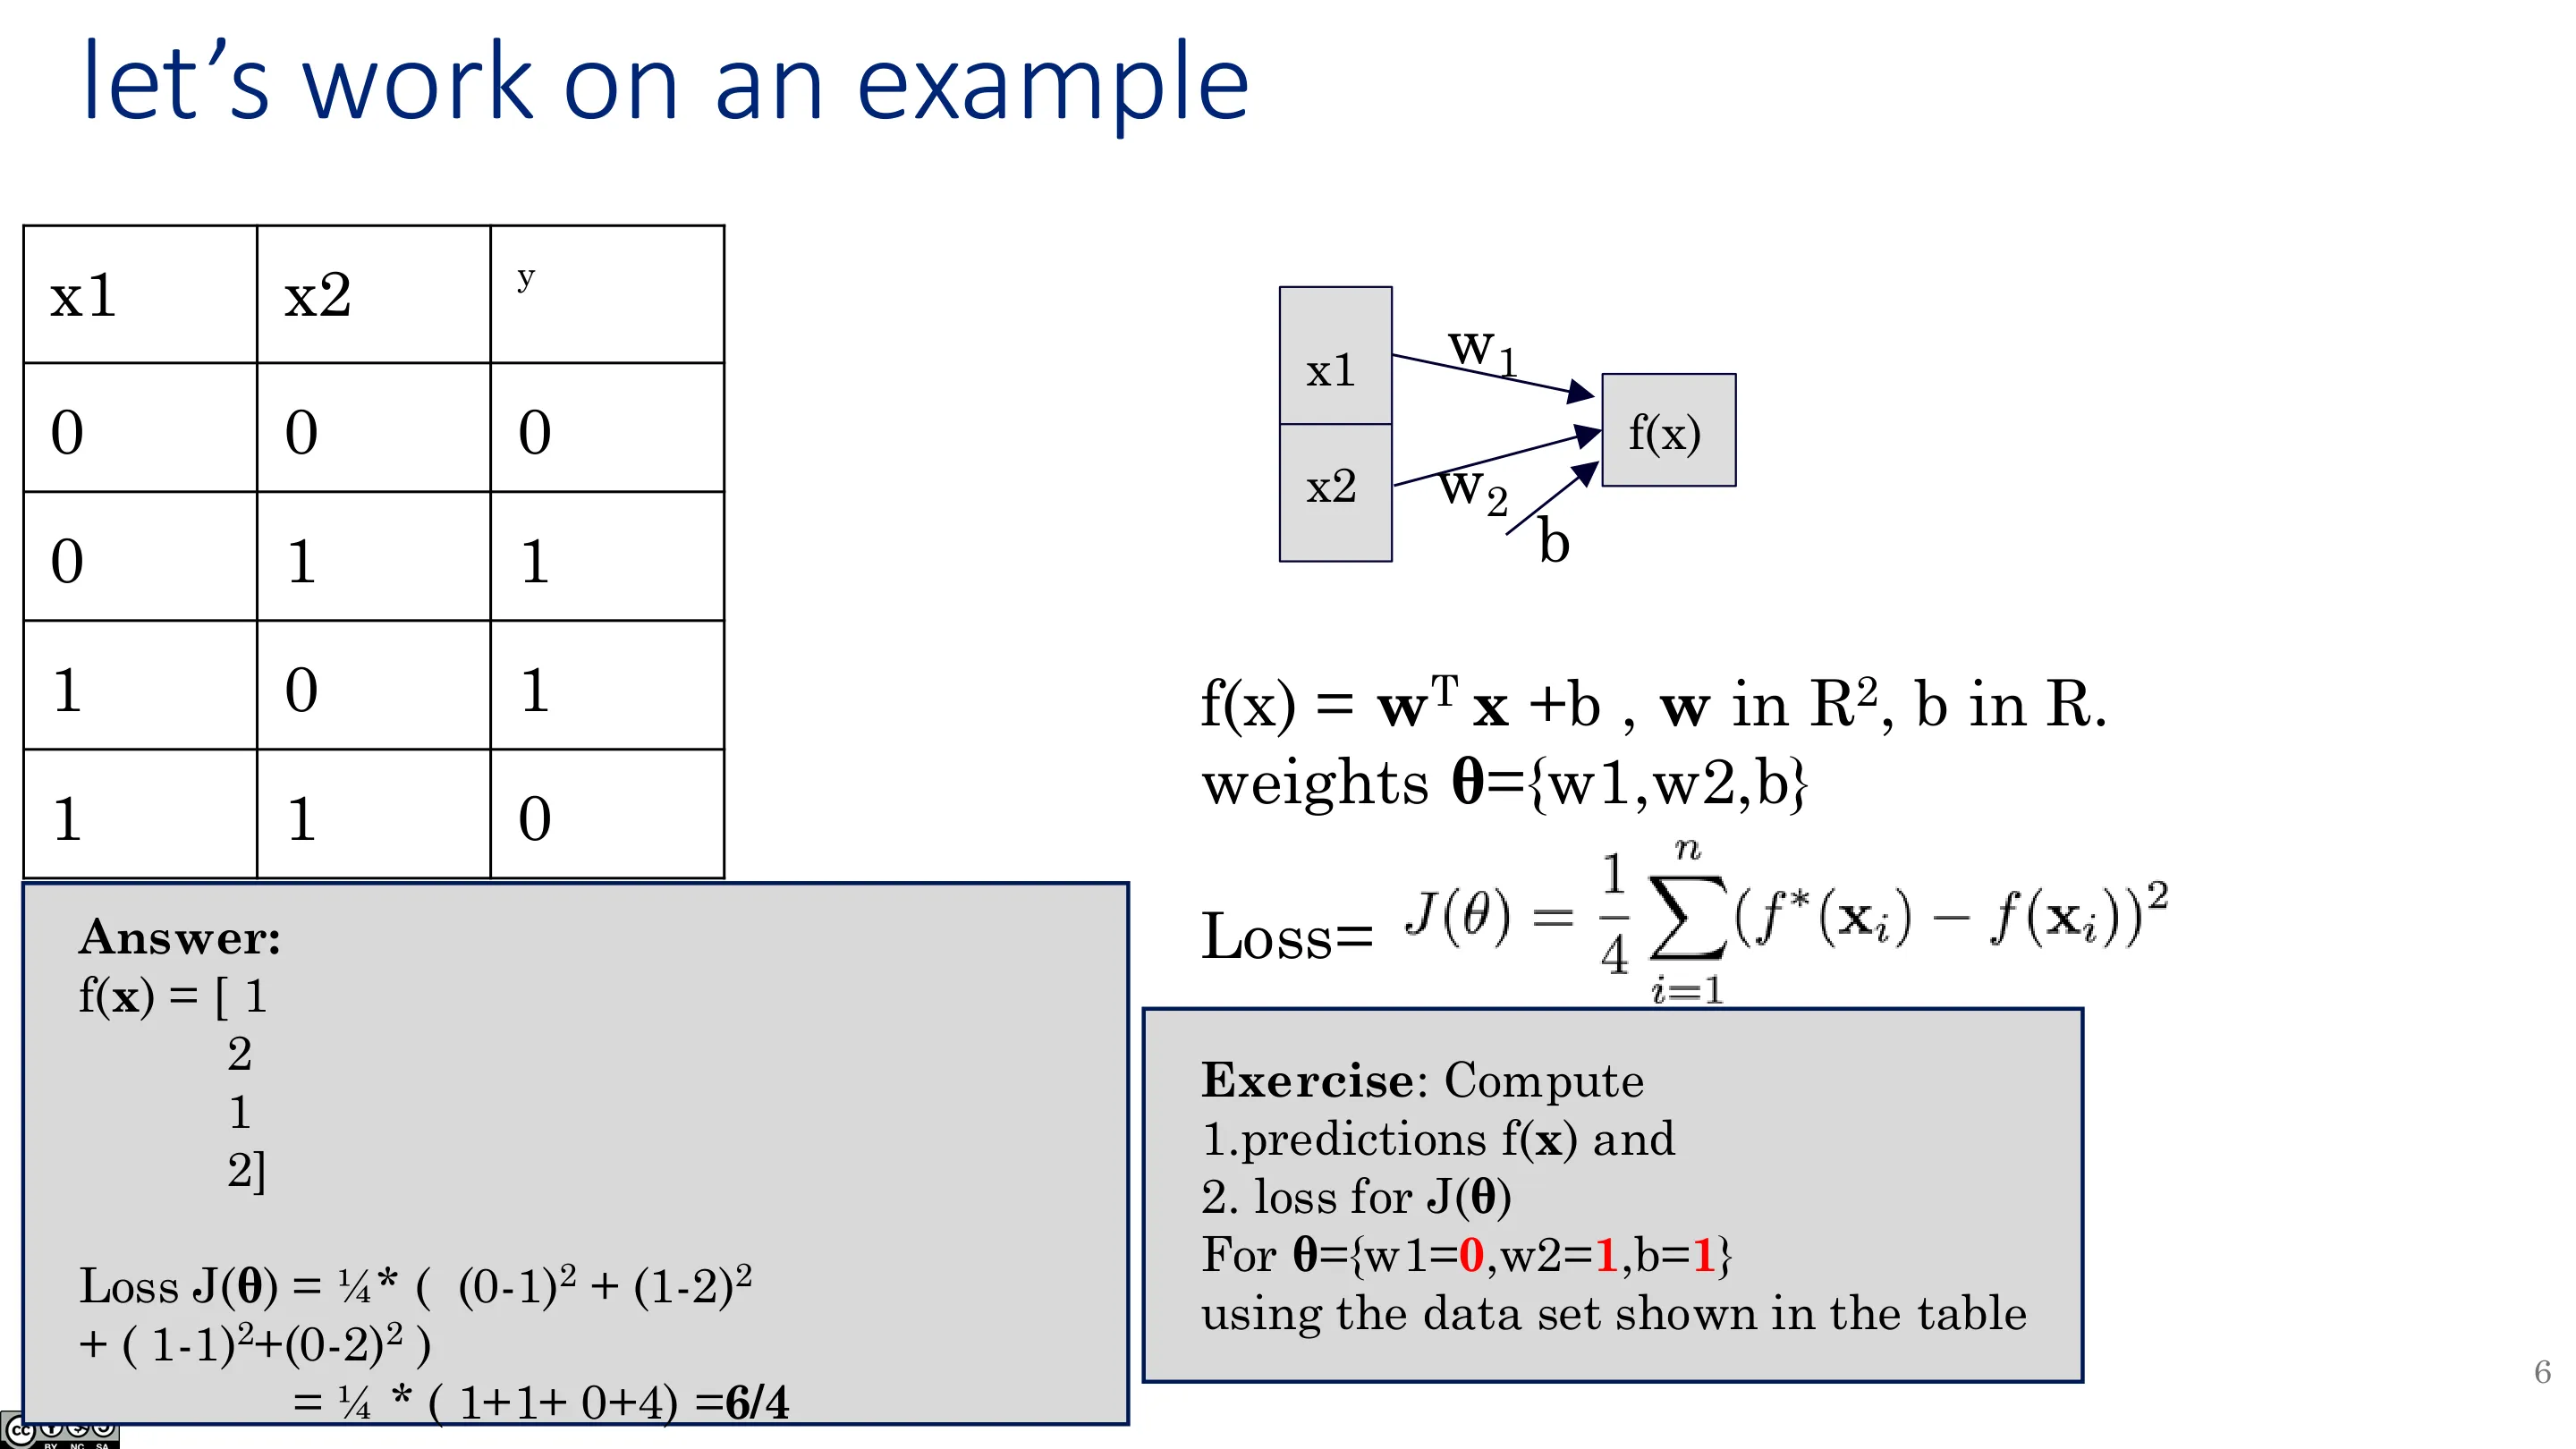
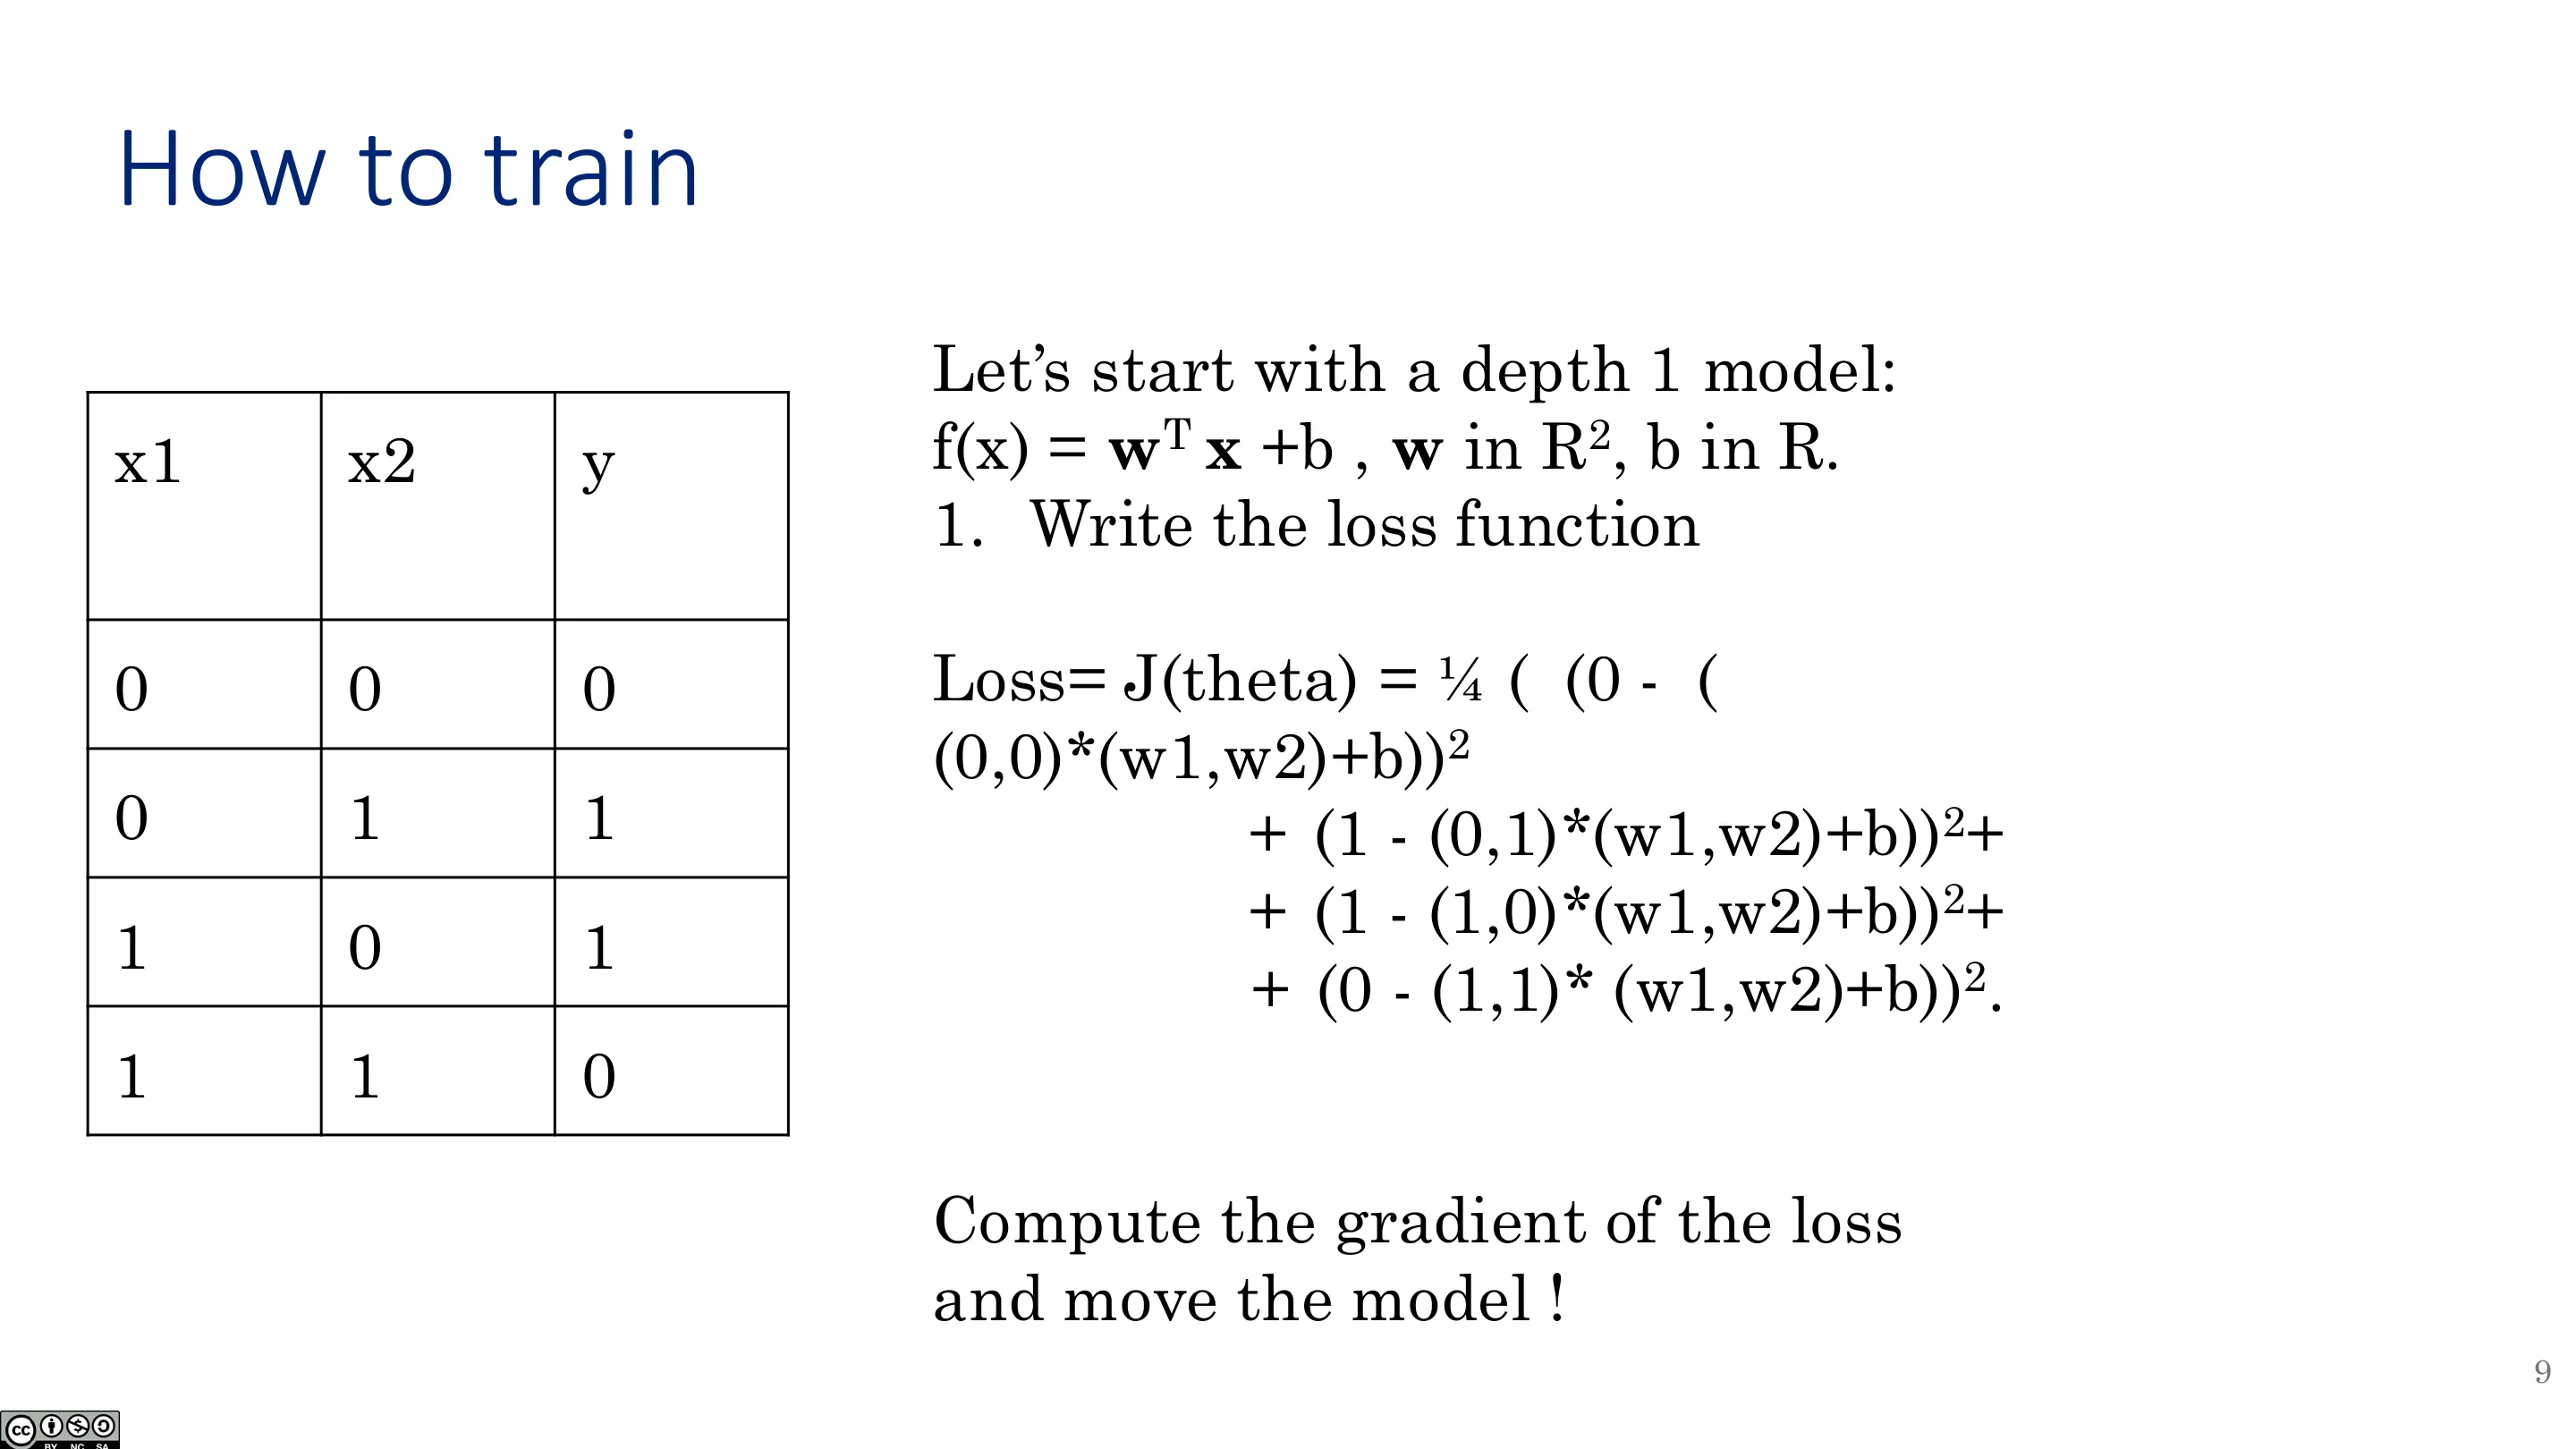
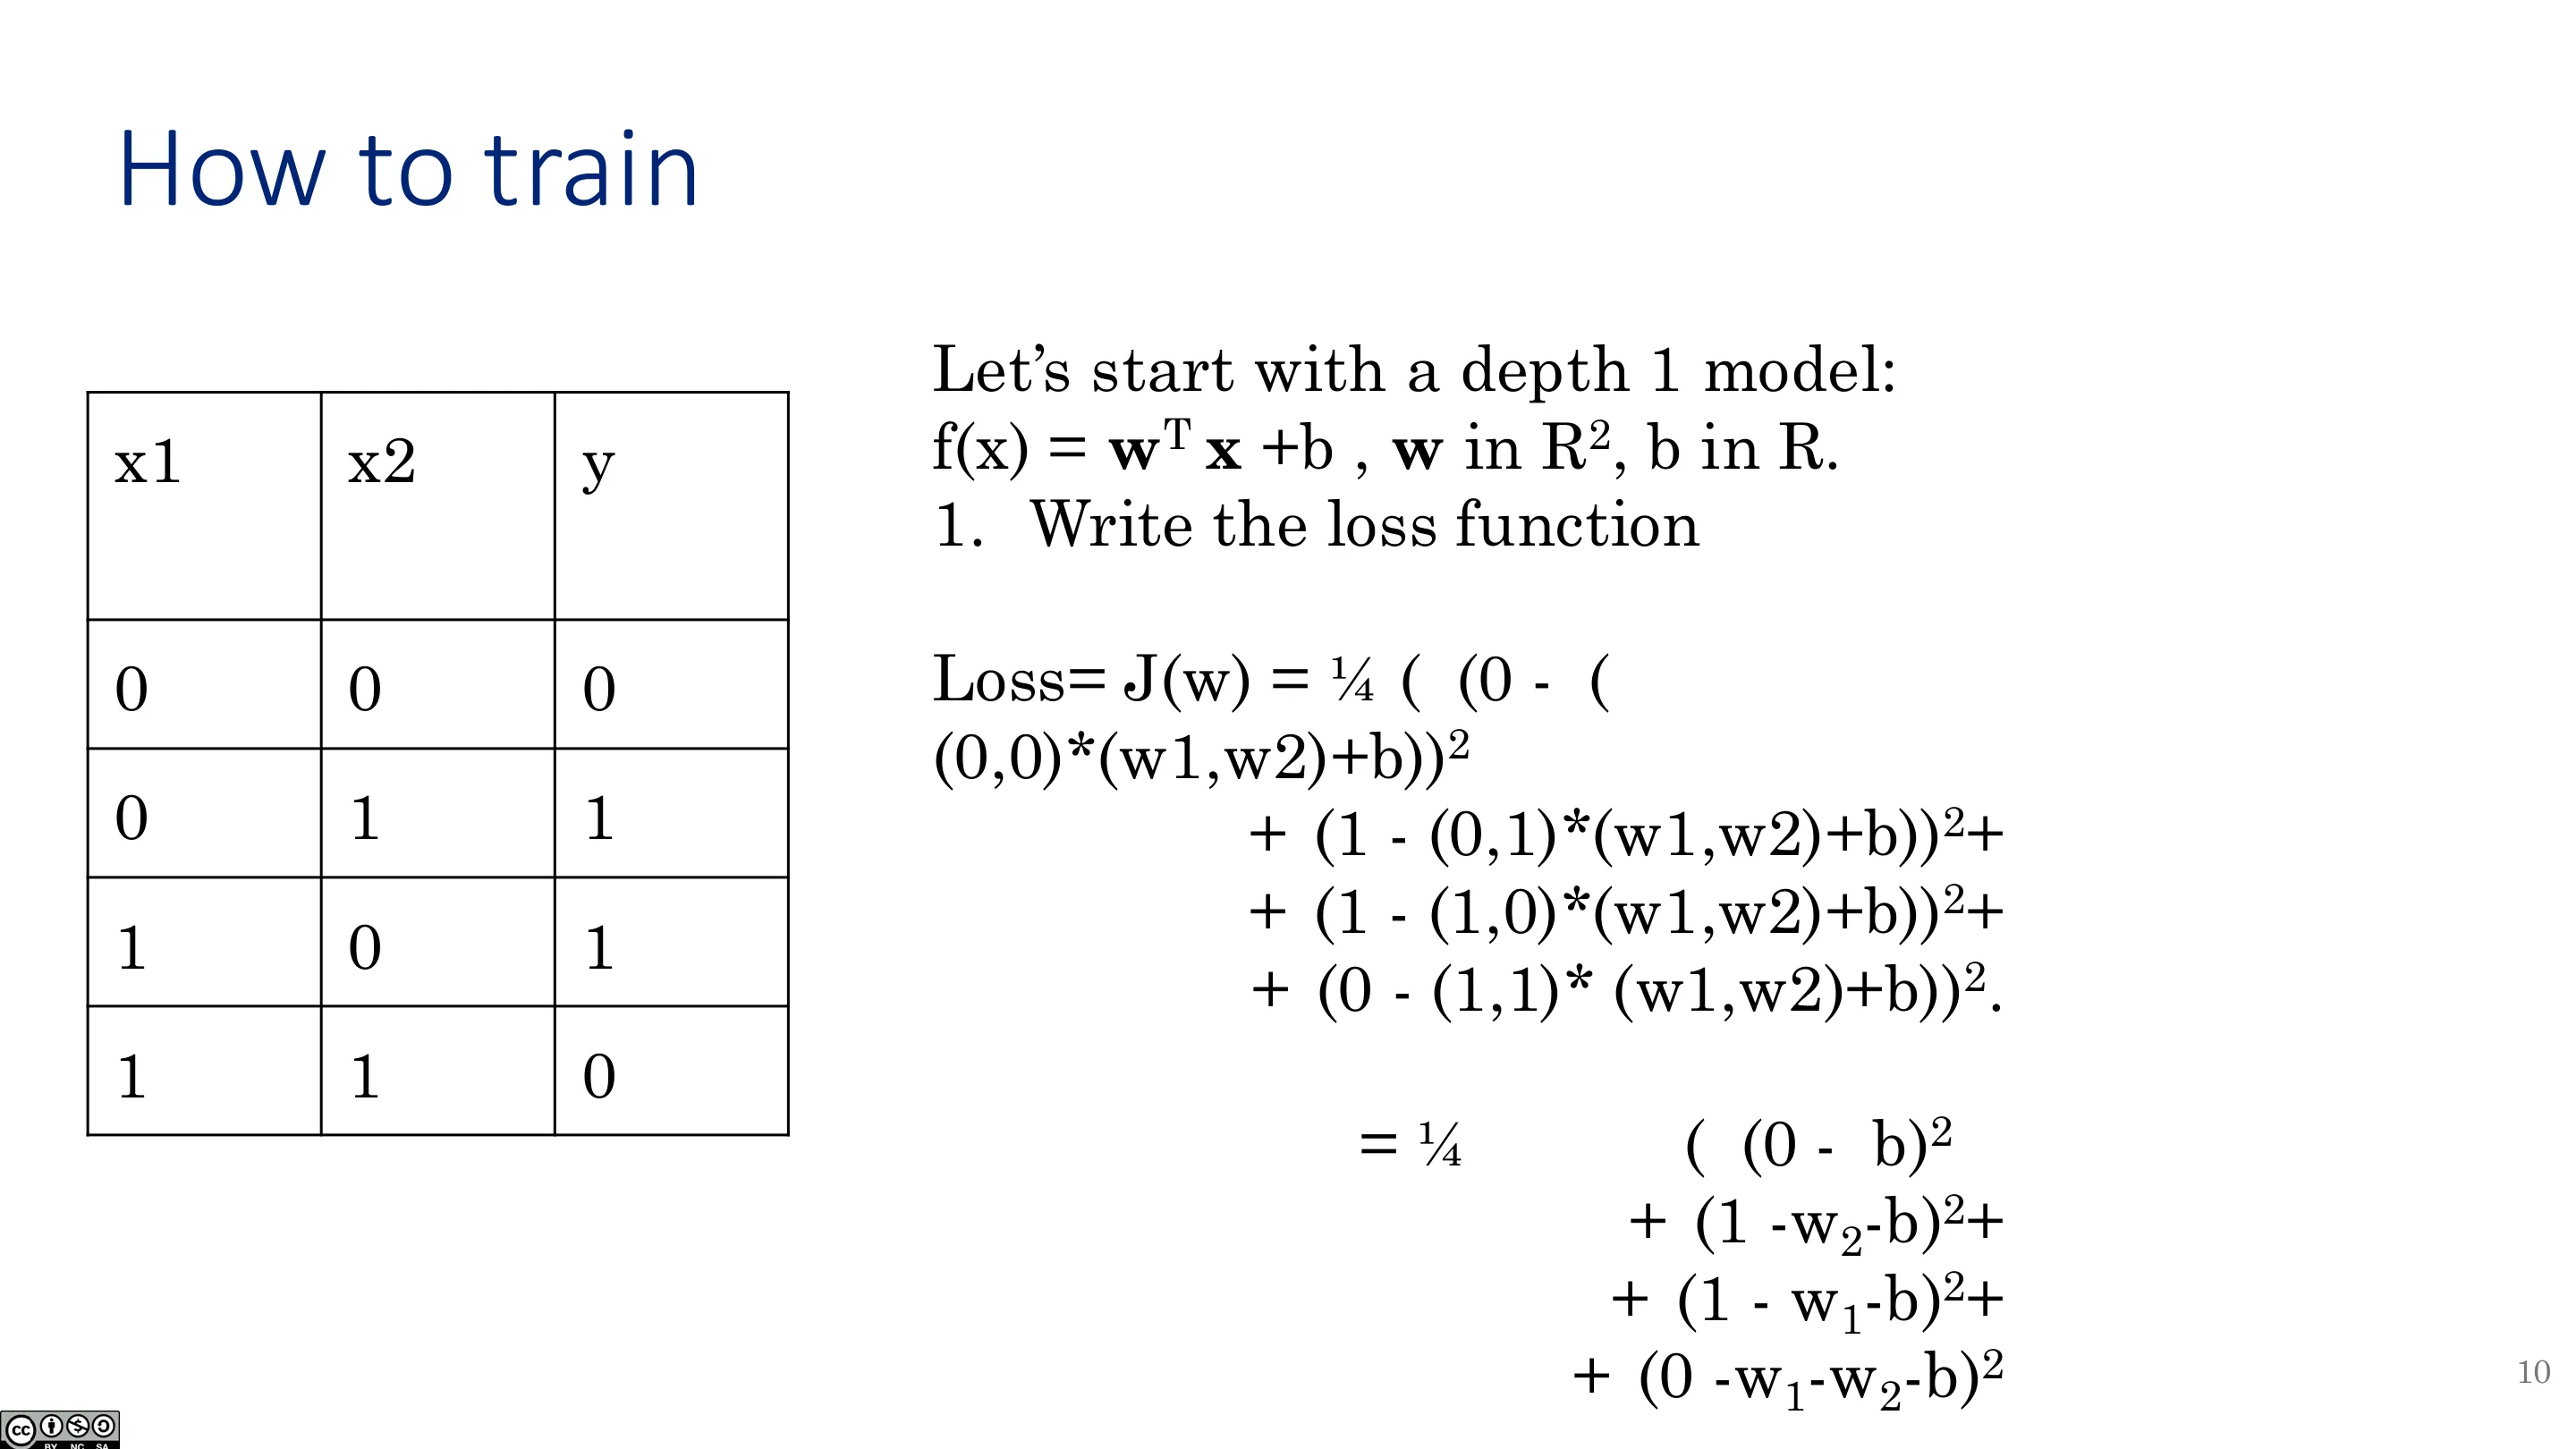
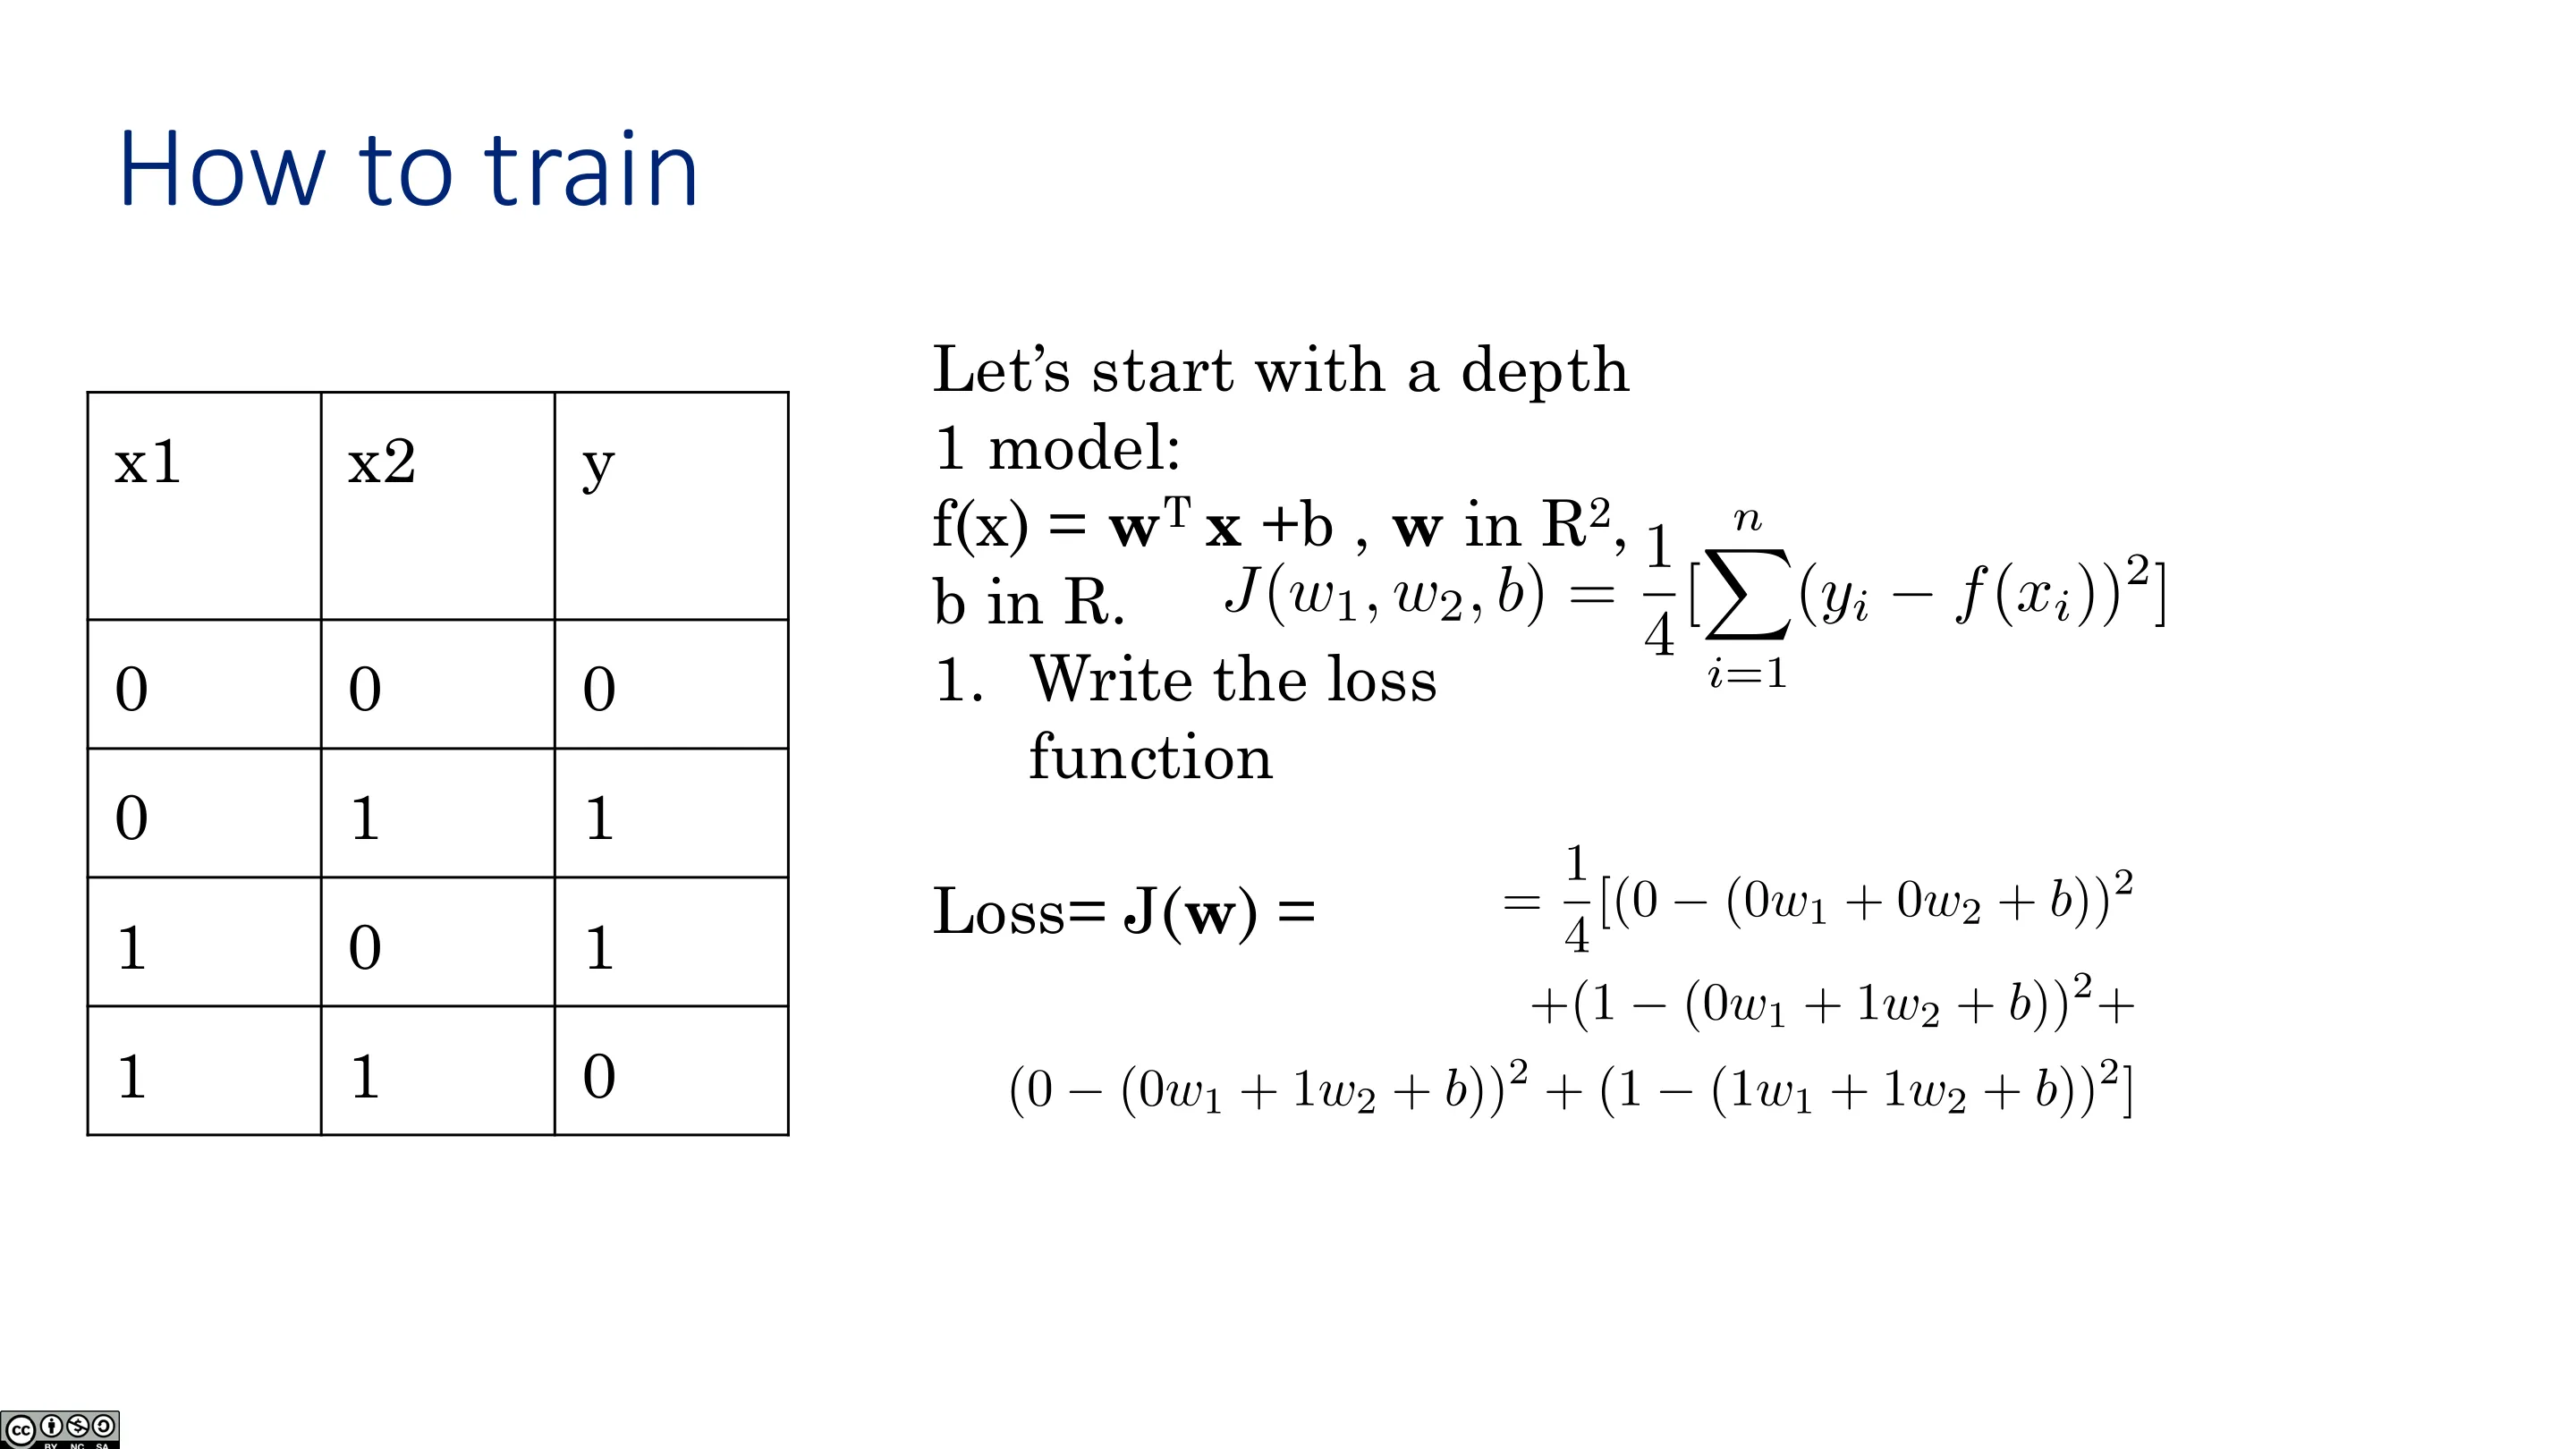
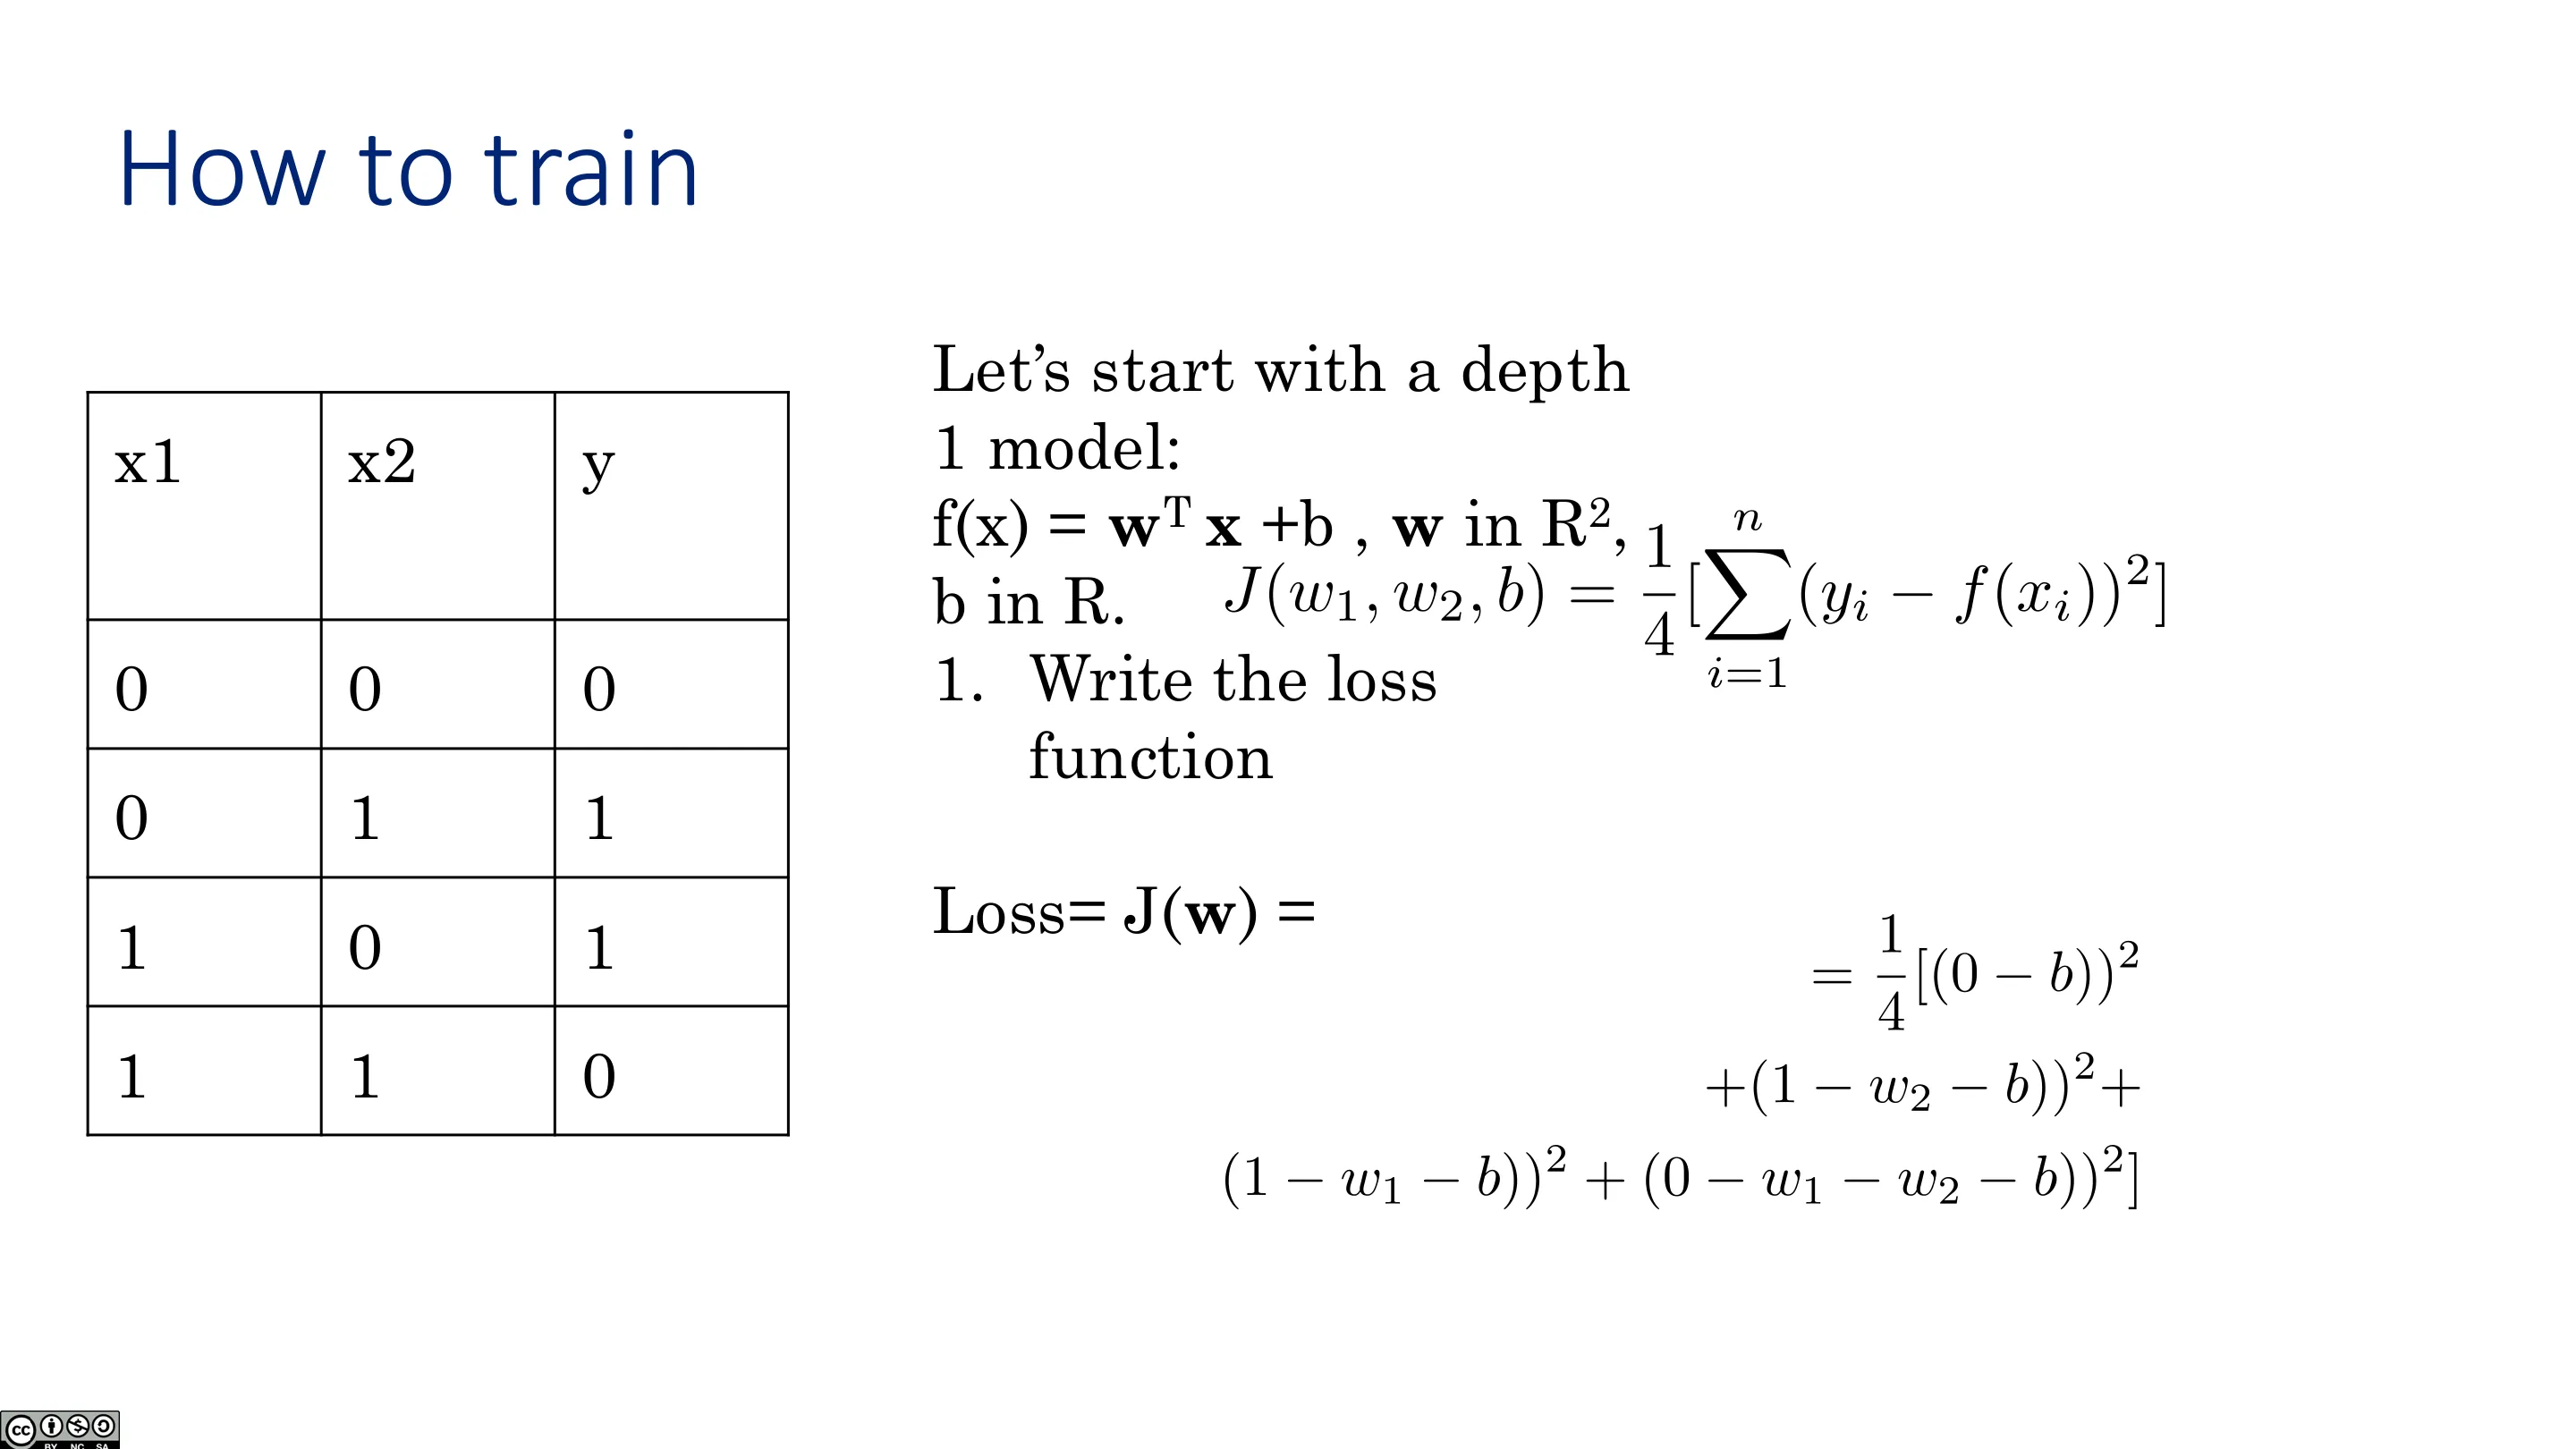
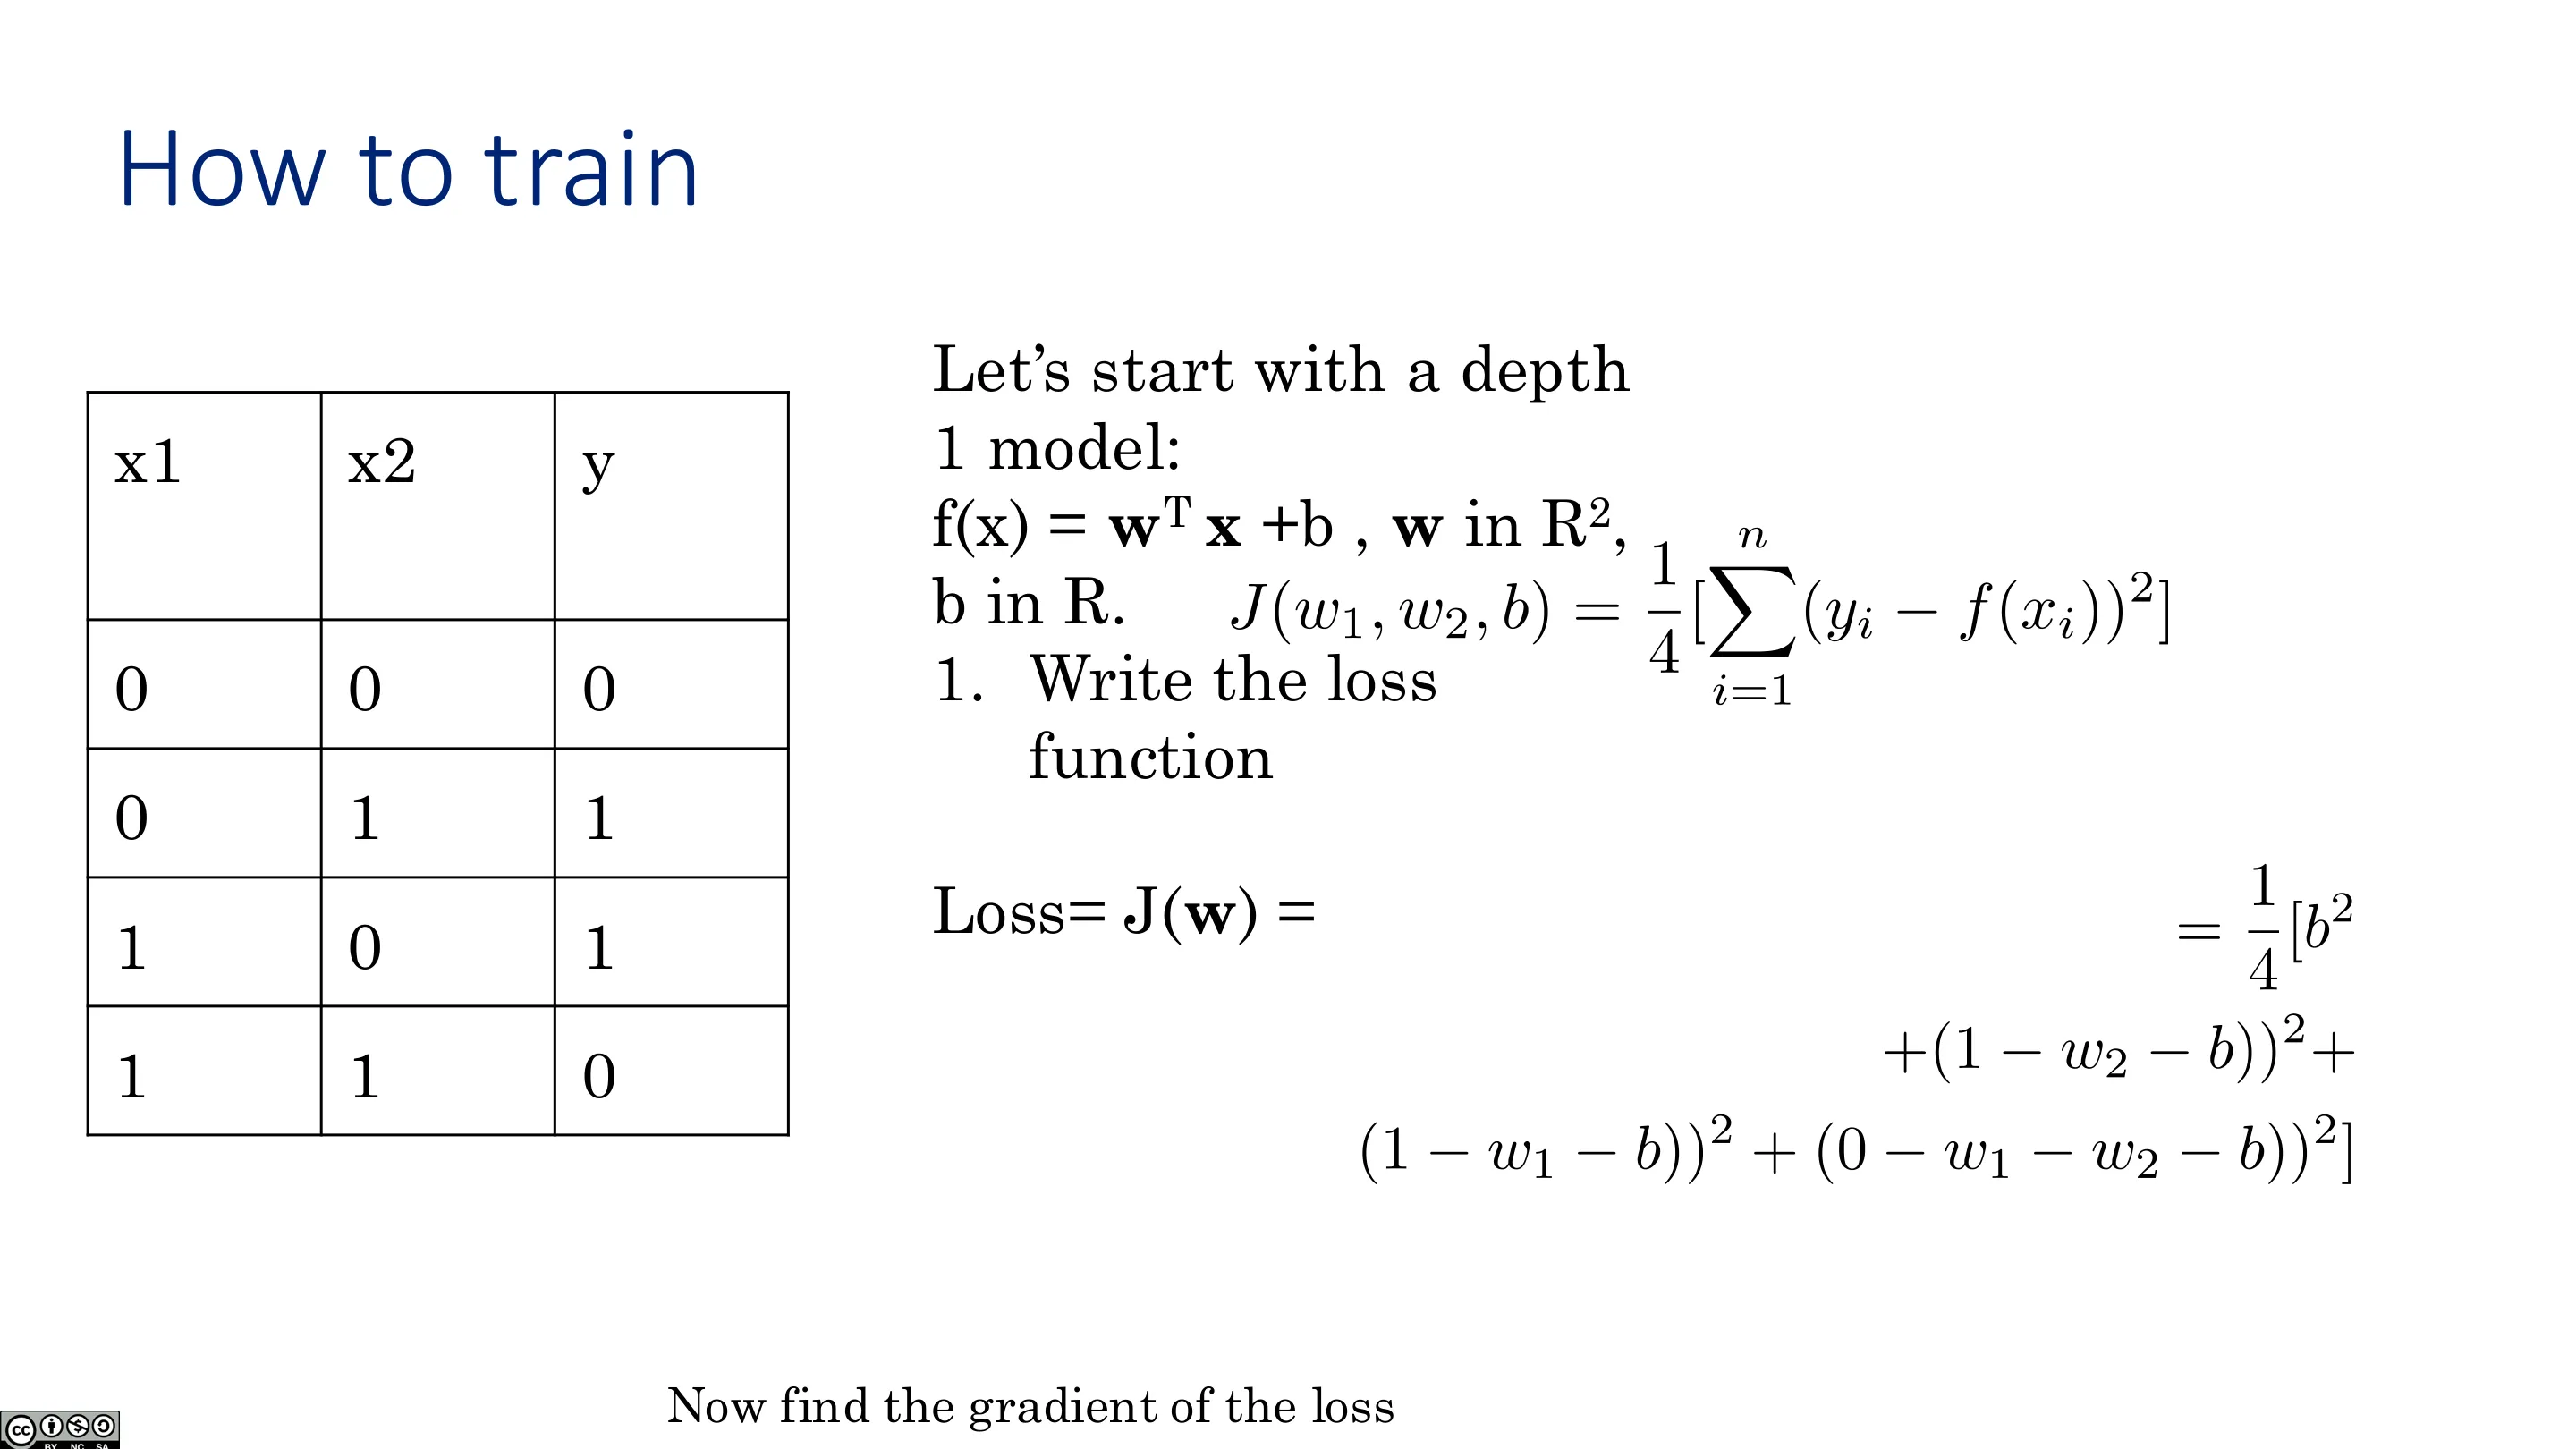
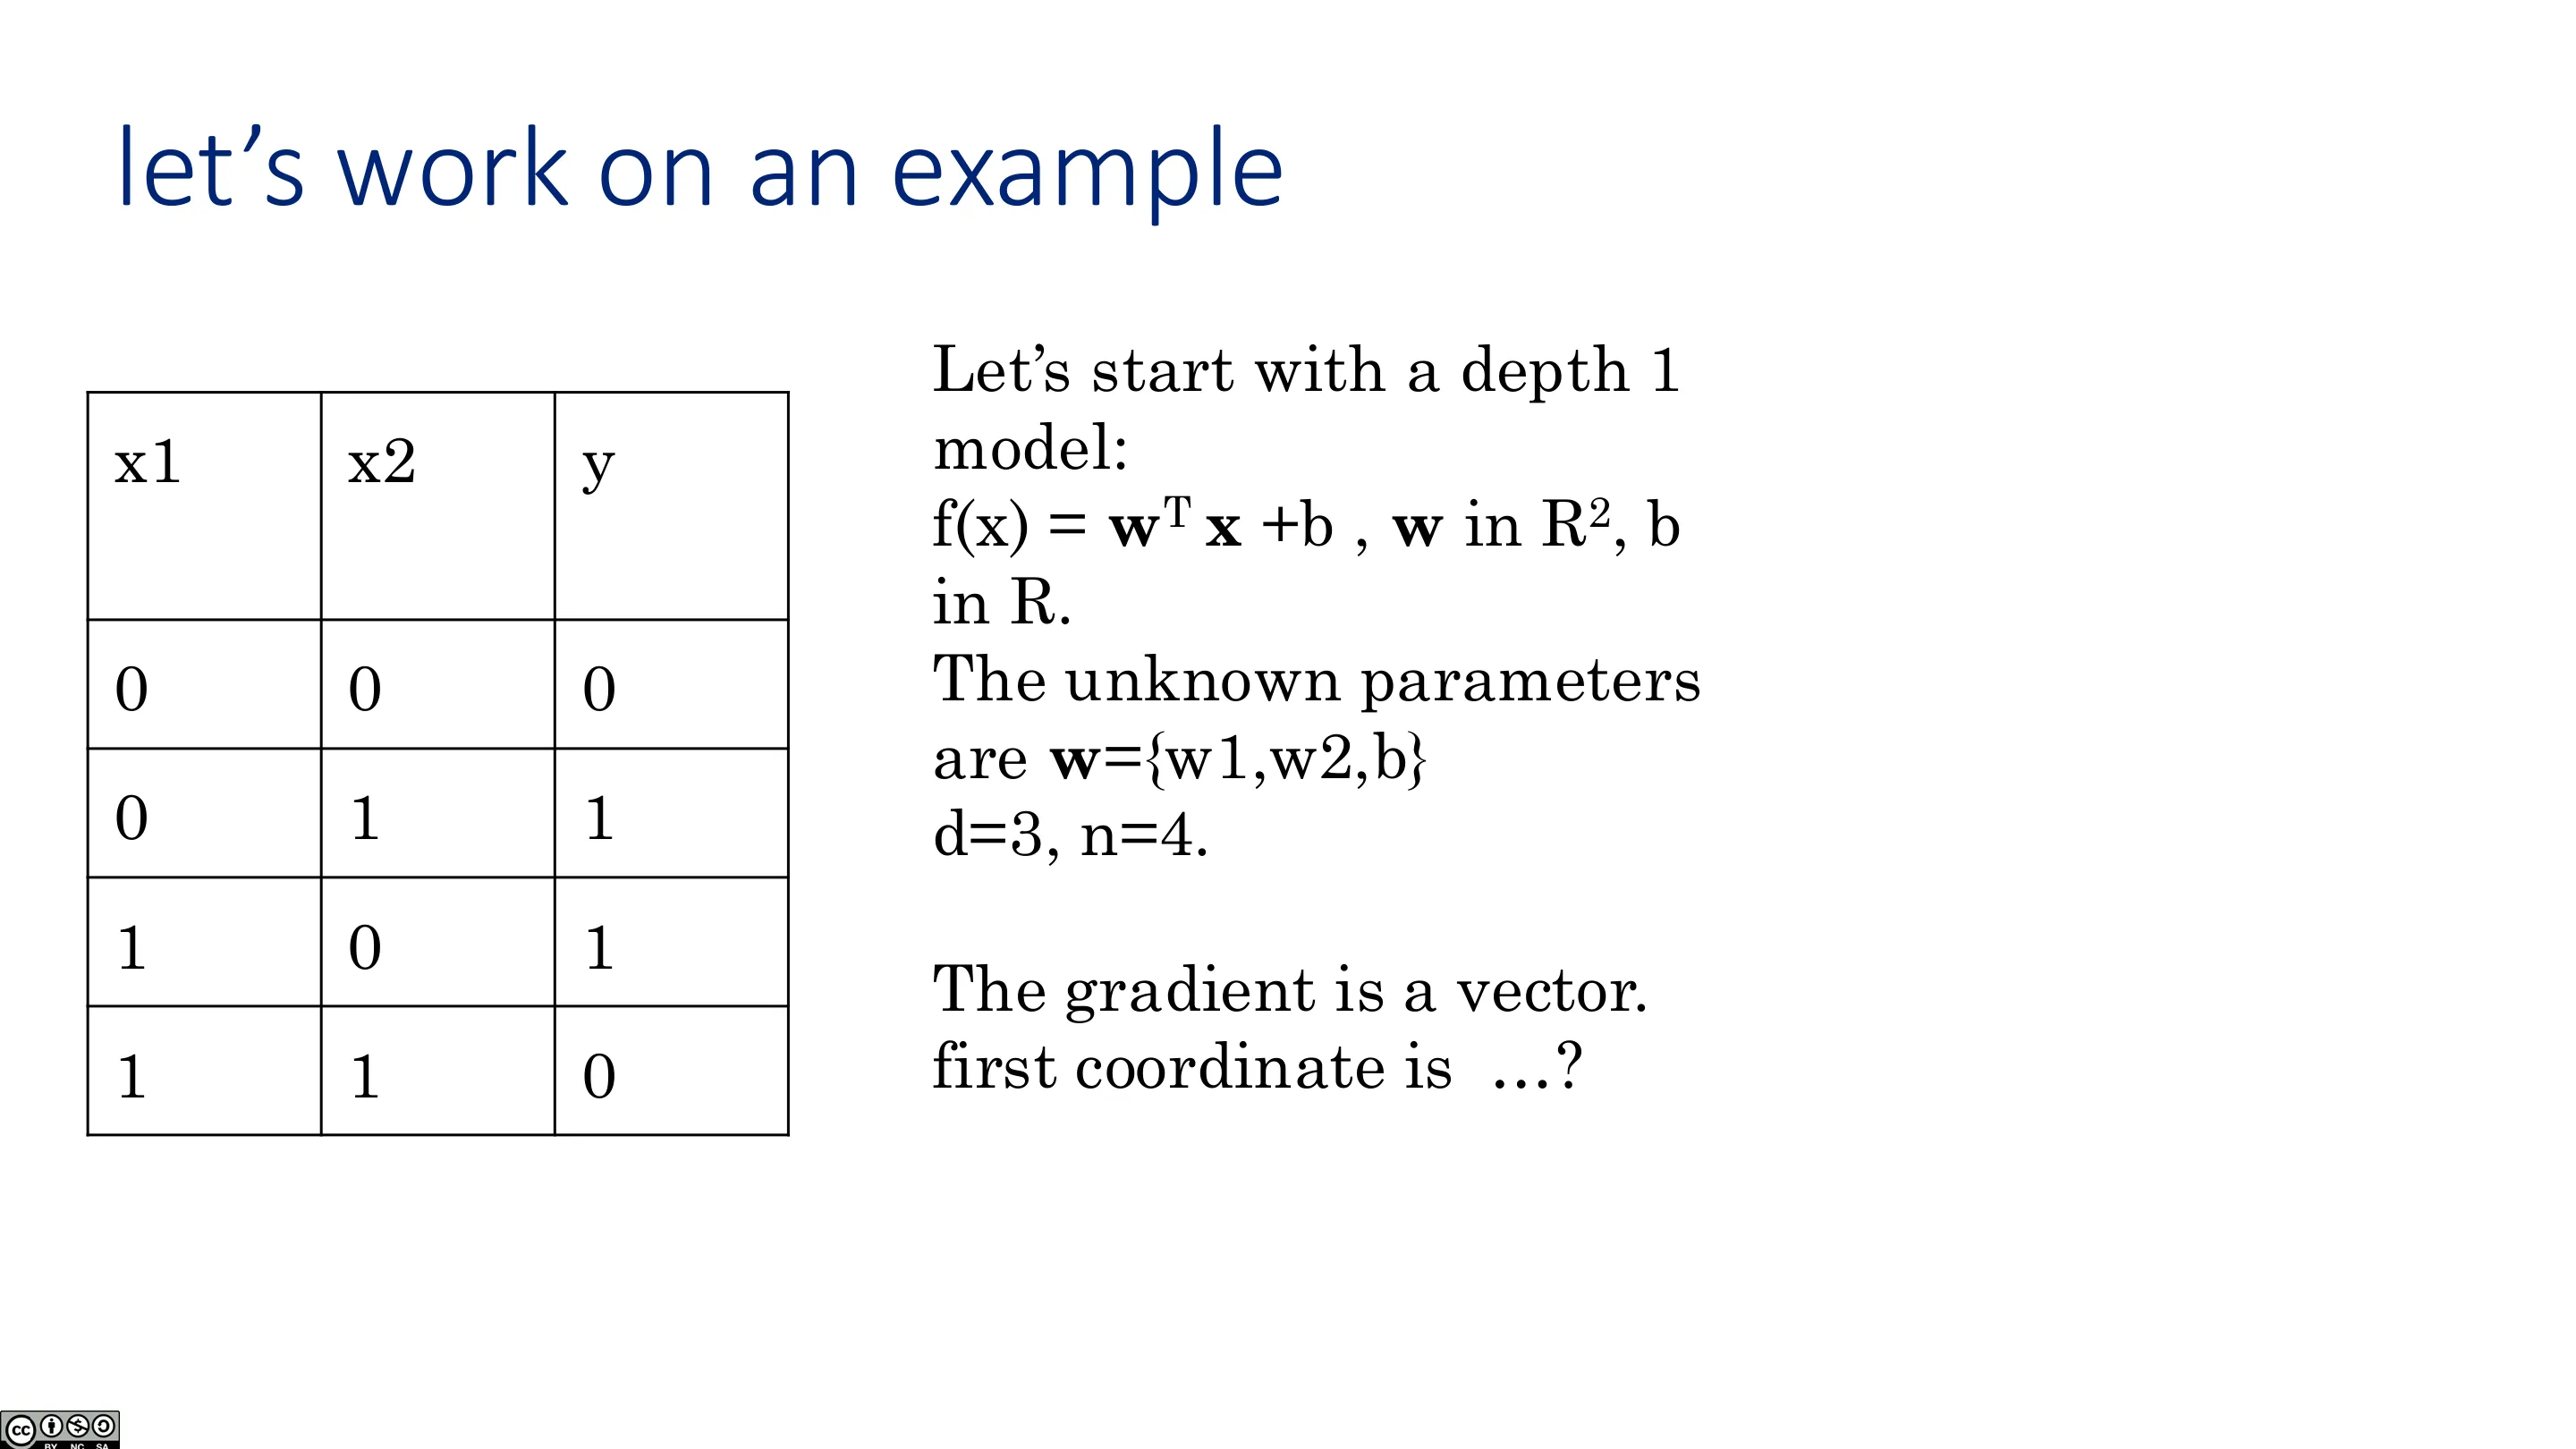
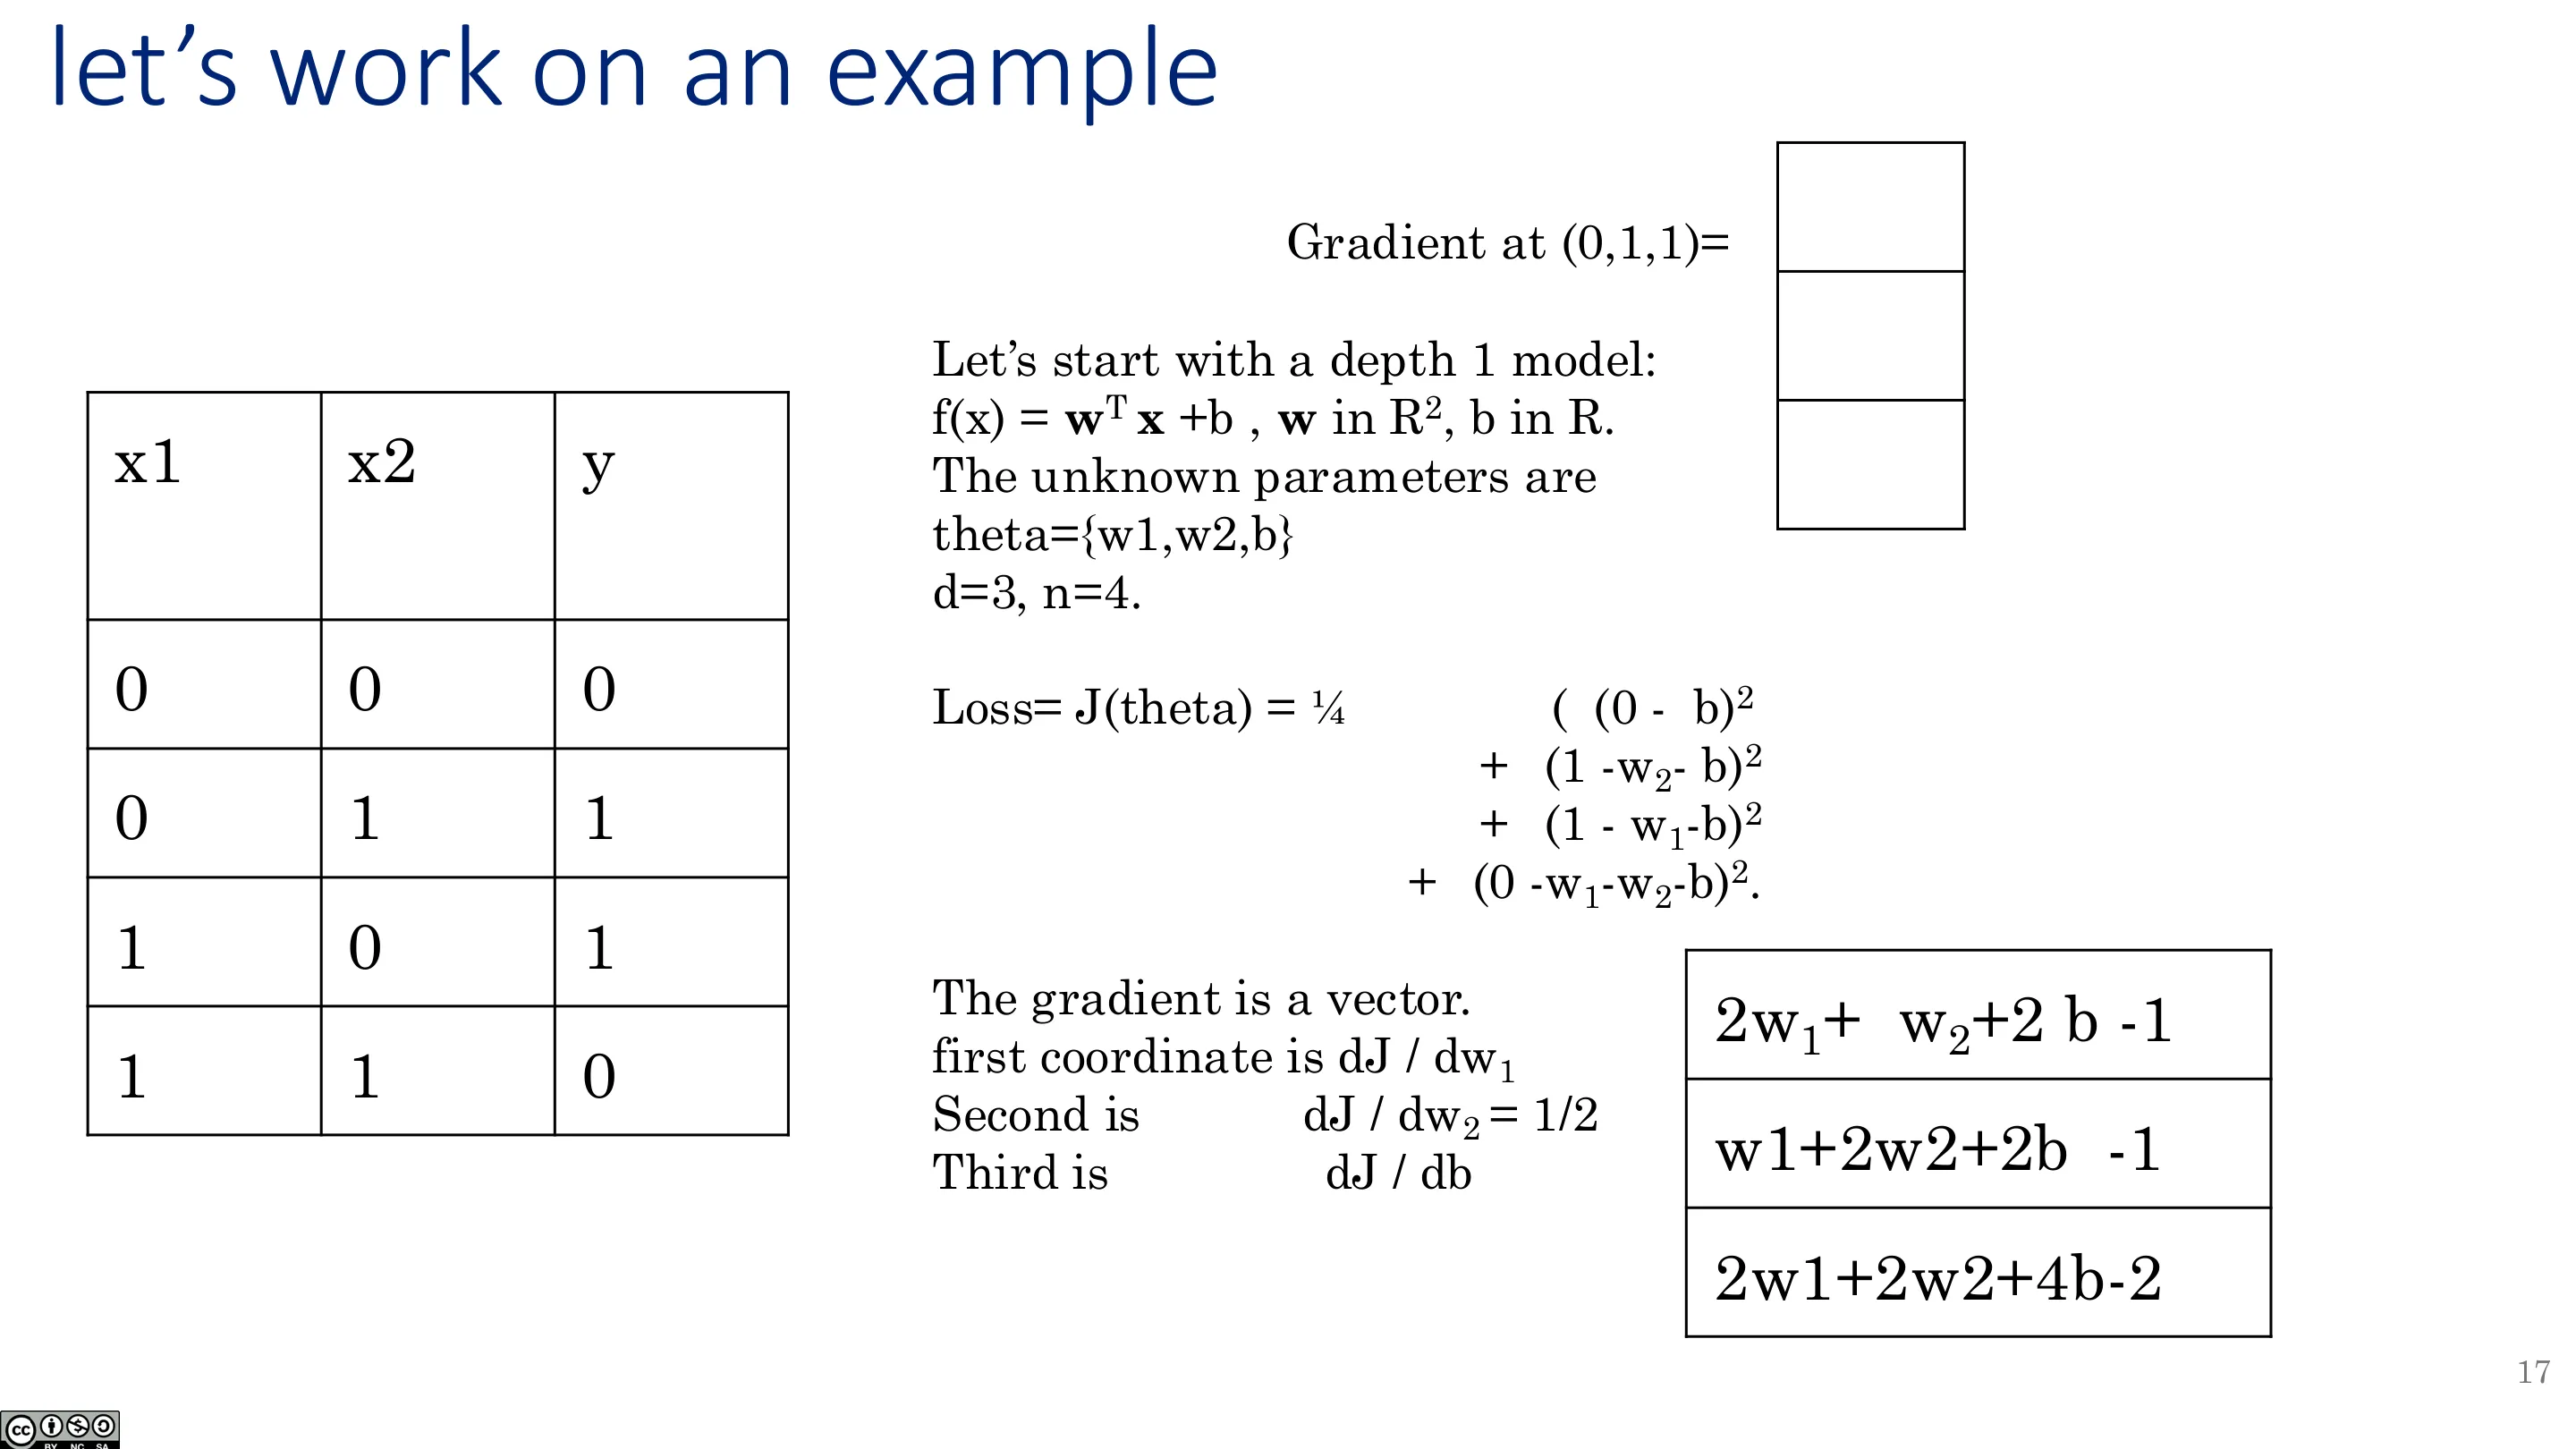
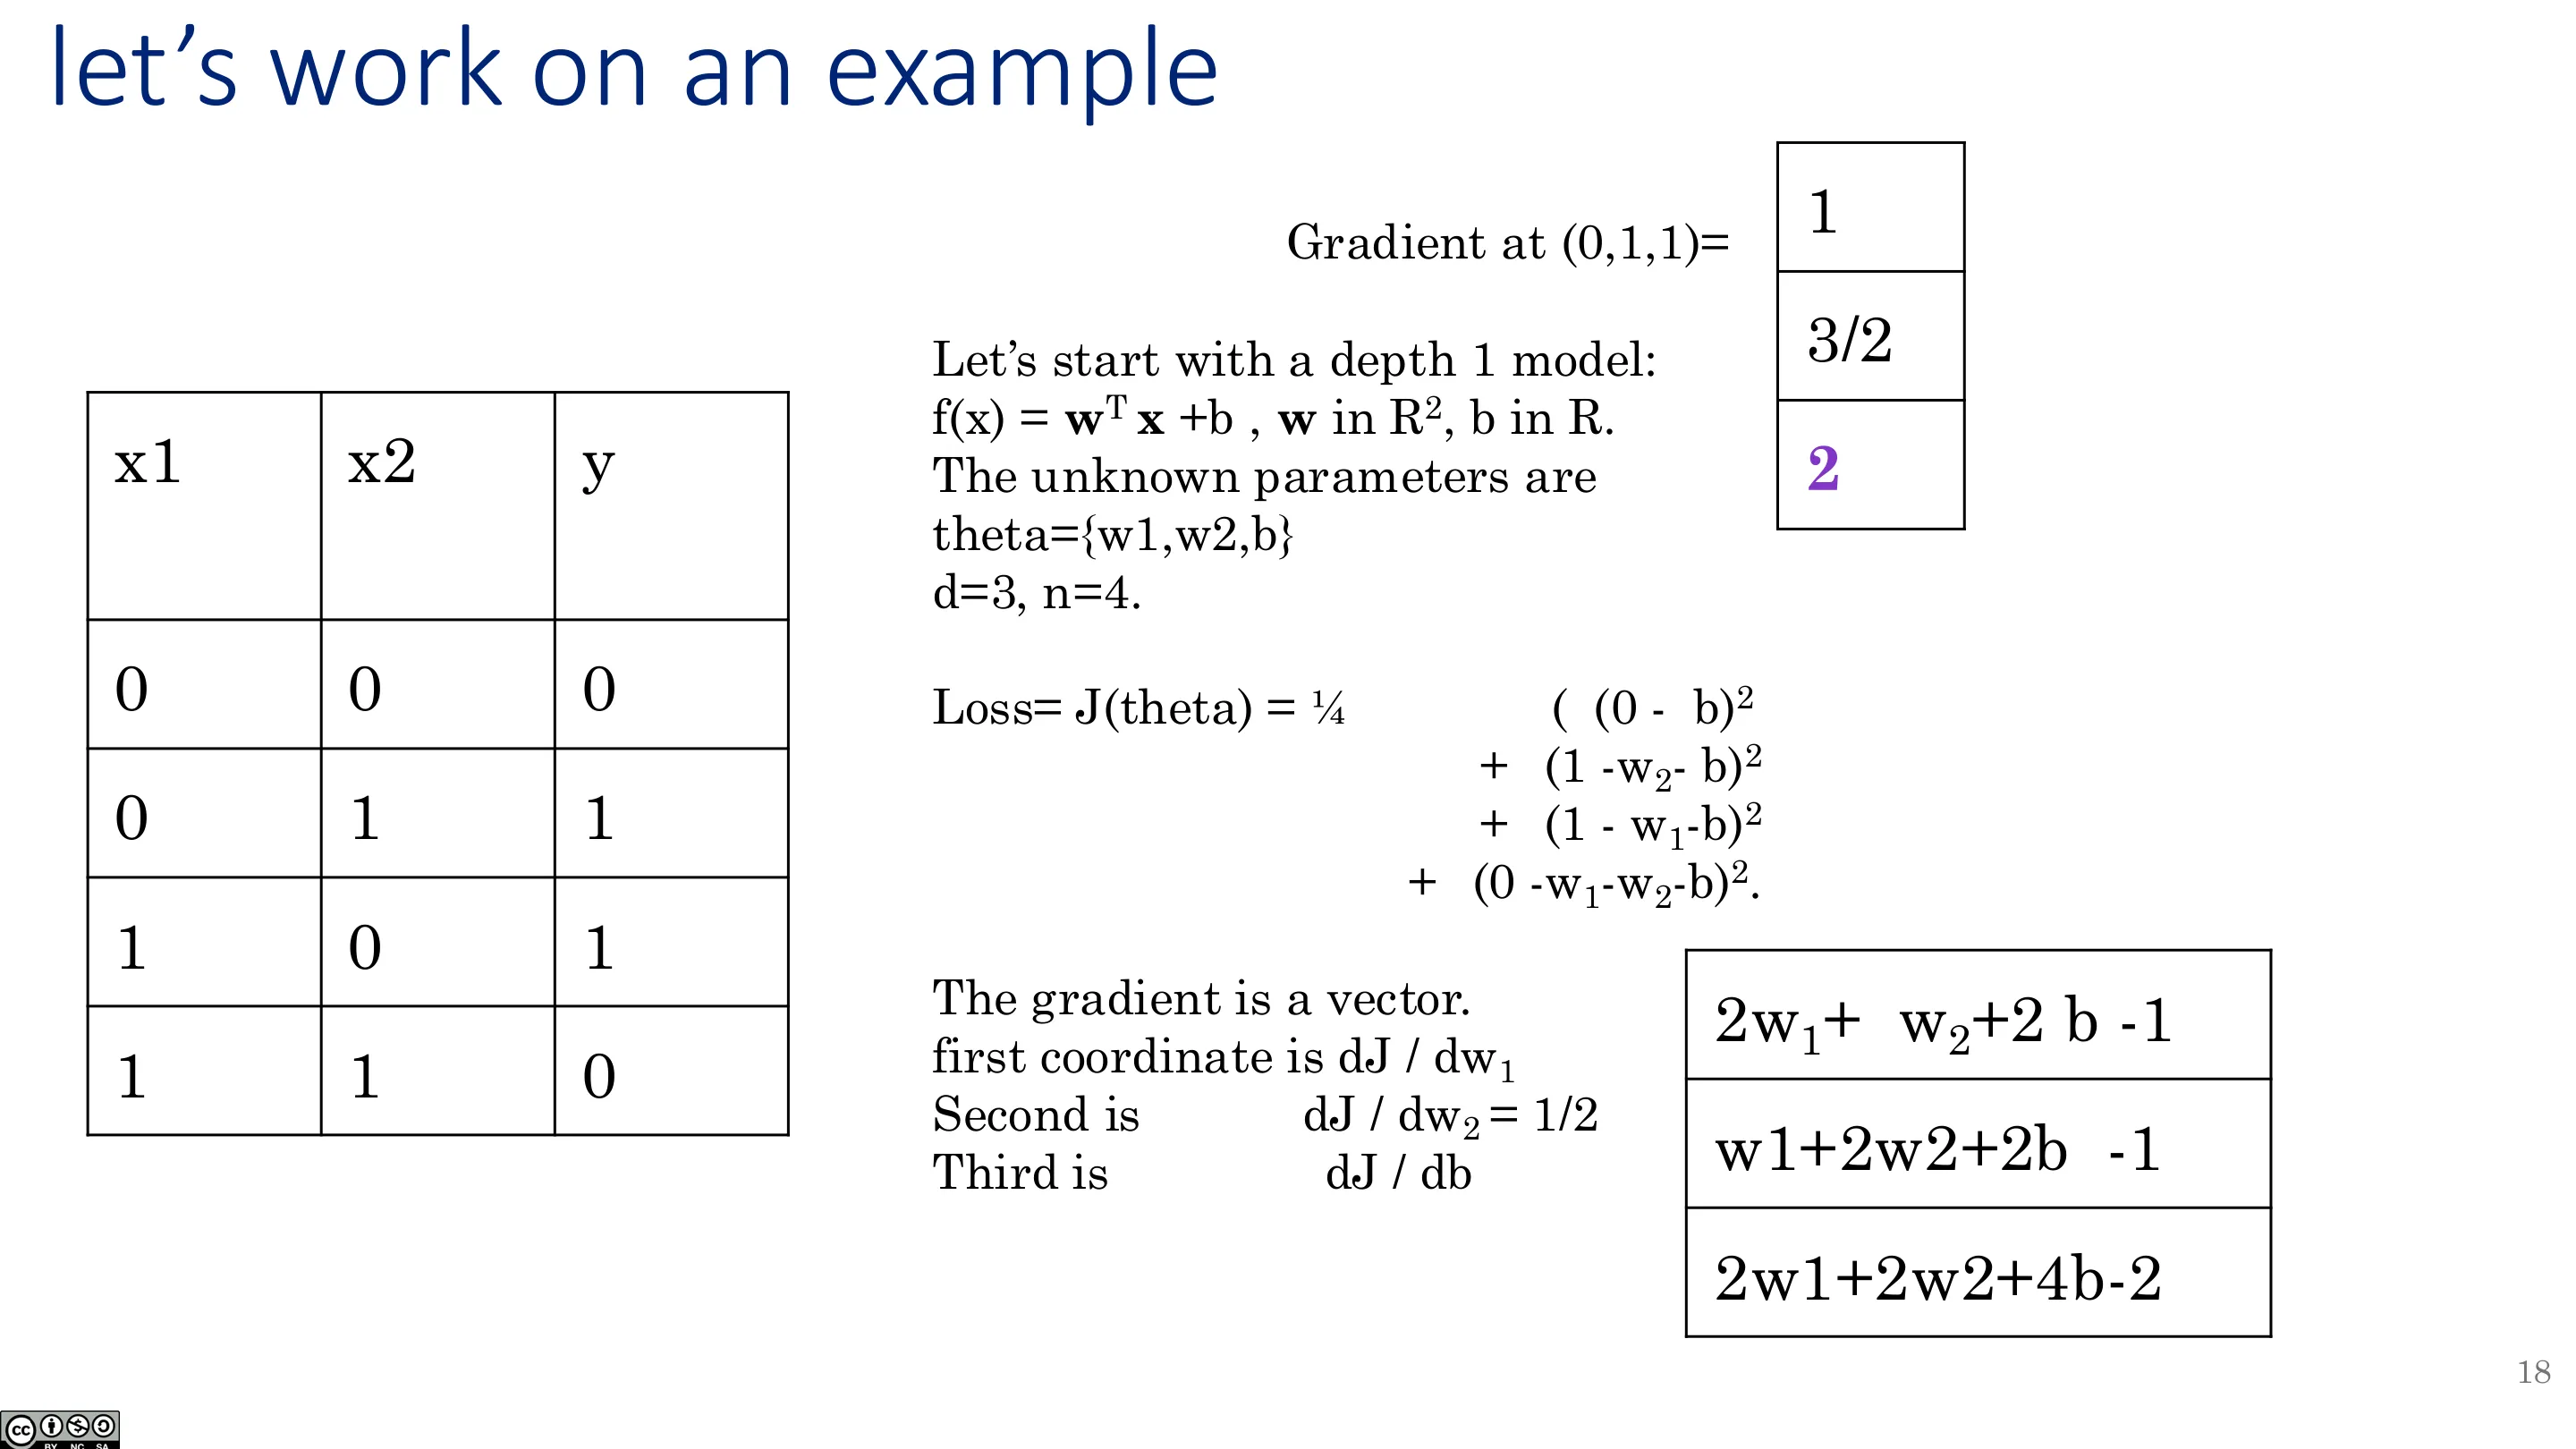
模型:三个参数的小型线性回归(一个「单神经元」):$\hat y = w_1x_1 + w_2x_2 + b$。把 $b$ 也当作一个权重,参数向量为 $w=(w_1,w_2,b)\in\mathbb{R}^3$。
训练数据(4 个样本,均方误差损失):
| 样本 | $x_1$ | $x_2$ | $t$ |
|---|---|---|---|
| 1 | 0 | 0 | 0 |
| 2 | 0 | 1 | 1 |
| 3 | 1 | 0 | 1 |
| 4 | 1 | 1 | 2 |
损失($J=\text{MSE}=\tfrac14\sum(\text{预测}-\text{真值})^2$):
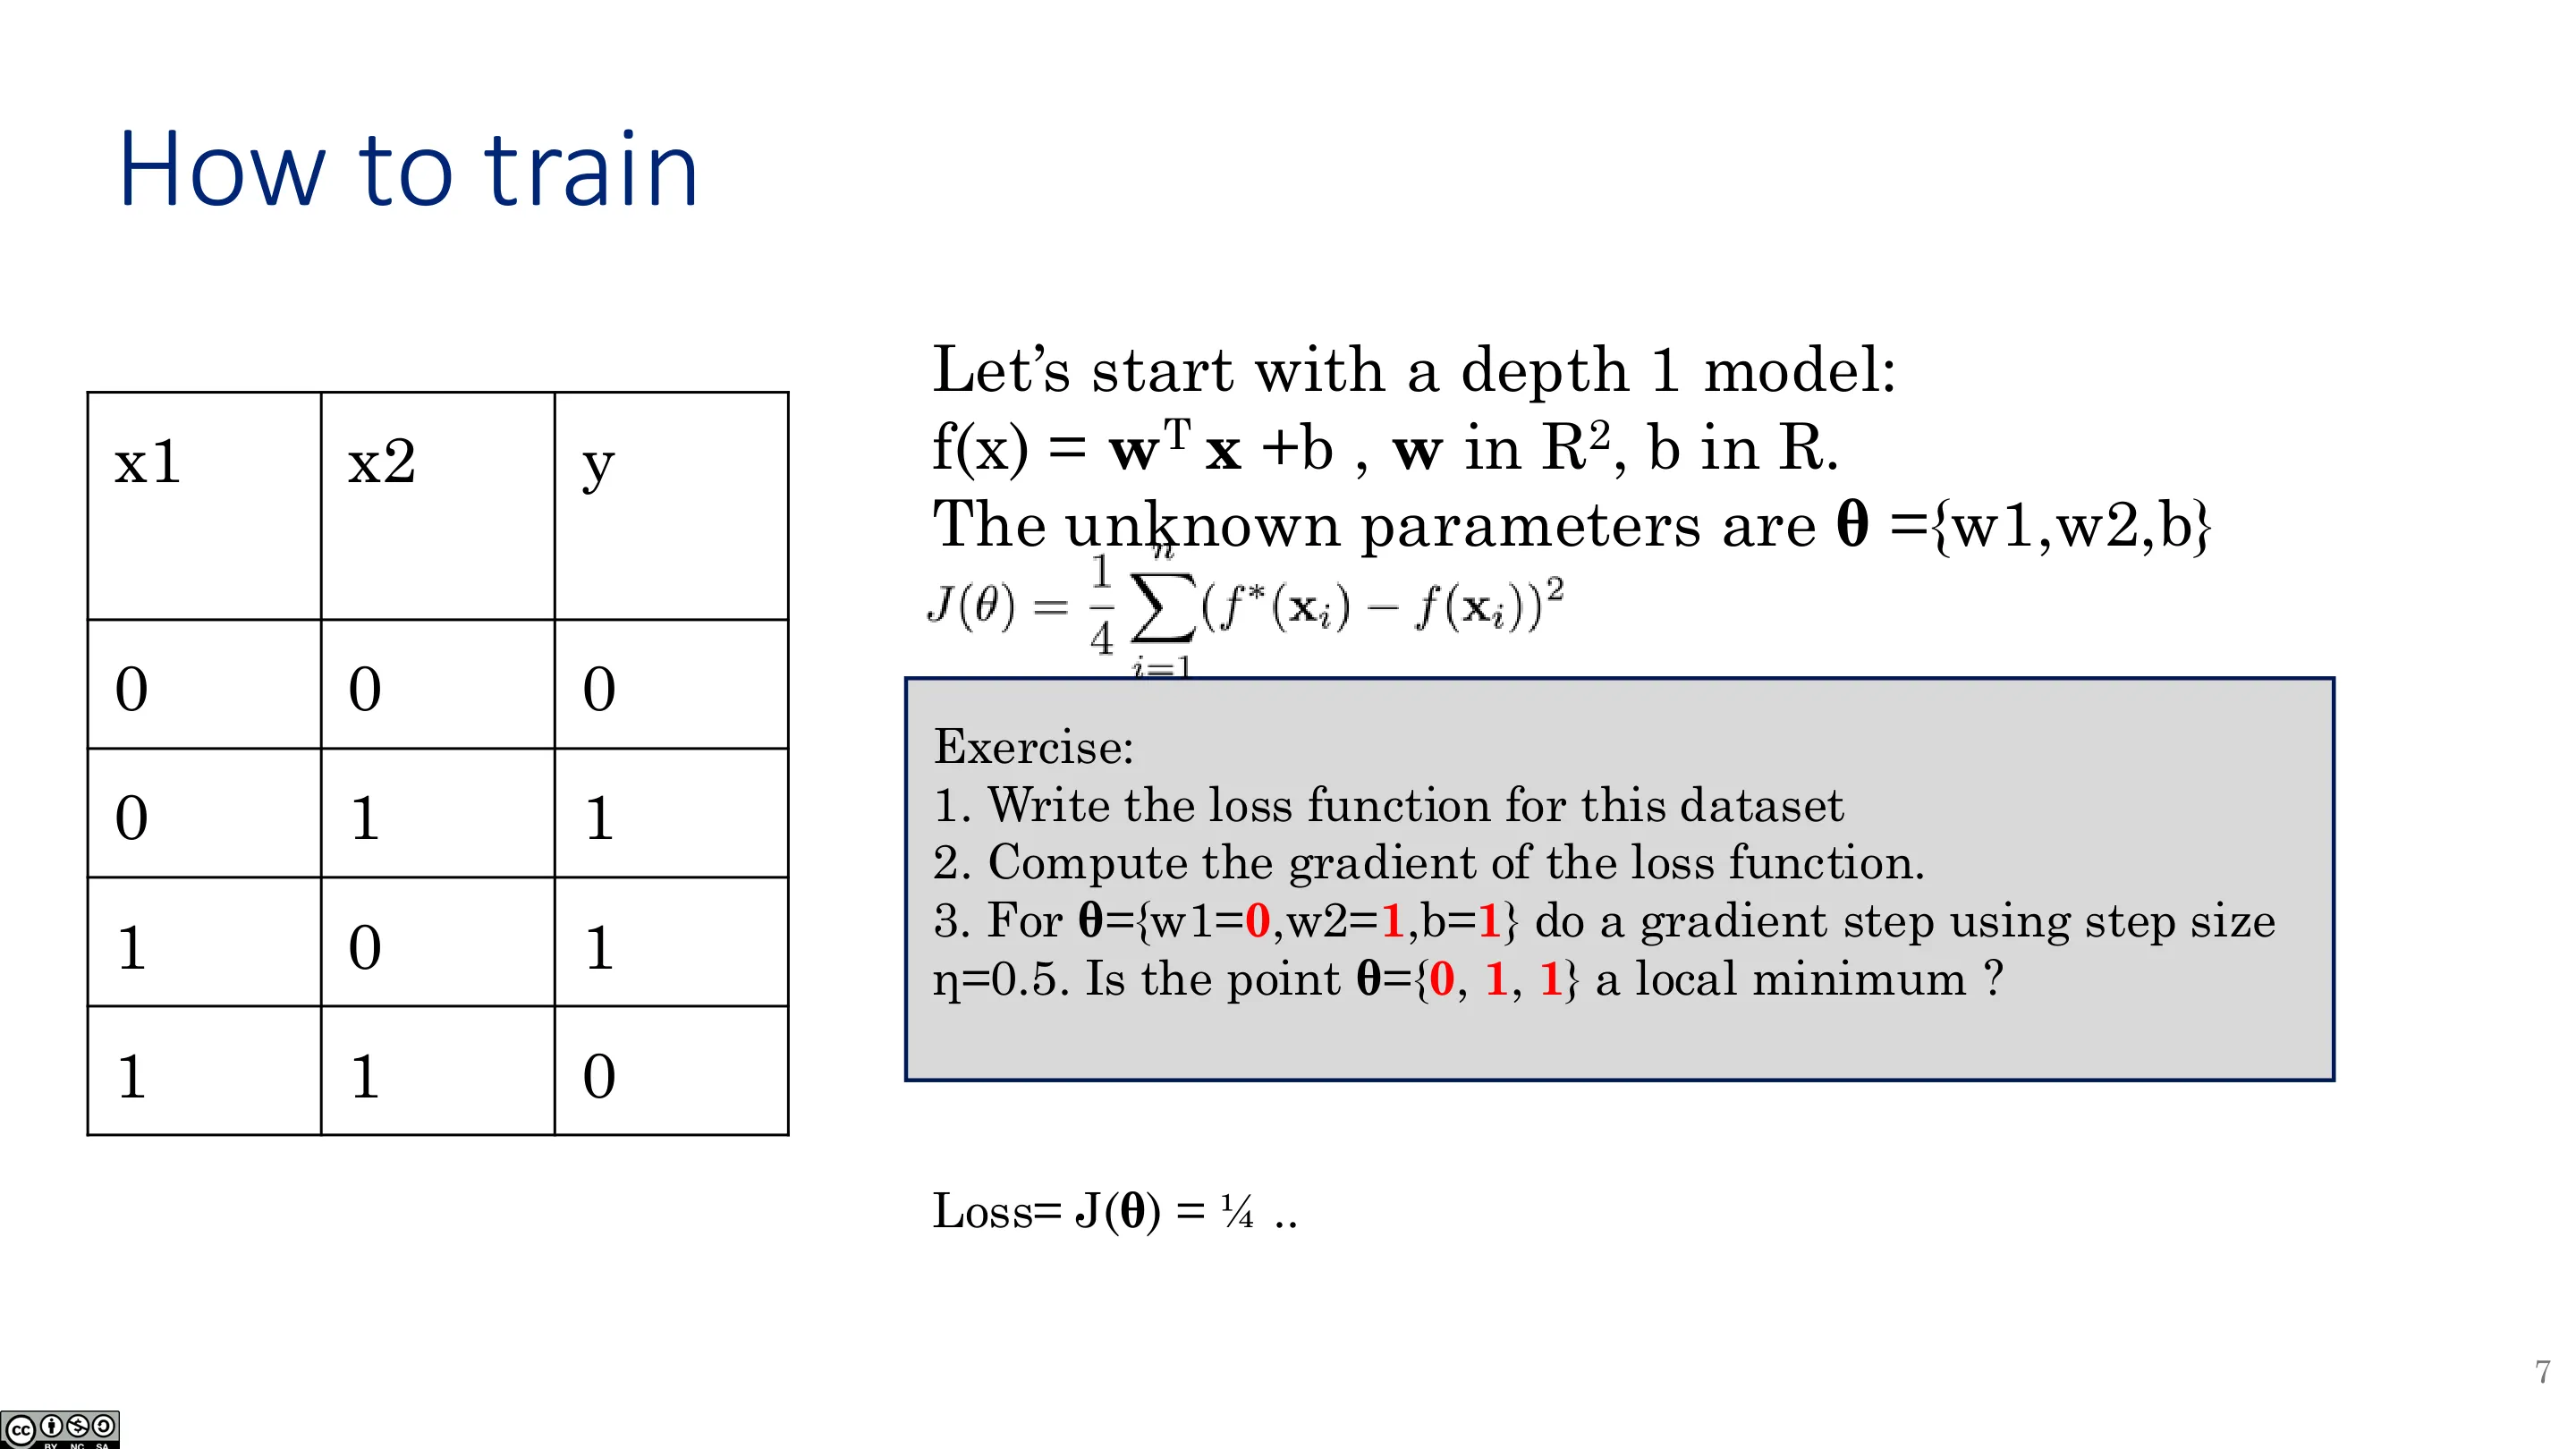
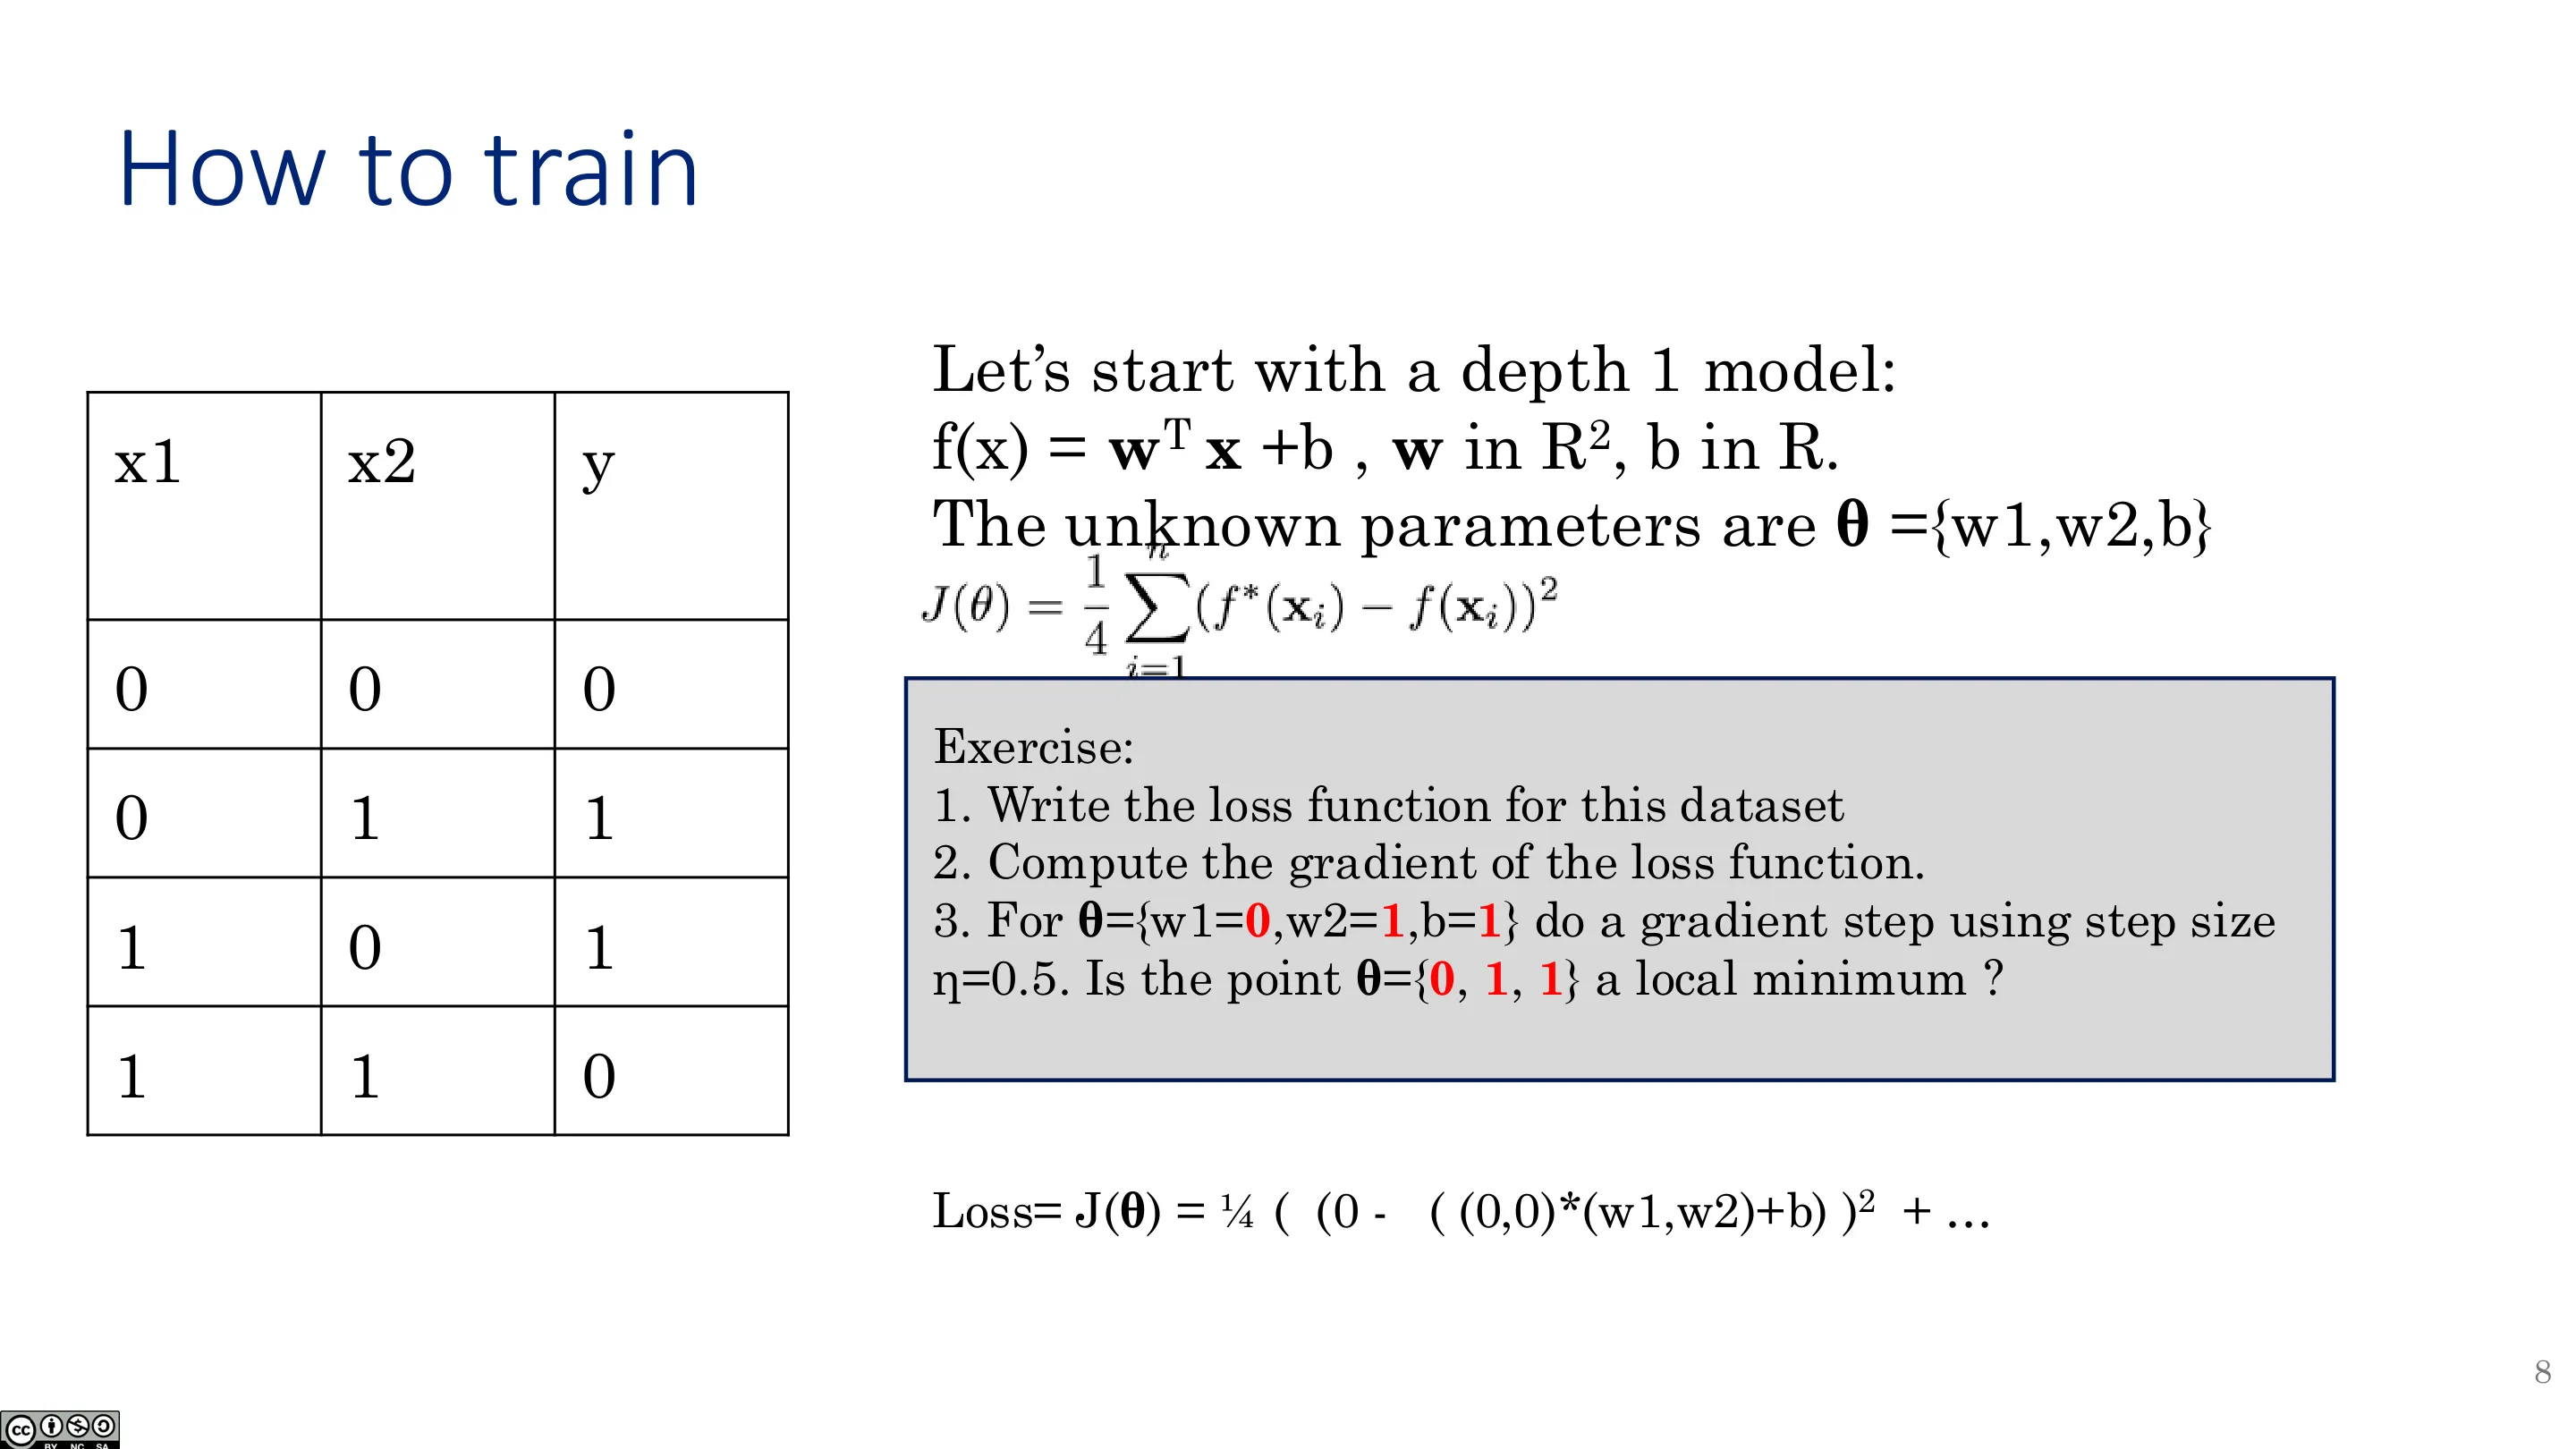
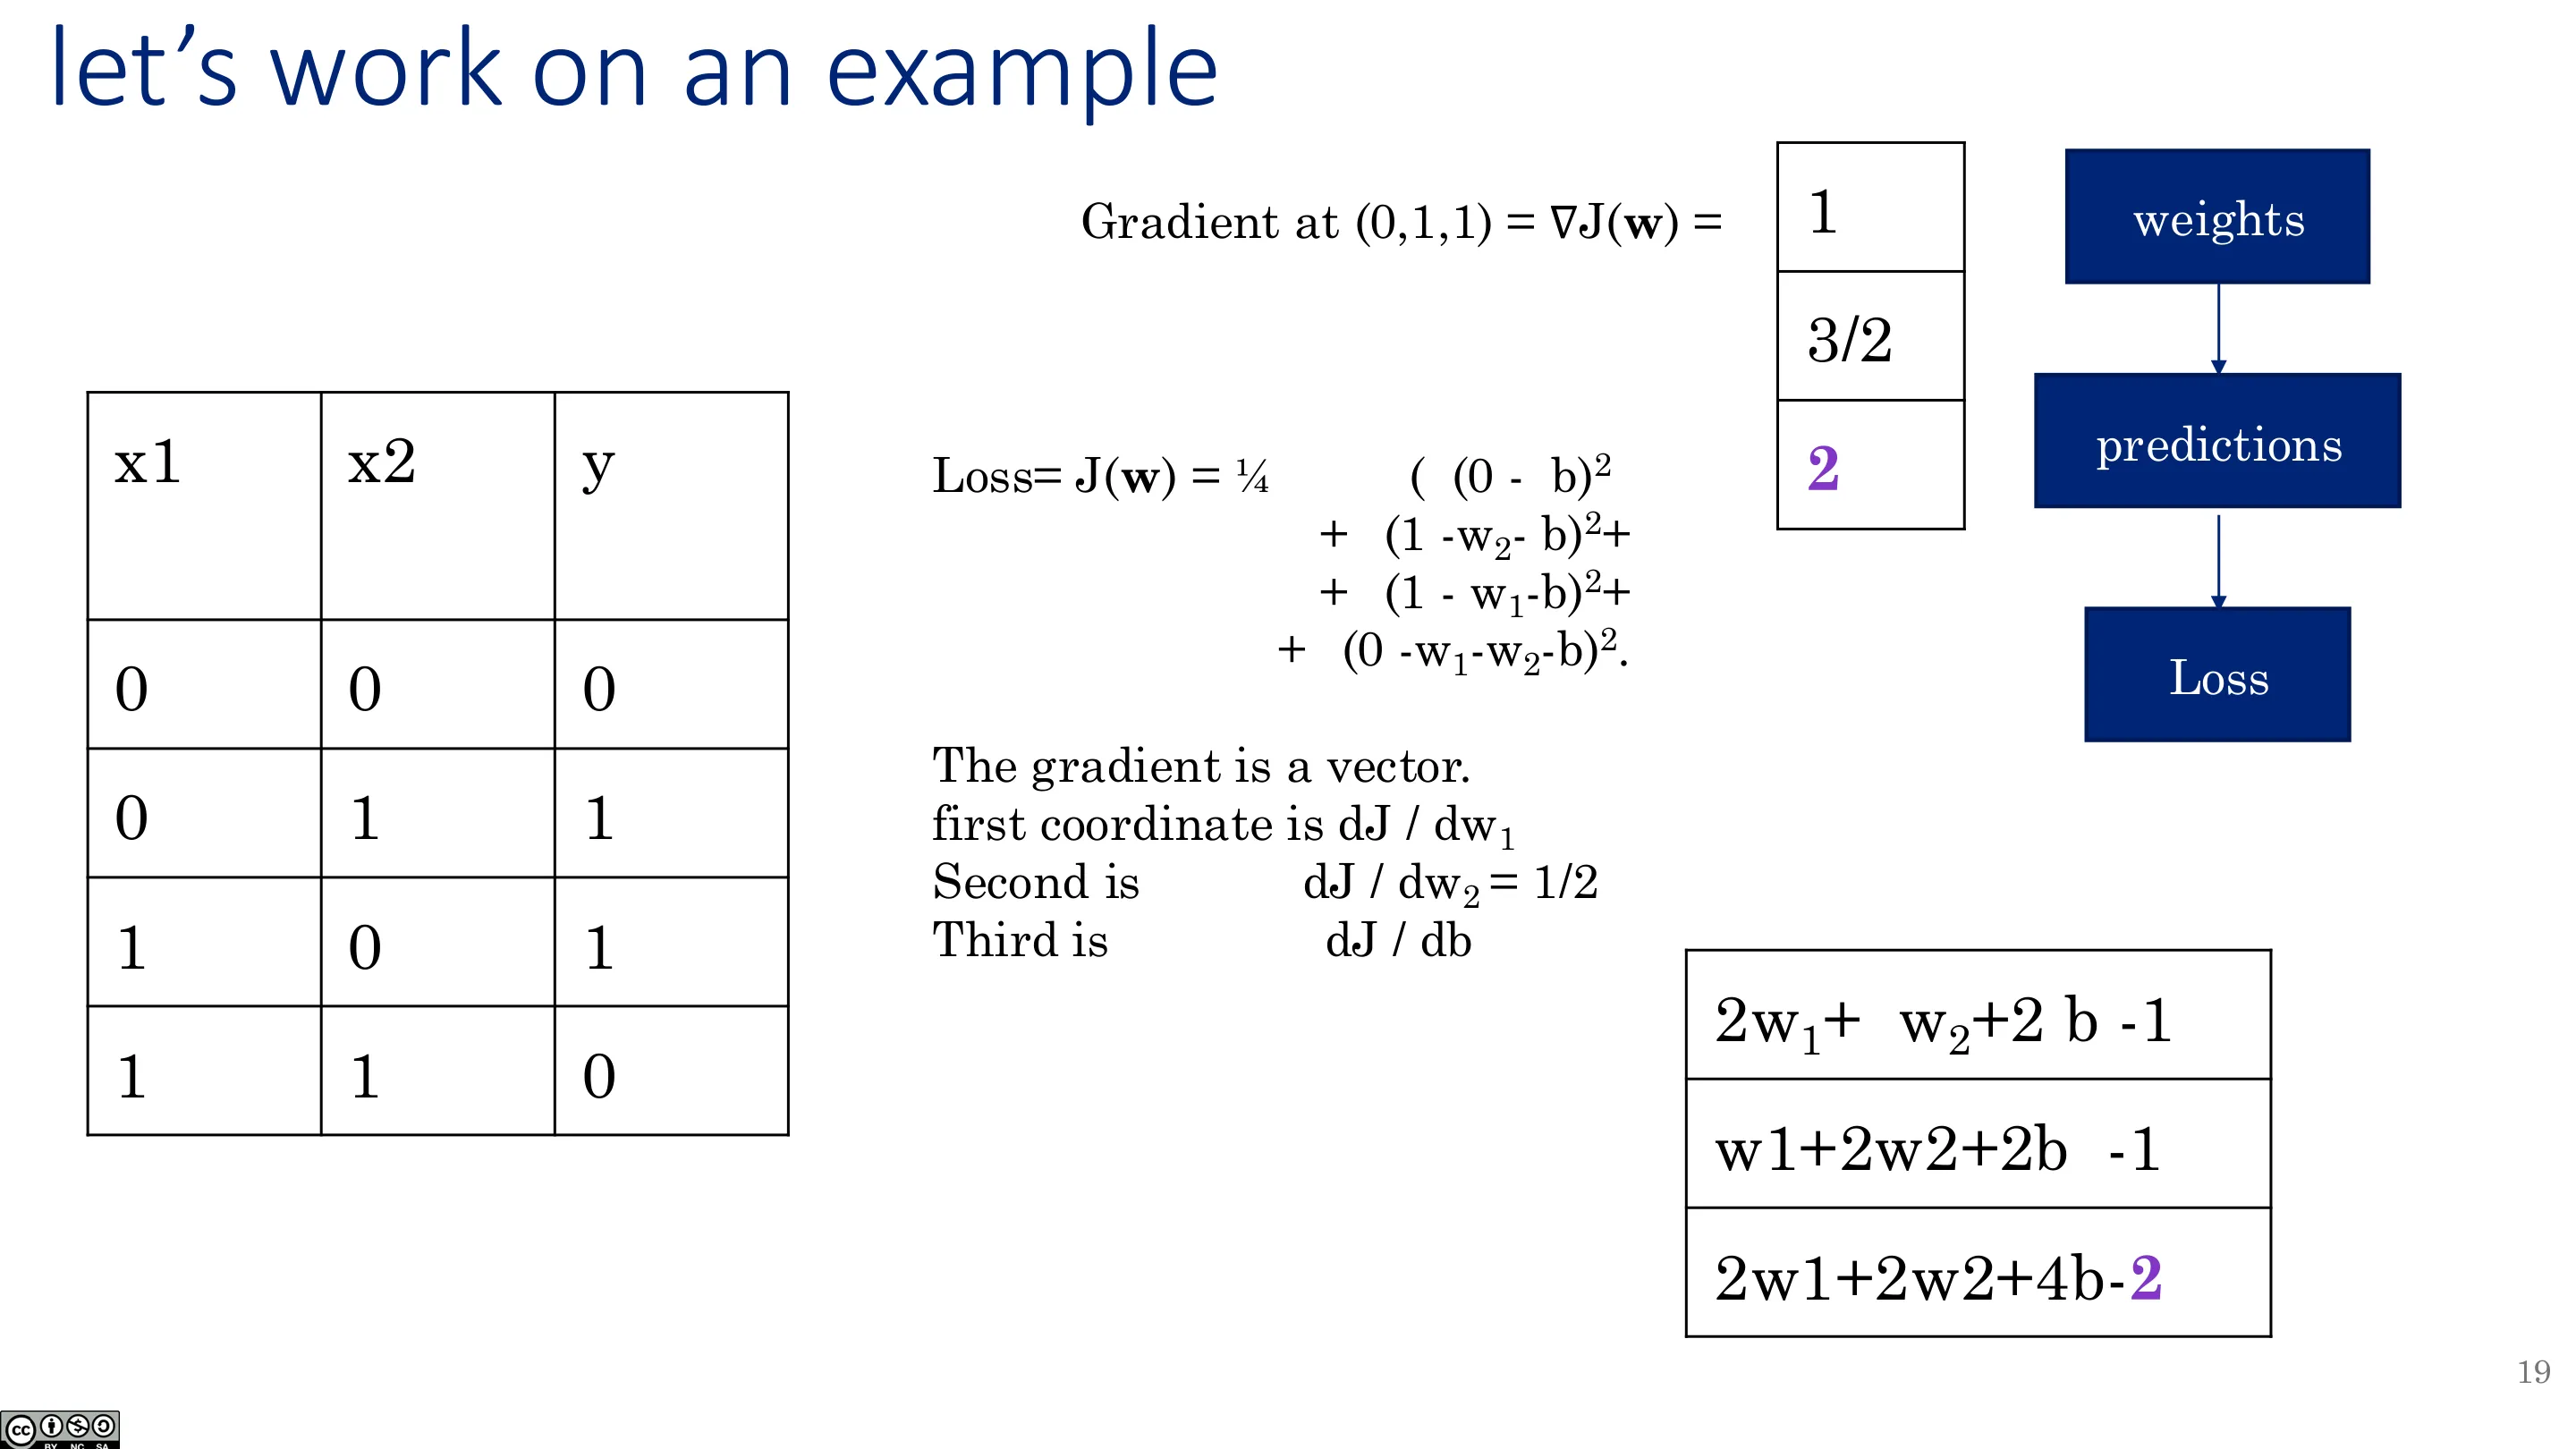
$$ J(w_1,w_2,b)=\frac14\Big[\big(w_1\cdot0+w_2\cdot0+b-0\big)^2+\big(w_1\cdot0+w_2\cdot1+b-1\big)^2+\big(w_1\cdot1+w_2\cdot0+b-1\big)^2+\big(w_1+w_2+b-2\big)^2\Big] $$
编者说明:$1/4$ 只是把损失整体缩放,不影响最小值的位置;但它会让梯度(进而「有效学习率」)缩放,所以写损失时别漏掉。
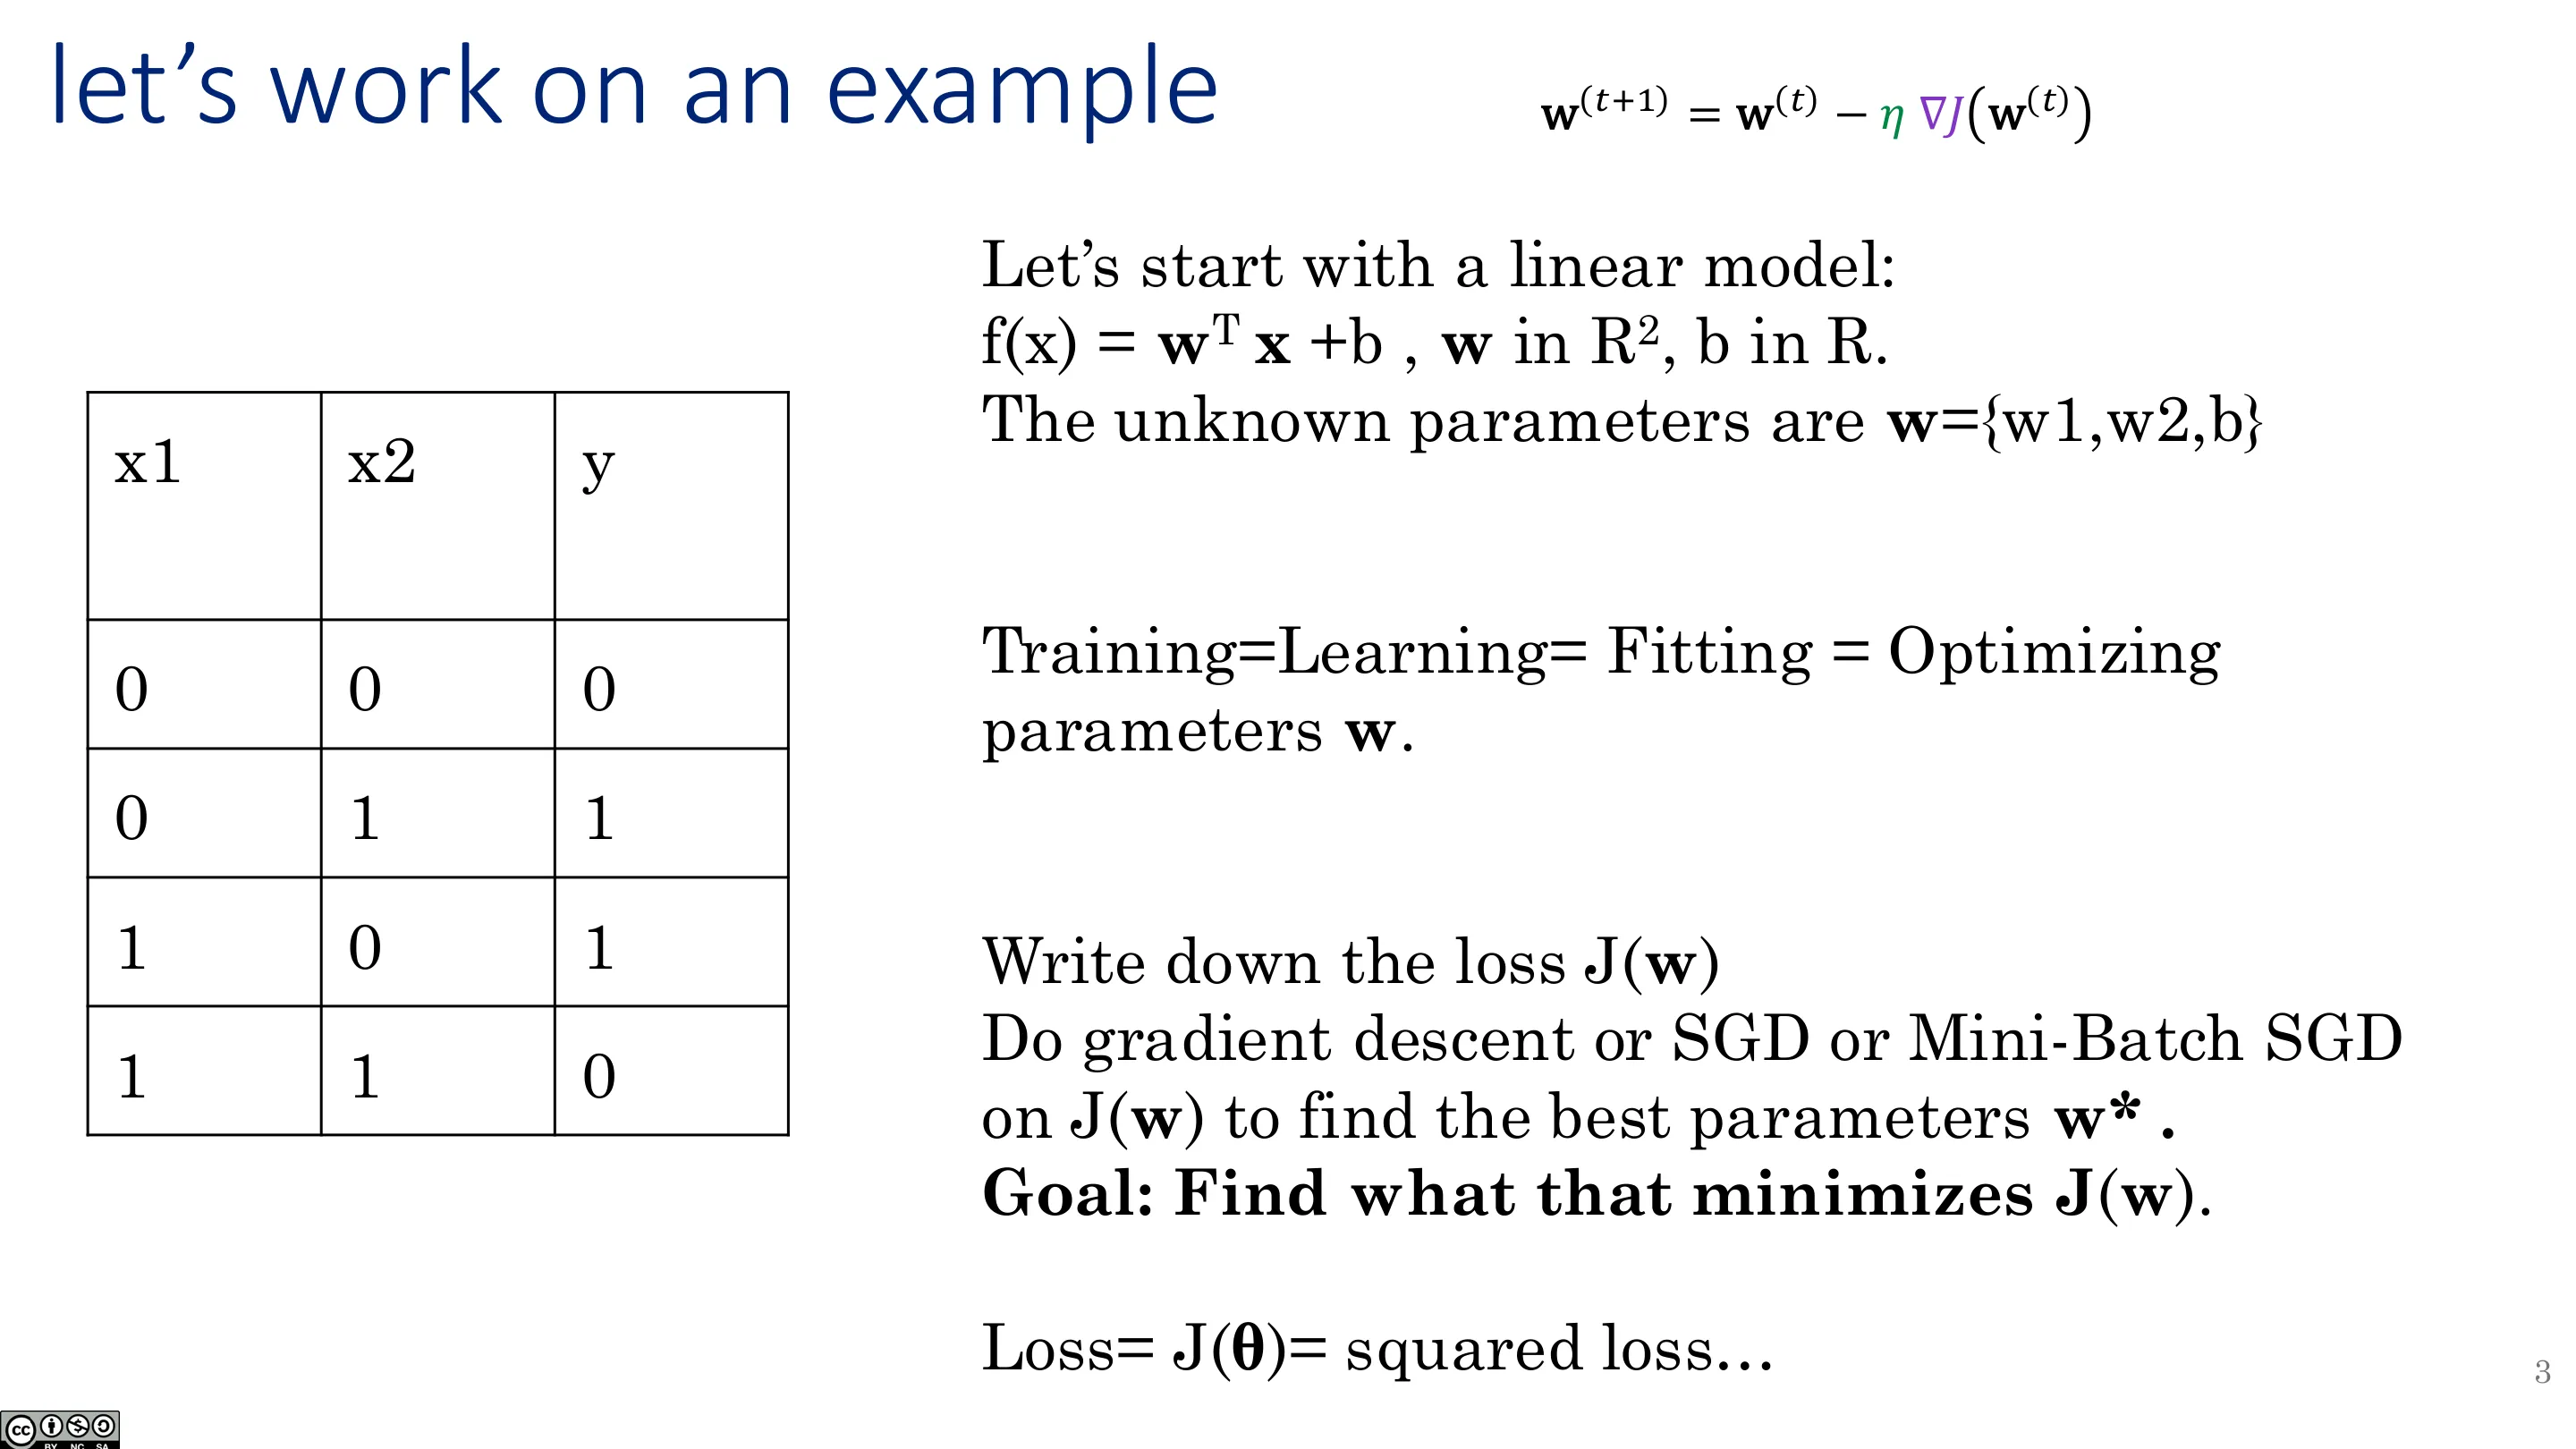
📷 手算示例(一)
回到原视频 (00:02:46)
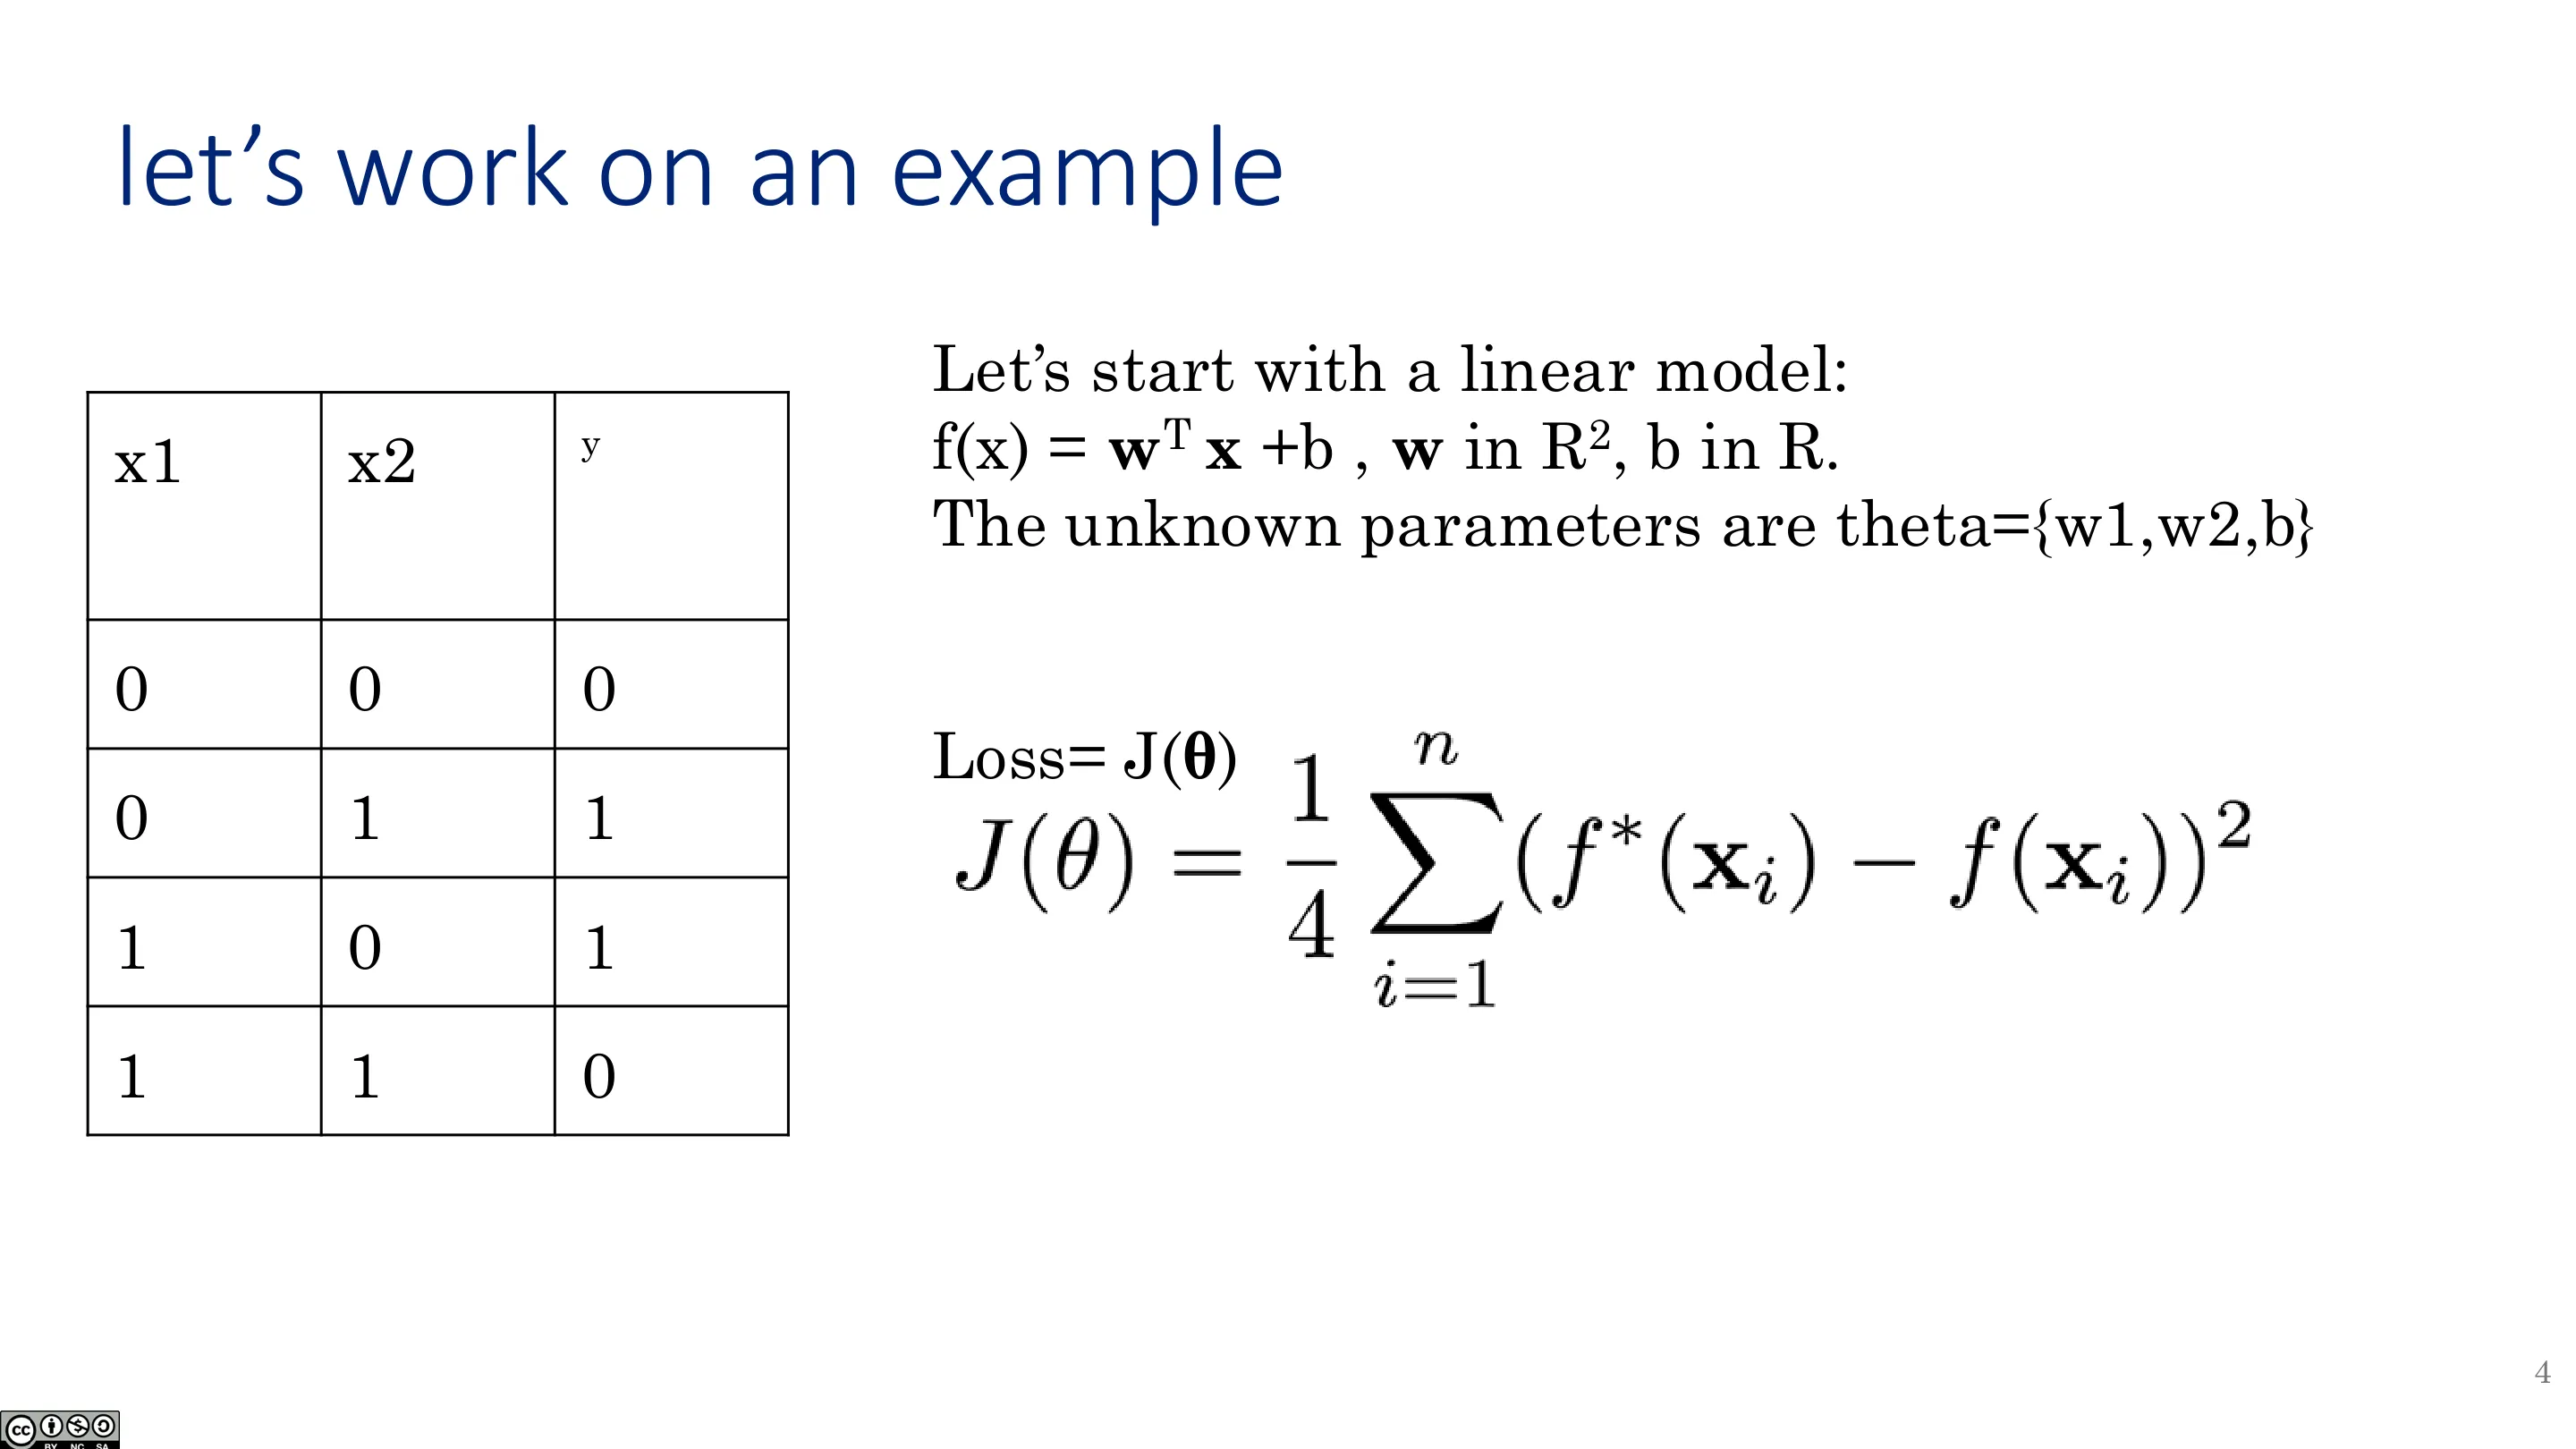
📷 手算示例(二)
回到原视频 (00:03:59)
📷 手算示例(三)
回到原视频 (00:05:12)
📷 手算示例(四)
回到原视频 (00:06:25)
📷 如何训练(一)
回到原视频 (00:07:38)
📷 如何训练(二)
回到原视频 (00:08:51)
📷 如何训练(三)
回到原视频 (00:10:04)
📷 如何训练(四)
回到原视频 (00:11:17)
📷 如何训练(五)
回到原视频 (00:12:30)
📷 如何训练(六)
回到原视频 (00:13:43)
📷 如何训练(七)
回到原视频 (00:14:56)
📷 手算示例(五)
回到原视频 (00:16:09)
📷 手算示例(六)
回到原视频 (00:17:22)
📷 手算示例(七)
回到原视频 (00:18:35)
📷 手算示例(八)
回到原视频 (00:19:48)
📷 手算示例(九)
回到原视频 (00:21:01)
📷 手算示例(十)
回到原视频 (00:22:14)
📷 学习率 0.5 的梯度步
回到原视频 (00:23:27)
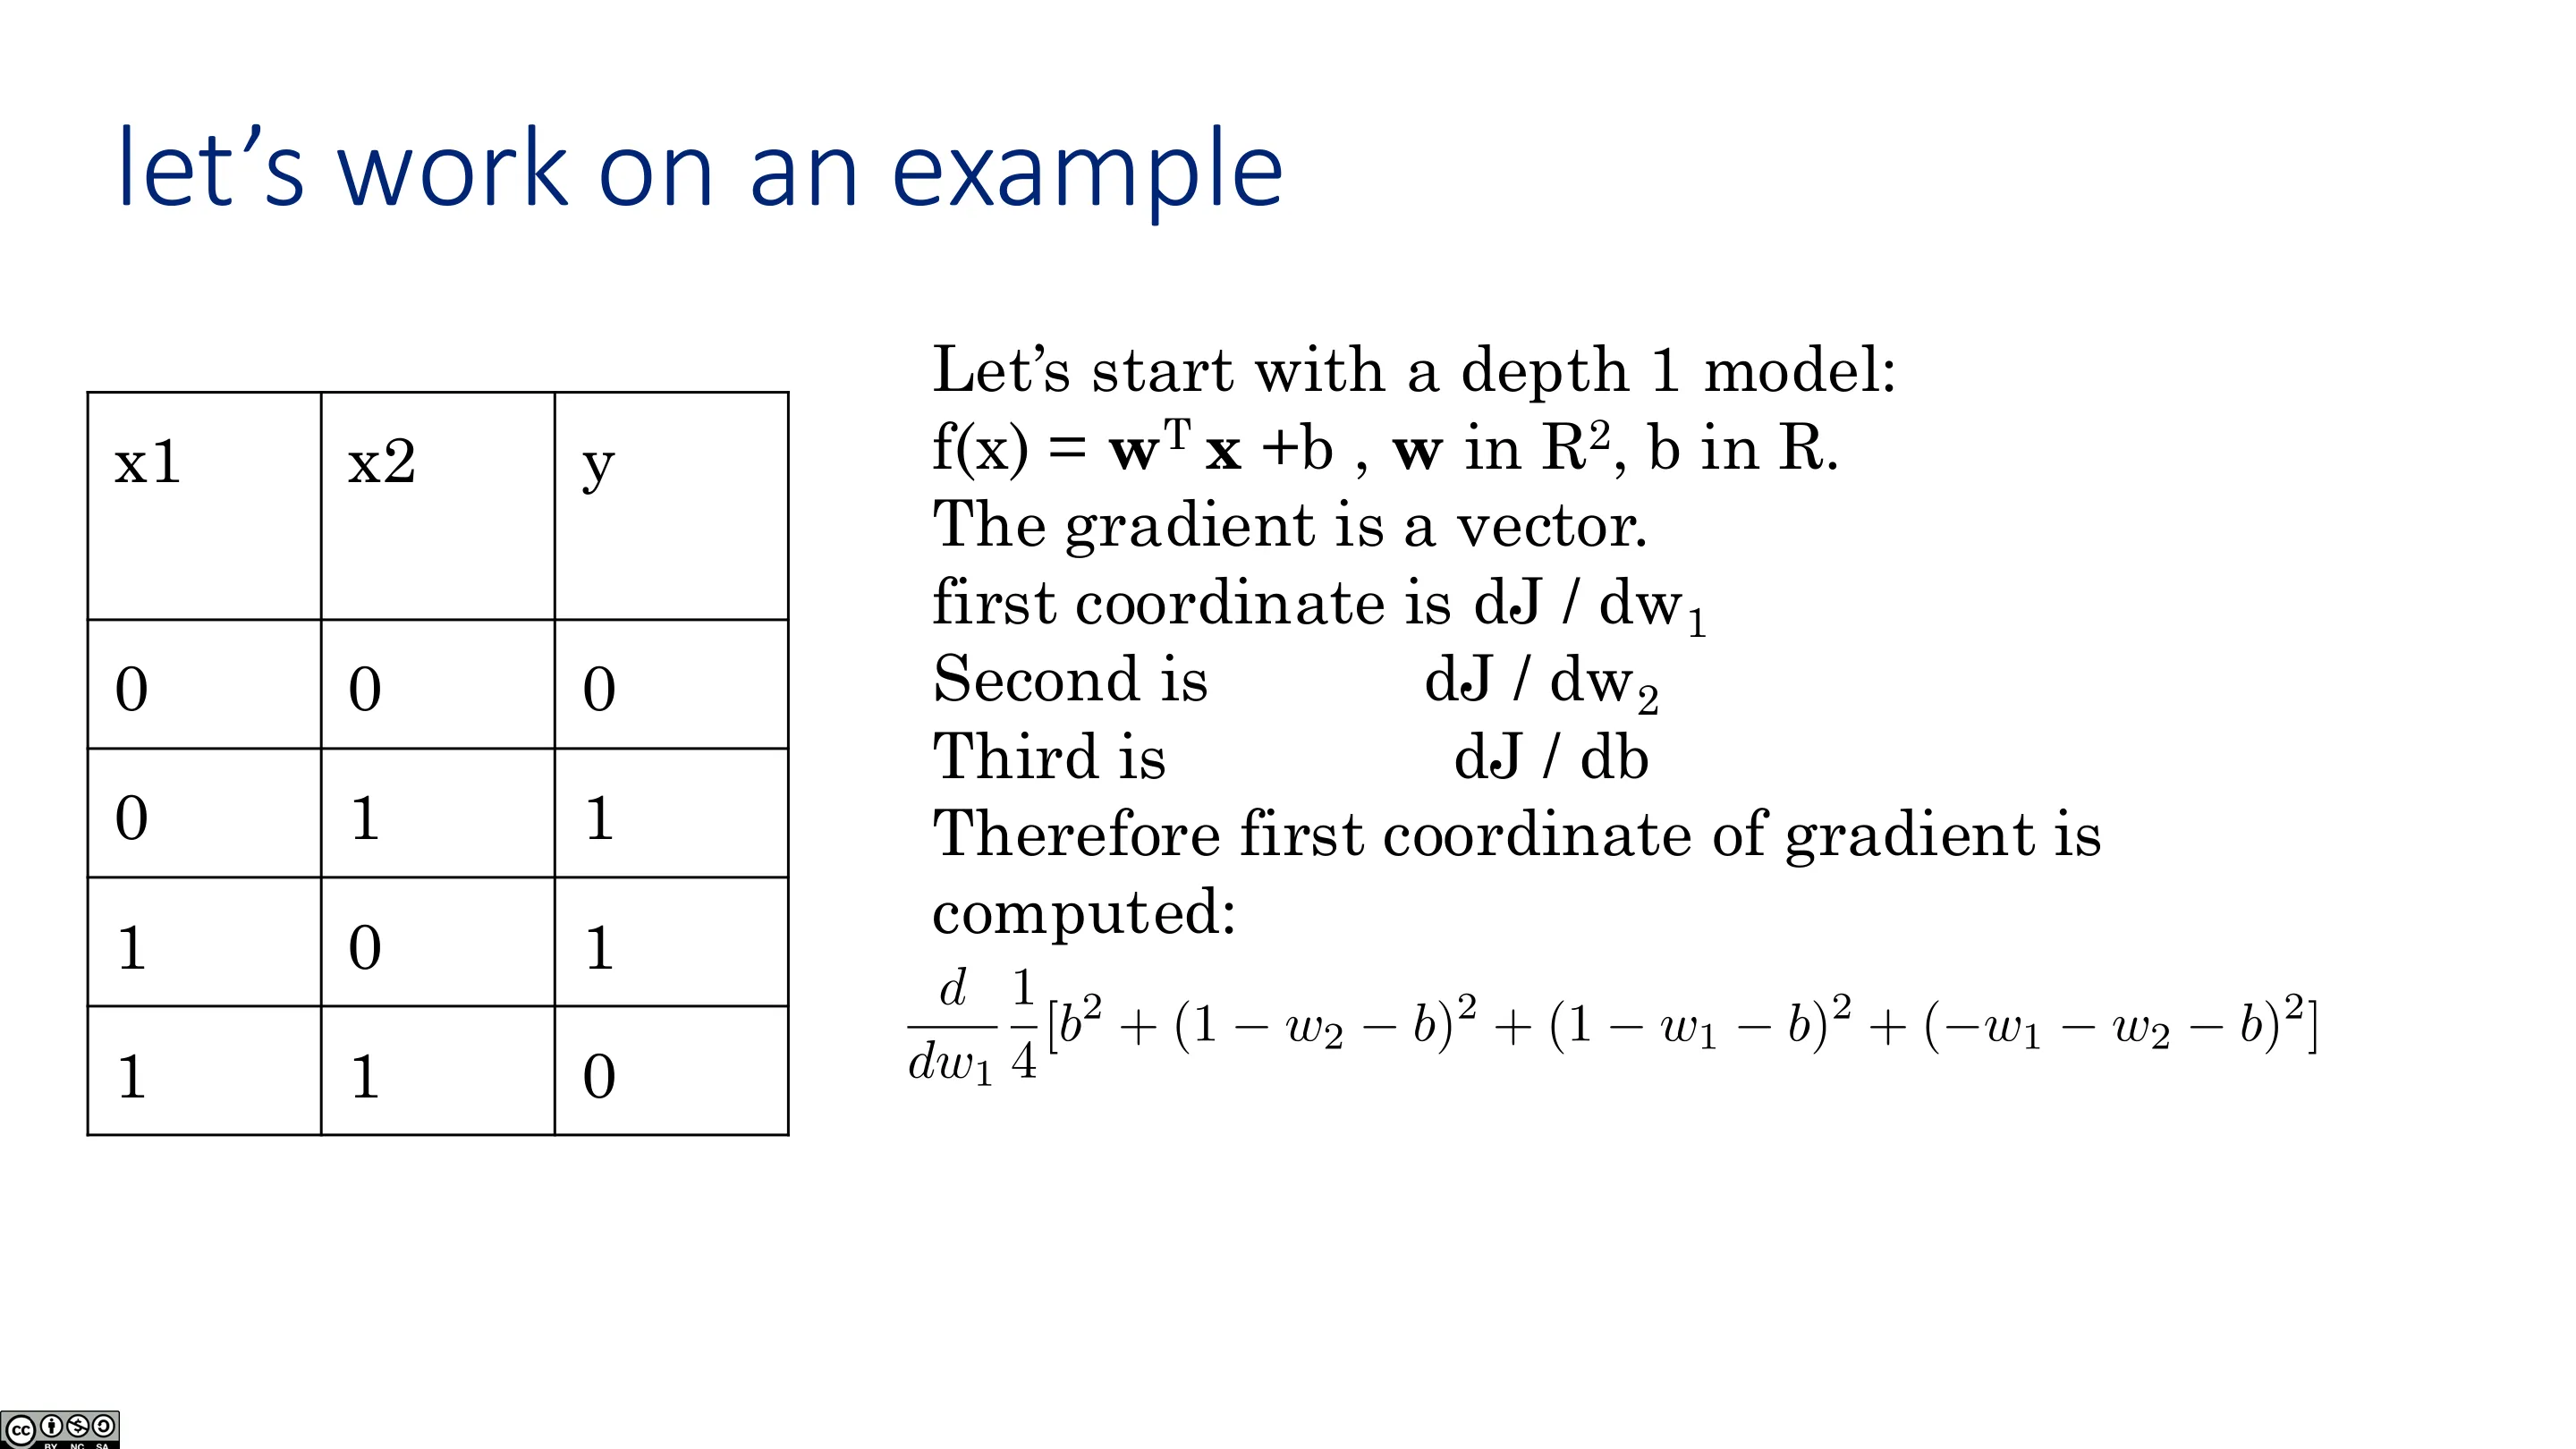
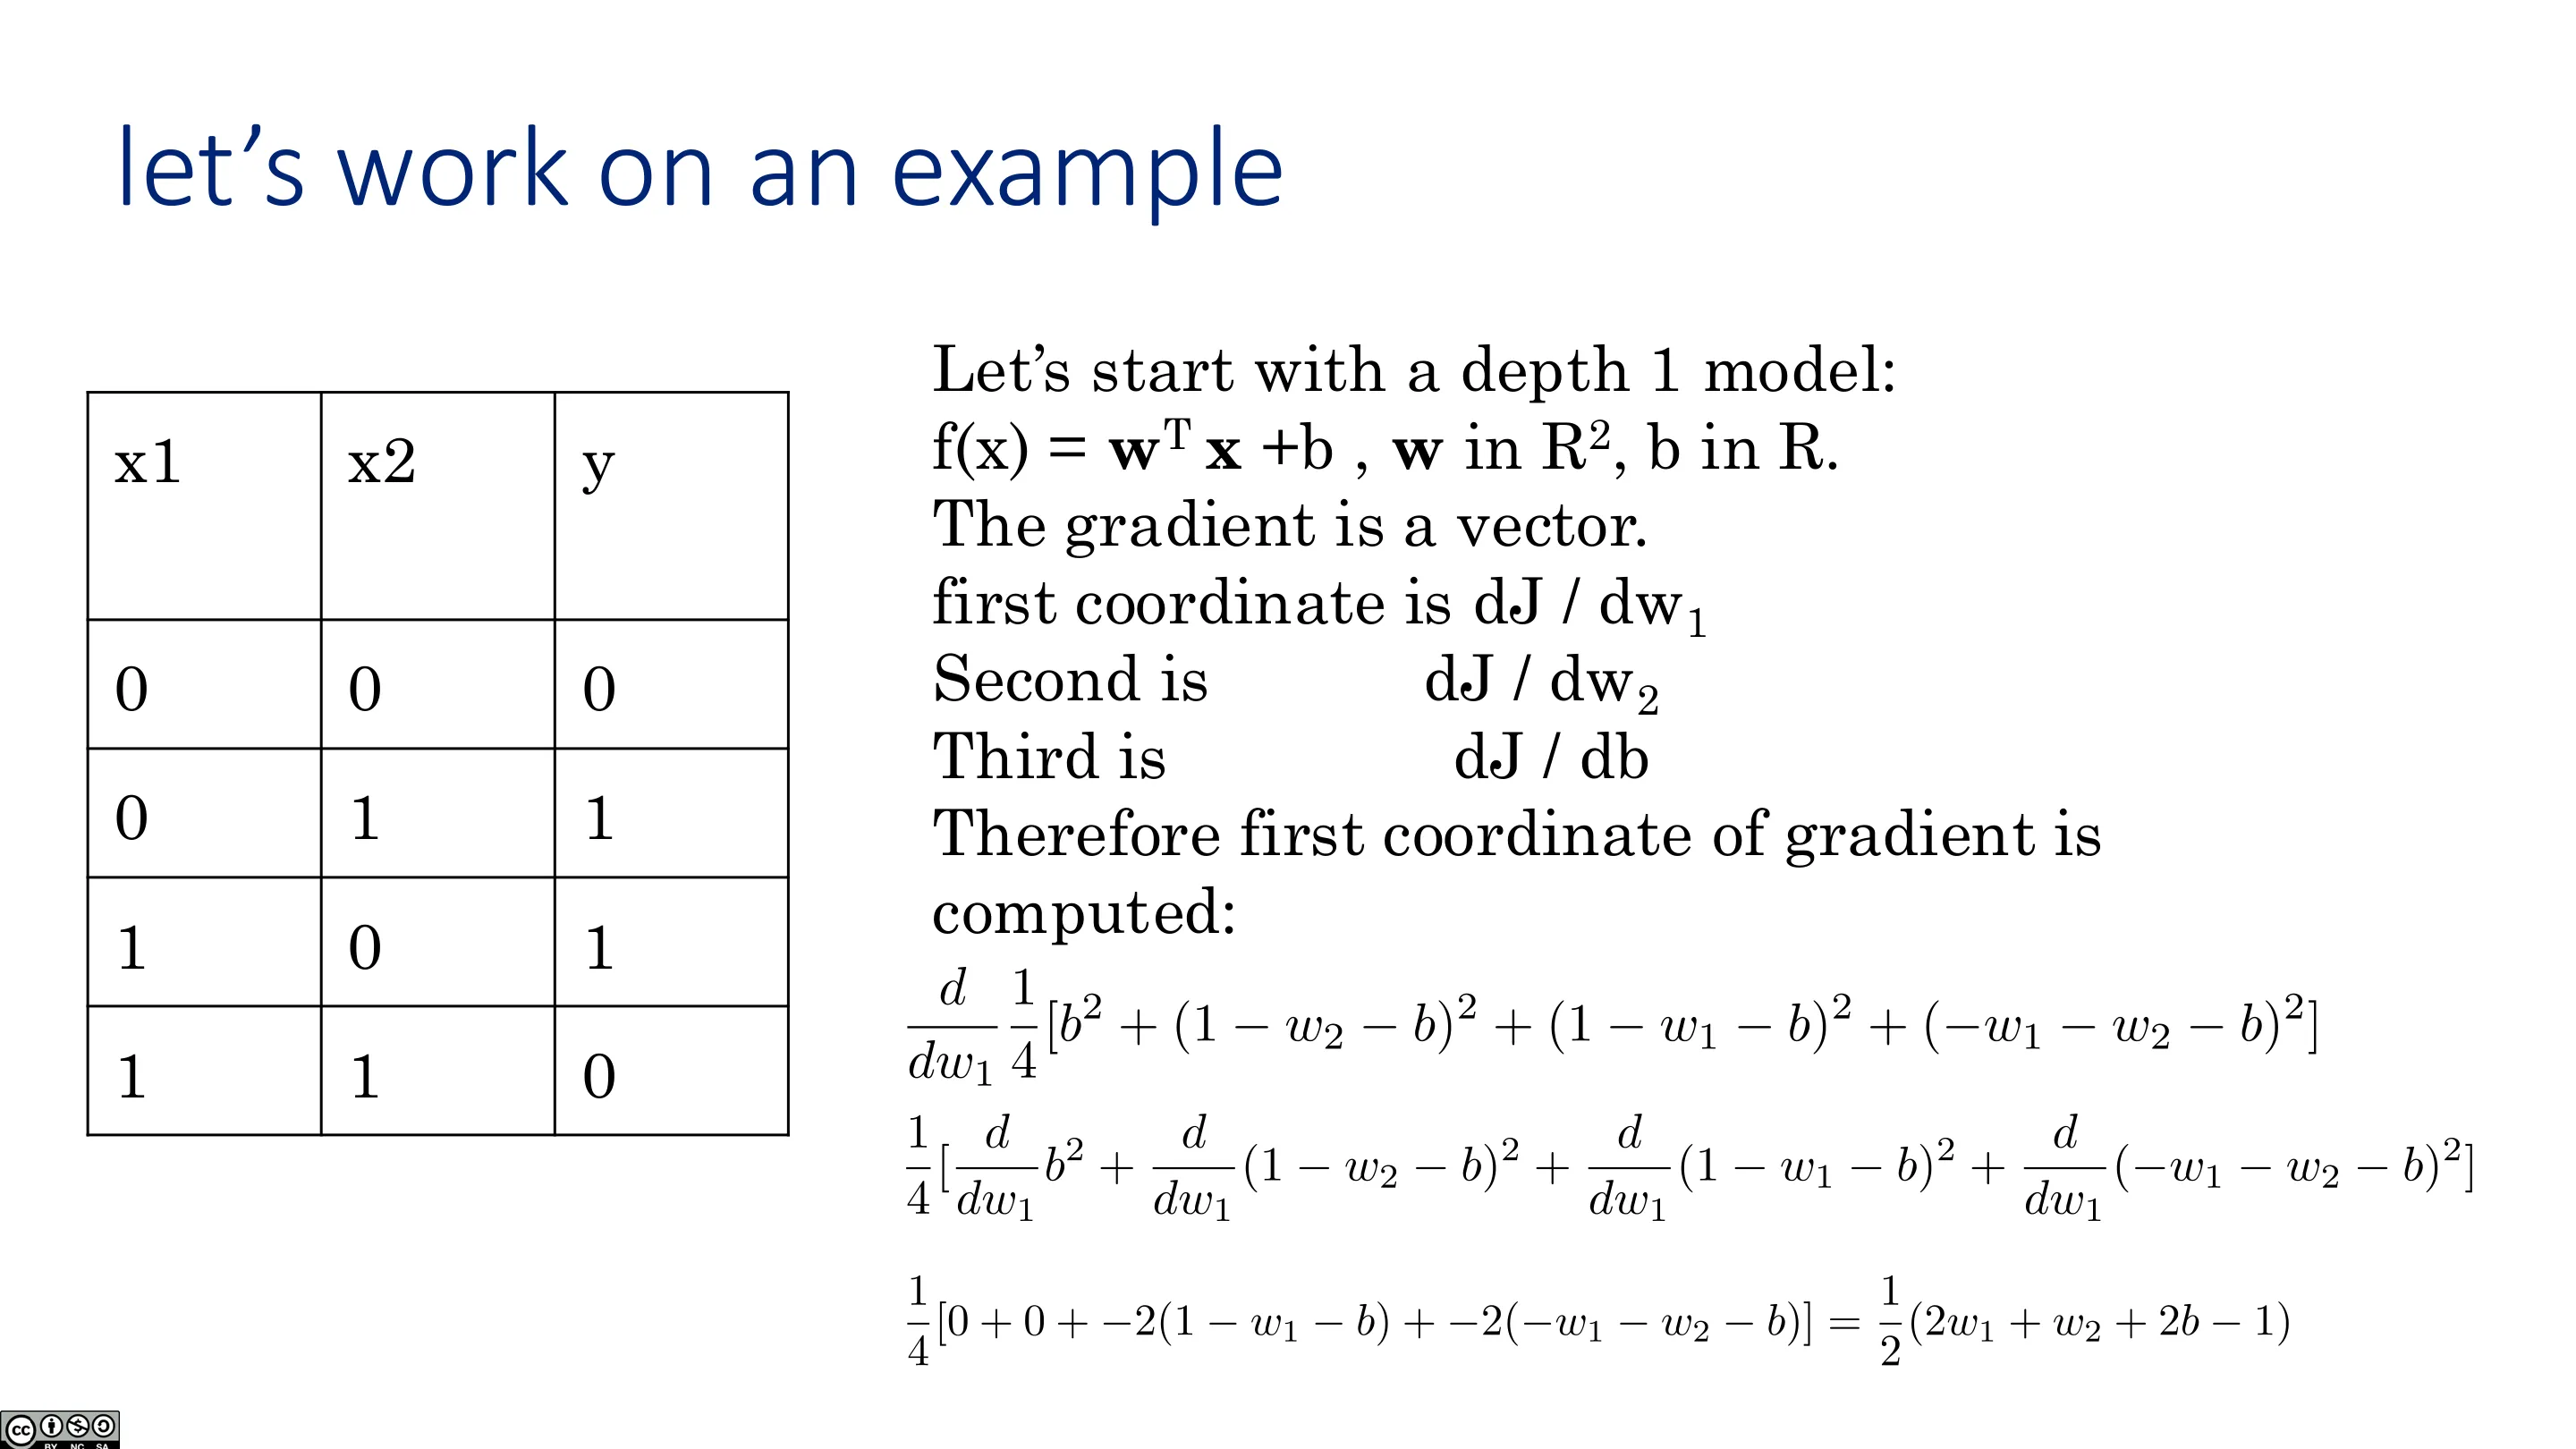
求梯度:$\nabla J=\big(\partial J/\partial w_1,\ \partial J/\partial w_2,\ \partial J/\partial b\big)$。以 $\partial J/\partial w_1$ 为例:样本 1、2 的第一列都是 0,所以它们的预测与 $w_1$ 无关,对应偏导为 0;只有样本 3、4 贡献:
$$ \frac{\partial J}{\partial w_1}=\frac14\Big[2(w_1+b-1)\cdot1+2(w_1+w_2+b-2)\cdot1\Big] $$
关键点:偏导数仍依赖 $(w_1,w_2,b)$——所以给定一组具体参数,就能算出一个数值梯度向量,用它更新。这就是符号微分 + 反向传播(链式法则) 要解决的问题。
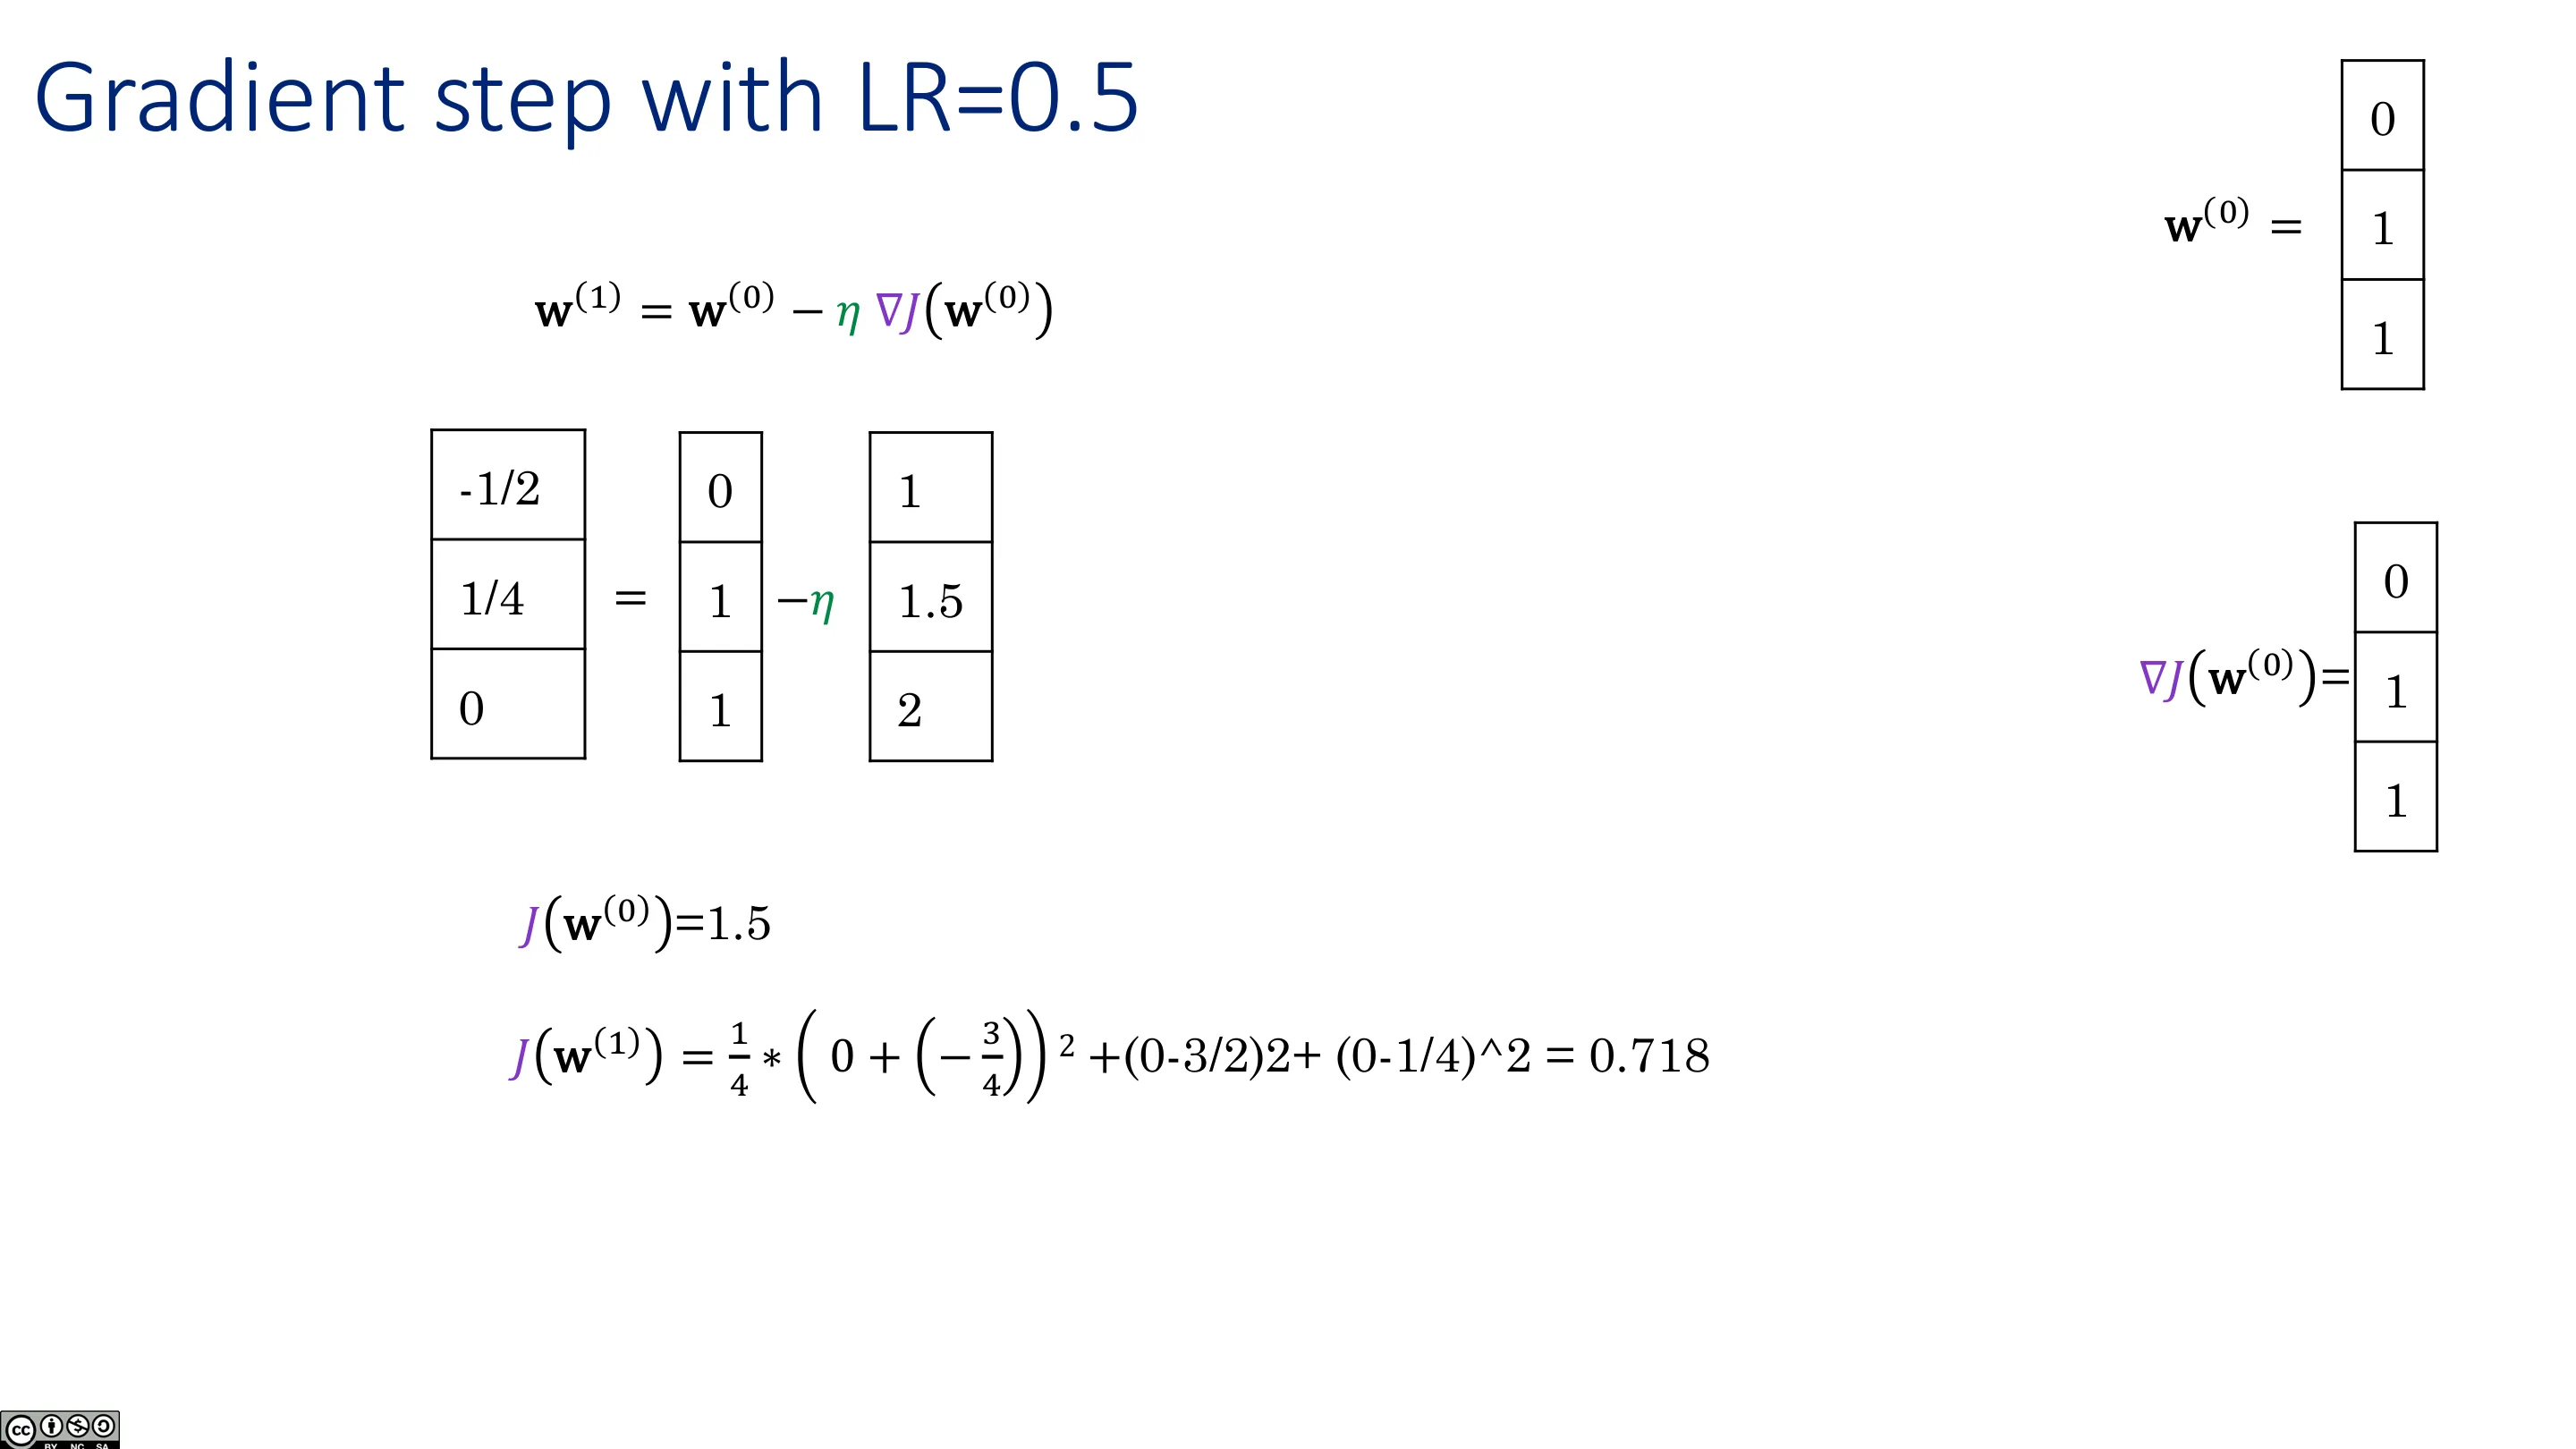
从 $w^{(0)}=(0,1,1)$ 出发,$\eta=0.5$,走一步:算得梯度为 $(2,2,2)$,于是
$$ w^{(1)}=(0,1,1)-0.5\cdot(2,2,2)=(-1,\,0,\,0) $$
损失从 $1.5$ 降到约 $0.25$——下降成功。
问题:换 $\eta=1,0.8,0.1$ 还能收敛吗?答案取决于损失的曲率。
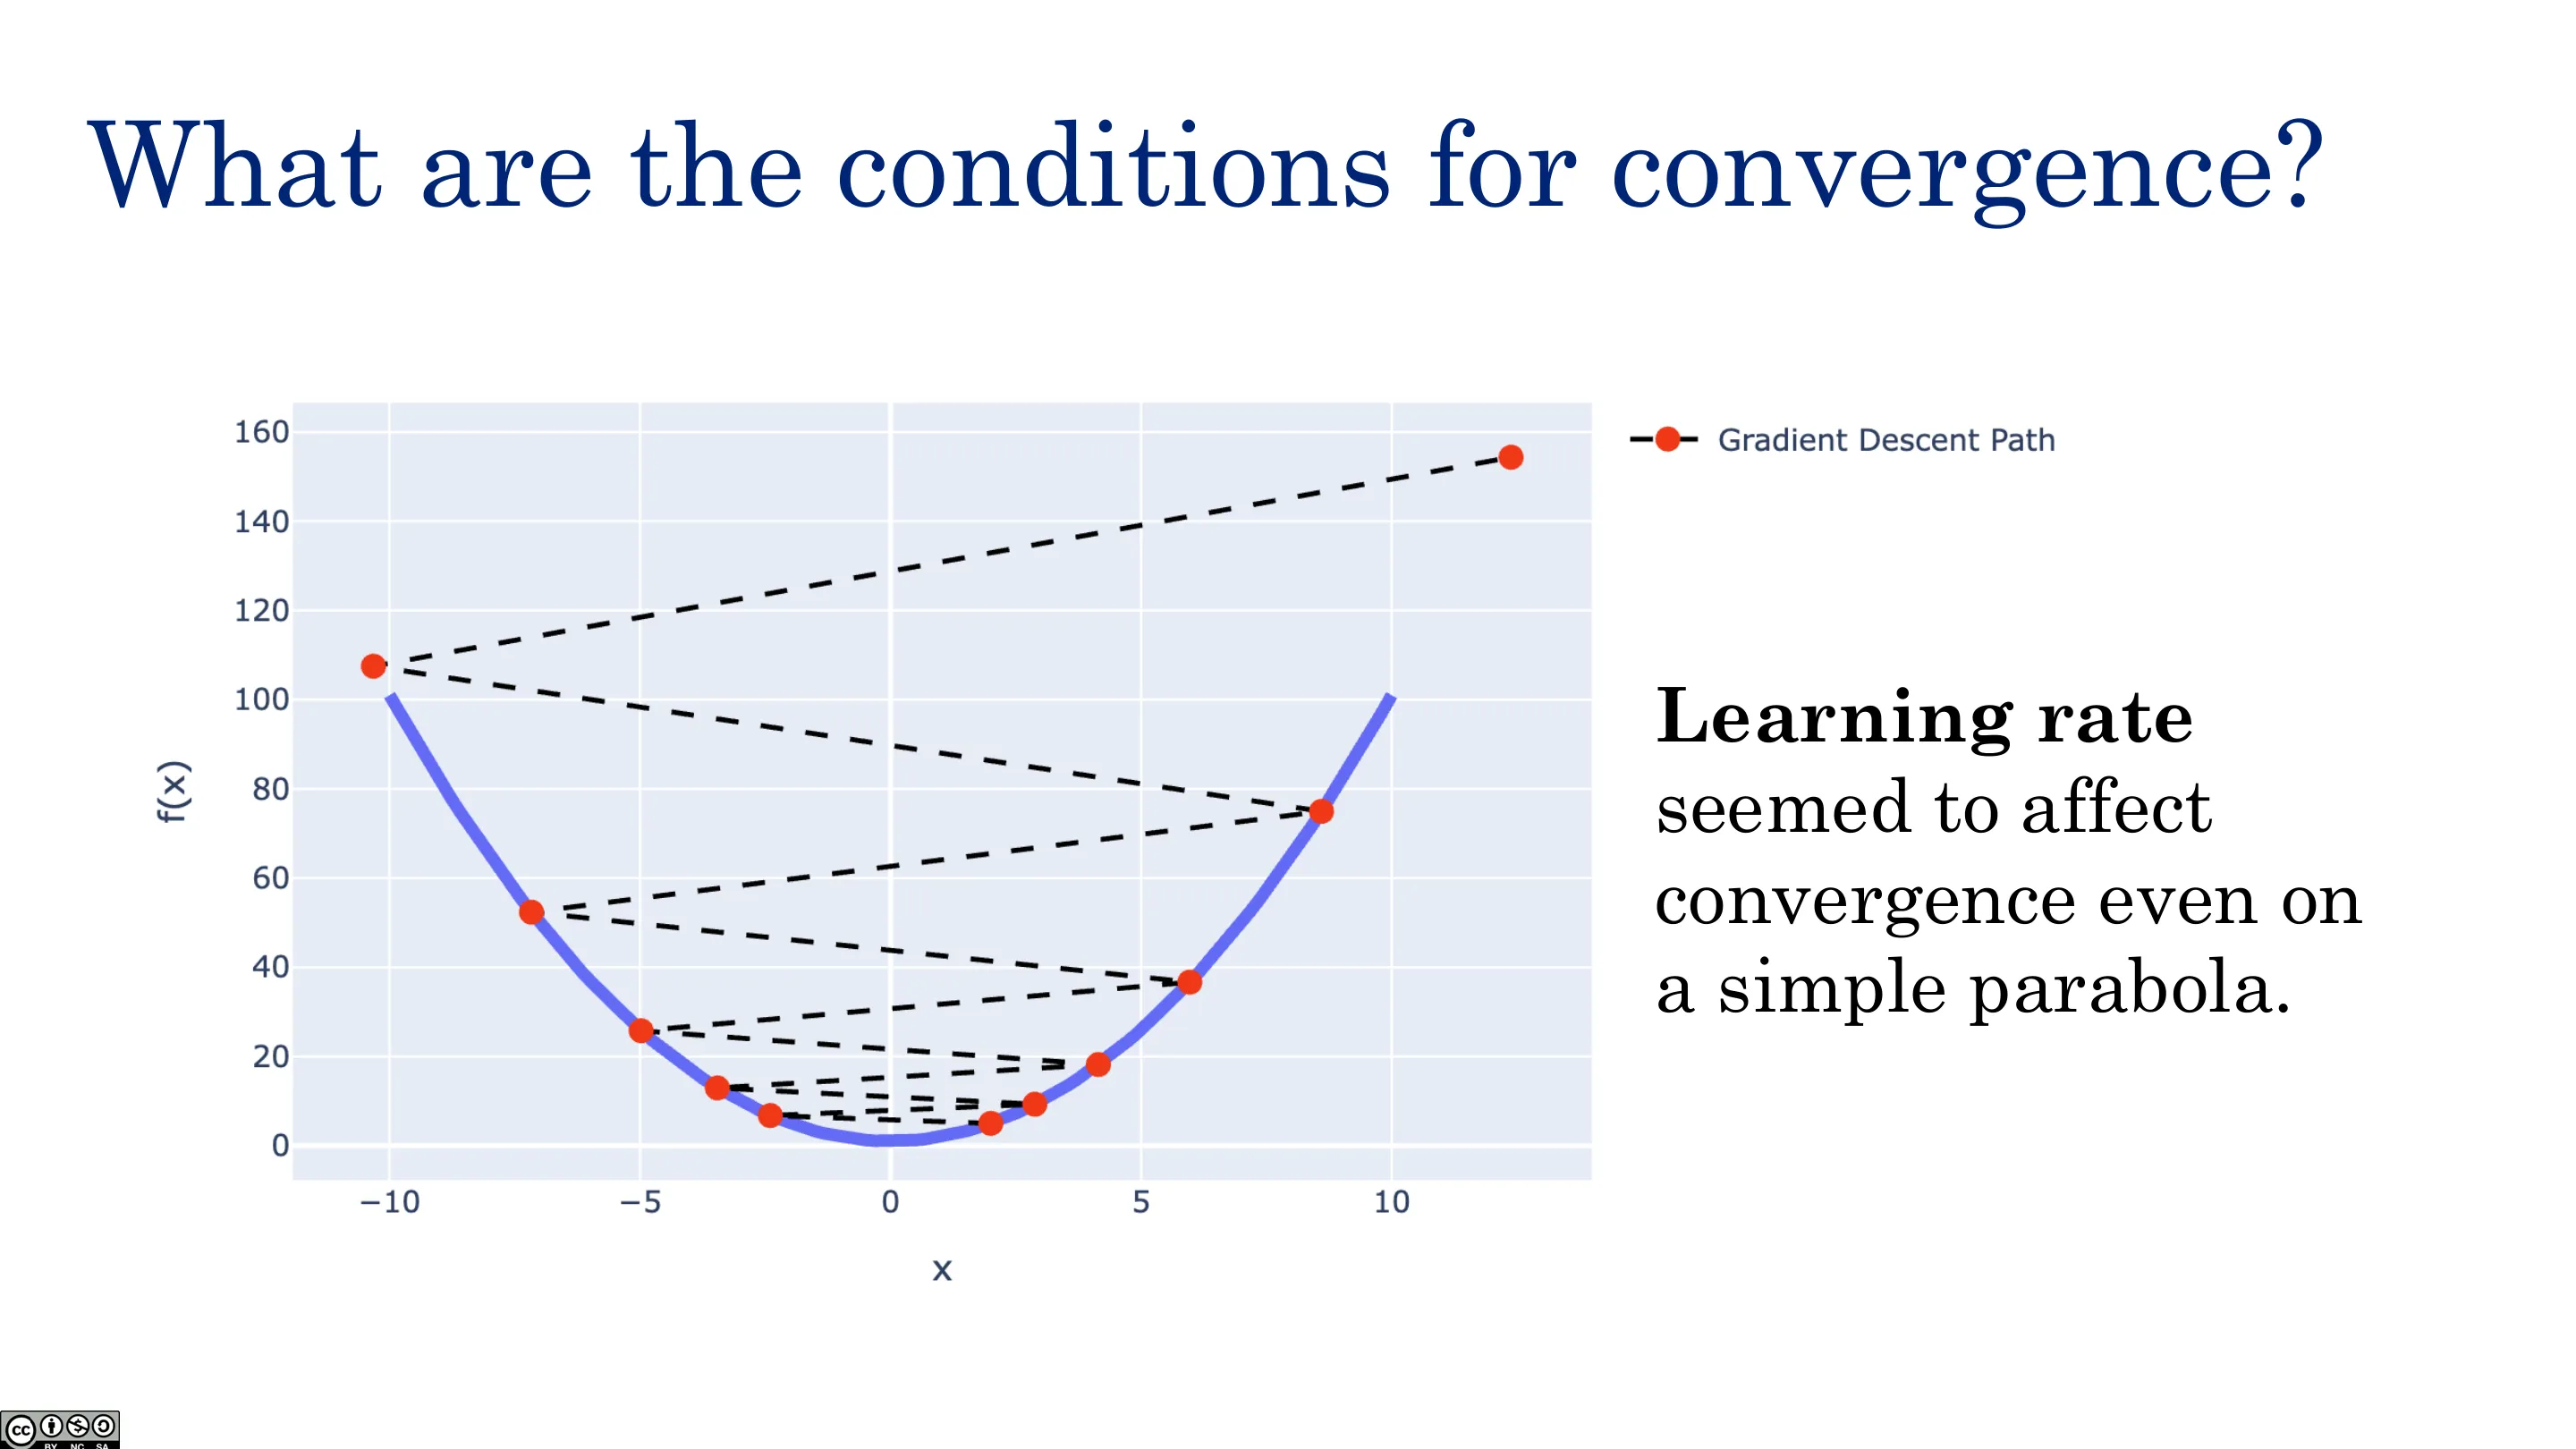
📷 收敛的条件
回到原视频 (00:24:40)
📷 收敛(假设之下)
回到原视频 (00:25:53)
📷 二次近似
回到原视频 (00:27:06)
二、收敛分析:Taylor 近似与 Hessian
(参考时间: 00:24)
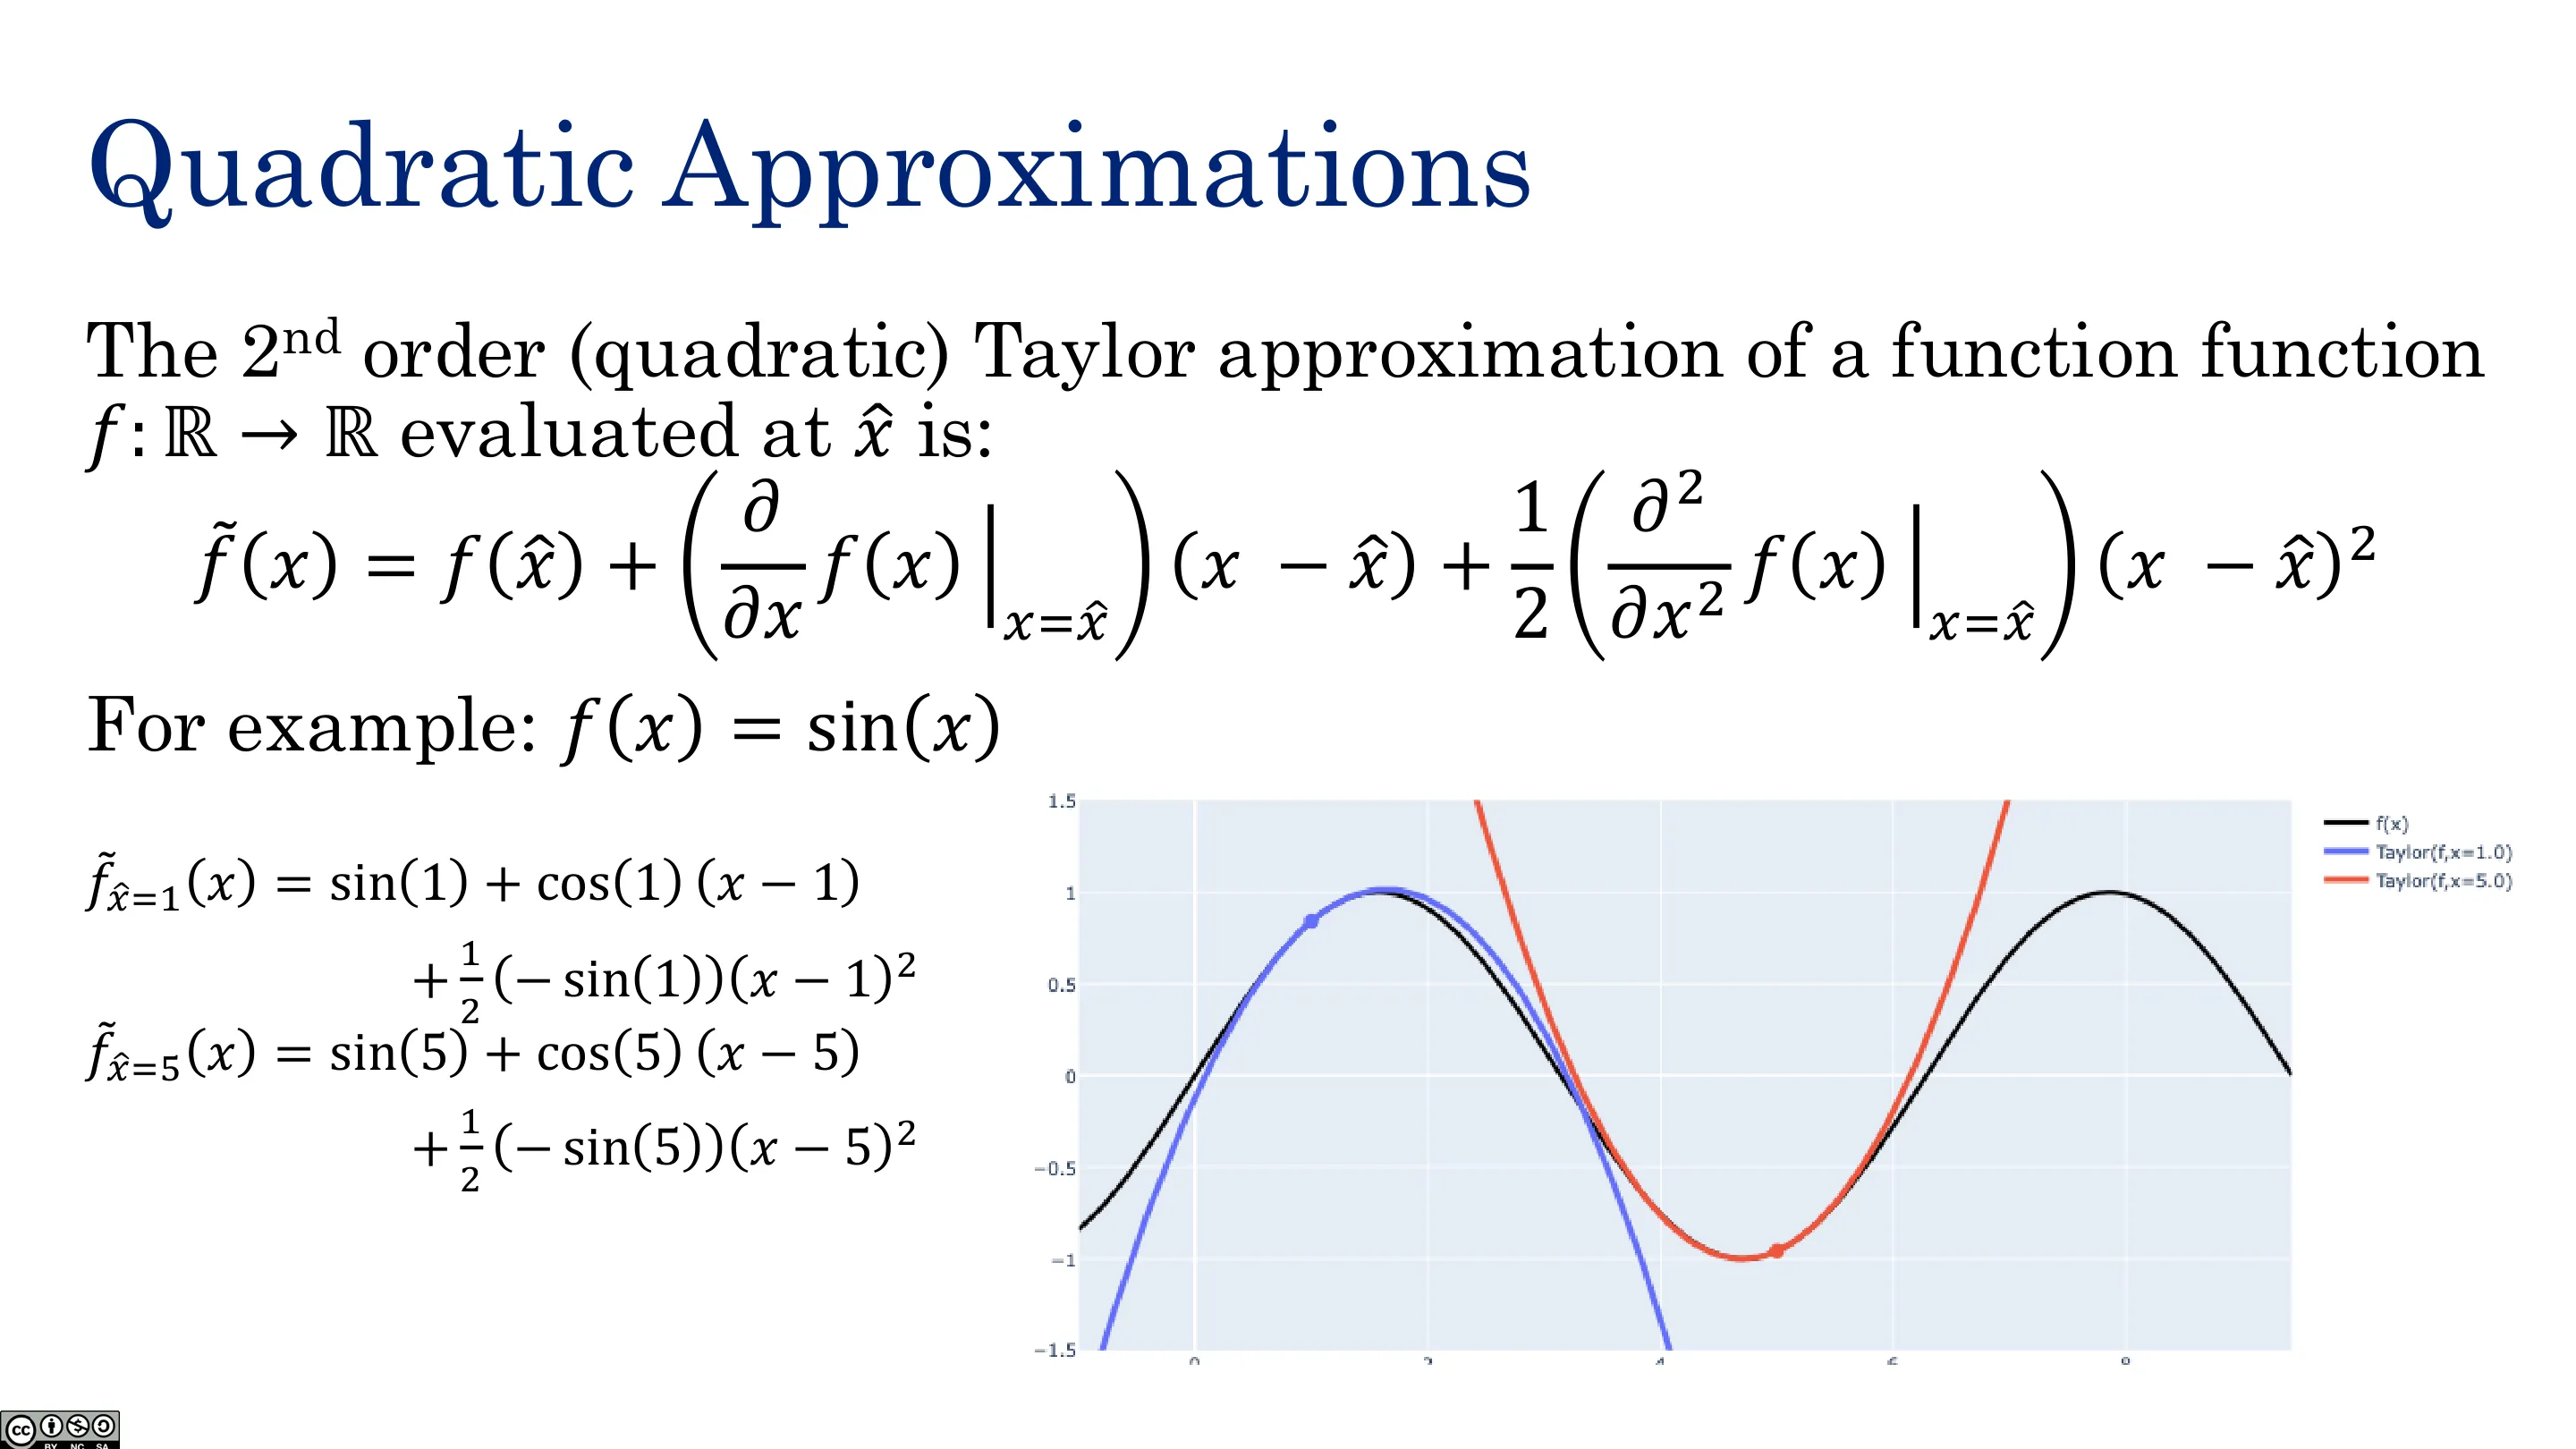
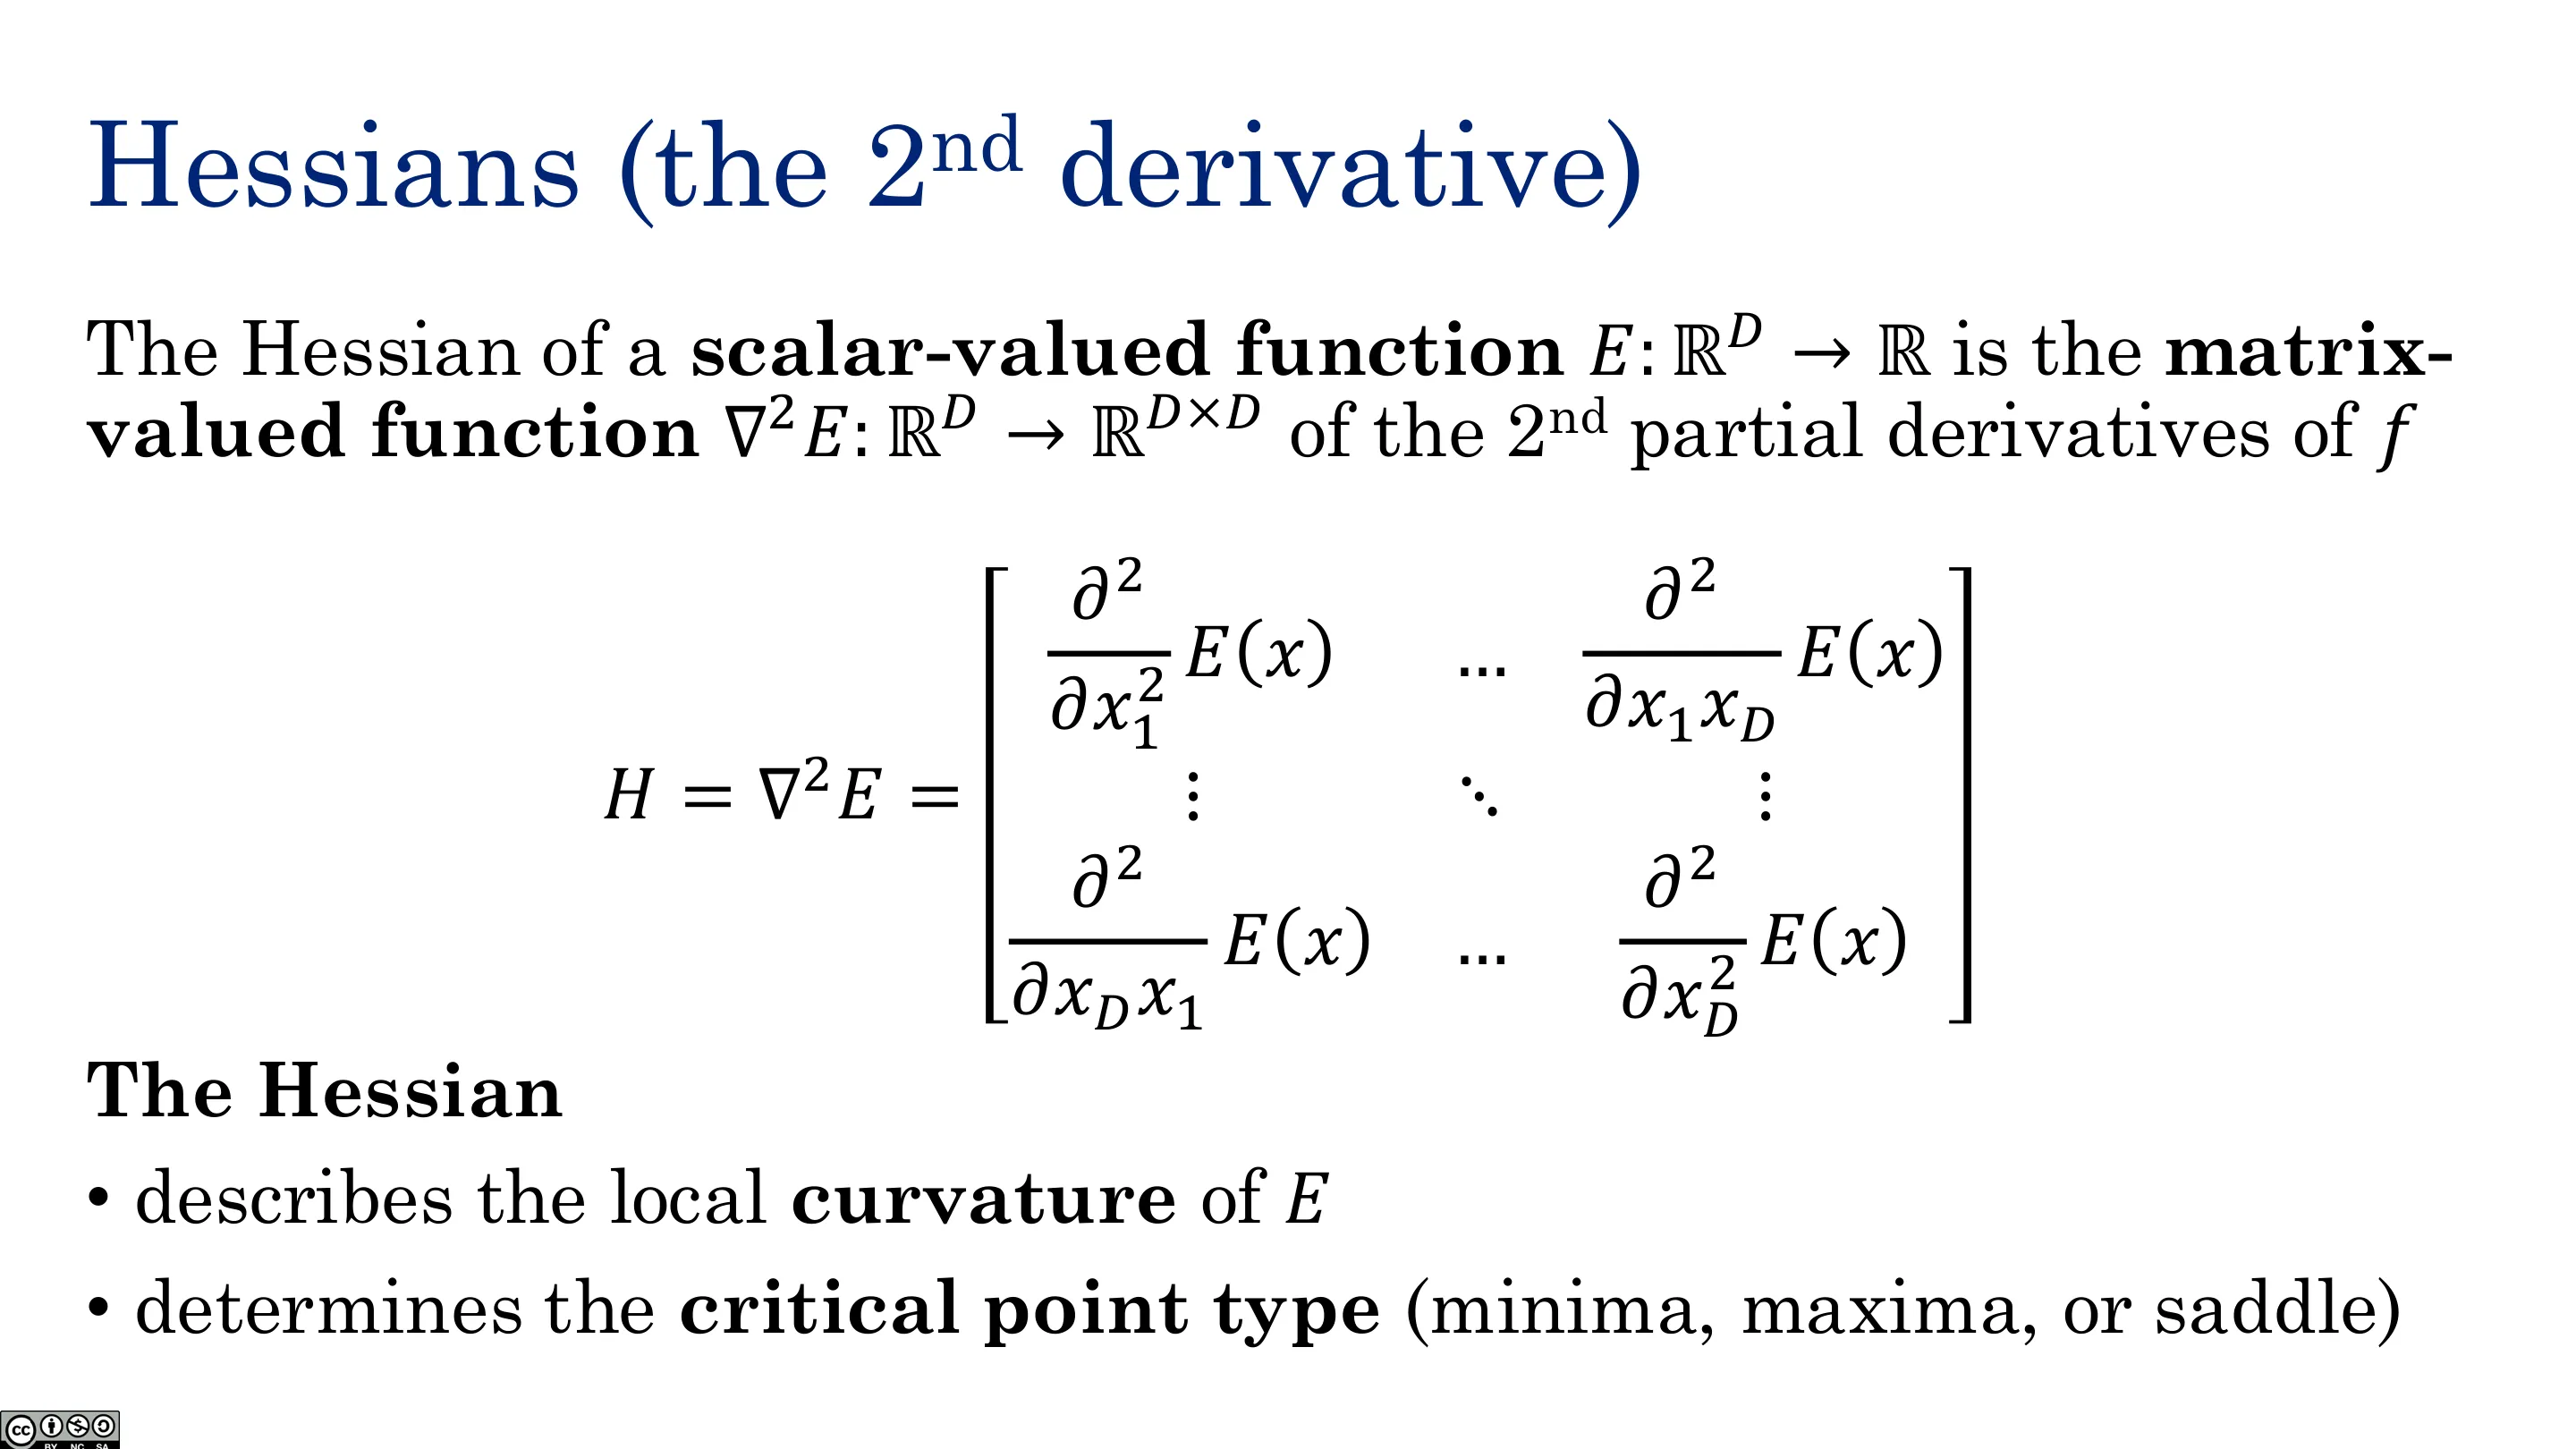
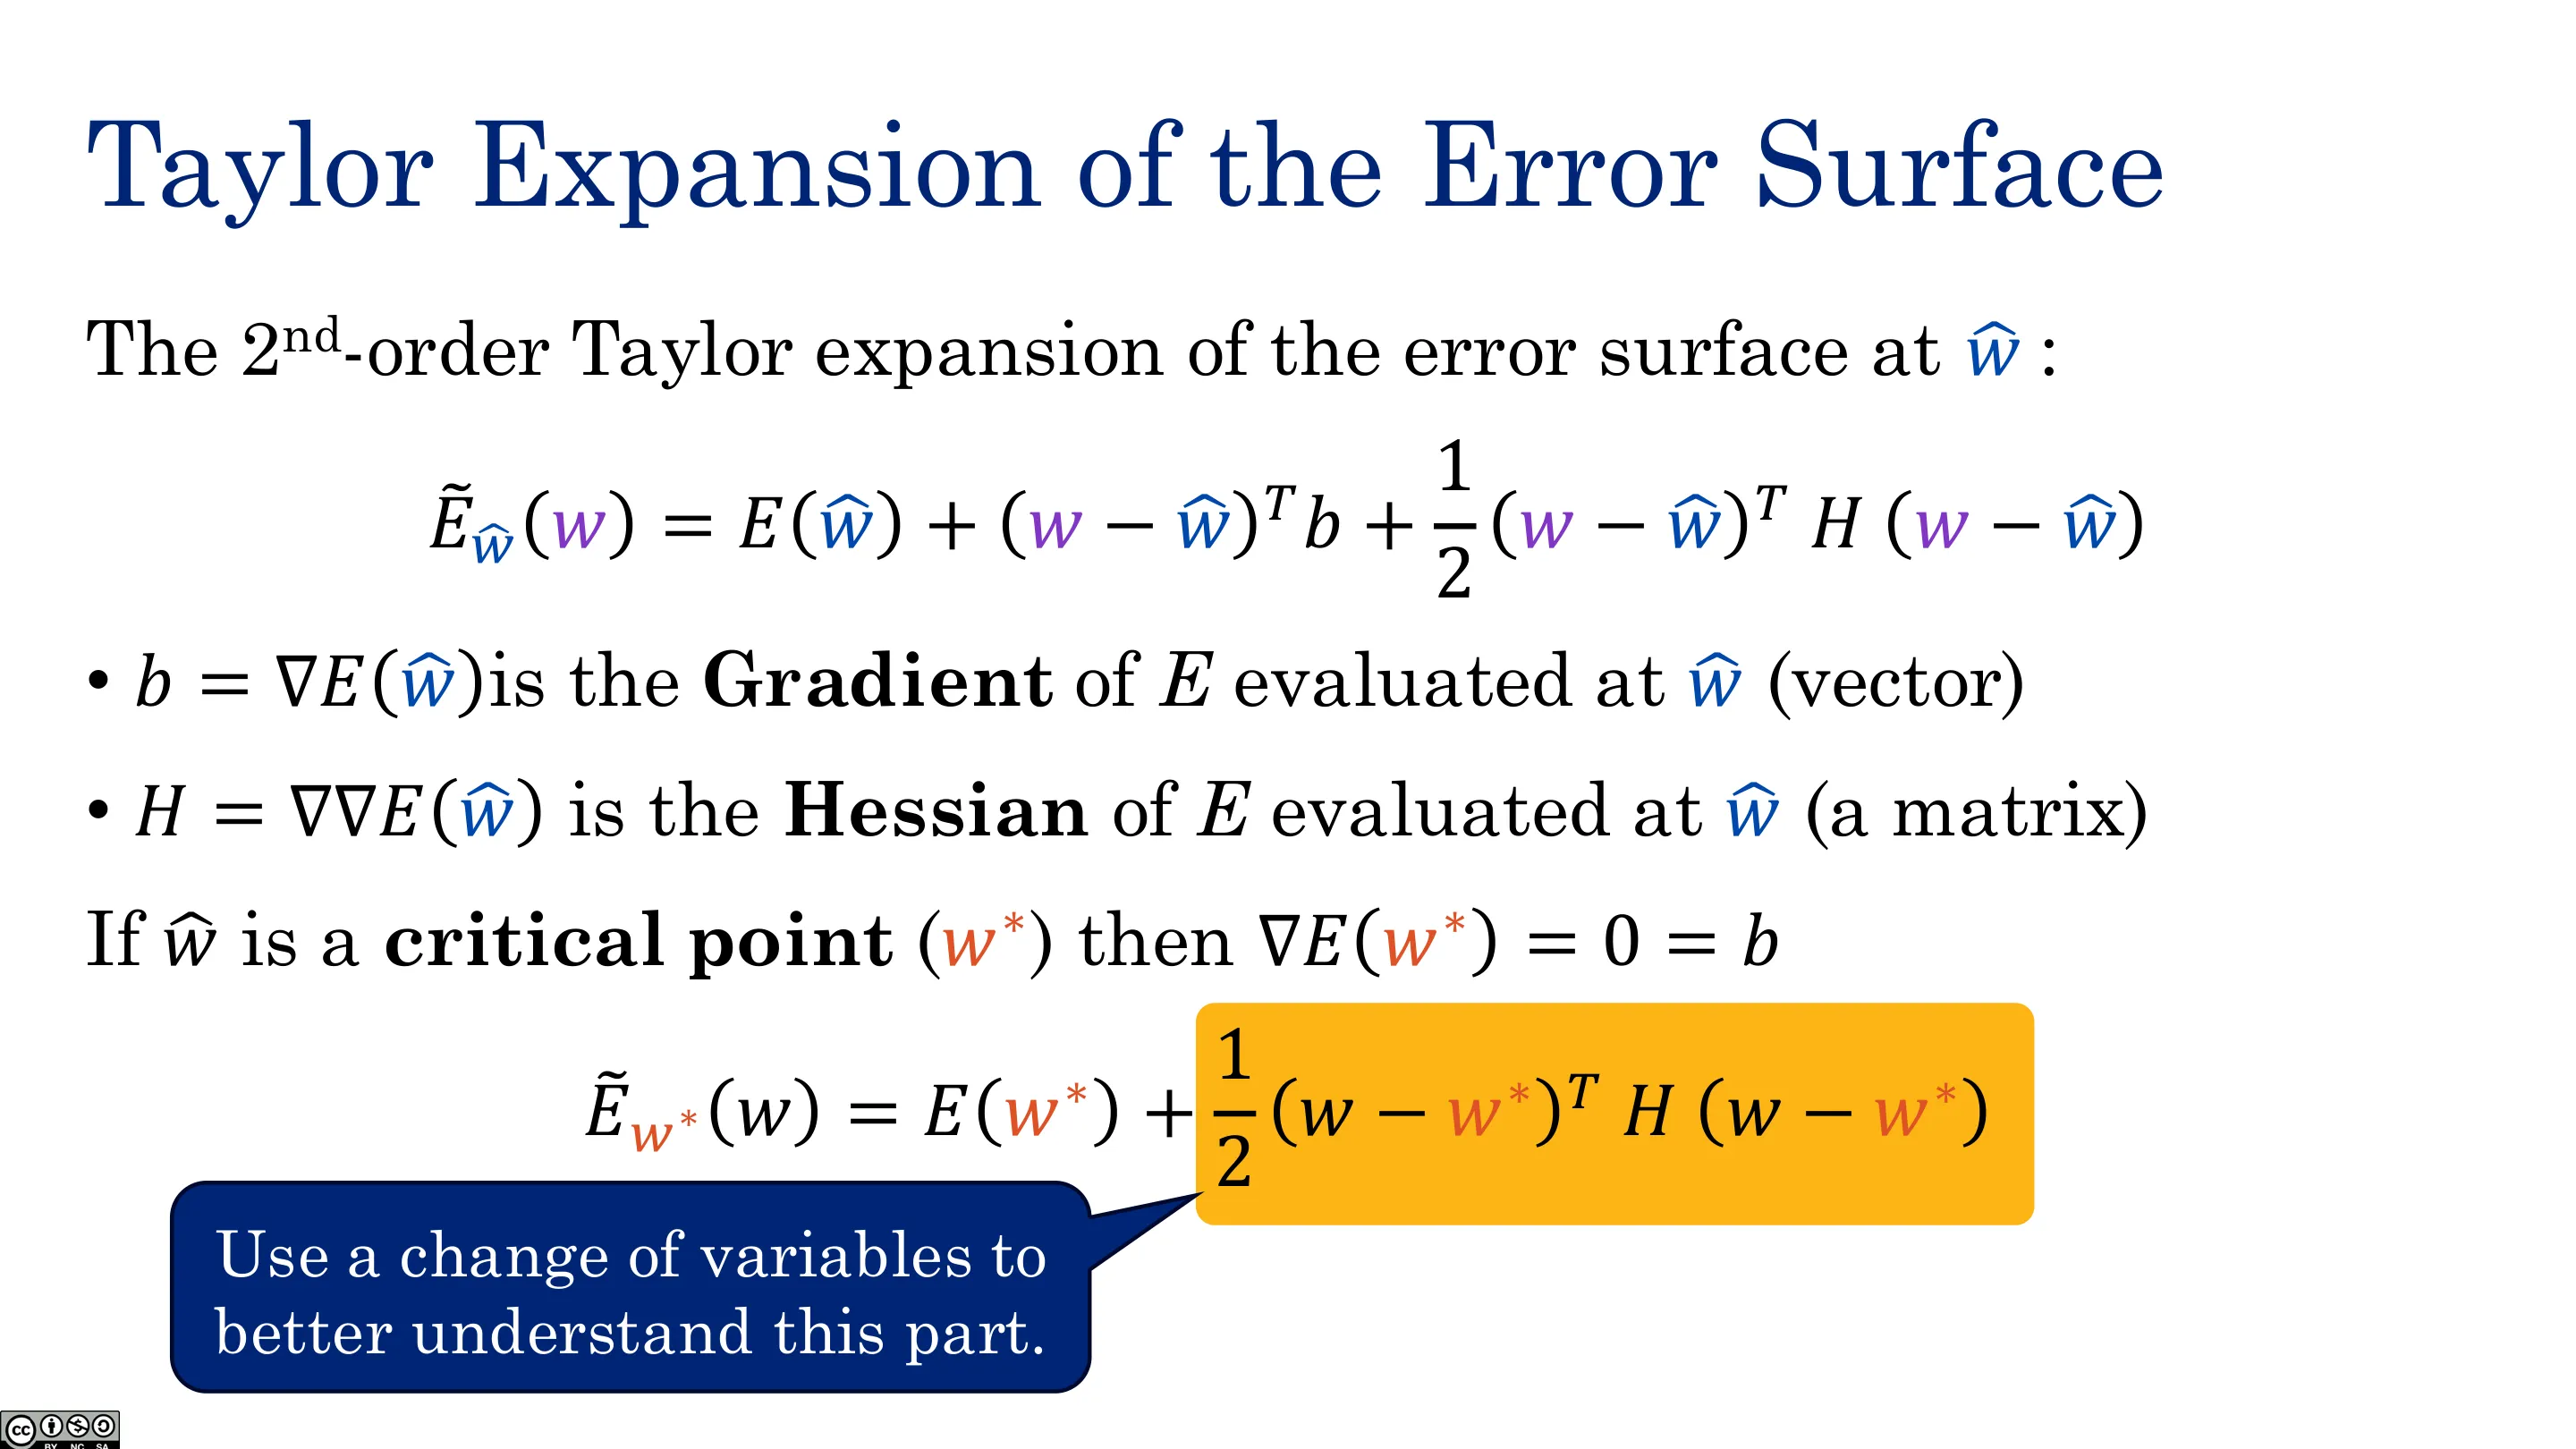
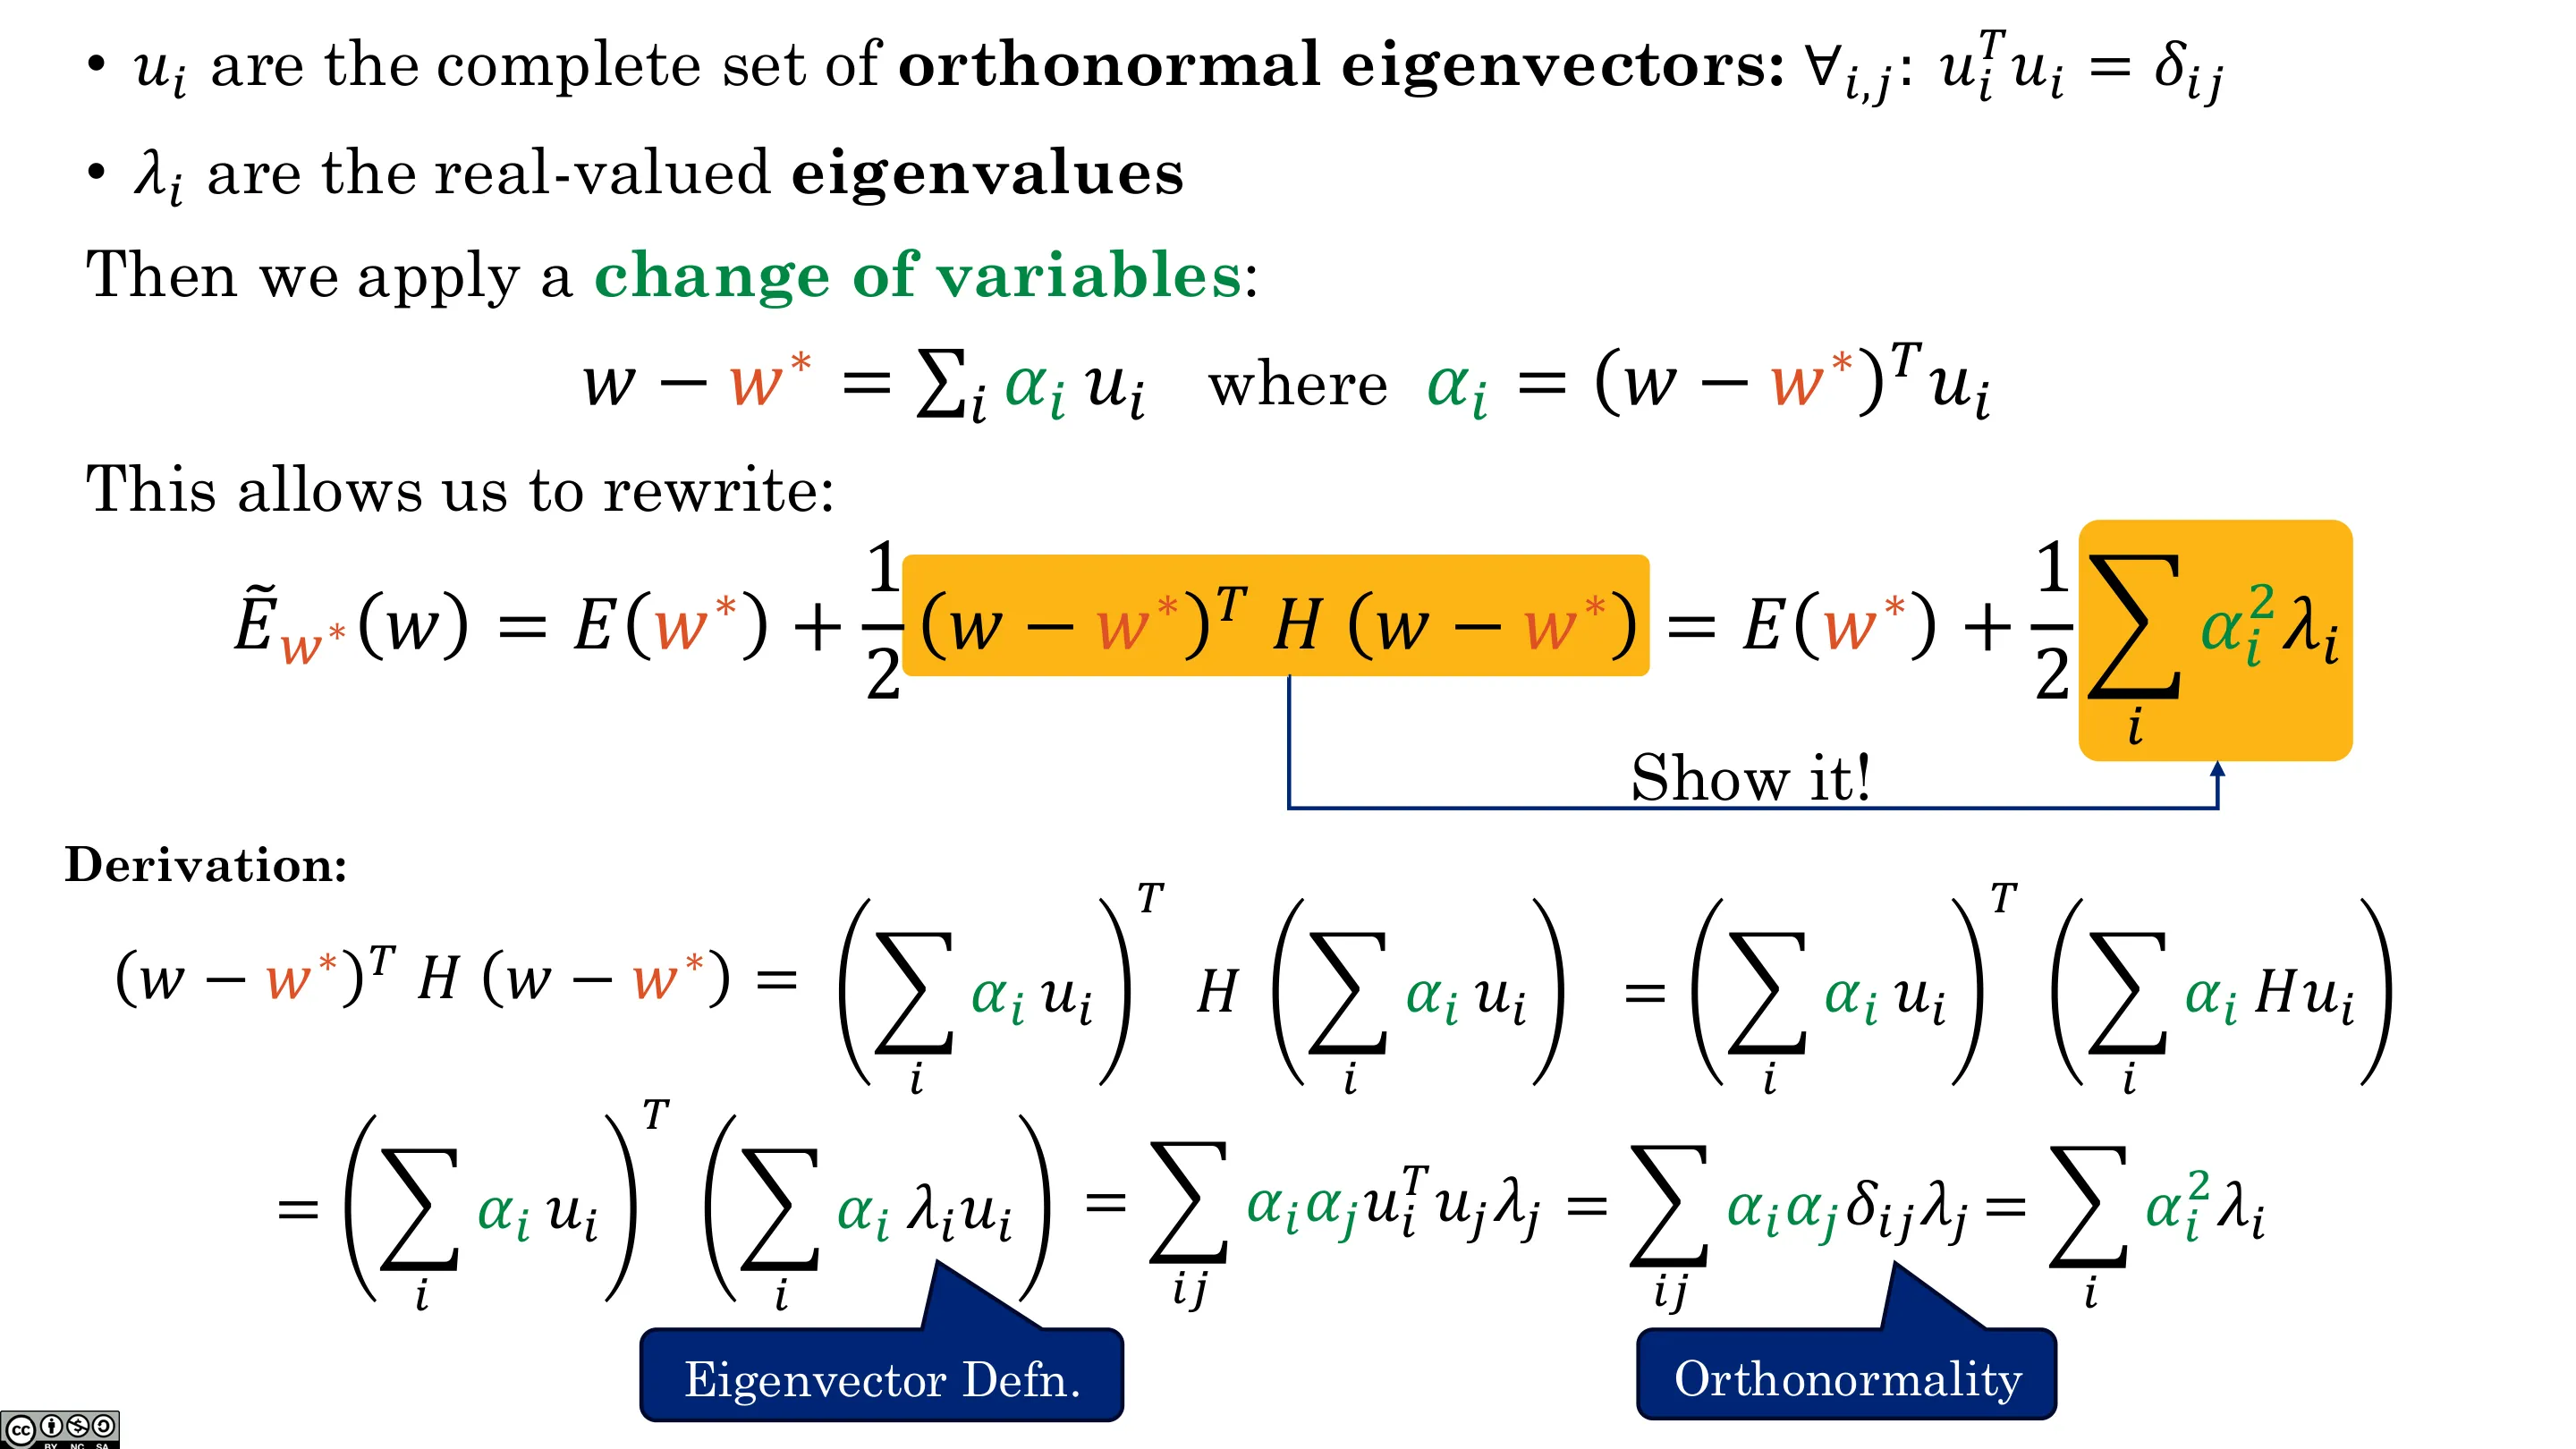
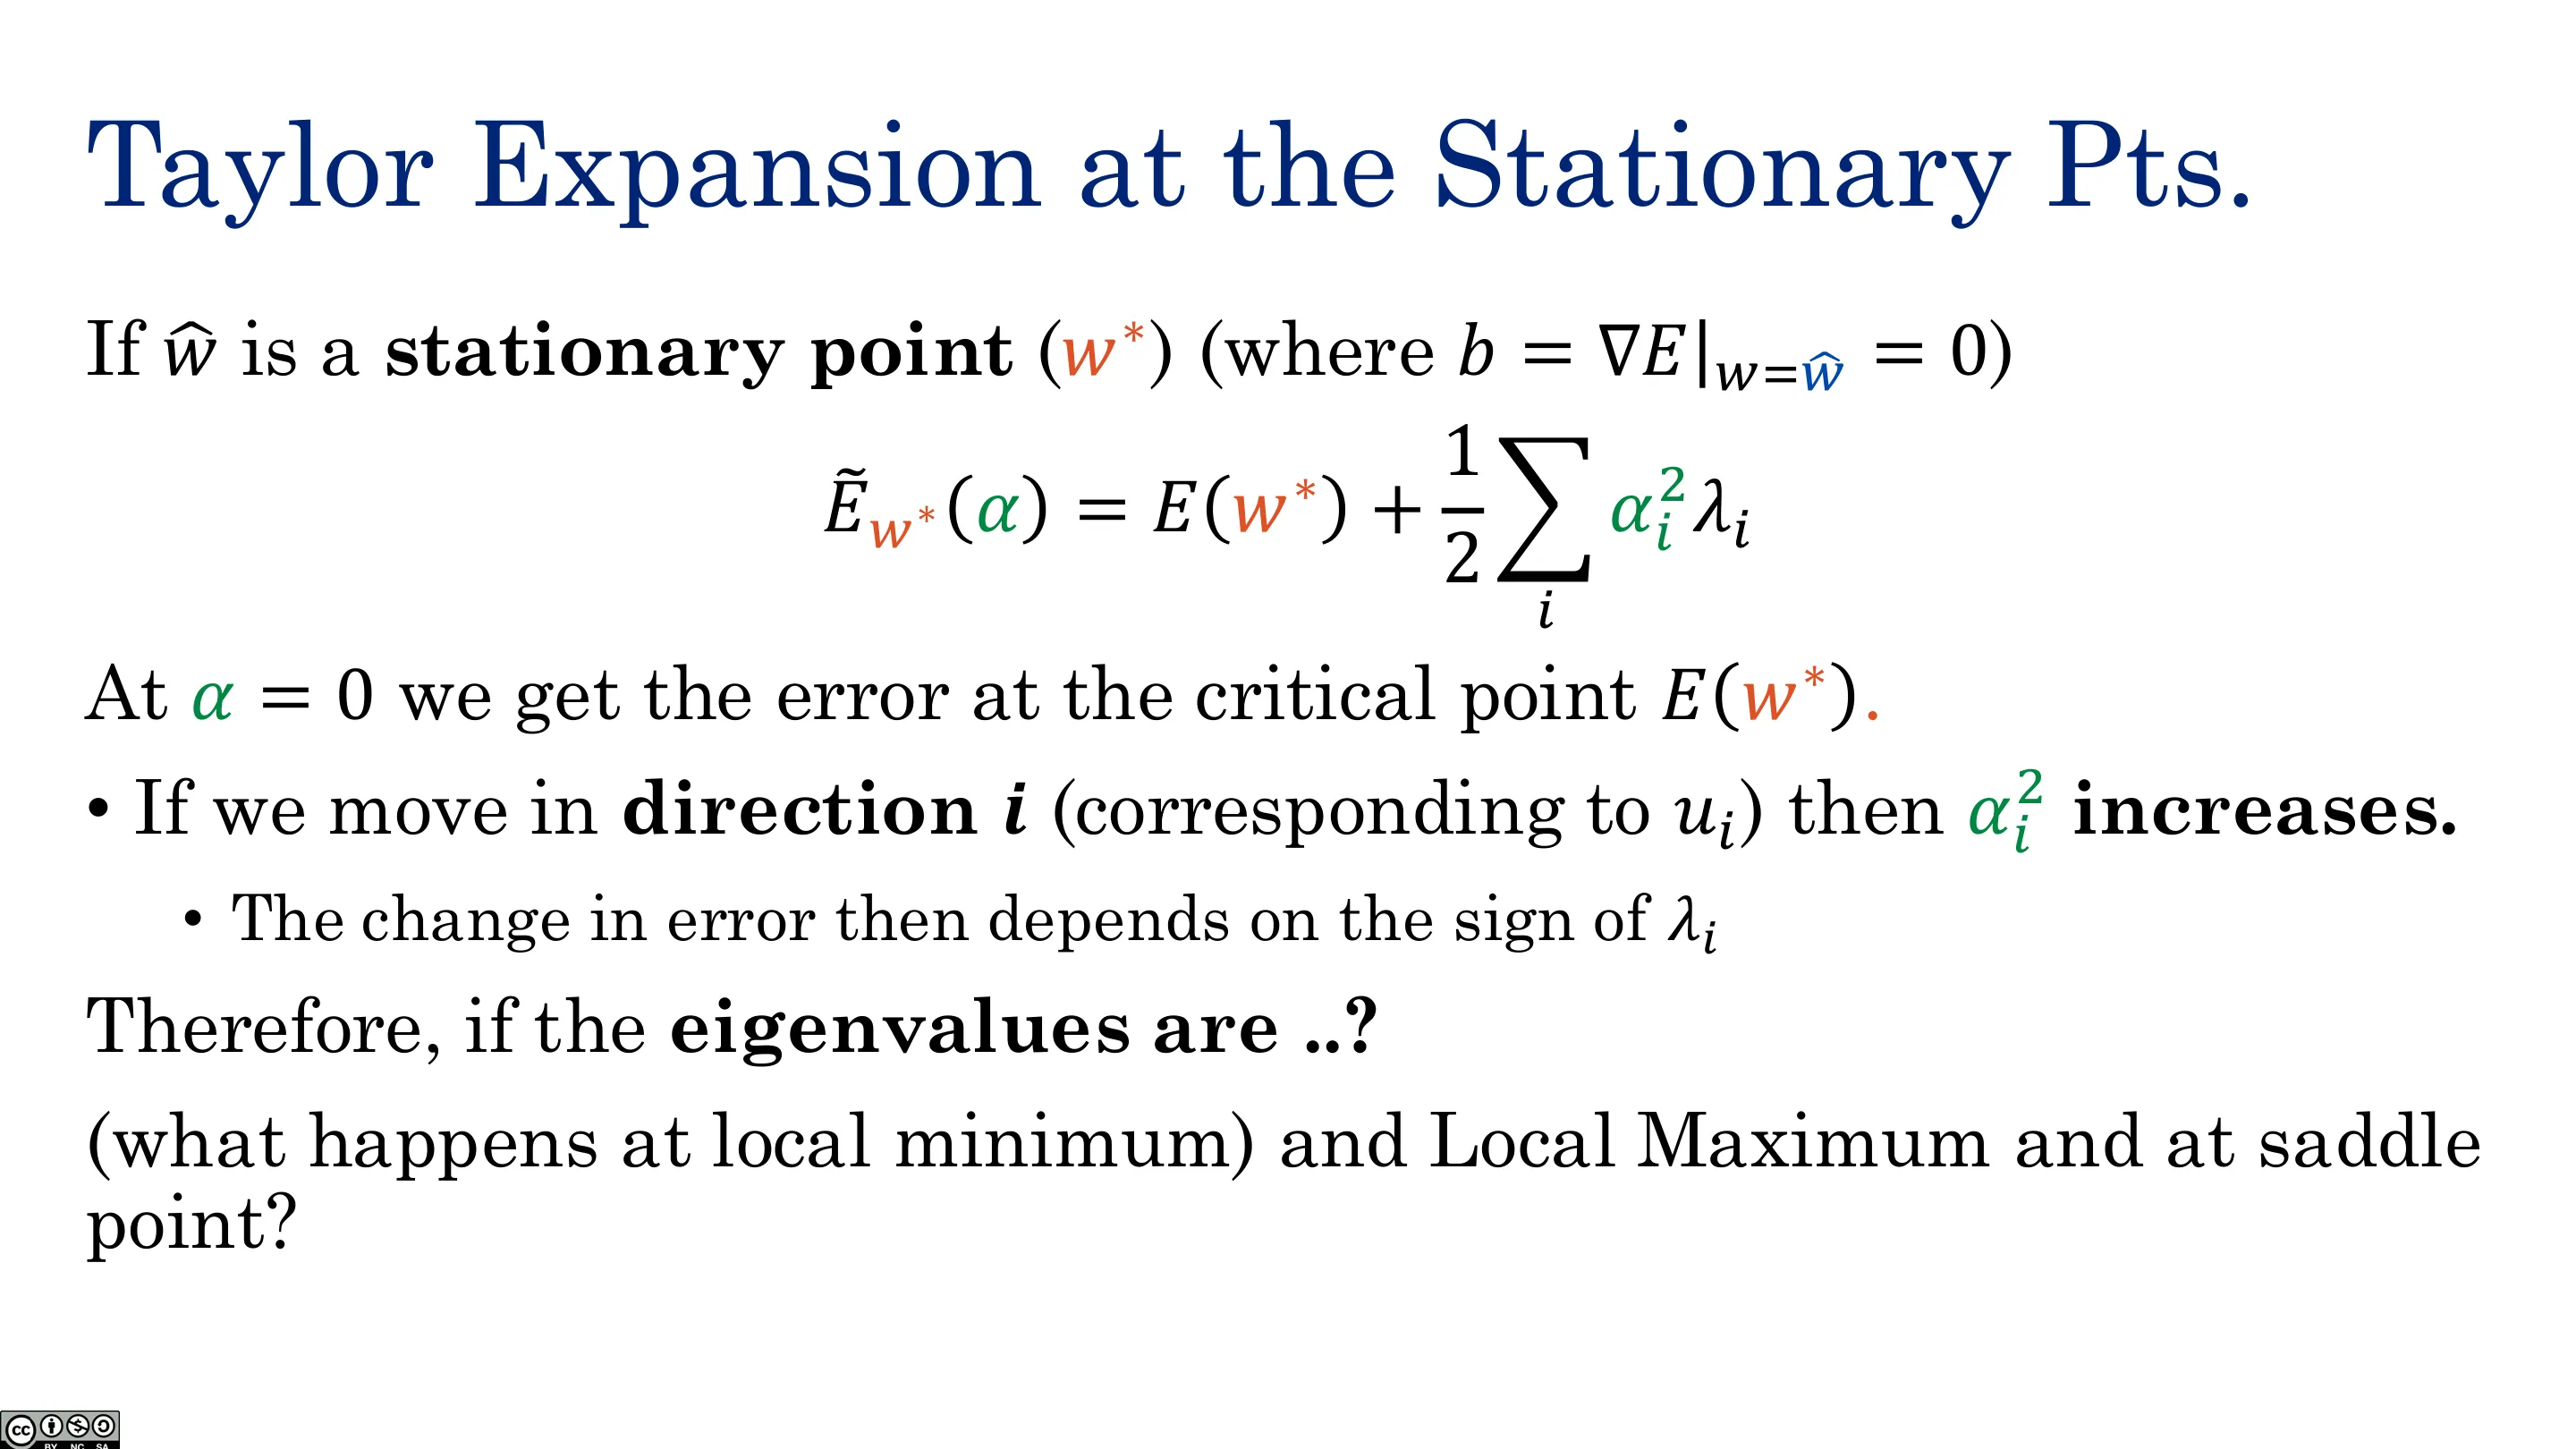
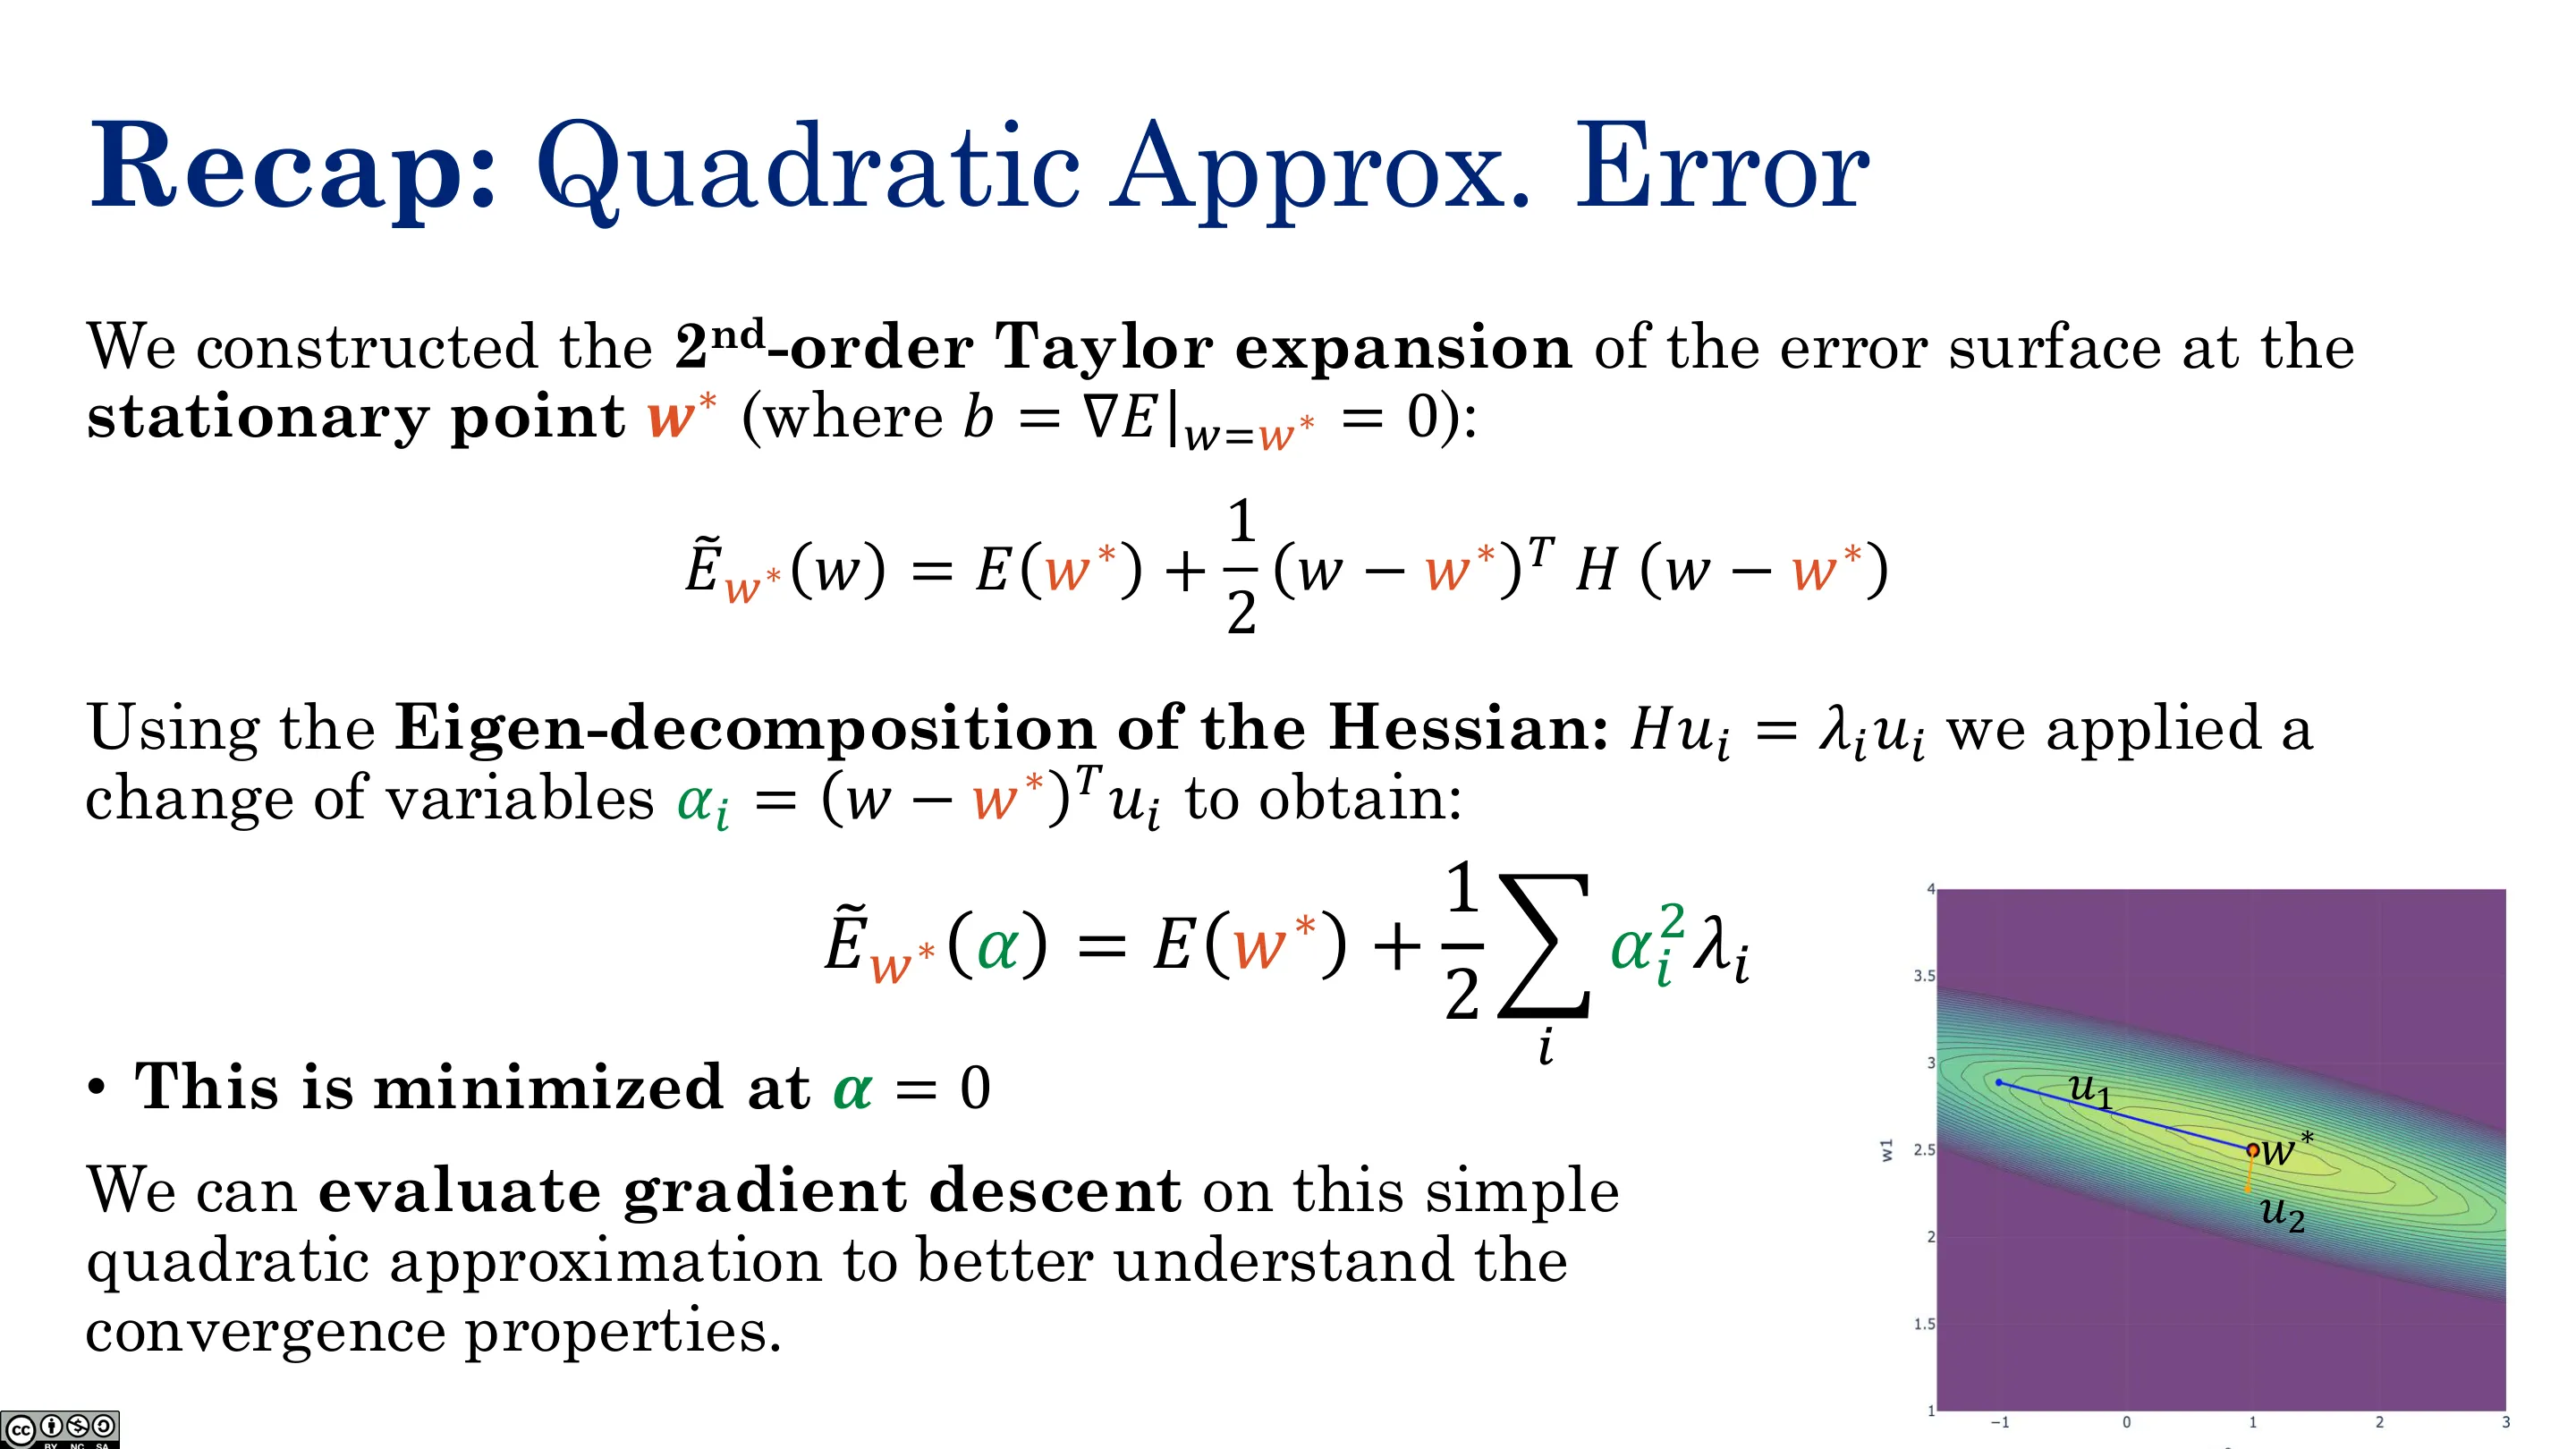
对任意(即便非二次的)损失,在某点附近做二阶 Taylor 近似:
$$ f(x)\approx f(x_0)+\nabla f(x_0)^\top(x-x_0)+\tfrac12(x-x_0)^\top H(x-x_0),\qquad H=\nabla^2 f(x_0) $$
- 标量情形:$f''(x)$ 就是曲率;$50x^2$ 陡,$0.1x^2$ 平。
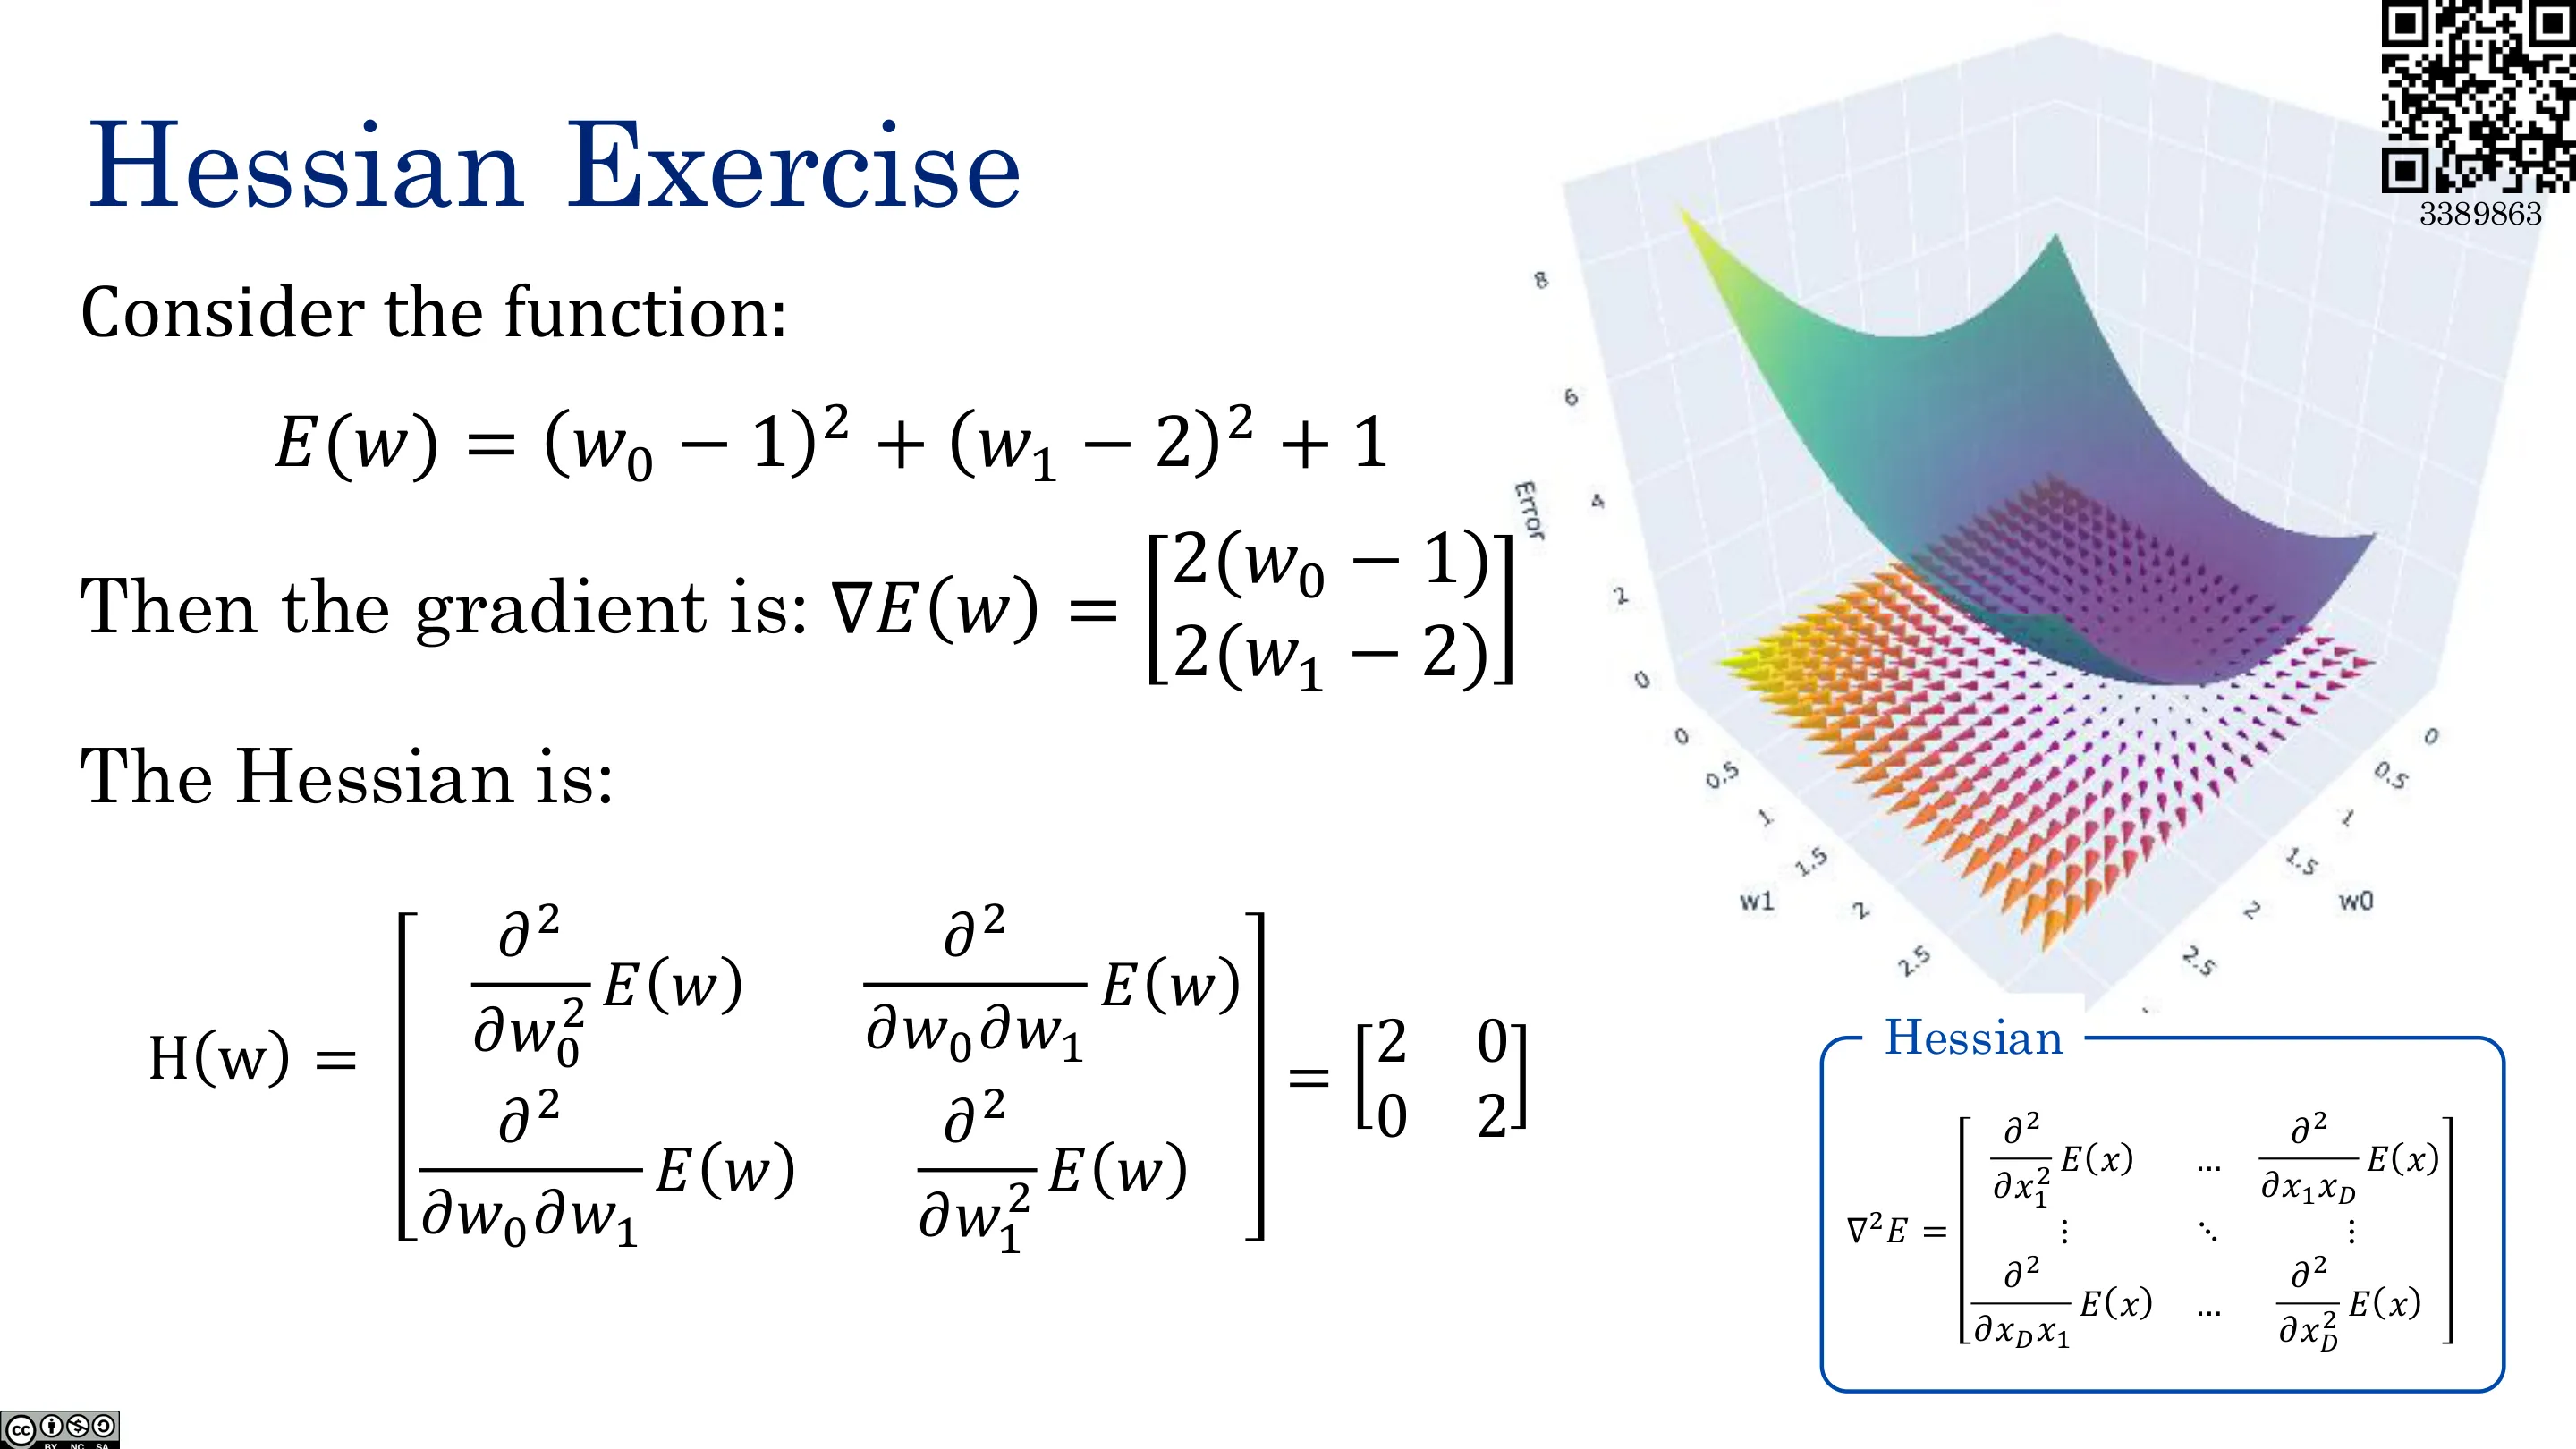
- 向量情形:二阶导是矩阵 Hessian $H$(对每个坐标两两求偏导);对称。
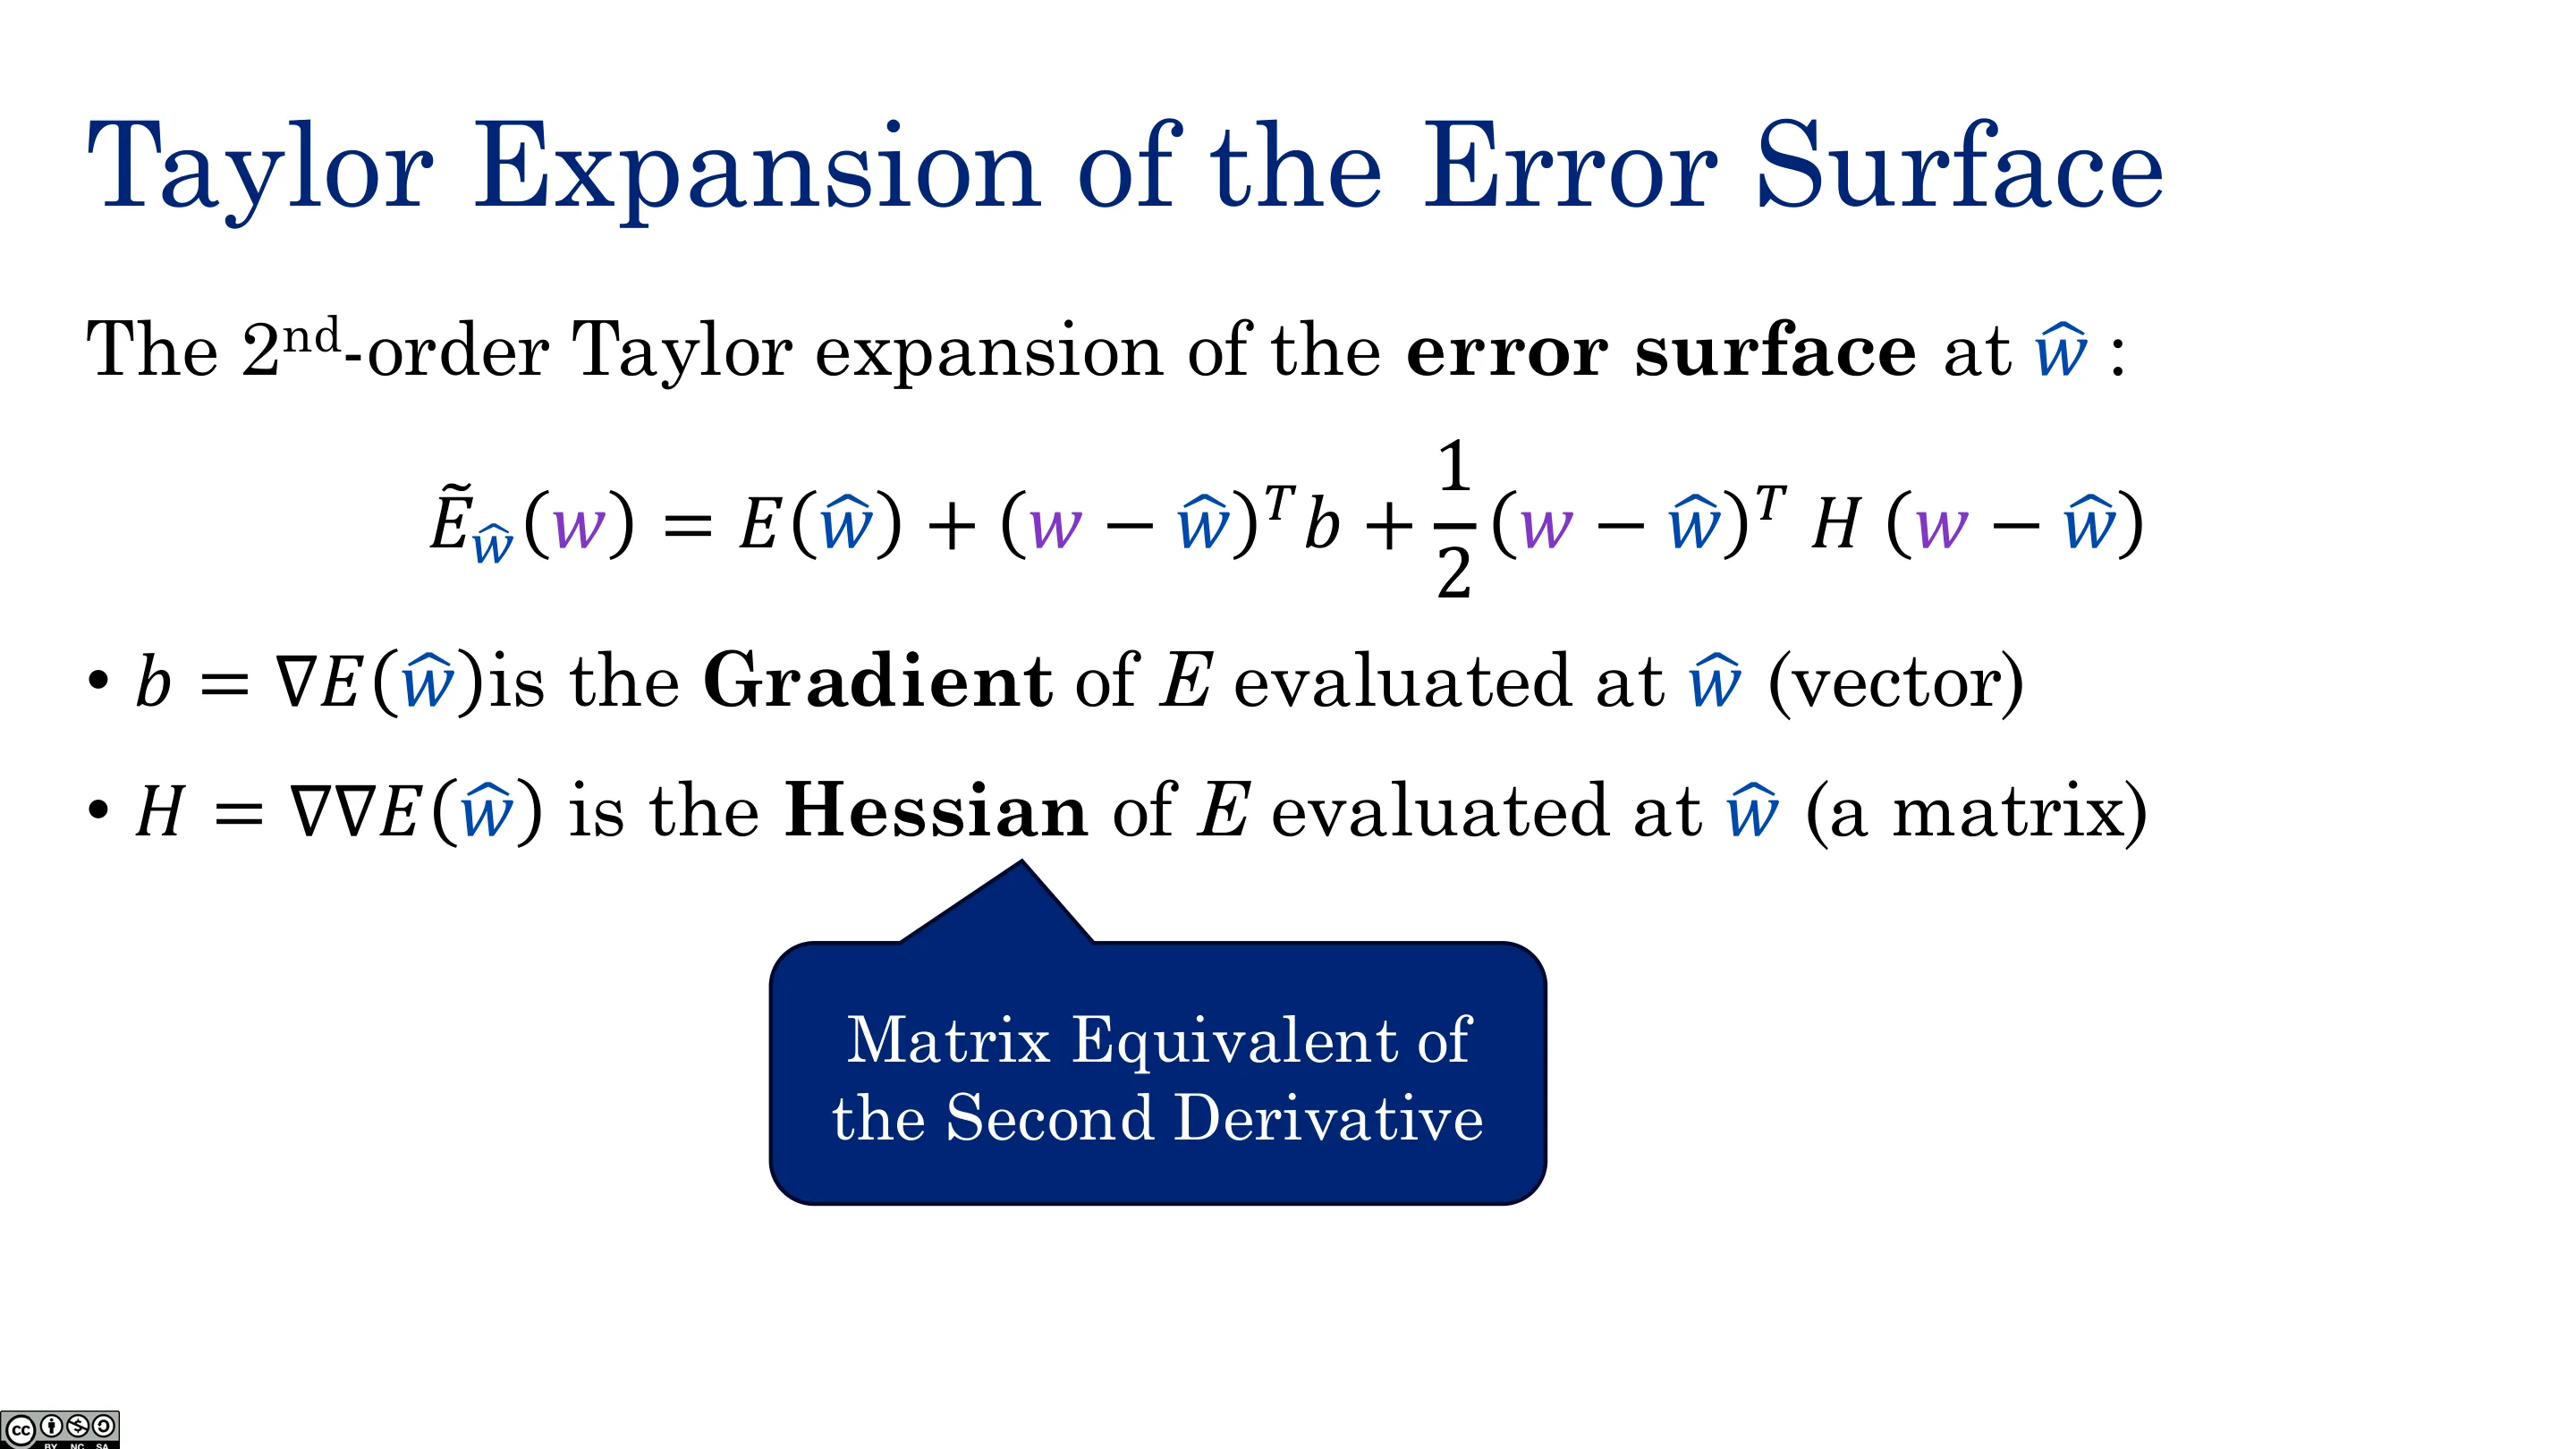
📷 误差曲面的 Taylor 展开
回到原视频 (00:28:19)
📷 Hessian(二阶导)
回到原视频 (00:29:32)
📷 Hessian 练习
回到原视频 (00:30:45)
📷 误差曲面的 Taylor 展开(续)
回到原视频 (00:31:58)
📷 推导(一)
回到原视频 (00:33:11)
📷 推导(二)
回到原视频 (00:34:24)
📷 驻点处的 Taylor 展开(一)
回到原视频 (00:35:37)
📷 驻点处的 Taylor 展开(二)
回到原视频 (00:36:50)
📷 驻点与 Hessian
回到原视频 (00:38:03)
📷 Hessian 的特征向量
回到原视频 (00:39:16)
2.1 临界点分类
(参考时间: 00:33)
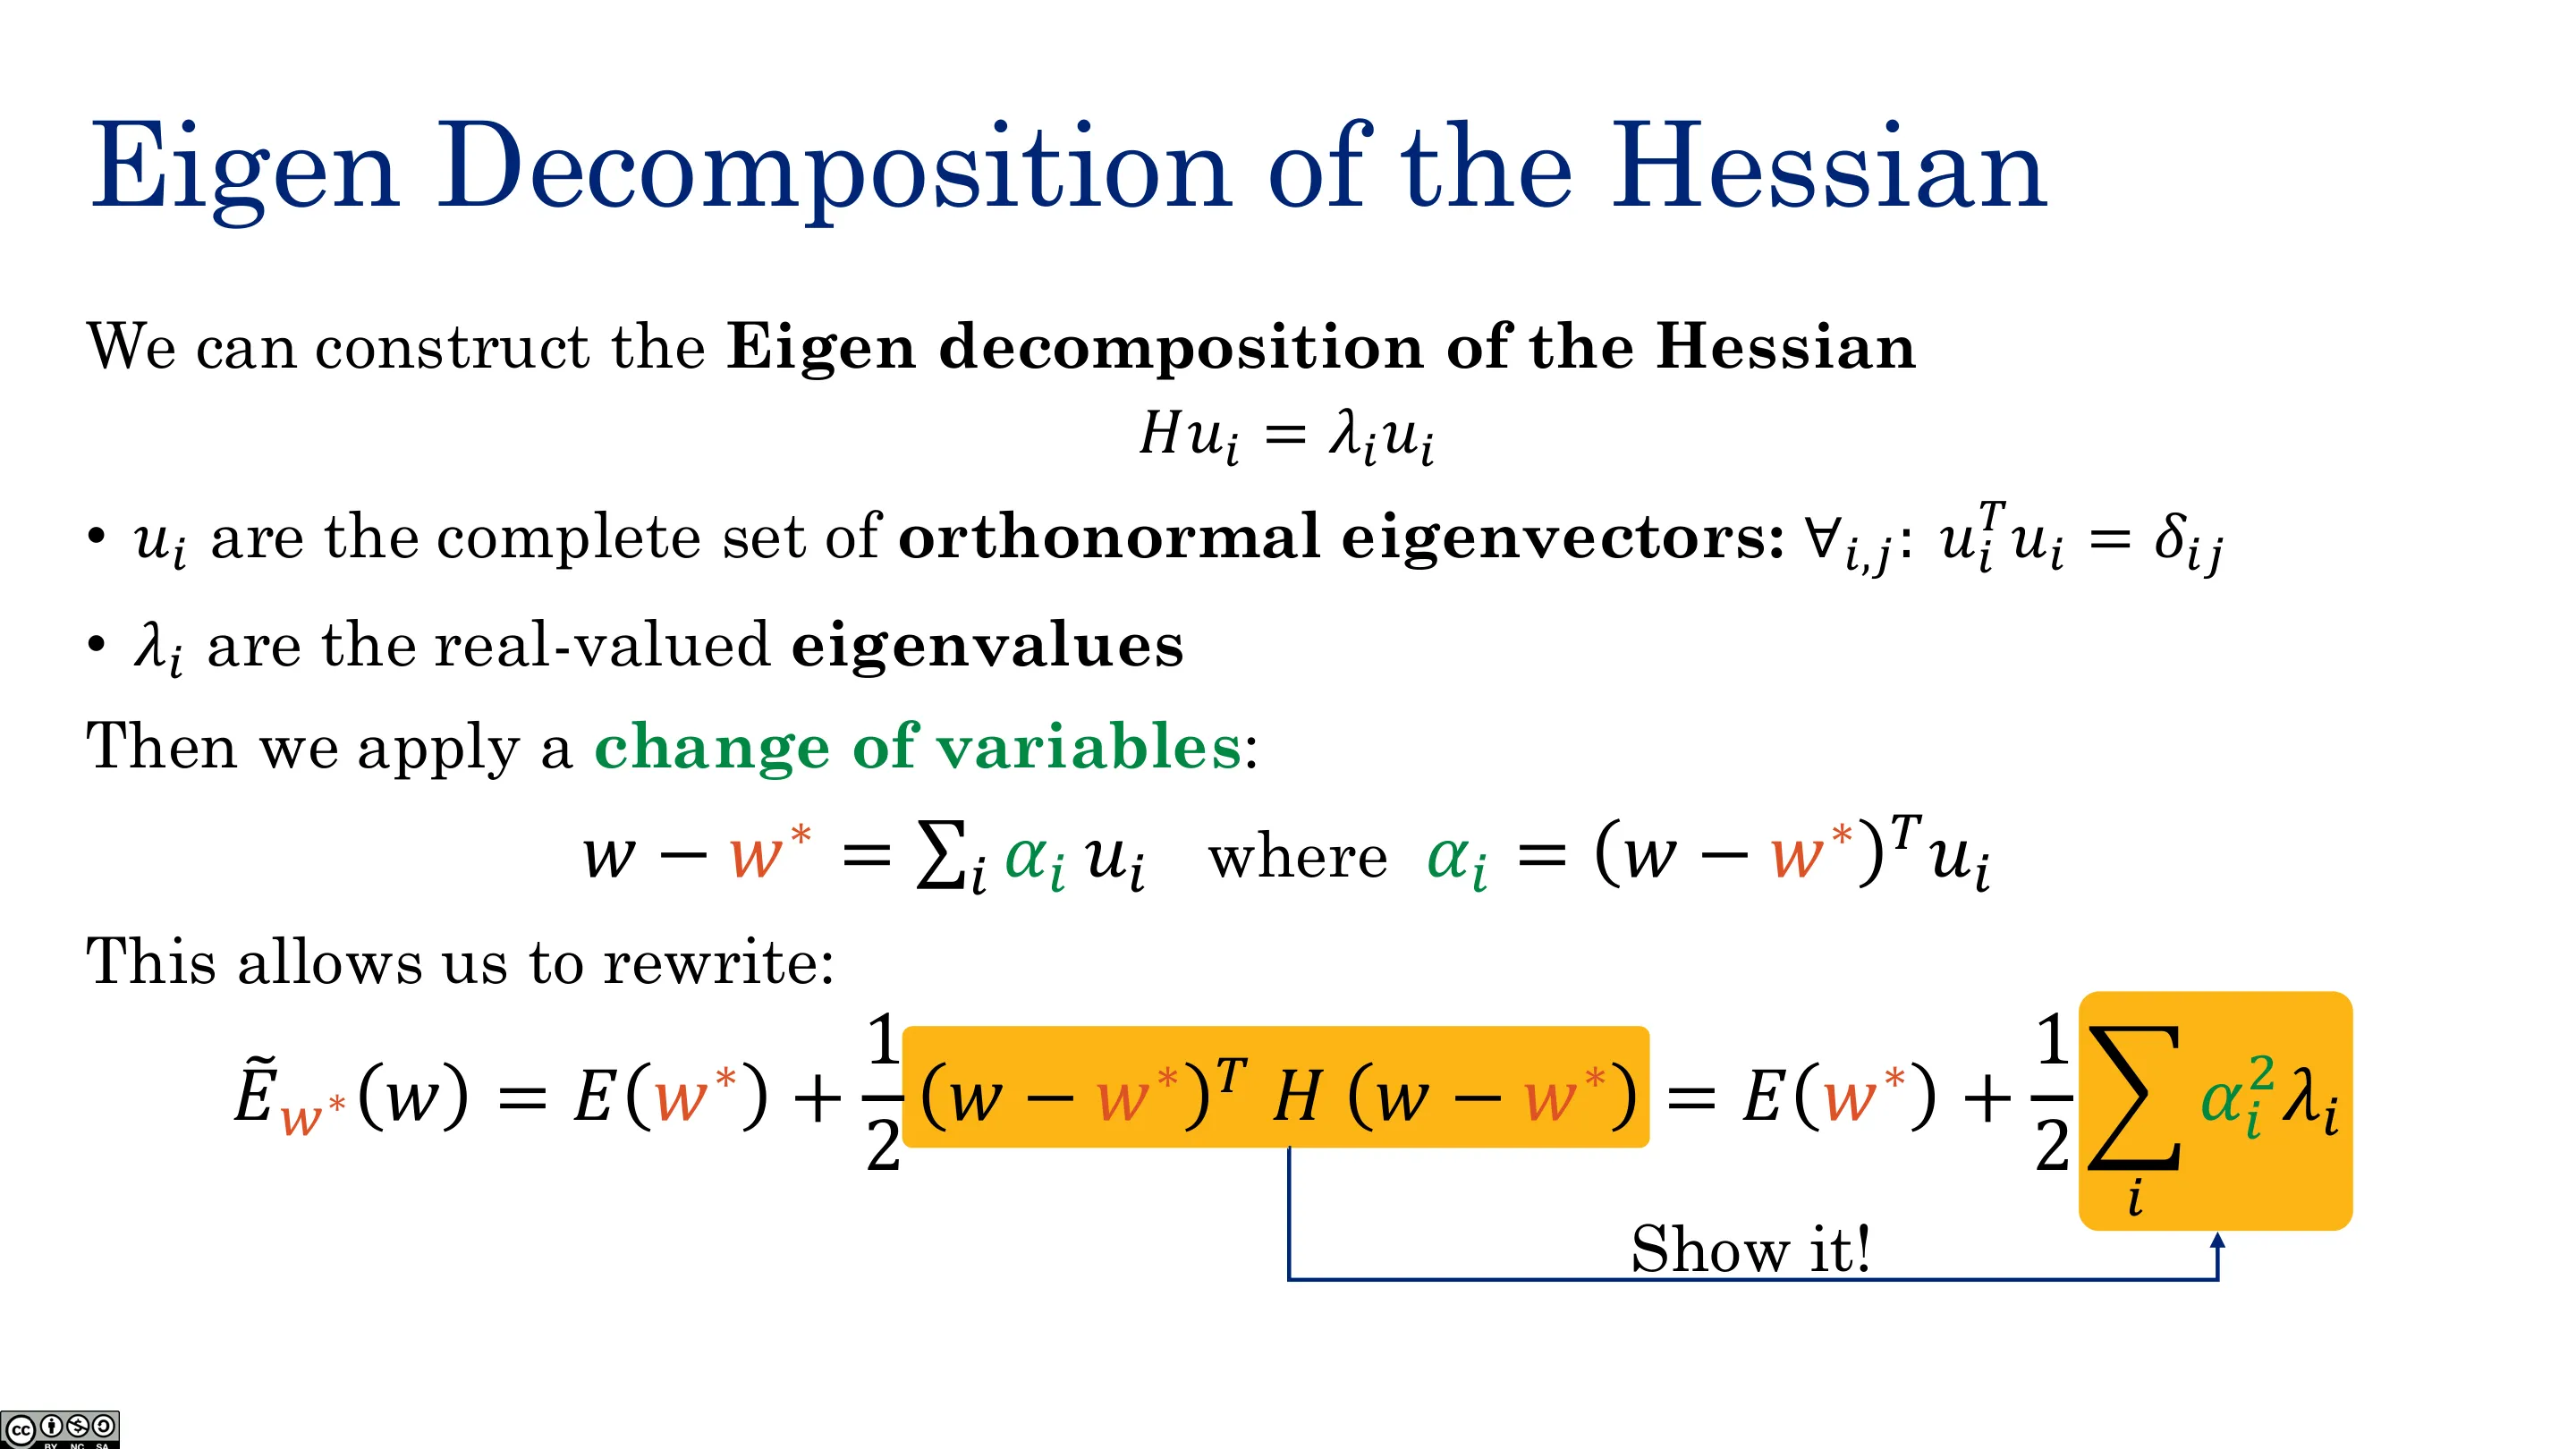
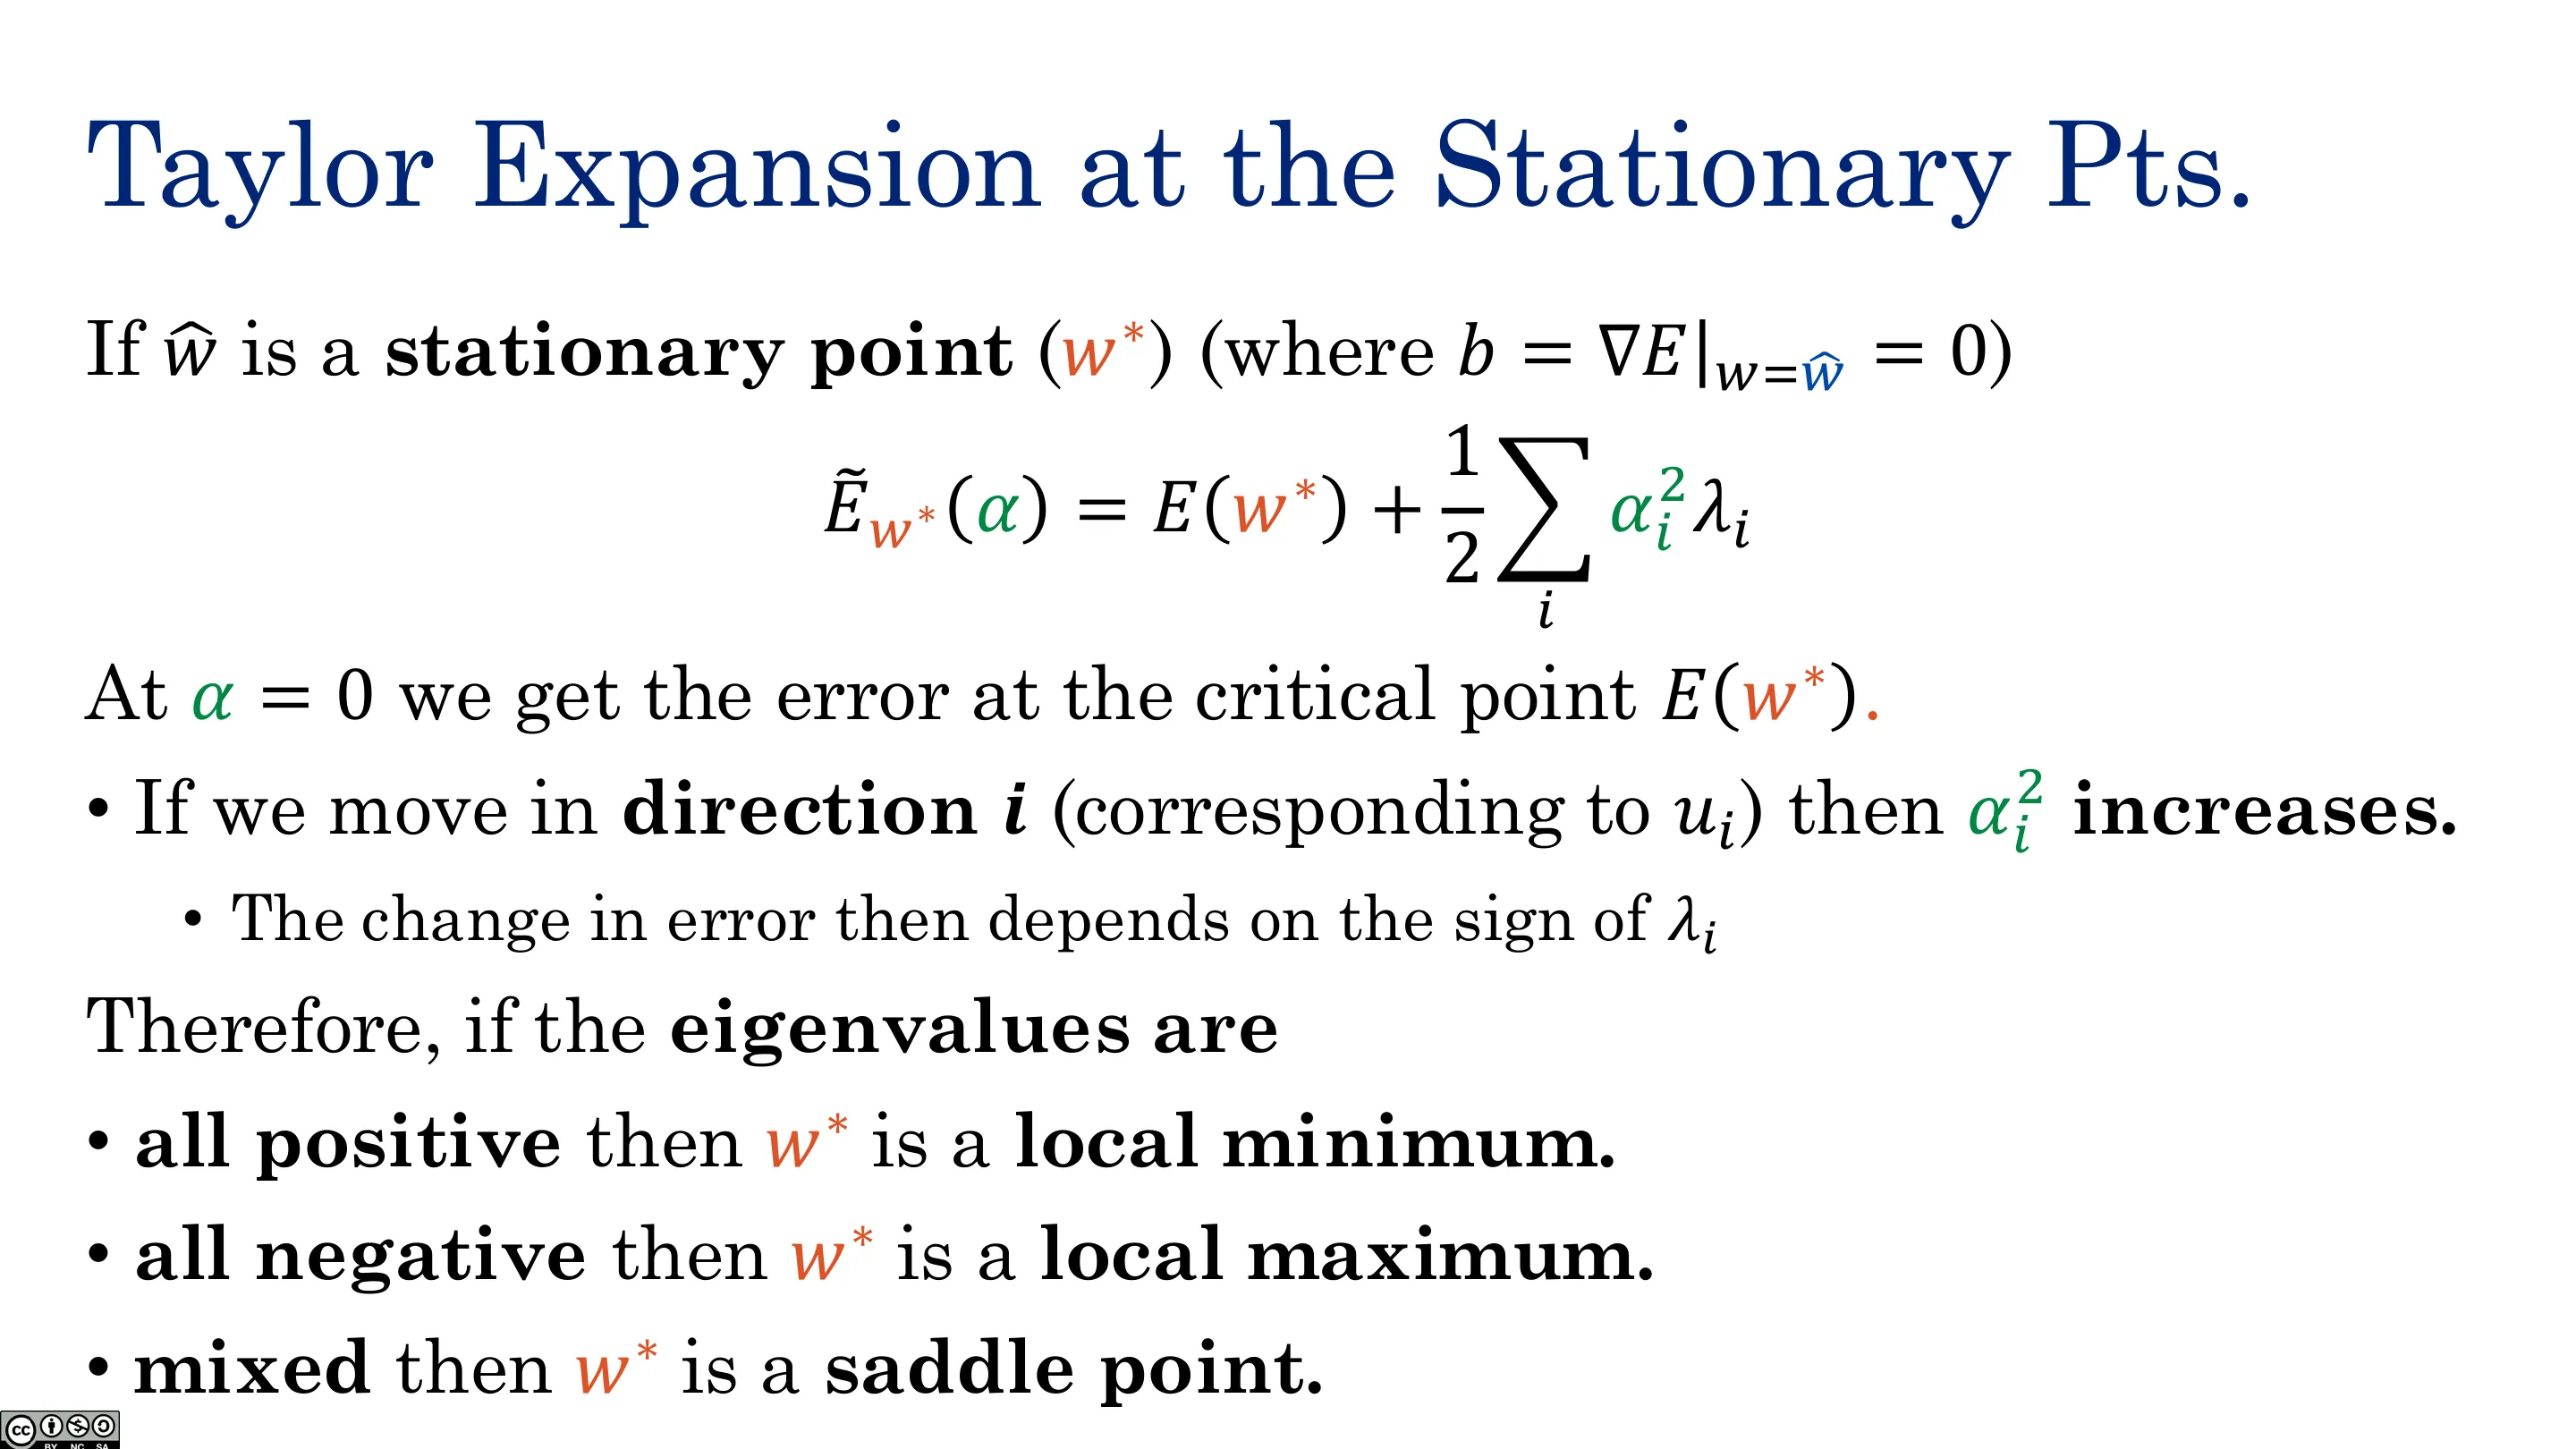
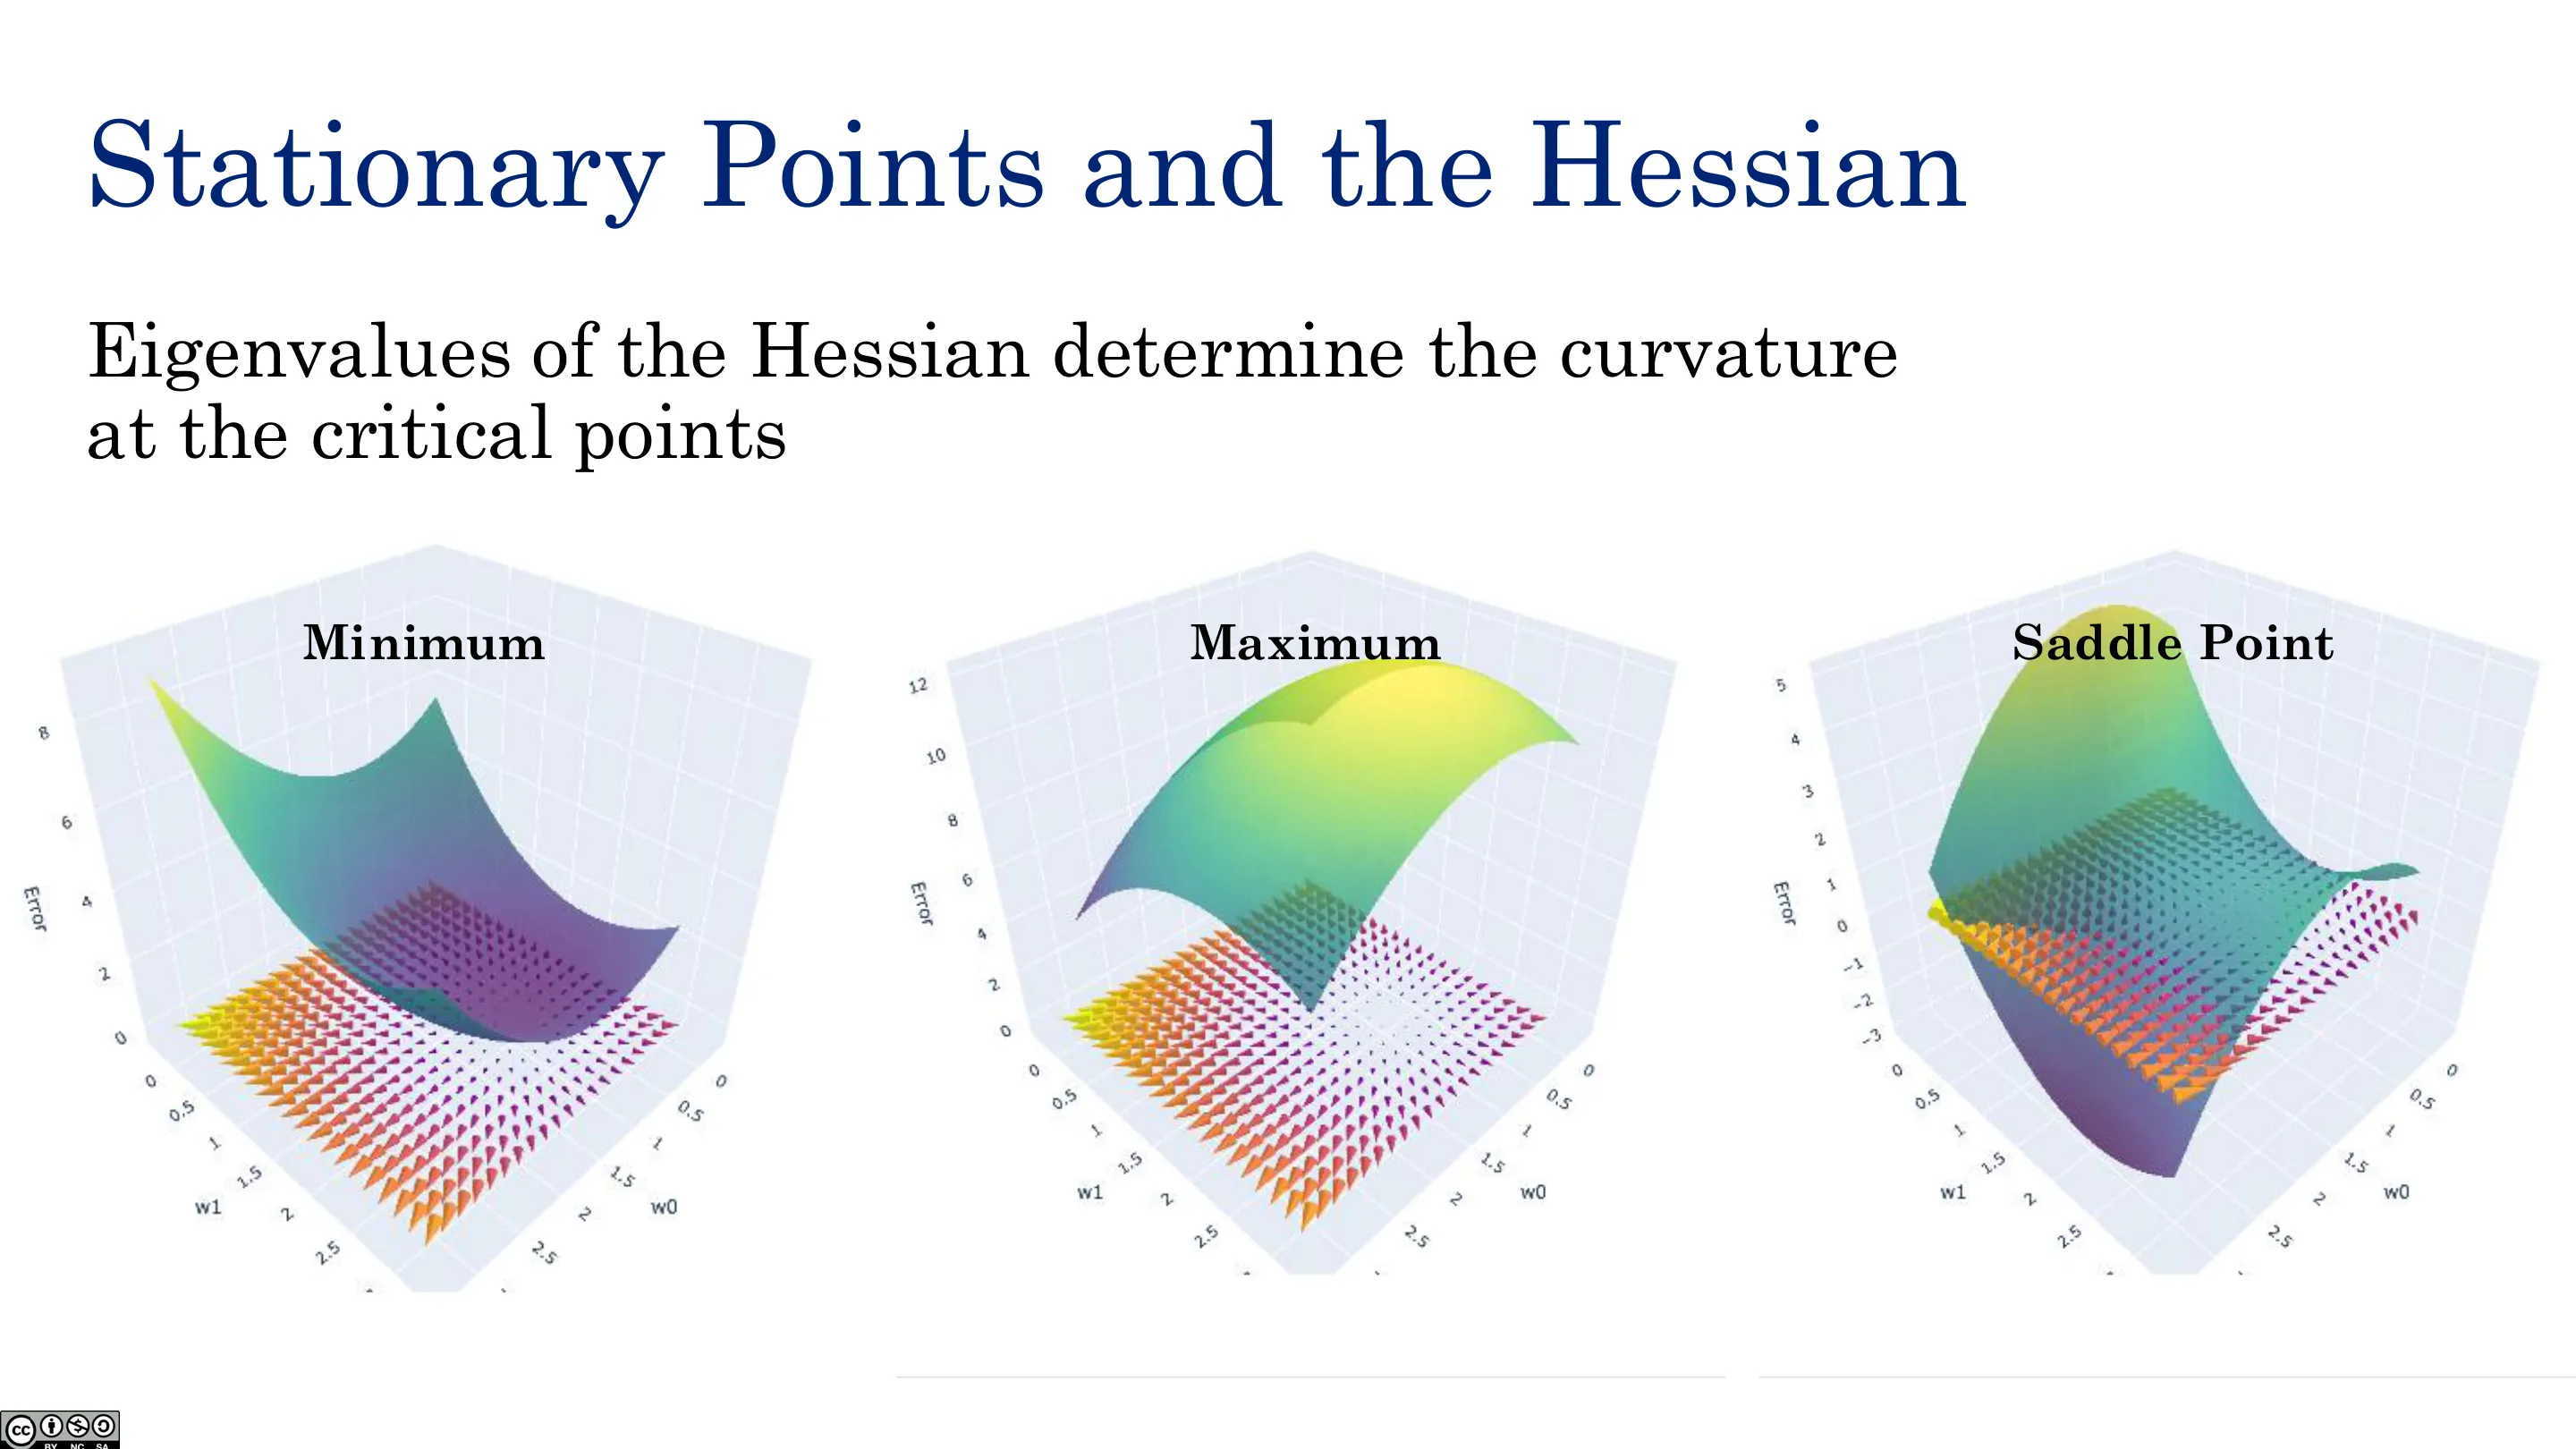
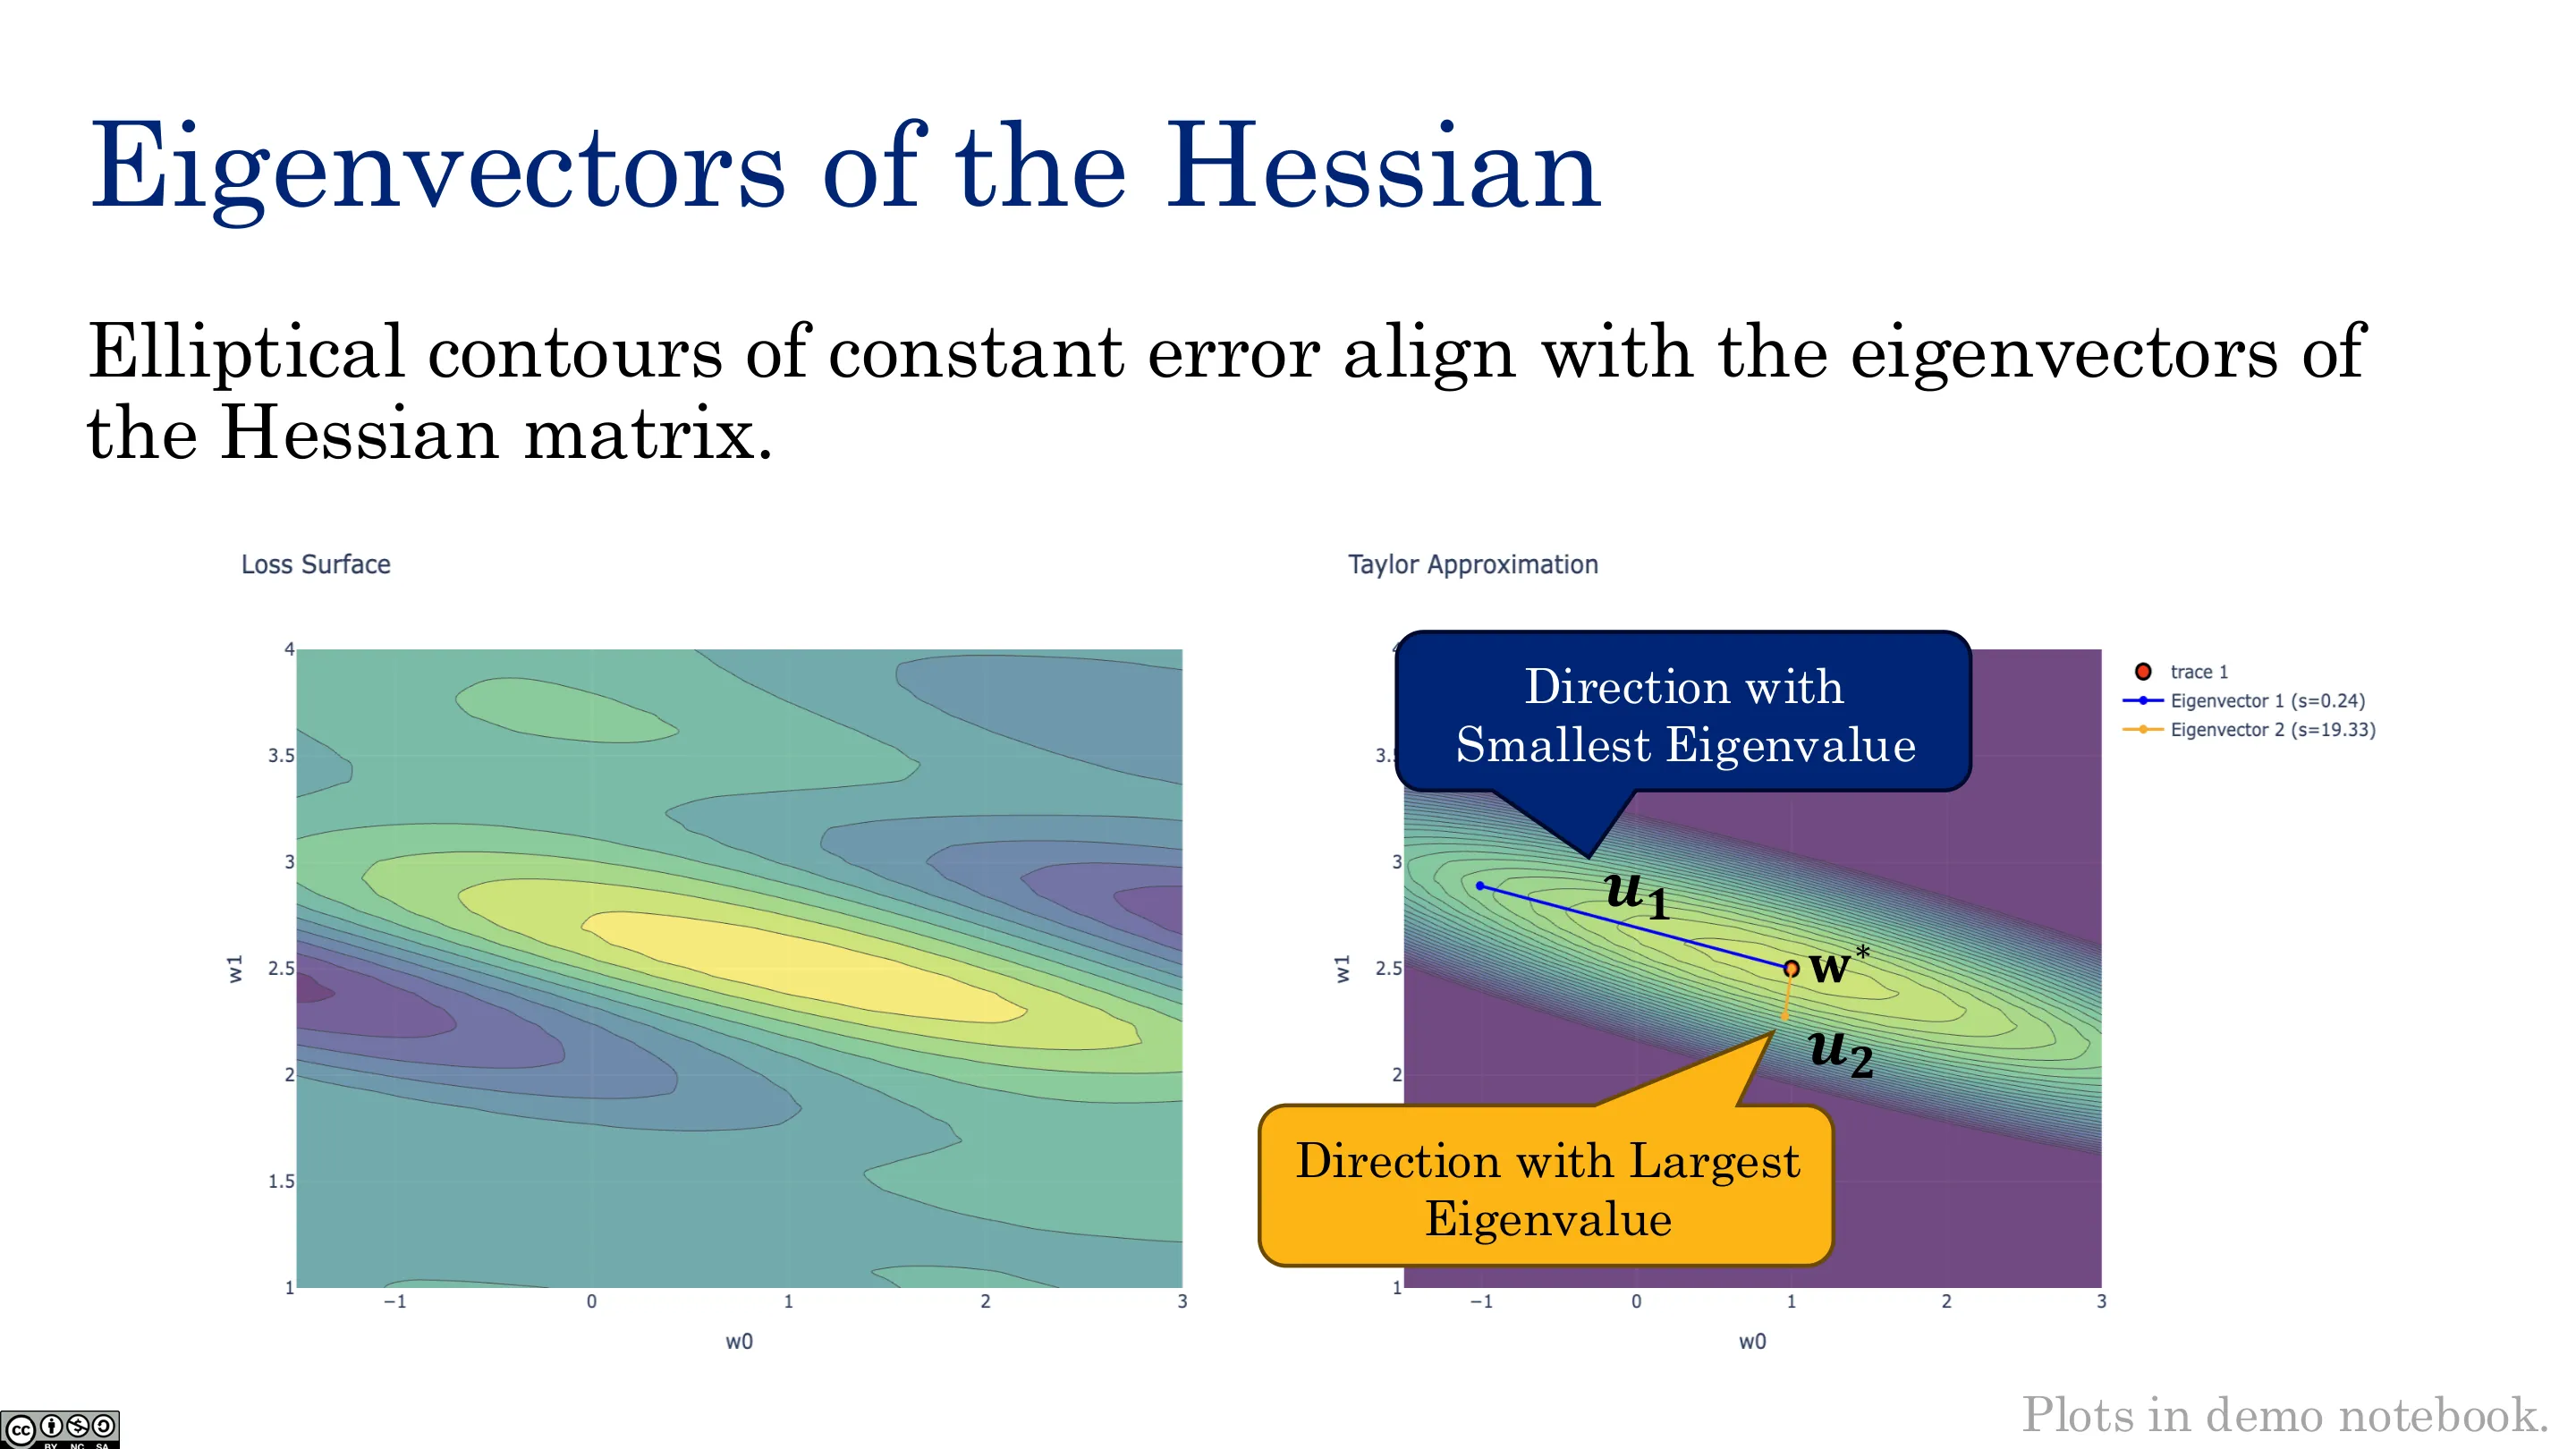
梯度为零的点是临界点,其类型由 Hessian 的特征值(特征分解 $H=Q\Lambda Q^\top$,正交归一基)决定:
| Hessian 特征值 | 类型 |
|---|---|
| 全部 $\lambda_i>0$ | 局部极小(碗) |
| 全部 $\lambda_i<0$ | 局部极大(倒碗) |
| 有正有负 | 鞍点(saddle)——像「薯片」 |
标量退化情形:$f''(x)=0$ 对应平坦/高阶鞍点。二维以上才可能「一个方向极小、另一个方向极大」——这就是 鞍点(一维看不到这种「薯片」几何)。
几何直觉:梯度指向最速上升方向,所以 $-\nabla$ 是最速下降方向。最优解是算法的不动点(从极小点出发不再移动)。
📷 小结:二次近似误差
回到原视频 (00:40:29)
📷 二次近似上的梯度下降(一)
回到原视频 (00:41:42)
📷 二次近似上的梯度下降(二)
回到原视频 (00:42:55)
2.2 学习率与条件数
(参考时间: 01:01)
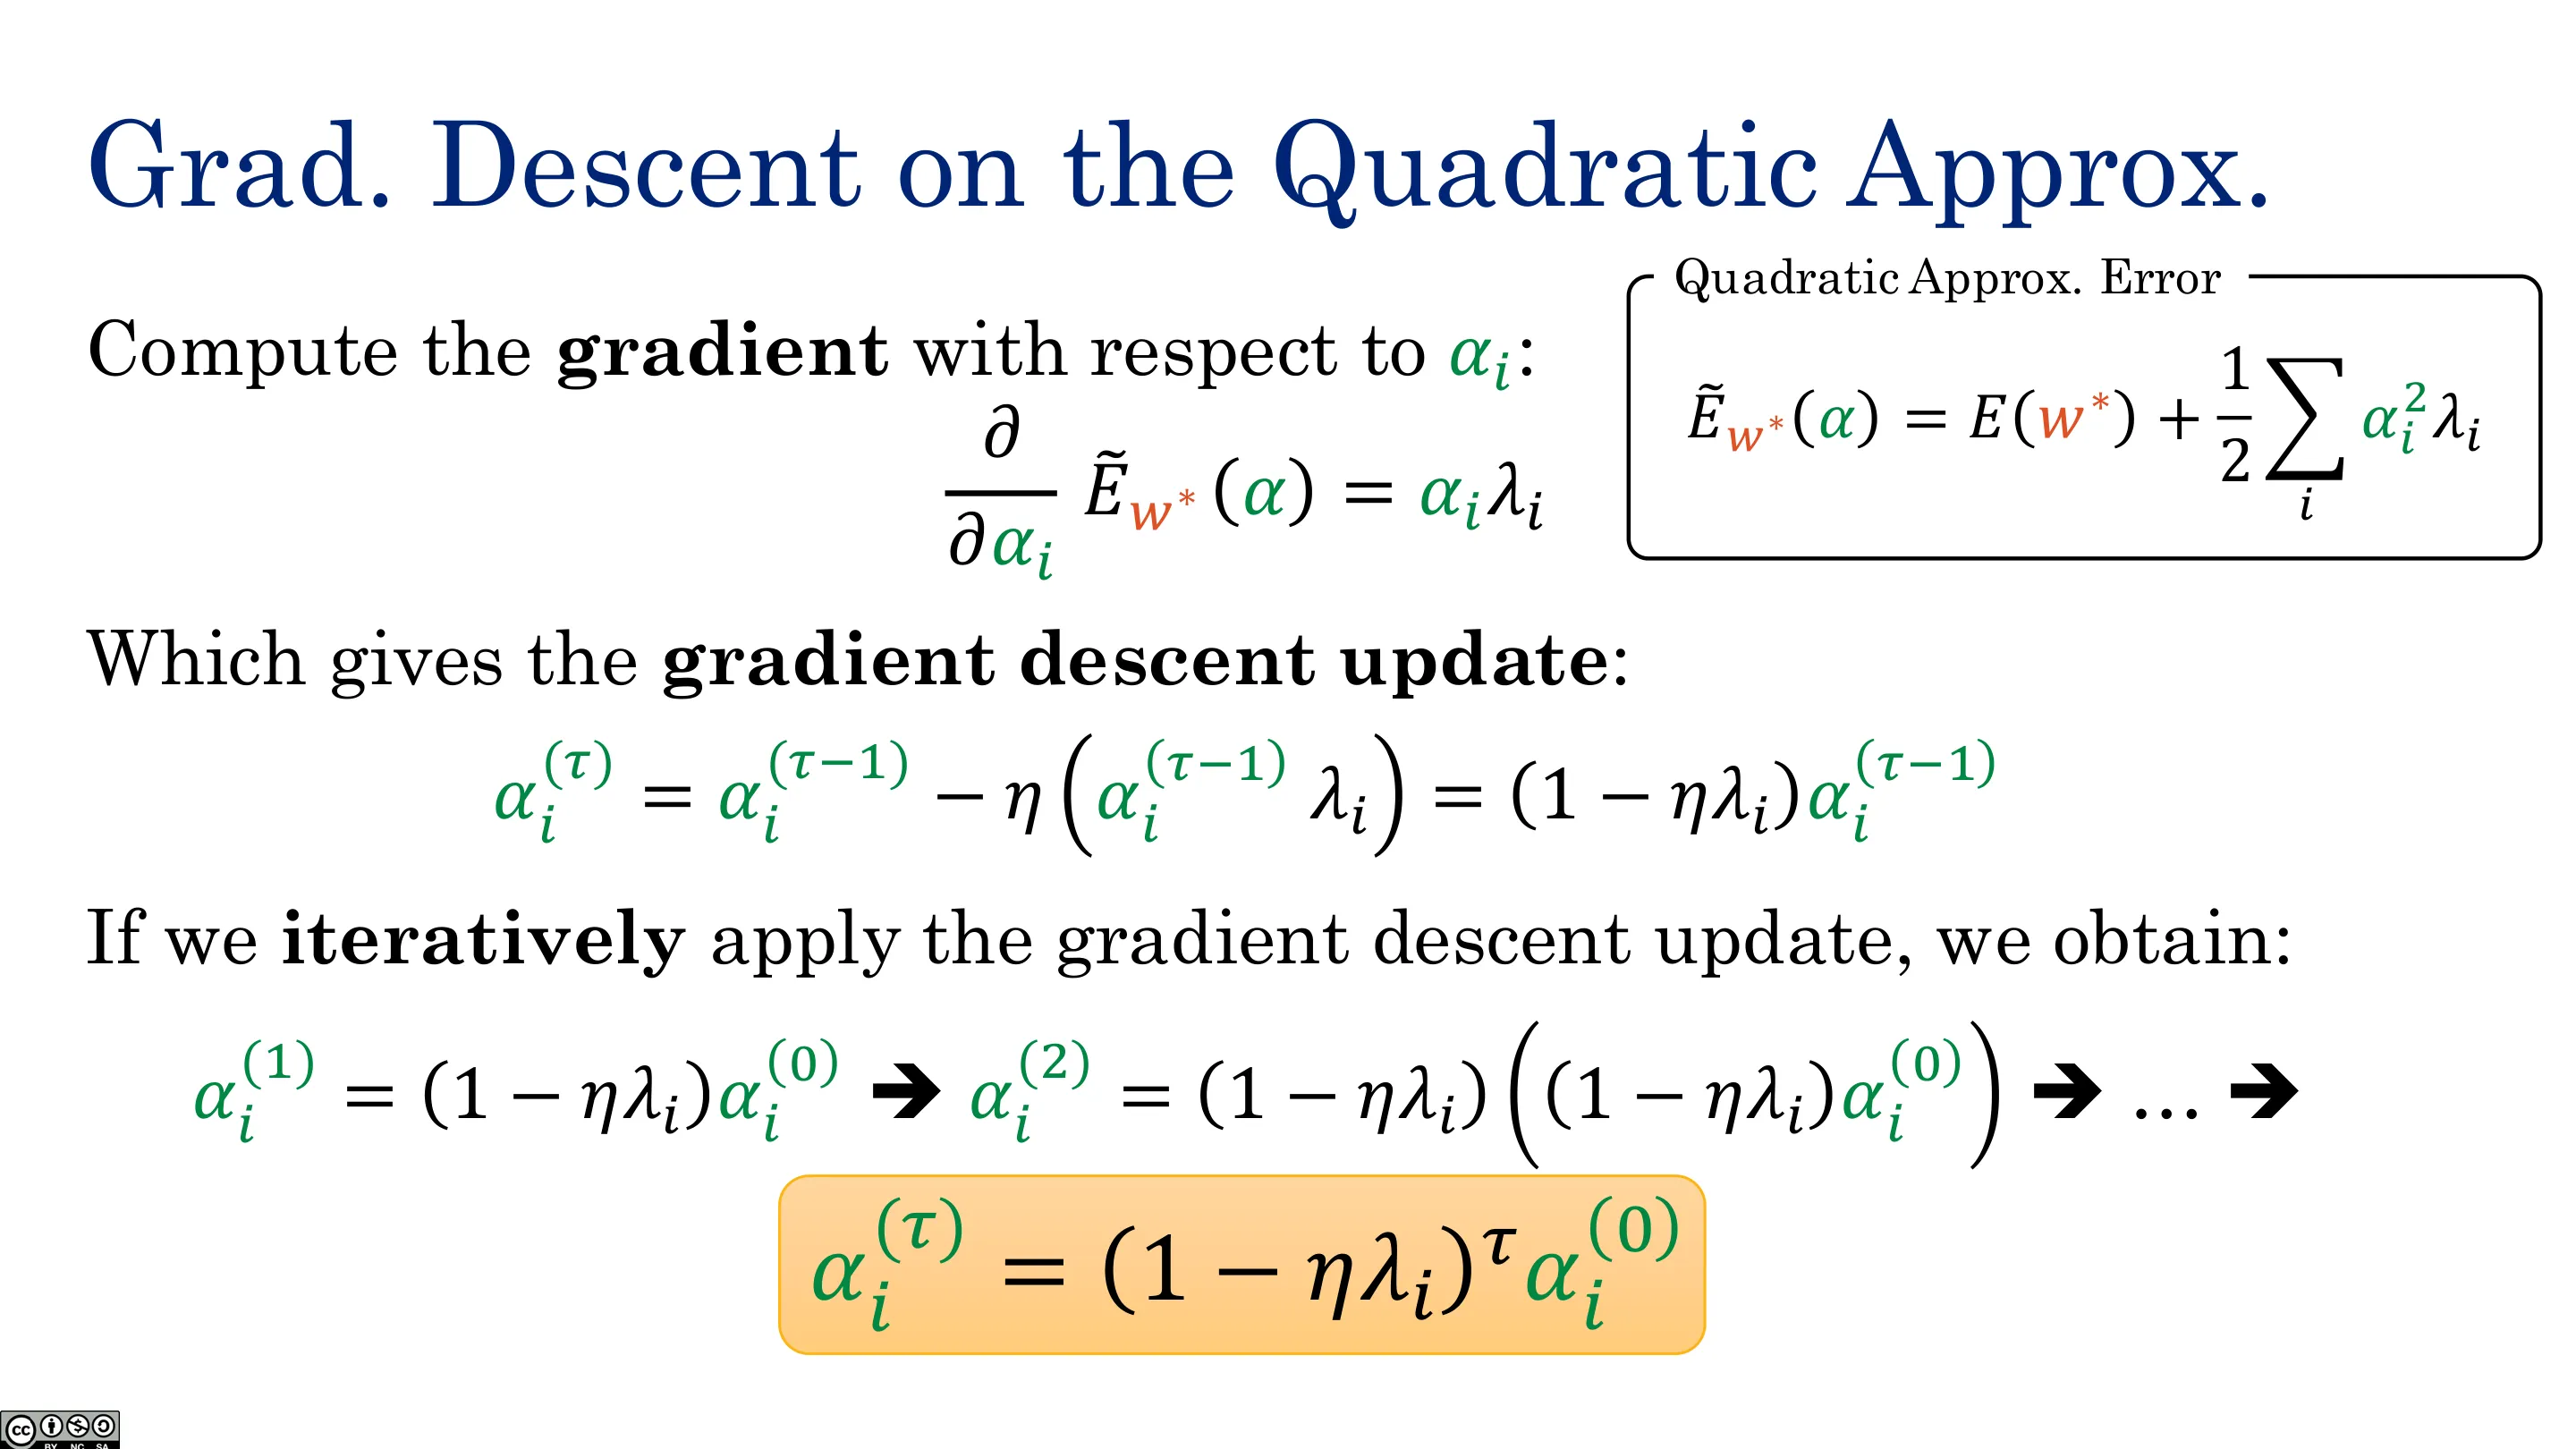
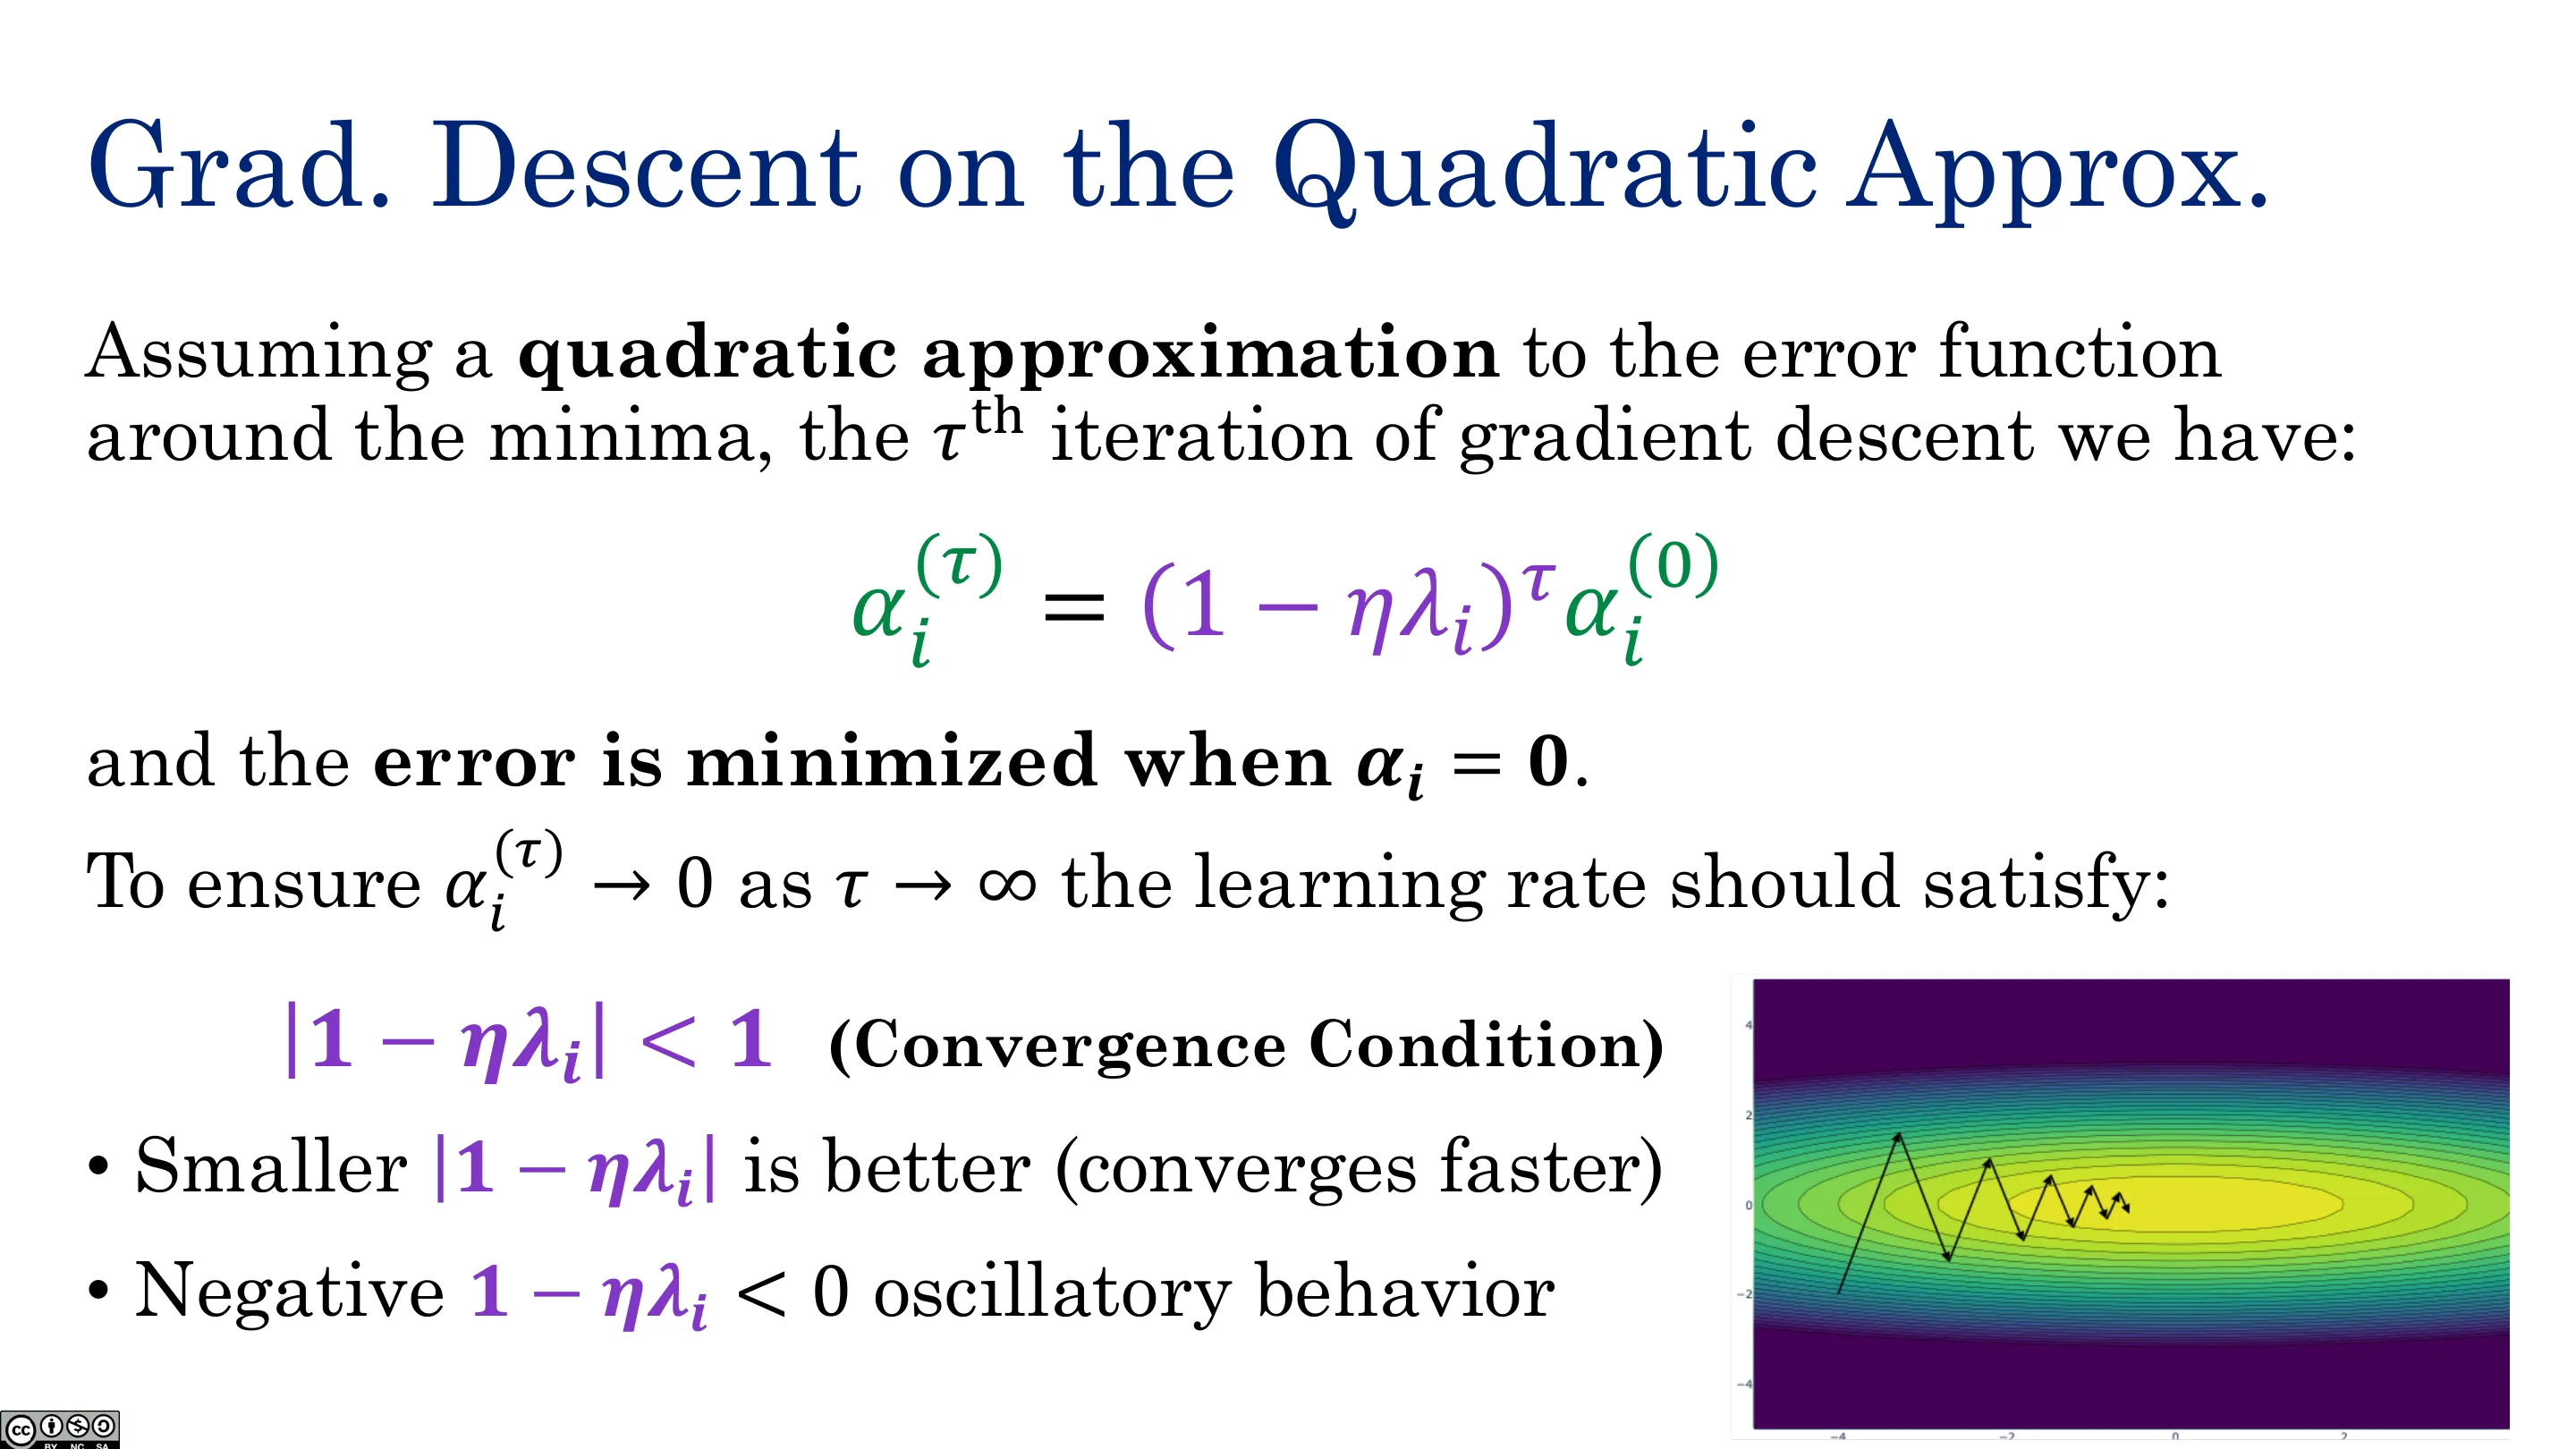
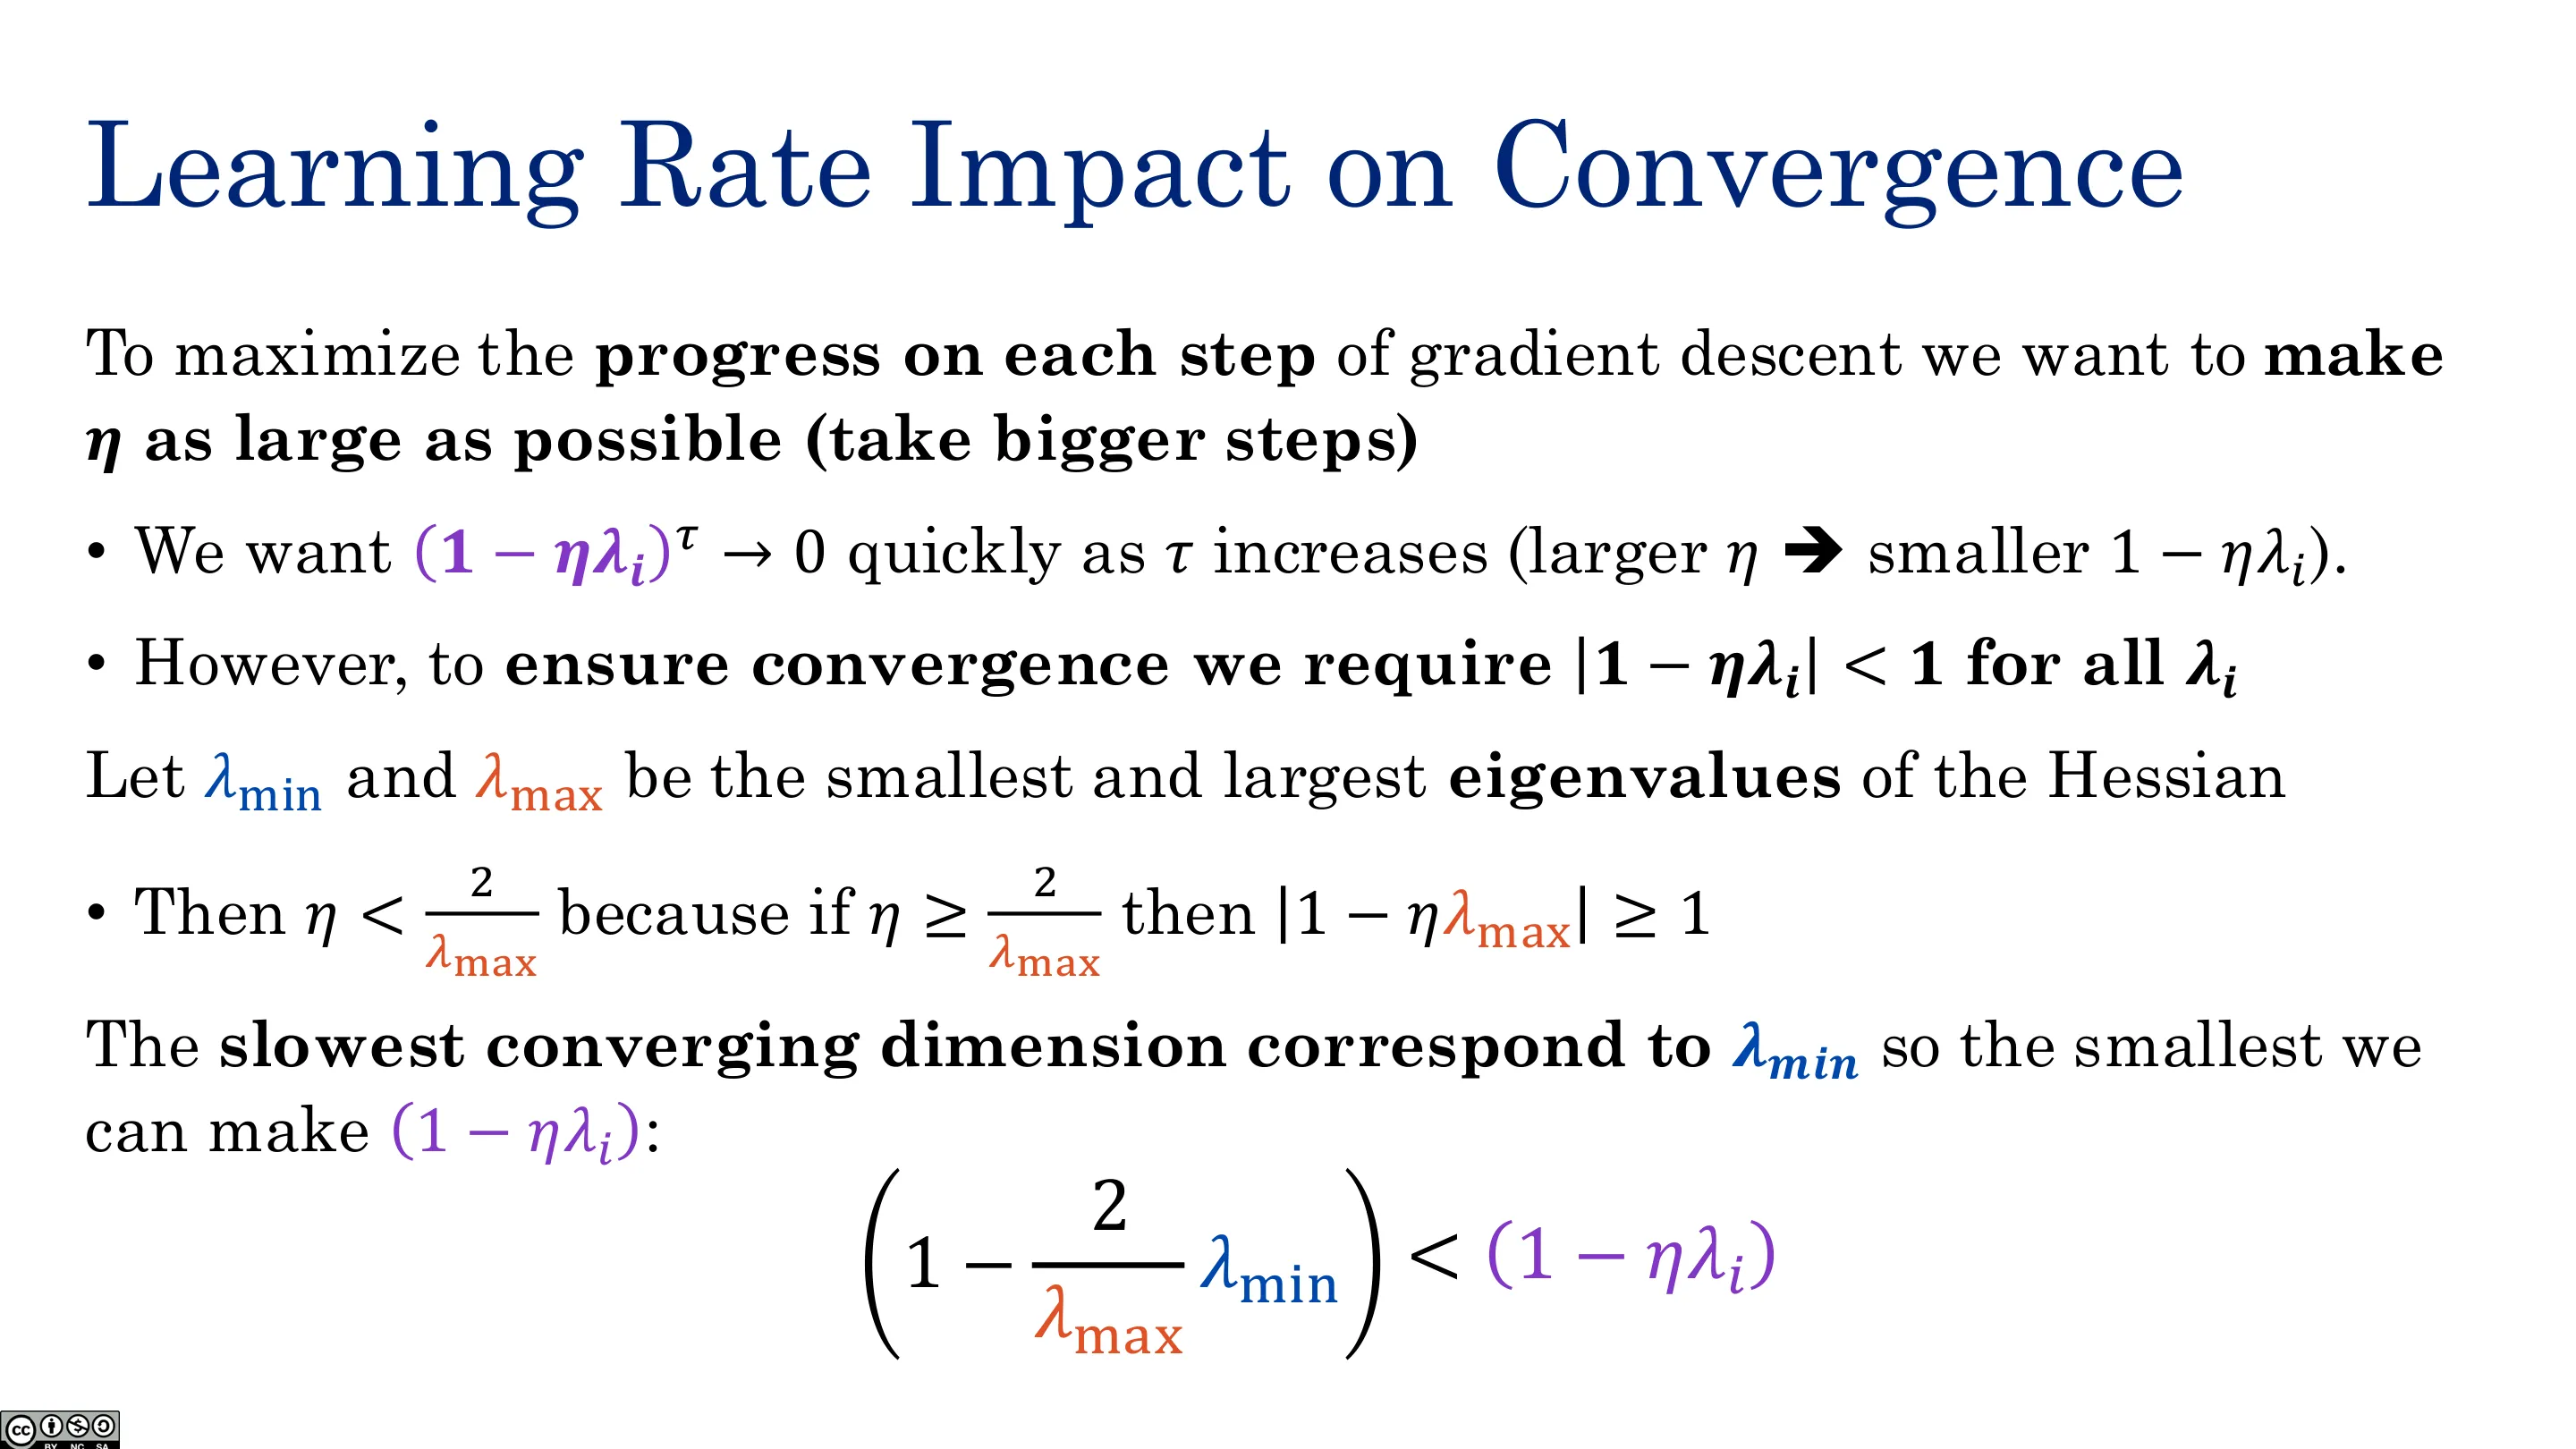
对二次函数,收敛速率由 $|1-\eta\lambda|<1$ 控制 ⇒ 学习率上限约 $2/\lambda_{\max}$:
- $\lambda_{\max}$(最大曲率)告诉你别迈太大步,否则震荡/发散;
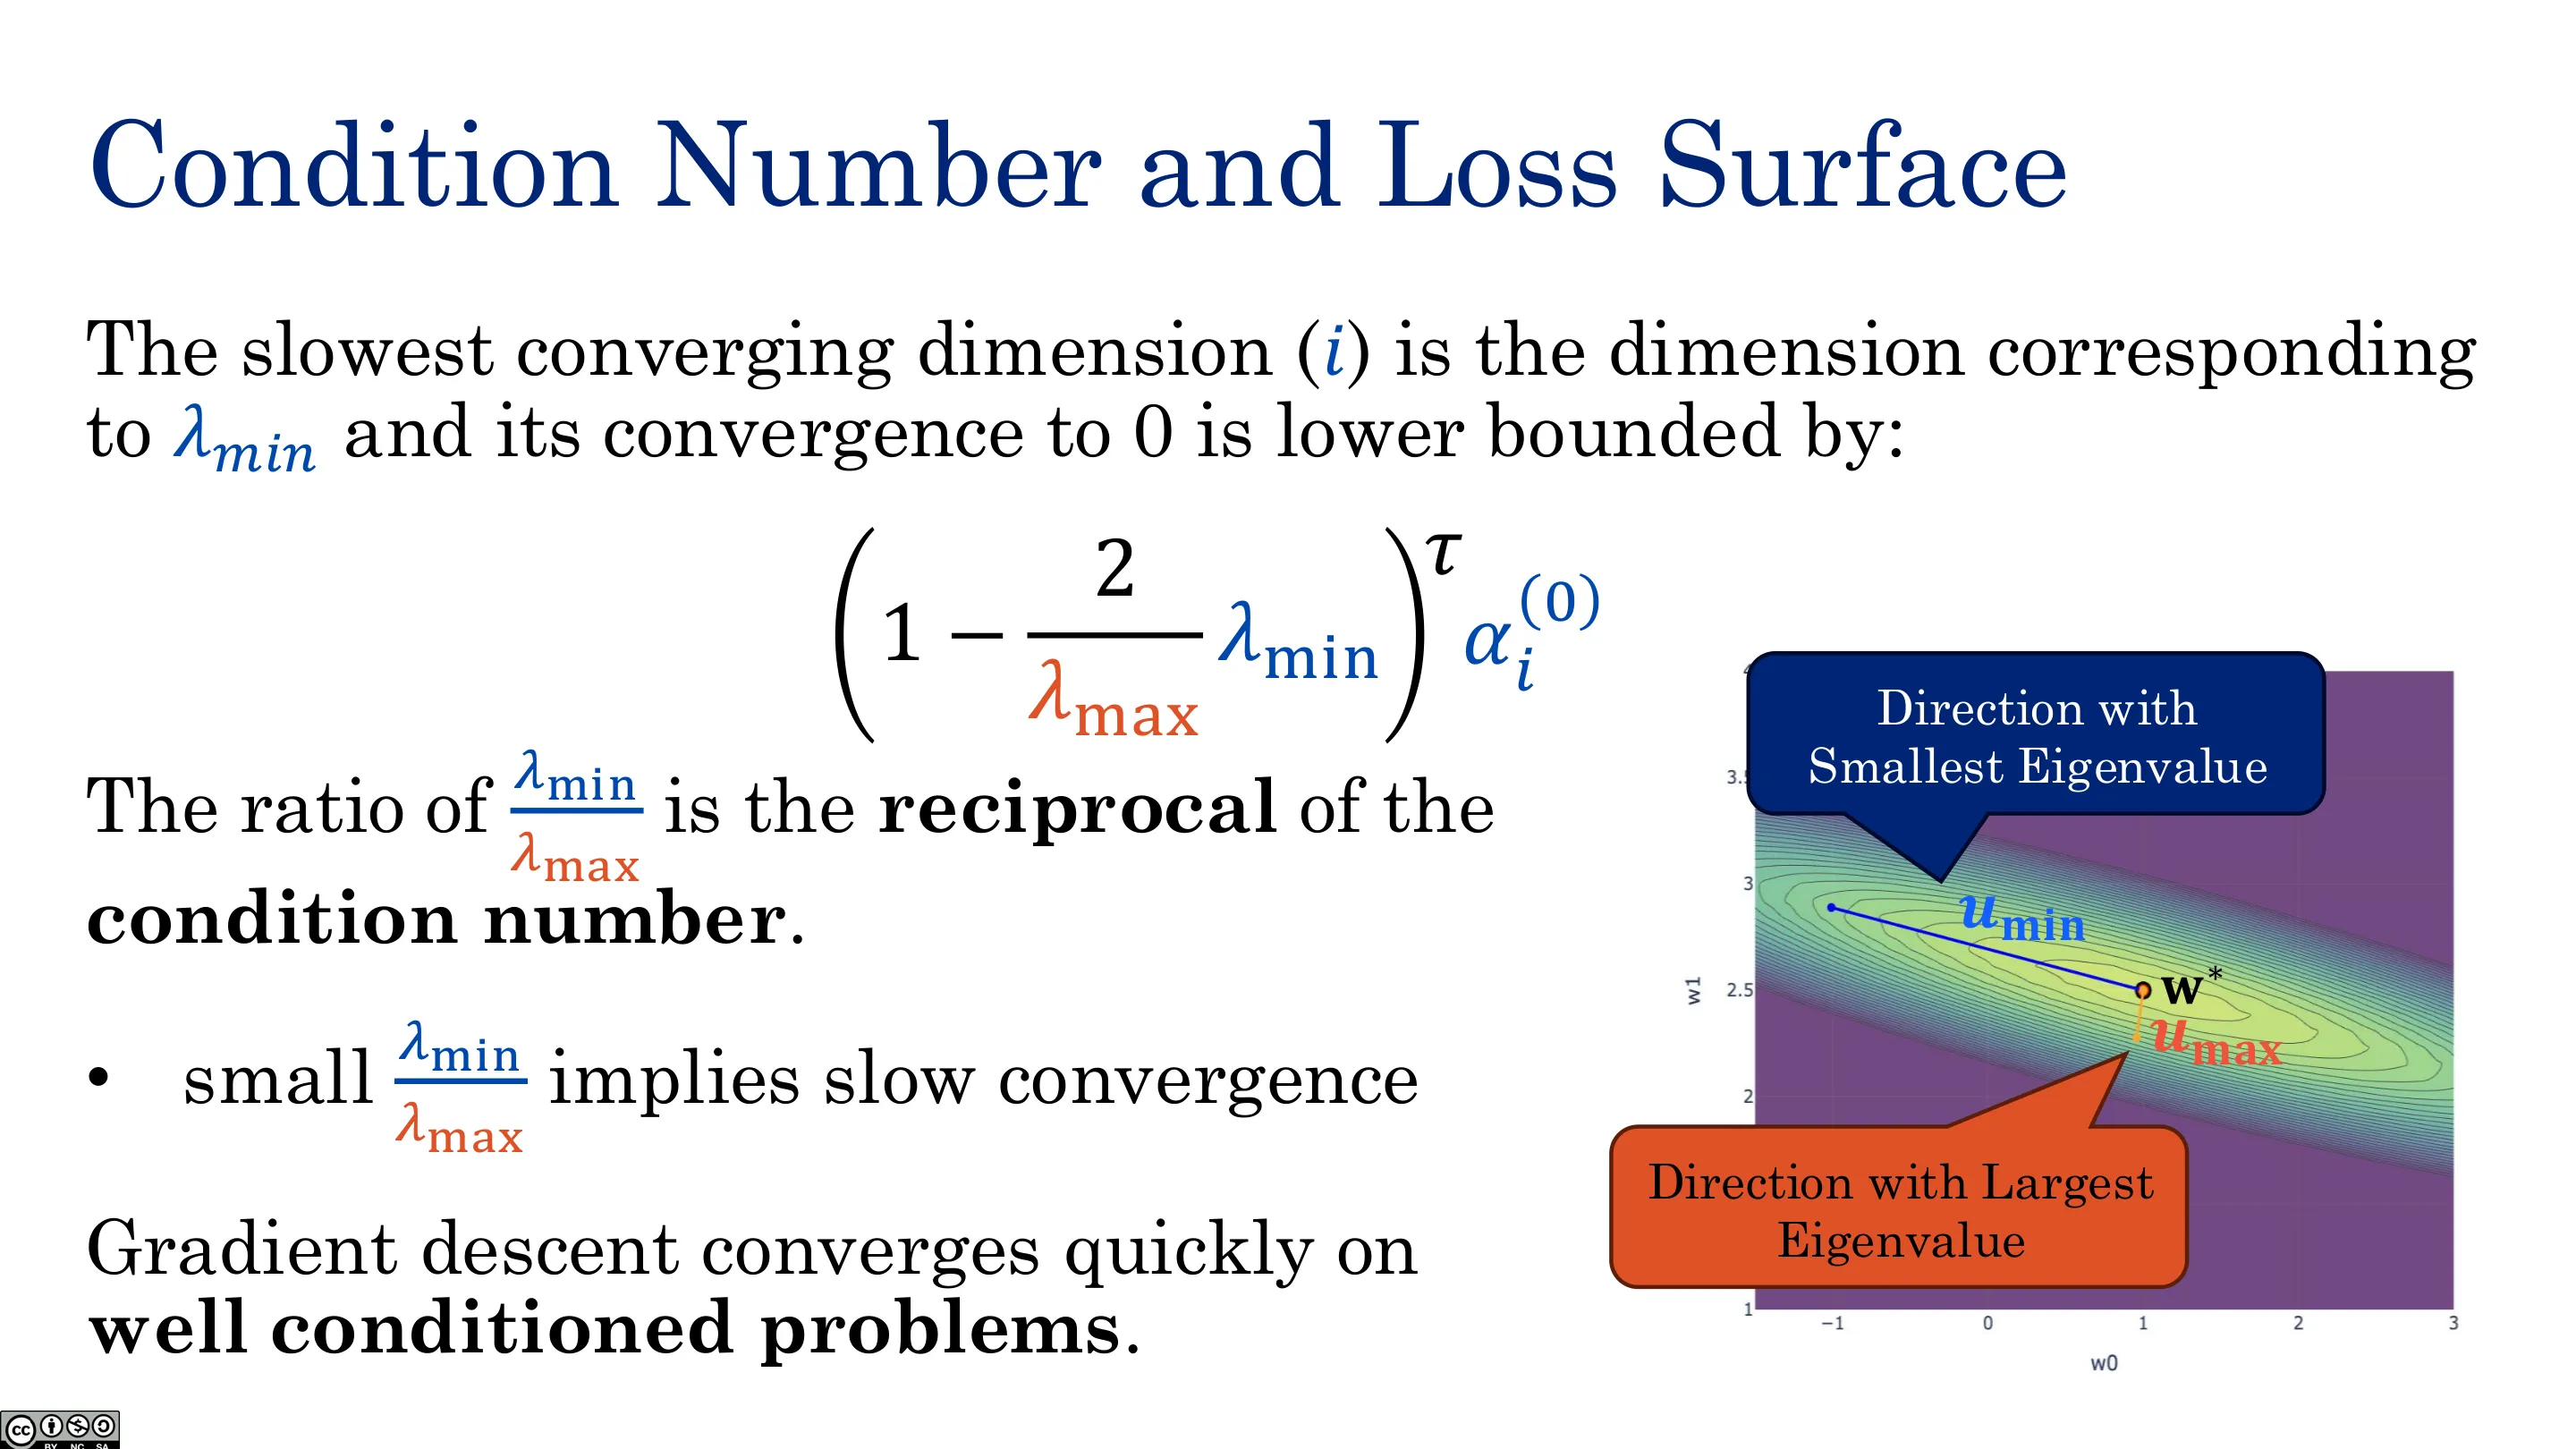
- $\lambda_{\min}$(最平坦方向)决定最慢的收敛方向,需要很多步。
条件数 $\kappa=\lambda_{\max}/\lambda_{\min}$:
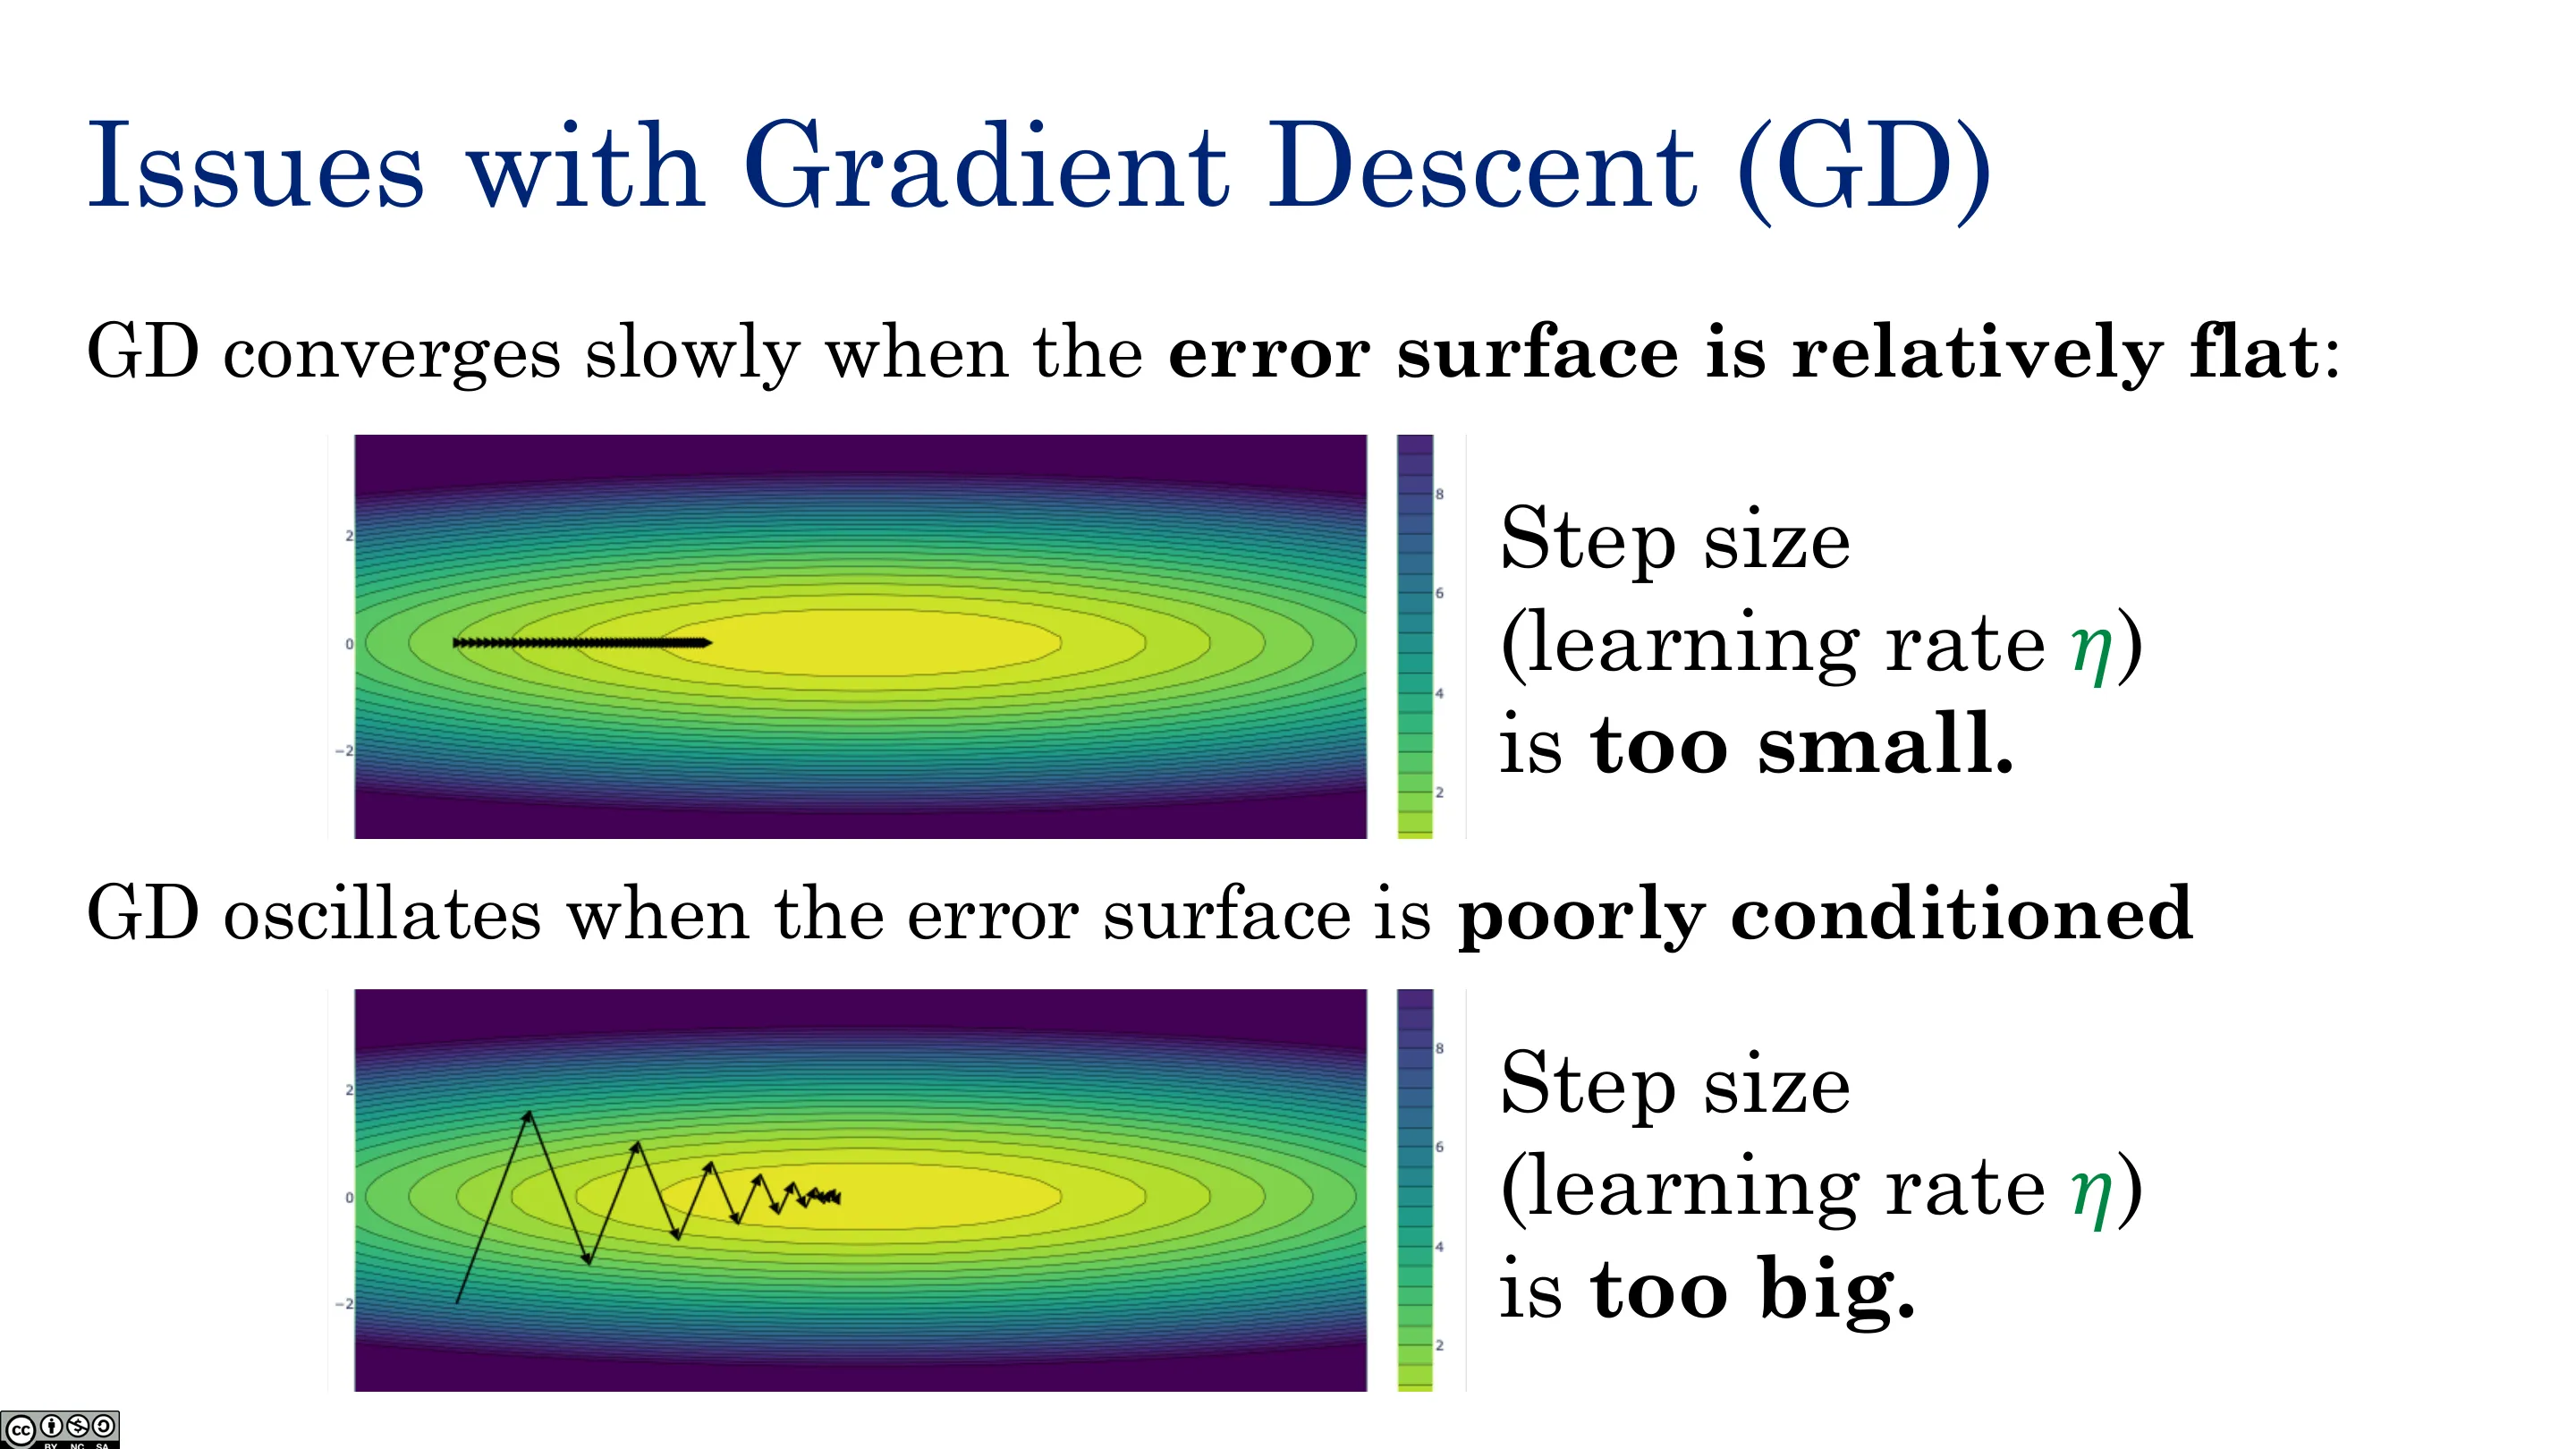
- $\kappa\approx1$(等高线是圆)⇒ 良态、收敛快;
- $\kappa\gg1$(等高线是细长的「沟」)⇒ 病态、梯度下降几乎不动。
📷 学习率对收敛的影响
回到原视频 (00:44:08)
📷 条件数与损失曲面
回到原视频 (00:45:21)
规模问题:对 GPT 级模型,Hessian 是 $d\times d$,$d\sim10^{10}$ ⇒ 矩阵大到宇宙分子数级别,根本写不下。损失又是数万亿 token 求和。所以永远拿不到真实 Hessian——只能近似。
📷 梯度下降的问题
回到原视频 (00:46:34)
三、动量与自适应学习率
(参考时间: 01:10)
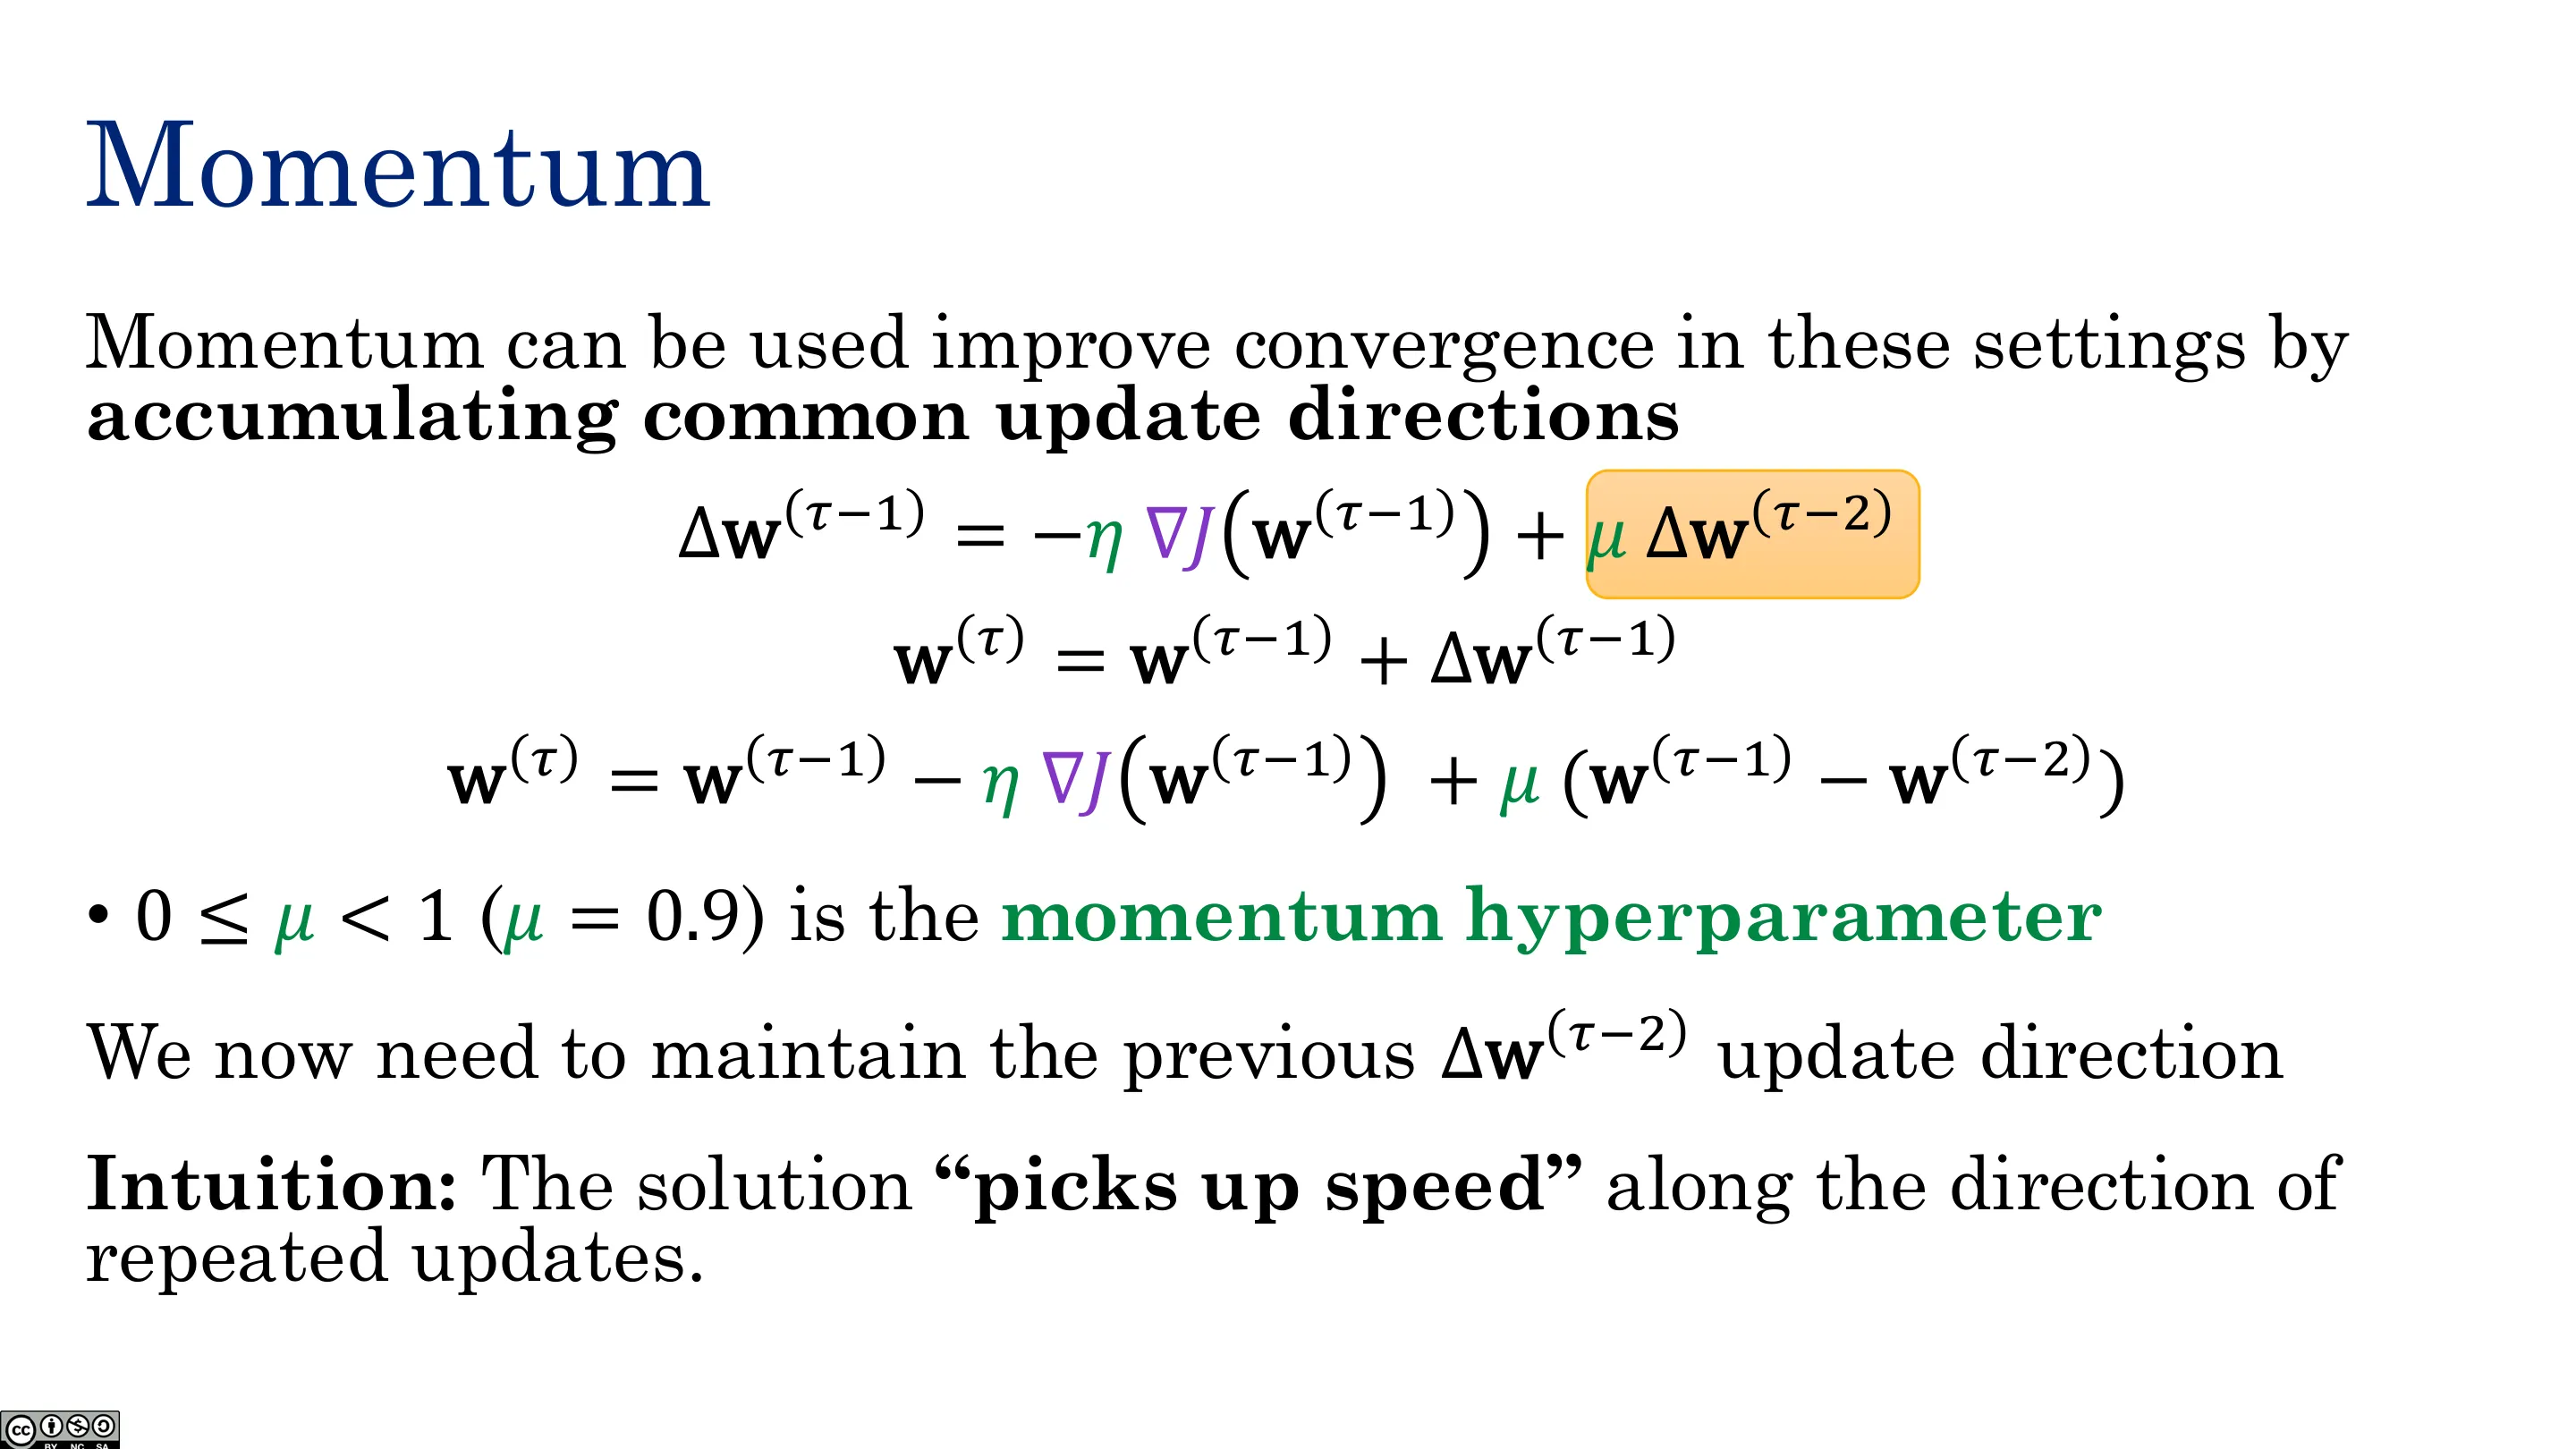
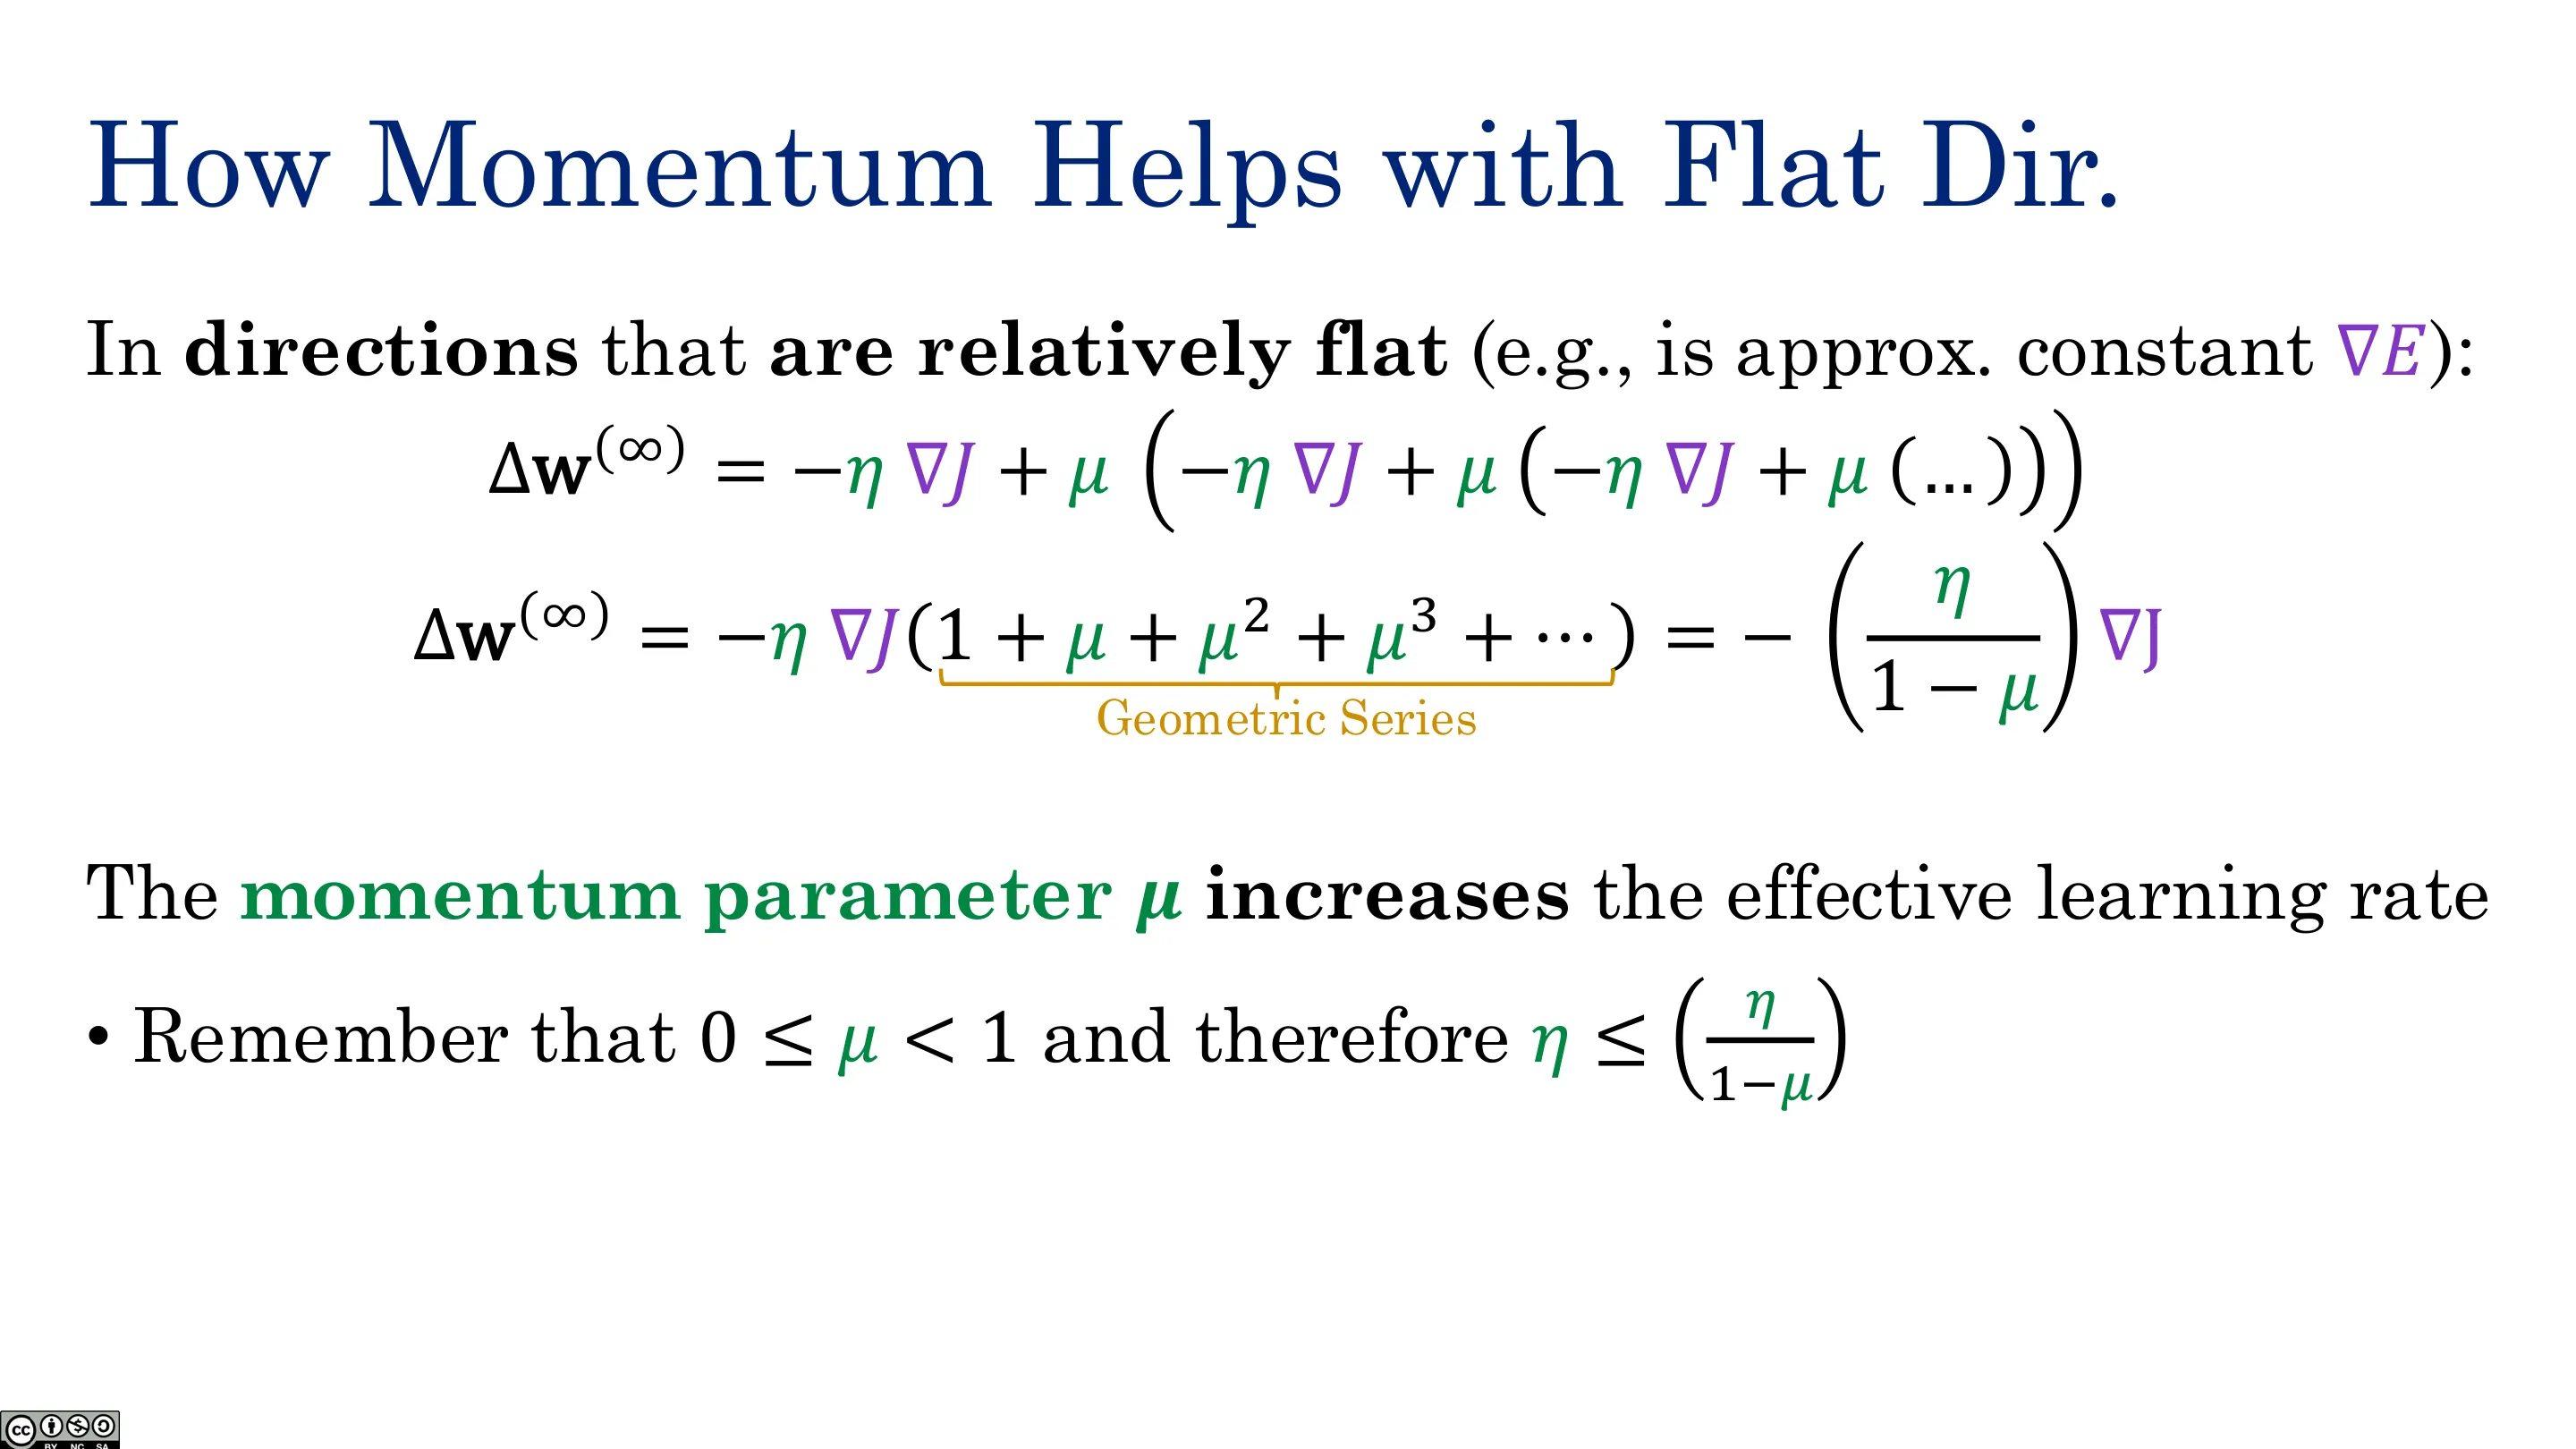
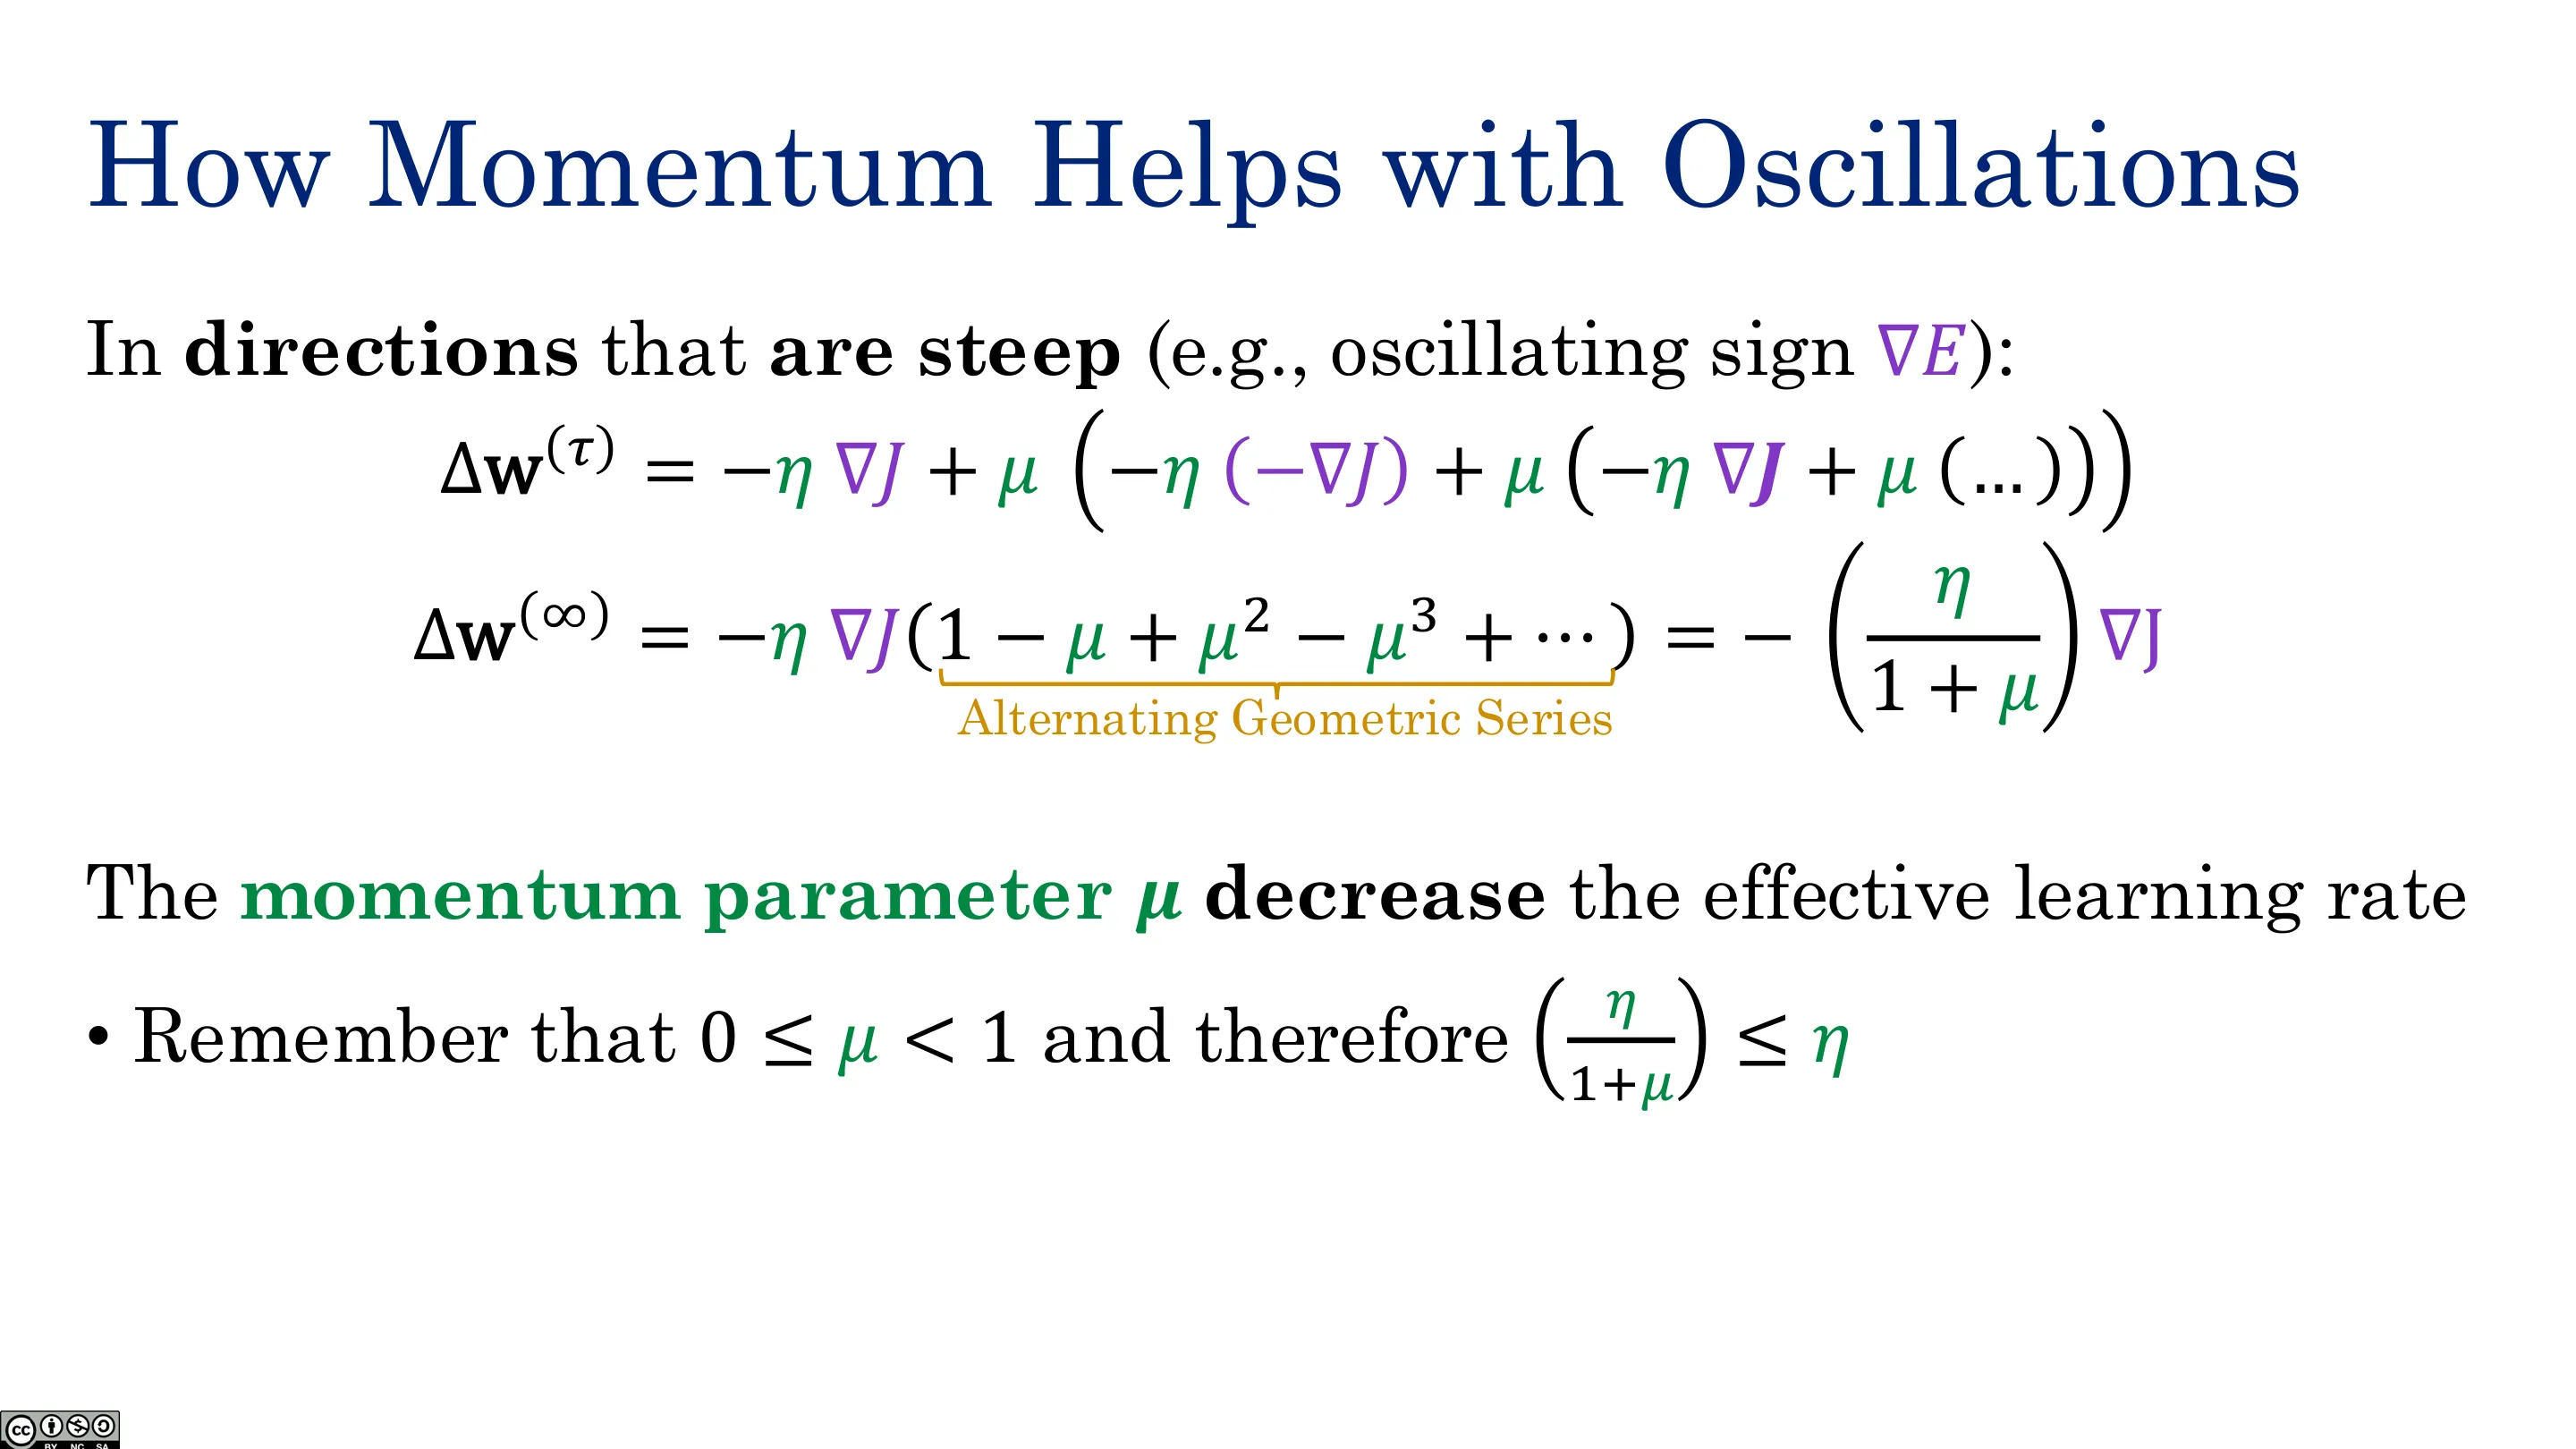
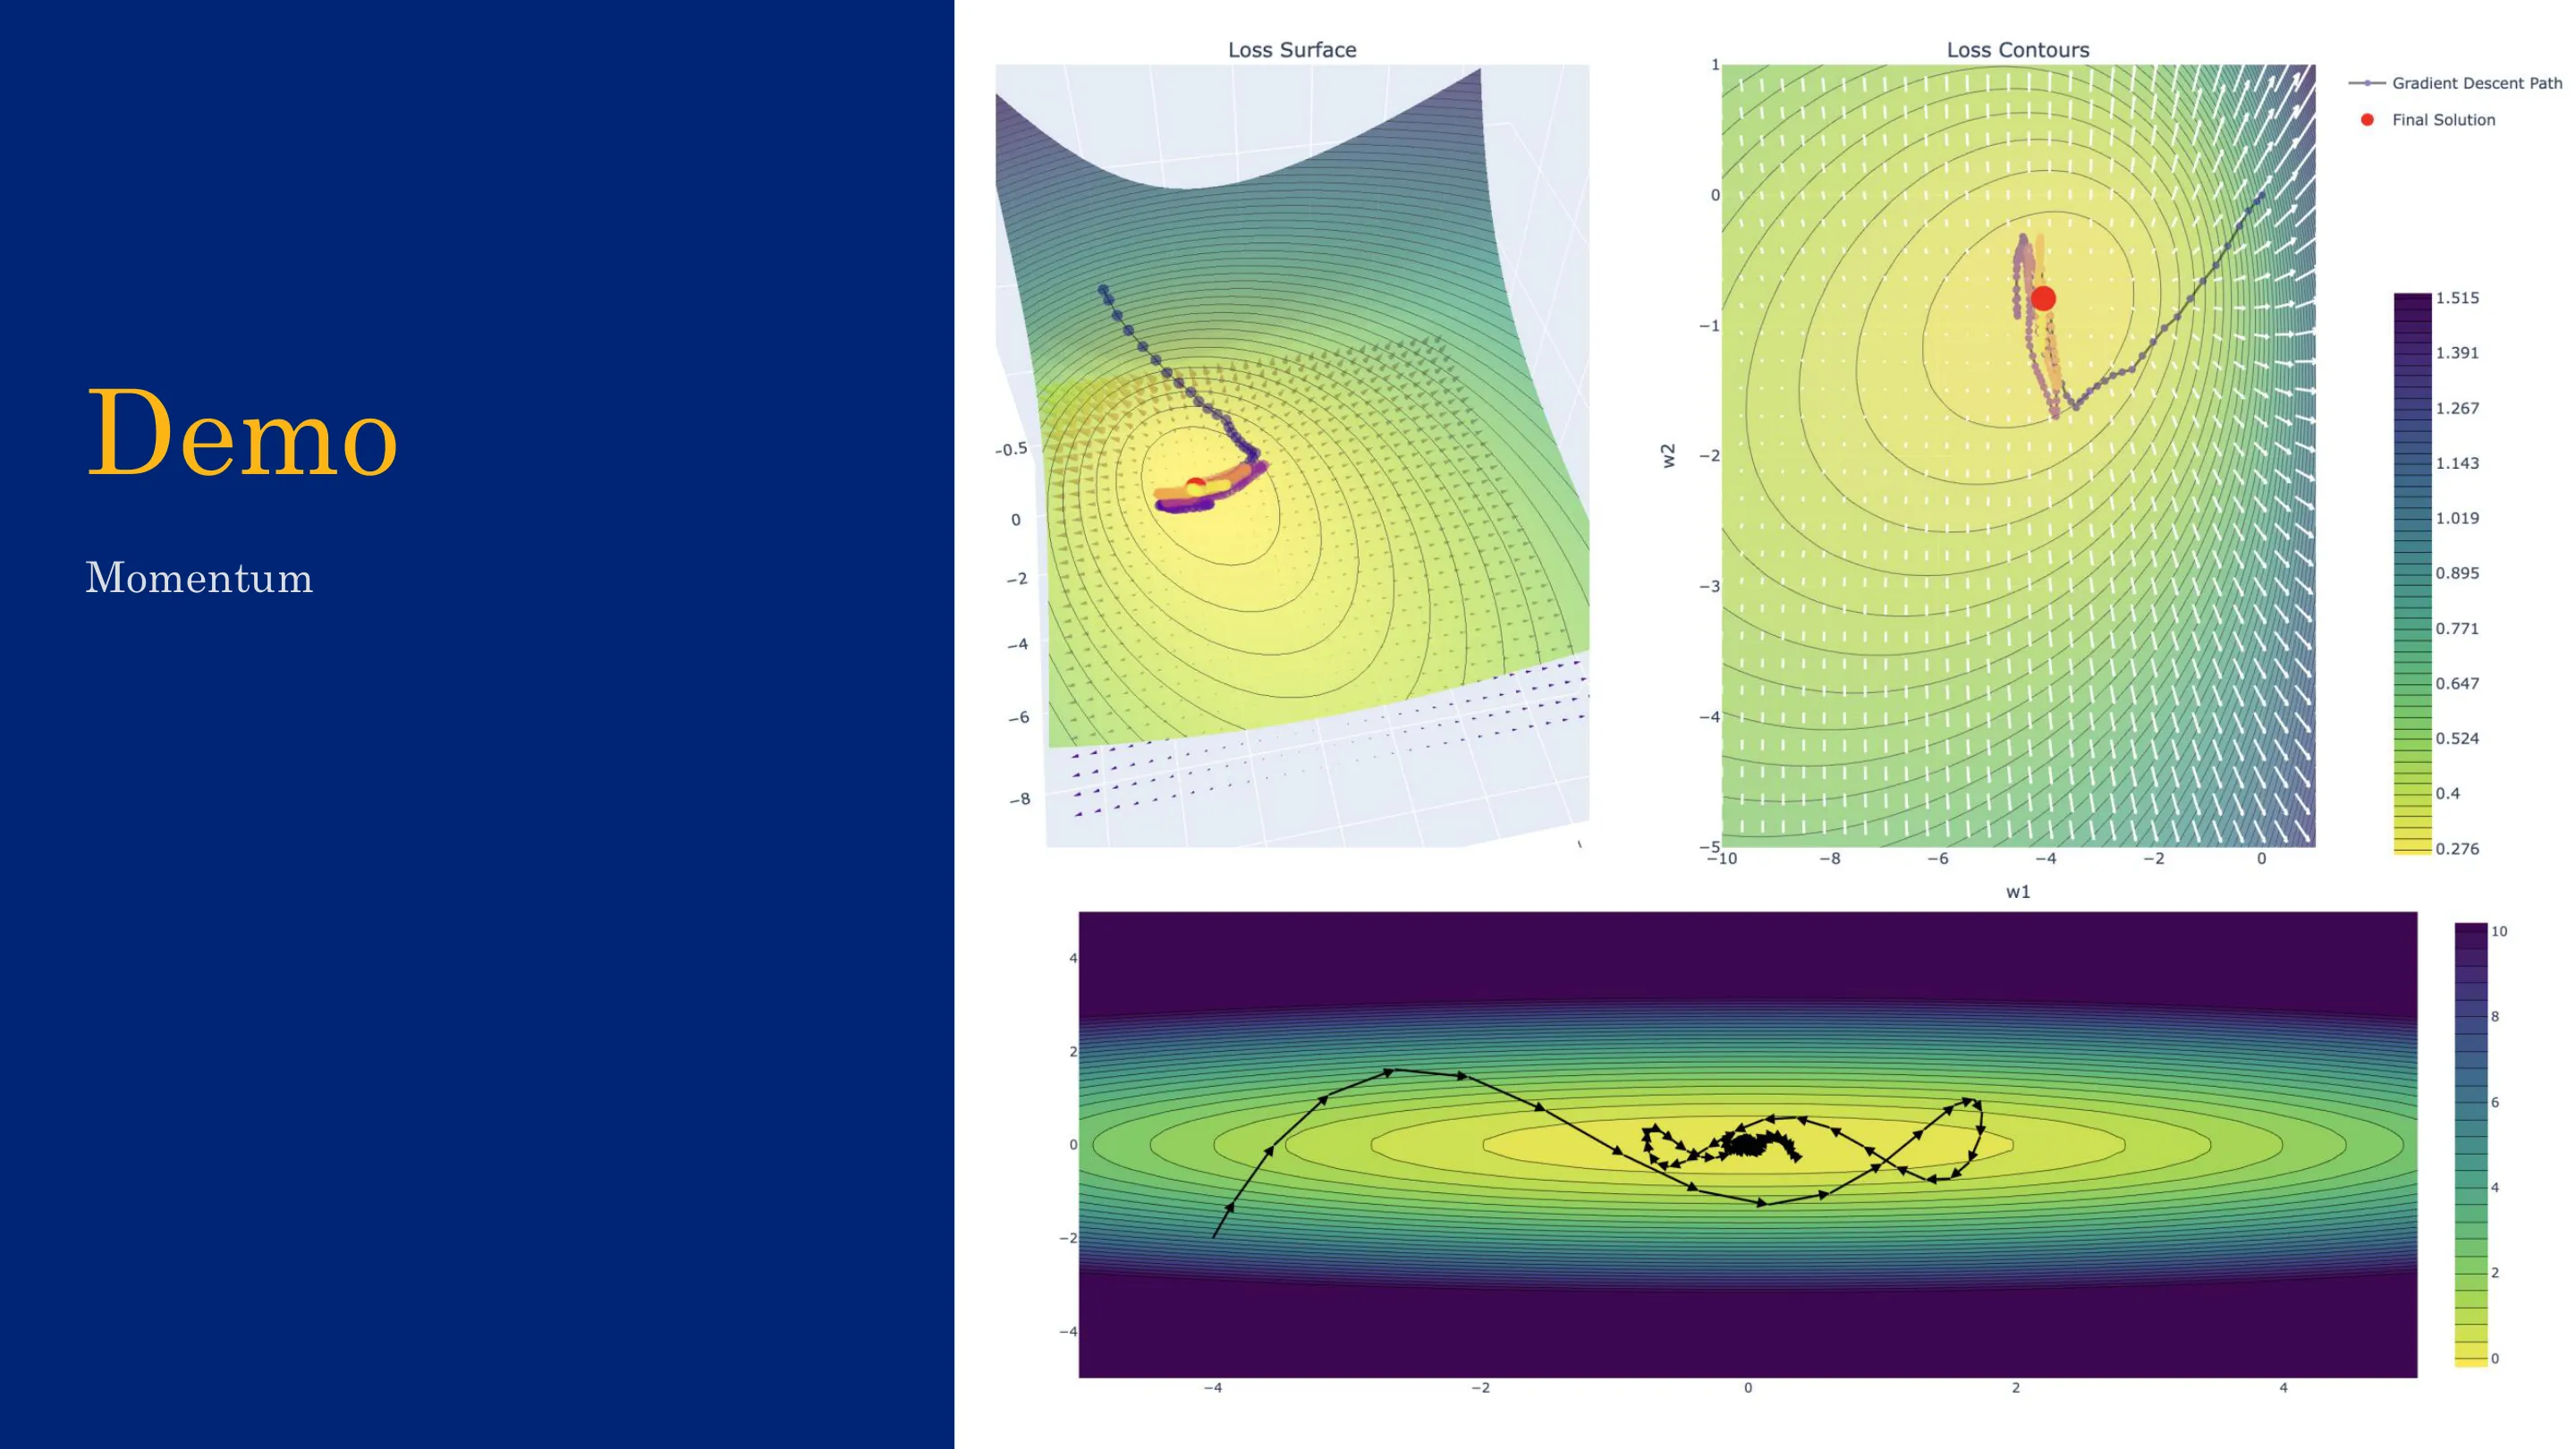
动量(Momentum):在更新中加入「上一轮的位移」
$$ w^{(t+1)}=w^{(t)}-\eta\nabla J+\beta\,(w^{(t)}-w^{(t-1)}) $$
像「有质量的粒子」:在重复更新的方向加速,从而
- 帮助穿越平坦区域(梯度近零时靠惯性继续走);
- 抑制陡峭方向的震荡(有效降低该方向的学习率)。
$\beta$ 是控制动量多少的超参数;$\beta=0$ 就退回普通梯度下降。
📷 动量
回到原视频 (00:47:47)
📷 动量如何帮助平坦方向
回到原视频 (00:49:00)
📷 动量如何抑制震荡
回到原视频 (00:50:13)
📷 动量(小结)
回到原视频 (00:51:26)
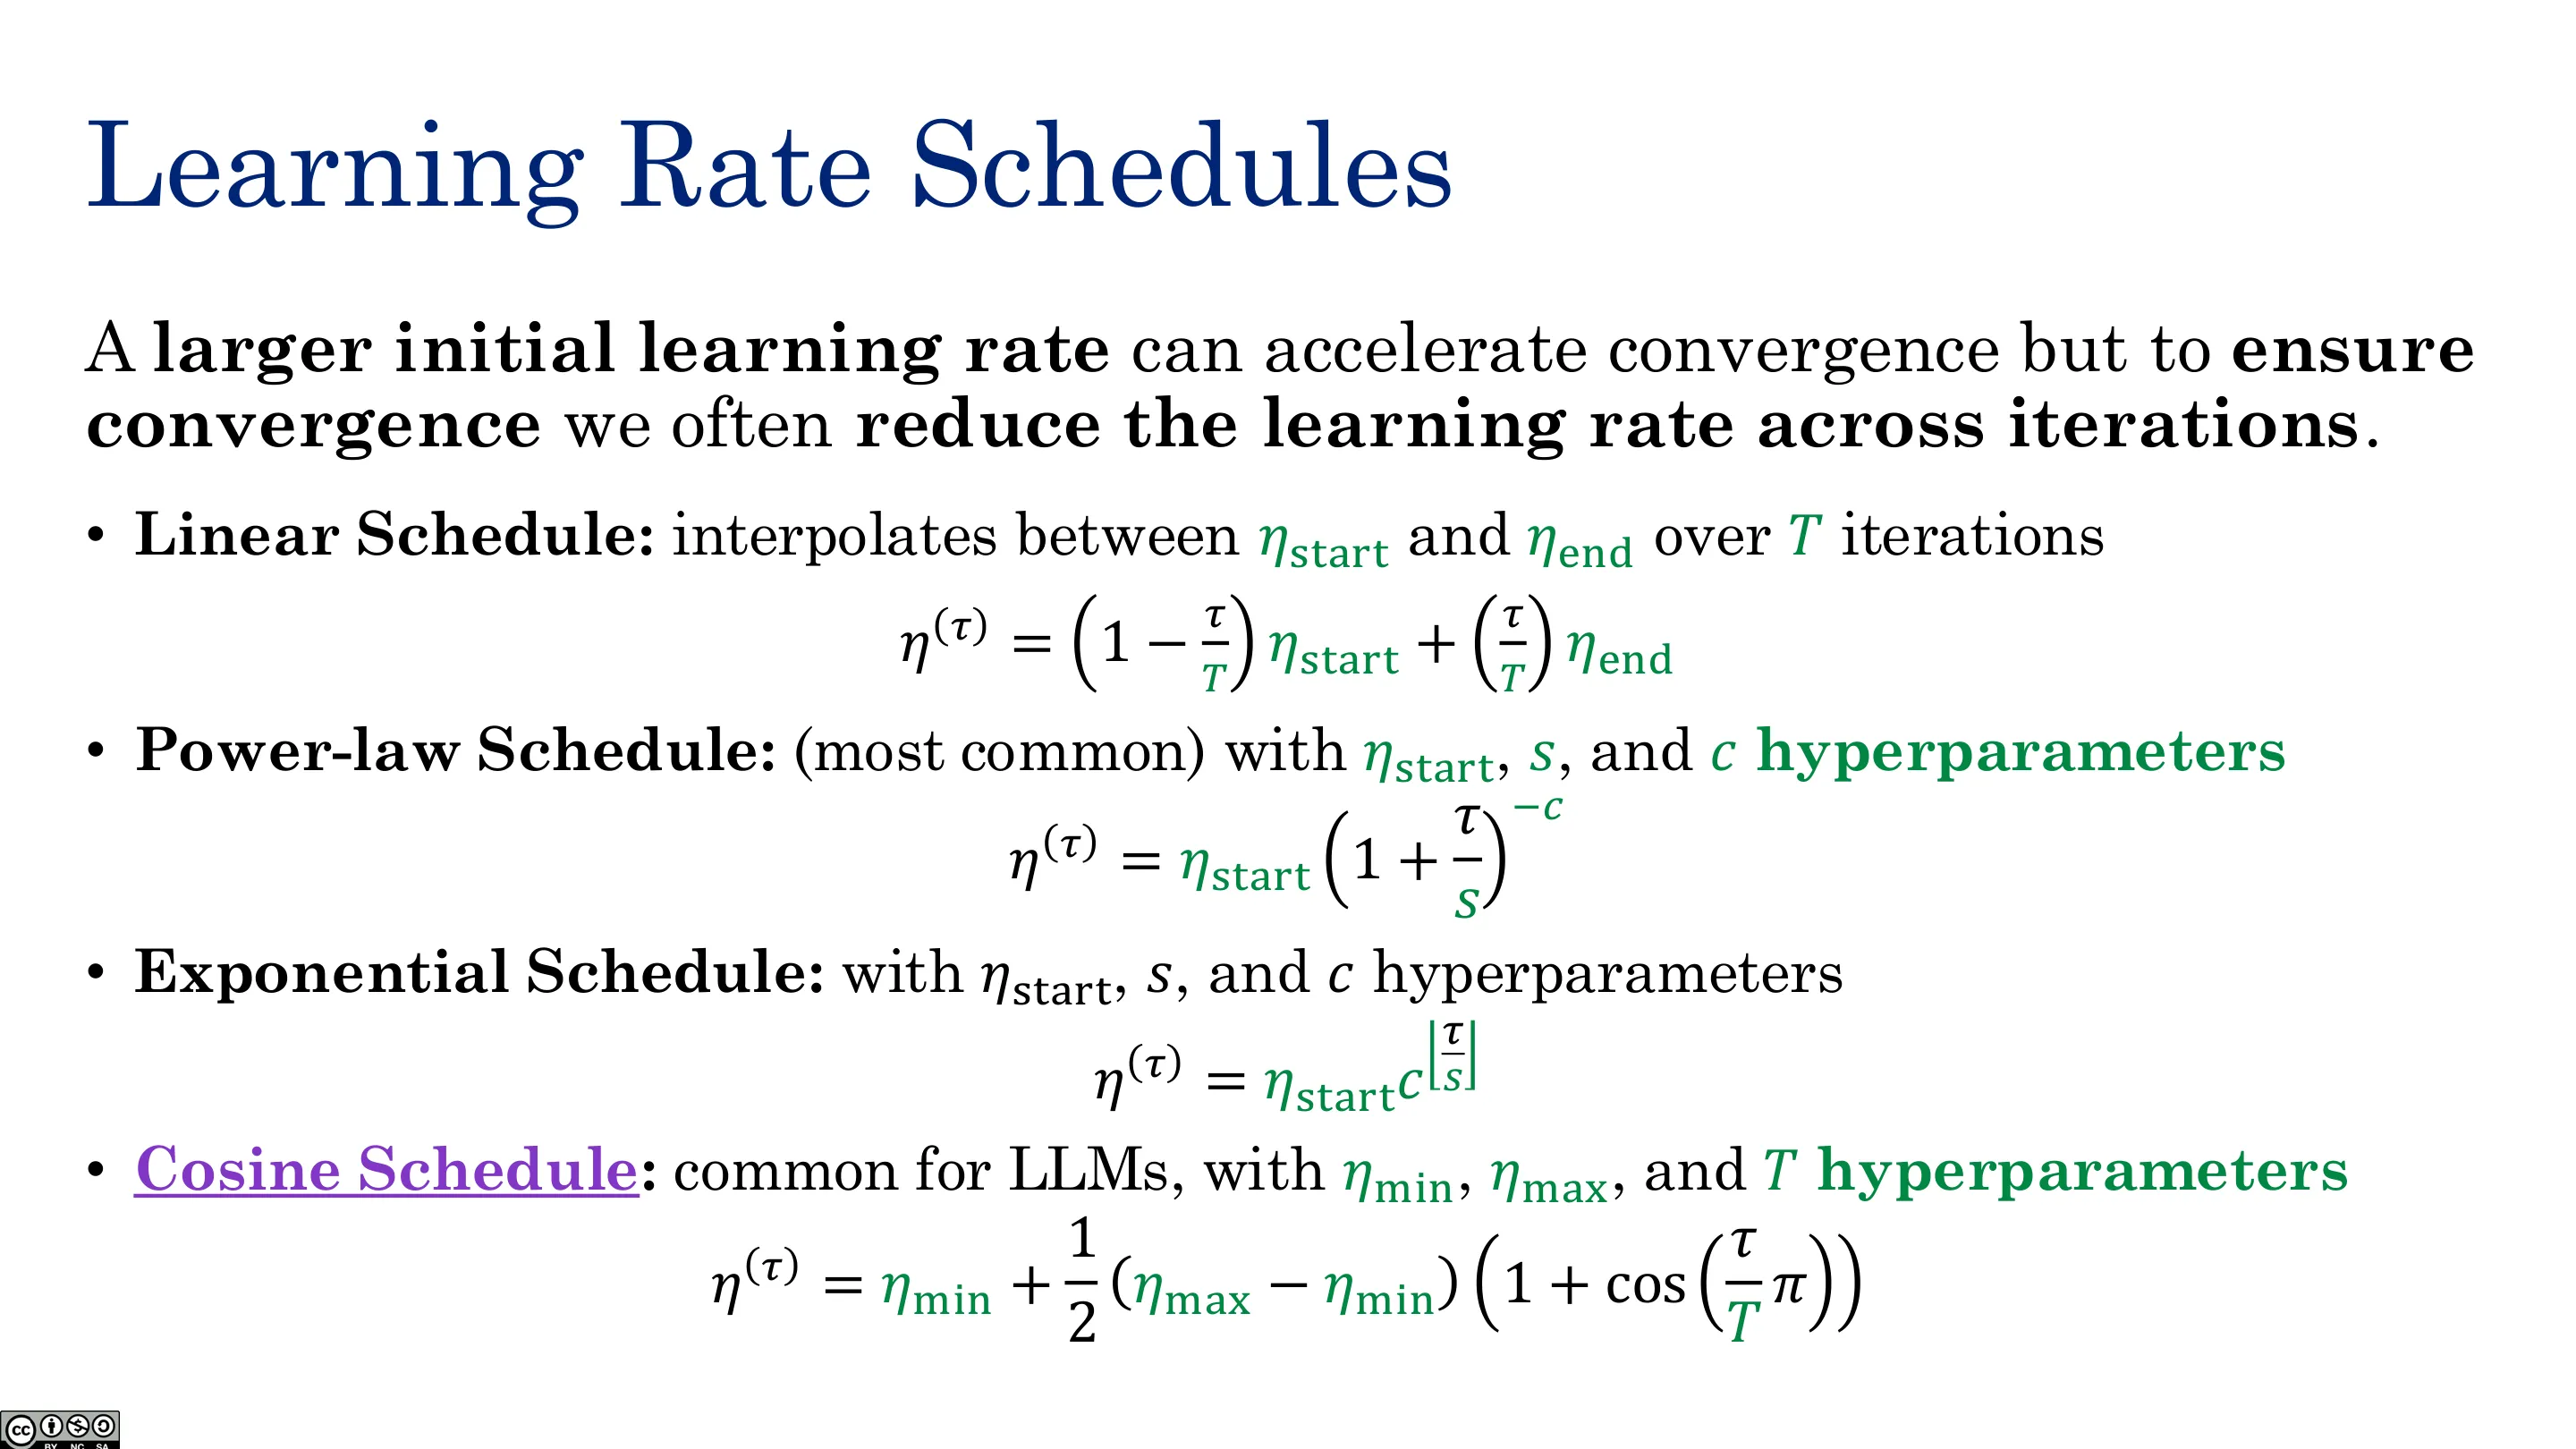
学习率调度:随迭代调整 $\eta$。自适应方法:不用 Hessian,而是用「每个坐标过去的梯度」估计逐坐标的学习率:
- AdaGrad:按梯度平方的累积衰减每个坐标的学习率;
- RMSProp:用梯度平方的指数滑动平均代替累加;
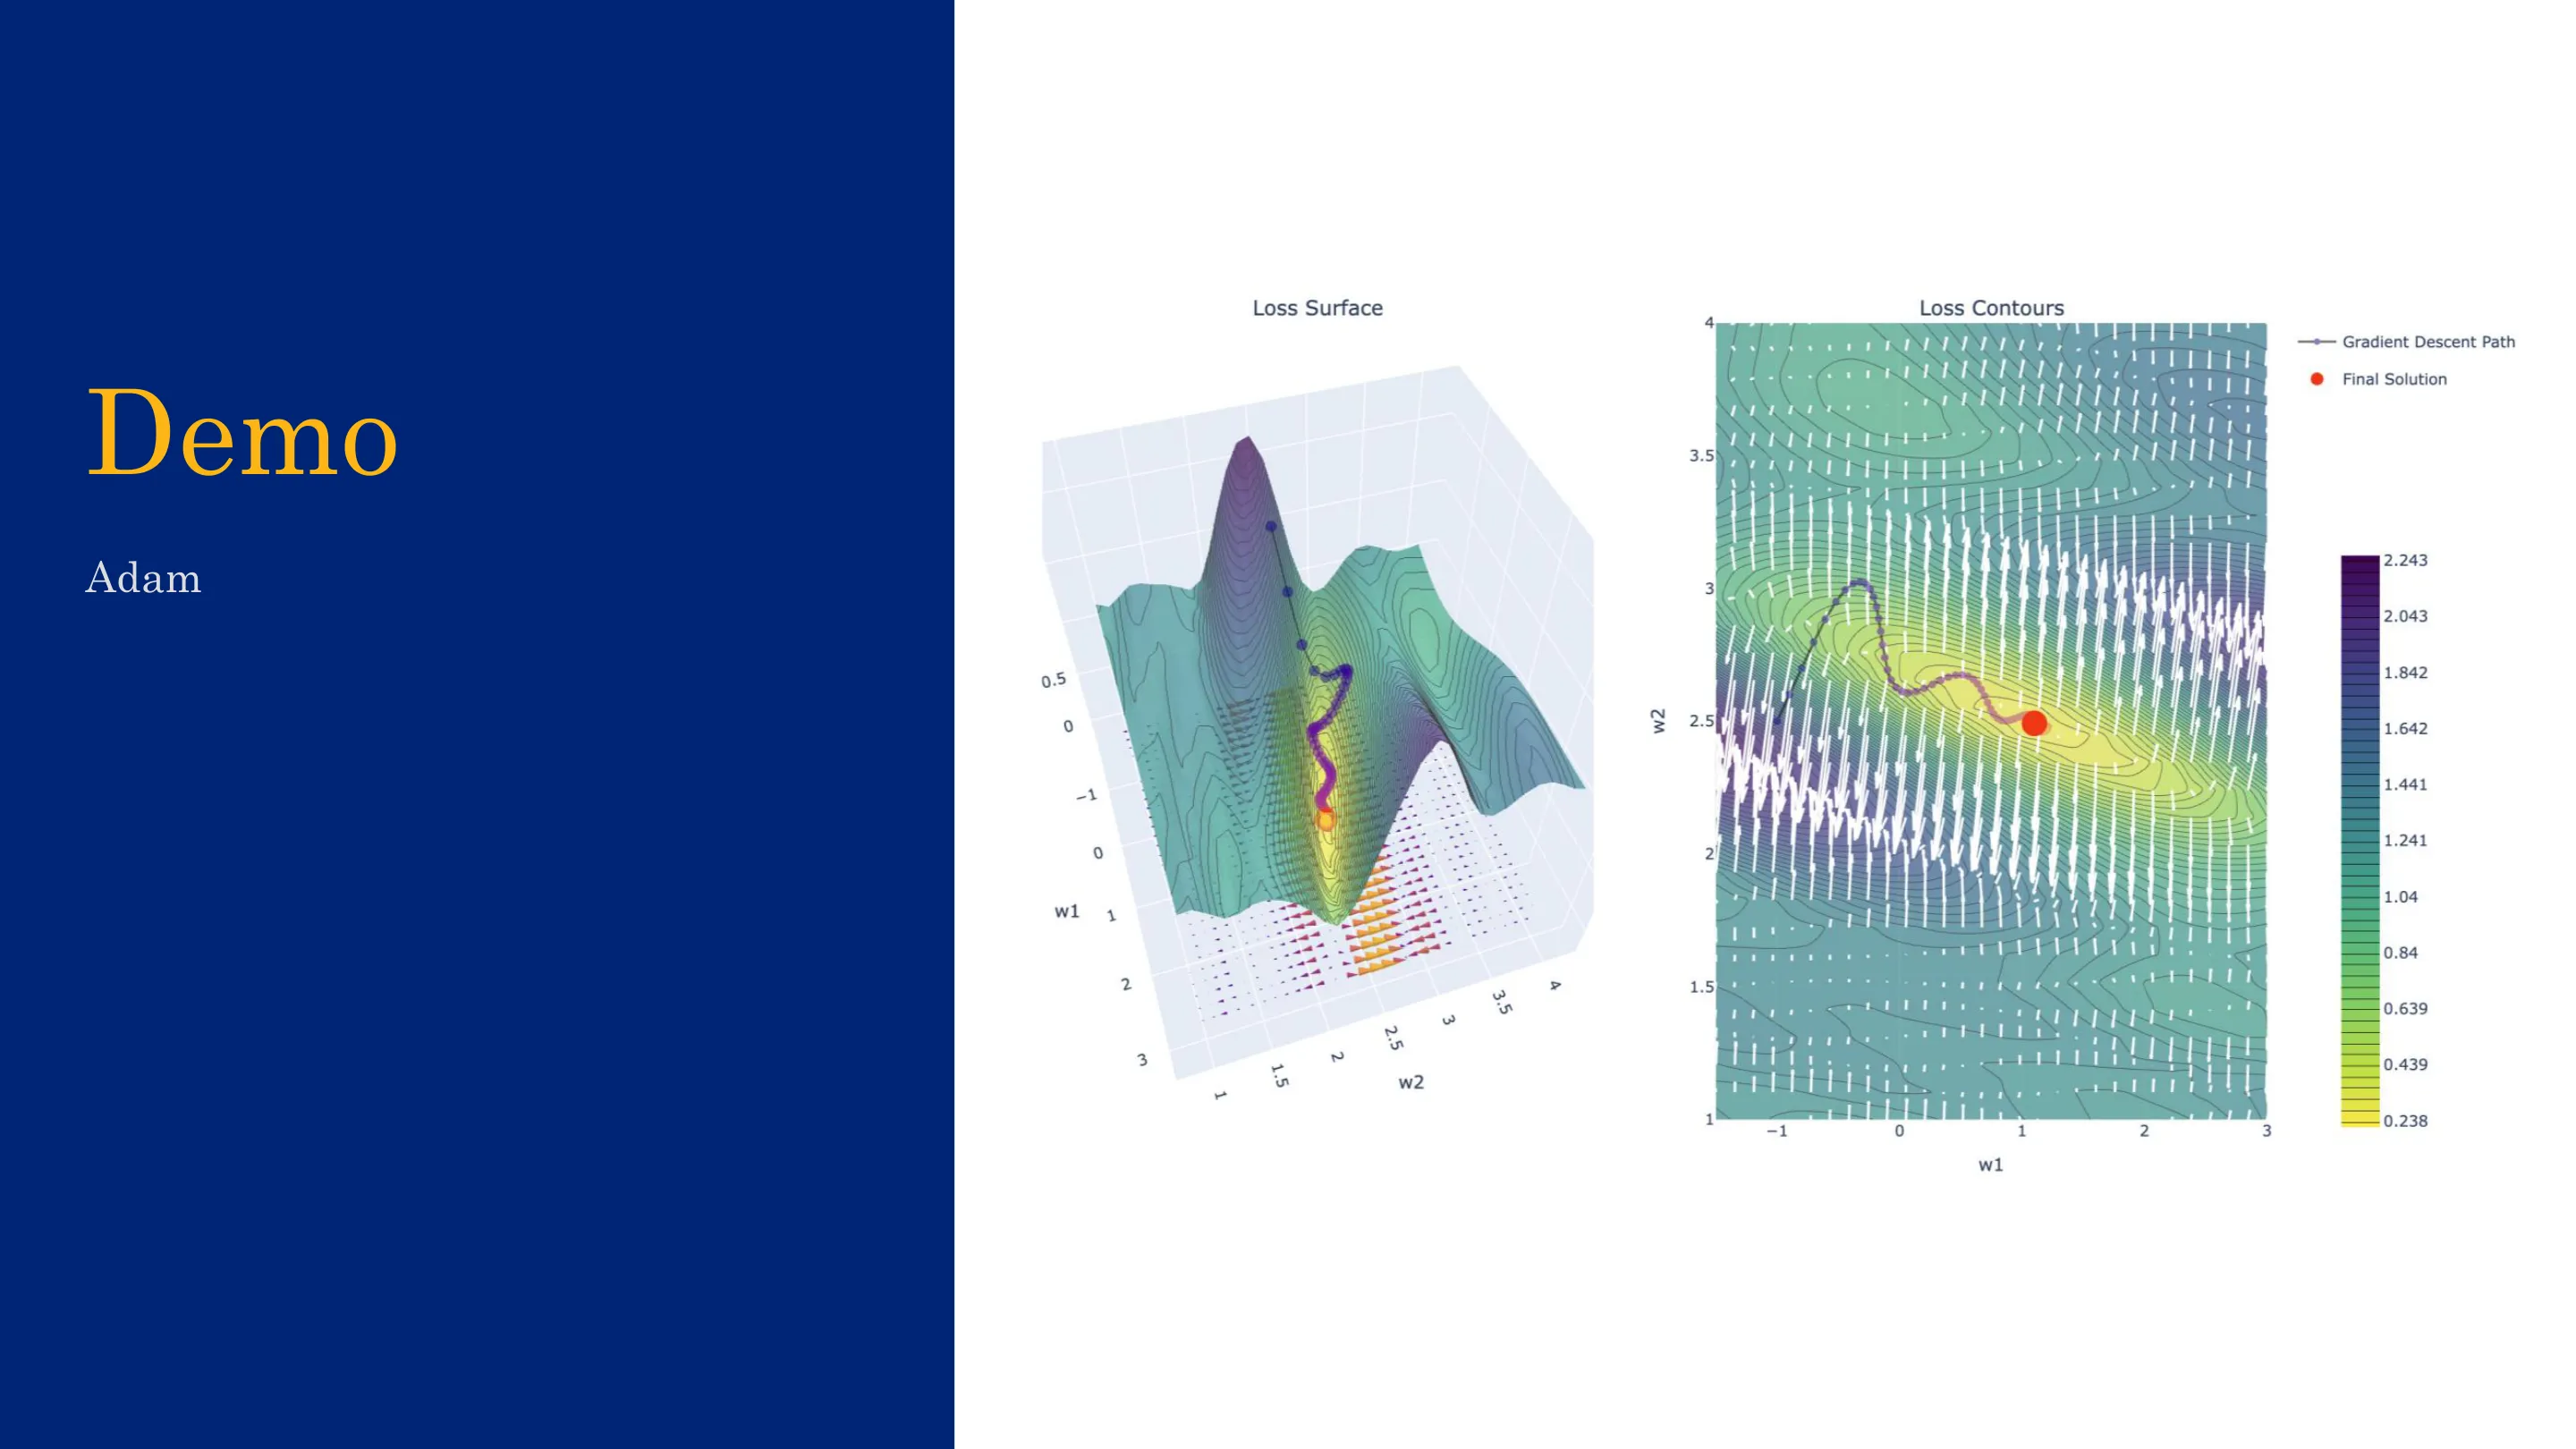
- Adam = RMSProp + Momentum:伯克利提出的经典优化器,是 Adagrad 的进化版。
实践中很多人从 mini-batch SGD 起步(最简单、常常很有效),需要时再换 Adam。
📷 学习率调度(一)
回到原视频 (00:52:39)
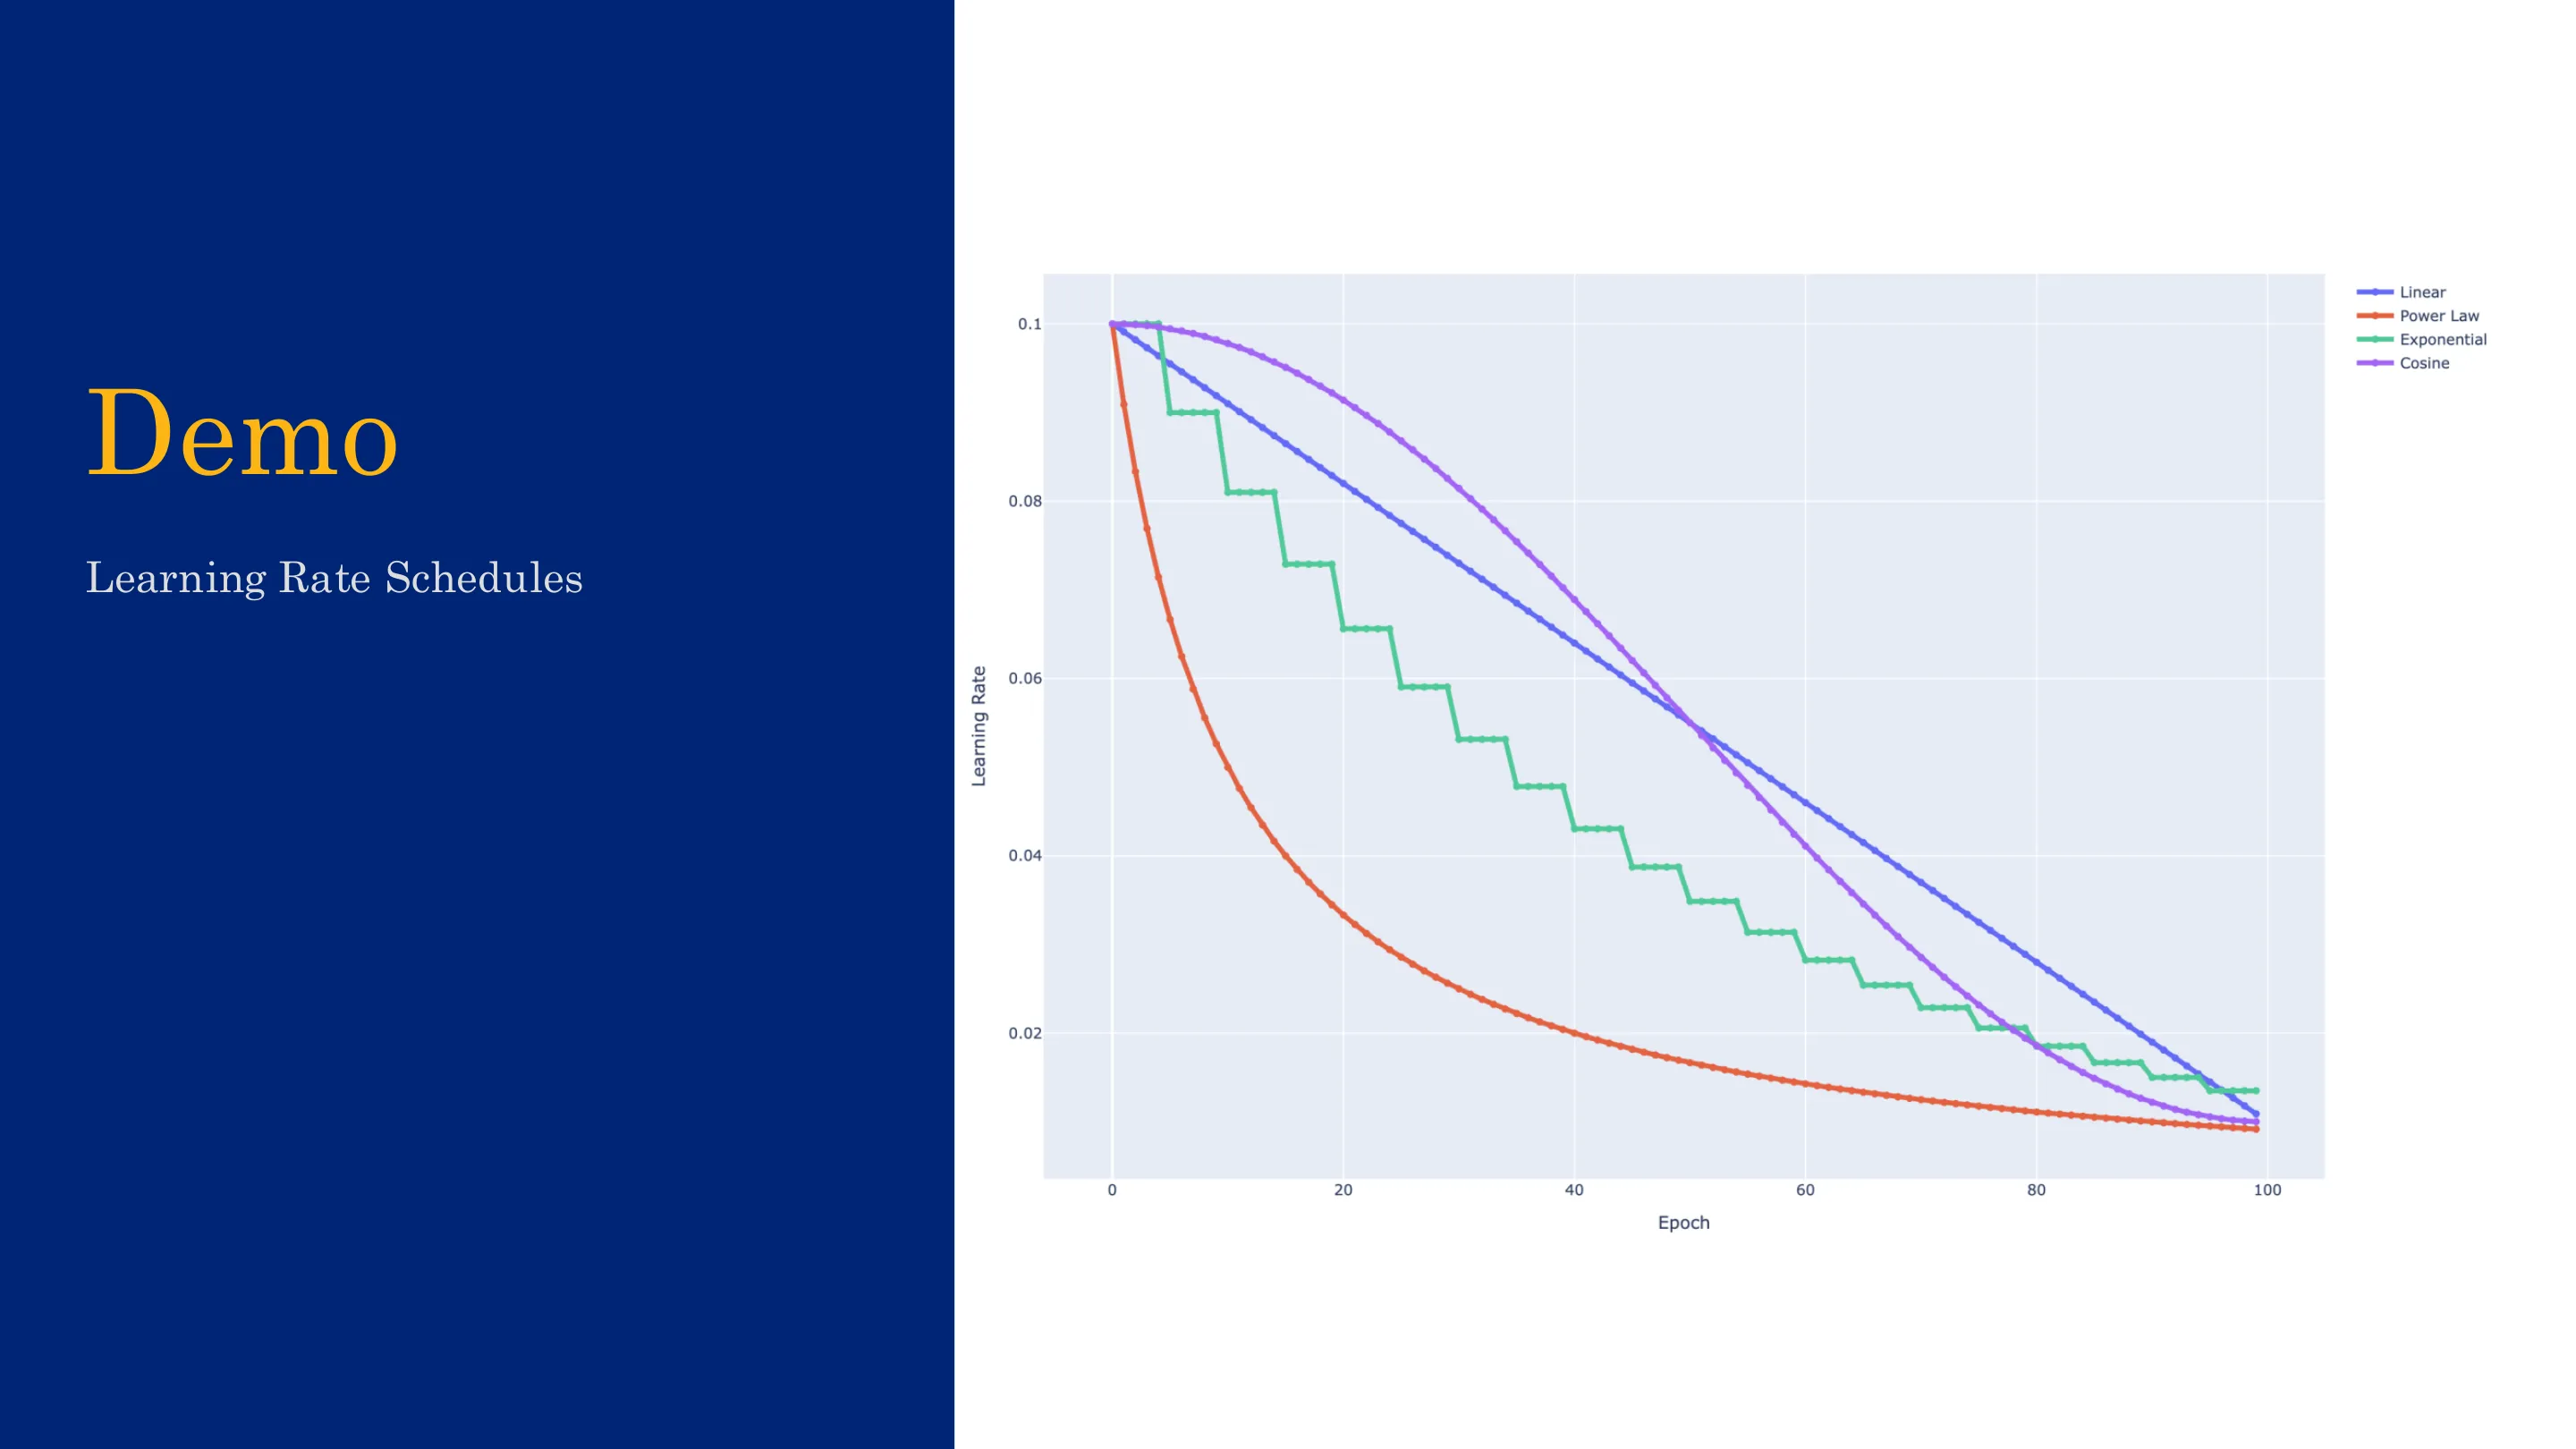
📷 学习率调度(二)
回到原视频 (00:53:52)
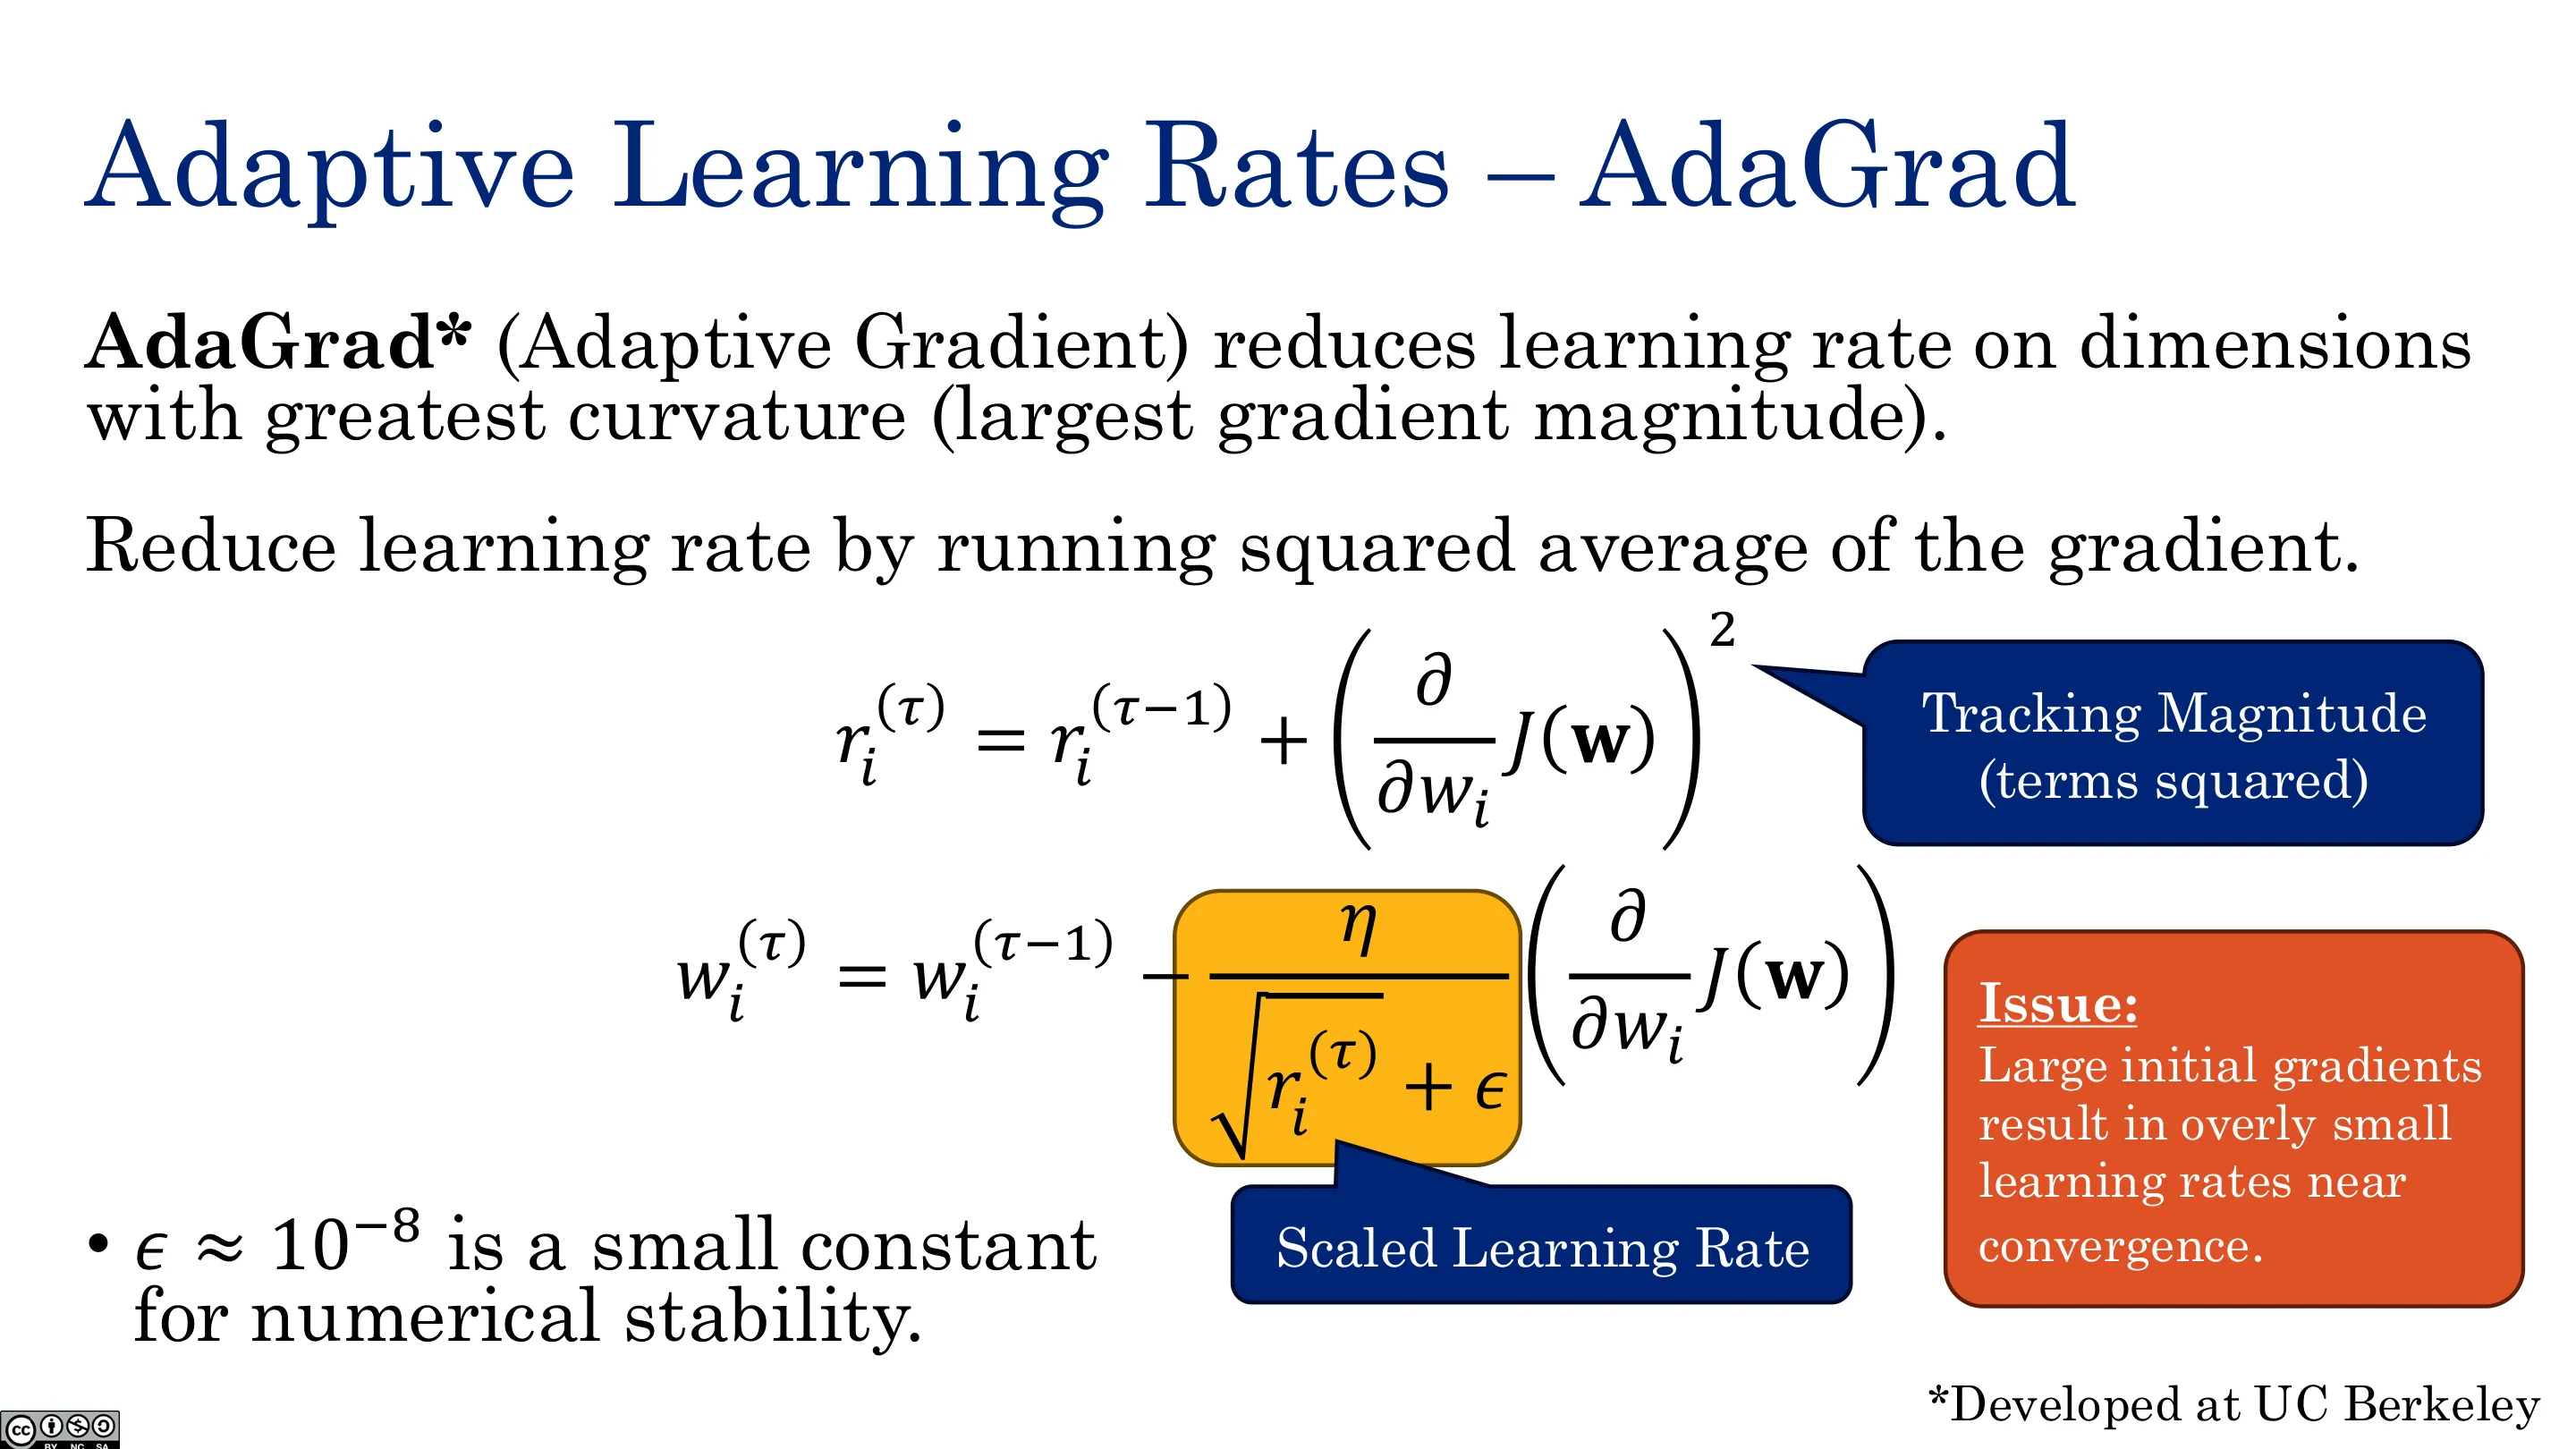
📷 自适应学习率:AdaGrad
回到原视频 (00:55:05)
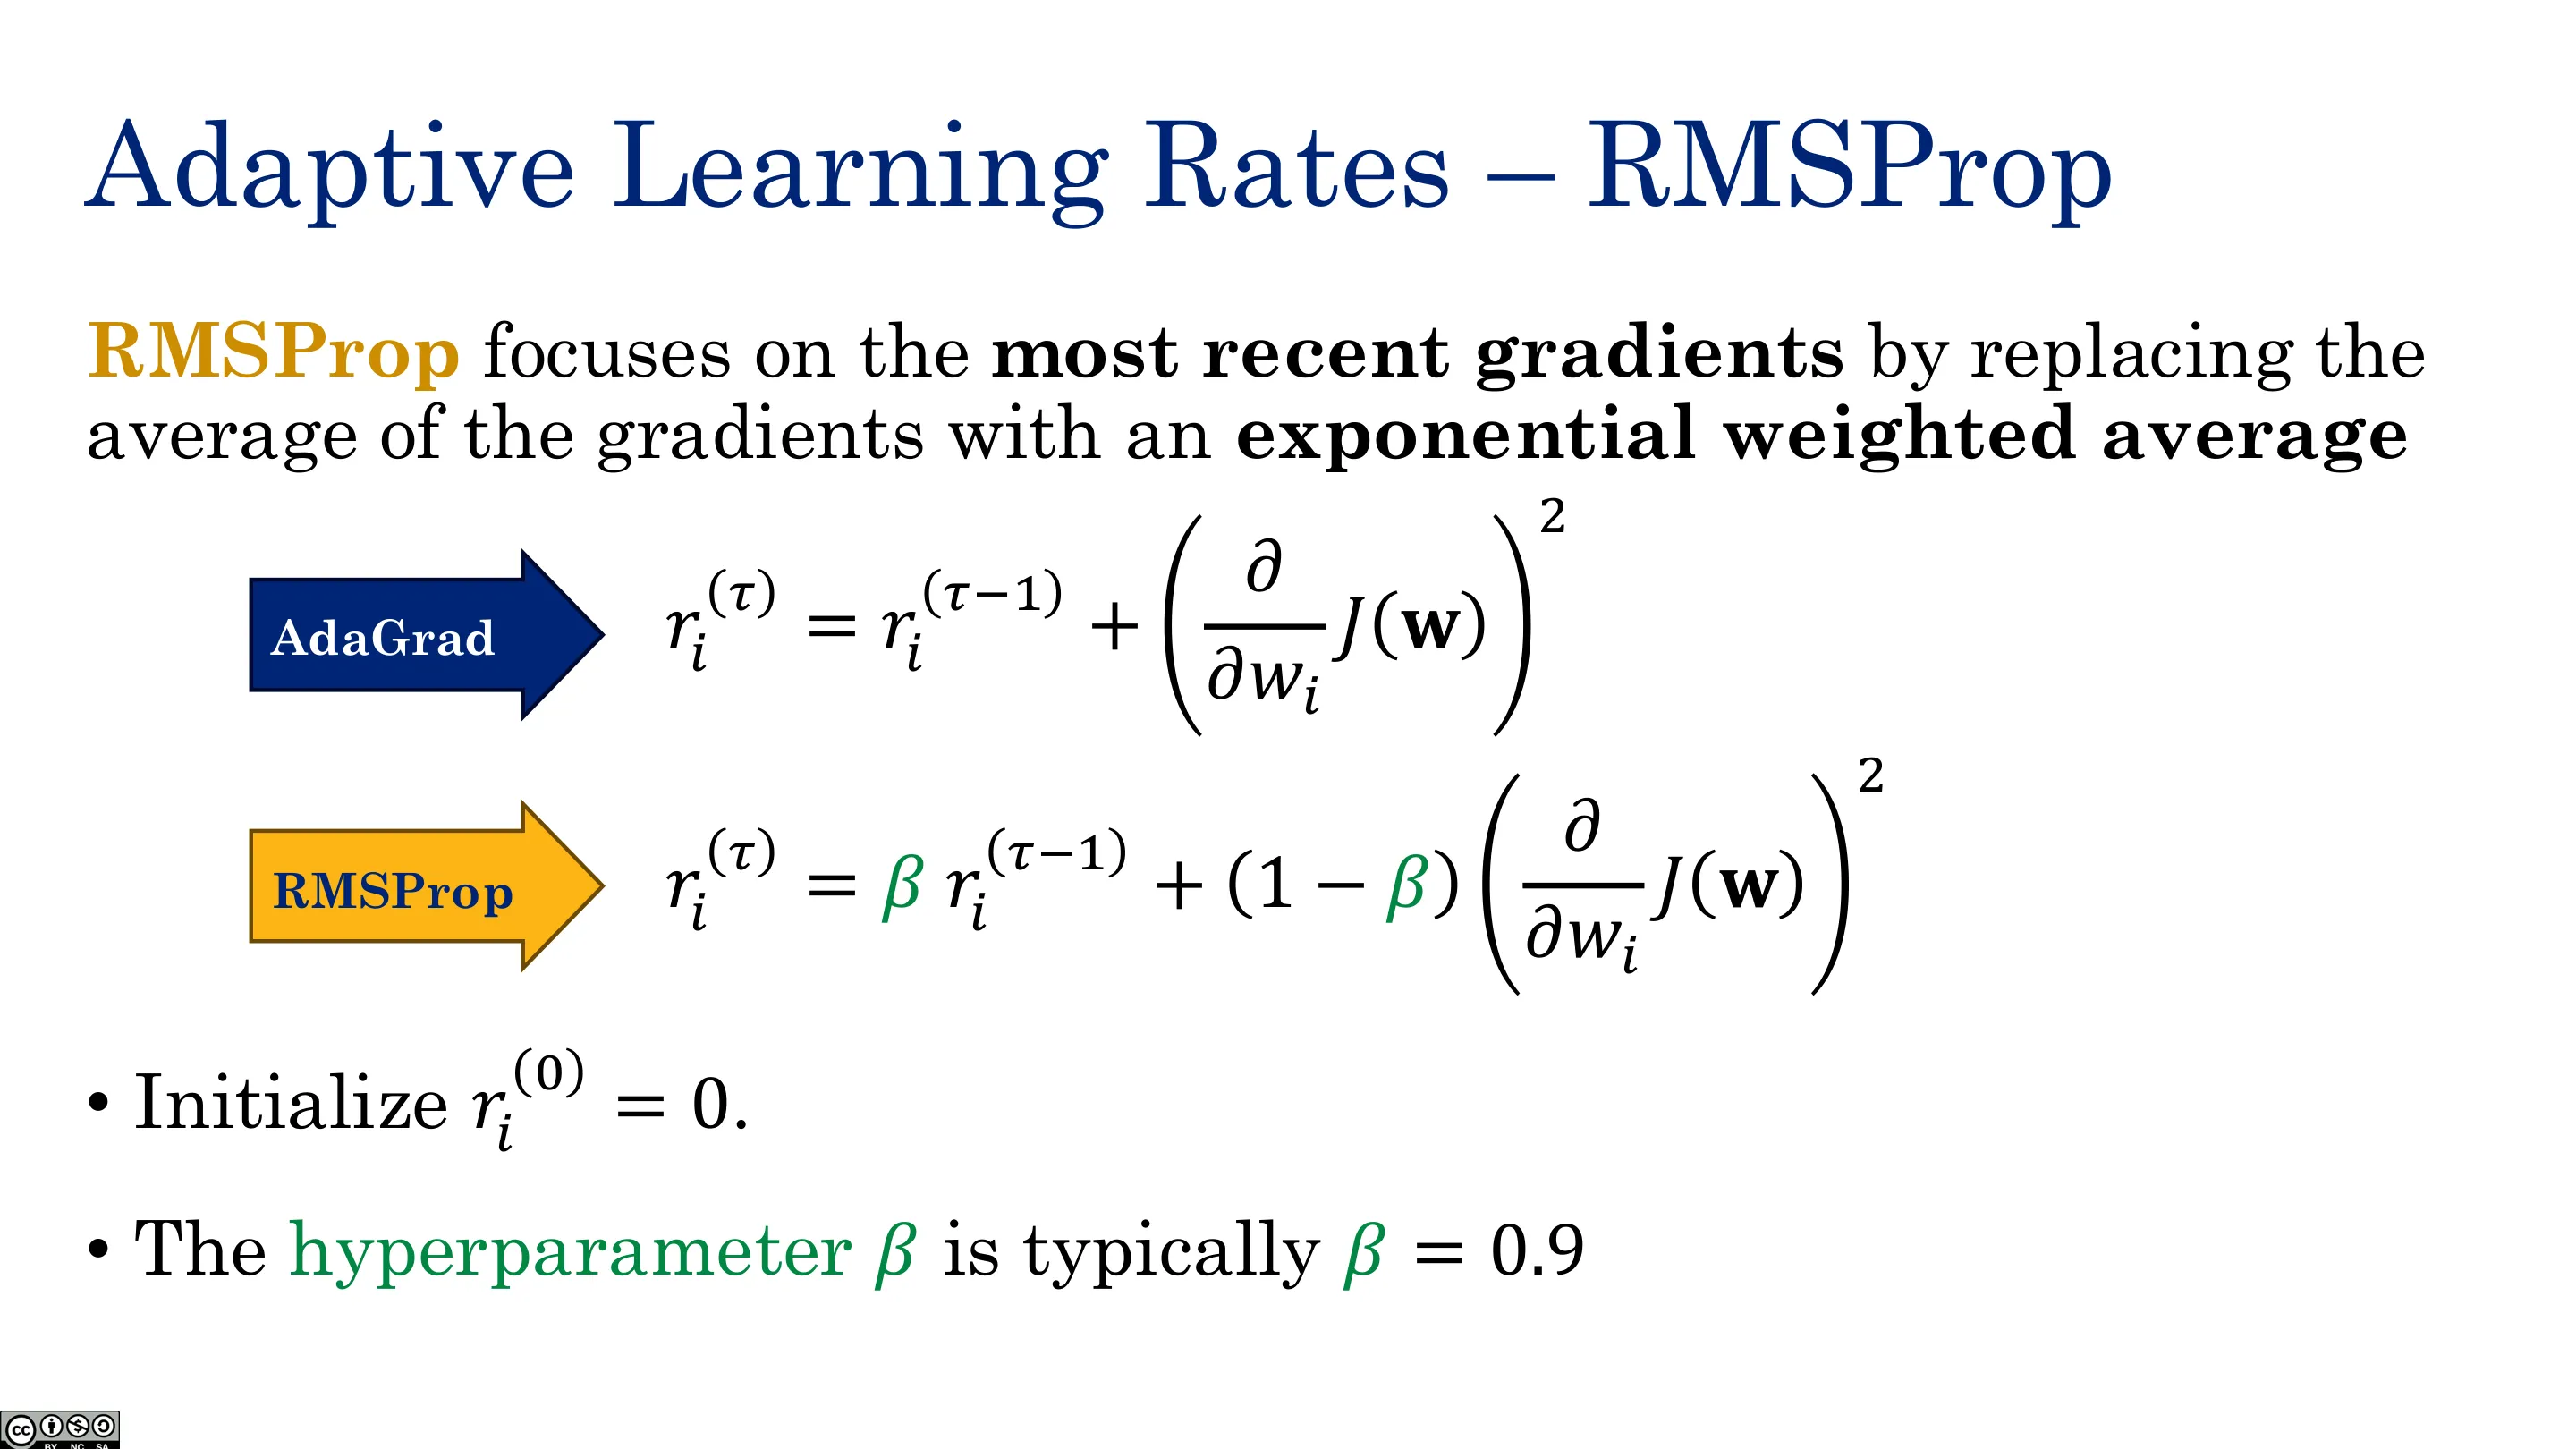
📷 自适应学习率:RMSProp
回到原视频 (00:56:18)
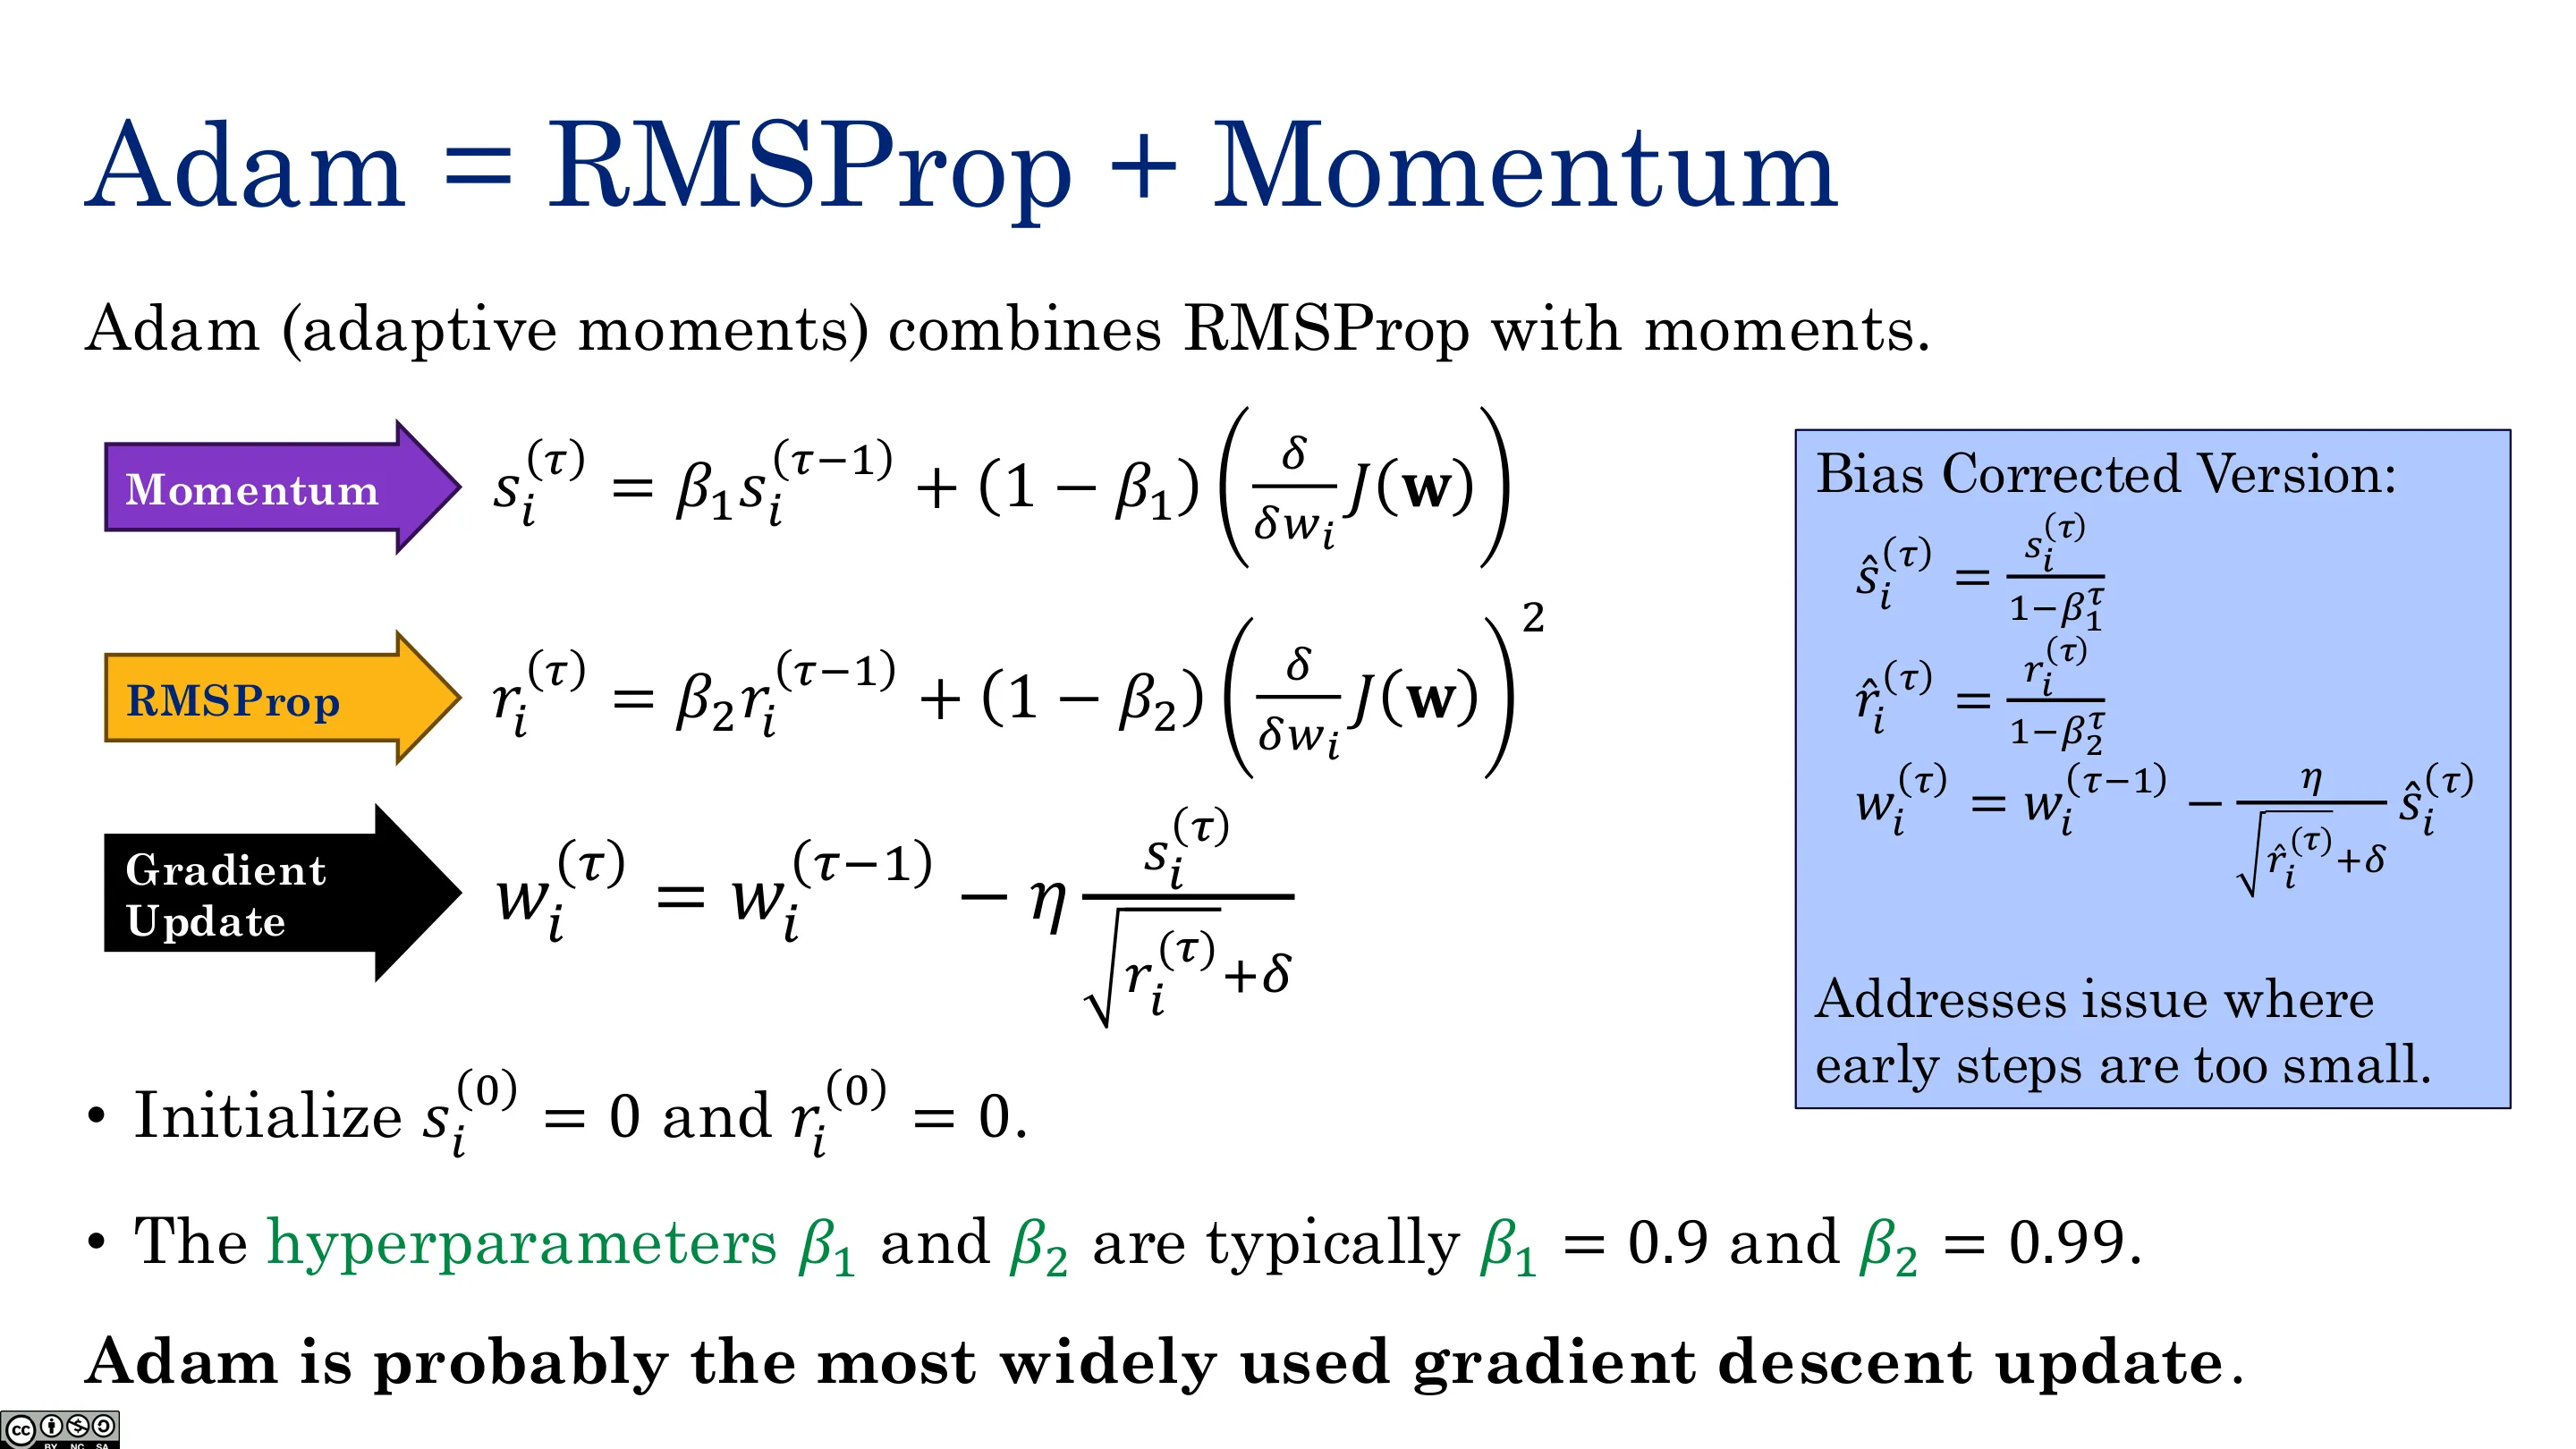
📷 Adam = RMSProp + Momentum
回到原视频 (00:57:31)
📷 Adam
回到原视频 (00:58:44)
四、从批量到随机:SGD 与小批量
(参考时间: 01:07)
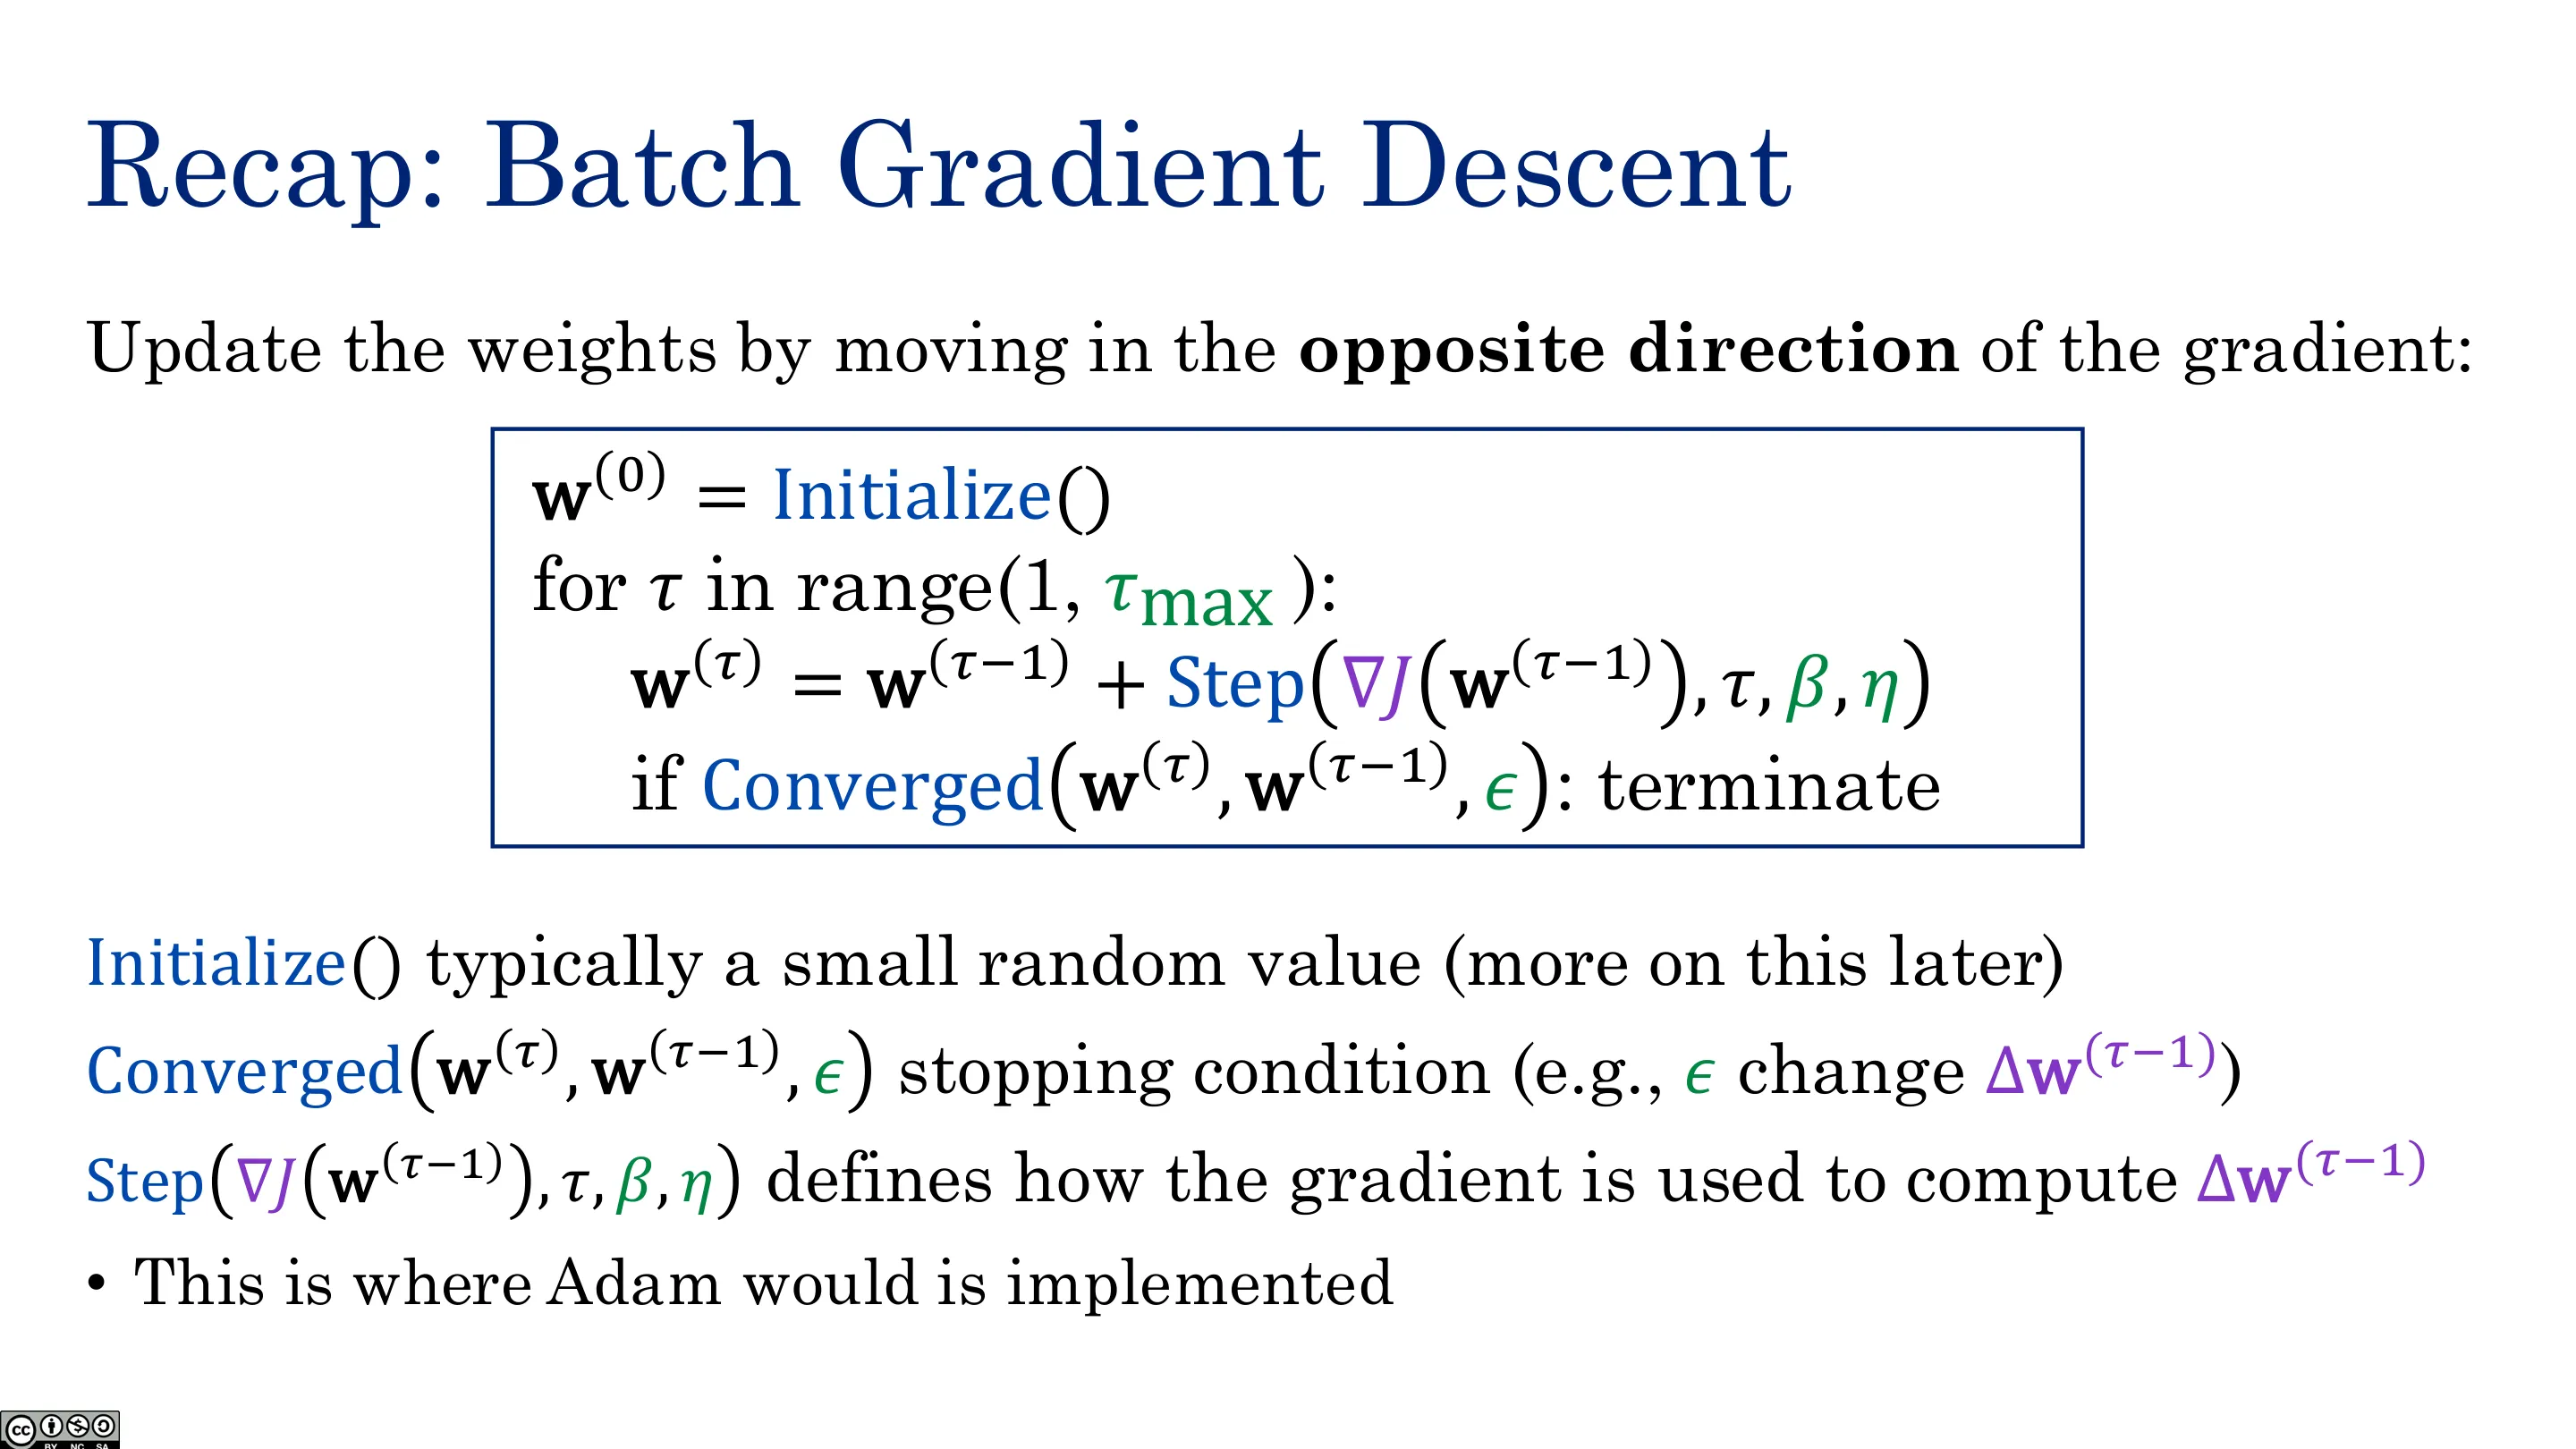
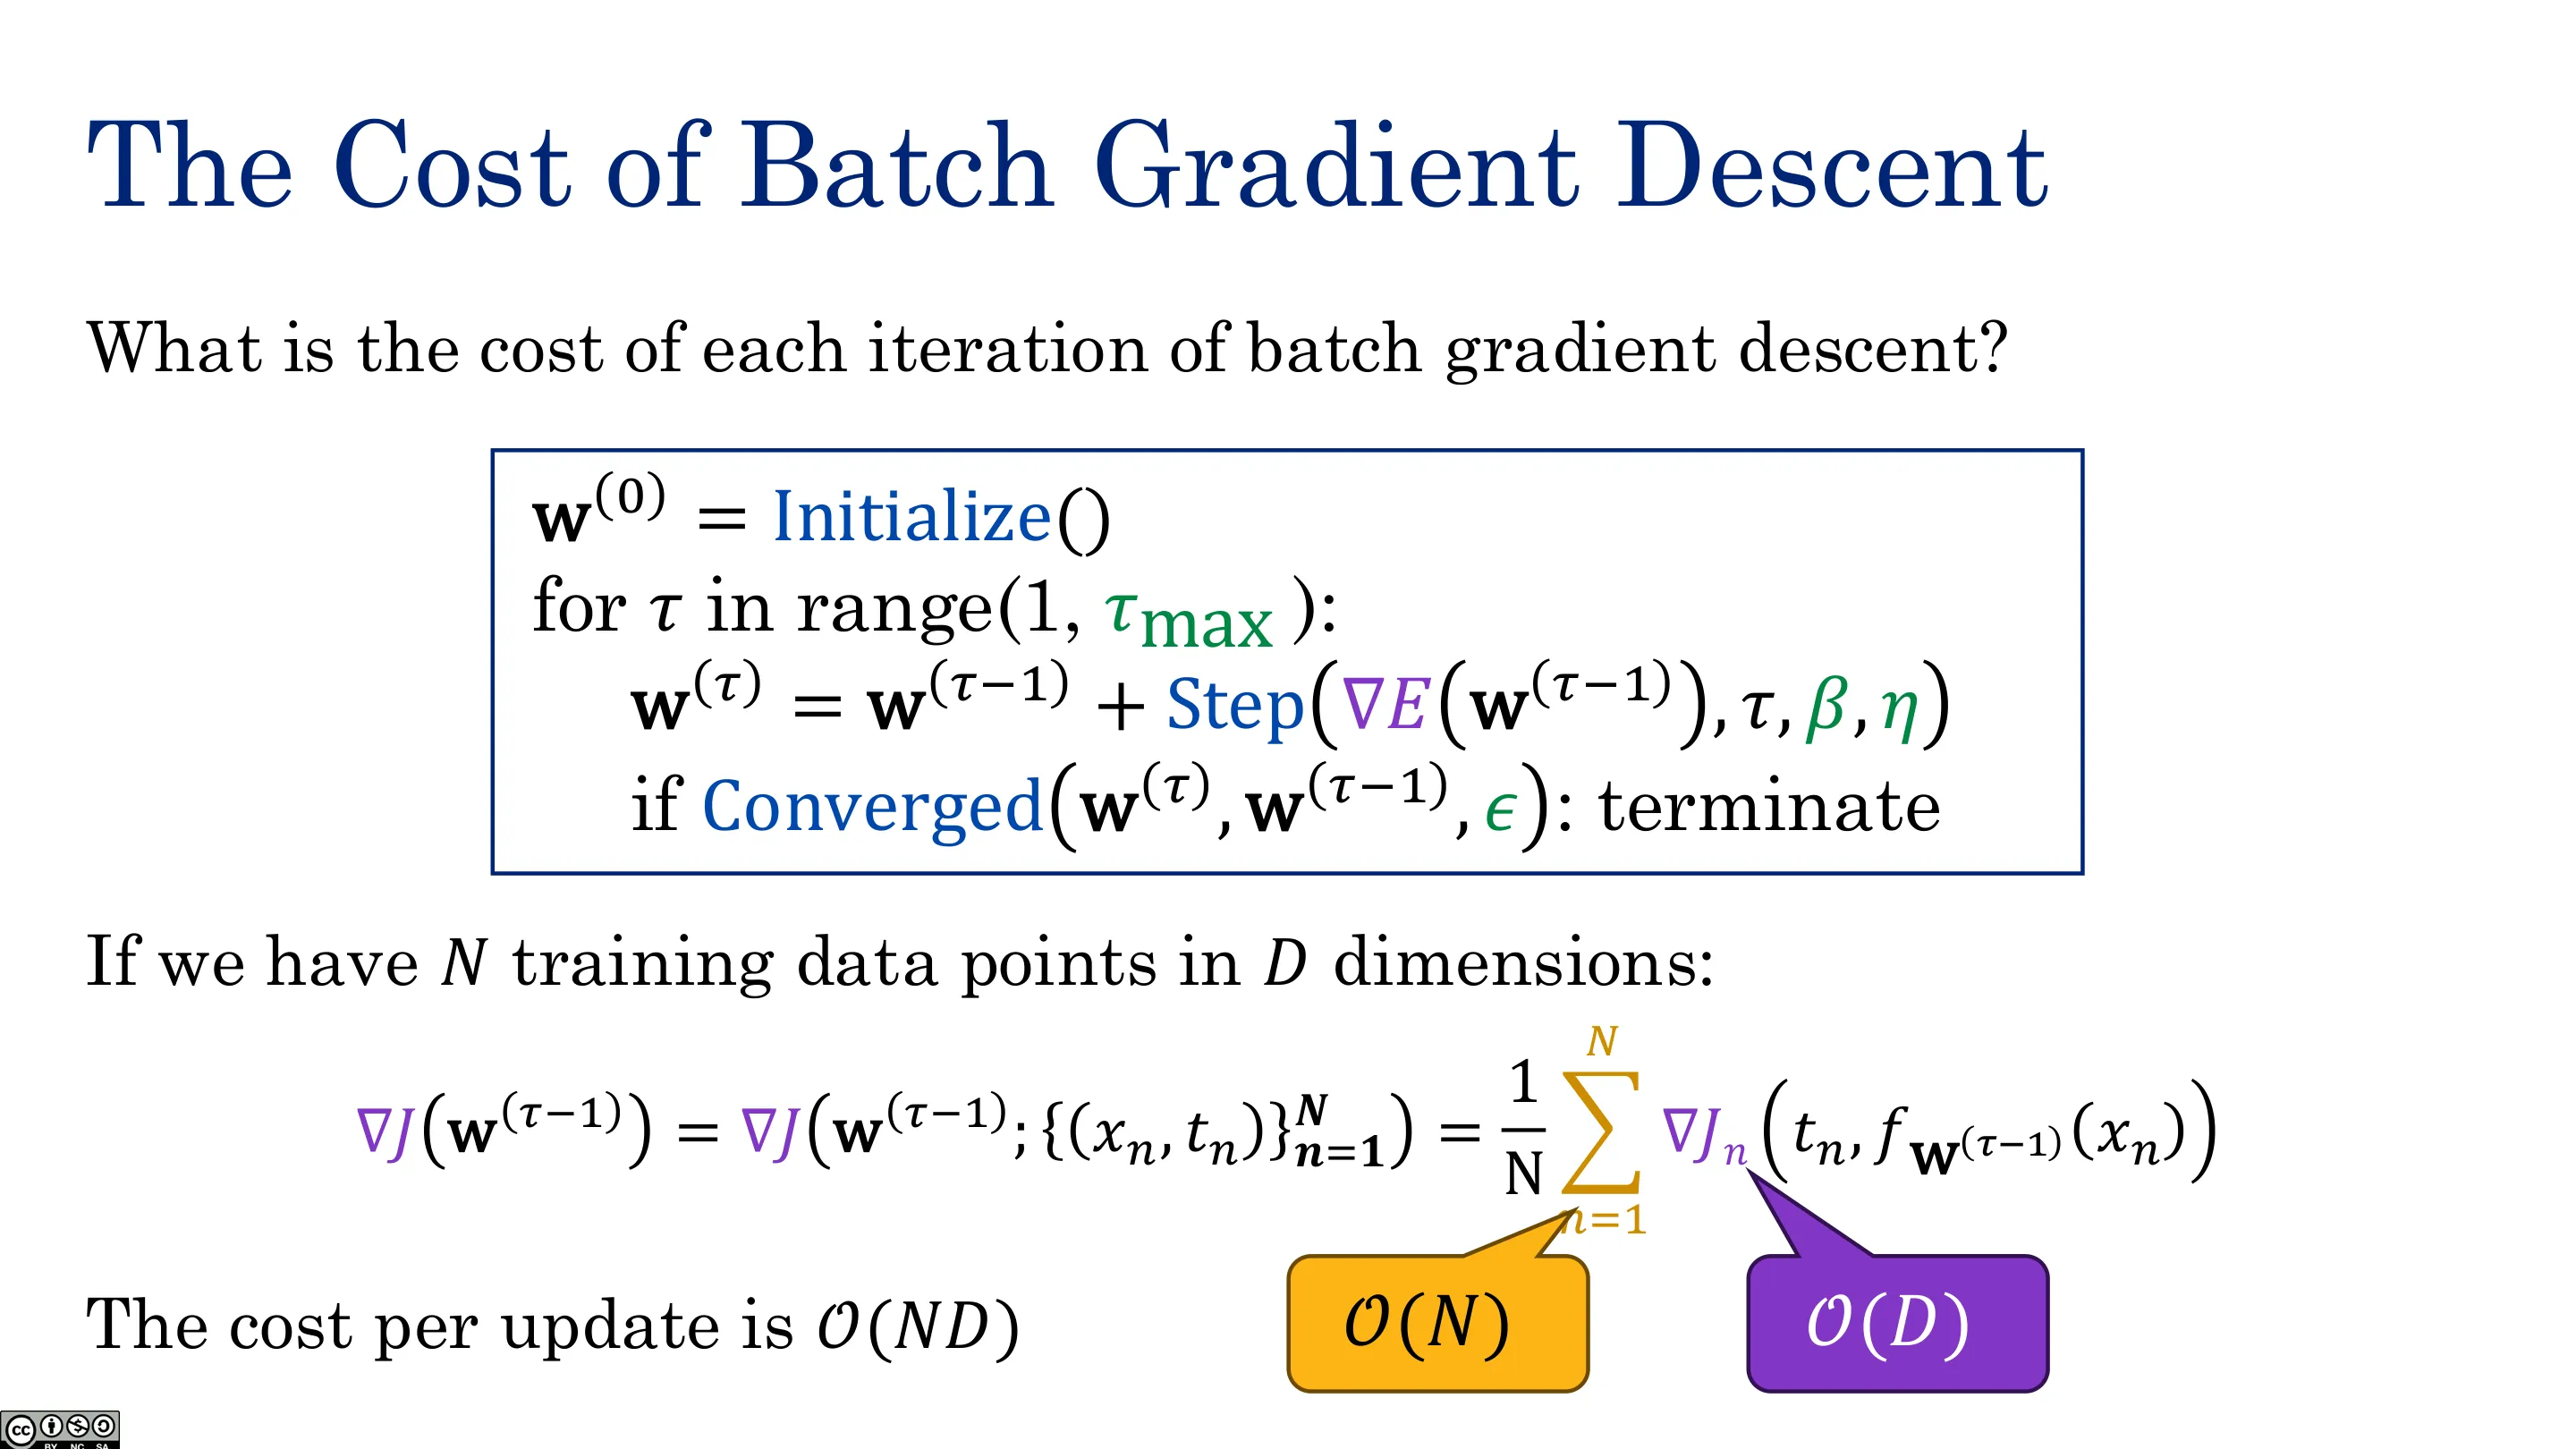
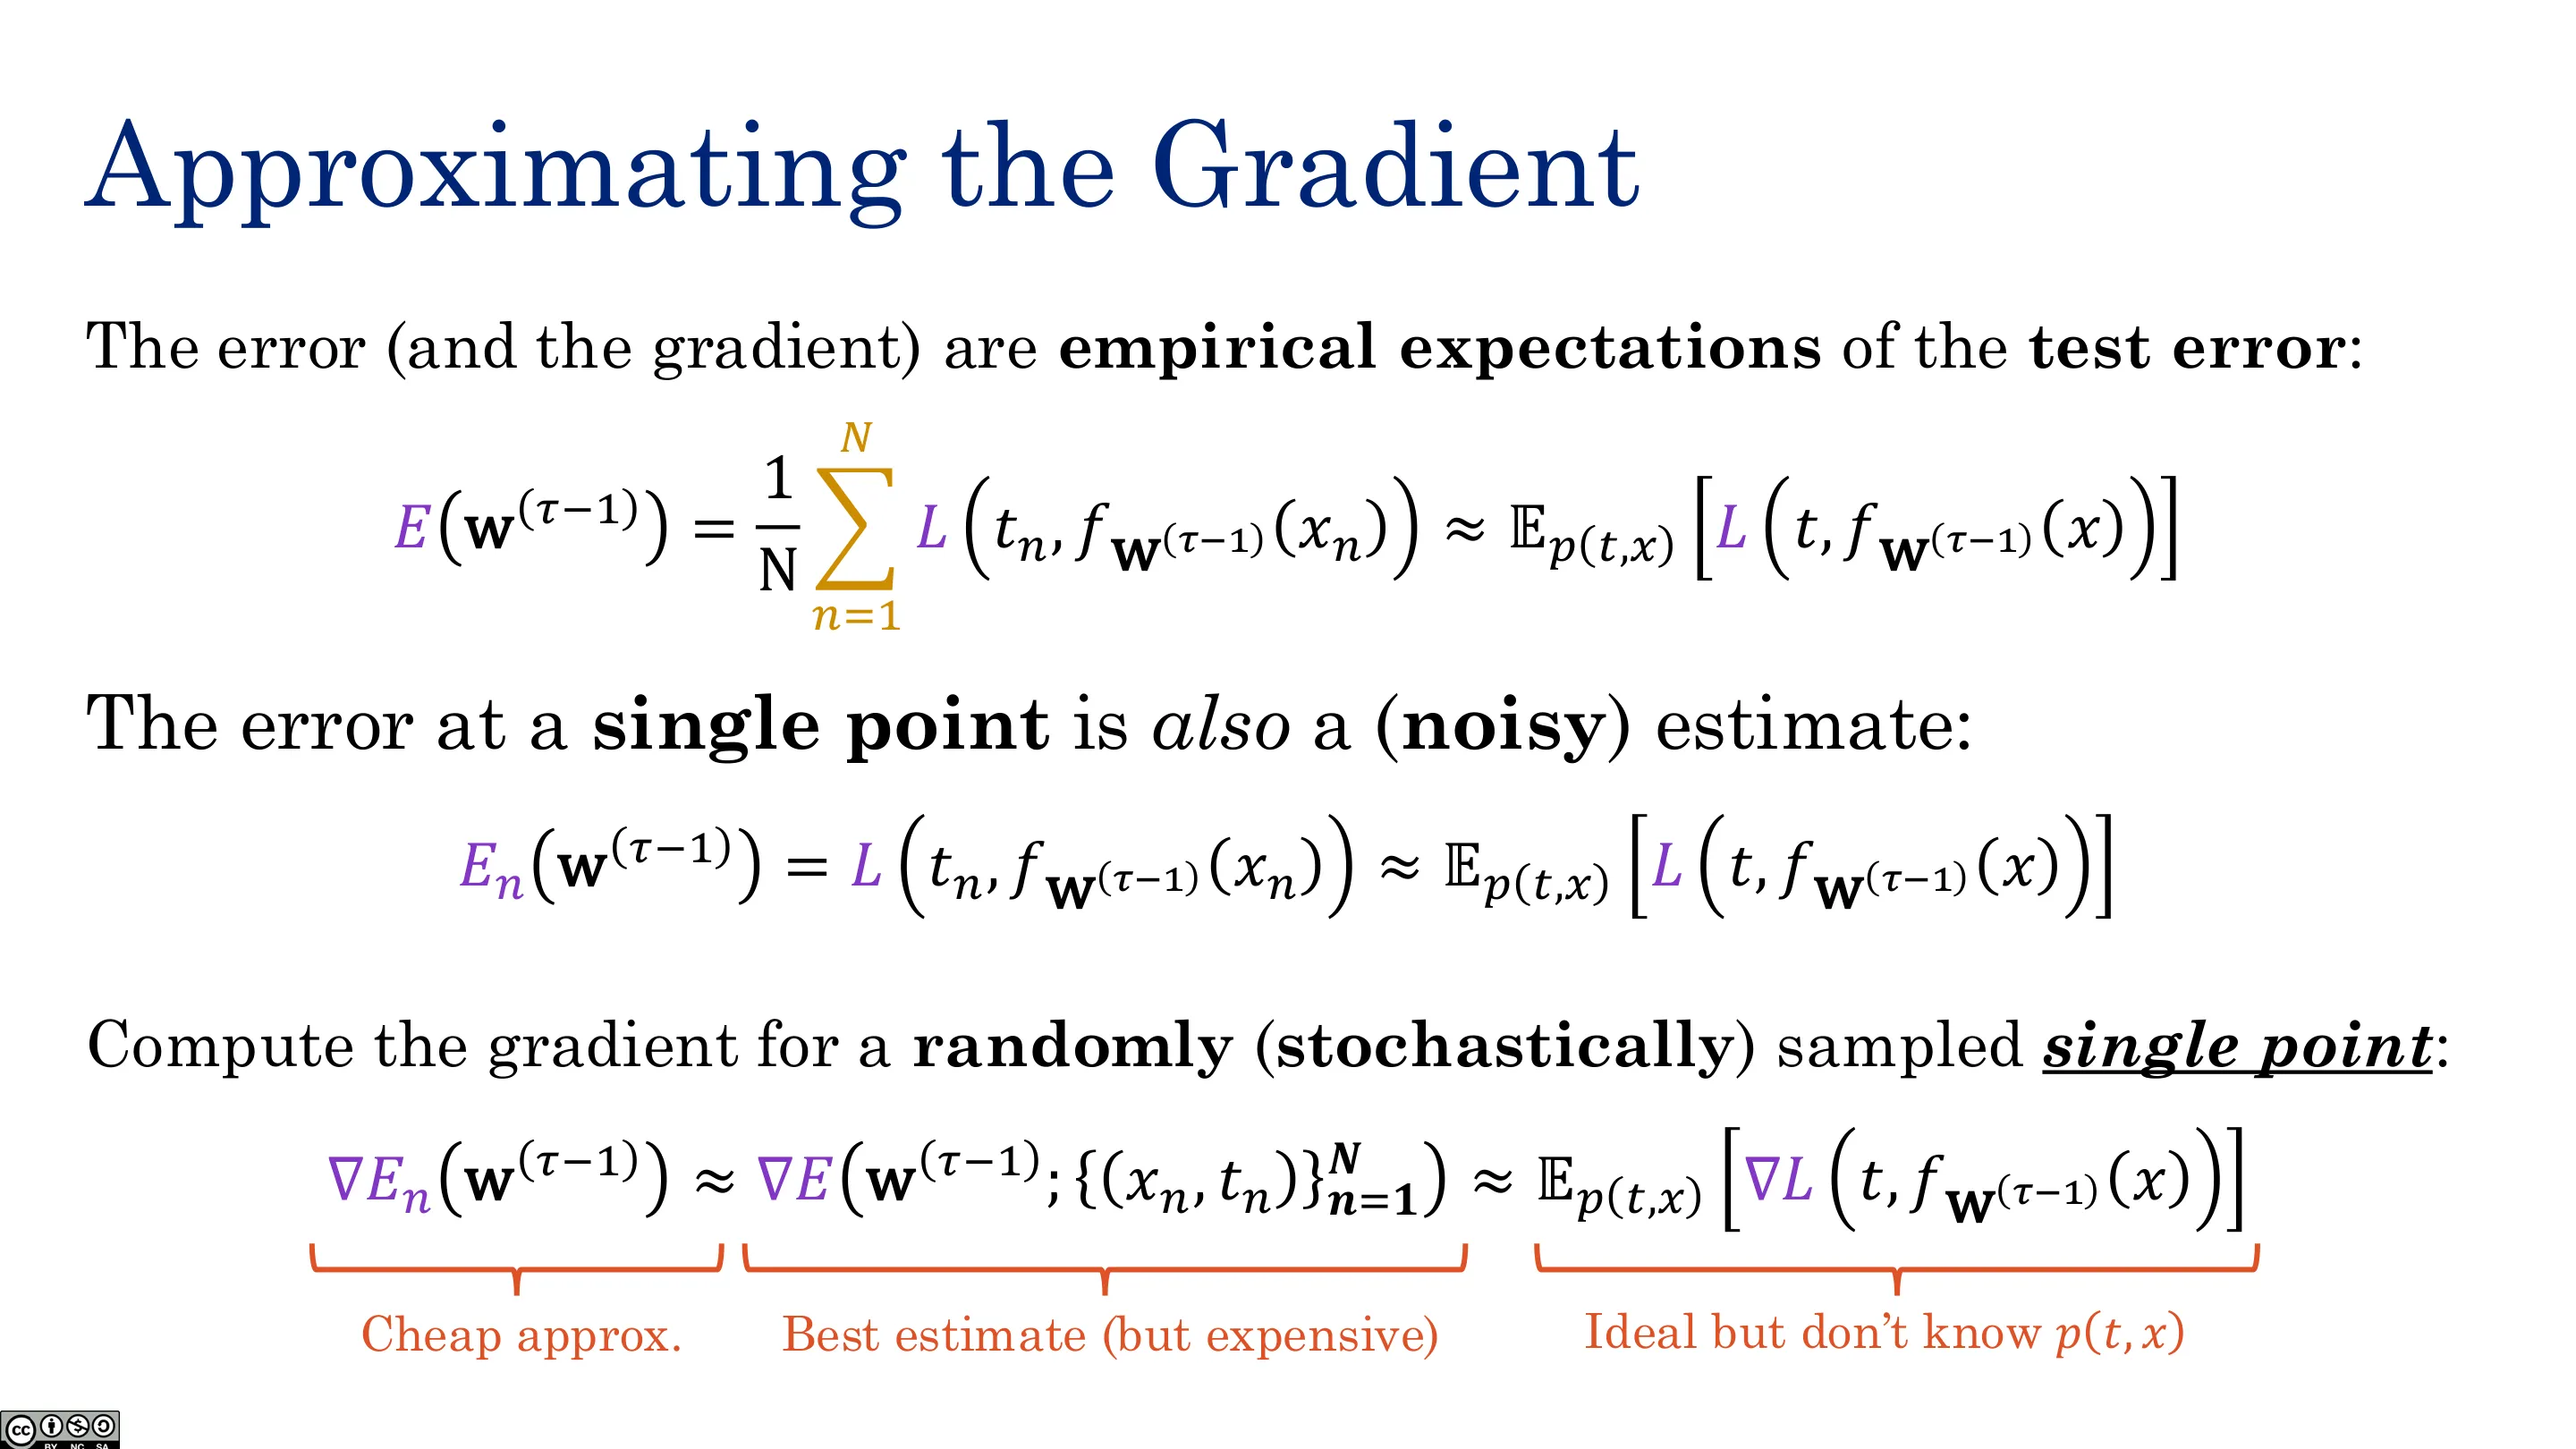
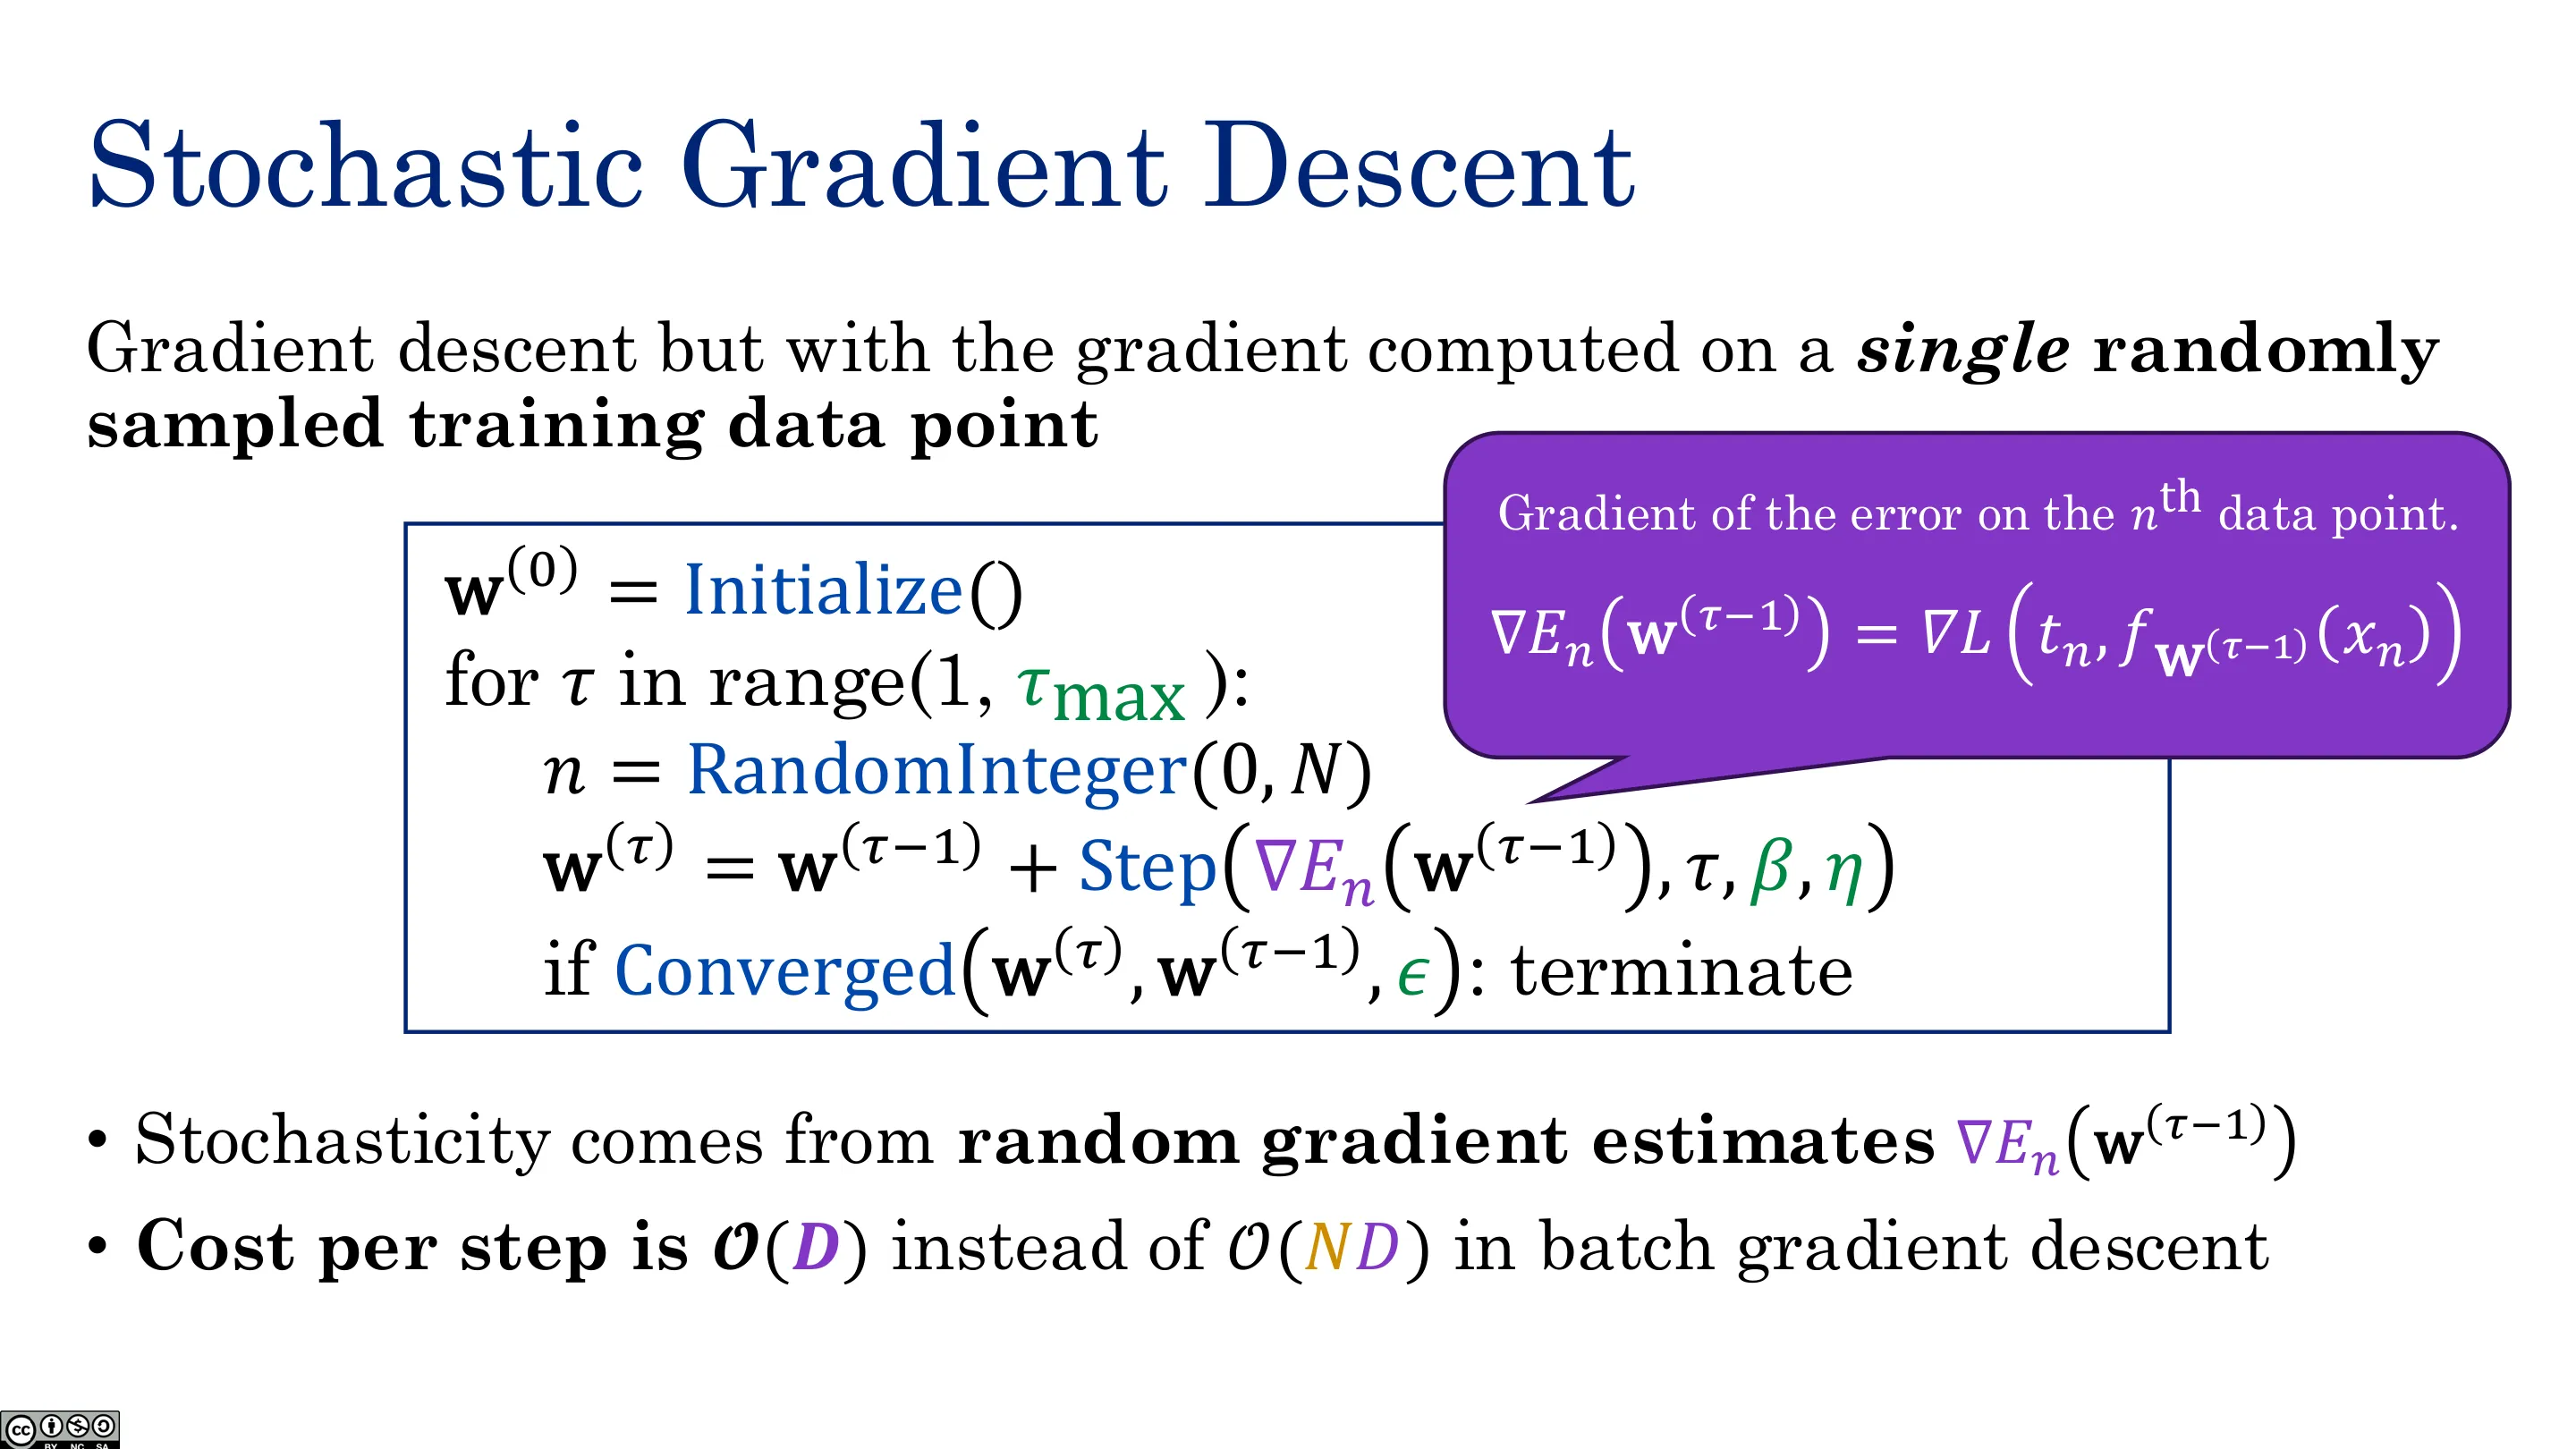
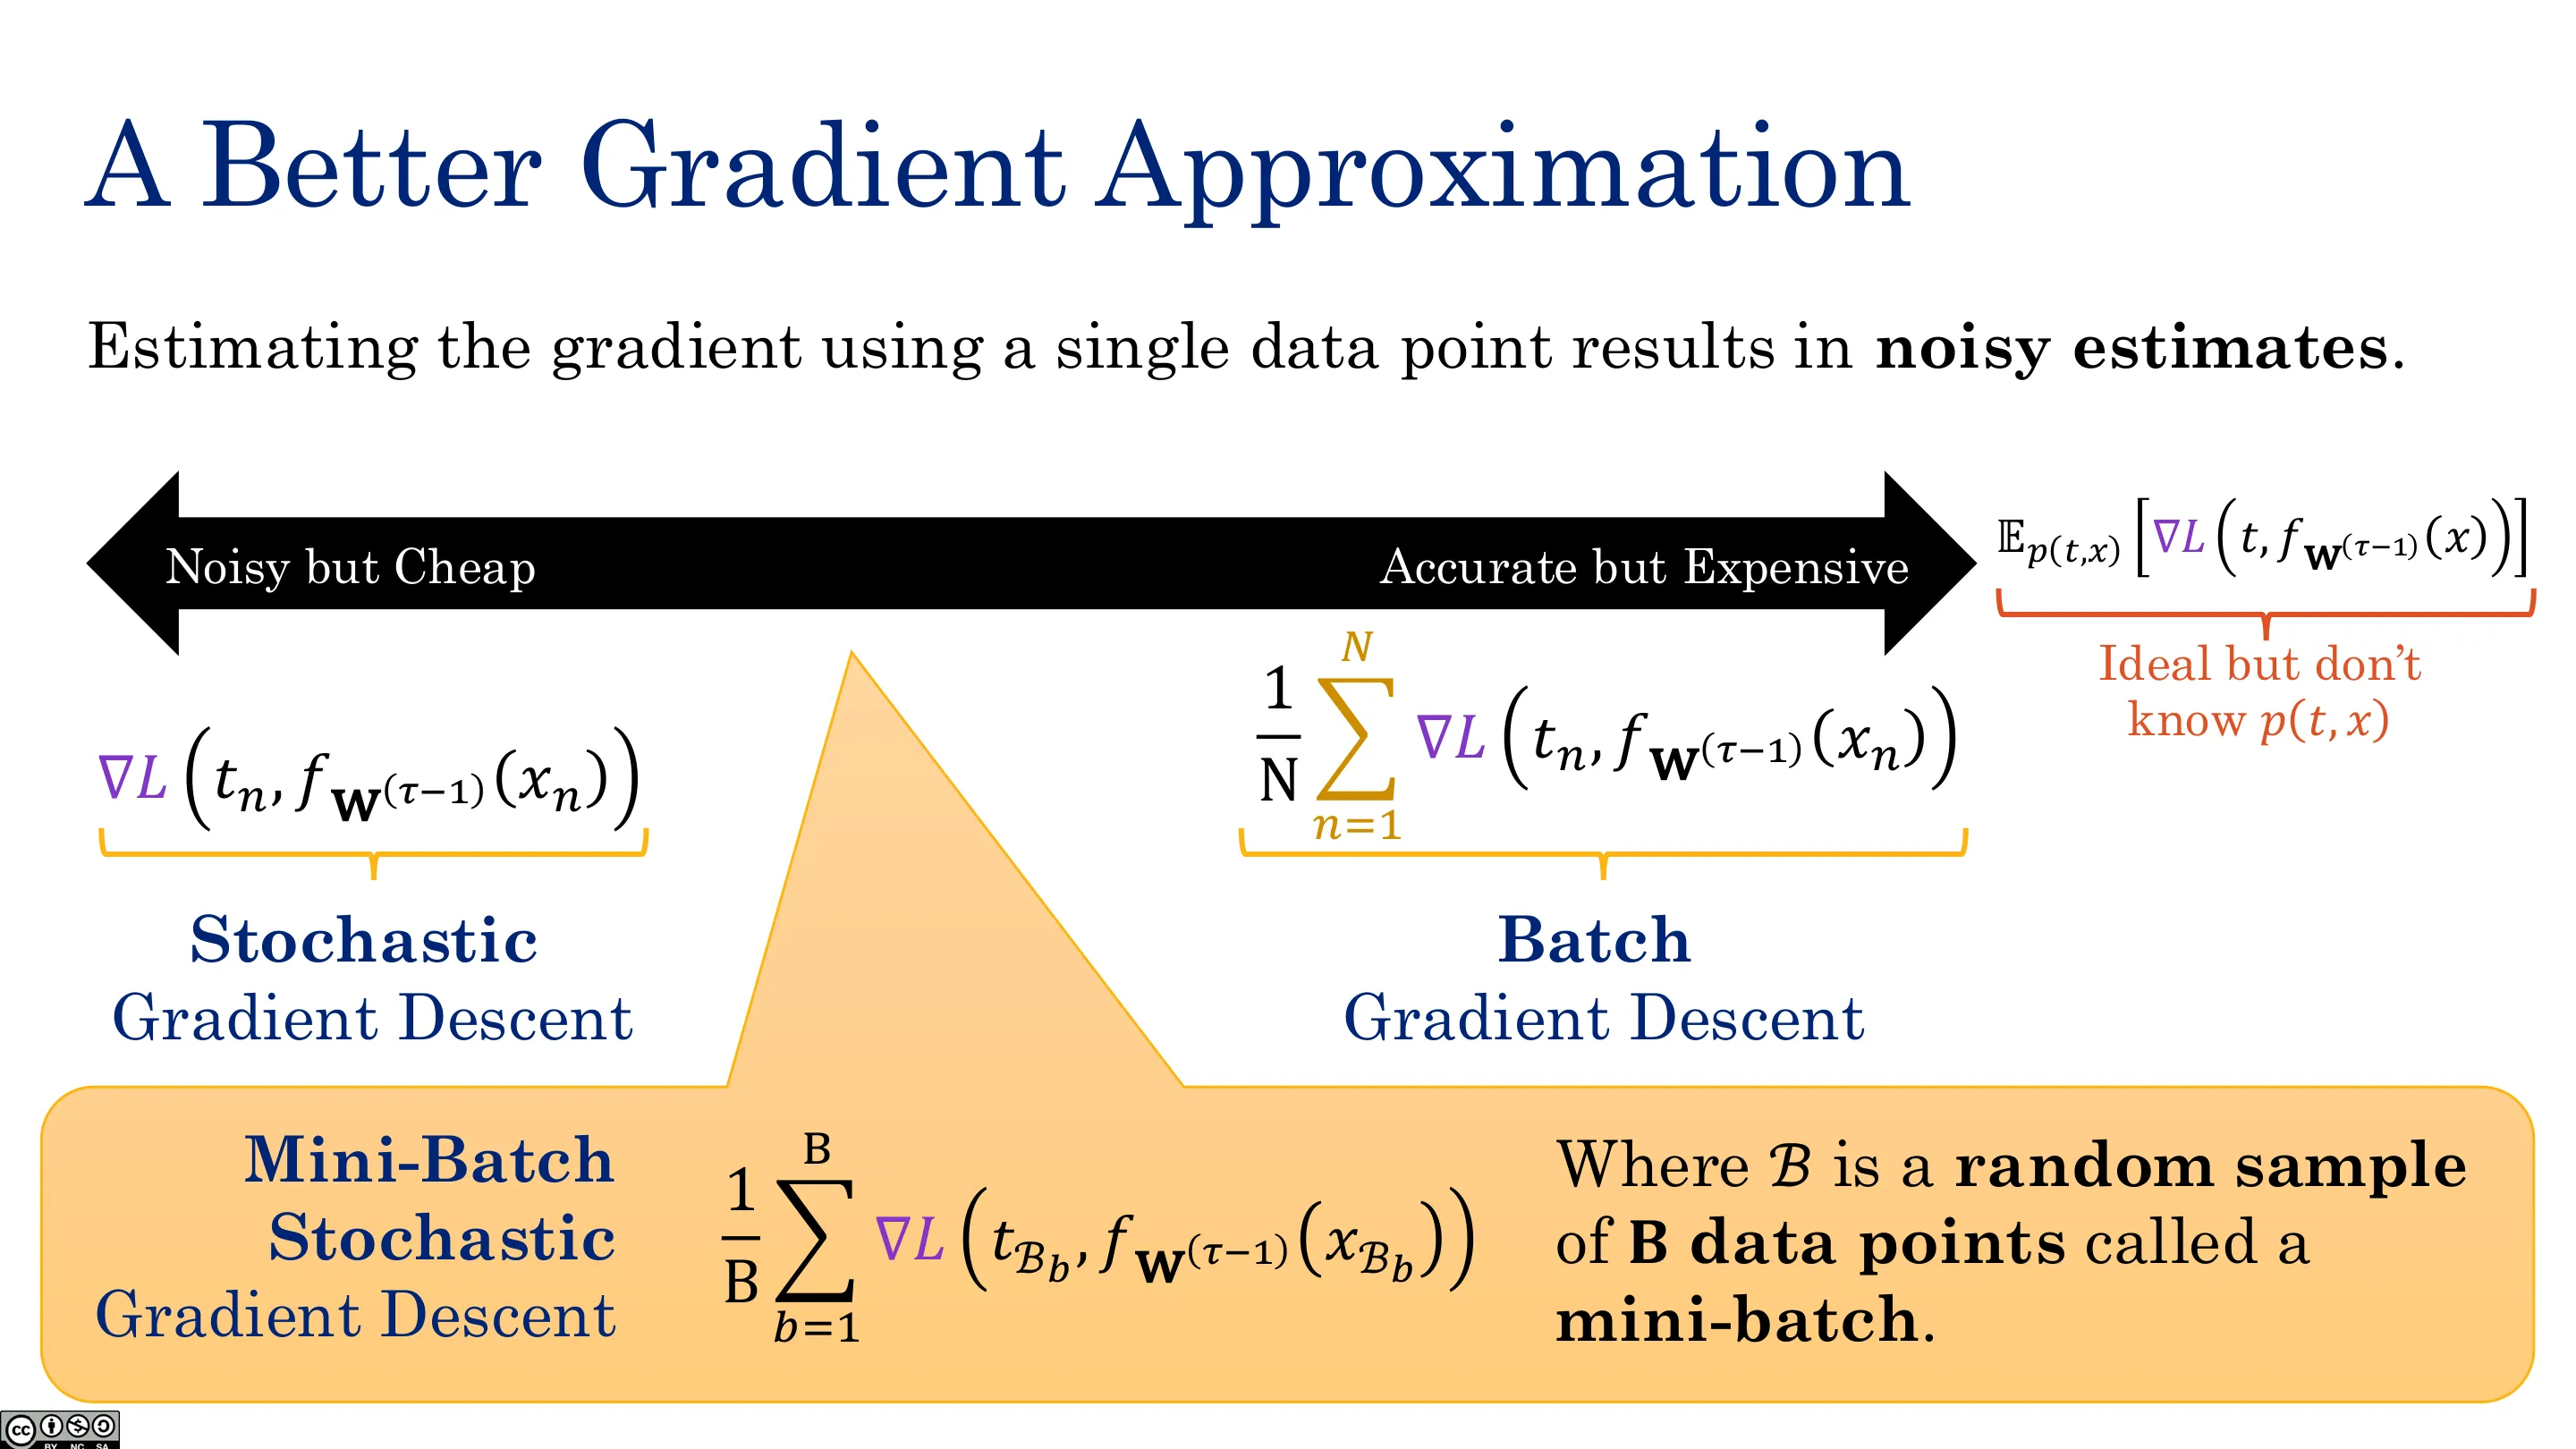
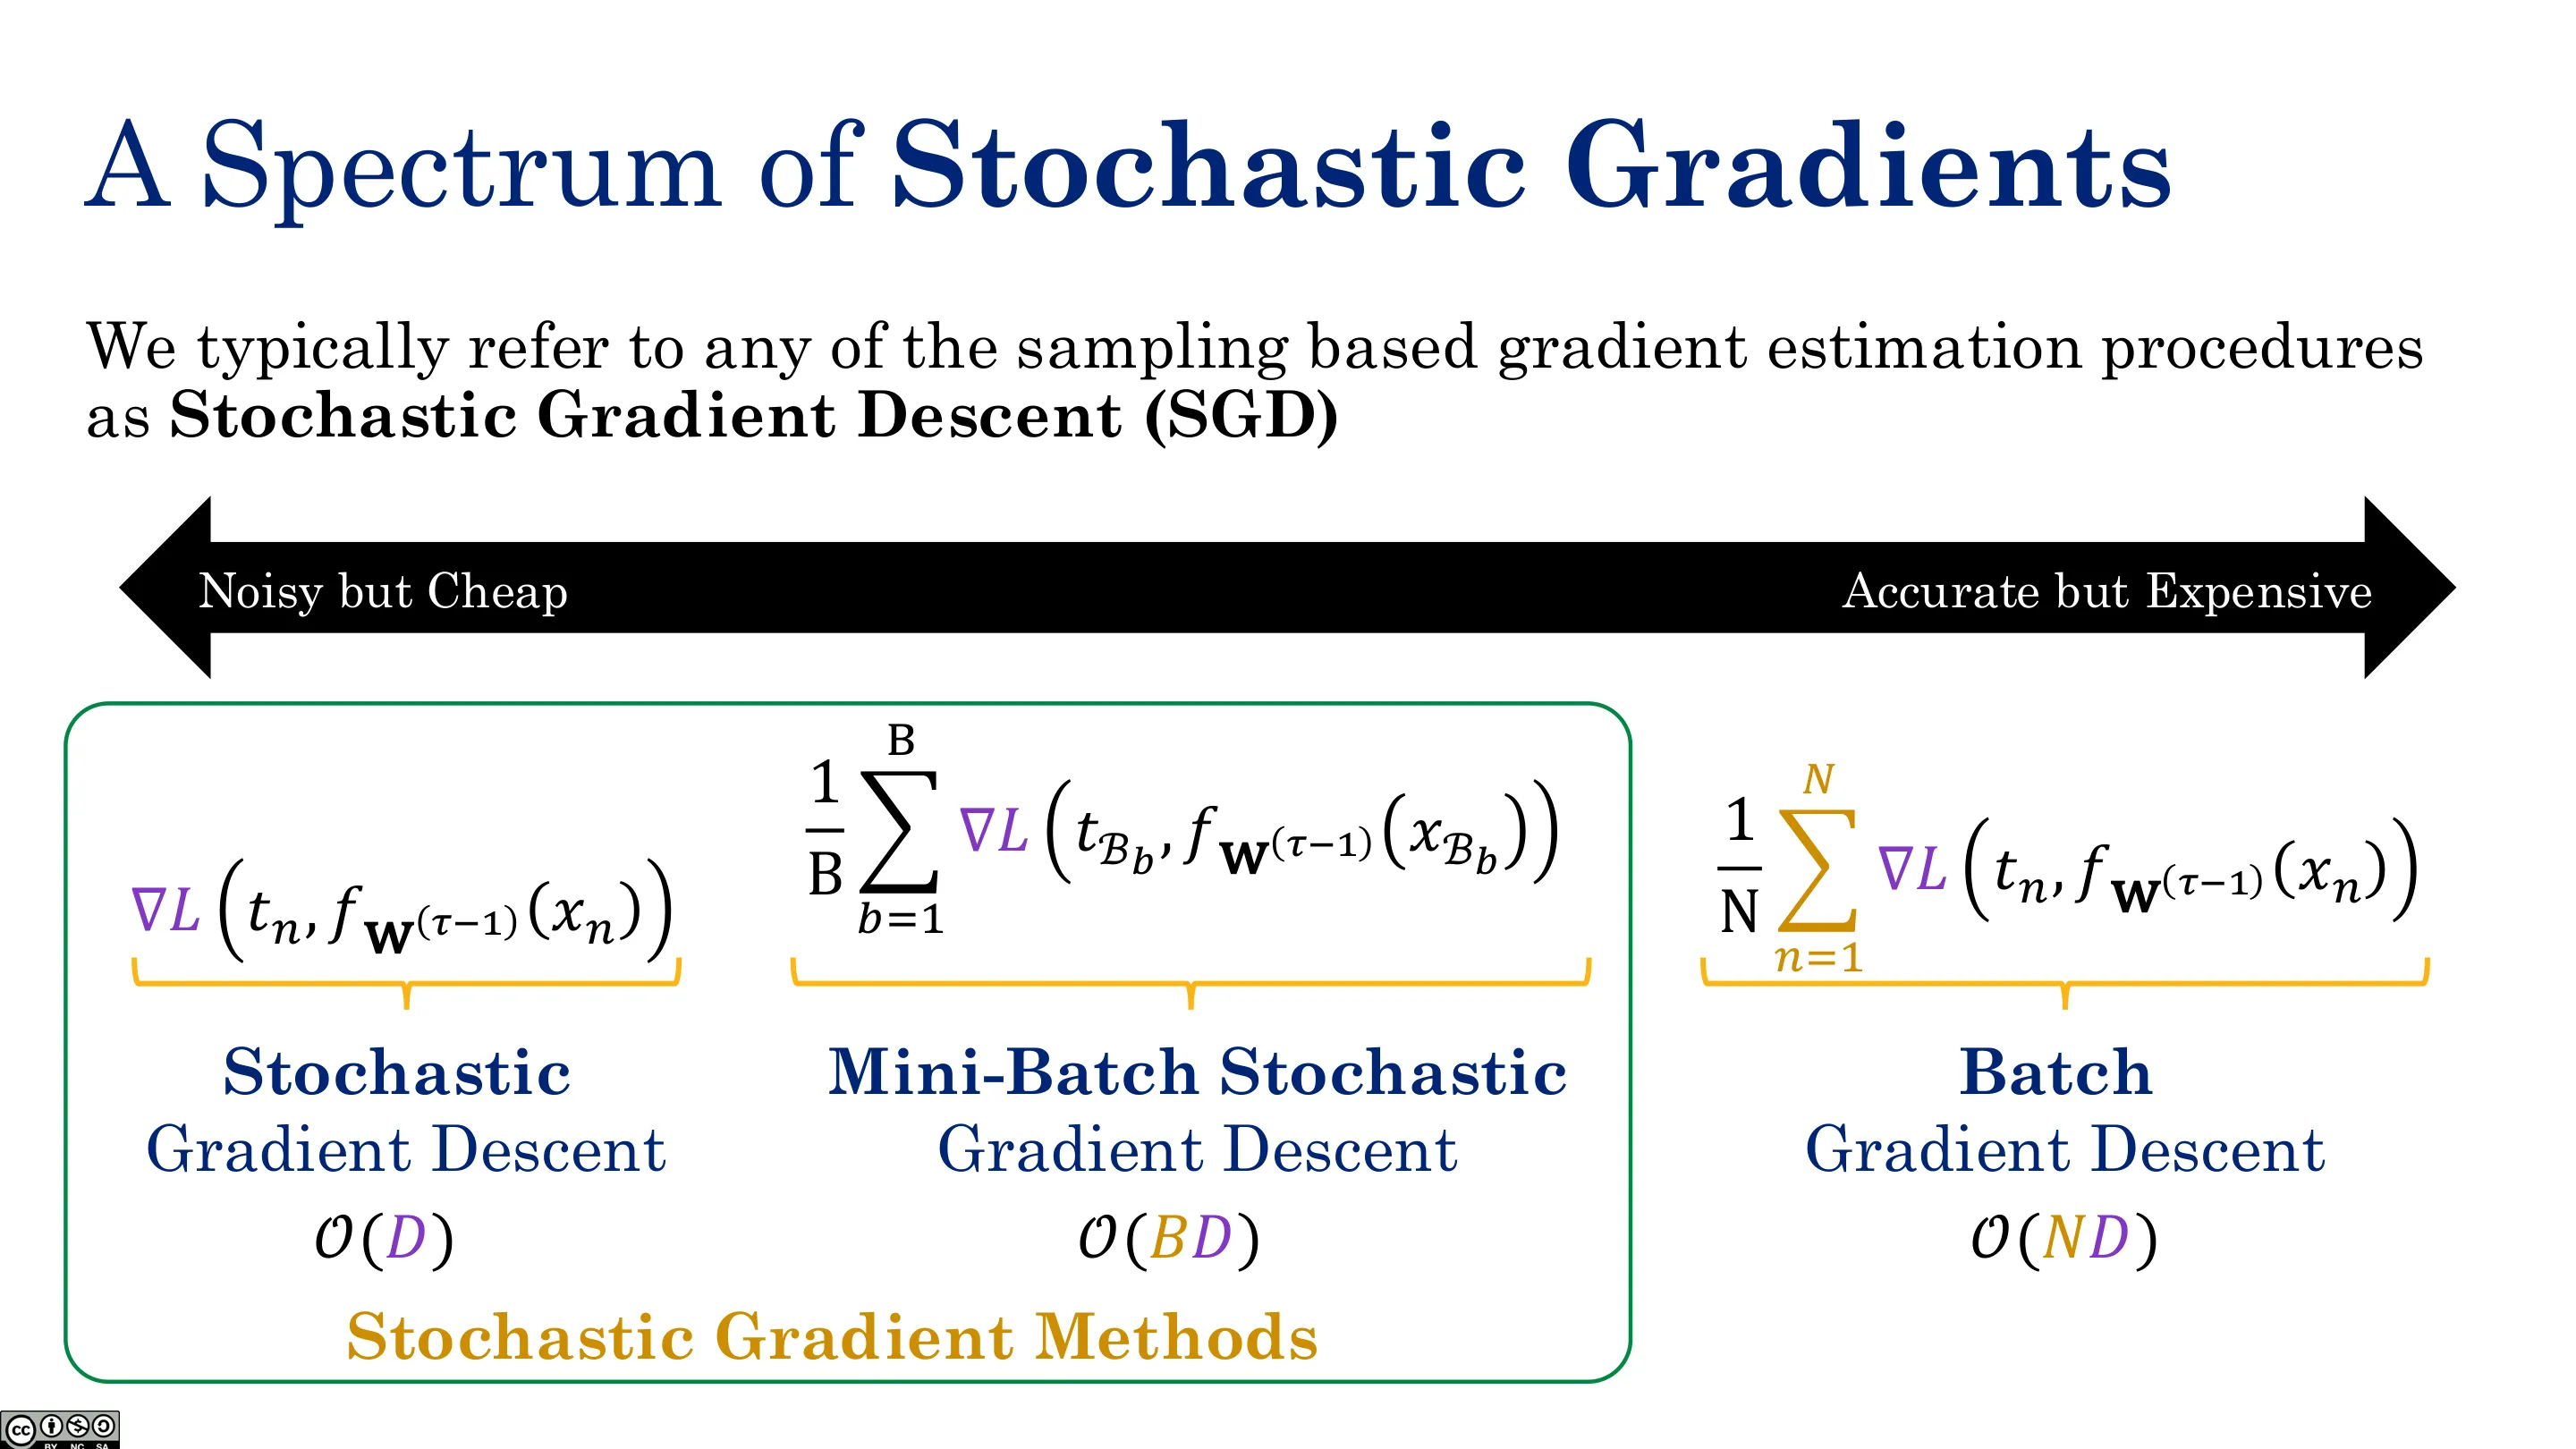
批量梯度下降每步要列出全部 $N$ 项(GPT:$N\sim10^{13}$)——代价高到不可能。随机梯度下降(SGD)每次随机取一行,用它的梯度近似真实梯度:
$$ w^{(t+1)}=w^{(t)}-\eta\,\nabla J_i(w^{(t)}) $$
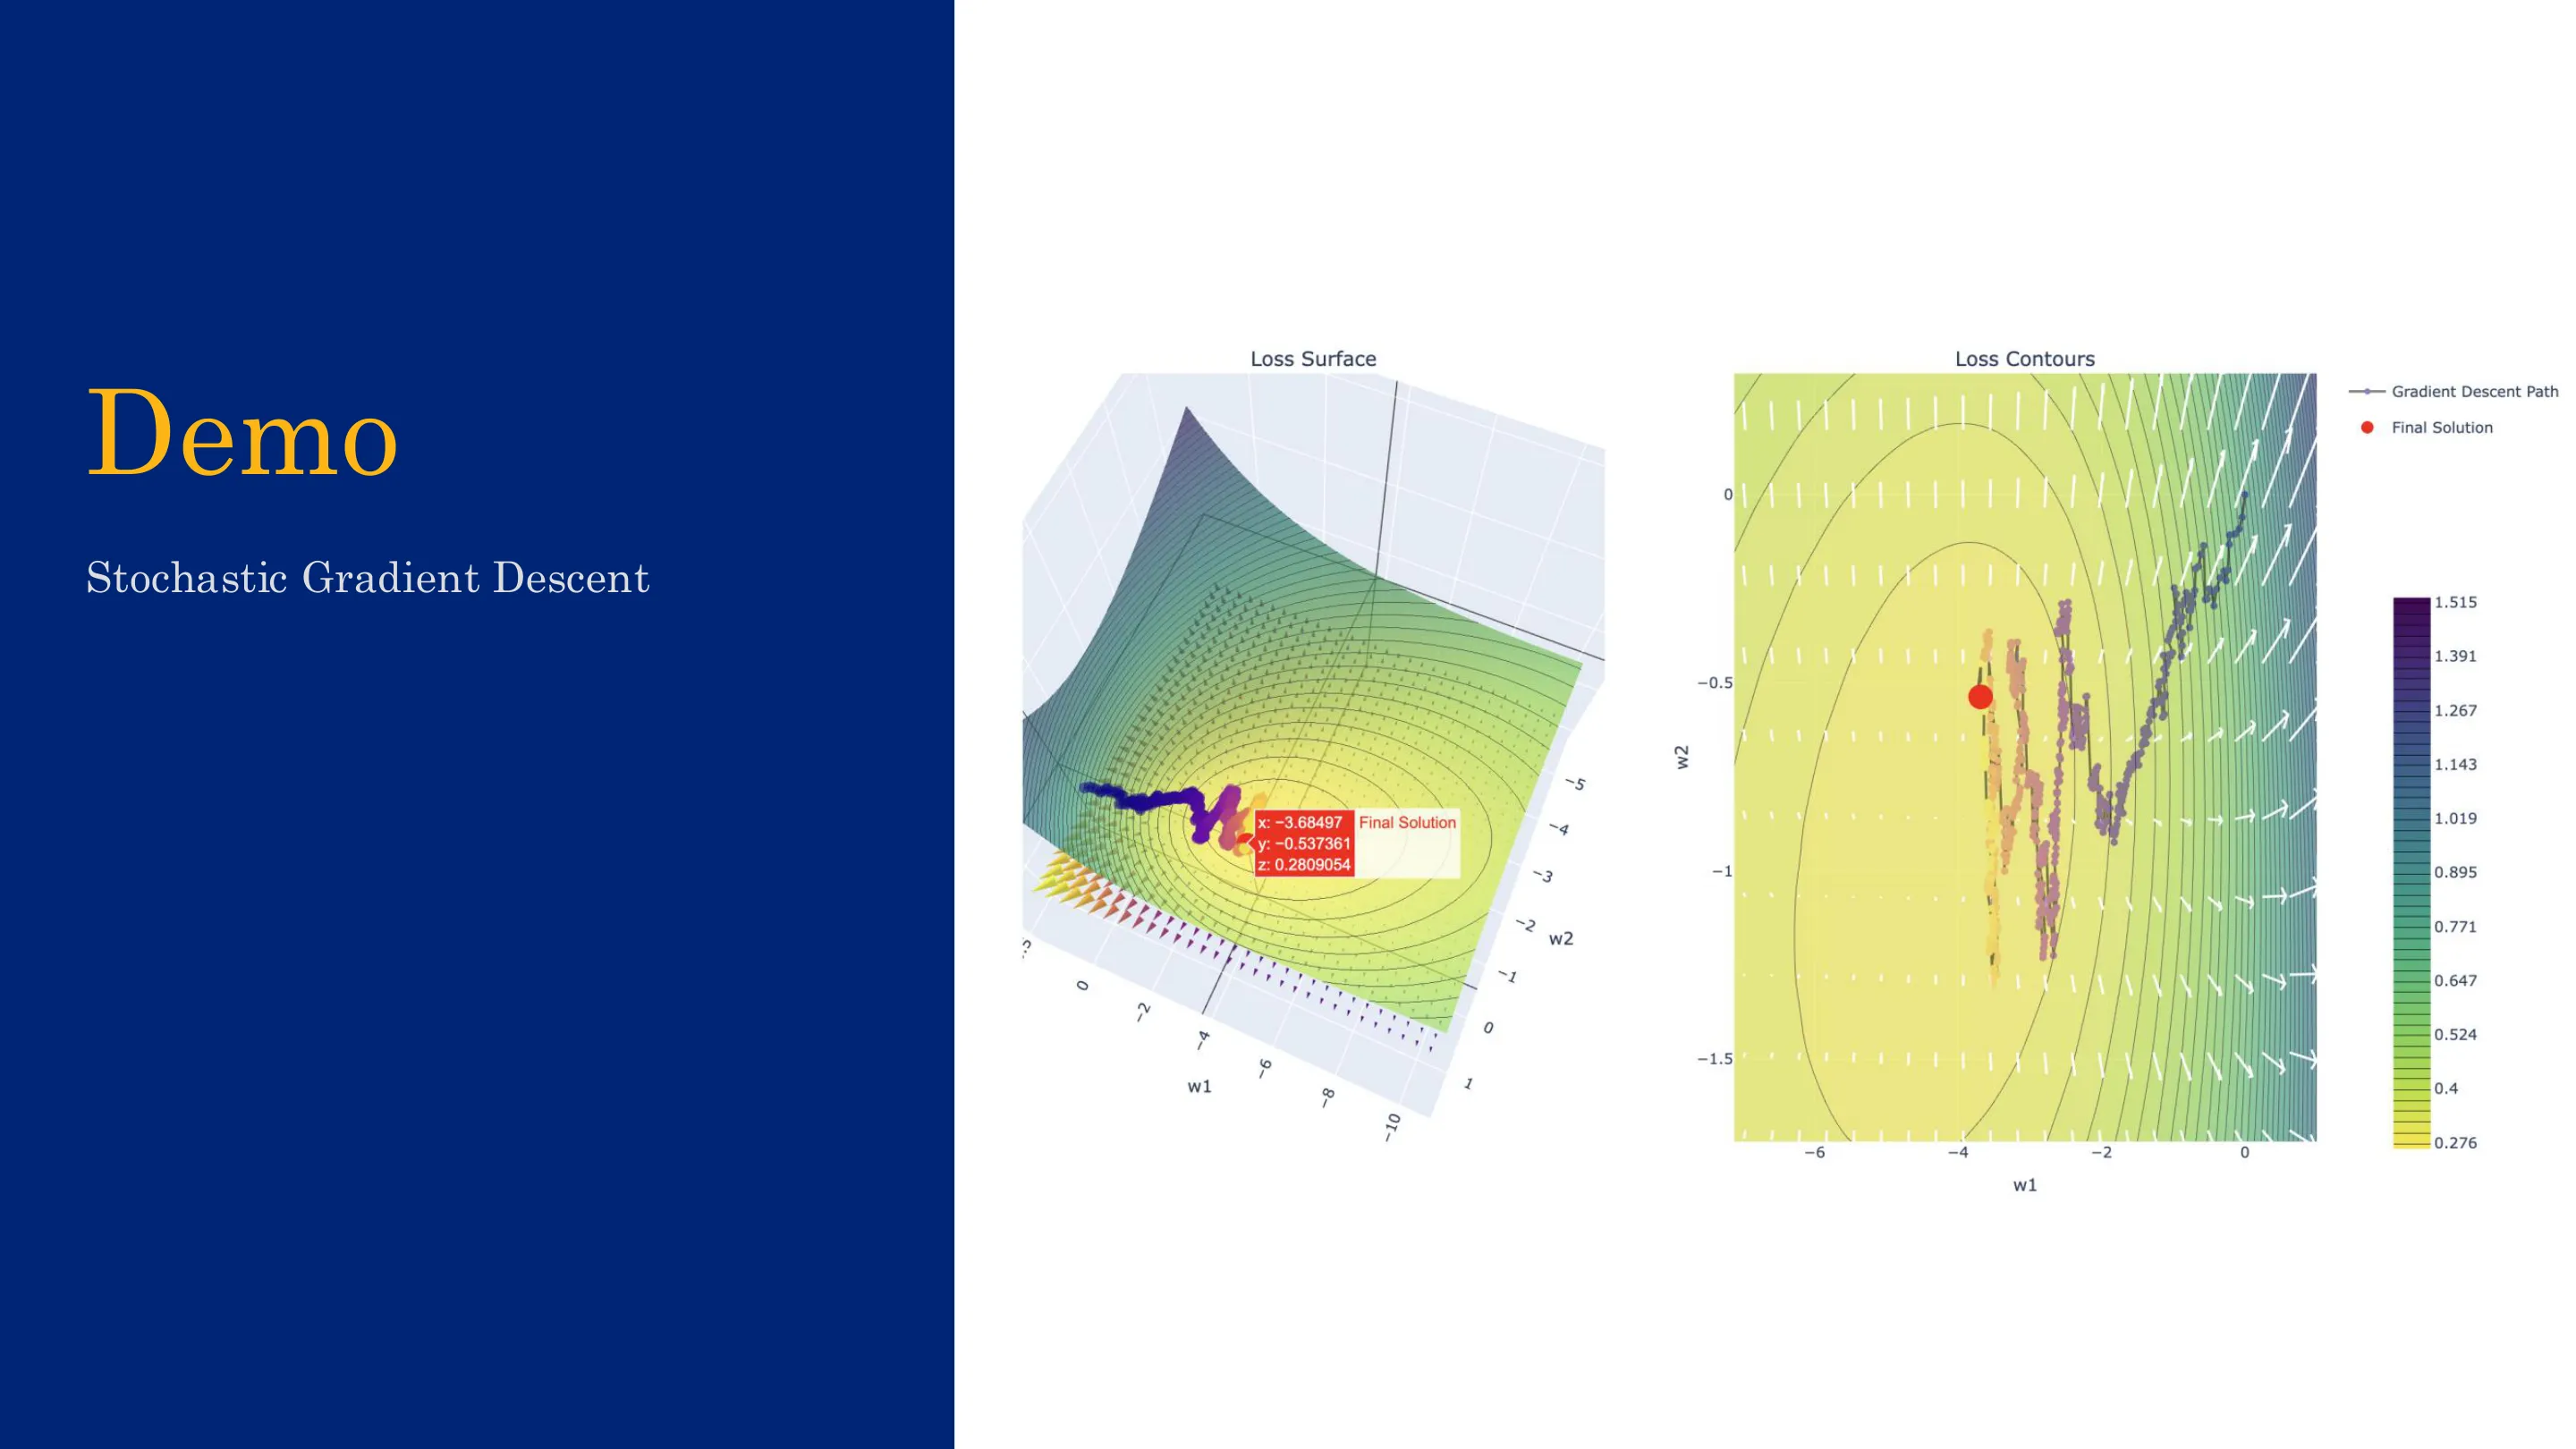
它是真实下降方向的有噪近似(轨迹呈小幅抖动),但足够多步之后通常也走到类似的最小值。
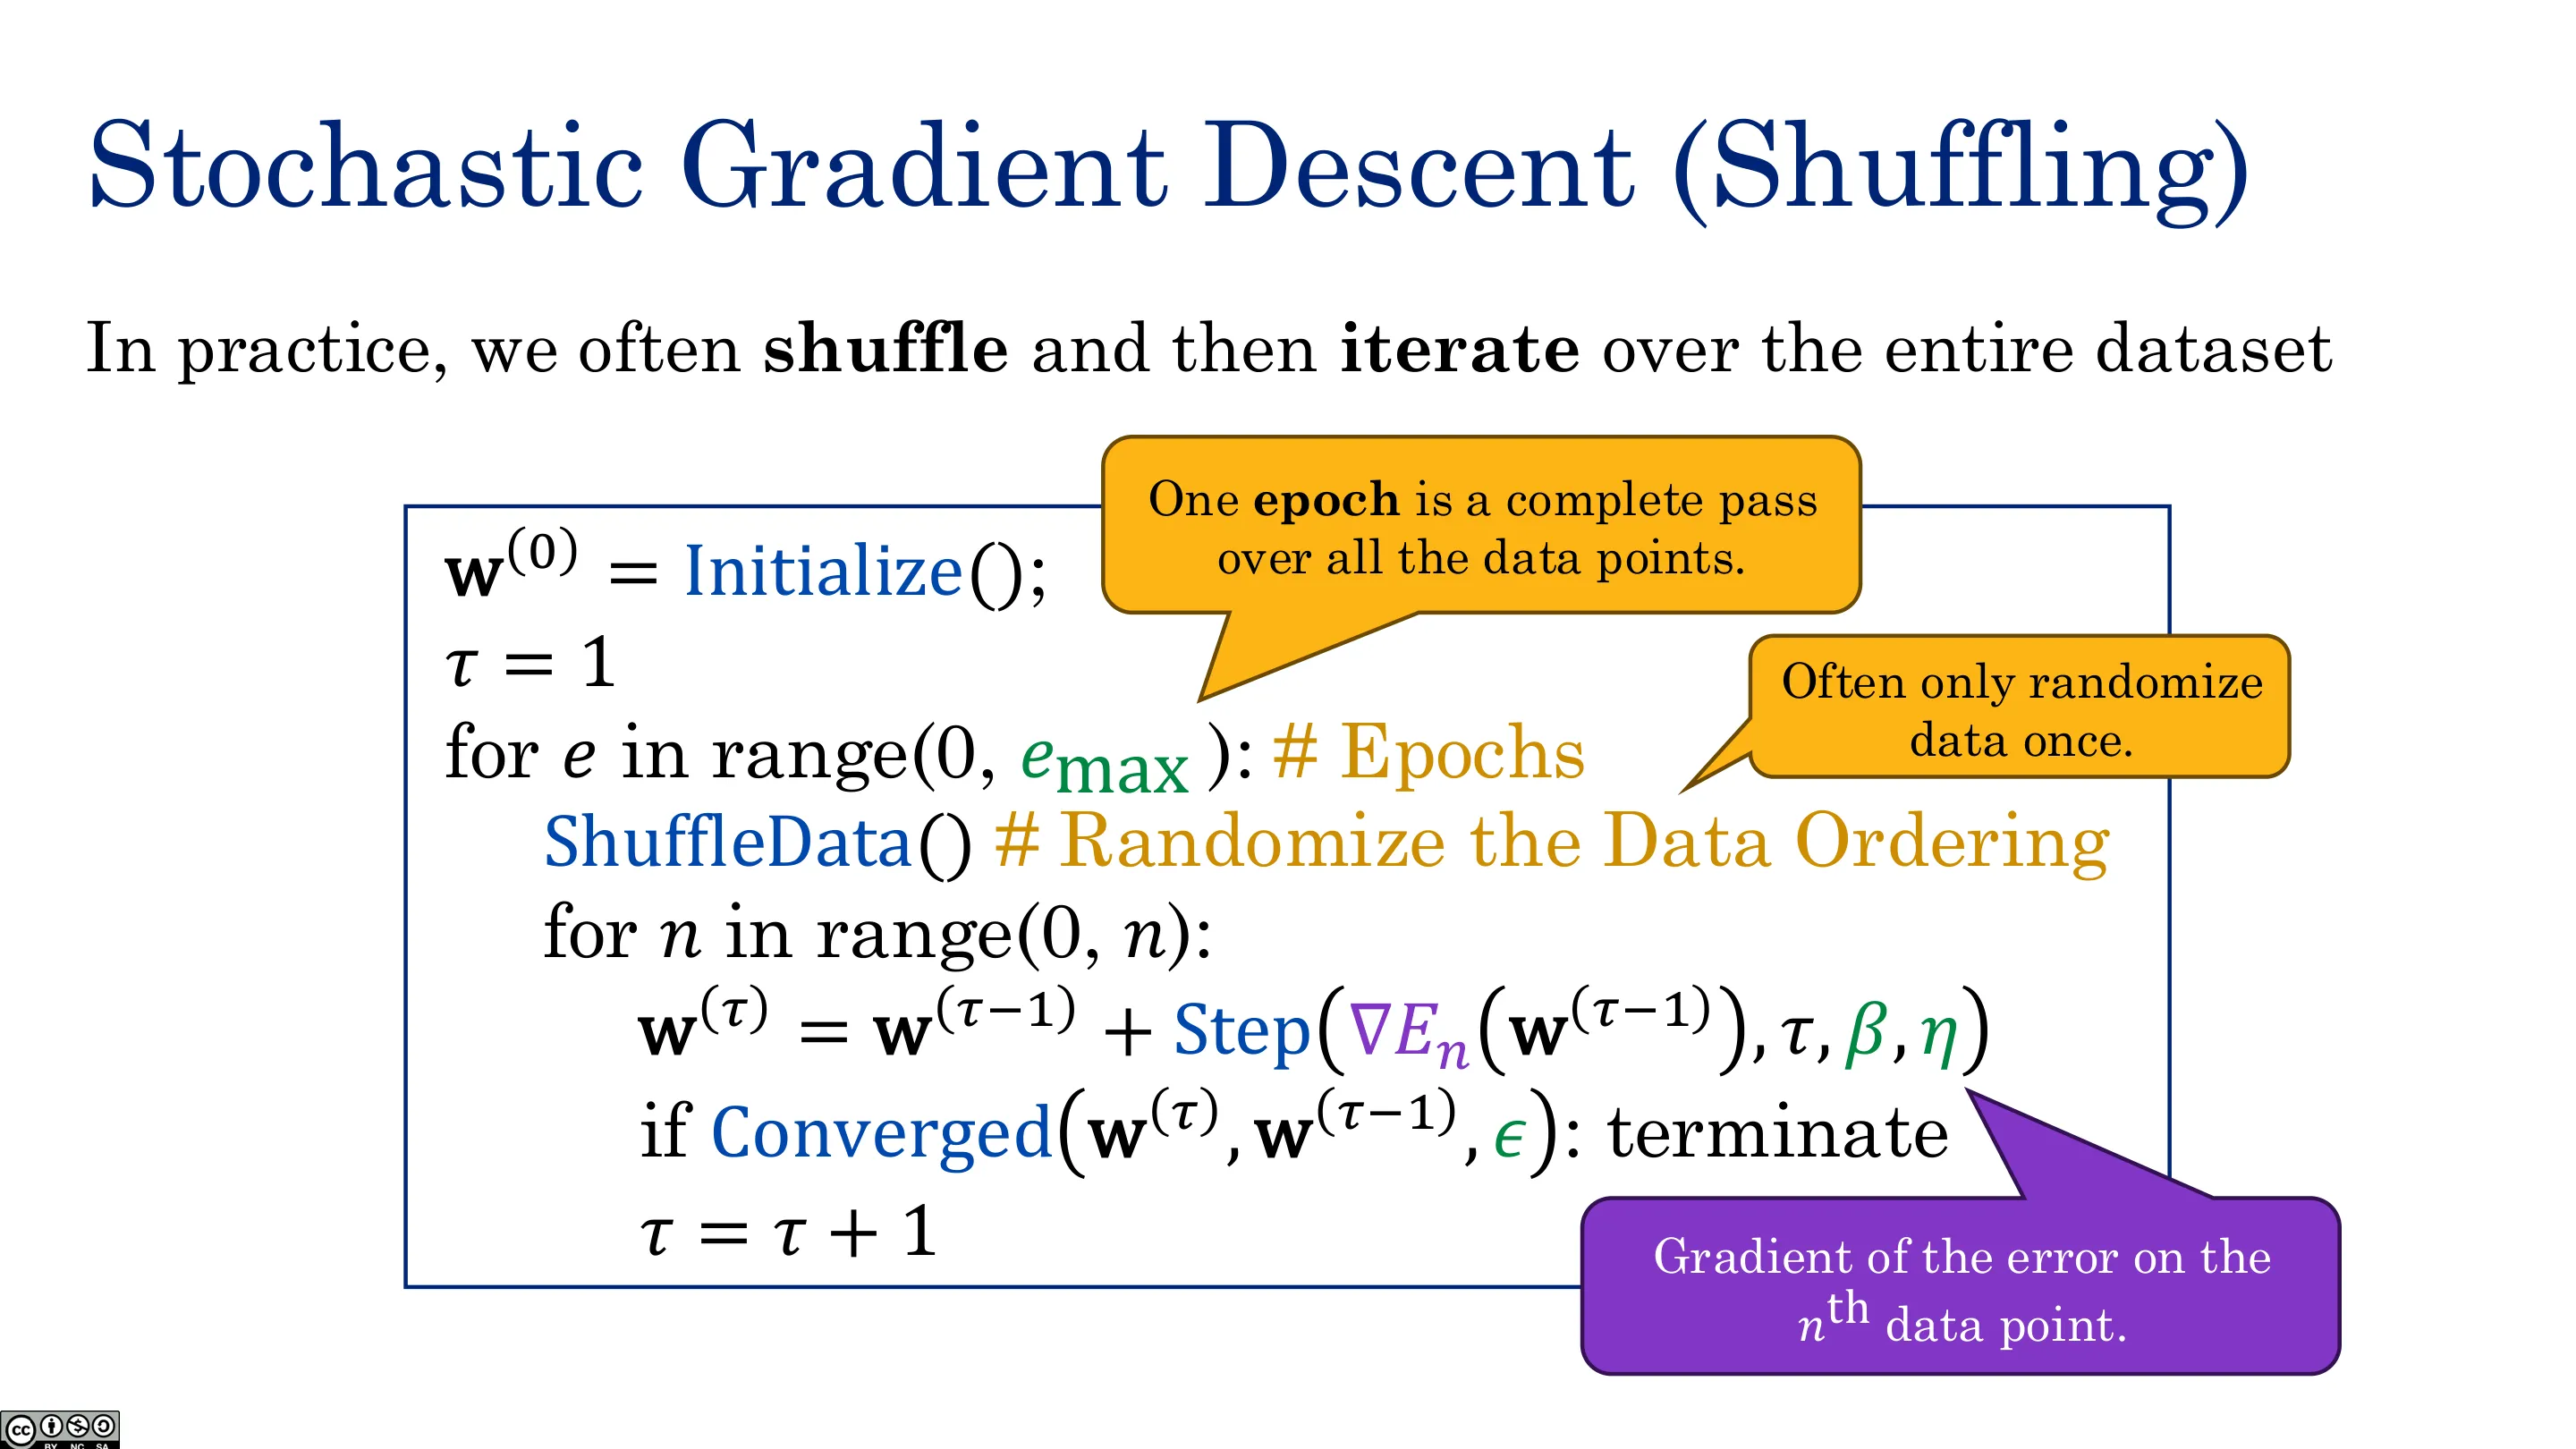
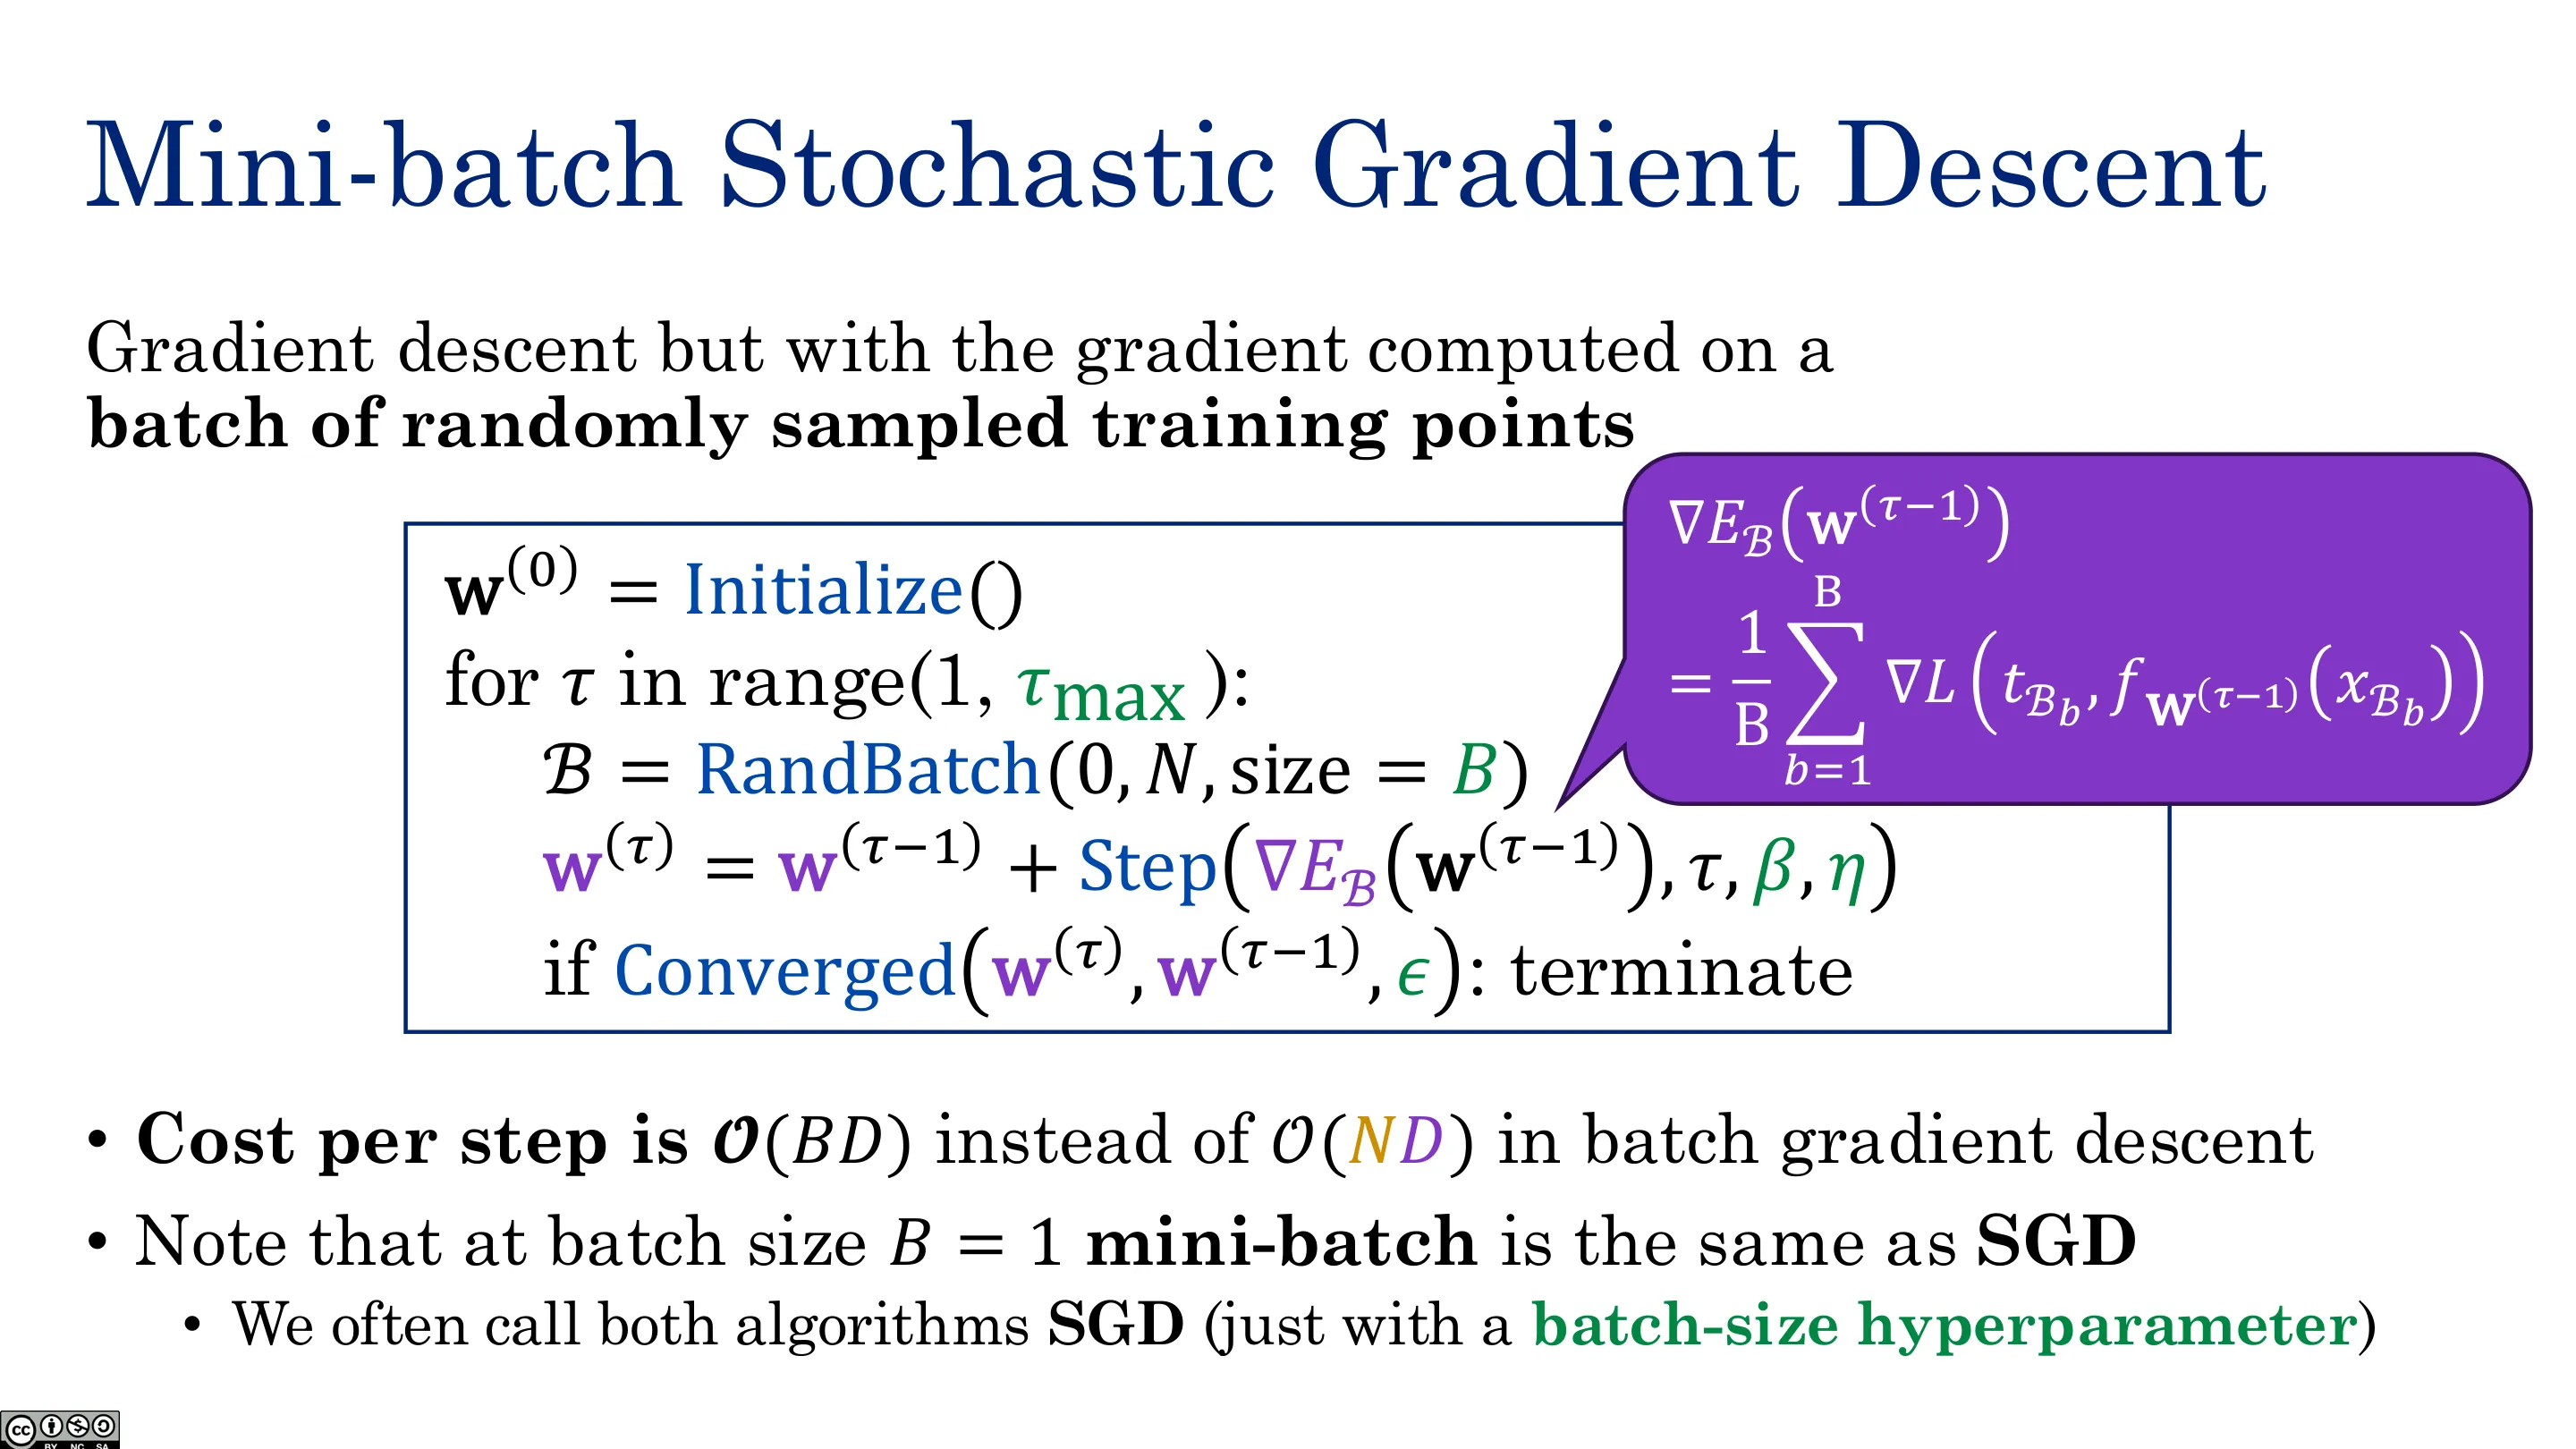
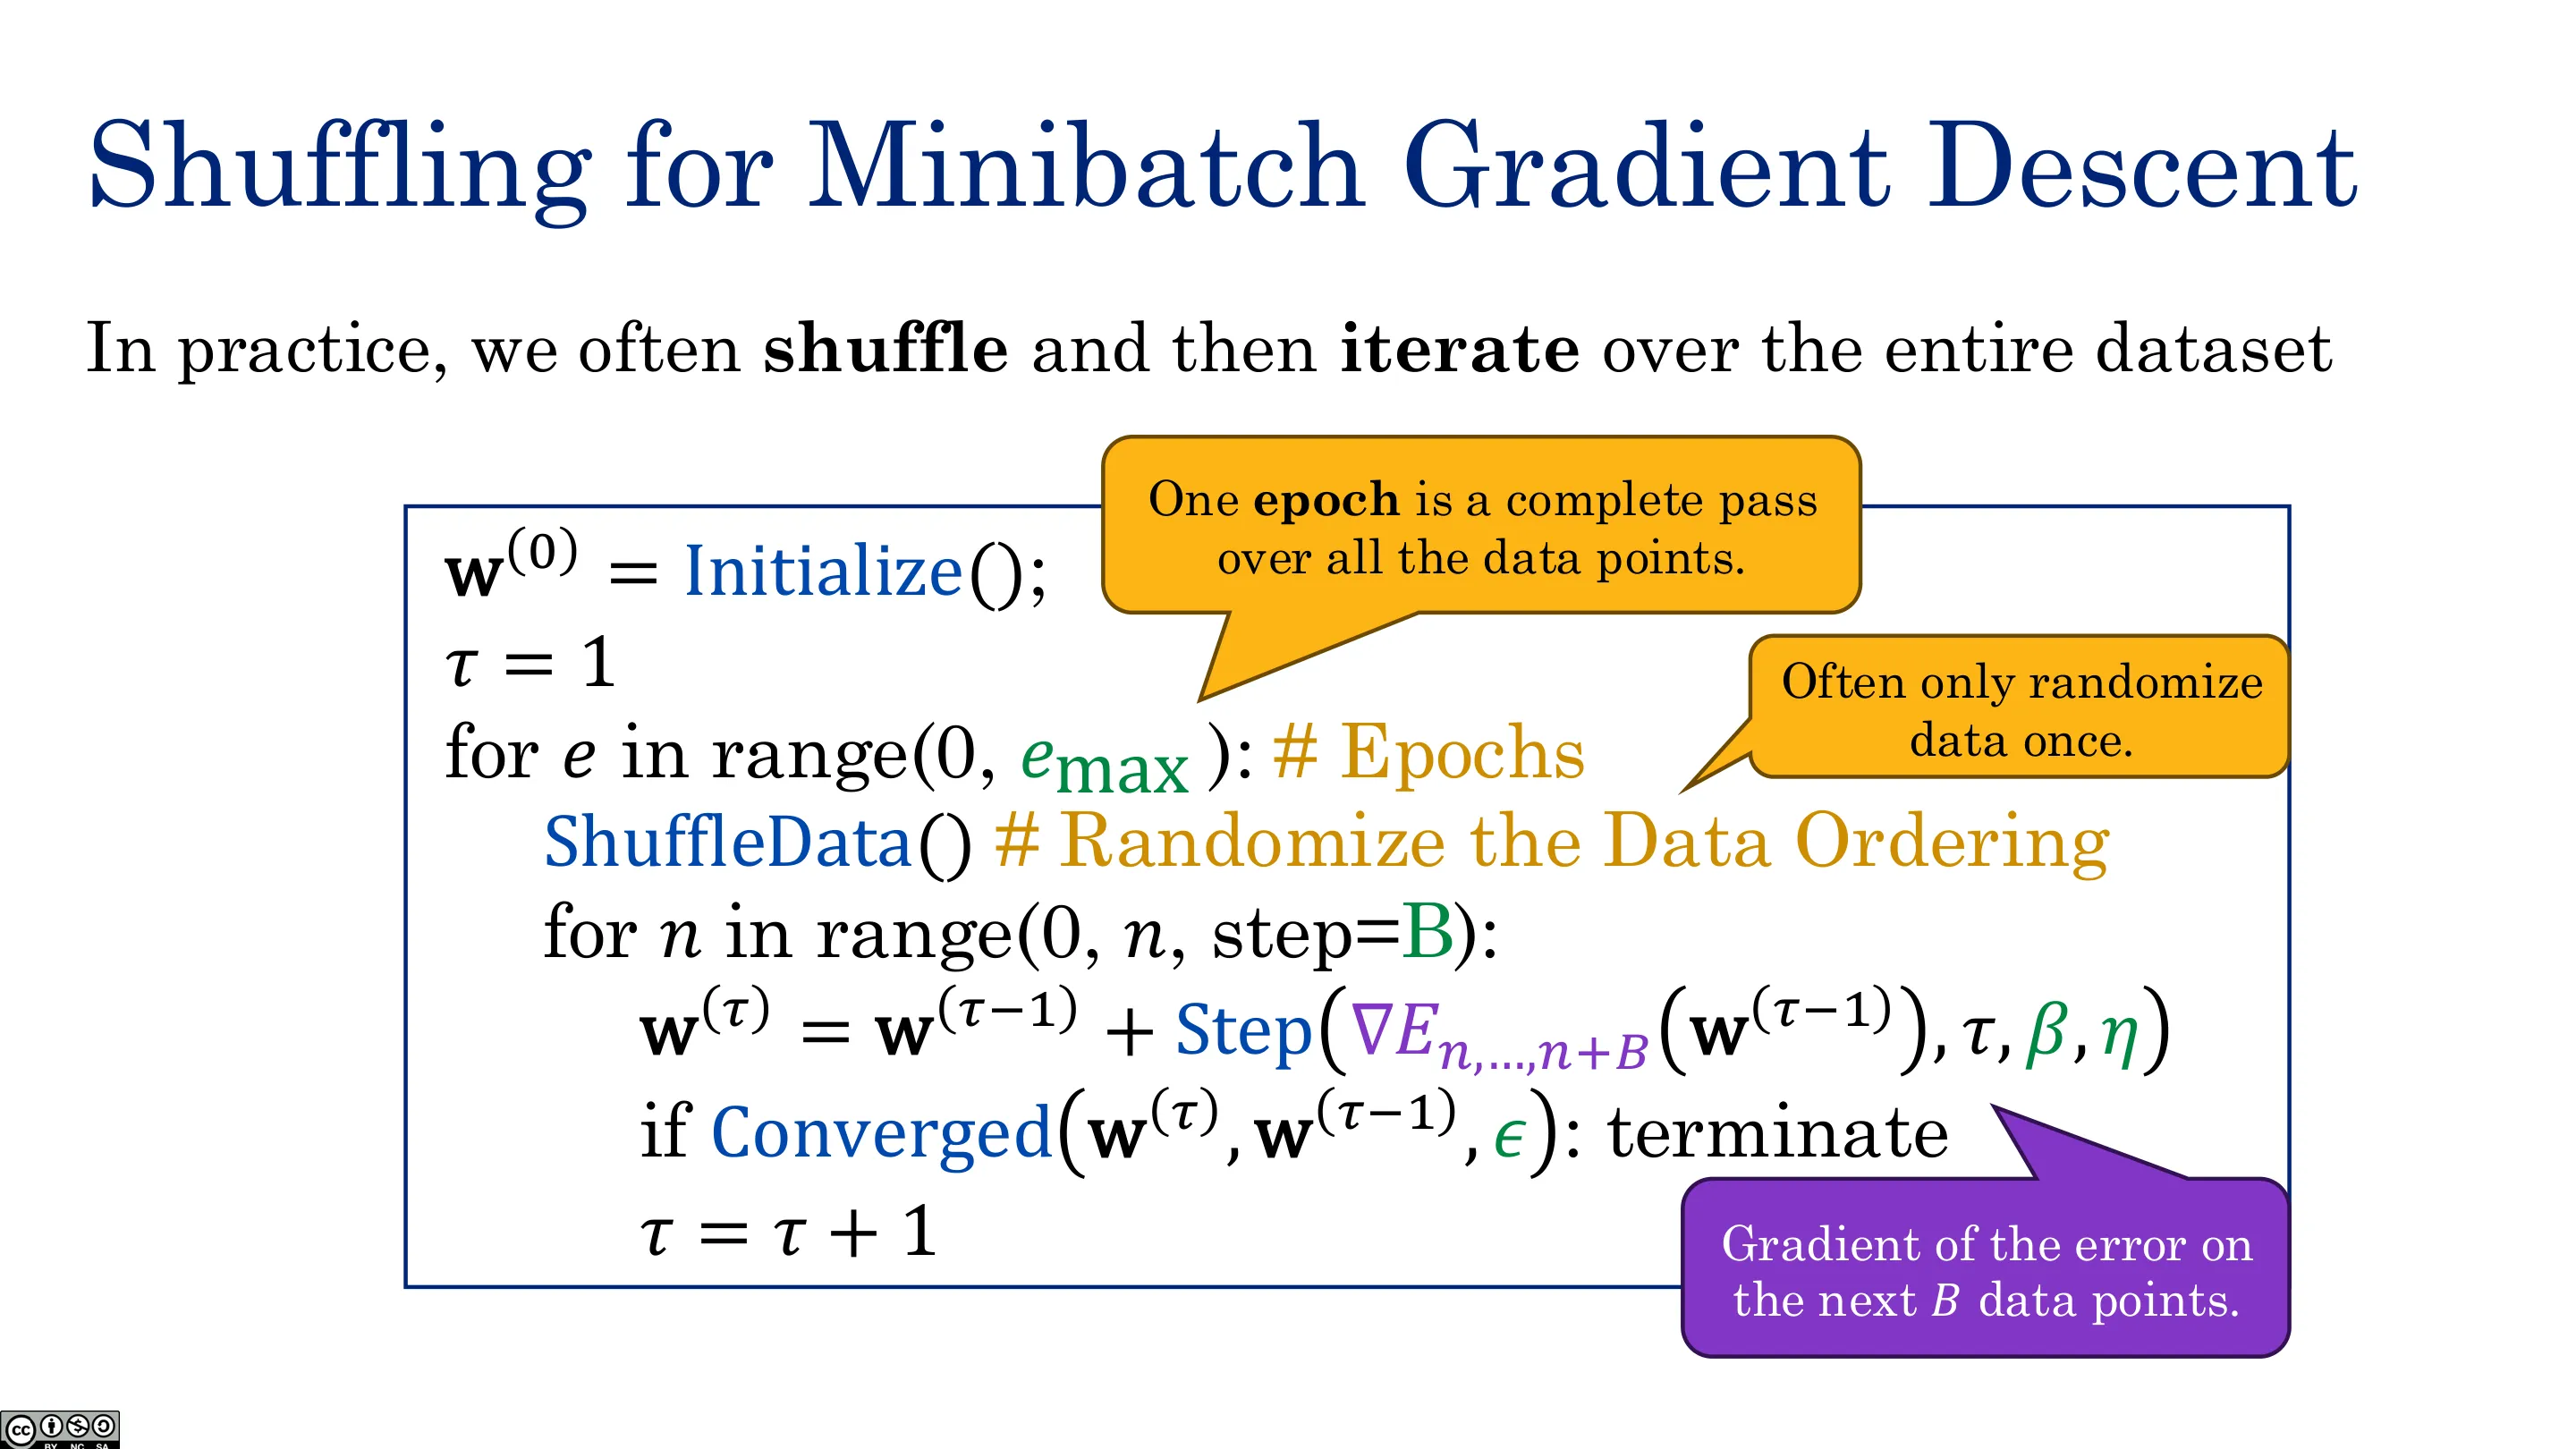
小批量(mini-batch):一次取 $k$ 行。批次越大梯度越准、可并行、GPU 利用率越高;受限于显存,所以「能塞进 GPU 的最大批次」通常是首选。shuffling:每个 epoch 前打乱样本顺序。
📷 回顾:批量梯度下降
回到原视频 (00:59:57)
📷 批量梯度下降的代价
回到原视频 (01:01:10)
📷 训练误差估计测试误差
回到原视频 (01:02:23)
📷 梯度的近似
回到原视频 (01:03:36)
📷 随机梯度下降
回到原视频 (01:04:49)
📷 SGD:打乱(shuffling)
回到原视频 (01:06:02)
📷 SGD(小结)
回到原视频 (01:07:15)
📷 (过渡)
回到原视频 (01:08:28)
📷 随机梯度的谱系
回到原视频 (01:09:41)
📷 小批量随机梯度下降
回到原视频 (01:10:54)
📷 小批量 SGD 的打乱
回到原视频 (01:12:07)
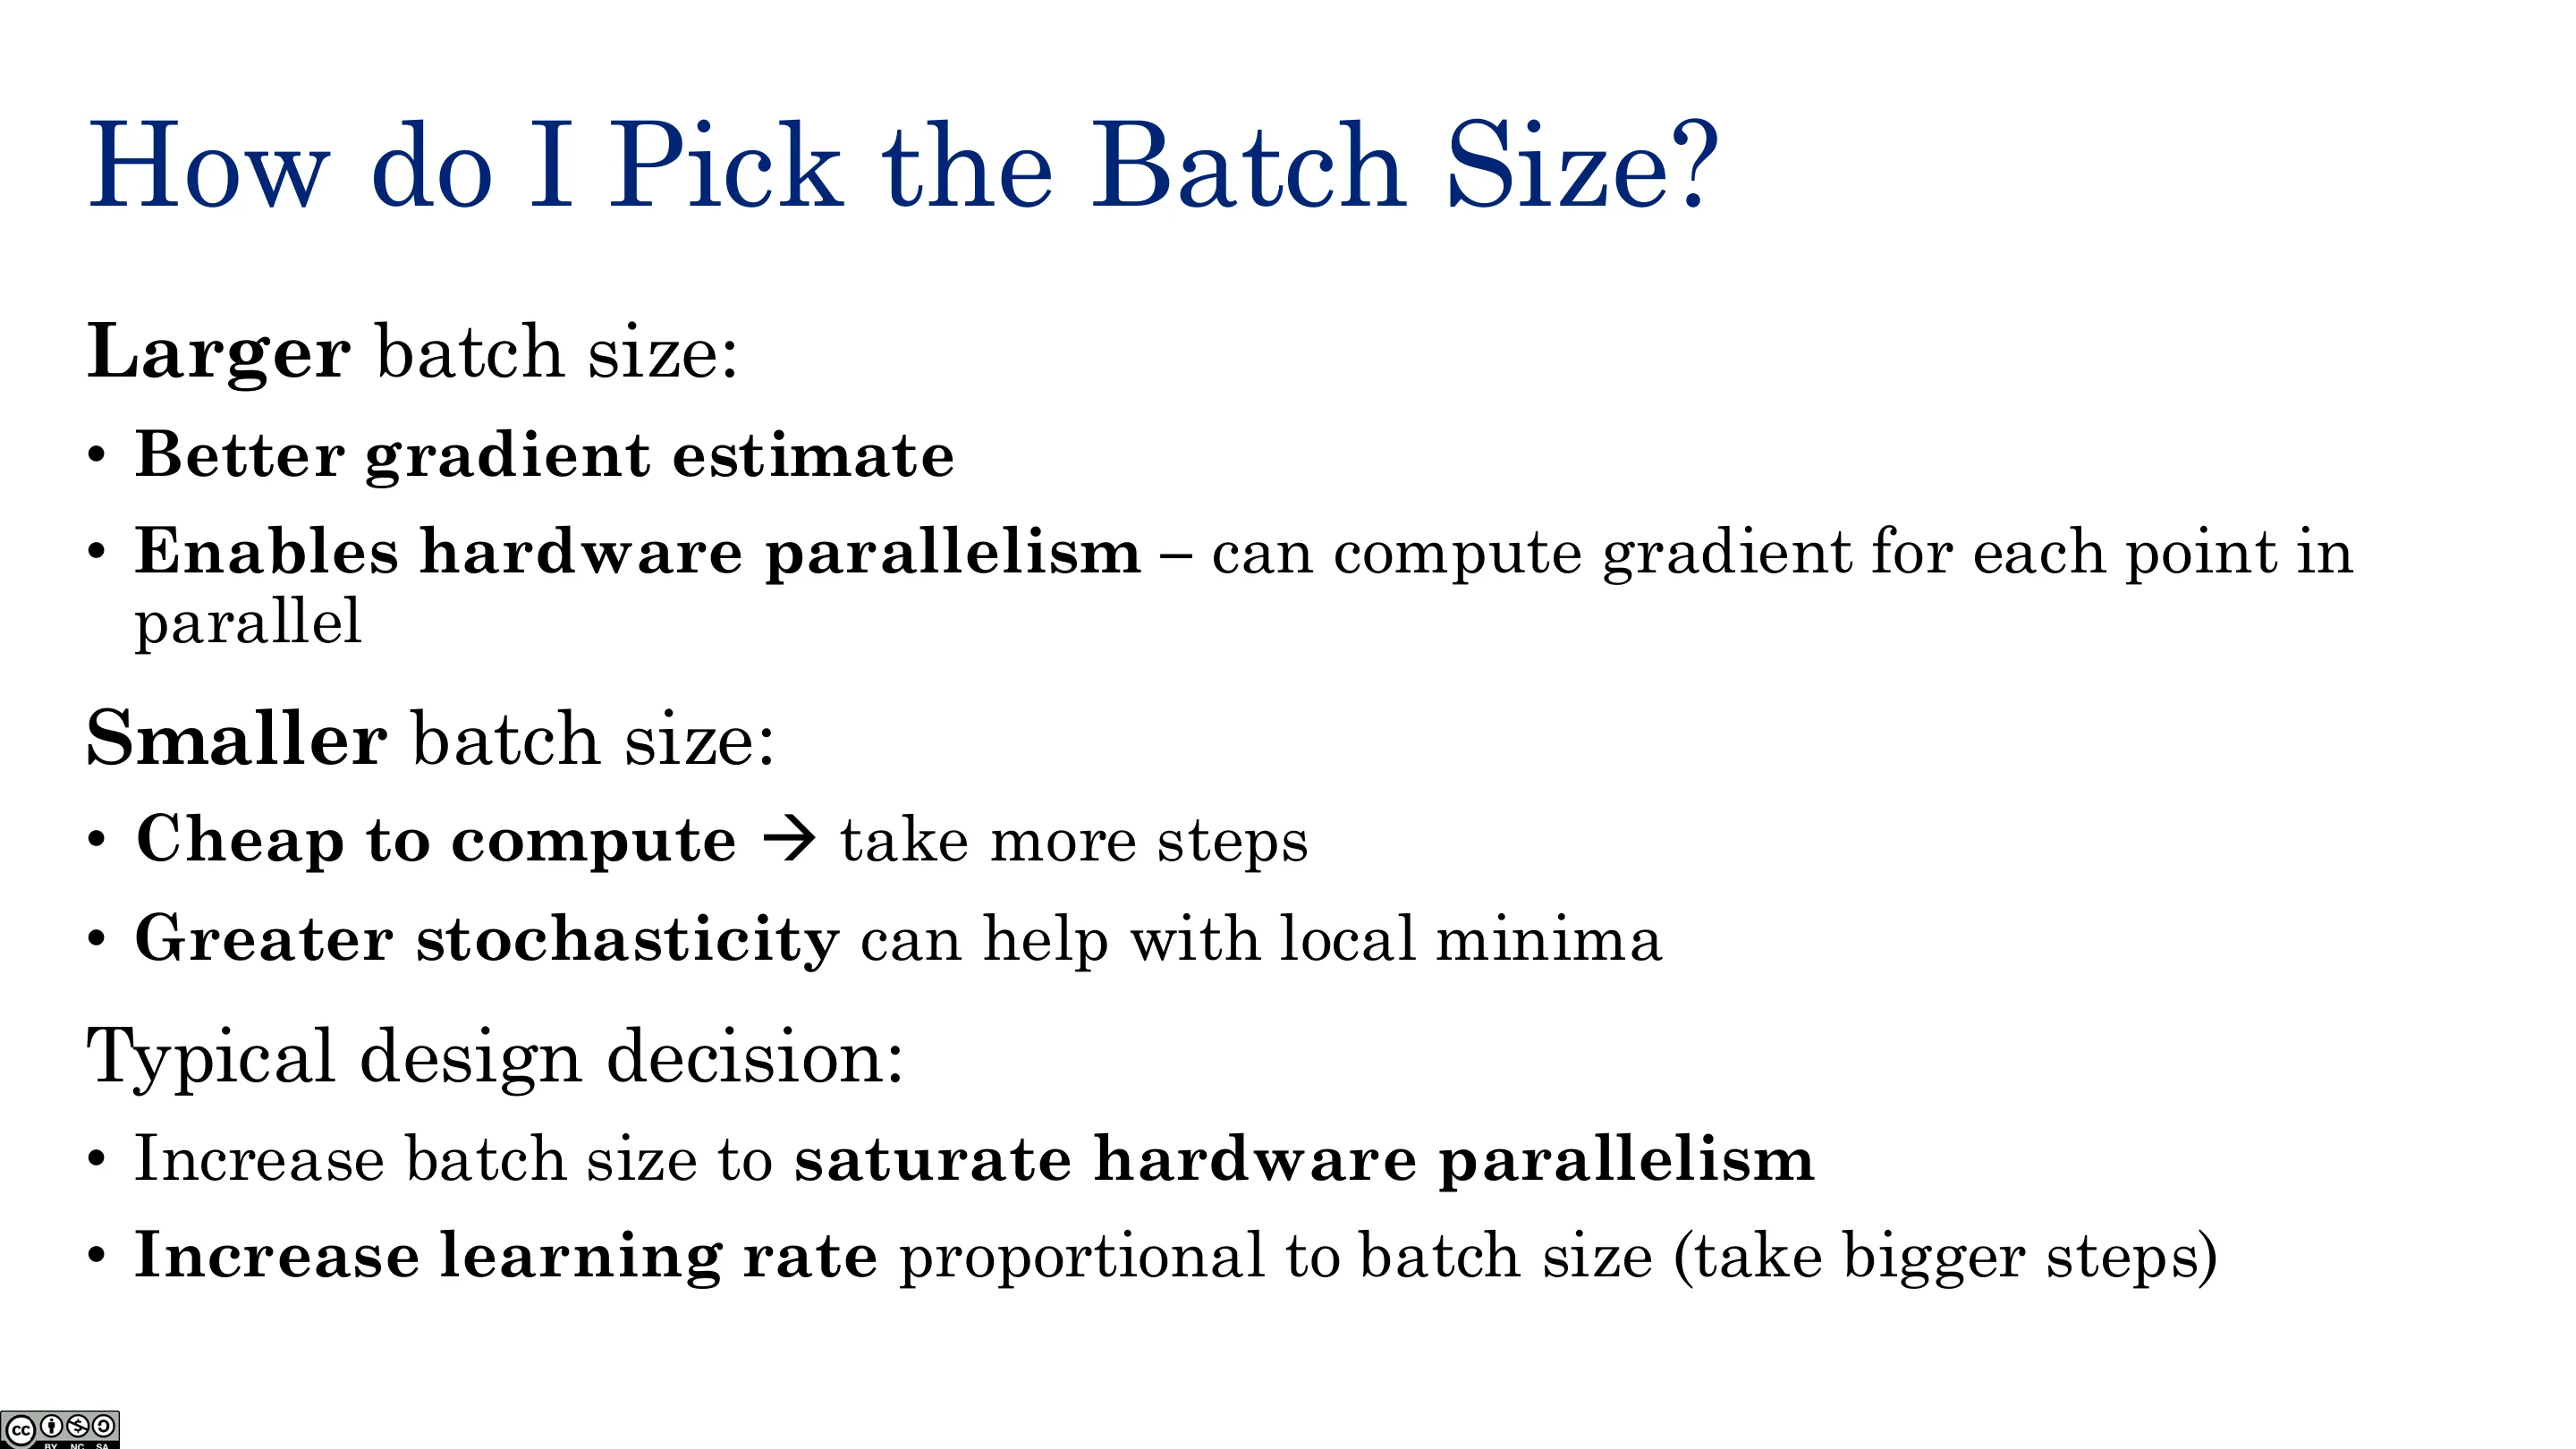
📷 如何选择批次大小
回到原视频 (01:13:20)
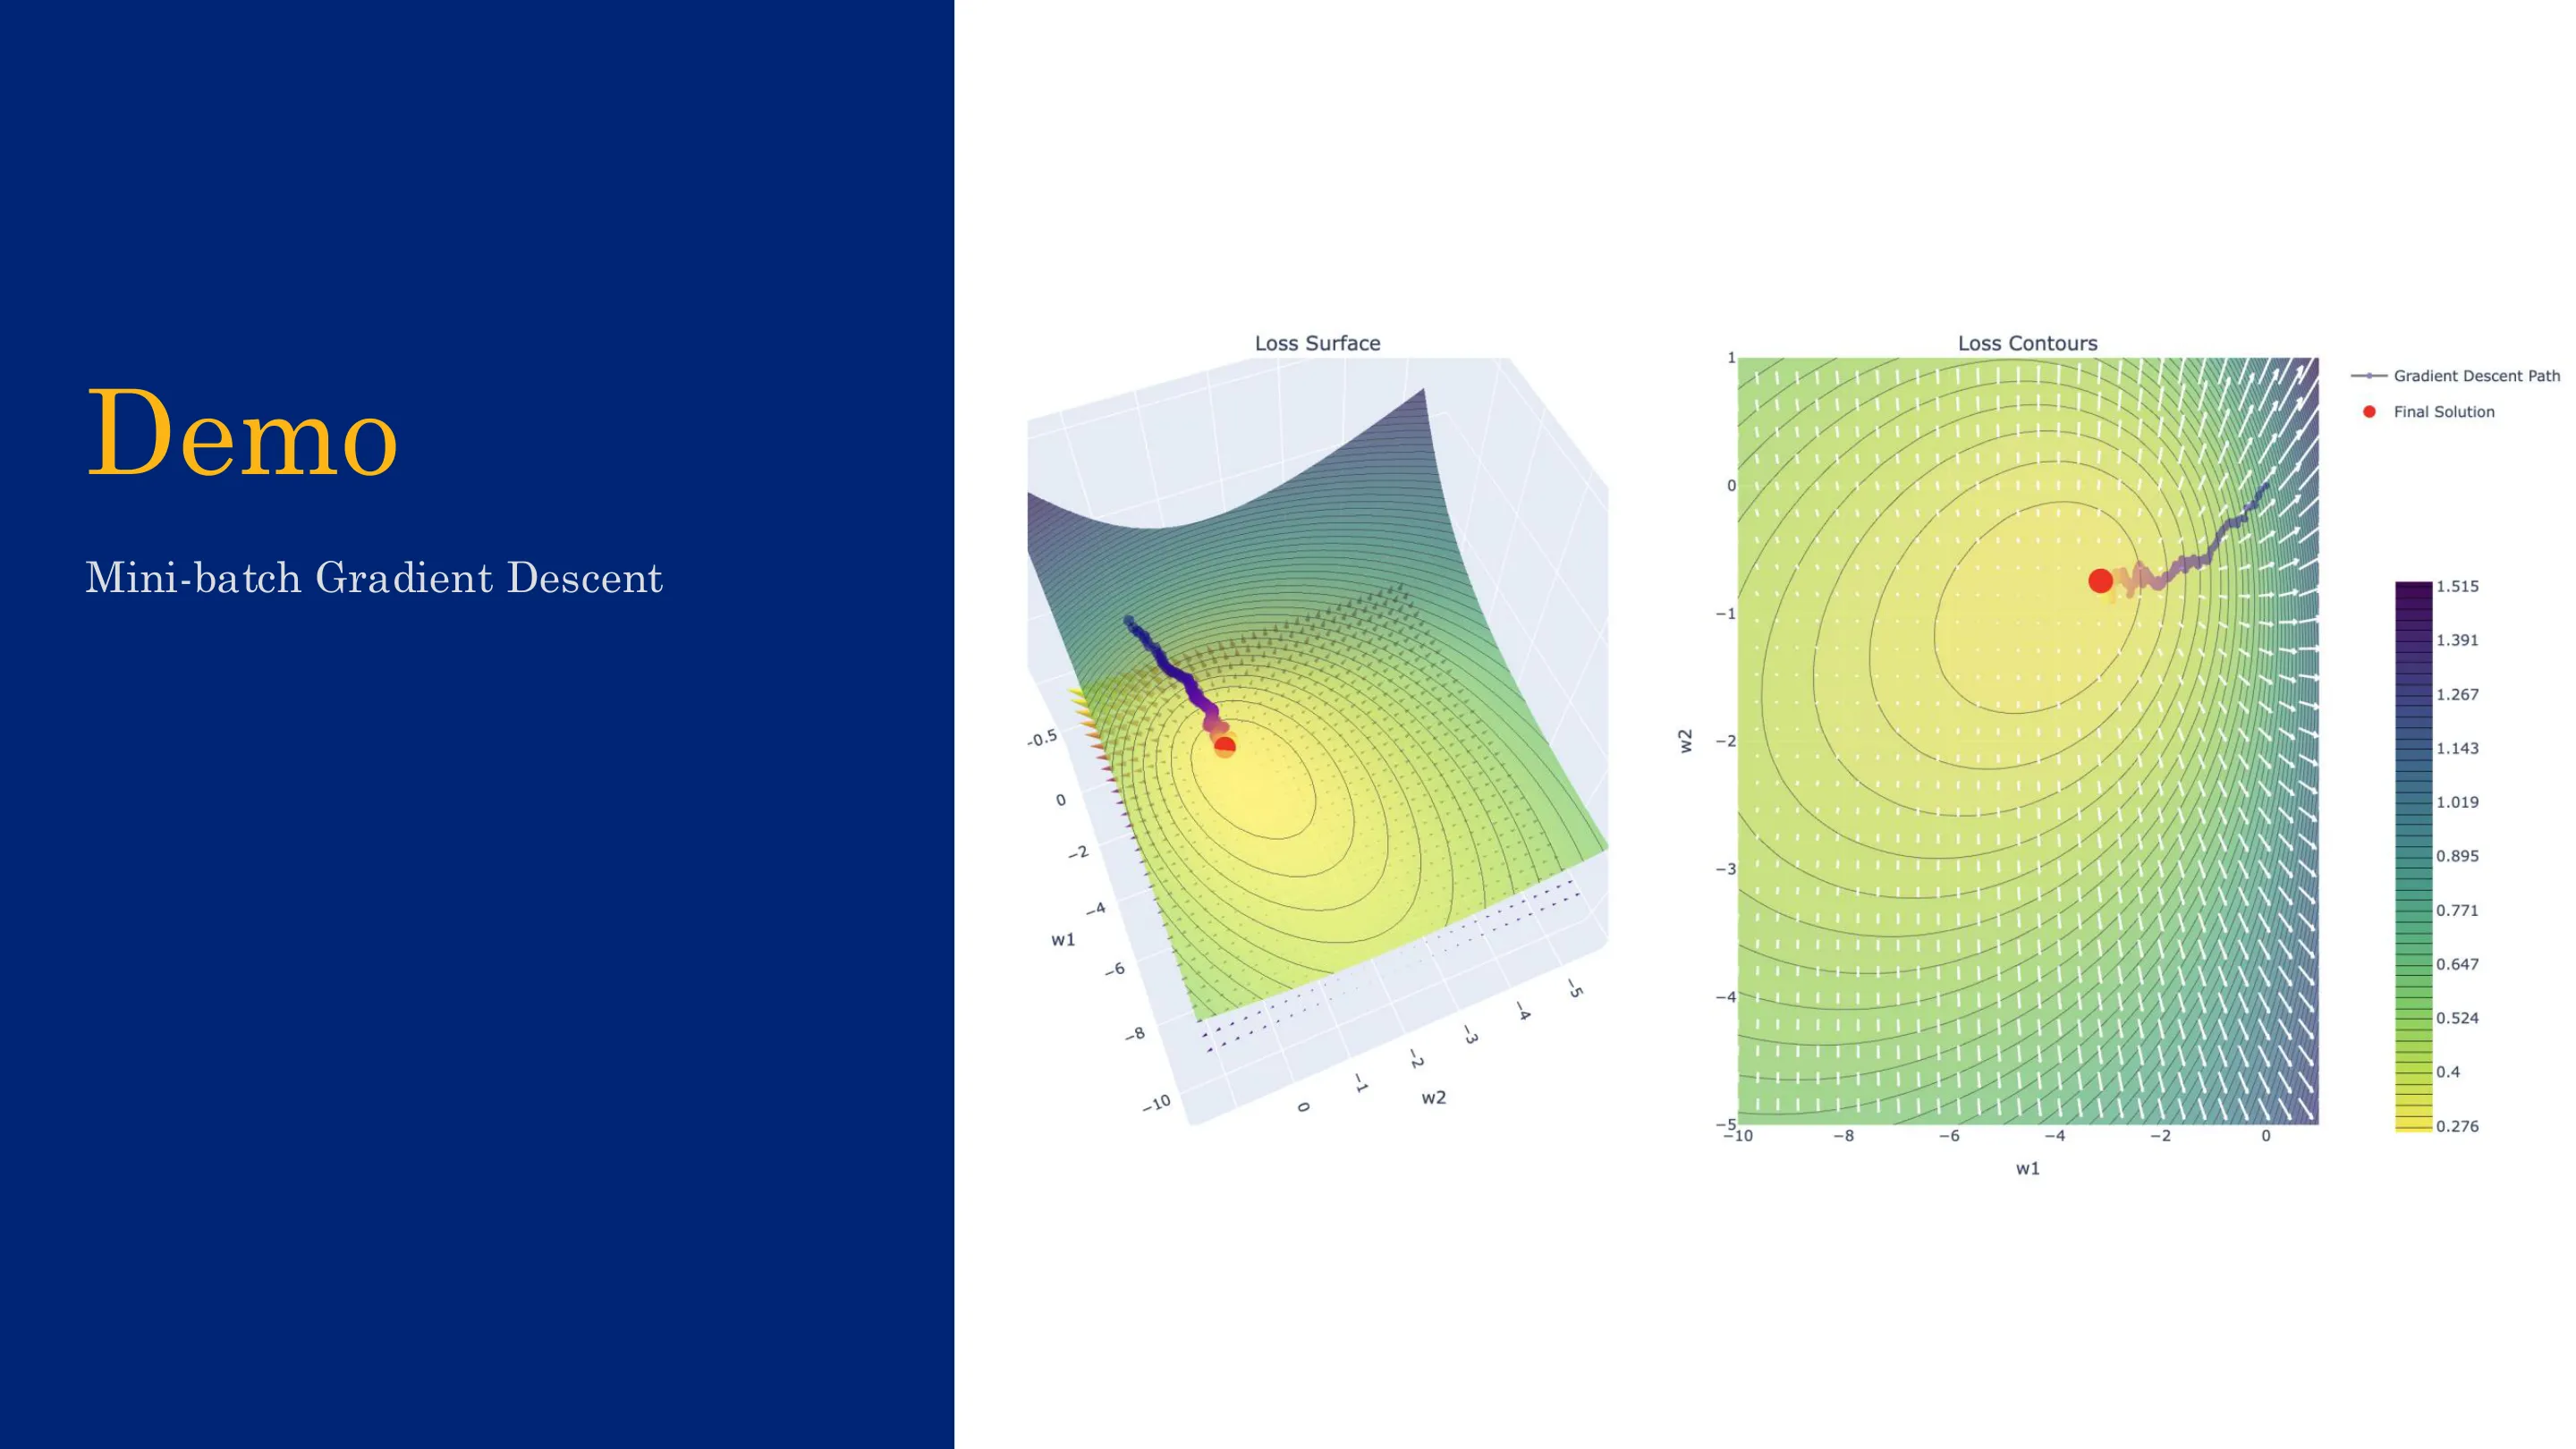
📷 小批量梯度下降
回到原视频 (01:14:33)
总结(Takeaways)
- 梯度下降就是学习:初始化 → 计算损失/梯度(链式法则/反向传播)→ 沿负梯度走一步 → 反复。学习率与迭代数是两个核心超参数。
- 曲率决定学习率:对二次型,$\eta\lesssim 2/\lambda_{\max}$;收敛快慢由条件数 $\lambda_{\max}/\lambda_{\min}$ 决定。
- Hessian 的特征值给出临界点的几何:全正=极小、全负=极大、正负混合=鞍点。
- Hessian 太大无法计算 ⇒ 用近似:动量、AdaGrad/RMSProp/Adam 逐坐标自适应。
- SGD / mini-batch 用随机梯度近似全量梯度,把「不可避免的大数据」变成可训练的问题;批次大小受 GPU 显存限制。
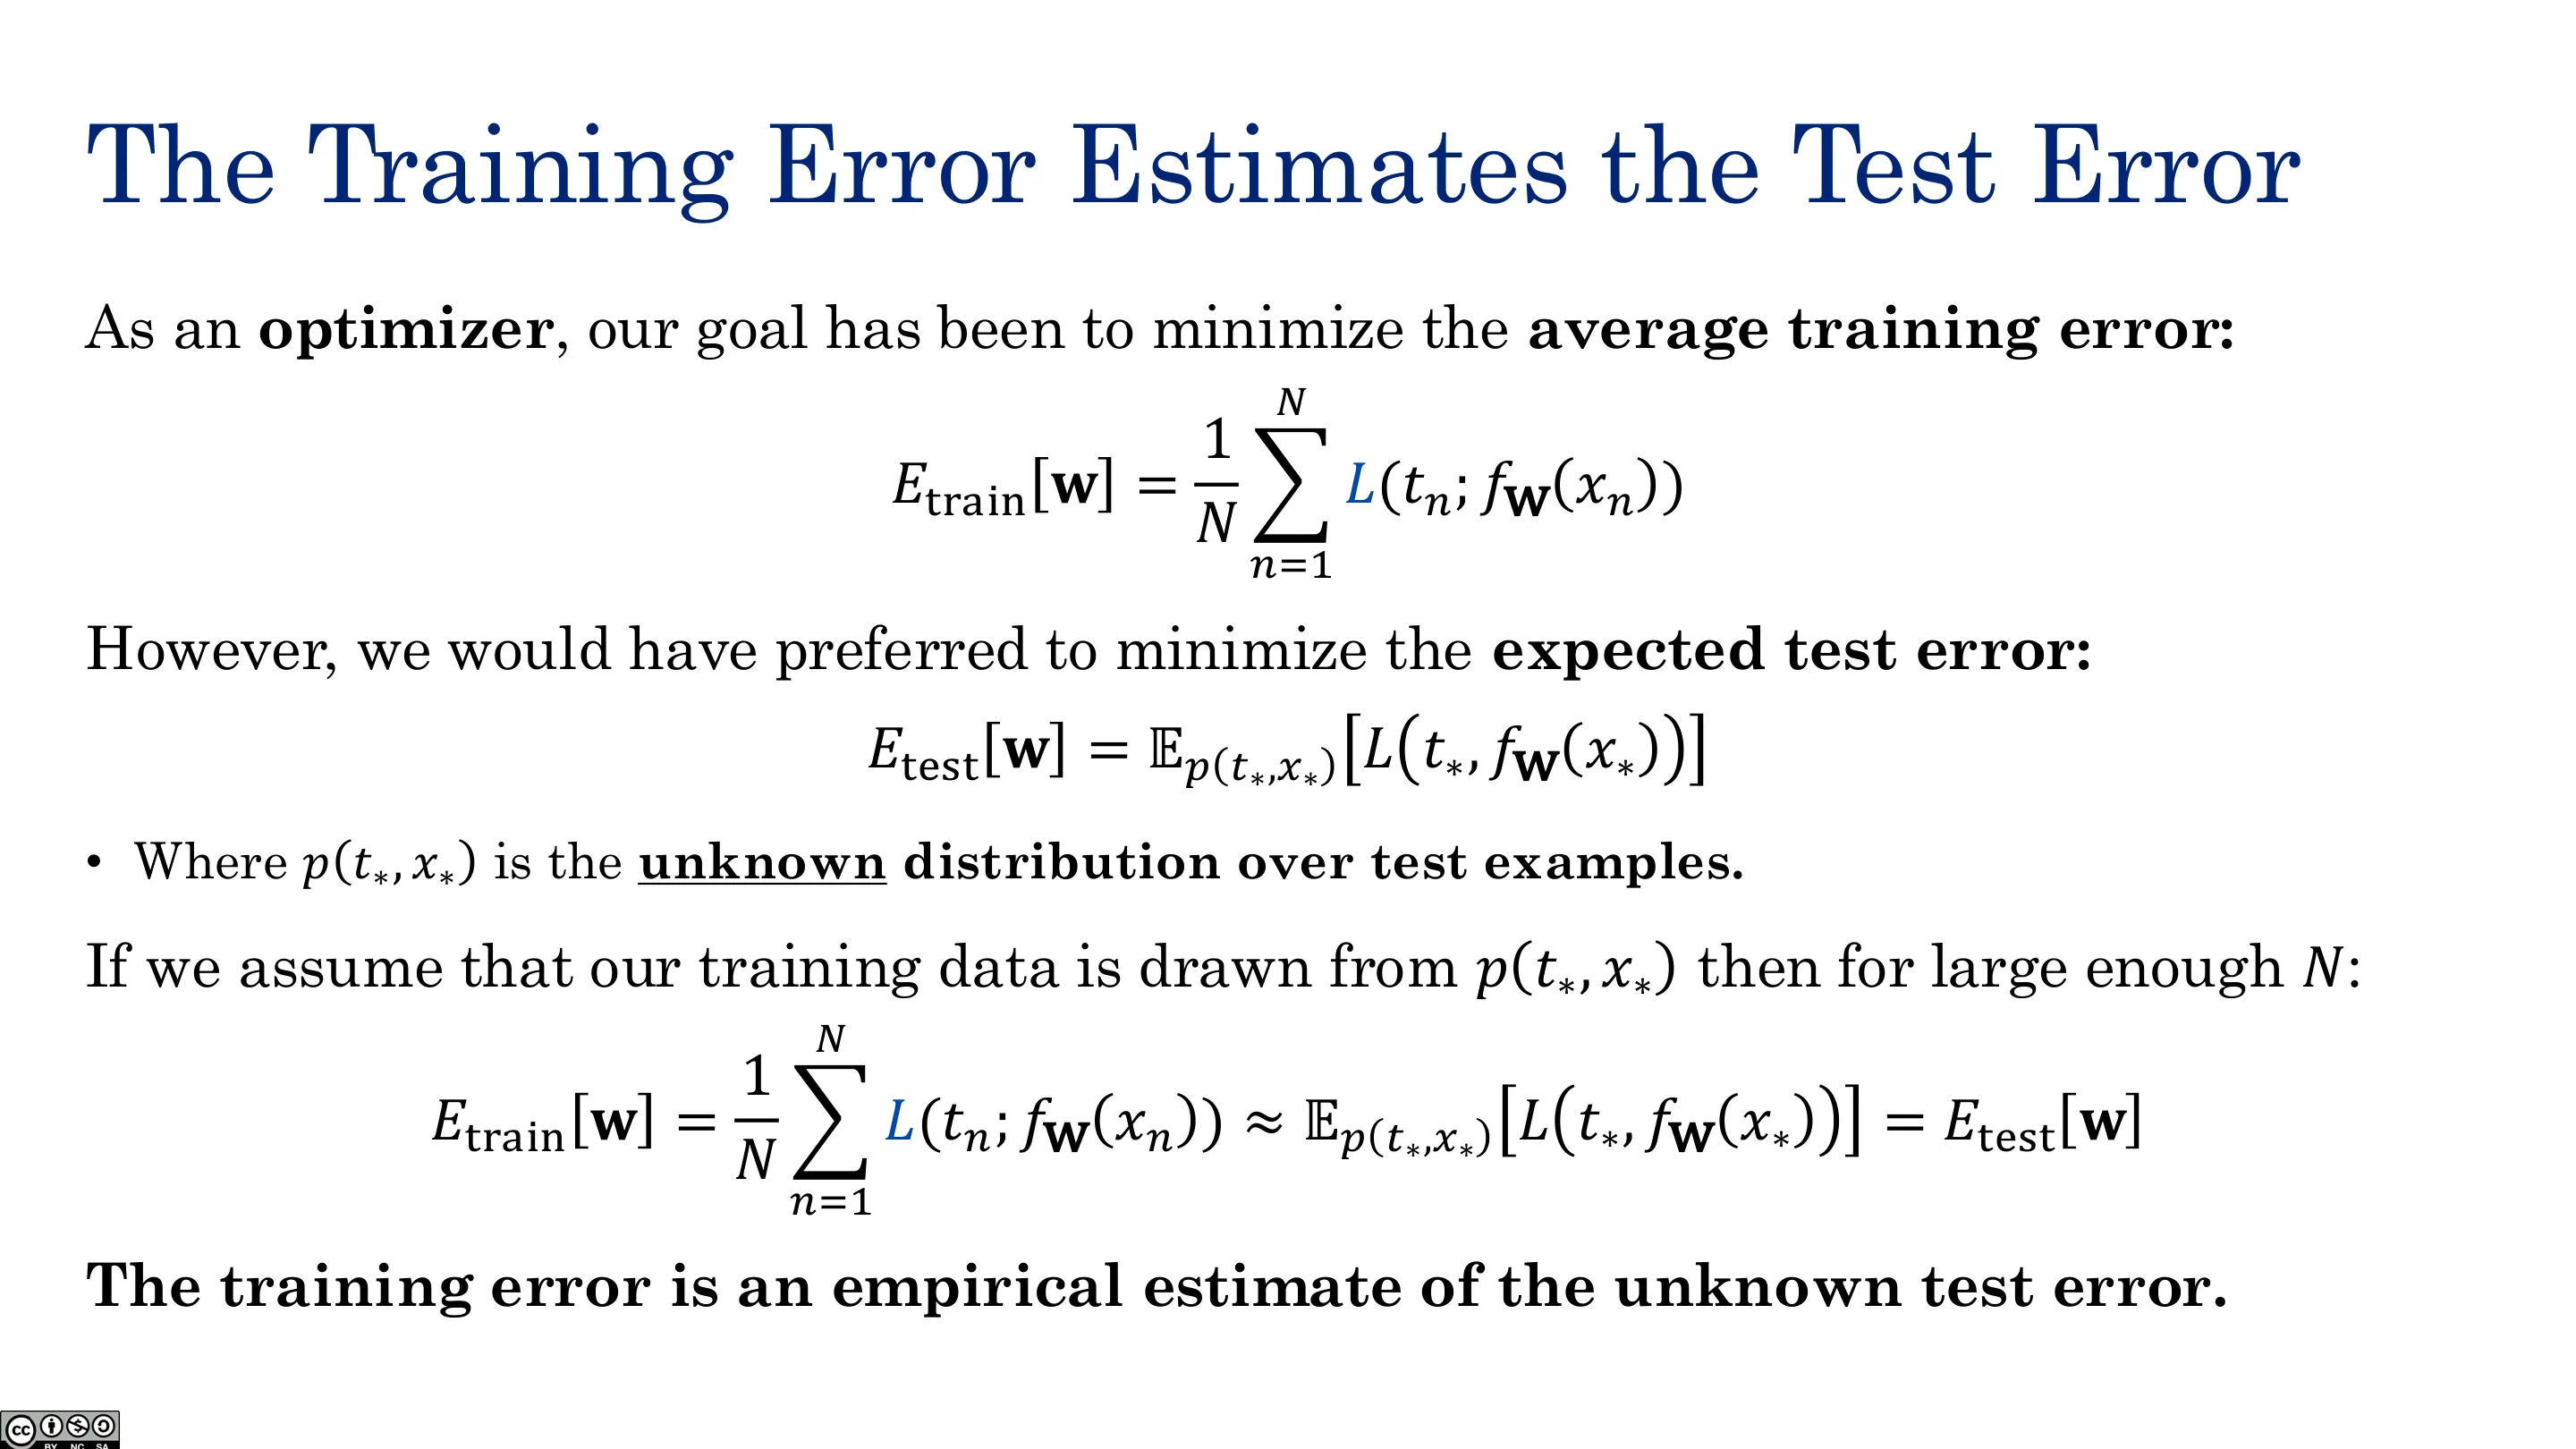
- 优化好 ≠ 泛化好;训练误差可估计测试误差(同分布假设下)。
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=6zV_GGgUa0Y |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 15) | Google Drive 文件夹 |
| 教材 Machine Learning: A First Course for Engineers and Scientists | 梯度下降、Hessian、条件数、SGD、Adam 相关章节 · https://doi.org/10.1017/9781108919371 |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。