第16讲 · EECS 189:熵、信息与逻辑回归
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | Entropy, Information and Logistic Regression |
| 视频 | https://www.youtube.com/watch?v=ArSadC8hY-Q |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 16) | Google Drive 文件夹 |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第16讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
本讲路线图
(参考时间: 00:00)
- 熵:如何度量「信息」——香农压缩定理、典型序列、horse race 例子;
- KL 散度与交叉熵:用「为 Q 设计压缩方案却收到 P」来理解二者;
- 逻辑回归:把最大似然推到交叉熵损失;
- 多类逻辑回归 / Softmax、可视化权重;
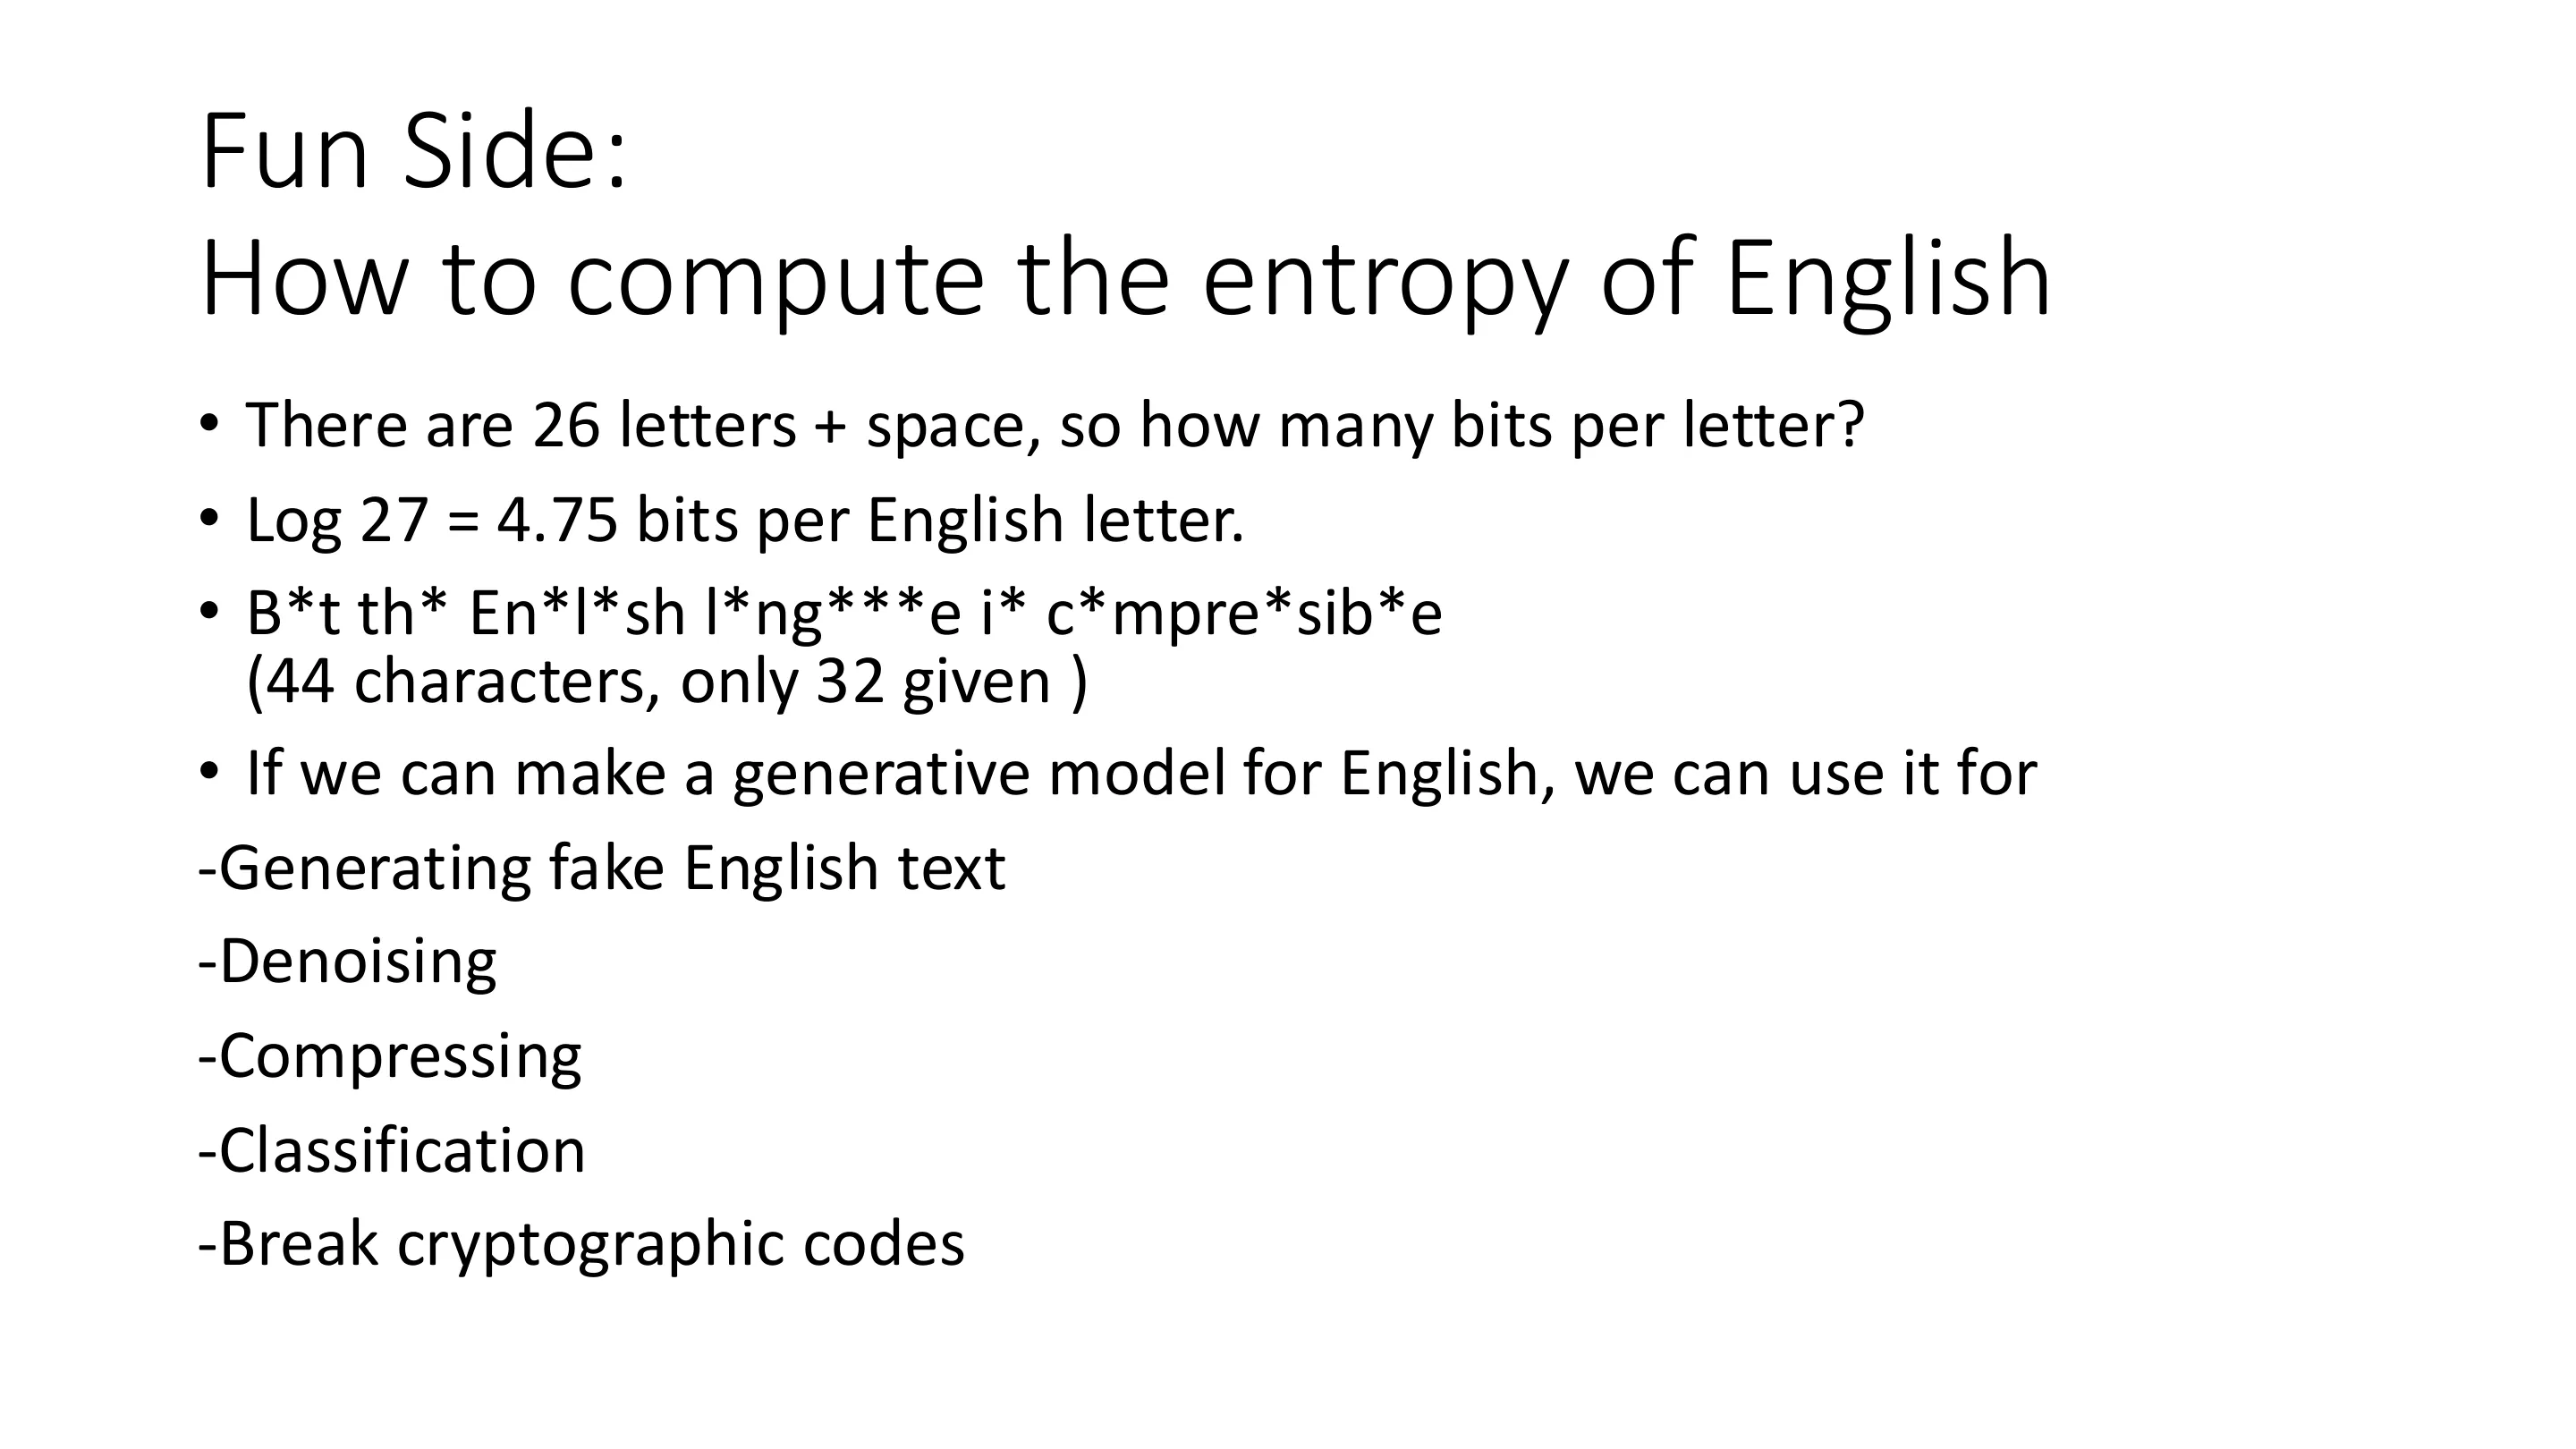
- 附:香农如何用语言模型生成英文。
📷 标题页
回到原视频 (00:00:20)
一、信息与熵
1.1 用随机变量定义信息
(参考时间: 00:00)
度量「信息」的前提,是先引入随机变量这个概念(香农相对玻尔兹曼的优势所在)。
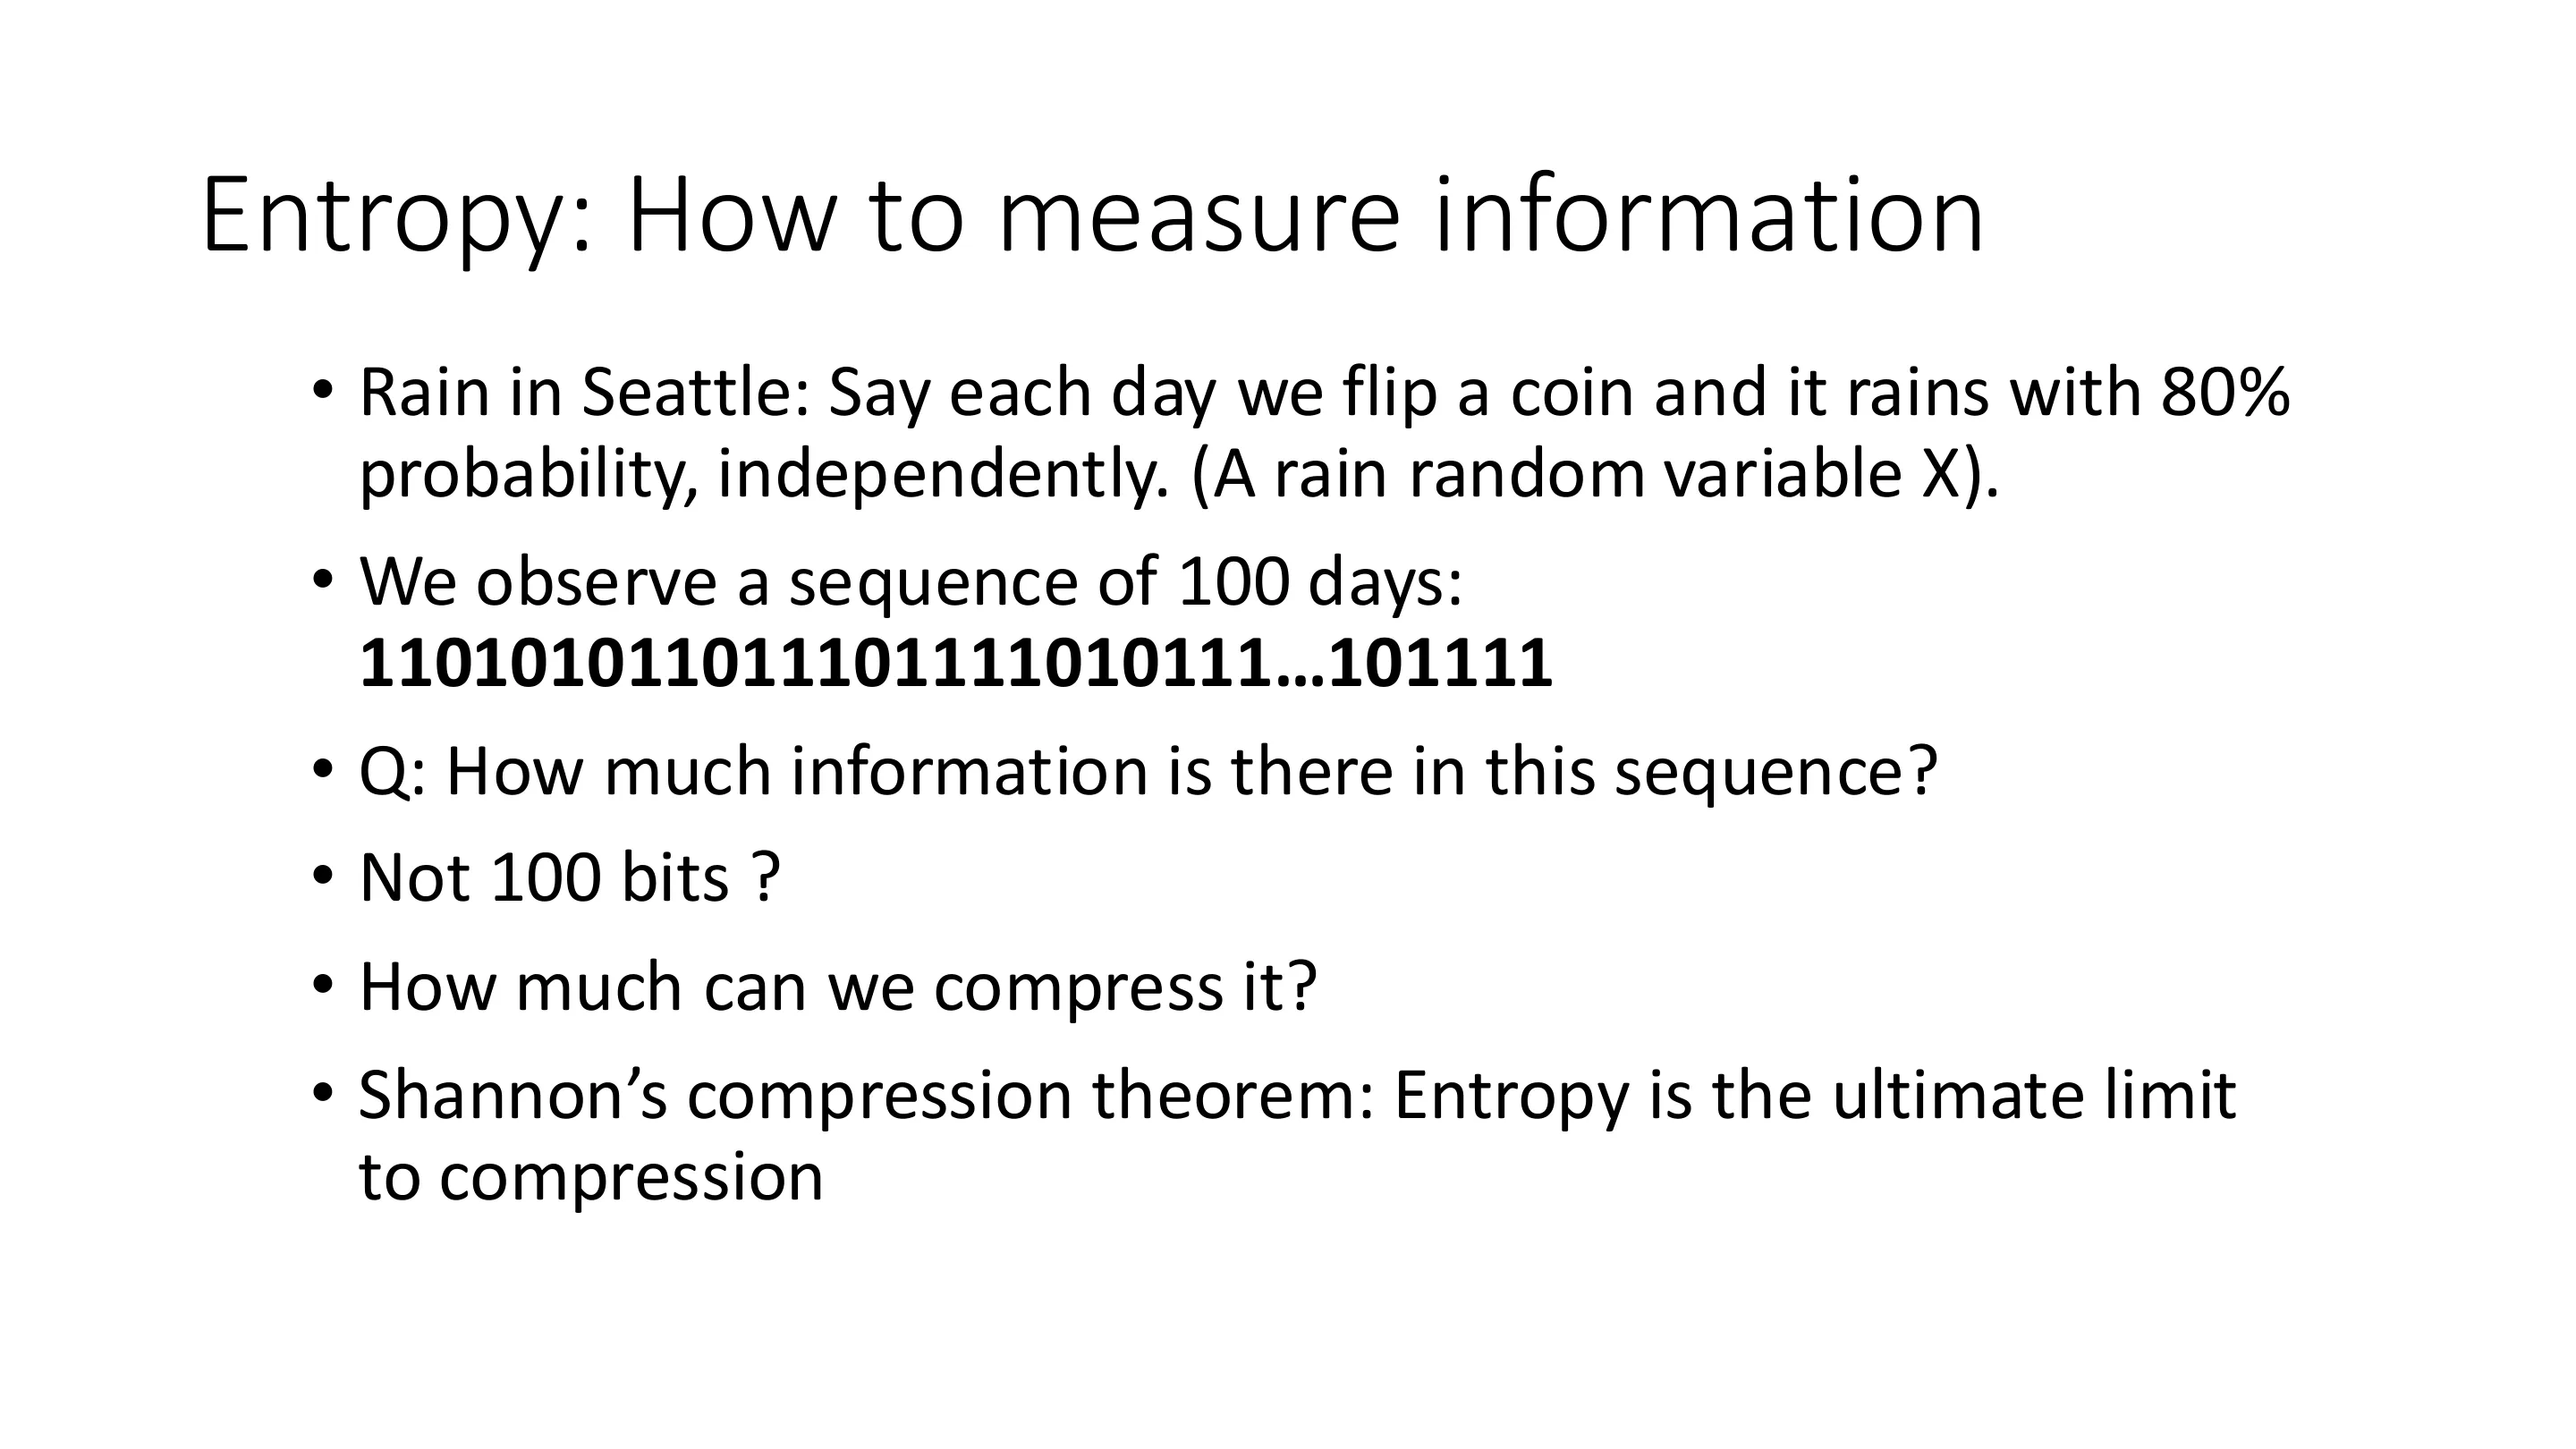
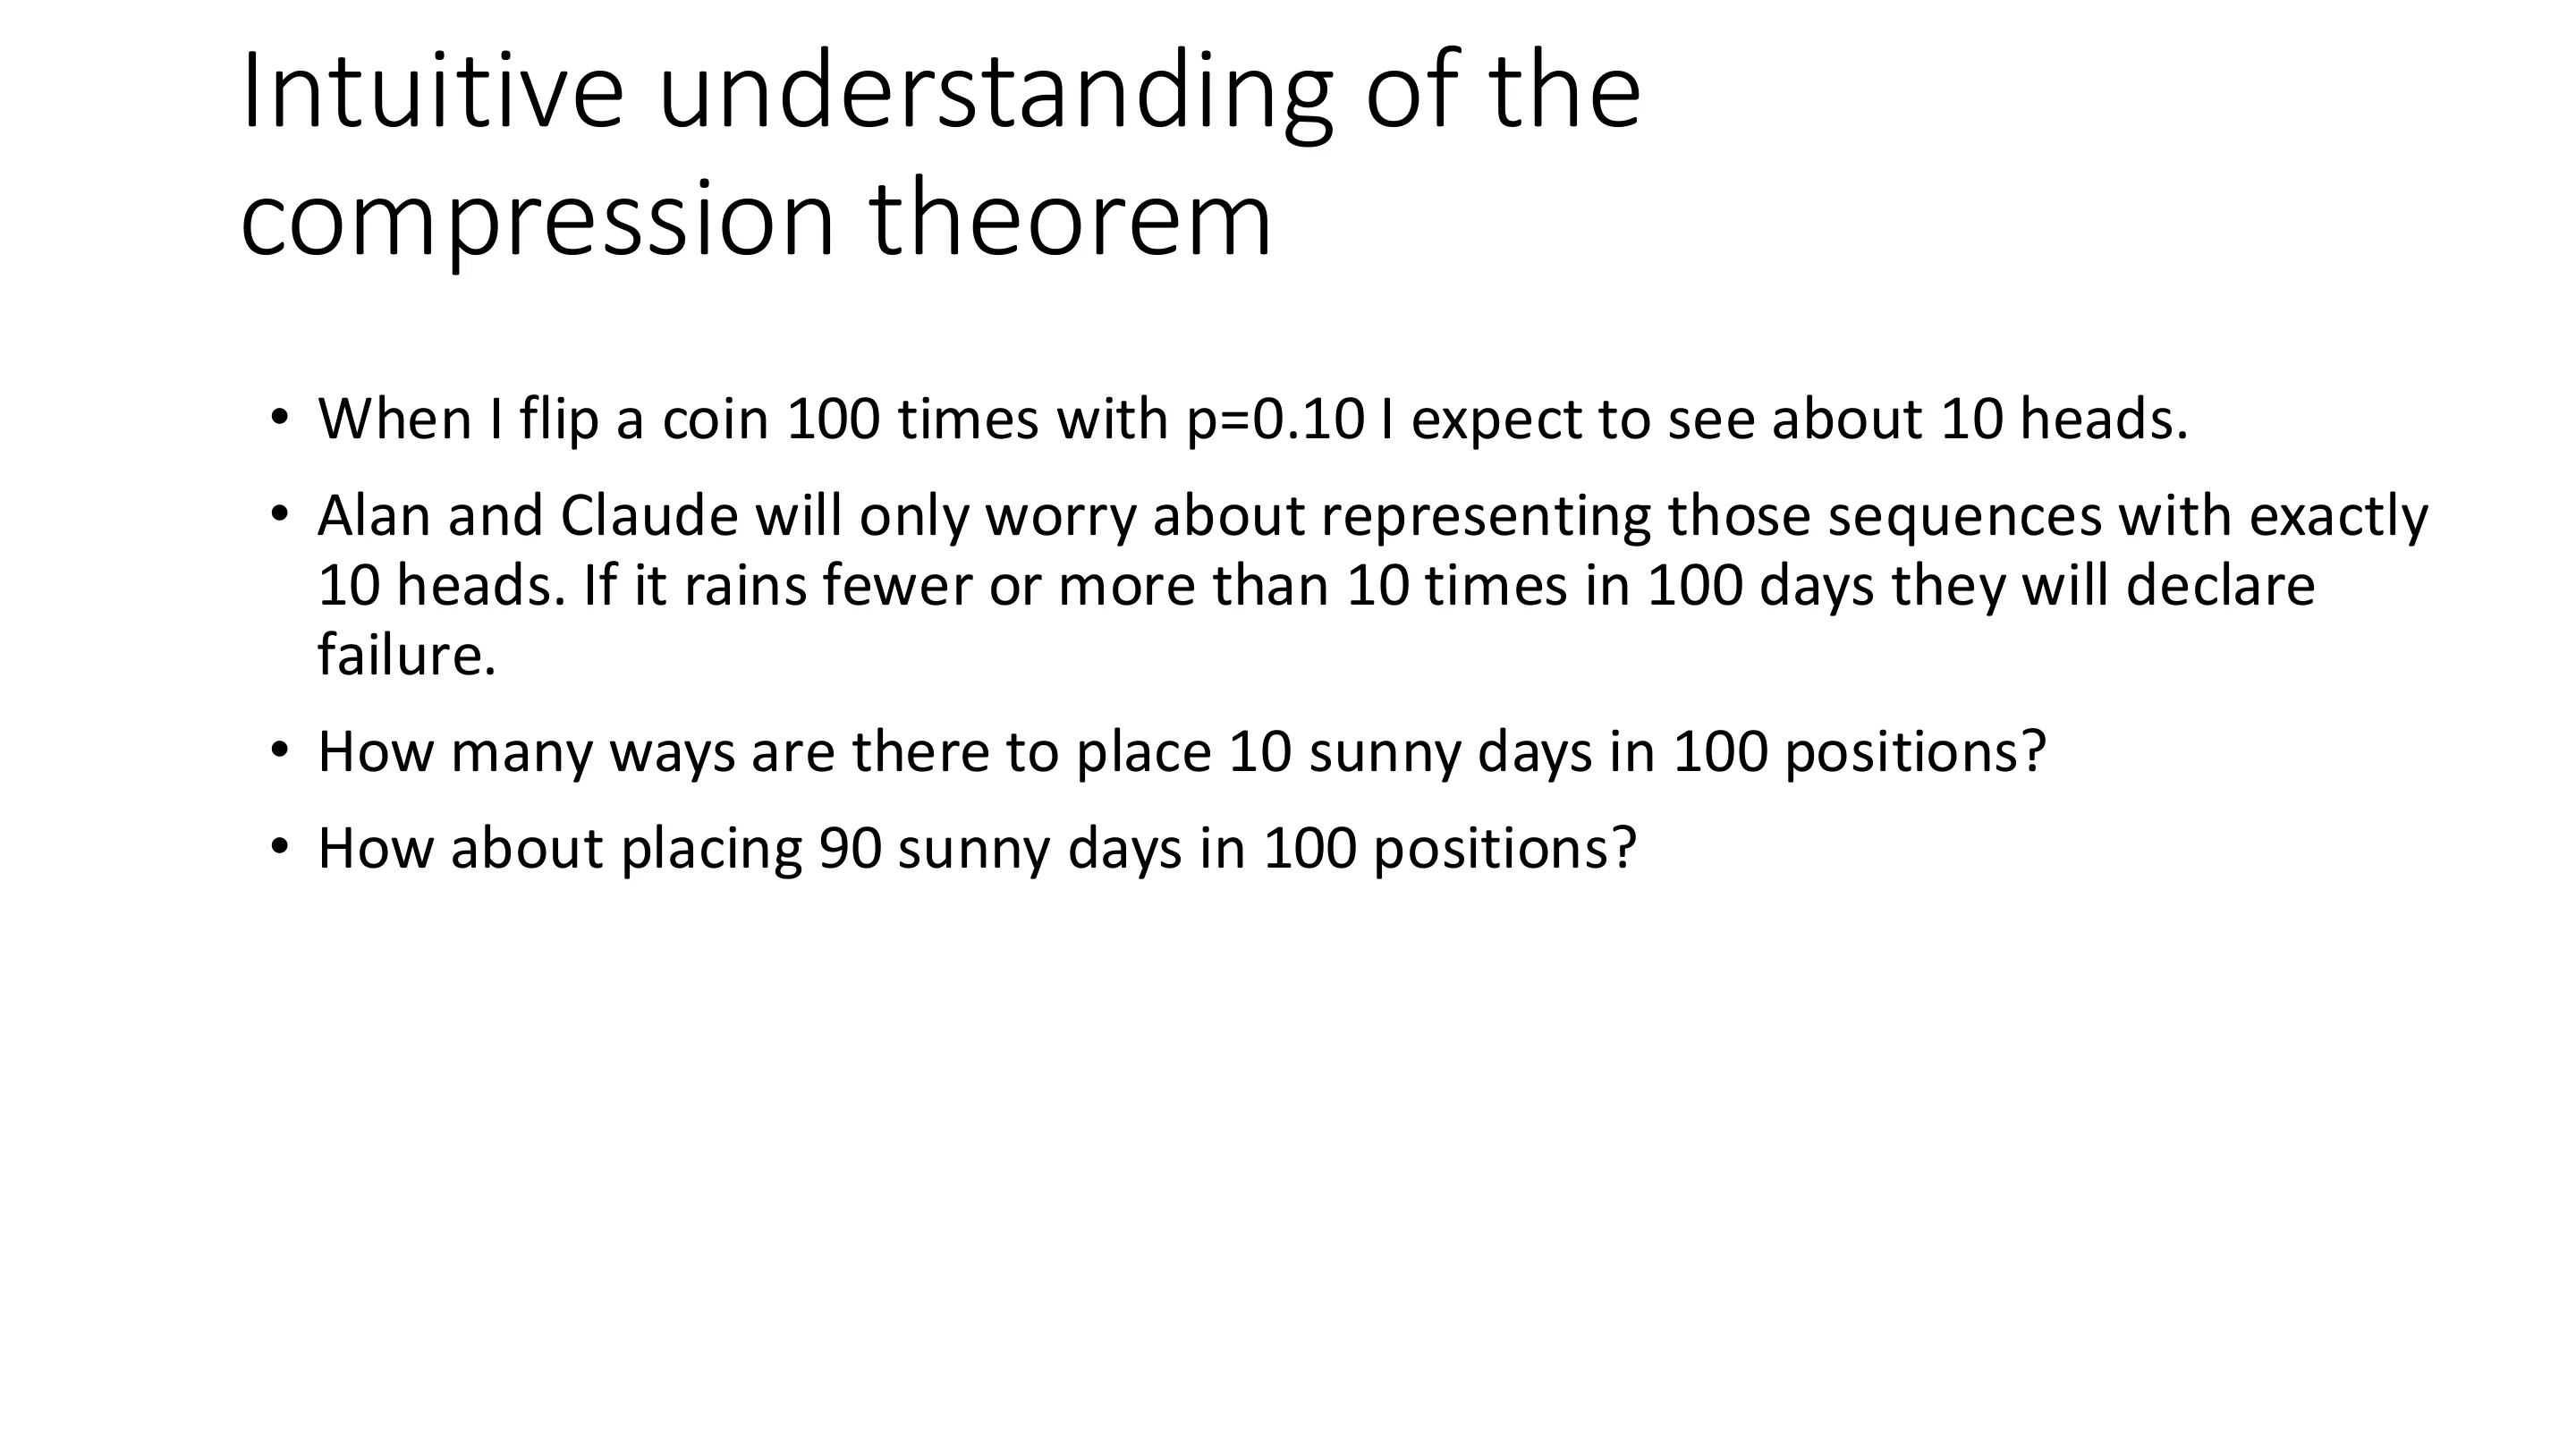
例子:西雅图每天下雨的概率为 $80\%$,独立。观测 100 天得到一串 0/1。它有多少信息(比特)?
- 朴素地用 100 比特?——那等于没压缩;序列中约 80 个 1(大数定律),说明它有结构、可压缩。
- 香农定理:熵 $H\approx 0.73$ bit/天 ⇒ 100 天可压到约 73 比特;而且无法压得更短(否则必然以正概率出错)。
📷 熵:如何度量信息
回到原视频 (00:01:33)
📷 香农压缩定理的设定(一)
回到原视频 (00:02:46)
📷 香农压缩定理的设定(二)
回到原视频 (00:03:59)
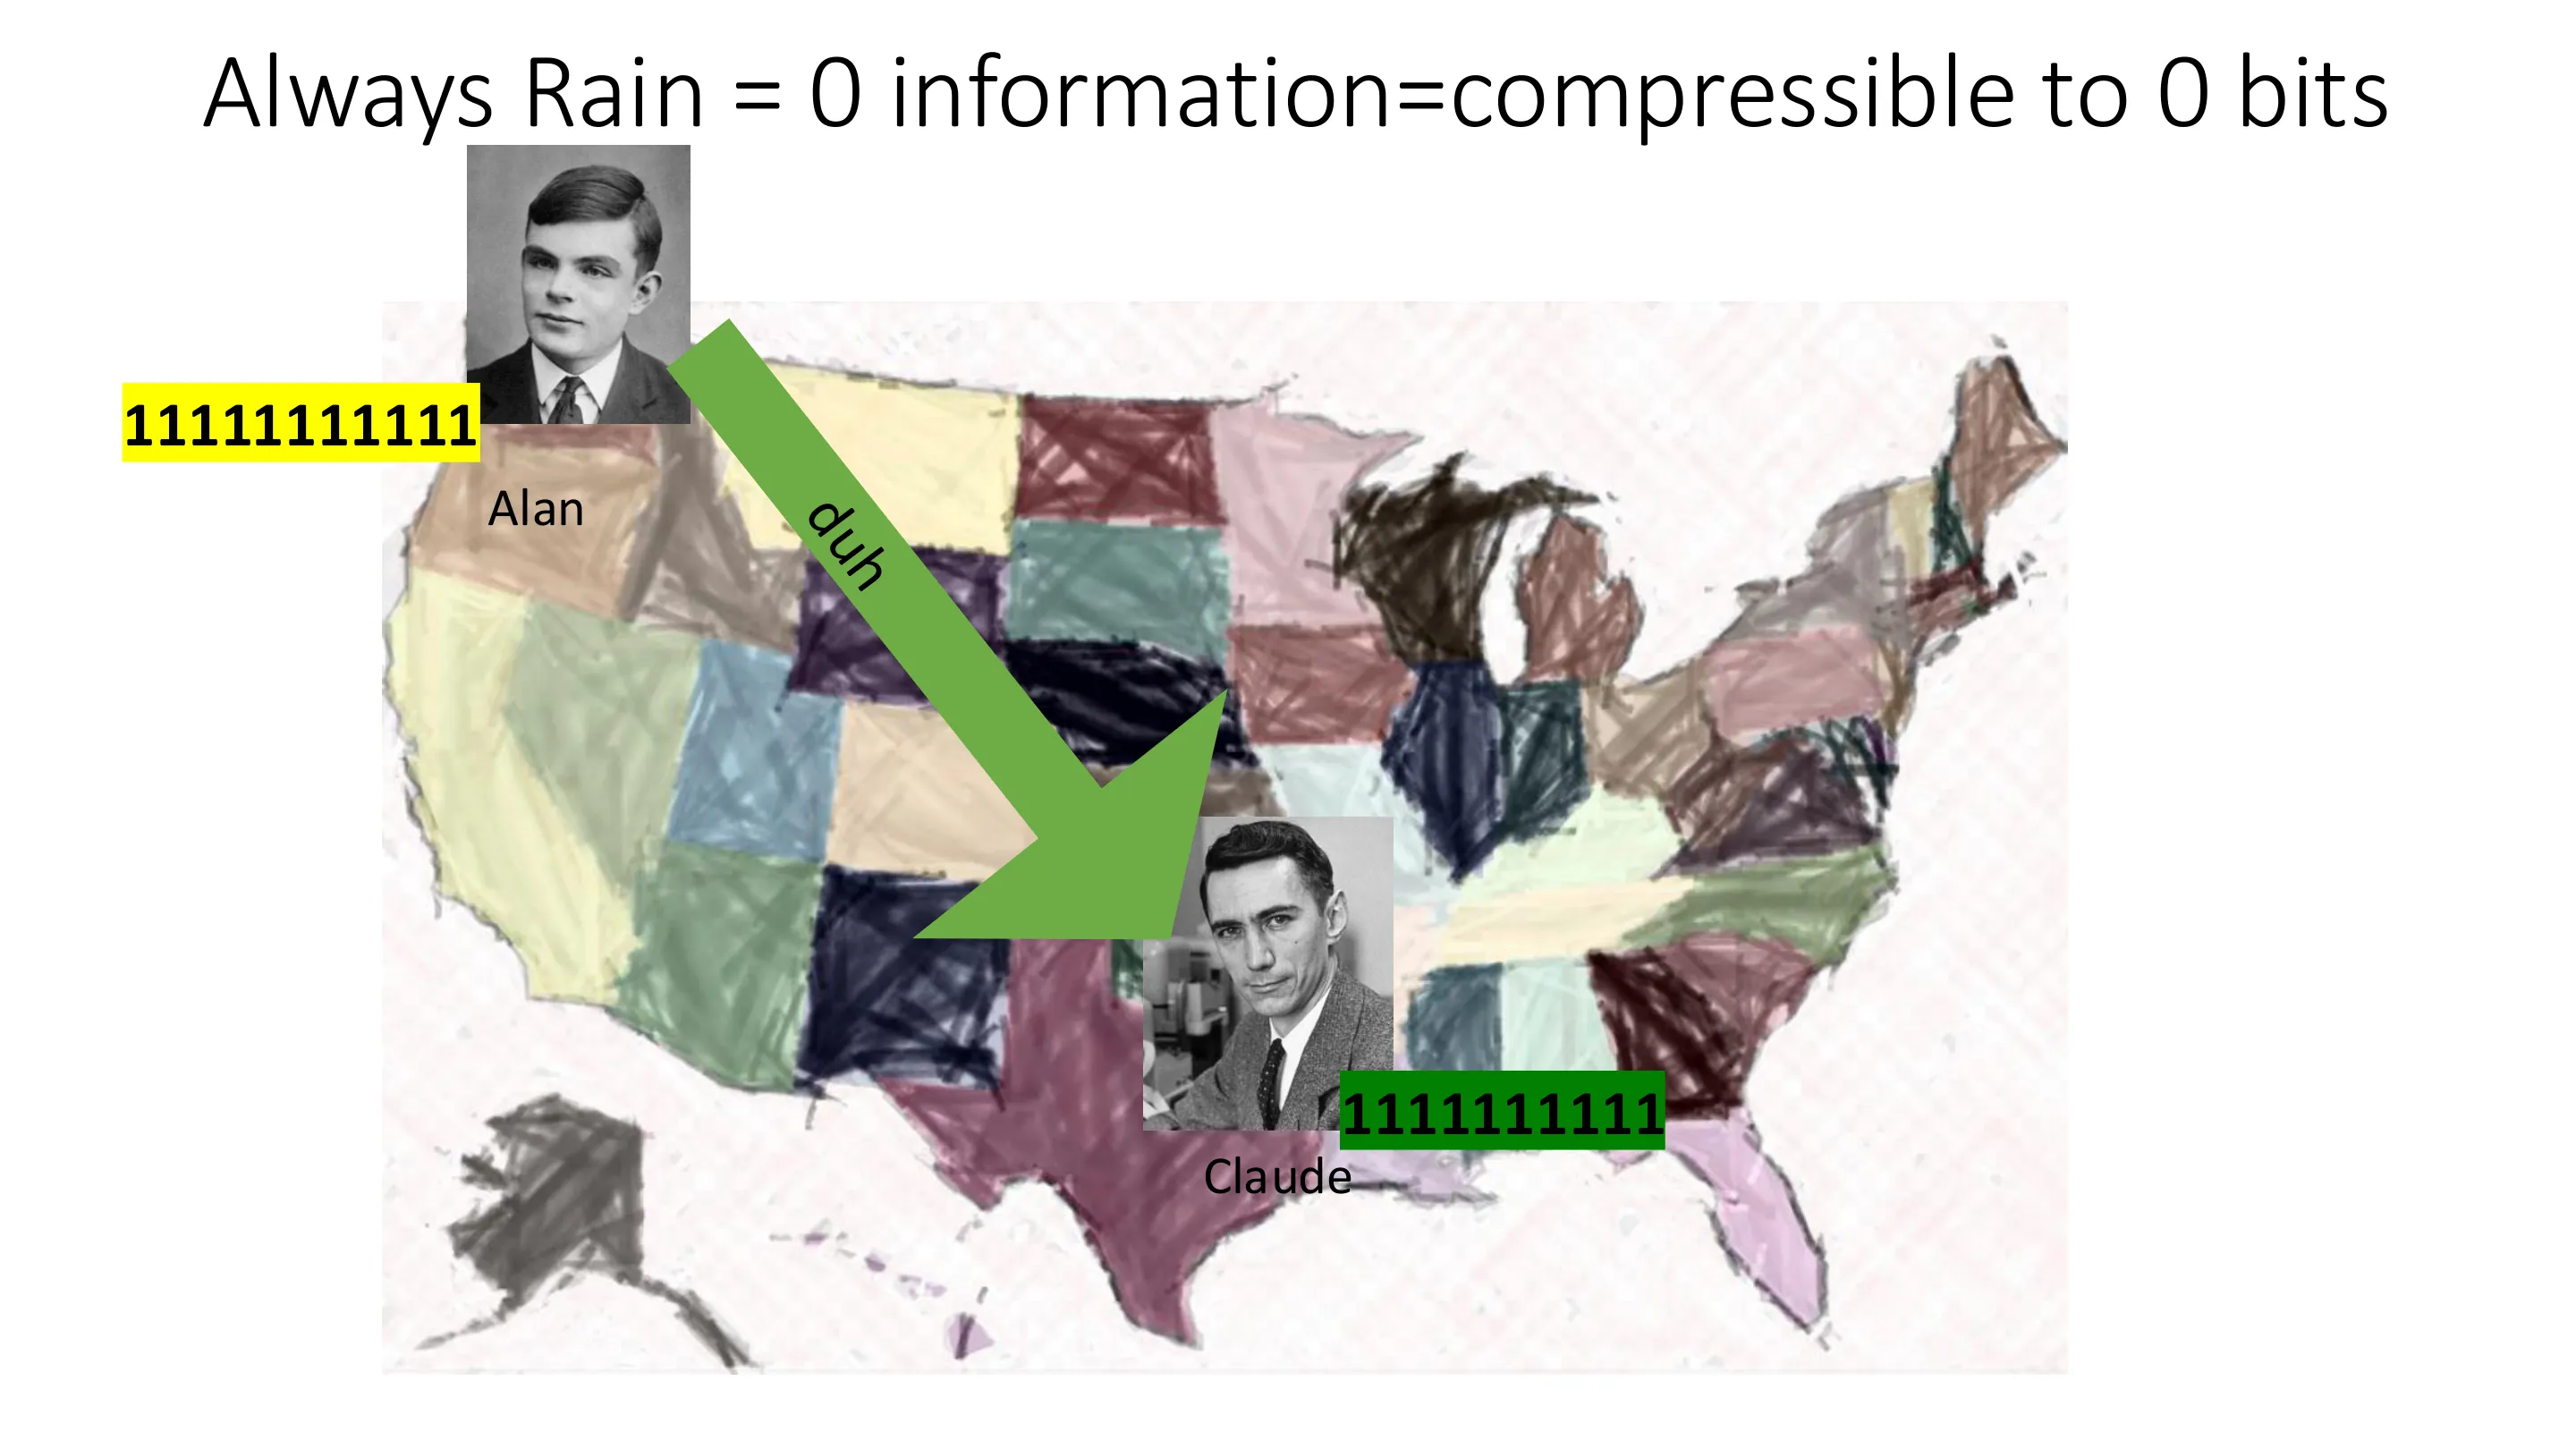
📷 总是下雨 = 0 信息 = 可压到 0 比特
回到原视频 (00:05:12)
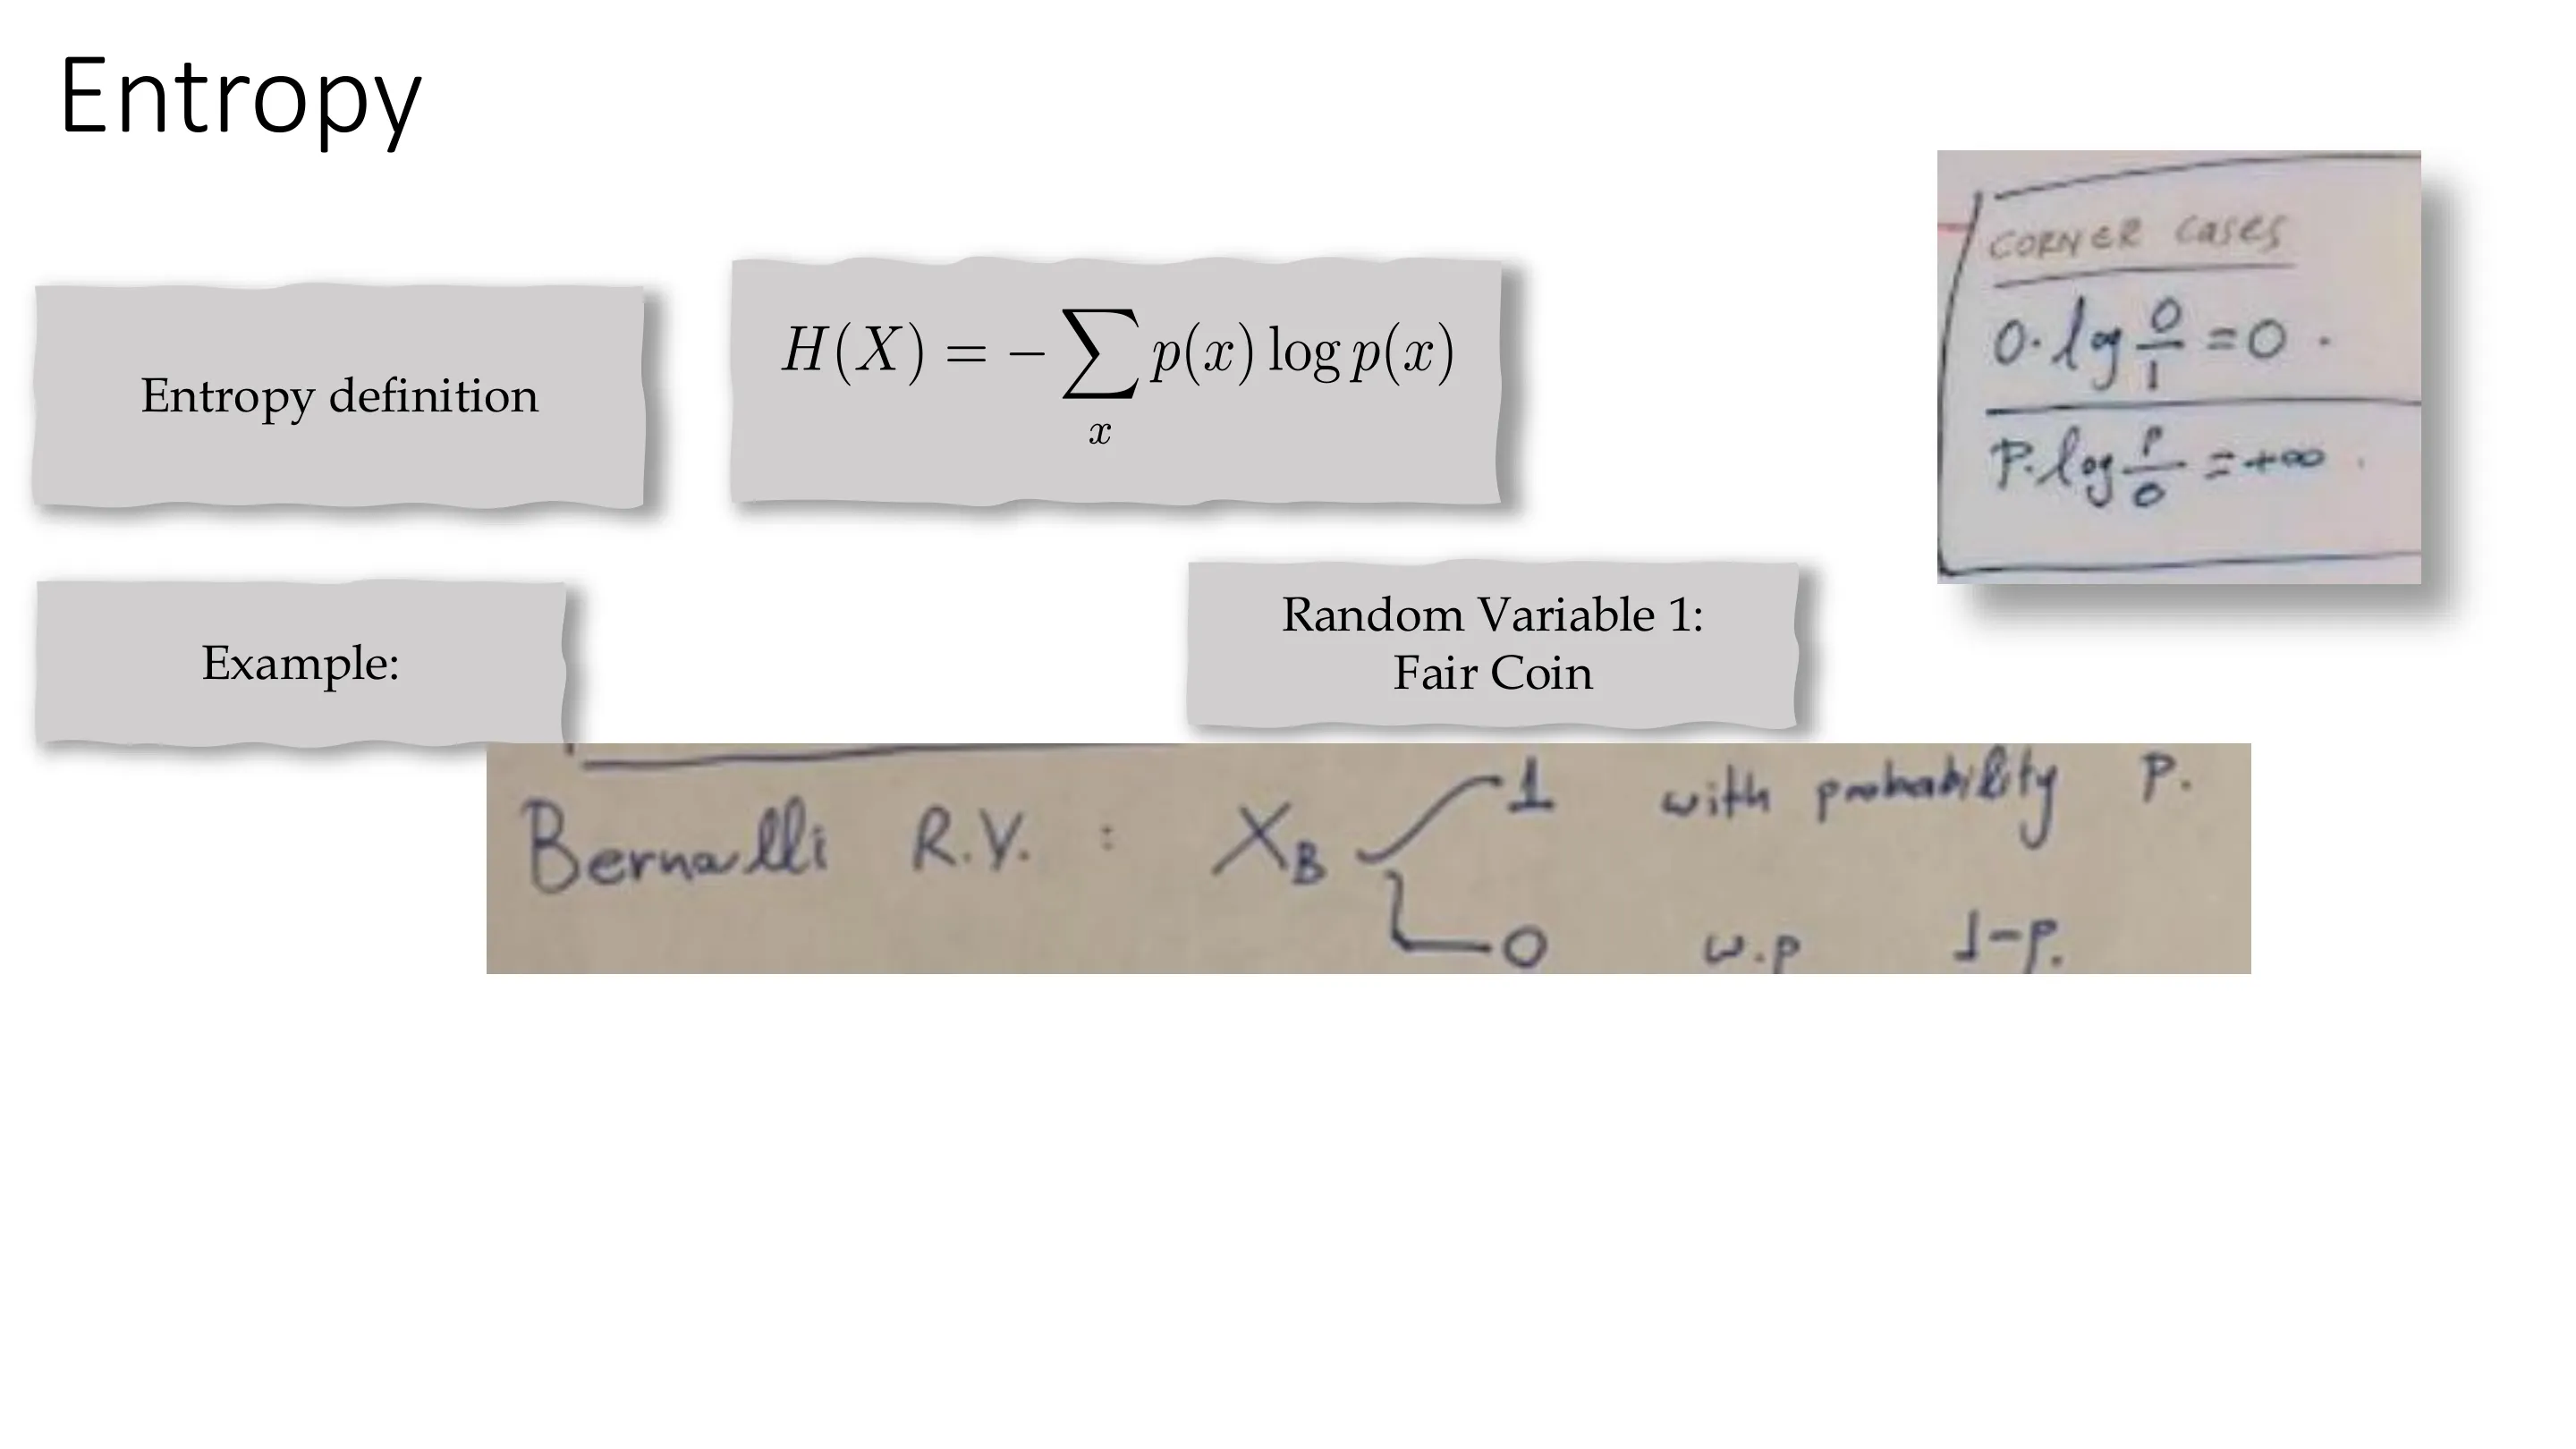
熵的定义(离散随机变量 $X$):
$$ H(X)=-\sum_x p(x)\log_2 p(x) $$
约定 $0\log 0=0$(由连续性)。
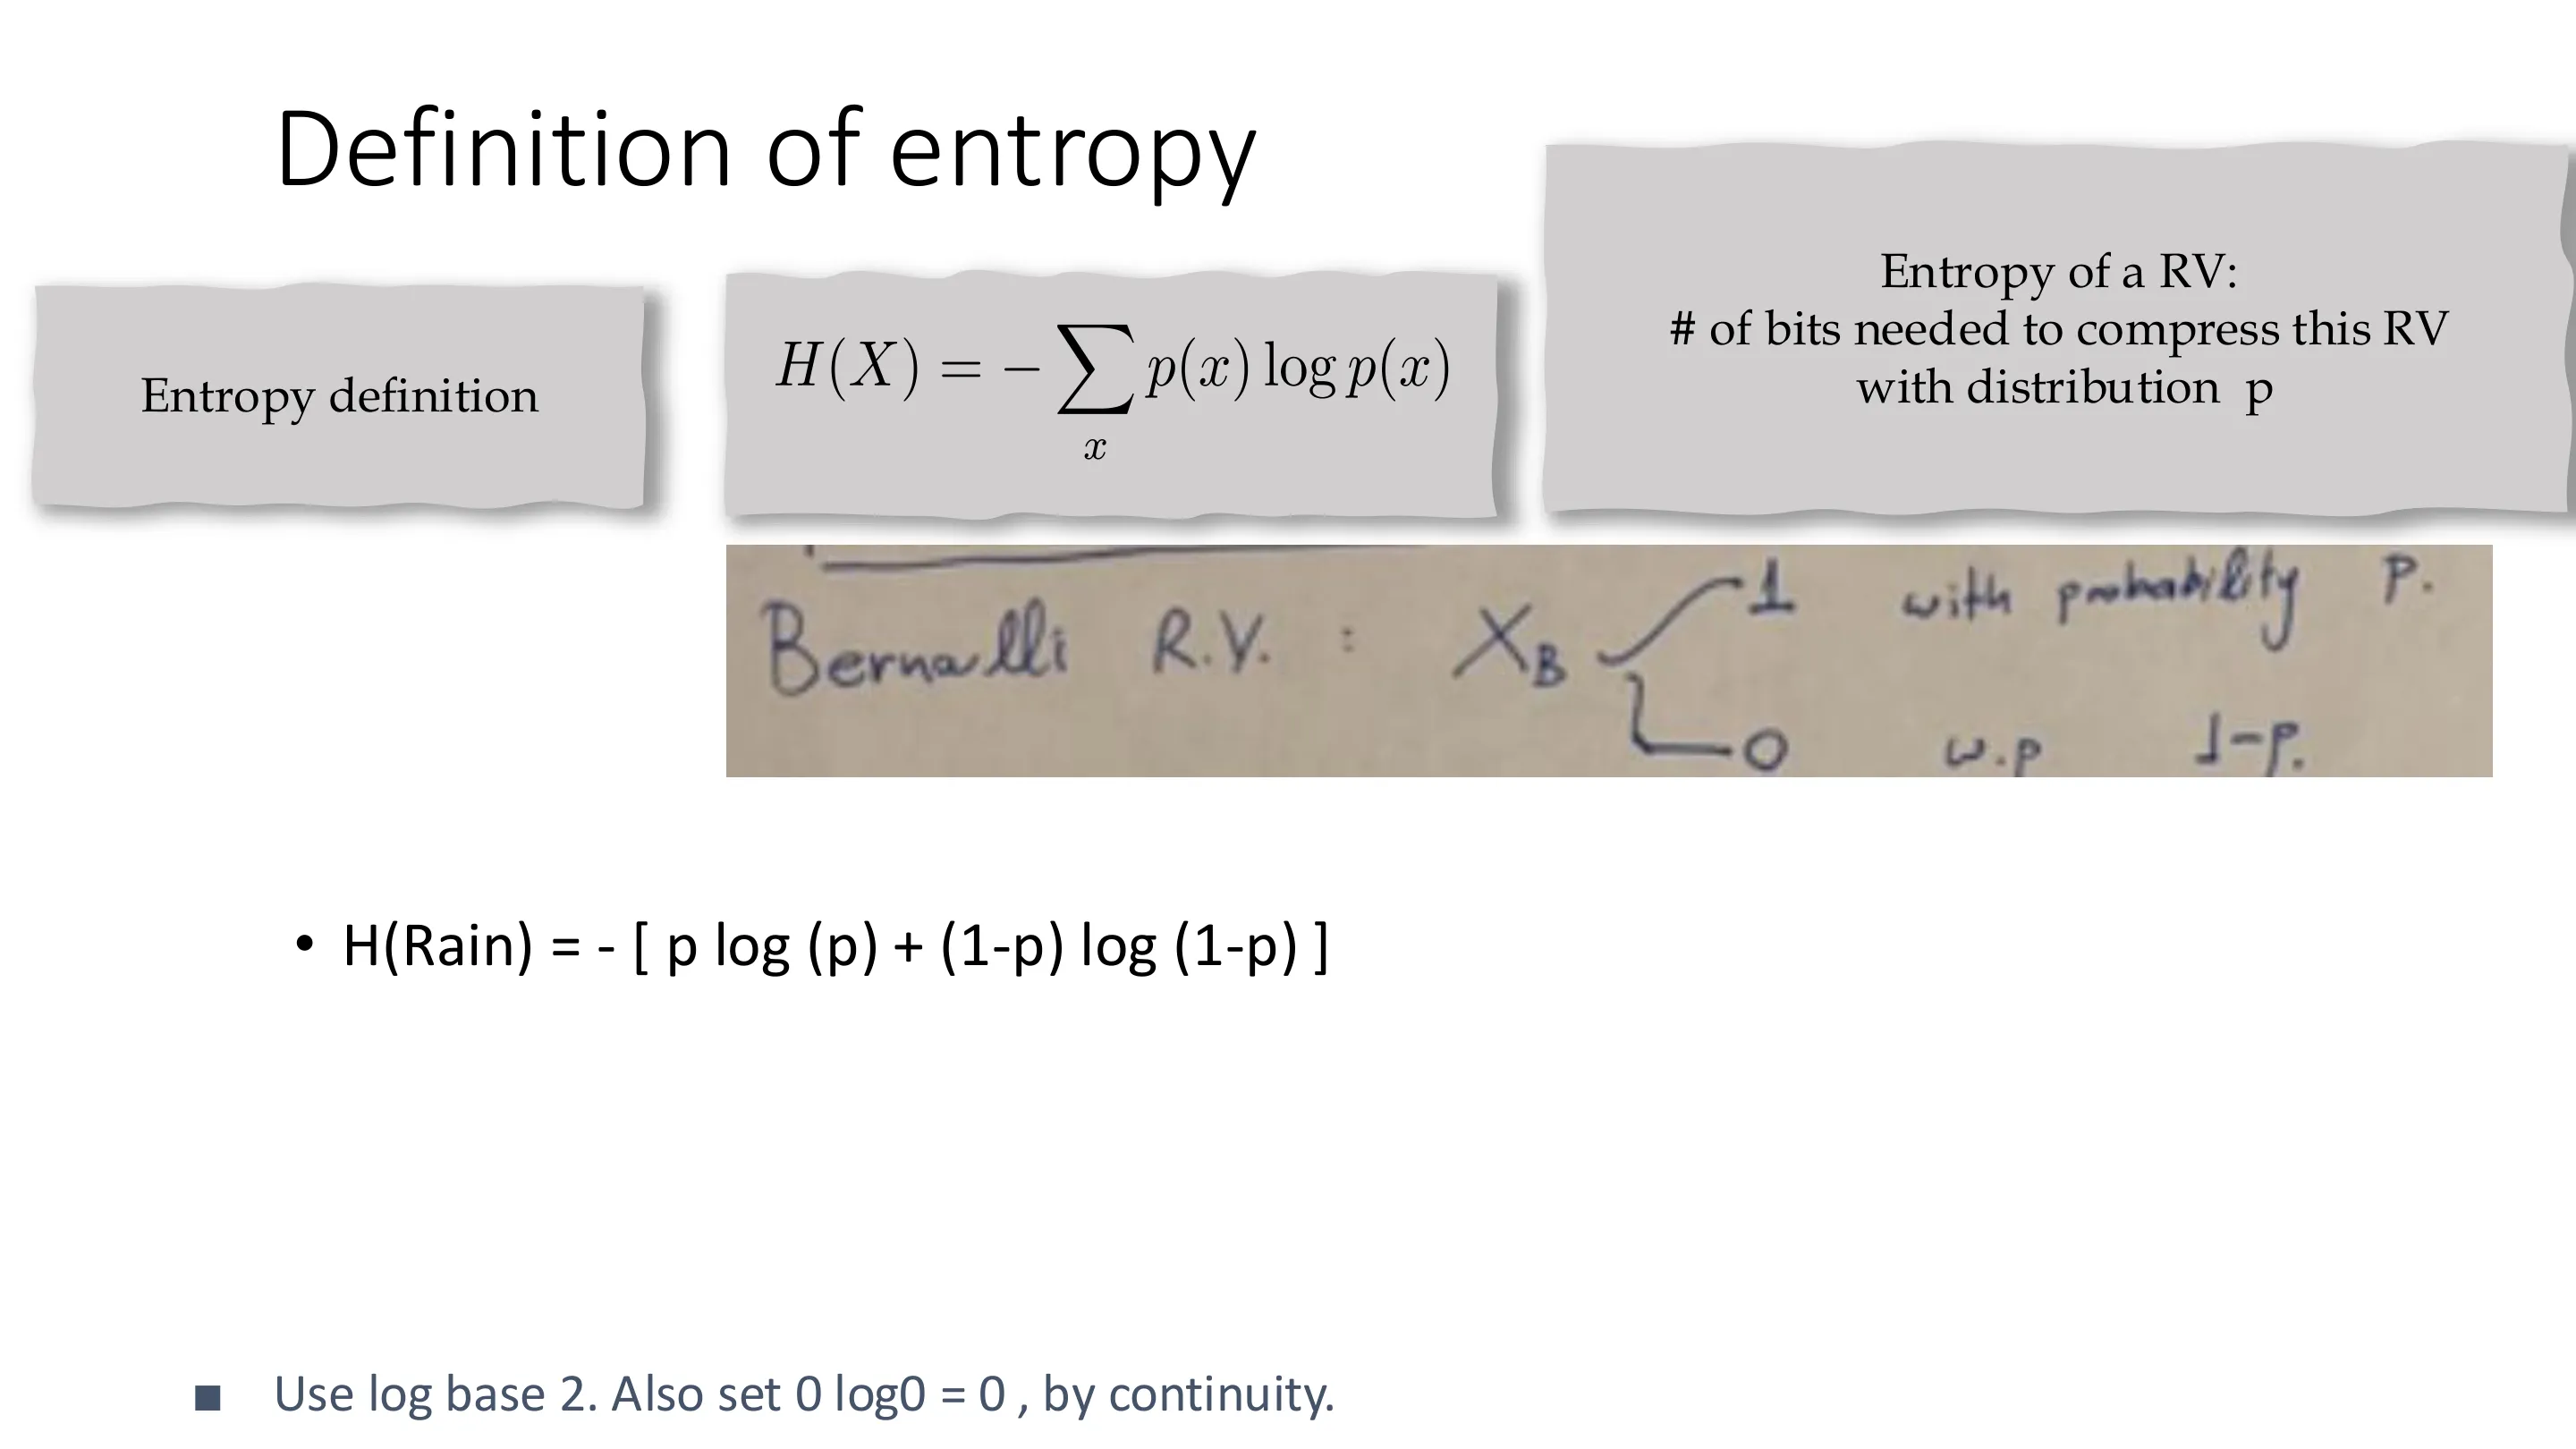
📷 熵的定义
回到原视频 (00:06:25)
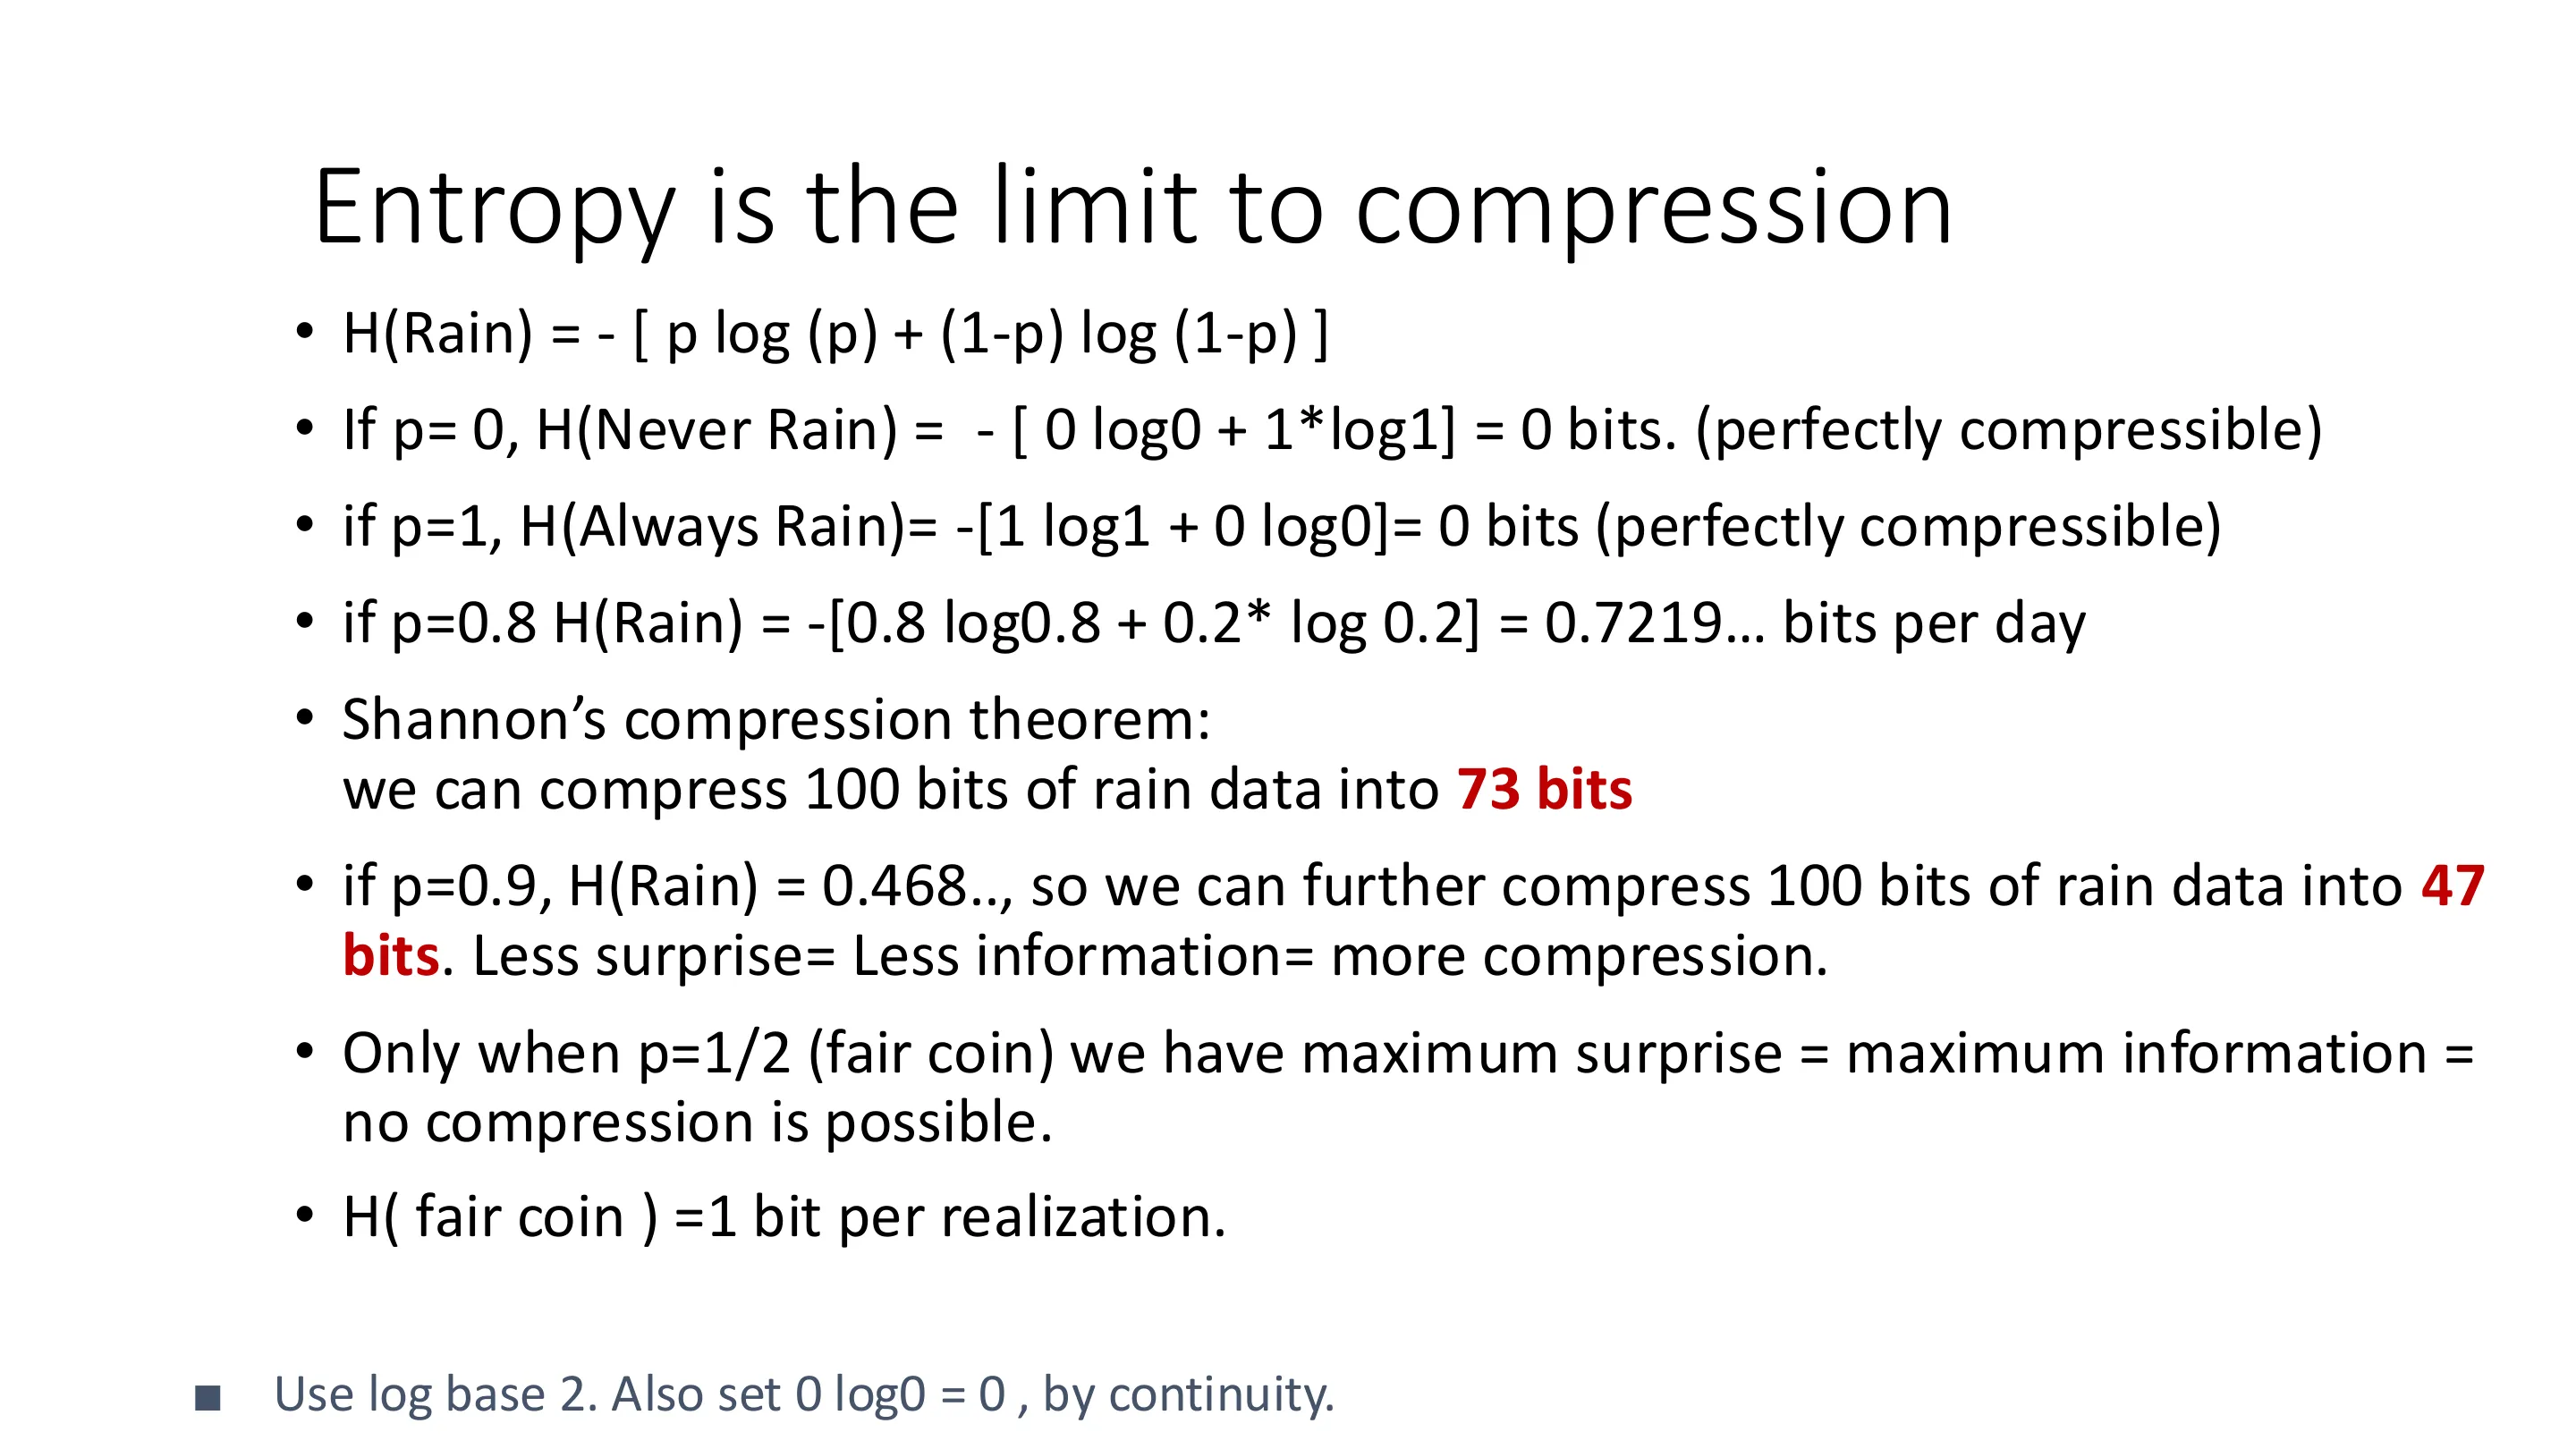
📷 熵是压缩的极限
回到原视频 (00:07:38)
📷 熵的直观理解(一)
回到原视频 (00:08:51)
📷 熵的直观理解(二)
回到原视频 (00:10:04)
📷 熵的直观理解(三)
回到原视频 (00:11:17)
📷 熵的直观理解(四)
回到原视频 (00:12:30)
📷 熵的直观理解(五)
回到原视频 (00:13:43)
📷 熵的直观理解(六)
回到原视频 (00:14:56)
📷 熵的直观理解(七)
回到原视频 (00:16:09)
📷 熵的直观理解(八)
回到原视频 (00:17:22)
Bernoulli$(p)$ 的特例:
| 情形 | 熵 |
|---|---|
| $p=1$ 或 $p=0$(确定性) | $0$ bit |
| $p=0.8$(西雅图) | $\approx0.73$ bit |
| $p=0.9$ | $\approx0.47$ bit |
| $p=0.5$(公平硬币) | $1$ bit |
要点:随机性就是信息;只有当结果完全均匀时,1 次观测才恰好携带 1 比特。意外性越小、信息越少。
1.2 压缩定理的证明思路
(参考时间: 00:10)
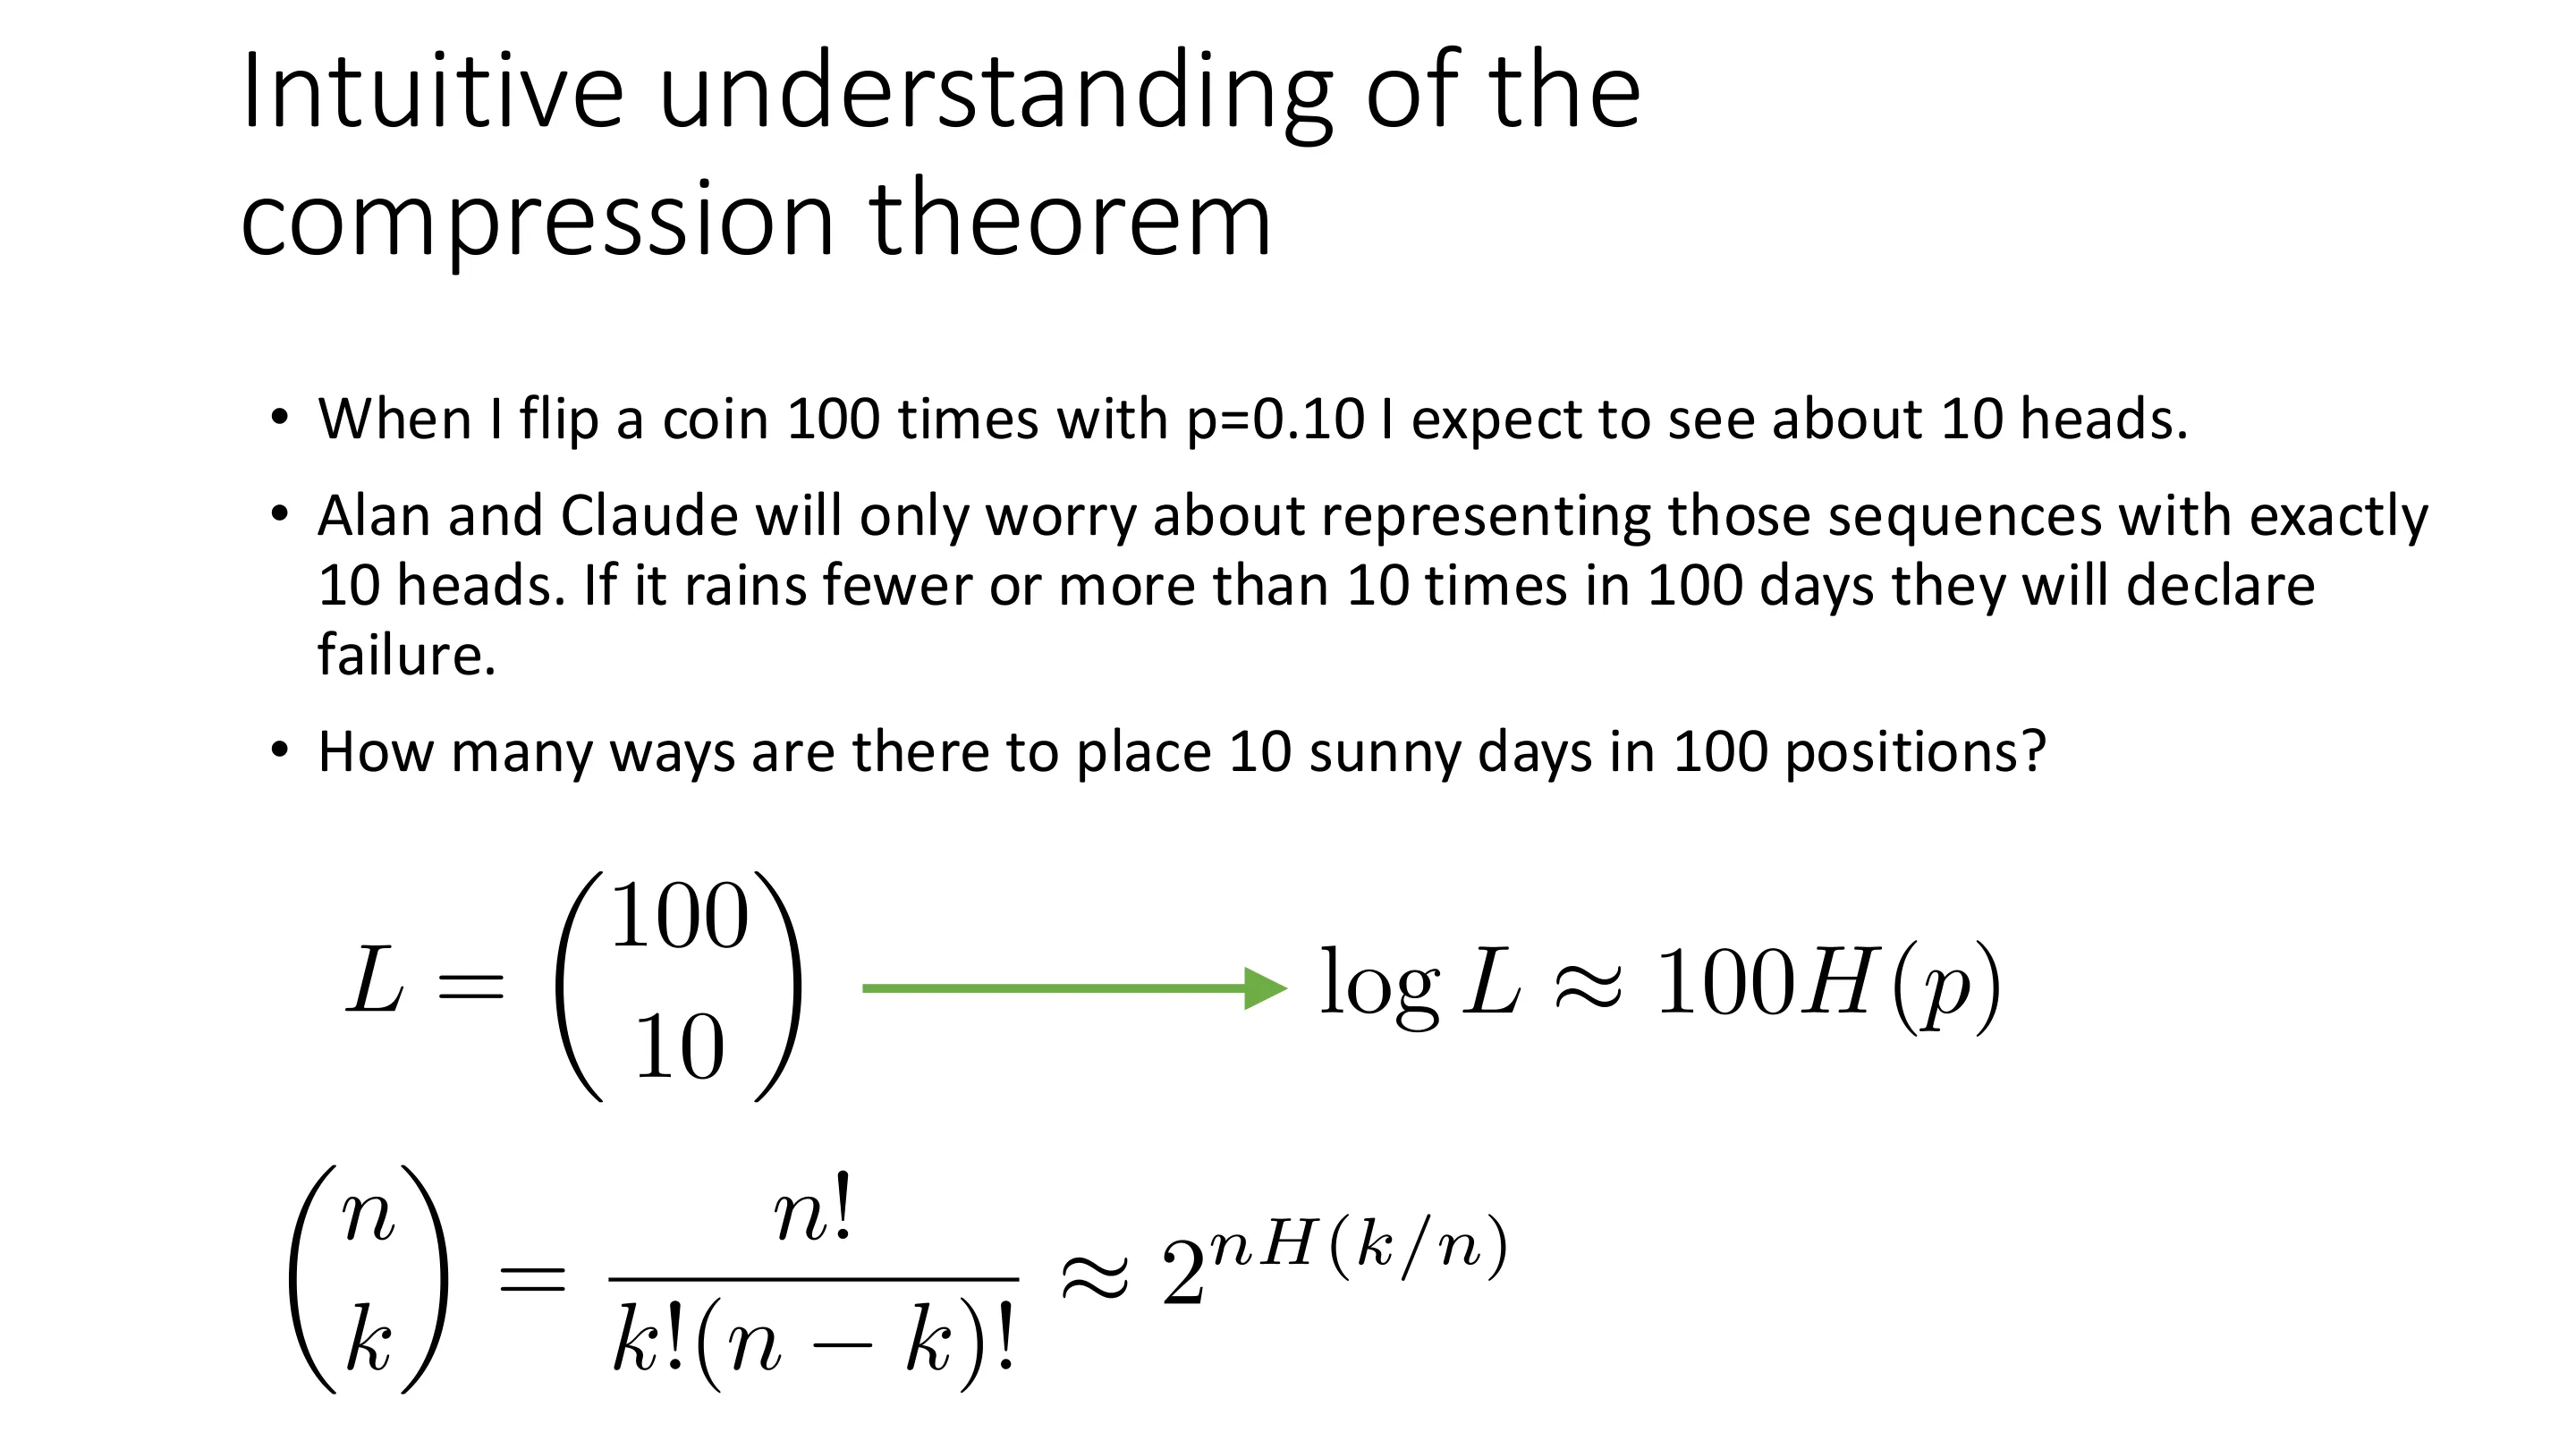
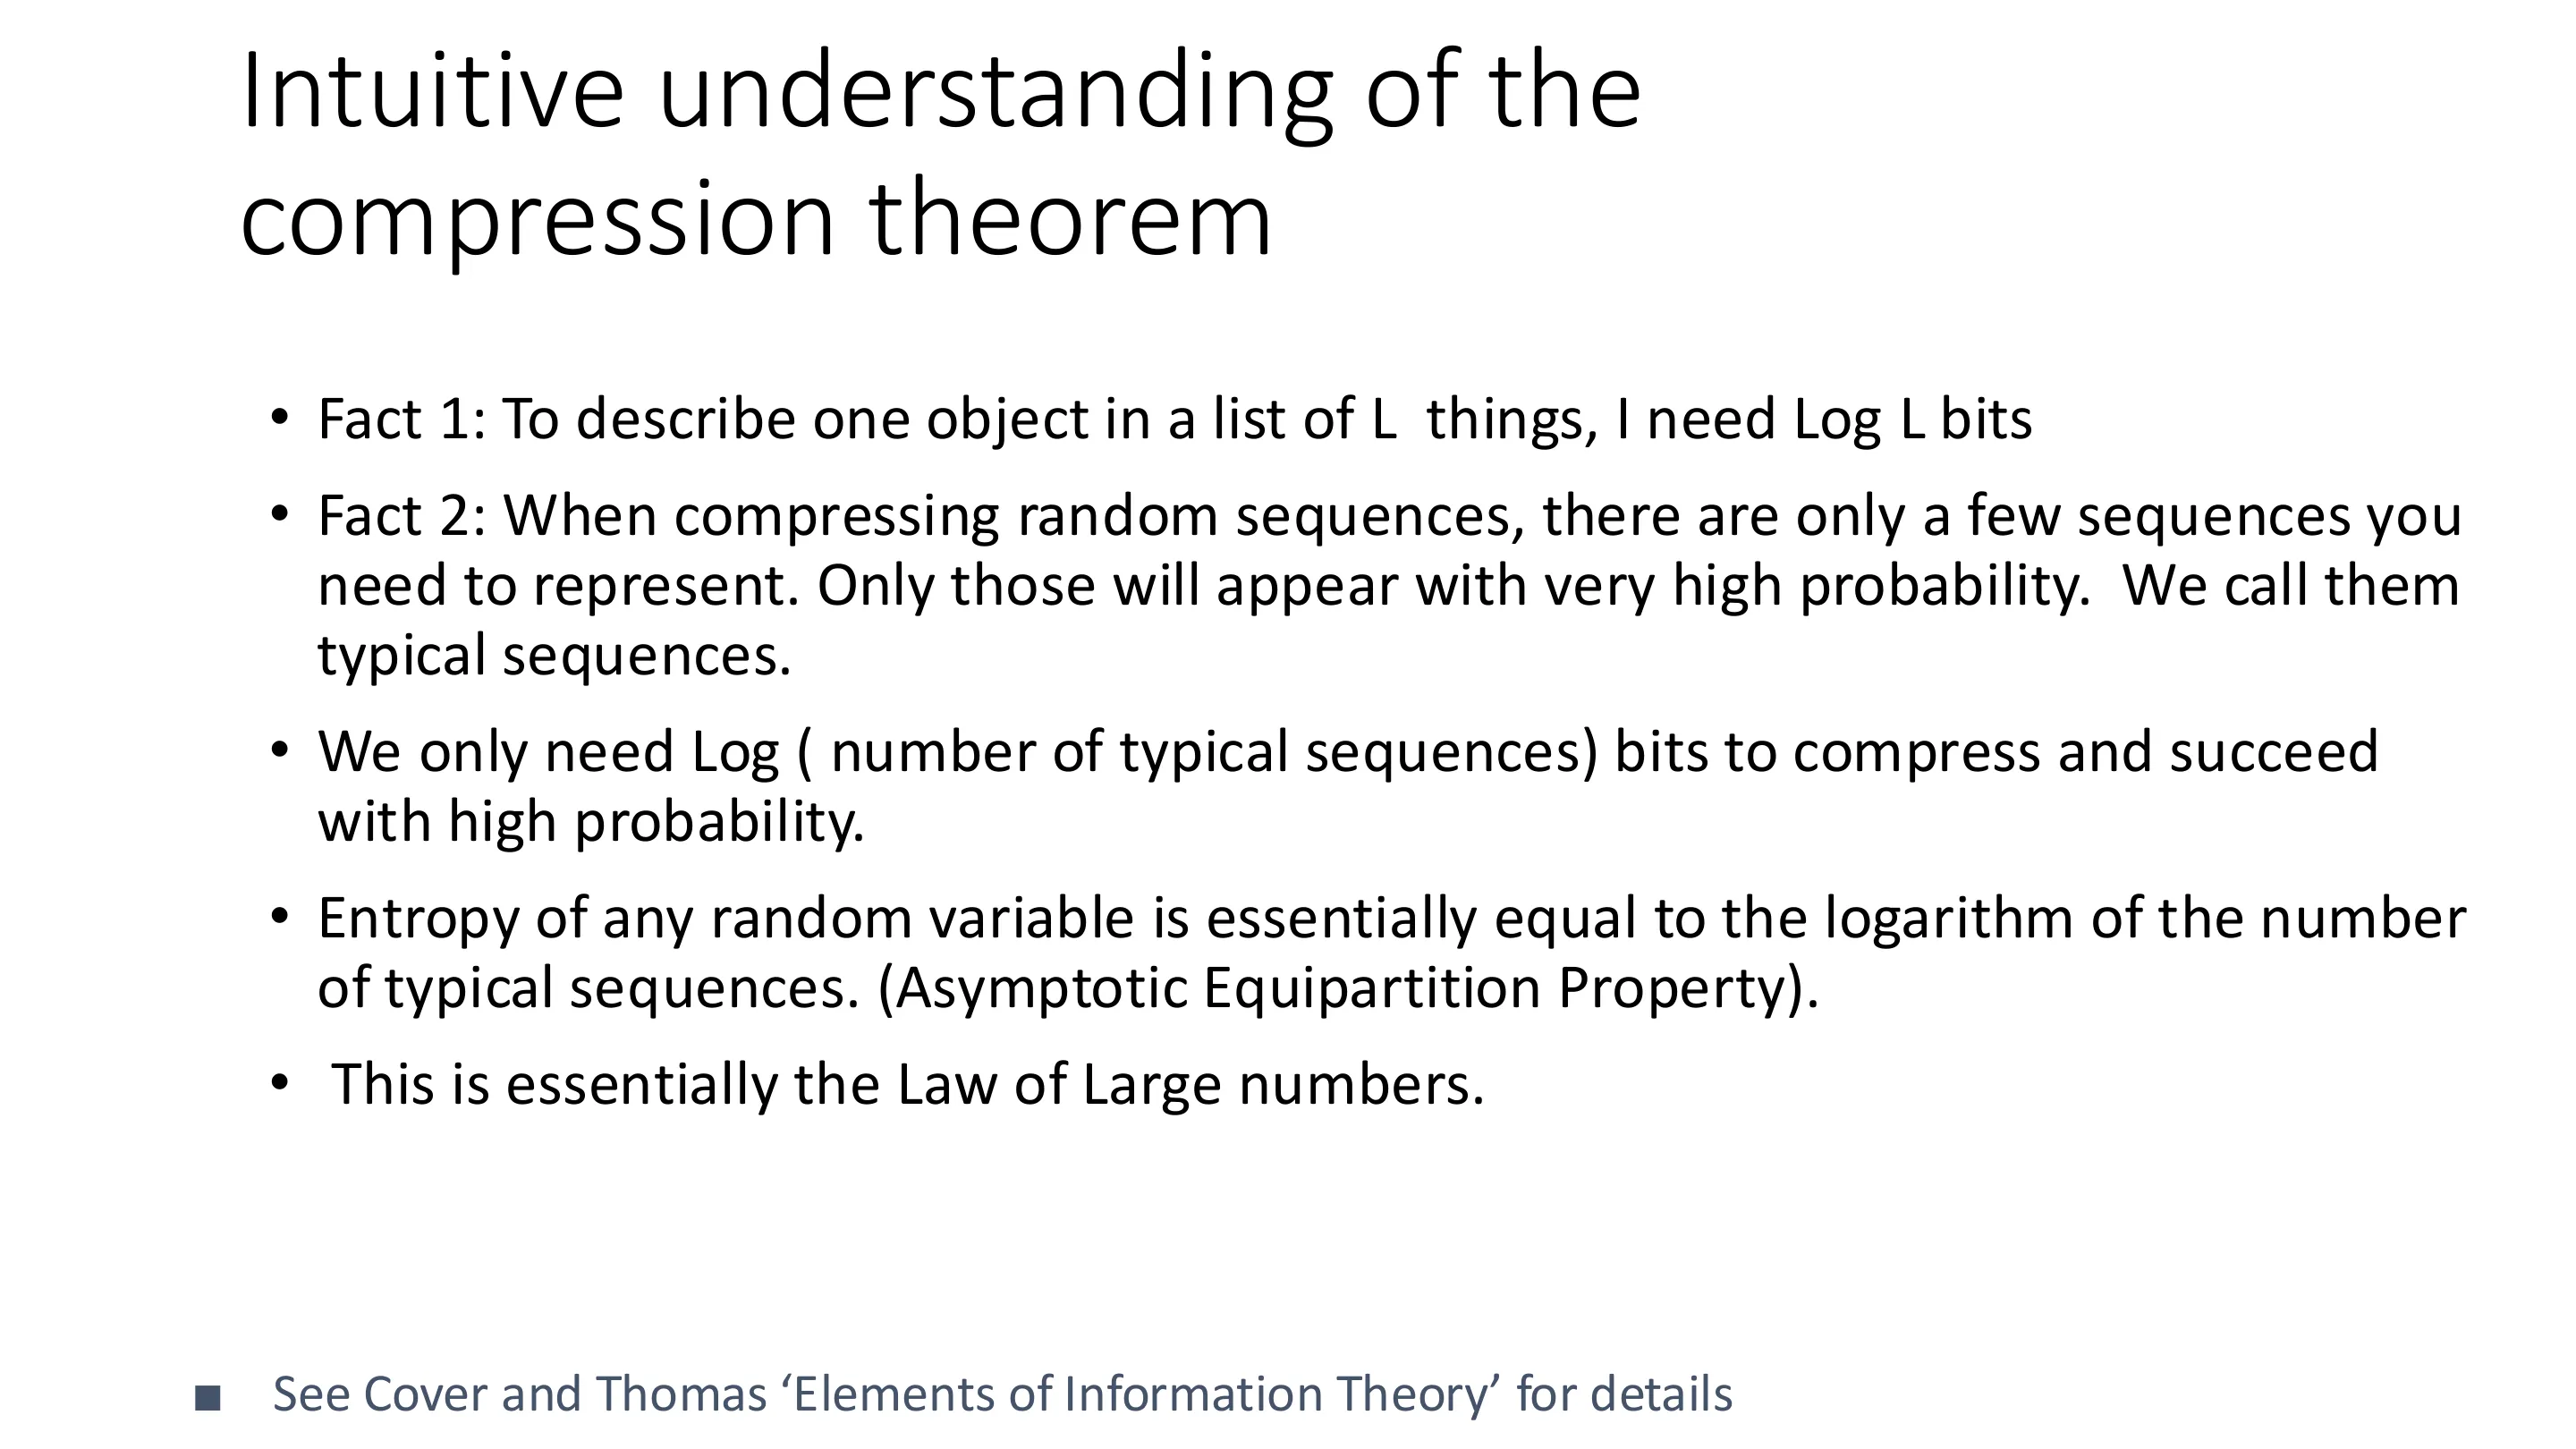
两个事实:
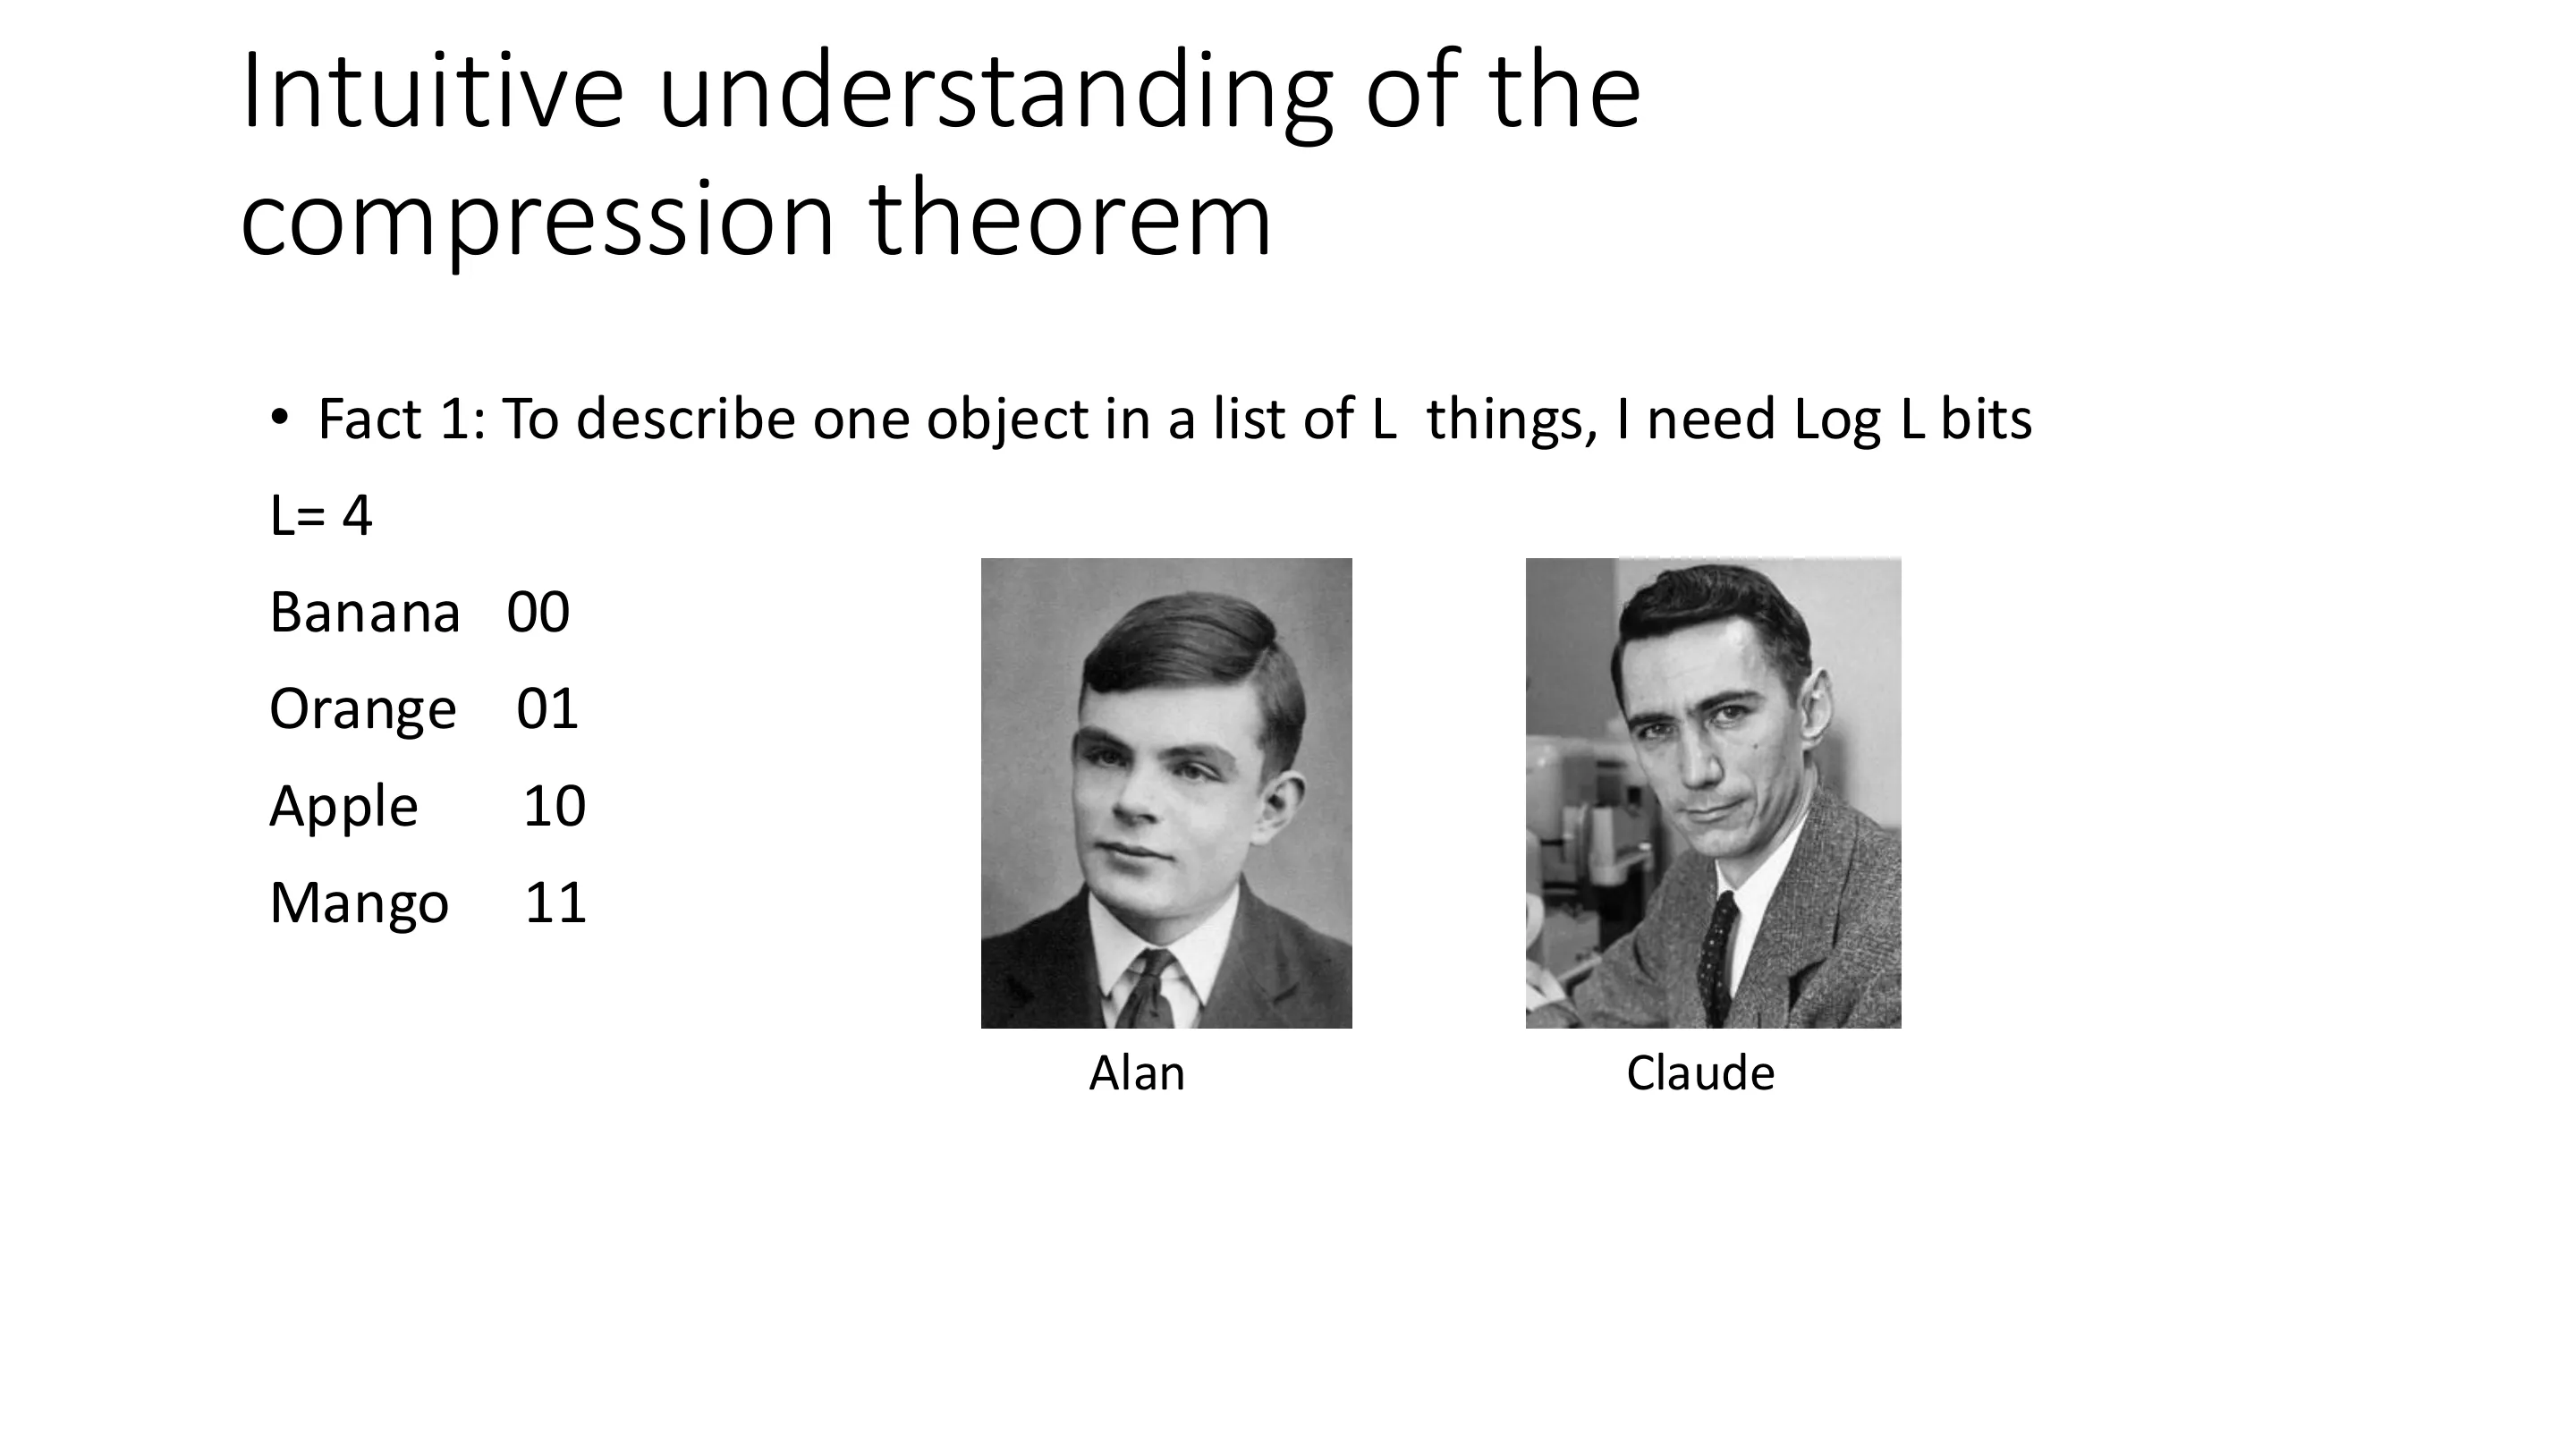
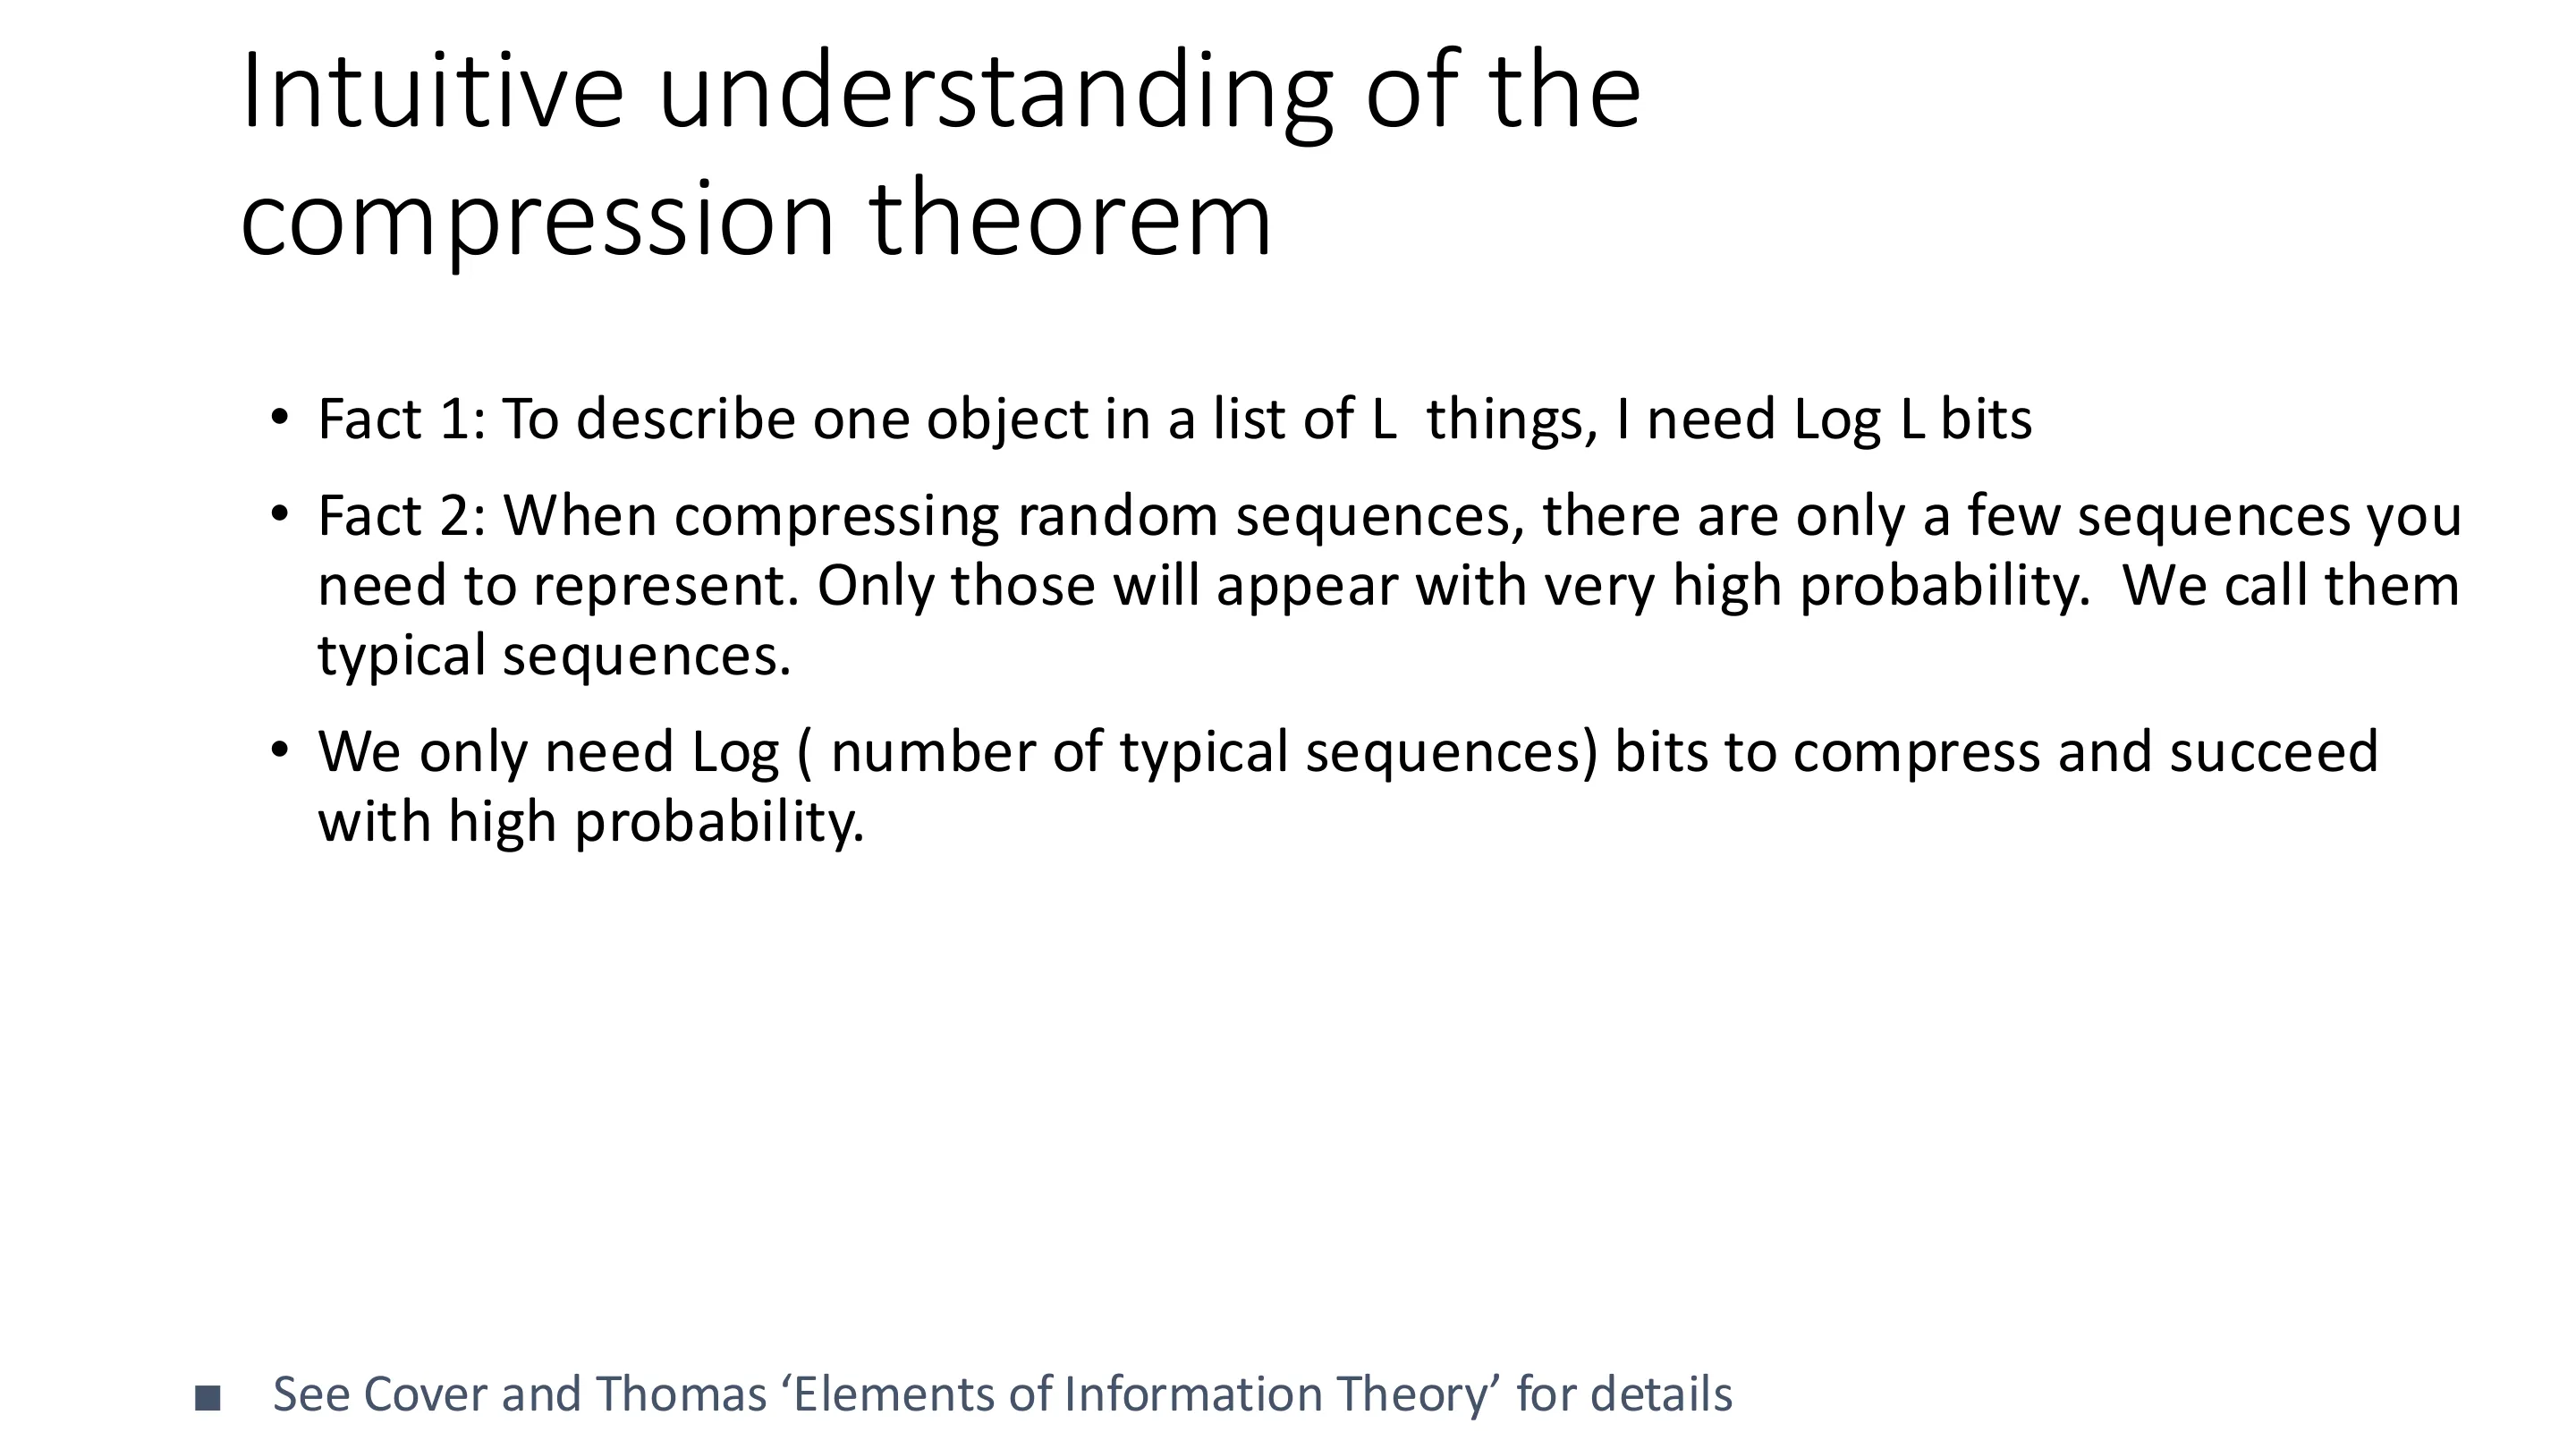
- 从 $L$ 个等可能对象里指定一个,需要 $\log_2 L$ 比特;
- 压缩时只需为典型序列(出现概率趋近 1 的序列)编码——非典型序列的总概率随 $n\to\infty$ 趋近于 0。
于是只需数「典型序列」的个数 $L$,发送 $\log_2 L$ 比特。这本质上是大数定律:方差 $\sim n$ 但标准差 $\sim\sqrt n$,相对于期望 $np$ 可忽略,所以 $\log_2 L\to nH$。
📷 赛马问题(一)
回到原视频 (00:18:35)
📷 赛马问题(二)
回到原视频 (00:19:48)
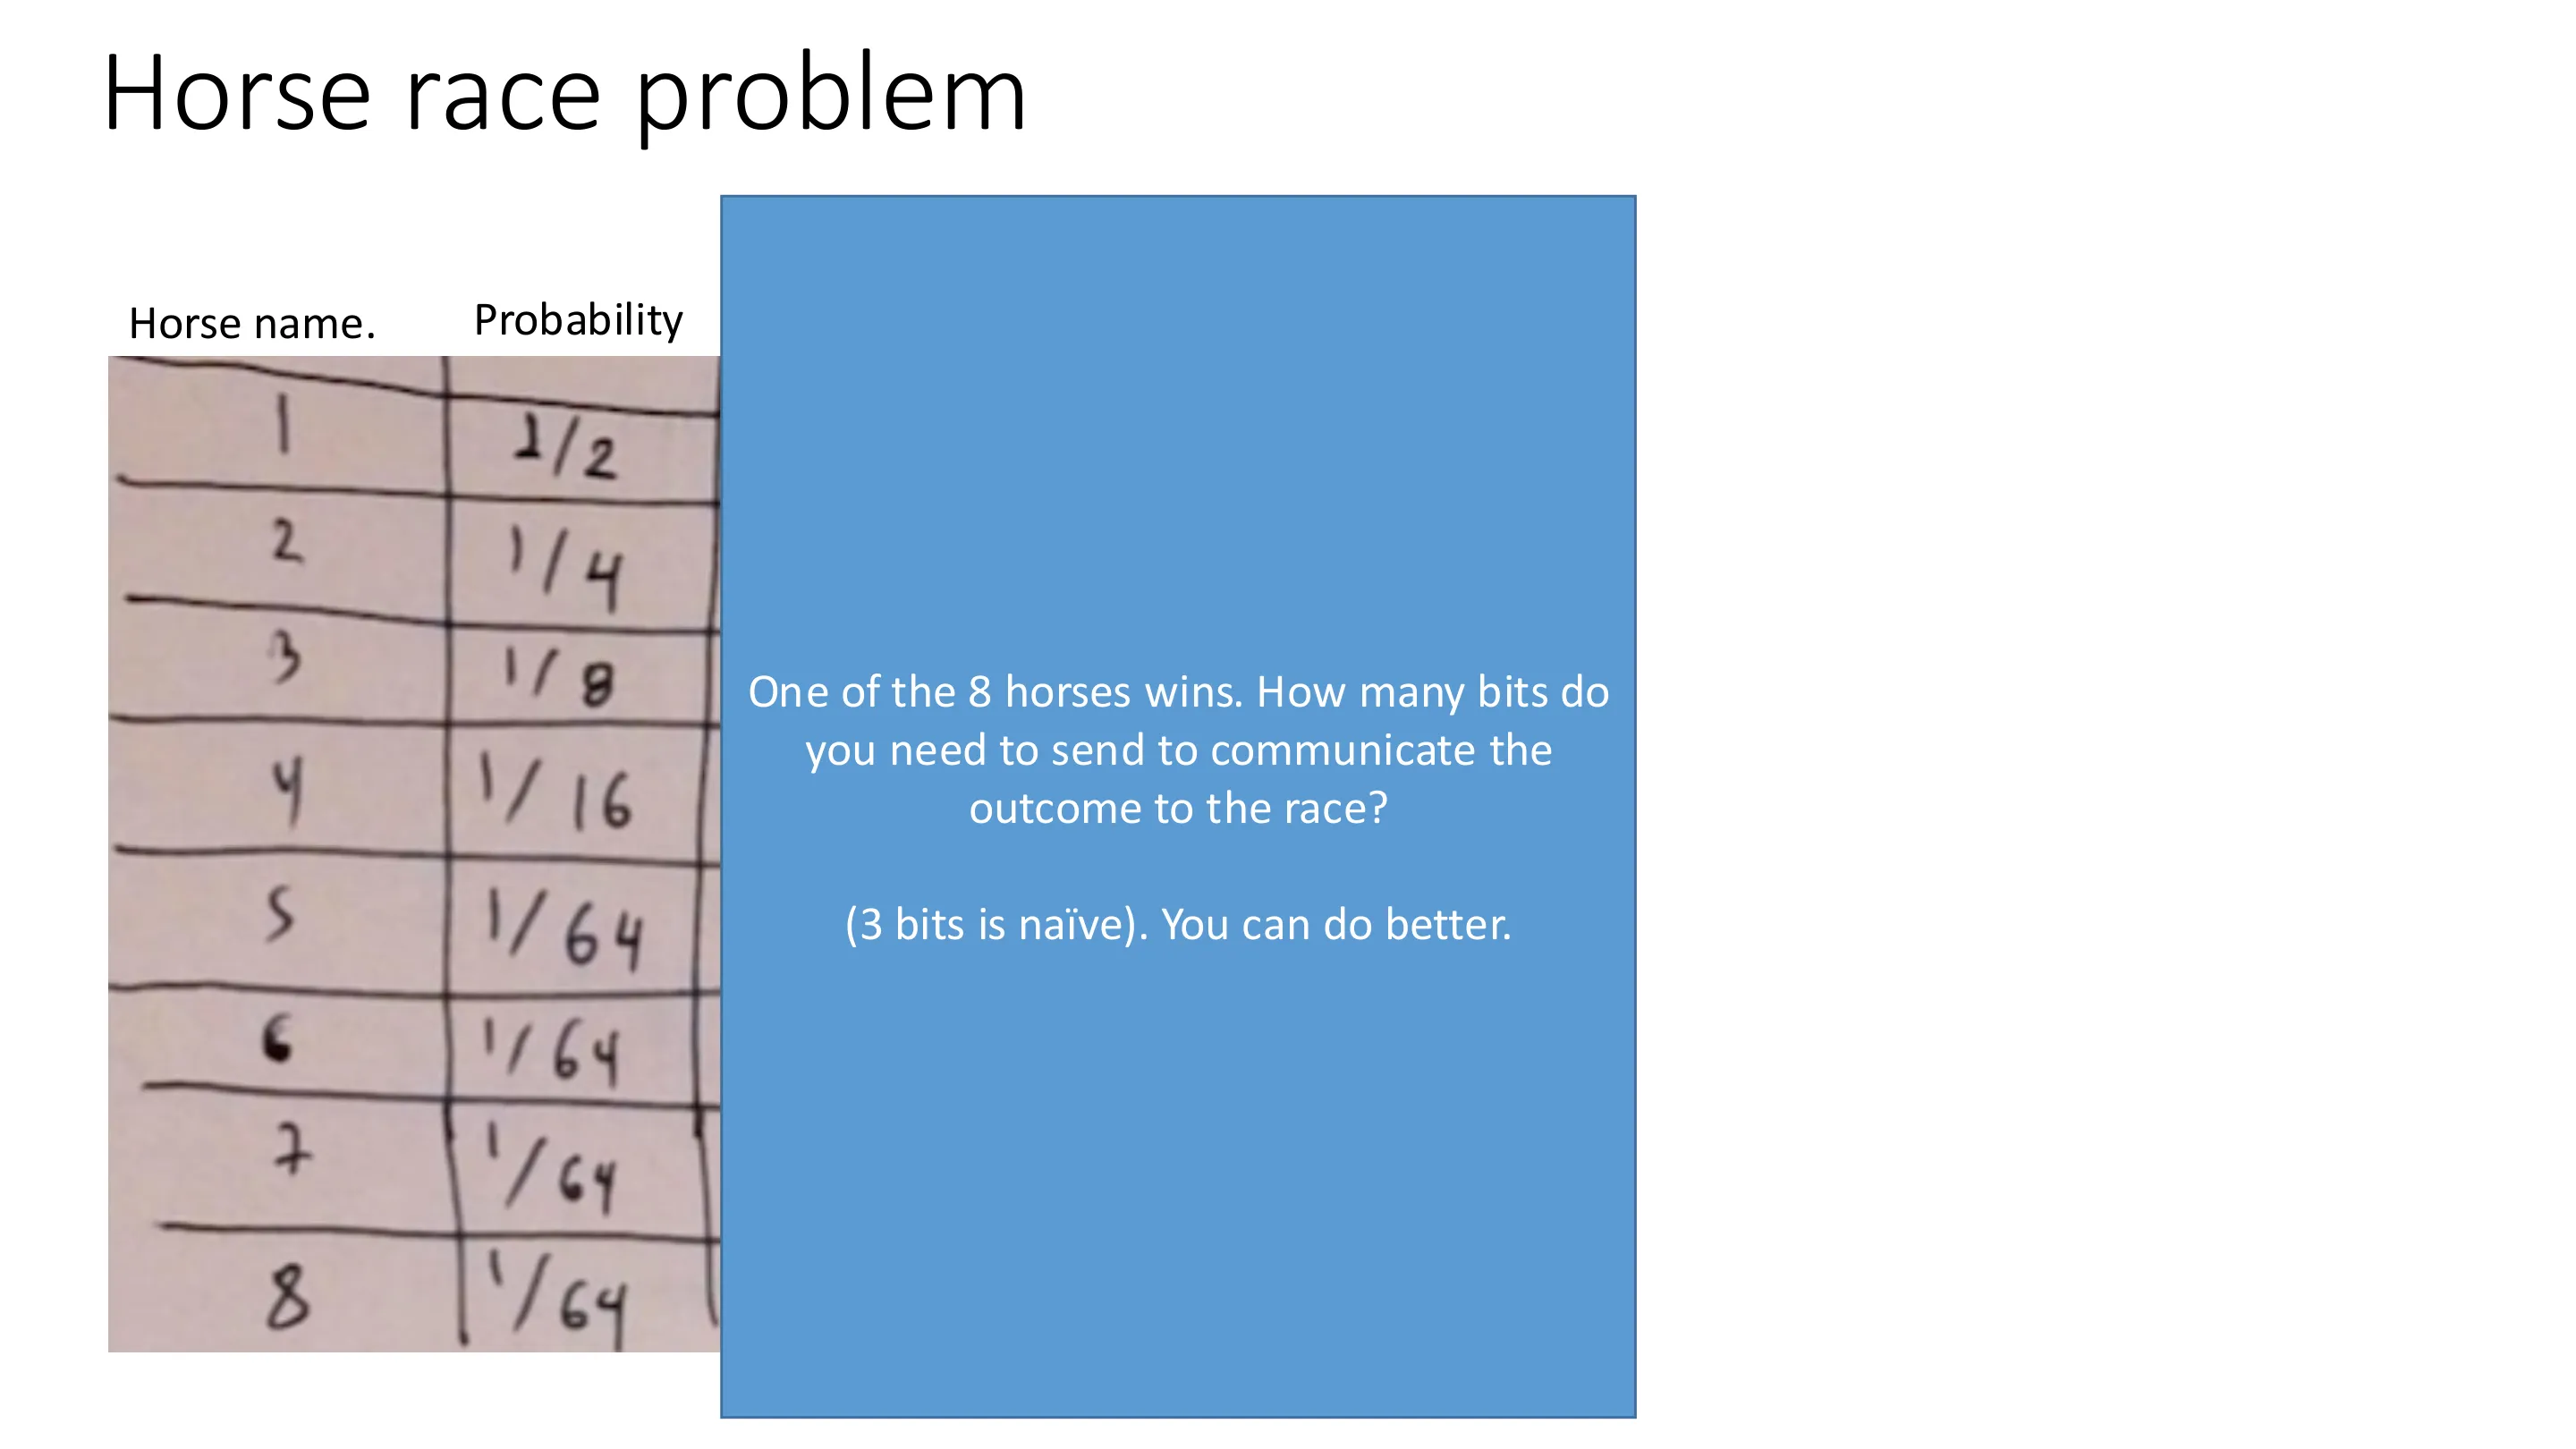
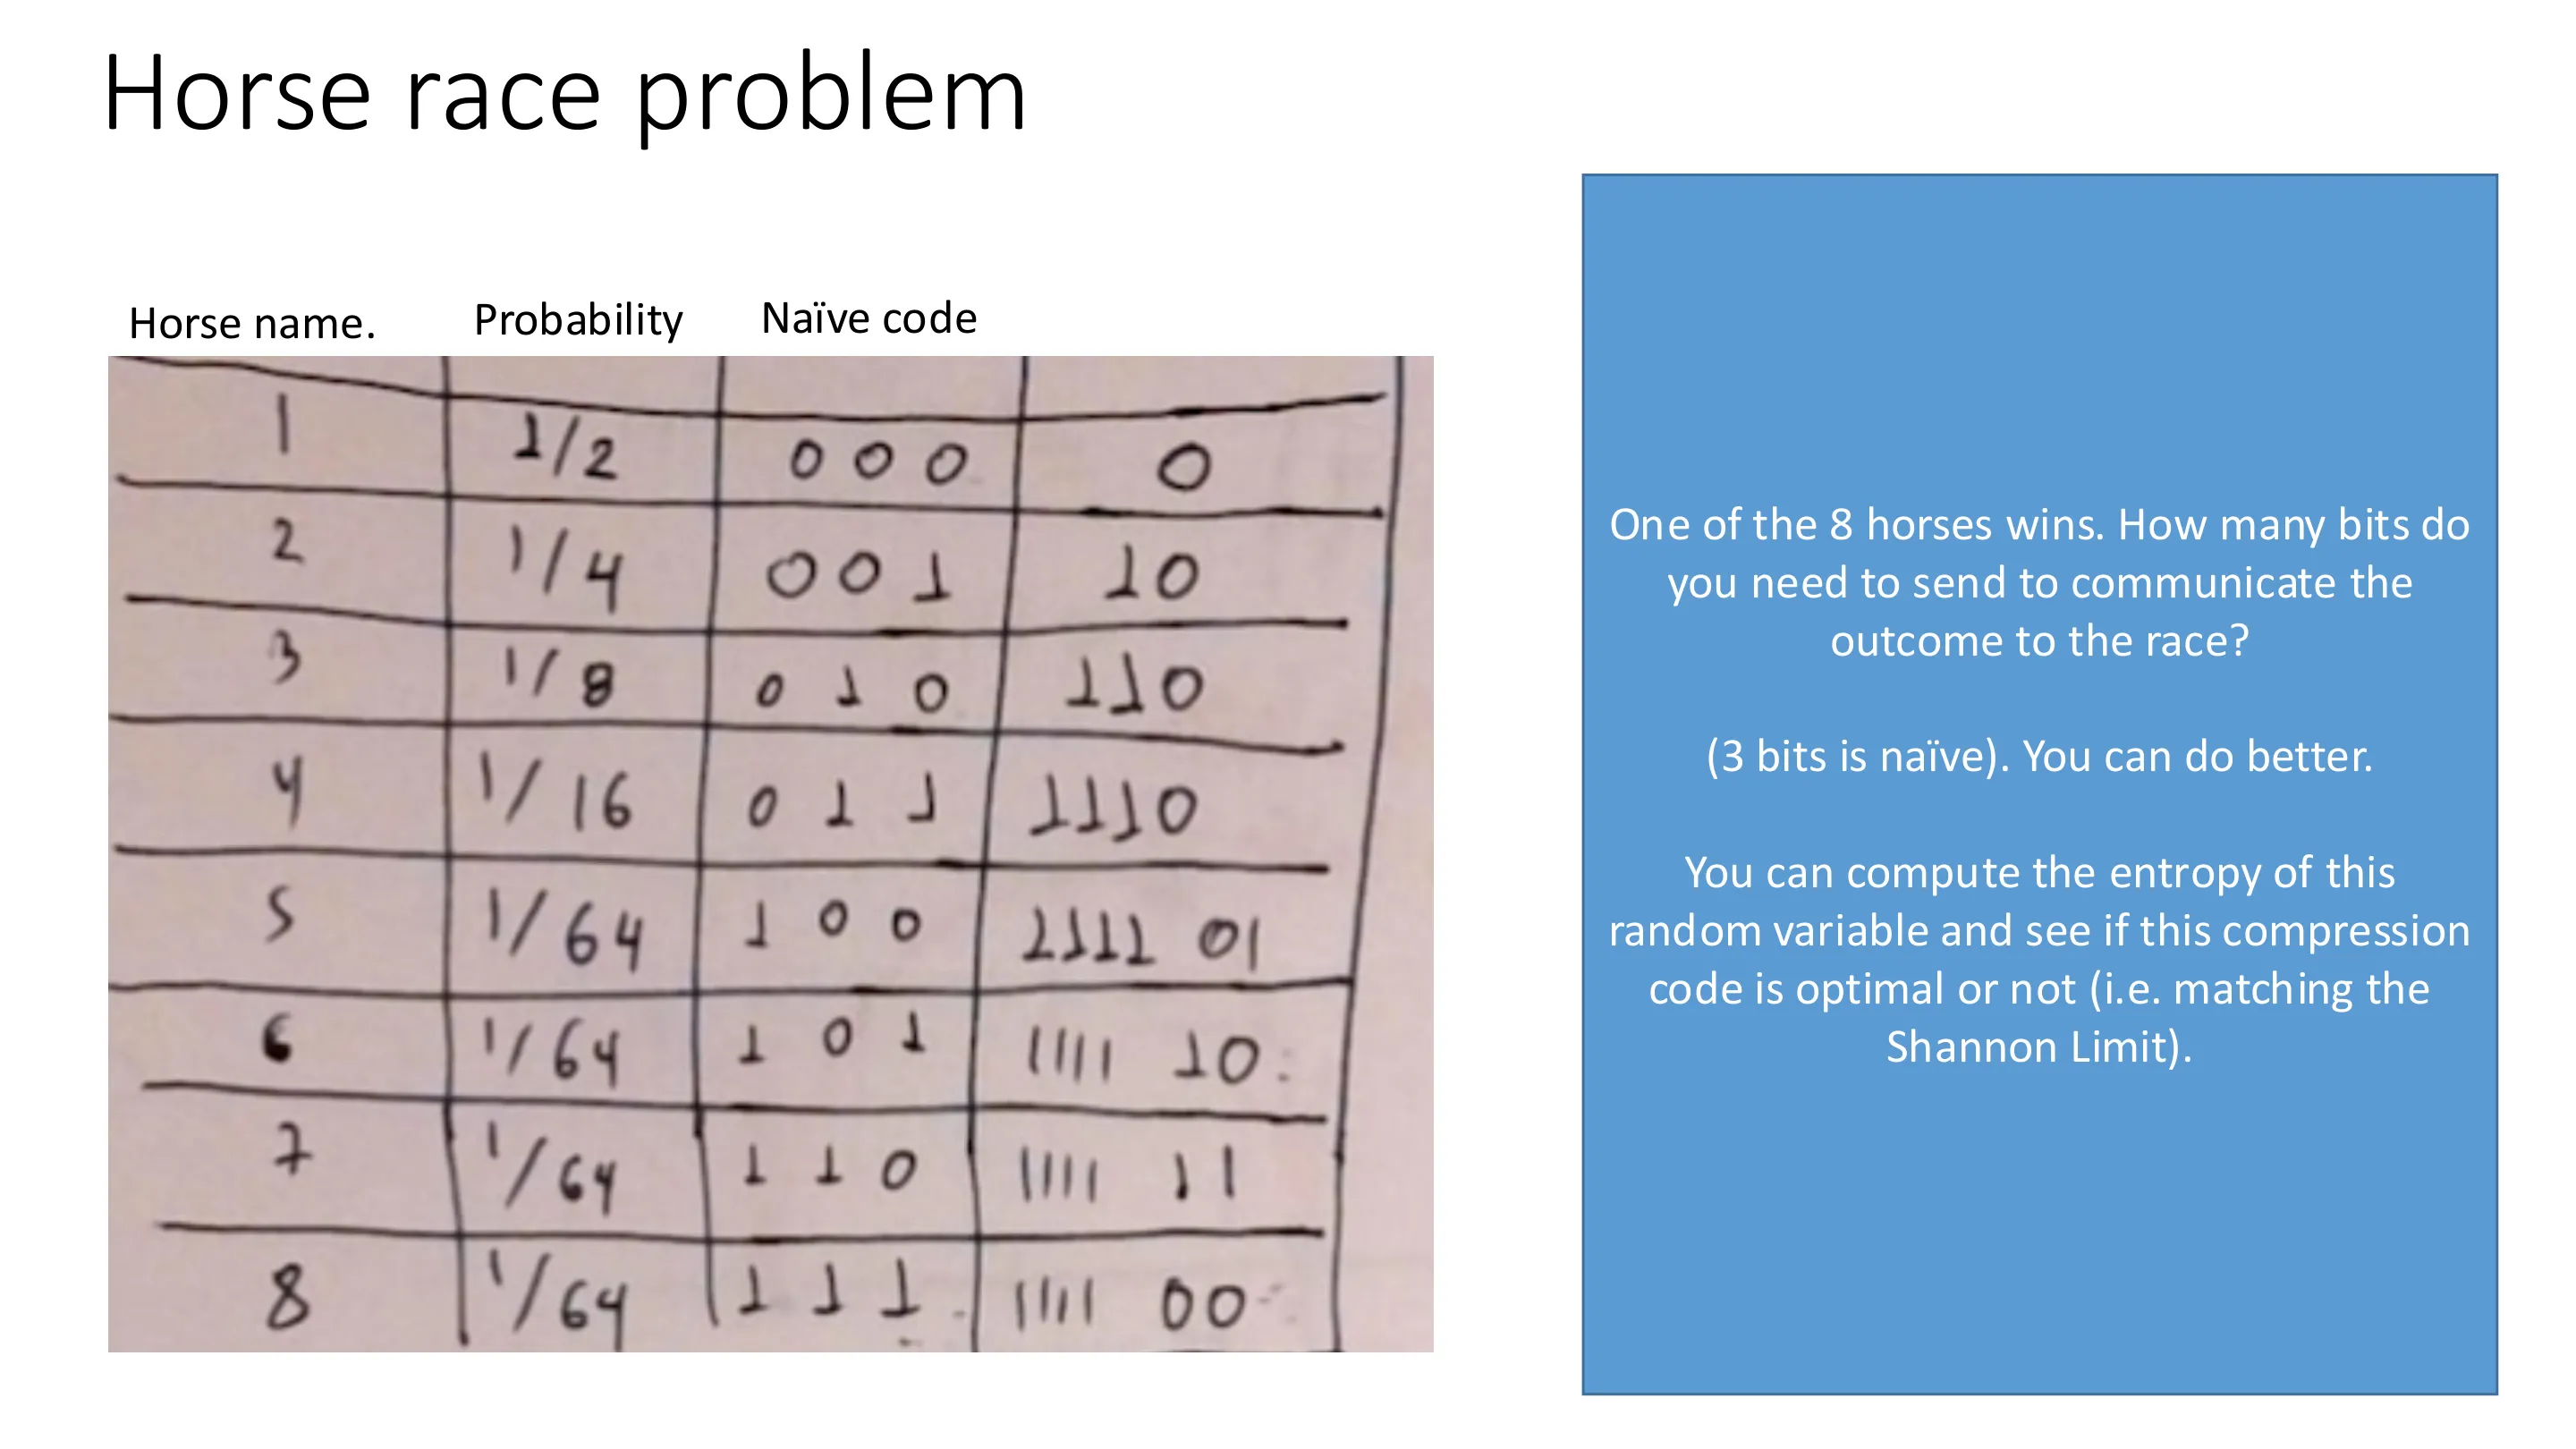
Horse race 例:8 匹马,快马胜率 $1/2$,其余 $1/4,1/8,1/16,\dots$。朴素编码固定 3 比特/次;但按概率分配码长($1,01,001,\dots$)后期望比特数恰为熵 2 比特,达到香农极限。推广:压缩/源编码是一个独立的研究领域。
📷 更多细节:熵与信息论
回到原视频 (00:21:01)
二、KL 散度与交叉熵
(参考时间: 00:25)
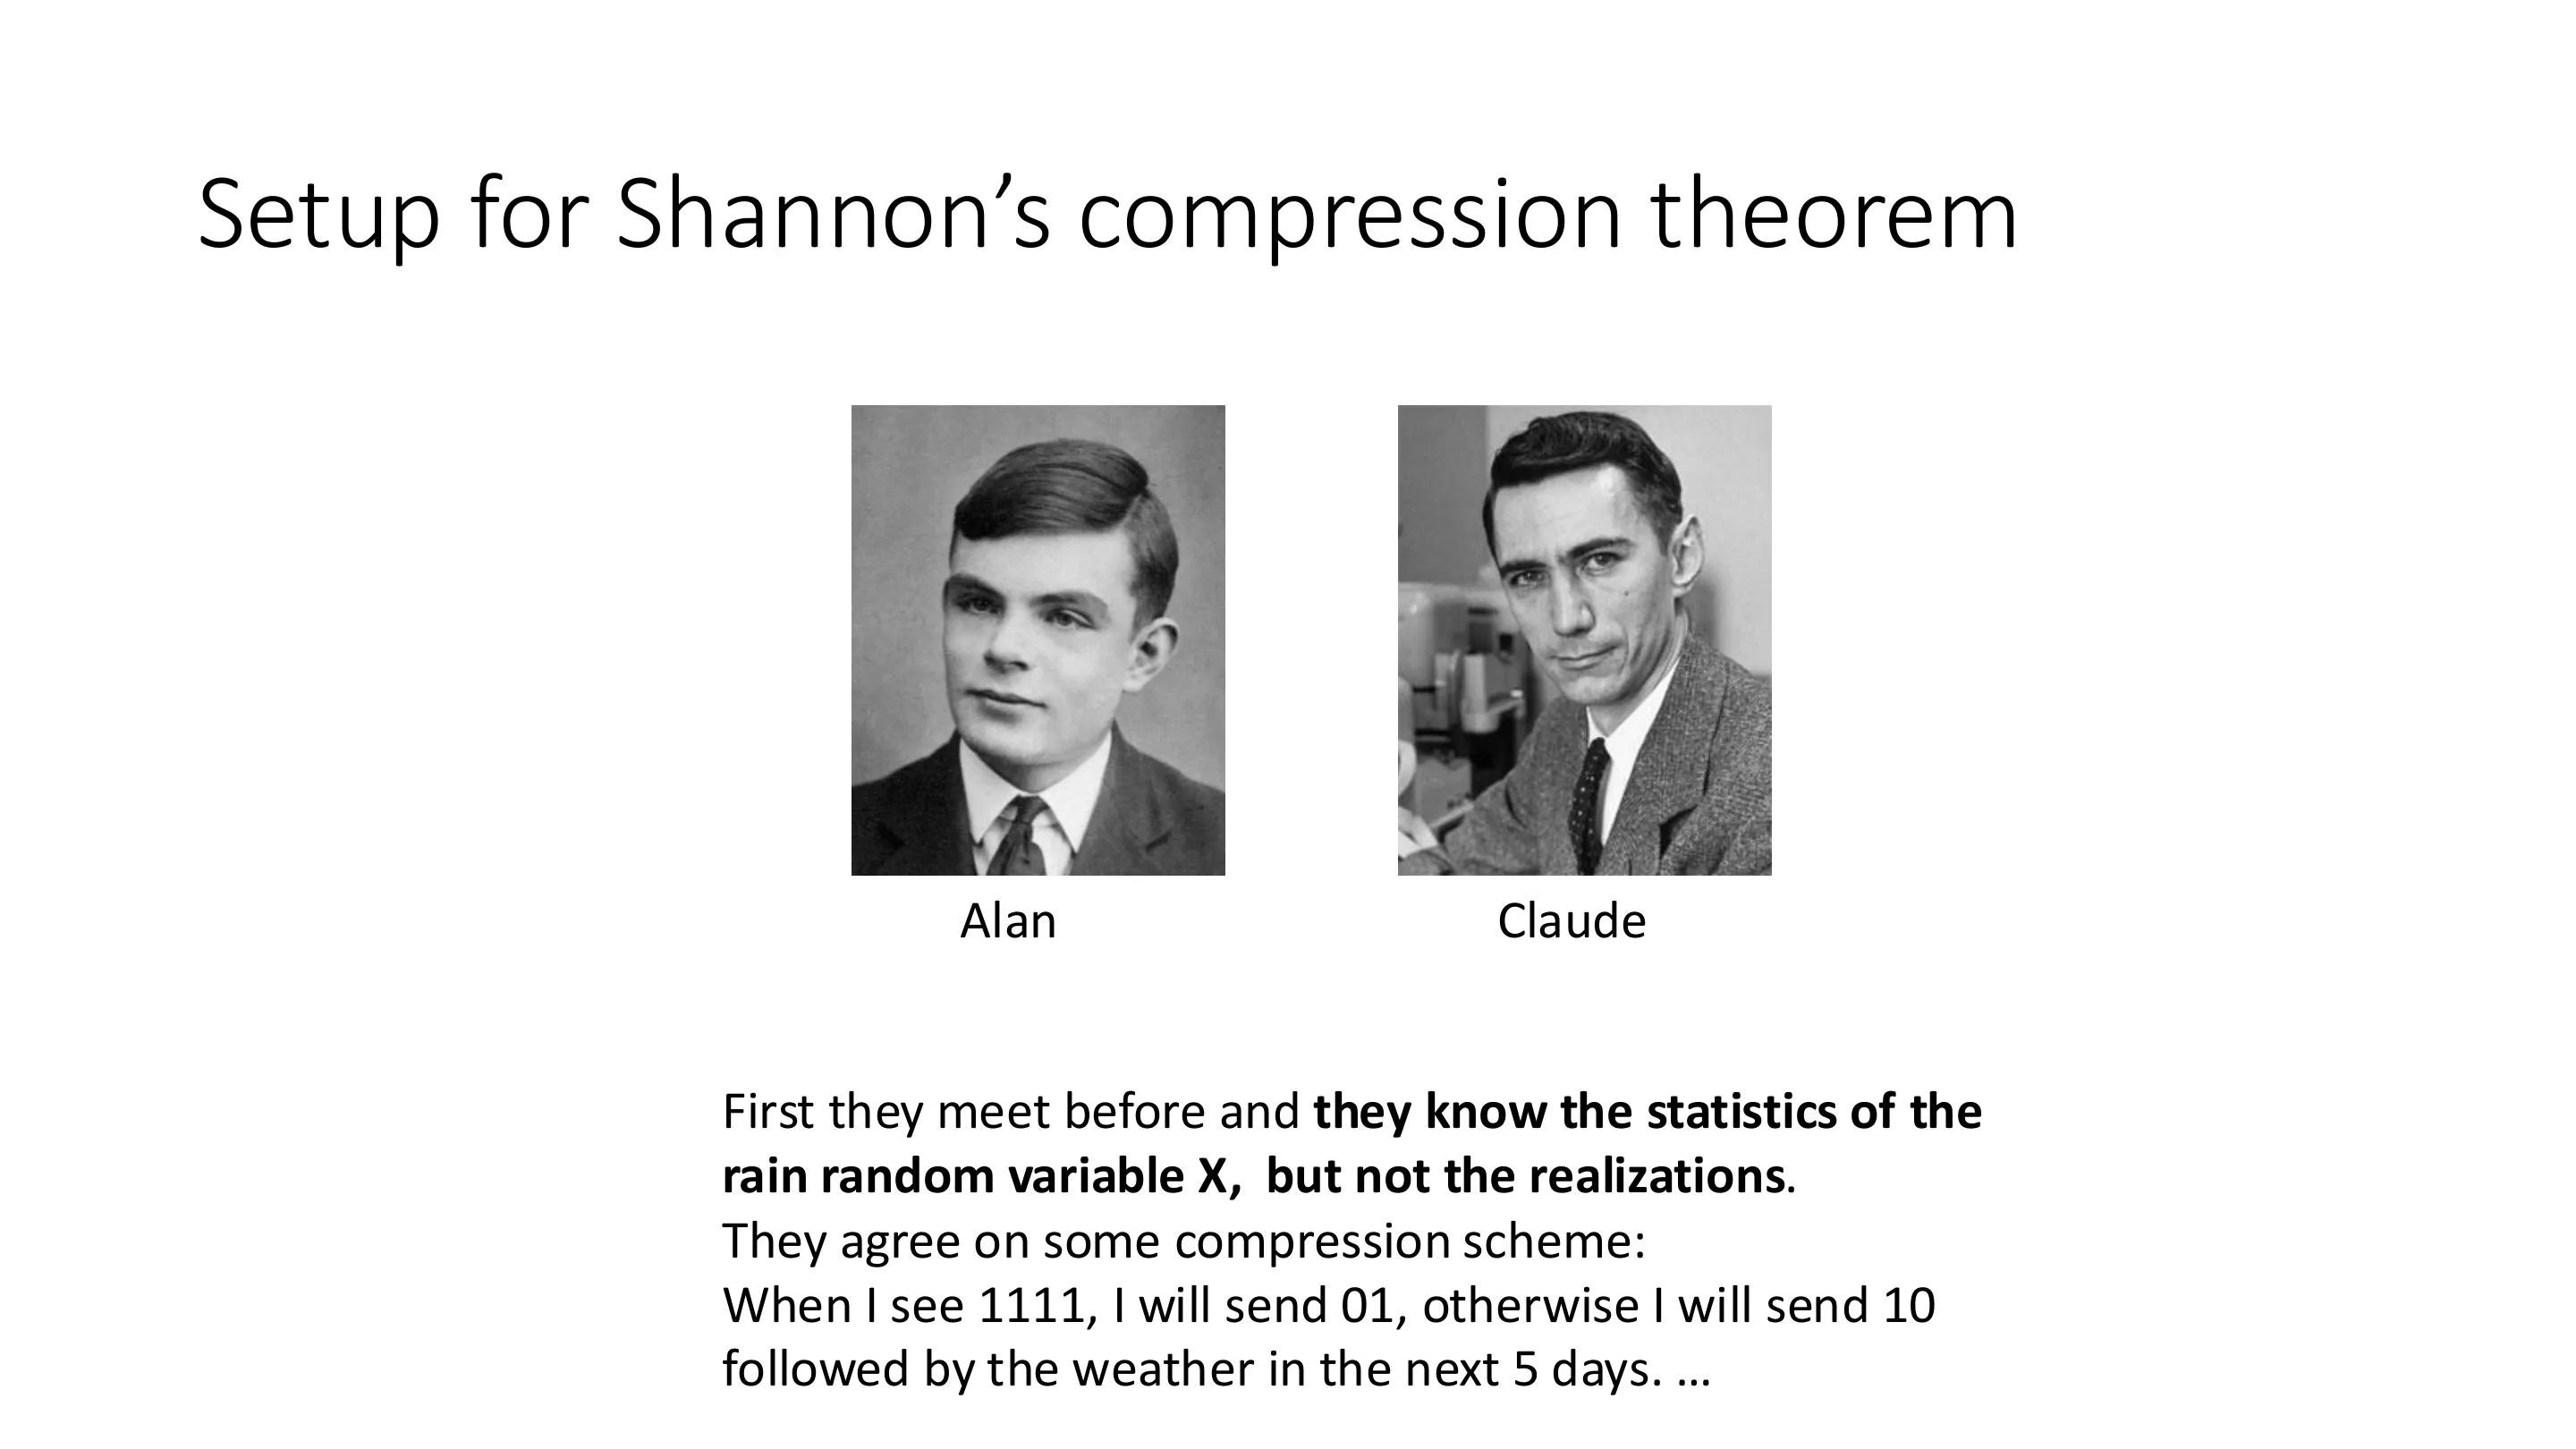
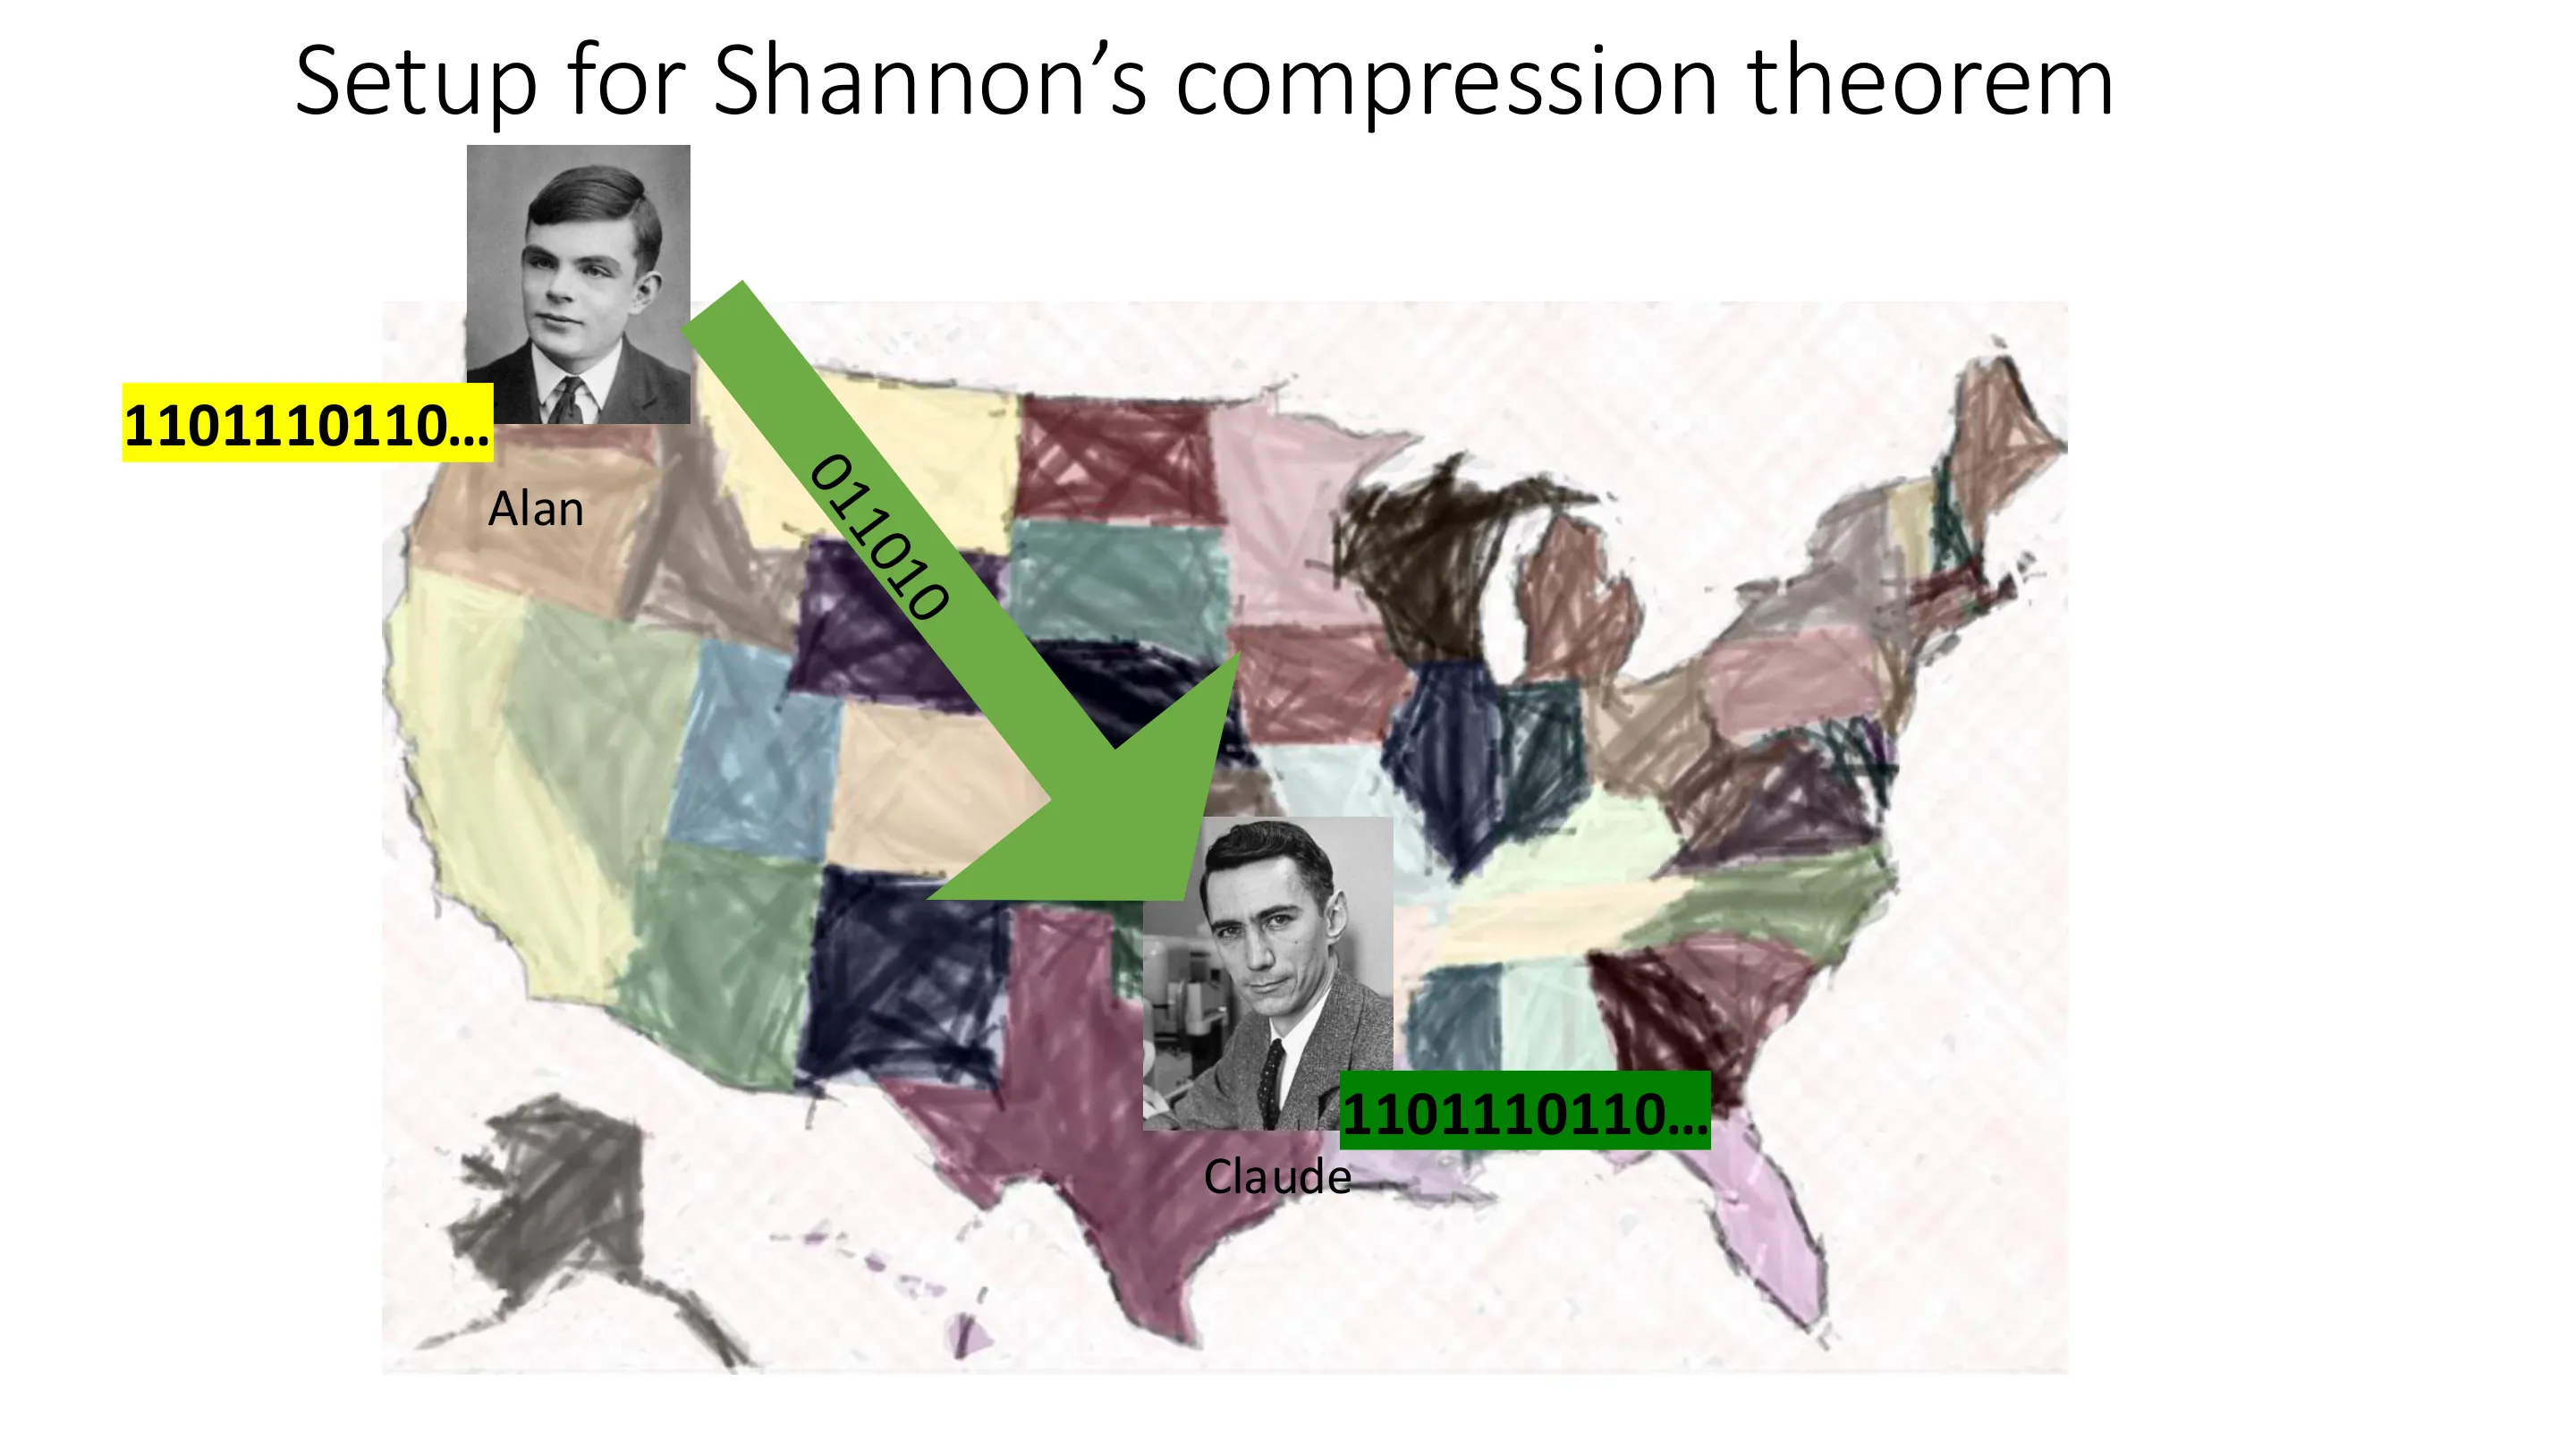
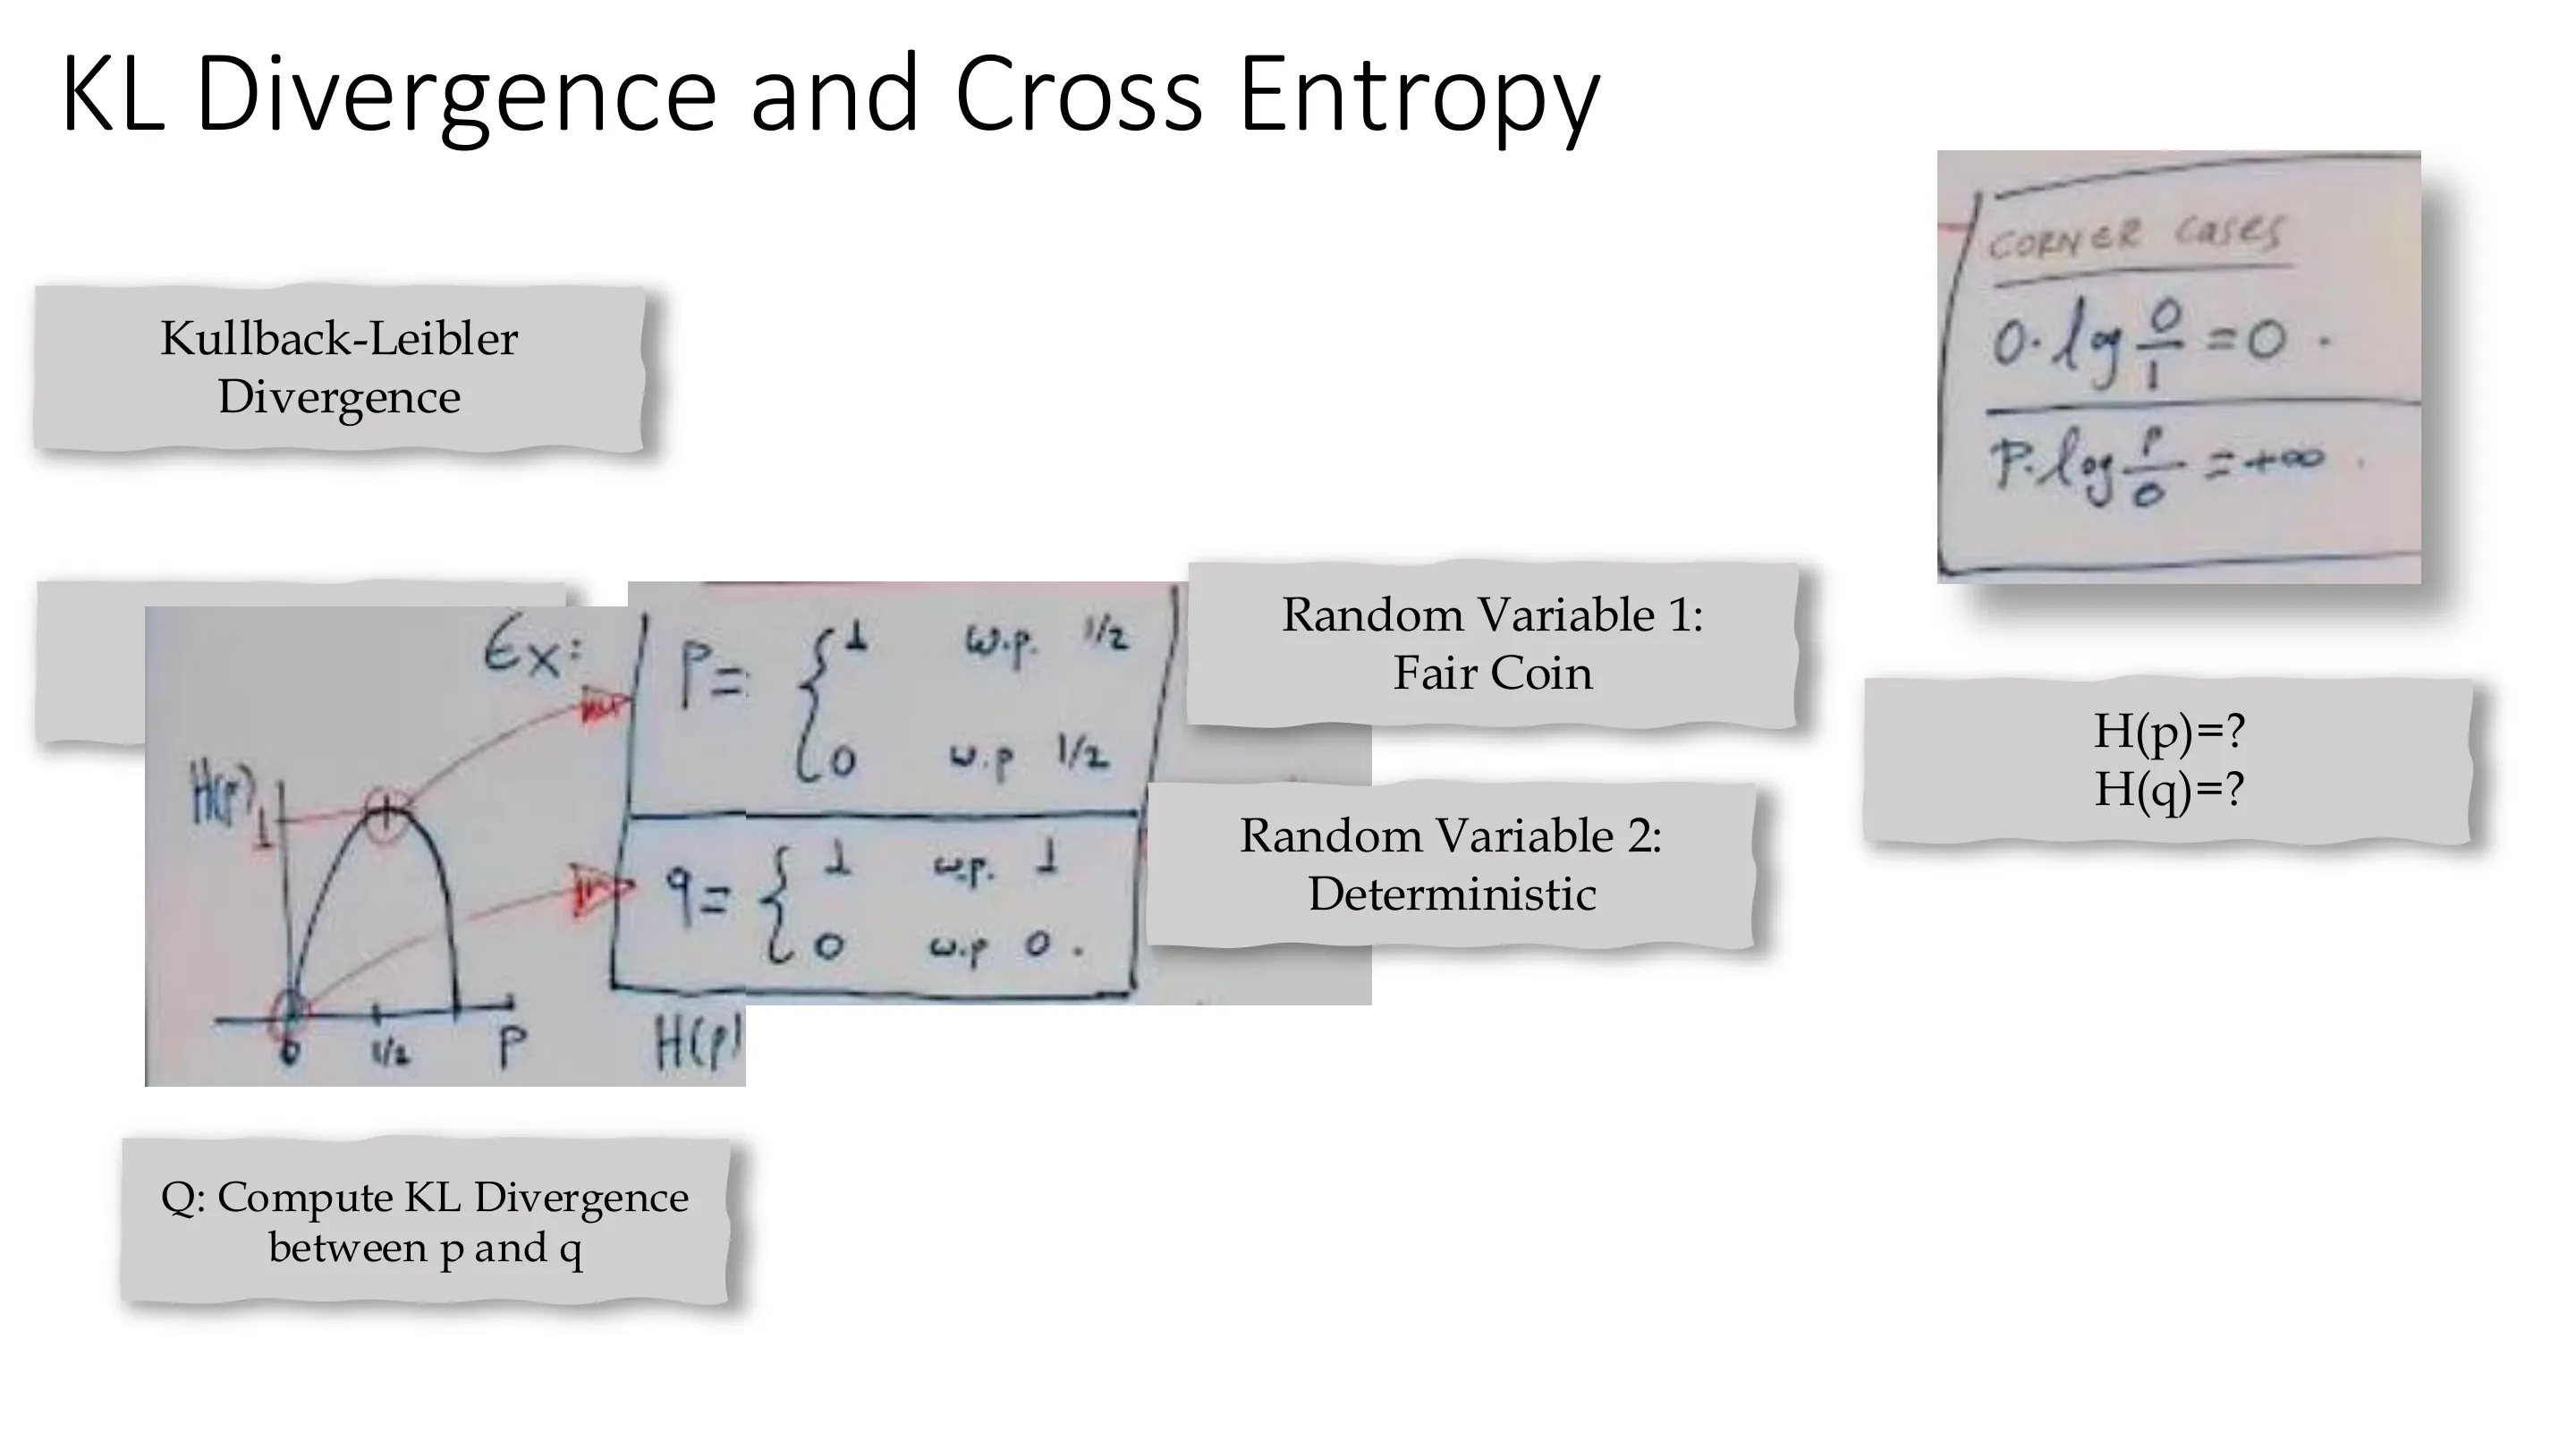
设两个分布 $P$(真实)与 $Q$(模型)。用「为 $Q$ 设计最优压缩方案,却收到服从 $P$ 的数据」来理解:
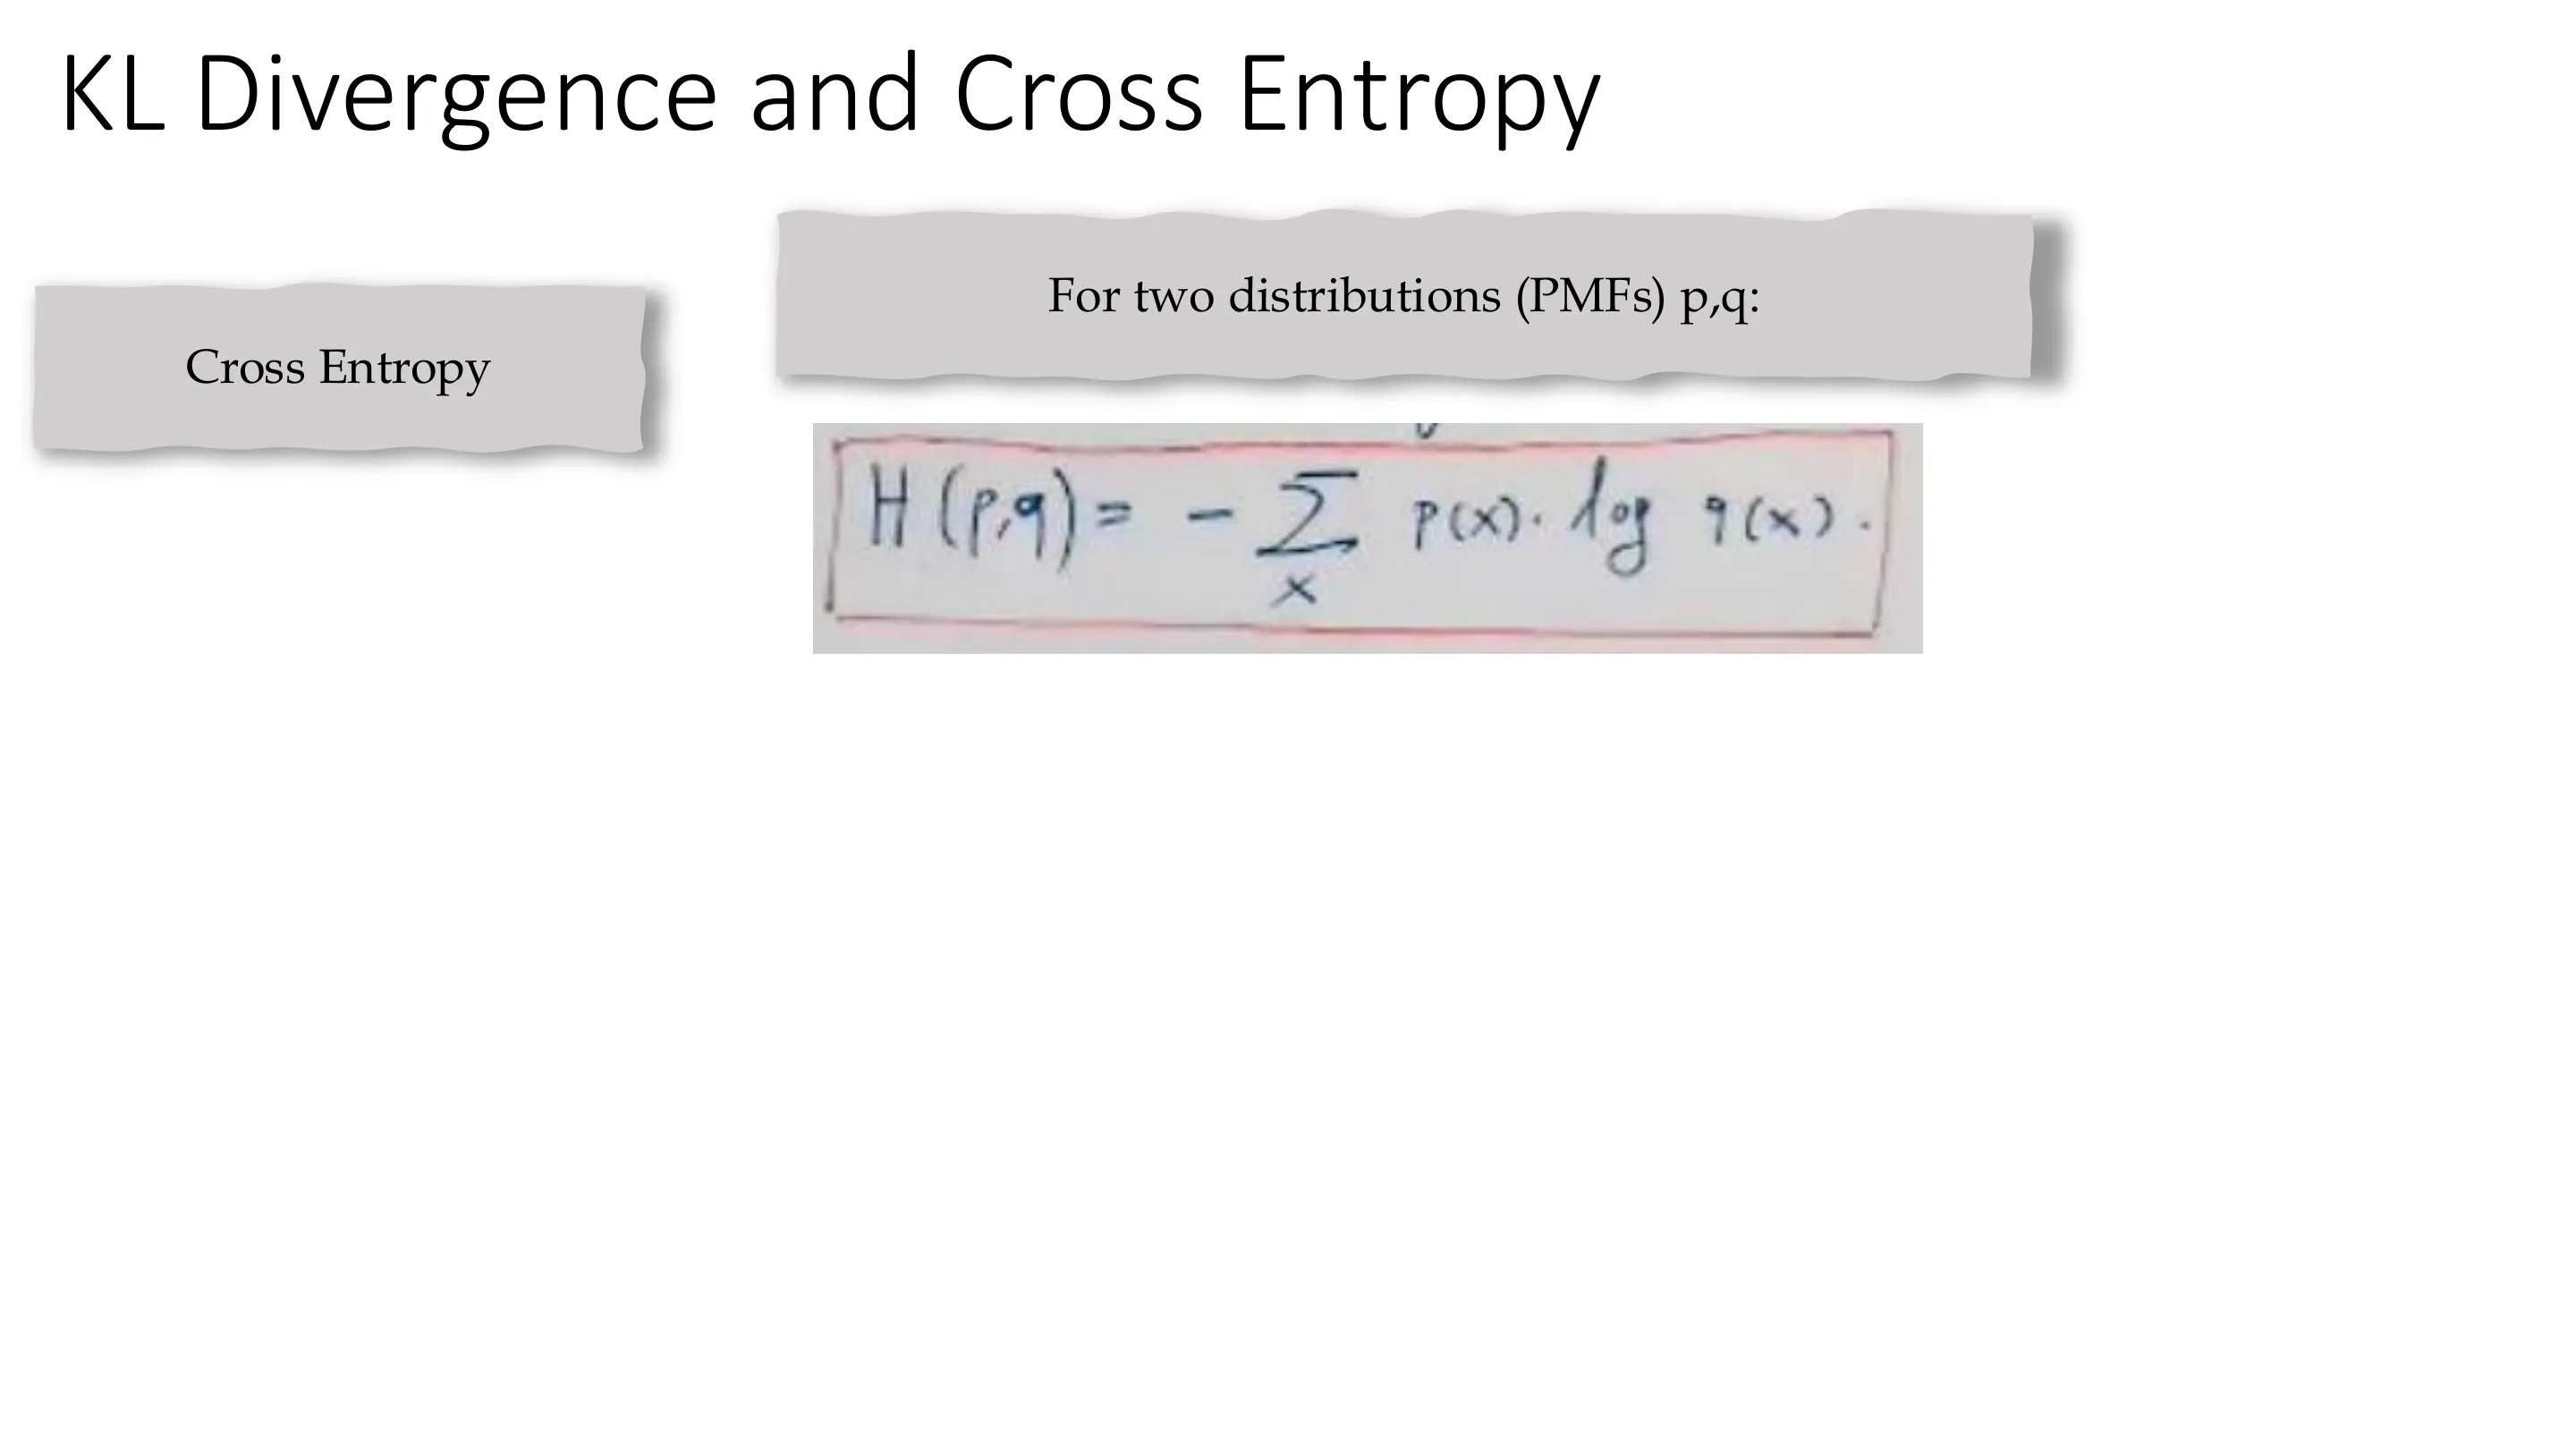
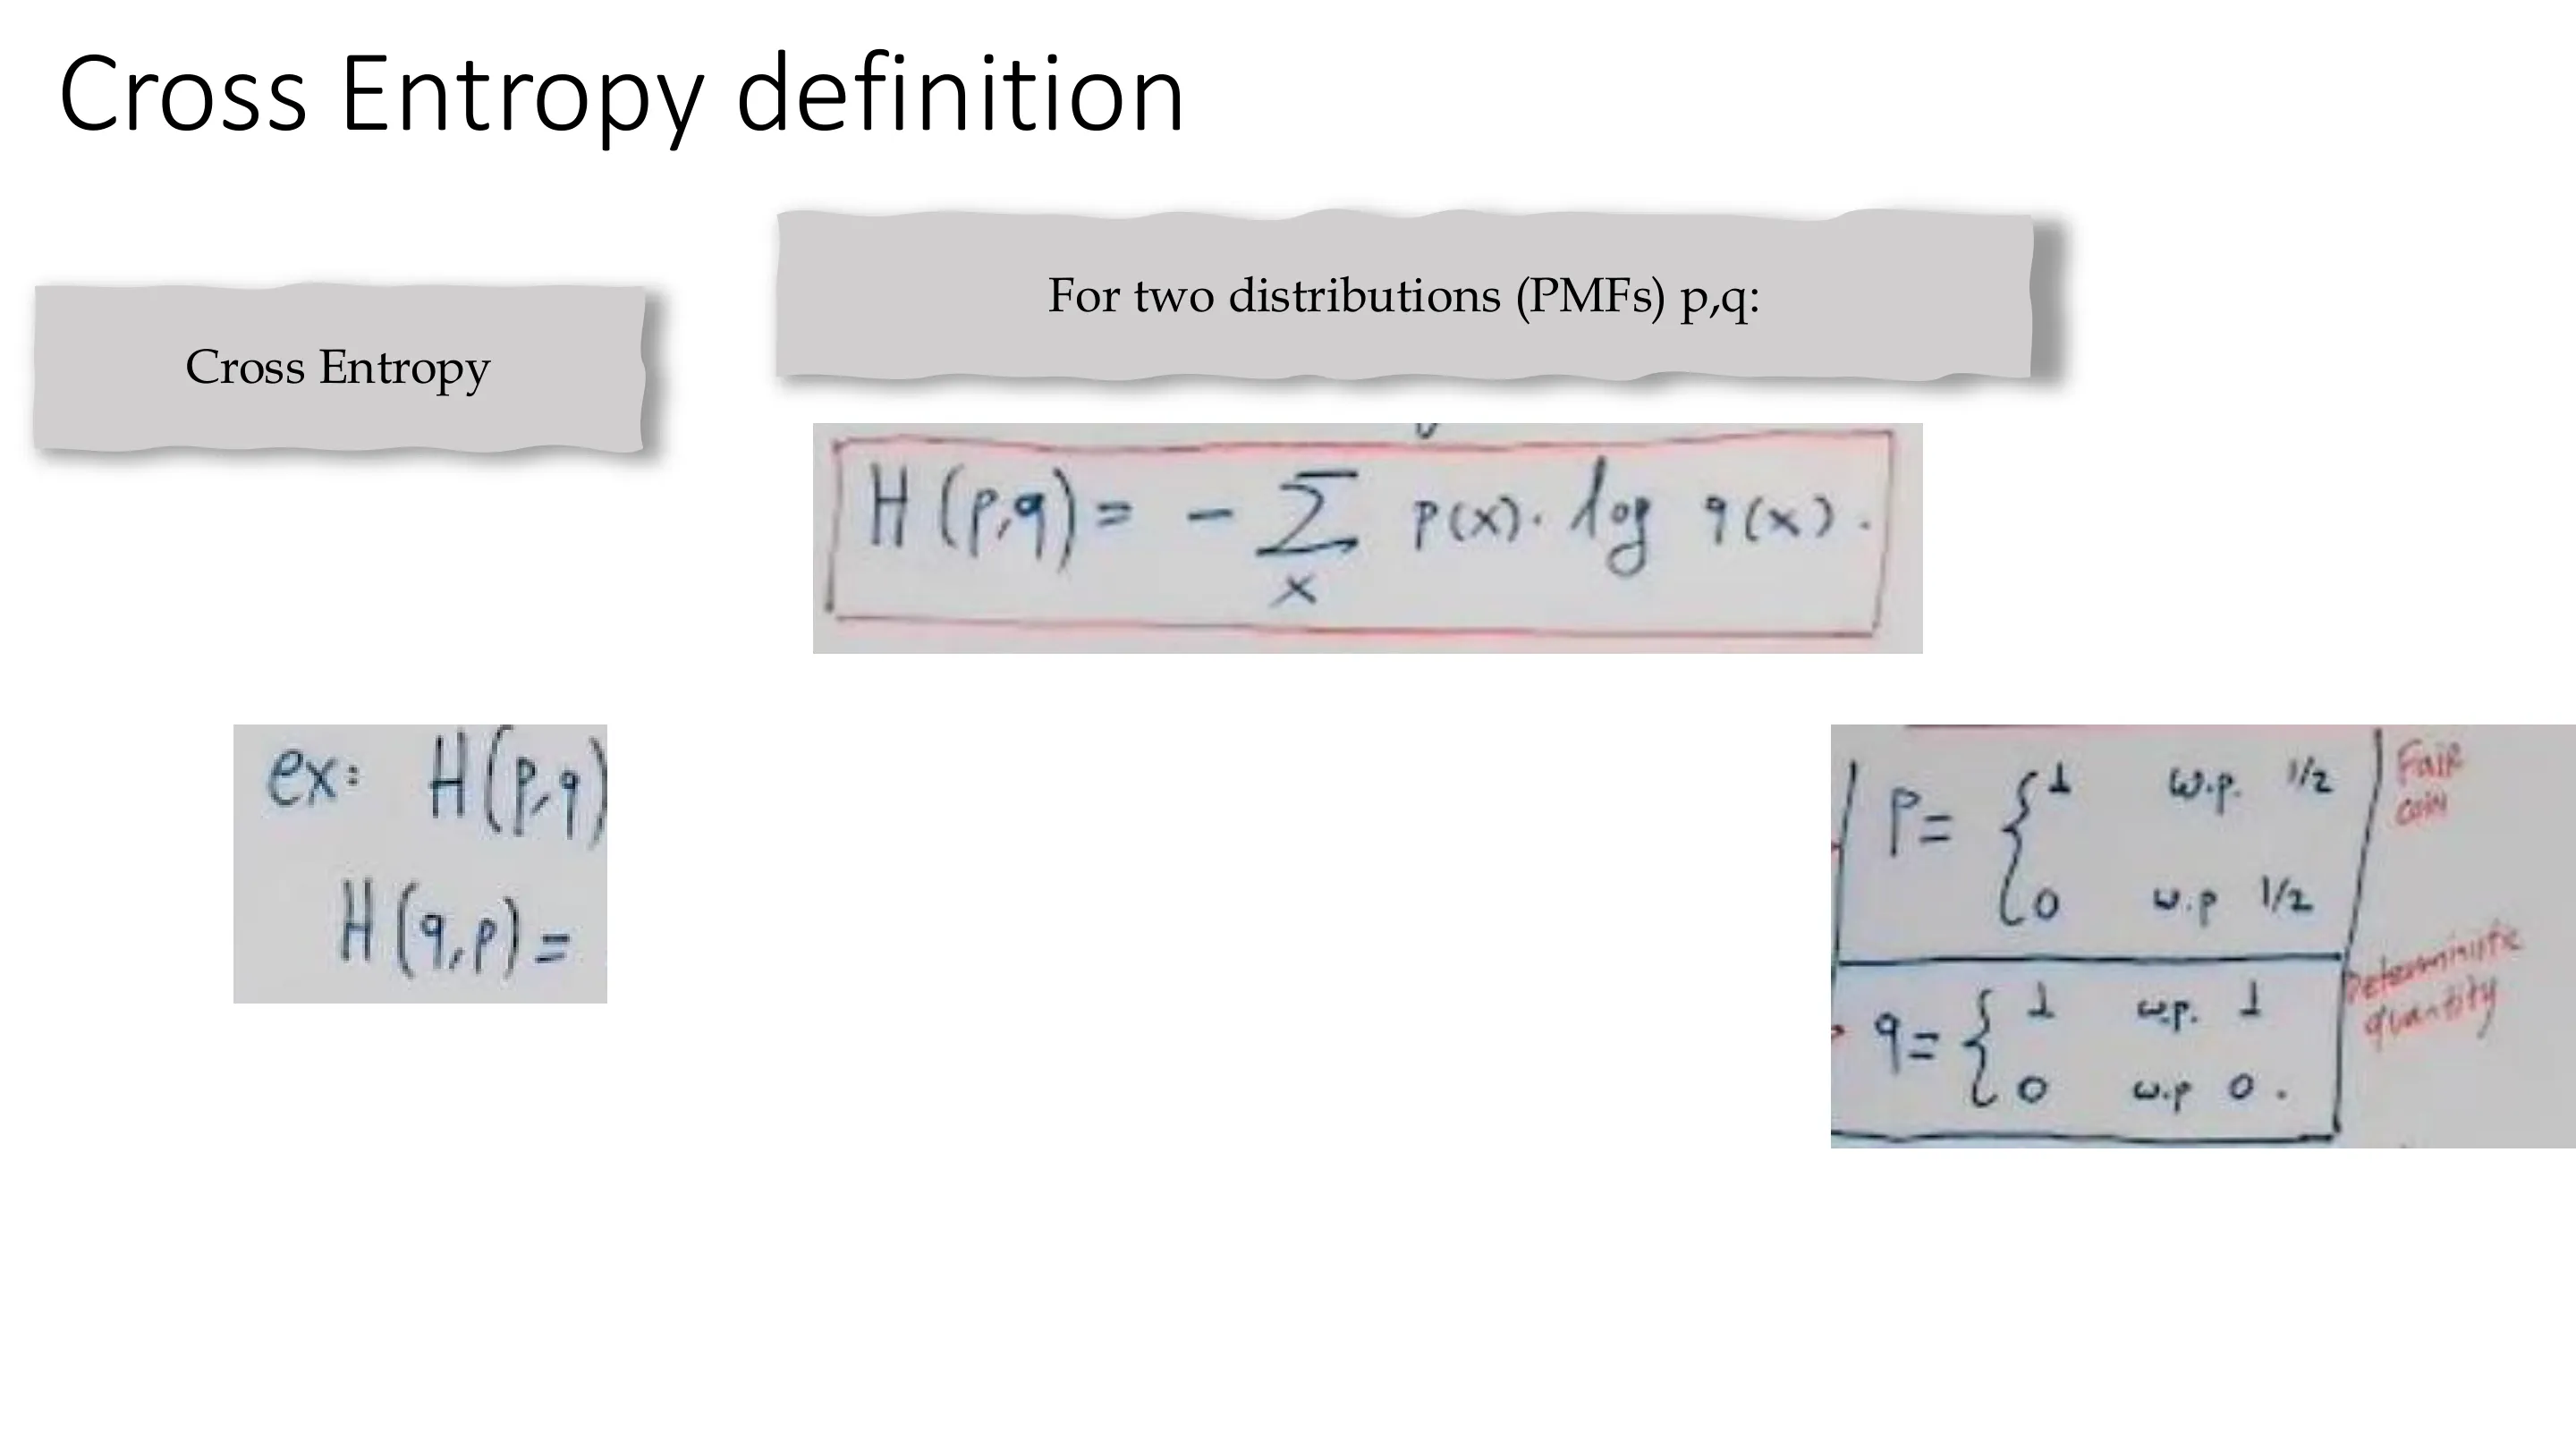
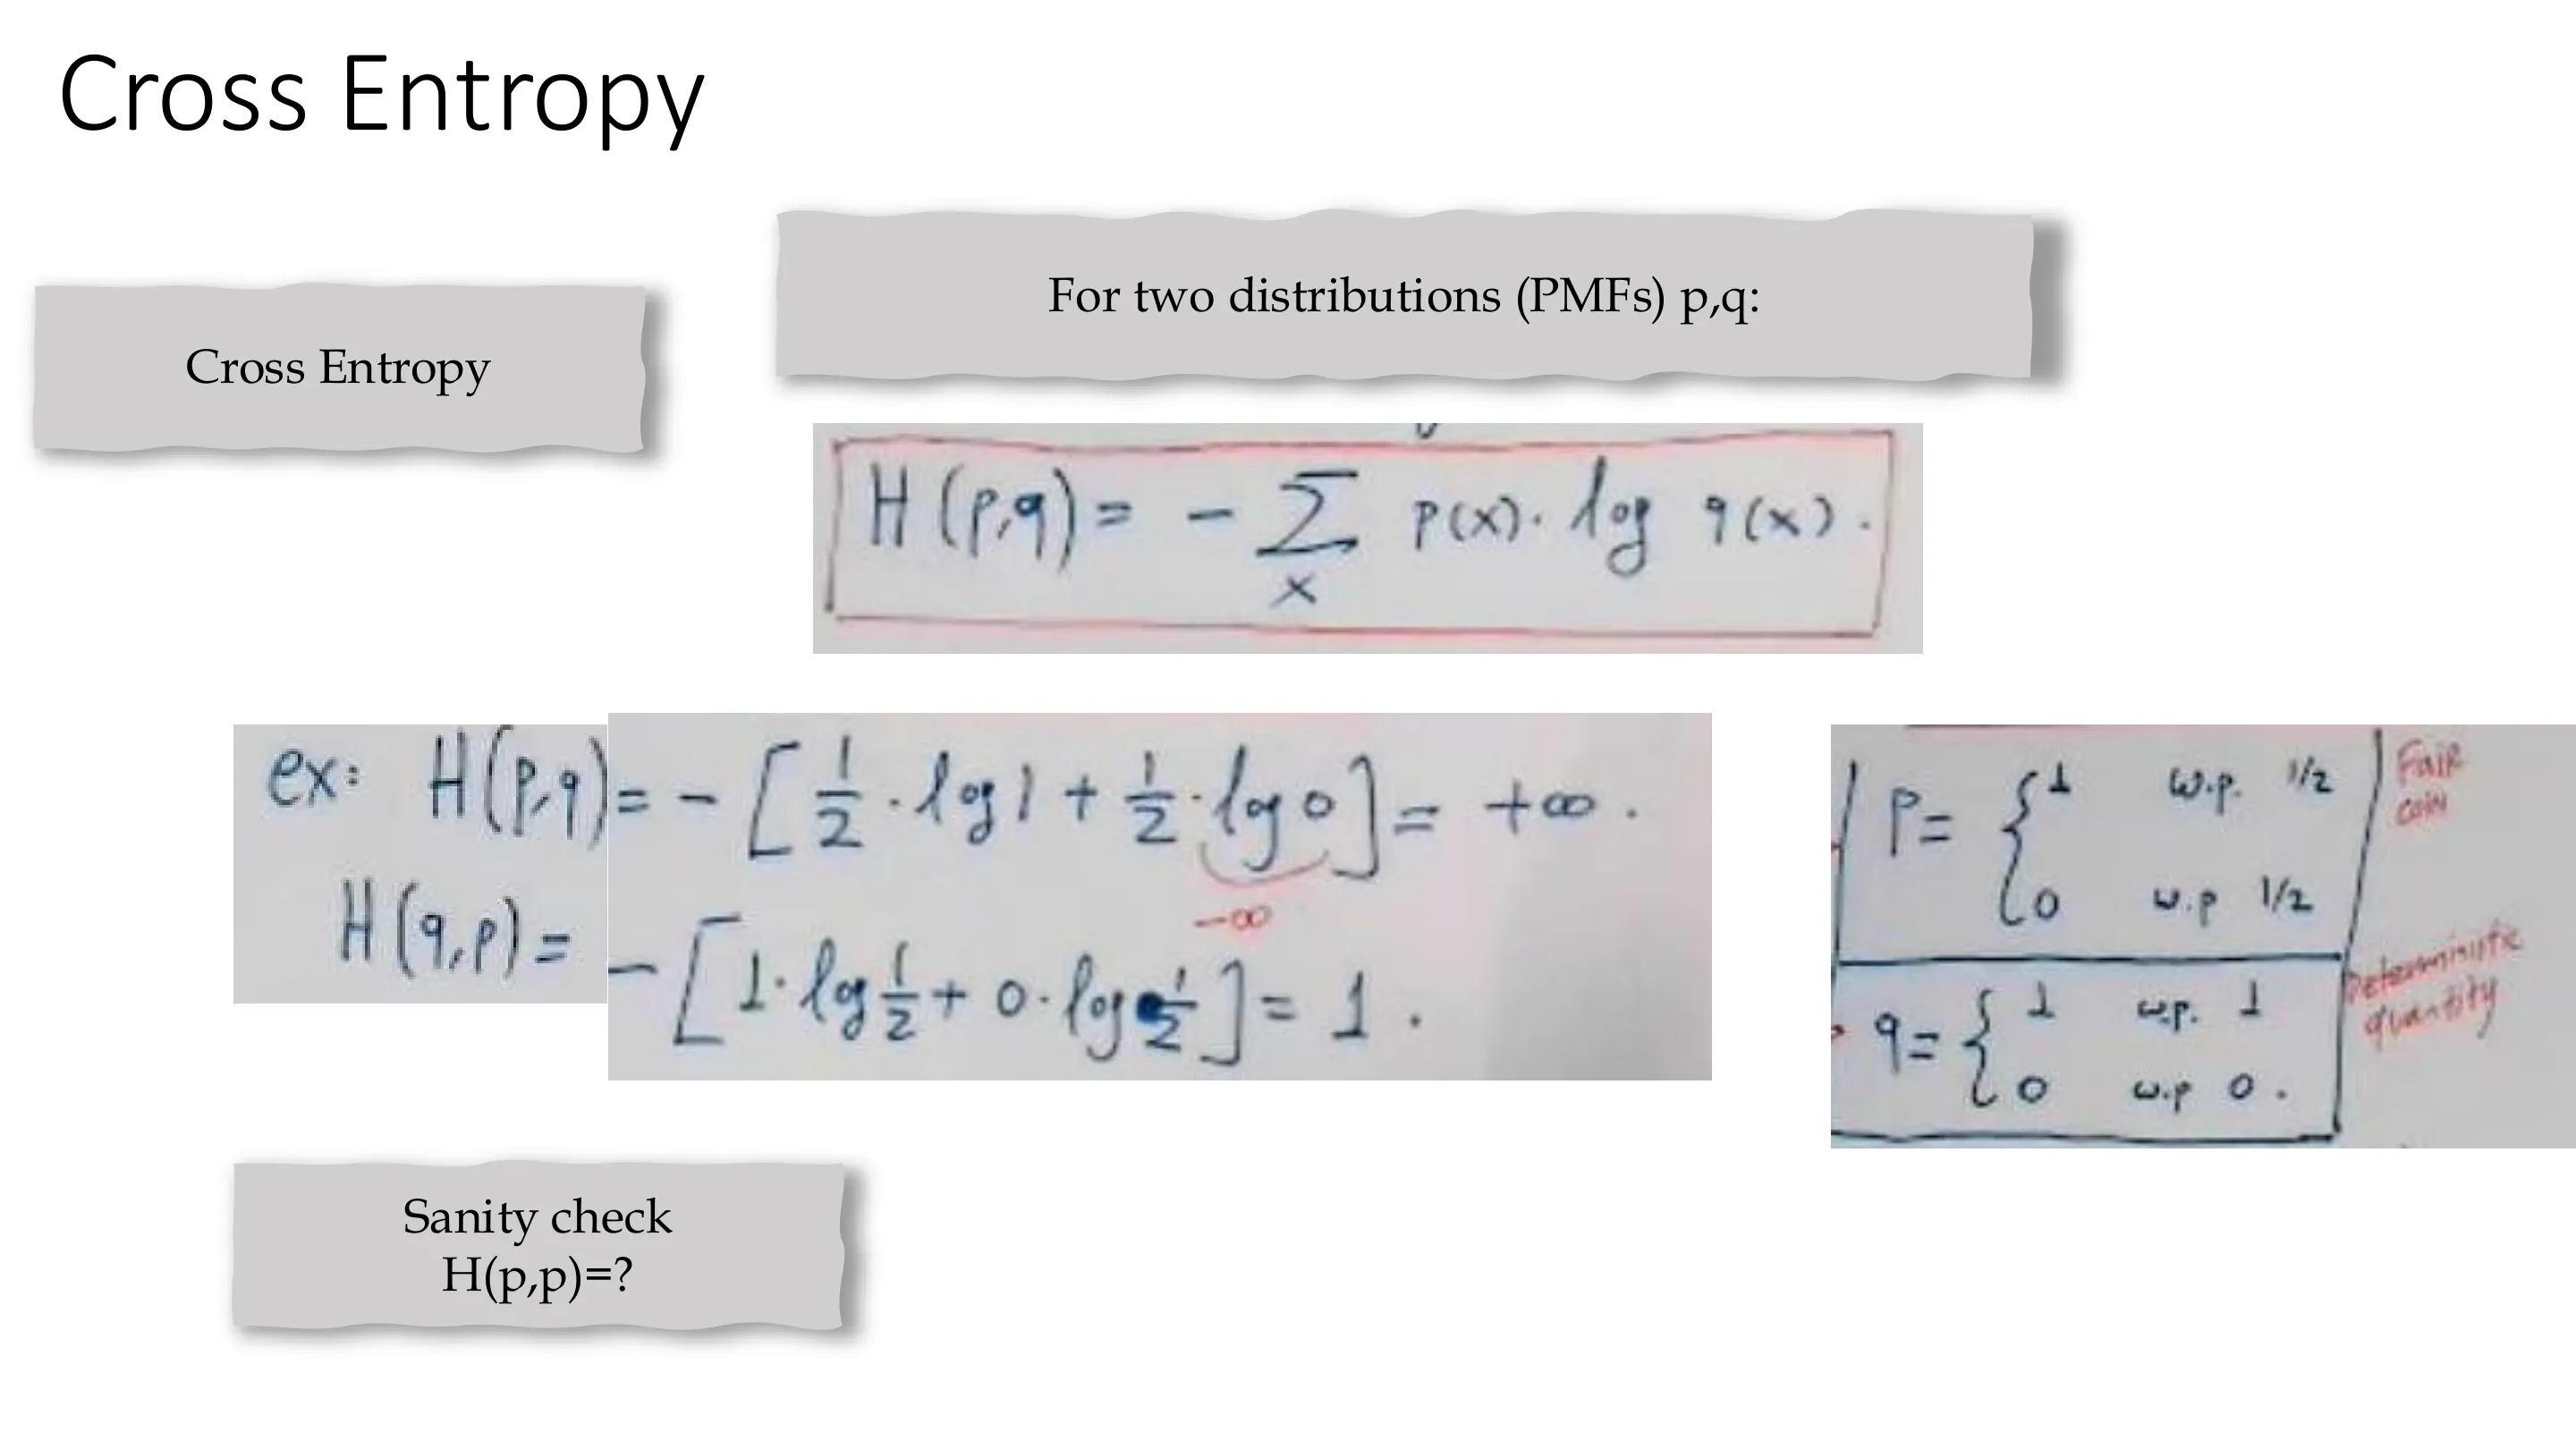
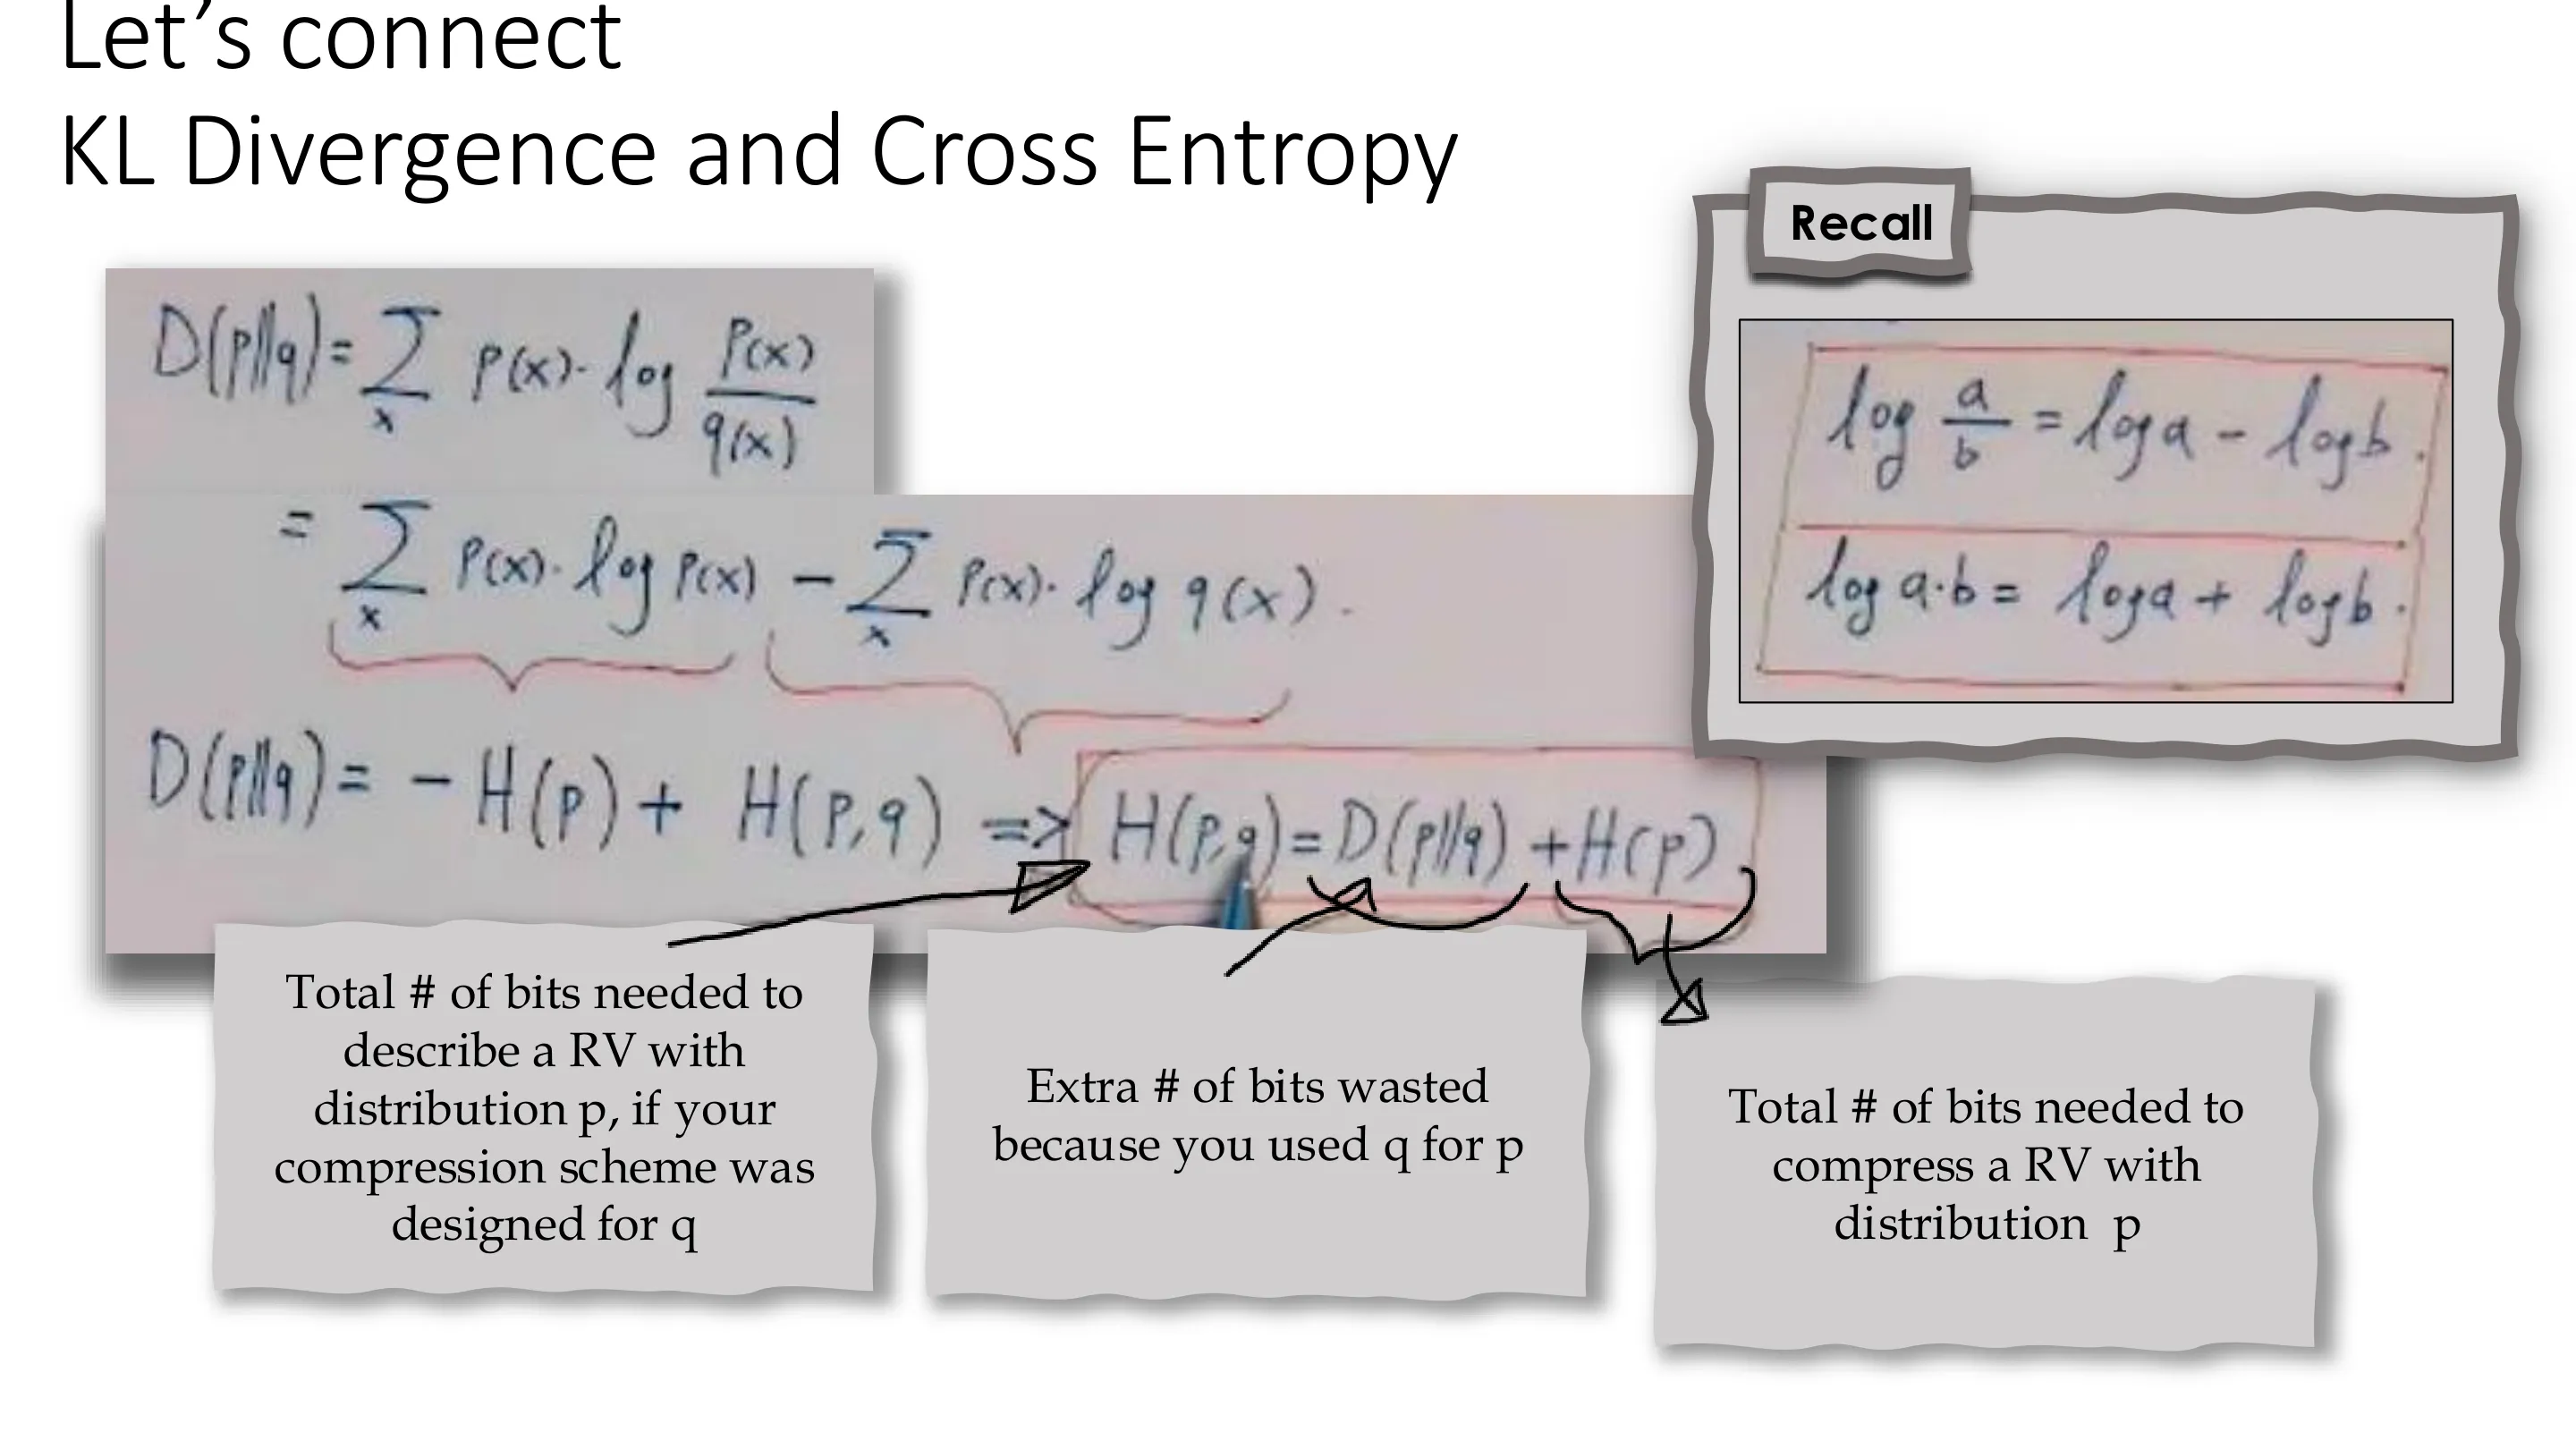
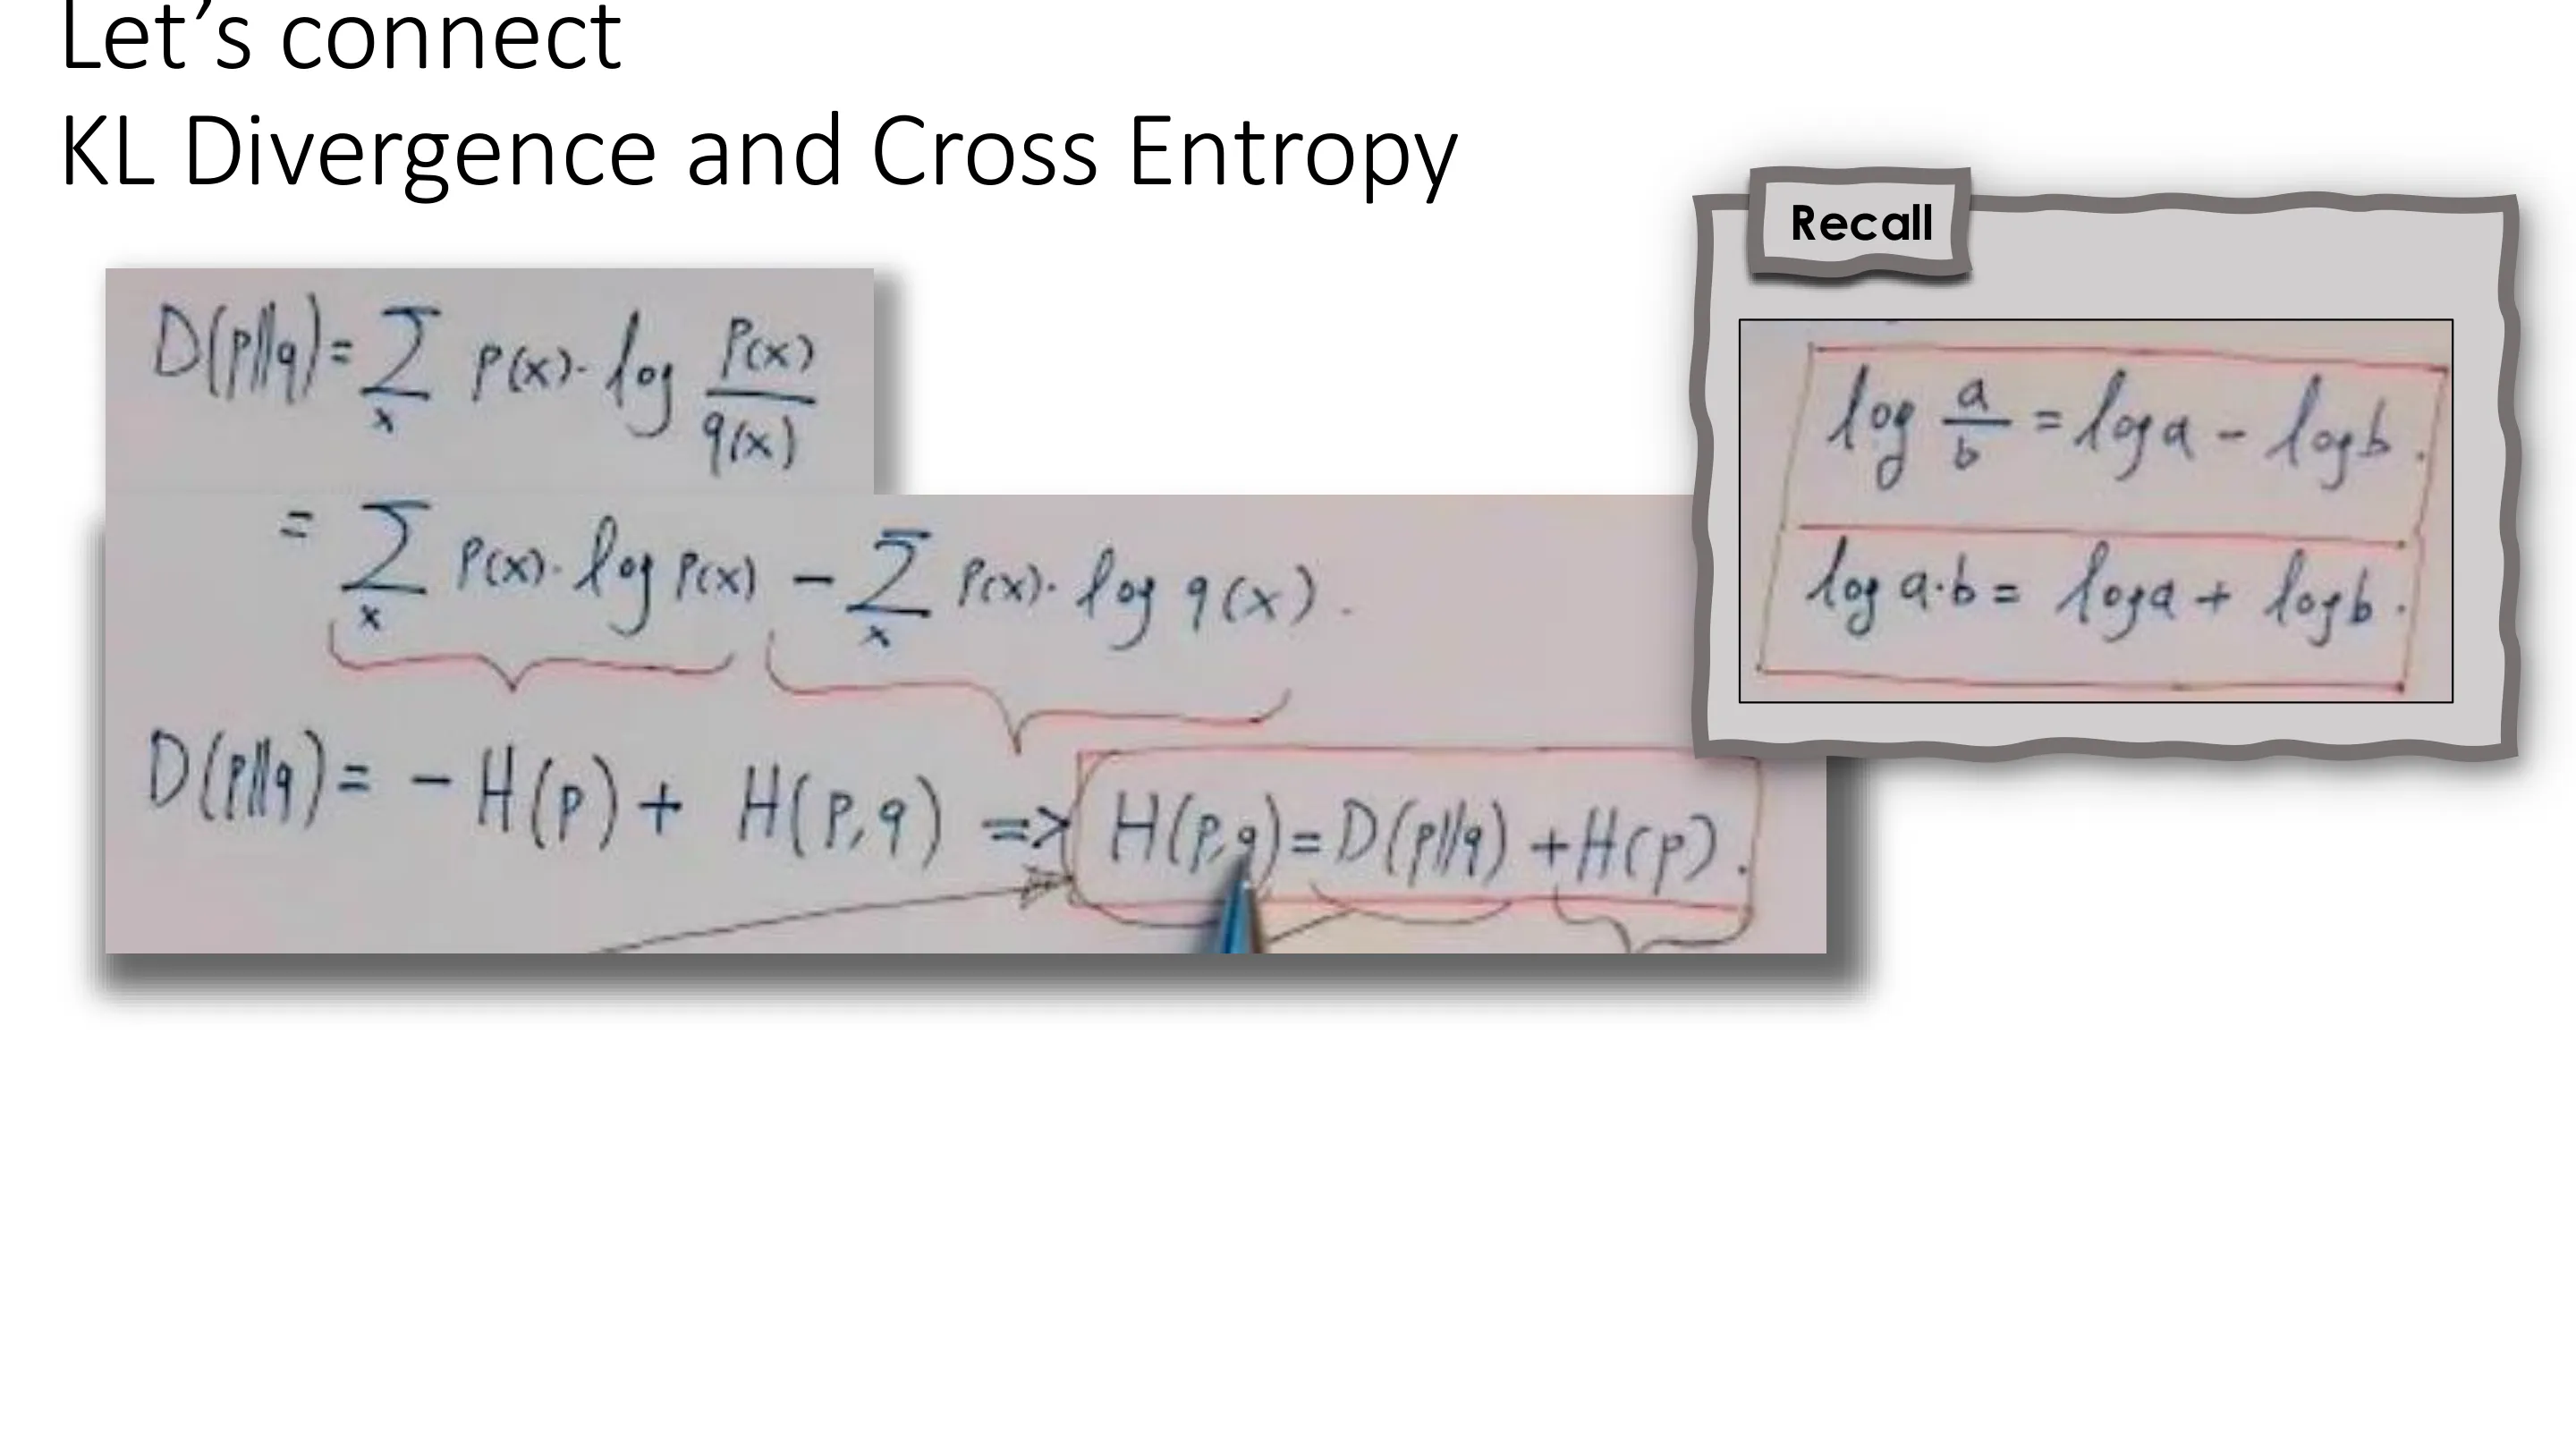
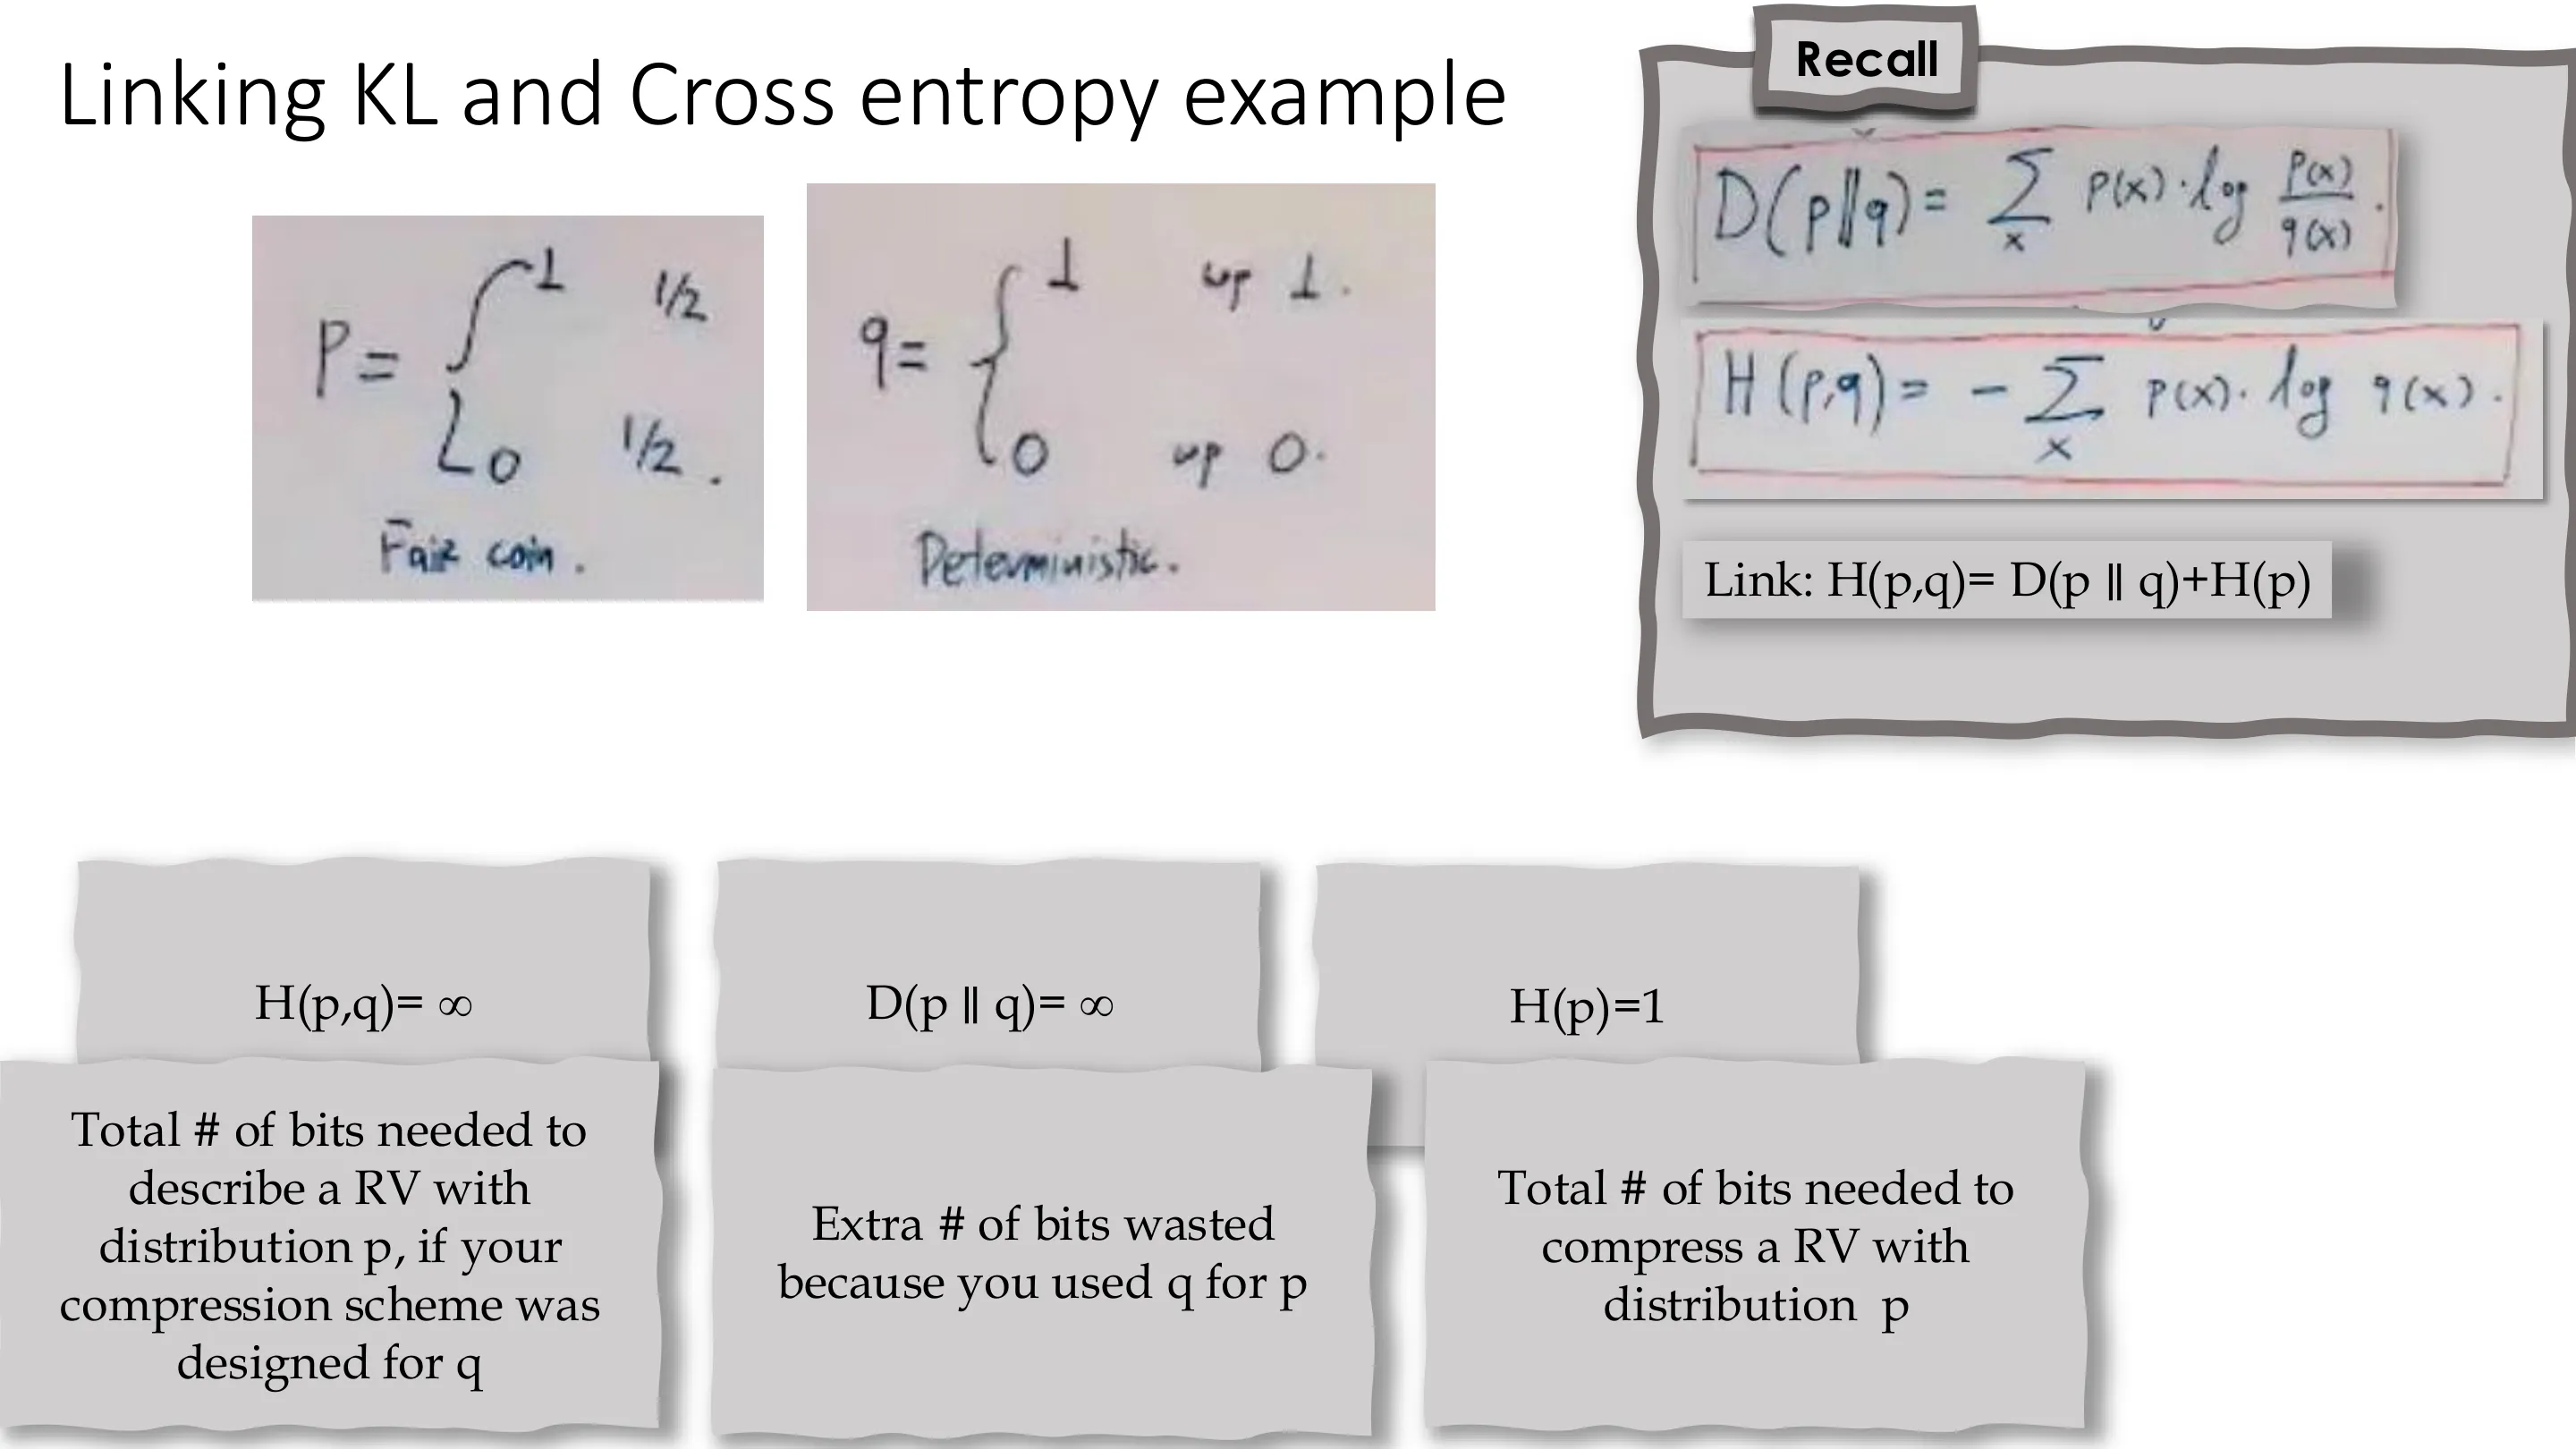
- 交叉熵 $H(P,Q)=-\sum_x p(x)\log q(x)$:用 $Q$ 的方案发送 $P$ 的数据,平均所需总比特数;
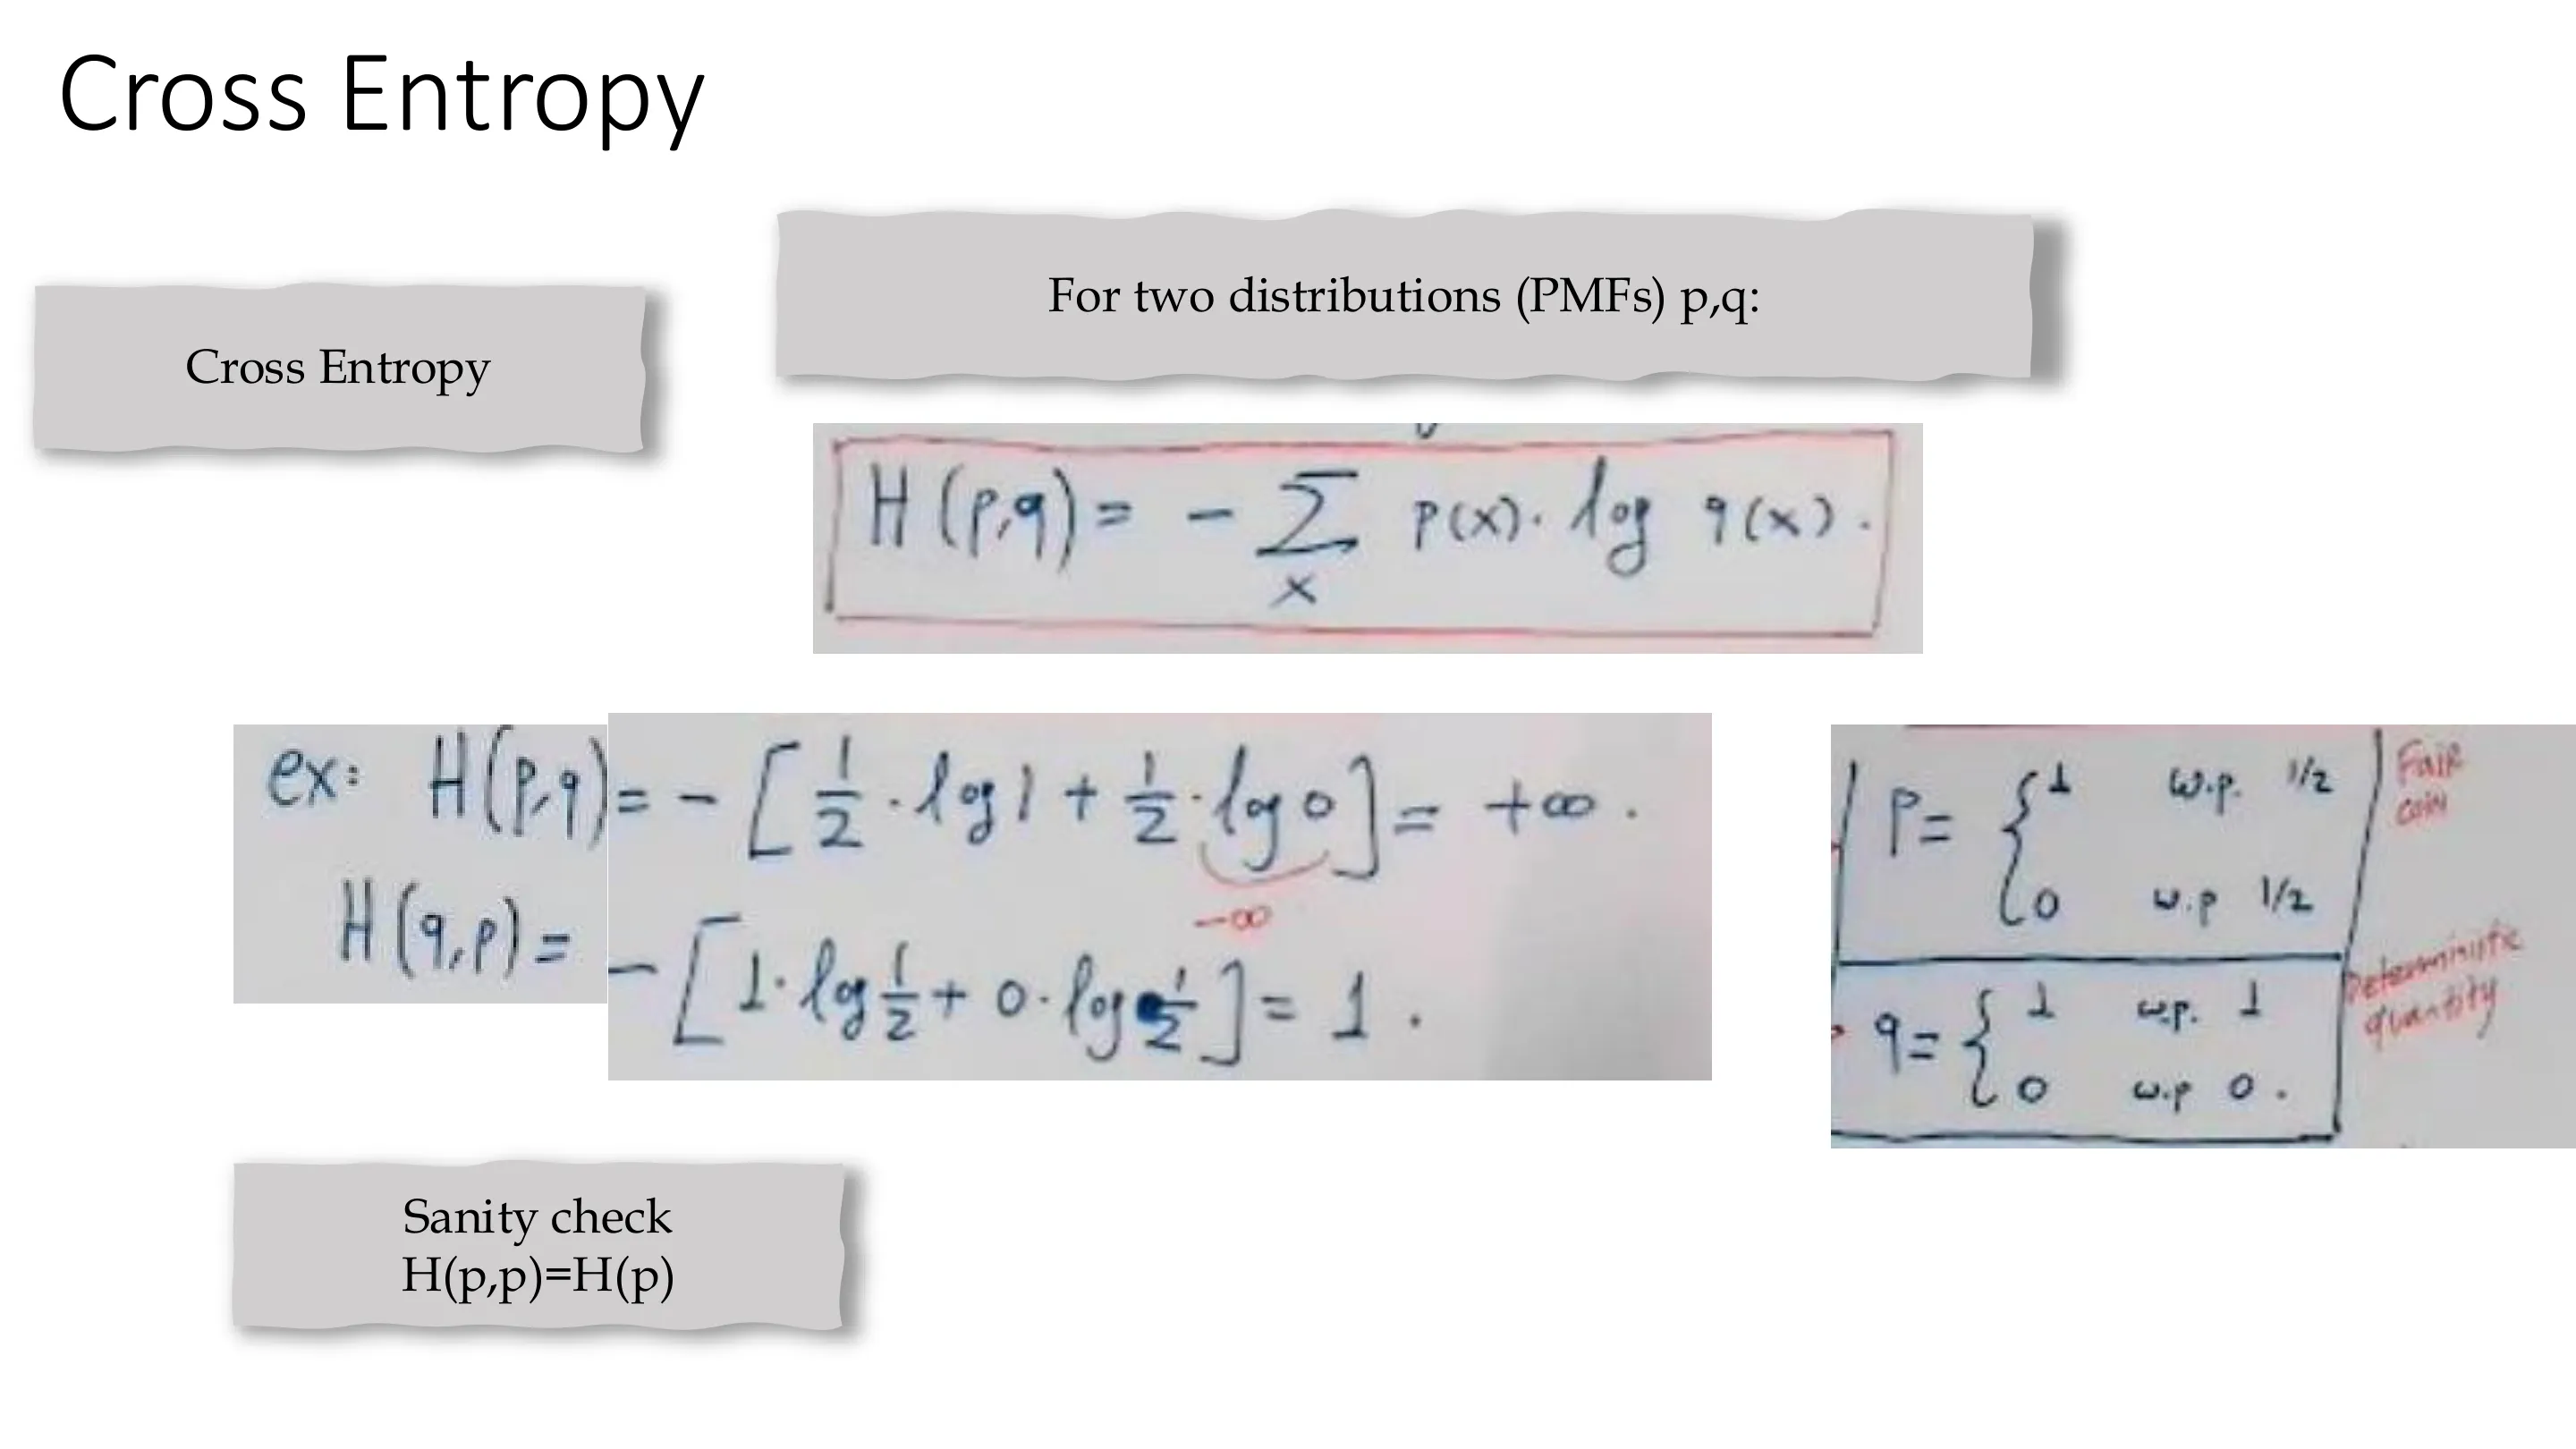
- 熵 $H(P)=-\sum_x p(x)\log p(x)$:用 $P$ 自己的最优方案,所需比特数;
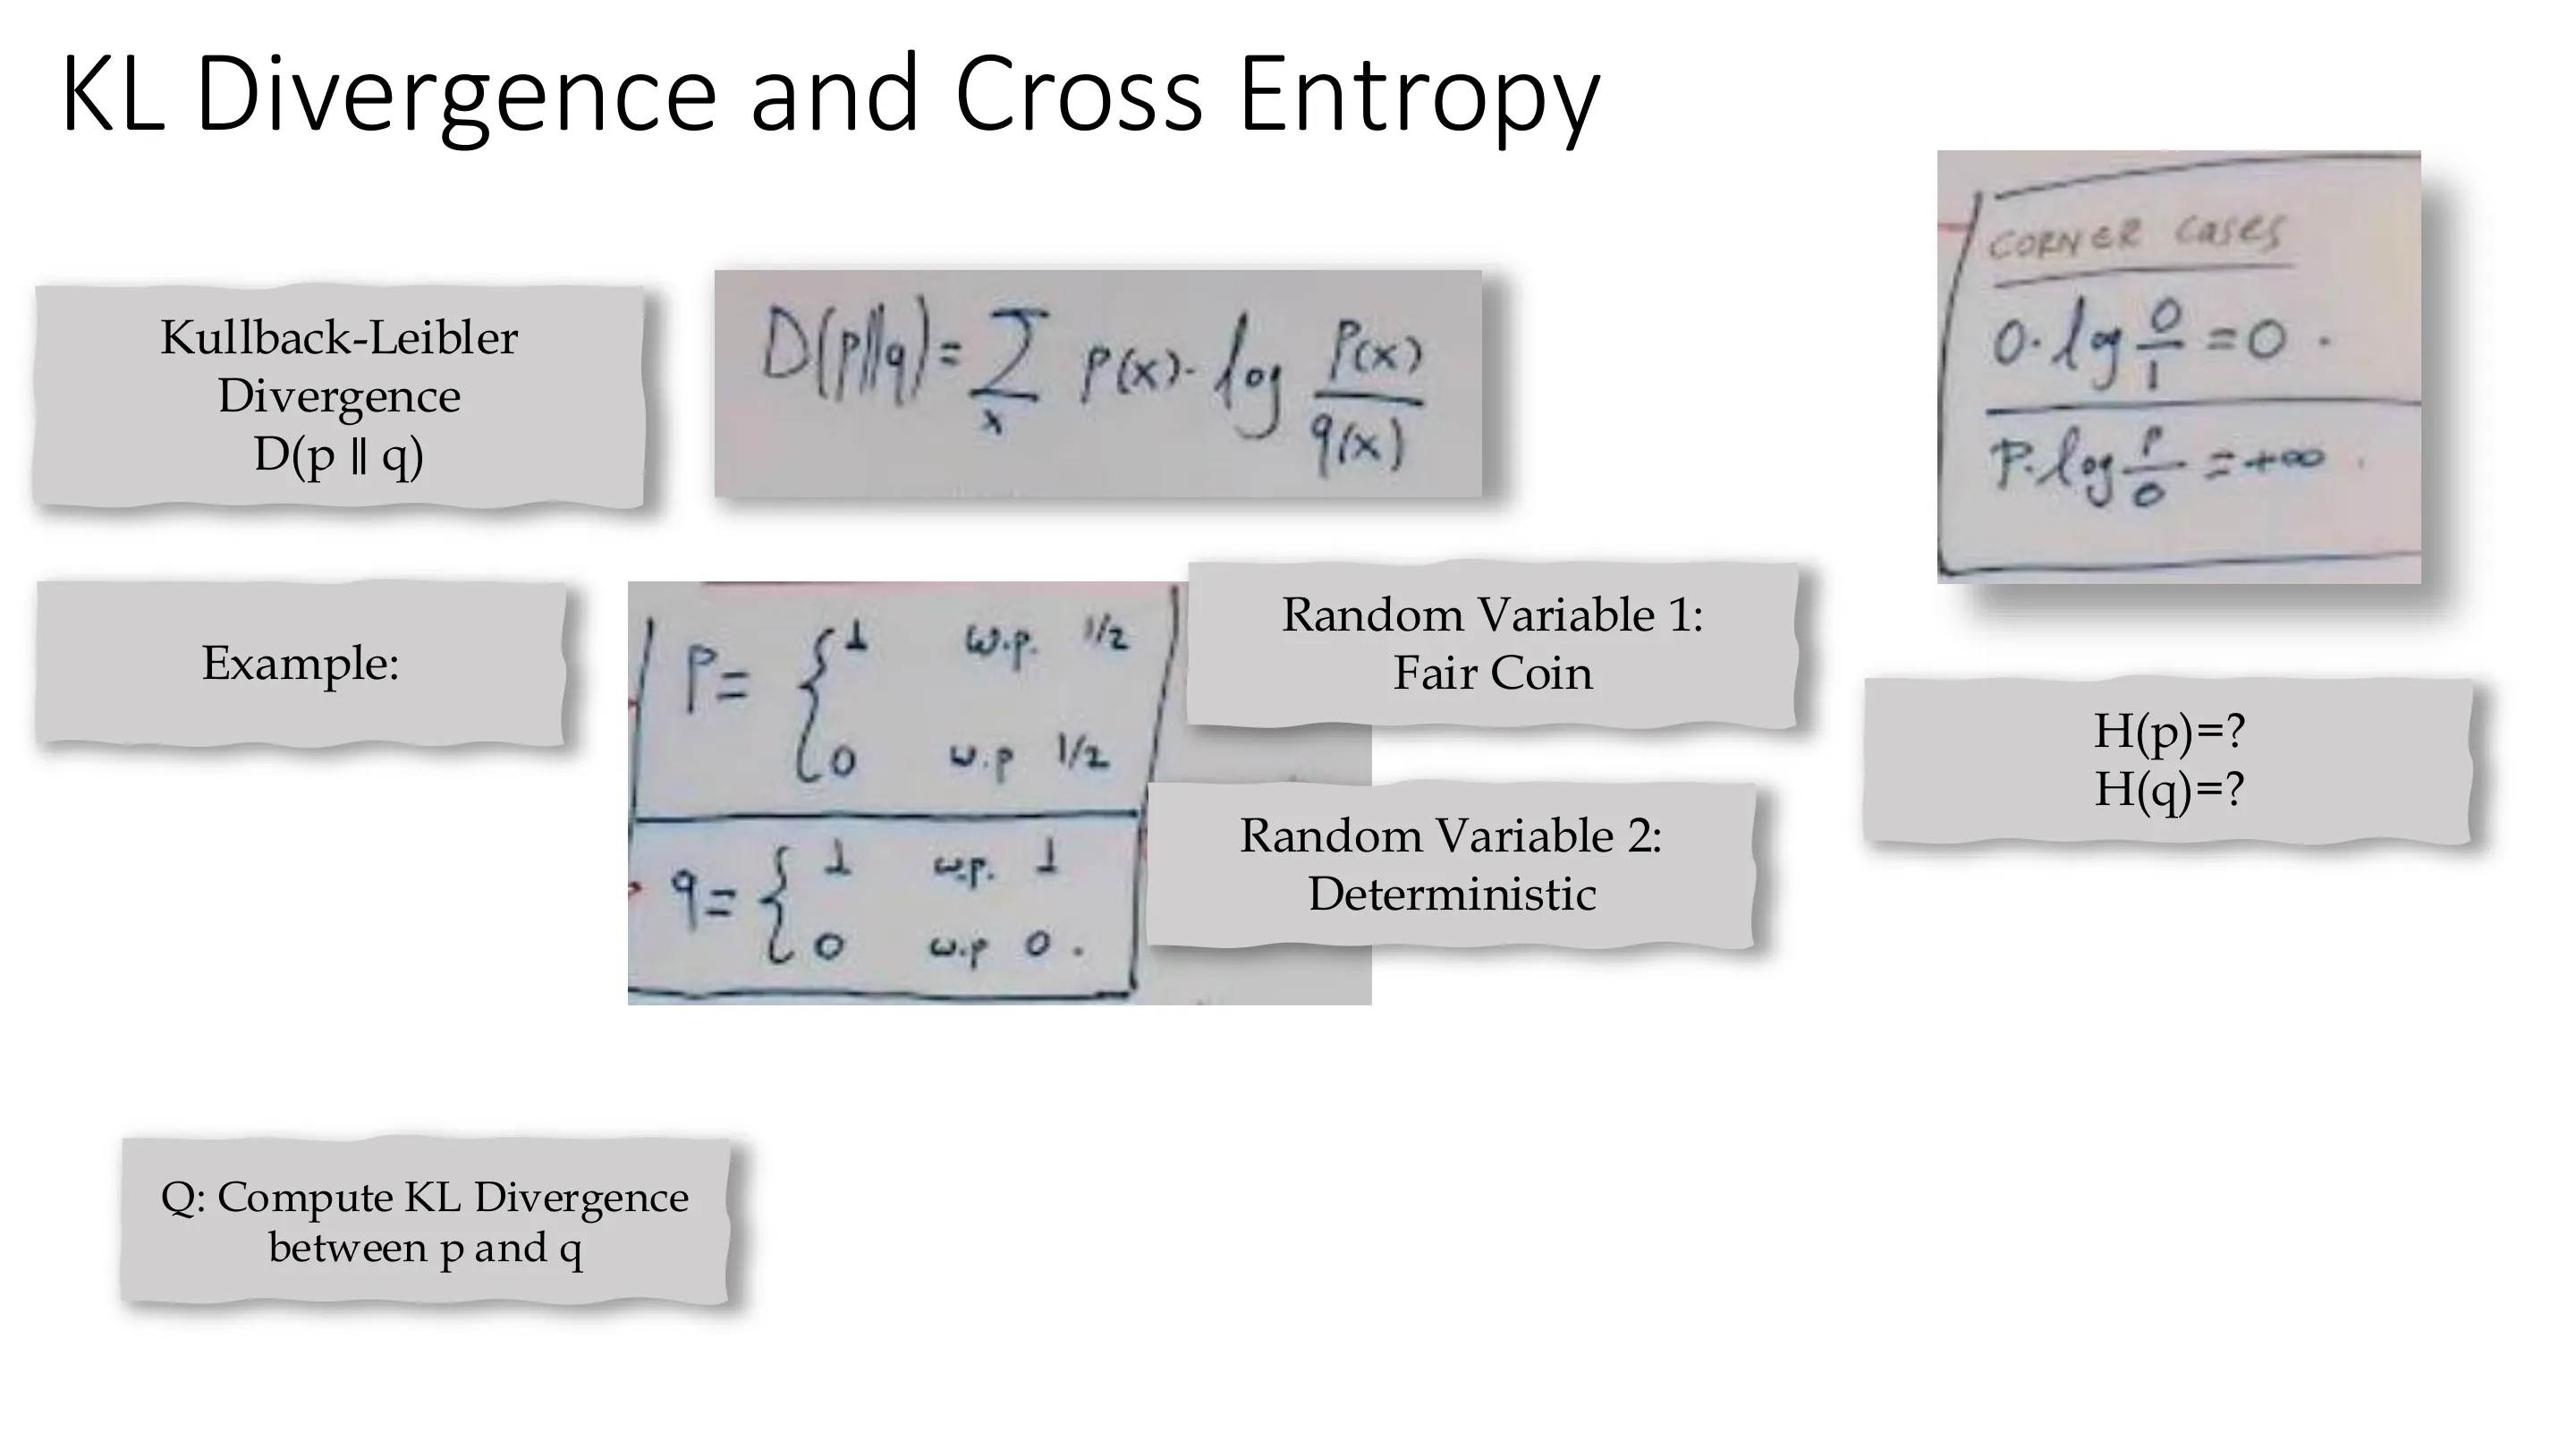
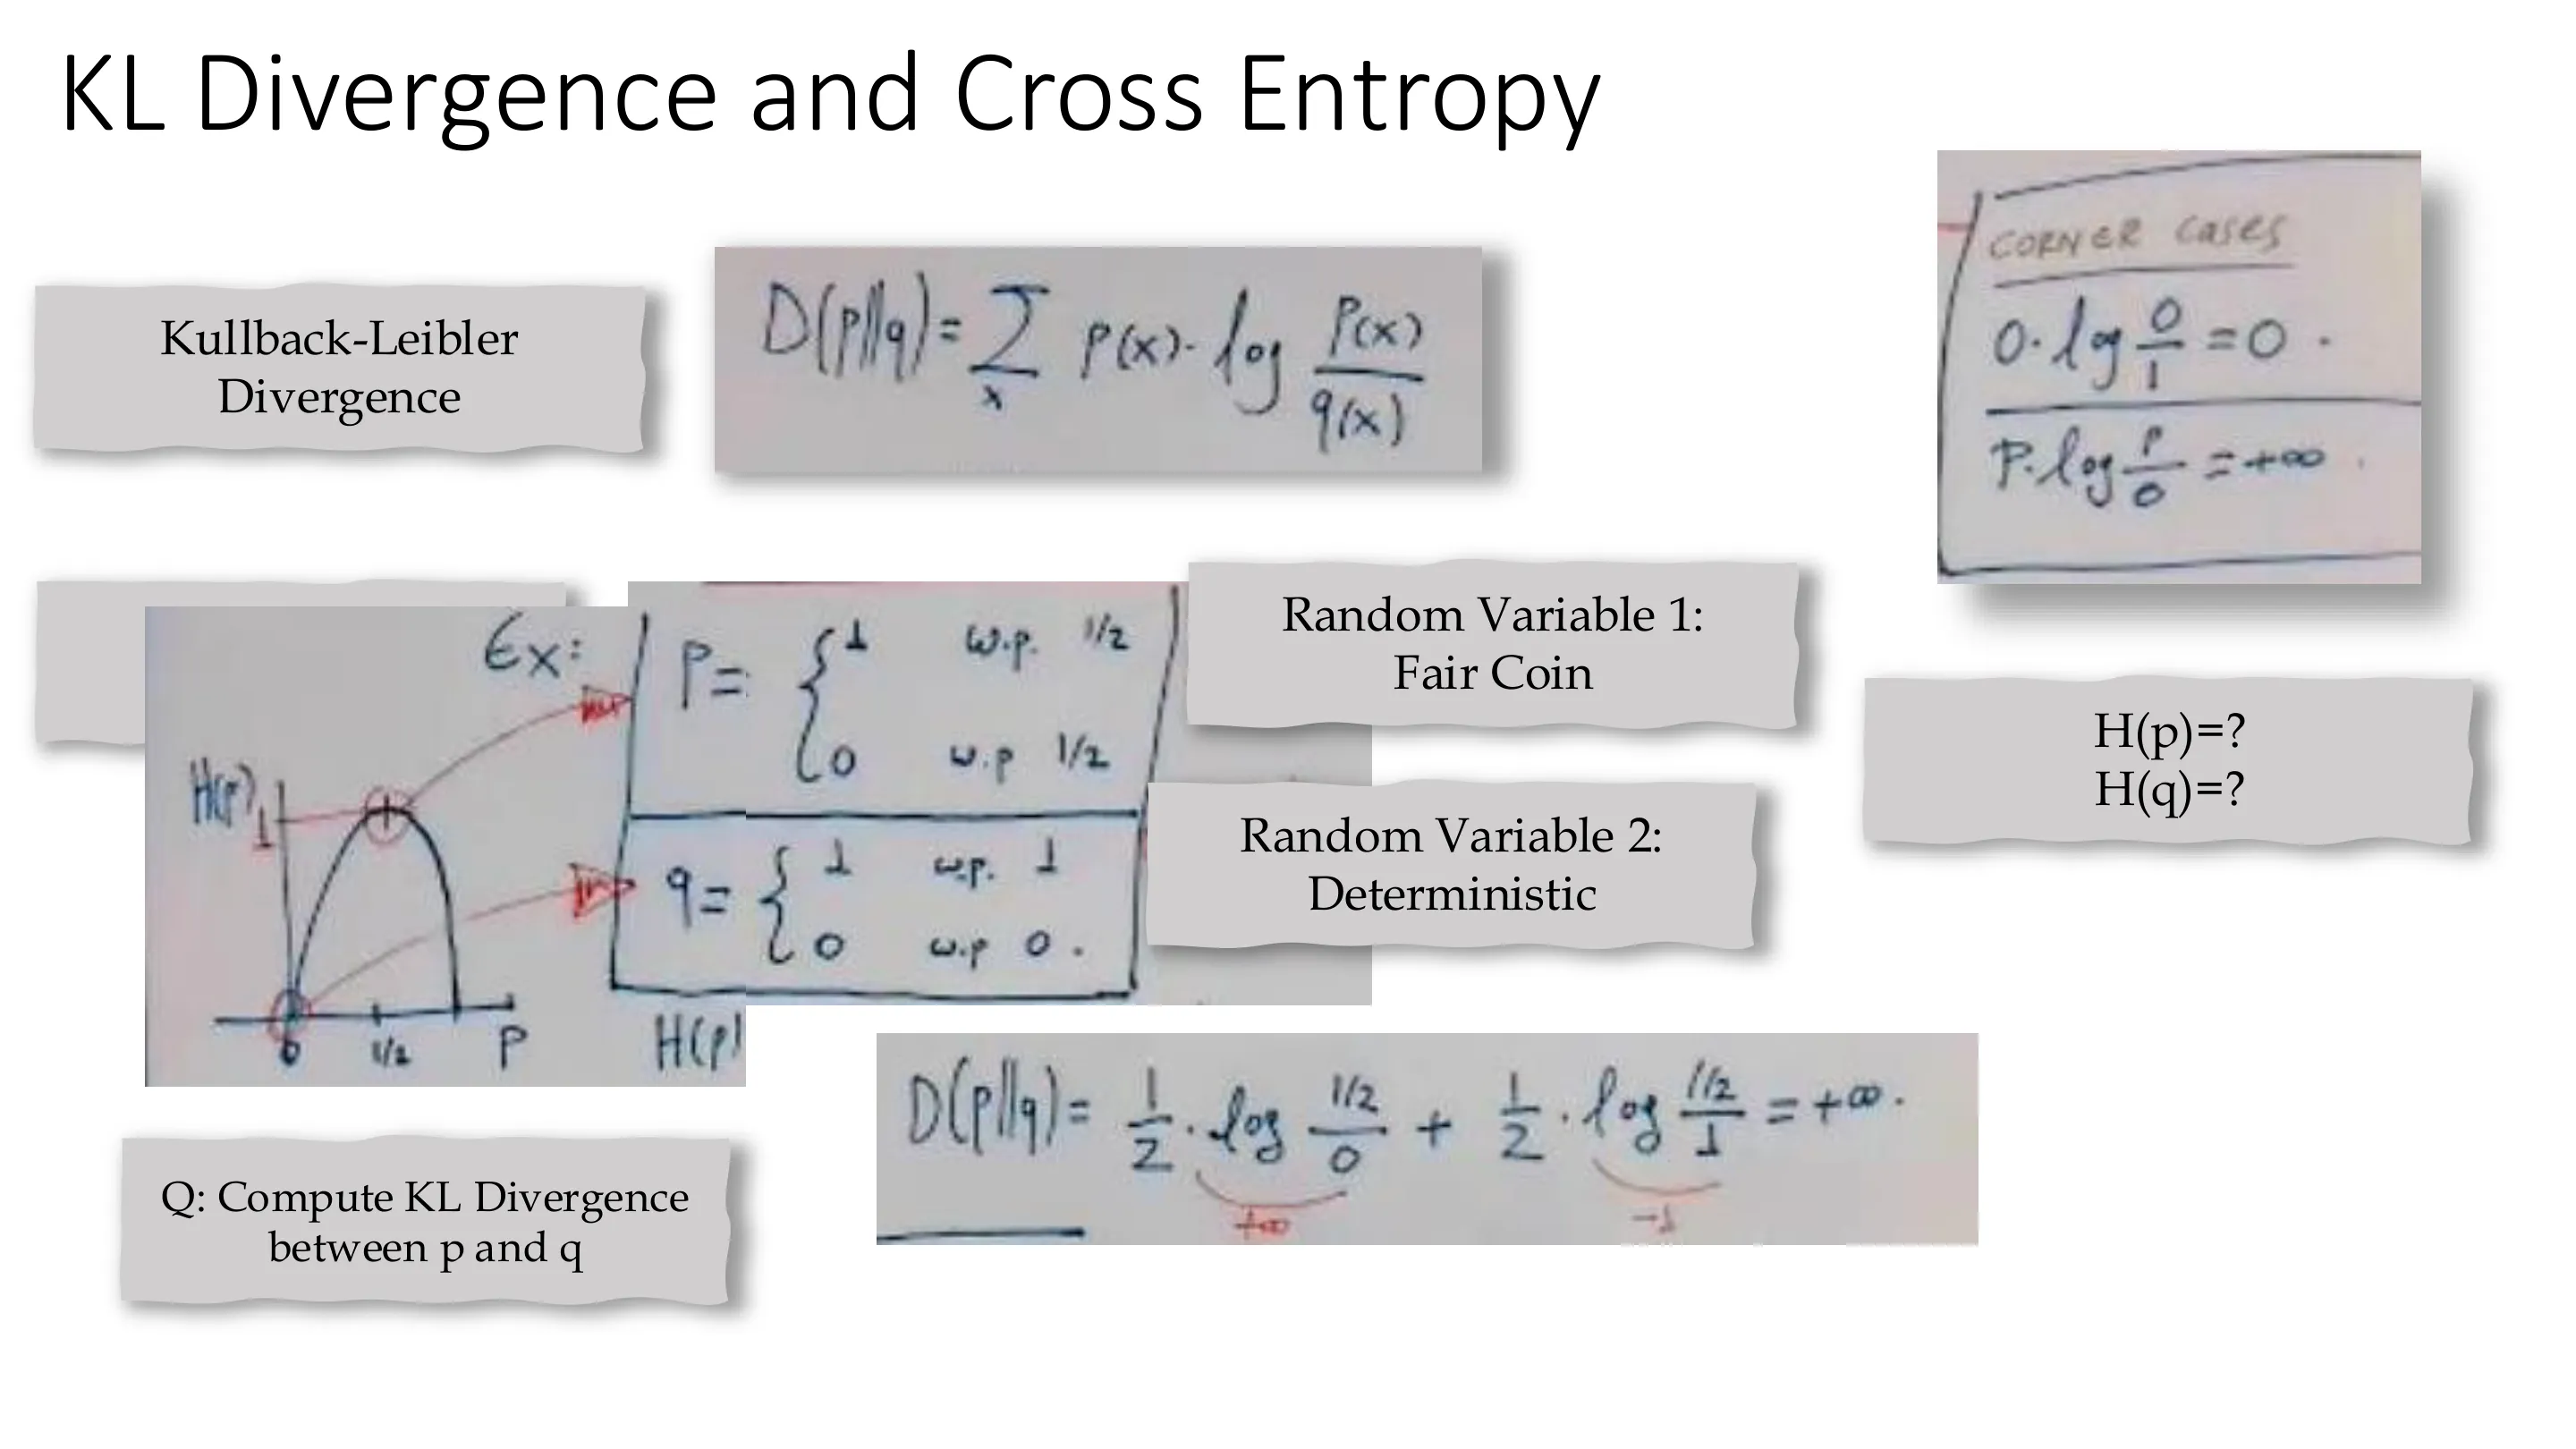
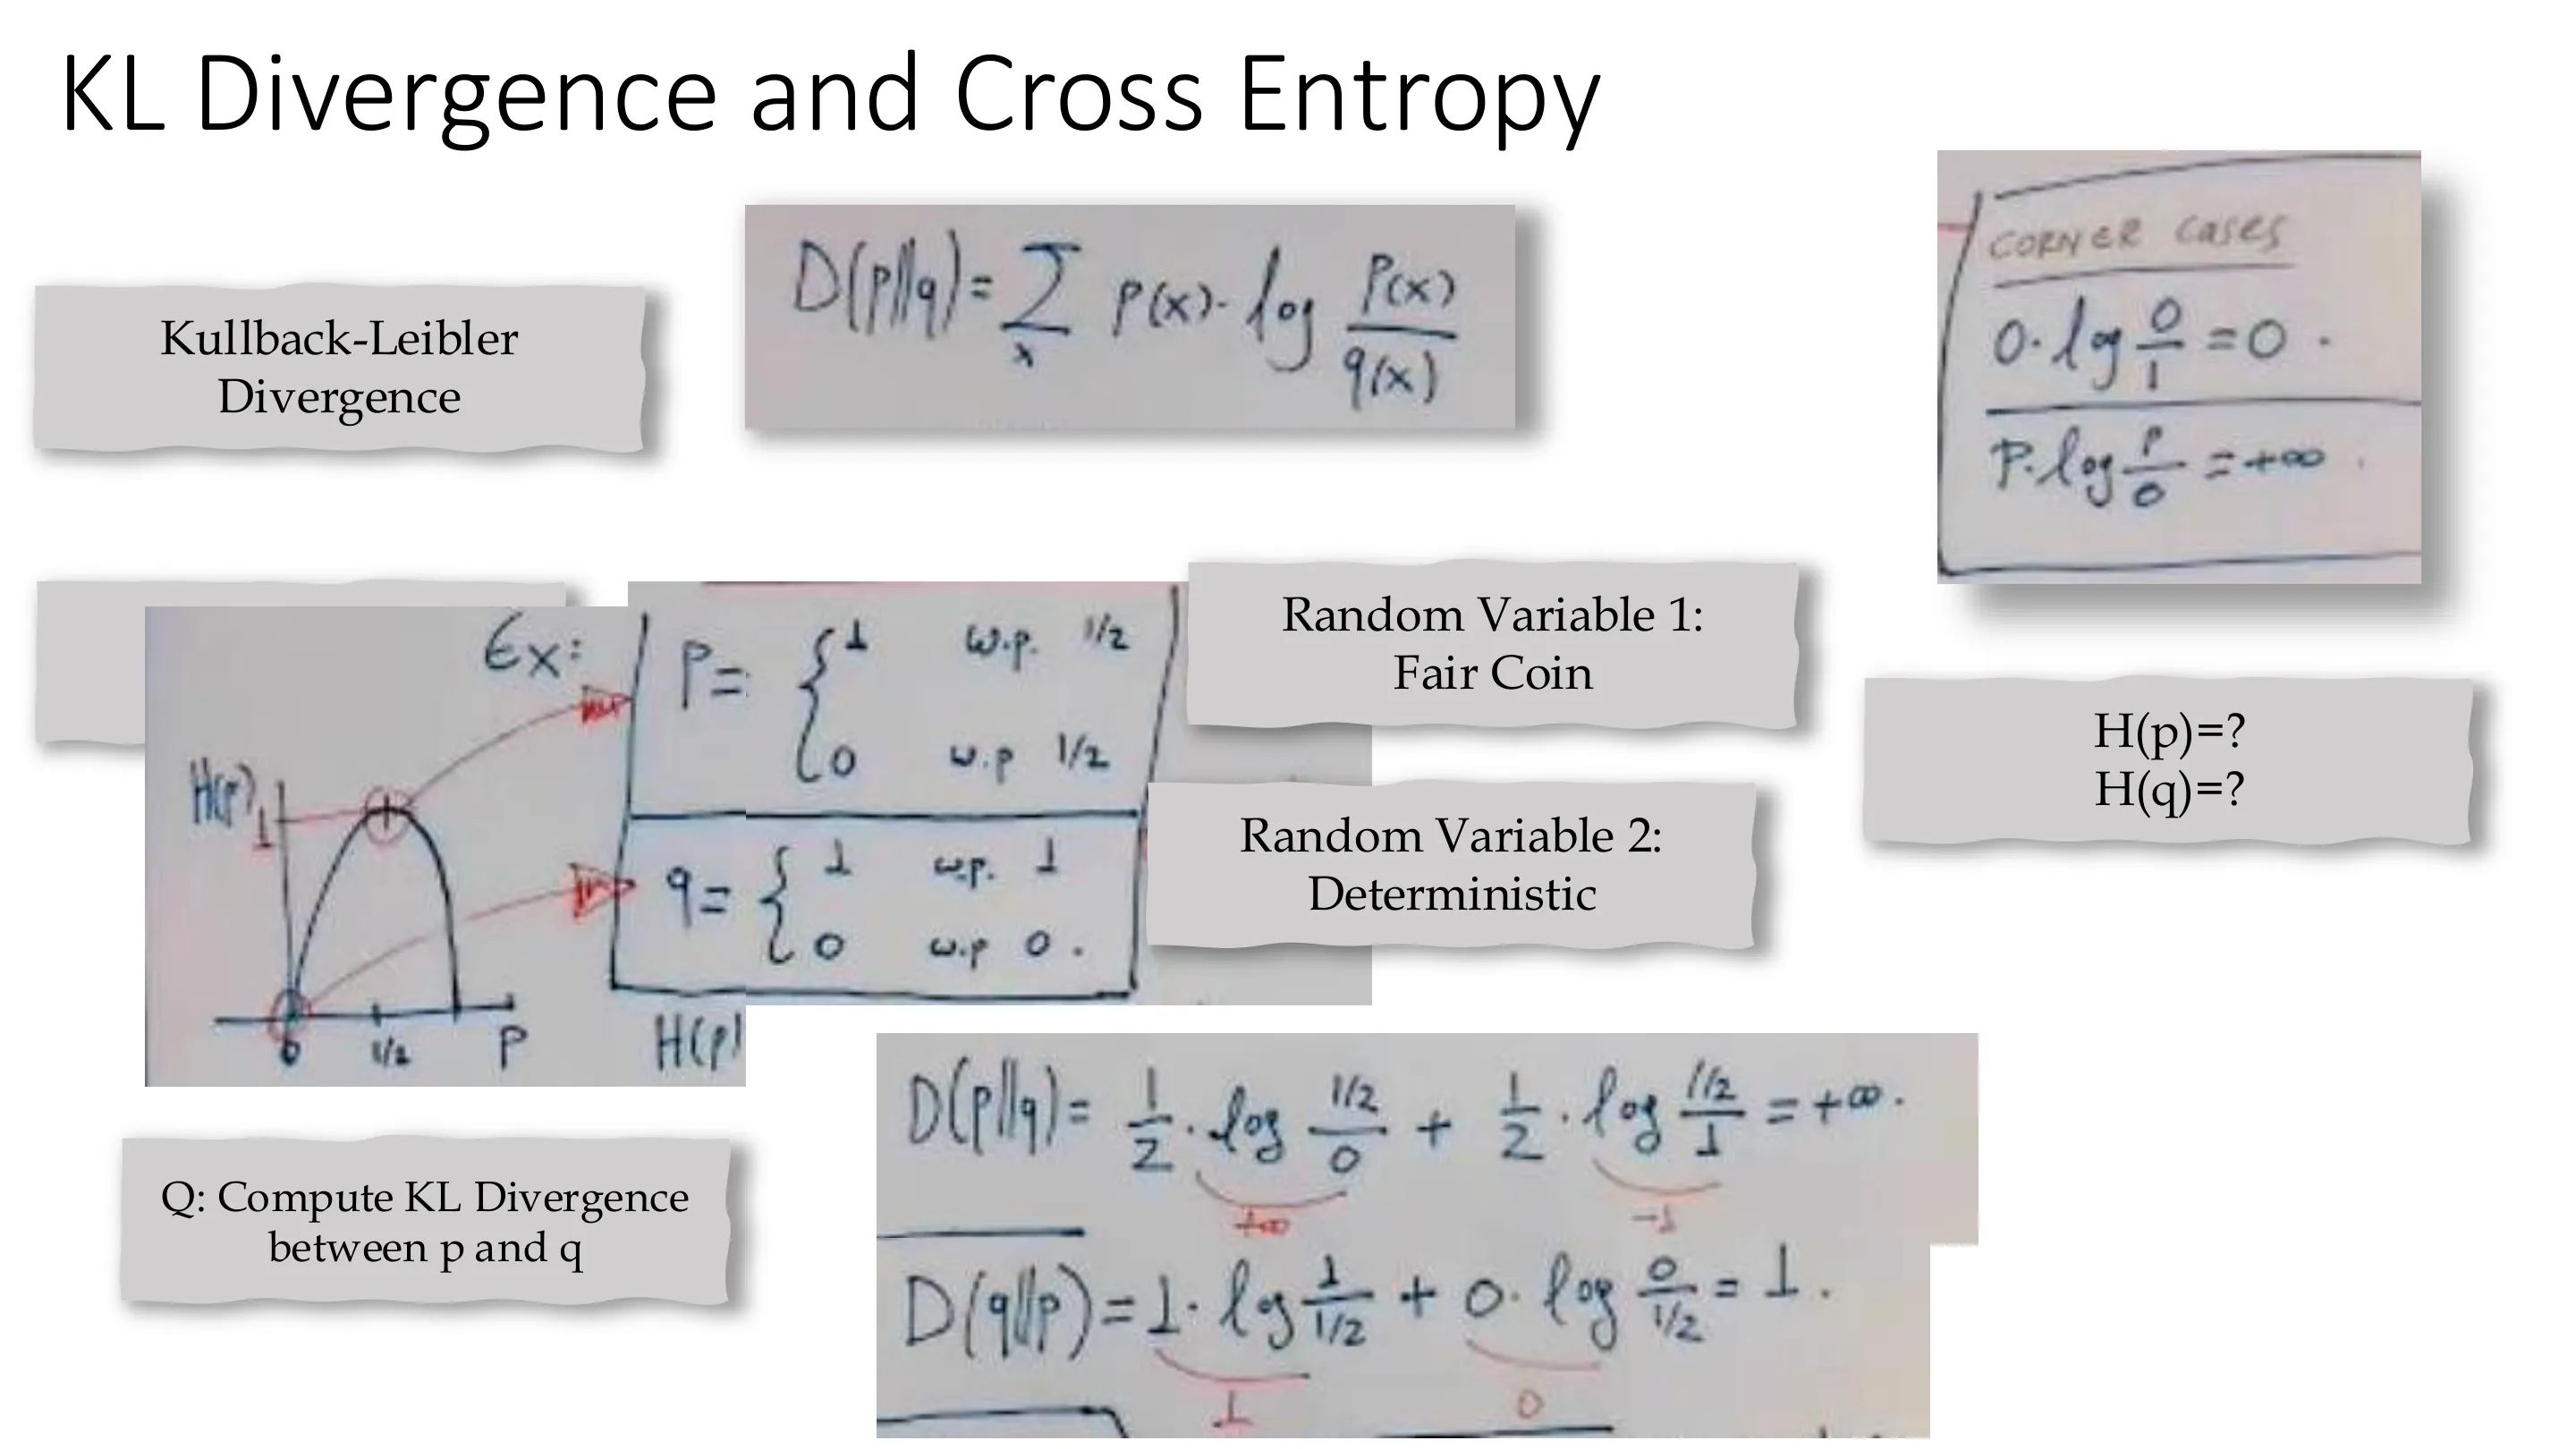
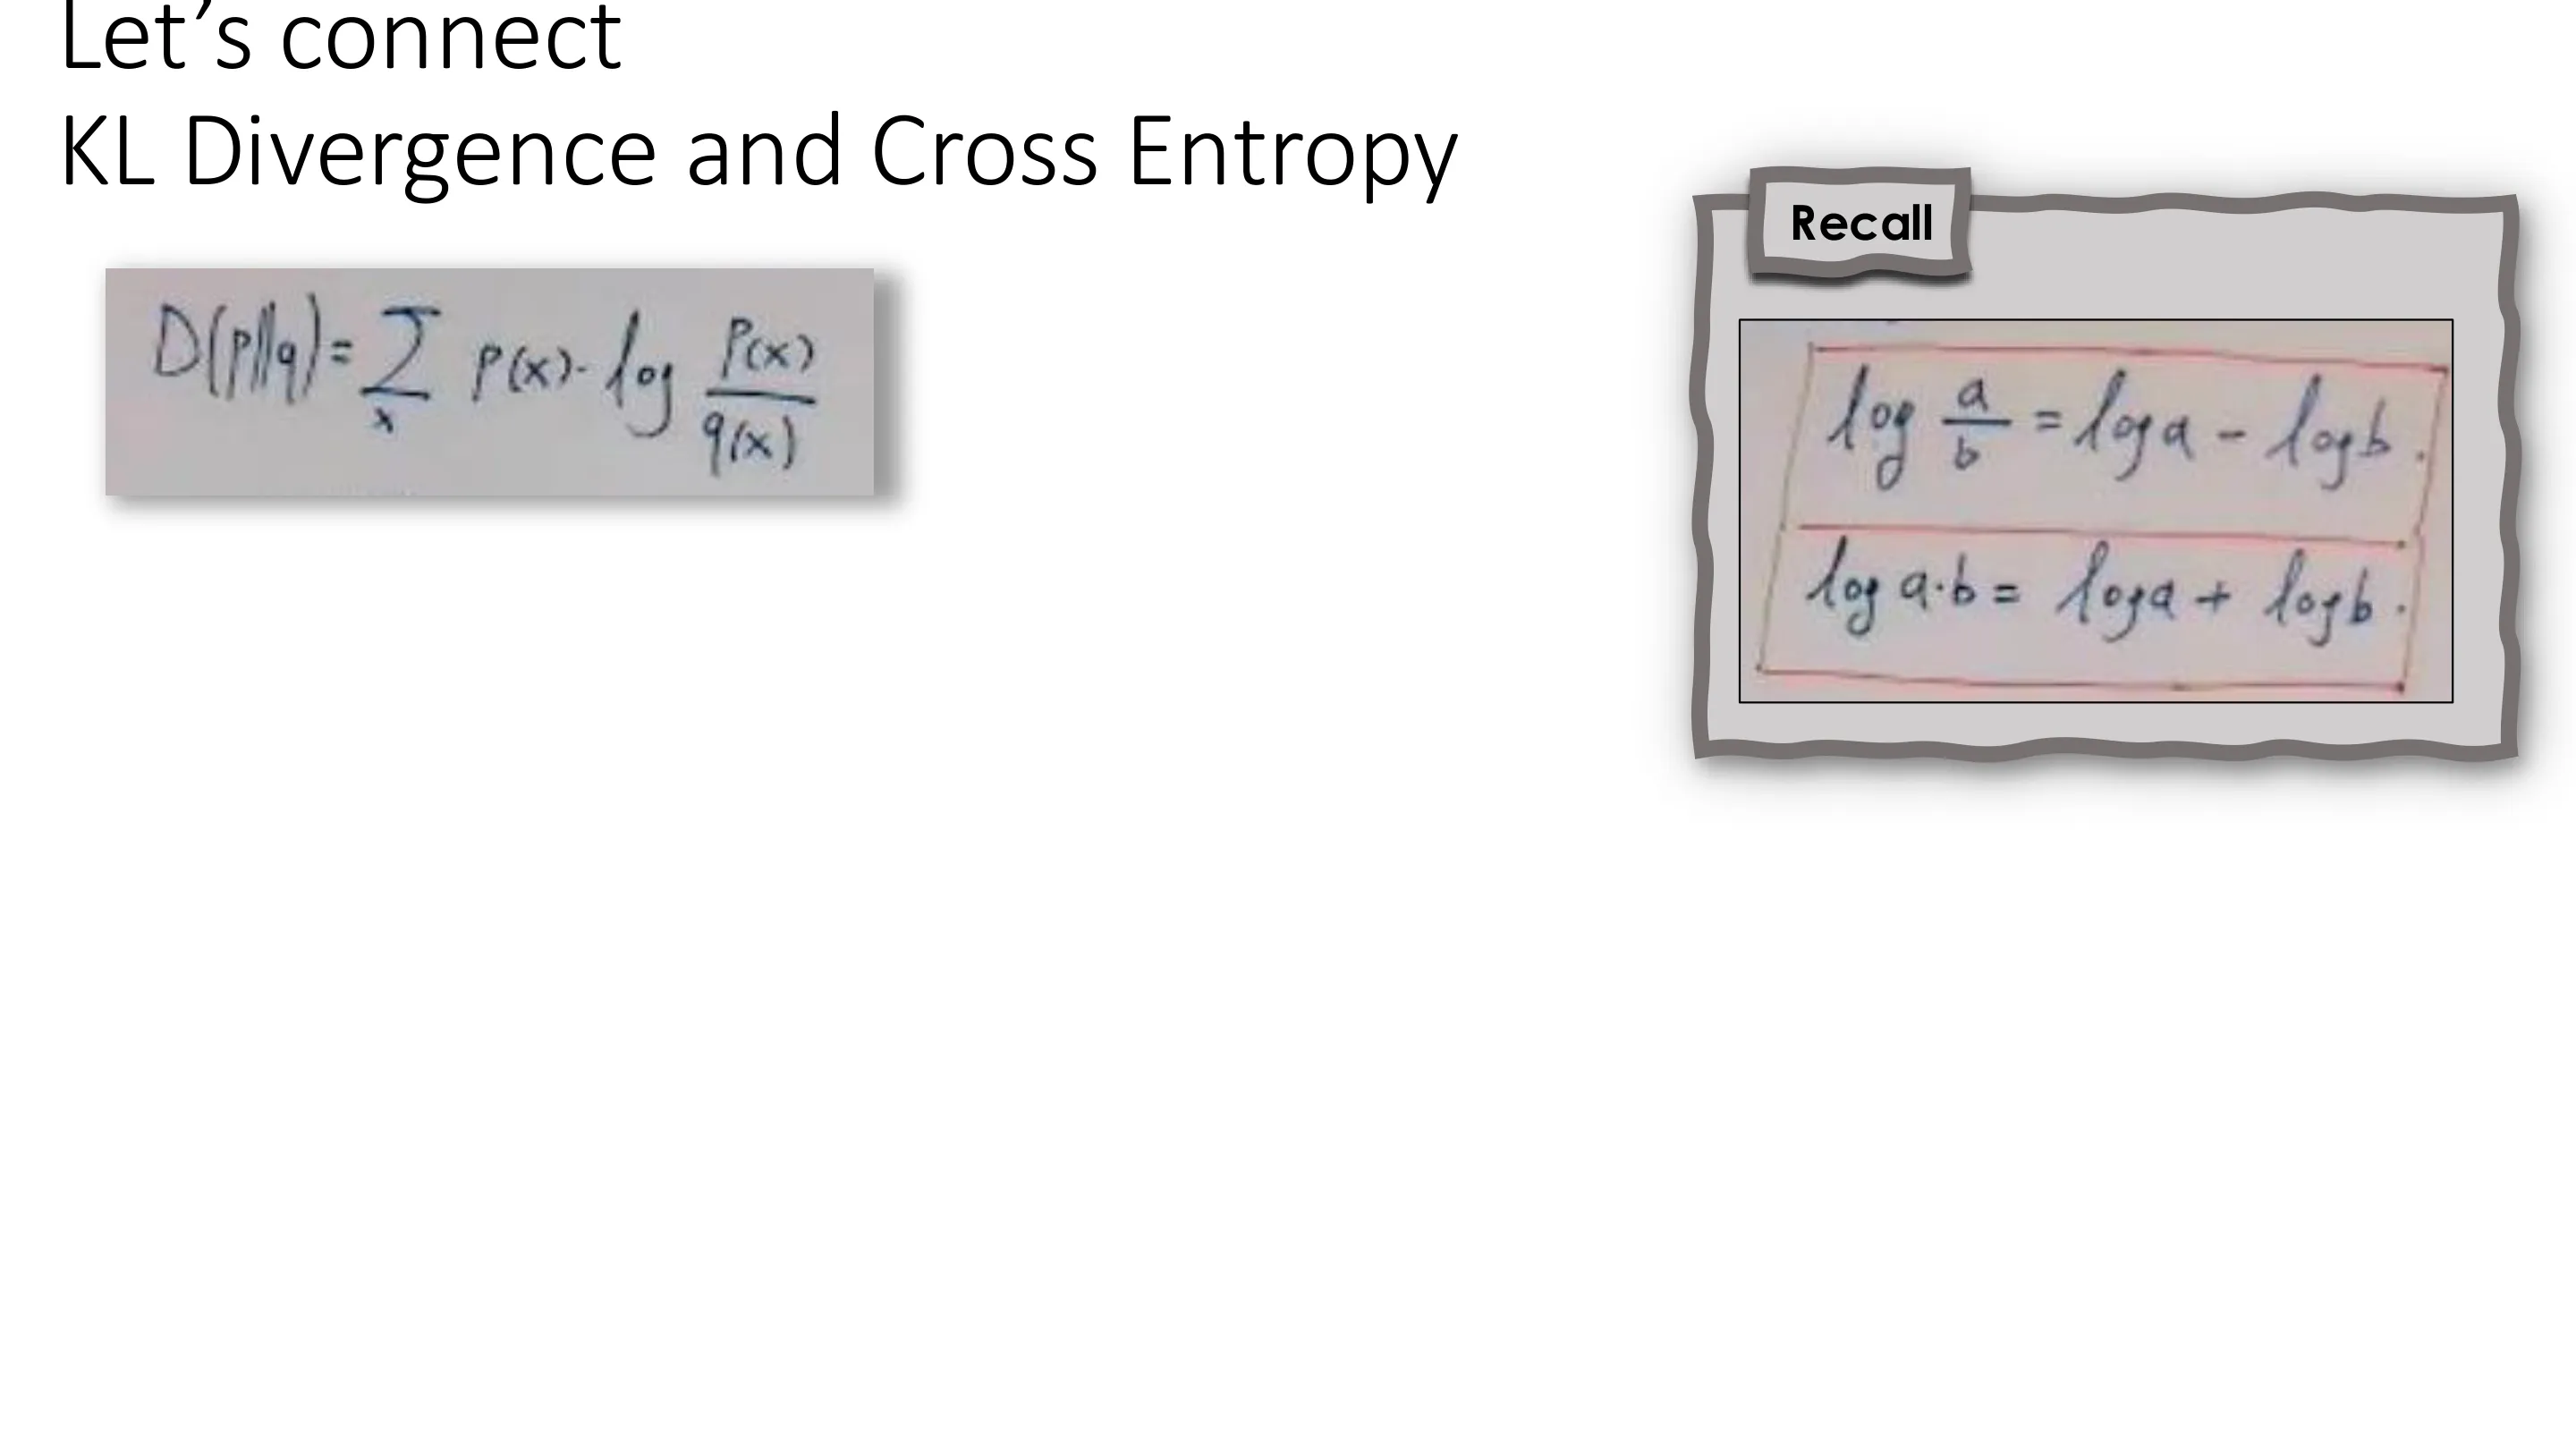
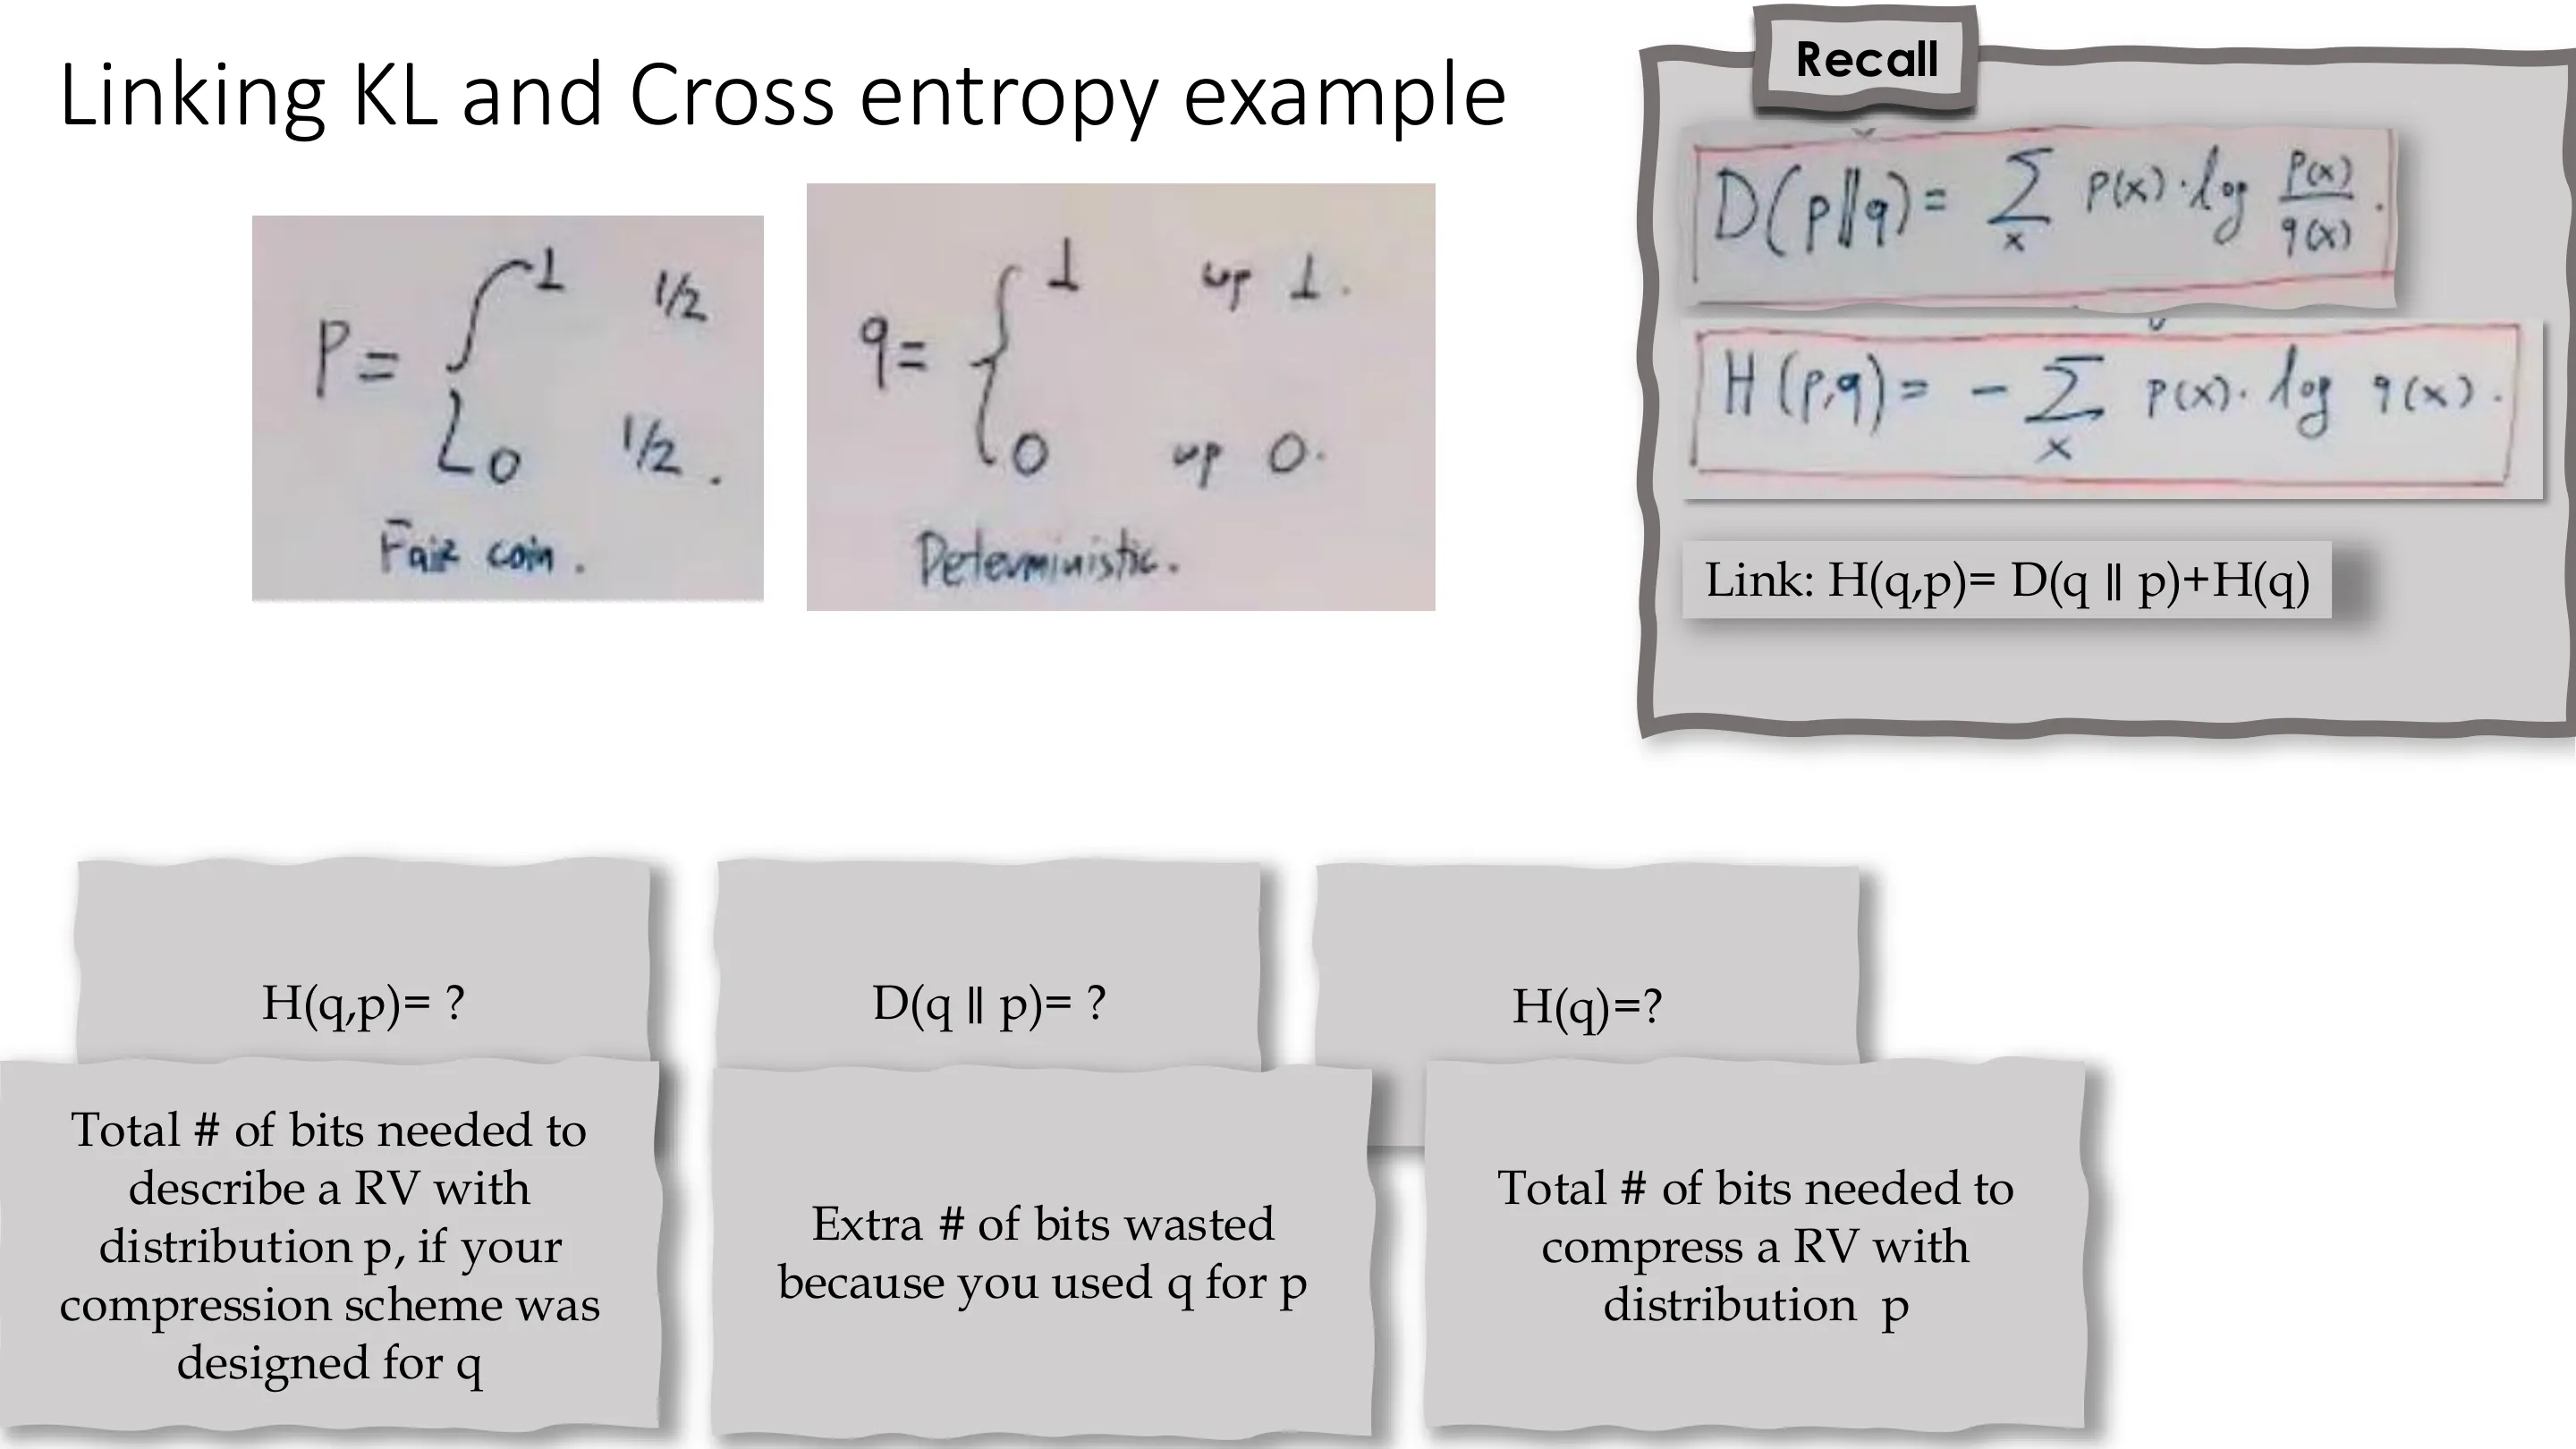
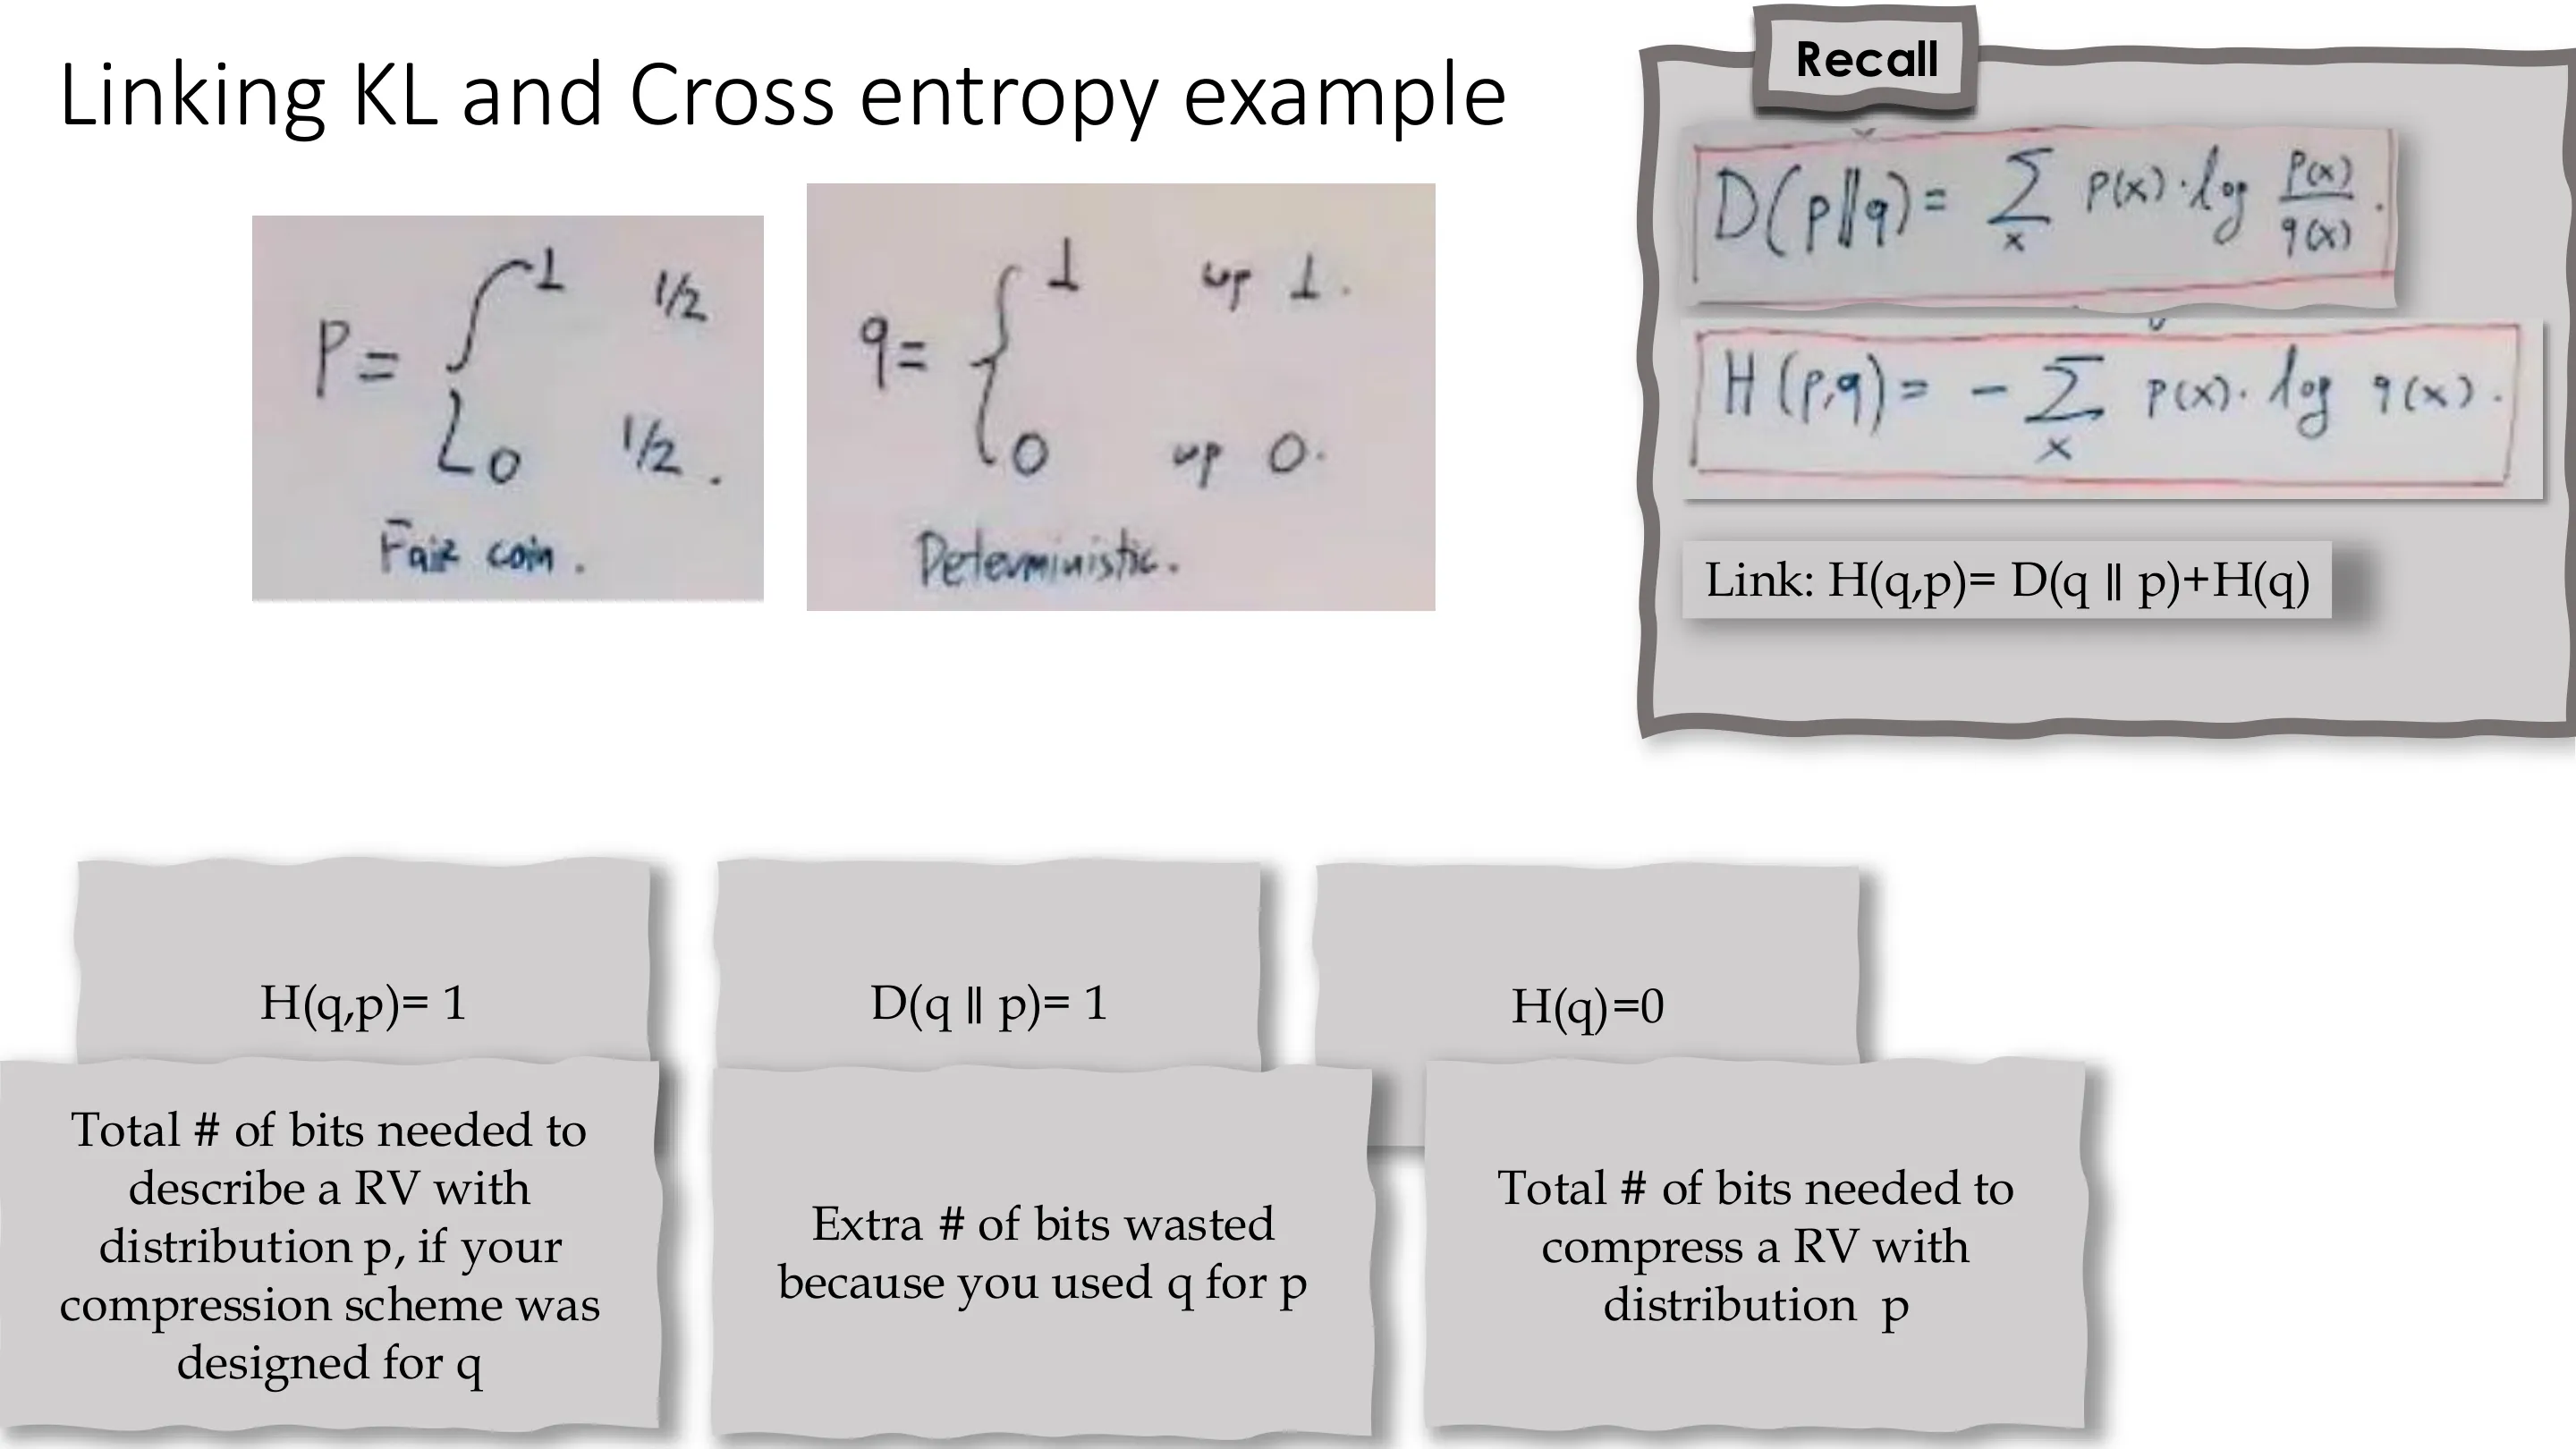
- KL 散度 $D_{\mathrm{KL}}(P\|Q)=H(P,Q)-H(P)=\sum_x p(x)\log\dfrac{p(x)}{q(x)}$:因用错方案而浪费的比特数。
性质:$D_{\mathrm{KL}}\ge0$,且 $D_{\mathrm{KL}}(P\|P)=0$;但不对称——所以叫「散度」而非「距离」。
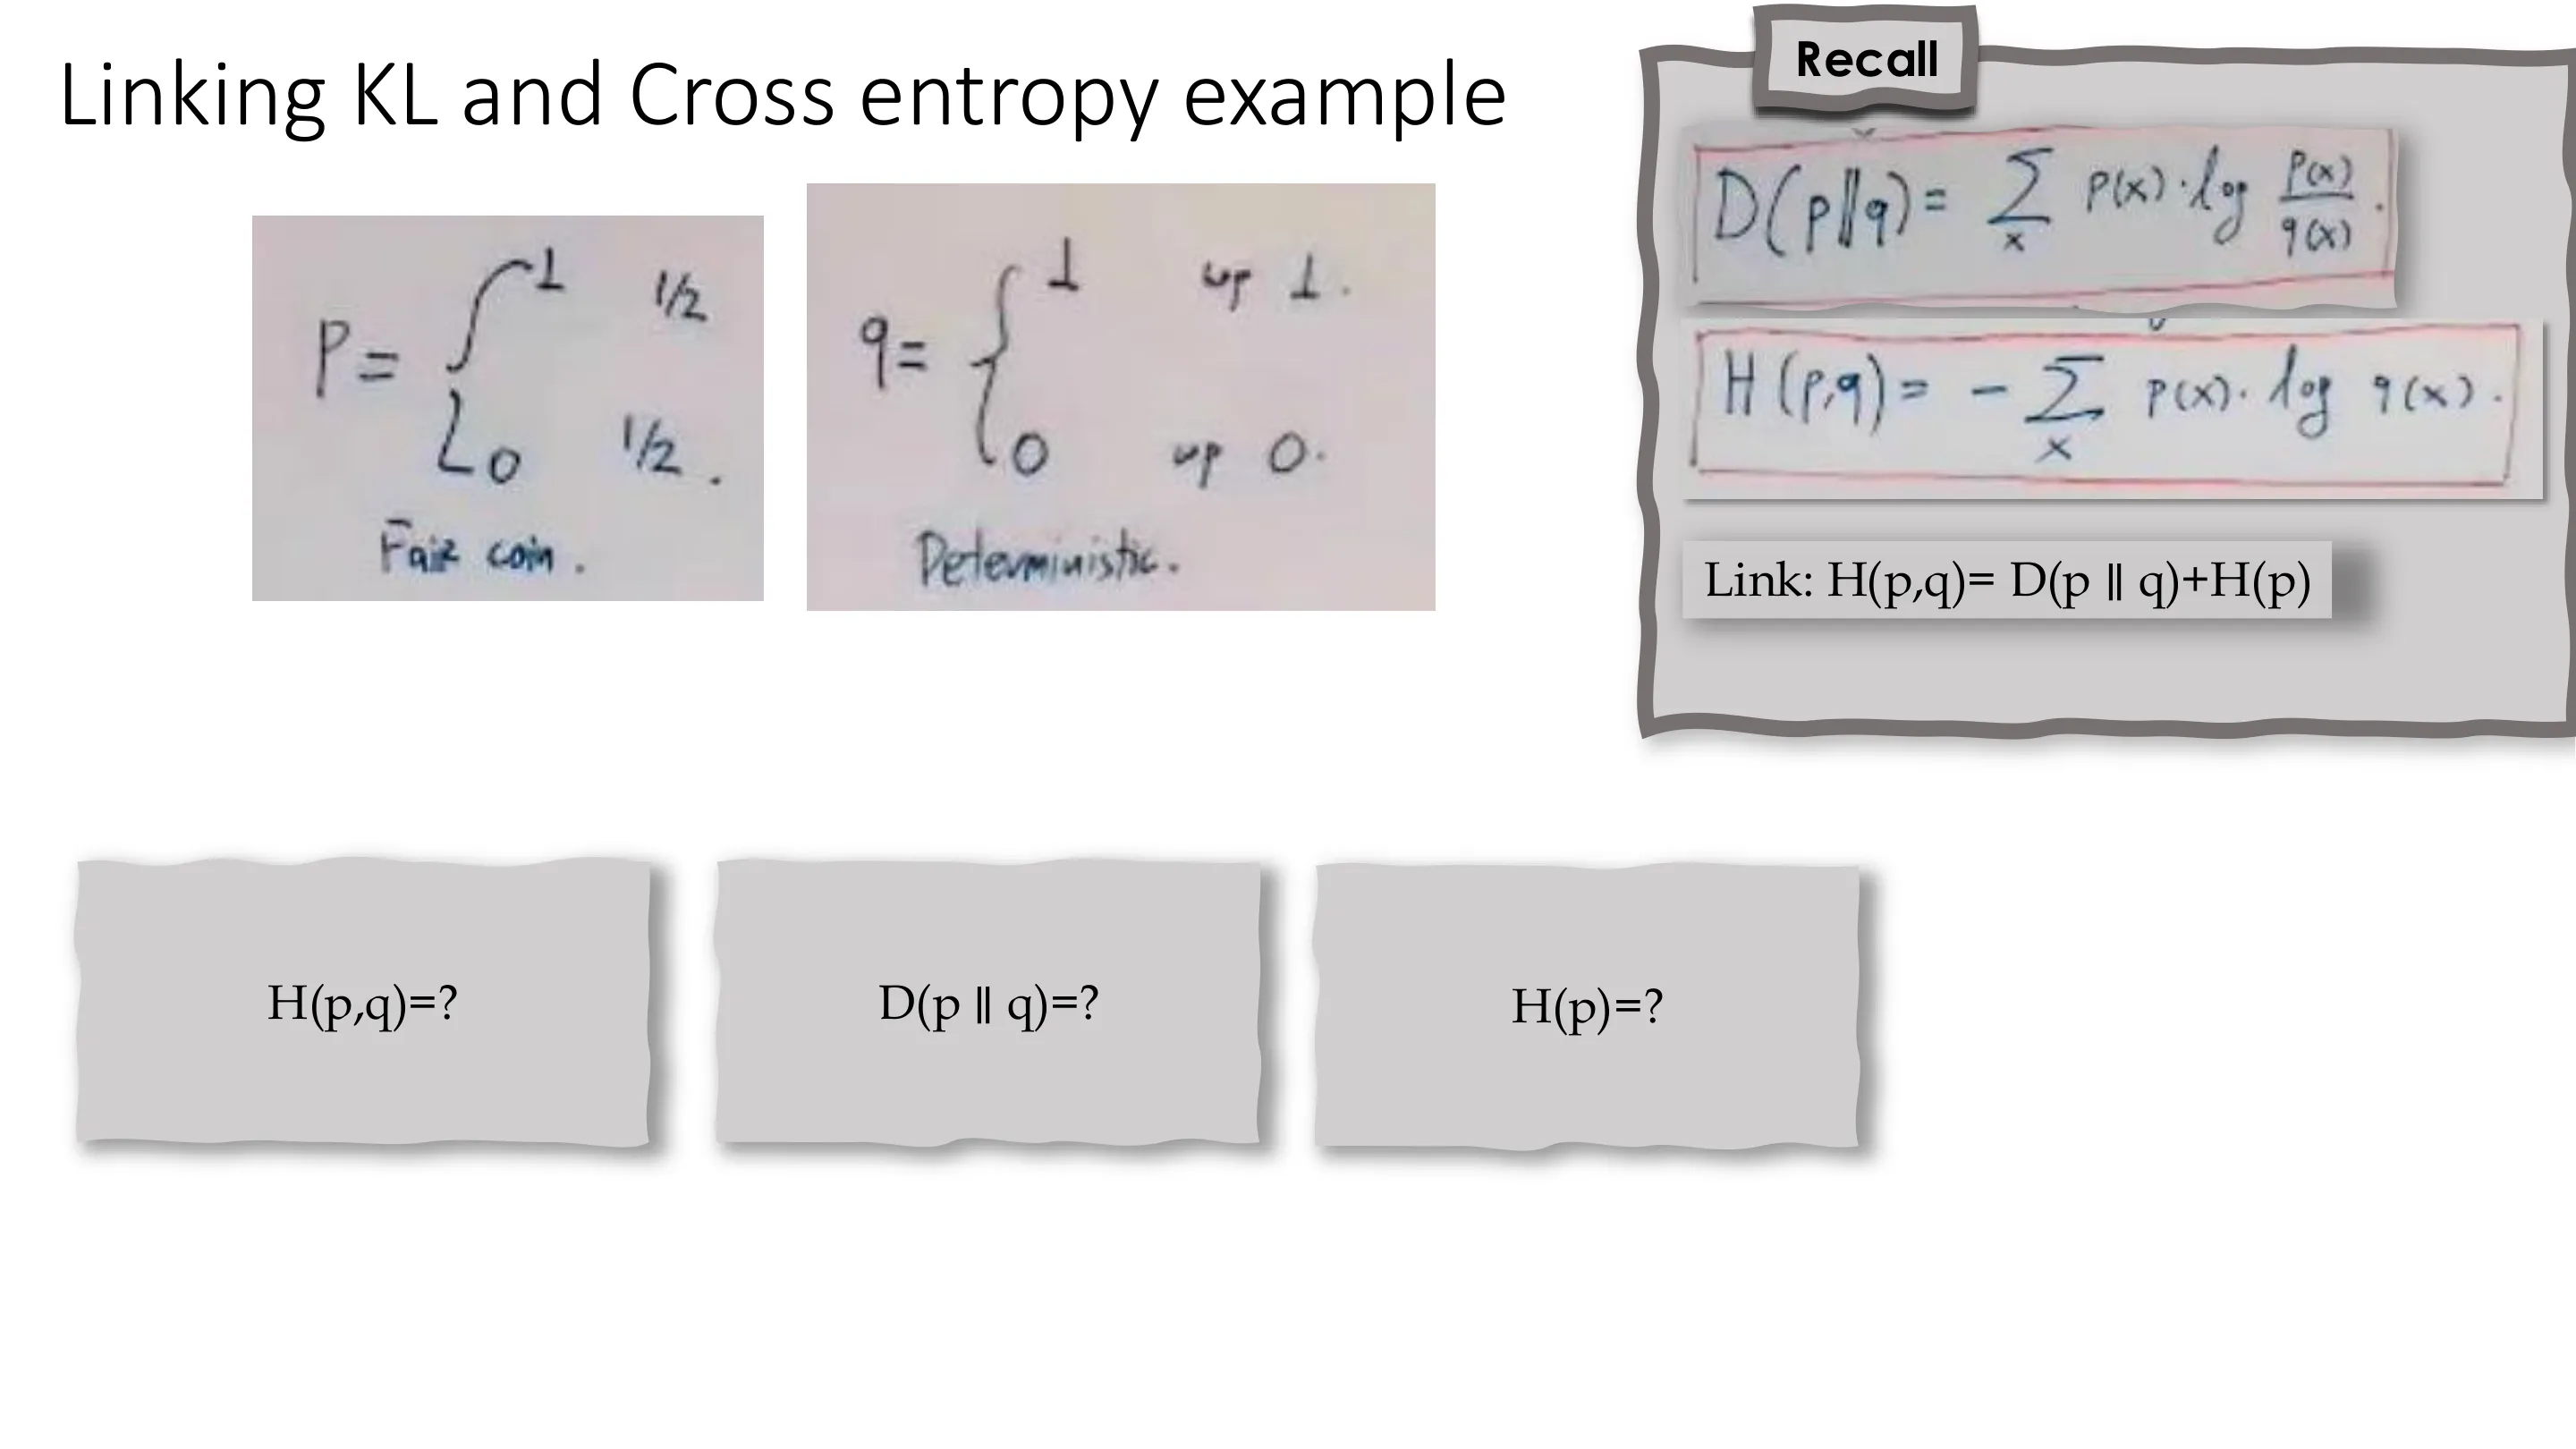
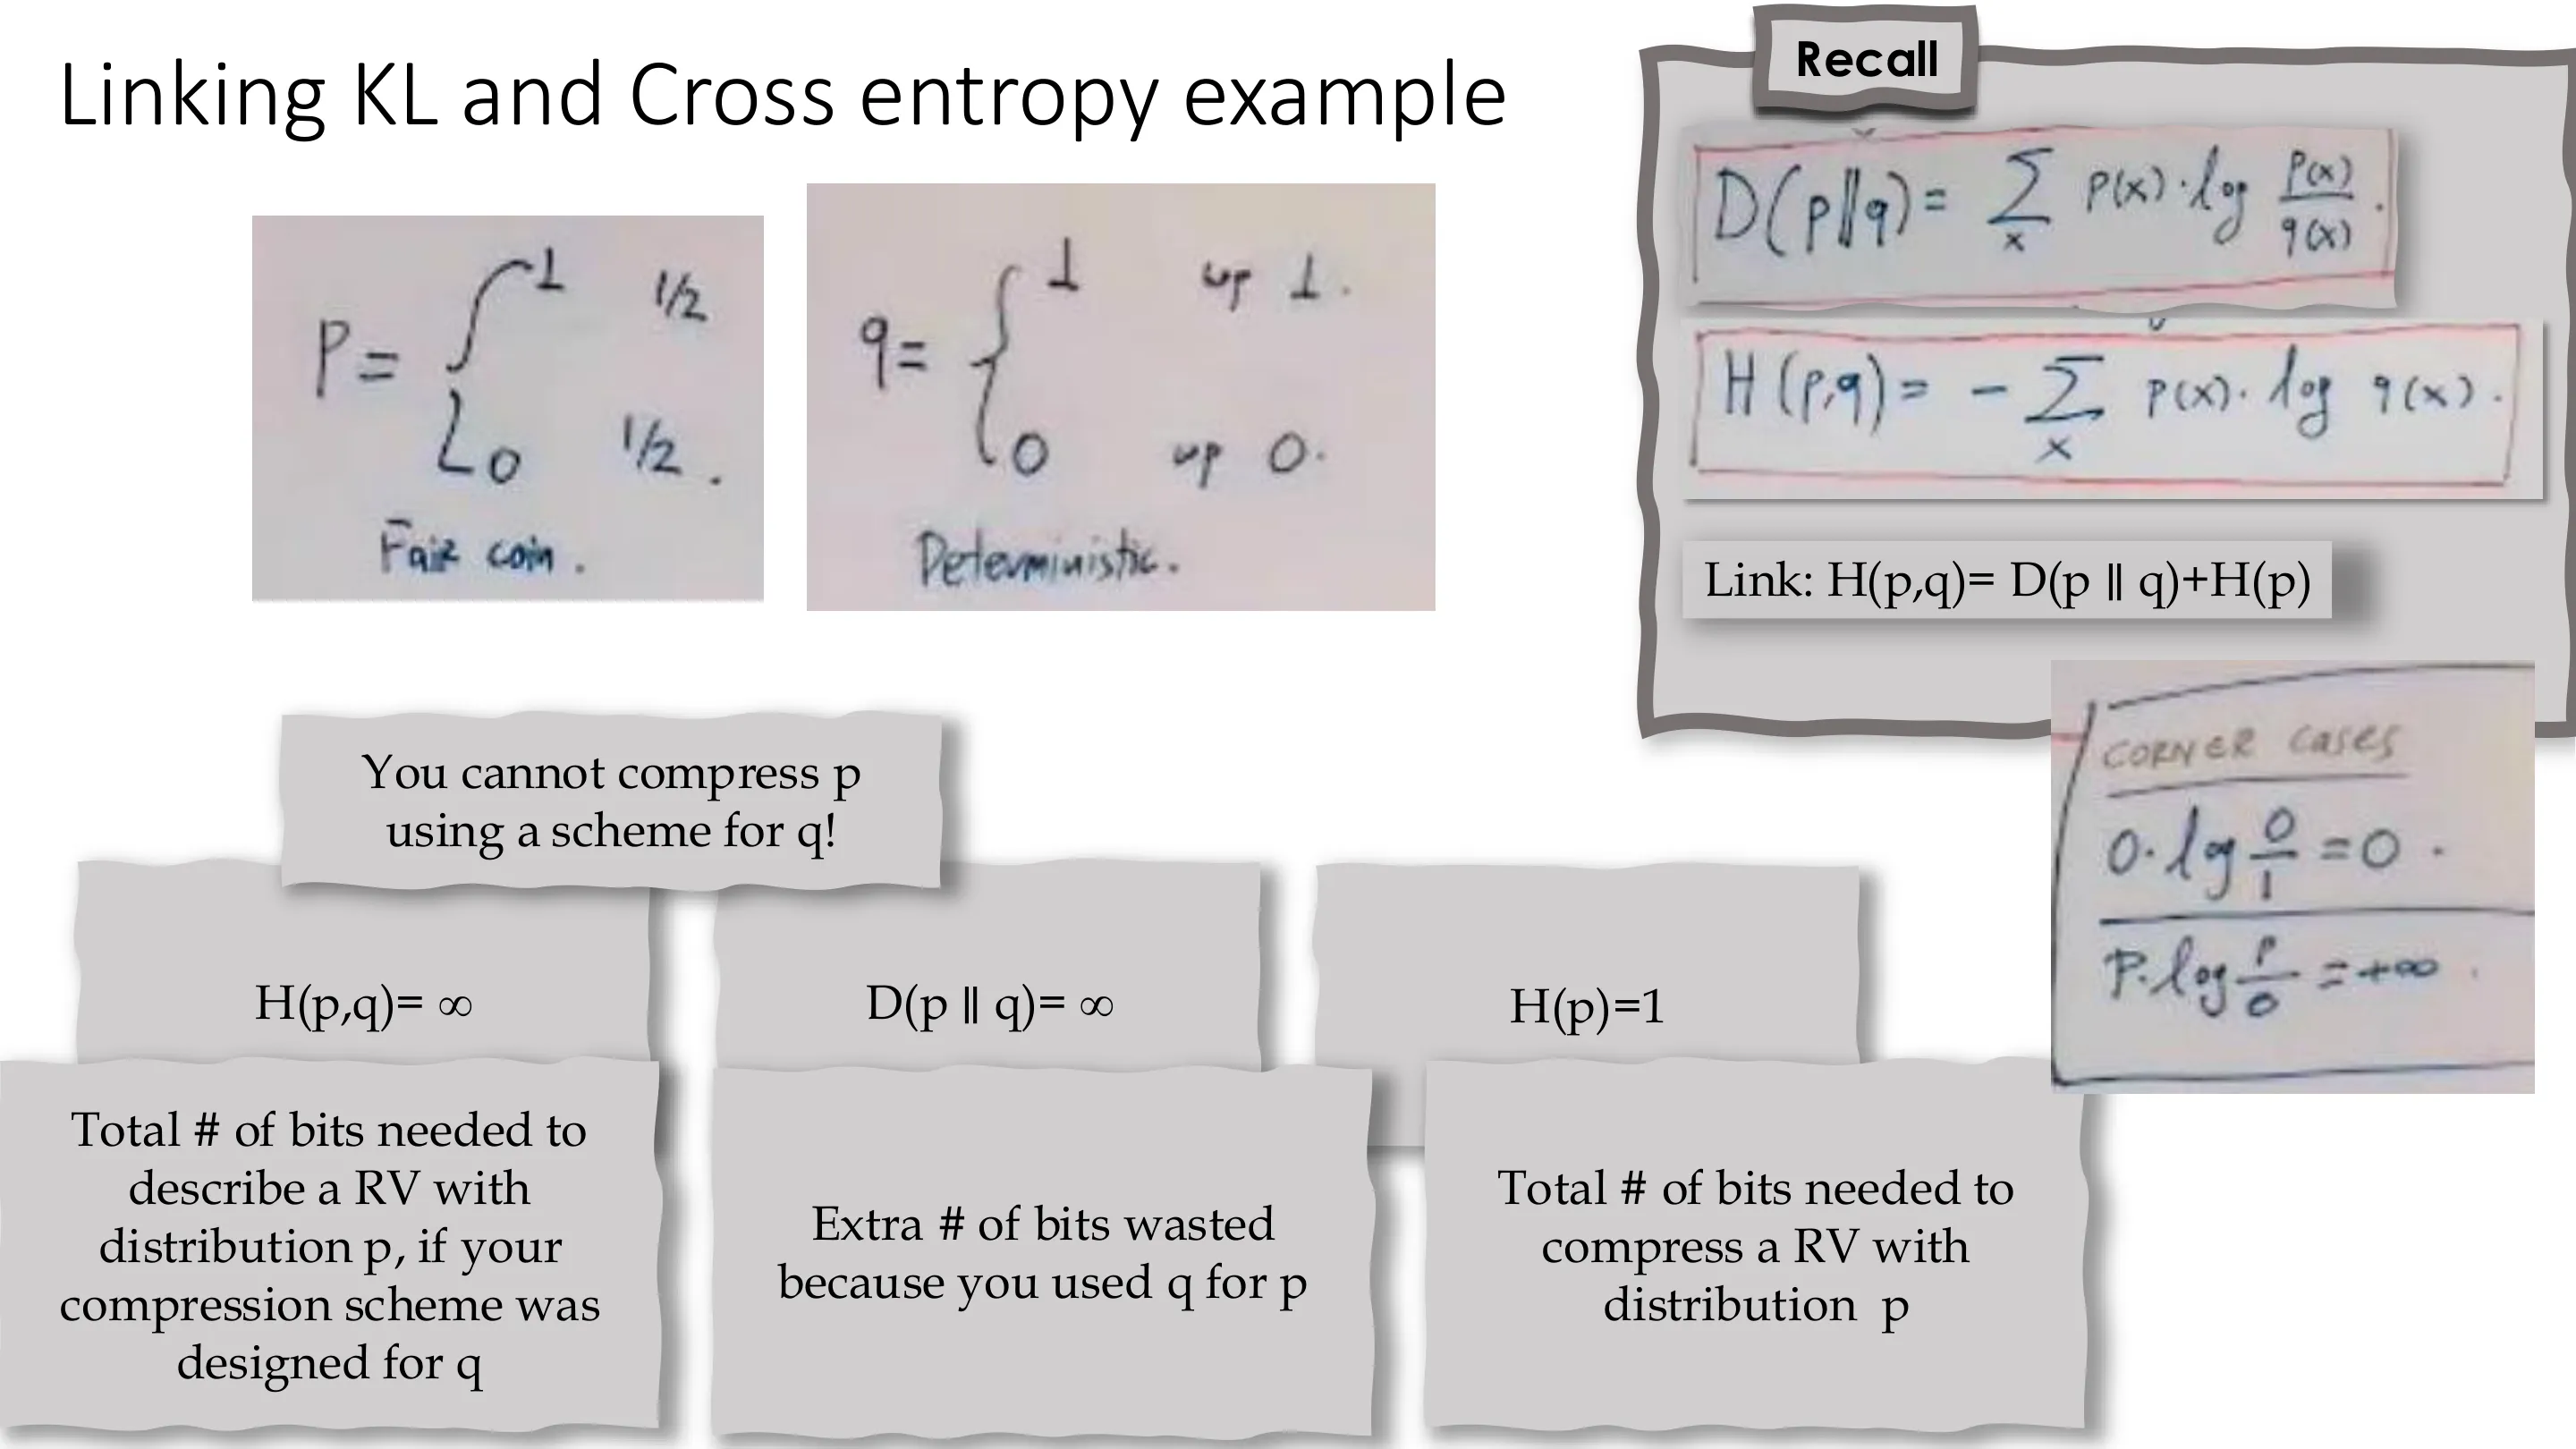
例子:$P=$ Bernoulli(0.5)(公平硬币),$Q=$ 确定性(从不"下雨")。$H(P)=1$,$H(P,Q)=+\infty$;反方向 $H(Q,P)=0$。$\infty$ 表示:为 $Q$ 设计的最优方案里根本没有表示另一个结果的符号,因此无法表示 $P$。
📷 KL 散度与交叉熵(一)
回到原视频 (00:23:27)
📷 KL 散度与交叉熵(二)
回到原视频 (00:24:40)
📷 KL 散度与交叉熵(三)
回到原视频 (00:25:53)
📷 KL 散度与交叉熵(四)
回到原视频 (00:27:06)
📷 KL 散度与交叉熵(五)
回到原视频 (00:28:19)
📷 交叉熵的定义
回到原视频 (00:29:32)
📷 交叉熵(一)
回到原视频 (00:30:45)
📷 交叉熵(二)
回到原视频 (00:31:58)
📷 让我们建立联系
回到原视频 (00:33:11)
📷 描述所需的总比特数
回到原视频 (00:34:24)
📷 回顾
回到原视频 (00:35:37)
📷 KL 与交叉熵的联系示例(一)
回到原视频 (00:36:50)
📷 KL 与交叉熵的联系示例(二)
回到原视频 (00:38:03)
📷 KL 与交叉熵的联系示例(三)
回到原视频 (00:39:16)
📷 KL 与交叉熵的联系示例(四)
回到原视频 (00:40:29)
📷 KL 与交叉熵的联系示例(五)
回到原视频 (00:41:42)
📷 小结
回到原视频 (00:42:55)
在分类中的意义:$P$ 是「自然界给猫狗的分布」(对每张图,真实标签是确定性的 one-hot),$Q$ 是你的分类器给出的分布。当分类器完美时 $Q=P$,KL 为零,交叉熵达到下界 = 熵。这正是我们要最小化的目标。
三、逻辑回归就是交叉熵
3.1 逻辑回归回顾
(参考时间: 00:43)
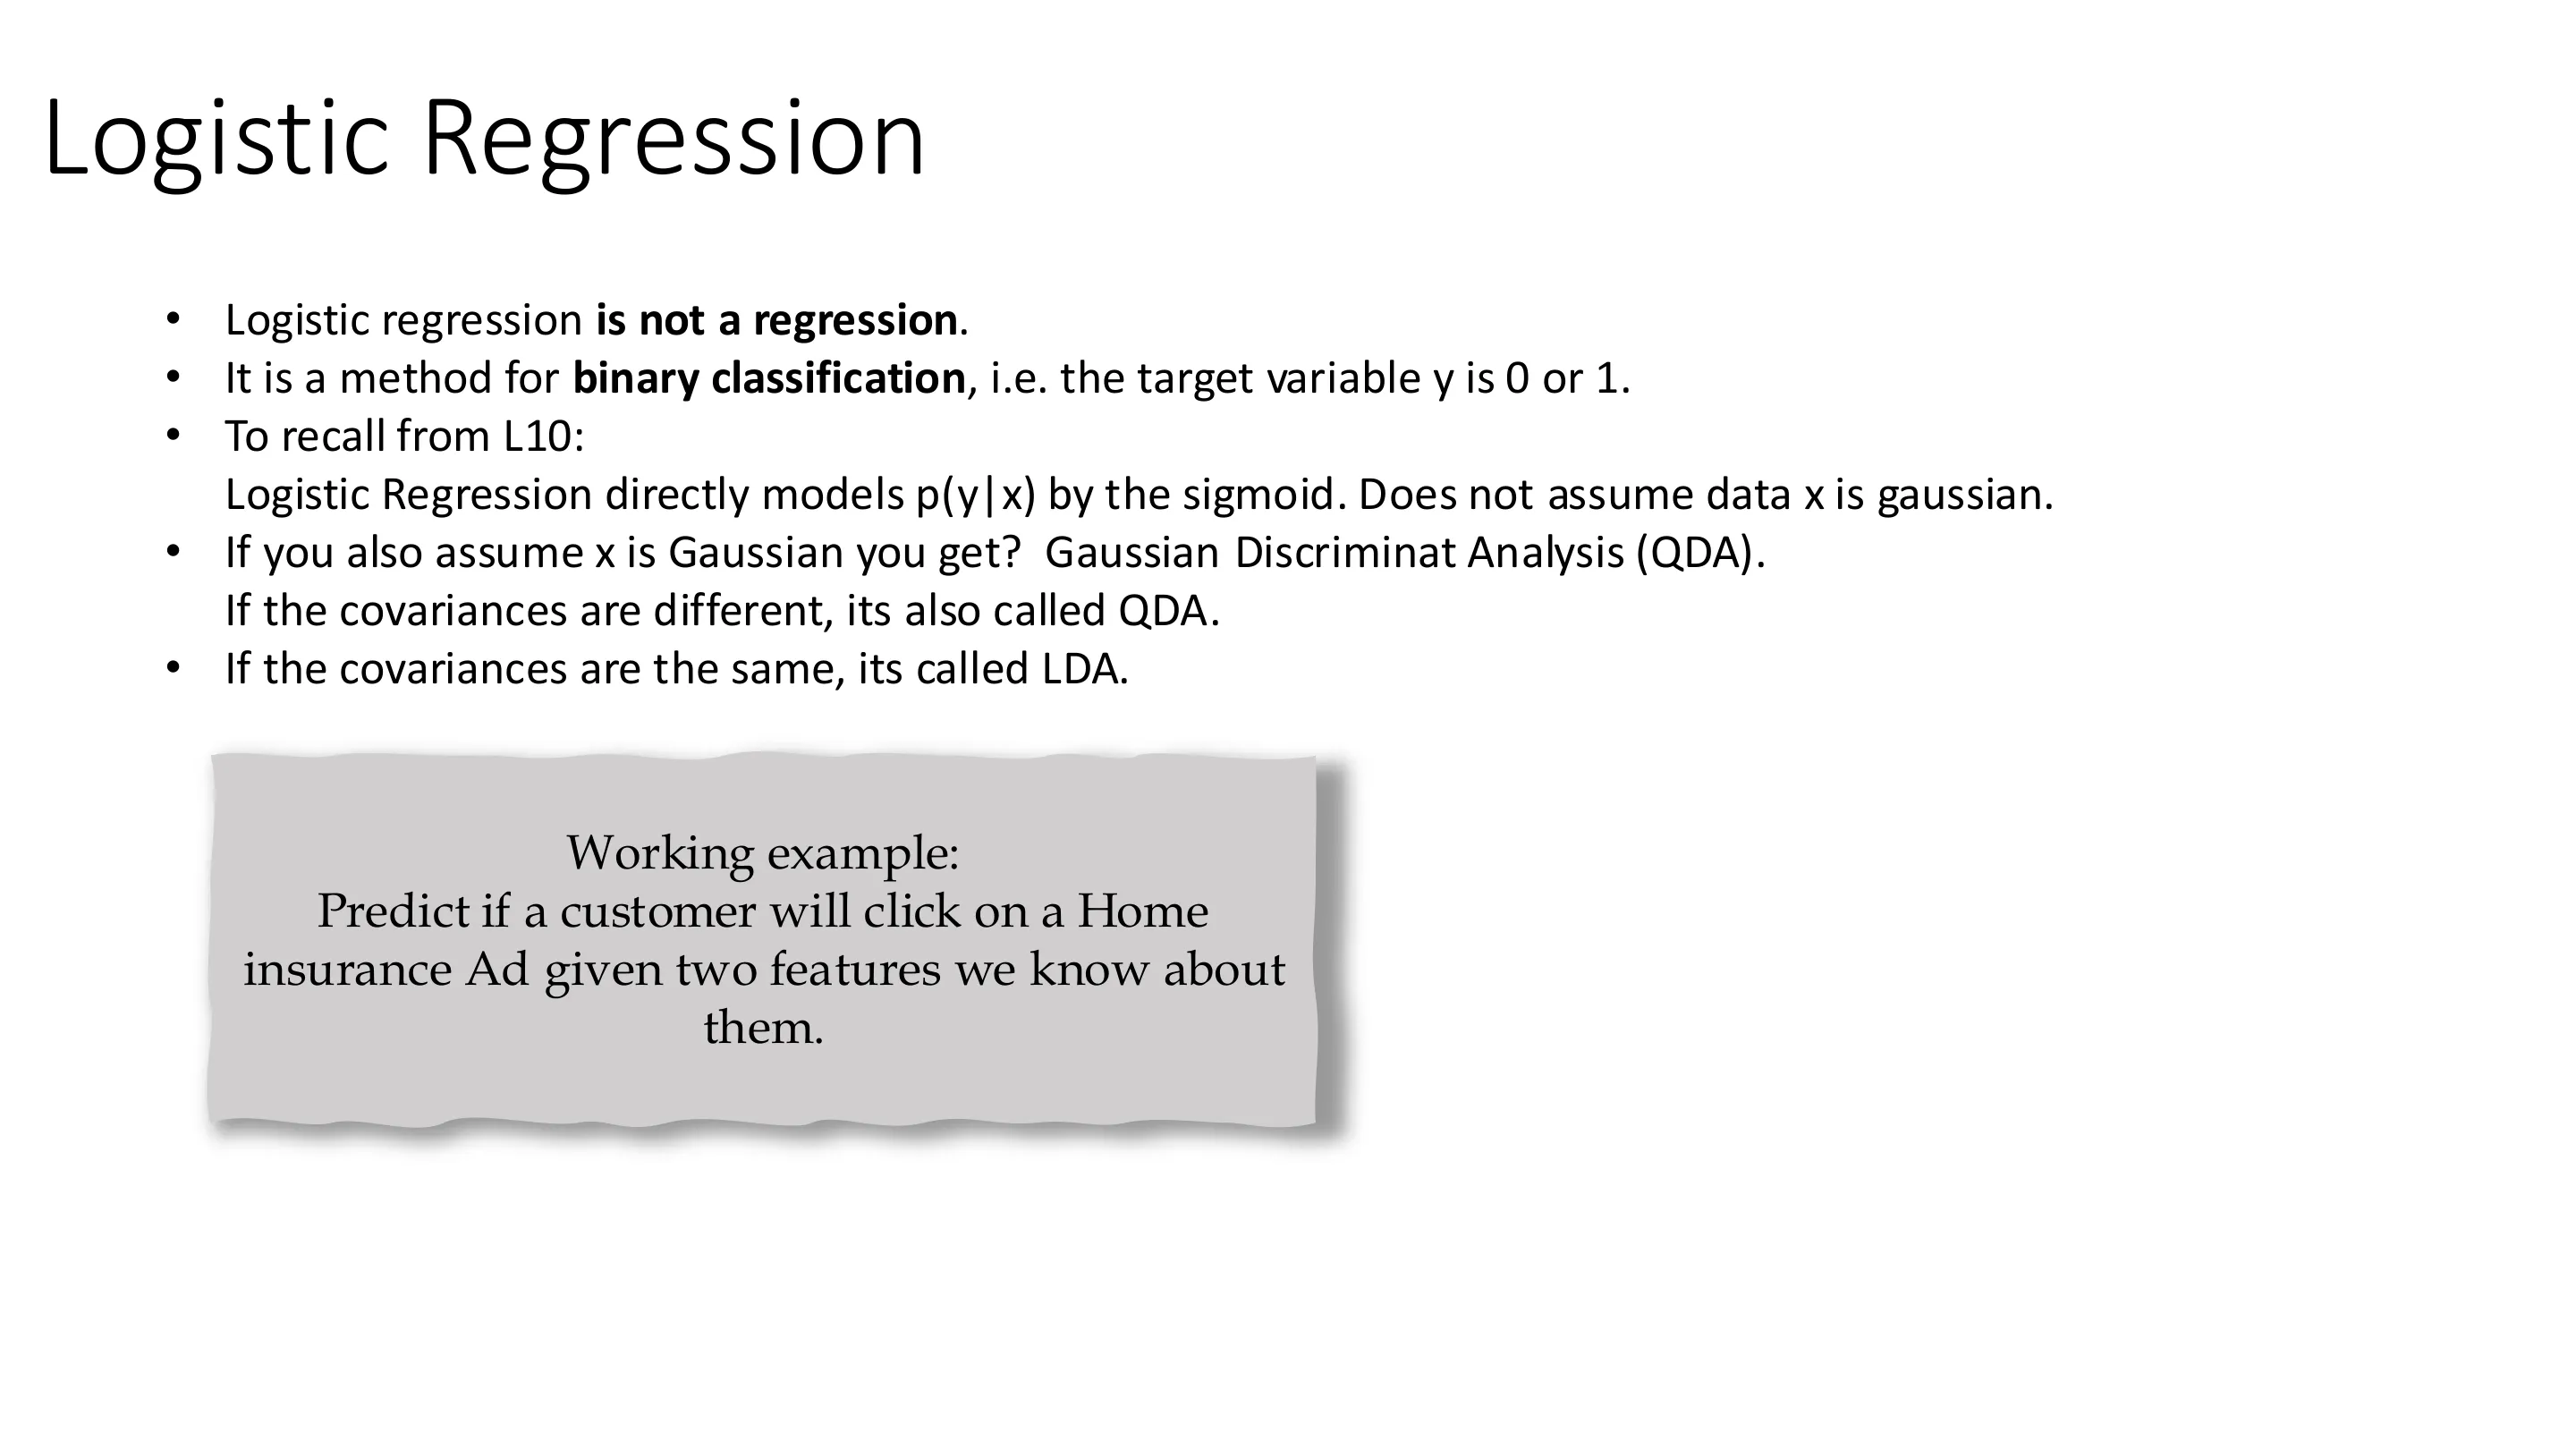
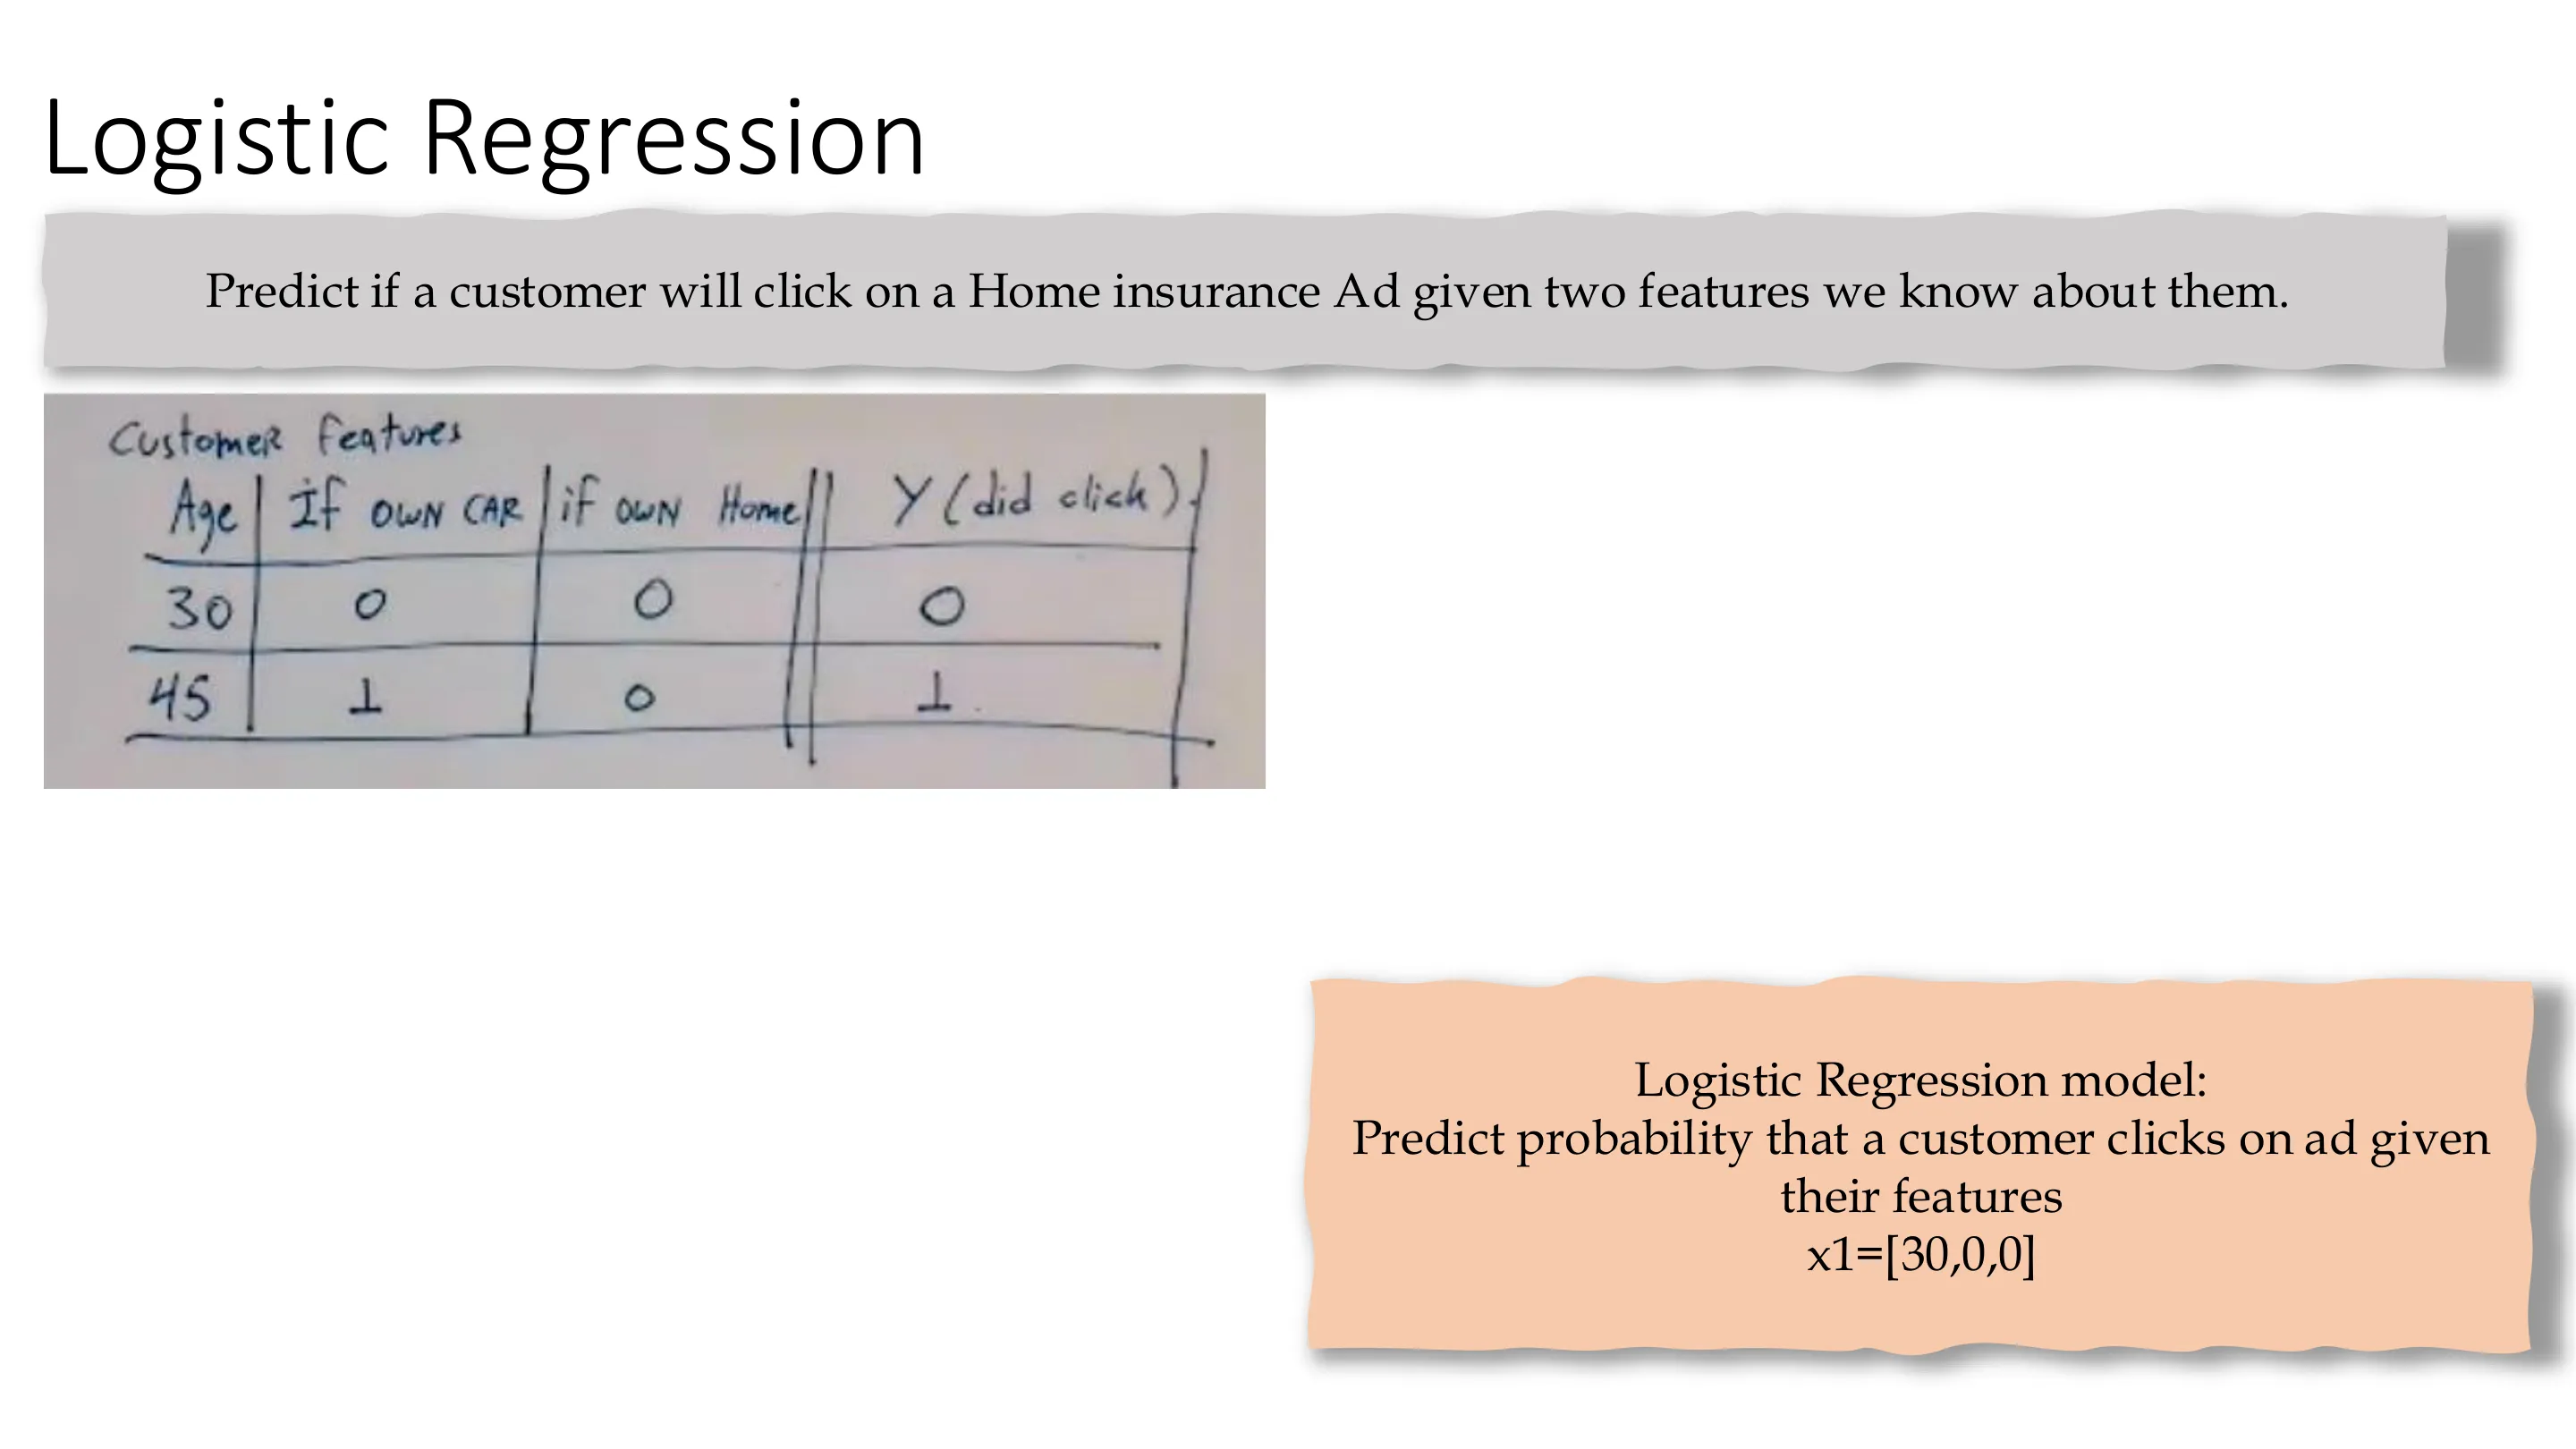
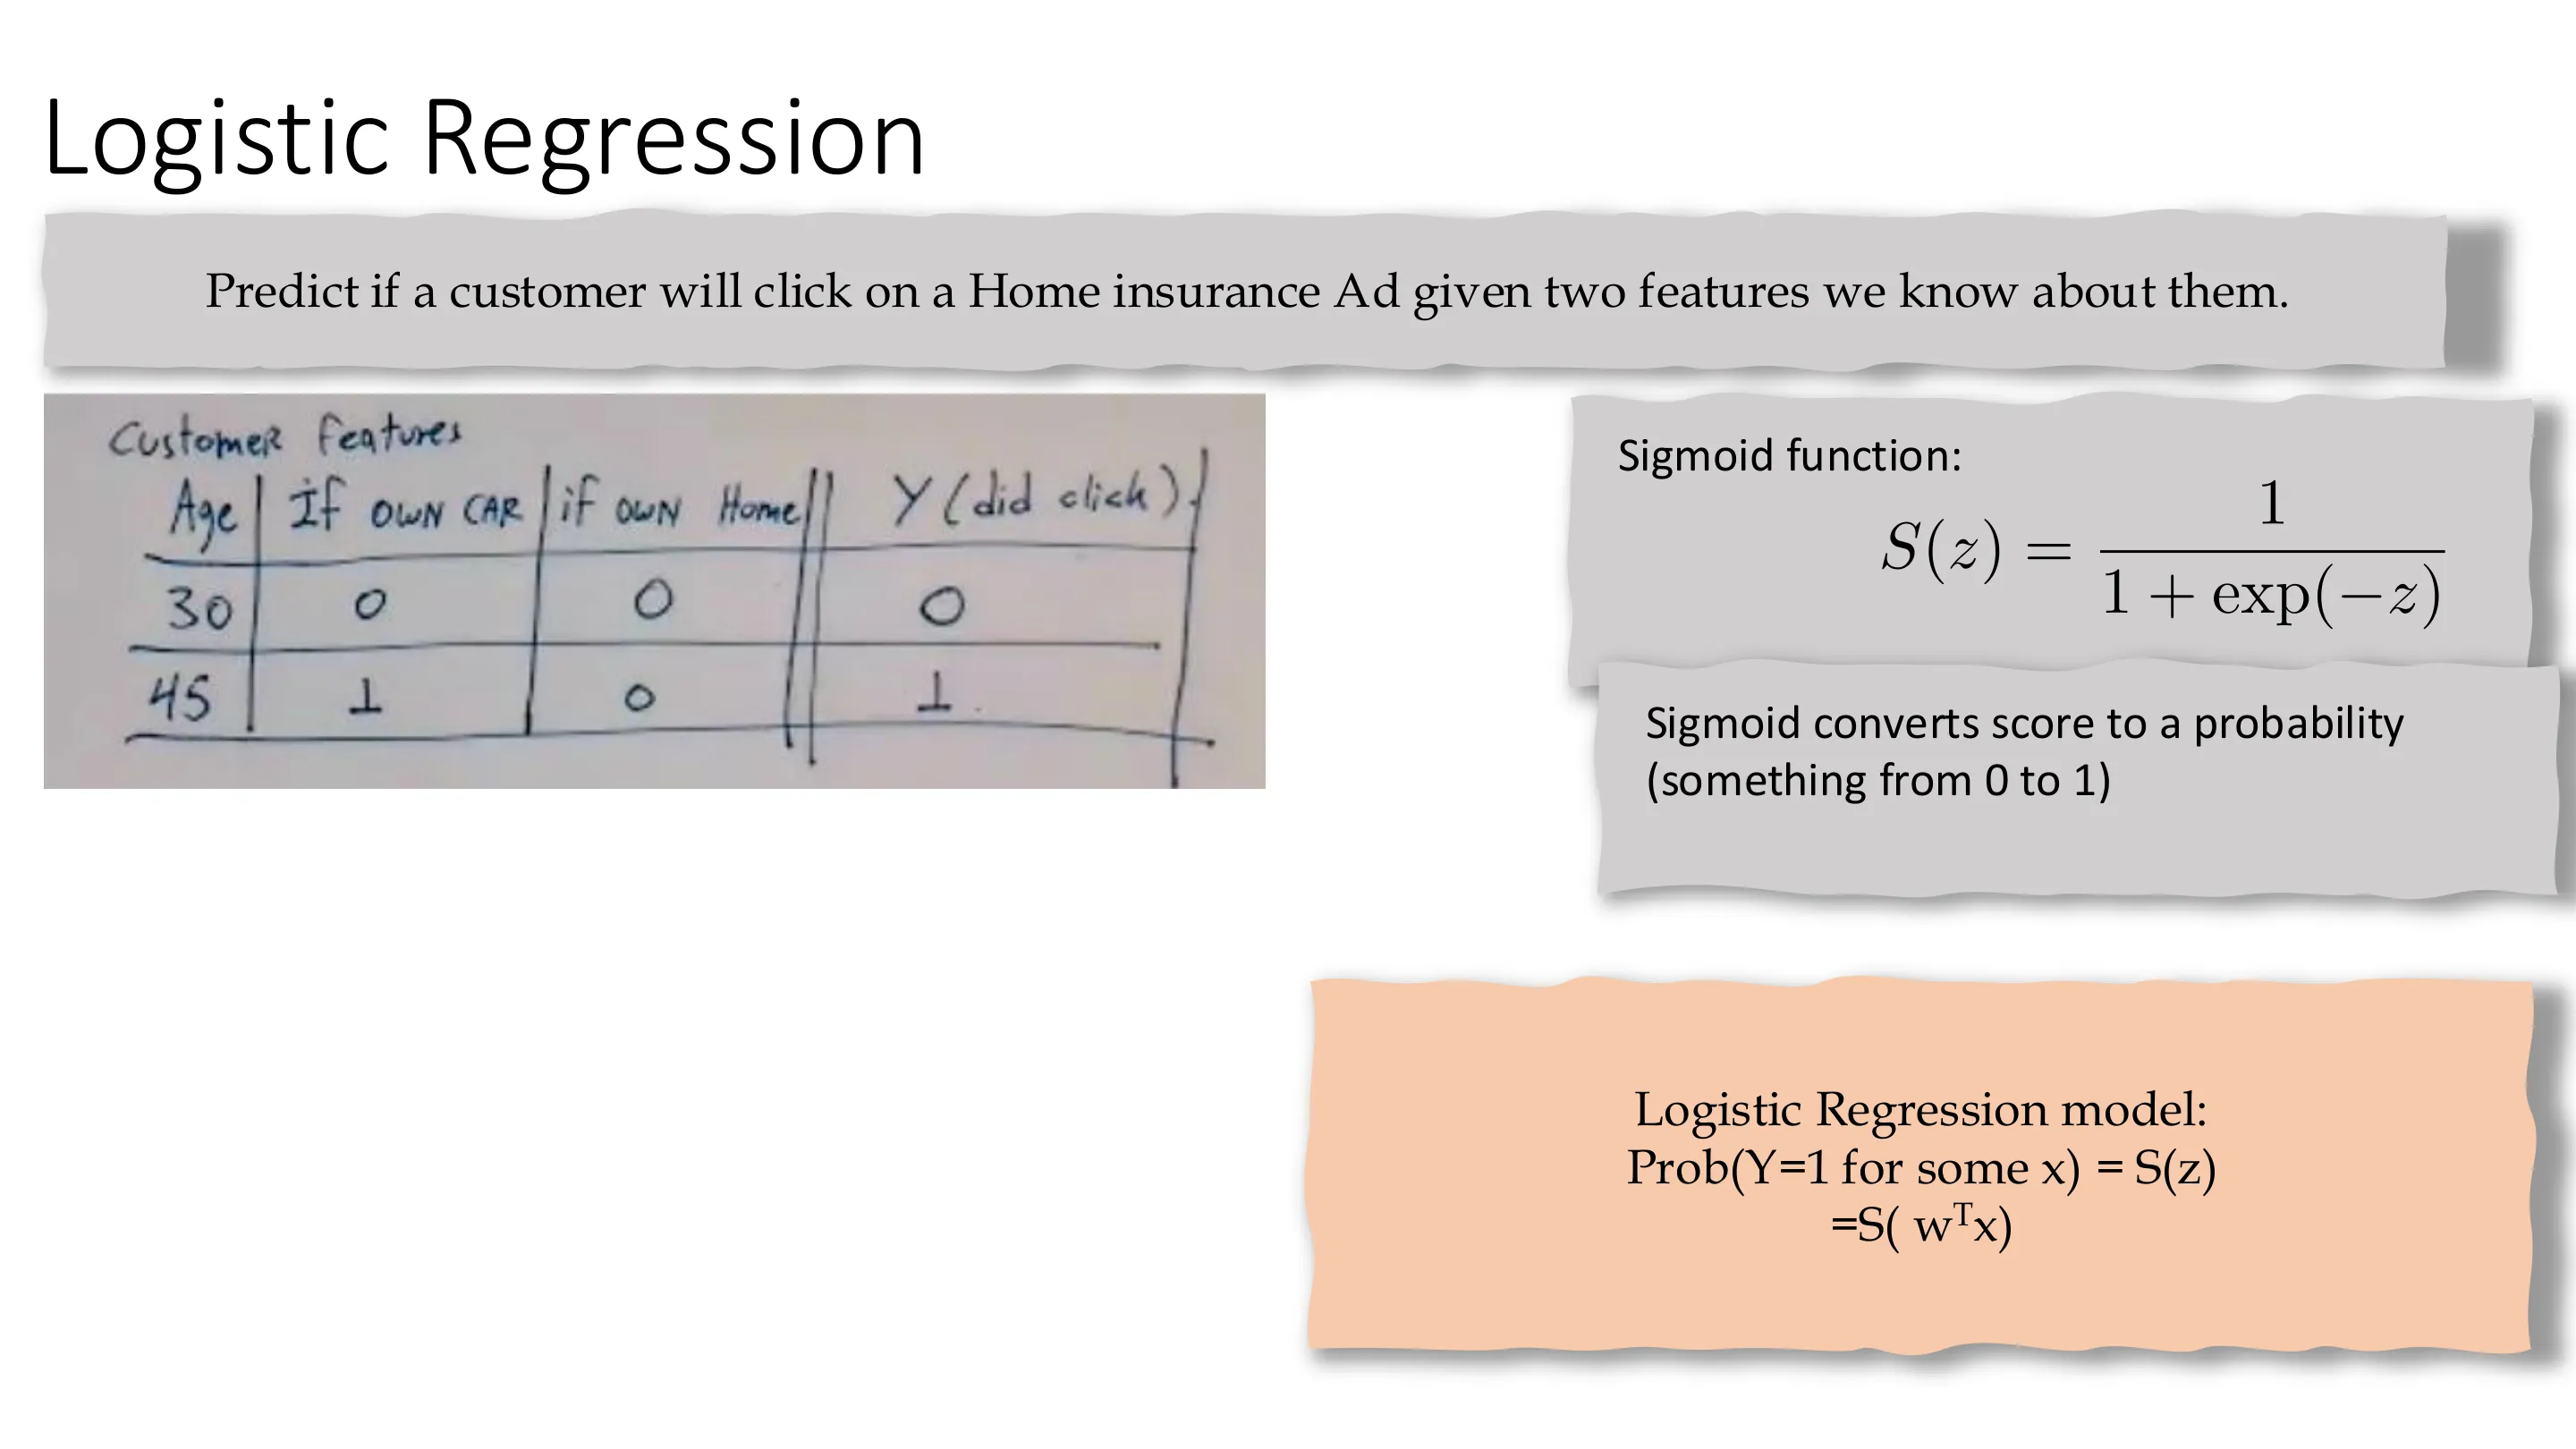
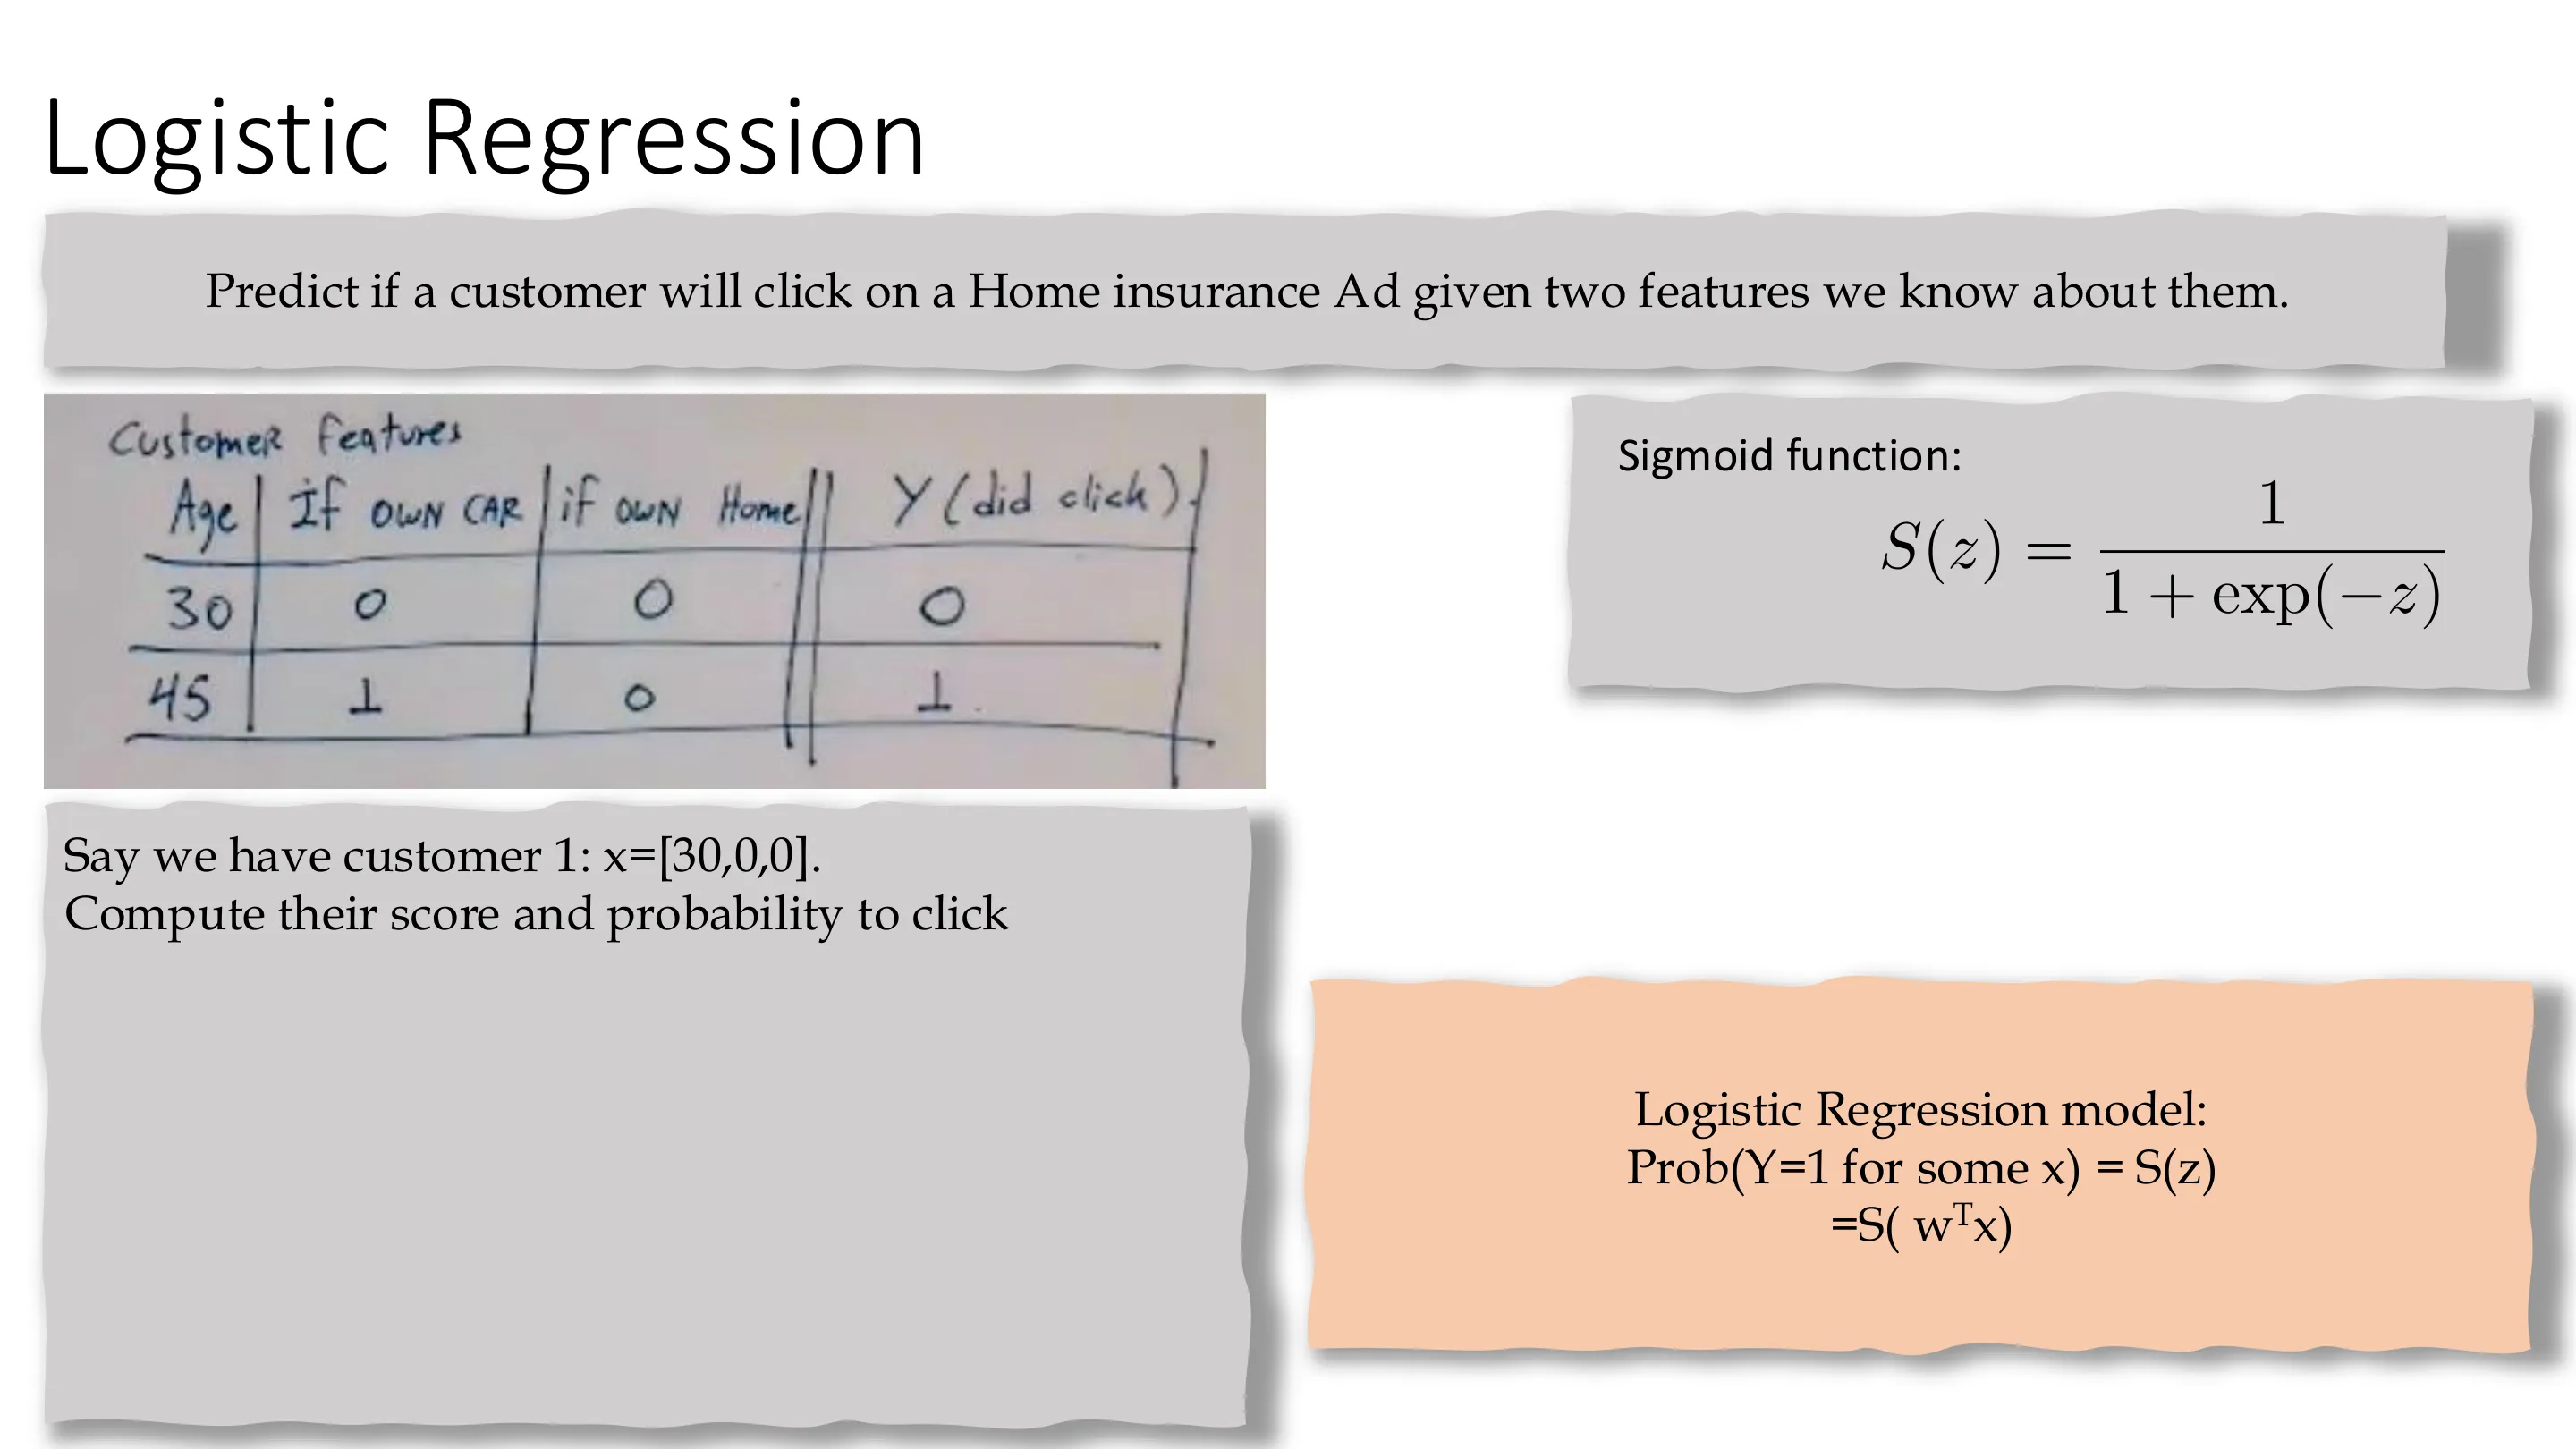
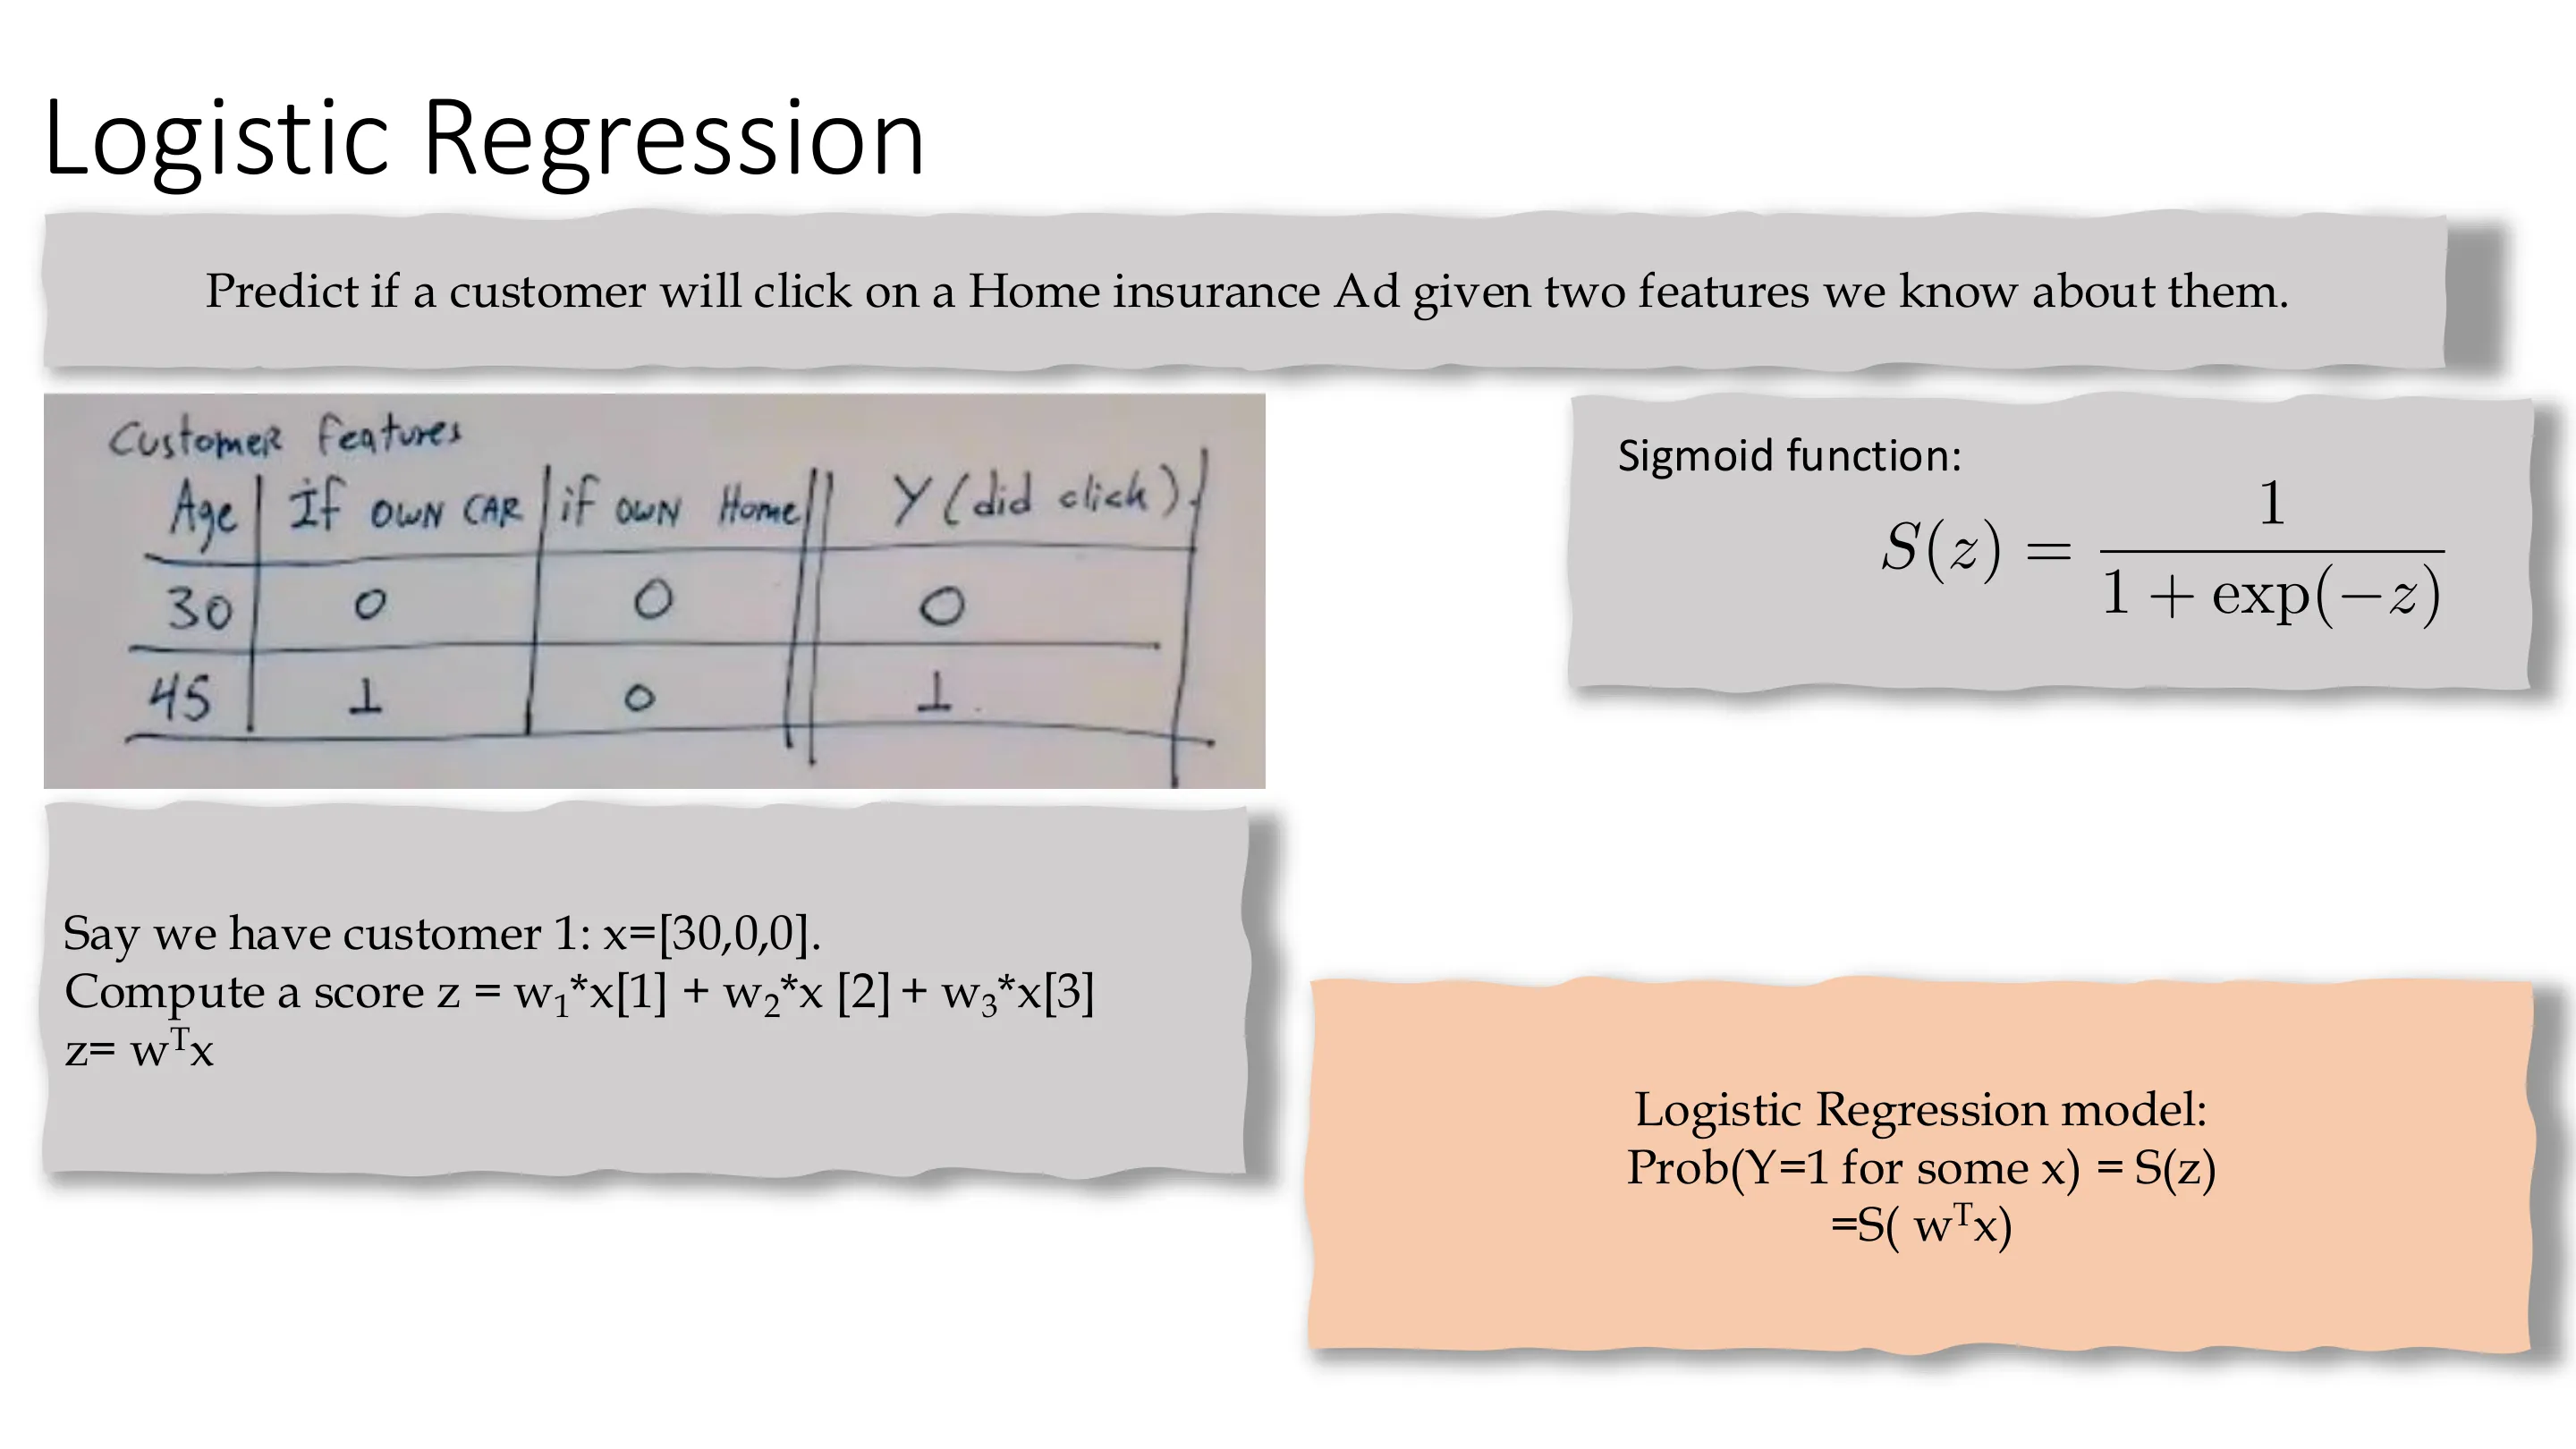
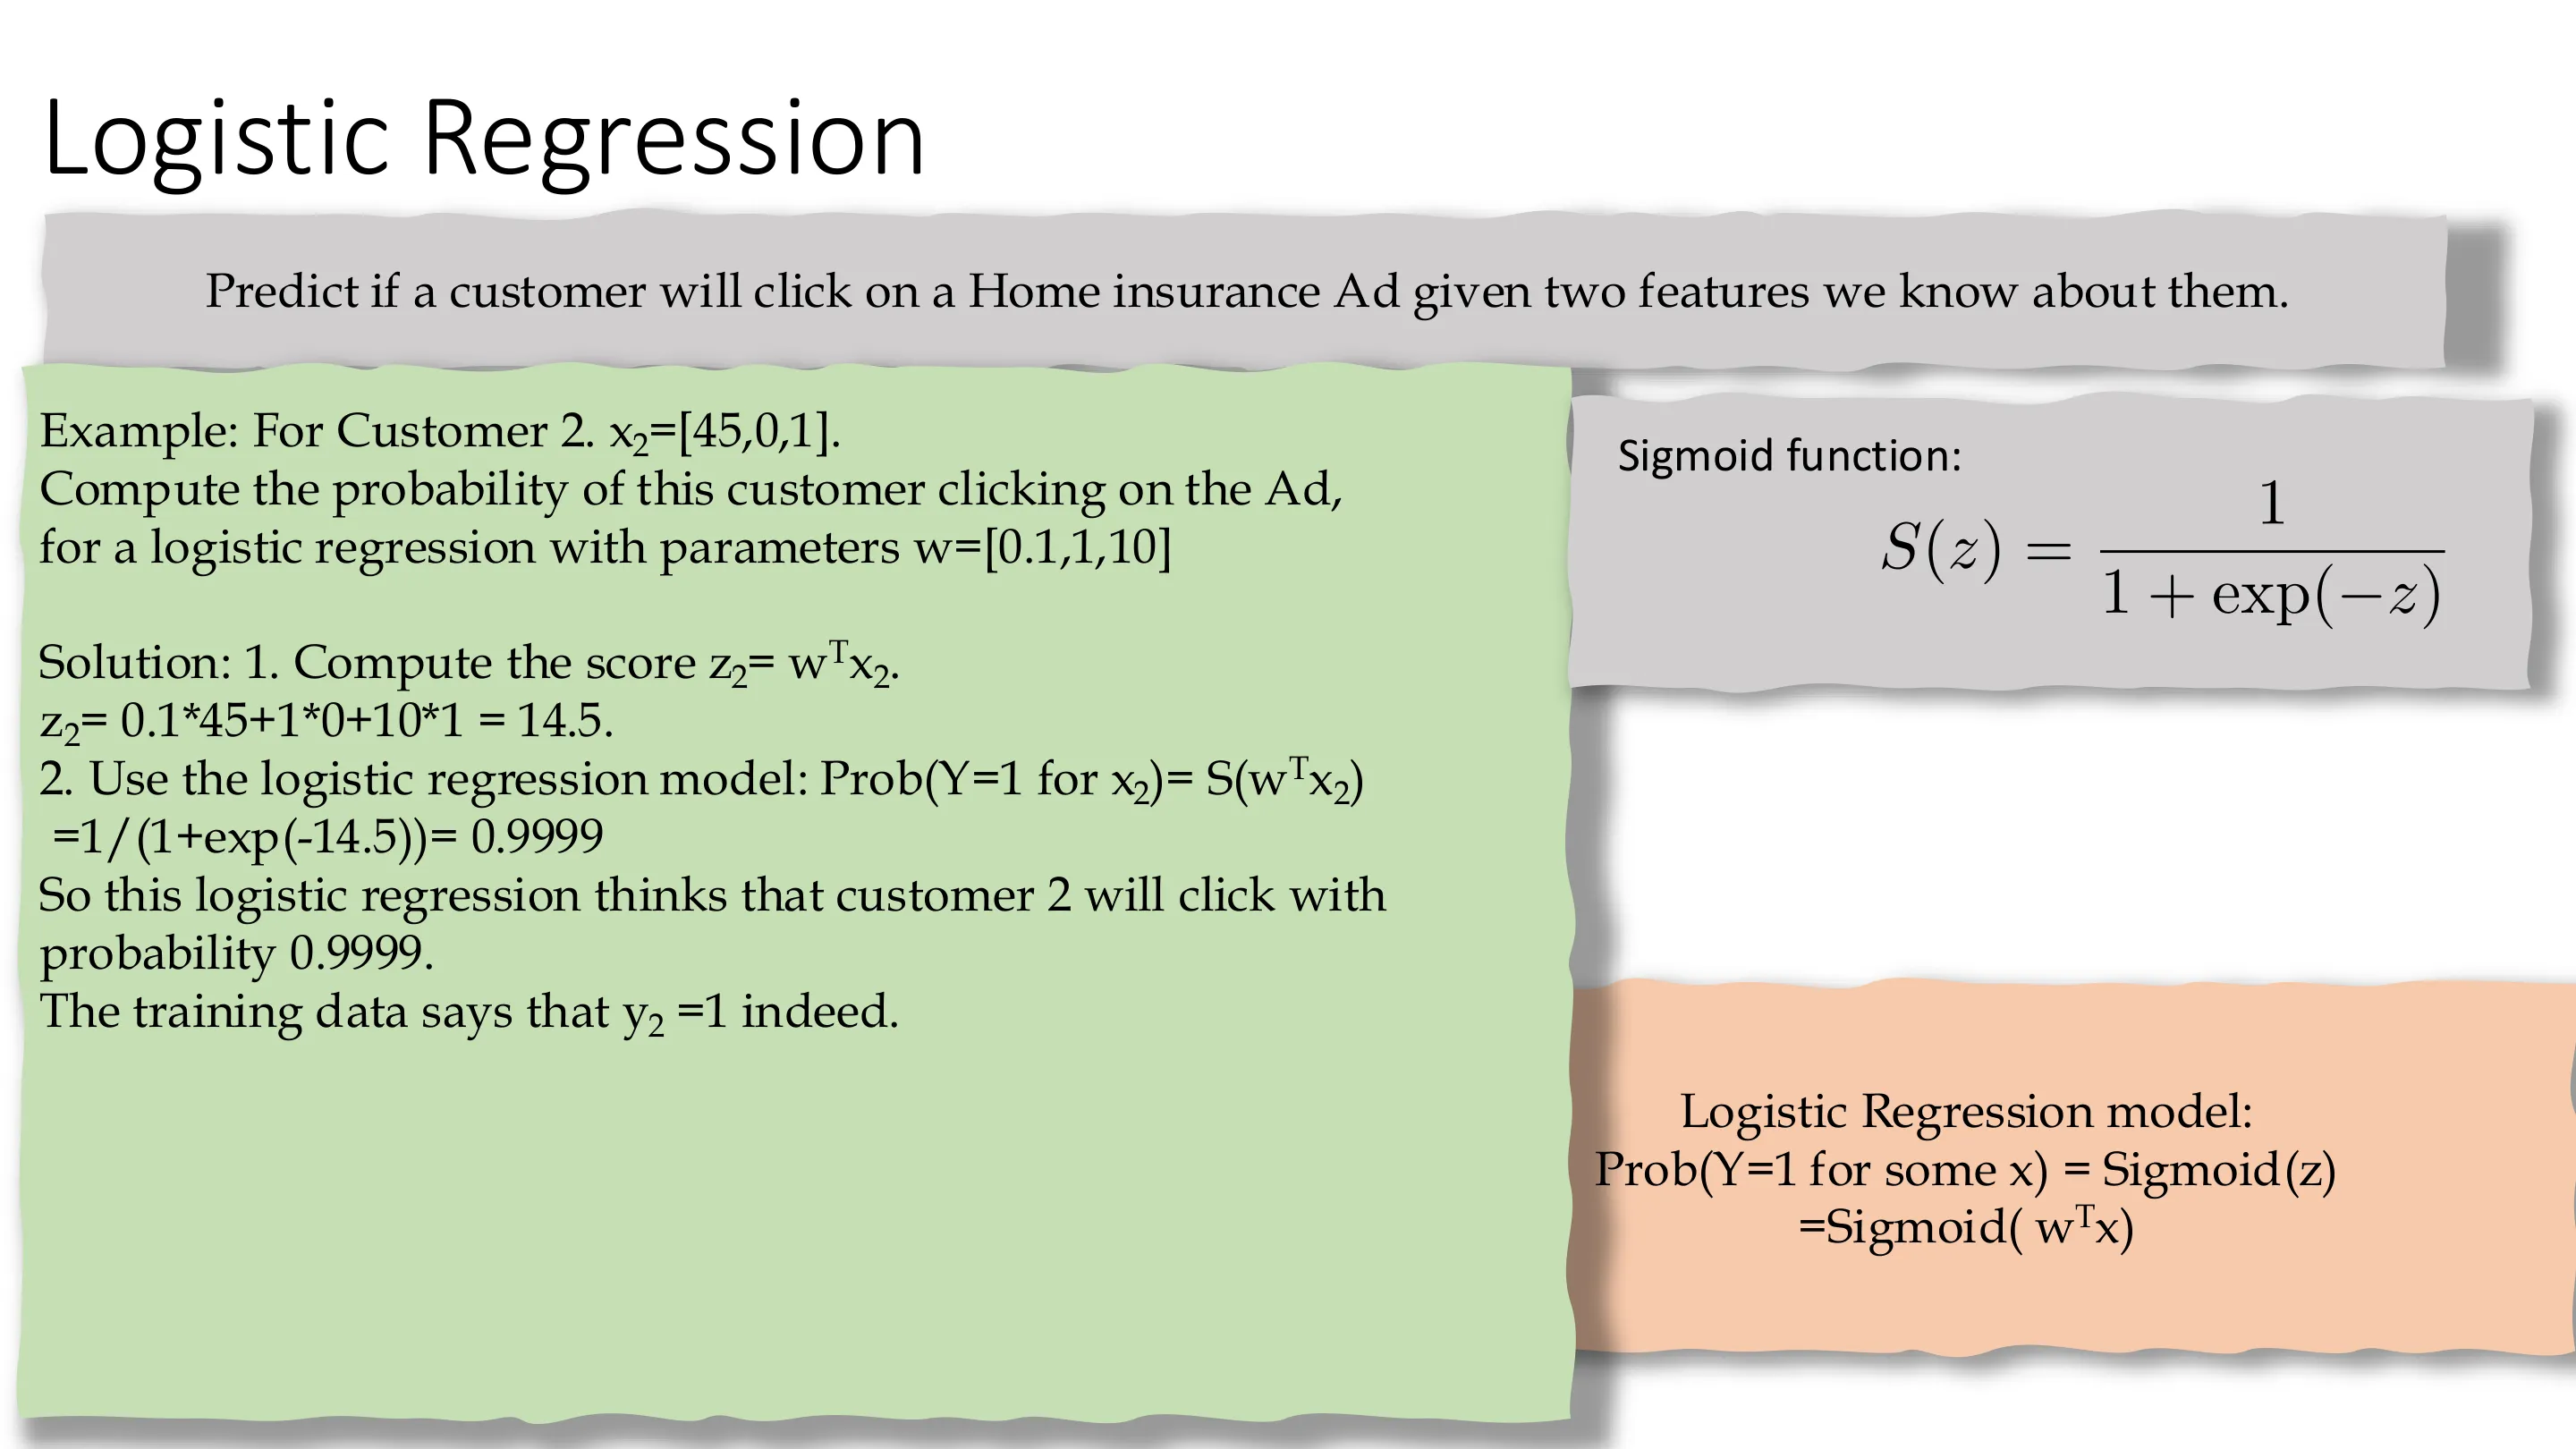
逻辑回归不是回归,而是二元分类;它只建模 $P(Y\mid X)$,因此是判别式分类器(生成式则还要建模 $P(X)$,如假设高斯先验会得到 LDA/QDA)。
模型:特征 $x$ 与权重 $w$ 内积得分数,过 Sigmoid 得到概率:
$$ P(Y=1\mid x)=\sigma(w^\top x)=\frac{1}{1+e^{-w^\top x}} $$
- 内积很大 ⇒ 概率趋近 1;很负 ⇒ 趋近 0。
📷 回顾逻辑回归
回到原视频 (00:44:08)
📷 逻辑回归(一)
回到原视频 (00:45:21)
📷 逻辑回归(二)
回到原视频 (00:46:34)
📷 逻辑回归(三)
回到原视频 (00:47:47)
📷 逻辑回归(四)
回到原视频 (00:49:00)
📷 逻辑回归(五)
回到原视频 (00:50:13)
📷 逻辑回归(六)
回到原视频 (00:51:26)
📷 逻辑回归(七)
回到原视频 (00:52:39)
3.2 从最大似然到交叉熵
(参考时间: 00:47)
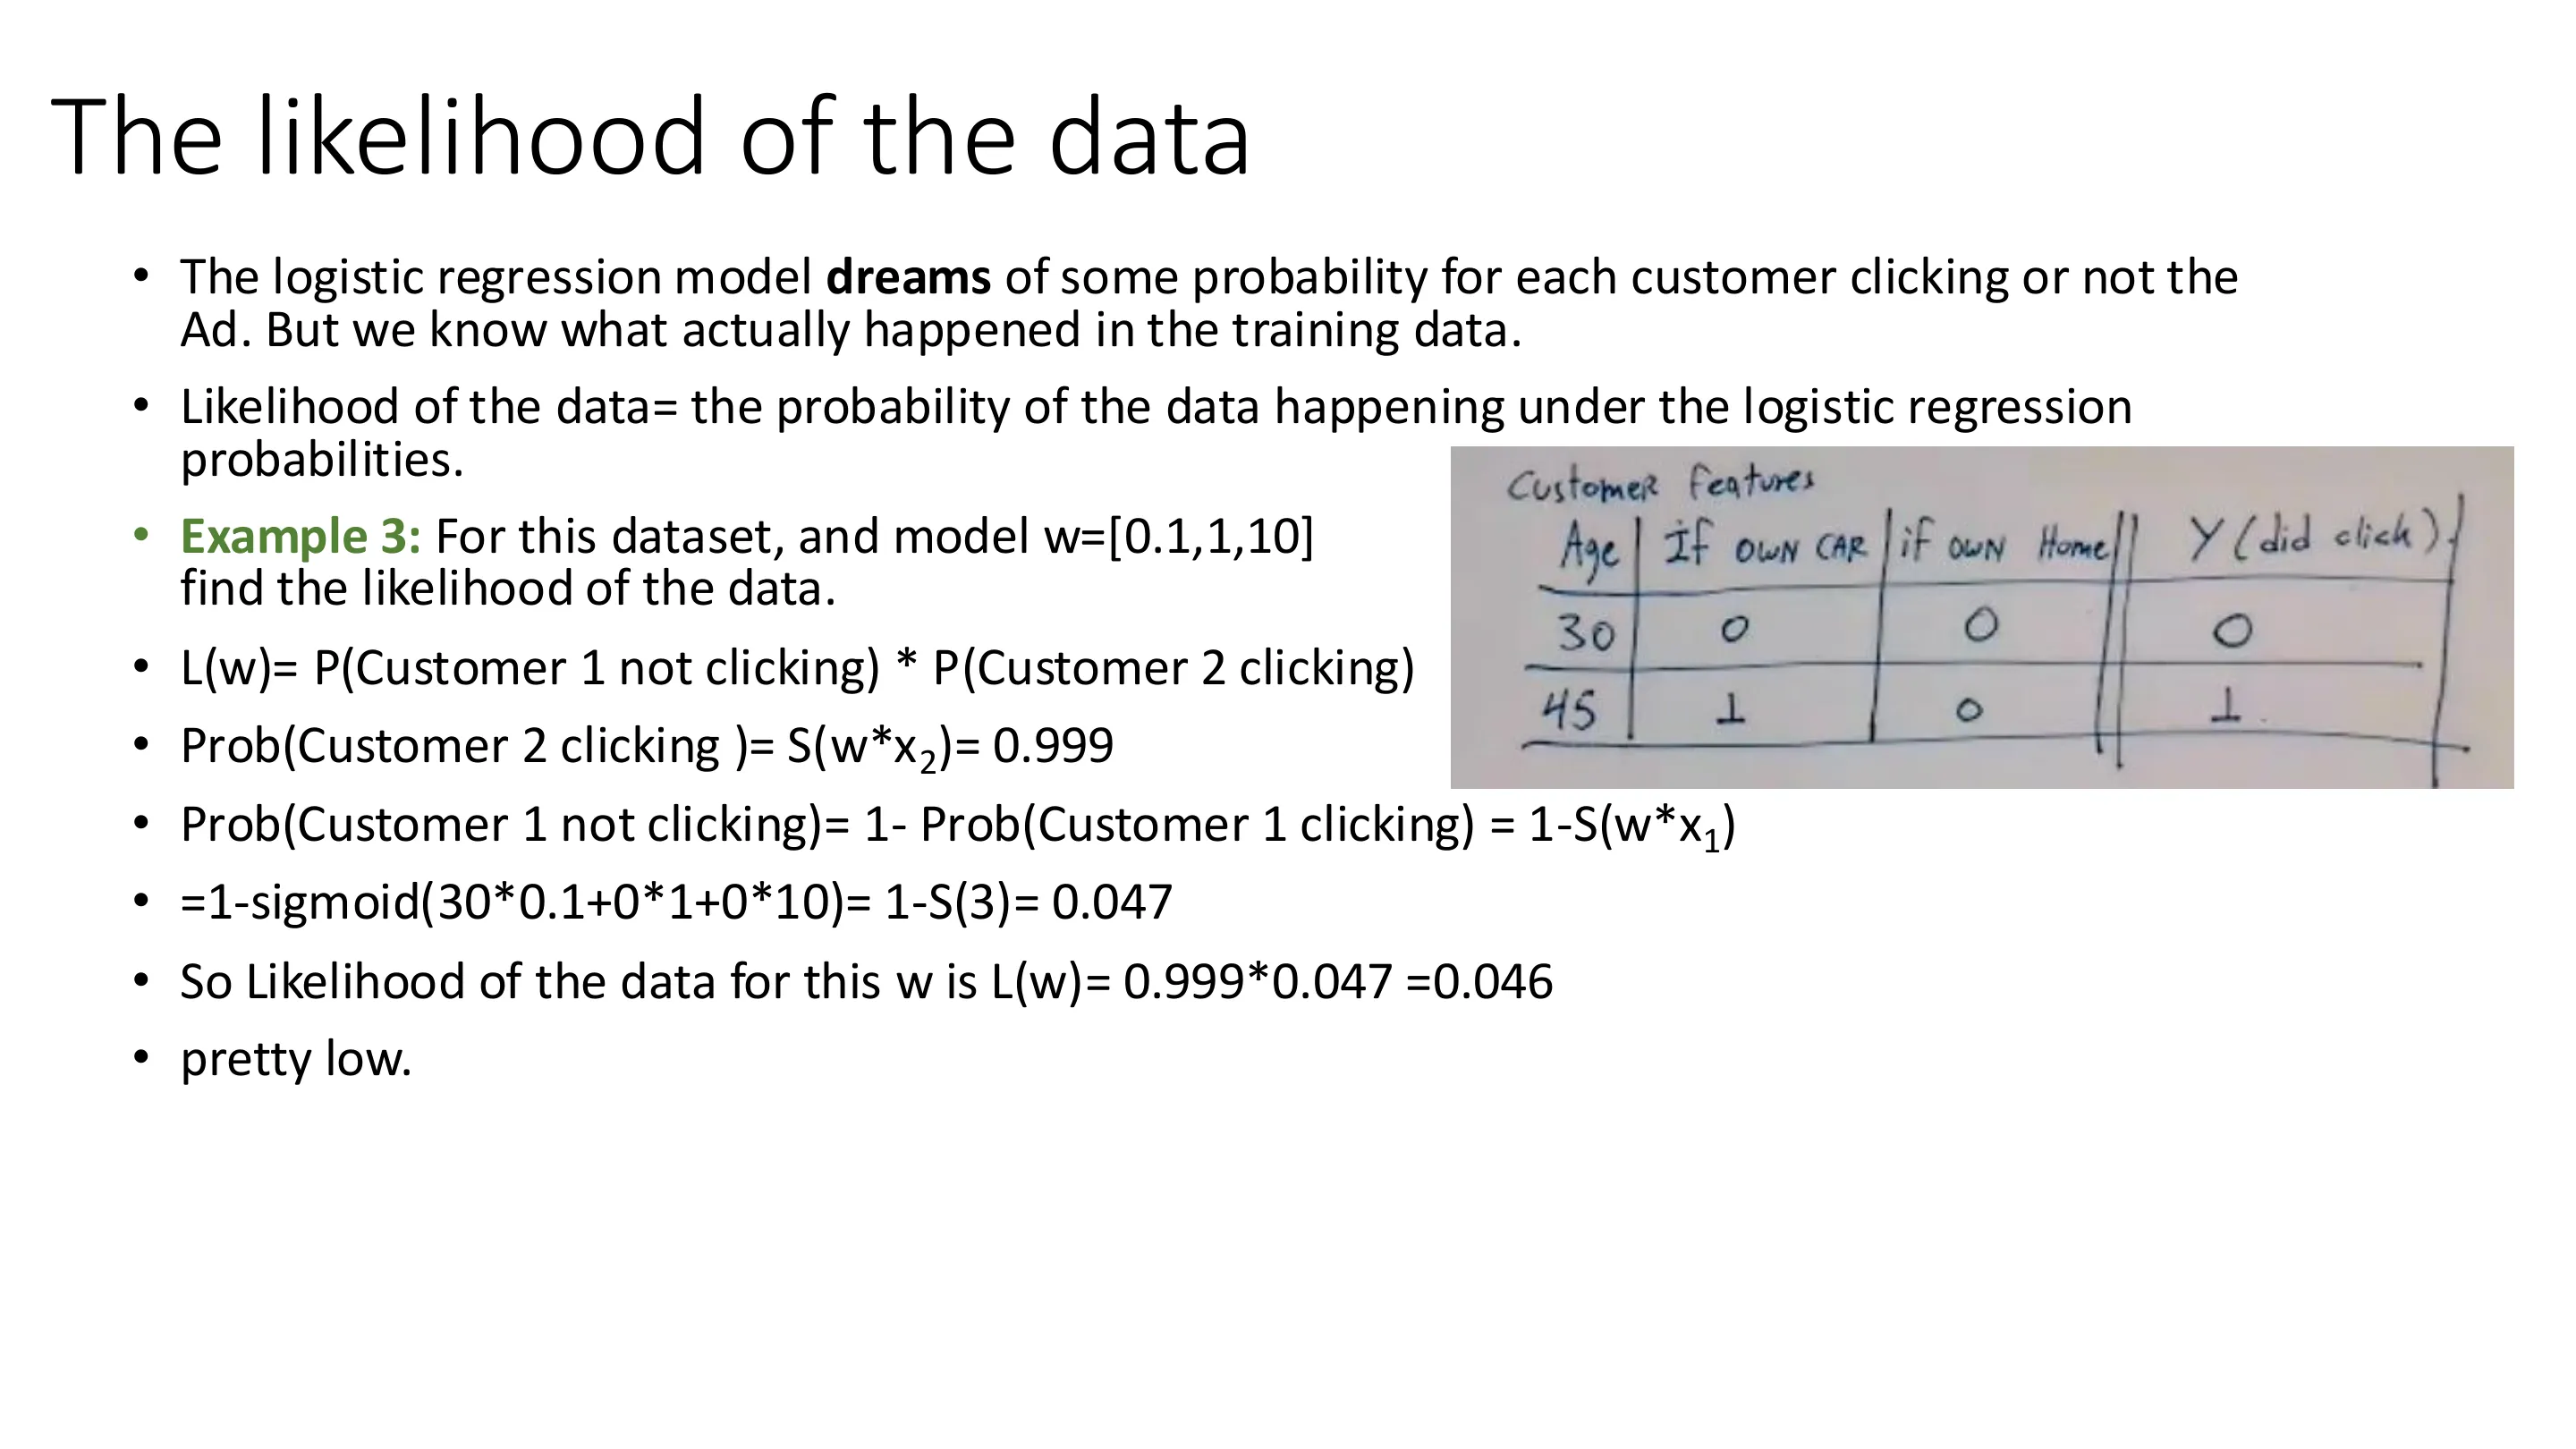
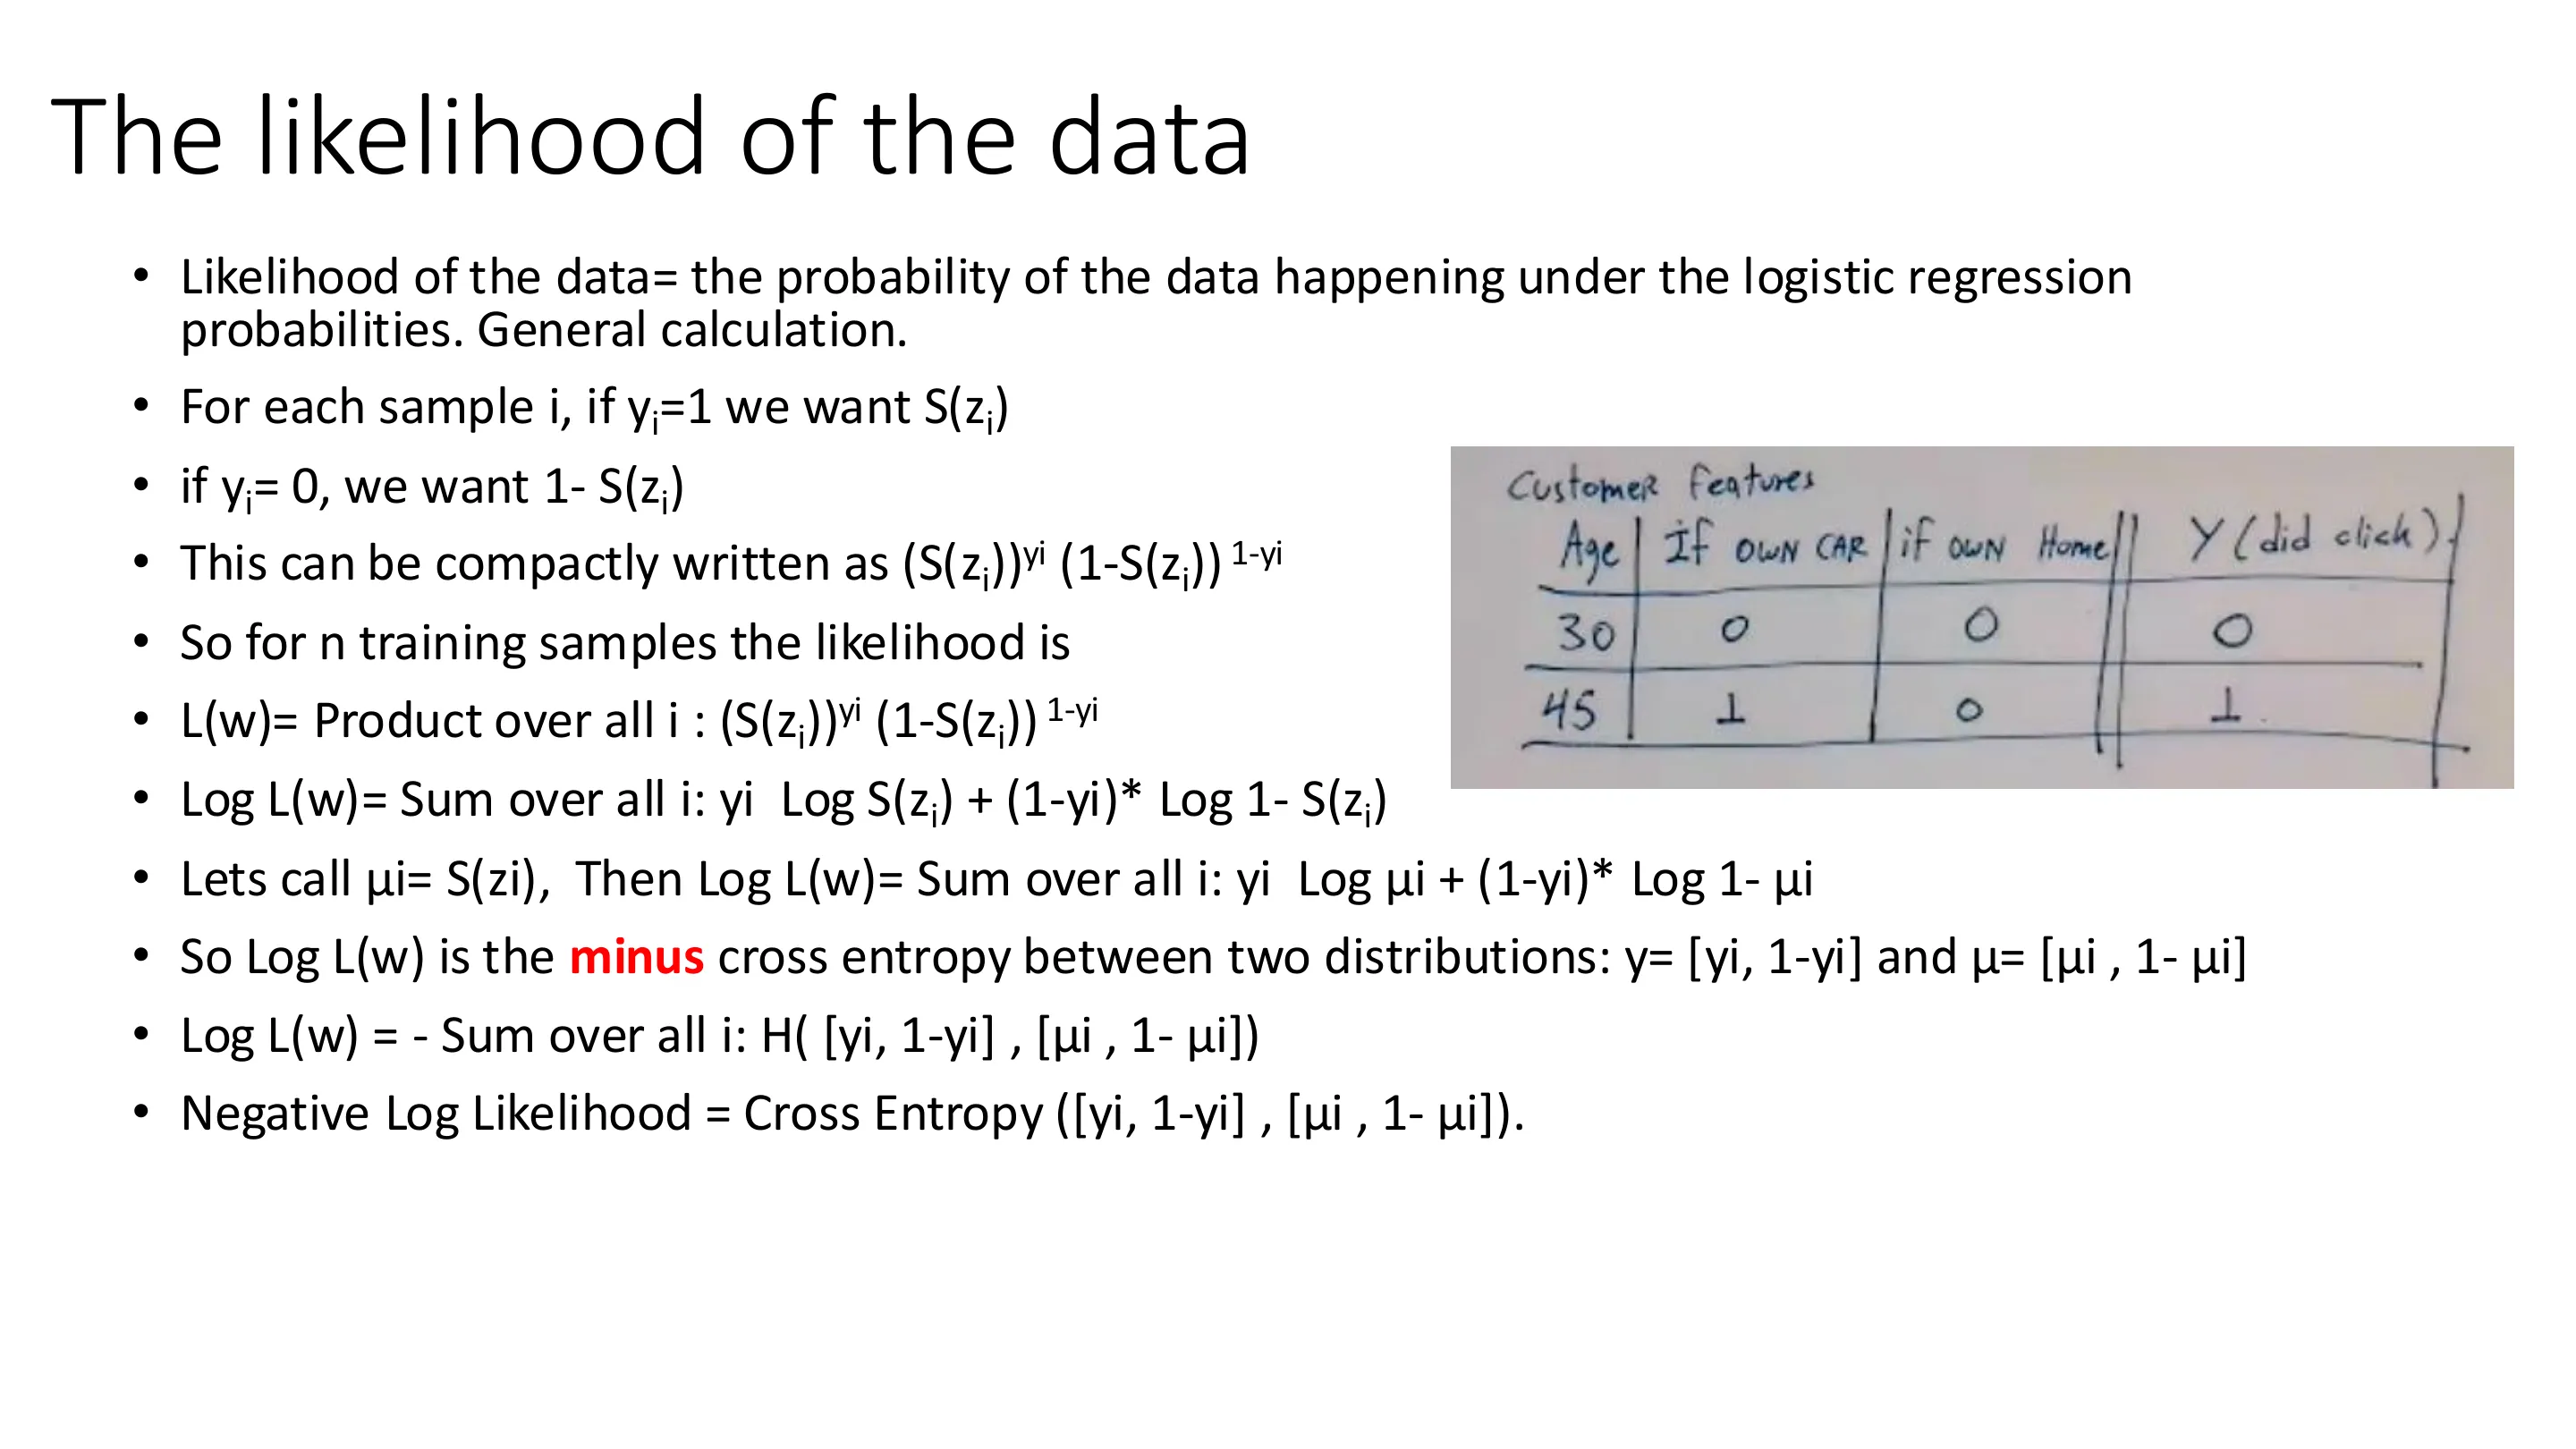
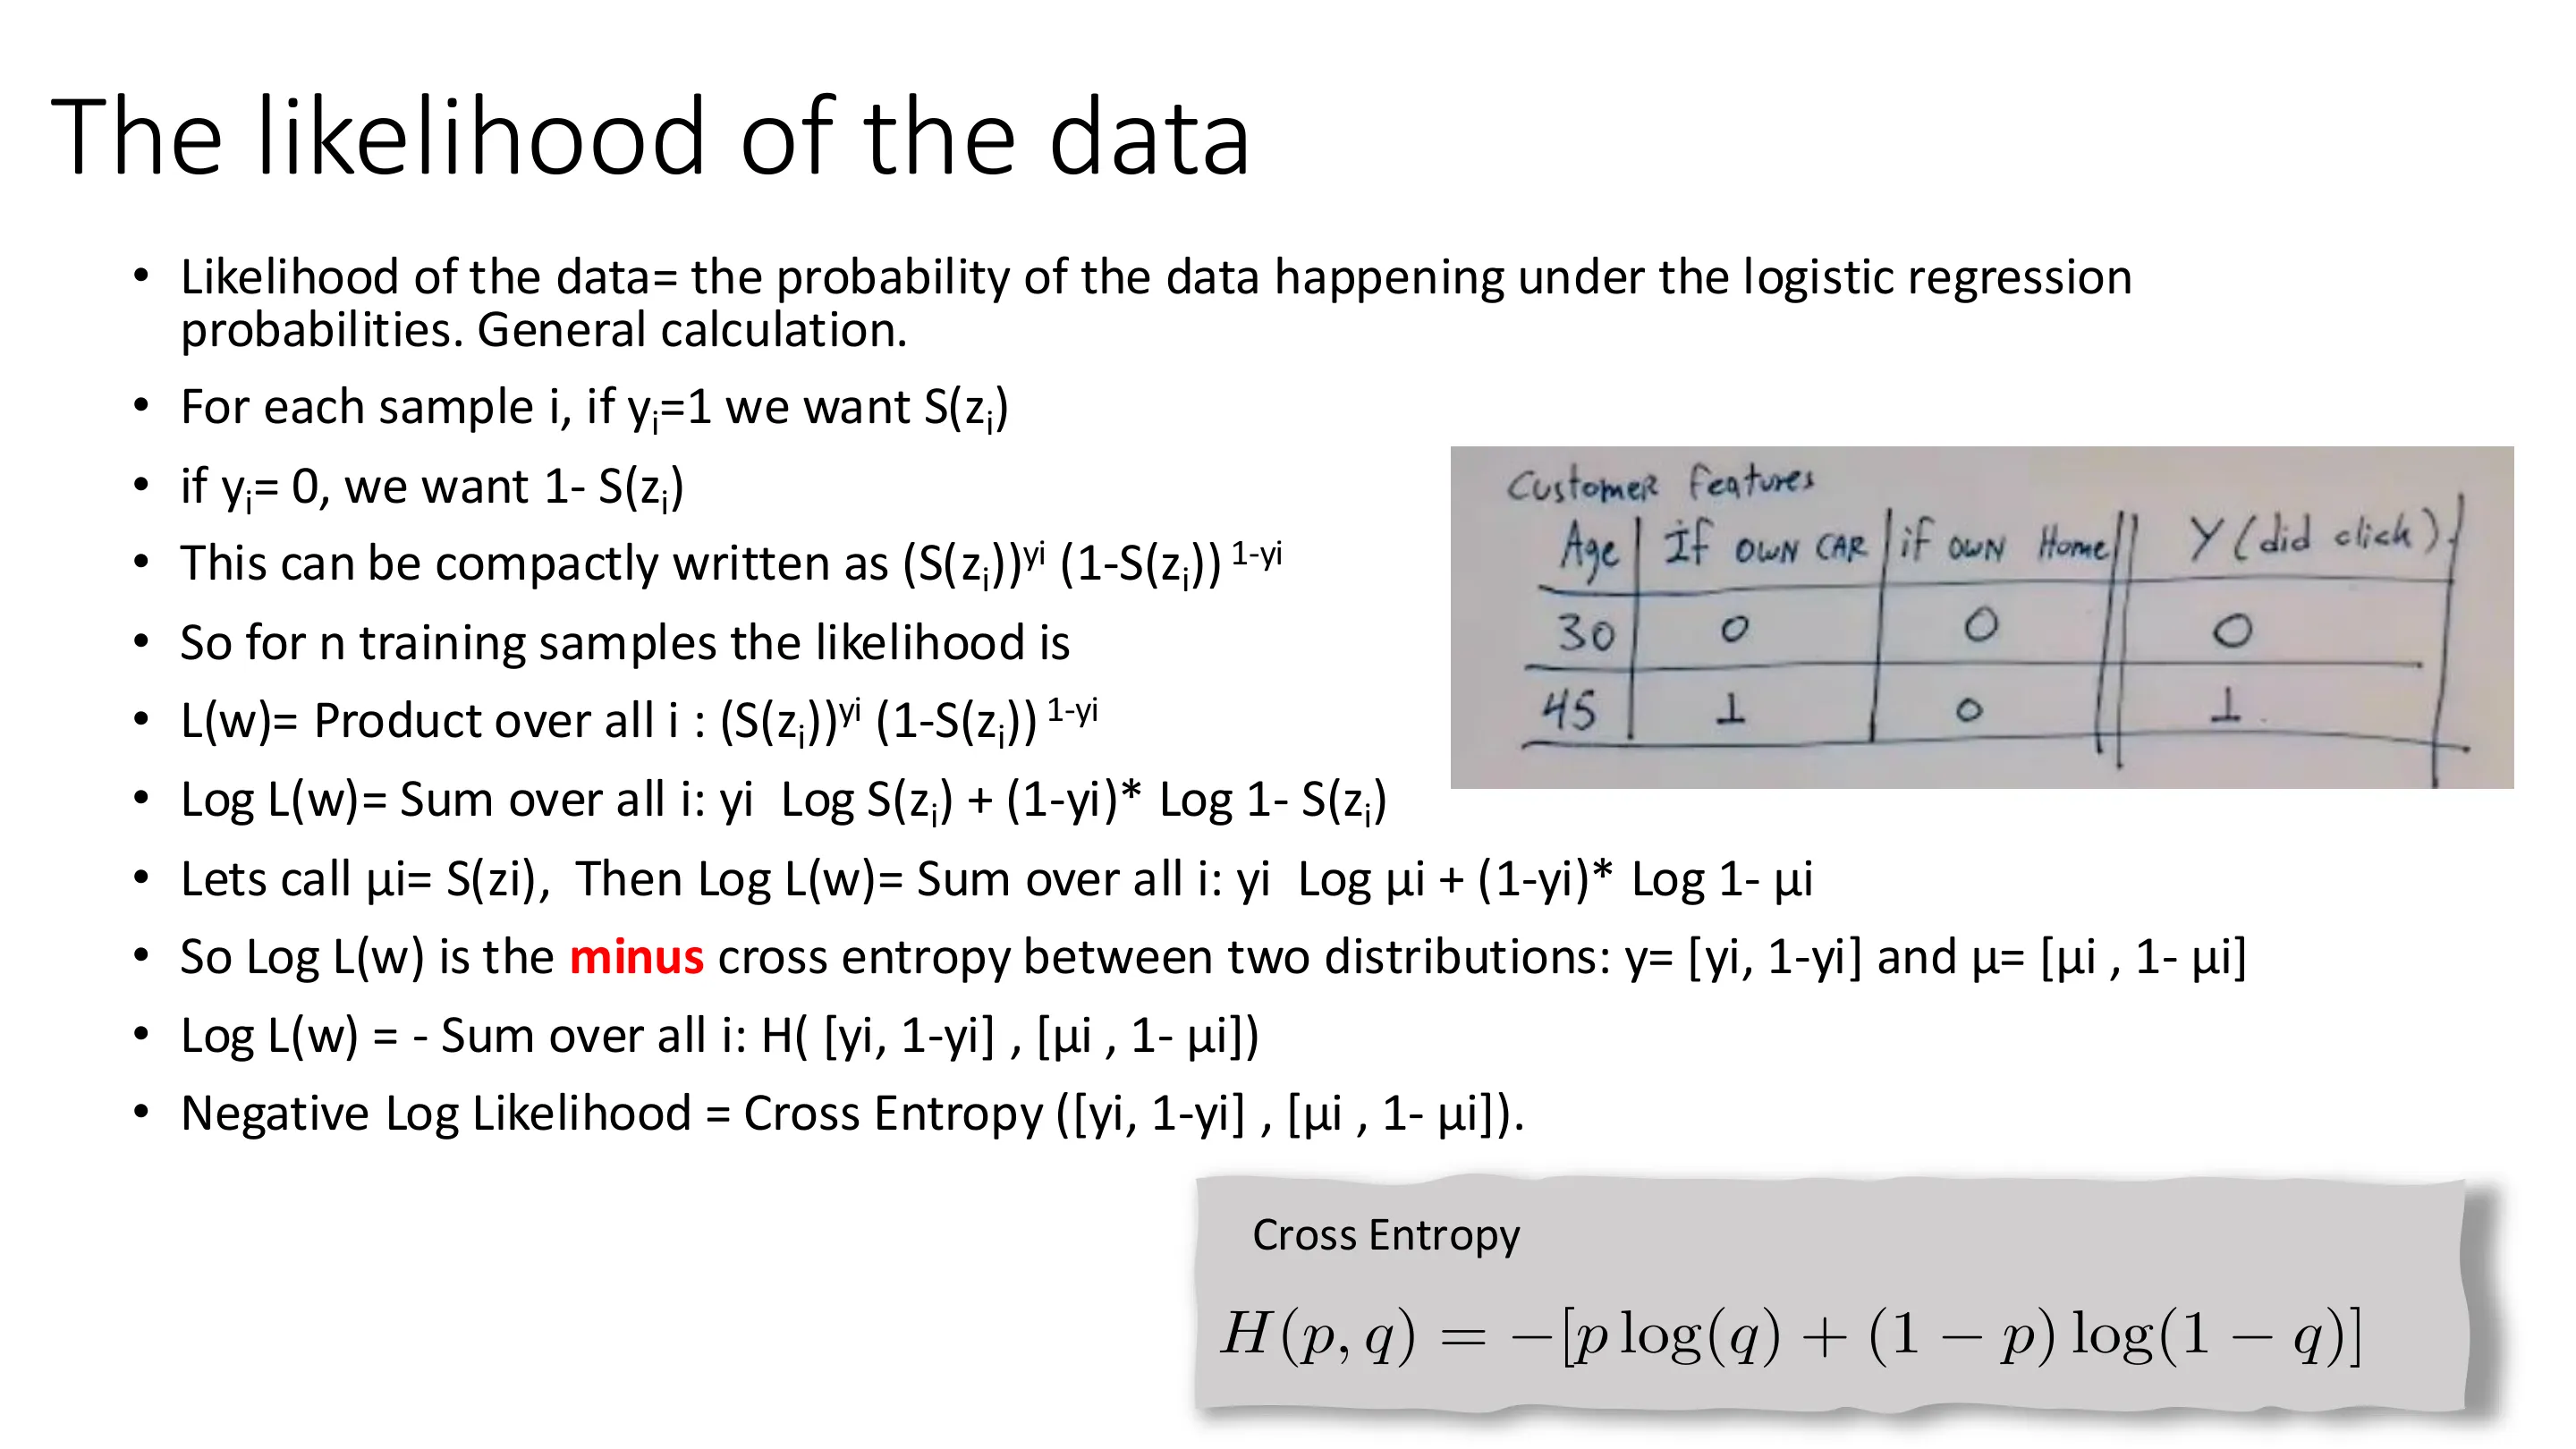
记 $z_i=w^\top x_i$、$\mu_i=\sigma(z_i)$。用「切换函数」$y_i^{?}(1-y_i)^{?}$ 写出似然:
$$ p(D\mid w)=\prod_i \mu_i^{\,y_i}(1-\mu_i)^{\,1-y_i} $$
取负对数(把乘积变和、最大值变最小值):
$$ -\log p(D\mid w)=-\sum_i\Big[y_i\log\mu_i+(1-y_i)\log(1-\mu_i)\Big] $$
这正是真实标签分布 $y_i$(one-hot)与模型分布 $\mu_i$ 的交叉熵之和。
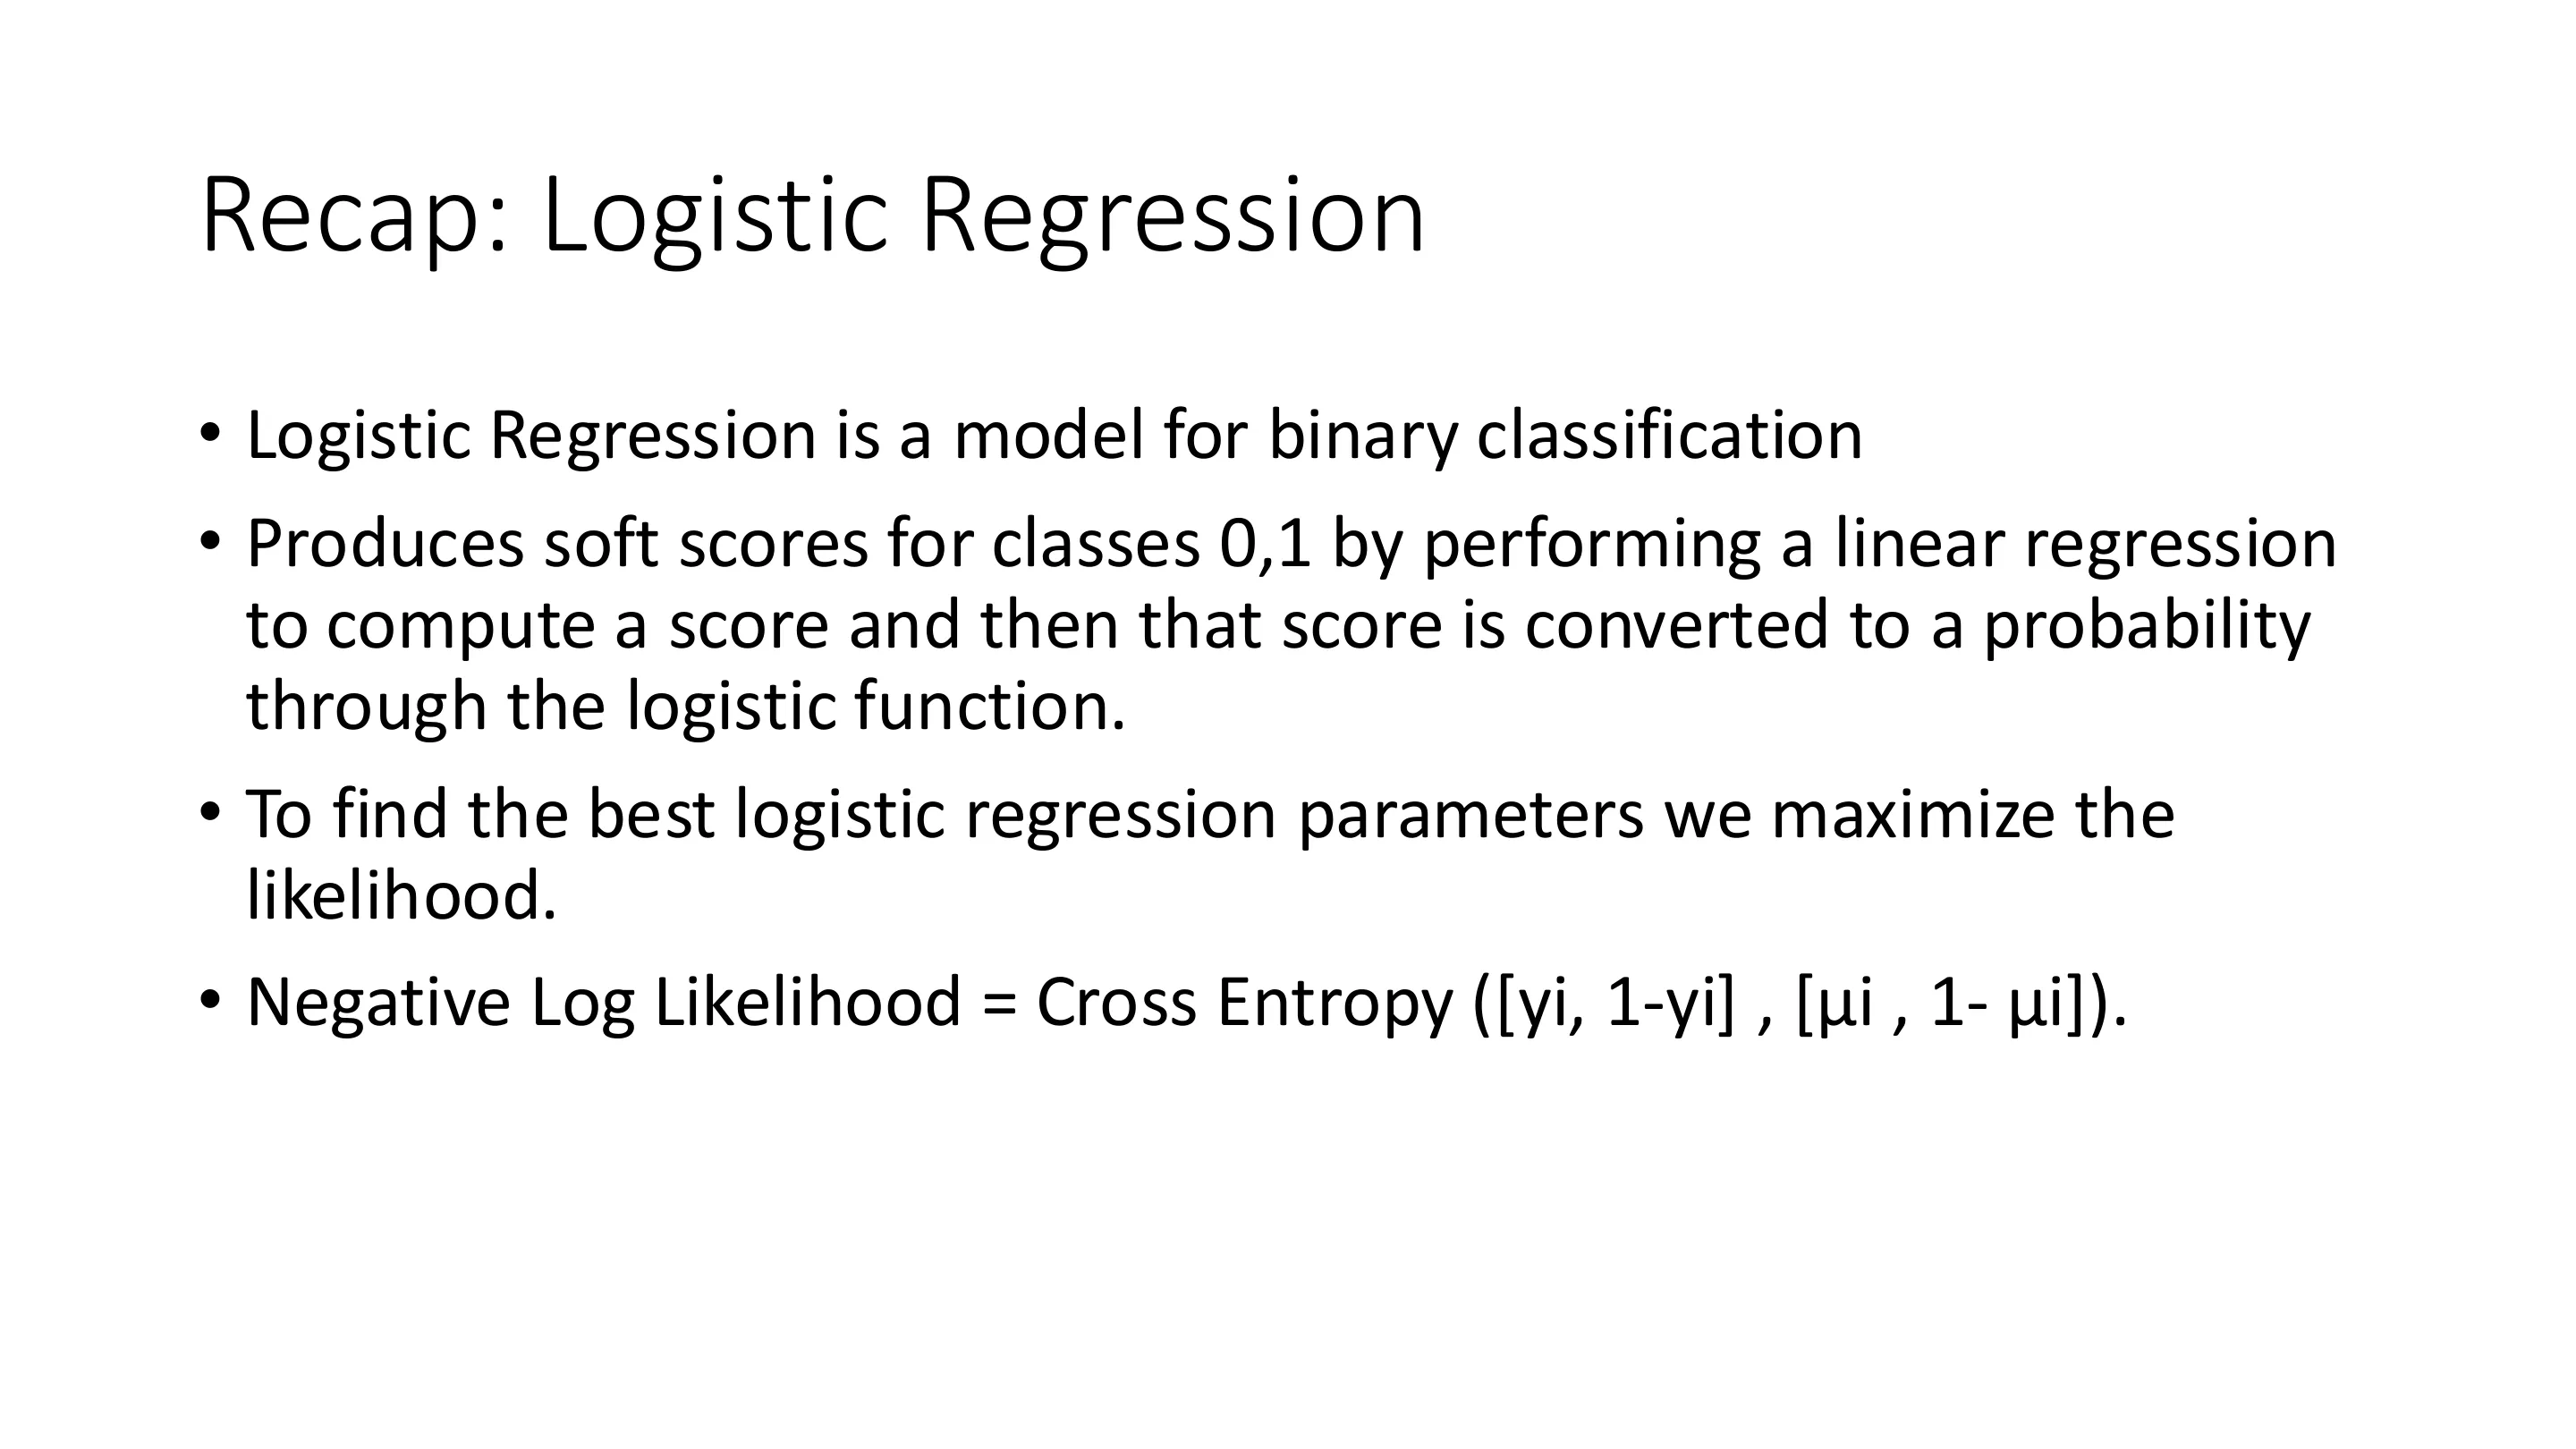
结论:逻辑回归的负对数似然 ≡ 交叉熵损失;最小化它 ⇒ 最大化似然。多类情形(Softmax)完全同理。
📷 数据的似然(一)
回到原视频 (00:53:52)
📷 数据的似然(二)
回到原视频 (00:55:05)
📷 数据的似然(三)
回到原视频 (00:56:18)
📷 回顾:逻辑回归
回到原视频 (00:57:31)
为什么会「过大权重」:对某个确定标签,最小化交叉熵会要求分数趋近 $\pm\infty$(即 $w$ 巨大),这也解释了为什么逻辑回归通常要加 L2 正则(约束 $w$,降低方差)。
四、多类逻辑回归与可视化
4.1 多类 / Softmax
(参考时间: 00:49)
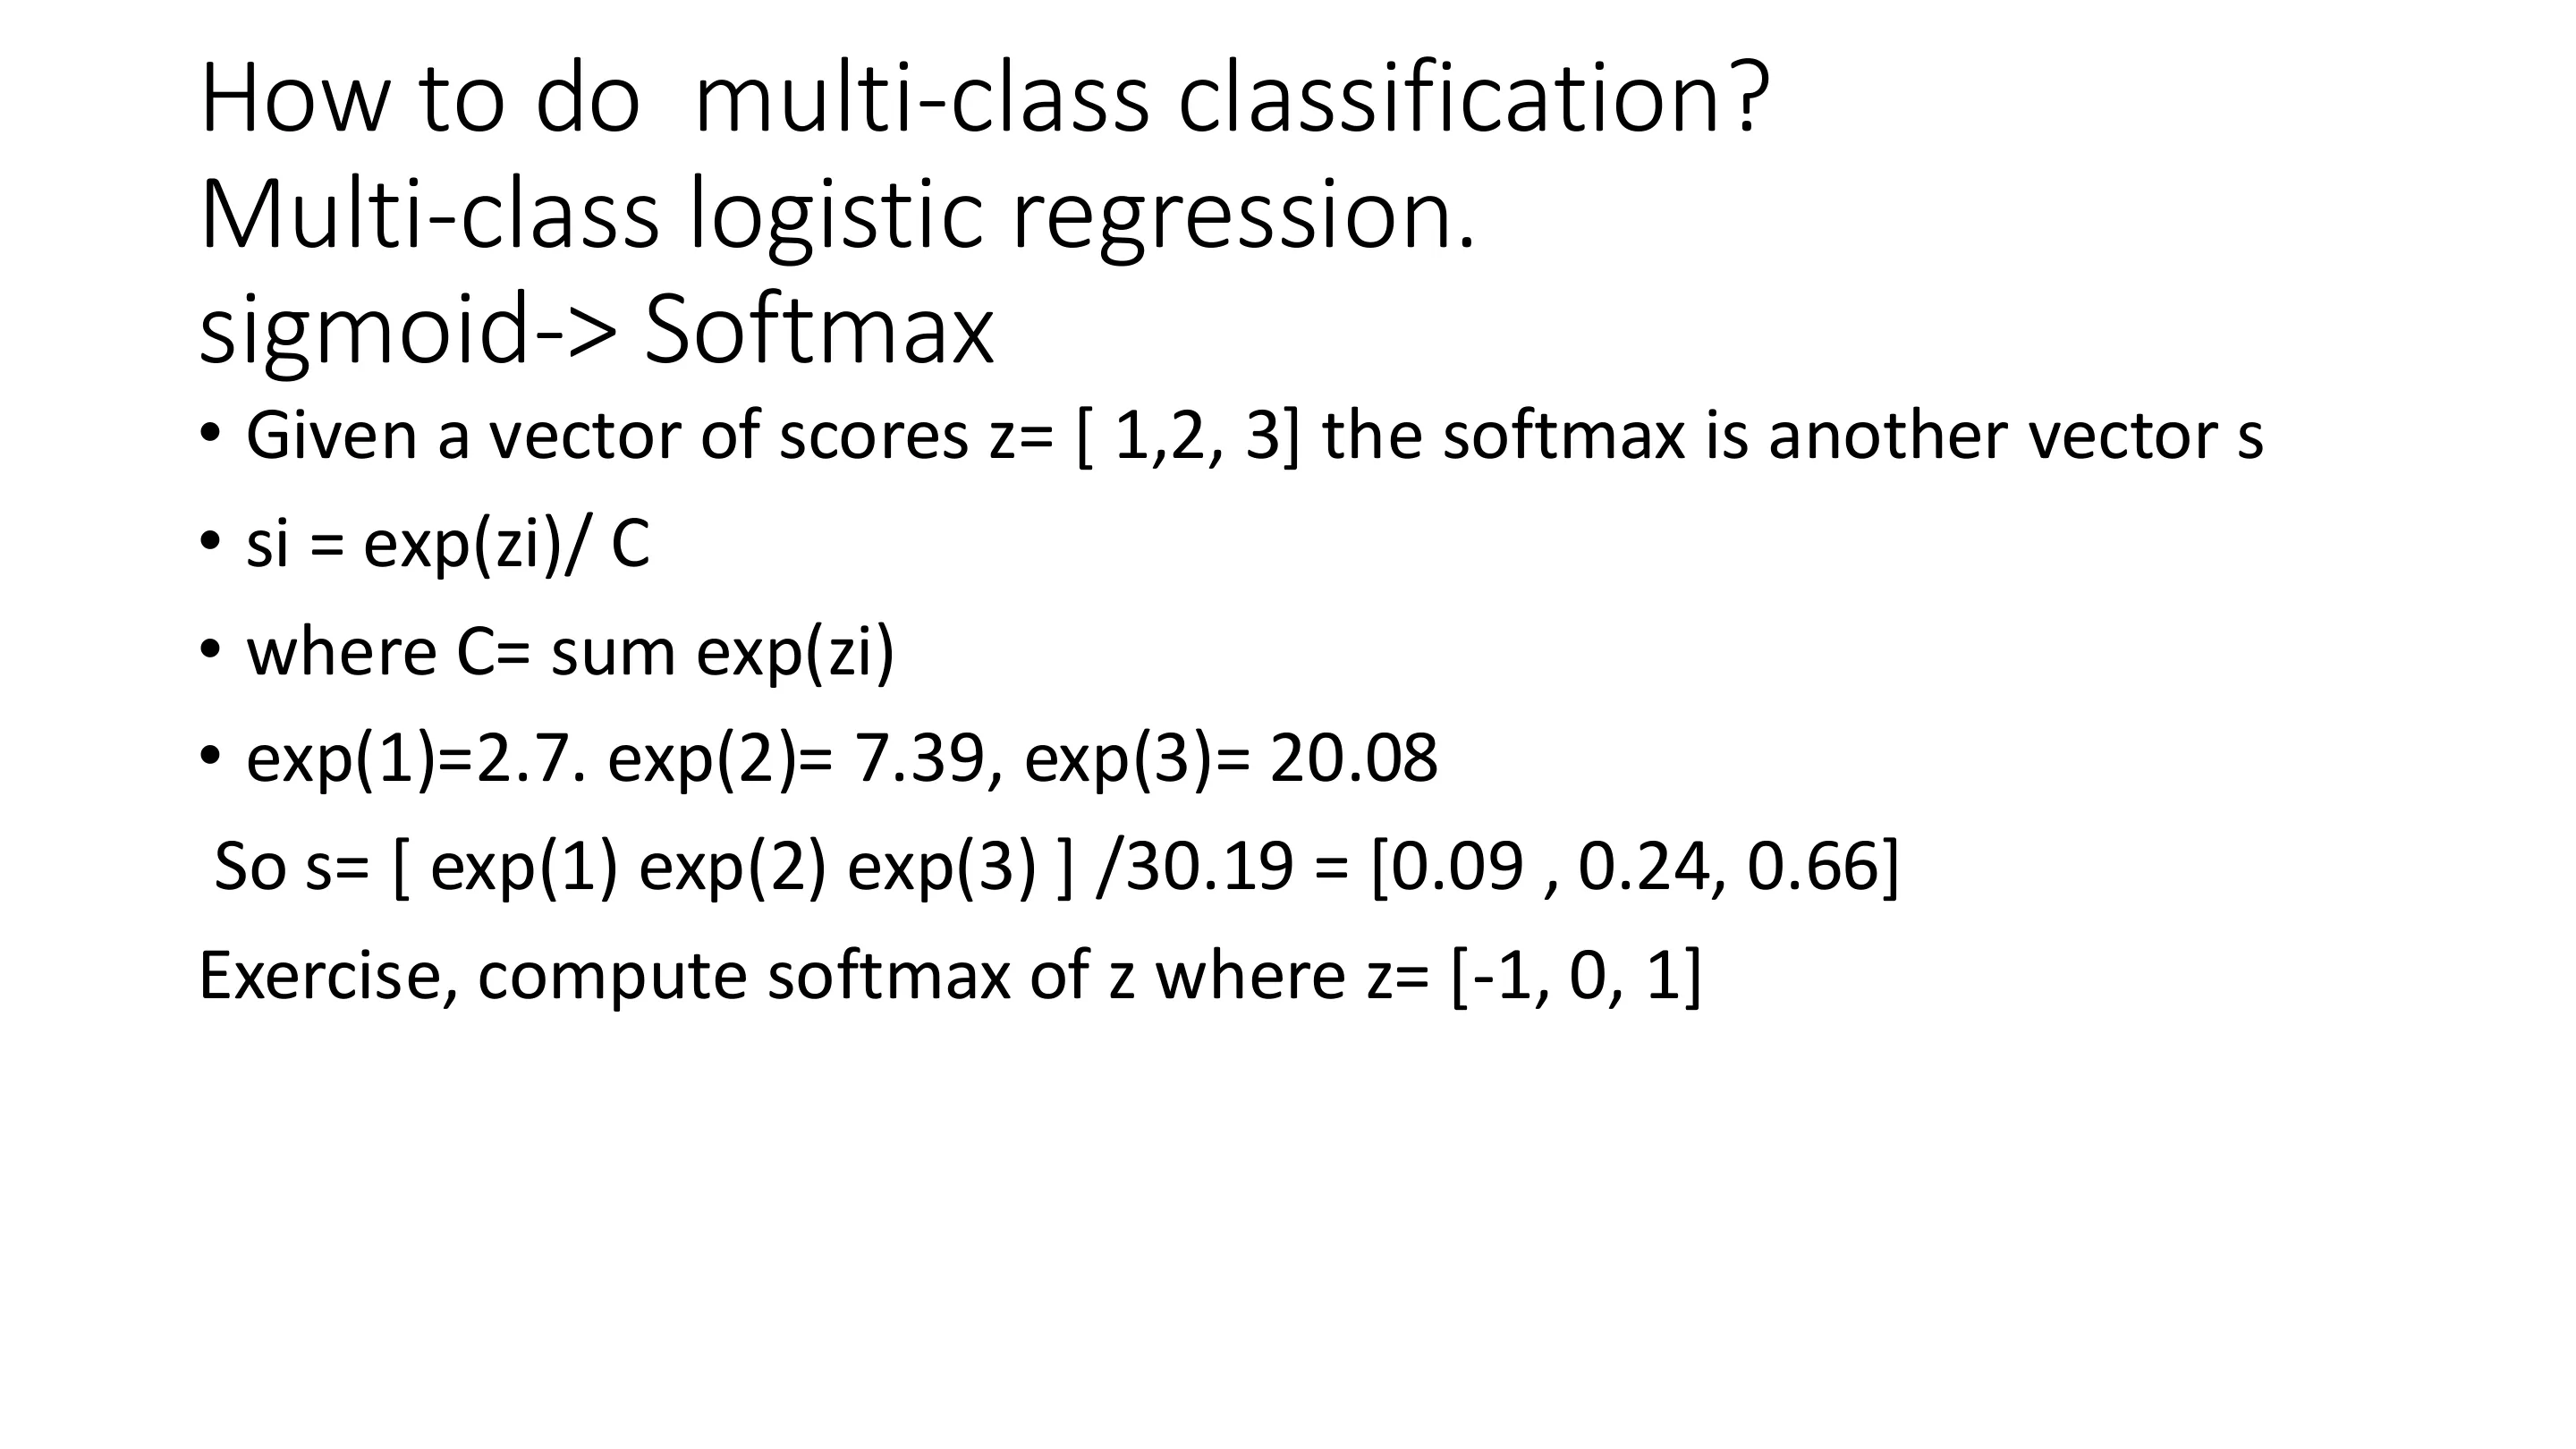
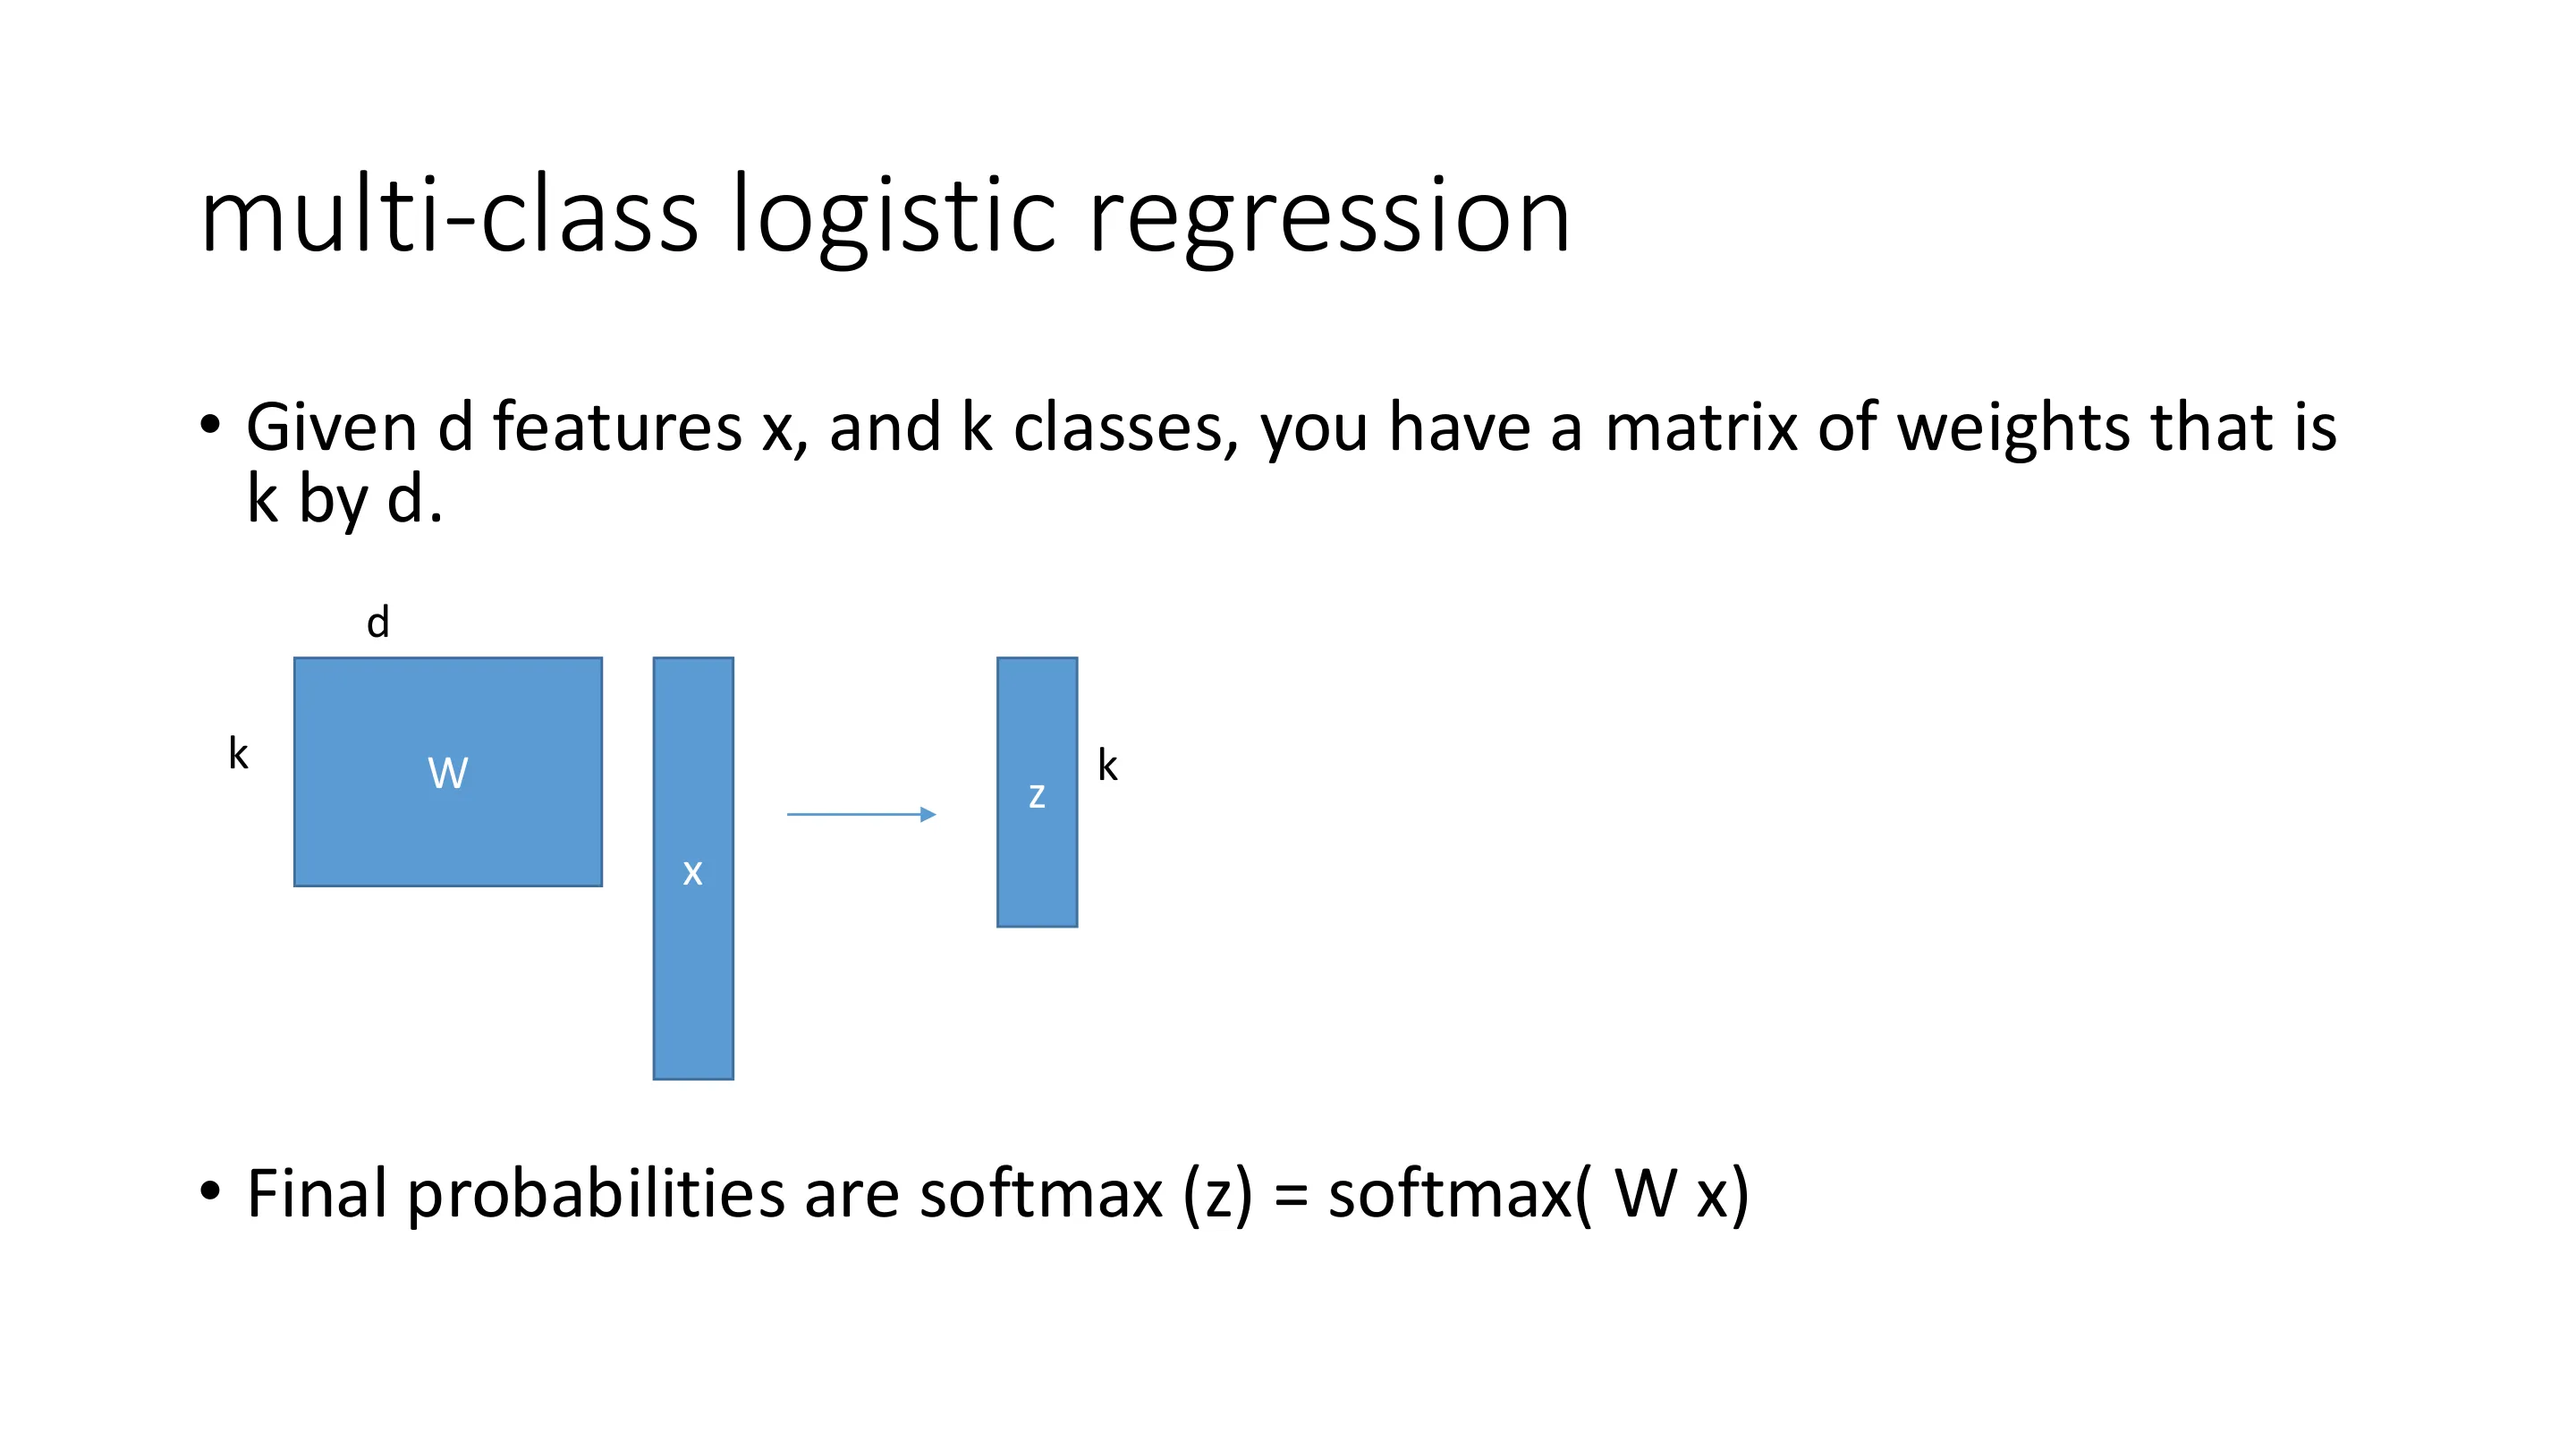
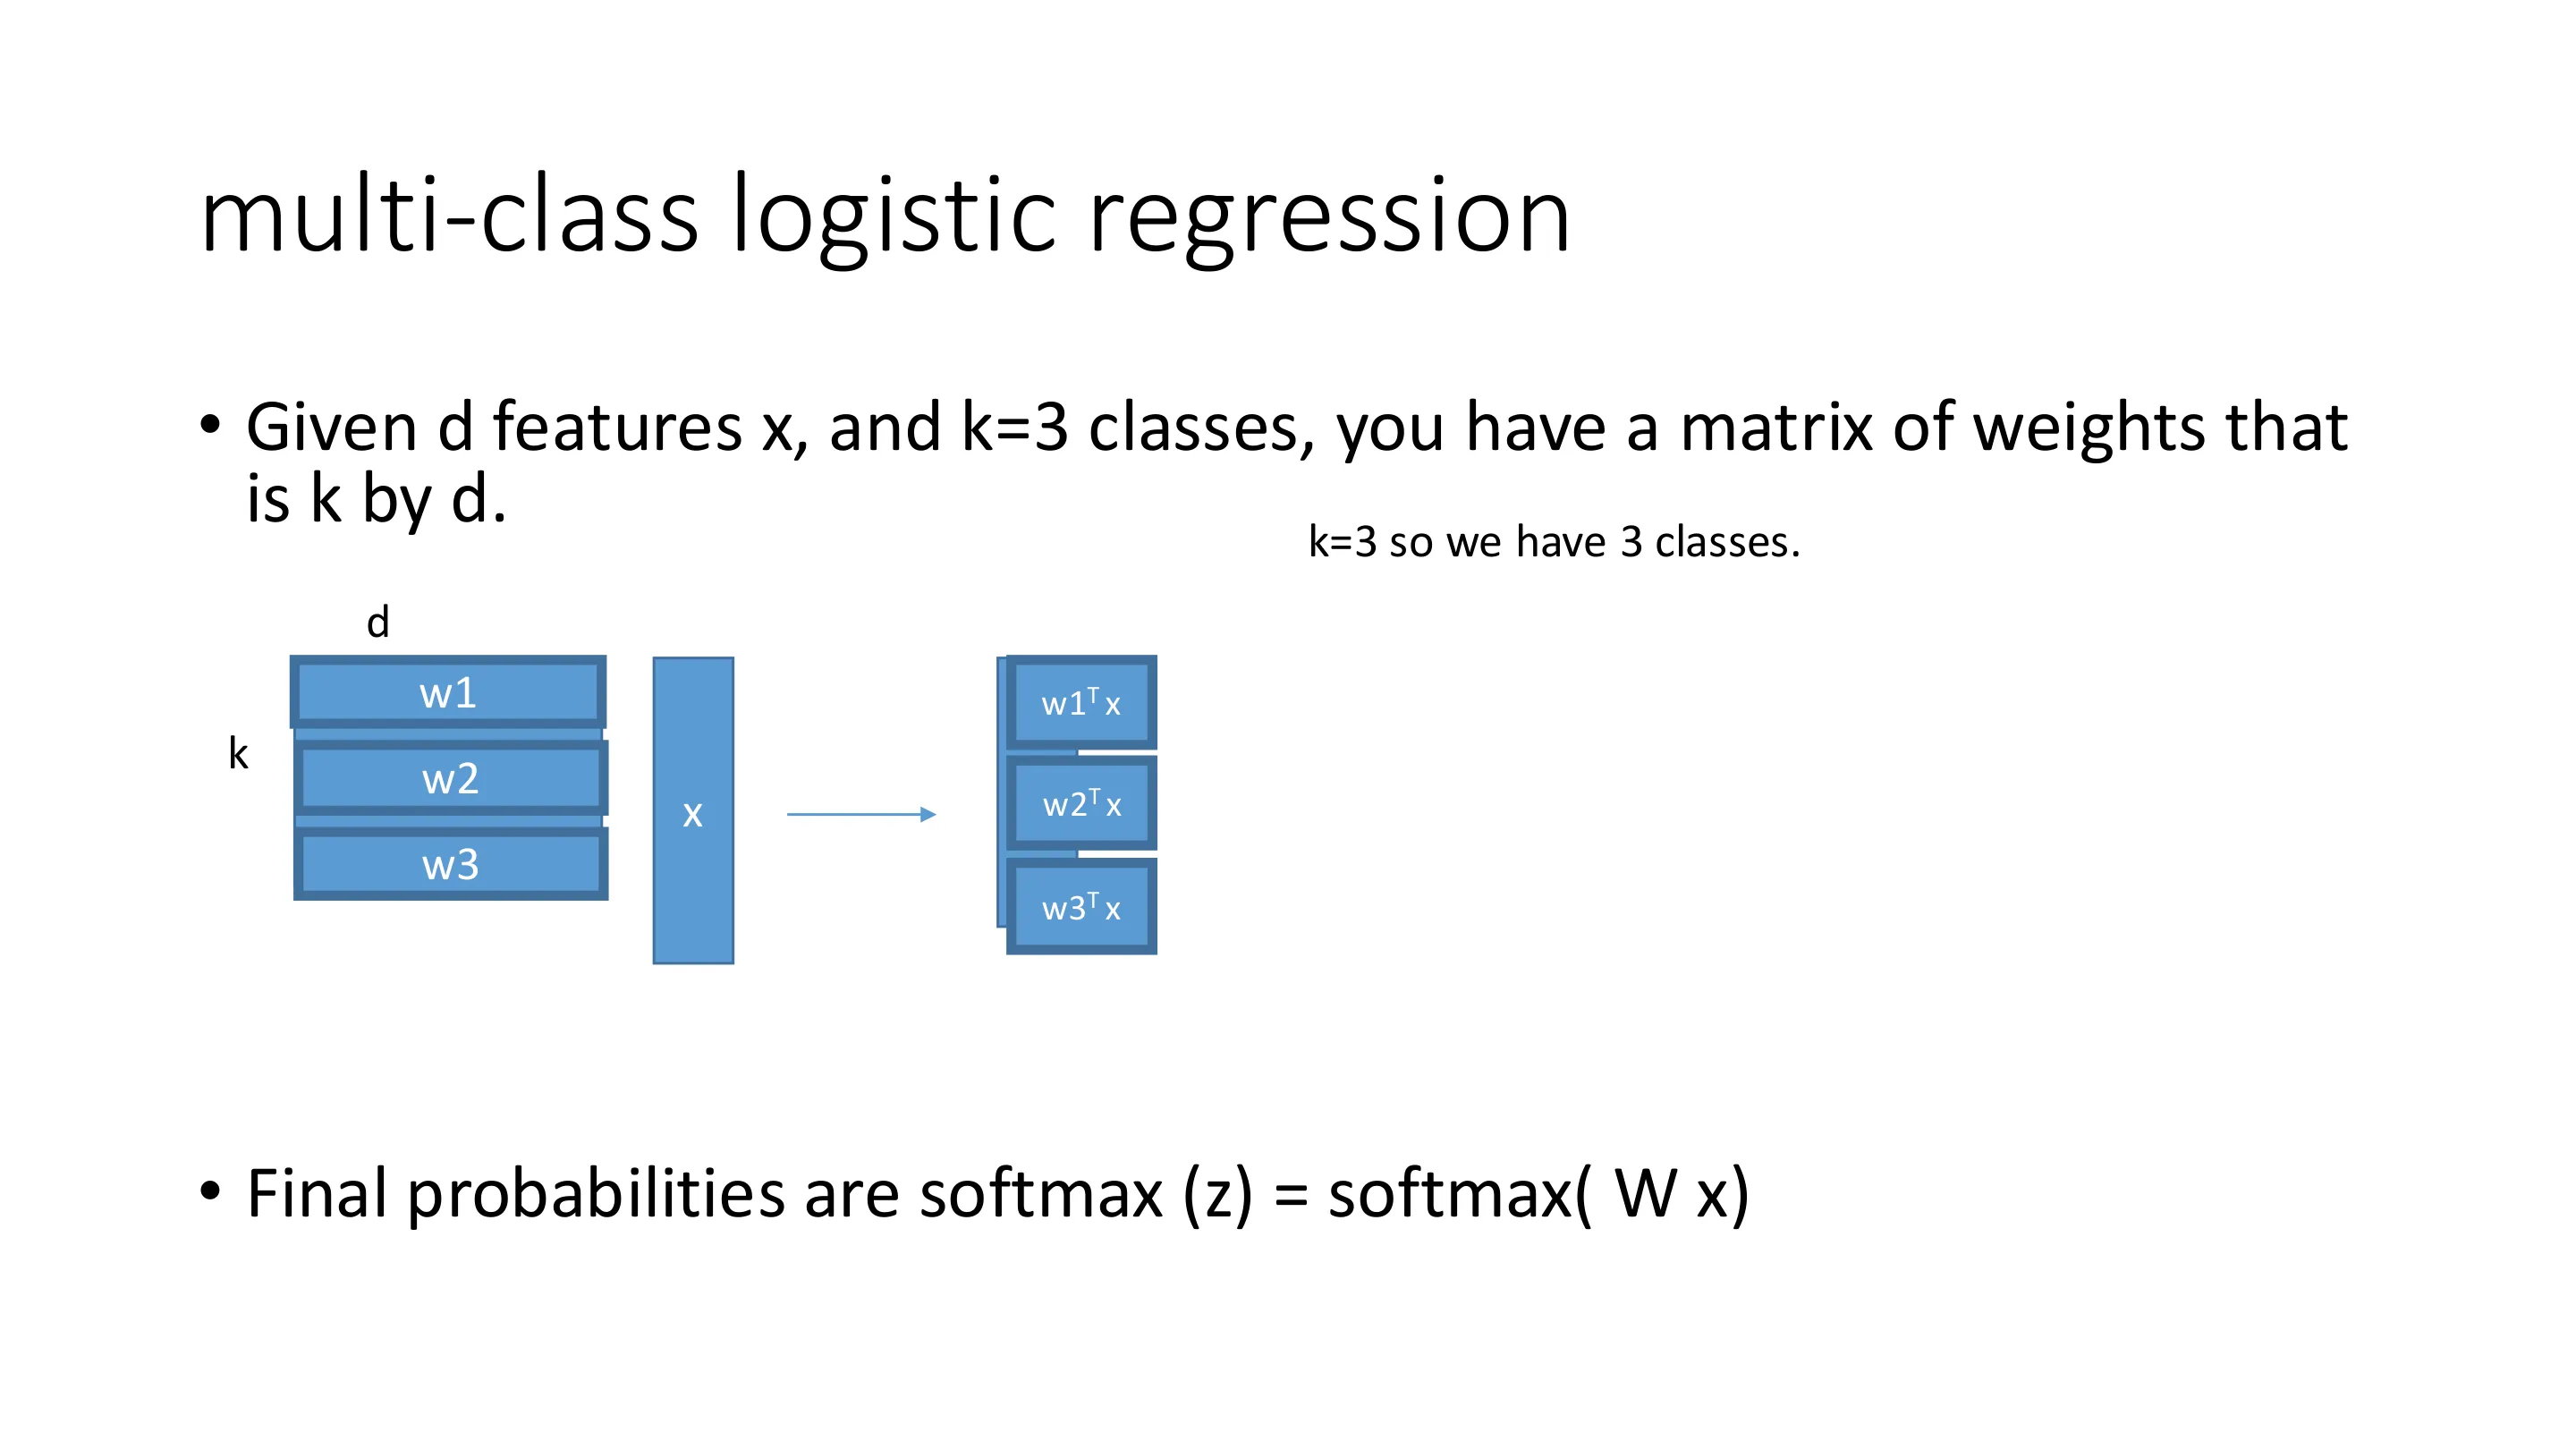
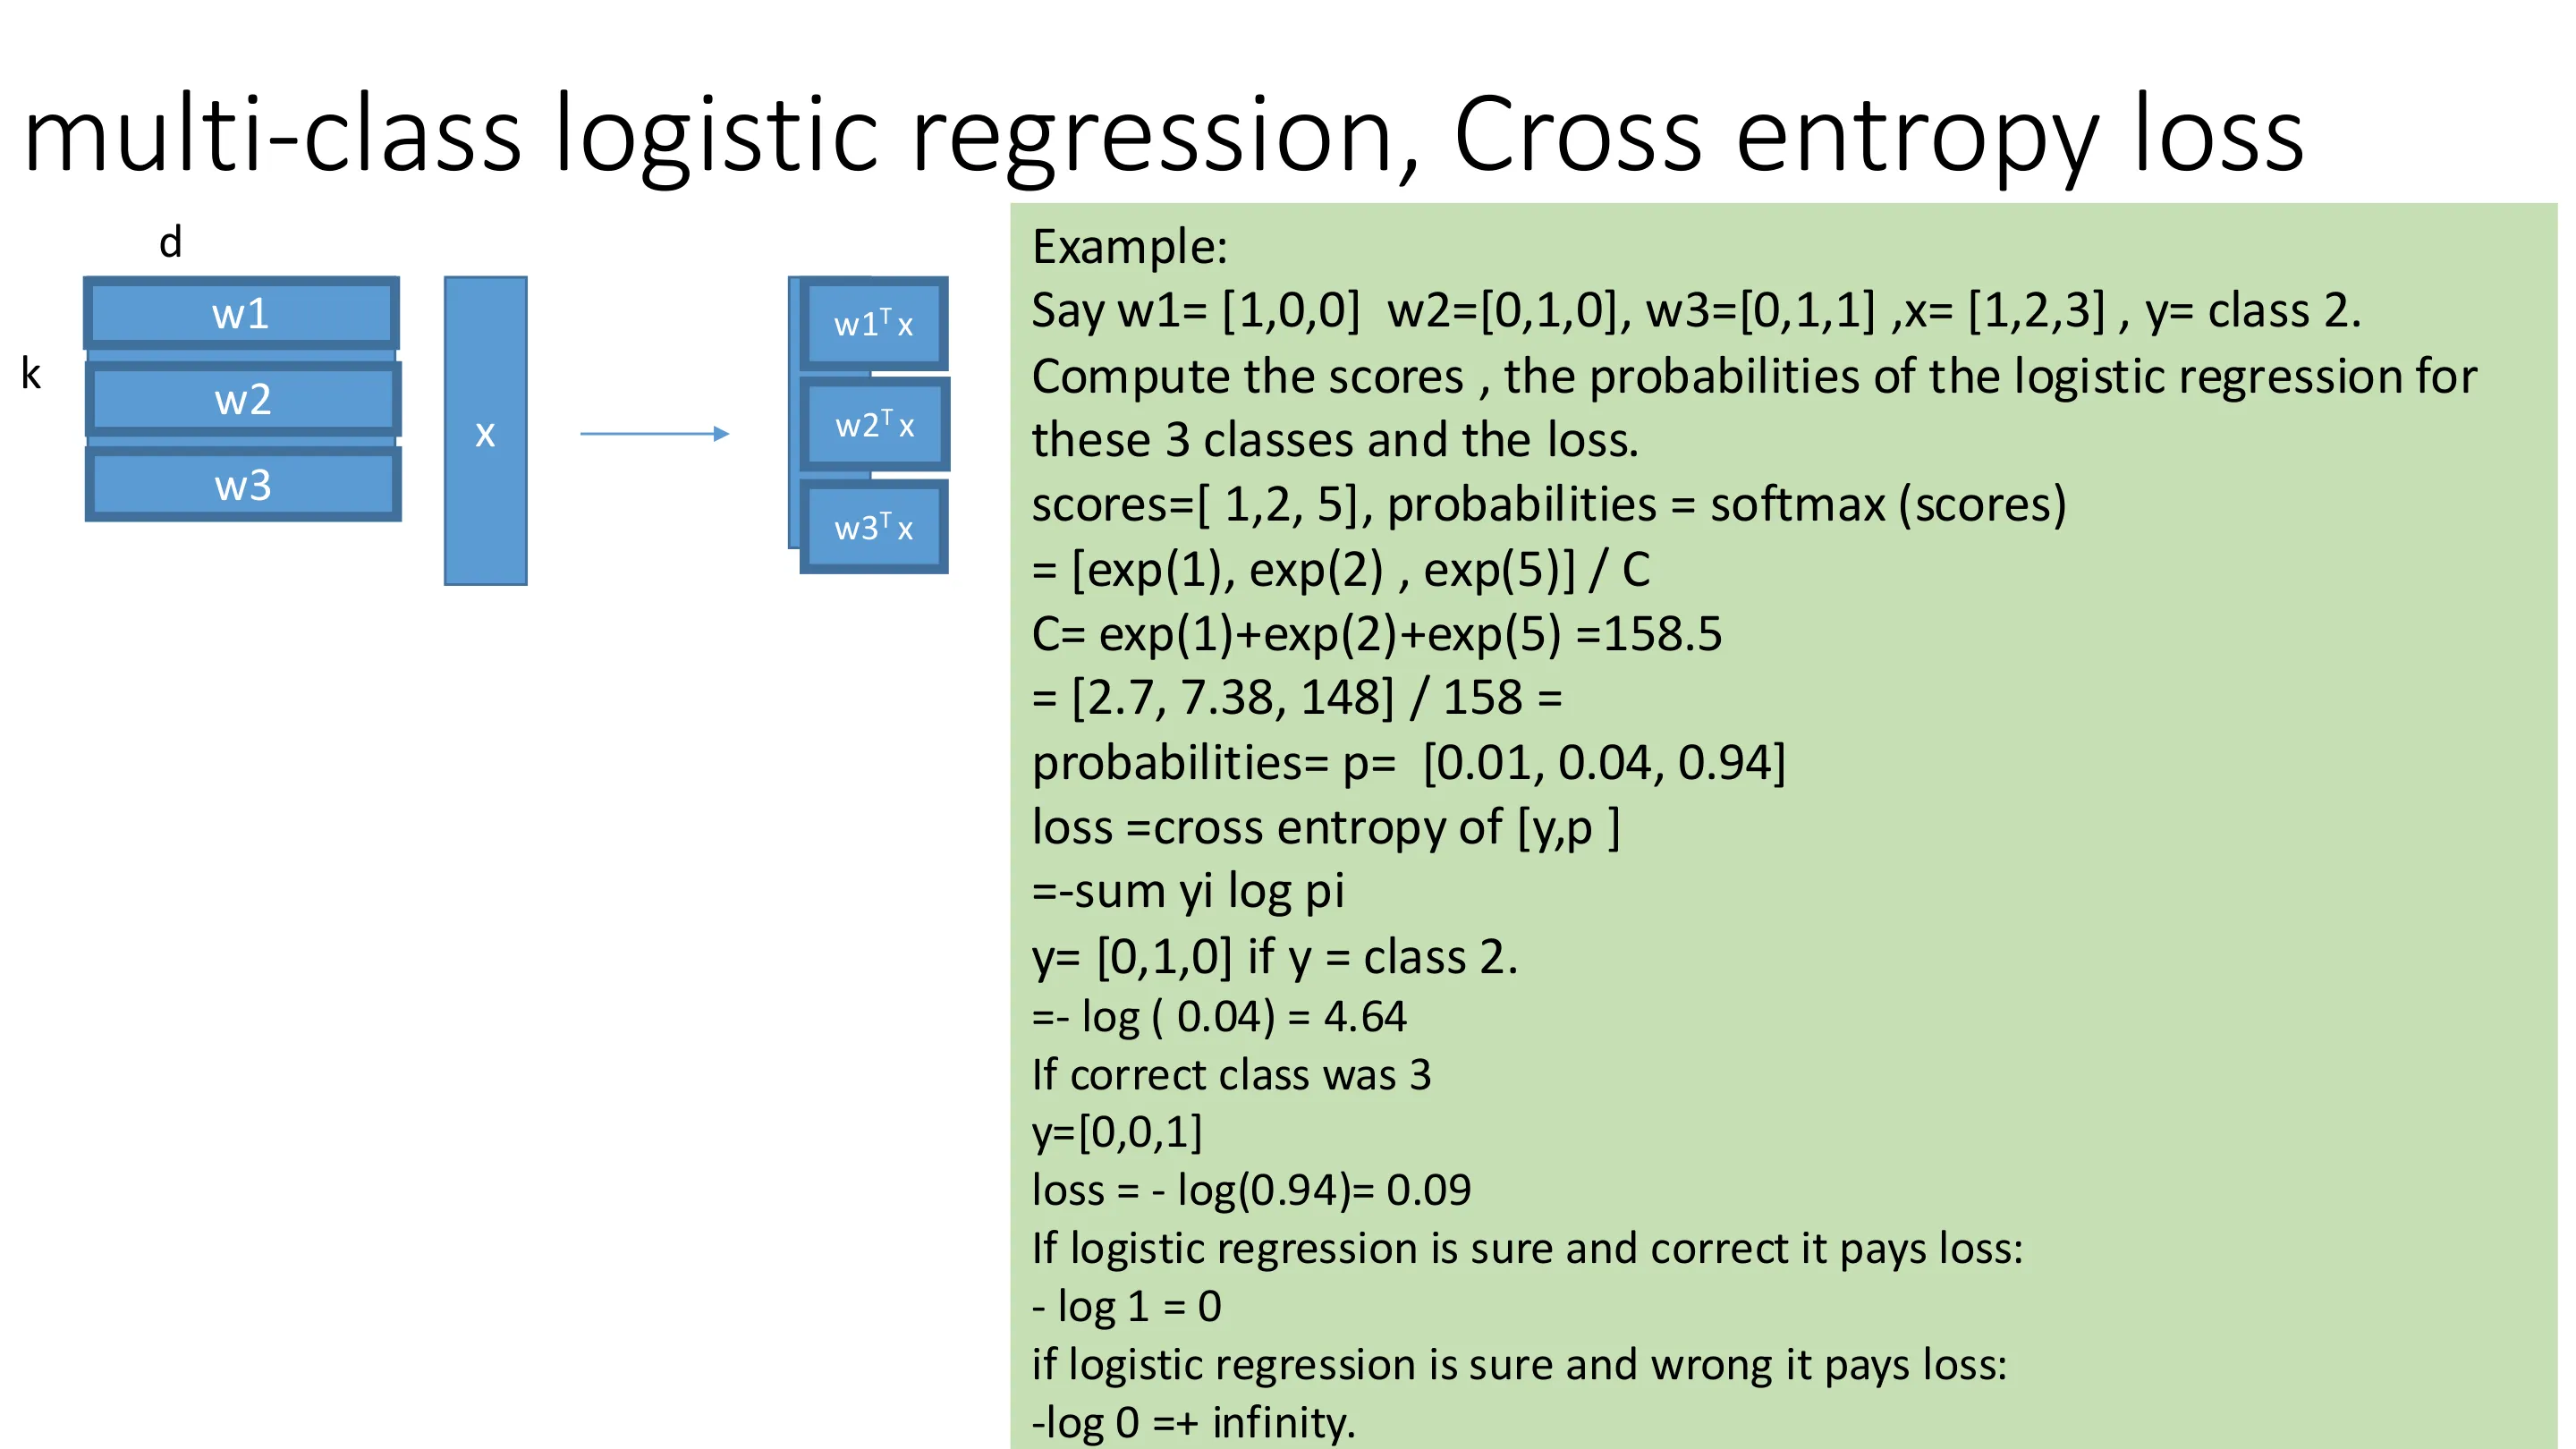
把 Sigmoid 换成 Softmax:为每个类别 $k$ 学一个权重向量 $w_k$,得到 logits,再归一化成概率:
$$ P(Y=k\mid x)=\frac{e^{w_k^\top x}}{\sum_{j}e^{w_j^\top x}} $$
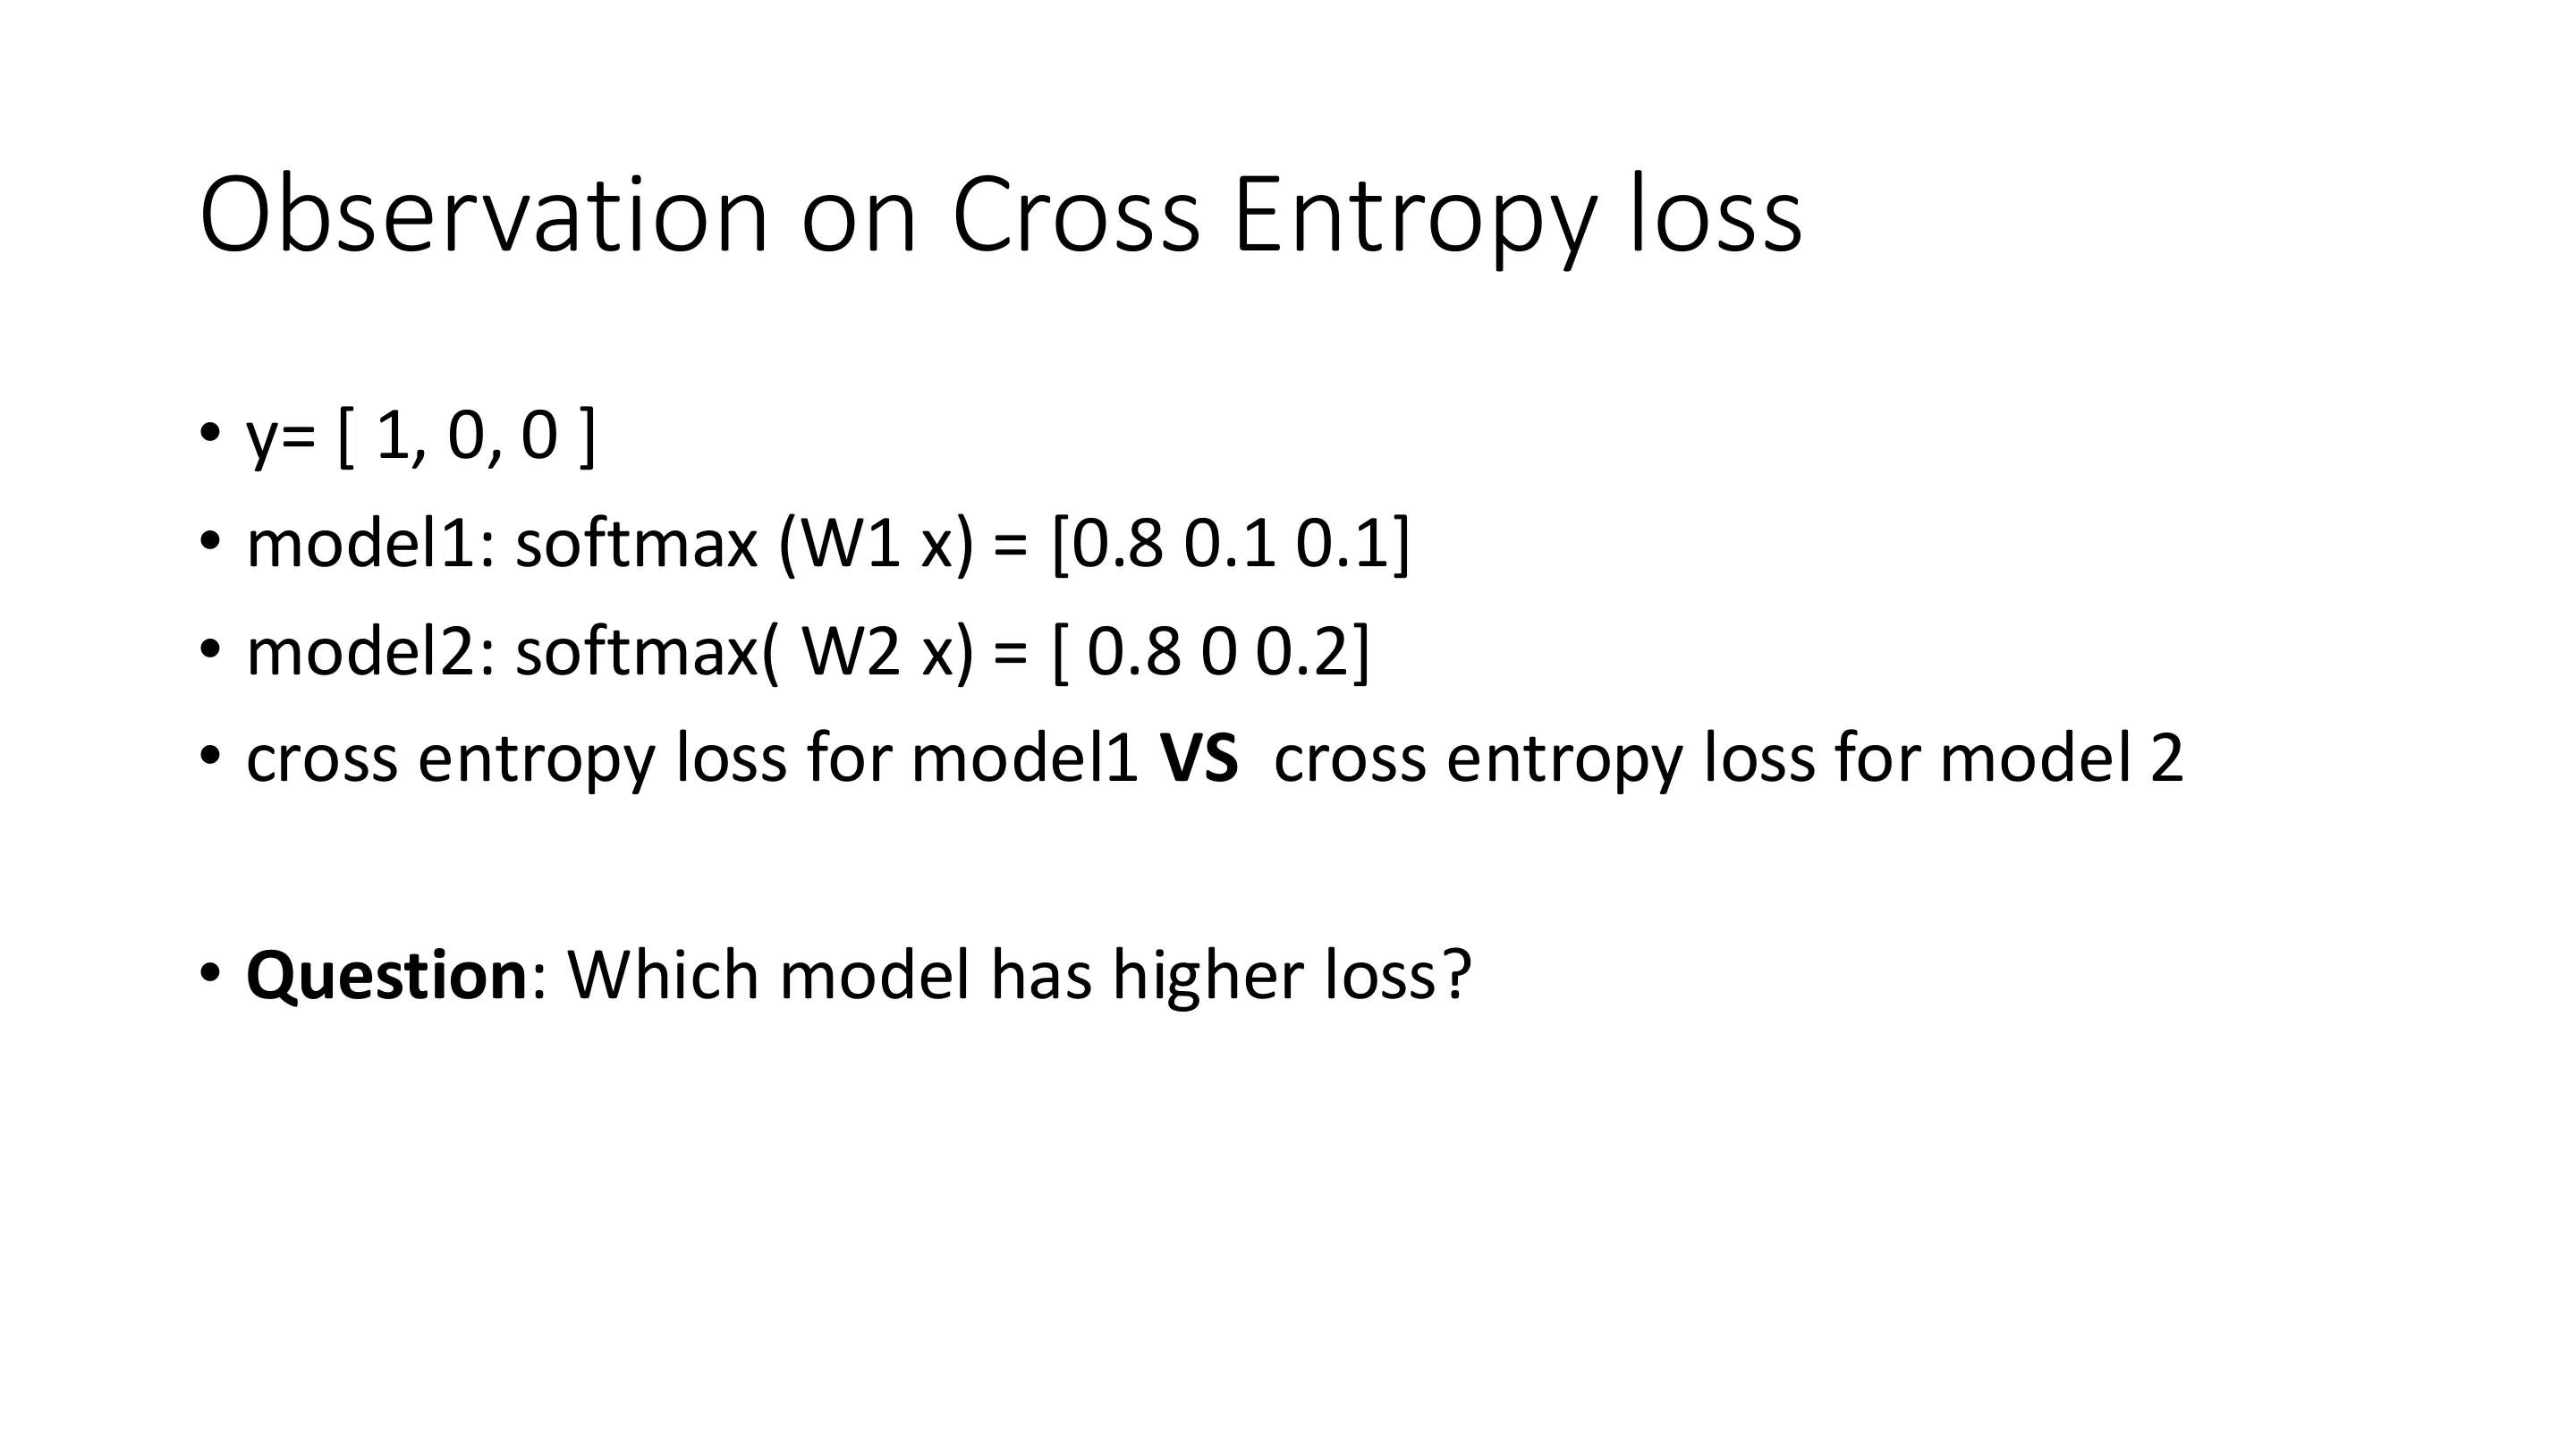
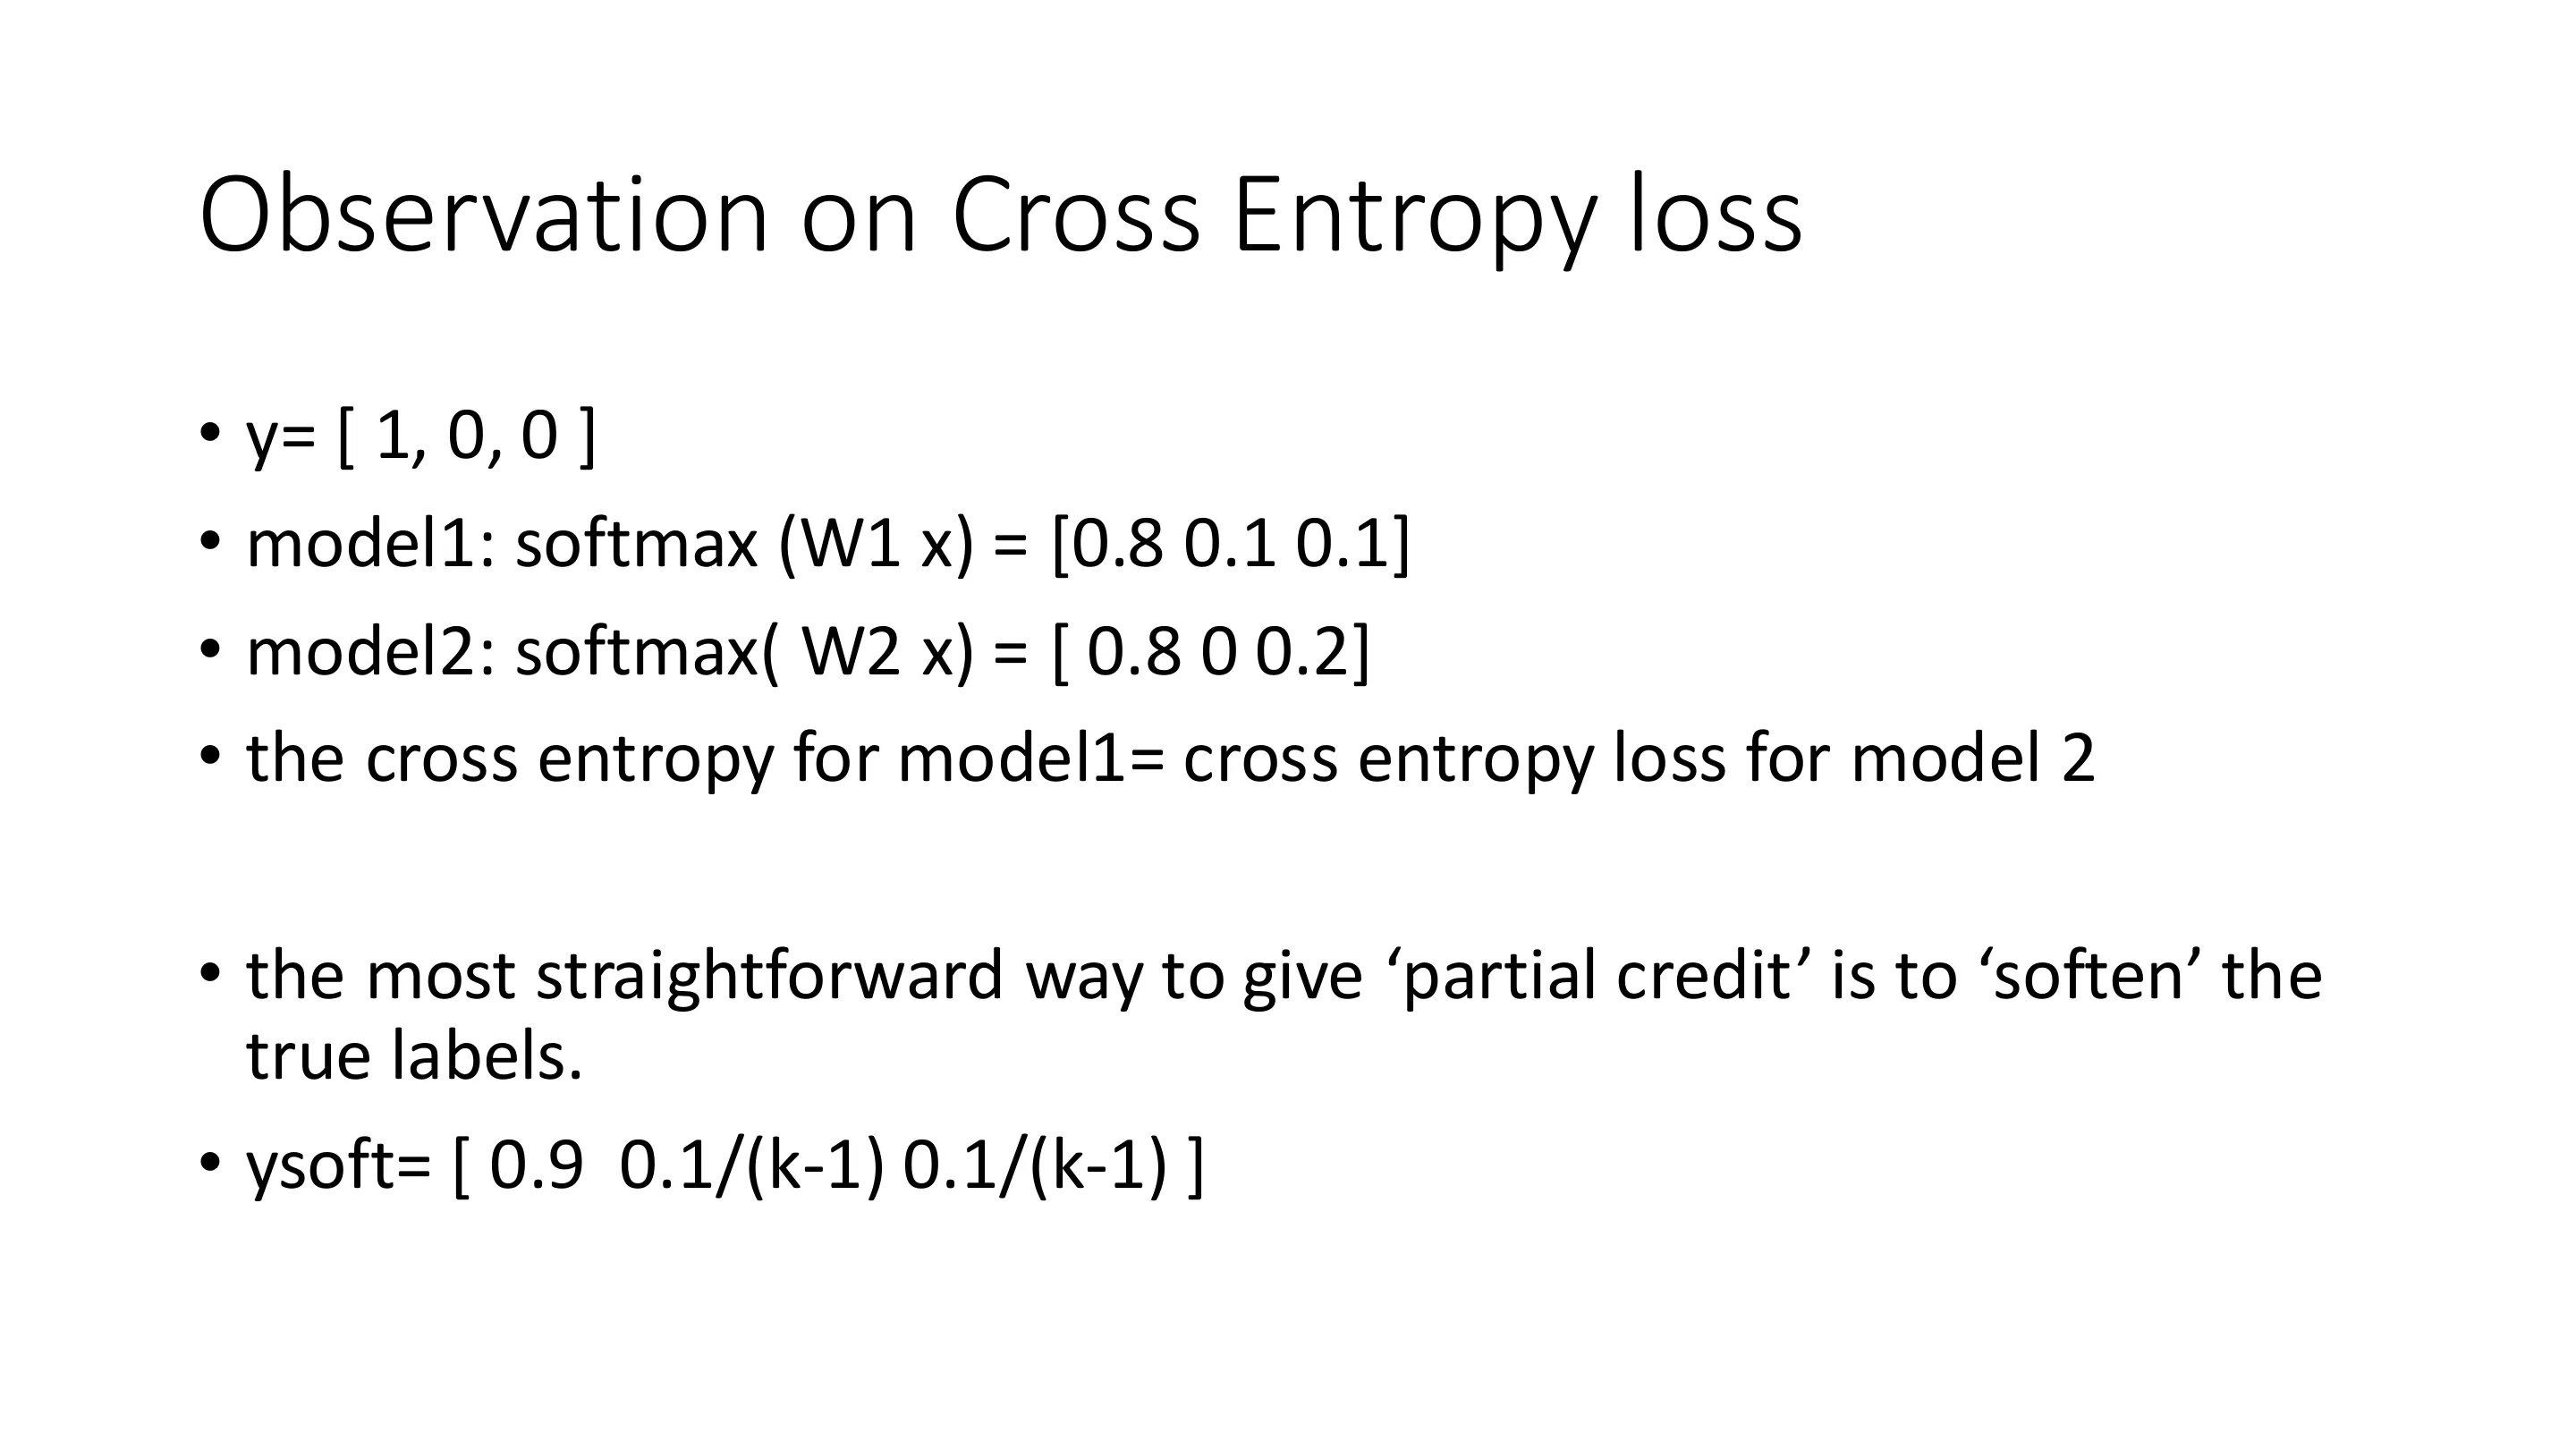
损失 = 多类交叉熵 $=-\log P(Y=y_{\text{true}}\mid x)$。
分类器把「确定性 one-hot」与「softmax 分布」的距离最小化——这就是它的全部含义。但输出的是灰色地带;要让概率变成 0/1,需要 logits 趋于 $\pm\infty$。
📷 如何做多类分类
回到原视频 (00:58:44)
📷 多类逻辑回归(一)
回到原视频 (00:59:57)
📷 多类逻辑回归(二)
回到原视频 (01:01:10)
📷 MNIST 数据集
回到原视频 (01:02:23)
📷 CIFAR10 数据集(一)
回到原视频 (01:03:36)
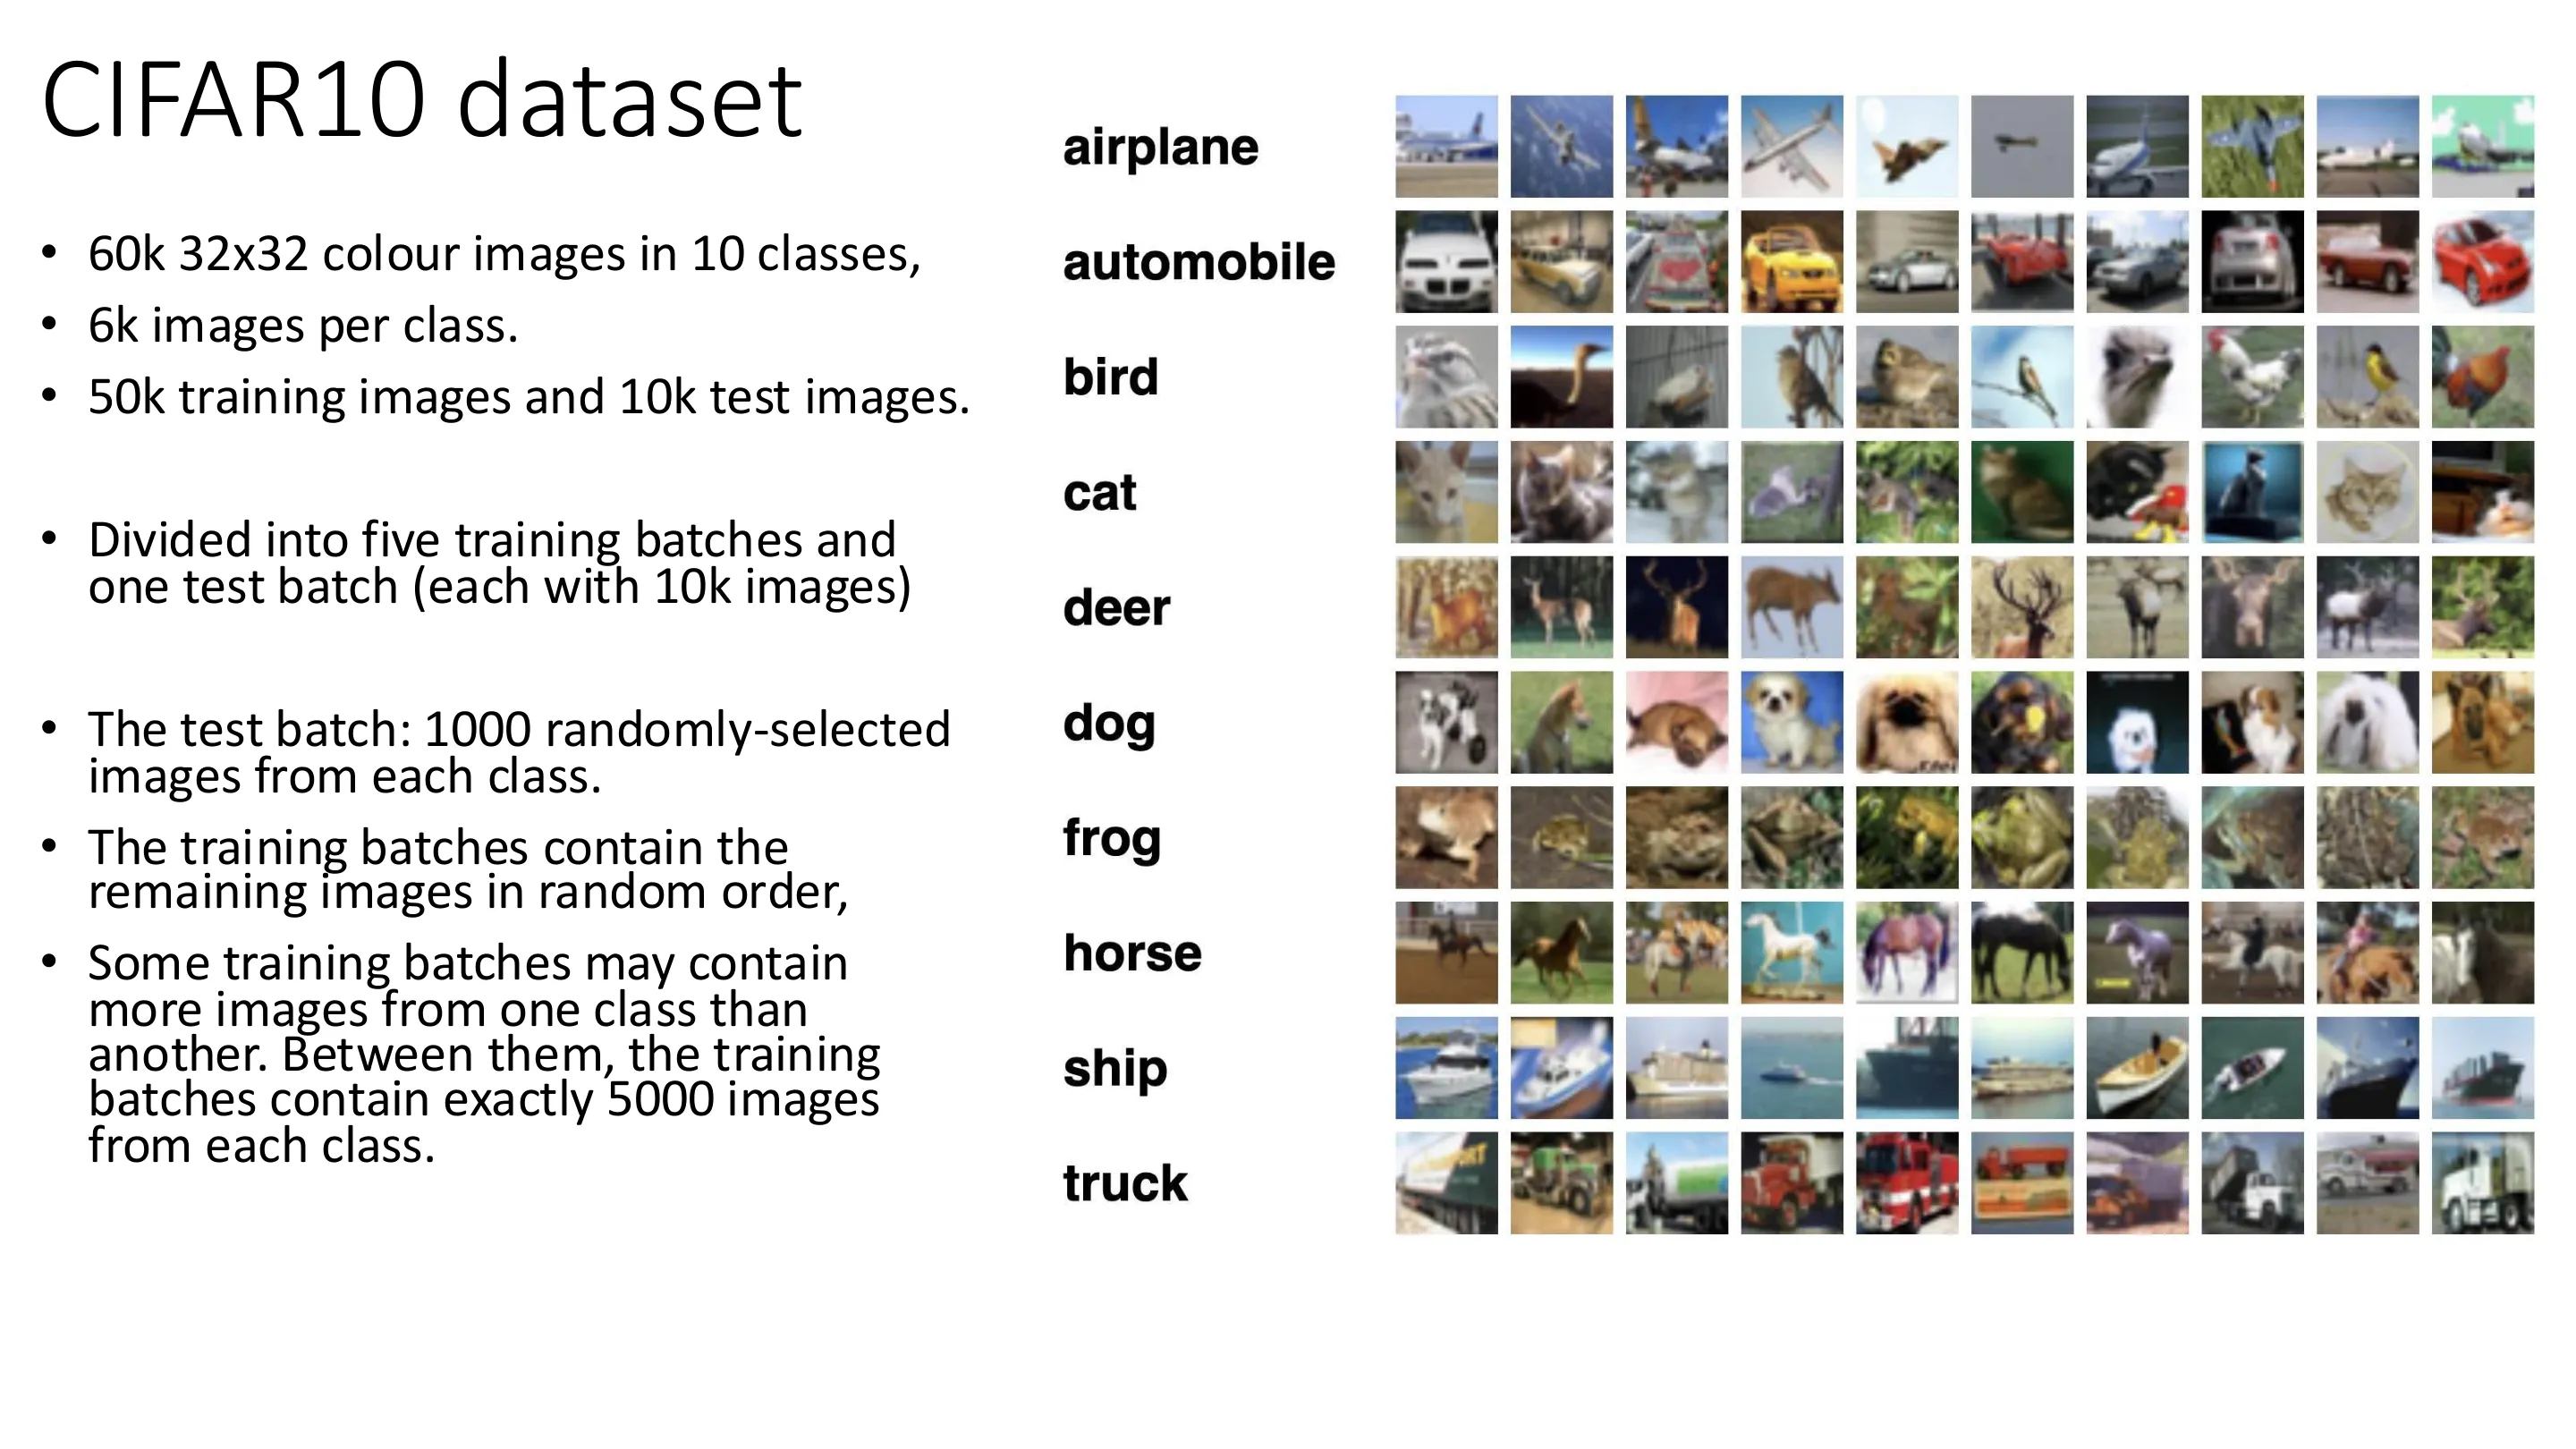
📷 CIFAR10 数据集(二)
回到原视频 (01:04:49)
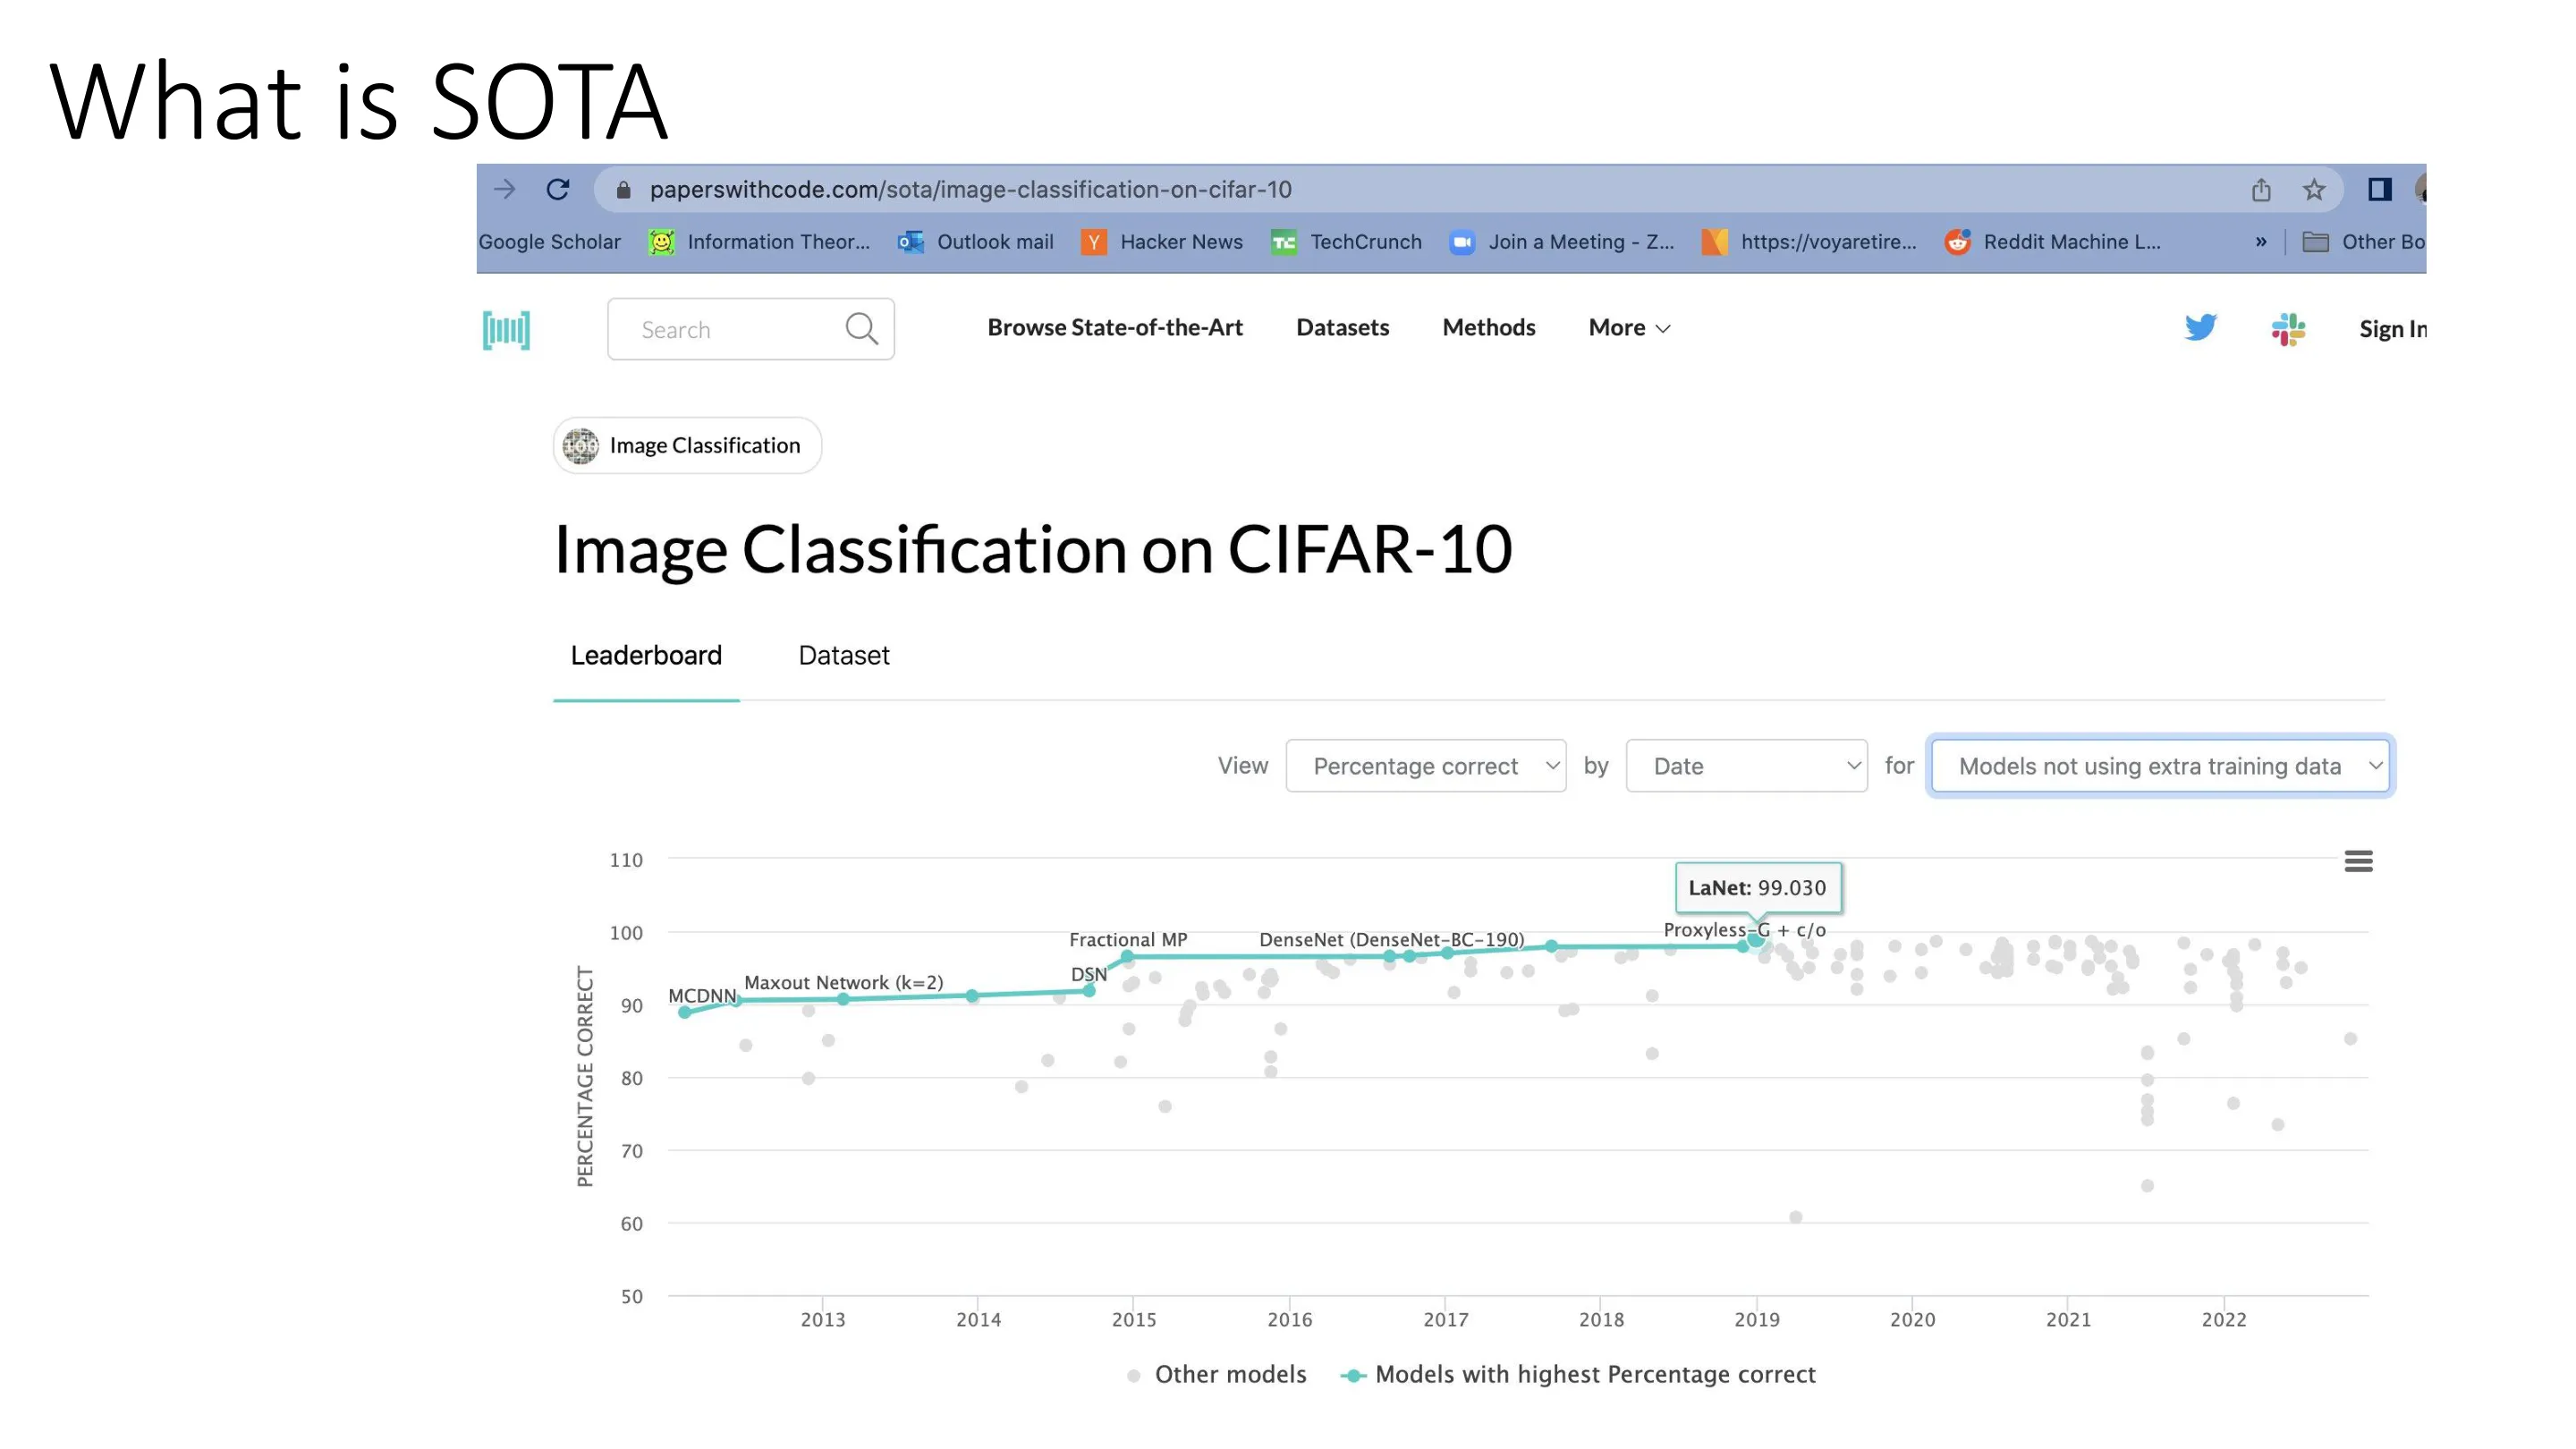
📷 什么是 SOTA
回到原视频 (01:06:02)
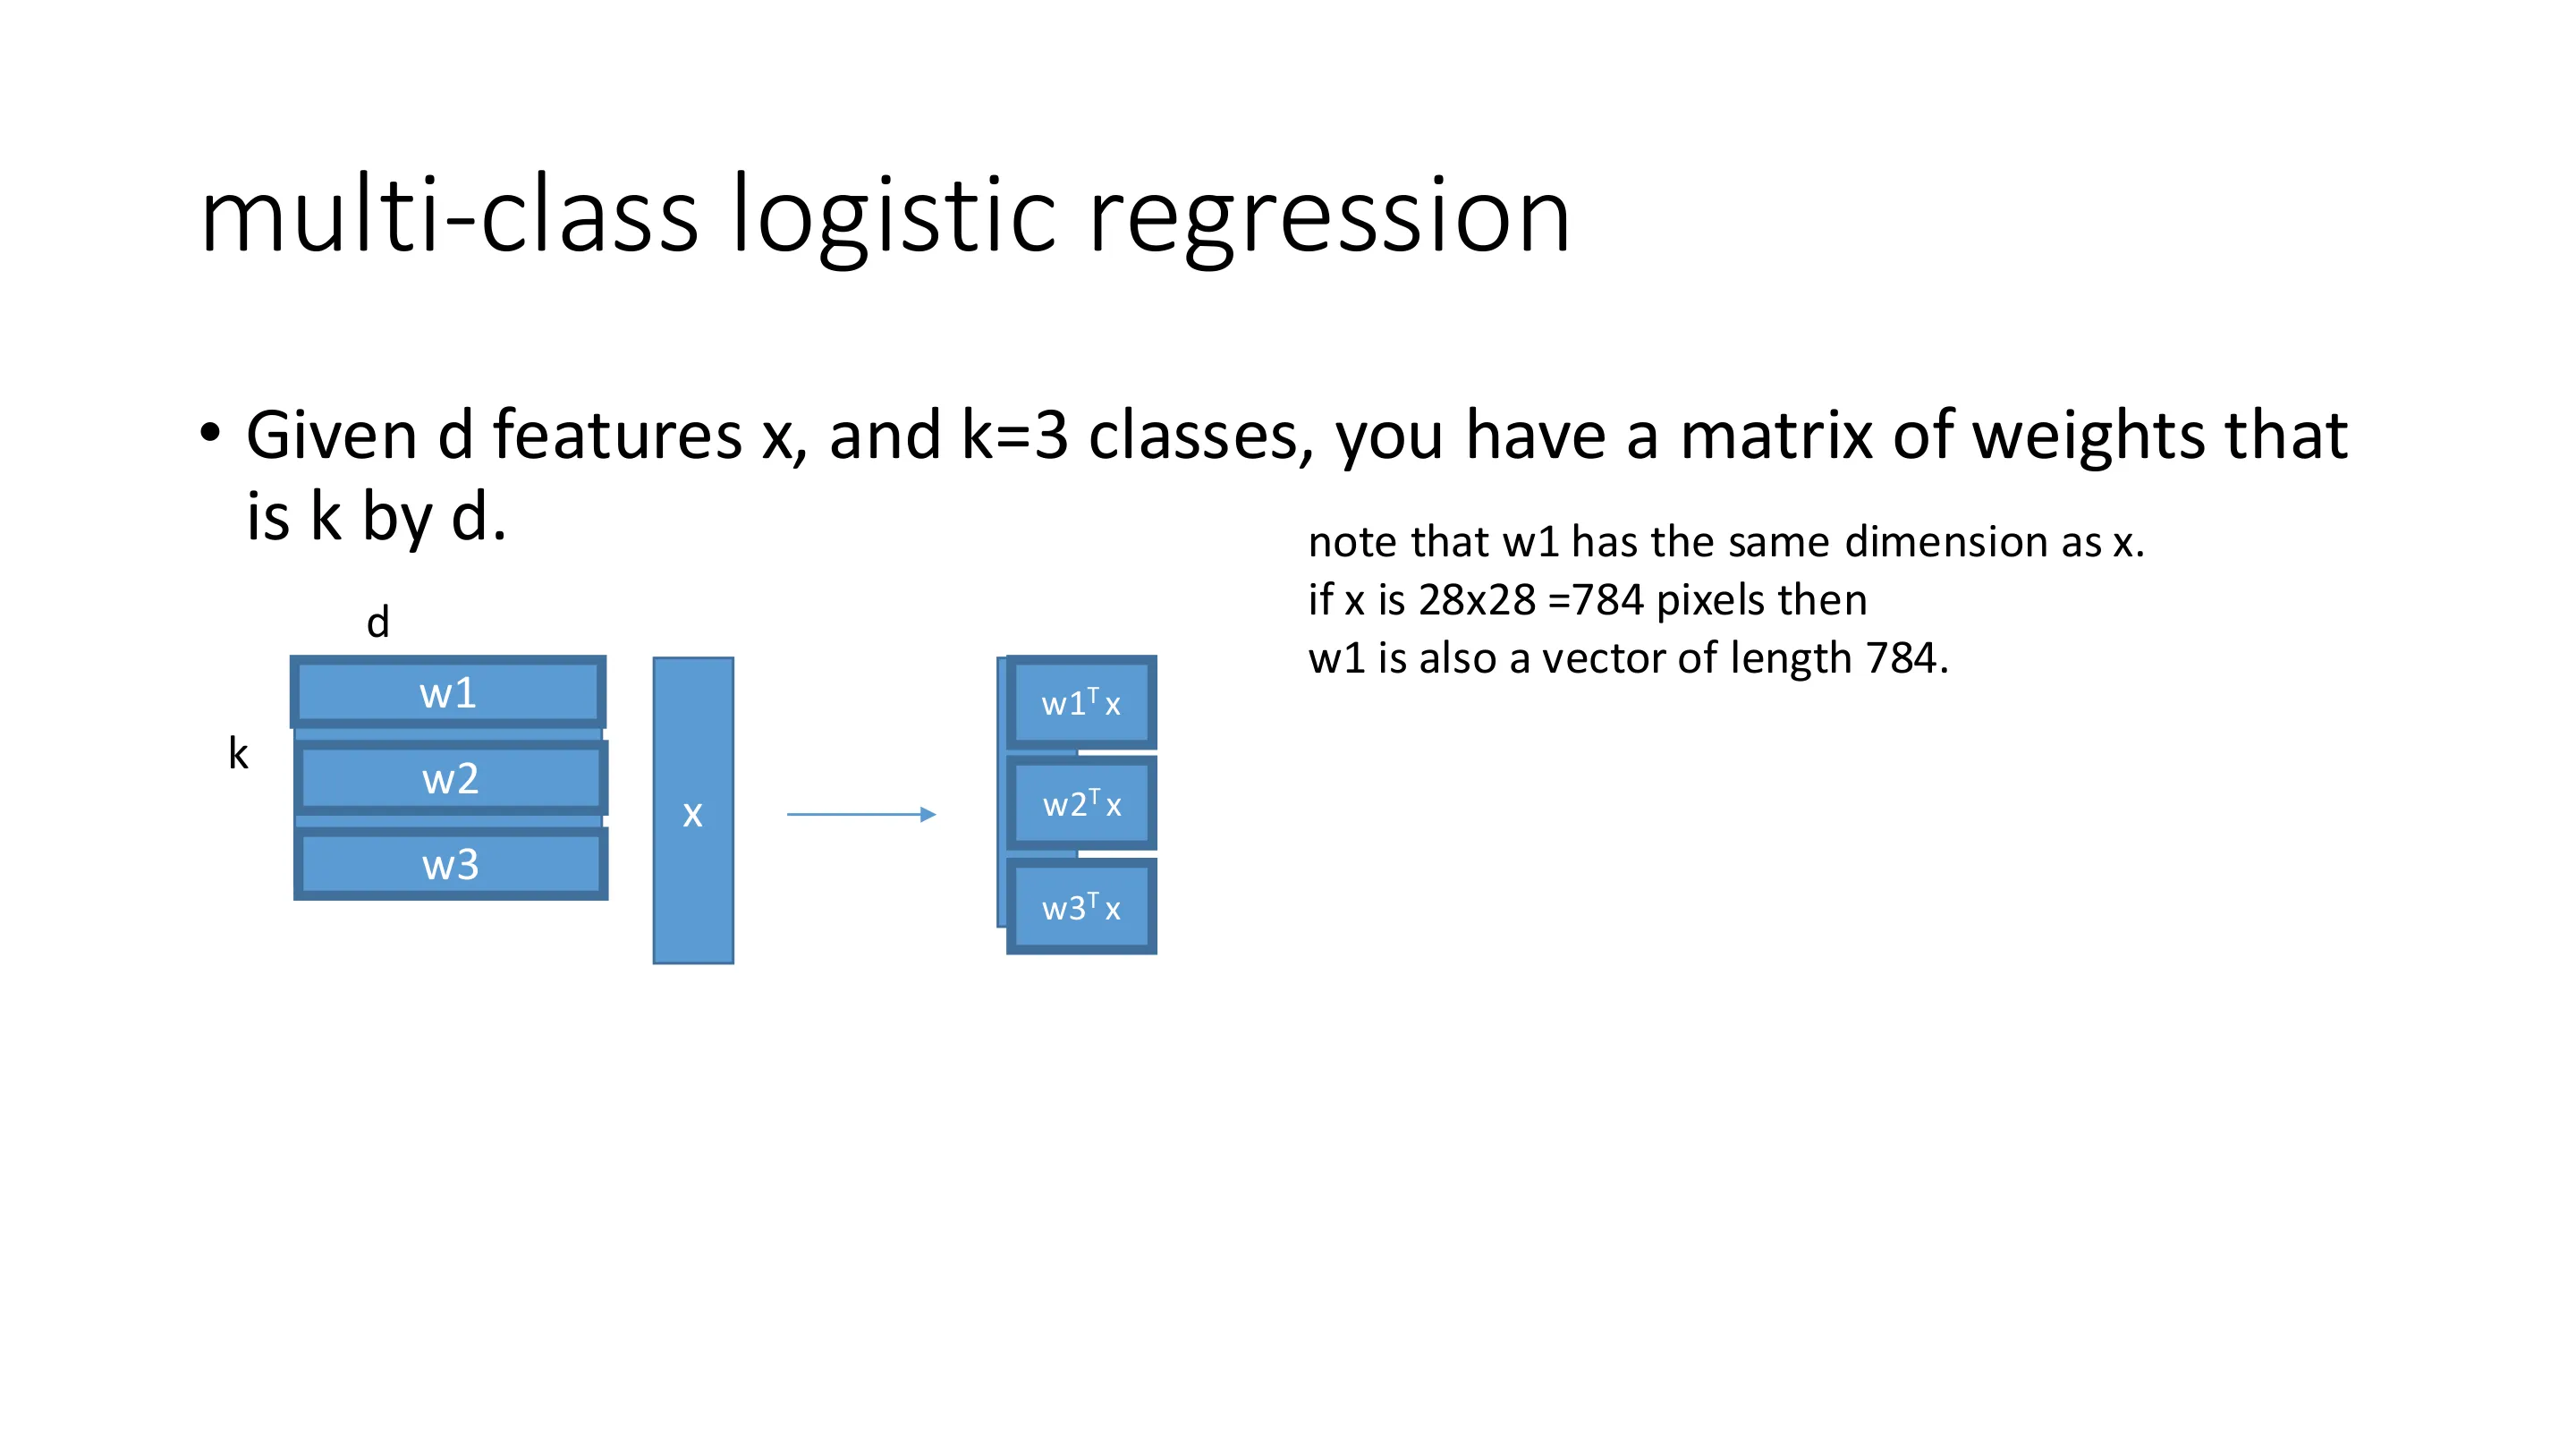
📷 多类逻辑回归(三)
回到原视频 (01:07:15)
📷 多类逻辑回归:交叉熵损失
回到原视频 (01:08:28)
📷 关于交叉熵损失的观察(一)
回到原视频 (01:09:41)
📷 关于交叉熵损失的观察(二)
回到原视频 (01:10:54)
4.2 可视化权重
(参考时间: 01:01)
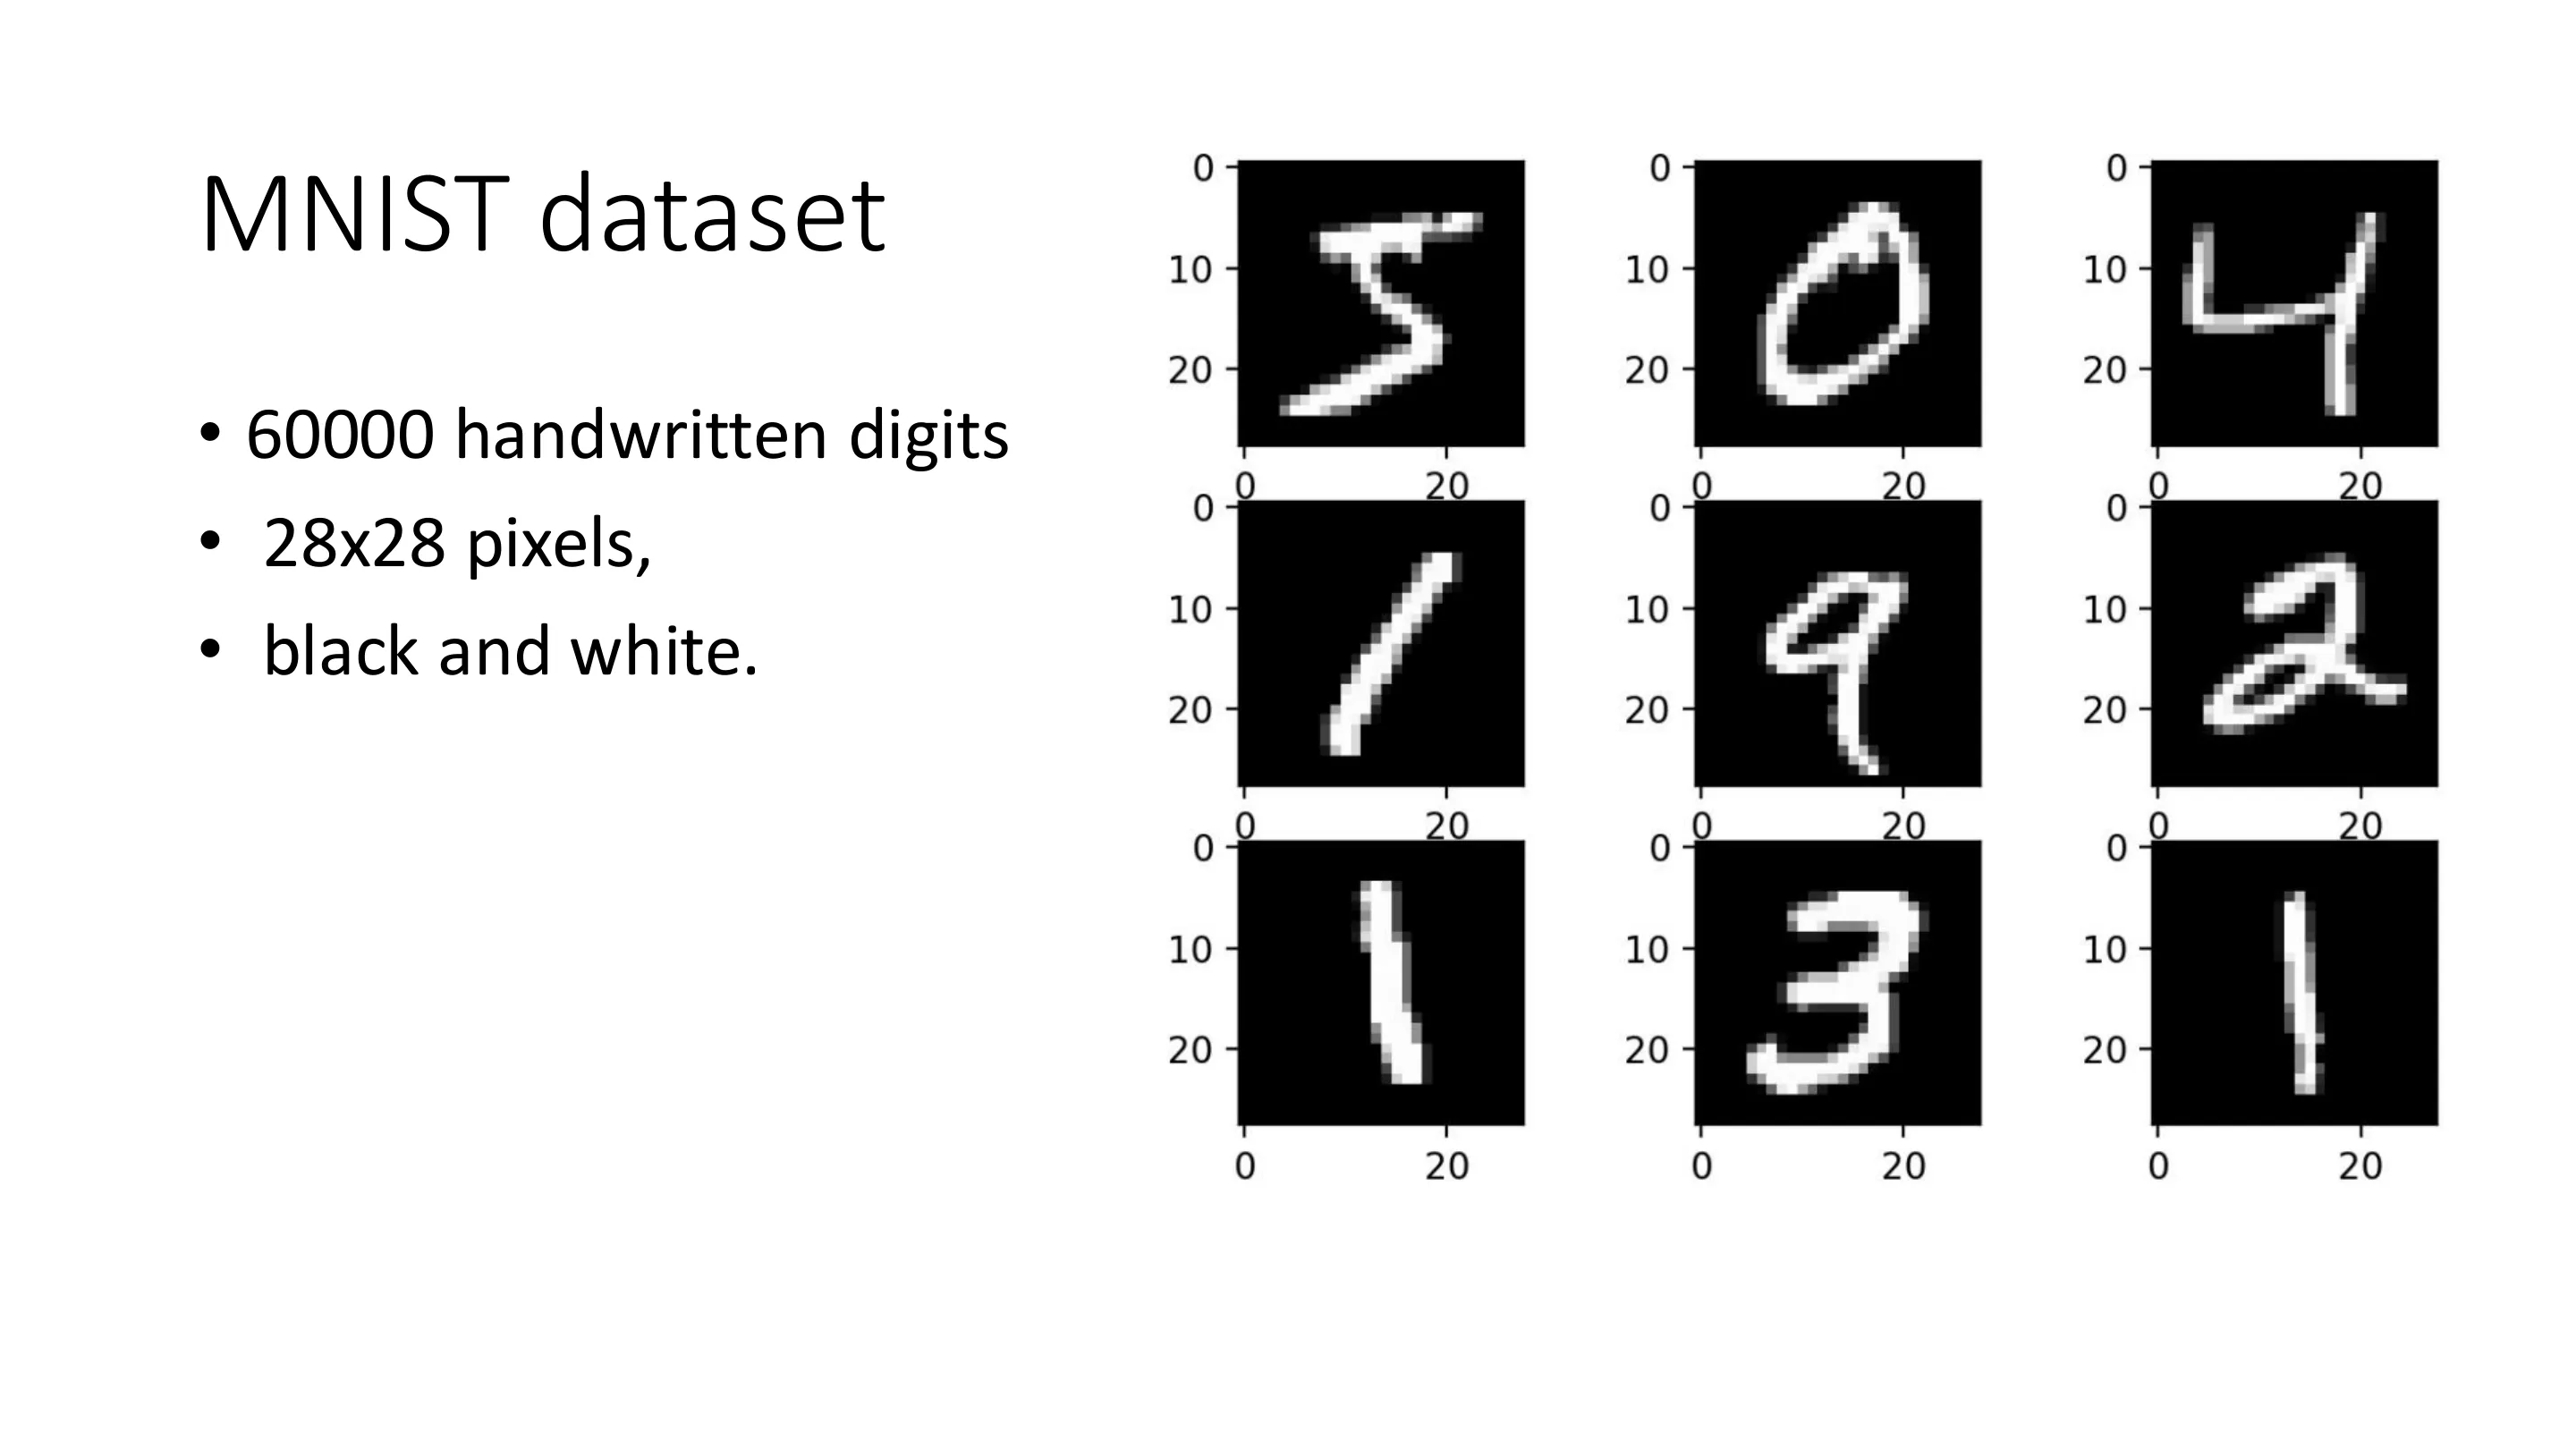
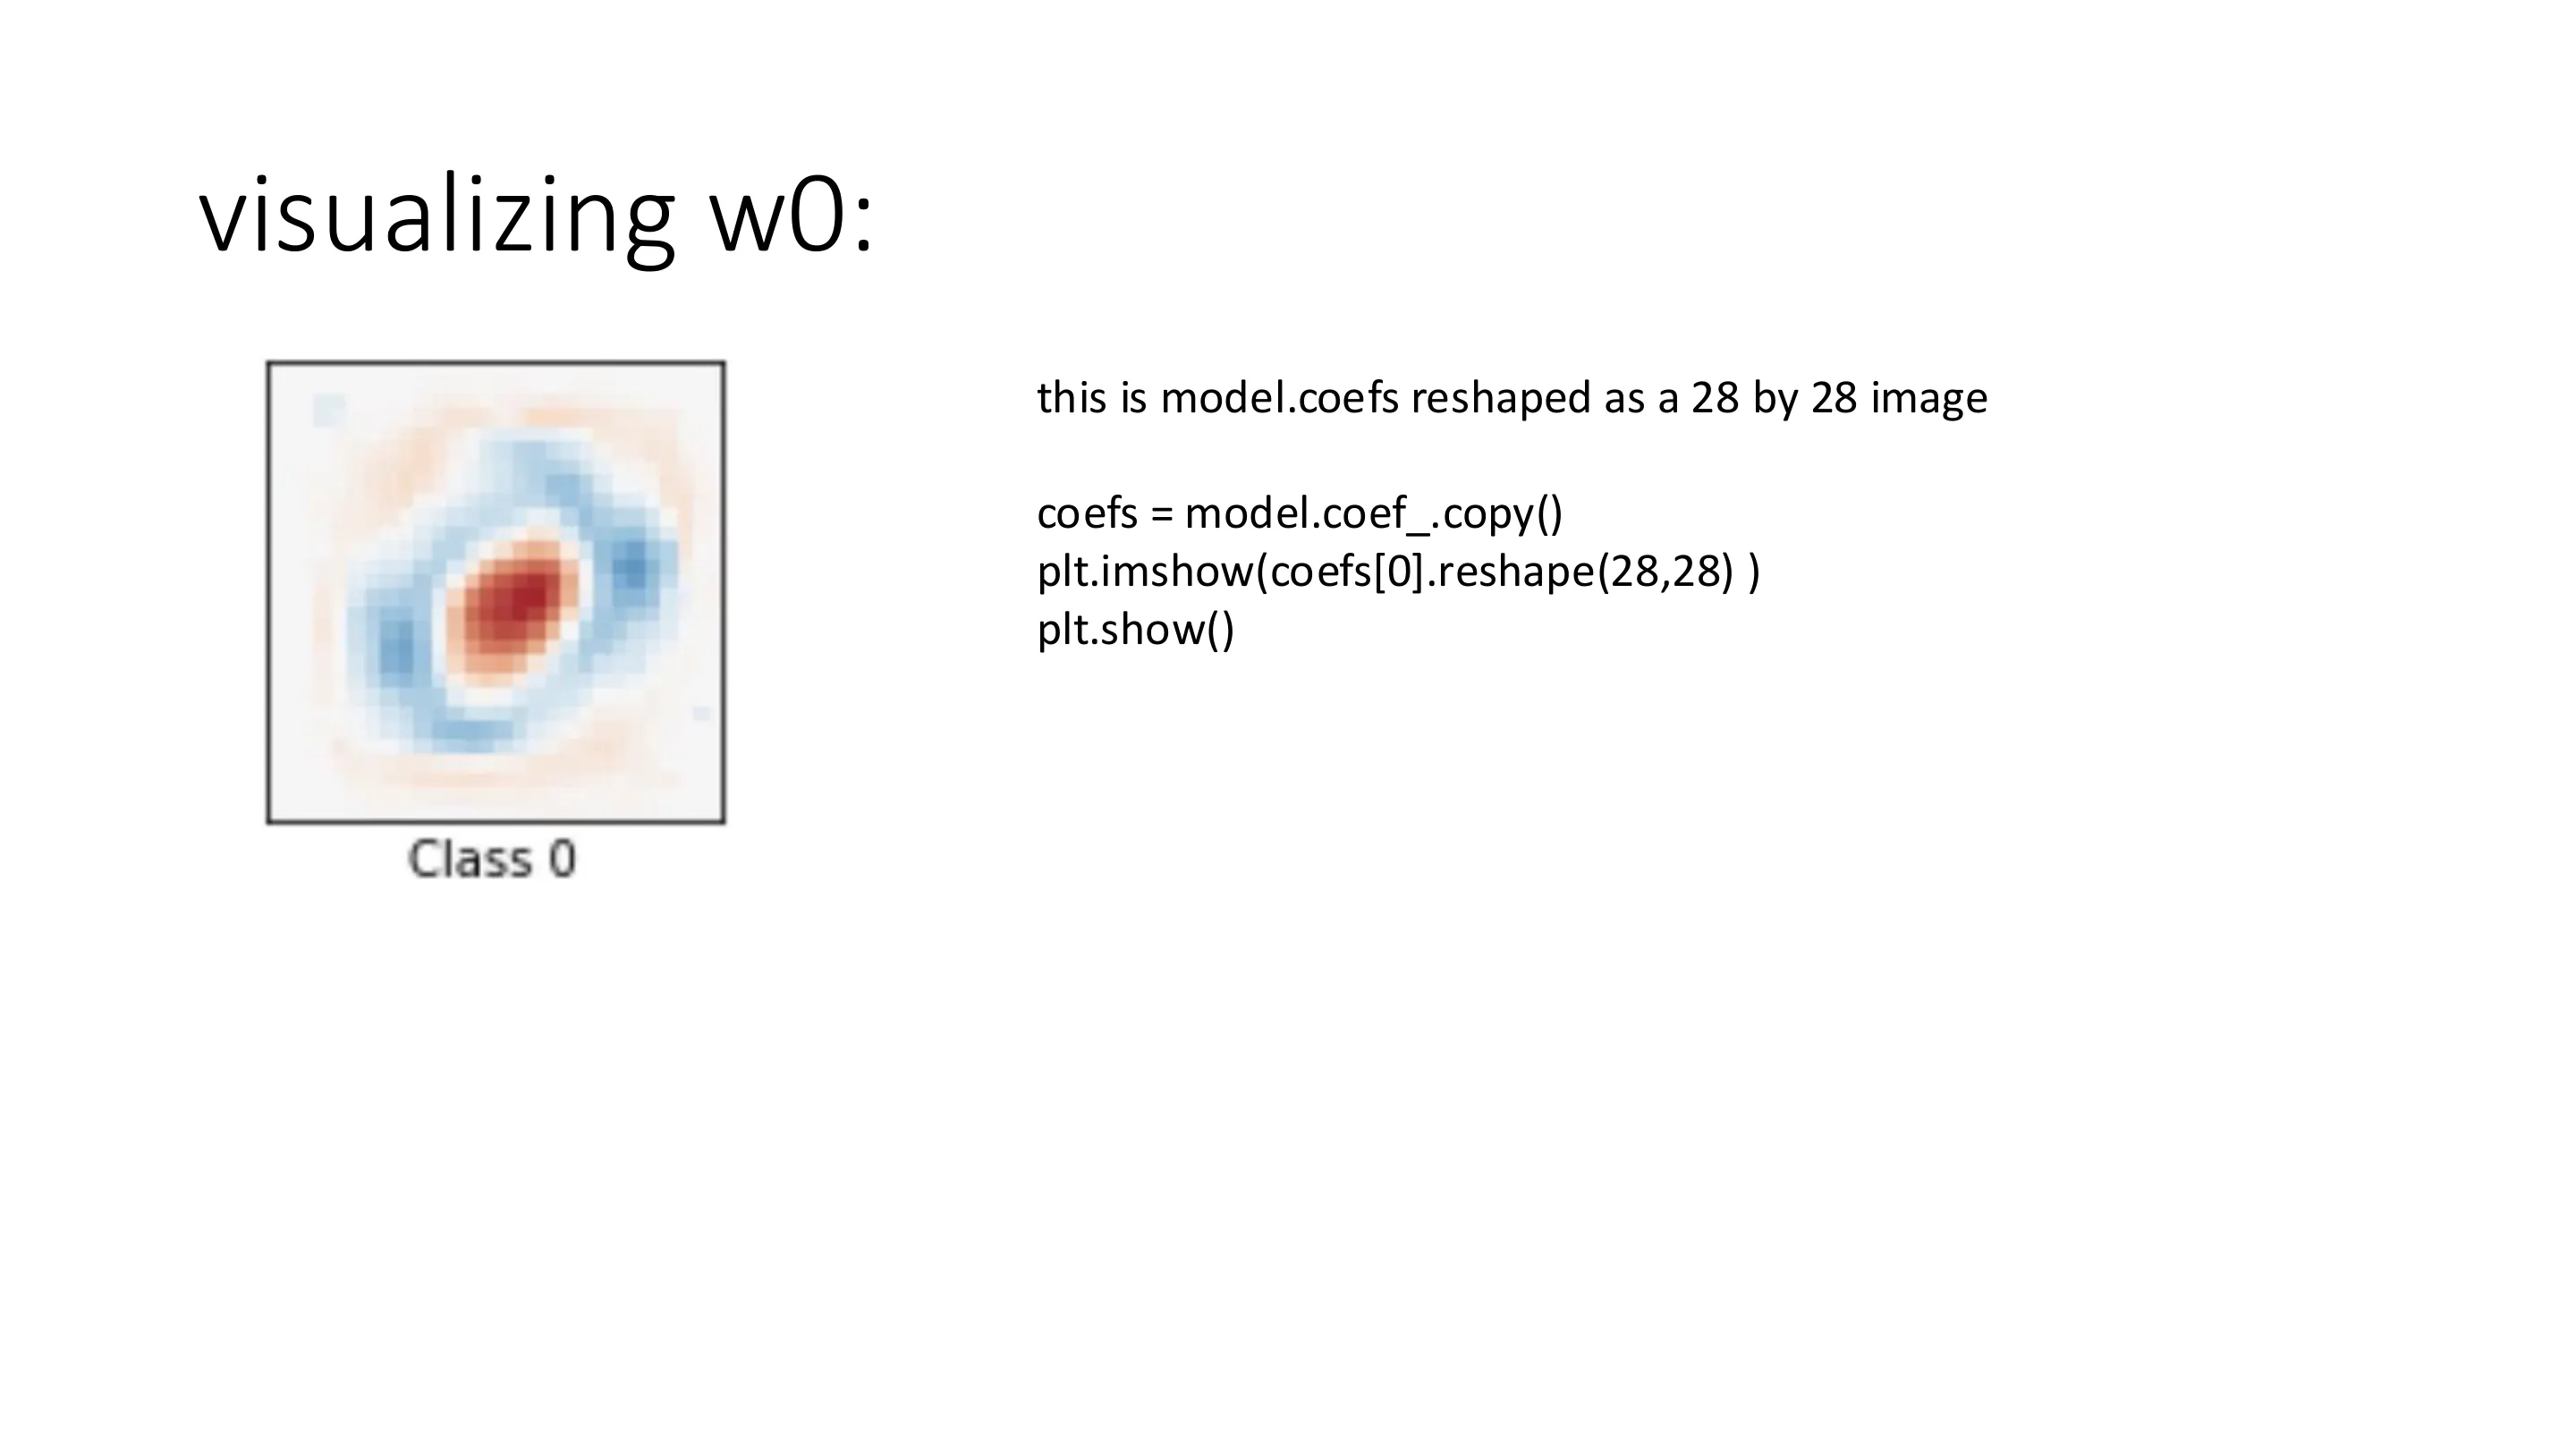
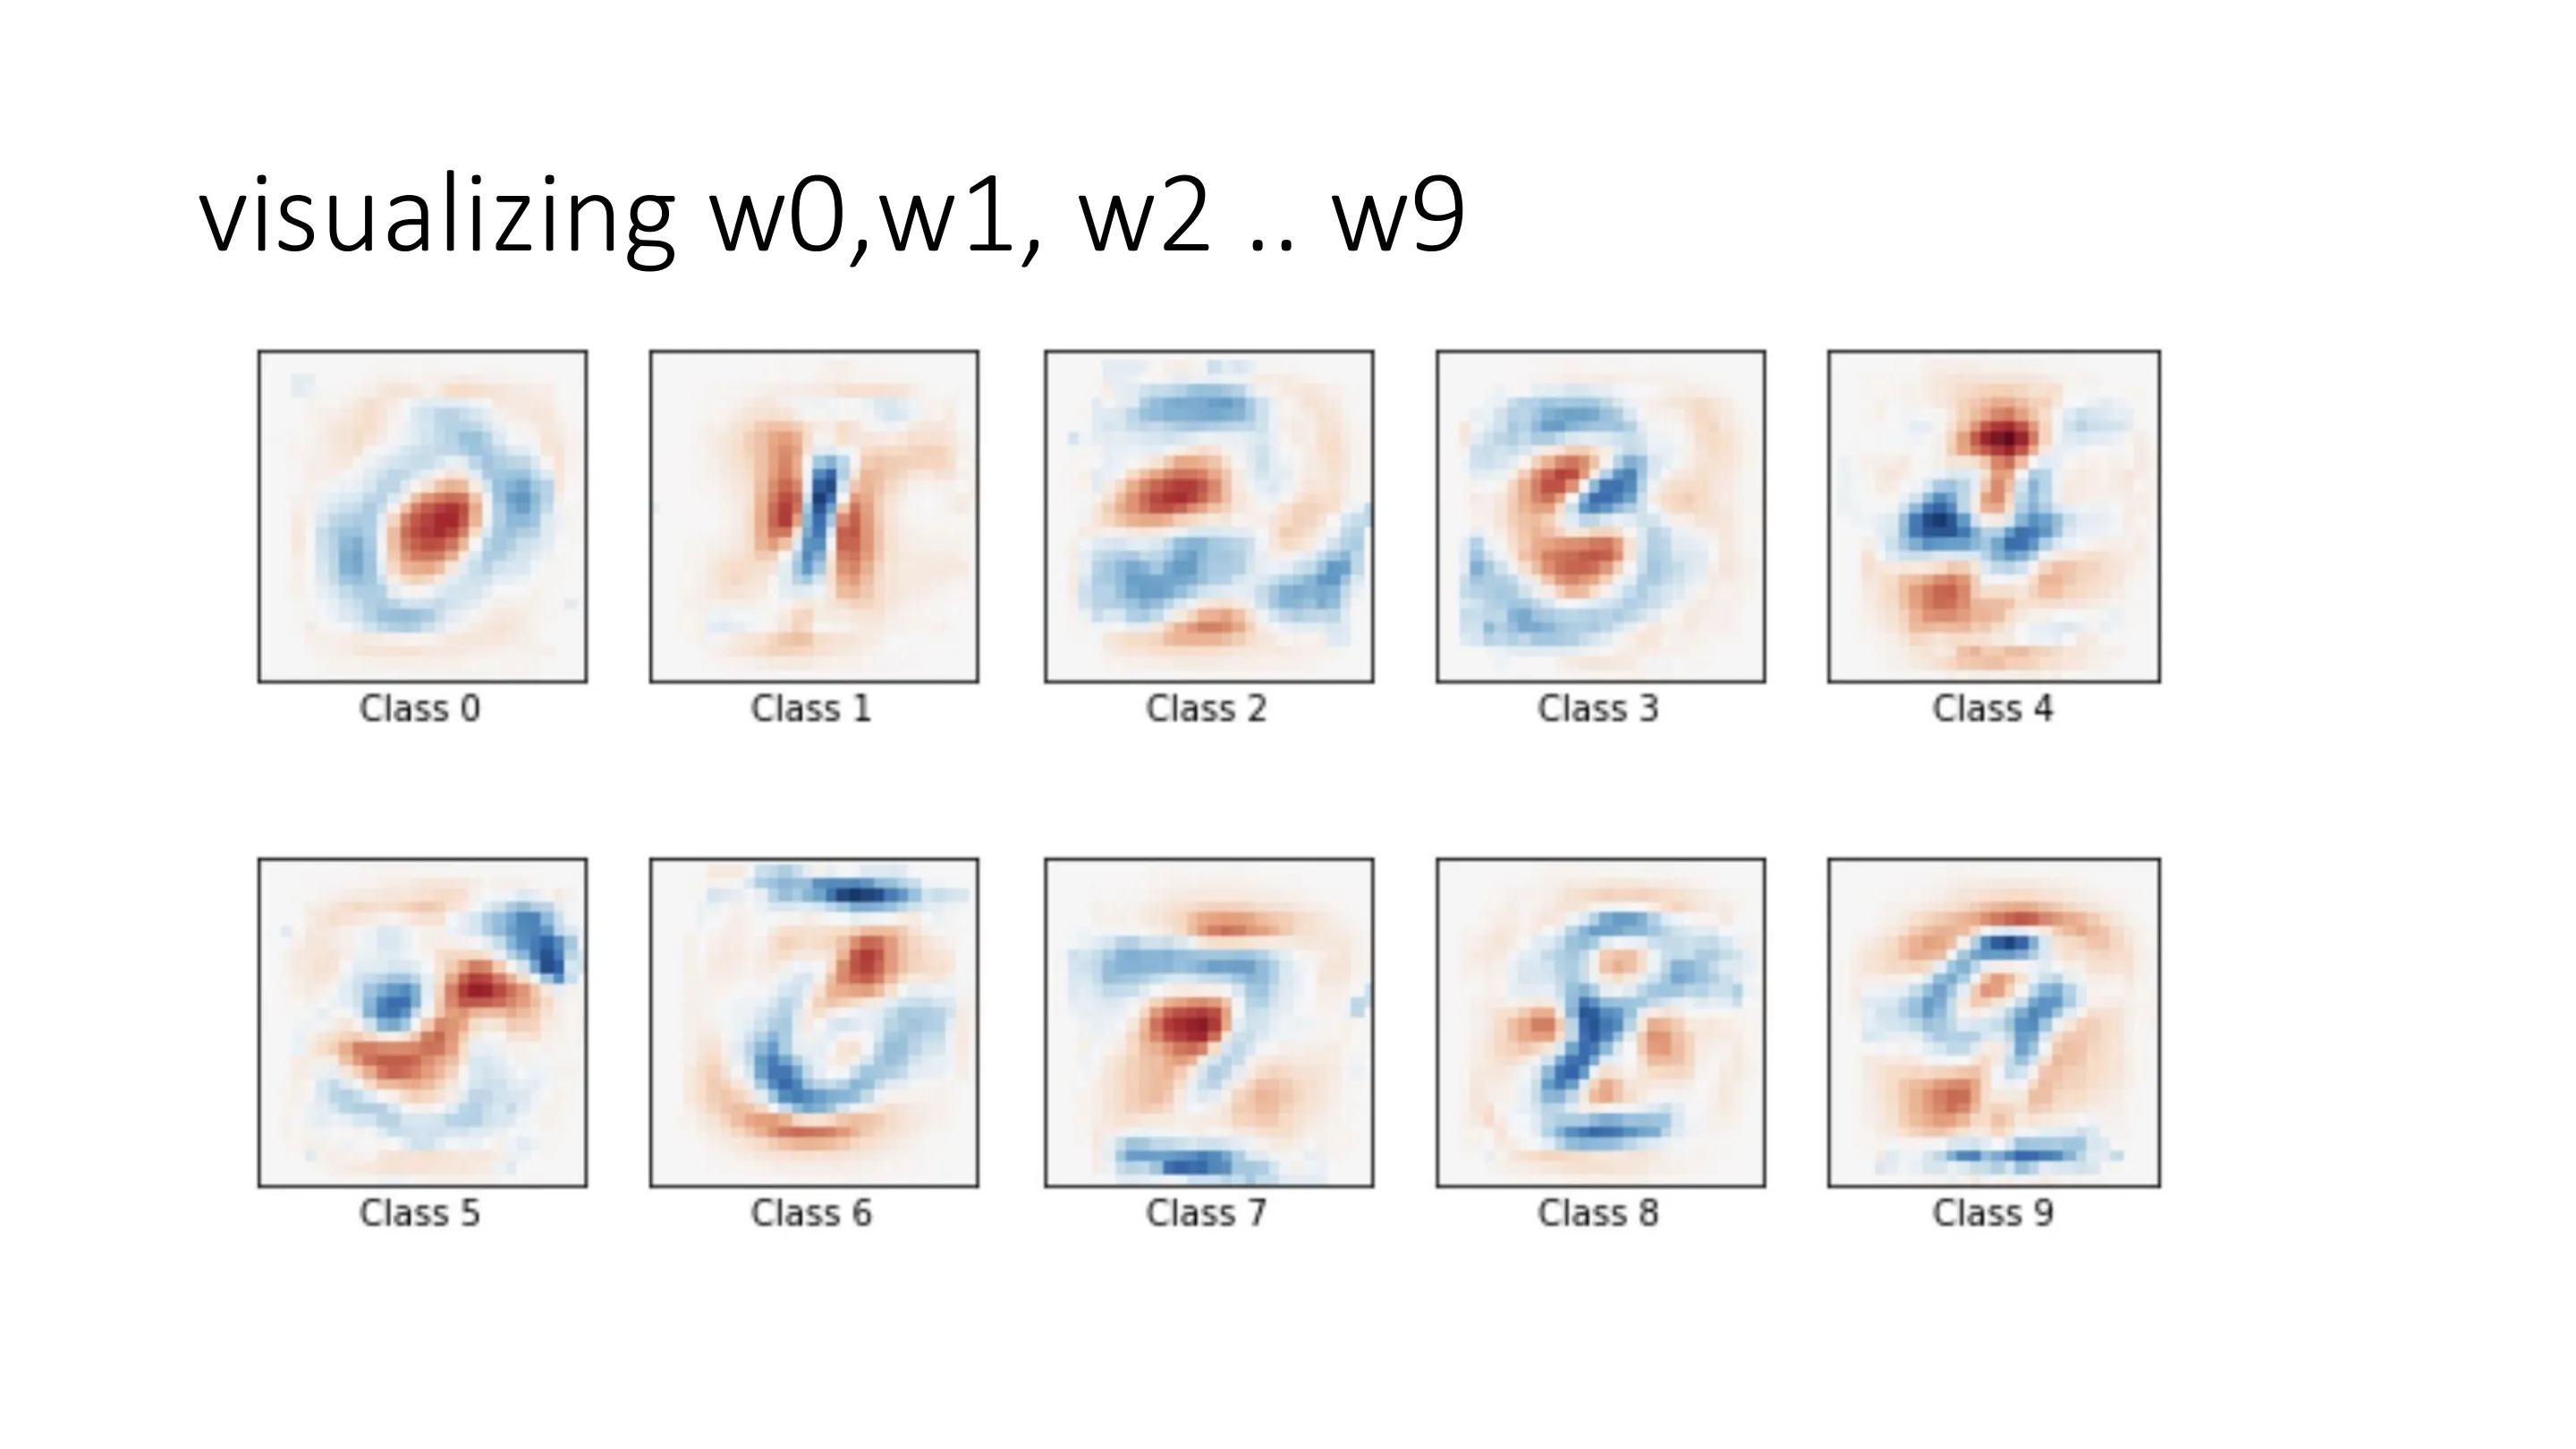
在 MNIST 上训练 softmax 逻辑回归后,把每个类别的 $w_k$ reshape 成 $28\times28$ 图像:
- $w_0$(数字「0」)看起来就像一个 0;
- 内积 = 把图像与这个「模板」做匹配:像 0 的像素给正分,中心多出的点(甜甜圈洞)给负分。
- 这是可解释性 / 表征学习的起点:深层网络里,中间层会学到边缘、曲率,乃至眼睛/耳朵检测器。
📷 可视化 w0
回到原视频 (01:12:07)
📷 可视化 w0, w1, ..., w9
回到原视频 (01:13:20)
📷 趣味环节
回到原视频 (01:14:33)
五、附:香农的文本生成
(参考时间: 01:03)
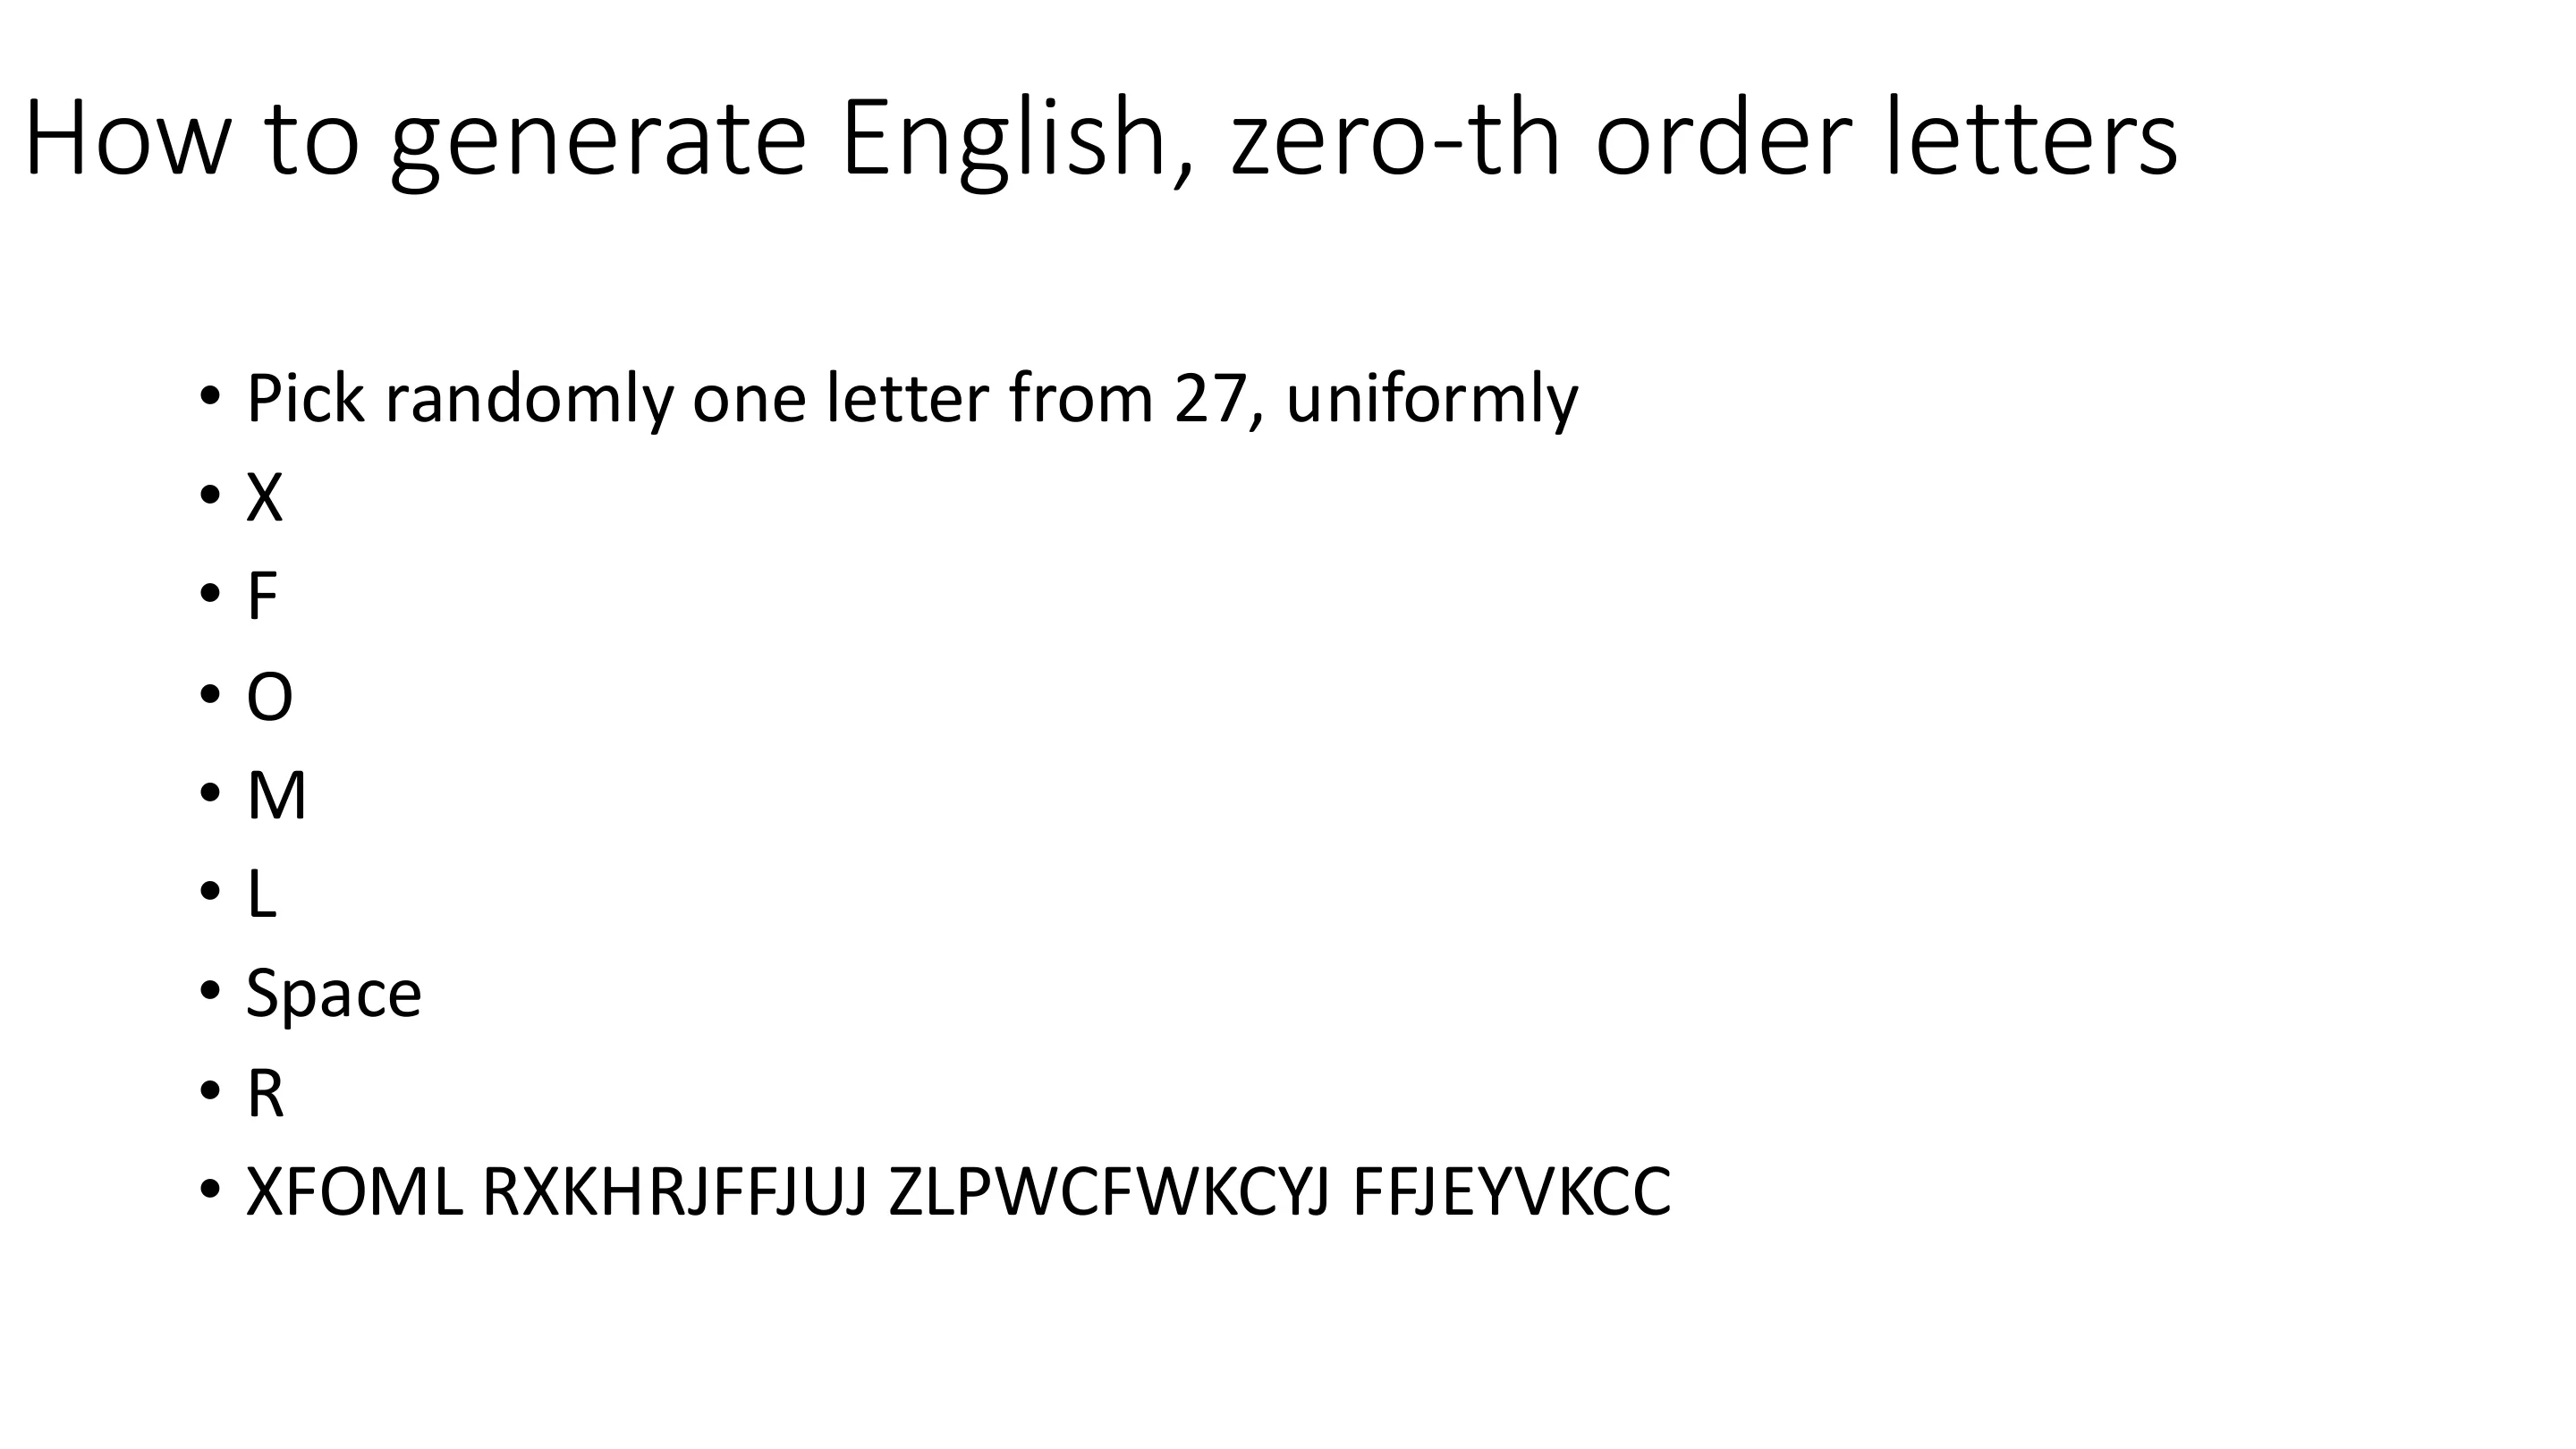
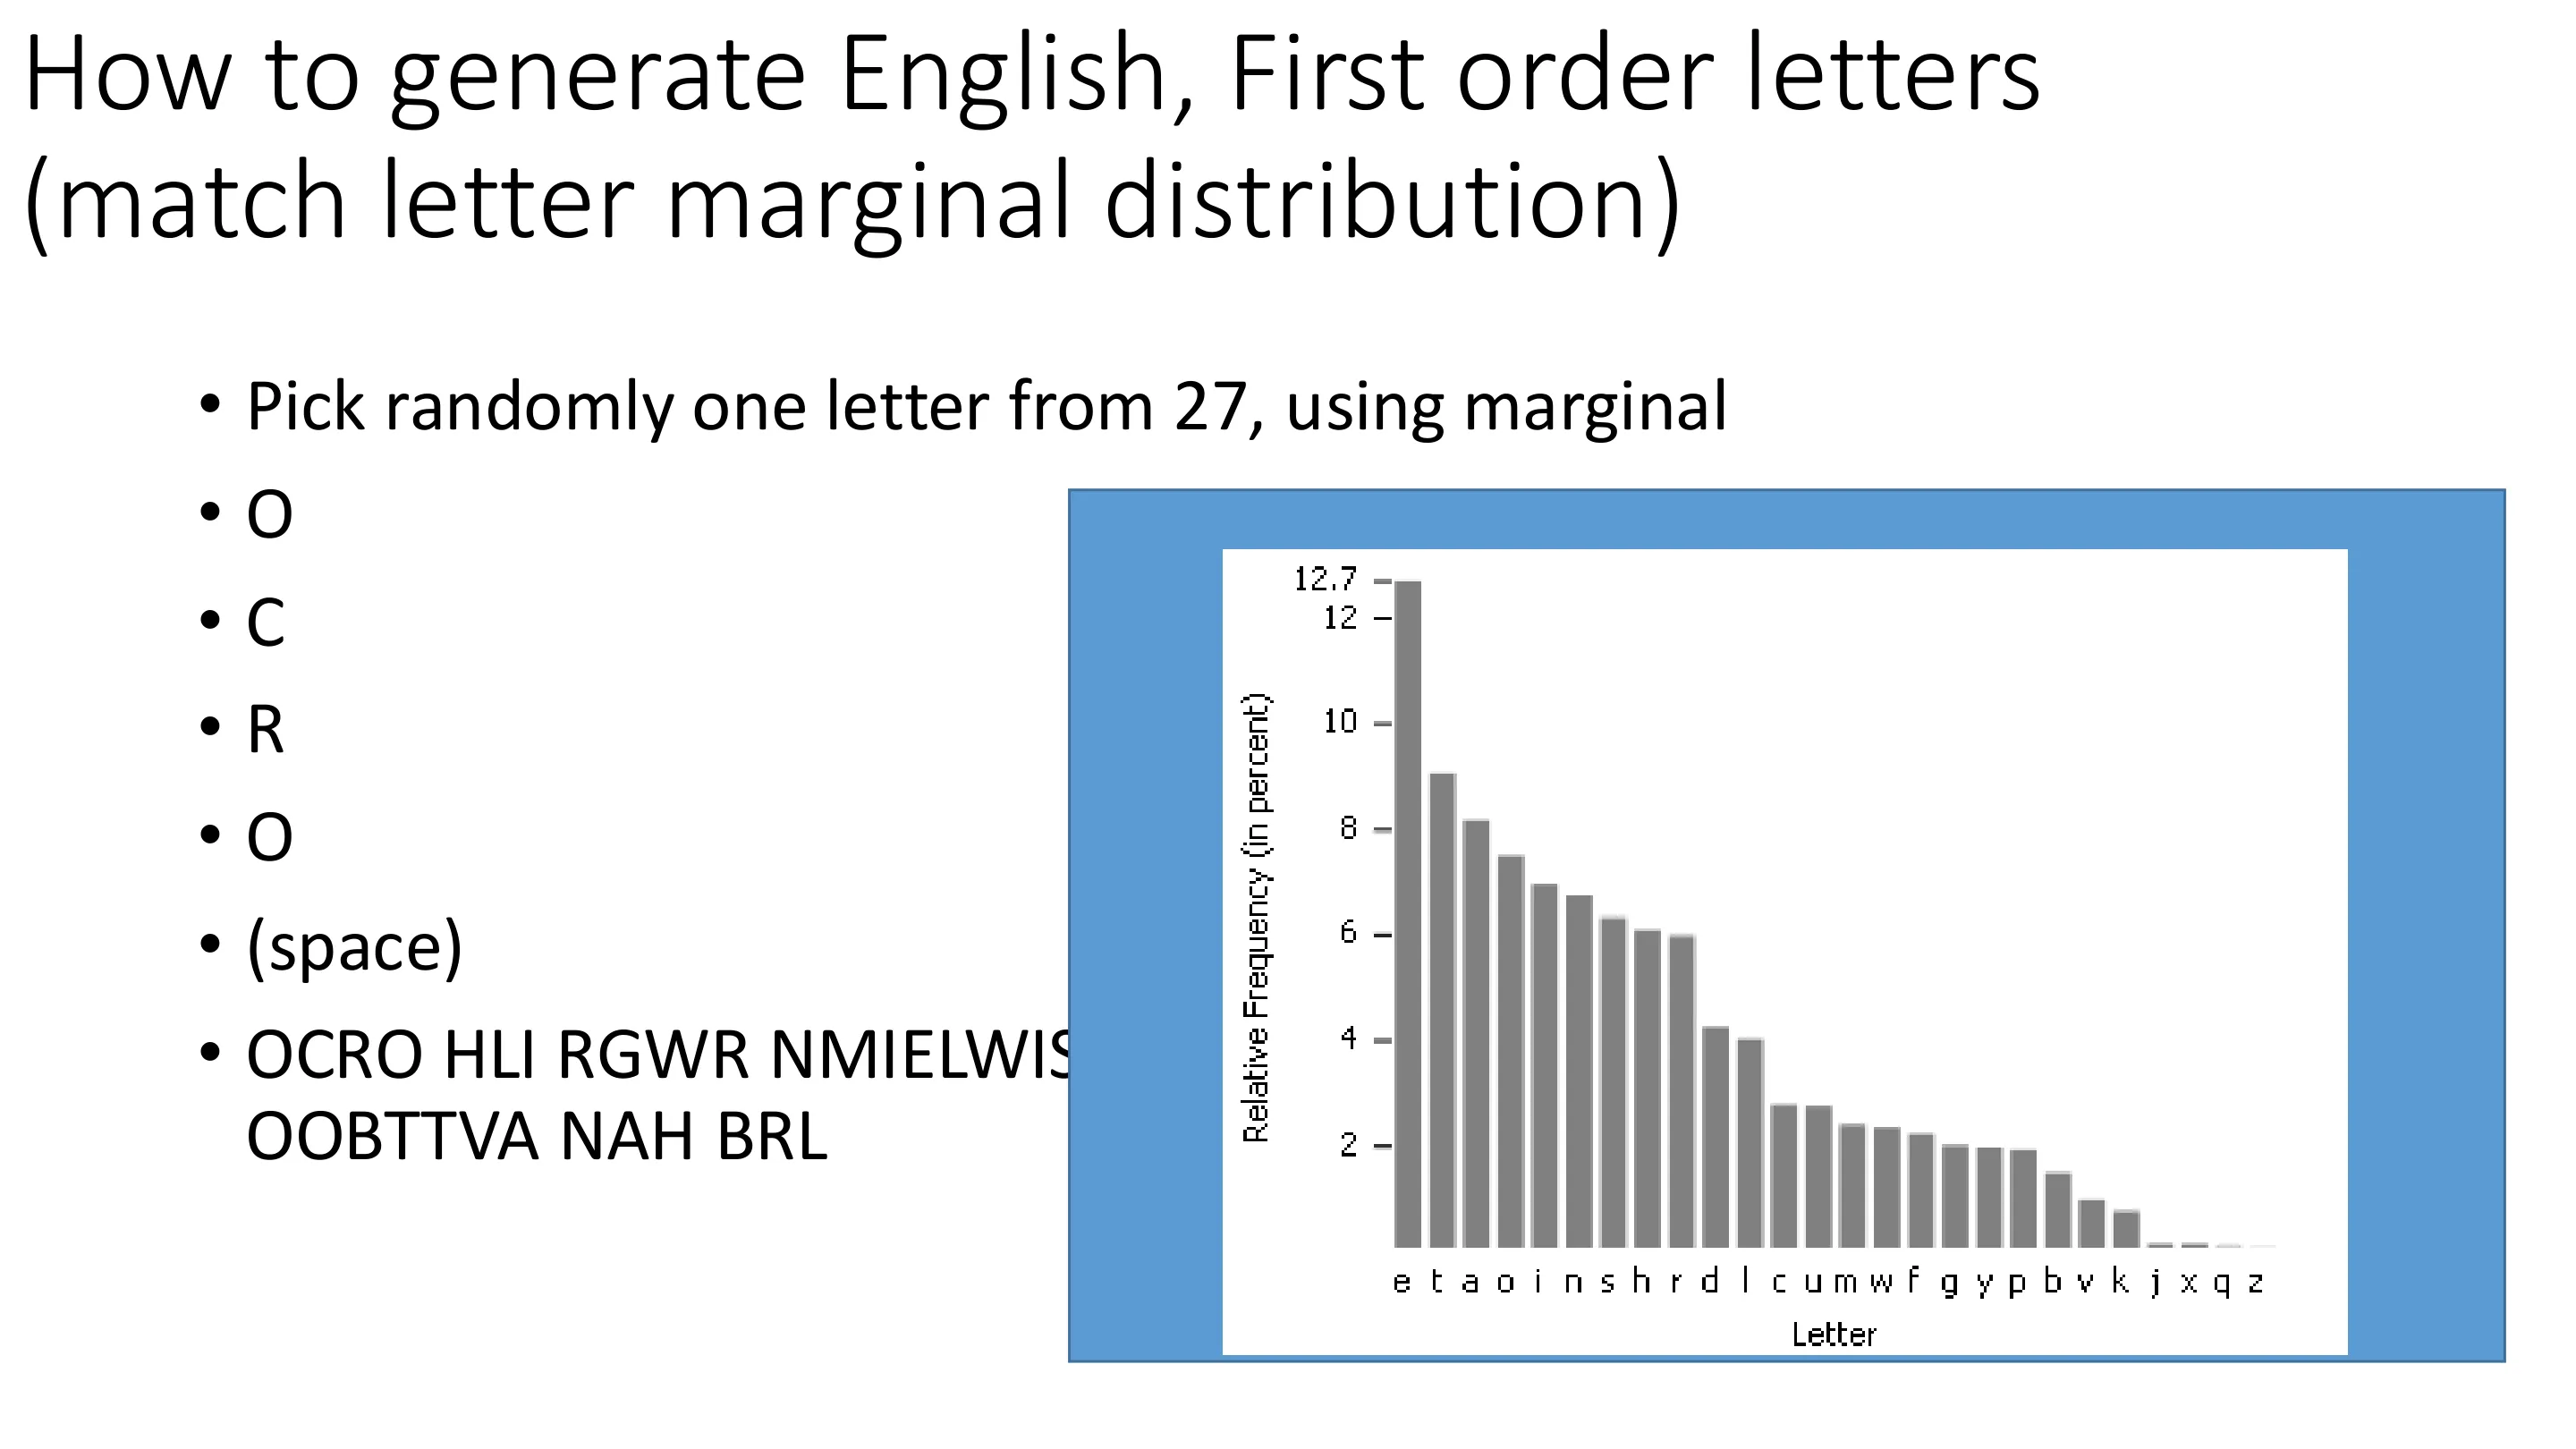
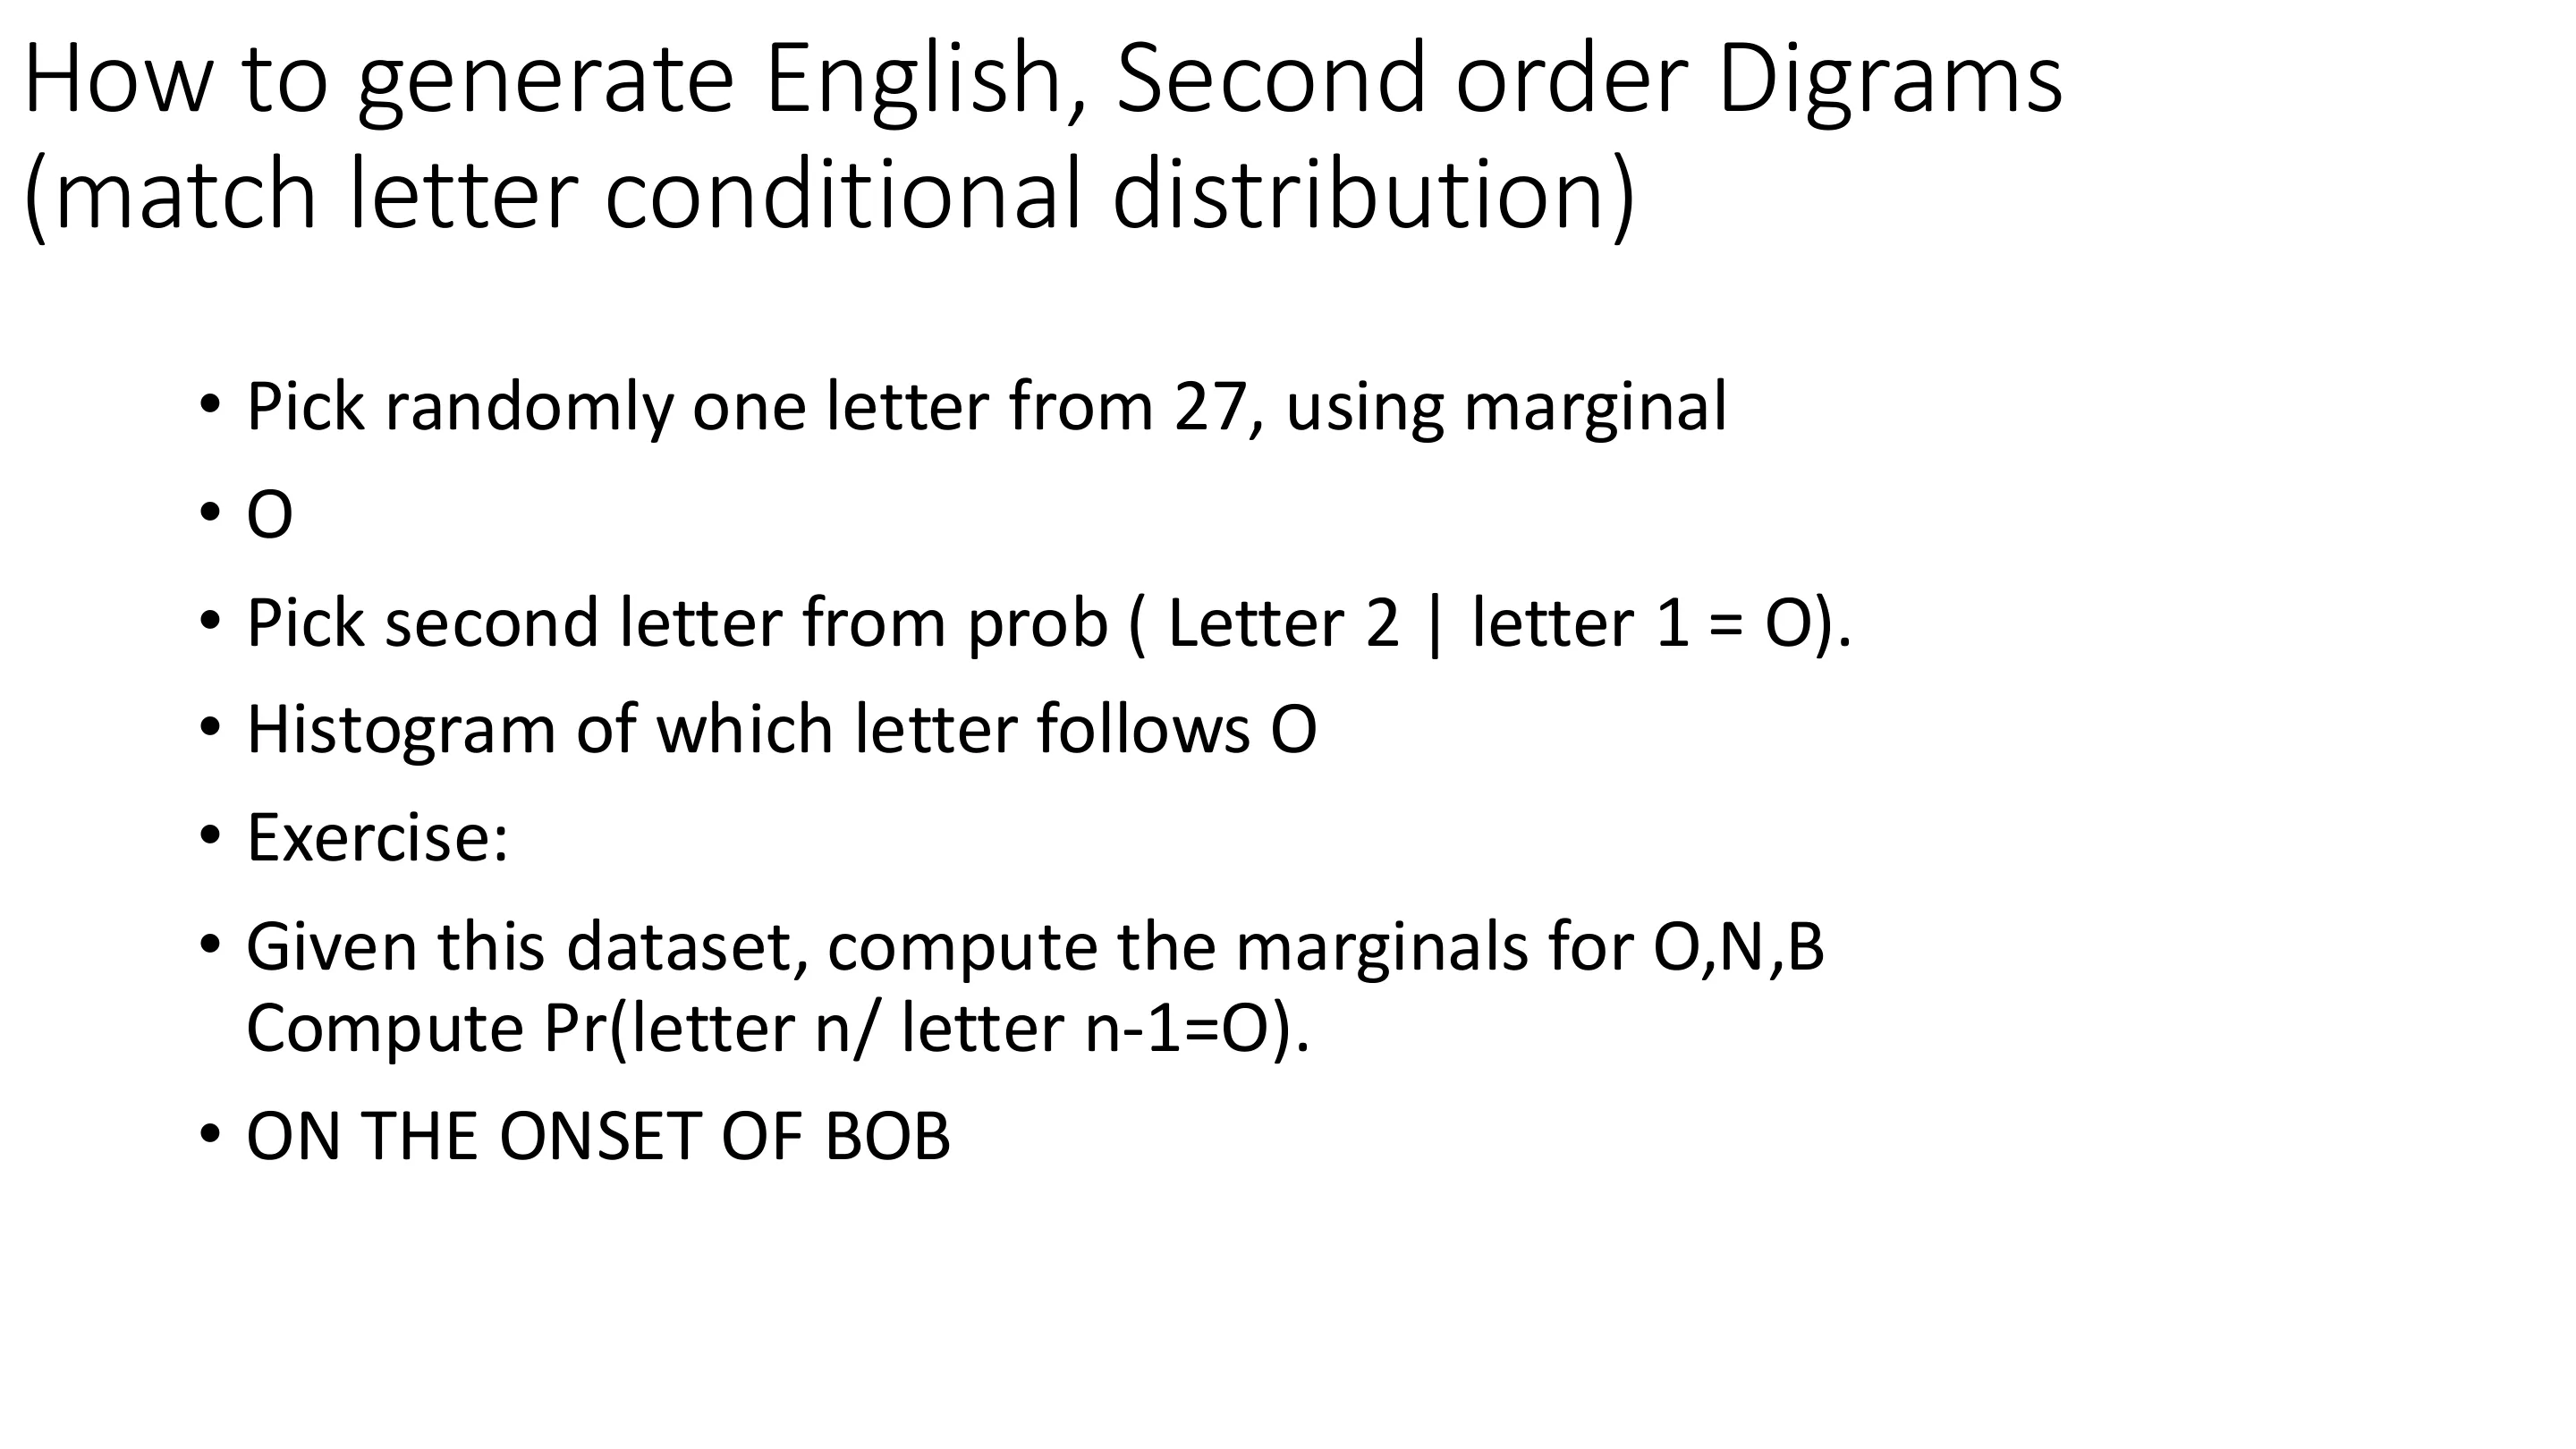
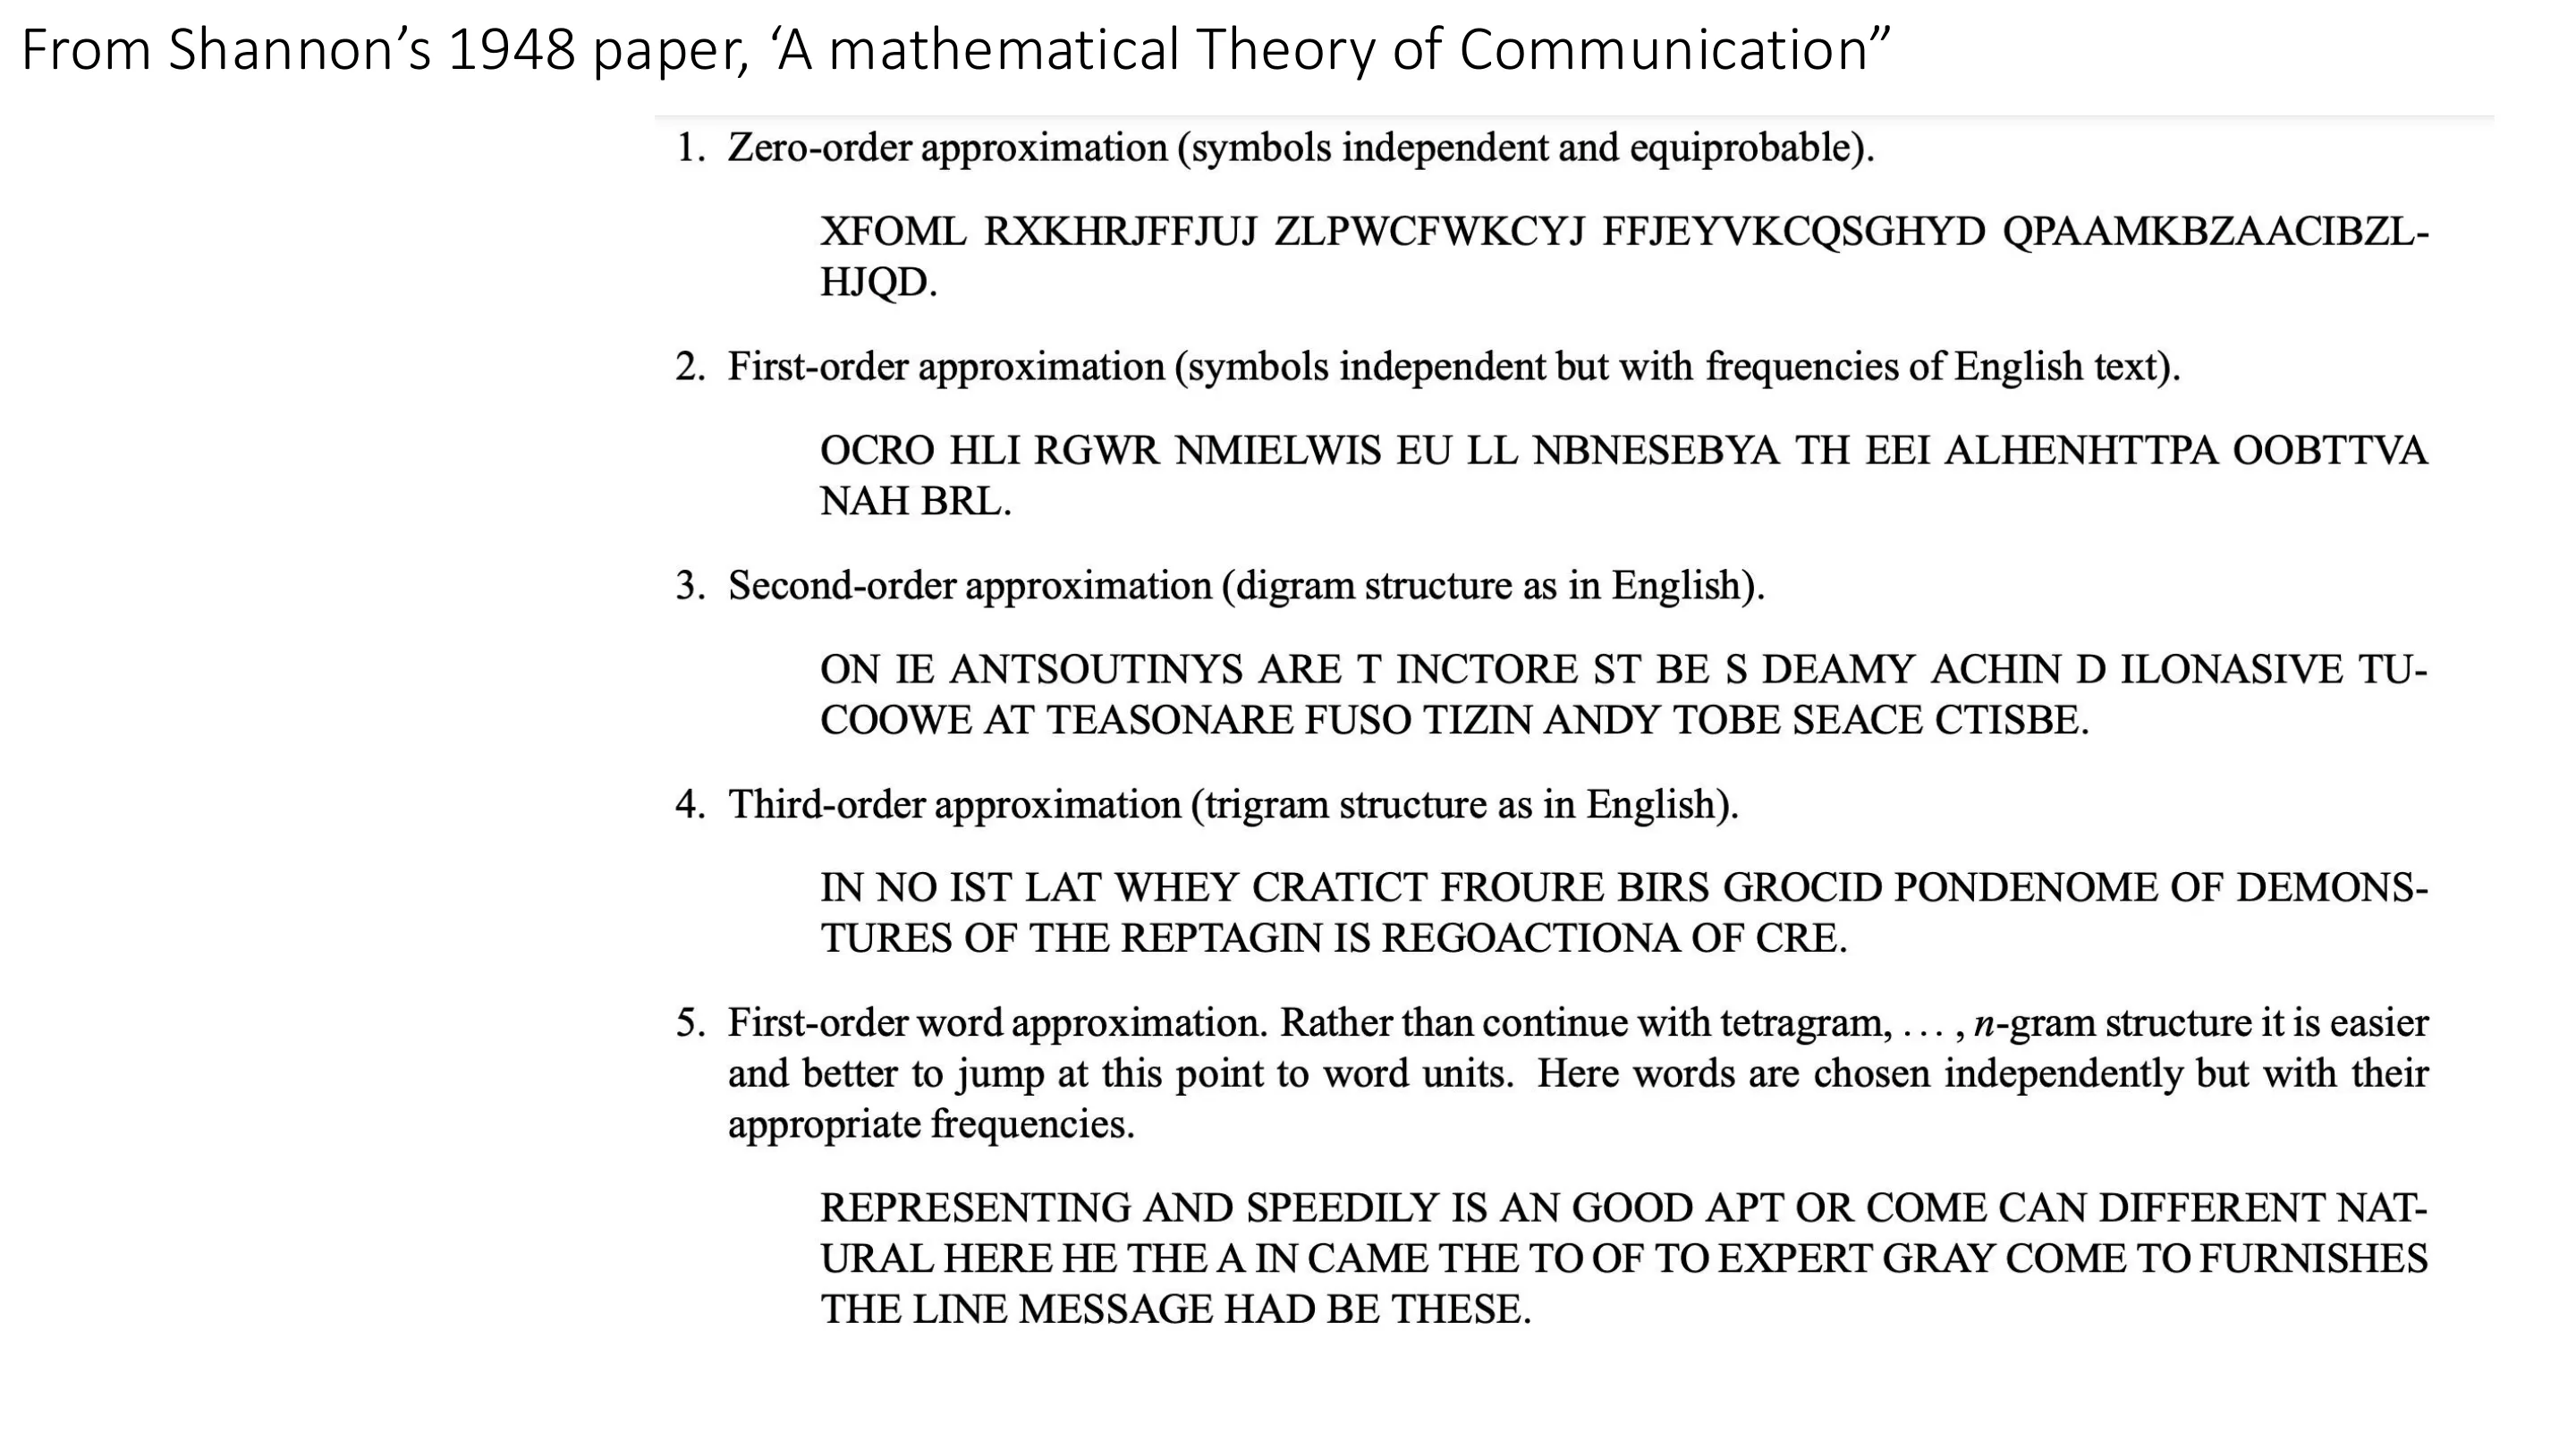
香农 1948 年论文用 n-gram 语言模型演示「信息」:分别按 0 阶(独立字母)、1 阶(字母频率)、2 阶(双字母组 digram) 采样,生成越来越像英文的文本。这正是现代语言模型 / LLM 的思想源头。
📷 生成英文:0 阶字母
回到原视频 (01:15:46)
📷 生成英文:1 阶字母
回到原视频 (01:16:59)
📷 生成英文:2 阶双字母组
回到原视频 (01:18:12)
📷 香农 1948 年论文《通信的数学理论》
回到原视频 (01:19:25)
总结(Takeaways)
- 熵 $H(X)=-\sum p\log p$ 度量随机变量的信息量,也是无损压缩的极限(Shannon)。
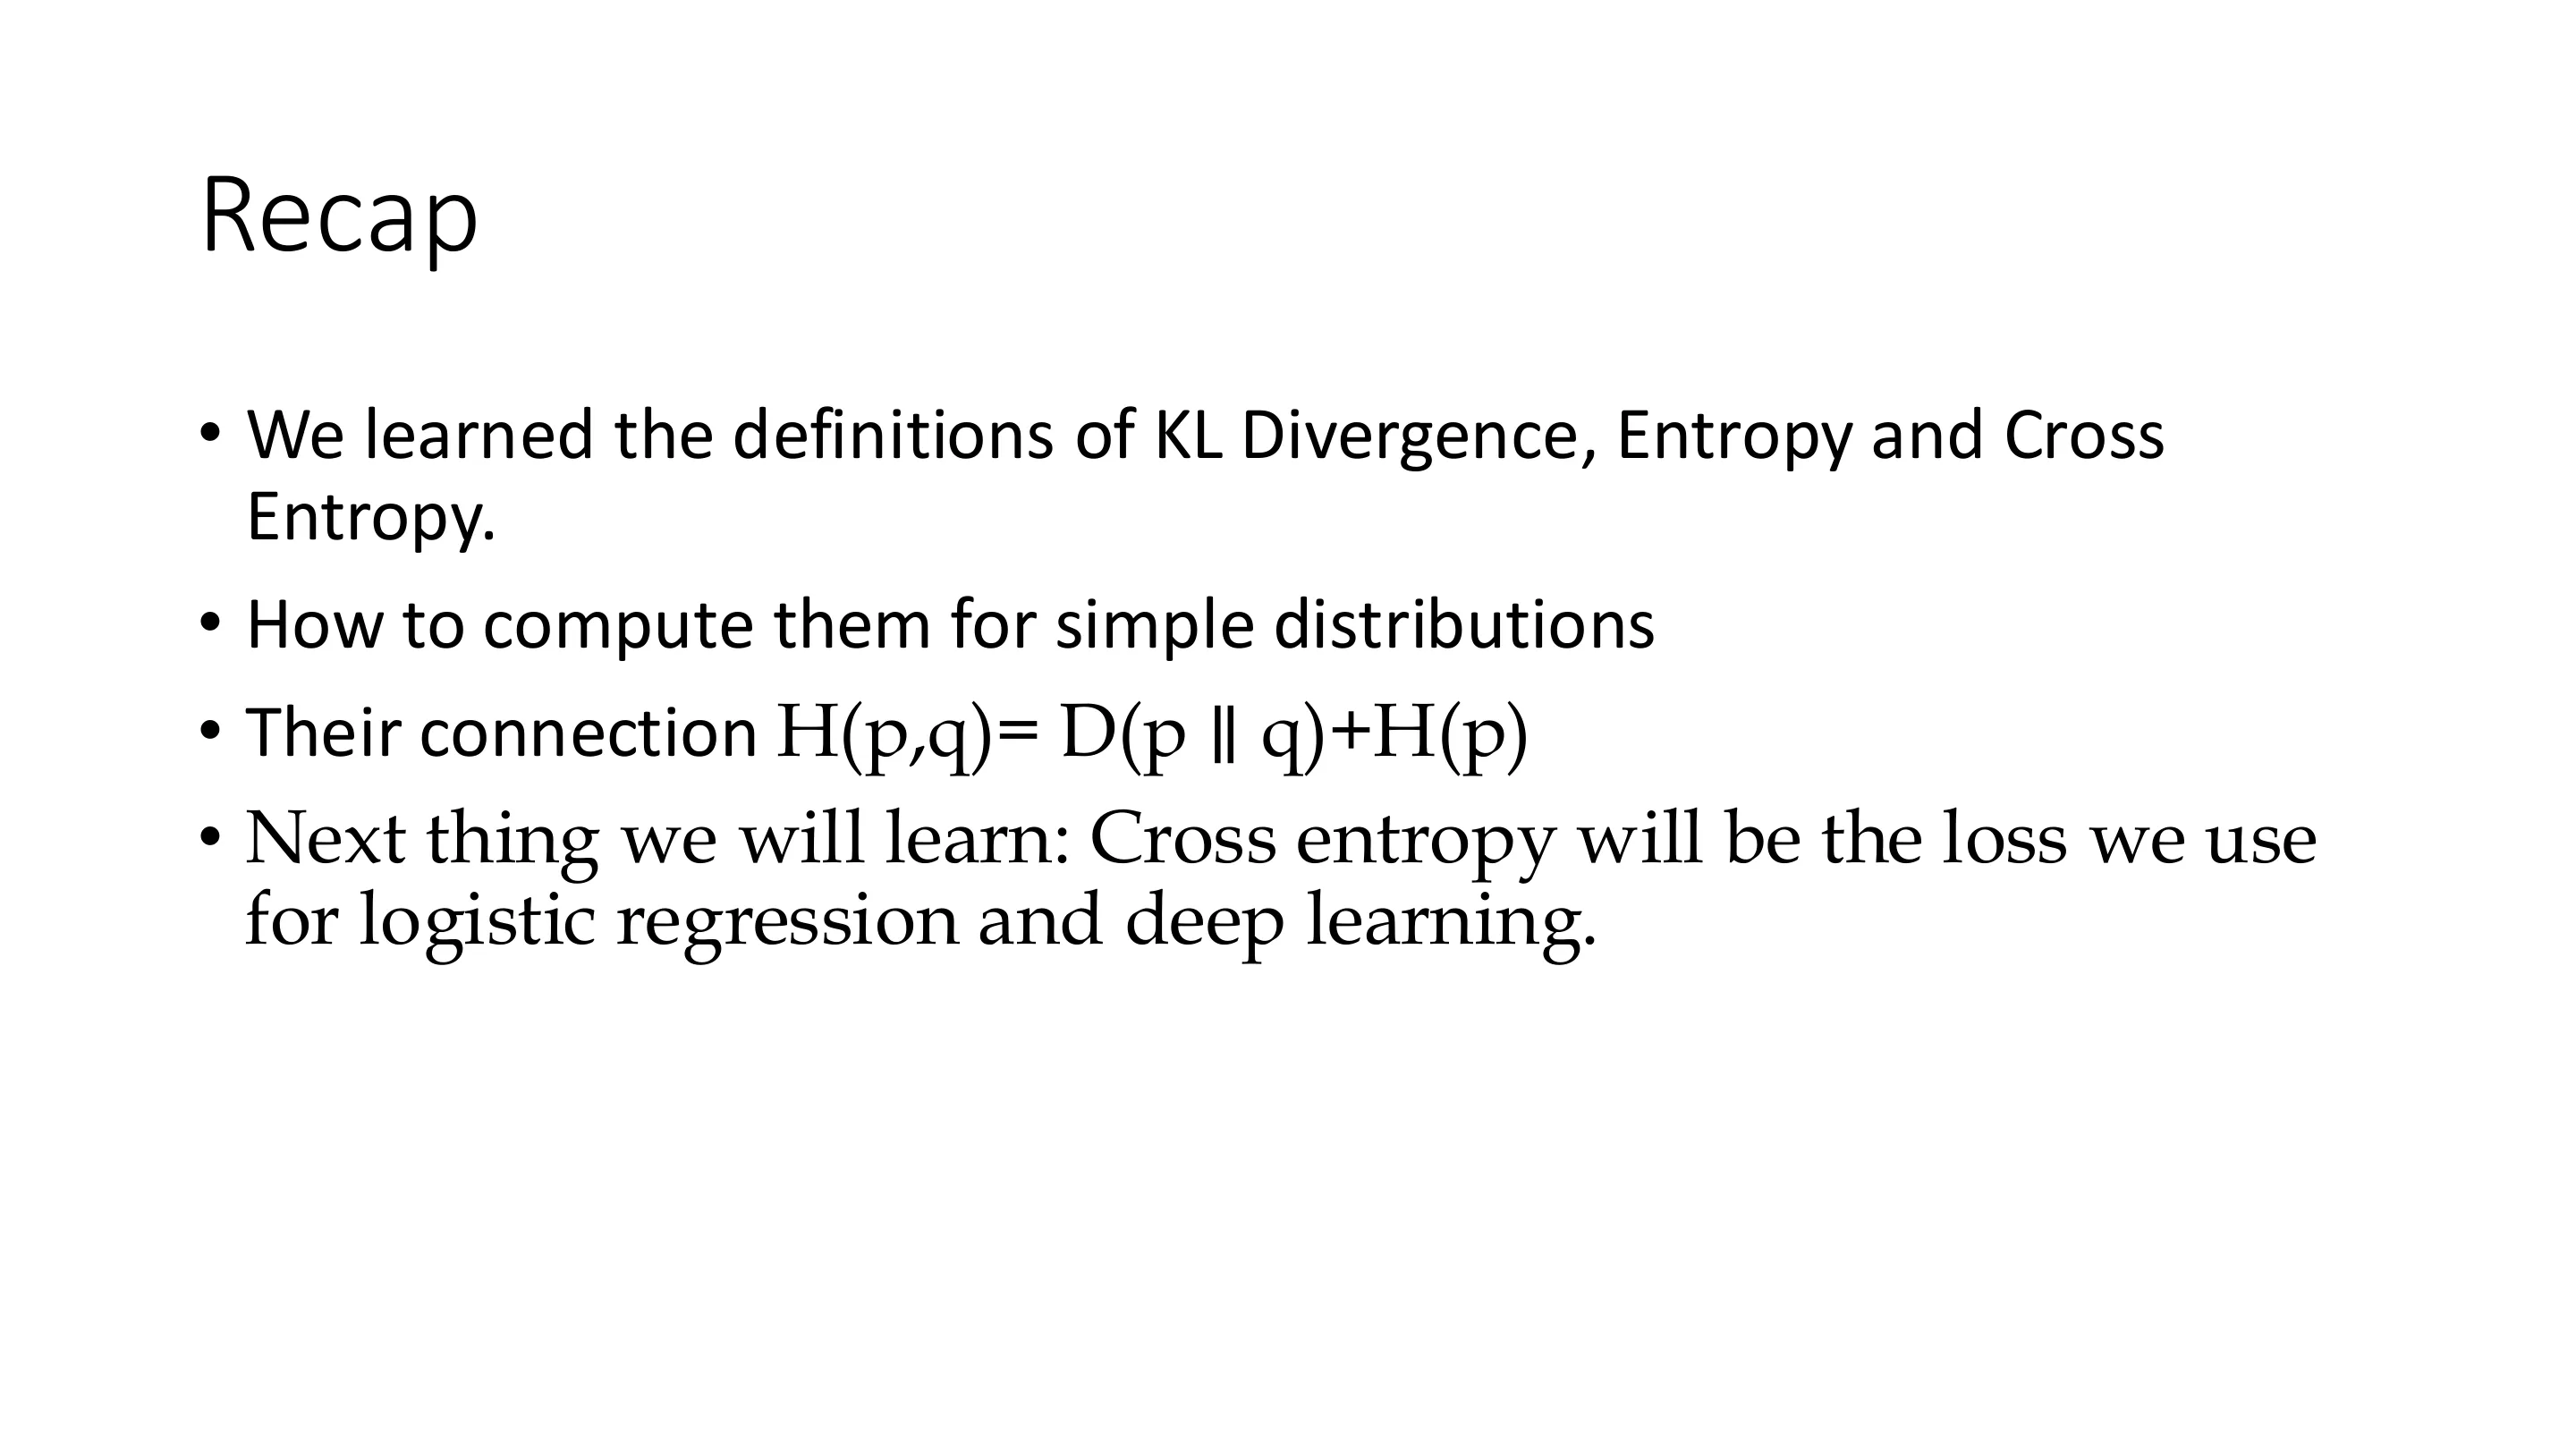
- 交叉熵 $H(P,Q)$:用 $Q$ 的方案编码 $P$ 的总比特数;KL 散度:多花的比特数;二者差一个熵。$D_{\mathrm{KL}}\ge0$ 且不对称。
- 逻辑回归 = 判别式二元分类;负对数似然 = 交叉熵损失;多类 ⇒ Softmax + 交叉熵。
- 交叉熵/LLMs 的损失函数都源于此;过大权重问题用 L2 正则缓解。
- 模型越复杂 ⇒ 方差越大;加正则 ⇒ 方差下降。
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=ArSadC8hY-Q |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 16) | Google Drive 文件夹 |
| 教材 Machine Learning: A First Course for Engineers and Scientists | 熵、交叉熵、逻辑回归、多类分类相关章节 · https://doi.org/10.1017/9781108919371 |
| Cover & Thomas, Elements of Information Theory | 熵与压缩定理 |
| Shannon (1948), A Mathematical Theory of Communication | 论文原文 |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。